Fragen Sie mehrere KIs gleichzeitig und sehen Sie, wo sie sich uneinig sind — Tools
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
Wenn Sie eine KI eine Frage stellen, erhalten Sie eine selbstsichere Antwort und keine einfache Möglichkeit, um zu erkennen, ob sie richtig ist. Das Fragen einer zweiten und dritten KI hilft, aber nur, wenn Sie sehen können, wo sich ihre Antworten unterscheiden, und nur, wenn Sie wissen, wie viel ihre Übereinstimmung wirklich wert ist. After Chat ist ein kleiner Satz kostenloser, quelloffener Python-Skripte, die eine Frage gleichzeitig an mehrere KIs stellen und beides tun: Es zeigt, wer was gesagt hat, und es berechnet, wie viel ihre Übereinstimmung wert ist. Es läuft auf Ihrem eigenen Computer, über die KI-Tools, bei denen Sie bereits angemeldet sind, ohne API-Schlüssel und ohne zusätzliches Abonnement, und die Skripte selbst benötigen nichts weiter als Python.
Eine KI reicht nicht aus, und vier KIs sind nicht vier
KI-Modelle verschiedener Unternehmen werden unterschiedlich trainiert, daher machen sie nicht immer die gleichen Fehler. Deshalb kopieren Menschen eine Frage in ChatGPT, Claude, Gemini und Grok und vergleichen die Antworten von Hand. Ihre Fehler überlappen sich jedoch mehr als es scheint. Eine Studie von 2025 über mehr als 350 Sprachmodelle ergab, dass zwei Modelle, wenn beide falsch liegen, oft die gleiche falsche Antwort geben: in einem Leaderboard-Datensatz 60 % der Zeit. Wenn also vier KIs übereinstimmen, haben Sie weniger als vier unabhängige Bestätigungen. Der echte Wert, mehrere zu befragen, liegt in der Uneinigkeit: ein Punkt, den nur eines von ihnen angebracht hat, oder die gleiche Aussage mit unterschiedlichen Zahlen darin.
Ein echtes Beispiel
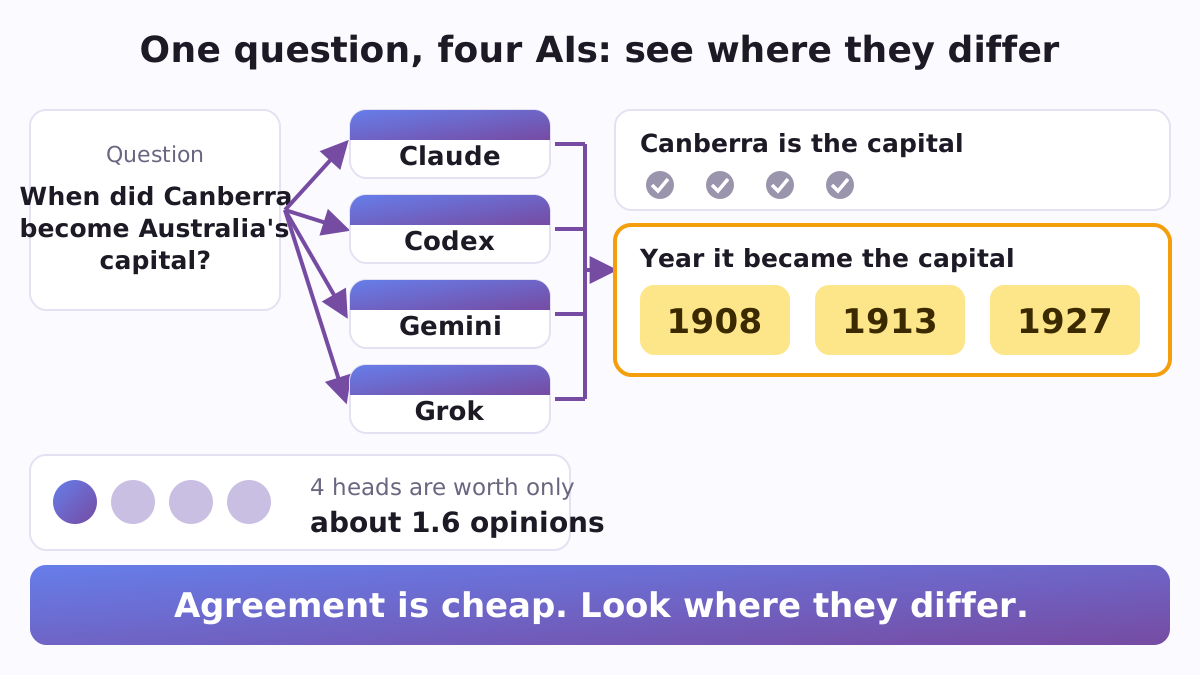
Am 21. September 2026 stellte der Autor vier KI-Befehlszeilentools eine Frage: „In einem Satz: Was ist die Hauptstadt von Australien, und in welchem Jahr wurde sie zur Hauptstadt?" Alle vier antworteten innerhalb von 25 Sekunden, und alle vier sagten Canberra. Bei dem Jahr teilten sie sich auf drei Weisen auf: 1908, 1913 und 1927. Jedes Jahr lässt sich verteidigen: Der Ort wurde 1908 gewählt, die Stadt wurde 1913 benannt, und das Parlament zog 1927 dorthin um. Einzeln befragt, hätte Codex 1927 gegeben und Grok 1913, jeweils als bloße Tatsache. Nebeneinander zeigten die Antworten sofort, dass die Frage drei ehrliche Antworten hat, und wiesen auf die genaue Stelle hin, die eine Person überprüfen muss.
Was ist enthalten
- Alle gleichzeitig fragen (
fanout.py). Das Programm sendet zunächst jedes KI-Werkzeug auf der Liste eine schnelle Testfrage und überspringt alle Werkzeuge, die nicht installiert sind oder nicht antworten. Dann stellt es Ihre Frage gleichzeitig allen aktiven Werkzeugen unter einer von Ihnen gewählten Zeitvorgabe und leitet jede Antwort in ihre eigene Datei. Wenn ein Werkzeug noch schreibt, wenn die Zeit abläuft, wird das bisher Geschriebene beibehalten und als unvollständig markiert, nicht verworfen. Jede KI startet in ihrem eigenen leeren Ordner anstelle des Ordners, von dem aus Sie das Programm gestartet haben, sodass sie nur von Ihrer Frage ausgeht. Eine lange Frage, etwa eine Seite Text, die alle überprüfen sollen, wird mit--question-filein eine Datei eingegeben. - Sehen, wer was gesagt hat (
provenance.py). Das Programm teilt jede Antwort in kurze Aussagen auf, gruppiert die ähnlich formulierten Aussagen und gibt eine Tabelle aus: jede Aussage und welche KI sie gemacht hat. Unter der Tabelle folgen die beiden wichtigsten Listen: Aussagen, die nur eine KI gemacht hat (etwas, das die anderen übersehen haben, oder ein Fehler dieser einen KI), und Aussagen, bei denen die KIs unterschiedliche Zahlen, Prozentsätze oder Daten angeben. Das Programm liest jeden Ordner mit Textdateien, sodass Sie auch Antworten von Chat-Websites in Dateien einfügen können, eine pro KI, und diese vergleichen. - Wissen, was Übereinstimmung wert ist (
neff.py). Geben Sie dem Programm eine Handvoll Fragen mit bekannten Antworten, für jede KI als richtig oder falsch markiert, und es misst, wie oft Ihre KIs gemeinsam falsch liegen. Daraus berechnet es, wie vielen unabhängigen Meinungen die KIs wirklich entsprechen. Im eingebauten Beispiel sind vier KIs, deren Fehler überlappen, etwa 1,6 unabhängige Meinungen wert, und keine Anzahl solcher KIs würde je mehr als 2,1 wert sein. - Eine zweite Meinung in Claude Code (
second-opinion/SKILL.md). Eine fertig gemachte Fähigkeit: Kopieren Sie den Ordner in~/.claude/skills/, und Claude Code kann eine KI von einem anderen Unternehmen dieselbe Frage stellen lassen, diese Antwort genau wie erhalten anzeigen und eine kurze Tabelle hinzufügen, wo die beiden übereinstimmen, wo sie abweichen und was nur eine von ihnen erwähnt. Es verschmilzt die beiden nie zu einem selbstsicheren Text, und es behandelt die Antwort der anderen KI als Material zum Vergleichen, nie als Anweisungen zum Befolgen. - Sichere Einstellungen für KI-Agenten (
safety/). Ein fertiges Beispiel für Claude Codes Berechtigungseinstellungen (settings.json), die jede Sitzung im Planmodus starten, Befehle wierm -rf,sudo,curlundgit pushablehnen,.env-Dateien und einensecrets-Ordner unlesbar halten und vorrm,mvund Web-Abrufen nachfragen. Einstellungen für Codex ermöglichen es, nur innerhalb des Arbeitsordners zu schreiben, das Netzwerk auszuschalten und vor Operationen darüber hinaus nachzufragen. Eine 14-Punkte-Checkliste behandelt die Gewohnheiten rund um diese Einstellungen: in einer Kopie arbeiten, zuerst einen Plan anfragen, ein Undo behalten, wissen, wie man einen langen Job stoppt. - Werkzeuge für Forschende (
crossings.py,crossings.schema.json,jsonl_log.py). Ein Datensatzformat mit strenger Überprüfung für Studien darüber, wie Menschen vom Chat mit KI zum Ausführen echter Arbeiten durch KI-Agenten übergehen. Das Installieren einer App zählt nicht als Verwendung, ein abgeschlossener Schritt braucht etwas, das der Agent wirklich erstellt hat, und wenn jemand stoppt, behält die Aufzeichnung ihre eigenen Worte bei. Ein winziger Logger schreibt jede Entscheidung, etwa einen abgelehnten Plan oder eine eingeholte zweite Meinung, als eine Zeile mit Zeitstempel in JSON.
Warum es auf diese Weise aufgebaut ist
Viele „LLM-Rat"-Tools enden mit einer zusammengefassten Antwort. Andrej Karpathys beliebtes llm-council beispielsweise sendet Ihre Frage über OpenRouter, einen API-Dienst, für den Sie Credits kaufen, an die Modelle und lässt ein „Vorsitzenden"-Modell die endgültige Antwort schreiben. After Chat durchläuft die Befehlszeilentools, die Sie bereits mit Ihren eigenen Konten verwenden, und stoppt absichtlich vor der Zusammenfassung: Sie erhalten die Tabelle mit den Aussagen aller Modelle, und die Bewertung bleibt bei Ihnen. Jedes Skript verwendet nur Pythons Standardbibliothek und passt in eine kurze Datei (die längste ist unter 200 Zeilen), sodass Sie genau sehen können, was es tut, und es ändern können.
Erste Schritte
Die Skripte laufen überall dort, wo Python 3 läuft; unter Windows führen Sie fanout.py innerhalb von WSL aus. Ein Live-Vergleich nutzt zwei oder mehr KI-Befehlszeilentools, bei denen Sie sich mit Ihren eigenen Konten angemeldet haben. Die integrierte Liste umfasst Claude Code (claude), OpenAI Codex (codex), Googles Antigravity CLI (agy, das am 18. Juni 2026 von Gemini CLI für persönliche Google-Konten übernommen hat) und xAIs Grok Build (grok). Der Befehl jedes Tools ist eine Zeile in einer kleinen JSON-Datei, die mit --tools übergeben wird, sodass das Hinzufügen eines anderen Tools oder das Nachvollziehen einer Flagge, die sich in einer neuen Version geändert hat, eine Minute dauert. Kein Befehlszeilentool vorhanden? Fügen Sie die Antworten von einer beliebigen KI-Chat-Website in .txt-Dateien ein, eine pro KI, und führen Sie provenance.py für diesen Ordner aus: Der Name jeder Datei wird zu einer Spalte der Tabelle.
git clone https://github.com/vadimchernets/after-chat
cd after-chat
python3 neff.py --demo                       # what four agreeing AIs are worth
python3 fanout.py "Your question" --out run  # ask every live AI at once
python3 provenance.py run                    # who said what, and where they differ
Die 28 Tests werden mit python3 -m unittest tests/test_patterns.py ausgeführt. Der Code, die Tests und die Sicherheitseinstellungen befinden sich alle unter github.com/vadimchernets/after-chat.
Woher es kommt
After Chat ist der begleitende Code des Papiers Nach Chat: Die drei Übergänge zwischen Nicht-Programmierern und agentengestützter KI von Vadym Chernets (September 2026, SSRN 7520019, DOI 10.2139/ssrn.7520019). Das Papier stellt die Frage, warum so wenige Menschen vom Chatten mit KI dazu übergegangen sind, KI-Agenten für sich arbeiten zu lassen, und wie man diesen Übergang messen kann. Der Code steht unter der MIT-Lizenz und ist auf Zenodo archiviert (DOI 10.5281/zenodo.22944451). Zwei vorgefertigte Claude Code Plugins entstanden aus denselben Mustern: Sidecall fragt die KI-Befehlszeilenwerkzeuge auf Ihrem Computer ab, und Roundcall fragt KI-Chat-Websites über Ihren eigenen Browser ab.
Vadym Chernets entwickelt auch Poly A1, eine App, in der KIs verschiedener Unternehmen die Arbeit voneinander überprüfen.