Schwach diskriminativ, nicht durch Profile Injection reparierbar und manipulierbar: Selbstvertrauen in der KI-Bewertung
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
Vadym Chernets, Independent Researcher · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197651 · GitHub
Akzeptiert als Poster auf dem NeurIPS 2026 Workshop „TAE (Trust-AI-Eval): Can We Trust AI Evaluation?" (nicht-archivarisch). Archivierte Kopie: 10.5281/zenodo.23197651. PDF: self-confidence-evaluation.pdf. Abbildungen und Tabellen unten sind aus dem LaTeX-Quelltext konvertiert; das PDF ist maßgeblich.
Zusammenfassung
Evaluierungs-Pipelines nutzen zunehmend das vom Modell selbst angegebene Vertrauen als Vertrauenssignal – als Gewicht für die Beurteilerzuverlässigkeit, als Verzichtsauslöser oder als selbstberichtetes Kompetenzprofil. Wir testen, ob dieses Signal das Gewicht verdient, mit einer vorregistrierten, protokollgefrorenen Sammlung (16 Modelle – ein Budget-/Mid-Tier-API-Modell von jedem von neun Anbietern, plus sieben lokale Open-Weights; 22.248 bewertete Antworten bei Temperatur null mit angegebener 0–100-Konfidenz). Vier Erkenntnisse. (1) Überconfidence ist konsistent über alle sechzehn evaluierten Modelle hinweg: typische angegebene Konfidenz liegt bei 85–95 für sieben von neun API-Modellen, während die Genauigkeit 16,5–66,5 % beträgt, und 60,1 % der Frontier-Antworten mit Konfidenz 80 sind falsch. (2) Selbstvertrauen ist schwach diskriminativ: sein AUROC zur Vorhersage der eigenen Korrektheit des Modells reicht von 0,532–0,788 und liegt unter 0,62 für sechs von neun Modellen. (3) Ein Panel unabhängiger Modelle erreicht AUROC 0,832, wo Selbstbewertung 0,545 ergibt ( , 95%-KI ); unter einer strengeren kennzeichnungsfreien Neukodierung der Panel-Übereinstimmung führt das Panel immer noch (0,775 vs. 0,545). (4) Die Injektion des gemessenen Pro-Domänen-Genauigkeitsprofils des Modells verbesserte die Diskriminierung in der einen bestätigenden Stufe einer placebokontrollierten Single-Vendor-Leiter nicht nachweisbar (AUROC , Holm-angepasst ), während der gleiche Injektionskanal kausal manipulierbar ist: ein falsches Profil trieb das AUROC der Selbstbewertung einer explorativen Stufe auf Zufallsniveau (0,474) und verschlechterte, sobald Elemente themenbeschriftet sind, die Kalibrierung in vier von fünf lokalen Modellen. Wir schlussfolgern, dass selbstbewertetes Vertrauen, wie es hier bei verbalisierter Integer-Konfidenz bei offener faktischer Rückruf elicitiert und gemessen wird, ein Ziel für Messung ist, nicht ein Input für Vertrauen: Systeme, die selbstberichtete Kompetenz aufnehmen, erben einen nicht authentifizierten Input-Kanal. Die drei Klauseln des Titels ruhen auf unterschiedlichen Belegen und wir kennzeichnen sie als solche durchgehend: schwach diskriminativ ist bestätigend über sechzehn Modelle; nicht repariert durch Profil-Injektion ist eine bestätigende Stufe auf einer Anbieter-Familie, untermächtig für den beobachteten Effekt; manipulierbar ist explorativ, mit der kausalen Richtung auf übereinstimmenden Elementen gezeigt, aber kein getesteter Angriff auf ein bereitgestelltes System. Richter-Stil-Selbstbewertung, bei der ein Modell die Antwort eines anderen Modells bewertet, ist eine andere Aufgabe und wird hier nicht getestet.
Einführung
Die moderne Evaluierungspraxis behandelt stillschweigend die angegebene Sicherheit eines Modells als Messinstrument: KI-Richter berichten Sicherheitswerte, Agent-Frameworks leiten basierend auf selbstbewerteter Kompetenz weiter, Verzichtsrichtlinien werden durch verbalisierte Unsicherheit ausgelöst, und Kalibrierungsbenchmarks gehen davon aus, dass der Selbstmeldungskanal zumindest ehrlich ist. Die Annahme ist zweckmäßig – Selbstmeldungen sind kostenlos, immer verfügbar und werden im gleichen Durchgang wie die Antwort erstellt – und sie wird am Konsumtionspunkt fast nie überprüft. Wir stellen die vorherige Frage: Wie diskriminativ ist das Selbsteinschätzungssignal, kann es mit dem gemessenen Profil des Modells repariert werden, und kann es manipuliert werden?
Wir antworten mit einer vorregistrierten, protokollfixierten, blinden Erhebung: sechzehn Modelle (ein Budget-/Mid-Tier-API-Modell von jeweils neun Anbietern plus sieben lokale Open-Weights-Modelle), je 1.500 Faktenfragen nach 2023, Temperatur null, jede Antwort mit einer angegebenen Sicherheit von 0–100 – 22.248 bewertete Antworten, alle Analysen deterministisch aus Rohdaten. Nach diesem Messwertstandard verweigert der Selbstmeldungskanal drei nacheinander weniger kritische Tests.
C1 (schwach diskriminativ). Die angegebene Sicherheit ist gesättigt und entkoppelt von der Kompetenz: die modellspezifischen Mediane liegen bei 85–95 für sieben von neun API-Modellen, während die Genauigkeit 16,5–66,5 % beträgt, und 60,1 % der Frontier-Antworten, die mit Sicherheit 80 angegeben wurden, sind falsch. Als Prädiktor für die eigene Korrektheit des Modells pro Element erreicht Selbstsicherheit nur ein AUROC von 0,532–0,788 je nach Modell – jedes Bootstrap-CI schließt Zufall aus, aber sechs von neun Modellen liegen unter 0,62, und selektive Vorhersage selbst auf dem besten von ihnen hinterlässt einen erheblichen Restfehler (Abschnitt 4). Ein Gremium unabhängiger Modelle erreicht 0,832, während Selbsteinschätzung 0,545 erreicht – ein Vorteil, der eine strengere labelfreie Umkodierung der Panelübereinstimmung überlebt – während das scheinbare Gegenbeispiel auf dem anderen Panel größtenteils die Identität zwischen Modellen widerspiegelt und nicht das Item-spezifische Selbstwissen (Zerlegung in Abschnitt 4); die Identifikation des einen Modells, dessen Selbstmeldung gut diskriminiert, erfordert immer noch die unabhängige Messung, die die Selbstmeldung ersetzen sollte.
C2 (keine bestätigende Reparatur durch Profilinjection). Die direkteste Reparatur – das Modell mit seinem gemessenen pro-Domain-Genauigkeitsprofil zum Antwortzeitpunkt zu versorgen – schlug nicht signifikant ein Placebo-Profil auf der einen bestätigenden Stufe eines gefrorenen, Placebo-kontrollierten Leiternexperiments (AUROC , roh , Holm-angepasst ; kein bestätigender Endpunkt wurde erreicht). Wir berichten dies als Null, nicht als Trend (Abschnitt 5).
C3 (manipulierbar). Der Injektionskanal, den eine Reparatur nutzen würde, akzeptiert Fälschungen: ein gemischtes (falsches) Profil trieb die Selbsteinschätzungs-AUROC einer explorativen Frontier-Stufe auf Zufallsniveau (0,474 vs. 0,710; Rückgang ), eine einzelne erfundene „95%-Genauigkeit"-Aussage verschob die angegebene Sicherheit eines lokalen Modells von 50 auf 95 bei einem Element, das es falsch versteht, und sobald Items mit Themen gekennzeichnet sind, verbrauchen vier von fünf lokalen Modellen ein falsches Profil zu ihrem eigenen Nachteil (Brier bis ; Abschnitt 6).
Zusammengenommen argumentieren diese Ergebnisse für eine Rollenänderung: selbstbewertete Sicherheit sollte ein gemessenes Evaluierungsziel sein, nicht ein ungeprüfter Input. Abschnitt 7 erläutert die Konsequenzen für Judge-Pipelines, Agent-Routing und Harness-Design; das begleitende Papier (Chernets, 2026) untersucht die Fehlermuster der Panel-basierten Alternative und wird hier zitiert, nicht wiederholt.
Verwandte Arbeiten
Verbalisierte Konfidenz und Kalibrierung. Die Fehlkalibrierung moderner Netzwerke ist ein lange bekanntes Phänomen (Guo et al., 2017), und bei QA-abgestimmten Sprachmodellen wurde bereits lange vor der aktuellen Modellgeneration eine mangelnde Kalibrierung festgestellt (Jiang et al., 2021). Modelle können gelehrt werden, Unsicherheit in Worten auszudrücken (Lin et al., 2022b), und größere Modelle „wissen teilweise, was sie wissen" in Selbstevaluierungs-Sonden (Kadavath et al., 2022), doch sie scheitern weitgehend darin, zu erkennen, was sie nicht wissen (Yin et al., 2023); empirische Audits der ausgelösten Konfidenz zeigen persistente Überconfidence über verschiedene Elicitationsformate hinweg (Xiong et al., 2024), wobei verbalisierte Scores manchmal besser kalibriert sind als Token-Wahrscheinlichkeiten, aber immer noch erhöht (Tian et al., 2023). Abtastung von internen Zuständen schärft den Blickwinkel: einfache Klassifizierer über Aktivierungen verborgener Schichten gewinnen Wahrheitsgehalt mit 71–83% (Azaria und Mitchell, 2023)—der Fehler liegt im verbalisierten Ausgabe-Kanal, nicht notwendigerweise in internen Repräsentationen. Unser Beitrag liegt in Skalierung und Design: eine vorregistrierte, eingefrorene, 16-Modell-Blindsammlung, die denselben Elicitationsansatz gegen Grundwahrheit und gegen unabhängige Panel-Übereinstimmung auf identischen Elementen bewertet—plus zwei Fragen, die diese Literatur selten stellt: Kann das Signal mit dem gemessenen Profil des Modells selbst repariert werden, und kann der Reparaturkanal angegriffen werden?
Konsumption von Selbstberichten im Downstreamprozess. LLM-als-Richter-Pipelines erben Richtervorgaben und Zuverlässigkeitsgrenzen (Zheng et al., 2023), und Übereinstimmungs-basierte Konfidenz-Signale selbst werden geprüft (Ding, 2026); semantische-Entropie-Detektoren (Farquhar et al., 2024) umgehen Selbstberichte durch die Messung von Antwortverteilungen stattdessen. Drittanbieter-Evaluierungsrahmen machen den Governance-Fall für unabhängige Messungen (Raji et al., 2022); wir geben ihm einen quantitativen Unterbau: bei sechs von neun API-Modellen trägt der Selbstbericht, den eine Pipeline konsumieren würde, ein AUROC unter 0,62.
Nicht vertrauenswürdige Eingaben. Indirekte Prompt-Injection zeigt, dass jeder Textkanal, den ein LLM aufnimmt, eine Angriffsfläche ist (Greshake et al., 2023). Abschnitt 6 lokalisiert eine spezifische, bislang unbenannte Instanz: der Selbstkompetenz-Profil-Slot, den Kalibrierungs-Reparaturen verwenden würden, ist ein nicht authentifizierter Eingabekanal, und die Fälschung degradiert die Diskriminierung auf Zufallsniveau.
Panels und ihre eigenen Ausfallmodi. Panels vielfältiger Modelle sind ein zunehmend standardisiertes Evaluierungsinstrument (Verga et al., 2024). Das Panel-Signal, das wir als Komparator verwenden, ist kein kostenloses Mittagessen: seine Ausfallregime (Schwierigkeitsinversion, eingeschränkte Antwortbereiche, Annahmen zur label-basierten Unabhängigkeit, Konformität) werden in einer Begleiteinreichung (Chernets, 2026) auf derselben Rohsammlung gemessen; dieses Papier trägt die Selbstevaluierungs-Geschichte, die Begleiterin trägt die Panel-Geschichte, und keine Tabelle wird zwischen ihnen dupliziert.
Benchmarks. Wir elicitieren auf einer SimpleQA-Teilmenge nach 2023 (Wei et al., 2024) genau wegen der Benchmark-Alters-Lücke, die wir gegen das 2021er TruthfulQA (Lin et al., 2022a) messen (Abschnitt 3).
Vorregistrierte Experimente: Entwurf und Daten
Eine vorregistrierte, verblindete Datenerfassung mit vor der Bestätigungsphase öffentlich fixiertem Protokoll: sechzehn Modelle (ein Budget-/Mid-Tier-API-Modell pro Anbieter über neun Anbieter hinweg, plus sieben lokale Open-Weights-Modelle) beantworteten dieselben 1.500 faktischen Fragen nach 2023 (SimpleQA-Teilmenge) bei Temperatur null, jede Antwort mit einer angegebenen Konfidenz von 0–100; insgesamt 22.248 bewertete Antworten (13.446 Frontier, 8.802 lokal).
Vorregistrierung und Fixierung.
Das Erfassungsprotokoll wurde in einer öffentlichen Registrierung vor jeglichen Bestätigungsdaten fixiert (Zugangsweg im Reproduzierbarkeitsbeilage). Die Registrierung spezifiziert vorab den Benchmark und die Teilstichprobe (zufällig , fester Seed, SHA-256 der Teilstichprobendatei aufgezeichnet), das Modellaufgebot, das Elicitationsformat, das Bewertungsverfahren, den Analyseplan – einschließlich des AUROC-Vergleichs der Panelübereinstimmung gegen eigene Konfidenz aus Abschnitt 4, eine vorspezifizierte Sekundärmetrik (der Primärendpunkt der Registrierung, die Quote der sicheren Fehler bei Paneluneinigkeit, ist eine panelseitige Größe, die in der Begleiteinreichung gemeldet wird) – und eine Entscheidungsregel gegen nachträgliche Metrikauswahl. Ein kleines exploratives Pilotprojekt (95 TruthfulQA-Elemente, drei lokale Modelle) wurde vor der Fixierung durchgeführt, um die Pipeline zu validieren; ihre Zahlen werden nie mit Bestätigungsdaten vermischt.
Modelle und Elicitation.
Neun Frontier-Anbieter über ihre APIs – ein Budget-/Mid-Tier-Modell pro Anbieter, daher benennen Anbieternamen unten einzelne Modelle, keine Produktlinien (genaue Modell-IDs und Erfassungsdaten in der Reproduzierbarkeitsbeilage) – und sieben lokale Open-Weights-Modelle. Jedes Modell beantwortet jede Aufgabe unabhängig bei Temperatur 0 und gibt eine ganzzahlige Konfidenz von 0–100 in derselben Antwort an; Panels sind analytische Kombinationen dieser einzelnen verblindeten Erfassung – kein Modell sieht jemals die Ausgabe eines anderen Modells.
Bewertung.
Normalisierte Stringäquivalenz zu Gold und Verweigerungserkennung zunächst; ungelöste offene Fälle gehen an einen lokal begrenzten Open-Weights-LLM-Bewerter, der nur auf Äquivalenz zu Gold beschränkt ist (qwen3:8b, lokal). Eine Stichprobenkontrolle von 50 Elementen durch Menschen ergab 98%ige Übereinstimmung (ein konservativer Fehler); eine Auditmethode über Familien der 342 schwierigsten Konsensusurteile stimmte 342/342 überein (Limitations). Keine Ausschlüsse außer Parsing-Fehlern (gemeldet); diese konzentrieren sich in einem lokalen Reasoning-Modell, das nur 98 bewertbare Antworten von 1.500 behält – alle lokalen Ansprüche tragen pro Modell . Alle bestätigenden Analysen sind deterministisch aus dem Raw-JSONL.
Benchmark-Wahl, gemessen.
Der Post-2023-Primär-Benchmark ist eine Designentscheidung, die durch Messung begründet wird, nicht durch Annahmen: In einem explorativen Benchmark-Altersvergleich erzielten dieselben Modelle bis Prozentpunkte höher bei TruthfulQA MC von 2021 als bei Post-2023 SimpleQA (deepseek pp, 95% KI ; mistral ; zhipu ; z. B. 89,2% vs. 28,4%) – eine Lücke, die konsistent mit Benchmark-Alter und Expositionseffekten ist, obwohl dieses Design Kontamination nicht von Schwierigkeit und Konstruktionsunterschieden trennen kann. Keine Schlagzahl basiert auf dem älteren Benchmark; der 750-Item-TruthfulQA MC1-Arm auf der lokalen Ebene wird nur dort verwendet, wo er als solcher gekennzeichnet ist.
Vorregistriert versus explorativ.
Vorregistriert und bestätigend: die oben beschriebene Erfassung und der Panel-vs-Eigen-AUROC-Vergleich (Abschnitt 4). Explorativ und überall dort gekennzeichnet, wo verwendet: der Benchmark-Altersvergleichsarm, die Frontier-Profil-Injektions-Stufe und lokale Mikrosonde von Abschnitt 6. Die Profil-Injektions-Leiter von Abschnitt 5 ist ein separates fixiertes, placebokontrolliertes Protokoll (Arme, Endpunkte und Holm-Familie vor der bestätigenden Phase fixiert).
Ergebnis 1: Selbstvertrauen ist fehlkalibriert und schwach diskriminativ
Wir trennen zwei Eigenschaften, die der Begriff „Kalibrierung" häufig vermischt: Kalibrierung im Großen (entspricht die Konfidenzebene der Genauigkeitsebene?) und Diskriminanz (ordnet Vertrauen die eigenen korrekten Antworten des Modells über seine falschen ein?).
Kalibrierung. Das angegebene Vertrauen ist gesättigt und von der Kompetenz entkoppelt: Bei neun API-Modellen liegt das angegebene Vertrauen bei sieben von neun bei 85–95 (Median pro Modell), während die Genauigkeit 16,5–66,5 % umfasst; zwei weichen ab – das ablehnungslastige Modell (Median 42 bei 10,3 % Genauigkeit) und ein Modell mit verteiltem Vertrauen (Median 60). Jedes Modell ist im Großen überconfident: Die Konfidenz-minus-Genauigkeit-Lücke (CITL, Tabelle 1) reicht von bis Prozentpunkten. Die ECE-Spalte entspricht fast CITL: Die Konfidenz-Genauigkeit-Lücke ist in jedem besetzten Behälter für sieben von neun Modellen positiv (für die anderen beiden alle bis auf eine), sodass binned und globale Fehlkalibrierung zusammenfallen. Auch das ablehnungslastige Modell behält PP (ECE 0,310) – sein niedriges Band widerspiegelt Ablehnungsverhalten, nicht kalibriertes Selbstwissen. Ein Teil seines Diskriminationsvorteilsmag ebenfalls mechanisch sein – Ablehnungen, die bei niedriger angegebener Konfidenz als falsch bewertet werden, erhöhen AUROC (ausgenommen Ablehnungszeilen ist es 0,660, ) – daher lesen wir seine 0,788 als Obergrenze für eliziertes Selbstwissen, nicht als Kalibrierungsranking. Über die neun API-Modelle zusammengefasst, sind 60,1 % der Antworten, die mit Konfidenz 80 angegeben wurden, falsch (5.598 von 9.310); die Rate pro Modell reicht von 29,0–83,2 % (Makro-Durchschnitt 57,6 %). Ein Verbraucher, der hohes angegebenes Vertrauen akzeptiert, akzeptiert eine Mehrheit von Fehlern. Diskriminanz. Als Prädiktor für die eigene Korrektheit des Modells erreicht Selbstvertrauen AUROC 0,532–0,788 je nach Modell. Bootstrap-95%-KIs (Tabelle 1) schließen 0,5 für jedes Modell aus, das Signal ist also nicht buchstäblich zufällig – aber für sechs von neun Modellen liegt es unter 0,62. Die Konsequenz ist operativ: Bei 20 % Abdeckung (nur die top-konfidenten fünftel der Elemente beantworten), sind die Fehlerquoten der drei stärksten Self-AUROC-Modelle immer noch 75,3 %, 33,3 % und 15,1 % (Tabelle 2) – eine sinnvolle Verringerung nur für das dritte und weit entfernt von einem Vertrauenstor für die anderen beiden.
Eine architektonische Alternative – das Zählen unabhängiger Modelle, die übereinstimmen – erreicht AUROC 0,832 (95% KI ) auf dem Panel, während die Selbsteinschätzung 0,545 ergibt (); die item-geclusterte Differenz, , schließt Null mit großem Abstand aus. Die drei vordefinierten Panels: US (Anthropic, OpenAI, Google), CN (DeepSeek, Alibaba, Moonshot), blockübergreifend (Anthropic, DeepSeek, Mistral); der Hauptvergleich ist das CN-Panel. Auf dem anderen vordefinierten Panel scheint sich der gepoolte Vergleich umzukehren: Selbsteinschätzung 0,842 gepolt über die Panel-Population vs. Panel 0,697; . Eine Zerlegung zeigt, dass diese scheinbare Umkehrung weitgehend die Modellidentität zwischen Modellen widerspiegelt, nicht das Selbstwissen pro Item: Der gepoolte Wert von 0,842 mischt drei Modelle, deren Selbst-AUROCs innerhalb des Modells nur 0,596–0,784 betragen (Makro-Durchschnitt 0,709; Panel-Population-Werte – Tabelle 1 berichtet den vollständigen graduierten Datensatz), und nach Rang-Normalisierung innerhalb des Modells (die zwischen den Modellen bestehende Niveauunterschiede entfernt, während die eigene Rangfolge jedes Modells erhalten bleibt) fällt der gepoolte Wert auf 0,672 – ein Beitrag der Modellidentität von zwischen den Modellen. Das 0,545-Panel besteht denselben Test (0,545 gepolt vs. 0,582 rangkorrigiert): sein Selbsteinschätzungsversagen ist wirklich pro Item. Das, was von der Umkehrung bleibt, ist eine engere Aussage: Das Verweigerungs-lastige Modell mit der stärksten Selbstvertrauens-Diskrimination (0,788 auf dem vollständigen graduierten Datensatz) übertrifft tatsächlich das Übereinstimmungssignal dieses Panels – und die Identifizierung des betreffenden Modells erfordert genau die unabhängige Messung, die Selbstberichte ersetzen sollten. Das dritte vordefinierte Panel (blockübergreifend) liegt dazwischen: Panel 0,722 vs. eigen 0,659 , .
Sensitivität gegenüber kennzeichnungsfreier Rekodierung des Panel-Signals.
Die kanonische Äquivalenzkodierung hinter dem Panel-Signal befasst sich mit der eigenen Korrektheitskennzeichnung des Primärmodells (zwei Antworten, beide als korrekt bewertet, zählen als Übereinstimmung), sodass die Panel-Übereinstimmung teilweise eine deterministische Funktion der Zielkennzeichnung ist – eine kennzeichnungsvermittelte Abhängigkeit, obwohl kein Selbstabstimmungsleck: Der Aufbau nach enthält das Eigenprotokoll eines Modells niemals sein eigenes Panel-Signal. Eine kennzeichnungsfreie Rekodierung (nur Zeichenfolgenübereinstimmung; Korrektheitsflaggen des Primären und des Panelisten werden nicht berücksichtigt) senkt die Panel-AUROC von 0,832 auf 0,775 auf dem Panel, wo die Selbsteinschätzung 0,545 ergibt, und von 0,697 auf 0,628 auf dem anderen; der Vorteil des Haupt-Panels übersteht die strengere Kodierung (0,775 vs. 0,545).
Tabelle 1 zeigt das Bild pro Modell; Abbildung 1 zeigt dieselbe Entkopplung über alle sechzehn Modelle: Alle Modelle liegen über der Kalibrierungsdiagonalen, und die lokale Stufe kollabiert zu einem Band von 85–100 angegeben Vertrauens bei 9,2% Genauigkeit.
| Modell | Gen. (%) | Durchschn. Vertrauen | CITL (pp) | Brier | ECE | Selbst-AUROC | 95% KI | |
|---|---|---|---|---|---|---|---|---|
| 1.461 | 66,5 | 92,8 | 0,271 | 0,263 | 0,746 | [0,722, 0,770] | ||
| moonshot | 1.500 | 51,6 | 75,8 | 0,292 | 0,242 | 0,619 | [0,590, 0,648] | |
| alibaba | 1.497 | 47,4 | 92,3 | 0,446 | 0,448 | 0,532 | [0,510, 0,556] | |
| xai | 1.500 | 37,9 | 48,9 | 0,197 | 0,111 | 0,777 | [0,755, 0,798] | |
| deepseek | 1.500 | 35,7 | 89,2 | 0,513 | 0,535 | 0,570 | [0,549, 0,592] | |
| zhipu | 1.493 | 28,4 | 92,6 | 0,612 | 0,642 | 0,611 | [0,582, 0,639] | |
| openai | 1.500 | 16,7 | 77,6 | 0,531 | 0,610 | 0,598 | [0,559, 0,636] | |
| mistral | 1.495 | 16,5 | 90,6 | 0,686 | 0,742 | 0,584 | [0,550, 0,616] | |
| anthropic | 1.500 | 10,3 | 41,3 | 0,206 | 0,310 | 0,788 | [0,758, 0,817] |
Modellspezifische Kalibrierung auf der bestätigenden SimpleQA-Sammlung (Frontier-Schicht, vollständiger bewerteter Datensatz; Anbieter-Namen kennzeichnen das jeweils pro Anbieter erfasste Budget-/Mid-Tier-Modell). CITL: Kalibrierung im Großen, mittlere angegebene Konfidenz minus Genauigkeit, in Prozentpunkten. ECE: 10er-Bin-Expected-Calibration-Error. Self-AUROC: angegebene Konfidenz als Prädiktor der modellspezifischen itemweisen Korrektheit (tie-korrigierter Mann–Whitney), mit Bootstrap-95%-KI (Resampling auf Zeilenebene innerhalb des Modells, 2.000 Ziehungen, fester Seed). Alle Werte sind deterministische Neuberechnungen aus rohen bewerteten JSONL; jedes KI schließt 0,5 aus. CITL verwendet ungerundete Mittelwerte; angezeigte Werte sind auf eine Dezimalstelle gerundet. {#tab:vendor}
| Fehlerrate bei Abdeckung | |||||
|---|---|---|---|---|---|
| 2-6 Modell | 100% | 80% | 60% | 40% | 20% |
| anthropic (self-AUROC 0,788) | 89,7% | 87,1% | 82,9% | 80,3% | 75,3% |
| xai (0.777) | 62,1% | 52,8% | 45,1% | 39,5% | 33,3% |
| google (0.746) | 33,5% | 24,5% | 20,0% | 18,7% | 15,1% |
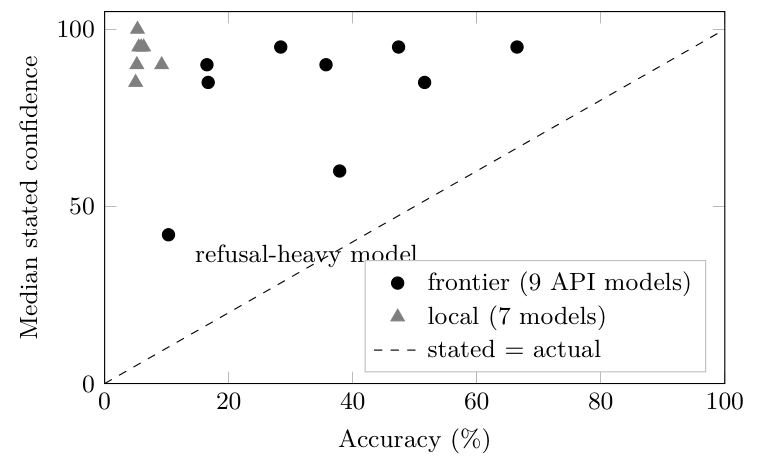 Durchgehende Überconfidence bei allen sechzehn evaluierten Modellen: pro Modell medianes angegebenes Vertrauen (Mittelwerte erscheinen in Tabelle 1) gegenüber tatsächlicher Genauigkeit für alle 16 Modelle bei denselben 1.500 blinden SimpleQA-Elementen. Alle Modelle liegen oberhalb der Kalibrierungsdiagonalen; das Ablehnungs-schwere Modell (medianes angegebenes Vertrauen 42 bei 10,3% Genauigkeit, CITL +31,0 pp) hat die beste Selbst-AUROC von 0,788, bleibt jedoch überconfident; die kleinste Kalibrierungslücke gehört dem dispersiven Vertrauensmodell (+11,1 pp). Frontier-Mediane pro Modell: 95/85/95/60/90/95/85/90/42 in der Zeilenreihenfolge von Tabelle 1; die lokale sieben-Modell-Schicht umfasst eine Genauigkeit von 5,0–9,2% bei medianem Vertrauen von 85–100 (Werte n pro lokalem Modell 98–1.498 nach Ausschluss von Parse-Fehlern; die lokale Schicht dient den Manipulationssonden und dieser Abbildung, nicht Diskriminationsansprüchen).
Ergebnis 2: keine bestätigte Verbesserung der Diskriminationsfähigkeit durch Injektion des gemessenen Profils
Eine natürliche Reparaturmaßnahme besteht darin, dem Modell sein eigenes gemessenes Kompetenzprofil – die pro-Domänen-Genauigkeit aus zurückgehaltenen Daten – zum Zeitpunkt der Antwort zur Verfügung zu stellen. In einem placebokontrollierten Stufenexperiment (Arme: kein Profil, Placeboprofil mit angepasstem Gesamtniveau, eigenes gemessenes Profil, permutiertes Profil) schlug der Arm mit eigenem Profil das Placebo beim bestätigten Endpunkt nicht signifikant: AUROC , 95 %-KI , rohes , Holm-adjustiert ; kein bestätigter Endpunkt wurde erreicht. Wir berichten dies als Nullbefund mit explizit engem Gültigkeitsbereich: auf einer bestätigten Stufe wurde die Diskriminationsfähigkeit durch Injektion des gemessenen Profils nicht korrigiert. Der Punktschätzer ist positiv, aber unter pre-registrierter Korrektur ist die Reparatur nicht nachgewiesen; das Design war nur für moderate Effekte ausgelegt (SE aus dem KI: 80 % Power nur für AUROC , größer als der beobachtete –die Daten sind also mit sowohl einem echten Nullbefund als auch einem kleinen echten Effekt vereinbar). Das Design-Limit ist nicht der begrenzende Faktor. Wenn man für jedes Item die eigene Bin-Genauigkeit – berechnet „leave-one-out", sodass ein Item niemals zu seinem eigenen Prädiktor beiträgt – als einzigen Prädiktor für die Korrektheit dieses Items nimmt, ergibt sich ein Oracle-AUROC von 0,758 für das bestätigte Subjekt (0,716–0,789 über die vier Stufen-Subjekte), mit SD der Bin-Genauigkeit von 0,195 und Bereich von 0,15–1,00 über die 21 Bins. Bins unterscheiden sich also ausreichend, damit ein wahrheitsgetreues Profil erhebliche Information tragen kann: der Nullbefund betrifft den Injektionskanal, nicht eine zu schwache Batterie, um ihn zu registrieren.1 Explorative Muster (größere Gewinne, wo die Kalibrierung schwächer ist) sind nur hypothesengenerierend.
Stufendesign und Placeboverifizierung.
Vier eingefrorene Stufen (Subjekte: Claude Haiku 4.5, Sonnet 5, Opus 4.8 und Fable 5; genaue IDs claude-haiku-4-5-20251001, claude-sonnet-5, claude-opus-4-8, claude-fable-5), jede mit vier verblindeten Armen in demselben Kalibrierungsplatz eines ansonsten identischen Prompts: off (profilförmige strukturelle Leere), placebo (kalibrierungsirrelevantes Profil, das für das Gesamtniveau angepasst ist; pro Stufe gegen das echte Profil validiert bei –gemessenes , , , ), core (das gemessene Pro-Domänen-Profil des Modells selbst) und shuffled (bin-permutiertes falsches Profil; explorativ, nachdem ein gescheiterter Manipulationscheck es aus dem bestätigten Status herabgestuft hatte). Die 315-Item-Batterie umfasst 21 Domänen-Bins mit Fallstricken und ein explizites Enthaltungs-Token; Item-Arm-Zuordnungen waren vor der bestätigten Phase eingefrorend, mit pro-Item zufälliger Arm-Reihenfolge und keine Armnamen im für das Subjekt sichtbaren Text. Eine pre-registrierte Degenerations-Schwelle (off-Genauigkeit ) stufte drei von vier Stufen aus aller bestätigten Berechnung herab; Tabelle 3 berichtet die eine zulässige Stufe. Die off-Arm-Genauigkeit der verbleibenden Stufe liegt bei 0,847 gegen den Schwellwert 0,85, während die herabgestuften Stufen bei 0,855, 0,888 und 0,900 liegen–mit off-Arm beantwortete-only AUROCs von 0,575, 0,628 und 0,500 (beschreibend, Genauigkeit an der Obergrenze lässt wenig Kalibrierungssignal zur Reparatur). Alle vier Subjekte stammen aus einer einzigen Hersteller-Familie; siehe Einschränkungen.
| Arm | Genauigkeit (alle Elemente) | AUROC | Brier | ECE | Gepaarte AUROC (corearm) |
|---|---|---|---|---|---|
| off (kein Profil) | 0.847 | 0.564 | 0.138 | 0.110 | [] |
| placebo | 0.857 | 0.578 | 0.127 | 0.090 | [] |
| core (eigenes Profil) | 0.857 | 0.625 | 0.127 | 0.099 | — |
| shuffled (falsch) | 0.842 | 0.589 | 0.140 | 0.113 | nicht berechnet (explorativ) |
Profile-Injection-Leiter, bestätigungsfähige Sprosse (Subjekt: Claude Sonnet 5; : 294 Nicht-Trap-Items 2 vorregistrierte Frisch-Prozess-Replikationen – das Harness legt weder Temperatur noch Seed offen; AUROC nur-beantwortet). Bestätigungskontraste (Item-geclustert Bootstrap): coreplacebo AUROC , 95% KI , Roh-; coreoff , KI , Roh-; beide verfehlen die Holm-Korrektur () und das zweigliedrige ItemBatch-Gatter (eine vorregistrierte Robustheitsanforderung, die nach Item und Sammlungsbatch geclustert wird). Die gepaarte--Spalte wiederholt die eingefrorenen Analysen der Item-geclusterten gepaarten Kontraste gegen core; sie sind nicht die arithmetische Differenz der Pro-Arm-AUROC-Spalte, und es wurde kein bestätigender gepaarter Kontrast für shuffled berechnet (vor der Bestätigungsphase auf explorativ herabgestuft). Wir vermerken entgegen unserer eigenen Hypothese, dass core bei der Kalibrierung nicht dominiert: deren ECE (0.099) ist schlechter als die von placebo (0.090), was ein weiterer Grund ist, die Bestätigungsnull als Null zu lesen. {#tab:ladder}
Ergebnis 3: Der Selbstbildkanal ist manipulierbar
Wenn ein Evaluierungsgerüst ein Selbstkompetenzprofil konsumiert, ist dieser Slot ein Eingabekanal, und Eingaben können gefälscht werden. Wir unterscheiden drei Ansprüche abnehmender Beweiskraft und geben an, welchen jedes Ergebnis unterstützt. (i) Kausale Manipulierbarkeit—nachfolgend demonstriert: Das Ersetzen eines falschen Profils verursacht kausal eine Änderung der angegebenen Konfidenz und verschlechtert die Kalibrierung in kontrollierten Läufen. (ii) Integritätsvulnerabilität—bedingt: Sie ist nur relevant für Gerüste, die Kompetenzniveaus tatsächlich aus einer Quelle injizieren, die ein Angreifer beeinflussen kann. (iii) Praktische Angriffsfläche in eingesetzten Evaluierungspipelines—eine Hypothese, die dieses Papier motiviert, aber nicht testet. Das Ersetzen des echten Profils durch ein gemischtes (falsches) führte die Selbsteinschätzung einer explorativen Grenzrung zu Zufallsniveau: 0,474 gegenüber 0,710 mit dem echten Profil (Deckenplafond-demotierte explorative Rung; Item-geclustert Bootstrap: 0,710 [0,586, 0,820] vs. 0,474 [0,349, 0,599], Differenz [, ]). Zum Vergleich lag auf der bestätigungsberechtigten Rung gemischt zwischen placebo und kern (0,589 vs. 0,578 und 0,625; Item-geclustert gepaarter Kontrast, explorativ: ). Diese Rung ist konstruktionsbedingt schwache Manipulationseverdacht: Das falsche Profil verfehlte zweimal die vorregistrierte Überprüfung (externer Beurteiler 0,99/0,94 gegenüber einer Grenze); die gefrorene Regel demotierte den Arm, bevor Bestätigungsdaten vorhanden waren, ein Subjekt kann ein erkannt unplausibles Profil diskontieren, und es gibt keine konsumierte Überprüfung. Eigenständiges Ergebnis: Ein Grenzrichter erkennt Fälschungen allein aus Plausibilität. An einem lokalen Nullkostenstand erhöhte eine einzelne erfundene Behauptung („95 % Genauigkeit in dieser Domäne") die angegebene Konfidenz eines Modells beim gleichen Element von 50 auf 95; der Effekt konzentriert sich auf Modelle, die deklarative Kalibrierung verlieren können; in dieser Sonde trat die größte Verschiebung ( Punkte) in dem Modell auf, das am meisten davon zu verwirken hat (glm4:9b). Zwei Randbedingungen begrenzen den Effekt: Das Modell muss in der Lage sein, das aktuelle Element einem Profilbereich zuzuordnen (bei nicht beschrifteten Elementen ignorieren kleine lokale Modelle das Profil; Deltas , konsistent mit der gefrorenen Nullhypothese von Ergebnis 2), und Deckenplafond-fixierte Modelle (Konfidenz unabhängig) haben nichts zu verlieren.
Die Manipulationseverdacht—eine explorative Grenzrung, eine lokale Mikrosonde und ein lokaler thematischer Pass—etabliert kausale Manipulierbarkeit, Anspruch (i). Tabelle 4 zeigt die Mikrosonde: das gleiche Element, das gleiche Modell und eine einzeilige Änderung im eingespielten Selbstprofil verschieben die angegebene Konfidenz um bis zu Punkte.
Explorativer thematischer Pass: beide Seiten der Grenze, live.
Die erste Randbedingung oben (das Modell muss das Element einem Profilbereich zuordnen können) ist selbst testbar: Die Beschriftung jeder Sonde mit ihrem Thema—eine offenbarte Abweichung vom gefrorenen Protokoll—beseitigt das Zuordnungshindernis. In einem vollständigen lokalen Pass (fünf Modelle, 16 zurückhaltende Sonden pro Arm, Temperatur 0, fester Seed) wird das falsche Profil, das bei unbeschrifteten Elementen inert war, von vier von fünf Modellen konsumiert, sobald Elemente beschriftet sind: Brier verschlechtert sich um (glm4:9b), (llama3.2:3b, mit Genauigkeit fallend 37,5 %25,0 %), (mistral:7b) und (phi4-mini); Pro-Sonden-Bootstrap-KIs bei schließen Null für jedes Modell ein, so dass die Mikrosonde Richtung und Mechanismus statt Pro-Modell-Effektgrößen etabliert;
Das fünfte (qwen3:8b) antwortet auf die Batterie an der Decke (100% Genauigkeit, Konfidenz 100 in beiden Armen, ), wodurch die Grenze „nichts anzugreifen" reproduziert wird. Der Mechanismus ist direktional und symmetrisch: eine falsche hohe Aussage bläht die Konfidenz genau in dem schwächsten Behälter auf (llama3.2 Physik: angegebene Konfidenz 0100 in einem Behälter mit 25% ausgelagerter Genauigkeit; phi4-mini Logik 1365), und eine falsche niedrige Aussage mindert die Konfidenz bei richtigen Antworten (llama3.2 Geschichte 1000 bei 75% ausgelagerter Genauigkeit), bis hin zur Induktion von Enthaltung bei Elementen, die das Modell sonst beantwortet. Beide Seiten der Grenze werden somit durch Live-Läufe gezeigt: nicht gekennzeichnete Elemente, Profil träge (das eingefrorene Null); gekennzeichnete Elemente, das gefälschte Selbstbild propagiert direkt in die angegebene Konfidenz und verschlechtert die Kalibrierung von Ende zu Ende.
| Modell | Konf. @ „0%" | Konf. @ „95%" | |
|---|---|---|---|
| glm4:9b | 50 | 95 | |
| llama3.2:3b | 80 | 95 | |
| mistral:7b | 90 | 100 | |
| phi4-mini | 90 | 95 | |
| qwen3:8b | 100 | 100 |
Lokale Mikrosonde (explorativ): angegebene Konfidenz beim gleichen (fälschlicherweise beantworteten) Element, wenn der eingefügte Profilplatz „0% Genauigkeit" gegenüber „95% Genauigkeit" in der Domäne des Elements behauptet; fünf lokale Open-Weights-Modelle, Temperatur 0. Das an der Decke festgespannte Modell (untere Reihe) hat keine deklarative Kalibrierung zum Angriff. {#tab:microprobe}
Implikationen für die Evaluierungspraxis
Unsere Ergebnisse werden an einer Task-Familie (nach 2023 offene faktische Fragen-Antwort) mit einem Elicitationsformat gemessen; die nachstehenden Implikationen extrapolieren aus diesen Messungen.
(1) Umkehrung der Rolle der angegebenen Sicherheit. Selbstberichtete Sicherheit sollte ein gemessenes Ziel der Evaluierung sein, nicht ein Input unter aktueller Elicitation. Stützende Zahlen: 60,1% der Antworten mit hoher Sicherheit an der Frontier sind falsch, und die beste Selbst-AUROC (0,788) gehört dem Modell, das ein Genauigkeits-Leaderboard zuletzt rangieren würde – weder Ranking sagt voraus, wessen Selbstberichte diskriminieren.
(2) Judge-Pipelines erben schwach diskriminative Gewichte. Jedes LLM-as-Judge- oder Ensemble-Schema, das Stimmen nach Selbstsicherheit gewichtet, importiert für sechs von neun Modellen hier ein Signal mit AUROC unter 0,62 – stillschweigend, weil die gesättigte 85–95-Band in den Logs beruhigend aussieht. Falls Sicherheitsgewichtung überhaupt verwendet wird, sollten die Gewichte aus gemessener modellspezifischer Kalibrierung stammen, nicht aus dem Bericht selbst.
(3) Authentifizierung des Profil-Slots. Das dreistufige Bedrohungsmodell in Abschnitt 6 ordnet die Besorgnis: kausale Manipulierbarkeit ist demonstriert, Integritätsvulnerabilität ist bedingt davon, dass ein Harness tatsächlich Profile aus einer beeinflussbaren Quelle injiziert, und eine praktische Angriffsfläche in eingesetzten Pipelines bleibt eine Hypothese. Für Harnesses in der bedingten Klasse ist der Reparaturkanal die Exposition: das gleiche injizierte Profil, das die Kalibrierung beheben sollte, akzeptiert Fälschungen, die Diskrimination auf Zufallsniveau (0,474) drücken und Brier-Scores end-to-end verschlechtern, sobald Items assoziierbar sind. Ein solcher Harness benötigt ein Integritäts-Gate – signierte Profile, Herkunftsprüfungen, oder zumindest die Trennung, wer das Profil misst, von wer es zur Inferenzzeit liefert. Ein nicht authentifizierter Selbstbild-Slot ist ein offener Prompt-Injection-Port mit einem Kalibrierungs-Payload.
(4) Externe Messung ist die Alternative – mit eigenem Audit. Unabhängige Panelübereinstimmung dominiert Selbsteinschätzung, wo Selbsteinschätzung am schlechtesten ausfällt (AUROC ), aber Panels haben ihre eigenen gemessenen Fehlersysteme, untersucht im Begleitpapier (Chernets, 2026); die Panel-Signal ohne dieses Audit zu übernehmen würde denselben Fehler eine Ebene höher wiederholen. Eine als explorativ vorab registrierte Erweiterung fügt einen dritten Winkel hinzu: über 12 gerichtete Profil-Swap-Paare (3.780 Aufrufe) verschiebte das Ersetzen eines anderen Modells gemessenem Profil die AUROC um maximal – und half manchmal – während die Ähnlichkeits-Rang-Vorhersage des Transferverlusts fehlschlug (Spearman ): gemessene Profile sind tragbare Instrumente, nicht privilegierter Selbstzugang. Eine praktische Selbsteinschätzungs-Diagnose-Batterie ist im Anhang beschrieben.
Einschränkungen
Eine einzelne Benchmark-Familie für die Schlagzeile (Frage-Antwort-Aufgaben in offener Form nach 2023); jeder Anbieter wird durch ein Budget-/Mid-Tier-Modell vertreten, daher wird keine Generalisierung auf Anbieterebene beansprucht; die Elicitation von angegebener Konfidenz ist ein Prompt-Format für die Schlagzahlwerte – obwohl ein exploratorischer zweistufiger Arm (150 Elemente fünf lokale Modelle) nahelegt, dass das Format nicht das Problem ist: eine zustandslose nachträgliche Konfidenzabfrage senkte die angegebene Konfidenz und die Raten sicherer Fehler, nicht jedoch die Diskriminierung (Self-AUROC 0,43–0,61 in beiden Formaten; gepoolter gepaarter Bootstrap AUROC bei Paaren, deterministische Beschriftungen ohne KI auf 142–150 Zeilen pro Modell – eine dokumentierte Abweichung vom reinen String-Bewerter, unter dem 90% der Fälle nicht auflösbar sind); die Injektions-Nullhypothese ist eine bestätigende Sprosse einer Leiter (315 Elemente, 21 Behälter), alle vier Subjekte aus einer einzelnen Anbieter-Familie, und sie schließt bessere Reparaturdesigns nicht aus; die Manipulationsevidenz kombiniert eine exploratorische Frontier-Sprosse, eine lokale Mikrosonde und einen themengelabelten lokalen Durchgang (eine dokumentierte Abweichung) – keine bestätigende Angriffsstudie; die Bewertung ist teilweise KI-basiert und ihre menschliche Validierung ist eine 50-Element-Stichprobe (98% Übereinstimmung, ein konservativer Fehler). Die Bewerter-Anbieter-Familie enthält auch ein CN-Panel-Mitglied, daher wird die Unabhängigkeit des Bewerters selbst gemessen: ein zweiter Bewerter aus einer Familie außerhalb aller Panels und der Bewerter selbst bewerteten alle 342 schwierigsten Konsens-Urteile des Quintils neu und stimmten 342/342 zu. Der Bewerter selbst ist ein lokales Subjekt; eine familienübergreifende Neubewertung aller 1.441 selbst bewerteten Zeilen stimmte zu 98,3%, wobei die Meinungsverschiedenheit zur Selbst-Kulanz tendierte (24 Abwärts-Flips vs. 1 Aufwärts-Flip; Genauigkeit 5,94,4%) – was das Übervertrauensbild stärkt; eine vollständigere geschichtete Nachprüfung bleibt zukünftige Arbeit. Vergleiche Panel vs. Selbst teilen Daten mit der Begleiteinreichung; keine Tabelle wird dupliziert, die Grenze ist in den Abschnitten 1–2 angegeben, und der Umfang dieser Arbeit bleibt nur auf Selbstbewertung beschränkt.
Fazit
Selbstbewertung erfüllt in ihrer derzeitigen Form drei Tests nicht, die ein Evaluationssignal bestehen muss: Sie verfolgt die Korrektheit zu schwach, um Entscheidungen zu steuern, bleibt aber schwerwiegend überconfident, die direkteste Intervention zur Selbstkenntnis zeigte unter Placebokontrolle keine nachweisbare Reparatur, und ihr Eingabekanal akzeptiert Fälschungen, die die Diskriminierung auf Zufallsniveau drücken. Solange Modelle die Kalibrierung anhand gemessener Evidenz nicht nachweisen, ist angegebenes Vertrauen ein Phänomen zum Studieren, nicht ein Signal zum Nutzen.
References
Vadym Chernets. Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop Who Verifies the Agents?, 2026. https://doi.org/10.5281/zenodo.23197641 (cited for panel-side regimes only).
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
K. Greshake, S. Abdelnabi, S. Mishra, C. Endres, T. Holz, and M. Fritz. Not what you’ve signed up for: Compromising real-world LLM-integrated applications with indirect prompt injection. In Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security (AISec), 2023. arXiv:2302.12173.
C. Guo, G. Pleiss, Y. Sun, and K. Q. Weinberger. On calibration of modern neural networks. In ICML, 2017. arXiv:1706.04599.
Z. Jiang, J. Araki, H. Ding, and G. Neubig. How can we know when language models know? On the calibration of language models for question answering. Transactions of the Association for Computational Linguistics, 9:962–977, 2021. arXiv:2012.00955.
S. Kadavath, T. Conerly, A. Askell, et al. Language models (mostly) know what they know. arXiv:2207.05221, 2022.
A. Azaria and T. Mitchell. The internal state of an LLM knows when it’s lying. In Findings of EMNLP, 2023. arXiv:2304.13734.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lin, J. Hilton, and O. Evans. Teaching models to express their uncertainty in words. Transactions on Machine Learning Research, 2022. arXiv:2205.14334.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
K. Tian, E. Mitchell, A. Zhou, A. Sharma, R. Rafailov, H. Yao, C. Finn, and C. D. Manning. Just ask for calibration: Strategies for eliciting calibrated confidence scores from language models fine-tuned with human feedback. In EMNLP, 2023. arXiv:2305.14975.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
J. Wei et al. Measuring short-form factuality in large language models (SimpleQA). arXiv:2411.04368, 2024.
M. Xiong, Z. Hu, X. Lu, Y. Li, J. Fu, J. He, and B. Hooi. Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. In ICLR, 2024. arXiv:2306.13063.
Z. Yin, Q. Sun, Q. Guo, J. Wu, X. Qiu, and X. Huang. Do large language models know what they don’t know? In Findings of ACL, 2023. arXiv:2305.18153.
L. Zheng, W.-L. Chiang, Y. Sheng, et al. Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. In NeurIPS Datasets and Benchmarks, 2023. arXiv:2306.05685.
Praktisches Werkzeug: eine Selbstbewertungsdiagnose
Ein Nebenprodukt dieser Studie ist eine kompakte Selbstbewertungsdiagnose: eine feste Batterie kurzer, deterministisch bewertbarer Sonden, die sich über die Domänenbereiche der Studie erstrecken (Numerik, Logik, Physik, Geschichte, Code, Wahrscheinlichkeit und andere), plus Fallstrickelemente mit einem expliziten Enthaltungstoken. Jede Antwort trägt ein angegebenes Vertrauen von 0–100, und das Werkzeug bewertet eine Zusammensetzung aus Brier-Score, Überconfidence-Lücke (durchschnittliches Vertrauen minus Genauigkeit), Vertrauensdiskriminierung (durchschnittliches Vertrauen bei korrekten minus inkorrekten Antworten) und Fallstrickel-Enthaltungsrate, wobei das Ergebnis auf Stufen von gut kalibriert bis zuversichtlich blind abgebildet wird. Es operationalisiert die These dieses Papers – Kalibrierung ist etwas, das man an einem Modell messen sollte, nicht aus seinen Selbstberichten ablesen – und wird mit dem Replikationspaket als Werkzeug, nicht als Ergebnis veröffentlicht: Es verwendet paraphrasierte Sonden anstelle der eingefrorenen Batterie, und sein Diskriminierungsscore ist ein Proxy, nicht der AUROC-Endpunkt der Leiter.
Reproduzierbarkeitsbeilage
Alle Kennzahlen in diesem Artikel sind deterministische Funktionen des freigegebenen rohen JSONL; kein Schritt beinhaltet Zufälligkeit, Netzwerkzugriff, GPU-Berechnung oder erneute Abfrage eines Modells.
Datenverfügbarkeit.
Die eingefrorene Vorregistrierung und das Replikationspaket (öffentliche OSF-Registrierung): https://osf.io/4y9dv. Das Oracle-Ceiling-Skript oracle_auroc.py wird mit diesem Artikel bei https://doi.org/10.5281/zenodo.23197651 deponiert.
Elicitierungsprompt (wörtlich).
System: You answer short factual questions. Respond with ONLY a JSON object like {"answer": "<short answer>", "confidence": 85}. confidence is an integer 0-100 for how sure you are the answer is correct. No other text. Der Benutzer-Turn enthält die bloße Frage; Verweigerungen werden aus dem Antwortfeld durch das eingefrorene Verweigerungslexikon im Bewertungsskript erkannt.
Modellidentifikatoren und Ausführungsdaten.
Ein Budget-/Mid-Tier-API-Modell pro Anbieter, rauchgeprüft live am 2026-07-24 und in spätem Juli 2026 erfasst (Zeitstempel pro Aufruf im Run-Manifest, mit dem Replikationspaket freigegeben): anthropic claude-haiku-4-5-20251001; openai gpt-5-mini; google gemini-3.6-flash; xai grok-4-fast; deepseek deepseek-chat; alibaba qwen-plus; moonshot kimi-k3 (eine offengelegte Erhebungsabweichung: 670 von 1.500 Elementen im Erstanbieterkonto, der Rest über eine Aggregatorroutte, die von derselben Erstanbieter-Infrastruktur bedient wird, mit deaktiviertem Reasoning, served_by pro Aufruf aufgezeichnet; eine reine Erstanbieterspaltung wurde vorab zugesagt); zhipu glm-4.5; mistral mistral-small-latest. Lokale Schicht (Ollama, Temperatur 0): gemma4:e4b, llama3.2:3b, phi4-mini, qwen3:8b, deepseek-r1:8b, glm4:9b, mistral:7b.
Das Begleitpapier (Chernets, 2026) teilt dieselbe eingefrorene Registrierung und Roherfassung. Das Replikationspaket enthält: den eingefrorenen Registrierungstext und das Protokoll, das Run-Manifest mit genauen Modellidentifikatoren, die rohen bewerteten Sammlungen (Frontier- und lokale Schichten sowie den explorativen Benchmark-Alter-Vergleichsarm) und drei abhängigkeitsfreie CPU-Skripte. Das erste (compute_panel_vs_own_auroc.py) ist die kanonische Definition des Panel-Übereinstimmungs- vs. eigenen-Konfidenz-AUROC-Vergleichs (Abschnitt 4) und gibt neben den kanonischen Werten alle nicht-kanonischen alternativen Lesarten aus (binales Panel-Signal, unbestimmte Codierung, Bindungsbehandlung, Pooling-Varianten), sodass die Wahl der Lesart überprüfbar ist. Das zweite (analysis_tae_week1.py) gibt Tabelle 1 neu aus, die Abbildung 1 Koordinaten, die Benchmark-Alter-Lücken von Abschnitt 3 und führt eine schreibgeschützte Überprüfung der eingefrorenen Leiterwerte durch, die in Tabelle 3 gegen die eingefrorene Analysedatei der Leiter gemeldet werden. Das dritte (analysis_tae_decomposition.py) gibt die gepoolte AUROC-Zerlegung und Rank-Normalisierung von Abschnitt 4 neu aus, die labelfreie Umcodierung des Panel-Signals, die Pro-Modell-Hochkonfidenz-Fehlerquoten, die CITL/Brier/ECE-Spalten von Tabelle 1, die Risiko–Abdeckungswerte von Tabelle 2 und die herabgestuften Sprossendeskriptive von Abschnitt 5. Jedes Skript wird in Sekunden auf einer Laptop-CPU nur mit der Python-Standardbibliothek ausgeführt. Die Profil-Injektions-Leiter wird als ihr eigenes eingefrorenes Paket versendet (Protokoll, Batterie, pro-Arm bewertete Zeilen und Analyse-JSON), auf das das Paket verweist.
Berechnet aus den eingefrorenen Pro-Element-Armwerten (
scored-arms-*.jsonl; nicht-Falle, Statusok; für den bestätigenden Gegenstand) durchoracle_auroc.py, mit diesem Artikel freigegeben; alle Arme und Replikate eines Elements werden zusammen weggelassen.↩︎
Wie man dieses Papier zitiert
Chernets, V. (2026). Schwach diskriminativ, nicht durch Profile Injection reparierbar und manipulierbar: Selbstvertrauen in der KI-Bewertung [Papierpräsentation]. NeurIPS 2026 Workshop: TAE. Zenodo. https://doi.org/10.5281/zenodo.23197651
@misc{chernets2026selfconfidenceevaluation,
  author       = {Chernets, Vadym},
  title        = {{Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: TAE},
  doi          = {10.5281/zenodo.23197651},
  url          = {https://doi.org/10.5281/zenodo.23197651}
}