Verification Theater: Gemessene Fehlermodi von KI-Verifier-Panels
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
Vadym Chernets, Independent Researcher · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197641 · GitHub
Akzeptiert als Poster beim NeurIPS-2026-Workshop „Who Verifies the Agents? Toward Reliable Agent Development" (nicht-archivarisch). Archivierte Kopie: 10.5281/zenodo.23197641. PDF: verification-theater.pdf. Zahlen und Tabellen unten wurden aus der LaTeX-Quelle konvertiert; das PDF ist maßgeblich.
Zusammenfassung
Multi-Agent-Verifikation wird zum Standard-Vertrauensmechanismus: Eine Antwort wird vertraut, weil unabhängige Modelle sich einig waren. Anhand einer vorregistrierten, verblindeten, temperaturgebundenen Sammlung, in der sechzehn Modelle (neun frontier-Anbieter, sieben lokal quelloffene Gewichtungen) dieselben 1.500 faktischen Fragen beantworteten (plus ein Multiple-Choice-Arm mit 750 Fragen und ein explorativer Dialog-Arm), messen wir, wann die Panel-Verifikation funktioniert nicht mehr, während sie weiterhin so aussieht, als würde sie funktionieren – ein Zustand, den wir Verifikationstheater nennen. Wir berichten vier Fehlermodi. Erstens eine Schwierigkeitsinversion: Der Zertifizierungsgewinn unabhängiger Übereinstimmung – 2,7–4,6 bei den drei leichteren Quintilen von Fragen – fällt auf 0,82 im zweitschwierigsten Quintil und auf null im schwierigsten, wobei replizierte Antworten in 0 von 342 Fällen korrekt waren (13 erwartet unter Unabhängigkeit). Eine Leave-Panel-Out-Neu-Schichtung (Schwierigkeit nach den 13 nicht-Panel-Modellen eingestuft) beseitigt die gepoolte Inversion (78/354 korrekt, Gewinn 2,36) während die Null für das Cross-Bloc-Panel bestehen bleibt (0/116); wir berichten beide Kodierungen zusammen durchgehend: Bei den Fragen, die die eingesetzte Population für am schwierigsten hält, funktioniert Übereinstimmung als Fehlerzertifizierung. Zweitens begrenzte Antworträume: Bei Multiple Choice (lokale Tier) zertifizierten Panels einstimmig eine falsche Antwort in 4,0–7,9% der Fragen, gegenüber 1,5–4,6% bei den offenen Antworten derselben Tier und 0,3–4,9% frontier-offene Antworten. Drittens versagen die als Proxies für Unabhängigkeit verwendeten Labels empirisch: Geopolitischer Bloc sagt Fehlerkorrelation nicht voraus (mittleres intra-Bloc 0,285 vs. Cross-Bloc 0,274, Unterschied ), und ein Reasoning-Modell, das aus derselben Basis wie sein Panel-Pendant destilliert wurde, war unter den am wenigsten korrelierten Paaren, die gemessen wurden (; 14. von den 15 US/CN-Bloc-lokalen Paaren, 20. von allen 21 lokalen Paaren). Viertens Konformität: Ein Verifizierer, der mit einer Antwort blind nicht einverstanden war, befürwortete dieselbe Antwort in 38,5% der Fälle, wenn sie als Antwort eines Kollegen gezeigt wurde; eine Reverse-Prompt-Kontrolle zeigt, dass diese Umstände die Anwesenheit eines überzeugten Vorschlags verfolgen, nicht dessen Wahrheit (38,9% zu falsch vs. 34,7% zu korrekt; McNemar exakt ). Wir argumentieren, dass diese Modi eine wirtschaftliche Wurzel teilen, und leiten eine Messdisziplin ab, die Verifikation von ihrem Theater unterscheidet.
Einleitung: das Theaterproblem
Panels von KI-Modellen, die sich gegenseitig überprüfen, werden als Vertrauensinfrastruktur eingesetzt, und die Übereinstimmung zwischen ihnen wird zunehmend als Beweis bewertet. Die Sicherheitsforschung hat lange einen Namen für Mechanismen, die die Ästhetik des Schutzes ohne dessen Substanz erzeugen (Schneier, 2003); wir fragen mit Messungen statt mit Metapher, wann die Panel-Verifizierung diesen Namen verdient. Die Kernfindung ist eine Inversion: Der Zertifizierungswert der Übereinstimmung konzentriert sich auf einfache Fragen und verschwindet – oder kehrt sich um – genau dort, wo die Verifizierung am wichtigsten ist. Wir behandeln dies nicht als eine einzelne Anomalie, sondern als einen von vier unterschiedlichen Regimen, in denen ein Verifier-Panel den Anschein der Überprüfung bewahrt, während es seine Substanz verliert, und wir verknüpfen die vier mit einer gemeinsamen wirtschaftlichen Ursache und einem gemeinsamen Mittel.
Konkret trägt dieses Papier bei: (C1) eine schwierigkeitsstratifizierte Messung des Zertifizierungsgewinns, die zeigt, dass der Zertifizierungswert der unabhängigen Übereinstimmung sich auf einfache Fragen konzentriert und unter dem Populationsschwierigkeitsmaß auf dem schwierigsten Quintil invertiert (0 von 342 replizierten richtigen Antworten; unter panel-unabhängiger Schwierigkeit verschwindet die gepoolte Inversion und das Nullergebnis bleibt für das cross-bloc-Panel bestehen, 0/116) – die beiden Kodierungen werden durchgehend zusammen berichtet; (C2) Evidenz, dass begrenzte (Multiple-Choice-)Antworträume einstimmige zertifizierte Fehler auf 4,0–7,9% treiben, deutlich über der offenen Spanne von 0,3–4,9%; (C3) zwei vorregistrierte Null-Ergebnisse, die zeigen, dass die Labels, die routinemäßig als Unabhängigkeitsproxys verwendet werden – geopolitischer Block und Modellabstammung – keine Fehlerkorrelation vorhersagen, sodass die Unabhängigkeit pro Paar als -Matrix gemessen werden muss, statt von Marke oder Stammbaum angenommen zu werden; und (C4) eine Konformitätsmessung mit einer Reverse-Prompt-Kontrolle, die zeigt, dass Dialog-Modus-Verifier die Anwesenheit eines selbstbewussten Vorschlags verfolgen, nicht dessen Wahrheit. Das blinde Erhebungsprotokoll und das Vertrauenskonstrukt werden im Begleitpapier vollständig angegeben und werden hier nur insoweit zusammengefasst, wie es die Messungen erfordern; alles, das in diesem Papier als Ergebnis berichtet wird (C1–C4), wird hier gemessen und wird nicht aus diesem entnommen. Daraus leiten wir (C5) eine Messdisziplin ab – veröffentlichte Pro-Aufgabenklasse -Matrizen, schwierigkeitsstratifizierte Zertifizierungsansprüche, blinde Elicitation und Eskalation im schwierigen Regime – die Verifizierung operativ von ihrem Theater trennt.
Stand der Forschung und Rahmensetzung
Fehlertoleranter Konsens (BFT) setzt unabhängige Ausfälle voraus – eine Annahme, die wir überprüfen und als unbegründet befinden. Die Literatur zum Konsens-Paradoxon benennt bereits fehlerhafte Einigungsstabilisierung in homogenen Schwärmen (Shehata und Li, 2026). zkML überprüft, dass eine Berechnung ablief, nicht dass ihre Antwort wahr ist – komplementär, nicht konkurrierend. Das Verifier's Dilemma liefert die Anreizanalyse; (Raji et al., 2022) liefern das Auditor-Auswahlproblem; (Du et al., 2024), (Farquhar et al., 2024) und (Ding, 2026) liefern die Literatur zum Einigungssignal, die diese Arbeit einer Belastungsprobe unterzieht. Das Vertrauenskonstrukt selbst wurde in einer Begleitarbeit eingeführt (Chernets, 2026); diese Arbeit zeigt auf, wo die Verifikationsengine des Konstrukts versagt, während sie zu laufen scheint. Arbeiten zu Test-Time-Compute erreichen die komplementäre Schlussfolgerung von der konstruktiven Seite: Ensembles vielfältiger aspekt-spezifischer Verifizierer übertreffen jeden einzelnen Verifizierer (Lifshitz et al., 2025); ein Gremium kleiner Richter aus disjunkten Familien übertrifft einen einzelnen großen Richter bei einem Bruchteil der Kosten (Verga et al., 2024); und eine systematische Neubewertung von Multi-Agent-Debatten identifiziert Modellheterogenität als den einzigen zuverlässigen Verbesserungsfaktor (Zhang et al., 2025); die Debattenlinie zeigt, dass strukturiertes adversariales Argument schwächeren Richtern hilft, wahrere Antworten zu erreichen (Khan et al., 2024). Gutachterlich überprüfte Evidenz dokumentiert bereits erhebliche Fehlerkorrelation zwischen Anbietern – am größten gerade unter den genauesten Modellen, sogar über unterschiedliche Architekturen und Anbieter hinweg (Kim et al., 2025) – was unabhängig davon motiviert, Abhängigkeit zu messen statt sie aus Etiketten zu folgern. Diese Literatur wählt Gremien nach Vielfalt aus; diese Arbeit misst, welchen Wert die ausgewählte Eigenschaft hat – und welche stillen Kosten ihre Abwesenheit verursacht – bei der Verifikation.
Daten und Messung
Eine vorregistrierte, verblindete Erhebung (Protokoll vor der bestätigenden Datenerfassung öffentlich eingefroren; öffentliche Registrierung unter https://osf.io/4y9dv): sechzehn Modelle eine vorregistrierte zufällige Teilstichprobe von 1.500 von SimpleQAs 4.326 Elementen (fester Seed, vor jeder Erfassung gezogen; Teilstichproben-CSV mit angehängtem SHA-256 zur eingefrorenen Registrierung) bei Temperatur Null mit angegebener 0–100 Konfidenz (13.446 saubere Frontier-Antworten; 8.802 Antworten der lokalen Stufe); ein 750-Element-TruthfulQA-MC1-Arm auf der lokalen Stufe, abgeleitet von einer eingefrorenen Kopie der offiziellen Repository-Datei (790 Elemente, byte-identisch mit der kanonischen CSV) durch einen vorregistrierten Konstruktor, der mindestens zwei unterschiedliche falsche Optionen pro Element erfordert (fester Shuffle-Seed; 695 Elemente vollständig von allen sieben Modellen beantwortet); ein exploratives aktiv-versus-blindes Dialog-Arm. SimpleQA wird adversarisch gegen ein Frontier-Modell erfasst, mit einer einzigen unbestreitbaren Antwort pro Frage (Wei et al., 2024): die schwere Schicht testet daher echte parametrische Wissensgrenzen, und die Bewertung reduziert sich auf Äquivalenz zum Gold-Standard. TruthfulQA liefert den Arm mit begrenztem Antwortbereich (Lin et al., 2022). Panels sind analytische Kombinationen der einzigen verblindeten Erhebung; alle Re-Analysen sind deterministisch (String-Äquivalenz-Kodierung mit Verweigerungen und Null-Überschneidungen als Nicht-Übereinstimmung gezählt; unbestimmte Paare als Klammern berichtet). Schwierigkeit wird observativ als mittlere 16-Modell-Genauigkeit pro Frage operationalisiert, aufgeteilt in Rang-Quintile von 300 Fragen. Dieselbe Roherfassung liegt der begleitenden Arbeit zugrunde (Chernets, 2026), die die gepoolten Zertifizierungsquoten und kurze Zusammenfassungen der hier detaillierten Analysen berichtet; die schwierigkeitsstratifizierte Lift-Leiter, die Robustheitssuite, -Matrix und Konformitätszerlegungen erscheinen nur in diesem Papier, und jede verbleibende Überschneidung ist im Text gekennzeichnet.
Open-Form-Bewertung ist zweistufig: ein deterministischer String-Äquivalenz-Pass (26,8 % der Frontier-Bewertungen) plus Verweigerungs-Erkennung (6,6 %), wobei die verbleibenden 66,5 % von einem LLM-Bewerter bewertet werden; eine menschliche Stichprobenkontrolle stimmte dem Bewerter bei 98 % einer zufälligen Stichprobe zu (). Da zwei Drittel der Bewertungen modellerzeugt sind, werden alle Haupt-Ergebnisse von einer Empfindlichkeits-Neuabtastung bei Bewertungsfehlern begleitet (10 % der modellgestützten Urteile umgekehrt, 200 geseedete Neustichproben; Abschnitt 4 und Anhang A).
Fehlerregime I: die Schwierigkeitsinversion
Die drei vordefinierten Grenzpanels sind analytische 3-Modell-Kombinationen der einfachen blinden Sammlung: US-Bloc (Anthropic, OpenAI, Google), CN-Bloc (DeepSeek, Alibaba, Moonshot) und länderübergreifend (Anthropic, DeepSeek, Mistral); eine Antwort gilt als repliziert, wenn mindestens einer der beiden Panel-Partner des Primärmodells unabhängig eine äquivalente Antwort unter der gefrorenen deterministischen Codierung von Abschnitt 3 produziert hat, und die Effektstärke ist . Über alle drei Panels hinweg steigt die Wahrscheinlichkeit, dass eine replizierte Antwort korrekt ist, von 0,0 % (0/342, KI 0,0–1,1) im schwierigsten Quintil über 12,8 %, 57,5 % und 81,0 % auf 95,1 % im einfachsten; die entsprechende Effektstärke gegenüber nicht-replizierten Antworten beträgt 0,00 / 0,82 / 2,68 / 3,09 / 4,56. Bei den schwierigsten 20 % der Fragen zertifizierte jede beobachtete Übereinstimmung eine falsche Antwort, und im nächsten Quintil liegt die Punktschätzung unter der Parität mit Uneinigkeit (0,82, KI [0,51, 1,21]); das Quintil mit den schwierigsten Fragen hat null Replikationen in jedem Panel separat (US 0,00–4,25, CN 0,00–9,76, länderübergreifend 0,00–4,04); die Unterparität Q2 gilt in den CN- und länderübergreifenden Panels, während die Q2-Effektstärke des US-Panels 1,20 beträgt. Ein großer Teil der gepoolten Zertifizierungseffektstärke wird durch einfache Fragen getragen, daher überzeichnet eine ungeschichtete Effektstärkebehauptung, was Verifizierung dort leistet, wo sie benötigt wird. Die Q1-Null wird gegen eine aktive Basisrate gemessen, nicht gegen einen Boden: nicht-replizierte Q1-Antworten sind 3,9 % der Zeit korrekt (89/2286), daher sagt Unabhängigkeit korrekte replizierte Antworten voraus—die beobachteten 0 (Obergrenze 1,1 %) liegen signifikant unter der eigenen Basisrate der Schicht. Der Unabhängigkeitsbenchmark ist hier konservativ, nicht liberal: ein Null-Modell, das die vollständig gemessene Inter-Modell-Korrelationsstruktur bewahrt – eine häufige Permutation von Korrekt-Etiketten über die Fragen der Schicht, Replikationsstruktur gefroren (2.000 Permutationen) – erwartet 11,7–12,4 korrekte replizierte Antworten und produzierte nie die beobachteten 0 (; Minimum 3); das Einfalten der gemessenen paarweisen in einen analytischen bivariaten Null erhöht die Erwartung weiter, da positiv korrelierte Fehler positiv korrelierte korrekte Antworten implizieren. Was die Schicht bevölkert, ist selbst informativ: die 342 Zellen erstrecken sich über 106 Fragen – gewöhnliche enge Faktoiden (Median 17 Wörter), keine mehrdeutige Formulierung, und Modelle verzichten selten auf sie (0,5 von 9 Antworten pro Frage). Ihre falschen Antworten clustern: bei 70,8 % dieser Fragen produzierten mindestens drei der neun Grenzmodelle die gleiche falsche Antwort, und bei 67,4 % der Fragen, die von mehr als einem Panel repliziert wurden, zertifizierten die unabhängig zusammengesetzten Panels den identischen falschen Konsens – typischerweise eine berühmte Nachbarschaftsantwort, die die korrekte, aber weniger prominente Entität verdrängt. Eine manuelle fachliche Überprüfung aller 106 Gold-Etiketten fand 2 anfechtbar und 0 eindeutig falsch; wenn man die eine eindeutig verteidigbare Panel-Antwort und zwei teilweise verteidigbare anrechnet, verschiebt sich die Anzahl des Quintils mit den schwierigsten Fragen von 0/342 auf höchstens 13/342 (3,8 %), sodass die nahe-Null-Schlussfolgerung gilt, während sie von einer wörtlichen Null gemildert wird (ein gekennzeichnetes Etikett: eine 2010er Royal Academy Wahl gegenüber einem Ehrentitel, den die Akademie nicht verleiht). Die Behauptung ist direkt testbar: sie sagt Q1-Effektstärke in jeder nach der Genauigkeit der bereitgestellten Population geschichteten Replikation voraus (unter Panel-unabhängiger Schichtung ist die Vorhersage die länderübergreifende Null, nicht die gepoolte Effektstärke). Auch die Null ist kein Graderartefakt: eine unabhängige zweite Grader von einer Anbieterfamilie außerhalb jedes Panels und der ursprünglichen Grader (Temperatur Null, die identische gefrorene Äquivalenz-zu-Gold-Aufforderung) bewertete alle 342 Q1-replizierten Urteile neu und stimmte 342/342 zu (Umkehrungen zu korrekt 0/342, Obergrenze 1,1 %); synthetisches Umkehren von 10 % der modellbenoteten Etiketten lässt die zertifizierte Fehlerrate in jedem Resampling ebenso bei oder über 86,5 % (Anhang).
Leave-panel-out Neu-Stratifizierung.
Da Panelmitglieder zum Populationsschwierigkeitsindex beitragen, ist das härteste Quintil teilweise durch das eigene Versagen des Panels bedingt. Bei Neu-Stratifizierung nur nach den 13 Nicht-Panel-Modellen sind replizierte Antworten im härtesten Quintil in 78/354 Fällen korrekt (22,0%, gepoolte Verstärkung 2,36, über den 33/354 erwarteten unter Unabhängigkeit), und die Null persisiert nur für das panel-übergreifende Panel (0/116; 0/88 in der Schicht, in der alle 13 Nicht-Panel-Modelle ausfallen). Die verbleibende Null ist selbst charakterisiert: die Basisrate der Schicht beträgt 31/778 = 3,98% (Wilson 2,8–5,6%), was eine Unabhängigkeitserwartung von 4,6 korrekten unter den 116 ergibt; eine korrelationserhaltende Permutations-Null (2.000 Permutationen) ergibt , 95%-Bereich , und — signifikant unter der Null, obwohl unter ihr erreichbar. Die Umkehrung oben ist daher eine Aussage darüber, wo die Verifikation relativ zu den Schwierigkeiten der bereitgestellten Population versagt, nicht relativ zur Panel-unabhängigen Schwierigkeit. Als zweite Sensitivitätsprüfung leiteten wir die Leiter unter vollständig kennzeichnungsfreier Replikationskodierung ab (deterministische Zeichenfolgenvergleich blinder Antworten nur, ohne die Korrektheitskennzeichnung zu konsultieren): das Q1-Ergebnis ist im Wesentlichen unverändert (2/344 replizierte Antworten korrekt, 0,6% [0,2–2,1]; Verstärkung 0,15) und die Verstärkungen unter 1 in den beiden härtesten Quintilen bleiben bestehen, während die Verstärkung des obersten Quintils schwächer wird (4,56 auf 2,33), weil reines Zeichenfolgenvergleich oberflächliche Varianten derselben korrekten Antwort vermisst; Multiple-Choice-Ergebnisse sind unberührt, da die Übereinstimmung dort nach Antwortkennzeichen kodiert ist und konstruktionsbedingt kennzeichnungsfrei ist.
Drei Robustheitsprüfungen unterstützen die Umkehrung. (i) Fragenlevel-Bootstrap (2.000 gezähmte Resamples innerhalb des Quintils) ergibt 95%-KIs für die fünf Verstärkungen von [0,00, 0,00], [0,51, 1,21], [2,32, 3,09], [2,84, 3,35] und [4,16, 5,03]: die Intervalle des Hard-Regimes schließen die des Easy-Regimes vollständig aus. (ii) Fehlerempfindlichkeit des Bewerters: Das Umkehren von 10% der modellbenoteten Urteile (200 gezähmte Resamples; 97,1% der 342 replizierten Antworten des härtesten Quintils sind modellbenotet und daher umkehrbar) lässt den zertifizierten Fehleranteil des härtesten Quintils in jedem Resample bei oder über 86,5% und hält die Q1-Verstärkung in 92% der Resamples unter 1 (Median 0,82), bringt die Q1–Q2-Verstärkungen aber nie in die Nähe der Q3–Q5-Verstärkungen, die in allen 200 Resamples über 2 bleiben. (iii) Das siebener-Modell-lokale Tier repliziert den Hard–Easy-Kontrast mit unabhängigen Modellen und Panels, nicht-monoton (Q3 ): Verstärkungen 0,00 / 0,94 / 0,00 / 1,89 / 4,37 über dieselben Quintile hinweg, mit 0 von 166 korrekten replizierten Antworten im härtesten Quintil; dieses Tier ist zu 94,8% LLM-benotet und ist von derselben Bewertungsempfindlichkeits-Resampling wie (ii) abgedeckt.
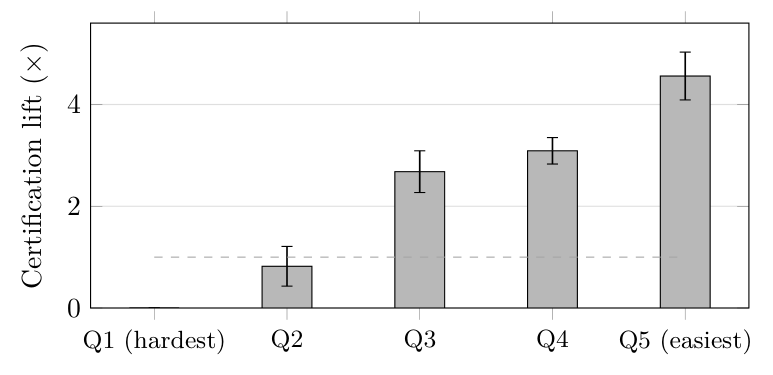 Zertifizierungs-Verstärkung nach Schwierigkeitsquintil, gepoolte drei Grenzpanels, mit Fragenlevel-Bootstrap-95%-Intervallen (2.000 gezähmte Resamples; Anhang A.1). Die gestrichelte Linie markiert Verstärkung = 1, Gleichstand mit nicht-replizierten Antworten: die beiden härtesten Quintile liegen nach Punktschätzung bei oder unter ihr (Q1 0,00×—eine gemessene Null, keine fehlenden Daten; Q2 0,82×, sein KI kreuzt Gleichstand), die drei leichtesten deutlich darüber.
Fehlerregime II: beschränkte Antwortbereiche
Bei Multiple-Choice-Fragen konvergierten vier vordefinierte lokale Panels einstimmig auf eine falsche Option bei 4,0–7,9 % der 695 vollständig beantworteten Fragen (pro Panel: 4,0, 5,9, 6,6, 7,9), gegenüber einer deterministischen Spanne von 0,3–4,9 % für sichere einstimmig falsche Antworten in offener Form auf der Frontier-Ebene. Die Neuberechnung derselben Zertifizierungsmetrik auf die eigenen Antworten in offener Form der lokalen Ebene (8.802 bewertete SimpleQA-Antworten) beseitigt die Ebenen-Format-Verwechslung: Die gleichen lokalen Panels zertifizieren einstimmig sichere Fehler nur bei 1,5–4,6 % der Items in offener Form unter strikter deterministischer Kodierung (bis zu 9,8 % inklusive der unbestimmten Spanne), was dem Frontier-Bereich in offener Form entspricht – ein Muster, das darauf hindeutet, dass der beschränkte Antwortbereich statt der Modell-Ebene die Fehlerzertifizierung antreibt; allerdings bleibt eine Verwechslung bestehen: Der Multiple-Choice-Arm und die Arme in offener Form sind unterschiedliche Fragesets (TruthfulQA MC1 gegenüber SimpleQA), sodass Format und Frageset hier nicht getrennt sind, und die kausale Form der Aussage wird nur durch einen Format-Wechsel bei derselben Frage geklärt, den wir nicht durchführten.1 Das Panel-Bootstrap setzt Intervalle auf die Lücke, wo sie aussagekräftig ist: Multiple Choice minus offene Form zertifizierten Konsens-Fehler ist Prozentpunkte [2,9, 6,8] (Pilot), Prozentpunkte [3,9, 8,1] (US-lokal) und Prozentpunkte [2,6, 6,3] (blockübergreifend), jeweils ohne Null; das CN-lokale Panel, dessen Zelle in offener Form auf dem 87-Item-Set der Fußnote basiert, klärt es nicht. Ein Menü wandelt verstreute Fehler in geteilte um: Wenn der Antwortbereich klein ist, landen ähnliche KIs auf derselben falschen Option und die Einstimmigkeit des Panels wird zu einem Fehler-Verstärker. Die Quoten sind nicht durch unabhängige Fehler erklärbar: Wenn jedes Mitglied unabhängig bei seiner Grenzquote falsch liegt und Fehler über die falschen Optionen verteilt sind (), beträgt die erwartete Quote für einstimmig gleich falsche Optionen 0,49–0,92 % über die vier Panels – die beobachteten 4,0–7,9 % sind ein 4,9–13,5 Überschuss gegenüber der Unabhängigkeitsgrundsätzlichkeit. Designfolge, als testbare Regel formuliert: Jede Schnittstelle, die Agenten einen festen Satz an Optionen zur Verfügung stellt, sollte deutlich höhere zertifizierte Konsens-Fehler erwarten als die Elizitation in offener Form zum gleichen Inhalt.
Die Anforderung von angegebener Zuverlässigkeit von allen drei Panelisten beeinträchtigt den Effekt kaum: Der zertifizierte Konsens-Fehler-Bereich bewegt sich von 4,0–7,9 % zu 4,0–7,2 % (pro Panel 4,0, 5,2, 6,0, 7,2), d. h. fast alle einstimmig falschen Antworten sind auch zuverlässige. Der Fehler beschränkt sich auch nicht auf eine thematische Nische: Über die zehn TruthfulQA-Kategorien mit mindestens 20 Items erstreckt sich der gepoolte zertifizierte Konsens-Fehler von 1,0 % (Verschwörungstheorien) bis 8,6 % (Wirtschaft), mit Recht, Gesundheit und Soziologie dazwischen (Anhang A).
Fehlverhalten III: Unabhängigkeitsetiketten sagen keine Unabhängigkeit voraus
Über 36 Frontier-Anbieterpaare (1.448 gemeinsame Fragen) erstreckt sich die paarweise Fehlerkorrelation von 0,123–0,395, und die Spanne wird nicht durch die Etiketten organisiert, zu denen Menschen greifen: die am stärksten und am wenigsten korrelierten Paare sind beide innerhalb von Blöcken (googlexai 0,395 vs. googleopenai 0,123), mittlere Intra- versus Cross-Bloc unterscheiden sich um , und das Paar derselben Abstammungslinie rangiert 14. von 15 Paaren, die von den sechs lokalen US/CN-Bloc-Modellen auf die 695 vollständig beantworteten Multiple-Choice-Fragen gebildet werden (; das siebte lokale Modell ist EU-Bloc und außerhalb des vorregistrierten Bloc-/Abstammungsdesigns—wenn Sie es einbeziehen, entstehen 21 Paare, von denen das Abstammungspaar den 20. Rang einnimmt). Beide vorregistrierten Null-Hypothesen (Bloc, Abstammung) überstehen eine Neuanalyse; was vorhersagbar bleibt, ist die gemessene Korrelation selbst. Die praktische Regel: Unabhängigkeit ist eine pro-Paar-, pro-Aufgabenklasse-Größe, die gemessen werden muss (eine -Matrix), nicht aus Marke, Flagge oder Stammbaum zu folgern—die Zusammensetzung eines Gremiums anhand von Etiketten ist Vermutung, nicht Verifikation. Paarweise misst empirische Fehlerabhängigkeit, nicht vollständige statistische Unabhängigkeit: niedriges schließt höherwertige Abhängigkeit in Gremien von drei oder mehr nicht aus, ein weiterer Grund, Unabhängigkeit als gemessene, aufgabenbedingteGröße zu behandeln, anstatt sie als angenommene Eigenschaft zu betrachten.
Ein exakter Permutationstest über alle 630 Zuweisungen der Bloc-Etiketten zu den neun Anbietern findet keinen Hinweis auf einen Bloc-Effekt: die beobachtete Intra-minus-Cross-Differenz von wird durch 132 von 630 Neubeschriftungen überschritten oder erreicht (einseitig ; gebündeltes Bootstrap-95%-KI für die Differenz ). Der Test begrenzt die Behauptung—kleine Bloc-Effekte werden nicht ausgeschlossen—und die operative Schlussfolgerung bleibt bestehen: das Etikett trägt kein Signal, das anstelle von Pro-Paar-Messung verwendbar ist. Da nach oben begrenzt ist, wenn sich die Basisfehlersätze des Paares unterscheiden, führten wir die Analyse auf das randnormalisierte Verhältnis erneut durch: beide vorregistrierten Null-Hypothesen überstehen (Bloc-Differenz , Permutation ; das Abstammungspaar bleibt 14. von 15), die Spanne bleibt erhalten (0,278–0,821 über Frontier-Paare), und die Extreme verlagern sich auf zwei Cross-Bloc-Paare (anthropicmoonshot 0,821, mistralopenai 0,278)—unter beiden Metriken organisiert kein Etikett die Spanne. Die Matrix auf alle sechzehn Modelle ausdehnend: auf die 81 Fragen, die von jedem Modell beantwortet werden, erstreckt sich paarweise von bis (120 Paare; Blockmittelwerte: Frontier–Frontier 0,320, lokal–lokal 0,350, Frontier–lokal 0,210)—eine Spanne in Größenordnung, die keine Etikett-Taxonomie in Ihren Daten vorhersagt (Abbildung 2). Mit 81 gemeinsamen Elementen tragen einzelne Zellenschätzungen breite Intervalle; das Ergebnis ist die Spanne selbst, nicht irgendeine einzelne Zelle.
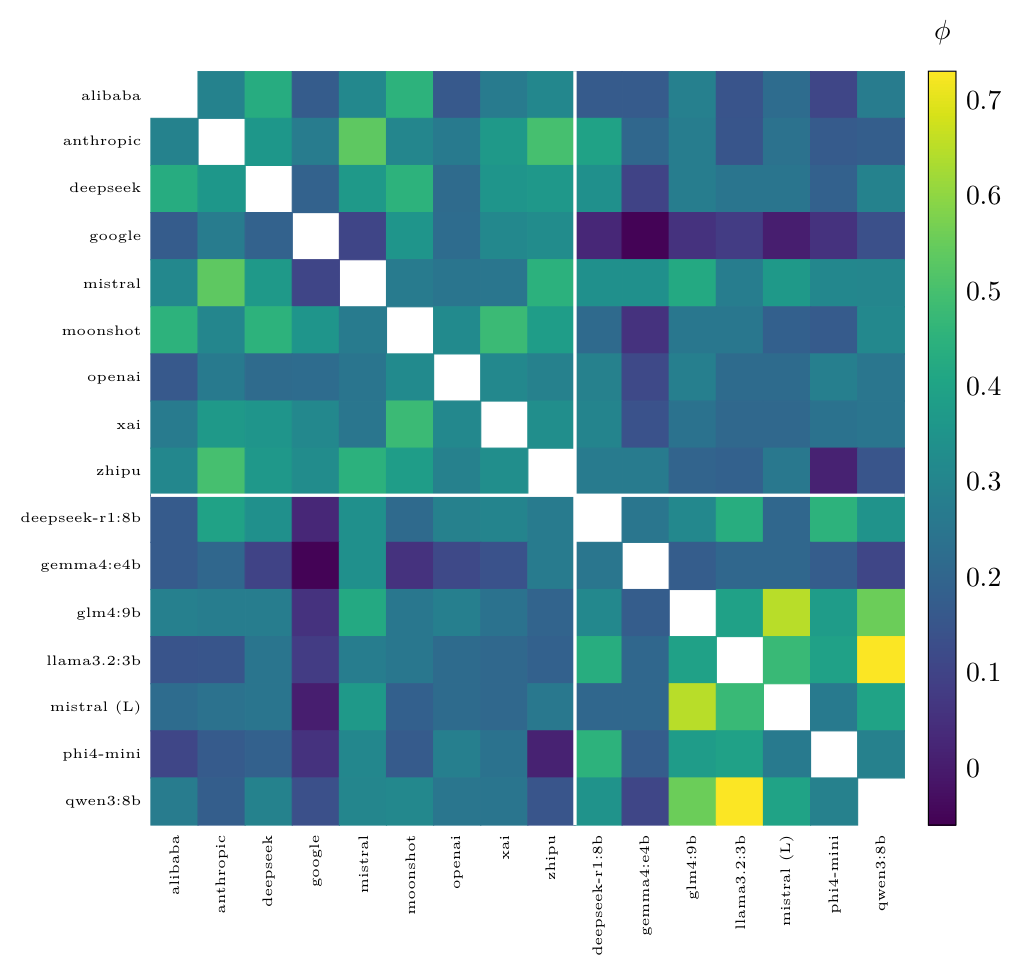 Paarweise Fehlerkorrelation (ϕ) unter allen sechzehn Modellen bei den 81 Fragen, die von jedem Modell beantwortet wurden (neun Frontier-Anbieter, dann sieben lokale Open-Weights; die Frontier-/lokale Aufteilung ist durch die weißen Linien gekennzeichnet). Jede Zelle außerhalb der Diagonalen ist eines der 120 eindeutigen Paare; die Diagonale (Selbstkorrelation = 1,0) wird absichtlich leer gelassen, damit sie die Farbskala nicht komprimiert. ϕ reicht von −0,05 bis 0,73 (Mittelwert 0,27): eine um eine Größenordnung verbreitete Spanne, wie korreliert die Fehler zweier beliebiger Verifizierer sind, was kein Bloc oder Abstammungslabel in unseren Daten vorhersagt. Die Werte werden deterministisch von emit_phi_matrix.py ausgegeben (wobei analysis_week1.py Abschn. W5 wiederverwendet wird); keine wurden von Hand eingegeben.
Fehlregime IV: Verifikation, die nachgibt (explorative)
Wenn einem Verifizierer, der blind nicht einverstanden war, die gleiche Antwort wie der Vorschlag eines Kollegen gezeigt wurde, kapitulierte er in 38,5 % der Fälle (168/436); als er die richtige Antwort blind erzeugt hatte, gab er sie in 30,9 % für die falsche auf (46/149), wobei die Aufgabequoten pro Anbieter von 13,1 % bis 51,6 % reichten (die Kapitulation pro Anbieter in der gesamten blind-nicht-einverstanden-Teilmenge erstreckt sich auf 20,4–58,1 %).
Könnten diese Wechsel rationale Überzeugungsaktualisierung statt Konformität sein? Ein umgekehrtes Prompt-Kontrollexperiment spricht dagegen. Auf einem sechsermodell-lokalen Panel haben wir das gepaarte Verfahren mit umgekehrter Expositionsrichtung erneut durchgeführt: einem Verifizierer, der blind nicht einverstanden war, wurde für denselben Fragensatz entweder die selbstbewusst falsche Antwort (direkter Arm) oder die Gold-Antwort (umgekehrter Arm) gezeigt. Die beiden Arme sind prompt-identisch – eine gemeinsame Vorlage („Vorgeschlagene Antwort: …"), wobei sich die angezeigte Antwort nur im Inhalt unterscheidet, ohne dass ein Vertrauenswert oder eine Quellenattribution angezeigt wird – daher isoliert der Kontrast den Wahrheitswert der angezeigten Antwort. Wenn Verifizierer auf Evidenz aktualisieren würden, sollte die Exposition gegenüber der richtigen Antwort sie stärker bewegen; stattdessen erzeugten die beiden Arme eine nahezu identische Wechselrate – 38,9 % zur falschen Antwort, 34,7 % zur richtigen – und der Innerhalb-Paar-Vergleich verläuft in die falsche Richtung für die Aktualisierungsgeschichte: von 174 diskordanten Paaren verließ der Verifizierer seine blinde Position in 104 für die falsche Antwort und in 70 für die richtige (McNemar exakt ). Auf Modelleben waren die beiden Arme nicht zu unterscheiden (Wechsel-Neigung 89,9 % vs. 89,9 % für den konformsten Verifizierer, 1,5 % vs. 1,5 % für den am wenigsten konformen): Was Zustimmung auslöst, ist die Anwesenheit eines selbstbewussten Vorschlags, nicht dass er wahr ist – die Panel-Verifikationsseite der Vorlieben-trainierten Speichelleckerei (Sharma et al., 2024). Die Asymmetrie hängt auch nicht vom konformsten Verifizierer ab: Wenn man ihn ausschließt, bleiben 835 gepaarte Elemente mit diskordanten Zählungen 94 vs. 60 (exakt ). Zwei weitere Zerlegungen stärken diese Interpretation (Anhang A): Jeder aufgezeichnete Wechsel in beiden Armen ging mit angegebenem Vertrauen nach der Exposition einher (0 Wechsel unter diesem Schwellwert, ), und im direkten Arm gaben Verifizierer, die blind richtig waren, die richtige Antwort in 40,8 % der Fälle auf (20/49), was den Grenzfund widerspiegelt. Die Kontrolle lief auf der lokalen Ebene (Einschränkungen). Eine Zusammenfassung dieser Kontrolle in Prosa erscheint auch im Begleitpapier (Chernets, 2026); die Pro-Modell-Zerlegung, die Vertrauens-Gate-Aufteilung und die Analyse der korrekten-blinden Aufgabe werden nur hier berichtet.
Dies grenzt einen Designanspruch ein: Wenn das Ziel darin besteht, unabhängige Meinungsverschiedenheiten zu messen, muss die Erhebung blind-zuerst erfolgen – ein Panel, das die Positionen vor dem Festlegen berät, misst seine Meinungsverschiedenheiten nicht, es löscht sie.
Diskussion: die Ökonomie des Theaters (Vermutung, keine Evidenz)
Dieser Abschnitt ist Diskussion statt Evidenz: er berichtet keine neuen Messungen, und nichts darin sollte als gleichwertig mit den vier gemessenen Regimen oben gelesen werden. Das gesagt, können die vier Regime bestehen bleiben, weil keine Partei bezahlt wird, sie zu bemerken: Verbraucher können die Qualität der Verifikation nicht bewerten, Plattformen werden für Vertrauen statt Zweifel bezahlt, und die billigste Strategie jedes Verifizierers ist, zuzustimmen. Addieren Sie das Auditor-Auswahlproblem (Unabhängigkeit ist eine Eigenschaft desjenigen, der die Prüfer auswählt) und das Link-Farm-Präzedenz (jedes Übereinstimmungssignal, das kommerzielles Gewicht trägt, lädt zu Farming ein), und Theater ist ein Gleichgewicht, kein Zufall—eine Vermutung, die die Messungen motivieren, aber nicht testen. Die Anreizrechnung ergänzt, statt auszuschließen, technische Trägheit und das Fehlen von Messnormen; sie wird hervorgehoben, weil sie die falsifizierbare Komponente ist. Dieser Abschnitt macht falsifizierbare Marktprognosen statt normativer Aussagen—z. B. sollten nicht überprüfte Panels im Laufe der Zeit zu Zusammensetzungen mit minimaler Vielfalt konvergieren, weil korrelierte Panels billiger sind und stärker übereinstimmen.
Vom Theater zur Messung
Das Mittel ist eine Disziplin, keine Komponente: (1) veröffentlichen Sie die gemessene -Matrix des Panels pro Aufgabenklasse, nicht ihre Marken-Liste (eine blinde Erhebung pro Aufgabenklasse genügt – die 16-Modell-Matrix dieses Papers stammt aus einem einzigen Durchgang mit 1.500 Elementen); (2) stratifizieren Sie jeden Zertifizierungsanspruch nach Schwierigkeit und berichten Sie die Verbesserung im harten Regime separat (Schwierigkeit wird pro Aufgabenklasse aus einer Kalibrierungssammlung operationalisiert, nicht pro Element bei der Inferenz); (3) elizitieren Sie immer zuerst blind – das Commit-Reveal-Schema der Panel-Verifizierung, das die Elizitation neu ordnet, anstatt Rechenleistung hinzuzufügen, da blinde Antworten parallelisierbar sind; (4) behandeln Sie das härteste Regime als Eskalationsauslöser – bei Fragen, bei denen die gemessene Verbesserung des Panels beträgt, muss die Übereinstimmung an einen Menschen oder zur Enthaltung weitergeleitet werden, niemals zur Zertifizierung. Jede Regel ist so formuliert, dass ein eingesetztes System dagegen überprüft werden kann.
Wenden Sie als praktisches Beispiel das Rezept auf das Frontier-Panel dieses Papers selbst an. Regel (1): seine Unabhängigkeit wird als die gemessene -Matrix von Abschnitt 6 berichtet (Spanne 0.123–0.395), nicht als Anbieter-Verzeichnis – was verborgen hätte, dass das am stärksten korrelierte Paar innerhalb eines Blocks liegt (googlexai). Regel (2): seine Zertifizierungsverbesserung wird stratifiziert berichtet (Tabelle 1), mit der Verbesserung im harten Regime ( bei Q1, bei Q2) separat angegeben, anstatt sie in eine einzelne gepoolte Schlagzeile zu falten. Regel (3): jede Antwort hier wurde blind elizitiert, bevor ein Panel zusammengestellt wurde, was genau das ist, was den Konformitätsarm (Abschnitt 7) messbar statt verwirrend macht. Regel (4): da die gemessene Verbesserung des Panels bei den zwei schwierigsten Quintilen beträgt, würde eine überprüfte Einsetzung desselben Panels diese Fragen zur Enthaltung oder Überprüfung durch Menschen weiterleiten, niemals zur Konsenszertifizierung. Die Disziplin ist daher nicht hypothetisch: sie ist das Protokoll, unter dem die Zahlen dieses Papers erzeugt wurden.
Einschränkungen
Eine Benchmark-Familie pro Stufe (SimpleQA offene Form Grenze; TruthfulQA MC lokal), daher sind Regime-Grenzen Benchmark-relativ; jeder Grenzanbieter wird durch ein Budget-/Mid-Tier-Modell vertreten, daher werden keine Ansprüche zur Anbieter-Fähigkeit gestellt. Die Schwierigkeitsstratifizierung ist observativ (nachträglich über eine vorregistrierte Sammlung) und die Quintil-Zuweisung teilt Daten mit den bewerteten Modellen. Der Konformitätsarm ist explorativ und bescheiden in ; die Reverse-Prompt-Kontrolle verwendete lokale Modelle, daher ist der Transfer zu Grenzpanels durch Analogie, nicht durch Messung. Etwa zwei Drittel der offenen Bewertungen stammen von einem KI-Grader (menschliche Stichprobe 98 % Übereinstimmung; eine familienübergreifende Neubewertung aller 342 schwierigsten Quintile replizierte Urteile stimmten 342/342 überein; Empfindlichkeitsresampling im Anhang). Beide Benchmarks sind öffentlich, daher kann Trainingssatz-Leckage nicht ausgeschlossen werden; bei SimpleQA begünstigt ihre Richtung memorierte korrekte Antworten, was die schwere Schicht schrumpft und die Ergebnisse des schwierigen Regimes konservativ macht; bei TruthfulQA trägt der öffentliche Korpus die Fehlvorstellungen selbst, daher ist die Richtung dort nicht eindeutig – eine alternative Lesart ist bereits durch den Format-Inhalt-Vorbehalt von Abschnitt 5 begrenzt. Es wird keine kausale Aussage darüber gemacht, warum die Übereinstimmung bei schwierigen Fragen fehlschlägt – die Mechanismus-Kandidaten (gemeinsame Priors, gemeinsame Blindflecken, gemeinsame Trainingsdaten) sind benannt, aber nicht getrennt.
Schlussfolgerung
Übereinstimmung ist nur dann ein Beweis, wenn Unabhängigkeit und Kompetenz gemessen werden, und die Messung ist kostengünstig – die gesamte hier durchgeführte Neuanalyse läuft in Sekunden auf handelsüblicher Hardware aus öffentlichen Rohdateien ab. Bis Panels mit ihren -Matrizen und geschichteten Lifts ausgeliefert werden, sollte „durch Konsens verifiziert" so gelesen werden, wie Sicherheitsingenieure gelernt haben, eine Taschendurchsuchung zu lesen.
References
B. Schneier. Beyond Fear: Thinking Sensibly About Security in an Uncertain World. Copernicus Books, 2003.
D. Shehata and M. Li. The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274, 2026.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
Y. Du, S. Li, A. Torralba, J. B. Tenenbaum, and I. Mordatch. Improving factuality and reasoning in language models through multiagent debate. In ICML, 2024. arXiv:2305.14325.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
E. Kim, A. Garg, K. Peng, and N. Garg. Correlated errors in large language models. In ICML, 2025. arXiv:2506.07962.
M. Sharma, M. Tong, T. Korbak, D. Duvenaud, et al. Towards understanding sycophancy in language models. In ICLR, 2024. arXiv:2310.13548.
A. Khan, J. Hughes, D. Valentine, L. Ruis, et al. Debating with more persuasive LLMs leads to more truthful answers. In ICML, 2024. arXiv:2402.06782.
J. Wei, K. Nguyen, H. W. Chung, Y. J. Jiao, S. Papay, A. Glaese, J. Schulman, and W. Fedus. Measuring short-form factuality in large language models. arXiv:2411.04368, 2024.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lifshitz, S. A. McIlraith, and Y. Du. Multi-agent verification: Scaling test-time compute with multiple verifiers. arXiv:2502.20379, 2025.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
H. Zhang, Z. Cui, J. Chen, et al. Stop overvaluing multi-agent debate—we must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788, 2025.
Vadym Chernets. Architectural trust: Verifiable decision architecture for agentic commerce. SSRN working paper 7191261, 2026. https://doi.org/10.2139/ssrn.7191261 (cited for the trust construct and for its summary treatment of the shared blind collection; overlapping analyses are cross-flagged where they occur).
Reproduzierbarkeitsanhang
Alle Reanalysen sind deterministisch gegeben die rohen bewerteten JSONL-Dateien und zwei Scripts mit festem Seed (ein Baseline-Script, das jede Schlagzahl reproduziert, und ein Woche-1-Add-on, das die Bootstrap-, Sensitivitäts- und Zerlegungstabellen unten erzeugt); die vollständige Neuberechnung dauert weniger als 15 Sekunden auf Standard-Hardware ohne GPU, Netzwerk oder Modellaufrufe. Das eingefrorene Vor-Registrierungs- und Replikationspaket (öffentliche OSF-Registrierung): https://osf.io/4y9dv.
Bootstrap-Konfidenzintervalle für die Lift-Leiter
Neu-Stichprobenziehung auf Fragenebene innerhalb von Quintil, 2.000 seeded Ziehungen, gepoolt über die drei Frontier-Panels.
| Quintil | Wilson 95% | Boot 95% | Lift | Lift Boot 95% | |
|---|---|---|---|---|---|
| Q1 (schwierigste) | 0/342 = 0,0% | [0,0, 1,1] | [0,0, 0,0] | 0,00 | [0,00, 0,00] |
| Q2 | 46/359 = 12,8% | [9,7, 16,7] | [8,2, 18,2] | 0,82 | [0,51, 1,21] |
| Q3 | 272/473 = 57,5% | [53,0, 61,9] | [50,7, 64,6] | 2,68 | [2,32, 3,09] |
| Q4 | 732/904 = 81,0% | [78,3, 83,4] | [76,6, 85,1] | 3,09 | [2,84, 3,35] |
| Q5 (leichteste) | 1700/1788 = 95,1% | [94,0, 96,0] | [93,4, 96,6] | 4,56 | [4,16, 5,03] |
Zertifizierungs-Lift nach Schwierigkeitsquintil mit Wilson- und Bootstrap-95%-Intervallen (Prozentsätze für , Verhältnisse für Lift). Unter Leave-Panel-Out-Schwierigkeit (rangiert nach den 13 Nicht-Panel-Modellen) ist die zusammengefasste Q1-Zelle 78/354 (22,0%, Lift 2,36), die Null bleibt für das Cross-Bloc-Panel (0/116); Abschnitt 4. Basisquoten pro Quintil: 3,9 / 15,6 / 21,5 / 26,2 / 20,8% ( = 2286 / 2308 / 2209 / 1778 / 912).
Grader-Fehler-Sensitivität
Umkehrung von 10% der 8.948 modellbewerteten Frontier-Urteile (200 seeded Resamples; Agreement-Kodierung und Quintil-Zuordnung gefroren beim ursprünglichen deterministischen Protokoll-Kodierung, sodass nur Korrektheitslabels sich ändern): Die Zelle „zertifiziert korrekt" des schwierigsten Quintils steigt von 0/342 auf einen Median von 33/342 (9,6%; 95%-Bereich 23–46), sodass der zertifiziert-fehlerhaften Anteil der Q1-Übereinstimmung in jedem Resample bei oder über 86,5% bleibt; der Q1-Lift bleibt in 92% der Resamples unter 1 (Median 0,82, 95%-Bereich 0,56–1,08), während die Q3–Q5-Lifts niemals unter 2 fallen (Mediane 2,17 / 2,51 / 3,42). Von den 342 Q1 replizierten Antworten sind 332 (97,1%) modellbewertete und daher in dieser Übung umkehrbar. Jenseits synthetischer Umkehrungen hat eine Cross-Family-Überprüfung alle 342 Q1 replizierten Urteile mit einem unabhängigen zweiten Grader erneut bewertet (eine Vendor-Familie außerhalb jedes Panels und außerhalb der Grader-Familie des Originals; Temperatur 0; byte-identisches gefrorenes Prompt): Übereinstimmung 342/342 (Umkehrungen zu korrekt 0/342, Wilson Obergrenze 1,1%), einheitlich über modellbewertete (332) und String/Ablehnungs-kodierte (10) Zellen. Da die 342 Zellen 106 eindeutige Fragen umfassen, liest eine Cluster-konservative Lesart Fragen als die Einheit: 0/106 ergibt eine Wilson-Obergrenze von 3,4%; das Fragen-Ebenen-Permutations-Null von Abschnitt 4 operiert bereits auf Cluster-Ebene.
Reverse-Prompt-Kontrolle: Modell-weise Zerlegung
Sechs lokale Modelle, 2.399 gültige gepaarte Beobachtungen; flip = die Verifiziererweicht ihrer blinden Antwort ab und übernimmt die gezeigte Antwort.
| Verifizerer | Direkt (zu falsch) | Umgekehrt (zu richtig) | Diff |
|---|---|---|---|
| qwen3:8b | 204/227 = 89.9% | 196/218 = 89.9% | pp |
| mistral | 132/213 = 62.0% | 113/203 = 55.7% | pp |
| glm4:9b | 66/213 = 31.0% | 39/200 = 19.5% | pp |
| llama3.2:3b | 40/234 = 17.1% | 38/227 = 16.7% | pp |
| gemma4:e4b | 33/202 = 16.3% | 19/195 = 9.7% | pp |
| phi4-mini | 2/137 = 1.5% | 2/130 = 1.5% | pp |
| Zusammengefasst | 477/1226 = 38.9% | 407/1173 = 34.7% | pp |
Flip-Raten nach Verifizerer und Arm. Kein Modell weicht häufiger zur richtigen Antwort ab als zur selbstbewussten falschen. Gepaarte Neuzählung: 1.028 Items in beiden Armen vorhanden (296 in beiden umgewechselt, 558 in keinem); diskordante Paare 104 (nur falsch) gegenüber 70 (nur richtig), exakter Binomial-McNemar (asymptotisch ). Alle 884 verzeichneten Umwechsel zeigen angegebenes Konfidenz nach Exposition ; Flip-Rate unterhalb dieser Schwelle ist 0/547.
MC bescheinigter-Konsens-Fehler nach TruthfulQA-Kategorie
Zusammengefasst über die vier vorher festgelegten lokalen Panels (Ereignisse pro Item-Panel; Kategorien mit mindestens 20 Items): Wirtschaft 8,6%, Fiktion 6,2%, Paranormales 6,0%, Recht 5,9%, Aberglauben 5,7%, Stereotype 5,4%, Soziologie 4,9%, Gesundheit 4,9%, Missverständnisse 2,6%, Verschwörungen 1,0%. Pro-Panel-Raten bei allen drei Mitgliedern mit Konfidenz : 4,0% (CN-lokal), 5,2% (blockübergreifend), 6,0% (Pilot), 7,2% (US-lokal).
Das obere Ende von 4,6% beruht auf dem einen lokalen Panel, das nur 87 Items mit den 98 bewertbaren Antworten des Begründungsmodells teilt; ohne dieses ist die strikte lokale Open-Form-Spanne 1,5–1,8%.↩︎
Wie Sie dieses Papier zitieren
Chernets, V. (2026). Verification Theater: Gemessene Fehlermodi von KI-Verifier-Panels [Paper presentation]. NeurIPS 2026 Workshop: Who Verifies the Agents?. Zenodo. https://doi.org/10.5281/zenodo.23197641
@misc{chernets2026verificationtheater,
  author       = {Chernets, Vadym},
  title        = {{Verification Theater: Measured Failure Modes of AI Verifier Panels}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: Who Verifies the Agents?},
  doi          = {10.5281/zenodo.23197641},
  url          = {https://doi.org/10.5281/zenodo.23197641}
}