Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
Vadym Chernets, PhD, KI-Systemarchitekt · ORCID 0009-0007-4845-3163
SSRN 7682960 · DOI 10.2139/ssrn.7682960 · Zenodo 10.5281/zenodo.24090580 · Analysis-Veröffentlichung 10.5281/zenodo.24090584 · GitHub
Preprint, 9. November 2026. SSRN: 7682960. Archivierte Kopie: 10.5281/zenodo.24090580. Daten und Code: 10.5281/zenodo.24090584. PDF: agreement-inversion.pdf. Das PDF ist maßgeblich.
Zusammenfassung
Wenn zwei Flaggschiff-Modelle, separat befragt, die gleiche Antwort auf eine der schwierigsten SimpleQA-Fragen geben, ist diese Antwort meist falsch. Bei den 106 SimpleQA-Fragen, bei denen Panels der mittleren Stufe im Juli fehlschlugen, haben 45 Flaggschiff-Paare ohne den client-served GPT-Arm, bei denen Websuche nicht ausgeschlossen werden kann, bei 96 von 691 Übereinstimmungen (13,9%) recht. Nur zu antworten, wenn ein zweites Modell zustimmt, benötigt keine Labels oder Parameter, und frühere Arbeiten führten die Ausfälle dieser Regel auf Modelle der mittleren Stufe zurück. In beiden von mir gemessenen Stufen folgt die Präzision vereinbarter Antworten der Genauigkeit des Paares, daher ist Inversion keine Eigenschaft der mittleren Stufe. Im schwierigsten Quintil, auf die gleiche Weise für jede Stufe definiert, beträgt die Präzision 17,3% im Juli und 15,5% im August; über alle fünf Quintile hinweg, bei der von den Genauigkeiten der beiden Modelle erwarteten Präzision, unterscheiden sich Flaggschiff-Paare von Paaren der mittleren Stufe um –0,2 Punkte [–3,1, +2,7]. Die Daten sind SimpleQA, frische zweistufige Fragen und Produktfakten, gesammelt im Juli, August und Oktober 2026 mit Flaggschiff-Modellen von elf Laboratorien. Ein Partner aus einem zweiten Laboratorium erwischt mehr Fehler, aber öffnet die Tür weniger oft: für ein freigegebenes Modell erwischt ein Partner aus demselben Laboratorium 2 von 29 Fehlern und ein Partner aus einem anderen Laboratorium 20 von 29 (–62,1 Punkte [–79,3, –43,8]), wobei die Tür bei 96% und 61% der Fragen offen ist. Wenn die breitere Tür durch angegebenes Vertrauen auf gleiche Abdeckung verdünnt wird, gilt dieser Vorteil nur dort, wo das Modell des Partners erheblich genauer ist. Ein kleines Modell mit gemessenen Genauigkeiten sagt die Out-of-Sample-Präzision mit mittlerem absolutem Fehler 0,037 gegenüber 0,099 für das beste einzelne Modell voraus, auf Augenhöhe mit einer Baseline unabhängiger Fehler von 0,032, und schneidet bei Produktfakten und öffentlichen Daten hoch ab. Bei denselben 100 Fragen erreicht die Kennung gpt-5.6-sol 92,0% in ihrer client-served Welle und 46,3% über die API bei einem anderen Aufwand-Setting, während acht andere Modelle sich um höchstens 4 Punkte bewegen.
1. Einleitung
Stellen Sie zwei große Sprachmodelle (KIs) aus verschiedenen Laboren dieselbe kurze Faktenfrage separat und geben Sie die Antwort nur frei, wenn die beiden übereinstimmen. Das Gate benötigt keine Kennzeichnung, keinen Schwellenwert und keinen Schiedsrichter, nur zwei verdeckte Aufrufe. Flaggschiff-Modelle machen es attraktiv, denn ihr erklärtes Vertrauen bietet wenig Schutz: Bei zehn Flaggschiff-Modellen im August 2026 waren 4.910 von 10.540 Antworten, die mit einer Konfidenz von mindestens 80 gegeben wurden, falsch (Chernets, 2026b).
Meine frühere Messung an proprietären Modellen, eine Sammlung von Modellen der mittleren Klasse aus Juli 2026, ergab replizierte Panel-Antworten zu den schwierigsten Quintilen von SimpleQA, die bei 0 von 342 Gelegenheiten korrekt waren (Chernets, 2026a). Dies deutet darauf hin, dass sich die Übereinstimmung bei schwachen Modellen umkehrt, so dass übereinstimmende Antworten häufiger falsch als richtig sind, und dass starke Modelle entkommen. Ein Flaggschiff-Paar schien es zu bestätigen: gpt-5.6-sol mit claude-fable-5 war bei 34 von 37 Übereinstimmungen bei denselben Fragen richtig (die 106 aus Abschnitt 3).
Auf der Flaggschiff-Ebene hält sich diese Interpretation nicht. Ohne den einzelnen Arm hinter den 34 von 37 kehrt gpt-5.6-sol, bereitgestellt über seinen Anbieter-Client, die Umkehrung zurück, und mit auf dieselbe Weise für beide Ebenen definierten Schwierigkeiten treffen sich die beiden Kurven am schwierigen Ende. Über alle Quintile hinweg unterscheiden sich Flaggschiff- und Mittelklasse-Paare, sobald die zwei Genauigkeiten jedes Paares berücksichtigt werden, um -0,2 Punkte [-3,1, +2,7]. Die Präzision verfolgt, wie genau die beiden Modelle in der Schicht sind, unabhängig von ihrer Klasse.
Tabelle 1 fasst vier Beiträge zusammen. Abschnitt 5.1 gibt eine Gate-Ebenen-Darstellung von Flaggschiffen, überall dort, wo möglich, ohne den Arm, der die Genauigkeitsspanne dominiert. Abschnitt 5.2 misst, was ein zweites Labor beiträgt, wobei das freigegebene Modell und der Partner variiert werden, mit und ohne GPT. Die Abschnitte 4 und 5.3 geben ein deskriptives Modell des Gates mit fünf Konstanten und testen es außerhalb der Stichprobe anhand von erklärten Baselines, und Abschnitt 5.4 vergleicht Anbieter-Clients mit direktem API-Zugriff für denselben Bezeichner bei denselben Fragen.
Tabelle 1. Ansprüche, Belege und Grenzen.
| Anspruch | Beleg | Grenze |
|---|---|---|
| Die Präzision übereinstimmender Antworten folgt der Paar-Genauigkeit auf beiden Ebenen | 96/691 bei den 106; schwierigste Quintile 17,3 % Juli, 15,5 % August; Ebene bei angepasster Genauigkeit -0,2 [-3,1, +2,7] | Assoziation; eine Quintile allein umfasst -1,8 [-22,1, +20,2] |
| Ein zweites Labor erfasst mehr Fehler zum Preis der Abdeckung | 20/29 gegen 2/29 erfasste Fehler, -62,1 [-79,3, -43,8]; Abdeckung 61 % gegen 96 % | Bei gleicher Abdeckung, nach Konfidenz, benötigt es einen weitaus genaueren Partner; zwei Labore im Oktober |
| Ein kleines Modell beschreibt die Präzision außerhalb der Stichprobe | Fehler 0,037 gegen 0,099 für das beste Modell, -0,062 [-0,085, -0,035] | Ebene mit unabhängigen Fehlern, +0,005 [-0,003, +0,012]; 13 Punkte hoch bei Produktfakten |
| Der Zugriffsmodus verschiebt einen Bezeichner | 92,0 % Client gegen 46,3 % API, gleiche 100 Fragen | Modus, Aufwand und mögliche Suche ändern sich zusammen |
2. Verwandte Arbeiten
Der meinen Frage am nächsten kommt Goel et al. (2025), die CAPA einführen, ein chancenbereinigtes Maß für die Übereinstimmung zwischen den Ausgabeverteilungen von Modellen, und zeigen über 130 Open-Weight-Modelle auf MMLU-Pro und BBH, dass Fehler mit Leistungsfähigkeit ähnlicher werden, was nach ihrer Ansicht die KI-Überwachung, einschließlich LM-Juries, gefährdet. Ich messe bei proprietären Modellen verschiedener Labore, was blinde Übereinstimmung zertifiziert, wenn sie die Freigabe einer kurzen freien Antwort kontrolliert: die Genauigkeit übereinstimmender Antworten, den Anteil der Fehler des freigegebenen Modells, die Uneinigkeit aufdeckt, und die Untergrenze gemeinsamer zuversichtlicher Fehler. Die Ergebnisse sind kompatibel: In meinen Daten zeigt sich die Kosten steigender Ähnlichkeit im Rückruf von Uneinigkeit, während die Genauigkeit dort hoch bleibt, wo die Genauigkeit hoch ist (Anhang L). Vereinbarungsbasierte Kaskadierung (Kolawole et al., 2025) nutzt ensemble-Übereinstimmung als trainingsfreie Aufschubregel mit einer Bedingung auf der gemeinsamen Fehlerrate, und meine geschichteten Ergebnisse zeigen, wo sich solche Fehler konzentrieren.
Korrelierte Fehler über Provider hinweg werden dokumentiert von Kim et al. (2025), und Hossain et al. (2026) stellen fest, dass sie unter Frontier-LLM-Schiedsrichtern stärker sind. Juries verschiedener kleiner Schiedsrichter erscheinen bei Verga et al. (2024), und die Verzerrung eines Modells bei der Beurteilung seiner eigenen Ausgabe bei Panickssery et al. (2024), was den Vergleich von zwei blinden Antworten bevorzugt. Übereinstimmung zwischen Stichproben eines Modells ist ein Konfidenzindikator bei Self-Consistency (Wang et al., 2023), SelfCheckGPT (Manakul et al., 2023) und semantischer Unsicherheit (Kuhn et al., 2023) sowie eine Aufschubregel in Yue et al. (2024); ich vergleiche sie mit Übereinstimmung zwischen Laboren (Abschnitt 5.2). Das Gate ist ein selektiver Prädiktor (Geifman & El-Yaniv, 2017), daher vergleiche ich Gates bei gleicher Abdeckung. Aktuelle Preprints sind sich uneinig, ob Aggregation hilft (Anhang E). Mir ist keine Arbeit bekannt, die ein Release-Gate auf Paar-Ebene für kurze freie Fakten bei proprietären Spitzenmodellen meldet, Rückruf bei gleicher Abdeckung mit einem festgehaltenen freigegebenen Modell, oder einen Identifikator, der in zwei Zugriffsmodi auf denselben Fragen gemessen wird.
3. Daten und Protokoll
Meine früheren Arbeiten berichteten über die Juli-Panels (Chernets, 2026a) und August- und Oktoberaggregate für ausgewählte Paare (Chernets, 2026c). Neu hier sind die Flagship-Paare ohne KI, die symmetrische Definition von Schwierigkeit, die Paare aus demselben Labor, die Vergleiche bei gleicher Abdeckung, die Out-of-Sample- und externen Tests sowie der Vergleich der Zugriffsmodi.
Sammlungen. Alle Antworten wurden verblindet erfasst: ein Aufruf pro Frage, wobei kein Modell die Antwort eines anderen sah. Der System-Prompt fordert ein JSON-Objekt mit einer kurzen Antwort und einer Konfidenz von 0 bis 100 an und fordert keine Quellen. Tabelle A1 listet Modelle, Daten und Zugriffsmodi auf, und Anhang F die Sammlungen vollständig. Neun API-Modelle und sieben lokale Modelle beantworteten 1.500 SimpleQA-Fragen (Wei et al., 2024) vom 24. bis 28. Juli, registriert auf OSF vor der Datenerfassung (Chernets, 2026a). Ein Flagship aus jeder von elf Laboratorien beantwortete die gleichen Fragen vom 3. bis 6. August, 1.459 gemeinsam für alle, und neun von ihnen beantworteten 100 dieser bei Temperatur 0,7 mit drei Samples (der Varianz-Arm). Hinzugefügt wurden 100 Zwei-Hop-Fragen, maschinell aus Wikidata zusammengestellt, wobei der Datei-Hash vor dem ersten Modellaufruf festgelegt wurde, und 267 Produktfakten. Im Oktober beantworteten gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 und claude-fable-5-1 300 SimpleQA-Fragen, geschichtet nach Juli-Quintil, die 106 unten und der frische Satz, drei disjunkte Sätze mit 503 Fragen gemeinsam für alle fünf Modelle (jedes Paar auf ihnen ist in Tabelle A2).
Die 106. Dies sind die Fragen des schwierigsten Quintils, auf die ein Juli-Panel eine Antwort replizierte (Chernets, 2026a). Sie wurden nach dem Versagen der Juli-Modelle ausgewählt, daher ist die Juli-Genauigkeit auf ihnen teilweise ein Produkt der Auswahl, und Abschnitt 5.1 paart sie mit einer symmetrischen Definition von Schwierigkeit, die diese Eigenschaft nicht trägt.
Zugriffsmodi. Im August liefen claude-fable-5, gpt-5.6-sol und mistral-medium-3.5 durch den eigenen First-Party-Client des Anbieters, den offiziellen Befehlszeilen-Agent, den Endbenutzer bereitstellen, und im Oktober tat es jeder Arm, sodass die Messungen herstellerseitige System-Prompts und Serving-Standards einschließen, wie sie ein Benutzer des Clients erhält. Die Juli-Welle und die verbleibenden August-Arme verwendeten direkte API- oder Aggregator-Routen, die an den Anbieter gebunden waren. Tabelle 2 gibt die Messbedingungen der Client-Arme an. Ich nenne einen Arm suchbar, wenn seine Nutzung von Websuche nicht ausgeschlossen werden kann, und ich berichte die Hauptergebnisse mit solchen Armen und ohne sie.
Tabelle 2. Messbedingungen nach Arm. Hinweis: Die Temperatur ist nicht in den Codex- und Claude-Clients gesetzt; die Codex-Event-Streams wurden nicht beibehalten. API-Arme der Juli- und August-Wellen liefen bei Temperatur 0. Ein Bindestrich markiert keine Einstellung oder keinen Eintrag in den Aufzeichnungen.
| Arm | Erreicht durch | Aufwand | Suche möglich |
|---|---|---|---|
| gpt-5.6-sol, August | Codex-Client | Client-Standard, nicht erfasst | nicht ausgeschlossen |
| claude-fable-5, August | Claude-Client | - | nein, 0 Suchanfragen erfasst |
| mistral-medium-3.5, August | Anbieter-Client | - | nein, leere Tool-Liste |
| gpt-6.1-sol, gpt-6-astra, gpt-6-sol, Oktober | Codex-Client | mittel | nicht ausgeschlossen |
| claude-opus-5-5, claude-fable-5-1, Oktober | Claude-Client | - | nein, Tools nicht erlaubt |
| kimi-k3, gemini-3.8-flash, frischer Satz | Anbieter-Client | - | Tools nicht deaktiviert, Prompt verbietet |
| gpt-5.6-sol, Varianz-Arm | direkte API | keine | - |
Gate und Maße. Das Gate öffnet sich, wenn beide Modelle antworten, keines ablehnt, und eine deterministische Äquivalenzmaschine, die für jede hier verwendete Welle gleich ist, die beiden Antworten als äquivalent befunden werden. Die Bewertung wendet die gleiche Maschine auf die Antwort und die Gold-Antwort an: normalisierte exakte Übereinstimmung, Enthaltensein von Zeichenketten mit vier oder mehr Zeichen und Regeln für Daten, Zahlen und Kennungen (Anhang D, mit einer Neubewertung in Tabelle A3). Eine Zelle ist ein Paar von Modellen auf einer Schicht von Fragen. Die Abdeckung zählt offene Gates zwischen Fragen, die beide Modelle beantwortet haben. Genauigkeit, PPV, ist der Anteil der Korrekten unter offenen Antworten, die der Bewerter als richtig oder falsch auflöst (K/O), und Delta ist die Genauigkeit minus die Genauigkeit des veröffentlichten Modells auf allen aufgelösten Fragen der Zelle. Recall ist der Anteil der Fehler des veröffentlichten Modells, bei denen das Gate geschlossen bleibt, berichtet als erfasste Fehler. Lift teilt die Genauigkeit des veröffentlichten Modells mit offenem Gate durch die mit geschlossenem Gate, und die Untergrenze zählt Fragen, bei denen beide Modelle eine Konfidenz von mindestens 80 angeben, zustimmen und falsch sind. Ich nenne eine Vereinbarung invertiert, wenn PPV unter einer Hälfte liegt. Das veröffentlichte Modell ist das erste Mitglied des Paares oder das genauere, wenn Paare zusammengefasst werden. Um Gates bei gleicher Abdeckung zu vergleichen, verdünne ich das breitere Gate: Offene Antworten werden nach dem kleineren der beiden angegebenen Konfidenzen bewertet und auf die Zielabdeckung gekürzt, Bindungen werden zufällig gelöst.
Inferenz. Einzelne Proportionen tragen Wilson-Intervalle. Differenzen und abgeleitete Größen tragen 95%-Bootstrap-Intervalle, bidirektional über Frage und Modell für gepoolte Ergebnisse (Owen, 2007; B = 2000, Seed festgelegt, mit dem Modell, das bei jedem Replikat angepasst wird) und über Frage für ein einzelnes Paar. Gepaarte Genauigkeitsvergleiche verwenden den exakten McNemar-Test und Äquivalenz einen Zweiseitig-Eins-Test (Schuirmann, 1987) mit einer Spanne von 2 Punkten. Zellen sind abhängig, daher tragen sie Intervalle und keine p-Werte.
4. Ein Modell des Gates
Seien und die gemessenen Genauigkeiten zweier Modelle bei einer Zelle und . Sei die Wahrscheinlichkeit, dass beide falsch liegen, und die Wahrscheinlichkeit, dass beide richtig liegen:
Hier erhöht die unabhängige Rate gemeinsamer Fehler. Zwei richtige Antworten stimmen mit Wahrscheinlichkeit überein. Zwei falsche Antworten stimmen mit Wahrscheinlichkeit überein, wobei bei 106, dessen falsche Antworten häufiger kollidieren, und 1 sonst. Dann
Angepasst an 335 Zellpaare verschiedener Laboratorien (Juli, August und Oktober, darunter 106; ist die Übereinstimmungsrate von zwei richtigen Antworten über alle angepassten Zellen), sind die Konstanten , , , (22.536 von 22.785) und .
Das Modell nimmt die gemessenen Genauigkeiten der Zelle als Eingabe und gibt Abdeckung, Präzision und den Anteil falsch übereinstimmender Antworten, , zurück, von dem der Boden von Abschnitt 3 der Teil mit einer Konfidenz von mindestens 80 ist. Bei zwei Genauigkeiten gibt es zurück, was das Gatter hinzufügt, und es zeigt, warum Präzision der Genauigkeit an der Spitze folgen muss: mit und übereinstimmenden richtigen Antworten, kann die Präzision übereinstimmender Antworten nicht unter fallen, selbst wenn jeder Fehler geteilt wird, da beide Modelle auf mindestens der Fragen recht haben und auf höchstens unrecht haben (0.947 bei ). Bei gibt es keine Schranke, und kann übersteigen, wenn sich falsche Antworten auf demselben String konzentrieren.
Ich vergleiche es mit zwei Baselines. Die unabhängige-Fehler-Baseline setzt und passt den Rest neu an, behält also . Die bestes-Modell-Baseline sagt voraus. Das Kriterium war, dass das Modell beide schlägt, wobei das Intervall der Differenz unter Null liegt, unter „leave-one-laboratory-out" (LOLO), „leave-one-model-out" (LOMO) und einer zeitlichen Aufteilung von Juli und August bis Oktober.
5. Ergebnisse
5.1 Inversion ist keine Mid-Tier-Eigenschaft
Tabelle 3 zeigt das Gate ohne die client-served GPT-Arme. Über die Gesamtheit von SimpleQA hinweg sehen die beiden Ebenen ähnlich aus: Genauigkeit 72,1 % im Juli und 80,6 % im August, mit einem Delta von +28,6 und +26,0 Punkten gegenüber dem veröffentlichten Modell. Bei den 106 ist die Genauigkeit in beiden Wellen niedrig: 5 von 717 im Juli und 96 von 691 im August ohne GPT. Das Ausschließen des GPT-Arms auch von der Juli-Seite ergibt 4 von 581, und der Unterschied August minus Juli beträgt +13,2 Punkte [+2,6, +30,8]. Die Genauigkeit im August ist höher und immer noch weit unter der Hälfte, daher ist die Übereinstimmung in beiden Wellen invertiert. Sie liegt auch unter dem besten einzelnen Arm auf der Schicht, um -9,5 Punkte [-16,3, -3,2] im Juli und -43,2 [-67,6, -16,1] im August. Der Lift beträgt 0,13 [0,00, 1,21] im Juli und 0,65 [0,23, 1,22] im August ohne GPT.
Tabelle 3. Das Gate ohne client-served GPT-Arme. Hinweis: über Paare verschiedener Laboratorien gepolt, falls nicht anders angegeben; Coverage bezieht sich auf Fragen, die beide Modelle beantwortet haben, K/O auf offene Antworten, die der Prüfer auflöst; Intervall auf PPV: zwei-Wege-Bootstrap. Produktfakten: die vier Arme ohne Suchenmöglichkeit.
| Ebene, Fragen | Paare | Coverage | PPV (K/O) [95%] | Genauigkeit des veröffentlichten | Delta, Punkte [95%] |
|---|---|---|---|---|---|
| Mid, Juli, 106 | 36 | 19,8% | 0,7% (5/717) [0,0, 3,7] | 4,6% | -3,9 [-8,3, +0,3] |
| Mid, Juli, alle SimpleQA | 36 | 20,6% | 72,1% (7743/10745) [53,2, 82,3] | 43,4% | +28,6 [+22,3, +32,4] |
| Flagship, August, 106, kein Suchenmöglichkeit-Arm | 45 | 19,1% | 13,9% (96/691) [3,3, 31,8] | 19,9% | -6,0 [-14,1, +2,9] |
| Flagship, August, alle SimpleQA, kein Suchenmöglichkeit-Arm | 45 | 29,1% | 80,6% (12357/15322) [69,6, 87,9] | 54,7% | +26,0 [+19,9, +30,7] |
| Flagship, August, frisch 100 (GPT über API) | 6 | 37,5% | 88,9% (200/225) [75,6, 97,4] | 66,8% | +22,1 [+7,9, +47,4] |
| Gleiches Laboratorium, Oktober, fable-5-1 + opus-5-5, 106 | 1 | 39,6% | 47,5% (19/40) | 30,0% | +17,5 [+6,2, +29,7] |
| Oktober, kimi-k3 + gemini-3.8-flash, frisch 100 (Werkzeuge nicht deaktiviert) | 1 | 72,0% | 95,8% (69/72) | 74,0% | +21,8 [+14,1, +30,0] |
| Produktfakten, 267, kein Suchenmöglichkeit-Arm | 6 | 63,6% | 75,0% (423/564) [66,4, 82,7] | 62,7% | +12,3 [+5,8, +20,4] |
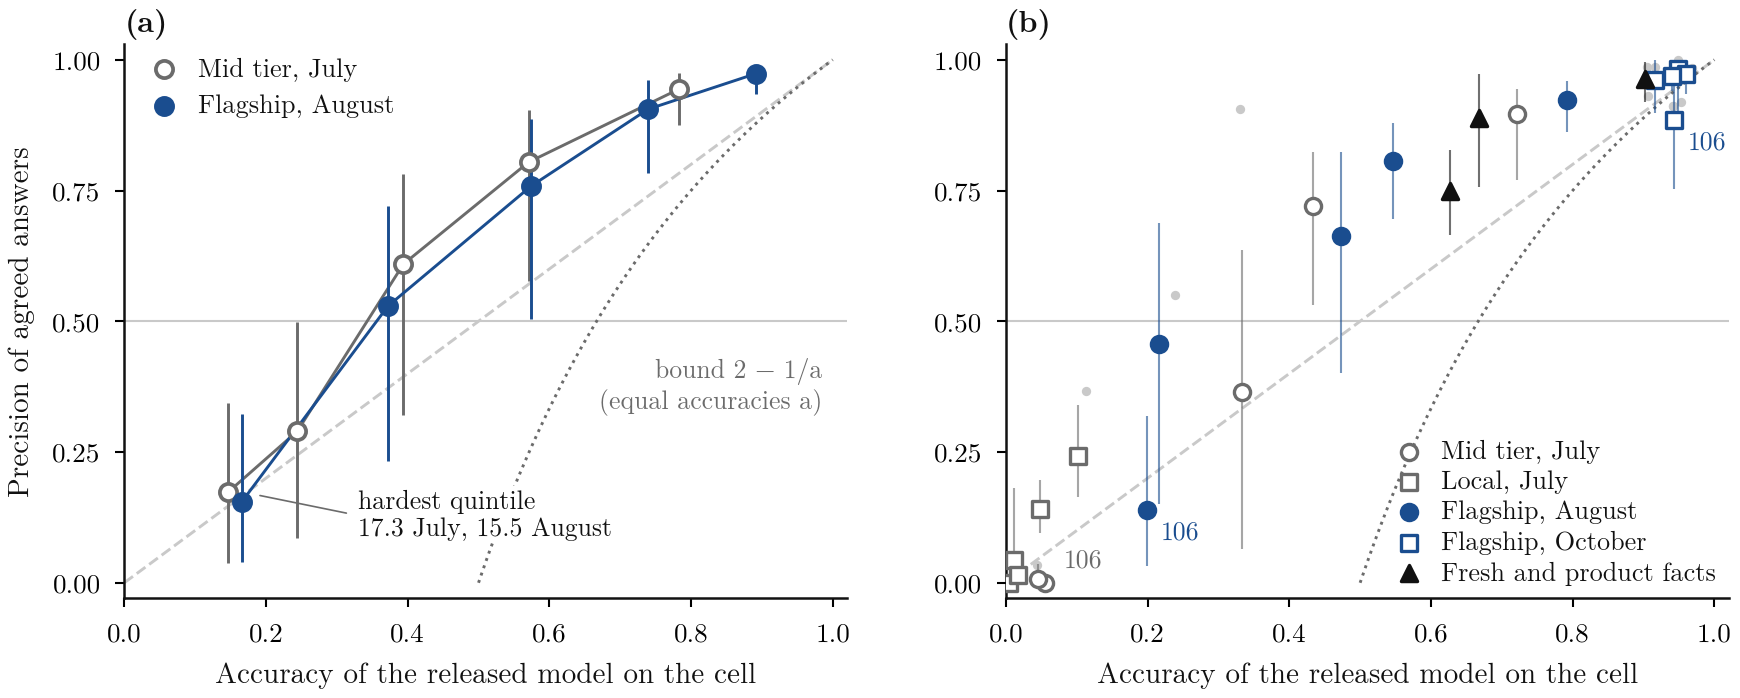
Abbildung 1. Die Genauigkeit der übereinstimmenden Antworten folgt der Genauigkeit des Paars. Hinweis: (a) Quintile der Schwierigkeit innerhalb jeder Ebene, Juli Mid-Tier und August Flagships ohne die client-served GPT-Arme. (b) Jede Bande jeder Ebene, Juli bis Oktober, gegen die Genauigkeit des veröffentlichten Modells; beschriftete Zellen sind die 106. Whisker sind 95%-Bootstrap-Intervalle, und kleine graue Punkte in (b) sind einzelne Paare; gestrichelte Linie ist Gleichheit, punktierte Linie die Grenze 2 - 1/a für gleiche Genauigkeiten a.
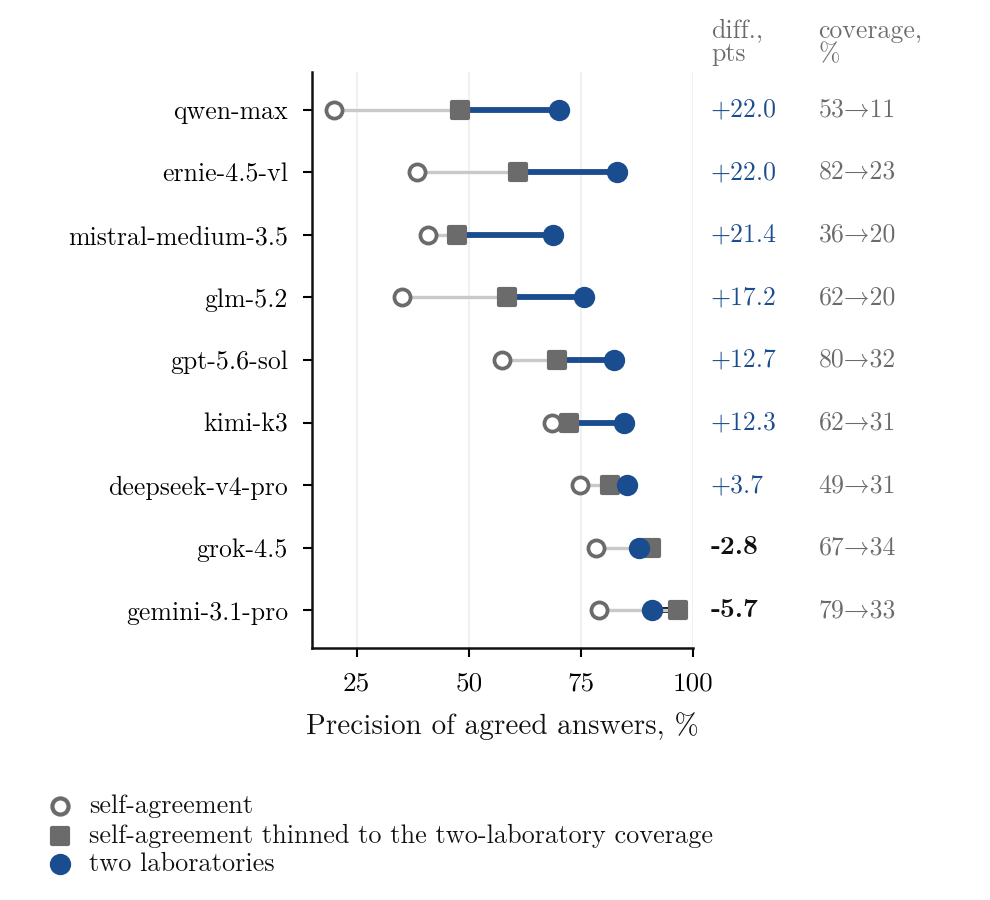
Abbildung 2. Selbstübereinstimmung gegen zwei Laboratorien, nach Modell. Hinweis: Varianz-Arm, neun Modelle, 100 Fragen. Offener Kreis, zwei Aufrufe an ein Modell; Quadrat, das gleiche ausgedünnt nach Konfidenz auf die Coverage des Zwei-Laboratorien-Gates; gefüllter Kreis, zwei Laboratorien, Mittelwert über Partner. Rechte Spalten geben die Differenz bei gleicher Coverage in Punkten und die Coverage beider Gates in Prozent an.
Drei-Modell-Panele ohne den client-served GPT-Arm ergeben das gleiche Ergebnis. Bei den 106 unter meiner Engine geben die Juli-Panele 0 von 318 (die 0 von 342 aus Abschnitt 1 ist das schwierigste Quintil unter der früheren Abgleichungsregel; die 5 von 717 oben zählen Paare). Im August gibt das Panel von DeepSeek, Qwen und Kimi 0 von 76 und das Block-übergreifende Panel von Claude, DeepSeek und Mistral 11 von 78 (14,1 % [2,7, 26,3]), während das Panel von Claude, GPT und Gemini, das den GPT-Arm hält, 106 von 131 (80,9 %) ergibt. Flagship-Paare reihen sich nach ihrer Genauigkeit auf der Schicht auf, von 4 von 21 für fable-5 mit deepseek-v4-pro bis 15 von 24 (62,5 % [42,6, 82,6]) für fable-5 mit gemini-3.1-pro, deren Mitglieder diese Gruppe dort anführen.
Da die 106 auf dem Juli-Fehler ausgewählt wurden, was die Juli-Genauigkeit auf ihnen senkt und den August begünstigt, setzt Abbildung 1a die Schwierigkeit innerhalb jeder Ebene fest. Für jede Ebene werden Fragen in Quintile nach der Genauigkeit der gleichen Ebene ohne das zu bewertende Paar eingeteilt, daher hat das schwierigste Quintil den gleichen Rang für jeweils, und die Genauigkeit des veröffentlichten Modells dort ist nah, 15,3 % im Juli und 16,0 % im August. Die Genauigkeit dort beträgt 159 von 917 (17,3 % [3,8, 34,3]) im Juli und 203 von 1.308 (15,5 % [4,0, 32,4]) im August ohne GPT, ein Unterschied von -1,8 Punkten [-22,1, +20,2]. Alle fünf Quintile gepolt ergeben einen schärferen Test. Das Modell aus Abschnitt 4 hat keinen Ebenen-Term. Gegeben die zwei Genauigkeiten jeder Zelle, liefert es die dort erwartete Genauigkeit und ein Ebenen-Effekt würde sich als Unterschied in den Residuen zeigen. Flagship-Zellen sitzen -0,2 Punkte [-3,1, +2,7] von Mid-Tier-Zellen entfernt, und -0,5 [-3,6, +2,4] wenn die Konstanten auf Juli-Zellen allein angepasst werden, sodass August außerhalb der Stichprobe ist. kimi-k3 gehört zu beiden Sammlungen; ohne sie beträgt der Unterschied +0,1 [-3,6, +3,8]. Bei bereinigten Gold-Antworten bleibt die Genauigkeit niedrig: bei den 24 der 106, die in SimpleQA Verified überleben (Haas et al., 2025), liegen August-Paare ohne GPT bei 18,7 % der Übereinstimmungen richtig [0,0, 57,1] (Anhang G).
Über jede Bande jeder Ebene (Abbildung 1b) hinweg steigt die Genauigkeit mit der Genauigkeit des veröffentlichten Modells in jeder Welle und liegt in 17 von 23 Zellen über der Diagonalen. Von den sechs darunter sind drei 106-Zellen und drei sind Banden mit veröffentlichter Genauigkeit unter 0,06. Oben erreichen kimi-k3 und gemini-3.8-flash 95,8 % auf dem frischen Datensatz (Anhang G).
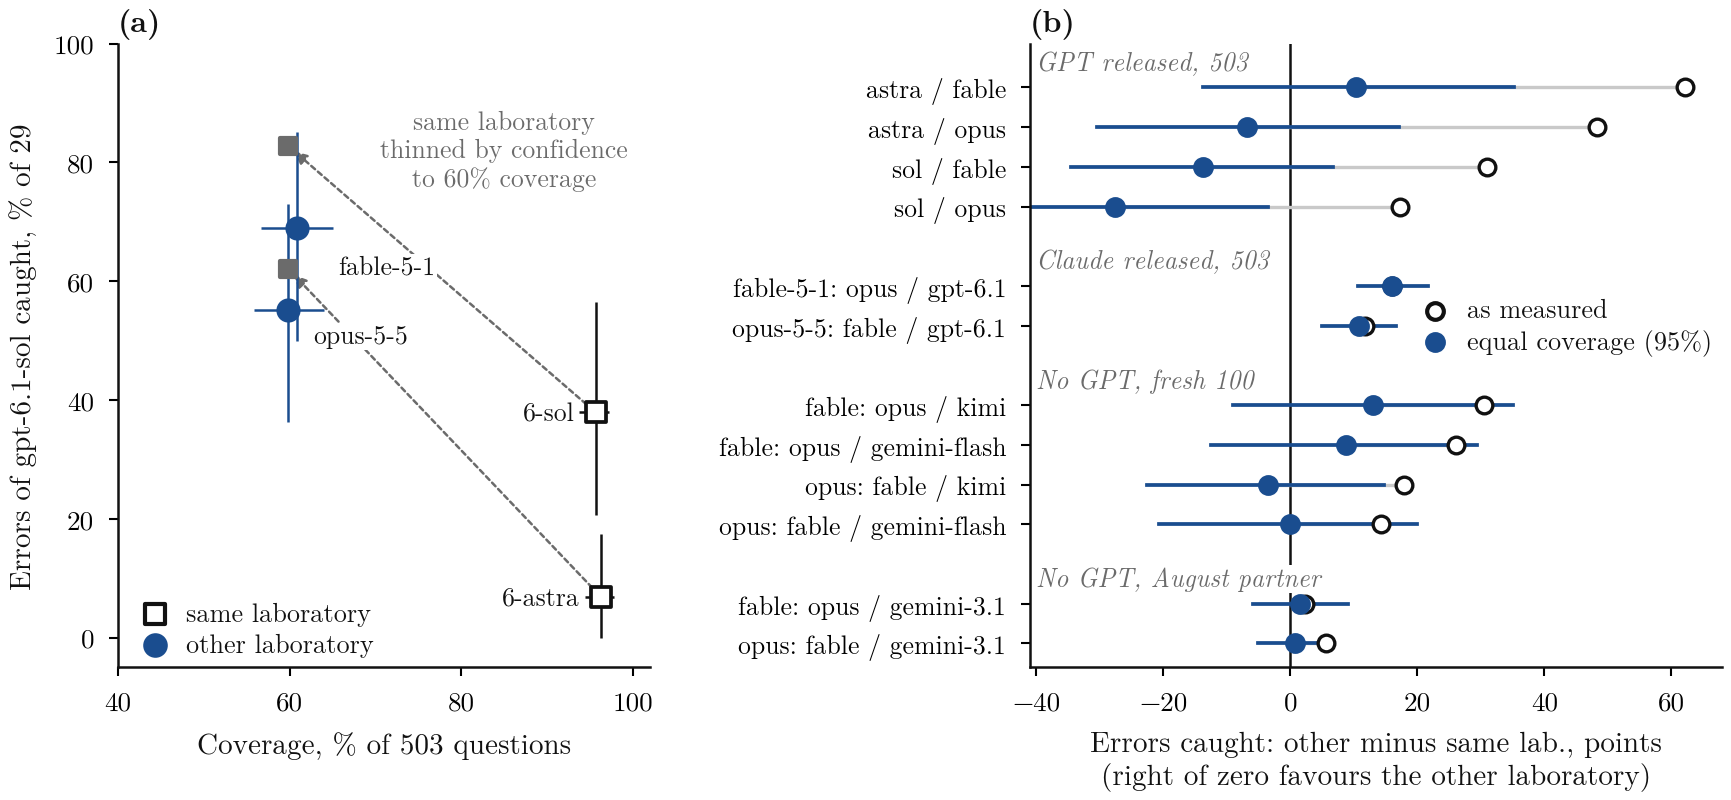
Abbildung 3. Ein zweites Labor: Abdeckung und erfasste Fehler. Anmerkung: (a) gpt-6.1-sol auf 503 häufigen Fragen, 29 Fehler, vier Partner aus Tabelle A4, 95%-Bootstrap-Konfidenzintervalle; Pfeile führen vom gleichen Labor-Gate zum gleichen Gate, ausgedünnt durch Konfidenz auf 60%-Abdeckung. (b) Die zwölf Vergleiche aus Tabelle A5: Fehler, die vom anderen Labor erfasst wurden, minus das gleiche Labor, gemessen (offen) und bei gleicher Abdeckung (gefüllt, 95%-Fragen-Bootstrap).
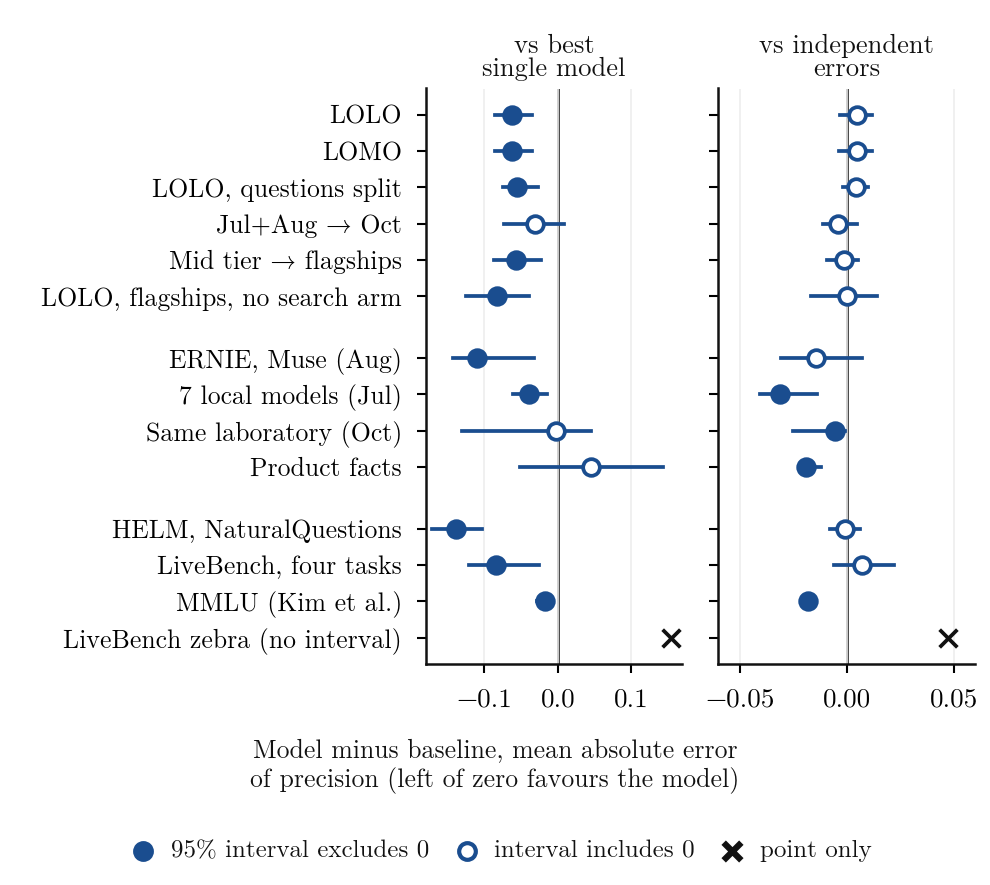
Abbildung 4. Das Modell gegen zwei Baselines, außerhalb der Stichprobe. Anmerkung: Modell minus Baseline in mittlerem absoluten Fehler der vorhergesagten Genauigkeit, unterhalb von Null begünstigt das Modell, mit 95%-zweiseitigen Bootstrap-Konfidenzintervallen (Tabellen A6 und A8). Oberste Gruppe, Fitting-Schemata; Mitte, Sets außerhalb des Fits mit gefrorenen Konstanten; unten, öffentliche Daten (Abschnitt 5.5). Gefüllter Marker, das 95%-Intervall schließt Null aus; offen, es schließt Null ein; Kreuz, eine Punktschätzung (die LiveBench-Zebra-Aufgabe).
5.2 Ein zweites Labor erfasst mehr Fehler, auf Kosten der Abdeckung
Genauigkeit allein kann die Fälle nicht trennen, da genaue Paare aus einem Labor auch hohe Genauigkeit aufweisen. Recall muss mit Abdeckung gelesen werden, da ein Gate, das sich seltener öffnet, konstruktionsbedingt mehr Fehler blockiert.
Ich beginne mit dem Varianz-Arm: zwei Aufrufe an ein Modell bei Temperatur 0,7, gegen zwei Aufrufe an verschiedene Labore (Abbildung 2). Zusammengefasst über neun Modelle und 100 Fragen, Selbstübereinstimmung deckt 63,5% bei einer Genauigkeit von 56,1% ab, und zwei Labore decken 26,1% bei 82,9% ab. Der Unterschied in der Genauigkeit beträgt +26,8 Punkte [+16,6, +34,6] wie gemessen und +9,0 [+0,5, +17,4] bei gleicher Abdeckung, wobei die Selbstübereinstimmung durch Konfidenz ausgedünnt wird, was sie begünstigt. Nach Modell führt das Zwei-Labor-Gate bei sieben von neun. Der Arm enthält kein Claude-Modell und hat GPT per API ohne Aufwand. Ohne GPT, über acht Modelle, beträgt der Unterschied bei gleicher Abdeckung +7,7 Punkte [-1,9, +16,5].
Die Oktober-Welle enthält zwei Modelle jeweils aus zwei Laboren, was einen direkten Test auf 503 häufigen Fragen ermöglicht (Abbildung 3a). Ein freigegebenes Modell, gpt-6.1-sol, behält die gleichen 29 Fehler in jeder Zeile bei und ändert nur den Partner. Sein Partner aus dem gleichen Labor gpt-6-astra erfasst 2 von ihnen und fable-5-1 erfasst 20, ein Unterschied von -62,1 Punkten [-79,3, -43,8]; gegen opus-5-5 beträgt der Unterschied -48,3 [-66,7, -29,6]. Der Preis ist Abdeckung, 60 bis 61% gegen 96%. Die Genauigkeit ist über die Zeilen hinweg ähnlich: 94,3 und 96,2% für das gleiche Labor, 95,6 und 97,0% über Labore hinweg (Tabelle A4). Partner aus dem gleichen Labor unterscheiden sich stark: gpt-6-sol erfasst 11 von 29 (Appendix H).
Um zu sehen, ob dies mehr ist als eine Bewegung entlang der Abdeckungskurve, und ob es GPT benötigt, behält jede Zeile von Abbildung 3b ein freigegebenes Modell und vergleicht seine zwei Partner, wie gemessen und bei gleicher Abdeckung (Tabelle A5). Wie gemessen, erfasst das andere Labor in jeder Zeile mehr Fehler. Bei gleicher Abdeckung bleibt sein Vorteil nur bestehen, wenn Claude mit gpt-6.1-sol als Partner freigegeben wird, ein Partner mit 93,9% Genauigkeit gegen 66,6 bis 69,2% für den Partner aus dem gleichen Labor im geschichteten Satz. Mit freigegebenem GPT ist das Gate aus dem gleichen Labor, ausgedünnt durch Konfidenz, gleichauf oder voraus, und ohne GPT ist der Unterschied gleichauf oder begünstigt das gleiche Labor gegen schwache Partner. Mit zwei Laboren im Oktober erkenne ich keine Auswirkung des Labors jenseits von Partner-Genauigkeit und Abdeckung, und HELM, mit 20 Entwicklern, zeigt keine, wenn beide übereinstimmen (Abschnitt 5.5).
5.3 Das Modell außerhalb der Stichprobe
Außerhalb der Stichprobe verbessert sich das Modell deutlich beim Ablesen des besseren Modells und ist gleichauf mit der Baseline für unabhängige Fehler (Abbildung 4, Tabelle A6). Unter LOLO beträgt sein Fehler 0,037 gegenüber 0,099 für die beste-Modell-Baseline (-0,062 [-0,085, -0,035]), und dieses Intervall liegt unter Null unter LOMO, der Fragenteilung und in sieben der zehn Zeilen von Tabelle A6. Die zeitliche Aufteilung ergibt 0,019 gegenüber 0,050, -0,031 [-0,074, +0,008], unter Null, wenn auf Frage oder auf Modell allein geclustert wird (Appendix I). Gegen unabhängige Fehler ist das Modell unter allen drei Schemata gleichauf und besser bei drei von vier Sets außerhalb des Fits, mit gefrorenen Konstanten, sodass das Kriterium aus Abschnitt 4 gegen die beste-Modell-Baseline erfüllt ist.
Die Genauigkeit wird durch die gemessenen Genauigkeiten und durch getragen: Das Entfernen von erhöht den LOLO-Fehler auf 0,323, und das Konstanthalten ergibt 0,046. Der Multiplikator trägt in den Hauptschemata nichts zur Genauigkeit bei und hilft bei Abdeckung und Log-Verlust.
Bei Produktfakten läuft das Modell hoch. Sein Fehler beträgt 0,130 gegenüber 0,086 für das beste Modell, alles davon Überstatement (13 Punkte), und 0,190 gegenüber 0,067 mit dem nativen Bewerter dieser Domäne, wieder alles Überstatement (19 Punkte). Appendix I sortiert die Zellen in Ergebnisklassen.
5.4 Modellzugriff und die GPT-Arme
Bei einem Satz von 100 SimpleQA-Fragen erreicht gpt-5.6-sol 92 von 100 (92,0%) in der Hauptwelle, 99 davon über den Codex-Client, und 139 von 300 Stichproben (46,3%) über die direkte API im Varianz-Arm, ein Unterschied von 45,7 Punkten (Abbildung 5). Die wörtliche Wiedergabe der Goldzeichenkette fällt damit, von 64,0% auf 26,0%. Der Client läuft bei seiner Standard-Aufwandseinstellung unter seinen eigenen Anweisungen, wobei die Temperatur nicht einstellbar ist, während die API bei Aufwand keine und Temperatur 0,7 läuft.
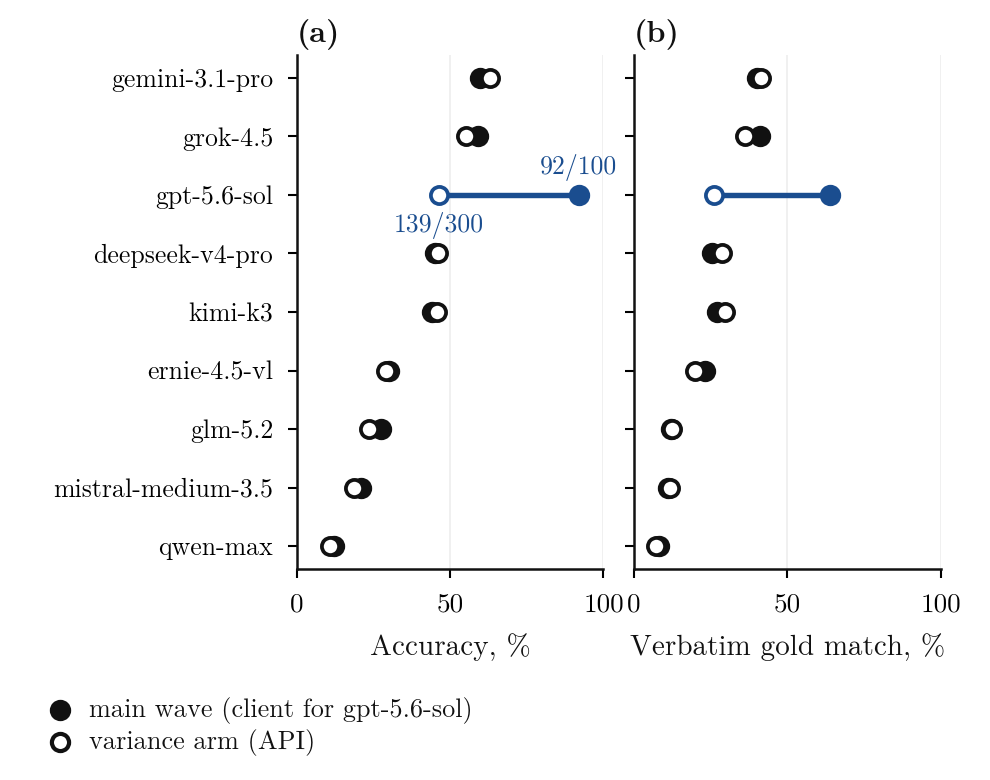
Abbildung 5. Ein Satz von 100 Fragen, zwei Arme, neun Modelle. Anmerkung: (a) Genauigkeit, (b) wörtliche Übereinstimmung mit der Goldzeichenkette. Gefüllt, Hauptwelle (Client-bedient für gpt-5.6-sol, 92/100); offen, Varianz-Arm über die API (139/300). Für gpt-5.6-sol unterscheiden sich die Arme auch in der Aufwandseinstellung.
Die acht anderen Modelle, deren Temperatur sich auch zwischen den beiden Spalten ändert, verschieben sich um höchstens 4,0 Punkte in beide Richtungen. Aufwand ist ein Kandidat, obwohl eine gepaarte Messung des Reasoning-Budgets auf gemini-3.1-pro die Genauigkeit nahezu unverändert ließ (Chernets, 2026c). Websuche ist der andere: Oktober-Antworten desselben Clients enthalten Links, die die Eingabeaufforderung nicht anfordert, in 3 von 506 Antworten von gpt-6.1-sol und 18 von 506 von gpt-6-astra, und die mediane Token-Nutzung pro August-Client-Aufruf beträgt 4.829.
Die Client-Zahl ist das, was eine Person, die das Produkt nutzt, erhält, und die API-Zahl ist das, was ein Benchmark-Gestell bei Aufwand null liest. Bei frischen Fragen im August mit GPT über die API sind gpt-5.6-sol und fable-5 bei 29 von 32 Übereinstimmungen richtig, Delta +57,6 Punkte [+46,3, +69,7]. Im Oktober, mit einem neueren GPT über den Client auf denselben Fragen, ist das Paar mit opus-5-5 bei 72 von 74 richtig, Delta +2,3 [-0,7, +6,0]. Die beiden Vergleiche unterscheiden sich auch im GPT-Modell und Datum, und in beiden folgt der Wert des Gates der Genauigkeit des veröffentlichten Arms wie in Abschnitt 5.1.
Die vom Client bereitgestellten GPT-Arme, aus Tabelle 3 weggelassen, sind genau: Der August-Arm mit fable-5 ist bei 997 von 1.016 Übereinstimmungen richtig (98,1%) und bei 34 von 37 bei den 106, wobei die Genauigkeit des Arms geerbt wird (Delta -3,3 [-10,3, +2,6]; Tabelle A7 und Anhang J).
5.5 Externe Überprüfung mit öffentlichen Daten
Ich wandte die eingefrorenen Konstanten ohne Neuanpassung auf öffentliche Daten an, die weder Modelle noch Anpassung mit meinen teilen: HELM Lite (Liang et al., 2023), 95 Modelle von 20 Entwicklern beantworten 1.000 geschlossene NaturalQuestions; LiveBench (White et al., 2025), 70 Modelle von 11 Laboren bei 346 Fragen mit einer kurzen Endantwort; und die gepaarten Aggregate von Kim et al. (2025) für 70 Modelle bei Multiple-Choice-MMLU (Tabelle A8). Die Ergebnisse stimmen mit Abschnitt 5.3 überein (Abbildung 4, untere Gruppe). Das Modell schlägt das Ablesen des besseren Modells in allen drei Quellen und ist gleichauf mit unabhängigen Fehlern in HELM und LiveBench. Es läuft um 5,3 bis 6,6 Punkte hoch und scheitert bei Zebra-Rätseln (0,231 gegen 0,076).
In HELM flacht die beobachtete Kurve ab, wo das Modell weiter ansteigt (Abbildung 6): bei gepaarter Genauigkeit zwischen 0,5 und 0,6 beträgt die Präzision 74,6% für Modelle von 2023 und Anfang 2024 und 75,9% für spätere, gegenüber 84,4% vorhergesagt in der Mitte des Bins. Bei MMLU beträgt die mediane Wahrscheinlichkeit, dass zwei falsche Antworten übereinstimmen, 0,621 gegenüber 0,368 aus , da vier Optionen Kollisionen erzwingen. Die Präzision steigt mit gepaarter Genauigkeit (Spearman +0,575 in HELM und +0,786 bei MMLU, über abhängige Zellen).
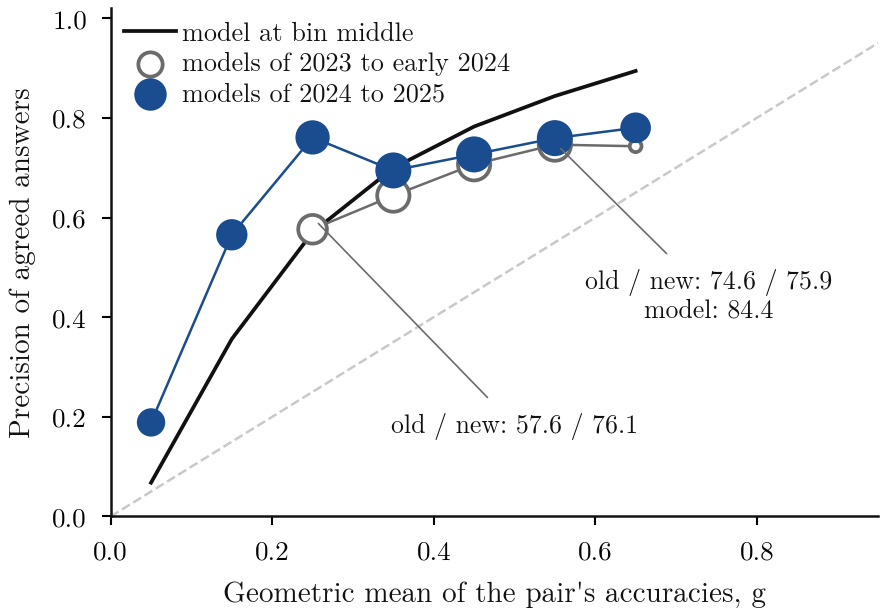
Abbildung 6. HELM Lite: Präzision übereinstimmender Antworten nach gepaarter Genauigkeit, ältere und neuere Modelle. Hinweis: Bins des geometrischen Mittels g der Genauigkeiten des Paares, Paare aus verschiedenen Laboren; die Markergröße wächst mit der Anzahl der Paare. Die Linie ist das eingefrorene Modell in der Mitte jedes Bins.
HELM ermöglicht auch den Test aus Abschnitt 5.2 mit vielen Laboren und ohne GPT-Abhängigkeit. Mit einem veröffentlichten Modell und Partnern innerhalb von 3 Punkten Genauigkeit fängt ein anderes Labor 75,5% der Fehler gegenüber 72,3% für das gleiche Labor, -3,2 Punkte [-4,2, -2,3], bei Abdeckung höher um 2,7 Punkte. Das Hinzufügen einer Übereinstimmung zur Abdeckung innerhalb von 3 Punkten hebt sie auf: 75,7 gegenüber 75,9%, -0,2 [-0,6, +0,2].
6. Diskussion
Das Betreiben des Gates erfordert keine Beschriftungen, aber die Überprüfung tut es. Messen Sie die Genauigkeit beider Modelle an einer gekennzeichneten Stichprobe der relevanten Schicht im Zugriffsmodus, der eingesetzt wird. In diesen Daten ist eine übereinstimmende Antwort von zwei Flaggschiffen zu einer Frage, die beide übersteigt, nicht sicherer als eine übereinstimmende Antwort von zwei Mittelklasse-Modellen. Das Koppeln zweier Laboratorien ist ein angemessener Standard, wenn keine Konfidenzwerte verfügbar sind, aber es muss auf der Schicht überprüft werden: ein Paar aus demselben Labor, das durch Konfidenz ausgedünnt wird, oder das Vertrauen des freigegebenen Modells kann genauso gut funktionieren (Abschnitt 5.2, Anhang J).
Zufallsangepasste Ähnlichkeit (Goel et al., 2025) und Präzision übereinstimmender Antworten sind unterschiedliche Größen, und Han (2026) nennt Dekorrelation als den Hebel, wo ich Genauigkeit und Abdeckung an erste Stelle setze (Anhang L). Für die Berichterstattung sollte eine Studie zur Modellübereinstimmung den Zugriffsmodus, den Aufwand, die Werkzeugbedingungen und die beibehaltenen Ereignisprotokolle für jeden Arm angeben.
7. Umfang und Randbedingungen
Tiers werden durch zwei Wellen an verschiedenen Daten und über unterschiedliche Zugriffswege verglichen, und der Tier-Vergleich ist auf etwa 3 Punkte bei angepasster Genauigkeit genau, deutlich weniger jedoch allein beim schwierigsten Quintil. Die neuen Daten bestehen aus einem Satz von 100 Fragen und acht Templates an zwei Daten, und October Delta enthält darin null. Paargenauigkeit und Präzision bewegen sich zusammen über die Daten hinweg und über Reasoning-Einstellungen, die sich zwischen den Wellen unterscheiden, und das Design isoliert die Fähigkeit nicht als Ursache.
Ob die Clients Codex, kimi und gemini-3.8-flash durchsucht wurden, kann von den erhaltenen Dateien aus nicht geklärt werden, daher messen ihre Genauigkeiten den Client wie er implementiert ist, nicht das Modellgedächtnis. Die Abschnitte 5.1 und 5.3 zeigen die Hauptergebnisse ohne diese Arme.
Paare aus demselben Labor existieren im Oktober für zwei Labore, und ohne GPT ist der Vergleich in derselben Welle die 100 neuen Fragen. October-Zellen basieren auf fünf Modellen aus zwei Laboren, daher hat die Modelldimension des zwei-Wege-Bootstrap wenige Ebenen und gepoolte Intervalle sind untere Grenzen der Unsicherheit. Vergleiche bei gleicher Abdeckung verwenden angegebenes Vertrauen, das das bloße Gate nicht tut, und zufälliges Tie-Breaking bewegt die breiteste Zeile zwischen 0,0 und +20,7 Punkte (Anhang H).
Die Engine ist regelbasiert, und ihre Überprüfungen hier sind das bereinigte Gold von SimpleQA Verified (Abschnitt 5.1) und eine Neubewertung von Antworteilen. Sie bewertet die gesamte Antwort, und lange Antworten können ein falsches „falsch" erhalten; Die Bewertung nur des ersten Teils verschiebt die Präzision von Referenzpaaren um höchstens 3 Punkte, und gpt-6-astra mit opus-5-5 auf den 106 von 80,0 auf 88,9 % (Tabelle A3).
Das Modell nimmt gemessene Genauigkeiten für jede Zelle als Eingabe, daher beschreibt es eine gekennzeichnete Überprüfung des Gates und ersetzt nicht eine. Es läuft hoch bei Produktfakten und öffentlichen Daten. HELM, LiveBench und die Aggregate von Kim et al. enthalten ältere Modelle in Few-Shot- oder Multiple-Choice-Formaten, daher testen sie die Beziehung an anderen Modellen, nicht an Flaggschiffen von 2026.
8. Fazit
Die Genauigkeit übereinstimmender Antworten steigt mit der Genauigkeit des Paars auf der betreffenden Schicht, auf beiden Ebenen und innerhalb von etwa 3 Punkten bei abgestimmter Genauigkeit. Inversion trat überall dort auf, wo ich ein schwaches Paar gemessen habe, Flaggschiffe eingeschlossen. Ein Partner aus einem zweiten Labor erfasst mehr Fehler hauptsächlich dadurch, dass er das Tor seltener öffnet, und bei gleicher Abdeckung behielt es seinen Vorteil nur dort, wo sein Modell weitaus genauer war. Ein kleines Modell des Tors beschreibt die Genauigkeit außerhalb der Stichprobe weitaus besser als das bessere Modell und ebenso gut wie unabhängige Fehler. Ein Identifier, der durch zwei Zugriffskonfigurationen gemessen wurde, unterscheidet sich um 45,7 Punkte, daher sollte eine Aussage über die Genauigkeit eines Modells den Zugriffsmodus angeben.
Auswirkungserklärung
Diese Arbeit untersucht, wann eine Übereinstimmung zwischen zwei Sprachmodellen als Regel für die Freigabe kurzer sachlicher Antworten zuverlässig sein kann. Praktiker können auf der Schicht, die für sie relevant ist, und im Zugriffsmodus, den sie einsetzen, überprüfen, ob eine Zwei-Modell-Gate präzise genug für ihre Verwendung ist, anstatt anzunehmen, dass stärkere Modelle oder ein zweiter Anbieter ausreichend sind. Das Hauptrisiko ist Übervertrauen in Übereinstimmung bei schwierigen Fragen, und die Ergebnisse zeigen die Schichten, in denen vereinbarte Antworten größtenteils falsch sind. Die Studie verwendet nur öffentliche Benchmarks und maschinell erstellte Fragen.
References
Chen, J. (2026). When does combining language models help? A co-failure ceiling on routing, voting, and mixture-of-agents across 67 frontier models. arXiv:2606.27288.
Chernets, V. (2026a). Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop: Who Verifies the Agents?
Chernets, V. (2026b). Weakly discriminative, not repaired by profile injection, and manipulable: Self-confidence in LLM evaluation. NeurIPS 2026 Workshop: Can We Trust AI Evaluation? Robustness, Causality, and Risk in Modern AI Assessment.
Chernets, V. (2026c). Architectural trust: When an AI agent buys for you, does trust belong to the model, or the architecture above it? SSRN 7191261.
Denisov-Blanch, Y., Kazdan, J., Chudnovsky, J., Schaeffer, R., Guan, S., Adeshina, S., and Koyejo, S. (2026). Consensus is not verification: Why crowd wisdom strategies fail for LLM truthfulness. arXiv:2603.06612.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Geifman, Y. and El-Yaniv, R. (2017). Selective classification for deep neural networks. In Advances in Neural Information Processing Systems 30. arXiv:1705.08500.
Goel, S., Strüber, J., Auzina, I. A., Chandra, K. K., Kumaraguru, P., Kiela, D., Prabhu, A., Bethge, M., and Geiping, J. (2025). Great models think alike and this undermines AI oversight. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267. arXiv:2502.04313.
Han, J. (2026). Partially correlated verifier cascades in LLM harnesses: Concave log-odds, polynomial reliability, and blind-spot ceilings. arXiv:2607.13918.
Haas, L., Yona, G., D'Antonio, G., Goldshtein, S., and Das, D. (2025). SimpleQA Verified: A reliable factuality benchmark to measure parametric knowledge. arXiv:2509.07968.
Hossain, E., Yousefi, N., and Lim, S.-N. (2026). Agreement overstates evidence: Error dependence in LLM judge consensus. arXiv:2609.22512.
Kim, D. (2026). Are diversity metrics measuring diversity? A capability-controlled audit of majority-vote gain in LLM ensembles. arXiv:2607.20768.
Kim, E., Garg, A., Peng, K., and Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267:30038-30066. arXiv:2506.07962.
Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
Kolawole, S., Dennis, D., Talwalkar, A., and Smith, V. (2025). Agreement-based cascading for efficient inference. Transactions on Machine Learning Research, 07/2025. arXiv:2407.02348.
Kuhn, L., Gal, Y., and Farquhar, S. (2023). Semantic uncertainty: Linguistic invariances for uncertainty estimation in natural language generation. In International Conference on Learning Representations. arXiv:2302.09664.
Liang, P., Bommasani, R., Lee, T., et al. (2023). Holistic evaluation of language models. Transactions on Machine Learning Research. arXiv:2211.09110.
Liu, N. (2026). LLMs as a jury: Cross-model consensus can outperform process reward models for LLM reasoning. arXiv:2607.10139.
Manakul, P., Liusie, A., and Gales, M. J. F. (2023). SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models. In Proceedings of EMNLP 2023. arXiv:2303.08896.
Naik, N. (2024). Probabilistic consensus through ensemble validation: A framework for LLM reliability. arXiv:2411.06535.
Owen, A. B. (2007). The pigeonhole bootstrap. The Annals of Applied Statistics, 1(2), 386-411.
Panickssery, A., Bowman, S. R., and Feng, S. (2024). LLM evaluators recognize and favor their own generations. In Advances in Neural Information Processing Systems 37.
Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657-680.
Tan, H., Sun, F., Liu, S., Su, D., Cao, Q., Chen, X., Wang, J., Cai, X., Wang, Y., Shen, H., and Cheng, X. (2025). Too consistent to detect: A study of self-consistent errors in LLMs. In Proceedings of EMNLP 2025. arXiv:2505.17656.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., and Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., and Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. In International Conference on Learning Representations.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., and Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
White, C., Dooley, S., Roberts, M., et al. (2025). LiveBench: A challenging, contamination-limited LLM benchmark. In International Conference on Learning Representations. arXiv:2406.19314.
Xue, Y., Greenewald, K., Mroueh, Y., and Mirzasoleiman, B. (2026). Verify when uncertain: Beyond self-consistency in black box hallucination detection. arXiv:2502.15845.
Yue, M., Zhao, J., Zhang, M., Du, L., and Yao, Z. (2024). Large language model cascades with mixture of thought representations for cost-efficient reasoning. In International Conference on Learning Representations. arXiv:2310.03094.
Erklärungen
Interessenskonflikte. Der Autor ist benannter Anmelder bei ausstehenden Patentanmeldungen, nicht erteilten Patenten, die KI-Orchestrierung und Multi-Modell-Validierungssysteme der Art abdecken, die dieses Papier untersucht.
Daten und Code. Pro-Call-Antworten, Analyseskripte und die Zuordnung von jeder gemeldeten Nummer zu ihrer Quelltabelle sind bei Zenodo archiviert, doi:10.5281/zenodo.24090584 (CC BY 4.0).
Anhang A. Modelle und Zugriffsmodi
Tabelle A1. Sammlungen und Zugriffsmodi pro Welle.
| Sammlung | Daten | Modelle | Zugriff |
|---|---|---|---|
| Juli mittlere Kategorie | 24. bis 28. Juli 2026 | claude-haiku-4-5, gpt-5-mini, gemini-3.6-flash, grok-4-fast, deepseek-chat, qwen-plus, kimi-k3, glm-4.5, mistral-small | Direkte API |
| Juli lokal | 24. bis 28. Juli 2026 | sieben lokale Open-Weight-Modelle | Lokale Inferenz |
| August Flaggschiffe | 3. bis 6. August 2026 | claude-fable-5, gpt-5.6-sol, mistral-medium-3.5 | Vendor-Client; gpt-5.6-sol mit der Standard-Anstrengungseinstellung des Clients, 14 von 1.500 Datensätzen durch API-Fallback |
| glm-5.2 | Vendor-Endpunkt | ||
| deepseek-v4-pro, grok-4.5, kimi-k3, qwen-max | Direkte API | ||
| gemini-3.1-pro, ernie-4.5-vl-424b, muse-spark-1.1 | Direkte API oder Aggregator-Route an den Vendor gebunden; muse-spark-1.1 teilweise (251 Antworten) | ||
| Varianzarm | 6. August 2026 | Neun Flaggschiffe, kein Claude | gpt-5.6-sol über direkte API, Anstrengung keine; mistral-medium-3.5 über seinen Vendor-Client, der die angeforderte Temperatur aufzeichnet; andere wie in der August-Welle; Temperatur 0,7, drei Stichproben |
| Aktuell, August | 6. August 2026 | gpt-5.6-sol (Anstrengung keine), claude-fable-5, deepseek-v4-pro, kimi-k3 | gpt-5.6-sol und deepseek-v4-pro über direkte API, claude-fable-5 über Vendor-Client, kimi-k3 über Aggregator-Route |
| Produktfakten | 15. August 2026 | Sechs Modelle, 15 Paare; vier ohne Suchfunktion, 6 Paare | Gemischt; gpt-5.4 und grok über Clients |
| Oktober | 26. und 27. Oktober 2026 | gpt-6.1-sol, gpt-6-astra, gpt-6-sol | Codex-Client, Anstrengung mittel, kein Suchflag, Event-Stream nicht beibehalten |
| claude-opus-5-5, claude-fable-5-1 | Claude-Client, Tools nicht zulässig | ||
| kimi-k3, gemini-3.8-flash (nur aktuell) | Vendor-Clients, Tools nicht deaktiviert |
In der August-Welle wurden 19 Antworten des claude-fable-5-Arms von anderen Claude-Modellen bereitgestellt. Die 34 von 37 der Welle bei 106 hängen nicht von ihnen ab (Chernets, 2026a).
Anhang B. Paare über die 503 häufigsten Fragen
Tabelle A2. Alle Paare verschiedener Laboratorien, erstes Element veröffentlicht, 503 häufigste Fragen.
| Paar | Abdeckung | PPV (K/O) | Delta, Punkte [95%] | Erfasste Fehler |
|---|---|---|---|---|
| gpt-6.1-sol + opus-5-5 | 59,8% | 95,6% (285/298) | +1,5 [-0,2, +3,3] | 16/29 |
| gpt-6.1-sol + fable-5-1 | 60,8% | 97,0% (294/303) | +2,9 [+1,1, +4,8] | 20/29 |
| gpt-6-astra + opus-5-5 | 58,3% | 94,8% (275/290) | +2,5 [+0,5, +4,7] | 23/38 |
| gpt-6-astra + fable-5-1 | 61,4% | 95,4% (291/305) | +3,1 [+1,1, +5,3] | 24/38 |
| gpt-6-sol + opus-5-5 | 61,6% | 95,4% (291/305) | -0,7 [-1,9, +0,6] | 5/19 |
| gpt-6-sol + fable-5-1 | 62,8% | 97,1% (301/310) | +1,0 [-0,4, +2,5] | 10/19 |
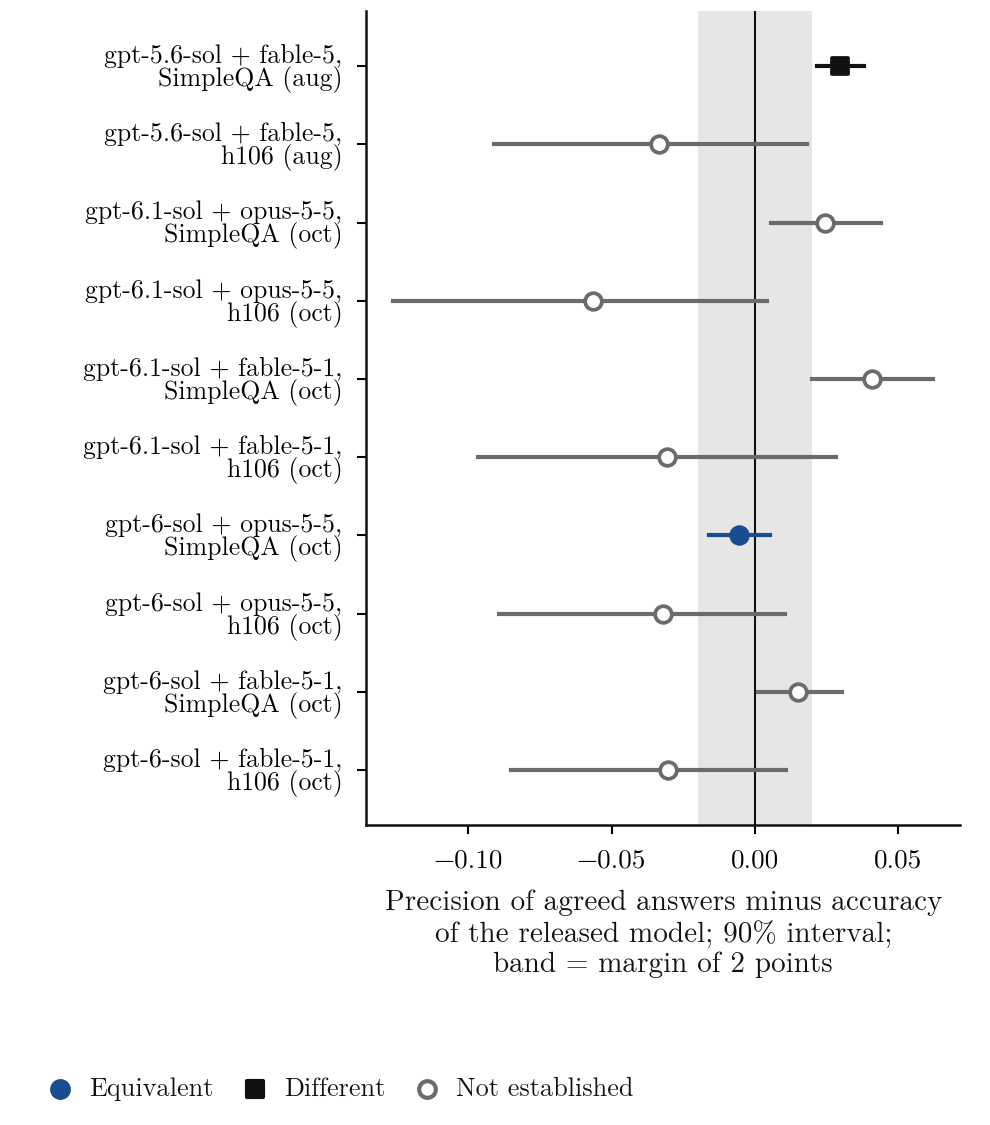
Abbildung A1. Äquivalenztest der Paargenauigkeit gegen das veröffentlichte Modell. Hinweis: 90%-Bootstrap der Fragen, Margin von 2 Punkten schattiert. Paare mit einem veröffentlichten Codex-Client-Arm.
Anhang C. Wortgetreue Übereinstimmung mit der Gold-Zeichenkette
Wortgetreue Übereinstimmung korreliert rankabhängig perfekt mit der SimpleQA-Genauigkeit über die neun Modelle mit sowohl einer SimpleQA- als auch einer neuen Messung, da eine korrekte Antwort oft die Gold-Zeichenkette ist. Die Korrelation mit der SimpleQA-minus-Frisch-Lücke beträgt +0,47 (exakte Permutations-p = 0,21, n = 9) oder +0,29 (p = 0,50) ohne gpt-5.6-sol, dessen zwei Genauigkeitsangaben aus verschiedenen Zugriffsmodi stammen (Abbildung A2). Beschränkt auf korrekte Antworten beträgt sie +0,10 (p = 0,81). Bei korrekten Antworten liegt die Rate bei 65,7 % für gpt-5.6-sol, 66,4 % für fable-5, 68,6 % für deepseek-v4-pro und 64,9 % für kimi-k3. Das Residuum des Modells hängt nicht davon ab, mit einer Steigung von +0,064 [-0,072, +0,167] über 112 Flagship-Zellen. Die Lücke selbst liegt für die meisten Modelle nahe Null oder negativ, bei -3,0 Punkten für fable-5, -20,5 für deepseek-v4-pro, -5,4 für opus-5-5 und -7,8 für fable-5-1, und sie ist nur für gpt-5.6-sol groß (+62,4), wo sich der Zugriffsmodus zwischen den beiden Messungen unterscheidet.
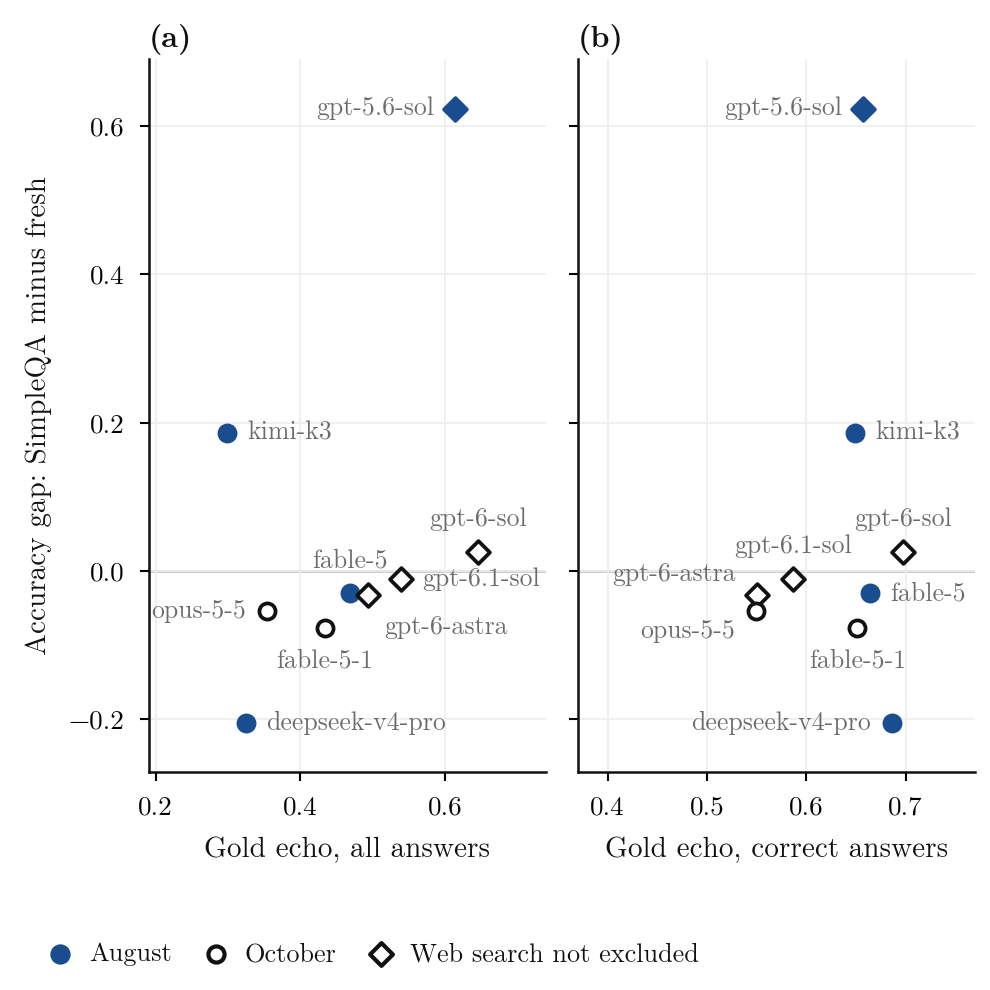
Abbildung A2. Wortgetreue Übereinstimmung mit der Gold-Zeichenkette gegen die Genauigkeitslücke. Anmerkung: (a) alle Antworten, (b) nur korrekte Antworten. Gefüllte Blaumarken, August-Welle; offen, Oktober-Welle. Diamanten kennzeichnen Arme, für die Websuche nicht ausgeschlossen ist.
Anhang D. Sensitivität des Bewerters
Die Engine normalisiert Groß- und Kleinschreibung, Artikel und Interpunktion, akzeptiert exakte Übereinstimmungen und das Vorhandensein von Zeichenketten mit vier oder mehr Zeichen, vergleicht Daten, Zahlen und alphanumerische Bezeichner nach Regel und vergleicht ansonsten Inhaltswörter; eine Antwort, die sie nicht gegen den Gold-Standard klären kann, bleibt ungelöst. In Tabelle A3 wird der erste Teil jeder Antwort ohne Klammern und nachfolgende Erklärung zum Abgleichen sowie zum Bewerten verwendet, sodass sich auch die offene Anzahl ändert.
Tabelle A3. Bewertung der gesamten Antwort gegenüber Bewertung ihres ersten Teils. Das erste Element wurde freigegeben.
| Paar, Menge | PPV, gesamte Antwort | PPV, erster Teil |
|---|---|---|
| gpt-5.6-sol + fable-5, alle, August | 997/1016 | 997/1019 |
| gpt-6.1-sol + opus-5-5, 106, Oktober | 31/35 | 30/34 |
| gpt-6.1-sol + fable-5-1, 106, Oktober | 31/34 | 31/35 |
| gpt-6-astra + opus-5-5, 106, Oktober | 28/35 | 32/36 |
| gpt-6.1-sol + opus-5-5, strat, Oktober | 183/190 | 189/195 |
| gpt-6.1-sol + fable-5-1, strat, Oktober | 187/191 | 198/201 |
| gpt-6.1-sol + opus-5-5, fresh, Oktober | 72/74 | 72/74 |
Anhang E. Weitere verwandte Arbeiten
Jüngste Preprints weisen in zwei Richtungen. Auf der skeptischen Seite zeigen Denisov-Blanch et al. (2026), dass die Aggregation im Abstimmungsstil über fünf Benchmarks und Modelle keinen konsistenten Genauigkeitsgewinn bei der 25-fachen Inferenzkosten ergibt, da Fehler korreliert sind. Ding (2026) prüft 265.000 Stichproben auf GPQA Diamond und AIME und stellt fest, dass Übereinstimmung ein positiver, aber schwacher Prädiktor ist (Spearman 0,20 bis 0,59), wobei 48 % der hochübereinstimmenden GPQA-Einträge des konsistentesten Frontier-Modells falsch sind. Bei einer explorativen Überprüfung von 46 Elementen überschreiten die gleichen falschen Antwortquoten zwischen gpt-4.1 und Claude-Ebenen ein randerhaltende Null für zwei von drei Ebenen. Kohli (2026) stellt fest, dass neun Frontier-Richter auf drei Inferenzdatensätzen etwa zwei unabhängige Stimmen tragen, und dass der beste einzelne Richter das Gremium erreicht oder übertrifft. Kim (2026) prüft 31.900 Teilmengen von 30 Modellen auf MMLU-Pro: Abstimmung schlägt das stärkste Mitglied in 9,98 % der Teilmengen der Größe 3, und ein striktes Diversitätsmaß ist nahezu kollinear mit eins minus mittlerer Genauigkeit (Spearman +0,991). Hossain et al. (2026) ermitteln eine durchschnittliche paarweise Fehlerkorrelation von 0,21 über zehn Richter, die etwa so viele Informationen tragen wie 3,5 unabhängige, mit stärkerer Abhängigkeit zwischen Frontier-Richtern verschiedener Anbieter. Chen (2026) zeigt, dass eine Politik, die die Antwort eines Mitglieds ausgibt, nicht die Quote überschreiten kann, mit der alle Modelle gemeinsam falsch liegen, und findet von 0,052 bei offener Mathematik über 67 Modelle gegenüber 0,023 unter einer Gaussian-Copula und 0,127 bei frei verfasster GPQA-Diamond. Auf der anderen Seite berichtet Naik (2024) über eine Präzision, die von 73,1 % auf 93,9 % mit zwei Modellen und auf 95,6 % mit drei Modellen in 78 Fällen im Mehrfachauswahlformat ansteigt, und Liu (2026) zeigt, dass ein Vier-Modell-Gremium Antworten besser auswählt als Selbstkonsistenz auf sieben Benchmarks, mit einem geschlossenen Gesetz in Mitgliedgenauigkeit, Fehlerkorrelation und einer gemeinsamen Fehlerquote, die die Konsenssgenauigkeit auf einen mittleren absoluten Fehler von 0,028 vorhersagt. Xue et al. (2026) berichten, dass modellübergreifende Konsistenz mit einem Verifizierer die Obergrenze der Selbstkonsistenz zur Halluzinations-Erkennung auf QA-Benchmarks verbessert, und Tan et al. (2025), dass sich Selbstkonsistenzfehler nicht mit Modellskala verringern, tendenziell modellspezifisch sind und mit einem zweiten Modell besser erkannt werden. Han (2026) gibt eine Theorie der seriellen Verifikationsgatter, in der eine blinde Fleckmasse die Zuverlässigkeit begrenzt und nennt Dekorrelation durch Änderung der Modellfamilie, Modalität oder Beweisquelle als praktischen Hebel. Zwei der Werke des Abschnitts 2 tragen Details, die für das Gatter relevant sind. Goel et al. (2025) definieren CAPA so, dass unterschiedliche falsche Optionen als Uneinigkeit zählen, und zeigen neben dem Trend mit Fähigkeit, dass neun Open-Weight-KI-Richter Modelle, die ihnen ähnlicher sind, höher bewerten, und dass Schwach-zu-Stark-Gewinne bei Aufgaben größer sind, bei denen Supervisor und Student weniger ähnliche Fehler machen (12 Modellpaare). Kolawole et al. (2025) geben eine sichere Aufschubungsbedingung für die gemeinsame Quote akzeptierter Fehler über die Testverteilung an, mit einem auf einem kleinen Validierungssatz geschätzten Schwellenwert. Eine Bedingung zur gemeinsamen Quote ermöglicht es, akzeptierte Fehler auf einer Schicht zu konzentrieren, und Abschnitt 5.1 findet eine solche Schicht: bei den 106 Fällen zertifizieren mittlere Gremien den Fehler, und so tun es auch Flaggschiff-Paare ohne den Arm mit der höchsten Genauigkeit.
Keine dieser Arbeiten berichtet, wie in Abschnitt 2 angemerkt, das paarweise Freigabegatter, den Rückruf bei gleicher Abdeckung mit einem Freigabemodell festgehalten, oder einen Identifier, der in zwei Zugriffsmodi gemessen wurde.
Anhang F. Daten- und Protokolldetails
Sammlungen. Das Protokoll ist das aus Abschnitt 3, und die Sammlungen folgen in vollem Umfang. Tabelle A1 listet Modelle, Daten und Zugriffsmodi auf.
- Juli mittlere Kategorie (24. bis 28. Juli). Neun API-Modelle und sieben lokale Modelle zu 1.500 SimpleQA-Fragen (Wei et al., 2024), eine feste zufällige Teilstichprobe der 4.326 Fragen in der Benchmark. Die Sammlung wurde vor der Datenerfassung auf OSF registriert (Chernets, 2026a).
- August Flaggschiffe (3. bis 6. August). Ein Flaggschiff aus jedem von elf Laboren zu denselben 1.500 Fragen, von denen 1.459 den gemeinsamen Pool bilden.
- Varianzarm (6. August). Neun der Flaggschiffe zu 100 dieser Fragen, 20 pro Quintil, bei Temperatur 0,7 mit drei Stichproben pro Frage.
- Neue Fragen (6. August und 26. Oktober). 100 Zwei-Hop-Fragen, maschinell aus Wikidata über acht Templates zusammengestellt, mit dem Datei-Hash vor dem ersten Modellaufruf fixiert.
- Produktfakten (15. August). 267 Fragen zu kommerziellen Produkten, ebenfalls aus Wikidata zusammengestellt, auf sechs Modellen, vier davon ohne Suchfunktion.
- Oktober Flaggschiffe (26. und 27. Oktober). gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 und claude-fable-5-1 zu 300 SimpleQA-Fragen geschichtet nach Juli-Quintil (60, 120, 120; 297 gemeinsam für alle fünf; „strat" in den Tabellen), die 106 Fragen unten und die neue Menge, 503 gemeinsame Fragen insgesamt. kimi-k3 und gemini-3.8-flash beantworteten die neue Menge.
Zugriffsmodi. Auf Modelle wurde auf die zwei in Abschnitt 3 beschriebenen Weisen zugegriffen. gpt-5.6-sol lief auch per direkter API im Varianzarm und auf der August-Neuemenge. Modellkennungen und Client-Versionen werden pro Aufruf erfasst.
Da die Clients die Messbedingungen festlegen, gebe ich sie vollständig an. Die Temperatur kann in ihnen nicht gesetzt werden. Der August-Codex-Arm lief bei der Client-Standardeinstellung für Reasoning-Aufwand, den der Aufruf nicht setzt und die Datensätze nicht angeben. Die Oktober-Codex-Arme liefen mit auf mittel gesetztem Aufwand bei jedem Aufruf. Die August-Manifeste erfassen null Web-Suchanfragen für den Claude-Arm und eine leere Werkzeugliste für den Mistral-Arm, und die Oktober-Claude-Arme liefen mit deaktivierten Werkzeugen. Die Codex-Arme wurden ohne das Such-Flag gestartet, und ihre Event-Streams wurden nicht beibehalten, sodass nicht aus den Dateien bestimmt werden kann, ob sie suchten. In den kimi- und gemini-3.8-flash-Clients wurden Werkzeuge nicht deaktiviert und der Prompt untersagt sie.
Anhang G. Die 106 und die Ränge
Abbildung A3 zeigt die Panels und Paare aus Abschnitt 5.1 zu den 106 und zwei weitere Paare: fable-5 mit grok-4.5 hat 7 von 28 Übereinstimmungen und gemini-3.1-pro mit grok-4.5 hat 8 von 25.
Die 0 von 342 aus Abschnitt 1 hängt davon ab, wie die Schwierigkeit eingestuft wird. Wenn die eigenen Antworten jedes Panels aus der Schwierigkeitsrangfolge ausgelassen werden, wird die Anzahl zu 78 von 354, und das länderübergreifende Panel bleibt bei 0 von 116.
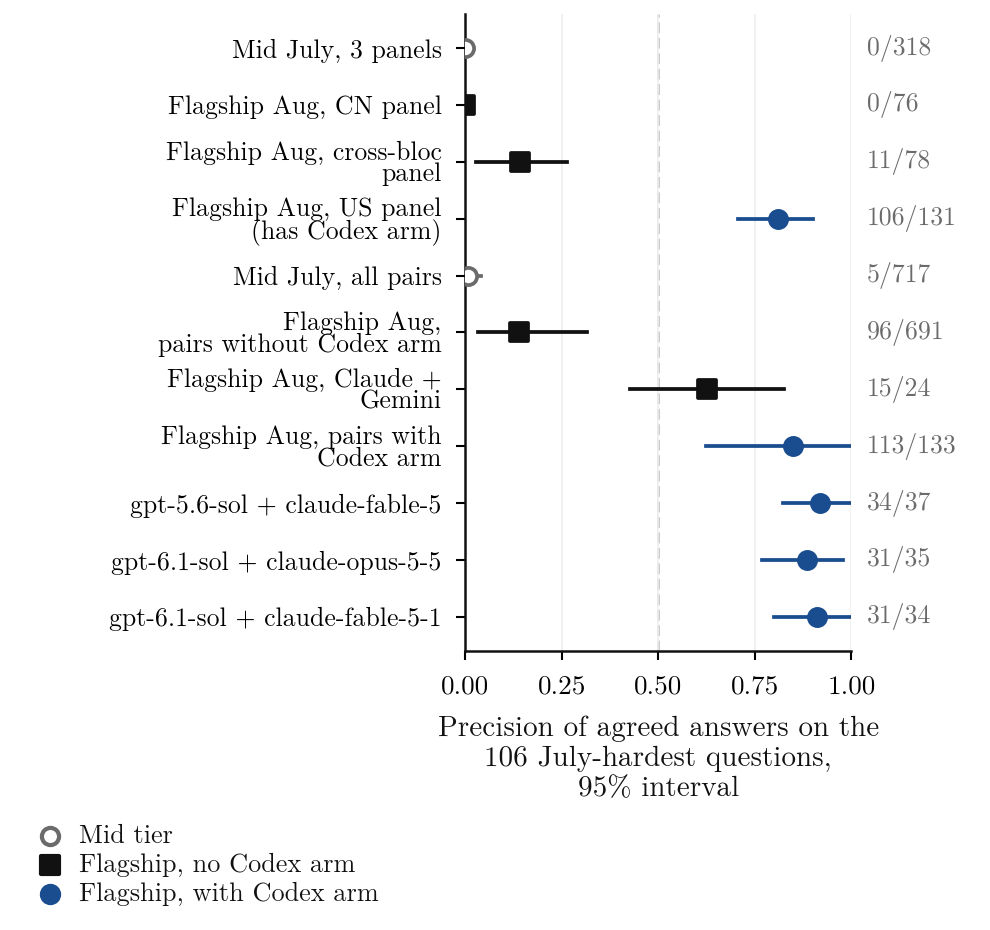
Abbildung A3. Präzision übereinstimmender Antworten zu den 106 Fragen. Hinweis: 95%-Bootstrap bidirektional für zusammengefasste Zeilen, Frage-Bootstrap für Panels und einzelne Paare. Blaue Zeilen enthalten einen Codex-Client-Arm. August- und Oktober-Erhebungen.
Abbildung A4 gibt die Quintile des eigenen Rangs aus Abschnitt 5.1 vollständig an. Mit allen Armen erreicht August 26,6 % [6,7, 53,4] im schwierigsten Quintil, ein Unterschied von +9,3 [-18,1, +39,8] gegenüber Juli. Ohne kimi-k3, das zu beiden Erhebungen gehört, ergibt das schwierigste Quintil 147 von 675 (21,8 %) im Juli und 192 von 995 (19,3 %) im August, −2,5 Punkte [−29,7, +28,2]. Der zusammengefasste Test von Abschnitt 5.1 nutzt alle fünf Quintile, 180 Zellen pro Rang; Mittlere-Rang-Zellen liegen bei +0,3 Punkten [−2,4, +2,9] und Flaggschiff-Zellen bei +0,0 [−1,4, +1,6] vom gefrorenen Modell. Die Steigerung im schwierigsten Quintil beträgt 1,15 [0,39, 1,90] im Juli und 0,97 [0,42, 1,49] im August. Über die Quintile hinweg erreicht August ohne GPT 15,5, 52,9, 75,8, 90,5 und 97,3 % und Juli 17,3, 29,0, 60,9, 80,4 und 94,4 %, während die Genauigkeit veröffentlichter Modelle 16,0, 36,6, 56,8, 73,3 und 88,5 % gegenüber 15,3, 25,0, 40,0, 57,7 und 78,9 % beträgt.
Die Präzision bleibt bei bereinigten korrekten Antworten niedrig. Haas et al. (2025) haben SimpleQA in einen bereinigten Satz von 1.000 Fragen umgewandelt, und 24 von den 106 sind darin enthalten, gegenüber 24,5 erwartet aus dem Anteil der beibehaltenen Benchmark, wobei die korrekte Antwort auf 21 identisch ist. Die Bereinigung entfernt diese Fragen nicht häufiger als andere, obwohl ihre Auswahl auch schwierige Fragen bevorzugt. Nach derselben Statistik und Bootstrap haben August-Paare ohne GPT 28 von 150 Übereinstimmungen bei diesen 24 Fragen richtig (18,7 % [0,0, 57,1]) und 67 von 538 bei den anderen 82 (12,5 % [2,8, 28,1]; das genauere Element wird bei jeder Teilmenge veröffentlicht, daher müssen die Teile nicht auf 96 von 691 summieren), und Juli-Paare 4 von 157 (2,5 % [0,0, 15,2]).
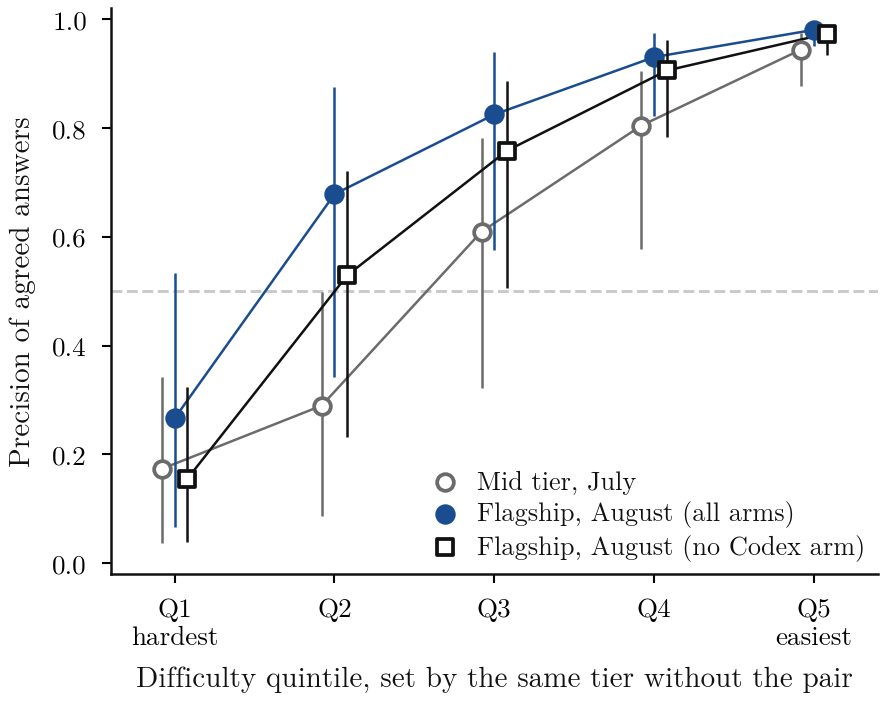
Abbildung A4. Präzision übereinstimmender Antworten nach Schwierigkeit des eigenen Rangs-Quintils. Hinweis: 95%-Bootstrap bidirektional. Die Schwierigkeit für jedes Paar wird vom gleichen Rang ohne dieses Paar festgelegt. Gestrichelte Linie bei 0,5.
Die genauesten Paare folgen derselben Relation. Das Paar kimi-k3 und gemini-3.8-flash erreicht 95,8 % auf dem neuen Satz, mit 23 von 26 Fehlern des veröffentlichten Modells erfasst und einer Steigerung von 5,37 [2,86, 21,36]. Das Modell gibt nur mit ihren Genauigkeitswerten von 0,74 und 0,82 95,1 % zurück. Und die beiden Claude-Flaggschiffe zusammen, ohne Suchfunktion in beiden Armen, erreichen 47,5 % bei den 106, wo die Genauigkeit des veröffentlichten Modells 30,0 % beträgt, und 86,2 % über alle 503 Fragen hinweg. Abbildung A5 stellt jedes Band jedes Rangs gegen die Genauigkeit des veröffentlichten Modells dar, mit Präzision über der Diagonalen in 17 von 23 Zellen.
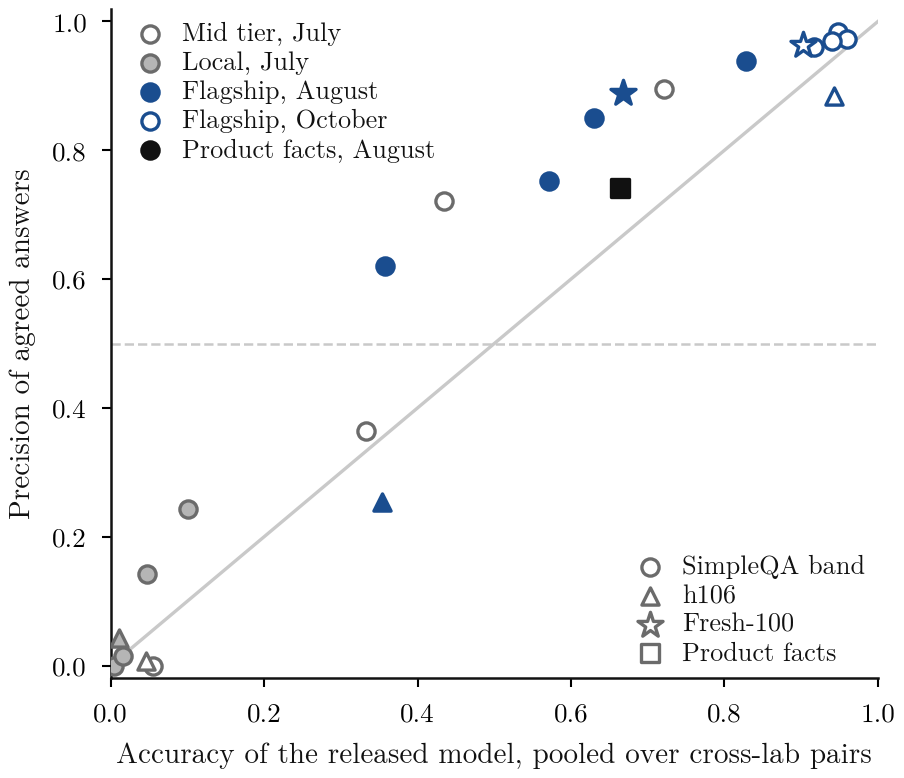
Abbildung A5. Präzision übereinstimmender Antworten gegen Genauigkeit des veröffentlichten Modells. Hinweis: zusammengefasst über Paare aus verschiedenen Laboren, nach Rang und Band. Farbe und Füllung geben den Rang an, die Markerform den Satz. Gestrichelte Linie bei 0,5, durchgezogene Linie ist Gleichheit.
Anlage H. Das zweite Labor im Detail
Der Varianzarm. Nach Modell bei gleicher Abdeckung (Abbildung 2) führt das Zwei-Labor-Gate in sieben von neun und liegt zurück bei gemini-3.1-pro (-5,7 Punkte) und grok-4.5 (-2,8). Ohne GPT deckt über acht Modelle Selbstübereinstimmung 61,4 % bei einer Präzision von 55,9 % ab und zwei Labore 24,4 % bei 83,3 %. Der Unterschied in der Präzision beträgt +27,4 Punkte [+16,0, +35,7] wie gemessen und +7,7 [-1,9, +16,5] bei gleicher Abdeckung, und erfasste Fehler unterscheiden sich um +38,3 Punkte [+26,0, +50,9] wie gemessen und +3,0 [-1,5, +8,4] bei gleicher Abdeckung. Oktober hat keine wiederholten Aufrufe, daher wird die Selbstübereinstimmung nur im August gemessen.
Vier Partner eines freigegebenen Modells. Tabelle A4 gibt die vier Partner von Abbildung 3a an: ein freigegebenes Modell, gpt-6.1-sol, sodass die 29 fehlerhaften Punkte in jeder Zeile gleich sind.
Tabelle A4. Ein freigegebenes Modell, vier Partner: gpt-6.1-sol bei 503 gemeinsamen Fragen (29 Fehler unter 495 gelösten, 95 % Frage-Bootstrap).
| Partner | Labor | Abdeckung [95 %] | PPV (K/O) | Delta, Punkte [95 %] | Erfasste Fehler [95 %] |
|---|---|---|---|---|---|
| gpt-6-astra | gleich | 96,2 % [94,4, 97,8] | 94,3 % (449/476) | +0,2 [-0,2, +0,8] | 2/29 = 6,9 % [0,0, 17,4] |
| gpt-6-sol | gleich | 95,6 % [93,6, 97,2] | 96,2 % (457/475) | +2,1 [+0,9, +3,4] | 11/29 = 37,9 % [20,7, 56,5] |
| claude-opus-5-5 | anders | 59,8 % [55,9, 64,0] | 95,6 % (285/298) | +1,5 [-0,2, +3,3] | 16/29 = 55,2 % [36,4, 73,0] |
| claude-fable-5-1 | anders | 60,8 % [56,7, 65,0] | 97,0 % (294/303) | +2,9 [+1,1, +4,8] | 20/29 = 69,0 % [50,0, 85,2] |
Der andere Partner im gleichen Labor, gpt-6-sol, erfasst 11 von 29, was -31,0 Punkte [-50,0, -10,7] gegen fable-5-1 und -17,2 [-37,0, +3,0] gegen opus-5-5 ist. Das Claude-Paar deckt ohne Suchfunktion in keinem Arm 60,6 % ab und erfasst 140 von 181 Fehlern von fable-5-1 bei einer Präzision von 86,2 % und einem Delta von +23,5 Punkten [+19,6, +27,2]. Zwei Modelle eines Labors, beide weit entfernt von der Obergrenze, können sich daher häufig genug uneinig sein, um die meisten Fehler zu erfassen.
Tabelle A5 prüft, ob dies mehr als eine Bewegung entlang der Abdeckungskurve ist, und ob GPT erforderlich ist. Jede Zeile behält ein freigegebenes Modell bei und vergleicht seinen Partner im gleichen Labor mit einem Partner aus einem anderen Labor, zunächst wie gemessen und dann bei gleicher Abdeckung, die durch Ausdünnung des breiteren Gates nach Konfidenz erreicht wird (Abschnitt 3).
Tabelle A5. Erfasste Fehler mit einem Partner im gleichen Labor und mit einem Partner aus einem anderen Labor. Unterschiede sind gleich minus anders, in Punkten, mit einem 95 %-Frage-Bootstrap, sodass negativ das andere Labor begünstigt; wie gemessen, teilen sich die Unterschiede in den ersten vier Zeilen den Bootstrap von Tabelle A4.
| Freigegeben | Gleich / anderer Partner | Fragen | Erfasst, wie gemessen | Unterschied [95 %] | Erfasst, gleiche Abdeckung | Unterschied [95 %] |
|---|---|---|---|---|---|---|
| gpt-6.1-sol | astra / fable-5-1 | 503 | 2/29, 20/29 | -62,1 [-79,3, -43,8] | 17/29, 20/29 | -10,3 [-35,3, +13,8] |
| gpt-6.1-sol | astra / opus-5-5 | 503 | 2/29, 16/29 | -48,3 [-66,7, -29,6] | 18/29, 16/29 | +6,9 [-17,1, +30,4] |
| gpt-6.1-sol | gpt-6-sol / fable-5-1 | 503 | 11/29, 20/29 | -31,0 [-50,0, -10,7] | 24/29, 20/29 | +13,8 [-6,7, +34,6] |
| gpt-6.1-sol | gpt-6-sol / opus-5-5 | 503 | 11/29, 16/29 | -17,2 [-37,0, +3,0] | 24/29, 16/29 | +27,6 [+3,4, +51,6] |
| fable-5-1 | opus-5-5 / gpt-6.1-sol | 503 | 140/181, 169/181 | -16,0 [-21,7, -10,6] | 140/181, 169/181 | -16,0 [-21,7, -10,6] |
| opus-5-5 | fable-5-1 / gpt-6.1-sol | 503 | 154/195, 177/195 | -11,8 [-17,8, -5,9] | 156/195, 177/195 | -10,8 [-16,7, -5,0] |
| fable-5-1 | opus-5-5 / kimi-k3 | frisch 100 | 13/23, 20/23 | -30,4 [-50,0, -12,5] | 17/23, 20/23 | -13,0 [-35,0, +9,1] |
| fable-5-1 | opus-5-5 / gemini-3.8-flash | frisch 100 | 13/23, 19/23 | -26,1 [-45,5, -8,7] | 17/23, 19/23 | -8,7 [-29,4, +12,5] |
| opus-5-5 | fable-5-1 / kimi-k3 | frisch 100 | 18/28, 23/28 | -17,9 [-38,5, +0,0] | 24/28, 23/28 | +3,6 [-14,7, +22,6] |
| opus-5-5 | fable-5-1 / gemini-3.8-flash | frisch 100 | 18/28, 22/28 | -14,3 [-33,3, +4,5] | 22/28, 22/28 | +0,0 [-20,0, +20,7] |
| fable-5-1 | opus-5-5 / gemini-3.1-pro (August) | 344 | 107/130, 110/130 | -2,3 [-9,8, +5,3] | 108/130, 110/130 | -1,5 [-9,1, +5,8] |
| opus-5-5 | fable-5-1 / gemini-3.1-pro (August) | 344 | 118/141, 126/141 | -5,7 [-12,1, +0,8] | 125/141, 126/141 | -0,7 [-6,4, +5,1] |
Die August-Zeilen sind der einzige SimpleQA-Vergleich ohne GPT und verbinden Modelle aus verschiedenen Daten. gemini-3.1-pro ist der August-Arm, der der Genauigkeit der Claude-Modelle bei diesen Fragen am nächsten kommt (65,4 % gegenüber 60,6 und 57,7 % bei diesen Fragen). Über alle sieben August-Partner zusammengefasst, von denen die meisten viel schwächer sind, beträgt der Unterschied -5,1 Punkte [-10,1, -0,3] für fable-5-1 und -6,0 [-10,6, -1,2] für opus-5-5 wie gemessen, und er dreht sich zu +7,9 [+4,8, +11,2] und +6,8 [+3,6, +10,2] bei gleicher Abdeckung zugunsten des gleichen Labors. Unentschieden in der Konfidenz werden zufällig aufgelöst, und über 200 Ziehungen bewegt sich die breiteste Zeile zwischen 0,0 und +20,7 Punkten.
Anhang I. Das Modell außerhalb der Stichprobe im Detail
Tabelle A6 zeigt die Fehler außerhalb der Stichprobe hinter Abschnitt 5.3. Die zeitliche Aufteilung ergibt 0.019 gegenüber 0.050 für das Best-Model-Baseline, eine Differenz von -0.031 [-0.074, +0.008] unter dem Two-Way-Bootstrap, und das Intervall liegt unter Null, wenn nach Frage allein oder nach Modell allein geclustert wird. Mit 9 und 23 Falten geben LOLO und LOMO denselben Fehler auf drei Dezimalstellen.
Tabelle A6. Mittlerer absoluter Fehler des vorhergesagten PPV, Zellen mit mindestens 20 offenen Antworten. Two-Way-Bootstrap, Frage nach Modell.
| Schema | Modell [95%] | Unabhängig | Beste | Modell minus beste [95%] | Modell minus unabhängig [95%] |
|---|---|---|---|---|---|
| LOLO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.035] | +0.005 [-0.003, +0.012] |
| LOMO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.036] | +0.005 [-0.004, +0.012] |
| LOLO, Fragen aufgeteilt | 0.054 [0.052, 0.088] | 0.050 | 0.109 | -0.055 [-0.075, -0.027] | +0.004 [-0.002, +0.010] |
| Juli und August bis Oktober | 0.019 [0.008, 0.041] | 0.023 | 0.050 | -0.031 [-0.074, +0.008] | -0.004 [-0.011, +0.005] |
| Mittleres Segment bis Flaggschiffe | 0.030 [0.025, 0.053] | 0.031 | 0.087 | -0.057 [-0.087, -0.022] | -0.001 [-0.009, +0.005] |
| LOLO, Flaggschiffe, kein Such-möglicher Arm | 0.037 [0.029, 0.071] | 0.038 | 0.120 | -0.083 [-0.125, -0.039] | -0.000 [-0.017, +0.014] |
| Zurückgehalten: ERNIE und Muse, August | 0.019 [0.015, 0.055] | 0.033 | 0.128 | -0.110 [-0.143, -0.032] | -0.014 [-0.031, +0.007] |
| Zurückgehalten: 7 lokale Modelle, Juli | 0.037 [0.018, 0.072] | 0.068 | 0.077 | -0.040 [-0.061, -0.015] | -0.031 [-0.041, -0.014] |
| Zurückgehalten: gleiches Labor, Oktober | 0.038 [0.017, 0.083] | 0.043 | 0.041 | -0.003 [-0.130, +0.045] | -0.006 [-0.025, -0.001] |
| Zurückgehalten: Produkttatsachen | 0.130 [0.077, 0.187] | 0.149 | 0.086 | +0.045 [-0.051, +0.143] | -0.019 [-0.021, -0.012] |
Der praktische Gewinn gegenüber dem Ablesen des besseren Modells ist groß, einschließlich Transfer vom mittleren Segment zu Flaggschiffen und zwei der vier Sätze, die nicht an der Anpassung teilnahmen (Abbildung A6). Der Multiplikator trägt nichts zur Präzision in den Hauptschemen bei, und die Arbeit wird von den gemessenen Genauigkeiten und von geleistet. Das vollständige Entfernen von erhöht den LOLO-Fehler auf 0.323, und das Halten konstant ergibt 0.046. Bei Abdeckung und Log-Verlust hilft : unter LOLO sind die Differenzen von unabhängigen Fehlern -0.0079 [-0.0111, -0.0020] und -0.0024 [-0.0045, -0.0003]. Bei drei der vier zurückgehaltenen Sätze liegt das Intervall gegen unabhängige Fehler unter Null, mit eingefrorenen Konstanten. Der gemeinsame Fehlerterm ist daher wichtig für die Abdeckung, während die Präzision auf den gemessenen Genauigkeiten und beruht.
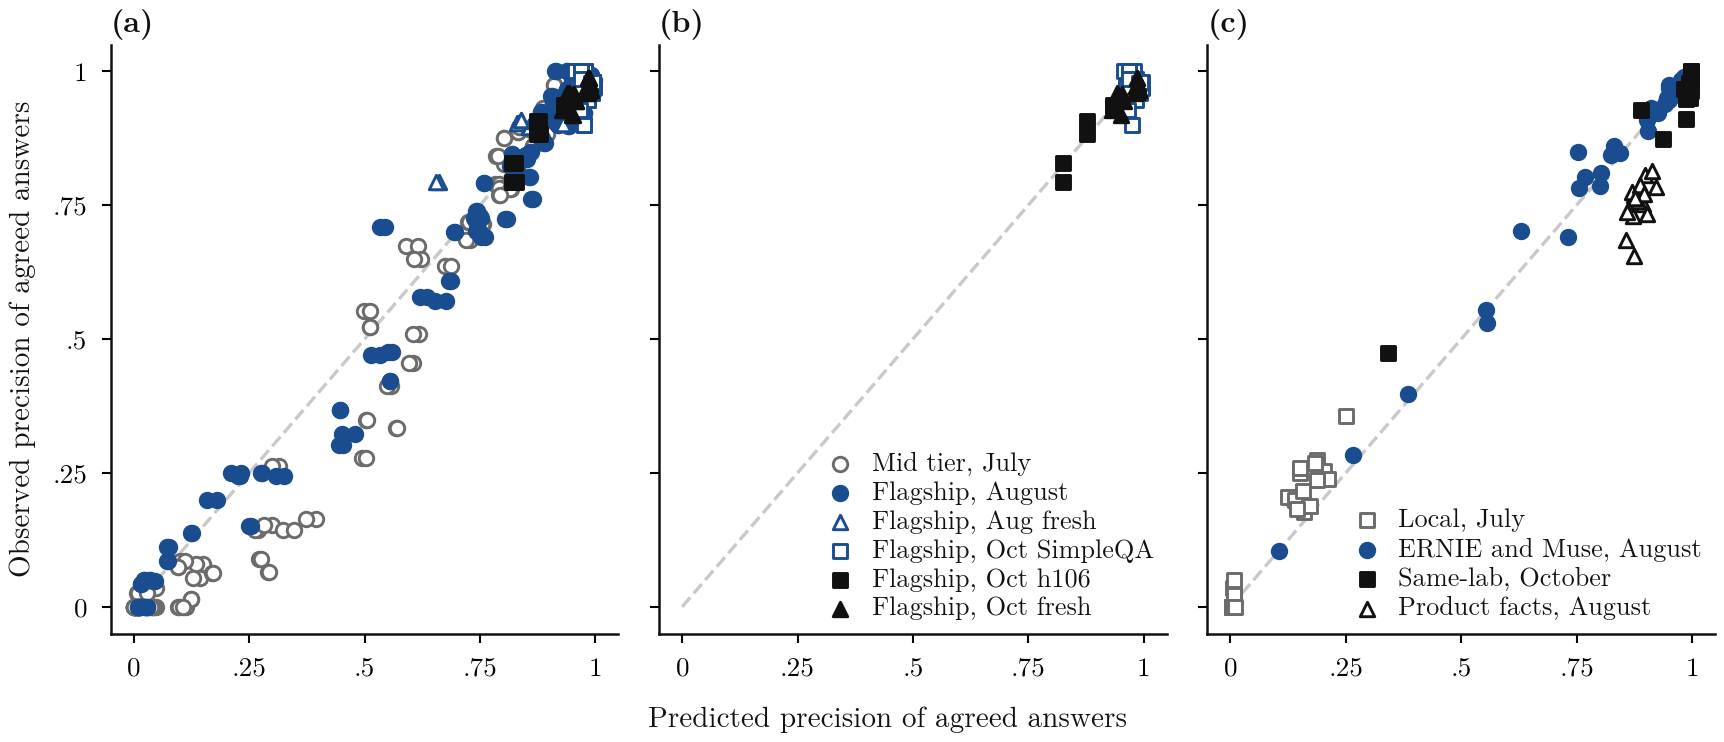
Abbildung A6. Vorhergesagte gegenüber beobachteter Präzision übereinstimmender Antworten. Hinweis: (a) ein Labor herauslassen. (b) Anpassung auf Juli und August und Vorhersage Oktober. (c) Sätze außerhalb der Anpassung, Konstanten fixiert. Gestrichelte Linie ist Gleichheit.
Bei Produkttatsachen läuft das Modell hoch. Der Fehler beträgt 0.130 gegenüber 0.086 für das beste Modell, mit einer mittleren Überaussage von 13 Punkten. Mit dem nativen Grader dieser Domäne steigt die Überaussage auf 19 Punkte (0.190 gegenüber 0.067). Produkttatsachen liegen außerhalb der Domäne, auf der die Konstanten angepasst wurden.
Beim Sortieren von Zellen in drei Ergebnisklassen (invertiert bei PPV unter 0.5, kein Gewinn bei Delta bis zu +2 Punkten, Gewinn darüber), stimmt die zeitliche Aufteilung 28 von 39 Zellen überein, und neun der Fehlschläge sagen keinen Gewinn dort voraus, wo Gewinn beobachtet wurde. Das Modell ist zuverlässig für die Größe der Präzision und schwächer beim Sortieren von Zellen auf beiden Seiten der +2-Punkte-Linie.
Anlage J. Zugriffsmodi und die GPT-Arme im Detail
Gleiche Kennung, gleiche Fragen. Bei einem Satz von 100 SimpleQA-Fragen erreicht gpt-5.6-sol 92 von 100 (92,0%) in der Hauptwelle, wobei 99 der 100 Datensätze über den Codex-Client und eine falsche Antwort über einen API-Fallback kamen, und 139 von 300 Stichproben (46,3%) über die direkte API im Varianzarm – ein Unterschied von 45,7 Punkten (Abbildung 5). Nur bei den 99 Client-Datensätzen liegen die Werte bei 92 von 99 (92,9%) und 139 von 297 (46,8%), ein Unterschied von 46,1 Punkten. Die wortgetreue Wiedergabe der Gold-Zeichenkette sinkt damit von 64,0% auf 26,0%. Die Bedingungen unterscheiden sich wie folgt: Der Client läuft mit seiner Standardeinstellung für die Anstrengung unter seinen eigenen Anweisungen, wobei die Temperatur nicht einstellbar ist, während die API mit Anstrengung none und Temperatur 0,7 läuft.
Über die beiden Spalten hinweg bewegen sich die anderen acht Modelle des Arms, deren Temperatur sich ebenfalls ändert, um höchstens 4,0 Punkte in jede Richtung. Anstrengung ist ein Kandidat für gpt-5.6-sol, obwohl eine gepaarte Messung des Reasoning-Budgets bei gemini-3.1-pro die Genauigkeit nahezu unverändert ließ (Chernets, 2026c). Websuche ist der andere. Antworten aus Oktober vom gleichen Client enthalten Links, die die Eingabeaufforderung nicht anfordert, in 3 von 506 Antworten von gpt-6.1-sol und in 18 von 506 von gpt-6-astra, einschließlich einer echten MusicBrainz-Kennung. Die mediane Token-Nutzung pro August-Client-Aufruf beträgt 4.829, wobei 36,4% der Aufrufe über 6.000 liegen. Diese Token können Reasoning oder Suche sein, und der Event-Stream, der diese trennen würde, wurde nicht gespeichert.
Ein Benchmark-Rahmen und eine Person, die das Produkt nutzt, können somit Genauigkeiten sehen, die sich bei einer Kennung und einem Fragensatz um 45,7 Punkte unterscheiden, und eine Studie zum „Modell" muss angeben, welches sie gemessen hat. In der August-Welle erreicht der Client-Arm 1.392 von 1.457 (95,5%), und die 14 Datensätze, die von der API nach einem Client-Fehler bereitgestellt wurden, erreichen 11 (78,6%), bei Fragen, die durch diesen Fehler ausgewählt wurden. Bei dem neuen Satz erreicht gpt-5.6-sol über die API 33 von 100, wobei fable-5 76 erreicht, während gpt-6.1-sol über den Client im Oktober 95 erreicht. Und das Modell aus Abschnitt 4 behält seine Form unter dieser Frage, da es gemessene Genauigkeiten als Eingabe nimmt: Bei Flaggschiffen ohne Arme mit möglicher Suche beträgt sein LOLO-Fehler 0,037 gegenüber 0,120 für das beste Modell.
Gate-Wert nach Zugriffsmodus. Bei neuen Fragen im August mit GPT über die API ist das Paar gpt-5.6-sol und fable-5 bei 29 von 32 Übereinstimmungen korrekt, Delta +57,6 Punkte [+46,3, +69,7], erfasst 64 von 67 Fehlern, und sichere Fehler des GPT-Arms sinken von 61 von 91 auf 2 von 29. Im Oktober mit einem neueren GPT über den Client bei den gleichen Fragen ist das Paar mit opus-5-5 bei 72 von 74 korrekt, und das Paar mit fable-5-1 bei 76 von 78, mit einem Delta von +2,3 [-0,7, +6,0] und +2,4 [-0,5, +6,3] und 3 von 5 erfassten Fehlern. Der Gate-Wert verfolgt hier die Genauigkeit des veröffentlichten Arms, wie in Abschnitt 5.1.
Client-Arme bei SimpleQA. Tabelle A7 berichtet die in Abschnitt 5.1 beiseite gelegten Arme. Im August ist das Paar gpt-5.6-sol und fable-5 bei 997 von 1.016 Übereinstimmungen (98,1%) korrekt gegenüber 95,4% allein, Delta +2,8 Punkte [+1,9, +3,7], wobei die Untergrenze bei 15 von 1.459 liegt. Bei den 106 erreicht es 34 von 37 (91,9%), und alle Paare mit dem GPT-Arm erreichen 113 von 133 (85,0% [62,2, 100,0]), gegenüber 96 von 691 ohne ihn. Der Arm allein ist korrekt bei 100 von 105. Diese Übereinstimmungen erben diese Genauigkeit: Das Delta bei den 106 beträgt -3,3 Punkte [-10,3, +2,6] im August und -5,7 [-13,7, +1,2] mit opus-5-5 im Oktober. Im Gegensatz dazu ist das Mittelklasse-Paar der gleichen zwei Anbieter, gpt-5-mini und claude-haiku-4-5, bei 45 von 123 Übereinstimmungen (36,6% [28,6, 45,4]) insgesamt korrekt und 0 von 13 bei den 106, wobei sein erstes Mitglied bei 163 von 1.435 liegt.
Tabelle A7. Client-Arm-Paare. Das erste Mitglied ist veröffentlicht. Wilson-Intervall auf PPV, Frage-Bootstrap auf Delta.
| Paar, Satz | Abdeckung | PPV (K/O) [95%] | Veröffentlicht allein | Delta, Punkte [95%] | Erfasste Fehler |
|---|---|---|---|---|---|
| gpt-5.6-sol + fable-5, alle SimpleQA, August | 1028/1500 | 98,1% (997/1016) [97,1, 98,8] | 1403/1471 | +2,8 [+1,9, +3,7] | 49/68 |
| gpt-5.6-sol + fable-5, 106, August | 37/106 | 91,9% (34/37) [78,7, 97,2] | 100/105 | -3,3 [-10,3, +2,6] | 2/5 |
| gpt-6.1-sol + opus-5-5, strat, Oktober | 192/300 | 96,3% (183/190) [92,6, 98,2] | 276/294 | +2,4 [+0,2, +4,9] | 11/18 |
| gpt-6.1-sol + fable-5-1, strat, Oktober | 193/297 | 97,9% (187/191) [94,7, 99,2] | 273/291 | +4,1 [+1,6, +6,7] | 14/18 |
| gpt-6.1-sol + opus-5-5, 106, Oktober | 36/106 | 88,6% (31/35) [74,0, 95,5] | 98/104 | -5,7 [-13,7, +1,2] | 2/6 |
| gpt-6.1-sol + fable-5-1, 106, Oktober | 35/106 | 91,2% (31/34) [77,0, 97,0] | 98/104 | -3,1 [-10,9, +3,5] | 3/6 |
| gpt-6.1-sol + opus-5-5, frisch, Oktober | 74/100 | 97,3% (72/74) [90,7, 99,3] | 95/100 | +2,3 [-0,7, +6,0] | 3/5 |
| gpt-6.1-sol + fable-5-1, frisch, Oktober | 78/100 | 97,4% (76/78) [91,1, 99,3] | 95/100 | +2,4 [-0,5, +6,3] | 3/5 |
Gate-Wert nahe der Obergrenze. Bei bekannten Fragen trägt das Paar immer noch etwas bei (Abbildung A1). Im August bei SimpleQA ohne die 106 beträgt sein Delta +3,0 Punkte [+2,0, +4,0], ein Unterschied zugunsten des Paares. Im Oktober liegen die strat-Paare über Null, bei +2,4 [+0,2, +4,9] und +4,1 [+1,6, +6,7], und kommen nicht zu einer Entscheidung gegen die Marge. Die einzige Äquivalenz ist gpt-6-sol mit opus-5-5 bei -0,6 (90%-Intervall -1,6 bis +0,5, p = 0,020), was die Holm-Korrektur nicht übersteht (0,277). Bei den 106 ist jedes Paar mit gpt-6.1-sol und gpt-5.6-sol unentschieden mit abwärts gerichteter Tendenz. Außerhalb dieses Arms ist der Effekt groß: Bei dem gleichen August-Satz liegt fable-5 mit gemini-3.1-pro bei +19,3 Punkten und fable-5 mit grok-4.5 bei +18,0.
Das eigene Vertrauen des Arms ist ein Konkurrent in diesem Bereich. Durch sein eigenes Vertrauen auf die Abdeckung des Paares mit opus-5-5 ausgedünnt, liegt gpt-6.1-sol bei 34 bis 36 von 36 bei den 106, je nachdem wie Unentschieden aufgelöst werden, gegenüber 31 von 35 für das Paar, und 74 von 74 bei frischen Fragen gegenüber 72 von 74. Bei strat führt das Paar an, um +1,6 Punkte [-1,4, +4,7] mit opus-5-5 und um +3,2 [+0,6, +6,2] mit fable-5-1.
Welche KI und welcher Partner. Bei gemeinsamen Fragen schlagen beide Modelle gpt-6.1-sol gpt-6-astra 10 zu 1 bei diskordanten Paaren (p = 0,012, +1,83 Punkte [+0,61, +3,26]), und gpt-6-sol schlägt gpt-6-astra 21 zu 5 (p = 0,002, +3,29 [+1,23, +5,34]). gpt-6.1-sol gegen gpt-6-sol steht bei 5 zu 12 (p = 0,143). opus-5-5 gegen fable-5-1 steht bei 29 zu 44 (p = 0,101, -3,12 [-6,65, +0,21]). Paare der zwei stärksten KIs mit den zwei Claudes liegen zwischen 95,4 und 97,1 % über 503 Fragen (Table A2), wobei fable-5-1 in jedem Vergleich mehr Fehler erfasst. Und kimi-k3 mit gemini-3.8-flash, das Paar ohne KI, ist auf dem neuen Datensatz nicht von ihnen zu unterscheiden: Sein Unterschied zu gpt-6.1-sol mit opus-5-5 beträgt -1,5 Punkte [-6,3, +2,8] bei Präzision und -2,0 [-10,0, +6,0] bei Abdeckung.
Appendix K. Externe Daten im Detail
Die externe Überprüfung von Abschnitt 5.5 verwendet die eingefrorenen Konstanten ohne erneute Anpassung. HELM Lite (Liang et al., 2023) enthält kurze offene Antworten von 95 Modellen von 20 Entwicklern, die zwischen 2023 und 2025 veröffentlicht wurden, auf 1.000 Fragen aus NaturalQuestions ohne Nachschlagewerk, bewertet hier von meiner Engine. LiveBench (White et al., 2025) enthält Antworten von 70 Modellen von 11 Laboratorien auf 346 Fragen mit einer kurzen abschließenden Antwort, bewertet gegen die Ground Truth. Kim et al. (2025) veröffentlichen Paar-Aggregate für 70 Modelle bei dem Multiple-Choice-Test MMLU, die die beobachtete Präzision als Quote der korrekten Paare über der Übereinstimmungsquote angeben. Tabelle A8 zeigt das Ergebnis. Die Genauigkeitswerte in Tabelle 7 von Haas et al. (2025) enthalten keine Übereinstimmungsergebnisse, daher liefern sie Vorhersagen und keinen Test.
Tabelle A8. Das eingefrorene Modell auf anderen Modellen und Fragen. Mittlerer absoluter Fehler des vorhergesagten PPV für Paare verschiedener Laboratorien, Zellen mit mindestens 20 offenen Antworten in den ersten zwei Quellen. Zweiseitiger Bootstrap, nur nach Modell für MMLU. Versatz ist vorhergesagt minus beobachtet.
| Quelle | Zellen | Modell [95%] | Unabhängig | Beste | Modell minus beste [95%] | Modell minus unabhängig [95%] | Versatz |
|---|---|---|---|---|---|---|---|
| HELM, NaturalQuestions | 4.088 | 0,069 [0,054, 0,087] | 0,070 | 0,208 | -0,139 [-0,171, -0,103] | -0,001 [-0,008, +0,006] | +0,053 |
| LiveBench, vier Aufgaben | 952 | 0,114 [0,101, 0,150] | 0,107 | 0,198 | -0,084 [-0,121, -0,026] | +0,007 [-0,006, +0,022] | +0,056 |
| LiveBench, math_comp | 431 | 0,075 | 0,096 | 0,279 | -0,034 | ||
| LiveBench, zebra_puzzle | 203 | 0,231 | 0,184 | 0,076 | +0,230 | ||
| LiveBench, spatial | 161 | 0,148 | 0,114 | 0,167 | +0,148 | ||
| LiveBench, web_of_lies_v2 | 157 | 0,036 | 0,031 | 0,166 | -0,017 | ||
| Kim et al., MMLU (Aggregate) | 2.189 | 0,066 [0,060, 0,072] | 0,084 | 0,084 | -0,018 [-0,028, -0,010] | -0,018 [-0,019, -0,017] | +0,066 |
Wie in Abschnitt 5.3 schlägt das Modell das Ablesen des besseren Modells in allen drei Quellen insgesamt, und es schlägt bei Zebra-Rätseln fehl, mit 0,231 gegen 0,076. Es verbessert sich nicht bei unabhängigen Fehlern in HELM oder LiveBench. Es läuft insgesamt hoch, um 5,3 bis 6,6 Punkte. In HELM flacht die beobachtete Kurve ab, während das Modell weiter ansteigt: Bei Paar-Genauigkeit zwischen 0,5 und 0,6 beträgt die Präzision 74,6% für Modelle von 2023 und Anfang 2024 und 75,9% für spätere, gegenüber 84,4% vorhergesagt in der Mitte des Bins. Bei MMLU beträgt die mittlere Wahrscheinlichkeit, dass zwei falsche Antworten übereinstimmen, 0,621 gegen 0,368 aus , da vier Optionen Kollisionen erzwingen.
Bei diesen Modellen steigt die Präzision mit Paar-Genauigkeit (Spearman +0,575 in HELM und +0,786 bei MMLU, über abhängige Zellen). Ältere und neuere Modelle mit ähnlicher Genauigkeit ergeben ähnliche Präzision zwischen Paar-Genauigkeit 0,4 und 0,6 (70,7 und 72,7%, 74,6 und 75,9%), und sie unterscheiden sich mehr zwischen 0,2 und 0,3 (57,6 und 76,1%). Die untere Grenze von Abschnitt 4 gilt in allen 4.088 HELM-Zellen. Paare unterhalb einer Hälfte sind dort selten, 24 von 4.088, weil diese Zellen nicht nach Schwierigkeit stratifiziert sind.
HELM ermöglicht auch den Test von Abschnitt 5.2 mit vielen Laboratorien und ohne GPT-Abhängigkeit, da die Genauigkeit des Partners ohne Konfidenzwerte abgeglichen werden kann. Mit einem veröffentlichten Modell und Partnern innerhalb von 3 Punkten Genauigkeit fängt ein Partner aus demselben Labor 72,3% der Fehler ein und ein Partner aus einem anderen Labor 75,5%, ein Unterschied von -3,2 Punkten [-4,2, -2,3], bei einer um 2,7 Punkte höheren Abdeckung [+2,1, +3,4]. Das Hinzufügen einer Übereinstimmung bei Abdeckung innerhalb von 3 Punkten hebt ihn auf: 75,7 gegen 75,9%, -0,2 [-0,6, +0,2], mit Präzision -0,5 [-1,4, +0,1]. Zwei falsche Antworten stimmen in 31,6% der Fälle innerhalb eines Labors und 27,0% zwischen Laboratorien überein.
Gemeinsame Fehler stehen auch weit über dem Zufall in den Sammlungen von Abschnitt 3. Unter der Label-Permutations-Nullhypothese von Ding (2026), die die falschen Antworten jedes Modells beibehält und sie über Fragen verteilt, stimmen zwei falsche Antworten, die keine Verweigerungen sind, in 14,0% der Fälle im Juli und 15,4% im August ohne KI überein, gegenüber einer Nullhypothese von 0,1%. Bei den 106 liegen die Quoten bei 25,7% und 22,8% gegen 0,4% und 0,5%, und bei neuen Fragen 14,5% im August und 32,7% im Oktober gegen 0,8% und 3,8%. Offene Antworten kollidieren selten zufällig, daher liegt die beobachtete Übereinstimmung weit über dieser Nullhypothese, bei Fragen, die nach dem Release der Modelle erstellt wurden.
Anhang L. Weitere Diskussion
Bezug zu Goel et al. (2025). Ihr Trend betrifft die chancenbereinigt Ähnlichkeit, meiner betrifft die Präzision übereinstimmender Antworten, daher widersprechen sich die Erkenntnisse nicht. Die Daten tragen dazu durch den bedingten Anteil gemeinsamer Fehler, F/W, die Wahrscheinlichkeit, dass zwei falsche Antworten gleich sind, bei Fragen, bei denen beide Antworten bewertet werden und Verweigerungen als falsch gezählt werden. Bei den Referenzpaaren steigt dieser von 63 von 1.088 (0,058) für das Paar der mittleren Leistung auf 15 von 42 (0,357) für das Flaggschiff-Paar, etwa sechsfach. Über alle Paare gepoolrt, GPT eingeschlossen, ist der Anstieg kleiner und das Intervall schließt Null ein: 0,097 im Juli und 0,132 im August, ein Unterschied von +0,034 [−0,006, +0,084]. Bei der Oktober-Strategie-Menge ist F/W 0,493 [0,179, 0,840], ein Unterschied vom August von +0,361 [+0,041, +0,712]. Bei gleicher Abdeckung, Behälter für Behälter, ist der Recall des Flaggschiffs um 0,7 bis 2,5 Punkte niedriger, ein kleiner Effekt, und ist 0,140 [0,092, 0,192] gegenüber 0,113 [0,082, 0,146]. Die Richtung stimmt also mit ihrer überein, obwohl das gepoolte Intervall Null einschließt. Die unmittelbare Lesart ihrer Warnung, dass Ähnlichkeit das Gating gefährdet, erscheint tatsächlich im Recall: Oktober-Client-Paare erfassen 66,3 % der Fehler bei einer Abdeckung von 65,3 %, wo alle 55 August-Paare 88,2 % bei 32,5 % erfassen, ein Kontrast, den Abdeckung teilweise erklärt. Präzision bleibt hoch, hauptsächlich weil die Grenze in Abschnitt 4 bei diesen Genauigkeiten wenig Spielraum zum Fallen lässt.
Bezug zu Han (2026). Han nennt Dekorrelation als praktischen Hebel. Meine Messungen setzen Genauigkeit und Abdeckung an erste Stelle. Bei gleicher Abdeckung mit einem veröffentlichten Modell verschwindet der Vorteil eines zweiten Labors, es sei denn, sein Modell ist weitaus genauer (Abschnitt 5.2). In HELM, mit übereinstimmender Genauigkeit, fügt ein zweites Labor 3,2 Punkte Recall für 2,7 Punkte Abdeckung hinzu, und nichts, sobald auch die Abdeckung übereinstimmt. Dekorrelation ist dort sichtbar, bei 27,0 gegenüber 31,6 % übereinstimmender falscher Antworten, und sie ist klein. Hans Theorie betrifft die Tiefe von Serien-Gatings und meine ein einzelnes Gating, daher treffen sich die beiden nur beim ersten Schritt. Liu (2026) trennt dieselben zwei Dinge: Auswahl-Genauigkeit folgt Dekorrelation, wobei Cross-Modell-Panels dem Resampling um 12,5 bis 16,7 Punkte auf AIME-2024 bei übereinstimmender Element-Genauigkeit voraus sind, während die Kalibrierung des Übereinstimmungssignals der Element-Genauigkeit folgt. Die Präzision übereinstimmender Antworten, die hier gemessen wird, ist die zweite davon.
Die beiden Seiten von Abschnitt 2. Veröffentlichte Zahlen vergleichen die beiden Seiten teilweise. Lius einstimmiges Panel hat auf 100,0 % von AIME-2025 bei einer Antwort-auf-alles-Genauigkeit von 0,433 Recht, und auf 70,2 % von MMLU-Pro bei 0,458. Kohlis einstimmige neun Richter, je nahe 68 %, haben auf 90,9 % Recht. Ähnliche Genauigkeiten geben Präzision 30 Punkte auseinander, daher bringt Genauigkeit allein diese Ergebnisse nicht zusammen. Die Größe des Antwortbereichs erklärt mehr. Die Wahrscheinlichkeit, dass zwei falsche Antworten übereinstimmen, ist 0,621 bei vieroption MMLU, 0,270 bei NaturalQuestions und 0,132 bei SimpleQA für August-Flaggschiffe. Dies sind Panels und Paare bei verschiedenen Aufgaben, ohne gemeinsame Berechnung über die Papiere hinweg, und sie stimmen damit überein, dass Präzision der Genauigkeit innerhalb einer Aufgabe und eines Antwortformats folgt.
Vertrautheit. Eine Lücke zwischen SimpleQA und frischer Genauigkeit lädt zu einer Erklärung durch Benchmark-Exposition ein, und wörtliche Übereinstimmung mit der Gold-Zeichenkette sieht wie ihre Signatur aus. Meine Daten unterstützen dies nicht als Kovariate (Anhang C). Unter korrekten Antworten ist wörtliche Übereinstimmung modellübergreifend einem Wert sehr nahe, und sie erklärt nicht das Residuum des Modells. F/W bei der frischen Menge im August, 0,145 [0,033, 0,402], zeigt keinen sichtbaren Abstand von 0,132 bei SimpleQA, innerhalb eines breiten Intervalls.
Wie Sie dieses Papier zitieren
Chernets, V. (2026). Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7682960
@misc{chernets2026agreementinversion,
  author       = {Chernets, Vadym},
  title        = {{Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7682960},
  url          = {https://doi.org/10.2139/ssrn.7682960}
}