La Inversión de Acuerdo No es una Propiedad de Nivel Medio: La Precisión de Respuestas LLM Acordadas Sigue la Precisión de Pares
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7682960 · DOI 10.2139/ssrn.7682960 · Zenodo 10.5281/zenodo.24090580 · Analysis release 10.5281/zenodo.24090584 · GitHub
Preimpresión, 9 de noviembre de 2026. SSRN: 7682960. Copia archivada: 10.5281/zenodo.24090580. Datos y código: 10.5281/zenodo.24090584. PDF: agreement-inversion.pdf. El PDF es autorizado.
Resumen
Cuando dos modelos insignia, consultados por separado, dan la misma respuesta a una de las preguntas más difíciles de SimpleQA, esa respuesta suele ser incorrecta. En las 106 preguntas de SimpleQA donde los paneles de nivel medio de julio fallaron, 45 pares insignia sin el brazo de GPT servido al cliente, donde no se puede excluir la búsqueda web, tienen razón en 96 de 691 acuerdos (13,9%). Responder solo cuando un segundo modelo está de acuerdo no necesita etiquetas ni parámetros, y trabajos anteriores atribuyeron los fallos de esta regla a modelos de nivel medio. En ambos niveles que medí, la precisión de las respuestas acordadas sigue la exactitud del par, por lo que la inversión no es una propiedad de nivel medio. En el quintil más difícil, definido de la misma manera para cada nivel, la precisión es 17,3% en julio y 15,5% en agosto; en los cinco quintiles, a la precisión esperada de las dos exactitudes de cada par, los pares insignia difieren de los pares de nivel medio en -0,2 puntos [-3,1, +2,7]. Los datos son SimpleQA, preguntas de dos saltos recientes y hechos de productos, recopilados en julio, agosto y octubre de 2026 con modelos insignia de once laboratorios. Un socio de un segundo laboratorio detecta más errores pero abre la puerta con menos frecuencia: para un modelo publicado, un socio del mismo laboratorio detecta 2 de 29 errores y un socio de otro laboratorio 20 de 29 (-62,1 puntos [-79,3, -43,8]), con la puerta abierta en el 96% y 61% de las preguntas. Cuando la puerta más ancha se reduce por confianza indicada a cobertura igual, esta ventaja se mantiene solo donde el modelo del socio es mucho más exacto. Un modelo pequeño alimentado con exactitudes medidas predice la precisión fuera de muestra con error absoluto medio de 0,037 frente a 0,099 para el mejor modelo único, al mismo nivel que una línea de base de errores independientes de 0,032, y funciona bien en hechos de productos y datos públicos. En las mismas 100 preguntas, el identificador gpt-5.6-sol obtiene el 92,0% en su onda servida al cliente y el 46,3% a través de la API en otro ajuste de esfuerzo, mientras que ocho modelos más se desplazan como máximo 4 puntos.
1. Introducción
Plantee la misma pregunta fáctica breve a dos grandes modelos de lenguaje (LLMs) de laboratorios diferentes, por separado, y publique la respuesta solo si las dos coinciden. La compuerta no necesita etiqueta, umbral o árbitro, solo dos llamadas a ciegas. Los modelos insignia resultan atractivos, porque su confianza declarada ofrece poca protección: en diez brazos insignia en agosto de 2026, 4.910 de 10.540 respuestas declaradas con confianza de al menos 80 fueron incorrectas (Chernets, 2026b).
Mi medición anterior en modelos propietarios, una colección de julio de 2026 de modelos de nivel medio, encontró respuestas de panel replicadas en el quintil más difícil de SimpleQA correcto en 0 de 342 ocasiones (Chernets, 2026a). Esto sugiere que el acuerdo se invierte para modelos débiles, de modo que las respuestas acordadas son más a menudo incorrectas que correctas, y que los modelos fuertes escapan. Un par insignia parecía confirmarlo: gpt-5.6-sol con claude-fable-5 fue correcto en 34 de 37 acuerdos en esas mismas preguntas (los 106 de la Sección 3).
En el nivel insignia esta lectura no se sostiene. Sin el único brazo detrás de los 34 de 37, gpt-5.6-sol servido a través de su cliente proveedor, la inversión vuelve, y con dificultad definida de la misma manera para ambos niveles las dos curvas se encuentran en el extremo difícil. En todos los quintiles, una vez que se tienen en cuenta las dos precisiones de cada par, los pares insignia y de nivel medio difieren en -0,2 puntos [-3,1, +2,7]. La precisión sigue qué tan precisos son los dos modelos en el estrato, sea cual sea su nivel.
La Tabla 1 resume cuatro contribuciones. La Sección 5.1 proporciona un análisis a nivel de compuerta de los insignia, construido siempre que fue posible sin el brazo que domina el rango de precisión. La Sección 5.2 mide lo que contribuye un segundo laboratorio, variando el modelo liberado y el socio, con GPT y sin él. Las Secciones 4 y 5.3 dan un modelo descriptivo de la compuerta con cinco constantes y lo prueban fuera de la muestra frente a líneas de base declaradas, y la Sección 5.4 compara clientes proveedores con acceso directo a API para el mismo identificador en las mismas preguntas.
Tabla 1. Afirmaciones, evidencia y límite.
| Afirmación | Evidencia | Límite |
|---|---|---|
| La precisión de las respuestas acordadas sigue la precisión del par en ambos niveles | 96/691 en los 106; quintil más difícil 17,3% julio, 15,5% agosto; nivel con precisión equiparada -0,2 [-3,1, +2,7] | Asociación; un único quintil abarca solo -1,8 [-22,1, +20,2] |
| Un segundo laboratorio atrapa más errores al precio de la cobertura | 20/29 contra 2/29 errores atrapados, -62,1 [-79,3, -43,8]; cobertura 61% contra 96% | Con cobertura igual, por confianza, necesita un socio mucho más preciso; dos laboratorios en octubre |
| Un modelo pequeño describe la precisión fuera de la muestra | Error 0,037 contra 0,099 para el mejor modelo, -0,062 [-0,085, -0,035] | A nivel de errores independientes, +0,005 [-0,003, +0,012]; 13 puntos alto en hechos de productos |
| El modo de acceso mueve un identificador | 92,0% cliente contra 46,3% API, las mismas 100 preguntas | Modo, esfuerzo y búsqueda posible cambian juntos |
2. Trabajos relacionados
Lo más cercano a mi pregunta es Goel et al. (2025), quienes introducen CAPA, una medida de acuerdo ajustada por azar entre las distribuciones de salida de los modelos, y demuestran en 130 modelos de peso abierto en MMLU-Pro y BBH que los errores se vuelven más similares con la capacidad, lo que argumentan pone en riesgo la supervisión de IA, incluyendo jurados de LM. Mido, para modelos propietarios de diferentes laboratorios, qué certifica el acuerdo ciego cuando regula la liberación de una respuesta breve en formato abierto: la precisión de las respuestas acordadas, la proporción de errores del modelo liberado que el desacuerdo expone, y el piso de errores seguros compartidos. Los resultados son compatibles: en mis datos, el costo de la similitud creciente se refleja en la recuperación del desacuerdo, mientras que la precisión se mantiene alta donde la precisión es alta (Apéndice L). La cascada basada en acuerdo (Kolawole et al., 2025) utiliza el acuerdo de conjuntos como una regla de aplazamiento sin entrenamiento con una condición en la tasa conjunta de errores aceptados, y mis resultados estratificados localizan dónde se concentran tales errores.
Errores correlacionados entre proveedores están documentados por Kim et al. (2025), y Hossain et al. (2026) los encuentran más fuertes entre jueces LLM fronterizos. Jurados de jueces pequeños diversos aparecen en Verga et al. (2024), y el sesgo de un modelo juzgando su propia salida en Panickssery et al. (2024), que favorece la comparación de dos respuestas ciegas. El acuerdo entre muestras de un modelo es una señal de confianza en la auto-consistencia (Wang et al., 2023), SelfCheckGPT (Manakul et al., 2023) e incertidumbre semántica (Kuhn et al., 2023), y una regla de aplazamiento en Yue et al. (2024); lo comparo con el acuerdo entre laboratorios (Sección 5.2). La puerta es un predictor selectivo (Geifman & El-Yaniv, 2017), así que comparo puertas con cobertura igual. Los preprints recientes discrepan sobre si la agregación ayuda (Apéndice E). No conozco trabajos que reporten una puerta de liberación a nivel de par en hechos breves en formato abierto para flagships propietarios, recuperación con cobertura igual con un modelo liberado fijo, o un identificador medido en dos modos de acceso en las mismas preguntas.
3. Datos y protocolo
Mi trabajo anterior reportó los paneles de julio (Chernets, 2026a) y agregados de agosto y octubre para pares seleccionados (Chernets, 2026c). Lo nuevo aquí son los pares insignia sin GPT, la definición simétrica de dificultad, los pares del mismo laboratorio, las comparaciones a cobertura igual, las pruebas fuera de muestra y externas y la comparación de modo de acceso.
Colecciones. Todas las respuestas se recopilaron a ciegas: una llamada por pregunta, sin que ningún modelo viera la respuesta de otro. El sistema de instrucciones solicita un objeto JSON con una respuesta corta y una confianza de 0 a 100 y no solicita fuentes. La Tabla A1 enumera modelos, fechas y modos de acceso, y el Apéndice F las colecciones en su totalidad. Nueve modelos API y siete modelos locales respondieron 1.500 preguntas de SimpleQA (Wei et al., 2024) del 24 al 28 de julio, registradas en OSF antes de la recopilación de datos (Chernets, 2026a). Un insignia de cada uno de once laboratorios respondió las mismas preguntas del 3 al 6 de agosto, 1.459 comunes a todos, y nueve de ellos respondieron 100 de estas a temperatura 0,7 con tres muestras (el brazo de varianza). Se agregaron 100 preguntas de dos saltos compuestas por máquina a partir de Wikidata, con el hash del archivo fijo antes de la primera llamada del modelo, y 267 hechos de productos. En octubre gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 y claude-fable-5-1 respondieron 300 preguntas de SimpleQA estratificadas por quintil de julio, las 106 inferiores y el conjunto fresco, tres conjuntos disjuntos con 503 preguntas comunes a los cinco modelos (cada par sobre ellas está en la Tabla A2).
Las 106. Estas son las preguntas del quintil más difícil en las que un panel de julio replicó una respuesta (Chernets, 2026a). Fueron seleccionadas por el fracaso de los modelos de julio, por lo que la precisión de julio sobre ellas es parcialmente un producto de la selección, y la Sección 5.1 las empareja con una definición simétrica de dificultad que no tiene esta propiedad.
Modos de acceso. En agosto, claude-fable-5, gpt-5.6-sol y mistral-medium-3.5 se ejecutaron a través del cliente de primer nivel propio del proveedor, el agente de línea de comandos oficial que despliegan los usuarios finales, y en octubre cada brazo lo hizo, de modo que las mediciones incluyen avisos de sistema del lado del proveedor y valores predeterminados de servicio tal como los recibe un usuario del cliente. La onda de julio y los brazos restantes de agosto utilizaron rutas directas de API o agregador fijadas al proveedor. La Tabla 2 establece las condiciones de medición de los brazos del cliente. Llamo a un brazo búsqueda-posible cuando su uso de búsqueda web no puede excluirse, e informo los resultados principales con tales brazos y sin ellos.
Tabla 2. Condiciones de medición por brazo. Nota: la temperatura no se establece en los clientes de Codex y Claude; los flujos de eventos de Codex no se retuvieron. Los brazos de API de las ondas de julio y agosto se ejecutaron a temperatura 0. Un guión marca ninguna configuración o ninguna entrada en los registros.
| Brazo | Alcanzado por | Esfuerzo | Búsqueda posible |
|---|---|---|---|
| gpt-5.6-sol, agosto | Cliente Codex | predeterminado del cliente, no registrado | no excluida |
| claude-fable-5, agosto | Cliente Claude | - | no, 0 solicitudes de búsqueda registradas |
| mistral-medium-3.5, agosto | cliente del proveedor | - | no, lista de herramientas vacía |
| gpt-6.1-sol, gpt-6-astra, gpt-6-sol, octubre | Cliente Codex | medio | no excluida |
| claude-opus-5-5, claude-fable-5-1, octubre | Cliente Claude | - | no, herramientas deshabilitadas |
| kimi-k3, gemini-3.8-flash, conjunto fresco | cliente del proveedor | - | herramientas no deshabilitadas, instrucciones prohíben |
| gpt-5.6-sol, brazo de varianza | API directa | ninguno | - |
Puerta y medidas. La puerta se abre cuando ambos modelos responden, ninguno se niega, y un motor de equivalencia determinista, el mismo para cada onda aquí, encuentra las dos respuestas equivalentes. La calificación aplica el mismo motor a la respuesta y la respuesta dorada: coincidencia exacta normalizada, contención de cadenas de cuatro o más caracteres, y reglas para fechas, números e identificadores (Apéndice D, con una recalificación en la Tabla A3). Una celda es un par de modelos en un estrato de preguntas. La cobertura cuenta puertas abiertas entre preguntas que ambos modelos respondieron. Precisión, PPV, es la proporción correcta entre respuestas abiertas que el calificador resuelve como correctas o incorrectas (K/O), y Delta es precisión menos la precisión del modelo lanzado en todas las preguntas resueltas de la celda. El recall es la proporción de errores del modelo lanzado en los que la puerta permanece cerrada, reportada como errores detectados. Lift divide la precisión del modelo lanzado con la puerta abierta por la con la puerta cerrada, y el piso cuenta preguntas en las que ambos modelos declaran confianza de al menos 80, están de acuerdo, y son incorrectos. Llamo a un acuerdo invertido cuando PPV está por debajo de la mitad. El modelo lanzado es el primer miembro del par, o el más preciso cuando los pares se agrupan. Para comparar puertas a cobertura igual delgazo la puerta más ancha: las respuestas abiertas se clasifican por el menor de los dos niveles de confianza declarados y se cortan a la cobertura objetivo, los empates se rompen al azar.
Inferencia. Las proporciones simples llevan intervalos de Wilson. Las diferencias y cantidades derivadas llevan intervalos de arranque del 95%, bidireccionales sobre pregunta y modelo para resultados agrupados (Owen, 2007; B = 2000, semilla fija, con el modelo reajustado en cada réplica) y sobre pregunta para un par único. Las comparaciones de precisión emparejadas utilizan la prueba exacta de McNemar, y equivalencia una prueba de dos de un lado (Schuirmann, 1987) con un margen de 2 puntos. Las celdas son dependientes, por lo que llevan intervalos y sin valores p.
4. Un modelo de la puerta
Sean y las precisiones medidas de dos modelos en una celda y . Sea la probabilidad de que ambos sean incorrectos y la probabilidad de que ambos sean correctos:
Aquí amplifica la tasa independiente de error conjunto. Dos respuestas correctas coinciden con probabilidad . Dos respuestas incorrectas coinciden con probabilidad , donde en el 106, cuyas respuestas incorrectas colisionan con mayor frecuencia, y 1 en los demás casos. Entonces
Ajustado en 335 pares de células de diferentes laboratorios (julio, agosto y octubre, con 106 entre ellos; es la tasa de coincidencia de dos respuestas correctas en todas las células ajustadas), las constantes son , , , (22.536 de 22.785) y .
El modelo toma como entrada las precisiones medidas de la célula y devuelve cobertura, precisión y la proporción de respuestas acordadas incorrectas, , de la cual el piso de la Sección 3 es la parte con confianza de al menos 80. Dadas dos precisiones, devuelve lo que añade la puerta, y muestra por qué la precisión debe seguir a la exactitud en la parte superior: con y respuestas correctas coincidentes, la precisión de respuestas acordadas no puede caer por debajo de , incluso si todos los errores se comparten, ya que ambos modelos están en lo correcto juntos en al menos de las preguntas y en lo incorrecto juntos en como máximo (0.947 en ). En no hay cota, y puede exceder siempre que respuestas incorrectas se concentren en la misma cadena.
Lo comparo con dos líneas base. La línea base errores independientes establece y reajusta el resto, por lo que mantiene . La línea base mejor modelo predice . El criterio era que el modelo supera a ambas, con el intervalo de la diferencia por debajo de cero, bajo validación dejando fuera un laboratorio (LOLO), dejando fuera un modelo (LOMO) y una división temporal de julio y agosto a octubre.
5. Resultados
5.1 La inversión no es una propiedad de nivel intermedio
La tabla 3 proporciona la puerta sin los brazos GPT servidos por cliente. En conjunto en SimpleQA los dos niveles se ven similares: precisión 72,1% en julio y 80,6% en agosto, con un Delta de +28,6 y +26,0 puntos frente al modelo lanzado. En el 106 la precisión es baja en ambas olas: 5 de 717 en julio y 96 de 691 en agosto sin GPT. Excluyendo el brazo GPT del lado de julio también se obtienen 4 de 581, y la diferencia agosto menos julio es +13,2 puntos [+2,6, +30,8]. La precisión de agosto es más alta y sigue estando muy por debajo de la mitad, por lo que el acuerdo se invierte en ambas olas. También está por debajo del mejor brazo individual en el estrato, por -9,5 puntos [-16,3, -3,2] en julio y -43,2 [-67,6, -16,1] en agosto. La ganancia es 0,13 [0,00, 1,21] en julio y 0,65 [0,23, 1,22] en agosto sin GPT.
Tabla 3. La puerta sin brazos GPT servidos por cliente. Nota: agrupada sobre pares de laboratorios diferentes a menos que se indique; la cobertura es sobre preguntas que ambos modelos respondieron, K/O sobre respuestas abiertas que el evaluador resuelve; intervalo en PPV: bootstrap bidireccional. Hechos de productos: los cuatro brazos sin posibilidad de búsqueda.
| Nivel, preguntas | Pares | Cobertura | PPV (K/O) [95%] | Exactitud del modelo lanzado | Delta, puntos [95%] |
|---|---|---|---|---|---|
| Intermedio, julio, 106 | 36 | 19,8% | 0,7% (5/717) [0,0, 3,7] | 4,6% | -3,9 [-8,3, +0,3] |
| Intermedio, julio, todo SimpleQA | 36 | 20,6% | 72,1% (7743/10745) [53,2, 82,3] | 43,4% | +28,6 [+22,3, +32,4] |
| Insignia, agosto, 106, sin brazo con posibilidad de búsqueda | 45 | 19,1% | 13,9% (96/691) [3,3, 31,8] | 19,9% | -6,0 [-14,1, +2,9] |
| Insignia, agosto, todo SimpleQA, sin brazo con posibilidad de búsqueda | 45 | 29,1% | 80,6% (12357/15322) [69,6, 87,9] | 54,7% | +26,0 [+19,9, +30,7] |
| Insignia, agosto, 100 nuevos (GPT por API) | 6 | 37,5% | 88,9% (200/225) [75,6, 97,4] | 66,8% | +22,1 [+7,9, +47,4] |
| Mismo laboratorio, octubre, fable-5-1 + opus-5-5, 106 | 1 | 39,6% | 47,5% (19/40) | 30,0% | +17,5 [+6,2, +29,7] |
| Octubre, kimi-k3 + gemini-3.8-flash, 100 nuevos (herramientas no deshabilitadas) | 1 | 72,0% | 95,8% (69/72) | 74,0% | +21,8 [+14,1, +30,0] |
| Hechos de productos, 267, sin brazo con posibilidad de búsqueda | 6 | 63,6% | 75,0% (423/564) [66,4, 82,7] | 62,7% | +12,3 [+5,8, +20,4] |
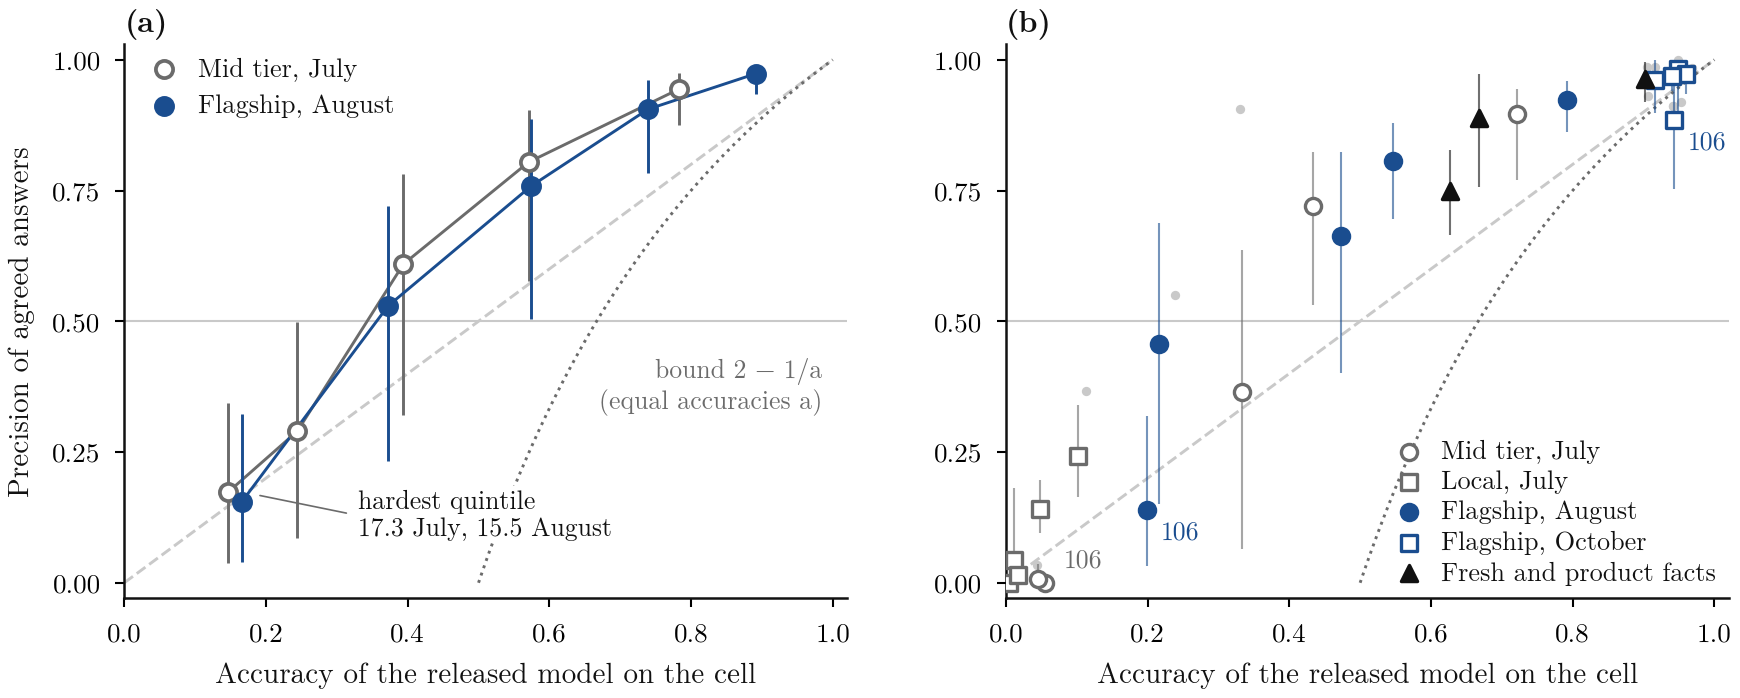
Figura 1. La precisión de las respuestas acordadas sigue la exactitud del par. Nota: (a) quintiles de dificultad establecidos dentro de cada nivel, julio nivel intermedio y agosto insignias sin los brazos GPT servidos por cliente. (b) Cada banda de cada nivel, julio a octubre, contra la exactitud del modelo lanzado; las celdas etiquetadas son el 106. Los bigotes son intervalos bootstrap del 95%, y los pequeños puntos grises en (b) son pares individuales; la línea discontinua es igualdad, la línea de puntos el límite 2 - 1/a para exactitudes iguales a.
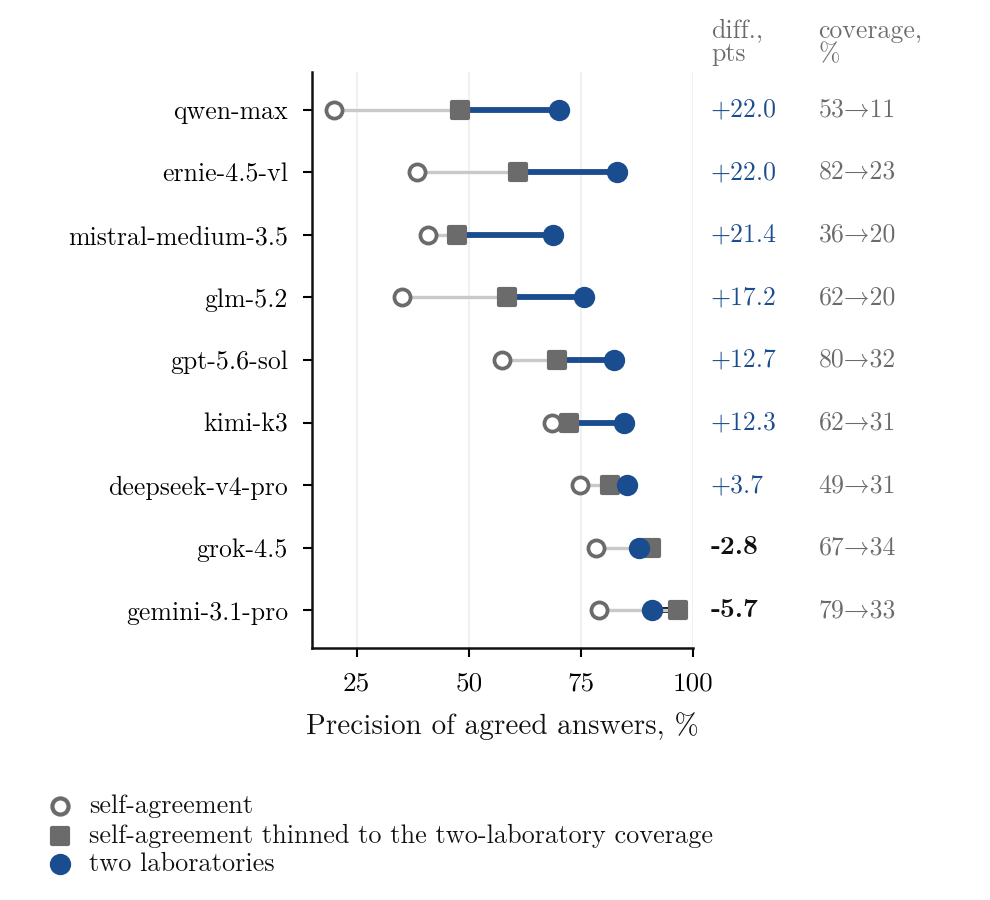
Figura 2. Autocoherencia frente a dos laboratorios, por modelo. Nota: brazo de varianza, nueve modelos, 100 preguntas. Círculo abierto, dos llamadas a un modelo; cuadrado, el mismo reducido por confianza a la cobertura de la puerta de dos laboratorios; círculo relleno, dos laboratorios, media sobre asociados. Las columnas de la derecha dan la diferencia a cobertura igual, en puntos, y la cobertura de ambas puertas, en porcentaje.
Los paneles de tres modelos sin el brazo GPT servido por cliente dan el mismo resultado. En el 106 bajo mi motor los paneles de julio dan 0 de 318 (el 0 de 342 de la sección 1 es el quintil más difícil bajo la regla de emparejamiento anterior; los 5 de 717 anteriores cuentan pares). En agosto el panel de DeepSeek, Qwen y Kimi da 0 de 76 y el panel entre bloques de Claude, DeepSeek y Mistral 11 de 78 (14,1% [2,7, 26,3]), mientras que el panel de Claude, GPT y Gemini, que mantiene el brazo GPT, da 106 de 131 (80,9%). Los pares insignia se alinean con su exactitud en el estrato, de 4 de 21 para fable-5 con deepseek-v4-pro a 15 de 24 (62,5% [42,6, 82,6]) para fable-5 con gemini-3.1-pro, cuyos miembros lideran este grupo allí.
Debido a que el 106 se eligió en el fallo de julio, lo que reduce la precisión de julio en ellos y favorece agosto, la Figura 1a establece dificultad dentro de cada nivel. Para cada nivel, las preguntas se clasifican en quintiles por la exactitud del mismo nivel sin el par bajo evaluación, por lo que el quintil más difícil tiene el mismo rango para cada uno, y la exactitud del modelo lanzado allí es cercana, 15,3% en julio y 16,0% en agosto. La precisión allí es 159 de 917 (17,3% [3,8, 34,3]) en julio y 203 de 1.308 (15,5% [4,0, 32,4]) en agosto sin GPT, una diferencia de -1,8 puntos [-22,1, +20,2]. Agrupando los cinco quintiles se obtiene una prueba más nítida. El modelo de la sección 4 no tiene término de nivel. Dadas las dos exactitudes de cada celda, proporciona la precisión esperada allí, y un efecto de nivel se mostraría como una diferencia en los residuos. Las celdas insignia están -0,2 puntos [-3,1, +2,7] de las celdas de nivel intermedio, y -0,5 [-3,6, +2,4] cuando las constantes se ajustan solo en celdas de julio, de modo que agosto está fuera de muestra. kimi-k3 pertenece a ambas colecciones; sin él la diferencia es +0,1 [-3,6, +3,8]. En respuestas de oro limpiadas la precisión sigue siendo baja: en los 24 del 106 que sobreviven en SimpleQA Verified (Haas et al., 2025), los pares de agosto sin GPT tienen razón en el 18,7% de los acuerdos [0,0, 57,1] (Apéndice G).
En cada banda de cada nivel (Figura 1b), la precisión aumenta con la exactitud del modelo lanzado en cada ola y está por encima de la diagonal en 17 de 23 celdas. De las seis por debajo de ella, tres son celdas 106 y tres son bandas con exactitud lanzada por debajo de 0,06. En la parte superior, kimi-k3 con gemini-3.8-flash alcanzan 95,8% en el conjunto nuevo (Apéndice G).
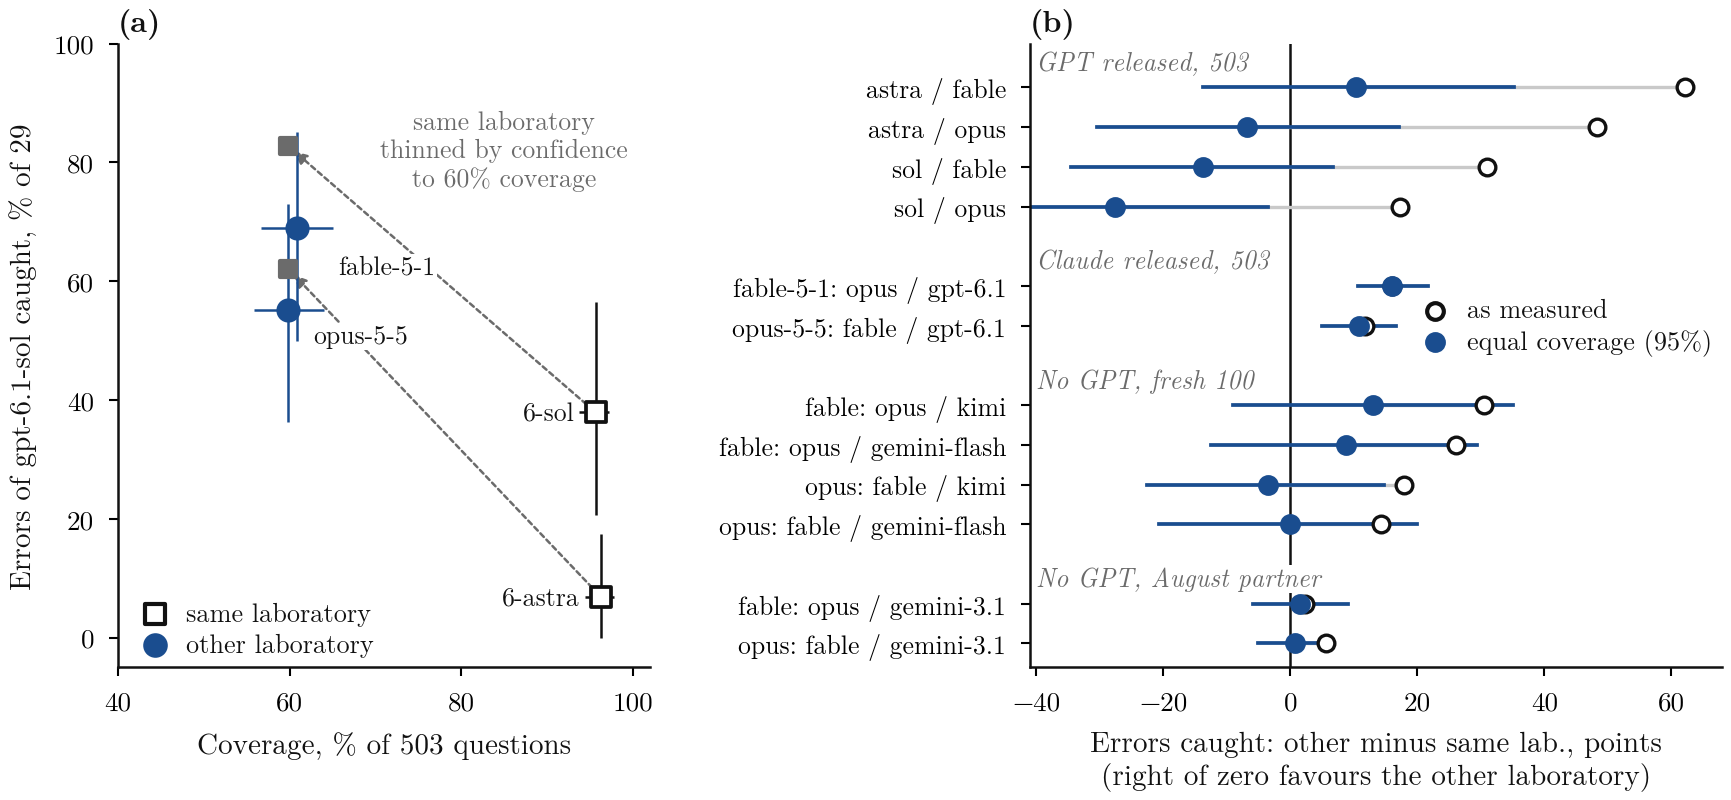
Figura 3. Un segundo laboratorio: cobertura y errores detectados. Nota: (a) gpt-6.1-sol en 503 preguntas comunes, 29 errores, cuatro partners de la Tabla A4, intervalos bootstrap del 95%; las flechas van desde la compuerta del mismo laboratorio hasta la misma compuerta reducida por confianza al 60% de cobertura. (b) Las doce comparaciones de la Tabla A5: errores detectados por el otro laboratorio menos el mismo, medidos (abierto) y a cobertura igual (lleno, bootstrap de preguntas del 95%).
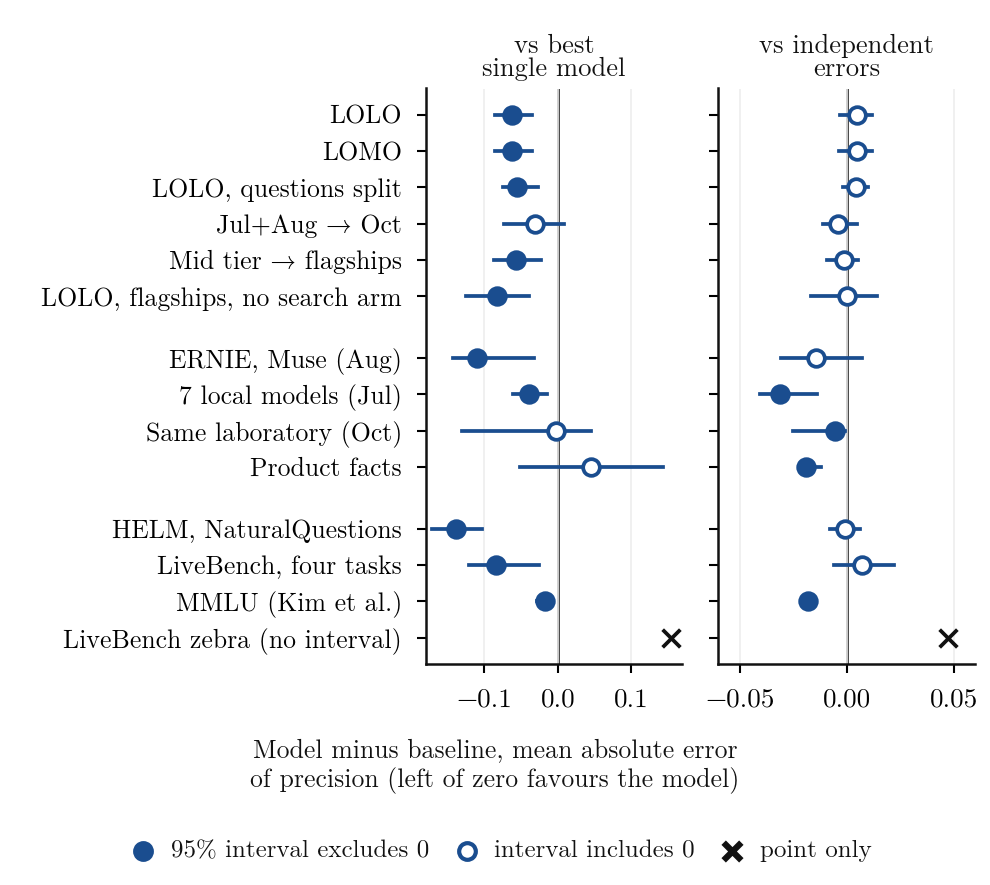
Figura 4. El modelo frente a dos líneas de base, fuera de muestra. Nota: modelo menos línea de base en error absoluto medio de precisión predicha, por debajo de cero favorece el modelo, con intervalos bootstrap bidireccionales del 95% (Tablas A6 y A8). Grupo superior, esquemas de ajuste; centro, conjuntos fuera del ajuste con constantes congeladas; inferior, datos públicos (Sección 5.5). Marcador lleno, el intervalo del 95% excluye cero; abierto, incluye cero; cruz, una estimación puntual (la tarea de la cebra de LiveBench).
5.2 Un segundo laboratorio detecta más errores, al precio de la cobertura
La precisión sola no puede separar los casos, porque los pares precisos de un laboratorio también tienen alta precisión. La exhaustividad debe leerse con la cobertura, ya que una compuerta que se abre menos frecuentemente bloquea más errores por construcción.
Comienzo con el brazo de varianza: dos llamadas a un modelo a temperatura 0.7, frente a dos llamadas a diferentes laboratorios (Figura 2). Agrupados en nueve modelos y 100 preguntas, el acuerdo consigo mismo cubre el 63.5% con una precisión del 56.1%, y dos laboratorios cubren el 26.1% al 82.9%. La diferencia en precisión es de +26.8 puntos [+16.6, +34.6] medida y +9.0 [+0.5, +17.4] a cobertura igual, donde el acuerdo consigo mismo se reduce por confianza, lo que lo favorece. Por modelo, la compuerta de dos laboratorios lidera en siete de nueve. El brazo no contiene ningún modelo Claude y tiene GPT por API sin esfuerzo. Sin GPT, en ocho modelos, la diferencia a cobertura igual es de +7.7 puntos [-1.9, +16.5].
La oleada de octubre contiene dos modelos cada uno de dos laboratorios, lo que proporciona una prueba directa en 503 preguntas comunes (Figura 3a). Un modelo lanzado, gpt-6.1-sol, mantiene los mismos 29 errores en cada fila y cambia solo el partner. Su partner del mismo laboratorio gpt-6-astra detecta 2 de ellos y fable-5-1 detecta 20, una diferencia de -62.1 puntos [-79.3, -43.8]; frente a opus-5-5 la diferencia es -48.3 [-66.7, -29.6]. El precio es la cobertura, 60 a 61% frente a 96%. La precisión es similar en las filas: 94.3% y 96.2% para el mismo laboratorio, 95.6% y 97.0% entre laboratorios (Tabla A4). Los partners del mismo laboratorio difieren ampliamente: gpt-6-sol detecta 11 de 29 (Apéndice H).
Para ver si esto es más que un movimiento a lo largo de la curva de cobertura, y si necesita GPT, cada fila de la Figura 3b mantiene un modelo lanzado y compara sus dos partners, medidos y a cobertura igual (Tabla A5). Medidos, el otro laboratorio detecta más errores en cada fila. A cobertura igual su ventaja se mantiene solo cuando Claude se lanza con gpt-6.1-sol como partner, un partner con precisión del 93.9% frente al 66.6% a 69.2% para el del mismo laboratorio en el conjunto estratificado. Con GPT lanzado, la compuerta del mismo laboratorio reducida por confianza está al mismo nivel o adelante, y sin GPT la diferencia está al mismo nivel, o favorece el mismo laboratorio frente a partners débiles. Con dos laboratorios en octubre no detecto efecto del laboratorio más allá de la precisión del partner y la cobertura, y HELM, con 20 desarrolladores, no muestra ninguno una vez que ambos se igualan (Sección 5.5).
5.3 El modelo fuera de muestra
Fuera de muestra, el modelo mejora claramente en la lectura del mejor modelo y está al mismo nivel que la línea de base de errores independientes (Figura 4, Tabla A6). Bajo LOLO su error es 0.037 frente a 0.099 para la mejor línea de base (-0.062 [-0.085, -0.035]), y ese intervalo está por debajo de cero bajo LOMO, la división de preguntas y en siete de las diez filas de la Tabla A6. La división temporal da 0.019 frente a 0.050, -0.031 [-0.074, +0.008], por debajo de cero cuando se agrupa por pregunta o por modelo solo (Apéndice I). Frente a errores independientes el modelo está al mismo nivel bajo los tres esquemas y mejor en tres de cuatro conjuntos fuera del ajuste, con constantes congeladas, por lo que se cumple el criterio de la Sección 4 frente a la mejor línea de base.
La precisión se lleva por las precisiones medidas y por : eliminar eleva el error LOLO a 0.323, y mantenerlo constante da 0.046. El multiplicador no añade nada a la precisión en los esquemas principales y ayuda en cobertura y pérdida logarítmica.
En hechos de producto el modelo tiene valores altos. Su error es 0.130 frente a 0.086 para el mejor modelo, todo sobreestimación (13 puntos), y 0.190 frente a 0.067 con el calificador nativo de ese dominio, nuevamente todo sobreestimación (19 puntos). El Apéndice I ordena las celdas en clases de resultado.
5.4 Acceso a modelos y los brazos de GPT
En un conjunto de 100 preguntas de SimpleQA, gpt-5.6-sol obtiene 92 de 100 (92.0%) en la oleada principal, 99 de ellas a través del cliente Codex, y 139 de 300 muestras (46.3%) a través de la API directa en el brazo de varianza, una brecha de 45.7 puntos (Figura 5). La reproducción textual de la cadena de oro cae con ella, de 64.0% a 26.0%. El cliente se ejecuta en su configuración de esfuerzo predeterminado bajo sus propias instrucciones, con temperatura no configurable, mientras que la API se ejecuta sin esfuerzo y temperatura 0.7.
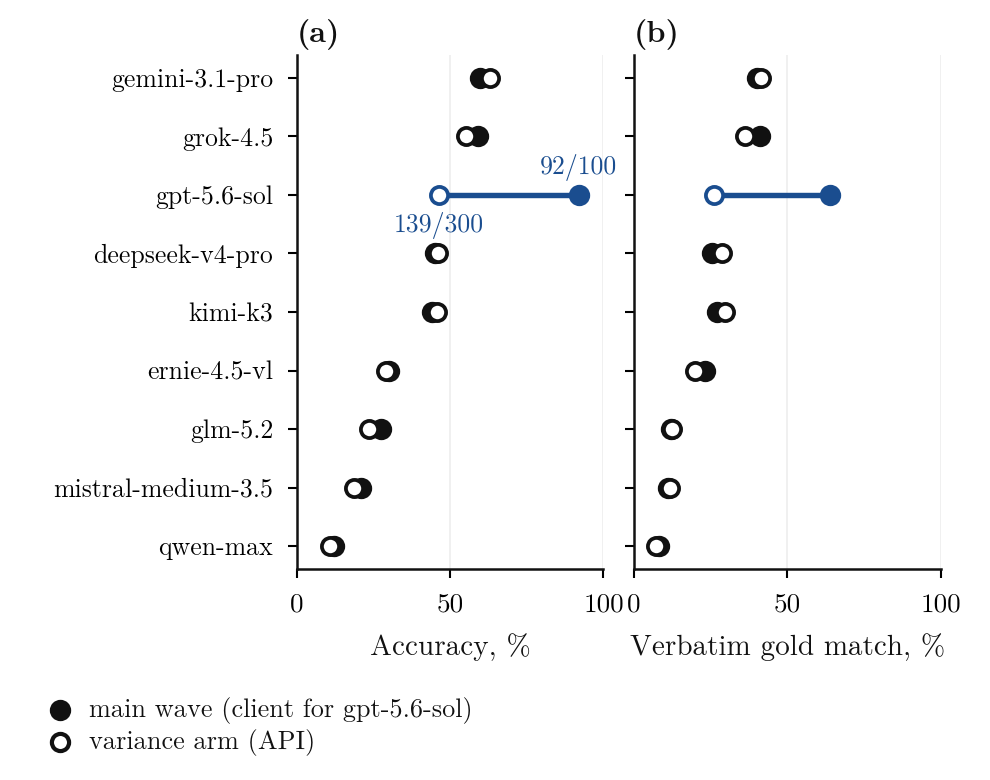
Figura 5. Un conjunto de 100 preguntas, dos brazos, nueve modelos. Nota: (a) precisión, (b) coincidencia textual con la cadena de oro. Lleno, oleada principal (servido por cliente para gpt-5.6-sol, 92/100); abierto, brazo de varianza a través de la API (139/300). Para gpt-5.6-sol los brazos también difieren en la configuración de esfuerzo.
Los otros ocho modelos, cuya temperatura también cambia entre las dos columnas, se desplazan como máximo 4,0 puntos en cualquier dirección. El esfuerzo es un candidato, aunque una medición de presupuesto de razonamiento emparejada en gemini-3.1-pro dejó la precisión prácticamente sin cambios (Chernets, 2026c). La búsqueda web es la otra: las respuestas de octubre del mismo cliente contienen enlaces que el prompt no solicita, en 3 de 506 respuestas de gpt-6.1-sol y 18 de 506 de gpt-6-astra, y el uso mediano de tokens por llamada de cliente en agosto es de 4.829.
La cifra del cliente es lo que recibe una persona que utiliza el producto, y la cifra de la API es lo que lee un arnés de referencia sin esfuerzo. En preguntas nuevas en agosto, con GPT a través de la API, gpt-5.6-sol y fable-5 son correctas en 29 de 32 acuerdos, Delta +57,6 puntos [+46,3, +69,7]. En octubre, con un GPT más nuevo a través del cliente en las mismas preguntas, el par con opus-5-5 es correcto en 72 de 74, Delta +2,3 [-0,7, +6,0]. Las dos comparaciones también difieren en el modelo GPT y la fecha, y en ambas el valor de la puerta sigue la precisión del brazo publicado, como en la sección 5.1.
Los brazos GPT servidos por cliente, excluidos de la tabla 3, son precisos: el brazo de agosto con fable-5 es correcto en 997 de 1.016 acuerdos (98,1%) y en 34 de 37 en los 106, heredando la precisión del brazo (Delta -3,3 [-10,3, +2,6]; tabla A7 e apéndice J).
5.5 Verificación externa con datos públicos
Apliqué las constantes congeladas, sin reajustes, a datos públicos que no comparten ni modelos ni ajustes con los míos: HELM Lite (Liang et al., 2023), 95 modelos de 20 desarrolladores respondiendo 1.000 preguntas NaturalQuestions de libro cerrado; LiveBench (White et al., 2025), 70 modelos de 11 laboratorios en 346 preguntas con una respuesta final breve; y los agregados de pares de Kim et al. (2025) para 70 modelos en MMLU de opción múltiple (tabla A8). Los resultados coinciden con la sección 5.3 (figura 4, grupo inferior). El modelo supera la lectura del mejor modelo en las tres fuentes y es parejo con errores independientes en HELM y LiveBench. Se ejecuta alto entre 5,3 y 6,6 puntos y falla en puzles de cebra (0,231 frente a 0,076).
En HELM la curva observada se aplana donde el modelo continúa subiendo (figura 6): en precisión de exactitud de par entre 0,5 y 0,6 es 74,6% para modelos de 2023 e inicios de 2024 y 75,9% para posteriores, frente a 84,4% predichos en el medio de la categoría. En MMLU la probabilidad mediana de que dos respuestas incorrectas coincidan es 0,621 frente a 0,368 de , ya que cuatro opciones fuerzan colisiones. La precisión aumenta con la exactitud de par (Spearman +0,575 en HELM y +0,786 en MMLU, sobre celdas dependientes).
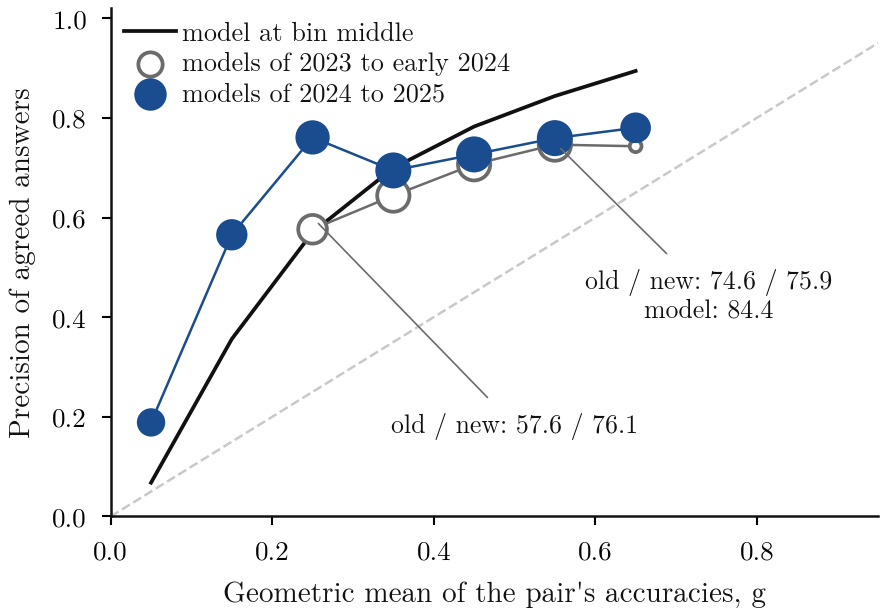
Figura 6. HELM Lite: precisión de las respuestas acordadas por exactitud de par, modelos antiguos y nuevos. Nota: categorías de la media geométrica g de las exactitudes del par, pares de laboratorios diferentes; el tamaño del marcador crece con el número de pares. La línea es el modelo congelado en el medio de cada categoría.
HELM también permite la prueba de la sección 5.2 con muchos laboratorios y sin dependencia de GPT. Con un modelo publicado y socios dentro de 3 puntos de exactitud, otro laboratorio detecta el 75,5% de los errores frente al 72,3% para el mismo laboratorio, -3,2 puntos [-4,2, -2,3], en cobertura superior en 2,7 puntos. Añadir una coincidencia en cobertura dentro de 3 puntos lo elimina: 75,7 frente a 75,9%, -0,2 [-0,6, +0,2].
6. Discusión
Ejecutar la puerta no necesita etiquetas, pero verificarla sí. Mida la exactitud de ambos modelos en una muestra etiquetada del estrato que importa, en el modo de acceso que se desplegará. En estos datos, una respuesta acordada de dos modelos insignia sobre una pregunta más allá de ambos no es más segura que una respuesta acordada de dos modelos de nivel medio. Emparejar dos laboratorios es un valor predeterminado razonable cuando no hay valores de confianza disponibles, pero debe verificarse en el estrato: un par del mismo laboratorio adelgazado por confianza, o la confianza del modelo lanzado, puede funcionar igual de bien (Sección 5.2, Apéndice J).
La similitud ajustada al azar (Goel et al., 2025) y la precisión de las respuestas acordadas son cantidades diferentes, y Han (2026) nombra la descorrelación como el mecanismo donde pongo la exactitud y cobertura en primer lugar (Apéndice L). Para la presentación de informes, un estudio del acuerdo entre modelos debe establecer el modo de acceso, el esfuerzo, las condiciones de la herramienta y los registros de eventos retenidos para cada rama.
7. Alcance y condiciones límite
Los niveles se comparan a través de dos oleadas en fechas y rutas de acceso diferentes, y la comparación de niveles es precisa hasta aproximadamente 3 puntos con precisión coincidente, mucho menos en el quintil más difícil solo. La evidencia nueva es un conjunto de 100 preguntas y ocho plantillas en dos fechas, y octubre Delta en ella incluye cero. La precisión y exactitud de pares se mueven juntas entre fechas y entre configuraciones de razonamiento que difieren entre oleadas, y el diseño no aísla la capacidad como causa.
Si los clientes Codex, kimi y gemini-3.8-flash buscaron no puede determinarse a partir de los archivos retenidos, por lo que sus precisiones miden el cliente según se implementó, no la memoria del modelo. Las secciones 5.1 y 5.3 muestran los resultados principales sin esos brazos.
Existen pares del mismo laboratorio en octubre, para dos laboratorios, y sin GPT la comparación de la misma oleada es de las 100 preguntas nuevas. Las celdas de octubre se basan en cinco modelos de dos laboratorios, por lo que la dimensión del modelo del bootstrap bidireccional tiene pocos niveles e intervalos agrupados son límites inferiores de incertidumbre. Las comparaciones con cobertura igual utilizan confianza indicada, que la puerta desnuda no tiene, y el desempate aleatorio mueve la fila más ancha entre 0.0 y +20.7 puntos (Apéndice H).
El motor es basado en reglas, y sus comprobaciones aquí son el oro limpio de SimpleQA Verified (Sección 5.1) y una puntuación nueva de partes de respuesta. Evalúa la respuesta completa, y las respuestas largas pueden obtener un "incorrecto" falso; puntuar solo la primera parte mueve la precisión de pares de referencia en como máximo 3 puntos, y gpt-6-astra con opus-5-5 en los 106 de 80.0 a 88.9% (Tabla A3).
El modelo toma precisiones medidas para cada celda como entrada, por lo que describe una comprobación etiquetada de la puerta y no reemplaza una. Se ejecuta alto en hechos de productos y datos públicos. HELM, LiveBench y los agregados de Kim et al. mantienen modelos más antiguos en formatos de pocos ejemplos o opción múltiple, por lo que prueban la relación en otros modelos, no en los buques insignia de 2026.
8. Conclusión
La precisión de las respuestas acordadas aumenta con la exactitud del par en el estrato en cuestión, en ambos niveles y dentro de aproximadamente 3 puntos en exactitud coincidente. La inversión apareció dondequiera que medí un par débil, incluidos los buques insignia. Un socio de un segundo laboratorio detecta más errores principalmente por abrir la compuerta con menos frecuencia, y a cobertura igual mantuvo su ventaja solo donde su modelo era mucho más preciso. Un modelo pequeño de la compuerta describe la precisión fuera de muestra mucho mejor que el modelo mejor y tan bien como los errores independientes. Un identificador medido a través de dos configuraciones de acceso difiere en 45,7 puntos, por lo que una afirmación sobre la exactitud de un modelo debe indicar el modo de acceso.
Declaración de Impacto
Este artículo estudia cuándo se puede confiar en el acuerdo entre dos modelos de lenguaje como regla para publicar respuestas fácticas breves. Los profesionales pueden verificar, en el estrato que importa y en el modo de acceso que implementan, si una compuerta de dos modelos es lo suficientemente precisa para su uso, en lugar de asumir que modelos más fuertes o un segundo proveedor son suficientes. El riesgo principal es la sobreconfianza en el acuerdo sobre preguntas difíciles, y los resultados muestran los estratos donde las respuestas acordadas son mayormente incorrectas. El estudio utiliza solo puntos de referencia públicos y preguntas compuestas por máquinas.
References
Chen, J. (2026). When does combining language models help? A co-failure ceiling on routing, voting, and mixture-of-agents across 67 frontier models. arXiv:2606.27288.
Chernets, V. (2026a). Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop: Who Verifies the Agents?
Chernets, V. (2026b). Weakly discriminative, not repaired by profile injection, and manipulable: Self-confidence in LLM evaluation. NeurIPS 2026 Workshop: Can We Trust AI Evaluation? Robustness, Causality, and Risk in Modern AI Assessment.
Chernets, V. (2026c). Architectural trust: When an AI agent buys for you, does trust belong to the model, or the architecture above it? SSRN 7191261.
Denisov-Blanch, Y., Kazdan, J., Chudnovsky, J., Schaeffer, R., Guan, S., Adeshina, S., and Koyejo, S. (2026). Consensus is not verification: Why crowd wisdom strategies fail for LLM truthfulness. arXiv:2603.06612.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Geifman, Y. and El-Yaniv, R. (2017). Selective classification for deep neural networks. In Advances in Neural Information Processing Systems 30. arXiv:1705.08500.
Goel, S., Strüber, J., Auzina, I. A., Chandra, K. K., Kumaraguru, P., Kiela, D., Prabhu, A., Bethge, M., and Geiping, J. (2025). Great models think alike and this undermines AI oversight. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267. arXiv:2502.04313.
Han, J. (2026). Partially correlated verifier cascades in LLM harnesses: Concave log-odds, polynomial reliability, and blind-spot ceilings. arXiv:2607.13918.
Haas, L., Yona, G., D'Antonio, G., Goldshtein, S., and Das, D. (2025). SimpleQA Verified: A reliable factuality benchmark to measure parametric knowledge. arXiv:2509.07968.
Hossain, E., Yousefi, N., and Lim, S.-N. (2026). Agreement overstates evidence: Error dependence in LLM judge consensus. arXiv:2609.22512.
Kim, D. (2026). Are diversity metrics measuring diversity? A capability-controlled audit of majority-vote gain in LLM ensembles. arXiv:2607.20768.
Kim, E., Garg, A., Peng, K., and Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267:30038-30066. arXiv:2506.07962.
Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
Kolawole, S., Dennis, D., Talwalkar, A., and Smith, V. (2025). Agreement-based cascading for efficient inference. Transactions on Machine Learning Research, 07/2025. arXiv:2407.02348.
Kuhn, L., Gal, Y., and Farquhar, S. (2023). Semantic uncertainty: Linguistic invariances for uncertainty estimation in natural language generation. In International Conference on Learning Representations. arXiv:2302.09664.
Liang, P., Bommasani, R., Lee, T., et al. (2023). Holistic evaluation of language models. Transactions on Machine Learning Research. arXiv:2211.09110.
Liu, N. (2026). LLMs as a jury: Cross-model consensus can outperform process reward models for LLM reasoning. arXiv:2607.10139.
Manakul, P., Liusie, A., and Gales, M. J. F. (2023). SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models. In Proceedings of EMNLP 2023. arXiv:2303.08896.
Naik, N. (2024). Probabilistic consensus through ensemble validation: A framework for LLM reliability. arXiv:2411.06535.
Owen, A. B. (2007). The pigeonhole bootstrap. The Annals of Applied Statistics, 1(2), 386-411.
Panickssery, A., Bowman, S. R., and Feng, S. (2024). LLM evaluators recognize and favor their own generations. In Advances in Neural Information Processing Systems 37.
Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657-680.
Tan, H., Sun, F., Liu, S., Su, D., Cao, Q., Chen, X., Wang, J., Cai, X., Wang, Y., Shen, H., and Cheng, X. (2025). Too consistent to detect: A study of self-consistent errors in LLMs. In Proceedings of EMNLP 2025. arXiv:2505.17656.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., and Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., and Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. In International Conference on Learning Representations.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., and Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
White, C., Dooley, S., Roberts, M., et al. (2025). LiveBench: A challenging, contamination-limited LLM benchmark. In International Conference on Learning Representations. arXiv:2406.19314.
Xue, Y., Greenewald, K., Mroueh, Y., and Mirzasoleiman, B. (2026). Verify when uncertain: Beyond self-consistency in black box hallucination detection. arXiv:2502.15845.
Yue, M., Zhao, J., Zhang, M., Du, L., and Yao, Z. (2024). Large language model cascades with mixture of thought representations for cost-efficient reasoning. In International Conference on Learning Representations. arXiv:2310.03094.
Declaraciones
Conflictos de intereses. El autor es solicitante nombrado en solicitudes de patentes pendientes, no patentes otorgadas, que cubren sistemas de orquestación de IA y validación multimodelo del tipo que este artículo examina.
Datos y código. Las respuestas por llamada, scripts de análisis y el mapeo de cada número reportado a su tabla de origen están archivados en Zenodo, doi:10.5281/zenodo.24090584 (CC BY 4.0).
Apéndice A. Modelos y modos de acceso
Tabla A1. Colecciones y modos de acceso, por onda.
| Colección | Fechas | Modelos | Acceso |
|---|---|---|---|
| Julio nivel medio | 24 a 28 de julio de 2026 | claude-haiku-4-5, gpt-5-mini, gemini-3.6-flash, grok-4-fast, deepseek-chat, qwen-plus, kimi-k3, glm-4.5, mistral-small | API directa |
| Julio local | 24 a 28 de julio de 2026 | siete modelos de código abierto locales | Inferencia local |
| Agosto buques insignia | 3 a 6 de agosto de 2026 | claude-fable-5, gpt-5.6-sol, mistral-medium-3.5 | Cliente del proveedor; gpt-5.6-sol en la configuración de esfuerzo predeterminada del cliente, 14 de 1500 registros por respaldo de API |
| glm-5.2 | Punto de conexión del proveedor | ||
| deepseek-v4-pro, grok-4.5, kimi-k3, qwen-max | API directa | ||
| gemini-3.1-pro, ernie-4.5-vl-424b, muse-spark-1.1 | API directa o ruta de agregador fijada al proveedor; muse-spark-1.1 parcial (251 respuestas) | ||
| Brazo de varianza | 6 de agosto de 2026 | Nueve buques insignia, sin Claude | gpt-5.6-sol por API directa, esfuerzo ninguno; mistral-medium-3.5 a través de su cliente de proveedor, que registra la temperatura solicitada; otros según la onda de agosto; temperatura 0,7, tres muestras |
| Fresco, agosto | 6 de agosto de 2026 | gpt-5.6-sol (esfuerzo ninguno), claude-fable-5, deepseek-v4-pro, kimi-k3 | gpt-5.6-sol y deepseek-v4-pro por API directa, claude-fable-5 por cliente del proveedor, kimi-k3 por ruta de agregador |
| Hechos del producto | 15 de agosto de 2026 | Seis modelos, 15 pares; cuatro sin posibilidad de búsqueda, 6 pares | Mixto; gpt-5.4 y grok a través de clientes |
| Octubre | 26 y 27 de octubre de 2026 | gpt-6.1-sol, gpt-6-astra, gpt-6-sol | Cliente Codex, esfuerzo medio, sin marca de búsqueda, flujo de eventos no retenido |
| claude-opus-5-5, claude-fable-5-1 | Cliente Claude, herramientas no permitidas | ||
| kimi-k3, gemini-3.8-flash (solo fresco) | Clientes de proveedores, herramientas no deshabilitadas |
En la onda de agosto, 19 respuestas del brazo claude-fable-5 fueron servidas por otros modelos Claude. El 34 de 37 de la onda en los 106 no depende de ellas (Chernets, 2026a).
Apéndice B. Pares sobre las 503 preguntas comunes
Tabla A2. Todos los pares de laboratorios diferentes, primer miembro publicado, 503 preguntas comunes.
| Par | Cobertura | VPP (K/O) | Delta, puntos [95%] | Errores detectados |
|---|---|---|---|---|
| gpt-6.1-sol + opus-5-5 | 59,8% | 95,6% (285/298) | +1,5 [-0,2, +3,3] | 16/29 |
| gpt-6.1-sol + fable-5-1 | 60,8% | 97,0% (294/303) | +2,9 [+1,1, +4,8] | 20/29 |
| gpt-6-astra + opus-5-5 | 58,3% | 94,8% (275/290) | +2,5 [+0,5, +4,7] | 23/38 |
| gpt-6-astra + fable-5-1 | 61,4% | 95,4% (291/305) | +3,1 [+1,1, +5,3] | 24/38 |
| gpt-6-sol + opus-5-5 | 61,6% | 95,4% (291/305) | -0,7 [-1,9, +0,6] | 5/19 |
| gpt-6-sol + fable-5-1 | 62,8% | 97,1% (301/310) | +1,0 [-0,4, +2,5] | 10/19 |
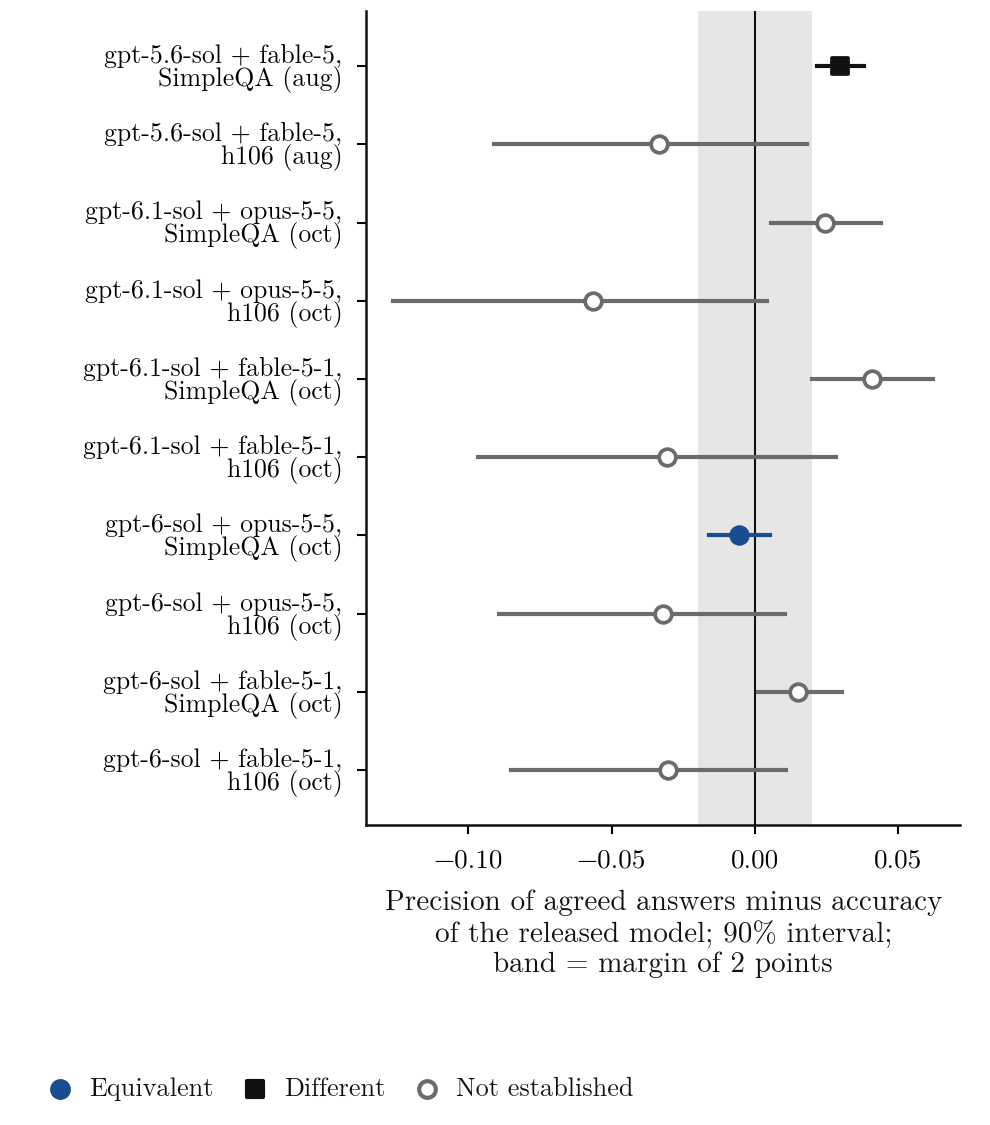
Figura A1. Prueba de equivalencia de la precisión del par frente al modelo publicado. Nota: 503 preguntas con bootstrap del 90%, margen de 2 puntos sombreado. Pares con un brazo de cliente Codex publicado.
Apéndice C. Coincidencia exacta con la cadena de referencia
La coincidencia exacta se correlaciona perfectamente en rango con la precisión de SimpleQA en los nueve modelos con medición tanto de SimpleQA como reciente, ya que una respuesta correcta es a menudo la cadena de referencia. Su correlación con la brecha SimpleQA menos reciente es +0,47 (p de permutación exacta = 0,21, n = 9), o +0,29 (p = 0,50) sin gpt-5.6-sol, cuyas dos precisiones provienen de modos de acceso diferentes (Figura A2). Restringida a respuestas correctas, es +0,10 (p = 0,81). Entre las respuestas correctas, la tasa es del 65,7 % para gpt-5.6-sol, 66,4 % para fable-5, 68,6 % para deepseek-v4-pro y 64,9 % para kimi-k3. El residuo del modelo no depende de ella, con una pendiente de +0,064 [-0,072, +0,167] en 112 celdas insignia. La brecha en sí es cercana a cero o negativa para la mayoría de los modelos, en -3,0 puntos para fable-5, -20,5 para deepseek-v4-pro, -5,4 para opus-5-5 y -7,8 para fable-5-1, y es grande solo para gpt-5.6-sol (+62,4), donde el modo de acceso difiere entre las dos mediciones.
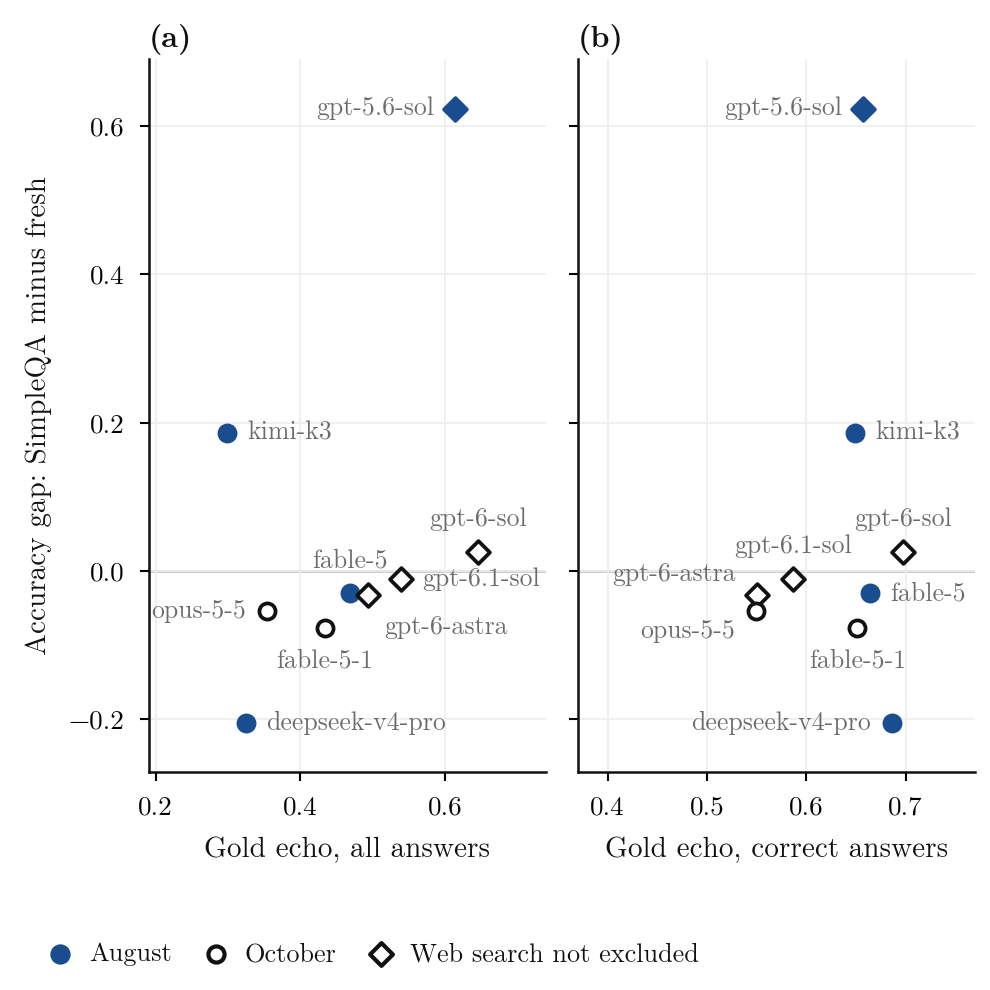
Figura A2. Coincidencia exacta con la cadena de referencia frente a la brecha de precisión. Nota: (a) todas las respuestas, (b) solo respuestas correctas. Azul lleno, ola de agosto; abierto, ola de octubre. Los diamantes marcan brazos para los cuales la búsqueda web no está excluida.
Apéndice D. Sensibilidad del evaluador
El motor normaliza mayúsculas, artículos y puntuación, acepta coincidencias exactas y contención de cadenas de cuatro o más caracteres, compara fechas, números e identificadores alfanuméricos por regla, y de otro modo compara palabras de contenido; una respuesta que no puede resolver contra el oro no se resuelve. En la Tabla A3 la primera parte de cada respuesta, sin paréntesis ni explicación complementaria, se utiliza tanto para la búsqueda como para la puntuación, por lo que el recuento abierto también cambia.
Tabla A3. Puntuación de la respuesta completa frente a puntuación de su primera parte. El primer miembro se publica.
| Par, conjunto | PPV, respuesta completa | PPV, primera parte |
|---|---|---|
| gpt-5.6-sol + fable-5, todo, agosto | 997/1016 | 997/1019 |
| gpt-6.1-sol + opus-5-5, 106, octubre | 31/35 | 30/34 |
| gpt-6.1-sol + fable-5-1, 106, octubre | 31/34 | 31/35 |
| gpt-6-astra + opus-5-5, 106, October | 28/35 | 32/36 |
| gpt-6.1-sol + opus-5-5, strat, October | 183/190 | 189/195 |
| gpt-6.1-sol + fable-5-1, estrategia, octubre | 187/191 | 198/201 |
| gpt-6.1-sol + opus-5-5, fresco, octubre | 72/74 | 72/74 |
Apéndice E. Trabajo relacionado adicional
Preprints recientes apuntan en dos direcciones. En el lado escéptico, Denisov-Blanch et al. (2026) encuentran que la agregación de estilo encuesta en cinco puntos de referencia y modelos no produce ganancia de precisión consistente a 25 veces el costo de inferencia, porque los errores están correlacionados. Ding (2026) audita 265.000 muestras en GPQA Diamond e AIME y encuentra que la concordancia es un predictor positivo pero débil (Spearman 0,20 a 0,59), con el 48% de las entradas de GPQA con alto acuerdo del modelo de frontera más consistente incorrectas. En una verificación exploratoria de 46 elementos, las tasas de respuesta-incorrecta-igual entre gpt-4.1 y los niveles de Claude superan un nulo que preserva márgenes en dos de tres niveles. Kohli (2026) encuentra que nueve jueces de frontera en tres conjuntos de datos de inferencia llevan aproximadamente dos votos independientes, y que el mejor juez individual iguala o supera al panel. Kim (2026) audita 31.900 subconjuntos de 30 modelos en MMLU-Pro: la votación vence al miembro más fuerte en el 9,98% de subconjuntos de tamaño 3, y una medida de diversidad estricta es casi colineal con uno menos la precisión media (Spearman +0,991). Hossain et al. (2026) encuentran una correlación de error promedio por pares de 0,21 en diez jueces, que llevan aproximadamente tanta información como 3,5 independientes, con dependencia más fuerte entre jueces de frontera de diferentes proveedores. Chen (2026) muestra que cualquier política que produzca la respuesta de un miembro no puede exceder uno menos la tasa a la que todos los modelos están equivocados juntos, y encuentra de 0,052 en matemáticas de final abierto en 67 modelos frente a 0,023 bajo una cópula gaussiana, y 0,127 en GPQA-Diamond de respuesta libre. Por otro lado, Naik (2024) reporta precisión que aumenta del 73,1% al 93,9% con dos modelos y al 95,6% con tres en 78 casos en formato opción múltiple, y Liu (2026) muestra que un panel de cuatro modelos selecciona respuestas mejor que auto-consistencia en siete puntos de referencia, con una ley de forma cerrada en precisión de miembro, correlación de error y una tasa de concepto erróneo compartido que predice la precisión de consenso con un error absoluto medio de 0,028. Xue et al. (2026) reportan que la consistencia entre modelos con un verificador mejora el techo de la auto-consistencia para la detección de alucinación en puntos de referencia de preguntas y respuestas, y Tan et al. (2025) que los errores auto-consistentes no se reducen con la escala del modelo, tienden a ser específicos del modelo, y se detectan mejor con un segundo modelo. Han (2026) presenta una teoría de puertas de verificación en serie en la que una masa ciega limita la confiabilidad y nombra decorrelación, cambiando familia de modelo, modalidad o fuente de evidencia, como el mecanismo práctico. Dos de los trabajos de la Sección 2 llevan detalles que inciden en la puerta. Goel et al. (2025) definen CAPA de modo que opciones incorrectas distintas cuenten como desacuerdo, y además de la tendencia con capacidad muestran que nueve jueces LLM de peso abierto puntúan modelos más similares a sí mismos más alto, y que las ganancias débil-a-fuerte son mayores en tareas donde el supervisor y el estudiante cometen errores menos similares (12 pares de modelos). Kolawole et al. (2025) establecen una condición de deferencia segura en la tasa conjunta de errores aceptados en la distribución de prueba, con un umbral estimado en un pequeño conjunto de validación. Una condición en la tasa conjunta permite que los errores aceptados se concentren en un estrato, y la Sección 5.1 encuentra tal estrato: en los 106, los paneles de nivel medio certifican el error, al igual que los pares de punta sin el brazo de mayor precisión.
Ninguno de estos trabajos reporta, como se señala en la Sección 2, la puerta de lanzamiento a nivel de par, la recuperación con cobertura igual con un modelo lanzado mantenido fijo, o un identificador medido en dos modos de acceso.
Apéndice F. Detalles de datos y protocolo
Colecciones. El protocolo es el de la Sección 3, y las colecciones siguen en su totalidad. La Tabla A1 enumera modelos, fechas y modos de acceso.
- Nivel medio de julio (24 a 28 de julio). Nueve modelos API y siete modelos locales en 1500 preguntas de SimpleQA (Wei et al., 2024), una submuestra fija aleatoria de las 4326 preguntas del conjunto de datos. La colección fue registrada en OSF antes de la recopilación de datos (Chernets, 2026a).
- Buques insignia de agosto (3 a 6 de agosto). Un buque insignia de cada uno de once laboratorios en las mismas 1500 preguntas, de las cuales 1459 forman el conjunto común.
- Brazo de varianza (6 de agosto). Nueve de los buques insignia en 100 de esas preguntas, 20 por quintil, a temperatura 0,7 con tres muestras por pregunta.
- Preguntas nuevas (6 de agosto y 26 de octubre). 100 preguntas de dos saltos compuestas por máquina a partir de Wikidata en ocho plantillas, con el hash del archivo fijado antes de la primera llamada del modelo.
- Hechos de productos (15 de agosto). 267 preguntas sobre productos comerciales, también compuestas a partir de Wikidata, en seis modelos, cuatro de ellos sin posibilidad de búsqueda.
- Buques insignia de octubre (26 y 27 de octubre). gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 y claude-fable-5-1 en 300 preguntas de SimpleQA estratificadas por quintil de julio (60, 120, 120; 297 comunes a los cinco; "strat" en las tablas), las 106 preguntas de abajo y el conjunto nuevo, 503 preguntas comunes en total. kimi-k3 y gemini-3.8-flash respondieron el conjunto nuevo.
Modos de acceso. Se accedió a los modelos de las dos formas descritas en la Sección 3. gpt-5.6-sol también se ejecutó por API directa en el brazo de varianza y en el conjunto nuevo de agosto. Los identificadores de modelo y las versiones del cliente se registran por llamada.
Debido a que los clientes establecen las condiciones de medición, las enuncio en su totalidad. La temperatura no se puede establecer en ellos. El brazo Codex de agosto se ejecutó con la configuración de cliente predeterminada para el esfuerzo de razonamiento, que la llamada no establece y los registros no indican. Los brazos Codex de octubre se ejecutaron con el esfuerzo establecido en medio en cada llamada. Los registros de manifiesto de agosto registran cero solicitudes de búsqueda web para el brazo Claude y una lista de herramientas vacía para el brazo Mistral, y los brazos Claude de octubre se ejecutaron con herramientas deshabilitadas. Los brazos Codex se iniciaron sin la bandera de búsqueda, y sus flujos de eventos no se retuvieron, por lo que no se puede determinar a partir de los archivos si realizaron búsquedas. En los clientes kimi y gemini-3.8-flash, las herramientas no fueron deshabilitadas y el indicador las prohíbe.
Apéndice G. El 106 y los niveles
La figura A3 muestra los paneles y pares de la sección 5.1 en el 106 y dos pares más: fable-5 con grok-4.5 está en lo correcto en 7 de 28 acuerdos y gemini-3.1-pro con grok-4.5 en 8 de 25.
El 0 de 342 de la sección 1 depende de cómo se clasifique la dificultad. Cuando se excluyen las respuestas propias de cada panel de la clasificación de dificultad, el conteo se convierte en 78 de 354, y el panel entre bloques se mantiene en 0 de 116.
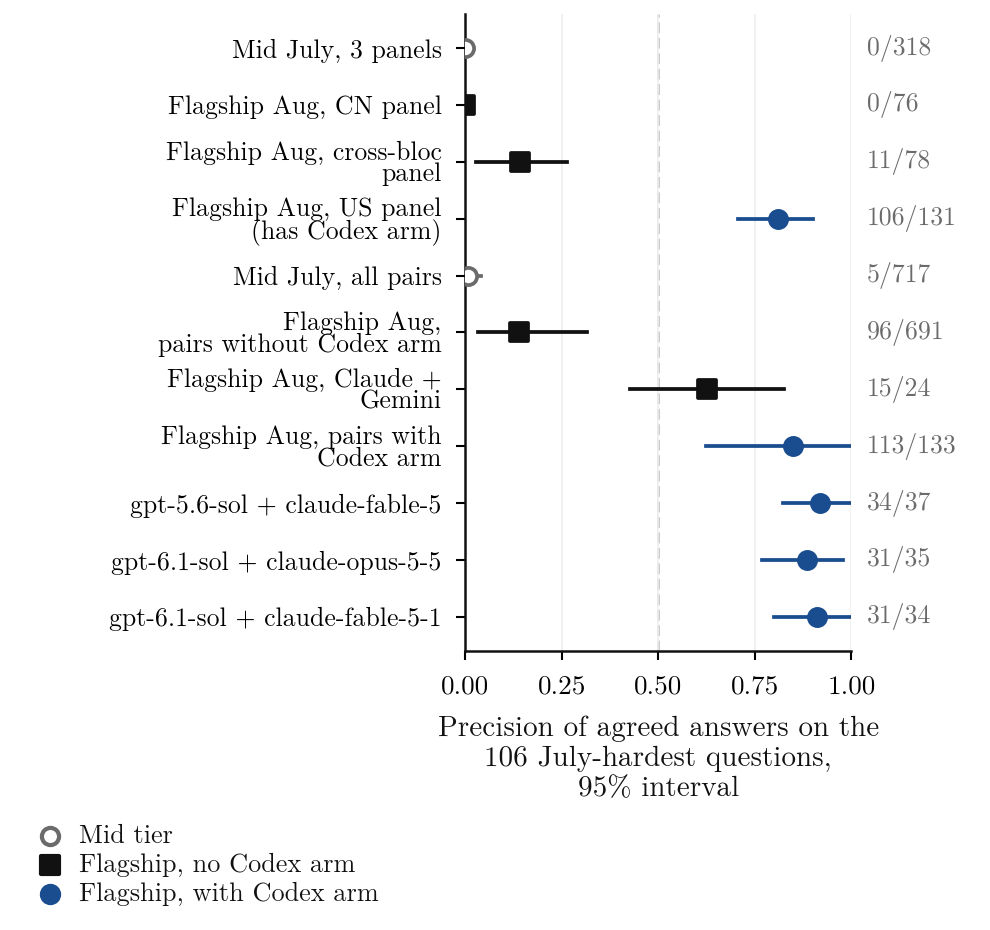
Figura A3. Precisión de respuestas acordadas en las 106 preguntas. Nota: bootstrap bidireccional del 95% para filas agrupadas, bootstrap de preguntas para paneles y pares únicos. Las filas azules contienen un brazo cliente de Codex. Colecciones de agosto y octubre.
La figura A4 proporciona los quintiles de nivel propio de la sección 5.1 en su totalidad. Con todos los brazos, agosto alcanza el 26,6% [6,7, 53,4] en el quintil más difícil, una diferencia de +9,3 [-18,1, +39,8] desde julio. Sin kimi-k3, que pertenece a ambas colecciones, el quintil más difícil da 147 de 675 (21,8%) en julio y 192 de 995 (19,3%) en agosto, -2,5 puntos [-29,7, +28,2]. La prueba agrupada de la sección 5.1 utiliza los cinco quintiles, 180 celdas por nivel; las celdas de nivel medio están +0,3 puntos [-2,4, +2,9] y las celdas insignia +0,0 [-1,4, +1,6] desde el modelo congelado. El aumento en el quintil más difícil es 1,15 [0,39, 1,90] en julio y 0,97 [0,42, 1,49] en agosto. En los quintiles, agosto sin GPT da 15,5, 52,9, 75,8, 90,5 y 97,3% y julio 17,3, 29,0, 60,9, 80,4 y 94,4%, mientras que la precisión del modelo lanzado se ejecuta 16,0, 36,6, 56,8, 73,3 y 88,5% contra 15,3, 25,0, 40,0, 57,7 y 78,9%.
La precisión sigue siendo baja en respuestas de oro limpiadas. Haas et al. (2025) reconstruyeron SimpleQA en un conjunto limpio de 1.000 preguntas, y 24 de los 106 sobreviven en él, contra 24,5 esperados de la parte del punto de referencia retenida, siendo la respuesta de oro idéntica en 21. La limpieza no elimina estas preguntas con más frecuencia que otras, aunque su selección también favorece preguntas difíciles. Bajo la misma estadística y bootstrap, los pares de agosto sin GPT están en lo correcto en 28 de 150 acuerdos en esas 24 preguntas (18,7% [0,0, 57,1]) y en 67 de 538 en las otras 82 (12,5% [2,8, 28,1]; el miembro más preciso se lanza en cada subconjunto, por lo que las partes no necesitan sumar a 96 de 691), y los pares de julio en 4 de 157 (2,5% [0,0, 15,2]).
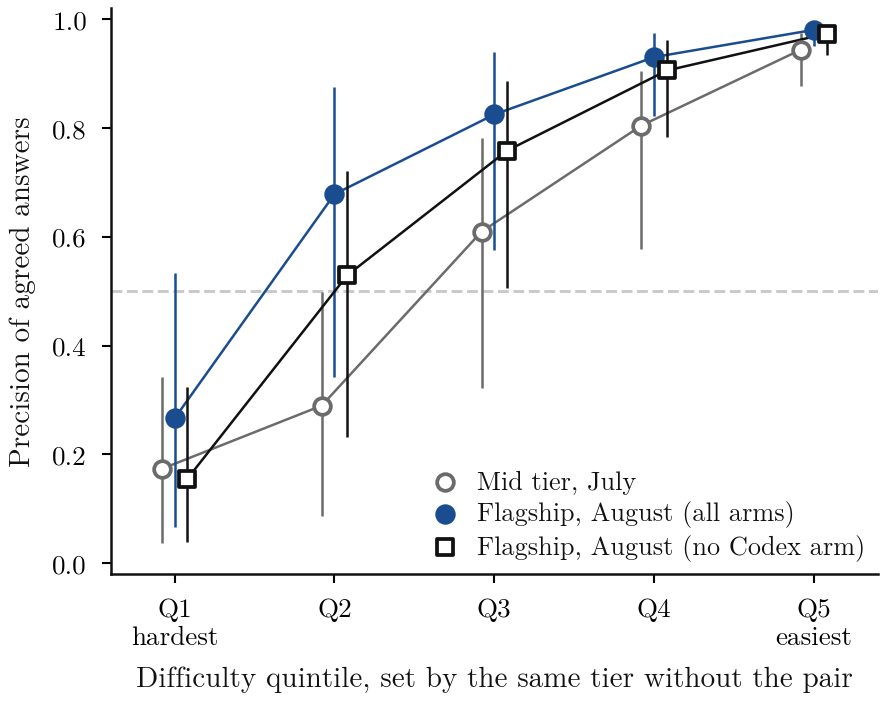
Figura A4. Precisión de respuestas acordadas por quintil de dificultad de nivel propio. Nota: bootstrap bidireccional del 95%. La dificultad para cada par se establece por el mismo nivel sin ese par. Línea discontinua en 0,5.
Los pares más precisos se ajustan a la misma relación. El par kimi-k3 y gemini-3.8-flash alcanzan el 95,8% en el conjunto nuevo, con 23 de 26 errores del modelo lanzado capturados y un aumento de 5,37 [2,86, 21,36]. El modelo, dados solo sus valores de precisión de 0,74 y 0,82, devuelve 95,1%. Y los dos Claude insignia juntos, sin posibilidad de búsqueda en ninguno de los brazos, alcanzan 47,5% en el 106, donde la precisión del modelo lanzado es 30,0%, y 86,2% en todas las 503 preguntas. La figura A5 traza cada banda de cada nivel contra la precisión del modelo lanzado, con precisión por encima de la diagonal en 17 de 23 celdas.
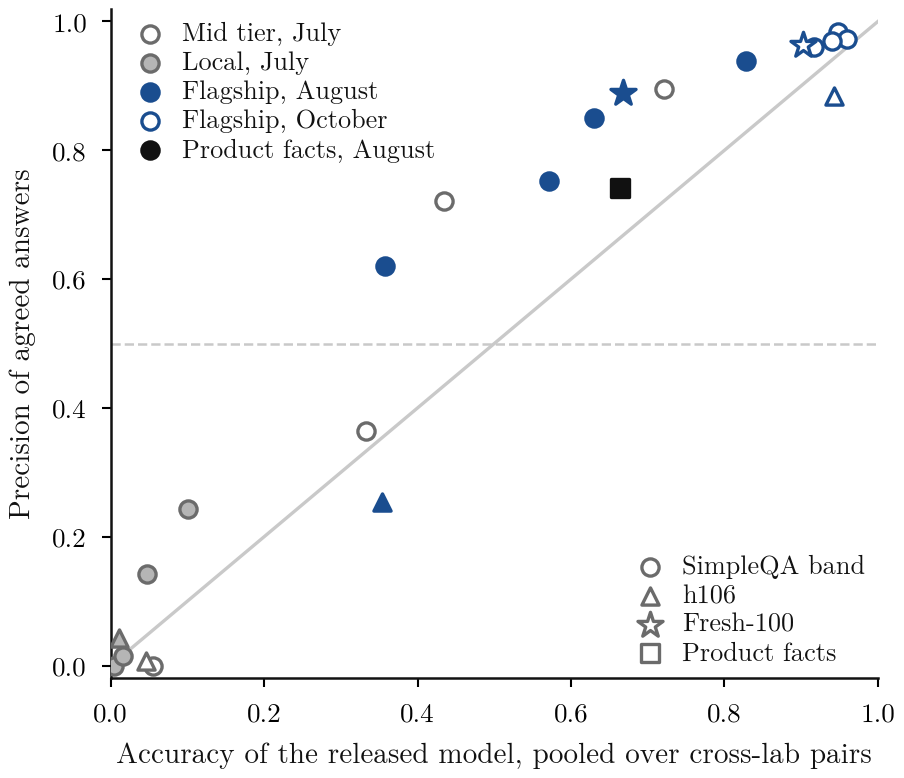
Figura A5. Precisión de respuestas acordadas contra precisión del modelo lanzado. Nota: agrupado en pares de diferentes laboratorios, por nivel y banda. El color y relleno dan el nivel, la forma del marcador el conjunto. Línea discontinua en 0,5, línea sólida es igualdad.
Apéndice H. El segundo laboratorio en detalle
El brazo de varianza. Por modelo a cobertura igual (Figura 2), la puerta de dos laboratorios lidera en siete de nueve y va rezagada para gemini-3.1-pro (-5,7 puntos) y grok-4.5 (-2,8). Sin GPT, sobre ocho modelos, el autoconsenso cubre el 61,4 % con una precisión del 55,9 % y dos laboratorios el 24,4 % con el 83,3 %. La diferencia en precisión es de +27,4 puntos [+16,0, +35,7] medida y +7,7 [-1,9, +16,5] a cobertura igual, y los errores detectados difieren en +38,3 puntos [+26,0, +50,9] medidos y +3,0 [-1,5, +8,4] a cobertura igual. Octubre no tiene llamadas repetidas, por lo que el autoconsenso se mide solo en agosto.
Cuatro socios de un modelo publicado. La Tabla A4 proporciona los cuatro socios de la Figura 3a: un modelo publicado, gpt-6.1-sol, por lo que los 29 errores en juego son los mismos en cada fila.
Tabla A4. Un modelo publicado, cuatro socios: gpt-6.1-sol en 503 preguntas comunes (29 errores entre 495 resueltos, bootstrap de pregunta al 95 %).
| Socio | Laboratorio | Cobertura [95%] | VPP (K/O) | Delta, puntos [95%] | Errores detectados [95%] |
|---|---|---|---|---|---|
| gpt-6-astra | igual | 96,2% [94,4, 97,8] | 94,3% (449/476) | +0,2 [-0,2, +0,8] | 2/29 = 6,9% [0,0, 17,4] |
| gpt-6-sol | igual | 95,6% [93,6, 97,2] | 96,2% (457/475) | +2,1 [+0,9, +3,4] | 11/29 = 37,9% [20,7, 56,5] |
| claude-opus-5-5 | diferente | 59,8% [55,9, 64,0] | 95,6% (285/298) | +1,5 [-0,2, +3,3] | 16/29 = 55,2% [36,4, 73,0] |
| claude-fable-5-1 | diferente | 60,8% [56,7, 65,0] | 97,0% (294/303) | +2,9 [+1,1, +4,8] | 20/29 = 69,0% [50,0, 85,2] |
El otro socio del mismo laboratorio, gpt-6-sol, detecta 11 de 29, lo que es -31,0 puntos [-50,0, -10,7] frente a fable-5-1 y -17,2 [-37,0, +3,0] frente a opus-5-5. El par de Claude, sin posibilidad de búsqueda en ningún brazo, cubre el 60,6 % y detecta 140 de 181 errores de fable-5-1 con una precisión del 86,2 % y un Delta de +23,5 puntos [+19,6, +27,2]. Dos modelos de un laboratorio, ambos lejos del techo, pueden así discrepar lo suficientemente a menudo para detectar la mayoría de errores.
La Tabla A5 comprueba si esto es más que un movimiento a lo largo de la curva de cobertura, y si requiere GPT. Cada fila mantiene un modelo publicado y compara su socio del mismo laboratorio con un socio de otro laboratorio, primero medido y luego a cobertura igual, alcanzada adelgazando la puerta más amplia por confianza (Sección 3).
Tabla A5. Errores detectados con un socio del mismo laboratorio y con un socio de otro laboratorio. Las diferencias son igual menos otro, en puntos, con un bootstrap de pregunta al 95 %, por lo que negativo favorece el otro laboratorio; las diferencias medidas en las primeras cuatro filas comparten el bootstrap de la Tabla A4.
| Publicado | Socio igual / otro | Preguntas | Detectados, medido | Diferencia [95%] | Detectados, cobertura igual | Diferencia [95%] |
|---|---|---|---|---|---|---|
| gpt-6.1-sol | astra / fable-5-1 | 503 | 2/29, 20/29 | -62,1 [-79,3, -43,8] | 17/29, 20/29 | -10,3 [-35,3, +13,8] |
| gpt-6.1-sol | astra / opus-5-5 | 503 | 2/29, 16/29 | -48,3 [-66,7, -29,6] | 18/29, 16/29 | +6,9 [-17,1, +30,4] |
| gpt-6.1-sol | gpt-6-sol / fable-5-1 | 503 | 11/29, 20/29 | -31,0 [-50,0, -10,7] | 24/29, 20/29 | +13,8 [-6,7, +34,6] |
| gpt-6.1-sol | gpt-6-sol / opus-5-5 | 503 | 11/29, 16/29 | -17,2 [-37,0, +3,0] | 24/29, 16/29 | +27,6 [+3,4, +51,6] |
| fable-5-1 | opus-5-5 / gpt-6.1-sol | 503 | 140/181, 169/181 | -16,0 [-21,7, -10,6] | 140/181, 169/181 | -16,0 [-21,7, -10,6] |
| opus-5-5 | fable-5-1 / gpt-6.1-sol | 503 | 154/195, 177/195 | -11,8 [-17,8, -5,9] | 156/195, 177/195 | -10,8 [-16,7, -5,0] |
| fable-5-1 | opus-5-5 / kimi-k3 | fresh 100 | 13/23, 20/23 | -30,4 [-50,0, -12,5] | 17/23, 20/23 | -13,0 [-35,0, +9,1] |
| fable-5-1 | opus-5-5 / gemini-3.8-flash | fresh 100 | 13/23, 19/23 | -26,1 [-45,5, -8,7] | 17/23, 19/23 | -8,7 [-29,4, +12,5] |
| opus-5-5 | fable-5-1 / kimi-k3 | fresh 100 | 18/28, 23/28 | -17,9 [-38,5, +0,0] | 24/28, 23/28 | +3,6 [-14,7, +22,6] |
| opus-5-5 | fable-5-1 / gemini-3.8-flash | fresh 100 | 18/28, 22/28 | -14,3 [-33,3, +4,5] | 22/28, 22/28 | +0,0 [-20,0, +20,7] |
| fable-5-1 | opus-5-5 / gemini-3.1-pro (agosto) | 344 | 107/130, 110/130 | -2,3 [-9,8, +5,3] | 108/130, 110/130 | -1,5 [-9,1, +5,8] |
| opus-5-5 | fable-5-1 / gemini-3.1-pro (agosto) | 344 | 118/141, 126/141 | -5,7 [-12,1, +0,8] | 125/141, 126/141 | -0,7 [-6,4, +5,1] |
Las filas de agosto son la única comparación de SimpleQA sin GPT, y emparejan modelos de diferentes fechas. gemini-3.1-pro es el brazo de agosto más cercano en precisión a los modelos de Claude en estas preguntas (65,4 % frente a 60,6 y 57,7 % en estas preguntas). Agrupado sobre los siete socios de agosto, la mayoría de ellos mucho más débiles, la diferencia es -5,1 puntos [-10,1, -0,3] para fable-5-1 y -6,0 [-10,6, -1,2] para opus-5-5 medidos, y se convierte en +7,9 [+4,8, +11,2] y +6,8 [+3,6, +10,2] a cobertura igual, a favor del mismo laboratorio. Los empates en confianza se rompen al azar, y sobre 200 extracciones la fila más amplia se mueve entre 0,0 y +20,7 puntos.
Apéndice I. El modelo fuera de muestra en detalle
La Tabla A6 proporciona los errores fuera de muestra detrás de la Sección 5.3. La división temporal da 0.019 frente a 0.050 para el modelo de referencia más adecuado, una diferencia de -0.031 [-0.074, +0.008] bajo el bootstrap bidireccional, y el intervalo se encuentra por debajo de cero cuando se agrupa solo por pregunta o solo por modelo. Con 9 y 23 pliegues, LOLO y LOMO dan el mismo error a tres decimales.
Tabla A6. Error absoluto medio del VPP predicho, celdas con al menos 20 respuestas abiertas. Bootstrap bidireccional, pregunta por modelo.
| Esquema | Modelo [95%] | Indep. | Mejor | Modelo menos mejor [95%] | Modelo menos indep. [95%] |
|---|---|---|---|---|---|
| LOLO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.035] | +0.005 [-0.003, +0.012] |
| LOMO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.036] | +0.005 [-0.004, +0.012] |
| LOLO, preguntas divididas | 0.054 [0.052, 0.088] | 0.050 | 0.109 | -0.055 [-0.075, -0.027] | +0.004 [-0.002, +0.010] |
| Julio y agosto a octubre | 0.019 [0.008, 0.041] | 0.023 | 0.050 | -0.031 [-0.074, +0.008] | -0.004 [-0.011, +0.005] |
| Gama media a modelos insignia | 0.030 [0.025, 0.053] | 0.031 | 0.087 | -0.057 [-0.087, -0.022] | -0.001 [-0.009, +0.005] |
| LOLO, modelos insignia, sin rama posible de búsqueda | 0.037 [0.029, 0.071] | 0.038 | 0.120 | -0.083 [-0.125, -0.039] | -0.000 [-0.017, +0.014] |
| Retenido: ERNIE y Muse, agosto | 0.019 [0.015, 0.055] | 0.033 | 0.128 | -0.110 [-0.143, -0.032] | -0.014 [-0.031, +0.007] |
| Retenido: 7 modelos locales, julio | 0.037 [0.018, 0.072] | 0.068 | 0.077 | -0.040 [-0.061, -0.015] | -0.031 [-0.041, -0.014] |
| Retenido: mismo laboratorio, octubre | 0.038 [0.017, 0.083] | 0.043 | 0.041 | -0.003 [-0.130, +0.045] | -0.006 [-0.025, -0.001] |
| Retenido: datos de producto | 0.130 [0.077, 0.187] | 0.149 | 0.086 | +0.045 [-0.051, +0.143] | -0.019 [-0.021, -0.012] |
La ganancia práctica sobre leer el mejor modelo es grande, incluyendo la transferencia de la gama media a los modelos insignia y dos de los cuatro conjuntos que no participaron en el ajuste (Figura A6). El multiplicador no añade nada a la precisión en los esquemas principales, y el trabajo lo realizan las precisiones medidas y . Eliminar completamente eleva el error LOLO a 0.323, y mantenerlo constante da 0.046. En cobertura y pérdida logarítmica, sí ayuda: bajo LOLO las diferencias respecto a errores independientes son -0.0079 [-0.0111, -0.0020] y -0.0024 [-0.0045, -0.0003]. En tres de los cuatro conjuntos retenidos, el intervalo frente a errores independientes se encuentra por debajo de cero, con constantes congeladas. El término de error conjunto, por lo tanto, importa para la cobertura, mientras que la precisión descansa en las precisiones medidas y .
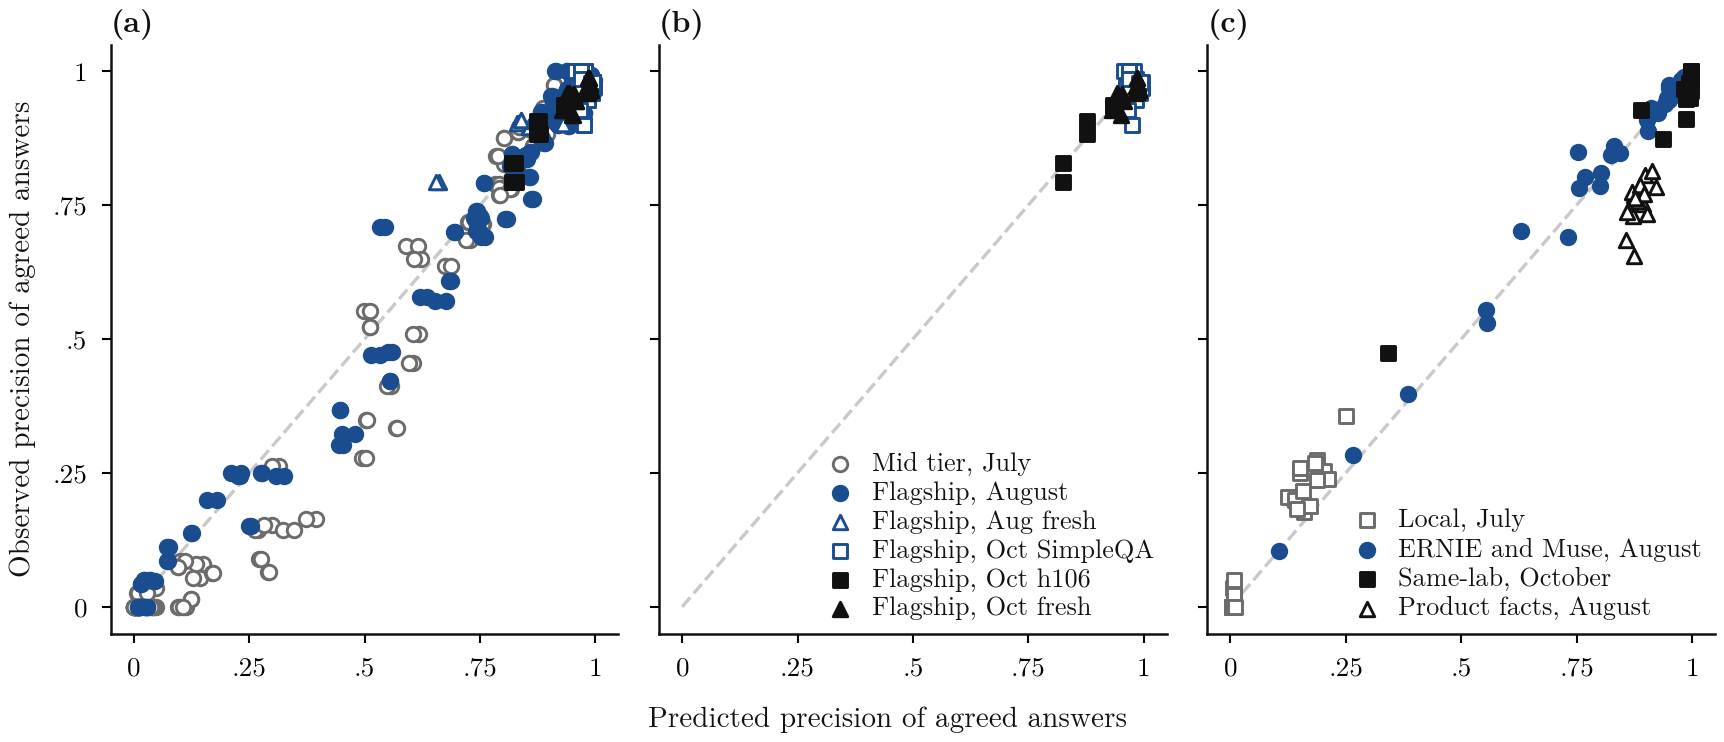
Figura A6. Precisión predicha frente a observada de respuestas acordadas. Nota: (a) dejar un laboratorio fuera. (b) Ajuste en julio y agosto y predicción de octubre. (c) Conjuntos fuera del ajuste, constantes fijadas. La línea punteada es la igualdad.
En datos de producto el modelo se ejecuta alto. El error es 0.130 frente a 0.086 para el mejor modelo, con una sobreestimación media de 13 puntos. Con el calificador nativo de ese dominio, la sobreestimación se eleva a 19 puntos (0.190 frente a 0.067). Los datos de producto están fuera del dominio en el que se ajustaron las constantes.
Clasificando celdas en tres clases de resultado (invertidas con VPP por debajo de 0.5, sin ganancia con Delta hasta +2 puntos, ganancia por encima de eso), la división temporal coincide con 28 de 39 celdas, y nueve de los errores predicen sin ganancia donde se observó ganancia. El modelo es confiable para el tamaño de precisión y más débil al clasificar celdas a ambos lados de la línea de +2 puntos.
Apéndice J. Modos de acceso y los brazos GPT en detalle
Mismo identificador, mismas preguntas. En un conjunto de 100 preguntas de SimpleQA, gpt-5.6-sol obtiene 92 de 100 (92,0%) en la onda principal, donde 99 de los 100 registros vinieron a través del cliente Codex y una respuesta incorrecta a través de una alternativa de API, y 139 de 300 muestras (46,3%) a través de la API directa en el brazo de varianza, una diferencia de 45,7 puntos (Figura 5). Solo en los 99 registros del cliente, las cifras son 92 de 99 (92,9%) y 139 de 297 (46,8%), una diferencia de 46,1 puntos. La reproducción textual de la cadena de oro cae junto con ella, del 64,0% al 26,0%. Las condiciones difieren como sigue: el cliente se ejecuta con su configuración de esfuerzo predeterminada bajo sus propias instrucciones, sin temperatura ajustable, mientras que la API se ejecuta sin esfuerzo y con temperatura 0,7.
En las dos columnas, los otros ocho modelos del brazo, cuya temperatura también cambia, se mueven como máximo 4,0 puntos en cualquier dirección. El esfuerzo es un candidato para gpt-5.6-sol, aunque una medición de presupuesto de razonamiento emparejada en gemini-3.1-pro dejó la precisión prácticamente sin cambios (Chernets, 2026c). La búsqueda web es la otra. Las respuestas de octubre del mismo cliente contienen enlaces que la solicitud no requiere, en 3 de 506 respuestas de gpt-6.1-sol y en 18 de 506 de gpt-6-astra, incluido un identificador real de MusicBrainz. El uso mediano de tokens por llamada de cliente en agosto es 4.829, con el 36,4% de las llamadas por encima de 6.000. Esos tokens pueden ser razonamiento o búsqueda, y la secuencia de eventos que los separaría no se conservó.
Un arnés de evaluación comparativa y una persona que usa el producto pueden así ver precisiones 45,7 puntos aparte en un identificador y un conjunto de preguntas, y un estudio del «modelo» tiene que indicar cuál midió. Dentro de la onda de agosto, el brazo del cliente obtiene 1.392 de 1.457 (95,5%), y los 14 registros servidos por API después de un fallo del cliente obtienen 11 (78,6%), en preguntas seleccionadas por ese fallo. En el conjunto nuevo, gpt-5.6-sol a través de la API obtiene 33 de 100, donde fable-5 obtiene 76, mientras que gpt-6.1-sol a través del cliente obtiene 95 en octubre. Y el modelo de la Sección 4 mantiene su forma bajo esta pregunta, ya que toma precisiones medidas como entrada: en modelos insignia sin brazos donde es posible la búsqueda su error LOLO es 0,037 frente a 0,120 para el mejor modelo.
Valor de compuerta por modo de acceso. En preguntas nuevas en agosto, con GPT a través de la API, el par gpt-5.6-sol y fable-5 acierta en 29 de 32 acuerdos, Delta +57,6 puntos [+46,3, +69,7], capturando 64 de 67 errores, y los errores seguros del brazo GPT caen de 61 de 91 a 2 de 29. En octubre, con un GPT más nuevo a través del cliente en las mismas preguntas, el par con opus-5-5 acierta en 72 de 74, y el par con fable-5-1 en 76 de 78, con un Delta de +2,3 [-0,7, +6,0] y +2,4 [-0,5, +6,3] y 3 de 5 errores capturados. El valor de compuerta aquí sigue la precisión del brazo publicado, como en la Sección 5.1.
Brazos del cliente en SimpleQA. La Tabla A7 informa los brazos reservados en la Sección 5.1. En agosto, el par gpt-5.6-sol y fable-5 acierta en 997 de 1.016 acuerdos (98,1%) frente a 95,4% solo, Delta +2,8 puntos [+1,9, +3,7], con el piso en 15 de 1.459. En los 106 alcanza 34 de 37 (91,9%), y todos los pares con el brazo GPT alcanzan 113 de 133 (85,0% [62,2, 100,0]), frente a 96 de 691 sin él. El brazo solo acierta en 100 de 105. Estos acuerdos heredan esa precisión: el Delta en los 106 es -3,3 puntos [-10,3, +2,6] en agosto y -5,7 [-13,7, +1,2] con opus-5-5 en octubre. En contraste, el par de gama media de los mismos dos proveedores, gpt-5-mini y claude-haiku-4-5, acierta en 45 de 123 acuerdos (36,6% [28,6, 45,4]) en general y 0 de 13 en los 106, con su primer miembro en 163 de 1.435.
Tabla A7. Pares de brazos del cliente. El primer miembro es publicado. Intervalo de Wilson en VPP, bootstrap de preguntas en Delta.
| Par, conjunto | Cobertura | VPP (K/O) [95%] | Publicado solo | Delta, puntos [95%] | Errores capturados |
|---|---|---|---|---|---|
| gpt-5.6-sol + fable-5, todo SimpleQA, agosto | 1028/1500 | 98,1% (997/1016) [97,1, 98,8] | 1403/1471 | +2,8 [+1,9, +3,7] | 49/68 |
| gpt-5.6-sol + fable-5, 106, agosto | 37/106 | 91,9% (34/37) [78,7, 97,2] | 100/105 | -3,3 [-10,3, +2,6] | 2/5 |
| gpt-6.1-sol + opus-5-5, estrat, octubre | 192/300 | 96,3% (183/190) [92,6, 98,2] | 276/294 | +2,4 [+0,2, +4,9] | 11/18 |
| gpt-6.1-sol + fable-5-1, estrat, octubre | 193/297 | 97,9% (187/191) [94,7, 99,2] | 273/291 | +4,1 [+1,6, +6,7] | 14/18 |
| gpt-6.1-sol + opus-5-5, 106, octubre | 36/106 | 88,6% (31/35) [74,0, 95,5] | 98/104 | -5,7 [-13,7, +1,2] | 2/6 |
| gpt-6.1-sol + fable-5-1, 106, octubre | 35/106 | 91,2% (31/34) [77,0, 97,0] | 98/104 | -3,1 [-10,9, +3,5] | 3/6 |
| gpt-6.1-sol + opus-5-5, nuevo, octubre | 74/100 | 97,3% (72/74) [90,7, 99,3] | 95/100 | +2,3 [-0,7, +6,0] | 3/5 |
| gpt-6.1-sol + fable-5-1, nuevo, octubre | 78/100 | 97,4% (76/78) [91,1, 99,3] | 95/100 | +2,4 [-0,5, +6,3] | 3/5 |
Valor de compuerta cerca del techo. En preguntas familiares el par aún agrega un poco (Figura A1). En agosto en SimpleQA sin los 106, su Delta es +3,0 puntos [+2,0, +4,0], una diferencia a favor del par. En octubre los pares estrat están por encima de cero, en +2,4 [+0,2, +4,9] y +4,1 [+1,6, +6,7], y por debajo de una decisión contra el margen. La única equivalencia es gpt-6-sol con opus-5-5 en -0,6 (intervalo del 90% -1,6 a +0,5, p = 0,020), que no sobrevive a la corrección de Holm (0,277). En los 106, cada par con gpt-6.1-sol y gpt-5.6-sol no está decidido con dirección hacia abajo. Fuera de este brazo el efecto es grande: en el mismo conjunto de agosto, fable-5 con gemini-3.1-pro está en +19,3 puntos y fable-5 con grok-4.5 en +18,0.
La confianza propia del brazo es un competidor en este rango. Afinada por su propia confianza a la cobertura del par con opus-5-5, gpt-6.1-sol está en 34 a 36 de 36 en los 106, dependiendo de cómo se rompan los empates, frente a 31 de 35 para el par, y 74 de 74 en nuevo frente a 72 de 74. En estrat el par lidera, por +1,6 puntos [-1,4, +4,7] con opus-5-5 y por +3,2 [+0,6, +6,2] con fable-5-1.
Cuál GPT y cuál socio. En preguntas comunes que ambos modelos resuelven, gpt-6.1-sol supera a gpt-6-astra 10 a 1 en pares discordantes (p = 0,012, +1,83 puntos [+0,61, +3,26]), y gpt-6-sol supera a gpt-6-astra 21 a 5 (p = 0,002, +3,29 [+1,23, +5,34]). gpt-6.1-sol contra gpt-6-sol se sitúa en 5 a 12 (p = 0,143). opus-5-5 contra fable-5-1 se sitúa en 29 a 44 (p = 0,101, -3,12 [-6,65, +0,21]). Los pares de los dos GPT más fuertes con los dos Claudes se sitúan entre el 95,4 y el 97,1% en 503 preguntas (tabla A2), siendo fable-5-1 quien detecta más errores en cada comparación. Y kimi-k3 con gemini-3.8-flash, el par sin GPT, no es diferenciable de ellos en el conjunto nuevo: su diferencia respecto a gpt-6.1-sol con opus-5-5 es de -1,5 puntos [-6,3, +2,8] en precisión y -2,0 [-10,0, +6,0] en cobertura.
Apéndice K. Datos externos en detalle
La verificación externa de la Sección 5.5 utiliza las constantes congeladas sin reajuste. HELM Lite (Liang et al., 2023) contiene respuestas abiertas cortas de 95 modelos de 20 desarrolladores, lanzados entre 2023 y 2025, a 1.000 preguntas de NaturalQuestions de libro cerrado, calificadas aquí por mi motor. LiveBench (White et al., 2025) contiene respuestas de 70 modelos de 11 laboratorios a 346 preguntas con una respuesta final corta, calificadas contra su verdad fundamental. Kim et al. (2025) publican agregados de pares para 70 modelos en el MMLU de opción múltiple, que dan precisión observada como la tasa de ambos correctos sobre la tasa de acuerdo. La Tabla A8 presenta el resultado. Las precisiones en la Tabla 7 de Haas et al. (2025) no conllevan resultados de acuerdo, por lo que generan predicciones y ninguna prueba.
Tabla A8. El modelo congelado en otros modelos y preguntas. Error absoluto medio del VPP predicho para pares de laboratorios diferentes, celdas con al menos 20 respuestas abiertas en las dos primeras fuentes. Remuestreo de dos vías, solo por modelo para MMLU. El desplazamiento es predicho menos observado.
| Fuente | Celdas | Modelo [95%] | Indep. | Mejor | Modelo menos mejor [95%] | Modelo menos indep. [95%] | Desplazamiento |
|---|---|---|---|---|---|---|---|
| HELM, NaturalQuestions | 4.088 | 0,069 [0,054, 0,087] | 0,070 | 0,208 | -0,139 [-0,171, -0,103] | -0,001 [-0,008, +0,006] | +0,053 |
| LiveBench, cuatro tareas | 952 | 0,114 [0,101, 0,150] | 0,107 | 0,198 | -0,084 [-0,121, -0,026] | +0,007 [-0,006, +0,022] | +0,056 |
| LiveBench, math_comp | 431 | 0,075 | 0,096 | 0,279 | -0,034 | ||
| LiveBench, zebra_puzzle | 203 | 0,231 | 0,184 | 0,076 | +0,230 | ||
| LiveBench, spatial | 161 | 0,148 | 0,114 | 0,167 | +0,148 | ||
| LiveBench, web_of_lies_v2 | 157 | 0,036 | 0,031 | 0,166 | -0,017 | ||
| Kim et al., MMLU (agregados) | 2.189 | 0,066 [0,060, 0,072] | 0,084 | 0,084 | -0,018 [-0,028, -0,010] | -0,018 [-0,019, -0,017] | +0,066 |
Como en la Sección 5.3, el modelo supera la lectura del modelo mejor en las tres fuentes tomadas en conjunto, y falla en los puzles de cebra, a 0,231 contra 0,076. No mejora en errores independientes en HELM o LiveBench. Corre alto, por 5,3 a 6,6 puntos en total. En HELM la curva observada se aplana donde el modelo sigue subiendo: a precisión de par accuracy entre 0,5 y 0,6 la precisión es 74,6% para modelos de 2023 e inicios de 2024 y 75,9% para posteriores, contra 84,4% predicho en el medio del intervalo. En MMLU la probabilidad mediana de que dos respuestas incorrectas coincidan es 0,621 contra 0,368 de , ya que cuatro opciones fuerzan colisiones.
En estos modelos la precisión aumenta con pair accuracy (Spearman +0,575 en HELM y +0,786 en MMLU, sobre celdas dependientes). Modelos antiguos y nuevos con precisión similar dan precisión similar entre pair accuracy 0,4 y 0,6 (70,7 y 72,7%, 74,6 y 75,9%), y difieren más entre 0,2 y 0,3 (57,6 y 76,1%). El límite inferior de la Sección 4 se sostiene en las 4.088 celdas de HELM. Los pares por debajo de uno y medio son raros allí, 24 de 4.088, porque estas celdas no están estratificadas por dificultad.
HELM también permite la prueba de la Sección 5.2 con muchos laboratorios y sin dependencia de GPT, porque la precisión del compañero puede coincidir sin valores de confianza. Con un modelo lanzado y compañeros dentro de 3 puntos de precisión, un compañero del mismo laboratorio captura 72,3% de errores y otro del laboratorio 75,5%, una diferencia de -3,2 puntos [-4,2, -2,3], a cobertura superior por 2,7 puntos [+2,1, +3,4]. Añadir una coincidencia en cobertura dentro de 3 puntos la elimina: 75,7 contra 75,9%, -0,2 [-0,6, +0,2], con precisión -0,5 [-1,4, +0,1]. Dos respuestas incorrectas coinciden en 31,6% de casos dentro de un laboratorio y 27,0% entre laboratorios.
Los errores compartidos también se sitúan muy por encima del azar en las colecciones de la Sección 3. Bajo la nula de permutación de etiquetas de Ding (2026), que conserva las respuestas incorrectas de cada modelo y las baraja entre preguntas, dos respuestas incorrectas que no son rechazos coinciden en 14,0% de casos en julio y 15,4% en agosto sin GPT, contra una nula de 0,1%. En los 106 las tasas son 25,7% y 22,8% contra 0,4% y 0,5%, y en preguntas nuevas 14,5% en agosto y 32,7% en octubre contra 0,8% y 3,8%. Las respuestas abiertas rara vez colisionan por azar, por lo que el compartir observado se sitúa muy por encima de esta nula, en preguntas compuestas después del lanzamiento de los modelos también.
Apéndice L. Discusión adicional
Relación con Goel et al. (2025). Su tendencia se refiere a la similitud ajustada por azar, y la mía se refiere a la precisión de las respuestas acordadas, por lo que los hallazgos no entran en conflicto. Los datos lo evidencian a través de la proporción condicional de error compartido, F/W, la probabilidad de que dos respuestas incorrectas sean iguales, en preguntas donde ambas respuestas se califican y los rechazos se cuentan como incorrectos. Para los pares de referencia aumenta de 63 de 1.088 (0,058) para el par de nivel medio a 15 de 42 (0,357) para el par insignia, aproximadamente seis veces. Agrupados en todos los pares, incluido GPT, el aumento es menor y el intervalo incluye cero: 0,097 en julio y 0,132 en agosto, una diferencia de +0,034 [-0,006, +0,084]. En el conjunto estratificado de octubre, F/W es 0,493 [0,179, 0,840], una diferencia respecto a agosto de +0,361 [+0,041, +0,712]. Con cobertura igual, contenedor por contenedor, el recuerdo del modelo insignia es inferior en 0,7 a 2,5 puntos, un efecto pequeño, y es 0,140 [0,092, 0,192] frente a 0,113 [0,082, 0,146]. La dirección coincide así con la suya, aunque el intervalo agrupado incluye cero. La lectura directa de su advertencia, que la similitud amenaza la puerta, sí aparece en el recuerdo: los pares cliente de octubre capturan el 66,3% de los errores con una cobertura del 65,3%, donde los 55 pares de agosto capturan el 88,2% con el 32,5%, un contraste que la cobertura explica parcialmente. La precisión se mantiene alta principalmente porque, en estas exactitudes, el límite de la Sección 4 le deja poco margen para caer.
Relación con Han (2026). Han nombra la descorrelación como el mecanismo práctico. Mis mediciones priorizan la exactitud y la cobertura. Con cobertura igual y un modelo lanzado, la ventaja de un segundo laboratorio desaparece a menos que su modelo sea mucho más exacto (Sección 5.2). En HELM, con exactitud igualada, un segundo laboratorio añade 3,2 puntos de recuerdo por 2,7 puntos de cobertura, y nada una vez que la cobertura también se iguala. La descorrelación es visible allí, con el 27,0 frente al 31,6% de coincidencia de respuestas incorrectas, y es pequeña. La teoría de Han se refiere a la profundidad de puertas en serie y la mía a una única puerta, por lo que las dos se encuentran solo en el primer paso. Liu (2026) separa las mismas dos cosas: la exactitud de selección sigue a la descorrelación, con paneles entre modelos por delante del remuestreo en 12,5 a 16,7 puntos en AIME-2024 con exactitud de miembro igualada, mientras que la calibración de la señal de acuerdo sigue la exactitud del miembro. La precisión de las respuestas acordadas medida aquí es la segunda de estas.
Los dos lados de la Sección 2. Los números publicados reconcilian parcialmente los dos lados. El panel unánime de Liu es correcto en el 100,0% de AIME-2025 con una exactitud de respuesta-todo de 0,433, y en el 70,2% de MMLU-Pro con 0,458. Los nueve jueces unánimes de Kohli, cada uno cerca del 68%, son correctos en el 90,9%. Exactitudes similares dan una precisión de 30 puntos de diferencia, por lo que la exactitud sola no acerca estos resultados. El tamaño del espacio de respuesta explica más. La probabilidad de que dos respuestas incorrectas coincidan es 0,621 en MMLU de cuatro opciones, 0,270 en NaturalQuestions y 0,132 en SimpleQA para modelos insignia de agosto. Estos son paneles y pares en diferentes tareas, sin cálculo conjunto entre los artículos, y son consistentes con la precisión siguiendo la exactitud dentro de una tarea y formato de respuesta.
Familiaridad. Una brecha entre SimpleQA y exactitud reciente invita a una explicación a través de la exposición a referencias, y la coincidencia textual con la cadena de oro parece ser su firma. Mis datos no apoyan esto como covariable (Apéndice C). Entre las respuestas correctas, la coincidencia textual es cercana a un valor entre modelos, y no explica el residual del modelo. F/W en el conjunto reciente en agosto, 0,145 [0,033, 0,402], no muestra distancia visible de 0,132 en SimpleQA, dentro de un intervalo amplio.
Cómo citar
Chernets, V. (2026). La Inversión de Acuerdo No es una Propiedad de Nivel Medio: La Precisión de Respuestas LLM Acordadas Sigue la Precisión de Pares [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7682960
@misc{chernets2026agreementinversion,
  author       = {Chernets, Vadym},
  title        = {{Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7682960},
  url          = {https://doi.org/10.2139/ssrn.7682960}
}