Sealed Before the Open: A Verifiable Standard for Measuring AI Forecasts of Financial Markets
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
Vierzehn US-amerikanische und chinesische KI-Modelle, zwölf Märkte, vier Zeithorizonte: eine versiegelte Live-Liga, eine Zählung unabhängiger Stimmen hinter jedem Konsens und 30 registrierte Prognosen
Vadym Chernets, PhD, KI-Systemarchitekt · Gründer, PolyHelper (polyhelper.ai) · ORCID 0009-0007-4845-3163
SSRN 7653679 · DOI 10.2139/ssrn.7653679 · Zenodo 10.5281/zenodo.23552697 · OSF-Registrierung 10.17605/OSF.IO/9Q86N · Analyse-Veröffentlichung 10.5281/zenodo.23552700 · GitHub
Diese Arbeit herunterladen
- SSRN (bevorzugte Zitierweise): ssrn.com/abstract=7653679 · DOI 10.2139/ssrn.7653679
- Zenodo (archiviert, offener Zugang): doi.org/10.5281/zenodo.23552697
- OSF (die registrierten Prognosen von Abschnitt 8): doi.org/10.17605/OSF.IO/9Q86N
- GitHub (vollständiger Text und die Verifizierungsbefehle von Anlage B): https://github.com/vadimchernets/papers/tree/main/sealed-before-the-open
- Analyse-Veröffentlichung (die Dateien, die diese Version liest, eingefroren, mit einem SHA-256-Manifest): doi.org/10.5281/zenodo.23552700
- Live-Liga und offene Daten (CC BY 4.0): trends.polyhelper.ai/markets/ · trends.polyhelper.ai/api/v1/
Überprüfen Sie eine Versiegelung in drei Schritten (Anlage B): Laden Sie das Buch und den Stempel vom 20. Oktober herunter, hashen Sie das versiegelte Präfix, verifizieren Sie den Anker.
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt.ots
head -n 159 council-book.jsonl | shasum -a 256   # 59673b9e...a7d9, as in 130025Z.txt
ots verify 130025Z.txt.ots                       # Bitcoin block 972,334
Ohne einen Bitcoin-Knoten zeigt ots info 130025Z.txt.ots die Beglaubigung zu Block 972.334, dessen Merkle-Wurzel jeder Block Explorer anzeigt (Anhang B, Schritt 6). Schritt 10 überprüft den Stempel im Sigstore-Rekor-Protokoll.
Zitieren Sie das SSRN-Preprint. Die bewerteten Sitzungen werden vom 20. Oktober 2026 gelesen, aus den am 21. Oktober 2026 zwischen 02:42 und 05:33 UTC erzeugten offenen Dateien. Der erste gezählte Lauf vom 21. Oktober 2026 wird aus den um 22:16 UTC erzeugten Dateien gelesen. Tabelle 5 gibt den Konformitätsstatus wie am 21. Oktober 2026 um 15:05 UTC gelesen an, die Konformitätsprüfung der Anforderung 1 um 22:33 UTC und der Rekor-Eintrag der Anforderung 3 am 22. Oktober 2026 um 00:00:16 UTC.
Schlüsselwörter: KI-Vorhersage; große Sprachmodelle; Finanzmärkte; Vorhersageauswertung; Brier-Score; Kalibrierung; Look-Ahead-Bias; vertrauenswürdige Zeitstempelung; OpenTimestamps; effektive Anzahl unabhängiger Stimmen; Vorhersagemärkte; registrierte Vorhersagen
JEL: G17; C53; C52; G14; D84
Zusammenfassung
Wenn ein KI-Modell sagt, dass Gold steigen wird, kann ein Leser den Anruf beim Schließen bewerten, aber normalerweise nicht überprüfen, wann er gemacht wurde. Ein Backtest vermischt Speicher mit Geschick, und eine Handelssaison ist ein Weg durch den Markt. Ich schlage einen Standard mit nummerierten Anforderungen zur Messung von KI-Prognosen der Finanzmärkte vor und dokumentiere seine Referenzimplementierung, die offene Liga AI Council · Markets, betrieben von PolyHelper, mit einem veröffentlichten Status pro Anforderung. Vierzehn große Sprachmodelle, sieben aus US-amerikanischen und sieben aus chinesischen Laboren, beantworten die gleiche Frage auf einer gemeinsamen Preis-Momentaufnahme, jedes mit seinem eigenen Konto. Elf von ihnen prognostizieren zwölf Indikatoren an vier Horizonten vor jeder New Yorker Eröffnung. Jede gezählte Antwort wird versiegelt in eine SHA-256-Hash-Kette, bevor ihr Referenzpreis und verankert in Bitcoin durch OpenTimestamps. Vom 21. Oktober 2026 wird die gezählte Serie im Voraus erklärt, und unabhängige RFC 3161-Behörden unterzeichnen jeden gestempelten Datensatz, der auch das Sigstore-Rekor-Transparenzprotokoll einträgt. An diesem ersten gezählten Morgen war jede gezählte Antwort vor der 09:30-Uhr-ET-Eröffnung signiert, acht von ihnen 29 Minuten davor. Der Brier-Score des geforderten Ereignisses wird gegen einen 50%-Benchmark, die klimatologische Basisrate und Vorhersagemarktpreise gestellt, und Übereinstimmung wird als eine Anzahl unabhängiger Stimmen gemeldet. An den Entwicklungsmorgen des 19. und 20. Oktober waren die Wahrscheinlichkeitsbilder der Modelle so ähnlich wie die von etwa 1,6 unabhängigen Prognosen. Am 20. Oktober schlossen sich drei der vier engsten Paare einem US-amerikanischen und einem chinesischen Labor an. Gegen eine datierte Karte von 23 KI-Prognose- und Handelsanstrengungen ist die Liga die erste Live-KI-Liga für Finanzindikatoren, die diese Elemente kombiniert. Es ist auch die erste KI-Markt-Arena, in der sieben US-amerikanische und sieben chinesische Modelle unter einem Protokoll neben Lesern handeln, die einmal, zufällig, zugewiesen werden, um vor oder nach dem Sehen der Modelle zu prognostizieren. Dreißig datierte Vorhersagen, die auf OSF vor dem Posten registriert sind, werden in datierten Überarbeitungen bewertet.
Zusammenfassung
Eine Preisvorhersage ist nur dann ein Zeichen von Geschick, wenn der Prognostiker das Ergebnis nicht kannte, die Vorhersage davor existierte, und die bewertete Vorhersage diejenige ist, die zählt, unabhängig davon, was die anderen sagten. KI-Modelle belasten alle drei Bedingungen: Sie können das Ergebnis im Training gelesen haben, können in Sekunden erneut abgefragt werden, und ihre Bilanz wird normalerweise von demjenigen geführt, der sie abgefragt hat. Ich formulierte jede Bedingung als Anforderung, die ein Leser überprüfen kann. AI Council · Markets, betrieben von PolyHelper, ist die Referenzimplementierung.
Jede Frage betrifft ein noch bevorstehendes Ergebnis, das es aus dem Speicher eines Modells fernhält. Ein Markt ist ein Test, der sich selbst erneuert: Er stellt jeden Morgen eine neue Frage und beantwortet sie am selben Nachmittag, sodass kein Modell die Antwort gelesen haben kann. Zwei Vorhersagen vergleichen sich nur, wenn sie auf dasselbe setzen, und die Einheit ist daher ein Ereignisvertrag, der im Voraus festgelegt wird. Jede Antwort wird in eine Hash-Kette versiegelt, bevor sie aus dem Eröffnungskurs bewertet wird, da eine Vorhersage, die die Eröffnungsbewegung gesehen hat, eine andere Frage beantwortet. Ich wollte nicht, dass die Bilanz auf Vertrauen in denjenigen ruht, der sie führt, daher ist die Kette in Bitcoin verankert und wird seit 21. Oktober 2026 von unabhängigen Zeitstempel-Behörden signiert. Ein Durchlauf pro Sitzung zählt. Ab 21. Oktober wird die Regel, die ihn auswählt, im Voraus erklärt und versiegelt, und die anderen Durchläufe bleiben veröffentlicht und gekennzeichnet.
Die Punktzahl ist die Brier-Punktzahl des abgefragten Ereignisses. Sie ist eine echte Punktzahl, daher gewinnt ein Prognostiker nichts, wenn er etwas anderes als seinen Glauben angibt. Die Liga bewertet sie gegen eine Münze, die Basisquote des Ereignisses und Vorhersagemarktpreise, drei verschiedene Maßstäbe für Geschick. Korrelierte Modelle sind keine separaten Zeugen, und eine Übereinstimmung zwischen ihnen wird als Anzahl unabhängiger Stimmen gemeldet. Sieben US- und sieben chinesische Modelle teilen die Frage, den Snapshot, die Frist und die Regeln, sodass jeder Unterschied zwischen den Seiten auf einer Aufgabe gemessen wird. Leser werden einmal randomisiert, um die Modelle vor oder nach ihrer Vorhersage zu sehen, und bleiben in dieser Gruppe. Sie messen, ob Modelle Menschen helfen oder sie nur mitziehen (F28, F29).
Die zwei Entwicklungsvormittage zeigen, was diese Maße ablesen. Bei der eintägigen Frist waren die Wahrscheinlichkeitsbilder der vor der Eröffnung versiegelten Modelle so ähnlich wie die von weniger als zwei unabhängigen Prognostikern. Sie waren am entschiedensten in sechs Monaten, wo ihre Vorhersagen zuletzt aufgelöst werden, und am 20. Oktober schlossen sich drei der vier engsten Paare einem US- und einem chinesischen Labor an. Ein primärer Test und dreißig Vorhersagen, auf OSF vor der Veröffentlichung registriert, werden in datierten Revisionen auf offenen Daten und Code bewertet.
1. Einleitung
Montagmorgens fragt eine Person ein KI-Modell, ob sie Gold kaufen soll. Das Modell bejaht dies mit einiger Sicherheit und gibt einen Grund an. Bis Handelsschluss ist Gold gefallen. War das Modell falsch, oder einfach nur Pech gehabt, oder war dies eine von mehreren Antworten, die es an jenem Morgen gegeben hat? Existierte die Antwort um 09:00 Uhr, oder wurde sie um 12:00 Uhr geschrieben? Die Person kann das nicht feststellen. In den meisten der in Abschnitt 7 überprüften Evaluationen ruht der Zeitpunkt einer Prognose auf der Aufzeichnung des Betreibers. Die Liga, die ich hier beschreibe, hält diese Aufzeichnung außerhalb des Betreibers. Am Dienstag, 20. Oktober 2026, vor Handelsöffnung, gaben acht Modelle Gold im Durchschnitt eine 45%ige Chance, beim Tageskontrakt von Polymarket mit Gewinn zu schließen, und die Crowd bepreiste diesen Kontrakt mit 29%. Beide Zahlen wurden vor der 09:30 ET-Öffnung versiegelt, und jeder kann sie nachlesen (Anhang B).
Arenen, in denen Modelle mit echtem Geld handeln, zogen 2025 große Aufmerksamkeit auf sich (Forklog, 2025a, 2025b), und KI-Prognose-Benchmarks erreichten die wichtigsten Veranstaltungen im Bereich des maschinellen Lernens: ForecastBench bei der ICLR 2025 (Karger et al., 2025), FutureX (Zeng et al., 2025) und Prophet Arena (Yang et al., 2025) bei der ICLR 2026. Handels-Benchmarks stellten fest, dass die meisten Agenten „Buy and Hold" nicht schlugen (Y. Chen et al., 2025; Yu et al., 2025), und auf liquiden Prognosemärkten blieb ein starkes KI-Prognosesystem weiterhin hinter dem Marktkonsens zurück, während eine Kombination der beiden beide schlugen (Alur et al., 2025).
Diese Bemühungen teilen eine Abhängigkeit: der Nachweis, dass eine Prognose ihrem Ergebnis vorausging, wird von demjenigen aufbewahrt, der die Evaluierung durchführte. Backtests können ihn überhaupt nicht liefern, da das Modell das Ergebnis möglicherweise bereits kennt (Lopez-Lira et al., 2025; Paleka et al., 2026). Live-Benchmarks liefern ihn durch die Aufzeichnungen des Betreibers, und Prophet Arena fügt jeder Prognose ein gehashtes SHA-256-Siegel hinzu, mit optionalen signierten Quittungen, zeitgestempelt von der eigenen Uhr der Plattform (Prophet Arena, 2026). Foresight Arena speichert gehashte Prognosen von Polymarket-Events, einige davon zu Vermögenspreisen, auf der Polygon-Chain vor einer Frist und bewertet sie gegen den Marktpreis. Die überarbeitete Version meldet simulierte Ergebnisse und verschiebt Live-Ergebnisse (Nechepurenko & Shuvalov, 2026a). Prediction Arena gab Frontier-Modellen echtes Kapital auf Kalshi und Polymarket und führte Betreiberlogs ohne Verpflichtung (Zhang et al., 2026). Außerhalb der KI wurden Prognosen von Finanzblasen bereits 2010 durch Checksum mit verzögerter Offenlegung versiegelt (Sornette et al., 2010), und außerhalb von Märkten wurden die Fußballwahrscheinlichkeiten einer KI seit Juli 2026 in Bitcoin verankert (NeuPortal, 2026). Ich fand keine Live-Liga von KI-Prognosen auf einem festen Panel von Finanzindikatoren, die ihre Aufzeichnungen außerhalb der Kontrolle des Betreibers verankert (Abschnitt 7). Meine Forschungsfrage ist, was eine Messung von KI-Marktprognosen braucht, damit ein Leser gegen eine Uhr außerhalb der Kontrolle des Betreibers überprüfen kann, was prognostiziert wurde, bis wann, und welche Prognose zählte.
Ich schlage einen Standard für diese Messung vor, geschrieben als eine Checkliste von MUSS- und SOLLTE-Anforderungen (Abschnitt 3.13), und dokumentiere eine Implementierung davon, die offene Live-Liga AI Council · Markets, betrieben von PolyHelper, unter trends.polyhelper.ai/markets. Vierzehn Modelle, sieben aus US-amerikanischen und sieben aus chinesischen Laboren, betreiben simulierte Portfolios auf derselben Frage, Snapshot und Regeln, und elf von ihnen sitzen im Council und geben Wahrscheinlichkeiten. Jeden Morgen vor der New Yorker Öffnung prognostiziert der Council 12 Finanzindikatoren über Aktienindizes, Zinsen, den Dollar, Volatilität, Rohstoffe und Bitcoin in vier Zeithorizonten von einem Tag bis zu sechs Monaten. Jede Antwort wird in einem kettenverzahnten Buch versiegelt, dessen Kopf durch OpenTimestamps in Bitcoin verankert ist. Jede Antwort wird vom ersten Preis nach ihrer Versiegelung bewertet, und das Buch wird mit dem Bewertungscode und den Daten veröffentlicht. Ab 21. Oktober 2026 signieren auch unabhängige RFC 3161 Time-Stamping-Behörden jeden gestempelten Datensatz, sodass ein Leser gegen Uhren außerhalb der Kontrolle des Betreibers überprüfen kann, dass die gezählten Antworten vor dem Eröffnungspreis, auf den sie bewertet werden, existierten (Abschnitt 3.2). Der versiegelte Datensatz ist auch eine neue Art von offenen Daten für Finanzen: ein tägliches Panel von Wahrscheinlichkeiten von vielen KI-Modellen auf denselben Events, fixiert vor der Öffnung, bei dem ihre Meinungsverschiedenheiten und deren Wert gemessen werden können.
Der Event-Kontrakt wird als Schema mit einem Checker veröffentlicht, das jede andere Liga auf ihren eigenen Dateien ausführen kann (Abschnitt 3.13). Das, was ich beitrage, ist der Standard und eine Implementierung, die ein Leser überprüfen kann. Die ersten Sitzungen zeigen die Daten, die sie produziert, und die registrierten Tests von Abschnitt 8 entscheiden über Geschick. Abschnitt 3 legt den Standard fest und Abschnitt 4 ein Bewertungsdesign für eine Live-Markt-Umgebung. Abschnitt 5 misst die effektive Anzahl unabhängiger Stimmen auf Live-Daten, Abschnitt 6 legt ein Design für Menschen vor KI dar, und Abschnitt 7 zeichnet eine datierte Karte von KI-Markt-Arenen. Abschnitt 8 enthält die registrierten Vorhersagen, Abschnitt 9 die stärksten Einwände mit der Regel, die jede beantwortet, und Abschnitt 10 die Reichweite jeder Behauptung. Abschnitt 7.4 gibt an, was neu ist, in drei Behauptungen und drei weitere Designs zuerst unter den überprüften KI-Markt-Arenen, und worauf die Liga aufbaut, jeweils mit seinem nächsten Vorgänger. Anhang E gibt die Evidenz Zelle für Zelle.
2. Warum Rückblickwissen KI-Marktprognosen bricht
Menschliche Prognosewettbewerbe schützen die drei Bedingungen der Zusammenfassung durch Anmeldungsfristen und einen vertrauenswürdigen Organisator. KI-Modelle schlüpfen an jedem Schutzmechanismus vorbei. Ein Modell kann das Ergebnis aus seinem Training kennen, es kann innerhalb einer Minute viele Male abgefragt werden, und die Aufzeichnung dessen, was es sagte, wird in der Regel von der Person geführt, die fragte. Die ersten drei Unterabschnitte behandeln diese nacheinander, und der vierte erklärt, warum eine Handelssaison nicht als Prognosearchiv fungieren kann.
2.1 Was ein Modell sich merkt
Die kostengünstigste Bewertung eines KI-Modells beim finanziellen Prognostizieren ist ein Backtest, aber die Trainingsdaten des Modells können bereits enthalten, was danach geschah. Lopez-Lira et al. (2025) zeigten, dass große Sprachmodelle exakte Werte makroökonomischer und Finanzreihen vor ihrem Trainingsstichtag abrufen, dass eine Anweisung, später verfügbares Wissen nicht zu nutzen, diesen Abruf nicht entfernt, und dass der Abruf nach dem Stichtag endet: innerhalb des Trainingsfensters werden Geschick und Gedächtnis nicht unterschieden.
Gao et al. (2025) entwickelten einen Test für Look-ahead-Verzerrung, die Look-ahead-Neigung. In einer Replikation des Ergebnisses, dass Modellbewertungen von Nachrichtenschlagzeilen Aktienrenditen vorhersagen (Lopez-Lira & Tang, 2023), wurde die Vorhersagekraft bei Beobachtungen mit hoher Look-ahead-Neigung verstärkt. Nach dem Stichtag blieb das rohe Signal bestehen, während die mit Memorierung verbundene Wechselwirkung ihre Signifikanz verlor. Glasserman und Lin (2023) trennten zwei In-Sample-Verzerrungen von GPT-Sentiment-Backtests, Look-ahead und eine Ablenkung durch das, was das Modell über das benannte Unternehmen weiß, und stellten fest, dass letztere größer ist, besonders bei großen Unternehmen. Über zwanzig Jahre Daten stellte das FINSABER-Framework fest, dass die für LLM-Anlagestrategien gemeldeten Vorteile deutlich schrumpfen, wenn Survivorship, Data Snooping und Look-ahead kontrolliert werden (W. W. Li et al., 2025), und Benchmarks, die auf historischer Simulation aufbauen, wie InvestorBench (H. Li et al., 2025), erben dieselbe Anfälligkeit.
Die Literatur behebt dies auf zwei Wegen. Einer beschränkt das Modell: Chronologisch konsistente Sprachmodelle werden nur auf Text trainiert, der vor jedem Prognosedatum verfügbar ist (He et al., 2025). Der andere beschränkt die Zeit: Jedes Modell wird mit voller Kraft und mit Suche nach einem noch ausstehenden Ergebnis gefragt, und die Antwort wird überprüfbar festgelegt, bevor das Ergebnis existiert. Ich wählte, die Zeit zu beschränken und das Modell mit voller Kraft zu lassen. Die beiden Wege sind komplementär, da ein chronologisch konsistentes Modell in eine versiegelte Liga eintreten kann.
2.2 Leckagewege
Der Wechsel zu Live-Fragen beseitigt das größte Leck, aber nicht jedes Leck. Paleka et al. (2026) zeigen, dass zeitliche Lecks bei der Bewertung von Sprachmodell-Prognostizierern oft subtil sind, und dass die Leistung bei einer Bewertung möglicherweise nicht zur Prognose in der Welt überträgt. FutureX berichtet über Ausfallmodi der gleichen Familie, darunter gefälschte Webseiten und Antworten, deren zeitliche Gültigkeit falsch ist (Zeng et al., 2025). Bei makrofinanziellen Prognosen reduziert die Beschränkung der Eingaben eines Modells auf das, was zum Zeitpunkt der Entscheidung verfügbar war, einen großen Teil des scheinbaren Geschicks, das fehlerhafte Benchmarks melden (Guan & Chen, 2026). Eine genannte Form ist Tages-übergreifendes Ereignisdriften: Artikel aus den Tagen nach einer Gewinnmitteilung enthalten bereits die Reaktion des Marktes, und wenn sie in die Eingaben für einen früheren Tag eingehen, leckt das Ergebnis in die Prognose (Zhang & Zhang, 2026). Eine Prognose, die vor dem Referenzpreis versiegelt ist, kann nicht auf nach diesem geschriebene Texte zurückgreifen.
Für Finanzmärkte ist das Timing-Problem konkret. Eine Prognose für den Tag, die um 09:29 Uhr aufgezeichnet ist, und eine, die um 09:45 Uhr aufgezeichnet ist, sind unterschiedliche Objekte, weil die zweite die Eröffnungsbewegung sehen kann. Wenn die Aufzeichnung des Zeitpunkts einer Prognose nur vom Betreiber geführt wird, muss ein Leser darauf vertrauen, dass keine später abgegebene Antwort an die Stelle einer früheren trat. Voranmeldung trennt die Erzeugung einer Hypothese von ihrem Test, indem sie in einem öffentlichen Datensatz festgelegt wird, bevor die Daten existieren (Nosek et al., 2018). Eine versiegelte Prognose ist Anmeldung, die automatisch und täglich erfolgt, und vertrauenswürdige Zeitstempel lassen eine dritte Partei ihre Zeit überprüfen (Haber & Stornetta, 1991; Todd, 2016).
2.3 Viele Durchläufe, eine Bewertung
Ein Prognostizierender in einem Wettbewerb reicht normalerweise eine Antwort bis zu einer Frist ein. Ein Modell kann zehnmal abgefragt werden, mit etwas anderen Formulierungen oder zu etwas anderen Zeiten, und seine Antworten variieren. Ein Bewerter, der das beste von zehn behält, oder eine Pipeline nach einem Fehler neu ausführt und den Neustart behält, bläst das Geschick auf, ohne eine einzige Prognose zu ändern, und die Aufblähung ist unsichtbar, es sei denn, jeder Durchlauf wird aufgezeichnet und die Regel, welcher Durchlauf zählt, wird im Voraus festgelegt. Ich schrieb daher den Standard so, dass er jeden Durchlauf, den er sendet, versiegelt, einen Durchlauf pro Sitzung nach einer im Voraus geschriebenen Regel zählt und die anderen als beschriftete Referenzberechnungen behält (Abschnitt 3.4).
2.4 Eine Trajektorie ist keine Messung
Arenen, in denen Modelle Geld handeln, beantworten, wessen Entscheidungen Geld verdient hätten, aber die Rendite eines Portfolios über eine Saison ist ein Zug aus den Pfaden, die der Markt hätte nehmen können. Presseberichte der ersten beiden Jahreszeiten der Alpha Arena berichten von einer Umkehrung der Rangliste: Das Modell, das die erste Jahreszeit gewann, zu Kryptowährungs-Perpetual-Futures, war unter den schwächsten in der zweiten, zu tokenisierten US-Aktien mit neuen Formaten und Hebelwirkung (Forklog, 2025a, 2025b; Yahoo Finance, 2025). Vermögenswerte, Formate und Modelle änderten sich zwischen den Jahreszeiten, so dass die Umkehrung, wie diese Berichte sie darstellen, das Glück nicht identifiziert. Es ist das, was eine Jahreszeit als eine Trajektorie vorhersagt. StockBench stellte fest, dass die meisten Agenten, die Dow-Aktien für etwa vier Monate handelten, Buy and Hold nicht schlugen (Y. Chen et al., 2025), LiveTradeBench stellte über 50 Live-Tage fest, dass allgemeine Chat-Ranglisten keine Handelsergebnisse vorhersagten (Yu et al., 2025), und PredictionMarketBench stellte fest, dass naive Agenten gegen Gebühren und Abrechnung auf wiedergegebenen Kalshi-Orderbüchern verlieren (Arora & Malpani, 2026). Prediction Arena gab einer Kohorte von Frontier-Modellen echtes Kapital für 57 Tage, und die gleichen Modelle erzielten durchschnittlich eine Rendite von −22,6 % auf Kalshi und −1,1 % auf Polymarket (Zhang et al., 2026): der Veranstaltungsort verschob das Durchschnittsergebnis um mehr als zwanzig Punkte. Keiner kann sagen, ob ein Modell etwas über den Markt wusste, weil eine Rendite die Richtung eines Calls, seine Größe, sein Timing, seine Kosten und den Pfad des Marktes in eine Zahl mischt.
Wahrscheinlichkeiten isolieren die Richtung und Sicherheit einer Aussage. Ein Modell, das eine 70%-ige Chance angibt, dass Gold heute steigt, kann allein auf dieser Aussage bewertet werden, nach einer streng eigentlichen Regel (Brier, 1950; Gneiting & Raftery, 2007). Zwölf Märkte bei vier Zeithorizonten ergeben viele solche Aussagen pro Modell pro Tag, obwohl die zwölf Märkte eines Tages eine Sitzung teilen (Abschnitt 4.6). Bei Fragen aus einem regulierten Prognose-Markt, der nach dem Training der Modelle gelöst wurde, waren fünf führende Modelle überconfident, und erweiterte Überlegungen verschlechterten die Kalibrierung (Nel, 2025).
2.5 Was die drei Bedingungen erfordern
Die Prognose muss nach dem Cutoff-Datum des Modells über ein noch bevorstehend Ergebnis gemacht werden (2.1). Ihr Zeitpunkt muss vor dem Ergebnis in einem Datensatz festgelegt werden, dessen spätere Änderung eine dritte Partei erkennen kann (2.2). Die Regel, welche Prognose zählt, muss vor den Läufen festgelegt werden (2.3). Die Punktzahl muss ein eigentliches Ergebnis des gestellten Ereignisses sein, aggregiert über genug unabhängige Sitzungen, um Geschick von Glück zu unterscheiden, mit einer Überprüfung der Kalibrierung (2.4). Und die Übereinstimmung zwischen Modellen muss für die Korrelation ihrer Fehler bereinigt werden, bevor sie als Evidenz gelesen wird (Clemen & Winkler, 1985; Kim et al., 2025; Chernets, 2026a). Abschnitt 3 schreibt die fünf als Checkliste.
3. Das Protokoll
Das Protokoll macht den Moment einer Vorhersage zu einer Tatsache, die ein Dritter überprüfen kann, und es sagt, welche Schicht dieser Tatsache auf wem ruht. Alles Folgende wird in den offenen Dateien der Liga veröffentlicht (AI Council · Markets, 2026): das Protokoll als arena-protocol.json, das versiegelte Buch als council-book.jsonl, die Fragentexte unter asks/ und die gestempelten Listen mit ihren OpenTimestamps-Nachweisen auf einer Seite pro Tag (/markets/proof/<day>/). Ich beschreibe die Regeln, wie sie am 20. Oktober 2026 galten (Protokoll arena-3, Scoring-Methodik Version 2), und verwende den Lauf dieses Morgens, 2026-10-20-am, als durchgerechnetes Beispiel; jede Zeit und jeder Hash, der dafür zitiert wird, kann aus den offenen Dateien zurückgelesen werden (Appendix B). Jedes Siegel trägt die Version der Methodik, die in Kraft ist, und eine spätere Regeländerung lässt alles, das davor versiegelt wurde, so wie es war.
Der Ereignisvertrag. Der Standard misst Ereignisse. Ein Modell, ein Lauf oder eine Zeile einer Rangliste ist eine Sammlung davon, und ich definiere jedes Ereignis durch einen Vertrag, der festgelegt wird, bevor die Frage herausgeht (Tabelle 1). Zwei Vorhersagen gehören zum gleichen Ereignis nur, wenn jedes Feld übereinstimmt. Eine Vorhersage mit einer eigenen Referenz, wie z. B. eine Zeile, die nach der Eröffnung versiegelt wird (Abschnitt 3.3), ist eine Vorhersage auf ein anderes Ereignis. Sie wird auf dieses Ereignis bewertet und aus jeder Statistik ausgeschlossen, die Modelle auf ein gemeinsames Ereignis vergleicht (Anforderung 4).
Das Wort yield bezeichnet drei separate Ereignisse in dieser Liga. Die Vorhersage betrifft die 10-Jahres-Rendite selbst, in Renditeeinheiten, von ihrer Referenz zu ihrem Terminalpreis um 15:00 Uhr ET. Der Crowd-Vertrag, wenn die Frage einen auflistet, wird auf die 3:30-Uhr-ET-Par-Rendite des Treasury aufgelöst, von Schluss zu Schluss, und wird auf diesen Bedingungen bewertet (Abschnitt 4.9). Das Portfolio hält einen Treasury-Bond-Fonds (IEF), der steigt, wenn die Rendite fällt (Abschnitt 4.7). Am 20. Oktober bepreiste die Crowd den Renditevertrag mit 7 % gegenüber der vorherigen Par-Rendite von 5,15 %, ein Preis, der bereits den Rückgang vor Markteröffnung widerspiegelte; die eigene Frage der Liga zur Rendite beginnt mit der 09:30-Referenz und fragt etwas anderes. Ein richtiger Call auf einem sagt von selbst nichts über die anderen aus. VIX wird auf die gleiche Weise aufgeteilt: die Vorhersage betrifft den Index, das gewöhnliche Portfolio kann ihn nicht halten, die Pro-Liga kann.
Tabelle 1. Mindestfelder eines Ereignisvertrags und wo die Referenzimplementierung jedes davon festlegt.
| Feld | Was es festlegt | Referenzimplementierung |
|---|---|---|
| Target | Der Indikator selbst, nicht ein Instrument, das ihn abbildet | 12 Indikatoren nach Code; gehandelte Fonds erscheinen nur in den Portfolio-Ligas (assets, trades_as) |
| Prädikat und Horizont | Das Ereignis: ein strikter Anstieg von der Referenz zum Terminalpreis | prob_up; 1d; 1w, 1m, 6m als 5, 21 und 126 Sitzungen (Bitcoin 7, 30 und 182 Kalendertage) |
| Preisquelle | Anbieter, Symbol, Balkengröße und Zeitstempelregel für Referenz- und Terminalpreis pro Indikator | Anbieter, Symbol und Referenzregel in jeder Vorhersagezeile (price_provider, price_symbol, reference_rule; für den S&P 500 der Einminuten-Balken von ^GSPC zur oder nach der Referenzzeit), deklariert pro Indikator im Vertragschema; Quelle der Portfolio-Preise im Protokoll (prices) |
| Informationsabschnitt | Was eine Vorhersage verwenden darf: alles vor dem Referenzpreis, nie den Referenzpreis selbst | Preismomentaufnahme und Frage in die Laufzeile gehasht (snapshot_sha256, ask_sha256) |
| Frist und gezählter Lauf | Welche Antwort für die Sitzung zählt | Vom 21. Oktober 2026 der geplante Morgenlauf, im Voraus erklärt, versiegelt in asks.jsonl und auf der Nachweisseite veröffentlicht; darin die Zeile, die zuletzt vor der Referenz versiegelt wurde (counted), und ab Sitzung 11 (2. November 2026) die erste wohlgeformte Antwortzeile jedes Platzes, die vor der Referenz versiegelt wurde, spätere Zeilen desselben Platzes werden als Wiederholungen gekennzeichnet, nach einer in asks.jsonl erklärten Regel, Zeile 74, Text-SHA-256 0f42c93b…b0b6cd. Für den 19. und 20. Oktober der zuletzt vor der Eröffnung versiegelte Lauf (session_run), angewendet nach den Läufen; in jedem bis heute gezählten Lauf versiegelte jeder Platz eine Antwortzeile, sodass die erste und die letzte Zeile vor der Referenz gleich sind |
| Referenzpreis | Ein Referenzpreis pro Ereignis, genommen nach der Versiegelung | Erster Preis zur oder nach 09:30 Uhr ET; Bitcoin der Schluss des ersten Einminuten-Balkens, der zur oder nach dem Siegel der Zeile beginnt (reference, btc) |
| Auflösung | Terminalpreis, seine Zeit und seine Regel | Schluss der letzten Sitzung des Horizonts um 16:00 Uhr ET; die 10-Jahres-Rendite um 15:00 Uhr ET; Bitcoins Tag vom Siegel-Minute bis 16:00 Uhr ET der Bewertungssitzung |
| Draw-Regel | Welche kleinen Bewegungen Draws sind und wie sie bewertet werden | Band von 0,1 mal einer Einminuten-Balkenskala der Tagesbewegung, etwa 0,08 einer Sitzungs-Standardabweichung; Roll-Sitzungen ausgeschlossen (direction, noise_rolls) |
| Scoring-Regel und Benchmarks | Der angemessene Score und womit er verglichen wird | Brier-Score über alle Zeilen; 50 %-Benchmark; feste Klimatologie des Ereignisses (climatology_fixed, Abschnitt 4.3) |
| Regelversion | Welche Methodik gilt | methodology.version, versiegelt in jeder Laufzeile; methodology_version in jeder Vorhersagezeile |
| Ereigniskennung | Ein Schlüssel für „das gleiche Ereignis" | event_id_v2, ein Hash der neun Schlüssel des vollständigen Vertrags, mit der Fünf-Schlüssel-event_id daneben (event-contract.schema.json, Abschnitt 3.13) |
Hinweis: Feldnamen in Klammern sind die der offenen Dateien (arena-protocol.json, das Feld methodology jeder Laufzeile, council-stats.json, council-calibration.json und die Spalten von council-forecasts.csv). Das 15:00-Uhr-ET-Fenster der Rendite wird in der versiegelten Laufzeile vom 20. Oktober angegeben.
3.1 Ein Tag der Liga
Abbildung 1 verfolgt einen Ligentag von der Momentaufnahme bis zur Punktzahl.
Schnappschuss. Bevor die Frage hinausgeht, erstellt die Engine einen Preis-Schnappschuss von 12 Märkten: S&P 500, Nasdaq-100, Dow Jones, den Halbleiterindex (SOX), die US-10-Jahres-Rendite, den Dollar-Index (DXY), VIX, Gold, WTI, Brent, Kupfer und Bitcoin (Tabelle 2). Jede Zeile enthält ihren Preis, kürzliche Veränderungen, das 52-Wochen-Intervall und die Minute, in der es gelesen wurde; vor der Eröffnung enthalten die Aktienindex- und Renditezeilen die vorherige Sitzung, während die anderen Zeilen live sind. Der SHA-256 des Schnappschusses wird in die Laufzeile geschrieben (snapshot_sha256), sodass ein späterer Anspruch, dass die KIs unterschiedliche Preise sahen, geprüft werden kann.
Frage. Vierzehn Sitze handeln; elf von ihnen geben auch Wahrscheinlichkeiten an und bilden den Rat, fünf aus US- und sechs aus chinesischen Laboratorien, und drei Sitze auf der Bank handeln nur (Tabelle 8). Eine Frage geht an jedes Modell des Rates, Wort für Wort, außer einem Block, der jedem Modell sein eigenes Konto gibt. Der SHA-256 des gemeinsamen Textes wird in die Laufzeile geschrieben (ask_sha256) und in jeder Antwortzeile wiederholt, und der Text wird als asks/<sha256>.md veröffentlicht. Der Hash des Textes, den jedes Modell erhielt, einschließlich seines eigenen Kontos, wird versiegelt, wenn er gesendet wird (asks.jsonl). Am 20. Oktober öffnete sich die Frage um 08:30 EDT, und ihre veröffentlichte Datei wird zu dem Wert in der Laufzeile gehasht, 77d3c627…6f07. Sie gab auch die Pre-Open-Veränderungen der Aktienindex-Futures an und teilte den KIs mit, dass sie diese nutzen dürfen (Abschnitt 3.3).
Siegel vor 09:30 ET. Jede Antwort wird als eine Zeile des Hash-verketteten Buches gebucht. Am 20. Oktober tragen die acht gezählten Antworten Antwortzeiten von 12:31:11Z bis 12:42:02Z; die Laufzeile und die Antworten traten in einem Batch in das Buch ein, die Antworten mit booked_at 13:00:25Z, und der Batch wurde um 13:00:25Z gestempelt (09:00:25 ET). Ein Batch-Siegel zeitstempelt den Batch. Anforderung 12 siegelt jede Antwort bei der Ankunft, und der Morgen des 21. Oktober zeigt beide Formen. Die ersten acht gezählten Antworten (12:32:52Z bis 12:44:59Z) wurden in einem Batch um 13:00:19Z gebucht, die zweite, bei der zwei externe Behörden ihre gestempelte Liste unterzeichneten, und eine neunte wurde um 13:23:37Z gebucht, 14 Sekunden nach ihrer Ankunft, die zweite, bei der drei Behörden die nächste Liste unterzeichneten (Abschnitt 3.2). Die Nachweisseite vom 20. Oktober verzeichnet, dass „die Aufnahme für die Bewertung am Dienstag, 20. Oktober 2026, 9:30 Uhr ET (2026-10-20T13:30:00Z) geschlossen wurde". An diesem Tag wurden vier Stempel genommen, um 13:00:25Z, 15:00:12Z, 15:36:05Z und 16:52:54Z, verankert in Blöcken 972.334, 972.344, 972.354 und 972.359. Der erste deckt die Zeilen 1 bis 159 ab, die die Laufzeile (151) und die acht gezählten Antworten (152 bis 159) enthalten.
Eröffnung. Der Referenzpreis jedes Marktes außer Bitcoin ist der erste Preis am oder nach 09:30 ET; für Bitcoin, das rund um die Uhr handelt, ist es der Schluss des ersten Ein-Minuten-Balkens, der am oder nach dem Siegel der Zeile beginnt. Die Referenz wird immer nach dem Siegel genommen (Abschnitt 3.3).
Bewertung nach Schlusshandel. Nach dem Schlusshandel um 16:00 ET schreibt die Engine eine Bewertungszeile mit dem Referenzpreis, Schluss, Veränderung, Draw-Flag und der Wahrscheinlichkeit, die jedes Modell angab, in das gleiche Buch. Am 20. Oktober wurde die Bewertungszeile (Zeile 184) um 20:30:36Z gebucht, nach dem letzten Stempel des Tages, sodass sie vom nächsten Stempel abgedeckt wird, dem ersten vom 21. Oktober. Längere Zeiträume werden bewertet, wenn ihre Fenster schließen, als ihre eigenen Zeilen.
Abbildung 1. Ein Tag der Liga: Schnappschuss, Frage, Siegel, Eröffnung, Bewertung.
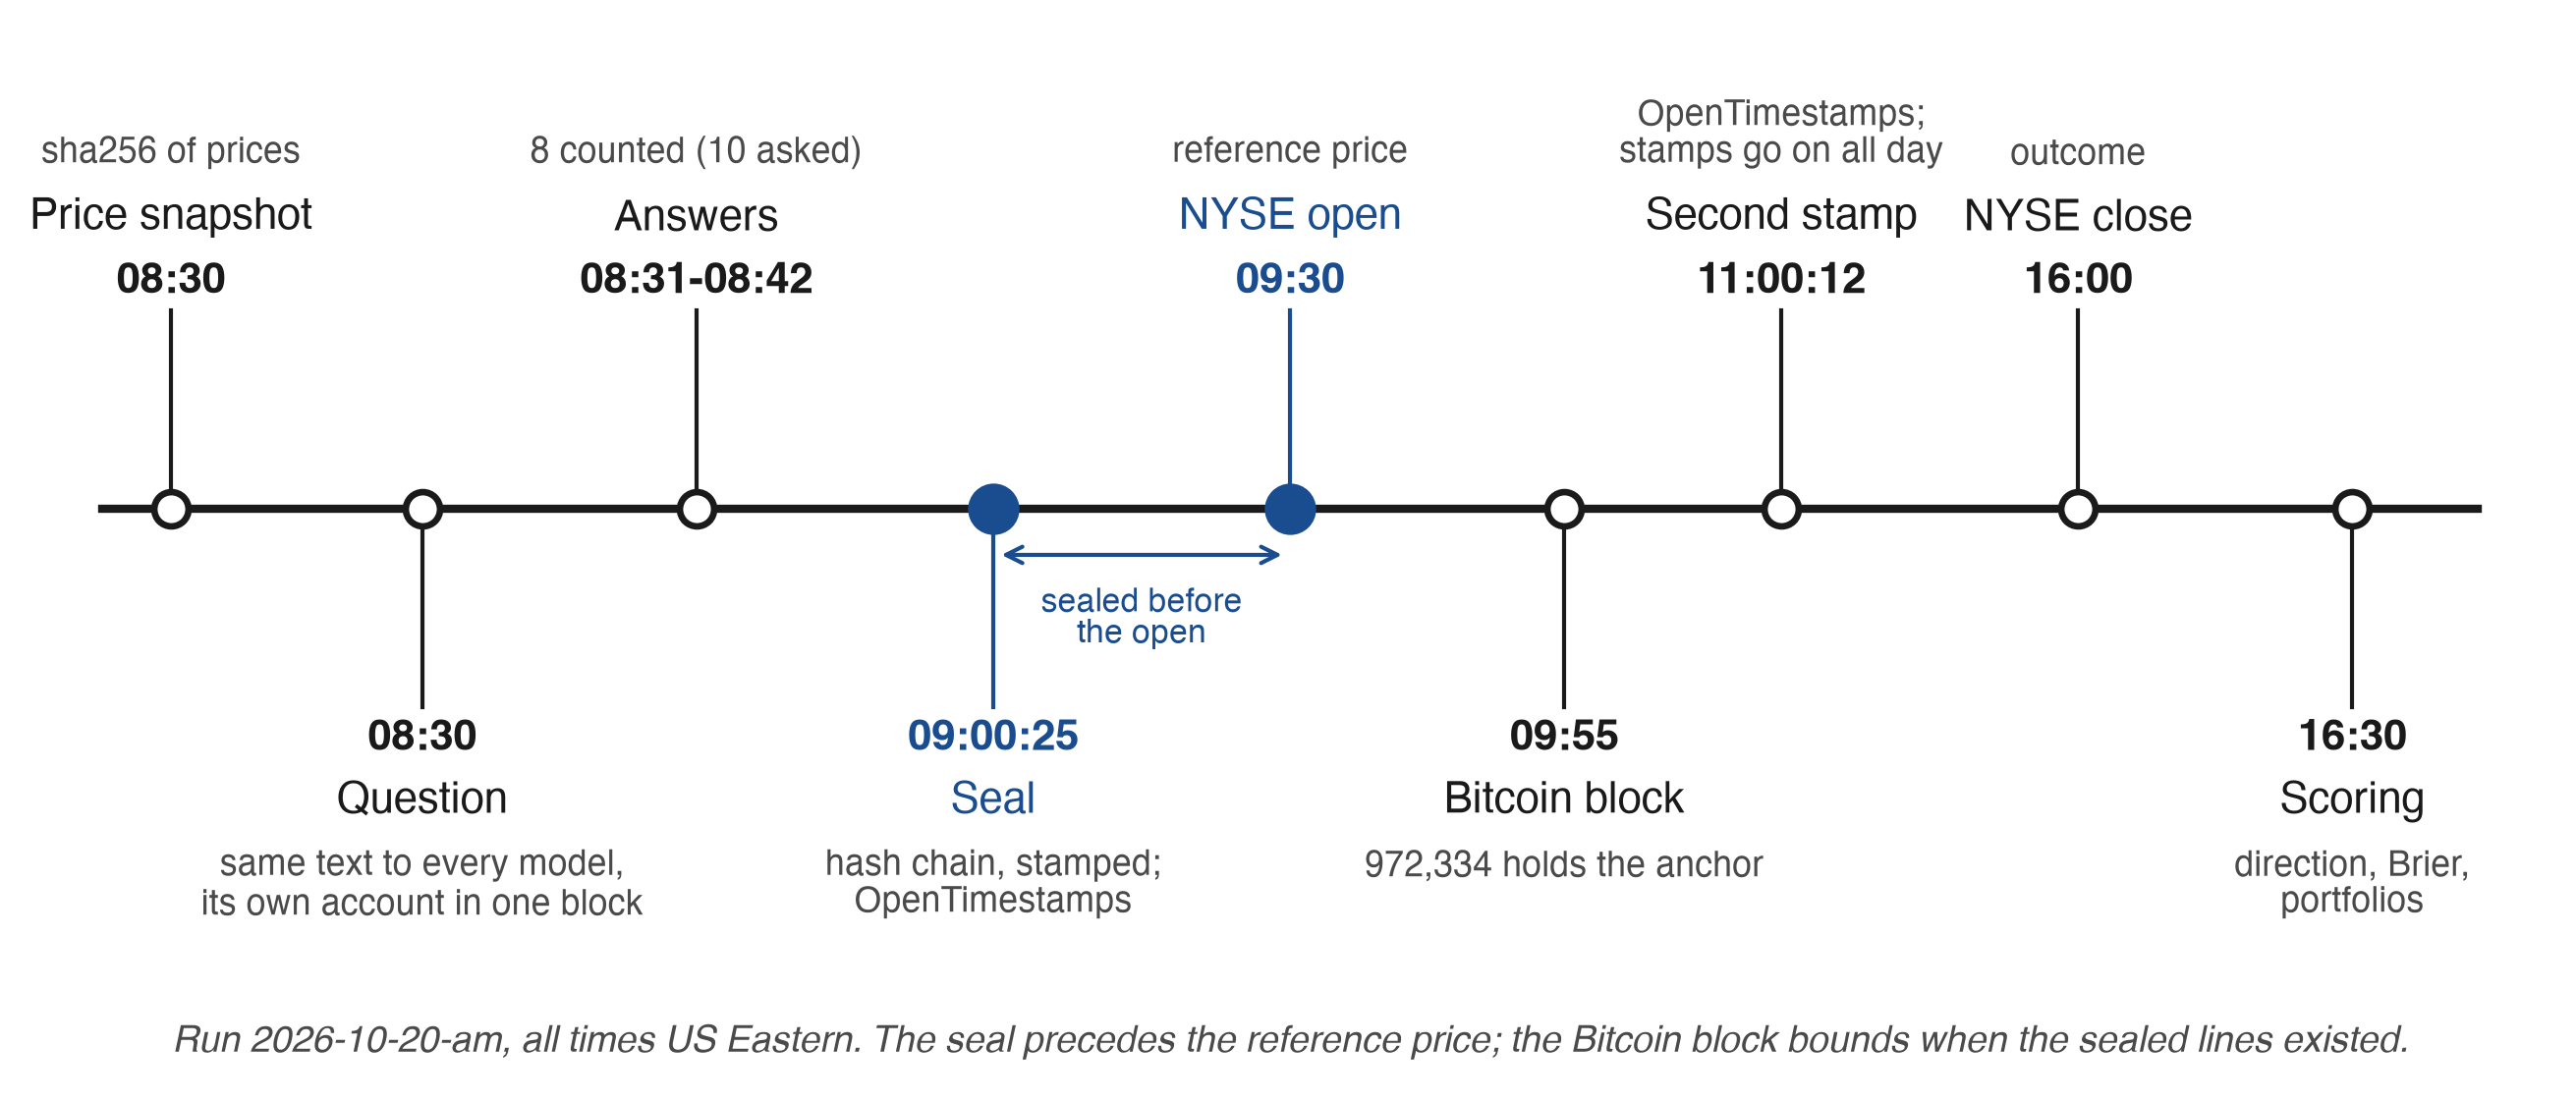
Hinweis: Zeiten sind diejenigen der Laufzeit 2026-10-20-am, gelesen aus council-book.jsonl und der Nachweisseite /markets/proof/2026-10-20/. ET ist New-York-Zeit. Die Bitcoin-Blockzeit ist die Header-Zeit von Block 972.334, der den Anker des 13:00:25Z-Stempels hält. Eine Header-Zeit begrenzt die Abbauzeit durch die praktische Grenze (Abschnitt 3.11). Der zweite Stempel des Tages, 15:00:12Z (11:00:12 ET), ist gekennzeichnet, um zu zeigen, dass Stempel den ganzen Tag über erfolgen; die Bewertungszeile von 20:30:36Z wird durch den ersten Stempel des nächsten Tages abgedeckt.
In Tabelle 2 gebe ich für jeden Markt das Preissymbol, auf das sein Ereignis aufgelöst wird, das Ende seines eintägigen Ereignisses, den Fonds, durch den die Portfolio-Ligen ihn halten, und den Crowd-Vertrag an, der mit der Frage am 20. Oktober 2026 versiegelt wurde.
Tabelle 2. Die zwölf Märkte: Preissymbol, Referenz und Ende des eintägigen Ereignisses, der Fonds, in dem jeder wie in den Portfolio-Ligen handelt, und der Crowd-Vertrag, der am 20. Oktober 2026 versiegelt wurde.
| Markt | Code | Preissymbol | Referenz | Ende des eintägigen Ereignisses (ET) | Gehandelt als | Crowd-Vertrag, 20. Oktober 2026 (Plattform, versiegeltes Volumen $) |
|---|---|---|---|---|---|---|
| S&P 500 | SPX | ^GSPC |
Erster 1-Min-Balken am oder nach 09:30 ET | 16:00 | SPY | Polymarket, 20.637 (Kalshi auch notiert) |
| Nasdaq-100 | NDX | ^NDX |
Gleich | 16:00 | QQQ | Kalshi, 1.150 |
| Dow Jones | DJI | ^DJI |
Gleich | 16:00 | DIA | Polymarket, 20 |
| Halbleiter | SOX | ^SOX |
Gleich | 16:00 | SOXQ | Keine |
| US-10-Jahres-Rendite | US10Y | ^TNX |
Gleich | 15:00 | IEF | Kalshi, 3.199 |
| Dollar-Index | DXY | DX-Y.NYB |
Gleich | 16:00 | UUP | Polymarket, 4 |
| VIX | VIX | ^VIX |
Gleich | 16:00 | Nicht gehalten (indicators_only) |
Keine |
| Gold | GOLD | GC=F |
Gleich | 16:00 | GLD | Polymarket, 3.112 (Kalshi auch notiert) |
| WTI | WTI | CL=F |
Gleich | 16:00 | USO | Polymarket, 3.736 (Kalshi auch notiert) |
| Brent | BRENT | BZ=F |
Gleich | 16:00 | BNO | Keine |
| Kupfer | COPPER | HG=F |
Gleich | 16:00 | CPER | Keine |
| Bitcoin | BTC | BTC-USD |
Schluss des ersten 1-Min-Balkens, der am oder nach dem Siegel der Zeile beginnt | 16:00 der Bewertungssitzung | BTC-USD | Polymarket, 38 |
Hinweis: Aus den Prognosereihen der Läufe vom 20. und 21. Oktober 2026 (price_provider, price_symbol, reference_rule, event_end_at), arena-protocol.json (assets, indicators_only) und Zeile 151 von council-book.jsonl (crowd.odds, crowd.kalshi). Jede Zeile nennt den Anbieter yahoo_finance_chart_v8_1m und die Regel first_1m_bar_at_or_after_reference_at__last_1m_bar_at_or_before_end_at__v1. Horizonte von einer Woche, einem Monat und sechs Monaten sind 5, 21 und 126 Sitzungen (Bitcoin 7, 30 und 182 Tage; Tabelle 1). Zeichnungsspannen werden pro Sitzung festgelegt (Tabelle 1) und sind nicht aufgelistet. Der primäre Vergleich mit der Menge lässt Kontrakte mit einem versiegelten Volumen von mindestens 1.000 Dollar zu (Abschnitt 4.9).
Die Preise existieren vor der Frage, die Frage vor den Antworten, die Antworten vor dem Preis, nach dem sie bewertet werden, und das Ergebnis nach all diesen. Jedes „davor" wird als Hash in das Buch geschrieben, und der Kopf des Buches ist außerhalb der Kontrolle des Betreibers verankert.
3.2 Was eine Siegel ist
Das Buch ist eine Folge von JSON-Zeilen , die einmal geschrieben und so beibehalten werden. Jede Zeile hat vier Verwaltungsfelder: ihre Position n, den Hash der vorherigen Zeile prev, ihren eigenen Inhalt-Hash seal und ihren verketteten Hash link. Sei SHA-256 (National Institute of Standards and Technology, 2015) und sei die Serialisierung eines JSON-Objekts mit sortierten Schlüsseln genau wie Pythons json.dumps(o, sort_keys=True, ensure_ascii=False) es schreibt, kodiert als UTF-8 (Anhang B, Schritt 4). Dann für Zeile mit Inhalt (jedes Feld außer den vier):
Das Siegel fixiert, was die Zeile besagt. Der Link fixiert, was sie besagt, wo sie steht und alles davor. Ich habe beide Hashes für alle 211 Zeilen des Buches vom 20. Oktober 2026 neu berechnet: jedes seal und jeder link reproduziert sich, und jeder prev entspricht dem link der Zeile davor.
Die Laufzeile enthält den Hash der Frage, den Hash der Preis-Momentaufnahme, die Aufstellung nach Seite, die geltende Bewertungsmethodik und die Vorhersagemarktpreise, die zum Zeitpunkt der Fragenveröffentlichung aufgezeichnet wurden. Die Antwortenzeile enthält das Modell, seinen Modus und seine vollständig geparste Antwort für die 12 Märkte und vier Horizonte, mit own_sha256, dem Hash der rohen Antwort, und ask_sha256. Die Bewertungszeile enthält das Ergebnis. Alle drei sind auf die gleiche Weise versiegelt.
Eine Kette allein beweist Reihenfolge und Inhalt. Ein Betreiber, der die Datei kontrolliert, könnte eine ganze Kette an einem Nachmittag neu aufbauen, daher nehme ich Zeit von außen. Bei jedem Lauf schreibt die Engine eine kurze zeitgestempelte Liste, die für jedes Buch angibt, wie viele Zeilen es hatte, die SHA-256 genau dieser Zeilen und den Link der letzten. Für dieses Buch am 20. Oktober 13:00:25Z heißt es „159 Zeilen, sha256 59673b9e…a7d9, letzter Link 378273fd…7175b2c". Die Liste ist mit OpenTimestamps (Todd, 2016) zeitgestempelt, das viele Hashes in einem Merkle-Baum aggregiert und seine Wurzel durch öffentliche Kalenderserver in einer Bitcoin-Transaktion committet. Der .ots-Beweis, veröffentlicht neben der Liste, enthält den Pfad von Hash-Operationen von der SHA-256 der Liste bis zur Merkle-Wurzel eines Block-Headers, hier Block 972.334, Header-Zeit 13:55:20Z. Die Konstruktion ist das verknüpfte Zeitstempel-Verfahren von Haber und Stornetta (1991) mit der Bitcoin-Kette (Nakamoto, 2008) als Zeuge.
Ich bewerte die Zeitevidenz danach, wem ein Leser vertrauen muss, von der eigenen Aufzeichnung des Betreibers bis zu einer signierten Zeit:
- Stufe 1, die Aufzeichnung des Betreibers. Jede Zeile wird in die Kette versiegelt (
at,prev,link; Antwortzeilen fügenbooked_athinzu, die Sekunde ihres Batch-Siegels), und der Referenzpreis wird nach dem Siegel genommen. Die Kette fixiert Reihenfolge und Inhalt; die Minute des Siegels ist das, was der Betreiber aufgezeichnet hat. - Übermittlung an die Kalender. Die Liste, die den Kopf der Kette hält, wird an öffentliche OpenTimestamps-Kalender gesendet (die Beweise nennen
alice.btc.calendar.opentimestamps.orgundbob.btc.calendar.opentimestamps.org). Eine ausstehende Quittung zeigt, dass der Hash akzeptiert wurde; sie trägt keine Zeit, die ein Leser überprüfen kann. - Stufe 2, der Bitcoin-Anker. Die Kalender verpflichten den Hash auf einen Bitcoin-Block. Das verankerte Präfix existierte nicht später als wenige Stunden nach der Header-Zeit des Blocks, durch die praktische Schranke (Abschnitt 3.11), und ein späteres Umschreiben einer Zeile darin ist für jeden erkennbar, der einen früheren Beweis hält. Der Block kann nach 09:30 ET abgebaut werden: am 20. Oktober erreichte der Stempel von 09:00:25 ET einen Block mit Header-Zeit 09:55:20 ET.
- Stufe 2+, signierte Zeit. Ab 21. Oktober 2026 unterzeichnen unabhängige RFC-3161-Zeitstempelungsbehörden (Adams et al., 2001), FreeTSA und DigiCert, denen sich Sectigo ab der dritten Liste dieses Tages anschloss, jede gestempelte Liste und fixieren die Sekunde, zu der jede darin abgedeckte Zeile existierte. Der Leser vertraut einer Behörde und ihrem Zertifikat statt dem Betreiber, und mit unabhängigen Behörden genügt jede einzelne. Das Token zeitstempelt den Batch. Die Ankunft jeder Antwort unterliegt Anforderung 12.
Eine Zeile ist versiegelt, wenn sie in die Kette eintritt, der Kopf ist gestempelt, wenn er zu den Kalendern geht, und er ist verankert, wenn er einen Block erreicht. Da das Buch nur wächst, ein Stempel, der bei Zeile 159 genommen wird, überprüft immer noch bei jeder späteren Länge: head -n 159 der heutigen Datei gibt die gestempelten Bytes unverändert zurück und hasht zu dem Wert, der an jenem Morgen gestempelt wurde, sodass das Präfix nach Zeilenanzahl genommen wird, nicht nach einem Filter, der die Zeilen umschreiben würde. Jede gestempelte Liste gibt die Byteregel an, die sie hasht: die Datei wie gespeichert, UTF-8 ohne Byte-Order-Marke und ohne etwas Umcodiertes, jede Zeile gezählt mit ihrem finalen LF, und eine letzte Zeile gezählt, sobald ihr LF geschrieben ist.
Offenlegungszeit und Siegelzeit. Die Siegelzeit ist, wenn eine Zeile in die Kette eintritt; die Offenlegungszeit ist, wenn ihr Text öffentlich wird. Die Liga veröffentlicht die Texte der Zeilen nach dem Tagesergebnis, wobei der Platz, das Siegel und die Zeit vorher sichtbar sind (Beweisseite). Verzögerte Offenlegung, die Eigenschaft von Sornette et al. (2010), hindert einen Dritten daran, eine versiegelte Wahrscheinlichkeit in der Öffentlichkeit zu verwenden. Die Bindung des Betreibers, der den Text hält, um ihn zu buchen, ist die Arbeit von P1b und P2 (Abschnitt 3.11). Innerhalb eines Batches zeichnet die Kette die Buchungsreihenfolge auf: am 20. Oktober steht die Laufzeile vor ihren Antworten und wurde mit ihnen gebucht, nach ihrer Ankunft.
3.3 Referenzpreis nach dem Siegel
Der Referenzpreis ist der erste Preis nach dem Siegel nach der Regel jedes Marktes. Eine Prognose wird nur auf dem Preisverlauf bewertet, der nach ihrer Fixierung beginnt. Informationen, die vor der Referenz existieren, sind erlaubt: die Frage kann die Pre-Open-Futures tragen (am 20. Oktober die S&P-500-, Nasdaq-100-, Dow- und Russell-2000-Futures gegen den vorherigen Schluss), und ein Modell darf nach News bis zu seiner Antwort suchen. Was das Protokoll ausschließt, ist der Referenzpreis und alles danach.
Eine Zeile, die nach der Öffnung versiegelt ist, wird beibehalten. Sie erhält ihre eigene Referenz, den ersten Preis nach ihrem eigenen Siegel, und ist als verspätet markiert (late_ref in der Score-Zeile). Eine Zeile, die nach dem Schluss versiegelt ist, wird für diese Sitzung nicht bewertet (counted). Eine solche Zeile beantwortet eine andere Frage: im Buch vom 20. Oktober kehrte die eigene Referenz einer nach der Öffnung versiegelten Zeile das Vorzeichen der bewerteten Bewegung in sechs ihrer neun Eintages-Zellen um. Ich behalte es daher aus allem heraus, das Modelle auf ein gemeinsames Ereignis vergleicht: den Konsens, die Zählungen gemeinsamer Fehler, das nächste Modell, die effektive Anzahl der Stimmen und jeden Kopf-an-Kopf-Vergleich (Anforderung 4). Die Score-Zeile markiert die Zeile, und die gezählte Reihe der Ligastatistiken lässt sie aus (Tabelle 5).
Dieselbe Regel fixiert eine Referenz pro gemeinsames Ereignis, Bitcoin eingeschlossen. In der Referenzimplementierung ist die Bitcoin-Referenz der Schluss des ersten Ein-Minuten-Balkens, der bei oder nach dem Siegel der Zeile beginnt (reference_rule, Yahoo Finance BTC-USD), sodass der Preis immer später als das Siegel ist, während die offenen Dateien das Siegel als zweites als reference_at und den Beginn des Preisbalkens als reference_price_at schreiben. Eine Zeile, die in einem späteren Batch versiegelt ist, erhält ihre eigene Bitcoin-Referenz und ist ein separates Ereignis. Am 21. Oktober teilen die acht Antworten, die um 13:00:19Z versiegelt sind, die Referenz 83.536,42, den Schluss des Balkens von 13:01Z; die neunte, versiegelt um 13:23:37Z, hat ihre eigene, 83.677,08, den Schluss des Balkens von 13:24Z, und wird separat bewertet (own_event, same_event false), außerhalb des gemeinsamen Bitcoin-Ereignisses. Da reference_at der Siegel-Sekunde entspricht, würde ein Schnitt bei „versiegelt vor reference_at" jede Bitcoin-Zeile fallen lassen. Ich verwende stattdessen eine Uhr für alle zwölf Märkte: eine Antwortzeile tritt in die Statistiken des gemeinsamen Ereignisses nur ein, wenn sie vor der Referenz von 09:30 ET der Sitzung versiegelt wurde. Bitcoin-Zeilen folgen demselben Schnitt von 09:30 ET, während der Bitcoin-Preis selbst aus der ersten Minute nach dem Siegel des Laufs referenziert wird. Dies ist die Regel der veröffentlichten gezählten Reihe (n_eff.counted) und der eingereichten Lösungsskripte. Sobald Antworten bei Ankunft versiegelt sind (Anforderung 12), ist die gemeinsame Referenz für einen Markt, der rund um die Uhr gehandelt wird, der Preis beim Schluss der Laufaufnahme, nach jedem gezählten Siegel.
3.4 Ein gezählter Lauf pro Sitzung
Die Liga fordert mehr als einmal am Tag an (ein Morgenlauf, ein Abendlauf, ein Wochenend-Bitcoin-Lauf und ein Sonntag-Radar), sodass mehrere Läufe auf eine Sitzung abzielen können. Genau einer zählt für jedes Modell und jede Sitzung, und die Norm verlangt, dass dieser Lauf durch eine vor den Läufen erklärte Regel festgelegt wird (Anforderung 6). Eine Regel der Form „der Lauf, der zuletzt vor der Öffnung versiegelt wurde" wird im Nachhinein angewendet. Sie lässt den Bediener frei, einen späteren Lauf vor der Öffnung zu senden, und so unter Läufen zu wählen. Ich machte daher den Zeitplan zur Regel. Ab dem 21. Oktober 2026, dem Anfang des gezählten Datensatzes, zählt der geplante Morgenlauf und jeder andere Lauf ist eine Referenzberechnung. Die Erklärung wird als erste Zeile der Kette ausgehender Fragen versiegelt (asks.jsonl, 04:16 UTC am 21. Oktober 2026, acht Stunden vor dem Morgenlauf) und auf der Proof-Seite mit ihrem SHA-256 (c24b0d4f…5df5) und einem Internet-Archive-Erfassung (05:35 UTC desselben Tages) veröffentlicht; ich las sie dort am 21. Oktober 2026 um 15:05 UTC. In den zwei Entwicklungssitzungen am 19. und 20. Oktober zählte die versiegelte Methodik den Lauf, der zuletzt vor der Öffnung der Sitzung versiegelt wurde (session_run), eine Regel, die nach den Läufen angewendet wurde. Diese Sitzungen bilden ein Entwicklungssegment außerhalb des Fensters des primären Vergleichs (Abschnitt 8). Die anderen Läufe werden auf ihrer eigenen Seite bewertet (not_counted, earlier_run), behalten, veröffentlicht und gekennzeichnet, und jeder kann die erklärte Regel auf die versiegelten Zeitstempel anwenden (P3, Abschnitt 3.11). Die Wiederholungen der Portfolio-Ligen (asked_again, Anlage A) werden mit ihren Frage-Hashes versiegelt und bleiben außerhalb jeder Prognose-Bewertung.
3.5 Richtung, Wahrscheinlichkeit und das Unentschieden
Das Modell gibt prob_up an, seine Wahrscheinlichkeit von 0 bis 100, dass der Indikator am Ende des Horizonts höher ist als zu seinem Referenzpreis. Für die 10-Jahres-Rendite ist ein „Kauf" eine Wette, dass die Rendite steigt; für VIX, dass die erwartete Volatilität steigt.
Ich behandle kleine Bewegungen als Unentschieden durch eine im Voraus festgelegte Regel. Das Band ist , wobei die mittlere absolute Ein-Minuten-Prozentrendite über die vier Sitzungen von Minutenbalken vor der Referenz ist; für normale Renditen beträgt dies etwa 0,08 der Standardabweichung einer Sitzung (council-stats.json, draw_band). Bei den Futures (WTI, Brent, Gold, Kupfer) werden Minutenbewegungen über eine aufgezeichnete Änderung des Front-Month-Kontrakts ausgelassen, da eine Rückkehr ein Sprung zwischen zwei Kontrakten ist (noise_rolls). Die Norm verlangt, dass das bewertete Ereignis das eingefragte Ereignis ist (Anforderung 7). Der primäre Brier-Score wird über alle Zeilen berechnet, wobei ein Anstieg eine Veränderung über Null bedeutet, und der Score ohne Unentschieden wird mit der Anzahl der verworfenen Zeilen zweite angegeben. Die Modelle werden nach der Wahrscheinlichkeit eines strikten Anstiegs gefragt und erhalten keine Benachrichtigung über die Unentschieden-Regel. Aus der Sitzung vom 21. Oktober ist der All-Rows-Score der Hauptscore der Liga (Feld pall). Die Entwicklungssitzungen stehen wie veröffentlicht als separates Segment (Anforderung 15) auf einem Score, der Unentschieden ausschließt. Ein solcher Score wird durch die Wahrscheinlichkeit eines Anstiegs bei einer Bewegung außerhalb des Bandes minimiert, sodass für die eingefragte Frage er nicht streng richtig ist.
Ein Unentschieden-Band und ein richtiger Score können zusammengehen. Ein Design fragt nach der Wahrscheinlichkeit eines Anstiegs bei einer Bewegung außerhalb des Bandes und bewertet ihn nur auf Zeilen, die keine Unentschieden sind. Das andere fragt nach drei Wahrscheinlichkeiten, eines Anstiegs, eines Unentschieden und eines Falls, bewertet durch den dreifach-Outcome-Brier-Score, streng richtig für das Tripel (Brier, 1950; Gneiting & Raftery, 2007):
Eine Prognose, die die Unentschieden-Wahrscheinlichkeit auf einer Zeile Null gibt, die kein Unentschieden ist, bewertet genau den binären Brier-Score, . Die gleichmäßige Prognose von je einem Drittel bewertet gegen 0,25 für die binäre Münze, sodass der dreifach-Outcome-Score seine eigene Benchmark braucht. Eine Wahrscheinlichkeit von genau 50 unterstützt keine Seite und wird von Brier nur bewertet.
3.6 „Auf Dips kaufen" als im Voraus festgelegte Ebene
„Kaufe bei Dips" ohne ein Level kann nicht bewertet werden, daher benötige ich eine Antwort mit der Aktion buy_dips, um entry zu geben, ein Level unterhalb der Referenz, bei dem das Modell hinzufügen würde. Wenn der Preis es während der Sitzung berührt, kauft das Portfolio zum Einstiegskurs, andernfalls wird nichts gekauft. In beiden Fällen wird die Wahrscheinlichkeit bewertet. Die fünf zulässigen Aktionen sind buy_strong, buy_dips, hold, trim und sell. Ein Wort außerhalb der Liste wird als action_word beibehalten, seine Wahrscheinlichkeit und Level werden bewertet, und es wird nicht gehandelt.
Jede Antwortzelle trägt daher zwei versiegelte Antworten zu einem Ereignis, eine Wahrscheinlichkeit und eine Aktion, und an den zwei letzten gezählten Morgen stimmen sie überein (Abbildung 2). Über die 384 Zellen der acht Sitze, die vor der Referenz am 20. Oktober 2026 versiegelt wurden, und die 432 Zellen der neun Sitze am 21. Oktober 2026 war kein Aktionsfeld leer, alle sell und trim lagen unter 50, hold lag bei etwa gleicher Chance (Median 52 an beiden Morgen) und der Median stieg Schritt für Schritt zu buy_strong. Ich finde einen Kauf bei Dips neben einer Wahrscheinlichkeit unter 50 in vier Zellen: drei Eintages-Zellen von Claude am 20. Oktober (S&P 500 48, Nasdaq-100 47, Halbleiter 46) und MiMos S&P 500 bei einer Woche am 21. Oktober (47). Ein Kauf bei Dips ist eine Order, die nur bei einem Einstiegslevel unterhalb der Referenz erfüllt wird, daher ist eine Wahrscheinlichkeit unter 50 daneben schlüssig. Tabelle 3 zählt die Aktionen nach Horizont. hold füllte 64 der Eintages-Zellen an jedem Morgen (von 96 und 108 Zellen), und bei sechs Monaten führte buy_dips (37 und 38 Zellen).
Abbildung 2. Angegebene Wahrscheinlichkeit eines Anstiegs durch die im gleichen Antwortzelle versiegelte Aktion: Durchläufe 2026-10-20-am (acht Sitze vor der Referenz versiegelt) und 2026-10-21-am (neun Sitze), alle vier Horizonte.
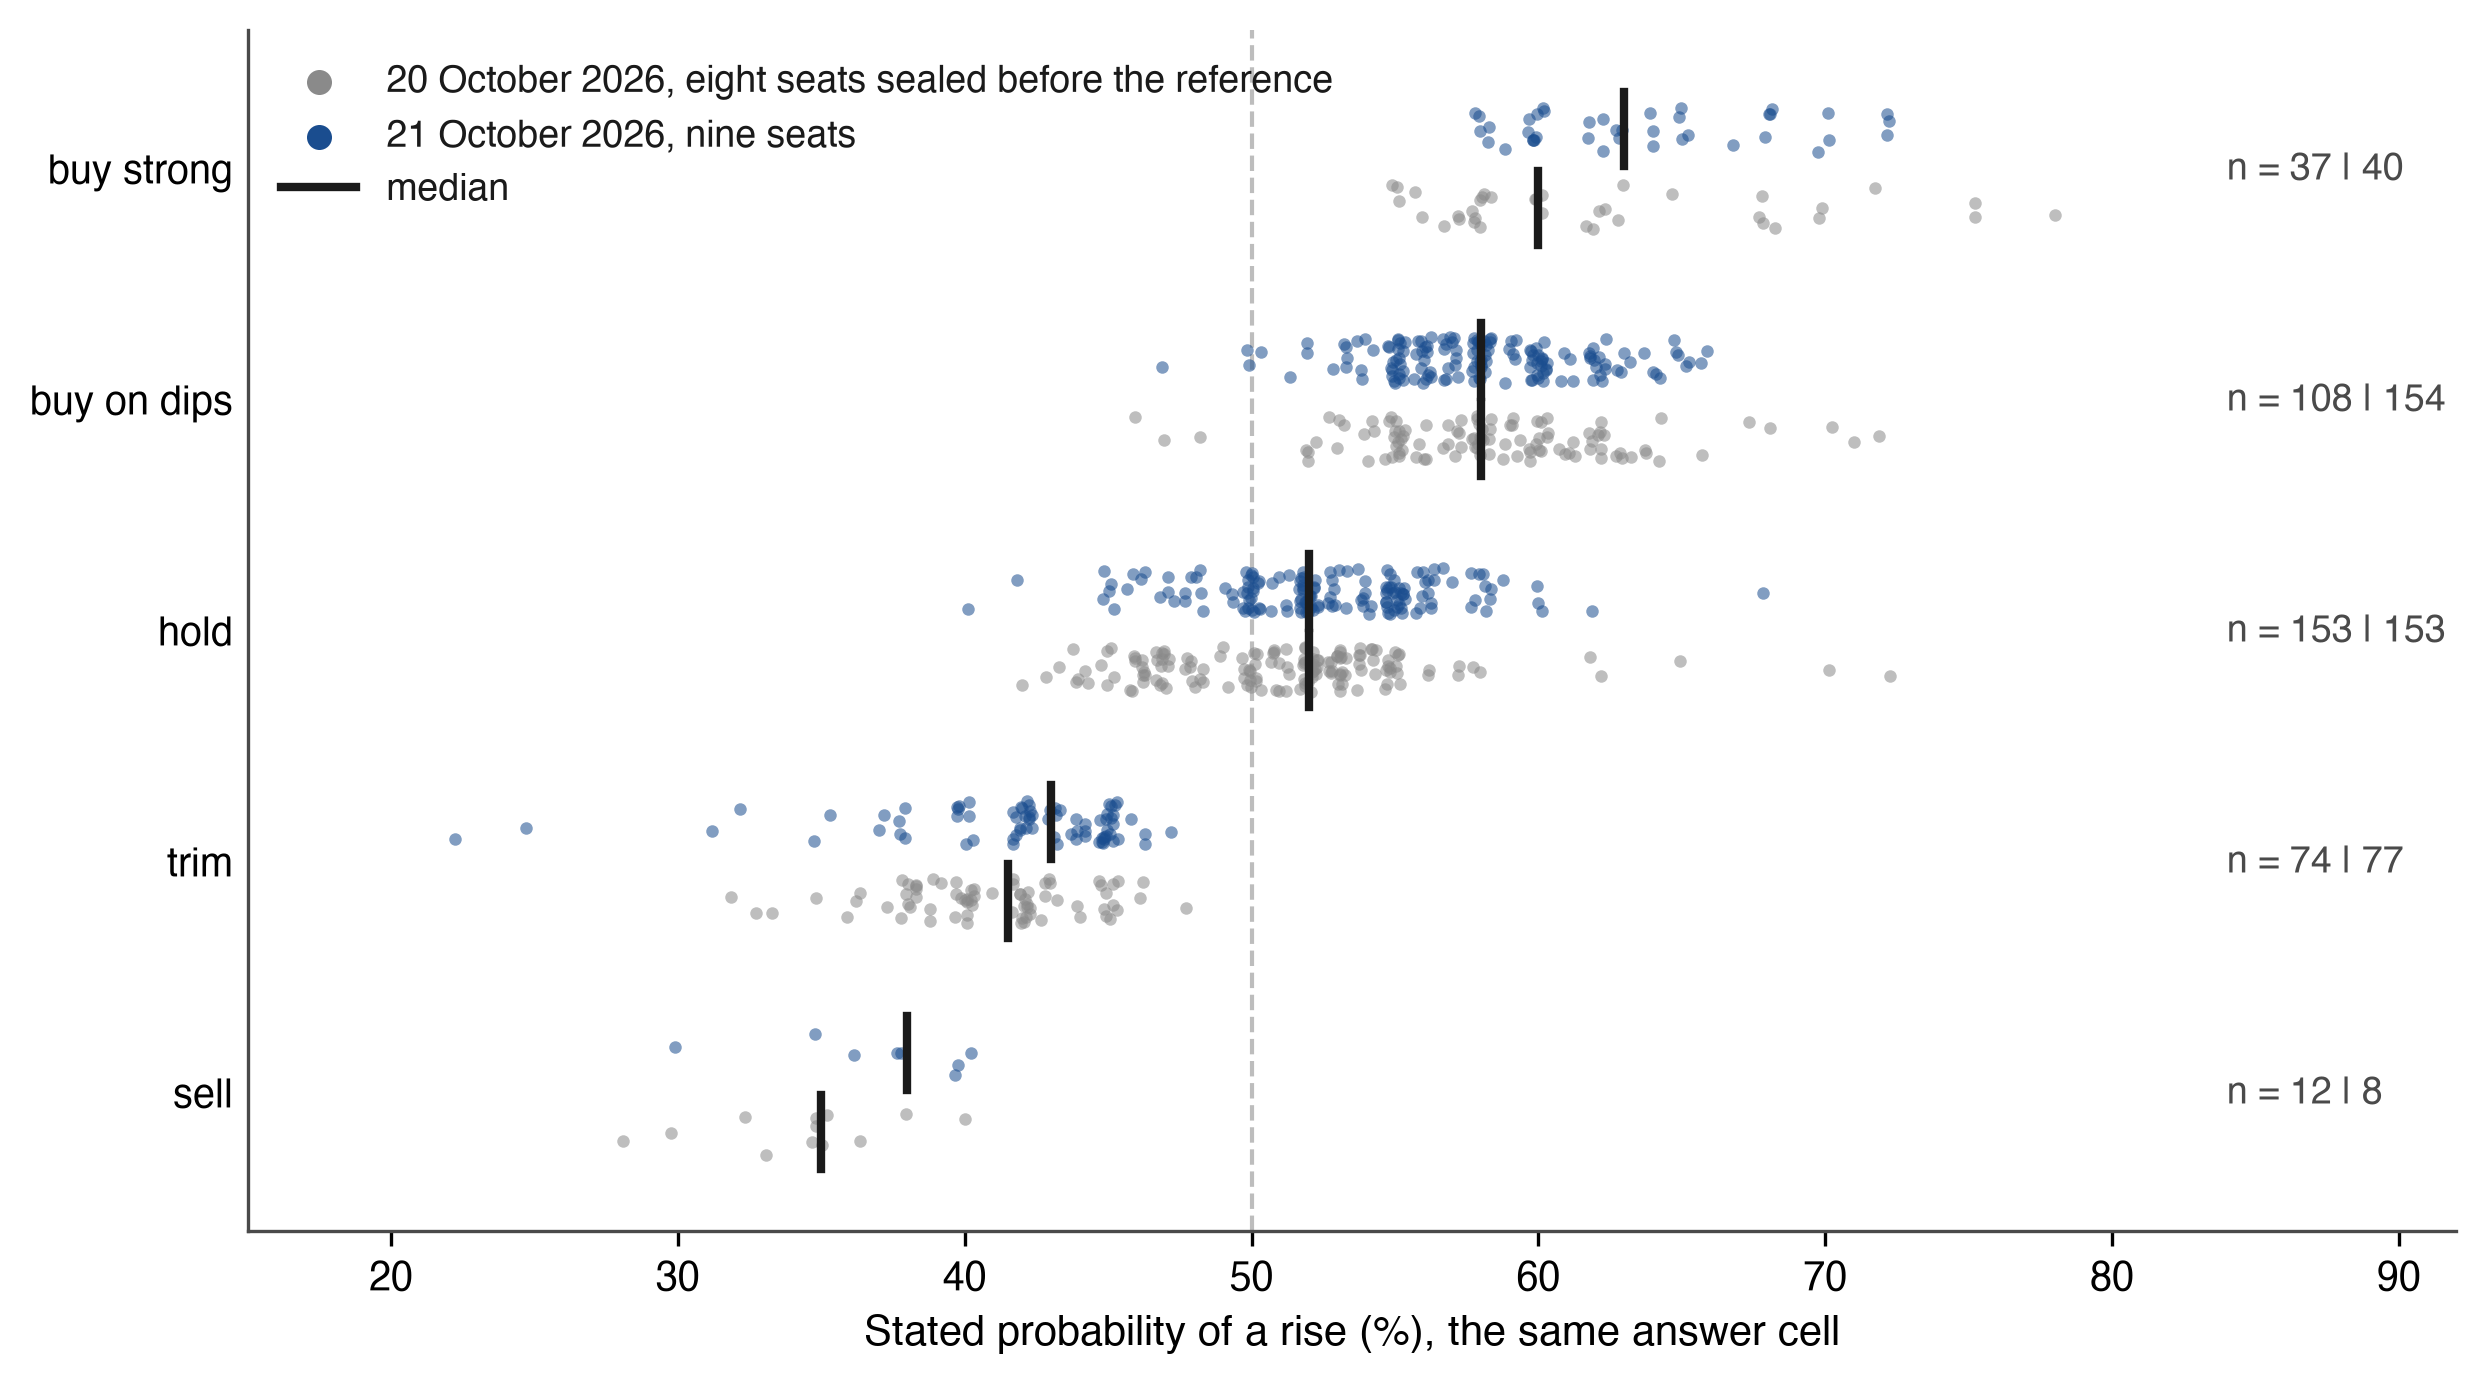
Anmerkung: Jeder Punkt ist eine Antwortzelle (Sitz × Markt × Horizont), leicht verzerrt; Balken markieren die Mediane (sell 35 und 38, trim 41,5 und 43, hold 52 und 52, Kauf bei Dips 58 und 58, buy strong 60 und 63); n gibt die Zellen von 20 | 21. Oktober an. Aktionen wie in items.<market>.<horizon>.action versiegelt, Wahrscheinlichkeiten in prob_up. Quelle: council-forecasts.csv gespeichert 22. Oktober 2026, 01:32 UTC. Wie jede Abbildung und Tabelle der Abschnitte 3 bis 5, die aus versiegelten Antworten erstellt wurden, zeigt sie kein Ergebnis.
Tabelle 3. Aktionen versiegelt nach Horizont: Durchläufe 2026-10-20-am (acht Sitze vor der Referenz versiegelt, 96 Zellen pro Horizont) und 2026-10-21-am (neun Sitze, 108 Zellen pro Horizont).
| Horizont | Durchlauf | Sell | Trim | Hold | Kauf bei Dips | Buy strong |
|---|---|---|---|---|---|---|
| 1 Tag | 20. Okt. 2026 | 1 | 11 | 64 | 16 | 4 |
| 1 Tag | 21. Okt. 2026 | 0 | 12 | 64 | 26 | 6 |
| 1 Woche | 20. Okt. 2026 | 3 | 23 | 33 | 31 | 6 |
| 1 Woche | 21. Okt. 2026 | 1 | 18 | 31 | 54 | 4 |
| 1 Monat | 20. Okt. 2026 | 2 | 15 | 42 | 24 | 13 |
| 1 Monat | 21. Okt. 2026 | 3 | 22 | 34 | 36 | 13 |
| 6 Monate | 20. Okt. 2026 | 6 | 25 | 14 | 37 | 14 |
| 6 Monate | 21. Okt. 2026 | 4 | 25 | 24 | 38 | 17 |
Anmerkung: Zählung der Antwortzellen nach der darin versiegelten Aktion. Quelle: council-forecasts.csv gespeichert 22. Oktober 2026, 01:32 UTC.
3.7 Vier Horizonte und das Jahr
Jede Antwort deckt vier Horizonte für jeden Markt ab: den nächsten Handelstag (1d), die Woche (1w), den Monat (1m) und sechs Monate (6m), plus einen unbewerteten Satz zum Jahr (years). Für die elf Börsengeschäftsstunden-Märkte sind die längeren Horizonte 5, 21 und 126 Sitzungen; für Bitcoin sind sie 7, 30 und 182 Kalendertage, und sein Tag läuft von der Versiegelungsminute bis zum 16:00-Uhr-ET-Schluss der Bewertungssitzung, etwa sieben Stunden für den Morgendurchlauf. Ich vergleiche Horizonte innerhalb jeder Definition. Ein Modell an einem Morgen gibt daher 48 Wahrscheinlichkeiten, jeweils mit seinem eigenen Fenster aufgelöst und alle in einer Minute auf einem Informationssatz versiegelt.
3.8 Ziel und „falsch wenn"
Für jeden Markt und Horizont gibt das Modell auch target an, wohin es den Preis erwartet, und invalidation, dargestellt als „Falsch wenn", das Level, bei dem es den Standpunkt als falsch zugeben würde, mit seinem Hauptrisiko und dem, das den Standpunkt überdenken würde (risk, revise_if). Alle werden mit der Wahrscheinlichkeit versiegelt, daher ist die Prognose in den eigenen Begriffen des Modells falsifizierbar. Eine versiegelte Antwort zeigt die Felder bei der Arbeit. Am 19. Oktober 2026 vor der Eröffnung gab ChatGPT (GPT-6.1 Sol) dem S&P 500 eine 54%-Chance auf einen Anstieg am Tag, mit einem Ziel von 7.678,59 und „Falsch wenn" bei 7.560, dann 42 % in einer Woche, 38 % in einem Monat und 61 % in sechs Monaten. Der angegebene Standpunkt war „Ich gewichte die unmittelbaren Inflationseffekte der KI-Ausgaben höher als ihre eventuelle Produktivitätsdividende", und seine Bedingung für Überdenken war „Ich würde den monatlich bärischen Standpunkt aufgeben, wenn SPX 8.000 neben verbesserter Gewinnprognose durchbricht" (Buchzeile 83). Jedes dieser Level kann gegen den Preisverlauf überprüft werden, ohne das Modell zu fragen, was es meinte. In Abbildung 3 zeichne ich die ganze Antwort, mit der Wahrscheinlichkeit, der Aktion, dem Ziel und dem „Falsch wenn"-Level bei jedem Horizont, und dem Einstiegslevel von 7.350 bei sechs Monaten, bei dem sein Kauf bei Dips erfüllt würde. Die Frage hatte den vorherigen Schluss, 7.659,44, gezeigt, und der Referenzpreis des Tages, 7.700,34, wurde nach der Versiegelung genommen.
Abbildung 3. Eine versiegelte Antwort: ChatGPT zum S&P 500, Durchlauf 2026-10-19-am (council-book.jsonl, Zeile 83), mit Wahrscheinlichkeit, Aktion, Ziel, „Falsch wenn"-Level und Einstiegslevel bei jedem Horizont.
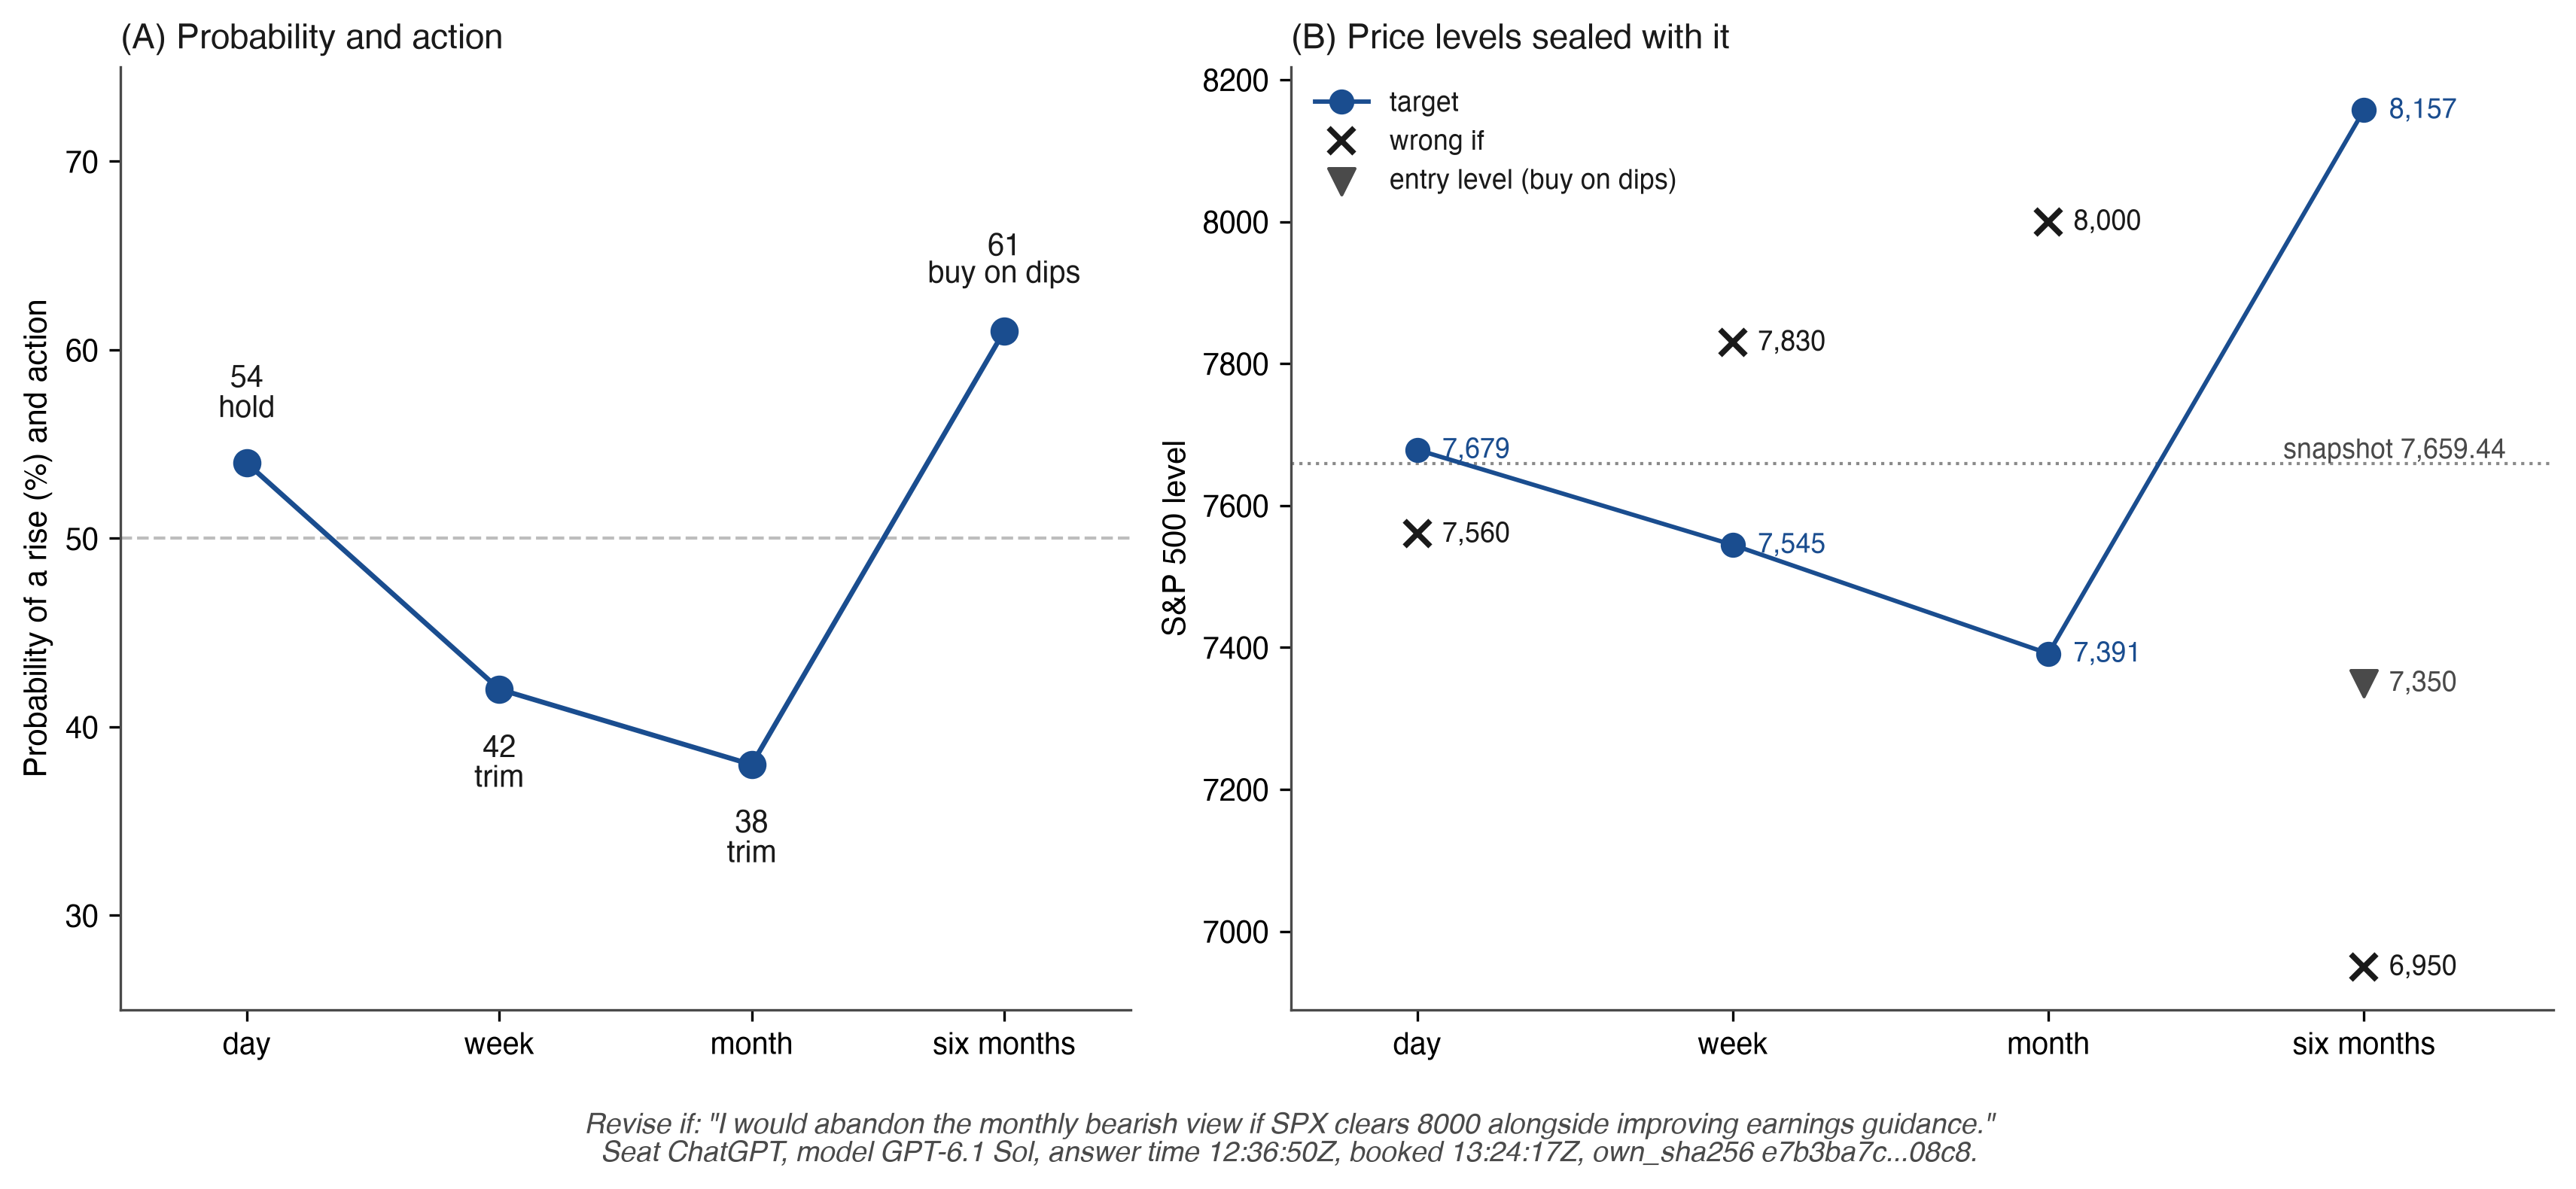
Hinweis: Alle Werte wie in der Antwortzelle versiegelt (Antwortzeit 12:36:50Z, gebucht 13:24:17Z, vor dem 09:30 ET-Bezug). Die gepunktete Linie ist der S&P 500-Kurs im Snapshot der Frage (asks/02577f9c….md); die Linie durch die Ziele verbindet die Horizonte zum Lesen und ist kein Pfad. Die Einstiegsstufe ist das Feld items.SPX.6m.entry der Antwortzelle; die Spalte entry von council-forecasts.csv ist für diese Zelle leer.
3.9 Leere Zellen
Jede Zelle einer Antwort wird bewertet. Eine Zelle, die ein Modell leer lässt, zählt als 50%, Brier 0,25, keine Seite (counted_50); sie kann das Münzwurf-Ergebnis nicht schlagen, kann aber schlechtere Leistungen als Münzwurf auf einem schwierigen Markt verbergen, daher melde ich die Anzahl der leeren Zellen neben jeder Punktzahl (Anforderung 8). Ein Sitz, der keine Antwortzelle sendet, wird als no_answer aufgezeichnet und fehlt in den Punktzahlen dieses Laufs. Die gefüllte 0,25 gehört zur Servicepunktzahl des Sitzes. Der Konsens und die Übereinstimmungszahlen werden aus den tatsächlich angegebenen Wahrscheinlichkeiten gebildet, und das Feld of zählt sie. Jeder Sitz hat daher bei jedem Horizont drei Ergebnisse, die jeweils separat rangiert werden: die Brier-Punktzahl für angegebene Wahrscheinlichkeiten, der Anteil der erwarteten Zellen, die bis zur Frist beantwortet wurden, und die Servicepunktzahl. Das Portfolio ist ein viertes Ergebnis in seiner eigenen Tabelle. Eine kombinierte Punktzahl würde verbergen, ob ein Sitz bei der Beurteilung, bei der Pünktlichkeit oder beim Handel verloren hat.
Die erwarteten Zellen müssen vor den Antworten bekannt sein. Der Standard fordert ein Verzeichnis erwarteter Antworten mit den Sitzen, Märkten, Horizonten, Fristen und Wiederholungsrichtlinien, versiegelt vor der ersten Frage eines Laufs (Anforderung 13), damit jede erwartete Zelle zu einem Status führt (counted, counted_50, no_answer oder refused). Die Lauflinie trägt das Verzeichnis nach Seite, und seit 21. Oktober 2026 ist das Verzeichnis vor der ersten Frage in der Kette ausgehender Fragen versiegelt (asks.jsonl). Das Verzeichnis überprüft die Vollständigkeit gegen den erklärten Zeitplan. Der Hash jeder ausgehenden Frage, versiegelt bei ihrem Versand, überprüft die Läufe, die versendet wurden (Anforderung 13).
3.10 Eine Änderung der Modellversion, eine Korrektur, eine Änderung der Regeln
Ein Sitz ist ein operativer Teilnehmer; eine Modellversion ist eine zeitspezifische Implementierung, und der Datensatz behält beides. Wenn sich die Version eines Sitzes ändert, läuft sein Konto weiter, die Änderung ist datiert, das Ergebnis seit der neuen Version wird separat angezeigt (new_model_version), jede Version erhält ihr eigenes Konto ab dem Tag, an dem sie übernahm (_ver:<model>:<n>), und ein Lauf, in dem sich eine Version änderte, wird gekennzeichnet (seat_versions_in_run).
Eine Korrektur ist eine neue Zeile, die die Zeilen benennt, die sie betreffen (of), und die Zeile, die sie korrigiert, bleibt wie geschrieben. Preise folgen der gleichen Regel: Das Protokoll erklärt, dass ab 22. Oktober 2026 ein korrigierter Referenz- oder Schlusspreis als versiegelte Korrekturzeile mit Quelle und Grund eingegeben wird, und die Ergebniszeile davor wird nicht umgeschrieben (price_corrections in arena-protocol.json). Am 20. Oktober waren 47 der 211 Zeilen des Buches Korrektionen: einige stellen das Modell und den Modus der Antworten in den ersten Läufen aus den Laufbelegen wieder her, andere verzeichnen, dass eine erneut versiegelte Antwort einer früheren Zeile entspricht (same_as, ältere Kopien in council-forecasts-copies.csv). Der Standard erfordert Modell, Version und Modus in der Antwortzelle selbst oder, in einer blinden Jahreszeit, eine gesalzene Verpflichtung zu ihnen (Anforderung 1).
Eine Änderung der Methodik ändert die Aufgabe und eröffnet ein neues Messsegment (Anforderung 15). Eine bestätigende Punktzahl, eine gepaarte Gewinndifferenz oder ein Portfoliovergleich wird innerhalb einer Methodologie-Version berechnet, oder die Versionen werden als separate Segmente berichtet; alte Vorhersagen, die nach einer neuen Regel neu bewertet werden, werden als alternative Analyse gekennzeichnet. Ein Anspruch, der auf einem Level-2+-Element beruht, umfasst die Siegel, die nach dem Erscheinen dieses Elements in den öffentlichen Dateien angebracht wurden.
3.11 Nachweis-vor-Versiegelung: drei Eigenschaften
Ich nenne einen Vorhersagedatensatz Nachweis-vor-Versiegelung, wenn eine dritte Partei, unter Verwendung öffentlicher Dateien und der Bitcoin-Blockchain, die nachstehenden Eigenschaften feststellen kann, und wenn der Datensatz angibt, auf welcher dieser Eigenschaften er beruht. Sei eine Vorhersage in Buchzeile enthalten, mit Referenzpreis zur Zeit und Ergebnis zur Zeit . Lass Stempel die ersten Zeilen durch den Digest verpflichten, und lass sein Nachweis die gestempelte Liste in Block mit Header-Zeit platzieren. Schreibe für die Spanne, um die die wahre Abbauzeit der Header-Zeit folgen kann: in der Praxis einige Stunden, nach der unten besprochenen Schranke.
P1a. Keine Rekonstruktion nach dem Anker. Für jede gezählte Vorhersage gibt es einen Stempel mit . Das gestempelte Präfix existierte praktisch gesehen spätestens am , und jede spätere Ergänzung, Entfernung oder Umschrift einer Zeile darin ändert , sodass es nicht mehr mit dem im Block festgeschriebenen Digest übereinstimmt. Für jeden Ausgang später als schließt dies eine nach dem Ausgang geschriebene Vorhersage aus.
P1b. Verpflichtung vor der Referenz. Die Vorhersage wurde vor versiegelt. Ab 21. Oktober 2026 gilt dies auf Stufe 2+ für jeden, der entweder eine Autorität und deren Zertifikat akzeptiert: zwei RFC 3161-Tokens, die vor auf einer gestempelten Liste mit unterzeichnet sind. Am 21. Oktober unterzeichneten zwei Behörden die Liste der Zeilen 1 bis 222, die Ausführungszeile (214) und acht gezählte Antworten (215 bis 222), um 13:00:19 UTC, 29 Minuten 41 Sekunden vor , und drei unterzeichneten die Liste mit der neunten gezählten Antwort (224) um 13:23:37 UTC, 6 Minuten 23 Sekunden vor (Anhang B, Schritt 9). Für Bitcoin ist die Referenz der Schlusskurs des ersten Ein-Minuten-Balkens nach der Versiegelung jeder Zeile, 13:01Z für die Charge und 13:24Z für die neunte Antwort, somit ist die Reihenfolge dort konstruktionsbedingt erfüllt. Für die Entwicklungssitzungen vom 19. und 20. Oktober, die Sitzungen, die diese Version bewertet, beruht P1b auf Stufe 1 auf der verketteten Aufzeichnung (at, booked_at, prev, link). Am 20. Oktober fiel der Ankerblock nach (Abschnitt 3.2).
P2. Keine Substitution. Das Ändern eines beliebigen Feldes von für ändert , folglich und jeden späteren Link, folglich . Eine nicht nachweisbare Substitution würde ein zweites Urbild von SHA-256 oder ein Umschreiben der Bitcoin-Blockchain erfordern, sofern der Verifizierer den Beweis hat, der zum Zeitpunkt des Stempels veröffentlicht wurde (Bedrohungsmodell unten).
P3. Keine Auswahl unter offengelegten versiegelten Durchläufen. Für jedes Modell und jede Sitzung ist die gezählte Zeile durch eine Regel festgelegt, die vor den Durchläufen erklärt und nur auf versiegelte Zeitstempel angewendet wurde. Ab 21. Oktober 2026 ist diese Regel der veröffentlichte Plan, versiegelt vor den Durchläufen. Innerhalb des Durchlaufs zählt die erste wohlgeformte Antwort jedes Platzes ab Sitzung 11 (erklärt in asks.jsonl, Zeile 74). Abschnitt 3.4 gibt die Regel der Entwicklungssitzungen. Jeder andere versiegelte Durchlauf verbleibt im Buch, gekennzeichnet, und ein Leser kann nachrechnen, welche Zeile zählt. Die volle Form umfasst auch Durchläufe, die gestellt und unversiegelt gelassen wurden: der Hash jeder ausgehenden Frage wird versiegelt, wenn sie gesendet wird (Stufe 2+). Ab 21. Oktober 2026 sind diese Hashes in asks.jsonl verkettet.
Bedrohungsmodell. Ein Zeitstempel belegt, dass ein Digest existierte. Er sagt nichts über andere Digests aus, die neben ihm gestempelt wurden. Ein Anbieter, der sowohl das Buch als auch die Beweise hostet, könnte bei jedem Durchlauf zwei Bücher stempeln und später Buch und Beweis zusammen austauschen; das Substitut verifiziert sich gegen Bitcoin und ebenso gegen eine Zeitstempelungsautorität. Anforderung 3 macht es daher zu einem MUSS, bei jedem Stempel das SHA-256 der gestempelten Liste auf mindestens einem Nur-Anfügen-Kanal zu veröffentlichen, den der Anbieter nicht kontrolliert (ein archiviertes Depot, einen öffentlichen Versionskontrollhost oder eine Web-Archive-Erfassung), und die Kanäle auf der Nachweistafel zu benennen. Ab 22. Oktober 2026 wird jede gestempelte Liste bei der Stempelung in das Sigstore Rekor-Transparenzprotokoll eingegeben, und die Listen früherer Tage wurden am 21. Oktober 2026 zwischen 23:45 und 23:47 UTC eingegeben (Tabelle 5). Für eine Liste im Protokoll gelten P1a und P2 gegen alle ab ihrer Protokollzeit, und vor dieser Zeit gegen jede Partei, die einen früheren Beweis behalten oder aus einem unabhängigen Archiv abrufen kann.
Tabelle 4 ordnet jede Eigenschaft dem Protokollelement zu, das sie bietet, und der Stufe, auf der ein Leser sie überprüfen kann.
Tabelle 4. Proof-of-before: welches Element des Protokolls gibt jede Eigenschaft, und auf welcher Ebene.
| Eigenschaft | Was sie ausschließt | Element, das sie gibt | Wie ein Leser sie überprüft |
|---|---|---|---|
| P1a Keine Rekonstruktion nach dem Anker (Ebene 2, mit einer unabhängigen Kopie des Beweises oder des Rekor-Eintrags der Liste) | Eine Prognose, die nach dem Anker geschrieben oder umgeschrieben wurde | Gestempelter Präfix-Hash pro Buch; OpenTimestamps-Anker in Bitcoin; Stempel-Digest auf einem unabhängigen Kanal | head -n m Hash entspricht dem gestempelten Digest; .ots Beweis führt zur Merkle-Wurzel des Blocks; Schranke vor dem Ergebnis |
| P1b Verpflichtung vor der Referenz (Ebene 1 für 19. und 20. Oktober; Ebene 2+ ab 21. Oktober) | Eine Prognose, die nach dem Referenzpreis versiegelt, aber von ihm bewertet wurde | Siegel-Minute in der Kette (booked_at); Referenz nach dem Siegel; Versiegelung bei Ankunft (erforderlich); ab 21. Oktober: RFC 3161-Token |
Vergleichen Sie die Siegel-Zeit der Zeile, max(at, booked_at), mit 09:30 ET der Sitzung; ab 21. Oktober: Anhang B, Schritt 9 |
| P2 Keine Substitution (Ebene 2, mit einer unabhängigen Kopie des Beweises oder des Rekor-Eintrags der Liste) | Eine versiegelte Prognose, die später geändert wurde | Pro-Zeile seal; verkettet link mit prev; nur-anhängliches Buch |
Berechnen Sie seal und link neu; jeder prev entspricht dem vorherigen link |
| P3 Keine Auswahl unter offengelegten versiegelten Läufen (Ebene-1-Regel; vollständige Form Ebene 2+) | Mehrmals fragen und den Lauf zählen, der gewonnen hat | Ein gezählter Lauf pro Sitzung, ab 21. Oktober 2026 im Voraus erklärt; jeder andere Lauf als not_counted beibehalten; Ebene 2+: ausgehende Fragen-Hashes werden beim Versand versiegelt (asks.jsonl, ab 21. Oktober) |
Wenden Sie die erklärte Regel auf die Siegel-Zeiten des Buches an; finden Sie alle Läufe in council-forecasts.csv (run_id, run_role) |
P1a hat eine Auflösung von Stunden, und seine Schranke ist praktisch. Die externe Zeit ist die Zeit eines Blocks in der Kette, die das Netzwerk akzeptiert hat, und die Header-Zeit dieses Blocks wird vom Miner gesetzt. Die Konsensregeln begrenzen sie von unten durch die Medianzeit der vorherigen 11 Blöcke und von oben durch etwa zwei Stunden vor den netzwerkjustierten Uhren der Knoten, die sie akzeptieren (Bitcoin Developer Documentation, n.d.). Keine Regel legt fest, wie lange nach seiner Header-Zeit ein Block tatsächlich geschürft wurde. Im normalen Betrieb liegt der Median um etwa eine Stunde hinter der realen Zeit, daher existierte der verankerte Digest nicht später als wenige Stunden nach . Ein Verifizierer, der eine Schranke nur aus den Konsensregeln wünscht, nutzt die Header-Zeit eines Blocks mehrere Bestätigungen später, und eine signierte Kalenderzeit auf jedem Siegel kommt nur von einer Zeitstempel-Autorität (Ebene 2+). Für Block 972.334 war die Medianzeit der vorherigen 11 Blöcke 12:45:12Z, 70 Minuten vor seiner Header-Zeit. Ein IETF Internet-Draft legt fest, wie ein Verifizierer Bitcoin-verankerte zeitliche Beweise überprüft (Fassbender, 2026). Am 17., 19. und 20. Oktober trugen die Anker-Blöcke (971.796, 972.153 und 972.334) Header-Zeiten innerhalb einer Stunde der Buchungszeit, und für den Tages-Horizont, der um 16:00 ET auflöst, fiel die Schranke mit ihrer Marge vor dem Ergebnis; für längere Horizonte ist die Auflösung irrelevant. Die Reihenfolge von Siegel und Referenz innerhalb der Sitzung ist P1b.
3.12 Die Vertrauensleiter
Öffentliche Behauptungen über „verifizierte" KI-Prognosen fallen in drei Ebenen, mit einem vierten Schritt über der letzten (Abbildung 4). Auf Ebene 0 vertraut der Leser dem Betreiber. Auf Ebene 1 führt der Betreiber einen Fingerabdruck oder ein verkettetes Datensatz, was beweist, dass ein späterer Text einem früheren Hash entspricht, aber nicht, wann der Hash erstellt wurde. Auf Ebene 2 wird der Fingerabdruck außerhalb des Betreibers verankert, in einem öffentlichen Datensatz, der nicht umgeschrieben oder backdatiert werden kann, ohne erkannt zu werden, und überprüft mit Werkzeugen, die der Betreiber nicht kontrolliert. Ebene 2+ ist Ebene 2 plus eine von Drittparteien signierte Zeit auf jedem Siegel (Abschnitt 3.2).
Abbildung 4. Die Vertrauensleiter: dem Betreiber vertrauen, Betreiber-Fingerabdruck, Anker außerhalb des Betreibers, und signierte Zeit von zwei Autoritäten (Ebene 2+, RFC 3161, ab 21. Oktober 2026).
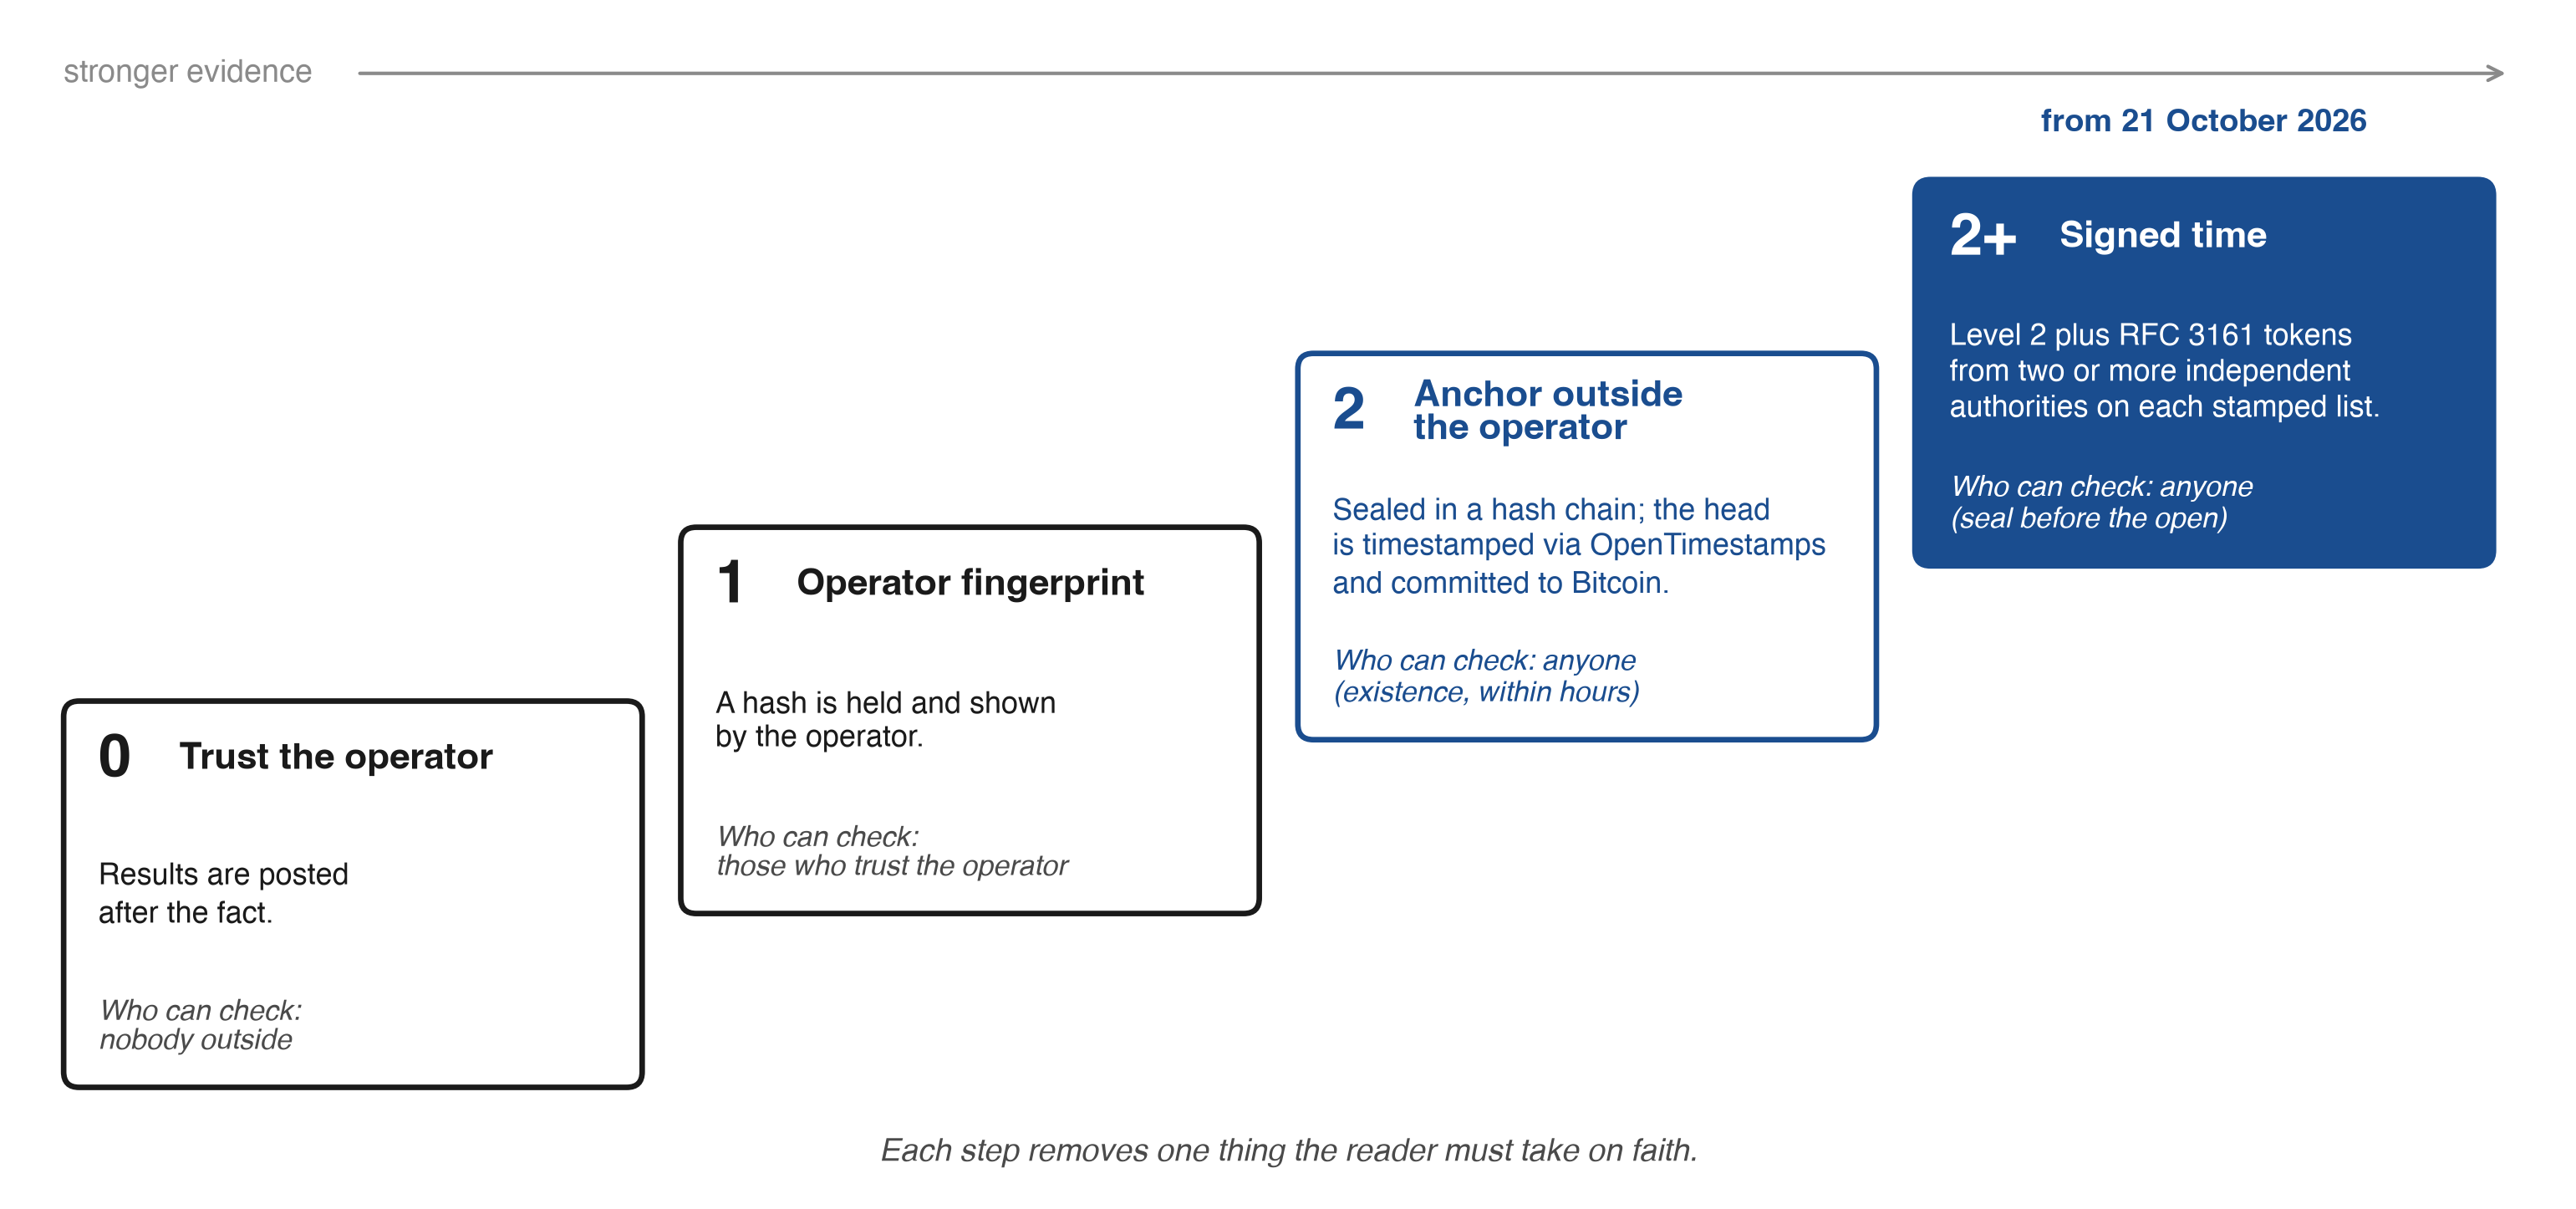
Hinweis: Die Ebenen beschreiben, worauf ein Leser über die Zeit eines Datensatzes vertrauen muss. Ebene 2+ fügt RFC 3161-Token hinzu, in der Liga ab 21. Oktober 2026, wenn der Datensatz mit den gezählten Antworten vor der 09:30 ET Öffnung signiert wurde. Versiegelung bei Ankunft, der Referenzpreis nach dem Siegel und die gezählte-Lauf-Regel sind separate Anforderungen (Abschnitt 3.13).
In der Referenzimplementierung gibt der Anker Ebene 2 für P1a und P2, gegen jede Partei, die eine unabhängige Kopie eines Beweises hält, und gegen alle für jede gestempelte Liste, die in das Rekor-Log eingegeben wird (Abschnitt 3.11). P1b steht auf Ebene 2+ im gezählten Datensatz (Abschnitt 3.11). P3 ruht auf Ebene 1 auf dem verketteten Datensatz des Betreibers und, ab 21. Oktober 2026, auf einer gezählten-Lauf-Regel, die im Voraus erklärt wird. Die Leiter misst Vertrauen in die Uhr. Was ein Leser über Preise oder Fähigkeit behaupten darf, erklimmt eine zweite Leiter, die Behauptungsleiter (Tabelle B1, Anhang B): veröffentlichte Regeln, neuberechnete Dateien, eine verifizierte externe Verpflichtung, Ergebnisse, die mit einer unabhängigen Preisquelle abgestimmt sind, eine prospektive gepaarte Evaluierung, die vor ihrem Fenster eingefroren ist, und Replikation durch eine zweite Pipeline. Diese zweite Leiter endet in den registrierten Vergleichen von Abschnitt 8.
3.13 Checkliste des vorgeschlagenen Standards
Ich schreibe die Anforderungen unten als das, was eine Arena, ein Benchmark oder ein Fonds annimmt, wenn es behauptet, dem Standard zu folgen. MUSS kennzeichnet eine Anforderung, ohne die die Behauptung nicht haltbar ist; SOLLTE kennzeichnet die Ebene-2+-Spezifikation.
- MUSS jede Aufgabe durch einen vor der Frage festgelegten Ereignisvertrag definieren, mit mindestens den Feldern von Tabelle 1, einschließlich der Preisquelle jedes Indikators (Anbieter, Symbol, Balkengröße und Zeitstempelregel für Referenz- und Terminalpreis); Prognoseergebnisse, die in der Zukunft liegen; und das Modell, seine Version und seinen Modus in der Antwortzeile selbst versiegeln. In einer blinden Saison trägt die Zeile diese als Salt-SHA-256-Commitment, , und die Salze werden nach der Saison veröffentlicht, sodass die Identität beim Versiegeln festgelegt und bis zum Ende der Saison verborgen bleibt.
- MUSS ein nur-anhängen-Datensatz mit Hashkettenverkettung führen, in dem jede Zeile beim Eintritt versiegelt wird, der Fragetext und die Preisaufnahme in den Lauf gehasht werden, die Frage veröffentlicht wird, und eine Korrektur eine neue Zeile ist, die die betroffenen Zeilen benennt.
- MUSS den Kopf des Datensatzes außerhalb des Betreibers bei jedem Lauf (Stufe 2) verankern, die Beweise veröffentlichen, die Schranke mit ihrer Marge angeben und jeden gestempelten Digest im Moment des Stempelns auf mindestens einem nur-anhängen-Kanal veröffentlichen, den der Betreiber nicht kontrolliert.
- MUSS einen Referenzpreis pro gemeinsames Ereignis nach dem Versiegeln nach einer veröffentlichten Regel für jedes Instrument nehmen; eine später versiegelte Zeile erhält ihre eigene Referenz und ist ein separates Ereignis. Prognosen werden zusammengefasst (Konsens, Übereinstimmung, Fehlerzahlen, Vergleiche zwischen Modellen) nur, wenn jedes Feld ihrer Ereignisverträge übereinstimmt.
- MUSS jeden Lauf, gezählt oder nicht, mit seinem Label veröffentlichen.
- MUSS den gezählten Lauf jeder Sitzung durch eine Regel fixieren, die vor den Läufen deklariert wird (zum Beispiel ein veröffentlichter Zeitplan), und SOLLTE die Deklaration mit ihrem Hash auf einem Kanal veröffentlichen, den der Betreiber nicht kontrolliert. Eine Regel, die danach auf die gemachten Läufe angewandt wird, erfüllt sie nicht.
- MUSS das abgefragte Ereignis nach einer streng eigentlichen Regel bewerten: der primäre Brier-Score eines strikten Anstiegs über alle Zeilen, mit jedem gefilterten Score zweiten und der Anzahl der Zeilen, die er verwirft; oder mit einem Ziehband entweder die Wahrscheinlichkeit eines Anstiegs angesichts einer Bewegung außerhalb des Bandes abfragen, oder drei Wahrscheinlichkeiten abfragen und sie durch den Drei-Ausgang-Brier-Score bewerten (Abschnitt 3.5).
- MUSS leere Zellen und fehlende Antworten neben jedem Score berichten, einen gefüllten Wert aus dem Konsens und den Übereinstimmungszahlen herausholen und die Qualität bei angegebenen Wahrscheinlichkeiten, Abdeckung und jeden Dienst-Score als separate Ergebnisse berichten.
- MUSS die nicht-informative 50%-Benchmark und eine klimatologische Basisquote desselben Ereignisses für jeden Vermögenswert und Horizont berichten, geschätzt auf einem festen Fenster, das vor der Saison endet und durch einen veröffentlichten Hash versiegelt wird, mit dem Brier-Skill-Score dagegen; ein als Benchmark verwendeter Vorhersagemarktpreis wird mit seinem gehandelten Volumen versiegelt, und ein deklarierter Volumenboden definiert den primären Vergleich.
- MUSS nur nach einer Mindestzahl von Sitzungen pro Horizont einordnen, mit Intervallen gruppiert nach Sitzung und, für Horizonte länger als ein Tag, Intervallen, die überlappende Fenster respektieren; ein Vergleich ist für Präzision auf die gepaarte Sitzungs-Ebene Brier-Differenz geplant, und ein Anspruch ohne Unterschied erfordert ein Intervall innerhalb einer deklarierten Äquivalenzmarge (Abschnitt 4.6).
- MUSS die Daten und den Scoring-Code veröffentlichen, damit jeder Score von einer dritten Partei neu berechnet werden kann, und in jeder Papiervision eine unveränderliche Analyseveröffentlichung mit einer Prüfsumme für jede Datei zitieren (Anlage C).
- MUSS jede Antwort bei Ankunft versiegeln, ohne auf einen Stapel zu warten, und SOLLTE (Stufe 2+) ein RFC-3161-Token von einer öffentlichen Zeitstempelstelle auf jedem Siegel erhalten.
- SOLLTE (Stufe 2+) den Hash jeder abgehenden Frage versiegeln, wenn sie gesendet wird, und das Roster erwarteter Antworten mit ihrer Frist und Wiederholungsrichtlinie vor der ersten Frage eines Laufs versiegeln.
- MUSS jeden veröffentlichten Konsens von Modellen auf derselben Oberfläche mit der Anzahl der angegebenen Wahrscheinlichkeiten, die eingegangen sind, ihrer durchschnittlichen paarweisen Korrelation und dem von Abschnitt 5.1 für diesen Lauf und Horizont begleiten, damit ein Leser sieht, wie viele unabhängige Stimmen hinter der Übereinstimmung stehen.
- MUSS eine Änderung der Methodik als den Anfang eines neuen Messsegments behandeln und eine Korrektur als eine angefügte Zeile, die das Original an Ort und Stelle lässt; bestätigende Scores werden innerhalb eines Segments berechnet (Abschnitt 3.10).
- MUSS, wo Leser neben den Modellen Prognosen erstellen: jeden Leser einmal und zufällig zuweisen, nie neu zugewiesen; eine erste Prognose pro Markt, Kennung und Sitzung zählen; Leserprognosen zur Referenzzeit schließen; eine Zurücksetzer-Kennung als neuen Leser behandeln und den Anteil der Zurücksetzer berichten; die blinde Gruppe im Datenwörterbuch vor der ersten bewerteten Prognose kennzeichnen; und keine Adresse eines Lesers speichern, höchstens einen gesalzenen Hash davon mit dem Tag, das nur verwendet wird, um wiederholte Stimmen zu begrenzen, keines veröffentlichend (Abschnitt 6).
- SOLLTE die Diagnostiken der Abschnitte 4 bis 6 neben den Scores berichten: der Anteil des größten Eigenwertes und das Beteiligungsverhältnis der Ähnlichkeitsmatrix, je zwei Zählungen der Unterscheidbarkeit jedes Sitzes, der Test der Seiten als Blöcke, ein Abruf-Datensatz für jeden zitierten Link, der in eine Überlappsumme eingeht, den Nur-Preise-Arm, Wahrscheinlichkeitswiederholungen unter einem gefrorenen Paket, Geld-, Brief- und letzte Handelszeitangabe auf jeder Menge-Zeile, und den Umsatz und die Kosten jedes Kontos neben einem Nicht-Handel-Schatten.
Teil der Checkliste läuft als Code. Die Liga veröffentlicht den Ereignisvertrag als JSON-Schema (event-contract.schema.json) und einen eigenständigen Checker, der nur mit der Python-Standardbibliothek geschrieben ist (tools/conformance.py, unter der gleichen Adresse wie die Daten, SHA-256 e1f929a9…63db2e wie am 21. Oktober 2026, 22:33 UTC abgerufen, unverändert gespeichert unter tools/archive/conformance-e1f929a9.py; environment.json listet jede Version des Checkers mit seinem Datum und Hash auf). Der vollständige Vertrag umfasst neun Schlüssel: asset, horizon, Referenzzeit, Endzeit, Regel, Resolver-Version, Referenzregel, Preisanbieter und Preissymbol, und sein event_id_v2 ist ev2- gefolgt von den ersten 16 Hexadezimalziffern des SHA-256 ihrer kanonischen JSON (sortierte Schlüssel, keine Leerzeichen, UTF-8). Der erste Identifikator, event_id (ev1-, die ersten fünf Schlüssel), bleibt daneben, sodass sich kein veröffentlichter Identifikator jemals ändert. Zwei Ligen, die denselben Vertrag schreiben, erhalten den gleichen Identifikator, sodass die Prüfung von Anforderung 4 zu einem Vergleich der Identifikatoren für jedes Feld wird, das das Ergebnis festlegt, und die Bewertungsregeln werden durch die in der gleichen Zeile versiegelte Methodologie-Version festgelegt. Der Checker validiert jede Zeile gegen das Schema, erstellt seinen Identifikator neu, prüft die Zeiten, den Wahrscheinlichkeitsbereich und die Ergebnisfelder, lehnt einen Identifikator ab, der für zwei Ereignisse verwendet wird, und erfordert die Methodologie-Version jeder Zeile (Anforderung 15). Jede Liga kann python3 conformance.py its.csv auf ihren eigenen Export ausführen. In der Prognosedatei der Liga vom 21. Oktober 2026, 22:33 UTC, meldete es „3792 Zeilen, OK", wobei beide Identifikatoren bei jeder Zeile neu erstellt wurden. Ein bestandener Test zeigt einen wohlgeformten Datensatz, und Tabelle 5 liest die Konformitätsanforderung Anforderung für Anforderung auf.
Tabelle 5 zeigt den Status der Referenzimplementierung gegenüber jeder Anforderung. Ein Anspruch, der sich auf eine Anforderung stützt, gilt ab dem Datum, an dem die Anforderung erfüllt ist. „Erfüllt" bedeutet sichtbar in den öffentlichen Dateien, als ich diese am 21. Oktober 2026 um 15:05 UTC las (siehe die Anmerkung), „Teilweise erfüllt" bedeutet, dass ein Teil der Anforderung dort sichtbar ist, und „In Bearbeitung" bedeutet, dass die Implementierung läuft, wobei die bereits vorhandenen Teile daneben aufgelistet sind.
Tabelle 5. Konformität der Referenzimplementierung, wie am 21. Oktober 2026 gelesen (Anforderung 3 am 22. Oktober 2026).
| Anf. | Ebene | Status | Was vorhanden ist |
|---|---|---|---|
| 1 Ereignisvertrag | MUSS | Erfüllt seit 21. Oktober 2026 | Vertragfelder versiegelt in der Methodologie; Vertragschema, Checker und beide Identifikatoren bei jeder Prognosezeile, der neunschlüsselige event_id_v2 mit Anbieter, Symbol und Referenzregel; Modell mit seiner Versionsnummer und Modus versiegelt in jeder Antwortzeile (wiederhergestellt durch Korrekturzeilen für die ersten Läufe) |
| 2 Hash-verketteter Datensatz | MUSS | Erfüllt | Kette, Frage und Snapshot-Hashes, veröffentlichte Fragen, Korrektionen als Zeilen |
| 3 Externer Anker | MUSS | Erfüllt seit 22. Oktober 2026 | OpenTimestamps-Anker bei jedem Lauf, Nachweise veröffentlicht; ab 21. Oktober RFC 3161-Token von zwei unabhängigen Behörden bei jeder gestempelten Liste (drei ab 13:23 UTC), jede Liste benannt die vorherige durch ihren SHA-256; jede gestempelte Liste ab dem Stempel in das Sigstore Rekor-Transparenzprotokoll eingegeben vom 22. Oktober 2026 (die erste bei Protokollindex 3.368.763.032, fünf Sekunden nach ihrem Stempel von 00:00:11 UTC), und die früheren Listen am 21. Oktober von 23:45 bis 23:47 UTC (die Liste vom 20. Oktober bei Protokollindex 3.368.351.276) |
| 4 Ein Verweis pro gemeinsamen Ereignis | MUSS | In Bearbeitung | Nach dem Verweis versiegelte Zeilen tragen ihren eigenen Verweis (late_ref); Zeilen tragen reference_at, same_event und event_id; die gezählte Serie von n_eff, das Hauptteil benannt, lässt solche Zeilen aus; der alle-Sitze n_eff, benannt „kein Schnitt nach der Siegelzeit", und together werden daneben ohne den Schnitt veröffentlicht |
| 5 Jeder Lauf veröffentlicht | MUSS | Erfüllt | Ungezählte Läufe beschriftet not_counted |
| 6 Gezählter Lauf | MUSS; SOLLTE | MUSS erfüllt seit 21. Oktober; SOLLTE erfüllt | Geplanter Morgenlauf im Voraus erklärt, versiegelt als erste Zeile von asks.jsonl (04:16 UTC) und auf der Beweisseite mit seinem SHA-256 und einer Internet Archive-Erfassung veröffentlicht (05:35 UTC); 19. und 20. Oktober folgen der Entwicklungsregel von Abschnitt 3.4 |
| 7 Ereignis gefragt | MUSS | In Bearbeitung | Alle-Zeilen Brier in der Sitzung vom 21. Oktober erklärt (main_metric, erste solche Punktzahl nach diesem Schluss); 19. und 20. Oktober stehen wie veröffentlicht, ein separates Segment (method_segments) |
| 8 Leere Zellen | MUSS | Erfüllt | counted_50, no_answer, of; drei Ergebnisse separat gemeldet |
| 9 Benchmarks | MUSS | In Bearbeitung | 50%-Benchmark veröffentlicht; feste Klimatologie veröffentlicht im Live-council-calibration.json ab 21. Oktober 2026, 08:54 UTC (climatology_fixed, 48 Markt-Horizont-Zellen, Inhalts-SHA-256 2810d11e…3cabb7, sha256_ok wahr); F12 und F13 wenden bereits die 1.000-Dollar-Untergrenze in ihren eigenen Definitionen an, und die Menschenmenge-Volumen-Untergrenze in der veröffentlichten Methodologie vervollständigt sie |
| 10 Ranking und Intervalle | MUSS | In Bearbeitung | 30/10-Regel, sitzungsgeclusterte Intervalle und gepaarte sitzungsstufen-Intervalle (pairs, council-pairs.csv) veröffentlicht; überlappende-Fenster-Intervalle und erklärte Spannweiten in der Registrierung |
| 11 Daten, Code, Freigabe | MUSS | In Bearbeitung | Daten und Code mit Hashes veröffentlicht; Analyseveröffentlichung bei jeder Revision hinterlegt |
| 12 Versiegelung bei Ankunft; RFC 3161 | MUSS; SOLLTE | Teilweise erfüllt | RFC 3161-Token bei jeder gestempelten Liste ab 21. Oktober; an jenem Morgen wurden acht Antworten in einem Stapel versiegelt und eine neunte 14 Sekunden nach deren Ankunft; das Versiegeln jeder Antwort bei Ankunft vervollständigt es |
| 13 Frage-Hashes, Roster vor der Frage | SOLLTE | Teilweise erfüllt ab 21. Oktober | Jeder Schritt eines Laufs versiegelt sein Roster (gefragte Sitze, bereits beantwortete Sitze, Stellvertreter) vor seiner ersten Frage, sodass eine zweite Anforderung sichtbar ist; ausgehende Frage-Hashes verkettet in asks.jsonl und abgedeckt durch die gestempelten Listen; beides auf der Beweisseite; Frist und Wiederholungsrichtlinie verbinden sich mit den Roster-Feldern |
| 14 Effektive Stimmen neben Konsens | MUSS | In Bearbeitung | n_eff veröffentlicht in council-stats.json; die gezählte Serie (gezählte Durchläufe, Antworten versiegelt vor 09:30 ET) ist als Hauptserie gekennzeichnet, die All-Seats-Serie wird daneben beibehalten; der Druck neben jedem angezeigten Konsens vervollständigt sie |
| 15 Segmente | MUSS | Erfüllt | Methodologieversion in jeder Durchlaufzeile und in jeder Prognoszeile versiegelt (methodology_version); Bewertungen nach Segment (method_segments); Änderungen datiert; nichts neu gezählt |
| 16 Leser | MUSS | In Bearbeitung | Zwei permanente Zufallsgruppen aktiv (experiment.g0, g1), nur erste Prognosen, Leserprognosen geschlossen um 09:30 ET, keine Adresse gespeichert (ein pro Tag gesalzener Hash begrenzt Abstimmungen); die Blindgruppen-Bezeichnung im Datenwörterbuch und der Anteil der Zurückstellungen vervollständigen sie |
| 17 Diagnose | SOLLTE | Teilweise erfüllt | Beteiligungsquote (n_eff_participation), die vorzeichenlosen und klimatologie-zentrierten Zählungen, Überschneidung gemeinsamer Quellen und der Closed-Book-Arm veröffentlicht; die anderen Diagnosen sind angegeben |
Anmerkung: Status wie in den öffentlichen Dateien und auf der Korrekturseite vom 21. Oktober 2026 um 15:05 UTC gelesen (council-stats.json erzeugt 14:51:50 UTC, council-book.jsonl mit 230 Zeilen); Anforderung 1 wie am gleichen Tag um 22:33 UTC überprüft (Abschnitt 3.13), und Anforderung 3 wie am 22. Oktober 2026 um 00:00:16 UTC im Rekor-Protokoll eingetragen (Anhang B, Schritt 10).
4. Maßnahmen
Das Protokoll erfasst, was gesagt wurde und wann. Die Maßnahmen wandeln diesen Datensatz in Punktzahlen um; zusammen bilden sie die Prognoseauswertung, die der Standard verlangt. Ich beschreibe jede Maßnahme, wie sie in der Methodik (Version 2) und dem Liga-Protokoll (arena-3, Pro-Liga pro-1) veröffentlicht wurde, und wo der Standard mehr verlangt, die Anforderung. Abschnitt 5 berichtet die Abhängigkeitswerte für Live-Daten, und Genauigkeitsergebnisse erscheinen als datierte Überarbeitungen dieses Papiers.
4.1 Richtung
War der Indikator am Ende des Horizonts höher oder niedriger als in seiner Referenz, und unterlagerte das Wahrscheinlichkeit des Modells diese Seite? Über 50 unterstützt einen Anstieg, unter 50 einen Fall, genau 50 keinen von beiden. Ein Aufruf von 51% und ein Aufruf von 95% erhalten das gleiche Ergebnis, daher kann die Richtung ein selbstbewusstes Modell nicht von einem zaudernden unterscheiden, und die Hauptmaßnahme ist der Brier-Score.
4.2 Brier-Score
Für eine Prognose mit angegebener Wahrscheinlichkeit (in Prozent) eines Anstiegs und Ergebnis ,
und die Punktzahl eines Modells über gelöste Prognosen ist der Mittelwert (Brier, 1950), von 0 für eine perfekte Prognose bis 1 für die schlechteste. Der Brier-Score ist streng angemessen für das Ereignis, auf dem er berechnet wird (Gneiting & Raftery, 2007); für die Frage der Liga ist dieses Ereignis ein strenger Anstieg über alle Zeilen (Abschnitt 3.5, Anforderung 7).
4.3 Der uninformative 50%-Richtwert und die Klimatologie
Ein Prognostiker, der immer 50% sagt, erzielt bei jeder Prognose 0,25. Dies ist der uninformative 50%-Richtwert (die „Münze" der Liga-Dateien), eine neutrale Referenz. Ein Prognostiker, der die Basisrate von Anstiegen kennt, kann mit keinem Geschick über den Tag hinweg unter 0,25 erreichen, und bei längeren Horizonten kann die Basisrate weit weg von einer Hälfte sein. Ich füge daher einen klimatologischen Richtwert hinzu (Anforderung 9): die Häufigkeit eines strikten Anstiegs desselben Ereignisses für jeden Vermögenswert und Horizont, geschätzt auf einem festen Fenster, das vor der Saison endet und in der Methodik versiegelt ist, mit dem Brier-Geschicklichkeitsscore
auf denselben Zeilen. Das gleiche Ereignis bedeutet das Ereignis, das der Vertrag bewertet: für den Tag, vom Referenzpreis zum Preis am Terminal nach der Preisquellen-Regel von Tabelle 1 (09:30 bis 16:00 ET, die Rendite bis 15:00 ET, Bitcoin von der Versiegelungsminute bis 16:00 ET). Bei längeren Horizonten läuft es über die gleiche Anzahl von Sitzungen oder Kalendertagen (Abschnitt 3.7). Eine Basisrate eines anderen Ereignisses würde den Richtwert verfälschen.
In der Referenzimplementierung ist die feste Klimatologie das Feld climatology_fixed von council-calibration.json: pro Vermögenswert und Horizont, p_up, die Häufigkeit 2016 bis 2025 eines strikten Anstiegs mit jeder gezählten Zeile, p_up_ex_draw, dasselbe mit Unentschieden ausgelassen, die Anzahlwerte n und n_independent, das Fenster und die Regel. Der primäre Richtwert ist = p_up, weil der primäre Brier-Score alle Zeilen zählt. p_up_ex_draw dient dem Geschicklichkeitsscore der Liga ohne Unentschieden (bss_reference). Das Feld ist versiegelt durch council-clim-window.json, veröffentlicht unter der Datenadresse, mit 2810d11e…3cabb7, dem SHA-256 seines Inhalts: Pythons json.dumps des Objekts ohne seinen sha256-Schlüssel, mit sortierten Schlüsseln und Standardeinstellungen. Das eingereichte Skript berechnet diesen Inhaltshash neu, bevor es liest. Das Feld trat am 21. Oktober 2026 um 08:54 UTC in die Live-Datei ein, sein Inhaltshash prüft (sha256_ok), und es ist der Richtwert des primären Vergleichs. Wenn das Live-Fenster keine tägliche Historie hat, steht das nächste tägliche Ereignis ein: der Tagesbalken für Gold, WTI, Brent, Kupfer und den Dollar-Index, der Tagesschluss für die 10-Jahres-Rendite, der UTC-Tag für Bitcoin und ab eine Woche Bewegungen vom Eröffnungskurs. Die vier US-Aktienindizes nehmen ihre aus dem Tagesbalken der 09:30 bis 16:00 ET-Sitzung selbst, das Ereignis, auf das die Modelle antworten, und der primäre Test wird auch nur auf diese vier allein berichtet (Abschnitt 8). Die Näherungen verfälschen und lassen die Prognosen unverändert (Abschnitt 10).
4.4 Kalibrierung und Schärfe
Kalibrierung fragt, ob angegebene Wahrscheinlichkeiten mit der angegebenen Rate eintreffen. Die Liga meldet die direktionale Konfidenzkallibrierung: Jede aufgelöste Wahrscheinlichkeit wird auf die Seite gefaltet, die sie unterstützt ( wird zu mit umgekehrtem Ergebnis, und genau 50 wird ausgelassen), die gefalteten Prognosen fallen in vier Behälter, [50, 60), [60, 70), [70, 80) und [80, 100], und jeder Behälter zeigt die mittlere angegebene Wahrscheinlichkeit und den Anteil, der eintraf, aufgetragen aus 20 Prognosen (calib_min). Falten misst, ob die Konfidenz in der unterstützten Seite durch die Trefferquote auf dieser Seite abgebildet wird. Die Kalibrierung der rohen Wahrscheinlichkeit eines Anstiegs kann auch aus den offenen Reihen berechnet werden. Der Brier-Score teilt sich in einen Kalibrierungsterm und einen Auflösungsterm (Murphy, 1973), und die Behälter sind ein lesbares Gegenstück zu dieser Aufteilung.
Behälter benötigen viele Prognosen, also füge ich für jeden Sitz die Logit-Kalibrierungsanpassung für den Konsens und jeden Horizont hinzu: auf alle Reihen des abgefragten Ereignisses (Cox, 1958). Eine Steigung unter 1 bedeutet, dass angegebene Wahrscheinlichkeiten zu weit von einer Hälfte entfernt sind, über 1 zu nah; misst eine Neigung zu Anstiegen oder Rückgängen. Die Steigung verwendet jede Prognose und trägt einen Standardfehler, berechnet mit zusammengehaltenen Sitzungen (Abschnitt 4.6). Die gleiche Anpassung mit nach Ereignis geclusterten Intervallen wurde auf Polymarket-Preise angewendet (Walker, 2026).
Kalibrierung wird zusammen mit Schärfe beurteilt, da ein Prognostiker, der immer 50% sagt, kalibriert und uninformativ ist (Gneiting et al., 2007). Ich frage auch nach, pro Sitz, Konsens und Horizont,
von 0 (immer 50%) bis 100 (immer sicher), auf angegebenen Wahrscheinlichkeiten nur, und mit der klimatologischen Wahrscheinlichkeit aus Abschnitt 4.3 anstelle von 50. Schärfe gegen eine Hälfte wird voraussichtlich mit dem Horizont wachsen, wo langfristige Basistaten weit von einer Hälfte entfernt sind; Schärfe gegen Klimatologie ist die eigene des Prognostikers. Keiner benötigt ein Ergebnis. Bei der gezählten Auswertung vom 20. Oktober 2026 hatten die acht Sitze, die vor der Referenz versiegelt wurden, K von 9,2 bei einem Tag, 14,1 bei einer Woche, 13,9 bei einem Monat und 20,3 bei sechs Monaten (Abbildung 5; die Zellen selbst sind in Abbildung 6B). Sie standen ungefähr fünf Punkte von einer gleichen Chance für den Tag entfernt und waren am meisten entschieden am Horizont, der zuletzt auflöst, ein Teil davon ist die Basisrate, die entfernt. Am 21. Oktober 2026 gaben die neun Sitze 10,1, 12,5, 14,6 und 19,9. Die meisten angegebenen Wahrscheinlichkeiten lagen zwischen 40 und 60. Bei einem Tag traf das auf 93% von ihnen am 20. Oktober und 95% am 21. Oktober zu, und sogar bei sechs Monaten für mehr als die Hälfte (58% und 61%).
Abbildung 5. Angegebene Wahrscheinlichkeiten eines Anstiegs nach Horizont: Läufe 2026-10-20-am (acht Sitze versiegelt vor der Referenz) und 2026-10-21-am (neun Sitze).
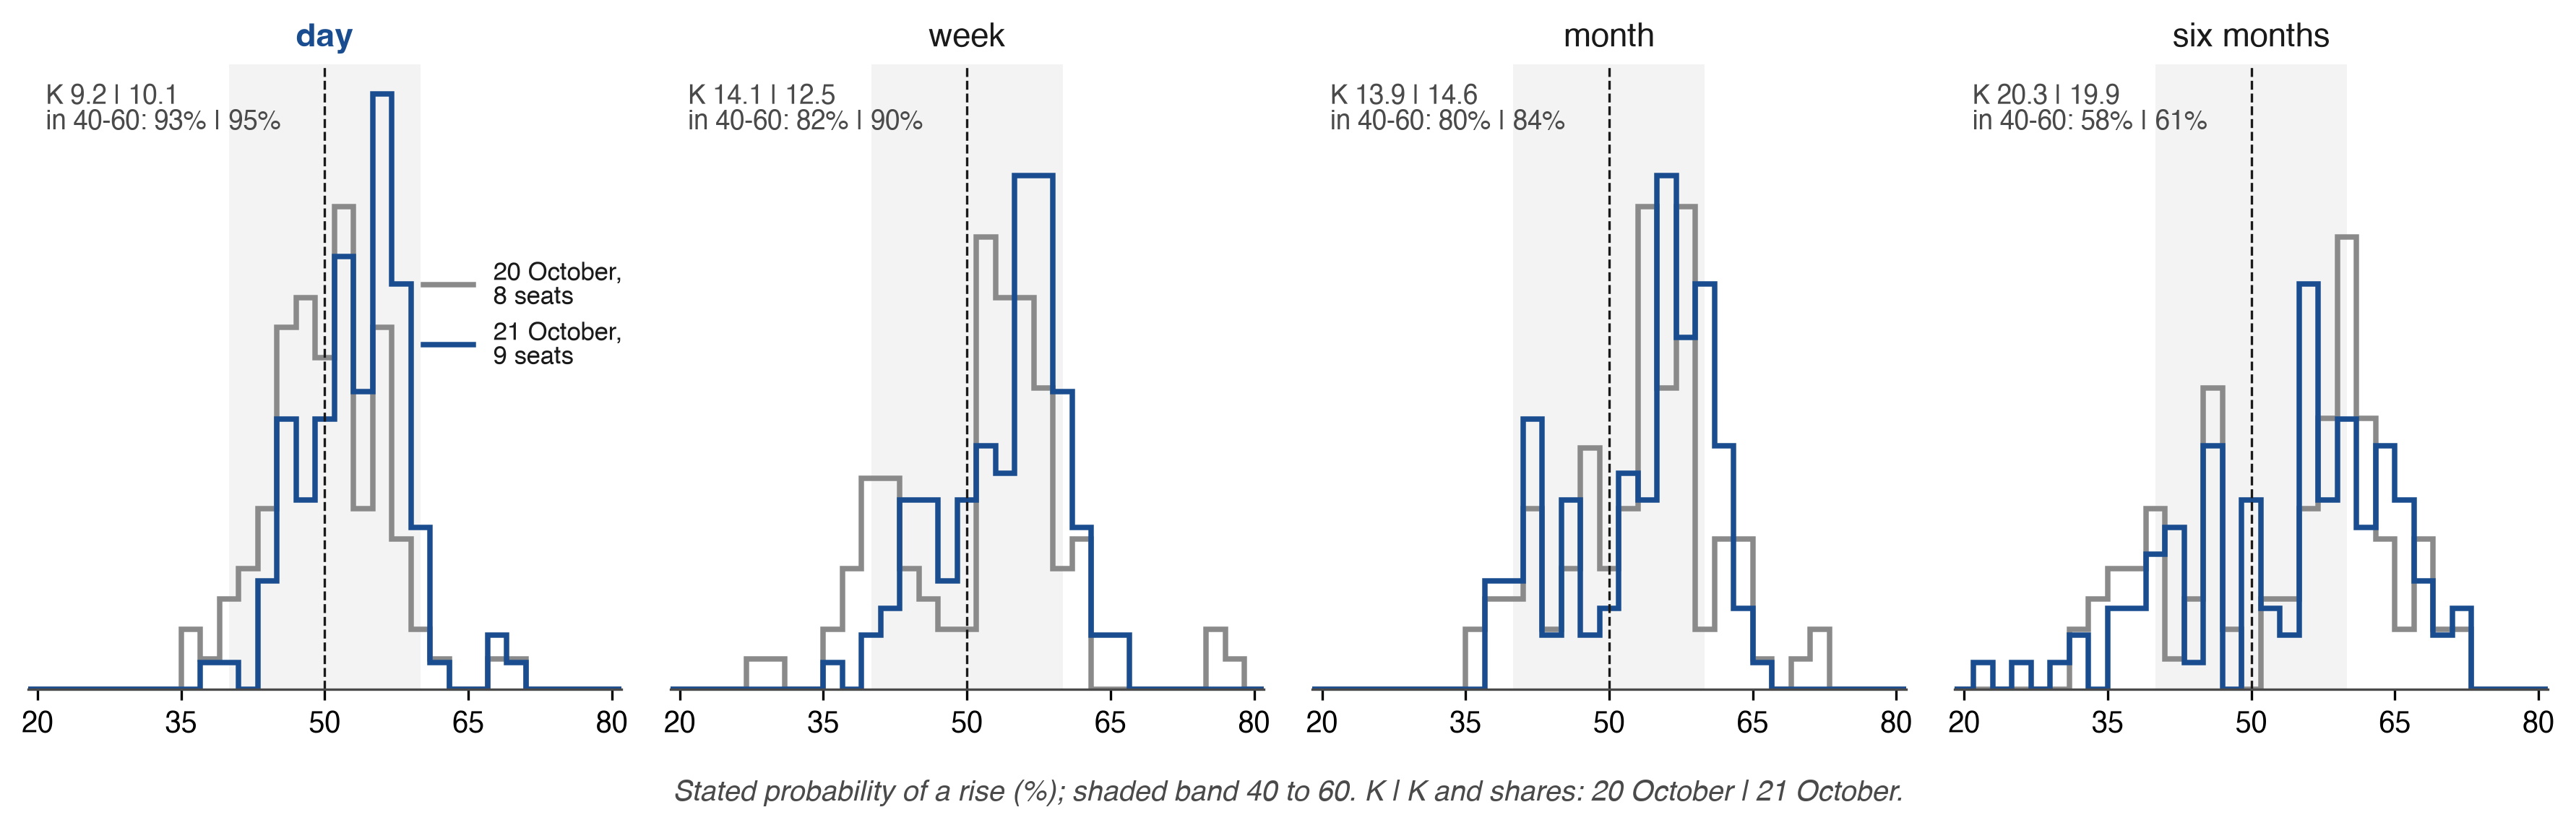
Hinweis: Histogramme in Schritten von 2 Punkten, skaliert auf gleiche Fläche; das schattierte Band läuft von 40 bis 60. K = (2/n)Σ|p − 50| (Abschnitt 4.4). Am 21. Oktober haben die vier Bitcoin-Zellen der neunten Antwort eine eigene Referenz (Abschnitt 3.3) und werden aus dieser und jeder anderen gepoolten Auswertung des Laufs ausgelassen (428 von 432 Zellen). Quelle: council-forecasts.csv gespeichert 22. Oktober 2026, 01:32 UTC.
4.5 Baselines
Die Liga bewertet die gleichen Reihen gegen feste Baselines:
- Münzwurf (0,25 bei jeder Prognose).
- Momentum: Gestrige Richtung des gleichen Indikators bei festem 55%, bewertet auf den gleichen Reihen wie der Konsens; das veröffentlichte Feld der Liga lässt Unentschieden aus, und die registrierte F15 bewertet es auf allen Reihen (Abschnitt 8.1).
- Buy and Hold (
_hold_all), S&P 500 (_spy), 60/40 (_passive), Bargeld beim 13-Wochen-Schatzwechsel (_cash) und Zufällig innerhalb der Regeln der Liga (_random).
Die ersten zwei sind Baselines für die Wahrscheinlichkeitswerte, und die anderen fünf sind Portfolios, die unter denselben Kosten und mit derselben Ausführung wie die Modelle laufen. Momentum überprüft eine triviale Regel. Wenn das Ergebnis eine gleichmäßige Chance unabhängig von gestern ist, erreicht ein festes 55% im Erwartungswert. Die klimatologische Benchmark ist die Messlatte, die der Standard verlangt. Die Methodik nennt auch eine Nicht-Änderungs-Baseline, eine Punktprognose ohne Wahrscheinlichkeit, die außerhalb des Brier-Vergleichs bleibt. Der Konsens des Rates ist auch eine Baseline: der Durchschnitt der Wahrscheinlichkeiten der Modelle, wobei der höchste und niedrigste Wert gestrichen werden, wenn fünf oder mehr antworten, ein zweiter Vertreter derselben Familie mit einem Drittel gewichtet, und das Ergebnis zwischen 2% und 98% gehalten.
Durchschnittsbildung bringt einen Gewinn, der keine Fähigkeit ist. Für ein Ereignis mit Ergebnis und Gewichten , die sich zu eins summieren, entspricht der Brier-Wert des gewichteten Durchschnitts dem gewichteten Durchschnitt der Werte der Mitglieder minus ihrer gewichteten Streuung (Krogh & Vedelsby, 1995):
Der Konsens kann daher gegenüber dem Durchschnitt der Mitglieder, die er behält, bei einem gemeinsamen Ereignis nicht verlieren, egal wie groß deren Fähigkeit ist; das Ergebnis zwischen 2% und 98% zu halten, kann höchstens 0.0004 pro Reihe kosten. Ein Befund, dass der Konsens sein durchschnittliches Mitglied schlägt, ist mechanisch zu erwarten. Seine Fähigkeit wird gegen die Münze, die klimatologische Basisrate, die Menge und das beste einzelne Modell der vorherigen Periode bewertet, und der Streuungsterm wird neben dem Konsenswert angegeben (Abschnitt 5.3).
4.6 Die 30/10-Regel: 30 Prognosen an mindestens 10 Handelstagen
Ein Modell erscheint in der Tabelle eines Horizonts nur, wenn es mindestens 30 aufgelöste Prognosen bei diesem Horizont und mindestens 10 Handelssitzungen mit jeweils mindestens einer aufgelösten Prognose bei diesem Horizont hat. Die versiegelte Methodik nennt die Regel und ihren Grund in einem Feld: „die 12 Indikatoren eines Tages bewegen sich zusammen: die Liga zeigt die Handelstage neben den Prognosen, und ein Modell wird nach 30 aufgelösten Prognosen an mindestens 10 Handelstagen eingestuft" (independence). Die Regel begrenzt nicht, wie ungleichmäßig die Prognosen über diese Sitzungen verteilt sind, daher zeigt die Tabelle neben dem Wert jedes Modells dessen Anzahl der Sitzungen an (days), und die zweite Bedingung ist diejenige, die bindet. Wenn Prognosen innerhalb einer Sitzung eine Korrelation aufweisen, dann tragen Prognosen aus einer Sitzung etwa die Information von unabhängigen, dem Designeffekt der Clusterstichprobenziehung (Kish, 1965). Mit und ist eine Sitzung etwa 3,75 unabhängige Prognosen wert, und dreißig Prognosen aus drei Morgen etwa elf. Die Forderung nach 10 Handelstagen zwingt die Stichprobe, verschiedene Nachrichten abzudecken; innerhalb eines Horizonts ist die Einheit der Resampling die Sitzung. Die 30/10-Regel entscheidet über die Berechtigung, und die Leistung wird unten behandelt. Die erste Tabelle nach der Sitzung vom 30. Oktober 2026 ist eine provisorische deskriptive Ordnung, und ein Modell, das eine der ersten zehn Sitzungen verpasst hat, wird später berechtigt.
Die Statistikdatei veröffentlicht Intervalle aus 5 bewerteten Sitzungen (Student-t auf Sitzungsmittelwerten) und aus 20 durch einen Bootstrap über Sitzungen, mit den 12 Indikatoren eines Tages als ein Cluster (council-stats.json, sample.note). Vor 5 Sitzungen wird kein Intervall angezeigt, und ein auf Zeilen berechnetes Intervall behandelt die zwölf Märkte eines Tages als unabhängig und ist zu eng. Für Horizonte länger als ein Tag teilen sich aufeinanderfolgende Prognosen die meisten ihrer Ergebnisfenster, daher benötige ich für Horizont in Sitzungen Heteroskedastizität und Autokorrelation konsistente Intervalle mit Verzögerung (Newey & West, 1987) oder einen Block-Bootstrap mit Blöcken von mindestens Sitzungen (Künsch, 1989), und kein Intervall vor Sitzungen (Anforderung 10). In einer Saison von 126 Sitzungen ergibt diese Regel Intervalle bei einer Woche ab Sitzung 25 und bei einem Monat ab Sitzung 105, und keine bei sechs Monaten, was 630 benötigen würde. Bestätigende Ansprüche beruhen auf dem Tag, dem primären Horizont, und auf der Woche und dem Monat, wo die Regel erfüllt ist. Ergebnisse von sechs Monaten und die Tagesintervalle sind in dieser Saison beschreibend. Ein Geschicklichkeitsanspruch wird an den registrierten Kontrollpunkten gelesen (Abschnitt 8), unabhängig davon, was die Sitzungen zwischen ihnen zeigen.
Kraft gehört zum Vergleich, der behauptet werden soll, eine gepaarte Brier-Differenz. Für einen Prognostizisten und eine Benchmark zu denselben Ereignissen sei der Mittelwert über die Ereignisse der Sitzung von . Bei einer Standardabweichung der Sitzungsmittelwerte und einem deklarierten kleinsten Effekt benötigt ein zweiseitiger Test bei 5% mit 80% Kraft etwa unabhängige Sitzungen. Persistenz erhöht die Zahl, und die registrierte Analyse hält aufeinanderfolgende Sitzungen zusammen (Diebold & Mariano, 1995; Künsch, 1989). Bei 126 Sitzungen erkennt die Brier-Berechnung der Datei (power_brier) einen Rückgang unter die Münze von 0.0105, und ein Rückgang von 0.005 benötigt 554 Sitzungen. Sie extrapoliert von 171 Prognosen aus zwei Sitzungen (die Datei wurde am 21. Oktober 2026, 05:33 UTC, auf den Daten vom 20. Oktober erzeugt; das Live-Feld wird bei jeder Ausführung neu berechnet), nimmt ihre Standardabweichung auf Prognoselevel von 0.062 und als Proxy, bis fünf Sitzungen bewertet sind. Sie wird bei Sitzung 30 auf Sitzungsebene neu berechnet, und die registrierten Tests hängen nicht davon ab. Die Hit-Rate-Berechnung der Datei (power) benötigt 209 Sitzungen, um 55% von 50% bei einem angenommenen zu unterscheiden. Eine unabhängige Analyse binärer Prognosemarktfragen erreicht die gleiche Größenordnung: etwa 350 aufgelöste Prognosen, um einen Brier-Vorteil von 0.02 über dem Markt zu erkennen (Nechepurenko & Shuvalov, 2026a).
Ein negatives Ergebnis benötigt seine eigene Regel. Eine kleine geschätzte Differenz, ein Intervall zu breit, um zu entscheiden, und Anzeichen für keine Differenz sind drei Befunde. Ich deklariere eine Äquivalenzmarge, ±0.01 Brier, für jeden bestätigenden Vergleich, und lese „kein wesentlicher Unterschied" nur, wenn das 90%-Intervall der gepaarten Differenz (zwei einseitige Tests bei 5%) ganz darin liegt. Ich habe die Marge gewählt. Sie liegt nahe bei dem, was die Extrapolation aus zwei Sitzungen sagt, dass 126 Sitzungen auflösen können (power_brier, oben), sie ändert sich nicht, wenn diese Extrapolation neu berechnet wird, und sie ist eine Bewertungstoleranz, verschieden von jeder wirtschaftlichen Schwelle.
4.7 Die Portfolio-Liga
Wahrscheinlichkeiten messen Urteilskraft. Ein Portfolio, ein sekundäres Maß, zeigt, was ein Modell damit anfängt. Jedes der 14 Modelle verwaltet 100.000 Dollar simulierten Geldes nach denselben Regeln: elf gehandelte Fonds repräsentieren die Märkte (VIX ist nur ein Indikator), Positionen sind nur long zwischen 5% und 25%, Bargeld verdient die 13-Wochen-Schatzanweisung, jeder Dollar, der wechselt, kostet 0,1%, und eine Entscheidung handelt zur ersten Eröffnung nach ihrer Versiegelung (der erste Kurs von 09:30 bis 09:45 ET). „Hold" ist eine Entscheidung ohne Handel und ohne Kosten. Eine Entscheidung, die gegen eine Regel verstößt, wird abgelehnt, und die Positionen bleiben bestehen. Jedes Konto wird bei Schließung mit seiner Rendite und seinem maximalen Drawdown markiert, und von 20 Sitzungen mit den Sharpe- und Sortino-Quoten (Sharpe, 1994; Sortino & Price, 1994). Die vollständigen Regeln befinden sich in der Protokolldatei (Anhang A, Tabelle A1). Das Konto bewertet das Instrument, einen Schatzfonds für die Rendite und einen Fonds für jeden Rohstoff-Future, sodass ein niedrigerer Brier-Score keinen höheren Kontowert etabliert. Das Konto wird stattdessen mit den passiven Baselines unter denselben Kosten innerhalb einer Regelversion verglichen.
4.8 Die Pro-Liga
Jedes Modell hält ein zweites Konto mit 100.000 Dollar in der Pro-Liga (pro-1), ein Long-Short-Buch mit signierten Gewichtungen von 5% bis 30% des Eigenkapitals und brutto-Exposure von 100% bis 200%, also Hebelwirkung bis 2×; KI kann hier gehandelt werden. Seine Baselines sind der S&P 500, long gehalten und short gehalten.
4.9 KI gegen die Menge
Für bis zu acht der 12 Märkte handeln Vorhersagemärkte eine tägliche Frage nahe an der der Liga. Die Frage jedes Laufs listet sie mit ihren vollständigen Auflösungsregeln auf und fragt jedes Modell nach seiner eigenen Wahrscheinlichkeit von „Up" für jede in einem separaten Feld seiner Antwortzeile (crowd_up). Die Anweisung, Polymarket, Kalshi oder Wettquoten nicht nachzuschlagen, ist in der Frage versiegelt, und was die Suche eines Modells zurückgegeben hat, liegt außerhalb der Versiegelung. Wenn Polymarket den Markt auflistet, beantworten die Modelle die Frage von Polymarket, und eine Kalshi-Frage wird nur für einen Markt gestellt, den Polymarket nicht auflistet (council-calibration.json, method.crowd_window). Die Preise und gehandelten Volumen der Menge (vol) werden aufgezeichnet, wenn die Frage gestellt wird und in der Laufzeile versiegelt (crowd.odds für Polymarket, crowd.kalshi für Kalshi). Am 20. Oktober wurden sie um 12:30:06Z aufgezeichnet, bevor das erste Modell seine Antwort begann. Ich verberge den Preis bewusst. Ein Modell, dem der Marktpreis gezeigt wird und das gebeten wird, ihn zu überarbeiten, kann bei einigen Kontrakten den Markt schlagen (S. Kim et al., 2026), aber seine Antwort ist dann keine unabhängige Evidenz von der Menge mehr. Die Liga hält die beiden auseinander: die versiegelte Antwort ist blind für den Preis, und jede Kombination mit der Menge ist eine separate Strategie, versiegelt, bevor sie bewertet wird (Abschnitt 5.3). Jeder Vergleich nennt seine Informationsuhr: der versiegelte Preis ist die Menge zur Fragezeit, während die Kalibrierungsdatei jede Antwort des Modells mit dem Preis der Menge zur eigenen Antwortminute des Modells vergleicht, beide bewertet nach der Auflösung der Menge. Nach der Auflösung berichtet die Liga pro Frage die Wahrscheinlichkeit der Modelle und die der Menge, den Brier-Score jedes und die Seiten, die jeder richtig bekam (Buchtitel crowd; council-league.json, Feld crowd).
Am 20. Oktober listete Polymarket sechs tägliche „Up or Down"-Fragen auf (S&P 500, Dow, Gold, WTI, Dollarindex und Bitcoin) und Kalshi fünf (S&P 500, Nasdaq-100, 10-Jahres-Rendite, Gold und WTI): acht Märkte, drei davon an beiden Handelsplätzen. Wenn beide Handelsplätze einen Markt auflistet, nutze ich den Polymarket-Kontrakt, den die Modelle beantwortet haben; ansonsten den Kalshi-Kontrakt. Jede Wahrscheinlichkeit der Menge kommt von einem Kontrakt. Eine Kalshi-Frage wird bei einem Strike gesetzt, und ihr Preis wird durch Interpolation zwischen den beiden benachbarten Strikes (lo, hi in der Laufzeile) in „über dem vorherigen Schlusskurs" umgewandelt. Der interpolierte Preis approximiert die Wahrscheinlichkeit dieses Ereignisses aus zwei gehandelten Preisen, und beide Seiten werden dann für dieses synthetische Ereignis nach der Quelle bewertet, die der Kontrakt nennt. Ich gebe einen Kontrakt dem primären Vergleich zu, wenn sein versiegeltes Volumen mindestens 1.000 Dollar zur Zeit ist, wenn die Frage gestellt wird, und berichte dünnere Kontrakte separat. Die Schwelle zeigt das auf dem Kontrakt gehandelte Geld. Anforderung 17 fordert Bid, Ask und die Zeit des letzten Handels für jede Mengenzeile an, da auf Polymarket Spreads bei unwahrscheinlichen Ergebnissen breiter sind (Dubach, 2026).
Die Fragen der Menge sind nah an denen der Liga, und ihre Uhren unterscheiden sich. Der Tag der Liga läuft von der 09:30-Referenz bis 16:00 ET (die Rendite bis 15:00 ET); die Fragen der Menge laufen Close zu Close und mehrere werden zu anderen Stunden und aus anderen Quellen aufgelöst: Gold und Dollarindex bei der 17:00-Uhr-ET-Kerze von Pyth, WTI beim täglichen Schlusskurs des aktiven Futures-Kontrakts, die Rendite bei der Par-Rendite von 15:30 Uhr des Treasury, Bitcoin von Mittag zu Mittag auf Binance. Ich führe daher den Vergleich Frage für Frage durch, nach den Bedingungen der Menge, mit der separat erhobenen Wahrscheinlichkeit. Vorhersagemarktpreise sind eine starke Baseline (Wolfers & Zitzewitz, 2004; Berg et al., 2008), und Kalshi's makroökonomische Kontrakte prognostizieren etwa so genau wie die Survey of Market Expectations und der Bloomberg-Konsens (Diercks et al., 2026). Schärfe (Abschnitt 4.4) wird auf denselben Kontrakten verglichen, Modell für Modell, von crowd_up, da die Menge das Ereignis von prob_up nicht bewertet.
Wie weit eine Diskrepanz von Ereignissen einen Score verschieben kann, lässt sich exakt angeben. Nehmen wir an, ein Index schloss gestern bei 100, öffnet bei 98 und schließt bei 99: Er fiel vom vorherigen Schluss und stieg von der Eröffnung. Lassen Sie zwei Versionen eines Ereignisses mit gegensätzlichen Ergebnissen auf einem Anteil von Zeilen auflösen, mit den Wahrscheinlichkeiten und den Zeilen festgelegt. Bei einer umgekehrten Zeile ändert eine Prognose ihren Brier-Score um , höchstens 1 im absoluten Wert, sodass sich ein mittlerer Brier-Score um höchstens verschiebt. Die Lücke zwischen den Prognostizierenden und ändert sich bei dieser Zeile um , sodass sich die Lücke um höchstens verschiebt, wobei die Menge der umgekehrten Zeilen ist. Die Grenzen gelten für feste Prognosen auf einer festen Stichprobe. Zwei Regeln folgen daraus. Prognosen treten in einen gemeinsamen Score nur bei einem Ereignis mit einem Referenzpreis ein (Anforderung 4). Und jeder Vergleich mit der Menge berichtet seinen Anteil von Marktsitzungen, auf denen die beiden Fragen mit entgegengesetzten Vorzeichen auflösen; eine Lücke, die nicht größer als ist, wird nicht als Vorteil einer der beiden Seiten gelesen.
4.10 Das Gitter: Modell × Markt × Horizont
Jede gezählte Antwort füllt eine Zelle eines dreidimensionalen Gitters: bis zu elf Councils-Modelle, 12 Märkte und vier Horizonte (Abbildung 6). Jede Zelle sammelt ihren eigenen Brier-Score, Hit-Rate, Kalibrierung und Schärfe. Das Gitter beantwortet Fragen, die eine einzelne Rangliste nicht kann: welche Märkte bei welchem Horizont vorhersehbar sind, ob der Vorteil eines Modells in einer Anlageklasse liegt, und ob der Monat einfacher ist als der Tag, wenn jeder gegen seine eigene Basisquote gemessen wird. Die marginalen Ansichten werden in council-league.json (models, by_asset, by_horizon) veröffentlicht, die vollständigen Zeilen in council-forecasts.csv.
Abbildung 6. Das Messgitter. (A) Das Design: Modell × Markt × Horizont. (B) Das ausgefüllte Gitter: die versiegelten Wahrscheinlichkeiten eines gezählten Morgens, 20. Oktober 2026.
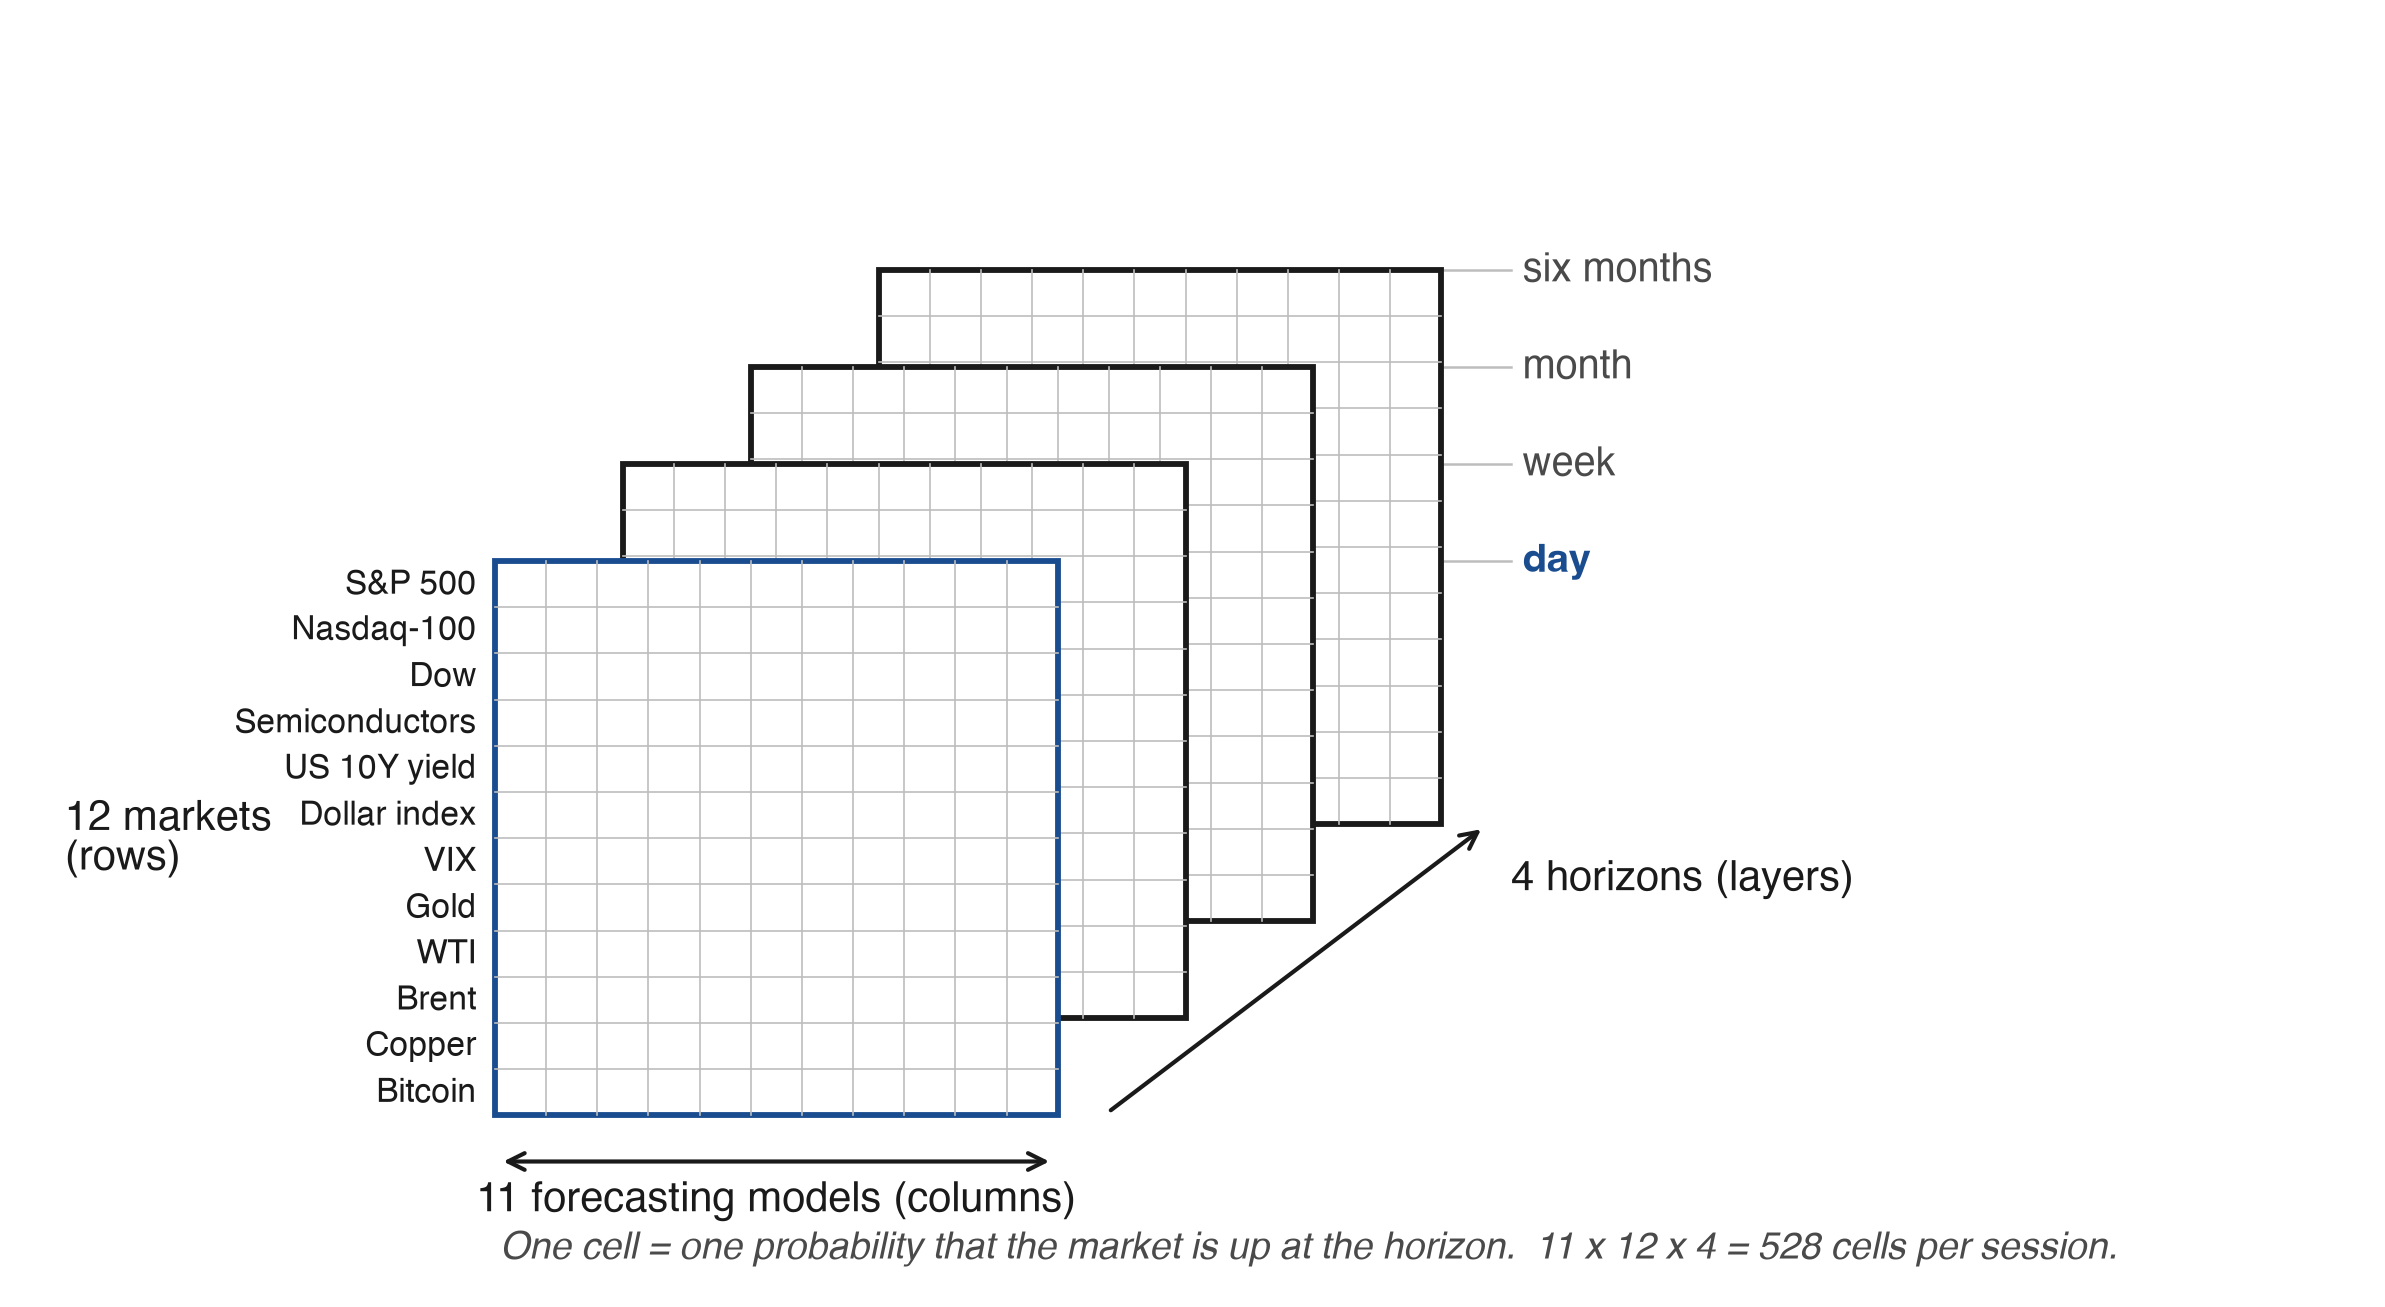
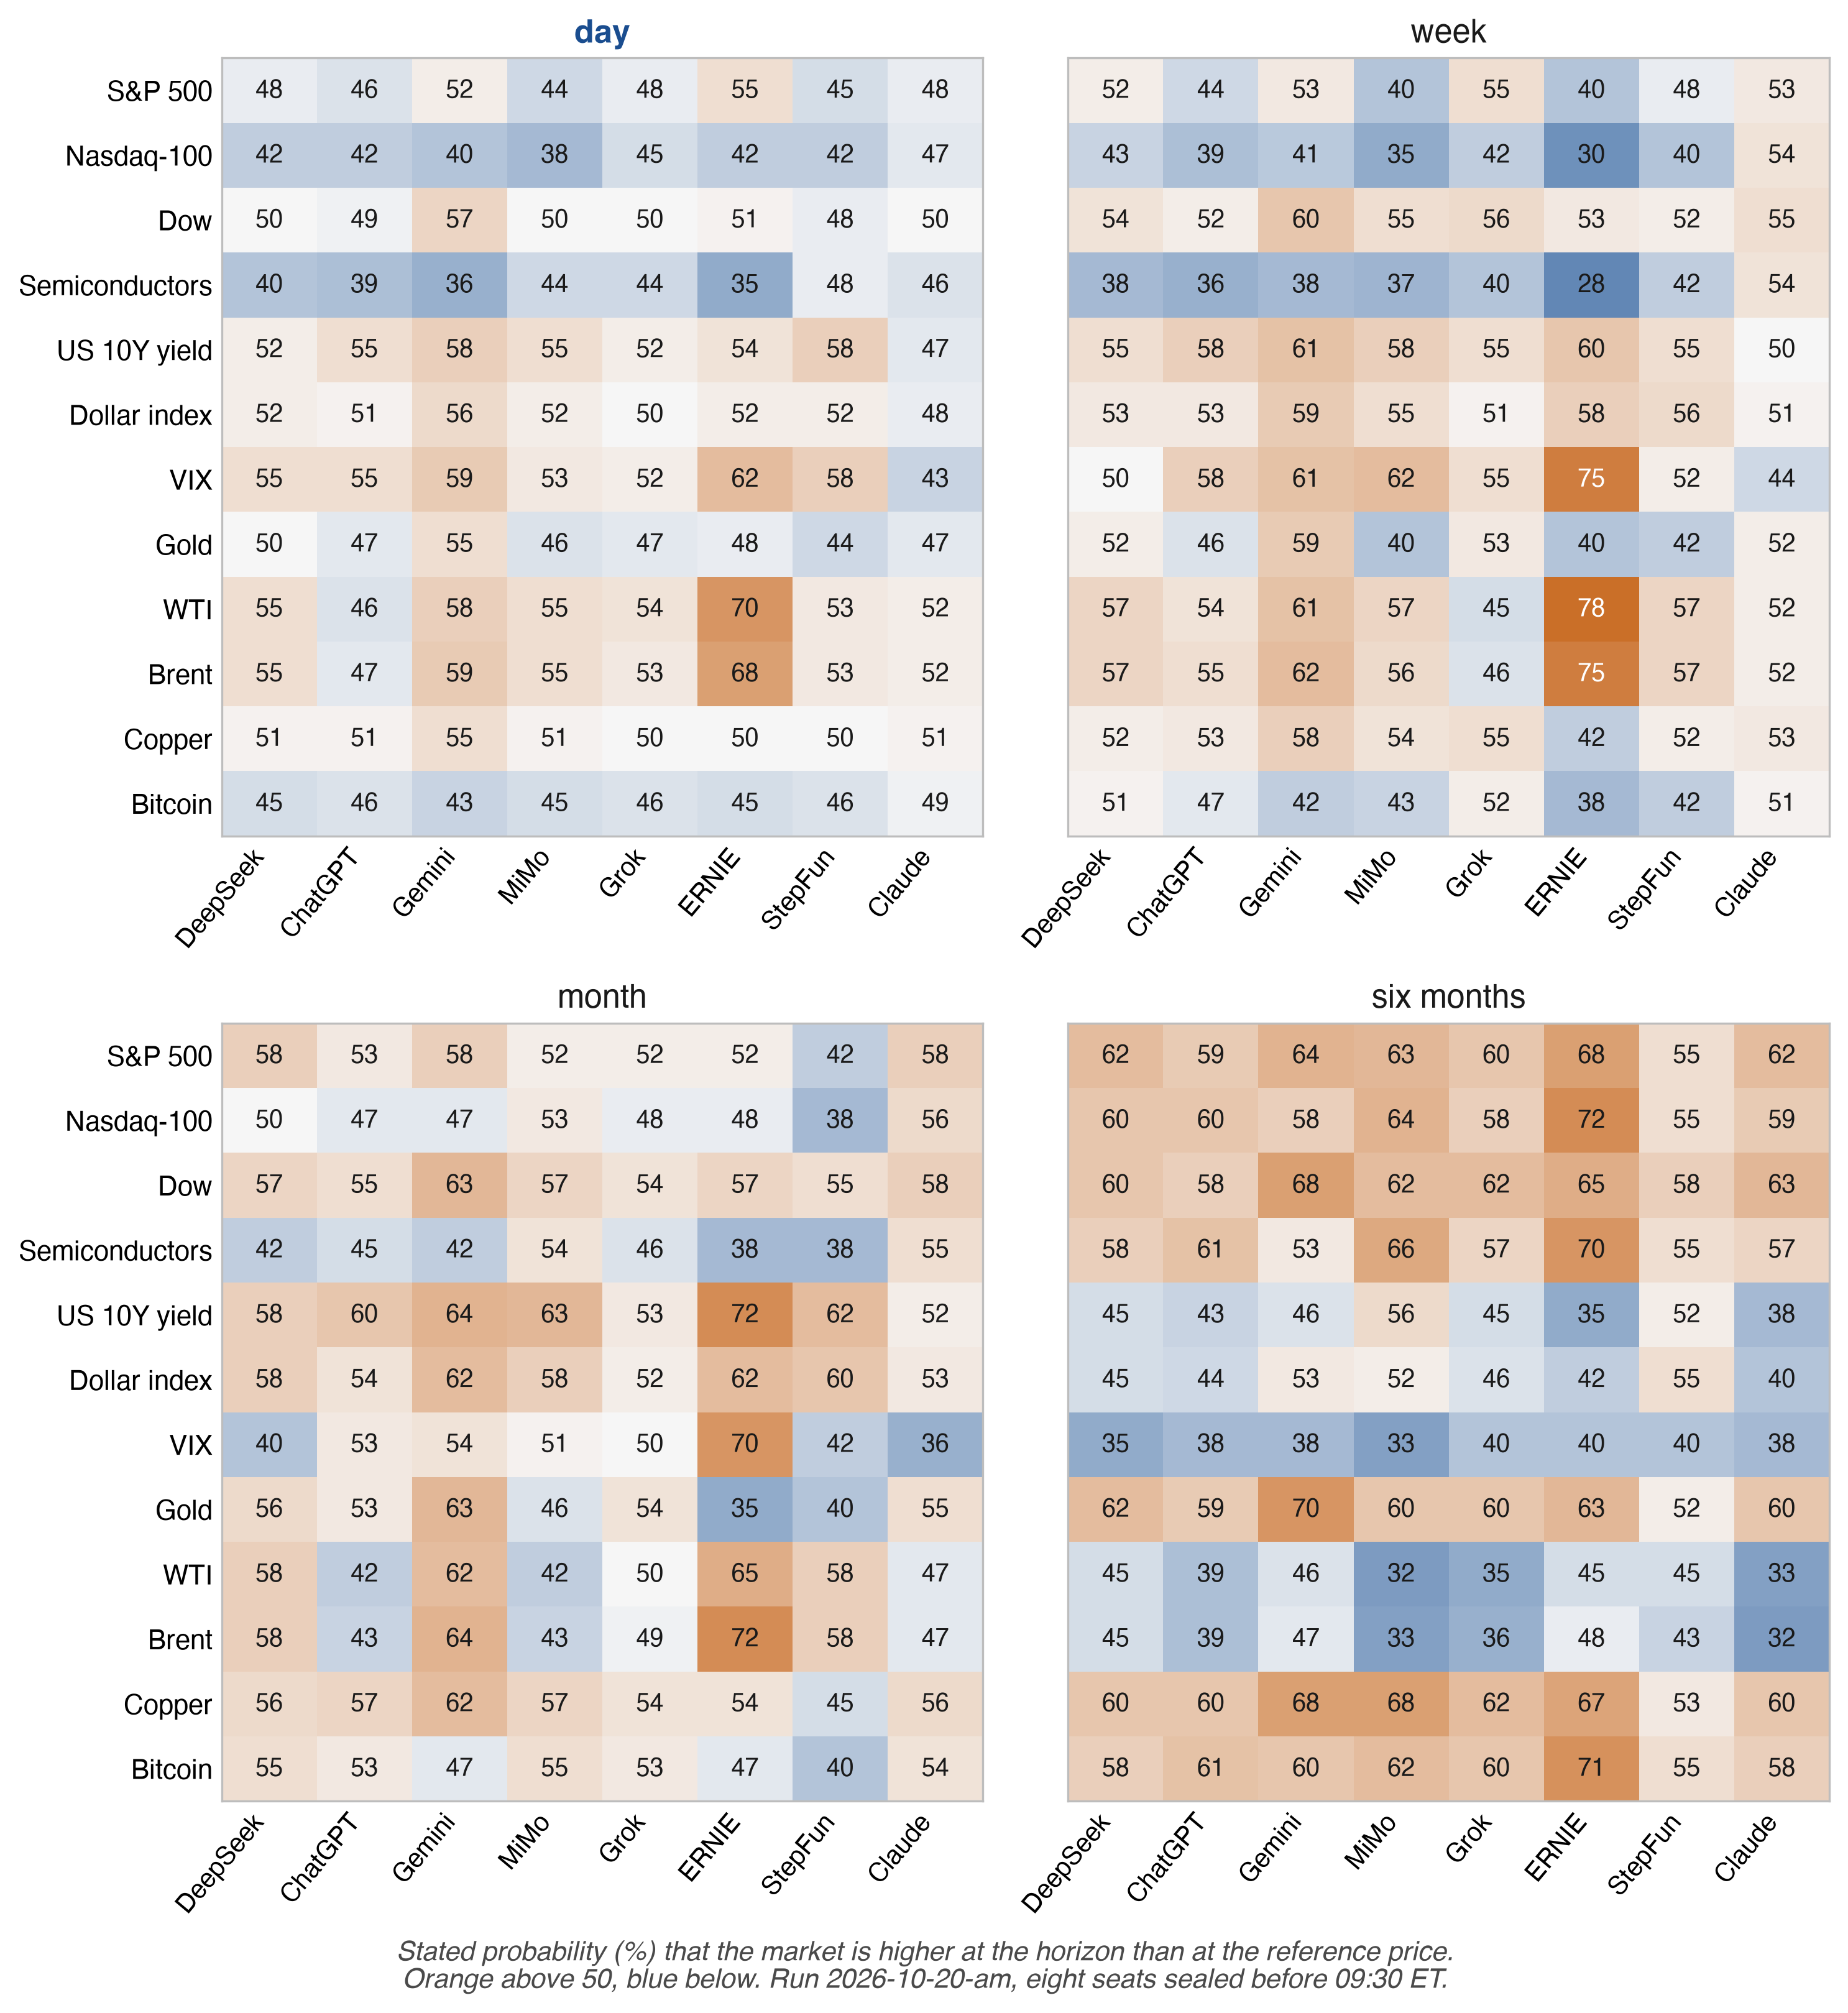
Hinweis: (A) Zellen werden aus den gezählten Zeilen von council-forecasts.csv gefüllt; eine Zelle wird nur nach der Regel in Abschnitt 4.6 rangiert. (B) Die acht Sitze, deren Antworten vor dem Referenzwert 09:30 ET am 20. Oktober 2026 versiegelt wurden (Durchlauf 2026-10-20-am), eine Zelle pro Markt und Horizont, farblich codiert nach der angegebenen Wahrscheinlichkeit eines Anstiegs und zentriert auf 50%. Sitze sind nach ihrer Gewichtung auf der ersten Hauptkomponente der Wahrscheinlichkeitsbilder geordnet, nicht nach Land. Quelle: council-forecasts.csv, gelesen am 21. Oktober 2026.
Tagesprognosen lösen sich jede Sitzung auf; die ersten Wochenprognosen der bewerteten Liga lösen sich ab 26. Oktober 2026 auf, die ersten Monatsprognosen um etwa 19. November 2026 und die ersten Halbjahresprognosen im April 2027.
4.11 Reproduzierbarkeit
Jede Bewertung kann aus offenen Dateien neu berechnet werden. Der Code der Portfolio-Engine wird als Text veröffentlicht, 19 Dateien und die Einstellungen der Liga, jeweils mit ihrem SHA-256 (arena-code.json). Ein Neuberechnungsskript (replay.py) berechnet den Wert, den Geldanteil, die Gebühren und die Gewichtungen jedes Kontos aus den Trades und den Preisen neu. In den Dateien vom 20. Oktober 2026 wurden alle 253 veröffentlichten Zeilen von 145 Konten innerhalb der Publikationsrundung reproduziert (Anhang B, Schritt 7). Ein zweites Skript, tools/replay_brier.py unter derselben Adresse, berechnet aus council-forecasts.csv den Brier-Score jeder gezählten Vorhersage und die Gesamtwerte nach Sitz, Horizont und Methodologieversion neu und vergleicht sie mit den veröffentlichten Zahlen; in den Live-Dateien vom 22. Oktober 2026, 00:09 UTC, stimmte es exakt mit allen 9.318 veröffentlichten Zahlen überein. Jede Vorhersagezeile in council-forecasts.csv nennt die Buchtrade, die sie besiegelt (line), sodass jede Bewertung zu einer versiegelten Antwort führt und von dort zu einem gestempelten Präfix und einem Bitcoin-Block (Anhang B). Eine Bewertungszeile wird durch den ersten Stempel nach ihr abgedeckt.
Jeder kann die veröffentlichten Ausgaben neu berechnen. Die Kette und der Anker fixieren die versiegelten Antworten, ihre Zeiten und ihre Fragen. Die Raw-Model-Aufrufe, der Price Feed und der bereitgestellte Code werden mit ihren Hashes veröffentlicht, wie sie der Betreiber bereitgestellt hat. Das Abgleichen von Referenz- und Schlusskursen mit einer zweiten unabhängigen Quelle ist die höchste Stufe der Leiter der Ansprüche (Tabelle B1). Da sich die Live-Dateien bei jedem Durchlauf ändern, zitiert jede Überarbeitung eine unveränderliche Analyseveröffentlichung auf Zenodo (10.5281/zenodo.23552700) mit einem Manifest des SHA-256, der Größe und der Abrufzeit jeder Datei (Anhang C).
5. Wie viele unabhängige Stimmen
Die Liga hat elf Prognoseplätze. Ein Rat dieser Größe sieht aus wie ebenso viele Meinungen, und die Liga ist dazu gebaut zu zählen, wie viele sie hat. Wenn die Fehler von N Prognostikern bei einem gemeinsamen ρ korrelieren, trägt ihr Durchschnitt die Evidenz von
N_eff = N / (1 + (N − 1)ρ)
unabhängigen Prognostikern, und wenn N wächst, nähert sich N_eff 1/ρ an und bleibt dort stehen. Die Formel ist der Design-Effekt des Cluster-Sampling (Kish, 1965), und die Sättigung des Wertes abhängiger Experten wurde für die Prognosekombination von Clemen und Winkler (1985) gezeigt. Das Begleitpapier wendet sie auf Panels von KI-Modellen an (Chernets, 2026a). Die Obergrenze hängt nicht davon ab, wie viele Modelle abgefragt wurden. Bei ρ = 0,5 sind tausend Modelle zwei Zeugen wert, und sobald ein Rat größer als 1/ρ ist, bringt das Senken von ρ mehr als das Hinzufügen von Mitgliedern. Die Eingabe wird gemessen. Wenn zwei Sprachmodelle beide falsch liegen, geben sie oft die gleiche falsche Antwort, stärker noch innerhalb einer Architektur oder eines Anbieters (Kim et al., 2025). Die Prognosefehler von drei Frontier-Modellen korrelieren bei einem mittleren r von 0,77 auf 568 binären Fragen (Spiro, 2026), und Frontier-Modelle machen hochkorrelierte Vorhersagen auf der Metaculus-KI-Benchmark (Aitchison et al., 2026). Wenn viele Entscheidungsträger einen Algorithmus übernehmen, kann die kollektive Entscheidung schlimmer werden, auch wenn der Algorithmus jeden von ihnen einzeln schlägt (Kleinberg & Raghavan, 2021). Theorie und Simulationen, die an institutionelle Bestände kalibriert sind, deuten darauf hin, dass die weit verbreitete Adoption ähnlicher KI-Modelle die Lebensdauer der Signale verkürzt, die sie handeln (Meng & Chen, 2026). Solche Argumente benötigen eine gemessene Ähnlichkeit der Modelle als Eingabe. Eine Marktliga liefert jeden Handelstag eine externe Grundwahrheit und bis zu elf Live-Streams von Wahrscheinlichkeiten, auf denen ρ geschätzt werden kann. N_eff ist eine Varianzanzahl. Ein Bias, den jedes Modell teilt, bleibt unabhängig von der Anzahl der Modelle im Durchschnitt erhalten, weshalb die Liga auch einen einstimmigen Fehler direkt zählt (Abschnitt 5.3). Ein Konsens von Modellen, der ohne seine effektive Anzahl von Stimmen gedruckt wird, ist eine Umfrage ohne Stichprobengröße: der Leser sieht den Anteil derer, die zustimmen, und kann nicht erkennen, wie viel Evidenz die Zustimmung hat. Anforderung 14 macht daher die Anzahl zu einer MUSS überall dort, wo ein Konsens gezeigt wird. Am 20. Oktober versiegelten acht Plätze ein Eintages-Bild vor der Eröffnung, und ihre Bilder waren so ähnlich wie die von 1,46 unabhängigen Prognostikern (Abschnitt 5.2).
5.1 Wie die Liga ρ schätzt
Jeder versiegelte Lauf gibt für jeden Prognoseplatz eine Wahrscheinlichkeit, dass jeder der 12 Märkte bei jedem Horizont nach oben geht. Für jeden Lauf und Horizont berechnet die Liga den Durchschnitt über Paare von Plätzen der Pearson-Korrelation ihrer Wahrscheinlichkeiten über die von beiden beantworteten Märkte und bewertet N_eff = n / (1 + (n − 1)ρ) mit dem eigenen n und ρ dieses Laufs. N_eff ist konvex in ρ, daher ist der Durchschnitt der Pro-Lauf-Zählungen mindestens die Zählung beim mittleren ρ, und das Stichprobenrauschen von ρ, geschätzt aus zwölf Märkten, drückt die Pro-Lauf-Zählung auch nach oben. Ein Durchschnitt unter einem Schwellenwert, wie in F1 und F2, ist daher die konservative Lesart, und ein Vergleich zwischen Horizonten wird auf ρ selbst gelesen (F9). Mit zwölf Märkten trägt eine paarweise Korrelation einen Standardfehler von etwa 0,26 bis 0,18 über den beobachteten Bereich von 0,38 bis 0,64; die Paare eines Laufs teilen Plätze und Märkte, daher ist ihr Durchschnitt stabiler als ein Paar, aber nicht um die Wurzel ihrer Zahl. Ein Intervall kommt aus fünf gezählten Läufen. Ich verwende jede Antwort-Zeile des Platzes und lasse Zellen aus, die nach der Versiegelung durch eine datierte correction-Zeile wiederhergestellt wurden, da sie nicht in der versiegelten Antwort waren. Die Zulassungsregel ist Teil des Schätzers. Ich gebe nur gezählte Läufe zu, und nur Antworten, die vor dem Referenzpreis versiegelt wurden, damit eine späte Antwort, die die Eröffnungsbewegung sehen könnte, nicht eingeht. Die öffentliche Datei council-stats.json veröffentlicht diese Serie unter n_eff.counted, mit der Regel in der Datei angegeben. Der ältere Block n_eff.per_run und sein Mittelwert erhalten alle versiegelten Läufe, Testläufe und späte Antworten eingeschlossen. Anhang C gibt die Felder zur Neuberechnung von council-forecasts.csv und council-book.jsonl. Tabelle 6 folgt den Zeilen der öffentlichen Datei durch diese Regel, von den sechs versiegelten Läufen zur gezählten Aufzeichnung.
Tabelle 6. Von der öffentlichen Datei zur gezählten Aufzeichnung, nach Lauf: Zeilen, Korrektionen, Plätze, Zeilen, die vor der Referenz versiegelt wurden, angegebene 50er, ungültige Zellen und gezählte Eintages-Zeilen (council-forecasts.csv, 3.792 Zeilen).
| Lauf | Rolle | Zeilen in Datei | Korrekturzeilen | Plätze antwortend | Plätze vor der Referenz versiegelt | Zeilen vor der Referenz versiegelt | Angegebene 50 | Ungültige Zellen | Gezählte Eintages-Zeilen |
|---|---|---|---|---|---|---|---|---|---|
| 2026-10-16-eve | Test | 1.056 | 39 | 9 | 9 | 1.017 | 20 | 0 | 0 |
| 2026-10-17-btc | Test | 864 | 32 | 9 | 9 | 832 | 40 | 0 | 0 |
| 2026-10-18-radar | Test | 672 | 21 | 8 | 8 | 651 | 22 | 0 | 0 |
| 2026-10-19-am | Entwicklung | 336 | 11 | 7 | 7 | 325 | 4 | 0 | 83 |
| 2026-10-20-am | Entwicklung | 432 | 0 | 9 | 8 | 384 | 14 | 12 | 105 (96 vor der Referenz versiegelt) |
| 2026-10-21-am | Gezählte Aufzeichnung | 432 | 0 | 9 | 9 | 432 | 24 | 0 | 108 |
Anmerkung: Korrekturzeilen sind Zellen, die von späteren Korrekturzeilen hinzugefügt werden (line_kind); die anderen Spalten zählen die Zellen von Antworttzeilen. Eine Zeile wird vor der Referenz versiegelt, wenn die Versiegelung ihrer Zeile, max(at, booked_at), 09:30 ET der Sitzung, auf die sie abzielt, vorausgeht; die drei Testläufe zielen auf 19. Oktober ab. Angegebene 50er und ungültige Zellen werden aus cell_status gelesen (explicit_50, invalid), gezählte Zeilen aus status. Am 20. Oktober versiegelte der neunte Platz, Meta AI, um 16:16:52Z: Seine 12 ungültigen Zellen enthalten keine Wahrscheinlichkeit, und seine neun gezählten Eintags-Zeilen werden aus seiner eigenen Referenz bewertet, außerhalb des gemeinsamen Ereignisses. Am 21. Oktober haben die vier Bitcoin-Zellen der neunten Antwort ihre eigene Referenz (Abschnitt 3.3). Quelle: council-forecasts.csv und council-book.jsonl gespeichert 22. Oktober 2026, 01:32 UTC (SHA-256 der CSV 9fa4747e…c299d).
Ich veröffentliche Begleitstatistiken neben der Zählung. Die Korrelation wird über Märkte hinweg berechnet, sodass sie berücksichtigt, wie Märkte zusammen reagieren (die drei US-Aktienindizes, WTI und Brent); eine zweite Version behält einen Markt pro Gruppe bei und lässt den Nasdaq-100, den Dow und Brent weg. Die Korrelation über Märkte hinweg hängt auch von der Richtung ab, in der jeder Markt abgefragt wird: Ein Anstieg des VIX, des Dollars oder der Rendite geht normalerweise mit einem Rückgang von Aktien einher, und die Liga fragt jeden Markt als Anstieg ab, festgelegt in seinem Ereignisvertrag. Ich berechne auch eine Version frei von dieser Konvention, die die Abweichungen von 50 korreliert, ohne den Durchschnitt jedes Platzes über die Märkte abzuziehen, sodass das Umkehren eines Marktes nichts ändert. Bei einem Tag ergibt es 1,85 und 1,54, am 19. und 20. Oktober, gegen 1,74 und 1,46 für die Schlagzeilenzählung. Aus der klimatologischen Wahrscheinlichkeit statt 50 entnommen, geben die gleichen Abweichungen die Lesung, die Abschnitt 4.3 für lange Horizonte verlangt. Das Partizipationsverhältnis der Matrix ist eine andere Dimensionszählung, und unter Äquikorrelation unterscheiden sich die beiden, daher lese ich es neben N_eff als zweite Zählung. Eine dritte Statistik entfernt zuerst den Konsens jedes Marktes. Das Subtrahieren eines aus den gleichen Modellen geschätzten Konsens macht die Abweichungen konstruktionsbedingt negativ korreliert, daher ist diese deskriptiv und nicht registriert. Anforderung 17 addiert den Anteil des größten Eigenwertes. Ein Anteil nahe eins bedeutet, dass ein einzelner gemeinsamer Faktor die Ähnlichkeit trägt, die Struktur, unter der ein gemeinsames ρ eine faire Zusammenfassung ist, und ein niedriger Anteil bedeutet, dass das einzelne ρ mehrere Faktoren verbirgt. Bei der gezählten Ausführung vom 20. Oktober 2026, über alle 48 Zellen der acht Plätze, die vor der Referenz versiegelt wurden, trägt der größte Eigenwert 68 % der Spur (5,47 von 8). Ein gemeinsamer Faktor hält den Großteil der Ähnlichkeit. Das Partizipationsverhältnis der Eintags-Matrix war 2,28 am 19. Oktober, 1,79 am 20. Oktober und 3,28 am 21. Oktober (n_eff_participation).
Die Schlagzeilenzählung misst, wie ähnlich die Wahrscheinlichkeitsbilder sind. Die Korrelation der Fehler, das ρ der obigen Formel, ist die zweite Zählung, und die Liga berechnet sie aus bewerteten Sitzungen: die mittlere paarweise Korrelation der Fehlerindikatoren der Plätze über die Märkte hinweg, in N_eff auf die gleiche Weise umgewandelt (n_eff_errors). Sie trägt auch die Mitbewegung von Ergebnissen. Wenn die drei Aktienindizes zusammen fallen, irren sich Modelle, die nach oben sagten, zusammen, egal wie ähnlich sie sind.
5.2 Eine erste Lesung der Methode
Ich lese die Methode zuerst auf den Entwicklungssitzungen vom 19. und 20. Oktober 2026 (Abschnitt 8). Bei ihren zwei gezählten Morgenläufen, unter Verwendung nur von Antworten, die vor dem Referenzpreis um 09:30 ET versiegelt wurden, finde ich N_eff bei einem Tag von 1,74 am 19. Oktober 2026 (n = 7 Plätze versiegelt vor der Referenz, ρ = 0,505) und 1,46 am 20. Oktober 2026 (n = 8, ρ = 0,64). Die Bilder dieser beiden Morgen waren genauso ähnlich wie die von etwa 1,6 unabhängigen Prognostikern. Mit einem Markt pro Gruppe ergibt sich 1,69 und 1,57. Der erste Lauf des gezählten Datensatzes am 21. Oktober 2026 ergab 2,23 (n = 9, ρ = 0,379) und 2,09 mit einem Markt pro Gruppe (council-stats.json, n_eff.counted.per_run, generiert 21. Oktober 2026, 22:16 UTC).
Die gleiche Regel bei jedem Horizont, mit den drei deskriptiven Maßen, die kein Ergebnis daneben benötigen, ergibt Tabelle 7.
Tabelle 7. Deskriptive Lesung nach Horizont der gezählten Morgenläufe, Antworten versiegelt vor der Referenz: N_eff der Wahrscheinlichkeitsbilder (mittlere paarweise ρ in Klammern), Schärfe K, Anteil der Wahrscheinlichkeiten zwischen 40 und 60 und Spreizung über Plätze.
| Lauf | Maßstab | 1 Tag | 1 Woche | 1 Monat | 6 Monate |
|---|---|---|---|---|---|
| 19. Okt. 2026 (n = 7) | N_eff (ρ) | 1,74 (0,51) | 2,81 (0,25) | 2,39 (0,32) | 1,16 (0,84) |
| K | 10,7 | 14,4 | 17,9 | 25,0 | |
| Anteil in [40, 60] (%) | 88 | 81 | 67 | 42 | |
| Spreizung (Punkte) | 4,2 | 6,3 | 7,4 | 5,1 | |
| 20. Okt. 2026 (n = 8) | N_eff (ρ) | 1,46 (0,64) | 1,99 (0,43) | 2,68 (0,28) | 1,14 (0,86) |
| K | 9,2 | 14,1 | 13,9 | 20,3 | |
| Anteil in [40, 60] (%) | 93 | 82 | 80 | 58 | |
| Spreizung (Punkte) | 3,5 | 5,7 | 6,2 | 4,7 | |
| 21. Okt. 2026 (n = 9) | N_eff (ρ) | 2,23 (0,38) | 2,63 (0,30) | 2,41 (0,34) | 1,58 (0,59) |
| K | 10,1 | 12,5 | 14,6 | 19,9 | |
| Anteil in [40, 60] (%) | 95 | 90 | 84 | 61 | |
| Spreizung (Punkte) | 4,3 | 4,8 | 5,7 | 6,8 |
Anmerkung: Zwölf Märkte pro Horizont. N_eff nach der Regel des eingereichten Skripts neff-horizons.py (Abschnitt 5.1), wobei Zellen, die ihre eigene Referenz tragen, ausgelassen sind (am 21. Oktober die Bitcoin-Zellen der neunten Antwort); der Eintags-Wert vom 21. Oktober entspricht dem veröffentlichten n_eff.counted.per_run. K = (2/n)Σ|p − 50| über die Zellen der Plätze (Abschnitt 4.4); Spreizung ist die Populationsstandardabweichung über die Plätze, gemittelt über die zwölf Märkte. Werte aus council-forecasts.csv und council-book.jsonl gespeichert 22. Oktober 2026, 01:32 UTC.
Bei allen drei Durchläufen sind die Stimmen am geringsten nach sechs Monaten und zahlreicher nach einer Woche und einem Monat als nach einem Tag. Die Ähnlichkeit nach sechs Monaten kann aus gemeinsamen Basisraten kommen (Aktien und Gold driften über sechs Monate nach oben), daher ist die Sechsmonatsanzahl auch gegen die klimatologische Wahrscheinlichkeit zu lesen. Ich sehe das Muster beim Durchlauf vom 20. Oktober (Abbildung 6B), und in Abbildung 7 zeichne ich es Markt für Markt. Die acht Sitze, die vor der Referenz versiegelt wurden, setzten fünf Märkte unterhalb einer Chancengleichheit für den Tag und knapp 60 % nach sechs Monaten. In mittlerer Wahrscheinlichkeit ging der S&P 500 von 48 auf 62, der Nasdaq-100 von 42 auf 61, Halbleiter von 42 auf 60, Gold von 48 auf 61 und Bitcoin von 46 auf 61, während Öl, VIX und die 10-Jahres-Rendite den anderen Weg gingen (WTI 55 auf 40, VIX 55 auf 38, die Rendite 54 auf 45). Der Rat beobachtete einen kurzen Schock, der abklingt. Nach sechs Monaten konvergierte er auf die langfristige Drift. Am 21. Oktober bewegte sich das kurze Ende und das lange Ende hielt. Die neun Sitze gaben dem S&P 500 55,9 für den Tag und 60,4 nach sechs Monaten, und nur Kupfer (47,9) und VIX (45,7) standen unterhalb einer Chancengleichheit für den Tag. Nach sechs Monaten standen die Risikoanlagen wieder bei 56,7 bis 62,7 und Öl, VIX, die Rendite und der Dollar bei 41,2 bis 46,1.
Abbildung 7. Mittlere angegebene Wahrscheinlichkeit eines Anstiegs nach einem Tag und nach sechs Monaten, nach Markt: (A) Durchlauf 2026-10-20-am, acht Sitze vor der Referenz versiegelt; (B) Durchlauf 2026-10-21-am, neun Sitze.
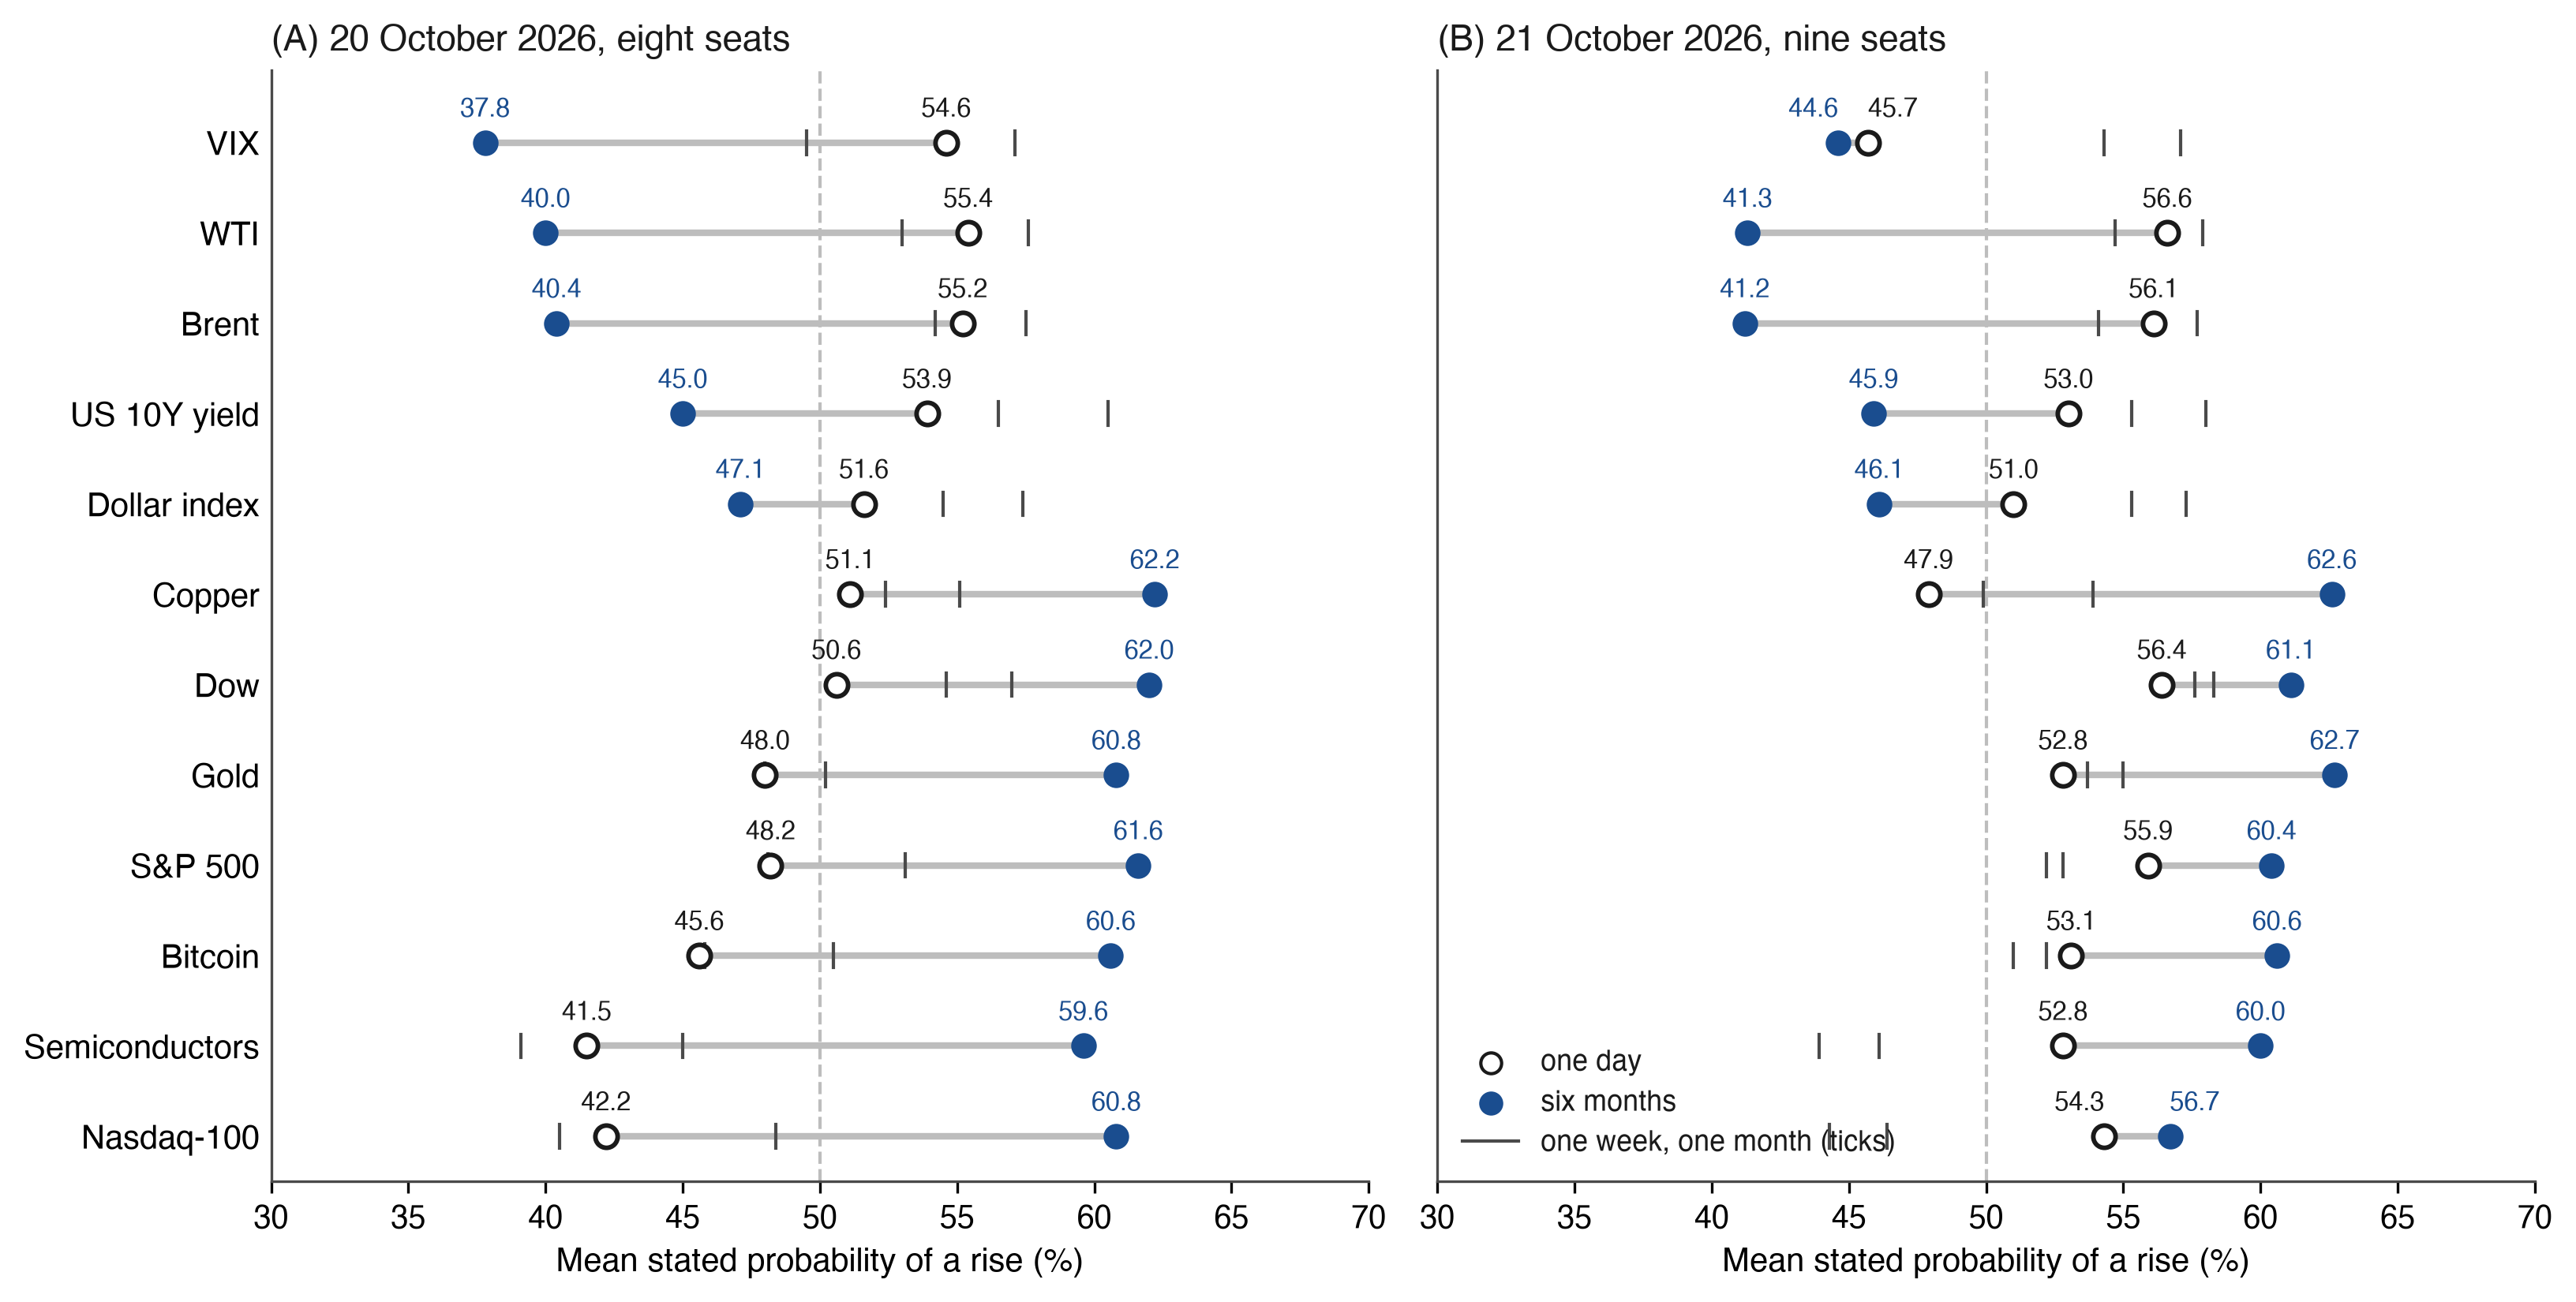
Anmerkung: Mittel der prob_up der Sitze; Markierungen kennzeichnen eine Woche und einen Monat. Märkte sind nach der Änderung von einem Tag zu sechs Monaten am 20. Oktober sortiert. Sechsmonats-Wahrscheinlichkeiten enthalten die Basisrate jedes Marktes (Abschnitt 4.3); die gleiche Lesart gegen die Klimatologie ist . Am 21. Oktober lässt der Bitcoin-Mittel die Zellen der neunten Antwort aus, die ihre eigene Referenz tragen. Quelle: council-forecasts.csv gespeichert 22. Oktober 2026, 01:32 UTC.
Der gleiche Durchlauf ergibt die Spanne, die Abschnitt 8 nutzt. Über die acht Sitze hinweg betrug die Populationsstandardabweichung der Wahrscheinlichkeiten im Durchschnitt 3,5 Punkte nach einem Tag, 5,7 nach einer Woche, 6,2 nach einem Monat und 4,7 nach sechs Monaten. Nach einem Tag reichte sie von 1,5 Punkten bei Kupfer bis 6,4 bei WTI, und die breitesten Zellen waren VIX und Brent nach einem Monat (9,9 und 9,8). Am 21. Oktober betrug die mittlere Spanne 4,3, 4,8, 5,7 und 6,8 Punkte, am breitesten nach sechs Monaten (Brent 9,5, WTI und VIX 8,4). Abbildung 8 zeigt jede Zelle an beiden Morgen.
Abbildung 8. Spanne der angegebenen Wahrscheinlichkeiten über Sitze, nach Markt und Horizont: (A) Durchlauf 2026-10-20-am, acht Sitze vor der Referenz versiegelt; (B) Durchlauf 2026-10-21-am, neun Sitze.
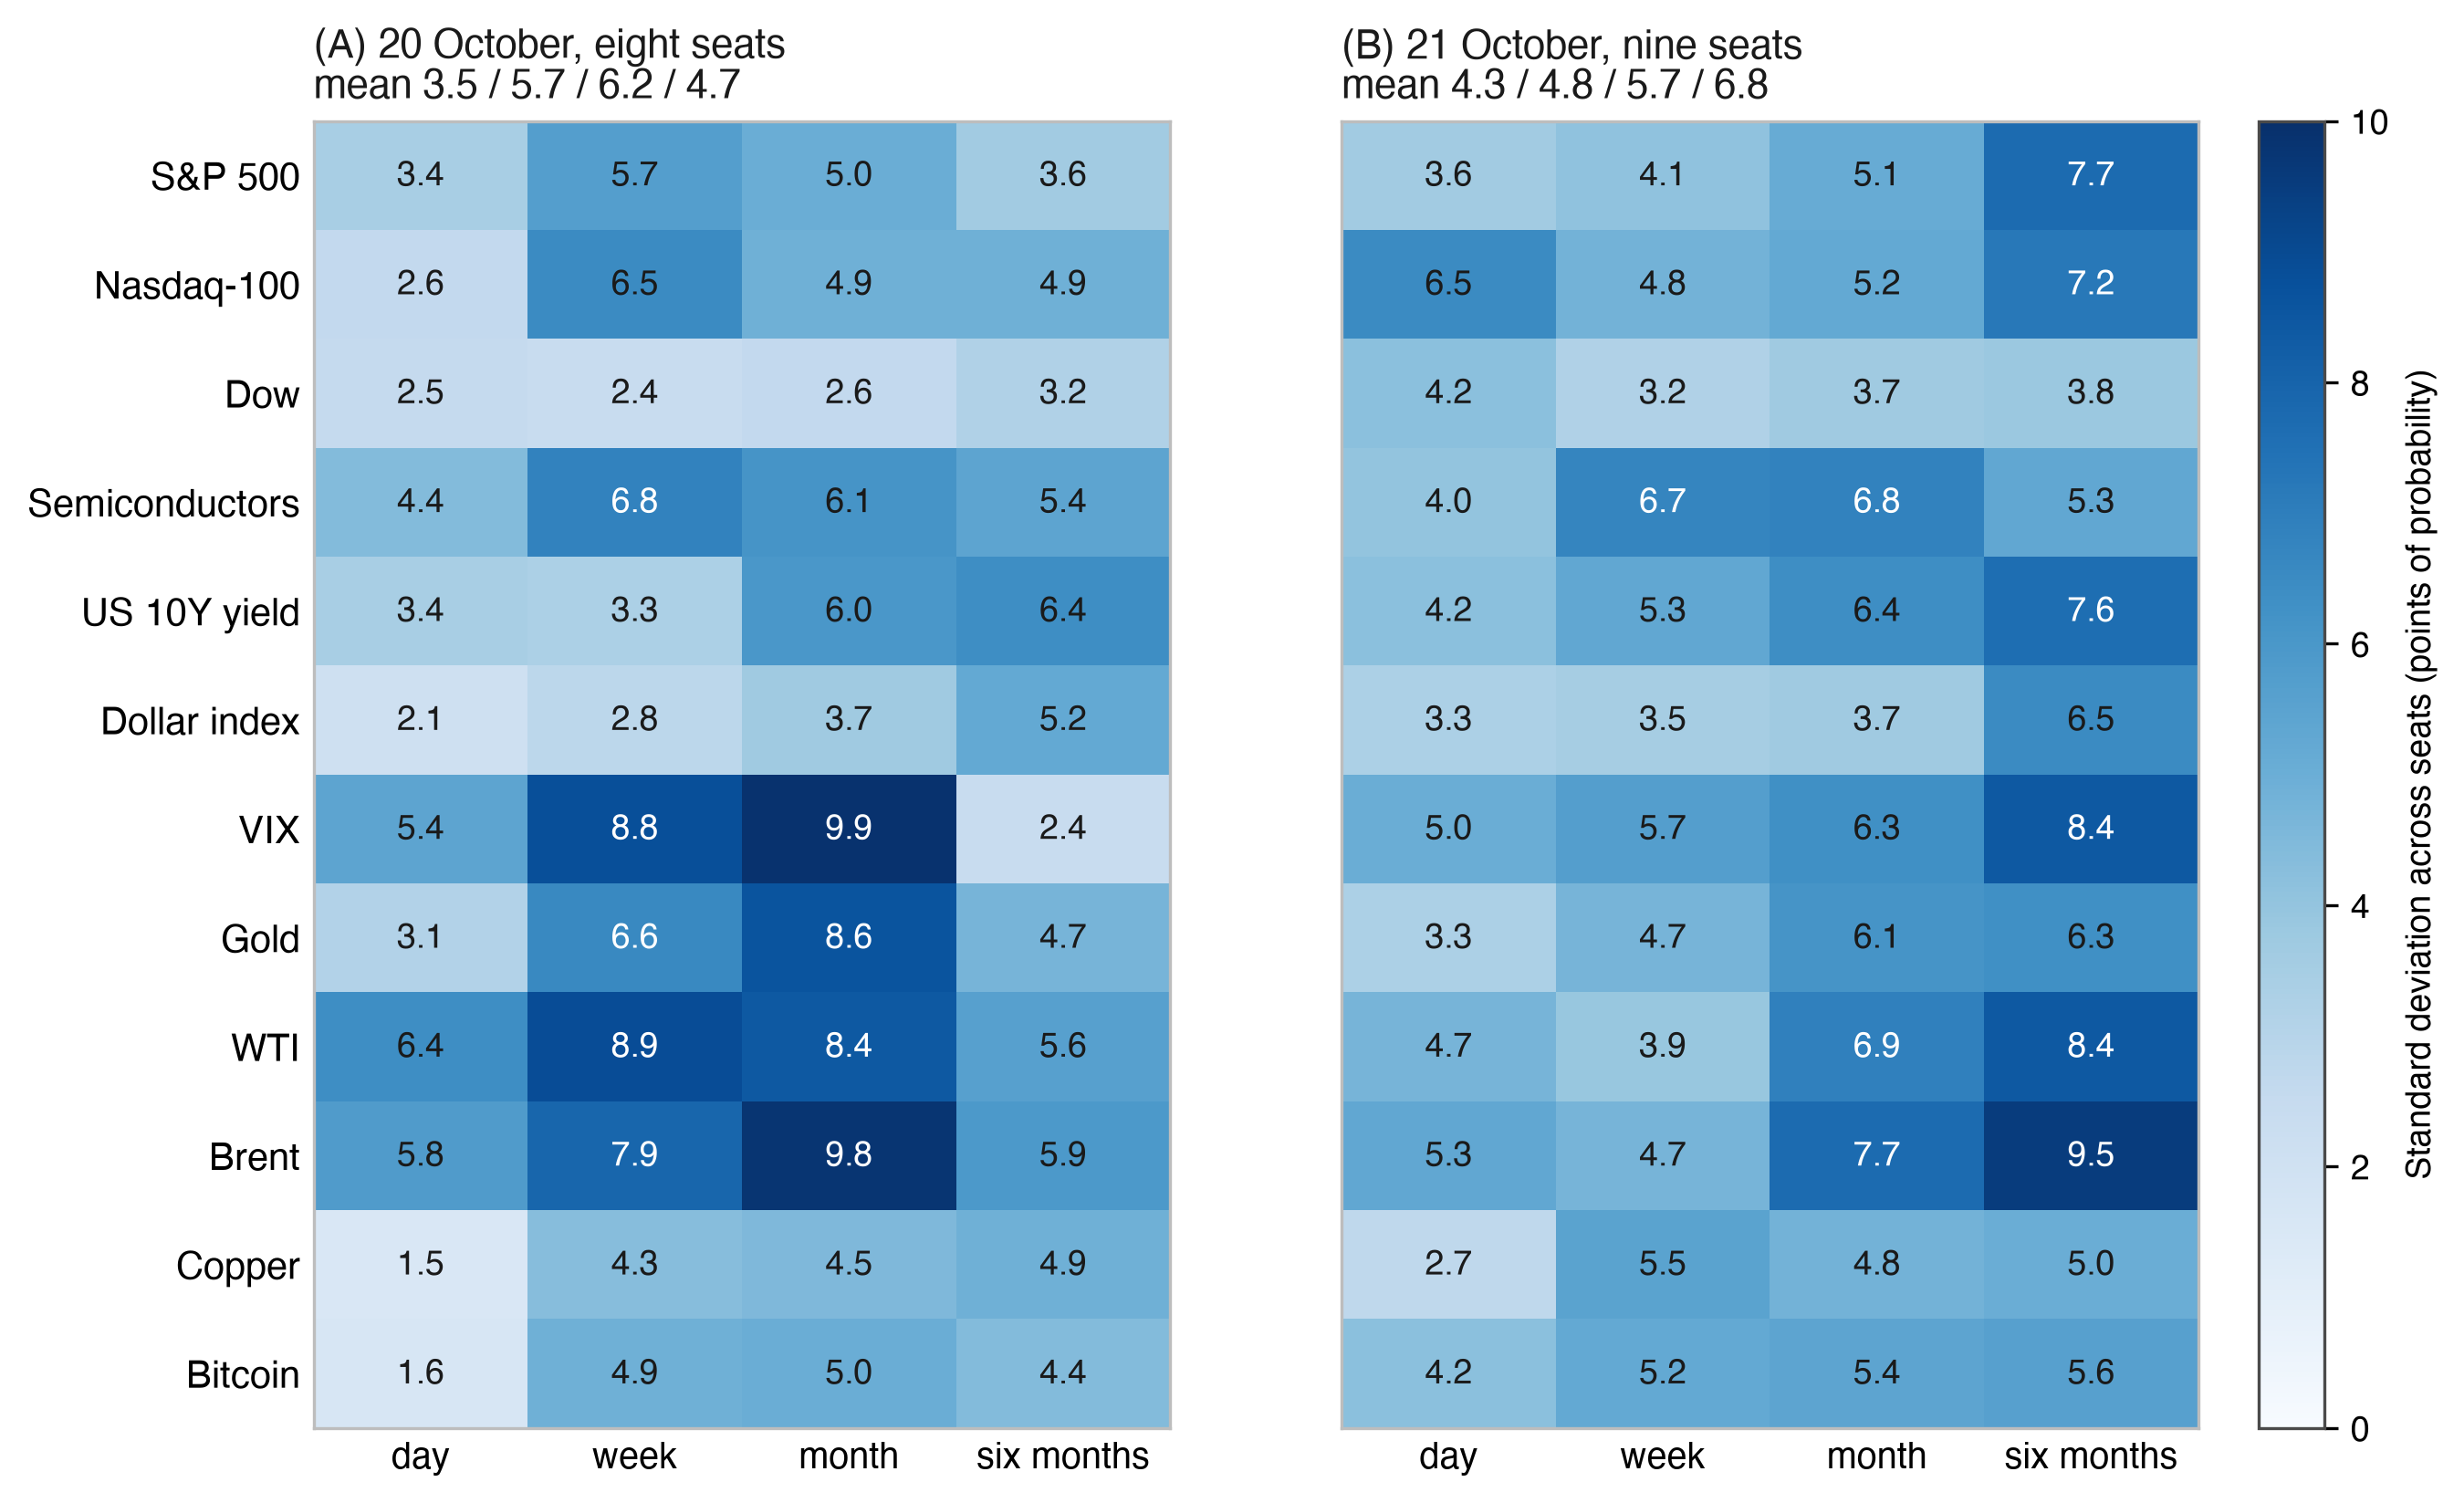
Anmerkung: Populationsstandardabweichung von prob_up über die Sitze in jeder Zelle, in Wahrscheinlichkeitspunkten; die Panel-Titel geben den Durchschnitt über die zwölf Märkte bei jedem Horizont. Abschnitt 8 registriert die Verwendung von Spanne als Sekundäranalyse. Quelle: council-forecasts.csv gespeichert 22. Oktober 2026, 01:32 UTC.
Aufeinanderfolgende Durchläufe beantworten überlappende Fragen zu den gleichen Märkten, und die Fenster einer Woche und eines Monats benachbarter Durchläufe überlappen sich. Ein Vergleich zwischen Horizonten wird daher auf der Grundlage von gepaarten Durchlauf-für-Durchlauf-Differenzen mit Intervallen über Blöcke von Durchläufen durchgeführt (F9). Die drei Testdurchläufe vom 16. bis 18. Oktober, alle auf die Sitzung vom 19. Oktober ausgerichtet und nicht mitgezählt, ergaben 4,01, 2,69 und 2,06 nach einem Tag. Die Zählung nach Fehlerindikatoren folgt der gleichen Zulassungsregel und wird durch das eingereichte Skript von F3 berechnet. Das Feld n_eff_errors der offenen Datei ist eine breitere Deskriptionsreihe und ist nicht die Schlagzeile. Abbildung 9 platziert die Pro-Durchlauf-Werte auf den Kurven der Formel. Die Vorhersagen F1 bis F3 und F9 (Abschnitt 8) geben an, was die gezählten Durchläufe nach der Registrierung zeigen sollten.
Abbildung 9. Effektive Anzahl unabhängiger Stimmen gegen die Anzahl der Modelle, mit den Pro-Durchlauf-Messwerten der ersten versiegelten Durchläufe und des ersten gezählten Durchlaufs.
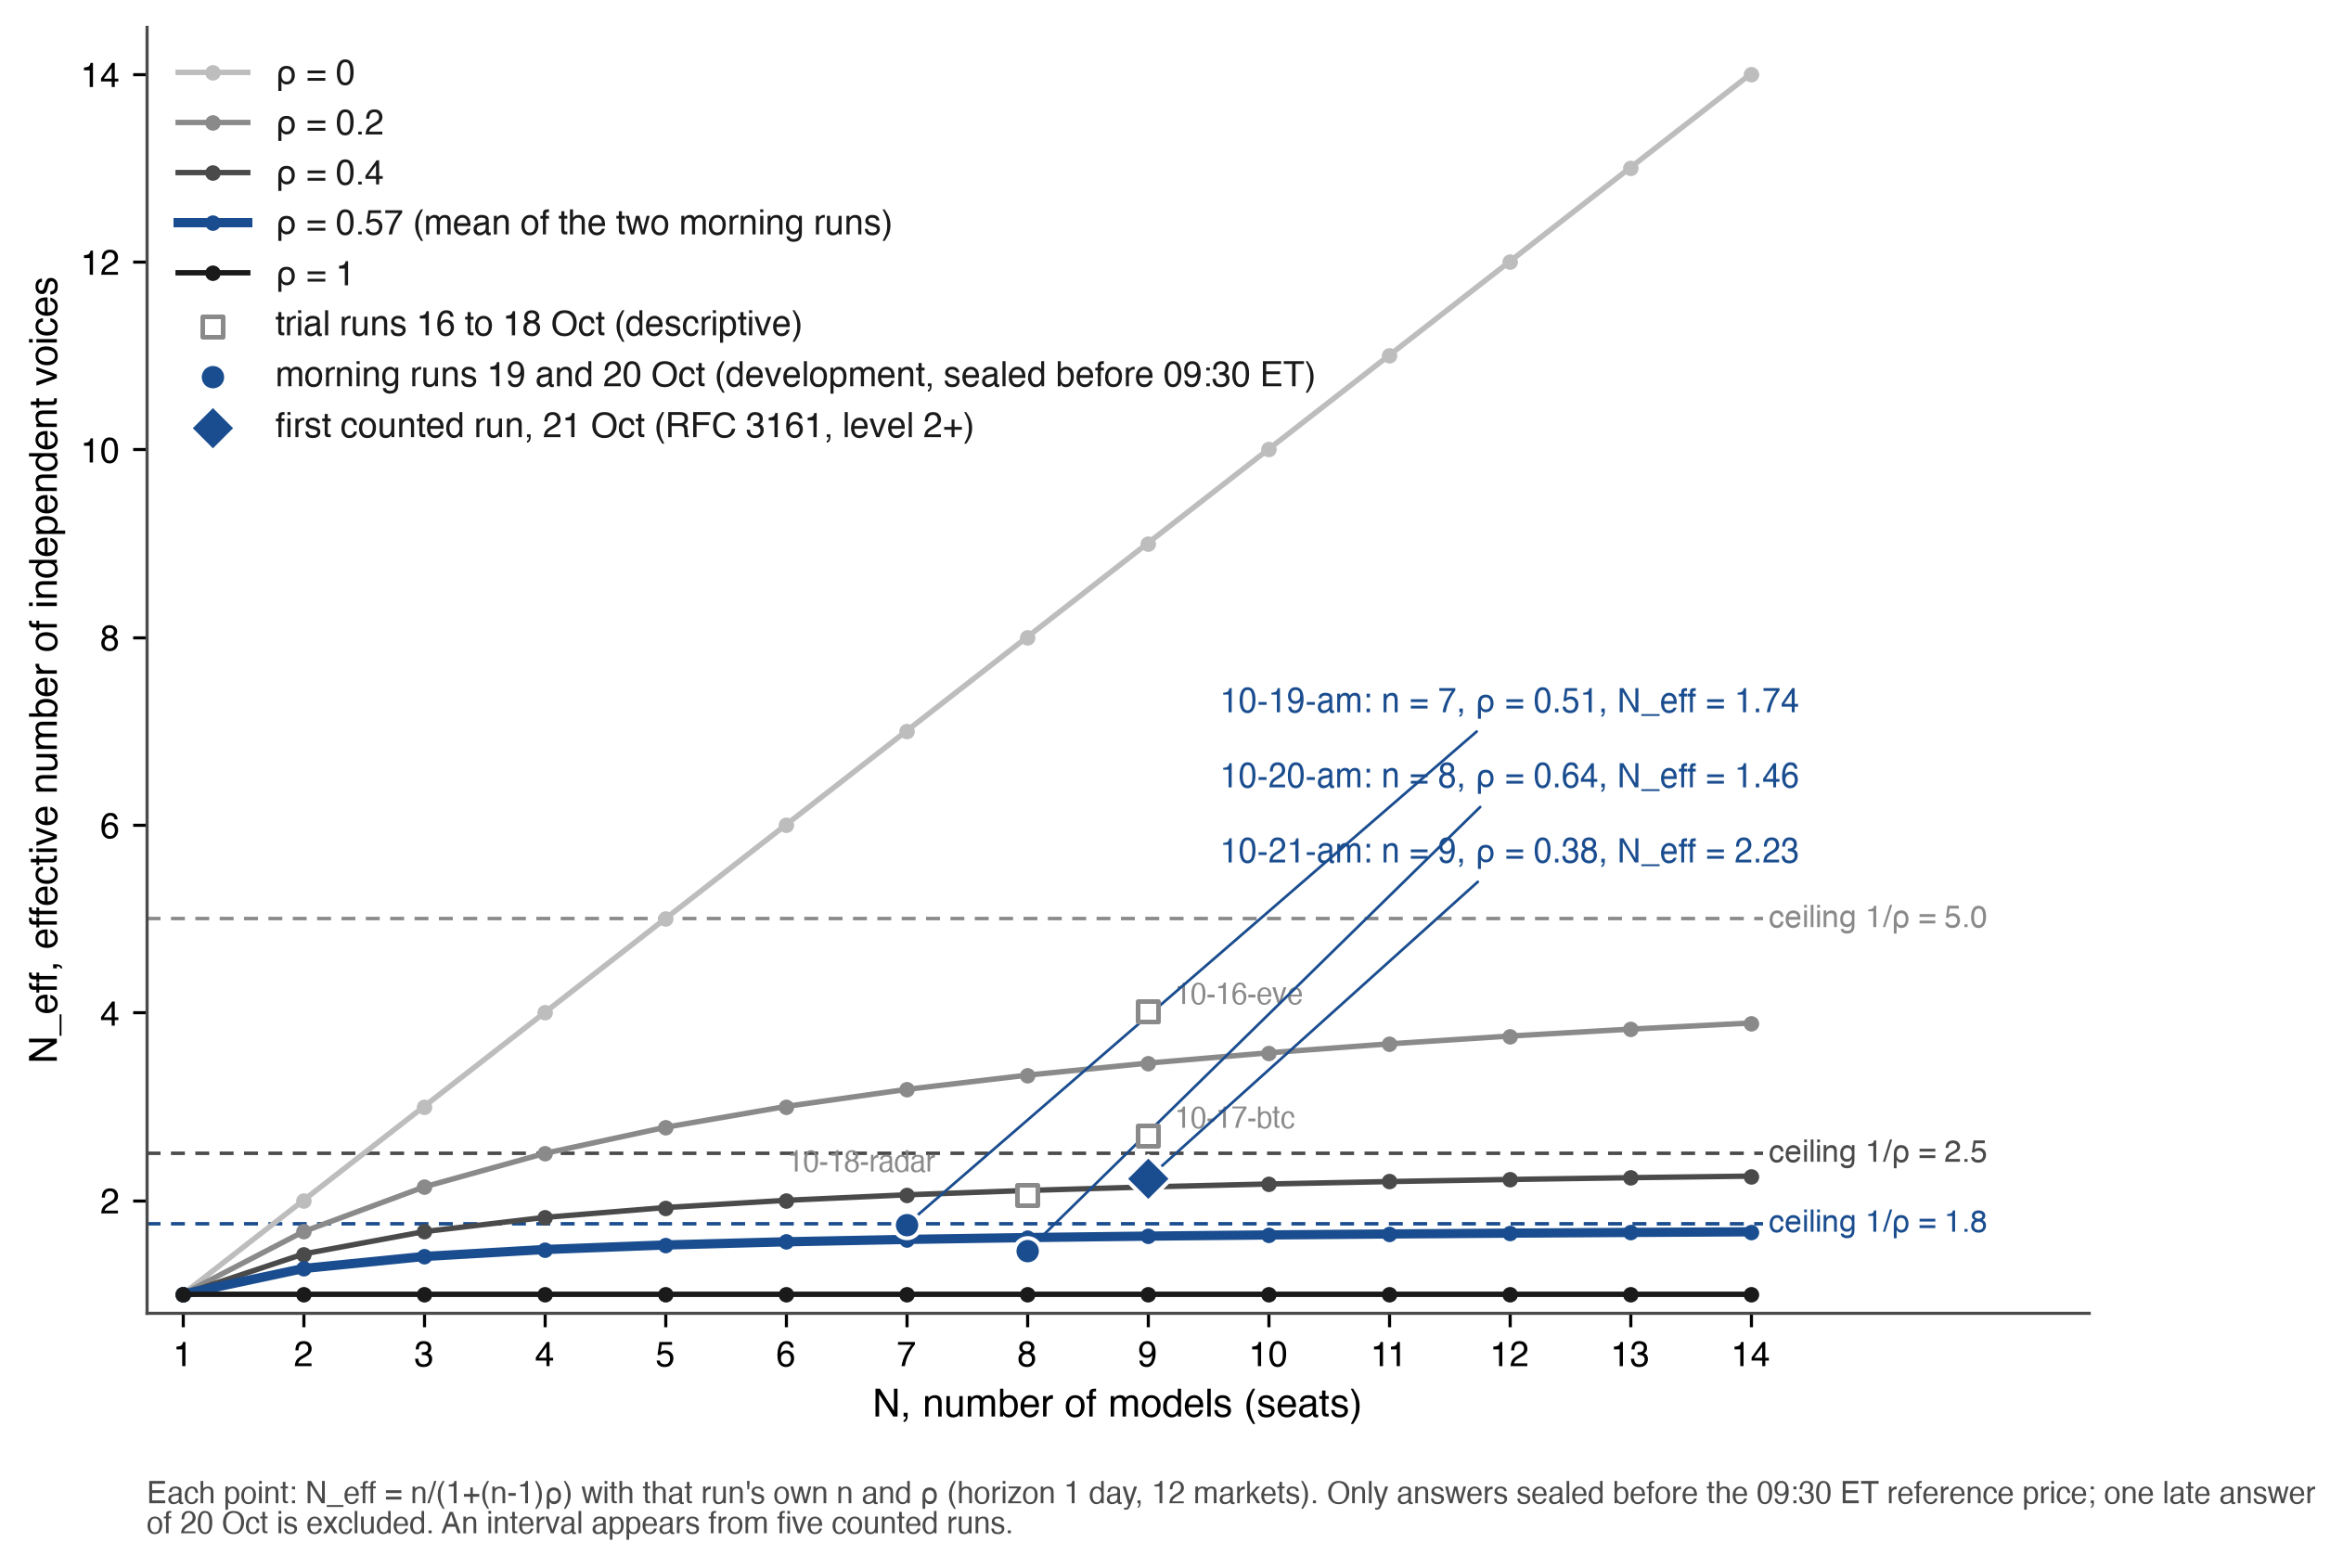
Anmerkung: N_eff = N / (1 + (N − 1)ρ) für N = 1 bis 14 und ρ von 0, 0,2, 0,4, 0,57 und 1; gestrichelte Linien kennzeichnen die Obergrenzen 1/ρ. Ausgefüllte Kreise: die Morgendurchläufe vom 19. und 20. Oktober nach einem Tag, Antworten vor der Referenz versiegelt (1,74, n = 7, ρ = 0,505; 1,46, n = 8, ρ = 0,64); die hervorgehobene Kurve ist ihr mittleres ρ, 0,57. Ausgefüllte Raute: der erste Durchlauf des gezählten Datensatzes, 21. Oktober 2026 (2,23, n = 9, ρ = 0,379). Offene Quadrate: die drei Testdurchläufe (4,01, 2,69, 2,06). Quelle: council-forecasts.csv und council-book.jsonl, gelesen 21. Oktober 2026, nach der Regel von Abschnitt 5.1.
5.3 Der Konsens und warum er Familien abwertet
Ich definiere den Konsens für einen Markt als den Durchschnitt der Wahrscheinlichkeiten der Sitze, mit drei Regeln. Wenn mindestens fünf Sitze antworten, werden die niedrigste und die höchste Wahrscheinlichkeit verworfen. Ein zweites Modell aus der gleichen Familie zählt ein Drittel, und ebenso jedes weitere, so dass ein Labor, das mehrere Modelle einsetzt, die anderen nicht durch Anzahl übertrumpfen kann. Unter einer Blockstruktur überschätzt die einheitliche Formel N_eff (Kim et al., 2025). Das Ergebnis wird auf 2 bis 98 % begrenzt. Jeder Sitz im aktuellen Verzeichnis stammt aus einem anderen Labor (Tabelle 8), daher beträgt jedes Familiengewicht 1. Die Regel wird in die offene Methodik geschrieben, bevor ein Labor zwei Sitze innehat.
Nach der Identität von Abschnitt 4.5 schlägt der Konsens den Durchschnitt der Mitglieder, die er mechanisch bei einem gemeinsamen Ereignis behält, und gegen den vollständigen Rat ist die Kürzung eine Wahl, die der Schattenkonsens und F10 messen, ein arithmetischer Gewinn. Geschicklichkeit wird nur gegen Referenzen außerhalb des Rates beurteilt: die Münze, die klimatologische Basisquote, die Menge und für F10 das Modell, das ein früheres Fenster leitete. Der Wert eines Sitzes wird direkt gemessen: der Konsens-Brier-Score bei gemeinsamen Ereignissen mit und ohne diesen Sitz in denselben Sitzungen. Ein Leave-One-Out, das nach den Ergebnissen berechnet wird, ist eine Beschreibung. Jede andere Gewichtung als die eingefrorene Kürzung, Familiengewichte und Klammer, gewählt, weil sie bei bereits gesehenen Jahreszeiten gewonnen hätte, ist eine neue Strategie (White, 2000): Sie wird vor der ersten Sitzung, die sie steuert, versiegelt und erst danach bewertet.
Ich versiegle eine solche Strategie mit der Registrierung als Test der eigenen These dieses Abschnitts: Wenn korrelierte Stimmen weniger wert sind, sollte ihre Diskontierung helfen. Der Schattenkonsens gewichtet jeden Sitz durch die Umkehrung seiner mittleren paarweisen Korrelation mit den anderen Sitzen, berechnet auf den Eintags-Wahrscheinlichkeitsbildern der gezählten, vor dem Registrierungszeitstempel versiegelten Läufe, Antworten, die nur vor der Referenz versiegelt sind, mit der mittleren Korrelation auf 0,05 begrenzt (ein Sitz ohne anrechenbare Antwort in diesem Fenster erhält das mittlere Gewicht der anderen). Die Gewichte werden mit der Registrierung eingereicht und für die Saison eingefroren. Bei jedem Ereignis werden sie über die antwortenden Sitze neu normalisiert, und die Kürzung von Extremen, die Familiengewichte und die Klammer sind die des veröffentlichten Konsenses. Ein eingreichtes Skript berechnet den Schatten aus den offenen Dateien und bewertet ihn anhand derselben Ereignisse wie den veröffentlichten Konsens, den es nie ersetzt. Abschnitt 8 erklärt den Vergleich. Anforderung 17 gibt jedem Sitz auch zwei beschreibende Zählungen von Eigenständigkeit: seine mittlere Korrelation mit den anderen antwortenden Sitzen und den Anteil seiner Richtungszellen, die mit der Mehrheit der anderen übereinstimmen. Ein Sitz, der eigenständig ist und beim Konsens bei gemeinsamen Ereignissen hinzufügt, ist der Sitz, den die Familienregel und die Decke von Abschnitt 5 argumentieren, behalten zu wollen. Am 20. Oktober 2026 liefen die beiden Zählungen über alle acht vor der Referenz versiegelten Sitze und alle 48 Zellen von einer mittleren Korrelation von 0,47 und 70% Übereinstimmung mit der Mehrheit der anderen (Claude) bis 0,71 und 88% (DeepSeek). Claude stand allein auf seiner Seite einer gleichmäßigen Chance in vier der 48 Zellen, mehr als jeder andere Sitz, darunter Halbleiter und der Nasdaq-100 in einer Woche, das es mit 54 bewertet, während die sieben anderen 28 bis 43 gaben. Die Genauigkeit wird separat bewertet.
all_wrong zählt die Markt-Sitzungen, bei denen jeder antwortende Sitz falsch lag, mit mindestens vier Antwortenden, und minority_right zählt diejenigen, bei denen der Konsens falsch und mindestens ein Sitz richtig war. In beiden sind Reihen alle Reihen mit dem Ergebnis „Anstieg", was eine Veränderung größer als Null bedeutet, und ein angegebenes 50% ist weder richtig noch falsch, sodass dieser Sitz nicht als antwortend für diese Reihe zählt. Unter Unabhängigkeit wäre einstimmiger Fehler unter vier oder mehr Sitzen mit Fehlerquoten nahe eins halb ungewöhnlich, und seine Häufigkeit gegen das Produkt der eigenen Fehlerquoten der antwortenden Sitze in denselben Reihen ist F6. Die Zählung ist ein Cluster-Diagnoseverfahren, das die Mitbewegung von Ergebnissen, die Schwierigkeit besonderer Sitzungen und eine gemeinsame Verzerrung mischt, und es identifiziert nicht Kopien. Eine richtige Minderheit, die wiederkehrt, ist der Fall dafür, jeden Aufruf jedes Sitzes neben dem Konsens zu zeigen.
5.4 Gemeinsame Quellen
Jede Prognosezeile von council-forecasts.csv trägt die Domänen und Links, die sein Modell zitiert hat (source_domains, source_urls). Für die Eintags-Antworten jedes Laufs berichte ich die Konzentration von Zitaten auf den am häufigsten zitierten Websites, die mittlere Jaccard-Überlappung zitierter Links und Websites zwischen Sitzpaaren und ob Paare, die einen Link teilen, bei der Aktion häufiger übereinstimmen als Paare, die dies nicht tun, innerhalb von Läufen und Märkten, durch Permutation. Bei den ersten fünf Läufen zog eine Nachrichtenwebsite etwa ein Fünftel aller Zitate, die Überlappung exakter Links war klein (mittlere Jaccard 0,006), und die höhere Übereinstimmung der 34 Paare, die einen Link teilten, war nicht vom Zufall unterscheidbar (Permutation p = 0,14). Ein zitierter Link ist eine Zeichenkette, die das Modell ausgegeben hat, und beweist nicht, dass die Seite gelesen wurde, und sein Label kann sich von seiner Adresse unterscheiden. Am 19. Oktober zitierte eine Antwort „Reuters" mit einem Link zu investing.com (Buchwort 83). Anforderung 17 fragt daher nach einem Abrufdatensatz (Status, Zeit, SHA-256 des Inhalts, angegebene Veröffentlichungszeit), bevor ein Link in die Überlappung eintritt. Nummern, die die Frage selbst geliefert hat, wie die Pre-Open-Futures, werden entfernt, bevor gemeinsame Zahlen gezählt werden. In Prediction Arena, wie viel ein Modell recherchiert hat, war nicht verbunden mit seinem Ergebnis (Zhang et al., 2026), daher misst die Liga, was Suche zu Übereinstimmung bewirkt, anstatt dies anzunehmen. Zitat-Überlappung misst gemeldete Herkunft, und F5 gibt an, was sie zeigen sollte.
In Abbildung 10 zähle ich, wer was zitiert. Die Eintags-Antworten, die vor der Referenz in den sechs Läufen vom 16. bis 21. Oktober 2026 versiegelt wurden, 918 Reihen, tragen 1.875 Zitate von 233 Websites. Reuters zog 407 davon (21,7%) und wurde von zehn der elf Sitze zitiert, alle außer Claude. Sein Anteil reichte von 6,2% bis 30,3% pro Lauf. Die nächsten Websites waren cnbc.com (139) und bloomberg.com (66). An den zwei am weitesten gezählten Morgen zogen Websites, die mindestens zwei Sitze zitierten, 68,5% und 58,3% der Zitate.
Abbildung 10. Zitierte Websites pro Sitz: Zitate in den Eintags-Antworten, die vor der Referenz versiegelt wurden, Läufe vom 16. bis 21. Oktober 2026, die zehn am häufigsten zitierten Websites.
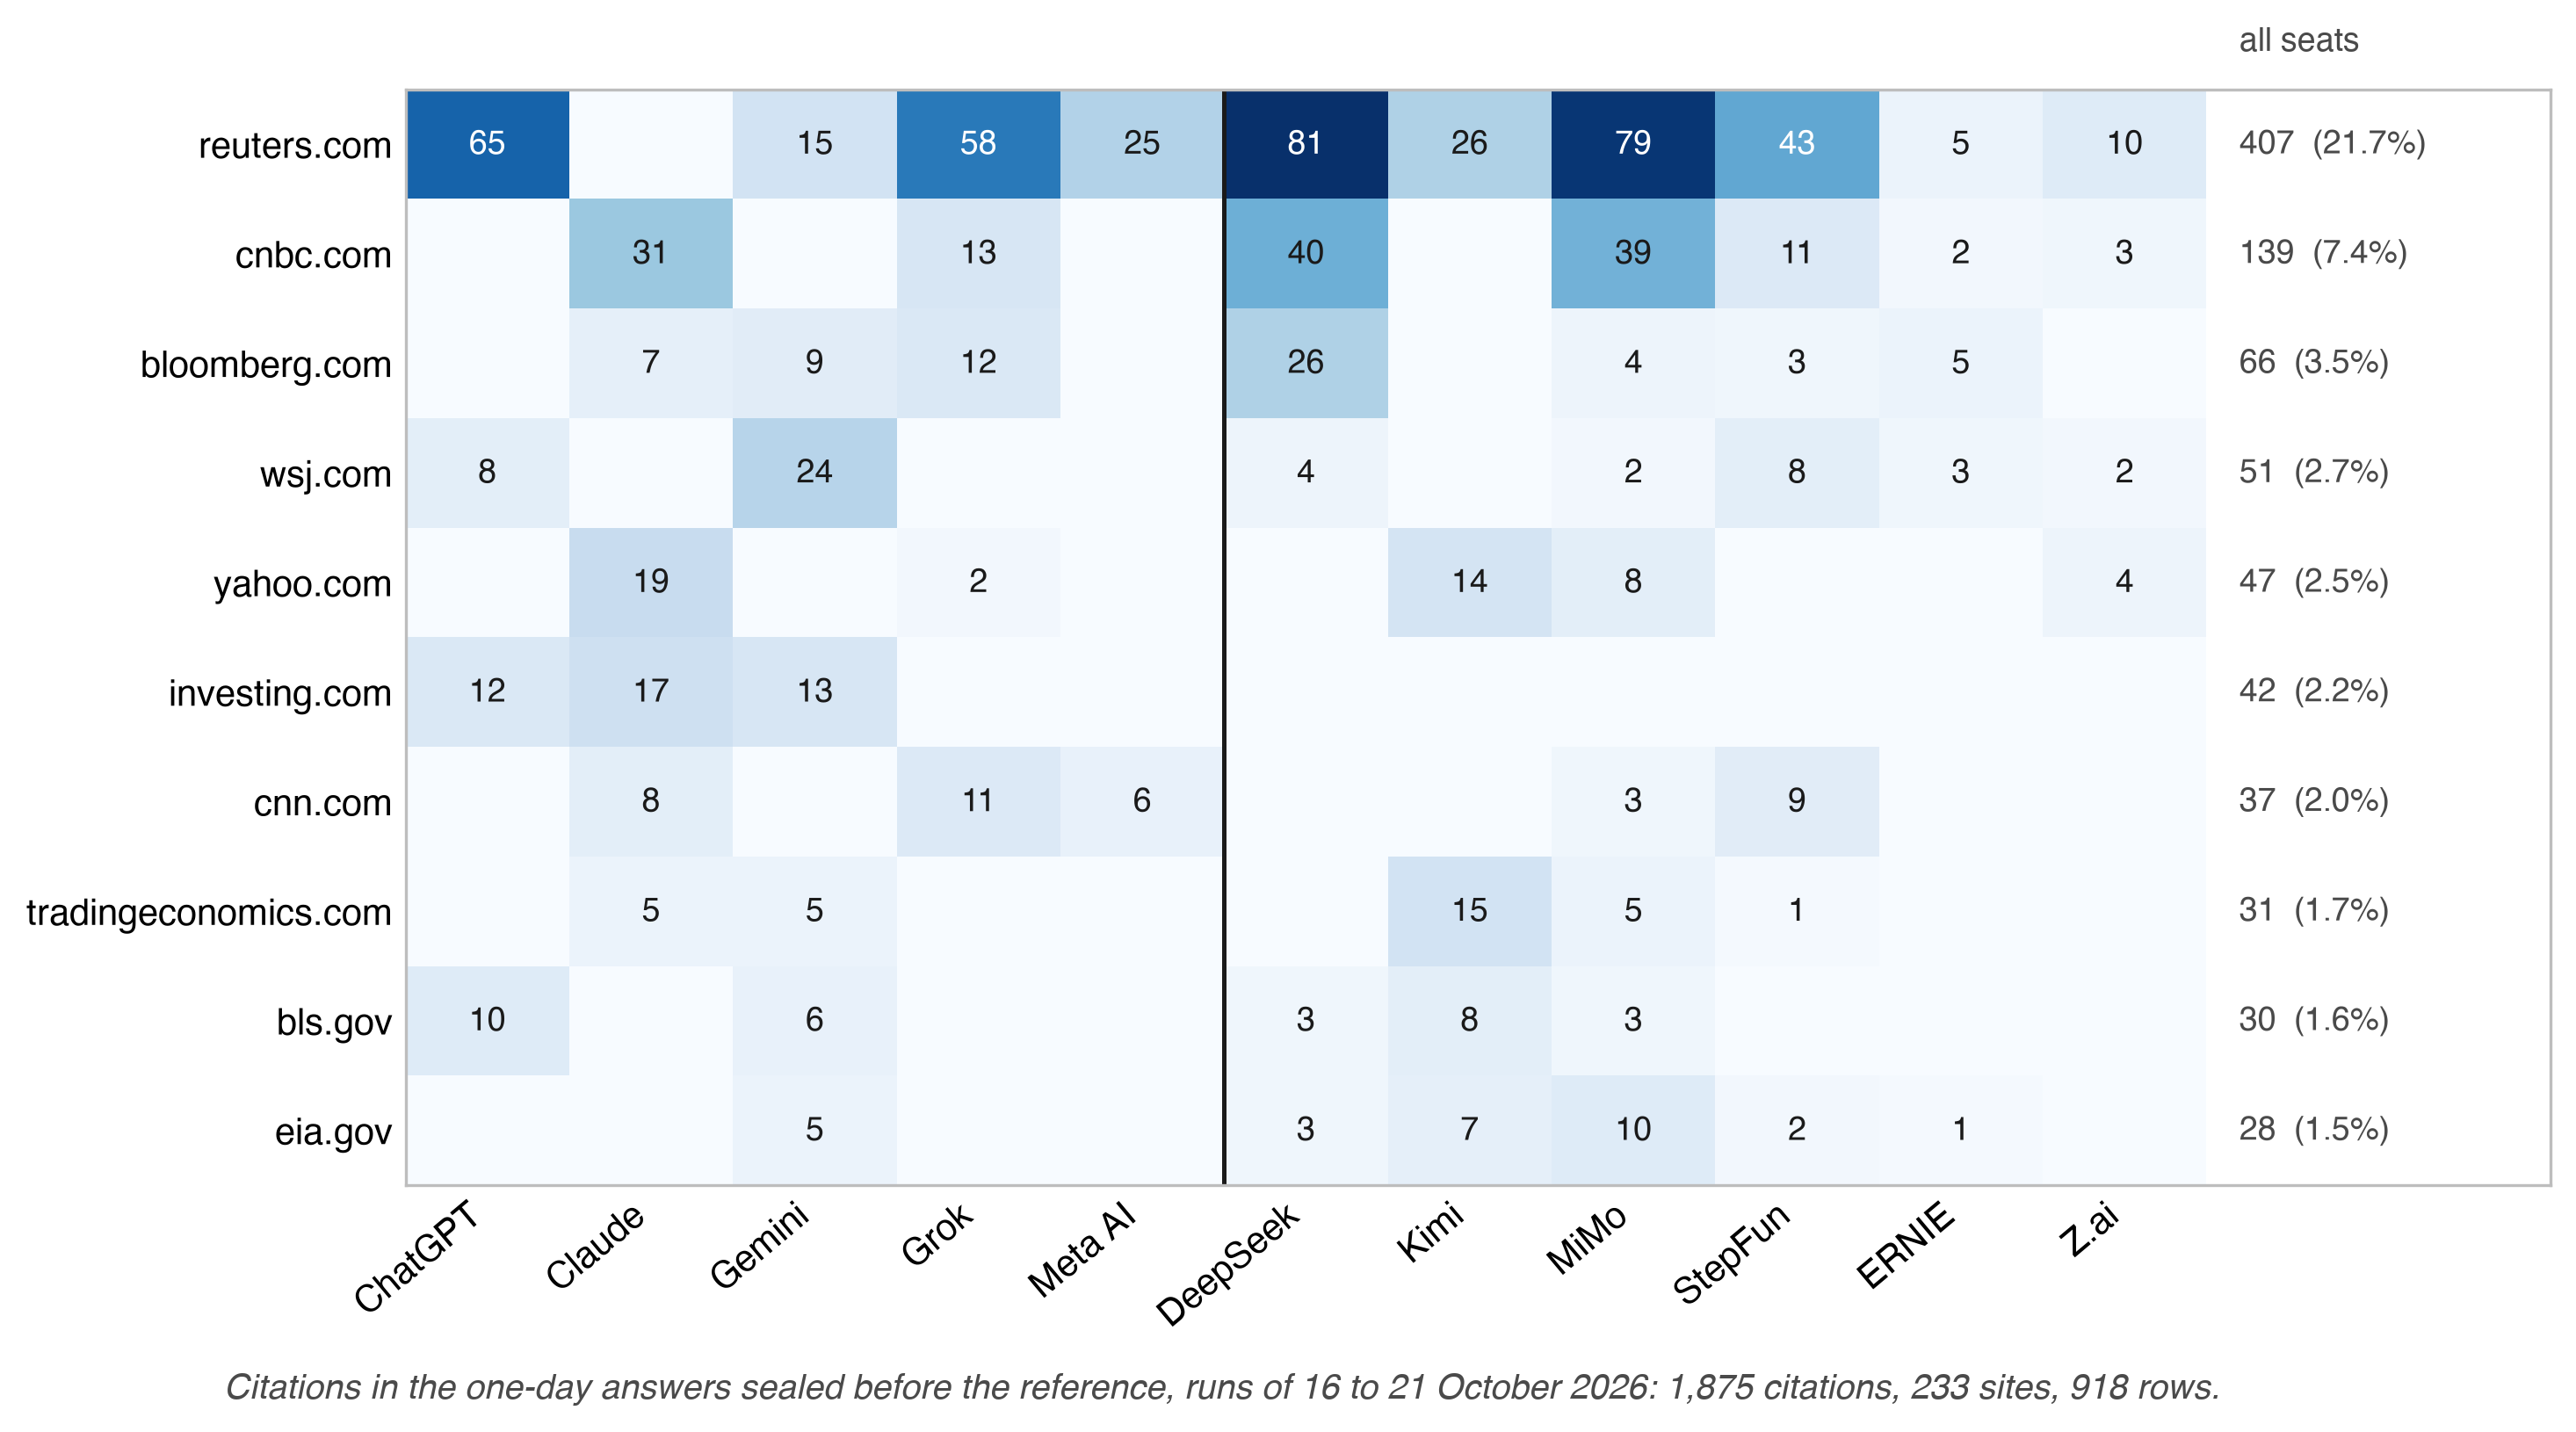
Hinweis: Eine Zählung pro zitierter Website pro Antwortzelle (source_domains), US-Sitze zuerst, mit einer Regel zwischen den Seiten; die rechte Spalte gibt jeder Website ihre Gesamtzahl und ihren Anteil an allen 1.875 Zitaten. Eine zitierte Domäne wird wie Abschnitt 5.4 einen zitierten Link liest. Quelle: council-forecasts.csv gespeichert 22. Oktober 2026, 01:32 UTC.
5.5 Das geschlossene Buch: dieselbe Frage ohne Suche
Hinzugefügte Nachrichten machen einen Sprachmodell-Prognostiker nicht standardmäßig besser: Bei Fragen, die nach den Schnittstellen der Modelle gelöst wurden, half Nachrichten-Kontext bei einigen Fragen und schadete bei anderen, durch Aktualitätsbias, Übergewichtung von Gerüchten und Verschiebung dessen, worauf sich ein Begriff bezieht (Karkar & Chopra, 2025).
In der Closed-Book-Liga erhält jedes Modell nach einem Lauf statt des offenen Webs ein versiegeltes Paket: den Preisabschnitt des Laufs und datierte Schlagzeilen, jeweils mit Quelle, Link, Veröffentlichungszeit und Hash, und es wird ihr mitgeteilt, nicht zu suchen oder Tools zu verwenden. Jede Antwortzeile verzeichnet den Suchzustand unter einer von drei Bezeichnungen: verified (die Tool-Konfiguration verhindert den Abruf und die Antwort zeigt keinen), configured but unverified, oder instruction only. Links außerhalb des Pakets sind mit outside gekennzeichnet. Das Paket wird mit seinem Hash versiegelt, bevor die Antworten vorliegen, und wird nicht neu erstellt, und die Closed-Book-Liga betreibt ihre eigenen $100.000-Konten außerhalb der täglichen Tabelle.
Die Datei arena-cb-experiment.json meldet Lauf für Lauf die Hitze der Uneinigkeit (100 mal die mittlere Teilung der Tagesmaßnahmen), N_eff und die Ausbreitung der Portfolios, geschlossen minus offen auf denselben Modellen. Wenn der geschlossene Rat mehr übereinstimmt, treiben identische Eingaben die Herde. Wenn er weniger übereinstimmt, zieht Suche die Modelle zu denselben Seiten. Ein Anspruch auf Suche hält stand, wenn sich die Arme nur bei der Suche unterscheiden. Jede geschlossene Antwort kommt aus einem frischen Kontext, dem die offene Antwort, die Menge oder ein anderer Platz nicht gezeigt wurde, mit derselben Frage, demselben Snapshot und Informationsfrist, abgestimmten Versionen und verzeichneten Zugriffszuständen. Für F20 und F21 werden die Antworten beider Arme vor derselben gemeinsamen Referenz versiegelt, andernfalls wird jeder Arm nach seiner eigenen Referenz bewertet, und die Reihenfolge, in der die Arme abgefragt werden, ist über Tage hinweg ausgewogen. Wenn der geschlossene Rat weniger nicht einverstanden ist und sein Brier-Verlust höher ist, haben identische Eingaben die Modelle ähnlich gemacht, ohne sie besser zu machen.
Zwei Arme können die zwei Quellen der Ähnlichkeit nicht trennen, dieselben Nachrichten am selben Morgen gelesen und dieselben Überzeugungen im Training gelernt. Anforderung 17 legt daher einen dritten Arm fest, nur Preise: dieselben Modelle erhalten den versiegelten Preisabschnitt des Laufs und die Frage, ohne Schlagzeilen und ohne Suche, unter derselben Frist und unabhängigen Regeln. Übereinstimmung, die ohne Nachrichten bleibt, kommt von gemeinsamen Priors; Übereinstimmung, die durch das Paket hinzugefügt wird, kommt von gemeinsamen Nachrichten; Übereinstimmung, die durch das offene Web hinzugefügt wird, kommt von Suche. Wenn der Arm läuft, meldet jeder Lauf N_eff und die Hitze der Uneinigkeit in allen drei Armen auf denselben Plätzen und Sitzungen.
5.6 Diskussion gegen klare Einstimmigkeit
Blind-parallele Elicitation gibt jedem Modell die rohe Frage ohne Sicht auf die anderen, daher trägt Übereinstimmung Beweiskraft. Informed-sequential Elicitation erkauft Fehlerkorrektur um den Preis der Unabhängigkeit (Chernets, 2026a). Bei sieben Sprachbenchmarks macht Mehrheitsvotum allein die meisten der Gewinne aus, die normalerweise Multi-Agent-Debatten zugeschrieben werden (Choi et al., 2025), also muss eine Diskussion die einfache Abstimmung über denselben Fragen schlagen, bevor sie einen Platz verdient. Die täglichen Vorhersagen sind nach Konstruktion blind-parallel. Die Diskussion läuft in einem separaten wöchentlichen Kurs, der niemals den täglichen Datensatz berührt: ein Vorsitzender, wechselnd zwischen den Seiten, liest jedes versiegelte Portfolio unter gemischten Buchstaben und schreibt das Portfolio des Rats und zwei oder drei Kritiken, jede benannt einen Markt, ein Risiko, eine Gewichtung und die Richtung des Fonds über die nächsten fünf Sitzungen, also hat jede Kritik eine überprüfbare Konsequenz. Jedes kritisierte Modell antwortet einmal und gibt das Portfolio an, das es halten würde. Shadow Accounts handeln das Portfolio des Vorsitzenden, die versiegelten Gewichtungen, die Gewichtungen mit angewendeter Kritik und die angegebene Antwort (council-talk.json, council-talk-critiques.csv; F22, F23).
5.7 Ein Modell, gefragt erneut
Einmal pro Woche wird die Portfoliofrage erneut gestellt, dreimal, von drei oder vier Modellen, und die Wiederholungen werden als ihre eigenen Zeilen versiegelt, nicht als Entscheidungen. council-repeats.json meldet die Hitze unter den eigenen Antworten eines Modells gegen die Hitze zwischen Modellen, was den Geräuschboden der Uneinigkeit gibt (F24). Da N_eff auf Wahrscheinlichkeiten berechnet wird, erweitert Anforderung 17 die Wiederholungen auf Wahrscheinlichkeiten: unter einem eingefrorenen Paket beantwortet ein ausgewähltes Modell die gleiche Wahrscheinlichkeitsfrage dreimal in unabhängigen Kontexten, jeweils als Diagnoszeile versiegelt, und die Liga meldet die Varianz innerhalb des Modells gegen die Varianz zwischen Modellen. Ein Modellversionswechsel wird datiert, und der Datensatz seit der Version wird separat angezeigt.
5.8 Ursprungslabor: die gleichen Bedingungen
Alle vierzehn Plätze handeln in der Portfolioliga. Elf Ratsplätze geben Wahrscheinlichkeiten an, fünf aus US-Laboren und sechs aus chinesischen Laboren, und drei Plätze sind auf der Bank und handeln nur (Tabelle 8). Jedes Modell erhält eine Frage, basierend auf einem Preisabschnitt, mit dem Text, der unter seinem SHA-256 veröffentlicht wird. Jede Antwort wird von einer Frist versiegelt und von einem Regelwerk bewertet, und jeder Platz hält dieselben $100.000, Kosten und Grenzen. Die Datei asks zeigt das Timing. Am 21. Oktober ging die erste Frage an jeden Platz innerhalb von 0,17 Sekunden, um 12:30:09Z, und ein Erneut an denselben Platz trägt denselben Hash. Die Plätze, die um 13:00 noch stille waren, wurden in einer zweiten Welle um 13:00:21Z unter ihrer eigenen Laufzeile und Fragenhash erneut abgefragt (asks.jsonl). Jedes Modell wird im stärksten Argumentationsmodus abgefragt, den sein Roster-Eintrag auflistet, und der auf der Antwortzeile versiegelte Modus ist der bewertete Modus. Jeder Anbieter versorgt sein Modell mit seinen eigenen Tools und seiner Rechenleistung, daher ist der Vergleich zwischen Laboren, wie sie ihre Modelle versorgen (Abschnitt 10).
Tabelle 8. Plätze der Liga (league-roster.json, generiert 21. Oktober 2026) und der auf jedem Platz der Liga versiegelte Versionstring durch 21. Oktober 2026.
| Platz | Labor | Seite | Rolle | Versiegelte Version |
|---|---|---|---|---|
| ChatGPT | OpenAI | US | Rat | GPT-6.1 Sol |
| Claude | Anthropic | US | Rat | Claude Opus 5.5 |
| Gemini | US | Rat | Gemini 4 Argon | |
| Grok | xAI | US | Rat | Grok 4.7 |
| Meta AI | Meta | US | Rat | Muse Spark 1.3 |
| Nemotron | NVIDIA | US | Bank | nur Portfolio |
| Amazon Nova | Amazon | US | Bank | nur Portfolio |
| DeepSeek | DeepSeek | CN | Rat | DeepSeek V4.1 |
| ERNIE (Wenxin) | Baidu | CN | Rat | ERNIE |
| StepFun | StepFun | CN | Rat | Step 5 Preview |
| MiMo | Xiaomi | CN | Rat | MiMo-V2.6-Pro |
| Kimi | Moonshot AI | CN | Rat | Kimi K3 |
| Z.ai | Zhipu | CN | Rat | GLM-5.3 |
| Qwen | Alibaba | CN | Bench | nur Portfolio |
Anmerkung: Der neben jeder Version angegebene Modus befindet sich in der Antwortreihe (Anhang C), und jede Version ist die Zeichenkette, die die Schnittstelle des Anbieters zurückgibt, bei ERNIE nur der Name selbst; jeder Sitz stammt aus einem anderen Labor, daher beträgt jedes Familiengewicht 1 (Abschnitt 5.3).
Frühere Vergleiche stellten die beiden Seiten nicht auf eine Frage und einen Schnappschuss. Cao et al. (2025) fanden heraus, dass ein US-amerikanisches Modell chinesische Unternehmen optimistischer und weniger genau prognostizierte als ein chinesisches Modell, und dass die Lücke verschwand, sobald chinesische Nachrichten hinzugefügt wurden, was auf den Zugang zu Informationen als Quelle hindeutet. Der Vergleich hier ist beobachtend, da Anbieter, Generation, Sprache und Werkzeuge mit dem Länderkennzeichen reisen (Abschnitt 10). Er wird zwischen und innerhalb der Seiten berichtet, und jede Lücke in Wahrscheinlichkeiten oder Punktzahlen wird mit ihrem Bereich veröffentlicht, wenn nacheinander jeder Sitz ausgelassen wird. Eine Lücke, die das Vorzeichen ändert oder die meiste ihrer Größe verliert, wenn ein Sitz wegfällt, wird als Lücke dieses Sitzes gemeldet, nicht der Seite (F18, F19). Anforderung 17 fragt auch, ob die Seite überhaupt ein Block ist. Für jeden Durchlauf wird die mittlere Korrelation der Wahrscheinlichkeiten innerhalb jeder Seite gegen die zwischen den Seiten mit der Wahrscheinlichkeit einer mindestens so großen Differenz gesetzt, wenn Seitenkennzeichen zwischen den antwortenden Sitzen permutiert werden. Mit fünf und sechs Sitzen ist der Test ein diagnostisches Instrument. Wenn sich die nächsten Paare den beiden Seiten anschließen, ist das Länderkennzeichen nicht dort, wo die Herde sich teilt. Ich las es zuerst beim gezählten Durchlauf vom 20. Oktober 2026 (acht Sitze vor der Referenz versiegelt, 48 Zellen) und finde keinen Block nach Land. Die mittlere Korrelation der Wahrscheinlichkeiten beträgt 0,66 innerhalb der Seiten und 0,61 zwischen ihnen, und drei der vier nächsten Paare verbinden sie: ChatGPT und MiMo (0,88), Gemini und DeepSeek (0,86), DeepSeek und Grok (0,77). Einzelne Zellen können sich nach Seite teilen. Die größte Lücke zwischen den Seitenmittelwerten in diesem Durchlauf lag bei Gold für einen Monat, 56 für die vier US-Sitze gegen 44 für die vier chinesischen Sitze, und Gold für eine Woche kam an dritter Stelle, 52,5 gegen 43,5. Ein Maximum über 48 Zellen ist konstruktionsbedingt groß. Wenn die acht Sitze in jeder der 70 möglichen Weisen vier und vier geteilt werden, erzeugen 26 der Teilungen eine größte Zellenlücke, die mindestens so breit ist (p = 0,37). DeepSeek gab Gold für einen Monat 56 ab, oberhalb von drei der vier US-Sitze, daher spaltet sich selbst die breiteste Zelle nicht sauber nach Seite. In Abbildung 11 zeige ich die gesamte Matrix, mit dem Morgen des 21. Oktober daneben.
Abbildung 11. Drei der vier nächsten Paare verbinden am 20. Oktober 2026 ein US-amerikanisches und ein chinesisches Labor, und das nächste Paar tut dies am 21. Oktober erneut: paarweise Korrelation der versiegelten Wahrscheinlichkeiten, (A) 20. Oktober, acht Sitze vor der Referenz versiegelt; (B) 21. Oktober, neun Sitze; mit der mittleren Korrelation jedes Sitzes und der Übereinstimmung mit der Mehrheit, sowie den Eigenwerten jeder Matrix.
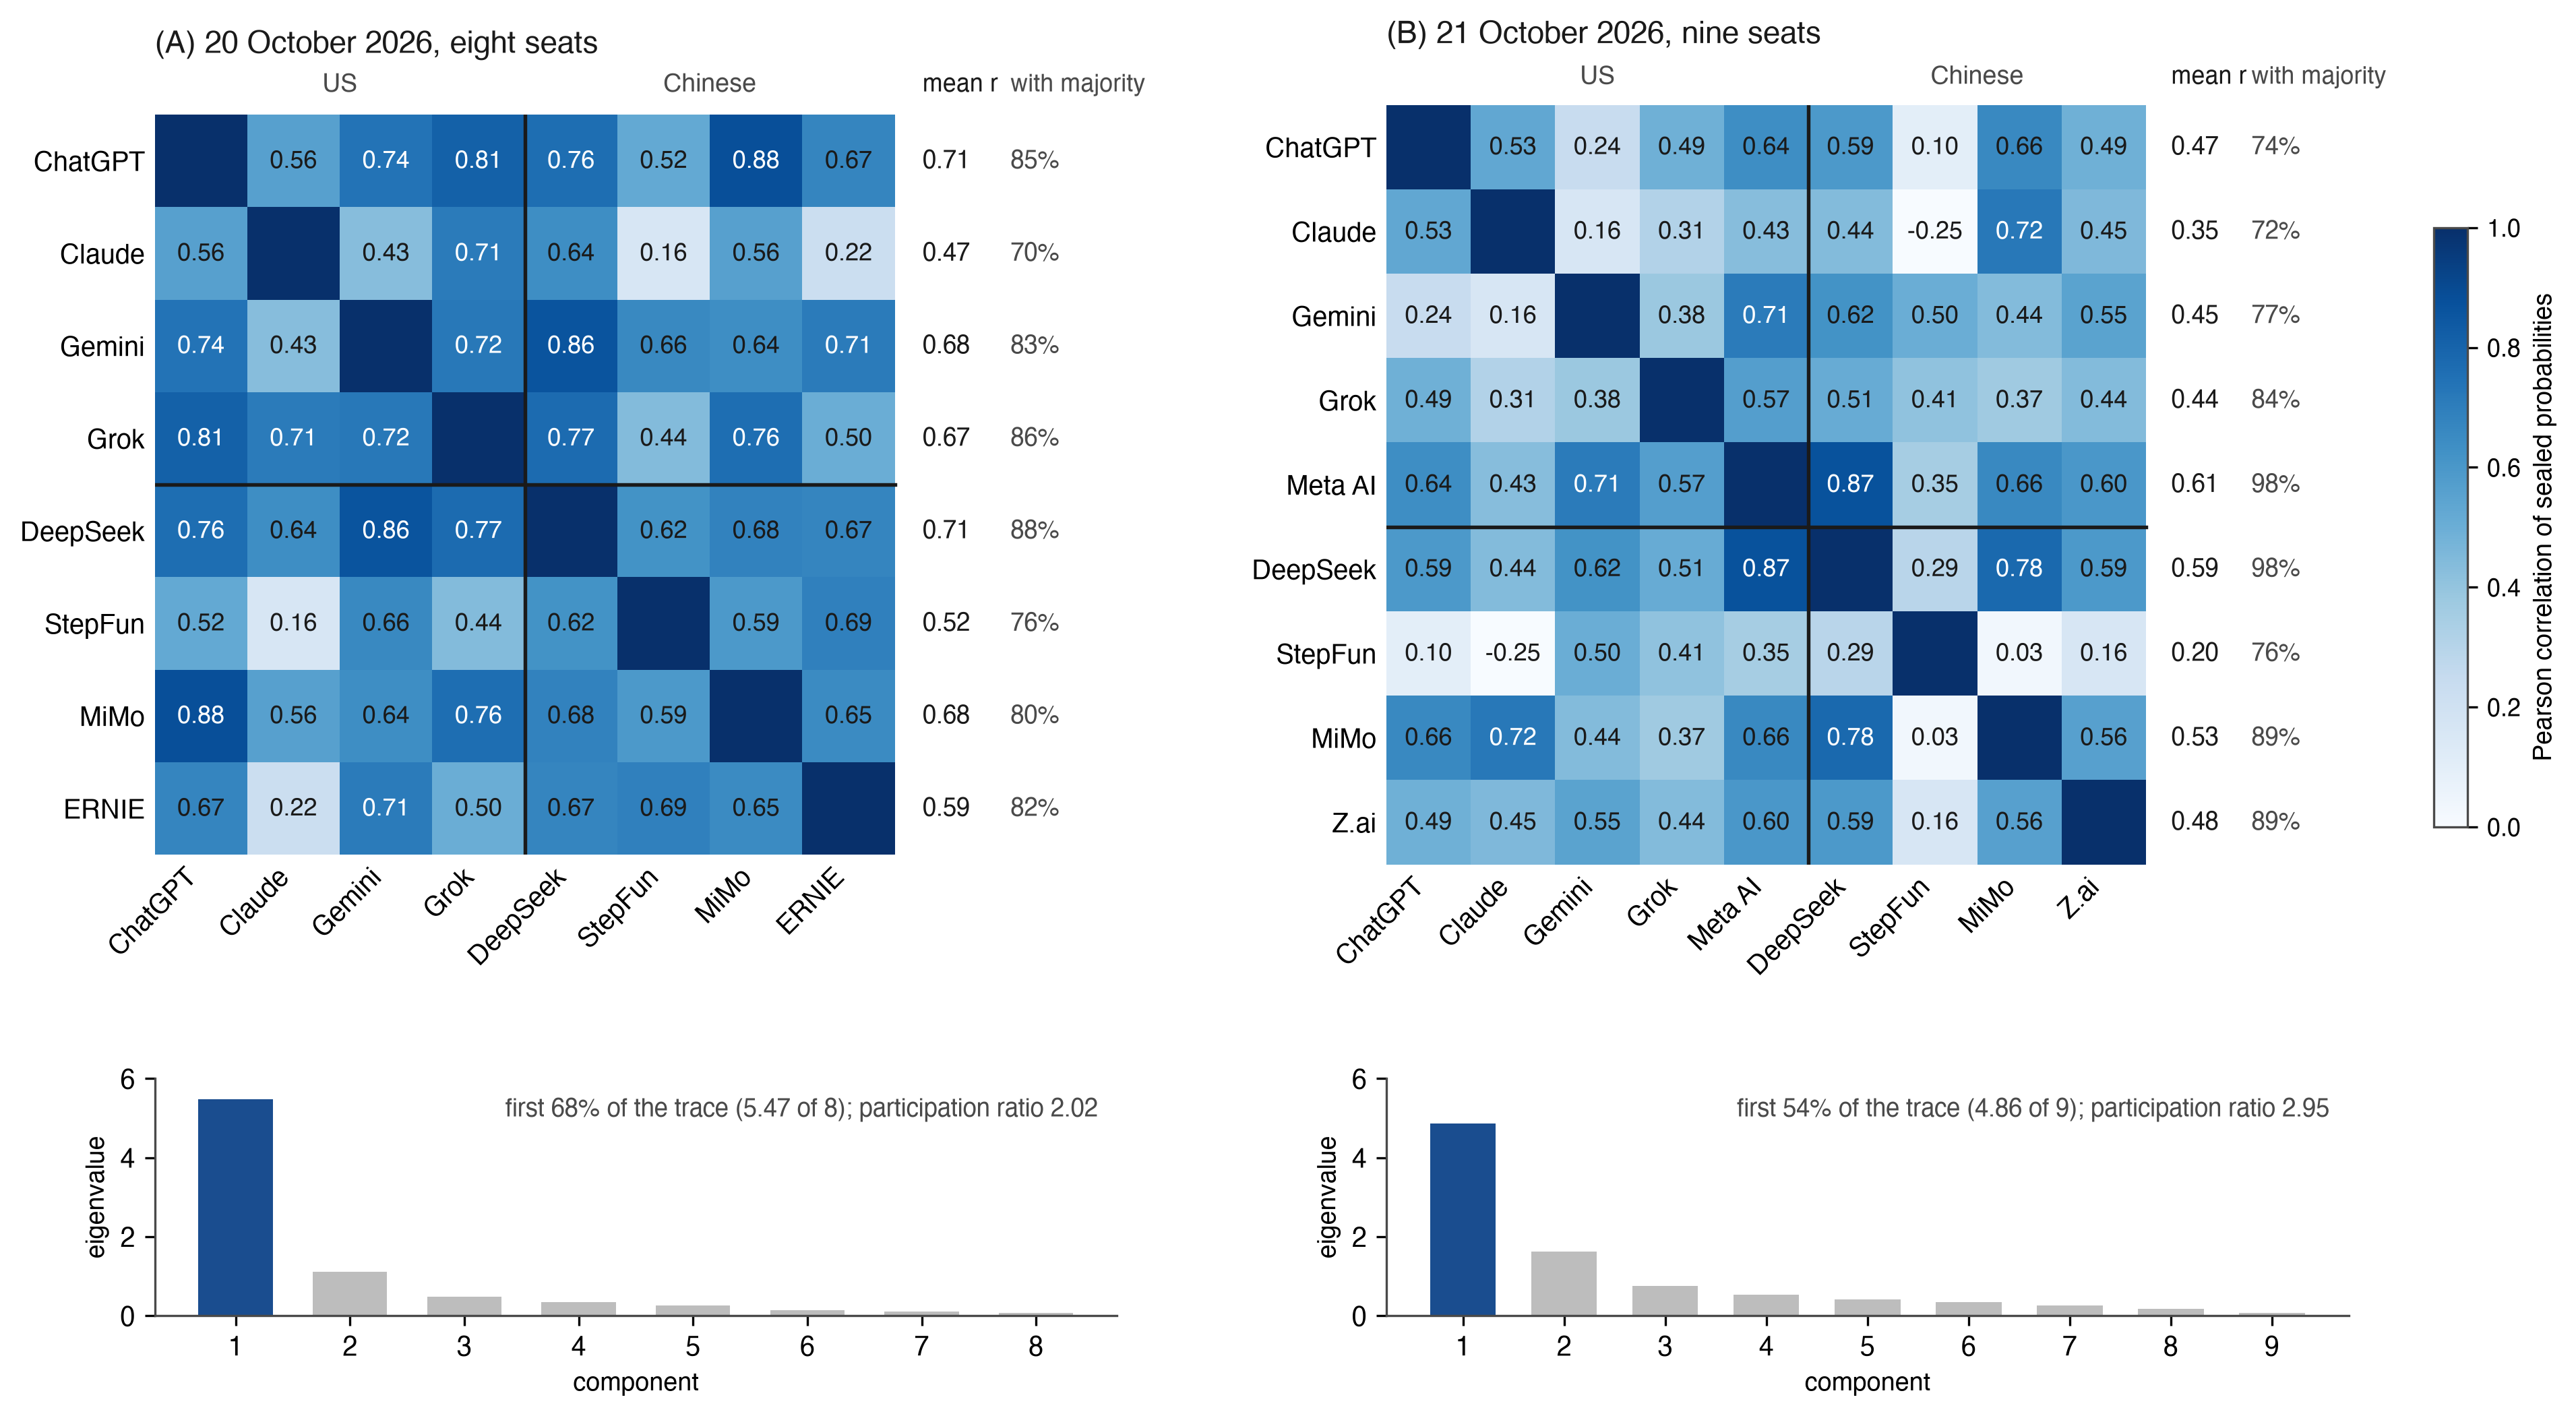
Anmerkung: Pearson-Korrelation über die 48 Zellen (12 Märkte × 4 Horizonte) der Durchläufe 2026-10-20-am und 2026-10-21-am, über die Zellen, die beide Sitze zu einem gemeinsamen Ereignis beantwortet haben (am 21. Oktober haben die Bitcoin-Zellen von Meta AI ihre eigene Referenz, daher verwenden ihre Paare 44 Zellen); US-Sitze zuerst, mit einer Regel zwischen den Seiten. Mittleres r ist die mittlere Korrelation des Sitzes mit den anderen Sitzen, und mit Mehrheit ist der Anteil der Richtungszellen des Sitzes auf derselben Seite von 50 wie die Mehrheit der anderen Sitze, Unentschieden und angegebene 50er ausgelassen. Unterhalb jeder Matrix ihre Eigenwerte, mit dem Anteil der ersten und dem Partizipationsverhältnis (Σλ)²/Σλ² (Anforderung 17). Mittelwert innerhalb der Seiten 0,66 und 0,43, zwischen ihnen 0,61 und 0,48. Quelle: council-forecasts.csv gespeichert 22. Oktober 2026, 01:32 UTC.
Ich las den ersten gezählten Durchlauf, am 21. Oktober 2026, auf die gleiche Weise mit neun Sitzen vor der Referenz versiegelt, fünf US-amerikanische und vier chinesische. Die mittlere Korrelation beträgt 0,43 innerhalb der Seiten und 0,48 zwischen ihnen. Das nächste Paar verbindet sie erneut, Meta AI und DeepSeek (0,87), mit Claude und MiMo (0,72) an dritter Stelle. Die größte Lücke zwischen den Seitenmittelwerten fiel auf 7,0 Punkte, bei Brent für einen Monat, und 110 der 126 Teilungen der neun Sitze in Gruppen von fünf und vier ergeben eine größte Lücke, die mindestens so breit ist (p = 0,87). Gold für einen Monat, am 20. Oktober 12,0 Punkte auseinander, stand 0,1 auseinander (Abbildung 12). Die Ähnlichkeit verbreitete sich auch auf mehr Faktoren. Der erste Eigenwert trug 54 % der Spur (4,86 von 9) gegenüber 68 % am Vortag mit einem Partizipationsverhältnis von 2,95 gegenüber 2,02. An beiden Morgen waren die beiden Sitze, die den anderen am weitesten entfernt waren, Claude und StepFun. Ihre mittleren Korrelationen betrugen 0,47 und 0,52 am 20. Oktober und 0,35 und 0,20 am 21. Oktober. Zwei Morgendurchläufe der Diagnose zeigen keinen Block nach Land, und F18 und F19 entscheiden dies über die Saison.
Abbildung 12. Unterschied zwischen den mittleren angegebenen Wahrscheinlichkeiten der US-amerikanischen und chinesischen Sitze, nach Markt und Horizont: (A) Durchlauf 2026-10-20-am (vier und vier Sitze vor der Referenz versiegelt); (B) Durchlauf 2026-10-21-am (fünf und vier Sitze).
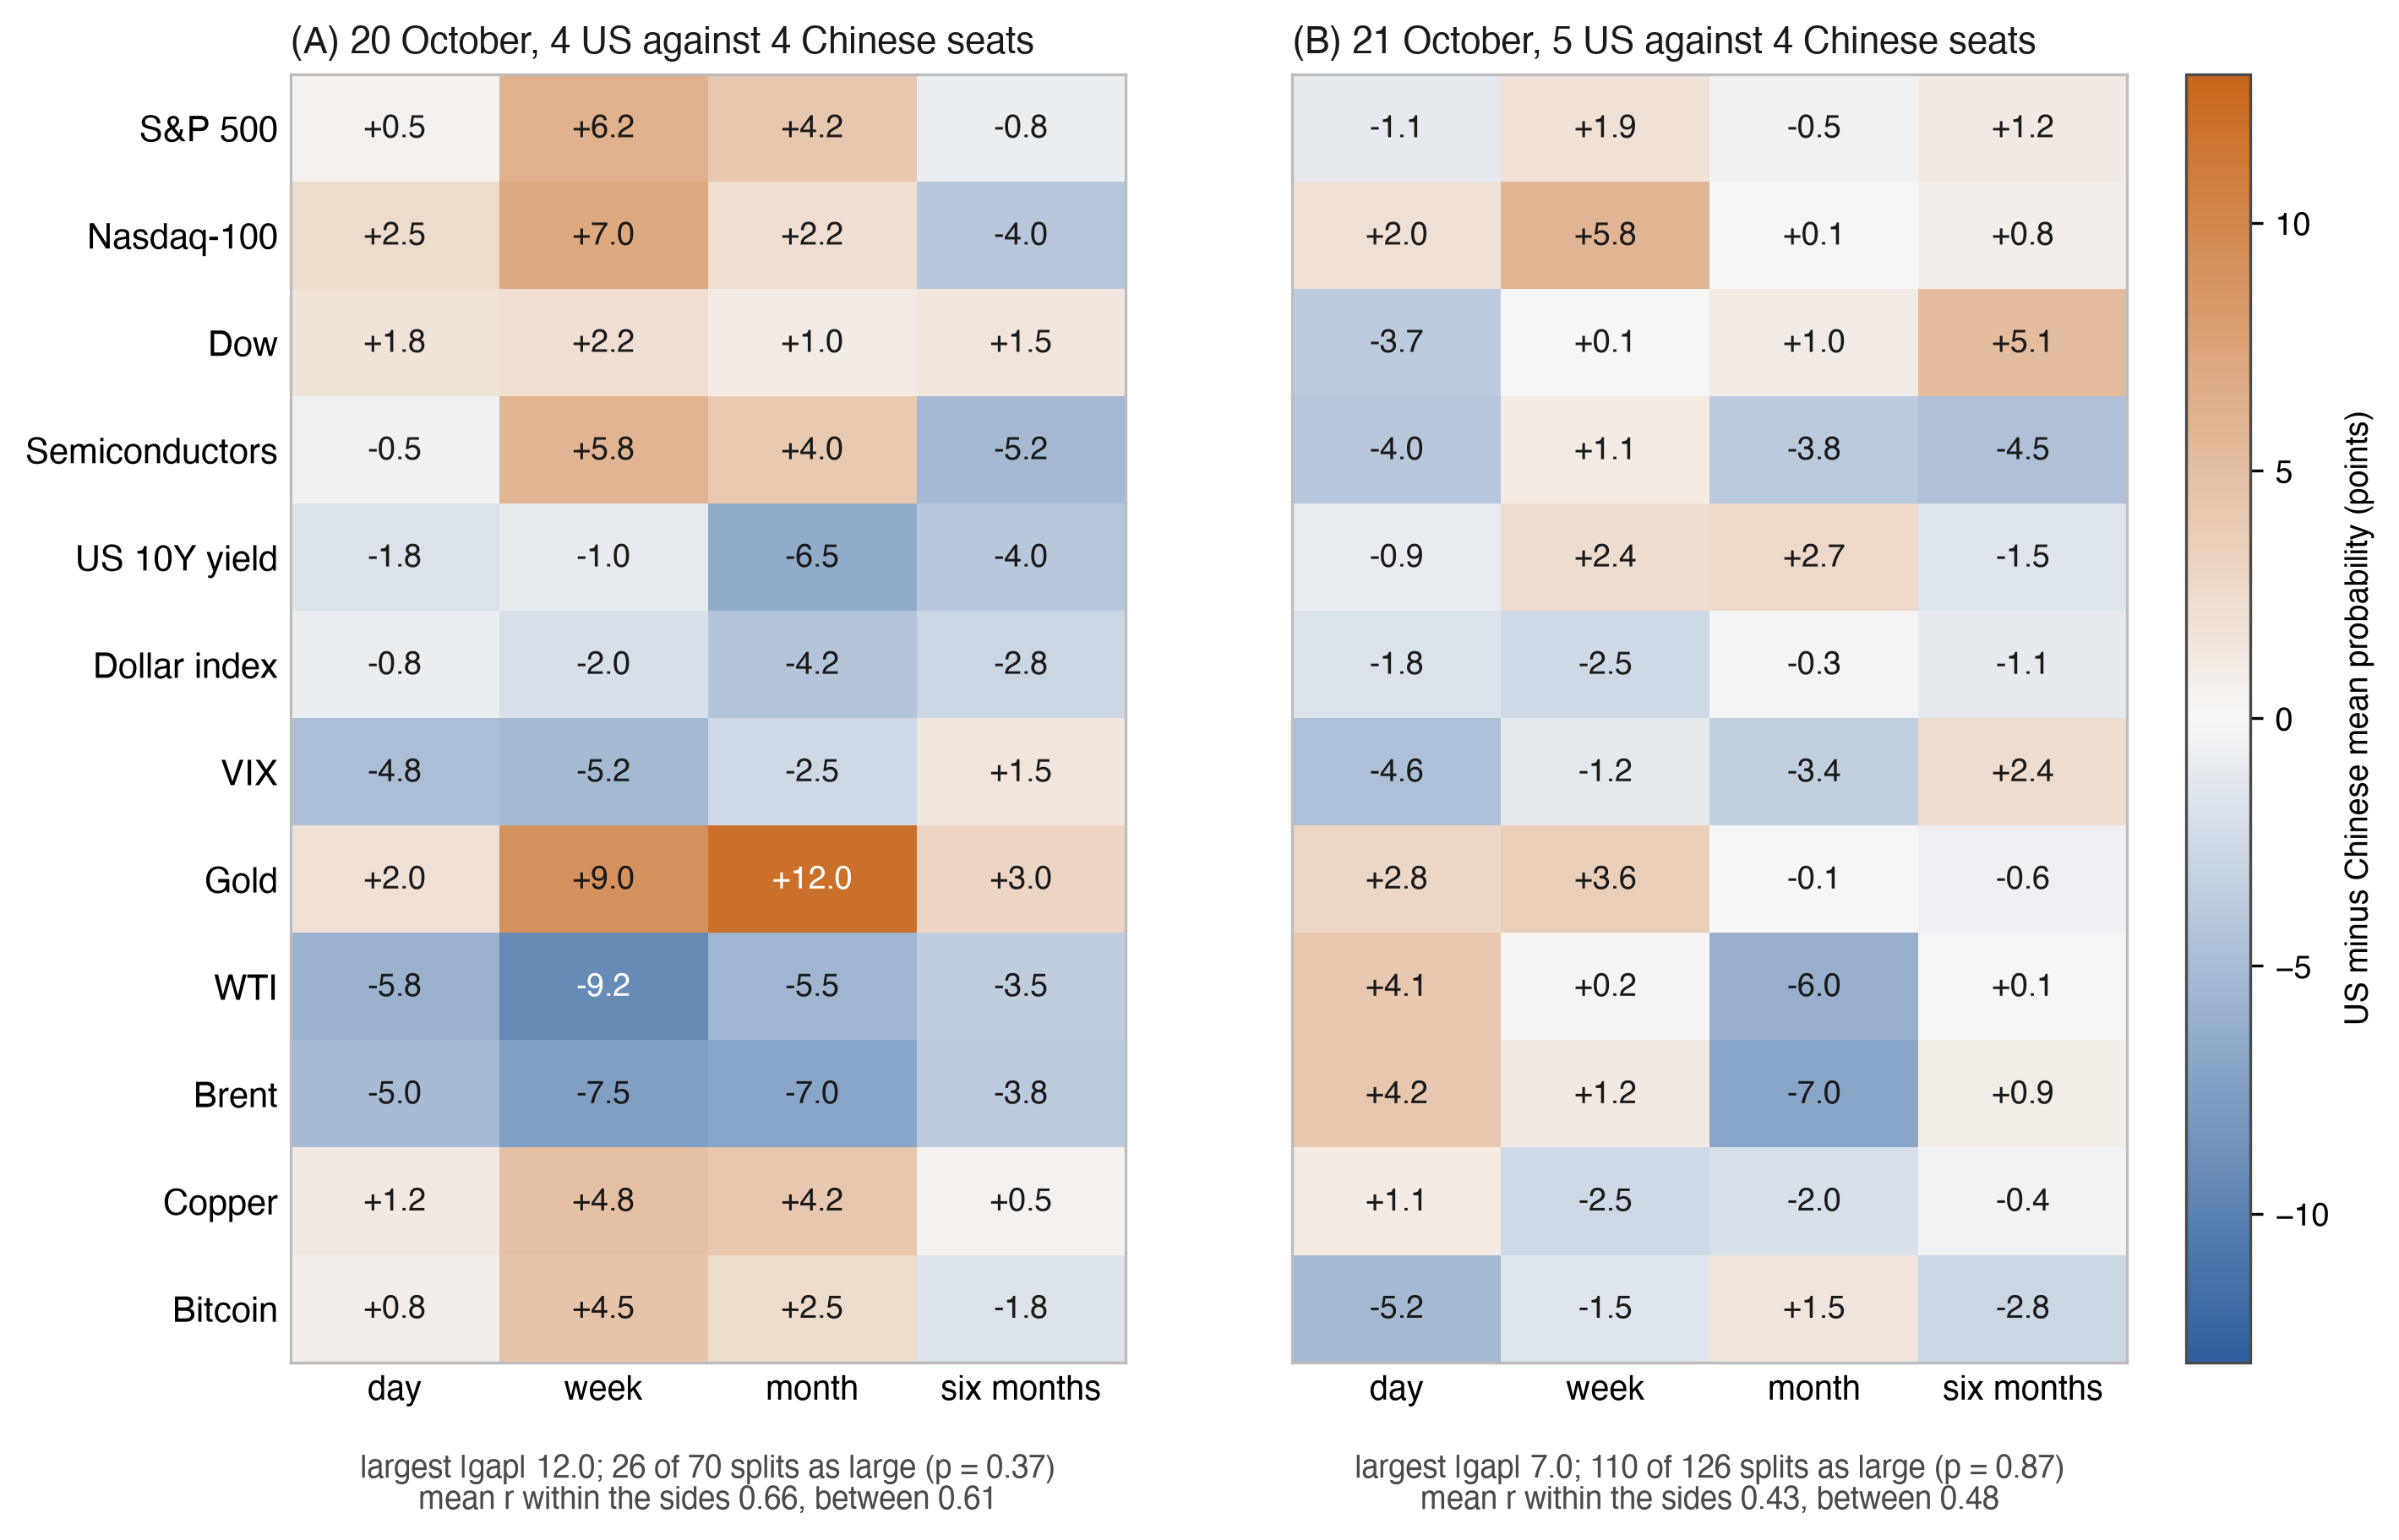
Anmerkung: Punkte der Wahrscheinlichkeit, US-amerikanisch minus chinesisch; orange, wo die US-Sitze höher stehen, blau, wo die chinesischen Sitze es tun. Unter jedem Panel die größte absolute Differenz, die Anzahl aller Teilungen der gleichen Sitze in Gruppen der gleichen Größen, die eine größte Differenz mindestens so groß ergeben (70 Teilungen in A, 126 in B), und die mittlere Korrelation innerhalb und zwischen den Seiten. Am 21. Oktober lässt die Bitcoin-Reihe die Zellen von Meta AI aus, die ihre eigene Referenz tragen. Quelle: council-forecasts.csv gespeichert 22. Oktober 2026, 01:32 UTC.
6. Menschen vor der KI
Die Liga misst Modelle. Die Seite, die sie anzeigt, fragt auch, ob das Sehen der Modelle einer Person hilft, eine Vorhersage zu treffen, oder sie nur zu ihnen hinzieht. Die meisten Belege stammen aus Designs, bei denen der Rat zuerst eintrifft. Schoenegger et al. (2025) gaben 991 Teilnehmern einen Sprachmodell-Assistenten und fanden Genauigkeitsgewinne von ungefähr einem Viertel, auch von einem Assistenten, der darauf ausgelegt war, verrauschte Ratschläge zu geben; Schoenegger et al. (2024) stellten fest, dass ein Ensemble von zwölf Modellen einer Menge von 925 Prognostizierern entsprach, und dass ein einfacher Durchschnitt von menschlichen und maschinellen Prognosen noch besser war. Menschen verlassen einen Algorithmus, nachdem sie ihn fehlschlagen sehen (Dietvorst et al., 2015), und in anderen Einstellungen gewichten ihn über menschliche Ratschläge (Logg et al., 2019). In einem geopolitischen Prognostizierungsturnier verließen sich Prognostizierer selten auf maschinelle Prognosen und tenderten dazu, Modelle zu wählen, die ihren früheren Überzeugungen entsprachen (Abeliuk et al., 2020). Was diese Designs nicht leicht trennen können, ist Hilfe vom Ankern.
6.1 Design
Jeder Besucher kann jedes der 12 Märkte für die Sitzung nach oben oder unten markieren, mit einer Konfidenz von 55 bis 95 %, ohne sich zu registrieren. Jeder Leser wird einmalig und dauerhaft durch eine anonyme zufällige Kennung einer von zwei Gruppen zugewiesen. Die sehende Gruppe sieht die Antworten der Modelle sofort; die blinde Gruppe sieht sie erst nach ihrer ersten Vorhersage der Sitzung.
6.2 Was wird gemessen
Für die erste Vorhersage in einer Sitzung zeichnet die Liga vier Größen auf. Ich nehme als primäres Ergebnis die Brier-Punktzahl (eine Konfidenz c auf einer Seite als Wahrscheinlichkeit c/100 dieser Seite gelesen), auf denselben Märkten für beide Gruppen, jeder Markt gewichtet nach der Anzahl der kleineren Gruppe darauf. Die Zeit bis zur ersten Vorhersage zeigt, ob die Modelle eine Entscheidung beschleunigen. Angegebene Konfidenz gegen die Trefferquote ergibt Überconfidence. Ankern ist der Anteil der ersten Vorhersagen, die in Richtung mit dem Konsens übereinstimmen, verglichen zwischen Gruppen. Ein blinder Leser, der die Modelle zuerst öffnet, wird als Blick gezählt. Die Analyse folgt der Zuweisung, mit Blicken als Nicht-Compliance. council-league.json veröffentlicht die Anzahlen, Trefferquoten, Zeiten, Konfidenz, Blicke und Brier-Punktzahlen unter experiment (g0, g1), und Anforderung 16 hat das Datenwörterbuch-Etikett, welche Gruppe vor der ersten bewerteten Vorhersage blind ist. Das Experiment ist live und offen für jeden Besucher, und am 21. Oktober stand es bei seinem Start, n = 0 bewertete erste Vorhersagen in beiden Gruppen. F28 und F29, registriert auf OSF mit den Vorhersagen von Abschnitt 8, fixieren seine zwei Ergebnisse auf 200 abgestimmte erste Vorhersagen pro Gruppe.
6.3 Schutz vor Manipulation
Nur erste Vorhersagen gehen in den Vergleich ein, und es werden keine Namen, Konten oder Kontaktdaten gesammelt. Anforderung 16 setzt eine erste Vorhersage pro Markt pro Kennung pro Sitzung fest. Die Adresse des Lesers wird nicht gespeichert: Die Liga behält nur einen gesalzenen Hash davon mit dem Tag, um wiederholte Abstimmungen zu begrenzen. Leservorhersagen schließen zum Referenzzeitpunkt, und eine zurückgesetzte Kennung wird als neuer Leser behandelt, wobei der Anteil der Zurückstellungen gemeldet wird.
6.4 Was der Vergleich zeigt
Zufällige Zuweisung macht die zwei Gruppen miteinander vergleichbar. Beide sind Besucher einer öffentlichen Seite, die sich entschieden haben zu kommen, daher spricht der Vergleich für sie und nicht für Investoren. Es misst einen Effekt des Zugangs, und das zweite Protokoll unten misst die Überprüfung eines früheren Urteils. Größere Übereinstimmung mit dem Rat wird als Verschiebung gemessen, und das Überprüfungsprotokoll erzählt vom Lernen durch Kopieren. Eine Kennung steht für einen beobachtbaren Teilnehmer, und eine Person kann mehrere halten, daher meldet die Liga Kennungen, die zugewiesen und beitragend sind, erste Vorhersagen und Rückkehrquoten nach Gruppe. Wiederholte Teilnahme ist eine sekundäre Analyse, geclustert nach Kennung und Sitzung.
Ein zweites Protokoll, das von dem Standard spezifiziert wird, misst die Überprüfung direkt. Jeder Leser zeichnet zunächst eine private Richtung und Konfidenz mit dem Rat versteckt auf, wird dann durch Zuweisung nach dem Zufallsprinzip dem Rat oder einer Kontrollanzeige gezeigt und zeichnet eine endgültige Vorhersage für denselben Markt und Sitzung auf. Das primäre Ergebnis ist der Unterschied zwischen den Armen in der Veränderung der Brier-Punktzahl von privater zu endgültiger Vorhersage; Bewegung zum Rat wird separat für Sitzungen gemeldet, auf denen sein Aufruf richtig oder falsch war, daher können Lernen und Kopieren unterschieden werden. Das Überprüfungsprotokoll tritt in die datierten Überarbeitungen dieses Papiers ein, wenn es ausgeführt wird.
7. Eine datierte Karte der KI-Marktarenen
7.1 Was die Karte aufzeichnet
Zwischen 2023 und 2026 wurde die Frage „Können KI-Modelle Märkte prognostizieren?" in vier Formen gestellt: Backtests von Modellurteilen auf historischen Preisen, Benchmarks auf noch offene Fragen, Arenen, in denen Modelle mit echtem oder virtuellem Geld handelten, und Vorhersagemärkte, die als Basislinie oder Austragungsort verwendet wurden. Die Karte verzeichnet, wer jede Anstrengung einleitete, wann und was sie gemessen hat. In Tabelle 9 stelle ich an jede sechs Fragen: wie die Zeit einer Prognose gesichert wird und auf welchem Vertrauensniveau, ob Wahrscheinlichkeiten nach einer streng eigentlichen Regel bewertet werden, ob mehrere Zeithorizonte auf denselben Vermögenswerten verglichen werden, ob Übereinstimmung zwischen Modellen gegen ihre Korrelation gelesen wird (eine Zählung unabhängiger Stimmen oder ein Korrelationsgewicht), ob ein Mensch prognostiziert, bevor er die KI sieht, und ob die Daten offen sind. In Anhang E vergleiche ich die Referenzimplementierung mit den nächstgelegenen Anstrengungen Merkmal für Merkmal (Tabelle E1).
Vertrauensstufen folgen Abbildung 4 und Abschnitt 3.12: 0, das Ankunftsprotokoll des Betreibers; 1, ein Betreiber-Fingerabdruck oder Hash-verknüpfter Datensatz, dessen Zeit vom Betreiber oder seinem Host abhängt; 2, ein Fingerabdruck, der außerhalb des Betreibers eingegeben wurde, was von außen beschränkt, wann der Datensatz existierte, innerhalb der Toleranz dieses Datensatzes (für Bitcoin, einige Stunden nach der Header-Zeit des Blocks, weil eine Header-Zeit den Median der vorherigen elf übersteigen muss und der realen Zeit voraus laufen kann); 2+, Stufe 2 plus eine von Drittparteien unterzeichnete Zeit (RFC 3161) auf jedem Siegel. Ein Backtest hat keine gesicherte Einreichungszeit. Ich baute die Karte aus veröffentlichten Papieren, Projektseiten, Repositorien und Presseberichten auf und schloss die Suche am 21. Oktober 2026 ab. Jeder Prioritätsanspruch in Abschnitt 7.4 ist auf die hier überprüften Bemühungen beschränkt. „ND" bedeutet nicht öffentlich dokumentiert ab 21. Oktober 2026: nicht in der öffentlichen Beschreibung gefunden, was Abwesenheit nicht beweist. Ich verzeichne, was jede Anstrengung aus ihren öffentlichen Materialien beweisen kann, und lasse deren Qualität unrangiert.
7.2 Die Zeitleiste
2023 bis 2024. Lopez-Lira und Tang (2023) zeigten, dass GPT-Bewertungen von Nachrichtenschlagzeilen nachfolgende Aktienrenditen prognostizierten, was das Feld und seinen zentralen Zweifel eröffnete (Abschnitt 2.1). 2024 kamen Live-Fragen an. Ein abrufverstärktes System näherte sich der menschlichen Gesamtzahl bei Fragen, die nach dem Trainingsdatum der Modelle veröffentlicht wurden (Halawi et al., 2024), ein Ensemble von zwölf Modellen entsprach einer Menge von 925 Menschen (Schoenegger et al., 2024), Metaculus führte vierteljährliche Turniere von Bots gegen Profis durch, die in jedem Quartal bis Mitte 2025 führten (Metaculus, 2025a, 2025b), und ForecastBench stellte etwa tausend generierte Fragen bei acht Zeithorizonten und fand Experten noch vor dem besten Modell (Karger et al., 2025).
2025. Finance-Benchmarks und Geld-Arenen folgten. InvestorBench bot simulierte Finanzentscheidungen auf historischen Daten an (H. Li et al., 2025), und Belege für Gedächtnis und Vorausschau in Backtests häuften sich an (Lopez-Lira et al., 2025; W. W. Li et al., 2025; Paleka et al., 2026; Gao et al., 2025). FutureX führte eine tägliche Live-Benchmark von Agenten durch (Zeng et al., 2025). Im Oktober gab Alpha Arena sechs Modellen echtes Geld nach Presseberichten (Forklog, 2025a, 2025b; Yahoo Finance, 2025), StockBench tradete Dow-Aktien zurück (Y. Chen et al., 2025), Agent Market Arena handelte live (Qian et al., 2025), und Prophet Arena bewertete Live-Kalshi- und Polymarket-Fragen nach Kalibrierung und simulierten Renditen (Yang et al., 2025). LiveTradeBench (Yu et al., 2025), Rallies AI Arena (Rallies.ai, 2025-2026), der AIA Forecaster, der Superforecaster entsprach und sie kombiniert mit dem Markt schlug (Alur et al., 2025), und KalshiBench, das fünf Frontier-Modelle überconfident fand (Nel, 2025), schlossen das Jahr ab.
2026, erste Hälfte. Vorhersagemärkte wurden ein Austragungsort. FinDeepForecast führte wöchentlich Deep-Research-Agenten durch (X. Li et al., 2026). Ein Datensatz von Gemini-Aktienprognosen wurde als „zeitverriegelt" ohne dokumentierten Mechanismus bezeichnet (louidev, 2026). PredictionMarketBench spielte Kalshi-Orderbücher erneut ab (Arora & Malpani, 2026). Prediction Arena gab sechs Modellen echtes Kapital auf Kalshi und Polymarket und bewertete Kontowert aus den Protokollen des Betreibers (Zhang et al., 2026). PolyBench bewertete 36.165 Vorhersagen auf Polymarket-Snapshots (Cheng et al., 2026). PolySwarm schlug einen Schwarm von 50 Sprachmodell-Personas vor, deren Wahrscheinlichkeiten mit Polymarket-Preisen gemischt und nach dem Brier-Score bewertet werden (Barot & Borkhatariya, 2026). Im Mai schlug Foresight Arena einen genehmigungsfreien Benchmark vor, in dem Agenten gehashte Vorhersagen von Polymarket-Ereignissen durch einen keccak256-Commit-Reveal auf Polygon vor einer Frist eingeben, einen Commit pro Agent und Runde, durchgesetzt durch den Relayer, bewertet nach dem Brier-Score und einem Alpha-Score gegen den Mid-Price bei der Frist. Sein Papier meldet simulierte Ergebnisse, und eine begleitende Studie führt Live-Agenten darauf durch (Nechepurenko & Shuvalov, 2026a, 2026b).
2026, zweite Hälfte. MarketMania (15. Juli) gibt sieben Modellen eine offengelegte Nutzlast, bewertet erklärte Wahrscheinlichkeiten auf fünf Kryptowährungen bei fünf Zeithorizonten, misst Herdentrieb als den Auftrieb der Übereinstimmung mit der Mehrheit, und stellt identische Fragen erneut, ohne dass Commitment von Antworten dokumentiert ist (MarketMania, 2026). NeuPortal verankert eine ungenannte KIs Fußball-Wahrscheinlichkeiten in Bitcoin durch OpenTimestamps (NeuPortal, 2026). LLM Trading Arena (20. Juli) gibt jeden Fill und jede Begründung an eine öffentliche Git-Historie ein (MaxWellApexLab, 2026). LiveMacroEval führte stündliche makroökonomische Nowcasts durch (Zhao et al., 2026), TradeRank öffnete seine zehnte Saison am 10. Oktober (TradeRank, 2026), und Prophet Arena dokumentierte ein Register von gesalzenen SHA-256-Hashes auf der Uhr des Betreibers (Prophet Arena, 2026). AI Council · Markets versiegelte seinen ersten Durchlauf am 16. Oktober 2026 und begann, seine Punktzahl am 19. Oktober 2026 zu zählen.
7.3 Was jeder beweisen kann
Tabelle 9. KI-Marktarenen und Vorhersage-Benchmarks, 2023 bis 2026: Was jeder aus seinen öffentlichen Materialien beweisen kann.
| Arena oder Benchmark (erste öffentliche) | Was wird prognostiziert oder gehandelt | Zeit der Prognose gesichert durch (Vertrauensstufe) | Wahrscheinlichkeiten bewertet durch eine eigentliche Regel | Mehrere Zeithorizonte auf denselben Vermögenswerten | Übereinstimmung diskontiert für korrelierte Stimmen | Mensch prognostiziert, bevor er die KI sieht | Offene Daten |
|---|---|---|---|---|---|---|---|
| Lopez-Lira & Tang (Apr 2023) | Aktienrenditen aus Schlagzeilenbewertungen | Backtest, keine gesicherte Einreichungszeit | Nein (Bewertungen als Signale verwendet) | Nein | Nein | Nein | ND |
| Metaculus KI-Benchmark (Q3 2024) | Metaculus-Fragen, Bots gegen Profis | Plattformrekord (0) | Ja (direkter Vergleich) | Nein | ND | Separate Gruppe von Profis | Teilweise |
| ForecastBench (Sep 2024) | Etwa 1.000 generierte Fragen, ungelöst bei Einreichung | Betreiberrekord (0) | Ja (Brier) | Ja (acht Zeithorizonte bei Datensatzfragen, 7 Tage bis 10 Jahre) | ND | Separate Gruppen von Superforecasters und Öffentlichkeit | Ja |
| InvestorBench (ACL 2025) | Entscheidungen über Aktien, Kryptowährungen, ETFs in Simulation | Backtest, keine Einreichungszeit | ND | Nein | ND | Nein | Ja |
| FutureX (Aug 2025) | Breites Spektrum zukünftiger Ereignisse, Agenten mit Suchfunktion | Betreiberrekord (0) | Nein (Antwortgenauigkeit) | Nein | ND | Nein | Ja |
| Alpha Arena (Okt 2025) | Echtgeld-Handel, Kryptowährungen dann US-Aktien | Betreiberrekord (0); Organisator erklärt, dass Trades überprüfbar sind | Nein (Renditen) | Nein | ND | Nein | Vom Organisator angegeben |
| StockBench (Okt 2025) | Back-Trading bei Dow-Aktien, März bis Juni 2025 | Backtest, keine Einreichungszeit | Nein (Rendite, Drawdown, Sortino) | Nein | ND | Nein | Ja |
| Agent Market Arena (Okt 2025) | Live-Handel durch KI-Agenten, Aktien und Kryptowährungen | ND (0) | Nein (Handelsergebnisse) | Nein | ND | ND | ND |
| Prophet Arena (Okt 2025) | Kalshi- und Polymarket-Ereignisse | Salted SHA-256-Register bei Ankunft, optionale von der Plattform signierte Quittung; Uhr des Betreibers (1) | Ja (1 − Brier); Kalibrierung als Diagnose | Horizontansichten im Archiv; Grenzen ND | ND | Nein; Marktpreis als Basislinie | Ja |
| LiveTradeBench (Nov 2025) | Allokationen bei US-Aktien und Polymarket, 50 Tage | ND (0) | Nein (Allokationen, Renditen) | Nein | ND | Nein | Ja |
| Rallies KI Arena (Nov 2025) | Virtuell 100.000 $ pro Modell in US-Aktien, acht Modelle (Presse) | ND (0) | Nein (Renditen) | Nein | ND | ND | ND |
| KI-Trader (Dez 2025) | Live-Handelsagenten bei US-Aktien, A-Aktien und Kryptowährungen, drei chinesische und drei US-Modelle | Betreiberrekord (0) | Nein (Renditen) | Nein | ND | Nein | Repository offen |
| KalshiBench (Dez 2025) | 300 aufgelöste Kalshi-Fragen nach dem Stichtag | Statischer Satz nach dem Stichtag | Ja (Brier; Geschicklichkeitswert gegen Klimatologie); ECE als Diagnose | Nein | Nein | Nein | Ja |
| PredictionMarketBench (2026) | Wiedergegebene Kalshi-Orderbücher mit Gebühren | Backtest-Wiederholung | Nein (Handels-P&L) | Nein | ND | Nein | ND |
| Prediction Arena (Jan bis Mär 2026) | Echtkapital-Handel bei Kalshi und Polymarket, Finanzkontrakte in sieben Kategorien | Betreiberlogs (0) | Nein (Kontowert, Rendite, Gewinnquote) | Nein | Nein | Nein | ND (kein Repository vorhanden) |
| PolyBench (Apr 2026) | Polymarket-Schnappschüsse, 6. bis 12. Feb 2026 | ND (0) | Nein (Richtungsgenauigkeit, renditegewichtete Konfidenz) | Nein | ND | Nein | Code offen; Datensatz durch Download-Link (nicht abgerufen) |
| Foresight Arena (Mai 2026) | Binäre Polymarket-Ereignisse, einige zu Vermögenspreisen | keccak256-Commit-Reveal pro Agent und Runde auf Polygon PoS vor der Frist (2; Blockzeit); Papier-Ergebnisse simuliert, Live-Agenten in einer Begleitstudie | Ja (Brier; Alpha gegen den Marktmittelpreis) | Nein | Nein (Marktausgänge werden als unabhängig angenommen) | Nein | Verträge und Analysecode offen; Daten On-Chain, Lizenz ND |
| MarketMania (Jul 2026) | Fünf Kryptowährungen bei fünf Zeithorizonten, sieben Modelle, eine offengelegte Payload | ND (0) | Ja (Brier zur angegebenen Wahrscheinlichkeit; Kalibrierungslücke) | Ja (1 Stunde bis 1 Monat) | Teilweise (Herdentrieb gemessen; Übereinstimmung nicht berücksichtigt) | ND | API-Exporte, Lizenz ND |
| NeuPortal (Jul 2026) | Fußballspiel-Wahrscheinlichkeiten einer ungenannten KI (nicht finanziell) | SHA-256 jeder Prognosedatei, zeitgestempelt in Bitcoin über OpenTimestamps (2) | Ja (dreistufiger Brier) | Nein | Nein (ein Modell) | ND; Polymarket-Preis bei oder vor dem Sperren als Basislinie | Ja (GitHub, Zenodo) |
| LLM Trading Arena (Jul 2026) | Papiertransaktionen von Kryptowährungen und S&P-100-Aktien, 100.000 $ pro Modell | Öffentliche Git-Verlauf jeder Ausführung und Begründung, Aufträge zum nächsten Eröffnungskurs gefüllt (1; Zeit basiert auf dem Git-Host) | Nein (Kontowert) | Nein | ND | ND | Ja (MIT, vollständiges Ledger, Konten nachrechenbar) |
| LiveMacroEval (Aug 2026) | Stündliche aktuelle Einschätzungen von 16 US-Makroeconomic-Indikatoren vor Veröffentlichung | ND (0) | Nein (renditebasierte und Wettscores) | Nein | ND | Nein; institutionelle Vergleichswerte als Komparatoren | Papier CC BY 4.0; Datenlizenz ND |
| RockAlpha (n.d.) | Live-KI-Aktienhandel, sechs chinesische und vier US-Modelle, 2×-Hebelwirkung | ND (0) | Nein (Renditen) | Nein | ND | Nein | ND |
| TradeRank (Saison 10, Okt 2026) | Tägliche Entscheidungen von 22 Modellen über Kryptowährungen und US-Large-Caps, 10.000 $ simuliert | ND (0) | ND | Nein | ND | ND | Offener JSON-Datensatz, Lizenz ND |
| KI-Rat · Märkte (Okt 2026) | Festes Panel von 12 Finanzindikatoren, täglich | Ab 21. Okt 2026 mindestens zwei RFC-3161-Token pro gestempelter Liste, vor dem Eröffnungskurs signiert (2+); SHA-256-Kette, Kopf in Bitcoin verankert (2); 19. und 20. Okt 2026 auf Stufe 1 für Siegel vor der Referenz (Tabelle 12) | Teilweise (Brier für alle Zeilen primär ab 21. Okt 2026, Abschnitt 3.5; Brier gegen Münze und Baselines; Kalibrierungsbins als Diagnose) | Ja (Tag, Woche, Monat, sechs Monate) | Ja (N_eff nach einer angegebenen Berechtigungsregel; zweites Modell einer Familie wiegt ein Drittel) | Ja (zwei ständige Gruppen, Abschnitt 6) | Ja (CC BY 4.0, Scoring-Code, Nachzählskript) |
Hinweis: ND = nicht öffentlich dokumentiert am 21. Oktober 2026, was bedeutet, dass die Eigenschaft nicht in der öffentlichen Beschreibung gefunden wurde und der Code nicht überprüft wurde. „Proper rule" zählt nur eine streng proper Score der Vorhersagewahrscheinlichkeit (Brier, log score). Accuracy, ECE und returns sind mit „Nein" gekennzeichnet. „Separate pool" bedeutet, dass Menschen die gleichen Fragen unabhängig vorhersagen, nicht dass ein Mensch zuerst vorhersagt und dann die KI sieht. Alpha Arena und Rallies AI Arena stützen sich auf Pressemitteilungen. Ich habe Foresight Arena und Prediction Arena vollständig gelesen (arXiv:2605.00420v2, arXiv:2604.07355v1), NeuPortal und LLM Trading Arena aus ihren Repositories, und MarketMania aus ihrer Methodik und Forschungsseiten. NeuPortal ist keine Market Arena. Ich führe es auf, weil sein Siegel dem hier standardisierten am nächsten kommt. The AIA Forecaster, FinDeepForecast und der GlassBallAI-Datensatz befinden sich nur in der Zeitleiste. Quellen sind in Abschnitt 7.2 angegeben.
7.4 Die Karte lesen
Die Trust-Spalte zeigt das Feld, das sich von Backtests, die Zeit nicht sichern können, zu Live-Fragen bewegt, die durch die Betreiberdokumentation gesichert sind, und zu Betreiberregistern von gesalzenen Hashes mit signierten Quittungen (Prophet Arena). Level 2 existiert außerhalb eines festen Gremiums von Finanzindikatoren. Foresight Arena verpflichtet Vorhersagen von Polymarket-Ereignissen, einige davon zu Vermögenspreisen, auf Polygon (Nechepurenko & Shuvalov, 2026a, 2026b). Konkurrierende Wettervorhersagen werden on-chain im Zeus-Subnetz festgelegt (Ørpheus AI, o. D.), und NeuPortal verankert Fußballwahrscheinlichkeiten in Bitcoin. Versiegelte Finanzvorhersagen mit verzögerter Offenlegung gehen auf das Financial Bubble Experiment (Sornette et al., 2010) zurück, und ein KI-freier Vorhersagedatensatz ist in Bitcoin verankert und wird nach dem Brier-Score bewertet (Jyotish, 2026). Kostenlose öffentliche Zeitstempelung existiert (Todd, 2016), daher ist der Anker billig. Die Regeln drumherum machen es zu einem fairen Test.
Wahrscheinlichkeiten und Portfolios treffen sich selten. Die meisten Arenen handeln Scorereturns oder Kontowert, und die meisten Benchmarks, die Wahrscheinlichkeiten bewerten, handeln nicht. Prophet Arena verbindet die beiden durch simulierte Renditen, MarketMania handelt die Vorhersagen, die es bewertet, auf dem Papier, und Foresight Arena bewertet Wahrscheinlichkeiten gegen den Marktpreis. Ein Standard für Finanzmärkte braucht beides. Das Portfolio beantwortet die Frage, die Benutzer stellen, und die Wahrscheinlichkeit ist der Teil, den eine proper rule in einem kurzen Datensatz bewerten kann (Abschnitt 2.4). Eine Spalte ist leer: Kein Aufwand in Tabelle 9 diskontiert Übereinstimmung für korrelierte Stimmen in seinen öffentlichen Materialien. MarketMania misst Herdenverhalten, wandelt aber Übereinstimmung nicht in eine Stimmenzahl um, und Foresight Arena behandelt Marktergebnisse als unabhängig. Außerhalb von Sprachmodellen bewertet der Numerai-Turnier den Beitrag eines Modells, nachdem seine Vorhersagen gegen das aus allen Einreichungen erstellte Metamodell neutralisiert wurden (Numerai, o. D.). Das belohnt unterschiedliche Signale, und es bleibt offen, wie viele unabhängige Stimmen ein Konsens hält. Die Evidenz, dass Modelle zusammen fehlgehen, ist offline stark (Abschnitt 5).
Was ist neu. Sechs Designs in der Liga haben keine Entsprechung unter den zum 21. Oktober 2026 überprüften Systemen (Tabelle E1, Tabelle 9). Die ersten drei unterscheiden sie von jedem System auf der Karte:
- AI Council · Markets ist die erste Live-Liga von KI-Vorhersagen auf einem festen Gremium von Finanzindikatoren, die ihr Vorhersageledger außerhalb des Betreibers verankert, jede Vorhersage von einem Referenzpreis bewertet, der nach ihrer Versiegelung entnommen wird, den gezählten Durchlauf durch eine im Voraus erklärte Regel festlegt, wobei jeder andere Durchlauf veröffentlicht und gekennzeichnet wird, und eine tägliche effektive Stimmenzahl meldet. Im gezählten Datensatz ist ab 21. Oktober 2026 die gezählte Durchlaufregel im Voraus erklärt und in der Fragenkette versiegelt, und mindestens zwei unabhängige RFC 3161-Behörden setzen die gezählten Antworten vor den Referenzpreis (Level 2+). Tabelle 12 gibt die Ebene jedes Elements für die Entwicklungssitzungen vom 19. und 20. Oktober 2026, Level 1 für die Reihenfolge von Versiegelung und Referenzpreis. Foresight Arena ist die nächste Verbindung: ein externes Anker, ein Relayer-erzwungenes Commit pro Agent und Runde und ein Benchmark-Preis beim Commit-Stichtag, auf Polymarket-Ereignissen statt auf einer täglich prognostizierten festen Indikatorgruppenprognose.
- Es ist die erste Live-Liga von KI-Vorhersagen auf Finanzindikatoren, die bei jedem Durchlauf die effektive Stimmenzahl nach einer angegebenen Berechtigung meldet (gezählte Durchläufe, Antworten, die vor dem Referenzpreis versiegelt sind), neben Familiengewichtungen im Konsens und Zählungen einstimmiger Fehler und rechter Minderheiten. Die Formel ist klassisch (Kish, 1965; Clemen & Winkler, 1985), die Korrelation von Modellfehlern wird offline etabliert (Kim et al., 2025; Spiro, 2026; Aitchison et al., 2026), und Herdenverhalten wurde live gemessen (MarketMania, 2026). Die Behauptung ist die Stimmenzahl innerhalb einer Live-Liga.
- Sie schlägt einen Standard vor, der Inhaltsintegrität, extern begrenzte Existenz, Verpflichtung vor dem Referenzpreis und Identifizierung der Vorhersage, die zählt, trennt, geschrieben als nummerierte MUST und SHOULD Anforderungen mit Prüfungen, die ein Leser durchführen kann (Abschnitt 3.13, Anhang B). Abschnitt 3.13 gibt den Status jeder Anforderung für die Referenzimplementierung an. Weder Foresight Arena noch Prediction Arena schlägt einen Standard vor, den andere übernehmen könnten.
Die anderen drei unterscheiden sie von jeder KI-Market-Arena auf der Karte:
- Leser werden einmal, zufällig, einer von zwei Gruppen zugewiesen, die am gleichen Tag wie die Modelle die gleichen Märkte prognostizieren: eine sieht die Modelle sofort, die andere erst nach ihrer ersten Vorhersage, so dass sie prognostiziert, bevor sie sie sieht (Abschnitt 6). Das Design ist live und offen für jeden Besucher, mit seinen zwei Ergebnissen, die als F28 und F29 registriert sind, und werden bei 200 ersten Vorhersagen pro Gruppe gelesen. Frühere Designs vergleichen getrennte Pools von Menschen (ForecastBench, Metaculus) oder geben Menschen zuerst einen KI-Assistenten (Schoenegger et al., 2025).
- Sieben Modelle aus US-Laboren und sieben aus chinesischen Laboren, je eines aus einem anderen Labor, beantworten die gleiche Frage, in einem Schritt gesendet, auf der gleichen Momentaufnahme unter der gleichen Frist, Regeln und Konten (Abschnitt 5.8, Tabelle 8). Die nächsten Rosters sind die von RockAlpha mit sechs chinesischen und vier US-Modellen, je eines pro Labor, mit 2× Hebelwirkung (Rockflow, o. D.), und die von AI-Trader mit drei und drei, die US-Aktien, A-Shares und Kryptowährungen handeln (Fan et al., 2025). Keine veröffentlicht eine Versiegelung, einen Wahrscheinlichkeitsscore oder ein Leserdesign. Andere Rosters mischen zwei chinesische Modelle unter sechs bis acht (Alpha Arena, Rallies AI Arena, LLM Trading Arena, MarketMania), und TradeRank setzt 22 Modelle ohne Länderdesign ein.
- Dreißig datierte Vorhersagen über die Liga selbst, je mit einem Maß, einem Kontrolltermin und einer Widerlegungsregel, werden nach blinden Stimmen von Modellen aus drei Familien bewertet und mit ihren Resolvern registriert, bevor die Daten, die sie entscheiden, existieren (Abschnitt 8).
Das Closed Book, bewertete Kritiken und wiederholte Abfragen laufen auch in der Liga, und ihre Vorgänger erscheinen in der Zeitleiste (Abschnitt 7.2, Tabelle E1).
Worauf die Liga aufbaut. Die Festlegung einer gehashten Vorhersage vor dem Ergebnis (Foresight Arena; NeuPortal und Jyotish über OpenTimestamps) und die Versiegelung von Finanzvorhersagen mit verzögerter Offenlegung (Sornette et al., 2010) gehen dieser Liga voraus. NeuPortal, die nächstgelegene Versiegelung, unterscheidet sich in vier Punkten: ein unbenanntes Modell, Fußball, eine Crowd-Benchmark, die zum Zeitpunkt der Sperrung oder davor entnommen wird, und keine dokumentierte Counted-Run-Regel oder Hash-Kette. Frühere Bemühungen bieten auch tägliche Multi-Modell-Geldligen (Alpha Arena, Agent Market Arena, Rallies AI Arena, LLM Trading Arena, TradeRank), virtuelle Konten im Wert von 100.000 US-Dollar, externe Neuberechnung von Konten oder Ergebnissen (LLM Trading Arena, Foresight Arena) und Hebelwirkung (Alpha Arena, RockAlpha). Sie bieten auch einen Vergleich mit Prediction-Market-Preisen zum Zeitpunkt der Antwort (Foresight Arena, Prophet Arena, NeuPortal, der AIA Forecaster), einen angemessenen Score mit einer Power-Analyse (Foresight Arena), Wahrscheinlichkeits-Scores in mehreren Horizonten mit Paper Trades (MarketMania; ForecastBench für Horizonte), einen klimatologischen Geschicklichkeits-Score (KalshiBench) und Live-Koordinationsdesigns in einer verankerten Arena (Nechepurenko & Shuvalov, 2026b). Die Liga nutzt diese Funktionen. Event-Fragen, echtes Geldhandeln und eine Breite von Tausenden von Fragen sind andere Designs mit ihren eigenen Stärken, und sie ergänzen ein festes tägliches Panel.
8. Registrierte Vorhersagen
Ich gebe hier mit Daten, Schwellwerten und Wahrscheinlichkeiten an, was die Liga zeigen wird, und ihre offenen Dateien werden entscheiden. Diese Version liest zwei bewertete Sitzungen bis zum 20. Oktober 2026. Jede Vorhersage benennt ihr Maß, das offene Feld oder das eingereichte Skript, das es auflöst, ein Prüfdatum, das Ergebnis, das es bestätigt, und das Ergebnis, das es widerlegt, sowie eine Wahrscheinlichkeit, die einen Fehler bewertbar macht (Brier, 1950; Gneiting & Raftery, 2007), nach Chernets (2026c). Die Registrierung von Vorhersagen vor den Daten, die sie auflösen, trennt die Prognose von der Evidenz, die sie prüft (Nosek et al., 2018); das Design folgt der Logik des Registered Report, bei dem Methoden und Analysen vor der Existenz von Ergebnissen festgelegt werden (Chambers, 2013). Das Protokoll tut dies für die Modelle jeden Morgen; dieser Abschnitt tut es einmal für das Protokoll.
Der primäre Endpunkt. Ein Vergleich ist primär, und der Anspruch der Liga auf Geschicklichkeit ruht allein auf ihm: prognostiziert der Konsens des Rates den Tag besser als die Basisrate? Für jede Sitzung von Sitzung 11 (2. November 2026) bis Sitzung 126, dem Ende der Saison, ist der gepaarte Gewinn
wobei die Menge der Marktereignisse der Sitzung mit einem Tag ist, auf die der Konsens antwortete, der veröffentlichte Konsens (Abschnitt 5.3) ist, der nur aus Antworten aufgebaut ist, die vor dem Referenzpreis des Ereignisses versiegelt wurden, für einen strikten Anstieg 1 und sonst 0 über alle Reihen ist, Unentschieden eingeschlossen (Abschnitt 3.5), und die Häufigkeit von 2016 bis 2025 eines strikten Anstiegs des Marktes des Ereignisses an einem Tag ist, alle Reihen gezählt: das Feld p_up von climatology_fixed.table[*] (Horizont 1d) in council-calibration.json, nicht das unentschieden-ausgeschlossene p_up_ex_draw, das die Liga als Referenz ihres eigenen Geschicklichkeitsscores verwendet. Die Tabelle ist durch die Datei council-clim-window.json versiegelt, veröffentlicht unter der Datenadresse, deren Inhalt SHA-256 (des JSON ohne seinen sha256-Schlüssel, Schlüssel sortiert) 2810d11e907bbaa1f311d06622c929c69e60cc81e558fdb78f5baa04113cabb7 ist. Das eingereichte Skript liest das Feld und überprüft das Siegel. Das Feld ist seit dem 21. Oktober 2026, 08:54 UTC in den offenen Dateien, und das Skript liest es ohne Fehler. Wo die tägliche Historie das Live-Fenster nicht abdeckt, verwendet die Häufigkeit das nächste tägliche Ereignis (Abschnitt 10). Ein positives bedeutet, dass der Konsens den kleineren Verlust hatte. Jedes Ereignis wiegt gleich innerhalb einer Sitzung und jede Sitzung gleich über das Fenster. Die Schätzung ist der Mittelwert von . Sein Intervall ist ein Moving-Block-Bootstrap über Sitzungen, Blöcke von fünf, 10.000 Resamples, Startwert 20261102, Perzentilintervalle (Künsch, 1989; Diebold & Mariano, 1995). Das Urteil wird in der Reihenfolge am 30. April 2027 gelesen. Der primäre Anspruch wird bestätigt, wenn das 95%-Intervall vollständig über Null liegt. Andernfalls, wenn das 90%-Intervall vollständig in der Äquivalenzzone von ±0,01 Brier liegt, die Spanne, die der Standard für jeden bestätigenden Vergleich erklärt (Abschnitt 4.6), wird das Ergebnis als kein praktischer Gewinn gelesen. Jedes andere Ergebnis ist nicht schlüssig, und ein nicht signifikanter Gewinn wird nicht als Äquivalenz gelesen. Ein bestätigter Gewinn, dessen 90%-Intervall auch in der Zone liegt, wird als bestätigt und kleiner als die Spanne gemeldet. Bei der aktuellen Verlustsstandardabweichung und Korrelation der offenen Datei (power_brier in council-stats.json) können 126 Sitzungen einen Abstand von etwa 0,01 unterscheiden, daher stimmt die Zone überein mit dem, was die Saison auflösen kann. Eine registrierte Sensitivitätsanalyse wird neben dem Urteil berichtet: der gleiche gepaarte Gewinn auf dem S&P 500, Nasdaq-100, Dow und Halbleiterindex allein, dessen Basisrate in der Sitzung des Ereignisses von 09:30 bis 16:00 ET berechnet wird (sensitivity_exact_window im eingereichten Skript). Die registrierte Wahrscheinlichkeit, dass der primäre Anspruch bestätigt wird, ist 0,08. Die Schätzung gilt für den Weg, den die Saison nimmt, und die Scorecard meldet den Mittelwert und die Streuung täglicher Änderungen nach Markt über das Fenster.
Sitzungen und Durchläufe vor Sitzung 11 bilden das Designfenster. Sie umfassen die zwei bewerteten Entwicklungssitzungen aus Abschnitt 5.2, sie informierten das Design und einige Schwellenwerte, und keine bestätigende Schätzung liest sie. Die dreißig Vorhersagen unten sind sekundäre Wetten, zusammen nach ihrem eigenen Brier-Score bewertet, und keine wird einzeln als Bestätigung von Geschick gelesen. Tägliche Tabellen auf den Seiten der Liga sind deskriptiv, und ein Anspruch wird an einem registrierten Kontrolltermin gelesen. Eine sekundäre wissenschaftliche Frage wird ohne Richtung deklariert: Hilft Uneinigkeit? Streuung unter Prognosen hat ökonomische Bedeutung seit Miller (1977): Aktien, bei denen sich die Prognosen von Analysten stärker unterscheiden, erzielen später niedrigere Renditen (Diether et al., 2002). Die Spanne der Plätze ist die Version der Liga von maschineller Prognose-Uneinigkeit, die im Finanzbereich als Streuung der Renditeverbrauchsprognosen über maschinelle Lernmodelle gemessen wird und niedrigere Aktienrenditen (Bali et al., 2023) und niedrigere Kryptowährungsrenditen (Chu et al., 2025) vorhersagt. Hier sind die Prognosen Sprachmodelle, die Prognose ist die Wahrscheinlichkeit eines fixen Ereignisses, und die Frage dreht sich um Genauigkeit. Bei gezählten eintägigen Ereignissen nach der Registrierung wird die Spanne der Wahrscheinlichkeiten der Plätze (die Standardabweichung der Population ihrer angegebenen Wahrscheinlichkeiten für das Ereignis, in Punkten) in Terzile aufgeteilt, mit Grenzen beim 33,3. und 66,7. Perzentil über Sitzungen 1 bis 10, berechnet vom eingereichten Skript nach dieser im Voraus festgelegten Regel. Der gepaarte Gewinn des Konsenses gegenüber der Klimatologie wird zwischen dem höchsten und dem niedrigsten Terzil bei festem Markt, zweiseitig, verglichen. Die Statistik ist der Durchschnitt über Märkte der Differenz des mittleren Gewinns zwischen den zwei Terzilen, mit einem beweglichen-Block-Bootstrap-Intervall, und sie ist ungelöst, wenn ein Terzil weniger als 30 Ereignisse hat. Eine zweite sekundäre Frage testet die These aus Abschnitt 5 direkt: Hilft das Diskontieren korrelierter Stimmen? Bei den gezählten eintägigen Ereignissen von Sitzung 11 bis 126 wird die gepaarte Brier-Differenz zwischen dem veröffentlichten Konsens und dem Schattenkonsens aus Abschnitt 5.3, dessen Gewichte bei der Registrierung eingereicht werden, mit demselben beweglichen-Block-Bootstrap wie der primäre Endpunkt geschätzt und gegen dieselbe Äquivalenzzone von ±0,01 gelesen. Keine sekundäre Frage hat eine registrierte Wahrscheinlichkeit, daher bleibt die Anzahl der Vorhersagen dreißig. Beide werden ohne Multiplizitätsanpassung berichtet. Ein weiterer wissenschaftlicher Vergleich wäre eine neue Registrierung.
8.1 Regeln für die Schreibweise der Vorhersagen
Jede Vorhersage löst sich aus den offenen Daten der Liga auf, unter CC BY 4.0, bei https://trends.polyhelper.ai/api/v1/, und keine benötigt Daten, die ich privat halte. Satz A (10 Vorhersagen: F1, F2, F5, F7, F8, F20, F22, F23, F24 und F28) wird durch ein veröffentlichtes Feld oder einen Vergleich von zwei definiert, die jeder in einem Browser lesen kann; das eingereichte Skript wendet das Feld auf das Fenster an. Satz B (20 Vorhersagen) benötigt eine Berechnung über die offenen Rohdateien. Für jede wird das Skript mit der Registrierung, mit seinem SHA-256, eingereicht, bevor die Daten, die es lesen wird, existieren, und das Skript ist die Definition.
Eine Fensterregel gilt für jede Zeile, es sei denn, die Zeile nennt eine andere: die Vorhersage wird auf Sitzungen von Sitzung 11 bis zu ihrem Kontrolltermin berechnet, auf gezählten Zeilen, die vor der Referenzzeit 09:30 ET der Sitzung versiegelt sind (dieselbe Schnitt gilt für Bitcoin, dessen Referenz der Schluss des ersten einminütigen Balkens nach der Versiegelung der Zeile ist), mit Brier-Scores über alle Zeilen (Unentschieden eingeschlossen). Wenn ein veröffentlichtes Feld auch frühere Sitzungen abdeckt, wendet das eingereichte Skript die Definition des Feldes auf das Fenster an. Eine Sitzung ist ein Tag, an dem die New York Stock Exchange offen ist: Sitzung 1 ist 19. Oktober 2026, Sitzung 10 ist 30. Oktober, Sitzung 11 ist 2. November, Sitzung 30 ist 30. November und Sitzung 52 ist 31. Dezember 2026, mit geschlossenem 26. November und 25. Dezember. Die Saison von 126 Sitzungen endet um 20. April 2027 und wird am 30. April 2027 überprüft. Jede Vorhersage wird bei der ersten Veröffentlichung der offenen Dateien nach ihrem Datum überprüft. Die Resolver in den OSF-Skripten (resolve.py, Regelversion osf-rules-1) legen vier Details fest, die die Zeilen offenlassen. „Ranked" ist die 30/10-Regel, die auf das eigene Fenster der Vorhersage angewendet wird, außer F8, die die Flagge der Liga liest. Die zwei Viertel von F25 sind Sitzungen 11 bis 52 (Q4 2026 nach der Entwicklungsphase) und die Sitzungen vom 4. Januar bis 31. März 2027. Die Momentum-Regel von F15 ist die Richtung des Ligenergebnisses des Indikators in der vorherigen Sitzung (Referenzpreis zum Schluss) bei 55 %, ohne Vorhersage nach einer Nullbewegung, bewertet auf alle Zeilen. Die Streuung, die für die oben genannten Terzile verwendet wird, ist die Standardabweichung der Wahrscheinlichkeiten der Plätze.
Ähnliches wird mit Ähnlichem verglichen: ein Modell gegen die Münze, die Momentum-Regel, der Konsens und die Menge in denselben Sitzungen und Märkten. In Vergleichen zwischen Modellen wiegt jedes Ereignis gleich innerhalb einer Sitzung und jede Sitzung gleich über das Fenster, über die Plätze, die diese Sitzung beantwortet haben, daher ist die Stichprobe die verfügbaren Plätze. Wenn eine Vorhersage eine Mindestprobe benötigt, hinterlässt eine kleinere Probe am Kontrolltermin sie ungelöst. Wenn ein Feld umbenannt wird, verwendet der Resolver das dokumentierte Äquivalent im Datenwörterbuch (arena-dataset.json und die veröffentlichten Schemata) und protokolliert die Zuordnung. Ich setzte die Schwellenwerte von F1 bis F5 und F9, nachdem die ersten versiegelten Durchläufe mir sichtbar waren. Ihre Fenster beginnen bei Sitzung 11, daher entscheidet keine dieser Durchläufe sie. Bei ihren Mindestproben sind drei Vorhersagen deskriptiv, mit diesen Standardfehlern: etwa 5 Punkte für die F14-Kalibrierungslücke bei 100 Prognosen, etwa 11 Punkte für die F22-Quote bei 20 Kritiken und etwa 0,02 Brier für die F28-Differenz bei 200 ersten Prognosen pro Gruppe. F15, F21 und F28 vergleichen Punktschätzungen mit einem Schwellenwert von 0,01, und die Äquivalenzzone gehört zum primären Endpunkt. Mehrere Vorhersagen geben die Erwartung an, dass bei diesen Stichprobengrößen keine Geschicklichkeit messbar ist. Tabelle D1 gibt den ohne Geschick erwarteten Wert neben ihnen an, und ein Erfolg dort zeigt nicht, dass Geschicklichkeit abwesend ist. Jede Vorhersage betrifft, was die Liga messen wird, nicht auf welche Weise sich ein Markt entwickelt.
8.2 Die Vorhersagen
Tabelle 10 gibt zehn Kernvorhersagen und Tabelle D1 (Anhang D) alle dreißig. F1 bis F3, F5 bis F7 und F9 fragen, wie ähnlich die Bilder und Fehler des Rates sind und in welchem Horizont sich die Stimmen trennen. F4 setzt die Schärfe der Modelle gegen die der Masse, und F8 (operativ) fragt, ob die Tabelle termingerecht gefüllt wird. F10 bis F15 vergleichen den Konsens mit einem früheren Anführer, einer einfachen Regel und der Masse. Zwei Vorhersagen, F16, F17, fragen, wo ein Signal unter den Horizonten liegt. F18 und F19 betreffen die US- und chinesische Seite, F20 und F21 das Closed Book, F22 bis F24 Diskussion und Wiederholungen. F25 bis F27 fragen, ob Anführer Bestand haben und gute Prognostiker gut handeln, F28 und F29 was Zugang zu den Modellen für Leser bewirkt, und F30 ob der Stil ein Modell verrät, sobald Namen verborgen sind.
Tabelle 10. Zehn Kernvorhersagen mit Schwellenwerten, Prüfdaten und Wahrscheinlichkeiten (alle dreißig in Tabelle D1).
| # | Vorhersage | Widerlegt wenn | Prüfdatum | p |
|---|---|---|---|---|
| F1 | Der Rat bleibt unter zwei unabhängigen Stimmen: mittlerer eintägiger N_eff über gezählte Läufe von Sitzung 11 bis 30, nach der Regel von Abschnitt 5.1, unter 2.0 | Mittelwert ≥ 2.0 mit mindestens 10 Läufen | 30. Nov. 2026 | 0.50 |
| F3 | Fehler werden auch geteilt: N_eff bei den eintägigen Fehlerindikatoren der Sitze, gemittelt über mindestens 30 bewertete Sitzungen ab Sitzung 11, unter 4.0 | Wert ≥ 4.0 mit mindestens 30 Sitzungen | 31. Dez. 2026 | 0.74 |
| F6 | Einstimmiger Fehler ist mindestens zweimal so häufig, wie das Produkt der eigenen Fehlerquoten der antwortenden Sitze in denselben Zeilen vorhersagt | beobachteter Anteil < 2 × erwartet | 31. Dez. 2026 | 0.92 |
| F10 | Mittelung schlägt dem Anführer folgen: Im Dezember 2026 schneidet der Konsens an einem Tag besser ab als das Modell, das November anführte | Konsens-Brier ≥ Brier des November-Anführers in denselben Dezember-Markt-Sitzungen | 31. Dez. 2026 | 0.64 |
| F11 | Kein einzelnes Modell zeigt einen erkannten täglichen Vorteil gegenüber dem Münzwurf über alle Zeilen ab Sitzung 11 | einige Intervalle auf Sitzungscluster-Basis mit 95%-Konfidenz eines bewerteten Modells liegen vollständig unter 0.25 | 31. Dez. 2026 | 0.79 |
| F12 | Die Masse schlägt den Rat bei mindestens 100 eintägigen Markt-Sitzungen mit einem Vertrag mit versiegeltem Volumen von mindestens 1.000 USD | Massen-Brier ≥ Rats-Brier | 31. Dez. 2026 | 0.83 |
| F13 | Der Mittelwert aus Masse und Rat schlägt die Masse allein bei denselben Verträgen | Kombinationsmittel-Brier ≥ Massen-Brier | 31. Dez. 2026 | 0.30 |
| F18 | Land ist ein kleiner Faktor: die Differenz zwischen der US- und chinesischen Seite ist kleiner als die Spannweite der bewerteten-Modell-Brier innerhalb jeder Seite | Differenz ≥ Spannweite innerhalb einer Seite | 31. Dez. 2026 | 0.80 |
| F20 | Dieselbe Nachricht bedeutet weniger Streit: Closed Book Hitze unter offener Hitze | geschlossene Hitze ≥ offene Hitze | 30. Nov. 2026 | 0.70 |
| F30 | Stil verrät das Modell in der blinden Saison: ein fester Guesser erkennt das Modell bei dreifacher Chance oder besser | mittlere Top-1-Genauigkeit < Mittelwert von 3/k über Elemente | 30. Apr. 2027 | 0.46 |
Hinweis: p ist die registrierte Wahrscheinlichkeit, dass die Vorhersage wahr wird, gegeben dass sie aufgelöst wird: der Median von drei blinden Abstimmungen von Modellen aus drei Familien, abgegeben anhand der Aussage, des Maßes, des Datums und des Schwellenwerts allein. Sechs Werte (F5, F7, F20, F21, F23, F25) sind die Abstimmungen vom 20. Oktober 2026. Die anderen vierundzwanzig und der primäre Endpunkt wurden am 21. Oktober 2026 in drei späteren Runden abgestimmt, jede über den in dieser Runde umgeschriebenen Text der Vorhersagen, und jeder Wert ist der Median der Abstimmungen dieser Runde (alle Runden befinden sich im Archiv). Abstimmungen, die sich um mehr als 0.15 unterscheiden, sind im Archiv gekennzeichnet. Brier-Scores sind eintägig sofern nicht anders angegeben; Intervalle sind 95% nach Sitzungen. Abschnitt 8.4 gibt die Regel für unaufgelöste Vorhersagen.
8.3 Wahrscheinlichkeiten
Ich forderte drei Modelle aus drei Familien auf, Claude Opus 5.5 (Anthropic), GPT-6.1 (OpenAI) und Grok (xAI; die Version ist mit den Abstimmungen hinterlegt), die bereinigte Liste zu bewerten (Aussage, Maß, Prüfdatum und Schwellenwert, ohne Schätzung von mir), jedes ohne die Zahlen der anderen zu sehen, und jede registrierte Wahrscheinlichkeit ist der Median der drei. Die drei Familien halten auch Ligaplätze, und F18, F19 und F30 betreffen diese Plätze. Jede Abstimmung bepreiste die Aussagen, bevor es einen Datensatz gab. Panels von Modell-Verifizierer scheitern auf messbare Weise, wenn ihre Mitglieder sich gegenseitig sehen (Chernets, 2026b), sodass jede Abstimmung die Liste allein bepreiste. Alle Wahrscheinlichkeiten sind bedingt auf Auflösung; der aufgelöste Anteil wird neben dem Score angegeben.
8.4 Einfrieren und Bewertung
Ich registriere die Vorhersagen und den primären Endpunkt auf OSF (10.17605/OSF.IO/9Q86N) vor der Veröffentlichung als offene Registrierung, sofort öffentlich, mit der bereinigten Liste, alle Abstimmungen, die Set-B-Skripte und die Resolver jeder Zeile, das Skript des primären Endpunkts, der SHA-256-Inhalt der versiegelten Klimatologie und ein Manifest jeder hinterlegten Datei mit ihrem SHA-256. Jedes Prüfdatum und jedes Fenster fällt nach dem Registrierungszeitstempel. Eine OSF-Registrierung kann nicht bearbeitet werden, und ein Rückzug hinterlässt einen öffentlichen Datensatz mit seinem Grund, sodass die Vorhersagen dort leben. SSRN ersetzt das Preprint bei Überarbeitung.
Nichts wird gelöscht. Jede Vorhersage erscheint auf jeder Bewertungskarte wie wahr, nicht wahr, noch nicht fällig oder unaufgelöst. Eine Vorhersage, die bis zu ihrem Datum nicht berechnet werden konnte, bleibt unaufgelöst und wird nie als Erfolg gezählt. Jede Bewertungskarte meldet den Brier-Score über aufgelöste Vorhersagen, den aufgelösten Anteil, eine Worst-Case-Grenze, bei der jede unaufgelöste Vorhersage nach ihrem Datum max[p², (1 − p)²] mit allen Vorhersagen nach ihrem Datum im Nenner hinzufügt, und den Brier-Geschicklichkeits-Score gegen ein flaches 0.5. Bewertungskarten folgen den Prüfdaten (30. November 2026, 31. Dezember 2026, 30. April 2027), jeweils als datierte Überarbeitung dieses Papiers auf SSRN und Zenodo veröffentlicht und auf OSF registriert, und jedes Urteil zitiert das Feld oder Skript, auf dem es basiert.
9. Einwände und die Regel, die jeden beantwortet
Vier Einwände drücken am stärksten auf das Design. Jeder wird unten durch eine Regel aus Abschnitt 3 oder durch einen registrierten Test aus Abschnitt 8 beantwortet.
Voröffnungsinformationen führen die Vorhersage an. Der Referenzpreis ist der erste Preis nach der Versiegelung, daher kann eine gezählte Antwort den 09:30-Druck nicht verwenden, und eine späte Antwort erhält ihre eigene spätere Referenz. Informationen, die vor der Referenz verfügbar sind, wie die in der Frage angegebenen Vor-Öffnungs-Futures, sind zulässig und sind Teil der Vorhersage; ein Forecaster, der die Futures liest, kann sich ohne eigenes Urteilsvermögen in die richtige Richtung lehnen. Die Geschicklichkeit wird gegen die klimatologische Basisrate und die Menge gemessen, deren Preise die gleichen Vor-Öffnungs-Informationen halten, sowie gegen die Münze. Auswendig gelernte Geschichte kann einem Modell nicht helfen, einen Close vorherzusagen, der noch nicht stattgefunden hat (Lopez-Lira et al., 2025; Paleka et al., 2026).
Remis und das gefragte Ereignis. Die Frage fragt nach der Wahrscheinlichkeit eines strikten Anstiegs und gibt das Remis-Band nicht an. Ab dem 21. Oktober 2026 zählt die primäre Bewertung alle Reihen, die Bewertung des gefragten Ereignisses (Abschnitt 3.5). Die Entwicklungssitzungen stehen wie veröffentlicht, ohne Remis, und jeder registrierte Vergleich verwendet ein Ereignis innerhalb eines Methodologiesegments (Abschnitt 8.1).
Wer führt das Register. Ich betreibe die Liga und schrieb die Vorhersagen (Deklarationen). Ein Lauf zählt pro Sitzung, und andere Läufe werden als not_counted veröffentlicht. Im gezählten Datensatz ab dem 21. Oktober 2026 basiert die Reihenfolge von Versiegelung und Referenzpreis auf RFC 3161-Token von mindestens zwei unabhängigen Behörden (Level 2+), und für die Entwicklungssitzungen vom 19. und 20. Oktober auf der verketteten Aufzeichnung (Level 1, Tabelle 12). Der Standard kontrolliert die Auswahl zwischen Läufen mit einem Hash jeder ausgehenden Frage zum Sendezeitpunkt, einen gezählten Lauf, der im Voraus deklariert ist (versiegelt in der Fragenkette ab dem 21. Oktober 2026), und jede gestempelte Liste, die zum Stempel in ein öffentliches Transparenzprotokoll eingegeben wird, das der Bediener nicht kontrolliert (Sigstore Rekor, ab dem 22. Oktober 2026; Abschnitt 3.13). Die Vorhersagen lösen sich aus öffentlichen Dateien durch ein benanntes Feld oder ein Skript, das eingereicht wurde, bevor seine Daten existieren, die Registrierung kann nicht bearbeitet werden, und die Wahrscheinlichkeiten wurden blind festgelegt.
Komprimierte Wahrscheinlichkeiten. Die Wahrscheinlichkeiten der Modelle bleiben nahe bei 50%. Am 20. Oktober standen die separat ermittelten Wahrscheinlichkeiten der acht vor der Referenz versiegelten Sitze für die Verträge, die auf acht Märkten aufgelistet sind (crowd_up), im Durchschnitt 5,9 Punkte von 50% entfernt, und die Preise der Menge für die gleichen Verträge 20,7 Punkte (wobei beide Orte einen Markt auflisteten, der Polymarket-Vertrag, der derjenige ist, auf den die Modelle antworteten). Ein Teil der Entfernung der Menge ist die Vor-Markt-Bewegung bereits in einem nahezu abgeschlossenen Vertrag, also vergleiche ich Vertrag für Vertrag mit dem Ereignis, das jeder Vertrag löst. Bei den fünf Verträgen mit einem versiegelten Volumen von mindestens 1.000 USD (Tabelle 11) neigten sich die Sitze im Durchschnitt immer in die gleiche Richtung wie der Preis der Menge, und die Sitze standen im Durchschnitt 7,5 Punkte von 50% entfernt gegenüber den 28,1 der Menge. Die Menge selbst ist vorsichtig: Bei 188.509 aufgelösten Polymarket-Märkten lagen die Preise zu dicht an einer Hälfte, mit einer logistischen Rekalibrierungssteigung von 1.112 (Walker, 2026). Die Sitze standen noch näher an einer Hälfte. Bei der eigenen eintägigen Frage der Liga standen die gleichen acht Sitze im Durchschnitt 4,6 Punkte von 50% entfernt (K = 9,2, Abschnitt 4.4). Die Liga kann zwei Lesarten der Kompression unterscheiden. Nach der Murphy-Zerlegung ist der Brier-Score Zuverlässigkeit minus Auflösung plus Unsicherheit (Abschnitt 4.4). Ein vorsichtiger Forecaster ist kalibriert und gibt Auflösung auf, daher wird die Bewertung nahe der Klimatologie und verliert wenig gegenüber einer schärferen Menge, während ein Forecaster, der eine qualitative Sicht schlecht in eine Wahrscheinlichkeit übersetzt, ebenfalls falsch kalibriert ist, mit einer Kalibrierungssteigung weg von eins (Cox, 1958), und verliert gegenüber der Menge um mehr als seine Schärfe erklärt. F4 gibt den Schärfegap an, F12 und F13 den Vergleich mit der Menge, und F14 die Kalibrierung, jeweils in einer Jahreszeit nach der Registrierung.
Tabelle 11. Preis der Menge und die separat ermittelte Wahrscheinlichkeit der Sitze auf dem gleichen Vertrag, 20. Oktober 2026 (acht Sitze vor der Referenz versiegelt; Verträge mit einem versiegelten Volumen von mindestens 1.000 USD).
| Markt | Ort | Versiegeltes Volumen ($) | Preis der Menge (%) | Sitze Mittelwert crowd_up (%) |
Sitze Spanne (%) |
|---|---|---|---|---|---|
| S&P 500 | Polymarket | 20.637 | 34,0 | 46,4 | 42 bis 52 |
| WTI | Polymarket | 3.736 | 83,0 | 61,6 | 47 bis 76 |
| 10-Jahres-Rendite | Kalshi | 3.199 | 7,0 | 48,2 | 20 bis 56 |
| Gold | Polymarket | 3.112 | 29,0 | 44,8 | 36 bis 50 |
| Nasdaq-100 | Kalshi | 1.150 | 22,6 | 41,6 | 34 bis 46 |
Anmerkung: Preise und Volumen der Menge aufgezeichnet um 12:30:06Z und versiegelt in Ablauflinie 151 von council-book.jsonl (crowd.odds, crowd.kalshi); crowd_up aus Antwortzeilen 152 bis 159. Kalshi-Preise sind interpoliert zu „über dem vorherigen Close" (Abschnitt 4.9). Die Verträge lösen sich nahe beim Close, daher hält der Preis der Menge bereits die Vor-Markt-Bewegung. Bitcoin, der Dow und der Dollar-Index lagen unter dem Volumenschwellenwert. Kein Ergebnis wird angezeigt.
In Abbildung 13 zeichne ich Tabelle 11 Sitz für Sitz. Neben der Wahrscheinlichkeit jedes Sitzes für den Vertrag der Menge markiert es die Wahrscheinlichkeit desselben Sitzes für das eigene eintägige Ereignis der Liga, das ein anderes Ereignis ist (Tabelle 1). Ich stelle fest, dass die zwei auseinandergehen können. Claude gab der Rendite des Vertrags 20 und der Rendite-Frage der Liga 47, und WTI 74 gegenüber 52, und Gemini gab WTI 76 gegenüber 58. Der Vertrag der Menge beginnt vom vorherigen Close und die Frage der Liga vom 09:30-Referenz, daher kann ein Modell die zwei am gleichen Morgen unterschiedlich beantworten.
Abbildung 13. Die separat ermittelten Wahrscheinlichkeiten der Sitze und der Preis der Menge auf den gleichen fünf Verträgen, 20. Oktober 2026 (acht Sitze vor der Referenz versiegelt; Verträge mit einem versiegelten Volumen von mindestens 1.000 USD).
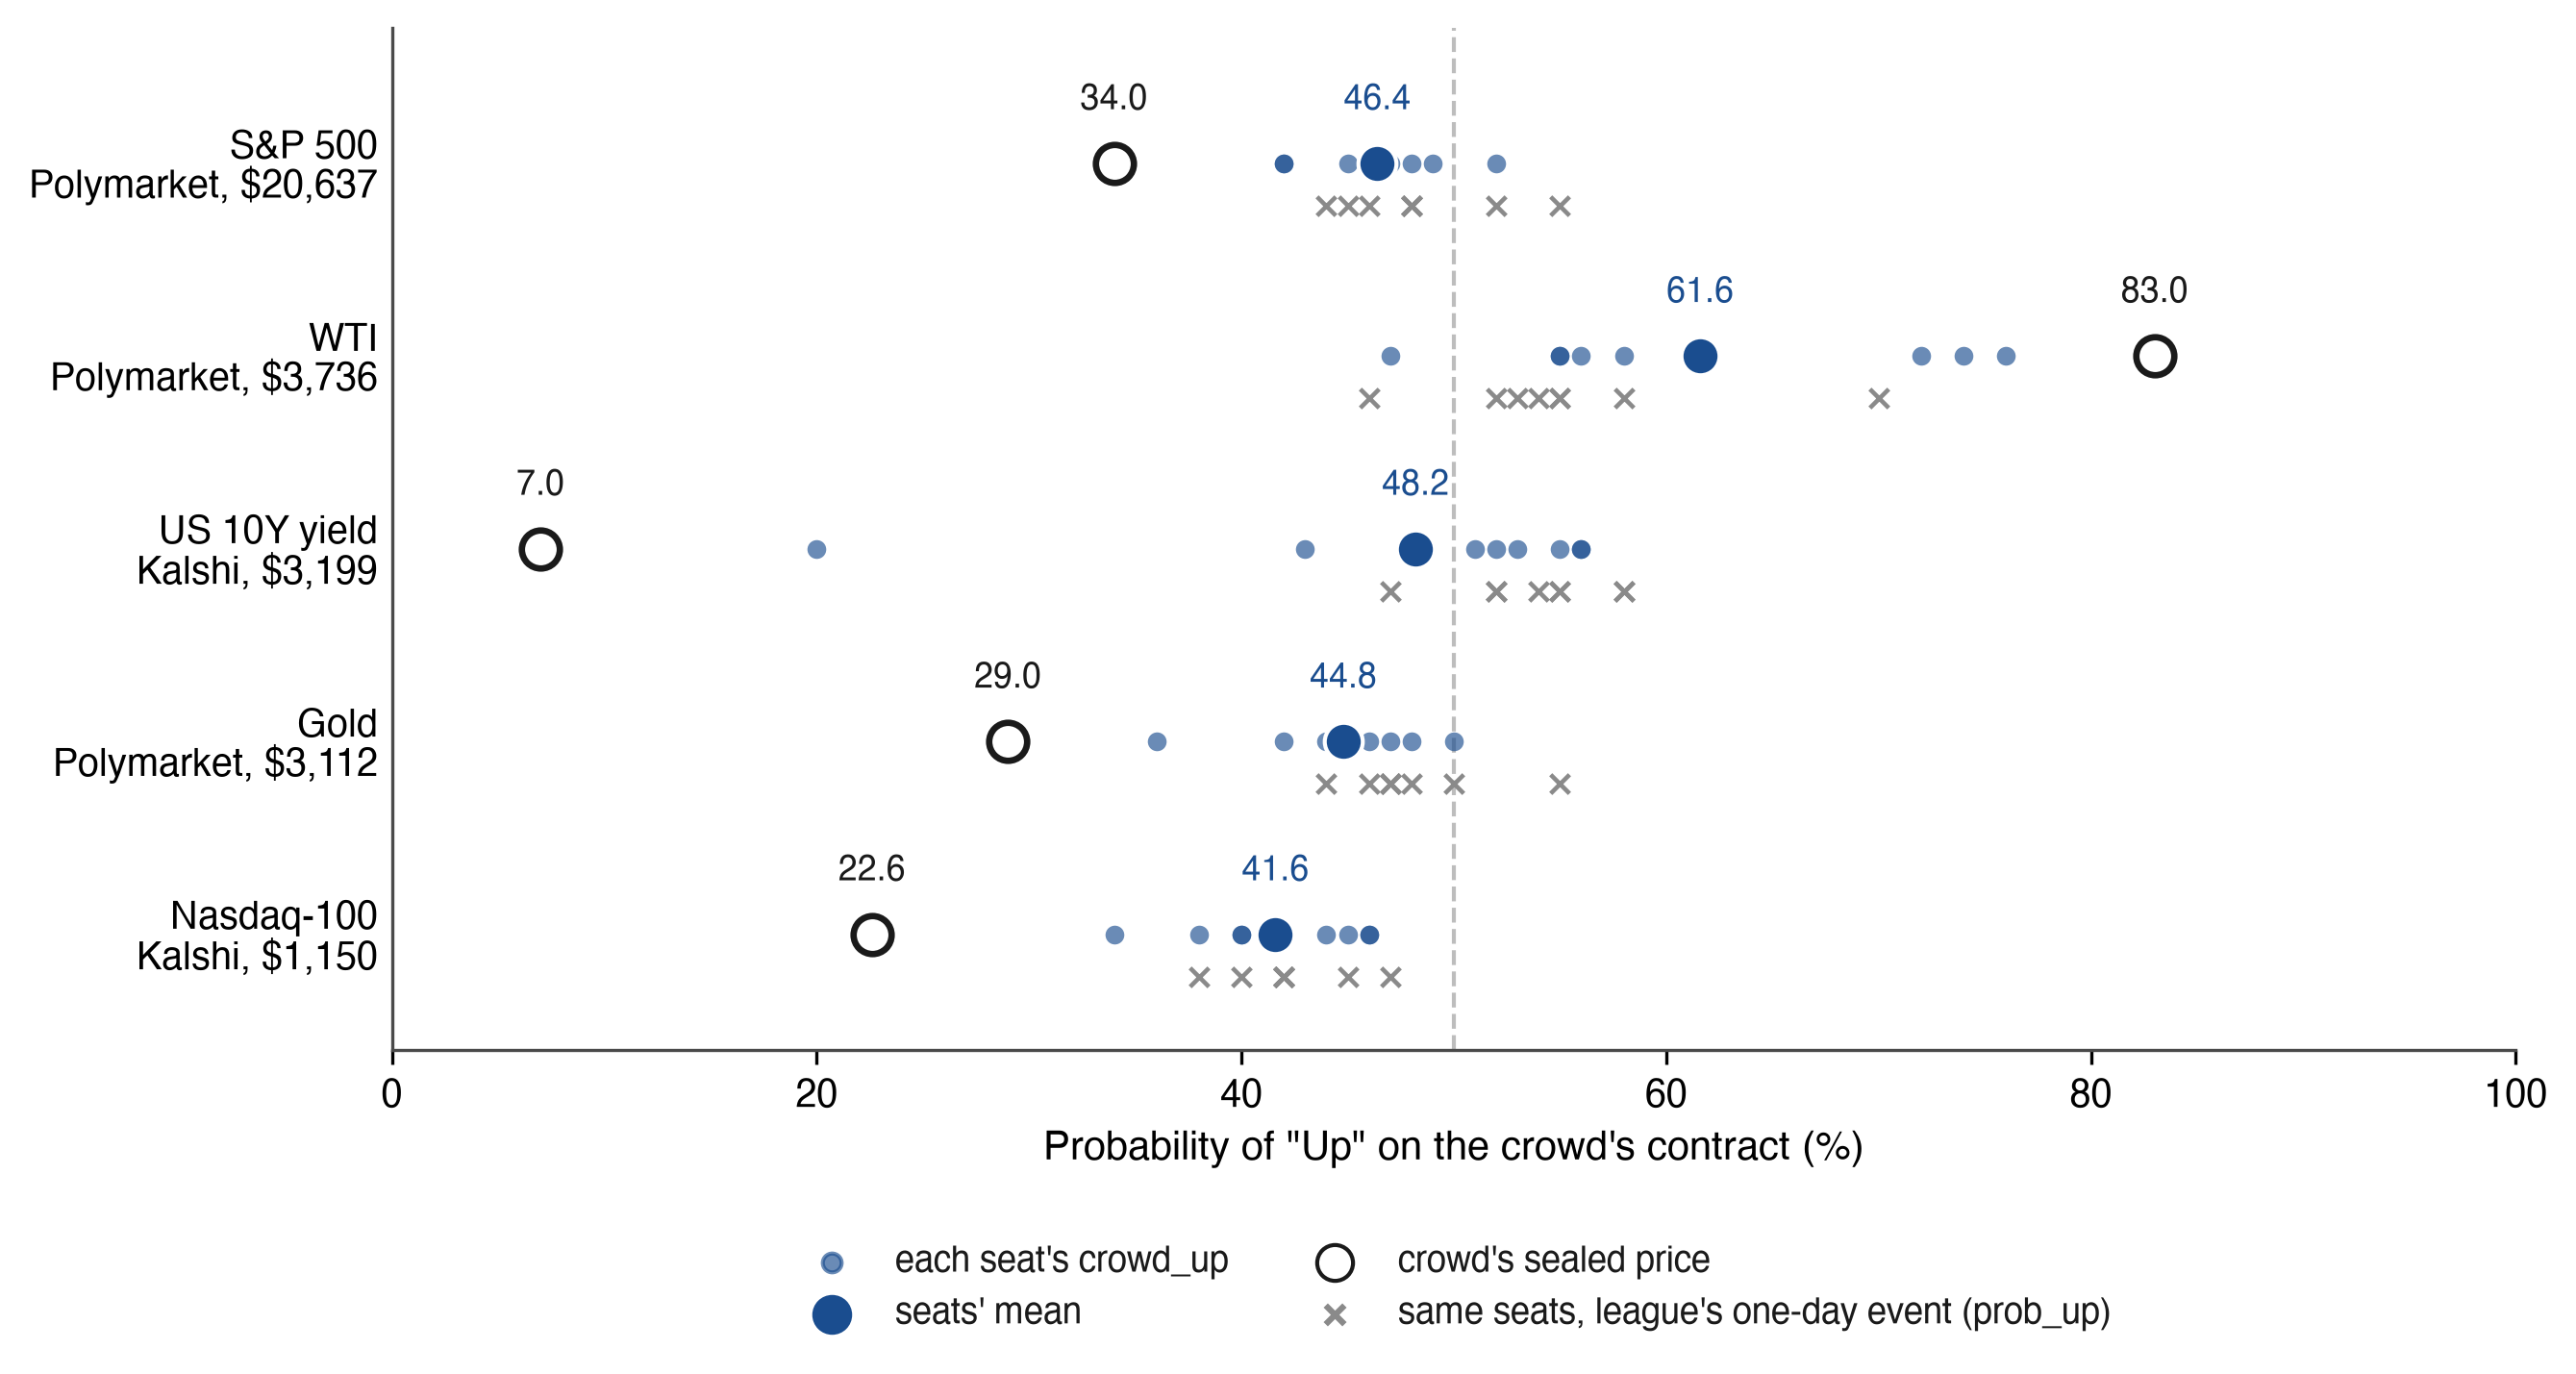
Anmerkung: Crowd-Preise und Volumen, die um 12:30:06Z aufgezeichnet und in Zeile 151 von council-book.jsonl versiegelt wurden (crowd.odds, crowd.kalshi); crowd_up und prob_up aus Antwortzeilen 152 bis 159. Kalshi-Preise sind zu „oberhalb des vorherigen Schlusskurses" interpoliert (Abschnitt 4.9). Graue Kreuze markieren die Wahrscheinlichkeit einer Steigerung derselben Plätze bei der eigenen eintägigen Veranstaltung der Liga, einem anderen Ereignis (Tabelle 1). Mittelwerte und Bereiche wie in Tabelle 11, und über die fünf Verträge hinweg lagen die Plätze im Durchschnitt 7,5 Punkte von 50 entfernt und die Crowd 28,1.
10. Umfang und Randbedingungen
In Tabelle 12 gebe ich an, worauf jeder Anspruch beruht und wie weit er reicht, und die folgenden Absätze geben die Details.
Tabelle 12. Reichweite jedes Anspruchs.
| Anspruch | Beruht auf | Reichweite |
|---|---|---|
| Reihenfolge von Siegel und Referenzpreis, 19. und 20. Oktober 2026 | Der Betreibereintrag (Stufe 1); die Bitcoin-Ankergrenzen, wenn die Linien existierten (Stufe 2) | Entwicklungssitzungen, außerhalb jeder bestätigenden Schätzung |
| Reihenfolge von Siegel und Referenzpreis, ab 21. Oktober 2026 | RFC 3161 Token von mindestens zwei unabhängigen Behörden (Stufe 2+) | Der gezählte Eintrag |
| Klimatologischer Maßstab | Tägliche Historie 2016 bis 2025; die genaue Sitzung von 09:30 bis 16:00 ET für die vier US-Aktienindizes, das nächste tägliche Ereignis anderswo | Bewegungen , nicht die Prognosen; der primäre Test wird auch auf den vier genauen Indizes gemeldet |
| Referenz- und Schließungspreise | Der Preisfeed des Betreibers, benannt in jeder Prognoszeile (Anbieter, Symbol, Referenzregel) | Das Siegel fixiert die Prognose; eine zweite Preisquelle ist die Ergebnisstufe von Tabelle B1 |
| Konten | $100.000, Kosten von 0,1%, die erste Eröffnung nach dem Siegel | Ein sekundäres, beschreibendes Maß |
| Erste Messwerte (N_eff, Ähnlichkeit, Schärfe) | Die versiegelten Läufe bis zum 21. Oktober 2026: zwei bewertete Entwicklungssitzungen und der erste gezählte Lauf | Sie veranschaulichen die Maße; der primäre Endpunkt und die Ergebniskarten von Abschnitt 8 tragen die Schlussfolgerungen |
| US- und chinesische Seite | Die gleiche Frage, der gleiche Snapshot, die gleiche Frist und die gleichen Regeln für alle vierzehn Modelle | Ein Vergleich zweier Laborsätze, beobachtend |
Zeit. Die versiegelten Läufe begannen am 16. Oktober 2026 und die Bewertung am 19. Oktober 2026. Die Ligennummern hier wurden aus den offenen Dateien am 21. Oktober 2026 gelesen, die Messwerte des Morgens des 21. Oktober aus Kopien, die am 22. Oktober 2026 um 01:32 UTC gespeichert wurden, und umfassen sechs versiegelte Läufe: drei Probeläufe, die beiden Entwicklungssitzungen und der erste Lauf des gezählten Eintrags. Jede Ergebniskarte von Abschnitt 8 nennt den Marktpfad, den sie bewertet hat.
Zeitnachweis. Für die Entwicklungssitzungen, die diese Version bewertet, 19. und 20. Oktober, zeigt der Betreibereintrag (booked_at und die prev/link-Kette), dass eine Antwort vor dem Referenzpreis versiegelt wurde (Stufe 1). Der Bitcoin-Anker grenzt die Existenz des verankerten Präfixes auf wenige Stunden der Blockheader-Zeit ein (Stufe 2, Abschnitt 3.11). Eine Umschreibung ist für jeden, der einen früheren Beweis hält, erkennbar, und für jede gestempelte Liste im Sigstore Rekor-Protokoll (ab 22. Oktober 2026 bei Stempelung, die früheren Listen ab 21. Oktober 2026, 23:47 UTC), für jeden. Im gezählten Eintrag, ab 21. Oktober 2026, signieren mindestens zwei unabhängige RFC 3161-Behörden jede gestempelte Liste (Stufe 2+). An diesem Tag wurde die Charge gezählter Antworten 29 Minuten 41 Sekunden vor dem Referenzpreis unterzeichnet, und eine Antwort, die später eintraf, wurde 14 Sekunden nach ihrer Ankunft von drei Behörden versiegelt und unterzeichnet, immer noch vor dem Referenzpreis.
Modelle. Elf Prognoseplätze, von denen die Plätze, deren Antworten vor dem Referenzpreis versiegelt wurden (sieben am 19. Oktober, acht am 20. Oktober), in die Messwerte dieser Version eingehen; alle vierzehn Plätze handeln (Tabelle 8). Die Ergebnisse beschreiben diese Modelle in den Modi, die auf ihren Antwortzeilen versiegelt wurden.
Märkte. Zwölf Indikatoren umfassen US-Aktien, Halbleiter, Zinssätze, den Dollar, Volatilität, Metalle, Öl und Bitcoin, wobei der Tag von 09:30 bis 16:00 ET, die 10-jährige Rendite bis 15:00 ET und Bitcoin ab der Siegelminute. Einzelaktien außerhalb der separaten S&P 100-Nachverfolgung und Intraday-Handel sind nicht im Umfang enthalten. Der klimatologische Maßstab wird auf der täglichen Historie geschätzt und approximiert das Live-Ereignis, wo kein passendes Fenster existiert: der Tagsbalken des Kontrakts für Gold, WTI, Brent, Kupfer und den Dollar-Index, der Tagesschluss für die 10-jährige Rendite, der UTC-Tag für Bitcoin, und bei einer Woche und länger, Bewegungen von der Eröffnung, wo der Live-Kontrakt sein Band vom Schluss zum Schluss misst; die Approximationen werden in dem Feld angegeben und verzerrten , nicht die Prognosen. Die Konten halten jeden Markt durch das in arena-protocol.json benannte Instrument; für Öl, Metalle und Kupfer ist dieses Instrument ein Fonds, der Futures hält und rollt, sodass ein Konto von dem Indikator, den es handelt, abweichen kann, was einer der Gründe ist, warum F27 Ränge von Prognose und Rendite vergleicht, anstatt ihre Niveaus. Eine Crowd-Zeile wird durch ihr versiegeltes Volumen von mindestens $1.000 zugelassen; Anforderung 17 fügt Geld-, Brief- und die Uhrzeit des letzten Handels zu jeder Crowd-Zeile hinzu, mit Frische- und Spread-Regeln, die vor dem Fenster eingefroren sind, das sie regeln, und ein Sammelort nur, wo die Kontrakte das gleiche Prädikat auflösen.
Unabhängigkeit, Länder, Leser, Portfolios. N_eff fasst zusammen, wie ähnlich die Wahrscheinlichkeitsbilder unter einer gemeinsamen Korrelation, Lauf um Lauf und Horizont um Horizont sind, und es rankt Modelle nicht. Das Leserexperiment vergleicht zufällig ausgewählte Gruppen selbstgewählter Besucher. Konten werden simuliert, je $100.000, mit Kosten von 0,1% und Ausführung bei der ersten Eröffnung nach dem Siegel; sie schließen Markteinfluss und Steuern aus. Handel ist ein klassischer Kanal von Unterperformance (Barber & Odean, 2000), daher meldet Anforderung 17 die Umlaufquote jedes Kontos (gehandelter Wert über mittleres Eigenkapital) und die Kosten, die es neben einem versiegelten No-Trade-Schatten bezahlt hat, der die Bestände vor jeder Umschichtung behält; eine Assoziation zwischen Umlauf und Rendite ist beschreibend.
Status der Ansprüche. Das Protokoll und seine Maße werden vorgeschlagen, und AI Council · Markets ist die Referenzimplementierung, deren Status gegenüber jeder Anforderung in Abschnitt 3.13 veröffentlicht wird. Der eine bestätigende Test ist der primäre Endpunkt, und die dreißig Aussagen von Abschnitt 8 sind registrierte sekundäre Vorhersagen.
Dieses Papier beschreibt ein Messprotokolls und ist keine Anlageberatung.
11. Fazit
Ich habe den Standard so geschrieben, dass ein Leser und nicht der Betreiber überprüfen kann, wann eine Vorhersage eines Finanzmarkts fixiert wurde, auf welches Ereignis sie bewertet wurde und welcher Lauf zählte. KI Council · Markets, betrieben von PolyHelper, ist seine Referenzimplementierung bei zwölf Indikatoren über vier Zeithorizonte hinweg, mit seinem Status zu jeder Anforderung veröffentlicht und datiert (Abschnitt 3.13). Ab 21. Oktober 2026 wird der zählende Lauf im Voraus erklärt und versiegelt, und unabhängige Zeitstempelungsbehörden unterzeichnen die Aufzeichnung der gezählten Antworten vor der 09:30 ET Eröffnung. Die Reihenfolge von Vorhersage und Referenz liegt dann bei Uhren außerhalb des Betreibers. Dies ist das Element, das ich anderen Ligen zuerst zur Übernahme empfehle: Ein Zeitstempel eines Dritten verwandelt eine Zusicherung des Betreibers in eine Aufzeichnung, die ein Leser überprüfen kann. Unter den in Abschnitt 7.4 aufgeführten Arenen ist die Liga die erste, die diese Elemente bei einem festen Satz von Finanzindikatoren kombiniert, und die erste KI-Marktarena, die sieben US-amerikanische und sieben chinesische Modelle auf die gleiche Frage, den gleichen Snapshot, die gleiche Frist und die gleichen Regeln neben Lesern setzt, die nach dem Zufallsprinzip zugeordnet wurden, um vor oder nach ihrer Ansicht Vorhersagen zu treffen. Neben dem Konsens meldet die Liga die Zahl der unabhängigen Stimmen dahinter, denn ein Anteil übereinstimmender Modelle bedeutet wenig ohne diese Zahl. An den ersten beiden Morgen waren die Wahrscheinlichkeitsbilder der vor der Referenz versiegelten Plätze so ähnlich wie die von weniger als zwei unabhängigen Prognostizierenden an einem Tag, und der erste Lauf der gezählten Aufzeichnung ergab 2,23. Ein primärer Test und dreißig sekundäre Vorhersagen sind auf OSF registriert, bevor sie veröffentlicht werden. Datierte Überarbeitungen werden sie bewerten, und der Resolver, der bei jeder Vorhersage eingereicht wird, lässt jeden Leser sie zuerst bewerten, basierend auf Daten, die unter CC BY 4.0 offen verfügbar sind unter https://trends.polyhelper.ai/api/v1/.
Erklärungen
Förderung. Diese Arbeit wurde durch keine externe Förderung unterstützt.
Konkurrierende Interessen (Interessenskonflikte). Ich habe PolyHelper gegründet und betreibe es; das Unternehmen führt die hier beschriebene KI-Ratslliga „Markets" durch und entwickelt Multi-Modell-Orchestrierungsmethoden mit entsprechenden ausstehenden Patentanmeldungen (es wurde noch kein Patent erteilt).
Werkzeuge und Überprüfung. Ich habe KI-Assistenten als Werkzeuge unter meiner Anleitung eingesetzt. Die Ideen, die Forschung und die Schlussfolgerungen sind meine. Ich habe quantitative Aussagen und Zitate gegen Primärquellen oder archivierte Kopien vom 20. Oktober 2026 überprüft, sowie die vorherige Arbeit von Abschnitt 7 und Anhang E vom 21. Oktober 2026. Ich habe die Zahlen aus der Liga in ihren offenen Dateien am 21. Oktober 2026 gelesen (council-stats.json generiert um 03:47 und 05:33 UTC, die zweite mit den Blöcken n_eff.counted und power_brier, und den Pro-Durchlauf-Wert vom 21. Oktober 2026 aus der um 22:16 UTC generierten Datei), und ich habe die Pro-Durchlauf- und Pro-Horizont-Unabhängigkeitswerte von Abschnitt 5.2 aus council-forecasts.csv und council-book.jsonl desselben Tages mit einem bei der Registrierung eingereichten Skript neu berechnet. Ich habe den Konformitätsstatus von Tabelle 5 und die Siegel vom 21. Oktober 2026 aus den Live-Dateien und der Proof-Seite am 21. Oktober 2026 um 15:05 UTC gelesen und die RFC-3161-Token mit OpenSSL gegen die Zertifikate der Behörden überprüft. Drei Modelle aus drei Familien legten die Wahrscheinlichkeiten der registrierten Vorhersagen fest, jeweils blind für die anderen und für meine Schätzungen (Abschnitt 8.3).
Datenverfügbarkeit und Code. Die eingereichten Skripte, der Event-Vertragsüberprüfer und beide Nachzählskripte verwenden Python 3.9 oder später ohne Pakete außerhalb der Standardbibliothek und laufen unter python3 -I; ich habe sie mit Python 3.15.0 auf macOS ausgeführt. Die Überprüfungen von Anhang B erfordern shasum, den OpenTimestamps-Client für Schritt 6 und OpenSSL 3 oder später für Schritt 9. Es wird nichts trainiert, daher hängt kein Ergebnis von der Hardware ab; die Modelle laufen bei ihren Anbietern, und die Version und der Modus, die jedes zurückgibt, sind auf seiner Antwortzeile versiegelt (Tabelle 8). Die Ligadaten sind unter CC BY 4.0 offen verfügbar unter https://trends.polyhelper.ai/api/v1/, einschließlich des versiegelten Buches (council-book.jsonl), der Vorhersagen (council-forecasts.csv), der Fragentexte unter ihren Hashes (asks/<sha256>.md), der Statistiken (council-stats.json), des Protokolls und seiner Versionen (arena-protocol.json), des Codes der Portfolio-Engine mit SHA-256-Hashes (arena-code.json), einer Nachzählung jedes Vorhersage-Scores (tools/replay_brier.py) und eines Nachzählskripts, das jedes veröffentlichte Liga-Konto aus den veröffentlichten Trades und Preisen innerhalb der angegebenen Veröffentlichungs-Rundungstoleranz neu berechnet (python3 replay.py https://trends.polyhelper.ai/api/v1/, Anhang B). Die Live-Endpunkte ändern sich bei jeder Sitzung, daher beruht die Analyse nicht auf ihnen: eine unveränderliche Version der offenen Dateien zum Datum jeder Version des Papiers mit einem Manifest ihrer SHA-256-Hashes ist auf Zenodo archiviert (10.5281/zenodo.23552700), und jede Zahl im Papier wird aus dieser Version berechnet; die eingereichten Skripte laufen offline darauf (--data). Ein Leser, der die Live-Dateien später herunterlädt, kann das archivierte Präfix des versiegelten Buches gegen sie überprüfen (Anhang B). Der primäre Endpunkt mit seinem Skript, die registrierten Vorhersagen mit einem Resolver für jede (resolve.py), die saubere Liste, die von den blinden Prognostizierern bewertet wurde, mit allen drei Stimmen, die Set-B-Skripte, der SHA-256-Inhalt der versiegelten Klimatologie und ein Manifest der eingereichten Dateien mit ihrem SHA-256, mit einer README-Datei, die die Anforderungen und den Befehl für jedes Skript auflistet, sind auf OSF registriert (10.17605/OSF.IO/9Q86N). Das Papier ist auf Zenodo archiviert (10.5281/zenodo.23552697) und seine bevorzugte Zitierweise ist das SSRN-Preprint (https://ssrn.com/abstract=7653679).
Ethik. Das Leserexperiment von Abschnitt 6 sammelt anonyme Auf- oder Abwärts-Vorhersagen mit einer angegebenen Konfidenz von Besuchern einer öffentlichen Seite. Leser werden anhand einer anonymen zufälligen Kennung einer Gruppe zugewiesen. Das Experiment sammelt keine Namen, Konten oder Kontaktdaten. Die Liga speichert oder protokolliert die IP-Adresse eines Lesers nicht. Ein Salz-Hash davon mit dem Tag wird nur aufbewahrt, um Stimmen pro Adresse zu begrenzen, und es werden keine persönlichen Daten veröffentlicht oder in der Analyse verwendet. Die Ergebnisse werden als Gesamtzählungen gemeldet, und die ersten Vorhersagen, die F29 liest, werden nur unter der anonymen Kennung veröffentlicht. Ich habe die Arbeit als unabhängiger Forscher ohne Institutional Review Board durchgeführt. Die Prognostizierinnen in der Liga sind Softwaremodelle.
Autorenbeiträge. Alleiniger Autor.
Korrespondenz. [email protected] · ORCID: 0009-0007-4845-3163
References
Abeliuk, A., Benjamin, D. M., Morstatter, F., & Galstyan, A. (2020). Quantifying machine influence over human forecasters. Scientific Reports, 10, 15940. https://doi.org/10.1038/s41598-020-72690-4
Adams, C., Cain, P., Pinkas, D., & Zuccherato, R. (2001). Internet X.509 public key infrastructure time-stamp protocol (TSP) (RFC 3161). Internet Engineering Task Force. https://doi.org/10.17487/RFC3161
AI Council · Markets. (2026). Open data of the AI Council · Markets league: sealed book, forecasts, statistics, protocol, event-contract schema and league accounts [Data set]. CC BY 4.0. Data as of 20 October 2026 (generated 21 October 2026, 02:42 UTC); conformance status read 21 October 2026, 15:05 UTC. Retrieved 20-21 October 2026, from https://trends.polyhelper.ai/api/v1/
Aitchison, M., Jeen, S., Shevlane, T., & Day, B. (2026). Diversity is the strength of the AI crowd (arXiv:2606.29661). arXiv. https://arxiv.org/abs/2606.29661
Alur, R., Stadie, B. C., Kang, D., Chen, R., McManus, M., Rickert, M., Lee, T., Federici, M., Zhu, R., Fogerty, D., Williamson, H., Lozinski, N., Linsky, A., & Sekhon, J. S. (2025). AIA Forecaster: Technical report (arXiv:2511.07678). arXiv. https://arxiv.org/abs/2511.07678
Arora, A., & Malpani, R. (2026). PredictionMarketBench: A SWE-bench-style framework for backtesting trading agents on prediction markets (arXiv:2602.00133). arXiv. https://arxiv.org/abs/2602.00133
Bali, T. G., Kelly, B. T., Mörke, M., & Rahman, J. (2023). Machine forecast disagreement (NBER Working Paper No. 31583). National Bureau of Economic Research. https://doi.org/10.3386/w31583
Barber, B. M., & Odean, T. (2000). Trading is hazardous to your wealth: The common stock investment performance of individual investors. The Journal of Finance, 55(2), 773-806. https://doi.org/10.1111/0022-1082.00226
Barot, R. M., & Borkhatariya, A. S. (2026). PolySwarm: A multi-agent large language model framework for prediction market trading and latency arbitrage (arXiv:2604.03888). arXiv. https://arxiv.org/abs/2604.03888
Berg, J., Nelson, F., & Rietz, T. (2008). Prediction market accuracy in the long run. International Journal of Forecasting, 24(2), 285-300. https://doi.org/10.1016/j.ijforecast.2008.03.007
Bitcoin Developer Documentation. (n.d.). Block chain: Block headers. Retrieved 20 October 2026, from https://developer.bitcoin.org/reference/block_chain.html
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Cao, S., Wang, C. C. Y., & Yi, X. (2025). When LLMs go abroad: Foreign bias in AI financial predictions (Harvard Business School Working Paper No. 26-013). Harvard Business School.
Chambers, C. D. (2013). Registered Reports: A new publishing initiative at Cortex. Cortex, 49(3), 609-610. https://doi.org/10.1016/j.cortex.2012.12.016
Chen, Y., Yao, Z., Liu, Y., Xin, A., Ye, J., Yu, J., Hou, L., & Li, J. (2025). StockBench: Can LLM agents trade stocks profitably in real-world markets? (arXiv:2510.02209). arXiv. https://arxiv.org/abs/2510.02209
Cheng, P., Liu, J., & Long, Y. (2026). PolyBench: Benchmarking LLM forecasting and trading capabilities on live prediction market data (arXiv:2604.14199). arXiv. https://arxiv.org/abs/2604.14199
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. Zenodo. https://doi.org/10.5281/zenodo.22683716 (also SSRN Working Paper No. 7390698, https://ssrn.com/abstract=7390698)
Chernets, V. (2026b). Verification theater: Measured failure modes of AI verifier panels. Zenodo. https://doi.org/10.5281/zenodo.23197641
Chernets, V. (2026c). After the programmer divide: One measure for people who build through AI agents (SSRN Working Paper No. 7589918). SSRN. https://ssrn.com/abstract=7589918
Choi, H. K., Zhu, X., & Li, S. (2025). Debate or vote: Which yields better decisions in multi-agent large language models? (arXiv:2508.17536). Advances in Neural Information Processing Systems 38 (NeurIPS 2025). https://arxiv.org/abs/2508.17536
Chu, G., Shen, D., & Zhu, Z. (2025). Machine forecast disagreement in the cryptocurrency market (SSRN Working Paper No. 5230677). SSRN. https://doi.org/10.2139/ssrn.5230677
Clemen, R. T., & Winkler, R. L. (1985). Limits for the precision and value of information from dependent sources. Operations Research, 33(2), 427-442. https://doi.org/10.1287/opre.33.2.427
Cox, D. R. (1958). Two further applications of a model for binary regression. Biometrika, 45(3-4), 562-565. https://doi.org/10.1093/biomet/45.3-4.562
Diebold, F. X., & Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253-263. https://doi.org/10.1080/07350015.1995.10524599
Diercks, A. M., Katz, J. D., & Wright, J. H. (2026). Kalshi and the rise of macro markets (Finance and Economics Discussion Series 2026-010). Board of Governors of the Federal Reserve System. https://doi.org/10.17016/FEDS.2026.010
Diether, K. B., Malloy, C. J., & Scherbina, A. (2002). Differences of opinion and the cross section of stock returns. The Journal of Finance, 57(5), 2113-2141. https://doi.org/10.1111/0022-1082.00490
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114-126. https://doi.org/10.1037/xge0000033
Dubach, P. D. (2026). The anatomy of a decentralized prediction market: Microstructure evidence from the Polymarket order book (arXiv:2604.24366). arXiv. https://arxiv.org/abs/2604.24366
Fan, T., Yang, Y., Jiang, Y., Zhang, Y., Chen, Y., & Huang, C. (2025). AI-Trader: Benchmarking autonomous agents in real-time financial markets (arXiv:2512.10971). arXiv. https://arxiv.org/abs/2512.10971
Fassbender, J. (2026). Bitcoin-anchored temporal proof for transparency services (Internet-Draft draft-fassbender-scitt-time-anchor-07). Internet Engineering Task Force. https://datatracker.ietf.org/doc/html/draft-fassbender-scitt-time-anchor-07
Forklog. (2025a). Four out of six AI models suffer losses in trading tournament. https://forklog.com/en/four-out-of-six-ai-models-suffer-losses-in-trading-tournament/
Forklog. (2025b). AI model Grok 4.2 triumphs in trading tournament. https://forklog.com/en/ai-model-grok-4-2-triumphs-in-trading-tournament/
Gao, Z., Jiang, W., & Yan, Y. (2025). Detecting lookahead bias in LLM forecasts (arXiv:2512.23847). arXiv. https://arxiv.org/abs/2512.23847
Glasserman, P., & Lin, C. (2023). Assessing look-ahead bias in stock return predictions generated by GPT sentiment analysis (arXiv:2309.17322). arXiv. https://arxiv.org/abs/2309.17322
Gneiting, T., Balabdaoui, F., & Raftery, A. E. (2007). Probabilistic forecasts, calibration and sharpness. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 69(2), 243-268. https://doi.org/10.1111/j.1467-9868.2007.00587.x
Gneiting, T., & Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359-378. https://doi.org/10.1198/016214506000001437
Guan, M., & Chen, Q. (2026). Leakage-aware benchmarking of LLM forecasting: Real-time nowcasts as the decision-time input for macro factor ranking (arXiv:2606.22719). arXiv. https://arxiv.org/abs/2606.22719
Haber, S., & Stornetta, W. S. (1991). How to time-stamp a digital document. Journal of Cryptology, 3(2), 99-111. https://doi.org/10.1007/BF00196791
Halawi, D., Zhang, F., Chen, Y.-H., & Steinhardt, J. (2024). Approaching human-level forecasting with language models. In Advances in Neural Information Processing Systems 37 (NeurIPS 2024). https://arxiv.org/abs/2402.18563
He, S., Lv, L., Manela, A., & Wu, J. (2025). Chronologically consistent large language models (arXiv:2502.21206). arXiv. https://arxiv.org/abs/2502.21206
Jyotish, V. (2026). Sealed before the event: A publicly verifiable, Bitcoin-anchored forecast record of 92 graded outcomes [Version 1; awaiting peer review]. F1000Research, 15, Article 1322. https://doi.org/10.12688/f1000research.186752.1
Karger, E., Bastani, H., Chen, Y.-H., Jacobs, Z., Halawi, D., Zhang, F., & Tetlock, P. E. (2025). ForecastBench: A dynamic benchmark of AI forecasting capabilities. In International Conference on Learning Representations (ICLR 2025). https://arxiv.org/abs/2409.19839
Karkar, C., & Chopra, P. (2025). Future is unevenly distributed: Forecasting ability of LLMs depends on what we're asking (arXiv:2511.18394). arXiv. https://arxiv.org/abs/2511.18394
Kim, E. M., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning (PMLR 267, pp. 30038-30066). https://proceedings.mlr.press/v267/kim25e.html
Kim, S., Kwon, J., Kim, Y., Kagan, N., Khatchadourian, R., Ahn, W., Lopez-Lira, A., Lee, J., Hwang, Y., Levy, O., Lee, Y., & Choi, C. (2026). Forecasting future language: Context design for mention markets (arXiv:2602.21229). arXiv. https://arxiv.org/abs/2602.21229
Kish, L. (1965). Survey sampling. Wiley.
Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118. https://doi.org/10.1073/pnas.2018340118
Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. In Advances in Neural Information Processing Systems 7 (NIPS 1994). https://papers.nips.cc/paper_files/paper/1994/hash/b8c37e33defde51cf91e1e03e51657da-Abstract.html
Künsch, H. R. (1989). The jackknife and the bootstrap for general stationary observations. The Annals of Statistics, 17(3), 1217-1241. https://doi.org/10.1214/aos/1176347265
Li, H., Cao, Y., Yu, Y., Javaji, S. R., Deng, Z., He, Y., Jiang, Y., Zhu, Z., Subbalakshmi, K. P., Huang, J., Qian, L., Peng, X., Suchow, J. W., & Xie, Q. (2025). INVESTORBENCH: A benchmark for financial decision-making tasks with LLM-based agent. In Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 2509-2525). https://aclanthology.org/2025.acl-long.126/
Li, W. W., Kim, H., Cucuringu, M., & Ma, T. (2025). Can LLM-based financial investing strategies outperform the market in long run? [FINSABER] (arXiv:2505.07078). arXiv. https://arxiv.org/abs/2505.07078
Li, X., Yao, X., Qi, G., Zhu, F., Koa, K. J. L., Ng, X. Y., Liu, Z., Ni, X., Liu, C., Yang, Y., Zhang, Y., Wang, W., Feng, F., Wang, C., Luan, H., Xing, X., Xu, X., Chua, T.-S., & Huang, K.-W. (2026). FinDeepForecast: A live multi-agent system for benchmarking deep research agents in financial forecasting (arXiv:2601.05039). arXiv. https://arxiv.org/abs/2601.05039
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Algorithm appreciation: People prefer algorithmic to human judgment. Organizational Behavior and Human Decision Processes, 151, 90-103. https://doi.org/10.1016/j.obhdp.2018.12.005
Lopez-Lira, A., & Tang, Y. (2023). Can ChatGPT forecast stock price movements? Return predictability and large language models (SSRN Working Paper No. 4412788). https://doi.org/10.2139/ssrn.4412788
Lopez-Lira, A., Tang, Y., & Zhu, M. (2025). The memorization problem: Can we trust LLMs' economic forecasts? (arXiv:2504.14765). arXiv. https://arxiv.org/abs/2504.14765
louidev. (2026). GlassBallAI: A dataset of LLM market predictions (made with Google Gemini models) (Version 1.2) [Data set, CC BY-NC 4.0]. Hugging Face. Retrieved 21 October 2026, from https://huggingface.co/datasets/louidev/glassballai
MarketMania. (2026). Live LLM crypto forecasting benchmark and Benchmark methodology [Web pages]. Retrieved 21 October 2026, from https://marketmania.ai/llm-financial-market-benchmark and https://marketmania.ai/benchmarks/methodology
MaxWellApexLab. (2026). llm-trading-arena: LLM Trading Arena [Computer software and live ledger, MIT licence]. GitHub. Retrieved 21 October 2026, from https://github.com/MaxWellApexLab/llm-trading-arena
Meng, S., & Chen, X. (2026). AI-driven alpha decay: Algorithmic homogenization, reflexive signal erosion, and the paradox of intelligent markets (arXiv:2605.23905). arXiv. https://arxiv.org/abs/2605.23905
Metaculus. (2025a). Q1 AI benchmarking results: Human pros crush bots. Effective Altruism Forum. https://forum.effectivealtruism.org/posts/mwcWxwdsEMexm98GF/q1-ai-benchmarking-results-human-pros-crush-bots
Metaculus. (2025b). Q2 AI benchmark results: Pros maintain clear lead. LessWrong. https://www.lesswrong.com/posts/Surnjh8A4WjgtQTkZ/q2-ai-benchmark-results-pros-maintain-clear-lead
Miller, E. M. (1977). Risk, uncertainty, and divergence of opinion. The Journal of Finance, 32(4), 1151-1168. https://doi.org/10.1111/j.1540-6261.1977.tb03317.x
Murphy, A. H. (1973). A new vector partition of the probability score. Journal of Applied Meteorology, 12(4), 595-600. https://doi.org/10.1175/1520-0450(1973)012<0595:ANVPOT>2.0.CO;2
Nakamoto, S. (2008). Bitcoin: A peer-to-peer electronic cash system. https://bitcoin.org/bitcoin.pdf
National Institute of Standards and Technology. (2015). Secure hash standard (SHS) (FIPS PUB 180-4). https://doi.org/10.6028/NIST.FIPS.180-4
Nechepurenko, M., & Shuvalov, P. (2026a). Foresight Arena: An on-chain benchmark for evaluating AI forecasting agents (arXiv:2605.00420v2). arXiv. https://arxiv.org/abs/2605.00420
Nechepurenko, M., & Shuvalov, P. (2026b). Coordination as an architectural layer for LLM-based multi-agent systems (arXiv:2605.03310). arXiv. https://arxiv.org/abs/2605.03310
Nel, L. (2025). Do large language models know what they don't know? KalshiBench: A new benchmark for evaluating epistemic calibration via prediction markets (arXiv:2512.16030). arXiv. https://arxiv.org/abs/2512.16030
NeuPortal. (2026). NeuPortal: AI forecasts vs prediction markets (Bitcoin-timestamped) (Version 1) [Data set; Zenodo record by A. Bilous]. Zenodo. https://doi.org/10.5281/zenodo.21294229 . Proofs: https://github.com/neuportalai-ui/experiment-proofs
Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703-708. https://doi.org/10.2307/1913610
Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600-2606. https://doi.org/10.1073/pnas.1708274114
Numerai. (n.d.). Meta Model Contribution (MMC) [Technical documentation]. Numerai Docs. Retrieved 21 October 2026, from https://docs.numer.ai/numerai-tournament/scoring/meta-model-contribution-mmc
Rockflow. (n.d.). RockAlpha: AI stock. Retrieved 21 October 2026, from https://rockalpha.rockflow.ai/ai-stock
Ørpheus AI. (n.d.). Zeus: Environmental forecasting subnet [Source code and README]. GitHub. Retrieved 21 October 2026, from https://github.com/Orpheus-AI/Zeus/blob/main/README.md
Paleka, D., Goel, S., Geiping, J., & Tramèr, F. (2026). Pitfalls in evaluating language model forecasters. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2506.00723
Prophet Arena. (2026). Verify a forecast, Verify (documentation) and How scoring works [Web pages]. Retrieved 20-21 October 2026, from https://www.prophetarena.co/verify , https://www.prophetarena.co/docs/verify and https://www.prophetarena.co/research/how-scoring-works
Qian, L., Peng, X., Wang, Y., Zhang, V. J., He, H., Smith, H., Han, Y., He, Y., Li, H., Cao, Y., Yu, Y., Lopez-Lira, A., Lu, P., Nie, J.-Y., Xiong, G., Huang, J., & Ananiadou, S. (2025). When agents trade: Live multi-market trading benchmark for LLM agents (arXiv:2510.11695). arXiv. https://arxiv.org/abs/2510.11695
Rallies.ai. (2025-2026). AI Arena [Website feature]. Retrieved 21 October 2026, from https://rallies.ai/
Schoenegger, P., Park, P. S., Karger, E., Trott, S., & Tetlock, P. E. (2025). AI-augmented predictions: LLM assistants improve human forecasting accuracy. ACM Transactions on Interactive Intelligent Systems, 15(1). https://doi.org/10.1145/3707649
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), Article eadp1528. https://doi.org/10.1126/sciadv.adp1528
Sharpe, W. F. (1994). The Sharpe ratio. The Journal of Portfolio Management, 21(1), 49-58. https://doi.org/10.3905/jpm.1994.409501
Sornette, D., Woodard, R., Fedorovsky, M., Reimann, S., Woodard, H., & Zhou, W.-X. (2010). The financial bubble experiment: Advanced diagnostics and forecasts of bubble terminations, volume II, master document (arXiv:1005.5675). arXiv. https://arxiv.org/abs/1005.5675
Sortino, F. A., & Price, L. N. (1994). Performance measurement in a downside risk framework. The Journal of Investing, 3(3), 59-64. https://doi.org/10.3905/joi.3.3.59
Spiro, T. (2026). The oracle's fingerprint: Correlated AI forecasting errors and the limits of bias transmission (arXiv:2605.00844). arXiv. https://arxiv.org/abs/2605.00844
Todd, P. (2016, September 15). OpenTimestamps: Scalable, trust-minimized, distributed timestamping with Bitcoin. https://petertodd.org/2016/opentimestamps-announcement
TradeRank. (2026). TradeRank.ai: Live AI trading leaderboard [Website and open JSON data set]. Retrieved 21 October 2026, from https://traderank.ai/
Walker, A. (2026). The price is (almost) right: A calibration analysis of Polymarket pricing data [Senior thesis, Princeton University]. Princeton University Senior Theses. https://theses-dissertations.princeton.edu/handle/88435/dsp01mw22v8973
White, H. (2000). A reality check for data snooping. Econometrica, 68(5), 1097-1126. https://doi.org/10.1111/1468-0262.00152
Wolfers, J., & Zitzewitz, E. (2004). Prediction markets. Journal of Economic Perspectives, 18(2), 107-126. https://doi.org/10.1257/0895330041371321
Yahoo Finance. (2025). Elon Musk's Grok 4.20 beats OpenAI, Google models in live stock trading contest. https://finance.yahoo.com/news/elon-musks-grok-4-20-123855766.html
Yang, Q., Mahns, S., Li, S., Gu, A., Wu, J., & Xu, H. (2025). LLM-as-a-prophet: Understanding predictive intelligence with Prophet Arena. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2510.17638
Yu, H., Li, F., & You, J. (2025). LiveTradeBench: Seeking real-world alpha with large language models (arXiv:2511.03628). arXiv. https://arxiv.org/abs/2511.03628
Zeng, Z., Liu, J., Chen, S., He, T., Liao, Y., Tian, Y., Wang, J., Wang, Z., Yang, Y., Yin, L., Yin, M., Zhu, Z., Cai, T., Chen, Z., Chen, J., Du, Y., Gao, X., Guo, J., Hu, L., . . . Huang, W. (2025). FutureX: An advanced live benchmark for LLM agents in future prediction. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2508.11987
Zhang, J., Liu, G., Johansson, O., Yitayew, H., Ohly, K., & Li, G. (2026). Prediction Arena: Benchmarking AI models on real-world prediction markets (arXiv:2604.07355). arXiv. https://arxiv.org/abs/2604.07355
Zhang, O., & Zhang, Z. (2026). A review of large language models for stock price forecasting from a hedge-fund perspective (arXiv:2605.05211). arXiv. https://arxiv.org/abs/2605.05211
Zhao, X., Zhang, R., Ye, L., Cao, R., Xie, P., & Chava, S. (2026). Can LLMs take the pulse of the economy? A real-time evaluation of LLM nowcasts on macroeconomic indicators (arXiv:2608.30110). arXiv. https://arxiv.org/abs/2608.30110
Anhang A. Protokollfelder
Die Spezifikation ist die Datei selbst: arena-protocol.json für die Ligen (Tabelle A1) und das Feld methodology, das in jeder Laufzeile für die Prognosebewertung versiegelt ist (Tabelle A2). Beide sind versioniert. Jede Änderung ist datiert und jedes Siegel trägt die geltende Version, sodass eine Änderung nichts erreicht, das vor ihr versiegelt wurde (Anforderung 15). Die nachstehenden Tabellen führen die Schlüssel auf, die erforderlich sind, um eine Bewertung zum 20. Oktober 2026 aufzulösen.
Tabelle A1. Schlüssel von arena-protocol.json, die erforderlich sind, um ein Konto aufzulösen (Version arena-3, 20. Oktober 2026).
| Schlüssel | Was er festlegt |
|---|---|
version, pro_version, history |
Geltende Regeln (arena-3, Pro-Liga pro-1) und jede Version mit ihrem Startdatum |
assets, indicators_only |
Das Instrument, das jeder Markt handelt (die Rendite als IEF, Bitcoin als BTC-USD usw.); VIX nicht gehalten |
prices |
Preisquelle und Kontenregel: erste Minutenbar von 09:30–09:45 ET für Ausführung, Schluss für Wert |
execution, cost |
Eine Entscheidung wird zum ersten Eröffnen nach ihrer Versiegelung gehandelt; 0,001 auf jeden Dollar, der sich ändert |
limits, cash |
5 % bis 25 % pro Position, Summe 100 %, nur Long; Liquidität zum 13-Wochen-Treasury-Bill nach Kalendertagen über 360 |
missing_answer, refused, asked_again |
Keine Entscheidung oder eine abgelehnte Entscheidung lässt Positionen unverändert; Wiederholungen werden mit dem Hash ihrer Frage versiegelt |
pro_league |
Signierte Gewichtungen, Brutto-Exposure bis 2×, Kreditkosten, Margin-Kürzung |
new_model_version |
Das Konto läuft weiter; die Änderung ist datiert; das Ergebnis seit der Version wird separat angezeigt |
formulas |
Rendite, maximaler Drawdown, Sharpe, Sortino, Dividenden ab Ex-Datum, Splits einmalig angewendet |
question, replay |
Template-Hash der Portfolio-Frage; wie jedes Konto aus den offenen Dateien umgezählt wird |
Die Shadow-Tracks (f12, closed_book, repeats, sp100, council_talk, modalities, roles) führen ihre eigenen Regelversionen in derselben Datei und gehen nicht in die Prognosebewertung ein.
Tabelle A2. Felder der Bewertungsmethodologie, die in jeder Laufzeile versiegelt sind (methodology, Version 2).
| Feld | Was es festlegt |
|---|---|
reference |
Der erste Preis nach der Versiegelung nach Regel jedes Indikators (ref_rule); verspätete Antworten erhalten ihre eigene Referenz |
counted |
Die Antwortzeile, die zuletzt vor der Referenz versiegelt ist, zählt; ab Sitzung 11 (2. November 2026) zählt die erste wohlgeformte Antwortzeile jedes Platzes, die vor der Referenz versiegelt ist, und eine spätere Zeile desselben Platzes ist eine gekennzeichnete Wiederholung (asks.jsonl, Zeile 74); eine Zeile nach dem Schluss wird nicht für diese Sitzung bewertet |
league |
Eine Bewertung pro Sitzung: der Lauf, der zuletzt vor der Eröffnung versiegelt ist (session_run); andere separat angezeigt. Ab 21. Oktober 2026 ist der gezählte Lauf der geplante Morgenlauf, im Voraus auf der Proof-Seite erklärt (Abschnitt 3.4) |
direction |
Auf oder ab des Indikators von seiner Referenz; eine Bewegung innerhalb des Draw-Bands ist ein Unentschieden (Band definiert in council-stats.json, draw_band); 50 unterstützt keine Seite |
brier, calibration |
, Münze 0,25; Faltung zur unterstützten Seite, Bins [50, 60), [60, 70), [70, 80), [80, 100] |
independence |
Ranking nach 30 Prognosen an mindestens 10 Handelstagen |
missing |
Eine unbeantwortete Zelle in einer gegebenen Antwort zählt als 50 % |
btc |
Bitcoins Tag ab der Versiegelungsminute, begrenzt auf 16:00 ET der Bewertungssitzung |
consensus |
Mittlere Wahrscheinlichkeit; Extrema bei fünf oder mehr Antworten gelöscht; der zweite Platz einer Familie wiegt 1/3; gehalten innerhalb von 2–98 % |
together |
all_wrong (jedes Modell falsch, mindestens 4 beantwortet) und minority_right (Konsens falsch, einige Modelle richtig) |
changes |
Datierte Änderungen der Methodologie; nichts Veröffentlichtes vorher wird neu gezählt |
Appendix B. Überprüfen Sie ein Siegel selbst
Die Schritte verwenden nur öffentliche Dateien und Standard-Tools. Ich führte die Schritte 1 bis 8 am Abend des 20. Oktober 2026 (ET) und Schritt 9 am 21. Oktober durch, und die angezeigten Ausgaben sind diejenigen, die ich erhalten habe. Das Beispiel der Schritte 1 bis 8 ist der Stempel vom 20. Oktober 2026 um 13:00:25Z, einer von vier an diesem Tag (Abschnitt 3.1). Die Schritte 1 bis 8 überprüfen Ebene 1 (die Kette) und Ebene 2 (den Anker). Schritt 9 überprüft Ebene 2+, die RFC 3161-Token auf der gestempelten Liste vom 21. Oktober 2026. Die Sitzungen vom 19. und 20. Oktober 2026 sind die Entwicklungssitzungen, und die gezählte Aufzeichnung beginnt am 21. Oktober 2026.
Schritt 1. Laden Sie das Buch und den Stempel herunter.
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt.ots
Die Proof-Seite https://trends.polyhelper.ai/markets/proof/2026-10-20/ listet jeden Stempel des Tages und jede Buchzeile des Laufs mit seinem Siegel und Link auf.
Schritt 2. Lesen Sie die gestempelte Liste. cat 130025Z.txt zeigt unter anderem Büchern die Zeile für dieses an:
daily/council/book.jsonl: 159 lines, sha256 59673b9e21ac6d358e7dc3b811dc3d78f5286390094f7133e3704f57cac1a7d9, last link 378273fd057fcbf364746b032f67f42cd811d281da80f39ff0792c4047175b2cSchritt 3. Überprüfen Sie, dass das heutige Buch mit dem gestempelten Präfix beginnt.
head -n 159 council-book.jsonl | shasum -a 256
# 59673b9e21ac6d358e7dc3b811dc3d78f5286390094f7133e3704f57cac1a7d9  -
sed -n 159p council-book.jsonl | python3 -c "import json,sys; print(json.load(sys.stdin)['link'])"
# 378273fd057fcbf364746b032f67f42cd811d281da80f39ff0792c4047175b2c
Beide Werte stimmen mit der gestempelten Liste überein, daher sind die ersten 159 Zeilen genau die Zeilen, denen sie sich verpflichtet. Zeile 151 ist die Ausführungszeile von 2026-10-20-am und die Zeilen 152 bis 159 sind deren Antwortzeilen. Die gleiche Überprüfung mit 150012Z.txt, 153605Z.txt und 165254Z.txt umfasst 165, 167 und 173 Zeilen.
Eine Regel, die in jeder gestempelten Liste gedruckt wird, bestimmt die Bytes. Die Datei wird wie gespeichert verwendet (UTF-8, keine Byte-Order-Marke, nichts neu kodiert oder normalisiert) und jede Zeile endet mit LF. Der Hash von N Zeilen umfasst die Zeilen 1 bis N, jeweils mit ihrem LF, und eine letzte Zeile ohne LF wird noch nicht gezählt. Ein Mirror, der Zeilenumbrüche umschreibt, schlägt die Überprüfung fehl.
Schritt 4. Berechnen Sie jeden Siegel und Link neu.
import json, hashlib
H = lambda o: hashlib.sha256(json.dumps(o, sort_keys=True, ensure_ascii=False).encode()).hexdigest()
lines = [json.loads(l) for l in open("council-book.jsonl", encoding="utf-8")]
prev = ""
for i, x in enumerate(lines, 1):
    assert x["n"] == i and x["prev"] == prev
    assert x["seal"] == H({k: v for k, v in x.items() if k not in ("seal", "link", "prev", "n")})
    assert x["link"] == H({k: v for k, v in x.items() if k != "link"})
    prev = x["link"]
print("chain ok:", len(lines), "lines")
In der Datei vom 20. Oktober wurde dies gedruckt chain ok: 211 lines.
Schritt 5. Überprüfen Sie die Frage, die ein Durchlauf beantwortet hat.
curl -s https://trends.polyhelper.ai/api/v1/asks/77d3c627c7c69d2f6e740ccd89113872b1ac08053554a4651bc2d3064b4e6f07.md | shasum -a 256
# 77d3c627c7c69d2f6e740ccd89113872b1ac08053554a4651bc2d3064b4e6f07  -
Schritt 6. Den Bitcoin-Anker überprüfen. Installieren Sie den OpenTimestamps-Client (pip install opentimestamps-client). Mit einem lokalen Bitcoin-Knoten werden mit ots verify 130025Z.txt.ots die Hashes von 130025Z.txt berechnet, dem Beweis gefolgt und dieser gegen den Block-Header überprüft. Ohne einen Knoten zeigt ots info 130025Z.txt.ots den Datei-Hash (5c7d3a357f3cd8b9c27aa4c5d1e9e4750d522bd90b58ffe5193fc61356079d0f, gleich wie shasum -a 256 130025Z.txt), die Operationen des Beweises und seine Attestation, BitcoinBlockHeaderAttestation(972334). Das Anwenden der Operationen auf den Datei-Hash ergibt 74072ae1fdee72c9a3f749462490b46f896e0fab58f7d101dc1a403d967e5c30, die Merkle-Wurzel von Block 972.334, wie jeder Block-Explorer zeigt (Header-Zeit 2026-10-20 13:55:20Z; Medianzeit der vorherigen 11 Blöcke 12:45:12Z). Beide Dateien können auch auf https://opentimestamps.org abgelegt werden. Ein Beweis, der nur eine ausstehende Kalenderattestation zeigt, wird mit ots upgrade vervollständigt. Eine ausstehende Attestation trägt keine Zeit mit sich, die ein Leser überprüfen kann.
Schritt 7. Die Liga neu zählen.
curl -s https://trends.polyhelper.ai/api/v1/arena-code-tools-replay.py.txt -o replay.py
python3 replay.py https://trends.polyhelper.ai/api/v1/
Bei den Dateien vom 20. Oktober 2026 gab das Skript aus (Auszug):
replay: 253 published rows, 145 accounts, 2 sessions (2026-10-19 .. 2026-10-20), 1006 trades, rules arena-3
exact to the cent (|d| <= 0.01): 204; within the rounding of the published trades: 49; DIFFERENT: 0; not recounted (other price sets): 0
result: the published scores are reproduced
Schritt 8. Überprüfen Sie den Code der Engine. arena-code.json listet jede Code-Datei mit ihrem SHA-256 auf; jede Datei wird als arena-code-<file>.txt veröffentlicht:
curl -s https://trends.polyhelper.ai/api/v1/arena-code-council_arena.py.txt | shasum -a 256
# 9ff5575c2b5c7736fba06bec1b63a608f5f290aacdee6df6b24a51381f22686c  -
was dem Eintrag für council_arena.py entspricht.
Schritt 9. Überprüfen Sie die signierten Zeiten vom 21. Oktober 2026 (Stufe 2+). Führen Sie am 21. Oktober 2026, 09:10 ET, mit OpenSSL 3 aus (beide Überprüfungen bestehen mit OpenSSL 3.6 und 4.0). Die FreeTSA-Zertifikate werden unter tsa/ kopiert und vom Dienst veröffentlicht (https://freetsa.org/files/); die Kette von DigiCert befindet sich im System-Vertrauensspeicher.
P=https://trends.polyhelper.ai/markets/proof/2026-10-21
for f in 130019Z.txt 130019Z.txt.freetsa.tsr 130019Z.txt.digicert.tsr tsa/freetsa-cacert.pem tsa/freetsa-tsa.crt; do curl -sO $P/$f; done
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
shasum -a 256 130019Z.txt
# 986bd13907397901ceed70131a70c3674eba05dfdcb9ededbc7cbc0e57bd3714  130019Z.txt
openssl ts -verify -data 130019Z.txt -in 130019Z.txt.freetsa.tsr -CAfile freetsa-cacert.pem -untrusted freetsa-tsa.crt
# Verification: OK   (after a warning that freetsa-tsa.crt is not a CA certificate, which is expected)
openssl ts -verify -data 130019Z.txt -in 130019Z.txt.digicert.tsr -CAfile /etc/ssl/cert.pem
# Verification: OK
openssl ts -reply -in 130019Z.txt.digicert.tsr -text | grep "Time stamp"
# Time stamp: Oct 21 13:00:19 2026 GMT   (the same for the FreeTSA token)
head -n 222 council-book.jsonl | shasum -a 256
# a9359a7741ef5f7aad7436e022a60813e2fc2f9ce76e130abe21dc820e59bd8c  -
Die Liste gibt 222 Zeilen mit diesem Hash an. Die Zeilen 214 bis 222 sind die Lauflinie und die Antworten von 2026-10-21-am, die in der ersten Charge verbucht wurden, und beide Behörden ordnen sie um 13:00:19 UTC ein, 29 Minuten 41 Sekunden vor der Referenz um 13:30:00 UTC. Die Token von 130035Z.txt, die asks.jsonl abdeckt, geben 13:00:36 UTC an. Die gleichen Schritte bei 132337Z.txt abdecken 224 Zeilen. Zeile 224, eine Antwort, die um 13:23:23 UTC eintraf, wurde 14 Sekunden später verbucht, und drei Behörden (FreeTSA, DigiCert und Sectigo) unterzeichneten sie um 13:23:37 UTC, vor der Referenz. Die erste Zeile von asks.jsonl gibt an, welcher Lauf vom 21. Oktober 2026 zählt. Sie wurde um 04:16:39 UTC versiegelt, bevor die Frage des Laufs gesendet wurde, und ihr Texthash wird auf der Beweisseite gedruckt.
Was die Schritte feststellen. Die Schritte 3 und 4 liefern P2 für jede Zeile bis zum Zeitstempel. Schritt 6 platziert das versiegelte Präfix spätestens wenige Stunden nach der Kopfzeilenzeit von Block 972.334, und diese praktische Grenze, in Abschnitt 3.11 anstelle einer durch die Konsensregeln bewiesenen Konstanten festgelegt, liefert P1a für jedes Ergebnis danach, gegen jeden, der diesen Beweis oder eine unabhängige Kopie davon besitzt.
Der Block fiel nach 09:30 ET. Für den 20. Oktober wird die Reihenfolge von Siegel und Referenzpreis (P1b) auf Stufe 1 aus der Siegelzeit der Zeile im Buch, max(at, booked_at), gegen 09:30 ET der Sitzung gelesen, und die Spalte sealed_at von council-forecasts.csv gibt die Antwortzeit an. Ich habe P3 überprüft, indem ich die gezählte Laufregel auf diese Siegelzeiten angewendet habe. Für die Entwicklungssitzungen beruht P3 auf dem Betreibereintrag, dass jeder Lauf veröffentlicht und gekennzeichnet wird. Im gezählten Datensatz ist der gezählte Lauf der geplante Morgenlauf, der im Voraus deklariert und in der Fragenkette vor dem Lauf versiegelt wurde (Schritt 9), sodass der Leser P3 gegen eine Erklärung überprüft, die vor den Antworten existierte. Schritt 9 liefert P1b auf Stufe 2+ für die Sitzung des 21. Oktober, gegen jeden, der eine der Unterzeichnungsbehörden und deren Zertifikat akzeptiert. In der blinden Saison laufen die gleichen Schritte auf Zeilen, die das Modell als salzigen Verpflichtung versiegeln (Anforderung 1), und die Identität wird überprüft, wenn die Salze nach der Saison veröffentlicht werden.
Tabelle B1. Die Leiter der Ansprüche: was jede Überprüfungsstufe unterstützt und was sie offen lässt.
| Überprüfungsstufe | Anspruch, den sie unterstützt | Anspruch, den sie offen lässt | In diesem Papier |
|---|---|---|---|
| Regeln veröffentlicht | Ein Leser kann den Ereignisvertrag, die Punktzahl und die gezählte Laufregel angeben | Dass die Dateien die Regeln befolgen | Abschnitt 3; Anlage A |
| Dateien neu berechnet | Die veröffentlichten Ergebnisse und Konten folgen aus den veröffentlichten Datensätzen | Dass die Preise einer unabhängigen Quelle entsprechen; dass das benannte Modell die Antwort erzeugt hat | Schritte 4, 7 und 8 |
| Externe Verpflichtung überprüft (Stufe 2; Stufe 2+ für die Reihenfolge von Siegel und Referenz) | Die zugesagten Bytes existierten bis zur angegebenen Grenze, und ein späteres Umschreiben dieses Präfixes ist erkennbar; auf Stufe 2+ (ab 21. Oktober 2026), vor dem Referenzpreis | Dass jede erwartete Prognose offengelegt wurde; die Anbietermodell-Identität; jede Ankunftszeit der Antwort | Schritte 3, 6 und 9 |
| Ergebnisse abgestimmt | Referenz- und Schlusskurse stimmen mit einer zweiten, benannten Quelle zur benannten Zeit überein | Jeder Vorhersagevorteil | Anforderung des Standards; in einer datierten Überarbeitung hinzuzufügen |
| Prospektive gepaarte Bewertung, eingefroren vor seinem Fenster | Ein Verlustunterschied bei den angegebenen Ereignissen, Gewichtungen und dem Vergleichswert | Andere Märkte, Horizonte und Regimes | Abschnitt 8 |
| Unabhängige Replikation | Eine zweite Pipeline in anderen Händen reproduziert die Ergebnisse aus derselben Version | Leistung in späteren Saisons | Offen für jeden Leser (Anlage C) |
Hinweis: Der Anker bescheinigt den Datensatz. Ein Beweis der TLS-Sitzung mit dem Anbieter (TLSNotary) kann die Leiter auf den Anspruch erweitern, dass der benannte Endpunkt die versiegelte Antwort zurückgegeben hat, und das Protokoll hat Platz dafür als Feld der Antwortzeilte. Geschick wird durch die registrierten Vergleiche von Abschnitt 8 festgelegt.
Schritt 10. Überprüfen Sie den Zeitstempel in einem unabhängigen Protokoll. Jede versiegelte Liste wird auch im Sigstore Rekor-Transparenzprotokoll eingetragen, das der Betreiber nicht betreibt; der Eintrag enthält die SHA-256 der Liste.
shasum -a 256 130025Z.txt
# 5c7d3a357f3cd8b9c27aa4c5d1e9e4750d522bd90b58ffe5193fc61356079d0f  130025Z.txt
curl -s "https://rekor.sigstore.dev/api/v1/log/entries?logIndex=3368351276"
# the base64 body holds spec.data.hash.value, the same SHA-256; integratedTime 1792626303 is 21 October 2026, 23:45:03 UTC
Die Liste vom 20. Oktober 2026 wurde am 21. Oktober 2026 bei Log-Index 3.368.351.276 eingetragen. Ab 22. Oktober 2026 wird jede Liste bei der Zeitstempelung eingetragen, und die erste, Index 3.368.763.032, wurde um 00:00:16 UTC integriert, fünf Sekunden nach ihrer Zeitstempelung.
Appendix C. Datenwörterbuch
Alle Dateien befinden sich unter https://trends.polyhelper.ai/api/v1/, veröffentlicht unter CC BY 4.0 mit der Namensnennung „AI Council · Markets, trends.polyhelper.ai/markets/". Die Indexseite dieser Adresse listet jede Datei auf und zeigt, wie oft sie sich ändert, und arena-dataset.json beschreibt die Spalten jeder Datei; Tabelle C1 listet die Dateien auf, die die Vorhersagen lesen, mit Spaltennamen wie am 21. Oktober 2026 um 08:16 UTC gelesen. Eine Reader-KI, die große Dateien nicht öffnen kann, beginnt mit markets-digest.json (unter 30 KB) oder den Pro-Run-Schichten in council-forecasts-index.json.
Tabelle C1. Hauptdateien.
| Datei | Inhalt | Aktualisiert |
|---|---|---|
council-book.jsonl |
Das versiegelte Buch: jeder Run, jede Antwort, jeder Score, jedes Portfolio und jede Liga-Zeile, Hash-verkettet | Jeder Run |
council-forecasts.csv |
Eine Zeile pro versiegelter Prognosezelle mit ihrem Ergebnis | Jeder Run und Score |
council-stats.json |
Brier-Intervalle nach Sitzungen, Unentschieden-Bereich, Leistungsberechnungen, n_eff (mit der gezählten Serie n_eff.counted), gepaarte Intervalle (pairs), Scores nach Methodensegment (method_segments), gemeinsame Quellen |
Jeder Build |
council-calibration.json |
Kalibrierung, Skill Scores gegen die Münze, die Menge und Klimatologie, die Methode jedes Vergleichs (method); die feste Klimatologie climatology_fixed bei Veröffentlichung |
Jeder Build |
council-pairs.csv |
Gepaarte Verluste jedes zwei Sitze bei denselben Ereignissen | Jeder Build |
league-roster.json |
Jedes Modell, seine Seite, Council oder Bench, sein Status in beiden Ligen | Jeder Build |
{lang}/council-league.json |
Die Liga: Modelle, Baselines, Kalibrierung, Horizonte, die Menge, die Portfolio-Liga | Jeder Run und Score |
arena-protocol.json, arena-code.json |
Das Protokoll (Appendix A); der Code der Engine mit SHA-256 | Jeder Build |
arena-trades.csv, arena-accounts.csv, arena-prices.json |
Ausgeführte Trades; jedes Konto jede Sitzung; Ausführungs- und Schließungspreise | Jede Sitzung |
asks/<sha256>.md, asks/index.json |
Der Fragetext hinter jedem ask_sha256 |
Jeder Run |
event-contract.schema.json, tools/conformance.py |
Der Ereignisvertrag als JSON-Schema; die Prüfung, die jede Liga auf ihre eigene Prognosedatei anwenden kann (Abschnitt 3.13) | Bei jeder Änderung des Vertrags |
council-forecasts.csv (eine Zeile pro Modell, Run, Markt und Horizont): run_id; session; seat; model, mode; line (Position n der Versiegelungslinie); sealed_at (UTC); status (counted, not_counted, counted_50, no_answer, refused_shape); asset, horizon; action, action_word; prob_up (0–100); exp_pct; target, invalidation; ref, close, actual_pct; draw; source_domains, source_urls; why_missing; run_role (session_run oder earlier_run); seat_versions_in_run; line_kind (issue, die Zelle wie in der Antwortzelle versiegelt, oder correction, eine Zelle, die durch eine spätere Korrekturlinie hinzugefügt wurde); reference_at (Zeit, von der an die Preisregel der Zeile gilt; für Bitcoin die Versiegelungssekunde, wobei der Preis der Schlusskurs des ersten Ein-Minuten-Balkens ist, der bei dieser Zeit oder später beginnt); same_event (false, wenn die Zeile aus ihrer eigenen Referenz gewertet wird); cell_status (elicited, explicit_50 oder invalid); attempt; event_id, event_reference_at, event_end_at (der Ereignisvertrag, Abschnitt 3.13); methodology_version. sealed_at ist die Antwortzeit, das at der Antwortzeil; die Zeit, in der die Zeile ins Buch versiegelt wurde, ist max(at, booked_at) dieser Zeile (am 20. Oktober, Antworten von 12:31Z bis 12:42Z, Versiegelung um 13:00:25Z), was die Zeitbasis von council-stats.json ist (time_basis: book_sealed_at) und der eingereichten Skripte. Für Bitcoin ist reference_at die Versiegelungssekunde der Versiegelungslinie der Zeile (13:00:19Z für den Batch vom 21. Oktober, 13:23:37Z für die neunte Antwort), und reference_price_at ist der Anfang des Ein-Minuten-Balkens, dessen Schlusskurs die Referenz ist (13:01:00Z und 13:24:00Z). Eine Zelle mit cell_status explicit_50 ist eine angegebene Wahrscheinlichkeit von 50; counted_50, no_answer, refused_shape und ein leeres prob_up sind nicht angegeben und gehen in keinen Brier Score angegebener Wahrscheinlichkeiten und keinen Konsens ein. Die Antwort des Modells auf eine Publikumsfrage, crowd_up, ist nicht in dieser Datei; sie ist in den Antwortzeilendes Buchs.
Buchzeilen. Jede Zeile hat n, at, kind, prev, seal und link. Die Arten, die die Prognosen tragen, sind run (fügt run_id, ask_sha256, snapshot_sha256, roster, methodology und crowd hinzu, mit crowd.at, den Polymarket-Verträgen unter crowd.odds und den Kalshi-Verträgen unter crowd.kalshi, jeweils mit p_up und vol), answer (fügt seat, model, mode, items, years hinzu und in späteren Durchläufen own_sha256, ask_sha256, booked_at; die Wahrscheinlichkeit des Modells für eine Crowd-Frage ist items.<asset>.1d.crowd_up), score und score_h (die Ergebnisse des Tages und der Horizonte, mit late_ref, noise und of), crowd (löst jeden Vertrag auf: rows.<code> für Polymarket und rows.<code>@kalshi für Kalshi, mit dem Ergebnis up; ab 21. Oktober 2026 nur für den Durchlauf 2026-10-19-am vorhanden), und correction (nennt die Zeilen, die sie betreffen, in of). Andere Arten zeichnen die Portfolio-Ligen und die Shadow Tracks auf.
Feste Klimatologie. In council-calibration.json enthält climatology_fixed table[*] mit asset, h, p_up, p_up_ex_draw, n, n_independent, window und rule, plus sha256 und sha256_ok. Sein Siegel ist der Inhalts-Hash von council-clim-window.json (unter der Datenadresse), 2810d11e907bbaa1f311d06622c929c69e60cc81e558fdb78f5baa04113cabb7, berechnet wie in Abschnitt 4.3; die primäre Benchmark liest p_up beim Horizont 1d. Das Feld trat am 21. Oktober 2026 um 08:54 UTC in die Live-Datei ein, daher wird es in Tabelle C1 um 08:16 UTC nicht aufgelistet.
Statuswerte und der Ereignisvertrag. counted_50 kennzeichnet eine Zelle, die mit 50 % für die Service-Bewertung des Sitzes ausgefüllt ist; es handelt sich nicht um eine angegebene Wahrscheinlichkeit und geht nicht in den Konsens oder die Übereinstimmungszahler ein, deren Anzahl der beitragenden Wahrscheinlichkeiten of ist. Eine Zeile mit late_ref ist eine Prognose für ein separates Ereignis (Abschnitt 3.3); eine Analyse, die Modelle zu einem gemeinsamen Ereignis zusammenfasst, wählt Zeilen aus, deren Referenz gleich der gemeinsamen Referenz der Sitzung ist.
Analyse-Veröffentlichung. Jede Überarbeitung basiert auf einer unveränderlichen Veröffentlichung, die auf Zenodo hinterlegt ist (10.5281/zenodo.23552700): das Buch, die Prognosen, die Statistiken, das Protokoll, die Code-Dateien, die Dateien der Neuauszählung, die veröffentlichten Fragen und jede zeitgestempelte Liste mit ihrem .ots-Beweis, mit einem Manifest der SHA-256, Größe, Abrufszeit und, wo angegeben, Generierungszeit jeder Datei. Einzeln abgerufene Dateien bilden eine Sammlung identifizierter Versionen, und die Veröffentlichung ist der atomare Snapshot. Das Buch wächst nur, und das Buch der Veröffentlichung ist daher ein Präfix jedes späteren Downloads (Abschnitt 3.2).
Appendix D. Registrierte Vorhersagen (vollständige Tabelle)
Tabelle D1 listet die dreißig sekundären Vorhersagen von Abschnitt 8 auf einen Blick auf, und Tabelle D2 gibt ihren registrierten Text an. Drei Modelle aus drei Familien, jeweils allein, bewerteten die bereinigte Liste blind, und das registrierte p ist der Median der drei. Diese Liste, die Set-B-Skripte mit ihrem SHA-256 und der primäre Endpunkt mit seinem Skript sind bei der OSF-Registrierung hinterlegt (10.17605/OSF.IO/9Q86N).
Regeln, die für jede Zeile gelten. Sofern eine Zeile ein anderes Fenster nicht benennt, wird eine Vorhersage anhand von Sitzungen von Sitzung 11 (2. November 2026) bis zu ihrem Prüfdatum berechnet. Sie verwendet gezählte Zeilen (ein Durchlauf pro Sitzung), deren Buchungssiegel-Zeit, max(at, booked_at), vor der Referenzzeit 09:30 ET der Sitzung liegt, und der gleiche Schnitt gilt für Bitcoin, dessen Referenz der Schlusskurs des ersten Ein-Minuten-Balkens nach dem Siegel der Zeile ist. Brier-Scores sind eintägig und über alle Zeilen, Remis eingeschlossen. Wenn ein veröffentlichtes Feld auch frühere Sitzungen abdeckt, wendet das eingereichte Skript die Definition des Feldes auf das Fenster an.
Felder sind die der offenen Dateien unter https://trends.polyhelper.ai/api/v1/ wie am 21. Oktober 2026 dokumentiert, und ein umbenanntes Feld wird durch sein dokumentiertes Äquivalent mit der protokollierten Zuordnung ersetzt. Wenn eine Zeile einen Wert benötigt, den kein offenes Feld trägt, soll das Feld veröffentlicht werden, und der Resolver in den OSF-Skripten berechnet den Wert aus council-forecasts.csv und council-book.jsonl nach der Regel der Zeile. „Ranked" bedeutet 30 aufgelöste Vorhersagen an mindestens 10 Handelstagen (die 30/10-Regel, Abschnitt 4.6), angewendet innerhalb des Vorhersagefensters, außer F8, das das Flaggen der Liga liest. Crowd-Zeilen sind Marktsitzungen, bei denen die versiegelte Fragenliste einen Tageskontrakt auflistet (Abschnitt 4.9), und der Kontrakt ist derjenige, den die Modelle mit crowd_up beantwortet haben, der Polymarket-Kontrakt, falls Polymarket den Markt auflistet, und ansonsten der Kalshi-Kontrakt, in beiden Fällen mit einem versiegelten Volumen von mindestens 1.000 USD (ein Zulassungsschwellenwert). Intervalle sind 95% mit der Sitzung als Cluster, durch ein Bootstrap von 10.000 Resamples mit Seed 20261102 in den eingereichten Skripten.
Eine nicht erreichte Mindeststichprobe, eine fehlende Datei oder ein Feld ohne dokumentiertes Äquivalent lässt die Vorhersage unaufgelöst und nicht erfolgreich. Keine Vorhersage wird gelöscht. p ist die registrierte Wahrscheinlichkeit, dass die Vorhersage wahr wird, angesichts der Tatsache, dass sie aufgelöst ist: der Median von drei blinden Abstimmungen. Sechs Werte (F5, F7, F20, F21, F23, F25) sind die Abstimmungen vom 20. Oktober 2026. Die anderen vierundzwanzig und der primäre Endpunkt wurden am 21. Oktober 2026 abgestimmt, in drei späteren Runden, jeweils über den Text der in dieser Runde umformulierten Vorhersagen. Die nach der letzten Runde festgelegte Formulierung gibt an, wie eine Zeile aufgelöst wird, und wurde nicht neu bewertet, und alle Runden und Abstimmungen sind bei der Registrierung hinterlegt.
Tabelle D1. Die dreißig registrierten Vorhersagen auf einen Blick.
| # | Vorhersage (registrierte Aussage, bis zum Doppelpunkt) | Set | Prüfdatum | p | P(wahr) ohne Geschick |
|---|---|---|---|---|---|
| F1 | Der Rat bleibt an einem Tag unter zwei unabhängigen Stimmen | A | 30. Nov 2026 | 0.50 | |
| F2 | Marktbewegungen erklären die Ähnlichkeit nicht | A | 31. Dez 2026 | 0.50 | |
| F3 | Fehler werden auch geteilt | B | 31. Dez 2026 | 0.74 | |
| F4 | Modelle sind weniger präzise als das Publikum | B | 31. Dez 2026 | 0.40 | |
| F5 | Gemeinsame Links bedeuten gemeinsame Aufrufe | A | 31. Dez 2026 | 0.56 | |
| F6 | Alle zusammen falsch | B | 31. Dez 2026 | 0.92 | |
| F7 | Eine richtige Minderheit ist häufiger als ein einstimmiger Fehler | A | 31. Dez 2026 | 0.63 | |
| F8 | Die Tabelle wird planmäßig gefüllt | A | 30. Nov 2026 | 0.88 | operativ |
| F9 | Die Unabhängigkeit ist im Monat größer als am Tag | B | 31. Dez 2026 | 0.30 | |
| F10 | Durchschnittswertbildung schlägt dem Anführer zu folgen | B | 31. Dez 2026 | 0.64 | |
| F11 | Kein einzelnes Modell zeigt einen erkannten täglichen Vorteil | B | 31. Dez 2026 | 0.79 | mindestens etwa 0.78 |
| F12 | Das Publikum schlägt den Rat | B | 31. Dez 2026 | 0.83 | |
| F13 | Die Kombination schlägt das Publikum | B | 31. Dez 2026 | 0.30 | |
| F14 | Modelle sind überconfident | B | 31. Dez 2026 | 0.80 | |
| F15 | Der Rat schlägt eine einfache Regel nicht mit deutlichem Vorsprung | B | 31. Dez 2026 | 0.80 | |
| F16 | Kein Horizont trägt über eine Saison ein erkanntes Signal | B | 30. Apr 2027 | 0.63 | mindestens etwa 0.93 |
| F17 | Relativ zur Klimatologie ist der Tag der schwierigste Horizont | B | 30. Apr 2027 | 0.37 | |
| F18 | Das Land ist ein kleiner Faktor | B | 31. Dez 2026 | 0.80 | |
| F19 | Die US-Seite schneidet über eine Saison besser ab | B | 30. Apr 2027 | 0.57 | |
| F20 | Die gleichen Nachrichten bedeuten weniger Streit | A | 30. Nov 2026 | 0.70 | |
| F21 | Die Suche trägt wenig zur Genauigkeit bei | B | 31. Dez 2026 | 0.72 | |
| F22 | Die Diskussion findet echte Risiken | A | 31. Dez 2026 | 0.30 | |
| F23 | Der Kritik Gehör zu schenken zahlt sich aus | A | 31. Dez 2026 | 0.42 | |
| F24 | Ein Modell widerspricht sich selbst viel | A | 30. Nov 2026 | 0.60 | |
| F25 | Anführer halten sich nicht | B | 30. Apr 2027 | 0.62 | etwa 0.85 (elf bewertete Sitze), 0.82 (zehn) |
| F26 | Der Index ist schwer zu schlagen | B | 30. Apr 2027 | 0.60 | |
| F27 | Gute Prognostiker sind nicht die besten Trader | B | 30. Apr 2027 | 0.83 | |
| F28 | Der Zugriff auf die Modelle vor der ersten Prognose verbessert die Brier-Werte der Leser nicht um 0,01 oder mehr | A | 31 Dec 2026 | 0.46 | |
| F29 | Der Zugriff bewegt die Leser näher zum Rat | B | 31 Dec 2026 | 0.41 | |
| F30 | Der Stil verrät das Modell | B | 30 Apr 2027 | 0.46 |
Hinweis: Eine Zeile pro registrierter Prognose; der vollständige Text jeder einzelnen mit ihrem Maß, ihrer Quelle und ihren Auflösungsregeln ist in Tabelle D2 enthalten. Satz A ist durch ein oder zwei veröffentlichte Felder definiert, Satz B durch ein bei der Registrierung eingereichtess Skript. p ist die registrierte Wahrscheinlichkeit, dass die Prognose wahr wird, gegeben, dass sie aufgelöst wird: der Median aus drei blinden Abstimmungen. P(wahr) ohne Geschick ist die Wahrscheinlichkeit, dass die Prognose wahr wird, wenn kein Modell Geschick hat, wie in der Anmerkung zu Tabelle D2 abgeleitet; eine leere Zelle bedeutet, dass die Zeile keinen solchen Wert angibt.
Tabelle D2. Alle dreißig registrierten Prognosen vollständig: Aussagen, Maße, Quellen, Sätze, Prüfdaten, Regeln und Wahrscheinlichkeiten.
| # | Aussage | Maß (Datei öffnen) | Satz | Prüfdatum | Wahr, wenn | Widerlegt, wenn | p |
|---|---|---|---|---|---|---|---|
| F1 | Der Rat bleibt unter zwei unabhängigen Stimmen an einem Tag: Über gezählte Durchläufe von Sitzung 11 zu Sitzung 30 ist der Mittelwert N_eff der Wahrscheinlichkeitsbilder für einen Tag, berechnet pro Durchlauf nach der Berechtigungsregel von Abschnitt 5.1, unter 2,0 | Mittelwert von n_eff.counted.per_run[*].n_eff über Durchläufe, deren run-ID vom 2. bis 30. November 2026 datiert ist, council-stats.json |
A | 30 Nov 2026 | Mittelwert < 2,0 mit mindestens 10 gezählten Durchläufen | Mittelwert ≥ 2,0 mit mindestens 10 gezählten Durchläufen; weniger = ungelöst | 0.50 |
| F2 | Die Marktmitbewegung erklärt die Ähnlichkeit nicht: Über gezählte Durchläufe von Sitzung 11 zu Sitzung 52 ist der Mittelwert des N_eff für einen Tag mit einem Markt pro Gruppe (Nasdaq-100, Dow und Brent fallen weg), nach der Regel von Abschnitt 5.1, unter 2,5 | Mittelwert von n_eff.counted.one_per_group.per_run[*].n_eff über Durchläufe, deren run-ID vom 2. November bis 31. Dezember 2026 datiert ist, council-stats.json |
A | 31 Dec 2026 | Mittelwert < 2,5 mit mindestens 20 gezählten Durchläufen | Mittelwert ≥ 2,5 mit mindestens 20 gezählten Durchläufen; weniger = ungelöst | 0.50 |
| F3 | Fehler werden auch geteilt: Über bewertete Sitzungen von Sitzung 11 zu Sitzung 52 ist N_eff, berechnet auf den Fehlerindikatoren der Sitze für einen Tag (Antworten versiegelt vor der Referenz, alle Zeilen, eine angegebene 50% ausgelassen), gemittelt über Sitzungen, unter 4,0 (die Fehleranzahl trägt auch die Mitbewegung der Ergebnisse über die Märkte hinweg). Pro Sitzung sind die Befragten die Sitze mit einer berechtigten Zeile, n ist ihre Anzahl in dieser Sitzung, ρ ist die mittlere paarweise Pearson-Korrelation ihrer 0/1-Fehlerindikatoren über die beiden beantworteten Märkte (ein Paar mit einem konstanten Indikator wird ausgelassen, ebenso wie eine Sitzung ohne berechenbares Paar), und der Mittelwert über Sitzungen gewichtet jede Sitzung gleich | Feld, das veröffentlicht werden soll (das veröffentlichte n_eff_errors umfasst verspätete Zeilen); der Resolver in den OSF-Skripten berechnet ihn aus den gezählten 1-Tage-Zeilen von council-forecasts.csv und council-book.jsonl |
B | 31 Dec 2026 | Wert < 4,0 mit mindestens 30 bewerteten Sitzungen | Wert ≥ 4,0 mit mindestens 30 bewerteten Sitzungen; weniger = ungelöst | 0.74 |
| F4 | Modelle sind weniger präzise als die Masse: Auf Masseverträge für einen Tag mit einem versiegelten Volumen von mindestens 1.000 USD (der Vertrag, auf den die Modelle antworteten: Polymarket, wenn vorhanden, ansonsten Kalshi), von Sitzung 11 zu Sitzung 52, ist der Mittelwert über Sitze der mittlere Abstand jedes Sitzes von 50% seiner crowd_up-Antworten kleiner als die Hälfte des mittleren Abstands der Massenpreise von 50% auf denselben Verträgen |
Massenpreise und vol in den Durchlaufzeilen von council-book.jsonl (crowd.odds, crowd.kalshi); crowd_up von vor der Referenz versiegelten Antwortzeln; eingereichtess Skript |
B | 31 Dec 2026 | Mittlerer Abstand der Sitze < 0,5 × mittlerer Abstand der Masse, auf mindestens 100 Vertrags-Sitzungen | Mittlerer Abstand der Sitze ≥ 0,5 × mittlerer Abstand der Masse; weniger als 100 Vertrags-Sitzungen = ungelöst | 0.40 |
| F5 | Gemeinsame Links bedeuten gemeinsame Aufrufe: Modellpaare, die denselben Link zitieren, stimmen der Aktionsklasse häufiger zu als Paare, die dies nicht tun, um mindestens 5 Punkte innerhalb von Schichten, Permutations-p < 0,05 | sources.agreement_by_shared_link.diff_within_strata und p_permutation, council-stats.json, angewendet auf das Fenster nach eingereichtessem Skript (Definition reproduziert auf den Dateien vom 21. Oktober 2026) |
A | 31 Dec 2026 | diff ≥ 0,05 und p < 0,05 | diff < 0,05 oder p ≥ 0,05 | 0.56 |
| F6 | Alle zusammen falsch: Der Anteil aufgelöster 1-Tage-Markt-Sitzungen mit mindestens 4 antwortenden Modellen, bei denen jedes antwortende Modell falsch war, ist mindestens doppelt so hoch wie der erwartete Anteil unter Unabhängigkeit, wobei der erwartete Anteil der Mittelwert über dieselben Markt-Sitzungen des Produkts der Fehlerraten der Modelle ist, die tatsächlich geantwortet haben, wobei jede Rate auf denselben Zeilen geschätzt wird | together.all_wrong / together.rows, council-league.json; Erwartung nach eingereichtessem Skript aus council-forecasts.csv |
B | 31 Dec 2026 | Beobachteter Anteil ≥ 2 × erwarteter Anteil | Beobachteter Anteil < 2 × erwarteter Anteil | 0.92 |
| F7 | Eine richtige Minderheit ist häufiger als ein einstimmiger Fehler: minority_right übersteigt all_wrong |
together-Definition (council-league.json), im Fenster nach eingereichtessem Skript nach der Regel dieses Papiers neu berechnet, aus Zeilen, die vor der Referenz versiegelt wurden, und alle Zeilen; das veröffentlichte Feld, das auch späte Zeilen zählt und Unentschieden auslässt, ist daneben gezeigt |
A | 31 Dec 2026 | minority_right > all_wrong | minority_right ≤ all_wrong | 0.63 |
| F8 | Die Tabelle füllt sich nach Plan: Nach der Bewertung von Sitzung 30 (30. November 2026) erfüllen mindestens 9 der 11 Ratsplätze die Rangfolgenregel bei einem Tag (30 aufgelöste Prognosen auf mindestens 10 Handelstagen, alle Sitzungen vom 19. Oktober 2026 gezählt) | ranked-Flaggen, council-league.json by_horizon.1d |
A | 30 Nov 2026 | 9 oder mehr Ratsplätze eingestuft | 8 oder weniger Ratssitze rangiert | 0.88 |
| F9 | Unabhängigkeit ist auf Monatsebene höher als auf Tagesebene: über gezählte Durchläufe von Sitzung 11 bis Sitzung 52 hat die Durchlauf-für-Durchlauf-Differenz zwischen der mittleren paarweisen Korrelation ρ an einem Tag und an einem Monat (jeweils nach der Regel von Abschnitt 5.1, sodass eine positive Differenz mehr unabhängige Stimmen auf Monatsebene bedeutet) einen positiven Mittelwert, mit einem 95%-Intervall für den verschiebenden Block-Bootstrap (Blöcke von fünf Durchläufen) ganz oberhalb von Null | gezählte Zeilen von council-forecasts.csv bei 1d und 1m, council-book.jsonl; eingereichte Skript | B | 31. Dezember 2026 | Intervall ganz oberhalb von Null, mit mindestens 20 gezählten Durchläufen | Intervall nicht ganz oberhalb von Null, mit mindestens 20 gezählten Durchläufen; weniger = ungelöst | 0.30 |
| F10 | Der Durchschnitt schlägt dem Anführer zu folgen: Der Konsens-1-Tages-Brier über Sitzungen 31 bis 52 (1. bis 31. Dezember 2026) ist niedriger als der des Anführers, des rangierten Ratsmodells mit dem niedrigsten 1-Tages-Brier über Sitzungen 11 bis 30 (2. bis 30. November 2026), bei den Dezember-Marktsitzungen, die beide beantwortet wurden | gezählte 1-Tages-Zeilen von council-forecasts.csv; Konsens nach der veröffentlichten Regel aus Antworten, die vor der Referenz versiegelt wurden; eingereichte Skript | B | 31. Dezember 2026 | Konsens-Brier < Brier des Anführers | Konsens-Brier ≥ Brier des Anführers; kein rangiertes Modell über Sitzungen 11 bis 30 = ungelöst | 0.64 |
| F11 | Kein einzelnes Modell zeigt einen erkannten täglichen Vorteil: Kein rangiertes Ratsmodell hat einen 1-Tages-Brier über alle Zeilen ab Sitzung 11, dessen 95%-Sitzungs-Cluster-Intervall ganz unterhalb von 0,25 liegt (ein unkorrigiertes Intervall pro rangiertem Sitz) | gezählte 1-Tages-Zeilen von council-forecasts.csv; eingereichte Skript | B | 31. Dezember 2026 | keine obere Grenze des Sitzes < 0,25 | mindestens eine obere Grenze eines Sitzes < 0,25 | 0.79 |
| F12 | Die Menge schlägt den Rat: Bei mindestens 100 unterschiedlichen 1-Tages-Marktsitzungen ab Sitzung 11 mit einem Crowd-Kontrakt, dessen versiegeltes Volumen mindestens 1.000 USD beträgt (der Kontrakt, den die Modelle beantwortet haben: Polymarket, wo es den Markt auflistet, ansonsten Kalshi), ist der Brier der Menge niedriger als der des getrimmten Konsenses des Rates von crowd_up, beide bewertet gegen die Auflösung dieses Kontrakts selbst |
Crowd-Preise und vol in den Durchlaufzeilen von council-book.jsonl (crowd.odds für Polymarket, crowd.kalshi); Auflösungen in seinen crowd-Zeilen (rows.<code>[@kalshi].up); crowd_up in den Antwortzeilen von council-book.jsonl; eingereichte Skript |
B | 31. Dezember 2026 | Crowd-Brier < Rats-Brier bei mindestens 100 Marktsitzungen | Crowd-Brier ≥ Rats-Brier; weniger als 100 Marktsitzungen = ungelöst | 0.83 |
| F13 | Die Kombination schlägt die Menge: Bei denselben Kontrakten wie F12 (mindestens 100 Marktsitzungen, versiegeltes Volumen mindestens 1.000 USD) hat der einfache Mittelwert des Crowd-Preises und des getrimmten Konsenses des Rates von crowd_up einen niedrigeren Brier als die Menge allein, bewertet gegen die Auflösung jedes Kontrakts selbst |
wie F12; eingereichte Skript | B | 31. Dezember 2026 | Kombinations-Brier < Crowd-Brier bei mindestens 100 Marktsitzungen | Kombinations-Brier ≥ Crowd-Brier; weniger als 100 Marktsitzungen = ungelöst | 0.30 |
| F14 | Modelle sind überconfident: über alle 1-Tages-Zeilen ab Sitzung 11, im zusammengefassten Bereich von 60 bis 70 % auf der unterstützten Seite (mindestens 100 Prognosen), liegt die beobachtete Häufigkeit mindestens 5 Punkte unter der angegebenen Wahrscheinlichkeit | gezählte 1-Tages-Zeilen von council-forecasts.csv; eingereichte Skript | B | 31. Dezember 2026 | Lücke ≥ 5 Punkte mit n ≥ 100 | Lücke < 5 Punkte mit n ≥ 100; n < 100 = ungelöst | 0.80 |
| F15 | Der Rat schlägt eine einfache Regel nicht mit großem Vorsprung: Bei den Sitzungen, bei denen beide bewertet werden, ist B(Konsens) − B(Momentum) an einem Tag größer als −0,01 | Konsens- und Momentum-1-Tages-Brier bei gemeinsamen Sitzungen, council-forecasts.csv; eingereichte Skript | B | 31. Dezember 2026 | B(Konsens) − B(Momentum) > −0,01 | B(Konsens) − B(Momentum) ≤ −0,01 | 0.80 |
| F16 | Kein Zeithorizont zeigt über eine Saison hinweg ein erkanntes Signal: Bei keinem der Zeithorizonte 1 Tag, 1 Woche und 1 Monat hat der Konsens-Brier ein 95%-Intervall ganz unterhalb von 0,25, Intervalle nach der Regel von Abschnitt 4.6 (Sitzungs-Cluster bei 1 Tag; Newey-West mit Lag h − 1, oder ein Block-Bootstrap mit Blöcken von mindestens h Sitzungen, bei Zeithorizont h) | Konsens-Brier nach Zeithorizont von council-forecasts.csv; eingereichte Skript | B | 30. April 2027 | keine obere Grenze des Zeithorizonts < 0,25 | mindestens eine obere Grenze eines Zeithorizonts < 0,25 | 0.63 |
| F17 | Relativ zur Klimatologie ist der Tag der schwierigste Zeithorizont: Unter den Zeithorizonten 1 Tag, 1 Woche und 1 Monat ist der Konsens-Brier-Skill-Score gegen die klimatologische Basisrate (Häufigkeit eines strikten Anstiegs pro Markt und Zeithorizont von 2016 bis 2025, alle Zeilen) am niedrigsten bei 1 Tag | Konsens-Brier nach Zeithorizont von council-forecasts.csv; Klimatologie climatology_fixed.table[*].p_up von council-calibration.json, Dichtung überprüft durch die eingereichte Skript (Abschnitt 8); Feld veröffentlicht 21. Oktober 2026 |
B | 30. April 2027 | 1-Tages-Skill-Score ist der niedrigste der drei | 1-Tages-Skill-Score ist nicht der niedrigste | 0.37 |
| F18 | Land ist ein kleiner Faktor: Die absolute Lücke zwischen dem US-seitigen und dem China-seitigen 1-Tages-Brier (jede Seite der Mittelwert ihrer rangierten Modelle' Brier bei gemeinsamen Sitzungen) ist kleiner als die Spanne (höchster minus niedrigster rangierter-Modell-Brier) innerhalb jeder Seite | by_horizon.1d, side, ranked, council-league.json; council-forecasts.csv; eingereichte Skript |
B | 31. Dezember 2026 | Lücke < Spanne innerhalb jeder Seite | Lücke ≥ Spanne innerhalb einer Seite; weniger als zwei rangierte Modelle auf einer Seite = ungelöst | 0.80 |
| F19 | Die US-Seite erzielt über eine Saison bessere Ergebnisse: Der 1-Tages-Brier der US-Seite, der Mittelwert ihrer rangierten Modelle' Brier über alle Zeilen bei gemeinsamen Sitzungen ab Sitzung 11, ist niedriger als der der China-Seite, auf dieselbe Weise berechnet | gezählte 1-Tages-Zeilen von council-forecasts.csv, side und ranked in council-league.json; eingereichte Skript |
B | 30. April 2027 | US < China | US ≥ China; weniger als zwei rangierte Modelle auf einer Seite = ungelöst | 0.57 |
| F20 | Dasselbe Ereignis bedeutet weniger Meinungsverschiedenheit: Bei Closed-Book-Durchläufen (versiegeltes Paket, keine Suche) ist die Hitze der Meinungsverschiedenheit niedriger als bei den offenen Durchläufen derselben Modelle und Tage | Mittelwert von heat_closed − heat_open über runs[*] im Fenster, arena-cb-experiment.json |
A | 30 Nov 2026 | closed heat < open heat | closed heat ≥ open heat | 0.70 |
| F21 | Suche trägt wenig zur Genauigkeit bei: der Brier-Score des nächsten Tages von Closed-Book-Calls liegt innerhalb von 0,01 der Open-Calls derselben Modelle und Sessions | closed_book-Zeilen von council-book.jsonl, council-forecasts.csv; eingereichte Skript. Ein Closed Call, der nach der gemeinsamen Referenz versiegelt wird, wird nur aus seinem eigenen Referenzpreis bewertet (Abschnitt 5.5). In den Dateien vom 21. Oktober 2026 wurde jede Closed-Book-Zeile nach dem Open abgefragt (asked_after_open) und trägt kein Ergebnis aus ihrer eigenen Referenz, daher kann die Zeile noch nicht aufgelöst werden; sie wird aufgelöst, sobald die Liga entweder vor der gemeinsamen Referenz versiegelte Calls veröffentlicht oder für jeden Closed Call seinen eigenen Referenzpreis, Schlusspreis und Ergebnis bereitstellt (zum Beispiel ein score-Feld pro Markt), das der Resolver bereits liest |
B | 31 Dec 2026 | absolute Differenz ≤ 0,01 | absolute Differenz > 0,01; keine vergleichbaren Paare = ungelöst | 0.72 |
| F22 | Diskussion findet echte Risiken: mindestens 55 % der Kritiken des Vorsitzenden mit einer aufgelösten 5-Session-Bewegung werden bestätigt, wobei „bestätigt" bedeutet, dass die Fondsrendite über die 5 Sessions das Vorzeichen hat, das die Kritik vorhergesagt hat | status, council-talk-critiques.csv (neu berechnet aus der Richtung der Kritik und der 5-Session-Rendite des Fonds, wo sich das Feld unterscheidet) |
A | 31 Dec 2026 | Anteil ≥ 55 % mit mindestens 20 aufgelösten Kritiken | Anteil < 55 % mit mindestens 20 aufgelösten Kritiken; weniger = ungelöst | 0.30 |
| F23 | Der Kritik Folge zu leisten lohnt sich: die Schatten, denen die Kritik entsprochen wurde, schlagen die behaltenen Portfolios im Durchschnitt | Mittelwert von weeks[*].criticised[*].heed_minus_keep_pp über die kritisierten Portfolios von Wochen, deren Sessions in das Fenster fallen, council-talk.json |
A | 31 Dec 2026 | Mittelwert > 0 | Mittelwert ≤ 0 | 0.42 |
| F24 | Ein Modell widerspricht sich selbst stark: die durchschnittliche Hitze zwischen den eigenen Wiederholungen eines Modells ist mindestens die Hälfte der Hitze zwischen Modellen | Mittelwerte von weeks[*].summary.noise_floor.heat_self und heat_between_models über Wochen aus dem Radar vom 1. November 2026, council-repeats.json |
A | 30 Nov 2026 | heat_self ≥ 0,5 × heat_between_models, mit heat_between_models > 0 | heat_self < 0,5 × heat_between_models; beide null = ungelöst | 0.60 |
| F25 | Leader halten nicht lange: von den drei besten platzierten Council-Modellen nach 1-Tage-Brier über Q4 2026 ist höchstens eines unter den besten drei über Q1 2027. Geeignet sind die Plätze mit Platz council in league-roster.json, die die 30/10-Regel innerhalb jedes Quartals erfüllen, Q4 2026 bedeutet Sessions 11 bis 52 (nach der Entwicklungsperiode) und Q1 2027 die Sessions vom 4. Januar bis 31. März 2027; ein Platz bleibt ein Platz über einen datierten Modellversionswechsel (Abschnitt 5.7); exakte Bindungen im Brier werden nach Platzname in alphabetischer Reihenfolge gelöst |
council-forecasts.csv, gezählte 1-Tage-Zeilen nach Quartal; league-roster.json; eingereichte Skript | B | 30 Apr 2027 | höchstens eines bleibt unter den besten drei | zwei oder mehr bleiben unter den besten drei; weniger als drei rangierte Council-Plätze in einem Quartal = ungelöst | 0.62 |
| F26 | Der Index ist schwer zu schlagen: in der letzten Session der Saison haben weniger als die Hälfte der 14 Modellkonten der Hauptliga einen höheren Wert als das S&P-500-Konto | value_usd der 14 Modellkonten und von _spy, arena-accounts.csv; eingereichte Skript |
B | 30 Apr 2027 | 6 oder weniger über _spy |
7 oder mehr über _spy |
0.60 |
| F27 | Gute Prognostiker sind nicht die besten Trader: über die Council-Plätze, die nach 1 Tag rangiert sind und ein Hauptliga-Konto halten, liegt die Spearman-Korrelation zwischen dem 1-Tage-Brier-Rang und dem Hauptliga-Rendite-Rang unter 0,5, wobei Rang 1 der niedrigste Brier und die höchste Rendite ist. Plätze sind diejenigen, die nach der 30/10-Regel über Sessions 11 bis 126 rangiert sind, Brier über alle ihre gezählten 1-Tage-Zeilen in diesem Fenster, Rendite aus dem value_usd des Kontos in der letzten Session der Saison; verbundene Werte nehmen den Durchschnitt ihrer Ränge |
gezählte 1-Tage-Zeilen von council-forecasts.csv, league-roster.json, arena-accounts.csv; eingereichte Skript | B | 30 Apr 2027 | rho < 0,5 mit mindestens 6 rangierte Plätze | rho ≥ 0,5 mit mindestens 6 rangierte Plätze; weniger = ungelöst | 0.83 |
| F28 | Zugang zu den Modellen vor der ersten Prognose verbessert den Brier-Score der Leser nicht um 0,01 oder mehr: bei übereinstimmenden Märkten (mindestens 200 erste Prognosen pro Gruppe) überschreitet der Brier-Score der Gruppe, denen die Modelle nicht gezeigt wurden, denjenigen der Gruppe, denen sie gezeigt wurden, um weniger als 0,01 (ein Effekt des Zugangs zwischen Gruppen; Konfidenz c auf einer Seite gelesen als Wahrscheinlichkeit c/100 dieser Seite; Trefferquoten daneben angegeben) | experiment.g0.brier und experiment.g1.brier, mit n von jedem, council-league.json |
A | 31 Dec 2026 | Differenz < 0,01 mit mindestens 200 pro Gruppe | Differenz ≥ 0,01 mit mindestens 200 pro Gruppe; weniger = ungelöst | 0.46 |
| F29 | Zugang bewegt Leser zum Council: die ersten Prognosen der Gruppe, denen die Modelle gezeigt wurden, stimmen in ihrer Richtung mit dem Council-Konsens mindestens 10 Punkte häufiger überein als diejenigen der Gruppe, denen sie nicht gezeigt wurden (ein Effekt des Zugangs zwischen Gruppen; mindestens 200 erste Prognosen pro Gruppe) | pro-Leser erste Prognosen des Experiments (Feld wird veröffentlicht und in arena-dataset.json dokumentiert) und der Konsens pro Lauf; eingereichte Skript | B | 31 Dec 2026 | Differenz ≥ 10 Punkte mit mindestens 200 pro Gruppe | Differenz < 10 Punkte mit mindestens 200 pro Gruppe; weniger = ungelöst | 0.41 |
| F30 | Stil verrät das Modell: in der blinden Saison (ab 2. November 2026) identifiziert ein fester Guesser (Modell, Version und der SHA-256 seines Prompts benannt in einem Zusatz zur vor 2. November 2026 eingereichten Registrierung, Temperatur 0, aus einer Familie ausgeschlossen aus den Kandidaten), dem eine versiegelte Antworttext pro Punkt und die Liste der k Kandidatenplätze, die geantwortet haben, gezeigt werden, das Modell mindestens dreimal so oft wie der Zufall | blind-season Antwortzeilen und die Post-Season-Enthüllung; eingereichte Skript | B | 30 Apr 2027 | mittlere Top-1-Genauigkeit über Punkte ≥ Mittelwert von 3/k | mittlere Top-1-Genauigkeit über Punkte < Mittelwert von 3/k | 0.46 |
Hinweis: Menge A wird durch ein oder zwei veröffentlichte Felder definiert. Menge B wird durch ein Skript definiert, das bei der Registrierung eingereicht und auf den offenen Rohdateien ausgeführt wird, und das Skript ist die Definition. Die Resolver jeder Zeile werden als resolve.py eingereicht (Regelversion osf-rules-1), mit den Details von Abschnitt 8.1: die Momentum-Regel von F15 ist die Richtung des Liga-Ergebnisses des Indikators in der vorherigen Sitzung bei 55 %, über alle Zeilen. Bei den Dateien vom 21. Oktober 2026 lesen F21, F29 und F30 ungelöst, und jede Zeile nennt die Daten, die sie benötigt. Ich habe die Schwellenwerte von F1 bis F5 und F9 festgelegt, nachdem die ersten versiegelten Läufe mir sichtbar wurden, und ihre Fenster beginnen bei Sitzung 11.
F14, F22 und F28 sind die Low-Power-Zeilen: der Standardfehler von F14 beträgt etwa 5 Punkte bei 100 Prognosen, von F22 etwa 11 Punkte bei 20 Kritiken und von F28 etwa 0,02 Brier bei 200 pro Gruppe. F15, F21 und F28 vergleichen Punktschätzungen mit einem Schwellenwert von 0,01 und sind keine Äquivalenztests.
Erwartet ohne Geschicklichkeit: F11, mindestens etwa 0,78 für zehn Rangmodelle, die unabhängig bei jeweils einseitigen 2,5 % fehlschlagen, höher, wenn sie über 0,25 liegen, und wieder höher, wenn ihre Fehler korreliert sind (F3). F16, mindestens etwa 0,93 über drei Horizonte unter der gleichen Annahme. F25, etwa 0,85 für elf Rangmodelle und 0,82 für zehn unter zufälligen Rankings. F10 ist offen für beide Ergebnisse: der Leiter wird auf einem früheren Fenster gewählt, und das Durchschnittsbilden garantiert einen Gewinn nur über dem Mittelwert der Mitglieder, die es behält (Abschnitt 4.5). F8 ist eine operative Prognose über die Liga. Kalibrierungsbehälter sind halboffene, [60,70) auf der gestützten Seite.
Prüfdaten: 30. November 2026 (Sitzung 30), 31. Dezember 2026 (Sitzung 52), 30. April 2027 (nach der 126-Sitzungs-Saison, die voraussichtlich um 20. April 2027 endet). Die blinde Saison beginnt am 2. November 2026. Darin versiegelt die Antwortzeile das Modell, seine Version und seinen Modus als ein gesalzenes SHA-256-Commitment, H(Salz || Modell || Version || Modus), sodass Anforderung 1 erfüllt ist, ohne den Namen zu zeigen. Die Salze werden nach der Saison veröffentlicht (Abschnitt 3.13), und F30 wird auf den versiegelten Antwortzeilen bewertet, sobald die Commitments geöffnet sind. Scorecards werden als datierte Überarbeitungen dieses Papiers veröffentlicht und auf OSF registriert.
Sekundäranalysen, die mit der Registrierung deklariert wurden, ohne Wahrscheinlichkeit. (1) Hilft Uneinigkeit: der gepaarte Gewinn des Konsenses gegenüber der Klimatologie in der höchsten gegen die niedrigste Terz der Ausbreitung der Sitze, Markt festgehalten, zweiseitig (Abschnitt 8). (2) Hilft die Diskontierung korrelierter Stimmen: der gepaarte eintägige Brier-Unterschied zwischen dem veröffentlichten Konsens und dem Schattenkonsens von Abschnitt 5.3, Sitzungen 11 bis 126, bewegender Block-Bootstrap (Blöcke von fünf, 10.000 Resamples, Seed 20261102) und die Äquivalenzzone von ±0,01; die Schattengewichte und das Skript, das sie berechnet, sind bei der Registrierung eingereicht. Keine ist eine F-Zeile, und keine geht in die Brier-Punktzahl der dreißig Vorhersagen ein.
Anhang E. Vergleich der Funktionen mit früheren Arbeiten (Stand 21. Oktober 2026)
Tabelle E1 stellt die Funktionen der Referenzimplementierung gegen die nächstliegenden Bemühungen dar, gelesen wie in der Anmerkung zu Tabelle 9 aufgeführt. Ja bedeutet, die Eigenschaft ist dokumentiert; Teilweise bedeutet, eine schwächere oder andere Form, wie in der Zelle angegeben; Nein bedeutet, dokumentierte Abwesenheit oder ein Design, das es ausschließt; ND bedeutet, nicht öffentlich dokumentiert bis 21. Oktober 2026 (Tabelle 9). Die Spalte für die Liga verwendet drei Status von ihr selbst, Stand 21. Oktober 2026: Implementiert bedeutet, sichtbar in den offenen Dateien. Spezifiziert bedeutet, in dem Standard oder der offenen Methodologie geschrieben und an diesem Datum in den Dateien abwesend. Vom Betreiber aufgezeichnet bedeutet, läuft, mit einem Datensatz, den eine dritte Partei durch Verlass auf den Betreiber überprüft. Eine Zelle kann zwei Status für zwei Teile einer Funktion angeben.
Tabelle E1. Funktionen von KI Council · Markets im Vergleich zu den nächstliegenden früheren Arbeiten, aus öffentlichen Materialien vom 21. Oktober 2026.
| Funktion | Unsere (Status) | Foresight Arena | Prediction Arena | NeuPortal | LLM Trading Arena | TradeRank | MarketMania | Andere |
|---|---|---|---|---|---|---|---|---|
| 1. Tägliche Live-Liga | Implementiert (ab 16. Oktober 2026) | Teilweise (Runden; Papierergebnisse simuliert, §6; Live-Agenten in Nechepurenko & Shuvalov, 2026b) | Ja (Zyklen alle 15 bis 45 Minuten, Januar bis März 2026) | Nein (pro Spiel) | Ja (Kryptowährungen zweimal täglich, Aktien an jedem Handelstag) | Ja (alle 24 Stunden) | Ja (ab 15. Juli 2026) | Ja: Alpha Arena, Agent Market Arena, Rallies, FutureX |
| 2. Sieben US-Labor- und sieben chinesische Labormodelle | Implementiert (14 Handelsplätze, 7 US und 7 chinesische Labore; 11 Prognoseplätze, 5 US und 6 chinesisch) | Nein (5 geplant, 1 chinesisch) | Nein (10 Modelle, 1 chinesisches Labor) | Nein (eine unbenannte KI) | Nein (6 Familien, 2 chinesisch) | Kein Länderdesign (22 Modelle) | Nein (7 Modelle, 2 chinesisch) | Nein: Alpha Arena 2 von 6; Rallies 2 von 8 |
| 3. Wahrscheinlichkeiten von Prognoseplätzen | Implementiert (11 Plätze) | Ja | Nein (nur Trades) | Ja (drei Ergebnisse) | Nein (Aufträge) | ND | Ja (angegebene Wahrscheinlichkeit) | Ja: Prophet Arena, ForecastBench |
| 4. Festes Fenster von Finanzindikatoren über Anlageklassen hinweg | Implementiert (12) | Nein (Polymarket-Events) | Teilweise (Kalshi-Finanzkontrakte in 7 Kategorien) | Nein (Fußball) | Teilweise (5 Kryptowährungen, S&P 100) | Teilweise (10 Kryptowährungen, 50 US-Aktien) | Teilweise (5 Kryptowährungen) | Teilweise: einzelne Aktien oder Kryptowährungen (StockBench, Agent Market Arena, GlassBallAI) |
| 5. Vier feste Horizonte auf dieselben Vermögenswerte | Implementiert | Nein | Nein | Nein | ND | ND | Ja (1 Stunde bis 1 Monat) | Ja, nicht Finanzfenster: ForecastBench acht Horizonte auf Datensatzfragen; Teilweise: GlassBallAI ein 10-Tage-Horizont |
| 6. Antworten versiegelt durch Hash vor der Referenz | Implementiert (SHA-256-Kette gebucht vor 09:30 ET); Datensatz des Betreibers für 19. und 20. Oktober 2026 (Stufe 1); öffentlich verifizierbar ab 21. Oktober 2026 (mindestens zwei RFC 3161-Token, Stufe 2+, Beweisnachweise); Versiegelung bei Ankunft spezifiziert | Teilweise (keccak256-Commit pro Agent und Runde, §3.2; keine Kette aller Antworten) | Nein | Teilweise (SHA-256 jeder Prognosedatei; keine dokumentierte Kette) | Teilweise (Git-Verlauf von Füllungen und Begründungen vor nächster Öffnungsfüllung) | ND | ND | Teilweise: Prophet Arena gesalzenes SHA-256-Register, Betreiberuhr; Sornette et al. (2010) Checksummen, nicht KI |
| 7. Anker außerhalb des Betreibers | Implementiert (Bitcoin, OpenTimestamps: Existenz nicht später als wenige Stunden nach dem Block; am 20. Oktober 2026 nach der Öffnung) | Teilweise (Polygon PoS, §3.2) | Nein | Ja (Bitcoin; Fußball, eine KI) | Nein (Zeit beruht auf Git-Host) | ND | ND | Ja, nicht Finanzen: Zeus On-Chain-Commits von Wetterprognosen; Jyotish (2026), nicht KI; Nein: Prophet Arena (Betreiberuhr) |
| 8. Referenzpreis nach der Versiegelung entnommen | Implementiert und öffentlich verifizierbar ab 21. Oktober 2026 (Stufe 2+, Anhang B, Schritt 9); vom Betreiber aufgezeichnet für 19. und 20. Oktober 2026 (booked_at, Stufe 1) |
Teilweise (Benchmark-Mittelkurs gespeichert nach der Frist; Ergebnis binär, Abb. 3) | Nein | Teilweise (Crowd-Preis bei oder vor dem Schloss) | Teilweise (Aufträge füllen sich bei nächster Öffnung) | ND | Teilweise (Eintrag bei der ersten 1-Minuten-Kerze nach der Antwort) | ND |
| 9. Ein gezählter Lauf nach einer im Voraus geschriebenen Regel; alle Läufe veröffentlicht | Implementiert (jeder Lauf veröffentlicht, andere mit not_counted gekennzeichnet); gezählter Lauf im Voraus erklärt und in der Kette der Fragen ab 21. Oktober 2026 versiegelt (Abschnitt 3.4); für die Entwicklungssitzungen vom 19. und 20. Oktober 2026 wurde die Regel nach den Läufen angewendet |
Teilweise (ein Commit pro Agent und Runde, Relayer-erzwungen, §4.3; alle Commits öffentlich auf Kette; Off-Chain-Läufe nicht abgedeckt) | Nein (Pre-Window-Lauf eines versteckten Modells, Anh. B.2) | ND | ND | ND | ND | ND |
| 10. Streng richtige Punktzahl und Kalibrierung | Teilweise implementiert (veröffentlichte Brier-Rückgänge, Unentschieden; Kalibrierungsbins); All-Rows-Brier spezifiziert als primär ab 21. Oktober 2026 und berechnet durch die eingereichten Skripte | Ja (Brier, Alpha, Murphy-Zerlegung, §3.3 bis §3.5) | Nein (Rückgabe, Gewinnquote, §3.3) | Ja (Drei-Ergebnis-Brier) | Nein (Kontowert) | ND | Ja (Brier, Kalibrierungslücke) | Ja: Prophet Arena, ForecastBench |
| 11. Uninformative 50% und klimatologische Benchmarks | Implementiert (50%); implementiert (2016 bis 2025 Häufigkeiten versiegelt; Feld climatology_fixed in den offenen Dateien ab 21. Oktober 2026, 08:54 UTC) |
Teilweise (zufällig und Markt-Baselines) | Nein | ND | ND | ND | ND | Teilweise: ForecastBench naive Baselines; KalshiBench Skill-Score gegen Klimatologie |
| 12. Mindestregel für Sitzungen vor der Rangliste | Implementiert (30/10, ranked Flaggen) |
Teilweise (Leistungsanalyse, empfohlene Mindestrunden, §3.6.2) | Nein | ND | ND | ND | ND | ND |
| 13. Simuliertes Portfolio von 100.000 $ pro Modell | Implementiert | Nein | Teilweise (echte 10.000 $ bei Ereignisverträgen) | Nein | Ja (100.000 $, Papier) | Teilweise (10.000 $ simuliert) | Teilweise (Papier-Futures-Trades) | Ja: Rallies 100.000 $; Alpha Arena echte 10.000 $ |
| 14. Leerverkäufe und 2× Hebelwirkung | Implementiert (Pro League) | Nein | Nein (keine Hebelwirkung, §4.5.1) | Nein | Teilweise (Krypto-Hebelwirkung, kein Leerverkauf) | ND | Teilweise (Long oder Short, Papier) | Ja: Alpha Arena gehebelte Perpetuals (Presse) |
| 15. Vorhersagemarktpreis zum Zeitpunkt der Antwort als Vergleich | Implementiert (crowd_up gegen den Vertragspreis) |
Ja (Alpha gegen Mittelkurs, §3.4) | Teilweise (Trades gegen Preise) | Ja | ND | ND | ND | Ja: Prophet Arena, AIA Forecaster |
| 16. Übereinstimmung diskontiert für korrelierte Stimmen, live | Implementiert (N_eff durch eine angegebene Zulassungsregel, n_eff.counted; Familiengewichte; Zählungen völlig falsch und Minderheit richtig) |
Nein (Marktunabhängigkeit angenommen, §7.5) | Nein | Nein (ein Modell) | ND | ND | Teilweise (Herdenverhalten gemessen, nicht diskontiert) | Nur offline: Kim et al. (2025), Spiro (2026), Aitchison et al. (2026) |
| 17. Geschlossenes Buch mit versiegeltem Nachrichtenpaket | Implementiert (versiegeltes Paket mit Hash); Abwesenheit des Suchoperators registriert, wo die Zeile nur Anweisung angibt | Nein (Suche optional, nicht gelöscht) | Nein (alle Modelle suchen) | ND | ND | ND | Teilweise (eine offengelegte Nutzlast mit Nachrichtenübersicht; Suche ND) | Teilweise: FinDeepForecast mit und ohne Suche, offline; MarketMania gemeinsame Nutzlast |
| 18. Diskussionsmodus des Rates | Implementiert | Nein (von Natur aus blind) | Nein (zukünftige Arbeit) | ND | ND | ND | ND | Teilweise: Koordinationskonfigurationen, live auf Foresight Arena (Nechepurenko & Shuvalov, 2026b) |
| 19. Wiederholte Abfragen eines Modells | Implementiert (Portfolios); Wahrscheinlichkeitswiederholungen angegeben | Nein | Nein | ND | ND | ND | Ja (Stabilitätsläufe) | Offline-Stichprobenstudien (Aitchison et al., 2026) |
| 20. Leser machen Vorhersagen, bevor sie die KI sehen, zwei permanente Gruppen | Live und offen für jeden Besucher; Ergebnisse registriert als F28 und F29, gelesen bei 200 ersten Vorhersagen pro Gruppe; Gruppenkennzeichnung angegeben | Nein | Nein | ND | ND | ND | ND | Teilweise: separate Pools (ForecastBench, Metaculus); Unterstützungsstudie (Schoenegger et al., 2025) |
| 21. Blinde Saison | Angegeben (ab 2. November 2026; Modell, Version und Modus versiegelt als salted SHA-256-Verpflichtung, Salze nach der Saison veröffentlicht) | Nein | Teilweise (ein Modell unter einer versteckten Kennung) | ND | ND | ND | ND | ND |
| 22. Datierte Vorhersagen über die Liga, blind bewertet | Implementiert (30, blind bewertet; auf OSF registriert vor dem Posten) | Nein | Nein | ND | ND | ND | ND | ND |
| 23. Offene Daten unter einer angegebenen Lizenz | Implementiert (CC BY 4.0) | Teilweise (on-chain, keine Datenlizenz angegeben) | ND (kein Repository angegeben) | Ja (GitHub, Zenodo) | Ja (MIT, vollständiges Ledger) | Teilweise (offenes JSON, Lizenz nicht angegeben) | Teilweise (API-Exporte, Lizenz ND) | Ja: ForecastBench, LiveTradeBench, StockBench; GlassBallAI CC BY-NC |
| 24. Open-Source-Scoring-Code mit Hashes | Implementiert (Engine-Code mit Hashes, arena-code.json; forecast-score Neuberechnung, tools/replay_brier.py; Resolver auf OSF eingereicht) | Ja (on-chain Verträge, Analyse-Repository) | Nein | ND | Teilweise (Code offen) | ND | ND | Teilweise: PolyBench, ForecastBench Code |
| 25. Neuberechnung jedes Kontos durch Dritte | Implementiert (replay.py) |
Ja („die vollständige Historie abspielen", Contributions 1) | Nein | ND | Ja (Ledger berechnet jedes Konto neu) | ND | ND | ND |
| 26. RFC 3161-Token beim Siegel | Implementiert ab 21. Oktober 2026, öffentlich verifizierbar (FreeTSA und DigiCert; Sectigo hinzugefügt am selben Morgen; Proof-Seite); Versiegelung bei Ankunft angegeben | Nein | Nein | ND | ND | ND | ND | Nicht KI: ein allgemeines Versiegelungswerkzeug für menschliche Vorhersagen |
Hinweis: § Nummern in den Spalten Foresight Arena und Prediction Arena beziehen sich auf Abschnitte dieser Arbeiten. Die Reihen 5, 10, 13 bis 15, 19 und 25 sind Funktionen, die die Liga mit früheren Arbeiten teilt. Reihen hinter den Ansprüchen von Abschnitt 7.4: Anspruch 1: Reihen 4 und 6 bis 9 (Reihe 8 auf Ebene 1 für 19. und 20. Oktober, Ebene 2+ ab 21. Oktober). Anspruch 2: Reihe 16. Anspruch 3: Reihen 6 bis 12, 16 und 26, lesen Sie mit der Statusspalte von Abschnitt 3.13. Anspruch 4: Reihe 20. Anspruch 5: Reihe 2. Anspruch 6: Reihe 22.
Wie Sie diese Arbeit zitieren
Chernets, V. (2026). Sealed Before the Open: A Verifiable Standard for Measuring AI Forecasts of Financial Markets [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7653679
@misc{chernets2026sealedbeforetheopen,
  author       = {Chernets, Vadym},
  title        = {{Sealed Before the Open: A Verifiable Standard for Measuring AI Forecasts of Financial Markets}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7653679},
  url          = {https://doi.org/10.2139/ssrn.7653679}
}