Sellado Antes de Abrirse: Un Estándar Verificable para Medir Pronósticos de IA en Mercados Financieros
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
Catorce modelos de IA estadounidenses y chinos, doce mercados, cuatro horizontes: una liga sellada en vivo, un recuento de voces independientes detrás de cada consenso y 30 predicciones registradas
Vadym Chernets, PhD, AI systems architect · Founder, PolyHelper (polyhelper.ai) · ORCID 0009-0007-4845-3163
SSRN 7653679 · DOI 10.2139/ssrn.7653679 · Zenodo 10.5281/zenodo.23552697 · OSF registration 10.17605/OSF.IO/9Q86N · Analysis release 10.5281/zenodo.23552700 · GitHub
Descargar este artículo
- SSRN (cita preferida): ssrn.com/abstract=7653679 · DOI 10.2139/ssrn.7653679
- Zenodo (archivado, acceso abierto): doi.org/10.5281/zenodo.23552697
- OSF (las predicciones registradas de la Sección 8): doi.org/10.17605/OSF.IO/9Q86N
- GitHub (texto completo y los comandos de verificación del Apéndice B): https://github.com/vadimchernets/papers/tree/main/sealed-before-the-open
- Analysis release (los archivos que esta versión lee, congelados, con un manifiesto SHA-256): doi.org/10.5281/zenodo.23552700
- Liga en vivo y datos abiertos (CC BY 4.0): trends.polyhelper.ai/markets/ · trends.polyhelper.ai/api/v1/
Verifica un sello en tres pasos (Apéndice B): descarga el libro y el sello del 20 de octubre, hash del prefijo sellado, verifica el ancla.
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt.ots
head -n 159 council-book.jsonl | shasum -a 256   # 59673b9e...a7d9, as in 130025Z.txt
ots verify 130025Z.txt.ots                       # Bitcoin block 972,334
Sin un nodo de Bitcoin, ots info 130025Z.txt.ots muestra la atestación al bloque 972.334, cuya raíz de Merkle cualquier explorador de bloques muestra (Apéndice B, Paso 6). El Paso 10 verifica la marca de tiempo en el registro Sigstore Rekor.
Cita el preprint de SSRN. Las sesiones puntuadas se leen a partir del 20 de octubre de 2026, a partir de los archivos abiertos generados el 21 de octubre de 2026 entre las 02:42 y las 05:33 UTC. La primera ejecución contada, del 21 de octubre de 2026, se lee a partir de los archivos generados a las 22:16 UTC. La Tabla 5 proporciona el estado de conformidad según se leyó el 21 de octubre de 2026 a las 15:05 UTC, la verificación de conformidad del requisito 1 a las 22:33 UTC y la entrada de Rekor del requisito 3 el 22 de octubre de 2026 a las 00:00:16 UTC.
Palabras clave: Predicción de IA; modelos de lenguaje grande; mercados financieros; evaluación de pronósticos; puntuación de Brier; calibración; sesgo de anticipación; marca de tiempo de confianza; OpenTimestamps; número efectivo de voces independientes; mercados de predicción; predicciones registradas
JEL: G17; C53; C52; G14; D84
Resumen
Cuando un modelo de IA dice que el oro subirá, un lector puede calificar la predicción al cierre, pero normalmente no puede verificar cuándo se realizó. Una prueba retrospectiva mezcla memoria con habilidad, y una temporada de negociación es un camino a través del mercado. Propongo un estándar de requisitos numerados para medir pronósticos de IA de mercados financieros y documento su implementación de referencia, la liga abierta AI Council · Markets, dirigida por PolyHelper, con un estado publicado por cada requisito. Catorce grandes modelos de lenguaje, siete de laboratorios estadounidenses y siete de laboratorios chinos, responden la misma pregunta en una instantánea de precio compartida, cada uno con su propia cuenta. Once de ellos pronostican doce indicadores en cuatro horizontes antes de cada apertura de Nueva York. Cada respuesta contada se sella en una cadena hash SHA-256 antes de su precio de referencia y se ancla en Bitcoin a través de OpenTimestamps. A partir del 21 de octubre de 2026, la ejecución contada se declara con anticipación, y autoridades RFC 3161 independientes firman cada registro marcado, que también ingresa al registro de transparencia Sigstore Rekor. En esa primera mañana contada, cada respuesta contada fue firmada antes de la apertura de las 09:30 ET, ocho de ellas 29 minutos antes. La puntuación de Brier del evento solicitado se establece en relación con un punto de referencia del 50%, la tasa base climatológica y los precios del mercado de predicciones, y el acuerdo se reporta como un recuento de voces independientes. En las mañanas de desarrollo del 19 y 20 de octubre, los panoramas de probabilidad de los modelos eran tan similares a los de aproximadamente 1,6 pronosticadores independientes. El 20 de octubre, tres de los cuatro pares más cercanos unieron un laboratorio estadounidense y uno chino. Contra un mapa fechado de 23 esfuerzos de pronóstico y negociación de IA, la liga es la primera liga de IA en vivo sobre indicadores financieros que combina estos elementos. También es la primera arena de mercado de IA donde siete modelos estadounidenses y siete chinos operan bajo un protocolo junto a lectores asignados una sola vez, al azar, para pronosticar antes o después de ver los modelos. Treinta predicciones fechadas, registradas en OSF antes de publicar, se califican en revisiones fechadas.
Resumen ejecutivo
Un pronóstico de un precio es evidencia de habilidad solo si el pronosticador no conocía el resultado, el pronóstico existía antes que este, y el pronóstico puntuado es el que cuenta, sin importar lo que digan los otros intentos. Los modelos de IA tensionan los tres: pueden haber leído el resultado en el entrenamiento, pueden ser consultados de nuevo en segundos, y su registro generalmente lo mantiene quien preguntó. Escribí cada condición como un requisito que un lector puede verificar. AI Council · Markets, operado por PolyHelper, es la implementación de referencia.
Cada pregunta concierne un resultado aún por venir, lo que la mantiene fuera de la memoria de un modelo. Un mercado es una prueba que se renueva a sí misma: hace una nueva pregunta cada mañana y la responde la misma tarde, así que ningún modelo puede haber leído la respuesta. Dos pronósticos se comparan solo cuando apuestan por lo mismo, y la unidad es por lo tanto un contrato de evento fijado de antemano. Cada respuesta se sella en una cadena de hash antes del precio de apertura a partir del cual se puntúa, ya que un pronóstico que ha visto el movimiento de apertura responde una pregunta diferente. No quise que el registro descansara en la confianza en su guardián, así que la cadena está anclada en Bitcoin y, desde el 21 de octubre de 2026, firmada por autoridades de sellado de tiempo independientes. Una ejecución por sesión cuenta. Desde el 21 de octubre, la regla que la selecciona se declara de antemano y se sella, y las otras ejecuciones permanecen publicadas y etiquetadas.
La puntuación es la puntuación de Brier del evento preguntado. Es una puntuación propia, así que un pronosticador no gana nada al afirmar nada más que su creencia. La liga la lee contra una moneda, la tasa base del evento y los precios del mercado de predicción, tres barras diferentes para la habilidad. Los modelos correlacionados no son testigos separados, y el acuerdo entre ellos se reporta como un número de voces independientes. Siete modelos estadounidenses y siete chinos comparten la pregunta, la captura de pantalla, el plazo y las reglas, así que cualquier diferencia entre los lados se mide en una tarea. Los lectores se aleatorizan una vez, para ver los modelos antes o después de que pronostiquen, y permanecen en ese grupo. Miden si los modelos ayudan a las personas o solo las arrastran (F28, F29).
Las dos mañanas de desarrollo muestran lo que estas medidas leen. En el horizonte de un día, las imágenes de probabilidad de los modelos sellados antes de la apertura eran tan parecidas como las de menos de dos pronosticadores independientes. Fueron más decididos a seis meses, donde sus pronósticos se resuelven al final, y el 20 de octubre tres de los cuatro pares más cercanos se unieron a un laboratorio estadounidense y uno chino. Una prueba primaria y treinta predicciones, registradas en OSF antes de publicar, se puntúan en revisiones fechadas en datos y código abiertos.
1. Introducción
El lunes por la mañana una persona pregunta a un modelo de IA si comprar oro. El modelo dice que sí, con cierta confianza, y da una razón. Al cierre, el oro ha caído. ¿Se equivocó el modelo, o tuvo mala suerte, o fue esta una de varias respuestas que dio esa mañana? ¿Existía la respuesta a las 09:00, o fue escrita al mediodía? La persona no puede saberlo. En la mayoría de las evaluaciones revisadas en la Sección 7, el momento de un pronóstico descansa en el registro del operador. La liga que describo aquí mantiene ese registro fuera del operador. El martes 20 de octubre de 2026, antes de la apertura, ocho modelos dieron al oro una probabilidad promedio del 45% de cerrar al alza en el contrato diario de Polymarket, y la multitud en ese contrato lo valoró al 29%. Ambos números fueron sellados antes de la apertura a las 09:30 ET, y cualquiera puede leerlos de nuevo (Apéndice B).
Las arenas en las que los modelos comercian dinero real recibieron amplia atención en 2025 (Forklog, 2025a, 2025b), y los puntos de referencia de pronósticos de LLM llegaron a los principales lugares de aprendizaje automático: ForecastBench en ICLR 2025 (Karger et al., 2025), FutureX (Zeng et al., 2025) y Prophet Arena (Yang et al., 2025) en ICLR 2026. Los puntos de referencia comerciales encontraron que la mayoría de los agentes no superaron la estrategia de comprar y mantener (Y. Chen et al., 2025; Yu et al., 2025), y en mercados de predicción líquidos un fuerte sistema de pronósticos de IA aún se quedaba atrás del consenso del mercado mientras que una combinación de los dos superó a ambos (Alur et al., 2025).
Estos esfuerzos comparten una dependencia: la evidencia de que un pronóstico precedió a su resultado es mantenida por quien ejecutó la evaluación. Los pruebas retrospectivas no pueden suministrarla en absoluto, porque el modelo puede ya conocer el resultado (Lopez-Lira et al., 2025; Paleka et al., 2026). Los puntos de referencia en vivo la suministran a través de los registros del operador, y Prophet Arena añade un sello SHA-256 salado de cada pronóstico, con recibos firmados opcionales, cronometrados por el reloj de la plataforma (Prophet Arena, 2026). Foresight Arena compromete pronósticos con hash de eventos de Polymarket, algunos de ellos sobre precios de activos, a la cadena de Polygon antes de una fecha límite y los califica contra el precio de mercado. Su versión revisada reporta resultados simulados y difiere los en vivo (Nechepurenko & Shuvalov, 2026a). Prediction Arena dio a modelos frontera capital real en Kalshi y Polymarket y mantuvo registros del operador sin un compromiso (Zhang et al., 2026). Fuera de la IA, los pronósticos de burbujas financieras fueron sellados por suma de comprobación con divulgación retrasada ya en 2010 (Sornette et al., 2010), y, fuera de los mercados, las probabilidades de fútbol de una IA han sido ancladas en Bitcoin desde julio de 2026 (NeuPortal, 2026). No encontré ninguna liga en vivo de pronósticos de IA en un panel fijo de indicadores financieros que ancle sus registros fuera del control del operador (Sección 7). Mi pregunta de investigación es qué necesita una medida de pronósticos de mercado de IA para que un lector pueda verificar, contra un reloj fuera del control del operador, qué fue pronosticado, cuándo, y qué pronóstico contó.
Propongo un estándar para esa medida, escrito como una lista de control de requisitos DEBE y DEBERÍA (Sección 3.13), y documento una implementación del mismo, la liga abierta en vivo AI Council · Markets, dirigida por PolyHelper, en trends.polyhelper.ai/markets. Catorce modelos, siete de laboratorios estadounidenses y siete de laboratorios chinos, ejecutan carteras simuladas sobre la misma pregunta, captura de pantalla y reglas, y once de ellos se sientan en el Consejo y dan probabilidades. Cada mañana antes de la apertura de Nueva York el Consejo pronostica 12 indicadores financieros, entre índices bursátiles, tasas, el dólar, volatilidad, materias primas y Bitcoin, en cuatro horizontes de un día a seis meses. Cada respuesta está sellada en un libro encadenado por hash cuya cabecera está anclada en Bitcoin a través de OpenTimestamps. Cada respuesta se califica desde el primer precio después de su sello, y el libro se publica con el código de calificación y los datos. A partir del 21 de octubre de 2026 autoridades de marca de tiempo RFC 3161 independientes también firman cada registro marcado con tiempo, para que un lector pueda verificar contra relojes fuera del control del operador que las respuestas contadas existían antes del precio de apertura con el cual se cuentan (Sección 3.2). El registro sellado es también un nuevo tipo de datos abiertos para las finanzas: un panel diario de probabilidades de muchos modelos de IA sobre los mismos eventos, fijo antes de la apertura, sobre el cual se pueden medir su desacuerdo y su valor.
El contrato de evento se publica como un esquema con un verificador que cualquier otra liga puede ejecutar en sus propios archivos (Sección 3.13). Lo que contribuyo es el estándar y una implementación que un lector puede verificar. Las primeras sesiones muestran los datos que produce, y las pruebas registradas de la Sección 8 deciden la habilidad. La Sección 3 enuncia el estándar y la Sección 4 un diseño de calificación para un escenario de mercado en vivo. La Sección 5 mide el número efectivo de voces independientes en datos en vivo, la Sección 6 establece un diseño para humanos antes de IA, y la Sección 7 traza un mapa fechado de arenas de mercado de IA. La Sección 8 contiene las predicciones registradas, la Sección 9 las objeciones más fuertes con la regla que responde a cada una, y la Sección 10 el alcance de cada afirmación. La Sección 7.4 enuncia qué es nuevo, en tres afirmaciones y tres diseños adicionales por primera vez entre las arenas de mercado de IA revisadas, y sobre qué se construye la liga, cada uno con su precedente más cercano. El Apéndice E da la evidencia celda por celda.
2. Por qué la retrospectiva invalida los pronósticos del mercado de IA
Los torneos de pronóstico humano resguardan las tres condiciones del Resumen ejecutivo mediante plazos de registro y un organizador de confianza. Los modelos de IA se cuelan más allá de cada salvaguarda. Un modelo puede conocer el resultado a partir del entrenamiento, puede ser interrogado muchas veces en un minuto, y el registro de lo que dijo se mantiene, por regla general, por la persona que preguntó. Las primeras tres subsecciones abordan estas cuestiones por turno, y la cuarta explica por qué una temporada de negociación no puede sustituir un registro de pronósticos.
2.1 Lo que recuerda un modelo
La evaluación más barata de un modelo de IA en pronósticos financieros es una prueba retrospectiva, pero los datos de entrenamiento del modelo pueden ya contener lo que sucedió después. Lopez-Lira et al. (2025) demostraron que los modelos de lenguaje grandes recuperan valores exactos de series macroeconómicas y financieras anteriores a su fecha de corte de entrenamiento, que una instrucción de no utilizar conocimiento posterior no elimina la recuperación, y que la recuperación se detiene después del corte: dentro de la ventana de entrenamiento, la habilidad y la memoria no se identifican.
Gao et al. (2025) construyeron una prueba para el sesgo de anticipación, la propensión a mirar hacia adelante. En una replicación del resultado de que las puntuaciones de los modelos sobre titulares de noticias predicen rentabilidades de acciones (Lopez-Lira & Tang, 2023), la potencia predictiva se amplificó en observaciones con alta propensión a mirar hacia adelante. Después del corte, la señal sin procesar persistió, mientras que la interacción asociada con la memorización perdió significancia. Glasserman y Lin (2023) separaron dos sesgos en la muestra de pruebas retrospectivas de sentimientos de GPT, anticipación y una distracción por lo que el modelo sabe sobre la empresa mencionada, y encontraron que la segunda era mayor, sobre todo para empresas grandes. En veinte años de datos, el marco FINSABER encontró que las ventajas reportadas para estrategias de inversión con LLM se reducen drásticamente una vez que se controlan la supervivencia, el sesgo de búsqueda de datos y la anticipación (W. W. Li et al., 2025), y los puntos de referencia construidos sobre simulación histórica, como InvestorBench (H. Li et al., 2025), heredan la misma exposición.
La literatura repara esto de dos maneras. Una restringe el modelo: los modelos de lenguaje cronológicamente consistentes se entrenan solo con texto disponible antes de cada fecha de pronóstico (He et al., 2025). La otra restringe el tiempo: cualquier modelo, a toda su potencia y con búsqueda, se interroga sobre un resultado aún por venir, y la respuesta se fija, verificablemente, antes de que el resultado exista. Opté por restringir el tiempo y dejar el modelo a toda su potencia. Las dos rutas son complementarias, ya que un modelo cronológicamente consistente puede entrar en una liga sellada.
2.2 Rutas de fuga
Pasar a preguntas en directo elimina la fuga más grande pero no toda fuga. Paleka et al. (2026) muestran que la fuga temporal en evaluaciones de pronosticadores de modelos de lenguaje es a menudo sutil, y que el desempeño en una evaluación puede no transferirse al pronóstico en el mundo real. FutureX reporta modos de fallo de la misma familia, incluyendo páginas web falsas y respuestas cuya validez temporal es incorrecta (Zeng et al., 2025). En pronósticos macrofinancieros, restringir las entradas de un modelo a lo que estuvo disponible al momento de la decisión elimina gran parte de la habilidad aparente que los puntos de referencia con fuga reportan (Guan & Chen, 2026). Una forma nombrada es la deriva de eventos entre días: artículos de los días posteriores a un informe de ganancias ya llevan la reacción del mercado, y si entran en las entradas para un día anterior, el resultado se filtra en el pronóstico (Zhang & Zhang, 2026). Un pronóstico sellado antes del precio de referencia no puede basarse en texto escrito después de él.
Para los mercados financieros el problema de sincronización es concreto. Un pronóstico para el día registrado a las 09:29 y uno registrado a las 09:45 son objetos diferentes, porque el segundo puede ver el movimiento de apertura. Si el registro de cuándo se hizo un pronóstico lo mantiene solo el operador, un lector debe confiar en que ninguna respuesta posterior ocupó el lugar de una anterior. La preregistración separa la generación de una hipótesis de su prueba al fijarla en un registro público antes de que los datos existan (Nosek et al., 2018). Un pronóstico sellado es una preregistración automatizada y diaria, y la marca de tiempo de confianza permite que un tercero verifique su hora (Haber & Stornetta, 1991; Todd, 2016).
2.3 Muchas ejecuciones, una puntuación
Un pronosticador en un torneo generalmente presenta una respuesta antes de una fecha límite. Un modelo puede ser interrogado diez veces, con redacción ligeramente diferente o en minutos ligeramente diferentes, y sus respuestas varían. Un evaluador que elige la mejor de diez, o vuelve a ejecutar una tubería después de una falla y mantiene la nueva ejecución, infla la habilidad sin cambiar un solo pronóstico, y la inflación es invisible a menos que cada ejecución se registre y la regla de qué ejecución cuenta se fije de antemano. Por lo tanto, escribí el estándar para sellar cada ejecución que envía, contar una ejecución por sesión según una regla escrita antes de las ejecuciones, y mantener las otras como cálculos de referencia etiquetados (Sección 3.4).
2.4 Una trayectoria no es una medida
Las arenas en las que los modelos cotizan dinero responden cuyas decisiones hubieran ganado dinero, pero el rendimiento de una cartera durante una temporada es un resultado de los caminos que el mercado podría haber tomado. Los relatos de prensa de las primeras dos temporadas de Alpha Arena reportan una inversión de la clasificación: el modelo que ganó la primera temporada, en futuros perpetuos de criptomonedas, fue uno de los más débiles en la segunda, en acciones estadounidenses tokenizadas con nuevos formatos y apalancamiento (Forklog, 2025a, 2025b; Yahoo Finance, 2025). Los activos, formatos y modelos cambiaron entre temporadas, por lo que la inversión, como esos relatos la reportan, no identifica la suerte. Es lo que una temporada como una trayectoria predice. StockBench encontró que la mayoría de los agentes que negociaban acciones Dow durante aproximadamente cuatro meses no superaban comprar y mantener (Y. Chen et al., 2025), LiveTradeBench encontró durante más de 50 días en directo que las clasificaciones de chat general no predecían resultados de negociación (Yu et al., 2025), y PredictionMarketBench encontró que agentes ingenuos pierden contra comisiones y liquidación en libros de órdenes de Kalshi reproducidos (Arora & Malpani, 2026). Prediction Arena dio capital real a una cohorte de modelos de frontera durante 57 días, y los mismos modelos promediaron un rendimiento de −22,6% en Kalshi y −1,1% en Polymarket (Zhang et al., 2026): la plataforma movió el resultado promedio por más de veinte puntos. Ninguno puede decir si un modelo sabía algo sobre el mercado, porque un rendimiento mezcla la dirección de una llamada, su tamaño, su sincronización, sus costos y la trayectoria del mercado en un número.
Las probabilidades aíslan la dirección y la confianza de una predicción. Un modelo que afirma una probabilidad del 70% de que el oro suba hoy puede evaluarse en función de esa declaración únicamente, mediante una regla estrictamente propia (Brier, 1950; Gneiting & Raftery, 2007). Doce mercados en cuatro horizontes temporales generan muchas afirmaciones de este tipo por modelo por día, aunque los doce mercados de un día comparten una sesión (Sección 4.6). En cuestiones de un mercado de predicción regulado que se resolvió después del entrenamiento de los modelos, cinco modelos fronterizos fueron excesivamente confiados, y el razonamiento ampliado empeoró la calibración (Nel, 2025).
2.5 Lo que exigen las tres condiciones
La predicción debe hacerse después del corte del modelo sobre un resultado aún por venir (2.1). Su tiempo debe fijarse antes del resultado en un registro cuyo cambio posterior un tercero pueda detectar (2.2). La regla para qué predicción cuenta debe fijarse antes de las ejecuciones (2.3). La puntuación debe ser una puntuación propia del evento preguntado, agregada sobre suficientes sesiones independientes para distinguir habilidad de una trayectoria afortunada, con una verificación de calibración (2.4). Y el acuerdo entre modelos debe descontarse por la correlación de sus errores antes de leerlo como evidencia (Clemen & Winkler, 1985; Kim et al., 2025; Chernets, 2026a). La Sección 3 escribe los cinco como una lista de verificación.
3. El protocolo
El protocolo convierte el momento de una predicción en un hecho que un tercero puede verificar, y especifica qué capa de ese hecho recae sobre quién. Todo lo que sigue se publica en los archivos abiertos de la liga (AI Council · Markets, 2026): el protocolo como arena-protocol.json, el libro sellado como council-book.jsonl, los textos de las preguntas bajo asks/, y las listas marcadas con sus pruebas OpenTimestamps en una página por día (/markets/proof/<day>/). Describo las reglas tal como estaban el 20 de octubre de 2026 (protocolo arena-3, versión 2 de la metodología de puntuación) y utilizo la ejecución de esa mañana, 2026-10-20-am, como el ejemplo resuelto; cada hora y hash citados para él pueden leerse de vuelta en los archivos abiertos (Apéndice B). Cada sello lleva la versión de la metodología en vigor, y un cambio posterior de reglas deja todo lo sellado antes como estaba.
El contrato de evento. El estándar mide eventos. Un modelo, una ejecución o una fila de una tabla de clasificación es una colección de ellos, y defino cada evento mediante un contrato fijado antes de que la pregunta se publique (Tabla 1). Dos predicciones pertenecen al mismo evento solo cuando todos los campos coinciden. Una predicción con una referencia propia, como una línea sellada después de la apertura (Sección 3.3), es una predicción sobre un evento diferente. Se puntúa en ese evento y se mantiene fuera de toda estadística que compare modelos en un evento común (requisito 4).
La palabra rendimiento nombra tres eventos separados en esta liga. La predicción es sobre el rendimiento a 10 años en sí, en unidades de rendimiento, desde su referencia hasta su precio terminal a las 15:00 ET. El contrato de multitud, cuando la pregunta lista uno, se resuelve en el rendimiento par del Tesoro a las 3:30 PM ET, cierre a cierre, y se puntúa en esos términos (Sección 4.9). La cartera mantiene un fondo de bonos del Tesoro (IEF), que sube cuando el rendimiento cae (Sección 4.7). El 20 de octubre la multitud precificó el contrato de rendimiento al 7% frente al rendimiento par anterior del 5,15%, un precio que ya incluía la caída previa a la apertura; la propia pregunta de la liga sobre el rendimiento comienza desde la referencia de las 09:30 y pregunta algo diferente. Un acierto en uno no dice nada por sí mismo sobre los otros. El VIX se divide de la misma manera: la predicción es sobre el índice, la cartera ordinaria no puede mantenerlo, la liga Pro sí.
Tabla 1. Campos mínimos de un contrato de evento, y dónde la implementación de referencia fija cada uno.
| Campo | Lo que fija | Implementación de referencia |
|---|---|---|
| Objetivo | El indicador en sí, no un instrumento que lo siga | 12 indicadores por código; los fondos negociados aparecen solo en las ligas de cartera (assets, trades_as) |
| Predicado y horizonte | El evento: una subida estricta desde la referencia hasta el precio terminal | prob_up; 1d; 1w, 1m, 6m como 5, 21 y 126 sesiones (Bitcoin 7, 30 y 182 días de calendario) |
| Fuente de precios | Proveedor, símbolo, tamaño de barra y regla de marca de tiempo para el precio de referencia y terminal, por indicador | Proveedor, símbolo y regla de referencia en cada fila de predicción (price_provider, price_symbol, reference_rule; para el S&P 500, la barra de un minuto de ^GSPC en o después de la hora de referencia), declarados por indicador en el esquema del contrato; fuente de los precios de la cartera en el protocolo (prices) |
| Corte de información | Lo que una predicción puede usar: cualquier cosa antes del precio de referencia, nunca la referencia en sí | Instantánea de precios y pregunta procesadas en la línea de ejecución (snapshot_sha256, ask_sha256) |
| Plazo y ejecución contada | Qué respuesta cuenta para la sesión | A partir del 21 de octubre de 2026, la ejecución matutina programada, declarada con anticipación, sellada en asks.jsonl y publicada en la página de prueba; dentro de ella, la línea sellada última antes de la referencia (counted), y desde la sesión 11 (2 de noviembre de 2026) la primera línea de respuesta bien formada de cada asiento sellada antes de la referencia, líneas posteriores del mismo asiento etiquetadas como reintentos, por una regla declarada en asks.jsonl, línea 74, SHA-256 de texto 0f42c93b…b0b6cd. Para el 19 y 20 de octubre, la ejecución sellada última antes de la apertura (session_run), aplicada después de las ejecuciones; en toda ejecución contada hasta la fecha cada asiento selló una línea de respuesta, por lo que la primera y última línea antes de la referencia son iguales |
| Precio de referencia | Una referencia por evento, tomada después del sello | Primer precio en o después de las 09:30 ET; Bitcoin, el cierre de la primera barra de un minuto que comienza en o después del sello de la línea (reference, btc) |
| Resolución | Precio terminal, su hora y su regla | Cierre de la última sesión del horizonte a las 16:00 ET; el rendimiento a 10 años a las 15:00 ET; el día de Bitcoin desde el minuto del sello hasta las 16:00 ET de la sesión de puntuación |
| Regla de empate | Qué movimientos pequeños son empates y cómo se puntúan | Banda de 0,1 veces una escala de barra de minuto del movimiento del día, aproximadamente 0,08 de una desviación estándar de sesión; sesiones de despliegue excluidas (direction, noise_rolls) |
| Regla de puntuación y puntos de referencia | La puntuación adecuada y con qué se compara | Puntuación de Brier sobre todas las filas; punto de referencia del 50%; climatología fija del evento (climatology_fixed, Sección 4.3) |
| Versión de reglas | Qué metodología se aplica | methodology.version, sellada en cada línea de ejecución; methodology_version en cada fila de predicción |
| Identificador de evento | Una clave para "el mismo evento" | event_id_v2, un hash de las nueve claves del contrato completo, con la event_id de cinco claves junto a él (event-contract.schema.json, Sección 3.13) |
Nota: Los nombres de campo entre paréntesis son los de los archivos abiertos (arena-protocol.json, el campo methodology de cada línea de ejecución, council-stats.json, council-calibration.json y las columnas de council-forecasts.csv). La ventana de las 15:00 ET del rendimiento se indica en la línea de ejecución sellada del 20 de octubre.
3.1 Un día de la liga
La Figura 1 sigue un día de liga desde la instantánea hasta la puntuación.
Instantánea. Antes de que la pregunta se envíe, el motor toma una instantánea de precios de los 12 mercados: S&P 500, Nasdaq-100, Dow Jones, el índice de semiconductores (SOX), el rendimiento del bono del Tesoro estadounidense a 10 años, el índice del dólar (DXY), VIX, oro, WTI, Brent, cobre y Bitcoin (Tabla 2). Cada fila contiene su precio, cambios recientes, rango de 52 semanas y el minuto en que se leyó; antes de la apertura, las filas del índice bursátil y el rendimiento contienen la sesión anterior, mientras que las otras filas están en tiempo real. El SHA-256 de la instantánea se escribe en la línea de ejecución (snapshot_sha256), por lo que una afirmación posterior de que los modelos vieron precios diferentes puede ser verificada.
Pregunta. Catorce asientos operan; once de ellos también dan probabilidades y forman el Consejo, cinco de laboratorios estadounidenses y seis de laboratorios chinos, y tres asientos en el banco solo operan (Tabla 8). Una pregunta va a cada modelo del Consejo, palabra por palabra excepto un bloque que da a cada modelo su propia cuenta. El SHA-256 del texto común se escribe en la línea de ejecución (ask_sha256) y se repite en cada línea de respuesta, y el texto se publica como asks/<sha256>.md. El hash del texto que cada modelo recibió, incluida su propia cuenta, se sella cuando se envía (asks.jsonl). El 20 de octubre, la pregunta se abrió a las 08:30 EDT, y su archivo publicado corresponde al valor en la línea de ejecución, 77d3c627…6f07. También dio los cambios previos a la apertura de los futuros del índice bursátil e informó a los modelos que pueden usarlos (Sección 3.3).
Sello antes de las 09:30 ET. Cada respuesta se registra como una línea del libro encadenado por hash. El 20 de octubre, las ocho respuestas contadas llevan tiempos de respuesta de 12:31:11Z a 12:42:02Z; la línea de ejecución y las respuestas ingresaron al libro en un lote, las respuestas con booked_at 13:00:25Z, y el lote fue marcado con hora a las 13:00:25Z (09:00:25 ET). Un sello de lote marca el tiempo del lote. El Requisito 12 sella cada respuesta a su llegada, y la mañana del 21 de octubre muestra ambas formas. Sus primeras ocho respuestas contadas (12:32:52Z a 12:44:59Z) se registraron en un lote a las 13:00:19Z, el segundo en el que dos autoridades externas firmaron su lista marcada con hora, y una novena se registró a las 13:23:37Z, 14 segundos después de su llegada, el segundo en el que tres autoridades firmaron la siguiente lista (Sección 3.2). La página de prueba del 20 de octubre registra que «la recepción para la puntuación cerró el martes, 20 de octubre de 2026, 9:30 AM ET (2026-10-20T13:30:00Z)». Se tomaron cuatro sellos ese día, a las 13:00:25Z, 15:00:12Z, 15:36:05Z y 16:52:54Z, anclados en los bloques 972,334, 972,344, 972,354 y 972,359. El primero cubre las líneas 1 a 159, que contienen la línea de ejecución (151) y las ocho respuestas contadas (152 a 159).
Apertura. El precio de referencia de cada mercado excepto Bitcoin es el primer precio en o después de las 09:30 ET; para Bitcoin, que opera continuamente, es el cierre de la primera barra de un minuto que comienza en o después del sello de la línea. La referencia siempre se toma después del sello (Sección 3.3).
Puntuación después del cierre. Después del cierre de las 16:00 ET, el motor escribe una línea de puntuación en el mismo libro con el precio de referencia, cierre, cambio, bandera de empate y la probabilidad que dio cada modelo. El 20 de octubre, la línea de puntuación (línea 184) se registró a las 20:30:36Z, después del último sello del día, por lo que está cubierta por el siguiente sello, el primero del 21 de octubre. Los horizontes más largos se puntúan cuando se cierran sus ventanas, como sus propias líneas.
Figura 1. Un día de la liga: instantánea, pregunta, sello, apertura, puntuación.
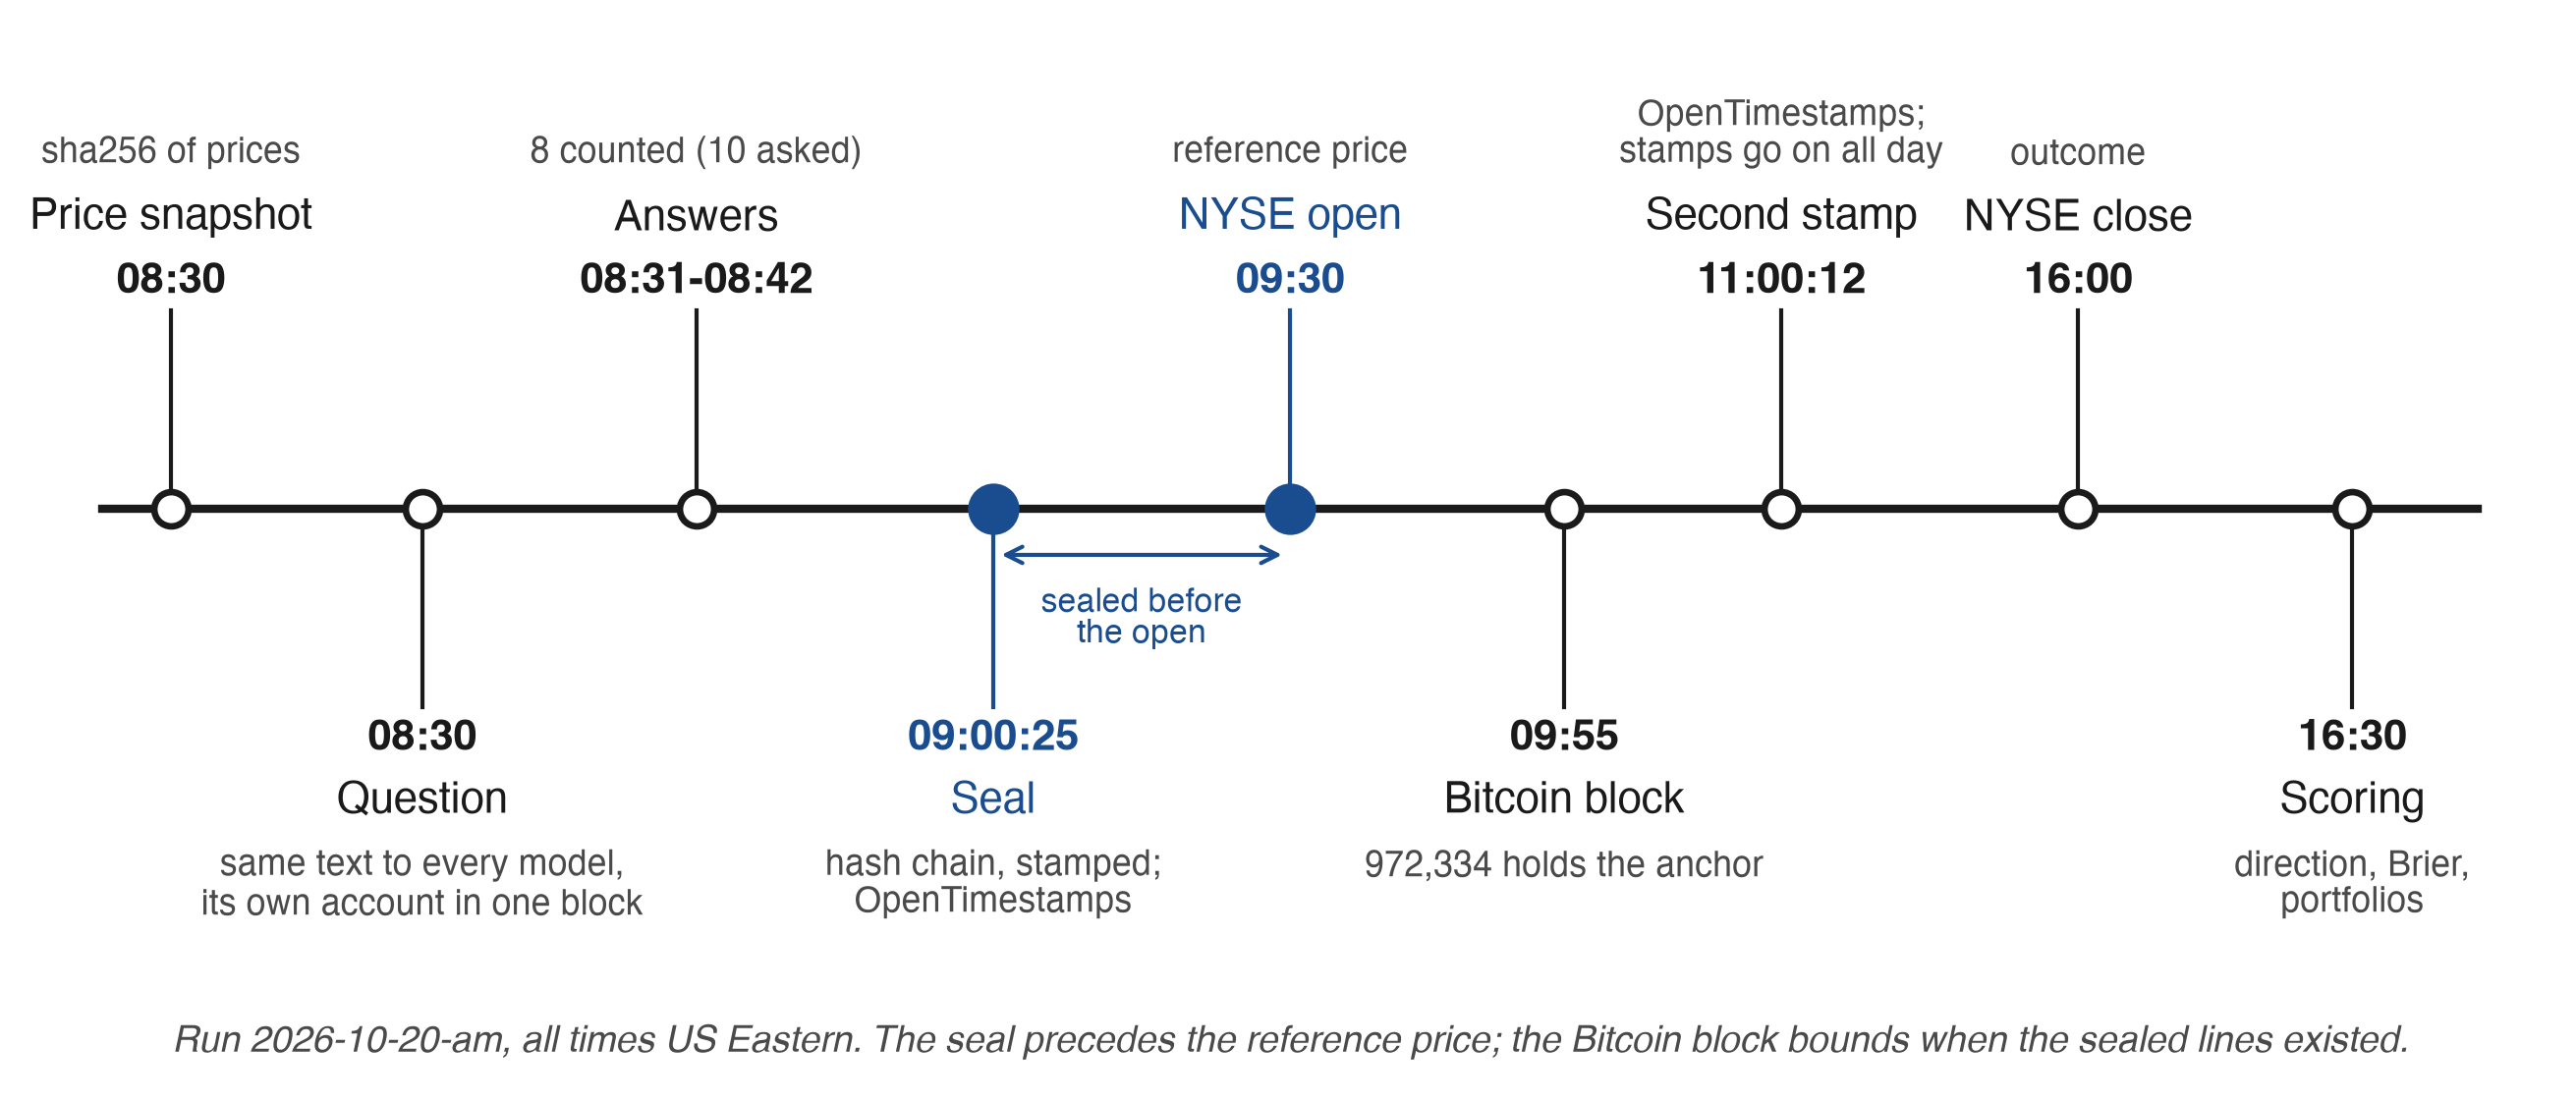
Nota: Los tiempos son los de la ejecución 2026-10-20-am leídos de council-book.jsonl y la página de prueba /markets/proof/2026-10-20/. ET es la hora de Nueva York. El tiempo del bloque de Bitcoin es la hora de encabezado del bloque 972,334, que contiene el ancla del sello de 13:00:25Z. Una hora de encabezado acota el tiempo de minería por el límite práctico (Sección 3.11). El segundo sello del día, 15:00:12Z (11:00:12 ET), está marcado para mostrar que los sellos se extienden a lo largo del día; la línea de puntuación de 20:30:36Z está cubierta por el primer sello del día siguiente.
En la Tabla 2 doy, para cada mercado, el símbolo de precio en el que se resuelve su evento, el final de su evento de un día, el fondo a través del cual las ligas de cartera lo mantienen y el contrato de multitud sellado con la pregunta el 20 de octubre de 2026.
Tabla 2. Los doce mercados: símbolo de precio, referencia y final del evento de un día, el fondo en el que se opera en las ligas de cartera, y el contrato de multitud sellado el 20 de octubre de 2026.
| Mercado | Código | Símbolo de precio | Referencia | Final del evento de un día (ET) | Se opera como | Contrato de multitud, 20 de octubre de 2026 (lugar, volumen sellado $) |
|---|---|---|---|---|---|---|
| S&P 500 | SPX | ^GSPC |
Primera barra de 1 minuto en o después de las 09:30 ET | 16:00 | SPY | Polymarket, 20,637 (Kalshi también listado) |
| Nasdaq-100 | NDX | ^NDX |
Igual | 16:00 | QQQ | Kalshi, 1,150 |
| Dow Jones | DJI | ^DJI |
Igual | 16:00 | DIA | Polymarket, 20 |
| Semiconductores | SOX | ^SOX |
Igual | 16:00 | SOXQ | Ninguno |
| Rendimiento del Tesoro estadounidense a 10 años | US10Y | ^TNX |
Igual | 15:00 | IEF | Kalshi, 3,199 |
| Índice del dólar | DXY | DX-Y.NYB |
Igual | 16:00 | UUP | Polymarket, 4 |
| VIX | VIX | ^VIX |
Igual | 16:00 | No se mantiene (indicators_only) |
Ninguno |
| Oro | GOLD | GC=F |
Igual | 16:00 | GLD | Polymarket, 3,112 (Kalshi también listado) |
| WTI | WTI | CL=F |
Igual | 16:00 | USO | Polymarket, 3,736 (Kalshi también listado) |
| Brent | BRENT | BZ=F |
Igual | 16:00 | BNO | Ninguno |
| Cobre | COPPER | HG=F |
Igual | 16:00 | CPER | Ninguno |
| Bitcoin | BTC | BTC-USD |
Cierre de la primera barra de 1 minuto que comienza en o después del sello de la línea | 16:00 de la sesión de puntuación | BTC-USD | Polymarket, 38 |
Nota: De las filas de pronóstico de las ejecuciones del 20 y 21 de octubre de 2026 (price_provider, price_symbol, reference_rule, event_end_at), arena-protocol.json (assets, indicators_only) y la línea 151 de ejecución de council-book.jsonl (crowd.odds, crowd.kalshi). Cada fila nombra el proveedor yahoo_finance_chart_v8_1m y la regla first_1m_bar_at_or_after_reference_at__last_1m_bar_at_or_before_end_at__v1. Los horizontes de una semana, un mes y seis meses son 5, 21 y 126 sesiones (Bitcoin 7, 30 y 182 días; tabla 1). Los bandos de sorteo se establecen por sesión (tabla 1) y no se enumeran. La comparación de multitudes principal admite contratos con un volumen sellado de al menos $1.000 (sección 4.9).
Los precios existen antes de la pregunta, la pregunta antes de las respuestas, las respuestas antes del precio por el que se califican, y el resultado después de todos ellos. Cada "antes" se escribe en el libro como un hash, y la cabeza del libro se ancla fuera del control del operador.
3.2 Qué es un sello
El libro es una secuencia de líneas JSON , escritas una sola vez y conservadas tal como están escritas. Cada línea tiene cuatro campos de contabilidad: su posición n, el hash de la línea anterior prev, su propio hash de contenido seal y su hash encadenado link. Sea SHA-256 (Instituto Nacional de Estándares y Tecnología, 2015) y sea la serialización de un objeto JSON con claves ordenadas exactamente como lo escribe json.dumps(o, sort_keys=True, ensure_ascii=False) de Python, codificado como UTF-8 (Apéndice B, paso 4). Entonces para la línea con contenido (cada campo excepto los cuatro):
El sello fija lo que dice la línea. El enlace fija lo que dice, dónde está y todo lo que viene antes. Recompute ambos hashes para las 211 líneas del libro al 20 de octubre de 2026: cada seal y cada link se reproduce, y cada prev es igual al link de la línea anterior.
La línea de ejecución lleva el hash de la pregunta, el hash de la instantánea de precio, el registro por lado, la metodología de puntuación en vigor y los precios del mercado de predicción registrados cuando la pregunta se envió. La línea de respuesta lleva el modelo, su modo y su respuesta analizada completa para los 12 mercados y cuatro horizontes, con own_sha256, el hash de la respuesta sin procesar, y ask_sha256. La línea de puntuación lleva el resultado. Los tres se sellan de la misma manera.
Una cadena por sí sola prueba el orden y el contenido. Un operador que controle el archivo podría reconstruir una cadena completa en una tarde, así que tomo tiempo de fuera. En cada ejecución, el motor escribe una lista breve con marca de tiempo que nombra, para cada libro, cuántas líneas tenía, el SHA-256 de exactamente esas líneas y el enlace de la última. Para este libro el 20 de octubre a las 13:00:25Z dice "159 líneas, sha256 59673b9e…a7d9, último enlace 378273fd…7175b2c". La lista está marcada con marca de tiempo con OpenTimestamps (Todd, 2016), que agrega muchos hashes en un árbol de Merkle y compromete su raíz en una transacción de Bitcoin a través de servidores de calendario públicos. La prueba .ots, publicada junto a la lista, contiene la ruta de operaciones hash desde el SHA-256 de la lista hasta la raíz de Merkle de un encabezado de bloque, aquí bloque 972.334, tiempo de encabezado 13:55:20Z. La construcción es la marca de tiempo vinculada de Haber y Stornetta (1991) con la cadena de Bitcoin (Nakamoto, 2008) como testigo.
Califico las pruebas de temporización por quién debe confiar un lector, desde el propio registro del operador hasta una marca de tiempo firmada:
- Nivel 1, el registro del operador. Cada línea se sella en la cadena (
at,prev,link; las líneas de respuesta añadenbooked_at, el segundo de su sello de lote), y el precio de referencia se toma después del sello. La cadena fija el orden y el contenido; el minuto del sello es lo que registró el operador. - Envío a los calendarios. La lista que contiene la cabeza de la cadena se envía a calendarios públicos de OpenTimestamps (las pruebas nombran
alice.btc.calendar.opentimestamps.orgybob.btc.calendar.opentimestamps.org). Un recibo pendiente muestra que el hash fue aceptado; no lleva ningún tiempo que un lector pueda verificar. - Nivel 2, el anclaje de Bitcoin. Los calendarios confirman el hash en un bloque de Bitcoin. El prefijo anclado existió no más tarde que unas pocas horas después de la hora del encabezado del bloque, según el límite práctico (Sección 3.11), y cualquiera que posea una prueba anterior puede detectar una reescritura posterior de una línea en él. El bloque puede minarse después de las 09:30 ET: el 20 de octubre la marca de las 09:00:25 ET llegó a un bloque con hora de encabezado 09:55:20 ET.
- Nivel 2+, marca de tiempo firmada. A partir del 21 de octubre de 2026, autoridades independientes de marcas de tiempo RFC 3161 (Adams et al., 2001), FreeTSA y DigiCert, unidas por Sectigo desde la tercera lista de ese día, firman cada lista sellada, fijando el segundo en el que existe cada línea que cubre. El lector confía en una autoridad y su certificado en lugar del operador, y con autoridades independientes cualquiera basta. El token marca la hora del lote. La llegada de cada respuesta es el asunto del requisito 12.
Una línea está sellada cuando entra en la cadena, la cabeza está marcada cuando va a los calendarios, y está anclada cuando llega a un bloque. Debido a que el libro solo crece, una marca tomada en la línea 159 aún verifica en cualquier longitud posterior: head -n 159 del archivo de hoy devuelve los bytes marcados sin cambios y genera un hash al valor marcado esa mañana, por lo que el prefijo se toma por recuento de línea, no por un filtro que reescribiría las líneas. Cada lista marcada imprime la regla de bytes que cifra: el archivo tal como se almacena, UTF-8 sin marca de orden de bytes y sin nada recodificado, cada línea contada con su LF final, y una última línea contada una vez escrito su LF.
Hora de divulgación y hora del sello. La hora del sello es cuando una línea entra en la cadena; la hora de divulgación es cuando su texto se hace público. La liga publica los textos de las líneas después de la puntuación del día, con el asiento, el sello y la hora visibles antes (página de prueba). La divulgación retrasada, la propiedad de Sornette et al. (2010), impide que un tercero utilice una probabilidad sellada en lo abierto. Vincular al operador, quien tiene el texto para reservarlo, es el trabajo de P1b y P2 (Sección 3.11). Dentro de un lote, la cadena registra el orden de reserva: el 20 de octubre la línea de ejecución está antes que sus respuestas y se reservó con ellas, después de su llegada.
3.3 Precio de referencia después del sello
El precio de referencia es el primer precio después del sello según la regla de cada mercado. Un pronóstico se califica solo en la trayectoria de precios que comienza después de que se fijó. Se permite información que existe antes de la referencia: la pregunta puede llevar los futuros previos a la apertura (el 20 de octubre, los futuros del S&P 500, Nasdaq-100, Dow y Russell 2000 contra el cierre anterior), y un modelo puede buscar noticias hasta su respuesta. Lo que el protocolo excluye es el precio de referencia y todo después de él.
Se conserva una línea sellada después de la apertura. Recibe su propia referencia, el primer precio después de su propio sello, y se marca como tardía (late_ref en la línea de puntuación). Una línea sellada después del cierre no se califica para esa sesión (counted). Tal línea responde una pregunta diferente: en el libro del 20 de octubre, la referencia propia de una línea sellada después de la apertura invirtió el signo del movimiento puntuado en seis de sus nueve celdas de un día. Por lo tanto, la mantengo fuera de todo lo que compara modelos en un evento común: el consenso, los recuentos de error compartido, el modelo más cercano, el número efectivo de voces y todas las comparaciones uno a uno (requisito 4). La línea de puntuación marca la línea, y la serie contada de las estadísticas de la liga la omite (Tabla 5).
La misma regla fija una referencia por evento común, incluido Bitcoin. En la implementación de referencia, la referencia de Bitcoin es el cierre de la primera barra de un minuto que comienza en o después del sello de la línea (reference_rule, Yahoo Finance BTC-USD), por lo que el precio siempre es posterior al sello, mientras que los archivos abiertos escriben el sello segundo como reference_at y el inicio de la barra con precio como reference_price_at. Una línea sellada en un lote posterior obtiene su propia referencia de Bitcoin y es un evento separado. El 21 de octubre, las ocho respuestas selladas a las 13:00:19Z comparten la referencia 83.536,42, el cierre de la barra 13:01Z; la novena, sellada a las 13:23:37Z, tiene la suya propia, 83.677,08, el cierre de la barra 13:24Z, y se califica por separado (own_event, same_event falso), fuera del evento común de Bitcoin. Debido a que reference_at es igual al segundo de sello, un corte en "sellado antes de reference_at" eliminaría cada fila de Bitcoin. Uso un reloj para los doce mercados: una línea de respuesta entra en las estadísticas de evento común solo si se selló antes de la referencia de las 09:30 ET de la sesión. Las líneas de Bitcoin siguen el mismo corte de 09:30 ET, mientras que el precio de Bitcoin se referencia desde el primer minuto después del sello de la ejecución. Esta es la regla de la serie contada publicada (n_eff.counted) y de los scripts de resolución presentados. Una vez que se sellan las respuestas en la llegada (requisito 12), la referencia común para un mercado que opera las veinticuatro horas es el precio al cierre de la admisión de la ejecución, después de cada sello contado.
3.4 Una ejecución contada por sesión
La liga pregunta más de una vez al día (una carrera matutina, una carrera vespertina, una carrera de Bitcoin de fin de semana y un radar dominical), por lo que varias carreras pueden dirigirse a una sesión. Exactamente una cuenta para cada modelo y sesión, y el estándar requiere que esa carrera sea fijada por una regla declarada antes de las carreras (requisito 6). Una regla de la forma "la carrera sellada última antes de la apertura" se aplica después de los hechos. Deja al operador libre para enviar una carrera posterior antes de la apertura, y así elegir entre carreras. Por lo tanto, hice del cronograma la regla. A partir del 21 de octubre de 2026, el inicio del registro contado, la carrera matutina programada cuenta y todas las demás carreras son un cálculo de referencia. La declaración se sella como la primera línea de la cadena de preguntas salientes (asks.jsonl, 04:16 UTC del 21 de octubre de 2026, ocho horas antes de la carrera matutina) y se publica en la página de prueba con su SHA-256 (c24b0d4f…5df5) y una captura de Internet Archive (05:35 UTC el mismo día); la leí allí el 21 de octubre de 2026 a las 15:05 UTC. En las dos sesiones de desarrollo, 19 y 20 de octubre, la metodología sellada contó la carrera sellada última antes de la apertura de la sesión (session_run), una regla aplicada después de las carreras. Esas sesiones forman un segmento de desarrollo fuera de la ventana de la comparación primaria (Sección 8). Las otras carreras se califican en su propia página (not_counted, earlier_run), se conservan, publican y etiquetan, y cualquiera puede aplicar la regla declarada a las marcas de tiempo selladas (P3, Sección 3.11). Los reintentos de las ligas de cartera (asked_again, Apéndice A) se sellan con sus hashes de pregunta y se mantienen fuera de cada puntuación de pronóstico.
3.5 Dirección, probabilidad y empate
El modelo da prob_up, su probabilidad de 0 a 100 de que el indicador sea más alto al final del horizonte que en su precio de referencia. Para el rendimiento a 10 años, una "compra" es una apuesta de que el rendimiento sube; para VIX, que la volatilidad esperada sube.
Trato los movimientos pequeños como empates mediante una regla fijada de antemano. La banda es , con la media absoluta del rendimiento porcentual de un minuto en las cuatro sesiones de barras de minutos antes de la referencia; para rendimientos normales esto es aproximadamente 0.08 de la desviación estándar de una sesión (council-stats.json, draw_band). Para los futuros (WTI, Brent, oro, cobre) los movimientos de minuto en un cambio registrado de contrato del mes de vencimiento más próximo se dejan fuera, porque un cambio es un salto entre dos contratos (noise_rolls). El estándar requiere que el evento puntuado sea el evento preguntado (requisito 7). La puntuación primaria de Brier se calcula en todas las filas, un aumento significando un cambio por encima de cero, y la puntuación sin empates se reporta segunda con el número de filas que descarta. Se pregunta a los modelos por la probabilidad de un aumento estricto y no se les dice la regla de empate. A partir de la sesión del 21 de octubre, la puntuación de todas las filas es la puntuación principal de la liga (campo pall). Las sesiones de desarrollo se presentan como publicadas, un segmento separado (requisito 15), en una puntuación que deja fuera los empates. Tal puntuación se minimiza por la probabilidad de un aumento dado un movimiento fuera de la banda, por lo que para la pregunta hecha no es estrictamente propia.
Una banda de empate y una puntuación propia pueden ir juntas. Un diseño pregunta por la probabilidad de un aumento dado un movimiento fuera de la banda y la puntúa solo en filas que no son empates. El otro pregunta por tres probabilidades, de un aumento, un empate y una caída, puntuadas por la puntuación de Brier de tres resultados, estrictamente propia para la triple (Brier, 1950; Gneiting & Raftery, 2007):
Un pronóstico que da la probabilidad cero de empate en una fila que no es un empate puntúa exactamente la puntuación de Brier binaria, . El pronóstico uniforme de un tercio cada uno puntúa contra 0.25 para la moneda binaria, por lo que la puntuación de tres resultados necesita su propio punto de referencia. Una probabilidad de exactamente 50 no respalda ningún lado y se puntúa por Brier solo.
3.6 "Comprar en caídas" como un nivel fijado de antemano
«Comprar en caídas» sin un nivel no se puede calificar, así que requiero una respuesta con la acción buy_dips que dé entry, un nivel por debajo de la referencia en el que el modelo añadiría. Si el precio lo toca durante la sesión, la cartera compra en el entry, y si no, no se compra nada. De cualquier forma se califica la probabilidad. Las cinco acciones permitidas son buy_strong, buy_dips, hold, trim y sell. Una palabra fuera de la lista se mantiene como action_word, se califican su probabilidad y niveles, y no genera operaciones.
Cada celda de respuesta lleva por tanto dos respuestas selladas sobre un evento, una probabilidad y una acción, y en las dos mañanas contadas más recientes se alinean (Figura 2). En las 384 celdas de los ocho asientos sellados antes de la referencia el 20 de octubre de 2026 y las 432 celdas de los nueve asientos el 21 de octubre de 2026, ningún campo de acción estuvo vacío, cada sell y trim estuvo por debajo de 50, hold se situó alrededor de una probabilidad pareja (mediana 52 en ambas mañanas) y la mediana subió paso a paso hacia buy_strong. Encuentro una compra en caídas junto a una probabilidad por debajo de 50 en cuatro celdas: tres celdas de un día de Claude el 20 de octubre (S&P 500 48, Nasdaq-100 47, semiconductores 46) y S&P 500 de MiMo a una semana el 21 de octubre (47). Una compra en caídas es una orden que se ejecuta solo en un nivel de entry fijado por debajo de la referencia, así que una probabilidad por debajo de 50 junto a ella es coherente. La tabla 3 cuenta las acciones por horizonte. hold completó 64 de las celdas de un día en cada mañana (de 96 y 108 celdas), y a seis meses buy_dips lideró (37 y 38 celdas).
Figura 2. Probabilidad declarada de una subida por la acción sellada en la misma celda de respuesta: ejecuciones 2026-10-20-am (ocho asientos sellados antes de la referencia) y 2026-10-21-am (nueve asientos), todos los cuatro horizontes.
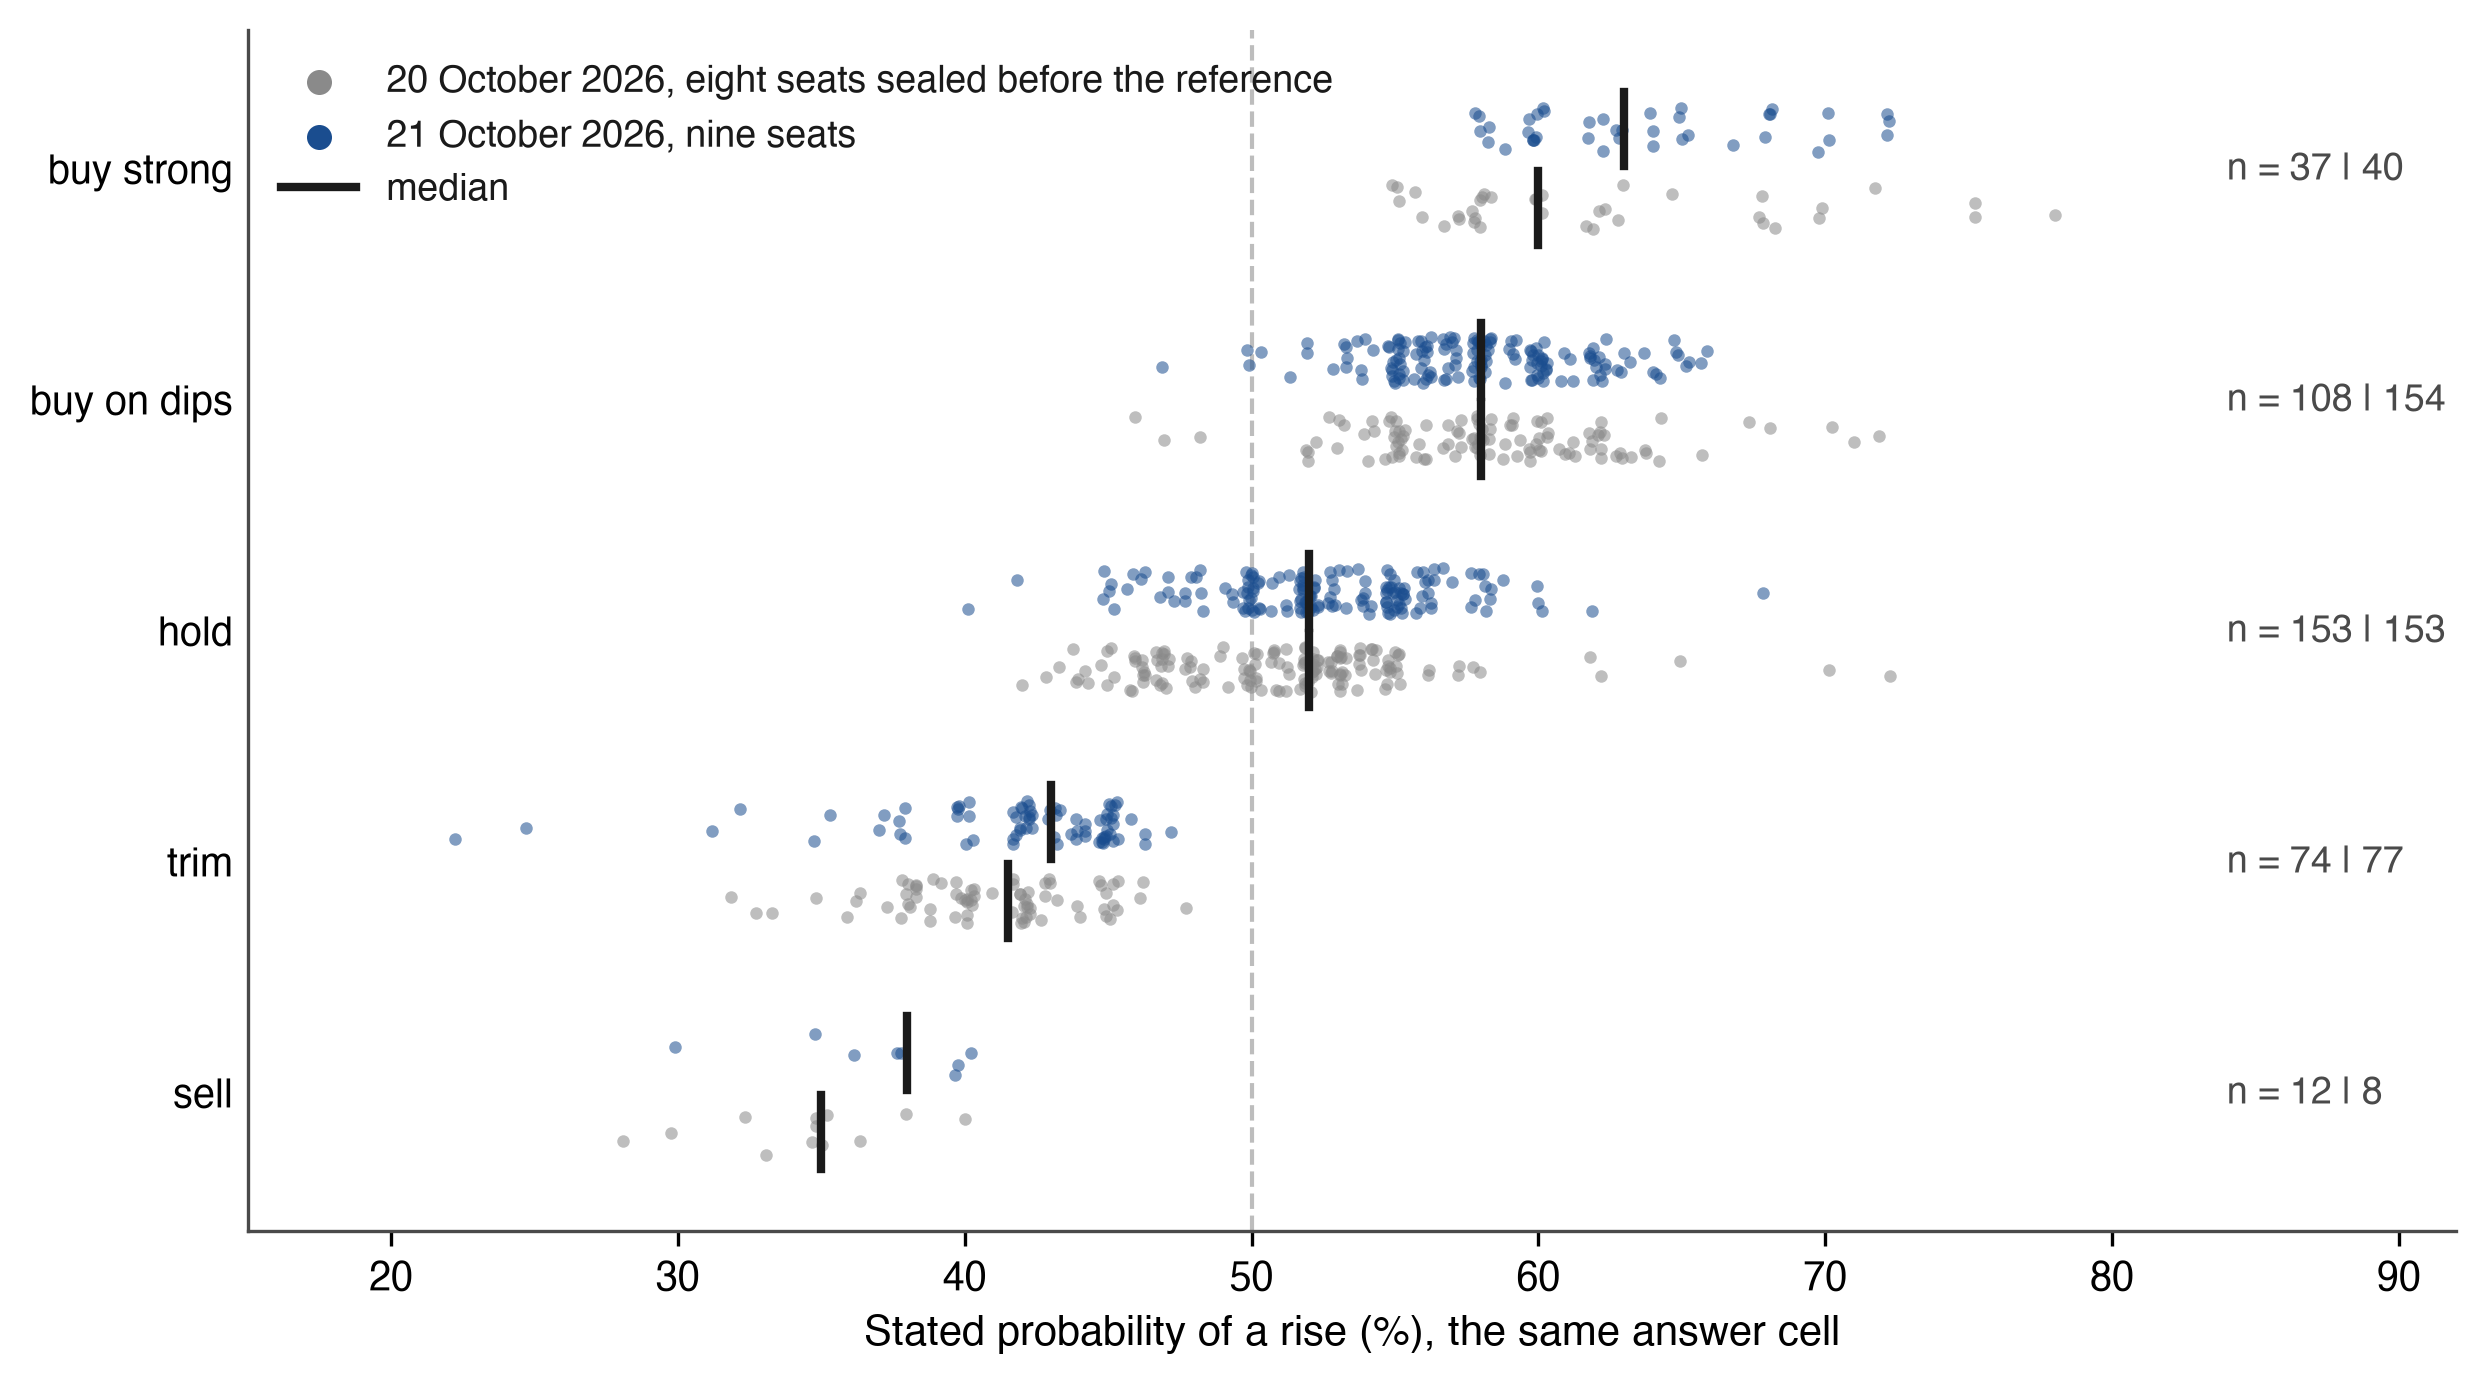
Nota: Cada punto es una celda de respuesta (asiento × mercado × horizonte), ligeramente dispersa; las barras marcan las medianas (sell 35 y 38, trim 41,5 y 43, hold 52 y 52, compra en caídas 58 y 58, buy strong 60 y 63); n da las celdas de 20 | 21 de octubre. Acciones como se sellaron en items.<market>.<horizon>.action, probabilidades en prob_up. Fuente: council-forecasts.csv guardado 22 de octubre de 2026, 01:32 UTC. Como cada figura y tabla de las secciones 3 a 5 construida a partir de respuestas selladas, no muestra resultado.
Tabla 3. Acciones selladas por horizonte: ejecuciones 2026-10-20-am (ocho asientos sellados antes de la referencia, 96 celdas por horizonte) y 2026-10-21-am (nueve asientos, 108 celdas por horizonte).
| Horizonte | Ejecución | Vender | Reducir | Mantener | Compra en caídas | Compra fuerte |
|---|---|---|---|---|---|---|
| 1 día | 20 oct 2026 | 1 | 11 | 64 | 16 | 4 |
| 1 día | 21 oct 2026 | 0 | 12 | 64 | 26 | 6 |
| 1 semana | 20 oct 2026 | 3 | 23 | 33 | 31 | 6 |
| 1 semana | 21 oct 2026 | 1 | 18 | 31 | 54 | 4 |
| 1 mes | 20 oct 2026 | 2 | 15 | 42 | 24 | 13 |
| 1 mes | 21 oct 2026 | 3 | 22 | 34 | 36 | 13 |
| 6 meses | 20 oct 2026 | 6 | 25 | 14 | 37 | 14 |
| 6 meses | 21 oct 2026 | 4 | 25 | 24 | 38 | 17 |
Nota: Conteos de celdas de respuesta por la acción sellada en ellas. Fuente: council-forecasts.csv guardado 22 de octubre de 2026, 01:32 UTC.
3.7 Cuatro horizontes y el año
Cada respuesta cubre cuatro horizontes para cada mercado: el próximo día de negociación (1d), la semana (1s), el mes (1m) y seis meses (6m), más una frase sin calificar sobre el año (years). Para los once mercados de hora de bolsa los horizontes más largos son 5, 21 y 126 sesiones; para Bitcoin son 7, 30 y 182 días de calendario, y su día va desde el minuto del sellado al cierre de las 16:00 ET de la sesión de puntuación, alrededor de siete horas para la ejecución matutina. Comparo horizontes dentro de cada definición. Un modelo en una mañana da por tanto 48 probabilidades, cada una resuelta en su propia ventana y todas selladas en un minuto en un conjunto de información.
3.8 Objetivo e «incorrecto si»
Para cada mercado y horizonte el modelo también da target, donde espera que vaya el precio, e invalidation, mostrado como «Incorrecto si», el nivel en el que admitiría que la visión era incorrecta, con su riesgo principal y qué haría que revisara la visión (risk, revise_if). Todos se sellan con la probabilidad, así que el pronóstico es falsable en los propios términos del modelo. Una respuesta sellada muestra los campos en funcionamiento. El 19 de octubre de 2026, antes de la apertura, ChatGPT (GPT-6.1 Sol) dio al S&P 500 una probabilidad del 54% de subir en el día, con un objetivo de 7.678,59 e «Incorrecto si» en 7.560, luego 42% a una semana, 38% a un mes y 61% a seis meses. Su visión declarada fue «Doy más peso a los efectos inflacionarios inmediatos del gasto en IA que a su eventual dividendo de productividad», y su condición para la revisión fue «Abandonaría la visión bajista mensual si SPX despeja 8000 junto con una guía de ganancias mejorada» (línea del libro 83). Cada uno de estos niveles se puede verificar contra la trayectoria del precio sin preguntarle al modelo qué quiso decir. En la Figura 3 dibujo la respuesta completa, con la probabilidad, la acción, el objetivo y el nivel «Incorrecto si» en cada horizonte, y el nivel de entry de 7.350 a seis meses en el que su compra en caídas se ejecutaría. La pregunta había mostrado el cierre anterior, 7.659,44, y el precio de referencia del día, 7.700,34, se tomó después del sellado.
Figura 3. Una respuesta sellada: ChatGPT en el S&P 500, ejecución 2026-10-19-am (council-book.jsonl, línea 83), con probabilidad, acción, objetivo, nivel «Incorrecto si» y nivel de entry en cada horizonte.
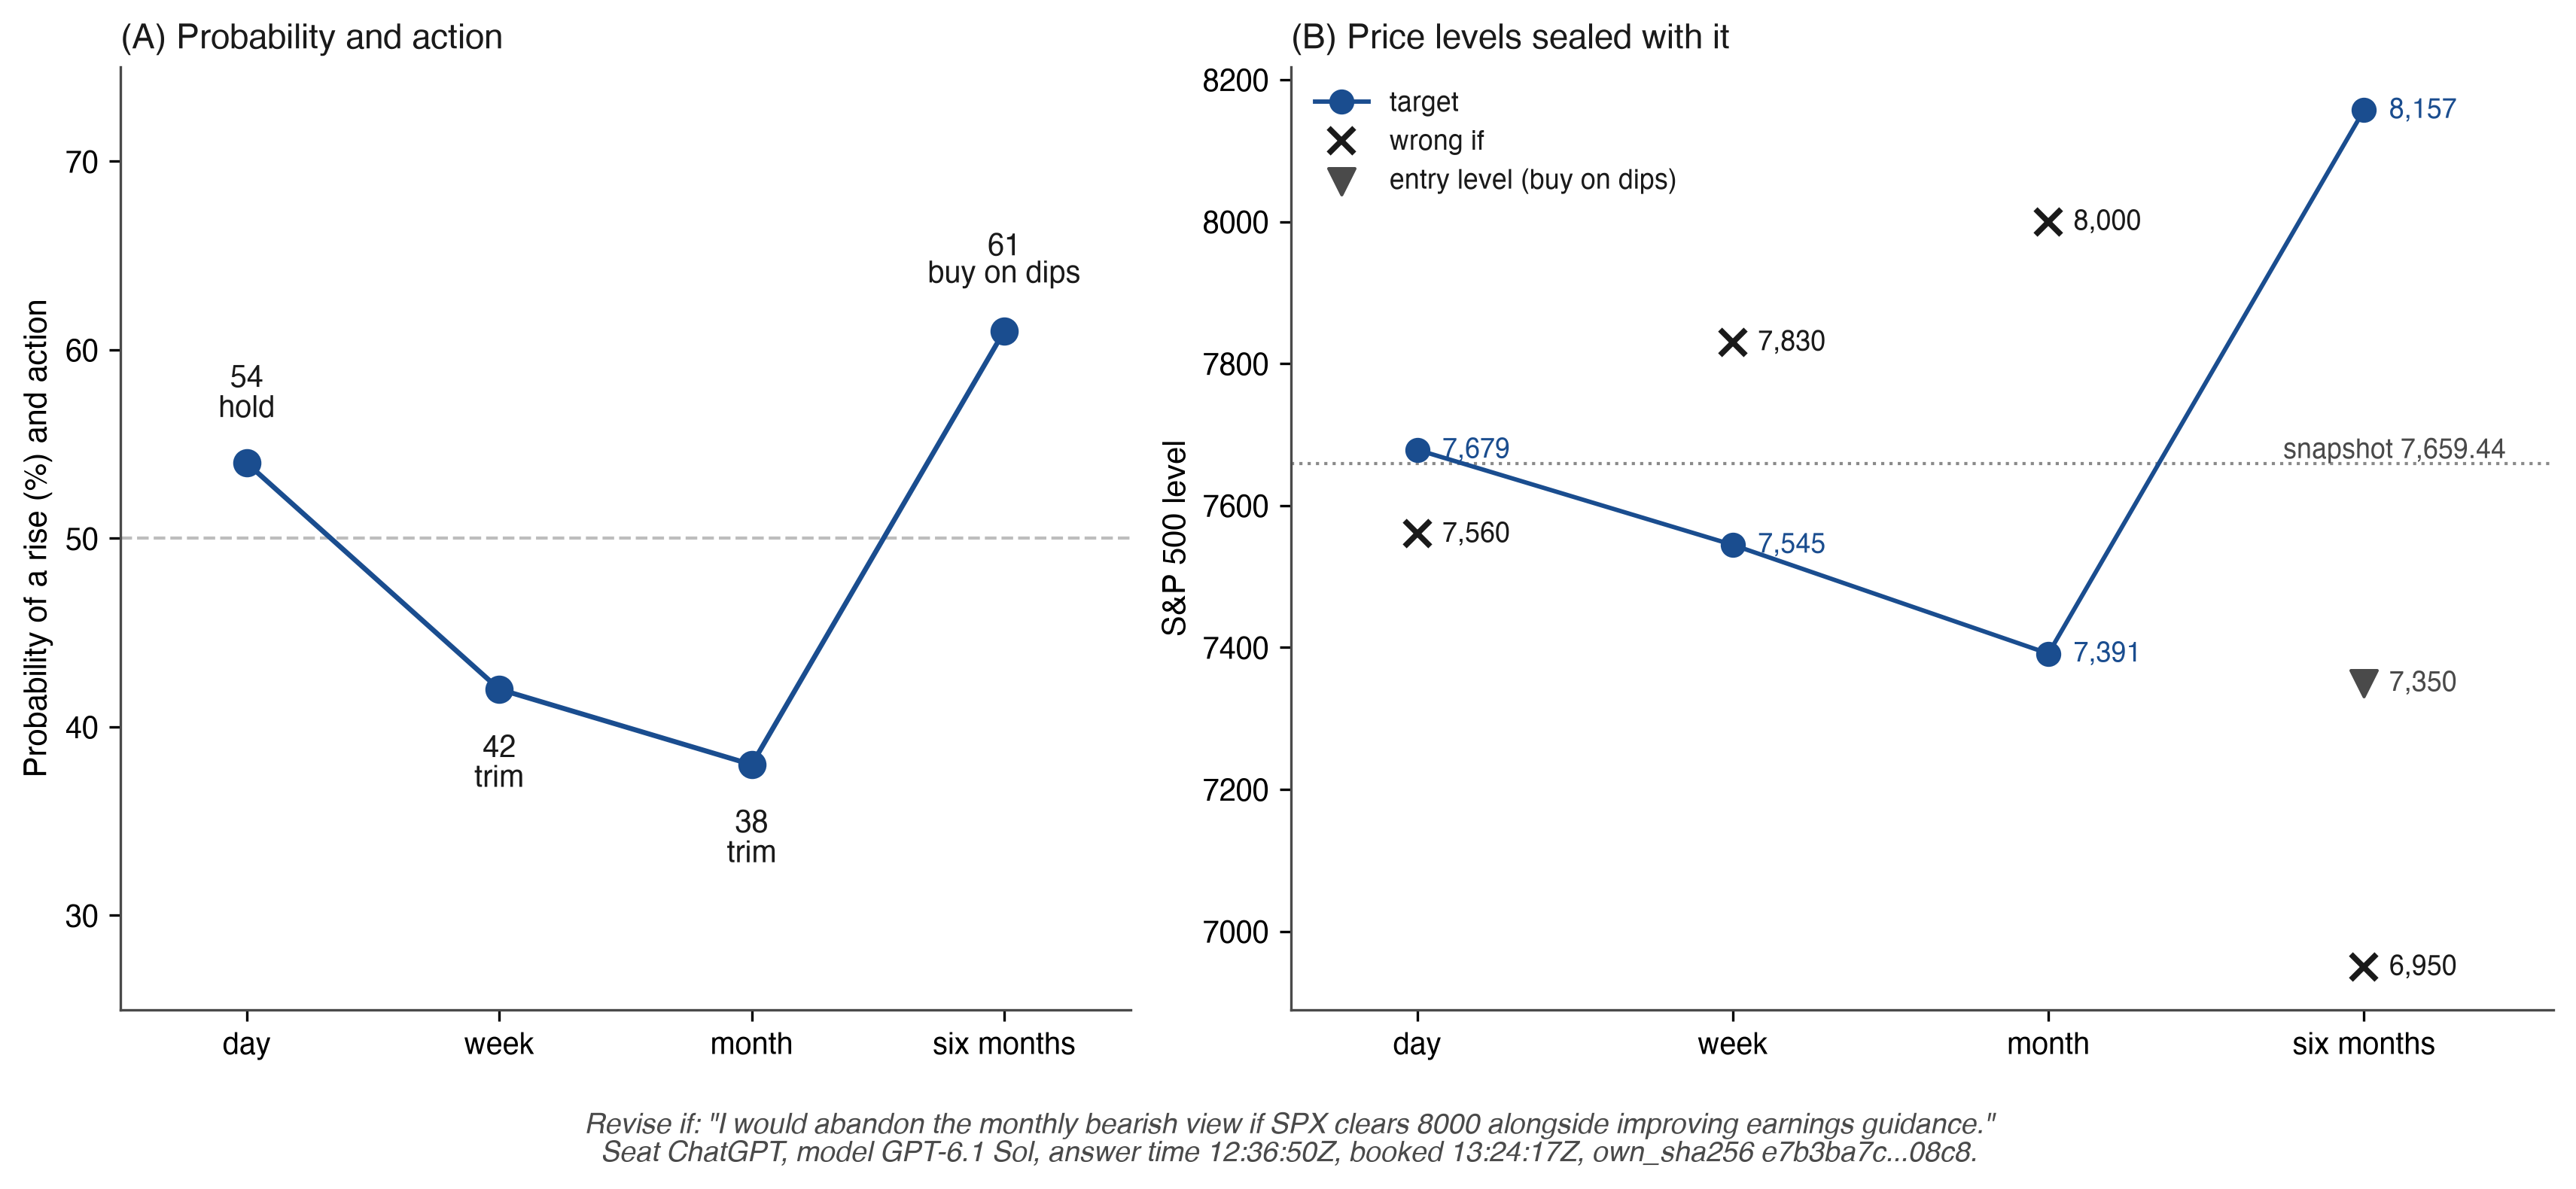
Nota: Todos los valores tal como se sellan en la línea de respuesta (hora de respuesta 12:36:50Z, reservado 13:24:17Z, antes de la referencia 09:30 ET). La línea punteada es el precio del S&P 500 en la instantánea de la pregunta (asks/02577f9c….md); la línea a través de los objetivos une los horizontes para lectura y no es una trayectoria. El nivel de entrada es el campo items.SPX.6m.entry de la línea de respuesta; la columna entry de council-forecasts.csv está vacía para esta celda.
3.9 Celdas vacías
Toda celda de una respuesta se puntúa. Una celda que un modelo deja vacía cuenta como 50%, Brier 0,25, sin lado (counted_50); no puede superar la moneda pero puede ocultar desempeño peor que la moneda en un mercado difícil, así que reporto el recuento de celdas vacías junto a cada puntuación (requisito 8). Un asiento que no envía línea de respuesta se registra como no_answer y está ausente de las puntuaciones de esa ejecución. El 0,25 lleno pertenece a la puntuación de servicio del asiento. El consenso y los recuentos de acuerdo se forman a partir de las probabilidades realmente dadas, y el campo of las cuenta. Cada asiento tiene por lo tanto tres resultados en cada horizonte, cada uno clasificado por sí solo: la puntuación de Brier sobre las probabilidades declaradas, la proporción de celdas esperadas respondidas antes de la fecha límite, y la puntuación de servicio. La cartera es un cuarto resultado en su propia tabla. Una puntuación combinada ocultaría si un asiento perdió en juicio, en puntualidad o en negociación.
Las celdas esperadas deben conocerse antes de las respuestas. El estándar requiere un listado de respuestas esperadas, con los asientos, mercados, horizontes, fecha límite y política de reintento, sellado antes de la primera pregunta de una ejecución (requisito 13), de modo que toda celda esperada se resuelva a un estado (contado, counted_50, no_answer o rechazado). La línea de ejecución lleva el listado por lado, y desde el 21 de octubre de 2026 el listado se sella antes de la primera pregunta, en la cadena de preguntas salientes (asks.jsonl). El listado comprueba la integridad contra el cronograma declarado. El hash de cada pregunta saliente, sellado cuando se envía, comprueba las ejecuciones que fueron enviadas (requisito 13).
3.10 Un cambio de versión del modelo, una corrección, un cambio de reglas
Un asiento es un participante operativo; una versión del modelo es una implementación específica en el tiempo, y el registro mantiene ambas. Cuando cambia la versión de un asiento, su cuenta continúa, el cambio se fecha, el resultado desde la nueva versión se muestra aparte (new_model_version), cada versión obtiene su propia cuenta desde el día en que se hizo cargo (_ver:<model>:<n>), y una ejecución en la que cambió una versión se marca (seat_versions_in_run).
Una corrección es una línea nueva que nombra las líneas que afecta (of), y la línea que corrige permanece como está escrita. Los precios siguen la misma regla: el protocolo declara que desde el 22 de octubre de 2026 una referencia corregida o un precio de cierre entra como una línea de corrección sellada con su fuente y razón, y la línea de puntuación anterior no se reescribe (price_corrections en arena-protocol.json). El 20 de octubre, 47 de las 211 líneas del libro eran correcciones: algunas restauran el modelo y modo de respuestas en las primeras ejecuciones de los recibos de ejecución, otras registran que una respuesta resellada es igual a una línea anterior (same_as, copias anteriores en council-forecasts-copies.csv). El estándar requiere modelo, versión y modo en la línea de respuesta misma, o, en una temporada ciega, un compromiso salado con ellos (requisito 1).
Un cambio de metodología cambia la tarea y abre un nuevo segmento de medición (requisito 15). Una puntuación confirmativa, una ganancia pareada o una comparación de cartera se calcula dentro de una versión de metodología, o las versiones se reportan como segmentos separados; pronósticos antiguos repuntuados bajo una regla nueva se etiquetan como análisis alternativo. Una afirmación que se basa en un elemento de nivel 2+ cubre los sellos hechos después de que ese elemento aparece en los archivos públicos.
3.11 Prueba-de-antes: tres propiedades
Llamo un registro de pronóstico prueba-de-antes cuando un tercero, utilizando archivos públicos y la cadena de Bitcoin, puede establecer las propiedades siguientes, y cuando el registro dice en cuál de ellas se basa. Sea un pronóstico mantenido en la línea del libro , con precio de referencia en el tiempo y resultado en el tiempo . Sea la marca comprometer las primeras líneas a través del resumen , y sea su prueba colocar la lista marcada en el bloque con tiempo de encabezado . Escriba para el margen por el cual la hora verdadera de minería puede seguir la hora del encabezado: algunas horas en la práctica, por el límite discutido a continuación.
P1a. Sin reconstrucción después del ancla. Para cada pronóstico contado hay una marca con . El prefijo marcado existía, según la cota práctica, no más tarde de , y cualquier adición, eliminación o reescritura posterior de una línea en él cambia , de modo que ya no coincide con el resumen comprometido en el bloque . Para cada resultado posterior a esto descarta un pronóstico escrito después del resultado.
P1b. Compromiso antes de la referencia. El pronóstico fue sellado antes de . A partir del 21 de octubre de 2026 esto se cumple en nivel 2+, para cualquiera que acepte una de las dos autoridades y su certificado: dos fichas RFC 3161 firmadas antes de en una lista marcada con . El 21 de octubre dos autoridades firmaron la lista que cubre las líneas 1 a 222, la línea de ejecución (214) y ocho respuestas contadas (215 a 222), a las 13:00:19 UTC, 29 minutos 41 segundos antes de , y tres firmaron la lista que cubre la novena respuesta contada (224) a las 13:23:37 UTC, 6 minutos 23 segundos antes de (Apéndice B, Paso 9). Para Bitcoin la referencia es el cierre de la primera barra de un minuto después del sello de cada línea, 13:01Z para el lote y 13:24Z para la novena respuesta, de modo que el orden se cumple allí por construcción. Para las sesiones de desarrollo de 19 y 20 de octubre, las sesiones que esta versión califica, P1b descansa en nivel 1 en el registro encadenado (at, booked_at, prev, link). El 20 de octubre el bloque de anclaje cayó después de (Sección 3.2).
P2. Sin sustitución. Cambiar cualquier campo de para cambia , por lo tanto y cada enlace posterior, por lo tanto . Una sustitución indetectable requeriría una segunda preimagen de SHA-256 o una reescritura de la cadena de Bitcoin, siempre que el verificador tenga la prueba que fue publicada en la marca (modelo de amenaza a continuación).
P3. Sin selección entre ejecuciones selladas divulgadas. Para cada modelo y sesión la línea contada se fija mediante una regla declarada antes de las ejecuciones y aplicada solo a marcas de tiempo selladas. A partir del 21 de octubre de 2026 esa regla es el calendario publicado, sellado antes de las ejecuciones. Dentro de la ejecución, la primera respuesta bien formada de cada asiento cuenta desde la sesión 11 (declarada en asks.jsonl, línea 74). La sección 3.4 da la regla de las sesiones de desarrollo. Cada otra ejecución sellada permanece en el libro, etiquetada, y un lector puede recomputar cuál línea cuenta. La forma completa también cubre ejecuciones preguntadas y dejadas sin sellar: el hash de cada pregunta saliente se sella cuando se envía (nivel 2+). A partir del 21 de octubre de 2026 estos hashes se encadenan en asks.jsonl.
Modelo de amenaza. Una marca de tiempo prueba que un resumen existía. No dice nada sobre otros resúmenes marcados junto a él. Un operador que aloje tanto el libro como las pruebas podría marcar dos libros en cada ejecución y después reemplazar el libro y la prueba juntos; el sustituto se verifica contra Bitcoin, y contra una autoridad de marca de tiempo también. El requisito 3 por lo tanto hace obligatorio publicar, en cada marca, el SHA-256 de la lista marcada en al menos un canal de solo adición que el operador no controla (un depósito archivado, un servidor de control de versiones público o una captura de archivo web) y nombrar los canales en la página de prueba. A partir del 22 de octubre de 2026 cada lista marcada entra en el registro de transparencia Sigstore Rekor en la marca, y las listas de días anteriores entraron en él el 21 de octubre de 2026 entre 23:45 y 23:47 UTC (Tabla 5). Para una lista en el registro, P1a y P2 se cumplen contra todos a partir de su hora de registro, y antes de ese tiempo contra cualquier parte que guardó, o puede recuperar de un archivo independiente, una prueba anterior.
La tabla 4 establece cada propiedad contra el elemento del protocolo que la proporciona y el nivel en el que un lector puede verificarla.
Tabla 4. Proof-of-before: qué elemento del protocolo proporciona cada propiedad y en qué nivel.
| Propiedad | Lo que descarta | Elemento que la proporciona | Cómo un lector la verifica |
|---|---|---|---|
| P1a Sin reconstrucción después del ancla (nivel 2, con una copia independiente de la prueba o la entrada de Rekor de la lista) | Una previsión escrita o reescrita después del ancla | Hash de prefijo marcado por libro; ancla de OpenTimestamps en Bitcoin; digest de marca en un canal independiente | head -n m el hash es igual al digest marcado; la prueba .ots lleva a la raíz de Merkle del bloque; el límite precede al resultado |
| P1b Compromiso antes de la referencia (nivel 1 para 19 y 20 de octubre; nivel 2+ desde 21 de octubre) | Una previsión sellada después del precio de referencia pero puntuada desde él | Minuto de sello en la cadena (booked_at); referencia después del sello; sellado en llegada (requerido); desde 21 de octubre: tokens RFC 3161 |
Compare el tiempo de sello de la línea, max(at, booked_at), con las 09:30 ET de la sesión; desde 21 de octubre: Apéndice B, paso 9 |
| P2 Sin sustitución (nivel 2, con una copia independiente de la prueba o la entrada de Rekor de la lista) | Una previsión sellada cambiada posteriormente | Por línea seal; encadenado link con prev; libro de solo anexión |
Recompute seal y link; cada prev es igual al link anterior |
| P3 Sin selección entre ejecuciones selladas divulgadas (regla de nivel 1; forma completa nivel 2+) | Preguntar varias veces y contar la ejecución que ganó | Una ejecución contada por sesión, declarada de antemano desde 21 de octubre de 2026; todas las demás ejecuciones conservadas como not_counted; nivel 2+: hashes de preguntas salientes sellados al enviar (asks.jsonl, desde 21 de octubre) |
Aplique la regla declarada a los tiempos de sello del libro; encuentre todas las ejecuciones en council-forecasts.csv (run_id, run_role) |
P1a tiene una resolución de horas y su límite es práctico. El tiempo externo es el tiempo de un bloque en la cadena que la red ha aceptado, y el tiempo de encabezado de ese bloque lo establece el minero. Las reglas de consenso lo limitan desde abajo por el tiempo mediano de los 11 bloques anteriores y desde arriba por aproximadamente dos horas adelante de los relojes ajustados por la red de los nodos que lo aceptan (Bitcoin Developer Documentation, n.d.). Ninguna regla fija cuánto tiempo después de su tiempo de encabezado se extrajo un bloque en realidad. En operación ordinaria, la mediana se atrasa respecto al tiempo real aproximadamente una hora, por lo que el digest anclado existió no más tarde de pocas horas después de . Un verificador que desea un límite de solo las reglas de consenso utiliza el tiempo de encabezado de un bloque varias confirmaciones más tarde, y un tiempo de calendario firmado en cada sello proviene solo de una autoridad de marca de tiempo (nivel 2+). Para el bloque 972.334, el tiempo mediano de los 11 bloques anteriores fue 12:45:12Z, 70 minutos antes de su tiempo de encabezado. Un Internet-Draft de la IETF especifica cómo un verificador comprueba pruebas temporales ancladas en Bitcoin (Fassbender, 2026). El 17, 19 y 20 de octubre, los bloques de anclaje (971.796, 972.153 y 972.334) tenían tiempos de encabezado dentro de una hora del tiempo de reserva, y para el horizonte de un día, que se resuelve a las 16:00 ET, el límite con su margen quedó antes del resultado; para horizontes más largos la resolución es irrelevante. El orden de sello y referencia dentro de la sesión es P1b.
3.12 La escalera de confianza
Las afirmaciones públicas sobre previsiones de IA "verificadas" se dividen en tres niveles, con un cuarto paso por encima del último (Figura 4). En el nivel 0, el lector confía en el operador. En el nivel 1, el operador mantiene una huella dactilar o un registro encadenado, que prueba que un texto posterior coincide con un hash anterior pero no cuándo se realizó el hash. En el nivel 2, la huella dactilar se ancla fuera del operador, en un registro público que no se puede reescribir ni antedatar sin detección, y se verifica con herramientas que el operador no controla. El nivel 2+ es el nivel 2 más un tiempo firmado por un tercero en cada sello (Sección 3.2).
Figura 4. La escalera de confianza: confiar en el operador, huella dactilar del operador, ancla fuera del operador, y tiempo firmado por dos autoridades (nivel 2+, RFC 3161, desde 21 de octubre de 2026).
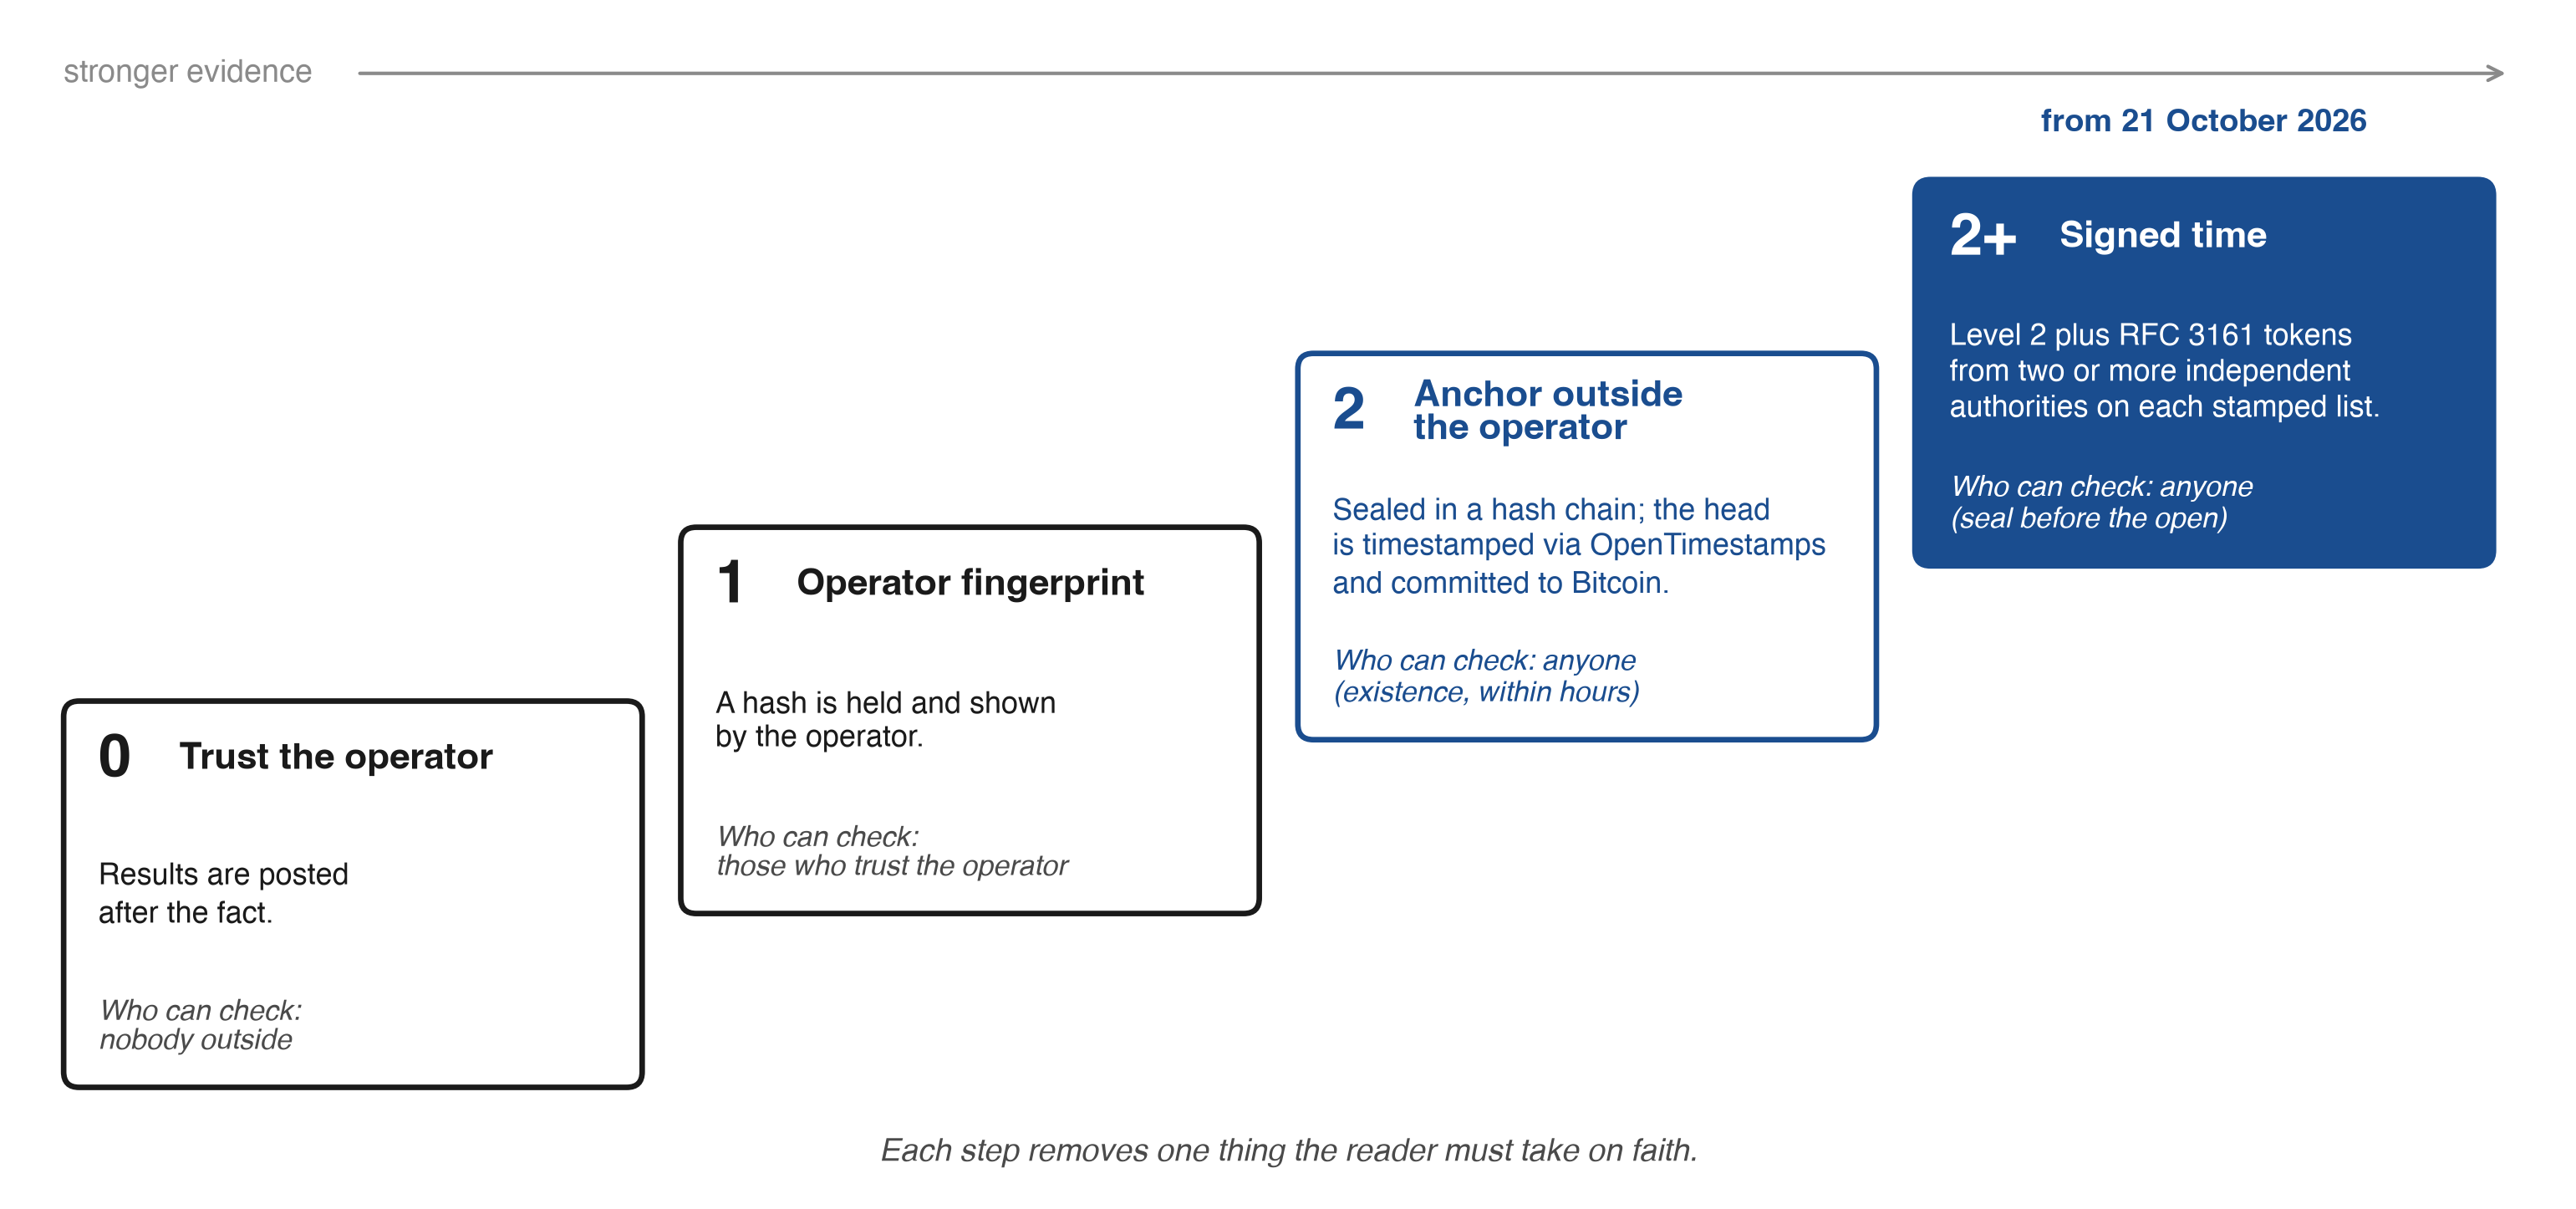
Nota: Los niveles describen en qué debe confiar un lector sobre el tiempo de un registro. El nivel 2+ añade tokens RFC 3161, en la liga desde 21 de octubre de 2026, cuando el registro que contiene las respuestas contadas fue firmado antes de la apertura de las 09:30 ET. El sellado en llegada, el precio de referencia después del sello y la regla de ejecución contada son requisitos separados (Sección 3.13).
En la implementación de referencia, el ancla proporciona nivel 2 para P1a y P2, contra cualquier parte que tenga una copia independiente de una prueba, y contra todos para cada lista marcada ingresada en el registro de Rekor (Sección 3.11). P1b se sitúa en el nivel 2+ en el registro contado (Sección 3.11). P3 se basa en el nivel 1 en el registro encadenado del operador y, desde 21 de octubre de 2026, en una regla de ejecución contada declarada de antemano. La escalera mide la confianza en el reloj. Lo que un lector puede afirmar sobre precios o habilidad sube una segunda escalera, la escalera de afirmaciones (Tabla B1, Apéndice B): reglas publicadas, archivos recomputados, un compromiso externo verificado, resultados conciliados con una fuente de precio independiente, una evaluación emparejada prospectiva congelada antes de su ventana, y replicación por un segundo pipeline. Esa segunda escalera termina en las comparaciones registradas de la Sección 8.
3.13 Lista de verificación del estándar propuesto
Escribo los requisitos a continuación como lo que una arena, referencia o fondo adopta cuando afirma seguir el estándar. MUST marca un requisito sin el cual la afirmación no se sostiene; SHOULD marca la especificación de nivel 2+.
- DEBE definir cada tarea por un contrato de evento fijado antes de que la pregunta se envíe, con al menos los campos de la Tabla 1, incluida la fuente de precio de cada indicador (proveedor, símbolo, tamaño de barra y regla de marca de tiempo para el precio de referencia y terminal); resultados de pronóstico que se encuentren en el futuro; y sellar el modelo, su versión y su modo en la línea de respuesta en sí. En una temporada ciega la línea los lleva como un compromiso SHA-256 salado, , y las sales se publican después de la temporada, por lo que la identidad se fija en el sello y se oculta hasta que la temporada finaliza.
- DEBE mantener un registro de solo anexión encadenado por hash en el cual cada línea se sella cuando entra, el texto de la pregunta y la instantánea de precio se hashean en la ejecución, la pregunta se publica, y una corrección es una nueva línea que nombra las líneas que le conciernen.
- DEBE anclar la cabecera del registro fuera del operador en cada ejecución (nivel 2), publicar las pruebas, declarar el límite con su margen, y publicar cada resumen sellado al momento del sellado en al menos un canal de solo anexión que el operador no controla.
- DEBE tomar un precio de referencia por evento común, después del sello, por una regla publicada para cada instrumento; una línea sellada después recibe su propia referencia y es un evento separado. Los pronósticos se agrupan (consenso, acuerdo, recuentos de error compartido, comparaciones entre modelos) solo cuando todos los campos de sus contratos de evento concuerdan.
- DEBE publicar cada ejecución, contada o no, con su etiqueta.
- DEBE fijar la ejecución contada de cada sesión por una regla declarada antes de las ejecuciones (por ejemplo, un programa publicado), y DEBERÍA publicar la declaración con su hash en un canal que el operador no controla. Una regla aplicada después a las ejecuciones que se realizaron no lo cumple.
- DEBE puntuación el evento consultado por una regla estrictamente propia: la puntuación Brier primaria de una subida estricta sobre todas las filas, con cualquier puntuación filtrada segunda y el número de filas que descarta; o, con una banda de empate, ya sea solicitar la probabilidad de una subida dado un movimiento fuera de la banda, o solicitar tres probabilidades y puntuarlas por la puntuación Brier de tres resultados (Sección 3.5).
- DEBE reportar celdas vacías y respuestas faltantes junto a cada puntuación, mantener un valor rellenado fuera del consenso y los recuentos de acuerdo, e informar calidad en probabilidades declaradas, cobertura y cualquier puntuación de servicio como resultados separados.
- DEBE reportar el punto de referencia no informativo del 50% y una tasa base climatológica del mismo evento para cada activo y horizonte, estimado en una ventana fija que finaliza antes de la temporada y sellado por un hash publicado, con la puntuación de habilidad Brier en su contra; un precio de mercado de predicción utilizado como punto de referencia se sella con su volumen negociado, y un piso de volumen declarado define la comparación primaria.
- DEBE clasificar solo después de un número mínimo de sesiones por horizonte, con intervalos agrupados por sesión y, para horizontes más largos que un día, intervalos que respeten ventanas superpuestas; se planifica una comparación por precisión en la diferencia Brier de nivel de sesión emparejada, y una afirmación de sin diferencia requiere un intervalo dentro de un margen de equivalencia declarado (Sección 4.6).
- DEBE publicar los datos y el código de puntuación para que cada puntuación pueda ser recomputada por un tercero, y citar en cada revisión de artículo una publicación de análisis inmutable con una suma de verificación para cada archivo (Apéndice C).
- DEBE sellar cada respuesta al llegar, sin esperar un lote, y DEBERÍA (nivel 2+) obtener un token RFC 3161 de una autoridad pública de marca de tiempo en cada sello.
- DEBERÍA (nivel 2+) sellar el hash de cada pregunta saliente cuando se envía, y sellar el registro de respuestas esperadas con su plazo y política de reintentos antes de la primera pregunta de una ejecución.
- DEBE acompañar cualquier consenso publicado de modelos, en la misma superficie, con el número de probabilidades declaradas que lo ingresaron, su correlación media por pares y el de la Sección 5.1 para esa ejecución y horizonte, de modo que un lector vea cuántas voces independientes respaldan el acuerdo.
- DEBE tratar un cambio de metodología como el inicio de un nuevo segmento de medición y una corrección como una línea anexada que deja el original en su lugar; las puntuaciones confirmatorias se calculan dentro de un segmento (Sección 3.10).
- DEBE, donde los lectores pronostican junto a los modelos: asignar cada lector una vez y al azar, nunca reasignado; contar un primer pronóstico por mercado, identificador y sesión; cerrar pronósticos de lectores al tiempo de referencia; tratar un identificador restablecido como un nuevo lector e informar la proporción de restablecimientos; etiquetar el grupo ciego en el diccionario de datos antes del primer pronóstico puntuado; y no almacenar la dirección de ningún lector, a lo sumo un hash salado de ella con el día utilizado solo para limitar votos repetidos, sin publicar ninguno (Sección 6).
- DEBERÍA reportar los diagnósticos de las Secciones 4 a 6 junto a las puntuaciones: la proporción del valor propio más grande y la relación de participación de la matriz de similitud, los dos recuentos de distintividad de cada asiento, la prueba de los lados como bloques, un registro de búsqueda para cada enlace citado que entra en un recuento de superposición, el brazo solo de precios, repeticiones de probabilidad bajo un paquete congelado, oferta, demanda y hora de último comercio en cada fila de multitud, y el volumen de negocios y costos de cada cuenta junto a una sombra sin comercio.
Parte de la lista de comprobación se ejecuta como código. La liga publica el contrato del evento como un esquema JSON (event-contract.schema.json) y un verificador independiente escrito solo con la biblioteca estándar de Python (tools/conformance.py, en la misma dirección que los datos, SHA-256 e1f929a9…63db2e según se recuperó el 21 de octubre de 2026 a las 22:33 UTC, mantenido sin cambios en tools/archive/conformance-e1f929a9.py; environment.json enumera cada versión del verificador con su fecha y hash). El contrato completo tiene nueve claves: asset, horizon, reference time, end time, rule, resolver version, reference rule, price provider y price symbol, y su event_id_v2 es ev2- seguido de los primeros 16 dígitos hexadecimales del SHA-256 de su JSON canónico (claves ordenadas, sin espacios, UTF-8). El primer identificador, event_id (ev1-, las primeras cinco claves), permanece junto a él, por lo que ningún identificador publicado cambia nunca. Dos ligas que escriben el mismo contrato obtienen el mismo identificador, por lo que la prueba del requisito 4 se convierte en una comparación de identificadores para cada campo que fija el resultado, y las reglas de puntuación se fijan por la versión de metodología sellada en la misma fila. El verificador valida cada fila contra el esquema, reconstruye su identificador, comprueba los tiempos, el rango de probabilidad y los campos de resultado, rechaza un identificador utilizado para dos eventos y requiere la versión de metodología de cada fila (requisito 15). Cualquier liga puede ejecutar python3 conformance.py its.csv en su propia exportación. En el archivo de pronósticos de la liga del 21 de octubre de 2026 a las 22:33 UTC, informó de "3792 rows, OK", con ambos identificadores reconstruidos en cada fila. Un resultado favorable muestra un registro bien formado, y la Tabla 5 lee el requisito de conformidad requisito por requisito.
La Tabla 5 proporciona el estado de la implementación de referencia con respecto a cada requisito. Una afirmación que descansa en un requisito se mantiene desde la fecha en que se cumple el requisito. "Cumplido" significa visible en los archivos públicos cuando los leí el 21 de octubre de 2026 a las 15:05 UTC (véase la nota), "Parcialmente cumplido" que parte del requisito es visible allí, e "En progreso" que la implementación está en curso, con las partes ya implementadas enumeradas junto a él.
Tabla 5. Conformidad de la implementación de referencia, según se leyó el 21 de octubre de 2026 (requisito 3 el 22 de octubre de 2026).
| Req. | Nivel | Estado | Qué está implementado |
|---|---|---|---|
| 1 Contrato del evento | DEBE | Cumplido desde el 21 de octubre de 2026 | Campos del contrato sellados en la metodología; esquema del contrato, verificador e identificadores en cada fila de pronóstico, el event_id_v2 de nueve claves con proveedor, símbolo y regla de referencia; modelo con su cadena de versión y modo sellados en cada línea de respuesta (restaurados por líneas de corrección para las primeras ejecuciones) |
| 2 Registro encadenado por hash | DEBE | Cumplido | Cadena, hashes de pregunta e instantánea, preguntas publicadas, correcciones como líneas |
| 3 Ancla externa | DEBE | Cumplido desde el 22 de octubre de 2026 | Ancla OpenTimestamps en cada ejecución, pruebas publicadas; desde el 21 de octubre, fichas RFC 3161 de dos autoridades independientes en cada lista sellada (tres desde las 13:23 UTC), cada lista nombrando la anterior por su SHA-256; cada lista sellada ingresada en el registro de transparencia Sigstore Rekor en el sellado desde el 22 de octubre de 2026 (la primera en el índice 3.368.763.032, cinco segundos después de su sello de 00:00:11 UTC), y las listas anteriores el 21 de octubre entre las 23:45 y 23:47 UTC (la lista del 20 de octubre en el índice 3.368.351.276) |
| 4 Una referencia por evento común | DEBE | En progreso | Líneas selladas después de la referencia llevan su propia referencia (late_ref); las filas llevan reference_at, same_event e event_id; la serie contada de n_eff, etiquetada como la principal, excluye tales líneas; el n_eff de todos los asientos, etiquetado "sin corte por el tiempo de sello", y together se publican junto a él sin el corte |
| 5 Cada ejecución publicada | DEBE | Cumplido | Ejecuciones no contadas etiquetadas como not_counted |
| 6 Ejecución contada | DEBE; DEBERÍA | DEBE cumplido desde el 21 de octubre; DEBERÍA cumplido | Ejecución matinal programada declarada con anticipación, sellada como la primera línea de asks.jsonl (04:16 UTC) y publicada en la página de prueba con su SHA-256 y una captura de Internet Archive (05:35 UTC); 19 y 20 de octubre siguen la regla de desarrollo de la Sección 3.4 |
| 7 Evento preguntado | DEBE | En progreso | Brier de todas las filas declarado la puntuación principal desde la sesión del 21 de octubre (main_metric, primera puntuación de este tipo después de ese cierre); 19 y 20 de octubre se presentan como publicados, un segmento separado (method_segments) |
| 8 Celdas vacías | DEBE | Cumplido | counted_50, no_answer, of; tres resultados reportados por separado |
| 9 Puntos de referencia | DEBE | En progreso | Punto de referencia del 50% publicado; climatología fija publicada en el council-calibration.json en vivo desde el 21 de octubre de 2026 a las 08:54 UTC (climatology_fixed, 48 celdas de mercado-horizonte, SHA-256 de contenido 2810d11e…3cabb7, sha256_ok verdadero); F12 y F13 ya aplican el piso de $1.000 en sus propias definiciones, y el piso de volumen de multitud en la metodología publicada lo completa |
| 10 Clasificación e intervalos | DEBE | En progreso | Regla 30/10, intervalos agrupados por sesión e intervalos pareados a nivel de sesión (pairs, council-pairs.csv) publicados; intervalos de ventana superpuesta y márgenes declarados en el registro |
| 11 Datos, código, publicación | DEBE | En progreso | Datos y código publicados con hashes; publicación de análisis depositada con cada revisión |
| 12 Sellado al llegar; RFC 3161 | DEBE; DEBERÍA | Parcialmente cumplido | Fichas RFC 3161 en cada lista sellada desde el 21 de octubre; esa mañana ocho respuestas fueron selladas en un lote y una novena 14 segundos después de su llegada; sellar cada respuesta al llegar lo completa |
| 13 Hashes de pregunta, lista antes de la pregunta | DEBERÍA | Parcialmente cumplido desde el 21 de octubre | Cada paso de una ejecución sella su lista (asientos preguntados, asientos ya respondidos, suplentes) antes de su primera pregunta, por lo que una segunda solicitud es visible; hashes de pregunta saliente encadenados en asks.jsonl y cubiertos por las listas selladas; ambos en la página de prueba; plazo y política de reintentos se unen a los campos de la lista |
| 14 Voces efectivas junto al consenso | DEBE | En progreso | n_eff publicado en council-stats.json; la serie contada (ejecuciones contadas, respuestas selladas antes de las 09:30 ET) se etiqueta como la principal, la serie de todos los escaños se mantiene junto a ella; imprimir junto a cada consenso mostrado lo completa |
| 15 Segmentos | DEBE | Cumplido | Versión de metodología sellada en cada línea de ejecución y en cada fila de pronóstico (methodology_version); puntuaciones por segmento (method_segments); cambios fechados; nada recontado |
| 16 Lectores | DEBE | En progreso | Dos grupos aleatorios permanentes activos (experiment.g0, g1), solo primeros pronósticos, pronósticos de lectores cerrados a las 09:30 ET, ninguna dirección almacenada (un hash salado por día limita votos); la etiqueta de grupo ciego en el diccionario de datos y la proporción de reinicializaciones lo completan |
| 17 Diagnósticos | DEBERÍA | Parcialmente cumplido | Razón de participación (n_eff_participation), los conteos sin signo y centrados en climatología, superposición de fuentes compartidas y el brazo Closed Book publicados; los demás diagnósticos están especificados |
Nota: Estado según se lee en los archivos públicos y en la página de prueba del 21 de octubre de 2026 a las 15:05 UTC (council-stats.json generado 14:51:50 UTC, council-book.jsonl de 230 líneas); el requisito 1 se verifica a las 22:33 UTC el mismo día (Sección 3.13), y el requisito 3 se ingresa en el registro de Rekor el 22 de octubre de 2026 a las 00:00:16 UTC (Apéndice B, Paso 10).
4. Medidas
El protocolo fija lo que se dijo y cuándo. Las medidas convierten ese registro en puntuaciones; juntas son la evaluación del pronóstico que el estándar requiere. Describo cada medida tal como se publicó en la metodología (versión 2) y el protocolo de la liga (arena-3, liga Pro pro-1) y, donde el estándar pide más, el requisito. La sección 5 reporta los valores de dependencia en datos en vivo, y los resultados de precisión llegan como revisiones fechadas de este artículo.
4.1 Dirección
¿Fue el indicador más alto o más bajo al final del horizonte que en su referencia, y respalda el modelo su probabilidad en ese lado? Por encima de 50 respalda una subida, por debajo de 50 una caída, exactamente 50 ninguna. Una predicción del 51% y una predicción del 95% obtienen el mismo acierto, por lo que la dirección no puede distinguir un modelo seguro de uno dubitativo, y la medida principal es la puntuación de Brier.
4.2 Puntuación de Brier
Para un pronóstico con probabilidad indicada (en porcentaje) de una subida y resultado ,
y la puntuación de un modelo sobre pronósticos resueltos es la media (Brier, 1950), de 0 para un pronóstico perfecto a 1 para el peor. La puntuación de Brier es estrictamente propia para el evento en el que se calcula (Gneiting & Raftery, 2007); para la pregunta de la liga ese evento es una subida estricta sobre todas las filas (sección 3.5, requisito 7).
4.3 El criterio de referencia del 50% no informativo y la climatología
Un pronosticador que siempre dice 50% obtiene una puntuación de 0,25 en cada pronóstico. Este es el criterio de referencia del 50% no informativo (la "moneda" de los archivos de la liga), una referencia neutral. Un pronosticador que conoce la tasa base de subidas puede obtener una puntuación inferior a 0,25 sin habilidad sobre el día, y en horizontes largos la tasa base puede estar lejos de una mitad. Por lo tanto, añado un criterio de referencia climatológico (requisito 9): la frecuencia de una subida estricta del mismo evento para cada activo y horizonte, estimada en una ventana fija que termina antes de la temporada y sellada en la metodología, con la puntuación de habilidad de Brier
en las mismas filas. El mismo evento significa el evento que puntúa el contrato: para el día, de la referencia al precio terminal según la regla de la fuente de precios de la tabla 1 (09:30 a 16:00 ET, el rendimiento a las 15:00 ET, Bitcoin desde el minuto de sellado a 16:00 ET). Para horizontes más largos se extiende sobre los mismos conteos de sesiones o días calendario (sección 3.7). Una tasa base de un evento diferente sesgaría el criterio de referencia.
En la implementación de referencia la climatología fija es el campo climatology_fixed de council-calibration.json: por activo y horizonte, p_up, la frecuencia 2016 a 2025 de una subida estricta con cada fila contada, p_up_ex_draw, lo mismo con empates dejados fuera, los conteos n y n_independent, la ventana y la regla. El criterio de referencia principal es = p_up, porque la puntuación de Brier principal cuenta todas las filas. p_up_ex_draw sirve la puntuación de habilidad propia de la liga sin empates (bss_reference). El campo está sellado por council-clim-window.json, publicado bajo la dirección de datos, con 2810d11e…3cabb7, el SHA-256 de su contenido: json.dumps de Python del objeto sin su clave sha256, con claves ordenadas y configuración por defecto. El script de archivo recomputa este hash de contenido antes de leer . El campo entró en el archivo en vivo el 21 de octubre de 2026 a las 08:54 UTC, su hash de contenido comprueba (sha256_ok), y es el criterio de referencia de la comparación principal. Donde la ventana en vivo no tiene historial diario, el evento diario más cercano se coloca en su lugar: la barra diaria para oro, WTI, Brent, cobre e índice del dólar, el cierre diario para el rendimiento a 10 años, el día UTC para Bitcoin y, desde una semana, movimientos desde la apertura. Los cuatro índices bursátiles estadounidenses toman los suyos de la barra diaria de la sesión 09:30 a 16:00 ET en sí, el evento que responden los modelos, y la prueba principal también se reporta solo en esos cuatro (sección 8). Las aproximaciones sesgan y dejan los pronósticos sin tocar (sección 10).
4.4 Calibración y agudeza
La calibración pregunta si las probabilidades declaradas se materializan a la tasa declarada. La liga informa la calibración de confianza direccional: cada probabilidad resuelta se pliega hacia el lado que respalda ( se convierte en con el resultado invertido, y exactamente 50 se deja fuera), los pronósticos plegados caen en cuatro contenedores, [50, 60), [60, 70), [70, 80) y [80, 100], y cada contenedor muestra la probabilidad declarada promedio y la proporción que se materializó, trazada a partir de 20 pronósticos (calib_min). El plegado mide si la confianza en el lado respaldado coincide con la tasa de aciertos en ese lado. La calibración de la probabilidad cruda de una subida también se puede calcular a partir de las filas abiertas. La puntuación de Brier se divide en un término de calibración y un término de resolución (Murphy, 1973), y los contenedores son un acompañamiento legible para esa división.
Los contenedores necesitan muchos pronósticos, así que añado, para cada escaño, el consenso y cada horizonte, el ajuste de calibración logística en todas las filas del evento preguntado (Cox, 1958). Una pendiente por debajo de 1 significa que las probabilidades declaradas están demasiado alejadas de la mitad, por encima de 1 demasiado cerca; mide una inclinación hacia subidas o caídas. La pendiente utiliza todos los pronósticos y lleva un error estándar, calculado manteniendo juntas las sesiones (Sección 4.6). El mismo ajuste, con intervalos agrupados por evento, se ha aplicado a los precios de Polymarket (Walker, 2026).
La calibración se juzga junto con la agudeza, ya que un pronosticador que siempre dice 50% está calibrado e no informativo (Gneiting et al., 2007). También pido, por escaño, consenso y horizonte,
de 0 (siempre 50%) a 100 (siempre seguro), en probabilidades declaradas únicamente, y con la probabilidad climatológica de la Sección 4.3 en lugar de 50. Se espera que la agudeza contra la mitad crezca con el horizonte donde las tasas base a largo plazo están lejos de la mitad; la agudeza contra la climatología es propia del pronosticador. Ninguna necesita un resultado. En la tirada contada del 20 de octubre de 2026, los ocho escaños cerrados antes de la referencia tenían K de 9,2 a un día, 14,1 a una semana, 13,9 a un mes y 20,3 a seis meses (Figura 5; las celdas mismas están en la Figura 6B). Estaban aproximadamente cinco puntos de una oportunidad pareja para el día y fueron más decididos en el horizonte que se resuelve último, parte del cual es tasa base que elimina. El 21 de octubre de 2026, los nueve escaños dieron 10,1, 12,5, 14,6 y 19,9. La mayoría de las probabilidades declaradas estaban entre 40 y 60. A un día eso se cumplió para el 93% de ellas el 20 de octubre y 95% el 21 de octubre, e incluso a seis meses para más de la mitad (58% y 61%).
Figura 5. Probabilidades declaradas de una subida por horizonte: tiradas 2026-10-20-am (ocho escaños cerrados antes de la referencia) y 2026-10-21-am (nueve escaños).
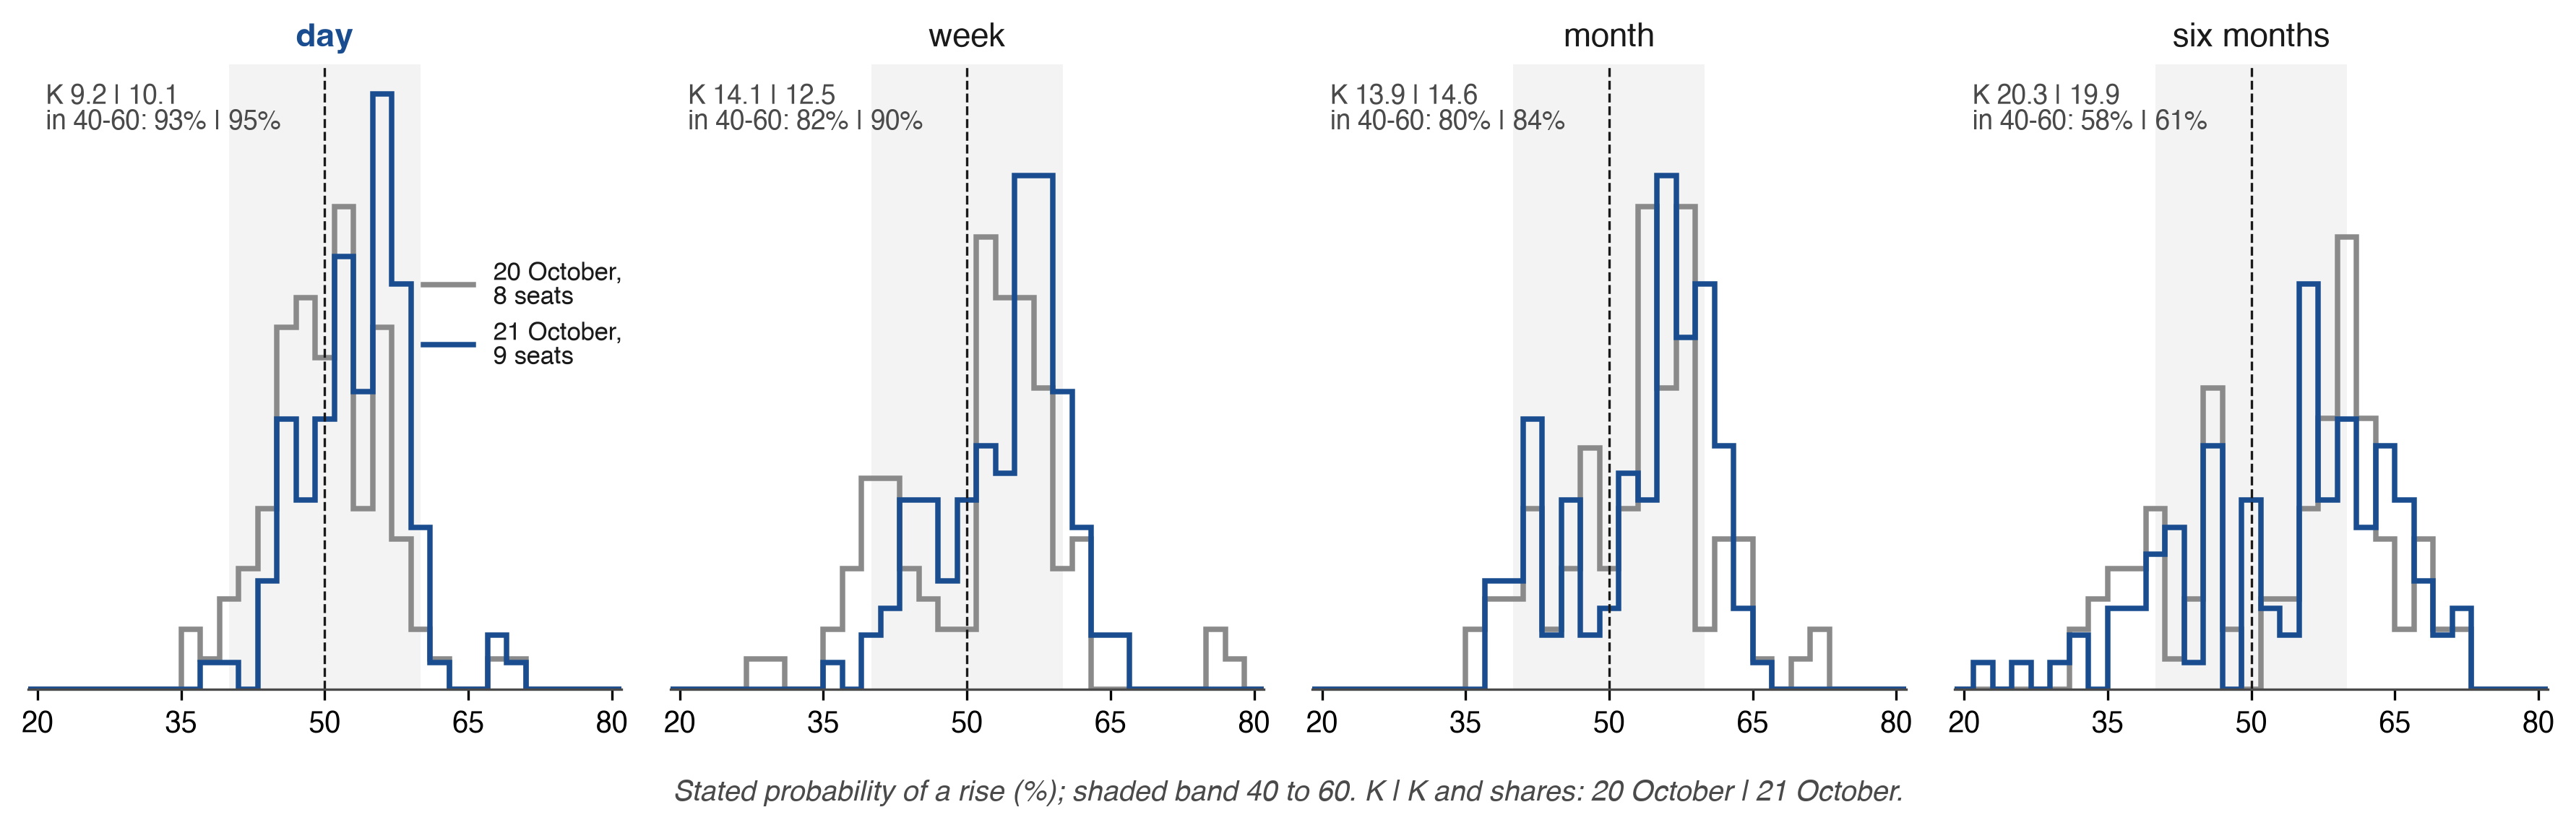
Nota: Histogramas en pasos de 2 puntos, escalados a área igual; la banda sombreada va de 40 a 60. K = (2/n)Σ|p − 50| (Sección 4.4). El 21 de octubre las cuatro celdas de Bitcoin de la novena respuesta llevan una referencia propia (Sección 3.3) y se dejan fuera de esta y de todas las demás lecturas agrupadas de la tirada (428 de 432 celdas). Fuente: council-forecasts.csv guardado 22 de octubre de 2026, 01:32 UTC.
4.5 Líneas base
La liga califica las mismas filas contra líneas base fijas:
- Moneda (0,25 en cada pronóstico).
- Impulso: dirección de ayer del mismo indicador a un fijo 55%, calificado en las mismas filas que el consenso; el campo publicado de la liga deja fuera los empates, y el F15 registrado lo califica en todas las filas (Sección 8.1).
- Comprar y mantener (
_hold_all), S&P 500 (_spy), 60/40 (_passive), Efectivo en la letra del Tesoro a 13 semanas (_cash) y Aleatorio dentro de las reglas de la liga (_random).
Los dos primeros son líneas de base para las puntuaciones de probabilidad, y los otros cinco son carteras ejecutadas bajo los mismos costos y ejecución que los modelos. Momentum comprueba una regla trivial. Cuando el resultado es una oportunidad par independientemente de ayer, un 55% fijo obtiene en expectativa. El punto de referencia climatológico es el umbral que requiere el estándar. La metodología también nombra una línea de base sin cambios, un pronóstico puntual sin probabilidad, que queda fuera de la comparación de Brier. El consenso del Consejo es también una línea de base: la media de las probabilidades de los modelos, con la más alta y la más baja descartadas cuando cinco o más responden, un segundo miembro de la misma familia ponderado un tercio, y el resultado contenido dentro del 2% al 98%.
El promediado conlleva una ganancia que no es habilidad. Para un evento con resultado y pesos que suman uno, la puntuación de Brier de la media ponderada es igual a la media ponderada de las puntuaciones de los miembros menos su dispersión ponderada (Krogh & Vedelsby, 1995):
El consenso por lo tanto no puede perder contra el promedio de los miembros que mantiene, en un evento común, sea cual sea su habilidad; mantener el resultado dentro del 2% al 98% puede costar como máximo 0,0004 en una fila. Un hallazgo de que el consenso supera a su miembro promedio es mecánicamente esperado. Su habilidad se juzga contra la moneda, la tasa base climatológica, la multitud y el mejor modelo único del período anterior, y el término de dispersión se informa junto a la puntuación de consenso (Sección 5.3).
4.6 La regla 30/10: 30 pronósticos en al menos 10 días de negociación
Un modelo entra en la tabla de un horizonte solo cuando tiene al menos 30 pronósticos resueltos en ese horizonte y al menos 10 sesiones de negociación con al menos un pronóstico resuelto en ese horizonte en cada una. La metodología sellada establece la regla y su razón en un campo: "los 12 indicadores de un día se mueven juntos: la tabla de posiciones muestra los días de negociación junto a los pronósticos, y un modelo se clasifica después de 30 pronósticos resueltos en al menos 10 días de negociación" (independence). La regla no limita cómo se distribuyen desigualmente los pronósticos en esas sesiones, por lo que la tabla muestra el número de sesiones de cada modelo junto a su puntuación (days), y la segunda condición es la que se impone. Si los pronósticos dentro de una sesión comparten una correlación , entonces pronósticos de una sesión llevan la información de aproximadamente independientes, el efecto de diseño del muestreo por conglomerados (Kish, 1965). Con y , una sesión vale 3,75 pronósticos independientes, y treinta pronósticos de tres mañanas aproximadamente once. Requerir 10 días de negociación obliga a la muestra a abarcar noticias diferentes; dentro de un horizonte la unidad de remuestreo es la sesión. La regla 30/10 decide la elegibilidad, y la potencia se trata a continuación. La primera tabla, después de la sesión del 30 de octubre de 2026, es un ordenamiento descriptivo provisional, y un modelo que se haya perdido cualquiera de las primeras diez sesiones se vuelve elegible después.
El archivo de estadísticas publica intervalos de 5 sesiones puntuadas (t de Student sobre medias de sesión) y de 20 mediante bootstrap sobre sesiones, con los 12 indicadores de un día como un clúster (council-stats.json, sample.note). Antes de 5 sesiones no se muestra intervalo alguno, e un intervalo calculado sobre filas trata los doce mercados de un día como independientes y es demasiado estrecho. Para horizontes más largos que un día, los pronósticos consecutivos comparten la mayor parte de su ventana de resultados, así que requiero, para horizonte en sesiones, intervalos consistentes con heterocedasticidad y autocorrelación con rezago (Newey & West, 1987) o un bootstrap de bloques con bloques de al menos sesiones (Künsch, 1989), y ningún intervalo antes de sesiones (requisito 10). En una temporada de 126 sesiones esa regla da intervalos a una semana desde la sesión 25 y a un mes desde la sesión 105, y ninguno a seis meses, que necesitaría 630. Las afirmaciones confirmatorias descansan en el día, el horizonte primario, y en la semana y el mes donde se cumple la regla. Los resultados de seis meses y los intervalos diarios son descriptivos en esta temporada. Una afirmación de habilidad se lee en las fechas de verificación registradas (Sección 8), sea cual sea lo que muestren las sesiones entre ellas.
El poder pertenece a la comparación que se reclamará, una diferencia de Brier emparejada. Para un pronosticador y una referencia sobre los mismos eventos, sea la media sobre los eventos de la sesión de . Con una desviación estándar de las medias de sesión y un efecto mínimo declarado , una prueba bilateral al 5% con poder del 80% necesita aproximadamente sesiones independientes. La persistencia aumenta el número, y el análisis registrado mantiene sesiones consecutivas juntas (Diebold & Mariano, 1995; Künsch, 1989). A 126 sesiones el cálculo de Brier del archivo (power_brier) detecta una caída por debajo de la moneda de 0.0105, y una caída de 0.005 necesita 554 sesiones. Extrapola a partir de 171 pronósticos de dos sesiones (el archivo fue generado el 21 de octubre de 2026, 05:33 UTC, en los datos del 20 de octubre; el campo en vivo se recomputa en cada ejecución), tomando su desviación estándar a nivel de pronóstico de 0.062 y como aproximación hasta que se puntúan cinco sesiones. Se recomputa en la sesión 30 sobre datos a nivel de sesión, y las pruebas registradas no dependen de ella. El cálculo de tasa de aciertos del archivo (power) necesita 209 sesiones para distinguir el 55% del 50% en un asumido. Un análisis independiente de preguntas binarias del mercado de predicciones llega al mismo orden: aproximadamente 350 predicciones resueltas para detectar una ventaja de Brier de 0.02 sobre el mercado (Nechepurenko & Shuvalov, 2026a).
Un resultado negativo necesita su propia regla. Una diferencia estimada pequeña, un intervalo demasiado amplio para decidir y evidencia de ninguna diferencia son tres hallazgos. Declaro un margen de equivalencia, ±0.01 Brier, para cada comparación confirmatoria, y leo "ninguna diferencia material" solo cuando el intervalo del 90% de la diferencia emparejada (dos pruebas unilaterales al 5%) se encuentra enteramente dentro de él. Elegí el margen. Está cerca de lo que la extrapolación de dos sesiones dice que 126 sesiones pueden resolver (power_brier, arriba), no se mueve cuando esa extrapolación se recomputa, y es una tolerancia de puntuación, distinta de cualquier umbral económico.
4.7 The portfolio league
Las probabilidades miden el juicio. Una cartera, una medida secundaria, muestra qué hace un modelo con ella. Cada uno de los 14 modelos gestiona $100,000 de dinero simulado bajo las mismas reglas: once fondos negociados representan los mercados (VIX es solo un indicador), las posiciones son solo largas al 5% al 25%, el efectivo gana la letra del Tesoro de 13 semanas, cada dólar que cambia cuesta el 0,1%, y una decisión se negocia en la primera apertura después de su cierre (el primer precio de 09:30 a 09:45 ET). "Hold" es una decisión sin operación y sin costo. Una decisión que incumple una regla se rechaza y las posiciones se mantienen. Cada cuenta se marca al cierre con su retorno y su máximo drawdown, y desde 20 sesiones con los índices de Sharpe y Sortino (Sharpe, 1994; Sortino & Price, 1994). Las reglas completas están en el archivo de protocolo (Apéndice A, Tabla A1). La cuenta puntúa el instrumento, un fondo del Tesoro por el rendimiento y un fondo para cada futuro de materia prima, por lo que una puntuación de Brier más baja no establece un valor de cuenta más alto. La cuenta se compara en su lugar con las líneas base pasivas bajo los mismos costos, dentro de una versión de reglas.
4.8 La liga Pro
Cada modelo mantiene una segunda cuenta de $100,000 en la liga Pro (pro-1), un libro largo-corto con pesos firmados del 5% al 30% del patrimonio y exposición bruta del 100% al 200%, por lo que apalancamiento hasta 2×; VIX se puede negociar aquí. Sus líneas base son el S&P 500 mantenido largo y mantenido corto.
4.9 IA contra la multitud
Para hasta ocho de los 12 mercados, los mercados de predicción negocian una pregunta diaria cercana a la de la liga. La pregunta de cada corrida las enumera con sus reglas de resolución completas y pide a cada modelo su propia probabilidad de "Up" en cada una, en un campo separado de su línea de respuesta (crowd_up). La instrucción de no consultar Polymarket, Kalshi ni ninguna cuota de apuestas está sellada en la pregunta, y lo que devolvió la búsqueda de un modelo está fuera del sello. Donde Polymarket enumera el mercado, los modelos responden la pregunta de Polymarket, y se hace una pregunta de Kalshi solo para un mercado que Polymarket no enumera (council-calibration.json, method.crowd_window). Los precios de la multitud y los volúmenes negociados (vol) se registran cuando sale la pregunta y se sellan en la línea de corrida (crowd.odds para Polymarket, crowd.kalshi para Kalshi). El 20 de octubre se registraron a las 12:30:06Z, antes de que el primer modelo comenzara su respuesta. Oculto el precio intencionalmente. Un modelo al que se le muestra el precio de mercado y se le pide que lo revise puede vencer al mercado en algunos contratos (S. Kim et al., 2026), pero su respuesta ya no es entonces evidencia independiente de la multitud. La liga mantiene los dos separados: la respuesta sellada es ciega al precio, y cualquier combinación con la multitud es una estrategia separada, sellada antes de ser puntuada (Sección 5.3). Cada comparación nombra su reloj de información: el precio sellado es la multitud en el momento de la pregunta, mientras que el archivo de calibración compara la respuesta de cada modelo con el precio de la multitud en el momento de respuesta del modelo, ambos puntuados sobre la resolución de la multitud. Después de la resolución, la liga informa, por pregunta, la probabilidad de los modelos y la de la multitud, la puntuación de Brier de cada uno y los lados que cada uno acertó (línea de libro crowd; council-league.json, campo crowd).
El 20 de octubre Polymarket enumeró seis preguntas diarias de "Up or Down" (S&P 500, Dow, oro, WTI, el índice del dólar y Bitcoin) y Kalshi cinco (S&P 500, Nasdaq-100, el rendimiento a 10 años, oro y WTI): ocho mercados, tres de ellos en ambos lugares. Donde ambos lugares enumeran un mercado, uso el contrato de Polymarket, el que los modelos respondieron; de lo contrario, el contrato de Kalshi. Cada probabilidad de la multitud proviene de un contrato. Una pregunta de Kalshi se fija en un strike, y su precio se convierte en "por encima del cierre anterior" mediante interpolación entre los dos strikes adyacentes (lo, hi en la línea de corrida). El precio interpolado aproxima la probabilidad de ese evento a partir de dos precios negociados, y ambos lados se puntúan entonces sobre ese evento sintético por la fuente que nombra el contrato. Admito un contrato a la comparación primaria cuando su volumen sellado es al menos $1,000 en el momento en que sale la pregunta, e informo contratos más finos aparte. El umbral muestra el dinero negociado en el contrato. El Requisito 17 solicita oferta, demanda y la hora de la última operación en cada fila de multitud, ya que en Polymarket los diferenciales son más amplios en resultados improbables (Dubach, 2026).
Las preguntas de la multitud son cercanas a las de la liga, y sus relojes difieren. El día de la liga va de la referencia de las 09:30 a las 16:00 ET (el rendimiento a las 15:00 ET); las preguntas de la multitud van de cierre a cierre y varias se resuelven en otras horas y de otras fuentes: oro e índice del dólar a las 5:00 PM ET vela de Pyth, WTI al cierre diario del contrato de futuros activo, el rendimiento a las 3:30 PM par yield del Tesoro, Bitcoin de mediodía a mediodía en Binance. Por lo tanto, hago la comparación pregunta por pregunta, en los propios términos de la multitud, con la probabilidad elicitada por separado. Los precios de los mercados de predicción son una línea base fuerte (Wolfers & Zitzewitz, 2004; Berg et al., 2008), y los contratos macroeconómicos de Kalshi pronostican aproximadamente tan precisamente como la Encuesta de Expectativas de Mercado y el consenso de Bloomberg (Diercks et al., 2026). La agudeza (Sección 4.4) se compara en los mismos contratos, modelo por modelo, desde crowd_up, ya que la multitud no cotiza el evento de prob_up.
Cuán lejos puede desplazarse una puntuación por una desajuste de eventos puede establecerse exactamente. Suponga que un índice cerró ayer a 100, abre a 98 y cierra a 99: cayó desde el cierre anterior y subió desde la apertura. Sean dos versiones de un evento que se resuelven con resultados opuestos en una participación de filas, con las probabilidades y las filas fijadas. En una fila invertida, un pronóstico cambia su puntuación de Brier por , como máximo 1 en valor absoluto, de modo que una puntuación de Brier media se desplaza como máximo por . La brecha entre pronosticadores y cambia en esa fila por , de modo que la brecha se desplaza como máximo por , donde es el conjunto de filas invertidas. Los límites se mantienen para pronósticos fijos en una muestra fija. Dos reglas se derivan. Los pronósticos entran en una puntuación común solo en un evento, con un precio de referencia (requisito 4). Y cada comparación con la multitud reporta su participación de sesiones de mercado en las que las dos preguntas se resuelven con signos opuestos; una brecha no mayor que no se interpreta como una ventaja de ninguno de los lados.
4.10 La cuadrícula: modelo × mercado × horizonte
Cada respuesta contada rellena una celda de una cuadrícula de tres vías: hasta once modelos del Consejo, 12 mercados y cuatro horizontes (Figura 6). Cada celda acumula su propia puntuación de Brier, tasa de aciertos, calibración y agudeza. La cuadrícula responde preguntas que una sola tabla de clasificación no puede: qué mercados son predecibles en qué horizonte, si la ventaja de un modelo se sitúa en una clase de activos, y si el mes es más fácil que el día una vez que cada uno se mide contra su propia tasa base. Las vistas marginales se publican en council-league.json (models, by_asset, by_horizon), las filas completas en council-forecasts.csv.
Figura 6. La cuadrícula de medición. (A) El diseño: modelo × mercado × horizonte. (B) La cuadrícula completada: las probabilidades selladas de una mañana contada, 20 de octubre de 2026.
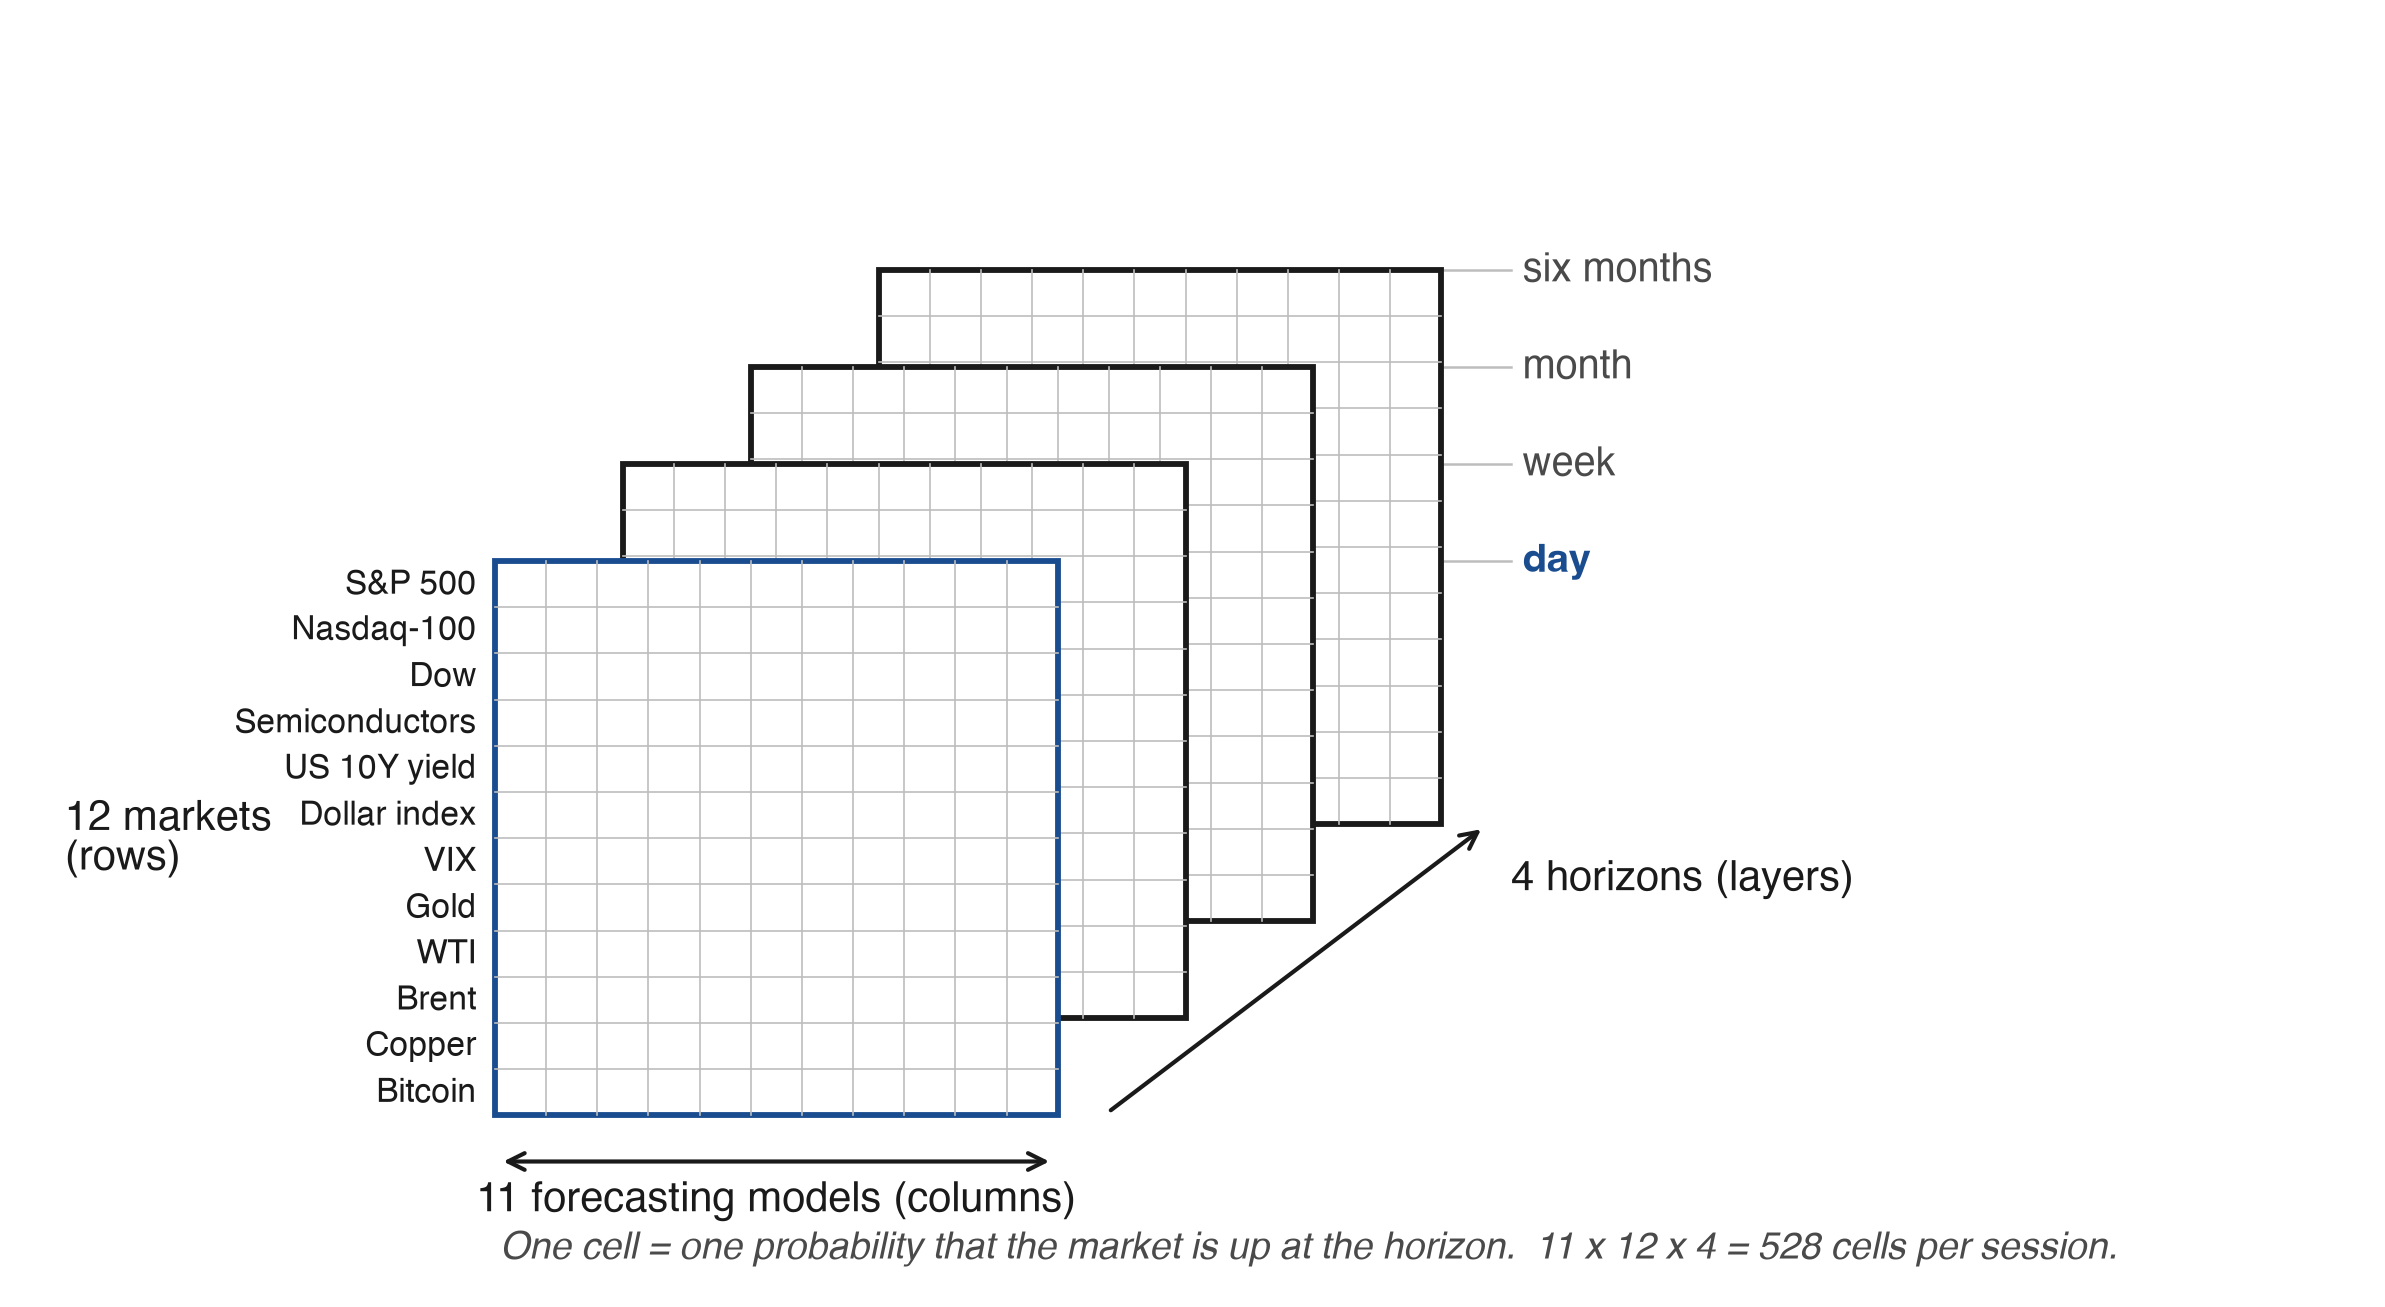
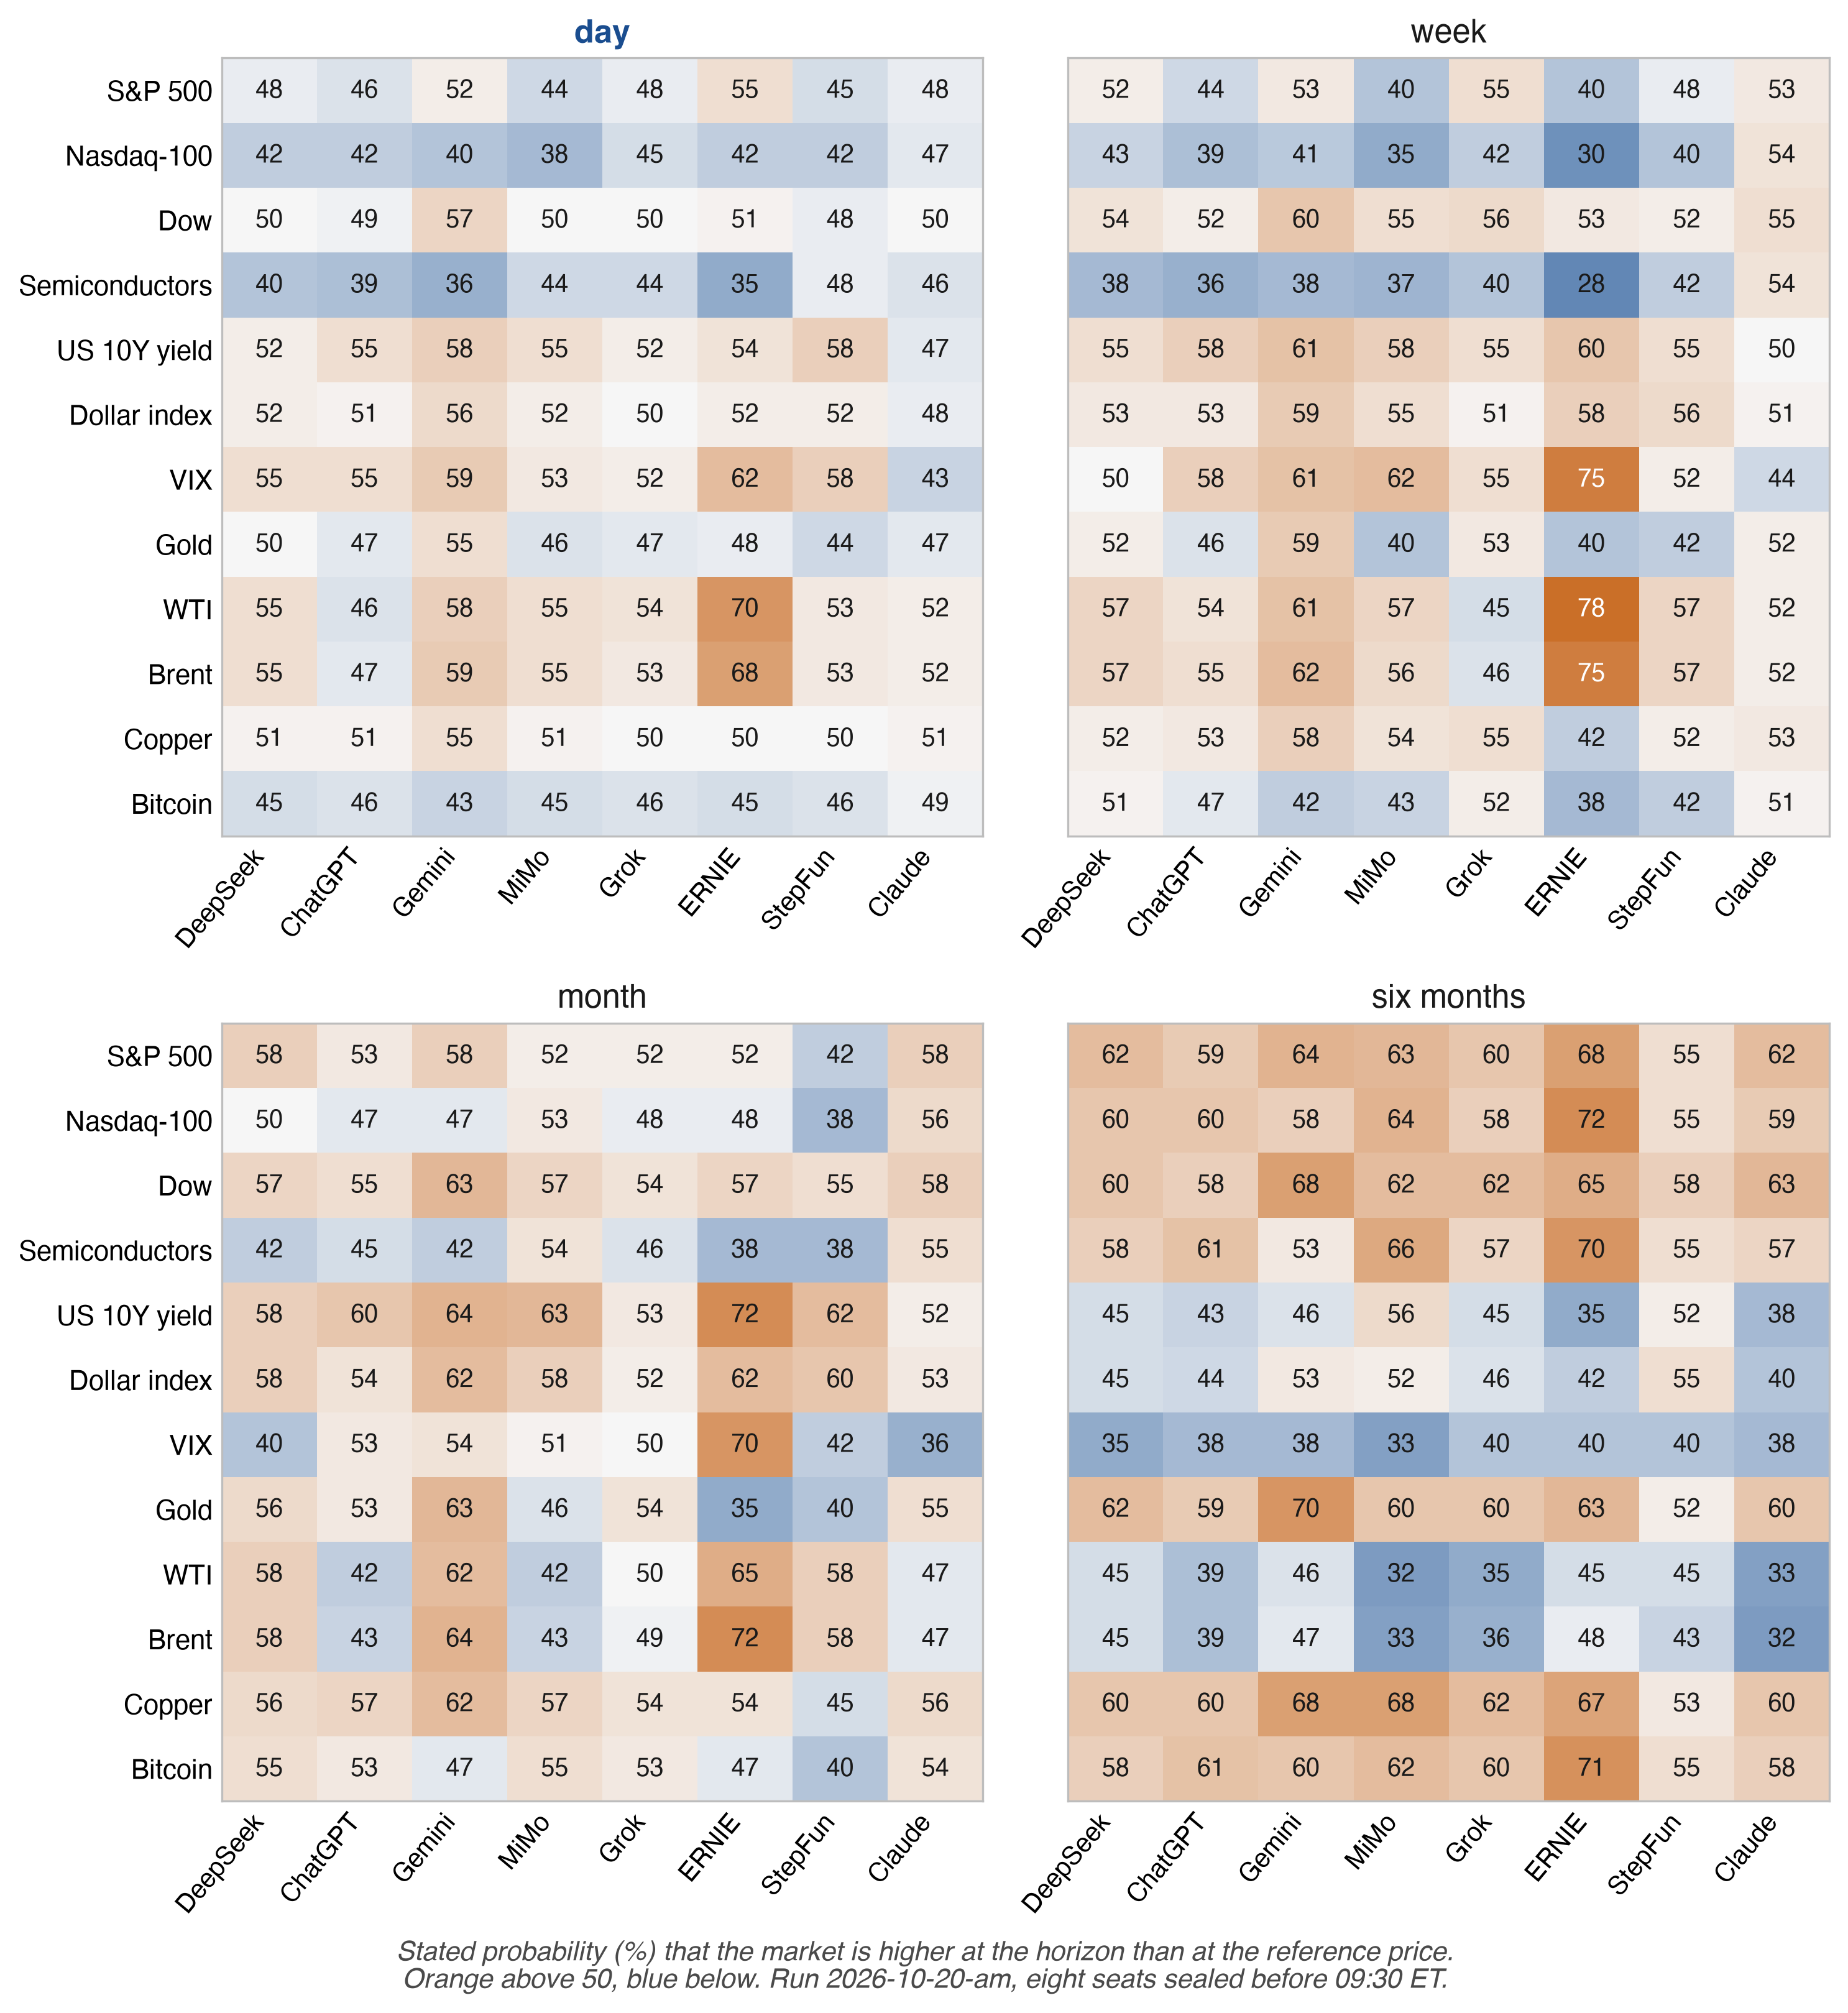
Nota: (A) Las celdas se rellenan a partir de las filas contadas de council-forecasts.csv; una celda se clasifica solo bajo la regla de la Sección 4.6. (B) Los ocho escaños cuyas respuestas fueron selladas antes de la referencia de 09:30 ET del 20 de octubre de 2026 (ejecución 2026-10-20-am), una celda por mercado y horizonte, coloreada por la probabilidad indicada de un aumento y centrada en el 50 %. Los escaños se ordenan por su carga en el primer componente principal de las imágenes de probabilidad, no por país. Fuente: council-forecasts.csv, leído el 21 de octubre de 2026.
Los pronósticos diarios se resuelven en cada sesión; los pronósticos de la primera semana de la liga puntuada se resuelven a partir del 26 de octubre de 2026, los pronósticos del primer mes alrededor del 19 de noviembre de 2026 y los pronósticos de los primeros seis meses en abril de 2027.
4.11 Reproducibilidad
Cada puntuación puede recomputarse a partir de archivos abiertos. El código del motor de cartera se publica como texto, 19 archivos y la configuración de la liga, cada uno con su SHA-256 (arena-code.json). Un script de recuento (replay.py) recomputa el valor, la participación en efectivo, las comisiones y los pesos de cada cuenta a partir de las operaciones y los precios. En los archivos de 20 de octubre de 2026, reprodujo todas las 253 filas publicadas de 145 cuentas dentro del redondeo de publicación (Apéndice B, paso 7). Un segundo script, tools/replay_brier.py bajo la misma dirección, recomputa a partir de council-forecasts.csv la puntuación de Brier de cada predicción contabilizada y los totales por asiento, horizonte y versión de metodología, y los compara con las cifras publicadas; en los archivos en vivo de 22 de octubre de 2026, 00:09 UTC, coincidió exactamente con los 9.318 números publicados. Cada fila de predicción en council-forecasts.csv nombra la línea de libro que la sella (line), por lo que cada puntuación se remonta a una respuesta sellada y de allí a un prefijo sellado y un bloque de Bitcoin (Apéndice B). Una línea de puntuación está cubierta por el primer sello posterior a ella.
Cualquiera puede recomputar los resultados publicados. La cadena y el anclaje fijan las respuestas selladas, sus tiempos y sus preguntas. Las llamadas del modelo sin procesar, el feed de precios y el código implementado se publican con sus hashes tal como los proporcionó el operador. Conciliar los precios de referencia y cierre con una segunda fuente independiente es el escalón de resultado de la escalera de afirmaciones (Tabla B1). Dado que los archivos en vivo cambian en cada ejecución, cada revisión cita un análisis inmutable publicado en Zenodo (10.5281/zenodo.23552700) con un manifiesto del SHA-256, tamaño y tiempo de recuperación de cada archivo (Apéndice C).
5. Cuántas voces independientes
La liga tiene once puestos de pronóstico. Un consejo de ese tamaño parece tener tantas opiniones, y la liga está diseñada para contar cuántas contiene. Si los errores de N pronosticadores correlacionan en una ρ común, su promedio lleva la evidencia de
N_eff = N / (1 + (N − 1)ρ)
pronosticadores independientes, y conforme N crece, N_eff se aproxima a 1/ρ y se detiene ahí. La fórmula es el efecto de diseño del muestreo de conglomerados (Kish, 1965), y la saturación del valor de expertos dependientes fue demostrada para la combinación de pronósticos por Clemen y Winkler (1985). El artículo complementario la aplica a paneles de modelos de IA (Chernets, 2026a). El límite no depende de cuántos modelos fueron consultados. Con ρ = 0,5 mil modelos valen dos testigos, y una vez que un consejo es mayor que 1/ρ, reducir ρ compra más que añadir miembros. La entrada se mide. Cuando dos modelos de lenguaje se equivocan, a menudo dan la misma respuesta equivocada, más aún dentro de una arquitectura o un proveedor (Kim et al., 2025). Los errores de pronóstico de tres modelos frontera correlacionaron en una r media de 0,77 en 568 preguntas binarias (Spiro, 2026), y los modelos frontera hacen predicciones altamente correlacionadas en el punto de referencia Metaculus IA (Aitchison et al., 2026). Cuando muchos tomadores de decisiones adoptan un algoritmo, la decisión colectiva puede empeorar incluso si el algoritmo vence a cada uno de ellos por separado (Kleinberg & Raghavan, 2021). La teoría y simulaciones calibradas a tenencias institucionales sugieren que la adopción generalizada de modelos de IA similares acorta la vida de las señales que comercian (Meng & Chen, 2026). Tales argumentos necesitan una semejanza medida de los modelos como entrada. Una liga de mercado proporciona una verdad fundamental externa cada día de negociación y hasta once transmisiones en vivo de probabilidades en las que ρ puede ser estimada. N_eff es un conteo de varianza. Un sesgo que todo modelo comparte permanece en la media sin importar el número de modelos, razón por la cual la liga también cuenta el error unánime directamente (Sección 5.3). Un consenso de modelos impreso sin su número efectivo de voces es una encuesta impresa sin su tamaño de muestra: el lector ve la proporción que está de acuerdo y no puede saber cuánta evidencia sustenta el acuerdo. El Requisito 14 por lo tanto hace que el conteo sea OBLIGATORIO dondequiera que se muestre un consenso. El 20 de octubre ocho puestos sellaron una imagen de un día antes de la apertura, y sus imágenes fueron tan parecidas como las de 1,46 pronosticadores independientes (Sección 5.2).
5.1 Cómo la liga estima ρ
Cada ejecución sellada da, para cada puesto de pronóstico, una probabilidad de que cada uno de los 12 mercados esté al alza en cada horizonte. Para cada ejecución y horizonte, la liga calcula el promedio sobre pares de puestos de la correlación de Pearson de sus probabilidades en todos los mercados a los que ambos respondieron, y evalúa N_eff = n / (1 + (n − 1)ρ) con el n y ρ de esa ejecución. N_eff es convexa en ρ, así que el promedio de los conteos por ejecución es al menos el conteo en el ρ promedio, y el ruido de muestreo de ρ, estimado de doce mercados, también empuja el conteo por ejecución hacia arriba. Un promedio por debajo de un umbral, como en F1 y F2, es por lo tanto la lectura conservadora, y una comparación entre horizontes se lee en ρ mismo (F9). Con doce mercados una correlación pairwise lleva un error estándar de aproximadamente 0,26 a 0,18 en el rango observado de 0,38 a 0,64; los pares de una ejecución comparten puestos y mercados, así que su promedio es más estable que un par pero no por la raíz de su número. Un intervalo proviene de cinco ejecuciones contadas. Uso la línea de respuesta más reciente de cada puesto y dejo fuera celdas restauradas después del sello por una línea de correction con fecha, porque no estaban en la respuesta sellada. La regla de elegibilidad es parte del estimador. Admito solo ejecuciones contadas, y solo respuestas selladas antes del precio de referencia, para que una respuesta tardía, que podría ver el movimiento de apertura, no entre. El archivo abierto council-stats.json publica esta serie bajo n_eff.counted, con la regla establecida en el archivo. El bloque más antiguo n_eff.per_run y su media promedian todas las ejecuciones selladas, ejecuciones de prueba y respuestas tardías incluidas. El Apéndice C proporciona los campos para recomputación desde council-forecasts.csv y council-book.jsonl. La Tabla 6 sigue las filas del archivo abierto a través de esta regla, desde las seis ejecuciones selladas al registro contado.
Tabla 6. Del archivo abierto al registro contado, por ejecución: filas, correcciones, puestos, filas selladas antes de la referencia, 50s indicados, celdas inválidas y filas de un día contadas (council-forecasts.csv, 3.792 filas).
| Ejecución | Rol | Filas en archivo | Filas de corrección | Puestos respondiendo | Puestos sellados antes de la referencia | Filas selladas antes de la referencia | 50s indicados | Celdas inválidas | Filas de un día contadas |
|---|---|---|---|---|---|---|---|---|---|
| 2026-10-16-eve | Prueba | 1.056 | 39 | 9 | 9 | 1.017 | 20 | 0 | 0 |
| 2026-10-17-btc | Prueba | 864 | 32 | 9 | 9 | 832 | 40 | 0 | 0 |
| 2026-10-18-radar | Prueba | 672 | 21 | 8 | 8 | 651 | 22 | 0 | 0 |
| 2026-10-19-am | Desarrollo | 336 | 11 | 7 | 7 | 325 | 4 | 0 | 83 |
| 2026-10-20-am | Desarrollo | 432 | 0 | 9 | 8 | 384 | 14 | 12 | 105 (96 selladas antes de la referencia) |
| 2026-10-21-am | Registro contado | 432 | 0 | 9 | 9 | 432 | 24 | 0 | 108 |
Nota: Las filas de corrección son celdas añadidas por líneas de corrección posteriores (line_kind); las otras columnas cuentan las celdas de líneas de respuesta. Una fila está sellada antes de la referencia cuando el sello de su línea, max(at, booked_at), precede a las 09:30 ET de la sesión a la que apunta; las tres ejecuciones de prueba apuntan al 19 de octubre. Las celdas de 50 indicado e inválidas se leen de cell_status (explicit_50, invalid), las filas contadas de status. El 20 de octubre el noveno asiento, Meta AI, se selló a las 16:16:52Z: sus 12 celdas inválidas no contienen probabilidad, y sus nueve filas de un día contadas se puntúan desde su propia referencia, fuera del evento común. El 21 de octubre las cuatro celdas Bitcoin de la novena respuesta tienen su propia referencia (Sección 3.3). Fuente: council-forecasts.csv y council-book.jsonl guardados el 22 de octubre de 2026, 01:32 UTC (SHA-256 del CSV 9fa4747e…c299d).
Publico estadísticas complementarias junto al recuento. La correlación se calcula entre mercados, por lo que incluye la forma en que los mercados se mueven juntos (los tres índices bursátiles estadounidenses, WTI y Brent); una segunda versión mantiene un mercado por grupo, eliminando el Nasdaq-100, el Dow y Brent. La correlación entre mercados también depende de la dirección en que se pregunta cada mercado: una subida del VIX, el dólar o la rentabilidad generalmente va acompañada de una caída de las acciones, y la liga pregunta cada mercado como una subida, fijada en su contrato de evento. También calculo una versión libre de esa convención, que correlaciona las desviaciones de 50 sin restar la media de cada asiento entre mercados, por lo que invertir cualquier mercado no cambia nada. En un día da 1,85 y 1,54, el 19 y 20 de octubre, frente a 1,74 y 1,46 para el recuento principal. Tomados de la probabilidad climatológica en lugar de 50, las mismas desviaciones dan la lectura que la Sección 4.3 solicita en horizontes largos. La razón de participación de la matriz es un recuento de dimensión diferente, y bajo equicorrelación los dos difieren, por lo que la leo junto a N_eff como un segundo recuento. Una tercera estadística elimina primero el consenso de cada mercado. Restar un consenso estimado de los mismos modelos hace que las desviaciones estén correlacionadas negativamente por construcción, por lo que esta es descriptiva y no registrada. El Requisito 17 añade la proporción del mayor autovalor. Una proporción cercana a uno dice que un único factor común lleva el parecido, la estructura bajo la cual un ρ común es un resumen justo, y una proporción baja dice que el ρ único oculta varios factores. En la ejecución contada del 20 de octubre de 2026, entre todas las 48 celdas de los ocho asientos sellados antes de la referencia, el mayor autovalor lleva el 68% de la traza (5,47 de 8). Un factor común sostiene la mayor parte del parecido. La razón de participación de la matriz de un día fue de 2,28 el 19 de octubre, 1,79 el 20 de octubre y 3,28 el 21 de octubre (n_eff_participation).
El recuento principal mide cuán parecidas son las imágenes de probabilidad. La correlación de errores, la ρ de la fórmula anterior, es el segundo recuento, y la liga la calcula a partir de sesiones puntuadas: la correlación media por pares de los indicadores de error de los asientos entre los mercados, convertida a N_eff de la misma forma (n_eff_errors). También lleva el movimiento conjunto de resultados. Cuando los tres índices bursátiles caen juntos, los modelos que dijeron alza se equivocan juntos independientemente de su parecido.
5.2 Una primera lectura del método
Leo el método primero en las sesiones de desarrollo del 19 y 20 de octubre de 2026 (Sección 8). En sus dos ejecuciones matutinas contadas, utilizando solo respuestas selladas antes del precio de referencia de las 09:30 ET, encuentro N_eff en un día de 1,74 el 19 de octubre de 2026 (n = 7 asientos sellados antes de la referencia, ρ = 0,505) y 1,46 el 20 de octubre de 2026 (n = 8, ρ = 0,64). Las imágenes de esas dos mañanas eran tan parecidas como las de aproximadamente 1,6 pronosticadores independientes. Manteniendo un mercado por grupo da 1,69 y 1,57. La primera ejecución del registro contado, el 21 de octubre de 2026, dio 2,23 (n = 9, ρ = 0,379), y 2,09 con un mercado por grupo (council-stats.json, n_eff.counted.per_run, generado el 21 de octubre de 2026, 22:16 UTC).
La misma regla en cada horizonte, con las tres medidas descriptivas que no necesitan resultado además, da la Tabla 7.
Tabla 7. Lectura descriptiva por horizonte de las ejecuciones matutinas contadas, respuestas selladas antes de la referencia: N_eff de las imágenes de probabilidad (ρ media por pares entre paréntesis), nitidez K, proporción de probabilidades entre 40 y 60, y dispersión entre asientos.
| Ejecución | Medida | 1 día | 1 semana | 1 mes | 6 meses |
|---|---|---|---|---|---|
| 19 oct 2026 (n = 7) | N_eff (ρ) | 1,74 (0,51) | 2,81 (0,25) | 2,39 (0,32) | 1,16 (0,84) |
| K | 10,7 | 14,4 | 17,9 | 25,0 | |
| Proporción en [40, 60] (%) | 88 | 81 | 67 | 42 | |
| Dispersión (puntos) | 4,2 | 6,3 | 7,4 | 5,1 | |
| 20 oct 2026 (n = 8) | N_eff (ρ) | 1,46 (0,64) | 1,99 (0,43) | 2,68 (0,28) | 1,14 (0,86) |
| K | 9,2 | 14,1 | 13,9 | 20,3 | |
| Proporción en [40, 60] (%) | 93 | 82 | 80 | 58 | |
| Dispersión (puntos) | 3,5 | 5,7 | 6,2 | 4,7 | |
| 21 oct 2026 (n = 9) | N_eff (ρ) | 2,23 (0,38) | 2,63 (0,30) | 2,41 (0,34) | 1,58 (0,59) |
| K | 10,1 | 12,5 | 14,6 | 19,9 | |
| Proporción en [40, 60] (%) | 95 | 90 | 84 | 61 | |
| Dispersión (puntos) | 4,3 | 4,8 | 5,7 | 6,8 |
Nota: Doce mercados por horizonte. N_eff por la regla del script presentado neff-horizons.py (Sección 5.1), con celdas que llevan una referencia propia dejadas fuera (el 21 de octubre las celdas Bitcoin de la novena respuesta); el valor de un día del 21 de octubre es igual al n_eff.counted.per_run publicado. K = (2/n)Σ|p − 50| entre las celdas de los asientos (Sección 4.4); la dispersión es la desviación estándar poblacional entre los asientos, promediada sobre los doce mercados. Valores de council-forecasts.csv y council-book.jsonl guardados el 22 de octubre de 2026, 01:32 UTC.
En las tres ejecuciones, las voces son menos numerosas a los seis meses y más numerosas en una semana y un mes que en un día. La similitud a los seis meses puede proceder de tasas base compartidas (las acciones y el oro suben durante seis meses), por lo que el recuento de seis meses también debe leerse en desviaciones de la probabilidad climatológica. Veo el patrón en la ejecución del 20 de octubre (Figura 6B), y en la Figura 7 lo trazo mercado por mercado. Los ocho asientos sellados antes de la referencia colocaron cinco mercados por debajo de una probabilidad uniforme para el día y cerca del 60 % a los seis meses. En probabilidad media el S&P 500 pasó de 48 a 62, el Nasdaq-100 de 42 a 61, los semiconductores de 42 a 60, el oro de 48 a 61 y Bitcoin de 46 a 61, mientras que el petróleo, el VIX y el rendimiento a 10 años fueron en sentido contrario (WTI 55 a 40, VIX 55 a 38, el rendimiento 54 a 45). El consejo vio un choque de corto plazo que se desvanece. A los seis meses converge en la tendencia a largo plazo. El 21 de octubre el extremo corto se movió y el extremo largo se mantuvo. Los nueve asientos dieron al S&P 500 55,9 para el día y 60,4 a los seis meses, y solo el cobre (47,9) y el VIX (45,7) estuvieron por debajo de una probabilidad uniforme para el día. A los seis meses los activos de riesgo nuevamente estuvieron entre 56,7 y 62,7 y el petróleo, el VIX, el rendimiento y el dólar entre 41,2 y 46,1.
Figura 7. Probabilidad media establecida de una subida en un día y a seis meses, por mercado: (A) ejecución 2026-10-20-am, ocho asientos sellados antes de la referencia; (B) ejecución 2026-10-21-am, nueve asientos.
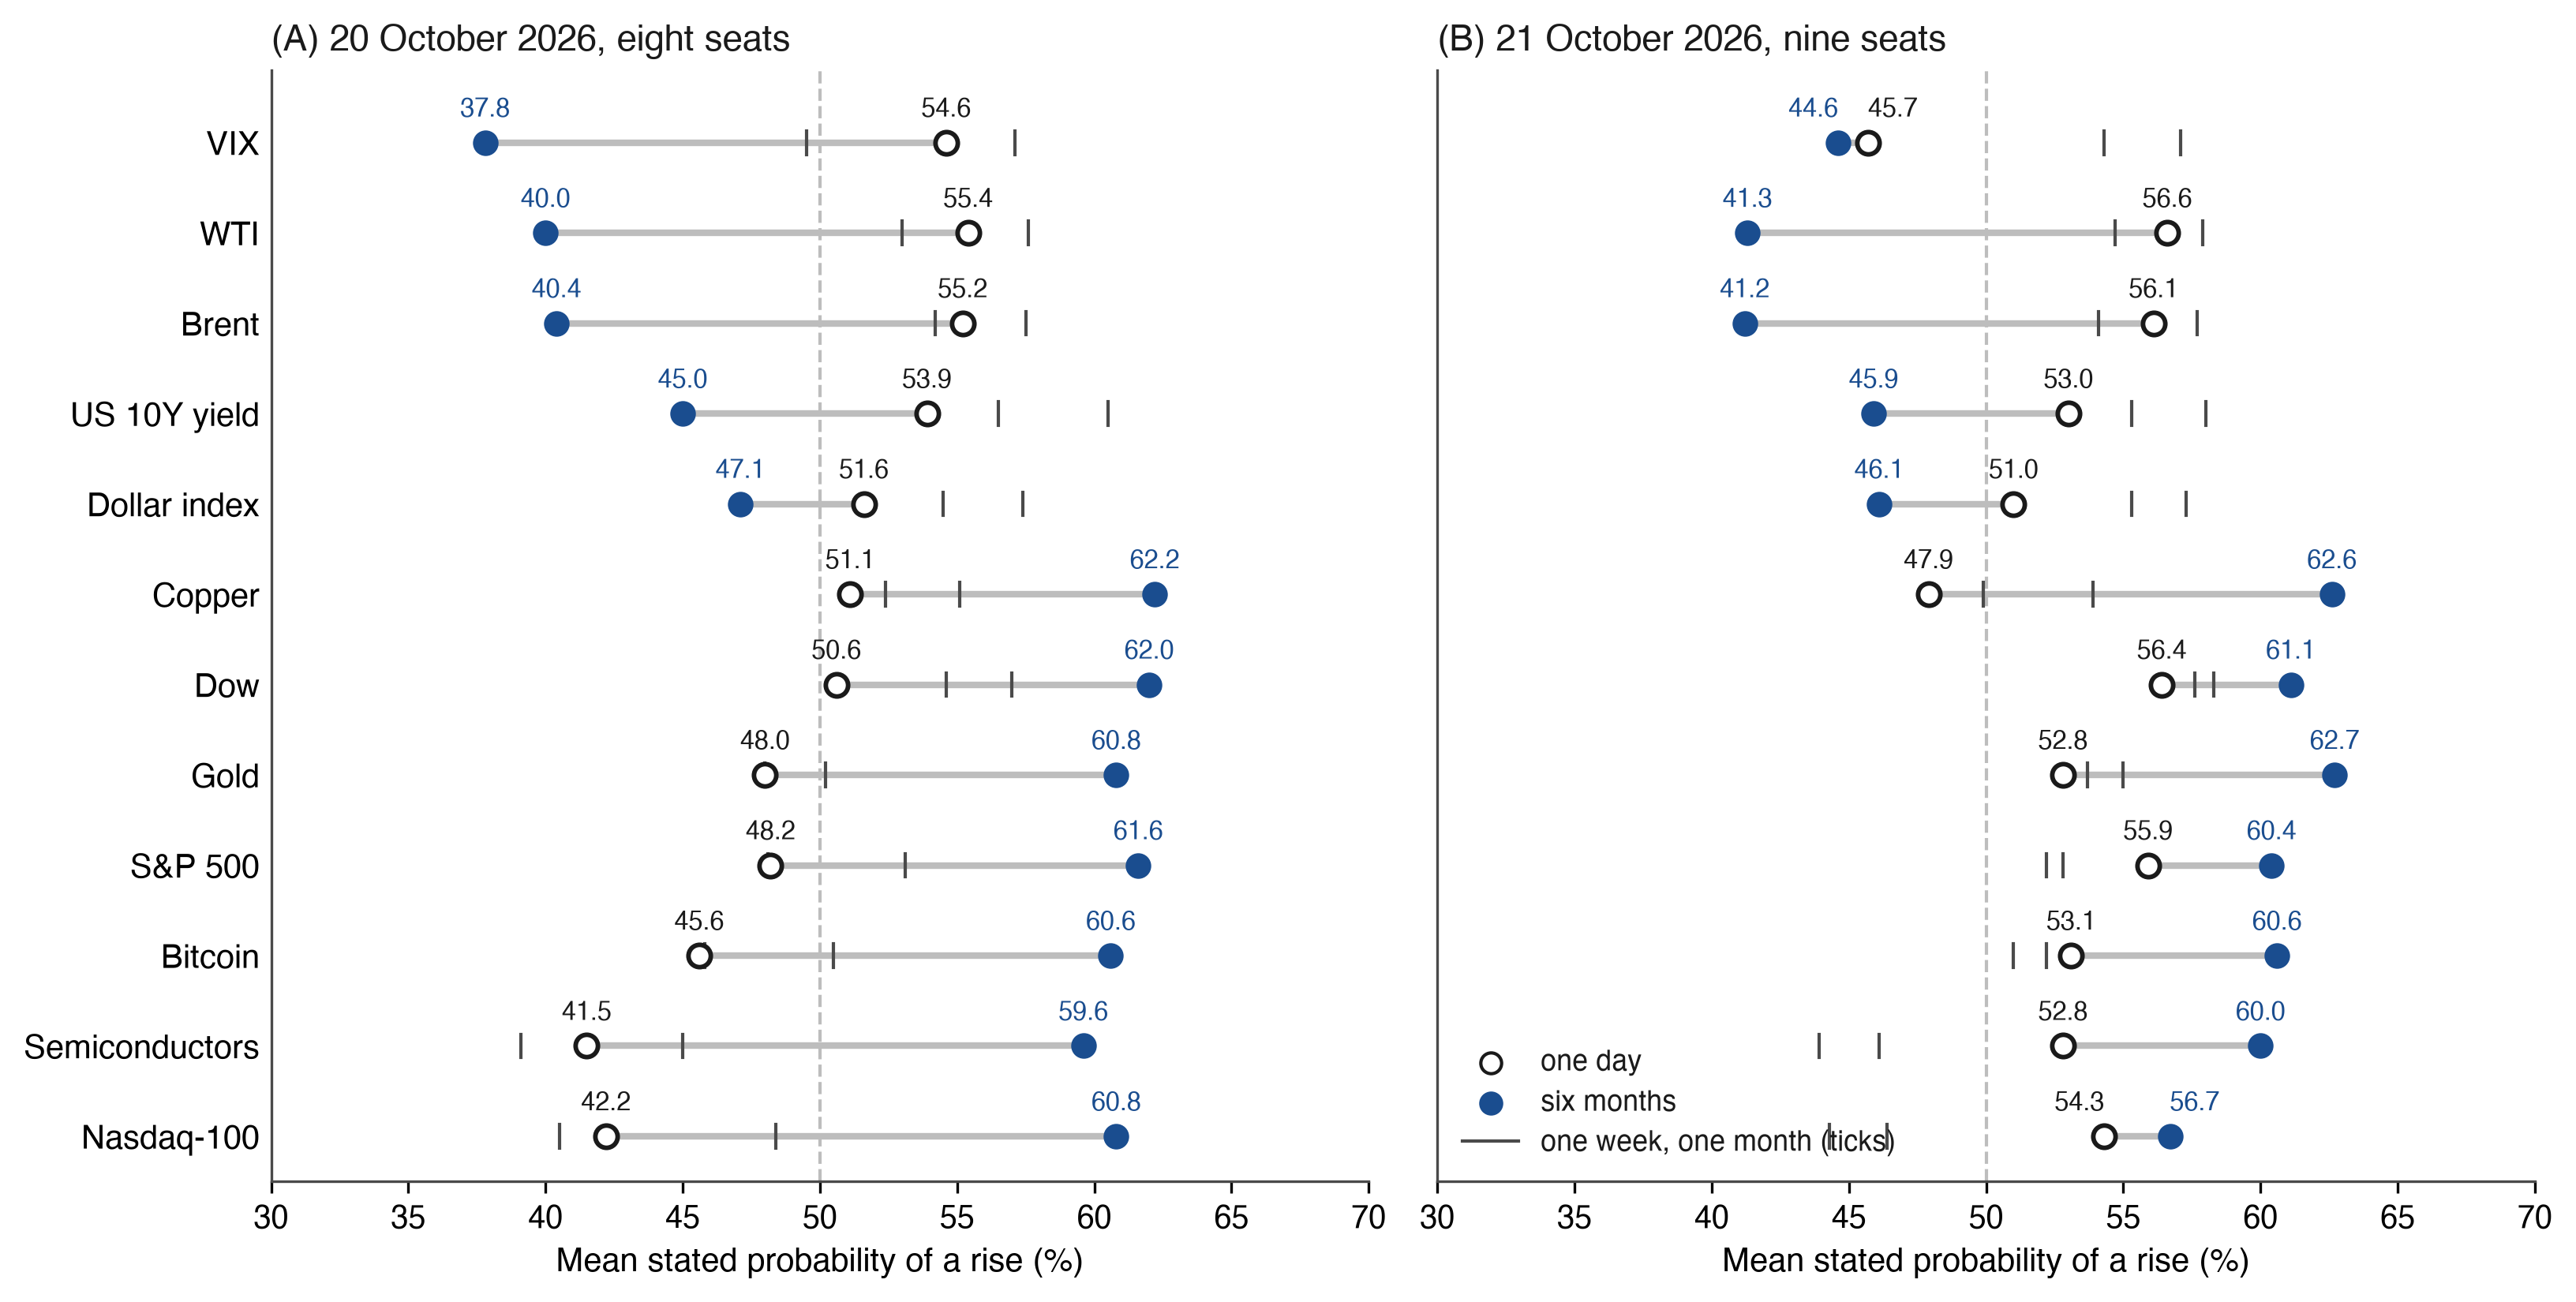
Nota: Media de prob_up de los asientos; las marcas indican una semana y un mes. Los mercados se ordenan por el cambio de un día a seis meses el 20 de octubre. Las probabilidades a seis meses incluyen la tasa base de cada mercado (Sección 4.3); la misma lectura contra climatología es . El 21 de octubre la media de Bitcoin excluye las celdas de la novena respuesta, que tienen su propia referencia. Fuente: council-forecasts.csv guardado el 22 de octubre de 2026, 01:32 UTC.
La misma ejecución da la dispersión que la Sección 8 utiliza. Entre los ocho asientos, la desviación estándar poblacional de las probabilidades promediaba 3,5 puntos en un día, 5,7 en una semana, 6,2 en un mes y 4,7 a los seis meses. En un día varió de 1,5 puntos en cobre a 6,4 en WTI, y las celdas más amplias fueron VIX y Brent en un mes (9,9 y 9,8). El 21 de octubre la dispersión media fue 4,3, 4,8, 5,7 y 6,8 puntos, más amplia a los seis meses (Brent 9,5, WTI y VIX 8,4). La Figura 8 muestra cada celda en ambas mañanas.
Figura 8. Dispersión de las probabilidades establecidas en los asientos, por mercado e horizonte: (A) ejecución 2026-10-20-am, ocho asientos sellados antes de la referencia; (B) ejecución 2026-10-21-am, nueve asientos.
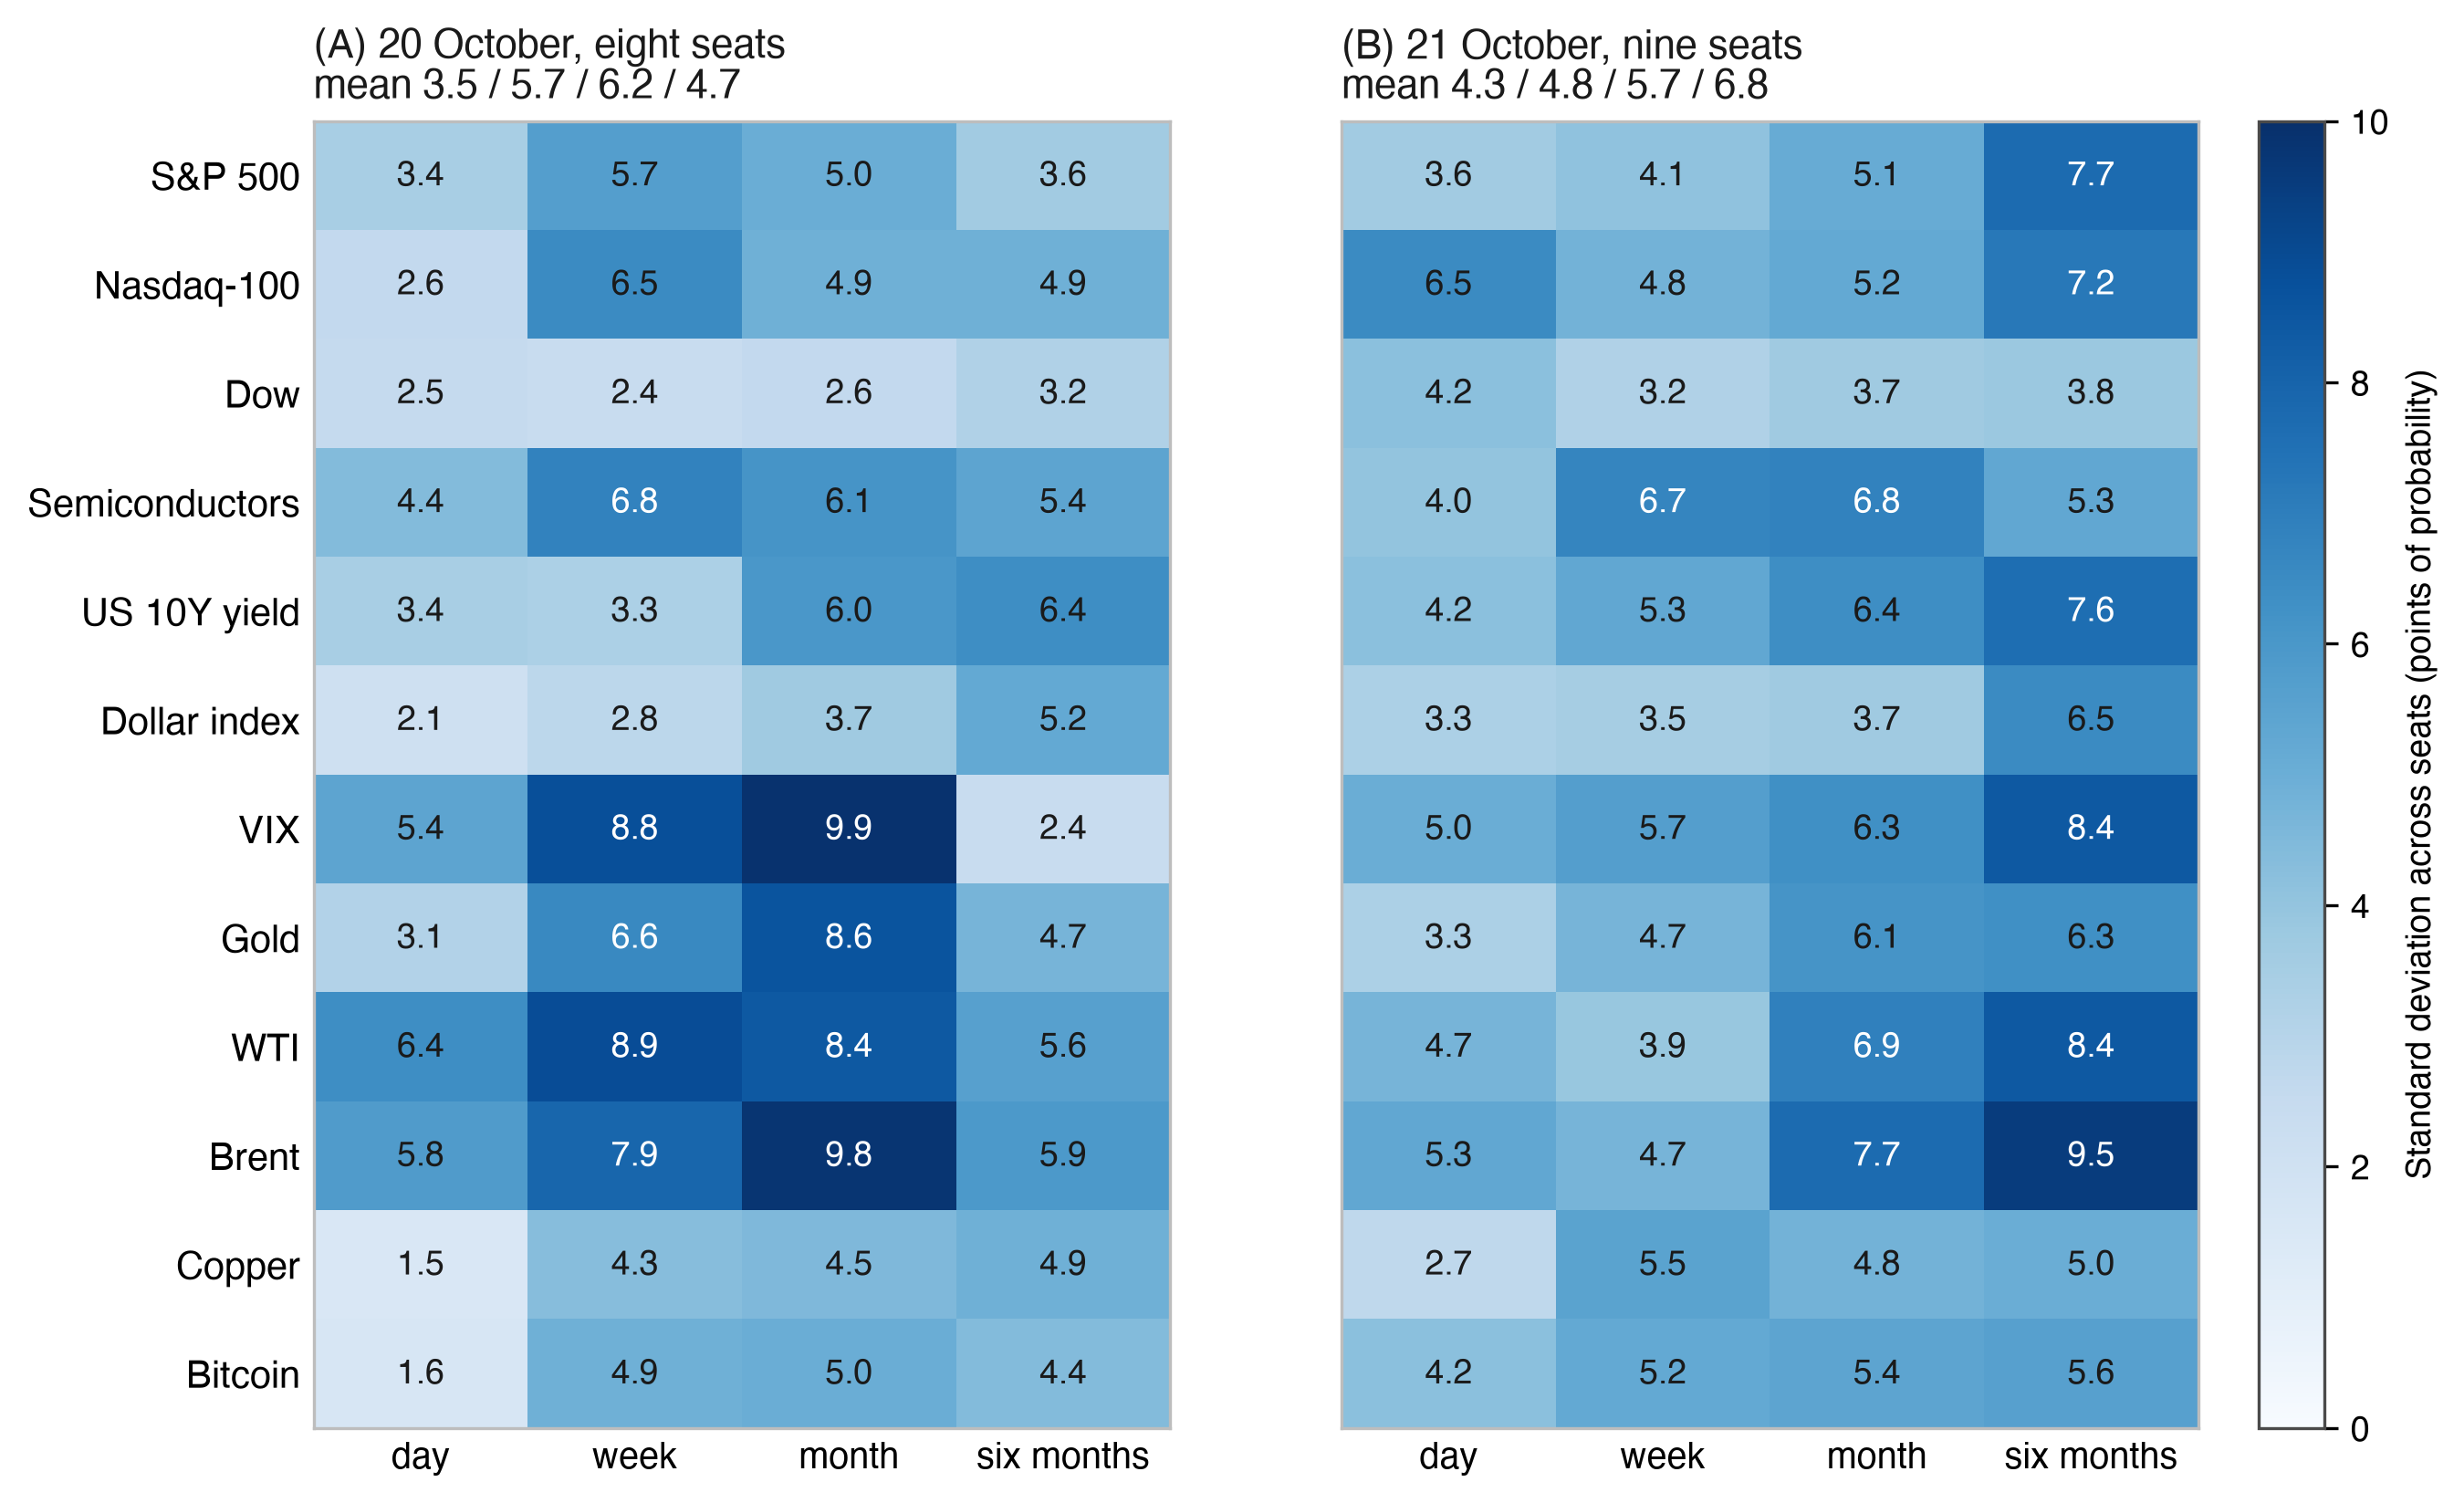
Nota: Desviación estándar poblacional de prob_up en los asientos de cada celda, en puntos de probabilidad; los títulos de los paneles dan la media en los doce mercados en cada horizonte. La Sección 8 registra el uso de la dispersión como análisis secundario. Fuente: council-forecasts.csv guardado el 22 de octubre de 2026, 01:32 UTC.
Las ejecuciones sucesivas responden a preguntas superpuestas sobre los mismos mercados, y los intervalos de una semana y un mes de las ejecuciones vecinas se superponen. Por lo tanto, una comparación entre horizontes se realiza en diferencias pareadas ejecución a ejecución, con intervalos en bloques de ejecuciones (F9). Las tres ejecuciones de prueba del 16 al 18 de octubre, todas destinadas a la sesión del 19 de octubre y no contadas, dieron 4,01, 2,69 y 2,06 en un día. El recuento en indicadores de error sigue la misma regla de elegibilidad y se calcula mediante el script archivado de F3. El campo n_eff_errors del archivo abierto es una serie descriptiva más amplia y no es el titular. La Figura 9 coloca los valores por ejecución en las curvas de la fórmula. Las predicciones F1 a F3 y F9 (Sección 8) indican lo que las ejecuciones contadas después del registro deberían mostrar.
Figura 9. Número efectivo de voces independientes frente al número de modelos, con las lecturas por ejecución de las primeras ejecuciones selladas y la primera ejecución contada.
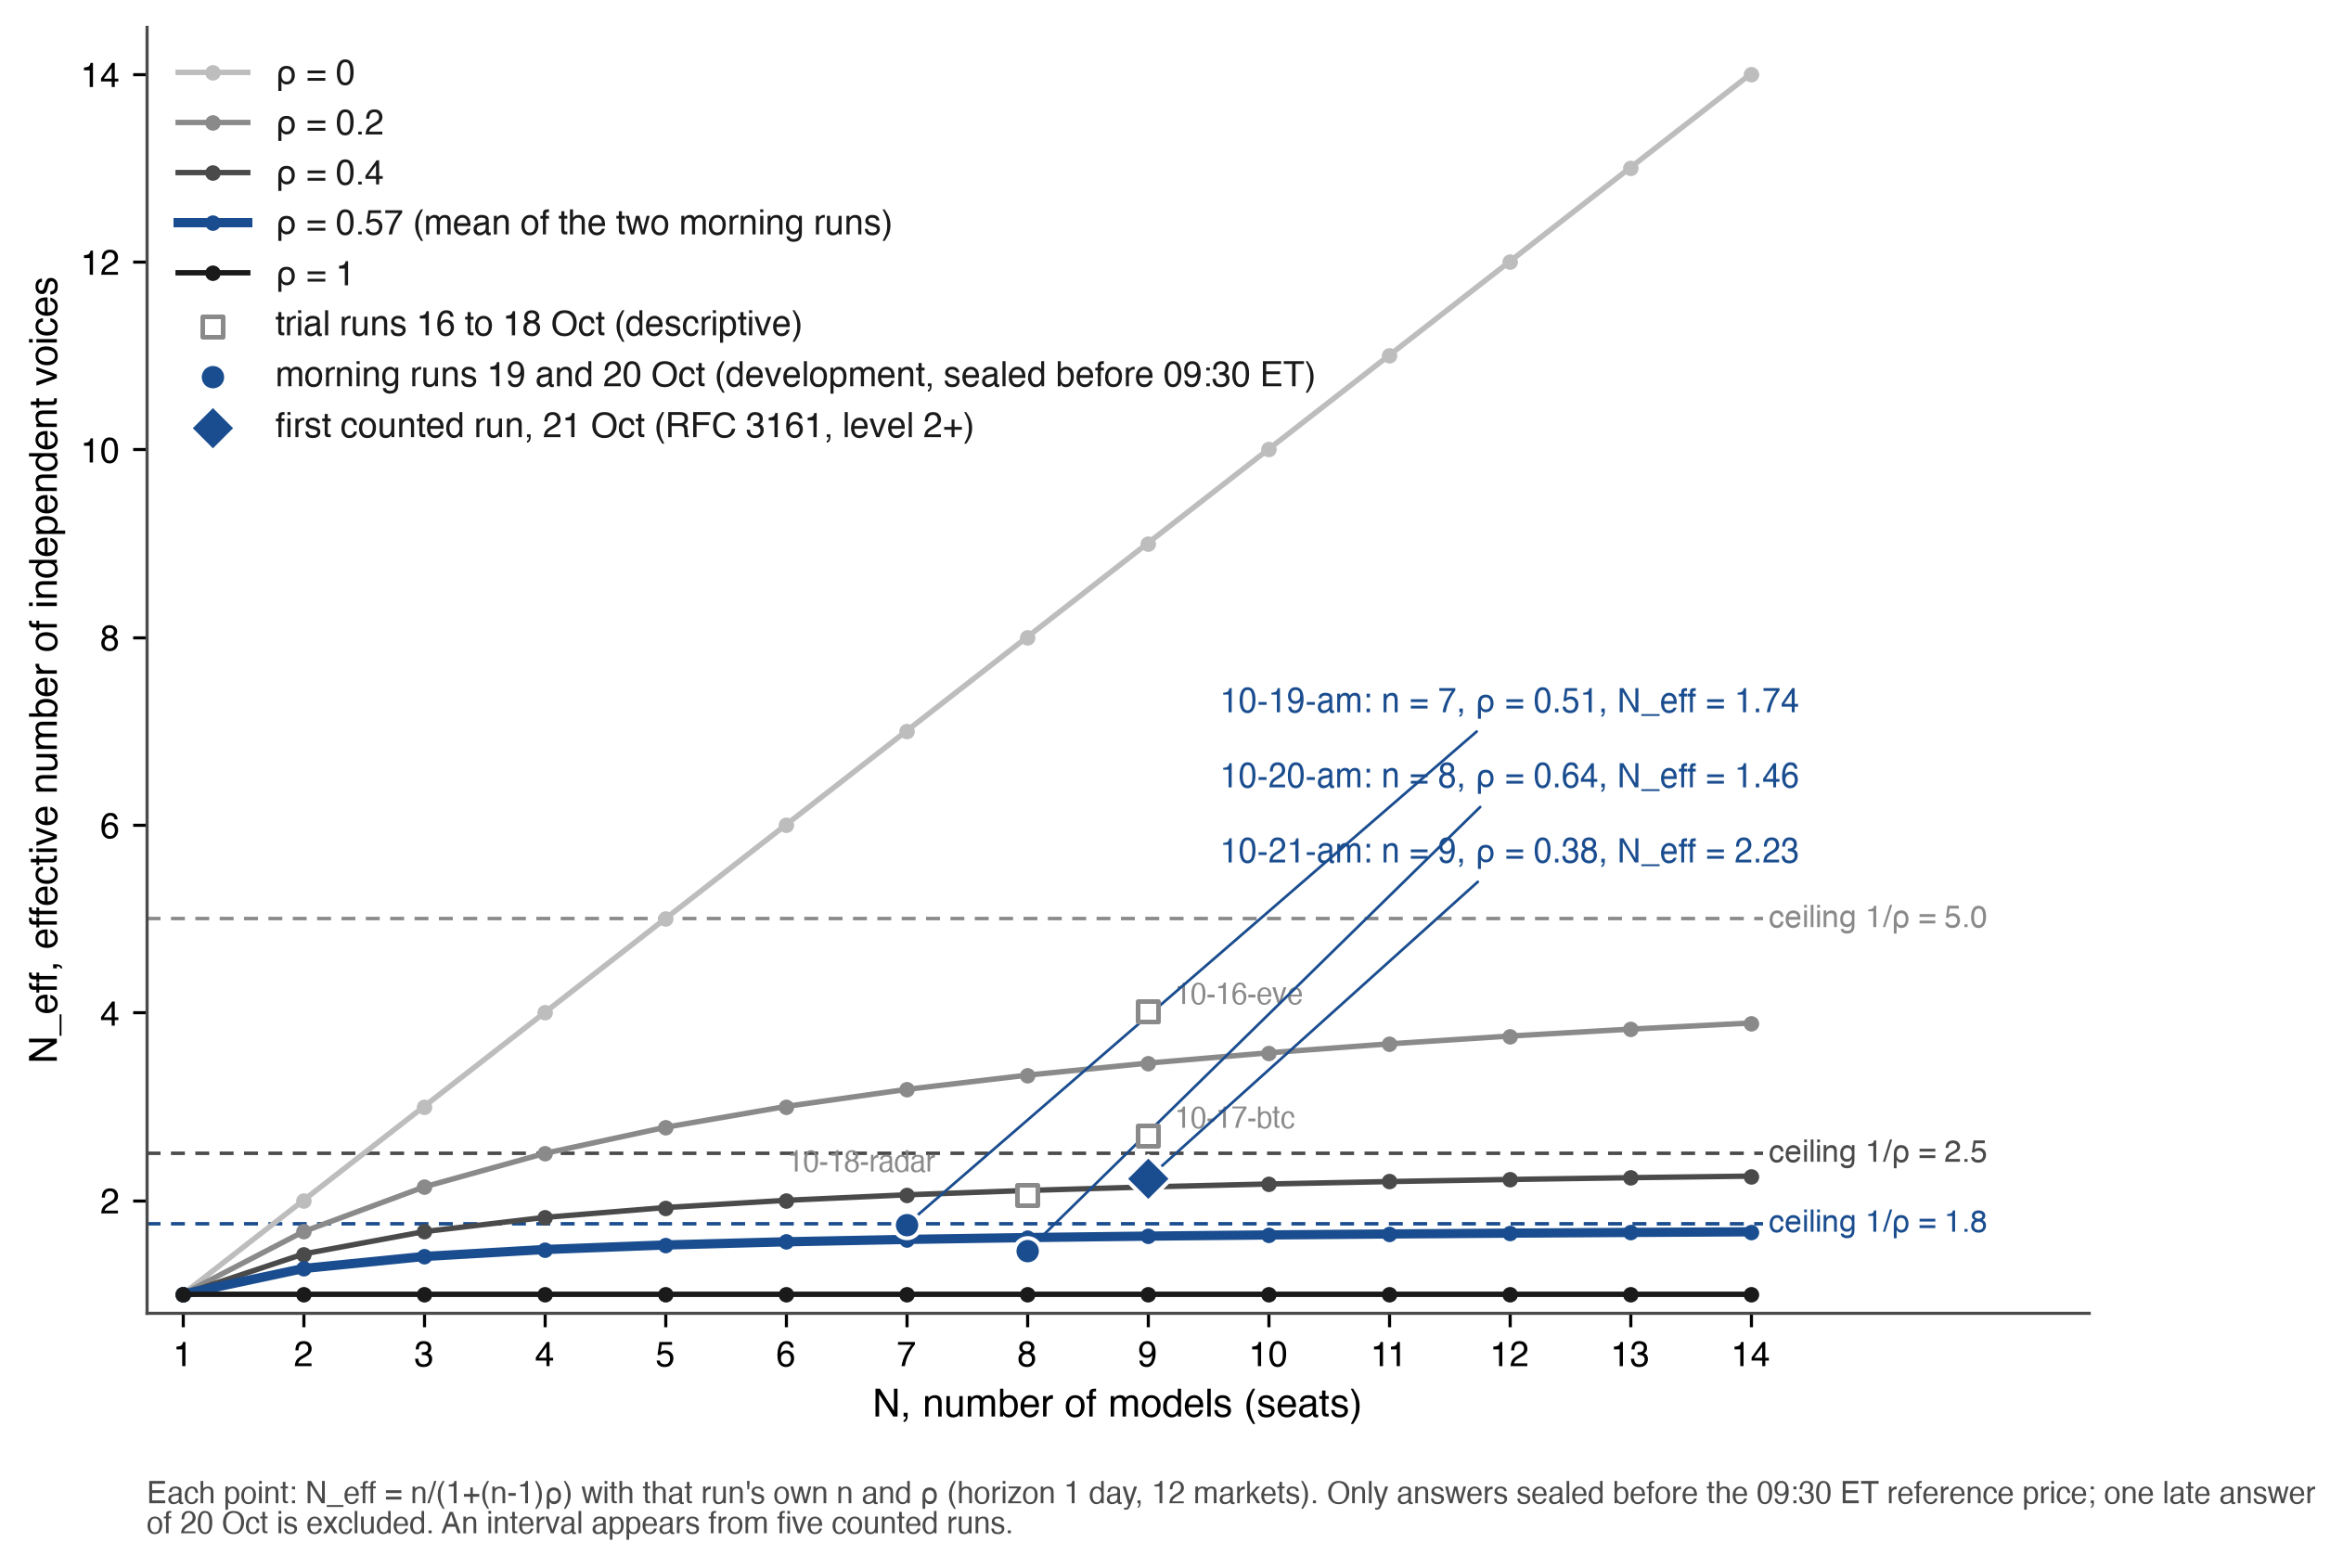
Nota: N_eff = N / (1 + (N − 1)ρ) para N = 1 a 14 y ρ de 0, 0,2, 0,4, 0,57 y 1; las líneas punteadas marcan los techos 1/ρ. Círculos rellenos: las ejecuciones matutinas del 19 y 20 de octubre en un día, respuestas selladas antes de la referencia (1,74, n = 7, ρ = 0,505; 1,46, n = 8, ρ = 0,64); la curva resaltada es su media ρ, 0,57. Diamante relleno: la primera ejecución del registro contado, 21 de octubre de 2026 (2,23, n = 9, ρ = 0,379). Cuadrados abiertos: las tres ejecuciones de prueba (4,01, 2,69, 2,06). Fuente: council-forecasts.csv y council-book.jsonl, leído el 21 de octubre de 2026, según la regla de la Sección 5.1.
5.3 El consenso y por qué descuenta familias
Defino el consenso para un mercado como la media de las probabilidades de los asientos, con tres reglas. Cuando al menos cinco asientos responden, se descartan la probabilidad más baja y la más alta. Un segundo modelo de la misma familia cuenta un tercio, y lo mismo cada uno siguiente, de modo que un laboratorio que presente varios modelos no puede superar a los otros por número. Bajo una estructura de bloques la fórmula uniforme sobreestima N_eff (Kim et al., 2025). El resultado se limita al 2 al 98 %. Cada asiento en la lista actual procede de un laboratorio diferente (Tabla 8), por lo que cada peso familiar es 1. La regla se escribe en la metodología abierta antes de que un laboratorio ocupe dos asientos.
Por la identidad de la Sección 4.5, el consenso supera la media de los miembros que mantiene mecánicamente en un evento común, y contra el consejo completo el ajuste es una opción que el consenso en la sombra y F10 miden, una ganancia aritmética. La destreza se juzga solo contra referencias fuera del consejo: la moneda, la tasa base climatológica, la multitud y, para F10, el modelo que encabezó una ventana anterior. El valor de un escaño se mide directamente: la puntuación Brier del consenso en eventos comunes con y sin ese escaño, en las mismas sesiones. Un análisis de validación cruzada calculado después de los resultados es una descripción. Cualquier ponderación distinta del ajuste congelado, los pesos de familia y el límite, elegidos porque habrían ganado en temporadas ya vistas, es una estrategia nueva (White, 2000): se sella antes de la primera sesión que gobierna y se califica solo después de ese sello.
Sello una estrategia de este tipo con el registro, como una prueba de la propia tesis de esta sección: si las voces correlacionadas valen menos, descontarlas debería ayudar. El consenso en la sombra pondera cada escaño por el inverso de su correlación por pares media con los otros escaños, calculado en las imágenes de probabilidad de un día de las ejecuciones contadas selladas antes de la marca de tiempo del registro, respuestas selladas solo antes de la referencia, con la correlación media limitada a 0.05 (un escaño sin respuesta elegible en esa ventana toma el peso mediano de los otros). Los pesos se presentan con el registro y se congelan para la temporada. En cada evento se renormalizan sobre los escaños que responden, y el ajuste de extremos, los pesos de familia y el límite son los del consenso publicado. Un script presentado calcula la sombra a partir de los archivos abiertos y la califica en los mismos eventos que el consenso publicado, al que nunca reemplaza. La Sección 8 declara la comparación. El Requisito 17 también proporciona a cada escaño dos conteos descriptivos de distinción: su correlación media con los otros escaños que responden y la proporción de sus celdas direccionales que concuerdan con la mayoría. Un escaño que es distinto y suma al consenso en eventos comunes es el escaño que la regla de familia y el techo de la Sección 5 argumentan por mantener. El 20 de octubre de 2026, en los ocho escaños sellados antes de la referencia y las 48 celdas, los dos conteos oscilaron entre una correlación media de 0.47 y 70% de acuerdo con la mayoría de los otros (Claude) a 0.71 y 88% (DeepSeek). Claude se mantuvo solo en su lado de una probabilidad par en cuatro de las 48 celdas, más que cualquier otro escaño, entre ellos semiconductores y el Nasdaq-100 a una semana, al que dio 54 mientras que los otros siete dieron 28 a 43. La precisión se califica por separado.
all_wrong cuenta las sesiones de mercado en las que cada escaño que responde fue incorrecto, con al menos cuatro respondiendo, y minority_right cuenta aquellas en las que el consenso fue incorrecto y al menos un escaño fue correcto. En ambos, las filas son todas las filas con el resultado "rise" significando un cambio mayor que cero, y un 50% declarado no es ni correcto ni incorrecto, por lo que ese escaño no cuenta como respondiendo para esa fila. Bajo independencia, error unánime entre cuatro o más escaños con tasas de error cerca de la mitad sería poco común, y su frecuencia contra el producto de las propias tasas de error de los escaños respondientes en las mismas filas es F6. El conteo es un diagnóstico de agrupamiento que mezcla el co-movimiento de resultados, la dificultad de sesiones particulares y un sesgo compartido, y no identifica copia. Una minoría correcta que se repite es el caso para mostrar la llamada de cada escaño junto al consenso.
5.4 Fuentes compartidas
Cada fila de pronóstico de council-forecasts.csv lleva los dominios y enlaces que su modelo citó (source_domains, source_urls). Para las respuestas de un día de cada ejecución informo de la concentración de citas en los sitios más citados, la superposición de Jaccard media de enlaces y sitios citados entre pares de escaños, y si los pares que comparten un enlace están de acuerdo en la acción más a menudo que los pares que no lo hacen, dentro de estratos de ejecución y mercado, por permutación. En las primeras cinco ejecuciones, un sitio de noticias extrajo aproximadamente una quinta parte de todas las citas, la superposición de enlaces exactos fue pequeña (Jaccard media 0.006), y el mayor acuerdo de los 34 pares que compartían un enlace no fue distinguible del azar (permutación p = 0.14). Un enlace citado es una cadena que el modelo emitió y no prueba que la página fue leída, y su etiqueta puede diferir de su dirección. El 19 de octubre, una respuesta citó "Reuters" con un enlace a investing.com (línea del libro 83). El Requisito 17 por lo tanto pide un registro de búsqueda (estado, tiempo, SHA-256 del contenido, tiempo de publicación declarado) antes de que un enlace entre en la superposición. Los números que la propia pregunta suministró, como los futuros pre-apertura, se eliminan antes de que se cuenten las figuras compartidas. En Prediction Arena, cuánto investigó un modelo no rastreó su resultado (Zhang et al., 2026), por lo que la liga mide qué hace la búsqueda en el acuerdo en lugar de asumir. La superposición de citas mide la procedencia declarada, y F5 expresa lo que debería mostrar.
En la Figura 10 cuento quién cita qué. Las respuestas de un día selladas antes de la referencia en las seis ejecuciones de 16 a 21 de octubre de 2026, 918 filas, llevan 1.875 citas de 233 sitios. Reuters extrajo 407 de ellas (21.7%) y fue citada por diez de los once escaños, todos excepto Claude. Su participación fue de 6.2% a 30.3% por ejecución. Los siguientes sitios fueron cnbc.com (139) y bloomberg.com (66). En las dos mañanas contadas más recientes, sitios que al menos dos escaños citaron extrajeron 68.5% y 58.3% de las citas.
Figura 10. Sitios citados por escaño: citas en las respuestas de un día selladas antes de la referencia, ejecuciones de 16 a 21 de octubre de 2026, los diez sitios más citados.
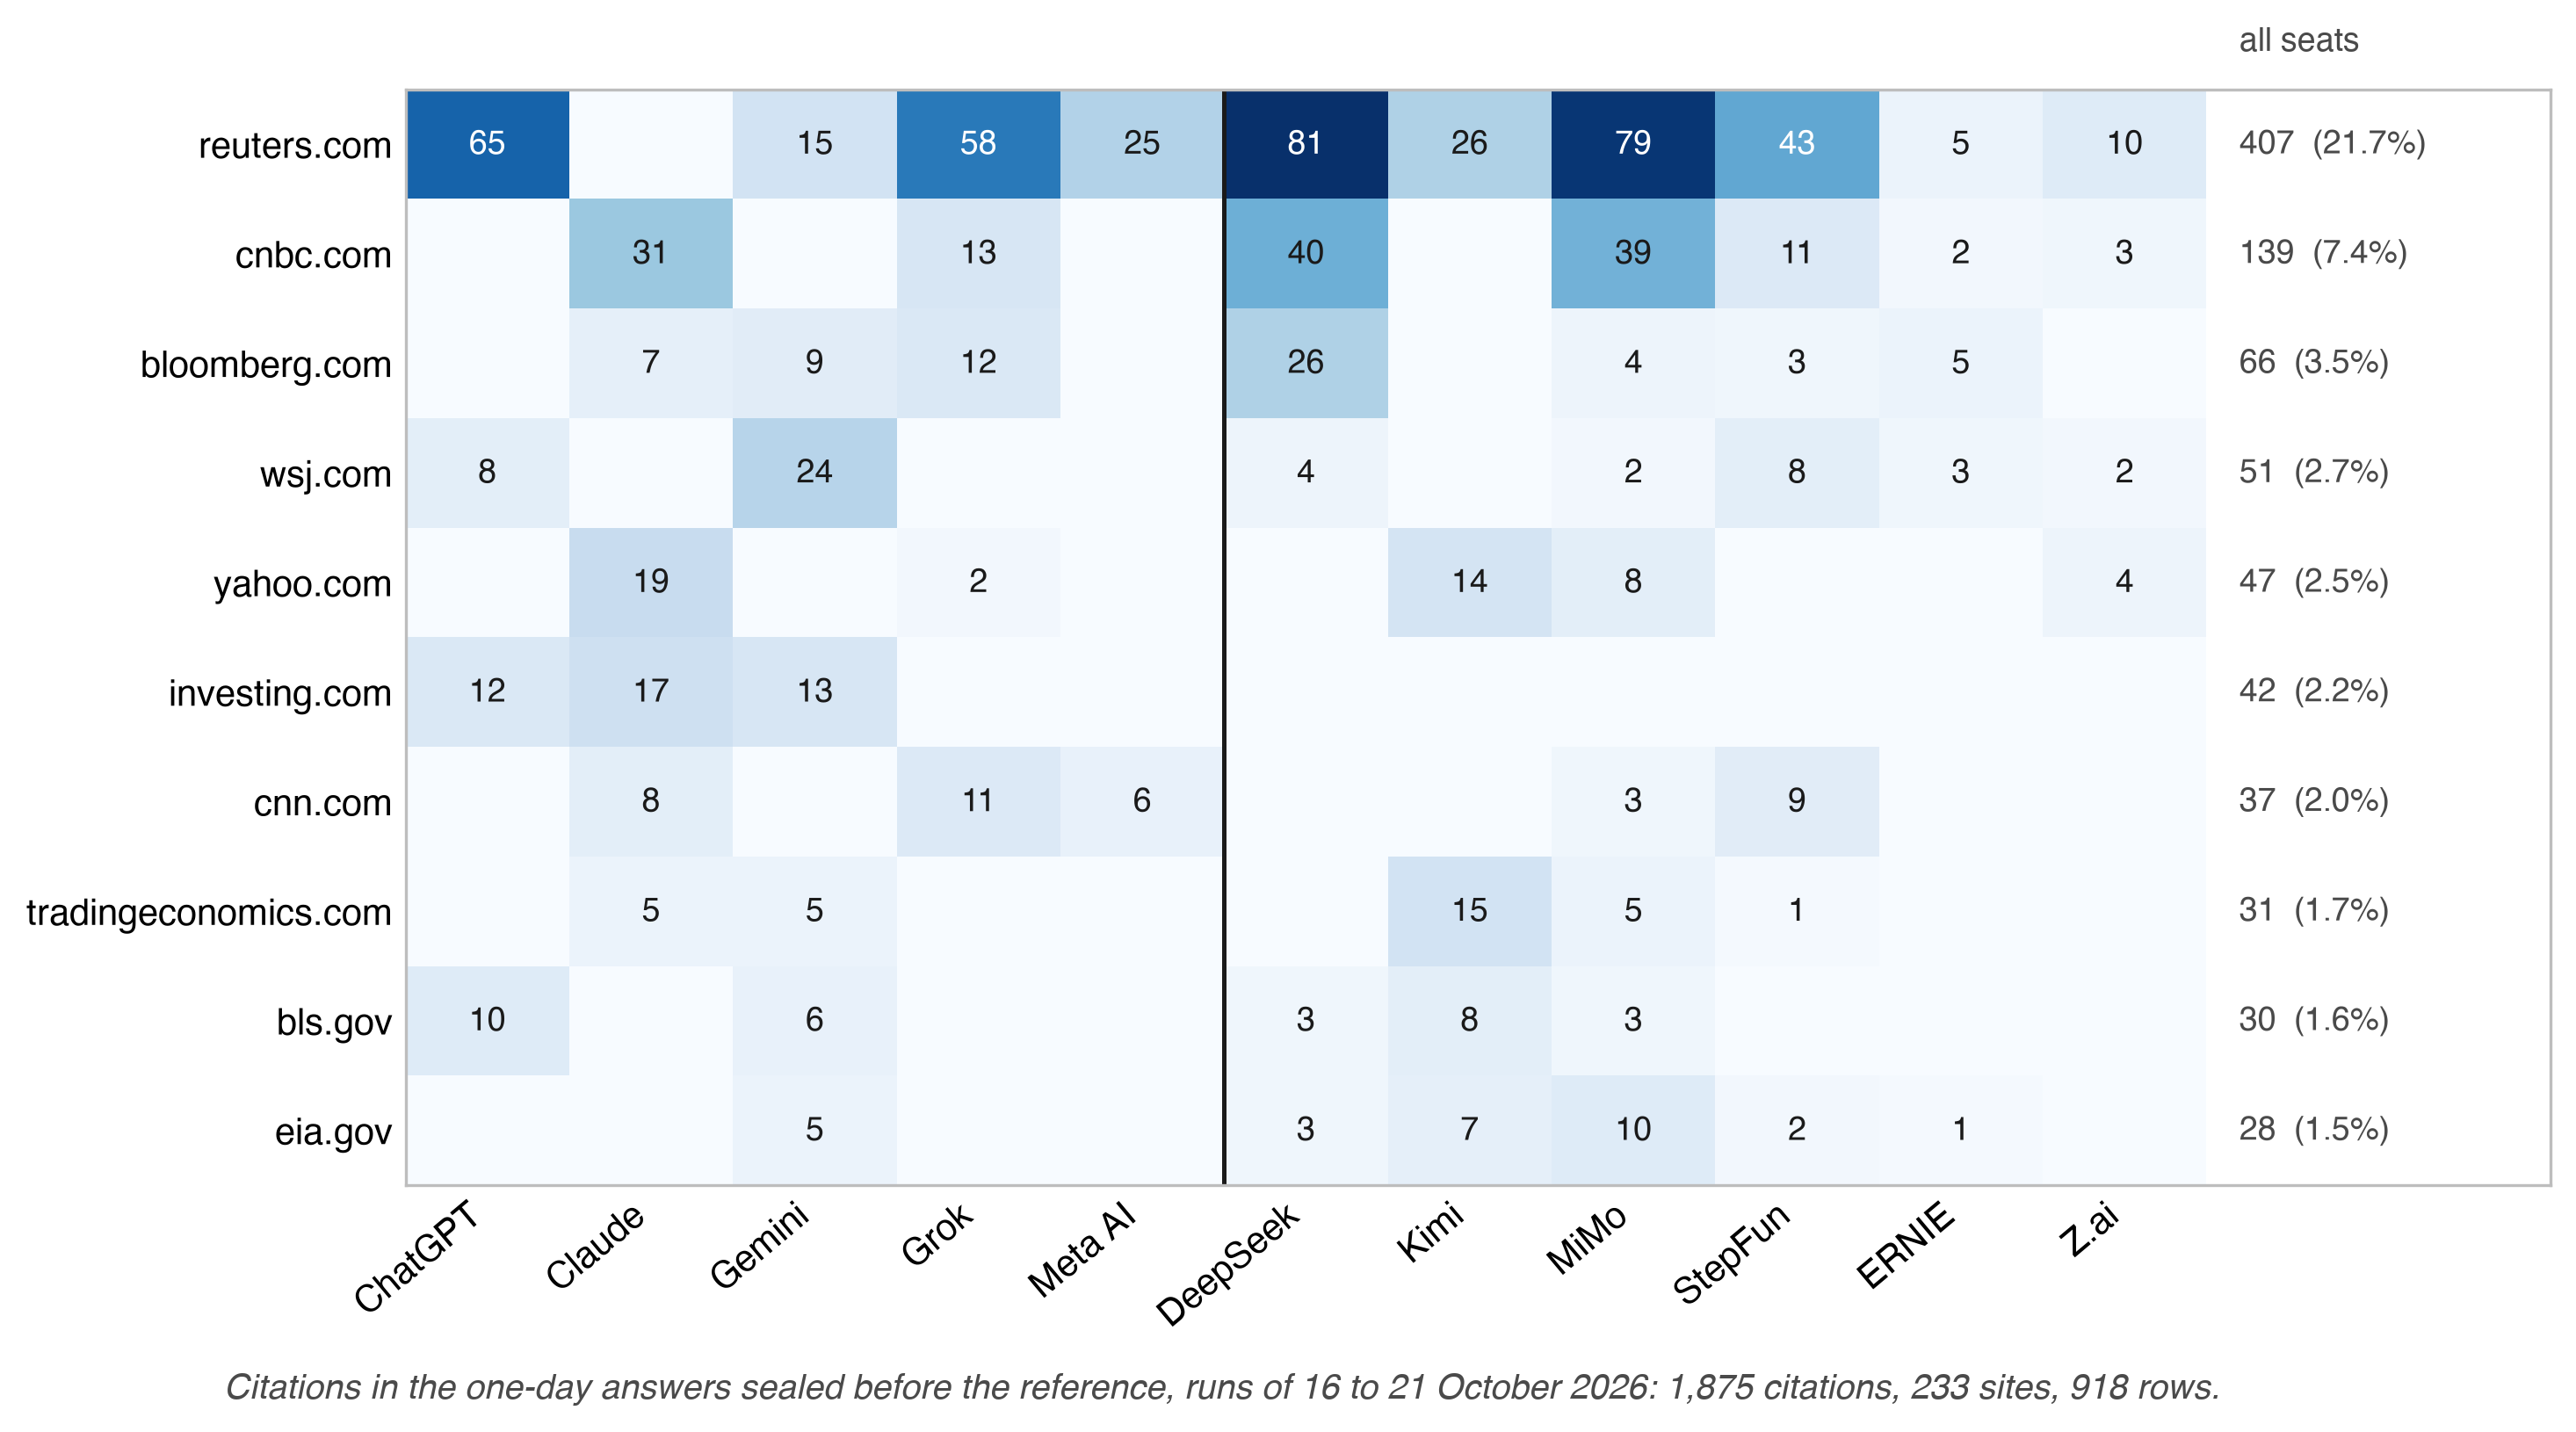
Nota: Un conteo por sitio citado por celda de respuesta (source_domains), escaños estadounidenses primero, con una regla entre los lados; la columna de la derecha da el total de cada sitio y su participación de las 1.875 citas totales. Un dominio citado se lee como la Sección 5.4 lee un enlace citado. Fuente: council-forecasts.csv guardado 22 de octubre de 2026, 01:32 UTC.
5.5 El libro cerrado: la misma pregunta sin búsqueda
Las noticias añadidas no hacen que un pronósticador de modelo de lenguaje sea mejor por defecto: en preguntas resueltas después de los puntos de corte de los modelos, el contexto de noticias ayudó en algunas preguntas y perjudicó en otras, a través del sesgo de recencia, sobreponderación de rumores y cambio en lo que un término se refiere (Karkar & Chopra, 2025).
En la liga Closed Book, después de cada ejecución, los mismos modelos reciben un paquete sellado en lugar de la web abierta: la instantánea de precios de la ejecución y titulares fechados, cada uno con fuente, enlace, hora de publicación y hash, y se les indica que no busquen ni utilicen herramientas. Cada línea de respuesta registra el estado de búsqueda bajo una de tres etiquetas: verificado (la configuración de la herramienta impide la recuperación y la respuesta no muestra ninguna), configurado pero no verificado, o solo instrucción. Los enlaces fuera del paquete se marcan outside. El paquete se sella con su hash antes de las respuestas y no se reconstruye, y las ejecuciones de Closed Book tienen sus propias cuentas de $100,000 fuera de la tabla diaria.
El archivo arena-cb-experiment.json reporta, ejecución por ejecución, el calor del desacuerdo (100 veces la división media de las acciones del día), N_eff y la dispersión de carteras, cerrada menos abierta en los mismos modelos. Si el consejo cerrado está más de acuerdo, las entradas idénticas impulsan al rebaño. Si está menos de acuerdo, la búsqueda atrae a los modelos hacia las mismas páginas. Una afirmación sobre la búsqueda se cumple cuando los brazos difieren solo en búsqueda. Cada respuesta cerrada proviene de un contexto fresco que no ha visto la respuesta abierta, la multitud u otro asiento, con la misma pregunta, instantánea e información de plazo, versiones coincidentes y estados de acceso registrados. Para F20 y F21, las respuestas de ambos brazos se sellan antes de la misma referencia común; de lo contrario, cada brazo se califica según su propia referencia, y el orden en que se preguntan los brazos se equilibra entre días. Si el consejo cerrado está menos de acuerdo y su pérdida de Brier es mayor, las entradas idénticas hicieron que los modelos fueran similares sin hacerlos mejores.
Dos brazos no pueden separar las dos fuentes de similitud, las mismas noticias leídas la misma mañana y las mismas creencias aprendidas en el entrenamiento. El Requisito 17 por lo tanto especifica un tercer brazo, solo precios: los mismos modelos reciben la instantánea de precios sellada de la ejecución y la pregunta, sin titulares ni búsqueda, bajo el mismo plazo y reglas de independencia. El acuerdo que persiste sin noticias proviene de prioridades compartidas; el acuerdo añadido por el paquete proviene de noticias compartidas; el acuerdo añadido por la web abierta proviene de la búsqueda. Cuando se ejecuta el brazo, cada ejecución reporta N_eff y el calor del desacuerdo en los tres brazos en los mismos asientos y sesiones.
5.6 Discusión contra el consenso simple
La elicitación ciega y paralela le da a cada modelo la pregunta sin procesar sin vista de los otros, por lo que el acuerdo tiene peso probatorio. La elicitación informada y secuencial compra corrección de errores al precio de la independencia (Chernets, 2026a). En siete puntos de referencia de lenguaje, la votación por mayoría sola representa la mayoría de las ganancias generalmente acreditadas al debate multiagente (Choi et al., 2025), por lo que una discusión tiene que superar el voto simple en las mismas preguntas antes de ganarse un lugar. Los pronósticos diarios son ciegos y paralelos por construcción. La discusión se ejecuta en una pista semanal separada que nunca toca el registro diario: una silla, alternada entre los lados, lee cada cartera sellada bajo letras mezcladas y escribe la cartera del consejo y dos o tres críticas, cada una nombrando un mercado, un riesgo, un peso y la dirección del fondo en las próximas cinco sesiones, por lo que cada crítica tiene una consecuencia verificable. Cada modelo criticado responde una vez y declara la cartera que mantendría. Las cuentas fantasma comercian la cartera de la silla, los pesos sellados, los pesos con la crítica aplicada, y la respuesta indicada (council-talk.json, council-talk-critiques.csv; F22, F23).
5.7 Un modelo, preguntado de nuevo
Una vez a la semana se pregunta nuevamente la pregunta de cartera, tres veces, a tres o cuatro modelos, y las repeticiones se sellan como sus propias líneas, no como decisiones. council-repeats.json reporta el calor entre las propias respuestas de un modelo contra el calor entre modelos, lo que da el piso de ruido del desacuerdo (F24). Como N_eff se calcula en probabilidades, el Requisito 17 extiende las repeticiones a probabilidades: bajo un paquete congelado un modelo seleccionado responde la misma pregunta de probabilidad tres veces en contextos independientes, cada una sellada como una línea de diagnóstico, y la liga reporta la varianza dentro del modelo contra la varianza entre modelos. Un cambio de versión del modelo está fechado, y el registro desde la versión se muestra aparte.
5.8 Laboratorio de origen: las mismas condiciones
Los catorce asientos operan en la liga de cartera. Once asientos del Consejo dan probabilidades, cinco de laboratorios estadounidenses y seis de laboratorios chinos, y tres asientos están en el banquillo, operando solo (Tabla 8). Cada modelo recibe una pregunta, construida en una instantánea de precios, con el texto publicado bajo su SHA-256. Cada respuesta se sella por un plazo y se califica por un conjunto de reglas, y cada asiento mantiene los mismos $100,000, costos y límites. El archivo asks muestra el cronograma. El 21 de octubre la primera pregunta se envió a cada asiento dentro de 0,17 segundos, a las 12:30:09Z, y un reenvío al mismo asiento lleva el mismo hash. Los asientos aún silenciosos a las 13:00 se preguntaron de nuevo en una segunda onda a las 13:00:21Z bajo su propia línea de ejecución y hash de pregunta (asks.jsonl). Cada modelo se pregunta en el modo de razonamiento más fuerte que su entrada de lista enumera, y el modo sellado en la línea de respuesta es el modo calificado. Cada proveedor sirve su modelo con sus propias herramientas y computación, por lo que la comparación es entre laboratorios tal como sirven sus modelos (Sección 10).
Tabla 8. Asientos de la liga (league-roster.json, generado el 21 de octubre de 2026) y la cadena de versión sellada en las líneas de respuesta de cada asiento hasta el 21 de octubre de 2026.
| Asiento | Laboratorio | Lado | Rol | Versión sellada |
|---|---|---|---|---|
| ChatGPT | OpenAI | US | Consejo | GPT-6.1 Sol |
| Claude | Anthropic | US | Consejo | Claude Opus 5.5 |
| Gemini | US | Consejo | Gemini 4 Argon | |
| Grok | xAI | US | Consejo | Grok 4.7 |
| Meta AI | Meta | US | Consejo | Muse Spark 1.3 |
| Nemotron | NVIDIA | US | Banquillo | solo cartera |
| Amazon Nova | Amazon | US | Banquillo | solo cartera |
| DeepSeek | DeepSeek | CN | Consejo | DeepSeek V4.1 |
| ERNIE (Wenxin) | Baidu | CN | Consejo | ERNIE |
| StepFun | StepFun | CN | Consejo | Step 5 Preview |
| MiMo | Xiaomi | CN | Consejo | MiMo-V2.6-Pro |
| Kimi | Moonshot AI | CN | Consejo | Kimi K3 |
| Z.ai | Zhipu | CN | Consejo | GLM-5.3 |
| Qwen | Alibaba | CN | Bench | solo cartera |
Nota: el modo sellado junto a cada versión está en la línea de respuesta (Apéndice C), y cada versión es la cadena que devuelve la interfaz del proveedor, para ERNIE solo su nombre; cada asiento proviene de un laboratorio diferente, por lo que cada peso de familia es 1 (Sección 5.3).
Las comparaciones anteriores no pusieron los dos lados en una pregunta y una instantánea. Cao et al. (2025) encontraron que un modelo estadounidense pronosticaba empresas chinas de manera más optimista y menos precisa que un modelo chino, y que la brecha desapareció una vez que se agregaron noticias chinas, lo que señala el acceso a la información como su fuente. La comparación aquí es observacional, porque proveedor, generación, idioma y herramientas viajan con la etiqueta de país (Sección 10). Se informa entre y dentro de los lados, y cualquier brecha, en probabilidades o puntuaciones, se publica con su rango cuando cada asiento se deja fuera a su vez. Una brecha que cambia de signo o pierde la mayor parte de su tamaño cuando se elimina un asiento se informa como del asiento, no del lado (F18, F19). El requisito 17 también pregunta si el lado es un bloque en absoluto. Para cada ejecución establece la correlación media de probabilidades dentro de cada lado contra la que hay entre los lados, con la probabilidad de una diferencia al menos tan grande cuando las etiquetas de lado se permutan entre los asientos respondentes. Con cinco y seis asientos la prueba es un diagnóstico. Si los pares más cercanos unen los dos lados, la etiqueta de país no es donde se divide el rebaño. Lo leí primero en la ejecución contada del 20 de octubre de 2026 (ocho asientos sellados antes de la referencia, 48 celdas) y no encuentro bloque por país. La correlación media de probabilidades es 0,66 dentro de los lados y 0,61 entre ellos, y tres de los cuatro pares más cercanos los unen: ChatGPT y MiMo (0,88), Gemini y DeepSeek (0,86), DeepSeek y Grok (0,77). Las celdas individuales pueden dividirse por lado. La brecha más grande entre los promedios laterales en esa ejecución estuvo en oro a un mes, 56 para los cuatro asientos estadounidenses contra 44 para los cuatro asientos chinos, y oro a una semana quedó tercero, 52,5 contra 43,5. Un máximo sobre 48 celdas es grande por construcción. Cuando los ocho asientos se dividen cuatro a cuatro en cada una de las 70 formas posibles, 26 de las divisiones producen una brecha de celda máxima al menos tan ancha (p = 0,37). DeepSeek dio oro a un mes 56, por encima de tres de los cuatro asientos estadounidenses, por lo que incluso la celda más ancha no se divide limpiamente por lado. En la Figura 11 muestro toda la matriz, con la mañana del 21 de octubre junto a ella.
Figura 11. Tres de los cuatro pares más cercanos unen un laboratorio estadounidense y uno chino el 20 de octubre de 2026, y el par más cercano lo hace de nuevo el 21 de octubre: correlación pareada de las probabilidades selladas, (A) 20 de octubre, ocho asientos sellados antes de la referencia; (B) 21 de octubre, nueve asientos; con la correlación media de cada asiento y acuerdo con la mayoría, y los valores propios de cada matriz.
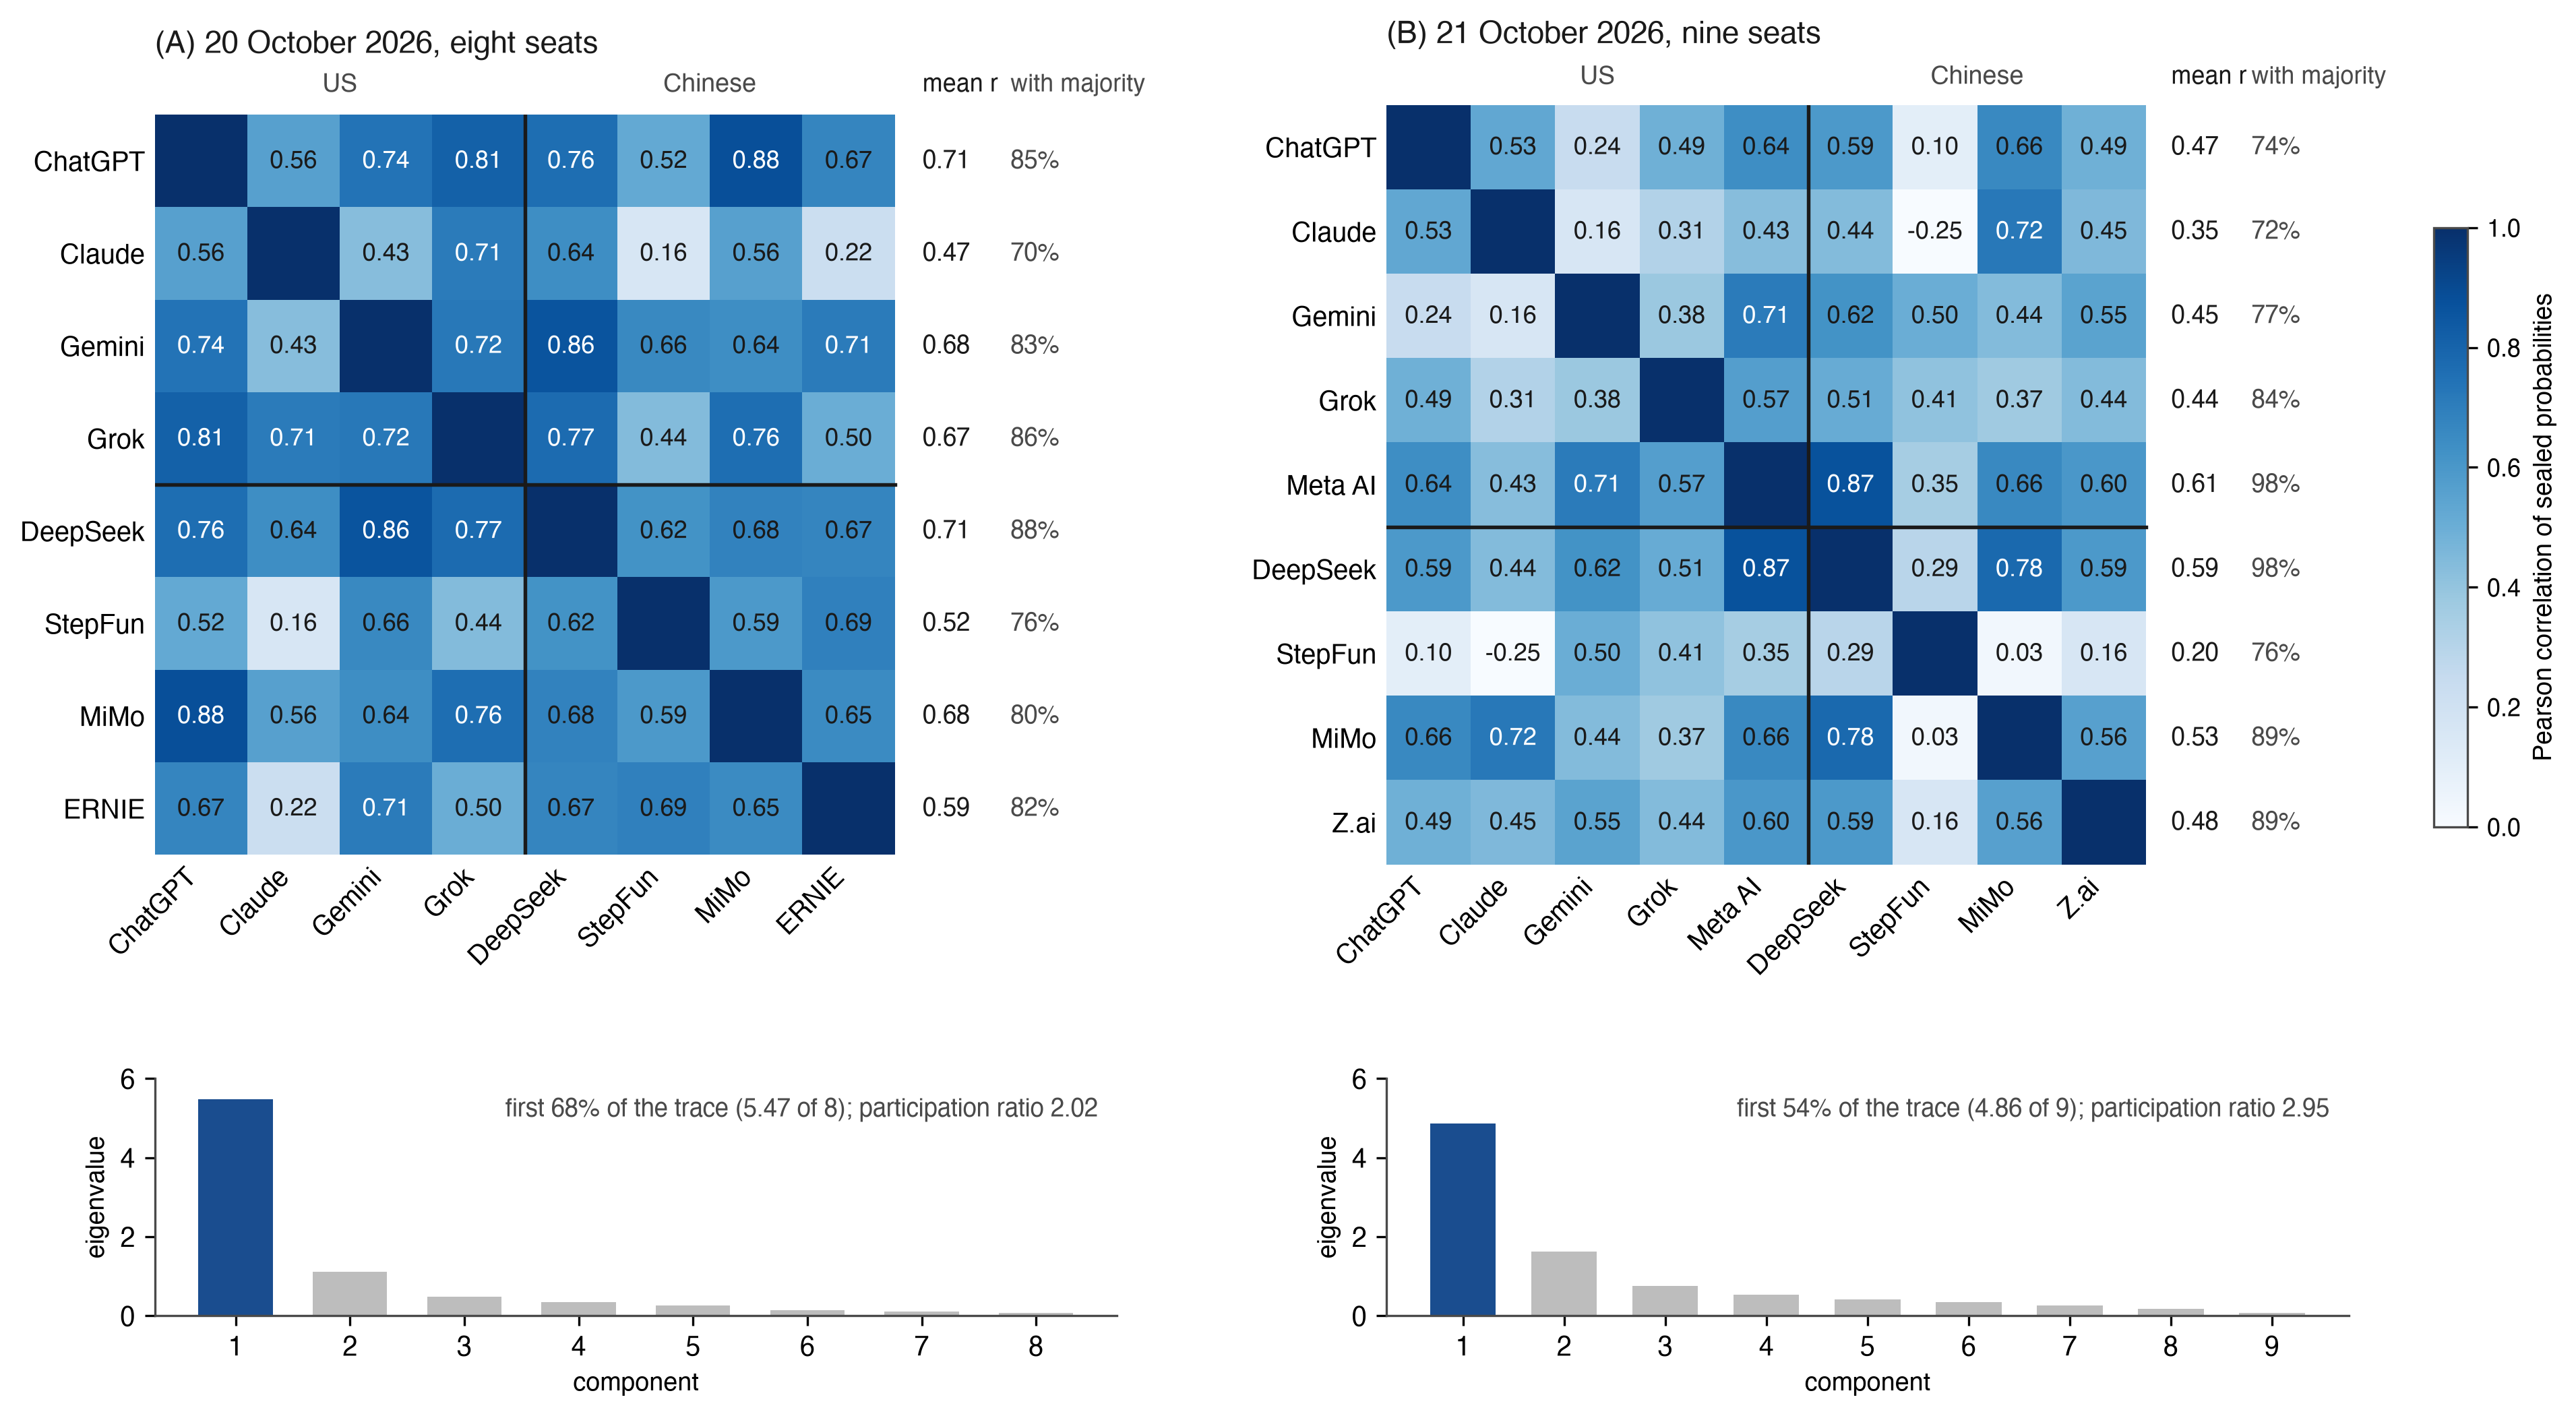
Nota: Correlación de Pearson sobre las 48 celdas (12 mercados × 4 horizontes) de ejecuciones 2026-10-20-am y 2026-10-21-am, sobre las celdas que ambos asientos respondieron en un evento común (el 21 de octubre las celdas de Bitcoin de Meta AI tienen su propia referencia, por lo que sus pares utilizan 44 celdas); asientos estadounidenses primero, con una regla entre los lados. Media r es la correlación media del asiento con los otros asientos, y con mayoría es la parte de las celdas direccionales del asiento en el mismo lado de 50 que la mayoría de los otros asientos, dejando fuera empates y 50s declarados. Debajo de cada matriz, sus valores propios, con la parte del primero y la razón de participación (Σλ)²/Σλ² (requisito 17). Media dentro de los lados 0,66 y 0,43, entre ellos 0,61 y 0,48. Fuente: council-forecasts.csv guardado 22 de octubre de 2026, 01:32 UTC.
Leí la primera ejecución contada, el 21 de octubre de 2026, de la misma manera con nueve asientos sellados antes de la referencia, cinco estadounidenses y cuatro chinos. La correlación media es 0,43 dentro de los lados y 0,48 entre ellos. El par más cercano nuevamente los une, Meta AI y DeepSeek (0,87), con Claude y MiMo (0,72) terceros. La brecha más grande entre los promedios laterales cayó a 7,0 puntos, en Brent a un mes, y 110 de las 126 divisiones de los nueve asientos en grupos de cinco y cuatro dan una brecha máxima al menos tan ancha (p = 0,87). Oro a un mes, 12,0 puntos de diferencia el 20 de octubre, se mantuvo 0,1 aparte (Figura 12). La similitud también se extendió a más factores. El primer valor propio transportó el 54% de la traza (4,86 de 9) contra el 68% el día anterior, con una razón de participación de 2,95 contra 2,02. En ambas mañanas los dos asientos más alejados de los otros eran Claude y StepFun. Sus correlaciones medias fueron 0,47 y 0,52 el 20 de octubre y 0,35 y 0,20 el 21 de octubre. Dos mañanas del diagnóstico muestran ningún bloque por país, y F18 y F19 lo deciden sobre la temporada.
Figura 12. Diferencia entre las probabilidades medias declaradas de los asientos estadounidenses y chinos, por mercado y horizonte: (A) ejecución 2026-10-20-am (cuatro y cuatro asientos sellados antes de la referencia); (B) ejecución 2026-10-21-am (cinco y cuatro asientos).
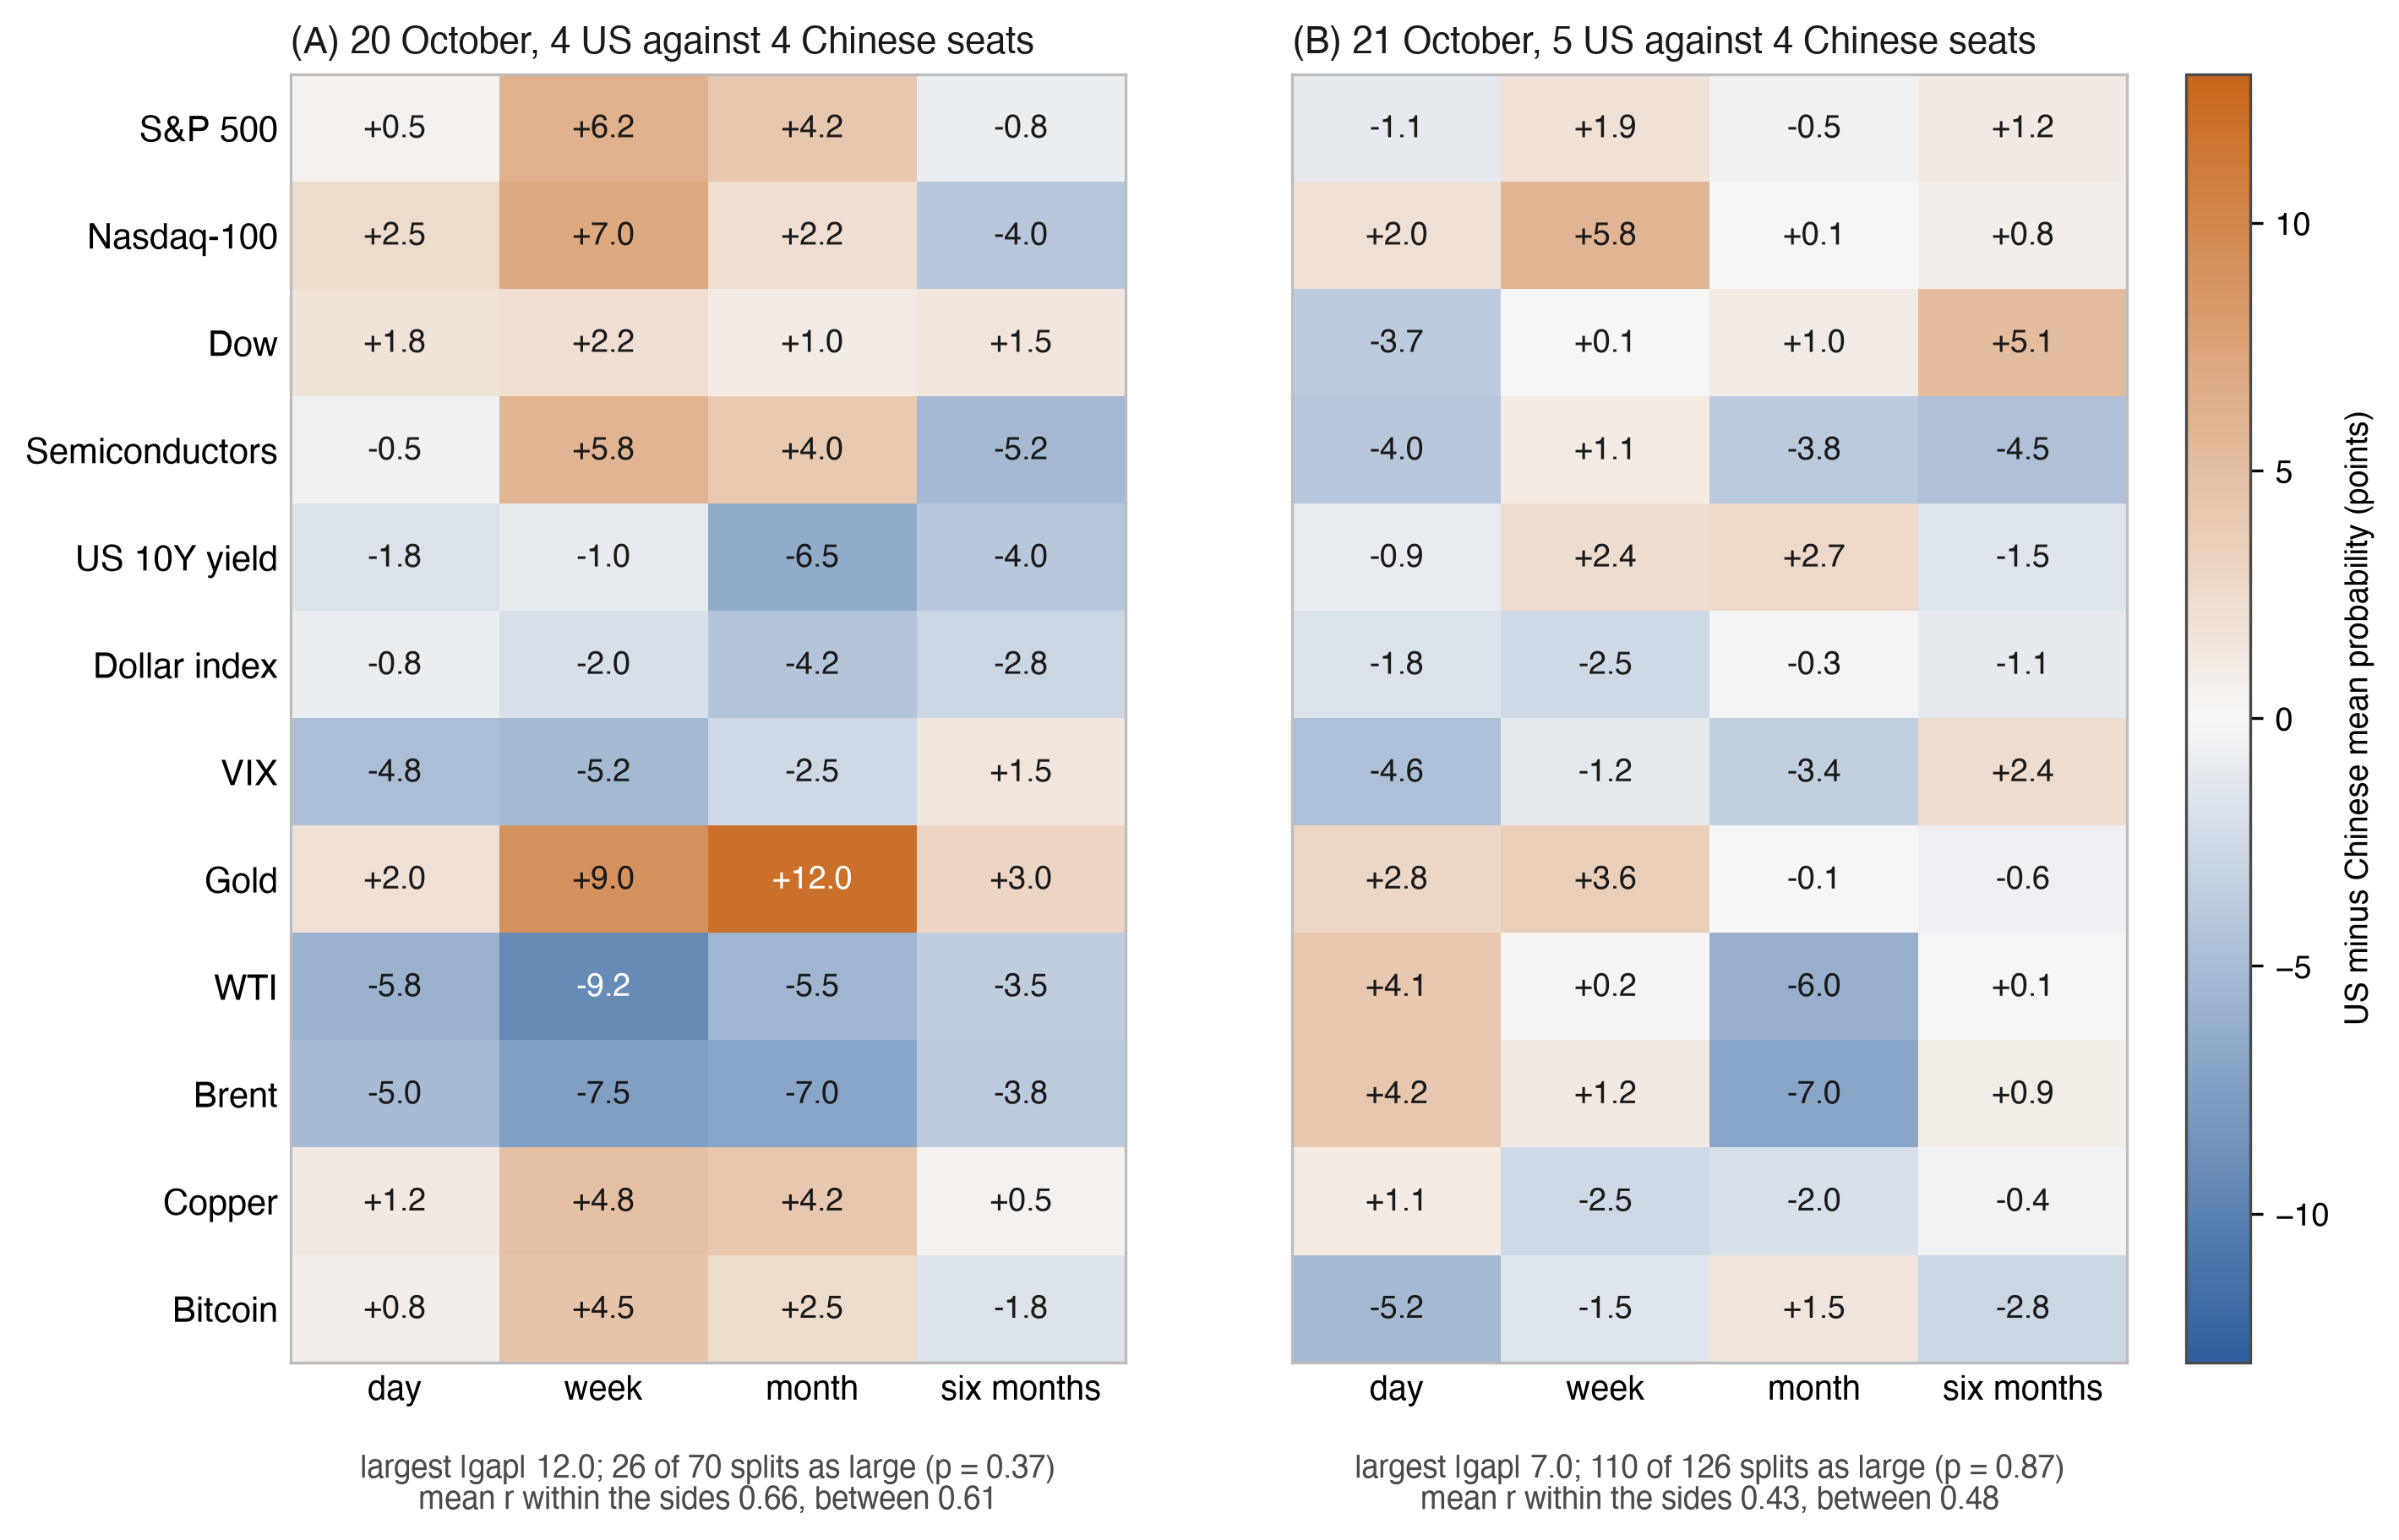
Nota: Puntos de probabilidad, estadounidenses menos chinos; naranja donde los asientos estadounidenses están más altos, azul donde están los asientos chinos. Bajo cada panel están la diferencia absoluta más grande, el número de todas las divisiones de los mismos asientos en grupos del mismo tamaño que dan una diferencia máxima al menos tan grande (70 divisiones en A, 126 en B), y la correlación media dentro y entre los lados. El 21 de octubre la fila de Bitcoin excluye las celdas de Meta AI, que llevan su propia referencia. Fuente: council-forecasts.csv guardado 22 de octubre de 2026, 01:32 UTC.
6. Los humanos antes que la IA
La liga mide modelos. La página que los muestra también pregunta si ver los modelos ayuda a una persona a hacer pronósticos o solo la acerca a ellos. La mayoría de las pruebas provienen de diseños en los que el consejo llega primero. Schoenegger et al. (2025) dieron a 991 participantes un asistente de modelo de lenguaje y encontraron ganancias de precisión de aproximadamente una cuarta parte, incluso de un asistente diseñado para dar consejos ruidosos; Schoenegger et al. (2024) encontraron que un conjunto de doce modelos igualaba a una multitud de 925 pronosticadores, y que un promedio simple de pronósticos humanos y automáticos funcionaba aún mejor. Las personas abandonan un algoritmo después de verlo fallar (Dietvorst et al., 2015), y en otros contextos lo ponderan por encima del consejo humano (Logg et al., 2019). En un torneo de pronósticos geopolíticos, los pronosticadores rara vez confiaron en pronósticos automáticos y tendieron a elegir modelos que estuvieran de acuerdo con sus creencias previas (Abeliuk et al., 2020). Lo que estos diseños no pueden separar fácilmente es la ayuda del anclaje.
6.1 Diseño
Cualquier visitante puede marcar cada uno de los 12 mercados hacia arriba o hacia abajo durante la sesión, con una confianza del 55 al 95%, sin registrarse. Cada lector se asigna una vez y permanentemente, mediante un identificador aleatorio anónimo, a uno de dos grupos. El grupo que ve ve las respuestas de los modelos de inmediato; el grupo ciego las ve solo después de su primer pronóstico de la sesión.
6.2 Qué se mide
Para el primer pronóstico en una sesión, la liga registra cuatro cantidades. Tomo como resultado primario la puntuación de Brier (una confianza c en un lado se lee como probabilidad c/100 de ese lado), en los mismos mercados para ambos grupos, cada mercado ponderado por el recuento del grupo más pequeño en él. El tiempo hasta el primer pronóstico muestra si los modelos aceleran una decisión. La confianza declarada contra la tasa de aciertos da exceso de confianza. El anclaje es la proporción de pronósticos iniciales que están de acuerdo en dirección con el consenso, comparada entre grupos. Un lector ciego que abre los modelos primero se cuenta como un vistazo. El análisis sigue la asignación, con vistazos como incumplimiento. council-league.json publica los recuentos, tasas de aciertos, tiempos, confianza, vistazos y puntuaciones de Brier bajo experiment (g0, g1), y el requisito 16 tiene la etiqueta de diccionario de datos de qué grupo es ciego antes del primer pronóstico calificado. El experimento está en vivo y abierto a todos los visitantes, y el 21 de octubre se encontraba en su comienzo, n = 0 pronósticos iniciales calificados en ambos grupos. F28 y F29, registrados en OSF con las predicciones de la Sección 8, fijan sus dos resultados en 200 pronósticos iniciales emparejados por grupo.
6.3 Protección contra relleno
Solo los pronósticos iniciales entran en la comparación, y no se recopilan nombres, cuentas ni datos de contacto. El requisito 16 establece un pronóstico inicial por mercado por identificador por sesión. La dirección del lector no se almacena: la liga mantiene solo un hash salado de ella con el día, para limitar votos repetidos. Los pronósticos del lector cierran en la hora de referencia, y un identificador reiniciado se trata como un nuevo lector, con la proporción de reinicializaciones informada.
6.4 Qué muestra la comparación
La asignación aleatoria hace que los dos grupos sean comparables entre sí. Ambos son visitantes de una página pública que eligieron venir, por lo que la comparación habla por ellos y no por los inversores. Mide un efecto de acceso, y el segundo protocolo a continuación mide la revisión de un juicio anterior. Un mayor acuerdo con el consejo se mide como un cambio, y el protocolo de revisión indica aprendizaje por copia. Un identificador representa a un participante observable, y una persona puede tener varios, por lo que la liga informa identificadores asignados y que contribuyen, pronósticos iniciales y tasas de retorno por grupo. La participación repetida es un análisis secundario agrupado por identificador y sesión.
Un segundo protocolo, especificado por el estándar, mide la revisión directamente. Cada lector primero registra una dirección privada y confianza con el consejo oculto, luego se le muestra el consejo o una pantalla de control mediante asignación aleatoria, y registra un pronóstico final para el mismo mercado y sesión. El resultado primario es la diferencia entre brazos en el cambio de puntuación de Brier del pronóstico privado al final; el movimiento hacia el consejo se informa por separado para sesiones en las que su llamada fue correcta e incorrecta, por lo que se puede distinguir el aprendizaje de la copia. El protocolo de revisión entra en las revisiones fechadas de este documento cuando se ejecuta.
7. Un mapa fechado de las arenas de mercado de IA
7.1 Qué registra el mapa
Entre 2023 y 2026 la pregunta "¿pueden los modelos de IA pronosticar mercados?" se formuló de cuatro formas: backtests de los juicios de modelos sobre precios históricos, benchmarks sobre cuestiones aún abiertas, arenas en las que los modelos comerciaban dinero real o virtual, y mercados de predicción utilizados como línea de base o lugar. El mapa registra quién introdujo cada esfuerzo, cuándo, y qué midió. En la Tabla 9 formulo seis preguntas sobre cada uno: cómo se asegura el momento de un pronóstico y con qué nivel de confianza, si las probabilidades se califican por una regla estrictamente propia, si varios horizontes se comparan en los mismos activos, si el acuerdo entre modelos se lee contra su correlación (un recuento de voces independientes o un peso de correlación), si un humano pronostica antes de ver la IA, y si los datos están abiertos. En el Apéndice E comparo la implementación de referencia con los esfuerzos más cercanos característica por característica (Tabla E1).
Los niveles de confianza siguen la Figura 4 y la Sección 3.12: 0, el registro del operador de llegada; 1, una huella digital del operador o un registro vinculado por hash cuyo tiempo descansa en el operador o su anfitrión; 2, una huella digital comprometida fuera del operador, que limita desde fuera cuándo existió el registro, dentro de la tolerancia de ese registro (para Bitcoin, unas pocas horas después de la hora del encabezado del bloque, porque la hora de un encabezado debe exceder la mediana de los once anteriores y puede adelantarse al tiempo real); 2+, nivel 2 más una hora firmada por un tercero (RFC 3161) en cada sello. Un backtest no tiene tiempo de envío que asegurar. Construí el mapa a partir de artículos publicados, páginas de proyectos, repositorios e informes de prensa, y cerré la búsqueda el 21 de octubre de 2026. Toda afirmación de prioridad en la Sección 7.4 se limita a los esfuerzos revisados aquí. "ND" significa no documentado públicamente a partir del 21 de octubre de 2026: no encontrado en la descripción pública, lo que no prueba la ausencia. Registro lo que cada esfuerzo puede probar a partir de sus materiales públicos y dejo su calidad sin clasificar.
7.2 La cronología
2023 a 2024. Lopez-Lira y Tang (2023) mostraron que las puntuaciones de GPT de titulares de noticias predijeron los rendimientos posteriores de las acciones, lo que abrió el campo y su duda central (Sección 2.1). En 2024 llegaron preguntas en directo. Un sistema aumentado por recuperación se acercó al agregado humano en preguntas publicadas después del corte de los modelos (Halawi et al., 2024), un conjunto de doce modelos igualó a una multitud de 925 personas (Schoenegger et al., 2024), Metaculus ejecutó torneos trimestrales de bots contra profesionales, que lideraron en cada trimestre hasta mediados de 2025 (Metaculus, 2025a, 2025b), y ForecastBench preguntó sobre mil preguntas generadas en ocho horizontes y encontró que los expertos aún estaban por delante del mejor modelo (Karger et al., 2025).
2025. Siguieron los benchmarks de finanzas y las arenas de dinero. InvestorBench ofreció decisiones financieras simuladas sobre datos históricos (H. Li et al., 2025), y se acumuló evidencia sobre la memoria y la anticipación en backtests (Lopez-Lira et al., 2025; W. W. Li et al., 2025; Paleka et al., 2026; Gao et al., 2025). FutureX ejecutó un benchmark en directo diario de agentes (Zeng et al., 2025). En octubre, Alpha Arena otorgó dinero real a seis modelos, según informes de prensa (Forklog, 2025a, 2025b; Yahoo Finance, 2025), StockBench operó retrospectivamente con acciones Dow (Y. Chen et al., 2025), Agent Market Arena operó en directo (Qian et al., 2025), y Prophet Arena calificó preguntas en directo de Kalshi y Polymarket por calibración y rendimientos simulados (Yang et al., 2025). LiveTradeBench (Yu et al., 2025), Rallies AI Arena (Rallies.ai, 2025-2026), el AIA Forecaster, que igualó a los superpronosticadores y, combinado con el mercado, lo superó (Alur et al., 2025), y KalshiBench, que encontró que cinco modelos fronterizos eran excesivamente confiados (Nel, 2025), cerraron el año.
2026, primer semestre. Los mercados de predicción se convirtieron en un lugar. FinDeepForecast ejecutó agentes de investigación profunda semanalmente (X. Li et al., 2026). Un conjunto de datos de pronósticos de acciones de Gemini se llamó "con bloqueo de tiempo" sin un mecanismo documentado (louidev, 2026). PredictionMarketBench reprodujo libros de órdenes de Kalshi (Arora & Malpani, 2026). Prediction Arena otorgó capital real a seis modelos en Kalshi y Polymarket y calificó el valor de la cuenta a partir de los registros del operador (Zhang et al., 2026). PolyBench calificó 36.165 predicciones en instantáneas de Polymarket (Cheng et al., 2026). PolySwarm propuso un enjambre de 50 personalidades de modelos de lenguaje cuyas probabilidades se mezclan con precios de Polymarket y se califican por la puntuación de Brier (Barot & Borkhatariya, 2026). En mayo, Foresight Arena propuso un benchmark sin permisos en el que los agentes se comprometen con pronósticos con hash de eventos de Polymarket a través de un commit-reveal keccak256 en Polygon antes de una fecha límite, un commit por agente y ronda aplicados en el retransmidor, calificados por la puntuación de Brier y una puntuación Alpha contra el precio medio en la fecha límite. Su artículo reporta resultados simulados, y un estudio complementario ejecuta agentes en directo sobre él (Nechepurenko & Shuvalov, 2026a, 2026b).
2026, segundo semestre. MarketMania (15 de julio) otorga a siete modelos una carga útil divulgada, califica las probabilidades indicadas en cinco criptomonedas en cinco horizontes, mide el pastoreo como el aumento de estar de acuerdo con la mayoría, y vuelve a hacer preguntas idénticas, sin documentación del compromiso de respuestas (MarketMania, 2026). NeuPortal ancla las probabilidades de fútbol de una IA sin nombre en Bitcoin a través de OpenTimestamps (NeuPortal, 2026). LLM Trading Arena (20 de julio) se compromete con cada ejecución y razonamiento al historial git público (MaxWellApexLab, 2026). LiveMacroEval ejecutó previsiones macroeconómicas por hora (Zhao et al., 2026), TradeRank abrió su décima temporada el 10 de octubre (TradeRank, 2026), y Prophet Arena documentó un registro de hashes SHA-256 salados en el reloj del operador (Prophet Arena, 2026). AI Council · Markets selló su primera ejecución el 16 de octubre de 2026 y comenzó a contar su puntuación el 19 de octubre de 2026.
7.3 Lo que cada uno puede probar
Tabla 9. Arenas de mercado de IA y benchmarks de pronóstico, 2023 a 2026: qué puede probar cada una a partir de sus materiales públicos.
| Arena o benchmark (público por primera vez) | Qué se pronostica o comercia | Tiempo del pronóstico asegurado por (nivel de confianza) | Probabilidades calificadas por una regla propia | Varios horizontes en los mismos activos | Acuerdo descontado por voces correlacionadas | Pronóstico humano antes de ver la IA | Datos abiertos |
|---|---|---|---|---|---|---|---|
| Lopez-Lira & Tang (abr 2023) | Rendimientos de acciones de puntuaciones de titulares | Backtest, sin tiempo de envío | No (puntuaciones utilizadas como señales) | No | No | No | ND |
| Benchmark de IA de Metaculus (Q3 2024) | Preguntas de Metaculus, bots contra profesionales | Registro de plataforma (0) | Sí (puntuación cara a cara) | No | ND | Grupo separado de profesionales | Parcialmente |
| ForecastBench (sep 2024) | Aproximadamente 1000 preguntas generadas, sin resolver al envío | Registro del operador (0) | Sí (Brier) | Sí (ocho horizontes en preguntas del conjunto de datos, 7 días a 10 años) | ND | Grupos separados de superpronosticadores y público | Sí |
| InvestorBench (ACL 2025) | Decisiones sobre acciones, criptomonedas y ETF en simulación | Prueba retrospectiva, sin tiempo de envío | ND | No | ND | No | Sí |
| FutureX (ago 2025) | Eventos futuros amplios, agentes con búsqueda | Registro del operador (0) | No (precisión de respuesta) | No | ND | No | Sí |
| Alpha Arena (oct 2025) | Comercio con dinero real, criptomonedas y luego acciones estadounidenses | Registro del operador (0); el organizador declara que las operaciones son verificables | No (rendimientos) | No | ND | No | Declarado por el organizador |
| StockBench (oct 2025) | Comercio retrospectivo en acciones del Dow, marzo a junio de 2025 | Prueba retrospectiva, sin tiempo de envío | No (rendimiento, pérdida máxima, Sortino) | No | ND | No | Sí |
| Agent Market Arena (oct 2025) | Comercio en vivo por agentes LLM, acciones y criptomonedas | ND (0) | No (resultados comerciales) | No | ND | ND | ND |
| Prophet Arena (oct 2025) | Eventos de Kalshi y Polymarket | Registro SHA-256 con sal al llegar, recibo opcional firmado por plataforma; reloj del operador (1) | Sí (1 − Brier); calibración como diagnóstico | Vistas de horizonte en archivo; límites ND | ND | No; precio de mercado como línea de base | Sí |
| LiveTradeBench (nov 2025) | Asignaciones en acciones estadounidenses y Polymarket, 50 días | ND (0) | No (asignaciones, rendimientos) | No | ND | No | Sí |
| Rallies AI Arena (nov 2025) | $100,000 virtuales por modelo en acciones estadounidenses, ocho modelos (prensa) | ND (0) | No (rendimientos) | No | ND | ND | ND |
| AI-Trader (dic 2025) | Agentes comerciales en vivo en acciones estadounidenses, acciones A y criptomonedas, tres modelos chinos y tres estadounidenses | Registro del operador (0) | No (rendimientos) | No | ND | No | Repositorio abierto |
| KalshiBench (dic 2025) | 300 preguntas de Kalshi resueltas después del corte | Conjunto estático después del corte | Sí (Brier; puntuación de habilidad contra climatología); ECE como diagnóstico | No | No | No | Sí |
| PredictionMarketBench (2026) | Libros de órdenes de Kalshi repetidos con comisiones | Reproducción de prueba retrospectiva | No (P&L comercial) | No | ND | No | ND |
| Prediction Arena (ene a mar 2026) | Comercio de capital real en Kalshi y Polymarket, contratos financieros entre siete categorías | Registros del operador (0) | No (valor de cuenta, rendimiento, tasa de ganancia) | No | No | No | ND (sin repositorio proporcionado) |
| PolyBench (abr 2026) | Instantáneas de Polymarket, 6 a 12 feb 2026 | ND (0) | No (precisión direccional, rendimiento ponderado por confianza) | No | ND | No | Código abierto; conjunto de datos por enlace de descarga (no recuperado) |
| Foresight Arena (may 2026) | Eventos binarios de Polymarket, algunos en precios de activos | Compromiso keccak256 por agente y ronda en Polygon PoS antes del plazo (2; tiempo de bloque); resultados del documento simulados, agentes en vivo en un estudio complementario | Sí (Brier; Alfa contra el precio medio de mercado) | No | No (resultados de mercados asumidos independientes) | No | Contratos y código de análisis abiertos; datos en la cadena, licencia ND |
| MarketMania (jul 2026) | Cinco criptomonedas en cinco horizontes, siete modelos, una carga útil divulgada | ND (0) | Sí (Brier en la probabilidad indicada; brecha de calibración) | Sí (1 hora a 1 mes) | Parcialmente (comportamiento gregario medido; acuerdo no descontado) | ND | Exportaciones de API, licencia ND |
| NeuPortal (jul 2026) | Probabilidades de partidos de fútbol de una IA sin nombre (no financiero) | SHA-256 de cada archivo de pronóstico, marcado en Bitcoin vía OpenTimestamps (2) | Sí (Brier de tres resultados) | No | No (un modelo) | ND; precio de Polymarket en o antes del cierre como línea de base | Sí (GitHub, Zenodo) |
| LLM Trading Arena (jul 2026) | Comercio en papel de criptomonedas y acciones del S&P 100, $100,000 por modelo | Historial git público de cada ejecución y justificación, órdenes ejecutadas en la siguiente apertura (1; el tiempo descansa en el servidor git) | No (valor de cuenta) | No | ND | ND | Sí (MIT, libro mayor completo, cuentas recalculables) |
| LiveMacroEval (ago 2026) | Previsiones por hora de 16 indicadores macroeconómicos estadounidenses antes de la publicación | ND (0) | No (puntuaciones basadas en rendimiento y apuestas) | No | ND | No; previsiones institucionales como comparadores | Documento CC BY 4.0; licencia de datos ND |
| RockAlpha (n.d.) | Comercio de acciones de IA en vivo, seis modelos chinos y cuatro estadounidenses, apalancamiento 2× | ND (0) | No (rendimientos) | No | ND | No | ND |
| TradeRank (temporada 10, oct 2026) | Decisiones diarias de 22 modelos en criptomonedas y grandes capitalizaciones estadounidenses, $10,000 simulados | ND (0) | ND | No | ND | ND | Conjunto de datos JSON abierto, licencia ND |
| AI Council · Markets (oct 2026) | Panel fijo de 12 indicadores financieros, diario | Desde el 21 oct 2026, al menos dos tokens RFC 3161 por lista sellada, firmados antes de la apertura (2+); cadena SHA-256, encabezado anclado en Bitcoin (2); 19 y 20 oct 2026 en nivel 1 para sello antes de la referencia (Tabla 12) | Parcialmente (Brier de todas las filas principal desde el 21 oct 2026, Sección 3.5; Brier contra moneda y líneas de base; bins de calibración como diagnóstico) | Sí (día, semana, mes, seis meses) | Sí (N_eff por regla de elegibilidad declarada; segundo modelo de una familia pesa un tercio) | Sí (dos grupos permanentes, Sección 6) | Sí (CC BY 4.0, código de puntuación, script de recuento) |
Nota: ND = no documentado públicamente a 21 de octubre de 2026, lo que significa que la propiedad no se encontró en la descripción pública y no se inspeccionó el código. "Regla propia" cuenta solo una puntuación estrictamente propia de la probabilidad del pronóstico (Brier, log score). La precisión, ECE y retornos están marcados como No. "Grupo separado" significa que los humanos pronostican las mismas preguntas de forma independiente, no que un humano pronostique primero y luego vea la IA. Alpha Arena y Rallies AI Arena se basan en reportes de prensa. Leí Foresight Arena y Prediction Arena en texto completo (arXiv:2605.00420v2, arXiv:2604.07355v1), NeuPortal y LLM Trading Arena de sus repositorios, y MarketMania de sus páginas de metodología e investigación. NeuPortal no es una arena de mercado. Lo incluyo porque su sello es el más cercano al estandarizado aquí. The AIA Forecaster, FinDeepForecast y el dataset GlassBallAI están solo en la línea de tiempo. Las fuentes se dan en la Sección 7.2.
7.4 Lectura del mapa
La columna de confianza muestra el campo moviéndose desde backtests, que no pueden asegurar tiempo, a preguntas en vivo aseguradas por el registro del operador, y a registros del operador de hashes salados con recibos firmados (Prophet Arena). El nivel 2 existe fuera de un panel fijo de indicadores financieros. Foresight Arena compromete pronósticos de eventos de Polymarket, algunos de ellos sobre precios de activos, a Polygon (Nechepurenko & Shuvalov, 2026a, 2026b). Los pronósticos meteorológicos en competencia se comprometen en cadena en la subred Zeus (Ørpheus AI, n.d.), y NeuPortal ancla probabilidades de fútbol en Bitcoin. Los pronósticos financieros sellados con divulgación retrasada se remontan al Financial Bubble Experiment (Sornette et al., 2010), y un registro de pronóstico no basado en IA está anclado en Bitcoin y calificado por la puntuación de Brier (Jyotish, 2026). Existe timestamping público gratuito (Todd, 2016), por lo que el ancla es barata. Las reglas que la rodean la convierten en una prueba justa.
Las probabilidades y carteras rara vez se encuentran. La mayoría de las arenas que comercian con retornos de puntuación o valor de cuenta, y la mayoría de los puntos de referencia que califican probabilidades no comercian. Prophet Arena une los dos a través de retornos simulados, MarketMania opera en papel los pronósticos que califica, y Foresight Arena califica probabilidades contra el precio de mercado. Un estándar para mercados financieros necesita ambos. La cartera responde la pregunta que hacen los usuarios, y la probabilidad es la parte que una regla propia puede calificar en un registro breve (Sección 2.4). Una columna está vacía: ningún esfuerzo en la Tabla 9 descuenta el acuerdo por voces correlacionadas en sus materiales públicos. MarketMania mide el comportamiento gregario pero no convierte el acuerdo en un recuento de voces, y Foresight Arena trata los resultados de mercado como independientes. Fuera de los modelos de lenguaje, el torneo Numerai califica la contribución de un modelo después de neutralizar sus predicciones contra el meta modelo construido a partir de todos los envíos (Numerai, n.d.). Eso recompensa señal distinta, y deja abierto cuántas voces independientes sostiene un consenso. La evidencia de que los modelos yerran juntos es fuerte offline (Sección 5).
Qué es nuevo. Seis diseños en la liga no tienen equivalente entre los sistemas revisados a 21 de octubre de 2026 (Tabla E1, Tabla 9). Los tres primeros la distinguen de cada sistema en el mapa:
- AI Council · Markets es la primera liga en vivo de pronósticos de IA en un panel fijo de indicadores financieros que ancla su libro mayor de pronósticos fuera del operador, califica cada pronóstico a partir de un precio de referencia tomado después de su sellado, fija el recuento contado por una regla declarada con anticipación con cada otro recuento publicado y etiquetado, e informa un recuento de voces efectivas diarias. En el registro contado, a partir del 21 de octubre de 2026, la regla de recuento contado se declara con anticipación y se sella en la cadena de preguntas, y al menos dos autoridades RFC 3161 independientes colocan las respuestas contadas antes del precio de referencia (nivel 2+). La Tabla 12 proporciona el nivel de cada elemento para las sesiones de desarrollo de 19 y 20 de octubre de 2026, nivel 1 para el orden de sellado y precio de referencia. Foresight Arena es la conjunción más cercana: un ancla externo, un compromiso reforzado por relayer por agente y ronda y un precio de referencia en el plazo de compromiso, en eventos de Polymarket en lugar de un pronóstico de panel de indicador fijo diario.
- Es la primera liga en vivo de pronósticos de IA en indicadores financieros que informa, cada ejecución, el número efectivo de voces por una regla de elegibilidad establecida (ejecuciones contadas, respuestas selladas antes de la referencia), además de pesos familiares en el consenso y recuentos de error unánime y de minorías correctas. La fórmula es clásica (Kish, 1965; Clemen & Winkler, 1985), la correlación de errores del modelo se establece offline (Kim et al., 2025; Spiro, 2026; Aitchison et al., 2026), y el comportamiento gregario ha sido medido en vivo (MarketMania, 2026). La afirmación es el recuento dentro de una liga en vivo.
- Propone un estándar que separa la integridad del contenido, la existencia limitada externamente, el compromiso antes del precio de referencia y la identificación del pronóstico que cuenta, escrito como requisitos numerados MUST y SHOULD con comprobaciones que un lector puede ejecutar (Sección 3.13, Apéndice B). La Sección 3.13 proporciona el estado de cada requisito para la implementación de referencia. Ni Foresight Arena ni Prediction Arena propone un estándar para que otros adopten.
Los otros tres la distinguen de cada arena de mercado de IA en el mapa:
- Los lectores se asignan una vez, al azar, y nunca se reasignan, a uno de dos grupos que pronostican los mismos mercados el mismo día que los modelos: uno ve los modelos de inmediato, el otro solo después de su primer pronóstico, por lo que pronostica antes de verlos (Sección 6). El diseño es en vivo y abierto a cada visitante, con sus dos resultados registrados como F28 y F29 y leídos a 200 primeros pronósticos por grupo. Los diseños anteriores comparan grupos separados de humanos (ForecastBench, Metaculus) o dan a la gente un asistente de IA primero (Schoenegger et al., 2025).
- Siete modelos de laboratorios estadounidenses y siete de laboratorios chinos, cada uno de un laboratorio diferente, responden la misma pregunta, enviada en un paso, en la misma captura bajo el mismo plazo, reglas y cuentas (Sección 5.8, Tabla 8). Las listas de oficiales más cercanas son las de RockAlpha, seis modelos chinos y cuatro estadounidenses, uno por laboratorio, con apalancamiento 2× (Rockflow, n.d.), y AI-Trader's, tres y tres, operando acciones estadounidenses, A-shares y criptomonedas (Fan et al., 2025). Ninguno publica un sellado, una puntuación de probabilidad o un diseño de lector. Otras listas mezclan dos modelos chinos entre seis a ocho (Alpha Arena, Rallies AI Arena, LLM Trading Arena, MarketMania), y TradeRank despliega 22 modelos sin un diseño de país.
- Treinta predicciones fechadas sobre la liga misma, cada una con una medida, una fecha de comprobación y una regla de refutación, se cotizan por votos ciegos de modelos de tres familias y se registran con sus solucionadores antes de que existan los datos que los deciden (Sección 8).
The Closed Book, las críticas puntuadas y las consultas repetidas funcionan en la liga también, y sus predecesores aparecen en la cronología (Sección 7.2, Tabla E1).
Lo que la liga construye sobre. El compromiso de un pronóstico hash antes del resultado (Foresight Arena; NeuPortal y Jyotish a través de OpenTimestamps) y el sellado de pronósticos financieros con divulgación retrasada (Sornette et al., 2010) preceden a esta liga. NeuPortal, el sello más cercano, difiere de cuatro maneras: un modelo sin nombre, fútbol, un punto de referencia de multitud tomado en o antes del bloqueo, y ninguna regla de ejecución contada o cadena hash documentada. Los esfuerzos anteriores también proporcionan ligas de dinero multimodelo diarias (Alpha Arena, Agent Market Arena, Rallies AI Arena, LLM Trading Arena, TradeRank), cuentas virtuales de $100,000, recomputación de terceros de cuentas o puntuaciones (LLM Trading Arena, Foresight Arena) y apalancamiento (Alpha Arena, RockAlpha). También proporcionan comparación con precios del mercado de predicción en el momento de la respuesta (Foresight Arena, Prophet Arena, NeuPortal, el AIA Forecaster), una puntuación propia con un análisis de potencia (Foresight Arena), puntuaciones de probabilidad en varios horizontes con operaciones en papel (MarketMania; ForecastBench para horizontes), una puntuación de habilidad climatológica (KalshiBench) y diseños de coordinación en vivo en una arena anclada (Nechepurenko & Shuvalov, 2026b). La liga utiliza estas características. Las preguntas de eventos, el comercio con dinero real y la amplitud de miles de preguntas son otros diseños con sus propias fortalezas, y complementan un panel diario fijo.
8. Predicciones registradas
Expongo aquí, con fechas, umbrales y probabilidades, lo que mostrará la liga, y sus archivos abiertos decidirán. Esta versión lee dos sesiones puntuadas, hasta el 20 de octubre de 2026. Cada predicción nombra su medida, el campo abierto o script archivado que la resuelve, una fecha de comprobación, el resultado que la confirma y el resultado que la refuta, y una probabilidad que hace un error puntuable (Brier, 1950; Gneiting & Raftery, 2007), siguiendo a Chernets (2026c). Registrar predicciones antes de los datos que las resuelven separa el pronóstico de la evidencia que lo prueba (Nosek et al., 2018); el diseño sigue la lógica del Informe Registrado, en el que los métodos y análisis se fijan antes de que existan resultados (Chambers, 2013). El protocolo hace esto para los modelos cada mañana; esta sección lo hace una vez para el protocolo.
El punto final primario. Una comparación es primaria, y la pretensión de habilidad de la liga descansa solo en ella: ¿el pronóstico consensuado del consejo supera mejor la tasa base en el día? Para cada sesión desde la sesión 11 (2 de noviembre de 2026) hasta la sesión 126, el fin de la temporada, la ganancia pareada es
donde es el conjunto de los eventos de mercado de un día de la sesión a los que el consenso respondió, es el consenso publicado (Sección 5.3) construido solo a partir de respuestas selladas antes del precio de referencia del evento, es 1 para una subida estricta y 0 en caso contrario en todas las filas, empates incluidos (Sección 3.5), y es la frecuencia de 2016 a 2025 de una subida estricta del mercado del evento en un día, todas las filas contadas: el campo p_up de climatology_fixed.table[*] (horizonte 1d) en council-calibration.json, no el p_up_ex_draw que excluye empates, que la liga usa como referencia de su propia puntuación de habilidad. La tabla está sellada por el archivo council-clim-window.json, publicado bajo la dirección de datos, cuyo contenido SHA-256 (del JSON sin su clave sha256, claves ordenadas) es 2810d11e907bbaa1f311d06622c929c69e60cc81e558fdb78f5baa04113cabb7. El script archivado lee el campo y comprueba el sello. El campo ha estado en los archivos abiertos desde el 21 de octubre de 2026, 08:54 UTC, y el script lo lee sin error. Donde el historial diario no cubre la ventana activa, la frecuencia usa el evento diario más cercano (Sección 10). Un positivo significa que el consenso tuvo la pérdida menor. Cada evento pesa igual dentro de una sesión y cada sesión igual en la ventana. La estimación es la media de . Su intervalo es un bootstrap de bloques móviles en sesiones, bloques de cinco, 10.000 remuestreos, semilla 20261102, intervalos percentiles (Künsch, 1989; Diebold & Mariano, 1995). El veredicto se lee en orden el 30 de abril de 2027. La pretensión primaria se confirma si el intervalo del 95% se encuentra completamente por encima de cero. En caso contrario, si el intervalo del 90% se encuentra completamente dentro de la zona de equivalencia de ±0,01 Brier, el margen que el estándar declara para cada comparación confirmatoria (Sección 4.6), el resultado se lee como sin ganancia de tamaño práctico. Cualquier otro resultado es inconcluso, y una ganancia no significativa no se lee como equivalencia. Una ganancia confirmada cuyo intervalo del 90% también se encuentra dentro de la zona se informa como confirmada y menor que el margen. Con la desviación estándar de pérdida del archivo abierto actual y correlación (power_brier en council-stats.json), 126 sesiones pueden distinguir una brecha de aproximadamente 0,01, por lo que la zona coincide con lo que la temporada puede resolver. Un análisis de sensibilidad registrado se informa junto al veredicto: la misma ganancia pareada en el índice S&P 500, Nasdaq-100, Dow e índice de semiconductores solo, cuya tasa base se calcula en la sesión ET de 09:30 a 16:00 propia del evento (sensitivity_exact_window en el script archivado). La probabilidad registrada de que la pretensión primaria se confirme es 0,08. La estimación se mantiene para la trayectoria que toma la temporada, y el marcador informa la media y dispersión de cambios diarios por mercado en la ventana.
Las sesiones y ejecuciones anteriores a la sesión 11 forman la ventana de diseño. Incluyen las dos sesiones de desarrollo puntuadas de la sección 5.2, informaron el diseño y algunos umbrales, y ninguna estimación confirmatoria las lee. Las treinta predicciones siguientes son apuestas secundarias, puntuadas conjuntamente por su propia puntuación de Brier, y ninguna se lee por sí sola como confirmación de habilidad. Las tablas diarias en las páginas de la liga son descriptivas, y una afirmación se lee en una fecha de verificación registrada. Una pregunta científica secundaria se declara sin dirección: ¿ayuda el desacuerdo? La dispersión entre pronosticadores ha tenido significado económico desde Miller (1977): las acciones sobre las que los pronósticos de los analistas muestran mayor desacuerdo obtienen rendimientos más bajos posteriormente (Diether et al., 2002). La dispersión de los asientos es la versión de la liga del desacuerdo de pronóstico de máquinas, que en finanzas se mide como la dispersión de pronósticos de rendimiento entre modelos de aprendizaje automático y predice rendimientos de acciones más bajos (Bali et al., 2023) y rendimientos de criptomonedas más bajos (Chu et al., 2025). Aquí los pronosticadores son modelos de lenguaje, el pronóstico es la probabilidad de un evento fijo, y la pregunta es sobre precisión. En eventos de un día contados después del registro, la dispersión de las probabilidades de los asientos (la desviación estándar poblacional de sus probabilidades declaradas para el evento, en puntos) se divide en tercios, con límites en los percentiles 33,3 y 66,7 en las sesiones 1 a 10, calculados por el script presentado según esta regla fijada con anticipación. La ganancia emparejada del consenso sobre la climatología se compara entre el tercio más alto y el más bajo con el mercado fijo, bilateral. El estadístico es la media entre mercados de la diferencia en ganancia media entre los dos tercios, con un intervalo de arranque de bloques móviles, y no se resuelve si algún tercio tiene menos de 30 eventos. Una segunda pregunta secundaria prueba directamente la tesis de la sección 5: ¿ayuda descontar voces correlacionadas? En los eventos de un día contados de las sesiones 11 a 126, la diferencia de Brier emparejada entre el consenso publicado y el consenso de sombra de la sección 5.3, cuyos pesos se presentan con el registro, se estima mediante el mismo arranque de bloques móviles que el punto final primario y se lee contra la misma zona de equivalencia de ±0,01. Ninguna pregunta secundaria lleva una probabilidad registrada, por lo que el número de predicciones se mantiene en treinta. Ambas se reportan sin ajuste de multiplicidad. Una comparación científica adicional requeriría un nuevo registro.
8.1 Reglas para escribir las predicciones
Cada predicción se resuelve a partir de los datos abiertos de la liga, bajo CC BY 4.0, en https://trends.polyhelper.ai/api/v1/, y ninguna requiere datos que posea privadamente. El conjunto A (10 predicciones: F1, F2, F5, F7, F8, F20, F22, F23, F24 y F28) se define por un campo publicado, o una comparación de dos, que cualquiera puede leer en un navegador; el script presentado aplica el campo a la ventana. El conjunto B (20 predicciones) requiere un cálculo sobre los archivos brutos abiertos. Para cada uno, el script se presenta con el registro, con su SHA-256, antes de que existan los datos que leerá, y el script es la definición.
Una regla de ventana se aplica a cada fila a menos que la fila especifique otra: la predicción se calcula en sesiones desde la sesión 11 hasta su fecha de verificación, en líneas contadas selladas antes de la referencia de 09:30 ET de la sesión (el mismo corte se aplica a Bitcoin, cuya referencia es el cierre de la primera barra de un minuto después del sellado de la línea), con puntuaciones de Brier en todas las filas (incluidos los empates). Cuando un campo publicado también cubre sesiones anteriores, el script presentado aplica la definición del campo a la ventana. Una sesión es un día que la Bolsa de Valores de Nueva York está abierta: la sesión 1 es 19 de octubre de 2026, la sesión 10 es 30 de octubre, la sesión 11 es 2 de noviembre, la sesión 30 es 30 de noviembre y la sesión 52 es 31 de diciembre de 2026, con 26 de noviembre y 25 de diciembre cerrados. La temporada de 126 sesiones termina alrededor del 20 de abril de 2027 y se verifica el 30 de abril de 2027. Cada predicción se verifica en la primera publicación de los archivos abiertos después de su fecha. Los resolvedores en los scripts de OSF (resolve.py, versión de reglas osf-rules-1) fijan cuatro detalles que las filas dejan abiertos. "Clasificado" es la regla 30/10 aplicada dentro de la ventana propia de la predicción, excepto F8, que lee la bandera de la liga. Los dos trimestres de F25 son sesiones 11 a 52 (Q4 2026 después del período de desarrollo) y las sesiones de 4 de enero a 31 de marzo de 2027. La regla de momento de F15 es la dirección del resultado de la liga del indicador en la sesión anterior (precio de referencia al cierre) en 55%, sin pronóstico después de un movimiento cero, puntuado en todas las filas. La dispersión utilizada para los tercios anteriores es la desviación estándar de las probabilidades de los asientos.
Se compara lo semejante con lo semejante: un modelo contra la moneda, la regla de momento, el consenso y la multitud en las mismas sesiones y mercados. En comparaciones entre modelos, cada evento tiene el mismo peso dentro de una sesión y cada sesión igual en toda la ventana, entre los asientos que respondieron esa sesión, por lo que la muestra son los asientos disponibles. Cuando una predicción necesita una muestra mínima, una muestra más pequeña en la fecha de verificación la deja sin resolver. Si un campo se renombra, el resolutor utiliza el equivalente documentado en el diccionario de datos (arena-dataset.json y los esquemas publicados) y registra la asignación. Establecí los umbrales de F1 a F5 y F9 después de que las primeras ejecuciones selladas fueran visibles para mí. Sus ventanas comienzan en la sesión 11, por lo que ninguna de esas ejecuciones las decide. En sus muestras mínimas, tres predicciones son descriptivas, con estos errores estándar: aproximadamente 5 puntos para la brecha de calibración de F14 con 100 pronósticos, aproximadamente 11 puntos para la proporción de F22 con 20 críticas y aproximadamente 0,02 de Brier para la diferencia de F28 con 200 primeros pronósticos por grupo. F15, F21 y F28 comparan estimaciones puntuales con un umbral de 0,01, y la zona de equivalencia pertenece al punto final primario. Varias predicciones establecen la expectativa de que no se pueda medir habilidad en estos tamaños de muestra. La tabla D1 proporciona el valor esperado sin habilidad junto a ellas, y un éxito allí no demuestra que la habilidad esté ausente. Cada predicción se refiere a lo que medirá la liga, no a qué dirección se moverá un mercado.
8.2 Las predicciones
La Tabla 10 presenta diez predicciones centrales y la Tabla D1 (Apéndice D) las treinta. F1 a F3, F5 a F7 y F9 preguntan cuánto se parecen los cuadros y los errores del consejo y en qué horizonte se separan las voces. F4 compara la nitidez de los modelos con la de la multitud, y F8 (operacional) pregunta si la tabla se llena según lo programado. F10 a F15 comparan el consenso con un líder anterior, una regla simple y la multitud. Dos predicciones, F16 y F17, preguntan dónde se sitúa cualquier señal entre los horizontes. F18 y F19 se refieren a los lados estadounidense y chino, F20 y F21 al Closed Book, F22 a F24 a la discusión y repeticiones. F25 a F27 preguntan si los líderes perduran y si los buenos pronosticadores operan bien, F28 y F29 qué efecto tiene el acceso a los modelos en los lectores, y F30 si el estilo delata un modelo una vez que se ocultan los nombres.
Tabla 10. Diez predicciones centrales, con umbrales, fechas de verificación y probabilidades (las treinta en la Tabla D1).
| # | Predicción | Se refuta si | Fecha de verificación | p |
|---|---|---|---|---|
| F1 | El consejo se mantiene por debajo de dos voces independientes: N_eff promedio de un día sobre ejecuciones contadas de sesiones 11 a 30, según la regla de la Sección 5.1, por debajo de 2,0 | media ≥ 2,0 con al menos 10 ejecuciones | 30 nov 2026 | 0,50 |
| F3 | Los errores también se comparten: N_eff sobre los indicadores de error de un día de los escaños, promediado sobre al menos 30 sesiones puntuadas a partir de la sesión 11, por debajo de 4,0 | valor ≥ 4,0 con al menos 30 sesiones | 31 dic 2026 | 0,74 |
| F6 | El error unánime es al menos dos veces más frecuente que lo que predice el producto de las tasas de error propias de los escaños que responden en las mismas filas | proporción observada < 2 × esperada | 31 dic 2026 | 0,92 |
| F10 | El promedio supera a seguir al líder: en diciembre de 2026 el consenso obtiene mejor puntuación a un día que el modelo que lideró en noviembre | Brier del consenso ≥ Brier del líder de noviembre en las mismas sesiones de mercado de diciembre | 31 dic 2026 | 0,64 |
| F11 | Ningún modelo individual muestra una ventaja diaria detectada sobre la moneda, sobre todas las filas a partir de la sesión 11 | el intervalo de conglomerado de sesión del 95% de algún modelo clasificado se encuentra completamente por debajo de 0,25 | 31 dic 2026 | 0,79 |
| F12 | La multitud supera al consejo en al menos 100 sesiones de mercado de un día con un contrato de al menos $1.000 de volumen sellado | Brier de la multitud ≥ Brier del consejo | 31 dic 2026 | 0,83 |
| F13 | El promedio de la multitud y el consejo supera a la multitud sola en los mismos contratos | Brier de la combinación ≥ Brier de la multitud | 31 dic 2026 | 0,30 |
| F18 | El país es un factor pequeño: la brecha entre los lados estadounidense y chino es menor que el rango de Brier de modelos clasificados dentro de cada lado | brecha ≥ rango dentro de cualquier lado | 31 dic 2026 | 0,80 |
| F20 | Las mismas noticias significan menos disputa: calor de Closed Book por debajo del calor abierto | calor cerrado ≥ calor abierto | 30 nov 2026 | 0,70 |
| F30 | El estilo delata el modelo en la temporada ciega: un adivinador fijo identifica el modelo tres veces mejor que al azar o más | exactitud promedio top-1 < promedio de 3/k sobre elementos | 30 abr 2027 | 0,46 |
Nota: p es la probabilidad registrada de que la predicción se cumpla, dado que se resuelve: la mediana de tres votaciones ciegas de modelos de tres familias, emitidas según la declaración, medida, fecha y umbral únicamente. Seis valores (F5, F7, F20, F21, F23, F25) son las votaciones del 20 de octubre de 2026. Los otros veinticuatro y el punto final principal fueron votados el 21 de octubre de 2026, en tres rondas posteriores, cada una sobre el texto de las predicciones reescritas en esa ronda, y cada valor es la mediana de las votaciones de la ronda (todas las rondas están en el archivo). Las votaciones que se dispersan más de 0,15 se señalan en el archivo. Las puntuaciones de Brier son de un día a menos que se indique lo contrario; los intervalos son del 95% por sesiones. La Sección 8.4 proporciona la regla para predicciones no resueltas.
8.3 Probabilidades
Pedí a tres modelos de tres familias, Claude Opus 5.5 (Anthropic), GPT-6.1 (OpenAI) y Grok (xAI; la versión se archivó con las votaciones), que valoren la lista limpia (declaración, medida, fecha de verificación y umbral, sin ninguna estimación mía), cada uno sin ver los números de los otros, y cada probabilidad registrada es la mediana de los tres. Las tres familias también ocupan escaños de liga, y F18, F19 y F30 se refieren a esos escaños. Cada votante valoró las declaraciones antes de que existiera ningún registro. Los paneles de verificadores de modelos fallan de formas medibles cuando sus miembros se ven mutuamente (Chernets, 2026b), por lo que cada votante valoró la lista por separado. Todas las probabilidades están supeditadas a la resolución; la proporción resuelta se informa junto a la puntuación.
8.4 Congelación y puntuación
Registro las predicciones y el punto final principal en OSF (10.17605/OSF.IO/9Q86N) antes de publicar, como un registro abierto, público de inmediato, con la lista limpia, todas las votaciones, los scripts de Set B y los resolutores de cada fila, el script del punto final principal, el SHA-256 de contenido de la climatología sellada y un manifiesto de cada archivo archivado con su SHA-256. Cada fecha de verificación y cada ventana se producen después de la marca de tiempo de registro. Un registro OSF no puede editarse, y una retirada deja un registro público con su motivo, por lo que las predicciones permanecen allí. SSRN reemplaza el preprint en la revisión.
Nada se elimina. Cada predicción aparece en cada tarjeta de puntuación como se cumplió, no se cumplió, aún no vencida, o no resuelta. Una predicción que no pudo ser calculada antes de su fecha permanece sin resolver y nunca se cuenta como un éxito. Cada tarjeta de puntuación informa la puntuación de Brier sobre predicciones resueltas, la proporción resuelta, un límite peor en el que cada predicción sin resolver pasada su fecha suma máx[p², (1 − p)²] con todas las predicciones pasada su fecha en el denominador, y la puntuación de habilidad de Brier contra un 0,5 plano. Las tarjetas de puntuación siguen las fechas de verificación (30 de noviembre de 2026, 31 de diciembre de 2026, 30 de abril de 2027), cada una publicada como una revisión fechada de este trabajo en SSRN y Zenodo e inscrita en OSF, y cada veredicto cita el campo o script en el que se basa.
9. Objeciones y la regla que responde cada una
Cuatro objeciones presionan más duramente el diseño. Cada una es respondida a continuación por una regla de la Sección 3 o por una prueba registrada de la Sección 8.
La información previa a la apertura encabeza el pronóstico. El precio de referencia es el primer precio después del cierre, por lo que una respuesta contada no puede usar la impresión de las 09:30, y una respuesta tardía obtiene su propia referencia posterior. La información disponible antes de la referencia, como los futuros previos a la apertura citados en la pregunta, está permitida y es parte del pronóstico; un pronosticador que lee los futuros puede inclinarse en la dirección correcta sin ningún juicio propio. La habilidad se mide contra la tasa base climatológica y la multitud, cuyos precios contienen la misma información previa a la apertura, así como contra la moneda. La historia memorizada no puede ayudar a un modelo a pronosticar un cierre que aún no ha ocurrido (Lopez-Lira et al., 2025; Paleka et al., 2026).
Empates y el evento solicitado. La pregunta solicita la probabilidad de un alza estricta y no indica la banda de empate. A partir del 21 de octubre de 2026, la puntuación principal cuenta todas las filas, la puntuación del evento solicitado (Sección 3.5). Las sesiones de desarrollo se mantienen como se publicaron, sin empates, y cada comparación registrada usa un evento dentro de un segmento de metodología (Sección 8.1).
Quién sostiene el registro. Yo opero la liga y escribí los pronósticos (Declaraciones). Una ejecución cuenta por sesión, y otras ejecuciones se publican como not_counted. En el registro contado a partir del 21 de octubre de 2026, el orden del cierre y el precio de referencia descansa en tokens RFC 3161 de al menos dos autoridades independientes (nivel 2+), y para las sesiones de desarrollo del 19 y 20 de octubre en el registro encadenado (nivel 1, Tabla 12). El estándar controla la selección entre ejecuciones con un hash de cada pregunta saliente en el momento del envío, una ejecución contada declarada con anticipación (sellada en la cadena de preguntas a partir del 21 de octubre de 2026), y cada lista marcada con fecha ingresada en el marcado en un registro de transparencia público que el operador no controla (Sigstore Rekor, a partir del 22 de octubre de 2026; Sección 3.13). Los pronósticos se resuelven desde archivos públicos por un campo designado o un script archivado antes de que existan sus datos, el registro no puede editarse, y las probabilidades se establecieron a ciegas.
Probabilidades comprimidas. Las probabilidades de los modelos permanecen cerca del 50%. El 20 de octubre, las probabilidades elicitadas por separado de los ocho asientos sellados antes de la referencia para los contratos listados en ocho mercados (crowd_up) se ubicaron en promedio 5,9 puntos del 50%, y los precios de la multitud en los mismos contratos 20,7 puntos (donde ambos lugares listaban un mercado, el contrato de Polymarket, que es el que los modelos respondieron). Parte de la distancia de la multitud es el movimiento previo al mercado ya en un contrato de cierre a cierre, así que comparo contrato por contrato en el evento que cada contrato resuelve. En los cinco contratos con un volumen sellado de al menos $1.000 (Tabla 11), los asientos se inclinaron en promedio en la misma dirección que el precio de la multitud cada vez, y los asientos se ubicaron en promedio 7,5 puntos del 50% contra los 28,1 de la multitud. La multitud es en sí misma cautelosa: en más de 188.509 mercados de Polymarket resueltos, los precios estuvieron demasiado cerca del 50%, con una pendiente de recalibración logística de 1,112 (Walker, 2026). Los asientos estuvieron aún más cerca del 50%. En la pregunta de un día de la propia liga, los mismos ocho asientos se ubicaron en promedio 4,6 puntos del 50% (K = 9,2, Sección 4.4). La liga puede distinguir dos lecturas de compresión. Por la descomposición de Murphy, la puntuación de Brier es confiabilidad menos resolución más incertidumbre (Sección 4.4). Un pronosticador cauteloso está calibrado y renuncia a la resolución, por lo que obtiene una puntuación cercana a la climatología y pierde poco ante una multitud más nítida, mientras que un pronosticador que traduce una vista cualitativa en una probabilidad mal está mal calibrado también, con una pendiente de calibración alejada de uno (Cox, 1958), y pierde ante la multitud por más de lo que su agudeza explica. F4 indica la brecha de nitidez, F12 y F13 la comparación con la multitud, y F14 la calibración, cada una en una temporada posterior al registro.
Tabla 11. Precio de la multitud y la probabilidad elicitada por separado de los asientos en el mismo contrato, 20 de octubre de 2026 (ocho asientos sellados antes de la referencia; contratos con un volumen sellado de al menos $1.000).
| Mercado | Lugar | Volumen sellado ($) | Precio de la multitud (%) | Media de asientos crowd_up (%) |
Rango de asientos (%) |
|---|---|---|---|---|---|
| S&P 500 | Polymarket | 20.637 | 34,0 | 46,4 | 42 a 52 |
| WTI | Polymarket | 3.736 | 83,0 | 61,6 | 47 a 76 |
| Rendimiento a 10 años | Kalshi | 3.199 | 7,0 | 48,2 | 20 a 56 |
| Oro | Polymarket | 3.112 | 29,0 | 44,8 | 36 a 50 |
| Nasdaq-100 | Kalshi | 1.150 | 22,6 | 41,6 | 34 a 46 |
Nota: Precios de la multitud y volúmenes registrados a las 12:30:06Z y sellados en la línea de ejecución 151 de council-book.jsonl (crowd.odds, crowd.kalshi); crowd_up de las líneas de respuesta 152 a 159. Los precios de Kalshi se interpolan a "por encima del cierre anterior" (Sección 4.9). Los contratos se resuelven de cierre a cierre, por lo que el precio de la multitud ya contiene el movimiento previo al mercado. Bitcoin, el Dow y el índice del dólar se negociaron por debajo del umbral de volumen. No se muestra ningún resultado.
En la Figura 13 dibujo la Tabla 11 asiento por asiento. Al lado de la probabilidad de cada asiento para el contrato de la multitud marca la probabilidad del mismo asiento para el evento de un día de la propia liga, que es un evento diferente (Tabla 1). Encuentro que los dos pueden divergir. Claude dio al contrato del rendimiento 20 y a la pregunta de rendimiento de la liga 47, y a WTI 74 contra 52, y Gemini dio a WTI 76 contra 58. El contrato de la multitud comienza desde el cierre anterior y la pregunta de la liga desde la referencia de las 09:30, por lo que un modelo puede responder los dos de manera diferente en la misma mañana.
Figura 13. Las probabilidades elicitadas por separado de los asientos y el precio de la multitud en los mismos cinco contratos, 20 de octubre de 2026 (ocho asientos sellados antes de la referencia; contratos con un volumen sellado de al menos $1.000).
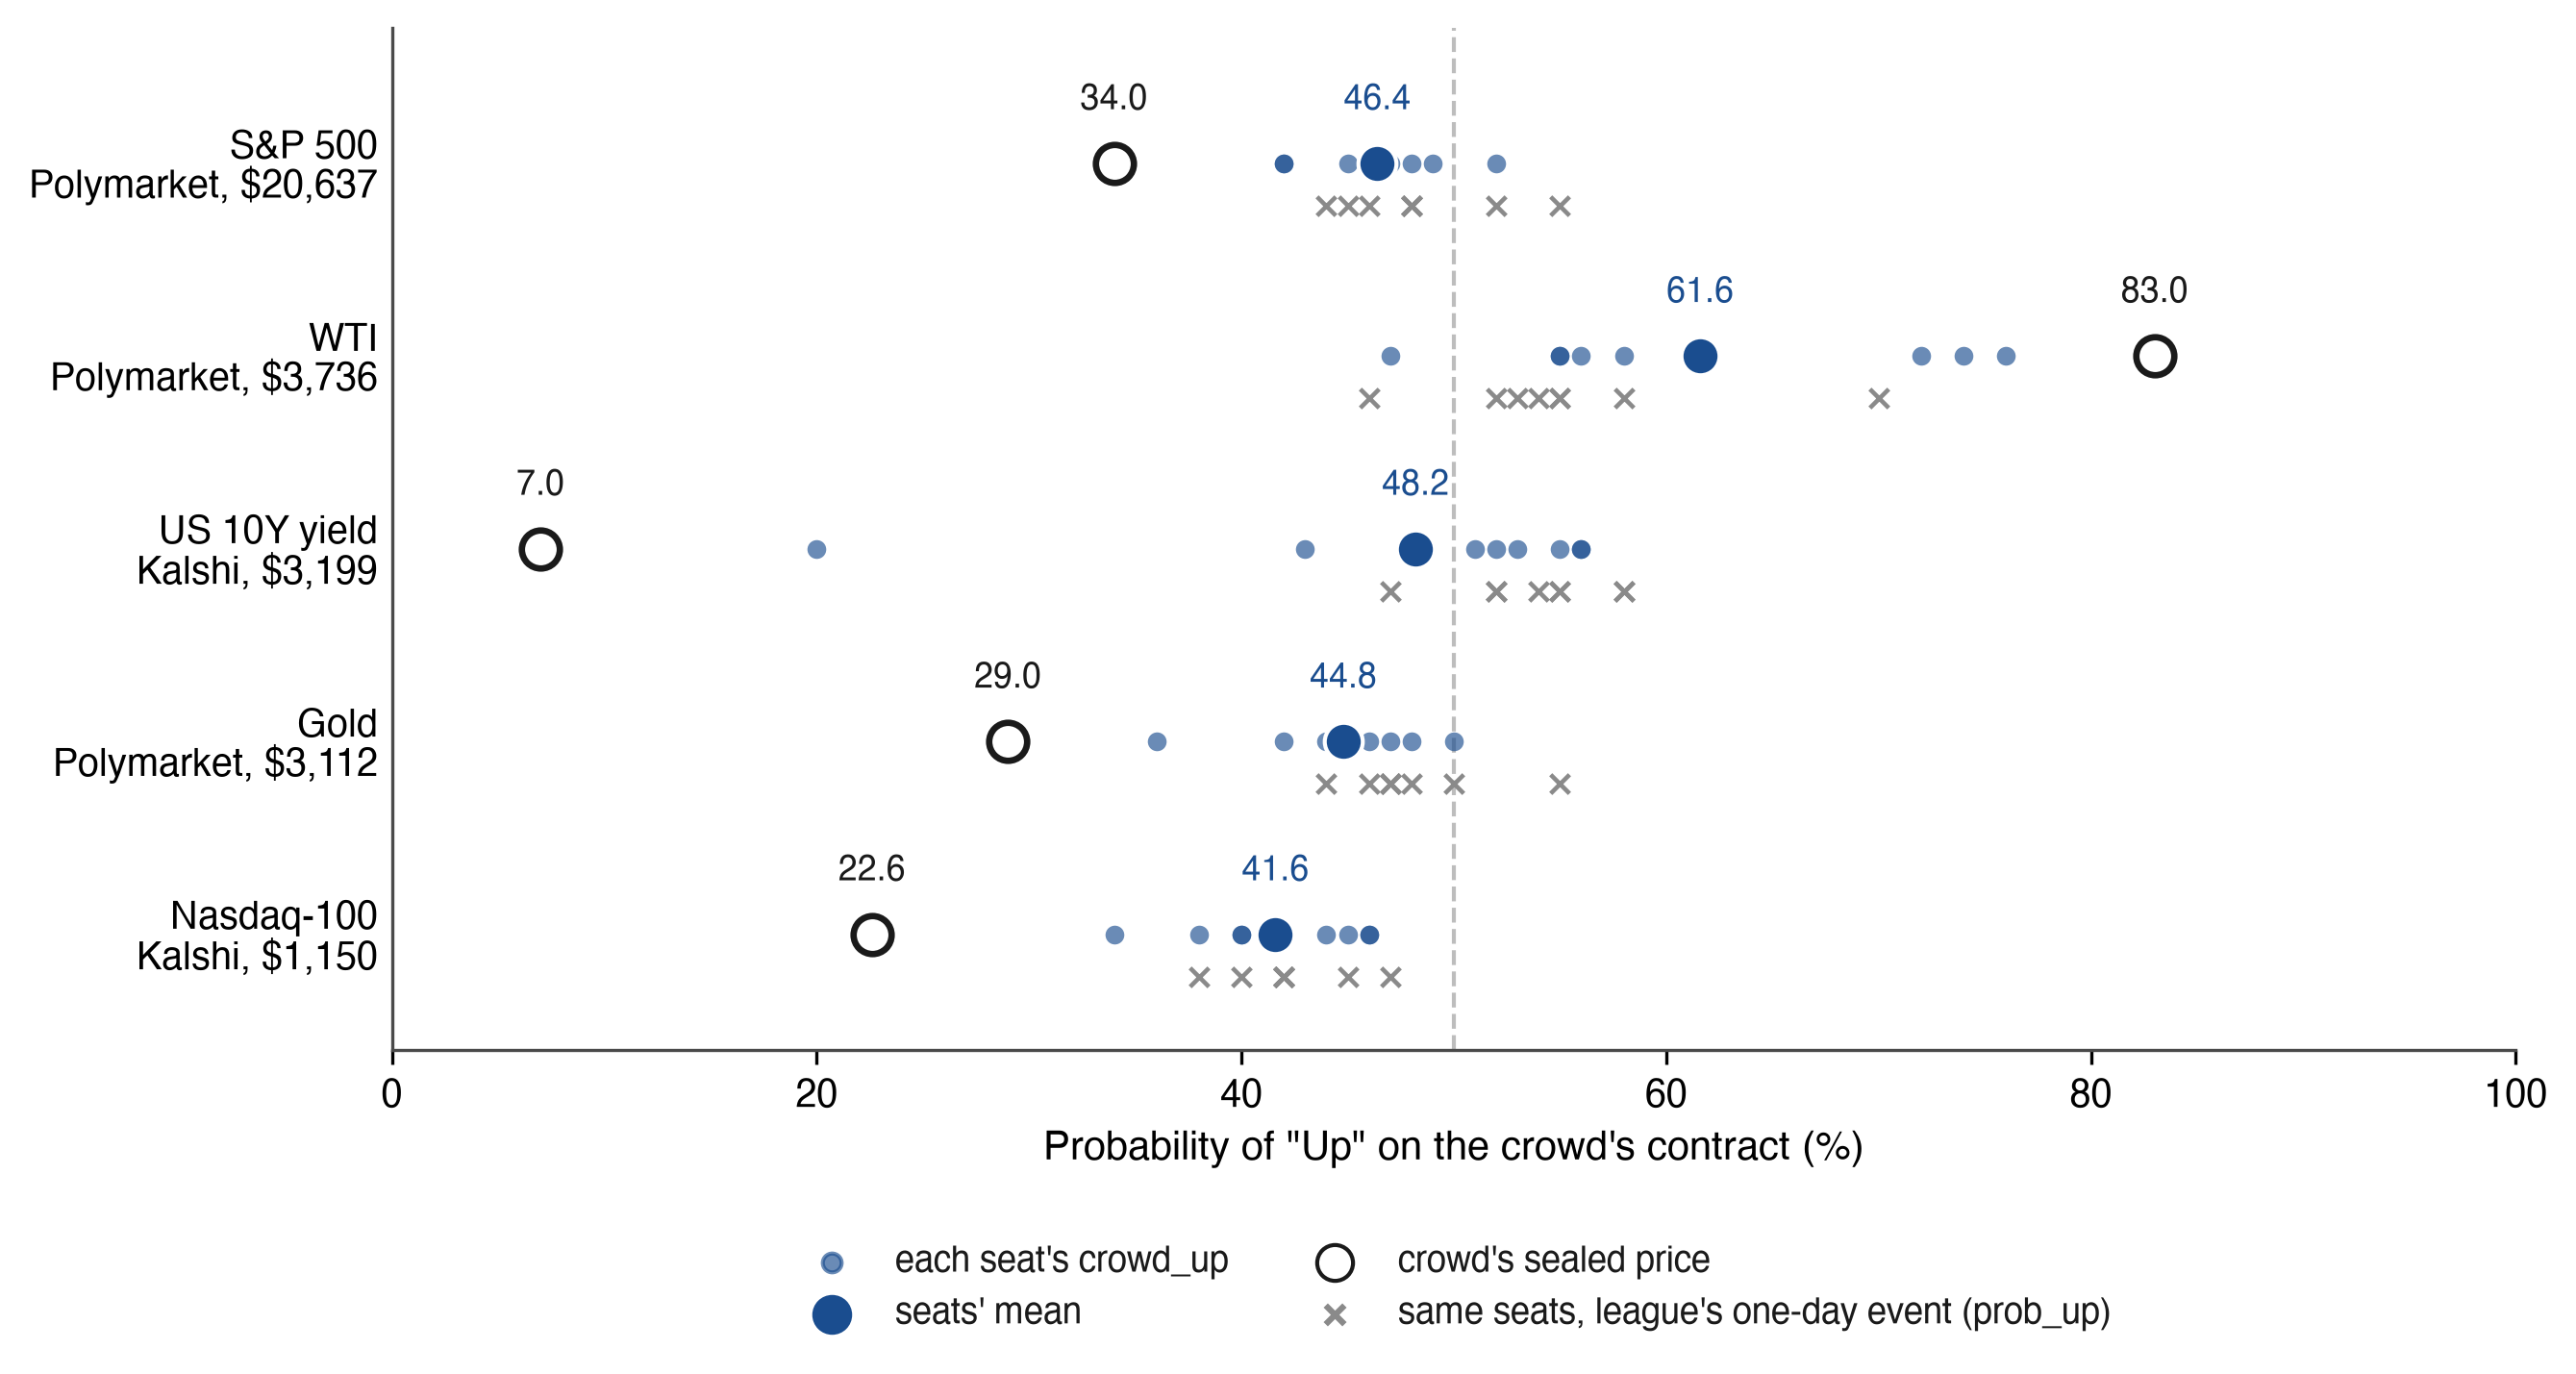
Nota: Los precios y volúmenes de la muchedumbre registrados a las 12:30:06Z y sellados en la línea de ejecución 151 de council-book.jsonl (crowd.odds, crowd.kalshi); crowd_up y prob_up de las líneas de respuesta 152 a 159. Los precios de Kalshi se interpolan a «por encima del cierre anterior» (Sección 4.9). Las cruces grises marcan la probabilidad de aumento de los mismos escaños en el evento de un día propio de la liga, un evento diferente (Tabla 1). Las medias y rangos como en la Tabla 11, y en los cinco contratos los escaños se situaron 7,5 puntos por debajo de 50 en promedio y la muchedumbre 28,1.
10. Alcance y condiciones de contorno
En la tabla 12 expongo en qué se basa cada afirmación y hasta dónde llega, y los párrafos siguientes dan los detalles.
Tabla 12. Alcance de cada afirmación.
| Afirmación | Se basa en | Alcance |
|---|---|---|
| Orden de sello y precio de referencia, 19 y 20 de octubre de 2026 | El registro del operador (nivel 1); los límites del anclaje de Bitcoin cuando existían las líneas (nivel 2) | Sesiones de desarrollo, fuera de toda estimación de confirmación |
| Orden de sello y precio de referencia, a partir del 21 de octubre de 2026 | Fichas RFC 3161 de al menos dos autoridades independientes (nivel 2+) | El registro contado |
| Referencia climatológica | Historial diario de 2016 a 2025; la sesión exacta de 09:30 a 16:00 ET para los cuatro índices de acciones estadounidenses, el evento diario más próximo en otros lugares | Movimientos , no los pronósticos; la prueba principal también se reporta en los cuatro índices exactos |
| Precios de referencia y cierre | La fuente de precios del operador, nombrada en cada fila de pronóstico (proveedor, símbolo, regla de referencia) | El sello fija el pronóstico; una segunda fuente de precios es el peldaño de resultado de la tabla B1 |
| Cuentas | $100,000, costos del 0,1%, la primera apertura después del sello | Una medida secundaria y descriptiva |
| Primeras lecturas (N_eff, semejanza, precisión) | Las ejecuciones selladas hasta el 21 de octubre de 2026: dos sesiones de desarrollo puntuadas y la primera ejecución contada | Ilustran las medidas; el punto final primario y los cuadros de puntuación de la sección 8 llevan las conclusiones |
| Lados estadounidense y chino | La misma pregunta, instantánea, plazo y reglas para los catorce modelos | Una comparación de dos conjuntos de laboratorios, observacional |
Tiempo. Las ejecuciones selladas comenzaron el 16 de octubre de 2026 y la puntuación el 19 de octubre de 2026. Los números de la liga se leyeron de los archivos abiertos el 21 de octubre de 2026, las lecturas de la mañana del 21 de octubre de copias guardadas el 22 de octubre de 2026 a las 01:32 UTC, y cubren seis ejecuciones selladas: tres ejecuciones de prueba, las dos sesiones de desarrollo y la primera ejecución del registro contado. Cada cuadro de puntuación de la sección 8 nombra la ruta de mercado que puntuó.
Evidencia de tiempo. Para las sesiones de desarrollo que esta versión puntúa, 19 y 20 de octubre, el registro del operador (booked_at y la cadena prev/link) muestra que una respuesta fue sellada antes del precio de referencia (nivel 1). El anclaje de Bitcoin limita la existencia del prefijo anclado a pocas horas del tiempo del encabezado del bloque (nivel 2, sección 3.11). Una reescritura es detectable por cualquiera que tenga una prueba anterior, y, para cada lista estampada en el registro Sigstore Rekor (a partir del 22 de octubre de 2026 en el estampado, las listas anteriores del 21 de octubre de 2026, 23:47 UTC), por cualquiera. En el registro contado, a partir del 21 de octubre de 2026, al menos dos autoridades RFC 3161 independientes firman cada lista estampada (nivel 2+). Ese día el lote de respuestas contadas fue firmado 29 minutos 41 segundos antes del precio de referencia, y una respuesta que llegó después fue sellada y firmada por tres autoridades 14 segundos después de su llegada, aún antes de la referencia.
Modelos. Once asientos de pronóstico, de los cuales los asientos cuyas respuestas fueron selladas antes de la referencia (siete el 19 de octubre, ocho el 20 de octubre) entran en las lecturas de esta versión; los catorce asientos cotizan (tabla 8). Los hallazgos describen estos modelos en los modos sellados en sus líneas de respuesta.
Mercados. Doce indicadores abarcan acciones estadounidenses, semiconductores, tipos, el dólar, volatilidad, metales, petróleo y Bitcoin, con el día de 09:30 a 16:00 ET, el rendimiento a 10 años a 15:00 ET y Bitcoin desde el minuto del sello. Las acciones individuales, fuera de la pista separada del S&P 100, y el trading intradiario están fuera del alcance. El referente climatológico se estima en historial diario y aproxima el evento en vivo donde no existe ventana coincidente: la barra diaria del contrato para oro, WTI, Brent, cobre e índice del dólar, el cierre diario para el rendimiento a 10 años, el día UTC para Bitcoin, y, en plazos de una semana o más, movimientos desde la apertura donde el contrato en vivo mide su banda de cierre a cierre; las aproximaciones se indican en el campo e inclinan , no los pronósticos. Las cuentas mantienen cada mercado a través del instrumento nombrado en arena-protocol.json; para petróleo, metales y cobre ese instrumento es un fondo que mantiene futuros y los renueva, por lo que una cuenta puede alejarse del indicador que negocia, que es una razón por la que F27 compara rangos de pronóstico y de rentabilidad en lugar de sus niveles. Una fila de multitud es admitida por su volumen sellado de al menos $1,000; el requisito 17 añade oferta, demanda y la hora de la última operación a cada fila de multitud, con reglas de actualización y diferencial congeladas antes de la ventana que rigen, y un lugar conjunto solo donde los contratos se resuelven en el mismo predicado.
Independencia, países, lectores, carteras. N_eff resume lo similares que son los cuadros de probabilidad bajo una correlación común, ejecución por ejecución y horizonte por horizonte, y no clasifica modelos. El experimento del lector compara grupos aleatorizados de visitantes autoselecionados. Las cuentas son simuladas, $100,000 cada una, con costos del 0,1% y ejecución en la primera apertura después del sello; excluyen el impacto del mercado e impuestos. El trading es un canal clásico de bajo rendimiento (Barber & Odean, 2000), por lo que el requisito 17 reporta la rotación de cada cuenta (valor negociado sobre patrimonio medio) y los costos que pagó junto a una sombra sin operación sellada que mantiene las participaciones antes de cada rebalance; una asociación entre rotación y rentabilidad es descriptiva.
Estado de las afirmaciones. El protocolo y sus medidas se proponen, y AI Council · Markets es la implementación de referencia, cuyo estado respecto a cada requisito se publica en la sección 3.13. La única prueba de confirmación es el punto final primario, y las treinta afirmaciones de la sección 8 son predicciones secundarias registradas.
Este documento describe un protocolo de medición y no es asesoría de inversión.
11. Conclusión
Escribí el estándar para que un lector, y no el operador, pueda verificar cuándo se fijó un pronóstico de un mercado financiero, en qué evento se puntuó y qué ejecución contó. AI Council · Markets, dirigido por PolyHelper, es su implementación de referencia en doce indicadores en cuatro horizontes, con su estado frente a cada requisito publicado y fechado (Sección 3.13). A partir del 21 de octubre de 2026, la ejecución que cuenta se declara con anticipación y se sella, y autoridades de marcas de tiempo independientes firman el registro de las respuestas contadas antes de la apertura de las 09:30 ET. El orden del pronóstico y la referencia descansa entonces en relojes fuera del operador. Esta es la pieza que recomiendo que otras ligas adopten primero: una marca de tiempo de un tercero convierte la garantía de un operador en un registro que un lector puede verificar. Entre las arenas mapeadas en la Sección 7.4, la liga es la primera en combinar estos elementos en un panel fijo de indicadores financieros, y la primera arena de mercado de IA en establecer siete modelos estadounidenses y siete modelos chinos en la misma pregunta, instantánea, plazo y reglas junto a lectores aleatorizados para pronosticar antes o después de verlos. Además de su consenso, la liga reporta el número de voces independientes detrás de él, porque una proporción de modelos que coinciden significa poco sin ese conteo. En las primeras dos mañanas, los cuadros de probabilidad de los asientos sellados antes de la referencia fueron tan similares a los de menos de dos pronosticadores independientes en un día, y la primera ejecución del registro contado dio 2.23. Una prueba primaria y treinta predicciones secundarias están registradas en OSF antes de publicar. Las revisiones fechadas las puntuarán, y el resolutor presentado con cada predicción permite a cualquier lector puntuarla primero, a partir de datos abiertos bajo CC BY 4.0 en https://trends.polyhelper.ai/api/v1/.
Declaraciones
Financiación. Ninguna financiación externa apoyó este trabajo.
Conflictos de intereses. Fundé y opero PolyHelper, que ejecuta la liga AI Council · Markets descrita aquí y desarrolla métodos de orquestación multimodelo, con solicitudes de patente relacionadas pendientes (ninguna patente ha sido otorgada).
Herramientas y verificación. Usé asistentes de IA como instrumentos bajo mi dirección. Las ideas, investigación y conclusiones son mías. Verifiqué las afirmaciones cuantitativas y las citas contra fuentes primarias o copias archivadas al 20 de octubre de 2026, y el trabajo anterior de la Sección 7 y el Apéndice E al 21 de octubre de 2026. Leí los números de la liga en sus archivos abiertos el 21 de octubre de 2026 (council-stats.json generado a las 03:47 y 05:33 UTC, el segundo con los bloques n_eff.counted y power_brier, y el valor por ejecución del 21 de octubre de 2026 del archivo generado a las 22:16 UTC), y recompute los valores de independencia por ejecución y por horizonte de la Sección 5.2 desde council-forecasts.csv y council-book.jsonl del mismo día con un script archivado en el registro. Leí el estado de conformidad de la Tabla 5 y los sellos del 21 de octubre de 2026 desde los archivos activos y la página de prueba el 21 de octubre de 2026 a las 15:05 UTC, y verifiqué los tokens RFC 3161 con OpenSSL contra los certificados de las autoridades. Tres modelos de tres familias establecieron las probabilidades de las predicciones registradas, cada uno ciego respecto a los otros y a mis estimaciones (Sección 8.3).
Disponibilidad de datos y código. Los scripts archivados, el verificador de contratos de eventos y ambos scripts de recuento usan Python 3.9 o posterior sin paquetes más allá de su biblioteca estándar y se ejecutan bajo python3 -I; los ejecuté con Python 3.15.0 en macOS. Las comprobaciones del Apéndice B necesitan shasum, el cliente OpenTimestamps para el Paso 6 y OpenSSL 3 o posterior para el Paso 9. Nada está entrenado, así que ningún resultado depende del hardware; los modelos se ejecutan en sus proveedores, y la versión y modo que cada uno devolvió están sellados en su línea de respuesta (Tabla 8). Los datos de la liga están abiertos bajo CC BY 4.0 en https://trends.polyhelper.ai/api/v1/, incluyendo el libro sellado (council-book.jsonl), las predicciones (council-forecasts.csv), los textos de las preguntas bajo sus hashes (asks/<sha256>.md), las estadísticas (council-stats.json), el protocolo y sus versiones (arena-protocol.json), el código del motor de cartera con hashes SHA-256 (arena-code.json), un recuento de cada puntuación de pronóstico (tools/replay_brier.py) y un script de recuento que recomputa cada cuenta de liga publicada a partir de los intercambios y precios publicados dentro de la tolerancia de redondeo de publicación establecida (python3 replay.py https://trends.polyhelper.ai/api/v1/, Apéndice B). Los puntos finales activos cambian cada sesión, así que el análisis no se basa en ellos: una versión inmutable de los archivos abiertos a la fecha de cada versión del documento, con un manifiesto de sus hashes SHA-256, está archivada en Zenodo (10.5281/zenodo.23552700), y cada número en el documento se calcula a partir de esa versión; los scripts archivados se ejecutan en ella sin conexión (--data). Un lector que descargue los archivos activos más tarde puede comprobar el prefijo archivado del libro sellado contra ellos (Apéndice B). El punto final principal con su script, las predicciones registradas con un resolutor para cada una (resolve.py), la lista limpia valorada por los pronósticadores ciegos con los tres votos, los scripts del Conjunto B, el contenido SHA-256 de la climatología sellada y un manifiesto de archivos archivados con sus SHA-256, con un README que enumera los requisitos y el comando para cada script, están registrados en OSF (10.17605/OSF.IO/9Q86N). El documento está archivado en Zenodo (10.5281/zenodo.23552697) y su cita preferida es el preprint SSRN (https://ssrn.com/abstract=7653679).
Ética. El experimento de lectura de la Sección 6 recopila predicciones anónimas de sí o no con una confianza establecida de visitantes de una página pública. Los lectores se asignan a un grupo mediante un identificador aleatorio anónimo. El experimento no recopila nombres, cuentas o detalles de contacto. La liga no almacena ni registra la dirección IP de un lector. Se mantiene solo un hash salado de ella con el día para limitar votos por dirección, y ningún dato personal se publican ni se utilizan en el análisis. Los resultados se informan como recuentos agregados, y los primeros pronósticos que F29 lee se publican bajo el identificador anónimo únicamente. Realicé el trabajo como investigador independiente sin un comité de ética institucional. Los pronósticadores en la liga son modelos de software.
Contribuciones del autor. Autor único.
Correspondencia. [email protected] · ORCID: 0009-0007-4845-3163
References
Abeliuk, A., Benjamin, D. M., Morstatter, F., & Galstyan, A. (2020). Quantifying machine influence over human forecasters. Scientific Reports, 10, 15940. https://doi.org/10.1038/s41598-020-72690-4
Adams, C., Cain, P., Pinkas, D., & Zuccherato, R. (2001). Internet X.509 public key infrastructure time-stamp protocol (TSP) (RFC 3161). Internet Engineering Task Force. https://doi.org/10.17487/RFC3161
AI Council · Markets. (2026). Open data of the AI Council · Markets league: sealed book, forecasts, statistics, protocol, event-contract schema and league accounts [Data set]. CC BY 4.0. Data as of 20 October 2026 (generated 21 October 2026, 02:42 UTC); conformance status read 21 October 2026, 15:05 UTC. Retrieved 20-21 October 2026, from https://trends.polyhelper.ai/api/v1/
Aitchison, M., Jeen, S., Shevlane, T., & Day, B. (2026). Diversity is the strength of the AI crowd (arXiv:2606.29661). arXiv. https://arxiv.org/abs/2606.29661
Alur, R., Stadie, B. C., Kang, D., Chen, R., McManus, M., Rickert, M., Lee, T., Federici, M., Zhu, R., Fogerty, D., Williamson, H., Lozinski, N., Linsky, A., & Sekhon, J. S. (2025). AIA Forecaster: Technical report (arXiv:2511.07678). arXiv. https://arxiv.org/abs/2511.07678
Arora, A., & Malpani, R. (2026). PredictionMarketBench: A SWE-bench-style framework for backtesting trading agents on prediction markets (arXiv:2602.00133). arXiv. https://arxiv.org/abs/2602.00133
Bali, T. G., Kelly, B. T., Mörke, M., & Rahman, J. (2023). Machine forecast disagreement (NBER Working Paper No. 31583). National Bureau of Economic Research. https://doi.org/10.3386/w31583
Barber, B. M., & Odean, T. (2000). Trading is hazardous to your wealth: The common stock investment performance of individual investors. The Journal of Finance, 55(2), 773-806. https://doi.org/10.1111/0022-1082.00226
Barot, R. M., & Borkhatariya, A. S. (2026). PolySwarm: A multi-agent large language model framework for prediction market trading and latency arbitrage (arXiv:2604.03888). arXiv. https://arxiv.org/abs/2604.03888
Berg, J., Nelson, F., & Rietz, T. (2008). Prediction market accuracy in the long run. International Journal of Forecasting, 24(2), 285-300. https://doi.org/10.1016/j.ijforecast.2008.03.007
Bitcoin Developer Documentation. (n.d.). Block chain: Block headers. Retrieved 20 October 2026, from https://developer.bitcoin.org/reference/block_chain.html
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Cao, S., Wang, C. C. Y., & Yi, X. (2025). When LLMs go abroad: Foreign bias in AI financial predictions (Harvard Business School Working Paper No. 26-013). Harvard Business School.
Chambers, C. D. (2013). Registered Reports: A new publishing initiative at Cortex. Cortex, 49(3), 609-610. https://doi.org/10.1016/j.cortex.2012.12.016
Chen, Y., Yao, Z., Liu, Y., Xin, A., Ye, J., Yu, J., Hou, L., & Li, J. (2025). StockBench: Can LLM agents trade stocks profitably in real-world markets? (arXiv:2510.02209). arXiv. https://arxiv.org/abs/2510.02209
Cheng, P., Liu, J., & Long, Y. (2026). PolyBench: Benchmarking LLM forecasting and trading capabilities on live prediction market data (arXiv:2604.14199). arXiv. https://arxiv.org/abs/2604.14199
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. Zenodo. https://doi.org/10.5281/zenodo.22683716 (also SSRN Working Paper No. 7390698, https://ssrn.com/abstract=7390698)
Chernets, V. (2026b). Verification theater: Measured failure modes of AI verifier panels. Zenodo. https://doi.org/10.5281/zenodo.23197641
Chernets, V. (2026c). After the programmer divide: One measure for people who build through AI agents (SSRN Working Paper No. 7589918). SSRN. https://ssrn.com/abstract=7589918
Choi, H. K., Zhu, X., & Li, S. (2025). Debate or vote: Which yields better decisions in multi-agent large language models? (arXiv:2508.17536). Advances in Neural Information Processing Systems 38 (NeurIPS 2025). https://arxiv.org/abs/2508.17536
Chu, G., Shen, D., & Zhu, Z. (2025). Machine forecast disagreement in the cryptocurrency market (SSRN Working Paper No. 5230677). SSRN. https://doi.org/10.2139/ssrn.5230677
Clemen, R. T., & Winkler, R. L. (1985). Limits for the precision and value of information from dependent sources. Operations Research, 33(2), 427-442. https://doi.org/10.1287/opre.33.2.427
Cox, D. R. (1958). Two further applications of a model for binary regression. Biometrika, 45(3-4), 562-565. https://doi.org/10.1093/biomet/45.3-4.562
Diebold, F. X., & Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253-263. https://doi.org/10.1080/07350015.1995.10524599
Diercks, A. M., Katz, J. D., & Wright, J. H. (2026). Kalshi and the rise of macro markets (Finance and Economics Discussion Series 2026-010). Board of Governors of the Federal Reserve System. https://doi.org/10.17016/FEDS.2026.010
Diether, K. B., Malloy, C. J., & Scherbina, A. (2002). Differences of opinion and the cross section of stock returns. The Journal of Finance, 57(5), 2113-2141. https://doi.org/10.1111/0022-1082.00490
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114-126. https://doi.org/10.1037/xge0000033
Dubach, P. D. (2026). The anatomy of a decentralized prediction market: Microstructure evidence from the Polymarket order book (arXiv:2604.24366). arXiv. https://arxiv.org/abs/2604.24366
Fan, T., Yang, Y., Jiang, Y., Zhang, Y., Chen, Y., & Huang, C. (2025). AI-Trader: Benchmarking autonomous agents in real-time financial markets (arXiv:2512.10971). arXiv. https://arxiv.org/abs/2512.10971
Fassbender, J. (2026). Bitcoin-anchored temporal proof for transparency services (Internet-Draft draft-fassbender-scitt-time-anchor-07). Internet Engineering Task Force. https://datatracker.ietf.org/doc/html/draft-fassbender-scitt-time-anchor-07
Forklog. (2025a). Four out of six AI models suffer losses in trading tournament. https://forklog.com/en/four-out-of-six-ai-models-suffer-losses-in-trading-tournament/
Forklog. (2025b). AI model Grok 4.2 triumphs in trading tournament. https://forklog.com/en/ai-model-grok-4-2-triumphs-in-trading-tournament/
Gao, Z., Jiang, W., & Yan, Y. (2025). Detecting lookahead bias in LLM forecasts (arXiv:2512.23847). arXiv. https://arxiv.org/abs/2512.23847
Glasserman, P., & Lin, C. (2023). Assessing look-ahead bias in stock return predictions generated by GPT sentiment analysis (arXiv:2309.17322). arXiv. https://arxiv.org/abs/2309.17322
Gneiting, T., Balabdaoui, F., & Raftery, A. E. (2007). Probabilistic forecasts, calibration and sharpness. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 69(2), 243-268. https://doi.org/10.1111/j.1467-9868.2007.00587.x
Gneiting, T., & Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359-378. https://doi.org/10.1198/016214506000001437
Guan, M., & Chen, Q. (2026). Leakage-aware benchmarking of LLM forecasting: Real-time nowcasts as the decision-time input for macro factor ranking (arXiv:2606.22719). arXiv. https://arxiv.org/abs/2606.22719
Haber, S., & Stornetta, W. S. (1991). How to time-stamp a digital document. Journal of Cryptology, 3(2), 99-111. https://doi.org/10.1007/BF00196791
Halawi, D., Zhang, F., Chen, Y.-H., & Steinhardt, J. (2024). Approaching human-level forecasting with language models. In Advances in Neural Information Processing Systems 37 (NeurIPS 2024). https://arxiv.org/abs/2402.18563
He, S., Lv, L., Manela, A., & Wu, J. (2025). Chronologically consistent large language models (arXiv:2502.21206). arXiv. https://arxiv.org/abs/2502.21206
Jyotish, V. (2026). Sealed before the event: A publicly verifiable, Bitcoin-anchored forecast record of 92 graded outcomes [Version 1; awaiting peer review]. F1000Research, 15, Article 1322. https://doi.org/10.12688/f1000research.186752.1
Karger, E., Bastani, H., Chen, Y.-H., Jacobs, Z., Halawi, D., Zhang, F., & Tetlock, P. E. (2025). ForecastBench: A dynamic benchmark of AI forecasting capabilities. In International Conference on Learning Representations (ICLR 2025). https://arxiv.org/abs/2409.19839
Karkar, C., & Chopra, P. (2025). Future is unevenly distributed: Forecasting ability of LLMs depends on what we're asking (arXiv:2511.18394). arXiv. https://arxiv.org/abs/2511.18394
Kim, E. M., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning (PMLR 267, pp. 30038-30066). https://proceedings.mlr.press/v267/kim25e.html
Kim, S., Kwon, J., Kim, Y., Kagan, N., Khatchadourian, R., Ahn, W., Lopez-Lira, A., Lee, J., Hwang, Y., Levy, O., Lee, Y., & Choi, C. (2026). Forecasting future language: Context design for mention markets (arXiv:2602.21229). arXiv. https://arxiv.org/abs/2602.21229
Kish, L. (1965). Survey sampling. Wiley.
Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118. https://doi.org/10.1073/pnas.2018340118
Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. In Advances in Neural Information Processing Systems 7 (NIPS 1994). https://papers.nips.cc/paper_files/paper/1994/hash/b8c37e33defde51cf91e1e03e51657da-Abstract.html
Künsch, H. R. (1989). The jackknife and the bootstrap for general stationary observations. The Annals of Statistics, 17(3), 1217-1241. https://doi.org/10.1214/aos/1176347265
Li, H., Cao, Y., Yu, Y., Javaji, S. R., Deng, Z., He, Y., Jiang, Y., Zhu, Z., Subbalakshmi, K. P., Huang, J., Qian, L., Peng, X., Suchow, J. W., & Xie, Q. (2025). INVESTORBENCH: A benchmark for financial decision-making tasks with LLM-based agent. In Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 2509-2525). https://aclanthology.org/2025.acl-long.126/
Li, W. W., Kim, H., Cucuringu, M., & Ma, T. (2025). Can LLM-based financial investing strategies outperform the market in long run? [FINSABER] (arXiv:2505.07078). arXiv. https://arxiv.org/abs/2505.07078
Li, X., Yao, X., Qi, G., Zhu, F., Koa, K. J. L., Ng, X. Y., Liu, Z., Ni, X., Liu, C., Yang, Y., Zhang, Y., Wang, W., Feng, F., Wang, C., Luan, H., Xing, X., Xu, X., Chua, T.-S., & Huang, K.-W. (2026). FinDeepForecast: A live multi-agent system for benchmarking deep research agents in financial forecasting (arXiv:2601.05039). arXiv. https://arxiv.org/abs/2601.05039
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Algorithm appreciation: People prefer algorithmic to human judgment. Organizational Behavior and Human Decision Processes, 151, 90-103. https://doi.org/10.1016/j.obhdp.2018.12.005
Lopez-Lira, A., & Tang, Y. (2023). Can ChatGPT forecast stock price movements? Return predictability and large language models (SSRN Working Paper No. 4412788). https://doi.org/10.2139/ssrn.4412788
Lopez-Lira, A., Tang, Y., & Zhu, M. (2025). The memorization problem: Can we trust LLMs' economic forecasts? (arXiv:2504.14765). arXiv. https://arxiv.org/abs/2504.14765
louidev. (2026). GlassBallAI: A dataset of LLM market predictions (made with Google Gemini models) (Version 1.2) [Data set, CC BY-NC 4.0]. Hugging Face. Retrieved 21 October 2026, from https://huggingface.co/datasets/louidev/glassballai
MarketMania. (2026). Live LLM crypto forecasting benchmark and Benchmark methodology [Web pages]. Retrieved 21 October 2026, from https://marketmania.ai/llm-financial-market-benchmark and https://marketmania.ai/benchmarks/methodology
MaxWellApexLab. (2026). llm-trading-arena: LLM Trading Arena [Computer software and live ledger, MIT licence]. GitHub. Retrieved 21 October 2026, from https://github.com/MaxWellApexLab/llm-trading-arena
Meng, S., & Chen, X. (2026). AI-driven alpha decay: Algorithmic homogenization, reflexive signal erosion, and the paradox of intelligent markets (arXiv:2605.23905). arXiv. https://arxiv.org/abs/2605.23905
Metaculus. (2025a). Q1 AI benchmarking results: Human pros crush bots. Effective Altruism Forum. https://forum.effectivealtruism.org/posts/mwcWxwdsEMexm98GF/q1-ai-benchmarking-results-human-pros-crush-bots
Metaculus. (2025b). Q2 AI benchmark results: Pros maintain clear lead. LessWrong. https://www.lesswrong.com/posts/Surnjh8A4WjgtQTkZ/q2-ai-benchmark-results-pros-maintain-clear-lead
Miller, E. M. (1977). Risk, uncertainty, and divergence of opinion. The Journal of Finance, 32(4), 1151-1168. https://doi.org/10.1111/j.1540-6261.1977.tb03317.x
Murphy, A. H. (1973). A new vector partition of the probability score. Journal of Applied Meteorology, 12(4), 595-600. https://doi.org/10.1175/1520-0450(1973)012<0595:ANVPOT>2.0.CO;2
Nakamoto, S. (2008). Bitcoin: A peer-to-peer electronic cash system. https://bitcoin.org/bitcoin.pdf
National Institute of Standards and Technology. (2015). Secure hash standard (SHS) (FIPS PUB 180-4). https://doi.org/10.6028/NIST.FIPS.180-4
Nechepurenko, M., & Shuvalov, P. (2026a). Foresight Arena: An on-chain benchmark for evaluating AI forecasting agents (arXiv:2605.00420v2). arXiv. https://arxiv.org/abs/2605.00420
Nechepurenko, M., & Shuvalov, P. (2026b). Coordination as an architectural layer for LLM-based multi-agent systems (arXiv:2605.03310). arXiv. https://arxiv.org/abs/2605.03310
Nel, L. (2025). Do large language models know what they don't know? KalshiBench: A new benchmark for evaluating epistemic calibration via prediction markets (arXiv:2512.16030). arXiv. https://arxiv.org/abs/2512.16030
NeuPortal. (2026). NeuPortal: AI forecasts vs prediction markets (Bitcoin-timestamped) (Version 1) [Data set; Zenodo record by A. Bilous]. Zenodo. https://doi.org/10.5281/zenodo.21294229 . Proofs: https://github.com/neuportalai-ui/experiment-proofs
Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703-708. https://doi.org/10.2307/1913610
Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600-2606. https://doi.org/10.1073/pnas.1708274114
Numerai. (n.d.). Meta Model Contribution (MMC) [Technical documentation]. Numerai Docs. Retrieved 21 October 2026, from https://docs.numer.ai/numerai-tournament/scoring/meta-model-contribution-mmc
Rockflow. (n.d.). RockAlpha: AI stock. Retrieved 21 October 2026, from https://rockalpha.rockflow.ai/ai-stock
Ørpheus AI. (n.d.). Zeus: Environmental forecasting subnet [Source code and README]. GitHub. Retrieved 21 October 2026, from https://github.com/Orpheus-AI/Zeus/blob/main/README.md
Paleka, D., Goel, S., Geiping, J., & Tramèr, F. (2026). Pitfalls in evaluating language model forecasters. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2506.00723
Prophet Arena. (2026). Verify a forecast, Verify (documentation) and How scoring works [Web pages]. Retrieved 20-21 October 2026, from https://www.prophetarena.co/verify , https://www.prophetarena.co/docs/verify and https://www.prophetarena.co/research/how-scoring-works
Qian, L., Peng, X., Wang, Y., Zhang, V. J., He, H., Smith, H., Han, Y., He, Y., Li, H., Cao, Y., Yu, Y., Lopez-Lira, A., Lu, P., Nie, J.-Y., Xiong, G., Huang, J., & Ananiadou, S. (2025). When agents trade: Live multi-market trading benchmark for LLM agents (arXiv:2510.11695). arXiv. https://arxiv.org/abs/2510.11695
Rallies.ai. (2025-2026). AI Arena [Website feature]. Retrieved 21 October 2026, from https://rallies.ai/
Schoenegger, P., Park, P. S., Karger, E., Trott, S., & Tetlock, P. E. (2025). AI-augmented predictions: LLM assistants improve human forecasting accuracy. ACM Transactions on Interactive Intelligent Systems, 15(1). https://doi.org/10.1145/3707649
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), Article eadp1528. https://doi.org/10.1126/sciadv.adp1528
Sharpe, W. F. (1994). The Sharpe ratio. The Journal of Portfolio Management, 21(1), 49-58. https://doi.org/10.3905/jpm.1994.409501
Sornette, D., Woodard, R., Fedorovsky, M., Reimann, S., Woodard, H., & Zhou, W.-X. (2010). The financial bubble experiment: Advanced diagnostics and forecasts of bubble terminations, volume II, master document (arXiv:1005.5675). arXiv. https://arxiv.org/abs/1005.5675
Sortino, F. A., & Price, L. N. (1994). Performance measurement in a downside risk framework. The Journal of Investing, 3(3), 59-64. https://doi.org/10.3905/joi.3.3.59
Spiro, T. (2026). The oracle's fingerprint: Correlated AI forecasting errors and the limits of bias transmission (arXiv:2605.00844). arXiv. https://arxiv.org/abs/2605.00844
Todd, P. (2016, September 15). OpenTimestamps: Scalable, trust-minimized, distributed timestamping with Bitcoin. https://petertodd.org/2016/opentimestamps-announcement
TradeRank. (2026). TradeRank.ai: Live AI trading leaderboard [Website and open JSON data set]. Retrieved 21 October 2026, from https://traderank.ai/
Walker, A. (2026). The price is (almost) right: A calibration analysis of Polymarket pricing data [Senior thesis, Princeton University]. Princeton University Senior Theses. https://theses-dissertations.princeton.edu/handle/88435/dsp01mw22v8973
White, H. (2000). A reality check for data snooping. Econometrica, 68(5), 1097-1126. https://doi.org/10.1111/1468-0262.00152
Wolfers, J., & Zitzewitz, E. (2004). Prediction markets. Journal of Economic Perspectives, 18(2), 107-126. https://doi.org/10.1257/0895330041371321
Yahoo Finance. (2025). Elon Musk's Grok 4.20 beats OpenAI, Google models in live stock trading contest. https://finance.yahoo.com/news/elon-musks-grok-4-20-123855766.html
Yang, Q., Mahns, S., Li, S., Gu, A., Wu, J., & Xu, H. (2025). LLM-as-a-prophet: Understanding predictive intelligence with Prophet Arena. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2510.17638
Yu, H., Li, F., & You, J. (2025). LiveTradeBench: Seeking real-world alpha with large language models (arXiv:2511.03628). arXiv. https://arxiv.org/abs/2511.03628
Zeng, Z., Liu, J., Chen, S., He, T., Liao, Y., Tian, Y., Wang, J., Wang, Z., Yang, Y., Yin, L., Yin, M., Zhu, Z., Cai, T., Chen, Z., Chen, J., Du, Y., Gao, X., Guo, J., Hu, L., . . . Huang, W. (2025). FutureX: An advanced live benchmark for LLM agents in future prediction. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2508.11987
Zhang, J., Liu, G., Johansson, O., Yitayew, H., Ohly, K., & Li, G. (2026). Prediction Arena: Benchmarking AI models on real-world prediction markets (arXiv:2604.07355). arXiv. https://arxiv.org/abs/2604.07355
Zhang, O., & Zhang, Z. (2026). A review of large language models for stock price forecasting from a hedge-fund perspective (arXiv:2605.05211). arXiv. https://arxiv.org/abs/2605.05211
Zhao, X., Zhang, R., Ye, L., Cao, R., Xie, P., & Chava, S. (2026). Can LLMs take the pulse of the economy? A real-time evaluation of LLM nowcasts on macroeconomic indicators (arXiv:2608.30110). arXiv. https://arxiv.org/abs/2608.30110
Apéndice A. Campos del protocolo
La especificación es el archivo mismo: arena-protocol.json para las ligas (Tabla A1) y el campo methodology sellado en cada línea de ejecución para la puntuación de pronóstico (Tabla A2). Ambos tienen versión. Cada cambio está fechado y cada sello lleva la versión en vigor, por lo que un cambio no afecta nada sellado antes (requisito 15). Las tablas siguientes enumeran las claves necesarias para resolver una puntuación a partir del 20 de octubre de 2026.
Tabla A1. Claves de arena-protocol.json necesarias para resolver una cuenta (versión arena-3, 20 de octubre de 2026).
| Clave | Lo que fija |
|---|---|
version, pro_version, history |
Reglas en vigor (arena-3, liga Pro pro-1) y cada versión con su fecha de inicio |
assets, indicators_only |
El instrumento que negocia cada mercado (el rendimiento como IEF, Bitcoin como BTC-USD y así sucesivamente); VIX no se mantiene |
prices |
Fuente de precio y regla de las cuentas: la barra del primer minuto de 09:30-09:45 ET para ejecución, el cierre para valor |
execution, cost |
Una decisión se negocia en la primera apertura después de su sello; 0,001 en cada dólar que cambia |
limits, cash |
5% a 25% por posición, suma del 100%, solo largo; efectivo en la letra del Tesoro de 13 semanas por días calendario sobre 360 |
missing_answer, refused, asked_again |
Sin decisión o una rechazada deja las posiciones sin cambios; los reintentos se sellan con el hash de su pregunta |
pro_league |
Pesos firmados, exposición bruta hasta 2×, costos de endeudamiento, corte de margen |
new_model_version |
La cuenta continúa; el cambio está fechado; el resultado desde la versión se muestra aparte |
formulas |
Retorno, máximo retroceso, Sharpe, Sortino, dividendos desde la fecha ex, desdoblamientos aplicados una vez |
question, replay |
Hash de la plantilla de la pregunta del portafolio; cómo recontar cada cuenta desde los archivos abiertos |
Las pistas sombra (f12, closed_book, repeats, sp100, council_talk, modalities, roles) llevan sus propias versiones de reglas en el mismo archivo y no entran en la puntuación de pronóstico.
Tabla A2. Campos de la metodología de puntuación sellada en cada línea de ejecución (methodology, versión 2).
| Campo | Lo que fija |
|---|---|
reference |
El primer precio después del sello según la regla de cada indicador (ref_rule); respuestas tardías obtienen su propia referencia |
counted |
La línea de respuesta sellada en último lugar antes de la referencia cuenta; desde la sesión 11 (2 de noviembre de 2026), la primera línea de respuesta bien formada de cada asiento sellada antes de la referencia cuenta y una línea posterior del mismo asiento es un reintento etiquetado (asks.jsonl, línea 74); una línea después del cierre no se puntúa para esa sesión |
league |
Una puntuación por sesión: la ejecución sellada en último lugar antes de la apertura (session_run); otras mostradas aparte. A partir del 21 de octubre de 2026, la ejecución contada es la ejecución matutina programada, declarada por adelantado en la página de prueba (Sección 3.4) |
direction |
Alza o baja del indicador desde su referencia; un movimiento dentro de la banda de empate es un empate (banda definida en council-stats.json, draw_band); 50 no respalda ningún lado |
brier, calibration |
, moneda 0,25; doblándose hacia el lado respaldado, contenedores [50, 60), [60, 70), [70, 80), [80, 100] |
independence |
Ranking después de 30 pronósticos en al menos 10 días de negociación |
missing |
Una celda sin respuesta en una respuesta dada cuenta como 50% |
btc |
Día de Bitcoin desde el minuto de sello, limitado a las 16:00 ET de la sesión de puntuación |
consensus |
Probabilidad media; extremos descartados en cinco o más respuestas; el segundo asiento de una familia pesa 1/3; contenido dentro del 2-98% |
together |
all_wrong (cada modelo errado, al menos 4 respondieron) y minority_right (consenso errado, algún modelo acertado) |
changes |
Cambios fechados en la metodología; nada publicado antes se recount |
Apéndice B. Verificar un sello usted mismo
Los pasos utilizan únicamente archivos públicos y herramientas estándar. Ejecuté los pasos 1 a 8 en la noche del 20 de octubre de 2026 (ET) y el paso 9 el 21 de octubre, y los resultados mostrados son los que obtuve. El ejemplo de los pasos 1 a 8 es el sello del 20 de octubre de 2026 a las 13:00:25Z, uno de cuatro ese día (Sección 3.1). Los pasos 1 a 8 verifican el nivel 1 (la cadena) y el nivel 2 (el ancla). El paso 9 verifica el nivel 2+, los tokens RFC 3161 en la lista sellada del 21 de octubre de 2026. Las sesiones del 19 y 20 de octubre de 2026 son las sesiones de desarrollo, y el registro contado comienza el 21 de octubre de 2026.
Paso 1. Descargue el libro y el sello.
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt.ots
La página de prueba https://trends.polyhelper.ai/markets/proof/2026-10-20/ enumera cada sello del día y cada línea de libro de la tirada, con su sello y enlace.
Paso 2. Lea la lista sellada. cat 130025Z.txt muestra, entre otros libros, la línea para este:
daily/council/book.jsonl: 159 lines, sha256 59673b9e21ac6d358e7dc3b811dc3d78f5286390094f7133e3704f57cac1a7d9, last link 378273fd057fcbf364746b032f67f42cd811d281da80f39ff0792c4047175b2cPaso 3. Verificar que el libro de hoy comienza con el prefijo estampado.
head -n 159 council-book.jsonl | shasum -a 256
# 59673b9e21ac6d358e7dc3b811dc3d78f5286390094f7133e3704f57cac1a7d9  -
sed -n 159p council-book.jsonl | python3 -c "import json,sys; print(json.load(sys.stdin)['link'])"
# 378273fd057fcbf364746b032f67f42cd811d281da80f39ff0792c4047175b2c
Ambos valores coinciden con la lista sellada, por lo que las primeras 159 líneas son exactamente las líneas a las que se compromete. La línea 151 es la línea de ejecución de 2026-10-20-am y las líneas 152 a 159 son sus líneas de respuesta. La misma verificación con 150012Z.txt, 153605Z.txt y 165254Z.txt cubre 165, 167 y 173 líneas.
Una regla impresa en cada lista sellada fija los bytes. El archivo se toma tal como se almacena (UTF-8, sin marca de orden de bytes, nada recodificado ni normalizado) y cada línea termina con LF. El hash de N líneas cubre las líneas 1 a N, cada una con su LF, y una última línea sin LF aún no se cuenta. Un espejo que reescribe los finales de línea falla en la verificación.
Paso 4. Recalcular cada sello y enlace.
import json, hashlib
H = lambda o: hashlib.sha256(json.dumps(o, sort_keys=True, ensure_ascii=False).encode()).hexdigest()
lines = [json.loads(l) for l in open("council-book.jsonl", encoding="utf-8")]
prev = ""
for i, x in enumerate(lines, 1):
    assert x["n"] == i and x["prev"] == prev
    assert x["seal"] == H({k: v for k, v in x.items() if k not in ("seal", "link", "prev", "n")})
    assert x["link"] == H({k: v for k, v in x.items() if k != "link"})
    prev = x["link"]
print("chain ok:", len(lines), "lines")
En el archivo del 20 de octubre se imprimió chain ok: 211 lines.
Paso 5. Verificar la pregunta que respondió una ejecución.
curl -s https://trends.polyhelper.ai/api/v1/asks/77d3c627c7c69d2f6e740ccd89113872b1ac08053554a4651bc2d3064b4e6f07.md | shasum -a 256
# 77d3c627c7c69d2f6e740ccd89113872b1ac08053554a4651bc2d3064b4e6f07  -
Paso 6. Verificar el anclaje Bitcoin. Instale el cliente OpenTimestamps (pip install opentimestamps-client). Con un nodo Bitcoin local, ots verify 130025Z.txt.ots calcula el hash de 130025Z.txt, sigue la prueba y la verifica contra el encabezado del bloque. Sin un nodo, ots info 130025Z.txt.ots imprime el hash del archivo (5c7d3a357f3cd8b9c27aa4c5d1e9e4750d522bd90b58ffe5193fc61356079d0f, igual a shasum -a 256 130025Z.txt), las operaciones de la prueba y su atestación, BitcoinBlockHeaderAttestation(972334). Aplicar las operaciones al hash del archivo da 74072ae1fdee72c9a3f749462490b46f896e0fab58f7d101dc1a403d967e5c30, la raíz de Merkle del bloque 972.334 como cualquier explorador de bloques lo muestra (hora del encabezado 2026-10-20 13:55:20Z; tiempo medio de los 11 bloques anteriores 12:45:12Z). Ambos archivos también pueden colocarse en https://opentimestamps.org. Una prueba que muestra solo una atestación de calendario pendiente se completa con ots upgrade. Una atestación pendiente no lleva consigo ninguna hora que un lector pueda verificar.
Paso 7. Recontar la liga.
curl -s https://trends.polyhelper.ai/api/v1/arena-code-tools-replay.py.txt -o replay.py
python3 replay.py https://trends.polyhelper.ai/api/v1/
En los archivos a partir del 20 de octubre de 2026 el script imprimió (extracto):
replay: 253 published rows, 145 accounts, 2 sessions (2026-10-19 .. 2026-10-20), 1006 trades, rules arena-3
exact to the cent (|d| <= 0.01): 204; within the rounding of the published trades: 49; DIFFERENT: 0; not recounted (other price sets): 0
result: the published scores are reproduced
Paso 8. Verificar el código del motor. arena-code.json enumera cada archivo de código con su SHA-256; cada archivo se publica como arena-code-<file>.txt:
curl -s https://trends.polyhelper.ai/api/v1/arena-code-council_arena.py.txt | shasum -a 256
# 9ff5575c2b5c7736fba06bec1b63a608f5f290aacdee6df6b24a51381f22686c  -
que coincide con la entrada de council_arena.py.
Paso 9. Verificar las marcas de tiempo firmadas del 21 de octubre de 2026 (nivel 2+). Ejecutado el 21 de octubre de 2026, 09:10 ET, con OpenSSL 3 (ambas comprobaciones pasan con OpenSSL 3.6 y 4.0). Los certificados de FreeTSA se copian en tsa/ y se publican por el servicio (https://freetsa.org/files/); la cadena de DigiCert está en el almacén de confianza del sistema.
P=https://trends.polyhelper.ai/markets/proof/2026-10-21
for f in 130019Z.txt 130019Z.txt.freetsa.tsr 130019Z.txt.digicert.tsr tsa/freetsa-cacert.pem tsa/freetsa-tsa.crt; do curl -sO $P/$f; done
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
shasum -a 256 130019Z.txt
# 986bd13907397901ceed70131a70c3674eba05dfdcb9ededbc7cbc0e57bd3714  130019Z.txt
openssl ts -verify -data 130019Z.txt -in 130019Z.txt.freetsa.tsr -CAfile freetsa-cacert.pem -untrusted freetsa-tsa.crt
# Verification: OK   (after a warning that freetsa-tsa.crt is not a CA certificate, which is expected)
openssl ts -verify -data 130019Z.txt -in 130019Z.txt.digicert.tsr -CAfile /etc/ssl/cert.pem
# Verification: OK
openssl ts -reply -in 130019Z.txt.digicert.tsr -text | grep "Time stamp"
# Time stamp: Oct 21 13:00:19 2026 GMT   (the same for the FreeTSA token)
head -n 222 council-book.jsonl | shasum -a 256
# a9359a7741ef5f7aad7436e022a60813e2fc2f9ce76e130abe21dc820e59bd8c  -
La lista indica 222 líneas con este hash. Las líneas 214 a 222 son la línea de ejecución y las respuestas de 2026-10-21-am registradas en el primer lote, y ambas autoridades las sitúan a las 13:00:19 UTC, 29 minutos 41 segundos antes de la referencia a las 13:30:00 UTC. Los tokens de 130035Z.txt, que cubre asks.jsonl, dan 13:00:36 UTC. Los mismos pasos en 132337Z.txt cubren 224 líneas. La línea 224, una respuesta que llegó a las 13:23:23 UTC, fue registrada 14 segundos después, y tres autoridades (FreeTSA, DigiCert y Sectigo) la firmaron a las 13:23:37 UTC, antes de la referencia. La primera línea de asks.jsonl declara qué ejecución cuenta desde el 21 de octubre de 2026. Fue sellada a las 04:16:39 UTC, antes de que se enviara la pregunta de la ejecución, y su hash de texto se imprime en la página de prueba.
Lo que establecen los pasos. Los pasos 3 y 4 dan P2 para cada línea hasta el sello. El paso 6 sitúa el prefijo sellado no más tarde que unas pocas horas después de la hora del encabezado del bloque 972334, y este límite práctico, establecido en la sección 3.11 en lugar de una constante demostrada por las reglas de consenso, da P1a para cada resultado posterior a este, contra cualquiera que posea esta prueba o una copia independiente de esta.
El bloque cayó después de 09:30 ET. Para el 20 de octubre, el orden de sello y precio de referencia (P1b) se lee en el nivel 1 desde la hora de sello de la línea en el libro, max(at, booked_at), contra 09:30 ET de la sesión, y la columna sealed_at de council-forecasts.csv da la hora de la respuesta. Verifiqué P3 aplicando la regla de ejecución contada a esas horas de sello. Para las sesiones de desarrollo P3 descansa en el registro del operador de que cada ejecución se publica y se etiqueta. En el registro contado, la ejecución contada es la ejecución matutina programada, declarada por adelantado y sellada en la cadena de preguntas antes de la ejecución (paso 9), por lo que el lector verifica P3 contra una declaración que existía antes de las respuestas. El paso 9 da P1b en el nivel 2+ para la sesión del 21 de octubre, contra cualquiera que acepte cualquiera de las autoridades firmantes y su certificado. En la temporada ciega los mismos pasos se ejecutan en líneas que sellan el modelo como un compromiso salado (requisito 1), y la identidad se verifica cuando se publican las sales después de la temporada.
Tabla B1. La escalera de afirmaciones: lo que cada nivel de verificación respalda y lo que deja abierto.
| Nivel de verificación | Afirmación que respalda | Afirmación que deja abierta | En este artículo |
|---|---|---|---|
| Reglas publicadas | Un lector puede exponer el contrato del evento, la puntuación y la regla de ejecución contada | Que los archivos sigan las reglas | Sección 3; Apéndice A |
| Archivos recalculados | Las puntuaciones y cuentas publicadas se derivan de los registros publicados | Que los precios coincidan con una fuente independiente; que el modelo nombrado produjo la respuesta | Pasos 4, 7 y 8 |
| Compromiso externo verificado (nivel 2; nivel 2+ para el orden de sello y referencia) | Los bytes comprometidos existieron en el límite establecido, y una reescritura posterior de ese prefijo es detectable; en el nivel 2+ (desde el 21 de octubre de 2026), antes del precio de referencia | Que cada pronóstico esperado se haya divulgado; la identidad del modelo del proveedor; la hora de llegada de cada respuesta | Pasos 3, 6 y 9 |
| Resultados reconciliados | Los precios de referencia y cierre coinciden con una segunda fuente nombrada en la hora nombrada | Cualquier ventaja predictiva | Requisito del estándar; se agregará en una revisión fechada |
| Evaluación prospectiva emparejada, congelada antes de su ventana | Una diferencia de pérdida en los eventos, pesos y comparador establecidos | Otros mercados, horizontes y regímenes | Sección 8 |
| Replicación independiente | Una segunda tubería en otras manos reproduce las puntuaciones de la misma versión | Desempeño en temporadas posteriores | Abierto a cualquier lector (Apéndice C) |
Nota: El anclaje certifica el registro. Una prueba de la sesión TLS con el proveedor (TLSNotary) puede extender la escalera a la afirmación de que el punto final nombrado devolvió la respuesta sellada, y el protocolo tiene espacio para ello como un campo de la línea de respuesta. La habilidad se establece por las comparaciones registradas de la sección 8.
Paso 10. Verificar el sello en un registro independiente. Cada lista sellada también se ingresa en el registro de transparencia Sigstore Rekor, que el operador no ejecuta; la entrada mantiene el SHA-256 de la lista.
shasum -a 256 130025Z.txt
# 5c7d3a357f3cd8b9c27aa4c5d1e9e4750d522bd90b58ffe5193fc61356079d0f  130025Z.txt
curl -s "https://rekor.sigstore.dev/api/v1/log/entries?logIndex=3368351276"
# the base64 body holds spec.data.hash.value, the same SHA-256; integratedTime 1792626303 is 21 October 2026, 23:45:03 UTC
La lista de 20 de octubre de 2026 se ingresó el 21 de octubre de 2026 en el índice de registro 3,368,351,276. A partir del 22 de octubre de 2026, cada lista se ingresa en el sellado, y la primera, índice 3,368,763,032, se integró a las 00:00:16 UTC, cinco segundos después de su sello.
Apéndice C. Diccionario de datos
Todos los archivos están en https://trends.polyhelper.ai/api/v1/, publicados bajo CC BY 4.0 con atribución «AI Council · Markets, trends.polyhelper.ai/markets/». La página de índice de esa dirección lista cada archivo y la frecuencia con que cambia, y arena-dataset.json describe las columnas de cada archivo; la Tabla C1 lista los archivos que las predicciones leen, con nombres de columna como se leyeron el 21 de octubre de 2026 a las 08:16 UTC. Una IA lectora que no pueda abrir archivos grandes comienza desde markets-digest.json (menos de 30 KB) o los segmentos por ejecución en council-forecasts-index.json.
Tabla C1. Archivos principales.
| Archivo | Contenido | Actualizado |
|---|---|---|
council-book.jsonl |
El libro sellado: cada ejecución, respuesta, puntuación, línea de cartera y liga, encadenado por hash | Cada ejecución |
council-forecasts.csv |
Una fila por celda de pronóstico sellada con su resultado | Cada ejecución y puntuación |
council-stats.json |
Intervalos de Brier por sesiones, banda de empate, cálculos de potencia, n_eff (con la serie contada n_eff.counted), intervalos pareados (pairs), puntuaciones por segmento de metodología (method_segments), fuentes compartidas |
Cada compilación |
council-calibration.json |
Calibración, puntuaciones de habilidad contra la moneda, la multitud y la climatología, el método de cada comparación (method); la climatología fija climatology_fixed cuando se publica |
Cada compilación |
council-pairs.csv |
Pérdidas pareadas de cada dos asientos en los mismos eventos | Cada compilación |
league-roster.json |
Cada modelo, su lado, Consejo o banca, su estado en ambas ligas | Cada compilación |
{lang}/council-league.json |
La liga: modelos, líneas base, calibración, horizontes, la multitud, la liga de cartera | Cada ejecución y puntuación |
arena-protocol.json, arena-code.json |
El protocolo (Apéndice A); el código del motor con SHA-256 | Cada compilación |
arena-trades.csv, arena-accounts.csv, arena-prices.json |
Transacciones ejecutadas; cada cuenta cada sesión; precios de ejecución y cierre | Cada sesión |
asks/<sha256>.md, asks/index.json |
El texto de la pregunta detrás de cada ask_sha256 |
Cada ejecución |
event-contract.schema.json, tools/conformance.py |
El contrato de eventos como esquema JSON; el verificador que cualquier liga puede ejecutar en su propio archivo de pronóstico (Sección 3.13) | Con cada cambio del contrato |
council-forecasts.csv (una fila por modelo, ejecución, mercado y horizonte): run_id; session; seat; model, mode; line (posición n de la línea de sellado); sealed_at (UTC); status (counted, not_counted, counted_50, no_answer, refused_shape); asset, horizon; action, action_word; prob_up (0-100); exp_pct; target, invalidation; ref, close, actual_pct; draw; source_domains, source_urls; why_missing; run_role (session_run o earlier_run); seat_versions_in_run; line_kind (issue, la celda como se selló en la línea de respuesta, o correction, una celda agregada por una línea de corrección posterior); reference_at (tiempo desde el cual la regla de referencia de la fila toma el precio; para Bitcoin el segundo de sellado, siendo el precio el cierre de la primera barra de un minuto que comienza en o después de él); same_event (falso cuando la fila se califica desde su propia referencia); cell_status (elicited, explicit_50 o invalid); attempt; event_id, event_reference_at, event_end_at (el contrato de eventos, Sección 3.13); methodology_version. sealed_at es la hora de la respuesta, el at de la línea de respuesta; la hora en que la línea se selló en el libro es máx(at, booked_at) de esa línea (el 20 de octubre, respuestas de 12:31Z a 12:42Z, sello a las 13:00:25Z), que es la base de tiempo de council-stats.json (time_basis: book_sealed_at) y de los scripts archivados. Para Bitcoin, reference_at es el segundo de sellado de la propia línea de la fila (13:00:19Z para el lote del 21 de octubre, 13:23:37Z para la novena respuesta), y reference_price_at es el inicio de la barra de un minuto cuyo cierre es la referencia (13:01:00Z y 13:24:00Z). Una celda con cell_status explicit_50 es una probabilidad establecida de 50; counted_50, no_answer, refused_shape y un prob_up vacío no se establecen y no entran en ninguna puntuación de Brier de probabilidades establecidas ni en consenso. La respuesta del modelo a una pregunta de multitud, crowd_up, no está en este archivo; está en las líneas de respuesta del libro.
Líneas del libro. Cada línea tiene n, at, kind, prev, seal y link. Los tipos que llevan los pronósticos son run (añade run_id, ask_sha256, snapshot_sha256, roster, methodology y crowd, con crowd.at, los contratos Polymarket bajo crowd.odds y los contratos Kalshi bajo crowd.kalshi, cada uno con su p_up y vol), answer (añade seat, model, mode, items, years, y en ejecuciones posteriores own_sha256, ask_sha256, booked_at; la probabilidad del modelo para una pregunta de multitud es items.<asset>.1d.crowd_up), score y score_h (los resultados del día y de los horizontes, con late_ref, noise y of), crowd (resuelve cada contrato: rows.<code> para Polymarket y rows.<code>@kalshi para Kalshi, con el resultado up; a partir del 21 de octubre de 2026 presente solo para la ejecución 2026-10-19-am), y correction (nombra las líneas que afecta en of). Otros tipos registran las ligas de cartera y las pistas ocultas.
Climatología fija. En council-calibration.json, climatology_fixed contiene table[*] con asset, h, p_up, p_up_ex_draw, n, n_independent, window y rule, más sha256 y sha256_ok. Su sello es el hash de contenido de council-clim-window.json (bajo la dirección de datos), 2810d11e907bbaa1f311d06622c929c69e60cc81e558fdb78f5baa04113cabb7, calculado como en la Sección 4.3; el índice de referencia principal lee p_up en el horizonte 1d. El campo entró en el archivo en vivo el 21 de octubre de 2026 a las 08:54 UTC, por lo que la Tabla C1 a las 08:16 UTC no lo enumera.
Valores de estado y el contrato de evento. counted_50 marca una celda rellenada con el 50% para la puntuación de servicio del asiento; no es una probabilidad indicada y no entra en los recuentos de consenso o acuerdo, cuyo número de probabilidades contribuyentes es of. Una línea con late_ref es un pronóstico sobre un evento separado (Sección 3.3); un análisis que agrupa modelos en un evento común selecciona filas cuya referencia sea igual a la referencia común de la sesión.
Lanzamiento del análisis. Cada revisión se basa en una liberación inmutable depositada en Zenodo (10.5281/zenodo.23552700): el libro, los pronósticos, las estadísticas, el protocolo, los archivos de código, los archivos del recuento, las preguntas publicadas y cada lista marcada con su prueba .ots, con un manifiesto del SHA-256 de cada archivo, tamaño, tiempo de recuperación y, donde conste, tiempo de generación. Los archivos recuperados uno a uno forman una colección de versiones identificadas, y la liberación es la instantánea atómica. El libro solo crece, y el libro de la liberación es por lo tanto un prefijo de cualquier descarga posterior (Sección 3.2).
Apéndice D. Predicciones registradas (tabla completa)
La tabla D1 enumera las treinta predicciones secundarias de la sección 8 de un vistazo, y la tabla D2 proporciona su texto registrado. Tres modelos de tres familias, cada uno por separado, fijaron el precio de la lista limpia a ciegas, y la p registrada es la mediana de los tres. Esa lista, los scripts del Conjunto B con su SHA-256 y el punto final principal con su script se encuentran depositados en el registro OSF (10.17605/OSF.IO/9Q86N).
Reglas que se aplican a cada fila. A menos que una fila nombre otra ventana, una predicción se calcula a partir de sesiones desde la sesión 11 (2 de noviembre de 2026) hasta su fecha de verificación. Utiliza líneas contadas (una ejecución por sesión) cuyo tiempo de sello de libro, máx(at, booked_at), es anterior a la referencia de las 09:30 ET de la sesión, y el mismo corte se aplica a Bitcoin, cuya referencia es el cierre de la primera barra de un minuto después del sello de la línea. Las puntuaciones de Brier son de un día y en todas las filas, incluidos los empates. Cuando un campo publicado también cubre sesiones anteriores, el script archivado aplica la definición del campo a la ventana.
Los campos son los de los archivos abiertos en https://trends.polyhelper.ai/api/v1/ según se documenta el 21 de octubre de 2026, y un campo renombrado se reemplaza por su equivalente documentado con la asignación registrada. Cuando una fila necesita un valor que ningún campo abierto contiene, el campo debe publicarse, y el solucionador en los scripts OSF calcula el valor de council-forecasts.csv y council-book.jsonl según la regla de la fila. "Clasificado" significa 30 pronósticos resueltos en al menos 10 días de negociación (la regla 30/10, sección 4.6), aplicada dentro de la ventana de la predicción, excepto F8, que lee la bandera de la liga. Las filas de multitud son sesiones de mercado en las que la lista de preguntas selladas enumera un contrato diario (sección 4.9), y el contrato es aquel con el que los modelos respondieron con crowd_up, el contrato de Polymarket donde Polymarket enumera el mercado y de otro modo el contrato de Kalshi, en ambos casos con un volumen sellado de al menos $1,000 (un umbral de admisión). Los intervalos son del 95% con la sesión como clúster, mediante un remuestreo de bootstrap de 10,000 con semilla 20261102 en los scripts archivados.
Una muestra mínima no alcanzada, un archivo faltante o un campo sin equivalente documentado deja la predicción sin resolver y no como un éxito. Ninguna predicción se elimina. p es la probabilidad registrada de que la predicción se cumpla, dado que se resuelve: la mediana de tres votos a ciegas. Seis valores (F5, F7, F20, F21, F23, F25) son los votos del 20 de octubre de 2026. Los otros veinticuatro y el punto final principal se votaron el 21 de octubre de 2026, en tres rondas posteriores, cada una sobre el texto de las predicciones reescritas en esa ronda. La redacción fijada después de la última ronda especifica cómo se resuelve una fila y no fue repreciada, y todas las rondas y votos se encuentran depositados en el registro.
Tabla D1. Las treinta predicciones registradas de un vistazo.
| # | Predicción (declaración registrada, hasta los dos puntos) | Conjunto | Fecha de verificación | p | P(verdadero) sin habilidad |
|---|---|---|---|---|---|
| F1 | El consejo se mantiene por debajo de dos voces independientes en un día | A | 30 nov 2026 | 0.50 | |
| F2 | El comovimiento del mercado no explica la similitud | A | 31 dic 2026 | 0.50 | |
| F3 | Los errores también se comparten | B | 31 dic 2026 | 0.74 | |
| F4 | Los modelos son menos precisos que la multitud | B | 31 dic 2026 | 0.40 | |
| F5 | Los enlaces compartidos significan llamadas compartidas | A | 31 dic 2026 | 0.56 | |
| F6 | Todos mal juntos | B | 31 dic 2026 | 0.92 | |
| F7 | Una minoría correcta es más común que un error unánime | A | 31 dic 2026 | 0.63 | |
| F8 | La tabla se completa según lo programado | A | 30 nov 2026 | 0.88 | operativo |
| F9 | La independencia es mayor en el mes que en el día | B | 31 dic 2026 | 0.30 | |
| F10 | El promedio supera al seguimiento del líder | B | 31 dic 2026 | 0.64 | |
| F11 | Ningún modelo único muestra una ventaja diaria detectada | B | 31 dic 2026 | 0.79 | al menos aproximadamente 0.78 |
| F12 | La multitud supera al consejo | B | 31 dic 2026 | 0.83 | |
| F13 | La combinación supera a la multitud | B | 31 dic 2026 | 0.30 | |
| F14 | Los modelos son excesivamente seguros | B | 31 dic 2026 | 0.80 | |
| F15 | El consejo no supera una regla simple por un margen claro | B | 31 dic 2026 | 0.80 | |
| F16 | Ningún horizonte lleva una señal detectada durante una temporada | B | 30 abr 2027 | 0.63 | al menos aproximadamente 0.93 |
| F17 | En relación con la climatología, el día es el horizonte más difícil | B | 30 abr 2027 | 0.37 | |
| F18 | El país es un factor pequeño | B | 31 dic 2026 | 0.80 | |
| F19 | El lado estadounidense obtiene mejores puntuaciones durante una temporada | B | 30 abr 2027 | 0.57 | |
| F20 | Las mismas noticias significan menos disputa | A | 30 nov 2026 | 0.70 | |
| F21 | La búsqueda añade poca precisión | B | 31 dic 2026 | 0.72 | |
| F22 | La discusión encuentra riesgos reales | A | 31 dic 2026 | 0.30 | |
| F23 | Hacer caso a la crítica compensa | A | 31 dic 2026 | 0.42 | |
| F24 | Un modelo discrepa consigo mismo mucho | A | 30 nov 2026 | 0.60 | |
| F25 | Los líderes no duran | B | 30 abr 2027 | 0.62 | aproximadamente 0.85 (once asientos clasificados), 0.82 (diez) |
| F26 | El índice es difícil de superar | B | 30 abr 2027 | 0.60 | |
| F27 | Los buenos pronosticadores no son los mejores operadores | B | 30 abr 2027 | 0.83 | |
| F28 | El acceso a los modelos antes del primer pronóstico no mejora la puntuación Brier de los lectores en 0,01 o más | A | 31 Dec 2026 | 0.46 | |
| F29 | El acceso acerca a los lectores hacia el consejo | B | 31 Dec 2026 | 0.41 | |
| F30 | El estilo delata el modelo | B | 30 Apr 2027 | 0.46 |
Nota: Una línea por predicción registrada; el texto completo de cada una, con su medida, fuente y reglas de resolución, está en la Tabla D2. El conjunto A se define por uno o dos campos publicados, el conjunto B por un script presentado con el registro. p es la probabilidad registrada de que la predicción se cumpla, dado que se resuelve: la mediana de tres votos ciegos. P(verdadero) sin habilidad es la probabilidad de que la predicción se cumpla si ningún modelo tiene habilidad, tal como se deriva en la nota de la Tabla D2; una celda vacía significa que la fila no establece tal valor.
Tabla D2. Las treinta predicciones registradas en su totalidad: enunciados, medidas, fuentes, conjuntos, fechas de verificación, reglas y probabilidades.
| # | Enunciado | Medida (abrir archivo) | Conjunto | Fecha de verificación | Se cumple si | Se refuta si | p |
|---|---|---|---|---|---|---|---|
| F1 | El consejo se mantiene por debajo de dos voces independientes en un día: sumadas las ejecuciones contadas de la sesión 11 a la sesión 30, la media N_eff de las imágenes de probabilidad de un día, calculada por ejecución según la regla de elegibilidad de la Sección 5.1, es inferior a 2,0 | media de n_eff.counted.per_run[*].n_eff en ejecuciones cuyo id de run está fechado del 2 al 30 de noviembre de 2026, council-stats.json |
A | 30 Nov 2026 | media < 2,0 con al menos 10 ejecuciones contadas | media ≥ 2,0 con al menos 10 ejecuciones contadas; menos = sin resolver | 0.50 |
| F2 | El co-movimiento del mercado no explica la similitud: sumadas las ejecuciones contadas de la sesión 11 a la sesión 52, la media N_eff de un día con un mercado por grupo (Nasdaq-100, Dow y Brent descartados), según la regla de la Sección 5.1, es inferior a 2,5 | media de n_eff.counted.one_per_group.per_run[*].n_eff en ejecuciones cuyo id de run está fechado del 2 de noviembre al 31 de diciembre de 2026, council-stats.json |
A | 31 Dec 2026 | media < 2,5 con al menos 20 ejecuciones contadas | media ≥ 2,5 con al menos 20 ejecuciones contadas; menos = sin resolver | 0.50 |
| F3 | Los errores también son compartidos: en las sesiones puntuadas de la sesión 11 a la sesión 52, N_eff calculado en los indicadores de error de un día de los asientos (respuestas selladas antes de la referencia, todas las filas, el 50% indicado dejado fuera), promediado en las sesiones, es inferior a 4,0 (el recuento de errores también lleva el co-movimiento de resultados en los mercados). Por sesión, los encuestados son los asientos con una línea elegible, n es su número esa sesión, ρ es la correlación media de Pearson por pares de sus indicadores de error 0/1 en los mercados ambos respondidos (un par con un indicador constante se deja fuera, y también una sesión sin par computable), y la media en las sesiones pondera cada sesión por igual | campo a ser publicado (el n_eff_errors publicado incluye líneas tardías); el resolutor en los scripts de OSF lo calcula a partir de las filas contadas de 1 día de council-forecasts.csv y council-book.jsonl |
B | 31 Dec 2026 | valor < 4,0 con al menos 30 sesiones puntuadas | valor ≥ 4,0 con al menos 30 sesiones puntuadas; menos = sin resolver | 0.74 |
| F4 | Los modelos son menos precisos que la multitud: en contratos de multitud de un día con un volumen sellado de al menos 1.000 dólares (el contrato al que los modelos respondieron: Polymarket donde aparece en la lista, de lo contrario Kalshi), de la sesión 11 a la sesión 52, la media en los asientos de la distancia media de cada asiento desde el 50% de sus respuestas de crowd_up es menor que la mitad de la distancia media de los precios de la multitud desde el 50% en los mismos contratos |
precios de multitud y vol en las líneas de ejecución de council-book.jsonl (crowd.odds, crowd.kalshi); crowd_up de líneas de respuesta selladas antes de la referencia; script presentado |
B | 31 Dec 2026 | distancia media de asientos < 0,5 × distancia media de multitud, en al menos 100 contratos-sesiones | distancia media de asientos ≥ 0,5 × distancia media de multitud; menos de 100 contratos-sesiones = sin resolver | 0.40 |
| F5 | Los enlaces compartidos significan llamadas compartidas: los pares de modelos que citan el mismo enlace están de acuerdo en la clase de acción más a menudo que los pares que no lo hacen, por al menos 5 puntos dentro de estratos, p de permutación < 0,05 | sources.agreement_by_shared_link.diff_within_strata y p_permutation, council-stats.json, aplicado a la ventana por el script presentado (definición reproducida en los archivos del 21 de octubre de 2026) |
A | 31 Dec 2026 | diff ≥ 0,05 y p < 0,05 | diff < 0,05 o p ≥ 0,05 | 0.56 |
| F6 | Todos equivocados juntos: la proporción de sesiones mercado-día resueltas con al menos 4 modelos respondiendo en las que cada modelo respondiente estaba equivocado es al menos el doble de la proporción esperada bajo independencia, donde la proporción esperada es la media, en las mismas sesiones mercado-día, del producto de las tasas de error de los modelos que realmente respondieron, cada tasa estimada en las mismas filas | together.all_wrong / together.rows, council-league.json; expectativa por el script presentado de council-forecasts.csv |
B | 31 Dec 2026 | proporción observada ≥ 2 × proporción esperada | proporción observada < 2 × proporción esperada | 0.92 |
| F7 | Una minoría acertada es más común que un error unánime: minority_right excede all_wrong |
definición de together (council-league.json), recomputada en la ventana por el script presentado según la regla de este documento, a partir de líneas selladas antes de la referencia y todas las filas; el campo publicado, que también cuenta líneas tardías y deja fuera empates, se muestra junto a él |
A | 31 Dec 2026 | minority_right > all_wrong | minority_right ≤ all_wrong | 0.63 |
| F8 | La tabla se completa según lo programado: después de la puntuación de la sesión 30 (30 de noviembre de 2026), al menos 9 de los 11 asientos del Consejo cumplen la regla de clasificación a un día (30 pronósticos resueltos en al menos 10 días de negociación, todas las sesiones desde el 19 de octubre de 2026 contadas) | indicadores ranked, council-league.json by_horizon.1d |
A | 30 Nov 2026 | 9 o más asientos del Consejo clasificados | 8 o menos escaños del Consejo clasificados | 0.88 |
| F9 | La independencia es mayor en el mes que en el día: en las ejecuciones contadas de la sesión 11 a la sesión 52, la diferencia ejecución por ejecución entre la correlación por pares media ρ en un día y en un mes (cada una por la regla de la Sección 5.1, de modo que una diferencia positiva significa voces más independientes en el mes) tiene una media positiva, con un intervalo de bootstrap de bloque móvil del 95% (bloques de cinco ejecuciones) completamente por encima de cero | filas contadas de council-forecasts.csv en 1d y 1m, council-book.jsonl; script presentado | B | 31 Dec 2026 | intervalo completamente por encima de cero, con al menos 20 ejecuciones contadas | intervalo no completamente por encima de cero, con al menos 20 ejecuciones contadas; menos = sin resolver | 0.30 |
| F10 | El promedio supera seguir al líder: el Brier de 1 día consensuado en las sesiones 31 a 52 (1 a 31 de diciembre de 2026) es más bajo que el del líder, el modelo del Consejo clasificado con el Brier de 1 día más bajo en las sesiones 11 a 30 (2 a 30 de noviembre de 2026), en las sesiones de mercado de diciembre respondidas | filas de 1 día contadas de council-forecasts.csv; consenso por la regla publicada de respuestas selladas antes de la referencia; script presentado | B | 31 Dec 2026 | Brier consensuado < Brier del líder | Brier consensuado ≥ Brier del líder; ningún modelo clasificado en las sesiones 11 a 30 = sin resolver | 0.64 |
| F11 | Ningún modelo individual muestra una ventaja diaria detectada: ningún modelo del Consejo clasificado tiene un Brier de un día, sobre todas las filas de la sesión 11 en adelante, cuyo intervalo de agrupamiento de sesión del 95% se encuentra completamente por debajo de 0.25 (un intervalo sin corregir por escaño clasificado) | filas de 1 día contadas de council-forecasts.csv; script presentado | B | 31 Dec 2026 | ningún límite superior del escaño < 0.25 | al menos un límite superior del escaño < 0.25 | 0.79 |
| F12 | La multitud supera al consejo: en al menos 100 sesiones de mercado de un día distintas de la sesión 11 en adelante con un contrato de multitud cuyo volumen sellado es al menos $1,000 (el contrato que respondieron los modelos: Polymarket donde lo lista el mercado, de lo contrario Kalshi), el Brier de la multitud es más bajo que el del consenso recortado del consejo de crowd_up, ambos puntuados contra la resolución del propio contrato |
precios de multitud y vol en las líneas de ejecución de council-book.jsonl (crowd.odds para Polymarket, crowd.kalshi); resoluciones en sus líneas de crowd (rows.<code>[@kalshi].up); crowd_up en las líneas de respuesta de council-book.jsonl; script presentado |
B | 31 Dec 2026 | Brier de multitud < Brier del consejo en al menos 100 sesiones de mercado | Brier de multitud ≥ Brier del consejo; menos de 100 sesiones de mercado = sin resolver | 0.83 |
| F13 | La combinación supera a la multitud: en los mismos contratos que F12 (al menos 100 sesiones de mercado, volumen sellado al menos $1,000), la media simple del precio de la multitud y el consenso recortado del consejo de crowd_up tiene un Brier más bajo que la multitud sola, puntuado contra la resolución de cada contrato |
como F12; script presentado | B | 31 Dec 2026 | Brier de combinación < Brier de multitud en al menos 100 sesiones de mercado | Brier de combinación ≥ Brier de multitud; menos de 100 sesiones de mercado = sin resolver | 0.30 |
| F14 | Los modelos tienen exceso de confianza: sobre todas las filas de un día de la sesión 11 en adelante, en el cubo agrupado de 60 a 70% en el lado respaldado (al menos 100 pronósticos), la frecuencia observada es al menos 5 puntos por debajo de la probabilidad establecida | filas de 1 día contadas de council-forecasts.csv; script presentado | B | 31 Dec 2026 | brecha ≥ 5 puntos con n ≥ 100 | brecha < 5 puntos con n ≥ 100; n < 100 = sin resolver | 0.80 |
| F15 | El consejo no supera una regla simple por un margen claro: en las sesiones en las que ambos se puntúan, B(consenso) − B(momentum) en un día es mayor que −0.01 | Brier de consenso y momentum de 1 día en sesiones comunes, council-forecasts.csv; script presentado | B | 31 Dec 2026 | B(consenso) − B(momentum) > −0.01 | B(consenso) − B(momentum) ≤ −0.01 | 0.80 |
| F16 | Ningún horizonte lleva una señal detectada en toda una temporada: para ninguno de 1 día, 1 semana y 1 mes el Brier consensuado tiene un intervalo del 95% completamente por debajo de 0.25, intervalos por la regla de la Sección 4.6 (agrupamientos de sesión en 1 día; Newey-West con retraso h − 1, o un bootstrap de bloque con bloques de al menos h sesiones, en horizonte h) | Brier consensuado por horizonte de council-forecasts.csv; script presentado | B | 30 Apr 2027 | ningún límite superior del horizonte < 0.25 | al menos un límite superior del horizonte < 0.25 | 0.63 |
| F17 | Relativo a la climatología, el día es el horizonte más difícil: entre 1 día, 1 semana y 1 mes, la puntuación de habilidad del Brier consensuado contra la tasa base climatológica (frecuencia de un aumento estricto por mercado y horizonte de 2016 a 2025, todas las filas) es más baja en 1 día | Brier consensuado por horizonte de council-forecasts.csv; climatología climatology_fixed.table[*].p_up de council-calibration.json, sello verificado por el script presentado (Sección 8); campo publicado 21 de octubre de 2026 |
B | 30 Apr 2027 | la puntuación de habilidad de 1 día es la más baja de las tres | la puntuación de habilidad de 1 día no es la más baja | 0.37 |
| F18 | El país es un factor pequeño: la brecha absoluta entre el Brier de 1 día del lado estadounidense y del lado chino (cada lado la media del Brier de sus modelos clasificados en sesiones comunes) es menor que el rango (más alto menos más bajo Brier del modelo clasificado) dentro de cada lado | by_horizon.1d, side, ranked, council-league.json; council-forecasts.csv; script presentado |
B | 31 Dec 2026 | brecha < rango dentro de cada lado | brecha ≥ rango dentro de cualquier lado; menos de dos modelos clasificados en cualquier lado = sin resolver | 0.80 |
| F19 | El lado estadounidense puntúa mejor en una temporada: el Brier de un día del lado estadounidense, la media del Brier de sus modelos clasificados sobre todas las filas en sesiones comunes de la sesión 11 en adelante, es más bajo que el del lado chino, calculado de la misma manera | filas de 1 día contadas de council-forecasts.csv, side y ranked en council-league.json; script presentado |
B | 30 Apr 2027 | EE.UU. < China | EE.UU. ≥ China; menos de dos modelos clasificados en cualquier lado = sin resolver | 0.57 |
| F20 | Las mismas noticias significan menos disputa: en las ejecuciones de Libro Cerrado (paquete sellado, sin búsqueda) el calor del desacuerdo es más bajo que en las ejecuciones abiertas de los mismos modelos y días | media de heat_closed − heat_open sobre runs[*] en la ventana, arena-cb-experiment.json |
A | 30 Nov 2026 | calor cerrado < calor abierto | calor cerrado ≥ calor abierto | 0.70 |
| F21 | La búsqueda añade poca precisión: el Brier del día siguiente de las llamadas de Libro Cerrado está dentro de 0.01 del de las llamadas abiertas de los mismos modelos y sesiones | líneas closed_book de council-book.jsonl, council-forecasts.csv; script archivado. Una llamada cerrada sellada después de la referencia común se puntuúa solo desde su propio precio de referencia (Sección 5.5). En los archivos del 21 de octubre de 2026, cada línea de Libro Cerrado fue consultada después de la apertura (asked_after_open) y no contiene ningún resultado de su propia referencia, por lo que la fila aún no puede resolverse; se resuelve una vez que la liga publica llamadas cerradas selladas antes de la referencia común o, para cada llamada cerrada, su propio precio de referencia, cierre y resultado (por ejemplo un campo score por mercado), que el resolver ya lee |
B | 31 Dec 2026 | diferencia absoluta ≤ 0.01 | diferencia absoluta > 0.01; sin pares comparables = sin resolver | 0.72 |
| F22 | La discusión encuentra riesgos reales: al menos el 55% de las críticas del presidente con un movimiento de 5 sesiones resuelto se confirman, «confirmado» significa que el rendimiento del fondo en las 5 sesiones tiene el signo que la crítica predijo | status, council-talk-critiques.csv (recomputado a partir de la dirección de la crítica y el rendimiento de 5 sesiones del fondo donde el campo difiere) |
A | 31 Dec 2026 | proporción ≥ 55% con al menos 20 críticas resueltas | proporción < 55% con al menos 20 críticas resueltas; menos = sin resolver | 0.30 |
| F23 | Hacer caso de la crítica vale la pena: las sombras que heeded critique superan los porfolios mantenidos en promedio | media de weeks[*].criticised[*].heed_minus_keep_pp sobre los porfolios criticados de semanas cuyas sesiones están en la ventana, council-talk.json |
A | 31 Dec 2026 | media > 0 | media ≤ 0 | 0.42 |
| F24 | Un modelo discrepa consigo mismo mucho: el calor medio entre las propias repeticiones de un modelo es al menos la mitad del calor entre modelos | medias de weeks[*].summary.noise_floor.heat_self y heat_between_models sobre semanas del radar del 1 de noviembre de 2026, council-repeats.json |
A | 30 Nov 2026 | heat_self ≥ 0.5 × heat_between_models, con heat_between_models > 0 | heat_self < 0.5 × heat_between_models; ambos cero = sin resolver | 0.60 |
| F25 | Los líderes no duran: de los tres modelos de Consejo mejor clasificados por Brier de 1 día en el cuarto trimestre de 2026, como máximo uno está entre los tres primeros en el primer trimestre de 2027. Los asientos elegibles son aquellos con lugar council en league-roster.json que cumplen la regla 30/10 dentro de cada trimestre, el cuarto trimestre de 2026 significa sesiones 11 a 52 (después del período de desarrollo) y el primer trimestre de 2027 las sesiones de 4 de enero a 31 de marzo de 2027; un asiento sigue siendo un asiento a través de un cambio fechado de versión de modelo (Sección 5.7); los empates exactos en Brier se desempatan por nombre de asiento en orden alfabético |
council-forecasts.csv, contado por trimestre en filas de 1 día; league-roster.json; script archivado | B | 30 Apr 2027 | como máximo uno permanece entre los tres primeros | dos o más permanecen entre los tres primeros; menos de tres asientos de Consejo clasificados en cualquier trimestre = sin resolver | 0.62 |
| F26 | El índice es difícil de superar: en la última sesión de la temporada, menos de la mitad de las 14 cuentas de modelo de la liga principal tienen un valor superior al de la cuenta S&P 500 | value_usd de las 14 cuentas de modelo y de _spy, arena-accounts.csv; script archivado |
B | 30 Apr 2027 | 6 o menos por encima de _spy |
7 o más por encima de _spy |
0.60 |
| F27 | Los buenos pronosticadores no son los mejores operadores: sobre los asientos de Consejo clasificados a 1 día que tienen una cuenta de la liga principal, la correlación de rangos de Spearman entre el rango de Brier a 1 día y el rango de rendimiento de la liga principal es inferior a 0.5, siendo el rango 1 el Brier más bajo y el rendimiento más alto. Los asientos son aquellos clasificados por la regla 30/10 sobre sesiones 11 a 126, Brier sobre todas sus filas de 1 día contadas en esa ventana, rendimiento del value_usd de la cuenta en la última sesión de la temporada; los valores empatados toman la media de sus rangos |
filas de 1 día contadas de council-forecasts.csv, league-roster.json, arena-accounts.csv; script archivado | B | 30 Apr 2027 | rho < 0.5 con al menos 6 asientos clasificados | rho ≥ 0.5 con al menos 6 asientos clasificados; menos = sin resolver | 0.83 |
| F28 | El acceso a los modelos antes del primer pronóstico no mejora la puntuación Brier de los lectores en 0.01 o más: en mercados emparejados (al menos 200 primeros pronósticos por grupo), la puntuación Brier del grupo que no se le mostraron los modelos excede la del grupo que se le mostraron por menos de 0.01 (un efecto del acceso entre grupos; confianza c en un lado se lee como probabilidad c/100 de ese lado; tasas de acierto reportadas junto a él) | experiment.g0.brier y experiment.g1.brier, con n de cada uno, council-league.json |
A | 31 Dec 2026 | diferencia < 0.01 con al menos 200 por grupo | diferencia ≥ 0.01 con al menos 200 por grupo; menos = sin resolver | 0.46 |
| F29 | El acceso acerca a los lectores hacia el consejo: los primeros pronósticos del grupo que se le mostraron los modelos concuerdan en dirección con el consenso del consejo al menos 10 puntos más a menudo que los del grupo que no se le mostraron (un efecto del acceso entre grupos; al menos 200 primeros pronósticos por grupo) | primeros pronósticos por lector del experimento (campo a ser publicado y documentado en arena-dataset.json) y el consenso por ejecución; script archivado | B | 31 Dec 2026 | diferencia ≥ 10 puntos con al menos 200 por grupo | diferencia < 10 puntos con al menos 200 por grupo; menos = sin resolver | 0.41 |
| F30 | El estilo delata el modelo: en la temporada ciega (a partir del 2 de noviembre de 2026), un adivinador fijo (modelo, versión y el SHA-256 de su prompt nombrado en un apéndice del registro presentado antes del 2 de noviembre de 2026, temperatura 0, de una familia excluida de los candidatos), mostrado un texto de respuesta sellada por elemento y la lista de los k asientos candidatos que respondieron, identifica el modelo al menos tres veces más a menudo que el azar | líneas de respuesta de la temporada ciega y la revelación después de la temporada; script archivado | B | 30 Apr 2027 | precisión media top-1 sobre elementos ≥ media de 3/k | precisión media top-1 sobre elementos < media de 3/k | 0.46 |
Nota: El Conjunto A se define por uno o dos campos publicados. El Conjunto B se define por un script presentado con el registro y ejecutado en los archivos sin procesar abiertos, y el script es la definición. Los resolutores de cada fila se presentan como resolve.py (versión de reglas osf-rules-1), con los detalles de la Sección 8.1: la regla de impulso de F15 es la dirección del resultado de la liga del indicador en la sesión anterior al 55%, en todas las filas. En los archivos del 21 de octubre de 2026, F21, F29 y F30 se leen sin resolver, y cada fila nombra los datos que necesita. Establecí los umbrales de F1 a F5 y F9 después de que las primeras ejecuciones selladas fueran visibles para mí, y sus ventanas comienzan en la sesión 11.
F14, F22 y F28 son las filas de baja potencia: el error estándar de F14 es de aproximadamente 5 puntos en 100 pronósticos, el de F22 de aproximadamente 11 puntos en 20 críticas y el de F28 de aproximadamente 0.02 Brier en 200 por grupo. F15, F21 y F28 comparan estimaciones puntuales con un umbral de 0.01 y no son pruebas de equivalencia.
Esperado sin habilidad: F11, al menos aproximadamente 0.78 para diez modelos clasificados con errores independientes al 2.5% unilateral cada uno, más alto si puntúan por encima de 0.25 y más alto aún cuando sus errores están correlacionados (F3). F16, al menos aproximadamente 0.93 en tres horizontes con la misma suposición. F25, aproximadamente 0.85 para once modelos clasificados y 0.82 para diez con clasificaciones aleatorias. F10 está abierto a cualquiera de los resultados: el líder se elige en una ventana anterior, y el promediado garantiza una victoria solo sobre la media de los miembros que mantiene (Sección 4.5). F8 es un pronóstico operacional sobre la liga. Los cubos de calibración son semiabiertos, [60,70) en el lado respaldado.
Fechas de verificación: 30 de noviembre de 2026 (sesión 30), 31 de diciembre de 2026 (sesión 52), 30 de abril de 2027 (después de la temporada de 126 sesiones, se espera que termine alrededor del 20 de abril de 2027). La temporada ciega comienza el 2 de noviembre de 2026. En ella, la línea de respuesta sella el modelo, su versión y su modo como un compromiso SHA-256 salado, H(salt || model || version || mode), por lo que el requisito 1 se cumple sin mostrar el nombre. Las sales se publican después de la temporada (Sección 3.13), y F30 se puntúa en las líneas de respuesta selladas una vez que se abren los compromisos. Las fichas de puntuación se publican como revisiones fechadas de este artículo y se registran en OSF.
Análisis secundarios declarados con el registro, sin probabilidad. (1) ¿Ayuda el desacuerdo: la ganancia pareada del consenso sobre la climatología en el tercil más alto en comparación con el más bajo de la dispersión de los asientos, mercado fijo, bilateral (Sección 8). (2) ¿Ayuda descontar voces correlacionadas: la diferencia Brier pareada de un día entre el consenso publicado y el consenso sombra de la Sección 5.3, sesiones 11 a 126, bootstrap de bloques móviles (bloques de cinco, 10,000 remuestreos, semilla 20261102) y la zona de equivalencia de ±0.01; los pesos de sombra y el script que los calcula se presentan con el registro. Ninguno es una fila F, y ninguno entra en la puntuación Brier de los treinta pronósticos.
Apéndice E. Comparación de características con trabajo previo (a 21 de octubre de 2026)
La Tabla E1 compara las características de la implementación de referencia con los esfuerzos más cercanos, leídos tal como aparecen en la nota de la Tabla 9. Sí significa que la propiedad está documentada; Parcialmente, una forma más débil o diferente, como se indica en la celda; No, ausencia documentada o un diseño que la excluye; ND, no documentado públicamente a 21 de octubre de 2026, (Tabla 9). La columna de la liga utiliza tres estados propios, a 21 de octubre de 2026: Implementado significa visible en los archivos abiertos. Especificado significa escrito en el estándar o la metodología abierta y ausente de los archivos en esa fecha. Registro del operador significa en funcionamiento, con un registro que un tercero verifica confiando en el operador. Una celda puede dar dos estados para dos partes de una característica.
Tabla E1. Características de AI Council · Markets frente al trabajo previo más cercano, de materiales públicos a 21 de octubre de 2026.
| Característica | La nuestra (estado) | Foresight Arena | Prediction Arena | NeuPortal | LLM Trading Arena | TradeRank | MarketMania | Otros |
|---|---|---|---|---|---|---|---|---|
| 1. Liga en vivo diaria | Implementado (desde 16 de octubre de 2026) | Parcialmente (rondas; resultados en papel simulados, §6; agentes en vivo en Nechepurenko & Shuvalov, 2026b) | Sí (ciclos cada 15 a 45 min, enero a marzo de 2026) | No (por partido) | Sí (criptomonedas dos veces al día, acciones cada día de negociación) | Sí (cada 24 h) | Sí (desde 15 de julio de 2026) | Sí: Alpha Arena, Agent Market Arena, Rallies, FutureX |
| 2. Siete modelos de laboratorio estadounidense y siete de laboratorio chino | Implementado (14 asientos de negociación, 7 de laboratorios estadounidenses y 7 chinos; 11 asientos de pronóstico, 5 estadounidenses y 6 chinos) | No (5 planeados, 1 chino) | No (10 modelos, 1 laboratorio chino) | No (una IA sin nombre) | No (6 familias, 2 chinas) | Sin diseño por país (22 modelos) | No (7 modelos, 2 chinos) | No: Alpha Arena 2 de 6; Rallies 2 de 8 |
| 3. Probabilidades de asientos de pronóstico | Implementado (11 asientos) | Sí | No (solo operaciones) | Sí (tres resultados) | No (órdenes) | ND | Sí (probabilidad declarada) | Sí: Prophet Arena, ForecastBench |
| 4. Panel fijo de indicadores financieros entre clases de activos | Implementado (12) | No (eventos de Polymarket) | Parcialmente (contratos financieros de Kalshi entre 7 categorías) | No (fútbol) | Parcialmente (5 criptomonedas, S&P 100) | Parcialmente (10 criptomonedas, 50 acciones estadounidenses) | Parcialmente (5 criptomonedas) | Parcialmente: acciones individuales o criptomonedas (StockBench, Agent Market Arena, GlassBallAI) |
| 5. Cuatro horizontes fijos en los mismos activos | Implementado | No | No | No | ND | ND | Sí (1 hora a 1 mes) | Sí, no paneles financieros: ForecastBench ocho horizontes en preguntas de conjunto de datos; Parcialmente: GlassBallAI un horizonte de 10 días |
| 6. Respuestas selladas por hash antes de la referencia | Implementado (cadena SHA-256 registrada antes de las 09:30 ET); registro del operador para 19 y 20 de octubre de 2026 (nivel 1); verificable públicamente desde 21 de octubre de 2026 (al menos dos tokens RFC 3161, nivel 2+, página de prueba); sellado al llegar especificado | Parcialmente (compromiso keccak256 por agente y ronda, §3.2; no una cadena de todas las respuestas) | No | Parcialmente (SHA-256 de cada archivo de pronóstico; no hay cadena documentada) | Parcialmente (historial git de rellenos y justificaciones antes del siguiente relleno abierto) | ND | ND | Parcialmente: registro SHA-256 salado de Prophet Arena, reloj del operador; Sornette et al. (2010) sumas de verificación, no IA |
| 7. Anclaje fuera del operador | Implementado (Bitcoin, OpenTimestamps: existencia no posterior a pocas horas después del bloque; el 20 de octubre de 2026 después de la apertura) | Parcialmente (Polygon PoS, §3.2) | No | Sí (Bitcoin; fútbol, una IA) | No (el tiempo descansa en el host git) | ND | ND | Sí, no financiero: compromisos en cadena de Zeus de pronósticos meteorológicos; Jyotish (2026), no IA; No: Prophet Arena (reloj del operador) |
| 8. Precio de referencia tomado después del sello | Implementado y verificable públicamente desde 21 de octubre de 2026 (nivel 2+, Apéndice B, Paso 9); registrado por el operador para 19 y 20 de octubre de 2026 (booked_at, nivel 1) |
Parcialmente (precio medio de referencia almacenado después del plazo; resultado binario, Fig. 3) | No | Parcialmente (precio de la multitud en o antes del bloqueo) | Parcialmente (órdenes se ejecutan en la siguiente apertura) | ND | Parcialmente (entrada en la primera vela de 1 minuto después de la respuesta) | ND |
| 9. Una ejecución contada por una regla escrita por adelantado; todas las ejecuciones publicadas | Implementado (cada ejecución publicada, otras etiquetadas not_counted); ejecución contada declarada por adelantado y sellada en la cadena de preguntas desde 21 de octubre de 2026 (Sección 3.4); para las sesiones de desarrollo de 19 y 20 de octubre de 2026 la regla se aplicó después de las ejecuciones |
Parcialmente (un compromiso por agente y ronda, impuesto por retransmisión, §4.3; todos los compromisos públicos en cadena; ejecuciones fuera de cadena no cubiertas) | No (ejecución previa a la ventana de un modelo oculto, App. B.2) | ND | ND | ND | ND | ND |
| 10. Puntuación estrictamente propia y calibración | Implementado en parte (caídas Brier publicadas empates calibración; bins de calibración); Brier de todas las filas especificado como primario desde 21 de octubre de 2026 y calculado por los scripts archivados | Sí (Brier, Alpha, descomposición Murphy, §3.3 a §3.5) | No (retorno, tasa de ganancia, §3.3) | Sí (Brier de tres resultados) | No (valor de la cuenta) | ND | Sí (Brier, brecha de calibración) | Sí: Prophet Arena, ForecastBench |
| 11. Puntos de referencia desinformativos del 50% y climatológicos | Implementado (50%); implementado (frecuencias 2016 a 2025 selladas; campo climatology_fixed en los archivos abiertos desde 21 de octubre de 2026, 08:54 UTC) |
Parcialmente (líneas de base aleatorias y de mercado) | No | ND | ND | ND | ND | Parcialmente: líneas de base ingenuas de ForecastBench; puntuación de habilidad KalshiBench contra climatología |
| 12. Regla de sesión mínima antes de la clasificación | Implementado (30/10, banderas ranked) |
Parcialmente (análisis de potencia, rondas mínimas recomendadas, §3.6.2) | No | ND | ND | ND | ND | ND |
| 13. Cartera simulada de $100,000 por modelo | Implementado | No | Parcialmente (real $10,000 en contratos de eventos) | No | Sí ($100,000, papel) | Parcialmente ($10,000 simulado) | Parcialmente (operaciones de futuros en papel) | Sí: Rallies $100,000; Alpha Arena real $10,000 |
| 14. Venta en corto y apalancamiento 2× | Implementado (liga Pro) | No | No (sin apalancamiento, §4.5.1) | No | Parcialmente (apalancamiento cripto, sin venta en corto) | ND | Parcialmente (largo o corto, papel) | Sí: Alpha Arena perpetuos apalancados (prensa) |
| 15. Precio del mercado de predicción en el momento de la respuesta como comparación | Implementado (crowd_up contra el precio del contrato) |
Sí (Alpha contra precio medio, §3.4) | Parcialmente (operaciones contra precios) | Sí | ND | ND | ND | Sí: Prophet Arena, AIA Forecaster |
| 16. Acuerdo descontado por voces correlacionadas, en vivo | Implementado (N_eff por una regla de elegibilidad establecida, n_eff.counted; ponderaciones familiares; recuentos de todo incorrecto y minoría correcta) |
No (se asume independencia del mercado, §7.5) | No | No (un modelo) | ND | ND | Parcialmente (comportamiento gregario medido, no descontado) | Solo sin conexión: Kim et al. (2025), Spiro (2026), Aitchison et al. (2026) |
| 17. Libro cerrado con un paquete de noticias sellado | Implementado (paquete sellado con hash); ausencia de operador de búsqueda registrada donde la línea dice solo instrucción | No (búsqueda opcional, no ablacionada) | No (todos los modelos buscan) | ND | ND | ND | Parcialmente (una carga útil divulgada con un resumen de noticias; búsqueda ND) | Parcialmente: FinDeepForecast con y sin búsqueda, sin conexión; carga útil común MarketMania |
| 18. Modo de discusión del consejo | Implementado | No (ciego por diseño) | No (trabajo futuro) | ND | ND | ND | ND | Parcialmente: configuraciones de coordinación, en vivo en Foresight Arena (Nechepurenko & Shuvalov, 2026b) |
| 19. Consultas repetidas de un modelo | Implementado (carteras); repeticiones de probabilidad especificadas | No | No | ND | ND | ND | Sí (ejecuciones de estabilidad) | Estudios de muestreo sin conexión (Aitchison et al., 2026) |
| 20. Lectores predicen antes de ver la IA, dos grupos permanentes | En vivo y abierto a todo visitante; resultados registrados como F28 y F29, leídos en 200 primeras predicciones por grupo; etiqueta de grupo especificada | No | No | ND | ND | ND | ND | Parcialmente: grupos separados (ForecastBench, Metaculus); ensayo de asistencia (Schoenegger et al., 2025) |
| 21. Temporada ciega | Especificado (desde 2 nov 2026; modelo, versión y modo sellados como compromiso SHA-256 con sal, sales publicadas después de la temporada) | No | Parcialmente (un modelo bajo un identificador oculto) | ND | ND | ND | ND | ND |
| 22. Predicciones fechadas sobre la liga, precificadas a ciegas | Implementado (30, precificadas a ciegas; registradas en OSF antes de publicar) | No | No | ND | ND | ND | ND | ND |
| 23. Datos abiertos bajo una licencia establecida | Implementado (CC BY 4.0) | Parcialmente (en cadena, sin licencia de datos establecida) | ND (no se proporcionó repositorio) | Sí (GitHub, Zenodo) | Sí (MIT, libro mayor completo) | Parcialmente (JSON abierto, licencia no establecida) | Parcialmente (exportaciones de API, licencia ND) | Sí: ForecastBench, LiveTradeBench, StockBench; GlassBallAI CC BY-NC |
| 24. Código de puntuación abierto con hashes | Implementado (código de motor con hashes, arena-code.json; recuento de puntuación de predicción, tools/replay_brier.py; resolvedores presentados en OSF) | Sí (contratos en cadena, repositorio de análisis) | No | ND | Parcialmente (código abierto) | ND | ND | Parcialmente: código PolyBench, ForecastBench |
| 25. Recomputo de todas las cuentas por terceros | Implementado (replay.py) |
Sí ("replay the full history", Contributions 1) | No | ND | Sí (el libro mayor recomputa todas las cuentas) | ND | ND | ND |
| 26. Token RFC 3161 en el sello | Implementado desde 21 oct 2026, verificable públicamente (FreeTSA y DigiCert; Sectigo añadido la misma mañana; página de prueba); sellado al llegar especificado | No | No | ND | ND | ND | ND | No es IA: una herramienta de sellado general para predicciones humanas |
Nota: Los números § en las columnas de Foresight Arena y Prediction Arena se refieren a secciones de esos artículos. Las filas 5, 10, 13 a 15, 19 y 25 son características que la liga comparte con trabajos anteriores. Las filas que respaldan las afirmaciones de la Sección 7.4: Afirmación 1: filas 4 y 6 a 9 (fila 8 en nivel 1 para 19 y 20 de octubre, nivel 2+ desde 21 de octubre). Afirmación 2: fila 16. Afirmación 3: filas 6 a 12, 16 y 26, leídas con la columna de estado de la Sección 3.13. Afirmación 4: fila 20. Afirmación 5: fila 2. Afirmación 6: fila 22.
Cómo citar
Chernets, V. (2026). Sellado Antes de Abrirse: Un Estándar Verificable para Medir Pronósticos de IA en Mercados Financieros [Preimpresión]. SSRN. https://doi.org/10.2139/ssrn.7653679
@misc{chernets2026sealedbeforetheopen,
  author       = {Chernets, Vadym},
  title        = {{Sealed Before the Open: A Verifiable Standard for Measuring AI Forecasts of Financial Markets}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7653679},
  url          = {https://doi.org/10.2139/ssrn.7653679}
}