Interrogez plusieurs IA à la fois et voyez où elles divergent — Outils
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
Quand vous posez une question à une seule IA, vous obtenez une réponse confiante et aucun moyen facile de savoir si elle est correcte. Poser la question à une deuxième et une troisième IA aide, mais seulement si vous voyez où leurs réponses divergent, et seulement si vous savez la valeur réelle de leur accord. After Chat est un petit ensemble de scripts Python gratuits et open source qui pose une question à plusieurs IA à la fois et fait les deux : il montre qui a dit quoi, et il calcule la valeur de leur accord. Il s'exécute sur votre propre ordinateur, par les outils IA auxquels vous êtes déjà connecté, sans clés API et sans abonnement supplémentaire, et les scripts eux-mêmes ne nécessitent que Python.
Une IA ne suffit pas, et quatre IA ne font pas quatre
Les modèles d'IA de différentes entreprises sont entraînés différemment, donc ils ne font pas toujours les mêmes erreurs. C'est pourquoi les gens copient une même question dans ChatGPT, Claude, Gemini et Grok et comparent les réponses à la main. Leurs erreurs se chevauchent plus qu'il n'y paraît, cependant. Une étude de 2025 portant sur plus de 350 modèles de langage a révélé que lorsque deux modèles se trompent tous les deux, ils donnent souvent la même mauvaise réponse : dans 60 % des cas sur un ensemble de données de classement. Donc quand quatre IA s'accordent, vous avez moins de quatre confirmations indépendantes. La véritable valeur de demander à plusieurs, c'est le désaccord : un point que seul l'un d'eux a soulevé, ou la même affirmation avec des chiffres différents.
Un exemple réel
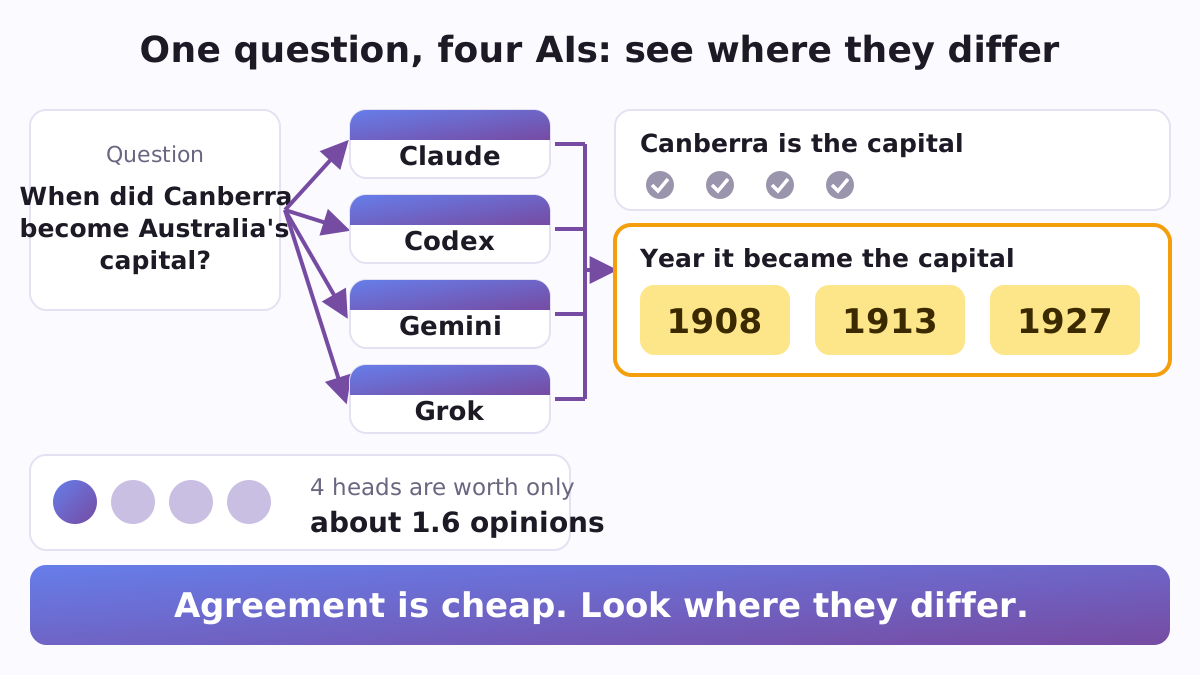
Le 21 septembre 2026, l'auteur a posé une question à quatre outils d'IA en ligne de commande : « En une phrase : quelle est la capitale de l'Australie, et en quelle année est-elle devenue la capitale ? » Les quatre ont répondu en moins de 25 secondes, et les quatre ont dit Canberra. Sur l'année, ils se sont divisés de trois façons : 1908, 1913 et 1927. Chaque année peut être défendue : le site a été choisi en 1908, la ville a été nommée en 1913, et le Parlement s'y est installé en 1927. Seul, Codex aurait donné 1927 et Grok 1913, chacun comme un fait établi. Côte à côte, les réponses ont montré immédiatement que la question a trois réponses honnêtes, et ont pointé la ligne exacte qu'une personne doit vérifier.
Ce qu'il y a dedans
- Les interroger tous à la fois (
fanout.py). Le script envoie d'abord à chaque outil IA de sa liste une question de test rapide et ignore tout outil qui n'est pas installé ou qui ne répond pas. Ensuite, il pose votre question à tous les outils actifs simultanément, sous une limite de temps que vous choisissez, et enregistre chaque réponse dans son propre fichier. Si un outil est encore en train d'écrire quand le temps s'écoule, ce qu'il a écrit jusqu'à présent est conservé et marqué comme partiel, non supprimé. Chaque IA démarre dans son propre dossier vide plutôt que dans le dossier à partir duquel vous avez lancé le script, de sorte qu'elle ne travaille qu'à partir de votre question. Une question longue, comme une page de texte que vous voulez qu'ils vérifient tous, se met dans un fichier avec--question-file. - Voir qui a dit quoi (
provenance.py). Le script divise chaque réponse en affirmations courtes, regroupe les affirmations formulées de manière similaire, et affiche un tableau : chaque affirmation, et quelle IA l'a faite. Sous le tableau figurent les deux listes qui importent le plus : les affirmations faites par une seule IA (quelque chose que les autres ont manqué, ou une erreur de celle-ci) et les affirmations où les IA donnent des nombres, pourcentages ou dates différents. Il lit n'importe quel dossier de fichiers texte, vous pouvez donc aussi coller des réponses de sites web de conversation dans des fichiers, un par IA, et les comparer. - Savoir ce que vaut l'accord (
neff.py). Donnez-lui une poignée de questions avec des réponses connues, marquées juste ou fausse pour chaque IA, et il mesure la fréquence à laquelle vos IA se trompent ensemble. À partir de là, il calcule le nombre d'opinions vraiment indépendantes qu'elles valent réellement. Dans l'exemple intégré, quatre IA dont les erreurs se chevauchent valent environ 1,6 opinion indépendante, et aucun nombre de telles IA ne vaudrait jamais plus de 2,1. - Un deuxième avis à l'intérieur de Claude Code (
second-opinion/SKILL.md). Une compétence prête à l'emploi : copiez le dossier dans~/.claude/skills/, et Claude Code peut poser la même question à une IA d'une autre entreprise, afficher cette réponse exactement telle qu'elle est venue, et ajouter un tableau court montrant où les deux s'accordent, où elles diffèrent, et ce que seule l'une d'elles mentionne. Il ne les fusionne jamais en un seul texte confiant, et il traite la réponse de l'autre IA comme du matériel à comparer, jamais comme des instructions à suivre. - Paramètres sûrs pour les agents IA (
safety/). Un exemple prêt à l'emploi des paramètres de permission de Claude Code (settings.json) qui démarre chaque session en mode plan, refuse des commandes commerm -rf,sudo,curletgit push, garde les fichiers.envet un dossiersecretsillisibles, et demande avantrm,mvet les récupérations web. Les paramètres pour Codex lui permettent d'écrire uniquement dans son dossier de travail, le réseau étant désactivé, et le font demander avant d'aller au-delà. Une liste de contrôle de 14 points couvre les habitudes autour d'eux : travaillez dans une copie, demandez d'abord un plan, conservez une annulation, sachez comment arrêter un travail long. - Outils pour les chercheurs (
crossings.py,crossings.schema.json,jsonl_log.py). Un format d'enregistrement, avec un vérificateur strict, pour des études sur la façon dont les gens passent de la conversation avec une IA à permettre aux agents IA de faire du vrai travail. L'installation d'une application ne compte pas comme l'utiliser, une étape terminée a besoin de quelque chose que l'agent a réellement créé, et quand quelqu'un s'arrête, l'enregistrement conserve ses propres paroles. Un petit enregistreur écrit chaque décision, comme un plan refusé ou un deuxième avis pris, comme une ligne horodatée de JSON.
Pourquoi c'est construit de cette façon
Beaucoup d'outils « conseil d'IA » se terminent par une réponse fusionnée. Par exemple, le populaire llm-council d'Andrej Karpathy envoie votre question aux modèles via OpenRouter, un service API pour lequel vous achetez des crédits, et laisse un modèle « président » écrire la réponse finale. After Chat passe par les outils en ligne de commande que vous utilisez déjà avec vos propres comptes, et s'arrête intentionnellement avant la fusion : vous obtenez le tableau de qui a dit quoi, et le jugement reste entre vos mains. Chaque script utilise uniquement la bibliothèque standard de Python et tient dans un seul fichier court (le plus long fait moins de 200 lignes), afin que vous puissiez lire exactement ce qu'il fait et le modifier.
Comment commencer
Les scripts s'exécutent partout où Python 3 s'exécute ; sous Windows, exécutez fanout.py dans WSL. Une comparaison en direct utilise deux IA ou plus en ligne de commande, connectées avec vos propres comptes. La liste intégrée couvre Claude Code (claude), OpenAI Codex (codex), Antigravity CLI de Google (agy, qui a remplacé Gemini CLI pour les comptes Google personnels le 18 juin 2026) et Grok Build de xAI (grok). La commande de chaque outil est une ligne dans un petit fichier JSON passé avec --tools, donc ajouter un autre outil ou suivre un indicateur qui a changé dans une nouvelle version prend une minute. Pas d'outil en ligne de commande du tout ? Collez les réponses de n'importe quel site de chat IA dans des fichiers .txt, un par IA, et exécutez provenance.py sur ce dossier : le nom de chaque fichier devient une colonne du tableau.
git clone https://github.com/vadimchernets/after-chat
cd after-chat
python3 neff.py --demo                       # what four agreeing AIs are worth
python3 fanout.py "Your question" --out run  # ask every live AI at once
python3 provenance.py run                    # who said what, and where they differ
Les 28 tests s'exécutent avec python3 -m unittest tests/test_patterns.py. Le code, ses tests et les paramètres de sécurité sont tous disponibles sur github.com/vadimchernets/after-chat.
D'où cela vient
After Chat est le code compagnon de l'article After Chat: The Three Transitions Between Non-Programmers and Agentic AI de Vadym Chernets (septembre 2026, SSRN 7520019, DOI 10.2139/ssrn.7520019). L'article se demande pourquoi si peu de gens sont passés de la conversation avec les IA à laisser les agents IA travailler pour eux, et comment mesurer ce passage. Le code est sous la licence MIT et archivé sur Zenodo (DOI 10.5281/zenodo.22944451). Deux plugins Claude Code prêts à l'emploi sont nés des mêmes schémas : Sidecall interroge les outils en ligne de commande de l'IA sur votre ordinateur, et Roundcall interroge les sites de discussion avec IA via votre propre navigateur.
Vadym Chernets développe aussi Poly A1, une application dans laquelle les IA de différentes entreprises vérifient le travail les unes des autres.