Verification Theater: Modes de défaillance mesurés des panneaux de vérificateurs IA
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
Vadym Chernets, Independent Researcher · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197641 · GitHub
Accepté comme affiche à l'atelier NeurIPS 2026 « Who Verifies the Agents? Toward Reliable Agent Development » (non-archivé). Copie archivée : 10.5281/zenodo.23197641. PDF : verification-theater.pdf. Les figures et tableaux ci-dessous sont convertis à partir de la source LaTeX ; le PDF fait autorité.
Résumé
La vérification multi-agents devient un mécanisme de confiance par défaut : une réponse est de confiance parce que des modèles indépendants ont convenu de celle-ci. À partir d'une collecte pré-enregistrée, en aveugle, à température zéro, dans laquelle seize modèles (neuf fournisseurs de pointe, sept poids ouverts locaux) ont répondu aux mêmes 1 500 questions factuelles (plus un volet de 750 questions à choix multiples et un volet de dialogue exploratoire), nous mesurons quand la vérification par panel cesse de fonctionner tout en continuant à sembler fonctionner—une condition que nous appelons théâtre de vérification. Nous rapportons quatre régimes de défaillance. Premièrement, une inversion de difficulté : le gain de certification de l'accord indépendant—2,7–4,6 sur les trois quintiles les plus faciles de questions—chute à 0,82 sur le deuxième quintile le plus difficile et à zéro sur le plus difficile, où les réponses reproduites étaient correctes dans 0 sur 342 cas (13 attendus selon l'indépendance). Une restratification de panel exclu (difficulté classée par les 13 modèles hors panel) supprime l'inversion regroupée (78/354 correct, gain 2,36) tandis que le zéro persiste pour le panel interbloc (0/116) ; nous rapportons les deux codages ensemble tout au long : sur les questions que la population déployée trouve les plus difficiles, l'accord fonctionne comme une certification d'erreur. Deuxièmement, les espaces de réponse contraints : en choix multiples (niveau local), les panels ont unanimement certifié une réponse erronée sur 4,0–7,9 % des questions, contre 1,5–4,6 % sur les réponses en forme ouverte du même niveau et 0,3–4,9 % pour le niveau de pointe en forme ouverte. Troisièmement, les étiquettes utilisées comme proxies pour l'indépendance échouent empiriquement : le bloc géopolitique ne prédit pas la corrélation d'erreur (moyenne intra-bloc 0,285 vs. interbloc 0,274, différence ), et un modèle de raisonnement distillé à partir de la même base que son collègue de panel figurait parmi les paires les moins corrélées mesurées ( ; 14e sur les 15 paires locales bloc US/CN, 20e sur les 21 paires locales). Quatrièmement, la conformité : un vérificateur qui avait été en désaccord avec une réponse a avalisé aveuglément la même réponse dans 38,5 % des cas quand on la lui a présentée comme celle d'un collègue ; un contrôle avec inversion de requête montre que ces retournements suivent la présence d'une proposition confiante, non sa véracité (38,9 % vers l'erreur vs. 34,7 % vers la correction ; McNemar exact ). Nous soutenons que ces régimes partagent une racine économique et dérivons une discipline de mesure qui sépare la vérification de son théâtre.
Introduction : le problème du théâtre
Des panneaux de modèles IA se vérifiant mutuellement sont déployés comme infrastructure de confiance, et l'accord entre eux est de plus en plus considéré comme une preuve. La recherche en sécurité a depuis longtemps un nom pour les mécanismes qui produisent l'esthétique de la protection sans sa substance (Schneier, 2003) ; nous demandons, à travers des mesures plutôt que des métaphores, quand la vérification par panel mérite ce nom. Le constat central est une inversion : la valeur de certification de l'accord est concentrée sur les questions faciles et disparaît—ou s'inverse—précisément là où la vérification compte le plus. Nous traitons cela non pas comme une seule anomalie mais comme l'un de quatre régimes distincts dans lequel un panel de vérificateurs conserve l'apparence de vérification tout en perdant sa substance, et nous rattachons les quatre à une cause économique commune et à un remède commun.
Concrètement, cet article contribue : (C1) une mesure de gain de certification stratifiée par difficulté montrant que la valeur de certification de l'accord indépendant se concentre sur les questions faciles et, selon la mesure de difficulté de la population, s'inverse sur le quintile le plus difficile (0 sur 342 réponses replicables correctes ; selon la difficulté indépendante du panel, l'inversion regroupée disparaît et le zéro persiste pour le panel inter-blocs, 0/116)—les deux codages sont rapportés ensemble tout au long ; (C2) des preuves que les espaces de réponses contraints (choix multiples) poussent l'erreur certifiée unanime à 4,0–7,9 %, bien au-dessus de la tranche de forme ouverte de 0,3–4,9 % ; (C3) deux résultats nuls pré-enregistrés montrant que les étiquettes régulièrement utilisées comme proxies d'indépendance—bloc géopolitique et lignée du modèle—ne prédisent pas la corrélation d'erreur, donc l'indépendance doit être mesurée par paire sous forme de -matrice plutôt que supposée à partir de la marque ou de l'arbre généalogique ; et (C4) une mesure de conformité avec un contrôle d'invite inversée démontrant que les vérificateurs en mode dialogue suivent la présence d'une proposition confiante plutôt que sa vérité. Le protocole de collecte en aveugle et la construction de la confiance sont énoncés complètement dans l'article complémentaire et sont résumés ici seulement dans la mesure où les mesures l'exigent ; tout ce qui est rapporté comme résultat dans cet article (C1–C4) est mesuré ici et n'est pas repris à partir de celui-ci. À partir de ceux-ci, nous dérivons (C5) une discipline de mesure—matrices publiées par classe de tâche, réclamations de certification stratifiées par difficulté, élicitation en aveugle d'abord, et escalade de régime difficile—qui sépare opérationnellement la vérification de son théâtre.
Travaux antérieurs et cadrage
Le consensus tolérant les pannes (BFT) suppose des défaillances indépendantes—l'hypothèse que nous testons et jugeons non fondée. La littérature du paradoxe du consensus nomme déjà l'erreur stabilisée par accord dans les essaims homogènes (Shehata et Li, 2026). zkML vérifie qu'un calcul s'est exécuté, non que sa réponse est vraie—complémentaire, non concurrent. Le dilemme du vérificateur fournit l'analyse incitatrice ; (Raji et al., 2022) fournissent le problème de sélection de l'auditeur ; (Du et al., 2024), (Farquhar et al., 2024), et (Ding, 2026) fournissent la littérature du signal d'accord que cet article met à l'épreuve. La construction de la confiance elle-même a été introduite dans un article compagnon (Chernets, 2026) ; cet article localise où le moteur de vérification de la construction échoue tout en paraissant fonctionner. Les travaux sur le calcul au moment du test atteignent la conclusion complémentaire du côté constructif : les ensembles de vérificateurs d'aspects divers surpassent tout vérificateur unique (Lifshitz et al., 2025), un collège de petits juges issus de familles disjointes surpasse un seul grand juge à une fraction du coût (Verga et al., 2024), et une réévaluation systématique du débat multi-agents identifie l'hétérogénéité des modèles comme le seul amélioration fiable (Zhang et al., 2025) ; la ligne du débat montre que l'argument contradictoire structuré aide les juges plus faibles à atteindre des réponses plus vraies (Khan et al., 2024). Les données révisées par les pairs documentent déjà une corrélation d'erreur substantielle entre fournisseurs—plus importante précisément parmi les modèles les plus précis, même entre architectures et fournisseurs distincts (Kim et al., 2025)—ce qui motive indépendamment la mesure de la dépendance plutôt que son inférence à partir des étiquettes. Cette littérature sélectionne les collèges pour la diversité ; cet article mesure la valeur de la propriété sélectionnée—et le coût silencieux de son absence—dans la vérification.
Données et mesure
Une collecte en aveugle pré-enregistrée (protocole gelé publiquement avant la collecte de données confirmatoire ; enregistrement public à https://osf.io/4y9dv) : seize modèles un sous-échantillon aléatoire pré-enregistré de 1 500 des 4 326 items de SimpleQA (graine fixe, tiré avant toute collecte ; CSV du sous-échantillon avec son SHA-256 joint à l'enregistrement gelé) à température zéro avec confiance affichée de 0–100 (13 446 réponses frontier nettoyées ; 8 802 réponses de niveau local) ; un bras MC1 TruthfulQA de 750 items au niveau local, dérivé d'une copie gelée du fichier du référentiel officiel (790 items, identiques octet pour octet au CSV canonique) par un constructeur pré-enregistré exigeant au moins deux options incorrectes distinctes par item (graine de mélange fixe ; 695 items entièrement répondus par les sept modèles) ; un bras exploratoire de dialogue actif vs aveugle. SimpleQA est collectée de manière antagoniste contre un modèle frontier, avec une seule réponse indiscutable par question (Wei et al., 2024) : la strate difficile sonde donc les véritables limites des connaissances paramétriques, et la notation se réduit à l'équivalence avec l'or. TruthfulQA fournit le bras de l'espace de réponses contraint (Lin et al., 2022). Les panneaux sont des combinaisons analytiques de la collecte en aveugle unique ; toute réanalyse est déterministe (codage par équivalence de chaîne avec les refus et le non-chevauchement comptés comme un désaccord ; les paires indéterminées signalées en crochets). La difficulté est opérationnalisée de manière observationnelle comme la précision moyenne de 16 modèles par question, répartie en quintiles de rang de 300 questions. La même collecte brute sous-tend l'article d'accompagnement (Chernets, 2026), qui rapporte les ratios de certification regroupés et de brefs résumés des analyses détaillées ici ; l'échelle de levée stratifiée par difficulté, la suite de robustesse, la -matrice et les décompositions de conformité n'apparaissent que dans cet article, et tout chevauchement restant est signalé de manière croisée dans le texte.
La notation en forme ouverte est en deux étapes : un passage par équivalence de chaîne déterministe (26,8 % des notes frontier) plus la détection de refus (6,6 %), les 66,5 % restants étant notés par un évaluateur LLM ; une vérification humaine aléatoire a concordé avec l'évaluateur sur 98 % d'un échantillon aléatoire (). Parce que les deux tiers des notes sont produites par modèle, tous les résultats principaux s'accompagnent d'un rééchantillonnage de sensibilité aux erreurs de l'évaluateur (10 % des verdicts notés par modèle inversés, 200 rééchantillons avec graine ; Section 4 et Appendice A).
Régime de défaillance I : l'inversion de difficulté
Les trois panels de frontière pré-spécifiés sont des combinaisons analytiques 3-modèles de la collection simple en aveugle : bloc US (Anthropic, OpenAI, Google), bloc CN (DeepSeek, Alibaba, Moonshot) et bloc croisé (Anthropic, DeepSeek, Mistral) ; une réponse compte comme reproduite lorsqu'au moins l'un des deux pairs du panel du modèle primaire a indépendamment produit une réponse équivalente selon le codage déterministe gelé de la section 3, et le gain est . Agrégée sur les trois panels, la probabilité qu'une réponse reproduite soit correcte passe de 0,0 % (0/342, IC 0,0–1,1) sur le quintile le plus difficile à 12,8 %, 57,5 % et 81,0 % pour atteindre 95,1 % sur le plus facile ; le gain correspondant par rapport aux réponses non reproduites est 0,00 / 0,82 / 2,68 / 3,09 / 4,56. Sur les 20 % les plus difficiles de questions, chaque accord observé a certifié une mauvaise réponse, et sur le quintile suivant l'estimation ponctuelle place l'accord en dessous de la parité avec le désaccord (0,82, IC [0,51, 1,21]) ; le zéro du quintile le plus difficile se reproduit dans chaque panel séparément (US 0,00–4,25, CN 0,00–9,76, bloc croisé 0,00–4,04) ; la sous-parité Q2 s'observe dans les panels CN et bloc croisé, tandis que le gain Q2 du panel US est 1,20. Une grande partie du gain de certification agrégé est portée par les questions faciles, donc une affirmation de gain non stratifiée surestime ce que la vérification livre là où elle est nécessaire. Le zéro Q1 est mesuré par rapport à un taux de base actif, non à un plancher : les réponses Q1 non reproduites sont correctes 3,9 % du temps (89/2286), donc l'indépendance prédit réponses reproduites correctes—les 0 observés (borne supérieure 1,1 %) s'asseoit significativement en dessous du taux de base de la strate elle-même. L'indépendance benchmark est ici conservatrice, non libérale : une hypothèse nulle préservant la structure complète de corrélation inter-modèles mesurée—une permutation courante des étiquettes de correction dans les questions de la strate, structure de reproduction gelée (2 000 permutations)—s'attend à 11,7–12,4 réponses reproduites correctes et n'a jamais produit le zéro observé ( ; minimum 3) ; plier le bivarié mesuré dans une hypothèse nulle analytique augmente l'attente davantage, car les erreurs positivement corrélées impliquent des réponses correctes positivement corrélées. Ce qui peuple la strate est en soi informatif : les 342 cellules s'étendent sur 106 questions—de simples factoides étroits (médiane 17 mots), non des formulations ambiguës, et les IA s'abstiennent rarement sur elles (0,5 des 9 réponses par question). Leurs mauvaises réponses s'agrègent : sur 70,8 % de ces questions au moins trois des neuf modèles de frontière ont produit la même mauvaise réponse, et sur 67,4 % des questions reproduites par plus d'un panel, les panels indépendamment composés ont certifié le même consensus erroné—typiquement une réponse de voisin célèbre déplaçant l'entité correcte mais moins prominente. Un jugement ad hoc thématique d'expert de tous les 106 labels or en a trouvé 2 discutables et 0 franchement erronés ; en créditant la seule réponse de panel clairement défendable et deux partiellement défendables, le compte du quintile le plus difficile passe de 0/342 à au maximum 13/342 (3,8 %), donc la conclusion quasi-nulle se maintient en s'adoucissant par rapport à un zéro littéral (un label signalé : une élection de l'Académie royale de 2010 cotée par rapport à un titre d'honneur que l'académie ne confère pas). L'affirmation est directement testable : elle prédit un gain Q1 dans toute réplication stratifiée par la précision de la population déployée (sous une stratification indépendante du panel la prédiction est le zéro bloc croisé, non le gain agrégé). Le zéro n'est pas non plus un artefact de notation : un deuxième notateur indépendant d'une famille de fournisseurs en dehors de chaque panel et du notateur original (température zéro, l'invitation de gelé d'équivalence-à-or identique) a noté à nouveau les 342 verdicts reproduits Q1 et a accepté 342/342 (retournements à correct 0/342, borne supérieure 1,1 %) ; le retournement synthétique de 10 % des étiquettes notées par modèle laisse également la part d'erreur certifiée à ou au-dessus de 86,5 % dans chaque rééchantillonnage (appendice).
Restratification en excluant le panel.
Parce que les membres du panel contribuent à l'indice de difficulté de la population, le quintile le plus difficile est en partie conditionné par l'échec du panel lui-même. En restratifiant uniquement par les 13 modèles hors panel, les réponses répliquées sur le quintile le plus difficile sont correctes dans 78/354 cas (22,0%, gain groupé 2,36, au-dessus des 33/354 attendus sous indépendance), et le zéro persiste uniquement pour le panel inter-bloc (0/116 ; 0/88 sur la strate où les 13 modèles hors panel échouent tous). Le zéro survivant est lui-même caractérisé : le taux de base de la strate est 31/778 = 3,98% (Wilson 2,8–5,6%), donnant une espérance d'indépendance de 4,6 réponses correctes parmi les 116 ; une permutation nulle préservant la corrélation (2 000 permutations) donne , intervalle à 95% , et — significativement au-dessous de la distribution nulle, bien que non impossible sous celle-ci. L'inversion ci-dessus est donc une affirmation sur l'endroit où la vérification échoue par rapport à ce que la population déployée trouve difficile, non par rapport à la difficulté indépendante du panel. Comme deuxième vérification de sensibilité, nous avons rederivé l'échelle sous un codage de réplication entièrement sans étiquette (comparaison de chaîne déterministe des réponses en aveugle uniquement, sans jamais consulter l'étiquette de correction) : le résultat Q1 est essentiellement inchangé (2/344 réponses répliquées correctes, 0,6% [0,2–2,1] ; gain 0,15) et les gains inférieurs à 1 sur les deux quintiles les plus difficiles persistent, tandis que le gain du quintile le plus élevé s'atténue (4,56 à 2,33) parce que la pure correspondance de chaîne ne détecte pas les variantes superficielles de la même réponse correcte ; les résultats à choix multiples ne sont pas affectés, car l'accord y est codé par la lettre de réponse et est sans étiquette de par sa construction.
Trois vérifications de robustesse soutiennent l'inversion. (i) Bootstrap au niveau des questions (2 000 rééchantillonnages générés au sein du quintile) donne les IC à 95% pour les cinq gains de [0,00, 0,00], [0,51, 1,21], [2,32, 3,09], [2,84, 3,35], et [4,16, 5,03] : les intervalles du régime difficile excluent entièrement ceux du régime facile. (ii) Sensibilité aux erreurs du correcteur : en inversant 10% des verdicts notation du modèle (200 rééchantillonnages générés ; 97,1% des 342 réponses répliquées du quintile le plus difficile sont notées par modèle et donc inversibles) maintient la part d'erreur certifiée du quintile le plus difficile à ou au-dessus de 86,5% dans chaque rééchantillonnage, garde le gain Q1 en dessous de 1 dans 92% des rééchantillonnages (médiane 0,82), et ne rapproche jamais les gains Q1–Q2 des gains Q3–Q5, qui restent au-dessus de 2 dans les 200 rééchantillonnages. (iii) Le palier local à sept modèles réplique le contraste difficile–facile avec des modèles et panels indépendants, de manière non monotone (Q3 ) : gains 0,00 / 0,94 / 0,00 / 1,89 / 4,37 sur les mêmes quintiles, avec 0 sur 166 réponses répliquées correctes sur le quintile le plus difficile ; ce palier est noté à 94,8% par LLM et est couvert par le même rééchantillonnage de sensibilité du correcteur que (ii).
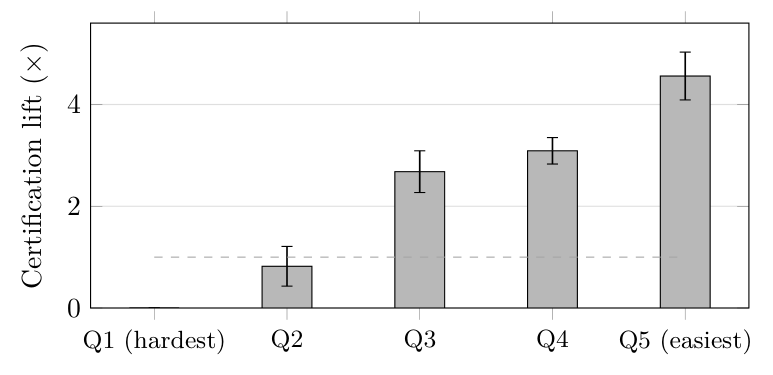 Gain de certification par quintile de difficulté, groupé sur trois panels de frontière, avec intervalles de confiance à 95% au niveau des questions (2 000 rééchantillonnages générés ; Appendice A.1). La ligne pointillée marque gain = 1, parité avec les réponses non répliquées : les deux quintiles les plus difficiles se situent à ou au-dessous de celle-ci par estimation ponctuelle (Q1 0,00×—un zéro mesuré, non une donnée manquante ; Q2 0,82×, son IC traversant la parité), les trois plus faciles bien au-dessus.
Régime de défaillance II : espaces de réponses contraints
En choix multiples, quatre panels locaux pré-spécifiés ont convergé à l'unanimité vers une mauvaise option sur 4,0–7,9 % des 695 questions entièrement répondues (par panel : 4,0, 5,9, 6,6, 7,9), contre une fourchette déterministe de 0,3–4,9 % pour les réponses unanimes confiantes et erronées en forme ouverte au niveau frontalier. En recalculant la même métrique de certification au niveau local sur les propres réponses en forme ouverte du panel (8 802 réponses SimpleQA notées), on élimine la confusion format–tier : les mêmes panels locaux certifient des erreurs unanimes confiantes sur seulement 1,5–4,6 % des items en forme ouverte selon un codage déterministe strict (jusqu'à 9,8 % en incluant la fourchette indéterminée), cohérent avec la plage en forme ouverte frontalière—un motif cohérent avec l'espace de réponses contraint, plutôt que le tier de modèle, conduisant la certification des erreurs ; une confusion persiste cependant : le bras choix multiples et les bras forme ouverte sont des ensembles de questions différents (TruthfulQA MC1 contre SimpleQA), donc le format et l'ensemble de questions ne sont pas séparés ici, et la forme causale de l'affirmation n'est établie que par un échange de format sur la même question, que nous n'avons pas exécuté.1 Le bootstrap par panel place des intervalles sur l'écart où il est alimenté : CM moins erreur-consensus-certifiée en forme ouverte est pp [2,9, 6,8] (pilote), pp [3,9, 8,1] (local-US), et pp [2,6, 6,3] (cross-bloc), chacun excluant zéro ; le panel CN-local, dont la cellule forme ouverte repose sur l'ensemble de 87 items de la note de bas de page, ne la résout pas. Un menu convertit les erreurs éparses en erreurs partagées : quand l'espace de réponses est petit, les modèles qui se ressemblent atterrissent sur le même distrait et l'unanimité du panel devient un amplificateur d'erreurs. Les taux ne s'expliquent pas par des erreurs indépendantes : chaque membre étant indépendamment erroné à son taux marginal et les erreurs s'étendant sur les mauvaises options (), le taux de mauvaise option unanime-même-erronée attendu est de 0,49–0,92 % sur les quatre panels—l'observé 4,0–7,9 % est un excédent de 4,9–13,5 par rapport à la ligne de base d'indépendance. Conséquence de conception, énoncée comme règle testable : toute interface qui fournit aux agents un ensemble d'options fixe devrait s'attendre à une erreur-consensus-certifiée matériellement plus élevée que l'élicitation en forme ouverte sur le même contenu.
Exiger une confiance déclarée de tous les trois panelistes affecte à peine l'effet : la fourchette d'erreur-consensus-certifiée passe de 4,0–7,9 % à 4,0–7,2 % (par panel 4,0, 5,2, 6,0, 7,2), c'est-à-dire que presque toutes les réponses unanimes erronées sont aussi des réponses confiantes. La défaillance n'est pas non plus confinée à une niche thématique : sur les dix catégories TruthfulQA avec au moins 20 items, l'erreur-consensus-certifiée regroupée s'étend de 1,0 % (Conspiracies) à 8,6 % (Economics), avec Law, Health, et Sociology entre les deux (Appendix A).
Régime de défaillance III : les étiquettes d'indépendance ne prédisent pas l'indépendance
Entre 36 paires de fournisseurs de frontière (1 448 questions partagées), la corrélation d'erreur par paire s'étend sur 0,123–0,395, et l'étendue n'est pas organisée par les étiquettes que les gens utilisent : les paires les plus et les moins corrélées sont toutes deux au sein du bloc (googlexai 0,395 vs. googleopenai 0,123), les moyennes intra- et inter-blocs diffèrent de , et la paire de lignée de même base se classe 14e sur les 15 paires formées par les six modèles locaux du bloc US/CN sur les 695 questions à choix multiples entièrement répondues ( ; le septième modèle local appartient au bloc UE et se situe en dehors du plan de conception bloc/lignée préenregistré—l'inclure donne 21 paires, dont la paire de lignée se classe 20e). Les deux hypothèses nulles préenregistrées (bloc, lignée) survivent à la réanalyse ; ce qui reste prédictif est la corrélation mesurée elle-même. La règle pratique : l'indépendance est une quantité par paire, par classe de tâche à mesurer (une -matrice), non déduite de la marque, du drapeau ou de l'arbre généalogique—assembler un panel par étiquettes, c'est faire du casting, non de la vérification. Les par paire mesurent la dépendance d'erreur empirique, non l'indépendance statistique complète : un faible n'exclut pas une dépendance d'ordre supérieur dans les panels de trois ou plus, une autre raison de traiter l'indépendance comme une quantité mesurée, conditionnée par la tâche, plutôt que comme une propriété supposée.
Un test de permutation exact sur les 630 assignments des étiquettes de bloc aux neuf fournisseurs ne trouve aucune preuve d'un effet de bloc : la différence intra-minus-cross observée de est dépassée ou égalée par 132 des 630 rééiquetages (unilatéral ; IC à 95 % « clustered-bootstrap » pour la différence ). Le test limite l'affirmation—les petits effets de bloc ne sont pas exclus—et la conclusion opérationnelle reste valable : l'étiquette ne porte aucun signal utilisable à la place de la mesure par paire. Parce que est limité vers le haut quand les taux d'erreur de base de la paire diffèrent, nous avons relancé l'analyse sur le ratio de normalisation marginale : les deux hypothèses nulles préenregistrées survivent (différence de bloc , permutation ; la paire de lignée reste 14e sur 15), l'étendue persiste (0,278–0,821 entre paires de frontière), et les extrêmes se relocalisent sur deux paires inter-bloc (anthropicmoonshot 0,821, mistralopenai 0,278)—sous l'une ou l'autre métrique, aucune étiquette n'organise l'étendue. En étendant la matrice aux seize modèles : sur les 81 questions répondues par chaque modèle, les par paire s'étendent de à (120 paires ; moyennes de bloc : frontière–frontière 0,320, local–local 0,350, frontière–local 0,210)—une étendue d'un ordre de grandeur qu'aucune taxinomie d'étiquettes dans nos données ne prédit (Figure 2). Avec 81 éléments communs, les estimations de cellules individuelles portent des intervalles larges ; le résultat est l'étendue elle-même, non une cellule unique.
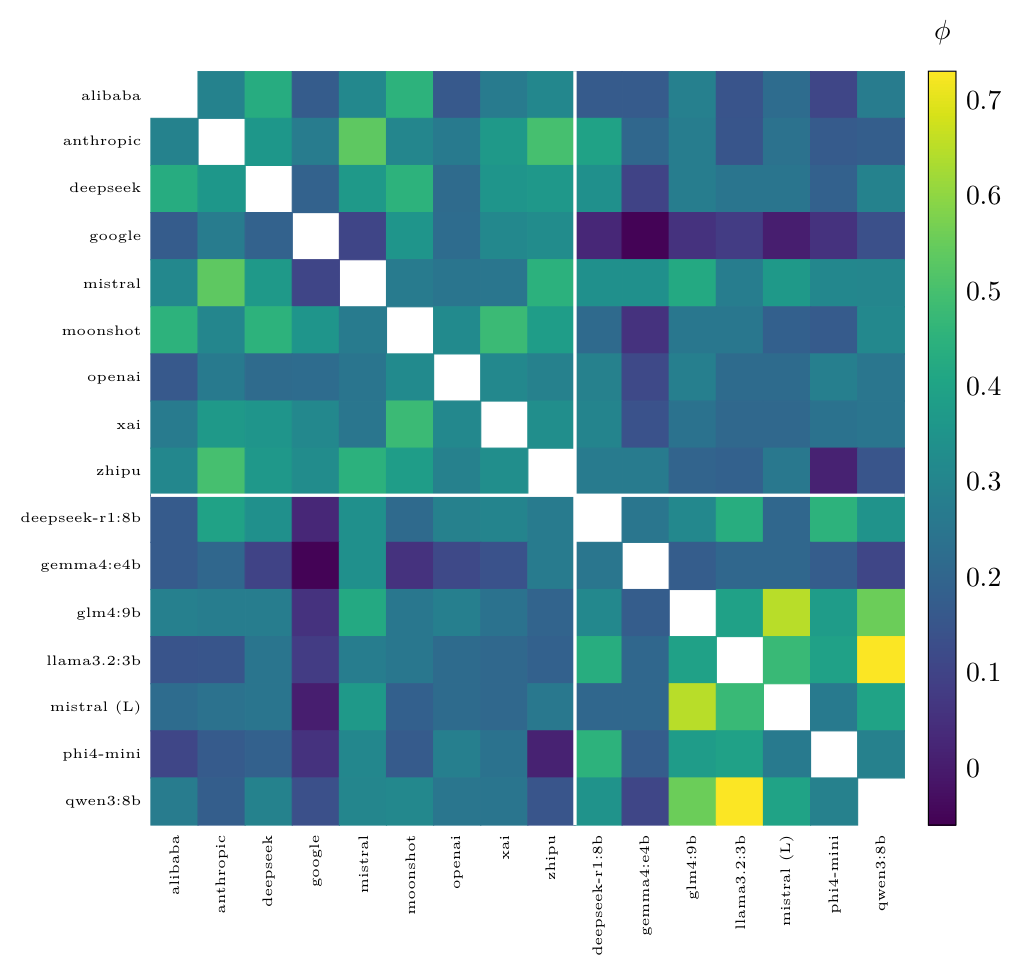 Corrélation d'erreur par paires (ϕ) parmi les seize modèles sur les 81 questions auxquelles chaque modèle a répondu (neuf fournisseurs de pointe, puis sept poids ouverts locaux ; la partition pointe/local est marquée par les règles blanches). Chaque cellule hors-diagonale est l'une des 120 paires uniques ; la diagonale (autocorrélation = 1,0) est laissée vide par conception pour qu'elle ne compresse pas l'échelle des couleurs. ϕ s'étend de −0,05 à 0,73 (moyenne 0,27) : une diffusion d'un ordre de grandeur dans la corrélation des erreurs de deux vérificateurs quelconques, que nul label de bloc ou de lignage dans nos données ne prédit. Les valeurs sont émises de manière déterministe par emit_phi_matrix.py (réutilisant analysis_week1.py sec. W5) ; aucune n'est saisie manuellement.
Régime de défaillance IV : vérification qui capitule (exploratoire)
Lorsqu'un vérificateur qui avait été en désaccord en aveugle s'est vu présenter la même réponse qu'une proposition de collègue, il a capitulé dans 38,5 % des cas (168/436) ; lorsqu'il avait produit la réponse correcte en aveugle, il l'a abandonnée pour la mauvaise dans 30,9 % des cas (46/149), avec des taux d'abandon par fournisseur allant de 13,1 % à 51,6 % (la capitulation par fournisseur sur l'ensemble du sous-ensemble en désaccord en aveugle s'étend de 20,4 % à 58,1 %).
Ces retournements pourraient-ils être une mise à jour rationnelle des croyances plutôt qu'une conformité ? Un contrôle d'invite inversée le conteste. Sur un panel local de six modèles, nous avons réexécuté la procédure appariée avec la direction d'exposition inversée : un vérificateur qui avait été en désaccord en aveugle s'est vu présenter, pour le même ensemble de questions, soit la réponse confiante mais erronée (bras direct), soit la réponse or (bras inverse). Les deux bras sont identiques du point de vue des invites—un modèle partagé (« Réponse proposée : … »), la réponse affichée différant uniquement par le contenu, sans valeur de confiance ni attribution de source affichées—de sorte que le contraste isole la valeur de vérité de la réponse affichée. Si les vérificateurs se mettaient à jour sur la base de preuves, l'exposition à la réponse correcte devrait les déplacer davantage ; au lieu de cela, les deux bras ont produit des taux de retournement presque identiques—38,9 % vers la mauvaise réponse, 34,7 % vers la bonne—et la comparaison intra-paire va à l'encontre de l'histoire de la mise à jour : sur 174 paires discordantes, le vérificateur a abandonné sa position en aveugle pour la mauvaise réponse dans 104 cas et pour la bonne dans 70 cas (exact de McNemar ). Au niveau du modèle, les deux bras étaient indiscernables (propension au retournement 89,9 % vs 89,9 % pour le vérificateur le plus complaisant, 1,5 % vs 1,5 % pour le moins complaisant) : ce qui déclenche l'accord est qu'une proposition confiante est présente, non qu'elle soit vraie—la face de vérification par panel de la flagornerie entraînée par les préférences (Sharma et al., 2024). L'asymétrie ne dépend pas non plus du vérificateur le plus complaisant : l'exclure laisse 835 éléments appariés avec des comptes discordants 94 vs 60 (exact ). Deux décompositions supplémentaires renforcent cette lecture (Appendice A) : chaque retournement enregistré dans l'un ou l'autre bras s'accompagnait d'une confiance post-exposition déclarée (0 retournement en dessous de ce seuil, ), et dans le bras direct, les vérificateurs qui avaient eu raison en aveugle ont abandonné la réponse correcte dans 40,8 % des cas (20/49), reflétant le résultat de frontière. Le contrôle a été exécuté sur le niveau local (Limitations). Un résumé en prose de ce contrôle figure également dans l'article complémentaire (Chernets, 2026) ; la décomposition par modèle, la division par porte de confiance et l'analyse de l'abandon avec raison en aveugle ne sont rapportées que dans le présent document.
Ceci délimite une affirmation de conception : lorsque l'objectif est de mesurer le désaccord indépendant, l'élicitation doit être en aveugle d'abord—un panel qui délibère avant de s'engager sur les positions ne mesure pas son désaccord, il l'efface.
Discussion : l'économie du théâtre (conjecture, non preuve)
Cette section est une discussion plutôt qu'une preuve : elle ne rend compte d'aucune nouvelle mesure, et rien en elle ne devrait être lu comme équivalent aux quatre régimes mesurés ci-dessus. Cela étant dit, les quatre régimes peuvent persister parce qu'aucune partie n'est payée pour les remarquer : les consommateurs ne peuvent pas évaluer la qualité de la vérification, les plateformes sont payées pour la confiance plutôt que pour le doute, et la stratégie la moins coûteuse pour chaque vérificateur est d'être d'accord. Ajoutez le problème de la sélection des auditeurs (l'indépendance est une propriété de celui qui choisit les vérificateurs) et le précédent des fermes de liens (tout signal d'accord qui porte un poids commercial invite à l'exploitation), et le théâtre est un équilibre, non un accident — une conjecture que les mesures motivent mais ne testent pas. Le compte des incitations complète plutôt qu'il n'exclut l'inertie technique et l'absence de normes de mesure ; il est isolé parce qu'il est la composante réfutable. Cette section formule des prédictions de marché réfutables plutôt que des affirmations normatives — par exemple, les panels non audités devraient converger vers des compositions de diversité minimale au fil du temps parce que les panels corrélés sont moins coûteux et s'accordent davantage.
Du théâtre à la mesure
Le remède est une discipline, non une composante : (1) publier la matrice mesurée du panel par classe de tâche, non sa liste de marques (une seule collection aveugle par classe de tâche suffit—la matrice de 16 modèles de ce document provient d'une seule passe de 1 500 éléments) ; (2) stratifier chaque affirmation de certification par difficulté et rapporter le gain du régime difficile séparément (la difficulté est opérationnalisée par classe de tâche à partir d'une collection d'étalonnage, non par élément en inférence) ; (3) recueillir en aveugle d'abord, toujours—le protocole de révélation engagée de vérification du panel, qui réordonne l'élicitation plutôt que d'ajouter du calcul, puisque les réponses aveugles sont parallélisables ; (4) traiter le régime le plus difficile comme un déclencheur d'escalade—sur les questions où le gain mesurée du panel est , l'accord doit être acheminé vers un humain ou vers l'abstention, jamais vers une certification. Chaque règle est énoncée de manière à ce qu'un système déployé puisse être audité par rapport à elle.
Comme exemple travaillé, appliquez la recette au panel de frontière de ce document. Règle (1) : son indépendance est rapportée comme la matrice mesurée de la section 6 (intervalle 0,123–0,395), non comme une liste de fournisseurs—qui aurait caché que la paire la plus corrélée est intra-bloc (googlexai). Règle (2) : son gain de certification est rapporté stratifié (tableau 1), avec le gain du régime difficile ( sur Q1, sur Q2) énoncé séparément plutôt que fusionné dans un seul titre global. Règle (3) : chaque réponse ici a été recueillie en aveugle avant que tout panel ne soit assemblé, ce qui est précisément ce qui rend le bras de conformité (section 7) mesurable plutôt que confondu. Règle (4) : parce que le gain mesuré du panel est sur les deux quintiles les plus difficiles, un déploiement audité de ce même panel acheminerait ces questions vers l'abstention ou l'examen humain, jamais vers une certification de consensus. La discipline n'est donc pas hypothétique : c'est le protocole selon lequel les chiffres de ce document ont été produits.
Limitations
Une seule famille de benchmark par niveau (SimpleQA réponse libre frontier ; TruthfulQA MC local), donc les frontières de régime sont relatives aux benchmarks ; chaque fournisseur frontier est représenté par un modèle budget/mid-tier, donc aucune affirmation sur les capacités des fournisseurs n'est faite. La stratification de la difficulté est observationnelle (post-hoc sur une collection préenregistrée) et l'assignation des quintiles partage des données avec les modèles évalués. Le bras de conformité est exploratoire et modeste en ; son contrôle de prompt inverse utilisait des modèles locaux, donc le transfert aux panels frontier se fait par analogie, non par mesure. Environ deux tiers des notes en réponse libre proviennent d'un évaluateur LLM (vérification humaine 98% d'accord ; une reclassification inter-familles des 342 verdicts du plus dur quintile a confirmé 342/342 ; rééchantillonnage de sensibilité en annexe). Les deux benchmarks sont publics, donc la fuite de données d'entraînement ne peut être exclue ; sur SimpleQA sa direction favorise les réponses mémorisées-correctes, ce qui réduit la strate difficile et rend les résultats du régime difficile conservateurs ; sur TruthfulQA le corpus public porte les idées fausses elles-mêmes, donc la direction n'est pas claire-coupée — une lecture alternative déjà bornée par la réserve format-contenu de la section 5. Aucune affirmation causale n'est faite sur le pourquoi l'accord échoue sur les questions difficiles — les candidats mécanismes (priors partagés, points aveugles partagés, données d'entraînement partagées) sont nommés mais non séparés.
Conclusion
L'accord ne constitue une preuve qu'après que l'indépendance et la compétence ont été mesurées, et la mesure est peu coûteuse—l'ensemble de la réanalyse présentée ici s'exécute en secondes sur du matériel courant à partir de fichiers bruts publics. Tant que les panneaux ne seront pas livrés avec leurs -matrices et des remontées stratifiées, « vérifié par consensus » devrait être lu de la manière dont les ingénieurs en sécurité ont appris à lire une fouille au sac.
References
B. Schneier. Beyond Fear: Thinking Sensibly About Security in an Uncertain World. Copernicus Books, 2003.
D. Shehata and M. Li. The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274, 2026.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
Y. Du, S. Li, A. Torralba, J. B. Tenenbaum, and I. Mordatch. Improving factuality and reasoning in language models through multiagent debate. In ICML, 2024. arXiv:2305.14325.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
E. Kim, A. Garg, K. Peng, and N. Garg. Correlated errors in large language models. In ICML, 2025. arXiv:2506.07962.
M. Sharma, M. Tong, T. Korbak, D. Duvenaud, et al. Towards understanding sycophancy in language models. In ICLR, 2024. arXiv:2310.13548.
A. Khan, J. Hughes, D. Valentine, L. Ruis, et al. Debating with more persuasive LLMs leads to more truthful answers. In ICML, 2024. arXiv:2402.06782.
J. Wei, K. Nguyen, H. W. Chung, Y. J. Jiao, S. Papay, A. Glaese, J. Schulman, and W. Fedus. Measuring short-form factuality in large language models. arXiv:2411.04368, 2024.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lifshitz, S. A. McIlraith, and Y. Du. Multi-agent verification: Scaling test-time compute with multiple verifiers. arXiv:2502.20379, 2025.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
H. Zhang, Z. Cui, J. Chen, et al. Stop overvaluing multi-agent debate—we must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788, 2025.
Vadym Chernets. Architectural trust: Verifiable decision architecture for agentic commerce. SSRN working paper 7191261, 2026. https://doi.org/10.2139/ssrn.7191261 (cited for the trust construct and for its summary treatment of the shared blind collection; overlapping analyses are cross-flagged where they occur).
Appendice de reproductibilité
Toute réanalyse est déterministe à partir des fichiers JSONL bruts notés et deux scripts à graine fixe (un script de référence reproduisant tous les chiffres clés et un complément de semaine 1 produisant les tableaux bootstrap, sensibilité et décomposition ci-dessous) ; le recalcul complet prend moins de 15 secondes sur du matériel standard sans GPU, réseau ou appels de modèle. Le préenregistrement figé et le paquet de réplication (enregistrement OSF public) : https://osf.io/4y9dv.
Intervalles de confiance bootstrap pour l'échelle de gain
Rééchantillonnage au niveau des questions dans le quintile, 2 000 tirages avec graine, regroupés sur les trois panneaux de la frontière.
| Quintile | Wilson 95 % | Bootstrap 95 % | Gain | Gain bootstrap 95 % | |
|---|---|---|---|---|---|
| Q1 (le plus difficile) | 0/342 = 0,0 % | [0,0, 1,1] | [0,0, 0,0] | 0,00 | [0,00, 0,00] |
| Q2 | 46/359 = 12,8 % | [9,7, 16,7] | [8,2, 18,2] | 0,82 | [0,51, 1,21] |
| Q3 | 272/473 = 57,5 % | [53,0, 61,9] | [50,7, 64,6] | 2,68 | [2,32, 3,09] |
| Q4 | 732/904 = 81,0 % | [78,3, 83,4] | [76,6, 85,1] | 3,09 | [2,84, 3,35] |
| Q5 (le plus facile) | 1700/1788 = 95,1 % | [94,0, 96,0] | [93,4, 96,6] | 4,56 | [4,16, 5,03] |
Gain de certification par quintile de difficulté avec intervalles Wilson et bootstrap à 95 % (pourcentages pour , rapports pour le gain). Selon la difficulté leave-panel-out (classée par les 13 modèles hors panel) la cellule Q1 regroupée est 78/354 (22,0 %, gain 2,36), le zéro persiste pour le panel inter-blocs (0/116) ; Section 4. Taux de base par quintile : 3,9 / 15,6 / 21,5 / 26,2 / 20,8 % ( = 2286 / 2308 / 2209 / 1778 / 912).
Sensibilité aux erreurs d'évaluation
Inversion de 10 % des 8 948 jugements de la frontière notés par modèle (200 rééchantillonnages avec graine ; codage d'accord et attribution de quintile figés au protocole de codage déterministe original de manière à ce que seuls les étiquettes de correction se déplacent) : la cellule « certifié correct » du quintile le plus difficile passe de 0/342 à une médiane de 33/342 (9,6 % ; gamme à 95 % 23–46), donc la part d'erreur certifiée de l'accord Q1 reste à ou au-dessus de 86,5 % dans chaque rééchantillonnage ; le gain Q1 reste inférieur à 1 dans 92 % des rééchantillonnages (médiane 0,82, gamme à 95 % 0,56–1,08) tandis que les gains Q3–Q5 ne tombent jamais en dessous de 2 (médianes 2,17 / 2,51 / 3,42). Des 342 réponses répliquées Q1, 332 (97,1 %) sont notées par modèle et donc interchangeables dans cet exercice. Au-delà des inversions synthétiques, un audit inter-familles a réévalué les 342 jugements répliquées Q1 avec un deuxième évaluateur indépendant (une famille de fournisseur en dehors de chaque panel et en dehors de la famille de l'évaluateur original ; température 0 ; invite figée byte-identique) : accord 342/342 (inversions vers correct 0/342, limite supérieure Wilson 1,1 %), uniforme dans les cellules notées par modèle (332) et codées par chaîne/refus (10). Parce que les 342 cellules couvrent 106 questions uniques, une lecture conservative en termes de grappe traite les questions comme unité : 0/106 donne une limite supérieure Wilson de 3,4 % ; la permutation nulle au niveau des questions de la section 4 fonctionne déjà au niveau de la grappe.
Contrôle en prompt inverse : décomposition par modèle
Six modèles locaux, 2 399 observations appariées valides ; flip = le vérificateur abandonne sa réponse en aveugle pour celle affichée.
| Vérificateur | Direct (vers incorrect) | Inverse (vers correct) | Diff |
|---|---|---|---|
| qwen3:8b | 204/227 = 89,9% | 196/218 = 89,9% | pp |
| mistral | 132/213 = 62,0% | 113/203 = 55,7% | pp |
| glm4:9b | 66/213 = 31,0% | 39/200 = 19,5% | pp |
| llama3.2:3b | 40/234 = 17,1% | 38/227 = 16,7% | pp |
| gemma4:e4b | 33/202 = 16,3% | 19/195 = 9,7% | pp |
| phi4-mini | 2/137 = 1,5% | 2/130 = 1,5% | pp |
| Groupé | 477/1226 = 38,9% | 407/1173 = 34,7% | pp |
Taux de flip par vérificateur et bras. Aucun modèle ne bascule plus facilement vers la réponse correcte que vers la réponse confidentielle incorrecte. Recompte appairé : 1 028 éléments présents dans les deux bras (296 basculés dans les deux, 558 dans aucun) ; paires discordantes 104 (incorrect uniquement) vs. 70 (correct uniquement), exact binomial McNemar (asymptotique ). Tous les 884 flips enregistrés comportent une confiance post-exposition déclarée ; le taux de flip au-dessous de ce seuil est 0/547.
Erreur de consensus certifiée MC par catégorie TruthfulQA
Groupé sur les quatre panels locaux pré-spécifiés (événements par item-panel ; catégories ayant au moins 20 items) : Économie 8,6%, Fiction 6,2%, Paranormal 6,0%, Droit 5,9%, Superstitions 5,7%, Stéréotypes 5,4%, Sociologie 4,9%, Santé 4,9%, Idées reçues 2,6%, Conspirations 1,0%. Taux par panel avec les trois membres à confiance : 4,0% (CN-local), 5,2% (inter-bloc), 6,0% (pilote), 7,2% (US-local).
L'extrémité supérieure de 4,6% repose sur le seul panel local partageant seulement 87 items avec les 98 réponses graduables du modèle de raisonnement ; en l'excluant, la plage stricte locale en forme libre est 1,5–1,8%.↩︎
Comment citer
Chernets, V. (2026). Verification Theater: Modes de défaillance mesurés des panneaux de vérificateurs IA [Présentation d'article]. NeurIPS 2026 Workshop: Who Verifies the Agents?. Zenodo. https://doi.org/10.5281/zenodo.23197641
@misc{chernets2026verificationtheater,
  author       = {Chernets, Vadym},
  title        = {{Verification Theater: Measured Failure Modes of AI Verifier Panels}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: Who Verifies the Agents?},
  doi          = {10.5281/zenodo.23197641},
  url          = {https://doi.org/10.5281/zenodo.23197641}
}