Faiblement discriminante, non corrigée par injection de profil, et manipulable : l'autoconfiance dans l'évaluation des LLM
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
Vadym Chernets, Independent Researcher · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197651 · GitHub
Accepté comme affiche au atelier NeurIPS 2026 « TAE (Trust-AI-Eval) : Can We Trust AI Evaluation? » (non-archivé). Copie archivée : 10.5281/zenodo.23197651. PDF : self-confidence-evaluation.pdf. Les figures et tableaux ci-dessous sont convertis à partir de la source LaTeX ; le PDF fait autorité.
Résumé
Les pipelines d'évaluation consomment de plus en plus la confiance affichée par le modèle lui-même en tant que signal de confiance—en tant que poids de fiabilité du juge, déclencheur d'abstention ou profil de compétence auto-déclaré. Nous testons si ce signal mérite le poids qu'on lui attribue, en utilisant une collection pré-enregistrée et protocolaire gelée (16 modèles—un modèle API budget/intermédiaire de chacun des neuf fournisseurs, plus sept modèles ouverts locaux; 22 248 réponses notées à température zéro avec confiance affichée 0–100). Quatre résultats. (1) La surévaluation de la confiance est cohérente dans les seize modèles évalués : la confiance affichée typique se situe à 85–95 pour sept des neuf modèles API tandis que la précision s'étend de 16,5–66,5%, et 60,1% des réponses de première ligne affichées avec confiance 80 sont incorrectes. (2) L'auto-confiance est faiblement discriminante : son AUROC pour prédire la justesse du modèle s'étend de 0,532–0,788 et se situe en dessous de 0,62 pour six des neuf modèles. (3) Un panel de modèles indépendants atteint AUROC 0,832 où l'auto-évaluation donne 0,545 ( , IC 95% ); sous un recodage sans étiquette plus strict de l'accord du panel, le panel maintient toujours l'avantage (0,775 vs. 0,545). (4) L'injection du profil de précision mesuré par domaine du modèle lui-même n'a pas sensiblement amélioré la discrimination sur l'un des échelons de confirmation d'une échelle placebo-contrôlée d'un seul fournisseur (AUROC , ajusté selon Holm), tandis que le même canal d'injection est causalement manipulable : un faux profil a conduit l'AUROC d'auto-évaluation d'un échelon exploratoire au hasard (0,474) et, une fois que les éléments sont étiquetés par sujet, a dégradé l'étalonnage dans quatre des cinq modèles locaux. Nous concluons que la confiance auto-évaluée, telle qu'elle est actuellement suscitée et mesurée ici sur la confiance entière verbalisée en rappel de fait en forme ouverte, est une cible de mesure, non un apport à la confiance : les harnais qui ingèrent la compétence auto-déclarée héritent d'un canal d'entrée non authentifié. Les trois clauses du titre reposent sur des preuves différentes et nous les étiquetez comme telles tout au long : faiblement discriminante est confirmée dans seize modèles; non réparée par injection de profil est un échelon de confirmation sur une famille de fournisseur, sous-alimentée pour l'effet observé; manipulable est exploratoire, avec la direction causale montrée sur les éléments appariés mais aucune attaque testée sur un harnais déployé. L'auto-évaluation de style juge, où un modèle évalue la réponse d'un autre modèle, est une tâche différente et n'est pas testée ici.
Introduction
La pratique moderne de l'évaluation traite silencieusement la confiance affichée d'un modèle comme un instrument de mesure : les juges IA rapportent des scores de certitude, les frameworks d'agents routent selon les compétences auto-évaluées, les politiques d'abstention se déclenchent sur l'incertitude verbalisée, et les benchmarks de calibrage supposent que le canal d'auto-rapport est au moins honnête. L'hypothèse est commode — les auto-rapports sont gratuits, toujours disponibles et produits lors du même passage que la réponse — et elle n'est presque jamais vérifiée au moment de la consommation. Nous posons la question préalable : quelle est la capacité discriminante du signal d'auto-évaluation, peut-elle être réparée avec le profil mesuré du modèle lui-même, et peut-elle être manipulée ?
Nous répondons par une seule collecte préenregistrée, protocol-gelée, en aveugle : seize modèles (un modèle d'API économique/intermédiaire de chacun des neuf fournisseurs, plus sept locaux à poids ouverts), 1 500 questions factuelles post-2023 chacun, température zéro, chaque réponse accompagnée d'une confiance affichée de 0–100 — 22 248 réponses évaluées, toute analyse déterministe à partir des données brutes. Par rapport à cette norme de mesure, le canal d'auto-rapport échoue trois tests successivement plus bienveillants.
C1 (faiblement discriminant). La confiance affichée est saturée et découplée de la compétence : les médianes par modèle se situent à 85–95 pour sept des neuf modèles d'API tandis que la précision s'étend de 16,5 à 66,5 %, et 60,1 % des réponses de frontier affichées avec une confiance 80 sont erronées. En tant que prédicteur de la justesse par élément du modèle lui-même, l'auto-confiance n'atteint qu'un AUROC de 0,532–0,788 selon le modèle — chaque IC de bootstrap exclut le hasard, mais six des neuf modèles se situent en dessous de 0,62, et la prédiction sélective même sur le meilleur d'entre eux laisse une erreur résiduelle substantielle (Section 4). Un panel de modèles indépendants atteint 0,832 où l'auto-évaluation donne 0,545 — un avantage qui survit à un recodage sans étiquette plus strict de l'accord du panel — tandis que l'apparente contre-exemple sur l'autre panel reflète largement l'identité inter-modèles plutôt que l'auto-connaissance par élément (décomposition en Section 4) ; identifier le seul modèle dont l'auto-rapport discrimine bien nécessite toujours la mesure indépendante que l'auto-rapport était censé remplacer.
C2 (aucune réparation confirmatoire par injection de profil). La réparation la plus directe — transmettre au modèle son propre profil de précision mesuré par domaine au moment de la réponse — n'a pas surpassé de manière significative un profil placebo sur l'échelon confirmatoire unique d'une expérience d'une échelle gelée contrôlée par placebo (AUROC , brut , ajusté selon Holm ; aucun point de terminaison confirmatoire n'a réussi). Nous le rapportons comme un résultat nul, non comme une tendance (Section 5).
C3 (manipulable). Le canal d'injection qu'une réparation utiliserait accepte les contrefaçons : un profil mélangé (faux) a ramené l'AUROC d'auto-évaluation de l'échelon frontier exploratoire au niveau du hasard (0,474 contre 0,710 ; baisse ), une seule affirmation « précision de 95 % » fabriquée a déplacé la confiance affichée d'un modèle local de 50 à 95 sur un élément où il se trompe, et une fois que les éléments sont étiquetés par sujet, quatre des cinq modèles locaux consomment un profil faux à leur propre détriment (Brier à ; Section 6).
Ensemble, ces résultats plaident pour un changement de rôle : la confiance auto-évaluée doit être une cible mesurée de l'évaluation, non un intrant non audité à celle-ci. La Section 7 explique les conséquences pour les pipelines de juges, le routage d'agents et la conception du harnais ; l'article complémentaire (Chernets, 2026) examine les modes de défaillance de l'alternative basée sur les panels et est cité, non restaté, ici.
Travaux connexes
Confiance verbalisée et calibrage. La décalibration des réseaux modernes est un résultat établi depuis longtemps (Guo et al., 2017), et pour les modèles de langage ajustés en QA, le calibrage s'est avéré insuffisant bien avant la génération actuelle de modèles (Jiang et al., 2021). On peut apprendre aux modèles d'exprimer l'incertitude en paroles (Lin et al., 2022b) et les modèles plus grands « savent partiellement ce qu'ils savent » sur les sondes d'auto-évaluation (Kadavath et al., 2022), mais ils ne parviennent largement pas à reconnaître ce qu'ils ne savent pas (Yin et al., 2023) ; les audits empiriques de la confiance élicitée révèlent une surestimation persistante dans les formats d'élicitation (Xiong et al., 2024), les scores verbalisés étant parfois mieux calibrés que les probabilités d'émission, mais toujours gonflés (Tian et al., 2023). L'examen de l'état interne affine le cadre : les classificateurs simples sur les activations des couches cachées retrouvent la véracité à 71–83 % (Azaria et Mitchell, 2023)—l'échec réside dans le canal de sortie verbalisé, pas nécessairement dans les représentations internes. Notre contribution porte sur l'échelle et la conception : une collecte pré-enregistrée, figée, portant sur 16 modèles, notant aveuglément la même élicitation par rapport à la vérité de terrain et par rapport à l'accord d'un jury indépendant sur des éléments identiques—plus deux questions que cette littérature pose rarement : le signal peut-il être réparé à partir du profil mesuré du modèle, et le canal de réparation peut-il être attaqué ?
Consommer les auto-rapports en aval. Les pipelines LLM-as-judge héritent les biais du juge et les limites de fiabilité (Zheng et al., 2023), et les signaux de confiance basés sur l'accord font eux-mêmes l'objet d'un audit (Ding, 2026) ; les détecteurs d'entropie sémantique (Farquhar et al., 2024) contournent les auto-rapports en mesurant les distributions de réponses à la place. Les cadres d'évaluation tiers font valoir la gouvernance pour une mesure indépendante (Raji et al., 2022) ; nous lui donnons un plancher quantitatif : pour six des neuf modèles API, l'auto-rapport qu'un pipeline consommerait présente une AUROC inférieure à 0,62.
Entrées non fiables. L'injection de requête indirecte montre que tout canal textuel qu'une IA ingère est une surface d'attaque (Greshake et al., 2023). La section 6 localise une instance spécifique, jusqu'à présent sans nom : l'emplacement du profil d'auto-compétence qu'utiliseraient les réparations de calibrage est un canal d'entrée non authentifié, et le falsifier dégrade la discrimination au hasard.
Jurys et leurs propres défaillances. Les jurys de modèles divers constituent un instrument d'évaluation de plus en plus standard (Verga et al., 2024). Le signal du jury que nous utilisons comme comparateur n'est pas un repas gratuit : ses régimes de défaillance (inversion de difficulté, espaces de réponse restreints, hypothèses d'indépendance basées sur les étiquettes, conformité) sont mesurés dans une soumission complémentaire (Chernets, 2026) sur la même collection brute ; cet article traite l'histoire de l'auto-évaluation, l'article complémentaire traite l'histoire du jury, et aucun tableau n'est dupliqué entre les deux.
Étalons. Nous élicitons sur un sous-ensemble SimpleQA post-2023 (Wei et al., 2024) précisément en raison du décalage d'ancienneté de l'étalon que nous mesurons par rapport à TruthfulQA de 2021 (Lin et al., 2022a) (section 3).
Expérience pré-enregistrée : design et données
Une collection pré-enregistrée, en aveugle, protocole gelé publiquement avant données de confirmation : seize modèles (un modèle API budget/milieu de gamme par fournisseur sur neuf fournisseurs, plus sept modèles open-weights locaux) ont répondu aux mêmes 1 500 questions factuelles post-2023 (sous-ensemble SimpleQA) à température zéro, chaque réponse accompagnée d'une confiance déclarée 0–100 ; 22 248 réponses évaluées au total (13 446 frontier, 8 802 locales).
Pré-enregistrement et gel.
Le protocole de collection a été gelé dans un enregistrement public avant l'existence de toute donnée de confirmation (itinéraire d'accès dans l'appendice de reproductibilité). L'enregistrement pré-spécifie l'indice de référence et le sous-échantillon (aléatoire , seed fixe, SHA-256 du fichier du sous-échantillon enregistré), la liste des modèles, le format d'élicitation, la procédure d'évaluation, le plan d'analyse—incluant la comparaison AUROC de l'accord du panel versus confiance propre utilisée en Section 4, une métrique secondaire pré-spécifiée (l'endpoint primaire de l'enregistrement, le taux de drapeau d'erreur confiant du désaccord du panel, est une quantité côté panel rapportée dans la soumission compagnon)—et une règle de décision contre la sélection de métrique post-hoc. Un petit pilote exploratoire (95 éléments TruthfulQA, trois modèles locaux) a été exécuté avant le gel pour valider le pipeline ; ses nombres ne sont jamais mélangés avec les données de confirmation.
Modèles et élicitation.
Neuf fournisseurs frontier via leurs API—un modèle budget/milieu de gamme par fournisseur, donc les noms de fournisseur ci-dessous désignent des modèles uniques, non des lignes de produits (IDs de modèles exacts et dates de collection dans l'appendice de reproductibilité)—et sept modèles open-weights locaux. Chaque modèle répond à chaque élément indépendamment à température 0 et déclare une confiance entière 0–100 dans la même réponse ; les panels sont des combinaisons analytiques de cette collection unique en aveugle—aucun modèle ne voit jamais la sortie d'un autre modèle.
Évaluation.
Équivalence de chaîne normalisée à l'or et détection de refus en premier ; les cas ouverts non résolus vont à un évaluateur IA LLM open-weights local limité à l'équivalence-à-l'or seulement (qwen3:8b, local). Une vérification ponctuelle humaine de 50 éléments a trouvé 98 % d'accord (une erreur conservative) ; un audit inter-famille des 342 verdicts de consensus de strate la plus difficile a convenu 342/342 (Limitations). Aucune exclusion sauf les défaillances d'analyse (rapportées) ; elles se concentrent dans un modèle de raisonnement local, qui ne conserve que 98 réponses évaluables sur 1 500—toutes les affirmations au niveau local portent par modèle. Toute analyse de confirmation est déterministe à partir du JSONL brut.
Choix d'indice de référence, mesuré.
L'indice de référence primaire post-2023 est une décision de design justifiée par la mesure, non par l'hypothèse : dans une comparaison exploratoire d'âge d'indice, les mêmes modèles ont marqué à points de pourcentage plus haut sur TruthfulQA MC 2021-vintage que sur SimpleQA post-2023 (deepseek pp, IC 95 % ; mistral ; zhipu ; par ex., 89,2 % vs. 28,4 %)—un écart cohérent avec les effets d'âge d'indice et d'exposition, bien que ce design ne puisse pas séparer la contamination de la difficulté et des différences de construction. Aucun nombre de titre ne repose sur l'indice ancien ; le bras MC1 TruthfulQA de 750 éléments au niveau local est utilisé uniquement où désigné comme tel.
Pré-enregistré vs. exploratoire.
Pré-enregistré et de confirmation : la collection ci-dessus et la comparaison AUROC panel-versus-propre (Section 4). Exploratoire, et désigné comme tel partout où utilisé : le bras de comparaison d'âge d'indice, l'échelon d'injection de profil frontier et la microsonde locale de la Section 6. L'échelle d'injection de profil de la Section 5 est un protocole séparé gelé, contrôlé par placebo (bras, endpoints, et famille Holm fixée avant sa phase de confirmation).
Résultat 1 : l'auto-confiance est mal calibrée et faiblement discriminante
Nous distinguons deux propriétés que le terme « calibration » confond souvent : la calibration en large (le niveau de confiance exprimée correspond-il au niveau de précision ?) et la discrimination (la confiance classe-t-elle les réponses correctes du modèle au-dessus de ses réponses incorrectes ?).
Calibration. La confiance exprimée est saturée et découplée de la compétence : parmi les neuf modèles API, la confiance exprimée se situe à 85–95 (médiane par modèle) pour sept des neuf modèles tandis que la précision varie de 16,5 à 66,5 % ; deux s'en écartent—le modèle lourd en refus (médiane 42 à 10,3 % de précision) et un modèle à confiance dispersée (médiane 60). Chaque modèle est surconfiant en large : l'écart confiance-moins-précision (CITL, tableau 1) va de à points de pourcentage. La colonne ECE est presque égale à CITL : l'écart confiance–précision est positif dans chaque classe occupée pour sept des neuf modèles (tous sauf un pour les deux autres), donc la miscalibration par classe et globale coïncident. Même le modèle lourd en refus conserve pp (ECE 0,310)—sa bande basse reflète le comportement de refus, non une connaissance de soi calibrée. Une partie de son avantage en discrimination pourrait être également mécanique—les refus notés incorrects à faible confiance exprimée augmentent l'AUROC (en excluant les lignes de refus, il est de 0,660, )—nous lisons donc son 0,788 comme une limite supérieure de la connaissance de soi élicitée, non un classement de calibration. Agrégé sur les neuf modèles API, 60,1 % des réponses exprimées avec une confiance 80 sont incorrectes (5 598 sur 9 310) ; le taux par modèle varie de 29,0 à 83,2 % (moyenne macro 57,6 %). Un consommateur qui fait confiance à une confiance exprimée élevée accepte une majorité d'erreurs. Discrimination. Comme prédicteur de la correction du modèle lui-même, l'auto-confiance atteint un AUROC de 0,532–0,788 selon le modèle. Les intervalles de confiance bootstrap à 95 % (tableau 1) excluent 0,5 pour chaque modèle, donc le signal n'est pas littéralement aléatoire—mais pour six des neuf modèles il se situe en dessous de 0,62. Les conséquences sont opérationnelles : à 20 % de couverture (réponse seulement au cinquième des éléments à confiance la plus élevée), les taux d'erreur des trois modèles à plus fort auto-AUROC sont encore 75,3 %, 33,3 % et 15,1 % (tableau 2)—une réduction significative seulement pour le troisième, et loin d'une barrière de confiance pour les deux autres.
Une alternative architecturale—comptant les modèles indépendants qui s'accordent—atteint une AUROC de 0,832 (IC 95 % ) sur le panel où l'auto-évaluation produit 0,545 () ; la différence groupée par item, , exclut zéro par une large marge. Les trois panels pré-spécifiés : US (Anthropic, OpenAI, Google), CN (DeepSeek, Alibaba, Moonshot), cross-bloc (Anthropic, DeepSeek, Mistral) ; la comparaison principale concerne le panel CN. Sur l'autre panel pré-spécifié, la comparaison groupée semble s'inverser : auto-évaluation 0,842 groupée sur la population du panel par rapport au panel 0,697 ; . Une décomposition montre que cette inversion apparente reflète largement l'identité entre modèles plutôt que l'auto-connaissance par item : la valeur groupée de 0,842 mélange trois modèles dont les AUROC d'auto-évaluation intra-modèle ne sont que de 0,596–0,784 (moyenne macroscopique 0,709 ; valeurs de population du panel—le tableau 1 rapporte l'ensemble gradué complet), et après normalisation du rang intra-modèle (qui supprime les différences de niveau entre modèles tout en préservant le classement de chaque modèle) la valeur groupée chute à 0,672—une contribution d'identité entre modèles de . Le panel 0,545 passe la même vérification (0,545 groupé vs. 0,582 normalisé par rang) : son échec en auto-évaluation est véritablement par item. Ce qui subsiste de l'inversion est une affirmation plus étroite : le modèle lourd en refus avec la plus forte discrimination de l'auto-confiance (0,788 sur l'ensemble gradué complet) surclasse bien le signal d'accord de ce panel—et identifier quel modèle il s'agit nécessite précisément la mesure indépendante que les rapports automatiques étaient censés remplacer. Le troisième panel pré-spécifié (cross-bloc) se situe entre les deux : panel 0,722 par rapport à propre 0,659 , .
Sensibilité au recodage sans étiquette du signal de panel.
Le codage d'équivalence canonique derrière le signal de panel consulte l'étiquette de justesse du modèle primaire (deux réponses toutes deux notées correctes comptent comme concordantes), de sorte que l'accord du panel dépend partiellement d'une fonction déterministe de l'étiquette cible—une dépendance médiatisée par l'étiquette, bien que non pas une fuite d'auto-vote : par construction le propre dossier d'un modèle n'entre jamais dans son propre signal de panel. Un recodage sans étiquette (accord de chaîne uniquement ; les indicateurs de justesse du modèle primaire ni du participant consulté) abaisse l'AUROC du panel de 0,832 à 0,775 sur le panel où l'auto-évaluation donne 0,545, et de 0,697 à 0,628 sur l'autre ; l'avantage principal du panel survit au codage plus strict (0,775 vs. 0,545).
Le tableau 1 donne la vue par modèle ; la figure 1 montre le même découplage dans tous les seize modèles : tous les modèles se situent au-dessus de la diagonale d'étalonnage, et le tier local s'effondre à une bande de 85–100 de confiance déclarée à 9,2 % de précision.
| Modèle | Préc. (%) | Conf. moyenne | CITL (pp) | Brier | ECE | Auto-AUROC | IC 95 % | |
|---|---|---|---|---|---|---|---|---|
| 1,461 | 66.5 | 92.8 | 0.271 | 0.263 | 0.746 | [0.722, 0.770] | ||
| moonshot | 1,500 | 51.6 | 75.8 | 0.292 | 0.242 | 0.619 | [0.590, 0.648] | |
| alibaba | 1,497 | 47.4 | 92.3 | 0.446 | 0.448 | 0.532 | [0.510, 0.556] | |
| xai | 1,500 | 37.9 | 48.9 | 0.197 | 0.111 | 0.777 | [0.755, 0.798] | |
| deepseek | 1,500 | 35.7 | 89.2 | 0.513 | 0.535 | 0.570 | [0.549, 0.592] | |
| zhipu | 1,493 | 28.4 | 92.6 | 0.612 | 0.642 | 0.611 | [0.582, 0.639] | |
| openai | 1,500 | 16.7 | 77.6 | 0.531 | 0.610 | 0.598 | [0.559, 0.636] | |
| mistral | 1,495 | 16.5 | 90.6 | 0.686 | 0.742 | 0.584 | [0.550, 0.616] | |
| anthropic | 1,500 | 10.3 | 41.3 | 0.206 | 0.310 | 0.788 | [0.758, 0.817] |
Étalonnage par modèle sur la collection SimpleQA de confirmation (palier de frontière, ensemble noté complet ; les noms de fournisseurs désignent le modèle budget/milieu collecté par fournisseur). CITL : étalonnage à grande échelle, confiance énoncée moyenne moins exactitude, en points de pourcentage. ECE : erreur d'étalonnage attendue sur 10 conteneurs. Self-AUROC : confiance énoncée en tant que prédicteur de l'exactitude par élément du modèle lui-même (Mann–Whitney corrigé des égalités), avec IC de bootstrap à 95 % (rééchantillonnage au niveau des lignes dans le modèle, 2 000 tirages, graine fixe). Toutes les valeurs sont des recalculs déterministes à partir de JSONL noté brut ; chaque IC exclut 0.5. CITL utilise les moyennes non arrondies ; les valeurs affichées sont arrondies à une décimale. {#tab:vendor}
| Taux d'erreur à la couverture | |||||
|---|---|---|---|---|---|
| 2-6 Modèle | 100 % | 80 % | 60 % | 40 % | 20 % |
| anthropic (self-AUROC 0.788) | 89.7 % | 87.1 % | 82.9 % | 80.3% | 75.3% |
| xai (0.777) | 62.1% | 52.8% | 45.1% | 39.5% | 33.3% |
| google (0.746) | 33.5% | 24.5% | 20.0% | 18.7% | 15.1% |
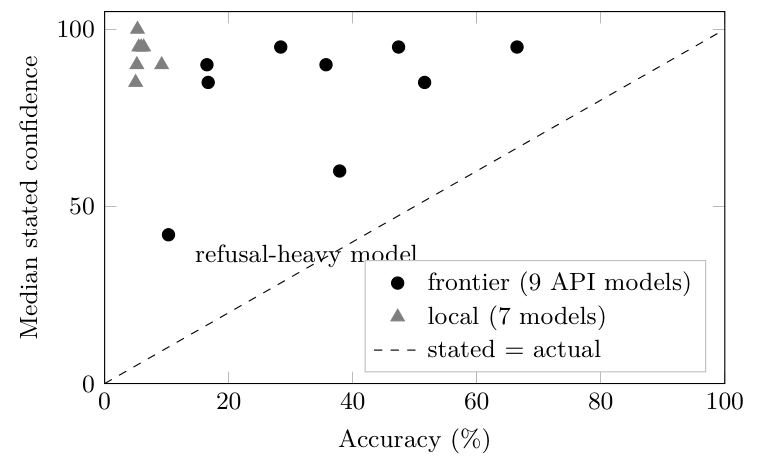 Surconfiance constante dans les seize modèles évalués : confiance déclarée médiane par modèle (les moyennes apparaissent dans le tableau 1) par rapport à la précision réelle pour les 16 modèles sur les mêmes 1 500 éléments SimpleQA en aveugle. Tous les modèles se situent au-dessus de la diagonale d'étalonnage ; le modèle lourd en refus (confiance déclarée médiane 42 à 10.3% de précision, CITL +31.0 pp) présente le meilleur auto-AUROC, 0.788, mais reste surconfiant ; l'écart d'étalonnage le plus petit appartient au modèle à confiance dispersée (+11.1 pp). Médianes des frontières par modèle : 95/85/95/60/90/95/85/90/42 dans l'ordre des lignes du tableau 1 ; le palier local des sept modèles s'étend sur une précision de 5.0–9.2% à confiance médiane 85–100 (n gradué par modèle local 98–1 498 après exclusion des défauts d'analyse ; le palier local sert aux sondes de manipulation et à cette image, non aux réclamations de discrimination).
Résultat 2 : aucune amélioration confirmée de la discrimination par l'injection de profil mesuré
Une réparation naturelle consiste à fournir au modèle son propre profil de compétence mesuré—la précision par domaine à partir de données retenues—au moment de la réponse. Dans une expérience d'échelle contrôlée par placébo (groupes : sans profil, profil placébo appariés pour le niveau global, profil mesuré propre, profil mélangé), le groupe profil-propre n'a pas surpassé significativement le placébo sur le critère confirmé : AUROC , IC 95 % , brut , ajusté par Holm ; aucun critère confirmé n'a été atteint. Nous rapportons ceci comme un nul avec un champ explicitement restreint : sur un échelon confirmé, la discrimination n'a pas été corrigée par l'injection de profil mesuré. L'estimateur ponctuel est positif, mais sous correction préenregistrée la réparation n'est pas démontrée ; l'étude était alimentée uniquement pour des effets modérés (ÉT de l'IC : 80 % de puissance seulement pour AUROC , supérieur à l'observé —les données sont donc compatibles avec à la fois un nul vrai et un petit effet vrai). Le plafond du plan n'est pas le facteur limitant. En prenant la précision du propre bac de chaque item—calculée leave-one-out, donc un item ne contribue jamais à son propre prédicteur—comme unique prédicteur de la justesse de cet item, on obtient un AUROC oracle de 0.758 pour le sujet confirmé (0.716–0.789 sur les quatre sujets d'échelle), avec ÉT de dispersion de précision par bac de 0.195 et étendue de 0.15–1.00 sur les 21 bacs. Les bacs diffèrent donc suffisamment pour qu'un profil véridique porte une information substantielle : le nul concerne le canal d'injection, non pas une batterie trop faible pour en enregistrer un.1 Les motifs exploratoires (gains plus importants là où l'étalonnage de base est le plus faible) ne sont que génératrices d'hypothèses.
Plan d'échelle et validation du placébo.
Quatre échelons figés (sujets : Claude Haiku 4.5, Sonnet 5, Opus 4.8, et Fable 5 ; identifiants exacts claude-haiku-4-5-20251001, claude-sonnet-5, claude-opus-4-8, claude-fable-5), chacun avec quatre groupes en aveugle occupant le même emplacement d'étalonnage d'une invite par ailleurs identique : arrêt (vide structurel en forme de profil), placébo (profil sans lien d'étalonnage appariés pour le niveau global ; validé par échelon par rapport au profil vrai à —mesuré , , , ), cœur (le profil par domaine mesuré propre du modèle), et mélangé (faux profil permuté par bac ; exploratoire après l'échec d'une vérification de manipulation qui l'a rétrogradé du statut confirmé). La batterie de 315 items couvre 21 bacs de domaine avec des items piégés et un jeton d'abstention explicite ; les attributions item–groupe ont été figées avant la phase confirmée, avec ordre de groupe aléatoire par item et aucun nom de groupe dans le texte visible par le sujet. Une limite de dégénérescence préenregistrée (arrêt précision ) a rétrogradé trois des quatre échelons de tous les calculs confirmés ; le tableau 3 rapporte l'échelon admissible. La précision du groupe arrêt de l'échelon survivant est de 0.847 par rapport au seuil de 0.85, tandis que les échelons rétrogradés sont à 0.855, 0.888, et 0.900—avec des AUROCs arrêt-groupe répondus seulement de 0.575, 0.628, et 0.500 (de manière descriptive, la précision près du plafond laisse peu de signal d'étalonnage à réparer). Les quatre sujets proviennent d'une seule famille de vendeur ; consultez Limitations.
| Bras | Prec. (tous les éléments) | AUROC | Brier | ECE | Appariement AUROC (corebras) |
|---|---|---|---|---|---|
| off (pas de profil) | 0.847 | 0.564 | 0.138 | 0.110 | [] |
| placebo | 0.857 | 0.578 | 0.127 | 0.090 | [] |
| core (propre profil) | 0.857 | 0.625 | 0.127 | 0.099 | — |
| shuffled (faux) | 0.842 | 0.589 | 0.140 | 0.113 | non calculé (exploratoire) |
Échelle d'injection de profil, échelon confirmant l'admissibilité (sujet : Claude Sonnet 5 ; : 294 éléments sans piège 2 réplications de processus frais pré-enregistrées—l'appareillage n'expose ni la température ni la graine ; AUROC réponses seules). Contrastes confirmatoires (bootstrap par grappes d'éléments) : coreplacebo AUROC , IC 95 % , brut ; coreoff , IC , brut ; les deux échouent la correction de Holm () et la porte bidirectionnelle élémentlot (une exigence de robustesse pré-enregistrée regroupant par élément et lot de collection). La colonne appariée répète les contrastes appariés par grappes d'éléments de l'analyse gelée par rapport à core ; ce ne sont pas la différence arithmétique de la colonne AUROC par groupe, et aucun contraste appariés confirmatoire n'a été calculé pour shuffled (rétrogradé à l'exploration avant la phase confirmatoire). Nous notons à l'encontre de notre propre hypothèse que core ne domine pas en étalonnage : son ECE (0.099) est pire que celui du placebo (0.090), ce qui est une raison supplémentaire de lire le nul confirmatoire comme un nul. {#tab:ladder}
Résultat 3 : le canal d'autoperception est manipulable
Si un dispositif d'évaluation consomme un profil d'autocompétence, cet emplacement est un canal d'entrée, et les entrées peuvent être falsifiées. Nous distinguons trois affirmations de force probante décroissante et précisons laquelle chaque résultat soutient. (i) Manipulabilité causale—démontrée ci-dessous : substituer un faux profil modifie causalement la confiance énoncée et dégrade l'étalonnage dans des exécutions contrôlées. (ii) Vulnérabilité d'intégrité—conditionnelle : elle n'importe que pour les dispositifs qui injectent réellement des profils de compétence d'une source qu'un adversaire peut influencer. (iii) Surface d'attaque pratique dans les pipelines d'évaluation déployés—une hypothèse que cet article motive mais ne teste pas. Le remplacement du vrai profil par un profil mélangé (faux) a ramené l'auto-évaluation d'un échelon frontalier exploratoire à un niveau aléatoire : 0,474 contre 0,710 avec le vrai profil (échelon exploratoire plafond-rétrogradé ; bootstrap agrégé par item : 0,710 [0,586, 0,820] vs 0,474 [0,349, 0,599], différence [, ]). Par contraste, sur l'échelon admissible aux confirmations mélangé s'est situé entre placebo et noyau (0,589 vs 0,578 et 0,625 ; contraste appairé agrégé par item, exploratoire : ). Cet échelon constitue par construction une faible preuve de manipulation : le faux profil a échoué deux fois à la vérification préenregistrée (juge externe 0,99/0,94 contre une limite ) ; la règle figée a rétrogradé le bras avant que les données de confirmation n'existent, un sujet peut rejeter un profil manifestement implausible, et aucune vérification consommée n'existe. Constatation autonome : un juge frontalier détecte la contrefaçon par la seule plausibilité. Sur un poste local à coût zéro, une seule affirmation fabriquée (« 95 % de précision dans ce domaine ») a relevé la confiance énoncée d'un modèle sur le même item de 50 à 95 ; l'effet se concentre dans les modèles qui ont un étalonnage déclaratif à perdre ; dans cette sonde le plus grand décalage ( points) s'est produit dans le modèle qui en avait le plus à forfaire (glm4:9b). Deux conditions limites bornent l'effet : le modèle doit pouvoir associer l'item actuel à un bac de profil (sur les items non étiquetés, les petits modèles locaux ignorent le profil ; les deltas , conformément à la nullité figée du Résultat 2), et les modèles plafond-bloqués (confiance indépendamment) n'ont rien à attaquer.
La preuve de manipulation—un échelon frontalier exploratoire, une microsonde locale, et un passage local étiqueté par sujet—établit la manipulabilité causale, affirmation (i). Le Tableau 4 montre la microsonde : le même item, le même modèle, et une modification d'une ligne dans le profil d'autoperception injecté déplacent la confiance énoncée de jusqu'à points.
Passage exploratoire étiqueté par sujet : les deux côtés de la limite, en direct.
La première condition limite ci-dessus (le modèle doit pouvoir associer l'item au bac de profil) est elle-même testable : étiqueter chaque sonde avec son sujet—une déviation divulguée du protocole figé—supprime l'obstacle d'association. Dans un passage local complet (cinq modèles, 16 sondes retenues par bras, température 0, graine fixe), le faux profil qui était inerte sur les items non étiquetés est consommé par quatre modèles sur cinq une fois les items étiquetés : Brier se dégrade de (glm4:9b), (llama3.2:3b, avec la précision chutant 37,5 %25,0 %), (mistral:7b), et (phi4-mini) ; les IC de bootstrap par sonde à incluent zéro pour chaque modèle, de sorte que la microsonde établit la direction et le mécanisme plutôt que les tailles d'effet par modèle ;
le cinquième (qwen3:8b) répond la batterie au plafond (précision de 100%, confiance de 100 dans les deux bras, ), reproduisant la frontière « rien à attaquer ». Le mécanisme est directionnel et symétrique : une fausse affirmation élevée gonfle la confiance exactement dans le bac le plus faible (physique llama3.2 : confiance déclarée 0100 dans un bac avec une précision retenue de 25% ; logique phi4-mini 1365), et une fausse affirmation basse dégonfle la confiance sur les réponses correctes (histoire llama3.2 1000 à une précision retenue de 75%), jusqu'à induire une abstention sur des éléments que le modèle répond par ailleurs. Les deux côtés de la frontière sont donc exposés par des exécutions en direct : éléments non étiquetés, profil inerte (le zéro gelé) ; éléments étiquetés, l'auto-image forgée se propage directement dans la confiance déclarée et dégrade l'étalonnage de bout en bout.
| Modèle | Conf. @ « 0% » | Conf. @ « 95% » | |
|---|---|---|---|
| glm4:9b | 50 | 95 | |
| llama3.2:3b | 80 | 95 | |
| mistral:7b | 90 | 100 | |
| phi4-mini | 90 | 95 | |
| qwen3:8b | 100 | 100 |
Microsondes locales (exploratoires) : confiance déclarée sur le même élément (répondu incorrectement) quand l'emplacement de profil injecté affirme « précision de 0% » par rapport à « précision de 95% » dans le domaine de l'élément ; cinq modèles ouverts locaux, température 0. Le modèle plafonné au plafond (dernière ligne) n'a pas d'étalonnage déclaratif à attaquer. {#tab:microprobe}
Implications pour la pratique d'évaluation
Nos résultats sont mesurés sur une famille de tâches unique (QA factuelles en forme ouverte post-2023) avec un format d'élicitation unique ; les implications ci-dessous extrapolent à partir de ces mesures.
(1) Inverser le rôle de la confiance déclarée. La confiance auto-rapportée devrait être une cible mesurée de l'évaluation, non une entrée pour celle-ci selon l'élicitation actuelle. Chiffres d'appui : 60,1 % des réponses de haute confiance en première ligne sont erronées, et le meilleur auto-AUROC (0,788) appartient au modèle qu'un classement de précision rangerait dernier—aucun classement ne prédit dont les auto-rapports discriminent.
(2) Les pipelines de jugement héritent de poids faiblement discriminants. Tout schéma IA-comme-juge ou d'ensemble pondérant les votes par certitude auto-rapportée importe, pour six des neuf modèles ici, un signal avec AUROC inférieur à 0,62—silencieusement, car la bande saturée 85–95 semble rassurante dans les journaux. Si la pondération par certitude est utilisée du tout, les poids devraient provenir d'une calibration mesurée par modèle, non du rapport lui-même.
(3) Authentifier l'emplacement du profil. Le modèle de menace à trois niveaux de la section 6 ordonne la préoccupation : la manipulabilité causale est démontrée, la vulnérabilité d'intégrité est conditionnelle à un harnais injectant effectivement les profils d'une source influençable, et une surface d'attaque pratique dans les pipelines déployés reste une hypothèse. Pour les harnais de la classe conditionnelle, le canal de réparation est l'exposition : le profil injecté qui était censé corriger la calibration accepte les contrefaçons qui poussent la discrimination au niveau du hasard (0,474) et dégradent les scores de Brier de bout en bout une fois les éléments associables. Un tel harnais a besoin d'une porte d'intégrité—profils signés, vérifications de provenance, ou à minima séparer qui mesure le profil de qui le fournit au moment de l'inférence. Un emplacement d'auto-image non authentifié est un port ouvert d'injection d'invite avec une charge utile de calibration.
(4) La mesure externe est l'alternative—avec son propre audit. L'accord de panel indépendant domine l'auto-évaluation où l'auto-évaluation échoue le plus (AUROC ), mais les panels ont leurs propres régimes d'échec mesurés, examinés dans l'article complémentaire (Chernets, 2026) ; adopter le signal du panel sans cet audit répéterait la même erreur un niveau plus haut. Une extension pré-enregistrée comme exploratoire ajoute un troisième angle : sur 12 paires d'échange de profil dirigées (3 780 appels), substituer le profil mesuré d'un autre modèle a décalé l'AUROC d'au maximum —et a parfois aidé—tandis que la prédiction du classement de similarité de la perte de transfert a échoué (Spearman ) : les profils mesurés sont des instruments portables, non un accès privilégié à soi-même. Une batterie diagnostique pratique d'auto-évaluation est décrite en annexe.
Limitations
Une seule famille de référence pour le titre (QA factuelle open-form post-2023) ; chaque fournisseur est représenté par un modèle budget/mid-tier, de sorte que la généralisation au niveau du fournisseur n'est pas revendiquée ; l'élicitation de confiance énoncée est un format de prompt pour les chiffres du titre—bien qu'un bras exploratoire à deux étapes (150 éléments cinq modèles locaux) suggère que le format n'est pas le coupable : une requête de confiance post-hoc sans état a réduit la confiance énoncée et les taux d'erreur confiant, mais pas la discrimination (self-AUROC 0,43–0,61 dans les deux formats ; AUROC bootstrap par paires regroupés sur paires, étiquettes sans LLM déterministes sur 142–150 lignes par modèle—une déviation étiquetée par rapport à l'évaluateur string-only, sous lequel 90 % des cas sont irrésolus) ; la nullité d'injection est un échelon confirmatoire d'une échelle (315 éléments, 21 bacs), tous quatre sujets d'une seule famille de fournisseur, et elle n'exclut pas de meilleurs modèles de réparation ; la preuve de manipulation combine un échelon exploratoire de la frontière, une microsonde locale, et une passe locale étiquetée par sujet (une déviation divulguée)—pas une étude d'attaque confirmatoire ; le classement est partiellement basé sur les IA et sa validation humaine est un spot-check de 50 éléments (accord de 98 %, une erreur conservatrice). La famille de fournisseurs de l'évaluateur accueille également un membre du panel CN, l'indépendance de l'évaluateur est elle-même mesurée : un deuxième évaluateur d'une famille en dehors de tous les panels et l'évaluateur lui-même a reclassé tous les 342 verdicts de consensus du quintile le plus difficile et a convenu 342/342. L'évaluateur est lui-même un sujet de tier local ; un reclassement cross-family de toutes les 1 441 lignes auto-évaluées a convenu à 98,3 %, le désaccord tendant vers l'indulgence personnelle (24 retournements vers le bas contre 1 vers le haut ; précision 5,94,4%)—renforçant le tableau de surconfiance ; un audit de révision stratifié plus complet reste un travail futur. Les comparaisons panel-vs-auto partagent des données avec la soumission complémentaire ; aucun tableau n'est dupliqué, la limite est énoncée aux sections 1–2, et la portée de cet article reste auto-évaluation uniquement.
Conclusion
L'auto-évaluation, telle qu'elle est actuellement sollicitée, échoue trois tests qu'un signal d'évaluation doit réussir : elle suit la justesse trop faiblement pour contrôler les décisions tout en restant gravement surconfiante, l'intervention d'auto-connaissance la plus directe n'a produit aucune réparation démontrable sous contrôle placebo, et son canal d'entrée accepte des contrefaçons qui poussent la discrimination au niveau du hasard. Tant que les modèles n'auront pas acquis d'étalonnage sur des preuves mesurées, la confiance énoncée est un phénomène à étudier, non un signal à consommer.
References
Vadym Chernets. Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop Who Verifies the Agents?, 2026. https://doi.org/10.5281/zenodo.23197641 (cited for panel-side regimes only).
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
K. Greshake, S. Abdelnabi, S. Mishra, C. Endres, T. Holz, and M. Fritz. Not what you’ve signed up for: Compromising real-world LLM-integrated applications with indirect prompt injection. In Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security (AISec), 2023. arXiv:2302.12173.
C. Guo, G. Pleiss, Y. Sun, and K. Q. Weinberger. On calibration of modern neural networks. In ICML, 2017. arXiv:1706.04599.
Z. Jiang, J. Araki, H. Ding, and G. Neubig. How can we know when language models know? On the calibration of language models for question answering. Transactions of the Association for Computational Linguistics, 9:962–977, 2021. arXiv:2012.00955.
S. Kadavath, T. Conerly, A. Askell, et al. Language models (mostly) know what they know. arXiv:2207.05221, 2022.
A. Azaria and T. Mitchell. The internal state of an LLM knows when it’s lying. In Findings of EMNLP, 2023. arXiv:2304.13734.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lin, J. Hilton, and O. Evans. Teaching models to express their uncertainty in words. Transactions on Machine Learning Research, 2022. arXiv:2205.14334.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
K. Tian, E. Mitchell, A. Zhou, A. Sharma, R. Rafailov, H. Yao, C. Finn, and C. D. Manning. Just ask for calibration: Strategies for eliciting calibrated confidence scores from language models fine-tuned with human feedback. In EMNLP, 2023. arXiv:2305.14975.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
J. Wei et al. Measuring short-form factuality in large language models (SimpleQA). arXiv:2411.04368, 2024.
M. Xiong, Z. Hu, X. Lu, Y. Li, J. Fu, J. He, and B. Hooi. Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. In ICLR, 2024. arXiv:2306.13063.
Z. Yin, Q. Sun, Q. Guo, J. Wu, X. Qiu, and X. Huang. Do large language models know what they don’t know? In Findings of ACL, 2023. arXiv:2305.18153.
L. Zheng, W.-L. Chiang, Y. Sheng, et al. Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. In NeurIPS Datasets and Benchmarks, 2023. arXiv:2306.05685.
Outil pratique : un diagnostic d'auto-évaluation
Un sous-produit de cette étude est un diagnostic d'auto-évaluation compact : une batterie fixe de sondes courtes, graduables de manière déterministe, couvrant les domaines de l'étude (numérique, logique, physique, histoire, code, probabilité, et autres), plus des éléments pièges avec un jeton d'abstention explicite. Chaque réponse porte une confiance affichée de 0–100, et l'outil calcule un composite du score de Brier, de l'écart de surconfiance (confiance moyenne moins exactitude), de la discrimination de confiance (confiance moyenne sur les réponses correctes moins incorrectes), et du taux d'abstention aux pièges, mappant le résultat à des niveaux allant de bien calibré à aveuglément confiant. Il opérationnalise la thèse de cet article — l'étalonnage est quelque chose à mesurer sur un modèle, non à lire sur ses auto-déclarations — et est publié avec le paquet de réplication comme outil, non comme résultat : il utilise des sondes paraphrasées plutôt que la batterie gelée, et son score de discrimination est un proxy, non le point d'extrémité AUROC de l'échelle.
Appendice reproducibilité
Tous les chiffres clés de cet article sont des fonctions déterministes du JSONL brut publié ; aucune étape n'implique de l'aléatoire, d'accès réseau, de calcul GPU ou de requête répétée auprès d'un modèle.
Disponibilité des données.
La pré-inscription gelée et le paquet de réplication (enregistrement OSF public) : https://osf.io/4y9dv. Le script oracle-ceiling oracle_auroc.py est déposé avec cet article à https://doi.org/10.5281/zenodo.23197651.
Invite d'élicitation (texte intégral).
Système : You answer short factual questions. Respond with ONLY a JSON object like {"answer": "<short answer>", "confidence": 85}. confidence is an integer 0-100 for how sure you are the answer is correct. No other text. Le tour utilisateur contient la question nue ; les refus sont détectés à partir du champ réponse par le lexique gelé de refus dans le script de notation.
Identifiants de modèle et dates d'exécution.
Un modèle API par budget/mid-tier par fournisseur, vérifié en direct le 2026-07-24 et collecté fin juillet 2026 (horodatages par appel dans le manifeste d'exécution, publié avec le paquet de réplication) : anthropic claude-haiku-4-5-20251001 ; openai gpt-5-mini ; google gemini-3.6-flash ; xai grok-4-fast ; deepseek deepseek-chat ; alibaba qwen-plus ; moonshot kimi-k3 (un écart de collecte divulgué : 670 éléments sur 1 500 sur le compte propriétaire, le reste via un itinéraire agrégateur servi par la même infrastructure propriétaire avec raisonnement désactivé, served_by enregistré par appel ; une division de sensibilité propriétaire uniquement a été pré-engagée) ; zhipu glm-4.5 ; mistral mistral-small-latest. Tier local (Ollama, température 0) : gemma4:e4b, llama3.2:3b, phi4-mini, qwen3:8b, deepseek-r1:8b, glm4:9b, mistral:7b.
L'article compagnon (Chernets, 2026) partage la même enregistrement gelé et collecte brute. Le paquet de réplication contient : le texte et le protocole d'enregistrement gelés, le manifeste d'exécution avec les identifiants exacts des modèles, les collections notées brutes (tiers frontier et local, plus le bras d'exploration comparant l'âge du benchmark), et trois scripts CPU sans dépendances. Le premier (compute_panel_vs_own_auroc.py) est la définition canonique de la comparaison AUROC accord de panel vs. confiance propre (section 4) et affiche, à côté des valeurs canoniques, chaque lecture alternative non canonique (signal de panel binaire, codage indéterminé, traitement des égalités, variantes de regroupement) pour que le choix de lecture soit auditable. Le deuxième (analysis_tae_week1.py) réimprime le tableau 1, les coordonnées de la figure 1, les écarts d'âge de benchmark de la section 3, et effectue une vérification en lecture seule des valeurs d'échelle gelées rapportées au tableau 3 par rapport au fichier d'analyse gelé de l'échelle. Le troisième (analysis_tae_decomposition.py) réimprime la décomposition AUROC regroupée et la normalisation de rang de la section 4, le recodage du signal de panel sans étiquette, les taux d'erreur haute confiance par modèle, les colonnes CITL/Brier/ECE du tableau 1, les valeurs risque–couverture du tableau 2, et les descriptifs de barreau rétrogradé de la section 5. Chaque script s'exécute en quelques secondes sur une CPU d'ordinateur portable avec la seule bibliothèque standard Python. L'échelle d'injection de profil est livrée comme son propre bundle gelé (protocole, batterie, lignes notées par bras, et JSON d'analyse), pointé depuis le paquet.
Calculé à partir des scores de bras gelés par élément (
scored-arms-*.jsonl; non-piège, statutok; pour le sujet confirmatoire) paroracle_auroc.py, publié avec cet article ; tous les bras et réplicas d'un élément sont laissés de côté ensemble.↩︎
Comment citer
Chernets, V. (2026). Faiblement discriminatif, non réparé par injection de profil, et manipulable : l'auto-confiance dans l'évaluation des LLM [Présentation de communication]. NeurIPS 2026 Workshop: TAE. Zenodo. https://doi.org/10.5281/zenodo.23197651
@misc{chernets2026selfconfidenceevaluation,
  author       = {Chernets, Vadym},
  title        = {{Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: TAE},
  doi          = {10.5281/zenodo.23197651},
  url          = {https://doi.org/10.5281/zenodo.23197651}
}