弱い判別力を持ち、プロファイルインジェクションでは改善されず、操作可能である:LLM評価におけるセルフコンフィデンス
これは翻訳です。正式版は英語の原文です。引用の際は原文をご参照ください。
Vadym Chernets, Independent Researcher · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197651 · GitHub
NeurIPS 2026ワークショップ「TAE (Trust-AI-Eval): Can We Trust AI Evaluation?」にポスターとして採択されました(非アーカイブ)。 アーカイブ版:10.5281/zenodo.23197651。PDF:self-confidence-evaluation.pdf。以下の図表はLaTeXソースから変換されています;PDFが最終版です。
Abstract
評価パイプラインは、モデルの自己報告される信頼度を信頼シグナルとして—判定信頼度の重み、棄却トリガー、または自己報告される能力プロファイルとして—ますます利用しています。その信号が当該の重みに値するかどうかを、事前登録され、プロトコルが固定されたコレクション(16モデル—9つのプロバイダーから各1つの予算/ミッドティアAPIモデルと7つのローカルオープンウェイト;温度ゼロで0~100の信頼度を述べた22,248の採点回答)を用いてテストします。4つの知見があります。(1)過度な自信は16個の評価されたすべてのモデル全体で一貫しています:典型的な述べられた信頼度は9つのAPIモデルの7つについて85~95で、精度は16.5~66.5%にわたり、信頼度80で述べられたフロンティア回答の60.1%は誤りです。(2)自己信頼度は弱い識別力を持ちます:モデル自身の正当性を予測するためのそのAUROCは0.532~0.788にわたり、9つのモデルの6つについて0.62以下です。(3)独立モデルのパネルは、自己評価が0.545を与える場所でAUROC 0.832に達します( 、95% CI );パネル合意のより厳密なラベルフリー再符号化の下で、パネルはまだリードしています(0.775対0.545)。(4)モデル自身の測定された各ドメイン精度プロファイルを注入することは、プラセボ対照単一ベンダーラダーの1つの確認段階で識別を実証的に改善しませんでした(AUROC 、Holm調整)、同じ注入チャネルは因果的に操作可能です:虚偽のプロファイルはある探索段階の自己評価AUROCをチャンスレベル(0.474)に駆動し、一度項目がトピックラベル付けされると、5つのローカルモデル中4つのキャリブレーションを低下させます。現在ここで引き出され、測定されている自己評価された信頼度は、言語化された整数信頼度の開放形式の事実想起において、測定のターゲットであって信頼への入力ではないという結論に達します:自己報告された能力を摂取するハーネスは認証されていない入力チャネルを継承します。タイトルの3つの句は異なる証拠に基づいており、私たちはそれらを通して同様にラベル付けしています:弱い識別力は16モデル全体で確認的です;プロファイル注入によって修復されないは1つのベンダーファミリーの1つの確認段階であり、観察された効果に対して力不足です;操作可能は探索的であり、因果方向は一致した項目で示されていますが、配置されたハーネスへのテストされた攻撃はありません。モデルが別のモデルの回答を評価する判定スタイルの自己評価は異なるタスクであり、ここではテストされていません。
はじめに
現代の評価実務は、モデルの述べられた信頼度を測定器として静かに扱っています。LLM判定者は確実性スコアを報告し、エージェントフレームワークは自己評価された能力に基づいてルーティングを行い、棄却ポリシーは言語化された不確実性に基づいてトリガーされ、キャリブレーションベンチマークは自己報告チャネルが少なくとも正直であると仮定しています。この仮定は便利です。自己報告は無料で、常に利用可能であり、回答と同じパスで生成されるため、消費の時点でほぼ監査されることはありません。より根本的な問題を提起します。自己評価信号はどの程度判別力があるのか、モデルの独自の測定されたプロフィールで修復できるのか、そして操作できるのかです。
1つの事前登録された、プロトコルが凍結された、ブラインド収集で答えます。16個のモデル(9つのプロバイダーから各1つの予算/中堅APIモデル、および7つのローカルオープンウェイト)、各1,500の2023年以降の事実質問、温度ゼロ、すべての回答に述べられた0~100の信頼度が伴う、22,248の段階付き回答、すべての分析は生データから決定的です。この測定基準に対して、自己報告チャネルは3つの段階的により寛容なテストに失敗します。
C1(弱判別力)。述べられた信頼度は飽和し、能力から切り離されています。9つのAPIモデルのうち7つについてモデルごとの中央値は85~95であり、精度は16.5~66.5%の範囲にあります。フロンティア回答の60.1%は信頼度80で述べられたものが間違っています。モデル独自の項目ごとの正確さの予測子として、自己信頼はモデルに応じてAUROC 0.532~0.788に達します。すべてのブートストラップ信頼区間は偶然を除外しますが、9つのモデルのうち6つは0.62未満にあり、最も優れたものでさえ選別的予測を行うと、かなりの残留誤差があります(セクション4)。独立モデルのパネルは自己評価が0.545を与えるところで0.832に達します。このアドバンテージはパネル合意のより厳密なラベルフリー再コーディングでも生き残りますが、他のパネルの明らかな反例は、項目ごとの自己知識よりも大部分がモデル間のアイデンティティを反映しています(セクション4での分解)。自己報告が十分に判別される1つのモデルを特定することは、依然として自己報告を置き換えることが目的だった独立した測定を必要とします。
C2(プロファイル注入からの確認修復なし)。最も直接的な修復、すなわち回答時にモデルに独自の測定されたドメインごとの精度プロフィールを提供することは、凍結されたプラセボ制御ラダー実験の1つの確認段階でプラセボプロファイルを有意に上回りませんでした(AUROC 、生 、Holm調整 。確認エンドポイントは通らず)。これを傾向ではなく、ヌル値として報告します(セクション5)。
C3(操作可能)。修復が使用するであろう注入チャネルは、偽造を受け入れます。シャッフルされた(偽の)プロファイルは、探索的フロンティア段階の自己評価AUROCを偶然レベル(0.474対0.710;ドロップ )に駆動しました。単一の捏造された「精度95%」という主張は、ローカルモデルの述べられた信頼度を、それが間違って得る項目で50から95に移しました。項目がトピックラベル付けされると、5つのローカルモデルのうち4つが独自の不利益に対して偽のプロファイルを消費します(Brier から;セクション6)。
これらの結果を合わせて、役割の変化を主張します。自己評価された信頼度は、評価への監査されない入力ではなく、評価の測定対象であるべきです。セクション7は、判定パイプライン、エージェントルーティング、およびハーネス設計の結果を説明します。関連論文(Chernets、2026)はパネルベースの代替案の障害モードを検討し、ここで言い直されるのではなく、引用されます。
関連研究
言語化された信頼度とキャリブレーション。 現代的なネットワークの不適切なキャリブレーションは長年の知見です(Guo et al., 2017)。QAチューニングされた言語モデルではキャリブレーションが不十分であることが現在のモデル世代の前から報告されています(Jiang et al., 2021)。モデルは言葉で不確実性を表現するよう教えることができ(Lin et al., 2022b)、より大規模なモデルは自己評価プローブで部分的に「自分が知っていることを知っている」状態になります(Kadavath et al., 2022)。しかし、彼らは自分が知らないことを認識することにはほぼ失敗しています(Yin et al., 2023)。抽出された信頼度の経験的監査は、複数の抽出形式にわたって一貫した過信を見つけており(Xiong et al., 2024)、言語化されたスコアはトークン確率よりもキャリブレーションされていることもありますが、依然として過剰評価されています(Tian et al., 2023)。内部状態プローブはフレーミングを明確にします。隠れ層活性化による単純な分類器は71~83%の信頼性を回復します(Azaria and Mitchell, 2023)。つまり、失敗は言語化された出力チャネルにあり、必ずしも内部表現にあるわけではありません。我々の貢献はスケールと設計です。事前登録された凍結された16モデルの盲検集約により、同じ抽出形式を真実値に対して、また独立したパネルの合意と同一項目に対してスコア付けしています。さらに、この文献がほとんど問わない2つの質問に答えます。モデル自身の測定されたプロファイルで信号を修復できるか、修復チャネルは攻撃される可能性があるか、という質問です。
下流での自己報告の利用。 LLM-as-judge パイプラインは判定者のバイアスと信頼性の限界を継承しており(Zheng et al., 2023)、合意ベースの信頼度信号そのものが監査下にあります(Ding, 2026)。意味的エントロピー検出器(Farquhar et al., 2024)は自己報告を回避し、代わりに回答分布を測定することで対処します。第三者評価フレームワークは独立した測定に関するガバナンスのケースを提示します(Raji et al., 2022)。我々はそれに定量的な下限を与えます。9つのAPIモデルのうち6つについて、パイプラインが利用する自己報告は0.62以下のAUROCを持ちます。
信頼できない入力。 間接プロンプトインジェクションは、LLMが取り込むあらゆるテキストチャネルが攻撃対象になることを示しています(Greshake et al., 2023)。セクション6は特定の、これまで未命名のインスタンスを特定します。キャリブレーション修復が使用する自己能力プロファイルスロットは、認証されていない入力チャネルであり、それを偽造すると判別性がチャンスレベルまで低下します。
パネルとそれら自身の失敗。 多様なモデルのパネルは、ますます標準的な評価器具になっています(Verga et al., 2024)。比較対象として使用するパネル信号は無料ではありません。その失敗レジーム(難易度反転、制約された回答空間、ラベルベースの独立性仮定、適合性)は、同じ生集団に関する関連投稿(Chernets, 2026)で測定されています。本論文は自己評価の話を扱い、関連論文はパネルの話を扱い、表は重複していません。
ベンチマーク。 我々は2023年以降のSimpleQAサブセット(Wei et al., 2024)で抽出を実施しています。測定するベンチマーク年齢ギャップのためです。これは2021年式のTruthfulQA(Lin et al., 2022a)に対するものです(セクション3)。
事前登録実験:設計とデータ
事前登録された盲検収集、事前に公開された凍結プロトコル、確認的データの前に:16個のモデル(9つのプロバイダー全体の1つの予算/ミッドティアAPIモデルごと、プラス7つのローカルオープンウェイト)は、同じ1,500個の2023年以降の事実問題(SimpleQAサブセット)に温度ゼロで回答し、各回答には0~100の信頼度が付随しており、合計22,248個の採点済み回答(13,446個の最前線、8,802個のローカル)です。
事前登録と凍結。
収集プロトコルは、確認的データが存在する前に公開登録で凍結されました(再現性補録のアクセスルート)。登録は、ベンチマークとサブサンプル(ランダム、固定シード、サブサンプルファイルのSHA-256が記録)、モデルロスター、引き出し形式、採点手順、分析計画(セクション4で使用されたパネル合意対自身の信頼度のAUROC比較を含む、事前指定の二次指標(登録の主要エンドポイント、パネル不合意の確信エラーフラグ率は、パネル側の量であり、コンパニオン投稿で報告)および事後ホックメトリック選択に対する決定ルール)、および小規模な探索的パイロット(95 TruthfulQAアイテム、3つのローカルモデル)は、パイプラインを検証するために凍結の前に実行されました;その数は確認的データと混合されることはありません。
モデルと引き出し。
9つの最前線プロバイダーのAPI経由で、プロバイダーごとに1つの予算/ミッドティアモデルなので、以下のプロバイダー名は単一モデルにラベルを付け、製品ラインではなく(正確なモデルIDと収集日は再現性補録)、および7つのローカルオープンウェイトモデル。すべてのモデルは、温度0で独立してすべてのアイテムに回答し、同じ応答で整数信頼度0~100を述べます;パネルはこの単一盲検収集の分析組み合わせです。モデルが別のモデルの出力を見ることはありません。
採点。
ゴールドへの正規化された文字列等価性と拒否検出を最初に;解決されていないオープンフォームケースはローカルオープンウェイトLLM採点者に送られます(同等性からゴールドのみに制限、qwen3:8b、ローカル)。50アイテムの人間スポットチェックで98%の合意が見つかりました(1つの保守的なエラー);342最も難しい階層合意評決のクロスファミリー監査は342/342に同意しました(制限)。解析失敗を除く除外なし(報告);それらは1つのローカル推論モデルに集中し、1,500の98採点可能な回答のみを保持します。すべてのローカル層の主張はモデル当たりを実行します。すべての確認的分析は生のJSONLから決定論的です。
ベンチマーク選択、測定済み。
2023年以降の主要ベンチマークは、仮定ではなく測定によって正当化された設計決定です。探索的なベンチマーク年齢比較では、同じモデルは2021年版TruthfulQA MCで~パーセンテージポイント高くスコアリングしました。2023年以降のSimpleQA(deepseek pp、95% CI;mistral;zhipu;たとえば、89.2% vs. 28.4%)。ベンチマーク年齢および曝露効果と一致するギャップですが、この設計は汚染と難易度および構築の違いを分離することはできません。見出し番号は古いベンチマークに基づいていません;ローカル層での750項目のTruthfulQA MC1アームは、そのようにラベル付けされているとおりにのみ使用されます。
事前登録対探索的。
事前登録および確認的:上記の収集およびパネル対自身AUROC比較(セクション4)。探索的、および使用されている場所ではどこでもそのようにラベル付けされた:ベンチマーク年齢比較アーム、セクション6の最前線プロファイルインジェクションランおよびローカルマイクロプローブ。セクション5のプロファイルインジェクションラダーは、別の凍結、プラセボ対照プロトコル(その確認的段階の前に固定されたアーム、エンドポイント、およびホルム族)です。
結果1:自信は較正されておらず、判別力が弱い
「較正」という用語がしばしば混同する2つの特性を区別します:大規模較正(信頼度レベルは正確度レベルと一致しているか?)と判別(信頼度はモデル自身の正答を誤答より上位にランク付けするか?)。
較正。表示された信頼度は飽和し、能力から切り離されています:9つのAPIモデル全体で、表示された信頼度は85~95(モデルごとの中央値)で9つ中7つにおいて正確度は16.5~66.5%の範囲にありますが、2つは異なります——拒否の多いモデル(中央値42で10.3%の正確度)と1つの分散した信頼度モデル(中央値60)です。すべてのモデルは大規模では過信です:信頼度マイナス正確度ギャップ(CITL、表1)はからパーセンテージポイントの範囲です。ECE列はほぼCITLに等しいです:信頼度-正確度ギャップは9つ中7つのモデル(他の2つは1つを除くすべて)で占有されたすべてのビンで正です。そのため、ビン化された較正と全体的な較正の不良が一致します。拒否の多いモデルでさえ、 pp(ECE 0.310)を保持します——その低いバンドは較正された自己知識ではなく、拒否動作を反映しています。その判別の利点の一部も同様に機械的である可能性があります——低い表示信頼度で不正と採点された拒否はAUROCを上げます(拒否行を除外すると0.660、)——そのため、その0.788を較正ランキングではなく、引き出された自己知識の上限として読みます。9つのAPIモデル全体で集約すると、信頼度80で述べられた回答の60.1%は誤りです(9,310のうち5,598);モデルごとの率は29.0~83.2%の範囲です(マクロ平均57.6%)。高い表示信頼度を信頼する消費者は、誤りの大多数を受け入れます。判別。モデル自身の正確性の予測因子として、自信はモデルに応じてAUROC 0.532~0.788を達成します。ブートストラップ95% CI(表1)はすべてのモデルで0.5を除外しているため、信号は文字通りランダムではありません——ただし、9つ中6つのモデルでは0.62未満です。その結果は操作上のものです:20%カバレッジ(項目の最高信頼度五分位数のみに回答)で、最も強い自信AUROC3モデルの誤差率はそれでも75.3%、33.3%、および15.1%です(表2)——3番目の場合のみ意味のある削減であり、他の2つの場合ははるかに信頼ゲートではありません。
独立したモデルの一致を数える建築学的代替案は、パネルでAUROC 0.832(95% CI )に達します。ここで自己評価は0.545()です。項目クラスタ化された差分は であり、ゼロを大幅に除外しています。3つの事前指定パネルは以下の通りです:US(Anthropic、OpenAI、Google)、CN(DeepSeek、Alibaba、Moonshot)、クロスブロック(Anthropic、DeepSeek、Mistral)。見出し比較はCNパネルです。もう一方の事前指定パネルでは、プール比較が反転するように見えます:パネル母集団全体でプールされた自己評価0.842対パネル0.697。 です。分解により、この見かけ上の反転は項目ごとの自己知識ではなく、モデル間のアイデンティティを大きく反映していることが示されます。プール値0.842は、モデル内自己AUROCがわずか0.596~0.784(マクロ平均0.709。パネル母集団値については表1に完全な段階付きセットが記載されています)である3つのモデルを混合しています。モデル内ランク正規化(モデル間レベルの違いを除去しながら各モデル自身のランキングを保持)後、プール値は0.672に低下します。これはモデル間のアイデンティティ寄与です。0.545パネルは同じチェックを通過します(プール0.545対ランク正規化0.582):その自己評価の失敗は本当に項目ごとのものです。反転から残存するものはより狭い主張です:最も強い自己信頼識別を持つ拒否が多いモデル(完全な段階付きセットで0.788)は確かにこのパネルの一致シグナルを上回ります。そしてそのモデルが何であるかを特定するには、自己報告が置き換えることを意図していた正確な独立測定が必要です。3番目の事前指定パネル(クロスブロック)はその2つの間にあります:パネル0.722 対自己0.659 、 です。
パネルシグナルのラベルフリー再符号化への感度。
パネルシグナルの背景にある正準等価性符号化は、プライマリモデル自身の正確性ラベルを参照します(2つの回答がどちらも正しいと評価される場合は一致とカウントされます)。そのため、パネルの一致は部分的にターゲットラベルの決定論的関数です。これはラベルを介した依存関係ですが、自己投票漏洩ではありません。構成上、モデル自身のレコードはその独自のパネルシグナルに入力されることはありません。ラベルフリー再符号化(文字列一致のみ。プライマリおよびパネリストの正確性フラグを参照しない)は、自己評価が0.545を与えるパネルでパネルAUROCを0.832から0.775に低下させ、もう一方では0.697から0.628に低下させます。見出しパネルの利点はより厳格な符号化でも継続します(0.775対0.545)。
表1はモデルごとの画像を示します。図1は16個すべてのモデル全体で同じ分離を示します。すべてのモデルは較正対角線を上回り、ローカルティアは9.2%の精度で85~100の陳述された信頼度のバンドに崩壊します。
| モデル | 精度(%) | 平均信頼度 | CITL(pp) | Brier | ECE | Self-AUROC | 95% CI | |
|---|---|---|---|---|---|---|---|---|
| 1,461 | 66.5 | 92.8 | 0.271 | 0.263 | 0.746 | [0.722, 0.770] | ||
| moonshot | 1,500 | 51.6 | 75.8 | 0.292 | 0.242 | 0.619 | [0.590, 0.648] | |
| alibaba | 1,497 | 47.4 | 92.3 | 0.446 | 0.448 | 0.532 | [0.510, 0.556] | |
| xai | 1,500 | 37.9 | 48.9 | 0.197 | 0.111 | 0.777 | [0.755, 0.798] | |
| deepseek | 1,500 | 35.7 | 89.2 | 0.513 | 0.535 | 0.570 | [0.549, 0.592] | |
| zhipu | 1,493 | 28.4 | 92.6 | 0.612 | 0.642 | 0.611 | [0.582, 0.639] | |
| openai | 1,500 | 16.7 | 77.6 | 0.531 | 0.610 | 0.598 | [0.559, 0.636] | |
| mistral | 1,495 | 16.5 | 90.6 | 0.686 | 0.742 | 0.584 | [0.550, 0.616] | |
| anthropic | 1,500 | 10.3 | 41.3 | 0.206 | 0.310 | 0.788 | [0.758, 0.817] |
確認的SimpleQAコレクション上でのモデルごとのキャリブレーション(フロンティアティア、完全採点セット;プロバイダー名はプロバイダーごとに収集された1つの予算/ミッドティアモデルにラベルを付けています)。CITL:大規模キャリブレーション、平均述べられた信頼度マイナス精度、パーセンテージポイント単位。ECE:10ビン期待キャリブレーションエラー。Self-AUROC:述べられた信頼度をモデル自身の項目ごとの正確性の予測因子として使用(タイ補正Mann–Whitney)、ブートストラップ95% CI(モデル内の行レベルのリサンプリング、2,000回の描画、固定シード)付き。すべての値は生の採点されたJSONLからの決定論的な再計算です;すべてのCIは0.5を除外します。CITLは丸められていない平均を使用します;表示される値は小数点以下1桁に丸めています。{#tab:vendor}
| カバレッジでのエラー率 | |||||
|---|---|---|---|---|---|
| 2-6 モデル | 100% | 80% | 60% | 40% | 20% |
| anthropic (self-AUROC 0.788) | 89.7% | 87.1% | 82.9% | 80.3% | 75.3% |
| xai (0.777) | 62.1% | 52.8% | 45.1% | 39.5% | 33.3% |
| google (0.746) | 33.5% | 24.5% | 20.0% | 18.7% | 15.1% |
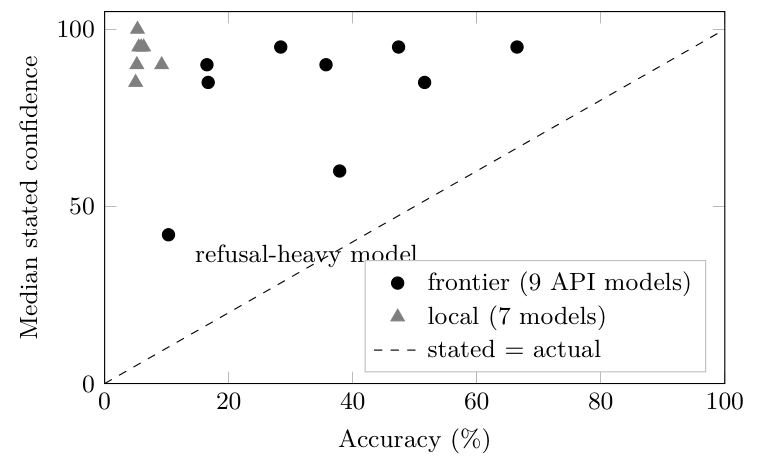 評価された16個のモデル全体における一貫した過度な確信:モデルあたりの中央値の述べられた信頼度(平均値は表1に表示される)対同じ1,500個のブラインドSimpleQA項目における16個のモデル全てに対する実際の精度。すべてのモデルは較正対角線より上にあり、拒否が多いモデル(中央値の述べられた信頼度42で10.3%の精度、CITL +31.0 pp)は最良の自己AUROC(0.788)を有しているものの、依然として過度に自信を持っています。最小の較正ギャップは分散された信頼度モデル(+11.1 pp)に属しています。モデルあたりのフロンティア中央値:表1の行順序で95/85/95/60/90/95/85/90/42;7モデルのローカル層は精度5.0–9.2%、中央値信頼度85–100にわたり、パース失敗除外後はモデルあたりの段階n 98–1,498(ローカル層は操作プローブとこの画像に役立ちます。識別クレームではなく)。
結果2:測定されたプロファイル注入による識別性能の確認可能な改善なし
自然な修復法は、モデルに回答時にその自身で測定された能力プロファイル—保持外データからのドメイン別精度—を与えることである。プラセボ対照ラダー実験(腕:プロファイルなし、全体的なレベルにマッチしたプラセボプロファイル、自身で測定されたプロファイル、シャッフルされたプロファイル)において、自身のプロファイル腕は確認的エンドポイントでプラセボを有意に上回らなかった:AUROC 、95% CI 、生のp値 、Holm調整済みp値 ;確認的エンドポイントを通過したものはない。これを明示的に狭い範囲を持つ帰無仮説として報告する:1つの確認的段階では、測定されたプロファイル注入によって識別性能は補正されなかった。点推定値は正であるが、事前登録された補正の下では修復は実証されていない。デザインは中程度の効果に対してのみ検出力を有していた(CI からの標準誤差 :AUROC に対して約80%の検出力のみ、観測された より大きい—したがってデータは真の帰無仮説と小さい真の効果の両方と矛盾しない)。デザインの上限は制限要因ではない。各項目自身のビン精度—リーブ・ワン・アウト計算されるため、項目はその予測子に貢献しない—をその項目の正確性の唯一の予測子として取ると、確認的対象に対するオラクルAUROCは0.758であり(4つのラダー対象全体では0.716–0.789)、ビンごとの精度スプレッドのSD は0.195で、21のビンにわたって0.15–1.00の範囲である。したがってビンは真実的なプロファイルが実質的な情報を運ぶのに十分異なる:帰無仮説は注入チャネルに関するもので、1つを登録するのに十分にバッテリが低いテストではない。1 探索的パターン(ベースライン校正が最も弱い場合の大きな利得)は仮説生成のみである。
ラダーデザインとプラセボ検証
4つの凍結段(対象:Claude Haiku 4.5、Sonnet 5、Opus 4.8、Fable 5;正確なID claude-haiku-4-5-20251001、claude-sonnet-5、claude-opus-4-8、claude-fable-5)、それぞれ4つの盲検腕を持つ、同じ校正スロットを占める、その他の点で同一のプロンプト:off(プロファイル形状の構造的空白)、placebo(校正無関連プロファイルで全体的なレベルにマッチ;真のプロファイルに対して で段ごとに検証—測定 、、、)、core(モデルの自身で測定されたドメイン別プロファイル)、shuffled(ビン置換偽プロファイル;確認的状態から格下げされた失敗した操作チェック後の探索的)。315項目のバッテリは21ドメインビンにまたがり、トラップ項目と明示的棄却トークンを含む;項目–腕割り当ては確認的段階前に凍結され、項目ごとのランダム化腕順序と対象可視テキストの腕名なし。事前登録された縮退境界(off 精度 )は4つの段のうち3つをすべての確認的計算から格下げした;表 3 は適格な1つの段を報告する。生き残った段のoff腕精度は0.85閾値に対して0.847である一方、格下げされた段は0.855、0.888、0.900に位置している—off腕回答済みのみAUROCは0.575、0.628、0.500である(記述的には、天井に近い精度は修復するための校正信号をほとんど残さない)。4つの対象すべては単一ベンダーファミリから抽出される;制限事項を参照。
| 腕 | 精度 (すべての項目) | AUROC | Brier | ECE | ペア比較 AUROC (core腕) |
|---|---|---|---|---|---|
| off (プロフィールなし) | 0.847 | 0.564 | 0.138 | 0.110 | [] |
| placebo | 0.857 | 0.578 | 0.127 | 0.090 | [] |
| core (独自プロフィール) | 0.857 | 0.625 | 0.127 | 0.099 | — |
| shuffled (false) | 0.842 | 0.589 | 0.140 | 0.113 | 計算されていません (探索的) |
プロファイル注入ラダー、確認的適格ランク(対象:Claude Sonnet 5;:294個の非トラップアイテム2つの事前登録済み新規処理レプリケート—ハーネスは温度もシードも露出しない;AUROC回答のみ)。確認的対比(アイテムクラスター化ブートストラップ):coreplacebo AUROC 、95% CI 、生値;coreoff 、CI 、生値;両者ともHolm補正に失敗()し、2元アイテムバッチゲート(アイテムと収集バッチの両方でクラスター化する事前登録済み堅牢性要件)に失敗した。ペアード-列は、凍結分析のアイテムクラスター化ペアード対比をcoreに対して繰り返す;これらは腕あたりのAUROC列の算術差ではなく、確認的ペアード対比はshuffledに対して計算されなかった(確認的段階前に探索的に降格)。我々は自身の仮説に反して、coreが較正で支配的でないことに注意する:そのECE(0.099)はplaceboのもの(0.090)より悪く、これは確認的帰無仮説を帰無として読むもう1つの理由である。{#tab:ladder}
結果3: 自己イメージチャネルは操作可能である
評価ハーネスが自己能力プロフィールを消費する場合、そのスロットは入力チャネルであり、入力は偽造可能です。我々は証拠力が低下する3つの主張を区別し、各結果がどの主張を支持しているかを述べます。(i) 因果的操作可能性—以下で実証: 偽のプロフィールを代入することで、制御された実行で述べられた信頼度が因果的に変化し、キャリブレーション(検定値との一致度)が低下します。(ii) 整合性脆弱性—条件付き: これは実際に敵対者が影響を与えることができるソースから能力プロフィールを注入するハーネスにのみ関係します。(iii) デプロイされた評価パイプラインにおける実践的な攻撃面—本論文が動機付けるが検定しない仮説です。真のプロフィールをシャッフルされた(偽の)プロフィールに置き換えることで、探索的フロンティア段階の自己評価AUROCが偶然レベルに低下しました: 真のプロフィール時の0.710と比較して0.474です(シーリングデモートされた探索的段階; 項目クラスタリングブートストラップ: 0.710 [0.586, 0.820] vs. 0.474 [0.349, 0.599]、差 [, ])。対照的に、確認適格段階では shuffled は placebo と core の間に位置していました(0.589 vs. 0.578 and 0.625; 項目クラスタリングペアコントラスト、探索的: ])。その段階は構成上弱い操作証拠です: 偽のプロフィールは事前登録された確認に2回失敗しました(外部審査官0.99/0.94 vs. 限界); 固定ルールは確認データが存在する前にアームをデモートし、主体は検出可能に非現実的なプロフィールを割り引くことができ、消費確認は存在しません。スタンドアロン知見: フロンティア審査官は尤もらしさから単独で偽造を検出します。ゼロコストのローカルスタンドで、単一の偽の主張(「このドメインでは95%の精度」)がモデルの同じ項目に関する述べられた信頼度を50から95に上げました; この効果は失うべき宣言的キャリブレーションを持つモデルに集中します; このプローブでは最大シフト( ポイント)は最もそれを失うべき立場にあるモデル(glm4:9b)で発生しました。2つの境界条件が効果を制限します: モデルは現在の項目をプロフィールビンと関連付けることができなければなりません(ラベルなしの項目では小さなローカルモデルはプロフィールを無視します; デルタ 、結果2の固定されたnullと一致)、およびシーリング固定モデル(信頼度 かかわらず)には攻撃するものがありません。
操作証拠—1つの探索的フロンティア段階、ローカルマイクロプローブ、およびトピックラベル付きローカルパス—は因果的操作可能性、主張(i)を確立します。表 4 はマイクロプローブを示しています: 同じ項目、同じモデル、および注入された自己プロフィールの1行の変更で、述べられた信頼度は最大 ポイント移動します。
探索的トピックラベル付きパス: 境界の両側、ライブ。
上記の最初の境界条件(モデルは項目をプロフィールビンと関連付けることができなければなりません)は、それ自体が検定可能です: 各プローブをそのトピックでラベル付けすること—固定されたプロトコルからの明確な逸脱—は関連付けの障害を除去します。完全なローカルパス(5つのモデル、アームあたり16個のホールドアウトプローブ、温度0、固定シード)では、ラベルなしの項目で不活性だった偽のプロフィールは、項目がラベル付けされると5つのモデル中4つによって消費されます: Brierは (glm4:9b)、 (llama3.2:3b、精度が37.5%25.0%低下)、 (mistral:7b)、および (phi4-mini)で低下します; でのプローブごとのブートストラップCI各モデルはゼロを含むため、マイクロプローブは方向性とメカニズムを確立するより、モデルごとの効果サイズよりも;
5番目(qwen3:8b)はバッテリーを天井値で回答し(100%の精度、両側で信頼度100、)、「攻撃するものがない」という境界を再現しています。このメカニズムは方向性があり対称です。偽りの高い請求は最も弱いビンで信頼度をちょうど膨らませ(llama3.2物理学:保持率25%のビンで表明された信頼度0100;phi4-miniロジック1365)、偽りの低い請求は正解に対する信頼度を低下させ(llama3.2履歴1000、保持率75%)、モデルが回答することを想定していた項目に対する棄権を誘発することまであります。従って境界の両側はライブラン通じて示されます。ラベルなし項目では、プロフィールは不活性(凍結されたヌル);ラベル付き項目では、偽りの自己イメージが表明された信頼度に直接伝播し、端から端までキャリブレーションを低下させます。
| モデル | 信頼度 @ 「0%」 | 信頼度 @ 「95%」 | |
|---|---|---|---|
| glm4:9b | 50 | 95 | |
| llama3.2:3b | 80 | 95 | |
| mistral:7b | 90 | 100 | |
| phi4-mini | 90 | 95 | |
| qwen3:8b | 100 | 100 |
局所的マイクロプローブ(探索的):注入されたプロフィールスロットが項目のドメインで「0%の精度」対「95%の精度」を主張するとき、同じ(誤って回答された)項目に対する表明された信頼度;5つの局所的オープンウェイト モデル、温度0。天井値にピン留めされたモデル(下の行)には宣言的キャリブレーションがありません。{#tab:microprobe}
評価実践への示唆
我々の結果は1つのタスクファミリー(2023年以降のオープンフォーム事実QA)と1つの引き出し方式で測定されており、以下の示唆はそれらの測定から外挿しています。
(1)述べられた信頼度の役割を逆転させる。 自己報告された信頼度は、現在の引き出し方式の下では評価への入力ではなく、測定された目標であるべきです。支持する数字:高い信頼度を示すフロンティアの回答の60.1%が誤りであり、最高の自己AUROC(0.788)は精度リーダーボードで最後にランク付けされるであろうモデルに属しており、どちらのランク付けも誰の自己報告が判別するかを予測していません。
(2) 判定パイプラインは弱い判別力を持つ重みを継承する。 自己確信度で投票を重み付けする任意のLLM-as-judge またはアンサンブルスキームは、ここでの9つのモデル中6つについて、AUROC が0.62未満の信号をインポートします—飽和した85–95帯がログで安心に見えるため、静かに。確信度重み付けが使用される場合、重みはレポート自体からではなく、測定されたモデルごとのキャリブレーションから来るべきです。
(3)プロファイルスロットを認証する。第6節の3段階脅威モデルは懸念を整序する:因果的操作可能性は実証される、完全性脆弱性は調整可能なソースからプロファイルを実際に注入するハーネスを条件とする、そして配備パイプラインの実際的な攻撃面は仮説のままである。条件付きクラスのハーネスについては、修復チャネルは露出である:キャリブレーション修正を意図していた注入プロファイルは、識別を機会水準(0.474)まで押しやり、アイテムが関連付け可能になるとBrierスコアを端から端まで低下させる偽造品を受け入れる。そのようなハーネスは完全性ゲート—署名されたプロファイル、由来チェック、または少なくとも推論時にプロファイルを測定する者と供給する者を分離する—を必要とする。認証されていない自己イメージスロットは、キャリブレーションペイロードを持つオープンプロンプト注入ポートである。
(4)外部測定は代替手段です—独自の監査を伴っています。 独立パネルの合意は、自己評価が最も失敗する場合に自己評価を優っています(AUROC )ですが、パネルには独自の測定された失敗レジームがあり、関連論文で検討されています(Chernets, 2026)。その監査なしにパネル信号を採用することは、同じ誤りを1つ上のレベルで繰り返すことになるでしょう。探索的として事前登録された拡張は、第3の視点を追加します:12の方向付けされたプロフィール交換ペア(3,780回の呼び出し)にわたって、別のモデルの測定されたプロフィールに置き換えると、AUROCは最大シフトしました—そして時には役に立ちました—一方、転移損失の類似性ランク予測は失敗しました(Spearman ):測定されたプロフィールは、特権的な自己アクセスではなく、可搬性のある計測器です。実用的な自己評価診断バッテリーは付録に記述されています。
制限事項
見出しの単一ベンチマークファミリー(2023年以降のオープン形式事実的QA);各プロバイダーは1つの予算/ミッドティアモデルで代表されるため、プロバイダーレベルの汎化は主張されていません;陳述信頼度抽出は見出し数字の1つのプロンプト形式です—ただし、探索的な2段階アーム(150項目5つのローカルモデル)はフォーマットが犯人ではないことを示唆しています:ステートレスの事後信頼度クエリは陳述信頼度と確実なエラー率を低下させましたが、弁別力は低下しませんでした(自己AUROC 0.43–0.61両形式;プーリング済みペアブートストラップAUROC ペア、モデルあたり142–150行の決定的なLLM非依存ラベル—文字列のみのグレーダーからの開示された逸脱、その下では90%のケースは解決不可能です);インジェクション帰無仮説は1つの確認段の1つのラダーです(315項目、21ビン)、単一ベンダーファミリーからのすべての4つのサブジェクト、およびそれはより良い修復設計を除外しません;操作証拠は1つの探索的フロンティア段、ローカルマイクロプローブ、およびトピック付けローカルパス(開示された逸脱)を組み合わせています—確認攻撃研究ではありません;グレーディングは部分的にLLMベースであり、その人間検証は50項目スポットチェックです(98%一致、1件の保守的エラー)。グレーダーのベンダーファミリーは1つのCNパネルメンバーも有しているため、グレーダー独立性自体が測定されます:すべてのパネルとグレーダー自身の外部のファミリーからの第2グレーダーがすべての342の最難四分位数合意判定を再グレードし、342/342と一致しました。グレーダー自体はローカルティアサブジェクトです;すべての1,441の自己グレード行のクロスファミリー再グレードは98.3%と一致し、不一致は自己寛容に向かって実行されました(24下方反転 対 1上方;精度5.94.4%)—過信図の強化;より完全な層化再監査は将来の作業のままです。パネル対自己比較は付随提出とデータを共有します;テーブルは複製されていません、境界は第1–2節に記載されており、本論文の範囲は自己評価のみに留まります。
結論
現在実施されているように引き出される自己評価は、評価信号が満たすべき3つのテストに不合格です。正確性の追跡が弱すぎて意思決定の判断基準としては機能せず、かつ極度に過信が生じ、最も直接的な自己知識介入はプラセボ対照下で測定可能な改善をもたらさず、その入力チャネルは識別を偶然レベルに押し下げる偽造品を受け入れます。モデルが測定された証拠に基づいて較正を達成するまで、述べられた信頼度は消費すべき信号ではなく、研究すべき現象です。
References
Vadym Chernets. Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop Who Verifies the Agents?, 2026. https://doi.org/10.5281/zenodo.23197641 (cited for panel-side regimes only).
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
K. Greshake, S. Abdelnabi, S. Mishra, C. Endres, T. Holz, and M. Fritz. Not what you’ve signed up for: Compromising real-world LLM-integrated applications with indirect prompt injection. In Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security (AISec), 2023. arXiv:2302.12173.
C. Guo, G. Pleiss, Y. Sun, and K. Q. Weinberger. On calibration of modern neural networks. In ICML, 2017. arXiv:1706.04599.
Z. Jiang, J. Araki, H. Ding, and G. Neubig. How can we know when language models know? On the calibration of language models for question answering. Transactions of the Association for Computational Linguistics, 9:962–977, 2021. arXiv:2012.00955.
S. Kadavath, T. Conerly, A. Askell, et al. Language models (mostly) know what they know. arXiv:2207.05221, 2022.
A. Azaria and T. Mitchell. The internal state of an LLM knows when it’s lying. In Findings of EMNLP, 2023. arXiv:2304.13734.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lin, J. Hilton, and O. Evans. Teaching models to express their uncertainty in words. Transactions on Machine Learning Research, 2022. arXiv:2205.14334.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
K. Tian, E. Mitchell, A. Zhou, A. Sharma, R. Rafailov, H. Yao, C. Finn, and C. D. Manning. Just ask for calibration: Strategies for eliciting calibrated confidence scores from language models fine-tuned with human feedback. In EMNLP, 2023. arXiv:2305.14975.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
J. Wei et al. Measuring short-form factuality in large language models (SimpleQA). arXiv:2411.04368, 2024.
M. Xiong, Z. Hu, X. Lu, Y. Li, J. Fu, J. He, and B. Hooi. Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. In ICLR, 2024. arXiv:2306.13063.
Z. Yin, Q. Sun, Q. Guo, J. Wu, X. Qiu, and X. Huang. Do large language models know what they don’t know? In Findings of ACL, 2023. arXiv:2305.18153.
L. Zheng, W.-L. Chiang, Y. Sheng, et al. Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. In NeurIPS Datasets and Benchmarks, 2023. arXiv:2306.05685.
実践的ツール:自己評価診断
本研究の副産物として、コンパクトな自己評価診断を開発しました。これは、研究の領域範囲(数値、論理、物理、歴史、コード、確率など)にわたる短い確定的採点可能なプローブの固定されたバッテリーと、明示的な棄権トークンを備えたトラップ項目からなります。各回答には0~100の信頼度が付与され、このツールはBrierスコア、過信ギャップ(平均信頼度マイナス正答率)、信頼度識別力(正答時の平均信頼度マイナス不正答時の平均信頼度)、およびトラップ棄権率の複合スコアを算出し、結果を十分に較正されているから自信過剰で盲目的までのティアにマッピングします。本論文の主張(較正はモデルについて測定すべきもので、そのモデルの自己報告から読み取るべきものではない)を実装し、再現パッケージとともにツール(結果ではなく)として公開されています。このツールは固定されたバッテリーではなく言い換えたプローブを使用し、その識別スコアはプロキシであり、ラダーのAUROCエンドポイントではありません。
再現性の付録
本論文のすべての主要な数値は、公開されている生のJSONLの確定的な関数です。ランダム性、ネットワークアクセス、GPU計算、またはモデルの再クエリを含むステップはありません。
データの入手可能性。
凍結された事前登録および複製パッケージ(公開OSF登録): https://osf.io/4y9dv。オラクル上限スクリプト oracle_auroc.py は本論文と共にこちらに保管されています: https://doi.org/10.5281/zenodo.23197651。
抽出プロンプト(逐語的)。
システム: You answer short factual questions. Respond with ONLY a JSON object like {"answer": "<short answer>", "confidence": 85}. confidence is an integer 0-100 for how sure you are the answer is correct. No other text. ユーザーターンには質問そのものが含まれており、拒否は採点スクリプト内の凍結された拒否辞書により回答フィールドから検出されます。
モデル識別子と実行日。
プロバイダーごとに1つのバジェット/ミッドティアAPIモデルで、2026年7月24日にスモークテストで検証されたライブで、2026年7月後半に収集されました(実行マニフェストのコール単位のタイムスタンプ、複製パッケージとともにリリース): anthropic claude-haiku-4-5-20251001; openai gpt-5-mini; google gemini-3.6-flash; xai grok-4-fast; deepseek deepseek-chat; alibaba qwen-plus; moonshot kimi-k3(開示された収集の逸脱: 最初のパーティアカウントの1,500項目のうち670項目、残りはアグリゲータルートを経由して同じ最初のパーティインフラストラクチャによって提供されており、推論は無効化、served_by はコール単位で記録); zhipu glm-4.5; mistral mistral-small-latest。ローカルティア(Ollama、温度0): gemma4:e4b, llama3.2:3b, phi4-mini, qwen3:8b, deepseek-r1:8b, glm4:9b, mistral:7b。
関連論文(Chernets, 2026)は同じ凍結登録および生収集を共有しています。複製パッケージに含まれるもの: 凍結された登録テキストおよびプロトコル、正確なモデル識別子付きの実行マニフェスト、生の段階化コレクション(フロンティアおよびローカルティア、プラス探索的ベンチマーク年齢比較アーム)、および3つの依存性のないCPUスクリプト。第1番目(compute_panel_vs_own_auroc.py)はパネル合意対自信AUROCの比較(セクション4)の正規定義であり、正規値と共に、すべての非正規代替読み取り(バイナリパネル信号、不確定コーディング、タイ処理、プーリング変種)を出力し、読み取りの選択が監査可能になります。第2番目(analysis_tae_week1.py)は表1を再印刷し、図1の座標、セクション3のベンチマーク年齢ギャップ、表3で報告された凍結されたラダー値に対するはしごの凍結分析ファイルの読み取り専用チェックを実行します。第3番目(analysis_tae_decomposition.py)はセクション4のプールされたAUROC分解とランク正規化、パネル信号のラベル無し再コーディング、モデルごとの高信頼誤り率、表1のCITL/Brier/ECE列、表2のリスク–カバレッジ値、およびセクション5の降格階段記述統計を再印刷します。各スクリプトはラップトップCPU上のPython標準ライブラリのみで秒単位で実行されます。プロフィール注入ラダーは独自の凍結バンドル(プロトコル、バッテリー、アーム単位の採点行、および分析JSON)として出荷され、パッケージからポイントされます。
凍結されたアイテム単位のアームスコア(
scored-arms-*.jsonl; トラップなし、ステータスok; 確認対象のため)からoracle_auroc.pyにより計算され、本論文とともにリリース; アイテムのすべてのアームおよび複製は一緒に除外されます。↩︎
この論文の引用方法
Chernets, V. (2026). 弱い判別力を持ち、プロファイルインジェクションでは改善されず、操作可能である:LLM評価におけるセルフコンフィデンス [Paper presentation]. NeurIPS 2026 Workshop: TAE. Zenodo. https://doi.org/10.5281/zenodo.23197651
@misc{chernets2026selfconfidenceevaluation,
  author       = {Chernets, Vadym},
  title        = {{Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: TAE},
  doi          = {10.5281/zenodo.23197651},
  url          = {https://doi.org/10.5281/zenodo.23197651}
}