Слабко дискримінаційна, не покращена впровадженням профілю та піддається маніпуляції: самовпевненість у оцінці LLM
Це переклад. Основна версія — оригінал англійською; посилайтеся на неї.
Vadym Chernets, Незалежний дослідник · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197651 · GitHub
Прийнято як постер на семінарі NeurIPS 2026 "TAE (Trust-AI-Eval): Can We Trust AI Evaluation?" (не архівна). Архівна копія: 10.5281/zenodo.23197651. PDF: self-confidence-evaluation.pdf. Наведені нижче фігури та таблиці перетворені з вихідного коду LaTeX; PDF є авторитетним.
Анотація
Конвеєри оцінювання все частіше використовують заявлену впевненість моделі як сигнал довіри—як вагу надійності судді, триґер утримання від відповіді або самозаявлений профіль компетентності. Ми перевіряємо, чи заслуговує цей сигнал на таку вагу, використовуючи попередньо зареєстровану, заморожену протоколом збірку (16 моделей—одна модель API з бюджетного/середнього рівня від кожного з дев'яти постачальників плюс сім локальних моделей з відкритими вагами; 22 248 оцінених відповідей при нульовій температурі з зазначеною впевненістю 0–100). Чотири висновки. (1) Надмірна впевненість послідовна для всіх шістнадцяти оцінених моделей: типова зазначена впевненість становить 85–95 для семи з дев'яти моделей API, тоді як точність становить 16,5–66,5%, і 60,1% передових відповідей, зазначених з впевненістю 80, є неправильними. (2) Впевненість у собі слабко розрізнює: її AUROC для передбачення власної правильності моделі становить 0,532–0,788 і менше 0,62 для шести з дев'яти моделей. (3) Група незалежних моделей досягає AUROC 0,832, де самооцінка дає 0,545 ( , 95% CI ); при строгішому рекодуванні узгодження групи без міток група все ще веде (0,775 vs. 0,545). (4) Введення виміряного профілю точності моделі за доменами не продемонструвало покращення розрізнення на одному підтвердженому щаблі контрольованої плацебо драбини одного постачальника (AUROC , коригована за Хольмом ), тоді як той самий канал введення піддається причинній маніпуляції: помилковий профіль довів розвідувальний щабель самооцінки AUROC до рівня випадковості (0,474) і, як тільки елементи отримали позначку за темою, погіршив калібрування в чотирьох з п'яти локальних моделей. Ми робимо висновок, що впевненість, яка самооцінюється, як зараз видобувається та вимірюється щодо вербалізованої цілої впевненості в откритому фактичному відкликанні, є метою для вимірювання, а не входом для довіри: системи, які поглинають самозаявлену компетентність, успадковують неавтентифікований вхідний канал. Три пункти заголовка спираються на різні докази, і ми позначаємо їх такими протягом: слабко розрізнює є підтвердженням для шістнадцяти моделей; не виправлено введенням профіля є одним підтвердженим щаблем однієї сім'ї постачальника, недостатньо потужним для спостереженого ефекту; маніпульована є розвідувальною, з причинним напрямком, показаним на узгоджених елементах, але без тестованої атаки на розгорнуту систему. Самооцінка у стилі судді, де модель оцінює відповідь іншої моделі, є іншим завданням і не перевіряється тут.
Введення
Сучасна практика оцінювання тихо розглядає заявлену впевненість моделі як вимірювальний інструмент: судді на основі LLM звітують про оцінки впевненості, каркаси агентів маршрутизують на основі самооціненої компетентності, політики утримання від голосу спрацьовують при вербалізованій невизначеності, й еталони калібрування припускають, що канал самозвіту принаймні чесний. Припущення зручне—самозвіти безкоштовні, завжди доступні й виробляються за один прохід з відповіддю—і вони майже ніколи не перевіряються в точці споживання. Ми ставимо попереднє питання: наскільки дискримінативний сигнал самооцінки, чи можна його виправити з використанням власного вимірюваного профілю моделі, і чи можна його маніпулювати?
Ми відповідаємо на основі однієї попередньо зареєстрованої, протоколом закритої, сліпої збірки: шістнадцять моделей (одна модель API бюджетного/середнього рівня від кожного з дев'яти провайдерів, плюс сім локальних моделей з відкритими вагами), по 1500 фактичних запитань після 2023 року кожна, температура нуль, кожна відповідь супроводжується заявленою впевненістю 0–100—22 248 оцінених відповідей, весь аналіз детермінований від вихідних даних. За цим стандартом вимірювання канал самозвіту не задовольняє три послідовно більш ліберальні тести.
C1 (слабо дискримінативна). Заявлена впевненість насичена й відокремлена від компетентності: медіани за моделями складають 85–95 для семи з дев'яти моделей API, тоді як точність охоплює 16,5–66,5%, і 60,1% граничних відповідей, заявлених з впевненістю 80, є помилковими. Як предиктор власної коректності моделі на кожен елемент, самовпевненість досягає AUROC лише 0.532–0.788 залежно від моделі—кожен CI бутстрепу виключає випадковість, але шість з дев'яти моделей розташовані нижче 0.62, і вибіркове прогнозування навіть на найкращій з них залишає суттєву залишкову помилку (Розділ 4). Панель незалежних моделей досягає 0.832, тоді як самооцінка дає 0.545—перевага, яка вистояла при суворішому перекодуванні без міток панельної згоди—тоді як очевидний контрприклад на іншій панелі значною мірою відображає тотожність між моделями, а не самознання на кожен елемент (декомпозиція в розділі 4); виявлення однієї моделі, чий самозвіт добре дискримінує, все ще вимагає незалежного вимірювання, яке мав замінити самозвіт.
C2 (немає підтвердної коригування від впорскування профілю). Найпрямішу коригування—передачу моделі її власного вимірюваного профілю точності для кожної галузі в момент відповіді—не значно перемогла плацебо профіль на одному підтвердному щаблі замороженого експерименту, контрольованого плацебо (AUROC , вихідний , Holm-скоригований ; жоден підтвердний кінцевий результат не був досягнут). Ми звітуємо про це як про нуль, а не про тренд (Розділ 5).
C3 (маніпульована). Канал впорскування, який використовувала б коригування, приймає підробки: перемішаний (помилковий) профіль привів AUROC самооцінки граничного щабля до рівня випадковості (0.474 проти 0.710; падіння ), одна вигадана заява про "95% точність" змістила заявлену впевненість локальної моделі з 50 на 95 для елемента, який вона розраховує неправильно, й як тільки елементи отримують мітки тем, чотири з п'яти локальних моделей споживають помилковий профіль на свою шкоду (Brier до ; Розділ 6).
Разом ці результати промовляють на користь зміни ролі: самооцінена впевненість повинна бути вимірюваною метою оцінювання, а не неперевіреним введенням до нього. Розділ 7 деталізує наслідки для конвеєрів судження, маршрутизації агентів та архітектури платформи; супровідна стаття (Chernets, 2026) розглядає режими відмови альтернативи на основі панелі й цитується, а не переформулюється, тут.
Пов'язані роботи
Вербалізована впевненість і калібрування. Невідповідність калібрування сучасних мереж є давнім результатом (Guo et al., 2017), і для мовних моделей, налаштованих на QA, калібрування було знайдено недостатнім задовго до поточного покоління моделей (Jiang et al., 2021). Моделей можна навчити висловлювати невизначеність словами (Lin et al., 2022b), а більші моделі частково «знають, що вони знають» на зондах самооцінки (Kadavath et al., 2022), однак вони значною мірою не розпізнають того, чого вони не знають (Yin et al., 2023); емпіричні аудити отриманої впевненості виявляють стійку надмірну впевненість у різних форматах отримання (Xiong et al., 2024), при цьому вербалізовані оцінки іноді краще калібровані, ніж ймовірності токенів, однак все ще завищені (Tian et al., 2023). Зондування внутрішнього стану загострює картину: прості класифікатори над активаціями прихованих шарів відновлюють правдивість на рівні 71–83% (Azaria and Mitchell, 2023)—невдача живе у вербалізованому каналі виводу, не обов'язково у внутрішніх представленнях. Наш внесок — це масштаб і дизайн: попередньо зареєстрована, зафіксована колекція з 16 моделей, оцінювана насліпо, оцінює одне й те саме отримання проти основної істини та проти узгодження незалежної панелі на однакових позиціях—плюс два питання, які ця література рідко ставить: чи можна відремонтувати сигнал за допомогою власного виміреного профілю моделі, і чи можна атакувати канал ремонту?
Споживання самозвітів далі. Конвеєри LLM-як-судді успадковують упередження судді та межі надійності (Zheng et al., 2023), а сигнали впевненості на основі узгодження самі перебувають під аудитом (Ding, 2026); детектори семантичної ентропії (Farquhar et al., 2024) обходять самозвіти, замість цього вимірюючи розподіли відповідей. Структури оцінювання третьою стороною обґрунтовують управління для незалежного вимірювання (Raji et al., 2022); ми даємо їй кількісну підлогу: для шести з дев'яти моделей API самозвіт, який конвеєр би споживав, містить AUROC нижче 0,62.
Недовірені входи. Непрямий інжект підказки показує, що будь-який текстовий канал, який LLM поглинає, є поверхнею атаки (Greshake et al., 2023). Розділ 6 локалізує конкретний, досі не названий випадок: слот профілю самокомпетентності, який ремонти калібрування мали б використовувати, є каналом входу без автентифікації, і його підробка знижує дискримінацію до рівня випадку.
Панелі та їх власні невдачи. Панелі різноманітних моделей є все більш стандартним інструментом оцінювання (Verga et al., 2024). Сигнал панелі, який ми використовуємо як компаратор, не є безплатним обідом: його режими відмов (інверсія складності, обмежені простори відповідей, припущення незалежності на основі мітки, конформність) вимірюються в супровідній статті (Chernets, 2026) на тій же необробленій колекції; ця стаття володіє історією самооцінки, супровідна стаття володіє історією панелі, і жодна таблиця не дублюється між ними.
Еталони. Ми отримуємо на підмножині SimpleQA після 2023 року (Wei et al., 2024) саме через розрив у віці еталона, який ми вимірюємо проти TruthfulQA 2021 року (Lin et al., 2022a) (Розділ 3).
Попередньо зареєстрований експеримент: дизайн та дані
Один попередньо зареєстрований сліпий збір, протокол закріплений публічно до появи даних підтвердження: шістнадцять моделей (одна модель бюджетного/середнього рівня API від одного провайдера в дев'яти провайдерів плюс сім локальних з відкритими вагами) відповідали на одні й ті самі 1,500 фактичних питань після 2023 року (підмножина SimpleQA) при температурі нуль, кожна відповідь супроводжувалася зазначеною впевненістю 0–100; всього 22,248 оцінених відповідей (13,446 frontier, 8,802 локальних).
Попередня реєстрація та закріплення.
Протокол збору було закріплено в публічній реєстрації до появи будь-яких даних підтвердження (маршрут доступу в додатку про відтворюваність). У реєстрації попередньо визначено бенчмарк та підмножину (випадкова , фіксоване насіння, SHA-256 файлу підмножини записано), перелік моделей, формат вилучення, процедуру оцінювання, план аналізу — включаючи порівняння AUROC узгодження панелі проти власної впевненості, використане в розділі 4, попередньо визначену вторинну метрику (первинною кінцевою точкою реєстрації є коефіцієнт позначення впевнено-помилкових при розходженні панелі, який є величиною на стороні панелі, про яку повідомляється в супровідній роботі) — та правило рішення проти вибору метрик post-hoc. Перед закріпленням проводився невеликий дослідницький пілот (95 елементів TruthfulQA, три локальні моделі) для перевірки конвеєру; його числа ніколи не змішуються з даними підтвердження.
Моделі та вилучення.
Дев'ять провайдерів frontier через їхні API — одна модель бюджетного/середнього рівня від одного провайдера, тому назви провайдерів нижче позначають окремі моделі, а не лінійки продуктів (точні ID моделей та дати збору в додатку про відтворюваність) — та сім локальних моделей з відкритими вагами. Кожна модель відповідає на кожен елемент незалежно при температурі 0 та заявляє цілочисельну впевненість 0–100 у тій самій відповіді; панелі є аналітичними комбінаціями цього єдиного сліпого збору — жодна модель ніколи не бачить виходу іншої моделі.
Оцінювання.
Нормалізована еквівалентність рядків до золотого стандарту та виявлення відмов спочатку; невирішені відкриті випадки йдуть до локального оцінювача LLM з відкритими вагами, обмеженого лише еквівалентністю до золотого стандарту (qwen3:8b, локальна). Вибіркова перевірка людиною 50 елементів виявила 98% узгодження (одна консервативна помилка); міжсімейний аудит 342 найважчих консенсусних вердиктів узгодився 342/342 (Обмеження). Без виключень, крім збоїв парсування (про що повідомляється); вони зосереджені в одній локальній моделі міркування, яка зберігає лише 98 придатних для оцінювання відповідей з 1,500 — усі претензії локального рівня мають per-model . Весь аналіз підтвердження є детермінованим із необробленого JSONL.
Вибір бенчмарку, вимірюваний.
Первинний бенчмарк після 2023 року — це рішення дизайну, виправдане вимірюванням, а не припущенням: в порівняльному дослідженні за віком бенчмарку одні й ті самі моделі набрали на до процентних пункти вищих результатів на 2021 року TruthfulQA MC, ніж на SimpleQA після 2023 року (deepseek pp, 95% CI ; mistral ; zhipu ; напр., 89.2% проти 28.4%) — розрив, що узгоджується з ефектами віку бенчмарку та експозиції, хоча цей дизайн не може розділити забруднення від складності та конструктивних різниць. Жодне основне число не ґрунтується на старішому бенчмарку; 750-елементна рука TruthfulQA MC1 на локальному рівні використовується лише там, де це вказано.
Попередньо зареєстровані проти дослідницьких.
Попередньо зареєстровані та підтверджувальні: збір вище та порівняння AUROC панелі проти власної (розділ 4). Дослідницькі, і позначені як такі де б вони не використовувалися: рука порівняння за віком бенчмарку, ступінь впровадження профілю frontier та локальний мікрозонд розділу 6. Драбина впровадження профілю розділу 5 — це окремий закріплений, плацебо-контрольований протокол (рукави, кінцеві точки та родина Holm зафіксовані перед його підтвердженою фазою).
Результат 1: самовпевненість неправильно калібрована та слабо розрізняє
Ми розрізняємо дві властивості, які термін «калібрування» часто змішує: калібрування в цілому (чи рівень впевненості відповідає рівню точності?) та розрізнення (чи впевненість ранжує правильні відповіді моделі вище за неправильні?).
Калібрування. Заявлена впевненість є насиченою та відокремленою від компетентності: в дев'яти моделях API заявлена впевненість становить 85–95 (медіана для кожної моделі) у семи з дев'яти, тоді як точність варіюється від 16,5 до 66,5%; два моделі вибиваються—модель з частими відмовами (медіана 42 при точності 10,3%) та одна модель з розподіленою впевненістю (медіана 60). Кожна модель є надмірно впевненою в цілому: розрив впевненість–точність (CITL, таблиця 1) варіюється від до процентних пункти. Колонка ECE майже дорівнює CITL: розрив впевненість–точність є позитивним в кожній заповненій групі для семи з дев'яти моделей (всіх крім однієї для двох інших), тому групове та глобальне неправильне калібрування збігаються. Навіть модель з частими відмовами зберігає pp (ECE 0.310)—її низька смуга відображає поведінку відмови, а не калібровану самосвідомість. Частина її переваги в розрізненні може бути також механічною—відмови, оцінені як невірні при низькій заявленій впевненості, підвищують AUROC (виключаючи рядки з відмовами, він становить 0.660, )—тому ми інтерпретуємо її 0.788 як верхню межу проявленої самосвідомості, а не як показник якості калібрування. На основі всіх дев'яти моделей API, 60,1% відповідей, заявлених з впевненістю 80, є невірними (5,598 з 9,310); показник для кожної моделі варіюється від 29,0 до 83,2% (макроусереднення 57,6%). Споживач, який довіряє високій заявленій впевненості, приймає більшість помилок. Розрізнення. Як предиктор власної правильності моделі, самовпевненість досягає AUROC 0.532–0.788 залежно від моделі. Довірчі інтервали Bootstrap 95% (таблиця 1) виключають 0.5 для кожної моделі, тому сигнал не є буквально випадковим—але для шести з дев'яти моделей він знаходиться нижче 0.62. Наслідок є операційним: при 20% охопленні (коли відповідаємо лише на п'яту найбільш впевнених позицій), показники помилок трьох найсильніших за AUROC моделей все ще становлять 75,3%, 33,3% та 15,1% (таблиця 2)—суттєве скорочення лише для третьої, й недостатньо надійний механізм фільтрування для двох інших.
Архітектурна альтернатива—підрахунок незалежних моделей, що узгоджуються—досягає AUROC 0.832 (95% ДІ ) на панелі, де самооцінка дає 0.545 (); різниця, кластеризована за елементами, , виключає нуль з великим запасом. Три попередньо визначені панелі: US (Anthropic, OpenAI, Google), CN (DeepSeek, Alibaba, Moonshot), cross-bloc (Anthropic, DeepSeek, Mistral); основне порівняння — панель CN. На іншій попередньо визначеній панелі об'єднане порівняння, здається, змінює напрямок: самооцінка 0.842 об'єднана по популяції панелі проти панелі 0.697; . Розкладання показує, що це очевидне змінення в основному відображає ідентичність між моделями, а не локальне самопізнання: об'єднана 0.842 змішує три моделі, чиї self-AUROCs у межах моделей становлять лише 0.596–0.784 (макросередня 0.709; значення популяції панелі—таблиця 1 наводить повний оцінений набір), і після нормалізації рангу у межах моделі (яка видаляє відмінності рівня між моделями, зберігаючи власний рейтинг кожної моделі) об'єднане значення падає до 0.672—внесок ідентичності між моделями . Панель 0.545 проходить той же тест (0.545 об'єднана проти 0.582 нормалізована за рангом): її відмова в самооцінці справді локальна. Те, що залишається від змінення, це більш вузька твердження: модель з багатьма відмовами з найсильнішою дискримінацією самовпевненості (0.788 на повному оціненому наборі) справді перевищує сигнал узгодження цієї панелі—і визначення, яка це модель, вимагає саме незалежного вимірювання, яке мали на меті замінити самозвіти. Третя попередньо визначена панель (cross-bloc) знаходиться між двома: панель 0.722 проти власної 0.659 , .
Чутливість до безетикеткового перекодування сигналу панелі.
Канонічне кодування еквівалентності, що лежить в основі сигналу панелі, звертається до власної етикетки правильності первинної моделі (дві відповіді, обидві оцінені як правильні, вважаються узгодженими), тому узгодження панелі є частково детермінованою функцією цільової етикетки—залежність, опосередкована етикеткою, хоча не витік самоголосування: за конструкцією власний запис моделі ніколи не входить у власний сигнал панелі. Безетикеткове перекодування (лише узгодження рядків; прапорці правильності ні первинної, ні панелістів не враховуються) знижує AUROC панелі з 0.832 до 0.775 на панелі, де самооцінка дає 0.545, і з 0.697 до 0.628 на іншій; основна перевага панелі зберігається при суворішому кодуванні (0.775 проти 0.545).
Таблиця 1 показує картину для кожної моделі; малюнок 1 показує те саме розв'язування по всіх шістнадцяти моделях: усі моделі лежать вище діагоналі калібрування, а локальний рівень схлопується до смуги заявленої впевненості 85–100 при точності 9.2%.
| Модель | Точність (%) | Середня впевненість | CITL (пп) | Brier | ECE | Self-AUROC | 95% ДІ | |
|---|---|---|---|---|---|---|---|---|
| 1,461 | 66.5 | 92.8 | 0.271 | 0.263 | 0.746 | [0.722, 0.770] | ||
| moonshot | 1,500 | 51.6 | 75.8 | 0.292 | 0.242 | 0.619 | [0.590, 0.648] | |
| alibaba | 1,497 | 47.4 | 92.3 | 0.446 | 0.448 | 0.532 | [0.510, 0.556] | |
| xai | 1,500 | 37.9 | 48.9 | 0.197 | 0.111 | 0.777 | [0.755, 0.798] | |
| deepseek | 1,500 | 35.7 | 89.2 | 0.513 | 0.535 | 0.570 | [0.549, 0.592] | |
| zhipu | 1,493 | 28.4 | 92.6 | 0.612 | 0.642 | 0.611 | [0.582, 0.639] | |
| openai | 1,500 | 16.7 | 77.6 | 0.531 | 0.610 | 0.598 | [0.559, 0.636] | |
| mistral | 1,495 | 16.5 | 90.6 | 0.686 | 0.742 | 0.584 | [0.550, 0.616] | |
| anthropic | 1,500 | 10.3 | 41.3 | 0.206 | 0.310 | 0.788 | [0.758, 0.817] |
Калібрування для кожної моделі на підтверджувальній колекції SimpleQA (рівень frontier, повна набір оцінених даних; назви постачальників позначають одну модель бюджетного/середнього рівня, зібрану на постачальника). CITL: калібрування в цілому, середня задекларована впевненість мінус точність, у відсоткових пунктах. ECE: очікувана помилка калібрування з 10-ю бінами. Self-AUROC: задекларована впевненість як предиктор коректності моделі за окремими елементами (з коригуванням нічиїх Mann–Whitney), з завантажувальною 95% CI (перевибір на рівні рядка в межах моделі, 2,000 повторень, фіксоване насіння). Усі значення є детерміністичними переобчисленнями з необробленого оціненого JSONL; кожна CI виключає 0,5. CITL використовує неокруглені середні значення; відображені значення округлені до одного десяткового знака. {#tab:vendor}
| Коефіцієнт помилок при охопленні | |||||
|---|---|---|---|---|---|
| 2-6 Модель | 100% | 80% | 60% | 40% | 20% |
| anthropic (self-AUROC 0.788) | 89.7% | 87.1% | 82.9% | 80.3% | 75.3% |
| xai (0.777) | 62.1% | 52.8% | 45.1% | 39.5% | 33.3% |
| google (0.746) | 33.5% | 24.5% | 20.0% | 18.7% | 15.1% |
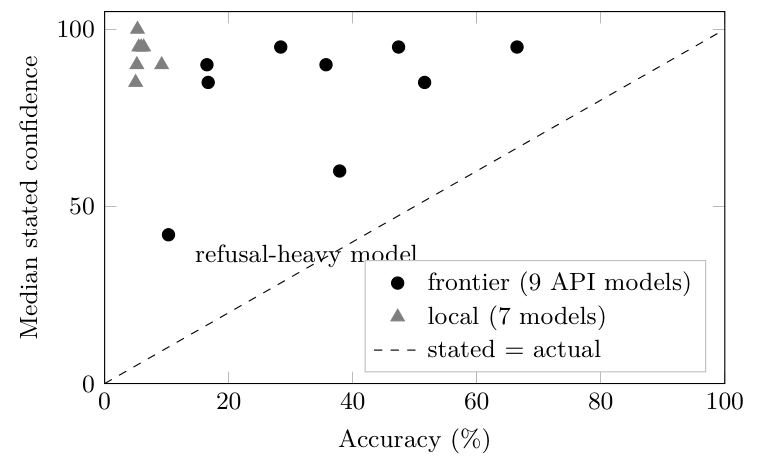 Послідовна надмірна впевненість у всіх шістнадцяти оцінених моделей: медіана заявленої впевненості за моделлю (середні значення представлені в Таблиці 1) порівняно з фактичною точністю всіх 16 моделей на одних і тих же 1500 сліпих елементів SimpleQA. Усі моделі розташовуються вище діагоналі калібрування; модель із великою часткою відмов (медіана заявленої впевненості 42 при точності 10,3%, CITL +31,0 pp) має найкращий AUROC самооцінки 0,788, але все ж залишається надмірно впевненою; найменший розрив калібрування належить моделі з розпорошеною впевненістю (+11,1 pp). Граничні медіани за моделлю: 95/85/95/60/90/95/85/90/42 у порядку рядків Таблиці 1; локальний шар із семи моделей охоплює точність 5,0–9,2% при медіані впевненості 85–100 (розмір вибірки n за локальною моделлю: 98–1498 після виключення помилок розбору; локальний шар служить для зондів маніпуляції та цього зображення, не для тверджень про розрізнення).
Результат 2: відсутність підтверджувального поліпшення дискримінації від введення виміряного профілю
Природна виправка полягає у наданні моделі її власного виміряного профілю компетентності—точності за доменами на основі відкладених даних—під час надання відповіді. У плацебо-контрольованому експерименті зі сходинками (умови: без профілю, плацебо-профіль підібраний за загальним рівнем, власний виміряний профіль, перетасований профіль) умова з власним профілем не значно перевищила плацебо на підтверджувальній кінцевій точці: AUROC , 95% CI , сирий , коригований за Хольмом ; жодна підтверджувальна кінцева точка не досягнута. Ми повідомляємо про це як про нульовий результат з явно вузькою областю: на одній підтверджувальній сходинці дискримінація не була виправлена введенням виміряного профілю. Оцінка точки позитивна, але при попередньо зареєстрованому коригуванні виправка не продемонстрована; дизайн мав потужність лише для помірних ефектів (SE з CI: 80% потужність лише для AUROC , більший за спостережуваний —отже, дані сумісні як зі справжнім нульовим результатом, так і з малим справжнім ефектом). Стеля дизайну не є обмежувальним фактором. Прийняття власної точності біна кожної позиції—обчисленої без залучення однієї позиції, щоб позиція ніколи не сприяла своєму власному предиктору—як єдиного предиктора коректності цієї позиції дає оракула AUROC 0.758 для підтверджувального суб'єкта (0.716–0.789 у чотирьох суб'єктів зі сходинками), з розповсюдженням точності біна SD 0.195 та діапазоном 0.15–1.00 у 21 біні. Бінці отже відрізняються досить, щоб правдивий профіль міг нести значну інформацію: нульовий результат стосується каналу введення, а не батареї занадто пласкої, щоб зареєструвати його.1 Дослідницькі закономірності (більші виграші там, де базова калібрування найслабкіше) є лише гіпотезо-генеруючими.
Дизайн зі сходинками та валідація плацебо.
Чотири фіксовані сходинки (суб'єкти: Claude Haiku 4.5, Sonnet 5, Opus 4.8 та Fable 5; точні ID claude-haiku-4-5-20251001, claude-sonnet-5, claude-opus-4-8, claude-fable-5), кожна з чотирма закритими умовами, що займають один і той же слот калібрування в іншому випадку ідентичного підказування: відключено (структурна пустота у формі профілю), плацебо (профіль, не релевантний для калібрування, підібраний за загальним рівнем; підтверджений на кожній сходинці проти істинного профілю при —виміряне , , , ), основна (власний виміряний профіль моделі за доменами), та перетасована (профіль з переставленими бінцями; дослідницька після неудалої перевірки маніпулювання, яку понизили від статусу підтверджувального). Батарея з 315 позицій охоплює 21 доменний біндл з пасткових позицій та явного токена утримання; призначення позиція–умова були заморожені перед підтверджувальною фазою, з випадковим порядком умови для кожної позиції та без назв умови у тексті, видимому суб'єктам. Попередньо зареєстрована межа виродженості (відключено точність ) понизила три з чотирьох сходинок від усіх підтверджувальних обчислень; Таблиця 3 повідомляє про єдину прийнятну сходинку. Точність сходинки, що пережила, для умови відключено становить 0.847 проти порога 0.85, тоді як понижені сходинки знаходяться на 0.855, 0.888 та 0.900—з AUROC умови відключено лише з відповідями 0.575, 0.628 та 0.500 (описово, точність близька до максимуму залишає мало сигналу калібрування для виправлення). Усі чотири суб'єкти взяті з однієї сімейства постачальника; див. Обмеження.
| Умова | Точність (усі елементи) | AUROC | Brier | ECE | Парні AUROC (основнеумова) |
|---|---|---|---|---|---|
| вимкнено (без профілю) | 0.847 | 0.564 | 0.138 | 0.110 | [] |
| плацебо | 0.857 | 0.578 | 0.127 | 0.090 | [] |
| основне (власний профіль) | 0.857 | 0.625 | 0.127 | 0.099 | — |
| перемішаний (хибний) | 0.842 | 0.589 | 0.140 | 0.113 | не обчислено (дослідницький) |
Драбина профільної ін'єкції, щабель, придатний для підтвердження (об'єкт дослідження: Claude Sonnet 5; : 294 непасткових елементи 2 попередньо зареєстровані свіжо-обробле́ні повторення—система тестування не розкривала ні температури, ні насіння; AUROC лише на основі відповідей). Підтверджуючі контрасти (бутстреп, кластеризо́ваний за елементами): основнеплацебо AUROC , 95% ДІ , некоригована ; основневимкнено , ДІ , некоригована ; обидва не пройшли корекцію Холма () та двофакторні ворота елементпартія (попередньо зареєстрована вимога надійності з кластеризацією за елементом та партією збірки). Стовпець парних- повторює парні контрасти попередньо визначеного аналізу, кластеризовані за елементами, порівняно з основне; вони не є арифметичною різницею стовпця AUROC для кожної групи, і для перемішане не було обчислено жодного підтверджуючого парного контрасту (переведено до дослідницького статусу перед фазою підтвердження). Ми відзначаємо, що, всупереч нашій гіпотезі, основне не домінує щодо калібрування: його ECE (0.099) гірше, ніж у плацебо (0.090), що служить ще однією причиною розглядати нульовий результат підтвердження як справжній нуль. {#tab:ladder}
Результат 3: канал самовідображення піддається маніпуляції
Якщо гарнесс оцінювання використовує профіль самокомпетентності, цей слот є каналом введення, і введення можна підробити. Ми розрізняємо три твердження зі зменшуючою доказовою силою та вказуємо, яке з них підтримує кожен результат. (i) Каузальна маніпульованість—продемонстрована нижче: підстановка хибного профілю причинно змінює задекларовану впевненість і погіршує калібрування в контрольованих запусках. (ii) Вразливість цілісності—умовна: має значення лише для гарнесів, які фактично вводять профілі компетентності з джерела, на яке зловмисник може вплинути. (iii) Практична поверхня атаки в розгорнутих конвеєрах оцінювання—гіпотеза, яку мотивує цей документ, але не перевіряє. Заміна істинного профілю на перемішаний (хибний) привела AUROC самооцінювання дослідницької прикордонної ланки до рівня випадковості: 0.474 проти 0.710 з істинним профілем (дослідницька ланка з понизженою стелею; бутстреп, згрупований за елементами: 0.710 [0.586, 0.820] vs. 0.474 [0.349, 0.599], різниця [, ]). Для контрасту на ланці, придатній для підтвердження, перемішаний розташовувався між плацебо та ядром (0.589 vs. 0.578 та 0.625; парний контраст, згрупований за елементами, дослідницький: ). Ця ланка за побудовою є слабким доказом маніпуляції: хибний профіль двічі не пройшов попередньо зареєстровану перевірку (зовнішній експерт 0.99/0.94 проти зв'язаного ); заморожене правило знизило варіант перед тим, як з'явилися дані підтвердження, модель може ігнорувати виявно неправдоподібний профіль, і перевірка споживання не існує. Окремо: прикордонний експерт виявляє підробку виключно на основі правдоподібності. На локальній станції з нульовою вартістю одне сфабриковане твердження («95% точність у цій галузі») підвищило задекларовану впевненість моделі щодо того самого елемента з 50 до 95; ефект зосереджується в моделях, які мають декларативне калібрування для втрати; у цьому зондуванні найбільший зсув ( балів) траплявся в моделі, яка мала найбільше втратити (glm4:9b). Дві граничні умови обмежують ефект: модель повинна мати можливість пов'язати поточний елемент з категорією профілю (на немаркованих елементах малі локальні моделі ігнорують профіль; дельти , узгоджуються з заморозеною нульовою гіпотезою Результату 2), та моделі, прикріплені до стелі (впевненість незалежно), не мають чого атакувати.
Свідоцтво маніпуляції—одна розвідувальна сходинка межи, локальний мікрозонд і локальний прохід з мітками тем—встановлює причинну маніпульованість, твердження (i). Таблиця 4 показує мікрозонд: той самий елемент, та сама модель, і однорядкова зміна в ін'єктованому профілі самого себе переміщує заявлену впевненість на до пунктів.
Розвідувальний прохід з мітками тем: обидва боки межи, наживо.
Перша межова умова вище (модель повинна мати можливість асоціювати елемент з категорією профілю) сама підлягає перевірці: маркування кожного зонда його темою—розкрита відхилення від заморозленого протоколу—усуває перешкоду в асоціації. У повному локальному проході (п'ять моделей, 16 зарезервованих зондів на рукав, температура 0, фіксоване насіння), неправдивий профіль, який був інертним на немічених елементах, впливає на чотири з п'яти моделей, як тільки елементи позначені: Brier деградує на (glm4:9b), (llama3.2:3b, з точністю, що падає, 37.5%25.0%), (mistral:7b), і (phi4-mini); бутстреп ДІ на один зонд при включають нуль для кожної моделі, тому мікрозонд встановлює напрямок і механізм, а не розміри ефекту за моделями;
п'яте (qwen3:8b) відповідає на батарею на максимумі (100% точність, впевненість 100 в обох гілках, ), відтворюючи межу «нічого атакувати». Механізм спрямований і симетричний: хибна висока претензія завищує впевненість саме в найслабішому діапазоні (llama3.2 фізика: заявлена впевненість 0100 в діапазоні з 25% контрольною точністю; phi4-mini логіка 1365), а хибна низька претензія знижує впевненість щодо правильних відповідей (llama3.2 історія 1000 при 75% контрольній точності), аж до спонукання модель утримуватися від відповідей на предмети, на які модель звичайно відповідає. Обидві сторони межи таким чином демонструються живими запусками: немічені предмети, профіль інертний (заморожена нуль); мічені предмети, підроблений образ себе поширюється прямо в заявлену впевненість і погіршує калібрування від кінця до кінця.
| Модель | Впев. @ «0%» | Впев. @ «95%» | |
|---|---|---|---|
| glm4:9b | 50 | 95 | |
| llama3.2:3b | 80 | 95 | |
| mistral:7b | 90 | 100 | |
| phi4-mini | 90 | 95 | |
| qwen3:8b | 100 | 100 |
Локальний мікрозонд (дослідницький): заявлена впевненість щодо того ж самого (неправильно відповіданого) пункту, коли введений слот профілю стверджує «0% точність» проти «95% точність» у межах області цього пункту; п'ять локальних моделей з відкритими вагами, температура 0. Модель з фіксованою верхньою межею (нижній рядок) не має декларативної калібрування для атаки. {#tab:microprobe}
Наслідки для практики оцінювання
Наші результати вимірюються на одному сімействі завдань (post-2023 open-form factual QA) з одним форматом отримання; наслідки, наведені нижче, екстраполюються з цих вимірювань.
(1) Перевернути роль заявленої впевненості. Власне звітування про впевненість має бути виміряною метою оцінювання, а не вхідним даним до неї при поточному способі отримання. Цифри на підтримку: 60,1% граничних відповідей з високою впевненістю помилкові, а найкраща self-AUROC (0,788) належить моделі, яку рейтинг точності поставив би на останнє місце—жоден рейтинг не передбачає, чиї власні звіти мають дискримінативну здатність.
(2) Конвеєри судді успадковують слабо дискримінаційні ваги. Будь-яка схема LLM-as-judge або ансамблю, що зважує голоси за самовпевненістю, імпортує для шести з дев'яти моделей тут сигнал з AUROC нижче 0.62—мовчки, тому що насичена смуга 85–95 виглядає успокійливо в логах. Якщо взагалі використовується зважування за впевненістю, ваги повинні походити від виміряної калібрування для кожної моделі, а не від самого звіту.
(3) Автентифікуйте слот профілю. Тривирівнева модель загроз розділу 6 впорядковує проблему: маніпульованість причинного зв'язку продемонстрована, вразливість цілісності залежить від того, що шлей насправді інжектує профілі з джерела, що піддається впливу, і практична поверхня атаки у розгорнутих конвеєрах залишається гіпотезою. Для шлей умовного класу канал ремонту - це розкриття: той самий інжектований профіль, що повинен був виправити калібрування, приймає підробки, які штовхають дискримінацію до рівня випадку (0.474) і погіршують оцінки Brier від кінця до кінця, як тільки елементи можна пов'язати. Такий шлей потребує шлюзу цілісності—підписаних профілів, перевірок походження, або як мінімум розділення того, хто вимірює профіль, від того, хто його поставляє в момент висновку. Неавтентифіковане слот самопредставлення - це відкритий порт prompt-injection з корисною навантаженням калібрування.
(4) Зовнішнє вимірювання - це альтернатива—зі своєю власною перевіркою. Узгодження незалежної панелі переважає самооцінку там, де самооцінка спрацьовує найгірше (AUROC ), але панелі мають свої виміряні режими відмовлення, розглянуті у супровідній статті (Chernets, 2026); прийняття сигналу панелі без цієї перевірки повторило б ту ж помилку на рівень вище. Розширення, попередньо зареєстроване як експериментальне, додає третій аспект: у 12 спрямованих парах обміну профіля (3,780 викликів) заміна виміряного профілю іншої моделі змістила AUROC не більше ніж на —і часом допомагала—тоді як прогноз рангу подібності втрати передачі не спрацював (Spearman ): виміряні профілі є портативними інструментами, а не привілейованим самодоступом. Практичний набір діагностики самооцінки описаний у додатку.
Обмеження
Одна сім'я бенчмарків для основних показників (фактичні запитання вільної форми після 2023 року); кожного постачальника представляє одна модель бюджетного/середнього рівня, тому узагальнення на рівні постачальника не заявляється; вирівнювання заявленої впевненості — один формат промпту для основних чисел — хоча дослідницька двоетапна гілка (150 позицій п'ять локальних моделей) припускає, що формат — не причина: запит впевненості без стану post-hoc знизив заявлену впевненість та темпи впевнених помилок, але не розрізнення (self-AUROC 0,43–0,61 в обох форматах; об'єднаний парно-бутстреп AUROC на парах, детерміновані мітки без LLM на 142–150 рядках на модель — помічене відхилення від оцінювача, що працює лише зі строками, під яким 90% випадків неможливо розв'язати); нульовий тест інжекції — один підтвердлюючий ступінь однієї шкали (315 позицій, 21 осередок), усі чотири суб'єкти з однієї сім'ї постачальника, і це не виключає кращих конструкцій ремонту; докази маніпуляції поєднують один дослідницький граничний ступінь, локальну мікрозонду та локальний прохід, помічений за темою (розкрите відхилення) — не підтвердлюуче дослідження атаки; оцінювання частково засноване на LLM, і його людська валідація — вибіркова перевірка 50 позицій (98% узгодження, одна консервативна помилка). Сім'я постачальників оцінювача також має одного члена CN-панелі, тому незалежність оцінювача сама вимірюється: другий оцінювач з сім'ї поза всіма панелями та сам оцінювач переоцінили всі 342 вердикти найскладніших квінтилів консенсусу й погодилися 342/342. Сам оцінювач — локальний суб'єкт рівня; перехресна переоцінка сім'єю всіх 1441 саморейтингового рядка погодилася на 98,3%, розходження, що тяжіють до самозміцнення (24 переходи вниз vs. 1 вгору; точність 5,94,4%) — посилення картини надмірної впевненості; повніша стратифікована переоцінка залишається майбутньою роботою. Порівняння панелі з собою поділяються даними із супровідною подачею; жодна таблиця не дублюється, границя зазначена в розділах 1–2, і обсяг цієї статті залишається лише самооцінюванням.
Висновок
Самооцінка, як вона наразі отримується, не проходить три тести, які повинна пройти сигнал оцінювання: вона відстежує коректність занадто слабко для контролю над рішеннями, та залишається вкрай впевненою, найбільш безпосереднє втручання у самопізнання не дало жодного помітного результату під контролем плацебо, а її канал введення приймає підроблення, які зводять дискримінацію на рівень випадковості. Доки моделі не набудуть калібрування на основі виміряних даних, заявлена впевненість — це явище для вивчення, а не сигнал для застосування.
References
Vadym Chernets. Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop Who Verifies the Agents?, 2026. https://doi.org/10.5281/zenodo.23197641 (cited for panel-side regimes only).
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
K. Greshake, S. Abdelnabi, S. Mishra, C. Endres, T. Holz, and M. Fritz. Not what you’ve signed up for: Compromising real-world LLM-integrated applications with indirect prompt injection. In Proceedings of the 16th ACM Workshop on Artificial Intelligence and Security (AISec), 2023. arXiv:2302.12173.
C. Guo, G. Pleiss, Y. Sun, and K. Q. Weinberger. On calibration of modern neural networks. In ICML, 2017. arXiv:1706.04599.
Z. Jiang, J. Araki, H. Ding, and G. Neubig. How can we know when language models know? On the calibration of language models for question answering. Transactions of the Association for Computational Linguistics, 9:962–977, 2021. arXiv:2012.00955.
S. Kadavath, T. Conerly, A. Askell, et al. Language models (mostly) know what they know. arXiv:2207.05221, 2022.
A. Azaria and T. Mitchell. The internal state of an LLM knows when it’s lying. In Findings of EMNLP, 2023. arXiv:2304.13734.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lin, J. Hilton, and O. Evans. Teaching models to express their uncertainty in words. Transactions on Machine Learning Research, 2022. arXiv:2205.14334.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
K. Tian, E. Mitchell, A. Zhou, A. Sharma, R. Rafailov, H. Yao, C. Finn, and C. D. Manning. Just ask for calibration: Strategies for eliciting calibrated confidence scores from language models fine-tuned with human feedback. In EMNLP, 2023. arXiv:2305.14975.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
J. Wei et al. Measuring short-form factuality in large language models (SimpleQA). arXiv:2411.04368, 2024.
M. Xiong, Z. Hu, X. Lu, Y. Li, J. Fu, J. He, and B. Hooi. Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. In ICLR, 2024. arXiv:2306.13063.
Z. Yin, Q. Sun, Q. Guo, J. Wu, X. Qiu, and X. Huang. Do large language models know what they don’t know? In Findings of ACL, 2023. arXiv:2305.18153.
L. Zheng, W.-L. Chiang, Y. Sheng, et al. Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. In NeurIPS Datasets and Benchmarks, 2023. arXiv:2306.05685.
Практичний засіб: діагностика самооцінювання
Побічним результатом цього дослідження є компактна самооцінна діагностика: фіксований набір коротких, детерміністично оцінюваних зондів, що охоплюють предметні категорії дослідження (числові, логіка, фізика, історія, код, ймовірність та інші), плюс пастки з явним токеном утримання. Кожна відповідь має зазначену впевненість 0–100, а інструмент оцінює композицію оцінки Брієра, розриву перевпевненості (середня впевненість мінус точність), дискримінації впевненості (середня впевненість на правильних мінус неправильних відповідях) та показника утримання на пастках, розподіляючи результат за рівнями від добре каліброваного до впевнено сліпого. Це операціоналізує тезу цієї статті — калібрування — це те, що слід вимірювати щодо моделі, а не читати з її самозвітів — і випускається разом із пакетом репродукції як інструмент, а не як результат: він використовує перефразовані зонди замість замороженого набору, і його показник дискримінації є проксі, а не кінцева точка AUROC драбини.
Додаток щодо відтворюваності
Усі основні числові результати в цій статті є детермінованими функціями випущеного необробленого JSONL; жодна з етапів не передбачає випадковість, доступ до мережі, обчислення на GPU або повторне запитування будь-якої моделі.
Доступність даних.
Заморожена реєстрація та пакет репліцирування (публічна реєстрація OSF): https://osf.io/4y9dv. Скрипт oracle-ceiling oracle_auroc.py депонується до цієї статті на https://doi.org/10.5281/zenodo.23197651.
Запит для отримання відповіді (дослівно).
Система: You answer short factual questions. Respond with ONLY a JSON object like {"answer": "<short answer>", "confidence": 85}. confidence is an integer 0-100 for how sure you are the answer is correct. No other text. Хід користувача містить саме питання; відмови виявляються з поля answer за допомогою замороженого лексикону відмов у скрипті оцінювання.
Ідентифікатори моделей та дати запусків.
По одній моделі API бюджетного/середнього рівня на кожного провайдера, димово перевірено в прямому ефірі на 2026-07-24 та зібрано наприкінці липня 2026 р. (часові позначки по викликам у маніфесті запусків, випущено з пакетом репліцирування): anthropic claude-haiku-4-5-20251001; openai gpt-5-mini; google gemini-3.6-flash; xai grok-4-fast; deepseek deepseek-chat; alibaba qwen-plus; moonshot kimi-k3 (розкрито відхилення збору: 670 з 1500 елементів на рахунку першої сторони, решта через маршрут агрегатора, обслуговується тією самою інфраструктурою першої сторони з вимкненим міркуванням, served_by записується за викликом; розділення чутливості тільки першої сторони було попередньо визначено); zhipu glm-4.5; mistral mistral-small-latest. Локальний рівень (Ollama, температура 0): gemma4:e4b, llama3.2:3b, phi4-mini, qwen3:8b, deepseek-r1:8b, glm4:9b, mistral:7b.
Супровідна стаття (Chernets, 2026) містить ту саму заморожену реєстрацію та необроблену збірку. Пакет репліката містить: текст та протокол заморожених реєстрацій, маніфест запуску з точними ідентифікаторами моделей, необроблені класифіковані збірки (frontier та local рубежи, плюс дослідницька гілка порівняння benchmark-age) та три скрипти CPU без залежностей. Перший (compute_panel_vs_own_auroc.py) — це канонічне визначення порівняння AUROC panel-agreement vs. own-confidence (розділ 4) та друкує разом з канонічними значеннями кожен неканонічний альтернативний варіант читання (binary panel signal, indeterminate coding, tie handling, pooling variants), тож вибір варіанту читання піддається перевірці. Другий (analysis_tae_week1.py) повторно друкує таблицю 1, координати рисунка 1, розриви benchmark-age розділу 3 та здійснює перевірку лише для читання заморожених значень ladder, повідомлених у таблиці 3 проти заморожених файлів аналізу ladder. Третій (analysis_tae_decomposition.py) повторно друкує розкладання pooled-AUROC та rank-normalization розділу 4, перекодування panel signal без мітки, коефіцієнти помилок high-confidence для кожної моделі, колонки CITL/Brier/ECE таблиці 1, значення risk–coverage таблиці 2 та описові характеристики demoted-rung розділу 5. Кожен скрипт виконується за кілька секунд на CPU ноутбука лише зі стандартною бібліотекою Python. Profile-injection ladder поставляється як власний заморожений пакет (protocol, battery, per-arm scored rows та analysis JSON), на який вказує пакет.
Обчислено на основі заморожених балів arm per-item (
scored-arms-*.jsonl; non-trap, statusok; для confirmatory subject) за допомогоюoracle_auroc.py, випущеного з цією статтею; всі гілки та реплікати позиції вилучаються разом.↩︎
Як цитувати
Chernets, V. (2026). Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation [Paper presentation]. NeurIPS 2026 Workshop: TAE. Zenodo. https://doi.org/10.5281/zenodo.23197651
@misc{chernets2026selfconfidenceevaluation,
  author       = {Chernets, Vadym},
  title        = {{Weakly Discriminative, Not Repaired by Profile Injection, and Manipulable: Self-Confidence in LLM Evaluation}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: TAE},
  doi          = {10.5281/zenodo.23197651},
  url          = {https://doi.org/10.5281/zenodo.23197651}
}