AI उत्पादकता को टोकन से नहीं, सत्यापित कार्य से कैसे मापें — उपकरण
यह एक अनुवाद है। प्रामाणिक संस्करण मूल अंग्रेज़ी पाठ है; कृपया उसी का हवाला दें।
यदि आप AI एजेंटों को काम सौंपकर वास्तविक काम करवाते हैं (Claude Code, Codex, Cursor और इसी तरह के), तो कोई नौकरी का शीर्षक, डिग्री या रिज़्यूमे लाइन यह नहीं दिखाती कि आप क्या करने के लिए विश्वसनीय हैं। 2026 में कई नियोक्ताओं द्वारा पहुँचा गया आंकड़ा, एक व्यक्ति कितने टोकन खपत करता है, यह और भी कम दिखाता है। Delegation Horizon एक निःशुल्क, खुला-स्रोत उपकरण है जो आप जो काम AI एजेंटों को सौंपते हैं उसके एक सरल लॉग को एक दिनांकित लाइन में बदल देता है:
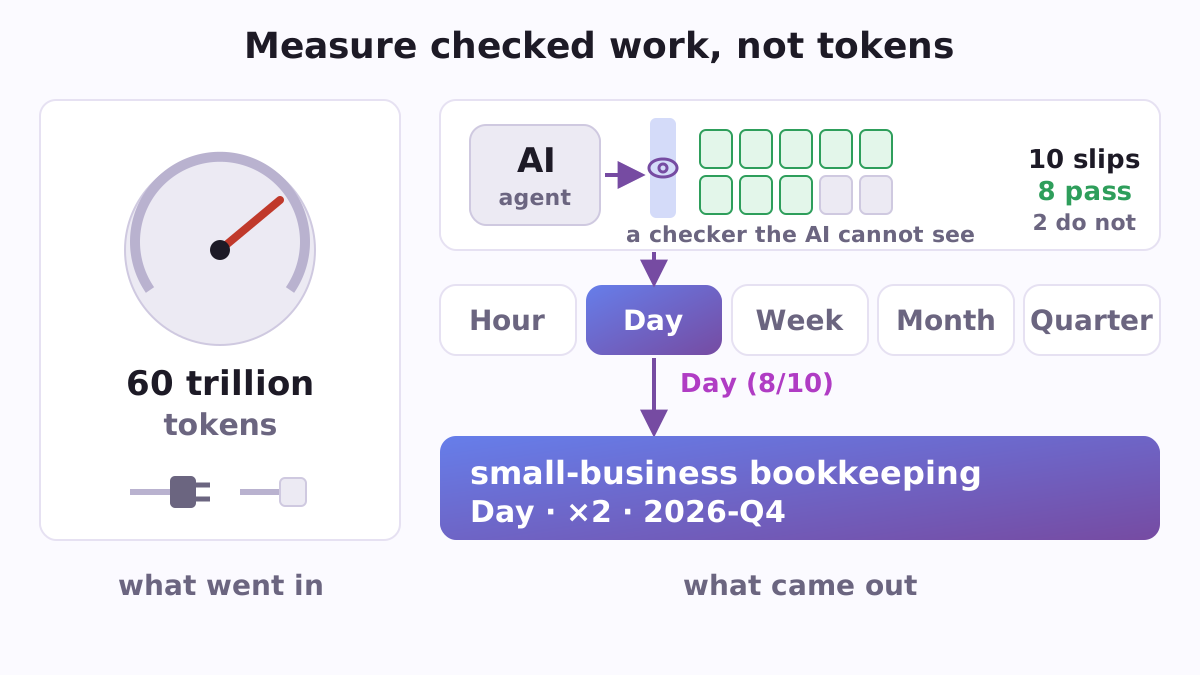
small-business bookkeeping · Day · ×2 · 2026-Q4यह पढ़ता है: छोटे व्यवसाय की बहीखाता में, यह व्यक्ति नियमित रूप से AI agents को काम के टुकड़े सौंपता है जो एक विशेषज्ञ को हाथ से करने में लगभग एक दिन लगता है, और agents द्वारा कभी नहीं देखा गया एक जाँच उन्हें पुष्टि करती है; उनके अपने ध्यान का हर घंटा कम से कम दो घंटे की जाँची गई काम लाता है; 2026 की चौथी तिमाही में स्कोर किया गया है। आप लॉग को किसी भी स्प्रेडशीट में रखते हैं, और स्कोर आपके अपने कंप्यूटर पर, एक छोटी Python script द्वारा या एक वेब पेज द्वारा काम किया जाता है जो ऑफ़लाइन चलता है। कोई खाता नहीं, कोई कुंजी नहीं, कुछ भी भुगतान करने के लिए नहीं, और लॉग कभी आपके कंप्यूटर से बाहर नहीं जाता है।
टोकन गिनती क्यों विफल हुई
2026 में कई बड़ी कंपनियों ने कर्मचारियों द्वारा AI का कितना उपयोग किया जाता है, इसके आधार पर यह मापने का प्रयास किया कि वे AI का कितनी अच्छी तरह उपयोग करते हैं, एक फैशन जिसे प्रेस ने tokenmaxxing नाम दिया। Meta पर, एक कर्मचारी द्वारा निर्मित लीडरबोर्ड जिसका उपनाम Claudeonomics था, 30 दिनों में 85,000 से अधिक कर्मचारियों में 60 ट्रिलियन टोकन लॉग किए गए (Shopifreaks)। Amazon पर, "कर्मचारी अपने स्कोर बढ़ाने के प्रयास में अनावश्यक कार्यों को करने के लिए AI एजेंट बना रहे थे", और ट्रैकर को ऑफलाइन कर दिया गया (CIO)। सितंबर में Meta ने कहा कि यह "प्रभाव का मूल्यांकन करने के लिए AI अपनाने वाले डैशबोर्ड या टोकन गिनती का उपयोग नहीं करेगा" (CIO)।
एक टोकन गिनती यह मापती है कि क्या अंदर गया, न कि क्या बाहर आया; DORA, Google Cloud का अनुसंधान कार्यक्रम, इसे "विशुद्ध रूप से इनपुट का एक उपाय" कहता है (DORA)। फिर भी LeadDev के 2026 सर्वेक्षण में 58% उत्तरदाताओं ने कहा कि उनका संगठन अभी भी टोकन उपयोग द्वारा AI प्रभाव को मापता है, जबकि केवल 19% ने इसे प्रभावी कहा (LeadDev)। Delegation Horizon इसके बजाय आउटपुट की गिनती करता है, किसी भी पेशे में।
दो संख्याएं और एक पंक्ति
आप जो भी काम एजेंटों को सौंपते हैं, वह लॉग की एक पंक्ति बन जाता है: इसका क्षेत्र, एक योग्य विशेषज्ञ को इसे हाथ से करने में कितना समय लगेगा (इसके "संदर्भ घंटे"), आपके अपने ध्यान का कितने मिनट लगे, यह किस जांच से गुजरा, और क्या यह पास हुआ।
- सत्यापित प्रत्यायोजन क्षितिज काम के सबसे बड़े आकार है जो आप नियमित रूप से एजेंटों को सौंपते हैं और एक जांच द्वारा पुष्टि प्राप्त करते हैं जिसे वे नहीं देख सकते। इसके पांच सीढ़ियां हैं: Hour, Day, Week, Month और Quarter (1, 8, 40, 160 और 500 संदर्भ घंटे)। Hour और Day को पिछले 91 दिनों में उस आकार की दस वस्तुओं की आवश्यकता है; Week को 182 दिनों में छह की आवश्यकता है; Month को एक साल में छह की आवश्यकता है; Quarter को एक साल में तीन की आवश्यकता है। एक बुककीपर और एक डेवलपर को समान नियम का सामना करना पड़ता है।
- प्रवर्धन लाभ पिछले 91 दिनों में आपके ध्यान के प्रति घंटे जांचे गए संदर्भ घंटे हैं, विफलताओं सहित, ×1, ×2, ×5, ×20 और ×60 के चरणों में दिखाए गए हैं।
दोनों को प्रति क्षेत्र रखा जाता है, इसलिए एक ही व्यक्ति वित्तीय उपकरणों में Week पर हो सकता है और वेब अनुप्रयोगों में Day पर हो सकता है। दोनों एक तारीख ले जाते हैं: एक सीढ़ी हर त्रैमासिक में फिर से अर्जित की जाती है, और Week से ऊपर इसके एक टुकड़े को पिछले 91 दिनों से आना चाहिए।
क्या चेक किया गया माना जाता है
एक रुंग के आकार के हर दस में कम से कम आठ टुकड़ों को चार प्रकार की जांच में से एक को पास करना चाहिए: छिपी हुई परीक्षाएं, एक योग्य विशेषज्ञ, उन लोगों द्वारा वास्तविक उपयोग जिनके लिए काम है, या किसी अन्य AI परिवार से एक मॉडल जो आपने स्वयं खोले गए स्रोतों के विरुद्ध जांच करता है। आपकी अपनी समीक्षा और एक ही परिवार के मॉडलों के बीच समझौता दर्ज किया जाता है लेकिन कभी नहीं गिना जाता। विफल और परित्यक्त टुकड़े लॉग में रहते हैं और आपके विरुद्ध गिने जाते हैं, और इसी तरह एक ऐसा टुकड़ा जिसमें किसी ने लॉग से बाहर मदद की, एक ऐसा टुकड़ा जिसकी बाद की ऑडिट विफल हुई, और एक परिणाम जो बाद में वापस ले लिया गया। एक ऐसा टुकड़ा जिसकी त्रुटियों को पूर्ववत नहीं किया जा सकता, जैसे भेजा गया पैसा, को पास करना चाहिए, और दूसरा AI परिवार इसे अपने आप पर जांचने के लिए कभी पर्याप्त नहीं है। सप्ताह से ऊपर, हस्तांतरण से पहले कम से कम एक कार्य में जानबूझकर त्रुटियां लगाई जाती हैं; उन्हें पकड़ना दिखाता है कि आप वास्तव में जांच करते हैं, और एक छूटी हुई त्रुटि सप्ताह और उससे ऊपर को अवरुद्ध करती है।
कठोरता का एक कारण है: लोग AI के साथ अपनी गति का न्याय बुरी तरह करते हैं। एक 2025 METR अध्ययन में, 16 अनुभवी डेवलपर्स को AI उपकरणों के साथ 19% अधिक समय लगा, फिर भी बाद में "वे अभी भी मानते थे कि AI ने उन्हें 20% तक गति दी है" (METR)।
एक कार्यरत उदाहरण
भंडार में एक काल्पनिक बहीखाता रक्षक, P07 की लॉग शामिल है: दस कार्य, प्रत्येक एक विशेषज्ञ का दिन या अधिक, जुलाई और सितंबर 2026 के बीच एजेंटों को सौंपे गए। 9 अक्टूबर 2026 को स्कोर किया गया:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
दस में से आठ सफल रहे, बिल्कुल वही जो दिन को चाहिए; एक टुकड़े की जांच केवल बुककीपर की अपनी समीक्षा से हुई और एक विशेषज्ञ की जांच में विफल रहा। आठ जांचे गए टुकड़े 80 संदर्भ घंटों तक जुड़ते हैं सभी दस पर लगभग 17.2 घंटे ध्यान के विरुद्ध, 4.66 का लाभ, जो ×2 चरण में आता है। यदि बुककीपर विफल टुकड़े को हटा देता, तो लॉग बेहतर दिखता और स्कोर बदतर होता: पायदान नौ टुकड़ों पर आराम करता, दस की गिनती को याद करता और घंटे से नीचे गिरता, जबकि लाभ ×5 तक कूदता। रिकॉर्ड प्राप्त करने वाला कोई भी तुरंत देखता है, क्योंकि कार्ड की तारीख पर एक रीस्कोर अब मेल नहीं खाता। यह इसलिए है कि विफलताएं रिकॉर्ड में होनी चाहिए।
जो लोग एजेंट के माध्यम से निर्माण करते हैं
record_card.pyआपकी स्प्रेडशीट पढ़ता है और पंक्ति और एक संक्षिप्त कार्ड प्रिंट करता है: रुंग, इसके पीछे की गिनती ("दिन आकार के 10 में से 8 टुकड़े इसकी 91-दिन की खिड़की में सत्यापित"), लाभ, और जांच के प्रकार।--format mdप्रोफ़ाइल या नियोक्ता को भेजे गए ईमेल के लिए एक कार्ड बनाता है;--format recordरिज्यूमे के लिए केवल पंक्ति प्रिंट करता है।tools/explain.py(संस्करण 1.1.0 में नया) आपको बताता है कि आपका लॉग जो रुंग अर्जित करता है वह क्यों: कौन सी स्थिति सत्य है या असत्य है और कौन सा टुकड़ा इसका फैसला करता है, रुंग कितनी और विफलताएं ले सकता है, दिन जब यह समाप्त हो जाएगा यदि आप कुछ नया लॉग नहीं करते हैं, और अगला रुंग अभी भी क्या चाहता है। यह यह भी दर्शाता है कि दस टुकड़े अपने आप पर कितना कम साबित करते हैं: दस में से आठ लगभग 44% से 97% तक किसी भी सच्ची पास दर को पूरा करते हैं।checker.htmlएक ब्राउज़र में, ऑफ़लाइन समान स्कोरिंग करता है; एक परीक्षण इसकी तुलना Python स्कोरर के साथ कार्यकारी उदाहरण और 40 यादृच्छिक लॉग पर करता है। दोनों एक स्प्रेडशीट पढ़ते हैं जिसे सेमीकोलन, दशमलव कॉमा और दिन.महीना.वर्ष तारीखों के साथ सहेजा जाता है, जैसे यूरोपीय स्प्रेडशीट उन्हें सहेजते हैं।tools/log_piece.pyआपसे प्रश्न पूछकर एक लॉग पंक्ति बनाता है। यदि आप Claude Code में काम करते हैं, तो एक तैयार हुक (एक छोटी स्क्रिप्ट जो Claude Code किसी घटना पर चलाता है) हर बार जब कोई एजेंट सत्र समाप्त होता है तो एक लंबित प्रविष्टि खोलता है, इसलिए एक विफल टुकड़ा कभी भुलाया नहीं जाता। यह कोई प्रतिलेख नहीं पढ़ता है और कहीं भी कुछ नहीं भेजता है; कोई भी एजेंट उपकरण जो किसी सत्र के अंत में कोई आदेश चला सकता है, इसका उपयोग कर सकता है।tools/planted.pyआपकी रोपित त्रुटियों की सूची को हस्तांतरण से पहले एक फिंगरप्रिंट के साथ सील करता है और बाद में इसे स्कोर करता है, गलत प्रविष्टियों और छोड़ी गई चीजों को अलग से गिना जाता है, और एक सूची को अस्वीकार करता है जो सीलिंग के बाद बदली जाती है।
चौथे प्रकार की जांच के लिए, एक अन्य AI पारिवारिक आपके स्रोतों को पढ़ रहा है, Sidecall आपके कंप्यूटर पर अन्य AI उपकरणों के लिए कार्य का एक टुकड़ा रखता है।
प्रबंधकों और एचआर के लिए
kits/ai-usage-in-reviews.md प्रदर्शन समीक्षाओं में AI के लिए एक तैयार नीति है। टोकन या व्यय के बजाय यह स्वीकृत कार्यों के टुकड़ों के लिए पूछता है जिनमें से प्रत्येक जांच उत्तीर्ण हुई है; "दैनिक AI का उपयोग करता है" के बजाय, एजेंटों को दिया गया सबसे बड़ा टुकड़ा और पिछली तिमाही में सत्यापित किया गया। इसकी समीक्षा बातचीत के तीन प्रश्न हैं, जिसमें शुरुआत यह है: इस तिमाही में आपने एजेंटों को कौन सा सबसे बड़ा कार्य दिया और इसे सही साबित किया, और कैसे?
एक टीम प्रति व्यक्ति एक बनाया-गया लेबल के साथ एक लॉग रखती है (स्कोरर अज्ञात कॉलम को अस्वीकार करता है, इसलिए वास्तविक नाम छिप नहीं सकते); examples/team-log.csv पाँच क्षेत्रों में चार लोगों को दिखाता है। हर तिमाही record_card.py प्रति व्यक्ति और क्षेत्र एक कार्ड प्रिंट करता है। एक को जांचने के लिए, tools/verify_record.py रिकॉर्ड और लॉग लेता है और क्षेत्र दर क्षेत्र कहता है कि क्या लॉग वह फ़ाइल है जिसे स्कोर किया गया था, स्कोरर समान है, और रिकॉर्ड पुनः स्कोर किए जाने पर समान है। audit_sample.py एक शब्द के बाद से पुनः जांचने के लिए एक यादृच्छिक नमूना खींचता है जो दूसरा जांचकर्ता लॉग प्राप्त करने के बाद चुनता है, इसलिए कोई भी यह अनुमान नहीं लगा सकता कि कौन से टुकड़े खींचे जाएंगे, और tools/too_clean.py लॉग को झंडी करता है जो बहुत अच्छे लगते हैं: कोई विफलता नहीं, आकार जो मुश्किल से भिन्न होते हैं, प्रत्येक टुकड़ा एक तरीके से जांचा गया है।
संदर्भ घंटे टीम के बाहर तय हैं: एक कार्य बैंक से, या दो रेटर्स से जो नहीं जानते कि किसका काम है। tools/reference_hours.py उनके अनुमानों को लेता है और जब वे एक दूसरे से 1.5 गुना के भीतर होते हैं तो उनका ज्यामितीय माध्य देता है, या एक तीसरे रेटर को बुलाता है; kits/reference-hours-raters.md कहता है कि उन्हें कैसे चुनें और संक्षिप्त करें।
डिग्री के बजाय सत्यापित काम द्वारा काम पर रखने के लिए, kits/hiring-test/ उम्मीदवार के अपने क्षेत्र में एक छिपी हुई जांच, रोपित त्रुटियों और एक रेटर के साथ एक भुगतान किए गए एक दिन का कार्य परीक्षण रखता है जो CV नहीं देखा है। kits/trade-screen.md किसी को भी स्वीकार करने से पहले व्यापार का एक पहली सप्ताह का प्रश्न जोड़ता है, क्योंकि एक प्रोफ़ाइल या नौकरी का शीर्षक यह प्रतीत होता है से कम कहता है: 60 लोगों में से एक सर्वेक्षण मंच के फ़िल्टर बुककीपर के रूप में स्वीकार किए गए, 11 ने ऐसा प्रश्न गलत किया, आठ ने डेबिट और क्रेडिट को स्वैप करके।
पहले परीक्षण में लोगों ने क्या पाया
"विशेषज्ञ के घंटों" में किसी भी माप की सबसे कमजोर कड़ी स्वयं अनुमान है, इसलिए इसे पहले परीक्षण किया गया। अक्टूबर 2026 में Prolific पर एक प्री-पायलट को OSF पर किसी भी डेटा के आने से पहले पंजीकृत किया गया था, जिसमें 119 काम करने वाले बहीखाता लेखकों और वेब डेवलपर्स को दस कार्यों में से प्रत्येक को हाथ से पूरा करने में कितना समय लगेगा, इसका अनुमान लगाने के लिए भुगतान दिया गया। बेतरतीब ढंग से चुने गए दो मूल्यांकनकर्ता बहीखाता कार्य में केवल 28% समय और वेब कार्य में 25% समय 1.5 गुना के भीतर आए, जबकि योजना ने 70% निर्धारित किया था। एक सप्ताह के काम के रूप में लिखे गए कार्यों को 8 से 20 घंटे की माध्यिका अनुमान मिली, और अंत में फिर से पूछे गए समान कार्य को अक्सर कम अनुमान की तुलना में उच्च अनुमान मिला।
जो कोई भी इस उपकरण का उपयोग करने वाले किसी के लिए निम्नानुसार है: दो अजनबियों का अनुमान एक टुकड़े को आकार देने के लिए बहुत शोरगुल है। बड़े पैनलों की माध्यिका जल्दी स्थिर हो जाती हैं; 15 बहीखाता लेखकों के दो अलग-अलग पैनल, या 21 वेब डेवलपर्स, कम से कम 70% ड्रा में 1.5 गुना के भीतर सहमत थे। इसलिए संदर्भ घंटे एक कार्य बैंक से आते हैं जिनके पास मापा गया समय है, या एक पैनल से, और अनाम किया गया डेटा, पंजीकृत विश्लेषण और खोजपूर्ण विश्लेषण सभी pilot/ में हैं ताकि कोई भी फिर से चला सके।
शोधकर्ताओं के लिए
METR AI मॉडल को समय क्षितिज से मापता है: कार्य की अवधि, विशेषज्ञ घंटों में, जो एक मॉडल विश्वसनीय रूप से पूरा करता है। Delegation Horizon किसी व्यक्ति से वही पूछता है, और इसका आठ-दस का हिस्सा METR के 80% क्षितिज को दर्शाता है। अनुकरणित लॉग पर एक डेस्क प्री-पायलट ने नियमों को ट्यून किया (संस्करण 1.1), ऊपर दिया गया Prolific प्री-पायलट ने संदर्भ घंटों का परीक्षण किया, और लोगों के साथ पूर्ण पायलट का प्रोटोकॉल, पूर्वपंजीकरण मसौदा और सहमति पत्र pilot/ में हैं। kits/process-vs-experience-study.md और kits/matched-task-study.md एक ही कार्यों पर समूहों की तुलना करने के लिए तैयार प्रोटोकॉल हैं, और tools/power.py कहता है कि ऐसे अध्ययन को कितने लोगों की आवश्यकता है।
उपकरण के पीछे का पत्र भी दिनांकित, जांचने योग्य दांव लगाता है। Anthropic के लगभग 400,000 Claude Code सत्रों के अध्ययन में, जिन सत्रों ने कोड का उत्पादन किया, वे सॉफ्टवेयर नौकरियों में लोगों के लिए सत्यापित सफलता में 34% और बाकी सभी के लिए 29% समाप्त हुए (Anthropic)। इकतालीस भविष्यवाणियां 9 October 2026 को OSF पर पंजीकृत की गईं, प्रत्येक संभाव्यता के साथ, जिनमें यह है कि METR का सर्वोत्तम सार्वजनिक मॉडल के लिए 80% क्षितिज 2027 के अंत तक एक कार्य दिवस तक पहुंचता है (0.80) और यह कि 2027 के दौरान Fortune 500 नियोक्ताओं में से दो से कम टोकन गणना का उपयोग आधिकारिक मूल्यांकन मानदंड के रूप में करते हैं (0.80)। एक परीक्षण दिखाता है कि प्रत्येक पंजीकृत फ़ाइल अभी भी दाखिल की गई फ़ाइल के बिल्कुल समान है, और brier.py, predictions/score.py और predictions/skill.py उन्हें हर साल स्कोर करते हैं; एक अध्ययन जो कभी नहीं चलाया जाता है वह चुप-चाप छोड़ा नहीं जाता, बल्कि एक मिस के रूप में गिना जाता है।
शुरुआत कैसे करें
आपको Python 3.9 या उससे नया संस्करण चाहिए और कुछ नहीं।
- GitHub पृष्ठ से रिपॉजिटरी डाउनलोड करें (Code, फिर Download ZIP) या इसे क्लोन करें।
templates/work-log.csvको किसी भी स्प्रेडशीट (Excel, Numbers, LibreOffice, Google Sheets) में खोलें और एजेंटों को सौंपे गए प्रत्येक कार्य के लिए एक पंक्ति जोड़ें: स्वीकृत, अस्वीकृत या परित्यक्त।templates/README.mdहर कॉलम को सरल शब्दों में समझाता है, औरexamples/c4-log.csvनकल करने के लिए एक भरा हुआ लॉग है।- इसे CSV के रूप में सहेजें और कार्ड चलाएँ, या यदि आप ब्राउज़र पसंद करते हैं तो
checker.htmlको डबल-क्लिक करें।
git clone https://github.com/vadimchernets/delegation-horizon
cd delegation-horizon
python3 record_card.py examples/c4-log.csv --as-of 2026-10-09
python3 record_card.py my-log.csv --format md --out card.md
python3 tools/explain.py my-log.csv
यह कहाँ से आता है
Delegation Horizon, पत्र प्रोग्रामर विभाजन के बाद: AI एजेंट के माध्यम से निर्माण करने वाले लोगों के लिए एक मापदंड का साथी कोड है, जिसे Vadym Chernets ने लिखा है (अक्टूबर 2026, SSRN 7589918, DOI 10.2139/ssrn.7589918)। वर्तमान रिलीज़, 11 अक्टूबर 2026 का संस्करण 1.1.0, Python 3.9 से 3.13 तक हर पुश पर परीक्षित है। कोड MIT लाइसेंस के तहत है और Zenodo पर संग्रहीत है (DOI 10.5281/zenodo.23267444, जो हमेशा नवीनतम रिलीज़ की ओर इशारा करता है); सब कुछ github.com/vadimchernets/delegation-horizon पर है। उसी लेखक का एक पहले का पत्र, After Chat, यह पूछता है कि इतने कम लोग AI के साथ बातचीत से AI एजेंट्स को काम करने देने तक क्यों नहीं गए हैं; इसका कोड, After Chat, कई AI से एक सवाल पूछता है और दिखाता है कि वे कहाँ असहमत हैं।
delegation-horizon को GitHub पर देखें
Vadym Chernets ने Poly A1 भी बनाया है, एक ऐसी ऐप जिसमें विभिन्न कंपनियों के AI एक-दूसरे का काम जाँचते हैं।