Как измерить производительность ИИ по проверенной работе, а не по токенам
Это перевод. Основная версия — оригинал на английском; ссылайтесь на него.
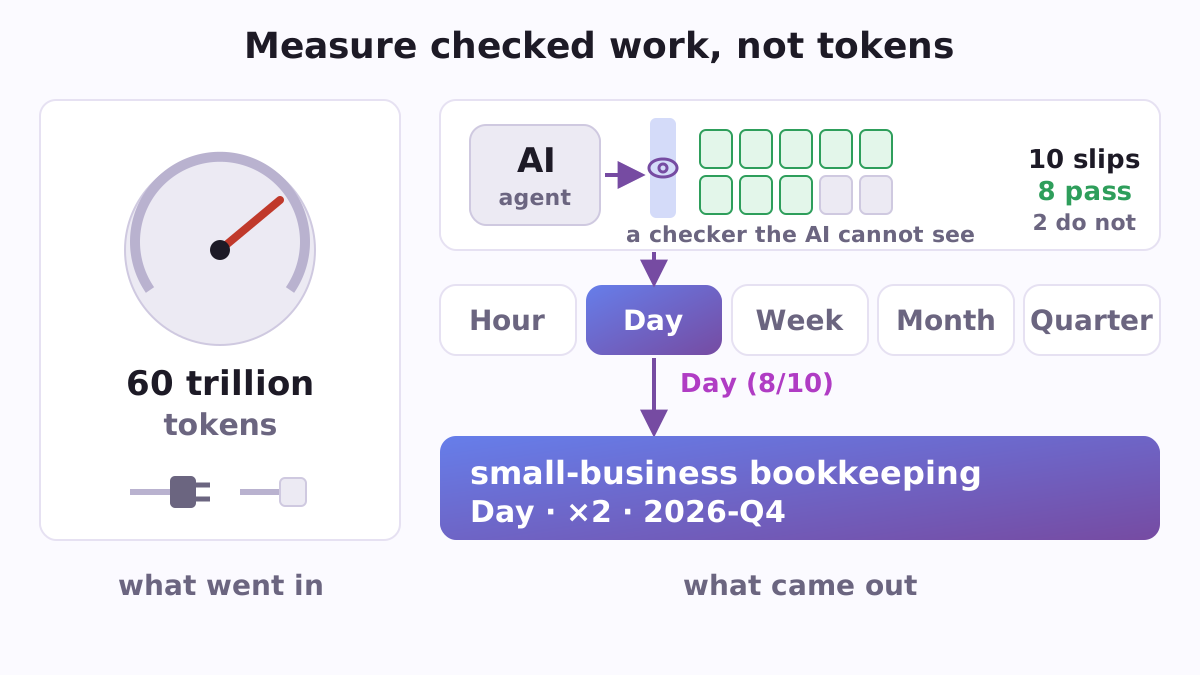
Если вы выполняете реальную работу, поручив ее агентам ИИ (Claude Code, Codex, Cursor и подобные), то ни должность, ни диплом, ни строка в резюме не покажут, что вы способны надежно доставить. Показатель, за которым многие работодатели следили в 2026 году — сколько токенов затрачивает человек — показывает еще меньше. Delegation Horizon — это бесплатный инструмент с открытым исходным кодом, который преобразует простой журнал работы, которую вы поручаете агентам ИИ, в одну датированную строку:
small-business bookkeeping · Day · ×2 · 2026-Q4Звучит так: в учёте малого бизнеса этот человек регулярно передаёт ИИ-агентам куски работы, на выполнение которых специалист потратил бы около дня вручную, и проверка, которую эти агенты никогда не видели, их подтверждает; каждый час его собственного внимания приносит по крайней мере два часа проверенной работы; оценено в четвёртом квартале 2026. Вы ведёте журнал в любой электронной таблице, а оценка рассчитывается на вашем собственном компьютере с помощью небольшого скрипта Python или веб-страницы, которая работает в автономном режиме. Никакого аккаунта, никакого ключа, платить нечего, и журнал никогда не покидает ваш компьютер.
Почему подсчёт токенов не сработал
В 2026 году несколько крупных компаний пытались измерить, насколько хорошо сотрудники использовали ИИ, исходя из объёма использованного ИИ — веяние, которое пресса назвала токенмаксингом. В Meta созданная сотрудниками таблица лидеров с прозвищем Claudeonomics зафиксировала 60 триллионов токенов за 30 дней среди более чем 85 000 сотрудников (Shopifreaks). В Amazon «сотрудники создавали ИИ-агентов для выполнения ненужных задач в попытке повысить свои баллы», и трекер был отключён (CIO). В сентябре Meta заявила, что «не будет использовать панели мониторинга внедрения ИИ или подсчёт токенов для оценки влияния» (CIO).
Подсчёт токенов измеряет входные данные, а не результаты; DORA, исследовательская программа Google Cloud, называет это «исключительно мерой входных данных» (DORA). Однако в опросе LeadDev 2026 года 58% респондентов сказали, что их организация всё ещё измеряет влияние ИИ по использованию токенов, в то время как только 19% считали это эффективным (LeadDev). Delegation Horizon вместо этого подсчитывает результаты в любой профессии.
Два числа и одна строка
Каждый кусок работы, который вы поручаете агентам, становится одной строкой журнала: её область, сколько времени потребовалось бы квалифицированному специалисту, чтобы сделать это вручную (её «эталонные часы»), сколько минут вашего внимания это заняло, какую проверку она прошла и была ли принята.
- Горизонт верифицированного делегирования — это наибольший размер работы, который вы регулярно поручаете агентам и получаете подтверждение посредством проверки, которую они заранее не видели. Он имеет пять уровней: Час, День, Неделя, Месяц и Квартал (1, 8, 40, 160 и 500 эталонных часов). Уровни Час и День требуют десять работ такого размера за последние 91 день; Неделя требует шесть работ за 182 дня; Месяц требует шесть работ в год; Квартал требует три работы в год. Один и тот же набор правил применяется к бухгалтеру и разработчику.
- Коэффициент усиления — это проверенные эталонные часы на час вашего внимания за последние 91 день, включая неудачи, представленные в виде шагов ×1, ×2, ×5, ×20 и ×60.
Оба ведутся отдельно по областям, поэтому один и тот же человек может находиться на уровне Неделя в финансовых инструментах и на уровне День в веб-приложениях. Оба имеют дату: уровень переподтверждается каждый квартал, и начиная с уровня Неделя одна из работ должна быть выполнена за последние 91 день.
Что считается проверенным
По меньшей мере восемь из каждых десяти фрагментов ступени должны пройти одну из четырёх видов проверки: скрытые тесты, квалифицированный эксперт, реальное применение людьми, для которых предназначена эта работа, или модель из другого семейства ИИ, проверяющая против источников, которые вы сами открыли. Ваш собственный обзор и согласованность между моделями одного семейства записываются, но никогда не считаются. Неудачные и заброшенные фрагменты остаются в журнале и учитываются против вас, так же как фрагмент, при котором кто-то помогал вне журнала, фрагмент, чья позднейшая проверка не прошла, и результат, который был позже отозван. Фрагмент, ошибки в котором невозможно отменить, например отправленные деньги, должен пройти проверку, и другое семейство ИИ никогда недостаточно для самостоятельной проверки. Начиная с Недели и выше, намеренные ошибки внедряются по меньшей мере в одну задачу перед передачей; их обнаружение показывает, что вы действительно проверяете, и пропущенная ошибка блокирует Неделю и выше.
Такая строгость имеет причину: люди плохо оценивают свою скорость работы с ИИ. В исследовании METR 2025 года 16 опытных разработчиков потратили на 19% больше времени с инструментами ИИ, но впоследствии «они всё ещё считали, что ИИ ускорил их работу на 20%» (METR).
Рабочий пример
Репозиторий содержит журнал вымышленного бухгалтера P07: десять работ, каждая — день работы специалиста или более, переданные агентам между июлем и сентябрём 2026 г. Оценено 9 октября 2026 г.:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
Восемь из десяти прошли, ровно то, что требуется Day; одна запись была проверена лишь самим бухгалтером и одна не прошла проверку эксперта. Восемь проверенных записей составляют 80 эталонных часов в сравнении с примерно 17.2 часами внимания на все десять, что дает выигрыш в 4.66, который попадает в ×2 ступень. Если бы бухгалтер удалил неудачную запись, журнал выглядел бы лучше и оценивался бы хуже: перекладина опиралась бы на девять записей, не дошла бы до десяти и упала бы ниже Hour, в то время как выигрыш прыгнул бы к ×5. Любой, кто получает запись, видит это сразу, потому что пересчет по дате карты больше не совпадает. Вот почему неудачи должны быть в записи.
Для людей, создающих с помощью агентов
record_card.pyчитает вашу таблицу и выводит строку и краткую карточку: уровень, количество по нему («8 из 10 элементов дневного размера проверены в его 91-дневном окне»), прирост и типы проверки.--format mdсоздаёт карточку для профиля или письма работодателю;--format recordвыводит только строку для резюме.tools/explain.py(новое в версии 1.1.0) показывает, почему ваш лог получает именно этот уровень: какое условие выполняется или не выполняется, какой элемент это определяет, сколько ещё сбоев может выдержать уровень, когда он истечёт при отсутствии новых записей, и что нужно для следующего уровня. Также показывает, как мало доказывают десять элементов сами по себе: восемь из десяти соответствуют любому истинному проценту прохождения от примерно 44% до 97%.checker.htmlвыполняет ту же оценку в браузере в автономном режиме; тест сравнивает его с Python-оценщиком на проработанном примере и 40 случайных логах. Оба читают таблицу, сохранённую с точками с запятой, десятичными запятыми и датами вида день.месяц.год, как это делают европейские таблицы.tools/log_piece.pyсоздаёт строку лога, задавая вам вопросы. Если вы работаете в Claude Code, готовый хук (небольшой скрипт, который Claude Code запускает при событии) открывает отложенную запись каждый раз, когда сеанс агента завершается, так что неудачный элемент никогда не забывается. Он не читает транскрипт и ничего никуда не отправляет; любой инструмент агента, который может выполнить команду в конце сеанса, может его использовать.tools/planted.pyзапечатывает ваш список посаженных ошибок отпечатком перед передачей и оценивает его впоследствии, неправильные записи и упущенные элементы считаются отдельно, и не принимает список, изменённый после запечатывания.
Для четвёртого типа проверки, другого семейства ИИ, читающего ваши источники, Sidecall отправляет часть работы другим инструментам ИИ на вашем компьютере.
Для менеджеров и отдела кадров
kits/ai-usage-in-reviews.md — это готовая политика использования ИИ при оценке производительности. Вместо отслеживания токенов или расходов требует представить принятые куски работы с проверкой каждого; вместо «использует ИИ ежедневно» — самый крупный кусок, переданный агентам и проверенный в прошлом квартале. Беседа при проверке содержит три вопроса, начиная с: какой самый крупный кусок работы вы передали агентам в этом квартале и показали его правильность, и как?
Команда ведёт один журнал с вымышленной меткой на каждого человека (система оценки отклоняет неизвестные столбцы, поэтому реальные имена не смогут просочиться); examples/team-log.csv показывает четырёх людей по пяти полям. Каждый квартал record_card.py выводит карточку на каждого человека и каждое поле. Чтобы проверить одну, tools/verify_record.py берёт запись и журнал и сообщает поле за полем, является ли файл в журнале тем же, который был оценён, оценивающий тот же самый, и запись та же при переоценке. audit_sample.py выбирает случайную выборку для повторной проверки на основе слова, которое выбирает второй проверяющий после получения журнала, чтобы никто не мог угадать, какие куски будут выбраны, и tools/too_clean.py отмечает журналы, которые выглядят слишком хорошо: отсутствие ошибок, размеры едва варьируются, каждый кусок проверен одинаково.
Эталонные часы устанавливаются вне команды: на основе банка задач или двумя оценивающими, которые не знают, чья это работа. tools/reference_hours.py берёт их оценки и выдаёт их геометрическое среднее, когда они находятся в пределах 1,5 раза друг от друга, или привлекает третьего оценивающего; kits/reference-hours-raters.md описывает, как выбрать и проинструктировать их.
Чтобы нанимать по проверенной работе, а не по диплому, kits/hiring-test/ проводит оплачиваемый одневный практический тест в области кандидата с скрытой проверкой, подставленными ошибками и оценивающим, который не видел резюме. kits/trade-screen.md добавляет вопрос по специальности на первой неделе перед тем, как допустить кого-либо, так как профиль или название должности говорит меньше, чем кажется: из 60 человек, допущенных платформой опроса в качестве бухгалтеров, 11 неправильно ответили на такой вопрос, восемь из них поменяв местами дебет и кредит.
Что показал первый тест с людьми
Самое слабое звено любой оценки в «часах специалиста» — это сама оценка, поэтому её тестировали в первую очередь. В октябре 2026 года предварительный пилот на Prolific, зарегистрированный на OSF до поступления каких-либо данных, оплатил работу 119 бухгалтеров и веб-разработчиков, которые оценили, сколько часов потребуется вручную для выполнения каждой из десяти задач. Два оценивающих, выбранных случайно, совпадали в пределах 1,5 раза друг с другом только в 28% случаев при ведении бухгалтерского учёта и в 25% при веб-разработке, против 70%, которые предусматривал план. Задачи, рассчитанные на неделю работы, получили медианные оценки от 8 до 20 часов, и когда одну и ту же задачу спрашивали повторно в конце, она получала более высокую оценку намного чаще, чем более низкую.
Следующее касается всех, кто пользуется инструментом: предположения двух незнакомцев слишком шумны, чтобы оценить объём задачи. Медианы больших групп быстро стабилизируются; две отдельные группы — 15 бухгалтеров и 21 веб-разработчика — совпадали в пределах 1,5 раза как минимум в 70% случаев. Таким образом, эталонные часы берут из банка задач с измеренным временем или из группы оценивающих, а анонимизированные данные, зарегистрированный анализ и поисковой анализ находятся в pilot/ для воспроизведения.
Для исследователей
METR оценивает модели ИИ по временному горизонту: продолжительность задачи в экспертных часах, которую модель надёжно выполняет. Delegation Horizon задаёт человеку тот же вопрос, и его восьмидесятипроцентная доля отражает 80%-й горизонт METR. Предварительное пилотное исследование на смоделированных логах настроило правила (версия 1.1), указанное выше предварительное пилотное исследование Prolific протестировало эталонные часы, и протокол, проект предварительной регистрации и форма согласия полного пилотного исследования с участниками находятся в pilot/. kits/process-vs-experience-study.md и kits/matched-task-study.md — готовые протоколы для сравнения групп на одних и тех же задачах, и tools/power.py показывает, сколько участников требуется для такого исследования.
Статья, лежащая в основе инструмента, также делает датированные, проверяемые прогнозы. В исследовании Anthropic примерно 400 000 сеансов Claude Code сеансы, которые привели к созданию кода, завершились проверенным успехом в 34% случаев для людей в сфере программного обеспечения и в 29% для остальных (Anthropic). Сорок один прогноз зарегистрирован на OSF 9 октября 2026 г., каждый с вероятностью, в том числе что 80%-й горизонт METR для лучшей публичной модели составит один рабочий день к концу 2027 г. (0,80) и что менее двух работодателей из Fortune 500 используют количество токенов как официальный критерий оценки в 2027 г. (0,80). Тест показывает, что каждый зарегистрированный файл по-прежнему полностью совпадает с поданным, и brier.py, predictions/score.py и predictions/skill.py оценивают эти прогнозы ежегодно; исследование, которое никогда не проводилось, считается ошибкой, а не молчаливо исключается.
Как начать
Вам нужен Python 3.9 или более новая версия, больше ничего.
- Загрузите репозиторий со страницы GitHub (Code, затем Download ZIP) или клонируйте его.
- Откройте
templates/work-log.csvв любой программе электронных таблиц (Excel, Numbers, LibreOffice, Google Sheets) и добавьте одну строку для каждого фрагмента работы, переданного вами агентам: принятого, отклоненного или заброшенного.templates/README.mdобъясняет каждый столбец простыми словами, аexamples/c4-log.csv- это заполненный образец журнала для копирования. - Сохраните как CSV и запустите карточку, или дважды щелкните
checker.html, если вы предпочитаете браузер.
git clone https://github.com/vadimchernets/delegation-horizon
cd delegation-horizon
python3 record_card.py examples/c4-log.csv --as-of 2026-10-09
python3 record_card.py my-log.csv --format md --out card.md
python3 tools/explain.py my-log.csv
Откуда это
Delegation Horizon — это код, сопровождающий статью After the Programmer Divide: One Measure for People Who Build Through AI Agents Vadym Chernets (октябрь 2026, SSRN 7589918, DOI 10.2139/ssrn.7589918). Текущий релиз 1.1.0 от 11 октября 2026 года тестируется при каждом push на Python 3.9 по 3.13. Код распространяется под лицензией MIT и архивирован на Zenodo (DOI 10.5281/zenodo.23267444, который всегда указывает на последний релиз); всё находится на github.com/vadimchernets/delegation-horizon. Более ранняя статья того же автора, After Chat, исследует, почему так мало людей перешли от общения с ИИ к использованию агентов для выполнения работ; её код, After Chat, ставит один вопрос нескольким ИИ и показывает, где они расходятся.
Посмотреть delegation-horizon на GitHub
Vadym Chernets также создает Poly A1 — приложение, в котором ИИ из разных компаний проверяют друг друга.