AIの生産性をトークンではなく検証済みの作業で測定する方法 — ツール
これは翻訳です。正式版は英語の原文です。引用の際は原文をご参照ください。
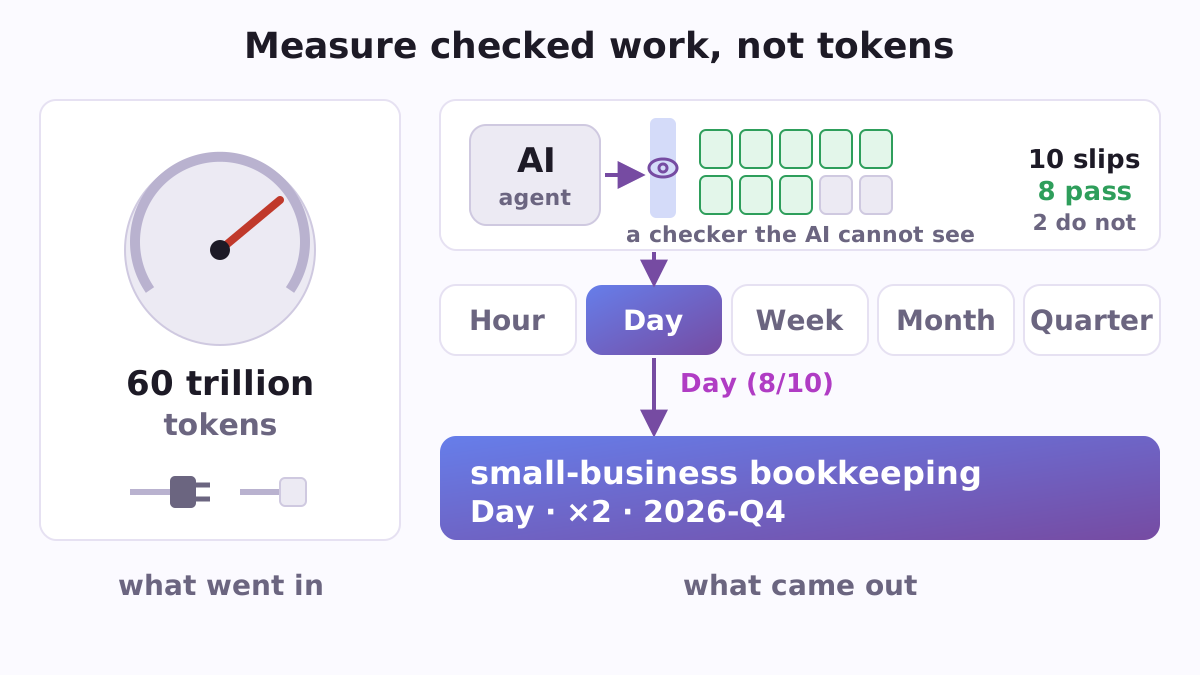
AIエージェント(Claude Code、Codex、Cursorなど)に委譲することで実際の仕事をこなしている場合、職務経歴書のどの職務経歴、学位、または履歴書行も、あなたが信頼して委譲できるものを示していません。2026年に多くの雇用主が目にした数字である、人が消費するトークンの数は、さらに少ないことを示しています。Delegation Horizonは、AIエージェントに委譲する仕事の簡潔なログを、1つの日付付きの行に変換する無料のオープンソースツールです。
small-business bookkeeping · Day · ×2 · 2026-Q4これは以下のことを述べています。小規模企業の簿記において、この人物は定期的にAIエージェントに、専門家が手作業で約1日かかるような仕事を割り当て、エージェントが見たことのないチェックによってそれらを確認します。その人物自身の注意を1時間費やすごとに、少なくとも2時間のチェック済み仕事がもたらされます。2026年第4四半期に評価されています。ログはどのようなスプレッドシートでも保持でき、スコアは自分のコンピュータ上で、小さなPythonスクリプトまたはオフラインで実行されるウェブページによって算出されます。アカウントなし、キーなし、支払うものなし、そしてログは決してあなたのコンピュータを離れません。
トークンカウントが失敗した理由
2026年、複数の大手企業が、AIをどの程度使用したかに基づいてスタッフがAIをどの程度上手く活用したかを測定しようとしました。これは、プレスが「tokenmaxxing」と名付けた流行です。Metaでは、従業員が構築したリーダーボード「Claudeonomics」が30日間で85,000人以上の従業員にわたり60兆トークンをログに記録しました(Shopifreaks)。Amazonでは、「従業員はスコアを向上させるために不要なタスクを実行するAIエージェントを作成していた」とのことで、トラッカーはオフラインになりました(CIO)。9月、Metaは「AI導入ダッシュボードやトークンカウントを影響を評価するために使用しない」と述べました(CIO)。
トークンカウントは入力を測定するもので、出力ではありません。Google Cloudの研究プログラムであるDORAはこれを「入力の純粋な測定」と呼んでいます(DORA)。しかし、LeadDevの2026年調査では、回答者の58%が自分の組織は依然としてトークン使用量によるAI影響を測定していると述べ、一方19%のみそれが有効であると述べています(LeadDev)。Delegation Horizonは、あらゆる職業において、代わりに出力をカウントします。
2つの数字と1本の線
エージェントに渡すすべての仕事は、ログの1行になります。その分野、資格のある専門家が手作業で行うのに必要な時間(「参照時間」)、あなた自身の注意が必要だった分数、それが通過したチェック、そしてそれが合格したかどうかです。
- 検証済み委譲の地平線は、定期的にエージェントに渡し、彼らが見なかったチェックで確認を得る仕事の最大サイズです。5段階あります。時間、日、週、月、四半期(1、8、40、160、500参照時間)です。時間と日は過去91日間にその規模の10個が必要です。週は182日間に6個必要です。月は1年間に6個必要です。四半期は1年間に3個必要です。簿記係と開発者は同じルールに直面します。
- 増幅ゲインは、過去91日間のあなたの注意1時間あたりのチェック済み参照時間であり、失敗を含め、×1、×2、×5、×20、×60の段階で表示されます。
どちらも分野ごとに維持されるため、同じ人が財務ツールで週レベルにあり、ウェブアプリケーションで日レベルにあることができます。どちらも日付を持ちます。段階は四半期ごとに再度獲得され、週以上では、その部分の1つが過去91日間から来ている必要があります。
チェック済みとしてカウントされるもの
ある段階のサイズの10個中少なくとも8個は、隠されたテスト、適格な専門家、その仕事の対象となる人による実際の使用、または自分で開いたソースに対してチェックする別のAIファミリーのモデルという4種類のチェックのいずれかに合格する必要があります。自分自身のレビューと同じファミリーのモデル間の一致は記録されますがカウントされません。失敗した部分と放棄された部分はログに残り、カウントされ、ログ外で誰かに手伝ってもらった部分、後の監査に失敗した部分、後で取り下げられた結果もカウントされます。送られた金銭など、間違いの影響を取り消すことができない部分は合格する必要があり、別のAIファミリーだけではこれをチェックするのに十分ではありません。Weekレベル以上では、引き継ぎ前に少なくとも1つのタスクに意図的なエラーが埋め込まれます。これを見つけることで本当にチェックしていることを示し、見落とすとWeekレベル以上がブロックされます。
この厳密さには理由があります。人々はAIとの速度を自分で判断するのが得意ではありません。2025年のMETR研究では、経験豊富な16人の開発者がAIツールを使って19%長くかかったにもかかわらず、その後「彼らはAIが20%速度を上げたと信じていた」(METR)。
実行例
このリポジトリには、架空の簿記係P07のログが含まれています。2026年7月から9月の間にエージェントに配置された、各々が専門家の1日以上の作業である10個の業務です。2026年10月9日にスコアリングされました。
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
10個のうち8個が合格し、Day が必要としたものと完全に一致しています。1つのピースは経理担当者自身のレビューのみでチェックされ、1つは専門家のチェックに不合格でした。チェックされた8つのピースは約17.2時間のすべての10つへの注視に対して80の参照時間に合計され、4.66のゲインをもたらします。これは×2ステップ内に収まります。経理担当者が不合格のピースを削除していた場合、ログはより良く見え、スコアはより悪くなるでしょう。その段階は9つのピースに支えられ、10個のカウントを逃し、Hour 以下に落ち、ゲインは×5 に跳ね上がるでしょう。記録を受け取った者は誰でもそれを一度に見ます。なぜなら、カードの日付のリスコアはもはや一致しないからです。これが不合格が記録に属する理由です。
エージェントを通じて構築する人のために
record_card.pyはスプレッドシートを読み込み、行と短いカードを出力します。ランク、その背後の数(「91日間のウィンドウで検証されたDay サイズの10個中8個」など)、獲得量、チェックの種類です。--format mdはプロフィールまたは雇用主へのメール用のカードを作成し、--format recordは履歴書用の行だけを出力します。tools/explain.py(バージョン1.1.0で新規)は、ログがそのランクを獲得する理由を教えてくれます。どの条件が成立または不成立か、どの要素がそれを決定するか、ランクがさらに何回の失敗に耐えられるか、新しいログを記録しなかった場合に失効する日、次のランクにまだ何が必要かを示します。また、10個だけでどれほど少ないことを証明するかも示します。10個中8個は、約44%から97%までの任意の真の成功率に適合します。checker.htmlはブラウザで同じスコアリングをオフラインで行います。テストは、作成した例と40個のランダムなログについて、Python スコアラーと比較します。両者は、セミコロン、小数点のカンマ、日.月.年の日付で保存されたスプレッドシート(ヨーロッパのスプレッドシートの保存方法)を読み込みます。tools/log_piece.pyは質問をしてログ行を構築します。Claude Codeで作業している場合、準備完了フック(Claude Codeがイベントで実行する小さなスクリプト)は、エージェント セッションが終了するたびに保留中のエントリを開くため、失敗した要素は決して忘れられません。トランスクリプトは読み込まず、どこにも何も送信しません。セッションの終了時にコマンドを実行できるエージェント ツールであればどれでも使用できます。tools/planted.pyは植え込まれたエラーのリストを引き渡し前に指紋で封じ、その後スコアを付けます。間違ったエントリと省略されたものを別にカウントし、封じた後に変更されたリストを拒否します。
4番目のチェックタイプの場合、ソースを読む別のAIファミリーの場合、Sidecallはコンピュータ上の他のAIツールに作業の一部を送ります。
マネージャーとHRのために
kits/ai-usage-in-reviews.mdは、パフォーマンスレビューにおけるAIの既成ポリシーです。トークンまたは支出の代わりに、検査に合格した受け入れられた仕事の成果物を求めます。「AIを毎日使用する」の代わりに、最後の四半期にエージェントに手渡され、確認された最大の仕事の成果物を求めます。レビューの会話には3つの質問があり、最初の質問は以下の通りです。この四半期にエージェントに手渡した最大の仕事の成果物は何であり、それが正しいことをどのように示しましたか?
チームは、人ごとに作られたラベルを持つ1つのログを保持します(スコアラーは不明な列を拒否するため、実名は滑り込むことができません)。examples/team-log.csvは5つのフィールドにわたって4人を示しています。毎四半期record_card.pyは人ごと、フィールドごとにカードを印刷します。1つをチェックするには、tools/verify_record.pyはレコードとログを取得し、フィールドごとに、ログがスコアされたファイルであるか、スコアラーが同じであるか、再スコアされたときにレコードが同じであるかを示します。audit_sample.pyは、ログを受け取った後、2番目のチェッカーが選ぶ単語から再チェック用のランダムサンプルを描きます。これにより、誰も描かれるピースを推測することができず、tools/too_clean.pyは良すぎるログにフラグを付けます。失敗がなく、サイズがほとんど変動せず、すべてのピースが1つの方法でチェックされているログです。
参照時間はチーム外で固定されます。タスク銀行からか、誰の仕事であるかを知らない2人の評定者によります。tools/reference_hours.pyは彼らの推定値を取得し、それらが互いに1.5倍以内の場合は幾何平均を与えるか、3番目の評定者を呼び出します。kits/reference-hours-raters.mdは彼らを選択してブリーフする方法を述べています。
学位ではなく確認された仕事で採用するために、kits/hiring-test/は候補者自身の分野での有給の1日の仕事テストを実施し、隠れたチェック、設置されたエラー、CVを見たことのない評定者を備えています。kits/trade-screen.mdは誰もが認められる前に、その職業の最初の週の質問を追加します。プロファイルまたは職務名は見かけほどは言われていないためです。調査プラットフォームのフィルターが簿記係として認めた60人のうち、11人がそのような質問を間違えました。そのうち8人は借方と貸方を入れ替えることによって。
最初の人による実験が明らかにしたこと
「スペシャリストの時間」という尺度のいかなる測定においても最も弱い環節は推定そのものです。そのため、これが最初にテストされました。2026年10月にProlificで事前パイロット研究が実施され、データ収集前にOSFに登録され、119人の就業簿記係とウェブ開発者が10個の各タスクを手作業で完了するのにどのくらい時間がかかるかを推定するために支払われました。無作為に選ばれた2人の評価者は、簿記で28%、ウェブ業務で25%の確率でしか互いに1.5倍以内に収まらず、これは計画が設定した70%に対して不足していました。1週間の業務として作成されたタスクは中央値で8~20時間の推定値を得、終了時に同じタスクを再び尋ねると、より低い推定値よりもはるかに高い推定値が得られることがより多くありました。
このツールを使用する誰もが留意すべきことは、2人の見知らぬ人の推測はピースのサイズ決定には雑音が多すぎるということです。より大きなパネルの中央値はすぐに安定します。簿記係15人の2つの別個のパネル、またはウェブ開発者21人は、抽出の少なくとも70%で1.5倍以内で一致しました。そのため、参照時間は測定された時間を伴うタスク銀行から、またはパネルから来ており、匿名化されたデータ、登録分析および探索的分析はすべてpilot/に保存されており、誰もが再実行できます。
研究者向け
METRはAIモデルを時間軸で測定します。それは、モデルが確実に完了するタスクの長さであり、専門家時間で測定されます。Delegation Horizonは人間に同じ質問をし、その8割のシェアはMETRの80%ホライズンを反映しています。机上の事前パイロットはシミュレーションログでルール(バージョン1.1)を調整し、上記のProlific事前パイロットは参照時間をテストし、人間を伴う本パイロットのプロトコル、事前登録ドラフト、同意書はpilot/にあります。kits/process-vs-experience-study.mdとkits/matched-task-study.mdは同じタスクでグループを比較するための準備完了プロトコルであり、tools/power.pyはそのような研究に必要な人数を示しています。
ツールの背後にある論文はまた、日付付きで検証可能な予測をしています。Anthropicの約400,000のClaude Codeセッションの研究では、コードを生成したセッションはソフトウェア職の人々で34%、その他の全員で29%の確認済み成功で終了しました(Anthropic)。41の予測は2026年10月9日にOSFに登録され、それぞれ確率が付与されており、その中にはMETRの最高の公開モデルの80%ホライズンが2027年末までに就業日に到達するという予測(0.80)と、2027年を通じてトークンカウントを公式評価基準として使用するフォーチュン500企業が2社未満であるという予測(0.80)が含まれています。テストはすべての登録ファイルがファイル済みのものと1バイト単位で同じであることを示し、brier.py、predictions/score.py、predictions/skill.pyは毎年それらをスコアしています。実施されない研究は静かにドロップされるのではなく、ミスとしてカウントされます。
始め方
Python 3.9以上があれば十分です。それ以外は何も必要ありません。
- GitHubページからリポジトリをダウンロード(Code、その後Download ZIP)するか、クローンしてください。
templates/work-log.csvをスプレッドシート(Excel、Numbers、LibreOffice、Google Sheets)で開き、エージェントに任せた作業ごとに1行追加してください。承認されたもの、拒否されたもの、または中止されたものです。templates/README.mdでは各列を簡潔に説明しており、examples/c4-log.csvはコピー用に記入済みのログです。- CSVとして保存してカードを実行するか、ブラウザを使いたい場合は
checker.htmlをダブルクリックしてください。
git clone https://github.com/vadimchernets/delegation-horizon
cd delegation-horizon
python3 record_card.py examples/c4-log.csv --as-of 2026-10-09
python3 record_card.py my-log.csv --format md --out card.md
python3 tools/explain.py my-log.csv
出所
Delegation Horizonは、Vadym Chernetsによる論文プログラマーの分断を超えて: AIエージェントを通じて構築する人々のための一つの指標(2026年10月、SSRN 7589918、DOI 10.2139/ssrn.7589918)の付属コードです。2026年10月11日の現在リリースバージョン1.1.0は、Python 3.9から3.13の全バージョンでテストされています。コードはMITライセンスの下にあり、Zenodoにアーカイブされています(DOI 10.5281/zenodo.23267444は常に最新リリースを指します)。すべてのファイルはgithub.com/vadimchernets/delegation-horizonにあります。同じ著者による以前の論文After Chatは、なぜ少数の人々しかAIとのチャットから、エージェントに仕事をさせることに移行していないのかを問い掛けています。そのコードであるAfter Chatは、複数のAIに1つの質問を出し、どこで意見が相違しているかを示します。
Vadym ChernetsはまたPoly A1も開発しており、これは異なる企業のAIが互いの仕事をチェックするアプリです。