Cómo medir la productividad de la IA por trabajo verificado, no por tokens
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
Si realizas trabajo real delegándolo a agentes de IA (Claude Code, Codex, Cursor y similares), ningún título de trabajo, grado o línea de currículum muestra lo que puedes ser confiable para entregar. El número que muchos empleadores buscaban en 2026, cuántos tokens quema una persona, muestra aún menos. Delegation Horizon es una herramienta gratuita y de código abierto que convierte un registro simple del trabajo que delegas a agentes de IA en una línea fechada:
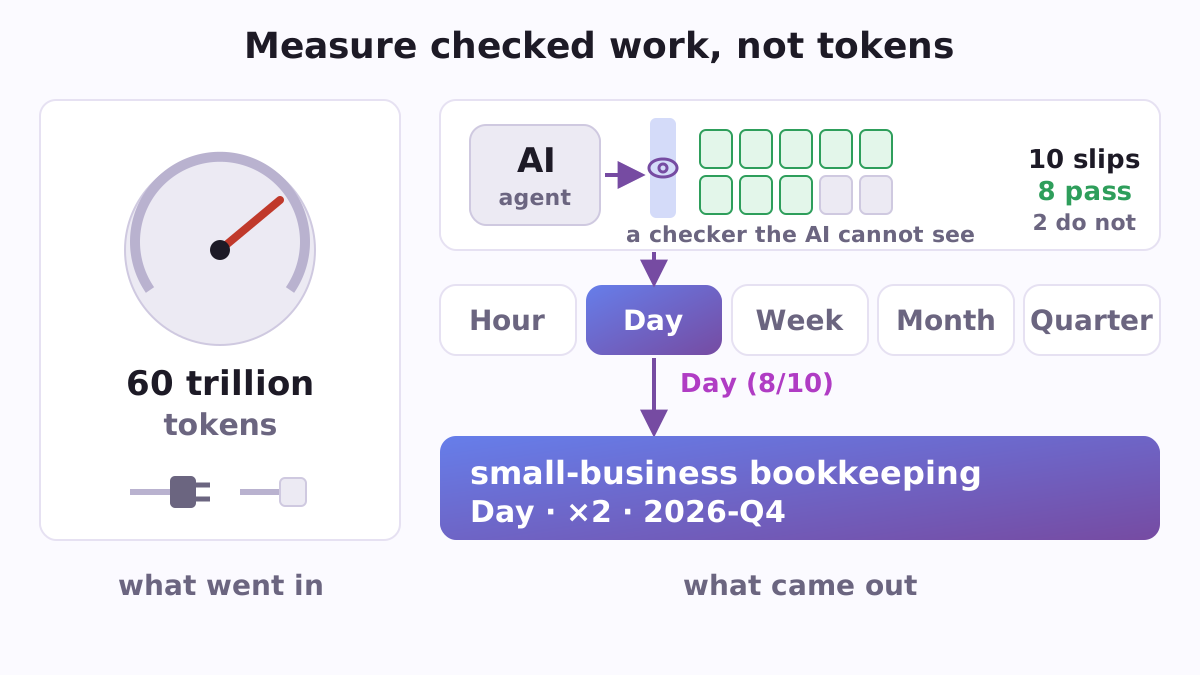
small-business bookkeeping · Day · ×2 · 2026-Q4Dice: en la contabilidad de pequeñas empresas, esta persona entrega regularmente a los agentes de IA fragmentos de trabajo que a un especialista le tomaría aproximadamente un día hacer a mano, y una verificación que los agentes nunca llegaron a ver los confirma; cada hora de su propia dedicación genera al menos dos horas de trabajo verificado; puntuado en el cuarto trimestre de 2026. Usted mantiene el registro en cualquier hoja de cálculo, y la puntuación se calcula en su propio ordenador, mediante un pequeño script de Python o mediante una página web que se ejecuta sin conexión. Sin cuenta, sin clave, nada que pagar, y el registro nunca abandona su ordenador.
Por qué el conteo de tokens fracasó
En 2026, varias grandes empresas intentaron medir qué tan bien el personal utilizaba IA midiendo cuánta IA utilizaban, una tendencia que la prensa llamó tokenmaxxing. En Meta, una tabla de clasificación construida por empleados apodada Claudeonomics registró 60 billones de tokens en 30 días en más de 85.000 empleados (Shopifreaks). En Amazon, "los empleados creaban agentes de IA para realizar tareas innecesarias en un intento de mejorar sus puntuaciones", y el rastreador fue desconectado (CIO). En septiembre, Meta dijo que "no utilizará paneles de adopción de IA ni conteos de tokens para evaluar el impacto" (CIO).
Un conteo de tokens mide qué entró, no qué salió; DORA, el programa de investigación de Google Cloud, lo llama "puramente una medida de entrada" (DORA). Sin embargo, en la encuesta de 2026 de LeadDev, el 58% de los encuestados dijo que su organización aún mide el impacto de la IA por el uso de tokens, mientras que solo el 19% lo consideró efectivo (LeadDev). Delegation Horizon cuenta el resultado en su lugar, en cualquier profesión.
Dos números y una línea
Cada trabajo que entregas a los agentes se convierte en una fila del registro: su campo, cuánto tiempo necesitaría un especialista cualificado para hacerlo manualmente (sus «horas de referencia»), cuántos minutos de tu propia atención requirió, a qué verificación se sometió, y si pasó.
- El horizonte de delegación verificado es el mayor volumen de trabajo que regularmente entregas a los agentes y que se confirma mediante una verificación que no han visto. Tiene cinco escalones: Hora, Día, Semana, Mes y Trimestre (1, 8, 40, 160 y 500 horas de referencia). Hora y Día requieren diez piezas de ese tamaño en los últimos 91 días; Semana requiere seis en 182 días; Mes seis en un año; Trimestre tres en un año. Un contable y un desarrollador se enfrentan a la misma regla.
- La ganancia de amplificación son las horas de referencia verificadas por hora de tu atención durante los últimos 91 días, incluidos los fallos, mostrada en pasos de ×1, ×2, ×5, ×20 y ×60.
Ambas se mantienen por campo, de modo que la misma persona puede estar en Semana en herramientas financieras y en Día en aplicaciones web. Ambas llevan una fecha: un escalón se gana nuevamente cada trimestre, y desde Semana en adelante una de sus piezas debe proceder de los últimos 91 días.
Lo que cuenta como verificado
Al menos ocho de cada diez piezas del tamaño de un peldaño deben pasar uno de cuatro tipos de verificación: pruebas ocultas, un experto calificado, uso real por parte de las personas para las que es el trabajo, o un modelo de otra familia de IA verificando contra fuentes que abriste tú mismo. Tu propia revisión y el acuerdo entre modelos de la misma familia se registran pero nunca cuentan. Las piezas fallidas y abandonadas permanecen en el registro y cuentan en tu contra, y lo mismo ocurre con una pieza con la que alguien te ayudó fuera del registro, una pieza cuya auditoría posterior falló y un resultado que fue retirado después. Una pieza cuyos errores no pueden deshacerse, como dinero enviado, debe pasar, y otra familia de IA nunca es suficiente por sí sola para verificarla. A partir de Week en adelante, se plantan errores deliberados en al menos una tarea antes de la entrega; detectarlos muestra que realmente verificas, y uno que se pasa por alto bloquea Week y superiores.
El rigor tiene una razón: las personas juzgan mal su propia velocidad con IA. En un estudio de METR de 2025, 16 desarrolladores experimentados tardaron un 19% más con herramientas de IA, sin embargo, después "seguían creyendo que la IA los había acelerado un 20%" (METR).
Un ejemplo trabajado
El repositorio incluye el registro de un contador inventado, P07: diez trabajos, cada uno un día de especialista o más, entregados a agentes entre julio y septiembre de 2026. Calificados el 9 de octubre de 2026:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
Ocho de diez pasaron, exactamente lo que Day necesita; una pieza fue verificada solo por la revisión propia del tenedor de libros y una falló en la revisión de un experto. Las ocho piezas verificadas suman 80 horas de referencia frente a aproximadamente 17.2 horas de atención en las diez, una ganancia de 4.66, que cae en el paso ×2. Si el tenedor de libros hubiera eliminado la pieza fallida, el registro se vería mejor y la puntuación sería peor: el peldaño descansaría en nueve piezas, no alcanzaría la cuenta de diez y caería por debajo de Hour, mientras que la ganancia saltaría a ×5. Cualquiera que reciba el registro lo ve de inmediato, porque una nueva puntuación en la fecha de la tarjeta ya no coincide. Por eso los fracasos pertenecen al registro.
Para personas que construyen a través de agentes
record_card.pylee tu hoja de cálculo e imprime la línea y una tarjeta corta: el peldaño, el recuento detrás del peldaño ("8 de 10 piezas de tamaño Day verificadas en su ventana de 91 días"), la ganancia y los tipos de verificación.--format mdcrea una tarjeta para un perfil o un correo electrónico a un empleador;--format recordimprime solo la línea para un currículum.tools/explain.py(nueva en la versión 1.1.0) te dice por qué tu registro merece el peldaño que tiene: qué condición se cumple o falla y qué pieza lo decide, cuántos más fallos puede soportar el peldaño, el día en que vence si no registras nada nuevo, y qué aún necesita el siguiente peldaño. También muestra cuán poco demuestran por sí solos diez piezas: ocho de diez se ajustan a cualquier tasa de aprobación real de aproximadamente el 44% al 97%.checker.htmlrealiza la misma puntuación en un navegador, sin conexión; una prueba la compara con el puntuador de Python en el ejemplo resuelto y 40 registros aleatorios. Ambos leen una hoja de cálculo guardada con puntos y comas, comas decimales y fechas day.month.year, como las guardan las hojas de cálculo europeas.tools/log_piece.pyconstruye una línea de registro haciéndote preguntas. Si trabajas en Claude Code, un gancho listo (un pequeño script que Claude Code ejecuta en un evento) abre una entrada pendiente cada vez que finaliza una sesión del agente, por lo que una pieza fallida nunca se olvida. No lee ninguna transcripción y no envía nada a ninguna parte; cualquier herramienta de agente que pueda ejecutar un comando al final de una sesión puede usarlo.tools/planted.pysella tu lista de errores plantados con una huella digital antes de la entrega y la puntúa después, las entradas incorrectas y las cosas omitidas contadas por separado, y rechaza una lista modificada después de sellar.
Para el cuarto tipo de verificación, otra familia de IA que lee tus fuentes, Sidecall envía un trabajo a las otras herramientas de IA en tu computadora.
Para gerentes y RR.HH.
kits/ai-usage-in-reviews.md es una política lista para IA en evaluaciones de desempeño. En lugar de fichas o gastos, solicita piezas de trabajo aceptadas con cada una verificada y aprobada; en lugar de «usa IA diariamente», la pieza más grande entregada a agentes y verificada el trimestre pasado. Su conversación de revisión tiene tres preguntas, comenzando con: ¿cuál es la pieza de trabajo más grande que entregó a los agentes este trimestre y demostró que era correcta, y cómo?
Un equipo mantiene un registro con una etiqueta inventada por persona (el evaluador rechaza columnas desconocidas, por lo que los nombres reales no pueden colarse); examples/team-log.csv muestra cuatro personas en cinco campos. Cada trimestre record_card.py imprime una tarjeta por persona y campo. Para verificar una, tools/verify_record.py toma el registro y la bitácora y dice, campo por campo, si la bitácora es el archivo que fue puntuado, el evaluador es el mismo, y el registro es el mismo cuando se puntúa nuevamente. audit_sample.py extrae una muestra aleatoria para reverificación de una palabra que el segundo evaluador elige después de recibir la bitácora, por lo que nadie puede adivinar qué piezas se extraerán, y tools/too_clean.py señala bitácoras que se ven demasiado bien: sin fallos, tamaños que apenas varían, cada pieza verificada de la misma forma.
Las horas de referencia se fijan fuera del equipo: de un banco de tareas, o por dos evaluadores que no saben de quién es el trabajo. tools/reference_hours.py toma sus estimaciones y proporciona su media geométrica cuando están dentro de un factor de 1,5, o llama a un tercer evaluador; kits/reference-hours-raters.md dice cómo elegirlos e instruirlos.
Para contratar por trabajo verificado en lugar de por título, kits/hiring-test/ realiza una prueba de trabajo pagada de un día en el propio campo del candidato, con una verificación oculta, errores plantados y un evaluador que no ha visto el CV. kits/trade-screen.md añade una pregunta básica del oficio antes de que se admita a alguien, ya que un perfil o título de trabajo dice menos de lo que parece: de 60 personas que los filtros de una plataforma de encuestas admitieron como contables, 11 se equivocaron en la pregunta, ocho de ellos intercambiando débito y crédito.
Lo que la primera prueba con personas encontró
El punto más débil de cualquier medida en "hours of a specialist" es la estimación misma, por lo que se probó primero. En octubre de 2026, un pre-piloto en Prolific, registrado en OSF antes de que llegaran datos, pagó a 119 contables y desarrolladores web para estimar cuánto tiempo tardaría cada una de las diez tareas si se realizaran a mano. Dos evaluadores seleccionados al azar estuvieron dentro de un factor de 1.5 uno del otro solo el 28% de las veces en contabilidad y el 25% en trabajo web, en comparación con el 70% que el plan había establecido. Las tareas diseñadas para ser una semana de trabajo obtuvieron estimaciones medianas de 8 a 20 horas, y la misma tarea preguntada nuevamente al final arrojó una estimación más alta mucho más a menudo que una más baja.
Lo que sigue para cualquiera que use la herramienta: las conjeturas de dos desconocidos son demasiado ruidosas para dimensionar una tarea. Las medianas de paneles más grandes se estabilizan rápidamente; dos paneles separados de 15 contables u 21 desarrolladores web estuvieron dentro de un factor de 1.5 en al menos el 70% de las ocasiones. Por lo tanto, las horas de referencia provienen de un banco de tareas con tiempos medidos, o de un panel, y los datos anonimizados, el análisis registrado y el análisis exploratorio se encuentran todos en pilot/ para que cualquiera pueda ejecutar de nuevo.
Para investigadores
METR mide modelos de IA por un horizonte temporal: la duración de la tarea, en horas de experto, que un modelo completa de forma confiable. Delegation Horizon plantea lo mismo para una persona, y su proporción de ocho de diez refleja el horizonte del 80% de METR. Un pre-piloto de escritorio sobre registros simulados ajustó las reglas (versión 1.1), el pre-piloto de Prolific anterior probó las horas de referencia, y el protocolo, borrador de preregistro y formulario de consentimiento del piloto completo con personas están en pilot/. kits/process-vs-experience-study.md y kits/matched-task-study.md son protocolos listos para comparar grupos en las mismas tareas, y tools/power.py dice cuántas personas necesita tal estudio.
El artículo detrás de la herramienta también hace predicciones fechadas y verificables. En el estudio de Anthropic de aproximadamente 400,000 sesiones de Claude Code, las sesiones que produjeron código terminaron en éxito verificado el 34% de las veces para personas en trabajos de software y el 29% para todos los demás (Anthropic). Cuarenta y una predicciones fueron registradas en OSF el 9 de octubre de 2026, cada una con una probabilidad, entre ellas que el horizonte del 80% de METR para el mejor modelo público alcance un día laboral antes del final de 2027 (0.80) y que menos de dos empleadores de Fortune 500 utilicen recuentos de tokens como criterio de evaluación oficial durante 2027 (0.80). Una prueba muestra que cada archivo registrado sigue siendo byte por byte el que se archivó, y brier.py, predictions/score.py y predictions/skill.py los califican cada año; un estudio que nunca se ejecuta se cuenta como un fallo, no se descarta en silencio.
Cómo empezar
Necesitas Python 3.9 o más reciente y nada más.
- Descarga el repositorio desde la página de GitHub (Code, then Download ZIP) o clónalo.
- Abre
templates/work-log.csven cualquier hoja de cálculo (Excel, Numbers, LibreOffice, Google Sheets) y agrega una fila por cada pieza de trabajo que delegaste a agentes: aceptada, rechazada o abandonada.templates/README.mdexplica cada columna con palabras sencillas, yexamples/c4-log.csves un registro ya rellenado del que copiar. - Guárdalo como CSV y ejecuta la tarjeta, o haz doble clic en
checker.htmlsi prefieres un navegador.
git clone https://github.com/vadimchernets/delegation-horizon
cd delegation-horizon
python3 record_card.py examples/c4-log.csv --as-of 2026-10-09
python3 record_card.py my-log.csv --format md --out card.md
python3 tools/explain.py my-log.csv
Origen
Delegation Horizon es el código complementario del artículo After the Programmer Divide: One Measure for People Who Build Through AI Agents de Vadym Chernets (octubre de 2026, SSRN 7589918, DOI 10.2139/ssrn.7589918). La versión actual, 1.1.0 de 11 de octubre de 2026, se prueba en cada push en Python 3.9 a 3.13. El código está bajo la licencia MIT y está archivado en Zenodo (DOI 10.5281/zenodo.23267444, que siempre apunta a la versión más reciente); todo está en github.com/vadimchernets/delegation-horizon. Un artículo anterior del mismo autor, After Chat, pregunta por qué tan pocas personas han pasado de chatear con IA a permitir que agentes realicen trabajo por ellas; su código, After Chat, plantea una pregunta a varios sistemas de IA y muestra en qué no están de acuerdo.
Ver delegation-horizon en GitHub
Vadym Chernets también desarrolla Poly A1, una aplicación en la que sistemas de IA de diferentes empresas verifican el trabajo de los demás.