複数のAIに同時に質問して、どこで意見が異なるかを見る — ツール
これは翻訳です。正式版は英語の原文です。引用の際は原文をご参照ください。
1つのAIに質問すると、1つの自信のある回答が得られ、それが正しいかどうかを簡単に判断する方法がありません。2つ目、3つ目のAIに質問することも役立ちますが、その回答がどこで異なるかを確認できる場合、かつそれらの合意が本当にどの程度の価値があるかを知っている場合のみです。After Chatは、複数のAIに同時に1つの質問を入力し、両方を実行する小さな無料のオープンソースPythonスクリプトのセットです。誰が何を言ったかを示し、それらの合意がどの程度の価値があるかを計算します。既にサインインしているAIツールを通じて自分のコンピュータで実行され、APIキーや追加のサブスクリプションは不要で、スクリプト自体はPythonのみで済みます。
1つのAIでは不十分であり、4つのAIは4つではない
異なる企業から提供されるAIモデルは異なる方法で訓練されるため、常に同じ間違いを犯すわけではありません。そのため、人々は1つの質問をChatGPT、Claude、Gemini、Grokにコピーして、手作業で回答を比較します。しかし、それらの間違いは見た目よりも多く重なっています。350以上の言語モデルに関する2025年の研究によれば、2つのモデルの両方が間違っている場合、多くの場合同じ間違った答えを提供します:1つのリーダーボードデータセットでは60%の確率です。したがって、4つのAIが同意する場合、独立した確認は4つ未満となります。複数のAIに尋ねることの真の価値は、不一致にあります:1つだけが提起したポイント、または異なる数字を含む同じ主張です。
実例
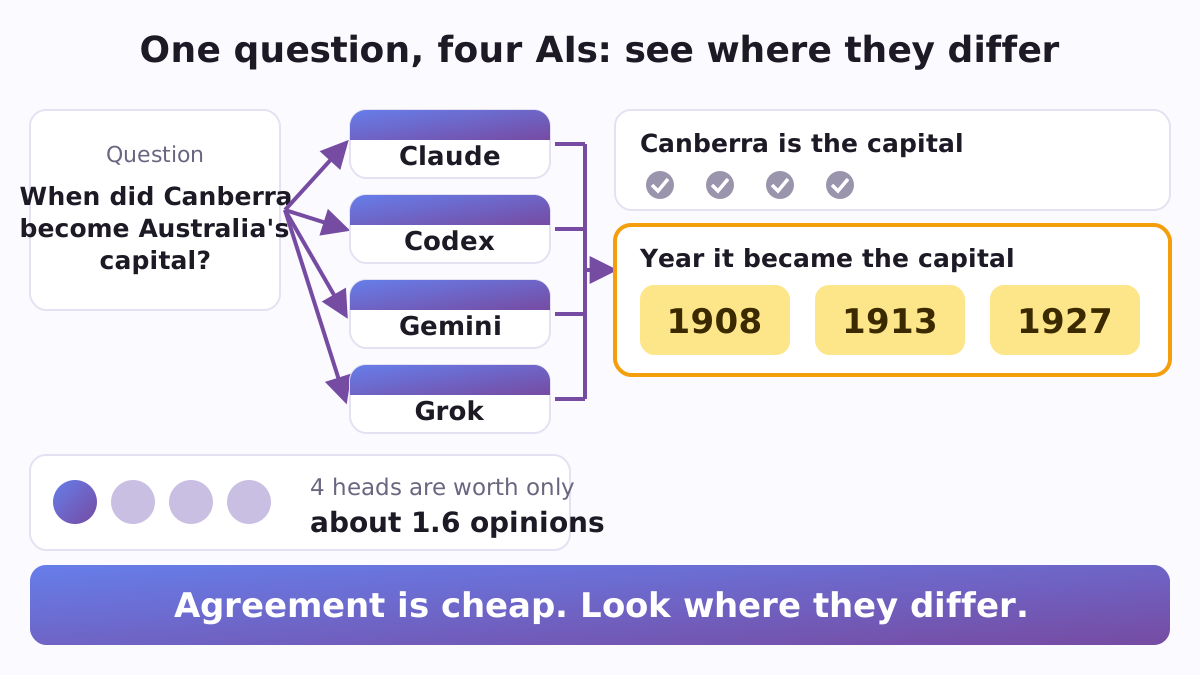
2026年9月21日、著者は4つのAIコマンドラインツールに1つの質問を投げかけました。「1文で:オーストラリアの首都は何か、そしてそれが首都になったのは何年か?」4つすべてが25秒以内に応答し、4つすべてがキャンベラと答えました。年については3つの答えに分かれました:1908年、1913年、1927年です。各年は根拠があります:敷地は1908年に選ばれ、都市は1913年に命名され、議会は1927年にそこに移転しました。単独で尋ねられた場合、Codexは1927年、Grokは1913年を、それぞれ事実として述べていたはずです。並べて示された答えは、その質問には3つの誠実な答えがあることをすぐに示し、人が確認する必要がある正確な行を指摘しました。
中身は何か
- すべてを一度に尋ねる(
fanout.py)。まずリスト内の各AIツールに簡単なテスト質問を送り、インストールされていないか回答しないツールをスキップします。次に、選択した時間制限の下で、すべての稼働しているツールに同時に質問を投げかけ、各回答を独自のファイルにストリーミングします。ツールが時間切れ時にまだ書き込み中の場合、これまでに書かれたものは保持され、破棄されずに部分的なものとしてマークされます。各AIは起動元のフォルダではなく独自の空のフォルダで開始されるため、質問だけから機能します。ページ分のテキストなど長い質問は、--question-fileを使用してファイルに入力します。 - 誰が何を言ったか見る(
provenance.py)。すべての回答を短い主張に分解し、表現が似ている主張をグループ化し、1つの表を印刷します。各主張と、それを述べたAIを示します。表の下には、最も重要な2つのリストが来ます。1つのAIのみが述べた主張(他のAIが見落とした、またはそのAIの誤り)と、AIが異なる数字、パーセンテージまたは日付を与える主張です。テキストファイルの任意のフォルダを読み込むため、チャットウェブサイトからの回答をAIごとに1つのファイルに貼り付けて、それらを比較することもできます。 - 合意がどの程度の価値があるかを知る(
neff.py)。既知の答えを持つ一握りの質問を与え、各AIについて正誤をマークし、AIが一緒に間違う頻度を測定します。そこから、AIが実質的に価値のある独立した意見がいくつあるかを計算します。組み込みの例では、誤りが重複する4つのAIは約1.6の独立した意見の価値があり、このようなAIの数がいくら多くても2.1以上の価値はありません。 - Claude Code内での別の意見(
second-opinion/SKILL.md)。既製のスキル。フォルダを~/.claude/skills/にコピーすると、Claude Codeは別の企業のAIに同じ質問をさせ、その回答をそのまま表示し、2つが合致する箇所、異なる箇所、一方だけが言及する内容を示す短い表を追加できます。2つを1つの確実なテキストにブレンドすることはなく、他のAIの回答を比較する材料として扱い、従うべき指示としては扱いません。 - AIエージェントの安全な設定(
safety/)。Claude Codeのパーミッション設定(settings.json)の既製の例。すべてのセッションをプランモードで開始し、rm -rf、sudo、curl、git pushなどのコマンドを拒否し、.envファイルとsecretsフォルダを読み込み不可に保ち、rm、mvおよびウェブ取得の前に尋ねます。Codexの設定では、ワーキングフォルダ内でのみ書き込みでき、ネットワークはオフで、その範囲を超えることを求める前に尋ねるようにします。14点のチェックリストはそれらの周囲の習慣をカバーします。コピーで作業し、最初に計画を求め、取り消しを保持し、長いジョブを停止する方法を知ってください。 - 研究者向けツール(
crossings.py、crossings.schema.json、jsonl_log.py)。厳密なチェッカー付きのレコード形式。AIとのチャットから、AIエージェントに実際の作業を行わせることへ移行する方法に関する研究用。アプリのインストールはそれを使用することにはカウントされず、完成したステップはエージェントが実際に作成したものが必要であり、誰かが停止する場合、レコードは彼らの自身の言葉を保持します。小さなロガーは、計画が拒否されたり、別の意見が取られたりするなど、各決定を1つのタイムスタンプ付きのJSON行として書き込みます。
なぜこのように構築されているのか
多くの「LLMコンシル」ツールは1つのマージされた回答で終了します。例えば、Andrej Karpathyの人気のあるllm-councilは、OpenRouterというAPIサービスを通じてあなたの質問をモデルに送信し、クレジットを購入して、「会長」モデルに最終的な返信を書かせます。Afterは既に使用しているコマンドラインツールを通じて質問を処理し、マージの前に意図的に停止します。つまり、誰が何を述べたかの表を取得でき、判断はあなたに委ねられます。すべてのスクリプトはPythonの標準ライブラリのみを使用し、1つの短いファイルに収まります(最長のものは200行未満です)ので、それが正確に何をするのか、そしてそれを変更する方法を読むことができます。
始め方
スクリプトはPython 3が動作するどこでも実行できます。Windows上では、fanout.pyをWSL内で実行してください。ライブ比較では、2つ以上のAIコマンドラインツールを自分のアカウントでサインインして使用します。組み込みリストはClaude Code(claude)、OpenAI Codex(codex)、GoogleのAntigravity CLI(agy。個人のGoogleアカウント向けに2026年6月18日にGemini CLIから引き継がれました)、およびxAIのGrok Build(grok)に対応しています。各ツールのコマンドは--toolsで渡される小さなJSONファイル内の1行なので、別のツールを追加したり、新しいリリースで変更されたフラグに対応したりするのに1分で済みます。コマンドラインツールがない場合は、任意のAIチャットウェブサイトから回答を.txtファイルにペーストし(AIごとに1つ)、そのフォルダに対してprovenance.pyを実行してください。各ファイル名がテーブルの列になります。
git clone https://github.com/vadimchernets/after-chat
cd after-chat
python3 neff.py --demo                       # what four agreeing AIs are worth
python3 fanout.py "Your question" --out run  # ask every live AI at once
python3 provenance.py run # who said what, and where they differ28個のテストはpython3 -m unittest tests/test_patterns.pyで実行されます。コード、テスト、安全設定はすべてgithub.com/vadimchernets/after-chatにあります。
どこから来たのか
After Chatは、論文After Chat: Non-Programmersとエージェント型AIの間の3つの転換(Vadym Chernets著、2026年9月、SSRN 7520019、DOI 10.2139/ssrn.7520019)の付属コードです。この論文は、AIとの会話からAIエージェントに仕事をさせることへ移行した人がなぜそれほど少ないのか、またその移行をどのように測定するのかを問うています。このコードはMITライセンスの下にあり、Zenodoにアーカイブされています(DOI 10.5281/zenodo.22944451)。同じパターンから生まれた2つの既製Claude Codeプラグインがあります:SidecallはコンピュータのコマンドラインツールをAIに尋ね、Roundcallはブラウザを通じてAIチャットサイトに尋ねます。
Vadym Chernetはまた、Poly A1というアプリも構築しており、これは異なる企業のAIが互いの仕事をチェックするアプリです。