Verification Theater: AI検証パネルの測定された失敗モード
これは翻訳です。正式版は英語の原文です。引用の際は原文をご参照ください。
Vadym Chernets、独立研究者 · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197641 · GitHub
NeurIPS 2026ワークショップ「Who Verifies the Agents? Toward Reliable Agent Development」(非アーカイバル)でポスターとして採択されました。 アーカイブコピー:10.5281/zenodo.23197641。PDF:verification-theater.pdf。以下の図表はLaTeXソースから変換されています。PDFが正式版です。
要旨
マルチエージェント検証は、デフォルトの信頼メカニズムになりつつあります。独立したモデルが同じ回答に合意したため、その回答は信頼されるという仕組みです。事前登録された盲検、温度ゼロの収集を使用して、16個のモデル(9つのフロンティアベンダー、7つのローカルオープンウェイト)が同じ1,500個の事実的質問に回答しました(さらに750問の多肢選択腕と探索的対話腕)。パネル検証が機能しなくなる一方で、機能しているように見える状態を測定します。この状態を検証劇場と呼びます。4つの失敗レジームを報告します。第1に、難易度の反転があります。独立した合意の認定リフト—より簡単な3五分位数では2.7–4.6—第2に難しい五分位数では0.82に低下し、最も難しい五分位数ではゼロになります。そこでは、複製された回答は342件中0件で正確でした(独立性のもとで期待される13)。パネル外leave-panel-out再層化(13の非パネルモデルでランク付けされた難易度)はプール反転を除去します(78/354正解、リフト2.36)が、クロスブロックパネルではゼロが持続します(0/116)。展開人口が最も難しいと判断する質問では、合意は誤り認定として機能します。第2に、制約された回答空間があります。多肢選択(ローカル層)では、パネルは4.0–7.9%の質問で間違った回答を満場一致で認定しました。同じ層のオープンフォーム回答では1.5–4.6%、フロンティアオープンフォームでは0.3–4.9%に対してです。第3に、独立性のプロキシとして使用されるラベルは経験的に失敗します。地政学的ブロックは誤り相関を予測しません(平均ブロック内 0.285対クロスブロック0.274、差)。同じベースから蒸留された推論モデルはパネルメイトの中で最も相関の低いペアの1つでした(; 15米国/中国ブロックローカルペアのうち14番目、すべての21ローカルペアのうち20番目)。第4に、適合性があります。盲検で回答に異なる検証者は、同じ回答が同僚のものとして提示されたとき、38.5%の場合に逆承認しました。逆プロンプト対照は、これらのフリップが正確性ではなく、確実な提案の存在を追跡することを示しています(間違いに向かって38.9%対正解に向かって34.7%; McNemar正確)。これらのレジームは経済的根拠を共有していると主張し、検証とその劇場を区別する測定規律を導き出します。
はじめに:劇場問題
AIモデルのパネルが互いをチェックする仕組みがトラスト・インフラストラクチャとして運用されており、それらの間の合意はますます証拠として価格付けされています。セキュリティ研究の分野では長い間、実質を伴わない保護の美学を生み出すメカニズムの名称がありました(Schneier, 2003)。我々は、隠喩ではなく測定によって、パネル検証がその名称に値するのはいつかを問います。核となる発見は反転です。すなわち、合意の認証価値は簡単な質問に集中し、検証が最も重要な場所でちょうど消失します。あるいは反転します。我々はこれを単一の異常ではなく、検証者パネルが外観上はチェックを続けながら実質を失う4つの異なる状態の1つとして扱い、この4つを共通の経済的原因と共通の対策に結びつけます。
具体的には、本論文は以下の貢献をしています。(C1)難度層別化された認証上昇の測定であり、独立した合意の認証価値が簡単な質問に集中し、人口難度測度の下では最も難しい五分位数で反転することを示しています(342個の複製回答のうち0個正解;パネル独立難度の下では、プール化された反転は消失し、クロス圏パネルではゼロが持続します、0/116)。この2つのコーディングは全体を通じて一緒に報告されています。(C2)制約された(多肢選択)回答空間が満場一致の認証誤りを4.0~7.9%に押し上げることを示す証拠で、これは開放形式の0.3~4.9%の括弧をはるかに上回っています。(C3)独立性の代理として日常的に使用されるラベル(地政学的圏とモデル系統)が誤り相関を予測しないことを示す2つの事前登録済みの帰無結果。したがって、独立性はブランドまたは系統樹から仮定するのではなく、行列として対ごとに測定する必要があります。(C4)逆プロンプト制御を伴う適合性測定であり、対話モード検証者が提案の存在をその真実ではなく追跡することを示しています。ブラインド収集プロトコルとトラスト構築は完全な形で補助論文に記載されており、ここでは測定に必要な範囲でのみ要約されています。本論文で結果として報告されているすべての内容(C1~C4)はここで測定されており、それから再述されていません。これらから、我々は(C5)測定規律を導出します。すなわち、公開されるタスククラスごとの行列、難度層別化された認証主張、ブラインド優先の引き出し、および困難状態のエスカレーションであり、これらは操作的に検証を劇場から分離します。
先行研究とフレーミング
フォールトトレランスコンセンサス(BFT)は独立した障害を仮定していますが、この仮定が成り立たないことを本論文が検証します。コンセンサス逆説文献は既に同質な群における合意安定化エラーを名付けています(Shehata and Li, 2026)。zkMLは計算が実行されたことを検証しますが、その答えが真実であることを検証するのではなく、相補的です。Verifier's Dilemmaはインセンティブ分析を提供し、(Raji et al., 2022)は監査人選択問題を提供し、(Du et al., 2024)、(Farquhar et al., 2024)、および(Ding, 2026)は本論文がストレステストを行う合意信号文献を提供します。信頼構造自体は関連論文で導入されました(Chernets, 2026)。本論文は、構造の検証エンジンが実行されているように見えながら失敗する場所をマッピングします。テスト時計算作業は建設的な側面から相補的な結論に達しています。多様なアスペクト検証器のアンサンブルは単一の検証器を上回り(Lifshitz et al., 2025)、互いに素な族から引き出された小さな判官のパネルは単一の大きな判官を分数のコストで上回り(Verga et al., 2024)、マルチエージェント討論の体系的な再評価はモデルの異質性が唯一の信頼できる改善者として特定しています(Zhang et al., 2025)。討論の流れは構造化された敵対的議論が弱い判官がより真実の答えに達するのを助けることを示しています(Khan et al., 2024)。ピアレビュー済みの証拠は既にプロバイダ間の実質的なエラー相関を文書化しており、最も正確なモデル間で最大であり、異なるアーキテクチャとプロバイダ間でさえもあります(Kim et al., 2025)。これは独立してラベルから依存性を推測するのではなく測定することを動機付けます。その文献は多様性のためにパネルを選択します。本論文は選択された特性がどの程度の価値があるのか、および検証においてその欠落が静かにどのようなコストをもたらすのかを測定します。
データと測定
事前登録された、ブラインド収集1件(プロトコルは検証的データ収集の前に公開で凍結;https://osf.io/4y9dvで公開登録):16個のモデル SimpleQAの4,326項目から事前登録された無作為抽出サブサンプル1,500件(固定シード、収集前に抽出;SHA-256が付属したサブサンプルCSV、凍結登録に添付)、温度ゼロで、0~100の確信度を明記(13,446個のクリーンなフロンティア回答;8,802個のローカル層回答);ローカル層でのTruthfulQA MC1アーム750項目、公式リポジトリファイルの凍結コピー(790項目、正規CSVとバイト同一)から派生、事前登録されたコンストラクタにより項目ごとに少なくとも2つの異なる不正解オプションが必須(固定シャッフルシード;695項目は全7モデルで完全に回答);探索的なアクティブ対ブラインド対話アーム。SimpleQAはフロンティアモデルに対して敵対的に収集され、質問ごとに単一の疑う余地のない回答があります(Wei et al., 2024):したがって、ハード層は真正なパラメトリック知識の境界を調査し、採点は金基準への等価性に帰着します。TruthfulQAは制約付き回答空間アーム(Lin et al., 2022)を提供します。パネルは単一ブラインド収集の分析的組み合わせです;すべての再分析は決定論的です(拒否と0重複をアグリーメント非該当と数える文字列等価性コーディング;不確定ペアは括弧として報告)。難易度は観測的に、質問あたりの平均16モデル精度として運用化され、300質問の順位五分位数に分割されます。同じ生データ収集は関連論文の基礎になります(Chernets, 2026)。その論文は、プール化された認証比率とここで詳述された分析の簡潔な要約を報告します;難易度層別化リフトラダー、ロバストネステスト、-行列、適合性分解はこの論文にのみ表示され、残りのすべての重複は本文で相互にフラグが立てられています。
オープンフォーム採点は2段階です:決定論的文字列等価性パス(フロンティア評点の26.8%)と拒否検出(6.6%)、残りの66.5%はLLM採点者により採点;人間による目視確認は、無作為サンプルの98%で採点者に同意しました()。採点の3分の2がモデルで生成されるため、すべての見出し結果には、採点者エラー感度リサンプリングが付属しています(モデル評定判定の10%を反転、200個のシード付きリサンプル;第4章および付録A)。
失敗体制 I: 難易度の反転
3 つの事前指定フロンティアパネルは、単一のブラインドコレクションの分析的 3 モデルの組み合わせです:US ブロック (Anthropic、OpenAI、Google)、CN ブロック (DeepSeek、Alibaba、Moonshot)、およびクロスブロック (Anthropic、DeepSeek、Mistral);第 3 節の凍結された決定論的コーディングの下で、主モデルの 2 つのパネルメイトの少なくとも 1 つが独立して同等の回答を生成した場合、その回答は複製されたものとカウントされ、リフトは です。3 つのパネル全体でプールされた場合、複製された回答が正しい確率は、最も難しい五分位数で 0.0% (0/342、CI 0.0–1.1) から 12.8%、57.5%、81.0% を経て最も簡単な五分位数で 95.1% に上昇します;複製されていない回答に対する対応するリフトは 0.00 / 0.82 / 2.68 / 3.09 / 4.56 です。最も難しい 20% の質問では、観測されたすべての一致が誤った回答を認定し、次の五分位数ではポイント推定値は不一致とのパリティ以下です (0.82、CI [0.51、1.21]);最も難しい五分位数のゼロ複製は各パネルで個別に存在します (US 0.00–4.25、CN 0.00–9.76、クロスブロック 0.00–4.04);Q2 サブパリティは CN とクロスブロックパネルに存在し、US パネルの Q2 リフトは 1.20 です。プールされた認定リフトの多くは簡単な質問によって運ばれるため、層化されていないリフト主張は検証が必要とされるところで何が配信されるかを過大評価します。Q1 ゼロはフロアに対してではなくライブベースレートに対して測定されます:複製されていない Q1 回答は 3.9% の時間で正しい (89/2286)、つまり独立性は 個の正しい複製回答を予測します—観測された 0 (上限 1.1%) は層の独自のベースレート以下に有意に位置します。独立性ベンチマークはここでは保守的です、リベラルではありません:測定された完全なモデル間相関構造を保存する無効仮説—層の質問全体で正確性ラベルの 1 つの共通順列、複製構造は凍結されたまま (2,000 順列)—は 11.7–12.4 個の正しい複製回答を予測し、観測された 0 を決して生成しません (;最小 3);測定されたペアワイズ を分析二変量無効仮説に折り込むと、正相関エラーが正相関正答を意味するため、期待値がさらに上昇します。層に何があるかそれ自体が情報提供的です:342 セルは 106 個の質問にまたがっています—曖昧な表現ではなく普通の狭い事実問題 (中央値 17 語)、およびモデルは稀にそれらで棄権します (質問ごとに 9 個の回答のうち 0.5)。それらの誤った回答がクラスタ化します:これら 106 個の質問の 70.8% では、9 つのフロンティアモデルのうち少なくとも 3 つが同じ誤った回答を生成し、複数のパネルによって複製された質問の 67.4% では、独立して構成されたパネルが同一の誤った合意を認定します—通常は正しいがあまり顕著でない実体を置き換える有名な隣人の回答です。すべての 106 個のゴールドラベルの手動の主題専門家裁定は 2 つの異議を唱える可能性があり、0 つ完全に間違っています;明らかに防御可能なパネル回答と 2 つの部分的に防御可能なものを信用すると、最も難しい五分位数の数は 0/342 から最大 13/342 (3.8%) に移動します、したがってほぼゼロの結論は文字通りのゼロから軟化しながら保持されます (1 つのフラグ付きラベル:2010 年王立美術アカデミー選出はアカデミーが付与しない名誉号に対してスコアされました)。この主張は直接テスト可能です:配備された集団独自の正確性によって層化された任意の複製で Q1 リフト を予測します (パネル独立層化の下で予測はプールされたリフトではなくクロスブロックゼロです)。ゼロはグレーダーの工芸品でもありません:すべてのパネルと元のグレーダーの外側ベンダーファミリーからの独立した 2 番目グレーダー (温度ゼロ、同一凍結等価性ゴールドプロンプト) が 342 個すべての Q1 複製評決を再採点し、342/342 で同意しました (正しいへの反転 0/342、上限 1.1%);モデルグレード付きラベルの 10% の合成反転も認定エラーシェアを各リサンプルで 86.5% 以上に保ちます (付録)。
パネル除外による再層化。
パネルメンバーは母集団難易度指数に貢献するため、最難関五分位数はパネル自体の失敗に部分的に条件付けられています。13の非パネルモデルのみで再層化すると、最難関五分位数での複製回答の正解率は78/354例(22.0%、プーリングされたリフト2.36、独立性下の33/354を上回る)であり、ゼロはクロスブロックパネルにのみ存在します(0/116;13の非パネルモデルすべてが失敗する層では0/88)。残存するゼロ自体は特徴付けられています:その層のベースレートは31/778 = 3.98%(Wilson 2.8–5.6%)であり、独立性下の期待値は116のうち4.6正解です;相関保存型順列帰無仮説(2,000回の順列)により、95%範囲、およびを得ます——帰無仮説を大きく下回っていますが、帰無仮説下では到達不可能ではありません。したがって上記の反転は、パネルに依存しない難易度に対してではなく、配備された母集団が困難だと判断する箇所に対して検証が失敗する場所についての主張です。2番目の感度チェックとして、完全にラベルフリーの複製コーディング(ブラインド回答の決定論的文字列比較のみ、正解性ラベルを参照しない)の下で梯子を再導出しました:Q1結果は本質的に変わりません(344個の複製回答のうち2個正解、0.6% [0.2–2.1];リフト0.15)、2つの最難関五分位数での1以下のリフトが存続し、トップ五分位数のリフトは減衰します(4.56から2.33)。純粋な文字列マッチングは同一の正解の表面的変種を見落とすためです;多肢選択結果は影響を受けません。そこでの一致は回答文字によりコード化され、構成上ラベルフリーであるためです。
3つの頑健性チェックが反転を支持します。(i)質問レベルブートストラップ(五分位数内で2,000個のシード再標本)は5つのリフトの95% CI [0.00, 0.00]、[0.51, 1.21]、[2.32, 3.09]、[2.84, 3.35]、[4.16, 5.03]を与えます:困難領域の区間は容易領域の区間を完全に除外します。(ii)採点者エラー感度:モデル採点判定の10%を反転する(200個のシード再標本;342個の最難関五分位数複製回答の97.1%はモデル採点であり反転可能)と、最難関五分位数の認定エラー率はすべての再標本で86.5%以上に留まり、Q1リフトを92%の再標本で1以下に保ち(中央値0.82)、Q1–Q2リフトを決してQ3–Q5リフトに接近させません。Q3–Q5リフトはすべての200再標本で2を上回ります。(iii)7モデルのローカル層は、独立したモデルとパネルで困難–容易コントラストを複製し、非単調に(Q3 ):リフト0.00 / 0.94 / 0.00 / 1.89 / 4.37が同じ五分位数全体で、最難関五分位数では166個の複製回答のうち0個が正解です;この層は94.8% LLM採点であり、(ii)と同じ採点者感度再標本の対象です。
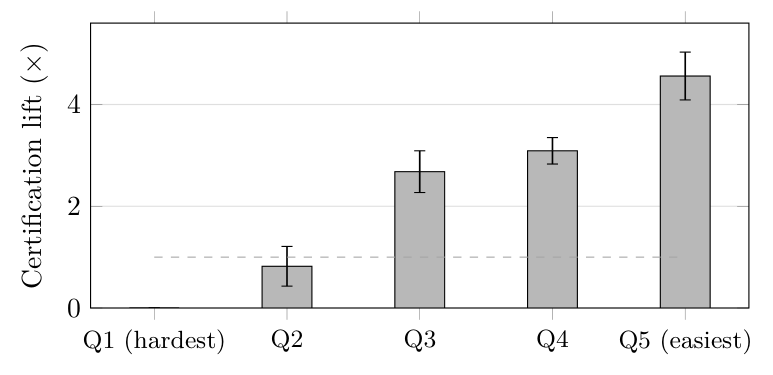 3つのフロンティアパネルでプーリングされた難易度五分位数別認定リフト。質問レベルブートストラップ95%区間(2,000個のシード再標本;付録A.1)。破線はリフト = 1、複製されていない回答とのパリティを示します:2つの最難関五分位数はポイント推定により(Q1 0.00×——測定されたゼロ、欠損データではなく;Q2 0.82×、そのCIはパリティを横切る)それ以下に位置し、3つの最容易五分位数はそれよりはるかに上に位置します。
失敗レジーム II:制約された回答空間
多肢選択問題では、4つの事前指定された局所層パネルが、695の完全に回答された質問のうち 4.0~7.9% で、一致して誤った選択肢を選びました(パネル別:4.0、5.9、6.6、7.9)。これに対し、フロンティア層の自由形式の確信度の高い一致した誤答は 0.3~4.9% の確定的範囲です。同じ認証指標を局所層自身の自由形式回答(8,802件の採点された SimpleQA 応答)で再計算すると、層・形式の交絡を除去します:同じ局所パネルは、厳密な確定的コーディングに基づく自由形式項目の一致した確信度の高い誤りを 1.5~4.6% でのみ認証します(決定不可ブラケットを含めて最大 9.8%)。これはフロンティア自由形式の範囲と一致しており、モデル層ではなく制約された回答空間がエラー認証を駆動していることと矛盾しない特徴です。ただし 1 つの交絡が残ります:多肢選択肢アームと自由形式アームは異なる質問セット(TruthfulQA MC1 対 SimpleQA)であるため、形式と質問セットはここでは分離されておらず、主張の因果的な形は同一質問の形式切り替えでのみ確立されます。これは実施しませんでした。1パネル単位のブートストラップは、検出力が十分な箇所でギャップに区間を設定します:多肢選択肢マイナス自由形式の認証済み一致エラーは、 pp [2.9, 6.8](パイロット)、 pp [3.9, 8.1](米国局所)、および pp [2.6, 6.3](クロス圏域)です。それぞれゼロを除外しています。自由形式セルが脚注の 87 項目セットに基づく中国局所パネルは、これを解決しません。メニューは散在するエラーを共有されたものに変換します:回答空間が小さい場合、類似したモデルは同じ誘導肢に着地し、パネルの一致がエラー増幅器になります。これらの率は独立したエラーでは説明できません:各メンバーが限界率で独立して誤り、エラーが の誤選択肢にわたって分散されている場合()、期待される一致した同じ誤選択肢率は 4 つのパネル全体で 0.49~0.92% です。観察された 4.0~7.9% は、独立性ベースラインに対する 4.9~13.5 超過です。設計上の帰結は、テスト可能なルールとして述べられます:エージェントに固定されたオプションセットを提供するインターフェースは、同じコンテンツでの自由形式抽出よりも実質的に高い認証済み一致エラーを予期すべきです。
3 つのパネリスト全員に対して述べられた信頼度 を要求することは、この効果をほぼ減らしません:認証済み一致エラー範囲は 4.0~7.9% から 4.0~7.2%(パネル別 4.0、5.2、6.0、7.2)に変わります。つまり、一致した誤答はほぼすべて確信度の高いものでもあります。この失敗は話題的なニッチに限定されていません:20 項目以上の 10 の TruthfulQA カテゴリーをまたいで、プール化された認証済み一致エラーは 1.0%(陰謀論)から 8.6%(経済学)にわたり、その間に法律、健康、社会学があります(付録 A)。
失敗レジーム III: 独立性ラベルは独立性を予測しない
36個のフロンティアベンダーペア(1,448個の共有質問)全体で、ペアワイズエラー相関は 0.123–0.395の範囲にあり、この範囲は人々が使用するラベルによって組織されていません。最も相関の高いペアと最も低いペアはどちらもブロック内(googlexai 0.395対googleopenai 0.123)です。ブロック内対ブロック間の平均はだけ異なり、同一ベースの系統ペアは695個の完全回答複数選択項目について6つの米国/中国ブロックのローカルモデルで形成された15個のペアのうち14位にランクされています(; 7番目のローカルモデルはEUブロックであり事前登録ブロック/系統デザインの外です—これを含めると21個のペアが生じ、そのうち系統ペアは20位にランクされます)。事前登録された両方の帰無仮説(ブロック、系統)は再分析後も有効です。測定された相関自体が予測力を持ちます。実用的なルール:独立性はペアごと、タスククラスごとの量であり、測定されるべきもの(行列)であって、ブランド、国旗、または家系図から推測されるべきものではありません—ラベルによってパネルを組み立てることは検証ではなく推測です。ペアワイズは経験的エラー依存性を測定し、完全な統計的独立性ではありません。低いは3個以上のパネルにおける高次依存性を除外しません。これは独立性を測定された、タスク条件付きの量として扱うべき別の理由です。
9個のベンダーへのブロックラベルの全630個の割り当てにわたる正確な順列検定により、ブロック効果の証拠は見つかりません。観測されたブロック内マイナスブロック間の差は630個の再ラベル付けのうち132個を上回るか同等です(片側; 差のクラスター化ブートストラップ95% CI )。この検定は主張を制約します—小さなブロック効果は除外されません—そして運用上の結論は有効です:ラベルはペアごとの測定の代わりに使用できる信号を持っていません。がペアの基本エラー率が異なるときに上限があるため、周辺正規化比率で分析を再実行しました:両方の事前登録された帰無仮説は有効です(ブロック差、順列; 系統ペアは15個のうち14位のままです)。広がりは持続し(フロンティアペア全体で0.278–0.821)、極値は2つのブロック間ペアに移動します(anthropicmoonshot 0.821、mistralopenai 0.278)—どちらの指標でも、ラベルは広がりを組織していません。行列を16個すべてのモデルに拡張すると、すべてのモデルで答えられた81個の質問に対して、ペアワイズはからの範囲にあります(120個のペア; ブロック平均:フロンティア–フロンティア 0.320、ローカル–ローカル 0.350、フロンティア–ローカル 0.210)—当社のデータにおけるラベル分類法では予測されない桁違いの広がり(図2)。81個の共通項目では、個別のセル推定値は広い区間を持っています;結果は広がり自体であり、単一のセルではありません。
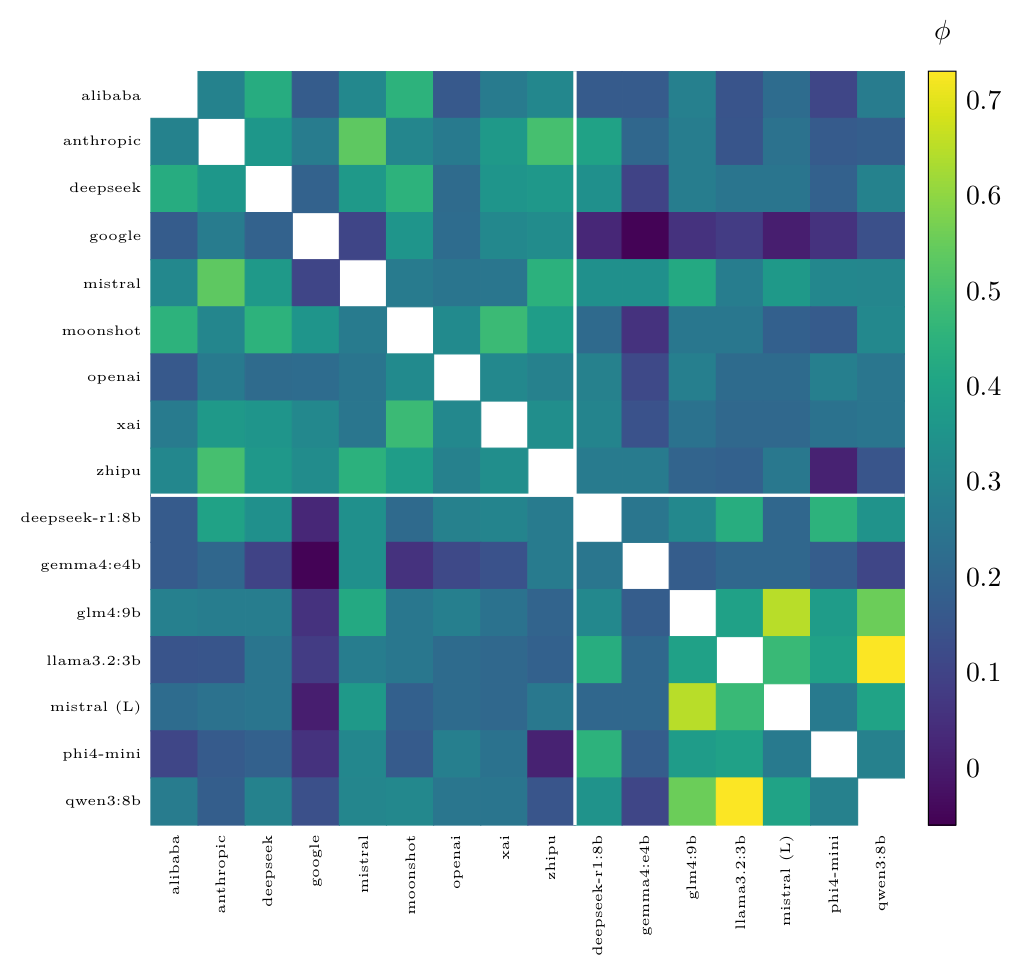 すべての16モデル間のペアワイズエラー相関(ϕ)。81の質問はすべてのモデルで回答されました(フロンティアベンダー9社、その後ローカルオープンウェイト7社。フロンティア/ローカルの分割は白い規則でマークされています)。各オフ対角セルは120の一意のペアの1つです。対角線(自己相関 = 1.0)は設計上意図的に空白のままで、色スケールを圧縮しません。ϕは−0.05から0.73の範囲(平均0.27)です。これは任意の2つの検証者のエラーがどの程度相関しているかについての桁違いの広がりであり、当社のデータ内のどのブロックまたは系統ラベルでも予測されていません。値はemit_phi_matrix.pyによって決定論的に出力されます(analysis_week1.py sec. W5を再利用)。手入力されたものはありません。
失敗状況 IV: 譲歩する検証(探索的)
盲目的に異なる意見を述べていた検証者が同僚の提案と同じ答えを示されたとき、38.5%の場合(168/436)に投降しました。盲目的に正しい答えを出していた検証者は、30.9%(46/149)の場合にそれを間違った答えのために放棄しており、ベンダーごとの放棄率は13.1%から51.6%です(盲目的に異なる全体のサブセットに対するベンダーごとの投降率は20.4–58.1%です)。
これらの翻転は合理的な信念の更新というより適合性でしょうか?逆プロンプト対照実験がそれに反論しています。6モデルのローカルパネルで、盲目的に異なる意見を述べていた検証者に対して、同じ質問セットについて、暴露方向を反転させた対比手順を再実行しました。検証者には、自信のある間違った答え(直接群)または正解(逆群)が示されました。2つの群はプロンプト同一です—共有テンプレート(「提案された答え:…」)で、示された答えが内容のみで異なり、信頼値や出典の帰属が表示されていません—したがって、対比は示された答えの真偽値を分離します。もし検証者が証拠について更新していたのであれば、正しい答えへの暴露がより強く彼らを動かすべきです。代わりに、2つの群はほぼ同じ翻転率を生み出しました—間違った答えに向かって38.9%、正しい答えに向かって34.7%—で、群内の比較は更新のストーリーに対して反対に走ります:174の不一致の対のうち、検証者は盲目的な立場を間違った答えのために104回、正しい答えのために70回放棄しました(McNemar正確)。モデルレベルでは、2つの群は区別できませんでした(最も従順な検証者で89.9% vs. 89.9%の翻転傾向、最も従わない検証者で1.5% vs. 1.5%):同意をトリガーするのは、自信のある提案が存在すること、それが真実であることではありません—パネル検証の面で選好訓練されたお追従(Sharma et al., 2024)です。また、非対称性は最も従順な検証者に依存しません:それを除外するとバランスの取れた数835対項目で不一致数94 vs. 60が残ります(正確)。さらに2つの分解(付録A)がこの読みを強化します:どちらかの群で記録されたすべての翻転には、暴露後の信頼度(その閾値以下でのフリップなし、)が記載されており、直接群では盲目的に正しかった検証者が40.8%の場合(20/49)で正しい答えを放棄し、最前線の知見を反映しています。対照実験はローカル層で実行されました(制限事項)。この対照実験の散文要約は、関連論文にも表示されます(Chernets, 2026)。モデルごとの分解、信頼ゲートの分割、正解盲目放棄分析はここにのみ報告されます。
これは設計請求を制限しています:独立した異議測定が目標の場合、引き出しは盲目優先である必要があります—立場に傾く前に意思疎通するパネルは、その異議を測定するのではなく、それを消去します。
議論:劇場経済学(推測であり証拠ではない)
本セクションは証拠ではなく議論です。新たな測定を報告せず、以下の4つの測定レジームと同等と読まれるべきものは何も含みません。ただしそう述べた上で、4つのレジームが存続するのは、それらに気付くよう誰も報酬を受けていないからかもしれません。消費者は検証品質に価格を付けることはできず、プラットフォームは懐疑ではなく確信のために報酬を受け、各検証者の最も安い戦略は同意することです。監査人選定問題(独立性は検査者を選ぶ者の特性)とリンクファーム先例(商業的な重みを持つあらゆる同意シグナルはファーミングを招待する)を加えると、劇場は事故ではなく均衡です。これは測定が動機付けるが検証しない推測です。インセンティブ説明は工学的慣性および測定基準の欠如を除外するのではなく補完します。それが検証可能な成分であるため取り上げられています。本セクションは規範的主張ではなく検証可能な市場予測を行います。例えば、監査されないパネルは相関したパネルはより安価で同意が多いため、時間とともに最小多様性構成に収束するはずです。
劇場から測定へ
対策は構成要素ではなく一つの規律です:(1) パネルの測定した行列をタスク類別ごとに公開します。ブランドリストではなく(タスク類別ごとに一つのブラインド収集で十分です—本論文の16モデル行列は単一の1,500項目パスから得られました)。(2) すべての認証主張を難易度で層別化し、困難な領域での向上を個別に報告します(難易度はタスク類別ごとにキャリブレーション収集から運用化され、推論時に項目ごとではありません)。(3) 常にブラインドファーストで引き出します—パネル検証のコミット・リビール方式は、ブラインド回答は並列化可能であるため、計算を追加するのではなく引き出しの順序を変え直します。(4) 最も困難な領域をエスカレーション・トリガーとして扱います—パネルの測定した向上がである質問では、合意は人間またはの棄権にルーティングされなければならず、認証には決してなりません。各規則は、配置されたシステムがそれに対して監査されうるように述べられています。
実例として、本論文自身の最前線パネルにこのレシピを適用します。規則(1):その独立性は第6節の測定した行列(範囲0.123–0.395)として報告され、ベンダー名簿としてではありません—そうしていたら最も相関の高いペアがブロック内(googlexai)であることを隠していたでしょう。規則(2):その認証向上は層別化(表1)として報告され、困難な領域での向上(Q1では、Q2では)は単一の集約見出しに折り込まれるのではなく個別に述べられています。規則(3):ここのすべての回答はパネルが組み立てられる前にブラインドで引き出されました。これはまさに適合性アーム(第7節)が測定可能である理由であり、交絡していない理由です。規則(4):パネルの測定した向上が最も困難な5分位数2つでであるため、このパネルの監査済み配置では、それらの質問を棄権または人間レビューにルーティングし、一致による認証には決してなりません。この規律は仮説的ではありません。本論文自身の数字が生産されたプロトコルです。
制限事項
ティアごとに単一のベンチマークファミリー(SimpleQAオープン形式フロンティア、TruthfulQA MC局所)であるため、体制境界はベンチマーク相対的であり、各フロンティアベンダーは1つの予算/中級層モデルで代表されるため、ベンダー能力の主張は行われていません。難易度の層別化は観測的(事前登録されたコレクション上の事後的)であり、五分位数の割り当ては評価されたモデルとデータを共有しています。適合性アームは探索的で、において控えめです。その逆プロンプト制御は局所モデルを使用したため、フロンティアパネルへの転移は類推によるもので、測定ではありません。オープン形式の評点の約3分の2はLLM評点者由来です(人間による抜き取り検査は98%の一致; すべての342個の最難五分位数の相互ファミリー再評点は342/342の評決が一致; 感度再サンプリングは付録に記載)。両ベンチマークは公開されているため、訓練セットの漏洩は排除できません。SimpleQAではその方向は記憶された正解の回答に有利であり、難度層を縮小し、難体制の結果は保守的です。TruthfulQAではパブリックコーパスが誤概念そのものを含んでいるため、その方向は明確ではありません。セクション5の形式-内容の注意による既に制限された代替的解釈があります。難しい質問でなぜ合意が失敗するかについて因果関係の主張は行われていません。機構の候補(共有事前分布、共有盲点、共有訓練データ)は名付けられていますが、分離されていません。
結論
合意は独立性と能力が測定された後のみ証拠となり、その測定は安価です—ここで行った完全な再分析は、公開の生データファイルからコモディティハードウェア上で数秒で実行されます。パネルが-行列と階層化されたリフトを備えて出荷されるまで、「合意によって検証された」は、セキュリティエンジニアがバッグ検査を読むことを学んだ方法で読むべきです。
References
B. Schneier. Beyond Fear: Thinking Sensibly About Security in an Uncertain World. Copernicus Books, 2003.
D. Shehata and M. Li. The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274, 2026.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
Y. Du, S. Li, A. Torralba, J. B. Tenenbaum, and I. Mordatch. Improving factuality and reasoning in language models through multiagent debate. In ICML, 2024. arXiv:2305.14325.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
E. Kim, A. Garg, K. Peng, and N. Garg. Correlated errors in large language models. In ICML, 2025. arXiv:2506.07962.
M. Sharma, M. Tong, T. Korbak, D. Duvenaud, et al. Towards understanding sycophancy in language models. In ICLR, 2024. arXiv:2310.13548.
A. Khan, J. Hughes, D. Valentine, L. Ruis, et al. Debating with more persuasive LLMs leads to more truthful answers. In ICML, 2024. arXiv:2402.06782.
J. Wei, K. Nguyen, H. W. Chung, Y. J. Jiao, S. Papay, A. Glaese, J. Schulman, and W. Fedus. Measuring short-form factuality in large language models. arXiv:2411.04368, 2024.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lifshitz, S. A. McIlraith, and Y. Du. Multi-agent verification: Scaling test-time compute with multiple verifiers. arXiv:2502.20379, 2025.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
H. Zhang, Z. Cui, J. Chen, et al. Stop overvaluing multi-agent debate—we must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788, 2025.
Vadym Chernets. Architectural trust: Verifiable decision architecture for agentic commerce. SSRN working paper 7191261, 2026. https://doi.org/10.2139/ssrn.7191261 (cited for the trust construct and for its summary treatment of the shared blind collection; overlapping analyses are cross-flagged where they occur).
再現性付録
すべての再分析は、生のグレード付きJSONLファイルと2つの固定シードスクリプト(すべての見出し数値を再現するベースラインスクリプトと、以下のブートストラップ、感度分析、分解テーブルを生成する週1追加スクリプト)が与えられれば決定論的です。完全な再計算はGPU、ネットワーク、モデル呼び出しなしにコモディティハードウェア上で15秒以下で完了します。凍結された事前登録とレプリケーションパッケージ(公開OSF登録): https://osf.io/4y9dvです。
リフトラダーのブートストラップ信頼区間
質問レベルの層内リサンプリング、2,000個のシード付き抽出、3つのフロンティアパネルにわたるプール。
| 五分位数 | ウィルソン95% | ブート95% | リフト | リフト ブート95% | |
|---|---|---|---|---|---|
| Q1(最難関) | 0/342 = 0.0% | [0.0, 1.1] | [0.0, 0.0] | 0.00 | [0.00, 0.00] |
| Q2 | 46/359 = 12.8% | [9.7, 16.7] | [8.2, 18.2] | 0.82 | [0.51, 1.21] |
| Q3 | 272/473 = 57.5% | [53.0, 61.9] | [50.7, 64.6] | 2.68 | [2.32, 3.09] |
| Q4 | 732/904 = 81.0% | [78.3, 83.4] | [76.6, 85.1] | 3.09 | [2.84, 3.35] |
| Q5(最容易) | 1700/1788 = 95.1% | [94.0, 96.0] | [93.4, 96.6] | 4.56 | [4.16, 5.03] |
難易度五分位数によるライセンス取得リフト(の百分率、リフトの比率)及びウィルソンとブートストラップ95%信頼区間。離脱パネル困難度(13個の非パネルモデルでランク付け)では、プール済みQ1セルは78/354(22.0%、リフト2.36)であり、クロスブロックパネルではゼロが継続します(0/116)。第4項「ベースレート」五分位数当たり: 3.9 / 15.6 / 21.5 / 26.2 / 20.8%( = 2286 / 2308 / 2209 / 1778 / 912)。
グレーダーエラー感度分析
8,948個のモデルグレード付きフロンティア判定の10%を反転(200個のシード付き再サンプル;同意コーディングと五分位数割り当ては元の決定論的プロトコルコーディングで凍結され、正確性ラベルのみが移動)した場合:最難関五分位数の「ライセンス取得正解」セルは0/342から中央値33/342(9.6%;95%範囲23–46)に上昇するため、Q1同意のライセンス取得エラーシェアはすべての再サンプルで86.5%以上のままです。Q1リフトはすべての再サンプルの92%で1未満に留まります(中央値0.82、95%範囲0.56–1.08)。一方Q3–Q5リフトは決して2未満に低下しません(中央値2.17 / 2.51 / 3.42)。342個のQ1複製された回答のうち、332個(97.1%)がモデルグレード付きであり、したがってこの演習で反転可能です。合成反転を超えて、クロスファミリー監査は、独立した2番目のグレーダー(すべてのパネルの外で、元のグレーダーのファミリーの外のベンダーファミリー;温度0;バイト同一の凍結プロンプト)を用いてすべての342個のQ1複製判定を再グレード付けしました:同意342/342(正解への反転0/342、ウィルソン上限1.1%)、モデルグレード付き(332)と文字列/拒否コード化(10)セル間で一様。342個のセルは106個の一意な質問にわたるため、クラスター保守的な読みは質問を単位として扱います:0/106はウィルソン上限3.4%を与えます。第4項の質問レベルの順列帰無仮説はすでにクラスターレベルで動作します。
逆プロンプト制御:モデル当たりの分解
6つのローカルモデル、2,399件の有効なペアード観測値;flip = 検証者がその盲検回答を提示された回答に置き換える。
| 検証者 | 直接(間違いへ) | 逆向き(正解へ) | 差分 |
|---|---|---|---|
| qwen3:8b | 204/227 = 89.9% | 196/218 = 89.9% | pp |
| mistral | 132/213 = 62.0% | 113/203 = 55.7% | pp |
| glm4:9b | 66/213 = 31.0% | 39/200 = 19.5% | pp |
| llama3.2:3b | 40/234 = 17.1% | 38/227 = 16.7% | pp |
| gemma4:e4b | 33/202 = 16.3% | 19/195 = 9.7% | pp |
| phi4-mini | 2/137 = 1.5% | 2/130 = 1.5% | pp |
| 統合 | 477/1226 = 38.9% | 407/1173 = 34.7% | pp |
検証者と条件別のflip率です。正解に向かってflipするよりも、確信を持った間違いに向かってflipするモデルはありません。ペアード再カウント:両方の条件に存在する1,028項目(両方でflipされた296、どちらでもflipされなかった558);不一致ペア104(間違いのみ)対70(正解のみ)、正確二項McNemar (漸近 )。記録されたすべての884件のflipは、提示後の信頼度 を伴います;その閾値以下のflip率は0/547です。
MC認定合意誤差(TruthfulQAカテゴリ別)
4つの事前指定ローカルパネル(項目パネルあたりのイベント;最低20項目のカテゴリ)全体でのプール:経済学8.6%、フィクション6.2%、超常現象6.0%、法律5.9%、迷信5.7%、ステレオタイプ5.4%、社会学4.9%、健康4.9%、誤解2.6%、陰謀論1.0%。3人全員が信頼度 であるパネル別率:4.0%(中国ローカル)、5.2%(クロスブロック)、6.0%(パイロット)、7.2%(米国ローカル)。
4.6%の上限は、推論モデルの98の採点可能な回答のうち87項目のみを共有する1つのローカルパネルに基づいています;それを除外すると、厳密なローカルオープンフォーム範囲は1.5~1.8%です。↩︎
引用方法
Chernets, V. (2026). Verification Theater: AI検証パネルの測定された失敗モード [論文発表]。NeurIPS 2026 Workshop: Who Verifies the Agents?。Zenodo。https://doi.org/10.5281/zenodo.23197641
@misc{chernets2026verificationtheater,
  author       = {Chernets, Vadym},
  title        = {{Verification Theater: Measured Failure Modes of AI Verifier Panels}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: Who Verifies the Agents?},
  doi          = {10.5281/zenodo.23197641},
  url          = {https://doi.org/10.5281/zenodo.23197641}
}