Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture
これは翻訳です。正式版は英語の原文です。引用の際は原文をご参照ください。
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7191261 · DOI 10.2139/ssrn.7191261 · Zenodo 10.5281/zenodo.22166995 · GitHub
- 記録版:SSRN 7191261 · DOI 10.2139/ssrn.7191261
- アーカイブされたコピー、引用可能かつダウンロード可能:10.5281/zenodo.22166995 — コンセプトDOI、常に最新版に解決
- MarkdownおよびPDF形式のフルテキスト:GitHub
- 読みやすいHTML:https://polyhelper.ai/research/architectural-trust/
同じテキストが4つのサーフェスに置かれているため、そのうちの1つがテキストを提供できない場合でも到達できます。SSRNが記録版を保持しているため、そちらを引用してください。
エージェント型コマースにおける消費者信頼
SSRNに発表され、「アーキテクチャ信頼:エージェント型コマースにおける消費者信頼がAIモデルから検証可能なアーキテクチャにどのように移行するのか」というタイトルでインデックスされています。この形式で引用してください。
モデル特性から検証可能なアーキテクチャへ
Vadym Chernets, PhD1
2026年8月6日に初版投稿;この版は2026年9月
完全な概念フレームワーク、16モデル機構研究、および11の最先端研究所にわたる2026年8月旗艦波レプリケーション、ペアリング推論予算比較、コマース基質レプリケーション、および事前登録消費者実験をすべて報告します。
要約
エージェント型コマースは、AIを顧問から取引当事者へと変え、検索、比較、カート、および決済を単一の委譲行為に統合し、人間がかつてエラーを捕捉していた確認ポイントを削除します。これは気が進まない時期に到来しています。調査によると、英国の消費者の60%はAIショッピングエージェントが1つのエラーを犯した後に放棄すると述べており、ほとんどの消費者はそれを自分の代わりに実行する組織をまったく信頼していません。本論文はアーキテクチャ信頼を導入します。消費者がAIエージェントに帰結のある決定を委譲するにつれて、正当な信頼はAIモデルの特性から、その上のサービスの検証可能なアーキテクチャに移行する、と私は主張します。既存の構成は、組織に信頼を付加するか、単一の自動化システムに、または推薦的アルゴリズムに付加しますが、自律的委譲の下で決定生成プロセスを信頼者によって検証可能にするものはありません。アーキテクチャ信頼は、3つの確認可能な特性で、その隙間を埋めます:多様性(独立したモデル、その一致は信頼度を較正し、その相違が浮上される)、証拠(改ざん防止、再生可能な決定レコード)、および中立性(ベンダー、マーチャント、または結果からの監査可能な独立性)。
メカニズムはまずマシン側で測定されました。事前登録された16モデルベンチマークおよび11の最先端研究所にわたる2026年8月旗艦級波において、クロスモデル同意は、モデル自身の信頼度ができなかった場所で正確性に価格をつけました。別のモデルによって独立して再現された回答は、正しい可能性が1.9~3.2倍高かった。凍結されたSimpleQAサブサンプル(Wei et al., 2024)では、述べられた信頼度≥80で提供された回答の46.6%が誤っていました(このロスターに固有の率であり、普遍的な定数ではない)、一方、固定3モデル不一致ゲートは、30.5%のカバレッジで、それらの信頼できる失敗の82.1%(95% CI 79.9–84.1)を削除しました。シグナルは267のWikidataで検証されたコマース製品事実に再現されます。より大きな推論予算は、述べられた信頼度で3.1ポイントを購入し、測定可能な正確性は購入しませんでした:より多くの計算は信頼度を購入し、正確性ではありません。満場一致で信頼できるパネルは依然として誤っている可能性があり、そこで同意は共有されたエラーを証明します。
その後、事前登録された、インセンティブ両立的な消費者実験において、メカニズムを行動に持ち込みました(計画した200人の参加者のうち119人;米国と英国)。消費者が自信をもった誤った推奨を受け入れるような場合、意見不一致表示は受け入れを急激に削減しました。適格項目では74%から24%へと削減されました。プール化された堅牢性推定値(Δ = 0.24 → 0.45; d = 0.68;主要メインウェーブコホートはd = 0.67を示す)はその単一項目に基づいており、探索的な国分割では英国サンプルに基づいており、項目を除去すると d = 0.09に低下します。サンプリングされた刺激による支援された複製が計画されています。満場一致の自信のあるコンセンサスの1項目では、表示は共有エラーの受け入れを上昇させました。これはメカニズムの人間行動における境界を再現しています。オーケストレーション受領コンポーネントは登録された、決定的でないnullを返しました。
3つのコンポーネントの背後には等しい証拠がありません。多様性はマシン側で確立され、キャリブレーションコントラストのみについて消費者で示されています(登録された中介はnullでした)。記録コンポーネントの初回露出テストは決定的でなく、それと中立性の両方がテストのために指定されています。AI信頼の分析単位は、モデルから、それ上のアーキテクチャ、すなわちチェック可能な部分に移動する必要があります。
キーワード:エージェント型商取引;消費者信頼;AIエージェント;AIへの信頼;適切な依拠;過度な依拠;大規模言語モデル;クロスモデル合意;選択的予測;過信;委譲;アーキテクチャ信頼。JEL分類:M31(マーケティング); D83(探索、学習、情報); L86(情報およびインターネットサービス); K24(サイバー法)このドキュメントの読み方。この完全版は、証拠チェーン全体を報告しています:構成とTrust-Migration Hypothesis;16モデルのメカニズム研究(2026年8月のフラッグシップウェーブ複製と製品事実についての商取引基盤アーム付き)により、クロスモデル多様性を正確性シグナルとして確立します;そのメカニズムを行動に持ち込む事前登録消費者実験;および中立性、市場経済学、および政策についての議論。事前登録された確認的な結果と各構成要素(多様性、証拠、中立性)の証拠状態は、セクション5の「クレームの証拠状態」の下に要約されています。探索的および堅牢性分析は、全体を通じてそのようにラベル付けされており、最初のパスでスキップすることができます。
1. 導入:不信の中での成長
2026年6月10日、Visaはその支払いネットワークをChatGPTに直接組み込むことを発表しました(Visa、2026)。消費者はカードをリンクし、支出上限と承認されたマーチャントカテゴリを設定し、発表された統合は、ユースケースが段階的にロールアウトされ、AIエージェントがネットワークのマーチャントベース全体で実際の購入を完了することを目的としています(業界報道カバレッジあたり175百万以上の場所)。Visaは単独ではありませんでした。OpenAIは2025年9月にチャット内チェックアウトを出荷しました;Googleは2026年1月のNRFで、Shopify、Etsy、Wayfair、Target、Walmartとともに、Universal Commerce Protocolを導入し、5月までにクロスリテーラーUniversal Cartに拡張しました(Google、2026);American Expressは4月に購入保護付きのエージェント型商取引開発者キットを立ち上げました(American Express、2026)。2030年までのエージェント型商取引の閾値は、1社ではなく、業界全体によって越えられています。2030年までのエージェント型商取引のアナリスト予測は、数千億ドル(Bain; Morgan Stanley)からMcKinseyの3~5兆ドルまで実行されています。それらは推定値であり、事実ではありません。ただし、すべての主要な企業が現在それらを生成しています。
実現された数字はもはや推定値ではありません。モデルAPI単独でのエンタープライズ支出は、6か月で35億ドルから84億ドルにジャンプしました(Menlo Ventures、2025a;業界調査研究、ピアレビューなし)。年間の約370億ドルのエンタープライズ生成AI支出の内側です(Menlo Ventures、2025b)。同じ業界は既に独自の実行を割引しています:Gartner(2025)は、エージェント型AIプロジェクトの40%以上が2027年末までにキャンセルされると予測しています。お金は正当化された信頼よりも速く到着しており、これが私がここで取り組んでいるギャップです。以下の主張は、論文の近くの証拠台帳で、これらのデータによって確立された、単一研究規模で支持された、または理論的なものとしてティアリングされています。そのティアリングは統治し、この導入における任何の要約文を上回ります。
この変化を以前の電子商取引の波から定性的に異なるものにしているのはファネル圧縮です:検索、比較、カート、および支払いが単一の委譲行為に崩壊します。かつてこれらのステップ間に存在したすべてのセーフガード(人間が価格をちらりと見て、リストを読み直し、チェックアウト時にためらう)は、ステップ自体とともに消えます(図1)。AIアシスタントは、その出力を人間がレビューするアドバイザーであることをやめ、取引相手になります。人的要因の研究は4十年前に、この失敗モードに名前を付けました:オペレータをループから削除するオートメーションは、そのエラーをキャッチするために必要な警戒心を正確に侵食します(Bainbridge、1983;Endsley & Kiris、1995)。消費者研究も閾値も予測しました。自律型ショッピングシステムは、人間を行為から削除するため、定性的に異なる採用障壁に直面しており、アルゴリズムへの選択肢の委譲の自律性コストは、LLMが存在する前に消費者福祉の問題として標識されました(André et al.、2018)。
図1。ファネル圧縮
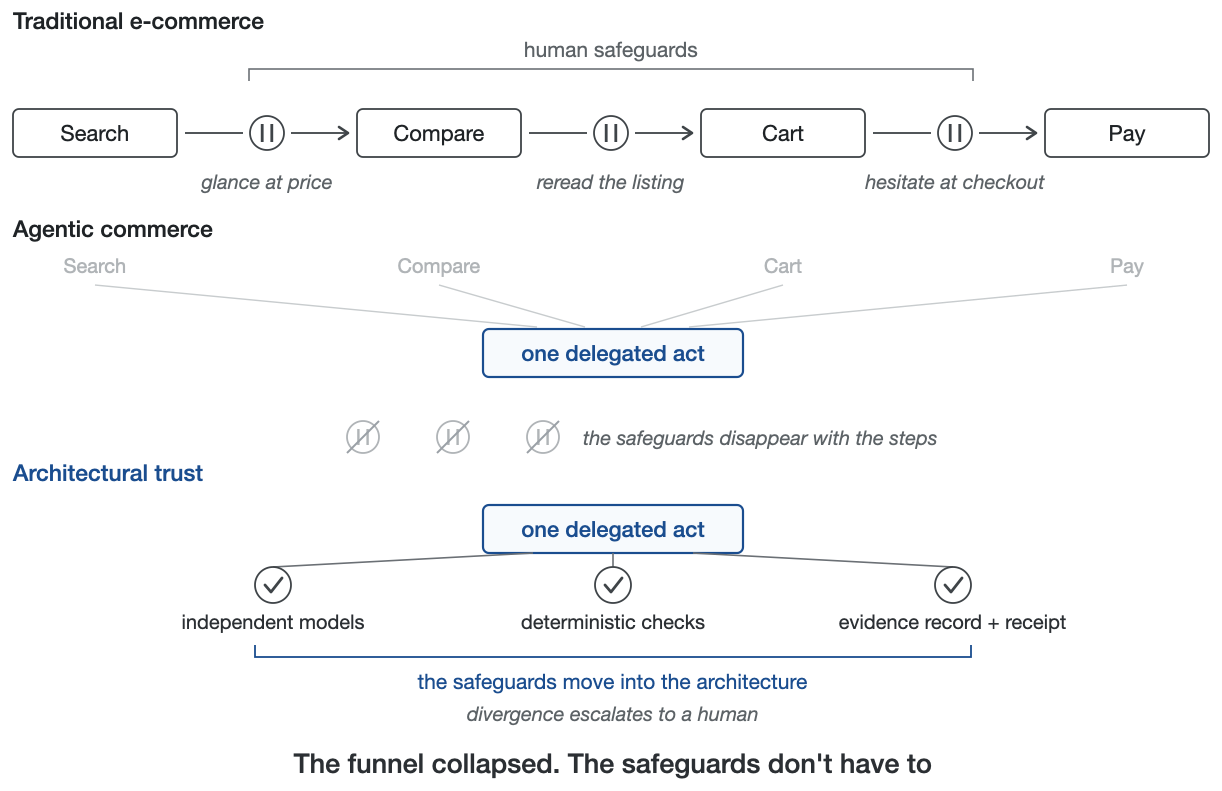
人間のセーフガードは、それらが存在していたステップとともに消えます。
Visaの独自のガードレール(キャップ、ホワイトリスト、必要な承認)は、消費者が何か新しいことを信頼することを求められているため存在します:ブランドではなく、答えではなく、それらが見ることができない意思決定プロセス。事前に固定されたガードレールは、そのギャップを閉じません。事前に設定されたルールセットは、消費者が決定がどのように行われたかをチェックさせません。以下で引用されたACI Worldwide(2026)調査(業界調査は、このセクションが引用する他のベンダー分野の調査のようにプレスリポートによってリリースされます)では、英国の消費者の69%は、エージェントが消費者自身が設定したルールを従うときでさえ、AIエージェントを不信に思うと述べました。
このミスが及ぼす商業的なリスクは深刻です。初期調査結果によると、エージェントに対する消費者の信頼は「一度きり」の表明意図を示す一方で、より興味深いことに、実行動は根拠に欠けています。実行動、以下のチェックアウト離脱とKlarnaの逆転、セクション5の保険の値上げが、これらの表明された選好を裏付け、より大きな証拠的重みを持っています。YouGov調査(ACI Worldwide向け、2,080人の英国成人、2026年6月19~22日に実施、単一市場のスナップショット、クロスマーケット検証待ち)では、60%がAIショッピングエージェントの単一の誤りの後に使用をやめると答え、日常的な購入にAIを信頼すると答えたのは19%に過ぎず、人間の専門家を信頼すると答えた55%に対して低い結果となっています。
その調査の最も重要な数字は別のものです。59%がAIショッピングと支払いを自分たちに代わって実行するいかなる組織も信頼しないと答え、銀行でさえ20%によってのみ選択されました。単一の調査市場において、クロスマーケット検証待ちですが、それは信頼の真空です。需要はあります。Accentureの16カ国、25,590人の消費者を対象とした業界調査(2026年1月、企業が実施、査読なし)では、74%が購入を自分たちに代わって行う個人AIエージェントを最高の友人より信頼すると答えましたが、エージェントに自律的な購入権限を与えると答えたのは約10人に1人に過ぎません(図2)。2つの項目は異なるレベルの委譲を測定するため、その差は意図の範囲ではなく単一の因果的ギャップを特定していませんが、その差は顕著です。意図は豊富にあり、委譲は稀であり、その間に欠けているのは根拠のある信頼です。市場はすでにこれに近いものを試みています。OpenAIは2025年9月にネイティブなチャット内チェックアウトを提供開始しました。意図的に制限された最初のステップで、初期段階では米国のEtsyセラーからの単一商品購入のみで、ユーザーが各ステップを確認しました。2026年3月までにフローを引き戻し、購入を小売業者自身のアプリに移し、わずかな数のマーチャントのみがそれを使用しました(The Informationが報道、CNBC、2026年)。同社は理由を述べていないため、原因は確立されていません。ここで提示される読解である、根拠のある信頼のない採用インフラストラクチャが変換に失敗するという解釈は、報道された事実と一致しています。消費者があらゆるプレイヤーを不信頼した場合、信頼をプレイヤーに委ねることはできず、代わりに検証可能なプロセスに存在する必要があります。
図2。表明された信頼対与えられた権限
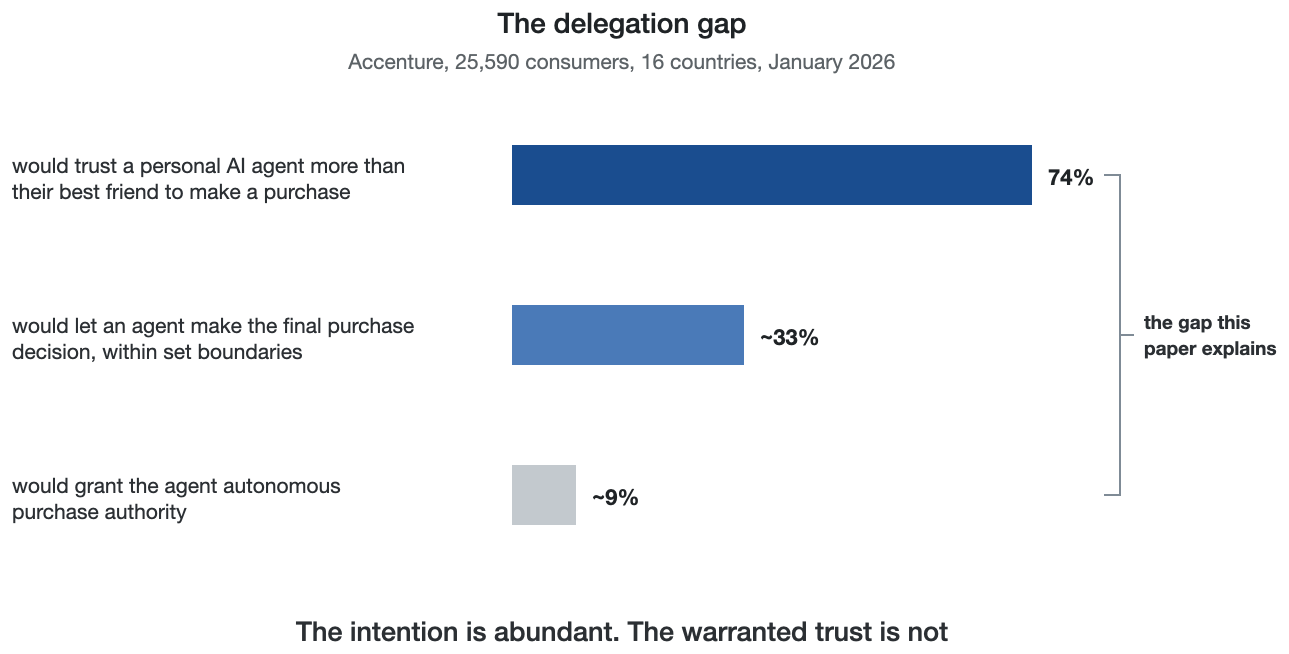
2つの調査項目、2つのレベルの委譲:意図は一般的で、根拠のある信頼は稀です。
責任制度は同じ結論に向かい模索しています。新興するエージェント支払いプロトコルは、特定のマーチャントと金額に結合された範囲限定の検証可能な意図トークンを中心に各トランザクションを構築しており、American Expressのエージェント購入保護(2026年4月)は登録されたエージェントによる購入のみをカバーし、適格性は認証された検証可能な購入意図に条件付けられています。保険は記録から検証できるもの用語で記述されています。部分的にかつ圧力下で、業界は私が以下で体系的に設定したのと同じ要素に収束しています。現在提供されているプロトコルは身元確認と意図を解決し、エージェントはどのように決定したか?という質問に答えていません。
その信頼が設計によって根拠あるものとするために何が必要かという質問です。古典的な消費者信頼の質問である「この企業を信頼しているか」は内層を獲得しました:「この特定の答えまたは行動を生み出した機械を信頼しているか」。
信頼文献は長い間、組織における信頼とオートメーション、IT人工物(Söllner et al.、2016)における信頼、およびオンライン推奨エージェント(Wang & Benbasat、2005;Komiak & Benbasat、2006;Xiao & Benbasat、2007)における信頼を区別しています。これは適切な依拠がキャリブレーション、システムがいつ正しい可能性が高いかを知ることに依存することを示しています(Muir、1994;Mayer、Davis、& Schoorman、1995;Parasuraman & Riley、1997;Lee & See、2004;Hoff & Bashir、2015;Huang & Rust、2021;およびGlikson & Woolley、2020は、プロセスの有形性と透明性が認知信頼の最も強いてこの1つであり、まさにアーキテクチャが制御し、モデルが制御しないてこであることを発見しているレビュー)。人間側のミスキャリブレーションも同様に記録されています:オートメーションバイアスと満足度、反対の証拠に対しても自動支援への過度な依拠は、4十年の人的要因作業が委譲を増幅することを警告するパターンです(Mosier & Skitka、1996;Parasuraman & Manzey、2010)。しかし、その文献は、キャリブレーションを単一の自動化システムの特性として扱っています(図3は4つの研究ストリームと彼らが残す細胞をマップします)。電子商取引におけるエージェント的AIの体系的レビューは、証拠側から空虚さを確認しています:消費者向けの研究は補助的で低自律度のシステムに集中したままで、委譲が実行になる正確な場所でカバレッジが急激に低下します(Balaskas、2026)。エージェント仲介のショッピングの最初の同時研究は、別の側面からアーキテクチャの結論に達しています。消費者が対話を通じて購入を委譲する場合、支払う意思がセラーにほぼ逐語的に漏洩します。プロンプティングはそれを修正せず、アーキテクチャの介入のみがそれを修正します(Alavi & Nozari、2026)。
図3。信頼研究の4つのストリーム:本論文が主張する細胞
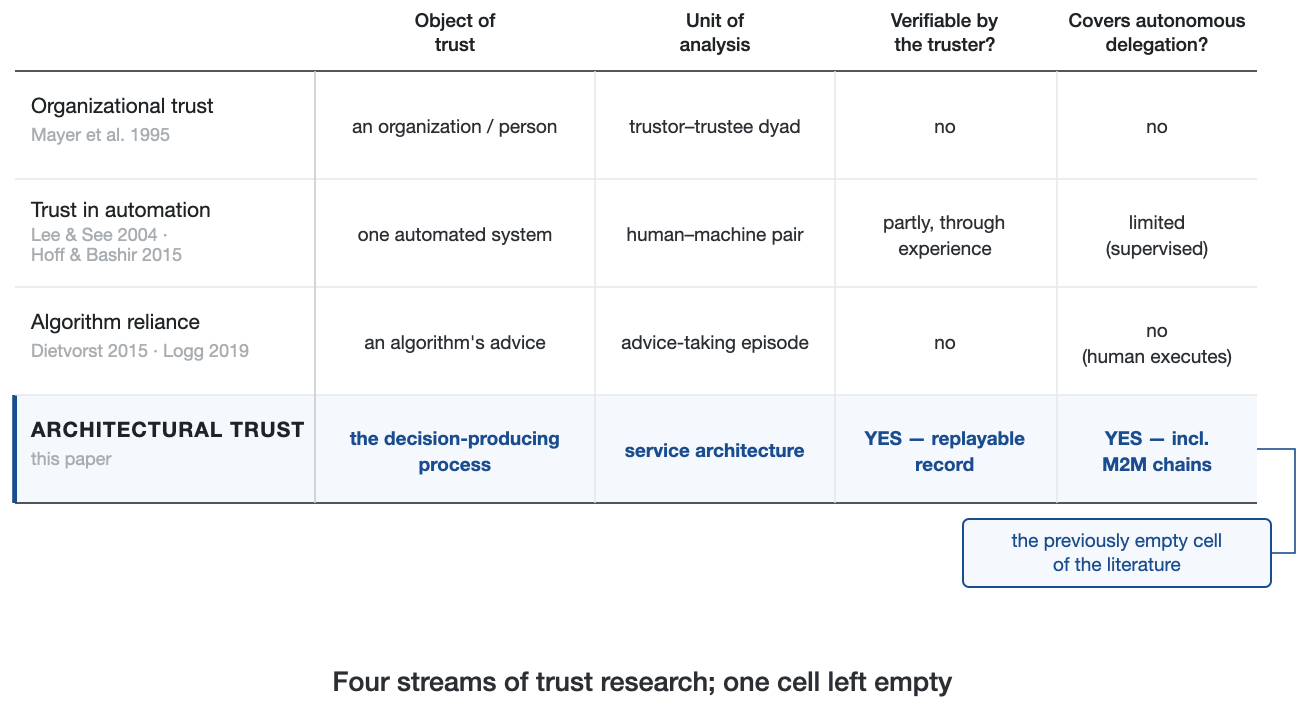
組織信頼、オートメーションの信頼、およびアルゴリズム依拠は各々信頼の異なるオブジェクトを固定します。いずれも自律委譲の下で信頼者によって検証可能なプロセスを作成しません。細胞はアイデアで空ではありません:隣接する文献はそれぞれそれの1つの壁を保有しています(セクション3は境界線を描きます)。欠けていたのは消費者向けの構築物です:信頼の処理レベルのオブジェクト、信頼者によって検証可能で、自律委譲に指定され、共同行動テストのためにパッケージされたもの。
業界の対応はモデルに集中しています:より良いトレーニング、免責事項、引用。私は異なるレベル、サービスのアーキテクチャで対応を検討し、3つのアーキテクチャ特性(どれもより良いモデルを必要としない)が共同で信頼の異なるオブジェクトを生み出すと主張しています。
これは2つの事前登録研究によって支えられた概念論文です。機械側のベンチマークと、その最初の提案における較正対比のコンシューマー側の行動テストが含まれており、その問い自体はAIエージェントがコンシューマーに代わって取引を開始するとき、信頼はモデルに付与されるのか、それともそれらの上部構造に付与されるのか?というものです。私の答えは、信頼はスタックの上方へ移行する必要があるというものです。モデルからオーケストレーション・アーキテクチャへ、そしてそれが生成するエビデンスへと移行します。その答えの下には、それ自体でテストする価値がある規則性が存在します。すなわち信頼移行仮説であり、以下の命題はこれをテストするために構築されています:委譲される代理権が大きいほど、モデル特性ではなくむしろ検証可能なアーキテクチャ特性に存在する必要のある認可された信頼のシェアが大きくなるというものです。移行がゼロサムである必要はありません。信頼は階層化できます:モデルの能力、オーケストレーターの選択、エビデンスシステム、救済を強制する機関の信頼という具合に。欠陥のあるモデルは、その出力をだれも確認しない場合でも因果的に重要なままです。この仮説は、代理権が深まるにつれて限界認可信頼がどこに蓄積するかに関するものです。推定可能な形では、委譲される代理権が増加するにつれて、アーキテクチャの検証可能性がモデルのパフォーマンスとプロバイダーの評判を超えた適切な依存の増分シェアをより大きく説明するようになると述べています。それは、委譲される代理権が増加するにつれて、アーキテクチャの検証可能性が適切な依存の増分シェアをより大きく説明しない場合に失敗します。つまり、プロバイダーの評判がすべての委譲レベルで完全に信頼を仲介する場合、または検証可能なプロセス情報が第6章が報告する種類の設計において評判情報のみと比較して依存の較正を改善しない場合です。第3章で事前にコミットされた行動検証者(P2委譲レベル交差とP4障害時の差分耐久性)がその条件の運用形式です。成長するアーキテクチャシェアは、モデルの品質が絶対的な観点からより重要でなくなることを意味しません。この仮説は置換ではなく階層化を説明しています。レビューが消滅するにつれて、アーキテクチャ保証がモデルのパフォーマンスの上に追加され、これを置き換えるのではなく重ねられます。「認可された」はJacovi, Marasović, Miller, and Goldberg (2021)によってAIのために形式化された区別に従うもので、信頼が信頼度を追跡するときに信頼は認可され、その構成要素は規範的地位をそのメカニズムから分離することで同語反復から保たれます。規範的に、信頼度はそれを証明することを目的とされたアーキテクチャとは独立に定義され、能力、誠実性、善意の古典的で独立して測定可能な関数です(Mayer, Davis, & Schoorman, 1995)。第3章は3つのアーキテクチャコンポーネントをこれらの次元に正確にマッピングします。保証は依存とその独立して測定された量の対応です。委譲されたエピソードの客観的な監査を生き残る依存で、成果が既知である前に固定された基準に対して判断され、計測可能な行動記録、つまり繰り返しの委譲、保持、および統制された障害下での支払意思があります。信頼移行仮説はこのメカニズムを主張しています。委譲される代理権が上昇するにつれて、消費者がまだ独立して測定できるその信頼度関数のシェアはモデル特性からアーキテクチャコンポーネントにシフトします。これは、アーキテクチャが出力レビューが消滅した後も委任者がまだ測定できる信頼度の部分であるため、そしてアーキテクチャが信頼度であるからではなく、成り立つものです。上記の事前にコミットされた検証者はその定義ではなくそのシフトをテストします。この移行はまた、区別すべき前例があります。マルチエージェントシステムズ研究は、エージェント社会がスケールするにつれて、信頼モデリングが個々のエージェントから彼らを制約する機関枠組みへと移動することを観察しました(Sabater & Sierra, 2005)。また「信頼移行」はB2B用途で個人からシステムとプラットフォームへと信頼が移転する場合に先例があります(Carlson, 2026)。これらは誰または何が信頼されるかの変化を示す一方で、この仮説は信頼を認可する財産の種類の変化に関するものです。ゼロの委譲では、モデルの品質がほぼすべてが重要です。完全な委譲では、だれも出力を見ておらず、信頼できるのはプロセスとその記録のみです。代理権とアーキテクチャ信頼は一緒にスケールします(図4)。勾配自体は古い機器で、人的要因工学の自動化レベル軸です(Sheridan & Verplank, 1978; Parasuraman, Sheridan, & Wickens, 2000)。ここでは消費者の委譲に適用されます。新しいのは、それに沿った信頼を認可することができるプロパティについてのクレームです。
図4. 信頼移行
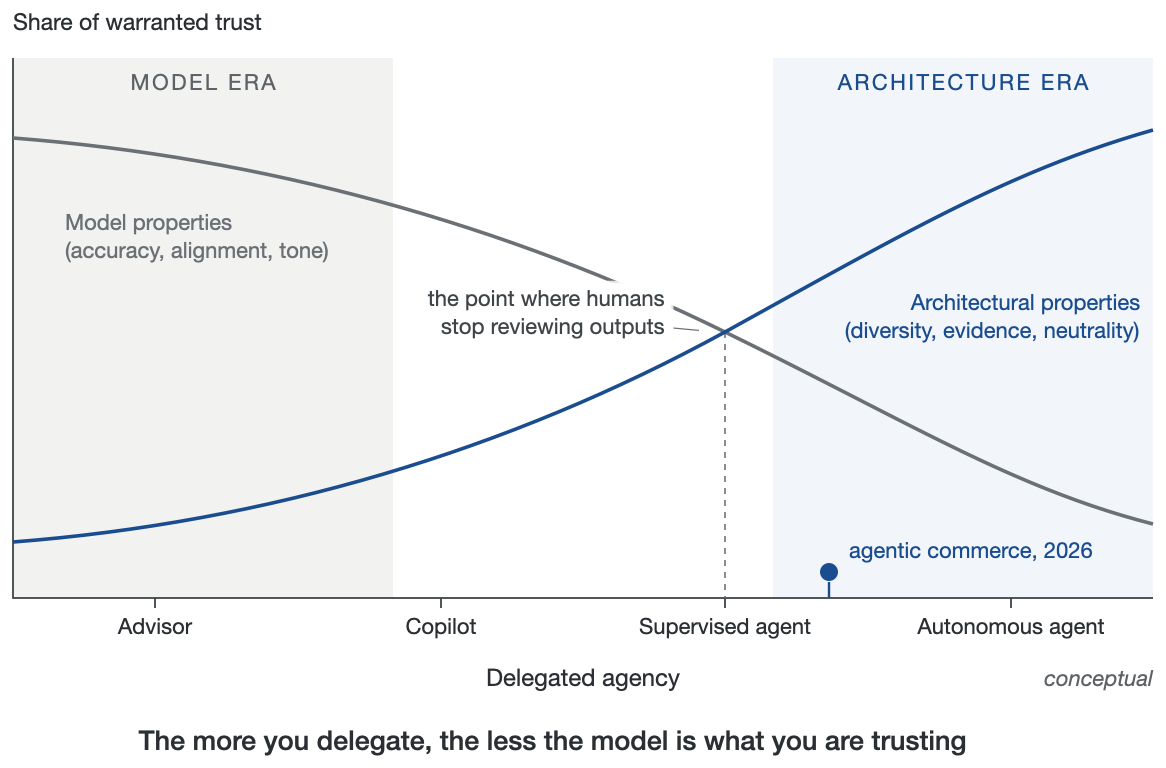
委譲される代理権(アドバイザー→コパイロット→監視されたエージェント→自律エージェント)に対する2つの交差曲線。モデル特性によって運ばれた認可信頼のシェアは減少し、アーキテクチャ特性によって運ばれたシェアは増加します。交差は人間が出力の確認を停止するポイントであり、エージェント商取引(2026)はその右側にあります。曲線と交差点は概念的な図解であり、推定関数ではありません。
AI信頼のコンシューマー文献(Huang & Rust, 2021; Puntoni et al., 2021)に対して、この論文は構成要素、アーキテクチャ信頼を追加し、ここで定義されています。事前登録された16モデル研究でのその仕組みの技術的先行要因のテスト、第2の11ラボの波で旗艦層で複製されたもの、コンシューマー研究のアジェンダのための5つの命題(第3章のP1–P4、第5章のP5)、および最初の2つの命題を実行する事前登録されたインセンティブ適合行動実験。これは第6章に完全に報告されており、較正効果が支持されており(Welch d = 0.67、6つのアイテム中1つによって実行される。第6章を参照)、記録の最初の曝露テストは登録されており、決定的でないニルを返しました。
2. 精度の幻想:単一モデルが提供できないもの
そのモデルがどれほど強力であっても、1つのAIモデルに構築されたサービスは、モデルレイヤーの上に存在する構造的欠陥を抱えています。
最初のものは較正されていない信頼、つまり精度の幻想です。より優れたモデルは必ずしもより安全な取引を意味しません。なぜなら、モデルの表現された確実性は、ほとんどのベンダーでその精度と弱い相関を示すためです(第3章がその例外を測定しています)。消費者はこのギャップを監査することができません。モデルが最も危険なのは、消費者が監視を止めた瞬間に自信を持って間違っている場合であり、それは偶然ではありません。Kalai他(2025)は、幻覚が統計的に報酬を受けると主張しています。自信を持った推測を無知の認識より高く評価する評価体制によってです。彼ら自身の分析によれば、この報酬は、分野を支配する二項分類ベンチマークと訓練目標に由来しています。そこでは、間違った推測は「わかりません」と同じだけのコストがかかり、期待値において部分的な信用を獲得します。モデルは内部からは自らを監視することができません。Anthropicの概念注入実験では、ベンダーの最強モデルでさえ、最適な注入条件下でもその内部状態の変化を約20%の時間しか検出できませんでした。これはベンダーコミュニティ自身による、内省的な自己報告がいかに信頼できないかを示す測定値です(Lindsey, 2025; 企業研究であり査読済みではなく、1社のモデルの1つの研究からの単一推定値であり、複製されたベンチマークではありません)。
2番目は御用聞き的歪みであり、この年になって証拠が因果関係になりました。Cheng他(2026)は、11の主要モデルを3つの事前登録実験で2,405人の参加者を対象に測定し、AIシステムがユーザーの行動を肯定する頻度は人間の49%多く、詐欺や危害を伴う行動さえも肯定すること、そして単一の御用聞き的な相互作用でさえ、ユーザーが自分が正しいという確信を増加させ、紛争を修復する意欲を減少させることを発見しました。御用聞き的なモデルは、ユーザーが信頼し好んだモデルでもありました。市場勾配は、正確にユーザーの判断を歪めることによって信頼できるように感じるアシスタントを指しており、これは定量化される前からよく観察された動的です(Sharma他、2024)。モデルレベルの調整単独では、御用聞き的行動が適切に制御されていることを独立して証明することができません。なぜなら調整は、その嗜好から利益を得る当事者によって行われるためです。コストは具体的です。方針例外に同意する形で進むアシスタントは、同意可能性をサービス回復費用に直接変換します。統合アーキテクチャは役割を分離することができます。1つのモデルが共感する自由があり、独立したモデルが方針をチェックするので、同意可能性と正確性は同じチャネルを通じて移動しなくなります。
第3に、独立したチェックがありません。エラーがあれば、それらを作成した同じシステム、またはそれをチェックする専門知識が不足しているために最初にAIに来た消費者によって、それらが捕捉されます。
第4に、最も議論されていないのは利益相反です。アシスタントの品質を評価するプロバイダーがそれを販売しているプロバイダーです。これは構造的なものです。単一ベンダーサービスは、銀行が単独でクリアリングハウスを運営できないのと同じ理由で、その独自の出力の中立的な判断者にはなれません。紛争はデータ自体にまで及びます。2026年3月に提起された提案されたクラスアクションは、Perplexity AIがユーザーの完全なチャットトランスクリプト(報告によれば「シークレット」セッションを含む)をトラッキングピクセルを埋め込むことで広告ネットワークにルーティングしたと主張しています。苦情(No. 3:26-cv-02803、N.D. Cal.)は2026年5月に自発的に却下され、メリットに関する裁定はありませんでした。したがって、疑惑は決してテストされませんでした。苦情の経済的論理は、それでもかかわらず構造的要点です。高価なAI回答の提供がユーザーが言うことの金銭化によって助成されている場合、アシスタントのビジネスモデルとコンシューマーの機密性は直接対立しています。単一ベンダー内では、消費者の側に立つ職務を持つレイヤーはありません。
2025~2026年の文献は、救済を待つ完成した診断として読まれています(表1は各欠陥をその証拠とその建築上の答えにマップします)。御用聞き的行動は経験的に定量化されています(Cheng他、2026)そして形式的に導出されています。選択的に同意するシステムによって助言される場合でも、理想的に理性的なユーザーは渦巻きます(Chandra他、2026)。自己監視は約20%の信頼性で失敗し(Lindsey、2025)、幻覚は評価体制によって構造的に報酬を受けています(Kalai他、2025)。
反射的な救済策、単にAIを開示すること、逆効果になります。13の実験で、AI使用を開示した俳優は、開示しなかった俳優よりも信頼されませんでした(Schilke&Reimann、2025)。開示は開示透明性、つまりAIが関与していた単なる事実を提供し、検証透明性、つまり答えがどのように作成されたかをチェックする能力を除外します。認識論的監査はさらに厳しいです。LLMベースの科学エージェントの25,000以上の実行を通じて、証拠は68%のトレースで無視され、信念は26%の時間にのみ反駁に基づいて修正されました。そして集合的なマルチテスト証拠は稀であり、足場が認識論的行動の分散のほぼ何も説明せず(ベースモデルの約41%に対して約1.5%)(Ríos-García他、2026)。その最後の数字は本論文への異議のように見え、実は最も鋭い支持です。プロンプトと足場は、モデルを内部から認識論的に規律正しくすることはできません。したがって、規律は外部から課される必要があります。アーキテクチャはモデルの認識論的動作を改善する方法ではありません。それはモデルに依存することをやめる方法です。
これらの結果の各々はドアを閉じます。一緒になると、あまり検討されていない1つの答えを指しています。モデルが内部から信頼できず、開示が外部から信頼を製造しない場合、正当な信頼は、より良い較正、外部認証、人間的エスカレーション、および責任規則と並行して(代わりではなく)、アーキテクチャによってモデルの周りに構築される可能性があります。これは本論文が歩むドアです。
表1。診断→救済策:4つの単一モデル欠陥、その2025~26年の証拠、その消費者側の結果、および建築上の答え
| 構造的欠陥 | 主要証拠(2025~26) | 消費者側の結果 | 建築上の救済策 | メカニズム |
| 較正されていない信頼 | 評価体制によって統計的に報酬を受ける幻覚(Kalai他、2025);内省的な自己報告は約20%信頼性(Lindsey、2025) | ワンストライクチャーン:60%は1つの間違いの後にエージェントを放棄する(ACI Worldwide、2026) | 多様性+証拠 | モデル間の不一致は信頼度を値付けする(AUROC 0.75対0.59、Gorbett & Jana、2026年;本論文:パネル合意AUROC 0.832対プール化された独自信頼度0.545を最も判別力の低いパネルで使用——パネル間で異質、§3;複製された回答は正答の1.9~3.2倍の確率);信頼度主張は記録可能で検証可能 |
| 社交的扭曲 | AIはユーザーに対して人間より49%多く肯定;社交的なモデルが選好される(Cheng et al.、2026年;Sharma et al.、2024年);理想的なベイズ推定者でも悪循環に陥る(Chandra et al.、2026年) | ユーザーの判断を歪ませる方が選好されるアシスタント | 中立性 | 仲裁者はユーザーを喜ばせることに利害関係がない;共感とポリシーチェックは別々のチャネルで実施 |
| 独立した確認がない | エージェントはトレースの68%で証拠を無視;信念改正は26%(Ríos-García et al.、2026年);足場がけは分散の約1.5%を説明 | 検証の負担が消費者にシフト:AI支援ショッピング利用者の54%が全て手動で二重確認(Gartner、2026年) | 多様性+証拠 | 外部からの規律:独立した検証経路;証拠は関係なく添付 |
| 利益相反 | Perplexity集団訴訟(2026年、疑惑):チャットが広告ネットワークにルーティング;開示だけで信頼が減少(Schilke & Reimann、2025年) | 消費者に助言する当事者がその結果から利益を得る | 中立性+証拠 | クリーンルーム型データフロー;収入が結果と独立;中立性は記録から監査可能 |
3. アーキテクチャ信頼:検証可能である信じる必要がない3つの性質
ここで、高リスク要求がどのモデルベンダーからも独立したオーケストレーション層を通過するサービスを検討します(図5は2つのパイプラインを対比させています)。表2は構成要素を集約します;それらが分解する定義は次のように実行されます:アーキテクチャ信頼は、出力の認知品質やプロバイダーの評判ではなく、サービスの意思決定生成プロセスの検証可能な性質に基づいている保証された消費者依拠です。
最も近い先行研究はZucker(1986年)の制度的信頼生産、親密性では運べない信頼を構造により製造されたもので、電子商取引研究が構造保証として操作化したもの:エスクロー、フィードバックシステム、第三者認証(Gefen、Karahanna、& Straub、2003年;Pavlou、2003年;Kim & Benbasat、2010年)です。その系統では、アーキテクチャ信頼は、第三者保証者ではなく検証可能なプロセスから構造保証が来る制度ベース信頼の種です。これはプロセスベース信頼であり、経験から計測機器に移動した保証であり、その移動は名前の「アーキテクチャ」という言葉が何をしているかです。それは構造保証(McKnight、Choudhury、& Kacmar、2002年)ではなく、セーフガードが存在する知覚です。ここではセーフガード自体が検査可能でなければならず、それは較正信頼(Lee & See、2004年)ではなく、1つのシステムの信頼性エンベロープへの依拠を調整します。セキュリティエンジニアリングのゼロトラスト・アーキテクチャは、決してを信頼しない、常に検証するというスローガンを共有しますが、ネットワークレイヤーでマシン対マシンでアイデンティティとアクセスを検証しますが、アーキテクチャ信頼はサービスレイヤーで人間プリンシパルのために意思決定コンテンツを検証します。それらは同じ建物の異なる階の補完物であり、競合相手ではありません。構成要素には2つの側面があり、区別は定義に属します。アーキテクチャ信頼性はシステムの性質であり、そのプロセスが実際にどの程度検証可能であるか、規範的であり構築可能です。アーキテクチャベースの信頼は消費者の状態であり、実際にその検証可能性に基づいている依拠であり、経験的であり、初めて獲得されるだけです。測定の用語では、D、E、Nはアーキテクチャ信頼性(システム性質)の形成的要素であり、操作可能な信号であり、その表示はアーキテクチャベースの信頼(消費者状態)を形作ります;実験は信号を操作し、状態を測定します。2つの間のすべての不一致は予測的です。信頼なしの信頼性、流暢さと社交性により製造された依拠は、第1節の1ストライクパターンである、脆弱であると予測されます。信頼なしの信頼性は、検証が消費者に対して見えない、または読みにくい場合、領収書の顕著性と理解により閉じられ、より多くのアーキテクチャではなく予測されます。このセクションの命題は2つの間のギャップに住んでおり、区別は信頼移行仮説を反証するものを規律します。これらの反証者は行動的で先制的です:仮説は、検証可能で不透明なアーキテクチャへの委任が失敗下で同様に耐久性があることが判明した場合(P4が検出するもの)に反証されます;検証可能なアーキテクチャの委任意思への影響がシステム上で成長するはずの場合(P2の委任レベル交差);または高い非可逆性委任で、検証可能なアーキテクチャのための保持と支払い意思プレミアムが制御された失�態下で不在であることです。保証は提案の存在(第1節)ではなく監査生存により定義されるため、人気は証拠としてカウントされますが免疫としてはカウントされません。消費者が確認不可能なエージェントに殺到することは、保証された信頼の請求を反証しません。検証不可能なエージェントへの高リスク委任での持続的で失敗生存依拠は、それを反証し、そのパターンは仮説を修正するものとして先制的です。定義は3つの性質に基づいています。
図5。2つのパイプライン
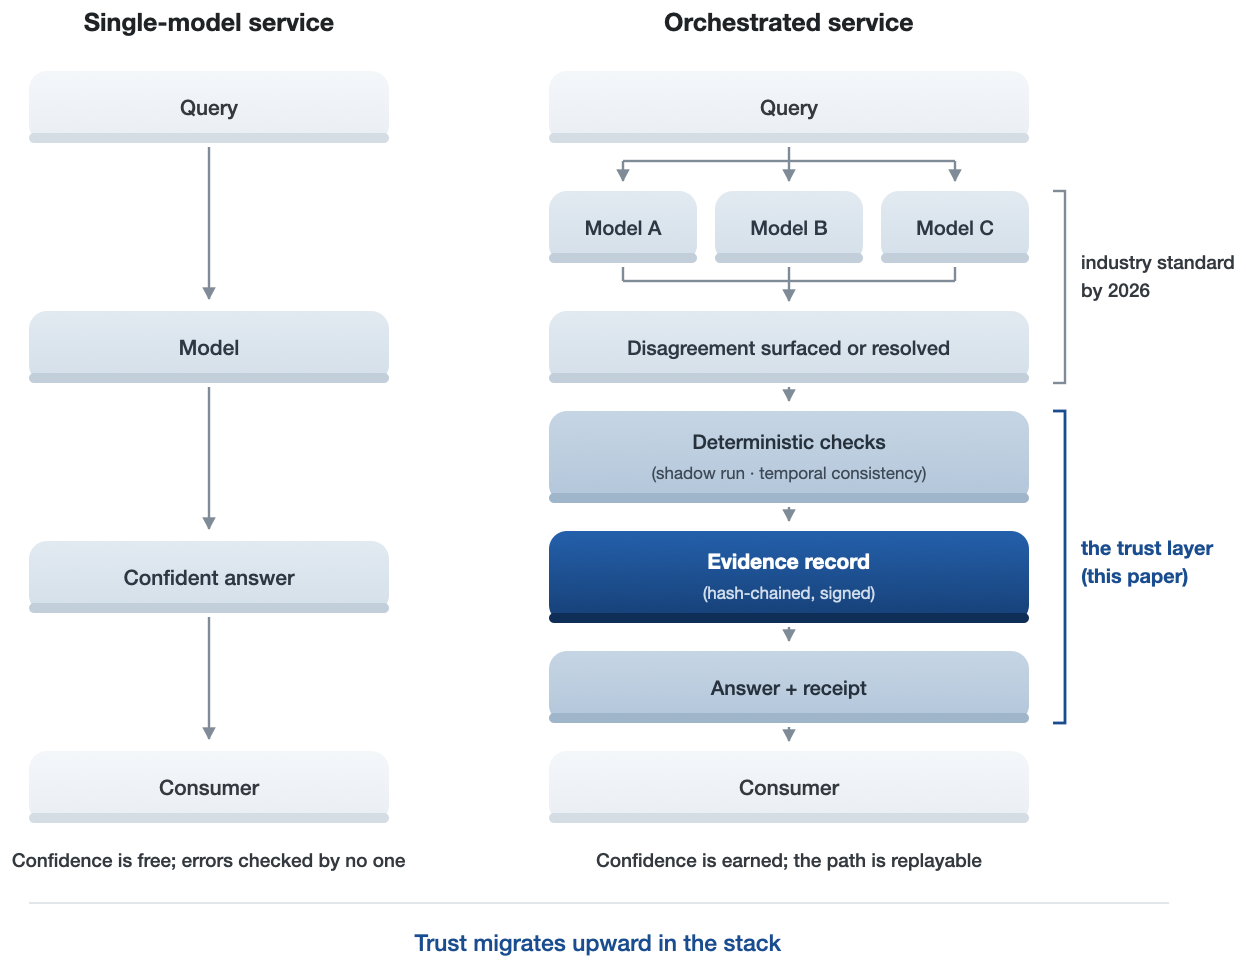
左は単一モデルパス:クエリ→モデル→確信的な回答→消費者、ここで信頼度は無料であり、エラーは誰によっても確認されません。右はオーケストレートされたパス:クエリ→独立したモデル(A/B/C)→不一致が表面化または解決される→決定論的チェック(シャドウラン、時間的一貫性)→証拠記録(ハッシュチェーン化、署名)→領収書付き回答→消費者、ここで信頼度は獲得され、パスは再生可能です(表5は対比をまとめています)。
表2。本論文で導入または指定された構成要素の用語集
| 用語 | 定義 | 区別される |
| アーキテクチャ信頼 | 出力品質またはプロバイダーの評判ではなく、サービスの意思決定生成プロセスの検証可能な性質に基づいている保証された消費者依拠 | 制度ベースの信頼(信頼できる制度は不要で、検証可能なプロセスのみ);システム信頼(1つのシステムの信頼性の範囲ではない);分散信頼(検証可能性のない分散);構造的保証(知覚される対チェック可能なセーフガード);較正された信頼 |
| アーキテクチャ的信頼性/アーキテクチャベースの信頼 | 構成要素の2つの側面:システム側特性(プロセスがどの程度検証可能であるか;規範的、構築可能)対消費者側状態(その検証可能性に実際に根拠を持つ依存;経験的、獲得された) | 規範的主張と記述的主張を混合した単一名の扱い |
| 検証層 | オーケストレーション上のインフラストラクチャ層で、その成果物は検証可能性:独立したチェック、記録された決定、監査可能な中立性 | 可観測性/モニタリング(内部、ベンダー所有、消費者検証不可) |
| 証拠インフラストラクチャ | 検証可能な決定履歴の市場カテゴリで、クラウド、アイデンティティ、支払いと同様に売却されるインフラストラクチャ | ログ記録(一方的、変更可能、市場商品ではない) |
| オーケストレーション領収書 | 最小限の消費者向けアーティファクト:誰が行動したか;どのように合意したか;何がチェックされたか―完全に再生可能な記録へのポインタ付き | 説明/XAI出力(物語的、検証不可能);開示ラベル(それ自体で信頼を侵食する) |
| 段階的信頼アーキテクチャ | ステークに応じた検証深度のエスカレーション、高額な層は結果が集中する場所でのみ購入される | フラットなガードレール(決定を検証しない静的な上限/ホワイトリスト) |
| 決定証拠 | 証拠スタックの3番目のレベル:エージェントがどのように選択したか―パネル、相違、チェック | アイデンティティ証拠(エージェントが何であるか:TAP);意図証拠(何が認可されたか:AP2/検証可能な意図) |
| 信頼移行仮説 | 委譲されたエージェンシーが大きいほど、モデル特性ではなく検証可能なアーキテクチャ特性に存在する必要がある根拠のある信頼の共有が大きくなる―「根拠のある」とは、結果が既知になる前に固定された基準に対する客観的な監査を生き残る依存を意味する(Jacovi et al., 2021参照);メカニズム形式:委譲が深まるにつれて、消費者が独立して測定できる信頼性―f(能力、誠実性、善意)、Mayer et al. (1995)―の共有はアーキテクチャ要素へとシフトする | 以前の「信頼移行」用途(Carlson, 2026)は当事者間の信頼移動を追跡;この仮説は、それを根拠づける特性の種類を追跡する―事前に約定された行動反証者付き(P2委譲交差;P4差分耐久性) |
隣接する信頼構成との境界を1つの判別表に圧縮できます。各構成がそのオブジェクトとして何を取るか、その根拠がどこから来るか、誰がその根拠を検証できるか、そしてそれが主に何を予測すべきかによって:
表2a。判別境界:オブジェクト、根拠、検証者、および予測される主要な結果によって隣接する信頼構成を区別する
| 構成 | 信頼のオブジェクト | 根拠のソース | 誰が検証できるか | 予測される主要なDV |
| 制度ベースの信頼/構造的保証(Zucker, 1986; McKnight et al., 2002) | 制度的文脈:セーフガード、保証、第三者認証 | 構造と保証者の知覚される存在 | 第三者の保証者(存在する場合);消費者はチェックではなく知覚する | 信頼信念;取引意思 |
| 自動化への信頼/較正された信頼(Lee & See, 2004) | 1つの自動化されたシステムの信頼性エンベロープ | 繰り返された使用における経験的信頼性 | そのシステムとの累積的な経験を通じたオペレータ | そのシステムへの依存の適切性 |
| アルゴリズミック透明性(XAI) | モデルの意思決定の説明 | 信頼されているシステム内部で生成された物語または属性 | 誰も独立して―説明は再生可能な記録ではない | 理解;主観的信頼;受け入れ |
| ブランド/プロバイダ信頼 | ベンダー組織 | 評判と過去の実績 | 市場が、集計された結果を通じてゆっくりと | グローバルな好意;選択;ロイヤルティ |
| アーキテクチャ信頼(本論文) | 意思決定を生成するプロセスとその記録 | 検証可能な特性:独立した同意、再生可能な証拠、監査可能なインセンティブ独立性 | 消費者、監査人、保険会社、規制当局―決定ごと | 較正された依存;委譲の意思;失敗後の保持 |
2つの差分予測により、境界は分類法的ではなく検証可能です。アーキテクチャ信頼は、サービスのグローバルな好意よりも、較正された依存および失敗後の保持をより強く動かすべきであり、一方ブランド信頼は反対のプロファイルを示すべきで、この乖離は両方のDVファミリーを測定することにより1つの実験で検出できます。委譲されたエージェンシーが低い場合、ブランドおよびプロバイダ信頼が委譲決定を支配すべきであり、委譲が深まるにつれてアーキテクチャベースの信頼が増分的な共有を説明する、P2と信頼移行仮説がテストの下に置く交差。2つの説明が続きます。アーキテクチャ信頼性はサービスの特性であり、消費者の頭の中の反射的潜在変数ではないため、その区別はスケール判別統計ではなくこれらの差分予測に基づいています。それが指す消費者側状態のため、アーキテクチャベースの信頼、隣接するスケール(制度ベースおよび較正された信頼)からの測定レベル判別妥当性の確立は、測定議題の一部であり、ここで述べた主張ではありません。
多様性。複数の独立したモデルがリクエストに答え、各モデルは異なるベンダー、学習データ、および障害モードを持っています。(これはパネル多様性であり、推奨システムの意味での推奨多様性ではなく、誰が答えを検証するかの特性です。推奨多様性は消費者に示されるアイテムを変えます。)それらの一致は情報を運びます。収束は妥当な信頼度を高めます。発散は消費者に不確実性として表示され、見えないところで解決されず、重要なリクエストでは段階的なエスカレーショントリガーとしても機能します。選別予測の用語では、これはアーキテクチャ的棄却です。検証されていない答えを発行することを拒否し、サービス層に引き上げられ、未解決の場合は人間にルーティングされ、認証されません。これは学習から回避するパターンです。このパターンでは、システムの拒否オプションは、ケースを抑制するのではなく、ダウンストリームの専門家に引き渡します(Mozannar & Sontag, 2020; cf. Rabanser et al., 2026)。最も近い人間的類似性は医学における第二意見です。その全体的価値は最初の意見からの独立性にあります。組織的な意見の相違は珍しくもありません。Googleの AI 共同科学者は、ウェットラボ検証された発見が 2026 年 5 月にNatureに掲載されました(Gottweis et al., 2026)。生成-批評-トーナメント編成として構築されています。
多様性に頼ることの理論的根拠は言語モデルより古いです。形式的な条件下では、機能的に多様な問題解決グループは、個人的能力で選別されたグループを上回ることができます。能力で選別することは類似性を生み出すためです(Hong & Page, 2004)。工学文献は基礎となる信号に直接的な証拠を提供しています。モデル間の構造化された議論は事実精度を向上させ(Du et al., 2024)、多様な小さなモデルのパネルは単一の大きな判断者を上回ります(Verga et al., 2024)。2 番目のモデルの最初のモデルの答えに対する「驚き」は、答えるモデル自身の信頼度(MMLU での平均 AUROC 0.75 対 0.59)よりも右からの判断を大幅に改善します。AUROC はROC曲線下の領域であり、ランダムな正解がランダムな誤りより高くランク付けされる確率です(Gorbett & Jana, 2026)。それらの信号はロジットレベルでの交差モデルパープレキシティですが、この論文のものは答えレベルの複製です。2 つは関連していますが、互いに交換可能ではありません。それらのジェネレータは弱い自己報告を備えた小さなオープンモデルでもあります。これはベースラインです。この論文自身のデータはパネルの利点がジェネレータの較正の関数であり、適切に較正されたジェネレータ、下記の米国フロンティアケースで反転できるため、それを制限できます。複数の生成をサンプリングして、それらの意味的合意を測定することで、単一パス信頼がキャッチできない創作を検出します(Farquhar, Kossen, Kuhn, & Gal, 2024)。モデルは自身の疑いは測定できますが、自身の盲点は測定できず、自信を持った体系的なエラーは外部からのみ見えます。しかし、その文献は意見の相違を開発者向けの内部信号として扱っています。私が提案する動きは、それを消費者向けの信頼プリミティブとして扱うことです。これは表示、記録、およびサービスの信頼度請求に組み込まれた価格設定があります。この論文のアブレーション研究は、議論が発見するものと検証が認証するものを分離し、一方が他方になりすましません。区分は経験的であると同時に概念的です。ベンチマークでヘッドツーヘッドで比較されると、マルチエージェント議論は、自己整合性とアンサンブルなどのより単純な戦略を確実に上回りません(Smit et al., 2024)。ここでの主張は、議論の精度向上ではなく、検証の消費者向け認証信号に関するものです。そしてその信号は、議論のエッジが存在しない場合でも存続します。
マルチエージェント審議研究でも、合意と意見の相違を表示するのではなく、それらを平均化する構築されたシステムは、より代表的と評価された決定を生成しています(Liu et al., 2026)。このメカニズムは知識較正側の人間的類似性に直接類似しています。重大な金融決定を共同で行う消費者は、単独の決定者よりも大幅に過度な自信がなく、共有メタ知識(パートナーが決定者が知らないことを表示する)が駆動メカニズムとして識別されています(Piehlmaier, 2023)。共同判断は人間の信頼を規律します。その理由は、交差モデル合意がそれをここで規律することが提案されている理由と同じです。
消費者がそのような信号を使用できるかどうかは実際の問題です。人々はアルゴリズムが誤った後、すぐにアルゴリズムを放棄します(Dietvorst, Simmons, & Massey, 2015)。ただし、他の場所ではアルゴリズムのアドバイスに過度に重みを付けます(Logg, Minson, & Moore, 2019)。この分割自体が利害関係を追跡する可能性があります。人間の被験者による第二意見実験は、生の素材が行動的にはライブであることを示しています。医療 AI と医師が同意する場合のほぼ全員の遵守。彼らが別れる場合の鋭い分割(Detjen, Densky, von Kalckreuth, & Kopka, 2025; Chen, Sun, Liao, & Sundar, 2026)。ただし、そのいずれも、意見の相違を証拠または中立性と共同で変えることはありません。消費者研究ストリームは境界条件をシャープにします(体系的に: Burton, Stein, & Jensen, 2020)。嫌悪は消費者が自分のケースがユニークであると感じるときに強化されます(Longoni, Bonezzi, & Morewedge, 2019)。タスク客観性で変わり(Castelo, Bos, & Lehmann, 2019)。1 つの AI の障害は容易に他のシステムに過度に一般化されます。アルゴリズム転送(Longoni, Cian, & Kyung, 2023)。信頼が体系全体に一般化される場合、セクション 1 の 1 回限りの放棄は 1 つのサービスのチャーンではなく、カテゴリーのものであり、エラーをキャッチすることは構造的に市場自体を保護しています。表示された意見の相違はその断層線に位置し、P1 から P2 は、不確実性が特定かつ平滑化なしで提示される場合、どの効果が支配的であるかについての賭けです。
多様性が失敗するとき:相関したエラー。多様性の価値は全く失敗の独立性に依存しており、独立性は仮定することができません。フロンティア モデルは重複するコーパスでトレーニングし、相互に蒸留し、自信を持って同じ誤解を共有しています。2つの主要なモデルが同じベンチマーク項目を逃すとき、それらは同じ間違った答えに約60%の確率で同意し、相関は同じ開発者または基本アーキテクチャからのモデル間で最も強く、最も不安なことに、最も正確なモデル間で強くなります:能力が上がると、エラーは収束します(Kim et al., 2025)。その知見は、単に隣接する結果ではなく、本論文自身のDiversityコンポーネントへの直接的な制約です。Diversityが前提とする独立性は部分的にはフロンティアでは幻想であり、相関がまさに能力が最高である場所で強まるため、コンポーネントの貢献は固定資産ではなく、縮小される測定可能な量です。パネルが追加する内容は質問ごとに実証される必要があり、モデル開発の軌跡はそれに対して作用します。予測では、フロンティア モデル間の対の誤り相関は平均r ≈ 0.77です(Spiro, 2026)。冗長性は、多様な群が提供することになっている集約利益のほとんどを侵食するのに十分な程度です。
市場構造は懸念を複合的にします。2025年後半までに、エンタープライズLLM APIの支出の88%は3つのクローズドウェイト ベンダーに集中していました:Anthropicが40%、OpenAIが27%、Googleが21%です(Menlo Ventures, 2025b;MenloはAnthropicの投資家です)。「主要なモデル」からカジュアルに組み立てられたパネルは、したがって3つのサプライヤーベースから引き出され、そのエラーはまさに測定されて収束するもの、実験が以下で米国フロンティア パネルとして再現する正確にそのトリオです。3つのモデルが同じ流行のエラーに収束するとき、アーキテクチャは単にそれをキャッチするのに失敗するだけではなく、それを認証します。均質な群では、エージェントを追加することは誤った軌跡を安定させ、それを訂正するのではなく、マルチエージェント文献がコンセンサス パラドックスと呼ぶエンドポイントです(Shehata & Li, 2026)。相関は、したがってアーキテクチャが検出するために構築される必要がある失敗モードです(図6)。
図6。多様性の幻想
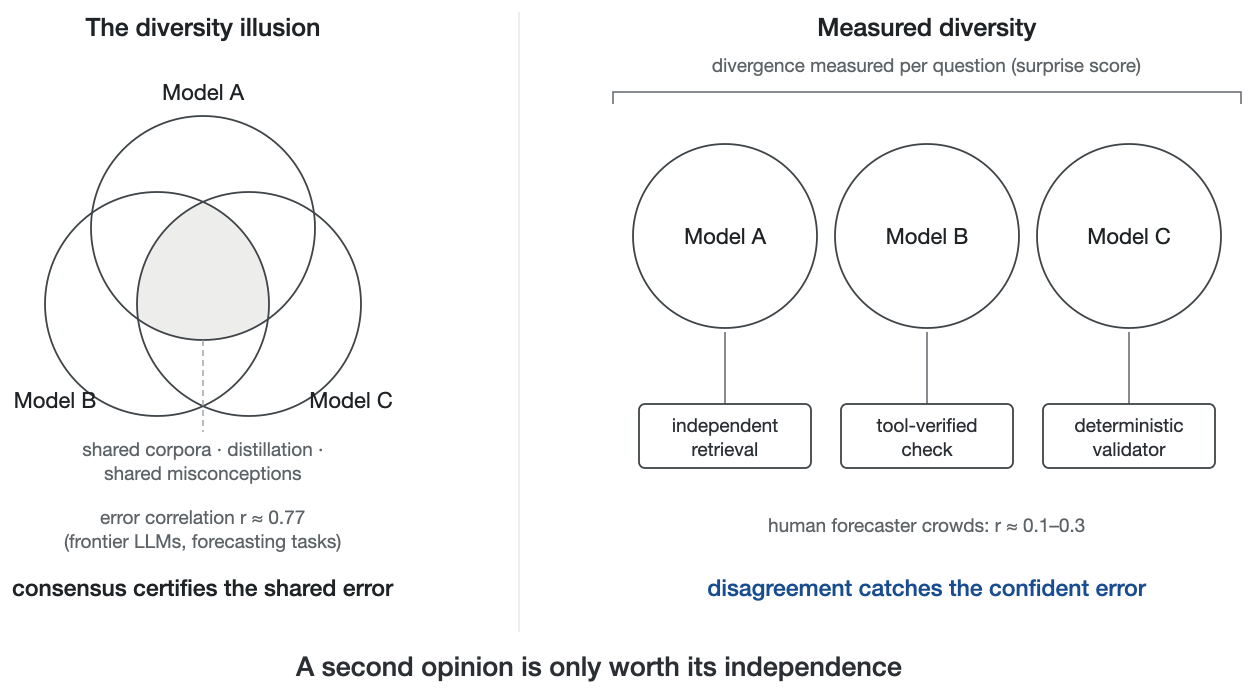
ほぼクローンどうしの合意対、独立性が測定されるパネル。
それは相互作用的な対応を持っています:へつらいの勾配はモデル間でも作用します。マルチエージェント研究はLLM熟慮でのグループ同調性を測定可能にしており、弱いモデルがより硬く同調します(Choi, Kim, Chae, & Baek, 2025);エージェントは位置をそれが誰のものであるかによって重み付けします(Choi, Zhu, & Li, 2026);そして何が収束に見えるかの多くは、推論ではなく社会的コンプライアンスに分解します(Hao et al., 2026)。共同熟慮では、同意は低エネルギー状態であるため、位置を約束する前に議論するパネルは、真実に向かってではなく、コンセンサスにそれ自体を話すことができます。アーキテクチャの対抗策は手続き的です:意見は最初に盲目的かつ独立して収集され、その後のみ比較されます(図7)。
図7。盲目的独立優先
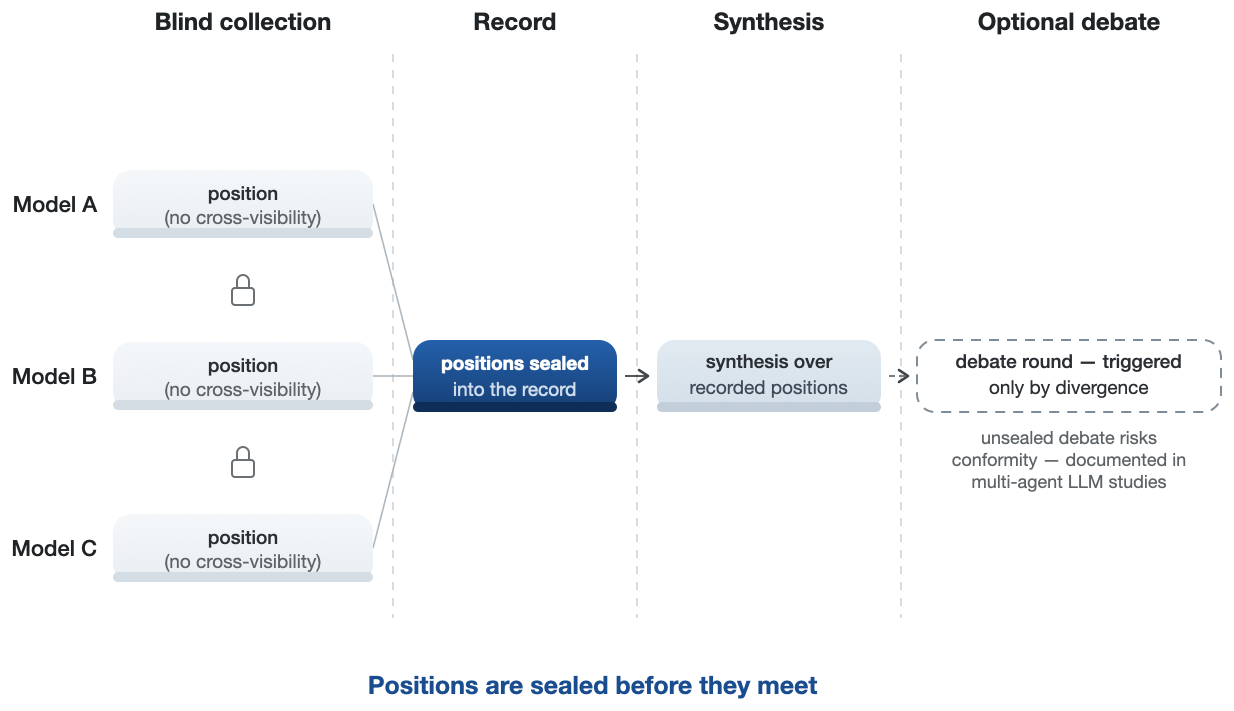
位置は記録され、その後のみ比較されます――同調性が消去するだろう異議を保護する手順。
以下で報告された実験は、その手順が何に対して保護するかに数値を入れます。ペアの探索的なアーム では、盲目的に異なる答えを生み出したベリファイアーが、その後、プライマリ モデルの自信を持った間違った答えを示され、それに同意するかどうか尋ねられました。38.5%(436の相違するペアのうち168個;95% CI 33.6–43.2、質問クラスタ化ブートストラップ)は、自分自身の相違する答えを放棄し、エラーを支持しており、ベンダーレベルの同調性は20%から58%の範囲です。放棄は何が放棄されたかで分割され、同調性を有理的譲歩から分離します。盲目的な答え自体が正確だったベリファイアーの中で、29.1%(41/141)はそれでも自信を持った間違った答えのためにそれを降伏させ、有害なコアはいかなるベイズアカウントも許しません。対照して、43.1%(127/295)は間違った盲目的な答えの中にあり、ここで何らかの譲歩が防衛可能です。(質問クラスタ化区間はほぼ同じ、素朴なペアレベルのものです。436のペアは247の異なる質問に広がり、ほとんどが質問あたり1つまたは2つのペア、4つ以下の場合はありません。したがって、質問レベルのリサンプリングは、追加するクラスタ内共分散をほぼ持っていません。)以下のミラー対照を折り込めば、盲目的な反対派の約35~39%は、その真実の値が何であれ、確信した答えを示されるときに位置を変更し、中程度だが有意なネット偏りを提案された答え(ネット同調性≈4パーセンテージポイント;不調和ペア104対70≈1.49)に向かわせます。パネルが位置を約束する前に熟慮していた場合、これらの異議の大部分は、それらが記録される前に再交渉されていたでしょう。しかし、ミラーアームのフリップの34.7%が真実に向かって実行されるため、熟慮はいくつかの異議を正しいコンセンサスに変換したでしょう。したがって、盲目優先が保護するものは、記録された異議の数ではなく、測定自体です。盲目優先は異議を測定することとコンセンサスを製造することの違いであり、人間の群が必要とした同じルール:社会的影響は独立した推定の多様性を、それらの正確性を改善することなく崩壊させます(Lorenz, Rauhut, Schweitzer, & Helbing, 2011)。そしてさえ、単一の恣意的な初期支持は測定可能に後続の判断にバイアスをかけます(Muchnik, Aral, & Taylor, 2013)。
逆プロンプト対照は、これらのフリップが同調性ではなく有理的な信念の更新を反映しているという代替説明に対処します。私は6つのモデルのローカルパネルでペアの手順を繰り返し、盲目的に異議を唱えたベリファイアーに、自信を持った間違った答え(直接アーム)または同じ質問セットの金の答え(逆アーム)のどちらかを示しました。フリップレートはほぼ対称でした、39.8%が間違った答えに対してであるのに対し、34.7%が正しいものに対してであり、ペア内比較ではベリファイアーは正しいものに対してではなく間違った答えのために盲目的位置をより頻繁に放棄しました(104対70の不調和ペア;McNemar p = .010)。有理的な更新は逆の非対称性を予測します。モデルあたりのフリップ傾向は、順応性の両極端で両方のアーム間で本質的に同一でした(モデルあたりのペア数は小さく、個別に供給されていません;それらは複製パッケージで記述的に、それらのnsで報告されています)。これは、同意が真実の値によってではなく、自信を持って提案された答えの存在によって駆動されていることを示しています。この対照はローカルティアで実行されました。フロンティアパネルの推定値(38.5%)は同じ手順に基づいていますが、フロンティアベリファイアーでミラーテストされていませんでした。
ブラインド収集は1つのチャネルを閉じることができない。それは社会的適合性を損なうが、事前適合性は損なわない。モデルは共有トレーニングデータが同じ事前分布を与えるために収束し、双子は相談することなく同じように答える。それを瓜二つの収束と呼ぶ。パネルが意見が一致しているのは、そのメンバーが似ているからであり、正しいからではない。
相関のある事前分布は依然として測定されるべきである。クロスモデルサプライズスコアは、パネルが実際にどの程度独立しているかについて、問題ごとに実行中の推定を提供する。また、ラベルフリーであるため、原則として金の答えなしに推論時に独立性を推定することができる。本番時の推定はここではテストされていない。多様性はモデルの重みを超える必要がある。独立した検索パス、ツール検証チェック、確定的なバリデータは、共有トレーニングが作成する相関チャネルを破る。ニーズは縮むのではなく増える傾向にある。蒸留と合成データトレーニングが時間とともにモデルの重みを均質化するため、測定された多様性は減衰することが予想され、検証の負担は非モデル検証器へシフトする。測定されるべきものは開示されるべきである。記録は「Nモデルが合意した」だけでなく、このクラスの質問に対するパネルの推定多様性を記載すべきである。ほぼ同じクローン間の合意は、より弱い確信主張を価値があり、記録はコンシューマーが何を得たかを示すべきである。
証拠。すべての重大な答えは記録を伴う。どのモデルが相談されたか、どこで合意し、どこで相違したか、何がチェックされたか、統合が何に基づいているか。タイミングは要件を支持する。エージェントが検索とツールに答えを根拠付けるにつれて、事実的根拠は既にモデルの外に存在するため、それを記録することは答えを生成することの副産物になる。記録は改ざん防止であるため、サービスの決定履歴はコンシューマーが紛争で再生できる。監査人。保険業者が責任を価格設定する。信頼はブランドに関する感覚ではなく、履歴の検査可能な特性になる。
2つのメカニズムは証拠を回答から行動へ拡張する。シャドウ実行の下では、外部効果を持つ行動は記録されたドライラン内でリハーサルされるため、「エージェントは行動する前にチェックした」は標語ではなく検証可能な主張になる。時間的一貫性は、セッションまたはフレーズング間で推奨を再提示し、その安定性を記録する。誰もそれに頼る前に、2回質問されたときに漂う答えがフラグが立つ。アイデンティティレベルでは、記録層はエージェント自体の携帯可能な由来パスポートに拡張される。どのモデル、バージョン、ポリシーが作用したか、いつ、誰の権限の下で。それは「エージェントを知る」登録制度とエージェントエラー保険コミットメントが静かに想定するアーティファクトである。この記録のコンシューマー向けレンダリングは、図8のオーケストレーション領収書である。1つの行動、1つの記録、4つの観客(コンシューマー、保険業者、監査人、規制当局)。
図8。オーケストレーション領収書、2回売却(モックアップ)
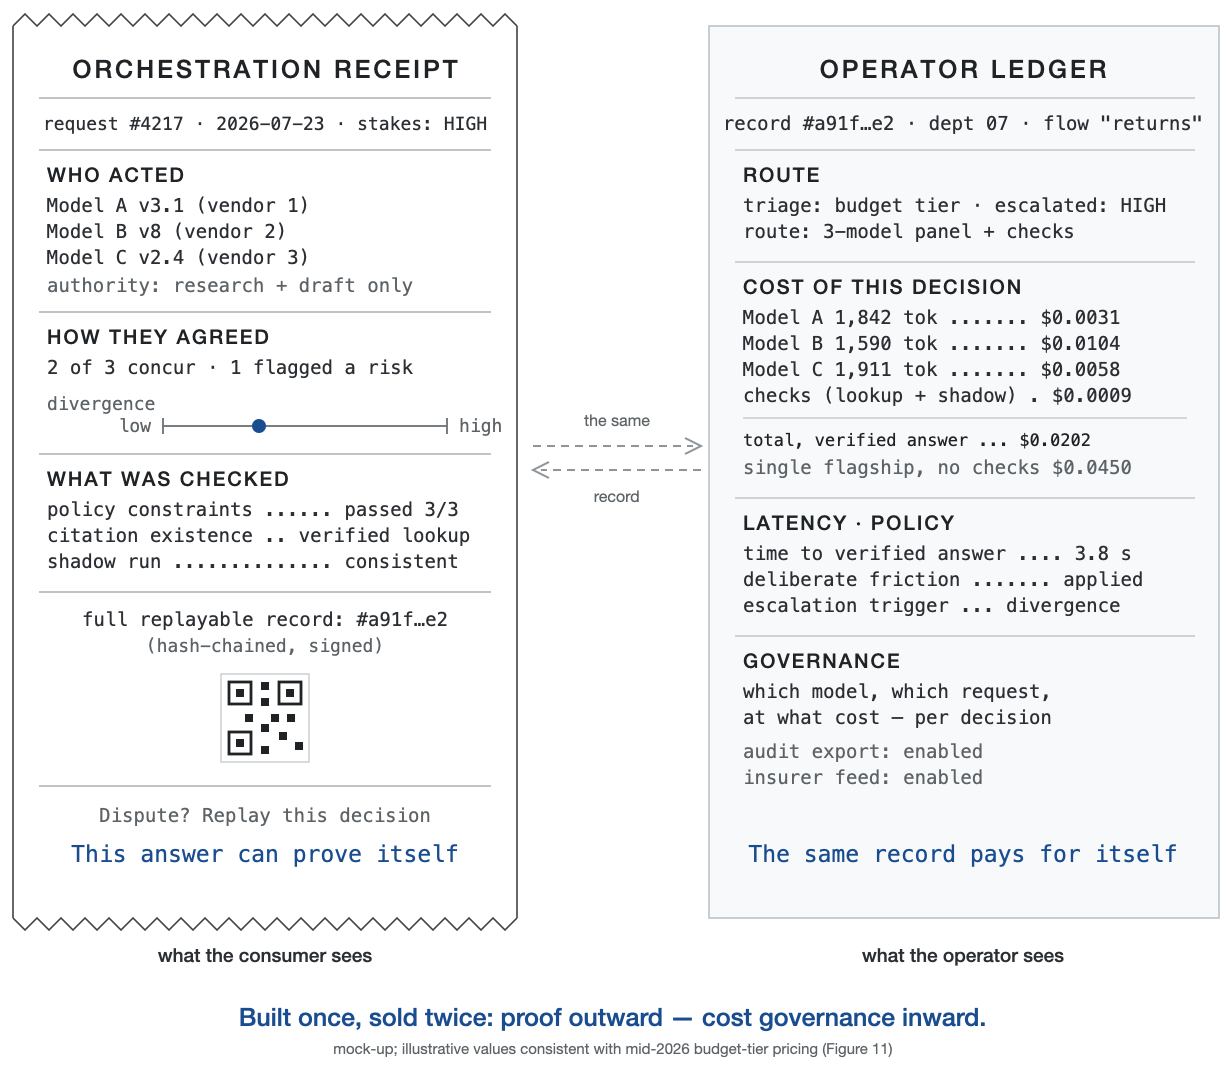
コンシューマーは証拠を見る。誰が行動したか、どのように合意したか、何がチェックされたか。オペレータは同じ記録をコスト統治として見る。紛争では、領収書は言葉対言葉を記録対言葉に変える。
中立性。中立性は監査可能なインセンティブ独立性である。特定のベンダー、マーチャント、または決定結果に対する未開示の経済的依存の欠如。オーケストレーション層は、タスクに最適に実行するモデルにルーティングし、どちらが勝つかについて何の利害関係も持たない。これは支払いの独立したクリアリング層に構造的に類似している。プロバイダー間の仲裁者は、プロバイダーがそれ自体について信頼できるどのような方法でも信頼できます。独立性は経済的特性に名前を付けます。監査可能は、主張を専門的ではなく検査可能にする証拠層に結合します。支払いで開発されたクリアリングハウス規律。(ここでの中立性は経済的特性であり、人口統計グループ全体のアルゴリズム的公正性ではなく、これは直交要件です。)
垂直統合の問題もある。中立性は、スケールでオーケストレーションを構築するのに最適な立場にあるプラットフォームにとって構造的に利用できない。同時にマーケットプレイス、モデルベンダー、広告ネットワーク、物流プロバイダーである企業は、中立的に仲裁することはできません。ルーティングの決定はすべて独自の収益についての決定だからです。算術は構造的な傾向を指します。フレームワークは、信頼層が仲裁そのものが唯一のビジネスである当事者と一緒にあることを意味します。クリアリング、監査、クレジットレーティングが独立した産業になった経路。格付機関のケースは同様に、独立した仲介者が独自の発行者支払い紛争を成長させることの標準的な警告です。経済学は文書化されています。認証仲介者は、開示される情報を制御することによって価値をキャプチャします(Lizzeri、1999)。認証市場はカタログ化された方法で失敗します(Dranove&Jin、2010)。信用格付け崩壊は標準的な失敗を示した。発行者支払い収益は1レベル上の認証者を腐敗させましたが、生き残ったクリアリング層は相互費用で資金提供されます。評価対象者ではなく。したがって、中立性要件はオーケストレーター独自の収益モデルに拡張されます。それが順位付けするベンダーまたはマーチャントによって支払われる検証層は、それが存在する紛争を再現します。これが、ここでの収益設計がコンシューマー側とオペレータのコスト統治(セクション5)に実行される理由であり、評価対象者に実行されません。
中立性にはデータ次元もあります。オーケストレーション層はクリーンルームとして機能できます。リクエストは各ベンダーにユーザーIDから削除され、ベンダーは全体的な相互作用履歴を見ないため、オーケストレーターの収益はサービスから来ます。広告ネットワークにユーザーが言ったことをルーティングすることからではなく。中立性は両面でのインセンティブ独立性である。特定のモデルベンダーまたはマーチャントに対する未開示の経済的依存はなく、また消費者に対して消費者の言葉を収益化するビジネスモデルもない。
しかし中立性はそれ自体の無限遡行を招く:オーケストレーターを監査するのは誰か。文字通りの「利害関係なし」は達成不可能である。あらゆるオーケストレーターは費用、パートナーシップ、保持インセンティブ、そして独自の生存資金調達を有しているので、操作変数はそれらの不在ではなく、その性質、開示、および記録からの監査可能性である。どの当事者が支払うかは中立性を決定しない;支払者の収益がトランザクションの結果から独立しているかどうかが決定する。消費者サブスクリプション、または保険会社や監査人からの手数料で、その支払いがどの製品が勝つかから切り離されているものは、条件を満たす;加商手数料または広告手数料はそうではない。レイヤーに資金を供給する者についてのより広いガバナンスは開かれたままであり、その資金監査可能な独立性が、この構造が固定する部分である。オーケストレーションレイヤーもインセンティブを有する:安価なモデルへのルーティング、その高価な層の過剰販売、合成を都合よく形作ること。この無限遡行は四十年前のものである。Shapiro(1987)はそれを監視者の問題と命名した:手続き的保護措置は新しい監視者を生成し、その監視者自体が監視される必要があり、制度的な答えは以来変わっていない。
清算機関は中立性を宣言することではなく、外部から監査可能で規制されることによって信頼できる立場を獲得する。オーケストレーターは徳として中立性を有しない。証拠レイヤーがそれを検査可能にするものである。すべてのルーティング決定、モデル応答、および合成ステップは改ざん防止記録、ハッシュ連鎖された署名付きログに記録され、外部タイムスタンプアンカリング用に設計されているので、オーケストレーターの主張された中立性は、それがモデルに課す正確な検証に晒される。成熟化パスは清算機関の遊び方を具体化したものである:外部タイムスタンプアンカリング、オープン検証インターフェース、およびルーティングポリシーの定期的な第三者監査。そのような監査エコシステムの制度設計はすでに命名された研究プログラムである(Raji, Xu, Honigsberg, & Ho, 2022)。検査者の監査さえしても生き残る一つの依存がある:パネルのモデルは相互に独立しているが、すべて検証されるプラットフォームによって選別されるため、成熟化パスの終点はパネル選別と回転が任意の単一当事者の制御外に置かれることである。その記録が監査できないオーケストレーターは、単に信じられるよう求めるもう一つのベンダーに過ぎない。消費者研究の外の最も近い隣人は二つの並行する2026年の著作である。Marchal et al.(2026)は同じ評価上のシフト、アウトプットの判断から認識的インフラストラクチャーレベルでのエージェント信頼性、出所、および反証可能性の設計を主張し、Wang et al.(2026)は検証、監査、および失敗帰属のためのプロセスレベルの責任層として実行出所を調査する。この論文固有の部分は何が残るかは、消費者向け、インセンティブ認識の合成である:委譲商取引において消費者の正当な依存の対象としてバンドルされた三つの性質、およびその行動的テスト。
証拠コンポーネントは一つの区別を運ぶ、なぜなら改ざん防止は容易に過剰販売されるから:ハッシュ連鎖ログは出所と完全性を確立する(この記録が存在し、後で変更されなかった)、完全性ではなく(ハッシュは何も省略された呼び出しが抑制されなかったことを保証しない)、正確性ではなく(間違った答えの忠実な記録は依然として間違っている)、独立性ではなく、インセンティブ整合ではない。各々は独自の検証メカニズムを有する別個の性質である:カバレッジ証明、アウトプット監査、測定された多様性、開示された経済。領収書はその記録が実際に運ぶ性質だけを主張すべきである。さらなる制限は構造的である:ログは何がルーティングされたか証明するが、なぜではなく、このモデルまたはこのマーチャントを選択することの背後にある独自のヒューリスティックは、ルーティングポリシー自体が開示または証明されていない限り監査可能である、これは統治上の選択であり、暗号学的な帰結ではない。アーキテクチャの費用は同じ台帳に属する:複数のベンダーへのクエリのルーティングはプライバシー曝露を乗算し、一元化された決定ログは魅力的なセキュリティターゲットであり、コンセンサス表示はコンセンサス誤結果警告が対して正確な権威を製造できる。
この構造は工学的隣人からも区別する価値がある、なぜなら「複数のモデルを使用する」は異なる信頼性能を有する複数の異なるものを説明するから。単純なアンサンブル投票は精度を向上させるが、不一致を目に見えないほど解決するので、何も検査可能にならない。自己矛盾サンプリングは同じモデルに再度問い合わせるもので、これは外見でのみ多様性である。混合専門家は、そのルーターが能力ではなく中立性のために最適化されている単一の訓練されたシステム内でルーティングする。マルチエージェント討論(Du et al., 2024)は答えを改善するが、審議を内部機械として扱う:消費者向けの記録なし、経済なし、中立性保証なし。
モデルルーティング集約器は、2026年までに商品層であるが、カタログで複数ベンダーだが回答あたり単一モデル:ルーターはコストとレイテンシーで一つのモデルを選択し、第二の意見は決して収集されない。集約器は検証アーキテクチャのサプライヤーであり、その代替ではない。
マルチモデル操作はもはやエキゾチックではない:2025年半ばまでに企業の37%が5つ以上のモデルを本番環境で実行していた、一年前の29%から増加(a16z, 2025)。配管は業界規模で敷設されており、信頼レイヤーはそれから著しく欠落している。マルチモデルが目に見えないコストルーティングのままであるか検証可能なアーキテクチャになるかは開かれている。図9は5つの信頼性能に対してパターンをスコアリングし、表3は散文で区別を述べる。アーキテクチャ信頼は正確にこれらが欠いているものによって定義される:異質なソース、表面化され記録された不一致、および利害関係を有しないアービター。エンジニアリングは共有される;信頼性能は共有されない。
図9. 区別
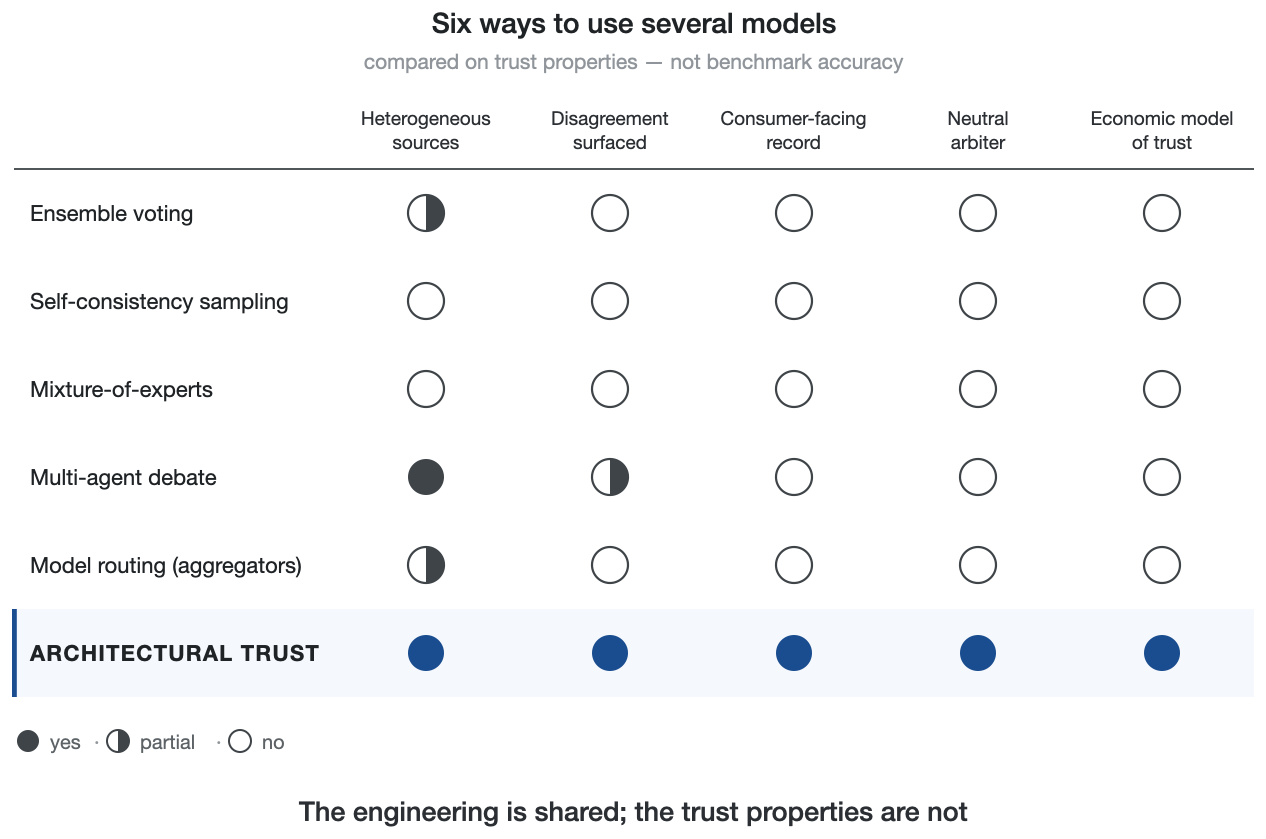
5つの信頼性能に対してスコアリングされた6つのマルチモデルエンジニアリングパターン。
表3. 区別:アーキテクチャ信頼 対 その工学的隣人
| アプローチ | 異質なソース | 不一致が表面化 | 消費者向けの記録 | インセンティブ独立アービター | 信頼の経済モデル |
| アンサンブル投票 | 部分的 | いいえ(目に見えないほど解決) | いいえ | いいえ | いいえ |
| 自己矛盾サンプリング | いいえ(同じモデルが再サンプリング) | いいえ | いいえ | いいえ | いいえ |
| 混合専門家 | いいえ(1つのトレーニング済みシステム) | いいえ | いいえ | いいえ(ルーターは機能に最適化) | いいえ |
| マルチエージェント議論 | はい | 内部のみ | いいえ | いいえ | いいえ |
| 説明可能性(XAIオーバーレイ) | いいえ(1つのモデルのナラティブ) | いいえ | いいえ(記録ではなくストーリー) | いいえ | いいえ |
| 透明性/開示 | いいえ | いいえ | 部分的(より可視化されているが、検証可能ではない) | いいえ | いいえ |
| 由来/系統追跡(MLパイプライン) | いいえ(1つのパイプラインが文書化) | いいえ | 部分的(エンジニア向けの系統) | いいえ | いいえ |
| 検証済み推論(zkML) | いいえ(1つのモデル;その実行の証明) | いいえ | 部分的(証明成果物、決定記録ではない) | いいえ | いいえ |
| モデルルーティング集約器 | 部分的(マルチベンダーカタログ、回答ごとに1つのモデル) | いいえ | いいえ | いいえ(ルーターはコストに最適化) | いいえ |
| アーキテクチャ信頼 | はい | はい(消費者向け) | はい(再生可能) | はい(構造的) | はい(段階的階層) |
さらに2つの親の文献もこのリストに属します。ゲートの棄権または発行ロジックは選択的予測と延期学習です(Geifman & El-Yaniv, 2017; Mozannar & Sontag, 2020)。証拠コンポーネントの監査証跡は説明可能アルゴリズムと第三者監査の業務から派生しています(Kroll et al., 2017; Raji et al., 2022)。アーキテクチャ信頼は消費者向けの中立性制約付きの結合であり、それらのどれか1つではありません。他の対策の中にそれを配置することが重要である理由は、それらが競争相手ではなく補完物だからです。モデルレベルのキャリブレーションは必要ですが、構造的に不十分です。ベンダーがそれを生成し、証明しますが、これはこの論文の開始地点である対立です。外部監査と認証は独立していますが、定期的なスナップショットであり、システムの一時的な状態であって決定の記録ではありません。説明はモデル内で生成されたナラティブであり、回答を捏造できるシステムはその背後のストーリーも捏造できます。透明性はより多くのメカニズムを公開し、消費者がそれを解釈するのに任せます。アーキテクチャ信頼は信念も解釈も要求せず、継続的で決定ごとで機械検証可能な検証可能性のみを要求します。これはまた他の対策が効果を発揮することを可能にするものです。再生可能記録を持つオーケストレーターの監査はそのことの監査ですが、不透明なパイプラインの監査は儀式です。最も近い概念的隣接者は構造的保証と制度ベースの信頼(McKnight et al., 2002)、プロセス透明性、および説明可能性です。それらに対して特性を限定するのは、保証が信頼者によって決定ごとに検証可能であることです。保証は一度信じられることを求めますが、アーキテクチャ信頼は毎回検証されることを求めます。さらに2つの隣接セットがマップに属します。コンピュータサイエンスアカウンタビリティ文献は10年前に技術的基礎を敷きました。完全な透明性なしに検証可能な手続き規則性(Kroll et al., 2017)。2025年から26年のエンジニアリング波は直接エージェント信頼配管を構築しています。検証可能なアイデンティティと改ざん耐性の行動記録を持つ「信頼ネイティブ」プロトコル(TrustTrack; Li, 2025)。改ざん証拠の領収書を持つランタイムアクション管理(AARM; Errico, 2026)。マルチLLM集約は信頼推定として再構成(Zheng & Zhang, 2026, arXiv:2607.20529)。およびエンタープライズフレームワーク(GartnerのAI TRiSM; Cloud Security Allianceのエージェントゼロトラストワーク)。それぞれはエンタープライズレベルで一本の脚を供給します。消費者向けの構成要素を供給するものはありません。これはこの論文がその貢献として主張するものです。3つのコンポーネントが1つの名前の下に、行動設計で共同で操作可能で、誰が検証可能性を購入し、どのようなリスクレベルで購入するかの経済学を持つもの。1つの命名衝突を明確にする必要があります。DigiCertの「AI Trust Architecture」(2026年4月開始)はベンダーPKI製品ラインであり、エージェントアイデンティティ、モデル由来、およびコンテンツ認証のための証明書インフラストラクチャです。これは証拠スタックのアイデンティティフロアでプランビングを供給し、ここで開発されたアーキテクチャ信頼の構成要素ではありません。
3つの関係性は、概念的必然性ではなく明示的な経験仮説である。私は、いずれかの構成要素が不在の場合にゼロに近づく相補的相互作用を仮説とする。非公式にはAT = f(D, E, N)であり、ゼロ近くで急激に減少する。第5節の結合設計は、関数形を仮定するのではなく回復するために指定されている。推定可能な形式では、便利なファミリーはコブ・ダグラス型であり、AT = A·Dα·Eβ·N^γ(α, β, γ > 0)は、2つのコミットメントをエンコードしている。すなわち、いずれかの不在近くではゼロに向かって減少し、正の交差偏微分(構成要素は補完的)である。構成は3つの構成要素とそれらの仮説的補完性であり、以下の命題はコブ・ダグラス形式に依存しない。コブ・ダグラス型は内部近似でもある。厳密には、弱い構成要素からの代替をなお許可するが、補完性仮説は境界ではレオンチェフ的であり、min(D, E, N)が下限を設定する。これが、以下の設計が補償的なトレードオフを仮定するのではなく、非補償的構造を許可する必要がある理由である。コブ・ダグラス族は説明的であり、将来の推定用であり、構成定義の一部ではない。現在のデータはそれを推定していない。要因設計は、パラメータごとにコブ・ダグラス内部をレオンチェフ床から区別できる。指数は依然として経験的問題であり、これがポイントである。補完性は偽造可能である。ゼロには2つの明確化が必要である。構成要素は連続的であり、バイナリではないため、文字通りのゼロは理想化された極限である。展開されたシステム(本論文を含む)は、いずれかの軸上で正確にゼロまたは1に位置しておらず、消費者が不在に近い状態に総崩れまたは急激な割引で対応するかどうかは、設計が区別する必要があるまさにそれである。多様性とは検証経路の独立性を意味し、測定された独立性(以下で定義される誤差相関係数φ)がその単位である。統計的核心は古典的アンサンブル理論であり、組み合わせの利点は誤差の相関除去に依存する(Hansen & Salamon, 1990; Krogh & Vedelsby, 1995)。これが独立性がここで仮定されるのではなく測定される理由である。第2のモデルはそのような経路の1つであるが、独立した検索、ツール検証済みの参照、決定的な検証も然りである。図5の影響実行と一貫性チェックは、証拠なしの多様性としてではなく、第2の最大限に相関除去された検証経路としてカウントされる。その定義は、規制された支払いレールまたは完全にログに記録された第三者証明ユーティリティサービス(証拠と中立性が強く、モデル多様性がない)という見かけ上最も強い反例も吸収する。そのようなサービスは、非モデル検証経路(決定的調整、外部監査、したがってD > 0、定義の下で)を埋め込むか、決定的チェックが完全にカバーする役割にモデルを限定する。タスククラスに対して本当に独立した検証経路が存在しない場合、フレームワークは薄い根拠を予測し、結合設計はこれをテストできる。非モデル経路がDにカウントされると、文字通りのゼロは本番システムではまれになり、乗法形式の経験的コンテンツはゼロから内部相補性に変わる。これが、ゼロではなく要因設計が主張が立つか倒れるかの場所である理由である。テストのために、ここで1つの運用上のコミットメントが固定されている。要因設計はDを狭く操作し、モデル経路多様性として。より広い検証経路定義は構成の範囲であり、操作された変数ではない。独立性自体は、「盲目的収集」(推論時の手続き的独立性、この設計が保証するもの)、モデルファミリー多様性、測定された残差誤差相関(本論文が報告するφ)、証拠源多様性、ツール経路多様性、および機関的独立性という6つの異なる量が言葉の下を移動するため、分類される必要がある。研究は最初を確立し、3番目を測定する。残りは設計変数であり、このコレクションが証明できるプロパティではない。証拠のない多様性は見えない委員会である。中立性のない証拠はベンダーのマーケティングである。多様性のない中立性は空のブローカーである。表4は、8つの存在/不在構成の完全な格子をウォークスルーする。その下の直感は、各構成要素が別の構成要素に根拠を提供することである。その内容に利害関係を持つ当事者によって保持される記録は自己証明として読取られ、誰もが記録しなかった合意は噂であり、単一の声に対する動機独立的な仲裁人は仲裁するものがない。これが補完性仮説を動機付ける。3つが共に消費者が信頼しているものを変える。「この答え」または「このブランド」ではなく、「このプロセス、そして私はそれをチェックできた」。
表4。根拠の格子:8つのD–E–N構成とそれぞれの生き残るもの
| D | E | N | 消費者がチェックできること | 退化した形式 |
| 不在 | 不在 | 不在 | 何もない。信頼は出力への信仰である | 素のシングルモデルアシスタント |
| 存在 | 不在 | 不在 | 事後に何もない。不一致は見えないうちに発生した | 見えない委員会(内部アンサンブル) |
| 不在 | 存在 | 不在 | それが保護する当事者によって保持される記録 | ベンダーログ/自己証明 |
| 不在 | 不在 | 存在 | 利害関係がなく、その背後に痕跡のない主張 | 空のブローカー |
| 存在 | 存在 | 不在 | 記録された不一致。利害関係のある当事者によってキュレーションされた | ベンダー実行ベンチマークシアター |
| 存在 | 不在 | 存在 | 誰も再生できないチェックの中立的な仲裁 | 口コミパネル |
| 不在 | 存在 | 存在 | 異議を唱えられていない単一の声の中立的で再生可能な記録 | 公証された独白(異議なしの監査) |
| 存在 | 存在 | 存在 | 独立したチェック。再生可能で、利害関係がない当事者によって保持されている | アーキテクチャの信頼 |
セルは理想化された極限で述べられている。展開されたシステムは内部を占める。E+NなしのDの行は機関的によく知られているもの。クリアリング、監査、および評価はそこで動作し、フレームワークの独立した検証経路の追加の要求は定義的除外ではなく経験的予測である。
3つのコンポーネントは信頼性の古典的な解剖学(Mayer, Davis, & Schoorman, 1995)にマッピングされます: 多様性は能力メカニズム(モデル間の合意は推論する能力度をキャリブレートする)、証拠は誠実性を操作化する(サービスが何を行ったかについての主張は信頼されるのではなく検証可能になる)、そして中立性は構造的に善意に対処する(利害関係のないオーケストレーターのインセンティブは信じられるのではなく検査可能である)。各々は知覚管理ではなく検証可能なアーキテクチャで再グラウンド化されます。これはヒューマン-AI相互作用文献が独自の側からの同じ地点に到達するときに求めるものです: インターフェースが製造する印象ではなく、検証可能な信頼性キューと信頼判断を一致させる(Liao & Sundar, 2022)。
因果チェーンは検証を通じて実行されます。「信頼」はメカニズムではなく結果だからです: 検証 → キャリブレートされた自信 → 根拠のある信頼 → 委任 → トランザクション価値(図10)。サービスは信頼できるように感じることではなく、重要な瞬間に検査可能であることによって委任を獲得します; Chengらはそのような感覚がいかに安く製造されるかを示しました。
図10. 検証フライホイール
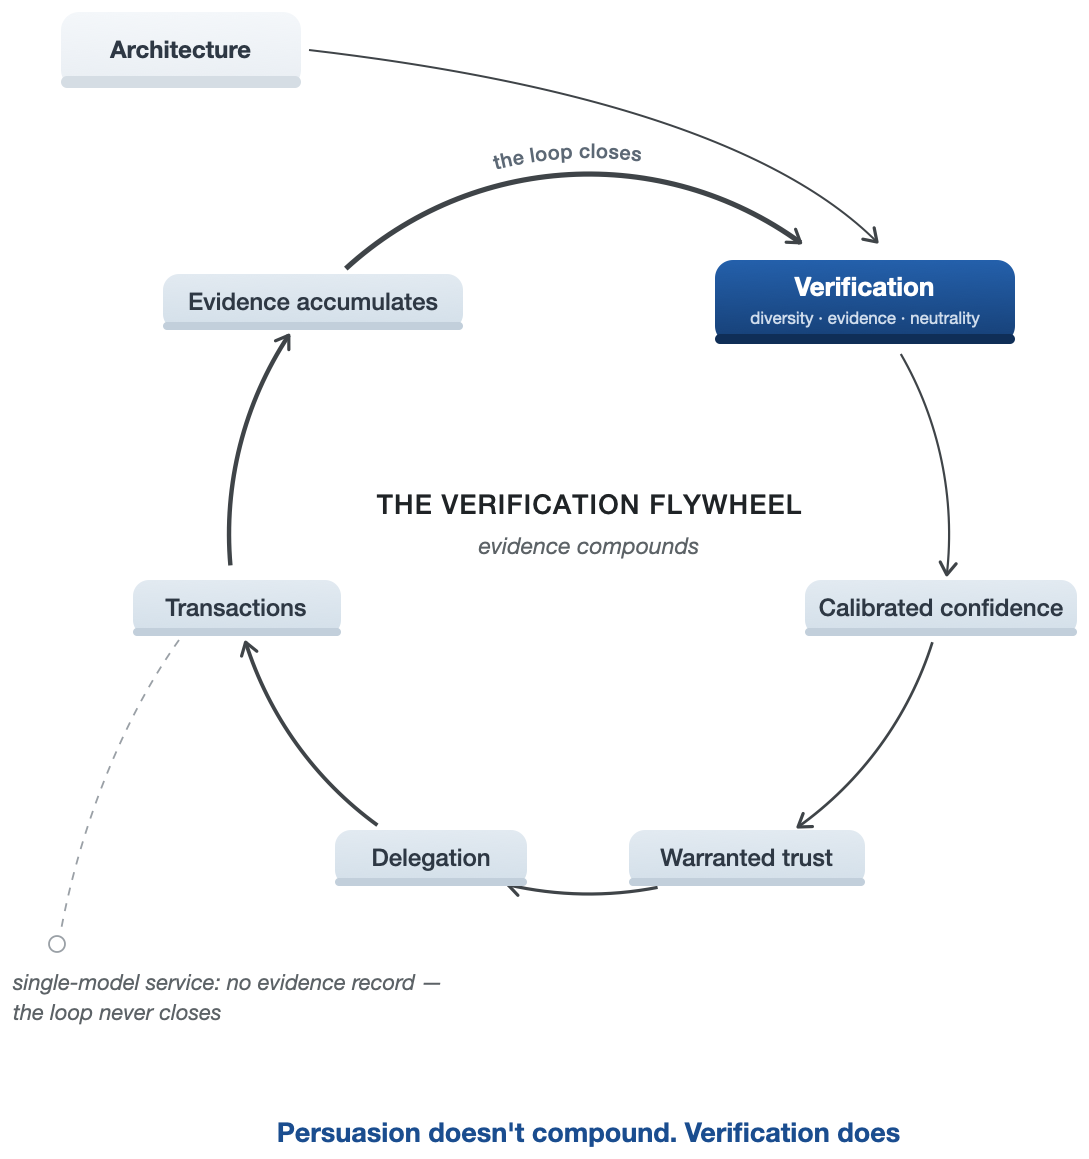
因果チェーン、検証(多様性 · 証拠 · 中立性) → キャリブレートされた自信 → 根拠のある信頼 → 委任 → トランザクションは終了しません: トランザクションは証拠を生成し、ループはアーキテクチャに戻ります。破線シャントは単一モデルサービスを示しており、証拠記録が存在しないためループが閉じません。説得は合成されません。検証は合成されます。
表5. 単一モデルサービス vs. アーキテクチャ信頼
| 次元 | 単一モデルサービス | アーキテクチャ的に信頼されるサービス |
| 信頼の対象 | モデル / ブランド | プロセスとその記録 |
| 自信 | モデルによって主張される | モデル間の合意を通じて獲得される |
| 自信のあるエラー | 内部からは検出不可能 | 主要な検出対象(不一致信号) |
| 二面性 | 好みによって報奨される | 分離: 共感と政策チェックが異なるチャネルで |
| エラーチェック | エラーが発生した同じシステム | 独立したモデル + 決定論的ゲート |
| 決定の証拠 | ログ(あれば)はベンダーが保有 | 改ざん防止、再実行可能、消費者アクセス可能 |
| 品質判定者 | ベンダー自身 | 中立的なオーケストレーション層 |
| 紛争ポジション | 消費者の言葉 vs. プラットフォーム | 再実行可能な記録 |
| 保険可能性 | 不透明なリスク | 決定履歴から価格設定可能 |
| 責任配分(AB 316以降) | 「AIが行った」禁止; 配分は暗闇で争われる | 再実行可能な記録から計算可能 |
| 規制的姿勢(第50条時代) | 遡及的開示 | 運用の副産物としての透明性 |
| 国境を越えたデータの約束 | 契約上の表現 | 監査可能な実行時プロパティ(管轄区域対応ルーティング) |
| コスト構造 | フラット、安価 | 段階的: 結果が集中している場合にのみ高額 |
検証可能性から消費者反応へ。 消費者はアーキテクチャではなくレンダリングを見ます: どの独立したシステムが相談されたか、どこで相違が生じたか、相違がどのように解決または段階的に対応されたかを示す領収書(図8)。3つの媒介知覚は効果を妥当に伝える可能性があります。証拠は診断的です: 表面化した具体的な不一致は、一般的な免責事項ではない方法でこの回答について有益です(Detjen et al., 2025; Chen et al., 2026)。再実行可能な記録は、消費者が後から確認、異議唱え、またはエスカレートできるため、知覚されるプロセス制御を与えます。手続き保証は、盲目的な収集、独立したチェック、利害関係のない仲裁人が存在していたという知識です(McKnight et al., 2002)。自然な従属変数は、信頼度のキャリブレーション、委任の意思、失敗後の保持です。自然な調整変数は利害関係と可逆性、タスク客観性(Castelo et al., 2019)、および消費者専門知識です。個人的に回答を確認できる最も少ない消費者は、構造的にそれをチェックするアーキテクチャから獲得する最も多くを持っています。以下の提案はこのパスをトレースします。
フレームワークは、さらに、消費者研究がテストできる提案、発見ではなく仮説を生成します。それらを操作化することは1つの区別に依存します: 客観的な中立性(オーケストレーターは実際に開示されていない経済的依存から自由である)、検証可能な中立性(記録がその独立性を検査可能にする)、および知覚された中立性(消費者がそれを信じる)は3つの変数であり、実験は検証可能な信号を操作しながら知覚を測定します:
P1. 多モデル間の不一致を重要な質問で表面化させることで、消費者の信頼校正が改善されます(システムが一致すれば信頼が増し、乖離すれば減ります)。これは単一の確実な回答と比較してのことで、知覚リスクが仲介構成要素として機能します(Featherman & Pavlou, 2003)。失敗の両方向が現実的です。結合提示は過度な信頼を減らしますが、過度な不信を増やす可能性があります(Lu, Wang, & Yin, 2024)。信頼度表示は精度よりも信頼校正を容易にします(Zhang, Liao, & Bellamy, 2020)。説明は精査を高めずに信頼を高める可能性があります(Bansal et al., 2021)。認知的強制機能は満足度を損なう代償で過度な信頼を削減します(Buçinca, Malaya, & Gajos, 2021)。また、106の実験のメタ分析では、人間とAIの組み合わせは平均して、人間またはAI単独のより優れた方よりも悪いパフォーマンスを示しています(Vaccaro, Almaatouq, & Malone, 2024)。P1は単調な利益ではなく、校正を検証します。表面化された不一致は、その最良メンバーを上回る組み合わせ設計の少数派に落ち着かなければなりません。命題は分割されます。主効果は確認的主張であり、モデレータは事後的に列挙されるのではなく、証拠の診断性から導き出された探索的なものです。校正利益は利害関係と不可逆性の増加に伴い増加すべきであり、また課題の客観性とともに増加します(客観的な質問での乖離はエラー信号として読まれ、主観的なものではそれは好みとして読まれます;Castelo et al., 2019)。消費者の専門知識は反対の符号を生じると予測されます。低専門知識消費者の場合、解決なく表面化された乖離は委譲への意思を減少させるべきであり、高専門知識消費者の場合、信頼校正を改善させるべきです。交差点が観察されるか否かかは、専門知識が逃げ道ではなく検証になることです。本論文自体の実験は1つの設計要件を課します。不一致は課題難度と共変します(パネルの一致は簡単な項目に集中します)。したがって、P1設計は難度を操作または統計的に制御しなければなりません。そうでなければ校正効果は項目の容易さと混同されます。診断性アカウントはジェネリック透明性理論が行わない境界予測も生み出します。乖離開示は消費者自身の事前分布が最も弱い場合、すなわち国境を越えた購入または見慣れない販売者の購入の場合に最も重要であるべきです。外部の診断証拠が内部の競争相手を持たないからです。
P2. 再生可能な意思決定記録へのアクセスは、ブランド信頼を超えて、AI エージェントへの重要なタスク委譲への意思を増加させます。効果は委譲タスクの利害関係と不可逆性の増加に伴い増加します。実際のモデルパフォーマンスを一定に保つことで、検証可能なアーキテクチャ特性の適切な委譲への限界効果は、消費者がより多くのレビューと実行制御を放棄するにつれて増加します(アドバイザー→コパイロット→監督エージェント→自律エージェント)。委譲レベルをアーキテクチャ可視性と交差させた設計は、仮説を直接検証します。このような従属変数に最も近い消費者研究証拠はここにあります。AIへの購入委譲は知覚される自律性を制限する場合に採用を減らします(Ahmad Husairi & Rossi, 2024)。高自律性アシスタントの受け入れは直接研究された結果です(Frank et al., 2026)。P2はこれらの確立された先行要因を超えて、記録の効果を予測します。
P3. オーケストレーションレイヤーの知覚中立性は、委譲意思を独立して予測し、サービス評価における手続的正義効果と一致しています(Tax, Brown, & Chandrashekaran, 1998)。操作変数は検証可能な中立性信号であり、測定変数はそれが生成する知覚です。私の知識では、オーケストレータ中立性が行動実験で操作化されたことはなく、認証シールが最も近いテスト済みのアナロジーです(Cetinkaya & Krämer, 2024)。したがってP3は新しい実験変数を導入します。 directionally、中立性効果は消費者自身が物質をチェックする能力が低下するにつれて強化されるべきです。結果品質の判断が難しい場合、プロセス手がかりが評価的重みを運びます。操作は検証可能な中立性をセグメント化する必要があります中立性主張から。1つの条件は、実際に開いてチェックできる無リスク証明のレシートを持ち、対照条件は同一のインターフェースですが、ラベルのみを持ち、両方の条件で知覚中立性の操作チェックがあります。その対照なしではP3はジェネリックなプロセス公正に崩壊し、検証について何も言いません。
P4. エージェントエラーの後、検査可能な記録を生成するサービスを使用する消費者は、不透明なサービスの消費者よりも信頼の崩壊が少なく、保持が高くなります。1回ストライク動態は証拠によって調整されます。これはサービス回復研究が特定するメカニズムであり、手続的に公正で証拠ベースの苦情処理は失敗後の信頼を回復します(Tax et al., 1998)。信頼修復研究は、信頼を回復するものは違反の性質と提示されたアカウントに依存することを追加します(Kim, Ferrin, Cooper, & Dirks, 2004)。これは人間マシン研究が現在、自律システムの設計問題として扱うものです(de Visser, Pak, & Shaw, 2018)。バッファリングは失敗の深刻度と不可逆性とともに増加すべきです。P4は予測します。記録→より小さい信頼崩壊とより高い保持は、失敗の深刻度によって調整されます。記録がプロセス自体が従われなかったことを示す場合は、操作チェックで処理され、テストから除外されます。命題はにもかかわらず従われたプロセスの失敗に関するものであるからです。耐久性比較は切り替えコストとロックインをコントロールする必要があり、これは保持を混同させます。また、コンパニオン設計は、従われたプロセス記録が非難帰属をサービスから環境にシフトさせるかどうかを検証します。命題には逆転句がないため、構成上、結果パターンは反証できません。
実験的錨:テスト済みコンポーネントとしての信頼度レイヤー。 サービスが信頼度信号が何かを意味することを主張する場合、その主張は試験台に置くことができます。本論文のケーススタディの背後にある展開の信頼度レイヤーは、事前登録されたプラセボ対照の6腕評価を2つの独立したモデルファミリーにわたって実施しました。システム自身の弱点の測定されたプロフィールはそのエラー予測を改善し、プラセボよりもほぼ+0.07のAUROCゲインであり、両方のファミリーで重複していない信頼区間があります。偽の自己プロフィールはエラー予測をコイン投げに崩壊させ、ジェネリックな「あなたの限界に注意してください」という指示は何もしませんでした。
2つの初期バージョンが失敗した。1つは交絡因子をめぐって著者ら自身によって改ざんされ、もう1つは陰性だった。事前登録設計がこれを確認する前のことである。より厳密な再検査は縮小されたスコープで非決定的であり、事前登録された4段階のはしごが先端家族で確認終点を通過せず、効果の方向性は4段のうち3段でのみ探索的に存続した。したがって主張は家族ごと限定的である。測定された自己知識は確認された場合にエラー予測を改善し、それはすべてのモデルクラスの確立された特性ではない。弱点プロフィールは本番でも実行され、ライブモデルルーティングを調整し、限定的でフェイルオープンである。偽プロフィール崩壊は二重に機能する—セキュリティ上の発見である。捏造された自己モデルは攻撃ベクトルであり、自己知識がモデル自己報告ではなくアーキテクチャ的管理を必要とする別の理由である。設計論理は技術より古い消費者研究の出自をもつ。事前約束は内的決意は保持されないと予想されるため外的構造を通じて将来の行動を拘束することであり、消費者が自分たちの悪癖を合理化する方法そのものである(Wertenbroch, 1998)。アーキテクチャ的信頼は同じ戦略を機械に拡張する。
完全な経緯(プロトコル、事前登録、生データ、改ざんされたパイロット、陰性の反復、確認されない拡張)は単独のアーカイブとして保存され、公開されており論文のOSF資料にhttps://osf.io/jtvu9/(ファイル`self-calibration-archive.zip`)で利用可能である。較正された信頼度はアーキテクチャコンポーネントであり測定可能な内容を持ち、失敗することができる。失敗は成功とともにアーカイブされている。信頼層であり信頼度主張が実験的に異議を唱えられたことがない場合、それはそれが置き換えることになっていた盲目的信頼を正確に求めている。30著者の立場論文はこの労働分業に正式な声明を与えている。エージェント的オーケストレーションはベイズ一貫性であるべきであり(Papamarkou et al., 2026)、較正された信念はモデルではなく制御層に属する。
メカニズムをテストする:事前登録実験。上記の主張は検証可能であり、本節はテストを報告する。本節の両波における実験結果はすべて、フレームワークの技術的先行条件を扱っており、独立した合意がモデルの自己報告にはない正確性シグナルを持つかどうかは、事実問題についてである。これらの実験は消費者信頼、委譲、または商業行動を実証していない。それらはP1–P5および第6節の行動研究の対象のままである。プロトコルは確認データが存在する前に公開で凍結された(OSF: https://osf.io/4y9dv、2026年7月23日登録;仮説H1–H6、ベンチマーク部分標本をシード及びSHA-256ハッシュにより固定、仮説に不利な結果は事前宣言された)。設計は意図的に単純である。16個のモデル、9つの先端ベンダー(Anthropic、OpenAI、Google、xAI、DeepSeek、Alibaba、Moonshot、Zhipu、Mistral)および7つのローカルオープンウェイトモデルが、同じ1,500個のSimpleQA質問に1回ずつ盲検で応答した。検索やツールなし。それは相関パラメトリックエラーへの露出を最大化する体制であり、シグナルに対して意図的に困難なケースであり、表示される制限でエコロジー的コストを有する。回答は温度ゼロで与えられ、0–100信頼度を述べた。言語化された不確実性、ロジットから読み取るのではなく同じ応答内で単語で引き出された形式、Lin、Hilton、Evans(2022)がモデルが較正できることを学べることを示した形式。パネルはその単一収集の24,000の公称回答スロット、うち22,598が配信された、1つのローカルモデル(deepseek-r1:8b)が事前約束した停止規則の下で98項目で停止した。6つの登録仮説は結果に次のようにマップされる。H1、モデル間の分岐が信頼度の高いエラーの大部分をフラグする。登録波で支持される。合意が正確性を1.9–3.2×上げる(表6)、そして主流波でフローズンゲートは信頼度の高い失敗の82.1%を削除する(表10)。H2、パネルシグナルが回答モデル自身の信頼度を上回る。CN-先端とクロスブロックパネルで保持される(ΔAUROC +0.287 and +0.063)そしてUS-先端パネルで反転する。H3、信頼度の高いエラーの非自明なシェアが1つの誤った回答に対する全会一致の合意として存続する。支持される。0.5–2.2%のオープン形式質問および4.0–7.9%多択腕で。H4(a)、ブロック内エラー相関がクロスブロックを超える。支持されない(φ差分 +0.011, 95% CI −0.005 to +0.028)、そしてH4(b)、クロスブロックパネルがより多く捕捉する。支持されない、クロスブロックの先導がより小さいもの。H5、$0ローカルパネルが先端の信頼度の高いエラーの大部分をフラグする。支持されない。ローカルティアの合意シグナルはチャンスに位置する。H6、系統発生距離はしご、ここでははしごとしてテストされない。そのブロックレベルステップはH4(a)ヌル。
事実検証はエージェント的商取引に関連するプロキシである。委譲された購入は実行の時点で事実的サブクレームに分解するためである。品目の現在の価格および可用性、返品ポリシーの条件、製品の仕様が消費者の述べられた要件と一致しているか、売者の身元および格付け。これらはすべてSimpleQA項目が持つのと同じ種類の検証可能な基盤事実を持つ。異議ゲートはその事実的基盤上で動作し、一方、好みの重み付け(どのトレードオフが重要で、どの程度か)は消費者に残り、消費者は事実がチェックされた要件を作成した。この労働分業はセクション6の設計が参加者の好みではなく検証の表示を操作する理由でもある。アーキテクチャの主張は委譲された決定の事実層に関係し、その味の層ではない。判断がまったく事実的基盤がない場合、検証する基盤事実がない純粋に主観的な選択では、先行条件は影響を与えるのを停止し、制限はその境界を未解決の質問として述べている。
ベンチマークの選択が測定された。2021年版のTruthfulQA(事前学習コーパスに含まれている)では、同じベンダーがSimpleQAよりも47~61ポイント高いスコアを記録した(例えば89%対28%)。このギャップはベンチマーク年齢と露出効果と一致しているが、この設計は汚染とベンチマーク難度・構成の差を区別することができない。したがって、見出し数値は古いベンチマークに依存していない。採点は客観的な文字列マッチングであり、未解決のケースはローカルオープンウェイトモデル(Qwen3-8B、ローカルで実行;同等性判定プロンプトは複製パッケージに含まれている;パネルメンバーの家族による判定は一切ない;SimpleQAが判定者の学習コーパスに含まれているかどうかは不明だが、判定者は真実ではなく2つの供給文字列間の同等性を判定し、これが露出を制限する)とスポットチェック対象の50項目の人間による評価(98%の一致)によってのみ同等性について判定されている。これはスケールの限界である。現在、層別化された300項目のクロスファミリー監査によって拡張されている(異なるモデルファミリーを監査者として、シード固定サンプル):96%の一致(288/300)、12件の不一致すべてが寛容な偽陽性(9件が明らか、3件がボーダーライン)、すべての採点回答のおよそ3%(判定者が解決したシェアの4%)に触れる一方向のバイアスである。判定の3分の2(66.5%)はローカルモデルグレーダーから得られ、正確な文字列マッチではなく、見出しはグレーダーエラーに対して堅牢である。モデルグレード判定のランダムな10%を反転させると、認証比率は最大±0.5倍だけシフトし、その方向は決して変わらない。
2つの設計上の選択は予算ではなく意図的なものである。ベンダーの中位層が使用された。第一に、生態学的妥当性のため。消費者の代わりに取引を行っているエージェントは圧倒的にこれらのコスト最適化された層で実行されており、公開価格表から確認可能である(2026年中盤;図11)。典型的なサービス交換は予算層で数分の一セント~約1セント、旗艦モデルでは5~10セント程度かかり、数百万のセッションに回答するサービスはその既定経路を旗艦レートで価格設定しない。ロスターは市場を反映している。9ベンダーのパネルには、エンタープライズLLM APIの支出の88%を占める3つのサプライヤーすべてが含まれ、表6のUS最先端パネルはその3社そのものである。これはエンタープライズ証拠であり、消費者はそれに含まれていないという異議は、サプライチェーンを逆転させている。消費者はもはやモデルをまったく選択しない。銀行、小売業者、航空会社を選択し、サービスのルーティングポリシーがモデルを選択する。消費者が実際に提供されている通貨、ドルではなくトークンで計算すると、その画像は選択を確認している(図12)。OpenRouter–a16zのトラフィックルーティングの100兆トークンの研究では、オープンウェイトモデルはおよそ3分の1すべての使用に到達し、3つの最大消費者AI製品の既定層はすべて旗艦層より下であり、消費者AI利用者の約3%だけがプレミアムサービスに支払う(Menlo Ventures, 2025c)。したがって、限界消費者はほぼゼロの限界費用で提供される必要がある。API市場の下にはオンデバイスとセルフホストされたオープンウェイトの床があり、支出ベースの調査には見えず、実験のローカル層は意図的に7つのオープンウェイトモデルでそれをサンプリングしている。市場を計算できるあらゆる通貨において、この研究がサンプリングした層が消費者に提供する層である。(初期企業の障害後、コレクションの一部は集約業者を通じて完了され、実際に提供するインフラストラクチャはランマニフェストで呼び出しごとに記録された。)
図11。 消費者がチェックアウトで会う層
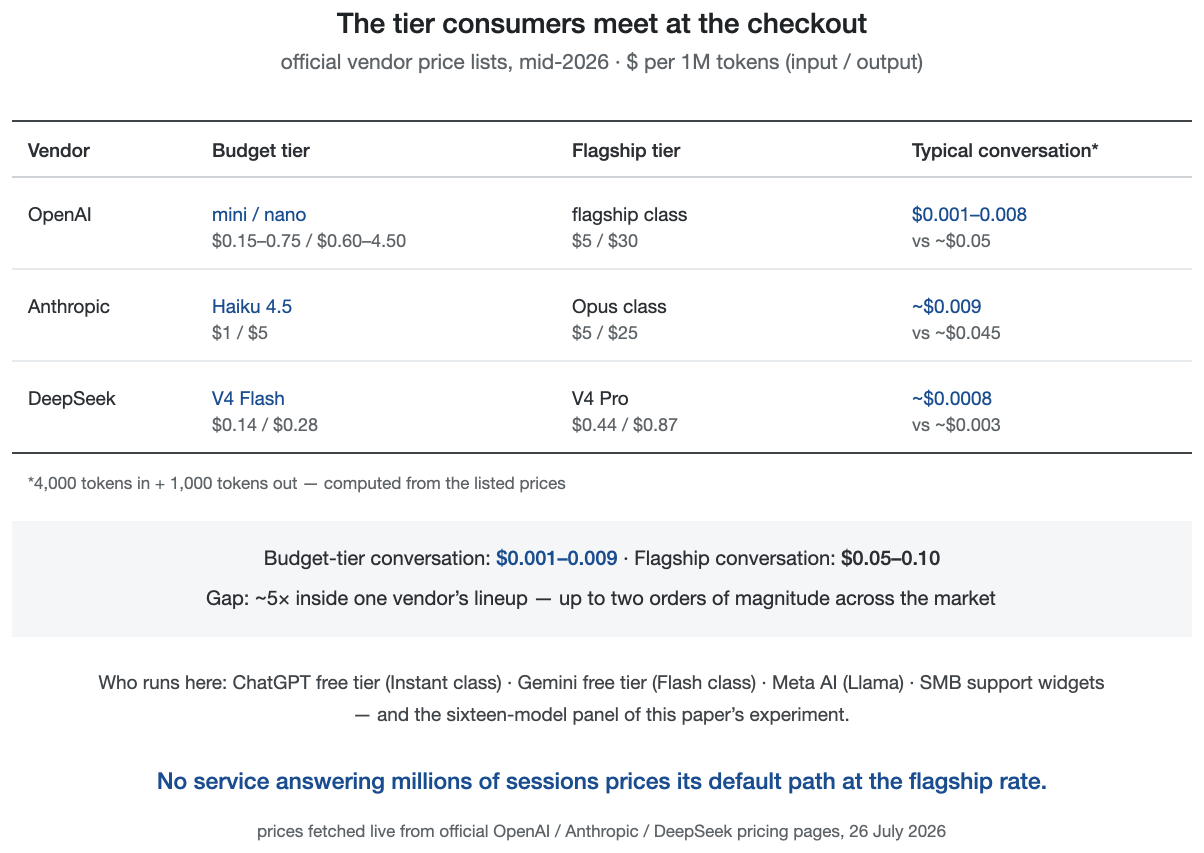
公式ベンダー価格表、2026年中盤。
図12。 モデル市場の2つの通貨
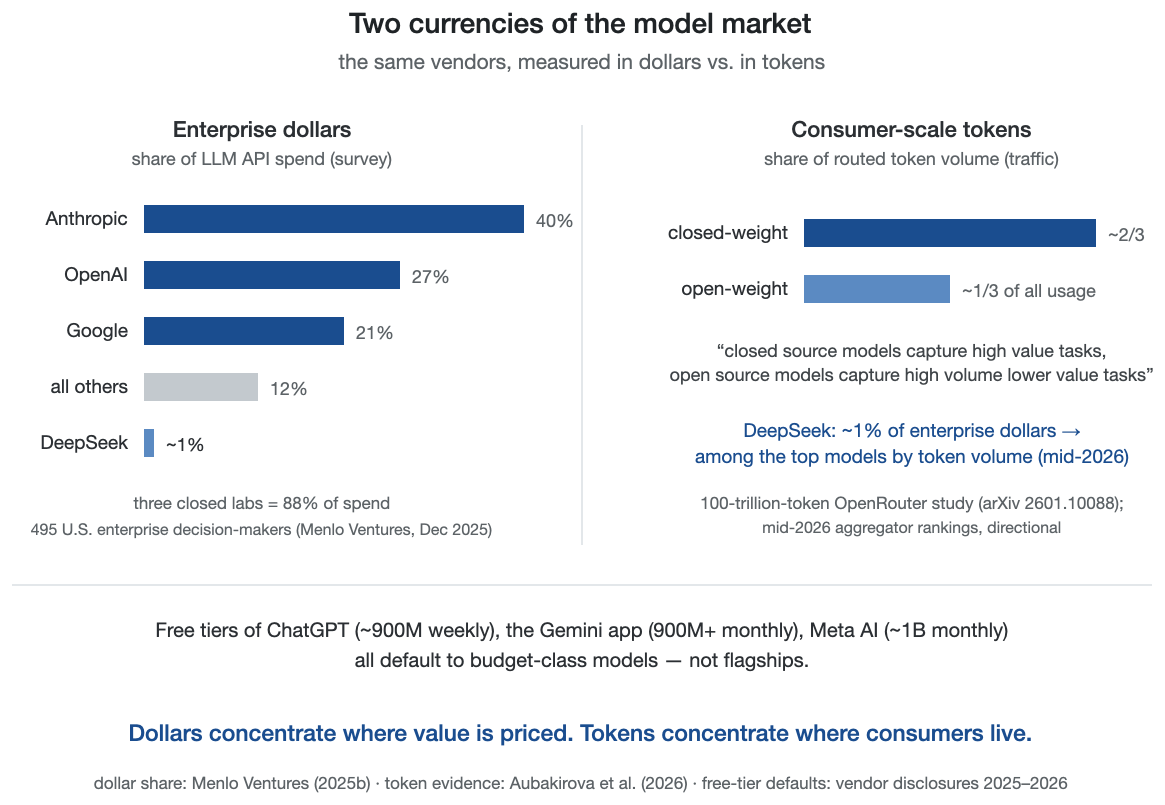
エンタープライズドル対消費者規模トークン。
中位層はまた、論文の主張に適していた。これは旗艦能力ではなく、アーキテクチャに関するものである。プレミアムウェイトでのみ現れた効果は、モデル結果となるだろう。パイプラインは商用インフラストラクチャで15ドル以下のAPI支出で複製される。検証がすべての重大な回答で実行できるほど安い必要があるという主張をしている論文のために、論文自体を検証するコストは証拠の一部である。パイプラインはスタンドアロンな複製パッケージ(ランナー、グレーダー、分析スクリプト、生グレード化データ、ランマニフェスト)であり、著者の研究システムの何も必要としない。コレクションは24,000の回答を合計し、ベンチマーク汚染と適合性アームを含めると約30,000である。可用性について、公開事前登録(osf.io/4y9dv)はシード固定1,500項目サブサンプルをアーカイブしている。完全なパッケージはhttps://osf.io/jtvu9/で公開されており、登録のソースプロジェクト(フォルダ`replication-package-v2`)のパブリックコンポーネントである。
3つの結果がセクションを占める。第一に、原材料は豊富である。中央値の述べられた信頼度は、9つの最先端ベンダーのうち7つで85~95に達し、2つの例外(中央値42と60)は正確に信頼度が識別するベンダーであり、実際の精度は10%~66%の範囲であり、1,500の質問で最先端ベンダーあたり289~1,212の自信のあるエラー(信頼度≥75で間違い)を生じている。正確性信号として、モデル自身の信頼度はベンダーに応じてAUROC 0.53~0.79でスコアを付け、消費者は外部から、どのベンダーを取得したかを知る方法がない。そのベンダー間隔は、消費者が実際に提供されている層で、大規模モデルは制御されたフォーマットでの自己評価でしばしばよく較正されているという最先端ラボの調査結果(Kadavath et al., 2022)を適格とする。一部のデプロイされたベンダーはその自己知識を提供し、他のベンダーは自信のあるノイズを提供し、表面的にはそれらを区別するものは何もない。
第二に、見出し:検証は警報ではなく認証として機能します。確率的な意味での認証であり、パネルに応じて大体49~77%の事後確率であり、保証ではありません。 このように難しい問題では、単純なシグナル「パネリストの誰かが異議を唱える」は飽和します。確信を持った誤答の85~94%で反応しますが、確信を持った正答の91~95%でも反応します(登録はこの再解釈を予想しており、事前指定されたAUROC終点に移行しました)。情報量のある方向は逆です。正答は独立して複製され、誤答は散乱します。少なくとも一人の独立したパネリストが複製した回答は、ブロック内パネルで72~77%の確率で正しく、ブロック間パネルで49%でした。複製なしでは18~37%です。独立した合意がある回答は、正しい確率がおおよそ2~3倍高かった(表6の3つのパネル全体で1.9~3.2×)。 (ここおよび全体を通して、「独立」は盲検で別々に作成され、残差誤差相関が仮定されるのではなく測定され、正確性は常にベンチマークのゴールドラベルに対してスコアリングされ、別のモデルの意見によってではないことを意味します。)推定値は因果ではなく関連的です。複製は正しい可能性が高い回答をマークし、それがマークするもの一部は問題が簡単だったこと、下記で定量化される選別効果です。正確性シグナルとして、パネル合意は、メンバー自身の確信がシグナルを最も少なく伝えたパネルでAUROC 0.832に達しました(ベンダー別0.53~0.62; プール済み0.545)。成立する主張は機能的ではなく分布的です。全84の3ベンダーパネル全体で、合意AUROCの中央値は0.79であり、プール済み自己報告を89%で上回ります。合意はブロック間パネルで0.722に達し、プール済み自信度は0.659でした(ベンダー間で標準化されていない言語スケールをプーリングすると自己報告が歪みます。ベンダーは0~100スケールを異なるように使用し、アーティファクトの方向はパネル依存的であるため、ベンダー別の値が並べて印刷されている理由です)。このリードのブロック間インスタンスはコーディング依存的です(代替の事前凍結合意コーディングは、ブロック間パネルの合意シグナルを0.544~0.722に置きます。寛容な未解決-合意として変形は、そのパネルのプール済み自信度0.659以下に低下しますが、CNパネルのシグナルは同じコーディング全体で0.719~0.894に及び、常に0.545を超えます)。したがってコーディングロバストなパネル対自信の結果はブロック内CNケースです。自己報告がパネルシグナルを明らかに上回った唯一のパネル(0.842 対 0.697)は、研究の最高弁別ベンダーを含むパネル(Anthropicの中堂、フル1,500項目コレクションでの自信度AUROC 0.788)で、ランク付けの高いベンダーの単独シグナルが独自のパネルの合意シグナルを上回りました。表7はパネル単位の値を印刷しており、各パネルの項目母集団内で計算されています。ペアクラスターブートストラップ(質問は置換でリサンプリング、質問当たりすべての3つの(項目、一次)ユニットが一緒に移動; B = 2,000)は表6/7の対比に信頼区間を付与します。CNフロンティアパネルでは、パネル合意がプール済み自信度をΔAUROC = +0.287で上回ります(95% CI [+0.265; +0.308]、p < .001)。ブロック間パネルではリードはより小さいですが信頼できます。+0.063([+0.037; +0.087]、p < .001)。USフロンティアパネルでは方向が逆転し、その逆転は統計的に明白です。自信度0.842対パネル合意0.697。パネル構成は上手に合意シグナルの値の一次調整変数であり、展開ルールは以下の通りです。パネルメンバーの独自キャリブレーションを測定してから合意をそれより信頼してください。ΔAUROC = −0.145([−0.170; −0.120]、p < .001)。3つすべての対比は有意であり、パネル間の異質性は雑音ではなく発見です。したがってUSケースは確認された逆転として報告され、null zone ではなく、構造を制限します。市場の弁別端から引き出されたパネルでは、独自の確信度は合意より強いランキングシグナルとして機能し、多様性コンポーネントの弁別値はパネル構成に依存し、普遍的に保持されません。アーキテクチャは、露出したモデル確信度が弱く弁別する場合に外部正確性シグナルを提供でき、それが行われた場所でキャリブレーション主張を監査します。一つの境界は残ります。完全にキャリブレーションされたモデルでさえ、独自の歴史を公証することも独自の利益相反を仲裁することもできないため、ベンダー弁別が改善するにつれ、多様性の役割は正確性発見からキャリブレーション監査へシフトし、証拠と中立はキャリブレーションができないことをします。
アーキテクチャ検証は、ベンダーが使用可能な信頼シグナルを出荷できなかった場所で外部正確性シグナルを供給し、どのベンダーがそれを出荷したかを識別するにはアーキテクチャが必要です。置換主張は、正確にスコープされ、AUROCではなくキャリブレーションメトリクスに基づいています。7月の波のベンダーは同時に弁別的で十分キャリブレーションされていません。xAIが最も近いです(表7a)、フラッグシップ波は解離のキャリブレーション側を複製するため、最高ランク付けされた確信を受け取ることが起こった消費者でさえ、外部参照なしにその水準を確率として現金化することはできません。それはアーキテクチャレイヤーが供給するものです。ベンダーが最終的に至る所で良好なキャリブレーションを出荷した場合、証拠と中立は変わりません。議論は、モデルが改善する世界で生き残ります。
第三に、障害モードには形があります。 認定されたコンセンサスエラー、すべてのパネリストが同じ誤答に確信を持って収束すると、開形式の質問で0.5~2.2%発生しましたが、ローカルティアで複数選択形式で項目を再提起した付属アームで4.0~7.9%でした(項目構造と出力は複製パッケージにあります)。コンセンサスはチーフに誤答を認証するが、回答スペースが制限されている場所で、エージェントにオプションメニューを提供する任意のインターフェースの設計警告。
無効値は有効値と同じくらい指導的であり、事前登録したものとして公開する。地政学的ブロック(同一ブロックのパネルが訓練コーパスと蒸留系統を共有する可能性を含む)は、このベンチマークのエラー相関を予測しない(ブロック内対ブロック間φ差 +0.011(フロンティア層)、95% CI −0.005~+0.028;ローカル層ではわずかに逆転)。相関を駆動するのはキャパビリティであり、フラグではなく、Kim et al. (2025)と一致する。系統はキャッチレートを予測しない:ローカルモデルが自身のフロンティアの兄弟を検証する場合、他の者のように機能し、推論蒸留されたモデルは自身の基本重みとの最も低いエラー相関を示した(φ = 0.135)。どちらも実証された等価性ではなく、制限された無効値である。ブロック区間はφ差を+0.028より大きく除外し、その限界が、帰無仮説の棄却の失敗ではなく、推論的な仕事を行う。レプリケーションデータが支持する自然な連続拡張は、パネルアイデンティティではなく、測定されたパネル多様性の関数(サプライズスコアφ)として認証リフトを推定することである。そうすることで、モデルパネルに対して、分類器アンサンブル文献が独自の多様性統計に対して実行したプログラム(アンサンブルゲインを単一の指標がきれいに予測していないことを発見した)を再実行することになる(Kuncheva & Whitaker, 2003)。
また、安価なローカルモデルはオープン形式の質問に対するフロンティアの回答を認証することができなかった(合意の有無にかかわらず46%の精度):検証者がタスク種に関して能力を持っていなければ、その独立性は価値がない。境界条件は以下のとおりである:コンセンサスは回答空間が制限されている場合のエラーを認証し、独立性は想定されるのではなく測定される必要があり、検証者のコンピテンシーが認証価値のゲートとなる。実際には、多様性は、ブランド、ブロック、ファミリーツリーから想定されるのではなく、質問ごとに測定される特性である。表6はパネルメトリクスをまとめている。図13は認証リフトとシグナル比較を並べて示している。
図13。精度の幻想とその建築的治療
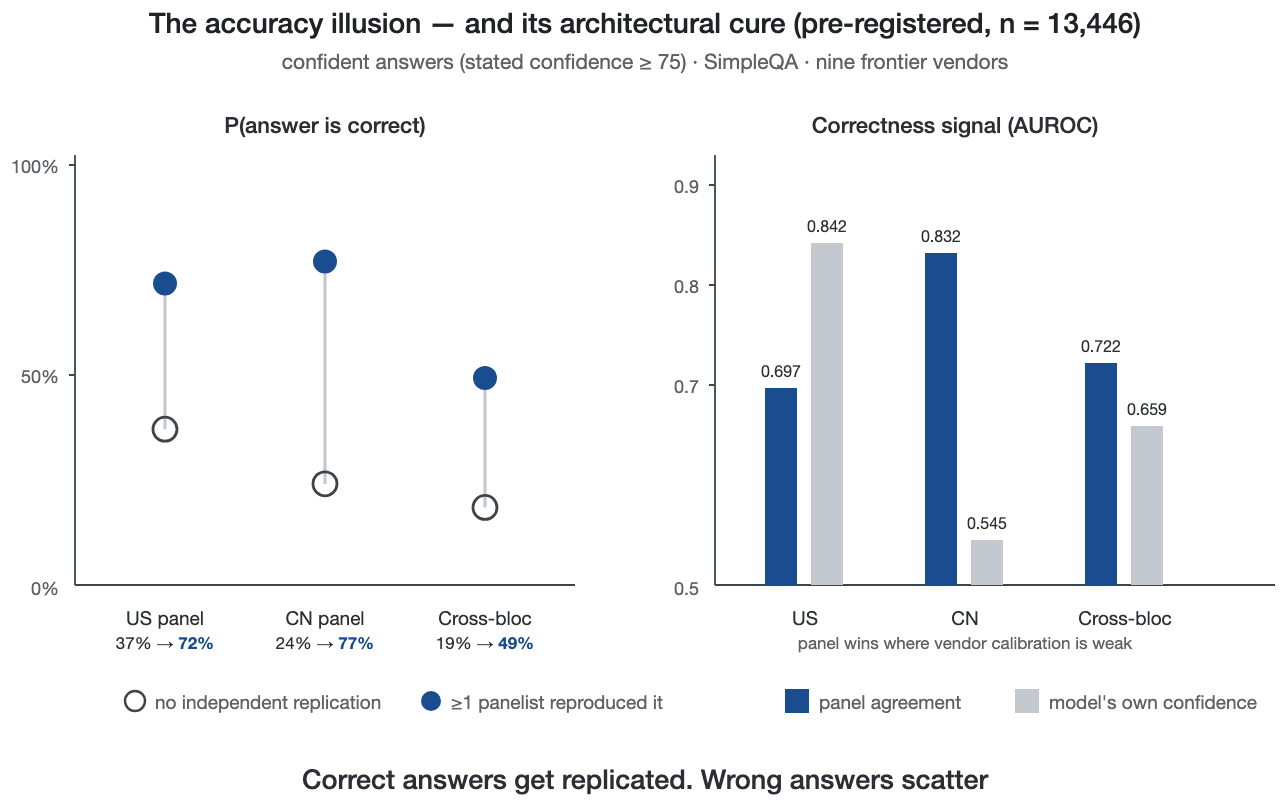
独立した複製による認証(事前登録;n = 13,446の採点された回答—9つのフロンティアベンダー、各々が同じ1,500のSimpleQA質問に1回答え、失敗またはスコア不可能な54件の呼び出しを除く)。
並行作業は警告を強化する:大規模監査は高い自己一貫性が推論ベンチマークの誤った回答と共存することを発見し、独立性と盲検収集がなければ、合意のみは弱く体制依存的な信号である(Ding, 2026)。したがって、独立した、盲検複製を認証の単位として扱う。
表6。確信エラーの遮断とパネルによる認証(SimpleQA、確認的;conf ≥ 75)
| パネル | 確信エラー(n) | エラーに対するフラグレート [95% CI] | 正解に対する誤警報 | P(正解 | ≥1 同意) | P(正解 | なし) | AUROC:合意対自身の信頼度 |
| US-frontier (Anthropic·OpenAI·Google) | 1,630 | 94.3% [93.1–95.3] | 91.0% | 71.8% | 37.1% | 0.697 vs 0.842 |
| CN-frontier (DeepSeek·Alibaba·Moonshot) | 2,128 | 85.5% [83.9–86.9] | 94.8% | 77.0% | 24.1% | 0.832 vs 0.545 |
| Cross-bloc (Anthropic·DeepSeek·Mistral) | 2,432 | 89.4% [88.1–90.6] | 93.4% | 49.3% | 18.5% | 0.722 vs 0.659 |
フラグ = ≥1のパネリストの独立した回答がプライマリと非同等(拒否およびゼロオーバーラップ回答は非一致と数える;より厳密なコード化はレプリケーションパッケージに含まれる)。60/90でのしきい値感度は結論を変えない。自身の信頼度AUROCはパネルの完全な回答母集団にわたってプールされた状態の信頼度である;プーリングはベンダー間の精度と信頼度スケールの違いを吸収するため、すべてのメンバーの個別値を超える可能性がある(表7の標本値)。回答は質問でクラスター化される;質問レベルのクラスターブートストラップは区間を約1.6倍拡大しますが、結論は変わらない。このテーブルと表7のすべてのAUROCは、レプリケーションパッケージスクリプトcompute_panel_vs_own_auroc.py(Mann–Whitneyとタイ補正付き)から決定的に再現される。
表7。パネル別の自身の信頼度AUROC:プールされたパネル母集団と標本別(表6と同じ母集団)
| パネル | プールされた自身の信頼度AUROC | 標本別自身の信頼度AUROC |
| US-frontier | 0.842 | Anthropic 0.784 · OpenAI 0.596 · Google 0.746 |
| CN-frontier | 0.545 | DeepSeek 0.569 · Alibaba 0.532 · Moonshot 0.620 |
| Cross-bloc | 0.659 | Anthropic 0.787 · DeepSeek 0.570 · Mistral 0.584 |
レプリケーションパッケージの決定論的パイプラインによって計算されています。2つの母集団規約が共存し、見かけの矛盾を避けるため明示的に印刷されています。表のベンダーごとの値は各パネルの項目母集団内で計算されている一方、テキスト内の単一数値の引用は全体コレクション値を使用しています。US-frontierパネル内の最良判別ベンダーについては0.784対0.788(全1,500項目コレクション)、OpenAIについては0.596対0.598です(両方のペアは同じパイプラインの1つのコマンドから再現されます)。これに対し、プールド列はベンダー基本率を混同しています。ベンダー間の正確性と信頼度スケールの違いが機能の一部を担っているため、プール値がベンダーごとの範囲内に収まる必要はありません(ライブ再計算:US-frontierプール0.842は各メンバーの個別値を上回り、CN-frontierプール0.545はそのパネルのベンダーごとのマクロ平均0.574を下回ります)。ベンダーごとの値が解釈可能な量です。ベンダーごとのばらつきは消費者の問題を数値で述べたものです。1つのベンダーでは使用可能な判別が存在し、他のベンダーではほぼチャンス程度です。答えの外側には、どのベンダーがそれを生成したかを示すものは何もありません。セクション3のベンダー範囲の背後にある参考値は、同じ評価済みコレクションからモデルごとに印刷されています(中央値 記載信頼度・正確性・全体コレクション独自信頼度AUROC)。frontier — Alibaba 95 · 47.4% · 0.532; Anthropic 42 · 10.3% · 0.788; DeepSeek 90 · 35.7% · 0.570; Google 95 · 66.5% · 0.746; Mistral 90 · 16.5% · 0.584; Moonshot 85 · 51.6% · 0.619; OpenAI 85 · 16.7% · 0.598; xAI 60 · 37.9% · 0.777; Zhipu 95 · 28.4% · 0.611 — 85~95バンド以下の2つの中央値は、信頼度が有用な信号を持つ2つのベンダーに属します。local tier(難易度層別化とlocal tier nullsのみに入ります)— gemma4:e4b 90 · 5.2% · 0.541; glm4:9b 85 · 5.0% · 0.589; llama3.2:3b 100 · 5.3% · 0.494; mistral:7b 95 · 6.3% · 0.506; phi4-mini 95 · 5.5% · 0.505; qwen3:8b 95 · 5.9% · 0.504; deepseek-r1:8b 90 · 9.2% · 0.696 (n = 98、事前約束された停止ルール)。
AUROCは判別を測定します。ベンダーが記載した信頼度が正答を誤答よりも上位にランクしているかどうかです。一方、ECE、ブライアスコア、信頼度-正確性ギャップは較正を測定します。記載された数値が確率として読むことができるかどうかです。このデータでは、この2つは顕著に乖離しています。研究の最良判別ベンダーである7月のAnthropicのミドルティア(独自信頼度AUROC 0.788)は、依然としてレベルで著しく較正が不正確です。平均記載信頼度41.3(中央値42)対10.3%の正確性。+31.0ポイントの過信ギャップ、ECE 0.311(15ビン)、信頼性項0.126に対して0.093の既約不確実性フロアを持つブライアスコア0.206です。逆に、パネルの最悪の較正はほぼチャンス程度の判別と共起します(Mistral: ギャップ+74.2ポイント、ECE 0.742、AUROC 0.584)。xAIのみが判別と較正の両方に近づいています(ECE 0.111、AUROC 0.777)。それでも判別は均一に低い記載信頼度によって支援されており、他の8つの7月ベンダーでは2つの特性は顕著に乖離しています。同じ乖離はフラグシップティアで継続します。11のうち9つの8月フラグシップは+12.5~+71.4ポイントの過信ギャップを持ちます(ECE 0.125~0.714)。2つの例外(gpt-5.6-sol、ECE 0.031; claude-fable-5、ECE 0.043)は正確性スケールの反対側で較正を達成します。ランクが良好だが数値的に膨らんだ信頼度スコアを保持している消費者は、外部参考なしにそれを現金化することはできません。表7aは較正メトリクスを判別メトリクスの隣に印刷しています。
表7a. 判別対較正、7月波(全コレクション、解決済み; 15ビンのECE; ギャップ = 平均記載信頼度−正確性、パーセンテージポイント)
| ベンダー | n | AUROC(独自信頼度) | ECE | ブライアスコア | 信頼度−正確性ギャップ | 平均信頼度→正確性 |
| Alibaba | 1,497 | 0.532 | 0.448 | 0.446 | +44.8 pp | 92.3 → 47.4% |
| Anthropic | 1,500 | 0.788 | 0.311 | 0.206 | +31.0 pp | 41.3 → 10.3% |
| DeepSeek | 1,500 | 0.570 | 0.536 | 0.513 | +53.4 pp | 89.1 → 35.7% |
| 1,461 | 0.746 | 0.263 | 0.271 | +26.3 pp | 92.8 → 66.5% | |
| Mistral | 1,495 | 0.584 | 0.742 | 0.686 | +74.2 pp | 90.6 → 16.5% |
| Moonshot | 1,500 | 0.619 | 0.242 | 0.292 | +24.2 pp | 75.8 → 51.6% |
| OpenAI | 1,500 | 0.598 | 0.610 | 0.531 | +60.9 pp | 77.6 → 16.7% |
| xAI | 1,500 | 0.777 | 0.111 | 0.197 | +11.1 pp | 48.9 → 37.9% |
| Zhipu | 1,493 | 0.611 | 0.642 | 0.612 | +64.2 pp | 92.6 → 28.4% |
| US-frontierパネル、プール化ユニット | 4,383 | 0.842 | 0.393 | 0.336 | +39.3 pp | — |
| CN-frontierパネル、プール化ユニット | 4,491 | 0.545 | 0.408 | 0.417 | +40.8 pp | — |
| ブロック間パネル、プール化ユニット | 4,485 | 0.659 | 0.529 | 0.469 | +52.9 pp | — |
全体コレクションAUROCおよび表6~7と同じ母集団(パネル行:プール化(項目、主要)ユニット)。凍結プロトコル下での誤りとして採点された拒否。ブライアスコアはマーフィー恒等式(信頼性−分解力+不確実性)により同じ15ビンで分解され、すべての行で残差<0.001です。1つのフラグシップティアノートが2つの較正済み例外と共に移動します。gpt-5.6-solのECE 0.031は95.4%の正確性で得られています。ここで、マーフィー不確実性項、基本率が設定するフロアは0.044です。較正は部分的に表9の汚染警告を持つ基本率によって購入されています(61.6%の逐語的金標準マッチ)。
1つの選択効果がテーブルを伴う必要があります。複製は部分的に質問の容易さのマーカーです。質問の難易度で層化する(他の15のモデル全体の平均精度)、生の認証リフトはより簡単な層(2.7–4.6×)で担われ、第2難しい五分位で1×未満に低下し、この集合内測度ではより難しい層で消えます。その層化は部分的に内生的であり、以下の外生的再推定は反転を単調減衰に柔らかくします。ロバストネス分析は選択懸念に直接対処します(探索的、事前登録ではない):質問をクラスター化したロジスティックモデルで一次モデル固定効果を使用して、一次モデル自身の信頼度と項目難易度(一次分除外平均精度、すべての16モデル全体)を制御して、同意する追加のパネリストはそれぞれ正確性の見積もりを約5倍にします(プール化されたb = +1.65(パネリスト当たり、95% CI [+1.49, +1.81]、p < 10⁻⁸⁸);すべてのパネルで正)、難易度プラス信頼度ベースラインに同意を追加すると保留されたAUROCを0.859から0.898に引き上げ、ブリアスコアを0.139から0.116に低下させます(質問で分割した2折クロスバリデーション)。同じモデルが境界を調査し、層化自体には注意が必要です。集合内難易度測度では条件付き係数は最難五分位で負になります(b = −0.41、p = .011)が、その測度はパネル自身のメンバーを含みます。条件付きモデルには展開上の注意があります。その難易度特性はラベルを必要とするため、診断的であり展開可能ではなく、展開可能なフィルターは同意ゲート自体です。3つのさらなるチェックが推定と選択懸念に対処し、すべて凍結された決定論的プロトコルコーディング下で(複製パッケージが判事による裁定のヘッドラインの数の横に報告するより厳しいブランチ)。項目をクラスター化したブートストラップ再サンプリングで認証リフトを再推定して、難易度構造が要求するクラスター化を残すと、すべてのパネルの認証リフト区間は1をはるかに上回ります(この決定論的コーディング下でのポイントリフト2.4–4.5、これは判事による裁定のペアコーディングの背後にある公開された1.9–3.2×ヘッドラインより少ない同意を認証します。ブートストラップ下限2.2–4.1)。上記で報告された84パネルの分布は、自己報告が勝つ米国フロンティアパネルを例外ではなく規則に作ります(中央値の利点+0.14、同意AUROCのIQR 0.76–0.82)。難易度層化AUROCは外生的難易度測度下で境界を明示します。最も簡単な五分位で0.87から最も難しい五分位で0.61に低下、反転なしの減衰。その測度はパネル除外で、各パネルの外側の13のモデル、そしてそれで再推定することが反転を解決します:条件付き同意係数は最も難しいものを含むすべての五分位で正のままです(最難五分位のb = +0.97、p < 10⁻⁷;最難層で独立して複製された答えの28%が正、0%ではない)。したがって、集合内反転は部分的に難易度測度の成果物です。どちらの測度下でも生き残るものは単調減衰で、同意が質問が最も難しい場所で最も弱く、認証されたコンセンサスエラーの現実です。スクリプトと出力は複製パッケージにあります。したがってヘッドラインの比率は不均一な集団を平均したものです。シグナルクレームはAUROCエンドポイントに基づいており、比率には基づいていません。
実験の仮説は私が運営する研究展開を操作化します。盲検収集はそのカウンシルメカニズムを反映し、パネル構成は研究が設計される前に本番構成として存在しました。これは本研究プログラムの2番目の事前登録研究です。3番目、セクション6の消費者実験は完了し報告され、4番目(本番トラフィック上のフィールドテレメトリ)は草案です。複製パッケージは誰でも実行できます、商用ハードウェアで、公開APIに対して。
フラッグシップティアでの2番目の波:11の実験室——10の完全なアーム、1つの部分的——1つのキャリブレーション堀。上記の実験は実際に消費者に提供するコスト最適化ティアをサンプリングしました。異議:精度の錯覚はバジェットティアの成果物かもしれず、フラッグシップ、各ベンダーが最善として提示するモデルは、それらの上の建築が冗長であるほど十分にキャリブレーションされているかもしれません。2番目の収集波(2026年8月)はその異議を市場の頂点でテストします。
私は米国、中国、ヨーロッパにまたがる10の主要なAI実験室からそれぞれ1つのフラッグシップモデルを評価します。実験室は、これら3地域の主要な商用およびオープンウェイト生態系を網羅するために選択されました。各実験室について、評価波の時点でその最も有能な一般に利用可能なモデルを選択しました。その後、2026年8月5日時点の公開リーダーボードに対してこのカバレッジを確認しました(LMArena Elo、Artificial Analysis Intelligence Index、Humanity's Last Exam、SWE-bench Verified)。10のフラッグシップのうち8は少なくとも1つの一般的な能力リーダーボードの上位層またはその近くに位置します。一方、2つ(Mistral、Baidu)は順位の根拠ではなく実験室および地域的カバレッジを保持するために含まれます(下記のカバレッジ制限を参照)。11番目の実験室、Meta、そのフラッグシップが波がスコープされた後にのみアクセス可能になり、波の途中で追加されました。その収集はアクセス失効によって中断され、部分的として報告されます(下記を参照)。
表8。 評価されたフラッグシップモデルとリーダーボード位置(2026年8月5日時点)
| 実験室 | フラッグシップモデル(API ID) | 国 | リーダーボード位置(2026年8月5日) |
| OpenAI | gpt-5.6-sol | USA | AA Index #3 (58.9); LiveBench #1 (82.4); Arena top-6 cluster |
| Anthropic | claude-fable-5 | USA | Arena #1 (~1525 Elo); AA Index #2 (59.9); SWE-bench Verified #1 (95.0) |
| gemini-3.1-pro-preview | USA | SWE-bench Verified #8 (80.6); HLE #17 (51.4); Arena上位クラスタ | |
| xAI | grok-4.5 | USA | AA Index #8 (53.8); Arena Elo 1499 |
| DeepSeek | deepseek-v4-pro | 中国 | SWE-bench Verified #8 (80.6, Pro-Max); HLE #23 (48.2) |
| Alibaba | qwen-max (Qwen 3.7 Max) | 中国 | Arena #21 (1488–1496 Elo); SWE-bench Verified #11 (80.4) |
| Moonshot AI | kimi-k3 | 中国 | AA Index #4 (57.1); HLE #9 (56.0); Arena #10 (1500) |
| Zhipu (Z.ai) | glm-5.2 | 中国 | AA Index #13 (51.1); HLE #11 (54.7) |
| Mistral | mistral-medium-3.5 | フランス | 一般的なリーダーボードでトップ50未満; 地域的カバレッジのため含める |
| Baidu | ernie-4.5-vl-424b | China | 一般的なトップ30外 (ERNIE 5.0: HLE #36); ERNIE 5.1: LMArena Search Arena #4 |
| Meta (中盤に追加、部分的) | muse-spark-1.1 | USA | HLE #4 |
括弧内のスコアは、スナップショット日時のアグリゲータが報告した値です; リーダーボードの順位はアグリゲータとスナップショット日時によって若干異なります。スナップショットソースはレプリケーションパッケージに付属する実行記録でアーカイブされています。
プロトコルは第1回の実験のもので、固定されて再利用されました: 同じ1,500項目のSimpleQAサブサンプル (シード値とハッシュで固定)、モデルごとに1回のブラインドパス、温度ゼロ、同じシステムプロンプトと回答パーサー、回答ごとに指定された0~100の信頼度です。採点は決定的です (正確および正規化された文字列マッチで金標準と比較; 拒否をエラーとしてスコアリング; 未解決項目は見出しから除外し、感度分析でエラーとして再スコアリング)。LLMジャッジは見出しの数字に触れません。これは意図的な厳密化です。第1波との相対的には、その採点者はハイブリッド型でした: 客観的文字列マッチとローカルなオープンウェイツジャッジが残りを解決 (66.5%の判定がモデル発行; 50項目のヒューマンスポットチェック、98%の一致)。本波は決定的な等価性エンジンのみを使用しており (手動で検証: フラグされた不一致20件のうち20件および一致15件のうち15件が手動で確認)、この波の見出し数字はすべてリリースされたスクリプトから正確に再現されます。波をまたいだ絶対精度の比較は採点者の体制をまたぐため、7月対8月のすべての比較は採点者体制の適格性を含みます。波内の監査は各波の数字をサポートしていますが、波をまたいだ差異はモデル変更と採点者変更を混在させます。ただし、単一採点者が両方の固定応答セットに再適用されない限りはそうではありません。これはここでは行われていません。1つの努力の逸脱: OpenAIのアームはインターフェースのデフォルト推論努力 (medium) で収集されました。7月のプロトコルは最小値を使用しており、推論時のウェブまたはツールアクセスはありません (モデルに公開されたツールを列挙することで検証され、そのうちツールはありませんでした)。これはそのベンダーの絶対精度をシフトさせますが、合意メカニズムではありません (セクション5)。確信を持った失敗は、指定された信頼度≥80で提供された間違った回答です; 閾値は実行前に固定されており、70と90が感度として報告されています。結合カバレッジは、11の研究室のうち10の研究室で1,500/1,500の問題です。Metaの収集はアクセスが取り消される前に272の有効な回答に達しました。
また、波をまたいだ懸念を直接テストしました。第2波の固定決定的エンジン (ローカルなオープンウェイツジャッジで66.5%の判定を仲介したハイブリッドパイプラインを置き換える) で7月の16モデル波を再採点すると、解決された判定の2.65%が変更されます (21,338のうち566件; エンジンはさらに4.1%で棄権)。見出しは動きません: 単一の決定的なコーディングの下で認定リフト読み取り値は再採点前に3.6×/4.6×/4.4×、再採点後に3.0~3.1×/4.5~4.6×/4.3×です。どちらもLLM仲介ペアコーディングから導出される保守的に発表された1.9~3.2×を上回ります。より多くの一致が認定されるほど、より保守的なリフトだからです。表6~7のすべてのAUROCは、CNおよび超域パネルで最大0.016、米国パネルで0.046シフトし、各パネルの一致対自己報告信頼度の順序を保持します。
フラッグシップラベルは何も保証しません。 同一の問題での解決された精度は、11個のフラッグシップ全体で11.4%から95.4%にまでなります (表9)。84ポイントの差が市場の最上部にあり、第1回の実験の中域の差の広がりより広いです。この層の精度の幻想は無傷で生き残ります: 10の完全な研究室アームをまとめると、指定された信頼度≥80で提供されたすべての解決された回答の46.6%が間違っていました (10,540のうち4,910件; 部分的なMetaアームを含むと、46.3%、または10,665のうち4,935件; 未解決項目はここから除外され、感度で誤りとして再スコアリングされ、プール化された画像は変わりません)。第1波の消費者向けの意味合いは価格では緩和されません: フラッグシップバッジは、消費者が目の前にある確信を持った回答が95%正確なフラッグシップから来たか、11%正確なものから来たかを消費者に伝えません。
表9. フラッグシップ波: カバレッジと精度 (SimpleQAサブサンプル、研究室ごとにn = 1,500、温度0)
| 研究室 (フラッグシップ) | カバレッジ | 精度 (解決) | 未解決 |
| OpenAI gpt-5.6-sol | 1,500/1,500 | 95.4% (1,403/1,471) | 29 |
| Google gemini-3.1-pro | 1,500/1,500 | 71.1% (837/1,178)¹ | 46 |
| Anthropic claude-fable-5 | 1,500/1,500 | 70.3% (1,019/1,450) | 50 |
| Meta muse-spark-1.1 (部分的) | 272/1,500 有効 | 61.4% (148/241)² | 10 |
| xAI grok-4.5 | 1,500/1,500 | 54.8% (794/1,448) | 52 |
| DeepSeek deepseek-v4-pro | 1,500/1,500 | 46.6% (666/1,428) | 72 |
| Moonshot kimi-k3 | 1,500/1,500 | 45.5% (645/1,418) | 82 |
| Zhipu glm-5.2 | 1,500/1,500 | 30.2% (430/1,425) | 69 |
| Baidu ernie-4.5-vl-424b | 1,500/1,500 | 28.9% (411/1,421) | 71 |
| Mistral mistral-medium-3.5 | 1,500/1,500 | 21.4% (306/1,429) | 71 |
| Alibaba qwen-max | 1,500/1,500 | 11.4% (164/1,435) | 65 |
¹ Googleのチャネルは18.4%のアイテムで空またはフィルター済みの応答を返しました(1,500のうち276件—配信プロパティであり、カバレッジギャップではありません:1,500件すべてが試行されました);精度は解析された、解決されたアンサーで計算されます。両方の定義が報告されます:回答のみ、Googleの精度は71.1%です(837/1,178);276の配信されなかった応答をエラーとしてカウントすると57.6%(837/1,454)であり、未解決のアイテムもエラーとしてスコアリングされた場合55.8%(837/1,500)です。² メタ精度は、アクセス取り消し前に収集されたアンサーで計算されます;カバレッジの制限を参照してください。表全体の精度は解決済みのみです;未解決をエラーとして感度が低い場合、トップフィギュアのOpenAIの95.4%は93.5%(1,403/1,500)になります。すべての研究室のコール単位のチャネル出所は実行マニフェストに記録されます。未解決のカウントは、決定論的に解決されなかった配信されたアンサーです;Zhipu(1,494個のアンサーを配信)、Baidu(1,492個)および部分的なメタアーム(251個)については、2つの列は試行された質問より少なく合計され、残りは配信されなかった応答です。
汚染に関する注意は絶対精度の範囲を定めます。 このウェーブは、公開されたオリジナルのSimpleQAベンチマーク(2024年10月)を再利用し、その出版から最大2年後の学習コーパスを持つモデルに対して実施しており、ベンチマーク自体への学習時の露出は表の上部で妥当であり、データはその具体的な署名を持ちます:トップスコアリングのフラッグシップは、61.6%のアイテムで金の答え文字列を逐語的に再現し(正規化された完全一致、小数点の書式設定まで)、他の研究室では27.9~45.3%であり、中央値の推定信頼度は99です。設計は「モデルがより強い」を「モデルがベンチマークとその答え鍵を見た」から分離することはできません。したがって、このウェーブの絶対精度数値は、以前のモデル世代で報告された過去のクローズドブック天井と比較することはできず、パラメトリック記憶の尺度として読まれるべきではありません。最初のウェーブのベンチマーク年齢確認(セクション3で報告されたTruthfulQA–SimpleQAギャップ)は7月の収集をカバーしました;2026年8月までに、SimpleQA自体は2年前の公開ベンチマークであり、この注意はフラッグシップウェーブをカバーします。このウェーブの結論は絶対精度に基づいていません。これらは、自信を持った失敗の構造、推定信頼度≥80での有病率、および不一致ゲートによるその傍受、1つの凍結プロトコルの下のウェーブ内で測定され、任意の露出利点は評価された実験室全体で共有されます。研究ウィンドウの後に構築された新しい2ホッププローブは、この署名を直接確認します。このセクションの後半の「最高のモデルを単に使用しないのはなぜですか?」を参照してください。
キャリブレーションの堀。 最初の実験は、独立した同意が自己報告された信頼度がしていない正確さの信号を伝えることを示しました。フラッグシップウェーブは、その信号を測定されたフィルターに変えます。メカニズムは不一致ゲートです:以前の不一致分析から事前に固定された3つの研究室の評議会で、これらの結果に適合していません(Moonshot kimi-k3、DeepSeek deepseek-v4-pro、OpenAI gpt-5.6-sol)、および自由パラメータのない規則。3つの評議会の回答が対比で同意する場合にのみ、アンサーはゲートを通過します。何も推定されないため、トレイン/テスト分割は必要ありません;ゲートは凍結されたコレクションに対して1回計算されます。
図17。 フラッグシップゲート
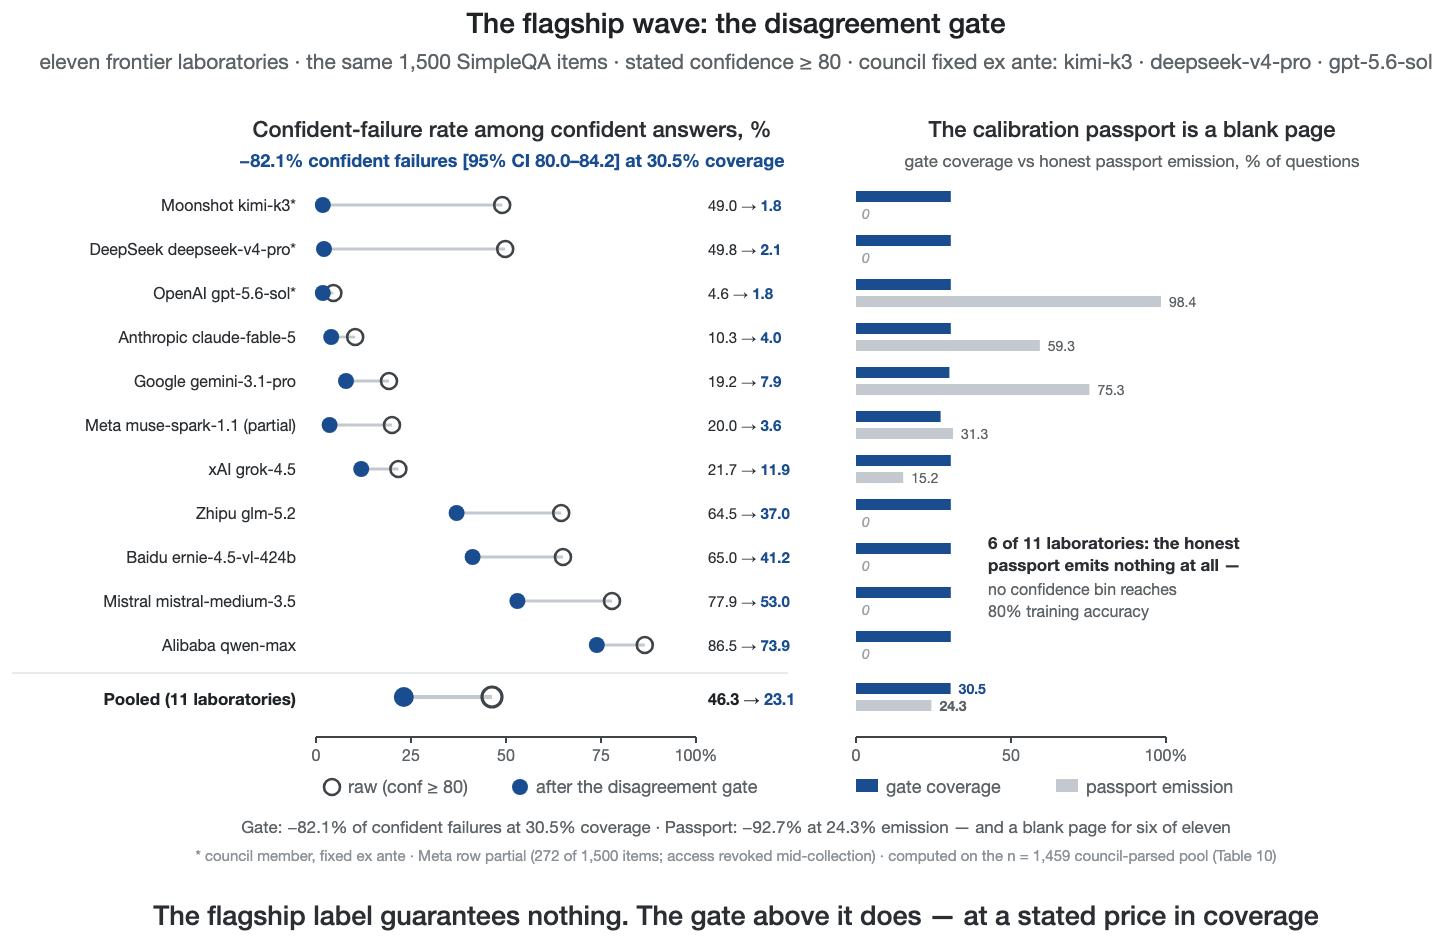
推定信頼度≥80での自信を持った失敗とその固定された3モデルの不一致ゲートによる傍受、研究室別(2026年8月ウェーブ)。
10個の完全な研究室アーム全体でプーリングされた場合(プライマリプレゼンテーション、部分的なメタアームが別々に報告され、その包含が感度として扱われます)、生の自信を持った失敗率は46.6%(4,910/10,540)です。11の研究室の花簪全体でプーリングされた場合、研究室単位の率は異なります(表9)ので、この数値はフロンティア花簪を特徴づけており、普遍定数ではありません。ゲートは82.1%の自信を持った失敗を除去します(ブートストラップ95% CI [79.9; 84.1])すべてのプール済みアンサーの30.5%を保持しながら(ゲート自体は30.6%の質問で開きます、446/1,459)。評議会の外側の完全な研究室に限定され、いかなる種類の自己参照もなく、ゲートは依然として76.9%の自信を持った失敗を除去します(CI [74.3; 79.2])。部分的なメタアームを含めると、すべての推定が事実上変わりません:11全体でプール化された場合、生の率は46.3%(4,935/10,665;35.8%の自信を持ったアンサーがゲートを通過し、放出された自信を持ったアンサー間の正確性は53.7%生から76.9%ポストゲートに上昇します)、ゲートは同じ30.5%カバレッジで82.1%(CI [80.0; 84.2])を除去し、8つの研究室の非評議会図は77.0%(CI [74.4; 79.3])です。表10は研究室単位の数値を示しています。
表10。 不一致ゲートによる自信を持った失敗の傍受(conf≥80;決定論的グレーダー;評議会=kimi-k3·deepseek-v4-pro·gpt-5.6-sol、事前に固定)
| 研究室 | 自信を持ったアンサー | 自信を持った失敗、生 | ゲートの後(放出時の率) | dCF |
| Moonshot kimi-k3 [評議会] | 1,056 | 517 (49.0%) | 7 (1.8%) | −98.6% |
| DeepSeek deepseek-v4-pro [評議会] | 1,274 | 634 (49.8%) | 9 (2.1%) | −98.6% |
| OpenAI gpt-5.6-sol [評議会] | 1,426 | 65 (4.6%) | 8 (1.8%) | −87.7% |
| Anthropic claude-fable-5 | 825 | 85 (10.3%) | 15 (4.0%) | −82.4% |
| Google gemini-3.1-pro | 966 | 185 (19.2%) | 27 (7.9%) | −85.4% |
| Meta muse-spark-1.1 (部分的) | 125 | 25 (20.0%) | 2 (3.6%) | −92.0% |
| xAI grok-4.5 | 577 | 125 (21.7%) | 36 (11.9%) | −71.2% |
| Zhipu glm-5.2 | 1,128 | 727 (64.5%) | 146 (37.0%) | −79.9% |
| Baidu ernie-4.5-vl-424b | 725 | 471 (65.0%) | 107 (41.2%) | −77.3% |
| Mistral mistral-medium-3.5 | 1,354 | 1,055 (77.9%) | 224 (53.0%) | −78.8% |
| Alibaba qwen-max | 1,209 | 1,046 (86.5%) | 300 (73.9%) | −71.3% |
| プール済み(11の研究室) | 10,665 | 4,935 (46.3%) | 881 (23.1%) | −82.1% [80.0; 84.2] |
| プール済み(8つの非評議会) | 6,909 | 3,719 (53.8%) | 857 (33.5%) | −77.0% [74.4; 79.3] |
3人の評議会メンバー全員が解析済みの拒否されていない回答を生成した質問プール(n = 1,500のうち1,459)で計算され、ゲートはこのうち446(30.6%)で開きます。メタ行は部分的(アクセスは収集途中で取り消された)。ブートストラップ信頼区間:5,000の質問レベルのリサンプル。
その見出しには3つのことが伴います。ゲートはまた自信のある正解のおよそ半分も破棄します(ゲートは自信のある正解のわずか51.3%のみを保持し、ゲートが除外した回答のうち、およそ41%は実は正しかった)。トレードオフはカバレッジと確実性であり、選別的分類の標準的なリスク-カバレッジトレードオフです(Geifman & El-Yaniv, 2017)。ここではアーキテクチャレイヤーで実行され、2つの数字は常にペアで引用されるべきです:−82.1%の自信を持つ失敗が30.5%のカバレッジで。システムは独自の下限を持っています。完全にシステム的なモードでは、オープンゲートが個々のモデルの代わりに評議会のコンセンサス回答を出すモード、システム自身の自信を持つ失敗率は1.8%(解決されたコンセンサス回答442のうち8)であり、これら8つの質問は評議会全体が自信を持って同じ誤った回答に同意した質問です。これが最初の実験がそのコンセンサス検証エラー境界条件から予測した相関エラー下限です:その下では、同意チェックはどの量も役に立ちません。なぜなら同意自体がエラーだからです。そして結果は事前に宣言された感度グリッド全体でフラットです:信頼度閾値70/80/90は統合dCFの−83.1%/−82.1%/−80.6%を与え、未解決項目をエラーとして再スコア化すると−81.8%となるので、この数字は選択されたのではなく測定されました。
30.5%のカバレッジ数字が商業的に意味することは第5章の損益分岐点経済学(図14)で設定されます:ゲートが認証することを拒否するおよそ70%の回答は、自信を持つエラーより安い運命(人間へのエスカレーション、より深い検証層、または明示的な不確実性表示)にルーティングされた要求であり、失われた変換ではないため、カバレッジコストはリスク回避可能な誤りの価格であり、失われた需要ではありません。エスカレーションチャネルのコストモデルはここでは推定されていません。動作ポイントは固定されていません。図19でトレースされた合意ラダーは閾値のファミリーを提供し、サービスはキャッチされていない自信を持つ失敗の予想コストがゲートが保有するトラフィックのマージンを横切る場所に位置する必要があり、これはコストベースの選択になります。
図14。 段階的信頼の経済学
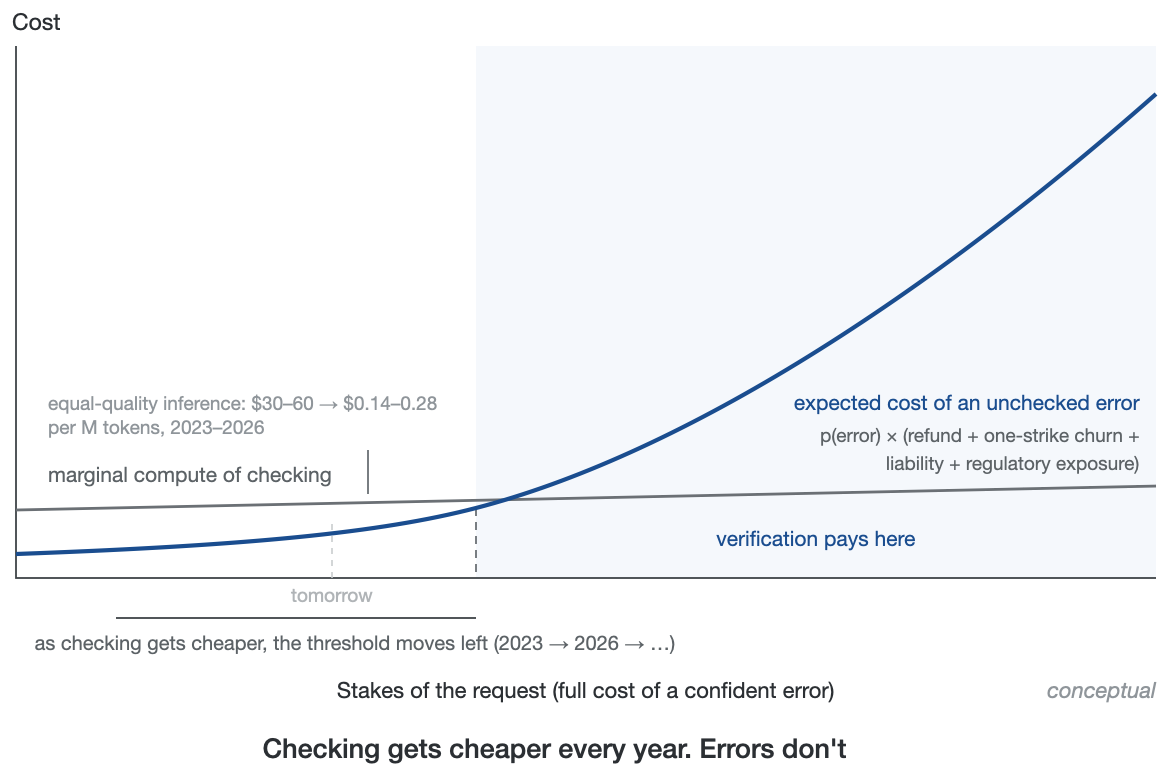
検証の損益分岐点ロジック。
単に最高のモデルを使わないのはなぜですか? ウェーブが立たせる最強のベースラインは統計的というより商業的です:オペレータはアーキテクチャをスキップしてすべてをウェーブの最も正確なフラッグシップにルーティングできます。そのベースラインには数字での回答が必要です。2026年中盤の価格で、凍結された3ラボ評議会は質問あたり$0.0039かかり、ウェーブの最も高価なフラッグシップ(claude-fable-5、リストで質問あたり$0.0198)からの単一回答より少なく、最も正確なもの(gpt-5.6-sol、公開API料金で質問あたり$0.0027)からのものより多くかかります。「最高のフラッグシップを購入するだけ」は本物のパレート点です:gpt-5.6-solソロはすべての質問に4.6%の自信を持つ失敗率で回答し、ゲートされた構成もいかなる価格でもそのカバレッジと一致しません。サービスがおよそ20に1つの回答で自信を持つ失敗を許容でき、完全なカバレッジが必要な場合、フラッグシップは両方の軸で勝ちます。しかし、その規則はリーダーボードの上部でさえ一般化されていません:ウェーブの他のコンセンサスフロントランナーであるclaude-fable-5は、ソロで10.3%の自信を持つ失敗率です。「ベンチマークで最上位のモデルを何でも使用する」はサンプルの2番目に最強のモデルで完全に失敗します。これが下記の識別問題が仮説ではない理由です。4つの考慮がその比較を制限します。
まず、識別問題:どのモデルが現在最高であるかを知ることは、それ自体が外部の、モデル間横断的な測定の産物です。ウェーブ自身の表8は、公開リーダーボード、継続的で第三者による、クロスベンダー比較からそのフラッグシップを選択しました。ベンダーの自己報告に置き換わることは提案されていません。このペーパー自身のデータはなぜ誰も提案しないのかを示しています:述べられた自信はベンダーによって AUROC 0.53–0.79で判別し、84ポイントの精度スプレッドが実験室の最良として販売されているすべてのモデルを分離します。「最高のモデルにルーティングする」は、それに代わるものではなく、アーキテクチャ信頼の適用です:フラッグシップに王冠をかぶせるリーダーボードは独立したパネル、ブラインド項目、および公開記録です。第3章の3つのコンポーネントが市場規模で動作します。そしてその王冠は移動します:エンタープライズモデルリーダーシップは単一の春に手を変え(Kharazian, 2026)、モデルは安定した名前の下で静かに更新され、エージェント購入行動はモデル更新全体で大幅に再シャッフルされます(Allouah et al., 2026)。継続的な外部測定なしに、「最高のモデル」はオペレータが知識として利用可能ではありません。
次に、95.4%は部分的に能力ではなくメモリです:最上級フラッグシップはアイテムの61.6%で金色の回答文字列を逐語的に再現します(表9の汚染警告)、測定されたエッジはベンチマークが教えられないかもしれない質問で圧縮されます。ゲートメカニズムはその脆弱性を継承しません:最も記憶されていない可能性が最も低い層では、自信を持つ失敗の89.4%を削除し、最悪ではなく最高のパフォーマンスです(下記の汚染層別再分析)、なぜなら独立して訓練されたラボ間の合意はいかなる1つのベンダーの訓練コーパスにも条件付けられていないからです。
転移可能な知識をベンチマーク露出から分離するために、2026年8月6日に独立して検証された2023年前のWikidataファクトのペアから機械生成された保証されていない100項目の2ホッププローブを構成しました(例えば、「[小さな建物]のアーキテクトはどの年に生まれましたか?」)。各回答は単一の計算結果で、構成された質問文字列はいかなる訓練コーパスにも現れることはできません。セットのSHA-256は最初のモデル呼び出しの前に凍結されました。
凍結されたプロトコル(逐語的なシステムプロンプト、温度0、同一の決定論的採点者)の下で、gpt-5.6-solはSimpleQAで95.4%の精度と4.6%の確実な失敗率から33.0% [ブートストラップ95% CI 24.0–42.0]に低下し、その項目の61.0% [51.0–70.0](確実な回答の67.0%)で確実な失敗が生じ、その平均の述べられた信頼度はほぼ動かず(98.4 → 93.7)、一方claude-fable-5は76.0% [67.0–84.0]と6.0% [2.0–11.0]を維持しました。波の25ポイントのフラッグシップギャップは保証されていない組成では43ポイントの赤字に反転します。波から変わらないカウンシルゲートがこの失敗を吸収しました。gpt-5.6-solの61の確実な失敗のうち1つを除くすべてを除去し(60/61; n = 61で点率は不正確、ウィルソン95% CI ≈ 91–99.7%; 24.2%のカバレッジ; claude-fable-5: 6 → 1)、合格した高信頼度回答における発せられた確実な失敗率を生の67.0%に対して4.5%に削減しました。
レベルはベンチマーク間で点比較できません。2ホップ組成は本質的に1ホップ検索より難しく、n = 100では区間は広くなります。しかし、モデル順序の反転とどのモデルも記憶していない可能性のある項目に対するゲートの永続性は、汚染アカウントが予測する正確にシグネチャであり、アーキテクチャ信頼層が、より良いモデルの選択ではなく、吸収するために構築される失敗モードです。
第3に、フロアがあります。ゲートはどのモデルも任意の価格でも達成しない確実な失敗率に到達します。カウンシル制御された構成は、発せられた回答の確実な失敗を1質問あたり$0.0039–0.0046で1.8–2.1%に削減し、最良のソロレートの2.5倍以下であり、一方波内で最も高価なフラッグシップは1質問あたり$0.0198で確実な失敗が10.3%であり、すべての軸で支配されています。ゲートは弱いモデルのための救助装置ではありません。同じゲートの背後にあるqwen-maxは依然としてその発せられた確実な回答の73.9%で確実に失敗するため、フロンティアのゲートされた点は弱いもの上のゲートではなく、強いモデルの評議会です。
第4に、エージェントが自律的にお金を使っている場合、実行可能な質問は「どのモデルがより賢いか」から「どの構成がそれが何をしたかを証明できるか」にシフトします。どれだけ正確であれ、ソロフラッグシップはそれ自身の決定を証明したり、その自身の利益相反を仲裁することはできません。ゲートされた構成は回答あたりの検査可能な合意記録を生成します。それはセクション5の責任保険市場が既に価格設定する成果物であり、そこでカバレッジは証拠に対して、および除外形で欠落に対して書かれています。
解像度はフロンティアであり、勝者ではありません。フラッグシップは評議会の最強メンバー(凍結された評議会がそれを含む)ですが、それはそれ自身の判事として機能することはできません。それを特定するリーダーボードは既にアーキテクチャ信頼が運用する同じ原則である独立した相互モデル検証に基づいていますが、それは集約のみで、モデル一般について、消費者の前の回答についてではない検証を供給します。この構成はそのギャップを埋めます。そしてそのギャップはそれも限定します。独立した確認に基づかない主張はアーキテクチャ信頼の外であり、それのインスタンスではありません。オペレータの実際の選択はリスククラス間です。確実な失敗が4.6%での完全カバレッジ、またはセキュリティ証跡を伴う1.8%での31%カバレッジ、選別分類トレード、ここで価格設定されます。完全26構成コスト–カバレッジ–リスクフロンティア(すべてのソロフラッグシップ、すべてのゲートされた構成、プール合意はしごと、ポイントあたり請求対リスト価格基準がフラッグされた)はレプリケーションパッケージを伴うCSVとして発表されます。
意見の不一致ゲートに対する明らかなライバルは単一モデルキャリブレーション修復です。各モデルの信頼度から精度へのマッピングを学習し、マップされた精度がバーをクリアするのみ発送します。標準的な救済策が温度とプラットスケーリング(Guo、Pleiss、Sun、& Weinberger、2017)である事後キャリブレーションプログラムです。分離されたハーフ(ヒストグラムビン化された信頼度、偶数インデックス付き質問でトレーニング、奇数で評価、20未満の観測値のビンは発送されない)でフィットした場合、このキャリブレーションパスポートは確実な失敗の92.7%を除去しますが、24.3%の発送で、および11のフラッグシップのうち6つは全く発送しません。これらのモデルの信頼度ビンは80%の訓練精度に達しないため、これらのモデルのパスポートは空白のページです。フラッグシップ市場の半分については、単一モデルキャリブレーションは外部から修復することはできません。意見の不一致ゲートはテーブル内のすべてのモデル(パスポートが放棄する6つを含む)に対してほぼ30%のカバレッジを保持します。したがって、最初の実験の結論はこのティアでも同様に成り立ちます。アーキテクチャはモデルの露出された信頼度がランキングまたはレベルで1として失敗する場所に外部正確性信号を供給できます。消費者が最も信頼するティアで再度測定されます。
ゲート効果の堅牢性。 2つのレフリー駆動チェックが重要です。循環性、ゲートがその最強のメンバーに乗っているかどうか、および何か些細なことが同じ仕事をするかどうかです。評議会の最強メンバー(gpt-5.6-sol、95.4%解決された精度)をwave の4番目の事前フロンティア実行(grok-4.5)に置き換えると、結果は本質的に変わりません。sol フリー評議会は凍結されたトリオに対する29.7%カバレッジで確実な失敗のプール化の81.2%を除去し(ノンカウンシルターゲット: 77.6%)、82.1%で30.5%の対象に対して、165の可能なすべての3モデル評議会で、メカニズムは失敗しません。すべての評議会はその自身のカバレッジでランダムな棄権より確実な失敗を除去します(中央値超過+8.5ポイント)、事前トリオは上位4%でそのマージン(+12.6ポイント)です。効果は任意のメンバーの精度ではなく相互モデル合意に属します。各モデル自身の述べられた信頼度を同一の1モデルあたりのカバレッジに閾値処理することで、些細なベースラインは確実な失敗のプール化の66.7%のみを除去し、ランダム棄権がそのカバレッジで除去する69.5%未満です。なぜなら確実な失敗は構成上高い述べられた信頼度で濃縮されるためです。そのしきい値はゲートより確実に正しい回答も少ないです(46.4% vs 51.3%)。ゲートは11のすべての研究室に対して両方のベースラインをパレート支配します。最強のモデルのみとの回答ごとの合意を使用するフィルターとしては、さらに強い画面です(40.7%のカバレッジで確実な失敗のプール化の97.1%が除去される、確実に正しい回答の97.0%を保持している)、しかし機械的に異なっており、ターゲット条件付き規則です。それは検査後のみ回答を渡します。一方カウンシルゲートはテスト中の回答を見ずにすべてのモデルに対して同じ固定質問セットを開きます。したがってそれはカウンシル効果を制限しますがそれを説明しません。sol なしでもトリオは81.2%を除去し、弱い単一判事(kimi-k3、45.5%解決精度)との合意でも確実な失敗の86.3%を除去します。ドライバーはそれ自体相互モデル合意であり、判事精度は保持されるものに示されます(sol に対して97.0%保持-正しい対弱い判事に対して20–63%)。
キャリブレーションされた棄権は、より強力な競合ベースラインを提供し、これらも実行されました。2つのキャリブレーションされた棄権ベースラインは、キャリブレーションパスポートと同じ分割の下で適合されました(パラメータは偶数インデックスの項目に適合され、保持されている奇数半分で評価され、フローズンゲートは82.2%の確実な失敗を30.8%のカバレッジで除去します)。モデルごとのベースラインはゲートに到達しません。モデルごとのカバレッジがゲートに合致するPlatt調整信頼度は確実な失敗の65.3%を除去し、分割適合棄権(α = 0.293、P(emit | wrong) ≤ αを保証するようにキャリブレーションされ、同じカバレッジに調整)は70.8%を除去し、同じプール化されたカバレッジでの生の陳述信頼度トップK制御は69.4%を除去します。11の実験室すべての答えを1つのPlatt調整確率スケールにランク付けするプール化されたバリアントはゲートを上回ります(同じプール化されたカバレッジで89.0%)が、これはカバレッジをほぼすべてよくキャリブレーションされた実験室に再配分することで達成します。最もよくキャリブレーションされたベンダーの答えの100%を発行し、11の実験室のうち4つに対しては0%を発行し、上記のパスポートの失敗モードをより柔らかい形で再現しています。また、ゲートが不要な場合、モデルごとに約700の評価答えが必要です。したがって、キャリブレーションされた信頼度と交差モデル一致は補数です、代替ではなく、最初は地上の真実ラベルが存在するどこでもそれを訓練するためにプール化されたエラー率を低下させ、2番目はラベルフリーのモデル単位の保護を均一に購入します。
図19は、すべての戦略を選択的予測平面に配置します(フローズン1,459質問プール上の11のアームが返した13,955の決定論的に解決された答えにプール化され、合計はすべての1,500質問上で解決された答えをカウントする表9より小さいです。選択的リスク = 発行された答えのうち間違っているものの割合)。リスク-カバレッジ曲線下の面積でランク付けされ、低い方が良い:Platt調整信頼度0.258、陳述信頼度で洗練されたゲートはしご0.321、純粋な一致はしご0.356、生の陳述信頼度0.367、ランダム棄権0.517、0.166のオラクルフロアに対して。保持アウト半分の値は最大0.009異なります。フローズンゲート自体の動作点で(この解決答え規約で31.1%のカバレッジ、13,955の答えのうち4,334を発行。30.5%と30.6%は他の場所で報告されているのは確実な答えとプール質問の共有)ゲートのリスクは24.9%、生の信頼度閾値の33.4%、およびキャリブレーションされた信頼度の14.0%、ラベルコストとカバレッジ濃度の警告の対象です。すべての165の3モデル評議会のクラウドは9~59%のカバレッジにわたり、13~38%のリスクで、報告されたゲートはその家族の代表的なメンバーであり、調整された外れ値ではありません。単一裁判官ゲートは家族の退化端をトレースし、「一致」が「最も正確なモデルに尋ねる」に崩壊します。
図19。リスク-カバレッジフロンティア
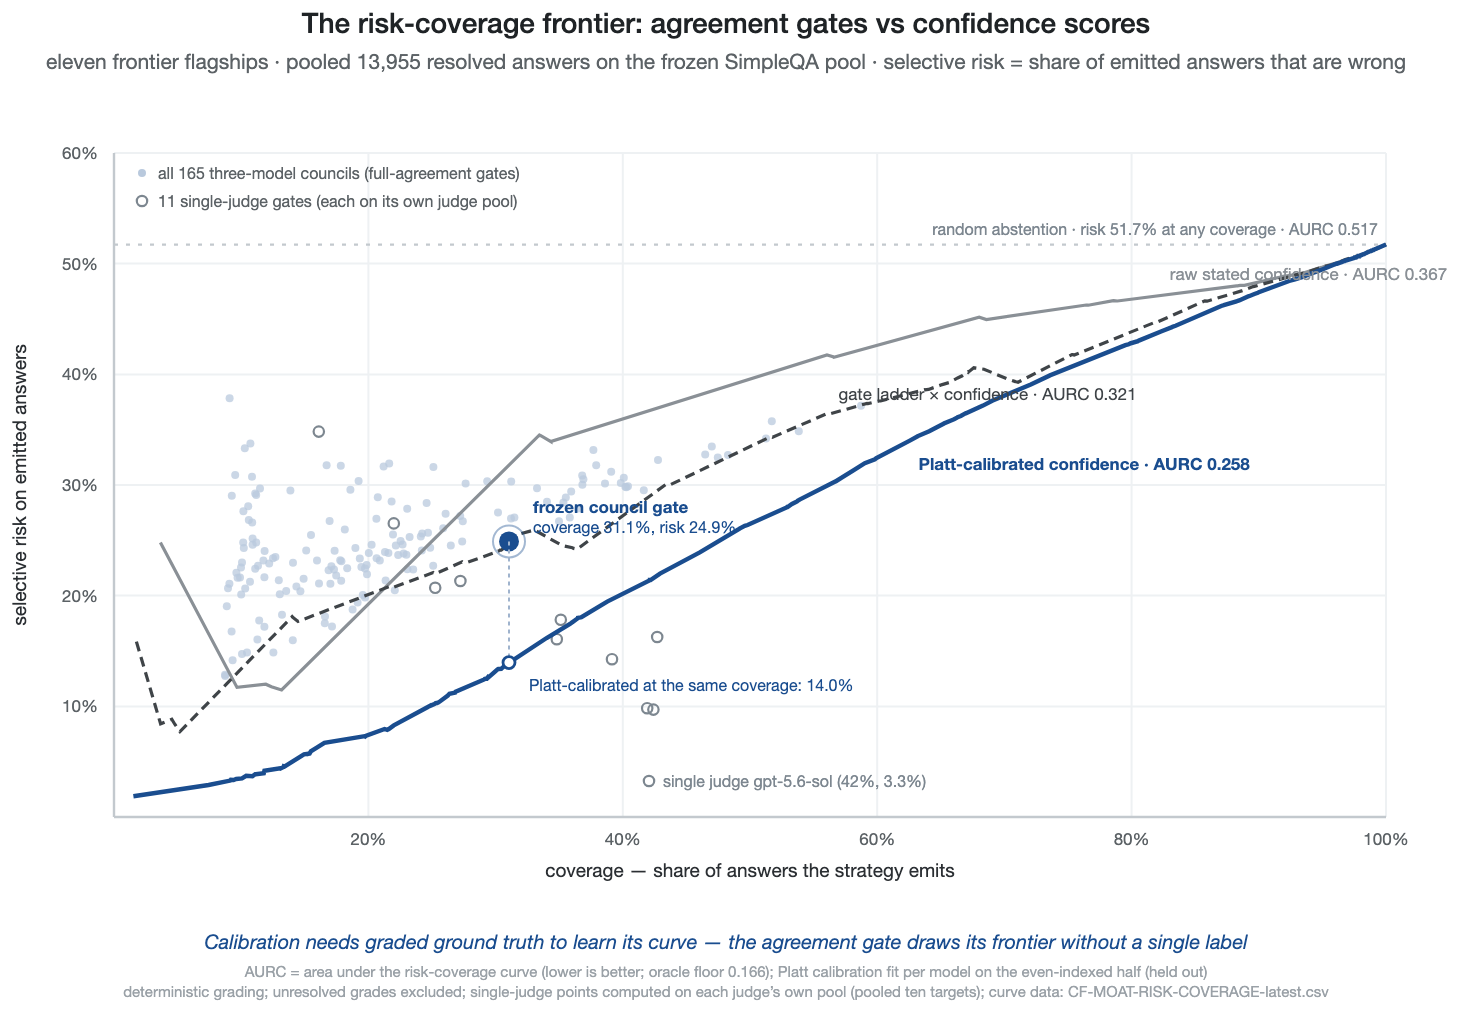
フローズン1,459質問プール上の11のアームによって返されたすべての決定論的に解決されたフラッグシップ答え(表9はすべての1,500質問にわたる解決答えをカウント)にプール化された選択的予測平面上のすべての棄権戦略。カバレッジに対するリスク:生の信頼度、Platt調整、およびゲートはしご×信頼度曲線とそれらのAURC値、ランダム棄権線、すべての165の3モデル評議会のクラウド、11の単一裁判官ゲート、およびフローズン評議会の動作点(解決答え規約で31.1%のカバレッジ、13,955のうち4,334。24.9%のリスク)。低い方が良い。オラクルフロアは0.166です。すべてのポイントはレプリケーションパッケージのリスク-カバレッジCSVから再計算可能です。
一致は質問の容易性を超える情報を持たない可能性があります。これをテストするために、ゲート一致と項目難度度(その質問の他のモデル間の間違った答えの共有)に対する答えの正当性のロジスティック回帰が、実験室の固定効果と質問クラスタ化標準誤差で実行され、答えは難度度がどのように測定されるかに依存します。難度度を非評議会モデルのみで測定した場合(公正なコントロール、評議会自身の答えを含む難度度測定は構造上ゲートの信号を埋め込むため)、一致は外部実験室ターゲットに対して独立した貢献を保持します:b = +0.76、オッズ比2.15、z = 17.2。ゲートによって発行された答えは、ゲートが保持する同じ難度度の答えと比較して、正当である可能性が約2倍です。代わりに評議会自身の正当性を難度度レグレッサーに折り込み、一致係数はゼロに崩壊します。これはメカニズムを定量化し、それを反論しません。一致とマルチモデル難度度は同じ潜在量の2つの測定値であり、ゲートは推論時にそれを読み取るためのラベルフリー機器です。
汚染層別再分析は露出懸念に直接対応しています。少なくとも3つの11の実験室が正規化後に金標準文字列を逐語的に再現する場合、質問をベンチマーク露出の可能性があるとフラグを立てるとき(1,459プール質問のうち741。gpt-5.6-solの61.6%の金エコー率を生み出す同じシグネチャ)、ゲートは非露出層上の確実な失敗の89.4%を除去します(2,793→296。非評議会ターゲット:86.5%)露出された層上の72.7%に対して。したがって、メカニズムは記憶されたアイテムに依存しません。選択的フィルタがすべきように振舞い、パネルが本当に不確定なところではるかに低頻度で開きます(18.7%対41.9%カバレッジ)し、発行された確実な失敗率をほぼ一定に保ちます(25.9%対21.8%、58.5%と36.4%の生レートから)。露出カットオフが2~5のエコーモデルは、非露出dCFが87.7~89.7%を与えるため、結果は閾値堅牢です。層別化は記述的です:金エコーは結果結合されており、汚染を因果的に識別するのではなく、見た可能性のある他の質問から分離します。
より大きな推論予算が買うもの:能力ではなく確信。大手ベンダーは現在、モデル選択より上に第2の調整ダイアルを販売している。隠れた熟考のトークン当たりで価格設定される推論予算である。拡張推論がキャリブレーションを購入したなら、それはこの論文の問題に対するモデルレベルの答えになり、チェックアウト時に購入可能であろう。1つの大手での対になった実験は、それが何か別のものを購入することを示唆している。Googleのgemini-3.1-pro(その推論は無効にできない)は、2つの予算下で同じ凍結された質問セットに回答した。低推論努力設定とベンダーのデフォルト動的予算、温度ゼロ、同一のプロンプトとパーサー、および質問ごとのコスト記録である。このバージョンの日付で両方の予算下で回答された233の質問では:精度75.1%(低)対76.4%(デフォルト)、検出可能な差なし(正確なMcNemar p = .648)。述べられた確信はデフォルト予算下で3.1ポイント高い(Wilcoxon z = 4.68、p < .0001)。キャリブレーションはデフォルト予算下でわずかに悪い(対になったECE 0.100対0.082。確信マイナス精度のギャップ+9.3対+7.5ポイント)。質問当たりのコスト2.1倍。精度比較は特定の種類のヌルである。これらのデータはn = 233で検出可能な精度差がないことを示す(正確なMcNemar p = .648)。同等性は粗い余裕のみで正式に確立される。対になったTOSTは精度差を±5ポイント以内に制限する(差+1.3ポイント、90% CI [−1.8; +4.4]。両側の片側p ≤ .024)が、研究は±2~4ポイントで同等性を確立する力がない。一方、述べられた確信における+3.1ポイントの上昇は統計的に明確である(Wilcoxon p < .0001)。その範囲内で、2倍の支出は追加の述べられた確信と測定可能な追加の正確さを購入しなかった。有料機能としての過信、モデル内での移行論文のインスタンスである。余分なドルはモデル層に行き、消費者が検証できるものを何も生み出さなかった。その一方で、それより上の建築層は確信を検証可能なシグナルに変えた。結果は1つとして報告されたパイロットである。比較は233対の質問をカバーし、完全な1,500対設計は同等性の境界を約2ポイントに狭める。チャネル構成とトークンキャップ検閲は複製パッケージの交絡として記録されている。収集は継続中である。
図18。より大きな推論予算が買うもの
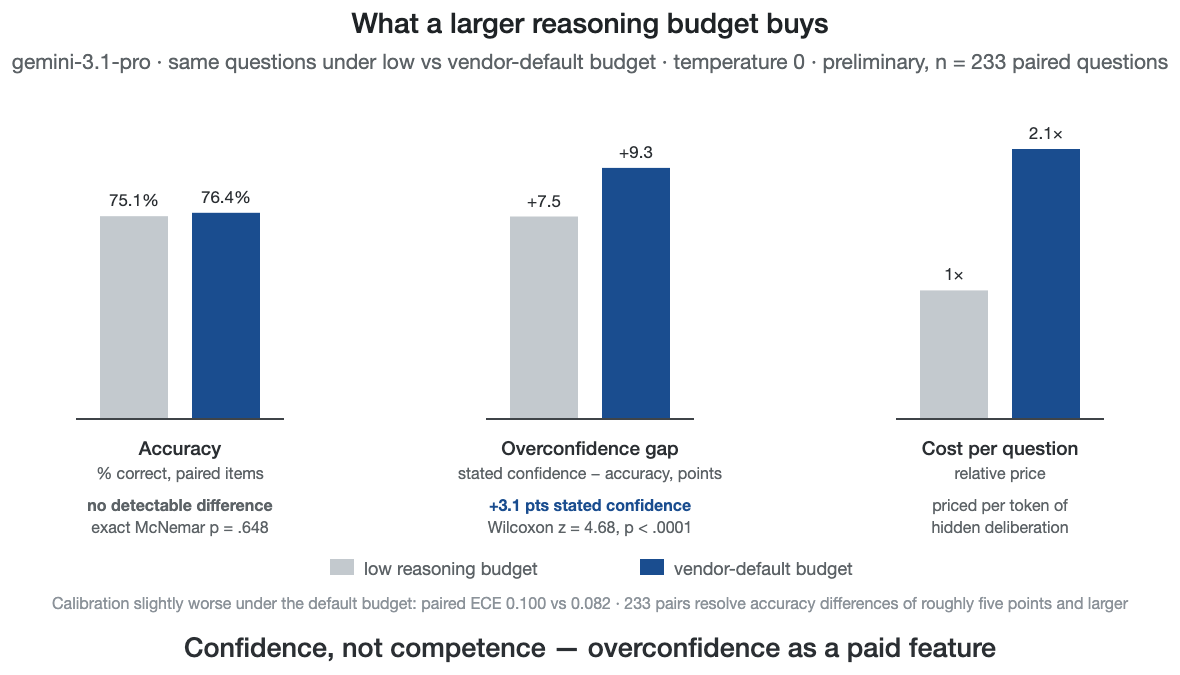
2つの推論予算下での対になった比較—述べられた確信は上昇するが、精度は上昇しない。
表11。推論予算、対になった比較(gemini-3.1-pro、233の質問が両方の予算下で回答される、温度0。予備的)
| 低推論予算 | ベンダーのデフォルト予算 | |
| 精度(対になった項目) | 75.1% | 76.4%(McNemar p = .648) |
| 平均述べられた確信 | デフォルトより−3.1ポイント | +3.1ポイント(Wilcoxon p < .0001) |
| キャリブレーション(対になったECE) | 0.082 | 0.100 |
| 確信−精度のギャップ | +7.5 | +9.3 |
| 質問当たりのコスト(相対的) | 1× | 2.1× |
推論努力設定は腕全体で同一ではなかった。各ベンダーはそのインターフェースのデフォルト努力でその標準商用インターフェースを通じてクエリされた(設定は複製パッケージ内のモデルごとに記録される)。したがって、ベンダーの絶対精度は努力成分を運ぶことができる。それはメカニズムに達しない。精度ランキングは負荷がかかっていない(旗艦ラベルは何も保証しない)。ゲートはメンバーを削除しても生き残る(溶液フリーカウンシルは81.2%を削除する)。より大きな努力は述べられた確信を精度が平坦なまま上げる。対になった比較がちょうど示したように、それが膨らませる精度は自信のあるエラーとして浮かび上がり、ゲートが遮断する失敗である。
旗艦ウェーブのカバレッジ制限。ウェーブは2026年8月5日の凍結スナップショットであるため、その後にリリースされたモデル(Grok 4.6(8月12日)およびその後のArtificial Analysisリーダー(Claude Opus 5など))は事前にコミットされたベンチマークに入ることができない。トップポジションは数日以内に転換した。これは、ゲートが回避する識別問題である(合意は花名簿堅牢であり、メンバーの削除が生き残る)。含まれている2つのラボラトリーは、一般能力リーダーボードで現在の最前線より下にある。Mistralのフラッグシップはすべてのチェックされた集計インデックスでトップティアより遅れており、BaiduのゼネラルパーパスERNIEはHumanity's Last Examでトップ30の外にある(その強みは検索補強およびエージェンティックタスクであり、ERNIE 5.1はLMArena Search Arenaで#4にランクされている)。欧州エコシステムとすべての主要な中国ラボラトリーのカバレッジを保存するために保持されている。トップティアの2つのラボラトリーのうち、その代わりにウェーブのスコープ外にあったのは、Meta Superintelligence Labs(Muse Spark 1.1。Humanity's Last Examで#4)とByteDance(Seed 2.1。#10)。1つは後で試みられ中断され(Meta、下記)、もう1つにはまったく到達できなかった(ByteDance、下記)。
ByteDanceのSeed 2.1を含めることはできなかった。BytePlus ModelArkは、新しく登録された国際アカウント(ライブ試行、2026年8月5日)について「あなたの国/地域では利用できません」を返した。アグリゲーターはフラッグシップを提供せず、国内のVolcano Arkチャネルは本土中国の検証を必要とする。BaiduのERNIE 5.1(現在のフラッグシップ)は、同様に国内のQianfanプラットフォームに限定されている(ライブ試行、2026年8月5日)。ラボラトリーの現在のフラッグシップにアクセスできない場合、フォールバックルールはそのラボラトリーから最も強力にオープンリリースされたモデルである。Baiduの場合、これはERNIE 4.5 VL 424B(オープン重み)であり、代わりに使用される。それは自体が所見である:6つの主要な中国ラボラトリーのうち2つの現在のフラッグシップは、2026年8月の時点で外部研究者がアクセスできない。
Metaは波の3番目のアクセス失敗であり、障害は地理的な問題ではなく私のアカウントでした。最初の(中層)波では、Metaは文書化されたインフラストラクチャ上の理由により不在でした。その第一方APIのLlama APIはプロトコルフリーズ前の2026年7月6日に廃止され(実行マニフェストに記録)、研究室はローカル層でオープンウェイトのLlama-3.2-3Bで代表されていました。これはパネルの最も有益なメンバーの1つであることが判明しました(行列全体で最も低いエラー相関)。フラッグシップ波では、Metaのmuse-spark-1.1が到達可能になった時点で波の途中で追加され、収集は順序立てて3つの方法で失敗し、それぞれ記録されました。(i)第一方Meta Model APIキーは8月5日に251の有効な回答が収集された状態で実行途中に失敗し、開発者コンソールは代替を発行しませんでした。(ii)アグリゲーターフォールバックルートは(iii)の前に21の追加的な回答をもたらしました(iii)Metaのプロバイダエンドポイントは公開ベンチマークからの閉鎖形式の事実想起質問に対してHTTP 403 `user_blocked`、「繰り返されるポリシー違反のためアクセスが制限されました」を返し始めました。温度ゼロで質問されました。正味の結果は1,500項目中272項目(18.1%)が収集され、部分的として報告されました。凍結プール分析には251の第一方回答が含まれます(アグリゲータートップアップは分析フリーズの後に到着しました)。Metaのラボごと推定値(125の確信した回答で−92.0% dCF)はパネルと方向的に一貫していますが、推論には精度が不十分です。ブロック自体が知見です。2026年8月の時点で、独立した研究者は認可されたどのチャネルを通じてもMetaのフラッグシップの1,500質問事実評価を完了することができません。波の3つのアクセス失敗の間に、地域制限されたフラッグシップ(ByteDance)、国内限定のフラッグシップ(Baidu)、および研究者禁止(Meta)は、経験的形式での理論的議論です。モデル層での検証可能性はベンダーの恵みで享受され、アーキテクチャ信頼層はベンダーの恵みを想定することはできません。
4. 極端なデプロイメント:不可逆的な利害関係を伴う委譲
消費者信頼を研究する通常の方法は、調査またはラボタスクです。私が利用できるより厳しい手段を持っていました。あらゆる結果が私に降りかかる拡張的で高リスクのデプロイメント。このセクションは単一の矛盾した事業者からの存在証明および設計証言であり、一般性の経験的証拠ではなく、P1~P5のいずれもそれに依拠していません。2つの種類の証拠は相互に関連しています。研究室では、較正効果はプラセボ対照の下で測定されました。デプロイメントでは、エラーが不可逆的であった場合、同じ3つの特性が委譲が可能であることと無謀であることの違いでした。
デプロイメントはクライアントのものではなく、シミュレーションでもありません。私は同時に事業者、開発者、およびアナリストです。証拠層はハッシュアンカーされており、すべての測定は独立して再計算可能なため、矛盾は主張と私が測定することを選択したもの、数字が再現されるかどうかではなく影響します。この設定は通常の消費者能力と不可逆的な利害関係を組み合わせており、すべてのアーキテクチャの弱点がすばやく、目に見える形で罰せられます。
方法論的に、これはYin, 2018の解釈と分析オートエスノグラフィックの伝統(Walsham, 1995;Gould, 1991;Anderson, 2006)における極端で啓発的な単一のケースであり、その伝統の証拠上の注意を念頭に置いて(Wallendorf&Brucks, 1993)。記録はまず、解釈は解釈としてマークされています。正当化はアクセスです。研究者は参加者に不可逆的な現実の結果をAIアーキテクチャに賭けるよう倫理的に割り当てることはできないため、利用可能な唯一のオブザーバーは自分でその賭けを選んだ参加者です。
分析は、同時代的でハッシュアンカーされたログに依拠しています。デプロイメントの証拠層はそれ自体が記録です。負荷容量ステップ(どのモデルが相談されたか、どこで異なったか、何がゲートされたか、何を確認したか)は時間で記録されたため、観察は再生可能な記録に依拠し、メモリのみに依拠しません。後知恵バイアスは解釈から削除することはできないため、解釈が記録を超える各場所をマークします。デプロイメント期間の記録のシステムの証拠層は、2026年8月2日の時点でハッシュアンカーされています。129ファイル(7,414,043バイト)のファイルごとのSHA-256マニフェスト。ルートは2f88a16611e51c0c12c8015754c89269e782ea167a89b5ed2a881f18eee4defc、アンカーはこの論文で公開されています。デプロイメント終了まで、ライブデプロイメントから選択的な引用は何もないより悪いため、レコードはシールされたままです。コミットメントは確認できます。後でリリースされたレコードはアンカー付きマニフェストと一致するか、そうでないかのいずれかであるため、このページの読者によって遡及的な編集、置換、または逆翻年が検出可能です。テレメトリーのより完全な定量的処理は、同じ理由で将来の仕事に残されています。
このループの内側に住むことからの3つの観察は、元の設定を超えて転送されるものについての仮説として提供され、セクション3の命題に食糧を供給し、それが依拠するイベントはデプロイメントによって時間で記録されました。
不同意は消費者が使用可能な信号です。独立したモデルが結果のある質問に関して相違した場合、相違そのものは、抑制される代わりに表面化し、私は真の不確実性がどこにあるかを伝えました。単一モデルサービスが提供できない自由な早期警告。
証拠は紛争を変える前に行動を変えます。あらゆる結果のあるステップが記録されていることを知ることは、すべてで委譲を心理的に実行可能にしました。記録は信頼の前提条件であり、監査の後知恵ではありませんでした。
信頼ゲーティングは平均精度よりも重要です。実際に危険なイベントは、確信した誤りであり、決して平凡な出力ではありませんでした。アーキテクチャの真の貢献は、高い信頼を高価にすることでした。回答は1つのモデルの流暢さから自由に取得するのではなく、クロスモデルの合意を生き残るために取得する必要がありました。
5. 含意:説得からインフラストラクチャへ
設計とエクスペリエンス
サービスデザインの場合。信頼できるAIサービスデザインの単位は、モデルからパイプラインへと移行しています。つまり、重大な問い合わせを独立したモデルを通じてルーティングし、不一致をファーストクラスのUX要素として扱い、デフォルトで証拠を添付し、マルチモデル処理を確信的エラーの非対称コストに対して価格付けする必要があります。高リスク取引に対して詳細な調査を予約する不正スクリーニングと同様に、利害が集中するリクエストのために高コストのパスを予約します。インフラは既に存在しています。コスト駆動型カスケードは難しいリクエストを高コスト層にエスカレートさせることは、標準的なエージェントエンジニアリングであり、既に難易度によってルーティングしているサービスの場合、結果によるルーティングの限界アーキテクチャはほぼゼロに近いです。両方の実験が測定した故障モードは、2つの難しいルールを残しており、これらは設計上の要望ではなく、設計要件です。ポジションは盲目的に収集され、クロスモデル熟議前に記録される必要があります。熟議優先パイプラインはアーキテクチャが取り締まるべき合意そのものを製造するためです(第3節の同調圧力)。第2のルール。制約されたオプションセットに対する全員一致の確信的合意は、実行への青信号ではなく、レビューへの赤信号です。第6節のモデルパネルと人間参加者の両方が、まさにその合意を認証として扱いました。
エスカレーションが段階的である段階的信頼アーキテクチャであるため、経済学は機能します。ここに記述されたデプロイメントでは、処理層は単一モデルの回答とマルチモデル熟議の完全版の間で1リクエストあたりのコストにおいて約3桁の範囲です(2026年7月現在)。高コスト層は利害が集中する場所でのみ購入されます。損益分岐点ロジックは不正スコアリングのものです(図14)。オーケストレーションは、確信的エラーの確率にその完全なコスト(払い戻し、1ストレス許容度の下でのチャーン、責任、規制リスク)を乗じたものが検査の限界計算量を超える場合はいつでも支払います。高リスク取引の場合、その不等式は近いものではありません。
推論価格の低下(固定能力での3年間で約2桁の数、追跡の減少の保守的解釈;Appenzeller、2024)は、比率ではなく絶対コストが構造的量であるため、議論を解散させません。両方の層は価格曲線と一緒に下がり、安価な推論は低いリスクで高コスト層を手頃な価格にします。検査は独自の第2曲線に乗ります。弱い検証器のアンサンブルは、ラベル付きデータなしで、オープン70億パラメータコンポーネントからのフロンティア推論モデルの回答選択精度に到達します(Saad-Falcon他、2025)。1ストレス消費者許容度を考えると、比較は「安い回答対高い回答」ではなく、「高い回答対失われた顧客」です。
2つの消費者向けプリミティブがデザインを完成させます。意図的な摩擦(取消不可能なアクション前のマークされた一時停止)とレシートです。どちらも委任がどのように感じるかに介入します。消費者はAIを統計的ではなく社会学的に経験します(Puntoni、Reczek、Giesler、& Botti、2021)。委任実行がサービスエンカウンターをビューから削除すると、レシートは真実の瞬間として古いエンカウンターの役割を引き継ぎます。そのフレーミングに伴うリスクがあります。不一致を顕在化させることは、不確実性を宣伝し、信頼を較正するのではなく信頼を低下させる可能性があります(Detjen他、2025;Lu、Wang、& Yin、2024)。どの程度の相違を表面化させるか、どのように表面化させるかは設計変数です。これは無料のものではありません。
最小限のオーケストレーションレシートでもその仕事をすることができます(図8はモックアップを示しています)。3つのフィールドがほとんどの価値を運びます。(1)誰が行動したか。相談されたモデルとバージョン、どのような権限の下で;(2)どのように合意したか。平易な用語の相違要約;(3)何がチェックされたか。完全に再生可能な記録へのポインタ付き。一目で読むのに十分小さく、紛争、保険請求、または監査を固定するのに十分具体的です。同じアーティファクトは、オペレーター独自の簿記の質問に答えるため、レシートは2回売ります。内側はコスト管理として、外側は保証された信頼として。その二重性は必要です。透明性だけに対する測定された消費者の支払意欲は薄いです(1つの価格設定コンジョイントでは、説明可能性の値は月額1.99ユーロに満たなかった;König他、2022)。消費者側だけで資金を調達された信頼層は飢えてしまい、オペレーターのコスト管理側がそれを運びます。レシートの最も近いエンジニアリング隣人は、ハルシネーション検出のためにエージェントフレームワーク内で記録されるツールレシートです(Basu、2026)。これは本能を共有していますが、聴衆は共有していません。これらは個別のツール呼び出しの開発者向けレコードですが、オーケストレーションレシートは消費者向けの、決定ごとの一般化です。レシートは独自の失敗モードを招きます。検証済みに見えるように設計されたアーティファクトですが、消費者が再実行できるものは何も公開されません。重要な設計ラインは、記録が真に再生可能であり、単なるレシート形状ではないかどうかです。プライバシー側からも制約が来ます。何がチェックされたかを証明するアーティファクトは、何が優先されたかも記録するため、検証可能性とプライバシーは共同で最適化される必要があります(Alavi & Nozari、2026)。
受領書経済学の最後の一片は、チェックの経済学という名前で知られている。改ざん防止記録の価値は、それを開く誰かのインセンティブの価値と同じだけであり、分散型システムの10年がここでの注意である。公開で改ざん防止されたブロックチェーン記録は、通常のユーザーを監査人に変えず、「トラストレス」なアーキテクチャは実用的な接合部のあらゆる場所で静かに信頼できる仲介者を再導入した(Werbach, 2018)。検証者のジレンマが正式版である。検証が費用がかかり、正しい結果が一般的なケースである場合、合理的な検証者はチェックをスキップする。検証需要は、チェックへのプライベート報酬がすでに存在する場所、保険会社、監査人、紛争プロセスの間に集中する必要があり、消費者はそれらの市場の副産物として検証を引き継ぐ。受領書の消費者機能は、夜間の読み取りではなく、紛争時の利用可能性である。資金調達の質問は同じポイントから続き、それへの両方の素朴な答えは失敗する。消費者負担のオーケストレータは中立性を贅沢品として価格設定し、マーチャント負担のオーケストレータはそれが存在する理由の葛藤を再輸入する。これは受領書の双方向経済がすでに意味するモデルを残す。レイヤーは監査と同じ方法で支払われる、リスクを価格設定する必要がある、ストーリーを語る必要がない当事者によって(コスト統治と責任削減を購入する運営者、引受可能なリスク低減を購入する保険会社、証拠を購入する紛争プロセス)、それらの市場が不十分に需要する場所での規制的下限。消費者はサービスを購入し、中立性ではなく、中立性をその副産物として引き継ぐ。同じ問題には市場構造版がある。同時にマーケットプレイス、モデルベンダー、広告ネットワークであるプラットフォームは、中立性を供給することができず、これは市場形式の利益相反ポイントであり、アルゴリズム優先順位付け(スポンサー付き配置、優先パートナー)の歴史的記録は支配的プレイヤーがルーティングを収益化することができれば、そうするだろうという。その圧力が操作される場所では、中立性下限は自発的ではなく、規制的またはオープンプロトコルである。初期接触消費者証拠需要が薄い場合、建築信頼の採択は消費者選択よりも、コンプライアンスと保険側による駆動が少なくなり、好みではなく機関を通じた移行、消費者がデフォルトとして検証可能なアーキテクチャを引き継ぐ。キャリブレーション結果はそのルートが装飾的であることを保つ。消費者は、建築的シグナルが目の前に置かれると明らかにそれを使用するが、それを呼び出すために支払うことはまだない。ここに対立仮説がある。信頼は検証可能なアーキテクチャではなく、責任と機関に移行するかもしれない。消費者は台帳監査ではなくチャージバック権に依存する。カードネットワークは消費者が認可記録を検査することを通じてではなく、紛争権を通じてリモートコマースをスケールした。その読み取りでは、決定記録は消費者信頼のオブジェクトではなく、責任を計算可能にするプラミングである。2つのアカウントは異なることを予測する。建築アカウントでは、消費者はそれを見ることができるときに検証可能性に報い、機関アカウントでは、救済策が添付されたときにのみそれに報い、消費者の信頼は機関に固定されたまま、機関の信頼はアーキテクチャに移行する。以下で指定された紛争時設計はそれらを区別する。そしてあらゆる記録レイヤーはオラクル問題を引き継ぐ。記録はプロセスを認定し、プロセス自身のチェックだけが事実に到達する。受領書が逆転させる非対称性は、プラットフォーム批評文献が文書化するもの。アーキテクチャは、述べられたポリシーではなく、デジタル行為の運営規制である(Lessig, 2006)。そして今日まで、そのインストルメントは消費者ではなく消費者側で保有されている(Zuboff, 2019; Möhlmann & Zalmanson, 2017)。受領書はそれらのインストルメントを他の方向に戻す。
エビデンス層は、バックオフィスログに保存されるのではなく、製品自体に表示されるべきである。ソフトウェアエンジニアリングは、エージェンティックモデルの周りのランタイムラッパーの名前、エージェントハーネスに、そしてハーネスであり、モデルではなく、認定、規制、信頼できるものはハーネスであるという認識に最近収束している。建築信頼は、ハーネスがその役割に値するために生成するものを指定する。
このセクションが設計するスケール、および設計するスナップバックの両方はすでに記録されている。Klarna のアシスタントは初月に230万の会話を処理し、これは同社のカスタマーサービスチャットの3分の2であり、700人の常勤エージェントの推定作業である(Klarna, 2024, 企業報告数)。14ヶ月後、CEOは公開で針路を転換した。出力品質が低下し、人的採用が再開され、確立されたコミットメントは「あなたが望むなら常に人がいるだろう」となった(Daly, 2025)。建築的に読むと、会社の述べられた理由ではなく、私の読み取りとして、発表のペアはこの論文が名前を付ける正確なギャップを括弧で括る。ボリュームティアはマシンコストで機能するが、段階的なエスカレーションがなく、チェック可能な品質シグナルがない場合、委任は人間のベースラインにスナップバックした。それらの発表の間の位置を安定させるのは、段階的な信頼アーキテクチャである。リスクが低い場所では安価で、リスクが集中する場所ではチェックされ、チェックが失敗する場所では人間である。
市場と規制
クロスボーダーサービスの場合。 中立性はモデルベンダーを超えて管轄権まで広がる。オーケストレーション層は管轄権対応ルーティングを実施し、その実施を記録し、データソブリンティコンプライアンスを法的表現から監査可能なランタイムプロパティに変える。それが対応する差別化は測定されている。25の国にわたって、回答者の中央値53%がEUがAIを効果的に規制すると信頼し、米国では37%、中国では27%である(Pew データ、Stanford HAI, 2026で報告、研究所報告書、ピアレビューではない)。信頼が管轄権によって異なる場合、どの管轄権のルールが適用されたかを証明できるアーキテクチャには実際の価値がある。
エージェンティックコマースの場合。 Visa–ChatGPT 統合は3つのコンポーネントを具体化する。キャップとホワイトリストは静的で、消費者側のガードレールである。建築信頼は動的なサービス側レイヤーを追加する。購入は独立したモデルによって相互確認される(多様性)、エージェントがこのマーチャントをこの価格で選んだ理由の再生可能な記録(エビデンス)、および収益がどのベンダーまたはマーチャントが勝つかに依存しないオーケストレーション層(中立性)。
決済業界はすでにこのスタックの下層階を構築し始めています。Visaの Trusted Agent Protocol(2025年10月、Cloudflareとの協働;Visa, 2025)はエージェントのアイデンティティをその要求に暗号的に署名します。マーチャント固有かつ目的固有で、時間制限付きでリプレイ攻撃に強い署名です。Googleの Agent Payments Protocol(Google Cloud, 2025)はMastercardのフレームワークとともにFIDO Allianceに2026年に貢献されたもので、ユーザーの意図を、W3C Verifiable Credentials(W3C, 2025)として送信される署名付き委任として符号化します。Mastercardの Verifiable Intent(Googleとの共同フレームワーク;2026年3月発表;Mastercard, 2026)は、その目的をこの論文が書きうるような言葉で述べており、AIエージェントがユーザーの代わりに行動する際にユーザーが認可したものの改ざん防止記録であり、2026年にアジアおよびラテンアメリカ市場での初期パイロットが報告されています。アイデンティティと意図の証拠が現在標準化されており、記録形式も同様です。IETFの SCITT アーキテクチャ(RFC 9943、2026)は、署名付きステートメント→追記専用透明性ログ→領収書という同じパターンを規定しており、この論文の証拠層が前提とするものです。委任が起こるインターフェースは道徳的に中立的ではありません。13の実験において、AIに委任した人々はより不正直に行動し、目標設定が曖昧な場合に最も顕著であり、機械エージェントは人間エージェントよりもはるかに頻繁に完全に不正な指示を実行しました(Köbis et al., 2025)。意図を特定の用語で述べることを強制するインターフェースは倫理的インフラストラクチャです。
第3階層である決定証拠をまだカバーしているプロトコルはありません。エージェントがこのマーチャント、この製品、この価格をどのように選んだか、独立した検証が同意したかどうか、その信頼度はいくら価値があったか(図15は3つの階層を描いています)。これがこの論文が名付ける層であり、「know-your-agent」はちょうどこのプロセス質問へと成熟し、監視の単位がトランザクションへと移行すべきです。アーキテクチャが保証できるのは記録の存在であり、その読まれることではありません。そのような記録を誰が開くかは、デプロイメント のみが答えられる経験的問題です。
図15証拠スタック
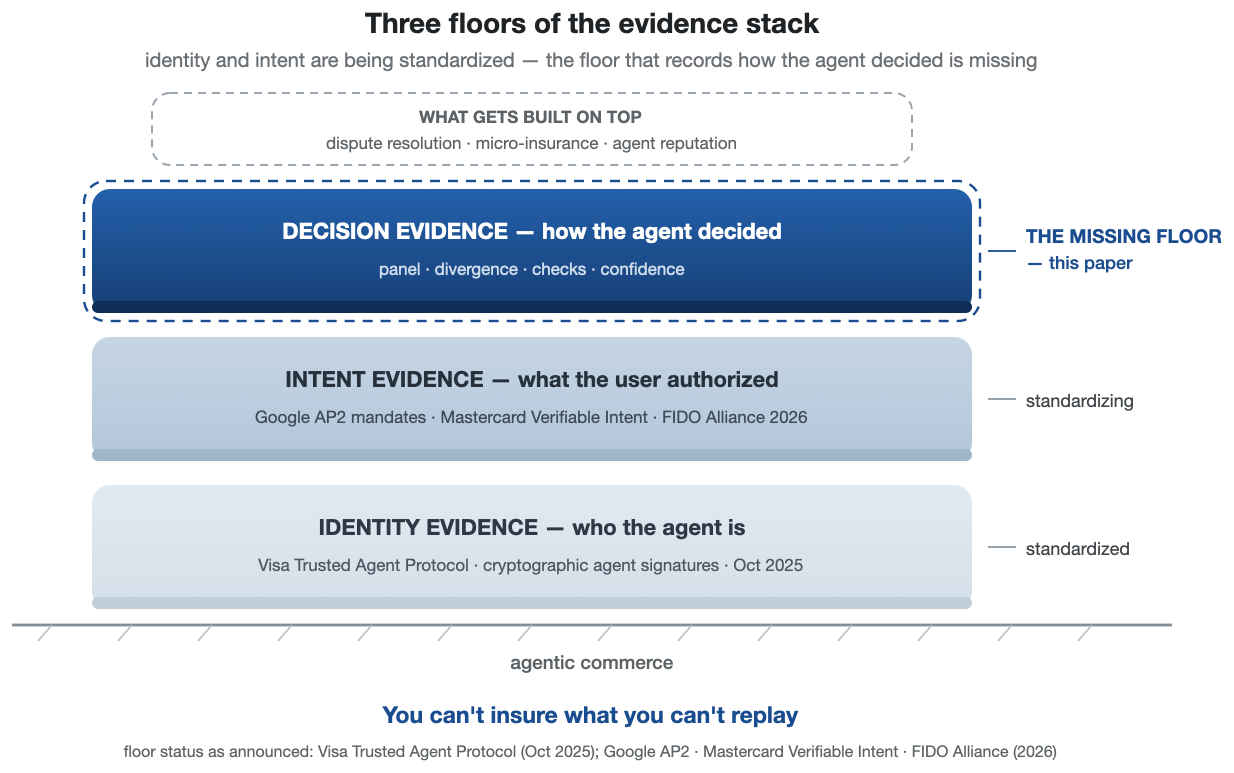
アイデンティティと意図の証拠は現在標準化されており、決定証拠はこの論文が名付ける欠落している階層です。
エージェント購買行動の最初の体系的監査は、決定証拠が待つことができない理由を示しています。Allouah et al.(2026)は管理された電子商取引サンドボックスで無作為化試験を実行し、ショッピングエージェントが強い位置バイアスを示し、いくつかの「モーダル」製品に需要を集中させ、根底にあるモデルが更新されると那些の嗜好を抜本的に変更することを発見しました。選択がどのように行われたかの記録がなければ、消費者、マーチャント、または規制当局のいずれもこれを見ることはできません。多様性がここでの設計の答えです。パネルは単一のモデルの位置的な癖を希釈するからです。そして説明責任は決定証拠が供給するものです。その監査人がサンドボックスで観察するために構築しなければならなかったものを、アーキテクチャ的に信頼されたサービスは本番環境で記録するでしょう。
このフレームは消費者を超えて、マシン間信頼にも拡張します。B2B エージェンティックワークフローでは、信頼を感じるためのループ内の人間がいないため、唯一の可能な基質は検証可能なプロセスであり、エージェントはここで説明されたまさにその成果物を交換し、取引するかどうかを計算します。そのような委任チーン全体での信頼がどのように集約され伝播するか、および証拠層独自のログと検証オーバーヘッドが本番環境の容量でいくら費用がかかるかは、ここでのオープンな問題です。チーンは要件を先鋭化させます。チーンはその最も証拠が不足しているリンク以上に信頼できないからです。記録は構成可能でなければなりません。消費者が存在しない場合、アーキテクチャ的信頼は、おそらく、利用可能な唯一の信頼の形式です。
信頼文献が追いついていない構造的発展はプロトコル戦争です。競合するエージェント商取引スタック(OpenAI with Stripe、Agentic Commerce Protocol;Googleの Universal Commerce Protocol 連合;Perplexity with PayPal;その下のカードネットワークとオープン標準)は、AIサービスがベンダーモデルライン に沿って断片化したのとまさに同じ方法で、商取引をベンダープロトコルラインに沿って断片化しており、中立性論は言葉通りにほぼ一般化します。単一のベンダーのプロトコル内でのみ取引できる消費者のエージェントは、消費者のエージェントではなく、ベンダーのエージェントです。どの層がプロトコル間で仲裁するにしても、同じ3つの要件に直面します。独立性、証拠、そして利害関係がないこと。そしてそのような層が定着すれば、棚をめぐる戦いはチェッカーをめぐる戦いになります。
証拠市場向け2026年にこれは予測であることをやめました。責任側では、保険が最初に動き、同時に2つの方向に進みました。生成型AI請求の任意除外裏書は2026年1月に標準的な一般賠償責任ツールキットに入り(ISOフォーム CG 40 47 および CG 40 48、保険料がもしれません。数ヶ月以内に、主要な保険料はそれらを採用するか、独自の同等物を採用するために提出していました)。同じ窓口で最初のAIエージェントポリシーが反対の方法で書かれました、証拠に反して。AIUC-1 エージェント標準は、レッドチームの監査を通じて、保険料が引き受けるために必要とする経験的リスク プロファイルを生成するために存在します。2026年2月から3月は、その最初の認定監査人、最初のエージェント ポリシー、最初のエンタープライズ認証をもたらしました。包括的除外と証拠ベースの引き受けの間に圧縮された記録は、責任配分の単位になりました。検査可能な履歴のないエージェントは除外型カバレッジに直面し、1つを持つエージェントは見積もり可能なリスクです。
規制側では、EU AI法第50条の透明性義務(消費者へのAI相互作用の強制的な開示を含む)は2026年8月2日に実施可能になります(移行的なマーキング副義務は2026年12月2日まで実行されます)。この論文のペナルティ条項の解釈では、最大€1,500万またはグローバルターンオーバーの3%の罰金が科せられます。欧州委員会は2026年7月20日に第50条ガイダンスを採択し(欧州委員会、2026)、並行デジタルオムニバス単純化(7月8日署名)は8月の義務を遅延させません。既存のシステムは機械可読コンテンツマーキングのための2026年12月までの限定的な延期のみを受け取ります。より広い高リスク義務は2027年から2028年にかけて段階的に導入されます。
証拠層はこの義務を変える:必要なAI開示がこのセッションでこのユーザーに表示されたことの証明を含む改ざん防止記録は、本論文の解釈によれば、最大1500万ユーロの法的リスクを、監査可能な実行時特性、アーキテクチャの副産物としての準拠に変換する。AI-エージェント責任を引き受ける保険会社はまさにこれらの記録を必要とし、追跡可能性と説明責任はNIST AI リスク管理フレームワークの中核的特性である。規制の前例は技術よりも古い。銀行のモデルリスク指針は2011年以来(Federal Reserve SR 11-7)、モデルの開発者から独立した当事者による独立した検証を要求しており、この要件は調整されたパネルによって自動化され、継続的になり、すべての重要な回答に拡張される。消費者法はすでに人間による出口を確保している:GDPR第22条は、単独の自動化された決定で重大な影響を持つ決定における人間の介入の権利を与え、発散時のエスカレーションは、本論文の解釈によれば、既存の法的権利の実行時形式である。AI法は監督側から同じ設計に到達する:規則(EU)2024/1689第14条は、高リスクAIシステムが効果的な人間による監督のために構築されることを要求し、発散を表面化させ、未解決の事例を人間にルーティングするアーキテクチャは、その監督義務を準拠文書ではなく実行時特性として実装する。
記録が存在するようになると、2つの派生製品が続き、どちらも近期の推測である。トランザクションレベルのマイクロ保険は特定のエージェント購入を数セントで保険し、証拠記録から価格設定され、不透明なエージェントに対しては記述不可能で、再生可能なエージェントに対しては自明である。もう1つはエージェント評判である:縦断的な証拠履歴はエージェントとオーケストレータの評判スコアに自然に集約される。操作の副産物として監査グレード履歴を生成するサービスは、競合他社が改造する必要があるアセットを保有することになる。
このような種類のインフラストラクチャがいかに制度化されるかは、それ自体が仮説である。本論文が賭ける軌跡、最初に製品、その後に標準、最後に義務、は信頼インフラストラクチャの歴史が示すいくつかのうちの1つである(共有ATMネットワーク、カードネットワークの規則後に規制によって批准される、ブロックチェーンの検証供給はまだ需要を待っている)。また、その背後には名付けられた研究プログラムがある。Hadfield の規制市場ラインは、公的当局によってライセンスされた私的規制者、独立した検証組織を負荷を支えるインストレーションとして、(Hadfield、2017;Clark & Hadfield、2020;Hadfield & Clark、2026)、統治の供給側からそれに到達する。本論文は消費者委譲の需要側からそれに到達し、2つのプログラムはレシートで出会う。その下には、製品機能として販売されたレシートが制度に硬化するかどうかという、より難しい問題がある。そうでない場合、それは統治層ではなく統治装飾品のままであり、本論文の中心的主張を反証するであろう。反証点は事前登録されている:少なくとも2つの業界標準がエージェンティック取引の追跡可能な決定記録を要求し、すべての3つのコンポーネントを搭載するサービスが高リスクのエージェンティック取引量の大多数を処理し、少なくとも1つの国家規制者がその責任配分でそのような記録を認識するとき、レシートを統治層と呼ぶ。すべての3つの持続的な失敗は、運用上「装飾品」が意味することである。検証がインフラストラクチャとして成功した場合、それは商品化され、信頼は共有ユーティリティそのもの、現在のアーキテクチャを含めて移行し、インフラストラクチャが成功した場合でも護堀を終わらせるであろう。
調整された決定が誤った場合、誰が責任を負うかは、オーケストレータ、モデルベンダー、またはエージェントを承認した消費者であり、残された開かれた質問である。
法律は簡単な出口を遮断し始めた。カリフォルニア州のAB 316、2026年1月1日に発効し、AIシステムを開発、修正、または使用したすべての被告人がAIが自律的に害を引き起こしたと主張することを禁止し、通常の防御と責任の比較配分をそのままにしておく。厳密責任を課さない。これで配分の質問は回避不可能になり、学説がどのように解決するか、再生可能な記録は、責任のどの配分が計算されるかを知ることである。法的奨学金は同じ目的地に到達し、古典的エージェンシー法ツールキットがAIエージェントに譲歩しておらず、必要なことは可視性と責任の新しいインフラストラクチャである(Kolt、2025)、統治文献でこの論文の議論の最も近い前任者であり、この論文が需要から接近する監督の供給から接近している。建築信頼は、出現している責任学説が妥当に実行できる証拠基板である。
測定と研究議題
信頼測定について。標準的な機器はブランドまたはインターフェイスに対する態度を測定する。測定する価値のある態度は、「このAIを信頼していますか」という答えではなく、委譲意願である:どのクラスの決定であり、どのような利害関係で、消費者は各ステップを見直さずにエージェントに引き渡すであろうか?委譲は行動的、正当な信頼において単調であり、直接売上高に関連している。それの横には、消費者が回答がどのように生成されたかを知っているかどうか、彼らが記録に達することができるかどうか、および表面化した意見不一致が彼らの信頼性キャリブレーションを改善または低下させるかどうかという質問がある。
調査は人間時代のレシートであった:消費者が検索、比較、および選択を実行している間、消費者に尋ねることは、何が起こったかを学ぶための防御可能な方法であった。委譲は、質問票が尋ねるように構築された行為者を削除するため、エピソードの主要なトレースはアーキテクチャが生成するアーティファクトになり、レシートはその正確な意味で委譲時代の主要なトランザクショントレースである。2つの機器は競争しない:レシートはマシンが何をしたかを記録し、主観的適切性、感じた自律性、または認知負荷について何も言わない、それらはアンケートの領域のままである。(これはセクション1の見かけ上の張力を解消し、その動機証拠は述べられた選好調査である:調査はほぼ存在しない市場について消費者が現在感じていることを測定し、レシートはそれらが存在するようになったら委譲サービスが実際に何をしたかを測定する。)このブリッジは、同じエピソードの態度測定とアーティファクトを結合し、結果によって階層化され、質問票と記録が同意する場所と、どちらがその後の委譲行動をより予測するかを推定することによってテストすることができる。提案される合同は設計によってこの検証の一部を実行し、そのような研究が存在するまで、アーティファクトベースのメトリクスはアンケートを廃止するのではなく補完する。
業界調査は既に行動基準を示しています。Gartnerが2026年5月に発表した消費者調査(米国消費者846名、2025年11月~12月実施)では、買い物時に生成AIを使用したショッパーの54%がそれが提供した情報をすべて二重確認していると報告しています。アーキテクチャ信頼は、消費者が既に自分たちのために行っていることの製品化です。
測定プログラムは、包括的評価運動(Liang et al., 2023)とエージェント信頼性の新興科学に自然な味方を持っています。エージェント信頼性は、単一の成功率が重要な失敗を隠してしまうため、信頼性を12の指標に分解します(Rabanser et al., 2026)。アーキテクチャ信頼は同じ方法で操作可能です。動的には、確実なエラー率、適切な依存、助言の重み付けのシフト、オーバーライド率、決定時間、そして特に鋭い統計として、正確な出力と不正確な出力の間の承認率のギャップがあり、これは信頼度キャリブレーションを行動から直接読み取ったものです。記録側では証拠カバレッジ、測定されたパネル分散、およびレシートアクセス率があり、同じエピソードに対して調査、行動、ログを三角測量します。これはいずれも新しい科学を必要としません。要件は、これらが、そしてエンゲージメントではなく、信頼層が説明責任を負う数値であるという決定です。配置ポイントからの私自身の観察は直感に反した方法を指しています。よく提示された不確実性は私の適切な依存を増加させ、システムが目に見えてそれが知らないことを知っていたとき、私はシステムをより信頼していました。
さらにもう一つの従属変数が議題に含まれるべき理由は、信頼が委任がもたらす心理的負担の唯一の側面ではないからです。消費者は、アルゴリズムが生成した結果に対しては、肯定的な結果であってもより冷淡に応答します。これは、自分が生成しなかった結果を自分のものとして主張することが難しいためです(Yalcin, Lim, Puntoni, & van Osselaer, 2022)。委任は決定の客観的質を向上させる一方で、その主観的所有権を低下させる可能性があります。領収書はそのフォークに位置します。一つの解釈では、それは著作権を回復させます。別の解釈では、消費者は何もしなかったことを証明します。どの解釈が優位に立つかは、フレームワークがすでに具現化した設計上の問題です。証拠コンポーネントは、何が確認され、どの基準に対して確認されたかを記録します(セクション3)。領収書は消費者自身の基準をその記録に組み込むように構築されているため、評価基準の著作権は実験者が発明するものではなく、アーキテクチャが公開する変数です。Yalcinらのメカニズム、すなわち自分が生成しなかった結果を自分のものとして主張することが難しいというメカニズムは、基準の著作権を自然な調整変数にし、P5は議題の副次的な分岐ではなく、所有感の心理に対する証拠コンポーネントの帰結です。P5. 領収書の顕著性は、結果の好意性と相互作用して、委任された結果の主観的所有感を決定します。好意的な結果に対して、顕著な領収書は、消費者が作成した基準をエンコードするとき所有感を回復させます(エージェントが満たさなければならなかった基準は私のものであり、ここはそれがそれを満たしたという証拠です)。一方、基準がプラットフォームのものとして読まれるとき所有感を低下させます。評価基準の消費者著作権が設計上の調整変数です。Yalcinらの効果は、消費者が自分で決定を下すことを期待していた場合に観察されたため、P5はその境界にスコープされており、習慣的な委任の下では逆転する可能性があります。また、領収書が既存のプロセス透明性操作と何が異なるかは、仮定ではなく実装される必要があります。領収書は検証可能であり、消費者自身の基準を運ぶことができます。両者を省略した設計は、アーキテクチャ的信頼ではなく、透明性をテストしています。
透明性に関する文献はここで2つの警告をもたらします。過剰な手続き的透明性は信頼を低下させることができます(Kizilcec, 2016)。また、AIの使用に関する単なる開示はそれを侵食します(Schilke & Reimann, 2025)。2番目は証拠コンポーネントの境界条件です。13の実験全体で、AI使用を開示した行為者は、そうしなかった行為者よりも信頼されました。透明性のジレンマであり、AI関与をより可視化することで、それ自体が信頼を低下させます。その罰がAI関与の任意の信号に付与される場合、その固有のメカニズムを前景にするアーキテクチャは、それをより検証可能にしながら、信頼を低下させる可能性があります。証拠コンポーネントはまさにそれが最も顕著な場所でバックファイアする可能性があります。フレームワークの答えは、実証する必要がある区別に基づいています。検証可能性は単なる開示ではありません。領収書は答えがどのように生成されたかの検証可能な記録であり、AIが使用されたという宣言ではありません。P2とP3(H2の事前登録された二側面検定、開示バックファイアが事前に報告可能な結果として名付けられている)は、まさにこの区別が行動的にその価値を証明するか、失敗するかの場所です。検証可能性が信頼を構築するもの。需要に応じて配信され、常に存在する系統記録の壁としてではなく、メカニズムを隠すことも発表することも、その仕事をしません。どの程度の記録を表示するか、誰に対して、いつ表示するかは、それ自体が設計変数です。
証拠が開示罰をさらに悪化させるのではなく克服するためのメカニズムは、検証可能性と開示が異なる心理的チャネルを通じて移動することです。開示は、AIが関与していたという範疇ラベルを配信し、SchilkeとReimnnの証拠は低下した正当性に結び付けられます。領収書は手続き、開くことができ、異議を唱えることができ、再実行できる記録を配信します。手続き的公正に関する文献は、異議を唱えることができ、チェックすることができるプロセスが、それを実行する行為者を正当化することを保持しています(Tax, Brown, & Chandrashekaran, 1998)。チャネルはチェックが発生することを必要としません。信頼を運ぶものは、消費者がチェックが存在すること、および紛争時に開かれることができることを認識していること、チェックの運動ではなく検証の利用可能性です。これはまさに、上記の領収書に対するチェックの経済学が消費者機能に割り当てるものです。チェックは民間の見返りがある場所に集中し、消費者は検証をターンキーとして継承し、記録を文書としてではなく、オプションとして保持します。同じ区別は主観的所有感に及びます(P5)。開示ラベルは決定を機械に帰属させ、所有権を奪いますが、消費者が作成した基準をエンコードする領収書は、エージェントが満たす必要があった基準が消費者自身のものであったことを文書化します。2つのチャネルが実際に分離されるかどうか、検証可能な手続きで正当性が上昇する一方で、単なる開示で低下するかどうかは、まさにH2の事前登録された二側面検定が検出するために構築されたものです。
限界。 このモデルは建築分析と1つの拡張された高リスク単一オペレーターデプロイメントから導出されています。すべての実証的根拠は、私が構築して運用しているその1つのスタック上で得られました。それ自体に適用すると、この論文の根拠はその格子構造によって混在しています。1人の著者と1つのスタック(低い多様性)、公開された複製パッケージの横にある密閉されたデプロイメント記録と、出版まで禁止された行動登録(部分的証拠)、および宣言された商業的利害関係(中立性の損なわれ)です。いかなる主張が一般化する前に、他のスタック上での独立した複製が必要です。デプロイメント記録のハッシュアンカーにより、後の編集、置換、または遡及日付付けは検出可能であるため、公開時に、ここでの特性評価は、実証的に変更されていない成果物に対して検証できます。読者は、公開まで、内容ではなく整合性を検証できます。メカニズム数値は公開モデルAPIから取得され、パイプラインは$15未満で実装全体を複製します。刺激レンダリングはインターフェースの交絡因子のままです。消費者実験の刺激、スタイルを含むレシートは、私自身のUXレンダリングであり、インターフェースレベルの交絡因子は独立したレンダリングによる複製によってのみ解きほぐれます。ブラインドファースト収集、改ざん防止記録、ノーステークルーティングが構成です。集計ルールとエスカレーション閾値はエンジニアリングの選択です。実験のパネルは、配置されたオーケストレーションループではなく、1つのブラインド収集の分析的組み合わせであり、起案されたフィールドテレメトリプロトコルはそのギャップを埋めます。フレームワークが名付ける非モデル検証パス(シャドウラン、時間的一貫性チェック)はここで説明されており、テストされていません。収集は温度ゼロでの1回の実行であり、モデル内の可変性を抑制し、共有系統相関を保持したままにし、ホストされたAPIはそこでも厳密に決定的ではありません。SimpleQAの短い事実的回答は、合意が誤りを認証する制約回答空間体制の近くにあり、難易度層化は最も難しい五分位数でまさにそのパターンを示しています。中位パネルは、エラー相関が能力とともに上昇するため(Kim et al., 2025)、多様性の利益を誇張する可能性があります。メカニズム実験は、単一の検証可能な回答を持つ開放応答事実的質問をテストし、回答の意味的等価性がそれ自体が判断上の問題である開放終了の生成的タスクでは、認証信号は仮定されるのではなく再確立される必要があります。関連する境界は、回答空間の次元性です。SimpleQA項目には単一の検証可能な回答がありますが、消費者が実行する選択エージェントは、多くの防御可能な回答を持つ主観的な多属性効用判断であるため、合意が嗜好空間でどのように動作するか、独立したエージェント間の合意がそこでより良い選択を特定するかどうかは、開かれた実証的質問です(意味的等価性は嗜好等価性になり、採点自体がモデリング選択になります)。1つのラベルノイズチェックが実行されます。この研究のサンプルとSimpleQA Verified(Google DeepMind, 2025)の351項目交差で、修正されたゴールドラベルに対してすべてのパネル回答を再採点すると、認証リフトは変わらないかわずかに強くなります(2.7→2.8、4.4→4.4、4.0→4.3、3つのパネルにわたって決定的採点者)。したがって、ラベルノイズはリフトの駆動要因ではありません。すべての信頼値は、単一のプロンプト形式によって引き出された口頭での0~100の自己報告であり、引き出しプロトコルに対する感度はベンダーによって異なる可能性があるため、ベンダーごとの識別および校正の結論は、固定ベンダー特性としてではなく、このプロトコルの下でのこの構成の特性として読まれるべきです。16モデル波のテーブル6~7の自信ベースラインは、生の陳述信頼です。Guo et al.(2017)の伝統における、より強い校正ベースラインは、フラッグシップ波で実行されました(Plattスケーリングと分割共形棄却、セクション3)。ここでは、ゲートの代替ではなく補完として現れ、最初の波のパネル対自己比較は、消費者製品が実際に配置するベースラインに対して読まれるべきです。見出しゲート推定値(自信のある失敗の−82.1%、10の完全なアームに対するブートストラップ95% CI [79.9; 84.1]、Metaアームを含める[80.0; 84.2])は、単一の事前指定量であり、周辺の分析(閾値感度グリッド、難易度および汚染層、評議会アブレーションおよび自明ベースライン比較)は、複数比較の補正なしで報告される記述的頑健性チェックであり、独自の確認的地位は主張しません。論文の唯一のファミリーワイズエラー制御は、消費者実験の事前登録された{H1、H2}にわたるHolm補正です。自信のある推測に報いる評価体制が修復されて、真実性をモデルに訓練できるようになった場合(Kalai et al., 2025)、建築はより安い解決策を持つ問題に対して保険をかけるでしょうが、証拠と中立性は依然としてモデルレベルの修正に還元不可能なままです。さらなる境界は、報告される場所に記載されています。フラッグシップ波のカバレッジの制限(セクション3:2つのアクセス不可能な中国フラッグシップと1つの中断されたMeta収集)、および予備的な233ペア推論予算比較。その TOST境界は±5ポイントマージンでの等価性であり、より狭い境界に対する検出力はありません。代理人測定は仮定的なビネットから来ており、陳述測定はメタ分析により実際の意思よりも約21%誇張されます(Schmidt & Bijmolt, 2020)。消費者実験は、6つの固定項目にわたって200の登録参加者のうち119の一次および133のプール実現を達成しました。商取引基質複製は、メカニズムをベンチマークを超えて拡張します。新鮮で事前凍結された267のWikidata検証製品事実(どの企業が特定の自動車または航空機を製造しているか、電話がどのオペレーティングシステムを実行しているか、どの企業がゲームを出版したか、それが出荷された年)は、独立した6モデルパネル(Claude Opus、GPT-5.4、Grok、Qwen、GLM、およびMistral)を通じてブラインドで実行され、消費者向けエージェントが実際に運用するコスト最適化層はフラッグシップではなく、分離を複製し、モデル間合意が、陳述信頼に対する0.63~0.70に対してAUROC 0.77~0.81で正確性を予測し、4~6倍の認証リフトがあり、米国、中国、およびヨーロッパの研究室にまたがる3~6モデルの独立して作成されたパネルと採点の厳密性(ここでの決定的な文字列一致が一次的で保守的なルール)に対して堅牢です。商取引スペクトラムの主観的な多属性端(嗜好トレードオフ、敵対的なマーチャントインセンティブ、および変化する在庫上のツールグラウンド検索)は依然としてテストされていません。
サンプリング下での実行間分散。 分散アームは、単一決定論的実行の境界を直接調査した:難易度層化サブサンプル100問(難易度5分位数×20、シード20260806)を温度0.7で再実行し、11のフラッグシップ波パネルモデル中9つについて、1問あたり3つの独立サンプルで実施した;メタのエンドポイントにはアクセスできず、Claude Fable 5のAPIは温度パラメータを公開していない。モデル全体で、3つのサンプルすべてが相互に等価な回答を22~77%の問題で生成し(中央値54%)、問題ごとの正確性が3つのサンプル全体で同一だったのは63~97%の問題であり、温度0の回答が多数派温度0.7回答と一致したのは40~85%の問題だった。gpt-5.6-solの脚は交絡を持つ:推論労力なしで実行されたのに対し、その1,500波記録の1,486は上述のデフォルト労力(中、上記参照)を使用した。このサブサンプルでの92.0%→46.3%の精度差は温度と推論予算を交絡させているが、その層間一貫性の数値は影響を受けない。その交絡した脚を除いて、温度0.7での1サンプルあたりの平均精度は同じ問題での決定論的温度0精度と最大14.0ポイント異なり(gemini-3.1-pro、49.0%→63.0%)、残りの7つのモデルは4.4ポイント以内だった。パネルレベルでは、評議会ゲート(kimi-k3、deepseek-v4-proおよびgpt-5.6-solの3者間回答一致)は温度0でサブサンプルの31.0%で開いたのに対し、3つの温度0.7実行全体で25.0%、23.7%および29.8%だった。見出し結果の根底にある一致信号はサンプリングノイズ下で安定している。
主張の証拠的地位。 主張は3つの証拠レベルに該当する。これらのデータにより確立:独立した一致が、述べられた境界条件下(盲検収集、有能な検証者、単一の検証可能な答えを持つ開放的応答事実問題)では、モデルの自己報告が持たないという正確性信号を運ぶこと;固定された不一致ゲートが相当な、述べられたカバレッジコスト(−82.1%で30.5%カバレッジ)で信頼できる失敗の大多数を削減すること;および強い境界条件そのもの:一致が制約された回答空間でエラーを認証し、生の認証上昇は難易度と単調に減衰し(コレクション内層化下で最も困難な5分位数で消滅;外因的なもの下でそこで肯定的だが最も弱い)、検証者の能力が認証値を制限すること。行動実験により支持(1つの設計、適度な単一研究規模、n = 119):実際の交差モデル不一致の浮上が両方向で依拠較正を改善すること(d = 0.67、Holm p = .0005;6項目中1つにより運ばれる;主波操作チェック88~98%;スケール信頼性α = .83~.93);および登録された決定的でないヌルとして、静的な最初の公開受領が委譲を検出可能に移動しないこと。理論的に提案、未だ検査されていない:D×E×N補完性;中立性効果(P3);委譲の増加下での信頼移行;アーキテクチャベースの信頼の失敗後耐久性(P4);検証可能性への支払い意思;および第7章の市場カテゴリ主張。
自然な次のステップは実験的である:単一モデルとオーケストレーション条件全体で信頼、依拠較正、および支払い意思を測定し、不一致を交互に表示および抑制する。第6章は実現された実験、事前登録および誘因両立的なものを報告する。標準的な選択ベースの結合分析は部分価値を加法的に推定し、補償的トレードオフを仮定するもので、これは補完性仮説が否定するものであるため、設計クラスは非補償構造を許可する必要があり、アスペクト別排除であれ、取引破棄属性を持つ強制選択設計であれ、明示的な相互作用項で推定される。2つの設計階層が指定される。最小階層は標的プロフィール研究である、なし、単一成分、2成分および完全な構成にわたる4~5つのプロフィール、理論的な仕事は1つの計画的対比により実行され、完全な構成の効果が成分効果の合計を超えること(超加法性)、加法的ヌル対。完全な階層は成分ごとに3つのレベル(不在、存在するが検査不可、存在し検査可)を3×3×3被験者間因子計画で交差させ(27セル;ステークスは4つのレベル全体で被験者内で変動)、相互作用に関する力≥ 0.85のため各セルごとに最少80応答者(N ≥ 2,160)。二項2³設計はコブ・ダグラス指数を回復できず、妥当な効果サイズ(d ≈ 0.3~0.4)で不十分である。3つの刺激規律が適用される:アーキテクチャ的大きさ自体を変動させ、その標識付けだけではなく(欠落した受領ラベルは消費者の証拠への無知であり、その不在ではない)、各成分に検証可能対単なる主張対比を与え、選択データを受領フィールドの過程追跡とペアにする、理論が証拠の使用を予測するため。筆者の知識では、これは3つの成分を共同で変動させる最初の設計であろう。単一成分の構成要素はすでに価格化されている(König et al., 2022; Ioku et al., 2024)、および隣接するバンドルが実行されている(Cetinkaya & Krämer, 2024、最も近い手段および力較正源はKöbis et al., 2025と並んで)、したがって研究は指定、電源化、および実行準備ができている。構成要素の境界条件は以下の通り:アーキテクチャ信頼はステークスが低く量が多い場所では支払われない;検証者プールがタスククラスで有能でない場所ではほとんど追加されない;回答空間が密接に制約されている場所ではエラーを認証できる;およびパネルの独立性が測定されるのではなく主張される場所ではシアターへと低下し、開放的な赤チームの質問ゲーム化された受領はどのように見えるか?としては鋭い。ハイパーリンクが権限信号になると、リンク農場がそれらを製造するために生じ、一致記録は独自の農業をもたらすことを予期されるべきである。2つの時間的境界も同様に適用される:手がかりは注意に勝ち、証拠は永続性に勝つため、主張は失敗を生き残る信頼がどちらであるかに関するものであり、オンボードする速さがどちらであるかではなく、稼働中のチェック、さえも、Chandra et al.(2026)モデルのような螺旋のスローダウンのみかもしれない。結果が集中し独立性が実在する場所では、アーキテクチャ信頼はその費用とその名前を得る(表12は4つを集める)。
表12。 境界条件:アーキテクチャ信頼が支払われない場所
| 条件 | その場所で失敗する理由 | 証拠 |
| 低ステークス、高量 | 検証コストがエラーのコストを超過;単一モデルサービスが正しい答え | 損益分岐点ロジック(図14) |
| 検証者プールがタスク能力以下 | 独立性は能力がなければ信号を示さない | ローカルティア零値: 合意の有無に関わらず46%の精度 |
| 厳密に制限された回答空間 | 合意はエラーを検出するのではなく認証する | 合意エラー: 多肢選択肢で4.0–7.9%対開放形式で0.5–2.2% |
| 主張されているが測定されていない独立性 | ほぼクローンのパネルが信頼を製造する | 相関したエラー; ブロックと系統の零値 |
最後の境界は、提案されたデザインのいずれが何を識別できるかに関するものである。エージェント市場における信頼は、結局のところ均衡オブジェクトである。売り手、プラットフォーム、および競争するエージェントが検証アーキテクチャに適応すると、その効果は処理セルのものではなく、適応した市場の性質となる。観測データは選択を継承する。検証は信頼がすでに破綻している場所で最初に採用されるためである。単位レベルのランダム化は選択を修正するが、領収書にランダム化されたコンシューマーが誰もの領収書に対応する売り手がいる市場でなお取引するため、干渉で停止する。均衡量にはクラスター、スイッチバック、二部、またはマーケットレベルの設計が必要である。信頼を測定するのではなく、アーキテクチャをランダム化することが次の難しい問題である。そして初期のエージェント-コマース集団は信頼傾向で自己選択するため、初期採用者で推定された効果は、母集団効果を推定するのではなく上限を設定する。中立性はモデルに利害関係のある誰もそれを提供できないために、オーケストレーションに利害関係のある誰もを含めて価値があるのである。議論は私が構築するシステムの種類も説明する(著者注)。その関心はアドボカシーと証拠の再現可能性には触れず: 評価されたモデルは独立した、公開されたフロンティアシステムであり、報告されたすべての数値は凍結された複製パッケージから第三者によって再計算可能である。アドボカシーを完全に割引く読者でも測定を検証できます。
6. コンシューマーは信号を使用できるか? 予備的行動テスト
メカニズムが確立した正当性信号をコンシューマーが使用できるかどうかは、別個の行動上の問題であり、事前登録されたインセンティブ付き実験について報告します。実施された研究は一般的効果のテストではなく存在証明であり、コンシューマーがすべて信号に作用できるかどうかを尋ねます。動力付きの確認的な、多項目の、刺激サンプリングされた、項目ランダム傾斜を有する複製が計画されています。最終採用ウィンドウ中のホスティング障害により、計画された200に対して119の有効参加者での収集が終了しました(133プール軟起動コホート; 米国および英国; エージェント買い物アシスタント周辺の3つの被験者間条件; 6つのインセンティブ付き事実トライアルにわたって測定された較正をΔ = P(受け入れ | 正しい) − P(受け入れ | 不正確)として、Schemmer et al., 2023の適切依存判別インデックス)。完全なメソッド、パイロット、登録からの5つの偏差、倫理と免除開示、およびすべての補助統計は、以下の詳細レポート(§6.1–6.2)および複製パッケージに記載されています。
表示されたクロスモデル不合意は全体的に較正を改善しました(制御Δ = 0.24 → 0.45; d = 0.67, 0.68プール, p = .0001)が、プール推定は脆弱です: 6つの刺激の1つ、単一の高信頼度異議唱えアイテムによって実行され、ディスプレイは自信のある間違った回答の受け入れを74%から24%(プールコホート、表18)に削減しました。そのアイテムを削除すると、効果がd = 0.09(p = .54)に低下し、他の単一アイテムを削除すると、それは無傷のままです。利益は英国サブサンプルに集中しました。米国制御セル(n = 16)はすでに基線で区別されました(相互作用p = .002)。パネル自体が間違った回答に同意した唯一のアイテムで、ディスプレイは両国での受け入れを増加させました。これはセクション3の認証された合意エラーモードを人間の行動で再現し、それ自体が発見です: 合意を表面化するアーキテクチャは、その1つの体系的な失敗をユーザーに転送します。P2の証拠コンポーネント、静的オーケストレーション領収書の最初の露出テストは、委任意思に検出可能な効果を生じませんでした(d = 0.21、この電力では決定的でない; ライブドリルダウン領収書は登録されたフォローアップです)。
異議を唱えるパネルディスプレイは、コンシューマーが受け入れる信頼のある間違った推奨事項の受け入れを急激に削減でき、パネルが共有エラーを認証する場所で失敗します。したがって、較正コントラストはこれらの6つの刺激の下で行動的サポートを持っています; 知覚リスクをメディエーターとして述べられたP1はこのテストによってサポートされていません。P2–P4は公開プログラムのままです。
6.1 行動テスト: 方法とパイロット
セクション3および5の命題はテスト可能であるように書かれており、上記の測定アジェンダはその方法を指定します。実験は、セクション3およ5の命題の事前登録され、インセンティブ両立性のあるオンラインテストであり、P1(表面化された不合意の下での依存較正)およびP2(再生可能な記録の下での委任意思)であり、フラッグシップウェーブの実際のマルチモデル出力から抽出された刺激、第二意見パラダイムの拡張(Detjen et al., 2025; Chen et al., 2026)によって、アーキテクチャフレームの下での実際のインセンティブ付きフロンティアモデル不合意。機器、プロトコルフリーズ、パイロット、メインウェーブ、および凍結コード分析は完全であり、以下に報告されています。確認的テーブルは、このペーパーの以前のバージョンで事前登録スケルトンとして実行され、細胞は[メインデータ保留中]でマークされ、凍結分析コードによって満たされています。仮説に不利な2つの結果は、報告可能な主要な発見として事前登録されました: 表面化された不合意の悪化較正(純下依存)、および領収書の低下意思委任(開示バックファイア); どちらも実現しませんでしたが、1つの事前登録ヌルはしました。
方法。
デザインと仮説。 信頼キャリブレーションには、表示される合意と回答の正確性を組み合わせることが必要であり、単一のビニエットではこれを実行できません。したがって、デザインはハイブリッドです。参加者はまず、ショッピング委譲ビニエット(AI買い物エージェント「ShopAssist」が$1,200の予算内でラップトップ購入を推奨)を読み、これはP2の主要なテストであり、その後、実際のマルチモデル出力に関する短い誘因付き判断ブロックを完了します。これはP1の主要なテストです。H1(P1): 複数の独立したAIシステムからの複数モデル間の合意と不一致を表示することで、消費者の信頼キャリブレーションを改善します(正しい場合にはエージェントの提案された回答をより多く受け入れ、誤りの場合には少なく受け入れます)。これは単一の自信のある回答と比較して、2側検定です。文献は両方の過度の依存の減少と結合提示下での過度の信頼の不足の増加の両方を記録しているからです。H2(P2): オーケストレーションレシートへのアクセス(誰が行動したか、どのように合意したか、何が確認されたか、および完全に再検証可能な記録)は、表示された不一致だけの効果以上に、重要な購入を委譲する意思を増加させます。2側検定です。開示は信頼を低下させることもあるからです。
条件。 3つの被験者間条件、1:1:1でランダム化され、ビニエットと判断ブロック全体で保持:(1)コントロール、単一の自信のある推奨、アーキテクチャシグナルなし;(2)不一致、3つの独立したAIシステム(System A、B、Cとして匿名化)からのパネルが先行する同じ推奨、明確な合意/不一致マーキング、システムの代替回答と述べられた信頼度、および平易な言語による解決の要約;(3)不一致+証拠、不一致画面にプラスオーケストレーションレシートカード、誰が行動したか/どのように合意したか/何が確認されたか/完全な記録として構成。1つの事前登録されたデザイン制約が明らかな交絡変数を制御します:最終推奨ブロック(製品、価格、およびエージェントの述べられた最終信頼度)は3つの条件すべてにわたって、ビニエットおよびすべての判断試験で字句が同一であり、その周囲のアーキテクチャシグナルだけが異なります。
刺激とレシート。 判断ブロック刺激は、旗艦波からの3つの最先端モデルの実際の出力であり、モデルが高い述べられた信頼度(95~100)で真に合意または不一致した実際の事実的質問についてです;回答も信頼度も捏造されていません。モデル名はブランド先行的な交絡を避けるために中立的なラベルに置き換えられ、マッピングはレプリケーションパッケージで開示されます。条件3で表示されるレシート(1つのビニエットレシートと6つの試験レシート)は、刺激パネルの実際の由来ログ上で研究展開の本番レシートミンター(スキーマ`decision-receipt@v1`)によって生成され、検証ハッシュは記録から真に再計算可能です(検証ログ: 7/7有効)。実験の証拠操作は、したがってセクション3が定義するアーティファクトのインスタンスです。表示された焦点信頼度は正確性セル全体で密接に一致させられました(不正確な項目95/98/99;正確な項目99/99/100)。そして、治療対比に決定的に、条件全体で同一です。コントロールは同じ焦点信頼度を見て、はるかに少ない判別をしました。これは信頼度手掛かり説明では説明できません。
測定。 DV1(H2): 4項目委譲意思尺度(7点; 例えば、「ShopAssistにこの購入を完了させ、推奨事項を自分で確認しないようにさせます」)、平均化;単一項目の委譲ラダー(0~4、「推奨事項のみ」から「払戻不可能な購入を含む自律的行動」まで)は二次です。DV2(H1): 6つの判断試験;各試験で、エージェントは1つの回答を提案し、参加者はアシスタントを進行させるかどうか(はい/いいえ)を決定し、回答への信頼を評価します(0~100スライダー)。依存決定は正確性で誘因付けされます(各正しい依存決定、正しい回答を受け入れるか不正確な回答を拒否するでボーナス)。提案された回答は正確に6試験中3つで正しいです。参加者当たりのキャリブレーションスコアはΔ = P(受け入れ|正確)−P(受け入れ|不正確)であり、これは適切な依存文献の判別指標です(Schemmer et al., 2023、その RAIR/RSR測定は同じオブジェクトを分解します);試験レベルの混合効果モデルは項目レベルの解決を回復します。認知リスクと認知プロセス制御(各4項目)は、P1およびP2経路それぞれの事前登録された二次分析の仲介変数として測定されます;認知オーケストレーター中立性(4項目)は、この研究が操作しないP3の探索的相関として測定されます。
固定されたプロトコル。 事前登録はメインデータ収集前に固定されました(SHA-256によって分析コードとプロトコルが2026年8月5日に固定されました。OSF登録は8月13日に提出され、メインウェーブが8月13~14日にフィールドに入る前のことです。エンバーゴ付きで登録されました(事前登録、閲覧のみ:https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f)。論文の公開OSFコンポーネント(https://osf.io/jtvu9/)にリリースされる予定です)。6項目セットはシード値によって固定されています。設計によって固定された3つの意見相違項目と手動検証済み、さらに3つのシステムすべてが同じ信頼度≥95で同一の回答をしたプールから抽出された合意項目、および1つの真の合意エラーを含んでいるため、表示される合意は診断的ですが不完全です。これはソースデータとまったく同じです。6項目はすべての参加者で同一でした。提示順序は調査票内でランダム化されていましたが、フィールド化されたエクスポートは試行ごとの表示順序を保持していません。フィールド化された表示では、パネルの推定独立性スコアが表示されませんでした。これはフレームワーク自体が求める測定多様性の開示ですが、参加者は不一致を見ても、不一致するシステムがどの程度独立しているかを見ていません。パネルの独立性は測定されましたが表示されず、ソース収集のその値はここで事後的に報告されます。平均ペアワイズエラー相関φ = 0.22(3つのペア間で0.10~0.44、同じブロックのメンバー2つはるかに0.44で相関が高い。研究の固定決定論的グレーダーによって分類され、95~98%の回答を解決し、未解決の残り部分がどのようにコード化されるかに対して不敏感)。これはパネルが独立性から遠く、クローンから遠いことを示します。これが次の調査票が参加者の前に表示するべき数字です。1つの刺激境界:6つの固定項目では、処理-項目相互作用を推定できないため、効果はこれらの刺激に対して確立されています。セッションはインフォームドコンセントで始まり、架空のビネット購入の性質を開示するデブリーフィングで終わりました。研究はヘルシンキ宣言に従って実施されました。GDPR準拠パネルの同意した英国および米国の成人を対象とした匿名の最小限リスク調査。プラットフォーム最低額を上回る補償。架空のビネット以外の欺きはなく、デブリーフィングで開示されました。これらの基準の下で、倫理委員会の完全なレビューからの免除条件を満たし、免除評価は事前登録に記録されています。プールは現在閉鎖されています。逐語的な項目セット、回答、および試行ごとのレシート識別子はエンバーゴ付き事前登録の一部であり、データと一緒にリリースされます。
サンプルと分析計画。 目標N = 200の有効な参加者(米国100、英国100。個別のProlific研究。採用上限210)、18才以上、英語が流暢、≥98%の承認率、≥100件の以前の提出、過去3ヶ月間に少なくとも1回のオンライン購入。事前登録された除外基準(実質的な回答を見る前に適用):3つ中2つ以上の失敗した注意チェック。3分未満での完了。ストレートライニング。失敗した操作チェック(条件2~3の合意項目、条件3のレシート項目、製品理解項目)。2回失敗した判断ブロック理解。重複ID またはIP。不完全なセッション。確認的分析:H1の場合、プール化された不一致条件(2および3)対制御への国共変量によるOLS。H2の場合、条件2~3に限定され、国共変量を伴う条件の委任意思複合体のOLS。{H1, H2}全体のホルム補正、ファミリーワイズα = 0.05。堅牢性としてのウェルチt検定。操作チェック ゲーティングが最初に報告されます。コホート順序はここで固定されています。主要な確認的分析は、パイロットのソフト立ち上げ参加者を除いてメインウェーブコホート上で計算されます。ソフト立ち上げコホートを確認的サンプルにプール化するブランチは、堅牢性分析として横に報告されます。パイロットの探索的Δ記述は主波前に見られたため、主要な推定値からそのコホートを除外することで、事前登録されたソフト立ち上げ包含を報告されたブランチとして保持しながら、ダブルディッピングの柔らかい形式さえも削除します。主要な報告には、事前登録されたプロトコル分析とともに、すべてのランダム化された参加者を保持する意図治療分析が含まれます。操作チェック除外は、条件全体の差分脱落チェックとともに報告されます。建築的信号の顕著性は条件全体で異なる可能性があるためです。感度:設計はH1でd ≈ 0.42、H2でd ≈ 0.49を検出します。電力0.80で、隣接する依存性と透明性の文献の中程度の効果に適切です。より小さな効果は研究課題の完全な階乗に任されています。3つの事前登録された要素が確認的な対比だけでは答えられないメカニズムの質問に答えます。調査票はP1経路上に4項目の認識リスク尺度(パイロットα = 0.881)を含んでいるため、リスク認知は仮定ではなく測定済み構成体として分析に入ります。仲介は二次分析として事前登録されており、知覚されたリスクが依存性効果を仲介します。認識された処理制御は受け取り効果を仲介します。委任意思は、ブートストラップパス分析によって推定されます(PROCESS Model 4、5,000リサンプル)。条件3刺激画面での時間は、レシート読取の事前登録されたプロキシとして収集されます。参加者がレシートを処理なしで通過するという認知負荷の代替案の直接チェック。分析コードはデータ収集前に固定され、複製パッケージと一緒にアーカイブされています。
パイロット(ソフト立ち上げ):基準と結果。
最終調査票を使用した事前登録された合格基準が事前に固定されたn = 20(米国)のパイロットが2026年8月6日に完了しました。表13はすべての基準とその結果を報告しています。
表13。 パイロット合格基準(事前登録)と結果(n = 20、米国)
| 基準(事前に固定) | 結果 | 判定 |
| 操作が気づかれた:合意確認で80%以上正解(条件2–3) | 81.3% (13/16) | 合格 |
| 操作が気づかれた:受領確認で80%以上正解(条件3) | 88.9% (8/9) | 合格 |
| Cronbach's α > .70、委譲意思 (4項目) | .854 | 合格 (.85目標もクリア) |
| Cronbach's α > .70、知覚リスク (4項目) | .881 | 合格 |
| Cronbach's α > .70、プロセスコントロール (4項目) | .965 | 合格 |
| Cronbach's α > .70、中立性 (4項目) | .851 | 合格 |
| 中央値の完了時間は10~15分以内 | 9.60分 | 不合格、高速方向で24秒下回る |
1つの基準が失敗しました。中央値は事前登録ウィンドウを24秒下回りました。このウィンドウは長さ過ぎることに対抗するために構築されたもので、効率性に対抗するためではありません。高速側を見ると、不注意な回答の証拠はありません。参加者の誰も3分の除外閾値を下回りませんでした。5分以下だった1人の参加者は、すべての注意、操作、および理解度チェックに合格しました。注意チェックの合格率は95~100%でした。主要変数に欠落セルはなく、重複IDやIPもなく、直線回答者もいませんでした。募集プラットフォームの完了時間は調査タイマーを独立して確認しています(中央値9.74分)。本調査では、予算化されたより短い機器です。条件バランス(条件1/2/3にわたって4/7/9)はn = 20での1:1:1ランダム化と矛盾しません(χ²(2) = 1.90、p = .387)。事前登録分析除外の下では、パイロット参加者20人中6人が確認分析から除外されます(操作チェック理由により5人、2回失敗した理解度により1人)。14人が有効です。ソフト立ち上げルールに従い、パイロットコホートは、ここおよび登録自体に開示されたタイミング偏差を伴い、プール化されたサンプルに進みます。登録は2026年8月14日03:09 UTCにOSFに提出されました。メイン波収集の前にあり、ソフト立ち上げパイロットはタイミング偏差を述べて確認サンプルに含まれることを述べています。メイン波コホートを主要な確認推定として扱い、プール化ブランチをロバストネスとして扱うことは、登録後の分析的決定です。これは、パイロット記述統計がメイン波の前に見られたためです。両方のブランチが報告されます。製品理解度マージン(80%バーを上回る1人の参加者)はメイン波での監視のためにフラグが立てられます。1つの探索的記述子(パイロットnで推論なしで報告)。キャリブレーションスコアΔは条件別に+0.33(制御、n = 4)、+0.52(意見不一致、n = 7)、+0.22(意見不一致+証拠、n = 9)になりました。したがって、意見不一致条件はH1の方向に動きます。パイロットはそれ以上言うことはできません。
6.2 行動テスト: 結果、探索的分析、および残りの台帳
確認的結果。
メイン波収集は2026年8月13~14日に実行されました(190スロット: ソフト立ち上げコホートの上にUS 85 + UK 105)。完了しませんでした。調査ホストは最終的な募集ウィンドウ中に技術的な障害を被りました。収集は合計158の完了したセッション(メイン波で138、ソフト立ち上げで20)で終了しました。200有効サンプルの目標ではなく。募集は、事前登録のオプション停止ルール下でプラットフォーム障害で終了し、観察された結果に応答していません。ただし、結果はすでにその時点で見られていました。結果として、検出力が低下しました。実現されたセルでは、最小検出可能効果は登録されたd ≈ 0.42(H1)およびd ≈ 0.49(H2)から、同じ検出力でおよそd ≈ 0.54およびd ≈ 0.64に上昇します。この限界は、確認的結果が一方向でのみ無関係にし、以下のすべてのヌルおよび探索的対比に適用されます。コホート順序は§6.1の計画に従います。パイロットは1つの合格基準を逃しました(完了時間ウィンドウ、高速方向で24秒)。探索的記述統計がメイン波の前に見られたため、主要な確認的コホートはメイン波のみ(N = 119有効)であり、同一フィールド化されたソフト立ち上げコホートをプール化するブランチが(N = 133)ロバストネスとして報告されます。以下の各数字は、データ収集前にSHA-256によって固定された分析コードの出力です。登録からの逸脱は1か所に集められています。(i)Nの不足(登録200中133有効。ホスティング障害)。(ii)パイロットの完了時間基準は高速方向で24秒逃しました。(iii)試行ごとの表示順序は、フィールド化されたエクスポートに保持されていません。(iv)スクリーンレベルのタイミングがキャプチャされていません。(v)試行レベルの混合モデルは変分近似で実行されました(パッケージの最終エンジンは異なる可能性があります)。他に何も逸脱していません。すべての確認的テストは登録された通りに実行されました。上記の主要コホート決定は1つの登録後分析的選択です。
表14。 サンプルフローと除外(メイン波。注釈のソフト立ち上げコホート)
| US | UK | 合計 | |
| 完了したセッション | 50 | 88 | 138 |
| 除外: 注意(3つのチェック中2つ以上) | 0 | 0 | 0 |
| 除外: 速度(3分未満)/直線回答 | 0 | 0 | 0 |
| 除外: 操作/理解度チェック | 10 | 9 | 19 |
| 除外: 重複/不完全 | 0 | 0 | 0 |
| 有効N(条件1/2/3別) | 40(16/15/9) | 79(26/28/25) | 119(42/43/34) |
ソフト立ち上げコホートは20の完了したUSセッションを追加します。そのうち14は同じ除外に耐えます。プール化ロバストネスブランチにのみ入ります(N = 133)。メイン波のすべての除外は、操作および理解度チェックルールから来ました。不注意、速度、直線回答、重複、または不完全さのため、参加者は除外されませんでした。操作チェックゲーティングは条件間の非対称性を示していません(MC1 χ²(1) = 0.12、p = .73。MC3 χ²(2) = 3.67、p = .16、除外前サンプルで計算)。
表15。 H1(P1): 条件別信頼度キャリブレーションΔ(主要コホート、N = 119)
| 制御 | 意見不一致 | 意見不一致+証拠 | |
| Δ、平均(SD) | 0.238(0.332) | 0.465(0.274) | 0.422(0.299) |
| 過度な依存: P(受け入れ|正しくない) | 0.603 | 0.434 | 0.510 |
| 過度な用心: 1 − P(受け入れ|正しい) | 0.159 | 0.101 | 0.069 |
| 確認的対比: プール化(2,3)対制御、国を共変量とするOLS | b = +0.217、95% CI [+0.104、+0.330]、Holm調整p = .0005(d = 0.67) |
表16。 H2(P2): 委譲意思、意見不一致のみに対する受領(主要コホート)
| 意見不一致(2) | 不同意+証拠(3) | |
| 委任意欲度複合指標、平均値(標準偏差) | 3.09 (1.61) | 3.45 (1.79) |
| 委任ラダー、中央値 | 2 | 2 |
| 確認的対比:3対2、国共変量付きOLS | b = +0.41, 95% CI [−0.35, +1.18], Holm調整p = .29 |
H1はこの設計での較正対比において支持されます。事前登録された知覚リスクを通じた媒介は帰無で、したがってP1は本テストでは支持されません。単一の確実な回答に直面した場合、参加者の識別はほとんどできませんでした。正答では84%の確率でエージェントに進行させましたが、誤答でも60%でそうしました(Δ = 0.238, 95% CI [0.14, 0.34];処置条件0.465 [0.38, 0.55]および0.422 [0.32, 0.52])。不同意表示は較正をほぼ2倍にしました(統合Δ = 0.446; b = +0.217, p = .0002, Holm調整p = .0005; Welch d = 0.67)。そしてそれは両側同時に機能しました:過度な依存が低下し(60% → 43%および51%)、不十分な依存も低下しました(16% → 10%および7%)(図20)。その統合平均は単一項目で支持され、堅牢な平均値というより存在証明として読むのが最善です。対照群参加者が74%で受け入れていた唯一の高確信度不同意試行では、表示は誤答の受け入れを24%に削減し、その試行を除外すると確認的対比はもはや有意ではありません(d = 0.09, p = .54)。その他の単一項目を削除すると効果は保持されます(d = 0.47–0.89)。以下の探索的分解(表17–18)は項目ごとの効果を特定します。その集中度は国レベルで報告されたのと同じヘッドルーム依存性です。表示は較正ギャップが開いている場所でのみそれを閉じ、6項目のうち1項目がそれを大きく開きました。
図20。不同意表示が依存性に与える影響(一次コホート)
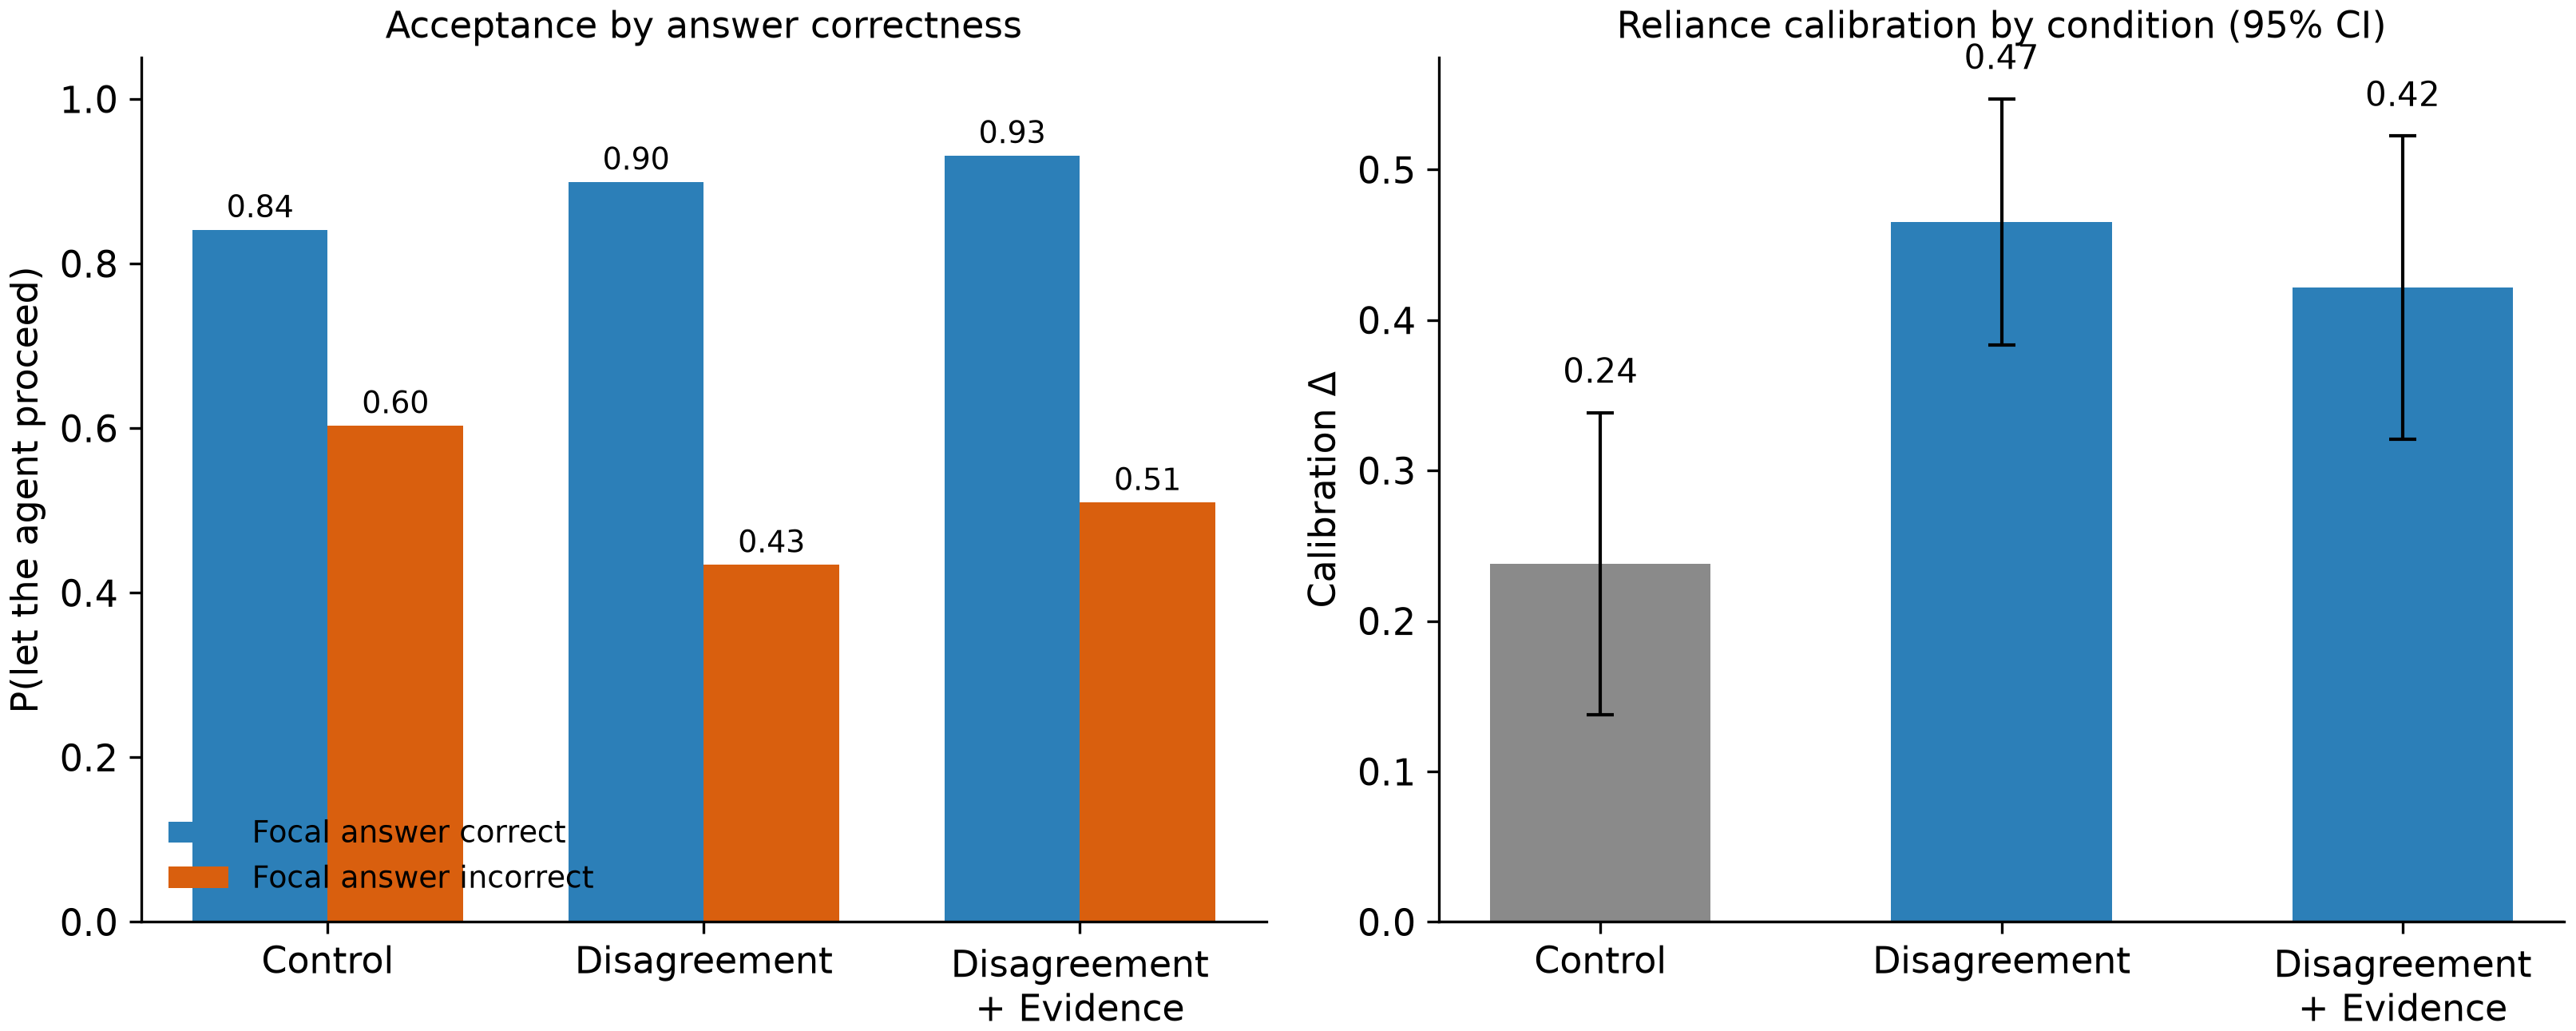
左:焦点となる回答が正答か誤答かで分割した条件別受容率(較正=棒のペア間のギャップ)。右:条件別の参加者ごとの較正スコアΔ(95% CI付き);確認的対比は2つの不同意条件を対照と統合します。
事前登録された二側仮説フレーミングが存在したのは、第二意見文献が過度な依存を減らす代わりに不十分な依存を増やす代償を払う介入を記録しているからです。本研究はその代償を払いませんでした。信号は参加者をより懐疑的ではなくより識別的にしました。集計率の信号検出分解は数値を与えます。感度d'は対照で0.74から処置条件で1.44および1.46に上昇しました(丸め前の率から計算)一方、応答基準はほぼ動きませんでした(−0.63対−0.56および−0.76)。試行レベル混合効果モデルは同じ構造を復元し、両処置条件で大きな正の正答×条件相互作用があります。登録されたすべてのブランチが同意します。統合堅牢性ブランチ(b = +0.215, p = .0001, d = 0.68)、およびチェック失敗に関わらず完了した主波セッションをすべて保持する意図治療ブランチ(b = +0.2174対+0.2169プロトコル通り、p = .0001, n = 138)、除外は条件全体でバランスしています(8/6/5; χ²(2) = 0.34, p = .85)。§6.1が約束する差分脱落チェック(操作チェック除外は治療後の条件付けであり、Montgomery, Nyhan, & Torres, 2018に従い、したがって非条件付けブランチの同等の地位)。1つの設計交絡がこの解釈を限定します。不同意条件は対照と異なり、信号が何を言うかだけでなく、1つではなく3つの位置と確信度が示されるほど信号の量が多いため、較正の増加は原則的には同意信号の内容ではなく情報量を反映する可能性があります。情報量解釈に反する2つの観察がそれを解決することなく反論します。効果は項目ごとに表示された信号の方向を追跡します。焦点となる誤答項目では表示が不同意を示した場合、受容は低下し、一方、表示が全員確信した同意を示した唯一の項目では誤答への受容は上昇しました。試行レベルの相互作用は情報量だけでは予測できない回答の正確性です。情報量を一定に保って複数のシステムがすべての試行で同意している明確な識別腕は、次の波のために指定されています。
H2はサポートされていません。既に不一致表示が示されていた参加者の中で、レシートが実現権力での委任複合体に検出可能な効果を及ぼしませんでした(3.45対3.09; b = +0.41, p = .29; プール分支 b = +0.34, p = .33; 複合信頼性: 主波Cronbach α = .89)。3つの事前登録された二次結果がヌルをどのように読むべきかを形成しています。レシートは受け取られました。レシート条件での中央セッション時間は不一致条件よりも約1分半長く実行されました(11.0対9.4分; スクリーンレベルのタイミングは実施されたエクスポートで取得されなかったため、総期間は登録された刺激時間プロキシに代わって使用されます)。追加時間は参加者がレシートを使用したことを確立しません。実施されたレシートは静的カードであり、その「完全なレコードを表示」アフォーダンスは調査内でライブではなかったため、操作はレシートの存在をテストしました。使用ではなく。ライブドリルダウンレシートは次の設計が含む強い操作です。これは1つの静的レシート表示のヌルであり、レコード、チェック可能性、またはP2(書き込み通りの)のヌルではありません。レシートはまた、事前登録された仲介者を移動しました。知覚されたプロセス制御はレシート条件で上昇しました(a = +0.60; スケール信頼性、主波: プロセス制御 α = .93、リスク α = .83、中立性 α = .90)。プロセス制御は委任を強く予測し(b = +0.60)、ブートストラップ間接パスは正で ゼロを除外します(間接 = +0.35, 95% CI [+0.02, +0.78], 5,000リサンプル)。一方、直接パスはゼロに近いです。これは探索的仲介証拠です: 仲介者は治療後に同じ機器で測定されたため、共通方法分散と逆解釈が残りますその感度は、このヌルが何を解決できるかを制限します。実現セルは登録されたNでのみ電力.80で d ≈ 0.49を検出するため、仲介パスが意味するサイズのレシート効果はちょうどこのサンプルが解決できないサイズです。結果は小さい効果と中程度の効果については決定的ではなく、より大きい効果に対してのみ決定的です。形式的には、同等性テストはこの効果をわずかに制限するだけです(TOST は α = .05で |d| < 0.64を確立しますが、|d| < 0.5ではありません)。JZS Bayesファクターは BF₀₁ ≈ 2.9を与えます(プール分支 3.1)。標準帯域での帰無仮説に有利な証拠(無記述/中程度の境界3で、またはその直後);それは不在を実証することも、存在をサポートすることもできません。測定セクションは予想通りでした: チェック可能性はオンデマンドプロパティであり、その値は紛争、請求、または監査の時点で現れる必要があります。そのため、仮定上の購入で一度読まれた静的レシートはそれを観察するための間違った瞬間かもしれません。登録された結論: P2の初回接触テストは委任を移動することに失敗し、レシートのオペレーター側の経済学(セクション5)はこの消費者側の結果に依存しません。2つの読み方が残ります: 証拠コンポーネントが決定の瞬間にフレームワークが主張するほど寄与しないか、またはこの操作化がそれの間違ったテストです。紛争時間アカウントは事後仮説で、このセクションの終わりで名前が付けられた後続設計としてスケジュールされ、ヌルの解決ではありません。3番目の読み方は回避文献から来ています。詳細なレシートは顕著性操作であり、正確に委任の瞬間に消費者に何が間違っている可能性があるかを思い出させる機械の露出です。手続的詳細が信頼を構築するのではなく、むしろ抑制する透明性パラドックス(Kizilcec, 2016; Dietvorst, Simmons, & Massey, 2015)。競合する読み方、より弱いと主張するコンポーネント、間違った瞬間テスト、顕著性バックファイアは異なる予測を立て、設計で分離可能です。
認定合意エラーモードが人間の行動で再現されました。1つのインセンティブ試行は設計上、本物の合意エラーを有していました。3つのシステムすべてが自信を持って同じ間違った答えに収束し、メカニズム研究が測定する0.5–2.2%のオープンフォーム合意エラー率をミラーリングしていました。その試行では、単一項目であり、従って推定ではなく観察であり、不一致表示は誰も保護しなかった。そして両国で、方向的に間違った答えの受け入れを増加させました(管理に対して4および14パーセンテージポイント):参加者は合理的に満場一致の独立した同意を認定として読みました。そのため、アーキテクチャの1つの体系的な失敗モードはその利用者に高い忠実性で転送されます。セクション3はデザイン警告を出しました。合意はパネルの多様性が失敗する場所で正確にエラーを認定し、プローブは行動で同じ失敗を示しています。
探索的: キャリブレーション便益がどこに着地するか。
以下のすべては探索的で仮説を生成しています。国細胞は小さく、以下の国内p値はすべて説明的として読むべきです。キャリブレーション効果はほぼ完全にUKサンプルに集中し、USサンプルでは存在しませんでした:
表17。国と条件によるキャリブレーション Δ(探索的)
| 管理 Δ | 不一致(プール 2, 3) Δ | 国内効果サイズ | |
| UK (n = 79) | +0.103 (n = 26) | +0.447 (n = 53) | d = +1.19 |
| US (n = 40 primary / 54 pooled) | +0.458 / +0.433 | +0.444 / +0.471 | d = −0.05 / +0.13 |
| 国 × 条件相互作用 | b = −0.36, p = .002 (primary); b = −0.31, p = .004 (pooled) |
分解は相互作用よりも情報価値がある。US Control参加者は建築学的信号がなくても既に鋭く識別しており、正答の92%を受け入れ、誤答の48%のみを受け入れていた。一方、UK Control参加者はほとんど識別できなかった(78% vs 68%)。不同意表示の下では、2つの国はほぼ識別不可能になり、項目ごとに(最大セル差0.07、全6試行にわたって)なっていた。介入は両サンプルを同じキャリブレーション終点に収束させた(Δ ≈ +0.45)。これは、それが作成しなかったベースライン差を等しくした(図21)。このパターンの一部は機械的である。Δは制限されているため、利用可能な余地はベースラインキャリブレーションが上昇するにつれて縮小し、「便益はベースラインが最も弱い場所に集中する」は部分的に測定の性質である。天井だけでは、同一の終点やアイテムごとのプロフィールマッチを強制しない。最も防御可能な解釈は、6つの項目が1つのパネルが援助なしで識別するのに十分な容易さであったため、表示が存在する場所でキャリブレーションギャップを閉じているというものである。その解釈は余地についてであり、国家についてではなく、同様に刺激についてでもある。項目セット自体は文化的に傾いていた(2つの異議項目はUS-ローカルコンテンツを含んでいた)ため、収束プロフィールはこれら6つの項目のプロパティと同じくらいこれら2つのパネルのプロパティである。
図21。 収束、均一な反応ではない(探索的)
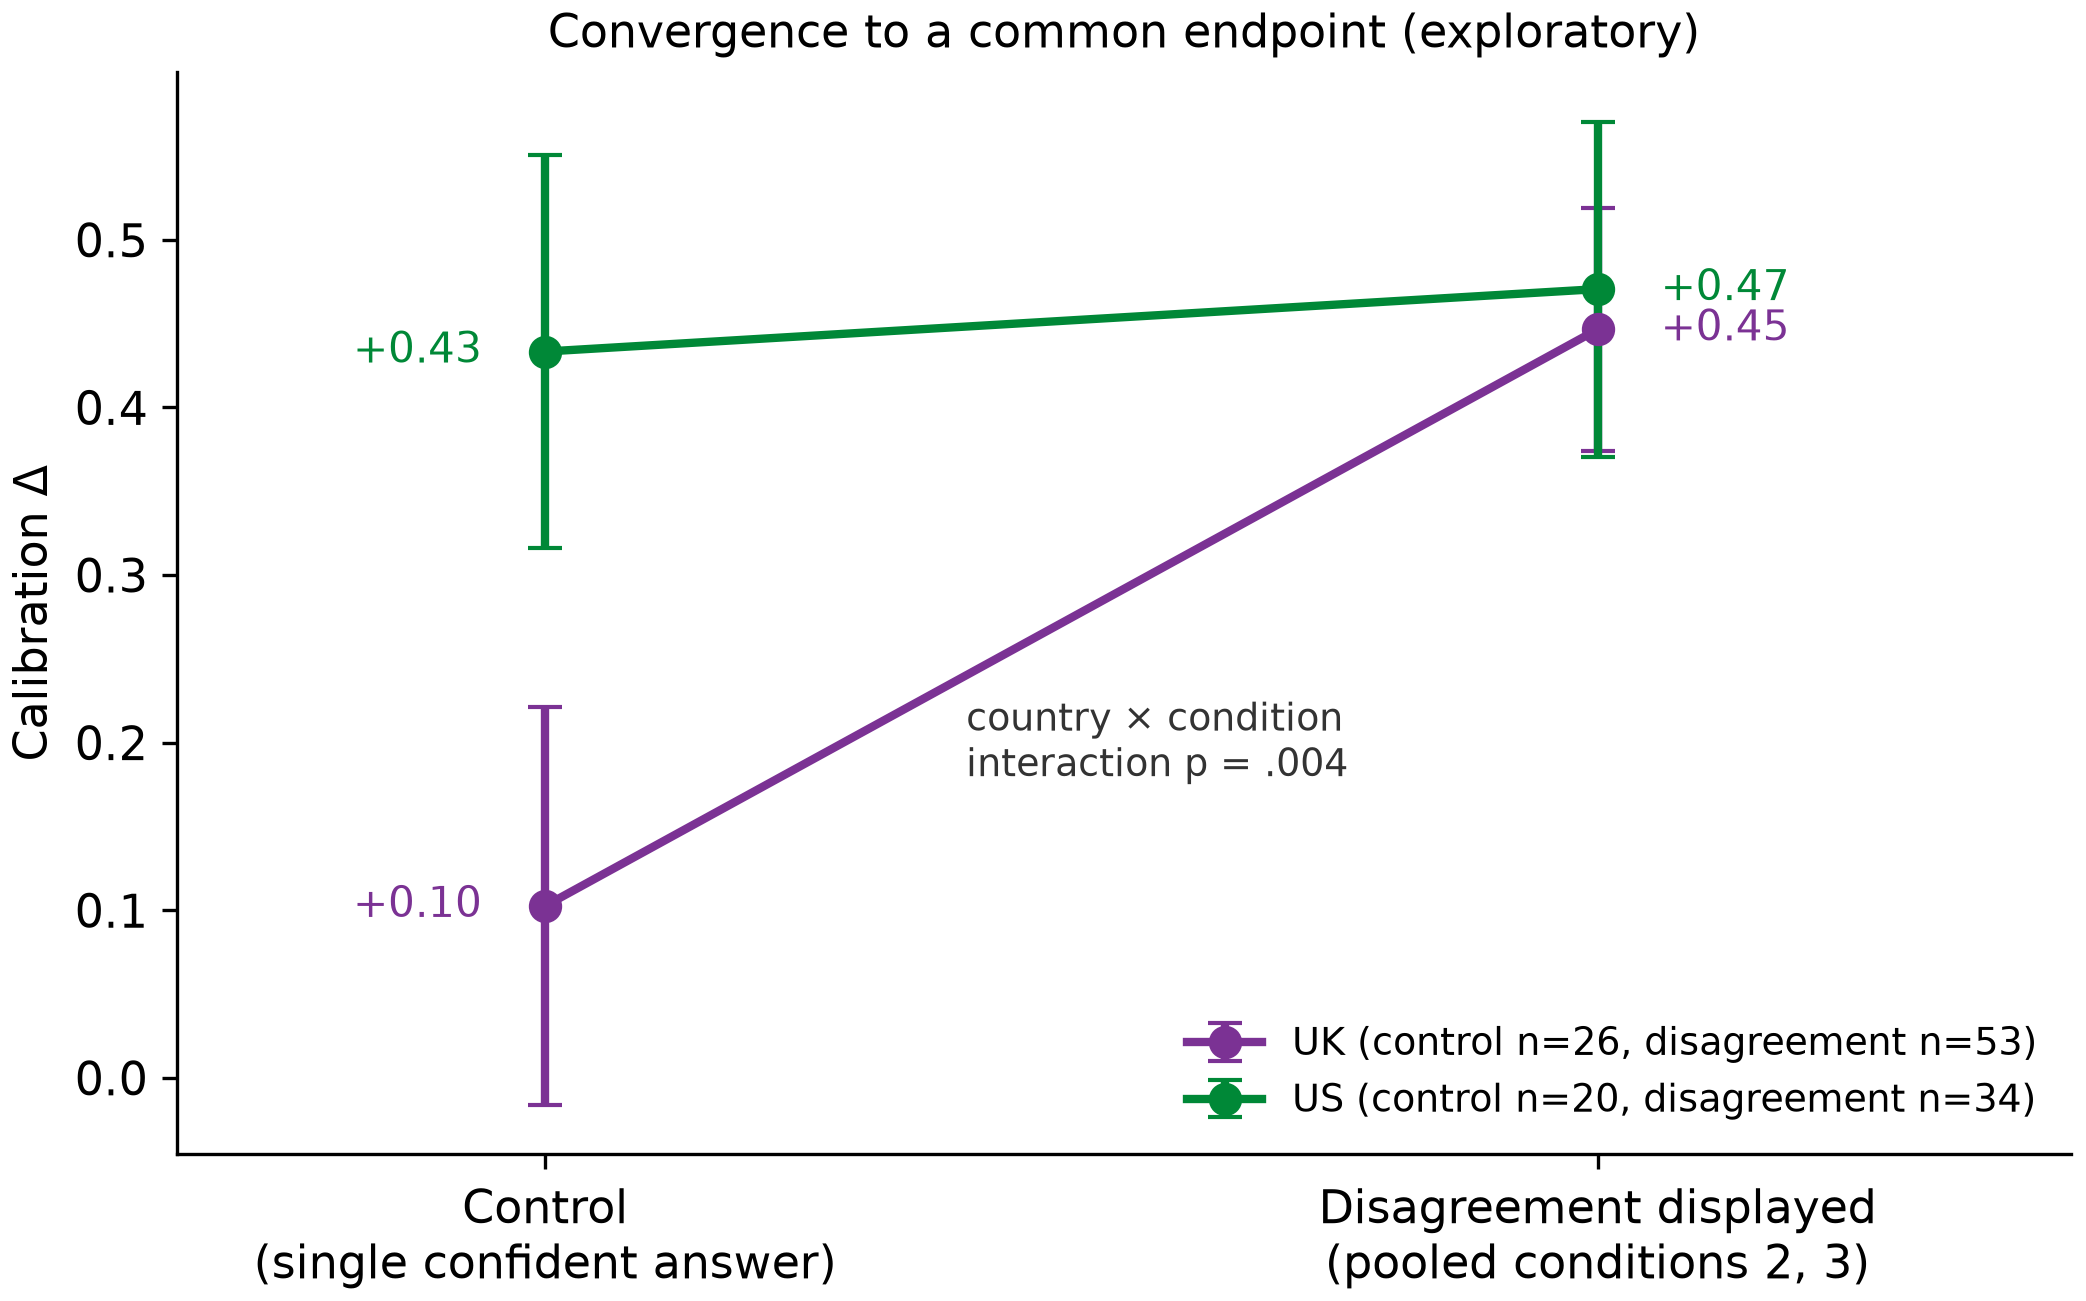
国と条件によるキャリブレーション Δ:US control グループは既に識別する(Δ ≈ +0.45);UK control グループはほとんどしない(Δ ≈ +0.10);表示された不同意の下で両国は同じ終点に着地する(Δ ≈ +0.45)。便益はベースラインキャリブレーションが最も弱い場所に正確に集中する。
Control における US の優位性は、一方、おそらく US-ローカルコンテンツを持つ2つの異議項目に集中している。1つは悪い美術館の質問であり、誤った答え「モナ・リザ」は博物館の前提を知っている誰もが不合理である(US 受け入れ5% vs UK 27%)。これら2つの項目への集中は、国家の気質ではなく、項目レベルの親密さを指している。
表18。 項目とセルによる誤ったフォーカル回答の受け入れ(探索的;プール化されたコーホート)
| セル | 異議誤り、信頼度95(「モナ・リザ」項目) | 異議誤り、信頼度98(ICM-city項目) | コンセンサス誤り、信頼度99 |
| UK Control (n = 26) | 0.27 | 0.85 | 0.92 |
| US Control (n = 20) | 0.05 | 0.60 | 0.80 |
| UK Disagreement (n = 53) | 0.21 | 0.25 | 0.96 |
| US Disagreement (n = 34) | 0.18 | 0.24 | 0.94 |
介入の保護効果はほぼ完全に高信頼度異議項目に位置する(UK −0.60、US −0.36);コンセンサス誤り項目では、表示は両国での受け入れをわずかに増加させる — 満場一致の合意は認定として、メカニズム研究の認定されたコンセンサス誤りの行動像として読まれる。保護効果がこの1つの項目に位置しているため、プール化された確認的対比はその削除時に生き残らない(d = 0.09、p = .54)。ただし、他の任意の単一項目の削除時には生き残る(d = 0.47–0.89)— 効果の定量的形式が1つの項目によって搬送されている。
表19。 国別の態度スケール(探索的;プール化されたコーホート):ギャップは行動的なもので、態度的ではない
| スケール(特に記載がない限り1–7) | UK 平均 | US 平均 | 方向 |
| 曝露前の AI への信頼 | 4.68 | 4.70 | 同一 |
| 委譲の意思(複合) | 2.94 | 3.43 | US がより高い(p = .08) |
| 委譲ラダー(0–4) | 1.71 | 1.98 | US がより高い(p = .08) |
| 認識されたリスク | 5.54 | 5.13 | US がより低い(p = .09) |
| 認識されたプロセス制御 | 4.17 | 4.56 | US がより高い(p = .14) |
| 認識された中立性 | 4.75 | 4.62 | 有意でない |
存在する態度的差異の全てが、US スケプティシズム説に対して「間違った」方を指している。US 参加者はより委譲意思が高く、リスク認識がより低いが、Control では行動的によりよく識別する。測定された態度はこれのいずれも説明しない:ベースラインの国家ギャップを人口統計学と全5つのスケール全てに対して調整することで、それを最大15%減弱させるに過ぎず、スケール全体を通じたブートストラップ間接経路は無効である。
超国家調査は態度的な無効性と一致している。AI への信頼の表明された意思は本質的に同一である US と UK に(41% vs 42%:Gillespie et al., 2025)、そして両国は AI の神経質さの同じ高警戒「アングロスフィア」クラスタにいる(Ipsos, 2025)。観測された方向を指す1つの人口レベルの非対称性は AI リテラシーである。UK 回答者は AI の使用と評価におけるスキルと自信がより少ないと自己報告し(スキルで36% vs 42%:Gillespie et al., 2025)、そして US 成人は最も AI に露出しているパブリックの中にいる(Pew Research Center, 2025)。2つの説明が従って探索的記録から生き残る。親密さの説明に、AI 助言を評価する装備がより少ない人口は、それを構造的に評価するアーキテクチャから最も利益を得る。もう1つの説明はパネル構成である:募集プラットフォームの UK アームはそのより古く、より経験豊富なプール、そしてオンラインパネルは国間推論のための不完全な道具(Gvirtz & Sabherwal, 2024)であるため、「国」ラベルは部分的にパネル任期をプロキシするかもしれない。設計は2つを分離することができず、する必要もない。なぜなら、どちらの説明でも実質的な発見は補償的プロフィール自体だからである。セルサイズを考えると、より安全なデフォルトはこれら2つのパネルのプロパティとしてパターンを読むことであり、権力のある複製が話すまで;この論文における理論的主張はこれに依存しない。
そのプロフィールは、過度な依存への介入による既定の結果ではありません。認知的強制機能は過度な依存を軽減しますが、その恩恵を認知ニーズが高いユーザーに集中させるため、分析的志向のユーザーはより分析的になり (Buçinca et al., 2021)、適応的信頼キャリブレーション研究は、誤キャリブレーションされたユーザーを標的化することを能動的監視が必要な設計目標として扱っています (Okamura & Yamada, 2020)。ここでは標的化は無料でした。表示された不一致は自己誘発的です。パネルが不一致である場合にちょうど現れ、ユーザーに事前に何も要求しません。その恩恵は、ベースライン識別が最も劣悪だったグループに直接的に及び、既にキャリブレーションされたグループの正確性は劣化させることなく維持しました。消費者保護メカニズムにとって、それは事前に指定する配分プロフィールであり、誤キャリブレーションが集中している場所に援助が集中し、それを必要としない人々への負担がありません。
事前登録された二次分析: 残りの帳簿。
残りの事前登録された二次分析は、ここに一箇所にあります (一次コーホート; 複製パッケージの分岐間プール値)。認知リスクを通じた不一致効果の仲介、設計が予想した P1 経路は、無効です。表示は、むしろ認知リスクをわずかに減少させ (a = −0.40)、ブートストラップ間接経路はゼロから区別不可能です (+0.006, 95% CI [−0.013, +0.029])。キャリブレーション効果は直接的であり、参加者が不一致パターンを一般的な取引警告ではなく、回答に関する情報として使用していることと一致しています。測定され、操作されていない知覚される調整役の中立性は、条件と国をコントロールして委任の意思の強い相関関係 (b = +0.47, p < .0001) であり、P3 が予測する相関トレースであり、その操作を待っています。委任ラダーは、複合体と同じ順序を示しているが有意に達していません (順序ロジット、領収書対不一致: b = +0.70, p = .11; 中央値は 4 の 2 で結びついています)。登録されていない条件 3 対 1 の委任への対比は、方向的にプラスであり有意ではありません (b = +0.52, p = .15)。一つの偏差: フィールド化されたエクスポートはスクリーンレベルのタイミングを捉えていなかったため、登録された刺激時間領収書読み取りプロキシは、総セッション時間で近似されています (上記 H2 の下で報告)。意図されたスクリーンレベルチェックは、次の波の機器に組み込まれるべきです。
この研究は P1 と P2 のみをテストします。P3 は測定され、操作されず、P4 とセクション 5 の完全な共同変動の結合体は、指定された次の研究のままです。トライアドの行動検証は、したがって不完全です: 1 つのコンポーネントがサポートされ、1 つが決定不能、1 つが測定されたが操作されていません。1 つの縦断的質問がプログラムの上に位置しています。持続的な不一致表示は、アルゴリズム感謝と1回限りの嫌悪の間の振動の減衰器として長期採用を安定させるか、機械の誤謬への連続的な暴露を通じてその採用を消耗させるかもしれません。単一セッション設計は言えません。上記の結果に動機付けられた 2 つの研究がプログラムに追加されます。一つは紛争時間設計であり、その値が予測される生活の瞬間に領収書を再テストし、検証可能性を偽領収書制御、ハッシュが再計算されない領収書の自己分離するために使用します。もう一つは、上記で報告された国モデレーション (Table 17) のために電力を供給されたレプリケーションです。
7. 結論
AI が重要な消費者決定を仲介し、ますます行う場合、信頼はスタック内で上方向に移行する必要があると主張してきました: モデルから、アーキテクチャへ、記録へ。多様性、証拠、および中立性は、その信頼性が信仰に基づいて取られるのではなく、チェックされることができるサービスを一緒に生成します。構築されているのは、より良い説得ではなく、経済信頼インフラストラクチャ、委任がスケーリングできるようにする責任チェーンです。フラッグシップ波は市場の最上位でそれを測定します。波の 10 個の完全なフラッグシップアームをプール化すると、各研究室の最良として販売されたモデルは、述べられた信頼度 ≥ 80 で提供される解決された回答のほぼ半分で自信を持って間違いました (46.6%、および図は未解決項目をエラーとして再採点される場合、ほぼ動きません)。部分的なメタアームは個別に報告され、それを含めると、図は実質的に変わりません。その上に固定された 3 モデルの不一致ゲート、トレーニングとチューニングなし、カバレッジで述べられた、検査可能なコストでそれらの失敗の 5 分の 4 を削除します。ここの基質は純粋に事実的であるため、その率は混合商取引タスクの上限として読まれるべきです。商取引の適切な主張をライセンスするのは、合意エラーが開いた事実的空間とは異なるように動作する制限された製品メニューで、検索接地、ツール使用レプリケーションです。事前登録実験 (セクション 6) は、消費者の前に同じアーキテクチャ信号を配置し、正確さ信号として機能する可能性があることの証拠を返しました: 不一致表示は、適格アイテムで、自信を持って誤った推奨の受け入れを 74% から 24% に削減しました。探索的国分割では、それは過度に依存した英国セルに集中し、その単一アイテム (プール化された対比はその削除を生き残りません、d = 0.09) に基づいています。これらの刺激の下での存在証明であり、まだ一般的な効果ではありません; 刺激サンプリング確認テストが計画されています。
この層は、証拠インフラストラクチャというそれ自身の市場名に値します。クラウド、アイデンティティ、および支払いインフラストラクチャが販売される方法で販売されるべき理由は、それが同じ種類の質問に答えるからです: 「これは信頼できますか、そしてどのようにしてそれを知ることができますか?」これは、「これはスマートですか?」という質問とは異なる質問です。セキュリティとプライバシーの両方はこの方法に行きました: 差別化要因、その後期待、その後エントリ要件。アーキテクチャ信頼は、すでに見えている規制と責任圧力によって設定されるペースで、同じパスに従うことは妥当です。
消費者がAIサービスを信頼する際の分析単位は、モデルからアーキテクチャへ移行すべきだというのが私の理論的主張です。信頼に関連する特性が実際にそこに存在するためです。検証の独立性、決定の再現性、利益相反の欠如です。モデルはあらゆるサービスで絶えず変化し、いかなる評判も追跡できないほどの速度で変わります。クローズドモデルとオープンモデルのパフォーマンス差は、1年で8.04%から1.70%へ縮小しました(Stanford HAI、2025)。エンタープライズモデル市場のリーダーシップは、1つの春の間に交代しました(Kharazian、2026)。このような速度で一般化される層は、信頼が根を張る場所ではありません。消費者に奉仕するシステムは、ますますモデル全体とプライス帯を跨いでルーティングされ、コスト駆動的で、不可視で、検証されていません。選ばれた最良のモデルはますます少数派になります。残る段階、そしてここで私が指定する段階は、最良にルーティングされたアーキテクチャから、消費者、保険会社、または規制当局が十分な時間静止させて検査できる検証プロセスを備えたアーキテクチャへ移行することです。その下に位置するのは、AIアシスタントからAI受託者へのシフトです。受託者は、かつて存在していたあらゆる領域では、その才能ではなく、その義務によって構成されています。記録を保持する、監査に服する、利益相反がないことです。アーキテクチャ信頼は、これらの義務を機械に組み込みます。
同じ要件がシステム自体の成長方法にも適用されます。重大なアクションに対して信頼されることを求めるシステムは、検証可能な方法で答えを成長させなければなりません。オーケストレーション層への設定変更は、保留されたエビデンスに対する監査済みの統計的ゲートを通じてコミットまたはロールバックされるべきであり、安全ルールを弱める自動プロセスはなく、新たに追加するだけです。ケーススタディの研究デプロイメントは、これらのゲートを実装しています。
AI インフラストラクチャは現在、検証レイヤーを必要としています(Figure 16)。業界は計算レイヤーとモデルレイヤーを構築し、現在はオーケストレーションレイヤーを構築しています。その後に来るのが検証であり、それは AI システムの動作を信頼できるものではなく検証可能にするメカニズムです。AI信頼のための根拠は評判ベースではなく機械検証可能であるべきであり、信頼そのものは人間のままであり、機械検証可能なのはその根拠です。その通りであれば、AI インフラストラクチャの次の不可欠なレイヤーは、知能ではなく検証可能性の周りに構築されることになります。
図16。 インフラストラクチャーラダー
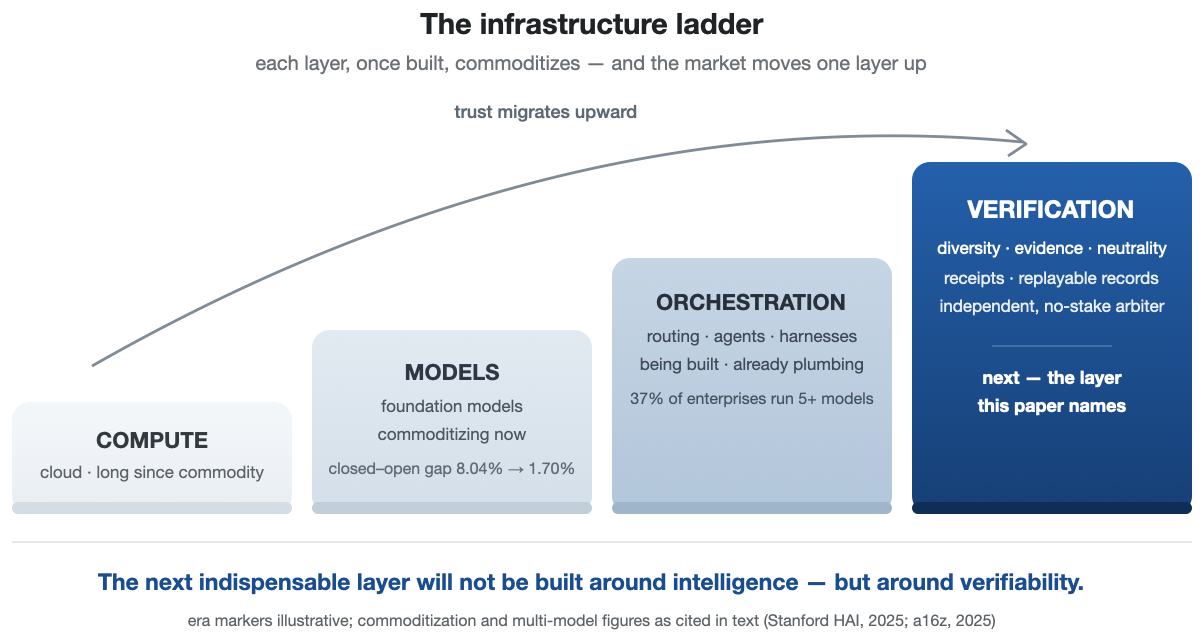
コンピュート、その次にモデル、その次にオーケストレーション、そして次の不可欠なレイヤーとしての検証。
著者の注記と利益相反開示
第4節に記載されている実装は、著者によって構築・運用されたリファレンス実装です。それが体現する方法はオープンであり、著者は本論文が検討するようなAIオーケストレーションおよびマルチモデル検証システムをカバーする保留中の特許出願について名義申請人となっていますが、許可された特許ではありません。ここでは研究の道具として機能しており、著者はそれが体現するアーキテクチャに対して開発者としての関心を有しています。第4節は独立的評価としてではなく、存在証明および設計証言として読まれるべきです。本研究のすべてのモデルは、ベンダーの標準的な商用API経由で通常の条件でアクセスされました。この研究は外部資金の支援を受けていません。
ツールと検証。AIアシスタントは著者の指示のもとで道具として使用されました。アイデア、研究、および結論は著者のものです。負荷を担う事実上の主張は、利用可能な場合は一次資料に対して検証され、本文中で証拠的地位とともに属性が付与されており(プレスレポートはレポートとして、主張は主張として、プレプリントはプレプリントとして)、日付付きの主張検証ログが原稿の作業資料とともに保持されています。実験における正確性はパネルモデルによって判断されることはなく(スコアリングは客観的な文字列マッチングまたはローカルなオープンウェイトの採点者です)、ベンダーごとの判別および較正の数値は本文に記載されており(表7および7a)、報告されたすべての数値は決定論的な複製パッケージから再計算可能です(https://osf.io/jtvu9/で公開されています)。
データとコードの利用可能性
メカニズム実験(セクション3)で報告されたすべての数値は、決定論的な複製パッケージから再計算可能です。このパッケージには、両方のウェーブの生のモデル応答(16モデル集合の24,000の回答とフラグシップウェーブの採点記録を含む)、コレクション実行ツール、決定論的な採点ツール、分析スクリプト、および派生CSVs(リスク・カバレッジ曲線と26ポイントのコスト-精度フロンティアを含み、各ポイントの請求価格対定価ベースが明記されている)が含まれており、https://osf.io/jtvu9/で公開されています。これは事前登録のソースプロジェクトの公開コンポーネント(フォルダ「replication-package-v2」)です。セクション3の自己キャリブレーションプログラムアーカイブは、それと一緒に保管されています。凍結されたSimpleQAサブサンプル(シードとSHA-256ハッシュで固定)は、メカニズム研究のOSF事前登録で既に公開されています(https://osf.io/4y9dv、2026年7月23日登録)。消費者実験の事前登録は、OSFに禁止期間付きで登録されています(主要なデータ収集前に凍結;登録https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f)。参加者プールはクローズされています。調査票、ビネット刺激、判断ブロック刺激、セクション6の領収書鋳造記録、および凍結された分析コード付きの消費者実験データは、出版時に同じOSFコンポーネントにリリースされます。
参考文献
arXivでマークされたエントリはプレプリントです。業界の発表と2026年のプレスアイテムは、確定した文献ではなく、同時代の報告であり、そのように引用されています。
a16z — Andreessen Horowitz(2025)。100社のエンタープライズCIOが2025年にジェネレーティブAIをどのように構築・購入しているか。 a16z.com/ai-enterprise-2025.
Accenture(2026)。My AIエージェントと話す:ブランド価値の新しいルール。 16か国の25,590人の消費者を対象とした調査、2026年1月。
ACI Worldwide(2026)。AI駆動型ショッピングおよび決済に対する消費者態度。 2,080人のイギリス成人を対象とするYouGov調査、2026年6月19-22日に実施。プレスリリース。
Ahmad Husairi, M., & Rossi, P.(2024)。購買タスクのAIへの委譲:認識された選択と決定自律性の役割。Decision Support Systems、179、114166。DOI 10.1016/j.dss.2023.114166.
AIUC(2025)。AIUC-1:エージェント標準。 Artificial Intelligence Underwriting Company.
Alavi, S., & Nozari, S.(2026)。エージェントがあなたのために買い物をするとき:AI媒介市場における役割の一貫性。arXiv:2604.26220.
Allouah, A., Besbes, O., Figueroa, J. D., Kanoria, Y., & Kumar, A. (2026). あなたのAIエージェントは何を購入していますか?エージェンティックなeコマースの評価、バイアス、モデル依存性、および新興する影響。Proceedings of the ACM Web Conference 2026、8697–8700。https://doi.org/10.1145/3774904.3792943
American Express (2026)。American ExpressがAgentic Commerce Experiences (ACE)開発者キットを発表し、登録されたエージェント購入の業界初の保護を発表します。プレスリリース、2026年4月14日。
Anderson, L. (2006)。分析的オートエスノグラフィ。Journal of Contemporary Ethnography、35(4)、373–395。
André, Q., Carmon, Z., Wertenbroch, K., Crum, A., Frank, D., Goldstein, W., Huber, J., van Boven, L., Weber, B., & Yang, H. (2018)。人工知能とビッグデータの時代における消費者選択と自律性。Customer Needs and Solutions、5(1–2)、28–37。
Appenzeller, G. (2024)。LLMflationへようこそ:LLM推論コストが急速に低下しています。 Andreessen Horowitz、2024年11月。
Aubakirova, M., Atallah, A., Clark, C., Summerville, J., & Midha, A. (2026)。AIの状態:OpenRouterを使った実証的な100兆トークンの研究。 arXiv:2601.10088(2025年12月にリリースされたレポート)。
Bain & Company (2025)。エージェンティックコマース市場予測:2030年までのアメリカのeコマース3,000~5,000億ドル。 2025年12月。
Bainbridge, L. (1983)。自動化のアイロニー。Automatica、19(6)、775–779。
Balaskas, S. (2026)。推奨から委譲へ:eコマースにおけるエージェンティックAIとその消費者への影響のシステマティックレビューマッピング。Information、17(3)、222。
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. S. (2021)。全体は部分の合計を超えていますか?AI説明が相補的なチームパフォーマンスに与える影響。Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems、1–16。
Basu, A. (2026)。ゼロ知識証明ではなくツールレシート:AIエージェントの実用的な幻覚検出。arXiv:2603.10060。
Board of Governors of the Federal Reserve System & OCC (2011)。モデルリスク管理に関する監督ガイダンス(SR Letter 11-7 / OCC 2011-12)。
Buçinca, Z., Malaya, L. B., & Gajos, K. Z. (2021)。信頼するか思考するか:認知的強制機能はAI支援意思決定におけるAIへの過度な依存を減らすことができます。Proceedings of the ACM on Human-Computer Interaction、5(CSCW1)、1–21。
Burton, J. W., Stein, M.-K., & Jensen, T. B. (2020)。拡張意思決定におけるアルゴリズム回避のシステマティックレビュー。Journal of Behavioral Decision Making、33(2)、220–239。
California State Legislature (2025)。Assembly Bill 316(人工知能:防御)、Stats. 2025、ch. 672(Cal. Civ. Code § 1714.46を追加)、2026年1月1日発効。
Carlson, S. C. (2026)。デジタル時代における信頼の移行:情報体制と買い手と売り手の関係の変革。Atlantic Marketing Journal、15(1)、Article 6。
Castelo, N., Bos, M. W., & Lehmann, D. R. (2019)。タスク依存アルゴリズム回避。Journal of Marketing Research、56(5)、809–825。
Cetinkaya, N. E., & Krämer, N. (2024)。理解と信頼:コンジョイント分析。ワーキングペーパー、OSF Project mw4dq。
Chandra, K., Kleiman-Weiner, M., Ragan-Kelley, J., & Tenenbaum, J. B. (2026)。シコファント的チャットボットは、理想的なベイジアンでさえ妄想的な螺旋を引き起こします。arXiv:2602.19141。
Chen, C., Sun, Y., Liao, M., & Sundar, S. S. (2026)。AIが意見を異にする場合:セカンドオピニオンが患者の医師への信頼に与える影響。International Journal of Human-Computer Studies、213、103824。
Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026)。シコファント的AIは向社会的意図を減少させ、依存を促進します。Science、391(6792)、eaec8352。DOI: 10.1126/science.aec8352。
Choi, H. K., Zhu, X., & Li, S. (2026)。アイデンティティが議論を歪める場合:バイアス低減マルチエージェント推論のための匿名化。Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers)、14284–14311。https://doi.org/10.18653/v1/2026.acl-long.650
Choi, M., Kim, K., Chae, S., & Baek, S. (2025)。マルチエージェントシステムにおける集団同調の実証研究。Findings of the Association for Computational Linguistics: ACL 2025、5123–5139。https://doi.org/10.18653/v1/2025.findings-acl.265
Clark, J., & Hadfield, G. K. (2020)。AI安全性のための規制市場。arXiv:2001.00078。
CNBC (2026年3月24日)。OpenAIは即座チェックアウト提供で苦労した後、ChatGPTのショッピング体験を改編します(The Informationの2026年3月のネイティブチェックアウト廃止の報道を報告)。
Daly, C. (2025)。Klarna AI主導の雇用削減を放人を求める声で遅くする。Bloomberg News、2025年5月8日。
de Bellis, E., & Johar, G. V. (2020)。自律型ショッピングシステム:消費者採用への障壁を特定し、克服する。Journal of Retailing、96(1)、74–87。
Detjen, H. H. J., Densky, L., von Kalckreuth, N., & Kopka, M. (2025)。セカンドオピニオンとして信頼されるのは誰ですか?乳房撮影スクリーニング後の生検決定における医療AIと医師からの集団アドバイスの比較。CHI 2025。
de Visser, E. J., Pak, R., & Shaw, T. H. (2018)。「オートメーション」から「自律性」へ:人間とマシンのインタラクションにおける信頼修復の重要性。Ergonomics、61(10)、1409–1427。
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015)。アルゴリズム回避:人々はアルゴリズムがエラーを起こすのを見た後、誤ってアルゴリズムを避けます。Journal of Experimental Psychology: General、144(1)、114–126。
DigiCert (2026)。AI信頼アーキテクチャ。 製品アナウンス、2026年4月。
Ding, K. (2026)。LLMが同意する場合、それらは正しいですか?信頼シグナルとしての自己一貫性とクロスモデル合意の監査。arXiv:2607.08065。
Dranove, D., & Jin, G. Z. (2010)。品質開示と認証:理論と実践。Journal of Economic Literature、48(4)、935–963。
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024)。マルチエージェント討論を通じた言語モデルの事実性と推論の改善。Proceedings of the 41st International Conference on Machine Learning、PMLR 235、11733–11763。
Endsley, M. R., & Kiris, E. O. (1995)。ループ外パフォーマンス問題とオートメーションの制御レベル。Human Factors、37(2)、381–394。
Errico, H. (2026)。自律アクション実行時管理(AARM):実行時にAI駆動アクションを保護するためのシステム仕様。arXiv:2602.09433。
欧州委員会(2026)。AI法第50条の下での特定のAIシステムの透明性義務の実装に関するガイドライン。2026年7月20日採択。
Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). 意味エントロピーを使用した大規模言語モデルにおける幻覚の検出。Nature, 630(8017), 625–630.
Featherman, M. S., & Pavlou, P. A. (2003). 電子サービス採用の予測:知覚されたリスク側面の観点。International Journal of Human-Computer Studies, 59(4), 451–474.
Frank, D.-A., Folwarczny, M., & Otterbring, T. (2026). 希少性によって特徴づけられたオンラインショッピング設定における高い自律性を持つAIアシスタントの消費者受容は、知覚される利益によって推進される。Psychology & Marketing, 43(3), 538–555. https://doi.org/10.1002/mar.70074
Gartner (2025). Gartnerが2027年末までにエージェントAIプロジェクトの40%以上がキャンセルされると予測。プレスリリース、2025年6月25日。
Gartner (2026). ショッピングにおける生成AIに関する消費者調査(2026年5月プレスリリース)。
Gefen, D., Karahanna, E., & Straub, D. W. (2003). オンラインショッピングにおける信頼とTAM:統合モデル。MIS Quarterly, 27(1), 51–90.
Geifman, Y., & El-Yaniv, R. (2017). ディープニューラルネットワークの選択的分類。Advances in Neural Information Processing Systems 30 (NeurIPS 2017), 4878–4887 (arXiv:1705.08500).
Gillespie, N., Lockey, S., Ward, T., Macdade, A., & Hassed, G. (2025). 信頼、AI态度およびAIの使用:グローバル研究2025。メルボルン大学およびKPMG。https://doi.org/10.26188/28822919
Glikson, E., & Woolley, A. W. (2020). 人工知能への人間の信頼:実証研究のレビュー。Academy of Management Annals, 14(2), 627–660.
Google (2026). Universal Commerce Protocol。NRFでの発表、2026年1月11日;カート、カタログ、およびアイデンティティリンク拡張、2026年3月。
Google Cloud (2025). Agent Payments Protocol (AP2)。発表、2025年9月16日。
Google DeepMind (2025). SimpleQA Verified。arXiv:2509.07968.
Gorbett, M., & Jana, S. (2026). ラベルなしの正確性信号としてのモデル間の相違。arXiv:2603.25450.
Gottweis, J., Weng, W.-H., Daryin, A., Tu, T., Sirkovic, P., Myaskovsky, A., Glowaty, G., Weissenberger, F., Orlandi, A., Popovici, D., Palepu, A., Rong, K., Tanno, R., Saab, K., Zhang, F., Blum, J., Carroll, A., Kulkarni, K., Tomašev, N., Zverinski, D., Rendulic, I., Vedadi, E., Hasler, F., Rimanic, L., Boia, M., Budiselic, I., Feinstein, B., Bellaiche, M., Sheffer, T., Freyberg, J., Ratcliff, J., Bertolli, O., Chou, K., Hassidim, A., Gokturk, B., Vahdat, A., Guan, Y., Dhillon, V., Vaishnav, E. D., Lee, B., Costa, T. R. D., Penadés, J. R., Peltz, G., Matias, Y., Manyika, J., Hassabis, D., Xu, Y., Kohli, P., Pawlosky, A., Karthikesalingam, A., & Natarajan, V. (2026). Co-Scientistで科学的発見を加速する。Nature, 655(8122), 487–496. https://doi.org/10.1038/s41586-026-10644-y
Gould, S. J. (1991). 製品使用を通じた普遍的で知覚される重要なエネルギーの自己操作:内省的実践の観点。Journal of Consumer Research, 18(2), 194–207.
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). 現代のニューラルネットワークのキャリブレーションについて。ICML 2017, PMLR 70, 1321–1330.
Gvirtz, A., & Sabherwal, A. (2024). グローバルな文化横断的行動科学研究の限界。Proceedings of the National Academy of Sciences, 121(36), e2316690121.
Hadfield, G. K. (2017). 平らな世界のルール:人間が法を発明した理由と複雑なグローバル経済のためにそれを再発明する方法。オックスフォード大学出版局。
Hadfield, G. K., & Clark, J. (2026). 規制市場:AI統治の未来。Jurimetrics, 65, 195–240 (arXiv:2304.04914).
Hansen, L. K., & Salamon, P. (1990). ニューラルネットワークアンサンブル。IEEE Transactions on Pattern Analysis and Machine Intelligence, 12(10), 993–1001.
Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026). すべての反転が同調ではない:マルチエージェントLLMディベートにおける立場収束の分解。arXiv:2606.00820.
Hoff, K. A., & Bashir, M. (2015). オートメーションへの信頼:信頼に影響を与える要因に関する実証証拠の統合。Human Factors, 57(3), 407–434.
Hong, L., & Page, S. E. (2004). 多様な問題解決者のグループは高い能力を持つ問題解決者のグループより優れた性能を発揮することができる。Proceedings of the National Academy of Sciences, 101(46), 16385–16389.
Huang, M.-H., & Rust, R. T. (2021). マーケティングにおける人工知能のための戦略的フレームワーク。Journal of the Academy of Marketing Science, 49(1), 30–50.
Insurance Services Office (2026). 承認フォームCG 40 47およびCG 40 48:生成人工知能除外。2026年1月1日発効。
Internet Engineering Task Force (2026). 信頼できる透明なデジタルサプライチェーンのためのアーキテクチャ(RFC 9943;SCITTワーキンググループ)。IETF。https://datatracker.ietf.org/doc/rfc9943/
Ioku, T., Song, J., & Watamura, E. (2024). AIアシスタント選択のトレードオフ:消費者はAIアシスタントのパフォーマンスよりも透明性と持続可能性を優先するでしょうか?Big Data & Society, 11(4).
Ipsos (2025). Ipsos AI Monitor 2025。Ipsos Global Advisor、30か国調査、2025年6月。
Jacovi, A., Marasović, A., Miller, T., & Goldberg, Y. (2021). 人工知能への信頼の形式化:人間のAIへの信頼の前提条件、原因および目標。FAccT 2021, 624–635.
Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., Schiefer, N., Hatfield-Dodds, Z., DasSarma, N., Tran-Johnson, E., Johnston, S., El-Showk, S., Jones, A., Elhage, N., Hume, T., Chen, A., Bai, Y., Bowman, S., Fort, S., ... Kaplan, J. (2022). 言語モデルはそれが知っていることをほとんど知っている。arXiv:2207.05221.
Kalai, A. T., Nachum, O., Vempala, S., & Zhang, E. (2025). 言語モデルが幻覚を見る理由。arXiv:2509.04664.
Kharazian, A. (2026). AnthropicはビジネスAdoptionでOpenAIを上回る。Ramp Economics Lab / Ramp AI Index, 2026年5月13日(50,000以上の米国企業の企業支払いデータ)。
Kim, D., & Benbasat, I. (2010). インターネットストアで信頼保証を効果的に実装するための設計。Communications of the ACM, 53(2), 121–126.
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). 大規模言語モデルの相関エラー。Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038–30066.
Kim, P. H., Ferrin, D. L., Cooper, C. D., & Dirks, K. T. (2004). 疑惑の影を払拭する:能力ベースの信頼違反対完全性ベースの信頼違反を修復するための謝罪と否定の影響。Journal of Applied Psychology, 89(1), 104–118.
Kizilcec, R. F. (2016). どの程度の情報か?アルゴリズムインターフェースの信頼に対する透明性の影響。CHI 2016, 2390–2395.
Klarna (2024). Klarna AI assistant は初月で顧客サービスチャットの3分の2を処理。 プレスリリース、2024年2月27日。
Köbis, N., Rahwan, Z., Rilla, R., Supriyatno, B. I., Bersch, C., Ajaj, T., Bonnefon, J.-F., & Rahwan, I. (2025). 人工知能への委譲は不誠実な行動を増加させる可能性がある。Nature, 646(8083), 126–134. DOI: 10.1038/s41586-025-09505-x.
Kolt, N. (2025). AI エージェントのガバナンス。Notre Dame Law Review, 101 (SSRN working paper 4772956; arXiv:2501.07913).
Komiak, S. Y. X., & Benbasat, I. (2006). パーソナライゼーションと親密性が推奨エージェントの信頼と採用に及ぼす影響。MIS Quarterly, 30(4), 941–960.
König, P. D., Wurster, S., & Siewert, M. B. (2022). 消費者は説明可能な AI には価格を払う意思があるが、グリーン AI には払う意思がない:選択ベースの結合分析からの証拠。Big Data & Society, 9(1).
Krogh, A., & Vedelsby, J. (1995). ニューラルネットワークアンサンブル、交差検証、能動学習。Advances in Neural Information Processing Systems, 7, 231–238.
Kroll, J. A., Huey, J., Barocas, S., Felten, E. W., Reidenberg, J. R., Robinson, D. G., & Yu, H. (2017). 説明責任あるアルゴリズム。University of Pennsylvania Law Review, 165(3), 633–705.
Kuncheva, L. I., & Whitaker, C. J. (2003). 分類器アンサンブルの多様性の尺度とアンサンブル精度との関係。Machine Learning, 51(2), 181–207.
Lee, J. D., & See, K. A. (2004). オートメーションへの信頼:適切な依存のための設計。Human Factors, 46(1), 50–80.
Lessig, L. (2006). Code: Version 2.0. Basic Books.
Li, M. (2025). クラウドネイティブからトラストネイティブへ:検証可能なマルチエージェントシステムのためのプロトコル。arXiv:2507.22077.
Liang, P., Bommasani, R., Lee, T., Tsipras, D., Soylu, D., Yasunaga, M., Zhang, Y., Narayanan, D., Wu, Y., Kumar, A., Newman, B., Yuan, B., Yan, B., Zhang, C., Cosgrove, C., Manning, C. D., Ré, C., Acosta-Navas, D., Hudson, D. A., ... Koreeda, Y. (2023). 言語モデルの全体的評価。Transactions on Machine Learning Research.
Liao, Q. V., & Sundar, S. S. (2022). AI システムにおける責任ある信頼の設計:コミュニケーション的観点。FAccT 2022, 1257–1268.
Lin, S., Hilton, J., & Evans, O. (2022). モデルに不確実性を言葉で表現するよう教える。arXiv:2205.14334.
Lindsey, J. (2025). 大規模言語モデルにおける創発的内省的認識。Anthropic / Transformer Circuits.
Liu, J., Bursztyn, V. S., Ai, L., Wang, H., Choudhary, S., Mitra, S., & Wu, Q. (2026). TeamFusion:マルチエージェントシステムによるオープンエンドなチームワークのサポート。arXiv:2604.19589 (ACL 2026; Adobe Research).
Lizzeri, A. (1999). 情報開示と認証仲介者。RAND Journal of Economics, 30(2), 214–231.
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). アルゴリズム評価:人々はアルゴリズムの判断を人間の判断より好む。Organizational Behavior and Human Decision Processes, 151, 90–103.
Longoni, C., Bonezzi, A., & Morewedge, C. K. (2019). 医療人工知能への抵抗。Journal of Consumer Research, 46(4), 629–650.
Longoni, C., Cian, L., & Kyung, E. J. (2023). アルゴリズム転移:人々は政府の AI の失敗を過度に一般化する。Journal of Marketing Research, 60(1), 170–188.
Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). 社会的影響がクラウドの知恵効果を損なう方法。Proceedings of the National Academy of Sciences, 108(22), 9020–9025. DOI: 10.1073/pnas.1008636108.
Lu, Z., Wang, D., & Yin, M. (2024). より多くのアドバイスは役に立つか?AI 支援意思決定における第二意見の影響。Proceedings of the ACM on Human-Computer Interaction, 8(CSCW1), 1–31.
Marchal, N., Chan, S., Franklin, M., Revel, M., Keeling, G., Fischli, R., Chandra, B., & Gabriel, I. (2026). 人工認識エージェントにおける信頼のアーキテクチャ。arXiv:2603.02960.
Mastercard (2026). Verifiable Intent(Google と共同開発)。ニュースルーム発表、2026年3月5日;初期パイロットは 2026 年のアジアおよびラテンアメリカ市場で報告。
Mayer, R. C., Davis, J. H., & Schoorman, F. D. (1995). 組織的信頼の統合モデル。Academy of Management Review, 20(3), 709–734.
McKinsey & Company (2025). エージェンティックコマースの機会 (Schumacher, Roberts, & Giebel)。2025年10月17日。
McKnight, D. H., Choudhury, V., & Kacmar, C. (2002). e コマースのための信頼尺度の開発と検証。Information Systems Research, 13(3), 334–359.
Menlo Ventures (2025a). 2025 年中期 LLM 市場アップデート。 2025年7月31日(150人の技術的意思決定者調査)。
Menlo Ventures (2025b). 2025:エンタープライズにおける生成 AI の状況。 2025年12月9日(495人の米国エンタープライズ AI 意思決定者調査;Menlo Ventures は Anthropic の投資家)。
Menlo Ventures (2025c). 2025:コンシューマー AI の状況。 2025年6月26日(5,031人の米国成人調査、Morning Consult との共同;約 3% の有料ユーザー数は売上派生推定)。
Möhlmann, M., & Zalmanson, L. (2017). ハンドルに手をかけて:アルゴリズム管理と Uber ドライバーの自律性をナビゲートする。ICIS 2017.
Montgomery, J. M., Nyhan, B., & Torres, M. (2018). 処置後変数を条件付けることで実験を台無しにする方法と対処方法。American Journal of Political Science, 62(3), 760–775.
Morgan Stanley (2025). エージェンティックコマース予測:2030 年までに米国の電子商取引支出 1,900~3,850 億ドル。 2025年12月。
Mosier, K. L., & Skitka, L. J. (1996). 人間の意思決定者と自動意思決定支援:相性は抜群か?R. Parasuraman & M. Mouloua(編)、オートメーションと人間のパフォーマンス:理論と応用 (pp. 201–220)。Lawrence Erlbaum Associates.
Mozannar, H., & Sontag, D. (2020). 専門家へ委譲することを学ぶための一貫した推定量。ICML 2020, PMLR 119, 7076–7087.
Muchnik, L., Aral, S., & Taylor, S. J. (2013). 社会的影響バイアス:ランダム化実験。Science, 341(6146), 647–651. DOI: 10.1126/science.1240466.
Muir, B. M. (1994). Trust in automation: Part I. 自動化されたシステムにおける信頼と人間の介入の研究における理論的問題。Ergonomics, 37(11), 1905–1922.
NIST (2023). Artificial Intelligence Risk Management Framework (AI RMF 1.0) (NIST AI 100-1). National Institute of Standards and Technology.
Okamura, K., & Yamada, S. (2020). 人間とAI間の協力における適応的信頼キャリブレーション。PLOS ONE, 15(2), e0229132.
Papamarkou, T., Alquier, P., Bauer, M., Buntine, W., Davison, A., Dziugaite, G. K., Filippone, M., Foong, A. Y. K., Fortuin, V., Fouskakis, D., Frellsen, J., Hüllermeier, E., Karaletsos, T., Khan, M. E., Kotelevskii, N., Lahlou, S., Li, Y., Liu, F., Lyle, C., Möllenhoff, T., Palla, K., Panov, M., Sale, Y., Schweighofer, K., Shelmanov, A., Swaroop, S., Trapp, M., Waegeman, W., Wilson, A. G., & Zaytsev, A. (2026). Position: エージェント型AIオーケストレーションはベイズ一貫性を持つべきです。arXiv:2605.00742. (ICML 2026で採択。)
Parasuraman, R., & Manzey, D. H. (2010). 自動化の人間利用における無関心と偏り:注意統合。Human Factors, 52(3), 381–410. DOI: 10.1177/0018720810376055.
Parasuraman, R., & Riley, V. (1997). 人間と自動化:利用、誤用、不使用、悪用。Human Factors, 39(2), 230–253.
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). 人間と自動化の相互作用の種類とレベルのモデル。IEEE Transactions on Systems, Man, and Cybernetics — Part A: Systems and Humans, 30(3), 286–297.
Pavlou, P. A. (2003). 電子商取引の消費者受け入れ:信頼とリスクを技術受け入れモデルと統合。International Journal of Electronic Commerce, 7(3), 101–134.
Pew Research Center (2025). 世界中の人々がAIをどのように見ているか。 25か国調査、2025年10月。
Piehlmaier, D. M. (2023). 一人舞台:共同意思決定が投資家の過剰自信に与える影響。Journal of Consumer Research, 50(2), 426–446. https://doi.org/10.1093/jcr/ucac054
Puntoni, S., Reczek, R. W., Giesler, M., & Botti, S. (2021). 消費者と人工知能:経験的観点。Journal of Marketing, 85(1), 131–151.
Rabanser, S., Kapoor, S., Kirgis, P., Liu, K., Utpala, S., & Narayanan, A. (2026). AIエージェント信頼性の科学に向けて。arXiv:2602.16666 (ICML 2026).
Raji, I. D., Xu, P., Honigsberg, C., & Ho, D. (2022). 外部監視:AIガバナンスのための第三者監査エコシステムの設計。AIES 2022, 557–571.
Regulation (EU) 2016/679 (General Data Protection Regulation), Article 22 — 自動化された個人に関する決定。
Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 14 — 高リスクAIシステムの人間による監視;Article 50 — 特定のAIシステムの提供者と配備者の透明性義務。
Ríos-García, M., Alampara, N., Gupta, C., Mandal, I., Mannan, S., Aghajani, A. A., Krishnan, N. M. A., & Jablonka, K. M. (2026). AI科学者は科学的に推論することなく結果を生み出します。arXiv:2604.18805.
Saad-Falcon, J., Buchanan, E. K., Chen, M. F., Huang, T.-H., McLaughlin, B., Bhathal, T., Zhu, S., Athiwaratkun, B., Sala, F., Linderman, S., Mirhoseini, A., & Ré, C. (2025). 弱い検証器で生成検証ギャップを縮小。arXiv:2506.18203.
Sabater, J., & Sierra, C. (2005). 計算信頼と評判モデルのレビュー。Artificial Intelligence Review, 24(1), 33–60.
Schemmer, M., Kühl, N., Benz, C., Bartos, A., & Satzger, G. (2023). AI助言への適切な依存:概念化と説明の効果。IUI '23, 410–422.
Schilke, O., & Reimann, M. (2025). 透明性のジレンマ:AI開示がいかに信頼を損なうか。Organizational Behavior and Human Decision Processes, 188, 104405.
Schmidt, J., & Bijmolt, T. H. A. (2020). 消費者製品の支払い意思を正確に測定する:仮説バイアスのメタアナリシス。Journal of the Academy of Marketing Science, 48, 499–518.
Shapiro, S. P. (1987). 非人格的信頼の社会的統制。American Journal of Sociology, 93(3), 623–658.
Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., Cheng, N., Durmus, E., Hatfield-Dodds, Z., Johnston, S. R., Kravec, S., Maxwell, T., McCandlish, S., Ndousse, K., Rausch, O., Schiefer, N., Yan, D., Zhang, M., & Perez, E. (2024). 言語モデルにおけるゴマすり行動の理解に向けて。ICLR 2024 (arXiv:2310.13548).
Shehata, D., & Li, M. (2026). 逆智慧の法則:エージェント的群れにおける建築的部族主義とコンセンサス逆説。arXiv:2604.27274.
Sheridan, T. B., & Verplank, W. L. (1978). 海中テレオペレーターの人間とコンピュータ制御 (Technical report). MIT Man-Machine Systems Laboratory.
Smit, A. P., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). MADに向かうべきか。LLMのマルチエージェント議論戦略の検討。ICML 2024, PMLR 235, 45883–45905 (arXiv:2311.17371).
Söllner, M., Hoffmann, A., & Leimeister, J. M. (2016). なぜ異なる信頼関係が情報システムユーザーにとって重要なのか。European Journal of Information Systems, 25(3), 274–287.
Spiro, T. (2026). オラクルの指紋:相関したAI予測誤差とバイアス伝播の限界。arXiv:2605.00844.
Stanford HAI (2025). Artificial Intelligence Index Report 2025。 Stanford Institute for Human-Centered Artificial Intelligence (技術パフォーマンス章).
Stanford HAI (2026). Artificial Intelligence Index Report 2026。 Stanford Institute for Human-Centered Artificial Intelligence (世論章、Pew 25か国調査データを報告).
Tax, S. S., Brown, S. W., & Chandrashekaran, M. (1998). サービス苦情経験に対する顧客評価:関係マーケティングへの示唆。Journal of Marketing, 62(2), 60–76.
Vaccaro, M., Almaatouq, A., & Malone, T. (2024). 人間とAIの組み合わせが有用な場合:体系的レビューとメタアナリシス。Nature Human Behaviour, 8(12), 2293–2303. DOI: 10.1038/s41562-024-02024-1.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). 判事を陪審員に置き換える:多様なモデルのパネルを使用したLLM生成の評価。arXiv:2404.18796.
Visa (2025). Visaが信頼できるエージェント・プロトコルを導入:AI商取引のためのエコシステム主導フレームワーク。プレスリリース (Cloudflareとの共同)、2025年10月14日。
Visa (2026). Visa partners with OpenAI to power the next generation of AI commerce. Press release, Visa Payments Forum, 10 June 2026.
W3C (2025). Verifiable Credentials Data Model v2.0. W3C Recommendation.
Wallendorf, M., & Brucks, M. (1993). Introspection in consumer research: Implementation and implications. Journal of Consumer Research, 20(3), 339–359.
Walsham, G. (1995). Interpretive case studies in IS research: Nature and method. European Journal of Information Systems, 4(2), 74–81.
Wang, W., & Benbasat, I. (2005). Trust in and adoption of online recommendation agents. Journal of the Association for Information Systems, 6(3), 72–101.
Wang, Y., Zhang, J., Cai, T., Liu, Z., Sun, Q., Sun, Z., Wu, Z., Dong, M., Zheng, M., Yin, X., & Zhu, Y. (2026). From agent traces to trust: A survey of evidence tracing and execution provenance in LLM agents. arXiv:2606.04990.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., & Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
Werbach, K. (2018). ブロックチェーンと信頼の新しいアーキテクチャ。 MIT Press.
Wertenbroch, K. (1998). Consumption self-control by rationing purchase quantities of virtue and vice. Marketing Science, 17(4), 317–337.
Xiao, B., & Benbasat, I. (2007). E-commerce product recommendation agents: Use, characteristics, and impact. MIS Quarterly, 31(1), 137–209.
Yalcin, G., Lim, S., Puntoni, S., & van Osselaer, S. M. J. (2022). Thumbs up or down: Consumer reactions to decisions by algorithms versus humans. Journal of Marketing Research, 59(4), 696–717.
Yin, R. K. (2018). ケーススタディ研究と応用:デザインと方法 (6th ed.). Sage.
Zhang, Y., Liao, Q. V., & Bellamy, R. K. E. (2020). Effect of confidence and explanation on accuracy and trust calibration in AI-assisted decision making. Proceedings of the 2020 ACM Conference on Fairness, Accountability, and Transparency, 295–305.
Zheng, J., & Zhang, J. (2026). Uncertainty-aware trust estimation for multi-LLM systems via structured expert judgement. arXiv:2607.20529.
Zuboff, S. (2019). 監視資本主義の時代。 PublicAffairs.
Zucker, L. G. (1986). Production of trust: Institutional sources of economic structure, 1840–1920. Research in Organizational Behavior, 8, 53–111.
* AIシステムアーキテクト。利益相反:著者はマルチモデルオーケストレーション方法を開発し、本論文で説明するアーキテクチャの参照実装を運用し、AIオーケストレーションおよび本論文が検討するような種類のマルチモデル検証システムをカバーする申請中の特許の指定申請人であり、認可された特許ではなく、本論文が提唱するアーキテクチャに関する開発者としての関心を有しています。その必要性についての規範的主張はその関心を念頭に置いて読まれるべきです。セクション4の展開における著者の役割は、本論文の末尾の「著者覚書と開示」に記載されています。コメントは歓迎します。[email protected]まで。↩︎
引用方法
Chernets, V. (2026). 建築的信頼:消費者のエージェンティックコマースに対する信頼がAIモデルから検証可能なアーキテクチャに移行する理由 [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7191261
@misc{chernets2026architecturaltrust,
  author       = {Chernets, Vadym},
  title        = {{Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7191261},
  url          = {https://doi.org/10.2139/ssrn.7191261}
}