일치 반전은 중간 수준 속성이 아닙니다: 합의된 LLM 답변의 정확도는 쌍 정확도를 따릅니다
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7682960 · DOI 10.2139/ssrn.7682960 · Zenodo 10.5281/zenodo.24090580 · Analysis release 10.5281/zenodo.24090584 · GitHub
프리프린트, 2026년 11월 9일. SSRN: 7682960. 아카이브 사본: 10.5281/zenodo.24090580. 데이터 및 코드: 10.5281/zenodo.24090584. PDF: agreement-inversion.pdf. PDF가 공식 버전입니다.
초록
두 개의 flagship 모델이 따로 물어볼 때 가장 어려운 SimpleQA 질문 중 하나에 같은 답변을 제시하면, 그 답변은 대체로 틀렸습니다. 7월 중간 계층 패널이 실패한 106개의 SimpleQA 질문 중에서, 클라이언트 서빙 GPT 팔 없는 45개의 flagship 쌍에서 웹 검색을 배제할 수 없을 때, 691개의 동의 중 96개(13.9%)에서 정답입니다. 두 번째 모델이 동의할 때만 답변하는 것은 라벨이나 매개변수가 필요 없으며, 이전 연구에서는 이 규칙의 실패를 중간 계층 모델에 속했습니다. 측정한 두 계층 모두에서 동의된 답변의 정밀도는 쌍의 정확도를 따르므로, 역전은 중간 계층 속성이 아닙니다. 각 계층에 대해 동일한 방식으로 정의된 가장 어려운 5분위수에서, 정밀도는 7월에 17.3%, 8월에 15.5%입니다. 5개 5분위수 전체에서 각 쌍의 두 정확도로 예상되는 정밀도에서, flagship 쌍과 중간 계층 쌍의 차이는 -0.2포인트 [-3.1, +2.7]입니다. 데이터는 SimpleQA이며, 신선한 2단계 질문 및 제품 사실로, 2026년 7월, 8월, 10월에 11개 실험실의 flagship 모델로 수집되었습니다. 두 번째 실험실의 파트너는 더 많은 오류를 감지하지만 게이트를 덜 자주 엽니다. 한 개의 공개 모델의 경우, 같은 실험실 파트너는 29개의 오류 중 2개를 감지하고 다른 실험실의 파트너는 29개 중 20개를 감지하며(-62.1포인트 [-79.3, -43.8]), 게이트는 질문의 96%와 61%에서 열립니다. 더 넓은 게이트가 동일한 커버리지를 위해 명시된 신뢰도로 축소될 때, 이 장점은 파트너의 모델이 훨씬 더 정확한 경우에만 유지됩니다. 측정된 정확도를 입력받은 소형 모델은 표본 외 정밀도를 평균 절대 오차 0.037로 예측하며, 최고 단일 모델의 0.099 대비 0.032의 독립 오류 기준선과 동등하고, 제품 사실 및 공개 데이터에서 높게 실행됩니다. 식별자 gpt-5.6-sol이 같은 100개의 질문에서 클라이언트 서빙 웨이브에서 92.0%를 기록하고 다른 노력 설정의 API를 통해 46.3%를 기록하는 동안, 8개의 다른 모델은 최대 4포인트만큼 이동합니다.
1. 소개
두 개의 서로 다른 연구실의 대형 언어 모델(LLM)에게 동일한 짧은 사실 질문을 각각 제시하고, 두 답변이 일치할 때만 답변을 공개합니다. 이 게이트는 레이블, 임계값 또는 심판이 필요하지 않으며, 단지 두 번의 맹검 호출만 필요합니다. 기함급 모델들이 매력적인 이유는 이들의 표명된 신뢰도가 거의 보호를 제공하지 않기 때문입니다. 2026년 8월의 10개 기함급 부문에서, 최소 80의 신뢰도로 표명된 10,540개 답변 중 4,910개가 틀렸습니다(Chernets, 2026b).
독점 모델에 대한 제 이전 측정인 2026년 7월 중급 모델 수집에서는 SimpleQA의 가장 어려운 5분위수에서 복제된 패널 답변이 342개 중 0개에서 올바릅니다(Chernets, 2026a). 이는 약한 모델의 경우 일치가 역전되어 일치된 답변이 옳기보다는 틀릴 가능성이 높으며, 강한 모델은 벗어난다는 것을 시사합니다. 기함급 쌍 하나가 이를 확인한 것으로 보였습니다. gpt-5.6-sol과 claude-fable-5는 동일한 질문 중 37개 일치 중 34개에서 정답이었습니다(섹션 3의 106개 중).
기함급 계층에서 이 해석은 유지되지 않습니다. 34개 중 37개를 뒤에서 지원하는 단일 부문이 없으면, 해당 공급업체 클라이언트를 통해 제공되는 gpt-5.6-sol은 역전이 반환되며, 어려움이 두 계층 모두에 대해 동일한 방식으로 정의되면 두 곡선이 어려운 끝에서 만납니다. 모든 5분위수에서, 각 쌍의 두 정확도를 고려하면, 기함급과 중급 쌍은 -0.2포인트 [-3.1, +2.7]만큼 차이가 납니다. 정밀도는 두 모델이 계층에 관계없이 분층에서 얼마나 정확한지를 추적합니다.
표 1은 4가지 기여를 요약합니다. 섹션 5.1은 정확도 범위를 지배하는 부문 없이 가능한 한 많이 구축된 기함급의 게이트 수준 설명을 제공합니다. 섹션 5.2는 두 번째 연구실이 기여하는 바를 측정하며, 공개된 모델과 파트너를 변경하고 GPT 포함 또는 제외합니다. 섹션 4와 5.3은 5개의 상수를 포함하는 게이트의 기술 모델을 제공하고 이를 표명된 기준에 대해 표본 외에서 테스트하며, 섹션 5.4는 동일한 식별자에서 동일한 질문에 대한 공급업체 클라이언트와 직접 API 접근을 비교합니다.
표 1. 주장, 증거 및 한계.
| 주장 | 증거 | 한계 |
|---|---|---|
| 일치된 답변의 정밀도는 두 계층 모두에서 쌍의 정확도를 따릅니다 | 106개 중 96/691; 가장 어려운 5분위수 7월 17.3%, 8월 15.5%; 일치된 정확도에서의 계층 -0.2 [-3.1, +2.7] | 연관성; 하나의 5분위수만 -1.8 [-22.1, +20.2]을 포함합니다 |
| 두 번째 연구실은 범위의 대가로 더 많은 오류를 포착합니다 | 20/29 대 2/29 오류 포착, -62.1 [-79.3, -43.8]; 범위 61% 대 96% | 동일한 범위에서, 신뢰도별로, 훨씬 더 정확한 파트너가 필요합니다; 10월 2개 연구실 |
| 소형 모델은 표본 외 정밀도를 설명합니다 | 최고 모델의 0.099에 대해 0.037 오류, -0.062 [-0.085, -0.035] | 독립 오류 수준, +0.005 [-0.003, +0.012]; 제품 팩트에서 13포인트 높음 |
| 접근 모드가 하나의 식별자를 이동시킵니다 | 동일한 100개 질문에서 클라이언트 92.0% 대 API 46.3% | 모드, 노력 및 가능한 검색이 함께 변합니다 |
2. 관련 연구
제 질문과 가장 관련성이 높은 것은 Goel et al. (2025)로, 모델의 출력 분포 간 합의의 기회조정 측도인 CAPA를 소개하고, MMLU-Pro와 BBH에서 130개의 개방형 가중 모델에 걸쳐 실수가 능력에 따라 더욱 유사해진다는 것을 보여주며, 이는 LM 배심원단을 포함한 AI 감시에 위험을 초래한다고 주장합니다. 저는 서로 다른 연구실의 독점 모델에 대해, 맹검 합의가 짧은 개방형 답변의 공개를 제어할 때 무엇을 입증하는지, 즉 합의된 답변의 정밀성, 불일치가 노출하는 공개된 모델 오류의 비중, 그리고 공유된 확신 있는 오류의 하한을 측정합니다. 결과는 양립 가능합니다: 제 데이터에서 유사성 증가의 비용은 불일치의 재현율에 나타나며, 정확성이 높은 곳에서는 정밀성이 높게 유지됩니다(부록 L). 합의 기반 캐스케이딩(Kolawole et al., 2025)은 허용된 오류의 결합 비율에 대한 조건을 가진 학습 없는 지연 규칙으로서 앙상블 합의를 사용하며, 제 계층화된 결과는 이러한 오류가 집중되는 위치를 파악합니다.
제공자 간 상관된 오류는 Kim et al. (2025)에 의해 문서화되었으며, Hossain et al. (2026)은 최첨단 LLM 판사 간에 더 강하다는 것을 발견합니다. 다양한 소규모 판사의 배심원단은 Verga et al. (2024)에 나타나며, 자신의 출력을 판단하는 모델의 편향은 Panickssery et al. (2024)에 나타나는데, 이는 두 개의 맹검 답변을 비교하는 것을 선호합니다. 한 모델의 샘플 간 합의는 자기 일관성(Wang et al., 2023), SelfCheckGPT(Manakul et al., 2023) 및 의미적 불확실성(Kuhn et al., 2023)의 신뢰도 신호이며, Yue et al. (2024)의 지연 규칙입니다. 저는 이를 연구실 간 합의와 비교합니다(섹션 5.2). 게이트는 선택적 예측자(Geifman & El-Yaniv, 2017)이므로, 저는 동일한 범위에서 게이트를 비교합니다. 최근의 사전 인쇄본은 집계가 도움이 되는지 여부에 대해 동의하지 않습니다(부록 E). 독점 기함에 대해 쌍 수준의 공개 게이트, 한 공개된 모델을 고정한 상태에서 동일한 범위의 재현율, 또는 동일한 질문에서 두 가지 접근 방식으로 측정된 하나의 식별자를 보고하는 작업을 알지 못합니다.
3. 데이터 및 프로토콜
저의 이전 연구는 7월 패널(Chernets, 2026a)과 8월 및 10월 선정된 쌍에 대한 집계(Chernets, 2026c)를 보고했습니다. 여기서 새로운 것은 GPT 없는 주력 쌍, 난이도의 대칭 정의, 동일 실험실 쌍, 동등 커버리지 비교, 표본 외 및 외부 테스트, 접근 방식 비교입니다.
수집. 모든 답변은 블라인드 상태에서 수집되었습니다. 질문당 한 번의 호출이고, 어떤 모델도 다른 모델의 답변을 보지 못했습니다. 시스템 프롬프트는 짧은 답변과 0부터 100까지의 신뢰도를 포함한 JSON 객체를 요청하며 출처를 요청하지 않습니다. 표 A1은 모델, 날짜 및 접근 방식을 나열하고, 부록 F는 수집을 완전히 설명합니다. 9개의 API 모델과 7개의 로컬 모델이 7월 24일부터 28일까지 1,500개의 SimpleQA 질문(Wei et al., 2024)에 답변했으며, 데이터 수집 전에 OSF에 등록되었습니다(Chernets, 2026a). 11개 실험실 각각의 한 주력 모델이 8월 3일부터 6일까지 같은 질문에 답변했으며, 모두에 공통인 1,459개 질문이 있고, 이 중 9개는 온도 0.7에서 3개 샘플로 100개 질문에 답변했습니다(분산 팔). 추가된 것은 Wikidata에서 기계로 구성한 100개의 2홉 질문(파일 해시는 첫 모델 호출 전에 고정됨)과 267개의 제품 사실입니다. 10월에 gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5, claude-fable-5-1이 7월 5분위수, 아래 106개, 신규 세트로 계층화된 300개의 SimpleQA 질문에 답변했으며, 모두 5개 모델에 공통인 503개 질문이 있습니다(모든 쌍이 표 A2에 있음).
106개. 이들은 7월 패널이 답변을 반복한 최상 5분위 질문입니다(Chernets, 2026a). 7월 모델의 실패로 선택되었으므로, 이들에 대한 7월 정밀도는 부분적으로 선택의 결과이며, 섹션 5.1은 이 속성을 갖지 않는 난이도의 대칭 정의로 이들을 짝짓습니다.
접근 방식. 8월에 claude-fable-5, gpt-5.6-sol, mistral-medium-3.5는 공급업체의 자체 1자 클라이언트인 최종 사용자가 배포하는 공식 명령줄 에이전트를 통해 실행되었고, 10월에는 모든 팔이 그렇게 했으므로 측정에는 공급업체 측 시스템 프롬프트 및 사용자가 받는 클라이언트의 서빙 기본값이 포함됩니다. 7월 웨이브와 나머지 8월 팔은 공급업체에 고정된 직접 API 또는 집계자 경로를 사용했습니다. 표 2는 클라이언트 팔의 측정 조건을 명시합니다. 웹 검색 사용을 배제할 수 없을 때 팔을 검색 가능하다고 부르며, 이러한 팔을 포함한 상태와 제외한 상태로 주요 결과를 보고합니다.
표 2. 팔별 측정 조건. 참고: Codex 및 Claude 클라이언트에서는 온도가 설정되지 않습니다. Codex 이벤트 스트림은 유지되지 않았습니다. 7월 및 8월 웨이브의 API 팔은 온도 0에서 실행되었습니다. 대시는 설정이 없거나 기록에 항목이 없음을 나타냅니다.
| 팔 | 도달 방식 | 노력 | 검색 가능 |
|---|---|---|---|
| gpt-5.6-sol, 8월 | Codex 클라이언트 | 클라이언트 기본값, 기록되지 않음 | 배제되지 않음 |
| claude-fable-5, 8월 | Claude 클라이언트 | - | 아니오, 0개 검색 요청 기록됨 |
| mistral-medium-3.5, 8월 | 공급업체 클라이언트 | - | 아니오, 빈 도구 목록 |
| gpt-6.1-sol, gpt-6-astra, gpt-6-sol, 10월 | Codex 클라이언트 | 중간 | 배제되지 않음 |
| claude-opus-5-5, claude-fable-5-1, 10월 | Claude 클라이언트 | - | 아니오, 도구 비활성화됨 |
| kimi-k3, gemini-3.8-flash, 신규 세트 | 공급업체 클라이언트 | - | 도구 비활성화되지 않음, 프롬프트 금지 |
| gpt-5.6-sol, 분산 팔 | 직접 API | 없음 | - |
게이트 및 측정. 게이트는 두 모델이 모두 답변하고, 둘 다 거부하지 않으며, 결정론적 동등성 엔진(여기의 모든 웨이브에서 동일)이 두 답변을 동등하다고 판단할 때 열립니다. 등급 매기기는 같은 엔진을 답변과 금표준 답변에 적용합니다. 정규화된 정확한 일치, 4자 이상 문자열 포함, 날짜, 숫자 및 식별자에 대한 규칙(부록 D, 표 A3의 재채점 포함). 셀은 질문 계층에서 한 쌍의 모델입니다. 커버리지는 두 모델이 답변한 질문 중 열린 게이트를 세습니다. 정밀도(PPV)는 채점기가 올바른 것 또는 잘못된 것(K/O)으로 해결한 열린 답변 중 올바른 것의 비율이며, Delta는 정밀도에서 셀의 모든 해결된 질문에서 공개 모델의 정확도를 뺀 것입니다. 재현율은 게이트가 닫혀 있는 공개 모델의 오류 비율이며, 포착된 오류로 보고됩니다. Lift는 게이트가 열려 있을 때 공개 모델의 정확도를 게이트가 닫혀 있을 때의 정확도로 나눈 값이며, 바닥은 두 모델이 최소 80의 신뢰도를 명시하고, 동의하며, 틀린 질문을 세습니다. PPV가 1/2 미만일 때 합의를 반전되었다고 부릅니다. 공개 모델은 쌍의 첫 번째 구성원이거나, 쌍이 풀링될 때 더 정확한 것입니다. 동등 커버리지에서 게이트를 비교하기 위해 더 넓은 게이트를 얇게 합니다. 열린 답변은 두 명시된 신뢰도 중 더 작은 것으로 순위가 지정되고 목표 커버리지로 자르며, 동점은 무작위로 깨집니다.
추론. 단일 비율은 Wilson 구간을 사용합니다. 차이 및 파생 수량은 95% 부트스트랩 구간을 사용하며, 풀링된 결과에 대해 질문 및 모델에 대한 2방향(Owen, 2007; B = 2000, 고정 시드, 각 복제에서 모델 재조정)이고 단일 쌍에 대해 질문에 대한 것입니다. 쌍 정확도 비교는 정확한 McNemar 테스트를 사용하고, 동등성은 2점 마진을 가진 2개의 일방향 테스트(Schuirmann, 1987)를 사용합니다. 셀은 종속적이므로 구간을 포함하고 p값을 포함하지 않습니다.
4. 게이트 모델
와 를 셀에서 두 모델의 측정된 정확도라고 하고 라고 합시다. 를 둘 다 틀릴 확률이고 를 둘 다 맞을 확률이라고 합시다:
여기서 는 결합 오류의 독립적 비율을 증가시킵니다. 두 개의 정답은 확률 로 일치합니다. 두 개의 오답은 확률 로 일치하며, 여기서 는 오답이 더 자주 충돌하는 106에서이고 다른 곳에서는 1입니다. 그러면
335개의 서로 다른 실험실의 쌍 세포에서 적합화했으며(7월, 8월, 10월, 그 중 106개; 는 모든 적합화된 세포에 대한 두 정답의 일치율), 상수는 , , , (22,536/22,785) 및 입니다.
이 모델은 세포의 측정된 정확도를 입력으로 받아 범위, 정밀도 및 잘못된 동의 답변의 비율인 를 반환하며, 3절의 하한은 최소 80의 신뢰도를 가진 부분입니다. 두 정확도가 주어지면, 게이트가 추가하는 것을 반환하고, 정밀도가 정확도를 따라야 하는 이유를 보여줍니다: 이고 정답이 일치하는 경우, 동의 답변의 정밀도는 이상으로 내려갈 수 없습니다. 모든 오류가 공유되더라도 두 모델 모두 최소 개 질문에서 함께 정답이고 최대 개에서 함께 오답이기 때문입니다(일 때 0.947). 에서는 제약이 없으며, 는 잘못된 답변이 같은 문자열에 집중될 때마다 를 초과할 수 있습니다.
이를 두 가지 기준선과 비교합니다. 독립 오류 기준선은 로 설정하고 나머지를 다시 적합화하므로 를 유지합니다. 최적 모델 기준선은 를 예측합니다. 기준은 모델이 두 기준선을 모두 능가하며, 차이의 구간이 0 이하인 leave-one-laboratory-out(LOLO), leave-one-model-out(LOMO) 및 7월과 8월에서 10월로의 시간 분할 아래에 있어야 한다는 것입니다.
5. 결과
5.1 역변환은 중간 계층의 특성이 아닙니다
표 3은 클라이언트 제공 GPT 팔(arm)이 없는 게이트를 제시합니다. SimpleQA 전체에서 두 계층은 유사해 보입니다: 7월 72.1%, 8월 80.6%의 정밀도로, 릴리스된 모델에 대해 +28.6, +26.0 포인트의 델타입니다. 106에서는 정밀도가 두 기간 모두 낮습니다: 7월 717 중 5개, 8월 GPT 없이 691 중 96개입니다. 7월 측면에서도 GPT 팔을 제외하면 581 중 4개이고, 8월과 7월의 차이는 +13.2 포인트 [+2.6, +30.8]입니다. 8월 정밀도가 더 높지만 여전히 0.5 이하이므로, 합의는 두 기간 모두에서 역전됩니다. 또한 이는 계층의 최고 단일 팔 아래입니다: 7월에는 -9.5 포인트 [-16.3, -3.2], 8월에는 -43.2 [-67.6, -16.1]입니다. GPT 없이 7월의 Lift는 0.13 [0.00, 1.21], 8월은 0.65 [0.23, 1.22]입니다.
표 3. 클라이언트 제공 GPT 팔이 없는 게이트입니다. 참고: 명시되지 않은 한 다양한 실험실의 쌍에 대해 풀링됨; 커버리지는 두 모델 모두 답변한 질문에 대한 것이고, K/O는 채점자가 해결하는 개방 답변에 대한 것입니다; PPV의 신뢰구간: 양방향 부트스트랩. 제품 팩트: 검색 가능성이 없는 4개 팔입니다.
| 계층, 질문 | 쌍 | 커버리지 | PPV (K/O) [95%] | 릴리스된 정확도 | 델타, 포인트 [95%] |
|---|---|---|---|---|---|
| 중간, 7월, 106 | 36 | 19.8% | 0.7% (5/717) [0.0, 3.7] | 4.6% | -3.9 [-8.3, +0.3] |
| 중간, 7월, 모든 SimpleQA | 36 | 20.6% | 72.1% (7743/10745) [53.2, 82.3] | 43.4% | +28.6 [+22.3, +32.4] |
| 플래그십, 8월, 106, 검색 가능 팔 없음 | 45 | 19.1% | 13.9% (96/691) [3.3, 31.8] | 19.9% | -6.0 [-14.1, +2.9] |
| 플래그십, 8월, 모든 SimpleQA, 검색 가능 팔 없음 | 45 | 29.1% | 80.6% (12357/15322) [69.6, 87.9] | 54.7% | +26.0 [+19.9, +30.7] |
| 플래그십, 8월, 새로운 100 (API를 통한 GPT) | 6 | 37.5% | 88.9% (200/225) [75.6, 97.4] | 66.8% | +22.1 [+7.9, +47.4] |
| 동일 실험실, 10월, fable-5-1 + opus-5-5, 106 | 1 | 39.6% | 47.5% (19/40) | 30.0% | +17.5 [+6.2, +29.7] |
| 10월, kimi-k3 + gemini-3.8-flash, 새로운 100 (도구 비활성화 안 함) | 1 | 72.0% | 95.8% (69/72) | 74.0% | +21.8 [+14.1, +30.0] |
| 제품 팩트, 267, 검색 가능 팔 없음 | 6 | 63.6% | 75.0% (423/564) [66.4, 82.7] | 62.7% | +12.3 [+5.8, +20.4] |
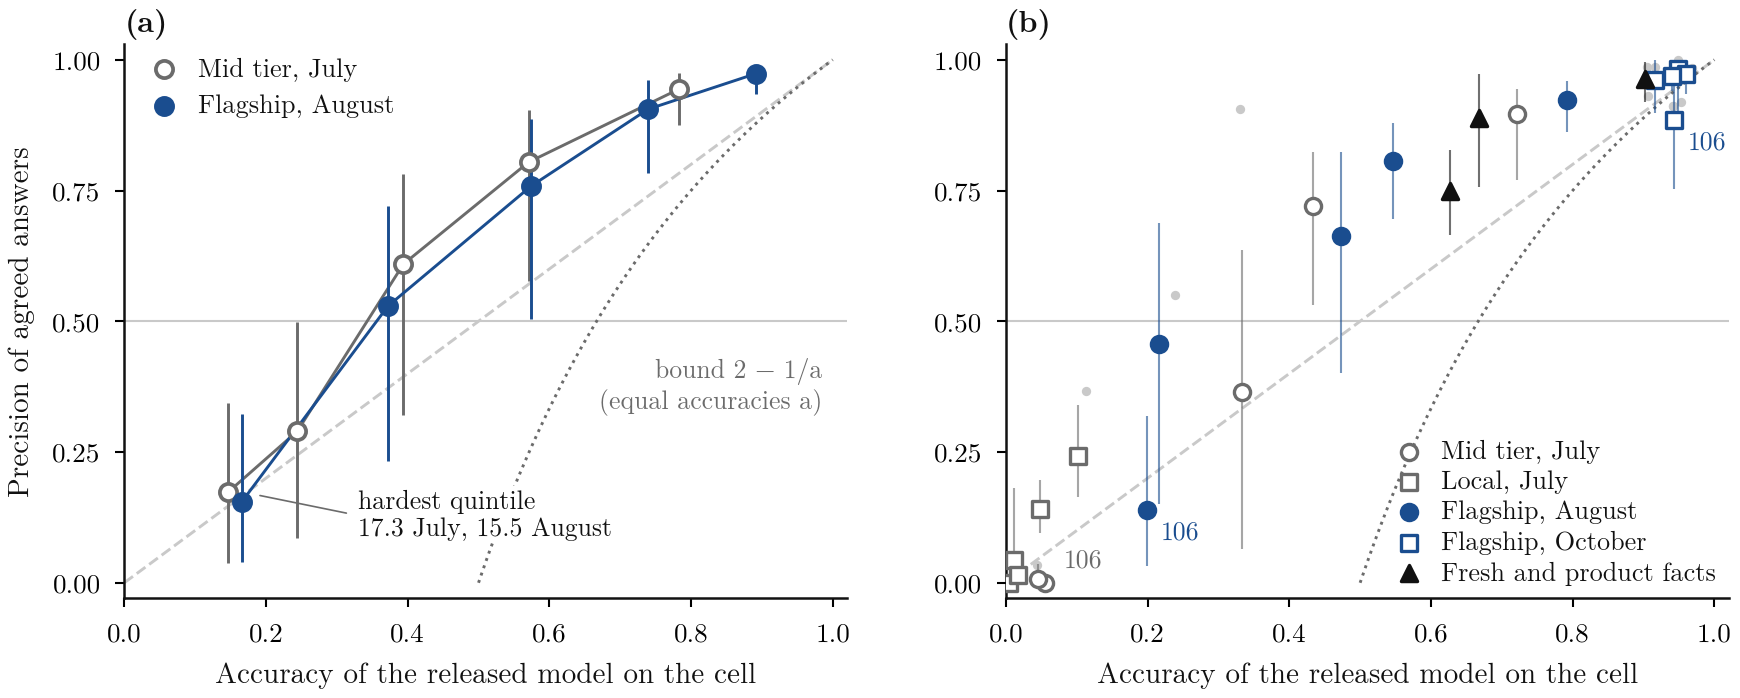
그림 1. 합의된 답변의 정밀도는 쌍의 정확도를 따릅니다. 참고: (a) 각 계층 내 난이도 5분위수, 7월 중간 계층 및 8월 플래그십(클라이언트 제공 GPT 팔 없음). (b) 모든 계층의 모든 대역, 7월부터 10월까지, 릴리스된 모델의 정확도에 대해; 표시된 셀은 106입니다. 수염은 95% 부트스트랩 신뢰구간이고, (b)의 작은 회색 점은 단일 쌍입니다; 점선은 등식이고, 점선은 한계 2 - 1/a(정확도가 같은 경우)입니다.
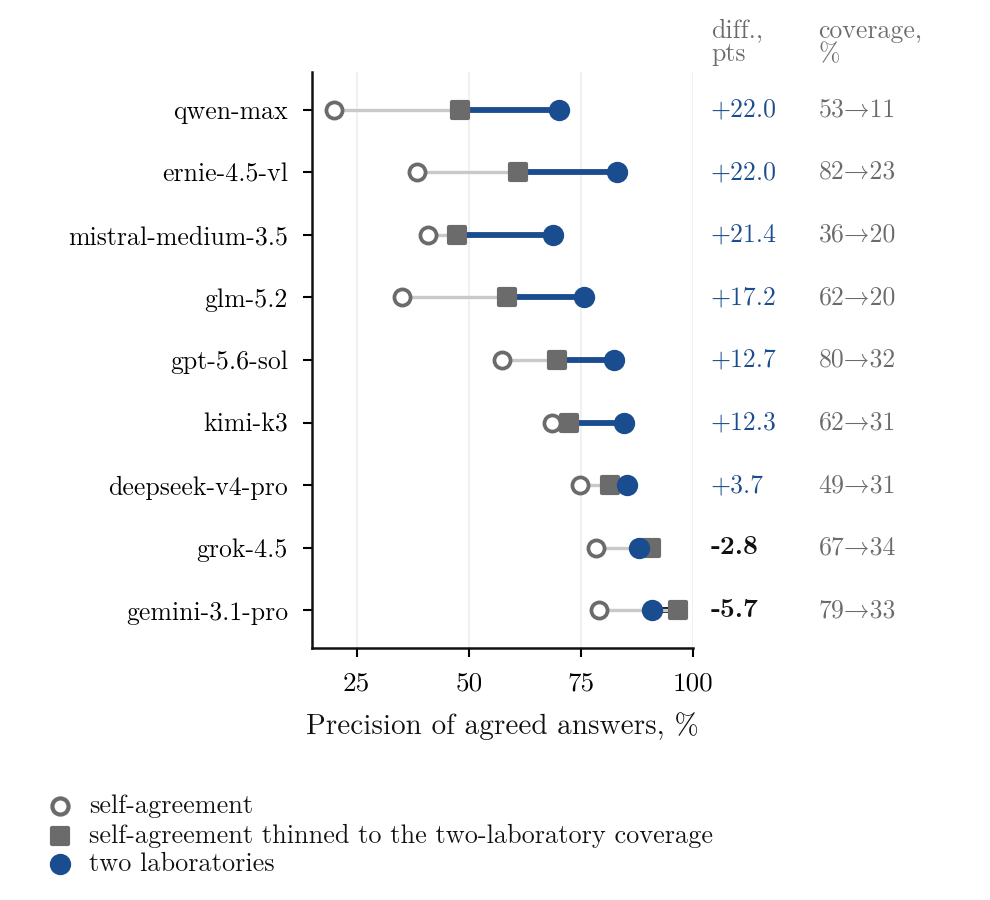
그림 2. 두 실험실에 대한 모델별 자가일치입니다. 참고: 분산 팔, 9개 모델, 100개 질문. 열린 원, 한 모델에 대한 두 번의 호출; 정사각형, 두 실험실 게이트의 커버리지로 신뢰도를 조정한 것과 동일; 채워진 원, 두 실험실, 파트너에 대한 평균. 오른쪽 열은 같은 커버리지에서의 차이(포인트)와 두 게이트의 커버리지(퍼센트)를 제시합니다.
클라이언트 제공 GPT 팔이 없는 3모델 패널은 같은 결과를 제시합니다. 내 엔진 아래의 106에서 7월 패널은 318 중 0개(섹션 1의 이전 매칭 규칙 아래 가장 어려운 5분위수의 342 중 0개; 위의 717 중 5개는 쌍을 계산함)를 제시합니다. 8월에 DeepSeek, Qwen, Kimi 패널은 76 중 0개를 제시하고 Claude, DeepSeek, Mistral의 크로스 블록 패널은 78 중 11개(14.1% [2.7, 26.3])를 제시합니다. GPT 팔을 보유한 Claude, GPT, Gemini 패널은 131 중 106개(80.9%)를 제시합니다. 플래그십 쌍은 계층의 정확도와 일치하며, fable-5와 deepseek-v4-pro의 21 중 4개부터 fable-5와 gemini-3.1-pro의 24 중 15개(62.5% [42.6, 82.6])까지 다양합니다. 이 그룹의 구성원들이 여기서 선도합니다.
106은 7월 실패에서 선택되었으므로, 이는 7월 정밀도를 낮추고 8월을 유리하게 합니다. 그림 1a는 각 계층 내에 난이도를 설정합니다. 각 계층에 대해 질문은 평가 중인 쌍 없이 동일 계층의 정확도로 5분위수로 순위가 매겨집니다. 따라서 가장 어려운 5분위수는 각각에 대해 동일한 순위를 보유하고, 릴리스된 모델의 정확도는 7월 15.3%, 8월 16.0%입니다. 그곳의 정밀도는 GPT 없이 7월 917 중 159개(17.3% [3.8, 34.3]), 8월 1,308 중 203개(15.5% [4.0, 32.4])로, 차이는 -1.8 포인트 [-22.1, +20.2]입니다. 5개 5분위수 모두를 풀링하면 더 날카로운 검정을 제공합니다. 섹션 4의 모델에는 계층 항이 없습니다. 각 셀의 두 정확도가 주어지면, 이는 그곳에서 예상되는 정밀도를 제공하고, 계층 효과는 잔차의 차이로 표시됩니다. 플래그십 셀은 중간 계층 셀에서 -0.2 포인트 [-3.1, +2.7], 상수가 7월 셀에서만 적합할 때 -0.5 [-3.6, +2.4]이므로 8월은 표본 외입니다. kimi-k3은 두 컬렉션에 속합니다; 없으면 차이는 +0.1 [-3.6, +3.8]입니다. 정리된 금 답변에서 정밀도는 낮게 유지됩니다: SimpleQA Verified에서 유지되는 106 중 24개(Haas et al., 2025)에서, 8월 쌍은 GPT 없이 합의의 18.7% [0.0, 57.1]에서 맞습니다 (부록 G).
모든 계층의 모든 대역에서(그림 1b), 정밀도는 각 기간의 릴리스된 모델의 정확도와 함께 상승하고 23개 셀 중 17개에서 대각선 위에 있습니다. 그 아래의 6개 중 3개는 106 셀이고 3개는 릴리스된 정확도가 0.06 미만인 대역입니다. 상단에서 kimi-k3과 gemini-3.8-flash는 새로운 세트에서 95.8%에 도달합니다(부록 G).
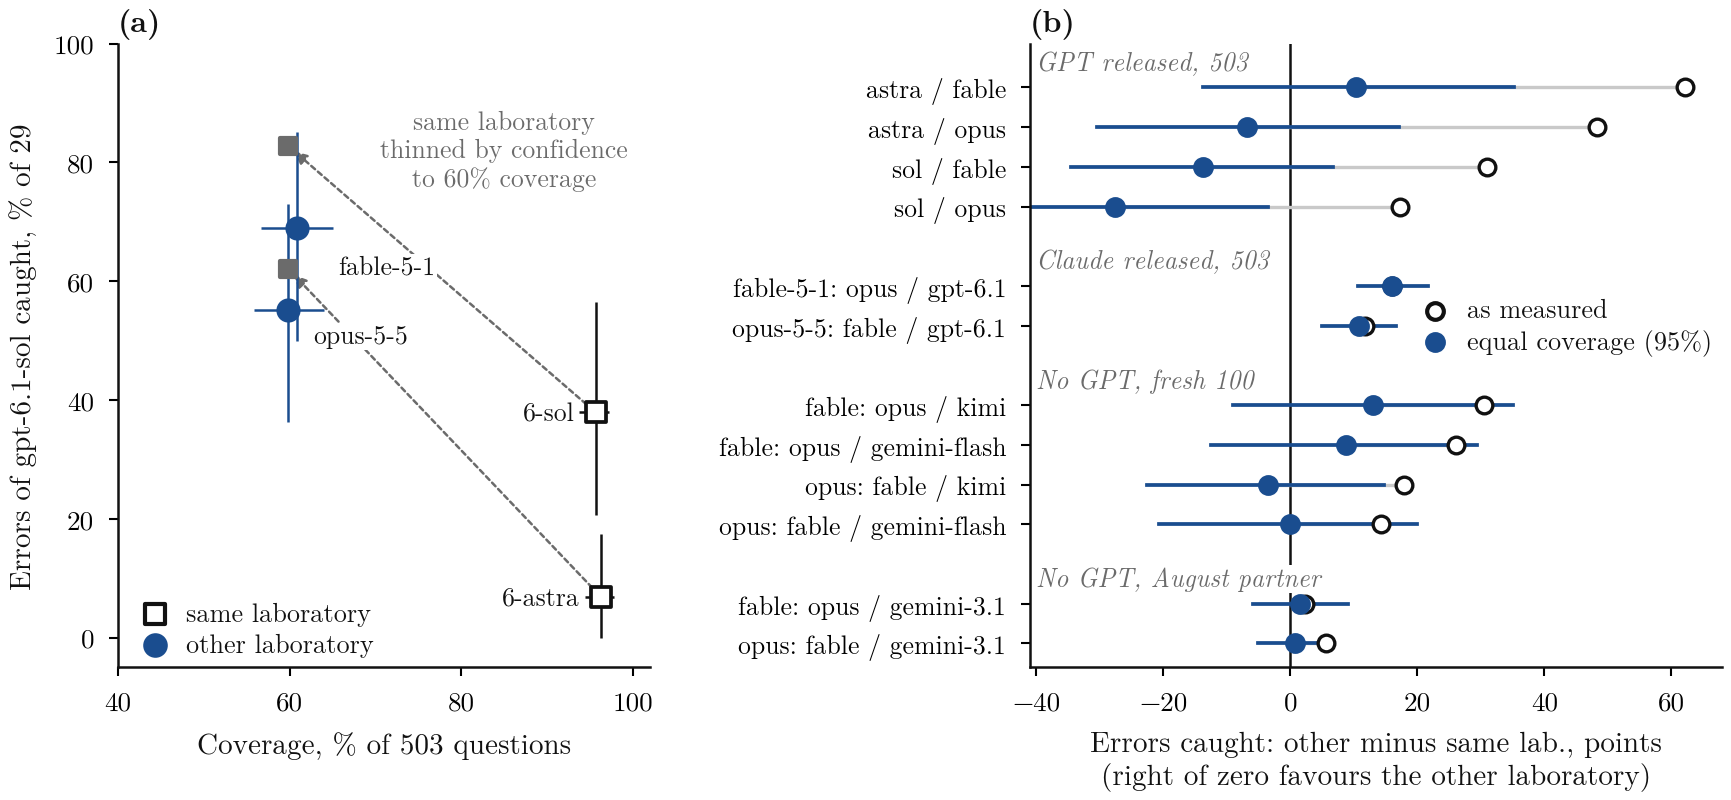
그림 3. 두 번째 실험실: 커버리지와 적발된 오류. 주: (a) gpt-6.1-sol이 503개의 일반적인 질문에서 29개의 오류, 표 A4의 4개 파트너, 95% 부트스트랩 신뢰구간; 화살표는 동일 실험실 게이트에서 신뢰도로 60% 커버리지로 얇아진 동일 게이트로 향함. (b) 표 A5의 12개 비교: 다른 실험실에서 적발된 오류에서 동일 실험실을 뺀 것, 측정값(열림)과 동일한 커버리지(채움, 95% 질문 부트스트랩).
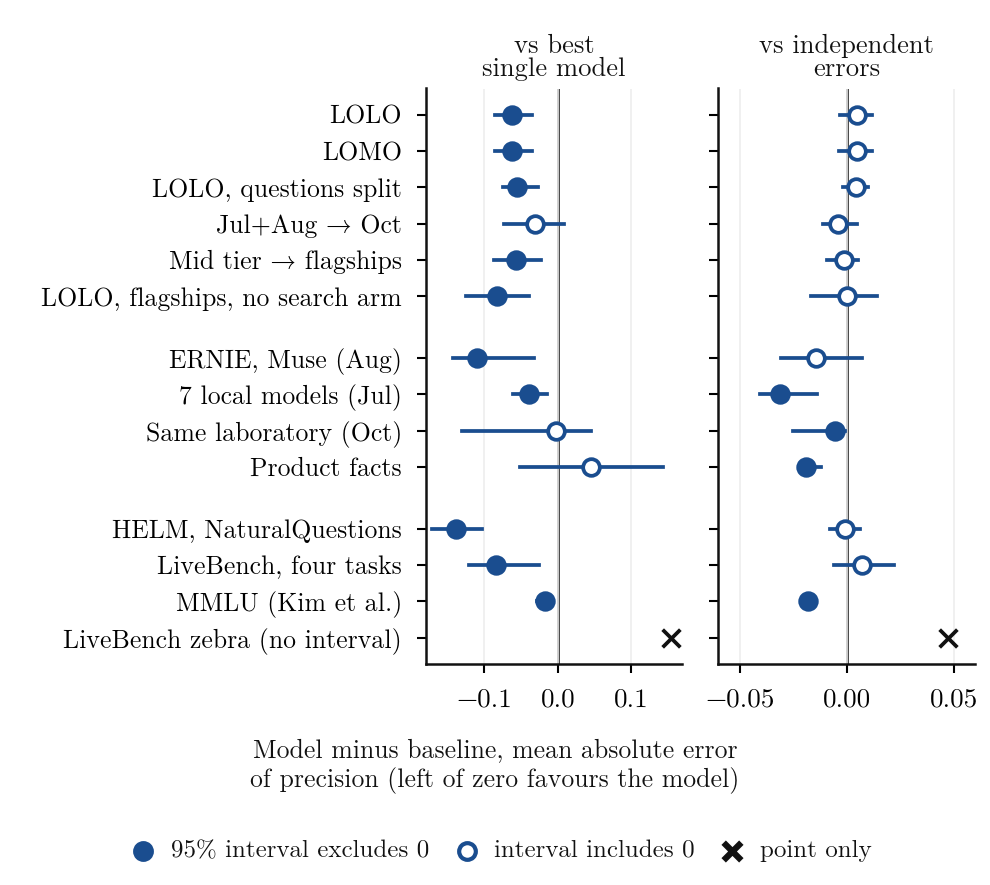
그림 4. 샘플 외부 모델 대 두 기준선. 주: 모델에서 기준선을 뺀 값으로 예측 정확도의 평균 절대 오류, 0 이하는 모델을 선호, 95% 양방향 부트스트랩 신뢰구간(표 A6 및 A8). 상단 그룹, 피팅 스킴; 중간, 상수가 고정된 피팅 외부 세트; 하단, 공개 데이터(섹션 5.5). 채워진 마커, 95% 신뢰구간이 0을 제외; 열림, 0을 포함; 교차, 점 추정값(LiveBench 얼룩말 작업).
5.2 두 번째 실험실이 더 많은 오류를 적발하지만 커버리지의 대가를 치르다
정확도만으로는 경우를 구분할 수 없습니다. 한 실험실의 정확한 쌍도 높은 정확도를 가지기 때문입니다. 재현율은 커버리지와 함께 읽어야 합니다. 덜 열리는 게이트가 구성상 더 많은 오류를 차단하기 때문입니다.
분산 암으로 시작합니다: 온도 0.7에서 한 모델에 대한 두 호출 대 두 개의 서로 다른 실험실에 대한 호출(그림 2). 9개 모델과 100개 질문에서 풀링하면, 자체 일치는 56.1%의 정확도에서 63.5%를 커버하고, 두 실험실은 82.9%에서 26.1%를 커버합니다. 정확도 차이는 측정값으로 +26.8포인트 [+16.6, +34.6]이고 동일한 커버리지에서 +9.0 [+0.5, +17.4]입니다. 여기서 자체 일치는 신뢰도로 얇아지므로 이를 유리하게 합니다. 모델별로, 두 실험실 게이트는 9개 중 7개에서 선도합니다. 암에는 Claude 모델이 없으며 API를 통한 GPT가 있습니다. GPT 없이, 8개 모델에서 동일한 커버리지에서의 차이는 +7.7포인트 [-1.9, +16.5]입니다.
10월 웨이브는 두 실험실에서 각각 두 모델을 보유하고 있으며, 이는 503개의 공통 질문에 대한 직접 테스트를 제공합니다(그림 3a). 한 공개 모델인 gpt-6.1-sol은 모든 행에서 동일한 29개의 오류를 유지하고 파트너만 변경합니다. 같은 실험실 파트너 gpt-6-astra는 2개를 적발하고 fable-5-1은 20개를 적발합니다. 차이는 -62.1포인트 [-79.3, -43.8]이고; opus-5-5에 대해서는 차이가 -48.3 [-66.7, -29.6]입니다. 대가는 커버리지로, 96% 대 60~61%입니다. 정확도는 행에서 일정합니다: 같은 실험실의 경우 94.3%와 96.2%, 실험실 간에는 95.6%와 97.0%(표 A4). 같은 실험실 파트너는 광범위하게 다릅니다: gpt-6-sol은 29개 중 11개를 적발합니다(부록 H).
이것이 커버리지 곡선을 따른 이동 이상인지, 그리고 GPT가 필요한지 보기 위해 그림 3b의 각 행은 한 공개 모델을 유지하고 두 파트너를 측정값과 동일한 커버리지(표 A5)에서 비교합니다. 측정값으로, 다른 실험실이 모든 행에서 더 많은 오류를 적발합니다. 동일한 커버리지에서 그 이점은 Claude가 93.9% 정확도의 파트너인 gpt-6.1-sol과 함께 공개될 때만 유지되며, 계층화된 세트에서 같은 실험실 파트너의 경우 66.6~69.2%입니다. GPT가 공개되면, 신뢰도로 얇아진 같은 실험실 게이트는 동등하거나 앞서고, GPT 없이는 차이가 동등하거나 약한 파트너에 대해 같은 실험실을 선호합니다. 10월의 두 실험실에서 저는 파트너 정확도와 커버리지를 넘어 실험실의 영향을 감지하지 못하며, 20명의 개발자를 가진 HELM도 둘 다 일치하면 아무것도 보여주지 않습니다(섹션 5.5).
5.3 샘플 외부 모델
샘플 외부에서, 모델은 더 나은 모델을 읽는 것에 명확히 개선되고 독립적 오류 기준선과 동등합니다(그림 4, 표 A6). LOLO에서 그 오류는 최고 모델 기준선의 0.099에 대해 0.037입니다 (-0.062 [-0.085, -0.035]), 그리고 그 신뢰구간은 LOMO, 질문 분할에서 0 아래에 있고 표 A6의 10행 중 7행에서입니다. 시간 분할은 0.050에 대해 0.019를 제공합니다. -0.031 [-0.074, +0.008], 질문이나 모델 단독으로 클러스터링될 때 0 아래(부록 I). 독립적 오류에 대해 모델은 세 스킴 모두에서 동등하고 상수가 고정된 피팅 외부 4개 세트 중 3개에서 더 좋으므로 섹션 4의 기준은 최고 모델 기준선에 대해 충족됩니다.
정확도는 측정된 정확도와 에 의해 수행됩니다: 를 제거하면 LOLO 오류가 0.323으로 증가하고, 그것을 상수로 유지하면 0.046을 제공합니다. 승수 는 주요 스킴에서 정확도에 아무것도 추가하지 않고 커버리지와 로그 손실에서 도움이 됩니다.
제품 사실에서 모델은 높게 실행됩니다. 그 오류는 최고 모델의 0.086에 대해 0.130입니다. 모두 과장(13포인트)이고, 그 도메인의 기본 채점자와 0.067에 대해 0.190입니다. 다시 모두 과장(19포인트)입니다. 부록 I은 셀을 결과 클래스로 정렬합니다.
5.4 모델 접근 및 GPT 암
100개의 SimpleQA 질문 세트에서, gpt-5.6-sol은 주 웨이브에서 100개 중 92개(92.0%)를 획득하고, 99개는 Codex 클라이언트를 통해, 분산 암의 직접 API를 통해 300개 샘플 중 139개(46.3%)를 획득합니다. 45.7포인트의 격차입니다(그림 5). 금 문자열의 정확한 재현은 64.0%에서 26.0%로 감소합니다. 클라이언트는 자체 지침에 따라 기본 노력 설정에서 실행되며, 온도는 설정할 수 없고, API는 노력 없음과 온도 0.7에서 실행됩니다.
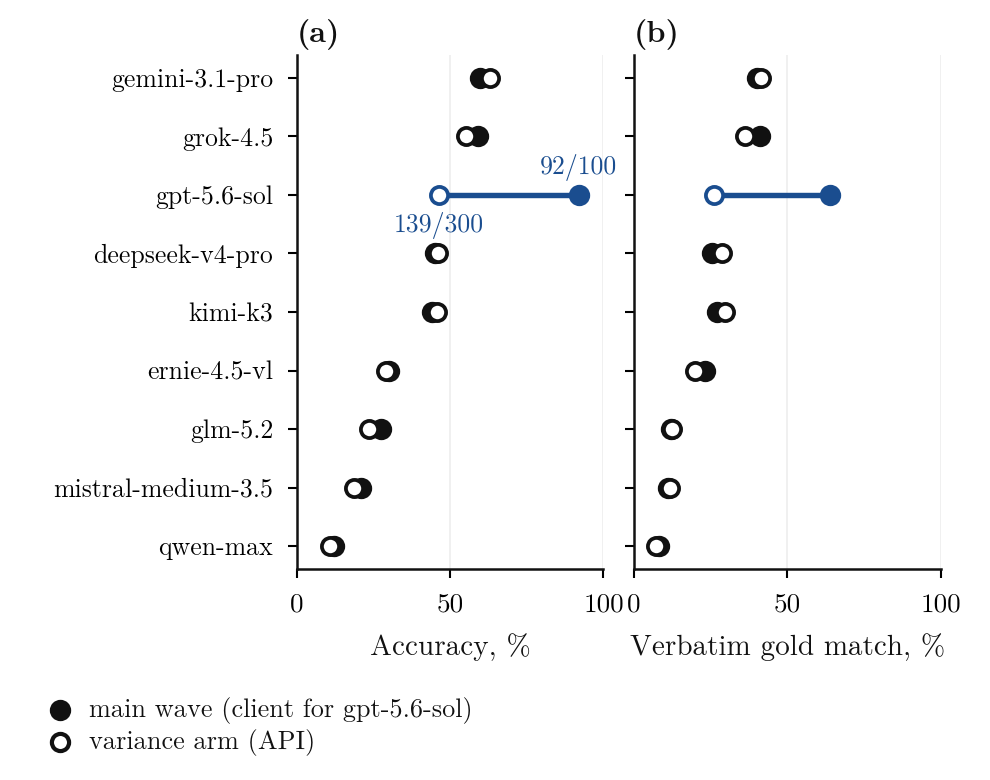
그림 5. 100개 질문 1세트, 2개 암, 9개 모델. 주: (a) 정확도, (b) 금 문자열과의 정확한 일치. 채움, 주 웨이브(gpt-5.6-sol의 경우 클라이언트 제공, 92/100); 열림, API를 통한 분산 암(139/300). gpt-5.6-sol의 경우 암은 노력 설정에서도 다릅니다.
8개의 다른 모델들은 온도가 두 열 사이에서도 변하지만, 어느 방향으로든 최대 4.0포인트만큼 움직입니다. 노력이 한 가지 후보이지만, gemini-3.1-pro에서 쌍을 이룬 추론-예산 측정은 정확도를 거의 변하지 않게 유지했습니다(Chernets, 2026c). 나머지 하나는 웹 검색입니다. 같은 클라이언트의 10월 응답에는 프롬프트가 요청하지 않은 링크가 포함되어 있으며, gpt-6.1-sol의 506개 응답 중 3개, gpt-6-astra의 506개 중 18개에서 그렇고, 8월 클라이언트 호출당 중앙값 토큰 사용량은 4,829입니다.
클라이언트 수치는 제품을 사용하는 사람이 받는 것이고, API 수치는 노력이 없는 벤치마크 하네스가 읽는 것입니다. 8월의 새로운 질문에서 API를 통한 GPT를 사용하면, gpt-5.6-sol과 fable-5는 32개 일치 중 29개에서 정답이며, Delta +57.6포인트 [+46.3, +69.7]입니다. 10월에, 같은 질문에서 클라이언트를 통한 더 최신의 GPT를 사용하면, opus-5-5와의 쌍은 74개 중 72개에서 정답이고, Delta +2.3 [-0.7, +6.0]입니다. 두 비교는 또한 GPT 모델과 날짜가 다르고, 둘 다에서 게이트의 값이 5.1절에서처럼 공개된 팔의 정확도를 추적합니다.
표 3에서 제외된 클라이언트 제공 GPT 팔들은 정확합니다. 8월 팔은 fable-5를 사용하여 1,016개 일치 중 997개에서 정답(98.1%)이고, 106에서 37개 중 34개에서 정답이며, 팔의 정확도를 상속합니다(Delta -3.3 [-10.3, +2.6]; 표 A7 및 부록 J).
5.5 공개 데이터에 대한 외부 검증
재적합 없이 고정 상수를 제 모델과 적합 모두를 공유하지 않는 공개 데이터에 적용했습니다. HELM Lite(Liang et al., 2023), 1,000개의 폐쇄형 NaturalQuestions에 답변하는 20개 개발자로부터의 95개 모델; LiveBench(White et al., 2025), 짧은 최종 답변이 있는 346개 질문에 대한 11개 연구소의 70개 모델; 그리고 다중 선택 MMLU에 대한 70개 모델에 대한 Kim et al. (2025)의 쌍 집계(표 A8). 결과는 5.3절과 일치합니다(그림 4, 하단 그룹). 모델은 세 가지 출처 모두에서 더 나은 모델을 읽는 것을 능가하고 HELM과 LiveBench에서 독립적인 오류와 동일합니다. 5.3에서 6.6포인트로 높게 실행되고 얼룩말 퍼즐에서 실패합니다(0.231 대 0.076).
HELM에서 관찰된 곡선은 모델이 계속 올라갈 때 평탄해집니다(그림 6). 쌍 정확도가 0.5에서 0.6 사이일 때 정밀도는 2023년과 2024년 초 모델의 경우 74.6%이고 더 최신 모델의 경우 75.9%이며, 구간의 중간에서 예측된 84.4%에 비해 낮습니다. MMLU에서 두 개의 잘못된 답변이 일치할 중앙값 확률은 0.621이고 에서 0.368입니다. 4개의 선택지가 충돌을 강제하기 때문입니다. 정밀도는 쌍 정확도에 따라 증가합니다(종속 셀에 걸쳐 HELM에서 Spearman +0.575, MMLU에서 +0.786).
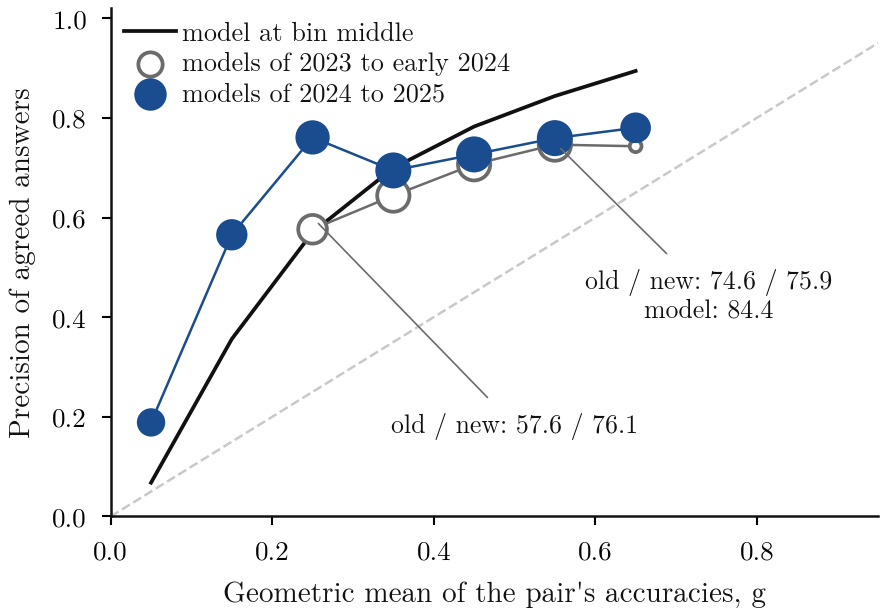
그림 6. HELM Lite: 쌍 정확도별 합의된 답변의 정밀도, 이전 모델과 최신 모델. 주: 쌍의 정확도의 기하 평균 g의 구간, 다양한 연구소의 쌍; 마커 크기는 쌍의 개수에 따라 증가합니다. 선은 각 구간의 중간에서 고정된 모델입니다.
HELM은 또한 많은 연구소와 GPT 의존성이 없는 5.2절의 테스트를 허용합니다. 하나의 공개된 모델과 정확도 내 3포인트의 파트너로, 다른 연구소는 같은 연구소의 경우 72.3%에 비해 오류의 75.5%를 포착합니다. -3.2포인트 [-4.2, -2.3], 범위는 2.7포인트 더 높습니다. 범위 내 3포인트 매치를 추가하면 제거됩니다. 75.7 대 75.9%, -0.2 [-0.6, +0.2].
6. 토론
게이트 실행에는 레이블이 필요하지 않지만 확인에는 필요합니다. 배포될 액세스 모드에서 중요한 계층의 레이블이 있는 샘플에 대해 두 모델의 정확도를 측정합니다. 이 데이터에서 두 개의 주요 모델이 둘 다를 넘어서는 질문에 대해 동의한 답변은 두 개의 중급 모델의 동의한 답변보다 안전하지 않습니다. 두 실험실을 연결하는 것은 신뢰도 값이 없을 때 합리적인 기본값이지만 계층에서 확인해야 합니다. 신뢰도로 걸러낸 동일 실험실 쌍 또는 배포된 모델의 자체 신뢰도가 동일하게 잘 작동할 수 있습니다(섹션 5.2, 부록 J).
확률 조정 유사도(Goel et al., 2025)와 동의한 답변의 정밀도는 서로 다른 량이며, Han (2026)은 제가 정확도와 범위를 우선시하는 곳에서 탈상관을 레버로 이름 붙입니다(부록 L). 보고의 경우, 모델 동의 연구는 각 군에 대해 액세스 모드, 노력, 도구 조건 및 유지된 이벤트 로그를 명시해야 합니다.
7. 범위 및 경계 조건
티어는 서로 다른 날짜와 접근 경로를 통해 두 파도로 비교되며, 티어 비교는 매칭된 정확도에서 약 3포인트 정도로 정확하지만, 가장 어려운 분위수만으로는 훨씬 덜 정확합니다. 새로운 증거는 두 날짜에서 100개의 질문과 8개의 템플릿 한 세트이며, October Delta는 여기에 0을 포함합니다. 쌍 정확도와 정밀도는 날짜 전체와 파도 간에 다른 추론 설정 전체에서 함께 이동하며, 설계는 원인으로서의 능력을 격리하지 않습니다.
Codex, kimi 및 gemini-3.8-flash 클라이언트가 검색했는지 여부는 보관된 파일에서 확인할 수 없으므로, 이들의 정확도는 모델 메모리가 아닌 배포된 클라이언트를 측정합니다. 5.1절과 5.3절은 그 팔 없이 주요 결과를 보여줍니다.
동일 실험실 쌍이 October에 두 실험실에 대해 존재하며, GPT 없이는 동일 파도 비교가 100개의 새로운 질문입니다. October 셀은 두 실험실의 5개 모델을 기반으로 하므로, 2방향 부트스트랩의 모델 차원은 수준이 적고 풀링된 간격은 불확실성의 하한입니다. 동일 범위의 비교는 명시된 신뢰도를 사용하며, 이는 기본 게이트가 하지 않으며, 무작위 동점 처리는 가장 넓은 행을 0.0~+20.7포인트 사이에서 이동합니다(부록 H).
엔진은 규칙 기반이며, 여기서의 검사는 SimpleQA Verified의 정제된 골드(5.1절)와 답변 부분의 재채점입니다. 전체 답변을 평가하며, 긴 답변은 거짓 "오류"를 야기할 수 있습니다. 첫 번째 부분만 채점하면 참조 쌍의 정밀도가 최대 3포인트 이동하며, gpt-6-astra와 opus-5-5는 80의 106개에서 80.0%에서 88.9%로 이동합니다(표 A3).
모델은 각 셀의 측정된 정확도를 입력으로 사용하므로, 게이트의 레이블이 지정된 검사를 설명하고 하나를 대체하지 않습니다. 제품 사실 및 공개 데이터에서 높게 실행됩니다. HELM, LiveBench 및 Kim 등의 집계는 몇 가지 샷 또는 다중 선택 형식으로 더 오래된 모델을 보유하므로, 2026 플래그십이 아닌 다른 모델의 관계를 테스트합니다.
8. 결론
합의된 답변의 정확도는 해당 계층에서 쌍의 정확도가 높을수록 증가하며, 두 계층 모두에서 일치된 정확도 범위 내 약 3포인트 이내입니다. 역전 현상은 약한 쌍을 측정한 모든 곳에서 나타났으며, 주력 모델도 포함됩니다. 두 번째 실험실의 파트너는 게이트를 덜 자주 열어서 대부분의 오류를 더 많이 포착했으며, 동일한 범위에서 자신의 모델이 훨씬 더 정확한 경우에만 장점을 유지했습니다. 게이트의 작은 모델은 더 나은 모델보다 표본 외 정확도를 더 잘 설명하며 독립적 오류와 마찬가지로 잘 설명합니다. 두 가지 접근 방식을 통해 측정한 하나의 식별자는 45.7포인트만큼 차이가 나므로, 모델의 정확도에 대한 주장은 접근 방식을 명시해야 합니다.
영향 진술
본 논문은 두 언어 모델 간의 합의가 짧은 사실적 답변 공개를 위한 규칙으로 신뢰할 수 있는 시점을 연구합니다. 실무자들은 더 강력한 모델이나 두 번째 공급업체로 충분하다고 가정하는 대신, 자신들이 배포하는 접근 방식과 중요한 계층에서 두 모델 게이트가 자신들의 용도에 충분히 정확한지 확인할 수 있습니다. 주요 위험은 어려운 질문에 대한 합의에 대한 과도한 신뢰이며, 결과는 합의된 답변이 대부분 틀린 계층을 보여줍니다. 본 연구는 공개 벤치마크와 기계 생성 질문만을 사용합니다.
References
Chen, J. (2026). When does combining language models help? A co-failure ceiling on routing, voting, and mixture-of-agents across 67 frontier models. arXiv:2606.27288.
Chernets, V. (2026a). Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop: Who Verifies the Agents?
Chernets, V. (2026b). Weakly discriminative, not repaired by profile injection, and manipulable: Self-confidence in LLM evaluation. NeurIPS 2026 Workshop: Can We Trust AI Evaluation? Robustness, Causality, and Risk in Modern AI Assessment.
Chernets, V. (2026c). Architectural trust: When an AI agent buys for you, does trust belong to the model, or the architecture above it? SSRN 7191261.
Denisov-Blanch, Y., Kazdan, J., Chudnovsky, J., Schaeffer, R., Guan, S., Adeshina, S., and Koyejo, S. (2026). Consensus is not verification: Why crowd wisdom strategies fail for LLM truthfulness. arXiv:2603.06612.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Geifman, Y. and El-Yaniv, R. (2017). Selective classification for deep neural networks. In Advances in Neural Information Processing Systems 30. arXiv:1705.08500.
Goel, S., Strüber, J., Auzina, I. A., Chandra, K. K., Kumaraguru, P., Kiela, D., Prabhu, A., Bethge, M., and Geiping, J. (2025). Great models think alike and this undermines AI oversight. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267. arXiv:2502.04313.
Han, J. (2026). Partially correlated verifier cascades in LLM harnesses: Concave log-odds, polynomial reliability, and blind-spot ceilings. arXiv:2607.13918.
Haas, L., Yona, G., D'Antonio, G., Goldshtein, S., and Das, D. (2025). SimpleQA Verified: A reliable factuality benchmark to measure parametric knowledge. arXiv:2509.07968.
Hossain, E., Yousefi, N., and Lim, S.-N. (2026). Agreement overstates evidence: Error dependence in LLM judge consensus. arXiv:2609.22512.
Kim, D. (2026). Are diversity metrics measuring diversity? A capability-controlled audit of majority-vote gain in LLM ensembles. arXiv:2607.20768.
Kim, E., Garg, A., Peng, K., and Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267:30038-30066. arXiv:2506.07962.
Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
Kolawole, S., Dennis, D., Talwalkar, A., and Smith, V. (2025). Agreement-based cascading for efficient inference. Transactions on Machine Learning Research, 07/2025. arXiv:2407.02348.
Kuhn, L., Gal, Y., and Farquhar, S. (2023). Semantic uncertainty: Linguistic invariances for uncertainty estimation in natural language generation. In International Conference on Learning Representations. arXiv:2302.09664.
Liang, P., Bommasani, R., Lee, T., et al. (2023). Holistic evaluation of language models. Transactions on Machine Learning Research. arXiv:2211.09110.
Liu, N. (2026). LLMs as a jury: Cross-model consensus can outperform process reward models for LLM reasoning. arXiv:2607.10139.
Manakul, P., Liusie, A., and Gales, M. J. F. (2023). SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models. In Proceedings of EMNLP 2023. arXiv:2303.08896.
Naik, N. (2024). Probabilistic consensus through ensemble validation: A framework for LLM reliability. arXiv:2411.06535.
Owen, A. B. (2007). The pigeonhole bootstrap. The Annals of Applied Statistics, 1(2), 386-411.
Panickssery, A., Bowman, S. R., and Feng, S. (2024). LLM evaluators recognize and favor their own generations. In Advances in Neural Information Processing Systems 37.
Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657-680.
Tan, H., Sun, F., Liu, S., Su, D., Cao, Q., Chen, X., Wang, J., Cai, X., Wang, Y., Shen, H., and Cheng, X. (2025). Too consistent to detect: A study of self-consistent errors in LLMs. In Proceedings of EMNLP 2025. arXiv:2505.17656.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., and Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., and Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. In International Conference on Learning Representations.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., and Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
White, C., Dooley, S., Roberts, M., et al. (2025). LiveBench: A challenging, contamination-limited LLM benchmark. In International Conference on Learning Representations. arXiv:2406.19314.
Xue, Y., Greenewald, K., Mroueh, Y., and Mirzasoleiman, B. (2026). Verify when uncertain: Beyond self-consistency in black box hallucination detection. arXiv:2502.15845.
Yue, M., Zhao, J., Zhang, M., Du, L., and Yao, Z. (2024). Large language model cascades with mixture of thought representations for cost-efficient reasoning. In International Conference on Learning Representations. arXiv:2310.03094.
선언
이해상충. 저자는 본 논문이 검토하는 종류의 AI 오케스트레이션 및 다중 모델 검증 시스템을 다루는 미허가 특허 출원의 명명된 출원인입니다.
데이터 및 코드. 호출별 응답, 분석 스크립트 및 보고된 모든 숫자에서 해당 원본 표로의 매핑은 Zenodo의 doi:10.5281/zenodo.24090584 (CC BY 4.0)에 보관되어 있습니다.
부록 A. 모델 및 접근 방식
표 A1. 파동별 컬렉션 및 접근 방식.
| 컬렉션 | 날짜 | 모델 | 접근 |
|---|---|---|---|
| 7월 중급 | 2026년 7월 24일~28일 | claude-haiku-4-5, gpt-5-mini, gemini-3.6-flash, grok-4-fast, deepseek-chat, qwen-plus, kimi-k3, glm-4.5, mistral-small | 직접 API |
| 7월 로컬 | 2026년 7월 24일~28일 | 7개의 로컬 오픈 가중치 모델 | 로컬 추론 |
| 8월 플래그십 | 2026년 8월 3일~6일 | claude-fable-5, gpt-5.6-sol, mistral-medium-3.5 | 공급업체 클라이언트; gpt-5.6-sol은 클라이언트 기본 노력 설정에서, API 폴백으로 1,500개 기록 중 14개 |
| glm-5.2 | 공급업체 엔드포인트 | ||
| deepseek-v4-pro, grok-4.5, kimi-k3, qwen-max | 직접 API | ||
| gemini-3.1-pro, ernie-4.5-vl-424b, muse-spark-1.1 | 직접 API 또는 공급업체에 고정된 애그리게이터 경로; muse-spark-1.1 부분(251개 답변) | ||
| 편차 그룹 | 2026년 8월 6일 | 9개의 플래그십, Claude 제외 | gpt-5.6-sol은 직접 API로 노력 없음; mistral-medium-3.5는 요청된 온도를 기록하는 공급업체 클라이언트를 통해; 나머지는 8월 파동처럼; 온도 0.7, 3개 샘플 |
| 신규, 8월 | 2026년 8월 6일 | gpt-5.6-sol(노력 없음), claude-fable-5, deepseek-v4-pro, kimi-k3 | gpt-5.6-sol 및 deepseek-v4-pro는 직접 API로, claude-fable-5는 공급업체 클라이언트로, kimi-k3는 애그리게이터 경로로 |
| 제품 사실 | 2026년 8월 15일 | 6개 모델, 15개 쌍; 검색 가능성이 없는 4개, 6개 쌍 | 혼합; gpt-5.4 및 grok은 클라이언트를 통해 |
| 10월 | 2026년 10월 26일~27일 | gpt-6.1-sol, gpt-6-astra, gpt-6-sol | Codex 클라이언트, 노력 중간, 검색 플래그 없음, 이벤트 스트림 유지 안 함 |
| claude-opus-5-5, claude-fable-5-1 | Claude 클라이언트, 도구 비허용 | ||
| kimi-k3, gemini-3.8-flash(신규만) | 공급업체 클라이언트, 도구 비활성화 없음 |
8월 파동에서 claude-fable-5 그룹의 19개 답변은 다른 Claude 모델에 의해 제공되었습니다. 파동의 106개 중 37개 중 34개는 이에 의존하지 않습니다(Chernets, 2026a).
부록 B. 503개 공통 질문에 대한 쌍
표 A2. 서로 다른 모든 실험실의 쌍, 첫 번째 멤버 공개, 503개 공통 질문.
| 쌍 | 커버리지 | PPV (K/O) | 델타, 포인트 [95%] | 적중된 오류 |
|---|---|---|---|---|
| gpt-6.1-sol + opus-5-5 | 59.8% | 95.6% (285/298) | +1.5 [-0.2, +3.3] | 16/29 |
| gpt-6.1-sol + fable-5-1 | 60.8% | 97.0% (294/303) | +2.9 [+1.1, +4.8] | 20/29 |
| gpt-6-astra + opus-5-5 | 58.3% | 94.8% (275/290) | +2.5 [+0.5, +4.7] | 23/38 |
| gpt-6-astra + fable-5-1 | 61.4% | 95.4% (291/305) | +3.1 [+1.1, +5.3] | 24/38 |
| gpt-6-sol + opus-5-5 | 61.6% | 95.4% (291/305) | -0.7 [-1.9, +0.6] | 5/19 |
| gpt-6-sol + fable-5-1 | 62.8% | 97.1% (301/310) | +1.0 [-0.4, +2.5] | 10/19 |
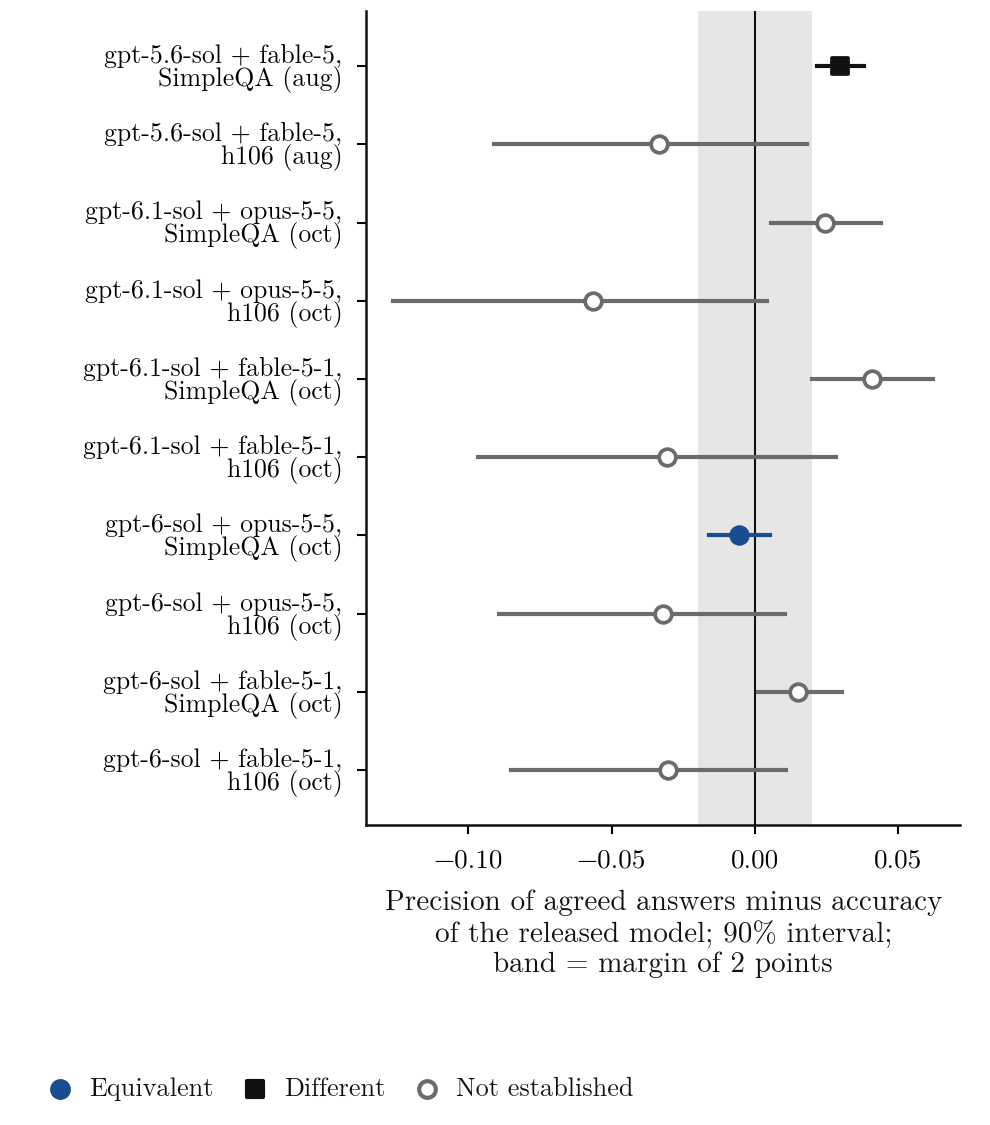
그림 A1. 공개된 모델에 대한 쌍 정밀도의 동등성 검정. 주: 90% 질문 부트스트랩, 2 포인트 여유 음영 처리. Codex 클라이언트 팔을 공개한 쌍.
부록 C. 골드 문자열과의 정확한 일치
정확한 일치 순위는 SimpleQA와 새로운 측정값을 모두 가진 9개 모델 전체에서 SimpleQA 정확도와 완벽하게 순위상관을 이루고 있으며, 정확한 답변은 종종 골드 문자열이기 때문입니다. SimpleQA와 새로운 측정값의 간격과의 상관관계는 +0.47입니다(정확한 순열 p = 0.21, n = 9). gpt-5.6-sol을 제외하면 +0.29입니다(p = 0.50). gpt-5.6-sol의 두 정확도는 서로 다른 접근 방식에서 나옵니다(그림 A2). 정확한 답변으로 제한할 때, +0.10입니다(p = 0.81). 정확한 답변 중에서 gpt-5.6-sol의 비율은 65.7%, fable-5는 66.4%, deepseek-v4-pro는 68.6%, kimi-k3는 64.9%입니다. 모델의 잔차는 이에 의존하지 않으며, 112개의 주요 셀 전체에서 +0.064 [-0.072, +0.167]의 기울기를 가집니다. 간격 자체는 대부분의 모델의 경우 0에 가깝거나 음수이며, fable-5의 경우 -3.0포인트, deepseek-v4-pro의 경우 -20.5, opus-5-5의 경우 -5.4, fable-5-1의 경우 -7.8입니다. gpt-5.6-sol의 경우 접근 방식이 두 측정값 간에 다르기 때문에 +62.4로 크습니다.
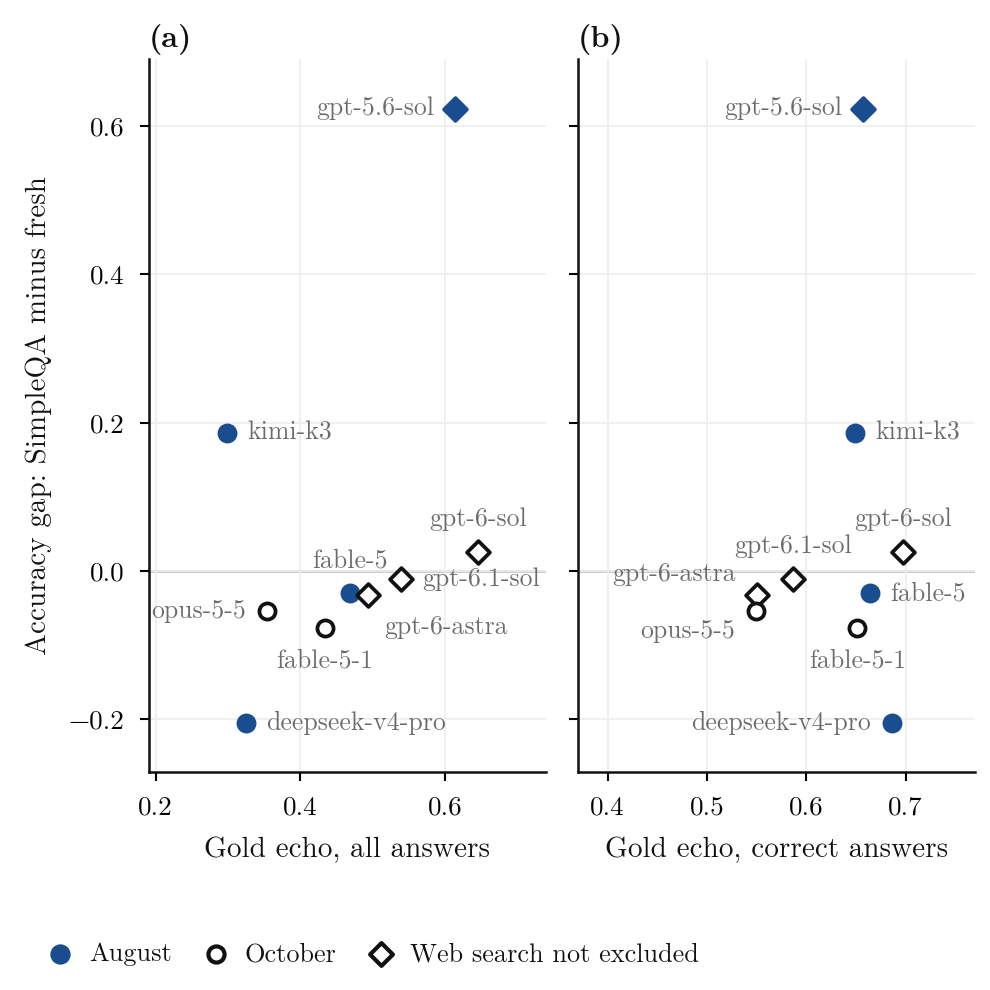
그림 A2. 골드 문자열과의 정확한 일치 대 정확도 간격. 참고: (a) 모든 답변, (b) 정확한 답변만. 파란색 채움, 8월 웨이브; 열림, 10월 웨이브. 다이아몬드는 웹 검색이 제외되지 않은 팔을 표시합니다.
부록 D. 채점자 민감도
엔진은 대소문자, 관사 및 구두점을 정규화하고, 정확한 일치 및 4자 이상의 문자열 포함을 허용하며, 규칙에 따라 날짜, 숫자 및 영숫자 식별자를 비교하고, 그 외에는 내용 단어를 비교합니다. 엔진이 금표준에 대해 결정할 수 없는 답변은 미결정 상태입니다. 표 A3에서 각 답변의 첫 부분은 괄호와 뒤따르는 설명 없이 일치 및 채점에 사용되므로, 열린 수도 함께 변합니다.
표 A3. 전체 답변 채점 대 첫 부분 채점. 첫 번째 구성원은 공개됩니다.
| 쌍, 집합 | PPV, 전체 답변 | PPV, 첫 부분 |
|---|---|---|
| gpt-5.6-sol + fable-5, 모두, 8월 | 997/1016 | 997/1019 |
| gpt-6.1-sol + opus-5-5, 106, 10월 | 31/35 | 30/34 |
| gpt-6.1-sol + fable-5-1, 106, 10월 | 31/34 | 31/35 |
| gpt-6-astra + opus-5-5, 106, 10월 | 28/35 | 32/36 |
| gpt-6.1-sol + opus-5-5, strat, 10월 | 183/190 | 189/195 |
| gpt-6.1-sol + fable-5-1, 전략, 10월 | 187/191 | 198/201 |
| gpt-6.1-sol + opus-5-5, 새로운, 10월 | 72/74 | 72/74 |
부록 E. 추가 관련 연구
최근 프리프린트들은 두 가지 방향을 가리킵니다. 회의적 입장에서 Denisov-Blanch et al. (2026)은 5개의 벤치마크와 모델 전체에 걸친 여론조사 방식의 집계가 오류의 상관관계로 인해 추론 비용의 25배에도 불구하고 일관된 정확도 향상을 나타내지 않음을 발견합니다. Ding (2026)은 GPQA Diamond와 AIME의 265,000개 샘플을 감시하고 동의가 긍정적이지만 약한 예측자임을 발견합니다(Spearman 0.20~0.59). 가장 일관된 최전선 모델의 높은 동의 GPQA 항목의 48%가 틀렸습니다. 46개 항목에 대한 탐색적 검사에서 gpt-4.1과 Claude 계층 간의 동일-오류-응답 비율은 3개 계층 중 2개의 한계 보존 귀무가설을 초과합니다. Kohli (2026)는 3개 추론 데이터셋에 대한 9명의 최전선 심판이 약 2개의 독립적 투표를 가지고 있으며, 최고의 단일 심판이 패널과 동등하거나 이기는 것을 발견합니다. Kim (2026)은 MMLU-Pro의 30개 모델의 31,900개 부분집합을 감시합니다. 투표는 크기 3 부분집합의 9.98%에서 가장 강한 멤버를 이기며, 엄격한 다양성 척도는 1에서 평균 정확도를 뺀 값과 거의 일직선상에 있습니다(Spearman +0.991). Hossain et al. (2026)은 10명의 심판 전체에 걸쳐 평균 쌍별 오류 상관관계 0.21을 발견하며, 이는 약 3.5개의 독립적인 심판만큼의 정보를 가지고 있고, 서로 다른 제공자의 최전선 심판 간에 더 강한 의존성을 나타냅니다. Chen (2026)은 한 멤버의 답변을 출력하는 모든 정책이 모든 모델이 함께 틀린 비율 에서 1을 뺀 값을 초과할 수 없음을 보여주며, 가우스 코플라 하에서 0.023에 대해 67개 모델에 걸친 개방형 수학에서 0.052를 발견하고, 자유 응답 GPQA-Diamond에서 0.127을 발견합니다. 다른 한편, Naik (2024)는 78개의 객관식 형식 사례에서 2개 모델로 73.1%에서 93.9%로 그리고 3개로 95.6%로 정확도가 상승함을 보고하며, Liu (2026)는 4개 모델 패널이 7개 벤치마크에서 자가 일관성보다 답변을 더 잘 선택함을 보여줍니다. 멤버 정확도, 오류 상관관계 및 공유 오류 비율의 폐쇄형 법칙은 합의 정확도를 평균 절대 오류 0.028로 예측합니다. Xue et al. (2026)는 검증자를 통한 교차 모델 일관성이 QA 벤치마크에서 환각 탐지를 위한 자가 일관성의 상한을 개선함을 보고하며, Tan et al. (2025)는 자가 일관성 오류가 모델 규모에 따라 축소되지 않으며, 모델별로 경향을 보이고, 두 번째 모델로 더 잘 탐지됨을 보고합니다. Han (2026)은 盲점 질량이 신뢰성을 제한하고 모델 계열, 양식 또는 증거 출처를 변경하여 장식 제거를 실행 가능한 지렛대로 이름 붙이는 직렬 검증 게이트 이론을 제공합니다. 2절의 작업 2개는 게이트와 관련된 세부 사항을 포함합니다. Goel et al. (2025)는 서로 다른 틀린 선택지를 동의하지 않음으로 CAPA를 정의하며, 능력의 추세 외에도 9개의 개방 가중치 LLM 심판이 자신과 유사한 모델에 더 높은 점수를 주며, 약-강 이득이 감독자와 학생이 덜 유사한 오류를 만드는 작업에서 더 큼을 보여줍니다(12개 모델 쌍). Kolawole et al. (2025)는 테스트 분포에 대한 수용된 오류의 결합 비율에 대한 안전한 지연 조건을 명시하며, 임계값은 작은 검증 집합에서 추정됩니다. 결합 비율 조건은 수용된 오류가 한 계층에 집중되는 것을 허용하며, 5.1절은 이러한 계층을 발견합니다. 106에서 중간 계층 패널은 오류를 인증하며, 최고 정확도 팔 없는 플래그십 쌍도 그렇게 합니다.
2절에서 언급한 대로, 이 작업들 중 어느 것도 쌍 수준 릴리스 게이트, 한 개의 릴리스된 모델을 고정한 동등한 커버리지에서의 재현율, 또는 두 가지 액세스 모드에서 측정된 하나의 식별자를 보고하지 않습니다.
부록 F. 데이터 및 프로토콜 세부사항
수집. 프로토콜은 섹션 3의 프로토콜이며, 수집은 전체적으로 다음과 같습니다. 표 A1은 모델, 날짜 및 접근 방식을 나열합니다.
- 7월 중간 계층 (7월 24일~28일). 1,500개의 SimpleQA 질문에 대한 9개의 API 모델과 7개의 로컬 모델 (Wei et al., 2024), 벤치마크의 4,326개 질문 중 고정된 무작위 부분표본. 수집은 데이터 수집 전에 OSF에 등록되었습니다 (Chernets, 2026a).
- 8월 주력 모델 (8월 3일~6일). 11개 연구기관 각각의 주력 모델 1개씩, 동일한 1,500개 질문에 대해 수행되었으며, 이 중 1,459개가 공통 풀을 구성합니다.
- 분산 팔 (8월 6일). 주력 모델 9개가 그 중 100개 질문에 대해, 5분위수당 20개씩, 온도 0.7에서 질문당 3개 샘플로 응답했습니다.
- 새로운 질문 (8월 6일 및 10월 26일). Wikidata에서 8개의 템플릿으로 기계 구성된 100개의 2홉 질문, 첫 번째 모델 호출 전에 파일 해시가 고정되었습니다.
- 상품 사실 (8월 15일). 상용 제품에 관한 267개의 질문, 역시 Wikidata에서 구성되었으며, 6개 모델에 대해 수행되었고, 이 중 4개는 검색 기능이 없습니다.
- 10월 주력 모델 (10월 26일 및 27일). gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 및 claude-fable-5-1이 7월 5분위수로 층화된 300개의 SimpleQA 질문에 대해 (60, 120, 120; 5개 모두에 공통인 297개; 표에서 "strat"), 아래의 106개 질문 및 새로운 질문 집합, 총 503개의 공통 질문에 대해 응답했습니다. kimi-k3 및 gemini-3.8-flash는 새로운 질문 집합에 응답했습니다.
접근 방식. 모델은 섹션 3에서 설명한 두 가지 방식으로 접근했습니다. gpt-5.6-sol은 분산 팔과 8월 새로운 질문 집합에서도 직접 API로 실행되었습니다. 모델 식별자 및 클라이언트 버전은 호출당 기록됩니다.
클라이언트가 측정 조건을 설정하므로, 전체적으로 명시합니다. 온도는 이들에서 설정할 수 없습니다. 8월 Codex 팔은 호출이 설정하지 않고 기록이 명시하지 않는 추론 노력의 클라이언트 기본 설정에서 실행되었습니다. 10월 Codex 팔은 각 호출에서 중간으로 노력이 설정되어 실행되었습니다. 8월 매니페스트 기록은 Claude 팔에 대한 0개의 웹 검색 요청과 Mistral 팔에 대한 빈 도구 목록을 표시하며, 10월 Claude 팔은 도구가 비활성화된 상태로 실행되었습니다. Codex 팔은 검색 플래그 없이 시작되었으며 이벤트 스트림이 보관되지 않아 파일에서 검색 여부를 확인할 수 없습니다. kimi 및 gemini-3.8-flash 클라이언트에서는 도구가 비활성화되지 않았으며 프롬프트가 이를 금지합니다.
부록 G. 106과 계층
Figure A3은 Section 5.1의 패널과 쌍을 106에서 보여주며, 추가로 두 쌍을 포함합니다: fable-5와 grok-4.5는 28개 합의 중 7개에서 정확하고, gemini-3.1-pro와 grok-4.5는 25개 중 8개에서 정확합니다.
Section 1의 342개 중 0개는 난이도의 순위 매김 방식에 따라 달라집니다. 각 패널의 자체 답변이 난이도 순위에서 제외되면, 개수는 354개 중 78개가 되고, 교차-블록 패널은 116개 중 0개로 유지됩니다.
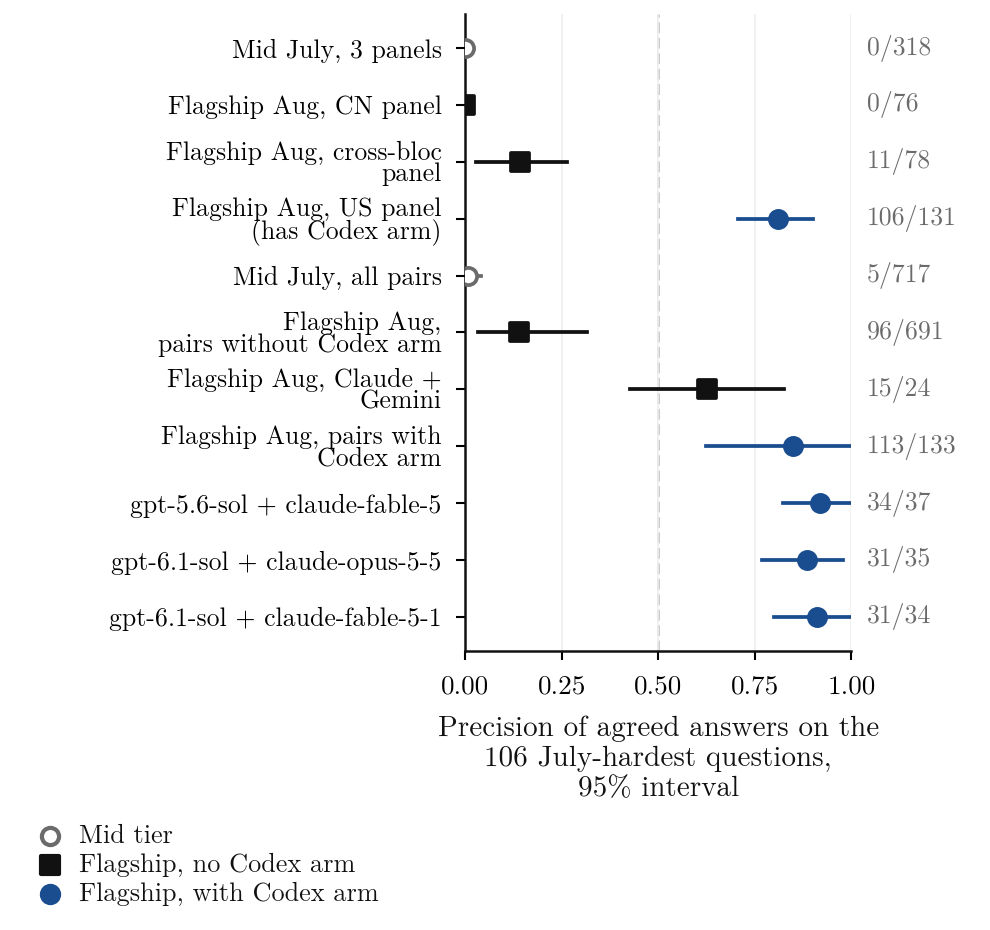
Figure A3. 106개 질문에 대한 합의 답변의 정확도. 주: 누적 행에 대한 95% 양방향 부트스트랩, 패널 및 단일 쌍에 대한 질문 부트스트랩. 파란 행에는 Codex 클라이언트 암이 포함됩니다. 8월 및 10월 수집.
Figure A4는 Section 5.1의 자체 계층 오분위수를 전체적으로 보여줍니다. 모든 암을 포함하면, 8월은 가장 어려운 오분위수에서 26.6% [6.7, 53.4]에 도달하며, 이는 7월에서 +9.3 [-18.1, +39.8]의 차이입니다. kimi-k3을 제외하면(두 수집에 모두 속함), 가장 어려운 오분위수는 7월에 675개 중 147개(21.8%), 8월에 995개 중 192개(19.3%)를 나타내며, -2.5포인트 [-29.7, +28.2]입니다. Section 5.1의 누적 검정은 모든 5개 오분위수를 사용하며, 계층당 180개 셀입니다. 중간 계층 셀은 고정 모델에서 +0.3포인트 [-2.4, +2.9]이고, 플래그십 셀은 +0.0 [-1.4, +1.6]입니다. 가장 어려운 오분위수에서의 상향은 7월에 1.15 [0.39, 1.90], 8월에 0.97 [0.42, 1.49]입니다. 오분위수 전체에서, GPT 제외 8월은 15.5, 52.9, 75.8, 90.5 및 97.3%이고 7월은 17.3, 29.0, 60.9, 80.4 및 94.4%이며, 공개 모델 정확도는 16.0, 36.6, 56.8, 73.3 및 88.5% 대 15.3, 25.0, 40.0, 57.7 및 78.9%로 실행됩니다.
정확도는 정제된 금 답변에서 낮게 유지됩니다. Haas et al. (2025)는 SimpleQA를 1,000개 질문의 정제된 집합으로 재구성했으며, 106개 중 24개가 보유되었으며 벤치마크의 공유에서 예상되는 24.5개에 대항하며, 금 답변이 21개에서 동일합니다. 정제는 이러한 질문을 다른 질문보다 더 자주 제거하지 않지만, 그 선택은 또한 어려운 질문을 선호합니다. 동일한 통계 및 부트스트랩 아래, GPT 제외 8월 쌍은 그 24개 질문의 150개 합의 중 28개에서 정확하며(18.7% [0.0, 57.1]) 다른 82개의 538개 중 67개에서 정확하며(12.5% [2.8, 28.1]; 더 정확한 구성원은 각 부분집합에서 공개되므로, 부분은 691개 중 96개로 합할 필요가 없음), 7월 쌍은 157개 중 4개(2.5% [0.0, 15.2])에서 정확합니다.
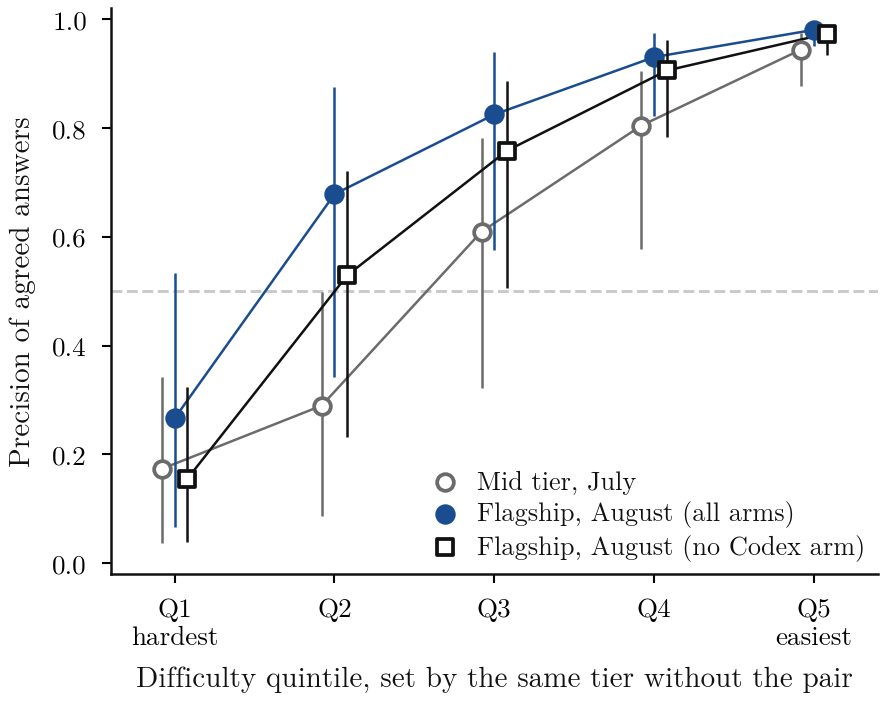
Figure A4. 자체 계층 난이도 오분위수별 합의 답변의 정확도. 주: 95% 양방향 부트스트랩. 난이도는 각 쌍에 대해 그 쌍이 없는 동일한 계층으로 설정됩니다. 0.5에서 점선.
가장 정확한 쌍들이 동일한 관계를 만족합니다. kimi-k3과 gemini-3.8-flash 쌍은 신선한 집합에서 95.8%에 도달하며, 공개 모델의 23개 중 26개 오류를 잡아내고 5.37 [2.86, 21.36]의 상향을 보입니다. 모델은 0.74와 0.82의 정확도만 주어지면 95.1%를 반환합니다. 그리고 두 Claude 플래그십이 함께하면, 어느 암에도 검색 가능성이 없으며, 106에서 47.5%에 도달하고, 공개 모델의 정확도는 30.0%이며, 모든 503개 질문에서 86.2%에 도달합니다. Figure A5는 공개 모델 정확도에 대한 모든 계층의 모든 대역을 나타내며, 정확도는 23개 셀 중 17개 셀에서 대각선 위에 있습니다.
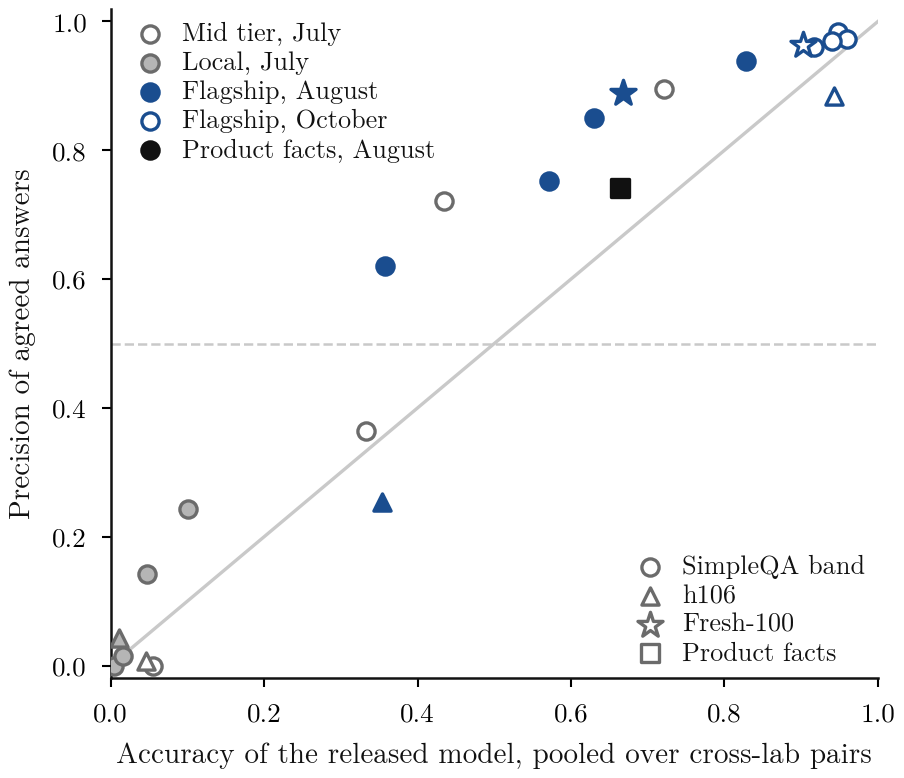
Figure A5. 공개 모델의 정확도에 대한 합의 답변의 정확도. 주: 다양한 실험실의 쌍 위에 누적, 계층 및 대역별. 색상과 채우기는 계층을 제공하고, 표식 모양은 집합을 제공합니다. 0.5에서 점선, 실선은 같음.
부록 H. 두 번째 실험실 상세 분석
분산 팔. 동일 커버리지에서 모델별로(그림 2), 두 실험실 게이트는 9개 중 7개에서 앞서고 gemini-3.1-pro(-5.7포인트)와 grok-4.5(-2.8)에서 뒤집니다. GPT 없이, 8개 모델에 걸쳐 자기일치는 정확도 55.9%에서 61.4%를 커버하고 두 실험실은 83.3%에서 24.4%를 커버합니다. 정확도의 차이는 측정된 바 +27.4포인트 [+16.0, +35.7]이고 동일 커버리지에서 +7.7 [-1.9, +16.5]이며, 발견된 오류는 측정된 바 +38.3포인트 [+26.0, +50.9]만큼 달라지고 동일 커버리지에서 +3.0 [-1.5, +8.4]입니다. 10월에는 반복된 호출이 없으므로 자기일치는 8월에만 측정됩니다.
하나의 출시된 모델의 네 파트너. 표 A4는 그림 3a의 네 파트너를 제시합니다: 하나의 출시된 모델, gpt-6.1-sol이므로 위험에 처한 29개 오류는 모든 행에서 동일합니다.
표 A4. 하나의 출시된 모델, 네 파트너: gpt-6.1-sol on 503개 공통 질문(495개 해결된 것 중 29개 오류, 95% 질문 부트스트랩).
| 파트너 | 실험실 | 커버리지 [95%] | PPV (K/O) | 델타, 포인트 [95%] | 발견된 오류 [95%] |
|---|---|---|---|---|---|
| gpt-6-astra | 동일 | 96.2% [94.4, 97.8] | 94.3% (449/476) | +0.2 [-0.2, +0.8] | 2/29 = 6.9% [0.0, 17.4] |
| gpt-6-sol | 동일 | 95.6% [93.6, 97.2] | 96.2% (457/475) | +2.1 [+0.9, +3.4] | 11/29 = 37.9% [20.7, 56.5] |
| claude-opus-5-5 | 다름 | 59.8% [55.9, 64.0] | 95.6% (285/298) | +1.5 [-0.2, +3.3] | 16/29 = 55.2% [36.4, 73.0] |
| claude-fable-5-1 | 다름 | 60.8% [56.7, 65.0] | 97.0% (294/303) | +2.9 [+1.1, +4.8] | 20/29 = 69.0% [50.0, 85.2] |
다른 같은 실험실 파트너인 gpt-6-sol은 29개 중 11개를 발견하는데, 이는 fable-5-1에 대해 -31.0포인트 [-50.0, -10.7]이고 opus-5-5에 대해 -17.2 [-37.0, +3.0]입니다. Claude 쌍은 두 팔에서 검색 가능성이 없으므로 60.6%를 커버하고 86.2%의 정확도에서 fable-5-1의 181개 오류 중 140개를 발견하며 +23.5포인트 [+19.6, +27.2]의 델타를 갖습니다. 한 실험실의 두 모델, 모두 천장에서 멀리 떨어져 있으므로 대부분의 오류를 발견할 정도로 충분히 자주 불일치할 수 있습니다.
표 A5는 이것이 커버리지 곡선을 따라 이동하는 것 이상인지 여부와 GPT가 필요한지 여부를 검사합니다. 각 행은 하나의 출시된 모델을 유지하고 같은 실험실 파트너와 다른 실험실의 파트너를 비교하며, 먼저 측정된 대로 그리고 나서 동일 커버리지에서 비교합니다. 동일 커버리지는 신뢰도에 의해 더 넓은 게이트를 얇게 하여 도달합니다(섹션 3).
표 A5. 같은 실험실 파트너와 다른 실험실의 파트너로 발견된 오류. 차이는 같은 것에서 다른 것을 뺀 것이며, 포인트 단위이며, 95% 질문 부트스트랩을 사용하므로 음수는 다른 실험실에 유리합니다. 처음 네 행의 측정된 그대로의 차이는 표 A4의 부트스트랩을 공유합니다.
| 출시됨 | 같은 / 다른 파트너 | 질문 | 발견됨, 측정된 그대로 | 차이 [95%] | 발견됨, 동일 커버리지 | 차이 [95%] |
|---|---|---|---|---|---|---|
| gpt-6.1-sol | astra / fable-5-1 | 503 | 2/29, 20/29 | -62.1 [-79.3, -43.8] | 17/29, 20/29 | -10.3 [-35.3, +13.8] |
| gpt-6.1-sol | astra / opus-5-5 | 503 | 2/29, 16/29 | -48.3 [-66.7, -29.6] | 18/29, 16/29 | +6.9 [-17.1, +30.4] |
| gpt-6.1-sol | gpt-6-sol / fable-5-1 | 503 | 11/29, 20/29 | -31.0 [-50.0, -10.7] | 24/29, 20/29 | +13.8 [-6.7, +34.6] |
| gpt-6.1-sol | gpt-6-sol / opus-5-5 | 503 | 11/29, 16/29 | -17.2 [-37.0, +3.0] | 24/29, 16/29 | +27.6 [+3.4, +51.6] |
| fable-5-1 | opus-5-5 / gpt-6.1-sol | 503 | 140/181, 169/181 | -16.0 [-21.7, -10.6] | 140/181, 169/181 | -16.0 [-21.7, -10.6] |
| opus-5-5 | fable-5-1 / gpt-6.1-sol | 503 | 154/195, 177/195 | -11.8 [-17.8, -5.9] | 156/195, 177/195 | -10.8 [-16.7, -5.0] |
| fable-5-1 | opus-5-5 / kimi-k3 | 새로운 100 | 13/23, 20/23 | -30.4 [-50.0, -12.5] | 17/23, 20/23 | -13.0 [-35.0, +9.1] |
| fable-5-1 | opus-5-5 / gemini-3.8-flash | 새로운 100 | 13/23, 19/23 | -26.1 [-45.5, -8.7] | 17/23, 19/23 | -8.7 [-29.4, +12.5] |
| opus-5-5 | fable-5-1 / kimi-k3 | 새로운 100 | 18/28, 23/28 | -17.9 [-38.5, +0.0] | 24/28, 23/28 | +3.6 [-14.7, +22.6] |
| opus-5-5 | fable-5-1 / gemini-3.8-flash | 새로운 100 | 18/28, 22/28 | -14.3 [-33.3, +4.5] | 22/28, 22/28 | +0.0 [-20.0, +20.7] |
| fable-5-1 | opus-5-5 / gemini-3.1-pro (8월) | 344 | 107/130, 110/130 | -2.3 [-9.8, +5.3] | 108/130, 110/130 | -1.5 [-9.1, +5.8] |
| opus-5-5 | fable-5-1 / gemini-3.1-pro (8월) | 344 | 118/141, 126/141 | -5.7 [-12.1, +0.8] | 125/141, 126/141 | -0.7 [-6.4, +5.1] |
8월 행은 GPT 없는 유일한 SimpleQA 비교이며 서로 다른 날짜의 모델을 쌍으로 만듭니다. gemini-3.1-pro는 이러한 질문에서 Claude 모델에 가장 가까운 정확도를 갖는 8월 팔입니다(이러한 질문에서 60.6% 및 57.7%에 대해 65.4%). 7개의 8월 파트너, 대부분 훨씬 약한 파트너에 걸쳐 모두 합치면, 측정된 바 fable-5-1의 경우 -5.1포인트 [-10.1, -0.3]이고 opus-5-5의 경우 -6.0 [-10.6, -1.2]입니다. 동일 커버리지에서 같은 실험실을 위해 +7.9 [+4.8, +11.2]와 +6.8 [+3.6, +10.2]로 돌아갑니다. 신뢰도의 동점은 무작위로 끊기며, 200번의 추첨에 걸쳐 가장 넓은 행은 0.0과 +20.7포인트 사이를 움직입니다.
부록 I. 모델 표본 외 상세 분석
표 A6은 섹션 5.3 뒤의 표본 외 오류를 제시합니다. 시간적 분할은 최고 모델 기준선의 0.050에 비해 0.019를 제공하며, 양방향 부트스트랩 하에서 -0.031 [-0.074, +0.008]의 차이를 나타내며, 질문만으로 클러스터링하거나 모델만으로 클러스터링할 때 구간은 영점 아래에 있습니다. 9개와 23개 폴드를 사용할 때, LOLO와 LOMO는 소수점 셋째 자리까지 동일한 오류를 제공합니다.
표 A6. 예측된 PPV의 평균절대오차, 최소 20개 개방 응답이 있는 셀. 양방향 부트스트랩, 질문별 모델.
| 방식 | 모델 [95%] | 독립 | 최고 | 모델 빼기 최고 [95%] | 모델 빼기 독립 [95%] |
|---|---|---|---|---|---|
| LOLO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.035] | +0.005 [-0.003, +0.012] |
| LOMO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.036] | +0.005 [-0.004, +0.012] |
| LOLO, 질문 분할 | 0.054 [0.052, 0.088] | 0.050 | 0.109 | -0.055 [-0.075, -0.027] | +0.004 [-0.002, +0.010] |
| 7월과 8월에서 10월로 | 0.019 [0.008, 0.041] | 0.023 | 0.050 | -0.031 [-0.074, +0.008] | -0.004 [-0.011, +0.005] |
| 중급형에서 플래그십으로 | 0.030 [0.025, 0.053] | 0.031 | 0.087 | -0.057 [-0.087, -0.022] | -0.001 [-0.009, +0.005] |
| LOLO, 플래그십, 검색 불가능 그룹 제외 | 0.037 [0.029, 0.071] | 0.038 | 0.120 | -0.083 [-0.125, -0.039] | -0.000 [-0.017, +0.014] |
| 제외됨: ERNIE와 Muse, 8월 | 0.019 [0.015, 0.055] | 0.033 | 0.128 | -0.110 [-0.143, -0.032] | -0.014 [-0.031, +0.007] |
| 제외됨: 7개 로컬 모델, 7월 | 0.037 [0.018, 0.072] | 0.068 | 0.077 | -0.040 [-0.061, -0.015] | -0.031 [-0.041, -0.014] |
| 제외됨: 동일 실험실, 10월 | 0.038 [0.017, 0.083] | 0.043 | 0.041 | -0.003 [-0.130, +0.045] | -0.006 [-0.025, -0.001] |
| 제외됨: 제품 사실 | 0.130 [0.077, 0.187] | 0.149 | 0.086 | +0.045 [-0.051, +0.143] | -0.019 [-0.021, -0.012] |
더 나은 모델을 읽는 것보다의 실질적 이득은 크며, 중급형에서 플래그십으로의 이전과 적합에 참여하지 않은 네 세트 중 두 개를 포함합니다(그림 A6). 승수 는 주요 방식에서 정밀도에 아무것도 더하지 않으며, 작업은 측정된 정확도와 에 의해 수행됩니다. 를 완전히 제거하면 LOLO 오류가 0.323으로 올라가며, 이를 상수로 유지하면 0.046을 제공합니다. 적용 범위와 로그 손실에서 는 도움이 됩니다: LOLO 하에서 독립 오류로부터의 차이는 -0.0079 [-0.0111, -0.0020]과 -0.0024 [-0.0045, -0.0003]입니다. 제외된 네 세트 중 세 개에서 독립 오류에 대한 구간은 상수가 고정되었을 때 영점 아래에 있습니다. 따라서 결합 오류 항은 적용 범위에 중요하며, 정밀도는 측정된 정확도와 에 달려 있습니다.
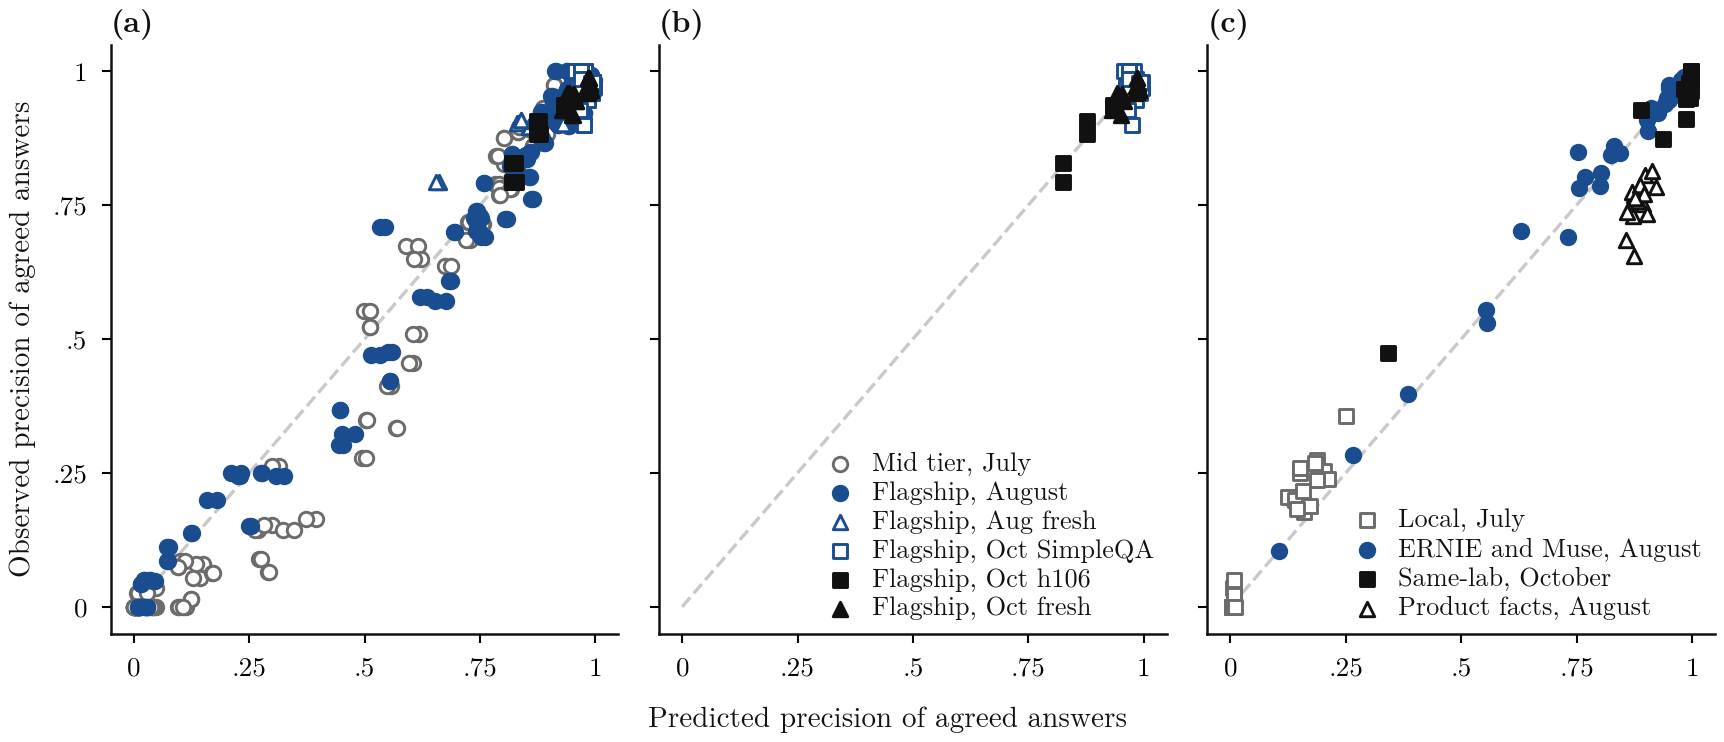
그림 A6. 예측된 대 관찰된 합의 답변의 정밀도. 주: (a) 하나의 실험실 제외. (b) 7월과 8월에 적합하고 10월을 예측. (c) 적합 외부 세트, 상수 고정. 파선은 동등성입니다.
제품 사실에 대해 모델은 높게 실행됩니다. 오류는 최고 모델의 0.086에 비해 0.130이며, 평균 13포인트의 과대 진술을 나타냅니다. 그 도메인의 기본 채점자를 사용하면 과대 진술은 19포인트로 올라갑니다(0.190 대 0.067). 제품 사실은 상수가 적합된 도메인 외부에 있습니다.
셀을 세 가지 결과 클래스로 정렬할 때(PPV 0.5 아래에서 역전, Delta까지 +2포인트에서 이득 없음, 그 이상에서 이득), 시간적 분할은 39개 셀 중 28개와 일치하며, 9개의 누락은 관찰된 이득이 있는 곳에서 이득이 없음을 예측합니다. 모델은 정밀도의 크기에 대해 신뢰할 수 있으며 +2포인트 라인의 양쪽에서 셀을 정렬하는 데는 약합니다.
부록 J. 액세스 모드 및 GPT 팔(arm)의 상세 분석
동일 식별자, 동일 질문. 100개의 SimpleQA 질문 세트에서 gpt-5.6-sol은 주요 웨이브에서 100개 중 92개(92.0%)를 정확히 답합니다. 이 중 100개 레코드 중 99개는 Codex 클라이언트를 통해 전달되었고 하나의 오답은 API 폴백을 통해 나타났으며, 분산 팔에서 직접 API를 통해 300개 샘플 중 139개(46.3%)를 달성합니다. 이는 45.7포인트의 격차입니다(그림 5). 99개의 클라이언트 레코드만 고려하면 수치는 99개 중 92개(92.9%)와 297개 중 139개(46.8%)로, 46.1포인트의 격차를 나타냅니다. 정확한 문자열 재현은 64.0%에서 26.0%로 감소합니다. 조건은 다음과 같이 다릅니다. 클라이언트는 자체 지시 사항에 따라 기본 노력 설정에서 실행되며, 온도는 설정 불가능하지만 API는 노력 없음과 온도 0.7에서 실행됩니다.
두 열에 걸쳐 팔의 다른 8개 모델 중에서 온도도 변하는 모델들은 최대 어느 방향이든 4.0포인트까지 이동합니다. 노력은 gpt-5.6-sol의 한 후보이며, gemini-3.1-pro에 대한 쌍을 이루는 추론 예산 측정은 정확도를 거의 변경하지 않았습니다(Chernets, 2026c). 웹 검색이 다른 후보입니다. 동일한 클라이언트의 10월 응답에는 프롬프트가 요청하지 않은 링크가 포함되어 있으며, gpt-6.1-sol의 506개 답변 중 3개, gpt-6-astra의 506개 중 18개에서 발견되며, 실제 MusicBrainz 식별자도 포함됩니다. 8월 클라이언트 호출당 중앙값 토큰 사용은 4,829이며, 호출의 36.4%가 6,000 이상입니다. 이러한 토큰은 추론 또는 검색일 수 있으며, 이를 분리했을 이벤트 스트림은 보존되지 않았습니다.
벤치마크 하니스와 제품을 사용하는 사용자는 하나의 식별자와 하나의 질문 세트에서 45.7포인트 떨어진 정확도를 볼 수 있으며, "모델"에 대한 연구는 어느 것을 측정했는지 명시해야 합니다. 8월 웨이브 내에서 클라이언트 팔은 1,457개 중 1,392개(95.5%)를 달성하고, 클라이언트 실패 후 API에서 제공된 14개 레코드는 해당 실패로 선택된 질문에서 11개(78.6%)를 달성합니다. 새로운 세트에서 API를 통한 gpt-5.6-sol은 100개 중 33개를 달성하며, fable-5는 76개를 달성하고, 10월에 클라이언트를 통한 gpt-6.1-sol은 95개를 달성합니다. 섹션 4의 모델은 측정된 정확도를 입력으로 취하므로 이 질문에서도 형태를 유지합니다. 검색 가능 팔이 없는 플래그십에서 LOLO 오류는 0.037이며 최적 모델의 경우 0.120입니다.
액세스 모드별 게이트 값. 8월의 새로운 질문에서 API를 통한 GPT의 경우, gpt-5.6-sol과 fable-5 쌍은 32개 동의 중 29개에서 정답입니다. Delta +57.6포인트 [+46.3, +69.7]이며, 67개 오류 중 64개를 포착하고, GPT 팔의 확실한 오류는 91개 중 61개에서 29개 중 2개로 감소합니다. 10월에는 동일한 질문에서 클라이언트를 통한 더 새로운 GPT를 사용하여, opus-5-5와의 쌍은 74개 중 72개에서 정답이며, fable-5-1과의 쌍은 78개 중 76개에서 정답입니다. Delta는 +2.3 [-0.7, +6.0]과 +2.4 [-0.5, +6.3]이며, 5개 오류 중 3개를 포착합니다. 게이트 값은 여기서 섹션 5.1에서와 같이 공개된 팔의 정확도를 추적합니다.
SimpleQA에서의 클라이언트 팔. 표 A7은 섹션 5.1에서 따로 설정된 팔을 보고합니다. 8월에는 gpt-5.6-sol과 fable-5 쌍이 1,016개 동의 중 997개(98.1%)에서 정답이며, 단독 95.4%에 대비합니다. Delta +2.8포인트 [+1.9, +3.7]이며, 하한값은 1,459개 중 15개입니다. 106개에서는 37개 중 34개(91.9%)에 도달하며, GPT 팔이 있는 모든 쌍은 133개 중 113개(85.0% [62.2, 100.0])에 도달하며, 이는 없는 경우 691개 중 96개에 대비합니다. 팔 단독은 105개 중 100개에서 정답입니다. 이러한 동의는 해당 정확도를 상속합니다. 106개에서의 Delta는 8월에 -3.3포인트 [-10.3, +2.6]이고 10월에 opus-5-5를 사용하면 -5.7 [-13.7, +1.2]입니다. 대조적으로, 동일한 두 공급업체의 중간 계층 쌍인 gpt-5-mini와 claude-haiku-4-5는 전체적으로 123개 동의 중 45개(36.6% [28.6, 45.4])에서 정답이며 106개에서는 13개 중 0개입니다. 첫 번째 멤버는 1,435개 중 163개에서 정답입니다.
표 A7. 클라이언트 팔 쌍. 첫 번째 멤버는 공개되었습니다. PPV의 Wilson 구간, Delta의 질문 부트스트랩.
| 쌍, 세트 | 커버리지 | PPV (K/O) [95%] | 단독 공개 | Delta, 포인트 [95%] | 포착된 오류 |
|---|---|---|---|---|---|
| gpt-5.6-sol + fable-5, 전체 SimpleQA, 8월 | 1028/1500 | 98.1% (997/1016) [97.1, 98.8] | 1403/1471 | +2.8 [+1.9, +3.7] | 49/68 |
| gpt-5.6-sol + fable-5, 106, 8월 | 37/106 | 91.9% (34/37) [78.7, 97.2] | 100/105 | -3.3 [-10.3, +2.6] | 2/5 |
| gpt-6.1-sol + opus-5-5, strat, 10월 | 192/300 | 96.3% (183/190) [92.6, 98.2] | 276/294 | +2.4 [+0.2, +4.9] | 11/18 |
| gpt-6.1-sol + fable-5-1, strat, 10월 | 193/297 | 97.9% (187/191) [94.7, 99.2] | 273/291 | +4.1 [+1.6, +6.7] | 14/18 |
| gpt-6.1-sol + opus-5-5, 106, 10월 | 36/106 | 88.6% (31/35) [74.0, 95.5] | 98/104 | -5.7 [-13.7, +1.2] | 2/6 |
| gpt-6.1-sol + fable-5-1, 106, 10월 | 35/106 | 91.2% (31/34) [77.0, 97.0] | 98/104 | -3.1 [-10.9, +3.5] | 3/6 |
| gpt-6.1-sol + opus-5-5, fresh, 10월 | 74/100 | 97.3% (72/74) [90.7, 99.3] | 95/100 | +2.3 [-0.7, +6.0] | 3/5 |
| gpt-6.1-sol + fable-5-1, fresh, 10월 | 78/100 | 97.4% (76/78) [91.1, 99.3] | 95/100 | +2.4 [-0.5, +6.3] | 3/5 |
천정 근처의 게이트 값. 친숙한 질문에서 쌍은 여전히 약간의 추가 가치를 제공합니다(그림 A1). 8월에 SimpleQA의 106을 제외하면 Delta는 +3.0포인트 [+2.0, +4.0]이며, 쌍에 유리한 차이입니다. 10월에는 strat 쌍이 0 이상에 있으며, +2.4 [+0.2, +4.9]와 +4.1 [+1.6, +6.7]이고 여백에 미치지 못합니다. 단일 동등성은 opus-5-5를 사용하는 gpt-6-sol로 -0.6입니다(90% 구간 -1.6~+0.5, p = 0.020). 이는 Holm 보정을 통과하지 못합니다(0.277). 106에서, gpt-6.1-sol과 gpt-5.6-sol을 사용하는 모든 쌍은 하향 방향으로 미결입니다. 이 팔 외에서는 효과가 큽니다. 동일한 8월 세트에서 fable-5와 gemini-3.1-pro는 +19.3포인트이고 fable-5와 grok-4.5는 +18.0입니다.
팔 자신의 신뢰도는 이 범위에서 경쟁자입니다. 자신의 신뢰도로 희석하여 opus-5-5와의 쌍의 커버리지로 제한하면, gpt-6.1-sol은 106에서 36개 중 34~36개(동점 처리 방식에 따라)에 있고, 쌍은 35개 중 31개이며, fresh에서는 74개 중 74개에 있고 쌍은 74개 중 72개입니다. strat에서는 쌍이 선도하며, opus-5-5와 -1.4, +4.7에서 +1.6포인트 [-1.4, +4.7]이고 fable-5-1과 +3.2 [+0.6, +6.2]입니다.
어느 GPT와 어느 파트너인가. 두 모델이 공통으로 해결하는 질문들에 대해 gpt-6.1-sol은 gpt-6-astra를 불일치 쌍에서 10 대 1로 이기고 있으며(p = 0.012, +1.83 포인트 [+0.61, +3.26]), gpt-6-sol은 gpt-6-astra를 21 대 5로 이깁니다(p = 0.002, +3.29 [+1.23, +5.34]). gpt-6.1-sol과 gpt-6-sol은 5 대 12입니다(p = 0.143). opus-5-5와 fable-5-1은 29 대 44입니다(p = 0.101, -3.12 [-6.65, +0.21]). 가장 강력한 두 GPT와 두 Claude의 조합은 503개 질문에 대해 95.4%와 97.1% 사이의 성능을 보이며(표 A2), fable-5-1이 각 비교에서 더 많은 오류를 포착합니다. GPT 없이 kimi-k3과 gemini-3.8-flash를 짝지은 경우 새로운 세트에서 이들과 구분할 수 없습니다. gpt-6.1-sol과 opus-5-5의 조합과의 차이는 정밀도에서 -1.5 포인트 [-6.3, +2.8], 커버리지에서 -2.0 [-10.0, +6.0]입니다.
부록 K. 외부 데이터 상세 분석
5.5절의 외부 검증은 재조정 없이 고정된 상수를 사용합니다. HELM Lite(Liang et al., 2023)는 2023년부터 2025년 사이에 출시된 20개 개발사의 95개 모델의 짧은 개방형 답변을 1,000개의 폐쇄형 NaturalQuestions에 대해 보유하고 있으며, 여기서는 제 엔진으로 채점합니다. LiveBench(White et al., 2025)는 11개 연구소의 70개 모델의 답변을 짧은 최종 답변을 포함한 346개 질문에 대해 보유하고 있으며, 그 정답으로 채점됩니다. Kim et al. (2025)는 다지선다형 MMLU에서 70개 모델에 대한 쌍 집계를 공개하며, 이는 일치율에 대한 정답률로 관찰된 정확도를 제공합니다. 표 A8이 결과를 제시합니다. Haas et al. (2025)의 표 7의 정확도는 일치 결과를 포함하지 않으므로 예측만 산출하고 검증하지 않습니다.
표 A8. 다른 모델 및 질문에서의 고정 모델. 서로 다른 연구소의 모델 쌍에 대한 예측 PPV의 평균 절대 오차, 처음 두 출처에서 최소 20개의 개방형 답변이 있는 셀. MMLU의 경우 모델만 기준으로 양방향 부트스트랩. 이동은 예측값에서 관찰값을 뺀 것입니다.
| 출처 | 셀 | 모델 [95%] | 독립 | 최선 | 모델 빼기 최선 [95%] | 모델 빼기 독립 [95%] | 이동 |
|---|---|---|---|---|---|---|---|
| HELM, NaturalQuestions | 4,088 | 0.069 [0.054, 0.087] | 0.070 | 0.208 | -0.139 [-0.171, -0.103] | -0.001 [-0.008, +0.006] | +0.053 |
| LiveBench, 4가지 작업 | 952 | 0.114 [0.101, 0.150] | 0.107 | 0.198 | -0.084 [-0.121, -0.026] | +0.007 [-0.006, +0.022] | +0.056 |
| LiveBench, math_comp | 431 | 0.075 | 0.096 | 0.279 | -0.034 | ||
| LiveBench, zebra_puzzle | 203 | 0.231 | 0.184 | 0.076 | +0.230 | ||
| LiveBench, spatial | 161 | 0.148 | 0.114 | 0.167 | +0.148 | ||
| LiveBench, web_of_lies_v2 | 157 | 0.036 | 0.031 | 0.166 | -0.017 | ||
| Kim et al., MMLU (집계) | 2,189 | 0.066 [0.060, 0.072] | 0.084 | 0.084 | -0.018 [-0.028, -0.010] | -0.018 [-0.019, -0.017] | +0.066 |
5.3절과 같이 모델은 세 출처 전체에서 더 나은 모델을 읽는 것을 능가하며, 얼룩말 퍼즐에서는 0.231 대 0.076으로 실패합니다. HELM이나 LiveBench에서 독립적 오류를 개선하지 못합니다. 전체적으로 5.3점에서 6.6점으로 높게 실행됩니다. HELM에서는 관찰된 곡선이 평탄화되는 반면 모델은 계속 상승합니다. 쌍 정확도 0.5와 0.6 사이에서 2023년과 2024년 초 모델의 정확도는 74.6%이고 이후 모델은 75.9%인 반면, 빈의 중간 부분에서 예측된 정확도는 84.4%입니다. MMLU에서 두 개의 잘못된 답변이 일치할 중앙값 확률은 0.621이고 에서 0.368이며, 4개의 옵션이 충돌을 강제합니다.
이들 모델에서 정확도는 쌍 정확도와 함께 상승합니다(HELM에서 Spearman +0.575, MMLU에서 +0.786, 종속 셀 이상). 유사한 정확도를 가진 이전 및 최신 모델은 쌍 정확도 0.4와 0.6 사이에서 유사한 정확도를 제공하고(70.7% 및 72.7%, 74.6% 및 75.9%), 0.2와 0.3 사이에서 더 차이가 납니다(57.6% 및 76.1%). 4절의 하한은 모든 4,088개 HELM 셀에서 유지됩니다. 이 셀들이 난이도로 계층화되지 않기 때문에 그 아래 쌍은 드물며, 4,088개 중 24개입니다.
HELM은 또한 많은 연구소와 GPT 의존성 없이 5.2절의 검증을 허용합니다. 파트너 정확도는 신뢰도 값 없이 일치될 수 있기 때문입니다. 1개의 공개 모델과 정확도 3점 내의 파트너가 있으면, 같은 연구소 파트너가 72.3%의 오류를 포착하고 다른 연구소의 75.5%를 포착하며, -3.2점[-4.2, -2.3]의 차이가 있고, 범위는 2.7점[+2.1, +3.4] 더 높습니다. 범위 3점 내의 일치를 추가하면 제거됩니다: 75.7 대 75.9%, -0.2[-0.6, +0.2], 정확도 -0.5[-1.4, +0.1]. 두 개의 잘못된 답변은 같은 연구소 내 31.6%의 경우와 연구소 간 27.0%의 경우에 일치합니다.
공유 오류는 또한 3절의 컬렉션에서 우연을 훨씬 초과합니다. Ding (2026)의 레이블 순열 귀무가설 아래에서, 각 모델의 잘못된 답변을 유지하고 질문 전체에 걸쳐 섞으면, 거부가 아닌 두 개의 잘못된 답변이 7월에 14.0%, 8월에 15.4%의 경우에 GPT 없이 일치하며, 귀무가설은 0.1%입니다. 106에서는 비율이 0.4% 및 0.5%에 대해 25.7% 및 22.8%이고, 신규 질문에서는 8월의 14.5%, 10월의 32.7%이며, 각각 0.8% 및 3.8%에 대해입니다. 개방형 답변은 우연히 충돌하기 거의 드물기 때문에 관찰된 공유는 이 귀무가설을 훨씬 초과하고, 모델 출시 후 작성된 질문에서도 마찬가지입니다.
부록 L. 추가 논의
Goel et al. (2025)과의 관계. 그들의 추세는 기회 조정 유사성에 관한 것이고, 제 것은 합의된 답변의 정확도에 관한 것이므로 결과가 충돌하지 않습니다. 데이터는 공유 오류의 조건부 비율 F/W, 즉 두 오답이 같을 확률을 통해 이에 대해 말합니다. 두 답변이 모두 채점되고 거부가 오답으로 계산되는 질문에서입니다. 참조 쌍의 경우 중간 계층 쌍의 경우 1,088개 중 63개(0.058)에서 플래그십 쌍의 경우 42개 중 15개(0.357)로 올라가며, 약 6배입니다. GPT를 포함한 모든 쌍에 대해 풀링하면 상승폭이 작고 구간에 0이 포함됩니다: 7월 0.097, 8월 0.132, 차이는 +0.034 [-0.006, +0.084]입니다. 10월 계층화 세트에서 F/W는 0.493 [0.179, 0.840]이며, 8월과의 차이는 +0.361 [+0.041, +0.712]입니다. 같은 범위에서 구간별로 플래그십 재현율은 0.7~2.5포인트 낮으며, 작은 효과이고, 는 0.140 [0.092, 0.192]이고 0.113 [0.082, 0.146]입니다. 따라서 방향은 그들의 방향과 일치하지만 풀링된 구간에는 0이 포함됩니다. 유사성이 게이트를 위협한다는 경고의 직접적인 해석은 재현율에서 실제로 나타납니다: 10월 클라이언트 쌍은 65.3%의 범위에서 66.3%의 오류를 포착하는 반면, 모든 55개 8월 쌍은 32.5%에서 88.2%를 포착하며, 이는 범위가 부분적으로 설명합니다. 정확도는 이 정확도에서 섹션 4의 한계가 정확도가 떨어질 여지를 거의 남기지 않기 때문에 주로 높게 유지됩니다.
Han (2026)과의 관계. Han은 비상관성을 실용적인 지렛대로 지목합니다. 제 측정은 정확도와 범위를 먼저 둡니다. 한 공개 모델과 같은 범위에서 두 번째 실험실의 이점은 두 번째 모델이 훨씬 더 정확하지 않으면 사라집니다(섹션 5.2). HELM에서 정확도가 일치하면 두 번째 실험실은 범위 2.7포인트에 대해 재현율 3.2포인트를 추가하며, 범위도 일치하면 아무것도 추가하지 않습니다. 비상관성은 일치하는 오답의 27.0%와 31.6%에서 보이며, 작습니다. Han의 이론은 직렬 게이트의 깊이에 관한 것이고 제 것은 단일 게이트에 관한 것이므로 두 가지가 첫 번째 단계에서만 만납니다. Liu (2026)는 같은 두 가지를 분리합니다: 선택 정확도는 비상관성을 따르며, 교차 모델 패널은 일치하는 구성원 정확도에서 AIME-2024에서 재표본화보다 12.5~16.7포인트 앞서 있고, 동의 신호의 보정은 구성원 정확도를 따릅니다. 여기서 측정된 합의된 답변의 정확도는 이 두 번째 것입니다.
섹션 2의 양측면. 발표된 숫자는 양측면을 부분적으로 조화시킵니다. Liu의 만장일치 패널은 답변 모두 정확도 0.433에서 AIME-2025의 100.0%에서 맞고, 0.458에서 MMLU-Pro의 70.2%에서 맞습니다. Kohli의 만장일치 9명 판사(각각 약 68%)는 90.9%에서 맞습니다. 비슷한 정확도는 정확도가 30포인트 떨어져 있으므로 정확도만으로는 이 결과를 함께 가져올 수 없습니다. 답변 공간의 크기가 더 많이 설명합니다. 두 오답이 일치할 확률은 4선택 MMLU에서 0.621, NaturalQuestions에서 0.270, 8월 플래그십에서 SimpleQA에서 0.132입니다. 이들은 다양한 작업의 패널과 쌍이며 논문 간 공동 계산이 없으며 정확도가 작업과 답변 형식 내에서 정확도를 따르는 것과 일치합니다.
친숙함. SimpleQA와 새로운 정확도 간의 간격은 벤치마크 노출을 통한 설명을 초대하며, 금 문자열과의 축자 일치는 그 서명처럼 보입니다. 제 데이터는 이를 공변량으로 지원하지 않습니다(부록 C). 올바른 답변 중에서 축자 일치는 모델 전체에서 거의 한 값에 가깝고, 모델의 잔차를 설명하지 않습니다. 8월의 새로운 세트에서 F/W, 0.145 [0.033, 0.402]는 SimpleQA의 0.132에서 보이는 거리가 없으며, 넓은 구간 내에 있습니다.
인용 방법
Chernets, V. (2026). 합의 역전은 중간 계층 속성이 아닙니다: 합의된 LLM 답변의 정확도는 쌍 정확도를 따릅니다 [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7682960
@misc{chernets2026agreementinversion,
  author       = {Chernets, Vadym},
  title        = {{Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7682960},
  url          = {https://doi.org/10.2139/ssrn.7682960}
}