공개 전에 봉인됨: 금융 시장의 AI 예측을 측정하기 위한 검증 가능한 표준
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
14개의 미국 및 중국 AI 모델, 12개의 시장, 4개의 시간 지평: 봉인된 라이브 리그, 각 합의 뒤의 독립적 목소리 수 및 30개의 등록된 예측
Vadym Chernets, PhD, AI systems architect · Founder, PolyHelper (polyhelper.ai) · ORCID 0009-0007-4845-3163
SSRN 7653679 · DOI 10.2139/ssrn.7653679 · Zenodo 10.5281/zenodo.23552697 · OSF registration 10.17605/OSF.IO/9Q86N · Analysis release 10.5281/zenodo.23552700 · GitHub
이 논문 다운로드
- SSRN (선호 인용): ssrn.com/abstract=7653679 · DOI 10.2139/ssrn.7653679
- Zenodo (보관, 공개 접근): doi.org/10.5281/zenodo.23552697
- OSF (섹션 8의 등록된 예측): doi.org/10.17605/OSF.IO/9Q86N
- GitHub (전체 텍스트 및 부록 B의 검증 명령): https://github.com/vadimchernets/papers/tree/main/sealed-before-the-open
- Analysis release (이 버전이 읽는 파일, 고정, SHA-256 매니페스트 포함): doi.org/10.5281/zenodo.23552700
- 라이브 리그 및 공개 데이터 (CC BY 4.0): trends.polyhelper.ai/markets/ · trends.polyhelper.ai/api/v1/
3단계로 봉인 확인 (부록 B): 책 및 10월 20일 스탬프를 다운로드하고, 스탬프가 있는 접두사를 해시하고, 앵커를 검증합니다.
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt.ots
head -n 159 council-book.jsonl | shasum -a 256   # 59673b9e...a7d9, as in 130025Z.txt
ots verify 130025Z.txt.ots                       # Bitcoin block 972,334
Bitcoin 노드 없이도, ots info 130025Z.txt.ots는 블록 972,334에 대한 증명을 표시하며, 모든 블록 탐색기에서 해당 블록의 머클 루트를 확인할 수 있습니다(부록 B, 6단계). 10단계에서는 Sigstore Rekor 로그에 있는 타임스탐프를 확인합니다.
SSRN 프리프린트를 인용합니다. 채점된 세션은 2026년 10월 21일에 02:42~05:33 UTC 사이에 생성된 오픈 파일에서 2026년 10월 20일 기준으로 읽었습니다. 2026년 10월 21일의 첫 번째 계산 실행은 22:16 UTC에 생성된 파일에서 읽었습니다. 표 5는 2026년 10월 21일 15:05 UTC에 읽은 적합성 상태, 22:33 UTC의 요구사항 1 적합성 검사, 2026년 10월 22일 00:00:16 UTC의 요구사항 3의 Rekor 항목을 나타냅니다.
키워드: AI 예측; 대형 언어 모델; 금융 시장; 예측 평가; Brier 점수; 보정; 미래정보 편향; 신뢰할 수 있는 타임스탐핑; OpenTimestamps; 유효 독립 음성 개수; 예측 시장; 등록된 예측
JEL: G17; C53; C52; G14; D84
초록
AI 모델이 금이 오를 것이라고 말할 때, 독자는 마감 시점에 그 예측을 평가할 수 있지만 보통 그것이 언제 만들어졌는지 확인할 수 없습니다. 백테스트는 기억과 기술을 섞으며, 거래 시즌은 시장을 통한 하나의 경로입니다. 나는 금융 시장에 대한 AI 예측을 측정하기 위한 번호가 매겨진 요구사항의 표준을 제안하고, PolyHelper가 운영하는 공개 리그 AI Council · Markets의 참조 구현을 문서화하며, 각 요구사항별 공개된 상태를 제시합니다. 미국 실험실 7개와 중국 실험실 7개에서 나온 14개의 대규모 언어 모델이 공유된 가격 스냅샷에 대해 동일한 질문에 각각의 계정으로 답변합니다. 이 중 11개는 뉴욕 개장 전 4개의 시간대에 걸쳐 12개의 지표를 예측합니다. 각 집계된 답변은 SHA-256 해시 체인으로 봉인되어 그 참조 가격 전에 기록되며 OpenTimestamps를 통해 Bitcoin에 앵커링됩니다. 2026년 10월 21일부터 집계된 실행이 미리 선언되며, 독립적인 RFC 3161 인증 기관이 모든 타임스탬프된 기록에 서명하고, 이는 Sigstore Rekor 투명성 로그에도 입력됩니다. 첫 번째 집계된 아침에 모든 집계된 답변은 09:30 ET 개장 전에 서명되었으며, 이 중 8개는 개장 29분 전에 서명되었습니다. 묻는 사건의 Brier 점수는 50% 벤치마크, 기후학적 기저율 및 예측 시장 가격에 대해 설정되며, 동의는 독립적인 목소리의 개수로 보고됩니다. 10월 19일과 20일의 개발 아침에 모델들의 확률 그림은 약 1.6명의 독립적인 예측자들의 그림만큼 유사했습니다. 10월 20일에 가장 가까운 4개 쌍 중 3개가 미국 실험실과 중국 실험실에 각각 포함되었습니다. 23개의 AI 예측 및 거래 노력의 날짜가 기재된 지도에 대해, 이 리그는 이러한 요소들을 결합한 금융 지표의 첫 번째 실시간 AI 리그입니다. 또한 7개의 미국 및 7개의 중국 모델이 한 프로토콜 하에서 거래하며, 독자들이 한 번씩 무작위로 모델을 본 후 또는 보기 전에 예측하도록 배정되는 첫 번째 AI 시장 경기장입니다. 30개의 날짜가 기재된 예측은 게시 전 OSF에 등록되며, 날짜가 기재된 개정판에서 평가됩니다.
Executive summary
가격 예측은 예측자가 결과를 알지 못했고, 예측이 그 이전에 존재했으며, 채점된 예측이 다른 시도가 무엇을 했든 상관없이 중요한 것이었을 때만 기술의 증거입니다. AI 모델은 세 가지 모두에 문제가 있습니다. 학습 중에 결과를 읽었을 수 있고, 몇 초 만에 다시 물어볼 수 있으며, 기록은 보통 질문한 사람이 보관합니다. 저는 각 조건을 읽자가 확인할 수 있는 요구사항으로 작성했습니다. PolyHelper가 운영하는 AI Council · Markets가 참조 구현입니다.
모든 질문은 아직 올 결과에 관한 것으로, 이는 그것을 모델의 기억 밖으로 유지합니다. 시장은 스스로 갱신하는 테스트입니다. 매일 아침 새로운 질문을 하고 같은 날 오후에 답변하므로 어떤 모델도 답변을 읽을 수 없습니다. 두 예측은 같은 것에 베팅할 때만 비교되며, 따라서 단위는 미리 고정된 이벤트 계약입니다. 각 답변은 채점되는 개시가격 전에 해시 체인에 봉인되며, 개시 움직임을 본 예측은 다른 질문에 답변하기 때문입니다. 기록이 그 보관자에 대한 신뢰에 의존하지 않기를 원했으므로, 체인은 비트코인에 고정되어 있으며, 2026년 10월 21일부터 독립적인 타임스탬핑 기관이 서명합니다. 세션당 한 번의 실행만 계산됩니다. 2026년 10월 21일부터 이를 선택하는 규칙은 미리 선언되고 봉인되며, 다른 실행들은 공개되고 레이블이 붙습니다.
점수는 요청된 이벤트의 Brier 점수입니다. 이는 적절한 점수이므로 예측자는 자신의 신념 이외의 것을 진술함으로써 아무 이득도 얻지 못합니다. 리그는 이를 동전, 이벤트의 기본 비율, 예측 시장 가격 세 가지 다른 기준과 비교합니다. 상관관계가 있는 모델은 별개의 증인이 아니며, 그들 간의 합의는 독립적인 목소리의 수로 보고됩니다. 일곱 개의 미국 모델과 일곱 개의 중국 모델이 질문, 스냅샷, 마감일과 규칙을 공유하므로, 양측 간의 차이는 한 가지 과제에서 측정됩니다. 독자들은 한 번 무작위로 선택되어 모델이 예측하기 전이나 후에 보게 되며, 그 그룹에 머물러 있습니다. 모델이 사람들을 돕는지 또는 단지 끌어갈 뿐인지를 측정합니다 (F28, F29).
두 개의 개발 아침은 이 측정 방법이 무엇을 읽는지 보여줍니다. 하루 호라이즌에서 개시 전에 봉인된 모델들의 확률 그림은 두 명 미만의 독립적인 예측자의 그림과 같았습니다. 그들은 예측이 마지막에 해결되는 6개월에서 가장 확실했으며, 10월 20일에 가장 가까운 네 쌍 중 세 쌍이 미국과 중국 연구실에 합류했습니다. 일차 테스트 및 30개의 예측은 게시 전에 OSF에 등록되었으며, 공개 데이터와 코드의 날짜별 개정판에서 채점됩니다.
1. 소개
월요일 아침에 한 사람이 AI 모델에게 금을 사야 할지 묻습니다. 모델은 어느 정도 확신을 가지고 그렇다고 대답하고 이유를 제시합니다. 장 마감까지 금은 하락했습니다. 모델이 틀렸을까요, 아니면 운이 없었을까요, 아니면 그 아침에 제시한 여러 답변 중 하나였을까요? 답변이 09:00에 존재했을까요, 아니면 정오에 작성되었을까요? 그 사람은 알 수 없습니다. 7장에서 검토한 대부분의 평가에서 예측의 시간은 운영자의 기록에 달려 있습니다. 제가 여기서 설명하는 리그는 그 기록을 운영자 외부에 보관합니다. 2026년 10월 20일 화요일 개장 전에 8개 모델은 Polymarket의 일일 계약에서 금이 평균적으로 마감 상승할 확률을 45%로 제시했고, 그 계약의 군중은 29%로 가격을 책정했습니다. 두 수치 모두 09:30 ET 개장 전에 봉인되었으며, 누구든지 이를 다시 읽을 수 있습니다 (부록 B).
모델이 실제 돈을 거래하는 경기장은 2025년에 광범위한 주목을 받았고 (Forklog, 2025a, 2025b), LLM 예측 벤치마크는 주요 기계 학습 행사에 도달했습니다: ICLR 2025의 ForecastBench (Karger et al., 2025), ICLR 2026의 FutureX (Zeng et al., 2025) 및 Prophet Arena (Yang et al., 2025). 거래 벤치마크는 대부분의 에이전트가 매매 보유를 이기지 못했음을 발견했고 (Y. Chen et al., 2025; Yu et al., 2025), 유동적인 예측 시장에서 강력한 AI 예측 시스템은 여전히 시장 합의보다 뒤처져 있었지만 둘의 조합은 둘 다를 이겼습니다 (Alur et al., 2025).
이러한 노력들은 공통적인 의존성을 공유합니다: 예측이 그 결과보다 먼저 있었다는 증거는 평가를 수행한 사람이 보관합니다. 백테스트는 모델이 이미 결과를 알 수 있기 때문에 이를 전혀 제공할 수 없습니다 (Lopez-Lira et al., 2025; Paleka et al., 2026). 라이브 벤치마크는 운영자의 기록을 통해 이를 제공하고, Prophet Arena는 각 예측의 해시된 SHA-256 봉인에 선택적 서명 영수증을 추가하며, 플랫폼 자체 시계로 시간을 정합니다 (Prophet Arena, 2026). Foresight Arena는 Polymarket 이벤트의 해시된 예측을 Polygon 체인에 기한 전에 커밋하고 시장 가격에 대해 점수를 매깁니다. 개정된 버전은 시뮬레이션된 결과를 보고하고 라이브 결과를 미룹니다 (Nechepurenko & Shuvalov, 2026a). Prediction Arena는 최고 수준의 모델에 Kalshi 및 Polymarket에서 실제 자본을 부여했고 약속 없이 운영자 로그를 유지했습니다 (Zhang et al., 2026). AI 외부에서 금융 거품의 예측은 2010년만큼 일찍 체크섬으로 봉인되었으며 지연된 공개를 했고 (Sornette et al., 2010), 시장 외부에서 한 AI의 축구 확률은 2026년 7월 이후 Bitcoin에 고정되어 있습니다 (NeuPortal, 2026). 저는 운영자 외부의 기록을 고정시키는 금융 지표의 고정 패널에 대한 AI 예측의 라이브 리그를 찾지 못했습니다 (7장). 제 연구 질문은 AI 시장 예측의 측정이 독자가 운영자의 제어 외부의 시계에 대해 무엇을 예측했고, 언제까지인지, 어느 예측이 계산되었는지 확인할 수 있도록 필요한 것입니다.
저는 MUST 및 SHOULD 요구사항의 체크리스트로 작성된 해당 측정을 위한 표준을 제안하고 (3.13장), 이의 구현인 PolyHelper가 운영하는 오픈 라이브 리그 AI Council · Markets를 문서화합니다 (trends.polyhelper.ai/markets). 14개 모델, 미국 7개 및 중국 7개 실험실의 모델이 동일한 질문, 스냅샷 및 규칙에 따라 시뮬레이션된 포트폴리오를 실행하며, 이 중 11개가 Council에 속하고 확률을 제시합니다. 뉴욕 개장 전 매일 아침 Council은 12개 금융 지표를 예측합니다: 주가 지수, 금리, 달러, 변동성, 상품 및 Bitcoin에서 1일부터 6개월까지 4개의 시간 범위에 걸쳐 있습니다. 모든 답변은 머리가 OpenTimestamps를 통해 Bitcoin에 고정되어 있는 해시-체인 된 책에 봉인됩니다. 각 답변은 봉인 이후 첫 번째 가격에서 점수를 매기고, 책은 점수 코드 및 데이터와 함께 발행됩니다. 2026년 10월 21일부터 독립적인 RFC 3161 타임스탬핑 기관도 각 타임스탬핑된 기록에 서명하므로, 독자는 운영자의 제어 외부의 시계에 대해 계산된 답변이 점수를 매기는 개장 가격 이전에 존재했는지 확인할 수 있습니다 (3.2장). 봉인된 기록은 또한 금융에 대한 새로운 종류의 오픈 데이터입니다: 동일한 이벤트에 대한 많은 AI 모델로부터의 확률의 일일 패널, 개장 전에 고정됨, 그들의 불일치와 그 가치를 측정할 수 있습니다.
이벤트 계약은 다른 리그가 자신의 파일에서 실행할 수 있는 체커와 함께 스키마로 발행됩니다 (3.13장). 제가 기여하는 것은 독자가 확인할 수 있는 표준과 구현입니다. 초기 세션은 생성되는 데이터를 표시하고, 8장의 등록된 테스트가 기술을 결정합니다. 3장은 표준을 명시하고 4장은 라이브 시장 설정을 위한 점수 설계를 명시합니다. 5장은 라이브 데이터에 대한 독립적인 음성의 효과적인 수를 측정하고, 6장은 AI 이전의 인간을 위한 설계를 제시하며, 7장은 AI 시장 경기장의 날짜가 있는 지도를 그립니다. 8장은 등록된 예측을 담고, 9장은 각각의 규칙이 있는 가장 강력한 이의를 담으며, 10장은 각 주장의 도달 범위를 담습니다. 7.4장은 AI 시장 경기장 검토 중 처음 3가지 주장과 3가지 추가 설계에서 새로운 것을 명시하고, 리그가 구축되는 것을 각각의 가장 가까운 선례와 함께 명시합니다. 부록 E는 셀별로 증거를 제공합니다.
2. 후향성이 AI 시장 예측을 깨뜨리는 이유
인간의 예측 토너먼트는 등록 마감과 신뢰할 수 있는 주최자를 통해 Executive summary의 세 가지 조건을 보호합니다. AI 모델은 각 보호를 빠져나갑니다. 모델은 학습 데이터로부터 결과를 알 수 있고, 1분 안에 여러 번 질문을 받을 수 있으며, 그것이 말한 내용의 기록은 규칙상 질문한 사람이 보관합니다. 처음 세 개의 소절에서는 이들을 차례로 다루고, 네 번째 절에서는 거래 시즌이 예측 기록을 대신할 수 없는 이유를 설명합니다.
2.1 모델이 기억하는 것
금융 예측에서 AI 모델을 평가하는 가장 저렴한 방법은 백테스트이지만, 모델의 학습 데이터에는 이미 그 다음에 일어난 일이 포함될 수 있습니다. Lopez-Lira et al. (2025)는 대형 언어 모델이 학습 마감 이전의 거시경제 및 금융 시계열의 정확한 값을 회상하고, 나중의 지식을 사용하지 말라는 명령이 회상을 제거하지 못하며, 회상이 마감 이후 중단된다는 것을 보였습니다: 학습 윈도우 내에서 기술과 기억은 구별되지 않습니다.
Gao et al. (2025)는 선제적 편향(lookahead propensity)을 테스트하기 위한 방법을 구축했습니다. 뉴스 헤드라인의 모델 점수가 주식 수익을 예측한다는 결과의 복제에서 (Lopez-Lira & Tang, 2023), 높은 선제적 편향을 가진 관측에서 예측 력이 증폭되었습니다. 마감 이후 원시 신호는 남아있었지만, 기억화와 관련된 상호작용은 유의성을 잃었습니다. Glasserman과 Lin (2023)은 GPT 감정 백테스트의 두 가지 표본 내 편향인 선제적 편향과 모델이 명명된 회사에 대해 알고 있는 것에 의한 산만을 분리하였고, 두 번째가 더 크다는 것을 발견했습니다, 특히 대형 기업의 경우. 20년의 데이터에 대해 FINSABER 프레임워크는 생존자 편향, 데이터 스누핑, 선제적 편향이 통제되면 LLM 투자 전략에 대해 보고된 이점이 급격히 축소된다는 것을 발견했고 (W. W. Li et al., 2025), 역사적 시뮬레이션에 기반한 벤치마크들(InvestorBench (H. Li et al., 2025) 등)도 같은 노출을 상속합니다.
문헌은 두 가지 방식으로 이를 수정합니다. 하나는 모델을 제한합니다: 시간적으로 일관된 언어 모델은 각 예측 날짜 이전에 사용 가능한 텍스트로만 학습됩니다 (He et al., 2025). 다른 하나는 시간을 제한합니다: 어떤 모델이든 전체 강도와 검색을 사용하여 아직 올 결과에 대해 질문받고, 그 답은 결과가 존재하기 전에 확인 가능하게 고정됩니다. 나는 시간을 제한하고 모델을 전체 강도로 유지하기로 선택했습니다. 시간적으로 일관된 모델이 봉인된 리그에 들어갈 수 있으므로 두 경로는 상호보완적입니다.
2.2 누수의 경로
라이브 질문으로 이동하면 가장 큰 누수를 제거하지만 모든 누수를 제거하지는 않습니다. Paleka et al. (2026)은 언어 모델 예측자의 평가에서 시간적 누수가 종종 미묘하며, 평가에서의 성능이 세상에서의 예측으로 이월되지 않을 수 있음을 보여줍니다. FutureX는 가짜 웹 페이지 및 시간적 유효성이 잘못된 답변을 포함한 같은 계열의 실패 모드를 보고합니다 (Zeng et al., 2025). 거시금융 예측에서, 모델의 입력을 결정 시점에 사용 가능했던 것으로 제한하면 누수 벤치마크가 보고하는 명백한 기술의 대부분을 제거합니다 (Guan & Chen, 2026). 한 가지 명명된 형태는 교차일 이벤트 드리프입니다: 수익 보고 이후 날들의 기사는 이미 시장의 반응을 담고 있으며, 이전 날의 입력에 들어가면 결과가 예측으로 누수됩니다 (Zhang & Zhang, 2026). 참조 가격 이전에 봉인된 예측은 그 이후에 작성된 텍스트를 활용할 수 없습니다.
금융 시장의 경우 타이밍 문제는 구체적입니다. 09:29에 기록된 날에 대한 예측과 09:45에 기록된 예측은 다른 객체입니다, 왜냐하면 두 번째는 개장의 움직임을 볼 수 있기 때문입니다. 예측이 이루어진 시간의 기록이 운영자에 의해서만 보관되면, 독자는 더 이후의 답변이 더 이전의 것을 대신하지 않았다고 신뢰해야 합니다. 사전 등록은 가설의 생성을 그 검증으로부터 분리하여 데이터가 존재하기 전에 공개 기록에 고정합니다 (Nosek et al., 2018). 봉인된 예측은 자동으로 매일 이루어지는 등록이며, 신뢰할 수 있는 타임스탬핑은 제3자가 그 시간을 확인하게 합니다 (Haber & Stornetta, 1991; Todd, 2016).
2.3 많은 실행, 하나의 점수
토너먼트의 예측자는 보통 마감까지 하나의 답변을 제출합니다. 모델은 조금 다른 표현이나 조금 다른 분에 열 번 질문을 받을 수 있으며, 그 답변은 다양합니다. 열 개 중 최고를 보관하거나 실패 후 파이프라인을 다시 실행하고 다시 실행을 보관하는 평가자는 단일 예측을 변경하지 않고 기술을 부풀리며, 모든 실행이 기록되고 어느 실행이 계산되는지의 규칙이 미리 고정되지 않으면 그 부풀림은 눈에 띄지 않습니다. 따라서 나는 전송하는 모든 실행을 봉인하고, 미리 작성된 규칙에 의해 세션당 하나의 실행을 계산하고, 다른 것들을 표지된 참조 계산으로 보관하는 표준을 작성했습니다 (섹션 3.4).
2.4 하나의 궤적은 측정이 아닙니다
모델이 돈을 거래하는 아레나는 어떤 결정이 돈을 벌었을 것인지에 대해 대답하지만, 포트폴리오의 시즌에 걸친 수익은 시장이 취할 수 있었던 경로의 한 번의 무작위 추출입니다. Alpha Arena의 처음 두 시즌에 대한 언론 기사는 순위 역전을 보고합니다: 첫 번째 시즌인 암호화폐 영구 선물에서 우승한 모델은 두 번째 시즌인 새로운 형식과 레버리지를 가진 토큰화된 미국 주식에서 가장 약한 것 중 하나였습니다 (Forklog, 2025a, 2025b; Yahoo Finance, 2025). 자산, 형식, 모델이 시즌 간에 변경되었으므로, 그 기사가 보고하는 역전은 운을 식별하지 않습니다. 그것이 하나의 시즌이 하나의 궤적으로 예측하는 것입니다. StockBench는 약 4개월 동안 Dow 주식을 거래한 대부분의 에이전트가 매수 후 보유를 이기지 못했음을 발견했습니다 (Y. Chen et al., 2025), LiveTradeBench는 약 50개의 라이브 날에 대해 일반 채팅 리더보드가 거래 결과를 예측하지 못했음을 발견했습니다 (Yu et al., 2025), PredictionMarketBench는 순진한 에이전트가 반복된 Kalshi 주문서에서 수수료와 결제로 손실을 본다는 것을 발견했습니다 (Arora & Malpani, 2026). Prediction Arena는 한 집단의 최전선 모델에 57일간 실제 자본을 제공했으며, 동일한 모델은 Kalshi에서 −22.6%의 수익률과 Polymarket에서 −1.1%의 수익률을 평균했습니다 (Zhang et al., 2026): 장소는 평균 결과를 20포인트 이상 이동시켰습니다. 반환이 호출의 방향, 크기, 타이밍, 비용, 시장의 경로를 하나의 숫자로 혼합하기 때문에 모델이 시장에 대해 뭔가를 알았는지 누군가 말할 수 없습니다.
확률은 콜의 방향과 신뢰도를 분리합니다. 금이 오늘 상승할 확률이 70%라고 명시하는 모델은 그 명시만으로 엄격히 적절한 규칙으로 채점할 수 있습니다(Brier, 1950; Gneiting & Raftery, 2007). 네 개의 지평선에서 열 두 개의 시장은 모델당 하루에 많은 그러한 명시를 생성하지만, 한 날의 열 두 개 시장은 세션을 공유합니다(섹션 4.6). 모델의 훈련 후에 해결된 규제 예측 시장의 질문에서 다섯 개의 최전선 모델은 과신했으며, 더 확장된 추론은 보정을 악화시켰습니다(Nel, 2025).
2.5 세 가지 조건이 요구하는 것
예측은 모델의 컷오프 이후 아직 올 결과에 대해 만들어져야 합니다(2.1). 그 시간은 제3자가 이후 변경을 감지할 수 있는 기록에서 결과 전에 고정되어야 합니다(2.2). 어느 예측이 계산되는지에 대한 규칙은 실행 전에 고정되어야 합니다(2.3). 점수는 묻는 사건의 적절한 점수여야 하며, 운의 경로에서 기술을 구분할 수 있을 만큼 충분한 독립적인 세션에 걸쳐 집계되고, 보정에 대한 확인이 있어야 합니다(2.4). 그리고 모델 간의 합의는 그것이 증거로 읽히기 전에 그들의 오류의 상관관계에 대해 할인되어야 합니다(Clemen & Winkler, 1985; Kim et al., 2025; Chernets, 2026a). 섹션 3은 다섯 개를 체크리스트로 작성합니다.
3. 프로토콜
프로토콜은 예측의 순간을 제3자가 검증할 수 있는 사실로 만들며, 그 사실의 각 계층이 누구에게 기반하는지 명시합니다. 다음의 모든 것은 리그의 공개 파일에 게시됩니다 (AI Council · Markets, 2026): arena-protocol.json으로 된 프로토콜, council-book.jsonl으로 된 봉인된 책, asks/ 아래의 질문 텍스트, 그리고 OpenTimestamps 증명과 함께 하루에 한 페이지씩 된 타임스탬프 목록 (/markets/proof/<day>/). 2026년 10월 20일 당시의 규칙을 설명하며 (arena-3 프로토콜, 채점 방법론 버전 2), 그 아침 실행인 2026-10-20-am을 작동 예제로 사용합니다. 이에 대해 인용된 모든 시간과 해시는 공개 파일에서 다시 확인할 수 있습니다 (부록 B). 각 봉인은 시행 중인 방법론의 버전을 담고 있으며, 나중의 규칙 변경은 그 이전에 봉인된 모든 것을 그대로 둡니다.
이벤트 계약. 표준은 이벤트를 측정합니다. 모델, 실행 또는 리더보드의 행은 이들의 모음이며, 각 이벤트를 질문이 나가기 전에 정해진 계약으로 정의합니다 (표 1). 두 예측이 모든 필드가 일치할 때만 같은 이벤트에 속합니다. 개방 후 봉인된 행과 같이 자체 참조를 가진 예측 (섹션 3.3)은 다른 이벤트에 대한 예측입니다. 그것은 그 이벤트에서 채점되며 모델을 공통 이벤트에서 비교하는 모든 통계에서 제외됩니다 (요구사항 4).
수익률이라는 단어는 이 리그에서 세 가지의 별개 이벤트를 지칭합니다. 예측은 10년 수익률 자체에 관한 것이며, 수익률 단위로, 참조에서 15:00 ET의 최종 가격까지입니다. 질문이 하나를 나열할 때의 군중 계약은 재무부의 3:30 PM ET 기준가 수익률로 해결되며, 그 조건에서 채점됩니다 (섹션 4.9). 포트폴리오는 재무 채권 펀드 (IEF)를 보유하고 있으며, 수익률이 하락할 때 상승합니다 (섹션 4.7). 10월 20일에 군중은 수익률의 계약을 이전 기준가 5.15%에 대해 7%로 가격 책정했으며, 이는 장 전 하락을 이미 반영한 가격입니다. 리그 자신의 수익률에 대한 질문은 09:30 참조에서 시작하여 다른 것을 묻습니다. 하나에 대한 올바른 판단은 그 자체로는 다른 것들에 대해 아무것도 말하지 않습니다. VIX는 같은 방식으로 분할됩니다: 예측은 지수에 관한 것이고, 일반 포트폴리오는 이를 보유할 수 없으며, Pro 리그는 보유할 수 있습니다.
표 1. 이벤트 계약의 최소 필드 및 참조 구현이 각각을 정하는 위치.
| 필드 | 이것이 정하는 것 | 참조 구현 |
|---|---|---|
| 대상 | 이를 추적하는 상품이 아닌 지표 자체 | 코드로 된 12개 지표; 거래 펀드는 포트폴리오 리그에만 나타남 (assets, trades_as) |
| 술어 및 기간 | 이벤트: 참조에서 최종 가격까지의 엄격한 상승 | prob_up; 1d; 1w, 1m, 6m을 5, 21, 126 세션으로 (Bitcoin 7, 30, 182 달력일) |
| 가격 출처 | 지표당 참조 및 최종 가격에 대한 공급자, 기호, 막대 크기 및 타임스탬프 규칙 | 각 예측 행의 공급자, 기호 및 참조 규칙 (price_provider, price_symbol, reference_rule; S&P 500의 경우, 참조 시간 이후의 ^GSPC의 1분 막대), 계약 스키마에서 지표별로 선언됨; 프로토콜의 포트폴리오 가격 출처 (prices) |
| 정보 마감 | 예측이 사용할 수 있는 것: 참조 가격 이전의 모든 것, 참조 자체는 절대 안 됨 | 실행 행으로 해시된 가격 스냅샷 및 질문 (snapshot_sha256, ask_sha256) |
| 마감일 및 계산된 실행 | 어떤 답변이 세션에 계산되는지 | 2026년 10월 21일부터, 예정된 아침 실행, 미리 선언됨, asks.jsonl에서 봉인되고 증명 페이지에 게시됨; 그 내에서, 참조 이전에 마지막으로 봉인된 행 (counted), 그리고 세션 11 (2026년 11월 2일)부터 각 좌석의 참조 이전에 봉인된 첫 번째 올바른 형식의 답변 행, 같은 좌석의 나중 행이 asks.jsonl의 74번 줄에 선언된 규칙에 의해 재시도로 표시됨, 텍스트 SHA-256 0f42c93b…b0b6cd. 10월 19일과 20일의 경우, 개방 이전에 마지막으로 봉인된 실행 (session_run), 실행 후 적용됨; 현재까지 계산된 모든 실행에서 각 좌석은 하나의 답변 행을 봉인했으므로 참조 이전의 첫 번째와 마지막 행은 동일합니다 |
| 참조 가격 | 봉인 후에 취한 이벤트당 하나의 참조 | 09:30 ET 이후의 첫 번째 가격; Bitcoin의 경우, 행의 봉인 시점 이후 또는 그 이후에 시작하는 첫 번째 1분 막대의 종가 (reference, btc) |
| 해결 | 최종 가격, 그 시간 및 규칙 | 기간의 마지막 세션의 종가 (16:00 ET); 10년 수익률 (15:00 ET); Bitcoin의 봉인 분부터 채점 세션의 16:00 ET까지의 날짜 |
| 비김 규칙 | 어떤 작은 움직임이 비김이고 어떻게 채점되는지 | 그날 움직임의 1분 막대 규모의 0.1배 밴드, 대약 세션 표준 편차의 0.08; 롤 세션 제외 (direction, noise_rolls) |
| 채점 규칙 및 벤치마크 | 적절한 점수 및 그것이 비교되는 것 | 모든 행에 대한 Brier 점수; 50% 벤치마크; 이벤트의 고정 기후학 (climatology_fixed, 섹션 4.3) |
| 규칙 버전 | 어떤 방법론이 적용되는지 | methodology.version, 각 실행 행에 봉인됨; methodology_version 각 예측 행에 |
| 이벤트 식별자 | "같은 이벤트"를 위한 하나의 키 | event_id_v2, 전체 계약의 9개 키의 해시, 옆에 5개 키 event_id (event-contract.schema.json, 섹션 3.13) |
참고: 괄호의 필드 이름은 공개 파일의 이름입니다 (arena-protocol.json, 각 실행 행의 methodology 필드, council-stats.json, council-calibration.json 및 council-forecasts.csv의 열). 수익률의 15:00 ET 윈도우는 10월 20일의 봉인된 실행 행에 명시되어 있습니다.
3.1 리그의 하루
그림 1은 스냅샷에서 점수까지의 하나의 리그 날을 추적합니다.
스냅샷. 질문을 보내기 전에 엔진은 12개 시장의 가격 스냅샷을 하나 촬영합니다: S&P 500, Nasdaq-100, Dow Jones, 반도체 지수(SOX), 미국 10년물 수익률, 달러 지수(DXY), VIX, 금, WTI, 브렌트유, 구리, 비트코인(표 2). 각 행은 가격, 최근 변화, 52주 범위 및 읽은 분을 포함합니다. 개장 전에는 주가지수와 수익률 행은 이전 세션의 데이터를 가지고 있으며, 다른 행들은 실시간입니다. 스냅샷의 SHA-256은 실행 라인에 기록되므로(snapshot_sha256), 나중에 모델들이 다른 가격을 본 것 아니냐는 주장은 검증될 수 있습니다.
질문. 14개 석에서 거래하며, 이 중 11개는 확률을 제공하고 위원회를 구성합니다. 미국 실험실 5개, 중국 실험실 6개이고, 3개 석은 벤치에서만 거래합니다(표 8). 한 개의 질문이 위원회의 모든 모델에 동일한 단어로 전달됩니다. 단, 각 모델의 계정을 제공하는 한 블록은 예외입니다. 공통 텍스트의 SHA-256은 실행 라인에 기록되며(ask_sha256), 각 답변 라인에서 반복되고, 텍스트는 asks/<sha256>.md로 공개됩니다. 각 모델이 받은 텍스트(자신의 계정 포함)의 해시는 전송할 때 봉인됩니다(asks.jsonl). 10월 20일에 질문은 ET 08:30에 열렸으며, 공개된 파일은 실행 라인의 값(77d3c627…6f07)과 해시가 일치합니다. 또한 주가지수 선물의 개장 전 변화를 제공했고, 모델들이 이를 사용할 수 있음을 알렸습니다(섹션 3.3).
ET 09:30 전 봉인. 각 답변은 해시 연쇄 장부의 한 줄로 기록됩니다. 10월 20일에 집계된 8개 답변의 답변 시간은 12:31:11Z부터 12:42:02Z까지입니다. 실행 라인과 답변은 한 배치에서 장부에 들어갔으며, 답변의 booked_at은 13:00:25Z이고, 배치는 13:00:25Z(ET 09:00:25)에 타임스탬프가 찍혔습니다. 배치 봉인이 배치에 타임을 표시합니다. 요구사항 12는 각 답변을 도착 시 봉인하며, 10월 21일 아침에는 두 형식 모두 표시됩니다. 처음 8개 집계 답변(12:32:52Z부터 12:44:59Z까지)은 13:00:19Z에 한 배치로 기록되었으며, 외부 2개 기관이 타임스탬프된 목록에 서명한 때이고, 9번째는 13:23:37Z에 기록되었습니다. 도착 후 14초이며, 3개 기관이 다음 목록에 서명한 두 번째 때입니다(섹션 3.2). 10월 20일의 증명 페이지는 "스코어 접수가 2026년 10월 20일 화요일 오전 9:30 ET(2026-10-20T13:30:00Z)에 마감되었습니다"라고 기록합니다. 그날 4개 타임스탬프가 촬영되었습니다: 13:00:25Z, 15:00:12Z, 15:36:05Z, 16:52:54Z. 이들은 블록 972,334, 972,344, 972,354, 972,359에 고정되었습니다. 첫 번째는 라인 1부터 159까지를 다룹니다. 실행 라인(151)과 8개 집계 답변(152부터 159까지)을 포함합니다.
개장. 비트코인을 제외한 모든 시장의 기준 가격은 ET 09:30 이후의 첫 가격입니다. 24시간 거래되는 비트코인의 경우, 라인의 봉인 시간 이후로 시작되는 첫 1분 바의 종가입니다. 기준 가격은 항상 봉인 후에 채택됩니다(섹션 3.3).
장 마감 후 스코어. ET 16:00 장 마감 후 엔진은 같은 장부에 스코어 라인을 기록합니다. 각 시장의 기준, 종가, 변화, 무승부 플래그, 각 모델이 부여한 확률을 포함합니다. 10월 20일에 스코어 라인(라인 184)은 20:30:36Z에 기록되었으며, 그날 마지막 타임스탐프 후이므로, 다음 타임스탐프인 10월 21일의 첫 번째 타임스탐프로 덮입니다. 더 긴 기간은 해당 기간의 창이 닫힐 때 자신의 라인으로 스코어됩니다.
그림 1. 리그의 하루: 스냅샷, 질문, 봉인, 개장, 스코어.
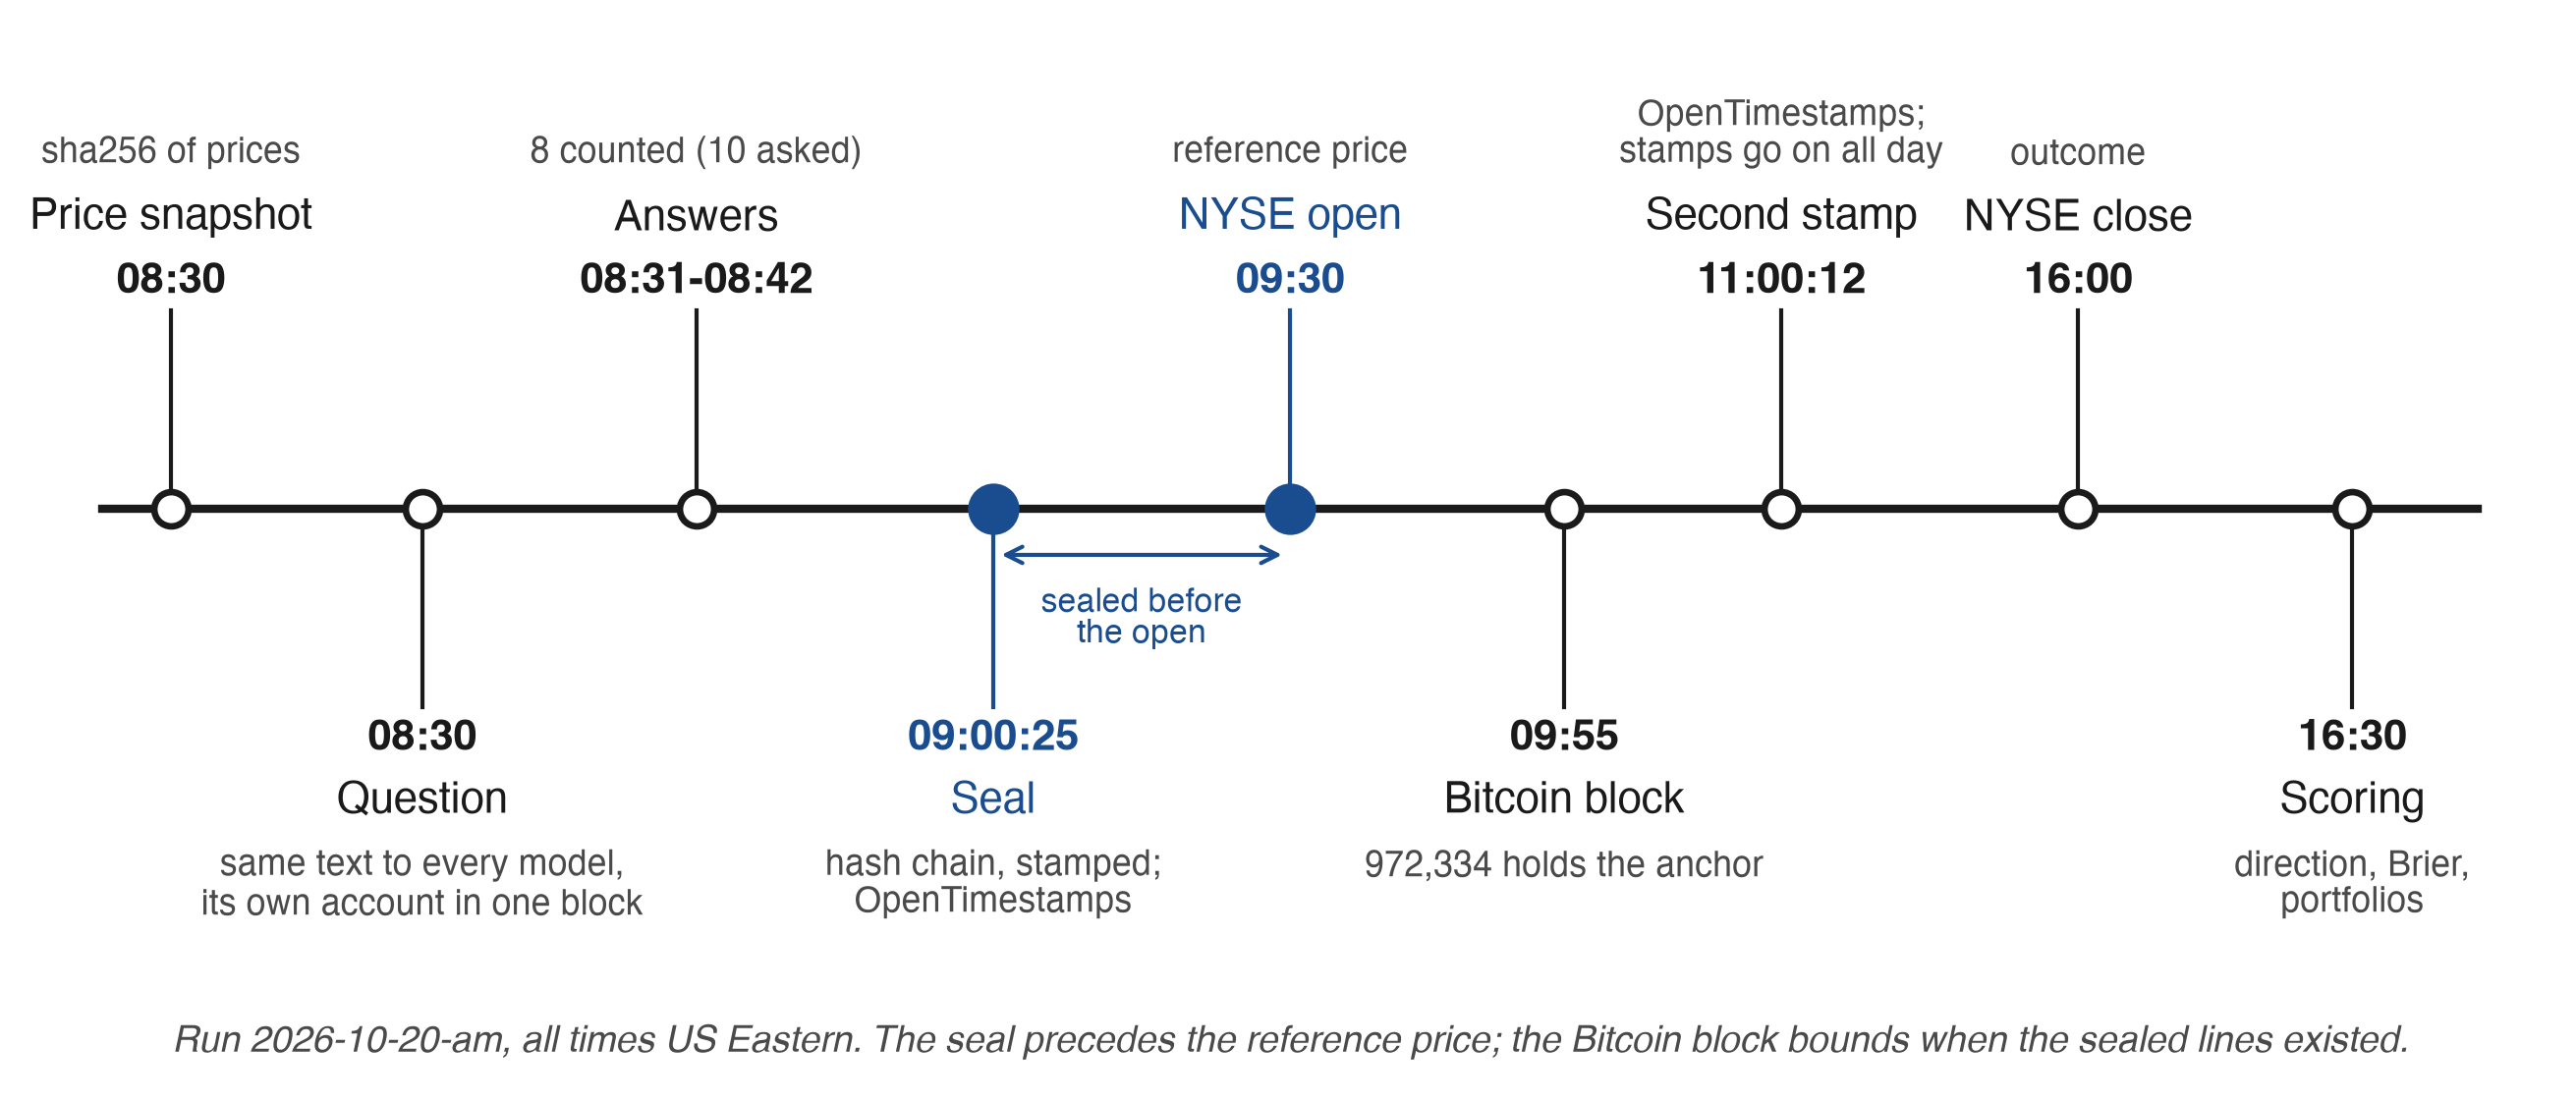
주: 시간은 실행 2026-10-20-am에서 council-book.jsonl과 증명 페이지 /markets/proof/2026-10-20/로부터 읽은 것입니다. ET는 뉴욕 시간입니다. 비트코인 블록 시간은 13:00:25Z 타임스탬프의 앵커를 보유한 블록 972,334의 헤더 시간입니다. 헤더 시간은 실질적인 범위로 채굴 시간을 제한합니다(섹션 3.11). 그날의 두 번째 타임스탐프인 15:00:12Z(ET 11:00:12)는 타임스탐프가 하루 종일 계속됨을 보여주도록 표시되어 있습니다. 20:30:36Z의 스코어 라인은 다음 날의 첫 타임스탐프로 덮입니다.
표 2에서 각 시장에 대해 이벤트가 해결되는 가격 기호, 1일 이벤트의 종료 시간, 포트폴리오 리그가 보유한 펀드, 2026년 10월 20일에 질문과 함께 봉인된 군중 계약을 제공합니다.
표 2. 12개 시장: 가격 기호, 기준 및 1일 이벤트의 종료 시간, 포트폴리오 리그에서 거래되는 각 펀드, 2026년 10월 20일에 봉인된 군중 계약.
| 시장 | 코드 | 가격 기호 | 기준 | 1일 이벤트 종료(ET) | 거래 대상 | 군중 계약, 2026년 10월 20일(거래소, 봉인된 거래량 $) |
|---|---|---|---|---|---|---|
| S&P 500 | SPX | ^GSPC |
ET 09:30 이후의 첫 1분 바 | 16:00 | SPY | Polymarket, 20,637 (Kalshi도 상장) |
| Nasdaq-100 | NDX | ^NDX |
동일 | 16:00 | QQQ | Kalshi, 1,150 |
| Dow Jones | DJI | ^DJI |
동일 | 16:00 | DIA | Polymarket, 20 |
| 반도체 | SOX | ^SOX |
동일 | 16:00 | SOXQ | 없음 |
| 미국 10년물 수익률 | US10Y | ^TNX |
동일 | 15:00 | IEF | Kalshi, 3,199 |
| 달러 지수 | DXY | DX-Y.NYB |
동일 | 16:00 | UUP | Polymarket, 4 |
| VIX | VIX | ^VIX |
동일 | 16:00 | 보유하지 않음(indicators_only) |
없음 |
| 금 | GOLD | GC=F |
동일 | 16:00 | GLD | Polymarket, 3,112 (Kalshi도 상장) |
| WTI | WTI | CL=F |
동일 | 16:00 | USO | Polymarket, 3,736 (Kalshi도 상장) |
| 브렌트유 | BRENT | BZ=F |
동일 | 16:00 | BNO | 없음 |
| 구리 | COPPER | HG=F |
동일 | 16:00 | CPER | 없음 |
| 비트코인 | BTC | BTC-USD |
라인의 봉인 시간 이후로 시작되는 첫 1분 바의 종가 | 스코어링 세션의 16:00 | BTC-USD | Polymarket, 38 |
주: 2026년 10월 20일과 21일 실행의 예측 행(price_provider, price_symbol, reference_rule, event_end_at), arena-protocol.json(assets, indicators_only) 및 council-book.jsonl 151번 줄(crowd.odds, crowd.kalshi)에서. 모든 행은 공급자 yahoo_finance_chart_v8_1m과 규칙 first_1m_bar_at_or_after_reference_at__last_1m_bar_at_or_before_end_at__v1을 명시합니다. 1주, 1개월, 6개월의 기간은 5, 21, 126개 세션입니다(비트코인 7, 30, 182일; 표 1). 드로우 밴드는 세션별로 설정되며(표 1) 나열되지 않습니다. 주요 군중 비교는 봉인된 거래량이 최소 $1,000 이상인 계약을 허용합니다(섹션 4.9).
가격은 질문 이전에 존재하고, 질문은 답변 이전에 존재하며, 답변은 이를 채점하는 가격 이전에 존재하고, 결과는 이 모든 것 이후에 존재합니다. 각 "이전"은 해시로 책에 기록되며, 책의 헤드는 운영자의 통제 밖에 고정됩니다.
3.2 봉인이란 무엇인가
이 책은 JSON 라인들의 수열 로, 한 번 작성된 후 그대로 유지됩니다. 각 라인은 4개의 부기 필드를 포함합니다: 위치 n, 이전 라인의 해시 prev, 자신의 콘텐츠 해시 seal, 그리고 체인된 해시 link입니다. 를 SHA-256(미국 표준 기술 연구소, 2015)이라고 하고, 를 정렬된 키를 가진 JSON 객체의 직렬화로서 Python의 json.dumps(o, sort_keys=True, ensure_ascii=False)가 작성하는 것과 정확히 같으며 UTF-8로 인코딩된 것(부록 B, 단계 4)이라고 합시다. 그러면 콘텐츠 (4개를 제외한 모든 필드)를 가진 라인 에 대해:
봉인 은 그 줄이 말하는 내용을 고정합니다. 링크 는 그것이 말하는 내용, 위치 및 그 이전의 모든 내용을 고정합니다. 2026년 10월 20일 현재 책의 모든 211개 줄에 대해 두 해시를 모두 다시 계산했습니다: 모든 seal과 모든 link가 재현되며, 모든 prev는 그 앞 줄의 link과 같습니다.
실행 줄은 질문의 해시, 가격 스냅샷의 해시, 측면별 명단, 시행 중인 채점 방법론 및 질문이 나갔을 때 기록된 예측 시장 가격을 포함합니다. 답변 줄은 모델, 그 모드 및 12개 시장과 4개 기간에 대한 전체 파싱된 답변, own_sha256(원본 응답의 해시) 및 ask_sha256을 포함합니다. 점수 줄은 결과를 포함합니다. 셋 모두 같은 방식으로 봉인됩니다.
체인만으로도 순서와 내용을 증명합니다. 파일을 제어하는 운영자라면 하루 만에 전체 체인을 재구성할 수 있으므로 저는 외부에서 시간을 확보합니다. 각 실행마다 엔진은 각 책에 대해 몇 줄이 있었는지, 정확히 그 줄들의 SHA-256 및 마지막 줄의 링크를 이름 붙인 짧은 타임스탬프 목록을 작성합니다. 2026년 10월 20일 13:00:25Z의 이 책에 대해 "159 lines, sha256 59673b9e…a7d9, last link 378273fd…7175b2c"로 읽힙니다. 목록은 OpenTimestamps(Todd, 2016)로 타임스탬프되며, 이는 많은 해시를 머클 트리로 집계하고 그 루트를 공개 달력 서버를 통해 비트코인 거래로 커밋합니다. 목록 옆에 공개되는 .ots 증명은 목록의 SHA-256에서 하나의 블록 헤더(여기서는 블록 972,334, 헤더 시간 13:55:20Z)의 머클 루트까지의 해시 연산 경로를 보유합니다. 이 구성은 Haber와 Stornetta(1991)의 링크된 타임스탬핑과 증인으로서의 비트코인 체인(Nakamoto, 2008)입니다.
나는 타이밍 증거를 독자가 누구를 신뢰해야 하는지에 따라 등급을 매깁니다. 운영자의 자체 기록에서 서명된 시간까지입니다:
- 레벨 1, 운영자의 기록. 각 라인은 체인에 봉인됩니다(
at,prev,link; 답변 라인은booked_at을 추가하며, 이는 배치 봉인의 초 단위입니다). 참조 가격은 봉인 이후에 기록됩니다. 체인은 순서와 내용을 고정하며, 봉인의 분 단위가 운영자가 기록한 시간입니다. - 달력으로의 제출. 체인의 헤드를 보유한 리스트는 공개 OpenTimestamps 달력(
alice.btc.calendar.opentimestamps.org과bob.btc.calendar.opentimestamps.org로 명명된 증명)으로 전송됩니다. 대기 중인 영수증은 해시가 수락되었음을 보여주지만, 독자가 검증할 수 있는 시간은 포함하지 않습니다. - 레벨 2, 비트코인 앵커. 달력은 해시를 비트코인 블록에 커밋합니다. 앵커된 접두사는 블록의 헤더 시간 이후 몇 시간 이내에 존재했으며(섹션 3.11, 실질적 한계), 그 안의 라인의 나중 재작성은 이전 증명을 보유한 누구나 감지할 수 있습니다. 블록은 09:30 ET 이후에 채굴될 수 있습니다: 10월 20일에 09:00:25 ET의 스탬프는 헤더 시간이 09:55:20 ET인 블록에 도달했습니다.
- 레벨 2+, 서명된 시간. 2026년 10월 21일부터 독립적인 RFC 3161 타임스탬핑 기관(Adams et al., 2001), FreeTSA 및 DigiCert는 그 날의 세 번째 리스트에서 Sectigo에 의해 합류하여 각 스탬프된 리스트에 서명하고, 그것이 포함하는 모든 라인이 존재한 초 단위를 고정합니다. 독자는 운영자 대신 기관과 그 인증서를 신뢰하며, 독립적인 기관이 있을 때 하나만으로도 충분합니다. 토큰은 배치의 시간을 기록합니다. 각 답변의 도착은 요구사항 12의 대상입니다.
라인이 체인에 들어갈 때 봉인되고, 달력으로 갈 때 헤드가 스탬프되며, 블록에 도달할 때 앵커됩니다. 책이 계속 증가하므로, 라인 159에서 취한 스탬프는 이후 어떤 길이에서도 여전히 검증됩니다: 오늘 파일의 head -n 159는 스탬프된 바이트를 변경하지 않고 반환하며 그 아침에 스탬프된 값으로 해시됩니다. 따라서 접두사는 라인 수로 취해지며, 라인을 다시 작성할 필터로는 취해지지 않습니다. 각 스탬프된 리스트는 해시하는 바이트 규칙을 인쇄합니다: 저장된 파일, UTF-8 바이트 순서 표시 없음 및 다시 인코딩된 것이 없으며, 각 라인은 최종 LF와 함께 계산되고 마지막 라인은 LF가 작성되면 한 번 계산됩니다.
공개 시간과 봉인 시간. 봉인 시간은 라인이 체인에 들어갈 때이고, 공개 시간은 그 텍스트가 공개될 때입니다. 리그는 그 날의 점수 이후 라인의 텍스트를 발표하며, 그 전에 자리, 봉인 및 시간이 표시됩니다(증명 페이지). Sornette et al. (2010)의 지연된 공개는 제3자가 공개적으로 봉인된 확률을 사용하는 것을 방지합니다. 텍스트를 예약하기 위해 보유하고 있는 운영자를 구속하는 것은 P1b 및 P2(섹션 3.11)의 작업입니다. 배치 내 체인은 예약 순서를 기록합니다: 10월 20일에 실행 라인은 그 답변 전에 서 있고 도착 후 함께 예약되었습니다.
3.3 봉인 이후의 참조 가격
참조 가격은 각 시장의 규칙에 따라 봉인 이후의 첫 번째 가격입니다. 예측은 고정된 이후에 시작되는 가격 경로에서만 점수가 매겨집니다. 참조 전에 존재하는 정보는 허용됩니다: 질문은 사전 개장 선물을 포함할 수 있으며(10월 20일, S&P 500, Nasdaq-100, Dow 및 Russell 2000 선물 대비 이전 종가), 모델은 그 답변까지 뉴스를 검색할 수 있습니다. 프로토콜이 제외하는 것은 참조 가격과 그 이후의 모든 것입니다.
개장 이후에 봉인된 라인은 유지됩니다. 자신의 참조를 받으며, 자신의 봉인 이후의 첫 번째 가격이며, 늦음으로 표시됩니다(점수 라인의 late_ref). 종장 이후에 봉인된 라인은 그 세션에 대해 점수가 매겨지지 않습니다(counted). 그러한 라인은 다른 질문에 답변합니다: 10월 20일의 책에서, 개장 이후에 봉인된 라인의 자신의 참조는 9개 중 6개의 하루 셀에서 점수가 매겨진 이동의 부호를 역전시켰습니다. 따라서 나는 공통 이벤트에서 모델을 비교하는 모든 것 밖에 두었습니다: 합의, 공유 오류 수, 가장 가까운 모델, 유효한 목소리의 수 및 모든 일대일 비교(요구사항 4). 점수 라인은 라인을 표시하며, 리그의 통계의 계산된 시리즈는 이를 제외합니다(표 5).
동일한 규칙은 비트코인을 포함한 공통 이벤트당 하나의 참조를 고정합니다. 참조 구현에서 비트코인의 참조는 라인의 봉인에서 시작하거나 그 이후의 첫 번째 1분 막대의 종가입니다(reference_rule, Yahoo Finance BTC-USD). 따라서 가격은 항상 봉인보다 늦으며, 열린 파일은 봉인을 두 번째로 작성하여 reference_at으로, 가격이 책정된 막대의 시작을 reference_price_at으로 작성합니다. 나중 배치에서 봉인된 라인은 자신의 비트코인 참조를 가지며 별도의 이벤트입니다. 10월 21일에 13:00:19Z에서 봉인된 8개의 답변은 참조 83,536.42를 공유하며, 이는 13:01Z 막대의 종가입니다; 아홉 번째는 13:23:37Z에서 봉인되었고, 자신의 83,677.08을 가지며, 이는 13:24Z 막대의 종가이며, 공통 비트코인 이벤트 밖에서 별도로 점수가 매겨집니다(own_event, same_event false). reference_at이 봉인 초와 같기 때문에, "봉인 전 reference_at"에서의 절단은 모든 비트코인 행을 제거합니다. 대신 12개 시장 모두에 하나의 시계를 사용합니다: 답변 라인은 세션의 09:30 ET 참조 전에 봉인된 경우에만 공통 이벤트 통계에 들어갑니다. 비트코인 라인은 동일한 09:30 ET 절단을 따르며, 비트코인 가격 자체는 실행의 봉인 이후의 첫 번째 분에서 참조됩니다. 이것은 발표된 계산된 시리즈(n_eff.counted)의 규칙이며 제출된 결정 스크립트의 규칙입니다. 답변이 도착 시 봉인되면(요구사항 12), 24시간 주변에서 거래하는 시장의 공통 참조는 실행의 섭취 종료 시 가격이며, 계산된 모든 봉인 이후입니다.
3.4 세션당 하나의 계산된 실행
리그는 하루에 한 번 이상(아침 런, 저녁 런, 주말 비트코인 런, 일요일 레이더)을 요청하므로, 여러 런이 한 세션을 목표로 할 수 있습니다. 각 모델과 세션마다 정확히 하나만 계산되며, 표준은 그 런이 런 전에 선언된 규칙으로 고정되어야 함을 요구합니다(요구사항 6). "오픈 직전에 봉인된 런"의 형태인 규칙이 사후에 적용됩니다. 이는 운영자가 오픈 전에 더 늦은 런을 보낼 자유를 남기고, 따라서 런 중에서 선택할 수 있습니다. 따라서 저는 일정을 규칙으로 만들었습니다. 계산된 기록의 시작인 2026년 10월 21일부터, 예정된 아침 런이 계산되고 다른 모든 런은 참고 계산입니다. 선언은 나가는 질문의 첫 번째 줄로 봉인되었으며(asks.jsonl, 2026년 10월 21일 UTC 04:16, 아침 런 8시간 전) 증명 페이지에 SHA-256(c24b0d4f…5df5)과 인터넷 아카이브 캡처(같은 날 UTC 05:35)와 함께 게시되었습니다. 저는 2026년 10월 21일 UTC 15:05에 그곳에서 읽었습니다. 두 개의 개발 세션인 10월 19일과 20일에서, 봉인된 방법론은 세션 오픈 직전에 봉인된 런(session_run)을 계산했으며, 이는 런 후에 적용된 규칙입니다. 이러한 세션들은 주요 비교 창 밖의 개발 세그먼트를 형성합니다(섹션 8). 다른 런들은 자신의 페이지에서 점수가 매겨지며(not_counted, earlier_run), 유지되고, 게시되고, 레이블이 지정되며, 누구나 봉인된 타임스탬프에 선언된 규칙을 적용할 수 있습니다(P3, 섹션 3.11). 포트폴리오 리그의 재시도(asked_again, 부록 A)는 질문 해시로 봉인되어 모든 예측 점수를 벗어납니다.
3.5 방향, 확률 및 무승부
모델은 prob_up을 제공하며, 이는 지표가 지평선 끝에서 참고 가격보다 높을 확률을 0에서 100 사이의 값으로 나타냅니다. 10년물 수익률의 경우 "매수"는 수익률이 상승한다는 베팅입니다. VIX의 경우 예상 변동성이 상승한다는 의미입니다.
저는 사전에 고정된 규칙으로 작은 움직임을 무승부로 처리합니다. 밴드는 이며, 은 참고 전 4개 분 봉 세션에 걸친 평균 절댓값 1분 수익률입니다. 정상 수익률의 경우 세션 표준편차의 약 0.08입니다(council-stats.json, draw_band). 선물(WTI, Brent, 금, 구리)의 경우 기록된 선물월물 계약 변경에 걸친 분 움직임은 제외됩니다. 롤은 두 계약 간의 점프이기 때문입니다(noise_rolls). 표준은 채점된 사건이 요청된 사건임을 요구합니다(요구사항 7). 주요 브리어 점수는 모든 행에 걸쳐 계산되며, 상승은 0 이상의 변화를 의미하고, 무승부 없는 점수는 두 번째로 보고되며 제외된 행의 수가 함께 보고됩니다. 모델은 엄격한 상승의 확률을 요청받으며 무승부 규칙을 알려지지 않습니다. 10월 21일 세션부터 모든 행 점수가 리그의 주요 점수입니다(필드 pall). 개발 세션은 게시된 그대로 유지되며, 별도 세그먼트(요구사항 15)이며, 무승부를 제외하는 점수로 계산됩니다. 이러한 점수는 밴드 외 움직임이 주어진 상승의 확률로 최소화되므로, 요청된 질문에 대해 엄격히 적절하지 않습니다.
무승부 밴드와 적절한 점수는 함께할 수 있습니다. 한 설계는 밴드 외 움직임이 주어진 상승의 확률을 요청하고 무승부가 아닌 행에서만 채점합니다. 다른 하나는 상승, 무승부, 하락의 확률 세 가지를 요청하며, 3개 결과 브리어 점수로 채점합니다. 이는 삼중(Brier, 1950; Gneiting & Raftery, 2007)에 대해 엄격히 적절합니다:
무승부에 0의 확률을 부여하는 예측은 무승부가 아닌 행에서 정확히 이진 Brier 점수인 를 기록합니다. 각각 1/3의 균등 예측은 이진 동전의 0.25에 비해 을 기록하므로, 3결과 점수는 자신의 벤치마크가 필요합니다. 정확히 50의 확률은 어느 쪽도 지지하지 않으며 Brier에 의해서만 채점됩니다.
3.6 미리 정해진 수준으로서의 "dips에 매입"
"Dips에서 매수"는 수준 없이는 점수를 매길 수 없으므로, buy_dips 동작을 가진 답변이 entry를 주어야 합니다. 이는 모델이 추가할 기준 아래의 수준입니다. 세션 중에 가격이 닿으면 포트폴리오는 진입점에서 매수하고, 그렇지 않으면 매수하지 않습니다. 어느 쪽이든 확률은 점수가 매겨집니다. 허용되는 다섯 가지 동작은 buy_strong, buy_dips, hold, trim, sell입니다. 목록 밖의 단어는 action_word로 유지되며, 그 확률과 수준은 점수가 매겨지고 거래하지 않습니다.
따라서 각 답변 셀은 하나의 사건에 대해 두 개의 봉인된 답변을 포함합니다. 확률과 동작이며, 최근 두 거래일 아침에 이들이 일치합니다(그림 2). 2026년 10월 20일 기준 이전에 봉인된 8개 좌석의 384개 셀과 2026년 10월 21일 9개 좌석의 432개 셀 전반에 걸쳐, 동작 필드가 비어 있지 않았으며, 모든 sell과 trim은 50 아래에 있었고, hold는 거의 50/50 확률 주변에 있었습니다(양쪽 아침 모두 중앙값 52). 중앙값은 단계별로 buy_strong까지 상승했습니다. 확률이 50 아래인 네 개의 셀에서 dips에서의 매수를 찾습니다. Claude의 10월 20일 3개 1일 셀(S&P 500 48, 나스닥-100 47, 반도체 46)과 10월 21일 1주일에서 MiMo의 S&P 500(47). Dips에서의 매수는 기준 아래에 고정된 진입 수준에서만 체워지는 주문이므로, 그 옆의 확률이 50 아래인 것은 일관성이 있습니다. 표 3은 지평선별로 동작을 계산합니다. hold는 각 아침의 1일 셀 64개를 채웠습니다(96개 및 108개 셀 중). 그리고 6개월에서 buy_dips가 주도했습니다(37개 및 38개 셀).
그림 2. 같은 답변 셀에 봉인된 동작으로 상승 확률: 2026-10-20-am 실행(기준 이전에 봉인된 8개 좌석) 및 2026-10-21-am(9개 좌석), 모든 4개 지평선.
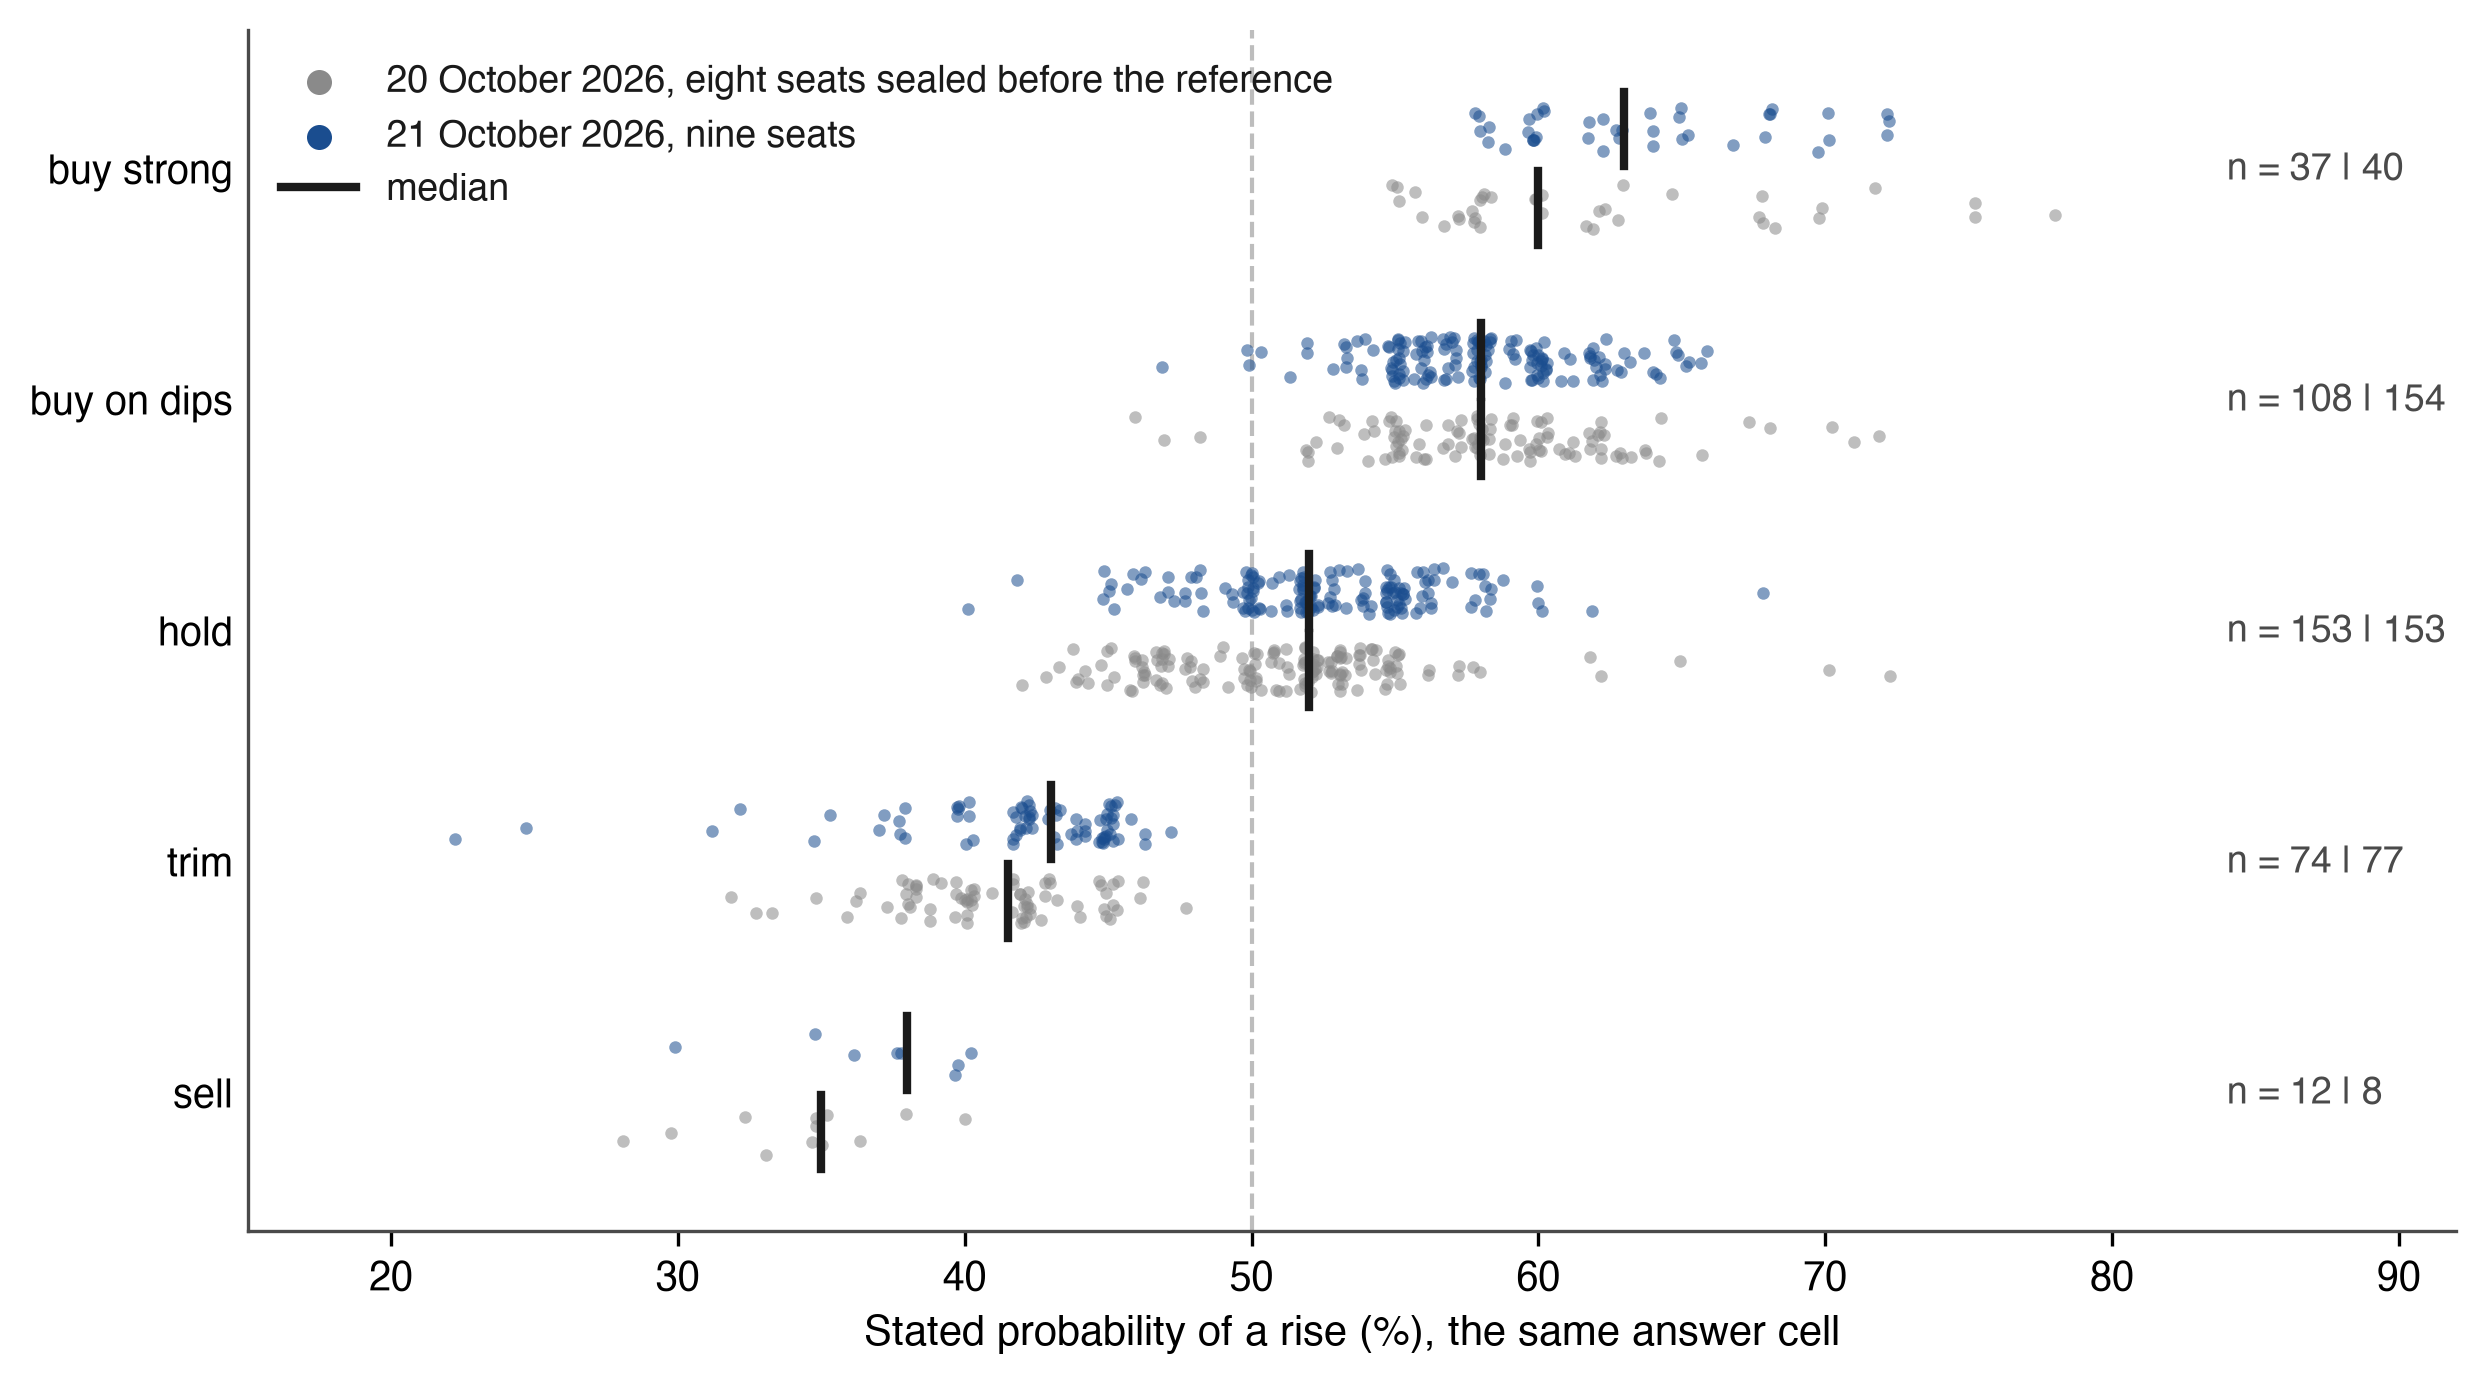
주: 각 점은 하나의 답변 셀입니다(좌석 × 시장 × 지평선). 약간 지터링됨. 막대는 중앙값을 표시합니다(sell 35 및 38, trim 41.5 및 43, hold 52 및 52, dips에서 매수 58 및 58, strong 매수 60 및 63). n은 10월 20일 | 21일의 셀입니다. items.<market>.<horizon>.action에 봉인된 동작, prob_up의 확률. 출처: 2026년 10월 22일, 01:32 UTC에 저장된 council-forecasts.csv. 섹션 3~5의 모든 그림과 표처럼 봉인된 답변에서 구축되었으며, 결과를 보여주지 않습니다.
표 3. 지평선별 봉인된 동작: 2026-10-20-am 실행(기준 이전에 봉인된 8개 좌석, 지평선당 96개 셀) 및 2026-10-21-am(9개 좌석, 지평선당 108개 셀).
| 지평선 | 실행 | 판매 | 정리 | 보유 | Dips에서 매수 | 강한 매수 |
|---|---|---|---|---|---|---|
| 1일 | 2026년 10월 20일 | 1 | 11 | 64 | 16 | 4 |
| 1일 | 2026년 10월 21일 | 0 | 12 | 64 | 26 | 6 |
| 1주 | 2026년 10월 20일 | 3 | 23 | 33 | 31 | 6 |
| 1주 | 2026년 10월 21일 | 1 | 18 | 31 | 54 | 4 |
| 1개월 | 2026년 10월 20일 | 2 | 15 | 42 | 24 | 13 |
| 1개월 | 2026년 10월 21일 | 3 | 22 | 34 | 36 | 13 |
| 6개월 | 2026년 10월 20일 | 6 | 25 | 14 | 37 | 14 |
| 6개월 | 2026년 10월 21일 | 4 | 25 | 24 | 38 | 17 |
주: 봉인된 동작별 답변 셀 수. 출처: 2026년 10월 22일, 01:32 UTC에 저장된 council-forecasts.csv.
3.7 4개 지평선과 연도
모든 답변은 모든 시장에 대해 4개 지평선을 다룹니다. 다음 거래일(1d), 1주(1w), 1개월(1m), 6개월(6m). 그리고 연도에 대한 1개의 채점되지 않은 문장(years). 11개의 거래시간 시장의 경우 더 긴 지평선은 5, 21, 126 세션입니다. Bitcoin의 경우 7, 30, 182 달력 일이며, 그 날은 봉인 분부터 채점 세션의 16:00 ET 마감까지 실행되며, 아침 실행의 경우 약 7시간입니다. 각 정의 내에서 지평선을 비교합니다. 한 모델이 한 아침에 48개의 확률을 제공하며, 각각은 자체 창에서 해결되고 모두 한 번의 정보 세트에서 한 분에 봉인됩니다.
3.8 목표 및 "Wrong if"
각 시장과 지평선에 대해 모델은 또한 target을 제공합니다. 가격이 갈 것으로 예상하는 곳, 그리고 invalidation, "Wrong if"로 표시됨. 자신의 견해가 틀렸다고 인정할 수준입니다. 주요 위험과 견해를 수정하도록 만드는 것(risk, revise_if). 모두 확률과 함께 봉인되므로 예측은 모델 자신의 용어로 반박할 수 있습니다. 한 개의 봉인된 답변은 필드를 작동시킵니다. 2026년 10월 19일, 개장 전, ChatGPT(GPT-6.1 Sol)는 S&P 500에 그날 상승할 확률 54%를 제공했습니다. 목표는 7,678.59이고 "Wrong if"는 7,560입니다. 그런 다음 1주일에 42%, 1개월에 38%, 6개월에 61%. 그것의 명시된 견해는 "저는 AI 지출의 즉각적인 인플레이션 효과에 최종 생산성 배당금보다 더 많은 가중치를 둡니다". 그리고 수정 조건은 "SPX가 8000을 클리어하고 수익 지침이 개선되면 월간 약세 견해를 포기할 것입니다"(책 라인 83). 이러한 각 수준은 모델에 그 의미를 물어보지 않고 가격 경로에 대해 확인할 수 있습니다. 그림 3에서 전체 답변을 그립니다. 확률, 동작, 목표, 각 지평선의 "Wrong if" 수준, 6개월에서 buy on dips가 채워질 7,350의 진입 수준을 포함합니다. 질문은 이전 종가 7,659.44를 표시했으며, 그 날의 기준 가격인 7,700.34는 봉인 후 적용되었습니다.
그림 3. 한 개의 봉인된 답변: S&P 500에서 ChatGPT, 2026-10-19-am 실행(council-book.jsonl, 라인 83). 확률, 동작, 목표, 각 지평선의 "Wrong if" 수준 및 진입 수준 포함.
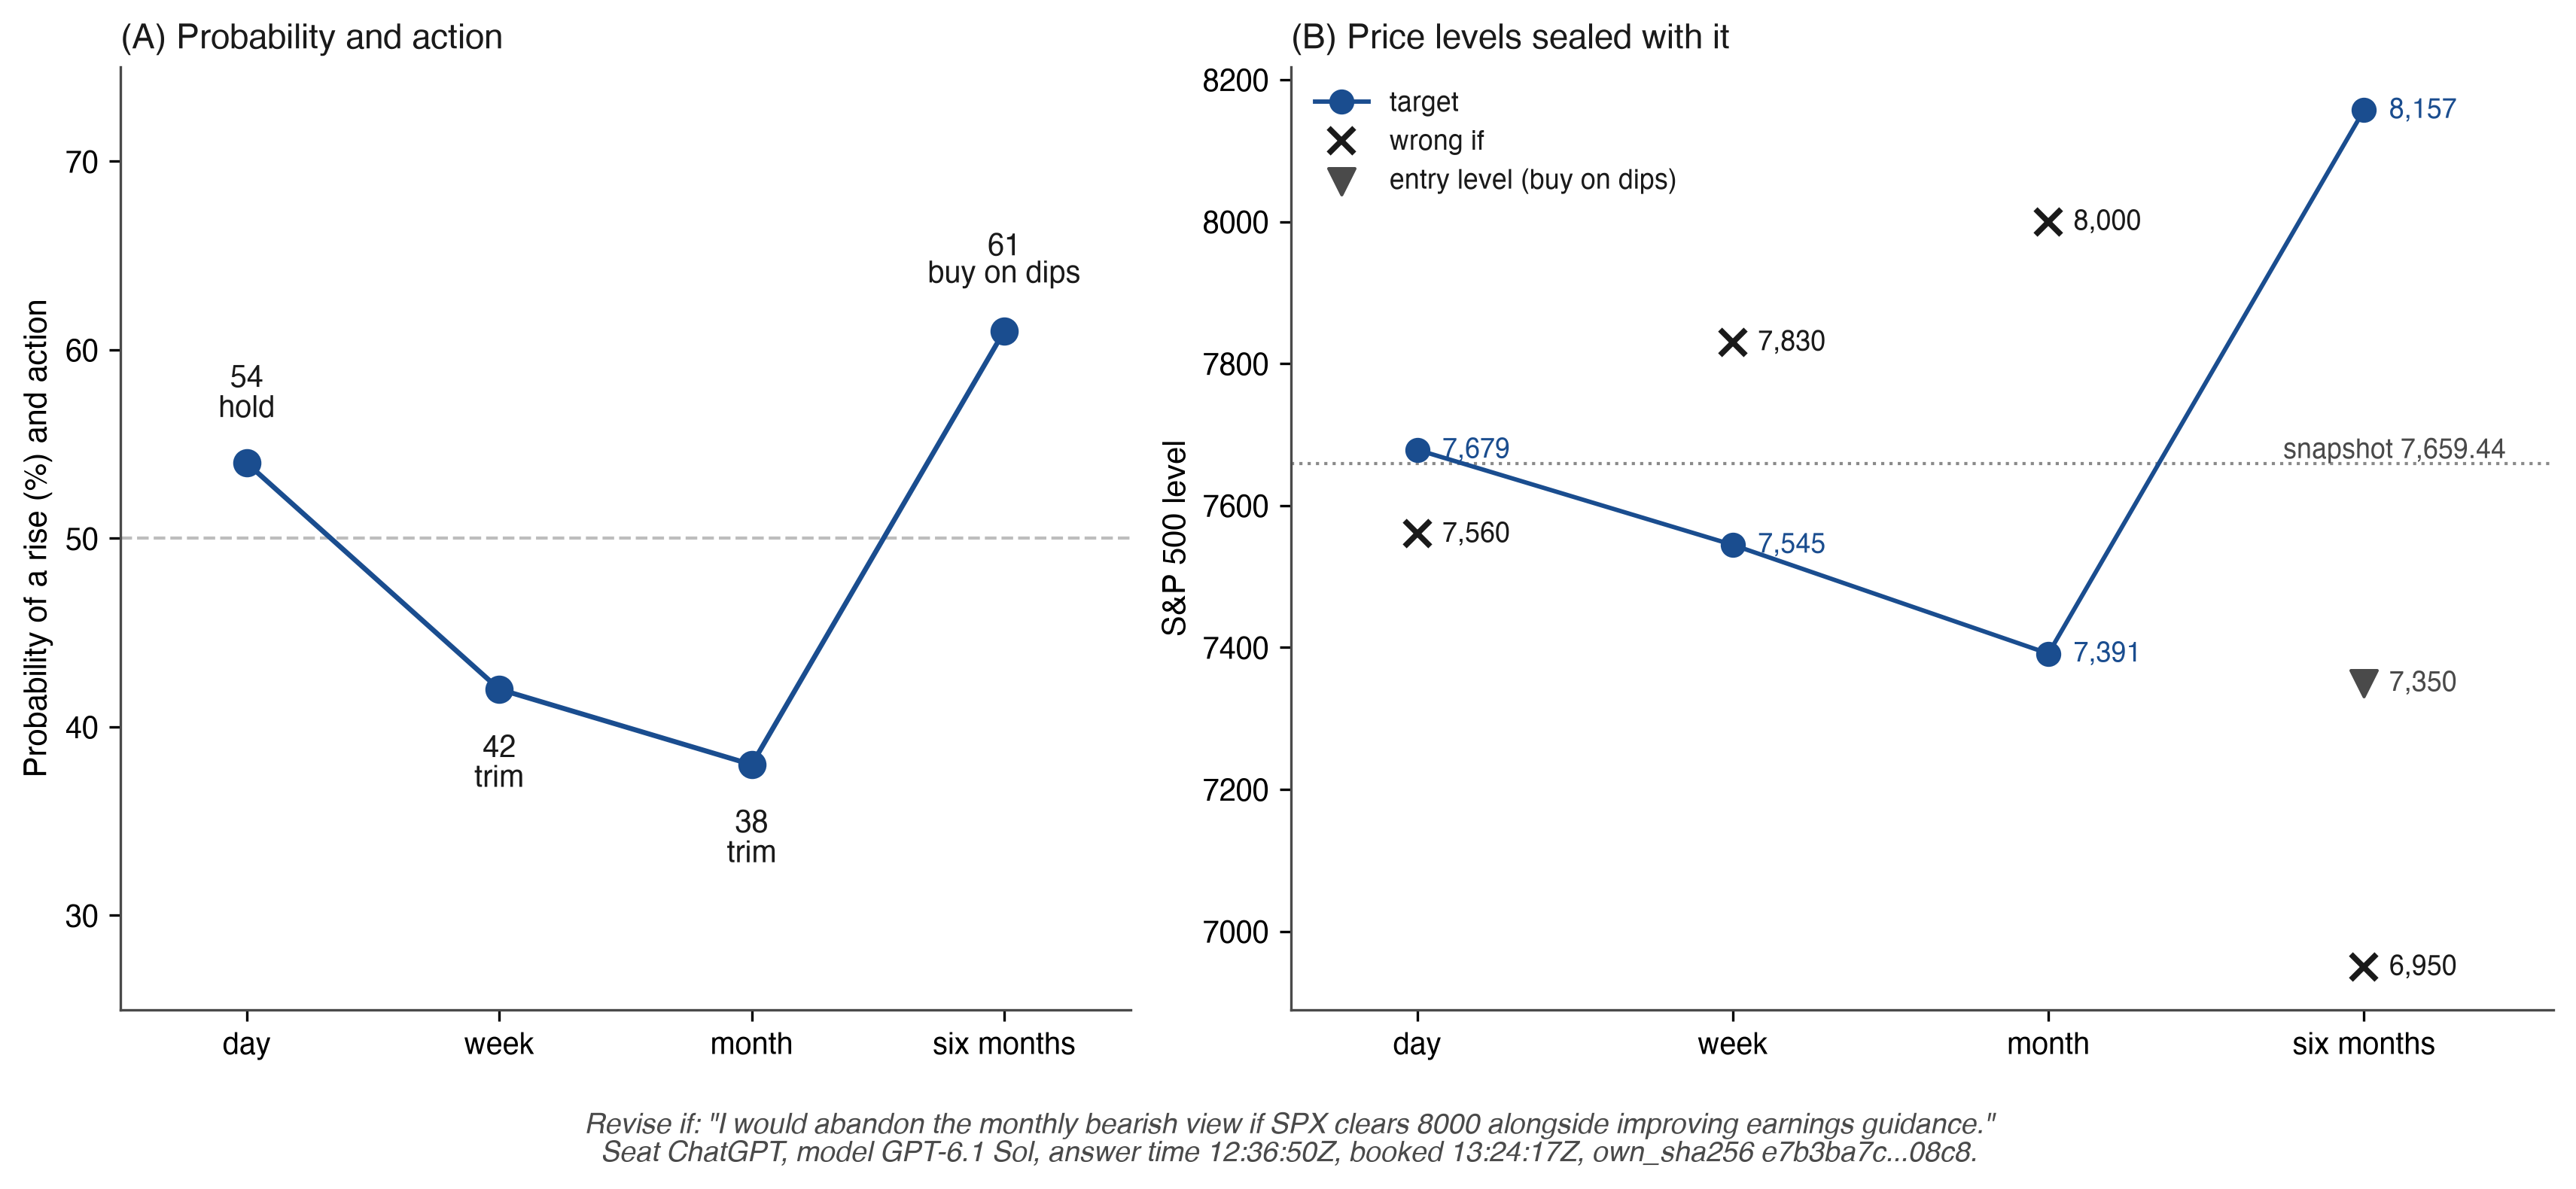
참고: 모든 값은 답변 라인에 봉인된 대로입니다(답변 시간 12:36:50Z, 예약됨 13:24:17Z, 09:30 ET 기준 이전). 점선은 질문의 스냅샷(asks/02577f9c….md)의 S&P 500 가격입니다. 대상을 통과하는 선은 읽기를 위한 수평선들을 연결하며 경로가 아닙니다. 진입 수준은 답변 라인의 items.SPX.6m.entry 필드입니다. council-forecasts.csv의 entry 열은 이 셀에 대해 비어 있습니다.
3.9 빈 셀
답변의 모든 셀은 점수 매겨집니다. 모델이 비워두는 셀은 50%로 계산되고, Brier 0.25, 방향 없음(counted_50)입니다. 동전 뒤에 이길 수 없지만 어려운 시장에서 동전보다 나쁜 성능을 숨길 수 있으므로, 각 점수 옆에 빈 셀의 개수를 보고합니다(요구 사항 8). 답변 라인을 보내지 않는 좌석은 no_answer로 기록되고 해당 실행의 점수에서 제외됩니다. 채워진 0.25는 좌석의 서비스 점수에 속합니다. 합의와 일치도 계수는 실제로 주어진 확률에서 형성되며, of 필드가 이들을 계산합니다. 따라서 각 좌석은 각 수평선에서 세 가지 결과를 가지며, 각각 자체적으로 순위가 매겨집니다: 명시된 확률에 대한 Brier 점수, 마감일까지 답변된 예상 셀의 비율, 그리고 서비스 점수입니다. 포트폴리오는 자신의 테이블에 있는 네 번째 결과입니다. 하나의 결합된 점수는 좌석이 판단, 신속성, 또는 거래에서 졌는지 여부를 숨길 것입니다.
예상되는 셀은 답변 전에 알아야 합니다. 표준은 좌석, 시장, 수평선, 마감일 및 재시도 정책을 포함한 예상 답변의 명단을 요청하며, 실행의 첫 번째 질문 전에 봉인됩니다(요구 사항 13). 따라서 모든 예상 셀은 하나의 상태(counted, counted_50, no_answer 또는 거부됨)로 해석됩니다. 실행 라인은 측면별로 명단을 전달하며, 2026년 10월 21일부터 명단은 발신 질문 체인(asks.jsonl)의 첫 번째 질문 전에 봉인됩니다. 명단은 선언된 일정에 대해 완전성을 확인합니다. 발송될 때 봉인된 각 발신 질문의 해시는 전송된 실행을 확인합니다(요구 사항 13).
3.10 모델 버전 변경, 정정, 규칙 변경
좌석은 운영 참여자이고, 모델 버전은 시간 특정 구현이며, 기록은 둘 다 유지합니다. 좌석의 버전이 변경되면 계정이 계속되고, 변경 날짜가 기록되며, 새 버전 이후의 결과는 별도로 표시됩니다(new_model_version). 각 버전은 인수한 날부터 자체 계정을 얻습니다(_ver:<model>:<n>), 버전이 변경된 실행은 플래그됩니다(seat_versions_in_run).
정정은 관련된 라인의 이름을 지정하는 새 라인입니다(of). 정정된 라인은 기록된 대로 유지됩니다. 가격도 같은 규칙을 따릅니다. 프로토콜은 2026년 10월 22일부터 정정된 참조 또는 종가가 출처와 이유를 포함한 봉인된 정정 라인으로 입력되며, 그 앞의 점수 라인은 다시 작성되지 않는다고 선언합니다(arena-protocol.json의 price_corrections). 2026년 10월 20일 책의 211개 라인 중 47개가 정정되었습니다. 일부는 실행 영수증에서 첫 번째 실행의 답변 모델과 모드를 복원하고, 다른 일부는 다시 봉인된 답변이 이전 라인과 같음을 기록합니다(same_as, council-forecasts-copies.csv의 이전 복사본). 표준은 답변 라인 자체의 모델, 버전 및 모드를 요구하거나, 맹검 시즌에서는 이들에 대한 솔티드 약속을 요구합니다(요구 사항 1).
방법론의 변경은 작업을 변경하고 새로운 측정 세그먼트를 엽니다(요구 사항 15). 확인 점수, 쌍을 이룬 이득 또는 포트폴리오 비교는 하나의 방법론 버전 내에서 계산되거나, 버전은 별도 세그먼트로 보고됩니다. 새로운 규칙에 따라 다시 점수가 매겨진 이전 예측은 대체 분석으로 표시됩니다. 레벨-2 이상 요소에 기반한 주장은 해당 요소가 공개 파일에 나타난 후에 만든 봉인을 다룹니다.
3.11 사전 증명: 세 가지 성질
제3자가 공개 파일과 비트코인 체인을 사용하여 아래의 성질을 확인할 수 있을 때, 그리고 기록이 어느 성질이 누구에게 달려 있는지 명시할 때, 예측 기록을 사전 증명이라고 부릅니다. 예측 를 책 라인 에 보유하고, 시간 의 참조 가격과 시간 의 결과를 가진다고 합시다. 우표 가 첫 번째 개 라인을 다이제스트 로 커밋하고, 증명이 우표가 있는 목록을 헤더 시간 를 가진 블록 에 배치한다고 합시다. 실제 마이닝 시간이 헤더 시간을 따를 수 있는 마진을 로 표기합니다. 실제로는 몇 시간이며, 아래에서 논의된 제한으로 제시됩니다.
P1a. 앵커 이후 재구성 없음. 계산된 모든 예측에 대해 라는 스탬프가 있으며, 입니다. 스탬프가 찍힌 접두사는 실제적 한계에 따라 최늦 까지 존재했으며, 그 이후의 어떤 라인의 추가, 제거 또는 재작성도 를 변경하므로 더 이상 블록 에 커밋된 다이제스트와 일치하지 않습니다. 보다 나중의 모든 결과에 대해 이는 결과 이후에 작성된 예측을 배제합니다.
P1b. 참조 전 약속. 예측은 이전에 봉인되었습니다. 2026년 10월 21일부터 이는 권한과 그 인증서를 수락하는 모든 사람에 대해 레벨 2+에서 성립합니다: 이전에 서명된 두 개의 RFC 3161 토큰이 를 포함하는 타임스탬프 목록에 있습니다. 10월 21일 두 권한이 1~222행, 실행 행(214)과 8개의 세어진 답변(215~222)을 포함하는 목록에 13:00:19 UTC(29분 41초, 이전)에 서명했으며, 3개가 9번째 세어진 답변(224)을 포함하는 목록에 13:23:37 UTC(6분 23초, 이전)에 서명했습니다(부록 B, 단계 9). Bitcoin의 경우 참조는 각 행의 봉인 후 첫 1분 봉의 마감이며, 배치의 경우 13:01Z, 9번째 답변의 경우 13:24Z이므로 순서는 구성상 그곳에서 성립합니다. 이 버전이 점수를 매기는 10월 19일과 20일의 개발 세션의 경우 P1b는 체이닝된 레코드(at, booked_at, prev, link)에서 레벨 1에 있습니다. 10월 20일 앵커링 블록은 이후에 떨어졌습니다(섹션 3.2).
P2. 대체 금지. 의 어떤 필드를 에 대해 변경하면 가 변경되고, 따라서 와 이후의 모든 링크가 변경되며, 따라서 가 변경됩니다. 탐지 불가능한 대체는 SHA-256의 두 번째 원상(second preimage) 또는 비트코인 체인의 재작성이 필요하며, 검증자가 타임스탐프에서 공개된 증명을 보유하는 것을 전제로 합니다(아래 위협 모델).
P3. 공개된 봉인된 실행 간의 선택 없음. 각 모델과 세션에서 계산되는 라인은 실행 전에 선언되고 봉인된 타임스탬프에만 적용되는 규칙으로 고정됩니다. 2026년 10월 21일부터 그 규칙은 실행 전에 봉인된 공개 일정입니다. 실행 내에서 각 좌석의 첫 번째 잘 형성된 답변은 세션 11부터 계산됩니다(asks.jsonl, 74행에 선언됨). 섹션 3.4는 개발 세션의 규칙을 제시합니다. 다른 모든 봉인된 실행은 책에 남아 있으며, 표시되어 있고, 독자는 어느 라인이 계산되는지 다시 계산할 수 있습니다. 전체 형식은 또한 요청되었지만 봉인되지 않은 채로 남겨진 실행을 포함합니다: 각 발신 질문의 해시는 전송될 때 봉인됩니다(수준 2+). 2026년 10월 21일부터 이러한 해시는 asks.jsonl에서 연결됩니다.
위협 모델. 타임스탬프는 다이제스트가 존재했음을 증명합니다. 그것은 옆에 타임스탬프된 다른 다이제스트에 대해 아무것도 말하지 않습니다. 책과 증명을 모두 호스팅하는 운영자는 각 실행에서 두 권의 책에 타임스탬프를 찍을 수 있으며 나중에 책과 증명을 함께 교체할 수 있습니다. 대체본은 비트코인에 대해, 그리고 시간 인증 기관에 대해서도 검증됩니다. 따라서 요구사항 3은 각 타임스탬프에서 타임스탬프된 목록의 SHA-256을 운영자가 제어하지 않는 적어도 하나의 추가 전용 채널(보관된 저장소, 공개 버전 관리 호스트 또는 웹 아카이브 캡처)에 게시하고 증명 페이지에서 채널을 명명하도록 하는 것을 반드시 요구합니다. 2026년 10월 22일부터 각 타임스탬프된 목록은 타임스탐핑 시점에 Sigstore Rekor 투명성 로그에 들어가며, 이전 날짜의 목록은 2026년 10월 21일 23:45~23:47 UTC 사이에 들어갔습니다(표 5). 로그의 목록에 대해 P1a와 P2는 로그 시간부터 모든 사람에 대해 유지되며, 그 이전 시간부터는 이전 증명을 보관했거나 독립적인 아카이브에서 검색할 수 있는 모든 당사자에 대해 유지됩니다.
표 4는 각 속성을 그것을 제공하는 프로토콜의 요소와 독자가 확인할 수 있는 수준에 대해 설정합니다.
표 4. 사전증명: 프로토콜의 각 요소가 어떤 성질을 제공하며, 어느 수준에서 제공하는가.
| 성질 | 배제하는 것 | 이를 제공하는 요소 | 독자가 확인하는 방법 |
|---|---|---|---|
| P1a 앵커 이후 재구성 없음 (수준 2, 증명의 독립적 복사본 또는 목록의 Rekor 항목 포함) | 앵커 이후 작성되거나 다시 작성된 예측 | 책당 타임스탬프된 접두사 해시; 비트코인의 OpenTimestamps 앵커; 독립적 채널의 스탬프 다이제스트 | head -n m 해시가 타임스탐프된 다이제스트와 같음; .ots 증명이 블록의 머클 루트로 연결됨; 한계가 결과보다 선행 |
| P1b 참조 전 약정 (10월 19일과 20일은 수준 1; 10월 21일부터 수준 2+) | 참조 가격 이후 봉인되었으나 그것으로부터 점수 매겨진 예측 | 체인의 봉인 분 (booked_at); 봉인 후의 참조; 도착 시 봉인 (필수); 10월 21일부터: RFC 3161 토큰 |
해당 행의 봉인 시간, max(at, booked_at)을 세션의 09:30 ET와 비교; 10월 21일부터: 부록 B, 단계 9 |
| P2 대체 없음 (수준 2, 증명의 독립적 복사본 또는 목록의 Rekor 항목 포함) | 봉인된 예측이 나중에 변경됨 | 행별 seal; prev를 가진 체인된 link; 추가 전용 책 |
seal과 link 재계산; 모든 prev가 이전 link과 같음 |
| P3 공개된 봉인된 실행 중 선택 없음 (수준 1 규칙; 완전한 형태 수준 2+) | 여러 번 요청하고 승리한 실행을 계산함 | 세션당 하나의 계산된 실행, 10월 21일부터 미리 선언; 다른 모든 실행은 not_counted로 보관; 수준 2+: 발신 질문 해시는 전송 시 봉인됨 (asks.jsonl, 10월 21일부터) |
선언된 규칙을 책의 봉인 시간에 적용; council-forecasts.csv에서 모든 실행 찾기 (run_id, run_role) |
P1a는 시간 단위의 해상도를 가지며, 그 한계는 실질적입니다. 외부 시간은 네트워크가 수락한 체인의 블록 시간이며, 해당 블록의 헤더 시간은 채굴자에 의해 설정됩니다. 합의 규칙은 이를 이전 11개 블록의 중앙값 시간 아래에서 제한하고, 네트워크 조정된 노드 클록 시간 약 2시간 이전으로 제한합니다 (비트코인 개발자 문서, n.d.). 어느 규칙도 블록이 헤더 시간 이후 실제로 채굴된 기간을 정하지 않습니다. 일반적인 작동에서 중앙값은 실시간에서 약 1시간 뒤쳐져 있으므로, 타임스탐프된 다이제스트는 이후 몇 시간 이내에 존재했습니다. 합의 규칙만으로 한계를 원하는 검증자는 여러 확인 이후의 블록 헤더 시간을 사용하며, 각 봉인의 서명된 달력 시간은 타임스탐프 기관 (수준 2+)에서만 옵니다. 블록 972,334의 경우 이전 11개 블록의 중앙값 시간은 12:45:12Z였으며, 헤더 시간 70분 전입니다. IETF 인터넷 초안은 검증자가 비트코인 기반 시간 증명을 확인하는 방법을 명시합니다 (Fassbender, 2026). 10월 17일, 19일, 20일에 앵커링 블록 (971,796, 972,153, 972,334)은 예약 시간 1시간 이내의 헤더 시간을 가졌으며, 16:00 ET에서 해상도를 갖는 일일 기간의 경우, 그 한계와 여유는 결과 전에 떨어졌습니다; 더 긴 기간의 경우 해상도는 무관합니다. 세션 내에서 봉인과 참조의 순서는 P1b입니다.
3.12 신뢰의 사다리
"검증된" AI 예측에 대한 공개 주장은 세 가지 수준과 마지막 위 네 번째 단계에 걸쳐 있습니다 (그림 4). 수준 0에서 독자는 운영자를 신뢰합니다. 수준 1에서 운영자는 지문 또는 체인된 기록을 유지하며, 이는 이후 텍스트가 이전 해시와 일치함을 증명하지만 해시가 생성된 시기는 증명하지 않습니다. 수준 2에서 지문은 운영자 외부에, 재작성되거나 백데이트될 수 없는 공개 기록에 고정되며, 운영자가 제어하지 않는 도구로 확인됩니다. 수준 2+는 수준 2에 각 봉인의 제3자 서명된 시간을 더한 것입니다 (섹션 3.2).
그림 4. 신뢰의 사다리: 운영자 신뢰, 운영자 지문, 운영자 외부의 앵커, 두 기관의 서명된 시간 (수준 2+, RFC 3161, 2026년 10월 21일부터).
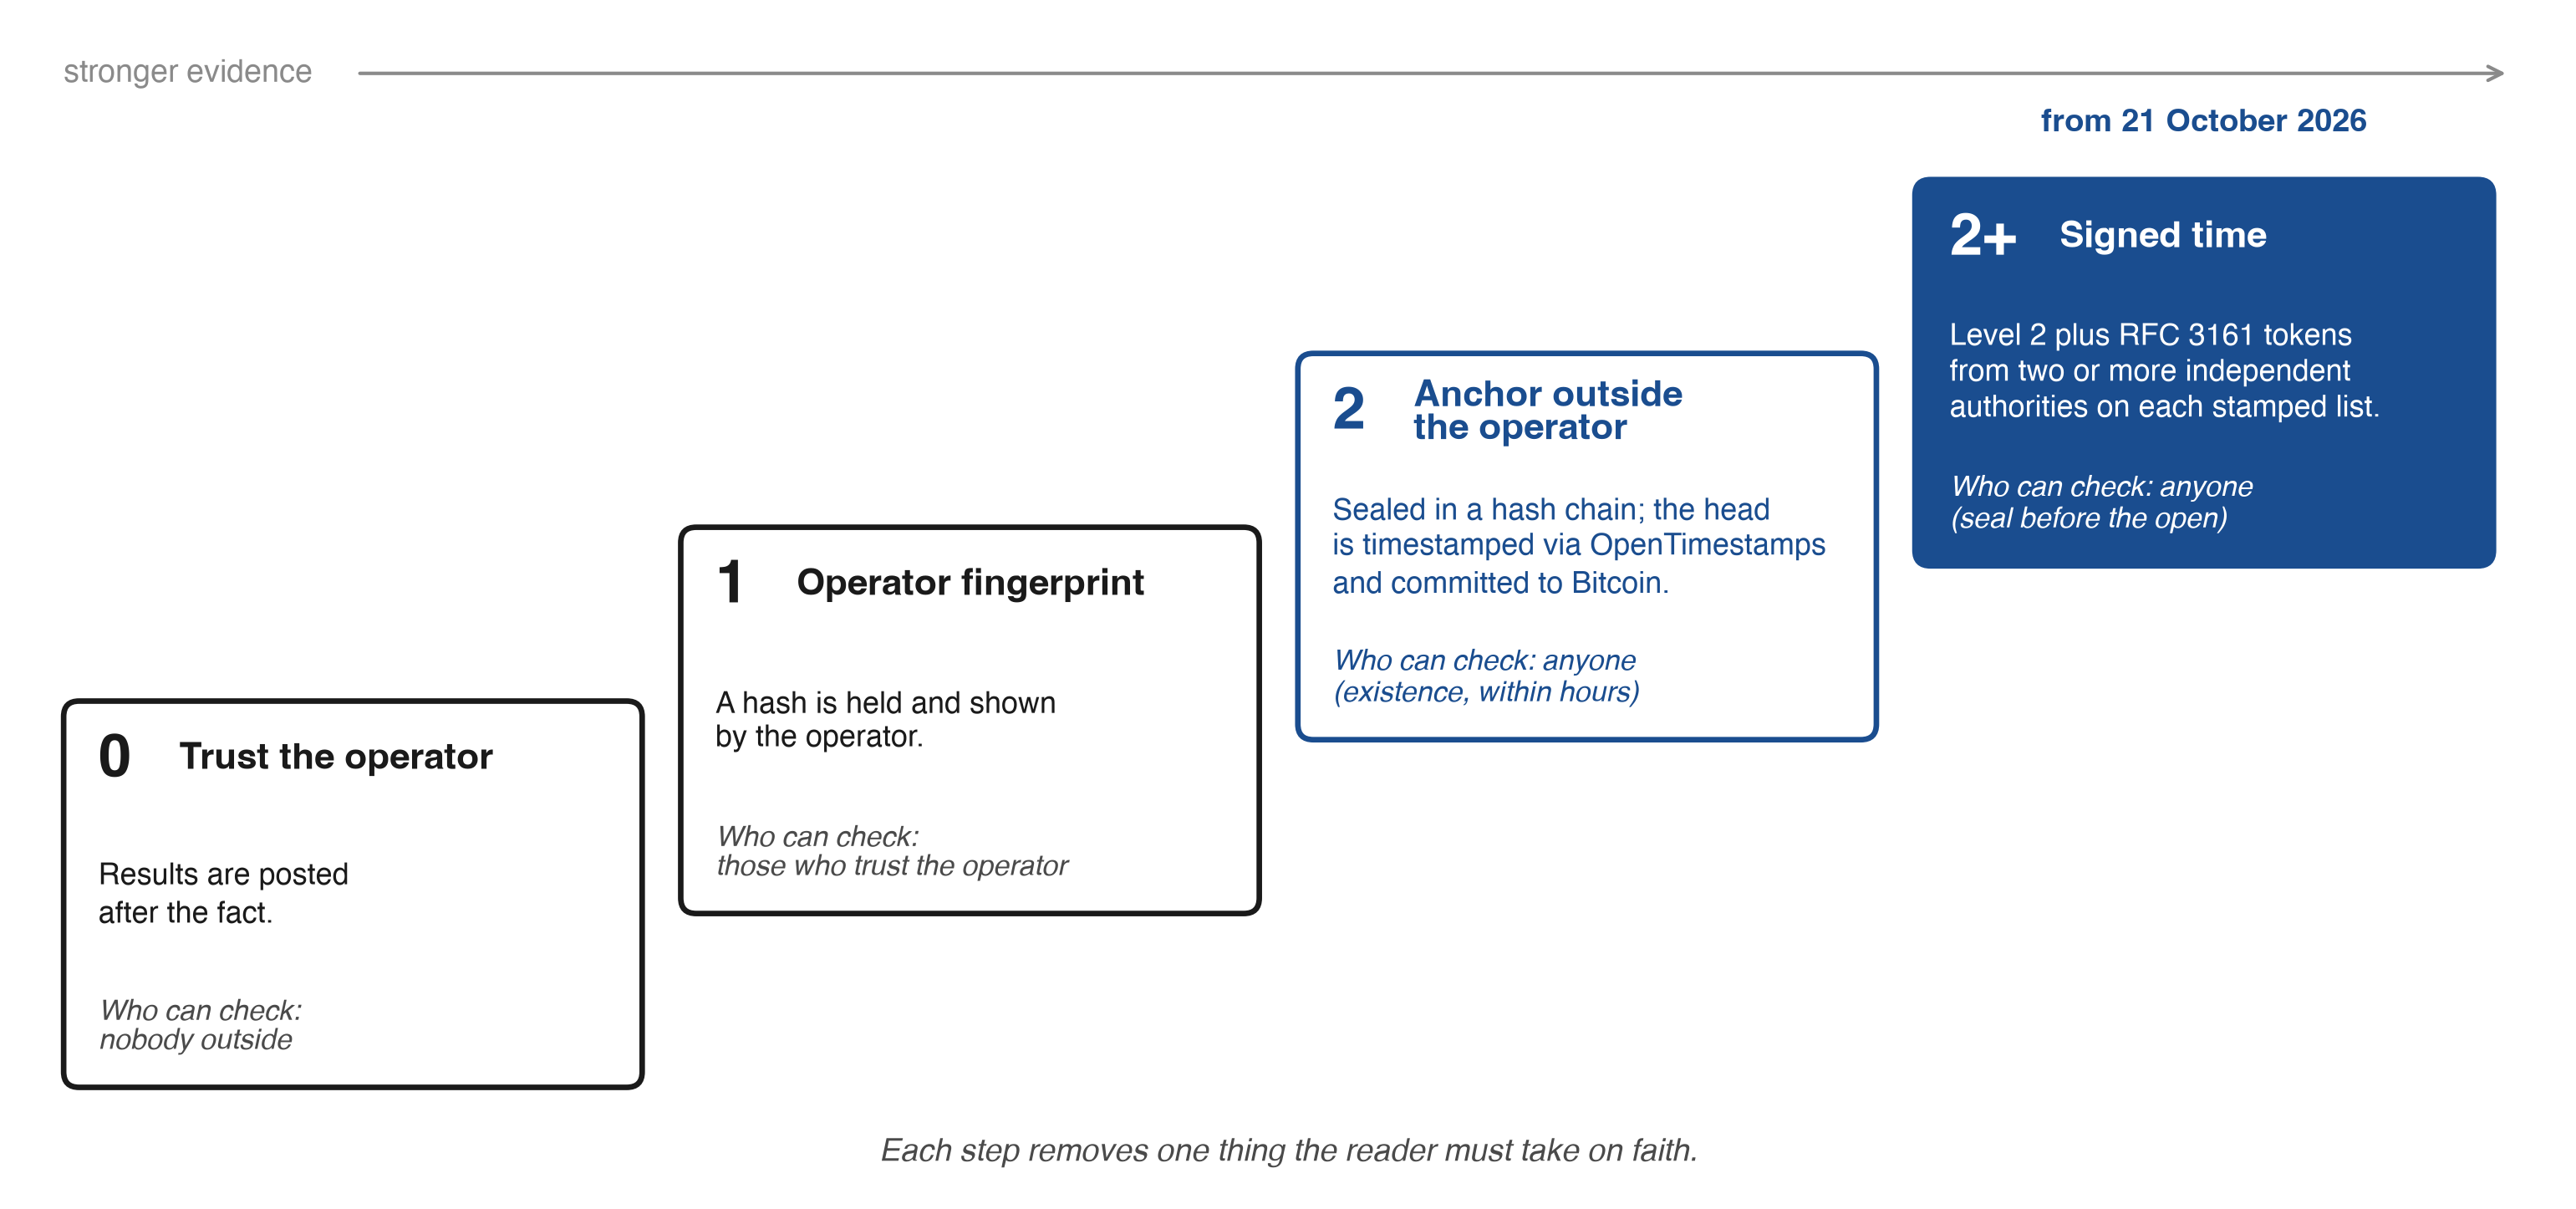
주: 수준은 기록의 시간에 대해 독자가 신뢰해야 할 사항을 설명합니다. 수준 2+는 RFC 3161 토큰을 추가하며, 기록이 09:30 ET 개시 전에 서명된 2026년 10월 21일부터의 리그에서 계산된 답변을 보유합니다. 도착 시 봉인, 봉인 후 참조 가격, 계산된 실행 규칙은 별도 요구사항입니다 (섹션 3.13).
참조 구현에서 앵커는 증명의 독립적 복사본을 보유한 모든 당사자에 대해 P1a와 P2에 대해 수준 2를 제공하며, Rekor 로그에 입력된 각 타임스탐프된 목록에 대해 모든 사람에 대해 수준 2를 제공합니다 (섹션 3.11). P1b는 계산된 기록에서 수준 2+에 서 있습니다 (섹션 3.11). P3는 운영자의 체인된 기록에서 수준 1에 있으며, 2026년 10월 21일부터 미리 선언된 계산된 실행 규칙에 있습니다. 사다리는 시계에 대한 신뢰를 측정합니다. 독자가 가격 또는 기술에 대해 주장할 수 있는 것은 두 번째 사다리인 주장의 사다리 (표 B1, 부록 B)를 타릅니다: 공개된 규칙, 재계산된 파일, 검증된 외부 약정, 독립적 가격 원본과 조정된 결과, 창 전에 고정된 미래 쌍 평가, 두 번째 파이프라인에 의한 복제. 그 두 번째 사다리는 섹션 8의 등록된 비교로 끝납니다.
3.13 제안된 표준 체크리스트
아래의 요구사항은 경기장, 벤치마크 또는 펀드가 표준을 따른다고 주장할 때 채택하는 것입니다. MUST는 이 주장이 성립하지 않는 요구사항을 표시합니다; SHOULD는 수준 2+ 사양을 표시합니다.
- MUST 각 작업을 질문이 나가기 전에 고정된 이벤트 계약으로 정의해야 하며, 표 1의 필드를 최소한 포함해야 합니다. 여기에는 각 지표의 가격 출처(공급업체, 심볼, 바 크기 및 참조 가격과 종료 가격에 대한 타임스탬프 규칙), 미래에 있을 예측 결과, 그리고 답변 라인에 모델, 그 버전 및 모드를 봉인해야 합니다. 맹검 시즌에서 라인은 이를 솔티드 SHA-256 커밋먼트로 전달합니다. , 그리고 솔트는 시즌 후에 발행되므로 정체성은 봉인 시점에 고정되고 시즌이 끝날 때까지 숨겨집니다.
- MUST 추가 전용 해시 체인 기록을 유지해야 하며, 각 라인은 들어올 때 봉인되고, 질문 텍스트와 가격 스냅샷이 실행에 해시되고, 질문이 발행되며, 정정은 그것이 관련된 라인을 지명하는 새로운 라인입니다.
- MUST 모든 실행(레벨 2)에서 기록의 헤드를 운영자 외부에 고정하고, 증명을 발행하고, 그 경계를 상한으로 함께 명시하고, 각 타임스탬프가 찍힌 다이제스트를 타임스탬프가 찍힌 순간에 운영자가 통제하지 않는 최소한 하나의 추가 전용 채널에 발행해야 합니다.
- MUST 봉인 후 공통 이벤트당 하나의 참조 가격을 각 상품에 대해 발행된 규칙으로 가져가야 합니다; 나중에 봉인된 라인은 자신의 참조를 받으며 별도의 이벤트입니다. 예측은 그들의 이벤트 계약의 모든 필드가 일치할 때만 풀링(합의, 동의, 공유 오류의 개수, 모델 간 비교)됩니다.
- MUST 계산되었는지 여부와 관계없이 모든 실행을 그 라벨과 함께 발행해야 합니다.
- MUST 실행이 이루어지기 전에 선언된 규칙으로 각 세션의 계산된 실행을 고정해야 하며(예를 들어, 발행된 일정), 그리고 운영자가 통제하지 않는 채널에서 그 해시와 함께 선언을 발행해야 합니다. 이루어진 실행에 나중에 적용된 규칙은 이를 충족하지 않습니다.
- MUST 엄격하게 적절한 규칙으로 요청된 이벤트를 점수 매겨야 합니다: 모든 행에 대한 엄격한 상승의 주요 브라이어 점수, 필터링된 점수는 두 번째이고 그것이 낙하시킨 행의 개수; 또는 드로우 밴드를 사용하여 밴드 외 이동이 주어진 상승의 확률을 묻거나, 세 가지 확률을 묻고 3-결과 브라이어 점수로 점수를 매깁니다(섹션 3.5).
- MUST 빈 셀과 누락된 답변을 각 점수 옆에 보고해야 하고, 합의와 동의 개수에서 채워진 값을 유지하고, 명시된 확률, 적용 범위 및 모든 서비스 점수에 대한 품질을 별도의 결과로 보고해야 합니다.
- MUST 비정보적 50% 벤치마크와 각 자산 및 시간 범위에 대해 같은 이벤트의 기후학적 기저율을 보고해야 하며, 시즌이 시작되기 전에 끝나는 고정된 윈도우에서 추정되고 발행된 해시로 봉인되며, 브라이어 스킬 점수와 함께; 벤치마크로 사용된 예측 시장 가격은 거래된 거래량과 함께 봉인되고, 선언된 거래량 하한이 주요 비교를 정의합니다.
- MUST 최소 세션 수 이후에만 순위를 매기며, 구간은 세션별로 클러스터되고, 하루보다 긴 기간에는 겹치는 윈도우를 존중하는 구간이어야 합니다. 쌍을 이룬 세션 수준 Brier 차이의 정밀도에 대한 비교가 계획되어 있으며, 차이가 없다는 주장은 선언된 동등성 마진 내의 구간을 필요로 합니다(Section 4.6).
- MUST 데이터와 채점 코드를 공개하여 모든 점수가 제3자에 의해 재계산될 수 있도록 하고, 각 논문 개정에서 모든 파일에 대한 체크섬이 있는 불변 분석 릴리스를 인용합니다(Appendix C).
- MUST 배치를 기다리지 않고 도착 시 각 답변을 봉인하고, SHOULD (level 2+) 각 봉인에서 공개 타임스탬프 기관으로부터 RFC 3161 토큰을 얻습니다.
- SHOULD (level 2+) 각 나가는 질문이 전송될 때 해시를 봉인하고, 실행의 첫 번째 질문 전에 예상되는 답변의 명단을 마감일과 재시도 정책과 함께 봉인합니다.
- MUST 같은 표면에서 모델의 게시된 합의와 함께 이를 입력한 명시된 확률의 개수, 이들의 평균 쌍별 상관계수 및 Section 5.1의 를 포함하여, 독자가 합의 뒤에 서 있는 독립적인 목소리가 몇 개인지 알 수 있도록 합니다.
- MUST 방법론의 변화를 새로운 측정 세그먼트의 시작으로 취급하고 수정을 원본을 제자리에 두는 추가된 라인으로 처리합니다. 확인 점수는 하나의 세그먼트 내에서 계산됩니다(Section 3.10).
- MUST 독자가 모델 옆에서 예측할 때: 각 독자를 한 번 무작위로 할당하고, 재할당하지 않습니다. 시장, 식별자 및 세션당 첫 번째 예측을 하나 계산합니다. 참조 시간에 독자 예측을 종료합니다. 리셋 식별자를 새 독자로 취급하고 리셋 점유율을 보고합니다. 첫 번째 채점된 예측 전에 데이터 사전에서 블라인드 그룹을 레이블하고, 독자의 주소는 저장하지 않으며, 최대 일자가만 반복 투표를 제한하는 데 사용되는 이것의 솔트 해시를 저장하고, 둘 다 게시하지 않습니다(Section 6).
- SHOULD Section 4~6의 진단 정보를 점수 옆에 보고합니다: 가장 큰 고유값의 점유율 및 유사성 행렬의 참여 비율, 각 자리의 두 개의 특이성 계산, 블록으로서의 측면 테스트, 겹침 계산을 입력하는 인용된 모든 링크에 대한 페치 기록, 가격 전용 팔, 동결된 패킷 아래의 확률 반복, 각 군중 행의 입찰, 매도 호가 및 마지막 거래 시간, 그리고 각 계정의 회전율과 비용을 무거래 섀도우 옆에 표시합니다.
체크리스트의 일부는 코드로 실행됩니다. 리그는 이벤트 계약을 JSON 스키마(event-contract.schema.json)와 Python 표준 라이브러리만으로 작성된 독립형 검사기(tools/conformance.py, 데이터와 같은 주소에 위치, SHA-256 e1f929a9…63db2e, 2026년 10월 21일 22:33 UTC에 검색됨, tools/archive/conformance-e1f929a9.py에 변경되지 않은 상태로 보관됨; environment.json은 검사기의 모든 버전과 날짜 및 해시를 나열함)으로 발행합니다. 전체 계약은 9개 키, asset, horizon, reference time, end time, rule, resolver version, reference rule, price provider 및 price symbol로 구성되며, 그 event_id_v2는 ev2- 다음에 이들의 canonical JSON(정렬된 키, 공백 없음, UTF-8)의 SHA-256 첫 16개 16진수 숫자가 옵니다. 첫 번째 식별자인 event_id(ev1-, 첫 5개 키)는 그 옆에 유지되므로 발행된 식별자는 절대 변경되지 않습니다. 동일한 계약을 작성하는 두 리그는 동일한 식별자를 얻으므로, 요구사항 4의 테스트는 결과를 고정하는 모든 필드에 대한 식별자 비교가 되며, 채점 규칙은 같은 행에 봉인된 방법론 버전으로 고정됩니다. 검사기는 각 행을 스키마에 대해 검증하고, 그 식별자를 재구성하며, 시간, 확률 범위 및 결과 필드를 확인하고, 두 이벤트에 사용된 식별자를 거부하며, 각 행의 방법론 버전(요구사항 15)을 요구합니다. 모든 리그는 자신의 내보내기에 대해 python3 conformance.py its.csv를 실행할 수 있습니다. 2026년 10월 21일 22:33 UTC의 리그 예측 파일에서 "3792 rows, OK"를 보고했으며, 두 식별자는 모든 행에서 재구성되었습니다. 통과는 잘 형성된 레코드를 보여주며, 표 5는 요구사항별 적합성을 읽습니다.
표 5는 각 요구사항에 대한 참조 구현의 상태를 제공합니다. 요구사항에 기반한 주장은 요구사항이 충족된 날짜부터 유지됩니다. "충족됨"은 2026년 10월 21일 15:05 UTC에 공개 파일에서 읽을 수 있을 때를 의미하며(참고 참조), "부분 충족"은 요구사항의 일부가 그곳에서 볼 수 있을 때를, "진행 중"은 구현이 진행 중이며 이미 시행된 부분이 그 옆에 나열될 때를 의미합니다.
표 5. 2026년 10월 21일에 읽은 참조 구현의 적합성(요구사항 3은 2026년 10월 22일).
| 요구사항 | 수준 | 상태 | 시행 중인 사항 |
|---|---|---|---|
| 1 이벤트 계약 | 반드시 | 2026년 10월 21일부터 충족됨 | 방법론에 봉인된 계약 필드; 계약 스키마, 검사기 및 모든 예측 행의 두 식별자, provider, symbol 및 reference rule을 포함한 9개 키 event_id_v2; 각 답변 라인에 봉인된 버전 문자열 및 모드를 포함한 모델(첫 실행의 경우 수정 라인으로 복원됨) |
| 2 해시 체인 레코드 | 반드시 | 충족됨 | 체인, 질문 및 스냅샷 해시, 발행된 질문, 라인으로 수정 |
| 3 외부 앵커 | 반드시 | 2026년 10월 22일부터 충족됨 | 모든 실행의 OpenTimestamps 앵커, 발행된 증명; 2026년 10월 21일부터 모든 스탬프된 목록의 두 독립 기관의 RFC 3161 토큰(13:23 UTC부터 3개), 각 목록은 이전 목록을 SHA-256으로 명명함; 모든 스탬프된 목록은 2026년 10월 22일 스탐핑 시 Sigstore Rekor 투명성 로그에 진입(첫 번째는 로그 인덱스 3,368,763,032, 00:00:11 UTC의 스탐프 후 5초), 그리고 2026년 10월 21일의 더 이전 목록은 23:45~23:47 UTC(2026년 10월 20일의 목록은 로그 인덱스 3,368,351,276)에 진입 |
| 4 일반 이벤트당 하나의 참조 | 반드시 | 진행 중 | 참조 후에 봉인된 라인은 자신의 참조(late_ref)를 보유함; 행은 reference_at, same_event 및 event_id를 보유함; n_eff의 계산된 계열, 메인 계열로 레이블됨, 그러한 라인을 제외함; 모든 자리 n_eff, "봉인 시간으로 자르지 않음"으로 레이블됨, 및 together는 자르지 않고 옆에 발행됨 |
| 5 모든 실행 발행됨 | 반드시 | 충족됨 | not_counted로 레이블된 계산되지 않은 실행 |
| 6 계산된 실행 | 반드시; 권장 | 반드시 2026년 10월 21일부터 충족됨; 권장 충족됨 | 예정된 아침 실행을 미리 선언하고, asks.jsonl의 첫 라인으로 봉인(04:16 UTC)하고, SHA-256 및 Internet Archive 캡처(05:35 UTC)와 함께 증명 페이지에 발행함; 10월 19일과 20일은 섹션 3.4의 개발 규칙을 따름 |
| 7 이벤트 요청됨 | 반드시 | 진행 중 | 2026년 10월 21일 세션의 모든 행 Brier를 메인 점수로 선언(main_metric, 그 이후의 첫 번째 점수); 10월 19일과 20일은 발행된 대로 유지됨, 별도 세그먼트(method_segments) |
| 8 빈 셀 | 반드시 | 충족됨 | counted_50, no_answer, of; 3개 결과 별도로 보고됨 |
| 9 벤치마크 | 반드시 | 진행 중 | 50% 벤치마크 발행됨; 2026년 10월 21일 08:54 UTC부터 라이브 council-calibration.json에 고정된 기후학 발행(climatology_fixed, 48개 시장-수평선 셀, 콘텐츠 SHA-256 2810d11e…3cabb7, sha256_ok 참); F12 및 F13은 이미 자신의 정의에서 $1,000 최소값을 적용하고 있으며, 발행된 방법론의 군중 볼륨 최소값이 이를 완성함 |
| 10 순위 지정 및 간격 | 반드시 | 진행 중 | 30/10 규칙, 세션 클러스터된 간격 및 페어링된 세션 수준 간격(pairs, council-pairs.csv) 발행됨; 겹치는 창 간격 및 등록에 선언된 한계 |
| 11 데이터, 코드, 릴리스 | 반드시 | 진행 중 | 해시와 함께 발행된 데이터 및 코드; 각 개정과 함께 예탁된 분석 릴리스 |
| 12 도착 시 봉인; RFC 3161 | 반드시; 권장 | 부분 충족됨 | 2026년 10월 21일부터 모든 스탐프된 목록의 RFC 3161 토큰; 그 아침 8개의 답변은 한 배치로 봉인되었고 9번째는 도착 후 14초 후에 봉인됨; 도착 시 각 답변을 봉인하면 완성됨 |
| 13 질문 해시, 질문 전 명단 | 권장 | 2026년 10월 21일부터 부분 충족됨 | 실행의 각 단계는 그 첫 질문 전에 그 명단(요청된 자리, 이미 답변한 자리, 예비)을 봉인하므로 두 번째 요청이 표시됨; asks.jsonl에서 체인된 발신 질문 해시 및 스탐프된 목록으로 처리됨; 증명 페이지의 둘 다; 기한 및 재시도 정책은 명단 필드에 추가됨 |
| 14 합의 옆의 유효한 음성 | 반드시 | 진행 중 | n_eff가 council-stats.json에 게시되었습니다; 계산된 시리즈(계산된 실행, 09:30 ET 이전에 봉인된 답변)가 주요 시리즈로 표시되고, 모든 석의 시리즈는 그 옆에 유지됩니다; 각 표시된 합의 옆에 인쇄하면 완성됩니다 |
| 15 Segments | MUST | 충족됨 | 각 실행 라인 및 각 예측 행에 봉인된 방법론 버전(methodology_version); 세그먼트별 점수(method_segments); 변경 사항 날짜 지정; 재계산 없음 |
| 16 Readers | MUST | 진행 중 | 두 개의 영구 무작위 그룹이 실행 중(experiment.g0, g1), 첫 예측만, 읽는 사람의 예측은 09:30 ET에 종료, 주소는 저장되지 않음(소금 처리된 일일 해시로 투표 제한); 데이터 사전의 블라인드 그룹 레이블과 재설정 공유로 완성됩니다 |
| 17 Diagnostics | SHOULD | 부분적으로 충족됨 | 참여 비율(n_eff_participation), 부호 없음 및 기후학 중심 계산, 공유 소스 겹침 및 폐쇄형 도서 분기가 게시됨; 다른 진단은 지정되어 있습니다 |
참고: 2026년 10월 21일 UTC 15:05의 공개 파일 및 증명 페이지에서 읽은 상태(council-stats.json 생성 14:51:50 UTC, council-book.jsonl 230줄); 요구사항 1은 같은 날 UTC 22:33에 확인한 대로입니다(섹션 3.13), 요구사항 3은 2026년 10월 22일 UTC 00:00:16에 Rekor 로그에 입력되었습니다(부록 B, 단계 10).
4. 측정
프로토콜은 무엇이 말해졌는지, 언제 말해졌는지를 기록합니다. 측정은 그 기록을 점수로 변환하며, 함께 이들은 표준에서 요구하는 예측 평가입니다. 방법론(버전 2)과 리그 프로토콜(arena-3, Pro 리그 pro-1)에 발표된 대로 각 측정을 설명하고, 표준에서 더 많은 것을 요구하는 경우 그 요구사항을 제시합니다. 섹션 5에서는 실시간 데이터에 대한 의존성 값을 보고하며, 정확도 결과는 이 논문의 날짜가 표시된 수정본으로 제공됩니다.
4.1 방향
지표가 참조점에서 만기 말까지 높았는지 낮았는지, 그리고 모델의 확률이 그 방향을 뒷받침했는지 여부입니다. 50 이상은 상승을, 50 미만은 하락을, 정확히 50은 둘 다 아닙니다. 51% 콜과 95% 콜은 동일한 적중을 얻으므로 방향은 확신 있는 모델과 망설이는 모델을 구분할 수 없으며, 주요 측정은 Brier 점수입니다.
4.2 Brier 점수
상승 확률이 (백분율)이고 결과가 인 예측의 경우,
그리고 개의 해결된 예측에 대한 모델의 점수는 평균 입니다(Brier, 1950). 완벽한 예측의 경우 0에서 최악의 예측의 경우 1입니다. Brier 점수는 계산되는 이벤트에 대해 엄격히 적절합니다(Gneiting & Raftery, 2007). 리그 질문의 경우 그 이벤트는 모든 행에서 엄격한 상승입니다(섹션 3.5, 요구사항 7).
4.3 정보 없는 50% 벤치마크와 기후학
항상 50%를 말하는 예측자는 모든 예측에서 0.25의 점수를 얻습니다. 이것이 정보 없는 50% 벤치마크(리그 파일의 "동전")이며, 중립 참조점입니다. 상승의 기초율을 아는 예측자는 날씨에 대한 기술 없이도 0.25 이하의 점수를 얻을 수 있으며, 장기 만기의 경우 기초율은 0.5와 멀 수 있습니다. 따라서 저는 기후학적 벤치마크(요구사항 9)를 추가합니다. 각 자산과 만기에 대해 동일한 이벤트의 엄격한 상승 빈도를 Brier 기술 점수와 함께 시즌 전에 끝나고 방법론에 봉인된 고정 윈도에서 추정합니다.
동일한 행에서. 동일한 이벤트는 계약이 점수를 매기는 이벤트를 의미합니다. 일일의 경우 표 1의 가격 출처 규칙에 따라 참조에서 종가까지입니다(09:30~16:00 ET, 수익률 15:00 ET, Bitcoin은 봉인 분에서 16:00 ET). 더 긴 만기의 경우 동일한 세션 또는 달력 일 수로 실행됩니다(섹션 3.7). 다른 이벤트의 기초율은 벤치마크에 편향을 줍니다.
참조 구현에서 고정 기후학은 council-calibration.json의 필드 climatology_fixed입니다. 자산 및 만기당, p_up, 모든 행이 계산된 2016~2025 엄격한 상승 빈도, p_up_ex_draw, 동일하지만 동점 제외, 카운트 n 및 n_independent, 윈도 및 규칙입니다. 주요 벤치마크는 = p_up입니다. 주요 Brier 점수가 모든 행을 계산하기 때문입니다. p_up_ex_draw는 리그의 자체 기술 점수 동점 제외(bss_reference)를 제공합니다. 필드는 council-clim-window.json에 의해 봉인되며, 데이터 주소 아래에 발표되고, 2810d11e…3cabb7, 해당 내용의 SHA-256입니다. Python의 json.dumps는 sha256 키 없이 정렬된 키 및 기본 설정이 있는 객체입니다. 제출 스크립트는 를 읽기 전에 이 내용 해시를 재계산합니다. 필드는 2026년 10월 21일 08:54 UTC에 라이브 파일에 들어갔으며, 해당 내용 해시는 확인됩니다(sha256_ok), 그리고 그것이 주요 비교의 벤치마크입니다. 라이브 윈도에 일일 기록이 없는 경우 가장 가까운 일일 이벤트가 대신합니다. 금, WTI, Brent, 구리, 달러 지수의 일일 바, 10년물 수익률의 일일 종가, Bitcoin의 UTC 일, 1주일부터 개장 이후입니다. 4개의 미국 주식 지수는 09:30~16:00 ET 세션 자체의 일일 바(모델이 응답하는 이벤트)에서 가져오며, 주요 테스트는 이 4개에서만 보고됩니다(섹션 8). 근사는 에 편향을 주고 예측에 영향을 주지 않습니다(섹션 10).
4.4 보정과 예리함
보정(calibration)은 명시된 확률이 명시된 비율로 실현되는지를 묻습니다. 리그는 방향성 신뢰도 보정을 보고합니다: 각 해결된 확률은 그것이 뒷받침하는 쪽으로 접혀집니다(는 결과가 뒤집혀서 가 되고, 정확히 50은 제외됨), 접혀진 예측은 네 개의 구간 [50, 60), [60, 70), [70, 80), [80, 100]에 떨어지며, 각 구간은 명시된 평균 확률과 실현된 비율을 보여주며, 20개의 예측에서 도출됩니다(calib_min). 접기는 뒷받침된 쪽에 대한 신뢰도가 그 쪽의 적중률과 일치하는지를 측정합니다. 상승의 원래 확률의 보정은 열린 행에서도 계산할 수 있습니다. Brier 점수는 보정 항과 해상도 항으로 나뉩니다(Murphy, 1973), 그리고 구간은 그 분할의 읽기 쉬운 동반입니다.
구간은 많은 예측이 필요하므로, 각 좌석에 대해 합의와 각 지평선에 대해 로지스틱 보정 적합 를 추가합니다(Cox, 1958). 기울기 가 1 미만이면 명시된 확률이 0.5에서 너무 멀고, 1을 초과하면 너무 가깝다는 뜻입니다; 는 상승 또는 하락에 대한 경향을 측정합니다. 기울기는 모든 예측을 사용하며 표준 오차를 수행하며, 이는 세션이 함께 유지되어 계산됩니다(섹션 4.6). 사건별로 군집화된 구간을 가진 동일한 적합은 Polymarket 가격에 적용되었습니다(Walker, 2026).
보정은 예각성과 함께 판단됩니다, 항상 50%를 말하는 예측자가 보정되고 비정보적이기 때문입니다(Gneiting et al., 2007). 또한 각 좌석, 합의 및 지평선에 대해
를 묻습니다(항상 50%에서 0부터 항상 확실함에서 100까지, 명시된 확률에만 해당), 그리고 는 섹션 4.3의 기후학적 확률을 50 대신 사용합니다. 반에 대한 예각성은 장기 기준율이 반에서 멀리 떨어져 있는 지평선에서 증가할 것으로 예상됩니다; 기후학에 대한 예각성은 예측자 자신의 것입니다. 둘 다 결과가 필요하지 않습니다. 2026년 10월 20일의 계산된 실행에서 참조 전에 봉인된 8개 좌석은 1일에 9.2, 1주일에 14.1, 1개월에 13.9, 6개월에 20.3의 K를 가졌습니다(그림 5; 세포 자체는 그림 6B에 있습니다). 그들은 하루에 균등할 가능성으로부터 약 5포인트 떨어져 있었고 마지막에 해결되는 지평선에서 가장 결정되었으며, 그 일부는 가 제거하는 기준율입니다. 2026년 10월 21일 9개 좌석은 10.1, 12.5, 14.6, 19.9를 제시했습니다. 명시된 확률 대부분은 40에서 60 사이에 있었습니다. 1일에 10월 20일에 93%, 10월 21일에 95%가 이를 유지했으며, 6개월에도 절반 이상(58%, 61%)이 유지했습니다.
그림 5. 지평선별 상승의 명시된 확률: 실행 2026-10-20-am(참조 전에 봉인된 8개 좌석)과 2026-10-21-am(9개 좌석).
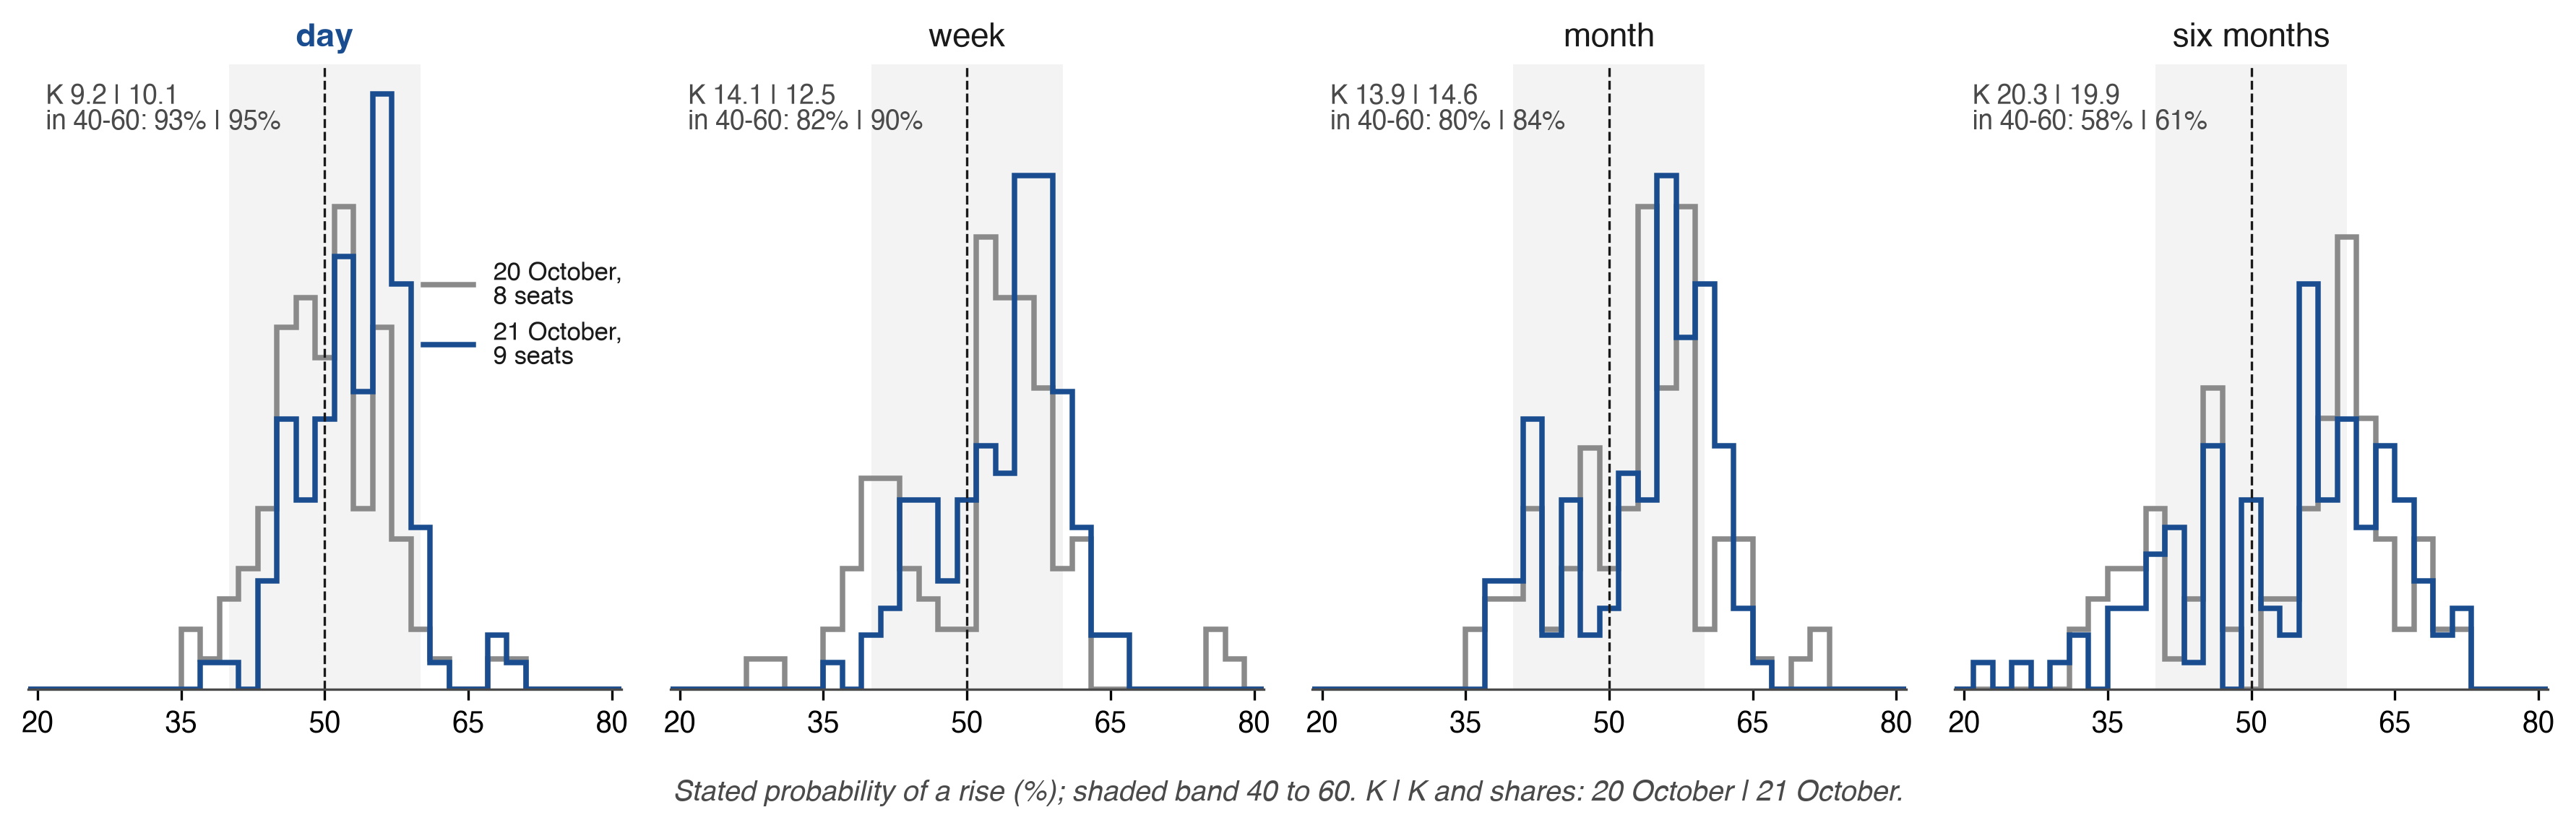
주: 2포인트 단위의 히스토그램, 동일 면적으로 확대; 음영 띠는 40에서 60까지 실행됩니다. K = (2/n)Σ|p − 50| (섹션 4.4). 10월 21일 9번째 답변의 4개 Bitcoin 세포는 자체 참조(섹션 3.3)를 수행하며 이 실행의 모든 다른 풀링 판독에서 제외됩니다(432개 중 428개 세포). 출처: council-forecasts.csv 2026년 10월 22일 01:32 UTC에 저장됨.
4.5 기준
리그는 동일한 행을 고정 기준에 대해 점수화합니다:
- 동전(모든 예측에서 0.25).
- 모멘텀: 어제의 동일 지표의 방향을 고정된 55%로, 합의와 동일한 행에서 점수화함; 리그의 공개 필드는 비김을 제외하고, 등록된 F15는 모든 행에서 점수화합니다(섹션 8.1).
- 매수 및 보유(
_hold_all), S&P 500(_spy), 60/40(_passive), 현금(13주 재무부 어음_cash) 그리고 무작위(리그의 규칙 내_random).
처음 두 개는 확률 점수의 기준이며, 나머지 다섯 개는 모델과 동일한 비용과 실행으로 운영되는 포트폴리오입니다. Momentum은 사소한 규칙을 확인합니다. 결과가 어제와 무관하게 동등한 확률일 때, 고정 55%는 기댓값에서 를 얻습니다. 기후학적 기준은 표준이 요구하는 바입니다. 방법론은 또한 변화 없음 기준을 제시하는데, 이는 확률이 없는 점 예측이며 Brier 비교 외부에 남아 있습니다. Council의 합의는 또한 기준입니다: 모델의 확률의 평균으로, 5개 이상의 답변이 있을 때 최고값과 최저값을 제외하고, 동일 계열의 두 번째 의석을 3분의 1 가중치로 두고, 결과를 2%에서 98% 사이로 유지합니다.
평균화는 기술력이 아닌 이득을 제공합니다. 결과 와 1로 합하는 가중치 를 가진 하나의 사건에 대해, 가중 평균 의 Brier 점수는 구성원 점수의 가중 평균에서 그들의 가중 분산을 뺀 값과 같습니다 (Krogh & Vedelsby, 1995):
따라서 합의는 공통 사건에 대해 유지하는 구성원의 평균에 졌을 수 없으며, 그들의 기술력이 무엇이든 상관없습니다. 결과를 2%에서 98% 사이로 유지하는 것은 한 행에서 최대 0.0004의 비용이 들 수 있습니다. 합의가 평균 구성원을 이기는 것이라는 발견은 기계적으로 예상됩니다. 그 기술력은 동전, 기후학적 기본 비율, 군중 및 이전 기간의 최고 단일 모델에 대해 판단되며, 분산항은 합의 점수 옆에 보고됩니다 (섹션 5.3).
4.6 30/10 규칙: 최소 10개의 거래일에 30개의 예측
모델이 그 지평선에서 최소 30개의 해결된 예측과 각 지평선에서 최소 10개의 거래 세션(각 세션에서 최소 하나의 해결된 예측 포함)을 가질 때만 지평선의 표에 진입합니다. 봉인된 방법론은 규칙과 그 이유를 한 필드에서 제시합니다: "하루의 12개 지표는 함께 움직입니다: 리그는 거래일을 예측 옆에 표시하고, 모델은 최소 10개의 거래일에서 30개의 해결된 예측 후에 순위가 매겨집니다" (independence). 규칙은 예측이 해당 세션 전체에 불균등하게 분산되는 방식을 제한하지 않으므로, 표는 각 모델의 세션 수를 점수 옆에 표시합니다 (days), 두 번째 조건이 결정적입니다. 세션 내 예측이 상관관계 를 공유하면, 한 세션의 개 예측은 약 개의 독립적인 정보를 담고 있습니다. 이것은 집단 표본 추출의 설계 효과입니다 (Kish, 1965). 이고 일 때, 한 세션은 3.75개의 독립적인 예측에 해당하고, 세 아침의 30개 예측은 약 11개에 해당합니다. 10개의 거래일을 요구하면 표본이 서로 다른 뉴스에 걸쳐 있도록 강제합니다. 지평선 내에서 재표본 추출의 단위는 세션입니다. 30/10 규칙은 적격 여부를 결정하며, 검정력은 아래에서 다룹니다. 2026년 10월 30일 세션 이후 첫 번째 표는 임시 기술적 순서이며, 처음 10개 세션 중 하나라도 놓친 모델은 나중에 적격이 됩니다.
통계 파일은 5개의 채점된 세션(세션 평균에 대한 Student t)에서의 구간과 세션에 대한 20개의 부트스트랩(한 날의 12개 지표를 하나의 클러스터로 함, council-stats.json, sample.note)을 발표합니다. 5개 세션 이전에는 구간이 표시되지 않으며, 행에 대해 계산된 구간은 한 날의 12개 시장을 독립적인 것으로 취급하여 너무 좁습니다. 하루보다 긴 예측 지평의 경우, 연속된 예측이 대부분의 결과 윈도우를 공유하므로, 세션의 지평 에 대해, 이분산성 및 자기상관 일관성 구간(지연 , Newey & West, 1987) 또는 최소 세션 길이의 블록을 가진 블록 부트스트랩(Künsch, 1989)을 요구하며, 세션 이전의 구간은 없어야 합니다(요구사항 10). 126개 세션의 시즌에서 이 규칙은 세션 25에서 1주일, 세션 105에서 1개월의 구간을 제공하며, 630이 필요한 6개월에는 없습니다. 확인적 주장은 날, 주요 지평, 그리고 규칙이 충족되는 주와 월에 근거합니다. 6개월 결과와 일일 구간은 이 시즌에서 기술적입니다. 기술의 주장은 등록된 확인 날짜(섹션 8)에서 읽혀지며, 그 사이의 세션이 무엇을 보이든 상관없습니다.
검정력은 주장될 예정인 비교, 쌍을 이룬 Brier 차이에 속합니다. 예측자 와 동일한 사건에 대한 벤치마크 의 경우, 를 세션 의 사건들에 대한 의 평균이라고 합시다. 세션 평균의 표준 편차 와 선언된 최소 효과 의 경우, 5% 수준의 양측 검정과 80% 검정력은 약 개의 독립 세션이 필요합니다. 지속성은 개수를 증가시키고, 등록된 분석은 연속 세션을 함께 유지합니다(Diebold & Mariano, 1995; Künsch, 1989). 126개 세션에서 파일의 Brier 계산(power_brier)은 동전 아래 0.0105의 감소를 감지하며, 0.005의 감소에는 554개 세션이 필요합니다. 이는 171개의 2개 세션 예측에서 추정하며(파일은 2026년 10월 21일 05:33 UTC에 생성되었고, 10월 20일의 데이터에 기반함, 라이브 필드는 각 실행마다 재계산됨), 5개 세션이 채점될 때까지 대리로 0.062의 예측 수준 표준 편차와 을 취합니다. 이는 세션 30에서 세션 수준 데이터에 대해 재계산되며, 등록된 검정은 이에 의존하지 않습니다. 파일의 적중률 계산(power)은 가정된 에서 55%를 50%로부터 구별하기 위해 209개 세션이 필요합니다. 이진 예측 시장 질문의 독립적 분석은 동일한 정도에 도달합니다: 시장 대비 0.02의 Brier 엣지를 감지하기 위해 약 350개의 해결된 예측이 필요합니다(Nechepurenko & Shuvalov, 2026a).
부정적 결과는 자체 규칙이 필요합니다. 작은 추정 차이, 결정하기에 너무 넓은 구간, 차이가 없다는 증거는 세 가지 발견입니다. 모든 확인적 비교에 대해 하나의 동치 마진(±0.01 Brier)을 선언하고, 쌍을 이룬 차이의 90% 구간(5% 수준의 두 개의 단측 검정)이 완전히 그 안에 있을 때만 "물질적 차이 없음"을 읽습니다. 마진을 선택했습니다. 이는 2개 세션 추정이 126개 세션이 해결할 수 있다고 말하는 것과 유사합니다(power_brier, 위), 그 추정이 재계산될 때 이동하지 않으며, 경제 임계값과 구별되는 채점 공차입니다.
4.7 포트폴리오 리그
확률은 판단을 측정합니다. 포트폴리오인 2차 척도는 모델이 그것으로 무엇을 하는지를 보여줍니다. 14개 모델 각각은 동일한 규칙 하에서 시뮬레이션된 $100,000을 관리합니다: 11개 거래 펀드가 시장을 나타내고(VIX는 지표만), 포지션은 5%에서 25% 범위의 롱 전용이며, 현금은 13주물 재무부 채권을 획득하고, 변경되는 모든 달러는 0.1%의 비용이 들며, 결정은 그 봉인 후 첫 번째 개장가에서 거래됩니다(09:30에서 09:45 ET의 첫 번째 가격). "보유"는 거래 없음과 비용 없음의 결정입니다. 규칙을 위반하는 결정은 거부되고 포지션은 유지됩니다. 각 계정은 마감 시 수익률과 최대 낙폭으로 표시되며, 20개 세션에서 샤프 비율과 소르티노 비율로 표시됩니다(Sharpe, 1994; Sortino & Price, 1994). 전체 규칙은 프로토콜 파일에 있습니다(부록 A, 표 A1). 계정은 수익률을 위한 국채 펀드와 각 상품 선물의 펀드와 같은 도구를 채점하므로, 더 낮은 브라이어 점수는 더 높은 계정 가치를 확립하지 않습니다. 계정은 대신 동일한 비용 하에서 동일한 규칙 버전 내에서 수동적 기준선과 비교됩니다.
4.8 프로 리그
각 모델은 프로 리그(pro-1)에서 두 번째 $100,000 계정을 보유하며, 이는 5%에서 30% 주식의 서명된 가중치와 100%에서 200%의 총 노출을 가진 롱-숏 부기입니다. 따라서 최대 2배까지 레버리지됩니다; VIX는 여기서 거래될 수 있습니다. 그 기준선은 롱으로 보유한 S&P 500과 숏으로 보유한 것입니다.
4.9 군중에 맞서는 AI
최대 12개 시장 중 8개에 대해 예측 시장은 리그의 것과 가까운 일일 질문을 거래합니다. 각 실행의 질문은 그것들을 완전한 해결 규칙과 함께 나열하고 각 모델에 그 자신의 "상승" 확률을 각각에 대해 답변 라인의 별도 필드에서 요청합니다(crowd_up). Polymarket, Kalshi 또는 배팅 확률을 조회하지 말라는 지침은 질문에 봉인되며, 모델의 검색이 반환한 것은 봉인 외에 있습니다. Polymarket이 시장을 나열하는 경우, 모델은 Polymarket의 질문에 답변하며, Kalshi 질문은 Polymarket이 나열하지 않은 시장에 대해서만 요청됩니다(council-calibration.json, method.crowd_window). 군중의 가격 및 거래량(vol)은 질문이 나갈 때 기록되고 실행 라인에 봉인됩니다(crowd.odds는 Polymarket의 경우, crowd.kalshi는 Kalshi의 경우). 10월 20일에 첫 번째 모델이 답변을 시작하기 전인 12:30:06Z에 기록되었습니다. 나는 의도적으로 가격을 숨깁니다. 시장 가격을 보여주고 수정하도록 요청받은 모델은 일부 계약에서 시장을 이길 수 있습니다(S. Kim et al., 2026). 하지만 그 답변은 더 이상 군중으로부터 독립적인 증거가 아닙니다. 리그는 둘을 분리합니다: 봉인된 답변은 가격을 모르고, 군중과의 모든 조합은 별도의 전략이며, 채점되기 전에 봉인됩니다(섹션 5.3). 각 비교는 그 정보 시계를 지정합니다: 봉인된 가격은 질문 시간의 군중이며, 보정 파일은 각 모델의 답변을 해당 모델 자신의 답변 분에서의 군중의 가격과 비교합니다. 둘 다 군중의 해결 내용에 따라 채점됩니다. 해결 후 리그는 질문당, 모델의 확률과 군중의 확률, 각각의 브라이어 점수 및 각각이 올바르게 얻은 쪽을 보고합니다(부기 라인 crowd; council-league.json, 필드 crowd).
10월 20일에 Polymarket은 6개의 일일 "상승 또는 하락" 질문(S&P 500, Dow, 금, WTI, 달러 지수 및 Bitcoin)을 나열했고 Kalshi는 5개(S&P 500, Nasdaq-100, 10년물 수익률, 금 및 WTI)를 나열했습니다: 8개 시장, 그 중 3개가 두 플랫폼 모두에서 나열됩니다. 두 플랫폼이 시장을 나열하는 경우, 나는 모델이 답변한 Polymarket 계약을 사용합니다. 그렇지 않으면 Kalshi 계약을 사용합니다. 각 군중 확률은 하나의 계약에서 나옵니다. Kalshi 질문은 행사가에서 설정되며, 그 가격은 두 인접한 행사가 사이의 보간을 통해 "이전 마감보다 위"로 변환됩니다(실행 라인의 lo, hi). 보간된 가격은 두 거래 가격에서 해당 이벤트의 확률을 근사하며, 양쪽은 그 계약이 지정하는 출처에 따라 그 합성 이벤트에 대해 채점됩니다. 나는 질문이 나갈 때 봉인된 거래량이 최소 $1,000일 때 계약을 1차 비교에 허용하고 더 얇은 계약은 별도로 보고합니다. 임계값은 계약에서 거래된 자금을 보여줍니다. 요구사항 17은 각 군중 행에서 입찰, 오퍼 및 마지막 거래 시간을 요청합니다. Polymarket에서 스프레드는 가능성 없는 결과에서 더 넓기 때문입니다(Dubach, 2026).
군중의 질문은 리그의 것과 가깝고, 그들의 시계는 다릅니다. 리그의 날은 09:30 기준에서 16:00 ET까지 실행됩니다(수익률은 15:00 ET까지); 군중의 질문은 close to close 근처에서 실행되고 여러 개는 다른 시간에 그리고 다른 출처에서 해결됩니다: 금과 달러 지수는 5:00 PM ET Pyth 캔들에서, WTI는 활성 선물 계약의 일일 마감에서, 수익률은 재무부의 3:30 PM 액면 수익률에서, Bitcoin은 Binance에서 정오에서 정오까지입니다. 따라서 나는 비교를 질문별로, 군중의 자신의 조건으로, 별도로 유도된 확률로 합니다. 예측 시장 가격은 강한 기준선입니다(Wolfers & Zitzewitz, 2004; Berg et al., 2008). Kalshi의 거시경제 계약은 시장 기대 조사 및 Bloomberg 합의만큼 정확하게 예측합니다(Diercks et al., 2026). 예리함(섹션 4.4)은 crowd_up에서 모델별로 동일한 계약에서 비교됩니다. 군중은 prob_up 이벤트를 가격 책정하지 않기 때문입니다.
어떤 이벤트의 불일치가 점수를 얼마나 이동시킬 수 있는지는 정확히 명시할 수 있습니다. 지수가 어제 100에서 마감했고, 98에서 시작했으며, 99에서 마감했다고 가정하면: 이전 마감에서 하락했고 시작에서 상승했습니다. 한 이벤트의 두 버전이 개의 행 중 일부에 대해 반대 결과로 해결되고, 확률과 행이 고정되어 있다고 가정하면, 뒤집힌 행에서 예측 는 그 브라이어 점수를 만큼 변경하며, 절대값으로 최대 1이므로, 평균 브라이어 점수는 최대 만큼 이동합니다. 예측자 와 사이의 격차는 그 행에서 만큼 변경되므로, 격차는 최대 만큼 이동하며, 여기서 는 뒤집힌 행의 집합입니다. 경계는 고정된 표본에 대한 고정된 예측을 유지합니다. 두 가지 규칙이 따릅니다. 예측은 한 이벤트에만, 하나의 참조 가격으로 공통 점수에 들어갑니다(요구사항 4). 그리고 군중과의 각 비교는 두 질문이 반대 부호로 해결되는 시장 세션의 일부 를 보고합니다; 보다 작거나 같은 격차는 어느 쪽이든 이점으로 읽히지 않습니다.
4.10 격자: 모델 × 시장 × 기간
계산된 각 답변은 3방향 격자의 한 셀을 채웁니다: 최대 11개의 Council 모델, 12개 시장, 4개 기간(그림 6). 각 셀은 자체 브라이어 점수, 적중률, 보정 및 선명도를 누적합니다. 격자는 단일 리더보드가 답할 수 없는 질문에 답합니다: 어느 시장이 어느 기간에 예측 가능한지, 모델의 이점이 한 자산 클래스에 있는지 여부, 월간 예측이 일간 예측보다 각각 자체 베이스 비율에 대해 측정될 때 더 쉬운지 여부. 한계 보기는 council-league.json(models, by_asset, by_horizon)에 게시되고, 전체 행은 council-forecasts.csv에 게시합니다.
그림 6. 측정 격자. (A) 설계: 모델 × 시장 × 기간. (B) 채워진 격자: 2026년 10월 20일 계산된 한 아침의 밀봉된 확률.
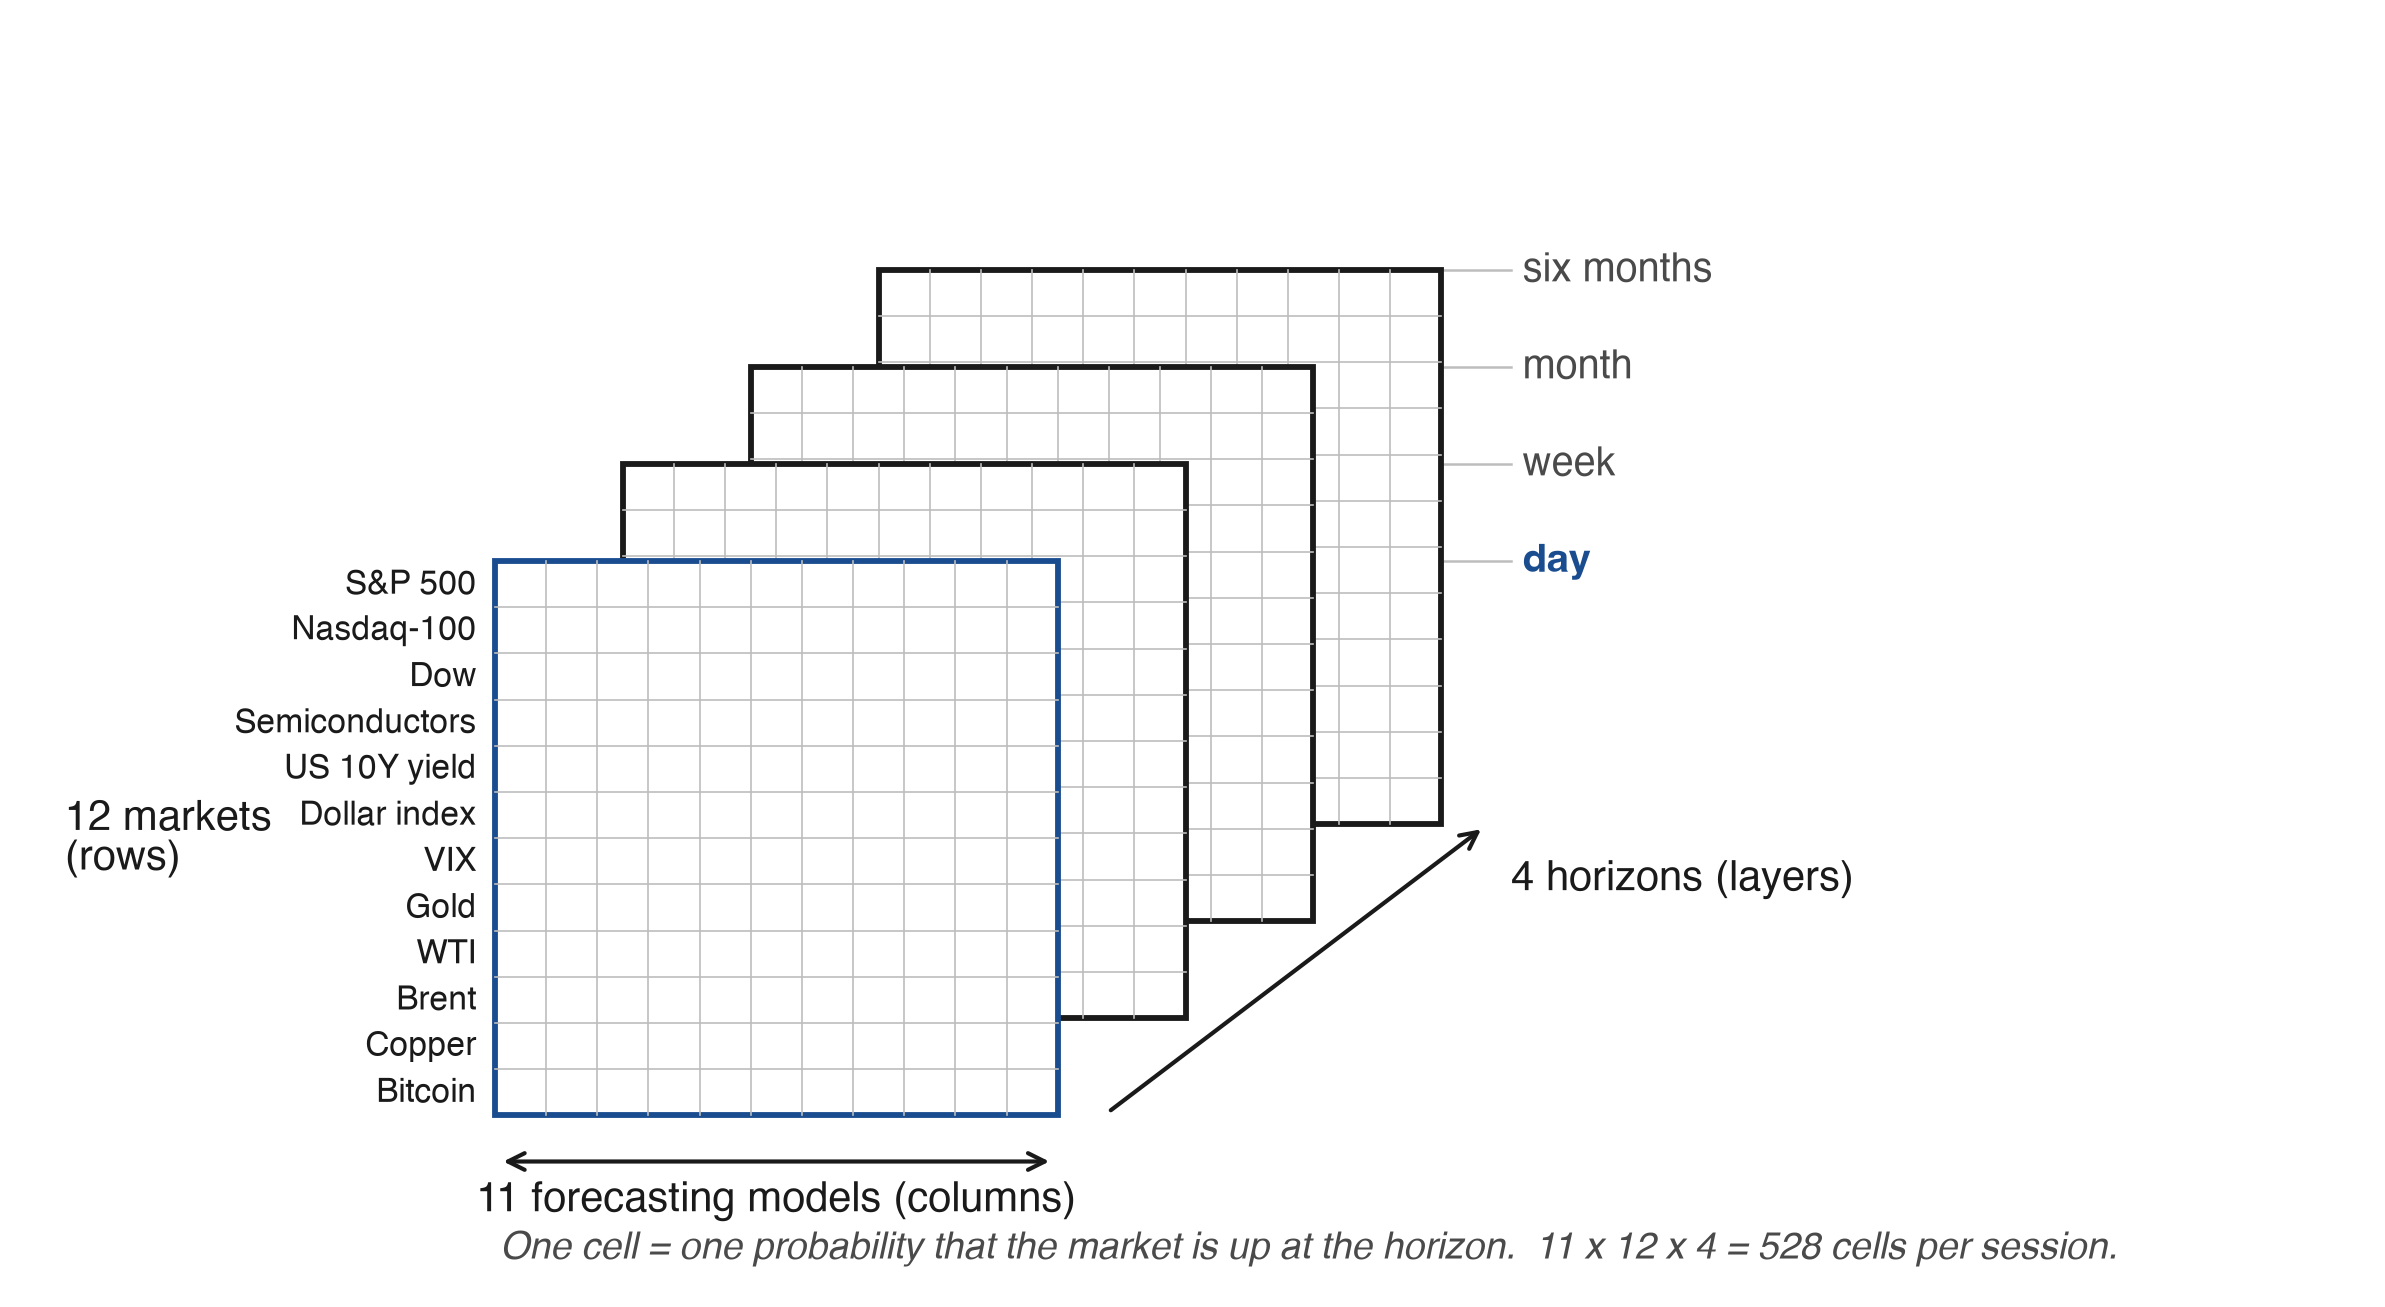
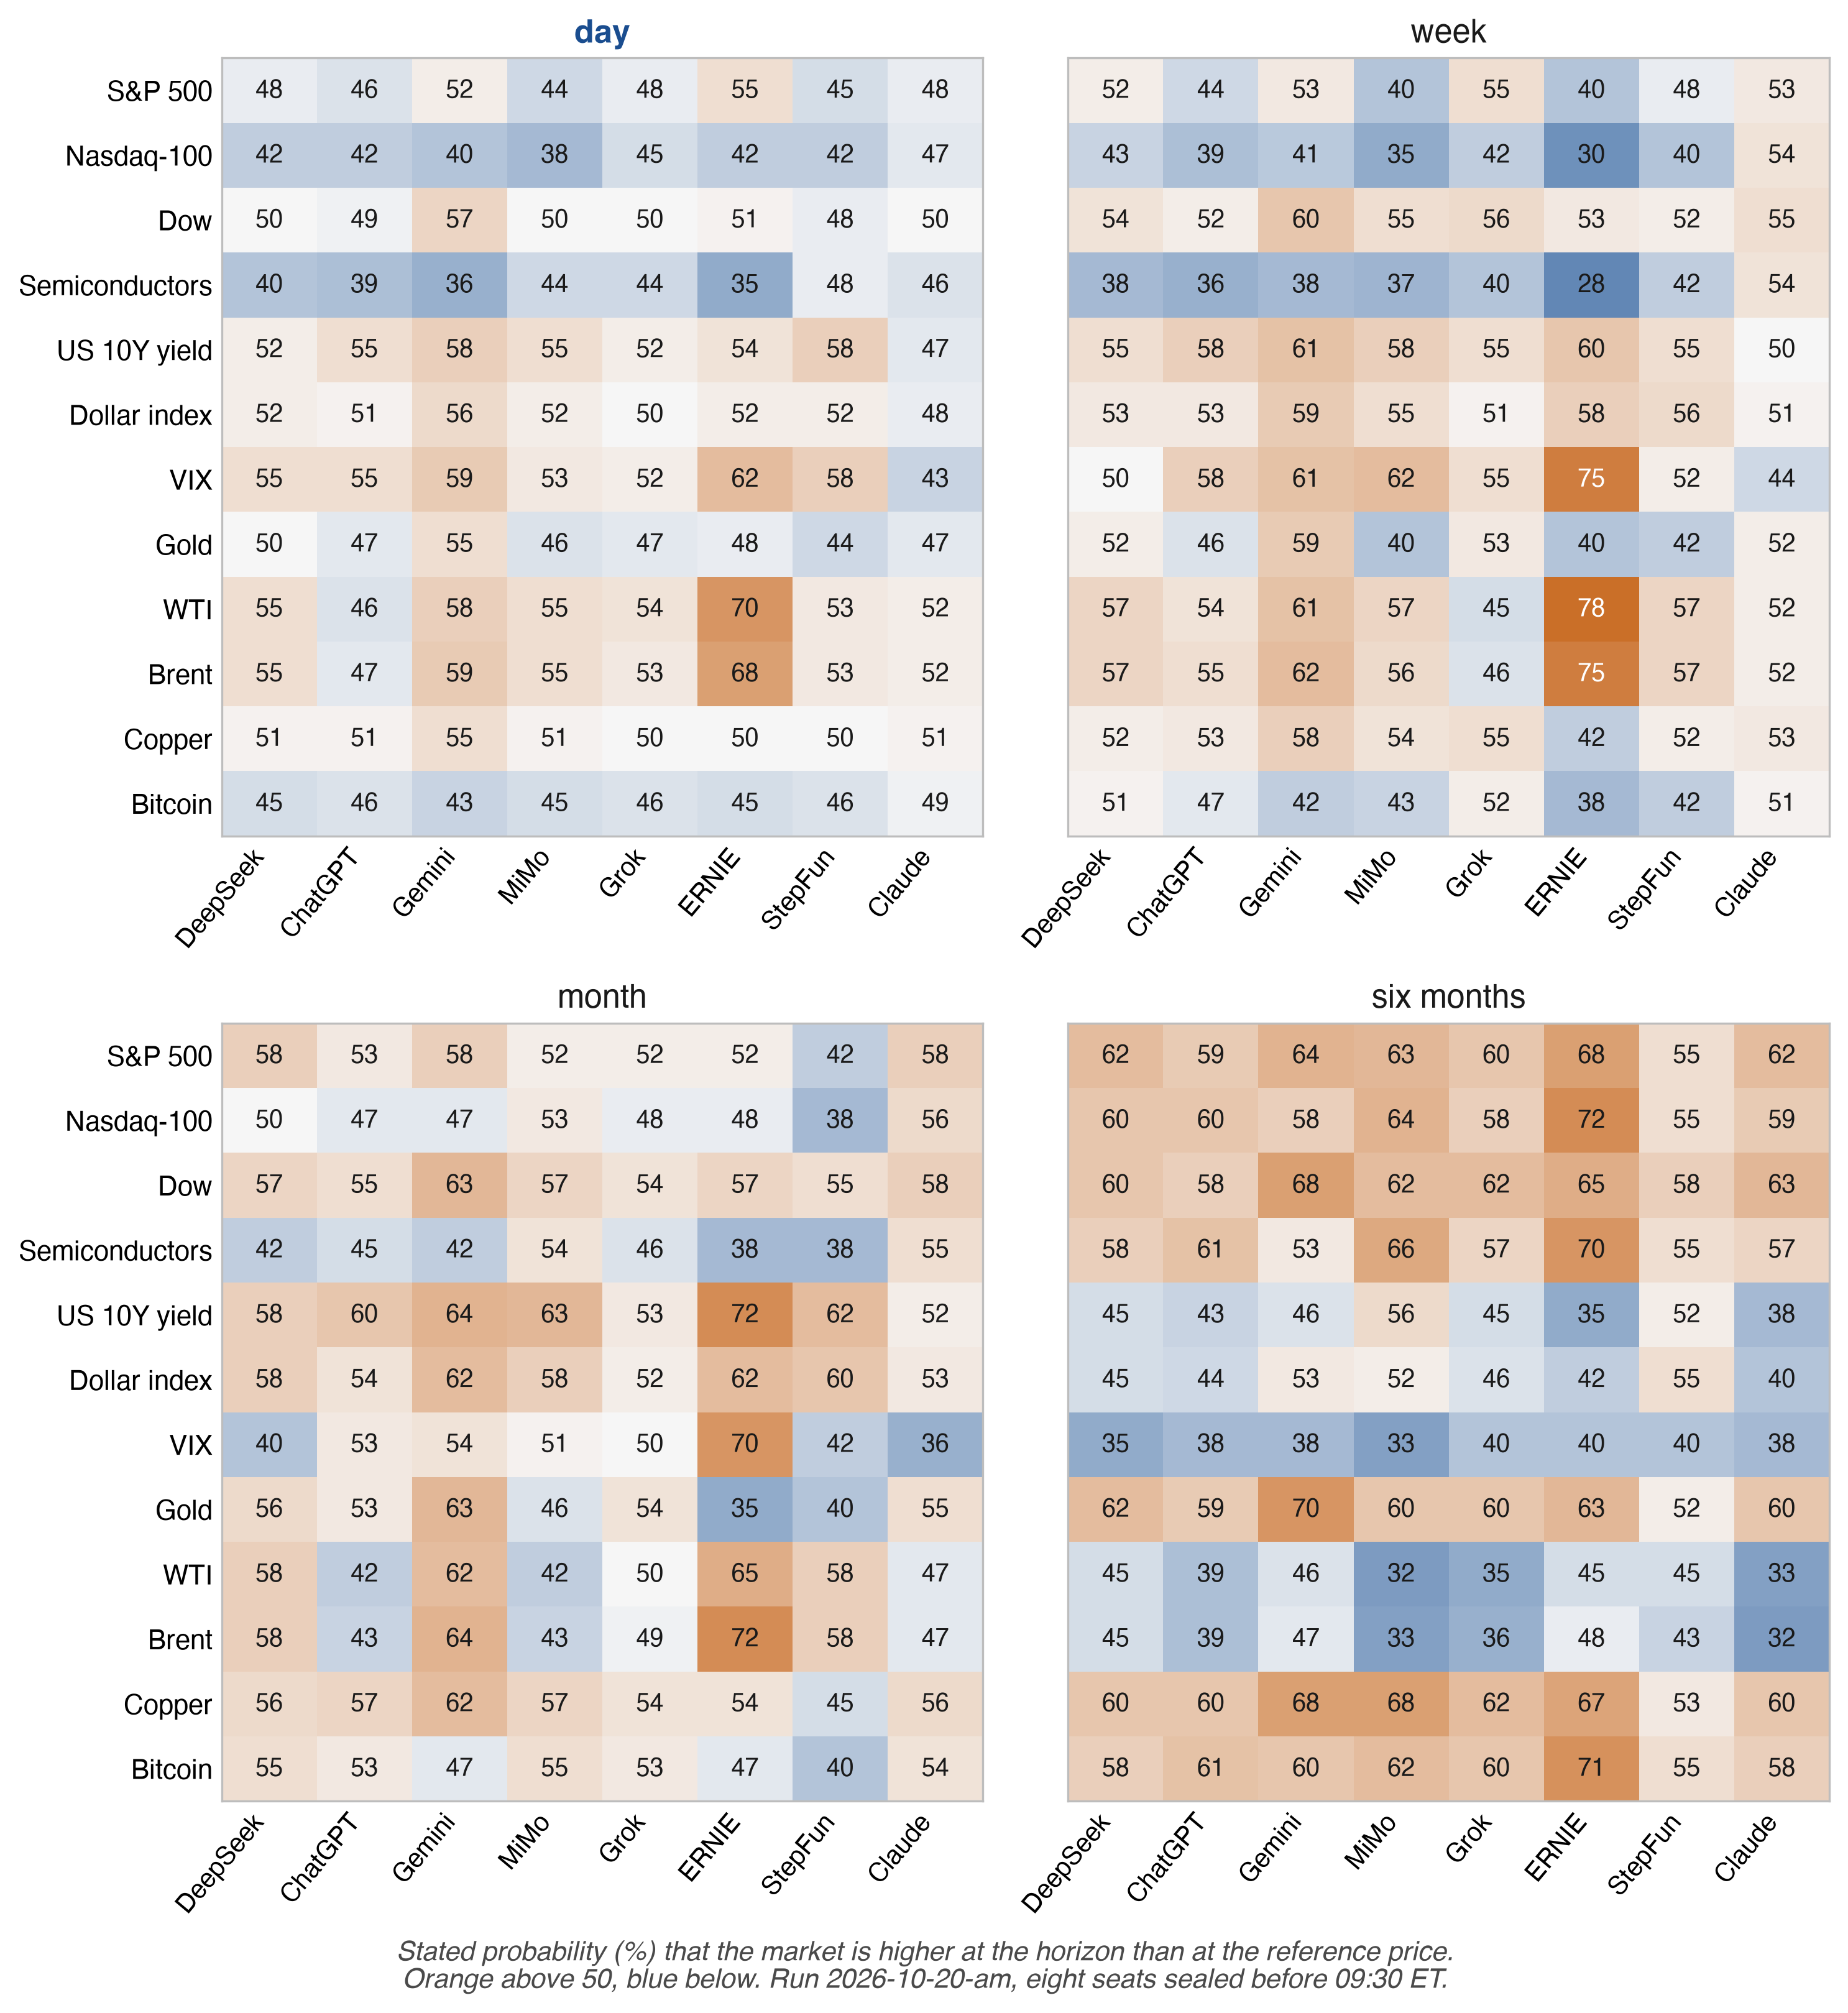
참고: (A) 셀은 council-forecasts.csv의 계산된 행에서 채워집니다; 셀은 4.6절의 규칙에 따라서만 순위가 매겨집니다. (B) 2026년 10월 20일 09:30 ET 기준 이전에 답변이 밀봉된 8개 의석(run 2026-10-20-am), 시장과 기간당 한 셀, 상승의 명시된 확률로 색칠하고 50%에 중심을 둔 것. 의석은 확률 그림의 첫 번째 주성분에 대한 로딩순으로 정렬되며, 국가순으로 정렬되지 않습니다. 출처: council-forecasts.csv, 2026년 10월 21일 읽음.
일간 예측은 각 세션마다 해결됩니다; 점수가 매겨진 리그의 첫 주간 예측은 2026년 10월 26일부터 해결되고, 첫 월간 예측은 2026년 11월 19일경부터 해결되며, 첫 6개월 예측은 2027년 4월에 해결됩니다.
4.11 재현성
모든 점수는 공개 파일에서 다시 계산할 수 있습니다. 포트폴리오 엔진의 코드는 텍스트로 공개되어 있으며, 19개 파일과 리그의 설정 각각에는 SHA-256이 있습니다(arena-code.json). 리카운트 스크립트(replay.py)는 거래와 가격에서 모든 계정의 가치, 현금 몫, 수수료 및 가중치를 다시 계산합니다. 2026년 10월 20일의 파일 기준으로 145개 계정의 공개된 253개 행 모두를 출판 반올림 범위 내에서 재현했습니다(부록 B, 단계 7). council-forecasts.csv에서 Brier 점수를 다시 계산하는 두 번째 스크립트 tools/replay_brier.py는 같은 주소 아래에 있으며, 계산된 모든 예측과 좌석, 지평선 및 방법론 버전별 합계의 Brier 점수를 다시 계산하고 공개된 수치와 비교합니다. 2026년 10월 22일 00:09 UTC의 라이브 파일에서 공개된 9,318개 숫자 모두와 정확히 일치했습니다. council-forecasts.csv의 모든 예측 행은 그것을 봉인하는 책 라인의 이름을 지으므로(line), 각 점수는 봉인된 답으로 추적되며 거기에서 타임스탬프 접두사와 비트코인 블록으로 추적됩니다(부록 B). 점수 행은 그 이후의 첫 번째 타임스탬프로 적용됩니다.
누구나 공개된 출력을 다시 계산할 수 있습니다. 체인과 앵커는 봉인된 답, 그 시간 및 질문을 고정합니다. 원시 모델 호출, 가격 피드 및 배포된 코드는 운영자가 제공한 대로 해시와 함께 공개됩니다. 참조 가격과 종가를 두 번째 독립적인 출처와 조정하는 것은 주장의 사다리의 결과 단계입니다(표 B1). 라이브 파일이 매번 실행할 때마다 변경되므로, 각 개정은 Zenodo의 불변 분석 릴리스(10.5281/zenodo.23552700)를 인용하며 모든 파일의 SHA-256, 크기 및 검색 시간의 매니페스트를 포함합니다(부록 C).
5. 몇 개의 독립적인 목소리
리그는 11개의 예측 좌석을 가지고 있습니다. 이러한 규모의 위원회는 많은 의견으로 보이며, 리그는 몇 개를 보유하고 있는지 세도록 구축되었습니다. N명의 예측자의 오류가 공통 ρ에서 상관관계가 있다면, 그들의 평균은 다음의 증거를 전달합니다.
N_eff = N / (1 + (N − 1)ρ)
독립적인 예측자, 그리고 N이 증가하면 N_eff는 1/ρ에 접근하고 거기서 멈춥니다. 공식은 군집 표본추출의 설계 효과(Kish, 1965)이며, 종속된 전문가 값의 포화는 예측 결합에 의해 Clemen과 Winkler(1985)에 의해 입증되었습니다. 동반 논문은 이를 AI 모델 패널에 적용합니다(Chernets, 2026a). 상한은 몇 개의 모델을 요청했는지에 따라 달라지지 않습니다. ρ = 0.5일 때 1,000개 모델은 두 명의 증인의 가치가 있으며, 위원회가 1/ρ보다 커지면, ρ를 낮추는 것이 구성원을 추가하는 것보다 더 많은 이득을 줍니다. 입력은 측정됩니다. 두 개의 언어 모델이 모두 틀렸을 때 그들은 종종 같은 잘못된 답을 제공하며, 특히 아키텍처나 제공자 내에서 더욱 그렇습니다(Kim et al., 2025). 세 가지 최첨단 모델의 예측 오류는 568개의 이진 질문에서 평균 r 0.77로 상관관계가 있습니다(Spiro, 2026), 그리고 최첨단 모델은 Metaculus AI 벤치마크에서 매우 상관관계가 높은 예측을 만듭니다(Aitchison et al., 2026). 많은 의사결정자가 하나의 알고리즘을 채택하면, 집단 의사결정이 악화될 수 있습니다. 알고리즘이 각각을 개별적으로 이기더라도 말입니다(Kleinberg & Raghavan, 2021). 기관 보유량에 보정된 이론 및 시뮬레이션은 유사한 AI 모델의 광범위한 채택이 거래하는 신호의 수명을 단축한다고 제안합니다(Meng & Chen, 2026). 이러한 주장은 입력으로 모델의 측정된 유사성이 필요합니다. 시장 리그는 매 거래일마다 외부 기준 진실을 제공하고 ρ를 추정할 수 있는 최대 11개의 라이브 확률 스트림을 제공합니다. N_eff는 분산의 개수입니다. 모든 모델이 공유하는 편향은 모델의 수가 무엇이든 평균에 남아 있으며, 이것이 리그가 만장일치 오류를 직접 계산하는 이유입니다(섹션 5.3). 효과적인 목소리의 개수 없이 출력된 모델의 합의는 표본 크기 없이 출력된 설문 조사와 같습니다: 독자는 동의하는 비율을 보지만 동의가 얼마나 많은 증거를 보유하고 있는지 알 수 없습니다. 따라서 요구 사항 14는 합의가 표시되는 모든 곳에서 개수를 필수로 만듭니다. 10월 20일 여덟 좌석이 개장 전 1일 사진을 봉인했으며, 그들의 사진은 1.46개의 독립적인 예측자의 사진만큼 유사했습니다(섹션 5.2).
5.1 리그가 ρ를 추정하는 방법
각 봉인된 실행은 모든 예측 좌석에 대해 각 12개 시장이 각 지평에서 상승할 확률을 제공합니다. 각 실행 및 지평에 대해 리그는 좌석 쌍의 평균을 계산하며, 둘 다 답변한 시장 전체에서 확률의 Pearson 상관관계를 계산하고, 그 실행의 자신의 n과 ρ를 사용하여 N_eff = n / (1 + (n − 1)ρ)를 평가합니다. N_eff는 ρ에서 볼록이므로, 실행별 개수의 평균은 최소한 평균 ρ에서의 개수이며, 12개 시장에서 추정된 ρ의 표본 오차는 실행별 개수도 밀어올립니다. F1 및 F2와 같이 임계값 아래의 평균은 따라서 보수적인 읽음이며, 지평 간 비교는 ρ 자체에서 읽습니다(F9). 12개 시장에서 하나의 쌍별 상관관계는 관찰된 0.38~0.64 범위에서 약 0.26~0.18의 표준 오차를 갖습니다. 한 실행의 쌍은 좌석과 시장을 공유하므로, 그들의 평균은 한 쌍보다 안정적이지만 그들의 수의 루트에 의해서는 아닙니다. 간격은 다섯 개의 계산된 실행에서 나옵니다. 나는 각 좌석의 최신 답변 라인을 사용하고 봉인 후에 날짜가 지정된 correction 라인으로 복원된 셀을 제외합니다. 왜냐하면 그들은 봉인된 답변에 없었기 때문입니다. 적격 규칙은 추정기의 일부입니다. 나는 계산된 실행만 인정하고, 참조 가격 전에 봉인된 답변만 인정하므로, 개장 움직임을 볼 수 있는 늦은 답변이 들어가지 않습니다. 공개 파일 council-stats.json은 n_eff.counted에서 이 시리즈를 발행하며, 규칙은 파일에 명시되어 있습니다. 더 오래된 블록 n_eff.per_run과 그 평균은 모든 봉인된 실행, 시험 실행 및 늦은 답변을 포함합니다. 부록 C는 council-forecasts.csv 및 council-book.jsonl에서 재계산을 위한 필드를 제공합니다. 표 6은 이 규칙을 통해 공개 파일의 행을 따르며, 6개의 봉인된 실행에서 계산된 기록까지입니다.
표 6. 공개 파일에서 계산된 기록으로, 실행별: 행, 수정, 좌석, 참조 전에 봉인된 행, 명시된 50s, 잘못된 셀 및 계산된 1일 행(council-forecasts.csv, 3,792행).
| 실행 | 역할 | 파일의 행 | 수정 행 | 답변하는 좌석 | 참조 전에 봉인된 좌석 | 참조 전에 봉인된 행 | 명시된 50 | 잘못된 셀 | 계산된 1일 행 |
|---|---|---|---|---|---|---|---|---|---|
| 2026-10-16-eve | 시험 | 1,056 | 39 | 9 | 9 | 1,017 | 20 | 0 | 0 |
| 2026-10-17-btc | 시험 | 864 | 32 | 9 | 9 | 832 | 40 | 0 | 0 |
| 2026-10-18-radar | 시험 | 672 | 21 | 8 | 8 | 651 | 22 | 0 | 0 |
| 2026-10-19-am | 개발 | 336 | 11 | 7 | 7 | 325 | 4 | 0 | 83 |
| 2026-10-20-am | 개발 | 432 | 0 | 9 | 8 | 384 | 14 | 12 | 105 (참조 전에 봉인된 96) |
| 2026-10-21-am | 계산된 기록 | 432 | 0 | 9 | 9 | 432 | 24 | 0 | 108 |
주의: 수정 행은 나중의 수정 라인(line_kind)에 의해 추가된 셀이며, 다른 열들은 답 라인의 셀을 계산합니다. 행은 그 라인의 seal, max(at, booked_at)이 목표하는 세션의 09:30 ET보다 앞설 때 참조 전에 봉인됩니다. 세 번의 시험 실행은 10월 19일을 목표합니다. 명시된 50과 무효 셀은 cell_status(explicit_50, invalid)에서 읽으며, 계산된 행은 status에서 읽습니다. 10월 20일 아홉 번째 자리인 Meta AI는 16:16:52Z에 봉인되었습니다. 이의 12개 무효 셀은 확률을 갖지 않으며, 아홉 개의 계산된 일일 행은 자신의 참조에서 점수가 매겨져 공통 이벤트 밖에 있습니다. 10월 21일 아홉 번째 답의 네 개 Bitcoin 셀은 자신의 참조를 가집니다(섹션 3.3). 출처: council-forecasts.csv와 council-book.jsonl (2026년 10월 22일, 01:32 UTC 저장, CSV의 SHA-256: 9fa4747e…c299d).
저는 계산 옆에 보조 통계를 발표합니다. 상관계수는 시장 전체에서 계산되므로 시장들이 함께 움직이는 방식(세 개의 미국 주식지수, WTI와 Brent)을 포함합니다. 두 번째 버전은 각 그룹당 한 개의 시장을 유지하여 Nasdaq-100, Dow, Brent를 제거합니다. 시장 전체의 상관계수는 또한 각 시장이 요청되는 방향에도 의존합니다. VIX, 달러 또는 수익률의 상승은 보통 주식의 하락과 함께 일어나며, 리그는 모든 시장을 상승으로 요청하고 이는 그 사건 계약에서 고정됩니다. 저는 또한 그 규칙이 없는 버전을 계산하는데, 이는 각 자리의 시장 전체 평균을 빼지 않고 50으로부터의 편차를 상관시키므로 어떤 시장을 뒤집어도 아무것도 변하지 않습니다. 1일일 때 10월 19일과 20일에 각각 1.85와 1.54를 제시하며, 이는 헤드라인 계산의 1.74와 1.46에 대비됩니다. 50 대신 기후학적 확률에서 취한 같은 편차는 섹션 4.3이 장기 지평에서 요청하는 읽기를 제공합니다. 행렬의 참여 비율은 다른 차원 계산이며, 등상관 하에서 둘은 다르므로 N_eff 옆에 두 번째 계산으로 읽습니다. 세 번째 통계는 먼저 각 시장의 합의를 제거합니다. 같은 모델에서 추정된 합의를 빼면 구성상 편차들이 음의 상관을 가지므로 이것은 기술적이며 등록되지 않습니다. 요구사항 17은 최대 고유값의 비중을 추가합니다. 1에 가까운 비중은 단일 공통 요소가 유사성을 담당함을 의미하며, 이것이 단일 공통 ρ가 공정한 요약인 구조이고, 낮은 비중은 단일 ρ가 여러 요소를 숨김을 의미합니다. 2026년 10월 20일의 계산된 실행에서, 참조 전에 봉인된 8개 자리의 모든 48개 셀에 걸쳐, 최대 고유값은 대각합의 68%를 담당합니다(8 중 5.47). 하나의 공통 요소가 대부분의 유사성을 담당합니다. 일일 행렬의 참여 비율은 10월 19일에 2.28, 10월 20일에 1.79, 10월 21일에 3.28이었습니다(n_eff_participation).
헤드라인은 확률 그림들이 얼마나 유사한지 계산합니다. 공식의 오류의 상관계수인 ρ는 두 번째 계산이며, 리그는 이를 점수가 매겨진 세션에서 계산합니다. 시장 전체에서 자리들의 오류 지표의 평균 쌍별 상관계수를 같은 방식으로 N_eff로 변환한 것입니다(n_eff_errors). 이것은 결과의 공동 움직임도 담당합니다. 세 개의 주식지수가 함께 하락할 때, 상승을 말한 모델들은 그들의 유사성이 무엇이든 함께 오류를 범합니다.
5.2 방법의 첫 번째 읽기
저는 2026년 10월 19일과 20일의 개발 세션에서 먼저 방법을 읽습니다(섹션 8). 참조 가격 09:30 ET 전에 봉인된 답만 사용하는 그들의 두 번의 계산된 아침 실행에서, 저는 1일에 N_eff를 2026년 10월 19일에 1.74(참조 전에 봉인된 n = 7개 자리, ρ = 0.505), 2026년 10월 20일에 1.46(n = 8, ρ = 0.64)으로 찾습니다. 그 두 아침의 그림들은 약 1.6명의 독립적인 예측자들의 그림들만큼 유사했습니다. 각 그룹당 한 개의 시장을 유지하면 1.69와 1.57을 얻습니다. 계산된 기록의 첫 번째 실행은 2026년 10월 21일에 2.23(n = 9, ρ = 0.379), 그룹당 한 개의 시장으로는 2.09를 얻었습니다(council-stats.json, n_eff.counted.per_run, 2026년 10월 21일, 22:16 UTC 생성).
같은 규칙을 각 지평에서 적용하고 결과 옆에 필요 없는 세 가지 기술적 측도를 사용하면 표 7을 얻습니다.
표 7. 계산된 아침 실행의 지평별 기술적 읽기, 참조 전에 봉인된 답: 확률 그림의 N_eff(괄호 안에 평균 쌍별 ρ), 선명도 K, 40과 60 사이의 확률 비중, 자리 전체 분산.
| 실행 | 측도 | 1일 | 1주 | 1개월 | 6개월 |
|---|---|---|---|---|---|
| 2026년 10월 19일 (n = 7) | N_eff (ρ) | 1.74 (0.51) | 2.81 (0.25) | 2.39 (0.32) | 1.16 (0.84) |
| K | 10.7 | 14.4 | 17.9 | 25.0 | |
| [40, 60] 범위의 비중 (%) | 88 | 81 | 67 | 42 | |
| 분산 (포인트) | 4.2 | 6.3 | 7.4 | 5.1 | |
| 2026년 10월 20일 (n = 8) | N_eff (ρ) | 1.46 (0.64) | 1.99 (0.43) | 2.68 (0.28) | 1.14 (0.86) |
| K | 9.2 | 14.1 | 13.9 | 20.3 | |
| [40, 60] 범위의 비중 (%) | 93 | 82 | 80 | 58 | |
| 분산 (포인트) | 3.5 | 5.7 | 6.2 | 4.7 | |
| 2026년 10월 21일 (n = 9) | N_eff (ρ) | 2.23 (0.38) | 2.63 (0.30) | 2.41 (0.34) | 1.58 (0.59) |
| K | 10.1 | 12.5 | 14.6 | 19.9 | |
| [40, 60] 범위의 비중 (%) | 95 | 90 | 84 | 61 | |
| 분산 (포인트) | 4.3 | 4.8 | 5.7 | 6.8 |
주의: 지평당 12개 시장. 섹션 5.1의 제출된 스크립트 neff-horizons.py의 규칙에 따른 N_eff는 자신의 참조를 가진 셀은 제외(10월 21일의 아홉 번째 답의 Bitcoin 셀); 10월 21일의 일일 값은 발표된 n_eff.counted.per_run과 같습니다. K = (2/n)Σ|p − 50| (섹션 4.4에서 자리들의 셀 위에); 분산은 12개 시장에 걸쳐 평균화된 자리 전체 모집단 표준편차입니다. 2026년 10월 22일, 01:32 UTC에 저장된 council-forecasts.csv와 council-book.jsonl의 값들입니다.
세 번의 실행 모두에서 목소리는 6개월에 가장 적고 1일에 비해 1주일과 1개월에 더 많습니다. 6개월 유사성은 공유된 기본 비율(주식과 금은 6개월에 걸쳐 상승)에서 나올 수 있으므로, 6개월 카운트는 기후학적 확률로부터의 편차로도 읽어야 합니다. 10월 20일 실행 패턴(그림 6B)에서 이를 보며, 그림 7에서는 시장별로 그것을 그립니다. 기준 전에 밀봉된 8개 의석은 1일에 5개 시장을 50% 미만으로, 6개월에는 약 60%로 두었습니다. 평균 확률에서 S&P 500은 48에서 62로, Nasdaq-100은 42에서 61로, 반도체는 42에서 60으로, 금은 48에서 61로, 비트코인은 46에서 61로 이동했고, 석유, VIX, 10년물 수익률은 반대 방향으로 이동했습니다(WTI 55에서 40으로, VIX 55에서 38로, 수익률 54에서 45로). 평의회는 사라지는 단기 충격을 보았습니다. 6개월에는 장기 표류에 수렴했습니다. 10월 21일에는 단기 끝이 이동했고 장기 끝은 유지되었습니다. 9개 의석은 S&P 500에 대해 1일에 55.9, 6개월에 60.4를 제시했고, 구리(47.9)와 VIX(45.7)만 1일에 50% 미만이었습니다. 6개월에 위험 자산은 다시 56.7에서 62.7 사이에, 석유, VIX, 수익률, 달러는 41.2에서 46.1 사이에 있었습니다.
그림 7. 시장별로 1일과 6개월에 상승할 평균 진술 확률: (A) 실행 2026-10-20-am, 기준 전 밀봉된 8개 의석; (B) 실행 2026-10-21-am, 9개 의석.
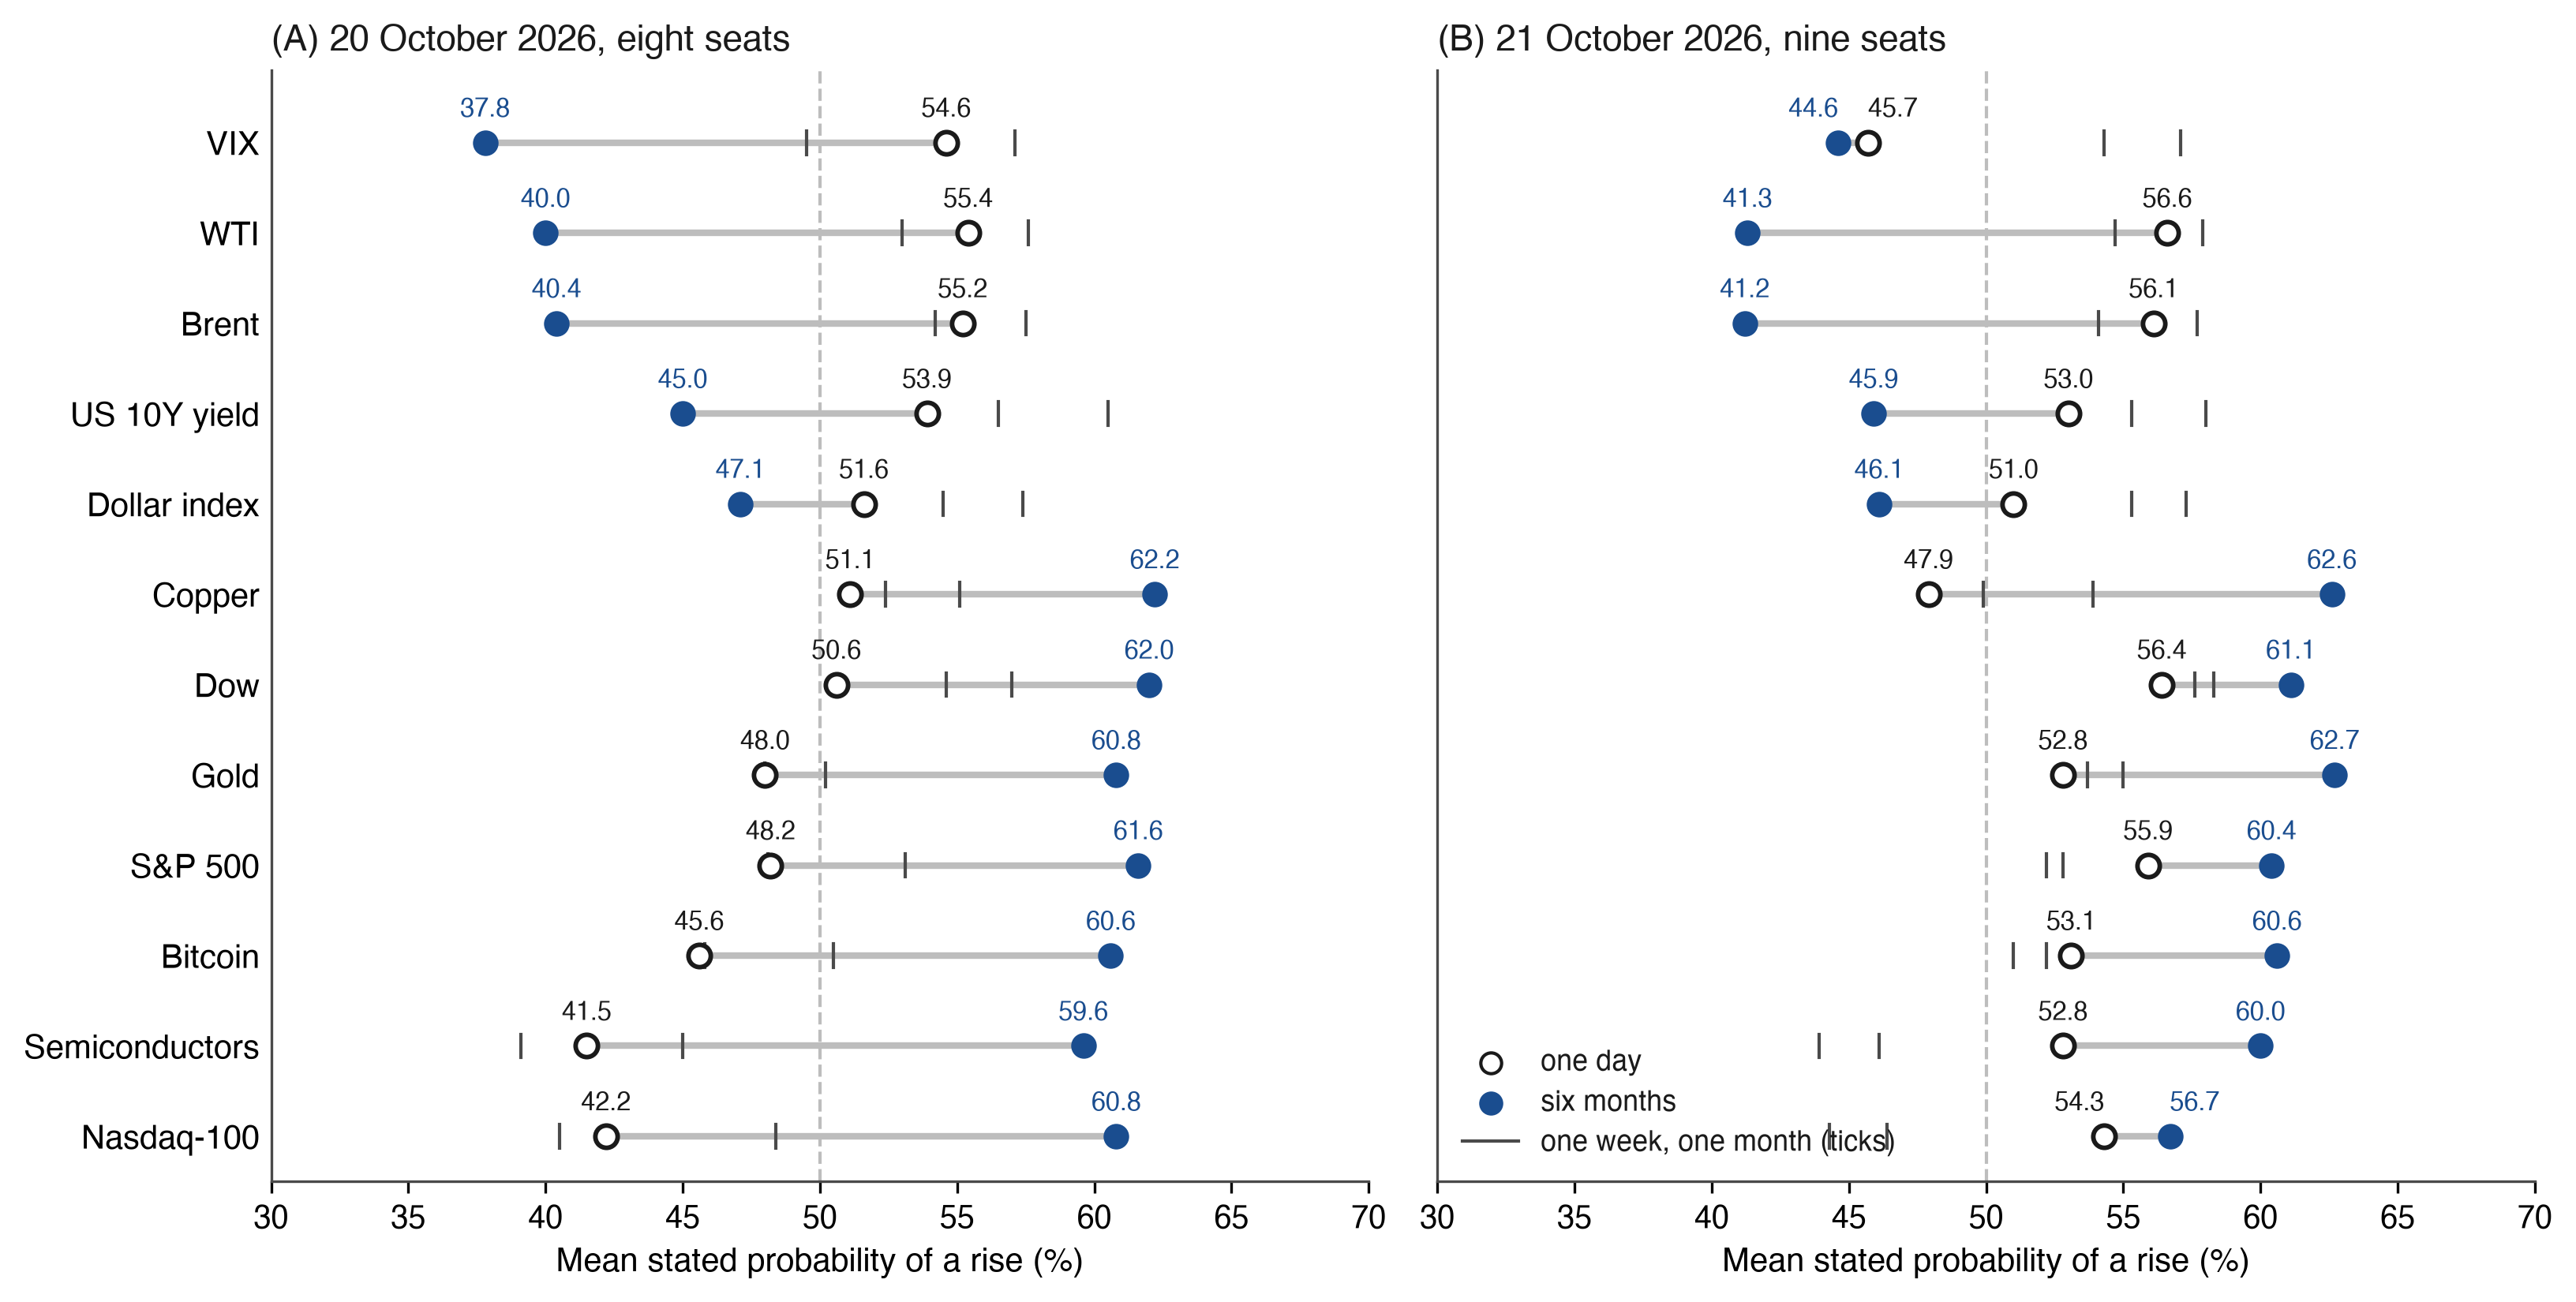
주: 의석의 prob_up의 평균; 눈금은 1주일과 1개월을 표시합니다. 시장은 10월 20일 1일에서 6개월까지의 변화순으로 정렬됩니다. 6개월 확률은 각 시장의 기본 비율을 포함합니다(섹션 4.3); 기후학에 대한 동일한 읽기는 입니다. 10월 21일 비트코인 평균은 자신의 참조를 가진 9번째 응답의 셀을 제외합니다. 출처: council-forecasts.csv 2026년 10월 22일, 01:32 UTC에 저장됨.
동일한 실행은 섹션 8이 사용하는 스프레드를 제공합니다. 8개 의석에 걸쳐 확률의 모집단 표준편차는 1일에 평균 3.5 포인트, 1주일에 5.7, 1개월에 6.2, 6개월에 4.7입니다. 1일에는 구리 1.5 포인트에서 WTI 6.4까지 달랐고, 가장 넓은 셀은 1개월에 VIX와 Brent였습니다(9.9 및 9.8). 10월 21일에 평균 스프레드는 4.3, 4.8, 5.7, 6.8 포인트였으며, 6개월에 가장 넓었습니다(Brent 9.5, WTI 및 VIX 8.4). 그림 8은 두 아침의 모든 셀을 보여줍니다.
그림 8. 시장 및 지평별로 의석 전반의 진술 확률의 스프레드: (A) 실행 2026-10-20-am, 기준 전 밀봉된 8개 의석; (B) 실행 2026-10-21-am, 9개 의석.
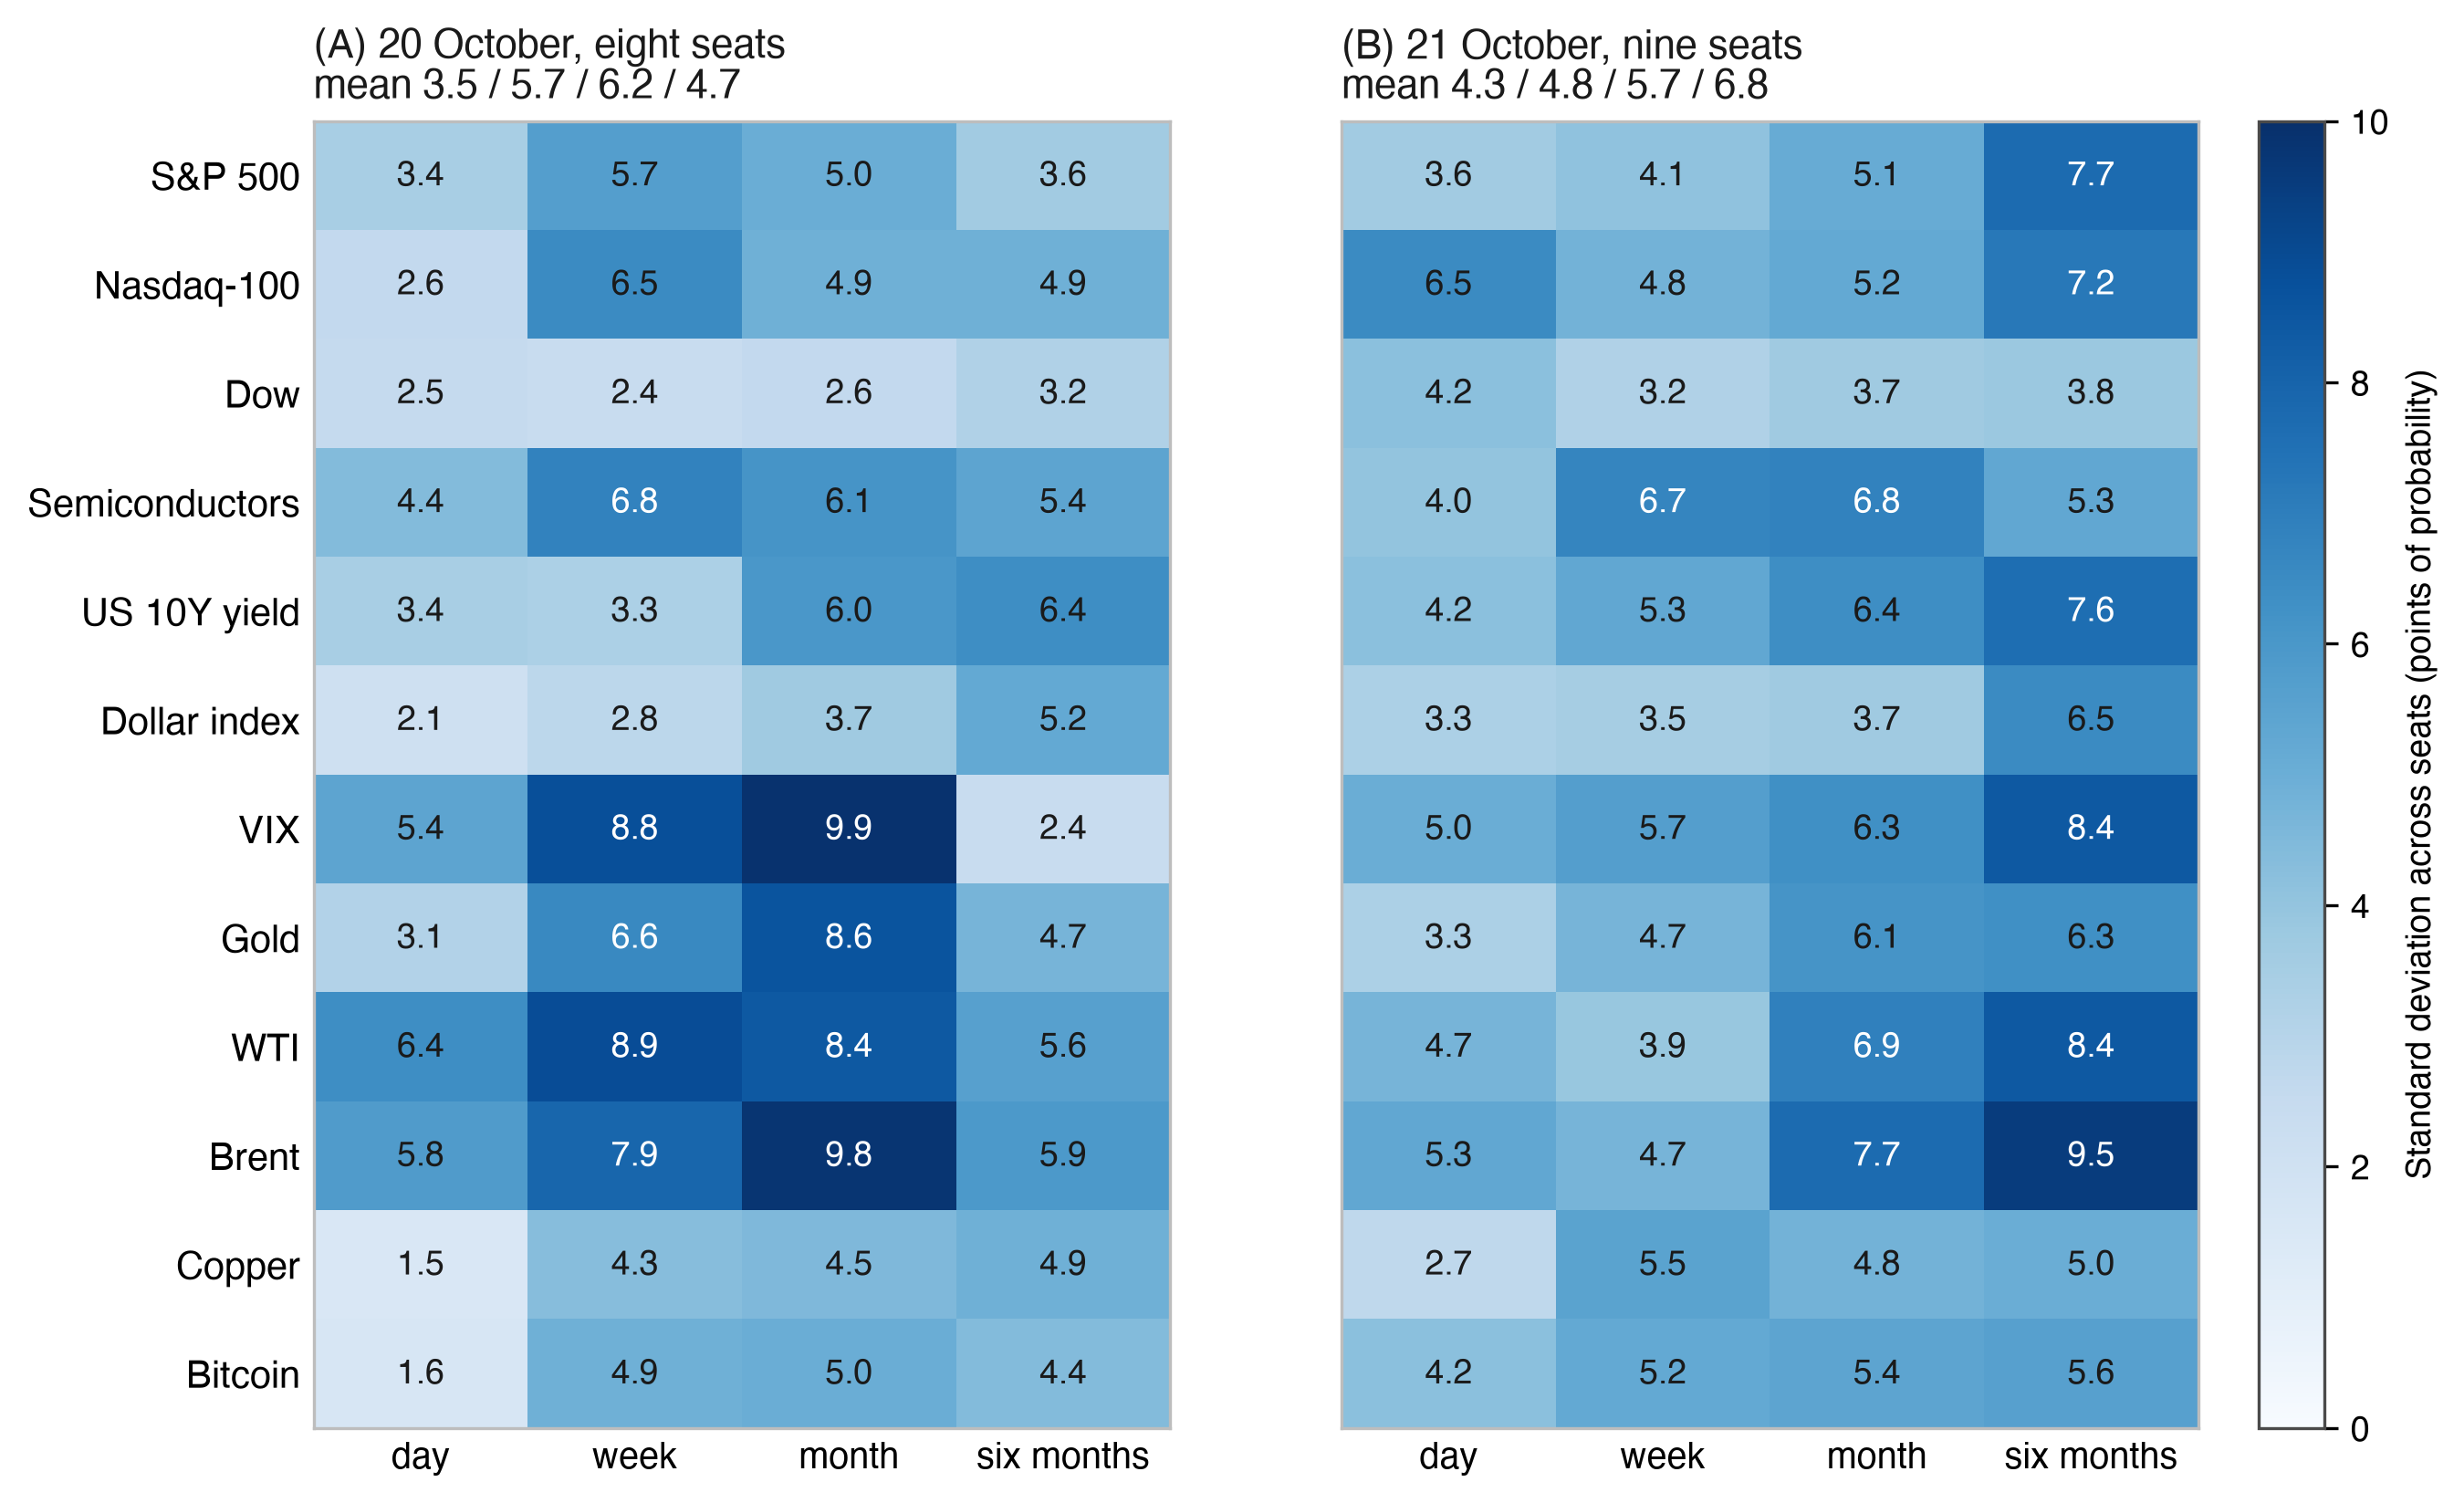
주: 각 셀의 의석 전반의 prob_up의 모집단 표준편차(확률 포인트 단위); 패널 제목은 각 지평의 12개 시장에 대한 평균을 제공합니다. 섹션 8은 2차 분석으로서 스프레드의 사용을 등록합니다. 출처: council-forecasts.csv 2026년 10월 22일, 01:32 UTC에 저장됨.
연속적인 실행은 동일한 시장에 대해 겹치는 질문에 답하며, 인접한 실행의 주 및 월 윈도우는 겹칩니다. 따라서 지평 간의 비교는 실행별 쌍 차이를 통해 이루어지며, 실행 블록에 걸친 간격이 있습니다(F9). 10월 16일부터 18일까지의 3개 시험 실행은 모두 10월 19일 세션을 목표로 하였으며 계산되지 않았으며 1일에 4.01, 2.69, 2.06을 제공했습니다. 오류 지표에 대한 카운트는 동일한 적격 규칙을 따르며 F3의 제출된 스크립트로 계산됩니다. 열린 파일의 필드 n_eff_errors는 더 넓은 설명 시리즈이며 표제가 아닙니다. 그림 9는 공식의 곡선에 실행별 값을 배치합니다. 예측 F1~F3 및 F9(섹션 8)은 등록 후 계산된 실행이 무엇을 표시해야 하는지 나타냅니다.
그림 9. 모델 수 대비 독립적 목소리의 유효 수(첫 번째 밀봉된 실행 및 첫 번째 계산된 실행의 실행별 판독값 포함).
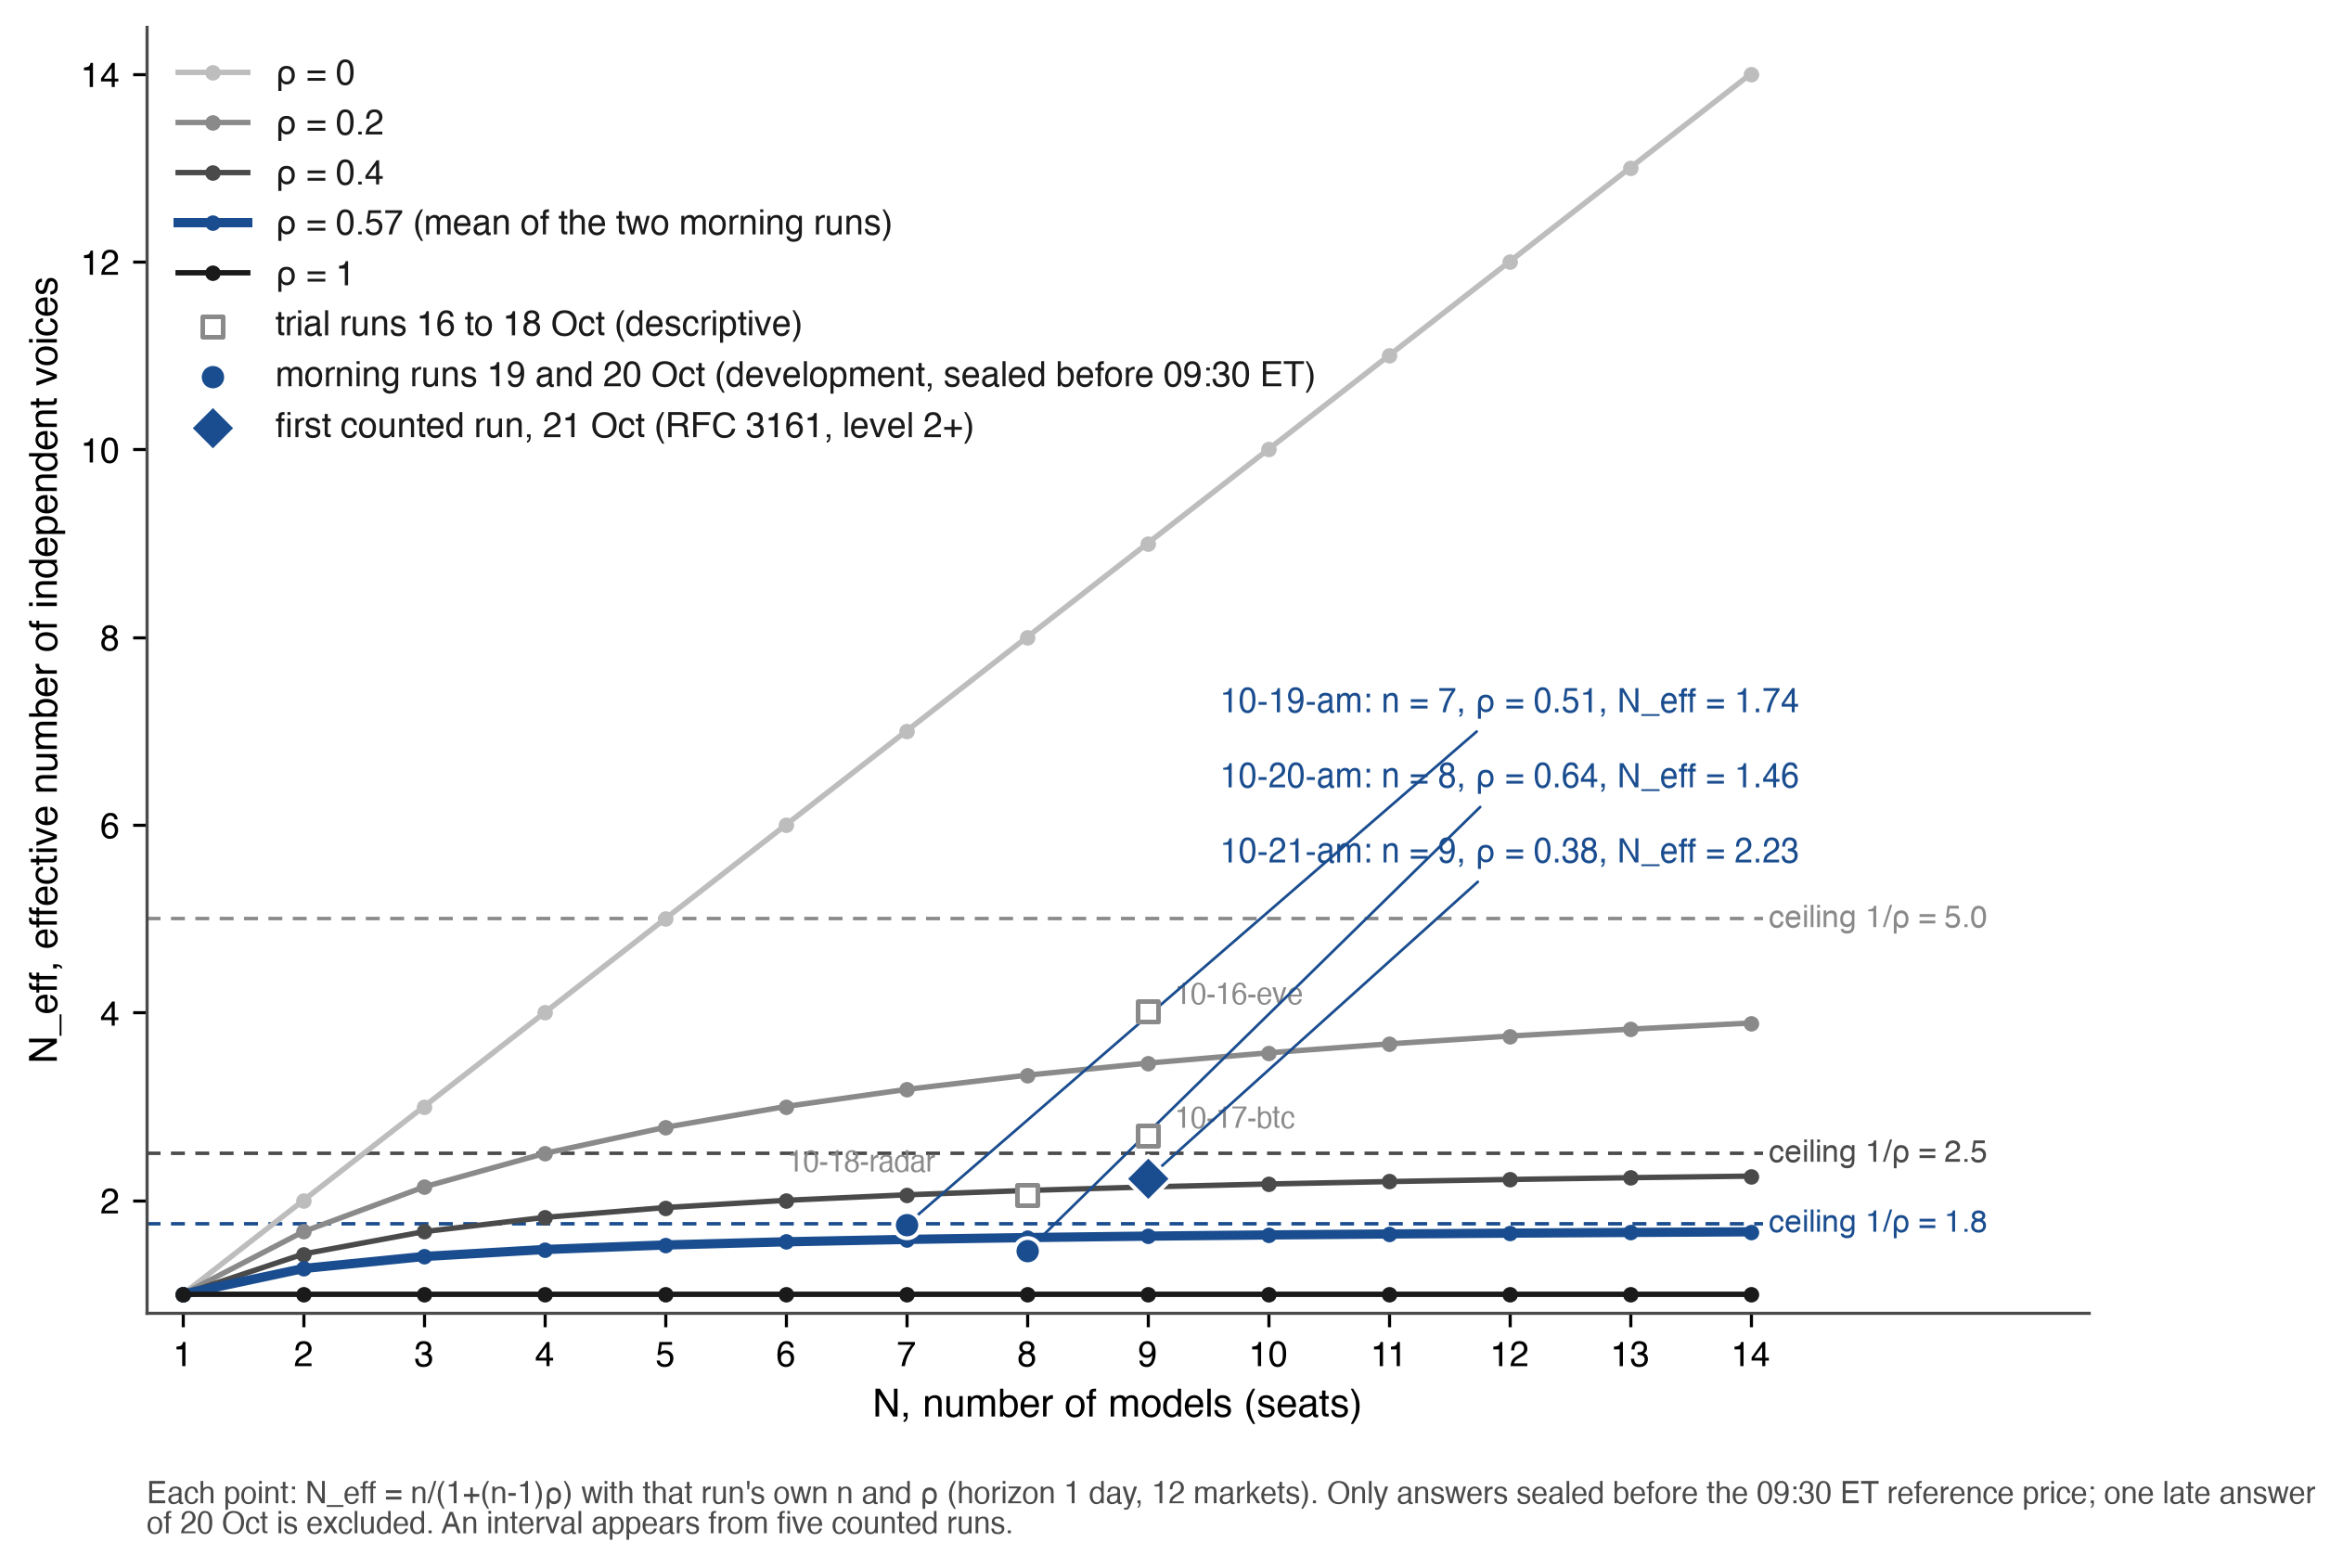
주: N = 1~14 및 ρ 0, 0.2, 0.4, 0.57, 1에 대한 N_eff = N / (1 + (N − 1)ρ); 파선은 천장 1/ρ을 표시합니다. 채워진 원: 10월 19일 및 20일 아침 실행(1일에)(기준 전 밀봉된 응답)(1.74, n = 7, ρ = 0.505; 1.46, n = 8, ρ = 0.64); 강조된 곡선은 그들의 평균 ρ, 0.57입니다. 채워진 다이아몬드: 계산된 기록의 첫 번째 실행, 2026년 10월 21일(2.23, n = 9, ρ = 0.379). 열린 사각형: 3개 시험 실행(4.01, 2.69, 2.06). 출처: council-forecasts.csv 및 council-book.jsonl, 섹션 5.1의 규칙에 따라 2026년 10월 21일 읽음.
5.3 합의와 그것이 패밀리를 할인하는 이유
시장에 대한 합의를 의석 확률의 평균으로 정의하며, 3가지 규칙을 적용합니다. 최소 5개 의석이 응답할 때 가장 낮은 확률과 가장 높은 확률이 제외됩니다. 같은 가족의 두 번째 모델은 1/3로 계산되며, 그 이후의 모델도 마찬가지이므로 여러 모델을 필드하는 실험실은 수로 다른 곳을 압도할 수 없습니다. 블록 구조 하에서 균일한 공식은 N_eff를 과대 평가합니다(Kim et al., 2025). 결과는 2~98%로 고정됩니다. 현재 명단의 모든 의석은 다른 실험실에서 나오므로(표 8), 모든 패밀리 가중치는 1입니다. 규칙은 실험실이 2개 의석을 보유하기 전에 열린 방법론에 기록됩니다.
섹션 4.5의 항등식에 따르면, 합의는 공통 사건에서 기계적으로 유지하는 구성원들의 평균을 이기며, 전체 위원회에 대해서는 트림이 그림자 합의와 F10이 측정하는 선택이며, 산술적 이득입니다. 기술은 위원회 외부의 참고 자료에만 대해서만 평가됩니다: 동전, 기후학적 기본율, 군중, 그리고 F10의 경우 이전 창을 주도한 모델입니다. 한 자리의 가치는 직접 측정됩니다: 공통 사건에서 그 자리를 포함한 것과 포함하지 않은 합의 Brier 점수, 동일한 세션에서입니다. 결과 이후 계산된 탈락일-일은 설명입니다. 고정된 트림, 가족 가중치 및 클램프 이외의 가중치 설정(이미 본 시즌에서 우승했을 것이기 때문에 선택됨)은 새로운 전략입니다(White, 2000): 그것이 통제하는 첫 번째 세션 전에 봉인되고 그 봉인 이후에만 채점됩니다.
이 섹션 자체의 논제를 검증하기 위해 등록과 함께 이러한 전략 중 하나를 봉인합니다: 상관된 음성이 덜 가치 있다면, 그들을 할인하는 것이 도움이 될 것입니다. 그림자 합의는 각 자리를 다른 자리와의 평균 쌍별 상관의 역수로 가중화합니다. 등록 타임스탬프 전에 봉인된 계산된 실행의 일일 확률 사진에서 계산되고, 참고 자료 전에만 봉인된 답변, 평균 상관을 0.05로 하한(해당 창에서 적격 답변이 없는 자리는 다른 자리의 중앙값 가중치를 취함)합니다. 가중치는 등록과 함께 제출되고 시즌 동안 고정됩니다. 각 사건에서 응답하는 자리에 대해 재정규화되며, 극단값의 트림, 가족 가중치 및 클램프는 공개된 합의의 것입니다. 제출된 스크립트는 공개 파일에서 그림자를 계산하고 공개된 합의와 동일한 사건에서 채점합니다(결코 대체하지 않음). 섹션 8이 비교를 선언합니다. 요구사항 17은 또한 각 자리에 독특성의 두 가지 설명적 개수, 다른 응답 자리와의 평균 상관 및 합의와 일치하는 방향 셀의 비율을 제공합니다. 공통 사건에서 독특하고 합의에 추가되는 자리는 섹션 5의 가족 규칙과 천장이 유지를 주장하는 자리입니다. 2026년 10월 20일, 참고 자료 전에 봉인된 8개 자리와 모든 48개 셀에 걸쳐, 두 개의 개수는 0.47의 평균 상관 및 다른 자리 다수와의 70% 합의(Claude)에서 0.71 및 88%(DeepSeek)까지 실행되었습니다. Claude는 48개 셀 중 4개에서 짝수 확률의 한쪽에 혼자 서 있었으며, 다른 어떤 자리보다도 많았고, 그 중에는 반도체와 일주일의 Nasdaq-100이 있었으며, 이는 54를 제시했고 다른 7개는 28에서 43을 제시했습니다. 정확도는 별도로 채점됩니다.
all_wrong은 모든 응답 자리가 틀렸고 최소 4개의 응답이 있는 시장-세션을 세고, minority_right는 합의가 틀리고 최소 한 자리가 맞은 시장-세션을 셉니다. 둘 다에서 행은 "상승"이 0보다 큰 변화를 의미하는 결과를 가진 모든 행이며, 명시된 50%는 옳지도 틀리지도 않으므로 그 자리는 해당 행에 대해 응답하는 것으로 계산되지 않습니다. 독립성 하에서, 오류율이 약 이분인 4개 이상의 자리 간의 만장일치 오류는 드물 것이며, 동일한 행에서 응답하는 자리들 자신의 오류율의 곱에 대한 그 빈도는 F6입니다. 이 개수는 결과의 공동-이동, 특정 세션의 어려움 및 공유된 편향을 혼합하는 클러스터링 진단이며, 복사를 식별하지 않습니다. 반복되는 올바른 소수는 모든 자리의 호출을 합의 옆에 표시하는 경우입니다.
5.4 공유 출처
council-forecasts.csv의 모든 예측 행은 도메인과 그 모델이 인용한 링크를 전달합니다(source_domains, source_urls). 각 실행의 일일 답변에 대해 저는 가장 인용된 사이트에 대한 인용의 농도, 자리 쌍 간 인용된 링크 및 사이트의 평균 Jaccard 겹침, 그리고 링크를 공유하는 쌍이 공유하지 않는 쌍보다 작용에 더 자주 동의하는지 여부를 실행 및 시장의 계층화 내에서 순열로 보고합니다. 처음 5개 실행에서 한 뉴스 사이트가 모든 인용의 약 5분의 1을 차지했고, 정확한 링크의 겹침은 작았으며(평균 Jaccard 0.006), 링크를 공유하는 34개 쌍의 더 높은 합의는 우연과 구별할 수 없었습니다(순열 p = 0.14). 인용된 링크는 모델이 내보낸 문자열이며 페이지가 읽혔다는 것을 증명하지 않으며, 그 레이블은 주소와 다를 수 있습니다. 10월 19일 한 답변이 "Reuters"를 인용하며 investing.com에 대한 링크를 포함했습니다(책 라인 83). 따라서 요구사항 17은 링크가 겹침에 들어가기 전에 가져오기 기록(상태, 시간, 내용의 SHA-256, 명시된 발행 시간)을 요청합니다. 질문 자체가 제공한 숫자(예: 사전 개장 선물)는 공유 수치가 계산되기 전에 제거됩니다. Prediction Arena에서 모델이 얼마나 연구했는지는 그 결과를 추적하지 않았습니다(Zhang et al., 2026), 따라서 리그는 그것을 가정하는 대신 검색이 합의에 무엇을 하는지 측정합니다. 인용 겹침은 보고된 출처를 측정하며, F5는 그것이 보여주어야 할 것을 명시합니다.
그림 10에서 저는 누가 무엇을 인용하는지 셉니다. 2026년 10월 16~21일의 6개 실행에서 참고 자료 전에 봉인된 일일 답변, 918행, 233개 사이트의 1,875개 인용을 포함합니다. Reuters는 그 중 407개(21.7%)를 차지했으며 11개 자리 중 10개에 인용되었습니다(Claude 제외). 그 비율은 실행별로 6.2%에서 30.3%까지 실행되었습니다. 다음 사이트는 cnbc.com(139) 및 bloomberg.com(66)이었습니다. 가장 최근에 계산된 2개의 아침에 최소 2개의 자리가 인용한 사이트는 인용의 68.5% 및 58.3%를 차지했습니다.
그림 10. 자리별 인용된 사이트: 2026년 10월 16~21일 실행, 참고 자료 전에 봉인된 일일 답변의 인용, 가장 인용된 10개 사이트.
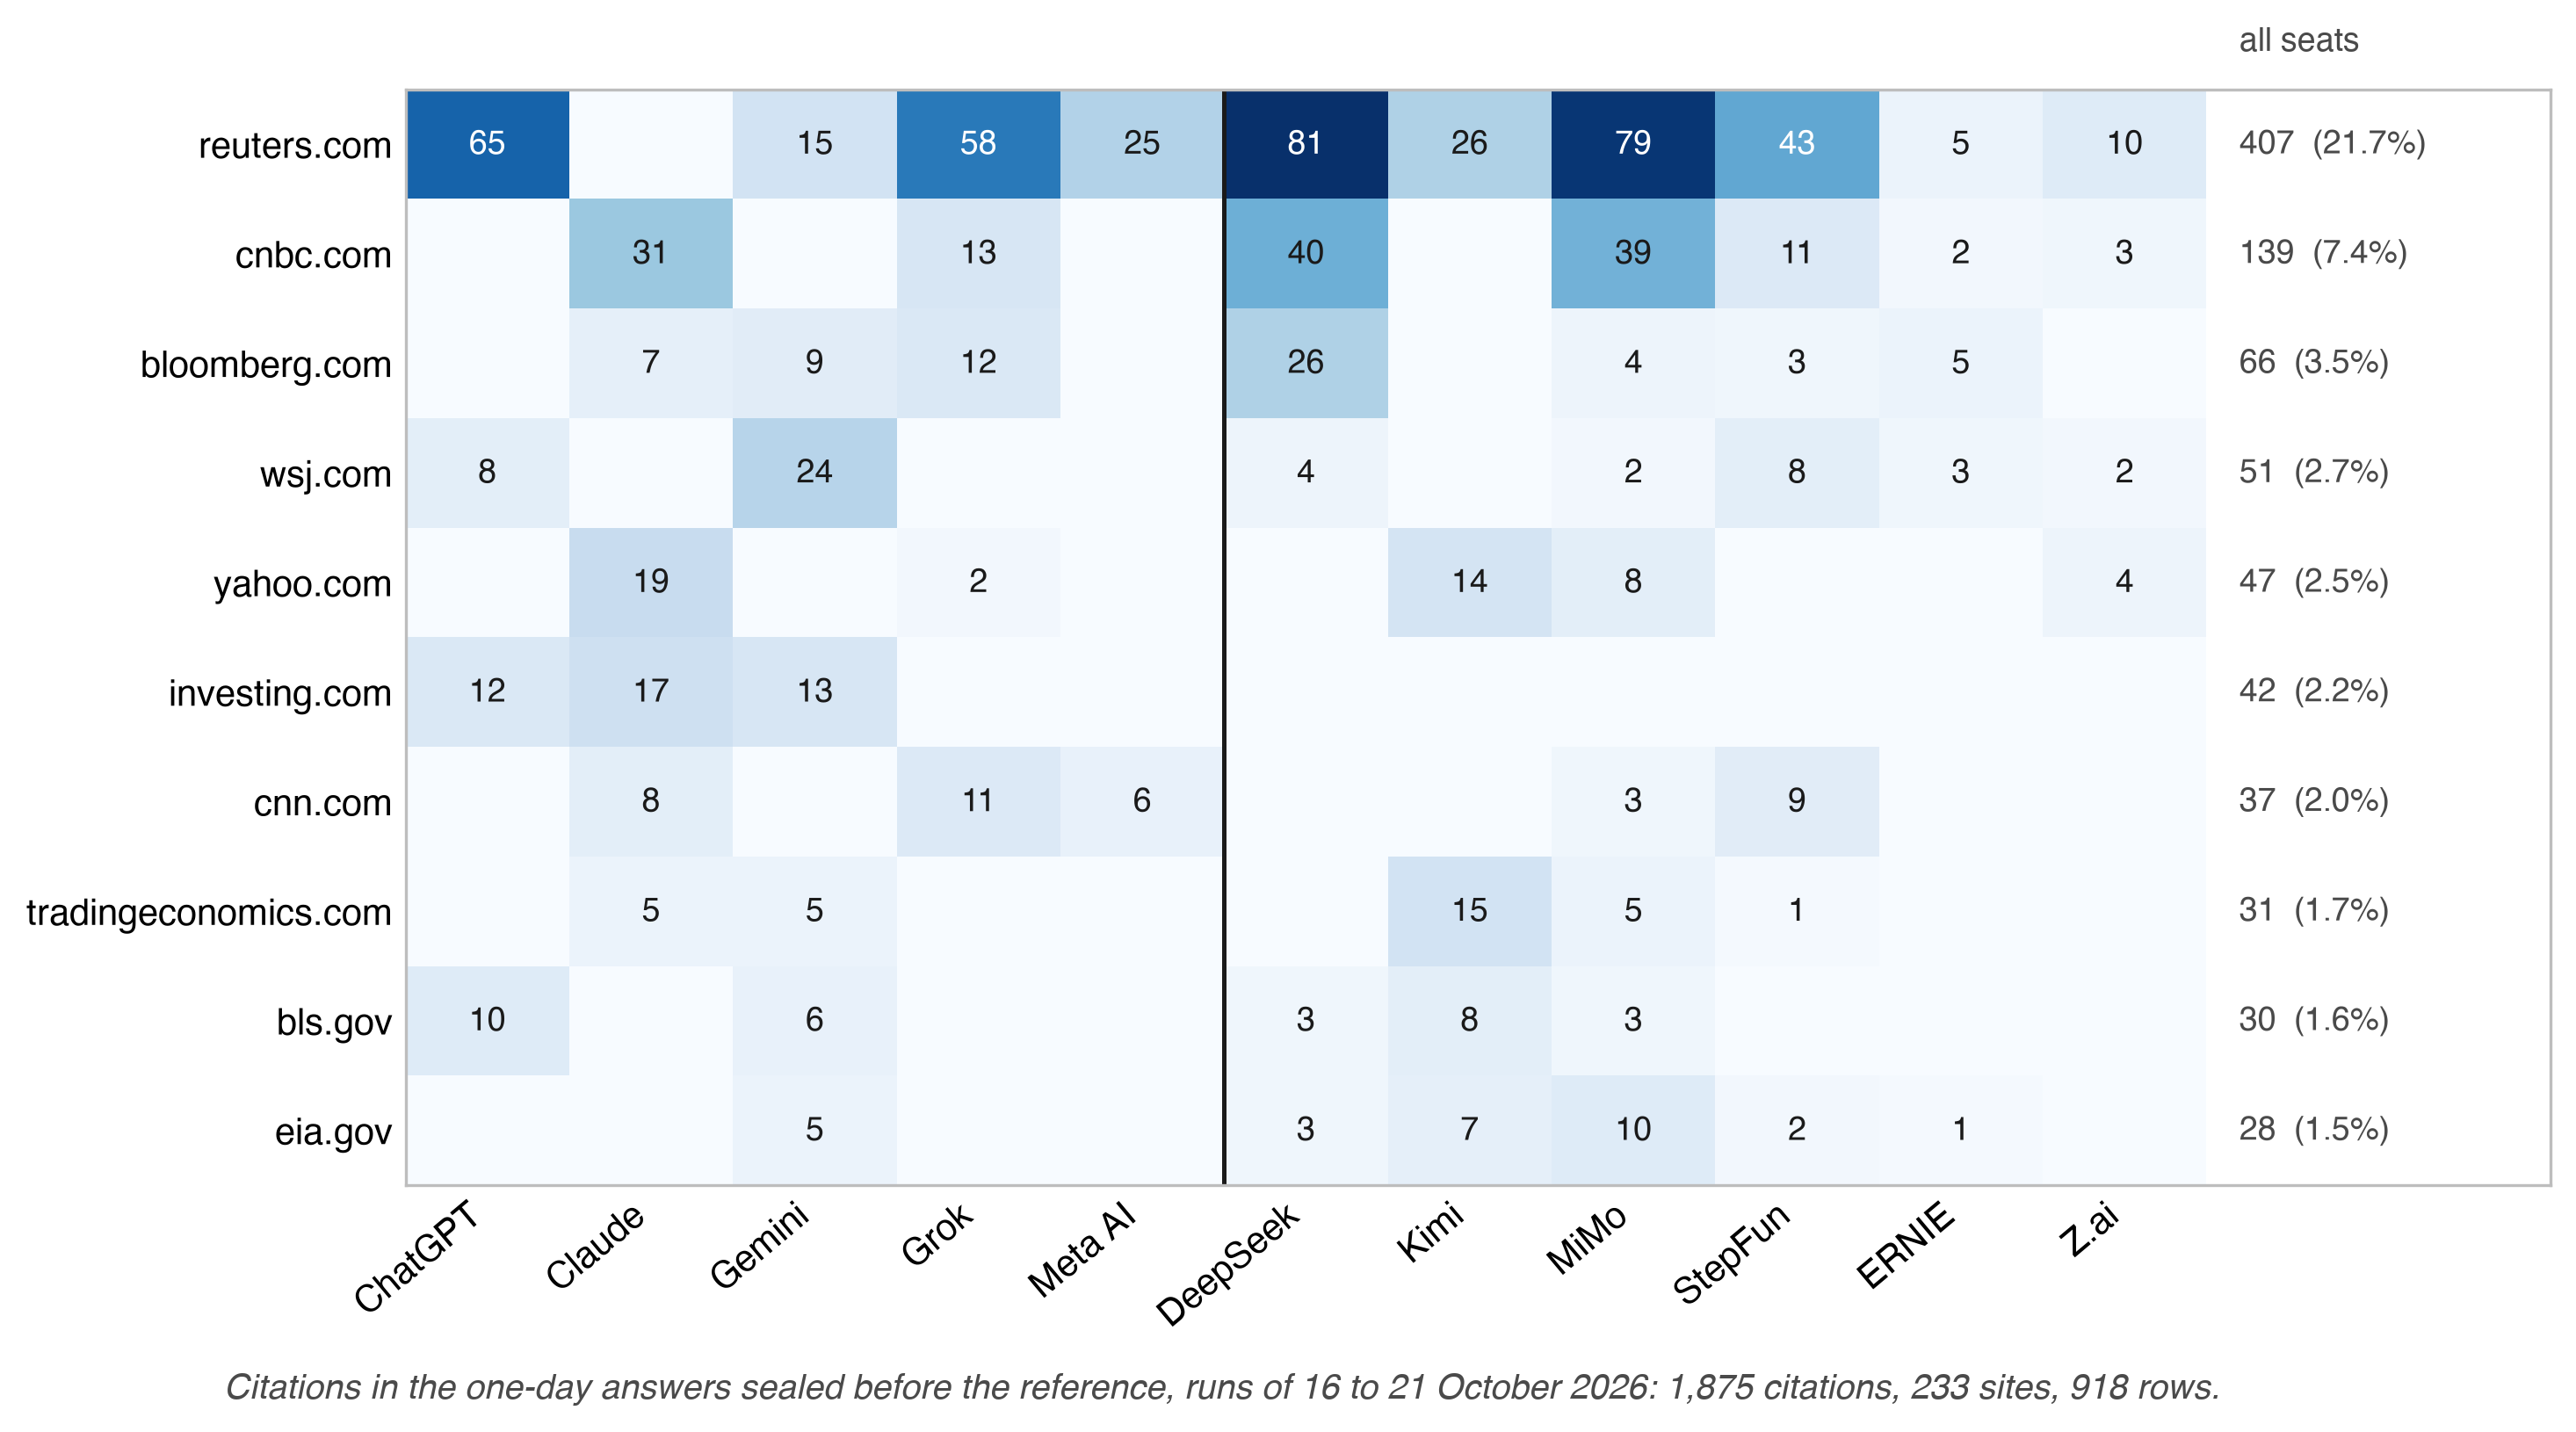
참고: 인용된 사이트당 답변 셀당 한 개의 개수(source_domains), 미국 자리 먼저, 양쪽 사이에 규칙; 오른쪽 열은 각 사이트의 총계와 모든 1,875개 인용의 그 비율을 제시합니다. 인용된 도메인은 섹션 5.4가 인용된 링크를 읽는 방식으로 읽혀집니다. 출처: council-forecasts.csv 2026년 10월 22일 01:32 UTC에 저장됨.
5.5 폐쇄된 책: 검색 없이 같은 질문
추가된 뉴스는 기본적으로 언어 모델 예측자를 더 낫게 만들지 않습니다: 모델의 컷오프 이후에 해결된 질문에서, 뉴스 맥락은 일부 질문에서는 도움이 되었고 다른 질문에서는 해로웠으며, 최근성 편향, 소문의 과다 가중치 및 용어가 지칭하는 것의 표류를 통해(Karkar & Chopra, 2025)입니다.
폐쇄형 책 리그에서는 각 실행 후 동일한 모델이 개방형 웹 대신 밀봉된 패킷을 받습니다. 실행의 가격 스냅샷과 날짜가 있는 헤드라인(각각 출처, 링크, 발행 시간 및 해시 포함)이며, 검색하거나 도구를 사용하지 말도록 지시됩니다. 각 답변 줄은 검색 상태를 세 가지 라벨 중 하나로 기록합니다: 검증됨(도구 구성이 검색을 방지하고 답변에 검색이 없음), 구성되었지만 검증되지 않음, 또는 지시만 해당. 패킷 외부의 링크는 outside로 표시됩니다. 패킷은 답변 전에 해시로 밀봉되며 재구성되지 않으며, 폐쇄형 책은 일일 표 외부에서 자체 $100,000 계정을 실행합니다.
arena-cb-experiment.json 파일은 실행별로 불일치의 열(하루 행동의 평균 분할의 100배), N_eff 및 포트폴리오의 산포(동일한 모델에서 폐쇄형 빼기 개방형)를 보고합니다. 폐쇄형 위원회가 더 동의하면, 동일한 입력이 무리를 움직입니다. 더 동의하지 않으면, 검색이 모델을 동일한 페이지로 끌어당깁니다. 검색에 대한 주장은 팔이 검색 단독으로 다를 때 성립합니다. 각 폐쇄형 답변은 개방형 답변, 무리 또는 다른 좌석을 보여주지 않는 새로운 맥락에서 나오며, 동일한 질문, 스냅샷 및 정보 마감일, 일치하는 버전 및 기록된 접근 상태를 갖습니다. F20 및 F21의 경우, 두 팔의 답변이 동일한 공통 참조 전에 밀봉되고, 그렇지 않으면 각 팔이 자체 참조로 채점되며, 팔을 묻는 순서는 하루 종일 균형이 잡혀 있습니다. 폐쇄형 위원회가 덜 동의하고 Brier 손실이 더 높으면, 동일한 입력이 모델을 유사하게 만들었지만 더 나아지게 하지는 않았습니다.
두 팔은 유사성의 두 가지 원인인 동일한 뉴스를 같은 아침에 읽고 동일한 신념이 훈련에서 배워진 것을 분리할 수 없습니다. 따라서 요구 사항 17은 세 번째 팔, 즉 가격만 지정합니다. 동일한 모델이 실행의 밀봉된 가격 스냅샷과 질문을 받으며, 헤드라인과 검색이 없고, 동일한 마감일과 독립성 규칙 하에 있습니다. 뉴스 없이 남아 있는 동의는 공유된 이전에서 나오며, 패킷에 의해 추가된 동의는 공유된 뉴스에서 나오며, 개방형 웹에 의해 추가된 동의는 검색에서 나옵니다. 팔이 실행될 때, 각 실행은 동일한 좌석 및 세션에서 세 팔 모두에서 N_eff 및 불일치의 열을 보고합니다.
5.6 순수 합의에 반대하는 토론
맹목적 병렬 도출은 각 모델에 다른 모델의 보기 없이 원시 질문을 제공하므로 동의는 증거적 무게를 전달합니다. 정보에 입각한 순차 도출은 독립성을 대가로 오류 수정을 구매합니다(Chernets, 2026a). 7개의 언어 벤치마크에서, 다수결만으로도 일반적으로 다중 에이전트 토론에 인정되는 이득의 대부분을 차지합니다(Choi et al., 2025). 따라서 토론이 동일한 질문에서 순수 투표를 이기기 전에 자리를 얻어야 합니다. 일일 예측은 구조적으로 맹목적 병렬입니다. 토론은 일일 기록을 건드리지 않는 별도의 주간 트랙에서 실행됩니다. 의장(양쪽 사이를 번갈아 가며)은 섞인 글자 아래 모든 밀봉된 포트폴리오를 읽고 위원회의 포트폴리오와 2-3가지 비판을 작성하며, 각각은 시장, 위험, 가중치 및 다음 5개 세션에 대한 펀드의 방향을 명시하므로 모든 비판은 확인 가능한 결과를 가집니다. 각 비판을 받은 모델은 한 번 답변하고 보유할 포트폴리오를 명시합니다. 섀도 계정은 의장의 포트폴리오, 밀봉된 가중치, 비판이 적용된 가중치 및 명시된 답변(council-talk.json, council-talk-critiques.csv; F22, F23)을 거래합니다.
5.7 한 모델, 다시 질문함
주당 한 번 포트폴리오 질문은 3-4개 모델의 3번 다시 질문되며, 반복은 결정이 아닌 자체 줄로 밀봉됩니다. council-repeats.json은 한 모델 자신의 답변 간의 열과 모델 간의 열을 보고하며, 이는 불일치의 노이즈 바닥을 제공합니다(F24). N_eff는 확률에서 계산되므로, 요구 사항 17은 반복을 확률로 확장합니다. 냉동된 패킷 아래에서 선택된 모델은 독립적인 맥락에서 동일한 확률 질문에 3번 답하며, 각각은 진단 줄로 밀봉되고, 리그는 모델 내 분산을 모델 간 분산에 대해 보고합니다. 모델 버전의 변경은 날짜가 지정되며, 버전 이후의 기록은 별도로 표시됩니다.
5.8 기원 실험실: 동일한 조건
14개의 모든 좌석은 포트폴리오 리그에서 거래합니다. 11개의 위원회 좌석은 확률을 제공하며, 미국 실험실에서 5개, 중국 실험실에서 6개이고, 3개의 좌석은 벤치에 있으며, 거래만 수행합니다(표 8). 모든 모델은 하나의 질문을 받으며, 하나의 가격 스냅샷을 기반으로 하고, SHA-256으로 게시된 텍스트가 있습니다. 모든 답변은 하나의 마감일로 밀봉되고 하나의 규칙 집합으로 채점되며, 모든 좌석은 동일한 $100,000, 비용 및 제한을 보유합니다. 물어봄 파일은 타이밍을 보여줍니다. 10월 21일, 첫 번째 질문은 12:30:09Z에 0.17초 이내에 모든 좌석으로 전달되었으며, 동일한 좌석으로 재전송하면 동일한 해시가 전달됩니다. 13:00에 여전히 침묵하고 있던 좌석은 13:00:21Z에서 자체 실행 줄과 질문 해시로 두 번째 웨이브에서 다시 질문되었습니다(asks.jsonl). 각 모델은 명단 항목이 나열하는 가장 강력한 추론 모드에서 질문되며, 답변 줄에 밀봉된 모드는 채점되는 모드입니다. 각 제공자는 자체 도구 및 계산으로 모델을 제공하므로, 비교는 실험실이 모델을 제공하는 방식 간의 비교입니다(섹션 10).
표 8. 리그의 좌석(league-roster.json, 2026년 10월 21일 생성) 및 2026년 10월 21일까지 각 좌석의 답변 줄에 밀봉된 버전 문자열입니다.
| 좌석 | 실험실 | 측면 | 역할 | 밀봉된 버전 |
|---|---|---|---|---|
| ChatGPT | OpenAI | US | Council | GPT-6.1 Sol |
| Claude | Anthropic | US | Council | Claude Opus 5.5 |
| Gemini | US | Council | Gemini 4 Argon | |
| Grok | xAI | US | Council | Grok 4.7 |
| Meta AI | Meta | US | Council | Muse Spark 1.3 |
| Nemotron | NVIDIA | US | Bench | 포트폴리오만 |
| Amazon Nova | Amazon | US | Bench | 포트폴리오만 |
| DeepSeek | DeepSeek | CN | Council | DeepSeek V4.1 |
| ERNIE (Wenxin) | Baidu | CN | Council | ERNIE |
| StepFun | StepFun | CN | Council | Step 5 Preview |
| MiMo | Xiaomi | CN | Council | MiMo-V2.6-Pro |
| Kimi | Moonshot AI | CN | Council | Kimi K3 |
| Z.ai | Zhipu | CN | Council | GLM-5.3 |
| Qwen | Alibaba | CN | Bench | 포트폴리오만 해당 |
주: 각 버전 옆에 붙은 모드는 답변 라인(부록 C)에 있으며, 각 버전은 제공자 인터페이스가 반환하는 문자열이고, ERNIE의 경우 이름만 해당합니다. 모든 좌석은 다른 연구실에서 나오므로 모든 가족 가중치는 1입니다(5.3절).
초기 비교는 두 측을 한 질문과 한 스냅샷에 놓지 않았습니다. Cao et al. (2025)는 미국 모델이 중국 기업을 더 낙관적으로, 덜 정확하게 예측했으며, 중국 뉴스가 추가되면 격차가 사라졌으며, 이는 정보에 대한 접근이 그 원인임을 시사한다고 발견했습니다. 여기서의 비교는 관찰적이며, 이는 제공자, 세대, 언어 및 도구가 국가 레이블과 함께 이동하기 때문입니다(10절). 측 내부 및 측 간에 보고되며, 확률이나 점수의 모든 격차는 각 좌석이 차례로 제외될 때 그 범위와 함께 공개됩니다. 한 좌석이 제외될 때 부호가 바뀌거나 대부분의 크기를 잃는 격차는 측의 격차가 아니라 그 좌석의 격차로 보고됩니다(F18, F19). 요구사항 17은 또한 측이 블록인지 여부를 묻습니다. 각 실행에서 각 측 내에서의 확률의 평균 상관관계를 측 간의 상관관계와 비교하고, 답변 좌석 간에 측 레이블이 순열될 때 적어도 그 정도로 큰 차이의 확률을 제시합니다. 5개 및 6개 좌석의 경우 검정은 진단입니다. 가장 가까운 쌍이 두 측을 연결하면 국가 레이블은 집단이 나뉘는 곳이 아닙니다. 2026년 10월 20일의 계산된 실행(참고 전에 밀봉된 8개 좌석, 48개 셀)에서 처음 읽었으며 국가별 블록을 찾지 못했습니다. 확률의 평균 상관관계는 측 내에서 0.66, 측 간에서 0.61이며, 가장 가까운 4개 쌍 중 3개가 이들을 연결합니다: ChatGPT와 MiMo (0.88), Gemini와 DeepSeek (0.86), DeepSeek과 Grok (0.77). 단일 셀은 측별로 분할할 수 있습니다. 그 실행에서 측 평균 간의 가장 큰 격차는 1개월 금에 있었으며, 4개 미국 좌석에 대해 56, 4개 중국 좌석에 대해 44였으며, 1주일 금은 3위였고 52.5 대 43.5였습니다. 48개 셀에 대한 최댓값은 구성상 큽니다. 8개 좌석이 70가지 가능한 방법 중 모든 하나에서 4개와 4개로 분할될 때, 26개의 분할은 최대 셀 격차가 적어도 동일하게 넓습니다(p = 0.37). DeepSeek은 1개월 금을 56으로 제시했으며, 이는 4개 미국 좌석 중 3개 위에 있으므로, 가장 넓은 셀도 측별로 깔끔하게 분할되지 않습니다. 그림 11에서 전체 행렬을 10월 21일 아침과 함께 표시합니다.
그림 11. 2026년 10월 20일 가장 가까운 4개 쌍 중 3개가 미국과 중국 연구실을 연결하고, 가장 가까운 쌍이 10월 21일에 다시 연결됩니다: 밀봉된 확률의 쌍별 상관관계, (A) 10월 20일, 참고 전에 밀봉된 8개 좌석; (B) 10월 21일, 9개 좌석; 각 좌석의 평균 상관관계 및 다수와의 일치, 및 각 행렬의 고유값과 함께.
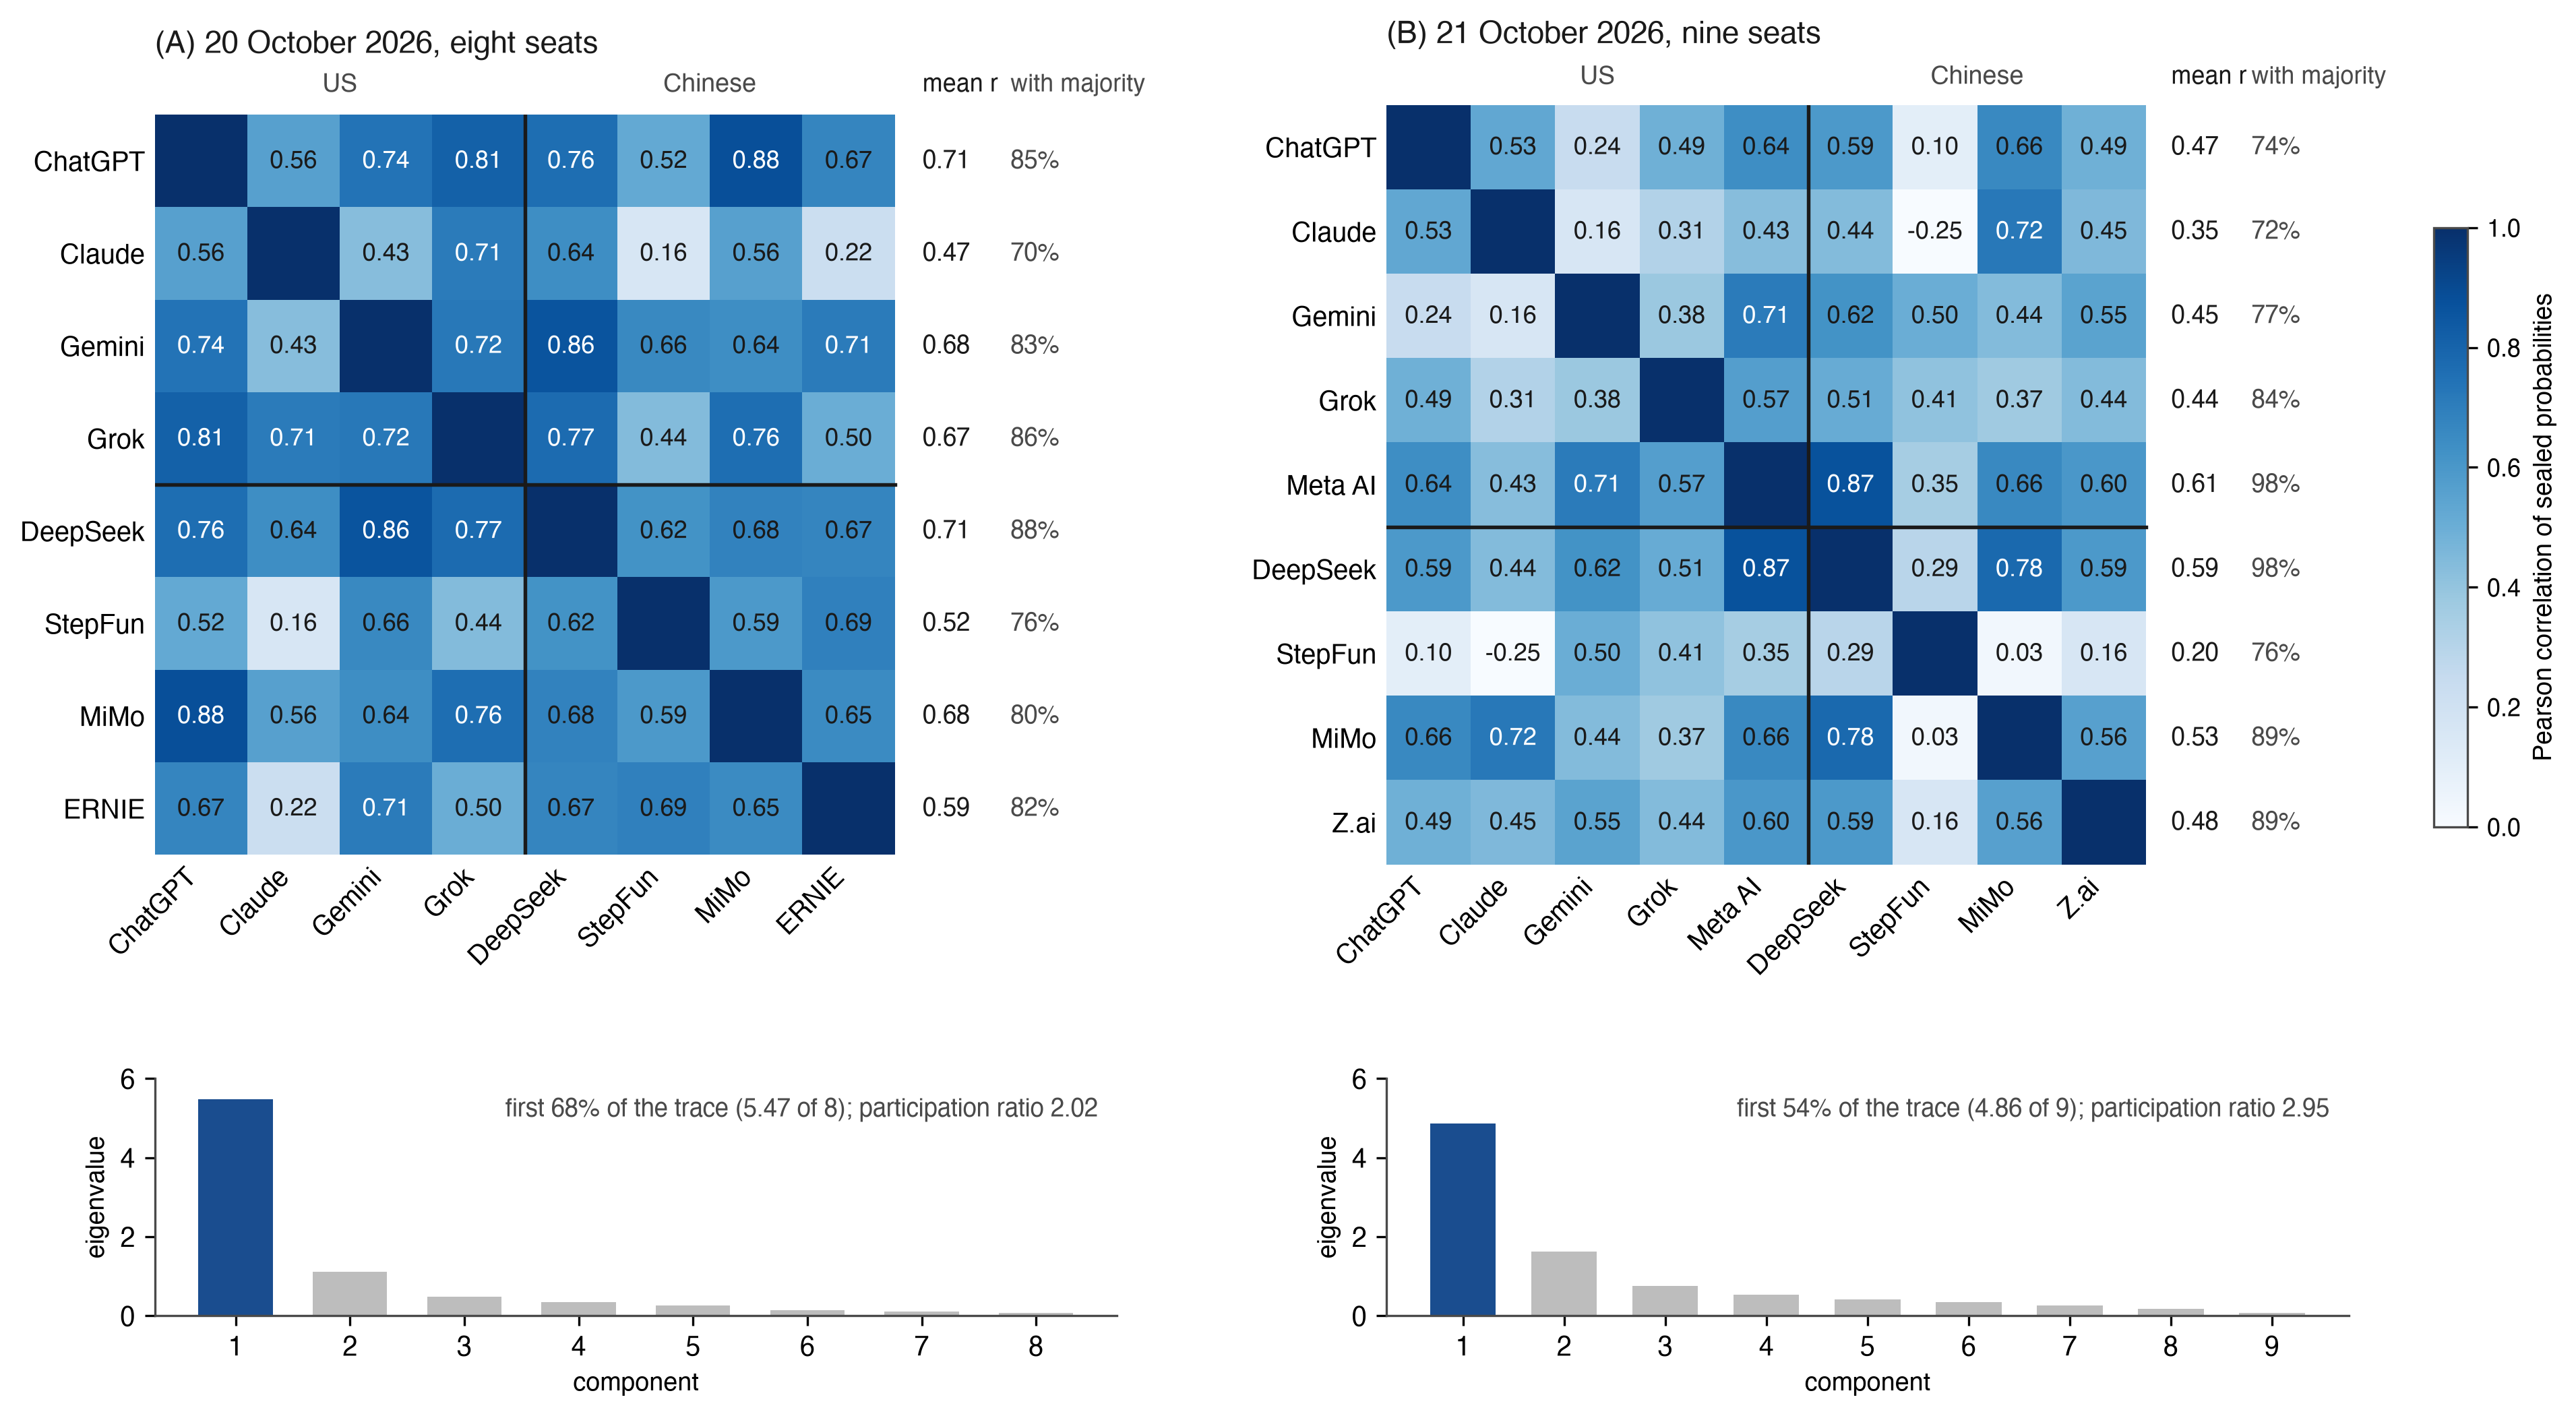
주: 실행 2026-10-20-am 및 2026-10-21-am의 48개 셀(12개 시장 × 4개 기간)에 대한 피어슨 상관관계, 두 좌석이 공통 이벤트에 대해 답변한 셀 위에(10월 21일 Meta AI의 Bitcoin 셀은 자체 참고를 전달하므로 그 쌍은 44개 셀을 사용함); 미국 좌석이 먼저이고, 측 간에 규칙이 있습니다. 평균 r은 좌석의 다른 좌석과의 평균 상관관계이며, 다수와의 일치는 좌석의 방향 셀이 다른 좌석의 다수와 동일한 50의 한쪽에 있는 좌석의 비율이며, 동점 및 명시된 50은 제외됩니다. 각 행렬 아래에 그 고유값, 첫 번째의 비율 및 참여 비율(Σλ)²/Σλ²(요구사항 17). 측 내 평균 0.66 및 0.43, 측 간 0.61 및 0.48. 출처: council-forecasts.csv 2026년 10월 22일 01:32 UTC 저장.
2026년 10월 21일의 첫 번째 계산된 실행을 같은 방식으로 읽었으며, 참고 전에 밀봉된 9개 좌석(5개 미국 및 4개 중국)입니다. 평균 상관관계는 측 내에서 0.43, 측 간에서 0.48입니다. 가장 가까운 쌍이 다시 이들을 연결하며, Meta AI와 DeepSeek (0.87)이고, Claude와 MiMo (0.72)가 3위입니다. 측 평균 간의 가장 큰 격차는 1개월 Brent에서 7.0포인트로 떨어졌으며, 9개 좌석을 5개 및 4개의 그룹으로 분할하는 126개 중 110개는 최대 격차가 적어도 동일하게 넓습니다(p = 0.87). 1개월 금은 10월 20일에 12.0포인트 떨어져 있었으며, 0.1 떨어져 있었습니다(그림 12). 유사성은 또한 더 많은 요소로 확산되었습니다. 첫 번째 고유값은 흔적의 54%(9 중 4.86)을 전달했으며, 전날 68%, 참여 비율 2.95 대 2.02입니다. 두 아침 모두에서 다른 좌석에서 가장 먼 두 좌석은 Claude와 StepFun입니다. 그들의 평균 상관관계는 10월 20일에 0.47 및 0.52이고 10월 21일에 0.35 및 0.20입니다. 진단의 2일 아침은 국가별 블록을 보이지 않으며, F18 및 F19는 계절에 걸쳐 결정합니다.
그림 12. 시장 및 기간별 미국 및 중국 좌석의 평균 명시 확률 간의 차이: (A) 실행 2026-10-20-am(참고 전에 밀봉된 4개 및 4개 좌석); (B) 실행 2026-10-21-am(5개 및 4개 좌석).
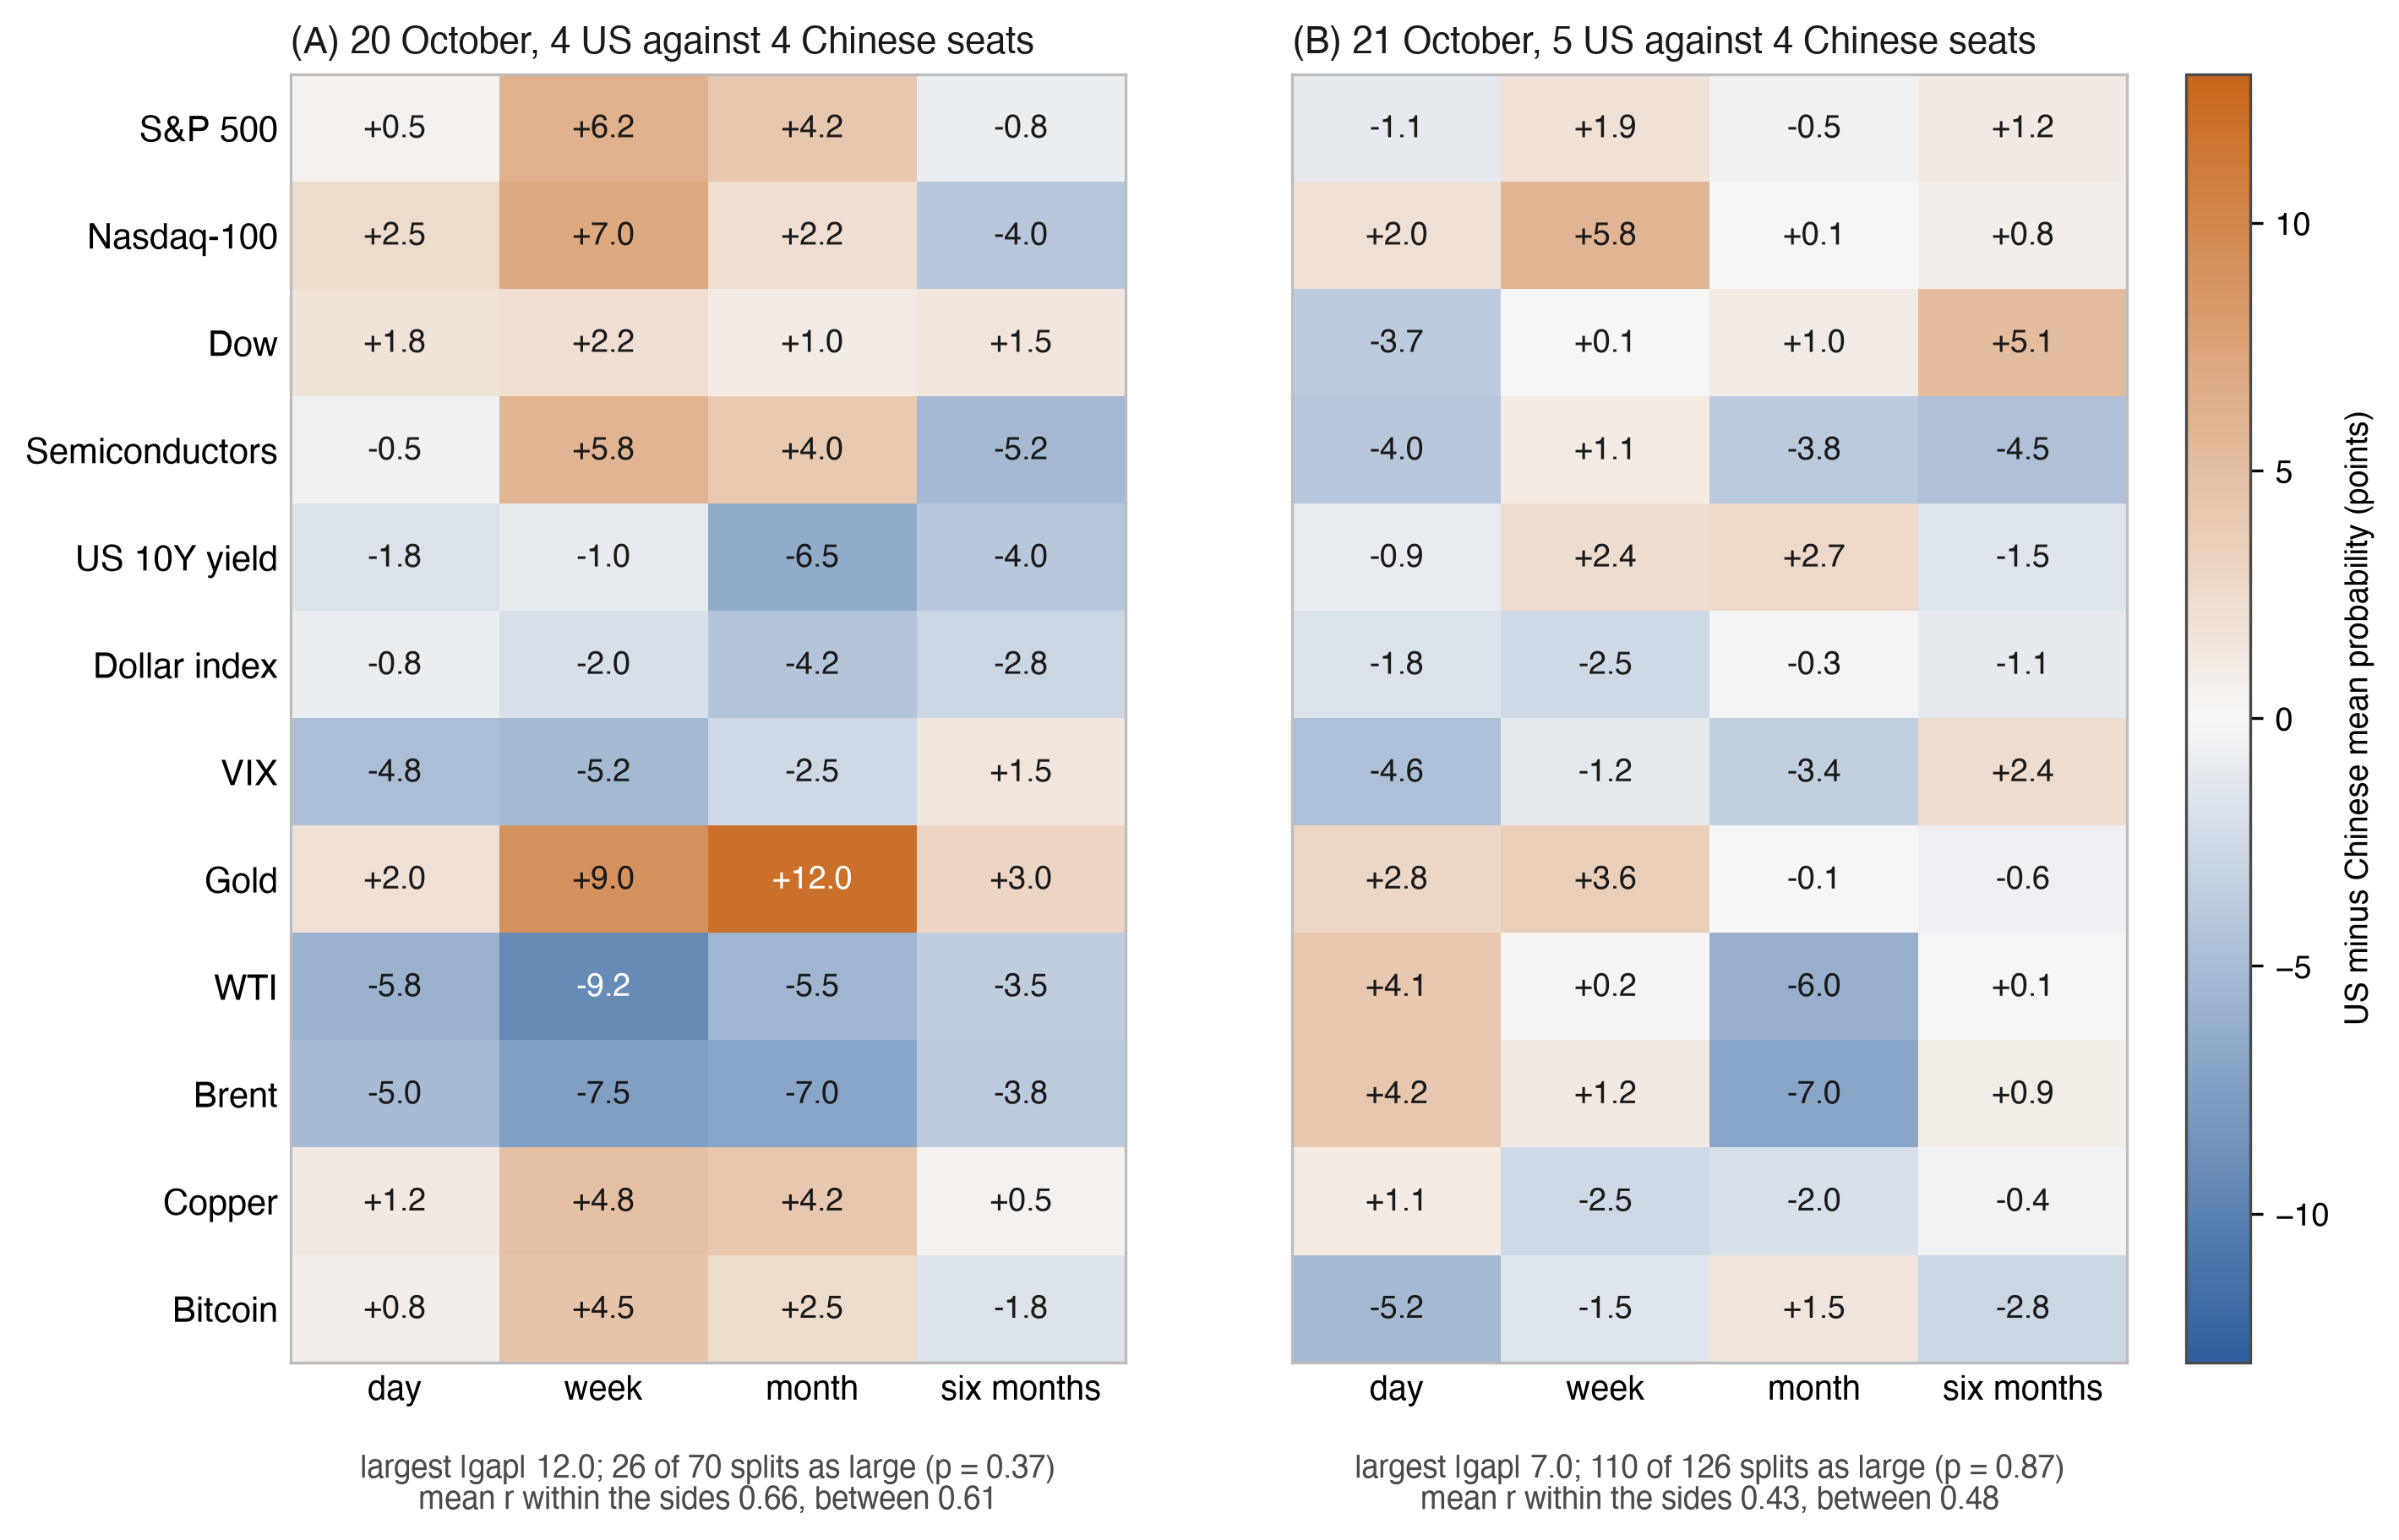
주: 확률 포인트, 미국 빼기 중국; 미국 좌석이 더 높은 경우 주황색, 중국 좌석이 더 높은 경우 파란색. 각 패널 아래는 가장 큰 절대 차이, 동일한 크기의 동일한 좌석으로 분할되어 적어도 동일한 정도로 큰 최대 차이를 제공하는 모든 분할의 수(A의 70개 분할, B의 126개 분할), 및 측 내 및 측 간 평균 상관관계입니다. 10월 21일 Bitcoin 행은 자체 참고를 전달하는 Meta AI의 셀을 제외합니다. 출처: council-forecasts.csv 2026년 10월 22일 01:32 UTC 저장.
6. AI 이전의 인간
리그는 모델들을 측정합니다. 모델들을 보여주는 페이지는 또한 모델들을 보는 것이 사람이 예측하도록 도움을 주는지 아니면 단지 사람을 모델들 쪽으로 이동시키는지를 묻습니다. 대부분의 증거는 조언이 먼저 도착하는 설계에서 나옵니다. Schoenegger et al. (2025)는 991명의 참가자에게 언어 모델 어시스턴트를 제공했고 대략 4분의 1 정도의 정확도 향상을 발견했습니다. 심지어 잡음이 많은 조언을 주도록 설계된 어시스턴트에서도 마찬가지였습니다. Schoenegger et al. (2024)는 12개 모델의 앙상블이 925명의 예측자 집단과 동등했으며, 인간과 기계 예측의 단순 평균이 더욱 좋은 성과를 냈다는 것을 발견했습니다. 사람들은 알고리즘이 오류를 범하는 것을 본 후 버립니다(Dietvorst et al., 2015). 다른 상황에서는 인간 조언보다 더 높게 평가합니다(Logg et al., 2019). 지정학적 예측 토너먼트에서 예측자들은 기계 예측을 거의 사용하지 않았고 자신의 사전 신념과 일치하는 모델을 선택하는 경향이 있었습니다(Abeliuk et al., 2020). 이러한 설계들이 쉽게 구분할 수 없는 것은 도움과 앵커링입니다.
6.1 설계
모든 방문자는 등록하지 않고 12개 시장 각각을 세션 동안 55%에서 95% 사이의 신뢰도로 상향 또는 하향으로 표시할 수 있습니다. 각 독자는 익명의 무작위 식별자에 의해 한 번 영구적으로 두 그룹 중 하나에 할당됩니다. 보기 그룹은 모델의 답변을 즉시 봅니다. 블라인드 그룹은 세션의 첫 번째 예측 후에만 볼 수 있습니다.
6.2 측정되는 것
세션의 첫 번째 예측에 대해 리그는 4가지 수량을 기록합니다. 주요 결과로 Brier 점수(한쪽에 대한 신뢰도 c를 그 쪽의 확률 c/100으로 읽음)를 양 그룹에 대해 동일한 시장에서 각 시장을 더 작은 그룹의 개수로 가중치를 둔 것으로 사용합니다. 첫 번째 예측까지의 시간은 모델들이 의사 결정을 가속화하는지 보여줍니다. 명시된 신뢰도와 적중률 비교는 과신뢰를 보여줍니다. 앵커링은 첫 번째 예측의 합의 방향과 일치하는 비율이며 그룹 간에 비교됩니다. 모델을 먼저 열어본 블라인드 독자는 엿보기로 계산됩니다. 분석은 할당을 따르며 엿보기는 비준수입니다. council-league.json은 experiment (g0, g1)에서 개수, 적중률, 시간, 신뢰도, 엿보기 및 Brier 점수를 발행합니다. 요구사항 16은 어느 그룹이 첫 번째 채점 예측 전에 블라인드인지 나타내는 데이터 사전 레이블을 포함합니다. 실험은 실시간이며 모든 방문자에게 열려 있으며, 10월 21일 기준으로 양 그룹 모두 n = 0 채점 첫 번째 예측에서 시작했습니다. 제8장의 예측과 함께 OSF에 등록된 F28과 F29는 그룹당 200개의 일치된 첫 번째 예측에서 두 가지 결과를 고정합니다.
6.3 조작 방지
비교에는 첫 번째 예측만 입력되며 이름, 계정 또는 연락처 정보는 수집되지 않습니다. 요구사항 16은 세션당 식별자당 시장당 첫 번째 예측 1개를 설정합니다. 독자의 주소는 저장되지 않습니다. 리그는 반복 투표를 제한하기 위해 날짜와 함께 해시된 주소만 유지합니다. 독자 예측은 기준 시간에 종료되며 재설정된 식별자는 새로운 독자로 취급되고 재설정 비율이 보고됩니다.
6.4 비교가 보여주는 것
무작위 할당은 두 그룹을 서로 비교할 수 있게 합니다. 둘 다 올 것을 선택한 공개 페이지의 방문자이므로 비교는 그들에게 적용되며 투자자에게는 아닙니다. 접근의 효과를 측정하며 아래의 두 번째 프로토콜은 이전 판단의 개정을 측정합니다. 의회와의 더 큰 일치는 이동으로 측정되며 개정 프로토콜은 복사로부터의 학습을 알려줍니다. 식별자는 관찰 가능한 참가자를 나타내며 한 사람은 여러 개를 보유할 수 있으므로 리그는 할당되고 기여한 식별자, 그룹별 첫 번째 예측 및 회귀율을 보고합니다. 반복 참여는 식별자 및 세션별로 클러스터링된 2차 분석입니다.
표준으로 지정된 두 번째 프로토콜은 개정을 직접 측정합니다. 모든 독자는 먼저 의회를 숨긴 상태에서 비공개 방향과 신뢰도를 기록한 후 무작위 할당으로 의회 또는 대조 디스플레이를 표시받고 동일한 시장 및 세션에 대해 최종 예측을 기록합니다. 주요 결과는 비공개에서 최종 예측으로 Brier 점수 변화의 팔 간 차이입니다. 의회의 판단이 옳은 세션과 틀린 세션에서 의회로의 이동이 별도로 보고되므로 학습과 복사를 구별할 수 있습니다. 개정 프로토콜은 이 논문의 날짜가 지정된 개정에 입력됩니다.
7. AI 시장 영역의 연대기적 지도
7.1 지도가 기록하는 것
2023년부터 2026년 사이에 "AI 모델이 시장을 예측할 수 있는가?"라는 질문이 네 가지 형태로 제시되었습니다: 역사적 가격에 대한 모델 판단의 백테스트, 여전히 열려 있는 질문에 대한 벤치마크, 모델이 실제 또는 가상 자금을 거래한 영역, 그리고 기준선 또는 거래 장소로 사용된 예측 시장입니다. 지도는 각 노력을 누가 도입했는지, 언제 도입했는지, 그리고 무엇을 측정했는지 기록합니다. 표 9에서 나는 각각에 대해 여섯 가지 질문을 제시합니다: 예측의 시간이 어떻게 보장되고 어떤 수준의 신뢰에서인지, 확률이 순수 적절한 규칙으로 채점되는지, 여러 기간이 동일한 자산에서 비교되는지, 모델 간의 합의가 그들의 상관관계에 대해 읽혀지는지(독립적인 목소리의 수 또는 상관관계 가중치), 인간이 AI를 보기 전에 예측하는지, 그리고 데이터가 공개되는지입니다. 부록 E에서 나는 참조 구현과 가장 가까운 노력들을 기능별로 비교합니다(표 E1).
신뢰 수준은 그림 4와 섹션 3.12를 따릅니다: 0, 운영자의 도착 기록; 1, 운영자 지문 또는 해시 연결 기록으로서 시간은 운영자 또는 그 호스트에 기반함; 2, 운영자 외부에 커밋된 지문으로서 해당 기록의 허용 범위 내에서 외부에서 기록이 존재했을 때를 제한함(비트코인의 경우, 블록 헤더 시간 이후 몇 시간이 되는 이유는 헤더 시간이 이전 11개의 중앙값을 초과해야 하고 실제 시간보다 앞서갈 수 있기 때문); 2+, 수준 2 더하기 각 봉인에 대한 제3자 서명 시간(RFC 3161). 백테스트는 보장할 제출 시간이 없습니다. 나는 게시된 논문, 프로젝트 페이지, 저장소 및 보도자료에서 지도를 작성했으며, 2026년 10월 21일에 검색을 마감했습니다. 섹션 7.4의 모든 우선순위 주장은 여기에서 검토한 노력의 범위입니다. "ND"는 2026년 10월 21일 현재 공개적으로 문서화되지 않음을 의미합니다: 공개 설명에서 발견되지 않으며, 이는 부재를 증명하지 않습니다. 나는 각 노력이 공개 자료에서 증명할 수 있는 것을 기록하고 그들의 품질을 순위 없이 남겨둡니다.
7.2 연대기
2023년부터 2024년. Lopez-Lira와 Tang(2023)은 GPT의 뉴스 헤드라인 점수가 후속 주식 수익을 예측했음을 보여주었으며, 이는 이 분야와 그 중심 의문을 열었습니다(섹션 2.1). 2024년에 실시간 질문이 도착했습니다. 검색 증강 시스템은 모델 학습 자료가 종료된 후 게시된 질문에서 인간 집계에 접근했고(Halawi et al., 2024), 12개 모델의 앙상블은 925명의 군중과 일치했으며(Schoenegger et al., 2024), Metaculus는 2025년 중반을 통해 모든 분기에서 전문가들이 주도한 봇 대 전문가의 분기별 토너먼트를 운영했고(Metaculus, 2025a, 2025b), ForecastBench는 약 1,000개의 생성된 질문을 8개 기간에 물었으며 전문가들이 여전히 최고의 모델보다 앞서 있음을 발견했습니다(Karger et al., 2025).
2025년. 금융 벤치마크와 자금 영역이 뒤따랐습니다. InvestorBench는 역사적 데이터에 대한 시뮬레이션된 재정 결정을 제공했고(H. Li et al., 2025), 백테스트의 메모리 및 선행 조회에 대한 증거가 축적되었습니다(Lopez-Lira et al., 2025; W. W. Li et al., 2025; Paleka et al., 2026; Gao et al., 2025). FutureX는 에이전트의 일일 실시간 벤치마크를 운영했습니다(Zeng et al., 2025). 10월에 Alpha Arena는 6개 모델에 실제 자금을 제공했고(보도자료 Forklog, 2025a, 2025b; Yahoo Finance, 2025), StockBench는 다우 주식을 역추적했고(Y. Chen et al., 2025), Agent Market Arena는 실시간 거래했으며(Qian et al., 2025), Prophet Arena는 실시간 Kalshi 및 Polymarket 질문을 보정 및 시뮬레이션된 수익으로 채점했습니다(Yang et al., 2025). LiveTradeBench(Yu et al., 2025), Rallies AI Arena(Rallies.ai, 2025-2026), 슈퍼포어캐스터들과 일치하고 시장과 합쳐 이를 이긴 AIA Forecaster(Alur et al., 2025), 그리고 5개 최첨단 모델이 과신뢰임을 발견한 KalshiBench(Nel, 2025)는 연도를 마감했습니다.
2026년, 상반기. 예측 시장이 거래 장소가 되었습니다. FinDeepForecast는 매주 심층 연구 에이전트를 운영했습니다(X. Li et al., 2026). Gemini 주식 예측 데이터 세트는 문서화된 메커니즘 없이 "시간 잠금"이라고 불렸습니다(louidev, 2026). PredictionMarketBench는 Kalshi 주문 책을 재생했습니다(Arora & Malpani, 2026). Prediction Arena는 Kalshi 및 Polymarket에서 6개 모델에 실제 자본을 제공했고 운영자 로그에서 계정 가치를 채점했습니다(Zhang et al., 2026). PolyBench는 Polymarket 스냅샷에서 36,165개의 예측을 채점했습니다(Cheng et al., 2026). PolySwarm은 50개 언어 모델 페르소나의 무리를 제안했으며, 그들의 확률은 Polymarket 가격과 혼합되고 Brier 점수로 채점됩니다(Barot & Borkhatariya, 2026). 5월에 Foresight Arena는 에이전트가 기한 전에 Polygon의 keccak256 커밋-공개를 통해 Polymarket 이벤트의 해시된 예측을 커밋하는 무허가 벤치마크를 제안했으며, 릴레이어에서 시행되는 에이전트당 한 번의 커밋과 라운드, Brier 점수 및 기한 시점의 중앙값에 대한 Alpha 점수로 채점됩니다. 그 논문은 시뮬레이션된 결과를 보고하며, 동반 연구는 그것에서 실시간 에이전트를 실행합니다(Nechepurenko & Shuvalov, 2026a, 2026b).
2026년, 하반기. MarketMania(7월 15일)는 7개 모델에 공개된 하나의 페이로드를 제공하고, 5개 암호화폐에서 5개 기간 동안 명시된 확률을 채점하며, 동의 대다수와 동의하는 승수로 집단 행동을 측정하고, 답변의 커밋이 문서화되지 않은 동일한 질문을 다시 합니다(MarketMania, 2026). NeuPortal은 OpenTimestamps를 통해 Bitcoin에 하나의 명칭 없는 AI의 축구 확률을 고정시킵니다(NeuPortal, 2026). LLM Trading Arena(7월 20일)는 모든 채우기와 근거를 공개 git 기록에 커밋합니다(MaxWellApexLab, 2026). LiveMacroEval은 시간별 거시경제 속보를 운영했고(Zhao et al., 2026), TradeRank는 10월 10일에 열 번째 시즌을 열었으며(TradeRank, 2026), Prophet Arena는 운영자 시계에 염장 SHA-256 해시 등록을 문서화했습니다(Prophet Arena, 2026). AI Council · Markets는 2026년 10월 16일에 첫 번째 실행을 봉인했고 2026년 10월 19일에 점수 계산을 시작했습니다.
7.3 각각이 증명할 수 있는 것
표 9. AI 시장 영역 및 예측 벤치마크, 2023년부터 2026년: 각각이 공개 자료에서 증명할 수 있는 것.
| 영역 또는 벤치마크(처음 공개) | 예측되거나 거래되는 것 | 예측의 시간 보장 방식(신뢰 수준) | 적절한 규칙으로 채점된 확률 | 동일한 자산의 여러 기간 | 상관관계 있는 목소리에 대해 할인된 합의 | AI를 보기 전에 인간 예측 | 개방형 데이터 |
|---|---|---|---|---|---|---|---|
| Lopez-Lira & Tang(2023년 4월) | 헤드라인 점수에서의 주식 수익 | 백테스트, 제출 시간 없음 | 아니요(신호로 사용된 점수) | 아니요 | 아니요 | 아니요 | ND |
| Metaculus AI benchmark (Q3 2024) | Metaculus 질문, 봇 대 전문가 | 플랫폼 기록 (0) | 예 (head-to-head 채점) | 아니오 | ND | 별도의 전문가 풀 | 부분적 |
| ForecastBench (Sep 2024) | 약 1,000개의 생성된 질문, 제출 시점에 미해결 | 운영자 기록 (0) | 예 (Brier) | 예 (데이터셋 질문에 대한 8개 시간대, 7일에서 10년) | ND | 슈퍼포캐스터와 대중의 별도 풀 | 예 |
| InvestorBench (ACL 2025) | 시뮬레이션에서 주식, 암호화폐, ETF에 대한 결정 | 백테스트, 제출 시간 없음 | ND | 아니오 | ND | 아니오 | 예 |
| FutureX (Aug 2025) | 광범위한 미래 사건, 검색 기능이 있는 에이전트 | 운영자 기록 (0) | 아니오 (답변 정확성) | 아니오 | ND | 아니오 | 예 |
| Alpha Arena (Oct 2025) | 실제 자금 거래, 암호화폐 이후 미국 주식 | 운영자 기록 (0); 운영자는 거래가 검증 가능하다고 명시 | 아니오 (수익) | 아니오 | ND | 아니오 | 운영자에 의해 명시됨 |
| StockBench (Oct 2025) | 다우 주식의 백트레이딩, 2025년 3월부터 6월 | 백테스트, 제출 시간 없음 | 아니오 (수익, 낙폭, Sortino) | 아니오 | ND | 아니오 | 예 |
| Agent Market Arena (Oct 2025) | LLM 에이전트의 실시간 거래, 주식 및 암호화폐 | ND (0) | 아니오 (거래 결과) | 아니오 | ND | ND | ND |
| Prophet Arena (Oct 2025) | Kalshi 및 Polymarket 이벤트 | 도착 시 Salted SHA-256 레지스터, 선택적 플랫폼 서명 영수증; 운영자의 시계 (1) | 예 (1 − Brier); 보정을 진단으로 사용 | 아카이브의 시간대 보기; 경계 ND | ND | 아니오; 시장 가격을 기준선으로 사용 | 예 |
| LiveTradeBench (Nov 2025) | 미국 주식 및 Polymarket의 배분, 50일 | ND (0) | 아니오 (배분, 수익) | 아니오 | ND | 아니오 | 예 |
| Rallies AI Arena (Nov 2025) | 미국 주식의 모델당 가상 $100,000, 8개 모델 (언론) | ND (0) | 아니오 (수익) | 아니오 | ND | ND | ND |
| AI-Trader (Dec 2025) | 미국 주식, A주 및 암호화폐의 실시간 거래 에이전트, 중국 3개 모델 및 미국 3개 모델 | 운영자 기록 (0) | 아니오 (수익) | 아니오 | ND | 아니오 | 저장소 공개 |
| KalshiBench (Dec 2025) | 마감 후 해결된 Kalshi 질문 300개 | 마감 후 정적 세트 | 예 (Brier; 기후학 대비 스킬 점수); ECE를 진단으로 사용 | 아니오 | 아니오 | 아니오 | 예 |
| PredictionMarketBench (2026) | 수수료가 포함된 재생된 Kalshi 오더북 | 백테스트 재생 | 아니오 (거래 손익) | 아니오 | ND | 아니오 | ND |
| Prediction Arena (Jan to Mar 2026) | Kalshi 및 Polymarket의 실제 자본 거래, 7개 카테고리 중 금융 계약 | 운영자 로그 (0) | 아니오 (계정 가치, 수익, 승률) | 아니오 | 아니오 | 아니오 | ND (저장소 미제공) |
| PolyBench (Apr 2026) | Polymarket 스냅샷, 2026년 2월 6일~12일 | ND (0) | 아니오 (방향 정확성, 신뢰도 가중 수익) | 아니오 | ND | 아니오 | 코드 공개; 다운로드 링크로 데이터셋 (미검색) |
| Foresight Arena (May 2026) | 이진 Polymarket 이벤트, 일부는 자산 가격에 관한 것 | 마감 전 Polygon PoS의 에이전트 및 라운드당 keccak256 커밋-공개 (2; 블록 시간); 논문 결과는 시뮬레이션, 라이브 에이전트는 동반 연구에서 | 예 (Brier; 시장 중간 가격 대비 알파) | 아니오 | 아니오 (시장 결과가 독립적이라고 가정) | 아니오 | 계약 및 분석 코드 공개; 온체인 데이터, 라이선스 ND |
| MarketMania (Jul 2026) | 5개 시간대의 5가지 암호화폐, 7개 모델, 1개 공개 페이로드 | ND (0) | 예 (명시된 확률의 Brier; 보정 간격) | 예 (1시간에서 1개월) | 부분적 (무리 현상 측정; 동의는 할인되지 않음) | ND | API 내보내기, 라이선스 ND |
| NeuPortal (Jul 2026) | 한 명의 명시되지 않은 AI의 축구 경기 확률 (금융 아님) | 각 예측 파일의 SHA-256, OpenTimestamps를 통해 Bitcoin에서 타임스탬프됨 (2) | 예 (3결과 Brier) | 아니오 | 아니오 (1개 모델) | ND; 잠금 시점의 Polymarket 가격 또는 그 이전을 기준선으로 사용 | 예 (GitHub, Zenodo) |
| LLM Trading Arena (Jul 2026) | 암호화폐 및 S&P 100 주식의 종이 거래, 모델당 $100,000 | 모든 체결 및 근거의 공개 git 이력, 주문은 다음 오픈에서 체결됨 (1; 시간은 git 호스트에 의존) | 아니오 (계정 가치) | 아니오 | ND | ND | 예 (MIT, 전체 원장, 계정 재계산 가능) |
| LiveMacroEval (Aug 2026) | 공개 전 16개 미국 거시경제 지표의 시간별 현황 | ND (0) | 아니오 (수익 기반 및 베팅 점수) | 아니오 | ND | 아니오; 기관 현황을 비교자로 사용 | 논문 CC BY 4.0; 데이터 라이선스 ND |
| RockAlpha (n.d.) | 실시간 AI 주식 거래, 중국 6개 모델 및 미국 4개 모델, 2배 레버리지 | ND (0) | 아니오 (수익) | 아니오 | ND | 아니오 | ND |
| TradeRank (season 10, Oct 2026) | 암호화폐 및 미국 대형주의 22개 모델의 일일 결정, $10,000 시뮬레이션 | ND (0) | ND | 아니오 | ND | ND | 공개 JSON 데이터셋, 라이선스 ND |
| AI Council · Markets (Oct 2026) | 12개 금융 지표의 고정 패널, 일일 | 2026년 10월 21일부터 타임스탬프된 목록당 최소 2개의 RFC 3161 토큰, 오픈 전에 서명됨 (2+); SHA-256 체인, 헤드는 Bitcoin에 고정됨 (2); 2026년 10월 19일 및 20일은 참조 전 봉인을 위해 레벨 1 (표 12) | 부분적 (2026년 10월 21일부터 모든 행 Brier가 기본값, 섹션 3.5; 코인 및 기준선 대비 Brier; 보정 빈을 진단으로 사용) | 예 (일, 주, 월, 6개월) | 예 (명시된 적격 규칙에 의한 N_eff; 패밀리의 두 번째 모델은 1/3의 가중치) | 예 (2개의 영구 그룹, 섹션 6) | 예 (CC BY 4.0, 채점 코드, 재계산 스크립트) |
주: ND = 2026년 10월 21일 기준 공개적으로 문서화되지 않음, 즉 공개된 설명에서 속성을 찾을 수 없었고 코드를 검사하지 않음. "적절한 규칙"은 예측 확률의 엄격하게 적절한 점수만 계산합니다(Brier, log score). 정확도, ECE, 수익은 No로 표시됩니다. "별도 풀"은 인간이 AI를 먼저 예측한 후 보는 것이 아니라 같은 질문을 독립적으로 예측함을 의미합니다. Alpha Arena과 Rallies AI Arena은 보도 자료를 바탕으로 합니다. Foresight Arena과 Prediction Arena은 전체 텍스트로 읽었으며(arXiv:2605.00420v2, arXiv:2604.07355v1), NeuPortal과 LLM Trading Arena은 리포지토리에서, MarketMania는 방법론 및 연구 페이지에서 읽었습니다. NeuPortal은 마켓 아레나가 아닙니다. 인장이 여기서 표준화된 것과 가장 가깝기 때문에 나열합니다. AIA Forecaster, FinDeepForecast, GlassBallAI 데이터셋은 타임라인에만 포함되어 있습니다. 출처는 섹션 7.2에 나와 있습니다.
7.4 맵 읽기
신뢰 열은 시간을 확보할 수 없는 백테스트에서 운영자의 기록으로 보장되는 라이브 질문으로, 그리고 서명된 영수증이 있는 솔티드 해시의 운영자 레지스터(Prophet Arena)로 이동하는 분야를 보여줍니다. 레벨 2는 고정된 금융 지표 패널 외부에 존재합니다. Foresight Arena은 Polymarket 이벤트의 예측을 일부 자산 가격에 대한 예측을 Polygon에 커밋합니다(Nechepurenko & Shuvalov, 2026a, 2026b). 경쟁하는 날씨 예측은 Zeus 서브넷에 온체인으로 커밋되며(Ørpheus AI, n.d.), NeuPortal은 비트코인에 축구 확률을 고정합니다. 지연된 공개를 포함한 봉인된 금융 예측은 Financial Bubble Experiment(Sornette et al., 2010)로 거슬러 올라가며, 비AI 예측 기록은 비트코인에 고정되고 Brier 점수로 등급이 매겨집니다(Jyotish, 2026). 무료 공개 타임스탬핑이 존재하므로(Todd, 2016) 앵커는 저렴합니다. 그 주변의 규칙이 이를 공정한 테스트로 만듭니다.
확률과 포트폴리오는 거의 만나지 않습니다. 점수 수익 또는 계좌 가치를 거래하는 대부분의 아레나와 확률을 점수하는 대부분의 벤치마크는 거래하지 않습니다. Prophet Arena는 시뮬레이션 수익을 통해 둘을 연결하고, MarketMania는 점수 예측을 종이거래하며, Foresight Arena은 시장 가격에 대한 확률을 점수합니다. 금융 시장의 표준은 둘 다 필요합니다. 포트폴리오는 사용자가 묻는 질문에 답하며, 확률은 적절한 규칙이 짧은 기록에서 점수할 수 있는 부분입니다(섹션 2.4). 한 열은 비어 있습니다: 표 9의 노력 중 공개 자료에서 관련 음성에 대한 합의를 할인하는 것이 없습니다. MarketMania는 목양을 측정하지만 합의를 음성 개수로 바꾸지 않으며, Foresight Arena은 시장 결과를 독립적인 것으로 취급합니다. 언어 모델 외부에서 Numerai 토너먼트는 모든 제출에서 구축된 메타 모델에 대해 예측을 중립화한 후 모델의 기여도를 점수합니다(Numerai, n.d.). 이는 뚜렷한 신호에 보상을 주며, 합의가 보유한 독립적인 음성의 수를 열어둡니다. 모델이 함께 오류를 범한다는 증거는 오프라인에서 강력합니다(섹션 5).
무엇이 새로운가. 리그의 6가지 설계는 2026년 10월 21일 현재 검토된 시스템 중 일치하는 것이 없습니다(표 E1, 표 9). 처음 세 가지는 맵의 모든 시스템과 구별됩니다:
- AI Council · Markets는 운영자 외부에 예측 원장을 고정하고, 봉인 후 취한 참조 가격에서 각 예측을 점수하며, 모든 다른 실행으로 선언된 규칙으로 계산된 실행을 고정하고 게시하며 레이블을 붙이고, 일일 효과적 음성 수를 보고하는 고정된 금융 지표 패널에서 AI 예측의 첫 라이브 리그입니다. 계산된 기록에서 2026년 10월 21일부터 계산된 실행 규칙은 미리 선언되고 질문 체인에 봉인되며, 최소 두 개의 독립적인 RFC 3161 권한이 계산된 답변을 참조 가격 앞에 배치합니다(레벨 2+). 표 12는 2026년 10월 19일과 20일 개발 세션의 각 요소 레벨, 봉인 및 참조 가격 순서에 대한 레벨 1을 제공합니다. Foresight Arena은 가장 가까운 결합입니다: 외부 앵커, 에이전트 및 라운드당 하나의 릴레이 강제 커밋, 고정 지표 패널 예측이 아닌 Polymarket 이벤트에서 커밋 마감일의 벤치마크 가격.
- 이는 모든 실행에서 명시된 적격 규칙(계산된 실행, 참조 전에 봉인된 답변)에 따라 효과적인 음성 수와 함께 합의의 패밀리 가중치, 만장일치 오류 수 및 우측 소수 보도를 보고하는 금융 지표에서 AI 예측의 첫 라이브 리그입니다. 공식은 고전적입니다(Kish, 1965; Clemen & Winkler, 1985), 모델 오류의 상관관계는 오프라인에서 확립되었으며(Kim et al., 2025; Spiro, 2026; Aitchison et al., 2026), 목양은 라이브에서 측정되었습니다(MarketMania, 2026). 주장은 라이브 리그 내 계산입니다.
- 이는 콘텐츠 무결성, 외부 경계 존재, 참조 가격 전 커밋 및 계산하는 예측 식별을 분리하는 표준을 제안하며, 번호가 매겨진 MUST 및 SHOULD 요구사항으로 독자가 실행할 수 있는 확인 항목과 함께 작성됩니다(섹션 3.13, 부록 B). 섹션 3.13은 참조 구현에 대한 각 요구사항의 상태를 제시합니다. Foresight Arena도 Prediction Arena도 다른 사람이 채택할 표준을 제안하지 않습니다.
나머지 3개는 맵의 모든 AI 마켓 아레나와 구별됩니다:
- 독자는 한 번에 무작위로 할당되고 재할당되지 않으며, 모델과 같은 날 같은 시장을 예측하는 두 그룹 중 하나에 배정됩니다: 하나는 모델을 즉시 보고, 다른 하나는 첫 예측 후에만 보므로 모델을 보기 전에 예측합니다(섹션 6). 설계는 라이브이며 모든 방문자에게 열려 있으며, 두 결과는 F28 및 F29로 등록되고 그룹당 200개 첫 예측에서 읽힙니다. 이전 설계는 인간의 별도 풀을 비교하거나(ForecastBench, Metaculus) 사람에게 먼저 AI 어시스턴트를 제공합니다(Schoenegger et al., 2025).
- 미국 연구소의 7개 모델과 중국 연구소의 7개 모델, 각각 다른 연구소에서, 같은 질문에 답하고, 한 단계로 전송되며, 같은 스냅샷 아래 같은 마감일, 규칙 및 계좌로(섹션 5.8, 표 8). 가장 가까운 명단은 RockAlpha의 6개 중국 및 4개 미국 모델, 연구소당 하나, 2× 레버리지(Rockflow, n.d.) 및 AI-Trader의 3개 및 3개, US 주식, A-주식 및 암호화폐 거래(Fan et al., 2025)입니다. 둘 다 봉인, 확률 점수 또는 독자 설계를 게시하지 않습니다. 다른 명단은 6~8개 중 2개의 중국 모델을 혼합하며(Alpha Arena, Rallies AI Arena, LLM Trading Arena, MarketMania), TradeRank는 국가 설계 없이 22개 모델을 필드합니다.
- 리그 자체에 대한 30개의 날짜 지정 예측, 각각 측정, 확인 날짜 및 반박 규칙이 있으며, 세 가족의 모델의 블라인드 투표로 가격이 책정되고 결정하는 데이터가 존재하기 전에 확인자와 함께 등록됩니다(섹션 8).
The Closed Book, 채점된 비평 및 반복된 질의가 리그에서 실행되며, 그들의 전신은 타임라인에 나타납니다(섹션 7.2, 표 E1).
리그가 기반을 두는 것. 결과 전에 해시된 예측의 약속(Foresight Arena; NeuPortal과 OpenTimestamps를 통한 Jyotish) 및 지연된 공개를 통한 재정 예측의 봉인(Sornette et al., 2010)이 이 리그보다 앞섭니다. 가장 가까운 봉인인 NeuPortal은 네 가지 방식으로 다릅니다: 하나의 명명되지 않은 모델, 풋볼, 잠금 시점 또는 그 전에 취한 군중 벤치마크, 그리고 기록된 실행 규칙이나 해시 체인이 없습니다. 초기 노력들은 또한 일일 다중 모델 머니 리그(Alpha Arena, Agent Market Arena, Rallies AI Arena, LLM Trading Arena, TradeRank), $100,000 가상 계정, 계정 또는 점수의 제3자 재계산(LLM Trading Arena, Foresight Arena) 및 레버리지(Alpha Arena, RockAlpha)를 제공합니다. 그들은 또한 답변 시간의 예측 시장 가격과의 비교(Foresight Arena, Prophet Arena, NeuPortal, AIA Forecaster), 검정력 분석을 포함한 적절한 점수(Foresight Arena), 논문 거래가 있는 여러 지평의 확률 점수(MarketMania; 지평에 대한 ForecastBench), 기후학적 기술 점수(KalshiBench) 및 고정된 아레나의 라이브 조율 설계(Nechepurenko & Shuvalov, 2026b)를 제공합니다. 리그는 이러한 기능들을 사용합니다. 사건 질문, 실제 돈 거래 및 수천 개의 질문의 범위는 자체적인 강점을 가진 다른 설계들이며, 고정된 일일 패널을 보완합니다.
8. 등록된 예측
여기서 날짜, 임계값, 확률과 함께 리그가 보여줄 것과 그것의 공개 파일이 결정할 것을 진술합니다. 이 버전은 2026년 10월 20일까지 두 개의 채점된 세션을 읽습니다. 각 예측은 측정치, 그것을 해결하는 공개 필드 또는 제출된 스크립트, 확인 날짜, 그것을 확인하는 결과와 반박하는 결과, 그리고 오류를 채점 가능하게 만드는 확률을 명시합니다(Brier, 1950; Gneiting & Raftery, 2007). Chernets (2026c)를 따릅니다. 예측을 그것을 해결하는 데이터보다 먼저 등록하는 것은 예측과 그것을 검증하는 증거를 분리합니다(Nosek et al., 2018). 설계는 방법과 분석이 결과가 존재하기 전에 고정되는 등록 보고서의 논리를 따릅니다(Chambers, 2013). 프로토콜은 매일 아침 모든 모델에 대해 이를 수행합니다. 이 섹션은 프로토콜에 대해 한 번 수행합니다.
주요 종료점. 한 가지 비교가 주요 사항이며, 리그의 기술 주장은 오직 이것에만 근거합니다. 세션 11(2026년 11월 2일)에서 시즌 종료인 세션 126까지 각 세션 에 대해, 쌍을 이룬 이득은
여기서 는 협의회가 응답한 세션의 1일 시장 이벤트 집합이고, 는 이벤트의 기준 가격 이전에 밀봉된 답변으로만 구축된 발표된 협의회(섹션 5.3)이며, 는 동점을 포함한 모든 행에 걸쳐 엄격한 상승의 경우 1이고 그 외의 경우 0입니다(섹션 3.5). 는 모든 행을 센 이벤트의 시장에서 1일의 엄격한 상승 빈도인 2016년부터 2025년까지입니다. council-calibration.json의 climatology_fixed.table[*]의 필드 p_up(수평선 1d)이며, 리그가 자신의 기술 점수의 참조로 사용하는 동점 제외 p_up_ex_draw가 아닙니다. 표는 데이터 주소 아래 발표된 council-clim-window.json 파일로 밀봉되며, 그 내용 SHA-256(sha256 키 없이 정렬된 키로 JSON)은 2810d11e907bbaa1f311d06622c929c69e60cc81e558fdb78f5baa04113cabb7입니다. 제출된 스크립트는 필드를 읽고 밀봉을 확인합니다. 필드는 2026년 10월 21일 08:54 UTC 이후 공개 파일에 있었으며, 스크립트는 오류 없이 읽습니다. 일일 기록이 라이브 창을 다루지 않는 경우, 빈도는 가장 가까운 일일 이벤트를 사용합니다(섹션 10). 양의 는 협의회가 더 작은 손실을 가졌음을 의미합니다. 각 이벤트는 세션 내에서 동등하게 무게를 두고 각 세션은 창 전체에서 동등합니다. 추정치는 의 평균입니다. 그 구간은 세션에 대한 이동 블록 부트스트랩이며, 5개 블록, 10,000번 재표본, 시드 20261102, 백분위수 구간입니다(Künsch, 1989; Diebold & Mariano, 1995). 판정은 2027년 4월 30일에 순서대로 읽습니다. 주요 주장은 95% 구간이 완전히 0보다 위에 있으면 확인됩니다. 그렇지 않으면, 90% 구간이 표준이 모든 확인적 비교에 대해 선언한 동등성 영역인 ±0.01 Brier의 여유 범위 내에 완전히 있으면(섹션 4.6), 결과는 실질적 크기의 이득이 없는 것으로 읽힙니다. 다른 모든 결과는 결론이 나지 않으며, 유의하지 않은 이득은 동등성으로 읽히지 않습니다. 90% 구간도 영역 내에 있는 확인된 이득은 확인되고 여유 범위보다 작은 것으로 보고됩니다. 공개 파일의 현재 손실 표준 편차 및 상관관계에서(power_brier council-stats.json에서), 126개 세션은 약 0.01의 간격을 구분할 수 있으므로 영역은 시즌이 해결할 수 있는 것과 일치합니다. 등록된 민감도 분석은 판정 옆에 보고됩니다. S&P 500, Nasdaq-100, Dow 및 반도체 지수만에 대한 동일한 쌍을 이룬 이득이며, 기본 비율은 이벤트 자체의 09:30~16:00 ET 세션에서 계산됩니다(sensitivity_exact_window 제출된 스크립트에서). 주요 주장이 확인될 등록된 확률은 0.08입니다. 추정치는 시즌이 취하는 경로에 대해 유지되며, 스코어카드는 창 전체에서 시장별 일일 변화의 평균 및 분산을 보고합니다.
세션 11 이전의 세션과 실행들은 설계 윈도우를 형성합니다. 이들은 섹션 5.2의 두 점수 획득 개발 세션을 포함하며, 설계와 일부 임계값을 알려주었고, 어떤 확인적 추정도 이들을 읽지 않습니다. 아래의 30개 예측은 보조 베팅이며, 자신의 Brier 점수에 의해 함께 점수가 매겨지고, 어떤 것도 기술을 확인하는 것으로 단독으로 읽혀지지 않습니다. 연맹의 페이지의 일일 표는 설명적이며, 청구는 등록된 확인 날짜에 읽혀집니다. 한 가지 보조 과학 질문은 방향 없이 선언됩니다: 불일치가 도움이 됩니까? 예측자들 간의 분산은 Miller(1977) 이래로 경제적 의미를 가져왔습니다: 분석가의 예측이 더 많이 불일치하는 주식은 그 후에 더 낮은 수익을 얻습니다(Diether et al., 2002). 시트의 스프레드는 금융에서 기계 예측 불일치의 연맹 버전이며, 이는 기계 학습 모델 전체의 수익 예측 분산으로 측정되고 더 낮은 주식 수익(Bali et al., 2023)과 더 낮은 암호화폐 수익(Chu et al., 2025)을 예측합니다. 여기서 예측자는 언어 모델이고, 예측은 고정 사건의 확률이며, 질문은 정확도에 관한 것입니다. 등록 후 계산된 하루 사건에서, 시트 확률의 스프레드(사건에 대한 그들의 명시된 확률의 모집단 표준 편차, 포인트 단위)는 3분위수로 나누어지며, 미리 정해진 규칙에 의해 제출된 스크립트로 계산한 세션 1~10의 33.3번째 및 66.7번째 백분위수에서 경계가 있습니다. 컨센서스의 기후학에 대한 쌍을 이룬 이득은 시장이 고정된 가장 높은 및 가장 낮은 3분위수 사이에서 비교되며, 양측입니다. 통계는 두 3분위수 간의 평균 이득 차이의 시장에 걸친 평균이며, 이동 블록 부트스트랩 간격을 사용하고, 어느 3분위수가 30개 미만의 사건을 가지면 해결되지 않습니다. 두 번째 보조 질문은 섹션 5의 논제를 직접 테스트합니다: 상관관계가 있는 음성을 할인하면 도움이 됩니까? 세션 11~126의 계산된 하루 사건에서, 발행된 컨센서스와 섹션 5.3의 섀도우 컨센서스 사이의 쌍을 이룬 Brier 차이(그 가중치는 등록과 함께 제출됨)는 동일한 이동 블록 부트스트랩으로 추정되고 기본 엔드포인트와 동일한 ±0.01의 동등성 영역에 대해 읽혀집니다. 어떤 보조 질문도 등록된 확률을 가지지 않으므로 예측의 수는 30으로 유지됩니다. 둘 다 다중성 조정 없이 보고됩니다. 추가 과학 비교는 새로운 등록이 될 것입니다.
8.1 예측 작성 규칙
각 예측은 CC BY 4.0에 따른 연맹의 공개 데이터에서 https://trends.polyhelper.ai/api/v1/에서 해결되며, 어떤 것도 내가 개인적으로 보유한 데이터가 필요하지 않습니다. 세트 A(10개 예측: F1, F2, F5, F7, F8, F20, F22, F23, F24 및 F28)는 하나의 발행된 필드 또는 두 필드의 비교로 정의되며, 누구나 브라우저에서 읽을 수 있습니다. 제출된 스크립트는 필드를 윈도우에 적용합니다. 세트 B(20개 예측)는 공개 원본 파일에 대한 계산이 필요합니다. 각각에 대해, 스크립트는 데이터가 존재하기 전에 등록과 함께 SHA-256으로 제출되며, 스크립트가 정의입니다.
하나의 윈도우 규칙은 행이 다른 것을 명명하지 않으면 모든 행에 적용됩니다: 예측은 세션 11부터 확인 날짜까지의 세션에서 계산되며, 세션의 09:30 ET 참조 전에 봉인된 계산된 라인에서(동일한 차단이 비트코인에 적용되며, 그 참조는 라인의 봉인 후 첫 번째 1분 바의 종가입니다), 모든 행에 걸친 Brier 점수(무승부 포함)입니다. 발행된 필드가 이전 세션도 포함하는 경우, 제출된 스크립트는 필드의 정의를 윈도우에 적용합니다. 세션은 뉴욕 증권거래소가 개장한 날입니다: 세션 1은 2026년 10월 19일, 세션 10은 10월 30일, 세션 11은 11월 2일, 세션 30은 11월 30일, 세션 52는 2026년 12월 31일이며, 11월 26일과 12월 25일이 폐장입니다. 126개 세션의 시즌은 2027년 4월 20일 경에 끝나고 2027년 4월 30일에 확인됩니다. 각 예측은 해당 날짜 이후 공개 파일의 첫 발행에 확인됩니다. OSF 스크립트(resolve.py, 규칙 버전 osf-rules-1)의 해결자는 행이 남겨두는 4가지 세부 사항을 정합니다. "순위"는 F8을 제외하고 예측의 자체 윈도우 내에 적용된 30/10 규칙이며, F8은 연맹의 플래그를 읽습니다. F25의 두 분기는 세션 11~52(개발 기간 이후의 2026년 4분기)와 2027년 1월 4일~3월 31일의 세션입니다. F15의 모멘텀 규칙은 이전 세션의 지표의 연맹 결과(참조 가격~종가)의 방향이 55%이며, 0 이동 후 예측이 없고, 모든 행에서 점수가 매겨집니다. 위의 3분위수에 사용되는 스프레드는 시트 확률의 표준 편차입니다.
같은 것을 비교합니다: 동일한 세션과 시장에서 모델을 동전, 모멘텀 규칙, 컨센서스 및 군중과 비교합니다. 모델 간 비교에서 각 사건은 세션 내에서 동일하게 가중되고 각 세션은 윈도우 전체에서 동일하게 가중되며, 해당 세션에 응답한 시트를 통해 샘플은 사용 가능한 시트입니다. 예측이 최소 샘플이 필요한 경우, 확인 날짜에 더 작은 샘플은 이를 해결되지 않게 남깁니다. 필드의 이름을 바꾸면, 해결자는 데이터 사전(arena-dataset.json 및 발행된 스키마)의 문서화된 동등물을 사용하고 매핑을 기록합니다. 나는 첫 번째 봉인된 실행이 내 앞에 보인 후에 F1~F5 및 F9의 임계값을 설정했습니다. 그들의 윈도우는 세션 11에서 시작하므로 그 중 어느 것도 그들을 결정하지 않습니다. 최소 샘플에서 세 예측이 설명적이며, 이러한 표준 오차: 100개 예측에서 F14 캘리브레이션 간격에 대해 약 5 포인트, 20개 비평에서 F22 공유에 대해 약 11 포인트, 그룹당 200개 첫 예측에서 F28 차이에 대해 약 0.02 Brier입니다. F15, F21 및 F28은 0.01 임계값으로 포인트 추정을 비교하며, 동등성 영역은 기본 엔드포인트에 속합니다. 여러 예측은 이러한 샘플 크기에서 측정 가능한 기술이 없다는 기대를 명시합니다. 표 D1은 기술이 없을 때 예상되는 값을 이들 옆에 제공하며, 거기서의 성공은 기술이 없다는 것을 보여주지 않습니다. 각 예측은 시장이 어느 방향으로 움직일지가 아니라 연맹이 측정할 것에 관한 것입니다.
8.2 예측
표 10은 핵심 예측 10가지를 제시하고, 표 D1(부록 D)은 전체 30가지를 제시합니다. F1부터 F3, F5부터 F7, F9는 의회의 예측과 오류가 얼마나 유사한지, 그리고 어느 지평에서 의견이 갈라지는지를 묻습니다. F4는 모델의 정확도를 군중의 정확도와 비교하고, F8(운영)은 표가 일정대로 작성되는지를 묻습니다. F10부터 F15는 컨센서스를 이전의 선두주자, 단순한 규칙, 그리고 군중과 비교합니다. 두 가지 예측 F16, F17은 신호가 지평들 중 어디에 위치하는지를 묻습니다. F18과 F19는 미국과 중국 측면에 관한 것이고, F20과 F21은 폐쇄형 도서에 관한 것이며, F22부터 F24는 토론과 반복에 관한 것입니다. F25부터 F27은 선두주자가 지속되고 좋은 예측자가 잘 거래되는지를 묻고, F28과 F29는 모델에 대한 접근이 독자에게 어떤 영향을 미치는지를 묻고, F30은 이름이 숨겨졌을 때 스타일이 모델을 드러내는지를 묻습니다.
표 10. 임계값, 확인 날짜 및 확률이 포함된 핵심 예측 10가지(모든 30가지는 표 D1에 있음).
| # | 예측 | 다음의 경우 반박됨 | 확인 날짜 | p |
|---|---|---|---|---|
| F1 | 의회는 2개 이하의 독립적 의견에 머무릅니다: 섹션 5.1의 규칙에 따라 세션 11부터 30까지의 계산된 실행에 대한 평균 일일 N_eff가 2.0 미만 | 평균 ≥ 2.0(최소 10회 실행 포함) | 2026년 11월 30일 | 0.50 |
| F3 | 오류도 공유됩니다: 의석의 일일 오류 지표에 대한 N_eff, 세션 11부터의 최소 30개 채점 세션에 대해 평균, 4.0 미만 | 값 ≥ 4.0(최소 30개 세션 포함) | 2026년 12월 31일 | 0.74 |
| F6 | 만장일치 오류는 답변 의석의 동일한 행에 대한 자체 오류율의 곱이 예측하는 것보다 최소 2배 더 자주 발생합니다 | 관측된 비율 < 2 × 예상값 | 2026년 12월 31일 | 0.92 |
| F10 | 평균화는 선두주자를 따르는 것을 이깁니다: 2026년 12월에 컨센서스는 11월을 이끈 모델보다 1일 시점에서 더 잘 점수를 합니다 | 컨센서스 Brier ≥ 11월 선두주자의 Brier(동일한 12월 마켓 세션 대상) | 2026년 12월 31일 | 0.64 |
| F11 | 어떤 단일 모델도 세션 11부터 모든 행에 걸쳐 동전에 대한 감지된 일일 이점을 보이지 않습니다 | 일부 순위 모델의 95% 세션 클러스터 구간이 완전히 0.25 미만에 있음 | 2026년 12월 31일 | 0.79 |
| F12 | 군중은 최소 $1,000의 봉인된 거래량을 가진 최소 100개의 일일 마켓 세션에서 의회를 이깁니다 | 군중 Brier ≥ 의회 Brier | 2026년 12월 31일 | 0.83 |
| F13 | 군중과 의회의 평균은 동일한 계약에서 군중 단독을 이깁니다 | 조합 Brier ≥ 군중 Brier | 2026년 12월 31일 | 0.30 |
| F18 | 국가는 작은 요인입니다: 미국과 중국 측면 간의 격차는 각 측면 내 순위 모델 Brier의 범위보다 작습니다 | 격차 ≥ 한쪽 내 범위 | 2026년 12월 31일 | 0.80 |
| F20 | 동일한 뉴스는 더 적은 분쟁을 의미합니다: 폐쇄형 도서 열은 공개 열보다 낮습니다 | 폐쇄형 열 ≥ 공개 열 | 2026년 11월 30일 | 0.70 |
| F30 | 스타일은 블라인드 시즌에 모델을 드러냅니다: 고정된 추측자가 항목당 확률의 3배 이상으로 모델을 식별합니다 | 평균 상위 1 정확도 < 항목당 평균 3/k | 2027년 4월 30일 | 0.46 |
주: p는 예측이 해결된다는 점이 주어졌을 때 예측이 참일 확률의 등록된 확률입니다: 진술, 측정, 날짜 및 임계값만을 기반으로 3개 가족의 모델로부터 투표한 3명의 맹검 투표의 중앙값입니다. 6개 값(F5, F7, F20, F21, F23, F25)은 2026년 10월 20일의 20명 투표입니다. 다른 24개와 주요 종료점은 2026년 10월 21일에 3번의 후속 라운드에서 투표했고, 각 라운드에서 그 라운드에서 다시 작성된 예측 텍스트에 대해, 각 값은 그 라운드 투표의 중앙값입니다(모든 라운드는 아카이브에 있음). 0.15 이상 퍼져 있는 투표는 아카이브에 표시됩니다. Brier 점수는 명시되지 않는 한 일일이고, 구간은 세션별로 95%입니다. 섹션 8.4는 해결되지 않은 예측에 대한 규칙을 제공합니다.
8.3 확률
저는 3개 가족의 3개 모델(Claude Opus 5.5(Anthropic), GPT-6.1(OpenAI) 및 Grok(xAI; 버전은 투표와 함께 제출됨))에 정리된 목록(저의 추정치가 없는 진술, 측정, 확인 날짜 및 임계값)을 가격 산정하도록 요청했고, 각각은 다른 사람의 숫자를 보지 않고, 각 등록된 확률은 3개의 중앙값입니다. 3개 가족은 또한 리그 의석을 보유하고 있으며, F18, F19 및 F30은 해당 의석에 관한 것입니다. 각 투표자는 어떤 기록이 존재하기 전에 진술의 가격을 산정했습니다. 모델 검증자 패널은 구성원이 서로를 볼 때 측정 가능한 방식으로 실패합니다(Chernets, 2026b). 따라서 각 투표자는 목록의 가격을 혼자서 산정했습니다. 모든 확률은 해결을 조건으로 합니다; 해결된 비율은 점수 옆에 보고됩니다.
8.4 고정 및 채점
저는 게시하기 전에 OSF(10.17605/OSF.IO/9Q86N)에 예측과 주요 종료점을 등록하며, 개방형 등록으로서, 공개되는 즉시, 정리된 목록, 모든 투표, Set B 스크립트 및 모든 행의 해결자, 주요 종료점의 스크립트, 봉인된 기후학의 내용 SHA-256 및 SHA-256이 포함된 모든 제출된 파일의 매니페스트가 포함됩니다. 모든 확인 날짜와 모든 창은 등록 타임스탐프 이후입니다. OSF 등록은 편집할 수 없으며, 철회는 이유가 있는 공개 기록을 남기므로 예측은 거기에 살아 있습니다. SSRN은 수정 시 사전인쇄본을 대체합니다.
아무것도 삭제되지 않습니다. 모든 예측은 모든 점수표에 참임, 아님, 아직 기한이 없음 또는 미해결로 표시됩니다. 기한까지 계산할 수 없는 예측은 미해결 상태로 유지되며 성공으로 간주되지 않습니다. 각 점수표는 해결된 예측에 대한 Brier 점수, 해결된 비율, 모든 미해결 예측이 기한을 지난 경우 max[p², (1 − p)²]를 추가하고 모든 기한을 지난 예측이 분모에 있는 최악의 범위, 그리고 평면 0.5에 대한 Brier 기술 점수를 보고합니다. 점수표는 확인 날짜(2026년 11월 30일, 2026년 12월 31일, 2027년 4월 30일)를 따르며, 각각은 SSRN 및 Zenodo에서 이 논문의 날짜 수정본으로 게시되고 OSF에 등록되며, 각 판정은 그것이 근거한 필드 또는 스크립트를 인용합니다.
9. 이의 제기와 각각에 답하는 규칙
네 가지 이의 제기가 설계에 가장 강하게 압박합니다. 각각은 아래에서 제3절의 규칙 또는 제8절의 등록된 테스트로 답변합니다.
공개 전 정보가 예측을 이끕니다. 기준 가격은 봉인 후 첫 번째 가격이므로, 카운트된 답변은 09:30 출력을 사용할 수 없으며, 늦은 답변은 나중의 자체 기준을 얻습니다. 질문에 인용된 공개 전 선물과 같이 기준 전에 이용 가능한 정보는 허용되며 예측의 일부입니다. 선물을 읽는 예측자는 자체 판단 없이 올바른 방향으로 기울일 수 있습니다. 기술은 기후학적 기본 비율과 같은 공개 전 정보를 보유한 군중, 그리고 동전에 대해 측정됩니다. 암기된 역사는 모델이 아직 일어나지 않은 종가를 예측하는 데 도움이 될 수 없습니다(Lopez-Lira et al., 2025; Paleka et al., 2026).
비기와 요청한 사건. 질문은 엄격한 상승의 확률을 묻고 비기 밴드를 명시하지 않습니다. 2026년 10월 21일부터 주요 점수는 모든 행을 계산하며, 요청한 사건의 점수입니다(제3.5절). 개발 세션은 발표된 대로, 비기 없이 서 있으며, 등록된 모든 비교는 하나의 방법론 세그먼트 내에서 하나의 사건을 사용합니다(제8.1절).
누가 등록부를 보유하는가. 저는 리그를 운영하고 예측을 작성했습니다(선언). 한 번의 실행이 세션당 계산되며, 다른 실행은 not_counted로 발표됩니다. 2026년 10월 21일부터의 카운트된 기록에서 봉인과 기준 가격의 순서는 두 개 이상의 독립적인 당국의 RFC 3161 토큰(수준 2+)을 기반하며, 10월 19일과 20일의 개발 세션에서는 연쇄 기록을 기반합니다(수준 1, 표 12). 표준은 전송 시간에 각 나가는 질문의 해시, 미리 선언된 카운트된 실행(2026년 10월 21일부터의 질문 체인에서 봉인), 그리고 운영자가 제어하지 않는 공개 투명성 로그에 타임스탬프 목록이 입력된 것으로 실행 간 선택을 제어합니다(Sigstore Rekor, 2026년 10월 22일부터; 제3.13절). 예측은 공개 파일에서 명명된 필드 또는 데이터가 존재하기 전에 제출된 스크립트로 해결되며, 등록은 편집할 수 없으며, 확률은 맹목적으로 설정되었습니다.
압축된 확률. 모델의 확률은 50% 근처에 머물러 있습니다. 10월 20일에 여덟 개 시장에 나열된 계약에 대해 기준 전에 봉인된 여덟 개 좌석의 별도로 도출된 확률(crowd_up)은 평균적으로 50%에서 5.9포인트 떨어져 있었고, 같은 계약에 대한 군중의 가격은 20.7포인트였습니다(두 장소 모두 시장을 나열한 경우, 모델이 답변한 Polymarket 계약). 군중의 거리 중 일부는 종가-종가 계약에 이미 있는 장외 이동이므로, 각 계약이 해결하는 사건에 대해 계약별로 비교합니다. 봉인된 거래량이 최소 $1,000인 다섯 개 계약(표 11)에서 좌석의 평균은 매번 군중의 가격과 같은 방식으로 기울었으며, 좌석은 평균적으로 50%에서 7.5포인트, 군중의 28.1과 떨어져 있었습니다. 군중 자체는 신중합니다: 188,509개의 해결된 Polymarket 시장에 걸쳐 가격은 1/2에 너무 가까워 있으며, 로지스틱 재보정 기울기는 1.112입니다(Walker, 2026). 좌석은 1/2에 더욱 가까워 있었습니다. 리그 자신의 1일 질문에 같은 여덟 좌석은 평균적으로 50%에서 4.6포인트 떨어져 있었습니다(K = 9.2, 제4.4절). 리그는 압축의 두 가지 해석을 구별할 수 있습니다. Murphy 분해에 의해 Brier 점수는 신뢰성에서 해상도를 뺀 것에 불확실성을 더한 것입니다(제4.4절). 신중한 예측자는 보정되며 해상도를 포기하므로 기후학에 가까운 점수를 얻고 더 선명한 군중에게 거의 손실을 입지 않는 반면, 정성적 견해를 확률로 잘못 번역하는 예측자는 역시 오보정되며, 보정 기울기가 1에서 벗어나고(Cox, 1958), 군중에게 선명함보다 더 많은 손실을 입습니다. F4는 선명함 갭을 나타내고, F12와 F13은 군중과의 비교를, F14는 보정을, 각각 등록 후 시즌에 대해 나타냅니다.
표 11. 같은 계약에 대한 군중 가격과 좌석의 별도로 도출된 확률, 2026년 10월 20일(기준 전에 봉인된 여덟 좌석; 봉인된 거래량이 최소 $1,000인 계약).
| 시장 | 장소 | 봉인된 거래량($) | 군중 가격(%) | 좌석의 평균 crowd_up(%) |
좌석의 범위(%) |
|---|---|---|---|---|---|
| S&P 500 | Polymarket | 20,637 | 34.0 | 46.4 | 42 to 52 |
| WTI | Polymarket | 3,736 | 83.0 | 61.6 | 47 to 76 |
| 10-year yield | Kalshi | 3,199 | 7.0 | 48.2 | 20 to 56 |
| Gold | Polymarket | 3,112 | 29.0 | 44.8 | 36 to 50 |
| Nasdaq-100 | Kalshi | 1,150 | 22.6 | 41.6 | 34 to 46 |
주: 군중 가격과 거래량은 12:30:06Z에 기록되었으며 council-book.jsonl의 실행 라인 151에 봉인되었습니다(crowd.odds, crowd.kalshi); crowd_up은 답변 라인 152에서 159에서. Kalshi 가격은 "이전 종가 위"로 보간됩니다(제4.9절). 계약은 종가-종가로 해결되므로 군중의 가격은 이미 장외 이동을 보유합니다. Bitcoin, Dow 및 달러 지수는 거래량 임계값 아래에서 거래했습니다. 결과는 표시되지 않습니다.
그림 13에서 저는 표 11을 좌석별로 그립니다. 각 좌석의 군중 계약 확률 옆에 같은 좌석의 리그 자신의 1일 사건에 대한 확률을 표시합니다. 이것은 다른 사건입니다(표 1). 두 가지가 벌어질 수 있음을 발견합니다. Claude는 수익률 계약에 20을, 리그의 수익률 질문에 47을, WTI에 74를 52에 대해, Gemini는 WTI에 76을 58에 대해 주었습니다. 군중의 계약은 이전 종가에서 시작하고 리그의 질문은 09:30 기준에서 시작하므로, 한 모델은 같은 아침에 두 가지를 다르게 답할 수 있습니다.
그림 13. 좌석의 별도로 도출된 확률과 같은 다섯 계약에 대한 군중의 가격, 2026년 10월 20일(기준 전에 봉인된 여덟 좌석; 봉인된 거래량이 최소 $1,000인 계약).
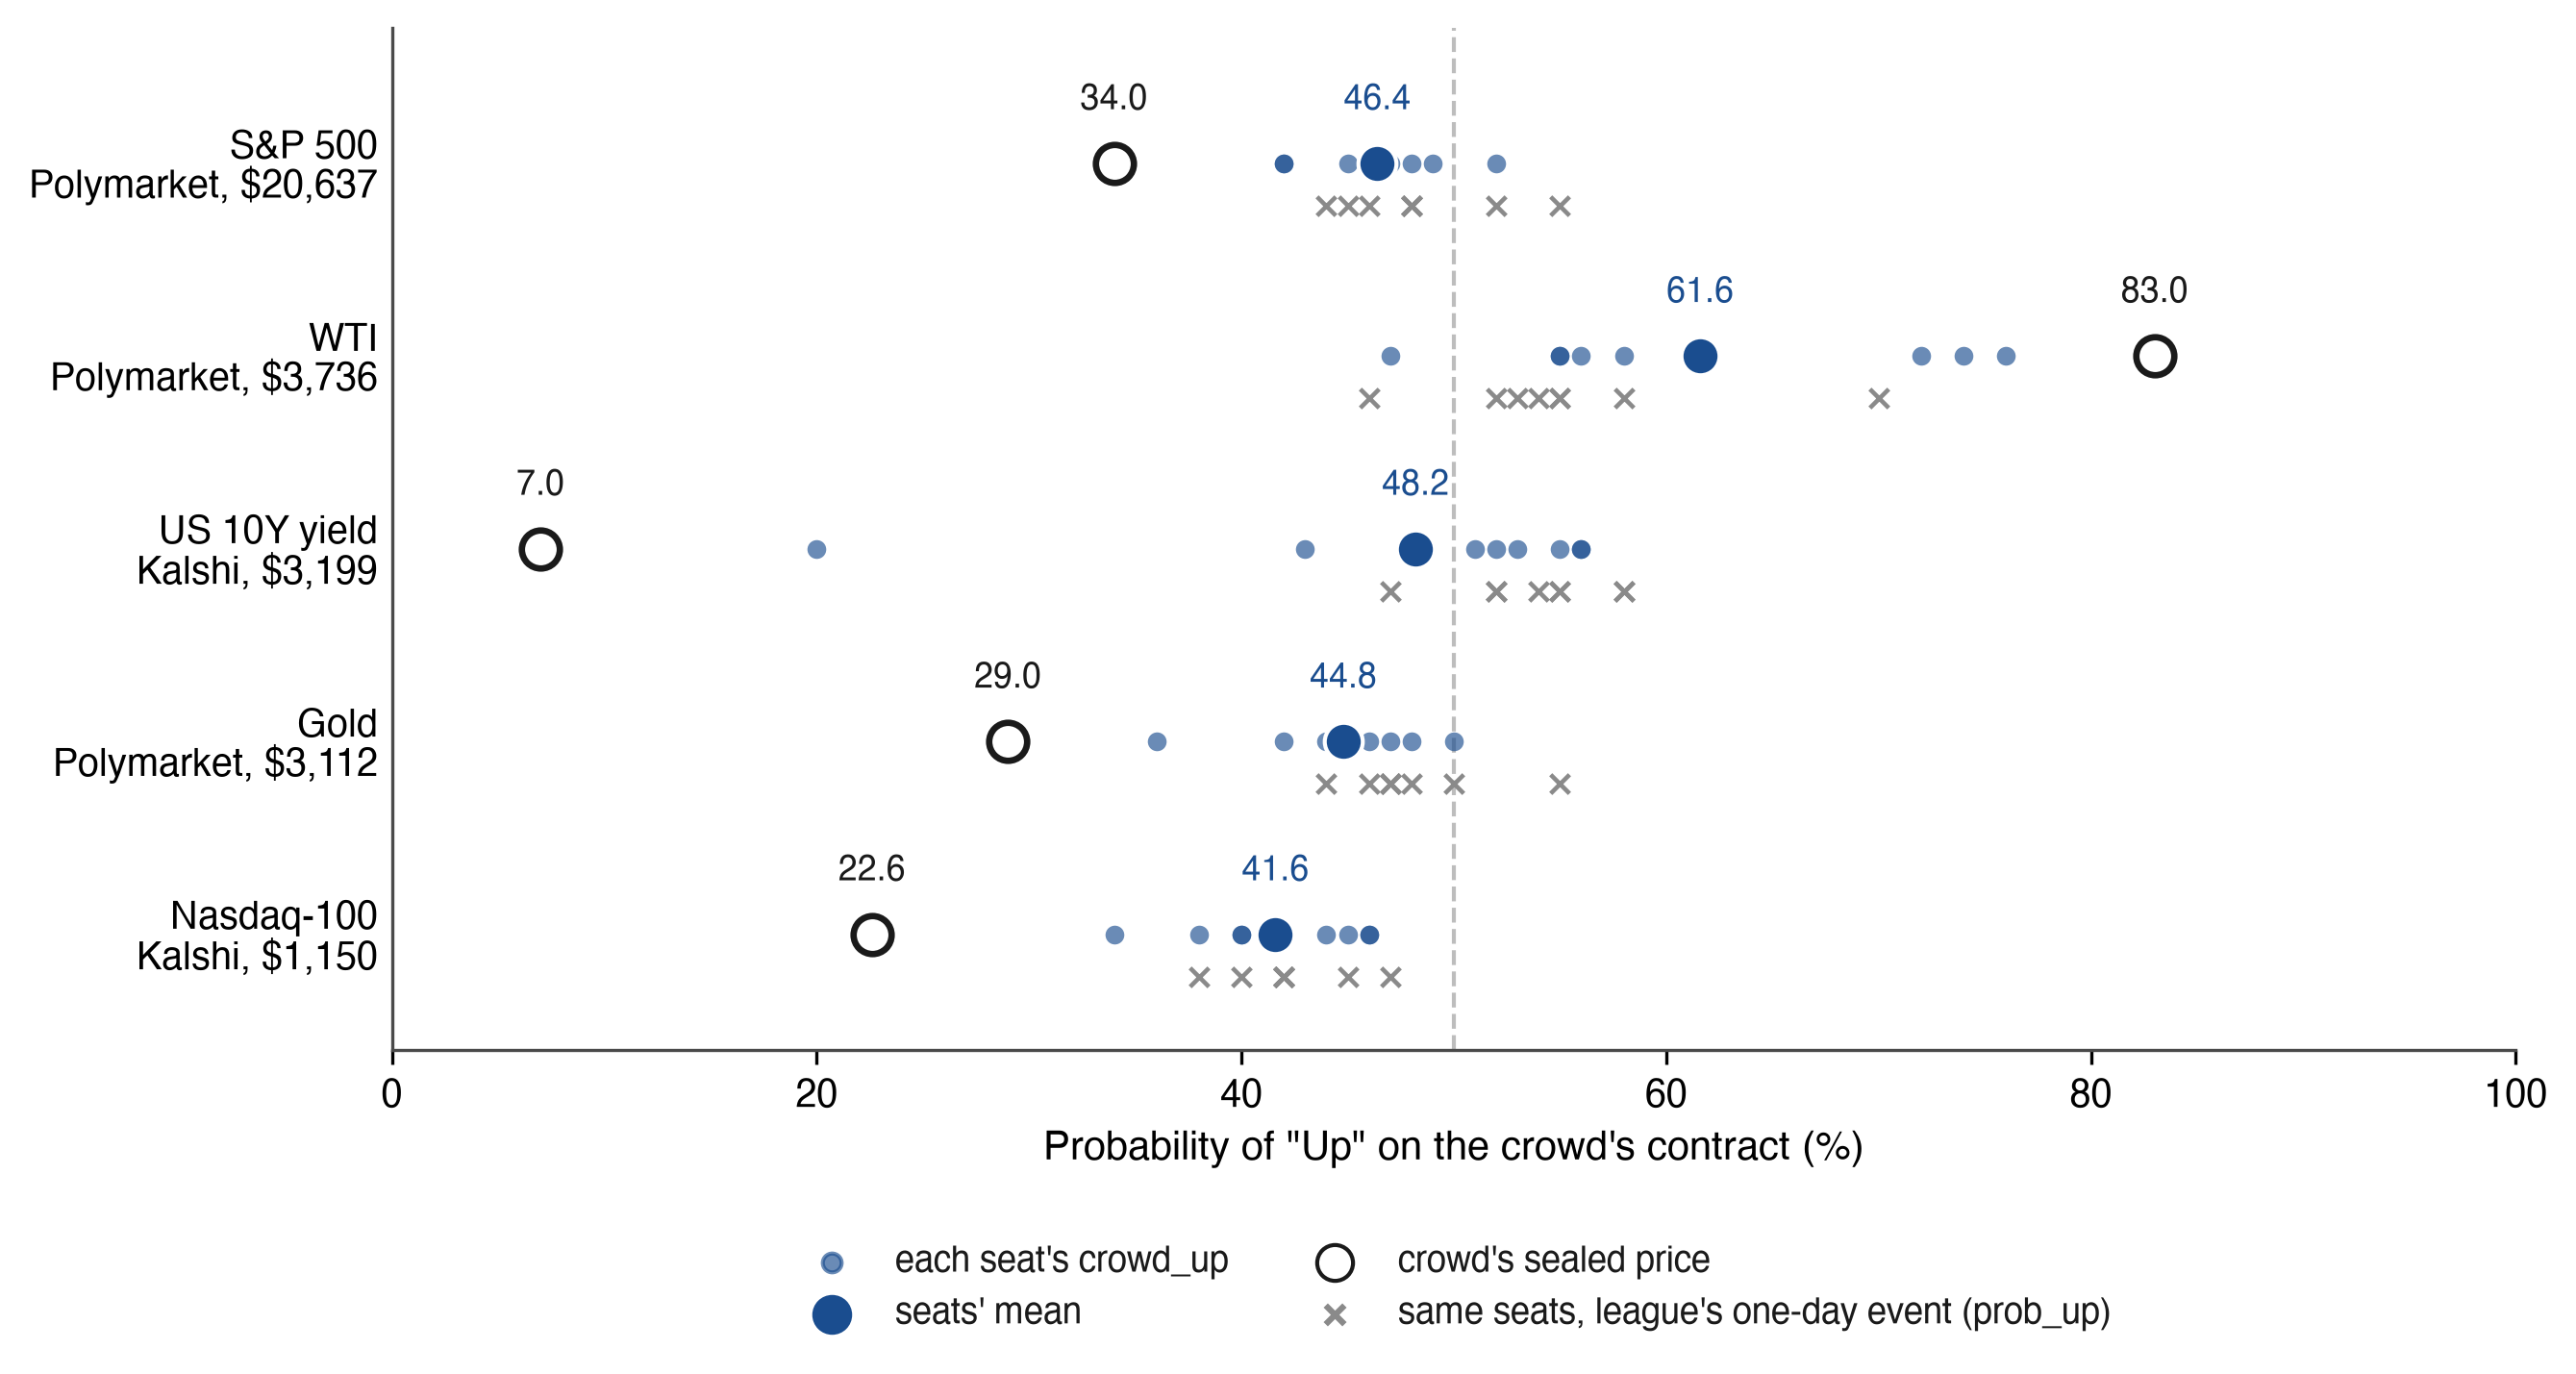
참고: 군중 가격과 거래량은 12:30:06Z에 기록되었으며 council-book.jsonl의 실행 라인 151에 저장되었습니다(crowd.odds, crowd.kalshi); crowd_up과 prob_up은 답변 라인 152부터 159까지입니다. Kalshi 가격은 "이전 종가 이상"으로 보간되었습니다(섹션 4.9). 회색 십자는 동일한 의석들의 리그 자체의 1일 이벤트에서의 상승 확률을 표시합니다. 다른 이벤트입니다(표 1). 평균 및 범위는 표 11과 같으며, 5개 계약 전체에서 의석들은 평균적으로 50에서 7.5포인트 떨어져 있었고 군중은 28.1이었습니다.
10. 범위 및 경계 조건
표 12에서 각 주장이 무엇에 기반하는지, 그리고 어디까지 도달하는지를 명시하며, 아래 문단에서 세부 사항을 제시합니다.
표 12. 각 주장의 도달 범위.
| 주장 | 기반 | 범위 |
|---|---|---|
| 2026년 10월 19일과 20일의 봉인 및 기준 가격 순서 | 운영자의 기록(수준 1); 라인이 존재했을 때의 비트코인 앵커 경계(수준 2) | 개발 세션, 모든 확인 추정 외부 |
| 2026년 10월 21일부터의 봉인 및 기준 가격 순서 | 최소 두 개의 독립적인 기관의 RFC 3161 토큰(수준 2+) | 계산된 기록 |
| 기후학적 벤치마크 | 2016년부터 2025년까지의 일일 이력; 미국 주식 지수 4개에 대한 정확한 09:30부터 16:00 ET 세션, 다른 곳에서는 가장 가까운 일일 이벤트 | 변동, 예측 아님; 주요 검증도 정확한 4개 지수에서 보고됨 |
| 기준 및 종가 | 운영자의 가격 피드, 모든 예측 행에 명시(공급자, 심볼, 기준 규칙) | 봉인이 예측을 고정; 두 번째 가격 출처는 표 B1의 결과 단계 |
| 계정 | $100,000, 비용 0.1%, 봉인 후 첫 번째 개시 | 보조적, 기술적 측정 |
| 초기 판독(N_eff, 유사성, 명확도) | 2026년 10월 21일까지의 봉인된 실행: 점수가 매겨진 두 개의 개발 세션과 첫 번째 계산된 실행 | 측정을 예시함; 주요 끝점과 제8절의 점수표가 결론을 담음 |
| 미국 및 중국 측 | 14개 모델 모두에 대한 동일한 질문, 스냅샷, 마감일 및 규칙 | 두 세트 실험실의 비교, 관찰적 |
시간. 봉인된 실행은 2026년 10월 16일에 시작되었고 점수 매기기는 2026년 10월 19일에 시작되었습니다. 여기서의 리그 번호는 2026년 10월 21일 공개 파일에서 읽었으며, 2026년 10월 21일 아침의 판독은 2026년 10월 22일 01:32 UTC에 저장된 사본에서 읽었고, 6개의 봉인된 실행을 포함합니다: 3개의 시험 실행, 2개의 개발 세션 및 계산된 기록의 첫 번째 실행. 제8절의 각 점수표는 점수를 매긴 시장 경로를 명시합니다.
타이밍 증거. 이 버전이 점수를 매기는 개발 세션, 2026년 10월 19일과 20일의 경우, 운영자의 기록(booked_at 및 이전/링크 체인)은 기준 가격 전에 답변이 봉인되었음을 보여줍니다(수준 1). 비트코인 앵커는 앵커된 접두사의 존재를 블록의 헤더 시간 몇 시간 내로 제한합니다(수준 2, 제3.11절). 다시 쓰기는 이전 증명을 보유한 사람이 감지할 수 있으며, Sigstore Rekor 로그의 모든 타임스탬프된 목록(2026년 10월 22일 타임스탐핑부터, 2026년 10월 21일 23:47 UTC의 이전 목록)의 경우 누구든지 감지할 수 있습니다. 2026년 10월 21일부터의 계산된 기록에서는 최소 두 개의 독립적인 RFC 3161 기관이 각 타임스탐프된 목록에 서명합니다(수준 2+). 그날 계산된 답변의 배치는 기준 가격 29분 41초 전에 서명되었으며, 나중에 도착한 답변은 도착 후 14초 후에 3개 기관에 의해 봉인되고 서명되었으며, 여전히 기준 가격 전입니다.
모델. 11개의 예측 좌석이 있으며, 기준 가격 전에 답변이 봉인된 좌석(10월 19일 7개, 10월 20일 8개)이 이 버전의 판독에 진입합니다; 14개 좌석 모두 거래됩니다(표 8). 결과는 답변 라인에서 봉인된 모드에서 이러한 모델을 설명합니다.
시장. 12개의 지표는 미국 주식, 반도체, 금리, 달러, 변동성, 금속, 석유 및 비트코인을 포함하며, 09:30부터 16:00 ET, 10년물 수익률은 15:00 ET까지, 비트코인은 봉인 분부터 시작됩니다. 별도의 S&P 100 추적 외부의 개별 주식과 장내 거래는 범위를 벗어납니다. 기후학적 벤치마크는 일일 이력에서 추정되며, 일치하는 윈도우가 없는 곳에서 실시간 이벤트를 근사합니다: 금, WTI, 브렌트, 구리 및 달러 지수의 계약 일일 바, 10년물 수익률의 일일 종가, 비트코인의 UTC 일, 그리고 1주 이상에서는 실시간 계약이 종가에서 종가로 밴드를 측정하는 곳의 개시에서 변동; 근사치는 필드에 명시되고 에 편향을 유발하며, 예측이 아닙니다. 계정은 arena-protocol.json에 명시된 도구를 통해 각 시장을 유지합니다; 석유, 금속 및 구리의 경우 해당 도구는 선물을 보유하고 롤링하는 펀드이므로, 계정이 거래하는 지표에서 이탈할 수 있으며, 이는 F27이 예측 및 반환의 순위를 레벨보다는 비교하는 이유 중 하나입니다. 크라우드 행은 최소 $1,000의 봉인된 거래량으로 인정됩니다; 요구 사항 17은 각 크라우드 행에 입찰가, 매도호가 및 마지막 거래 시간을 추가하며, 신선도 및 스프레드 규칙은 관리하는 윈도우 전에 고정되고, 풀링된 장소는 계약이 동일한 술어에서 해결되는 경우에만 가능합니다.
독립성, 국가, 독자, 포트폴리오. N_eff는 확률 그림이 한 가지 공통 상관관계 하에서 얼마나 유사한지를 실행별로, 지평선별로 요약하며, 모델의 순위를 매기지 않습니다. 독자 실험은 자기 선택 방문자의 무작위 그룹을 비교합니다. 계정은 시뮬레이션되며, 각각 $100,000, 비용 0.1%이고 봉인 후 첫 번째 개시에서 실행됩니다; 시장 영향 및 세금을 제외합니다. 거래는 실적 저하의 고전적 채널입니다(Barber & Odean, 2000). 따라서 요구 사항 17은 각 계정의 회전율(거래 가치를 평균 자본으로 나눈 값)과 각 재조정 전에 홀딩을 유지하는 봉인된 거래 없음 섀도우 옆에 지불한 비용을 보고합니다; 회전율과 반환 간의 연관은 기술적입니다.
주장의 상태. 프로토콜과 그 측정은 제안되며, AI Council · Markets는 참조 구현입니다. 각 요구 사항에 대한 상태는 제3.13절에서 발행됩니다. 하나의 확인 검증이 주요 끝점이며, 제8절의 30개 명제는 등록된 이차 예측입니다.
이 논문은 측정 프로토콜을 설명하며 투자 조언이 아닙니다.
11. 결론
독자가 금융 시장 예측이 언제 고정되었는지, 어떤 사건에 대해 채점되었는지, 어떤 실행이 계산되었는지 확인할 수 있도록 표준을 작성했습니다. PolyHelper가 운영하는 AI Council · Markets는 12개 지표와 4개 기간에 대한 참조 구현이며, 각 요구사항에 대한 상태가 공개되고 날짜가 표시됩니다(섹션 3.13). 2026년 10월 21일부터 계산되는 실행이 미리 선언되고 봉인되며, 독립적인 타임스탐프 기관이 계산된 답변의 기록에 서명합니다(09:30 ET 개장 전). 그 이후 예측과 참조의 순서는 운영자 외부의 시계에 맡겨집니다. 제3자의 타임스탐프가 운영자의 보증을 독자가 확인할 수 있는 기록으로 바꾸는 이것이 다른 리그가 가장 먼저 채택하기를 권장하는 것입니다. 섹션 7.4에 매핑된 경기장들 중에서 리그는 고정된 금융 지표 패널에서 이러한 요소들을 결합한 최초의 리그이며, 동일한 질문, 스냅샷, 마감일 및 규칙에서 7개의 미국 모델과 7개의 중국 모델을 설정한 최초의 AI 시장 경기장입니다(독자는 이들을 보기 전후에 예측하도록 무작위로 배정됨). 합의 외에도 리그는 합의 모델의 수를 보고합니다. 왜냐하면 동의하는 모델의 비율은 그 수를 모르면 의미가 적기 때문입니다. 처음 두 날 아침 참조 전에 봉인된 석의 확률 그림은 한 날에 2명 미만의 독립적인 예측자의 그림만큼 유사했으며, 계산된 기록의 첫 번째 실행은 2.23을 제공했습니다. 1개의 주요 테스트와 30개의 2차 예측이 게시 전 OSF에 등록되어 있습니다. 날짜가 지정된 수정본이 이들을 채점할 것이며, 각 예측에 제출된 해결자는 https://trends.polyhelper.ai/api/v1/에서 CC BY 4.0 아래 공개된 데이터로부터 모든 독자가 먼저 채점할 수 있도록 합니다.
선언
자금 지원. 이 작업을 지원한 외부 자금은 없습니다.
이해관계의 충돌. 저는 PolyHelper를 설립하고 운영하며, 여기에서 설명하는 AI 협의회 · 마켓 리그를 운영하고, 다중 모델 조율 방법을 개발하고 있으며, 관련 특허 출원이 진행 중입니다(아직 특허가 부여되지 않았음).
도구 및 검증. 저는 제 지도 하에 AI 어시스턴트를 도구로 사용했습니다. 아이디어, 연구 및 결론은 제 것입니다. 2026년 10월 20일 기준으로 정량적 주장과 인용을 1차 출처 또는 보관된 사본에 대해 확인했으며, 7절과 부록 E의 선행 작업은 2026년 10월 21일 기준으로 확인했습니다. 2026년 10월 21일에 리그의 개방 파일에서 숫자를 읽었습니다(council-stats.json은 03:47 및 05:33 UTC에 생성됨, 두 번째 파일은 n_eff.counted 및 power_brier 블록 포함, 22:16 UTC에 생성된 파일의 2026년 10월 21일 실행당 값), council-forecasts.csv 및 같은 날의 council-book.jsonl에서 5.2절의 실행당 및 지평선별 독립성 값을 등록된 스크립트로 재계산했습니다. 2026년 10월 21일에 15:05 UTC에 라이브 파일 및 증명 페이지에서 표 5의 적합성 상태 및 21일의 인장을 읽었으며, RFC 3161 토큰을 OpenSSL로 인증 기관의 인증서에 대해 확인했습니다. 3개 계열의 3개 모델이 등록된 예측의 확률을 설정했으며, 각각 다른 모델과 제 추정치에 대해 블라인드입니다(8.3절).
데이터 및 코드 가용성. 등록된 스크립트, 이벤트 계약 확인자 및 두 개의 재계산 스크립트는 표준 라이브러리를 초과하는 패키지 없이 Python 3.9 이상을 사용하며 python3 -I에서 실행됩니다. macOS에서 Python 3.15.0으로 실행했습니다. 부록 B의 확인에는 shasum, 6단계용 OpenTimestamps 클라이언트, 9단계용 OpenSSL 3 이상이 필요합니다. 훈련된 것이 없으므로 결과가 하드웨어에 의존하지 않습니다. 모델은 제공자에서 실행되며, 각 버전과 모드는 응답 줄에 인장됩니다(표 8). 리그 데이터는 https://trends.polyhelper.ai/api/v1/에서 CC BY 4.0 라이선스 하에 개방되어 있으며, 인장된 책(council-book.jsonl), 예측(council-forecasts.csv), 해시 아래의 질문 텍스트(asks/<sha256>.md), 통계(council-stats.json), 프로토콜 및 버전(arena-protocol.json), SHA-256 해시가 있는 포트폴리오 엔진 코드(arena-code.json), 모든 예측 점수의 재계산(tools/replay_brier.py) 및 발행된 거래 및 가격에서 발행된 모든 리그 계정을 재계산하는 스크립트(python3 replay.py https://trends.polyhelper.ai/api/v1/, 부록 B)를 포함합니다. 라이브 엔드포인트는 매 세션마다 변경되므로 분석은 이에 기반하지 않습니다. 논문의 각 버전 날짜의 개방 파일의 불변 릴리스, SHA-256 해시 매니페스트, Zenodo에 보관됨(10.5281/zenodo.23552700), 논문의 모든 숫자는 해당 릴리스에서 계산되며, 등록된 스크립트는 오프라인에서 실행됩니다(--data). 스크립트가 있는 기본 엔드포인트, 각각에 대한 확인자가 있는 등록된 예측(resolve.py), 블라인드 예측자가 3개 투표 모두로 가격을 매긴 정리 목록, 집합 B 스크립트, 인장된 기후학의 콘텐츠 SHA-256, 파일 매니페스트(SHA-256 포함), 각 스크립트의 요구 사항과 명령을 나열하는 README가 OSF에 등록되어 있습니다(10.17605/OSF.IO/9Q86N). 논문은 Zenodo에 보관되어 있으며(10.5281/zenodo.23552697), 선호되는 인용은 SSRN 전 인쇄본입니다(https://ssrn.com/abstract=7653679).
윤리. 6절의 읽기 실험은 공개 페이지 방문자로부터 명시된 신뢰도로 익명의 찬성 또는 반대 예측을 수집합니다. 읽기는 익명의 무작위 식별자로 그룹에 할당됩니다. 실험은 이름, 계정 또는 연락처 세부 정보를 수집하지 않습니다. 리그는 읽기의 IP 주소를 저장하거나 기록하지 않습니다. 주소의 염분 처리된 해시와 날짜는 투표당 투표 수를 제한하기 위해서만 유지되며, 개인 데이터는 발행되거나 분석에 사용되지 않습니다. 결과는 집계 수로 보고되며, F29가 읽는 첫 예측은 익명 식별자 아래에만 발행됩니다. 저는 기관 윤리 위원회 없이 독립 연구자로서 작업을 수행했습니다. 리그의 예측자는 소프트웨어 모델입니다.
저자 기여. 단독 저자.
대응. [email protected] · ORCID: 0009-0007-4845-3163
References
Abeliuk, A., Benjamin, D. M., Morstatter, F., & Galstyan, A. (2020). Quantifying machine influence over human forecasters. Scientific Reports, 10, 15940. https://doi.org/10.1038/s41598-020-72690-4
Adams, C., Cain, P., Pinkas, D., & Zuccherato, R. (2001). Internet X.509 public key infrastructure time-stamp protocol (TSP) (RFC 3161). Internet Engineering Task Force. https://doi.org/10.17487/RFC3161
AI Council · Markets. (2026). Open data of the AI Council · Markets league: sealed book, forecasts, statistics, protocol, event-contract schema and league accounts [Data set]. CC BY 4.0. Data as of 20 October 2026 (generated 21 October 2026, 02:42 UTC); conformance status read 21 October 2026, 15:05 UTC. Retrieved 20-21 October 2026, from https://trends.polyhelper.ai/api/v1/
Aitchison, M., Jeen, S., Shevlane, T., & Day, B. (2026). Diversity is the strength of the AI crowd (arXiv:2606.29661). arXiv. https://arxiv.org/abs/2606.29661
Alur, R., Stadie, B. C., Kang, D., Chen, R., McManus, M., Rickert, M., Lee, T., Federici, M., Zhu, R., Fogerty, D., Williamson, H., Lozinski, N., Linsky, A., & Sekhon, J. S. (2025). AIA Forecaster: Technical report (arXiv:2511.07678). arXiv. https://arxiv.org/abs/2511.07678
Arora, A., & Malpani, R. (2026). PredictionMarketBench: A SWE-bench-style framework for backtesting trading agents on prediction markets (arXiv:2602.00133). arXiv. https://arxiv.org/abs/2602.00133
Bali, T. G., Kelly, B. T., Mörke, M., & Rahman, J. (2023). Machine forecast disagreement (NBER Working Paper No. 31583). National Bureau of Economic Research. https://doi.org/10.3386/w31583
Barber, B. M., & Odean, T. (2000). Trading is hazardous to your wealth: The common stock investment performance of individual investors. The Journal of Finance, 55(2), 773-806. https://doi.org/10.1111/0022-1082.00226
Barot, R. M., & Borkhatariya, A. S. (2026). PolySwarm: A multi-agent large language model framework for prediction market trading and latency arbitrage (arXiv:2604.03888). arXiv. https://arxiv.org/abs/2604.03888
Berg, J., Nelson, F., & Rietz, T. (2008). Prediction market accuracy in the long run. International Journal of Forecasting, 24(2), 285-300. https://doi.org/10.1016/j.ijforecast.2008.03.007
Bitcoin Developer Documentation. (n.d.). Block chain: Block headers. Retrieved 20 October 2026, from https://developer.bitcoin.org/reference/block_chain.html
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Cao, S., Wang, C. C. Y., & Yi, X. (2025). When LLMs go abroad: Foreign bias in AI financial predictions (Harvard Business School Working Paper No. 26-013). Harvard Business School.
Chambers, C. D. (2013). Registered Reports: A new publishing initiative at Cortex. Cortex, 49(3), 609-610. https://doi.org/10.1016/j.cortex.2012.12.016
Chen, Y., Yao, Z., Liu, Y., Xin, A., Ye, J., Yu, J., Hou, L., & Li, J. (2025). StockBench: Can LLM agents trade stocks profitably in real-world markets? (arXiv:2510.02209). arXiv. https://arxiv.org/abs/2510.02209
Cheng, P., Liu, J., & Long, Y. (2026). PolyBench: Benchmarking LLM forecasting and trading capabilities on live prediction market data (arXiv:2604.14199). arXiv. https://arxiv.org/abs/2604.14199
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. Zenodo. https://doi.org/10.5281/zenodo.22683716 (also SSRN Working Paper No. 7390698, https://ssrn.com/abstract=7390698)
Chernets, V. (2026b). Verification theater: Measured failure modes of AI verifier panels. Zenodo. https://doi.org/10.5281/zenodo.23197641
Chernets, V. (2026c). After the programmer divide: One measure for people who build through AI agents (SSRN Working Paper No. 7589918). SSRN. https://ssrn.com/abstract=7589918
Choi, H. K., Zhu, X., & Li, S. (2025). Debate or vote: Which yields better decisions in multi-agent large language models? (arXiv:2508.17536). Advances in Neural Information Processing Systems 38 (NeurIPS 2025). https://arxiv.org/abs/2508.17536
Chu, G., Shen, D., & Zhu, Z. (2025). Machine forecast disagreement in the cryptocurrency market (SSRN Working Paper No. 5230677). SSRN. https://doi.org/10.2139/ssrn.5230677
Clemen, R. T., & Winkler, R. L. (1985). Limits for the precision and value of information from dependent sources. Operations Research, 33(2), 427-442. https://doi.org/10.1287/opre.33.2.427
Cox, D. R. (1958). Two further applications of a model for binary regression. Biometrika, 45(3-4), 562-565. https://doi.org/10.1093/biomet/45.3-4.562
Diebold, F. X., & Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253-263. https://doi.org/10.1080/07350015.1995.10524599
Diercks, A. M., Katz, J. D., & Wright, J. H. (2026). Kalshi and the rise of macro markets (Finance and Economics Discussion Series 2026-010). Board of Governors of the Federal Reserve System. https://doi.org/10.17016/FEDS.2026.010
Diether, K. B., Malloy, C. J., & Scherbina, A. (2002). Differences of opinion and the cross section of stock returns. The Journal of Finance, 57(5), 2113-2141. https://doi.org/10.1111/0022-1082.00490
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114-126. https://doi.org/10.1037/xge0000033
Dubach, P. D. (2026). The anatomy of a decentralized prediction market: Microstructure evidence from the Polymarket order book (arXiv:2604.24366). arXiv. https://arxiv.org/abs/2604.24366
Fan, T., Yang, Y., Jiang, Y., Zhang, Y., Chen, Y., & Huang, C. (2025). AI-Trader: Benchmarking autonomous agents in real-time financial markets (arXiv:2512.10971). arXiv. https://arxiv.org/abs/2512.10971
Fassbender, J. (2026). Bitcoin-anchored temporal proof for transparency services (Internet-Draft draft-fassbender-scitt-time-anchor-07). Internet Engineering Task Force. https://datatracker.ietf.org/doc/html/draft-fassbender-scitt-time-anchor-07
Forklog. (2025a). Four out of six AI models suffer losses in trading tournament. https://forklog.com/en/four-out-of-six-ai-models-suffer-losses-in-trading-tournament/
Forklog. (2025b). AI model Grok 4.2 triumphs in trading tournament. https://forklog.com/en/ai-model-grok-4-2-triumphs-in-trading-tournament/
Gao, Z., Jiang, W., & Yan, Y. (2025). Detecting lookahead bias in LLM forecasts (arXiv:2512.23847). arXiv. https://arxiv.org/abs/2512.23847
Glasserman, P., & Lin, C. (2023). Assessing look-ahead bias in stock return predictions generated by GPT sentiment analysis (arXiv:2309.17322). arXiv. https://arxiv.org/abs/2309.17322
Gneiting, T., Balabdaoui, F., & Raftery, A. E. (2007). Probabilistic forecasts, calibration and sharpness. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 69(2), 243-268. https://doi.org/10.1111/j.1467-9868.2007.00587.x
Gneiting, T., & Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359-378. https://doi.org/10.1198/016214506000001437
Guan, M., & Chen, Q. (2026). Leakage-aware benchmarking of LLM forecasting: Real-time nowcasts as the decision-time input for macro factor ranking (arXiv:2606.22719). arXiv. https://arxiv.org/abs/2606.22719
Haber, S., & Stornetta, W. S. (1991). How to time-stamp a digital document. Journal of Cryptology, 3(2), 99-111. https://doi.org/10.1007/BF00196791
Halawi, D., Zhang, F., Chen, Y.-H., & Steinhardt, J. (2024). Approaching human-level forecasting with language models. In Advances in Neural Information Processing Systems 37 (NeurIPS 2024). https://arxiv.org/abs/2402.18563
He, S., Lv, L., Manela, A., & Wu, J. (2025). Chronologically consistent large language models (arXiv:2502.21206). arXiv. https://arxiv.org/abs/2502.21206
Jyotish, V. (2026). Sealed before the event: A publicly verifiable, Bitcoin-anchored forecast record of 92 graded outcomes [Version 1; awaiting peer review]. F1000Research, 15, Article 1322. https://doi.org/10.12688/f1000research.186752.1
Karger, E., Bastani, H., Chen, Y.-H., Jacobs, Z., Halawi, D., Zhang, F., & Tetlock, P. E. (2025). ForecastBench: A dynamic benchmark of AI forecasting capabilities. In International Conference on Learning Representations (ICLR 2025). https://arxiv.org/abs/2409.19839
Karkar, C., & Chopra, P. (2025). Future is unevenly distributed: Forecasting ability of LLMs depends on what we're asking (arXiv:2511.18394). arXiv. https://arxiv.org/abs/2511.18394
Kim, E. M., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning (PMLR 267, pp. 30038-30066). https://proceedings.mlr.press/v267/kim25e.html
Kim, S., Kwon, J., Kim, Y., Kagan, N., Khatchadourian, R., Ahn, W., Lopez-Lira, A., Lee, J., Hwang, Y., Levy, O., Lee, Y., & Choi, C. (2026). Forecasting future language: Context design for mention markets (arXiv:2602.21229). arXiv. https://arxiv.org/abs/2602.21229
Kish, L. (1965). Survey sampling. Wiley.
Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118. https://doi.org/10.1073/pnas.2018340118
Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. In Advances in Neural Information Processing Systems 7 (NIPS 1994). https://papers.nips.cc/paper_files/paper/1994/hash/b8c37e33defde51cf91e1e03e51657da-Abstract.html
Künsch, H. R. (1989). The jackknife and the bootstrap for general stationary observations. The Annals of Statistics, 17(3), 1217-1241. https://doi.org/10.1214/aos/1176347265
Li, H., Cao, Y., Yu, Y., Javaji, S. R., Deng, Z., He, Y., Jiang, Y., Zhu, Z., Subbalakshmi, K. P., Huang, J., Qian, L., Peng, X., Suchow, J. W., & Xie, Q. (2025). INVESTORBENCH: A benchmark for financial decision-making tasks with LLM-based agent. In Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 2509-2525). https://aclanthology.org/2025.acl-long.126/
Li, W. W., Kim, H., Cucuringu, M., & Ma, T. (2025). Can LLM-based financial investing strategies outperform the market in long run? [FINSABER] (arXiv:2505.07078). arXiv. https://arxiv.org/abs/2505.07078
Li, X., Yao, X., Qi, G., Zhu, F., Koa, K. J. L., Ng, X. Y., Liu, Z., Ni, X., Liu, C., Yang, Y., Zhang, Y., Wang, W., Feng, F., Wang, C., Luan, H., Xing, X., Xu, X., Chua, T.-S., & Huang, K.-W. (2026). FinDeepForecast: A live multi-agent system for benchmarking deep research agents in financial forecasting (arXiv:2601.05039). arXiv. https://arxiv.org/abs/2601.05039
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Algorithm appreciation: People prefer algorithmic to human judgment. Organizational Behavior and Human Decision Processes, 151, 90-103. https://doi.org/10.1016/j.obhdp.2018.12.005
Lopez-Lira, A., & Tang, Y. (2023). Can ChatGPT forecast stock price movements? Return predictability and large language models (SSRN Working Paper No. 4412788). https://doi.org/10.2139/ssrn.4412788
Lopez-Lira, A., Tang, Y., & Zhu, M. (2025). The memorization problem: Can we trust LLMs' economic forecasts? (arXiv:2504.14765). arXiv. https://arxiv.org/abs/2504.14765
louidev. (2026). GlassBallAI: A dataset of LLM market predictions (made with Google Gemini models) (Version 1.2) [Data set, CC BY-NC 4.0]. Hugging Face. Retrieved 21 October 2026, from https://huggingface.co/datasets/louidev/glassballai
MarketMania. (2026). Live LLM crypto forecasting benchmark and Benchmark methodology [Web pages]. Retrieved 21 October 2026, from https://marketmania.ai/llm-financial-market-benchmark and https://marketmania.ai/benchmarks/methodology
MaxWellApexLab. (2026). llm-trading-arena: LLM Trading Arena [Computer software and live ledger, MIT licence]. GitHub. Retrieved 21 October 2026, from https://github.com/MaxWellApexLab/llm-trading-arena
Meng, S., & Chen, X. (2026). AI-driven alpha decay: Algorithmic homogenization, reflexive signal erosion, and the paradox of intelligent markets (arXiv:2605.23905). arXiv. https://arxiv.org/abs/2605.23905
Metaculus. (2025a). Q1 AI benchmarking results: Human pros crush bots. Effective Altruism Forum. https://forum.effectivealtruism.org/posts/mwcWxwdsEMexm98GF/q1-ai-benchmarking-results-human-pros-crush-bots
Metaculus. (2025b). Q2 AI benchmark results: Pros maintain clear lead. LessWrong. https://www.lesswrong.com/posts/Surnjh8A4WjgtQTkZ/q2-ai-benchmark-results-pros-maintain-clear-lead
Miller, E. M. (1977). Risk, uncertainty, and divergence of opinion. The Journal of Finance, 32(4), 1151-1168. https://doi.org/10.1111/j.1540-6261.1977.tb03317.x
Murphy, A. H. (1973). A new vector partition of the probability score. Journal of Applied Meteorology, 12(4), 595-600. https://doi.org/10.1175/1520-0450(1973)012<0595:ANVPOT>2.0.CO;2
Nakamoto, S. (2008). Bitcoin: A peer-to-peer electronic cash system. https://bitcoin.org/bitcoin.pdf
National Institute of Standards and Technology. (2015). Secure hash standard (SHS) (FIPS PUB 180-4). https://doi.org/10.6028/NIST.FIPS.180-4
Nechepurenko, M., & Shuvalov, P. (2026a). Foresight Arena: An on-chain benchmark for evaluating AI forecasting agents (arXiv:2605.00420v2). arXiv. https://arxiv.org/abs/2605.00420
Nechepurenko, M., & Shuvalov, P. (2026b). Coordination as an architectural layer for LLM-based multi-agent systems (arXiv:2605.03310). arXiv. https://arxiv.org/abs/2605.03310
Nel, L. (2025). Do large language models know what they don't know? KalshiBench: A new benchmark for evaluating epistemic calibration via prediction markets (arXiv:2512.16030). arXiv. https://arxiv.org/abs/2512.16030
NeuPortal. (2026). NeuPortal: AI forecasts vs prediction markets (Bitcoin-timestamped) (Version 1) [Data set; Zenodo record by A. Bilous]. Zenodo. https://doi.org/10.5281/zenodo.21294229 . Proofs: https://github.com/neuportalai-ui/experiment-proofs
Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703-708. https://doi.org/10.2307/1913610
Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600-2606. https://doi.org/10.1073/pnas.1708274114
Numerai. (n.d.). Meta Model Contribution (MMC) [Technical documentation]. Numerai Docs. Retrieved 21 October 2026, from https://docs.numer.ai/numerai-tournament/scoring/meta-model-contribution-mmc
Rockflow. (n.d.). RockAlpha: AI stock. Retrieved 21 October 2026, from https://rockalpha.rockflow.ai/ai-stock
Ørpheus AI. (n.d.). Zeus: Environmental forecasting subnet [Source code and README]. GitHub. Retrieved 21 October 2026, from https://github.com/Orpheus-AI/Zeus/blob/main/README.md
Paleka, D., Goel, S., Geiping, J., & Tramèr, F. (2026). Pitfalls in evaluating language model forecasters. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2506.00723
Prophet Arena. (2026). Verify a forecast, Verify (documentation) and How scoring works [Web pages]. Retrieved 20-21 October 2026, from https://www.prophetarena.co/verify , https://www.prophetarena.co/docs/verify and https://www.prophetarena.co/research/how-scoring-works
Qian, L., Peng, X., Wang, Y., Zhang, V. J., He, H., Smith, H., Han, Y., He, Y., Li, H., Cao, Y., Yu, Y., Lopez-Lira, A., Lu, P., Nie, J.-Y., Xiong, G., Huang, J., & Ananiadou, S. (2025). When agents trade: Live multi-market trading benchmark for LLM agents (arXiv:2510.11695). arXiv. https://arxiv.org/abs/2510.11695
Rallies.ai. (2025-2026). AI Arena [Website feature]. Retrieved 21 October 2026, from https://rallies.ai/
Schoenegger, P., Park, P. S., Karger, E., Trott, S., & Tetlock, P. E. (2025). AI-augmented predictions: LLM assistants improve human forecasting accuracy. ACM Transactions on Interactive Intelligent Systems, 15(1). https://doi.org/10.1145/3707649
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), Article eadp1528. https://doi.org/10.1126/sciadv.adp1528
Sharpe, W. F. (1994). The Sharpe ratio. The Journal of Portfolio Management, 21(1), 49-58. https://doi.org/10.3905/jpm.1994.409501
Sornette, D., Woodard, R., Fedorovsky, M., Reimann, S., Woodard, H., & Zhou, W.-X. (2010). The financial bubble experiment: Advanced diagnostics and forecasts of bubble terminations, volume II, master document (arXiv:1005.5675). arXiv. https://arxiv.org/abs/1005.5675
Sortino, F. A., & Price, L. N. (1994). Performance measurement in a downside risk framework. The Journal of Investing, 3(3), 59-64. https://doi.org/10.3905/joi.3.3.59
Spiro, T. (2026). The oracle's fingerprint: Correlated AI forecasting errors and the limits of bias transmission (arXiv:2605.00844). arXiv. https://arxiv.org/abs/2605.00844
Todd, P. (2016, September 15). OpenTimestamps: Scalable, trust-minimized, distributed timestamping with Bitcoin. https://petertodd.org/2016/opentimestamps-announcement
TradeRank. (2026). TradeRank.ai: Live AI trading leaderboard [Website and open JSON data set]. Retrieved 21 October 2026, from https://traderank.ai/
Walker, A. (2026). The price is (almost) right: A calibration analysis of Polymarket pricing data [Senior thesis, Princeton University]. Princeton University Senior Theses. https://theses-dissertations.princeton.edu/handle/88435/dsp01mw22v8973
White, H. (2000). A reality check for data snooping. Econometrica, 68(5), 1097-1126. https://doi.org/10.1111/1468-0262.00152
Wolfers, J., & Zitzewitz, E. (2004). Prediction markets. Journal of Economic Perspectives, 18(2), 107-126. https://doi.org/10.1257/0895330041371321
Yahoo Finance. (2025). Elon Musk's Grok 4.20 beats OpenAI, Google models in live stock trading contest. https://finance.yahoo.com/news/elon-musks-grok-4-20-123855766.html
Yang, Q., Mahns, S., Li, S., Gu, A., Wu, J., & Xu, H. (2025). LLM-as-a-prophet: Understanding predictive intelligence with Prophet Arena. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2510.17638
Yu, H., Li, F., & You, J. (2025). LiveTradeBench: Seeking real-world alpha with large language models (arXiv:2511.03628). arXiv. https://arxiv.org/abs/2511.03628
Zeng, Z., Liu, J., Chen, S., He, T., Liao, Y., Tian, Y., Wang, J., Wang, Z., Yang, Y., Yin, L., Yin, M., Zhu, Z., Cai, T., Chen, Z., Chen, J., Du, Y., Gao, X., Guo, J., Hu, L., . . . Huang, W. (2025). FutureX: An advanced live benchmark for LLM agents in future prediction. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2508.11987
Zhang, J., Liu, G., Johansson, O., Yitayew, H., Ohly, K., & Li, G. (2026). Prediction Arena: Benchmarking AI models on real-world prediction markets (arXiv:2604.07355). arXiv. https://arxiv.org/abs/2604.07355
Zhang, O., & Zhang, Z. (2026). A review of large language models for stock price forecasting from a hedge-fund perspective (arXiv:2605.05211). arXiv. https://arxiv.org/abs/2605.05211
Zhao, X., Zhang, R., Ye, L., Cao, R., Xie, P., & Chava, S. (2026). Can LLMs take the pulse of the economy? A real-time evaluation of LLM nowcasts on macroeconomic indicators (arXiv:2608.30110). arXiv. https://arxiv.org/abs/2608.30110
부록 A. 프로토콜 필드
사양은 파일 자체입니다: 리그의 경우 arena-protocol.json(표 A1), 각 실행 라인에 봉인된 methodology 필드의 경우 예측 점수(표 A2)입니다. 둘 다 버전이 관리됩니다. 각 변경 사항은 날짜가 지정되며 각 봉인에는 해당 버전이 포함되어 있으므로, 변경 사항은 이전에 봉인된 항목에 영향을 주지 않습니다(요구사항 15). 아래 표는 2026년 10월 20일 현재 점수를 해결하는 데 필요한 키를 나열합니다.
표 A1. 계정을 해결하는 데 필요한 arena-protocol.json의 키(버전 arena-3, 2026년 10월 20일).
| 키 | 고정되는 내용 |
|---|---|
version, pro_version, history |
시행 중인 규칙(arena-3, Pro 리그 pro-1)과 각 버전의 시작 날짜 |
assets, indicators_only |
각 시장이 거래하는 수단(IEF로서의 수익률, BTC-USD로서의 비트코인 등); VIX는 보유하지 않음 |
prices |
가격 소스 및 계정 규칙: 실행을 위한 09:30-09:45 ET의 첫 번째 분봉, 가치를 위한 종가 |
execution, cost |
결정은 봉인 후 첫 번째 오픈에서 거래되며, 변경되는 모든 달러에 대해 0.001 |
limits, cash |
포지션당 5% ~ 25%, 합계 100%, 롱 전용; 현금은 달력 일수 360으로 나눈 13주 국채로 계산 |
missing_answer, refused, asked_again |
결정이 없거나 거부된 경우 포지션은 변경되지 않음; 재시도는 해당 질문의 해시로 봉인됨 |
pro_league |
서명된 가중치, 최대 2배의 총 노출도, 차입 비용, 마진 컷 |
new_model_version |
계정이 계속됨; 변경 사항이 날짜가 지정됨; 해당 버전 이후의 결과가 별도로 표시됨 |
formulas |
수익률, 최대 낙폭, 샤프 비율, 소르티노 비율, 배당금은 배당락일부터, 분할은 한 번만 적용 |
question, replay |
포트폴리오 질문의 템플릿 해시; 공개 파일에서 모든 계정을 다시 계산하는 방법 |
섀도우 트랙(f12, closed_book, repeats, sp100, council_talk, modalities, roles)은 같은 파일에서 자신의 규칙 버전을 가지고 있으며 예측 점수에 포함되지 않습니다.
표 A2. 각 실행 라인에 봉인된 채점 방법론의 필드(methodology, 버전 2).
| 필드 | 고정되는 내용 |
|---|---|
reference |
각 지표의 규칙에 따른 봉인 후 첫 번째 가격(ref_rule); 늦은 답변은 자신의 참조값을 얻음 |
counted |
참조값 이전에 봉인된 마지막 답변 라인이 계산됨; 세션 11(2026년 11월 2일)부터 각 좌석의 첫 번째 적절한 형식의 답변 라인이 참조값 이전에 봉인되어 계산되고, 같은 좌석의 이후 라인은 레이블이 있는 재시도입니다(asks.jsonl, 74번 라인); 종가 이후의 라인은 해당 세션에 대해 채점되지 않음 |
league |
세션당 1점: 오픈 이전에 봉인된 마지막 실행(session_run); 나머지는 별도로 표시됨. 2026년 10월 21일부터 계산된 실행은 예정된 아침 실행으로, 증명 페이지에서 미리 선언됨(섹션 3.4) |
direction |
참조값에서 지표의 상승 또는 하락; 드로우 밴드 내의 움직임은 드로우입니다(council-stats.json, draw_band에서 정의됨); 50은 어느 쪽도 지지하지 않음 |
brier, calibration |
, 동전 0.25; 지지된 쪽으로 폴딩, 구간 [50, 60), [60, 70), [70, 80), [80, 100] |
independence |
최소 10개 거래일에서 30개 이상의 예측 후 순위 |
missing |
주어진 답변의 응답하지 않은 셀은 50%로 계산됨 |
btc |
봉인 시간부터의 비트코인 일수, 채점 세션의 16:00 ET에서 상한선 |
consensus |
평균 확률; 5개 이상의 답변에서 극값 제거됨; 패밀리의 두 번째 좌석은 1/3로 가중치; 2-98% 범위 내에서 유지 |
together |
all_wrong(모든 모델이 틀림, 최소 4개 응답) 및 minority_right(합의가 틀림, 일부 모델이 맞음) |
changes |
방법론에 대한 날짜별 변경사항; 이전에 게시된 항목은 다시 계산되지 않음 |
부록 B. 직접 봉인을 검증합니다
단계에서는 공개 파일과 표준 도구만 사용합니다. 저는 2026년 10월 20일 저녁(ET) 1단계부터 8단계까지 실행했고 10월 21일에 9단계를 실행했으며, 표시된 결과는 제가 얻은 것입니다. 1단계부터 8단계까지의 예는 2026년 10월 20일 13:00:25Z의 타임스탬프이며, 그날의 네 개 중 하나입니다(섹션 3.1). 1단계부터 8단계까지는 레벨 1(체인)과 레벨 2(앵커)를 확인합니다. 9단계는 레벨 2+, 2026년 10월 21일 타임스탬프된 목록의 RFC 3161 토큰을 확인합니다. 2026년 10월 19일과 20일의 세션은 개발 세션이며, 계산된 기록은 2026년 10월 21일부터 실행됩니다.
1단계. 책과 타임스탬프를 다운로드합니다.
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt.ots
증명 페이지 https://trends.polyhelper.ai/markets/proof/2026-10-20/에는 그날의 모든 스탬프와 실행의 모든 책 라인이 해당 봉인 및 링크와 함께 나열되어 있습니다.
2단계. 스탬프된 목록을 읽습니다. cat 130025Z.txt는 다른 책들 중에서 이 책의 라인을 보여줍니다:
daily/council/book.jsonl: 159 lines, sha256 59673b9e21ac6d358e7dc3b811dc3d78f5286390094f7133e3704f57cac1a7d9, last link 378273fd057fcbf364746b032f67f42cd811d281da80f39ff0792c4047175b2cStep 3. 오늘의 책이 도장이 찍힌 접두사로 시작하는지 확인합니다.
head -n 159 council-book.jsonl | shasum -a 256
# 59673b9e21ac6d358e7dc3b811dc3d78f5286390094f7133e3704f57cac1a7d9  -
sed -n 159p council-book.jsonl | python3 -c "import json,sys; print(json.load(sys.stdin)['link'])"
# 378273fd057fcbf364746b032f67f42cd811d281da80f39ff0792c4047175b2c
두 값이 도장이 찍힌 목록과 일치하므로, 처음 159줄은 정확히 이것이 커밋하기로 약속한 줄입니다. 151줄은 2026-10-20-am의 실행 줄이고 152~159줄은 답변 줄입니다. 150012Z.txt, 153605Z.txt, 165254Z.txt를 사용한 동일한 확인은 165, 167, 173줄을 포함합니다.
도장이 찍힌 모든 목록에 인쇄된 규칙은 바이트를 고정합니다. 파일은 저장된 상태(UTF-8, 바이트 순서 표시 없음, 재인코딩이나 정규화 없음)로 취급되며 각 줄은 LF로 끝납니다. N줄의 해시는 각각 LF를 포함한 1~N줄을 포함하며, LF 없는 마지막 줄은 아직 계산되지 않습니다. 줄 끝을 다시 쓰는 미러는 확인에 실패합니다.
4단계. 모든 도장과 링크를 다시 계산합니다.
import json, hashlib
H = lambda o: hashlib.sha256(json.dumps(o, sort_keys=True, ensure_ascii=False).encode()).hexdigest()
lines = [json.loads(l) for l in open("council-book.jsonl", encoding="utf-8")]
prev = ""
for i, x in enumerate(lines, 1):
    assert x["n"] == i and x["prev"] == prev
    assert x["seal"] == H({k: v for k, v in x.items() if k not in ("seal", "link", "prev", "n")})
    assert x["link"] == H({k: v for k, v in x.items() if k != "link"})
    prev = x["link"]
print("chain ok:", len(lines), "lines")
10월 20일 파일에서 이 명령은 chain ok: 211 lines를 출력했습니다.
단계 5. 질문이 실행으로 답변되었는지 확인합니다.
curl -s https://trends.polyhelper.ai/api/v1/asks/77d3c627c7c69d2f6e740ccd89113872b1ac08053554a4651bc2d3064b4e6f07.md | shasum -a 256
# 77d3c627c7c69d2f6e740ccd89113872b1ac08053554a4651bc2d3064b4e6f07  -
6단계. Bitcoin 앵커를 검증합니다. OpenTimestamps 클라이언트를 설치합니다(pip install opentimestamps-client). 로컬 Bitcoin 노드를 사용하면 ots verify 130025Z.txt.ots는 130025Z.txt를 해시하고, 증명을 따라가며 블록 헤더에 대해 확인합니다. 노드가 없으면 ots info 130025Z.txt.ots는 파일 해시(5c7d3a357f3cd8b9c27aa4c5d1e9e4750d522bd90b58ffe5193fc61356079d0f, shasum -a 256 130025Z.txt와 같음), 증명의 작업과 그 증명(BitcoinBlockHeaderAttestation(972334))을 출력합니다. 파일 해시에 작업을 적용하면 74072ae1fdee72c9a3f749462490b46f896e0fab58f7d101dc1a403d967e5c30을 얻습니다. 이는 블록 탐색기에서 보여주는 블록 972,334의 머클 루트입니다(헤더 시간 2026-10-20 13:55:20Z; 이전 11개 블록의 중간값 시간 12:45:12Z). 두 파일을 https://opentimestamps.org에 드롭할 수도 있습니다. 보류 중인 달력 증명만 표시하는 증명은 ots upgrade로 완료합니다. 보류 중인 증명은 읽는 사람이 검증할 수 있는 시간을 포함하지 않습니다.
7단계. 리그를 다시 계산합니다.
curl -s https://trends.polyhelper.ai/api/v1/arena-code-tools-replay.py.txt -o replay.py
python3 replay.py https://trends.polyhelper.ai/api/v1/
2026년 10월 20일 기준 파일에 대해 스크립트가 출력한 내용(발췌):
replay: 253 published rows, 145 accounts, 2 sessions (2026-10-19 .. 2026-10-20), 1006 trades, rules arena-3
exact to the cent (|d| <= 0.01): 204; within the rounding of the published trades: 49; DIFFERENT: 0; not recounted (other price sets): 0
result: the published scores are reproduced
Step 8. 엔진의 코드를 확인합니다. arena-code.json은 각 코드 파일과 해당 SHA-256을 나열하며, 각 파일은 arena-code-<file>.txt로 발행됩니다:
curl -s https://trends.polyhelper.ai/api/v1/arena-code-council_arena.py.txt | shasum -a 256
# 9ff5575c2b5c7736fba06bec1b63a608f5f290aacdee6df6b24a51381f22686c  -
이는 council_arena.py의 항목과 일치합니다.
단계 9. 2026년 10월 21일의 서명 시간 확인(레벨 2+). 2026년 10월 21일, 09:10 ET에 OpenSSL 3으로 실행합니다(OpenSSL 3.6 및 4.0 모두에서 두 검사가 통과합니다). FreeTSA 인증서는 tsa/ 아래에 복사되고 서비스에서 게시됩니다(https://freetsa.org/files/); DigiCert의 체인은 시스템 신뢰 저장소에 있습니다.
P=https://trends.polyhelper.ai/markets/proof/2026-10-21
for f in 130019Z.txt 130019Z.txt.freetsa.tsr 130019Z.txt.digicert.tsr tsa/freetsa-cacert.pem tsa/freetsa-tsa.crt; do curl -sO $P/$f; done
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
shasum -a 256 130019Z.txt
# 986bd13907397901ceed70131a70c3674eba05dfdcb9ededbc7cbc0e57bd3714  130019Z.txt
openssl ts -verify -data 130019Z.txt -in 130019Z.txt.freetsa.tsr -CAfile freetsa-cacert.pem -untrusted freetsa-tsa.crt
# Verification: OK   (after a warning that freetsa-tsa.crt is not a CA certificate, which is expected)
openssl ts -verify -data 130019Z.txt -in 130019Z.txt.digicert.tsr -CAfile /etc/ssl/cert.pem
# Verification: OK
openssl ts -reply -in 130019Z.txt.digicert.tsr -text | grep "Time stamp"
# Time stamp: Oct 21 13:00:19 2026 GMT   (the same for the FreeTSA token)
head -n 222 council-book.jsonl | shasum -a 256
# a9359a7741ef5f7aad7436e022a60813e2fc2f9ce76e130abe21dc820e59bd8c  -
이 해시가 있는 목록에는 222개 줄이 있습니다. 214~222 줄은 첫 번째 배치에서 예약된 2026-10-21-am의 실행 줄과 답변이며, 두 당국 모두 UTC 13:00:19에 이들을 배치했으며, 이는 UTC 13:30:00의 참조보다 29분 41초 앞입니다. asks.jsonl을 포함하는 130035Z.txt의 토큰은 UTC 13:00:36을 제공합니다. 132337Z.txt에서 동일한 단계는 224줄을 포함합니다. UTC 13:23:23에 도착한 답변인 224줄은 14초 후에 예약되었고, 세 당국(FreeTSA, DigiCert 및 Sectigo)이 UTC 13:23:37에 이를 서명했으며, 이는 참조 전입니다. asks.jsonl의 첫 번째 줄은 2026년 10월 21일부터 계산되는 실행을 선언합니다. 이는 UTC 04:16:39에 봉인되었으며, 실행의 질문이 전송되기 전이고, 해당 텍스트 해시는 증명 페이지에 인쇄됩니다.
단계가 확립하는 것. 단계 3과 4는 스탬프까지 모든 줄에 대해 P2를 제공합니다. 단계 6은 스탬프된 접두사를 블록 972,334의 헤더 시간 이후 몇 시간 이내로 배치하며, 합의 규칙에 의해 증명된 상수 대신 섹션 3.11에 설정된 이 실제 경계는 이 증명 또는 이의 독립적 사본을 보유한 누구에게나 이후의 모든 결과에 대해 P1a를 제공합니다.
블록은 ET 09:30 이후에 떨어졌습니다. 10월 20일의 경우 봉인과 참조 가격의 순서(P1b)는 레벨 1에서 책의 줄의 봉인 시간인 max(at, booked_at)에서 세션의 ET 09:30에 대해 읽혀지며, council-forecasts.csv의 sealed_at 열은 답변 시간을 제공합니다. 나는 이러한 봉인 시간에 계산된 실행 규칙을 적용하여 P3을 확인했습니다. 개발 세션의 경우 P3은 모든 실행이 발행되고 레이블이 지정되었다는 운영자의 기록에 기초합니다. 계산된 기록에서 계산된 실행은 사전에 선언되고 실행 전 질문 체인에 봉인된 예정된 아침 실행입니다(단계 9). 따라서 독자는 P3을 답변 전에 존재했던 선언에 대해 확인합니다. 단계 9는 서명 당국 중 하나와 그 인증서를 수락하는 누구에게나 10월 21일 세션에 대해 레벨 2+에서 P1b를 제공합니다. 암흑 시즌에는 동일한 단계가 모델을 소금에 절인 약속으로 봉인하는 줄에서 실행됩니다(요구 사항 1), 그리고 신원은 시즌 후 소금이 발행될 때 확인됩니다.
표 B1. 주장의 사다리: 각 검사 수준이 지원하는 것과 이것이 열어두는 것.
| 검사 수준 | 이것이 지원하는 주장 | 이것이 열어두는 주장 | 이 논문에서 |
|---|---|---|---|
| 규칙 발행됨 | 독자는 이벤트 계약, 점수 및 계산된 실행 규칙을 명시할 수 있습니다 | 파일이 규칙을 따릅니다 | 섹션 3; 부록 A |
| 파일 재계산됨 | 발행된 점수와 계정은 발행된 기록에서 따릅니다 | 가격이 독립적 출처와 일치합니다; 명명된 모델이 답변을 생성했습니다 | 단계 4, 7 및 8 |
| 외부 약속 검증됨(레벨 2; 봉인과 참조의 순서에 대해 레벨 2+) | 약속된 바이트는 명시된 경계까지 존재했으며, 해당 접두사의 후속 재작성은 감지 가능합니다; 레벨 2+(2026년 10월 21일부터), 참조 가격 이전 | 모든 예상 예측이 공개됨; 공급자의 모델 신원; 각 답변의 도착 시간 | 단계 3, 6 및 9 |
| 결과 조정됨 | 참조 및 종가가 명시된 시간에 두 번째로 명명된 출처와 일치합니다 | 예측 우위 | 표준의 요구 사항; 날짜가 지정된 수정본에 추가됨 |
| 전망적 쌍 평가, 그 창 이전에 고정됨 | 명시된 이벤트, 가중치 및 비교 도구에 대한 손실 차이 | 다른 시장, 기간 및 체계 | 섹션 8 |
| 독립적 복제 | 다른 사람의 손에 있는 두 번째 파이프라인이 동일한 릴리스에서 점수를 재현합니다 | 이후 시즌의 성과 | 모든 독자에게 개방됨(부록 C) |
참고: 앵커는 기록을 인증합니다. 공급자와의 TLS 세션 증명(TLSNotary)은 명명된 끝점이 봉인된 답변을 반환했다는 주장으로 사다리를 확장할 수 있으며, 프로토콜은 이를 답변 줄의 필드로 포함할 여지가 있습니다. 기술은 섹션 8의 등록된 비교에 의해 결정됩니다.
단계 10. 독립적 로그에서 스탬프를 확인합니다. 각 스탬프가 지정된 목록도 운영자가 실행하지 않는 Sigstore Rekor 투명성 로그에 입력되며, 항목은 목록의 SHA-256을 보유합니다.
shasum -a 256 130025Z.txt
# 5c7d3a357f3cd8b9c27aa4c5d1e9e4750d522bd90b58ffe5193fc61356079d0f  130025Z.txt
curl -s "https://rekor.sigstore.dev/api/v1/log/entries?logIndex=3368351276"
# the base64 body holds spec.data.hash.value, the same SHA-256; integratedTime 1792626303 is 21 October 2026, 23:45:03 UTC
20년 10월 20일의 목록은 21년 10월 21일에 로그 인덱스 3,368,351,276에서 입력되었습니다. 22년 10월 22일부터 각 목록은 타임스탬핑 시에 입력되며, 첫 번째 인덱스 3,368,763,032는 UTC 00:00:16에 통합되었으며, 이는 타임스탐프 이후 5초입니다.
부록 C. 데이터 사전
모든 파일은 https://trends.polyhelper.ai/api/v1/에 있으며, CC BY 4.0에 따라 "AI Council · Markets, trends.polyhelper.ai/markets/"로 귀속하여 공개됩니다. 해당 주소의 인덱스 페이지에는 모든 파일과 업데이트 빈도가 나열되어 있으며, arena-dataset.json에는 각 파일의 열이 설명되어 있습니다. 표 C1에는 예측이 읽는 파일들이 나열되어 있으며, 2026년 10월 21일 08:16 UTC에 읽은 대로의 열 이름이 표시됩니다. 큰 파일을 열 수 없는 독자-AI는 markets-digest.json(30 KB 미만) 또는 council-forecasts-index.json의 실행별 슬라이스에서 시작합니다.
표 C1. 주요 파일.
| 파일 | 내용 | 업데이트 |
|---|---|---|
council-book.jsonl |
봉인된 장부: 모든 실행, 답변, 점수, 포트폴리오 및 리그 라인, 해시 체인 | 각 실행 |
council-forecasts.csv |
봉인된 예측 셀 하나당 한 행, 그 결과 포함 | 각 실행 및 채점 |
council-stats.json |
세션별 Brier 구간, 무승부 대역, 전력 계산, n_eff(계산된 시리즈 n_eff.counted 포함), 쌍 구간(pairs), 방법 세그먼트별 점수(method_segments), 공유 출처 |
각 빌드 |
council-calibration.json |
보정, 동전, 군중 및 기후학에 대한 기술 점수, 각 비교의 방법(method); 발행 시 고정된 기후학 climatology_fixed |
각 빌드 |
council-pairs.csv |
같은 사건에서 두 좌석 각각의 쌍 손실 | 각 빌드 |
league-roster.json |
모든 모델, 그 편, Council 또는 벤치, 양쪽 리그에서의 상태 | 각 빌드 |
{lang}/council-league.json |
리그: 모델, 기준선, 보정, 범위, 군중, 포트폴리오 리그 | 각 실행 및 채점 |
arena-protocol.json, arena-code.json |
프로토콜(부록 A); SHA-256이 포함된 엔진의 코드 | 각 빌드 |
arena-trades.csv, arena-accounts.csv, arena-prices.json |
실행된 거래; 각 계정 각 세션; 실행 및 종가 | 각 세션 |
asks/<sha256>.md, asks/index.json |
각 ask_sha256 뒤의 질문 텍스트 |
각 실행 |
event-contract.schema.json, tools/conformance.py |
JSON 스키마로의 이벤트 계약; 모든 리그가 자신의 예측 파일에서 실행할 수 있는 체커(3.13절) | 계약의 각 변경과 함께 |
council-forecasts.csv (모델, 실행, 시장 및 범위당 한 행): run_id; session; seat; model, mode; line(봉인 라인의 위치 n); sealed_at(UTC); status(counted, not_counted, counted_50, no_answer, refused_shape); asset, horizon; action, action_word; prob_up(0-100); exp_pct; target, invalidation; ref, close, actual_pct; draw; source_domains, source_urls; why_missing; run_role(session_run 또는 earlier_run); seat_versions_in_run; line_kind(issue, 답변 라인에 봉인된 셀, 또는 correction, 나중 수정 라인으로 추가된 셀); reference_at(행의 참조 규칙이 가격을 취하는 시간; Bitcoin의 경우 봉인 초, 가격은 그 시점 이후에 시작하는 첫 1분 바의 종가); same_event(행이 자신의 참조에서 채점될 때 거짓); cell_status(elicited, explicit_50 또는 invalid); attempt; event_id, event_reference_at, event_end_at(이벤트 계약, 3.13절); methodology_version. sealed_at은 답변 시간, 답변 라인의 at입니다. 라인이 장부에 봉인된 시간은 해당 라인의 max(at, booked_at)입니다(10월 20일, 12:31Z~12:42Z의 답변, 13:00:25Z의 봉인), 이는 council-stats.json(time_basis: book_sealed_at)의 시간 기준이며 제출된 스크립트의 기준입니다. Bitcoin의 경우, reference_at은 행 자신의 라인의 봉인 초입니다(10월 21일 배치의 경우 13:00:19Z, 9번째 답변의 경우 13:23:37Z), reference_price_at은 종가가 참조인 1분 바의 시작입니다(13:01:00Z 및 13:24:00Z). cell_status가 explicit_50인 셀은 명시된 50%의 확률입니다. counted_50, no_answer, refused_shape 및 빈 prob_up은 명시되지 않으며 명시된 확률의 Brier 점수 및 합의에 들어가지 않습니다. 군중 질문에 대한 모델의 답변 crowd_up은 이 파일에 없습니다. 이는 장부의 답변 라인에 있습니다.
북 라인. 모든 라인은 n, at, kind, prev, seal과 link를 가집니다. 예측을 담는 종류는 run (run_id, ask_sha256, snapshot_sha256, roster, methodology와 crowd를 추가하며, crowd.at은 crowd.odds 아래의 Polymarket 계약, crowd.kalshi 아래의 Kalshi 계약이고, 각각은 p_up과 vol을 가짐), answer (seat, model, mode, items, years를 추가하며, 후속 실행에서는 own_sha256, ask_sha256, booked_at을 추가; 크라우드 질문에 대한 모델의 확률은 items.<asset>.1d.crowd_up), score와 score_h (당일 및 기간별 결과이며, late_ref, noise와 of를 포함), crowd (각 계약을 해결하며: Polymarket의 경우 rows.<code>, Kalshi의 경우 rows.<code>@kalshi이고, up의 결과를 가짐; 2026년 10월 21일 현재 실행 2026-10-19-am에만 존재), 그리고 correction (of에서 관련된 라인의 이름을 지정함)입니다. 다른 종류는 포트폴리오 리그와 섀도우 트랙을 기록합니다.
고정 기후학. council-calibration.json에서 climatology_fixed는 asset, h, p_up, p_up_ex_draw, n, n_independent, window과 rule을 가진 table[*]을 보유하며, sha256과 sha256_ok를 추가합니다. 그 인장은 council-clim-window.json의 콘텐츠 해시(데이터 주소 아래)이며, 2810d11e907bbaa1f311d06622c929c69e60cc81e558fdb78f5baa04113cabb7이고, 섹션 4.3에서와 같이 계산됩니다; 주요 벤치마크는 기간 1d에서 p_up을 읽습니다. 필드는 2026년 10월 21일 08:54 UTC에 라이브 파일에 진입했으므로, 08:16 UTC의 표 C1에는 이를 나열하지 않습니다.
상태 값과 이벤트 계약. counted_50은 시트의 서비스 점수에 50%로 채워진 셀을 표시합니다; 이는 명시된 확률이 아니며 합의 또는 합의 계수에 진입하지 않으며, 기여하는 확률의 수는 of입니다. late_ref가 있는 라인은 별도 이벤트에 대한 예측입니다(섹션 3.3); 공통 이벤트에서 모델을 풀링하는 분석은 참조가 세션의 공통 참조와 같은 행을 선택합니다.
분석 릴리스. 각 개정판은 Zenodo에 보관된 불변의 릴리스를 기반으로 합니다(10.5281/zenodo.23552700): 북, 예측, 통계, 프로토콜, 코드 파일, 재집계 파일, 게시된 질문 및 .ots 증명을 가진 모든 인장된 목록과 함께, 각 파일의 SHA-256, 크기, 검색 시간 및 명시된 경우 생성 시간의 매니페스트를 포함합니다. 개별적으로 검색된 파일은 식별된 버전의 컬렉션을 형성하며, 릴리스는 원자적 스냅샷입니다. 북은 계속 성장하므로, 릴리스의 북은 이후의 모든 다운로드의 접두사입니다(섹션 3.2).
부록 D. 등록된 예측 (전체 표)
표 D1은 섹션 8의 30개 보조 예측을 한눈에 나열하며, 표 D2는 등록된 텍스트를 제공합니다. 3개 계열의 3개 모델이 각각 독립적으로 클린 리스트를 맹검 방식으로 가격 책정했으며, 등록된 p는 3개의 중앙값입니다. 이 리스트, SHA-256이 포함된 Set B 스크립트 및 스크립트가 포함된 주요 종료점은 OSF 등록(10.17605/OSF.IO/9Q86N)에 제출되었습니다.
모든 행에 적용되는 규칙. 행이 다른 윈도우를 지정하지 않는 한, 예측은 세션 11(2026년 11월 2일)부터 확인 날짜까지의 세션에서 계산됩니다. 책 봉인 시간, max(at, booked_at)이 세션의 09:30 ET 기준 이전인 계산된 라인(세션당 1회 실행)을 사용하며, 동일한 기준이 Bitcoin에 적용되며, Bitcoin의 기준은 라인 봉인 후 첫 번째 1분 바의 종가입니다. Brier 점수는 1일이며 모든 행에 걸쳐 있고, 비김을 포함합니다. 공개된 필드가 이전 세션도 포함하는 경우, 제출된 스크립트는 윈도우에 필드의 정의를 적용합니다.
필드는 https://trends.polyhelper.ai/api/v1/의 열린 파일이며, 2026년 10월 21일에 문서화된 필드입니다. 이름이 변경된 필드는 매핑이 기록된 문서화된 동등 필드로 대체됩니다. 행이 열린 필드에 없는 값이 필요한 경우, 필드를 공개해야 하며, OSF 스크립트의 해석자는 council-forecasts.csv 및 council-book.jsonl에서 행의 규칙에 따라 값을 계산합니다. "Ranked"는 30개의 해결된 예측을 최소 10개의 거래일에서 의미합니다(30/10 규칙, 섹션 4.6), 예측의 윈도우 내에 적용되며, F8은 제외하며, F8은 연맹의 플래그를 읽습니다. 군중 행은 봉인된 질문이 일일 계약을 나열하는 시장 세션입니다(섹션 4.9), 계약은 모델이 crowd_up으로 답한 계약이며, Polymarket 목록이 시장인 Polymarket 계약 또는 그렇지 않으면 Kalshi 계약이며, 두 경우 모두 봉인된 거래량이 최소 $1,000입니다(허용 임계값). 구간은 95%이며 세션이 클러스터이며, 제출된 스크립트에서 시드 20261102를 사용한 10,000회 재샘플링의 부트스트랩입니다.
최소 샘플에 도달하지 못했거나, 파일이 누락되었거나, 문서화된 동등 필드가 없는 필드는 예측이 해결되지 않으며 성공이 아닙니다. 예측은 삭제되지 않습니다. p는 예측이 해결된 경우, 예측이 참일 등록된 확률입니다: 3개의 맹검 투표의 중앙값입니다. 6개 값(F5, F7, F20, F21, F23, F25)은 2026년 10월 20일의 투표입니다. 다른 24개 및 주요 종료점은 2026년 10월 21일에 투표되었으며, 각 라운드에서 그 라운드에서 다시 쓴 예측의 텍스트에서 3개의 나중 라운드입니다. 마지막 라운드 후에 고정된 표현은 행이 해결되는 방법을 지정하며 재가격 책정되지 않았으며, 모든 라운드 및 투표는 등록과 함께 제출되었습니다.
표 D1. 한눈에 보는 30개의 등록된 예측.
| # | 예측 (등록된 진술, 콜론까지) | Set | 확인 날짜 | p | 기술 없는 P(참) |
|---|---|---|---|---|---|
| F1 | 의회는 하루에 2개의 독립적인 음성 아래로 유지됩니다 | A | 2026년 11월 30일 | 0.50 | |
| F2 | 시장 공동 운동은 유사성을 설명하지 않습니다 | A | 2026년 12월 31일 | 0.50 | |
| F3 | 오류도 공유됩니다 | B | 2026년 12월 31일 | 0.74 | |
| F4 | 모델은 군중보다 덜 예리합니다 | B | 2026년 12월 31일 | 0.40 | |
| F5 | 공유된 링크는 공유된 호출을 의미합니다 | A | 2026년 12월 31일 | 0.56 | |
| F6 | 모두 함께 틀렸습니다 | B | 2026년 12월 31일 | 0.92 | |
| F7 | 옳은 소수는 만장일치 오류보다 더 흔합니다 | A | 2026년 12월 31일 | 0.63 | |
| F8 | 표는 일정에 따라 채워집니다 | A | 2026년 11월 30일 | 0.88 | 운영 |
| F9 | 독립성은 월에서 일보다 큽니다 | B | 2026년 12월 31일 | 0.30 | |
| F10 | 평균화는 지도자를 따르는 것을 이깁니다 | B | 2026년 12월 31일 | 0.64 | |
| F11 | 단일 모델은 감지된 일일 이점을 보이지 않습니다 | B | 2026년 12월 31일 | 0.79 | 최소 약 0.78 |
| F12 | 군중이 의회를 이깁니다 | B | 2026년 12월 31일 | 0.83 | |
| F13 | 조합이 군중을 이깁니다 | B | 2026년 12월 31일 | 0.30 | |
| F14 | 모델은 과신합니다 | B | 2026년 12월 31일 | 0.80 | |
| F15 | 의회는 간단한 규칙을 명확한 마진으로 이기지 않습니다 | B | 2026년 12월 31일 | 0.80 | |
| F16 | 어느 지평도 계절에 걸쳐 감지된 신호를 전달하지 않습니다 | B | 2027년 4월 30일 | 0.63 | 최소 약 0.93 |
| F17 | 기후학에 비해 하루가 가장 어려운 지평입니다 | B | 2027년 4월 30일 | 0.37 | |
| F18 | 국가는 작은 요소입니다 | B | 2026년 12월 31일 | 0.80 | |
| F19 | 미국 측은 계절에 걸쳐 더 나은 점수를 매깁니다 | B | 2027년 4월 30일 | 0.57 | |
| F20 | 동일한 뉴스는 더 적은 분쟁을 의미합니다 | A | 2026년 11월 30일 | 0.70 | |
| F21 | 검색은 거의 정확도를 추가하지 않습니다 | B | 2026년 12월 31일 | 0.72 | |
| F22 | 논의는 실제 위험을 발견합니다 | A | 2026년 12월 31일 | 0.30 | |
| F23 | 비판을 경청하는 것은 보상합니다 | A | 2026년 12월 31일 | 0.42 | |
| F24 | 모델은 자신과 많이 의견이 다릅니다 | A | 2026년 11월 30일 | 0.60 | |
| F25 | 지도자는 지속되지 않습니다 | B | 2027년 4월 30일 | 0.62 | 약 0.85 (11개의 순위 좌석), 0.82 (10개) |
| F26 | 지수는 이기기 어렵습니다 | B | 2027년 4월 30일 | 0.60 | |
| F27 | 좋은 예측자는 최고의 거래자가 아닙니다 | B | 2027년 4월 30일 | 0.83 | |
| F28 | 첫 번째 예측 전에 모델에 대한 접근이 독자의 Brier score를 0.01 이상 개선하지 않습니다 | A | 31 Dec 2026 | 0.46 | |
| F29 | 접근이 독자를 위원회 쪽으로 움직입니다 | B | 31 Dec 2026 | 0.41 | |
| F30 | 스타일이 모델을 드러냅니다 | B | 30 Apr 2027 | 0.46 |
주: 등록된 예측 1줄; 각 예측의 전체 텍스트(측도, 출처, 해결 규칙 포함)는 표 D2에 있습니다. 세트 A는 1~2개의 발표된 필드로 정의되며, 세트 B는 등록된 스크립트로 정의됩니다. p는 예측이 해결되었을 때 예측이 참이 될 확률(등록됨)입니다: 3명의 맹검 투표의 중앙값. P(true) without skill은 모델이 기술을 갖지 않은 경우 예측이 참이 될 확률이며, 표 D2의 주에서 파생됩니다; 빈 셀은 그 행이 이러한 값을 나타내지 않음을 의미합니다.
Table D2. 완전한 30개의 등록된 예측: 진술, 측도, 출처, 세트, 확인 날짜, 규칙 및 확률.
| # | 진술 | 측도 (파일 열기) | 세트 | 확인 날짜 | 참이 되는 경우 | 반박되는 경우 | p |
|---|---|---|---|---|---|---|---|
| F1 | 위원회가 1일 기준 2개 이하의 독립 음성 유지: 세션 11~30에서 계산된 실행에서 섹션 5.1의 적격성 규칙으로 계산된 1일 확률 그림의 평균 N_eff는 2.0 미만입니다 | 2~30 November 2026 날짜의 run id를 가진 실행에서 n_eff.counted.per_run[*].n_eff의 평균, council-stats.json |
A | 30 Nov 2026 | 계산된 실행 10개 이상으로 평균 < 2.0 | 계산된 실행 10개 이상으로 평균 ≥ 2.0; 미만 = 미해결 | 0.50 |
| F2 | 시장 동조가 유사성을 설명하지 않습니다: 세션 11~52에서 계산된 실행에서, 그룹당 1개 시장(Nasdaq-100, Dow, Brent 제외)으로 섹션 5.1의 규칙에 따라 계산된 1일 평균 N_eff는 2.5 미만입니다 | 2 November~31 December 2026 날짜의 run id를 가진 실행에서 n_eff.counted.one_per_group.per_run[*].n_eff의 평균, council-stats.json |
A | 31 Dec 2026 | 계산된 실행 20개 이상으로 평균 < 2.5 | 계산된 실행 20개 이상으로 평균 ≥ 2.5; 미만 = 미해결 | 0.50 |
| F3 | 오류도 공유됩니다: 세션 11~52에서 채점된 세션 동안, 좌석의 1일 오류 지표(참조 전에 봉인된 답변, 모든 행, 명시된 50% 제외)에서 계산된 N_eff는 4.0 미만입니다(오류 개수는 결과의 동조도 포함). 세션당, 응답자는 그 세션에 적격 라인을 가진 좌석이며, n은 그 세션의 해당 수, ρ는 응답한 두 시장에 걸친 0/1 오류 지표의 평균 쌍별 피어슨 상관관계입니다(상수 지표를 가진 쌍은 제외되며, 계산 가능한 쌍이 없는 세션도 제외됨), 세션에 걸친 평균은 각 세션을 동등하게 가중합니다 | 발표할 필드(발표된 n_eff_errors에는 지연된 행 포함); OSF 스크립트의 해결자는 council-forecasts.csv 및 council-book.jsonl의 계산된 1일 행에서 이를 계산합니다 |
B | 31 Dec 2026 | 채점된 세션 30개 이상으로 값 < 4.0 | 채점된 세션 30개 이상으로 값 ≥ 4.0; 미만 = 미해결 | 0.74 |
| F4 | 모델이 군중보다 덜 명확합니다: 봉인된 거래량이 $1,000 이상인 1일 군중 계약(모델이 답변한 계약: Polymarket(나열할 때) 또는 Kalshi), 세션 11~52에서, 각 좌석의 crowd_up 답변의 50%로부터의 평균 거리에 대한 좌석 평균이 같은 계약에서 군중 가격의 50%로부터의 평균 거리의 절반 미만입니다 |
council-book.jsonl의 실행 라인의 군중 가격 및 vol(crowd.odds, crowd.kalshi); 응답 라인의 crowd_up 참조 전에 봉인됨; 제출 스크립트 |
B | 31 Dec 2026 | 좌석의 평균 거리 < 0.5 × 군중의 평균 거리, 100개 이상의 계약-세션에서 | 좌석의 평균 거리 ≥ 0.5 × 군중의 평균 거리; 100개 미만의 계약-세션 = 미해결 | 0.40 |
| F5 | 공유 링크는 공유 호출을 의미합니다: 같은 링크를 인용하는 모델 쌍은 링크를 공유하지 않는 쌍보다 행동 클래스에 더 자주 동의하며, 층화 내에서 최소 5포인트, 순열 p < 0.05 | sources.agreement_by_shared_link.diff_within_strata 및 p_permutation, council-stats.json, 제출 스크립트로 적용된 윈도우(정의는 2026년 10월 21일 파일에 재현됨) |
A | 31 Dec 2026 | diff ≥ 0.05 및 p < 0.05 | diff < 0.05 또는 p ≥ 0.05 | 0.56 |
| F6 | 모두 함께 틀림: 4개 이상의 답변 모델이 있는 해결된 1일 시장-세션에서 모든 답변 모델이 틀린 경우의 비중이 독립성 가정에서 예상 비중의 최소 2배입니다. 예상 비중은 같은 시장-세션에서의 평균이며, 실제로 답변한 모델의 오류율의 곱이며, 각 율은 같은 행에서 추정됩니다 | together.all_wrong / together.rows, council-league.json; 제출 스크립트로 council-forecasts.csv에서 기대값 |
B | 31 Dec 2026 | 관찰 비중 ≥ 2 × 예상 비중 | 관찰 비중 < 2 × 예상 비중 | 0.92 |
| F7 | 옳은 소수가 만장일치 오류보다 더 흔합니다: minority_right가 all_wrong을 초과합니다 |
together 정의(council-league.json), 제출 스크립트로 이 논문의 규칙에 의해 윈도우에서 재계산, 참조 전에 봉인된 라인 및 모든 행; 지연된 라인도 계산하고 동점을 제외한 발표된 필드가 옆에 표시됨 |
A | 31 Dec 2026 | minority_right > all_wrong | minority_right ≤ all_wrong | 0.63 |
| F8 | 표가 일정에 따라 채워집니다: 세션 30 채점 후(2026년 11월 30일), 11개 중 최소 9개의 위원회 좌석이 1일 기준 순위 규칙을 충족합니다(2026년 10월 19일부터 계산된 모든 세션, 최소 10개 거래일에 30개 해결된 예측) | ranked 플래그, council-league.json by_horizon.1d |
A | 30 Nov 2026 | 9개 이상의 위원회 좌석 순위 매김 | 8개 이하의 의회 석수 순위 | 0.88 |
| F9 | 월 단위가 일 단위보다 독립성이 높습니다: 세션 11부터 세션 52까지 실행에 따라 계산된 평균 쌍별 상관 ρ의 일 단위와 월 단위 간의 차이(각각 5.1절의 규칙에 따라 양의 차이는 월 단위에서 더 독립적인 음성을 의미함)는 양의 평균을 가지며, 95% 이동 블록 부트스트랩 구간(5개 실행 블록)이 완전히 0 위에 있습니다 | council-forecasts.csv의 계산된 행 1d 및 1m, council-book.jsonl; 제출된 스크립트 | B | 31 Dec 2026 | 구간이 0 위에 완전히 있으며, 적어도 20개의 계산된 실행 | 구간이 0 위에 완전히 있지 않으며, 적어도 20개의 계산된 실행; 더 적음 = 미결정 | 0.30 |
| F10 | 평균화가 지도자 추종을 능가합니다: 세션 31부터 52(2026년 12월 1일부터 31일)에 걸친 합의 1일 Brier는 세션 11부터 30(2026년 11월 2일부터 30일)에 걸쳐 가장 낮은 1일 Brier를 가진 순위 의회 모형인 지도자보다 낮으며, 12월 시장 세션 모두에서 답변했습니다 | council-forecasts.csv의 계산된 1일 행; 참고 전에 밀봉된 답변으로부터 공개 규칙에 의한 합의; 제출된 스크립트 | B | 31 Dec 2026 | 합의 Brier < 지도자의 Brier | 합의 Brier ≥ 지도자의 Brier; 세션 11부터 30에 순위 모형이 없음 = 미결정 | 0.64 |
| F11 | 단일 모형이 감지된 일일 우위를 보이지 않습니다: 순위 의회 모형은 세션 11부터의 모든 행에 걸친 1일 Brier를 가지지 않으며, 그 95% 세션 클러스터 구간은 0.25 이하에 완전히 있습니다(순위 석수당 하나의 미보정 구간) | council-forecasts.csv의 계산된 1일 행; 제출된 스크립트 | B | 31 Dec 2026 | 어떤 석수의 상한도 < 0.25 없음 | 적어도 하나의 석수의 상한 < 0.25 | 0.79 |
| F12 | 군중이 의회를 능가합니다: 세션 11부터 적어도 100개의 서로 다른 1일 시장 세션에서 밀봉된 거래량이 최소 $1,000인 군중 계약이 있는 경우(모형이 답변한 계약: 목록이 있는 경우 Polymarket, 그 외에는 Kalshi), 군중의 Brier는 의회의 crowd_up의 손질된 합의보다 낮으며, 둘 다 그 계약 자체의 해결에 대해 채점됩니다 |
council-book.jsonl의 실행 라인에서 군중 가격 및 vol (crowd.odds Polymarket용, crowd.kalshi); 그 crowd 라인의 해결 (rows.<code>[@kalshi].up); council-book.jsonl의 답변 라인에서 crowd_up; 제출된 스크립트 |
B | 31 Dec 2026 | 군중 Brier < 의회 Brier, 적어도 100개 시장 세션 | 군중 Brier ≥ 의회 Brier; 100개 미만 시장 세션 = 미결정 | 0.83 |
| F13 | 조합이 군중을 능가합니다: F12와 동일한 계약(적어도 100개 시장 세션, 밀봉된 거래량 최소 $1,000)에서, 군중 가격과 의회의 crowd_up의 손질된 합의의 단순 평균은 각 계약의 해결에 대해 채점된 군중만보다 더 낮은 Brier를 가집니다 |
F12와 같음; 제출된 스크립트 | B | 31 Dec 2026 | 조합 Brier < 군중 Brier, 적어도 100개 시장 세션 | 조합 Brier ≥ 군중 Brier; 100개 미만 시장 세션 = 미결정 | 0.30 |
| F14 | 모형이 과신합니다: 세션 11부터의 모든 1일 행에서, 지원된 쪽의 풀링된 60~70% 버킷에서(적어도 100개 예측), 관찰된 빈도는 명시된 확률보다 최소 5포인트 이상 낮습니다 | council-forecasts.csv의 계산된 1일 행; 제출된 스크립트 | B | 31 Dec 2026 | 격차 ≥ 5포인트, n ≥ 100 | 격차 < 5포인트, n ≥ 100; n < 100 = 미결정 | 0.80 |
| F15 | 의회가 단순 규칙을 명확한 차이로 능가하지 않습니다: 둘 다 채점된 세션에서, 1일 단위로 B(합의) − B(모멘텀)은 −0.01보다 큽니다 | council-forecasts.csv의 공통 세션에서 합의 및 모멘텀 1일 Brier; 제출된 스크립트 | B | 31 Dec 2026 | B(합의) − B(모멘텀) > −0.01 | B(합의) − B(모멘텀) ≤ −0.01 | 0.80 |
| F16 | 어떤 지평도 한 시즌에 걸쳐 감지된 신호를 가지지 않습니다: 1일, 1주, 1개월 중 어떤 것도 합의 Brier가 0.25 이하에 완전히 있는 95% 구간을 가지지 않습니다, 4.6절의 규칙에 의한 구간(1일 단위 세션 클러스터; 1주 및 1개월에서는 래그 h − 1의 Newey-West 또는 적어도 h개 세션의 블록이 있는 블록 부트스트랩) | council-forecasts.csv의 지평별 합의 Brier; 제출된 스크립트 | B | 30 Apr 2027 | 어떤 지평의 상한도 < 0.25 없음 | 적어도 하나의 지평의 상한 < 0.25 | 0.63 |
| F17 | 기후학에 비해, 1일이 가장 어려운 지평입니다: 1일, 1주, 1개월 중에서, 기후학적 기저율(2016년부터 2025년까지 시장 및 지평별 순상승 빈도, 모든 행)에 대한 합의 Brier 기술 점수는 1일에서 가장 낮습니다 | council-forecasts.csv의 지평별 합의 Brier; council-calibration.json의 기후학 climatology_fixed.table[*].p_up, 제출된 스크립트(8절)로 밀봉 확인; 2026년 10월 21일 게시됨 |
B | 30 Apr 2027 | 1일 기술 점수가 3개 중 가장 낮음 | 1일 기술 점수가 가장 낮지 않음 | 0.37 |
| F18 | 국가는 작은 요소입니다: 미국 쪽과 중국 쪽 1일 Brier(각 쪽은 공통 세션에서 그 순위 모형의 Brier의 평균) 간의 절대 격차는 각 쪽 내 범위(가장 높은 순위 모형 Brier 빼기 가장 낮은)보다 작습니다 | by_horizon.1d, side, ranked, council-league.json; council-forecasts.csv; 제출된 스크립트 |
B | 31 Dec 2026 | 격차 < 각 쪽 내 범위 | 격차 ≥ 어느 쪽이든 범위 내; 어느 쪽이든 두 개 미만 순위 모형 = 미결정 | 0.80 |
| F19 | 미국 쪽이 한 시즌에 걸쳐 더 좋은 점수를 받습니다: 미국 쪽의 1일 Brier, 세션 11부터 공통 세션의 모든 행에 걸쳐 그 순위 모형의 Brier의 평균은 중국 쪽의, 같은 방식으로 계산된 것보다 낽니다 | council-forecasts.csv의 계산된 1일 행, council-league.json의 side 및 ranked; 제출된 스크립트 |
B | 30 Apr 2027 | 미국 < 중국 | 미국 ≥ 중국; 어느 쪽이든 두 개 미만 순위 모형 = 미결정 | 0.57 |
| F20 | 같은 뉴스는 더 적은 분쟁을 의미합니다: 폐쇄된 도서 실행(밀봉된 패킷, 검색 없음)에서 불일치의 열은 같은 모형 및 날의 개방 실행보다 낮습니다 | arena-cb-experiment.json의 창에서 runs[*]에 대한 heat_closed − heat_open의 평균 |
A | 30 Nov 2026 | closed heat < open heat | closed heat ≥ open heat | 0.70 |
| F21 | 검색은 정확도를 거의 높이지 못합니다: Closed Book 콜의 다음날 Brier는 동일한 모델 및 세션의 open 콜과 0.01 이내입니다 | council-book.jsonl, council-forecasts.csv의 closed_book 라인; 제출된 스크립트. closed 콜이 공통 참조 이후에 봉인되면 자체 참조 가격에서만 점수를 매깁니다(5.5절). 2026년 10월 21일 파일에서 모든 Closed Book 라인은 open 이후에 물었으며(asked_after_open) 자체 참조에서 결과를 가져오지 않으므로 행을 아직 해결할 수 없습니다. 리그가 공통 참조 이전에 봉인된 closed 콜을 발표하거나 각 closed 콜에 대해 자체 참조 가격, close 및 결과(예: 마켓당 score 필드)를 발표하면 해결됩니다. 리졸버는 이미 이를 읽습니다 |
B | 31 Dec 2026 | 절댓값 차이 ≤ 0.01 | 절댓값 차이 > 0.01; 비교 가능한 쌍 없음 = 미해결 | 0.72 |
| F22 | 토론은 실제 위험을 찾습니다: 해결된 5세션 이동이 있는 의장의 비판 중 최소 55%가 확인되며, "확인됨"은 펀드의 5세션 수익이 비판이 예측한 부호를 가진다는 의미입니다 | status, council-talk-critiques.csv (비판의 방향과 필드가 다른 펀드의 5세션 수익에서 재계산됨) |
A | 31 Dec 2026 | 최소 20개의 해결된 비판과 함께 비율 ≥ 55% | 최소 20개의 해결된 비판과 함께 비율 < 55%; 더 적음 = 미해결 | 0.30 |
| F23 | 비판을 청취하는 것이 도움이 됩니다: 비판을 반영한 섀도우가 유지된 포트폴리오를 평균적으로 능가합니다 | 윈도우에 세션이 있는 주의 비판된 포트폴리오에 대한 weeks[*].criticised[*].heed_minus_keep_pp의 평균, council-talk.json |
A | 31 Dec 2026 | 평균 > 0 | 평균 ≤ 0 | 0.42 |
| F24 | 모델은 자신과 자주 불일치합니다: 한 모델의 자체 반복 간 평균 heat는 모델 간 heat의 최소 절반입니다 | 2026년 11월 1일 레이더의 주에 대한 weeks[*].summary.noise_floor.heat_self와 heat_between_models의 평균, council-repeats.json |
A | 30 Nov 2026 | heat_self ≥ 0.5 × heat_between_models, heat_between_models > 0 | heat_self < 0.5 × heat_between_models; 둘 다 0 = 미해결 | 0.60 |
| F25 | 리더는 지속되지 않습니다: 2026년 Q4 동안 1일 Brier로 순위가 매겨진 상위 3개 Council 모델 중 최대 1개만 2027년 Q1의 상위 3개에 있습니다. eligible한 것은 league-roster.json에서 place council을 가진 좌석으로, 각 분기 내에서 30/10 규칙을 충족하며, Q4 2026은 세션 11~52(개발 기간 이후)를 의미하고 Q1 2027은 2027년 1월 4일~3월 31일의 세션입니다; 좌석은 모델 버전의 날짜가 지정된 변경 전에 한 좌석으로 유지됩니다(5.7절); Brier의 정확한 타이는 좌석 이름의 알파벳 순서로 깨집니다 |
council-forecasts.csv, 분기별 1일 행으로 계산됨; league-roster.json; 제출된 스크립트 | B | 30 Apr 2027 | 최대 1개가 상위 3개에 유지됨 | 2개 이상이 상위 3개에 유지됨; 어느 분기든 3개 미만의 순위 있는 Council 좌석 = 미해결 | 0.62 |
| F26 | 지수는 이기기 어렵습니다: 시즌의 마지막 세션에서 14개의 주 리그 모델 계정 중 절반 미만이 S&P 500 계정보다 높은 가치를 가집니다 | 14개 모델 계정과 _spy의 value_usd, arena-accounts.csv; 제출된 스크립트 |
B | 30 Apr 2027 | _spy 위에 6개 이하 |
_spy 위에 7개 이상 |
0.60 |
| F27 | 좋은 예측자가 최고의 거래자는 아닙니다: 1일로 순위가 매겨지고 주 리그 계정을 보유한 Council 좌석에 대해, 1일 Brier 순위와 주 리그 수익 순위 간의 Spearman 상관관계는 0.5 미만입니다. 순위 1은 최저 Brier이고 최고 수익입니다. 좌석은 세션 11~126에 대한 30/10 규칙으로 순위가 매겨지고, Brier는 해당 윈도우의 모든 계산된 1일 행에 대한 것이고, 수익은 시즌의 마지막 세션에서 계정의 value_usd에서 나옵니다; 타이된 값은 순위의 평균을 취합니다 |
council-forecasts.csv의 계산된 1일 행, league-roster.json, arena-accounts.csv; 제출된 스크립트 | B | 30 Apr 2027 | 최소 6개의 순위 있는 좌석과 함께 rho < 0.5 | 최소 6개의 순위 있는 좌석과 함께 rho ≥ 0.5; 더 적음 = 미해결 | 0.83 |
| F28 | 첫 번째 예측 이전에 모델에 접근하면 읽는 사람의 Brier 점수를 0.01 이상 향상시키지 않습니다: 일치하는 시장에서(그룹당 최소 200개의 첫 번째 예측), 모델을 보지 못한 그룹의 Brier 점수가 그들을 보여준 그룹의 점수를 0.01 미만으로 초과합니다(그룹 간 접근의 효과; 한쪽에 대한 신뢰 c는 그 측면의 확률 c/100로 읽힙니다; 명중률이 옆에 보고됨) | experiment.g0.brier과 experiment.g1.brier, 각각의 n, council-league.json |
A | 31 Dec 2026 | 차이 < 0.01, 그룹당 최소 200개 | 차이 ≥ 0.01, 그룹당 최소 200개; 더 적음 = 미해결 | 0.46 |
| F29 | 접근은 읽는 사람을 council로 이동시킵니다: 모델을 보여준 그룹의 첫 번째 예측이 모델을 보여주지 않은 그룹의 예측보다 council consensus와 방향 일치를 최소 10포인트 더 자주 합니다(그룹 간 접근의 효과; 그룹당 최소 200개의 첫 번째 예측) | 실험의 읽는 사람당 첫 번째 예측(arena-dataset.json에서 발행되고 문서화될 필드)과 실행당 consensus; 제출된 스크립트 | B | 31 Dec 2026 | 그룹당 최소 200개와 함께 차이 ≥ 10포인트 | 그룹당 최소 200개와 함께 차이 < 10포인트; 더 적음 = 미해결 | 0.41 |
| F30 | 스타일은 모델을 드러냅니다: 블라인드 시즌(2026년 11월 2일부터), 고정된 추측자(모델, 버전 및 2026년 11월 2일 이전에 제출된 등록에 대한 부록에 명명된 프롬프트의 SHA-256, 온도 0, 후보에서 제외된 패밀리)는 항목당 한 개의 봉인된 답변 텍스트와 답변한 k개 후보 좌석의 목록을 보여주고 모델을 우연보다 최소 3배 더 자주 식별합니다 | 블라인드 시즌 답변 라인 및 시즌 후 공개; 제출된 스크립트 | B | 30 Apr 2027 | 항목에 대한 평균 top-1 정확도 ≥ 3/k의 평균 | 항목에 대한 평균 top-1 정확도 < 3/k의 평균 | 0.46 |
참고: 집합 A는 공개된 하나 또는 두 개의 필드로 정의됩니다. 집합 B는 등록과 함께 제출되고 공개 원본 파일에서 실행되는 스크립트로 정의되며, 스크립트가 정의입니다. 모든 행의 리졸버는 resolve.py (규칙 버전 osf-rules-1)로 제출되며, 섹션 8.1의 세부사항은 다음과 같습니다: F15의 모멘텀 규칙은 이전 세션에서 지표의 리그 결과의 방향이 모든 행에서 55%입니다. 2026년 10월 21일 파일에서 F21, F29 및 F30은 미해결로 표시되며, 각 행은 필요한 데이터를 명시합니다. 첫 번째 봉인된 실행이 제 앞에 표시된 후 F1부터 F5와 F9의 임계값을 설정했으며, 이들의 윈도우는 세션 11에서 시작합니다.
F14, F22 및 F28은 저전력 행입니다: F14의 표준 오차는 100개 예측에서 약 5포인트이고, F22는 20개 비평에서 약 11포인트이며 F28은 그룹당 200에서 약 0.02 Brier입니다. F15, F21 및 F28은 0.01 임계값으로 포인트 추정치를 비교하며 동등성 검정이 아닙니다.
기술 없이 예상되는 값: F11은 한쪽당 2.5%에서 독립적으로 오류를 범하는 10개의 순위 모델에 대해 최소 약 0.78이며, 0.25 이상으로 점수를 매기면 더 높으며 오류가 상관관계가 있을 때 다시 더 높습니다 (F3). F16은 동일한 가정에서 세 개의 지평에 걸쳐 최소 약 0.93입니다. F25는 11개의 순위 모델에 대해 약 0.85이고 무작위 순위에서 10개에 대해 0.82입니다. F10은 어느 결과에나 개방되어 있습니다: 리더는 이전 윈도우에서 선택되며, 평균은 유지하는 회원의 평균 이상에서만 승리를 보장합니다 (섹션 4.5). F8은 리그에 관한 운영 예측입니다. 보정 버킷은 반개방이며, 뒷면에서 [60,70)입니다.
확인 날짜: 2026년 11월 30일 (세션 30), 2026년 12월 31일 (세션 52), 2027년 4월 30일 (126세션 시즌 이후, 2027년 4월 20일경에 종료될 것으로 예상). 블라인드 시즌은 2026년 11월 2일에 시작합니다. 이 시즌에 답변 라인은 솔트된 SHA-256 커밋인 H(salt || model || version || mode)로 모델, 버전 및 모드를 봉인하므로 요구사항 1은 이름을 표시하지 않고도 유지됩니다. 솔트는 시즌 후에 공개되며 (섹션 3.13), F30은 커밋이 개봉된 후 봉인된 답변 라인에서 점수가 매겨집니다. 스코어카드는 이 논문의 날짜가 지정된 개정판으로 공개되며 OSF에 등록됩니다.
확률 없이 등록과 함께 선언된 2차 분석입니다. (1) 의견 불일치가 도움이 되는가: 시장이 고정된 상태에서 좌석 확산의 최고 사분위수에 대한 최저 사분위수에서 기후학에 대한 컨센서스의 쌍 이득, 양측 (섹션 8). (2) 상관관계가 있는 음성을 할인하는 것이 도움이 되는가: 세션 11부터 126까지 공개된 컨센서스와 섹션 5.3의 섀도우 컨센서스 사이의 쌍 1일 Brier 차이, 이동 블록 부트스트랩 (5개의 블록, 10,000개의 리샘플, 시드 20261102) 및 ±0.01의 동등성 영역. 섀도우 가중치와 이를 계산하는 스크립트는 등록과 함께 제출됩니다. 둘 다 F행이 아니며, 둘 다 30개 예측의 Brier 점수에 포함되지 않습니다.
부록 E. 2026년 10월 21일 현재 선행 연구와의 기능 비교
표 E1은 참고 구현의 기능을 표 9의 주석에 나열된 대로 읽을 수 있는 가장 유사한 노력과 비교합니다. Yes는 속성이 문서화됨을 의미하고, Partly는 셀에 명시된 대로 더 약하거나 다른 형태이고, No는 문서화된 부재 또는 이를 제외하는 설계이며, ND는 2026년 10월 21일 현재 공개적으로 문서화되지 않음을 의미합니다(표 9). 리그의 열은 2026년 10월 21일 현재 세 가지 고유한 상태를 사용합니다. Implemented는 공개 파일에서 볼 수 있음을 의미합니다. Specified는 표준 또는 공개 방법론에 작성되었으며 해당 날짜의 파일에서 부재함을 의미합니다. Operator-recorded는 운영 중이며 제3자가 운영자에 의존하여 확인하는 기록을 의미합니다. 셀은 기능의 두 부분에 대해 두 가지 상태를 제공할 수 있습니다.
표 E1. 2026년 10월 21일 현재 공개 자료에서 AI Council · Markets의 기능과 가장 유사한 선행 연구 비교.
| 기능 | 본사(상태) | Foresight Arena | Prediction Arena | NeuPortal | LLM Trading Arena | TradeRank | MarketMania | 기타 |
|---|---|---|---|---|---|---|---|---|
| 1. 일일 실시간 리그 | 구현됨(2026년 10월 16일부터) | 부분(라운드; 논문 결과 시뮬레이션됨, §6; Nechepurenko & Shuvalov, 2026b의 실시간 에이전트) | Yes(15~45분마다 사이클, 2026년 1월~3월) | No(경기당) | Yes(암호화폐는 하루 두 번, 주식은 각 거래일) | Yes(매 24시간) | Yes(2026년 7월 15일부터) | Yes: Alpha Arena, Agent Market Arena, Rallies, FutureX |
| 2. 7개 미국 랩과 7개 중국 랩 모델 | 구현됨(14개 거래석, 7개 미국 및 7개 중국 랩; 11개 예측석, 5개 미국 및 6개 중국) | No(5개 계획, 1개 중국) | No(10개 모델, 1개 중국 랩) | No(1개 미명시 AI) | No(6개 계열, 2개 중국) | No 국가 설계(22개 모델) | No(7개 모델, 2개 중국) | No: Alpha Arena 6 중 2개; Rallies 8 중 2개 |
| 3. 예측석에서의 확률 | 구현됨(11개석) | Yes | No(거래만) | Yes(3가지 결과) | No(주문) | ND | Yes(명시된 확률) | Yes: Prophet Arena, ForecastBench |
| 4. 자산군 전반에 걸친 고정 금융 지표 | 구현됨(12개) | No(Polymarket 이벤트) | 부분(7개 범주 중 Kalshi 금융 계약) | No(축구) | 부분(5개 암호화폐, S&P 100) | 부분(10개 암호화폐, 50개 미국 주식) | 부분(5개 암호화폐) | 부분: 개별 주식 또는 암호화폐(StockBench, Agent Market Arena, GlassBallAI) |
| 5. 동일 자산에 대한 4가지 고정 시간대 | 구현됨 | No | No | No | ND | ND | Yes(1시간~1개월) | Yes, 금융 패널 아님: ForecastBench 데이터셋 질문에 대해 8가지 시간대; 부분: GlassBallAI 1개 10일 시간대 |
| 6. 참고값 이전에 해시로 봉인된 답변 | 구현됨(SHA-256 체인이 09:30 ET 이전에 예약됨); 2026년 10월 19~20일의 운영자 기록(레벨 1); 2026년 10월 21일부터 공개적으로 검증 가능(최소 2개의 RFC 3161 토큰, 레벨 2+, 증명 페이지); 도착 시 봉인 명시됨 | 부분(에이전트당 및 라운드당 keccak256 커밋, §3.2; 모든 답변의 체인 아님) | No | 부분(각 예측 파일의 SHA-256; 문서화된 체인 없음) | 부분(다음 오픈 채우기 이전의 채우기 및 근거 git 이력) | ND | ND | 부분: Prophet Arena 솔트된 SHA-256 레지스터, 운영자 시계; Sornette et al. (2010) 체크섬, AI 아님 |
| 7. 운영자 외부 앵커 | 구현됨(Bitcoin, OpenTimestamps: 블록 후 몇 시간 이내의 존재; 2026년 10월 20일 오픈 이후) | 부분(Polygon PoS, §3.2) | No | Yes(Bitcoin; 축구, 1개 AI) | No(시간은 git 호스트에 의존) | ND | ND | Yes, 금융 아님: 날씨 예측의 Zeus 온체인 커밋; Jyotish (2026), AI 아님; No: Prophet Arena(운영자 시계) |
| 8. 봉인 후 채취된 참고 가격 | 구현됨 및 2026년 10월 21일부터 공개적으로 검증 가능(레벨 2+, 부록 B, 단계 9); 2026년 10월 19~20일의 운영자 기록(booked_at, 레벨 1) |
부분(벤치마크 중간 가격이 마감 후 저장됨; 결과 이진, 그림 3) | No | 부분(잠금 시 또는 그 이전의 군중 가격) | 부분(주문이 다음 오픈에서 채워짐) | ND | 부분(답변 후 첫 1분 양초에 진입) | ND |
| 9. 사전에 작성된 규칙에 따른 1개 계산된 실행; 모든 실행 발표 | 구현됨(모든 실행이 발표됨, 기타는 not_counted로 표시됨); 2026년 10월 21일부터 계산된 실행이 사전에 선언되고 질문 체인에 봉인됨(섹션 3.4); 2026년 10월 19~20일의 개발 세션의 경우 규칙이 실행 후 적용됨 |
부분(에이전트당 및 라운드당 1개 커밋, 릴레이어 강제, §4.3; 모든 커밋이 온체인 공개; 오프체인 실행은 미포함) | No(숨겨진 모델의 사전 윈도우 실행, 부록 B.2) | ND | ND | ND | ND | ND |
| 10. 엄격한 적절한 점수 및 보정 | 부분적으로 구현됨(발표된 Brier 드롭 무승부; 보정 빈); 모든 행 Brier는 2026년 10월 21일부터 주요로 명시되고 제출된 스크립트로 계산됨 | Yes(Brier, Alpha, Murphy 분해, §3.3~§3.5) | No(수익, 승률, §3.3) | Yes(3결과 Brier) | No(계좌 가치) | ND | Yes(Brier, 보정 격차) | Yes: Prophet Arena, ForecastBench |
| 11. 비정보적 50% 및 기후학적 벤치마크 | 구현됨(50%); 구현됨(2016~2025년 빈도 봉인됨; 2026년 10월 21일 08:54 UTC부터 공개 파일의 필드 climatology_fixed) |
부분(무작위 및 시장 기준선) | No | ND | ND | ND | ND | 부분: ForecastBench 순진한 기준선; KalshiBench 기후학에 대한 기술 점수 |
| 12. 순위 매기기 전 최소 세션 규칙 | 구현됨(30/10, ranked 플래그) |
부분(전력 분석, 최소 라운드 권장, §3.6.2) | No | ND | ND | ND | ND | ND |
| 13. 모델당 $100,000의 시뮬레이션 포트폴리오 | 구현됨 | 아니오 | 부분적 (이벤트 계약에 실제 $10,000) | 아니오 | 예 ($100,000, 종이) | 부분적 ($10,000 시뮬레이션) | 부분적 (종이 선물 거래) | 예: Rallies $100,000; Alpha Arena 실제 $10,000 |
| 14. 공매도 및 2배 레버리지 | 구현됨 (Pro league) | 아니오 | 아니오 (레버리지 없음, §4.5.1) | 아니오 | 부분적 (암호화폐 레버리지, 공매도 없음) | ND | 부분적 (롱 또는 숏, 종이) | 예: Alpha Arena 레버리지 무기한 선물 (보도자료) |
| 15. 답변 시점의 예측 시장 가격 비교 | 구현됨 (crowd_up 계약 가격 대비) |
예 (Alpha 중간값 대비, §3.4) | 부분적 (가격 대비 거래) | 예 | ND | ND | ND | 예: Prophet Arena, AIA Forecaster |
| 16. 상관된 의견으로 인한 할인, 실시간 | 구현됨 (명시된 적격성 규칙 n_eff.counted에 의한 N_eff; 가족 가중치; 모두 틀림 및 소수 의견 정확 카운트) |
아니오 (시장 독립성 가정, §7.5) | 아니오 | 아니오 (하나의 모델) | ND | ND | 부분적 (집단행동 측정, 할인되지 않음) | 오프라인만: Kim et al. (2025), Spiro (2026), Aitchison et al. (2026) |
| 17. 봉인된 뉴스 패킷과 함께 폐쇄형 | 구현됨 (해시가 포함된 봉인된 패킷; 검색 연산자 기록 없음 - 명령만 있는 줄에서) | 아니오 (검색 선택, 제외 안 함) | 아니오 (모든 모델 검색) | ND | ND | ND | 부분적 (공개된 페이로드 하나와 뉴스 다이제스트; 검색 ND) | 부분적: 검색 포함/미포함 FinDeepForecast, 오프라인; MarketMania 공통 페이로드 |
| 18. 위원회 토론 모드 | 구현됨 | 아니오 (설계상 비공개) | 아니오 (향후 계획) | ND | ND | ND | ND | 부분적: 조정 구성, Foresight Arena에서 실시간 (Nechepurenko & Shuvalov, 2026b) |
| 19. 하나의 모델에 대한 반복 쿼리 | 구현됨 (포트폴리오); 확률 반복 지정 | 아니오 | 아니오 | ND | ND | ND | 예 (안정성 실행) | 오프라인 샘플링 연구 (Aitchison et al., 2026) |
| 20. 독자들이 AI를 보기 전에 예측, 2개 영구 그룹 | 라이브 및 모든 방문자에게 공개; 결과는 F28 및 F29로 등록, 각 그룹당 처음 200개 예측 읽음; 그룹 레이블 지정 | 아니오 | 아니오 | ND | ND | ND | ND | 부분적: 별도 풀 (ForecastBench, Metaculus); 보조 시험 (Schoenegger et al., 2025) |
| 21. 블라인드 시즌 | 지정됨 (2026년 11월 2일부터; 모델, 버전 및 모드는 솔트된 SHA-256 약속으로 봉인, 솔트는 시즌 후 공개) | 아니오 | 부분적 (숨겨진 식별자 아래 하나의 모델) | ND | ND | ND | ND | ND |
| 22. 리그에 대한 날짜가 지정된 예측, 블라인드 가격 책정 | 구현됨 (30개, 블라인드 가격 책정; OSF에 게시 전 등록) | 아니오 | 아니오 | ND | ND | ND | ND | ND |
| 23. 명시된 라이선스에 따른 공개 데이터 | 구현됨 (CC BY 4.0) | 부분적 (온체인, 데이터 라이선스 명시되지 않음) | ND (저장소 미제공) | 예 (GitHub, Zenodo) | 예 (MIT, 전체 원장) | 부분적 (공개 JSON, 라이선스 불명) | 부분적 (API 내보내기, 라이선스 ND) | 예: ForecastBench, LiveTradeBench, StockBench; GlassBallAI CC BY-NC |
| 24. 해시가 포함된 공개 채점 코드 | 구현됨 (해시가 포함된 엔진 코드, arena-code.json; forecast-score 재계산, tools/replay_brier.py; 해결사는 OSF에 제출) | 예 (온체인 계약, 분석 저장소) | 아니오 | ND | 부분적 (코드 공개) | ND | ND | 부분적: PolyBench, ForecastBench 코드 |
| 25. 제3자에 의한 모든 계정의 재계산 | 구현됨 (replay.py) |
예 ("전체 기록 재생", Contributions 1) | 아니오 | ND | 예 (원장이 모든 계정 재계산) | ND | ND | ND |
| 26. 봉인 시점의 RFC 3161 토큰 | 2026년 10월 21일부터 구현, 공개적으로 검증 가능 (FreeTSA 및 DigiCert; Sectigo는 같은 날 아침 추가; 증명 페이지); 도착 시 봉인 지정 | 아니오 | 아니오 | ND | ND | ND | ND | AI 아님: 인간 예측을 위한 일반 봉인 도구 |
참고: Foresight Arena 및 Prediction Arena 열의 § 번호는 해당 논문의 섹션을 나타냅니다. 행 5, 10, 13~15, 19, 25는 리그가 이전 연구와 공유하는 기능입니다. 섹션 7.4의 주장 뒤의 행: 주장 1: 행 4, 6~9 (10월 19, 20일의 1단계, 10월 21일부터 2단계 이상). 주장 2: 행 16. 주장 3: 행 6~12, 16, 26, 섹션 3.13의 상태 열과 함께 읽음. 주장 4: 행 20. 주장 5: 행 2. 주장 6: 행 22.
인용 방법
Chernets, V. (2026). 공개 전에 봉인됨: 금융 시장의 AI 예측을 측정하기 위한 검증 가능한 표준 [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7653679
@misc{chernets2026sealedbeforetheopen,
  author       = {Chernets, Vadym},
  title        = {{Sealed Before the Open: A Verifiable Standard for Measuring AI Forecasts of Financial Markets}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7653679},
  url          = {https://doi.org/10.2139/ssrn.7653679}
}