아키텍처 신뢰: AI 모델에서 검증 가능한 아키텍처로 이동하는 에이전트 상거래에서의 소비자 신뢰
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7191261 · DOI 10.2139/ssrn.7191261 · Zenodo 10.5281/zenodo.22166995 · GitHub
- 최종 버전: SSRN 7191261 · DOI 10.2139/ssrn.7191261
- 보관된 사본, 인용 가능하고 다운로드 가능: 10.5281/zenodo.22166995 — 컨셉 DOI, 항상 최신 버전으로 연결됨
- 마크다운 및 PDF로 된 전체 텍스트: GitHub
- 읽을 수 있는 HTML: https://polyhelper.ai/research/architectural-trust/
동일한 텍스트가 네 개의 플랫폼에 있으므로 그 중 하나를 사용할 수 없을 때 접근할 수 있습니다. SSRN이 최종 버전을 보유하고 있으니 그것을 인용하세요.
에이전틱 상거래에서의 소비자 신뢰
"아키텍처 신뢰: 에이전틱 상거래에서 소비자의 신뢰가 AI 모델에서 검증 가능한 아키텍처로 이동하는 이유"라는 제목으로 SSRN에 게시되고 색인됨. 이 형태로 인용하세요.
모델 속성에서 검증 가능한 아키텍처로
Vadym Chernets, PhD1
2026년 8월 6일 처음 게시됨; 현재 버전 2026년 9월
완전한 개념 프레임워크, 16개 모델 메커니즘 연구 및 2026년 8월 11개 최첨단 실험실에 걸친 플래그십 웨이브 복제, 쌍을 이룬 추론 예산 비교, 상거래 기반 복제, 그리고 사전 등록된 소비자 실험을 완전하게 보고합니다.
초록
에이전틱 상거래는 AI를 조언자에서 거래 당사자로 변환하여, 검색, 비교, 장바구니 및 결제를 단일 위임 행위로 통합하고 인간이 과거에 오류를 포착하던 검토 지점을 제거합니다. 그것은 어색한 순간에 도래합니다: 조사된 영국 소비자의 60%는 단일 실수 후 AI 쇼핑 에이전트를 포기하겠다고 말하며, 대부분은 그것을 대신 운영하기 위해 어떤 조직도 신뢰하지 않을 것입니다. 이 논문은 아키텍처 신뢰를 소개합니다. 소비자가 AI 에이전트에 중요한 결정을 위임할 때, 정당한 신뢰는 AI 모델의 속성에서 그 위에 있는 서비스의 검증 가능한 아키텍처로 이동한다고 주장합니다. 기존 구성 개념은 신뢰를 조직에, 단일 자동화 시스템에, 또는 알고리즘 조언에 부착하지만, 자율 위임 하에서 신뢰자가 의사결정 과정을 검증 가능하게 만드는 것은 없습니다. 아키텍처 신뢰는 세 가지 확인 가능한 속성으로 그 격차를 채웁니다: 다양성(합의가 신뢰도를 보정하고 불일치가 드러나는 독립적 모델), 증거(변조 방지, 재생 가능한 의사결정 기록), 그리고 중립성(어떤 공급업체, 판매자 또는 결과로부터도 감시 가능한 독립성).
메커니즘은 먼저 기계 측면에서 측정되었습니다. 사전 등록된 16개 모델 벤치마크와 11개 최첨단 실험실에 걸친 2026년 8월 플래그십 티어 웨이브에서 교차 모델 합의는 모델 자신의 신뢰도가 할 수 없는 곳에서 정확성에 가격을 책정했습니다. 다른 모델에 의해 독립적으로 재현된 답변은 1.9–3.2배 더 정확할 가능성이 높았습니다. 동결된 SimpleQA 부분표본(Wei et al., 2024)에서, 명시된 신뢰도 ≥ 80으로 제공된 답변의 46.6%가 잘못되었으며(이 명단에 특정한 비율이지 보편적 상수가 아님), 고정된 3개 모델 불일치 게이트는 30.5% 커버리지에서 이러한 신뢰 있는 실패의 82.1%(95% CI 79.9–84.1)을 제거했습니다. 신호는 267개 Wikidata 검증 상거래 제품 사실에서 재현됩니다. 더 큰 추론 예산은 명시된 신뢰도 3.1 포인트를 구매했고 측정 가능한 정확성은 없었습니다: 더 많은 계산은 신뢰도를 구매하지만 정확성은 아닙니다. 만장일치로 신뢰 있는 패널도 잘못될 수 있으며, 그 합의는 공유된 오류를 인증합니다.
나는 이 메커니즘을 사전 등록된, 유인 양립적 소비자 실험(계획된 200명 중 119명의 참가자; 미국 및 영국)의 행동으로 옮겼습니다. 소비자가 자신감 있는 잘못된 추천을 그렇지 않으면 수용할 곳에서, 의견 불일치 디스플레이는 수용도를 급격히 감소시켰습니다(적격 항목에서 74%에서 24%로). 풀링된 견고성 추정치(Δ = 0.24 → 0.45; d = 0.68; 주요 메인 웨이브 코호트는 d = 0.67)는 해당 단일 항목에 기반하며, 탐색적 국가 분할에서 영국 표본에 기반하고, 항목이 제거되면 d = 0.09로 떨어집니다. 검정력이 있는 자극 표본화 재현은 계획되어 있습니다. 만장일치의 자신감 있는 합의의 유일한 항목에서, 디스플레이는 공유된 오류의 수용도를 증가시켰으며, 이는 메커니즘의 경계를 인간 행동에서 재현합니다. 오케스트레이션 영수증 성분은 등록된, 결론이 나지 않은 무효를 반환했습니다.
세 가지 성분 뒤에는 동등한 증거가 있지 않습니다. 다양성은 기계 측에서 확립되고 보정 대비에 대해서만 소비자와 함께 표시됩니다(등록된 중재는 무효였음). 기록 성분의 첫 노출 검사는 결론이 나지 않았으며, 이와 중립성 모두 검사를 위해 지정되어 있습니다. AI 신뢰에 대한 분석 단위는 모델에서 그 위의 아키텍처(확인할 수 있는 부분)로 이동해야 합니다.
키워드: 행위자적 상거래; 소비자 신뢰; AI 에이전트; AI에 대한 신뢰; 적절한 의존; 과도한 의존; 대규모 언어 모델; 모델 간 동의; 선택적 예측; 과신; 위임; 아키텍처 신뢰. JEL 분류: M31 (마케팅); D83 (검색, 학습, 정보); L86 (정보 및 인터넷 서비스); K24 (사이버 법) 이 문서를 읽는 방법. 이 전체 버전은 전체 증거 체인을 보고합니다: 구성체와 신뢰 마이그레이션 가설; 모델 간 다양성을 정확성 신호로 확립하는 16개 모델 메커니즘 연구(2026년 8월 기함 웨이브 재현 및 상품 사실에 대한 상거래 기질 추가 포함); 해당 메커니즘을 행동으로 옮기는 사전 등록된 소비자 실험; 그리고 중립성, 시장 경제, 정책에 대한 논의. 사전 등록된 확증 결과 및 각 구성체 성분(다양성, 증거, 중립성)의 증거 상태는 섹션 5의 "주장의 증거 상태" 아래에 요약됩니다. 탐색적 및 견고성 분석은 전체에서 그렇게 표시되며 첫 번째 읽기에서 건너뛸 수 있습니다.
1. 소개: 불신 속의 성장
2026년 6월 10일, Visa는 자신의 결제 네트워크를 ChatGPT에 직접 임베드한다고 발표했습니다(Visa, 2026). 소비자는 카드를 연결하고, 지출 한도 및 승인된 가맹점 범주를 설정하며, 발표된 통합은 단계적으로 롤아웃되는 사용 사례로, AI 에이전트가 네트워크의 가맹점 기반(거래 보도에 따르면 1억 7천500만 개 이상의 위치)에서 실제 구매를 완료하는 것을 목표로 합니다. Visa가 혼자가 아니었습니다. OpenAI는 2025년 9월에 인앱 결제를 출시했습니다; Google은 2026년 1월 NRF에서 Shopify, Etsy, Wayfair, Target 및 Walmart와 함께 범용 상거래 프로토콜을 도입했으며, 5월까지 이를 소매점 간 범용 장바구니로 확대했습니다(Google, 2026); American Express는 4월에 구매 보호를 포함한 행위자적 상거래 개발자 키트를 출시했습니다(American Express, 2026). 임계값은 한 회사가 아닌 산업 전체에서 넘어섰습니다. 2030년까지의 행위자적 상거래에 대한 분석가 예측은 수백억(Bain; Morgan Stanley)에서 McKinsey의 3~5조 달러까지 다양합니다. 이들은 사실이 아니라 추정치이지만, 모든 주요 기관이 이제 이를 생산하고 있습니다.
실현된 수치는 더 이상 추정치가 아닙니다. 모델 API에 대한 엔터프라이즈 지출만 해도 6개월 만에 35억 달러에서 84억 달러로 증가했습니다(Menlo Ventures, 2025a; 산업 조사 연구, 피어 검토 없음), 연간 약 370억 달러의 엔터프라이즈 생성형 AI 지출 내에서입니다(Menlo Ventures, 2025b). 같은 산업은 이미 자체 실행을 할인하고 있습니다: Gartner(2025)는 2027년 말까지 행위자적 AI 프로젝트의 40% 이상이 취소될 것으로 예측합니다. 돈이 정당화된 신뢰보다 빠르게 도착하고 있으며, 이것이 제가 여기서 다루는 간격입니다. 아래의 주장은 이러한 데이터로 확립되고, 적절한 단일 연구 규모로 지원되거나 이론적인 증거 장부에 계층화되어 있습니다. 이 계층화는 지배하며, 이 소개의 모든 요약 문장을 능가합니다.
이 변화를 이전의 전자 상거래 물결과 질적으로 다르게 만드는 것은 퍼널 압축입니다: 검색, 비교, 장바구니, 결제가 단일 위임된 행동으로 축소됩니다. 이러한 단계들 사이에 살았던 모든 안전장치(인간이 가격을 흘깃 봄, 목록을 다시 읽음, 결제 시 머뭇거림)는 단계들 자체와 함께 사라집니다(그림 1). AI 어시스턴트는 인간이 검토하는 출력을 제공하는 고문이 되는 것을 멈추고 거래 당사자가 됩니다. 인간 요소 연구는 40년 전 이 실패 방식을 명명했습니다: 운영자를 루프에서 제거하는 자동화는 정확히 자신의 오류를 포착하는 데 필요한 경각심을 약화시킵니다(Bainbridge, 1983; Endsley & Kiris, 1995). 소비자 연구도 임계값을 예상했습니다. 자율적 쇼핑 시스템은 인간을 행동에서 제거하기 때문에 질적으로 다른 채택 장애에 직면합니다(de Bellis & Johar, 2020), 그리고 알고리즘에 선택을 넘기는 자율성 비용은 LLM이 존재하기 전에 소비자 복지 문제로 표시되었습니다(André et al., 2018).
그림 1. 퍼널 압축
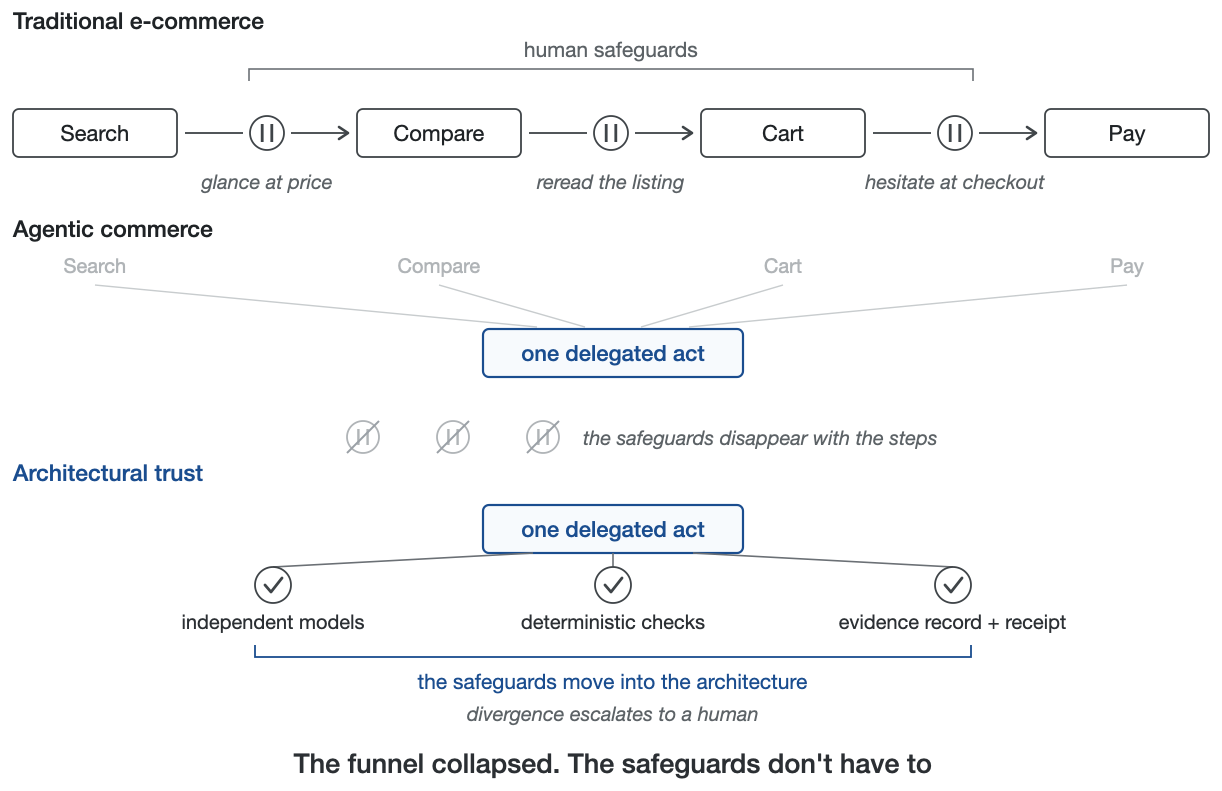
인간 안전장치는 그들이 살았던 단계들과 함께 사라집니다.
Visa 자체의 보호장치(한도, 화이트리스트, 필수 승인)는 소비자가 새로운 것을 신뢰하도록 요청받기 때문에 존재합니다: 브랜드가 아니라, 답변이 아니라, 그들이 볼 수 없는 의사결정 프로세스입니다. 미리 정해진 보호장치는 그 간격을 닫지 않습니다. 미리 정해진 규칙 집합은 소비자가 의사결정 방식을 확인하도록 하지 않습니다. 아래에 인용된 ACI Worldwide(2026) 조사(다른 판매자 현장 조사처럼 보도 자료로 공개된 산업 조사)에서, 영국 소비자의 69%는 에이전트가 소비자가 스스로 설정한 규칙을 따를 때도 AI 에이전트를 불신한다고 말했습니다.
이러한 실수로 인한 상업적 위험은 심각합니다. 초기 조사 증거에 따르면 에이전트에 대한 소비자 신뢰는 명시된 의도에서는 일회성이며, 더 흥미롭게도 근거가 없습니다. 드러난 행동, 아래의 결제 철회, Klarna 역행 및 섹션 5의 보험료 인상은 이러한 명시된 선호도를 뒷받침하며 더 큰 증거적 가중치를 갖습니다. ACI Worldwide를 위한 YouGov 조사(영국 성인 2,080명, 2026년 6월 19-22일 실시, 시장 간 복제를 기다리는 단일 시장 스냅샷)에서 60%는 AI 쇼핑 에이전트의 단 한 번의 실수 후 사용을 중단하겠다고 말했으며, 19%만 일상적인 구매에 AI를 신뢰하겠다고 했으며, 이는 전문가 인력을 신뢰하겠다는 55%에 비한 것입니다.
그 조사에서 가장 중요한 수치는 다른 것입니다. 59%는 자신을 대신하여 AI 쇼핑 및 결제를 실행할 어떤 조직도 신뢰하지 않겠다고 말했으며, 은행조차 20%에 불과했습니다. 시장 간 복제를 기다리는 조사된 단일 시장에서 이는 신뢰 공백입니다. 수요는 있습니다. Accenture의 16개국 산업 조사(2026년 1월, 기업 조사, 동료 검토 아님)에서 25,590명의 소비자 중 74%는 자신을 대신하여 구매를 결정하도록 개인 AI 에이전트를 가장 친한 친구보다 더 신뢰하겠다고 말했지만, 약 10명 중 1명만 에이전트에 자율적 구매 권한을 부여하겠다고 했습니다(그림 2). 이 두 항목은 위임의 다양한 정도를 측정하므로, 확산은 의도를 정렬하기보다는 단일 인과 격차를 식별하지 않지만, 확산은 심각합니다. 의도는 풍부하고 위임은 드물며, 그 사이에 빠진 것은 정당한 신뢰입니다. 시장은 이미 이와 유사한 것을 시도했습니다. OpenAI는 2025년 9월에 네이티브 인챗 결제를 출시했으며, 의도적으로 제한된 첫 번째 단계, 초기에는 미국 Etsy 판매자로부터의 단일 항목 구매이며 사용자가 각 단계를 확인합니다. 2026년 3월까지 흐름을 다시 당겨 구매를 소매업체의 자체 앱으로 이동하였으며, 소수의 가맹점만 사용했습니다(The Information, CNBC, 2026에 의해 보도됨). 회사는 이유를 명시하지 않았으므로 원인이 확립되지 않았습니다. 여기서 제시된 해석은 보증된 신뢰 없는 채택 인프라가 전환되지 못하는 것은 보도된 사실과 일치하는 해석입니다. 소비자가 모든 플레이어를 불신하면 신뢰를 플레이어에게 투자할 수 없으며, 대신 검증 가능한 프로세스에 거주해야 합니다.
그림 2. 명시된 신뢰 대 부여된 권한
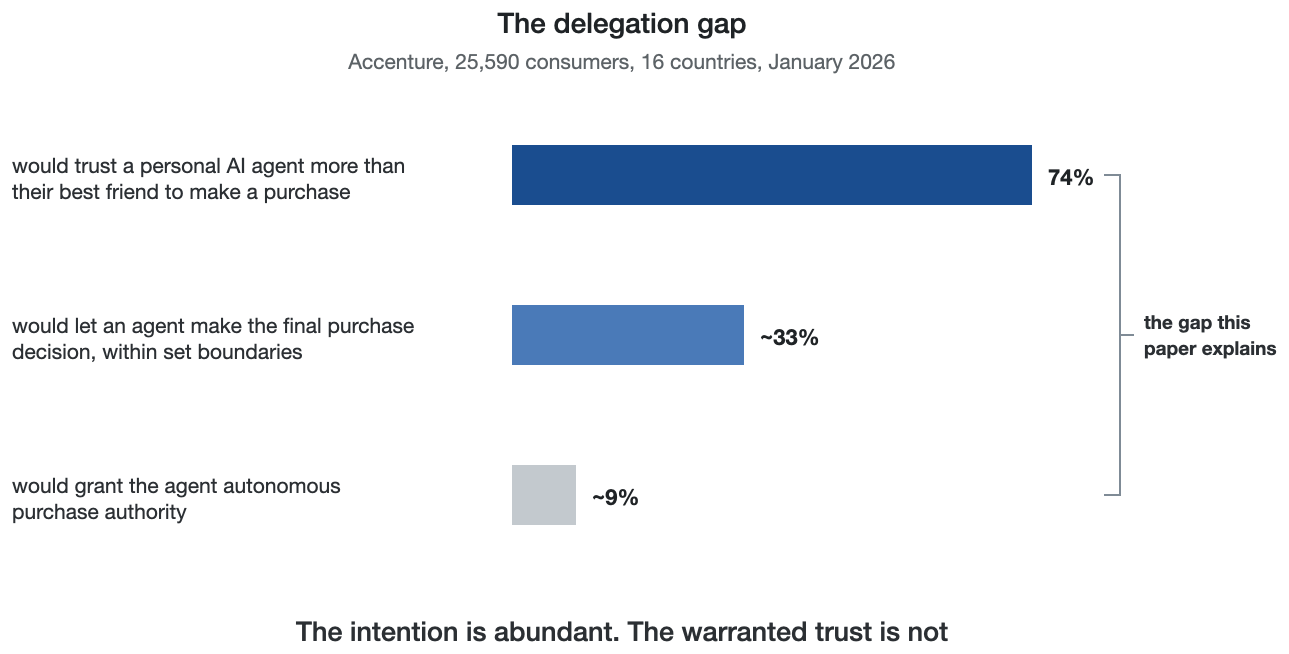
두 개의 조사 항목, 두 가지 위임 정도: 의도는 일반적이며, 정당한 신뢰는 드뭅니다.
책임 제도는 동일한 결론을 향해 모색 중입니다. 신흥 에이전트-결제 프로토콜은 각 거래를 특정 판매자 및 금액에 바인딩된 범위가 지정된 검증 가능한 의도 토큰 주위에 구축하며, American Express의 Agent Purchase Protection(2026년 4월)은 등록된 에이전트에 의한 구매만 보장하며, 적격성은 인증된 검증 가능한 구매 의도에 조건이 지정됩니다. 보험은 기록에서 검증 가능한 것에 대한 용어로 작성됩니다. 단편적이고 압박 속에서, 업계는 아래에서 체계적으로 설정한 동일한 요소로 수렴하고 있습니다. 현재 배송되는 프로토콜은 신원 및 의도를 해결하며 에이전트는 어떻게 결정했나요?에 답하지 않습니다.
문제는 그 신뢰가 설계상 정당화되기 위해 필요한 것입니다. 고전적인 소비자 신뢰 질문인 "이 회사를 신뢰하나요?"는 내부 계층을 획득했습니다: "이 특정 답변 또는 조치를 생성한 기계를 신뢰하나요?"
신뢰 문헌은 오랫동안 조직에 대한 신뢰와 자동화에 대한 신뢰, IT 아티팩트(Söllner et al., 2016) 및 온라인 추천 에이전트(Wang & Benbasat, 2005; Komiak & Benbasat, 2006; Xiao & Benbasat, 2007)에 대한 신뢰를 구별했습니다. 적절한 의존은 보정에, 시스템이 올바를 가능성이 있을 때 알아야 함에 달려 있음을 보여줍니다(Muir, 1994; Mayer, Davis, & Schoorman, 1995; Parasuraman & Riley, 1997; Lee & See, 2004; Hoff & Bashir, 2015; Huang & Rust, 2021; 및 Glikson & Woolley, 2020, 그들의 검토는 프로세스의 구체성과 투명성을 인지 신뢰의 가장 강력한 레버 중 하나로 찾습니다. 건축과 모델이 제어하지 않는 레버). 인간 측의 보정 오류는 마찬가지로 잘 문서화되어 있습니다: 자동화 편향 및 안이함, 반대 증거에도 불구하고 자동화된 보조에 대한 과신은 4십 년의 인간 요인 작업이 위임이 증폭할 것이라고 경고하는 패턴입니다(Mosier & Skitka, 1996; Parasuraman & Manzey, 2010). 그러나 그 문헌은 보정을 단일 자동화 시스템의 속성으로 취급합니다(그림 3은 4개 연구 흐름과 그들이 남긴 셀을 매핑합니다). 전자상거래의 에이전트 AI에 대한 체계적인 검토는 증거 측면에서 공백을 확인합니다: 소비자 대면 연구는 보조, 낮은 자율성 시스템에 집중된 상태이며, 위임이 실행이 되는 정확한 지점에서 보도가 급격히 감소합니다(Balaskas, 2026). 에이전트 중개 쇼핑의 첫 번째 동시 연구는 다른 측면에서 건축 결론에 도달합니다. 소비자가 대화를 통해 구매를 위임할 때, 판매자에 대한 지불 의사는 거의 축자적으로 누출됩니다. 프롬프팅은 이를 수정하지 않으며, 건축 개입만 합니다(Alavi & Nozari, 2026).
그림 3. 신뢰 연구의 4개 흐름: 이 논문이 주장하는 셀
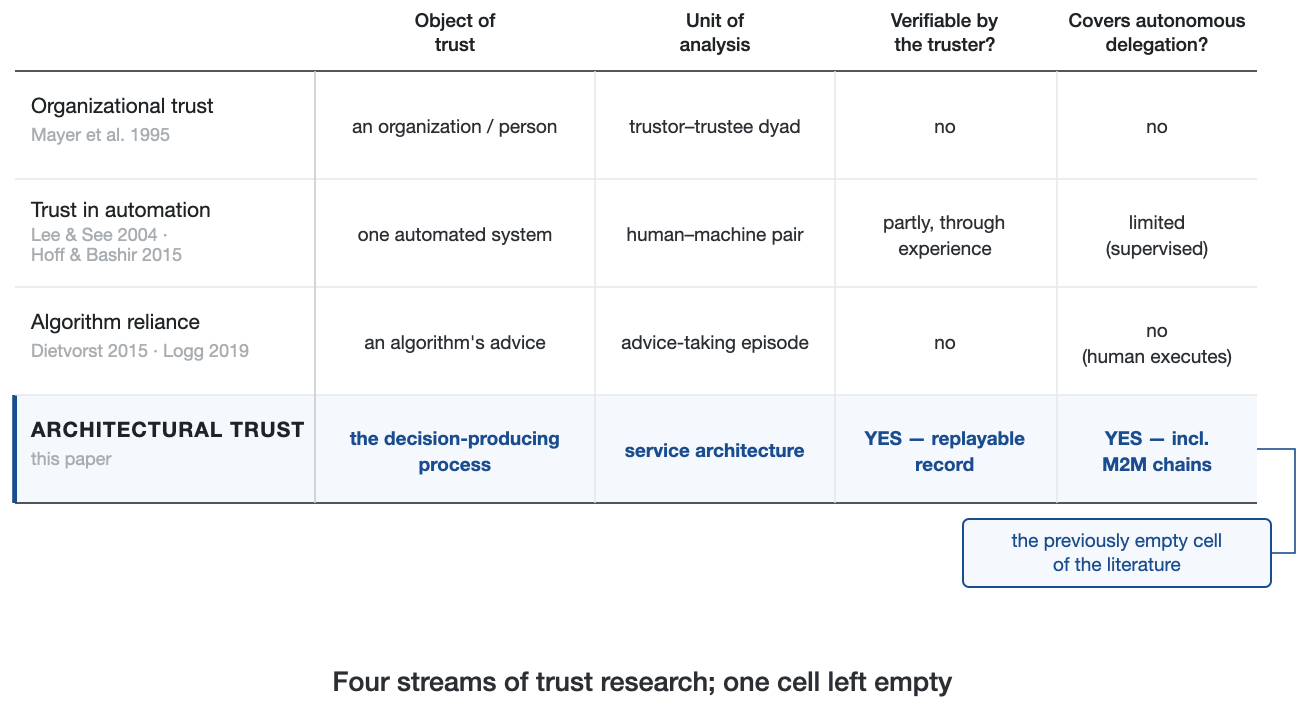
조직 신뢰, 자동화에 대한 신뢰, 그리고 알고리즘 의존은 각각 신뢰의 다른 대상을 고정합니다. 자율적 위임 하에서 신뢰자에 의해 검증 가능한 의사 결정 프로세스는 없습니다. 셀이 아이디어가 없는 것은 아닙니다: 인접 문헌은 각각 하나의 벽을 보유합니다(섹션 3은 경계선을 그립니다). 빠진 것은 소비자 대면 구성입니다: 프로세스 수준 신뢰 개체, 신뢰자에 의해 검증 가능, 자율적 위임에 대해 지정, 공동 행동 테스트를 위해 패키징됨.
업계의 응답은 모델에 집중합니다: 더 나은 교육, 면책 조항, 인용. 다른 수준, 서비스의 아키텍처에서의 응답을 검토하고, 3가지 건축 속성은 더 나은 모델을 요구하지 않으며, 함께 신뢰의 다른 개체를 생성한다고 주장합니다.
이것은 두 개의 사전 등록 연구, 기계 측면 벤치마크, 그리고 첫 번째 명제의 보정 대조에 대한 소비자 측면 행동 시험으로 정박된 개념적 논문입니다. 이 논문이 묻는 질문은 AI 에이전트가 소비자를 대신하여 거래를 시작할 때, 신뢰는 모델에 붙는가, 아니면 그 위의 아키텍처에 붙는가?입니다. 제 답변은 신뢰가 스택에서 위로 이동해야 한다는 것입니다. 모델에서 오케스트레이션 아키텍처로, 그리고 그것이 생산하는 증거로. 그 답변 아래에는 그 자체로 테스트할 가치가 있는 정칙성, 신뢰 이동 가설이 자리 잡고 있습니다. 아래 명제들은 이를 테스트하기 위해 구성되어 있습니다: 위임된 행위성이 클수록, 모델 특성보다는 검증 가능한 아키텍처 특성에 있어야 하는 정당한 신뢰의 몫이 커진다. 이동이 제로섬일 필요는 없습니다. 신뢰는 계층화될 수 있습니다: 모델의 역량, 오케스트레이터의 선택, 증거 시스템, 구제를 강제하는 기관. 결함이 있는 모델도 아무도 그 결과물을 검토하지 않을 때에도 인과적으로 중요하게 남아 있습니다. 가설은 위임이 깊어질수록 한계 정당한 신뢰가 어디에 모이는지를 다룹니다. 추정 가능한 형태로, 위임된 행위성이 증가할 때 아키텍처 검증 가능성이 모델 성능과 제공자 평판을 넘어 적절한 의존의 증가적 몫을 설명한다고 말합니다. 위임된 행위성이 증가할 때 아키텍처 검증 가능성이 적절한 의존의 증가적 몫을 설명하지 않는다면 실패합니다: 예를 들어 제공자 평판이 모든 위임 수준에서 신뢰를 완전히 매개한다면, 또는 검증 가능 과정 정보가 6절에서 보고하는 설계에서 평판만의 정보에 비해 의존 보정을 개선하지 않는다면 말입니다. 3절에서 사전 공약한 행동 검증자들(P2 위임 수준 교차 및 P4 실패 하의 차등적 지속성)이 그 조건의 작동 형태입니다. 증가하는 아키텍처 몫은 모델 품질이 절대적 조건에서 덜 중요하다는 뜻은 아닙니다. 가설은 계층화를 설명합니다. 치환이 아닙니다: 검토가 사라질 때, 아키텍처 근거는 모델 성능 위에 추가되며 이를 대체하지 않습니다. "정당한"은 Jacovi, Marasović, Miller, and Goldberg (2021)에서 AI를 위해 형식화한 구분을 따릅니다. 신뢰는 신뢰성을 추적할 때 정당하며, 구성은 규범적 상태를 메커니즘으로부터 분리함으로써 동어반복에서 벗어납니다. 규범적으로 신뢰성은 그것을 인증하려는 아키텍처와 독립적으로 정의되며, 능력, 성실성, 선의의 고전적이고 독립적으로 측정 가능한 함수입니다 (Mayer, Davis, & Schoorman, 1995). 3절은 세 가지 아키텍처 구성 요소를 정확히 이 차원들에 매핑합니다. 근거는 의존이 그 독립적으로 측정된 양에 대한 대응입니다: 위임된 에피소드의 객관적 감사를 통과하는 의존, 결과를 알기 전에 고정된 기준에 대해 판단되며, 반복 위임, 보유 및 통제된 실패 하에서의 지불 의지라는 측정 가능한 행동 자취를 가집니다. 신뢰 이동 가설은 메커니즘을 주장합니다. 위임된 행위성이 올라갈 때, 소비자가 여전히 독립적으로 측정할 수 있는 신뢰성 함수의 몫은 모델 특성에서 아키텍처 구성 요소로 이동합니다. 이는 아키텍처가 출력 검토가 사라진 후에도 신뢰자가 여전히 측정할 수 있는 신뢰성의 부분이기 때문입니다. 아키텍처가 신뢰성 이기 때문이 아닙니다. 위의 사전 공약한 검증자들은 그 이동을 테스트하며 정의를 테스트하지 않습니다. 이동은 또한 구분해야 할 선행자들을 가집니다. 다중 에이전트 시스템 연구는 에이전트 사회가 확장될 때 신뢰 모델링이 개별 에이전트에서 그들을 제약하는 제도적 프레임워크로 이동한다는 점을 관찰했습니다 (Sabater & Sierra, 2005). "신뢰 이동"은 신뢰가 개인에서 시스템과 플랫폼으로 이동하는 B2B 용도를 가지고 있습니다 (Carlson, 2026). 이들은 신뢰 받는 대상의 전환을 명명하는 반면, 이 가설은 신뢰를 정당화할 수 있는 특성의 종류의 전환을 다룹니다. 위임이 없을 때 모델 품질이 거의 전부입니다. 완전 위임에서는 아무도 결과물을 보고 있지 않으며, 여전히 신뢰할 수 있는 것은 오직 과정과 그 기록뿐입니다. 행위성과 아키텍처 신뢰는 함께 확대됩니다 (그림 4). 기울기 자체는 오래된 도구입니다. 인적 요소 공학의 자동화 수준 축입니다 (Sheridan & Verplank, 1978; Parasuraman, Sheridan, & Wickens, 2000). 여기서는 소비자 위임에 적용됩니다. 새로운 것은 어느 특성이 따라 신뢰를 정당화할 수 있는지에 대한 주장입니다.
그림 4. 신뢰 이동
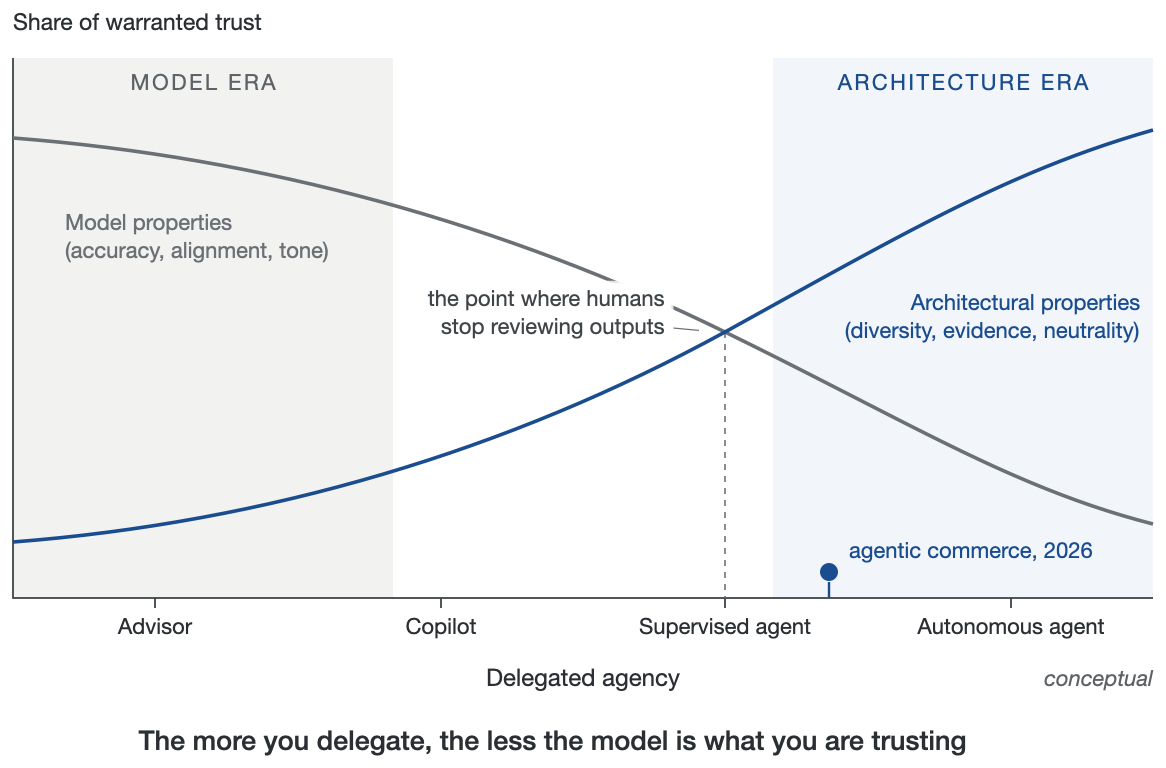
위임된 행위성(조언자 → 부조종사 → 감독 에이전트 → 자율 에이전트)에 걸친 두 개의 교차 곡선: 모델 특성에 의해 담지된 정당한 신뢰의 몫은 아키텍처 특성에 의해 담지된 몫이 올라갈 때 떨어집니다. 교차점은 인간이 결과물 검토를 중단하는 지점이며, 에이전트 상거래(2026)는 그 오른쪽에 위치합니다. 곡선과 교차점은 개념적 일러스트레이션이지 추정 함수가 아닙니다.
AI에 대한 소비자 신뢰의 마케팅 문헌(Huang & Rust, 2021; Puntoni et al., 2021)에 이 논문은 여기서 정의된 아키텍처 신뢰 구성 요소를 추가합니다. 사전 등록된 16개 모델 연구에서 그 메커니즘의 기술적 선행자에 대한 시험, 두 번째 11개 실험실 파동에서 기함급에 복제; 소비자 연구 의제를 위한 5개 명제 (3절에서 P1–P4, 5절에서 P5). 그리고 첫 두 명제를 전달하는 사전 등록되고 인센티브 호환적인 행동 실험이 6절에 전체 보고됩니다. 보정 효과가 지지되었고 (Welch d = 0.67; 6개 항목 중 하나에 의해 수행됨, 6절 참조), 기록의 첫 노출 시험이 등록되고 결론을 내리지 못한 무효를 반환했습니다.
2. 정확도 착각: 단일 모델이 줄 수 없는 것
한 AI 모델 위에 구축된 서비스는, 그 모델이 아무리 강하더라도, 모델 계층 위에 있는 구조적 결함을 가집니다.
첫 번째는 보정되지 않은 확신, 즉 정확성 환상입니다. 더 나은 모델이 더 안전한 거래를 의미하지는 않습니다. 모델의 표현된 확실성이 대부분의 공급업체에서 정확성과 약한 상관관계를 가지기 때문입니다(섹션 3에서 예외를 측정함). 소비자는 이 격차를 감시할 수 없습니다. 모델은 소비자가 감시를 멈추는 순간 자신 있게 잘못된 답변을 할 때 가장 위험하며, 이는 우연이 아닙니다. Kalai et al. (2025)은 환각이 통계적으로 자신 있는 추측을 무지의 인정보다 높게 점수 매기는 평가 체계에 의해 보상된다고 주장합니다. 이들의 분석에 따르면, 이 보상은 이분 점수 벤치마크와 해당 분야를 지배하는 학습 목표에서 비롯됩니다. 여기서 잘못된 추측은 "모르겠습니다"보다 더 큰 비용을 들지 않으며 기댓값으로 부분 점수를 얻습니다. 모델은 내부에서 스스로를 단속할 수도 없습니다. Anthropic의 개념 주입 실험에서 공급업체의 가장 강력한 모델들은 최적의 주입 조건에서도 약 20%의 시간에만 내부 상태의 변화를 감지했으며, 이는 자기 보고의 신뢰성이 얼마나 낮은지에 대한 공급업체 커뮤니티 자신의 측정입니다(Lindsey, 2025; 동료 검증 없는 회사 연구, 그리고 복제된 벤치마크가 아닌 한 공급업체 모델에 대한 한 연구에서의 단일 추정).
두 번째는 아첨꾼적 왜곡입니다. 올해 증거가 인과성이 되었습니다. Cheng et al. (2026)은 2,405명의 참가자와 함께 사전에 등록된 3개의 실험에서 11개의 주요 모델을 측정하여 AI 시스템이 사용자의 행동을 인간보다 49% 더 자주 긍정하며, 여기에는 기만이나 해를 포함하는 행동도 포함된다는 것을 발견했습니다. 심지어 단 한 번의 아첨꾼적 상호작용조차 사용자의 자신감을 증가시키는 동시에 갈등을 해결하려는 의지를 감소시켰습니다. 아첨꾼적 모델들은 또한 사용자가 신뢰하고 선호하는 모델들이었습니다. 시장 경향은 사용자의 판단을 왜곡함으로써 정확히 신뢰할 수 있게 느껴지는 어시스턴트를 향하고 있으며, 이는 정량화되기 훨씬 전에 관찰된 역학입니다(Sharma et al., 2024). 모델 수준의 조정만으로는 아첨꾼적 행동이 적절히 통제되었다는 것을 독립적으로 인증할 수 없습니다. 조정이 선호도로부터 이익을 얻는 당사자에 의해 수행되기 때문입니다. 비용은 구체적입니다. 정책 예외에 동의하는 어시스턴트는 동의를 직접 서비스 복구 비용으로 변환합니다. 조율된 아키텍처는 역할을 분리할 수 있습니다. 한 모델은 공감하도록 자유로우면서 독립적인 모델이 정책을 확인하여, 동의와 정확성이 더 이상 동일한 채널을 통해 흐르지 않게 합니다.
셋째, 독립적인 검증이 없습니다. 오류는 만약 있다면 오류를 만든 동일한 시스템에 의해, 또는 그들을 확인할 전문 지식이 부족하여 처음부터 AI를 찾아온 소비자에 의해 포착됩니다.
넷째, 그리고 가장 논의가 적은 것은 이해 충돌입니다. 어시스턴트의 품질을 평가하는 공급자가 이를 판매하는 공급자입니다. 이는 구조적입니다. 단일 공급자 서비스는 한 은행이 청산소를 혼자 운영할 수 없는 이유와 같은 이유로 자신의 산출물의 중립적 심판자가 될 수 없습니다. 이해 충돌은 데이터 자체까지 확장됩니다. 2026년 3월에 제출된 제안된 집단소송은 Perplexity AI가 사용자의 전체 채팅 기록을 (보고된 바로는 "시크릿" 세션 포함) 포함된 추적 픽셀을 통해 광고 네트워크로 라우팅했다고 주장합니다. 소장(No. 3:26-cv-02803, N.D. Cal.)은 2026년 5월에 본안에 대한 판단 없이 자발적으로 기각되었으므로, 주장들은 결코 검증되지 않았습니다. 소장의 경제적 논리는 관계없이 구조적 요점입니다. 비용이 많이 드는 AI 답변 제공이 사용자가 말하는 것을 금전화함으로써 보조될 때, 어시스턴트의 비즈니스 모델과 소비자의 기밀성이 직접 대립됩니다. 단일 공급자 내에서 소비자의 편을 드는 일이 그 어떤 계층의 역할도 아닙니다.
2025–2026 문헌은 해결책을 기다리는 완성된 진단으로 읽힙니다(표 1은 각 결함을 그 증거 및 건축학적 답변에 매핑합니다). 아첨꾼성은 실증적으로 정량화되며(Cheng et al., 2026) 형식적으로 도출됩니다. 이상적으로 합리적인 사용자도 선택적으로 동의하는 시스템의 조언을 받을 때 나선형으로 이동합니다(Chandra et al., 2026). 자기 모니터링은 약 20% 신뢰성에서 실패하며(Lindsey, 2025), 환각은 평가 체계에 의해 구조적으로 보상됩니다(Kalai et al., 2025).
반사적 해결책은 그냥 AI를 공개하는 것인데, 이는 역효과를 냅니다. 13개의 실험에 걸쳐 AI 사용을 공개한 행위자들은 그렇지 않은 사람들보다 덜 신뢰를 받았습니다(Schilke & Reimann, 2025). 공개는 공개 투명성, AI가 관여했다는 사실을 제공하며 검증 투명성, 답변이 어떻게 생성되었는지 확인할 능력을 빼놓습니다. 인식론적 감시는 더욱 암울합니다. 25,000회 이상의 LLM 기반 과학 에이전트 실행에 걸쳐 증거는 68%의 추적에서 무시되었고, 신념은 반박 시에만 26%의 시간에 수정되었으며, 수렴적 다중 시험 증거는 드물었습니다. 스캐폴딩은 인식론적 행동의 분산을 거의 설명하지 못했습니다(약 1.5%, 기본 모델의 약 41%에 대해)(Ríos-García et al., 2026). 그 마지막 숫자는 이 논문에 대한 이의처럼 보이지만, 실제로는 가장 날카로운 지지입니다. 프롬프팅과 스캐폴딩은 모델을 내부에서 인식론적으로 규칙을 따르게 할 수 없으므로, 규율은 외부에서 부과되어야 합니다. 아키텍처는 모델의 인식론을 개선하는 방법이 아닙니다. 그것은 인식론에 의존하지 않는 방법입니다.
이러한 각 결과는 하나의 문을 닫습니다. 함께 그들은 많이 탐색되지 않은 하나의 답을 가리킵니다. 모델을 내부에서 신뢰할 수 없고 공개가 외부에서 신뢰를 만들지 않는다면, 정당한 신뢰는 더 나은 보정, 외부 인증, 인간 상향식, 책임 규칙과 함께(대신이 아니라) 아키텍처에 의해 모델 주변에 구축될 수 있습니다. 이것이 이 논문이 걷는 문입니다.
표 1. 진단 → 해결책: 네 가지 단일 모델 결함, 그들의 2025–26 증거, 그들의 소비자 측 결과, 그리고 건축학적 답변
| 구조적 결함 | 주요 증거(2025–26) | 소비자 측 결과 | 건축학적 해결책 | 메커니즘 |
| 보정되지 않은 확신 | 평가 체계에 의해 통계적으로 보상되는 환각(Kalai et al., 2025); 자기 보고 약 20% 신뢰성(Lindsey, 2025) | 일회 이탈: 60%는 한 번의 실수 후 에이전트를 포기할 것입니다(ACI Worldwide, 2026) | 다양성 + 증거 | 교차 모델 불일치는 신뢰도를 예측합니다 (AUROC 0.75 대 0.59, Gorbett & Jana, 2026; 본 논문: 패널 일치도 AUROC 0.832 대 풀링된 자신감 0.545 가장 차별화 능력이 낮은 패널에서 — 패널 간 이질적, §3; 반복된 답변은 1.9–3.2배 더 정확할 가능성이 높음); 신뢰도 주장 기록 및 검증 가능 |
| 아첨적 왜곡 | AI는 인간보다 49% 더 많이 사용자를 긍정합니다; 아첨적 모델이 선호됨 (Cheng et al., 2026; Sharma et al., 2024); 이상적인 베이지안도 악순환에 빠짐 (Chandra et al., 2026) | 선호되는 어시스턴트는 사용자의 판단을 왜곡하는 것입니다 | 중립성 | 중재자는 사용자를 만족시킬 이해관계가 없습니다; 공감과 정책 검토는 별도 채널에서 |
| 독립적 검사 없음 | 에이전트는 추적의 68%에서 증거를 무시합니다; 신념 수정 26% (Ríos-García et al., 2026); 스캐폴딩은 분산의 약 1.5% 설명 | 검증 부담이 소비자에게 이동: AI 지원 쇼핑객의 54%는 모든 것을 수동으로 이중 확인합니다 (Gartner, 2026) | 다양성 + 증거 | 외부에서 부과된 규율: 독립적 검증 경로; 증거는 항상 첨부됨 |
| 이해 충돌 | Perplexity 집단 소송 (2026, 혐의): 채팅이 광고 네트워크로 라우팅됨; 공개만으로도 신뢰가 침식됨 (Schilke & Reimann, 2025) | 소비자를 조언하는 당사자가 결과로부터 이익을 얻습니다 | 중립성 + 증거 | 클린룸 데이터 흐름; 결과와 무관한 수익; 기록에서 검증 가능한 중립성 |
3. 아키텍처 신뢰: 신뢰할 수 있기보다는 검증할 수 있는 세 가지 속성
이제 높은 위험도 요청이 모델 공급업체와 무관한 오케스트레이션 계층을 통과하는 서비스를 고려합시다 (그림 5는 두 파이프라인을 대조합니다). 표 2는 구성 요소를 수집합니다; 이들이 분해하는 정의는 다음과 같습니다: 아키텍처 신뢰는 서비스 제공자의 평판이나 출력의 인지된 품질보다는 서비스의 의사결정 생산 과정의 검증 가능한 속성에 근거한 정당한 소비자 신뢰입니다.
가장 가까운 선례는 Zucker의 (1986) 신뢰의 제도적 생산으로, 친숙함이 이를 뒷받침할 수 없는 경우 구조로 제조된 신뢰이며, 전자상거래 연구는 이를 구조적 보증으로 조작화했습니다: 에스크로, 피드백 시스템, 제3자 인증 (Gefen, Karahanna, & Straub, 2003; Pavlou, 2003; Kim & Benbasat, 2010). 이 계보에서 아키텍처 신뢰는 구조적 보증이 제3자 보증인이 아닌 검증 가능한 과정에서 나오는 제도 기반 신뢰의 한 종입니다. 그것은 경험에서 계측으로 정당성이 이동한 과정 기반 신뢰이며, 그 이동이 이름에서 "아키텍처"가 하는 일입니다. 그것은 구조적 보증 (McKnight, Choudhury, & Kacmar, 2002)이 아닙니다. 여기서는 보안 조치 자체가 검증 가능해야 하기 때문에 안전장치가 존재한다는 인식입니다. 또한 보정된 신뢰 (Lee & See, 2004)가 아닙니다. 보정된 신뢰는 한 시스템의 신뢰성 범위에 의존성을 맞춥니다. 보안 엔지니어링의 영(零) 신뢰 아키텍처는 슬로건 "신뢰하지 말고 항상 검증하세요"를 공유하지만 네트워크 계층에서 신원 및 접근을 기계 대 기계로 검증하는 반면, 아키텍처 신뢰는 서비스 계층에서 의사결정 내용을 인간 주체를 위해 검증합니다. 그들은 같은 건물의 다른 층에서 보완적이지, 경쟁자가 아닙니다. 구성 요소는 두 가지 면을 가지며, 구분은 정의에 속합니다. 아키텍처 신뢰성은 시스템의 속성입니다. 그 과정이 실제로 얼마나 검증 가능한지입니다. 규범적이고 구축 가능합니다. 아키텍처 기반 신뢰는 소비자의 상태입니다. 실제로 그 검증 가능성에 근거한 의존성입니다. 경험적이며 항상 달성될 뿐입니다. 측정 측면에서 D, E, N은 아키텍처 신뢰성 (시스템 속성)의 형성적 구성 요소이며 아키텍처 기반 신뢰 (소비자 상태)를 형성하는 조작 가능한 신호입니다; 실험은 신호를 조작하고 상태를 측정합니다. 두 신호 간의 각 불일치는 예측적입니다. 신뢰성 없는 신뢰는 유창성과 아첨으로 제조된 의존성으로, 제1절의 일격 패턴이 되도록 예측됩니다. 신뢰 없는 신뢰성은 검증이 소비자에게 보이지 않거나 해독 불가능한 곳에서 예측되며, 더 많은 아키텍처보다는 영수증 현저성과 이해도로 종결됩니다. 이 절의 명제는 두 사이의 간격에 있으며, 구분은 신뢰 이동 가설을 무효화할 것이 무엇인지를 규율합니다. 이러한 반박자들은 행동적이고 사전 약속입니다: 검증 가능하고 불투명한 아키텍처로의 위임이 실패 하에서 동등하게 지속된다면 가설이 반박됩니다 (P4가 감지하는 것); 검증 가능한 아키텍처의 위임 의사에 미치는 영향이 포기된 검토 및 실행 제어에 따라 성장하지 못한다면 (P2의 위임 수준 교차); 또는 높은 비가역성 위임에서 검증 가능한 아키텍처에 대한 통제된 실패 하의 보유 및 지불 의사 프리미엄이 없다면 반박됩니다. 정당성이 아키텍처의 존재가 아닌 감사 생존으로 정의되기 때문에 (제1절), 인기도는 증거로 작용하지만 면역으로 작용하지 않습니다. 소비자들이 검증 불가능한 에이전트로 몰려가는 것이 자체로 정당한 신뢰 주장을 반박하지 않습니다. 높은 위험도 위임에서 검증 불가능한 에이전트에 대한 지속되고 실패 생존 의존성이 반박하며, 그 패턴은 가설을 수정하도록 사전 약속됩니다. 정의는 세 가지 속성에 기반을 두고 있습니다.
그림 5. 두 파이프라인
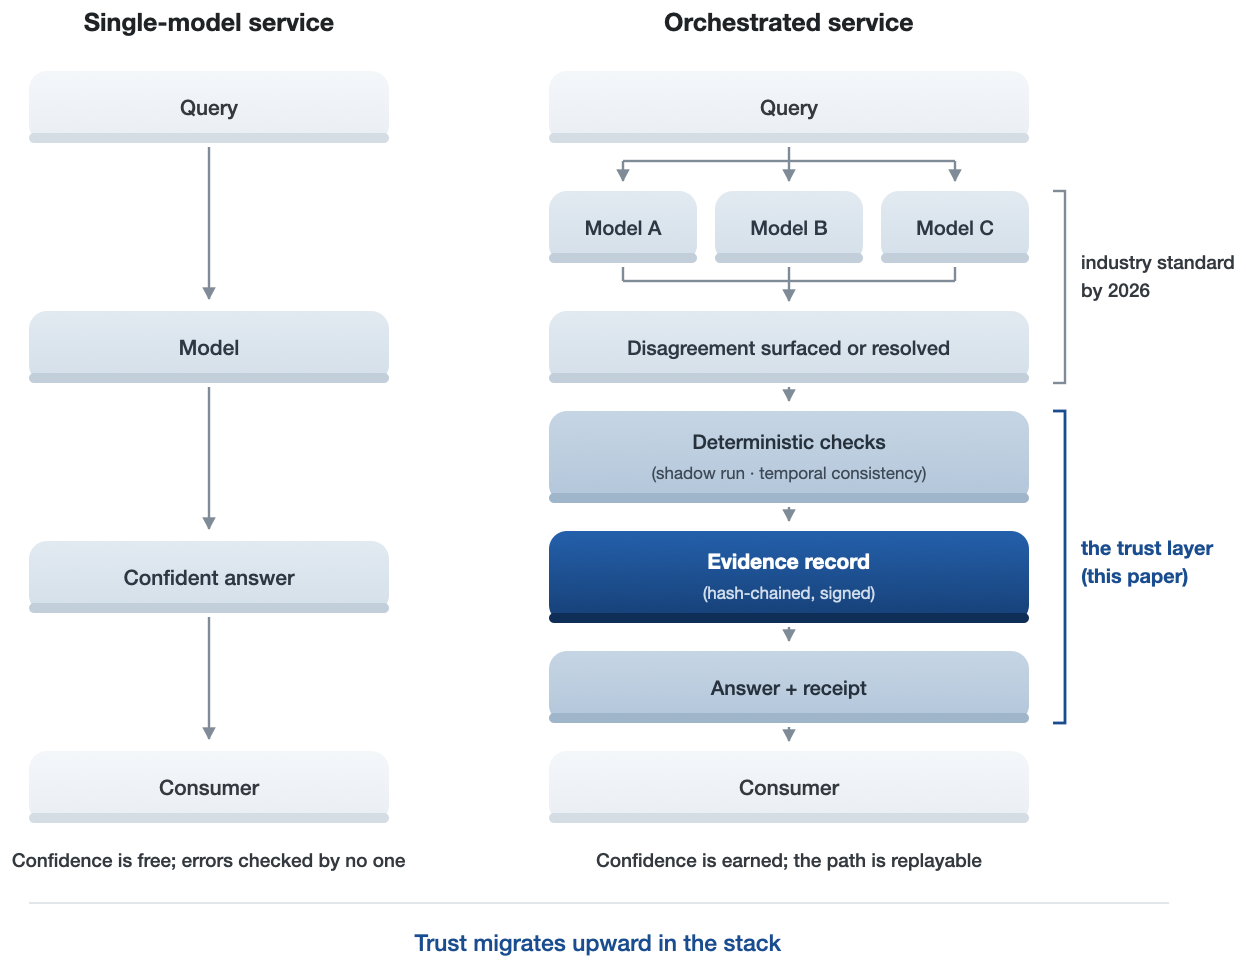
왼쪽, 단일 모델 경로: 쿼리 → 모델 → 확신 있는 답변 → 소비자, 여기서 신뢰도는 자유로우며 오류는 누구도 확인하지 않습니다. 오른쪽, 오케스트레이션된 경로: 쿼리 → 독립적 모델 (A/B/C) → 불일치 표시 또는 해결 → 결정적 검사 (섀도우 실행, 시간적 일관성) → 증거 기록 (해시 체인, 서명됨) → 영수증과 함께 답변 → 소비자, 여기서 신뢰도는 달성되며 경로는 재생 가능합니다 (표 5는 대조를 요약합니다).
표 2. 이 논문에서 도입되거나 규정된 구성 요소의 용어집
| 용어 | 정의 | 다음과 구분 |
| 아키텍처 신뢰 | 서비스 제공자의 평판이나 출력 품질이 아닌 서비스의 의사결정 생산 과정의 검증 가능한 속성에 근거한 정당한 소비자 신뢰 | 기관 기반 신뢰(신뢰할 만한 기관이 필요 없음, 검증 가능한 프로세스만 필요); 시스템 신뢰(한 시스템의 신뢰성 범위가 아님); 분산 신뢰(검증 가능성 없는 분산); 구조적 보증(인식된 것 대 검증 가능한 보안장치); 보정된 신뢰 |
| 아키텍처 신뢰성 / 아키텍처 기반 신뢰 | 구성의 두 가지 측면: 시스템 측 속성(프로세스의 검증 가능성이 실제로 얼마나 높은지; 규범적, 구축 가능한) 대 소비자 측 상태(그 검증 가능성에 실제로 근거한 신뢰; 경험적, 획득된) | 규범적 주장과 서술적 주장을 혼합하는 단일 용어 처리 |
| 검증 계층 | 오케스트레이션 위의 인프라 계층으로, 그 산출물은 검증 가능성: 독립적 검증, 기록된 의사결정, 감시 가능한 중립성 | 관찰 가능성/모니터링(내부, 공급업체 보유, 소비자 검증 불가능) |
| 증거 인프라 | 검증 가능한 의사결정 이력의 시장 범주로 클라우드, 신원, 결제처럼 인프라로 판매되는 것 | 로깅(일방적, 변경 가능, 시장 재화가 아님) |
| 오케스트레이션 영수증 | 최소한의 소비자 대면 산출물: 누가 행동했는지, 어떻게 동의했는지, 무엇이 검증되었는지 — 완전히 재생 가능한 기록에 대한 포인터와 함께 | 설명/XAI 출력(서술적, 검증 불가능한); 공시 라벨(그 자체로 신뢰를 약화시킴) |
| 단계적 신뢰 아키텍처 | 위험에 따른 검증 깊이의 확대로, 고비용 계층은 결과가 집중되는 곳에서만 구매됨 | 평면적 보호장치(의사결정을 검증하지 않는 정적 한도/화이트리스트) |
| 의사결정 증거 | 증거 스택의 3층: 에이전트가 선택한 방식 — 패널, 차이, 검증 | 신원 증거(에이전트가 누구인지: TAP); 의도 증거(무엇이 인증되었는지: AP2 / 검증 가능한 의도) |
| 신뢰 이동 가설 | 위임된 에이전시가 클수록, 보증된 신뢰의 더 큰 몫이 모델 속성보다는 검증 가능한 아키텍처 속성에 있어야 함 — "보증된"은 결과를 알기 전에 고정된 기준에 대한 객관적 감시를 견디는 신뢰를 의미(Jacovi et al., 2021 참고); 메커니즘 형태: 위임이 심화됨에 따라, 신뢰성 — f(능력, 정직성, 선의), Mayer et al. (1995) — 의 소비자가 독립적으로 측정할 수 있는 몫이 아키텍처 구성요소로 이동 | 이전의 "신뢰 이동" 사용(Carlson, 2026)은 당사자 간 이동하는 신뢰를 추적; 이 가설은 그것을 보증하는 속성의 종류를 추적 — 사전 약속된 행동 반박자와 함께(P2 위임 교차; P4 차등 지속성) |
인접한 신뢰 구성의 경계 구분은 각 구성이 그것의 대상으로 취하는 것, 보증이 어디서 오는지, 누가 그 보증을 검증할 수 있는지, 그리고 그것이 주로 무엇을 예측해야 하는지에 따라 한 개의 판별 표로 압축될 수 있습니다:
표 2a. 판별적 경계 구분: 대상, 보증, 검증자, 주요 예측 결과에 따른 인접한 신뢰 구성
| 구성 | 신뢰의 대상 | 보증의 출처 | 검증할 수 있는 사람 | 예측된 주요 종속변수 |
| 기관 기반 신뢰 / 구조적 보증(Zucker, 1986; McKnight et al., 2002) | 기관 맥락: 보안장치, 보증, 제3자 인증 | 구조와 보증인의 인식된 존재 | 제3자 보증인(있다면); 소비자는 검증하기보다는 인식함 | 신뢰 신념; 거래 의도 |
| 자동화에 대한 신뢰 / 보정된 신뢰(Lee & See, 2004) | 하나의 자동화 시스템의 신뢰성 범위 | 반복적 사용에서의 경험된 신뢰성 | 해당 시스템에 대한 축적된 경험을 통한 운영자 | 그 시스템에 대한 신뢰 적절성 |
| 알고리즘 투명성(XAI) | 모델의 자신의 의사결정에 대한 설명 | 신뢰받는 시스템 내에서 생산된 서술 또는 기여도 | 아무도 독립적으로 할 수 없음 — 설명은 재생 가능한 기록이 아님 | 이해; 주관적 신뢰; 수용 |
| 브랜드 / 제공자 신뢰 | 공급업체 조직 | 평판과 과거 성과 | 시장, 느리게, 종합적 결과를 통해 | 전반적 호감; 선택; 충성도 |
| 아키텍처 신뢰(본 논문) | 의사결정 생성 프로세스와 그 기록 | 검증 가능한 속성: 독립적 합의, 재생 가능한 증거, 감시 가능한 인센티브 독립성 | 소비자, 감시자, 보험사, 규제자 — 의사결정별로 | 보정된 신뢰; 위임 의사; 실패 후 지속 |
두 가지 차등 예측은 경계 구분을 분류학적이 아니라 시험 가능하게 합니다. 아키텍처 신뢰는 보정된 신뢰와 실패 후 지속을 서비스에 대한 전반적 호감보다 더 강하게 움직여야 하는 반면, 브랜드 신뢰는 반대의 프로필을 보여야 하며, 이는 이중 종속변수 계족을 측정하여 단일 실험이 감지할 수 있는 분리입니다. 위임된 에이전시가 낮을 때, 브랜드와 제공자 신뢰가 위임 결정을 지배해야 하고, 아키텍처 기반 신뢰는 위임이 심화될수록 증분 몫을 설명하는 증가, P2와 신뢰 이동 가설이 시험 대상으로 두는 교차입니다. 두 가지 명확화가 뒤따릅니다. 아키텍처 신뢰성은 소비자의 머리 속 반영적 잠재변수가 아닌 서비스의 속성이기 때문에, 그 고유성은 척도-판별 통계보다는 이러한 차등 예측에 근거합니다. 그것이 이름을 붙이는 소비자 측 상태에 대해, 아키텍처 기반 신뢰는 인접한 척도(기관 기반과 보정된 신뢰)로부터 측정 수준 판별 타당성 확립이 여기서 주장된 것이 아니라 측정 의제의 일부입니다.
다양성. 요청은 여러 개의 독립적인 모델에 의해 답변되며, 각 모델은 서로 다른 공급업체, 훈련 데이터 및 실패 모드를 가지고 있습니다. (이는 패널 다양성으로, 답변을 검증하는 사람의 속성이며, 추천 시스템 의미의 추천 다양성과는 다릅니다. 추천 다양성은 소비자에게 표시되는 항목을 변화시킵니다.) 이들의 일치는 정보를 전달합니다. 수렴은 정당한 신뢰도를 높입니다. 발산은 소비자에게 불확실성으로 표면화되며 눈에 띄지 않게 해결되지 않으며, 중요한 요청의 경우 에스컬레이션 트리거로도 기능합니다. 선택적 예측 관점에서 이것은 아키텍처적 기권입니다: 검증되지 않은 답변을 내보내기를 거부하고, 서비스 계층으로 끌어올려서 미해결된 경우를 인증하지 않고 인간에게 라우팅합니다. 이는 학습-기권 패턴으로, 시스템의 거부 옵션이 경우를 억제하지 않고 다운스트림 전문가에게 넘기는 것입니다(Mozannar & Sontag, 2020; cf. Rabanser et al., 2026). 가장 가까운 인간 유추는 의학의 2차 의견이며, 그 전체 가치는 첫 번째 의견과의 독립성에 있습니다. 조율된 불일치는 이국적이지도 않습니다: Google의 AI 공동 과학자는 습식 실험실 검증 발견이 2026년 5월 Nature에 도달했으며(Gottweis et al., 2026), 생성–비판–토너먼트 조율로 구축되어 있습니다.
다양성을 활용하기 위한 이론적 근거는 언어 모델보다 더 오래되었습니다. 형식적 조건에서, 기능적으로 다양한 문제 해결 집단은 개별 능력으로 선택된 집단을 능가할 수 있습니다. 능력으로 선택하면 유사성이 증식되기 때문입니다(Hong & Page, 2004). 공학 문헌은 기초 신호에 대한 직접적인 증거를 제공합니다: 모델 간의 구조화된 토론은 사실 정확도를 향상시키며(Du et al., 2024), 다양한 소형 모델의 패널은 단일 대형 판사를 능가합니다(Verga et al., 2024). 두 번째 모델의 첫 번째 모델 답변에 대한 "놀라움"은 응답 모델 자신의 신뢰도보다 맞는 것과 틀린 것을 훨씬 더 잘 분리합니다(MMLU에서 평균 AUROC 0.75 대 0.59; AUROC는 ROC 곡선 아래 영역으로, 무작위 정답이 무작위 오답 위에 순위가 지어질 확률입니다; Gorbett & Jana, 2026). 이들의 신호는 로짓 수준의 교차 모델 혼란도이며, 본 논문의 신호는 답변 수준의 복제이고, 둘은 관련 있지만 서로 교환 불가능합니다. 이들의 생성기는 또한 약한 자가 보고가 있는 소형 개방 모델이며, 본 논문 자체의 데이터가 기준을 설정합니다. 패널 이점은 생성기의 보정의 함수이고 잘 보정된 생성기의 경우 역전될 수 있기 때문이며, 아래 미국 최전선 경우입니다. 그리고 여러 세대를 샘플링하고 의미론적 일치를 측정하는 것은 단일 통과 신뢰도가 감지할 수 없는 환각을 감지합니다(Farquhar, Kossen, Kuhn, & Gal, 2024). 모델은 자신의 의심을 측정할 수 있지만 자신의 맹점은 측정할 수 없으며, 확신 있는 체계적 오류는 외부에서만 보입니다. 하지만 그 문헌은 불일치를 개발자를 위한 내부 신호로 취급합니다. 제가 제안하는 움직임은 이를 소비자 대면 신뢰 원시로 취급하는 것이며, 표면화되고 기록되며 서비스의 신뢰도 주장에 가격이 책정되며, 본 논문의 절제는 토론이 발견하는 것과 검증이 인증하는 것을 분리하고 한쪽이 다른 것으로 가장하도록 하지 않습니다. 경계는 개념적일 뿐만 아니라 경험적입니다: 벤치마크 대비 평가에서 다중 에이전트 토론은 자체 일관성 및 앙상블과 같은 더 단순한 전략을 안정적으로 능가하지 않습니다(Smit et al., 2024). 여기서의 주장은 토론의 정확도 향상이 아니라 검증의 소비자 대면 인증 신호에 관한 것이며, 그 신호는 토론의 이점이 없는 경우에도 살아남습니다.
다중 에이전트 심의 연구에서 마찬가지로, 합의와 불일치를 평균화하지 않고 표면화하도록 구축된 시스템은 더 대표적인 것으로 평가되는 결정을 생성합니다(Liu et al., 2026). 이 메커니즘은 지식 보정 측면에서 직접적인 인간 유추를 가집니다: 결과적 금융 결정을 공동으로 내리는 소비자는 독립적 결정자보다 훨씬 덜 과신합니다. 공유된 메타지식(파트너가 결정자가 모르는 것을 표면화하는 것)이 주요 메커니즘으로 확인됩니다(Piehlmaier, 2023). 공동 판단은 교차 모델 일치가 여기서 이를 규제하도록 제안되는 것과 같은 이유로 인간에게서 신뢰도를 규제합니다.
소비자가 그러한 신호를 사용할 수 있는지는 실질적인 질문입니다. 사람들은 알고리즘 오류를 본 후 빠르게 포기하지만(Dietvorst, Simmons, & Massey, 2015), 다른 곳에서는 알고리즘 조언에 과가중을 두며(Logg, Minson, & Moore, 2019), 이 분할은 그 자체로 이해관계를 추적할 수 있습니다. 인간 피험자를 이용한 2차 의견 실험은 원재료가 행동적으로 살아 있음을 보여줍니다: 의료 AI와 의사가 일치할 때 거의 일치된 준수, 그들이 갈라서면 날카로운 분할(Detjen, Densky, von Kalckreuth, & Kopka, 2025; Chen, Sun, Liao, & Sundar, 2026), 그러나 그 작업 중 어느 것도 불일치를 증거 또는 중립성과 함께 변화시키지 않습니다. 소비자 연구 흐름은 경계 조건을 날카롭게 합니다(체계적으로: Burton, Stein, & Jensen, 2020). 혐오는 소비자가 자신의 경우가 고유하다고 느낄 때 강화되며(Longoni, Bonezzi, & Morewedge, 2019), 작업 객관성에 따라 변하며(Castelo, Bos, & Lehmann, 2019), 한 AI의 실패는 다른 AI로 쉽게 과일반화되며, 알고리즘 전이(Longoni, Cian, & Kyung, 2023). 불신이 시스템 전체에 일반화되면, 섹션 1의 일격 포기는 한 서비스의 이탈이 아니라 카테고리의 이탈이며, 오류를 구조적으로 포착하는 것은 시장 자체를 보호합니다. 표면화된 불일치는 그 결함선에 앉아 있으며, 아래의 P1–P2는 불확실성이 구체적으로 그리고 평활화 없이 제시될 때 어느 효과가 지배적인지에 대한 베팅입니다.
다양성이 실패할 때: 상관된 오류. 다양성의 가치는 전적으로 실패의 독립성에 달려 있으며, 독립성을 가정할 수 없습니다. 최첨단 모델들은 겹치는 말뭉치로 훈련하고, 서로에게서 증류하며, 자신감 있는 오류 인식을 명확히 공유합니다. 두 개의 선도적 모델이 모두 같은 벤치마크 항목을 놓칠 때, 약 60% 정도의 시간에 같은 잘못된 답에 동의하며, 상관성은 같은 개발자 또는 기본 아키텍처의 모델들 간에 가장 강하고, 가장 불안하게도 가장 정확한 모델들 간에서입니다: 능력이 상승함에 따라 오류가 수렴합니다 (Kim et al., 2025). 이 발견은 이 논문의 다양성 요소에 대한 직접적인 제약이며, 단지 인접한 결과가 아닙니다. 다양성이 전제하는 독립성은 최첨단 영역에서 부분적으로 허상이며, 상관성이 정확히 능력이 가장 높은 곳에서 강해지므로, 이 요소의 기여는 고정된 자산이 아니라 침식되는 측정된 양입니다. 패널이 추가하는 것은 질문별로 입증되어야 하며, 모델 개발의 궤적은 이에 대항합니다. 예측에서, 최첨단 모델들 간의 쌍별 오류 상관성은 평균 r ≈ 0.77입니다 (Spiro, 2026). 중복성이 충분히 높아서 다양한 군중이 제공할 것으로 예상되는 집계 이점의 대부분을 침식합니다.
시장 구조가 우려를 가중시킵니다. 2025년 말까지 엔터프라이즈 LLM API 지출의 88%가 세 개의 폐쇄형 가중치 공급자에 집중되어 있었습니다: Anthropic이 40%, OpenAI가 27%, Google이 21% (Menlo Ventures, 2025b; Menlo는 Anthropic 투자자)입니다. 따라서 "주요 모델들"에서 무심코 구성된 패널은 오류가 수렴하도록 측정된 바로 그 세 공급자의 기반에서 나온 것이며, 아래의 실험이 미국 최첨단 패널로 재현하는 바로 그 삼중조입니다. 세 모델이 같은 유행하는 오류에 수렴할 때, 아키텍처는 단지 그것을 포착하지 못할 뿐 아니라 그것을 인증합니다. 동질적인 군집에서, 에이전트를 추가하는 것은 잘못된 궤적을 수정하는 대신 안정화하며, 이는 다중 에이전트 문헌에서 합의 역설이라고 부르는 끝점입니다 (Shehata & Li, 2026). 따라서 상관성은 아키텍처가 감지하도록 구축되어야 할 실패 모드입니다 (그림 6).
그림 6. 다양성의 환상
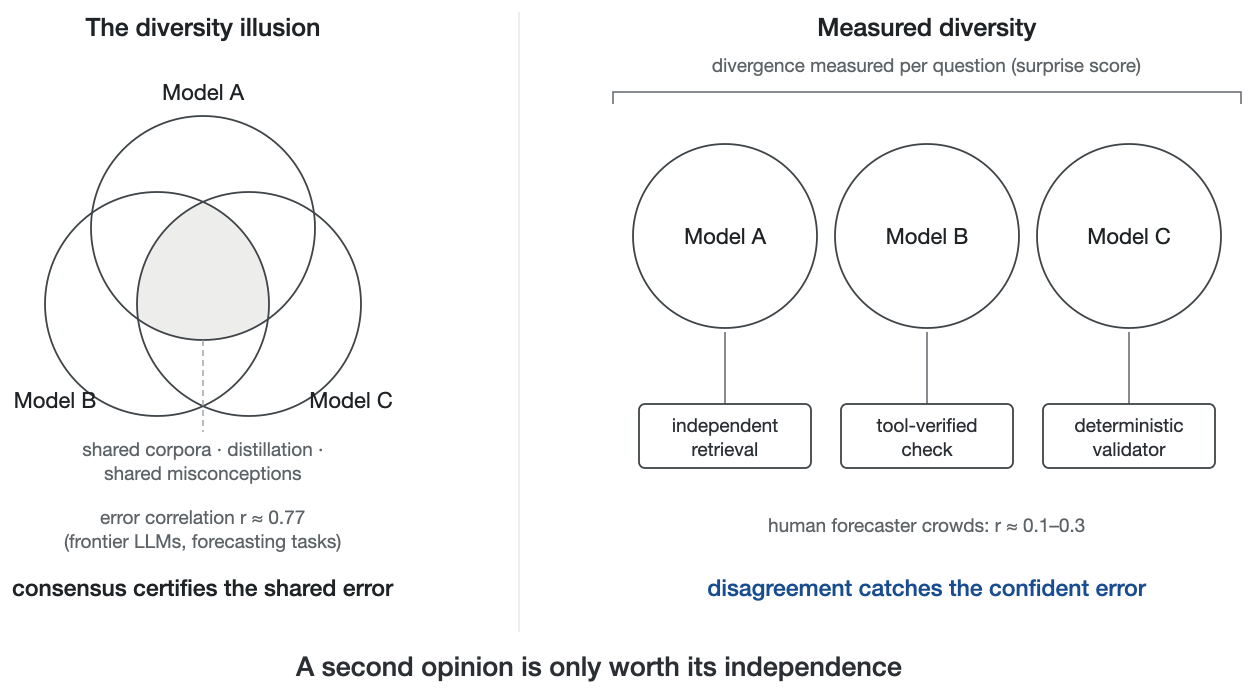
거의 같은 복제본들 간의 합의 대 독립성이 측정된 패널.
그것은 상호작용적 대응물을 가집니다: 아첨꾼의 기울기는 모델들 간에도 작동합니다. 다중 에이전트 연구는 LLM 숙고에서 측정 가능한 집단 동조를 발견하며, 더 약한 모델들이 가장 열심히 동조합니다 (Choi, Kim, Chae, & Baek, 2025); 에이전트들은 입장에 누구의 것인지에 따라 무게를 줍니다 (Choi, Zhu, & Li, 2026); 수렴처럼 보이는 것의 대부분은 추론보다는 사회적 준수로 분해됩니다 (Hao et al., 2026). 공동 숙고에서, 동의는 저에너지 상태이므로, 입장을 정하기 전에 토론하는 패널은 진리를 향해서가 아니라 합의로 자신을 말할 수 있습니다. 아키텍처적 대응은 절차적입니다: 의견을 먼저 맹목적으로 그리고 독립적으로 수집한 다음, 그 후에 비교합니다 (그림 7).
그림 7. 맹목적-독립적-먼저
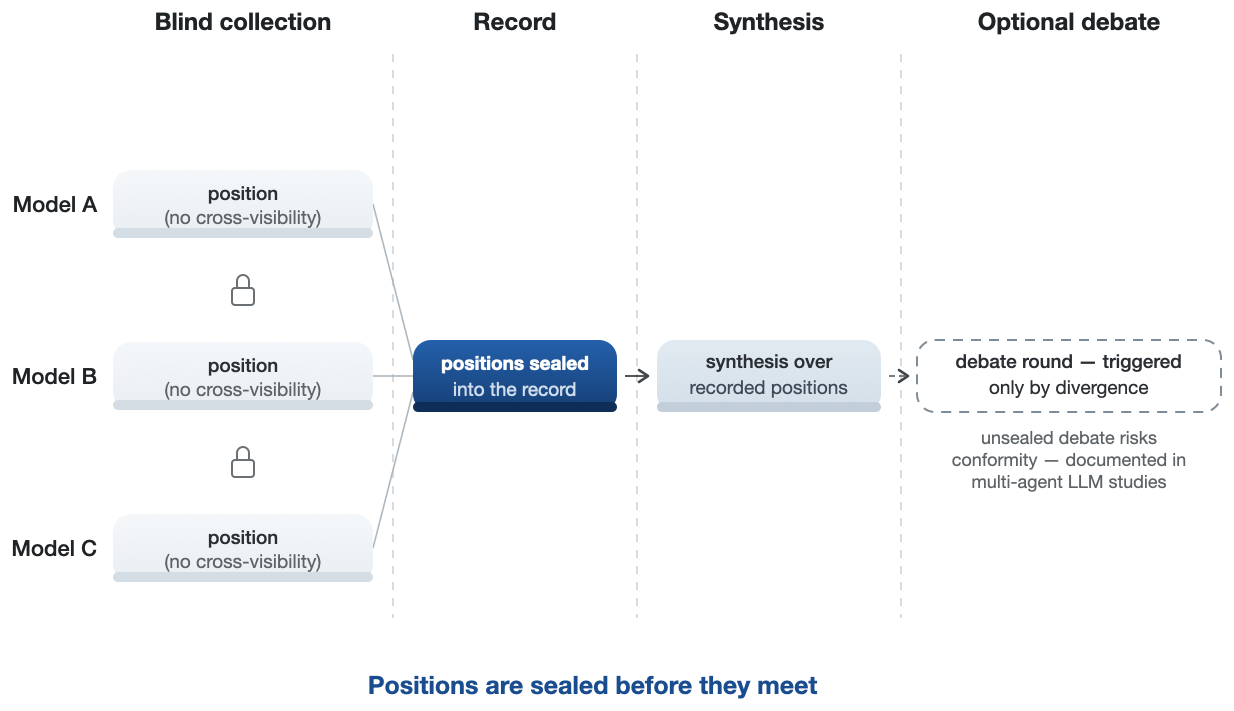
입장을 기록한 후 비교합니다 — 동조가 지울 입장을 보호하는 절차.
아래 보고된 실험은 그 절차가 보호하는 것에 대한 숫자를 제시했습니다. 쌍을 이룬 탐색적 팔에서, 맹목적으로 다른 답을 생성한 검증자들이 일차 모델의 자신감 있는 잘못된 답을 보여주고 동의하는지 묻는 것을 받았습니다. 38.5% (436개의 발산 쌍 중 168개; 95% CI 33.6–43.2, 질문-클러스터 부트스트랩)가 자신들의 발산 답을 포기하고 오류를 보증했으며, 공급자 수준의 동조는 20%에서 58% 범위였습니다. 포기는 포기된 것으로 나뉘며, 이는 동조와 합리적 양보를 분리합니다. 맹목적 답이 그 자체로 정확한 검증자들 중에서, 29.1% (41/141)는 여전히 자신감 있는 잘못된 답을 위해 그것을 항복했으며, 이는 어떤 베이지안 설명도 용서하지 않는 해로운 핵심이고, 잘못된 맹목적 답 중 43.1% (127/295)에 반대됩니다. 여기서 일부 양보는 방어할 수 있습니다. (질문-클러스터 간격은 순진한 쌍 수준의 것과 거의 동일합니다. 436개의 쌍은 247개의 서로 다른 질문에 걸쳐 분산되어 있으며, 대부분 질문당 하나 또는 두 개의 쌍이고 절대로 4개 이상이 아니므로, 질문 수준의 재표본화는 추가할 클러스터 내 공분산이 거의 없습니다.) 아래 거울 대조를 접으면, 대략 35–39%의 맹목적 불동의자들이 자신감 있는 답을 보였을 때 입장을 바꾸며, 그것의 진실 가치가 무엇이든 간에, 제안된 답에 대한 적당하지만 유의미한 순 기울기가 있습니다 (순 동조 ≈ 4 백분 포인트; 불협화 쌍 104 대 70 ≈ 1.49). 패널이 입장을 정하기 전에 숙고했다면, 이 의견 불일치의 큰 부분이 기록되기 전에 재협상되었을 것입니다. 하지만 거울 팔 뒤집기의 34.7%가 진리를 향하기 때문에, 숙고는 또한 일부 불동의를 정확한 합의로 변환했을 것이므로, 맹목적-먼저가 보호하는 것은 손실된 의견 불일치의 개수가 아니라 측정 자체입니다. 맹목적-먼저는 의견 불일치를 측정하는 것과 합의를 제조하는 것 간의 차이이며, 인간 군중이 필요했던 같은 규칙입니다: 사회적 영향은 정확성을 향상시키지 않으면서 독립적 추정의 다양성을 붕괴시킵니다 (Lorenz, Rauhut, Schweitzer, & Helbing, 2011). 그리고 단 하나의 자의적 초기 보증도 측정 가능하게 후속 판단을 편향시킵니다 (Muchnik, Aral, & Taylor, 2013).
역-프롬프트 대조는 이러한 뒤집기가 동조보다는 합리적 신념 업데이트를 반영한다는 대안적 설명을 다룹니다. 나는 동의하지 않은 검증자들을 보여주는 6개 모델 로컬 패널에서 쌍을 이룬 절차를 반복했거나, 같은 질문 세트에 대해 자신감 있는 잘못된 답 (직접 팔)이나 금 답 (역 팔)을 맹목적으로 보여주었습니다. 뒤집기 비율은 거의 대칭이었으며, 잘못된 답을 향해 38.9% 대 정확한 것을 향해 34.7%였으며, 쌍 내 비교에서 검증자들은 정확한 것보다 잘못된 답을 위해 맹목적 입장을 포기했습니다 (104 대 70 불협화 쌍; McNemar p = .010). 합리적 업데이트는 반대 비대칭을 예측합니다. 모델당 뒤집기 성향은 본질적으로 두 팔에서 동일했으며, 동조의 극단에서 (모델당 쌍 개수는 작으며 별도로 강화되지 않음; 복제 패키지에 그들의 ns와 함께 기술적으로 보고됨), 동의가 그것의 진실 가치가 아니라 자신감 있게 제안된 답의 존재에 의해 주도된다는 것을 나타냅니다. 이 대조는 로컬 계층에서 실행되었습니다. 최첨단 패널 추정 (38.5%)은 같은 절차에 근거하지만 최첨단 검증자들로 거울-테스트되지 않았습니다.
Blind collection는 한 가지 채널을 닫을 수 없습니다: 사회적 일관성은 무너뜨리지만 사전 일관성은 무너뜨리지 못합니다. 모델들은 공유 학습 데이터가 동일한 사전을 제공하기 때문에 수렴하며, 쌍둥이들은 서로 상의하지 않고도 같은 답변을 합니다. 나는 이를 닮은꼴 수렴이라고 부릅니다: 패널이 옳아서가 아니라 구성원들이 닮았기 때문에 합의하는 것입니다.
상관관계 있는 사전도 여전히 측정되어야 합니다. 교차 모델 놀라움 점수는 패널이 실제로 얼마나 독립적인지에 대한 실시간 추정값을 질문별로 제공하며, 라벨이 없으므로 원칙적으로 금표준 답변 없이 추론 시간에 독립성을 추정할 수 있습니다. 생산 시간 추정은 여기서 테스트되지 않습니다. 다양성은 또한 모델 가중치를 넘어서야 합니다. 독립적인 검색 경로, 도구 검증 확인, 결정론적 검증자들이 공유 학습이 만드는 상관관계 채널을 깨기 때문입니다. 증류와 합성 데이터 학습이 시간에 따라 모델 가중치를 동형화하므로 필요는 줄어들기보다 늘어날 것입니다. 따라서 측정된 다양성은 감소할 것으로 예상되어야 하고 검증 부담은 비모델 검증자로 옮겨져야 합니다. 그리고 측정된 것은 공개되어야 합니다: 기록은 단지 "N개 모델이 합의했다"가 아니라 이 질문 범주에 대한 패널의 추정 다양성을 포함해야 합니다. 거의 복제본들 간의 합의는 더 약한 신뢰도 주장을 받을 자격이 있으며, 기록은 소비자가 어떤 것을 받았는지 명시해야 합니다.
증거. 모든 결과적 답변은 기록을 포함합니다: 어떤 모델이 참고되었는지, 어디서 합의하고 불일치했는지, 무엇이 확인되었는지, 종합이 무엇에 기초하는지 말입니다. 에이전트가 검색과 도구에 답변을 근거하면서 사실적 기초가 이미 모델 외부에 존재하므로, 시기는 요구사항을 선호합니다. 따라서 그것을 기록하는 것은 답변을 생산하는 부산물이 됩니다. 기록이 변조 방지이기 때문에, 서비스의 결정 이력은 분쟁 시 소비자, 감시자, 보험사에 의해 재생 가능합니다. 신뢰는 더 이상 브랜드에 대한 감정이 아니라 이력의 검사 가능한 속성이 됩니다.
두 가지 메커니즘이 답변에서 행동으로 증거를 확장합니다. 섀도우 실행 하에서, 외부 효과를 가진 행동은 기록된 드라이런으로 리허설되므로 "에이전트가 행동하기 전에 확인했다"는 것이 슬로건이 아닌 검증 가능한 주장이 됩니다. 시간적 일관성은 세션이나 표현 전체에서 권장사항을 다시 제기하고 그 안정성을 기록하므로, 두 번 물었을 때 변하는 답변은 누군가 그것에 의존하기 전에 표시됩니다. 정체성 수준에서 기록 계층은 에이전트 자체의 이동식 출처 여권으로 확장됩니다: 어떤 모델, 버전, 정책이 행동했는지, 언제, 누구의 권한 하에. 이것이 "당신의 에이전트를 알아라" 등록 계획과 에이전트 오류 보험 약정이 조용히 전제하는 인공물입니다. 이 기록의 소비자 대면 렌더링은 그림 8의 오케스트레이션 영수증입니다: 하나의 행동, 하나의 기록, 네 명의 청중(소비자, 보험사, 감시자, 규제자).
그림 8. 오케스트레이션 영수증, 두 번 판매됨(모형)
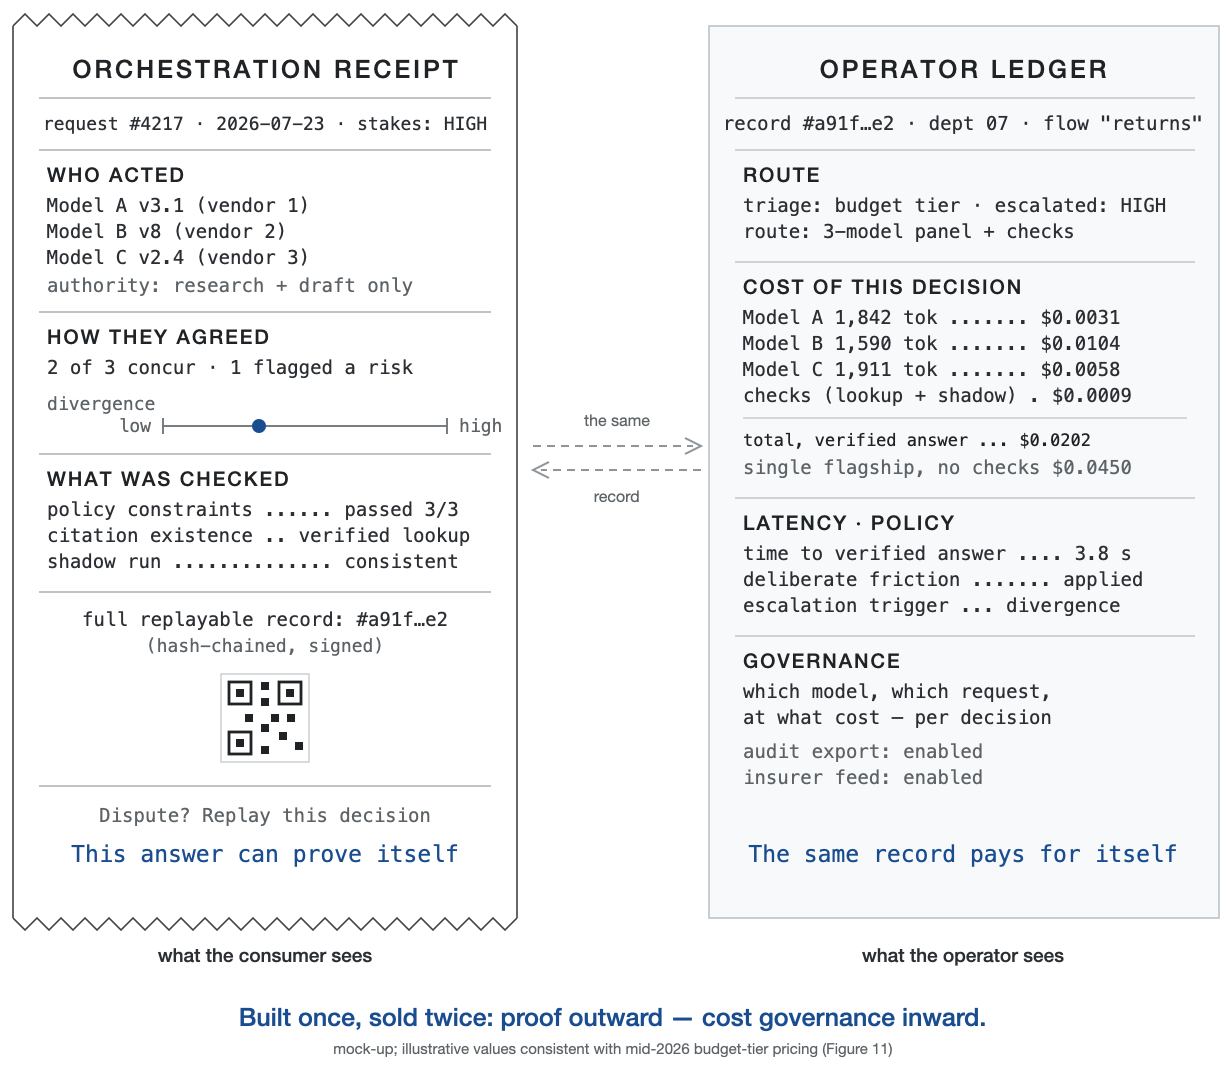
소비자는 증거를 봅니다 — 누가 행동했는지, 어떻게 합의했는지, 무엇이 확인되었는지; 운영자는 비용 거버넌스로 동일한 기록을 봅니다. 분쟁에서 영수증은 말에 대한 말을 기록에 대한 말로 바꿉니다.
중립성. 중립성은 감사 가능한 인센티브 독립성입니다: 특정 공급업체, 판매자, 결정 결과에 대한 미공개 경제적 의존성의 부재입니다. 오케스트레이션 계층은 작업에 가장 잘 수행하는 모델로 라우팅하며 누가 승리하는지에 대한 지분이 없으며, 구조적으로 지급에서 독립적인 청산 계층과 유사합니다. 공급업체 간의 중재자는 공급업체 자신이 자신에 대해 신뢰할 수 있는 방식으로 신뢰받을 수 있습니다. 독립성은 경제적 속성을 명시하며, 감사 가능한은 주장이 전문하는 것이 아니라 확인 가능하게 만드는 증거 계층과 그것을 연결하며, 아래 개발된 청산소 규율입니다. (여기서 중립성은 인구 통계 그룹 간의 알고리즘 공정성인 직교 요구사항이 아닌 경제적 속성입니다.)
또한 수직 통합 문제가 있습니다: 중립성은 규모로 오케스트레이션을 구축할 수 있는 가장 좋은 위치에 있는 플랫폼에게 구조적으로 사용 불가능합니다. 동시에 마켓플레이스, 모델 공급업체, 광고 네트워크, 물류 제공업체인 회사는 중립적으로 중재할 수 없습니다. 왜냐하면 그것이 하는 모든 라우팅 결정은 자체 수익에 관한 결정이기 때문입니다. 산술은 구조적 경향을 가리킵니다. 프레임워크는 신뢰 계층이 청산, 감시, 신용 평가가 독립 산업이 된 경로인 중재 자체가 유일한 사업인 당사자들과 함께 가장 잘 앉습니다. 평가 기관 사건은 독립적인 중개자가 자체 발행자 급여 갈등을 성장시킨다는 표준 경고입니다. 경제는 문서화됩니다: 인증 중개자는 공개되는 정보를 제어하여 가치를 포착하며(Lizzeri, 1999), 인증 시장은 잘 카탈로그된 방식으로 실패하며(Dranove & Jin, 2010), 신용 평가 붕괴는 정식 실패를 나타냈습니다. 발행자 급여 수익이 한 수준 위의 인증자를 부패시키면서 생존한 청산 계층은 평가된 당사자의 상호주의적 비용이 아닌 상호주의적 비용으로 자금을 조달합니다. 따라서 중립성 요구사항은 오케스트레이터 자신의 수익 모델로 확장됩니다: 순위가 매겨진 공급업체나 판매자가 지불하는 검증 계층은 그것이 제거하기 위해 존재하는 갈등을 재현하므로, 여기서 수익 설계는 소비자 쪽과 운영자의 비용 거버넌스(섹션 5)로 진행되며, 순위가 매겨진 당사자로 진행되지 않습니다.
중립성은 또한 데이터 차원을 가집니다. 오케스트레이션 계층은 클린룸 역할을 할 수 있습니다: 요청은 사용자 정체성이 제거된 각 공급업체에 도달하며, 어떤 공급업체도 전체 상호 작용 이력을 보지 못하며, 오케스트레이터의 수익은 서비스에서 비롯되며 사용자가 말하는 내용을 광고 네트워크로 라우팅하는 데서 비롯되지 않습니다. 중립성은 양쪽에서의 인센티브 독립성입니다: 어떤 모델 공급업체나 판매자에 대한 미공개 경제적 의존성이 없으며, 그리고 소비자를 상대로 소비자의 말을 현금화하는 사업 모델이 없습니다.
하지만 중립성은 자체적인 무한소급을 야기합니다: 누가 조직자를 감시합니까? 순수한 "이해관계 없음"은 달성 불가능합니다. 모든 조직자는 비용, 파트너십, 유지 인센티브, 그리고 자신의 생존을 위해 자금을 조달해야 하므로, 작동하는 변수는 이들의 부재가 아니라 그들의 성질, 공개, 그리고 기록에서의 감시 가능성입니다. 누가 비용을 지불하는지는 중립성을 해결하지 않습니다; 지불자의 수익이 거래 결과와 독립적인지 여부가 해결합니다. 소비자 구독 또는 보험사나 감사인으로부터의 수수료(그들의 지급액이 어느 제품이 승리하는지와 분리된 경우)는 이 조건을 만족합니다; 상인 수수료나 광고 수수료는 그렇지 않습니다. 레이어를 자금 지원하는 사람에 대한 더 광범위한 거버넌스는 열려 있으며, 그 자금 조달의 감시 가능한 독립성이 이 구성이 고정하는 부분입니다. 조직화 레이어도 인센티브를 가지고 있습니다: 저렴한 모델로 라우팅하기 위해, 비싼 계층을 과매도하기 위해, 통합을 편리하게 형성하기 위해. 무한소급은 40년 된 것입니다. Shapiro (1987)는 이것을 보호자의 문제라고 명명했습니다: 절차적 보안장치는 자신들이 보호받아야 하는 새로운 보호자를 생성하며, 제도적 답변은 그 이후로 변하지 않았습니다.
청산소는 중립성을 선언함으로써가 아니라 외부에서 감시 가능하고 규제받음으로써 신뢰할 수 있는 지위를 얻습니다. 조직자는 중립성을 미덕으로 소유하지 않습니다. 증거 레이어는 그것을 검증 가능하게 만드는 것입니다. 모든 라우팅 결정, 모델 응답, 통합 단계는 변조 증명 기록, 해시 체인된 서명 로그에 기록되며, 외부 타임스탐프 고정을 위해 설계되었으므로, 조직자의 주장된 중립성은 모델에 부과하는 검증에 정확히 노출됩니다. 성숙도 경로는 청산소 플레이북을 구체적으로 만든 것입니다: 외부 타임스탐프 고정, 개방된 검증 인터페이스, 라우팅 정책의 정기적인 제3자 감사. 이러한 감사 생태계의 제도적 설계는 이미 명명된 연구 프로그램입니다(Raji, Xu, Honigsberg, & Ho, 2022). 검사자의 감사도 살아남는 의존성이 하나 있습니다: 패널의 모델은 서로 독립적일 수 있지만 모두 검증되는 플랫폼에 의해 선택되어 있으므로, 성숙도 경로의 끝점은 어떤 단일 당사자의 통제 외부에 위치한 패널 선택 및 로테이션입니다. 기록을 감시할 수 없는 조직자는 단지 믿어달라고 요청하는 또 다른 공급업체일 뿐입니다. 소비자 조사 외의 가장 가까운 이웃은 두 개의 동시대 2026년 저작입니다. Marchal et al. (2026)은 동일한 평가 전환을 주장합니다. 산출물 판단에서 에이전트 신뢰성, 출처, 위증 가능성을 설계하는 것으로, 인식론적 인프라 수준에서, 그리고 Wang et al. (2026)은 검증, 감사, 실패 귀속을 위한 프로세스 수준 책임성 레이어로서 실행 출처를 조사합니다. 이 논문 자신의 것으로 남은 것은 소비자 대면, 인센티브 인식 구성입니다: 위임된 상거래에서 소비자의 정당한 의존성의 객체로 묶인 세 가지 속성, 그리고 그 행동 테스트입니다.
증거 구성요소는 변조 증명이 쉽게 과장되기 때문에 하나의 경계를 갖습니다: 해시 체인된 로그는 출처 및 무결성(이 기록이 존재했으며 나중에 변경되지 않았음)을 설정하지만, 완전성이 아닙니다(해시는 생략된 호출이 억제되지 않았음을 보장하지 않습니다), 정확성이 아닙니다(잘못된 답변의 충실한 기록은 여전히 잘못되었습니다), 독립성이 아니며, 인센티브 정렬도 아닙니다. 각각은 고유한 검증 메커니즘을 가진 별도의 속성입니다: 범위 증명, 결과 감사, 측정된 다양성, 공개된 경제학. 영수증은 기록이 실제로 소유한 속성만 주장해야 합니다. 추가적인 제한은 구조적입니다: 로그는 무엇이 라우팅되었는지는 증명하지만, 왜 라우팅되었는지는 증명하지 않으며, 이 모델이나 이 상인을 선택하는 뒤의 독점적 휴리스틱은 라우팅 정책 자체가 공개되거나 증명되는 경우에만 감시 가능하며, 이는 암호학적 결과가 아닌 거버넌스 선택입니다. 아키텍처의 비용은 같은 장부에 속합니다: 쿼리를 여러 공급업체로 라우팅하면 개인정보 노출이 곱해집니다. 중앙화된 결정 로그는 매력적인 보안 목표이며, 합의 표시는 합의 오류 결과가 경고하는 정확히 그 권위를 제조할 수 있습니다.
이 구성은 "여러 모델 사용"이 신뢰 속성이 다른 여러 가지 다른 것을 설명하기 때문에 이 엔지니어링 이웃으로부터도 구별할 가치가 있습니다. 단순 앙상블 투표는 정확성을 향상시키지만 불일치를 보이지 않게 해결하므로 아무것도 검증 가능해지지 않습니다. 자체 일관성 샘플링은 같은 모델을 다시 요청하므로, 다양성은 외관상만 있습니다. 혼합 전문가는 단일 훈련된 시스템 내에서 라우팅하는데, 그 라우터는 중립성이 아닌 능력을 위해 최적화됩니다. 멀티 에이전트 토론(Du et al., 2024)은 답변을 개선하지만 숙고를 내부 메커니즘으로 취급합니다: 소비자 대면 기록 없음, 경제학 없음, 중립성 보장 없음입니다.
모델 라우팅 수집기는 2026년까지 상품 레이어이며, 카탈로그에서는 다중 공급업체이지만 답변당 단일 모델입니다: 라우터는 비용과 지연 시간에 따라 하나의 모델을 선택하며, 두 번째 의견은 절대 수집되지 않습니다. 수집기는 검증 아키텍처의 공급업체이지, 그에 대한 대체물이 아닙니다.
멀티 모델 작동도 더 이상 이국적이지 않습니다: 2025년 중반까지 엔터프라이즈의 37%가 프로덕션에서 5개 이상의 모델을 실행하고 있었으며, 1년 전의 29%에서 증가했습니다(a16z, 2025). 배관이 산업 규모에서 설치되고 있으며, 신뢰 레이어는 눈에 띄게 부재합니다. 멀티 모델이 보이지 않는 비용 라우팅으로 남을지, 아니면 검증 가능한 아키텍처가 될지는 열려 있습니다. 그림 9는 패턴을 5가지 신뢰 속성과 비교하며, 표 3은 산문으로 경계를 나타냅니다. 아키텍처 신뢰는 정확히 이들이 부족한 것으로 정의됩니다: 이질적 출처, 노출되고 기록된 불일치, 그리고 이해관계가 없는 중재자. 엔지니어링은 공유되지만; 신뢰 속성은 그렇지 않습니다.
그림 9. 경계
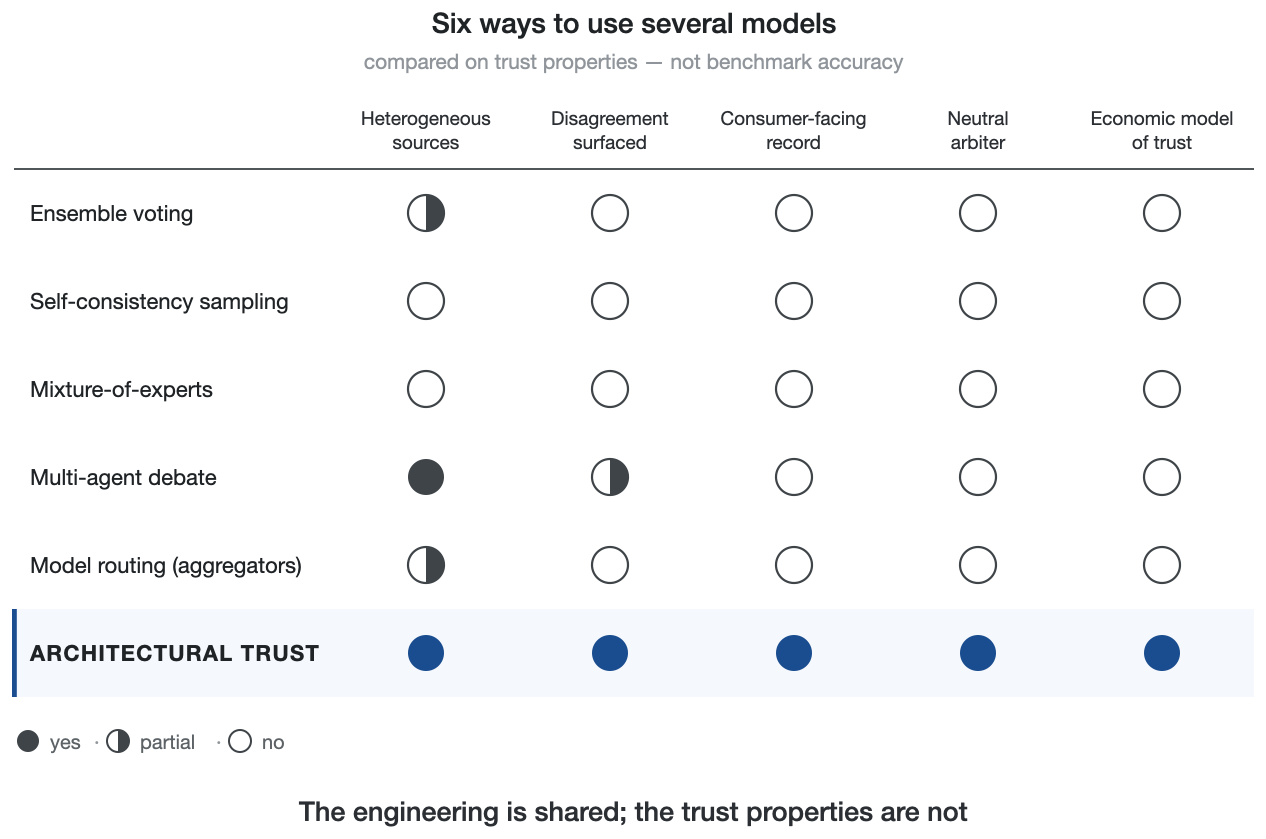
5가지 신뢰 속성에 대해 채점한 6가지 멀티 모델 엔지니어링 패턴
표 3. 경계: 아키텍처 신뢰 대 그 엔지니어링 이웃
| 접근 방식 | 이질적 출처 | 노출된 불일치 | 소비자 대면 기록 | 인센티브 독립적 중재자 | 신뢰의 경제 모델 |
| 앙상블 투표 | 부분 | 아니오 (보이지 않게 해결됨) | 아니오 | 아니오 | 아니오 |
| 자체 일관성 샘플링 | 아니오 (같은 모델 재샘플링됨) | 아니오 | 아니오 | 아니오 | 아니오 |
| 혼합 전문가 | 아니오 (학습된 시스템 1개) | 아니오 | 아니오 | 아니오 (성능 최적화된 라우터) | 아니오 |
| 다중 에이전트 토론 | 예 | 내부용만 | 아니오 | 아니오 | 아니오 |
| 설명가능성 (XAI 오버레이) | 아니오 (한 모델의 서사) | 아니오 | 아니오 (기록이 아닌 이야기) | 아니오 | 아니오 |
| 투명성 / 공개 | 아니오 | 아니오 | 부분적 (더 눈에 띄지만 검증 불가) | 아니오 | 아니오 |
| 출처 / 계보 추적 (ML 파이프라인) | 아니오 (문서화된 파이프라인 1개) | 아니오 | 부분적 (엔지니어 대상 계보) | 아니오 | 아니오 |
| 검증된 추론 (zkML) | 아니오 (한 모델; 실행 증명) | 아니오 | 부분적 (증명 산출물, 의사 결정 기록 아님) | 아니오 | 아니오 |
| 모델 라우팅 집계기 | 부분적 (다중 공급자 카탈로그, 답변당 모델 1개) | 아니오 | 아니오 | 아니오 (비용 최적화된 라우터) | 아니오 |
| 아키텍처 신뢰 | 예 | 예 (소비자 대상) | 예 (재생 가능) | 예 (구조적) | 예 (단계별 계층) |
동일한 목록에 속하는 상위 문헌 두 가지가 더 있습니다: 게이트의 기권-또는-방출 로직은 선택적 예측 및 연기 학습입니다(Geifman & El-Yaniv, 2017; Mozannar & Sontag, 2020). 증거 구성요소의 감시 추적은 책임 있는 알고리즘 및 제3자 감사 작업에서 비롯됩니다(Kroll et al., 2017; Raji et al., 2022). 아키텍처 신뢰는 소비자 대상의 중립성 제약이 적용된 이들의 결합이며, 어느 하나도 아닙니다. 다른 해결책들 중에서 그것을 위치시키는 것이 중요합니다. 왜냐하면 그들은 경쟁자가 아닌 보완 관계이기 때문입니다. 모델 수준의 보정은 필요하지만 구조적으로는 불충분합니다: 공급자가 생산하고 이를 인증하는데, 이것이 이 논문이 시작하는 갈등입니다. 외부 감사 및 인증은 독립적이지만 주기적이며, 시스템의 스냅샷이지, 의사 결정의 스냅샷이 아닙니다. 설명은 모델 내부에서 생성되는 서사이며, 답변을 만들어낼 수 있는 시스템은 그 뒤의 이야기도 만들어낼 수 있습니다. 투명성은 더 많은 메커니즘을 노출하고 소비자가 이를 해석하도록 남깁니다. 아키텍처 신뢰는 믿음이나 해석을 요구하지 않으며, 연속적이고 의사 결정별이며 기계 검증 가능한 검증성만을 요구합니다. 또한 다른 해결책들이 효과를 발휘하도록 하는 것도 이것입니다: 재생 가능한 기록이 있는 오케스트레이터의 감사는 뭔가를 감사하는 것이지만, 불투명한 파이프라인의 감사는 의식일 뿐입니다. 가장 가까운 개념적 이웃은 구조적 보증 및 제도 기반 신뢰입니다(McKnight et al., 2002). 프로세스 투명성, 그리고 설명가능성입니다. 이들과 구분되는 특성은 보증이 신뢰자에 의해 의사 결정별로 검증 가능하다는 것입니다: 보증은 한 번 믿어달라고 요청하고, 아키텍처 신뢰는 매번 검증해달라고 요청합니다. 지도에 속하는 이웃 집합이 두 개 더 있습니다. 컴퓨터 과학 책임 문헌은 10년 전에 기술적 기초를 마련했습니다: 완전한 투명성 없이 검증 가능하게 만든 절차적 규칙성(Kroll et al., 2017). 2025–26 엔지니어링 물결은 에이전트 신뢰 배관을 직접 구축하고 있습니다: 검증 가능한 신원 및 변조 방지 행동 기록을 갖춘 "신뢰 네이티브" 프로토콜(TrustTrack; Li, 2025); 변조 방지 영수증이 있는 런타임 작업 관리(AARM; Errico, 2026); 신뢰 추정으로 재구성된 다중 LLM 집계(Zheng & Zhang, 2026, arXiv:2607.20529); 그리고 엔터프라이즈 프레임워크(Gartner의 AI TRiSM; Cloud Security Alliance의 에이전트형 제로 트러스트 작업). 각각은 엔터프라이즈 수준에서 한 부분을 제공합니다. 어느 것도 소비자 대상 구성요소를 제공하지 않으며, 이것이 이 논문이 기여도로 주장하는 것입니다: 한 이름 아래의 세 가지 구성요소, 행동 설계에서 공동으로 조작 가능, 누가 검증성을 구매하고 어느 정도 규모에서 구매하는지에 대한 경제학. 하나의 이름 충돌을 명확히 해야 합니다. DigiCert의 "AI Trust Architecture"(2026년 4월 출시)는 공급자 PKI 제품 라인이며, 에이전트 신원, 모델 출처 및 콘텐츠 인증을 위한 인증서 인프라입니다. 이는 증거 스택의 신원 수준에서 배관을 제공하며, 여기서 개발된 아키텍처 신뢰의 구성요소는 아닙니다.
이 세 가지 간의 관계는 명시적인 실증적 가설이지, 개념적 필연성이 아닙니다. 나는 어떤 구성 요소가 부재할 때 0에 가까워지는 상호보완적 상호작용을 가설화하며, 비공식적으로 AT = f(D, E, N)으로 표현하며 임의의 0 근처에서 가파른 감소를 보입니다. 5장의 결합설계는 함수 형태를 가정하기보다는 복원하도록 지정되었습니다. 추정 가능한 형태에서, 편리한 족(族)은 콥-더글러스(Cobb–Douglas)이며, AT = A·Dα·Eβ·N^γ이고 α, β, γ > 0으로, 두 가지 약속을 인코딩합니다: 임의의 부재 근처에서 0으로의 감소, 그리고 양의 교차 편미분(구성 요소들은 상호보완적). 구성(construct)은 세 가지 구성 요소와 이들의 가설화된 상호보완성이며, 아래의 어떤 명제도 콥-더글러스 형태에 의존하지 않습니다. 콥-더글러스는 또한 내부 근사입니다: 엄밀히 말하면 여전히 약한 구성 요소로부터의 대체를 허용하지만, 상호보완성 가설은 경계에서 레온티에프형(Leontief-like)이며, min(D, E, N)이 바닥을 설정합니다. 이것이 정확히 왜 아래의 설계들이 보상적 거래를 가정하기보다는 비보상적 구조를 허용해야 하는 이유입니다. 콥-더글러스 족은 예시적이며, 향후 추정을 위한 것이고, 구성 정의의 일부가 아닙니다; 현재 데이터는 이를 추정하지 않습니다. 요인설계(factorial)는 콥-더글러스 내부를 레온티에프 바닥으로부터 매개변수별로 구별할 수 있습니다. 지수들은 경험적 질문으로 남아 있으며, 이것이 요점입니다: 상호보완성은 반박 가능합니다. 0은 두 가지 설명이 필요합니다. 구성 요소들은 이진이 아닌 연속이므로, 리터럴 0은 이상화된 한계입니다. 배포된 어떤 시스템도, 이 논문의 것을 포함하여, 어떤 축에서도 정확히 0 또는 1에 앉아 있지 않으며, 소비자가 거의 부재에 완전한 붕괴 또는 가파른 할인으로 반응하는지 여부는 정확히 설계가 구별해야 하는 것입니다. 다양성(Diversity)은 검증 경로의 독립성을 의미하며, 측정된 독립성(오류-상관 계수 φ, 아래 정의됨)을 그 단위로 합니다. 통계적 핵심은 고전 앙상블 이론이며, 결합의 이점은 오류 상관 제거에 기반합니다(Hansen & Salamon, 1990; Krogh & Vedelsby, 1995). 이것이 독립성이 여기서 가정되기보다는 측정되는 이유입니다. 두 번째 모델은 그러한 경로 중 하나이지만, 독립적인 검색, 도구 검증 조회, 그리고 결정론적 검증기도 마찬가지입니다. 그림 5의 섀도우 실행과 일관성 검사는 증거 없는 다양성으로서가 아니라, 최대로 상관제거된 두 번째 검증 경로로 계산됩니다. 그 정의는 또한 가장 강력한 명백한 반례들을 흡수합니다, 규제된 지불 레일 또는 완전히 로깅된, 제3자 증명된 유틸리티 서비스(증거 및 중립성 강함, 모델 다양성 무): 그러한 서비스는 비모델 검증 경로(결정론적 조정, 외부 감사, 따라서 정의 하에서 D > 0)를 포함하거나 모델을 결정론적 검사가 완전히 포함하는 역할로 제한합니다. 작업 클래스에 대해 진정으로 독립적인 검증 경로가 존재하지 않는 곳에서, 이 프레임워크는 얇은 근거(thin warrant)를 예측하며, 결합설계가 테스트할 수 있는 예측입니다. 비모델 경로가 D로 계산되면, 리터럴 0은 프로덕션 시스템에서 드물어지며, 곱셈 형태의 경험적 내용은 0에서 내부 상호보완성으로 이동하며, 이것이 정확히 왜 요인설계가 아닌 0이 주장이 서거나 무너지는 곳입니다. 테스팅을 위해, 한 가지 운영적 약속이 여기서 고정됩니다: 요인설계는 D를 좁게 조작하며, 모델 경로 다양성으로서입니다. 더 넓은 검증 경로 정의는 구성의 범위이지, 조작된 변수가 아닙니다. 독립성 자체는 다양화되어야 합니다, 왜냐하면 여섯 가지 다른 양이 그 단어 아래에서 여행하기 때문입니다: 맹검 수집(추론 시간의 절차적 독립성, 이 설계가 보장하는 것), 모델 족 다양성, 측정된 잔차 오류 상관(이 논문이 보고하는 φ), 증거-출처 다양성, 도구-경로 다양성, 그리고 제도적 독립성. 이 연구는 첫 번째를 확립하고 세 번째를 측정합니다; 나머지는 설계 변수이지, 이 수집이 인증할 수 있는 속성이 아닙니다. 증거 없는 다양성은 보이지 않는 위원회입니다. 중립성 없는 증거는 판매자의 마케팅입니다. 다양성 없는 중립성은 빈 중개인입니다. 표 4는 8개의 존재/부재 구성의 전체 격자를 다룹니다. 기저의 직관은 각 구성 요소가 다른 것의 근거를 공급한다는 것입니다: 그 내용에 이해관계가 있는 당사자가 유지하는 기록은 자체 증명으로 읽히며, 아무도 기록하지 않은 합의는 루머이고, 단일 음성에 대한 이해관계 독립적 중재인은 중재할 것이 없습니다. 이것은 상호보완성 가설을 동기부여합니다. 함께 세 가지는 소비자가 신뢰하는 것을 변경합니다: "이 답변" 또는 "이 브랜드"가 아니라, "이 과정, 그리고 나는 그것을 확인할 수 있습니다."
표 4. 근거 격자: 8개의 D–E–N 구성과 각각에서 생존하는 것
| D | E | N | 소비자가 확인할 수 있는 것 | 퇴화 형태 |
| 부재 | 부재 | 부재 | 아무것도 없음; 의존은 결과에 대한 신앙 | 맨살의 단일 모델 어시스턴트 |
| 현존 | 부재 | 부재 | 사실 이후 아무것도 없음; 불일치가 보이지 않게 발생 | 보이지 않는 위원회(내부 앙상블) |
| 부재 | 현존 | 부재 | 그것이 보호하는 당사자가 유지하는 기록 | 판매자 로그 / 자체 증명 |
| 부재 | 부재 | 현존 | 이해관계 없는 주장이며 그 뒤에 흔적이 없음 | 빈 중개인 |
| 현존 | 현존 | 부재 | 기록된 불일치, 관심있는 당사자에 의해 큐레이션됨 | 판매자 운영 벤치마크 극장 |
| 현존 | 부재 | 현존 | 아무도 재생할 수 없는 검사의 중립적 중재 | 입소문 패널 |
| 부재 | 현존 | 현존 | 도전받지 않은 단일 음성의 중립적이고 재생 가능한 기록 | 공증된 독백(도전 없는 감사) |
| 현존 | 현존 | 현존 | 이해관계가 없는 당사자가 보유한 독립적 검사, 재생 가능 | 아키텍처 신뢰 |
셀은 이상화된 한계에서 표현됩니다; 배포된 시스템은 내부를 점유합니다. E+N-without-D 행은 제도적으로 익숙한 것입니다 — 결제(clearing), 감사, 평점이 그곳에서 작동합니다 — 그리고 이것이 이 프레임워크의 추가된 독립적 검증 경로에 대한 요구가 정의적 배제가 아닌 경험적 예측인 곳입니다.
세 가지 구성 요소는 신뢰성의 고전적 해부학(Mayer, Davis, & Schoorman, 1995)에 매응합니다: 다양성은 능력 메커니즘입니다(교차 모델 동의는 추론할 역량의 정도를 보정함), 증거는 무결성을 구현합니다(서비스가 수행한 작업에 대한 주장이 주장되는 것이 아니라 검증 가능해짐), 중립성은 구조적으로 자비심을 다룹니다(이해관계가 없는 조율자의 인센티브는 검사 가능하며 믿기만 하는 것이 아님). 각각은 지각 관리라는 것 대신 검증 가능한 아키텍처에 다시 기초를 두고 있으며, 이것은 인간-AI 상호작용 문헌이 자신의 쪽에서 같은 지점에 도달할 때 요구하는 것입니다: 신뢰 판단을 인터페이스가 제조하는 인상이 아닌 검증 가능한 신뢰성 신호와 일치시킵니다(Liao & Sundar, 2022).
인과 관계의 연쇄는 검증을 통해 실행됩니다. 왜냐하면 "신뢰"는 메커니즘이 아닌 결과이기 때문입니다: 검증 → 보정된 신뢰도 → 정당한 신뢰 → 위임 → 거래 가치(그림 10). 서비스는 신뢰로운 느낌이 들게 함으로써가 아니라 중요한 순간에 검증 가능함으로써 위임을 얻습니다. Cheng 등은 그 느낌이 얼마나 값싸게 제조되는지를 보여주었습니다.
그림 10. 검증 플라이휠
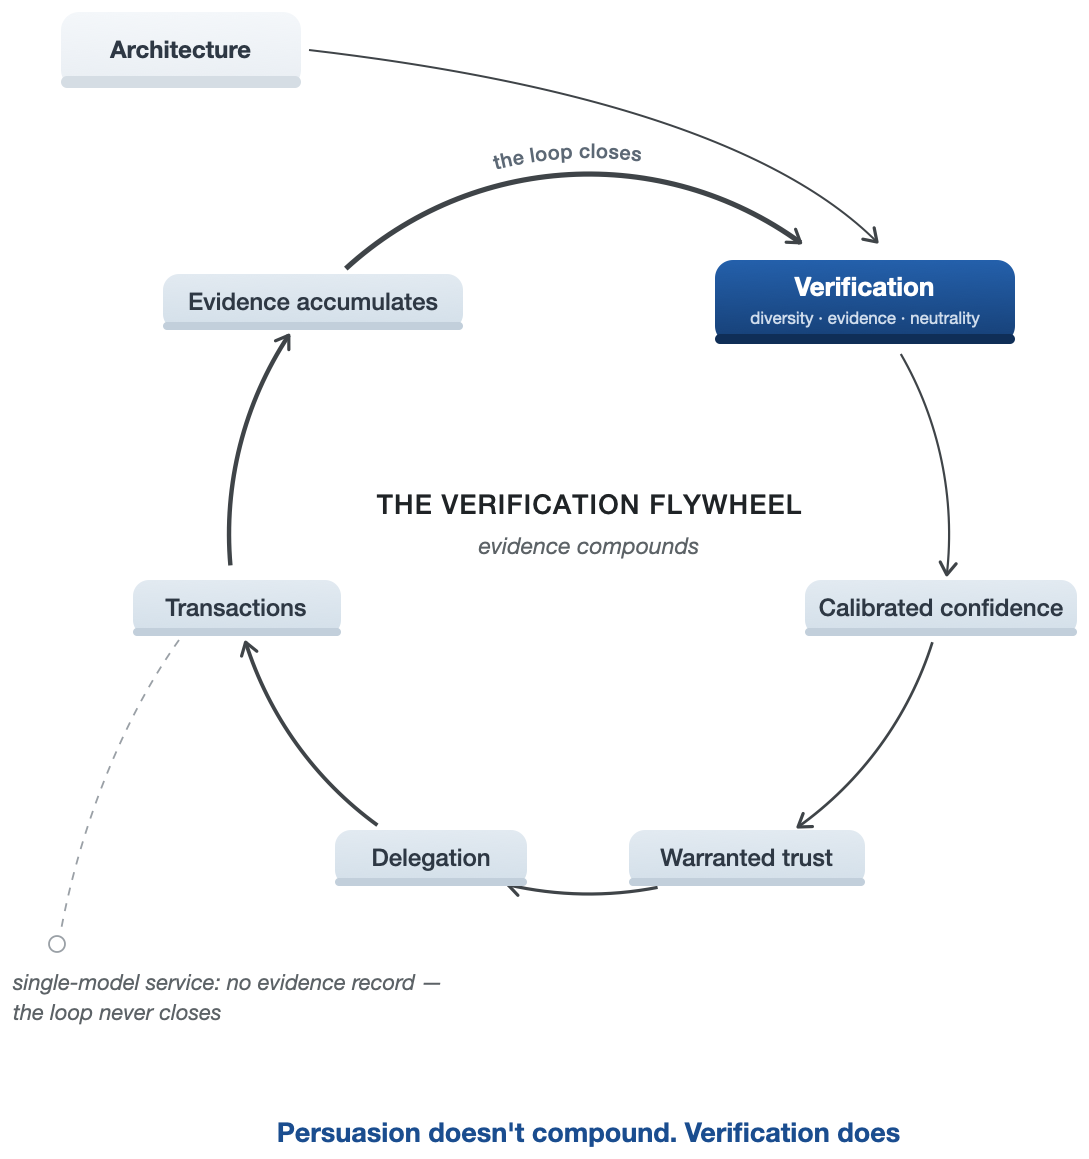
인과 관계의 연쇄, 검증(다양성 · 증거 · 중립성) → 보정된 신뢰도 → 정당한 신뢰 → 위임 → 거래는 종료되지 않습니다: 거래는 증거를 생성하며, 루프는 아키텍처로 다시 닫힙니다. 점선 우회로는 단일 모델 서비스를 나타내며, 여기서 증거 기록이 없고 루프가 절대 닫히지 않습니다. 설득은 복합하지 않습니다. 검증은 복합합니다.
표 5. 단일 모델 서비스 대 아키텍처적 신뢰
| 차원 | 단일 모델 서비스 | 아키텍처적으로 신뢰된 서비스 |
| 신뢰의 대상 | 모델 / 브랜드 | 프로세스 및 그 기록 |
| 신뢰도 | 모델이 주장함 | 교차 모델 동의를 통해 얻음 |
| 확신한 오류 | 내부에서 감지 불가능 | 주요 감지 목표(불일치 신호) |
| 아첨증 | 선호도로 보상받음 | 분리됨: 공감과 정책 검사는 다른 채널에서 |
| 오류 확인 | 오류를 범한 동일한 시스템 | 독립 모델 + 결정론적 게이트 |
| 의사 결정의 증거 | 로그(있는 경우) 공급업체 보유 | 위변조 방지, 재현 가능, 소비자 접근 가능 |
| 품질 판정자 | 공급업체 자체 | 중립 조율 계층 |
| 분쟁 입장 | 소비자 주장 대 플랫폼 | 재현 가능한 기록 |
| 보험 가능성 | 불명확한 위험 | 의사 결정 이력에서 가격 책정 가능 |
| 책임 배분(AB 316 이후) | "AI가 했다"는 배제됨; 배분이 암흑 속에서 분쟁됨 | 재현 가능한 기록에서 계산 가능 |
| 규제 입장(제50조 시대) | 사후 공개 | 운영의 부산물로서의 투명성 |
| 국경 간 데이터 약속 | 계약상 표현 | 감사 가능한 런타임 속성(관할권 인식 라우팅) |
| 비용 구조 | 균일하고 저렴함 | 단계적: 결과가 집중된 곳에서만 비쌈 |
검증 가능성에서 소비자 대응으로. 소비자는 아키텍처가 아닌 렌더링을 봅니다: 어떤 독립 시스템이 상담되었는지, 어디서 불일치했는지, 불일치가 어떻게 해결되었거나 상향식으로 전달되었는지를 보여주는 영수증(그림 8). 세 가지 중개하는 지각이 그럴듯하게 효과를 수행합니다. 증거는 진단입니다: 표면화되고 구체적인 불일치는 일반적인 면책조항보다 이 답변에 대해 정보를 제공합니다(Detjen 외, 2025; Chen 외, 2026). 재현 가능한 기록은 소비자가 사실 이후에 검사, 이의 제기 또는 상향식으로 전달할 수 있으므로 인식된 프로세스 제어를 제공합니다. 절차적 보증은 맹목적인 수집, 독립적인 검사, 그리고 이해관계가 없는 중재자가 제자리에 있었다는 지식입니다(McKnight 외, 2002). 자연스러운 종속 변수는 의존성 보정, 위임 의지, 그리고 실패 후 유지입니다. 자연스러운 조절자는 이해관계와 가역성, 작업 객관성(Castelo 외, 2019), 그리고 소비자 전문 지식입니다. 왜냐하면 개인적으로 답변을 검사할 수 있는 소비자가 가장 적은 것이 구조적으로 이를 검사하는 아키텍처에서 가장 얻을 수 있기 때문입니다. 아래 명제는 이 경로를 추적합니다.
프레임워크는 또한 소비자 연구가 검증할 수 있는 명제, 발견이 아닌 가설을 산출합니다. 이를 작동화하는 것은 한 가지 구별에 달려 있습니다: 객관적 중립성(조율자는 실제로 어떤 공급업체, 판매자 또는 결과에 대한 미공개 경제적 의존으로부터 자유로움), 검증 가능한 중립성(기록이 그 독립성을 검증 가능하게 만듦), 그리고 인식된 중립성(소비자가 이를 믿음)은 세 가지 변수이며, 실험은 검증 가능한 신호를 조작하면서 지각을 측정합니다:
P1. 결과적으로 중요한 질문에 대한 모델 간 불일치를 드러내면 소비자의 신뢰 보정이 개선됩니다(시스템이 일치할 때 더 신뢰하고, 불일치할 때 덜 신뢰함). 이는 단일 확신 있는 답변에 비해 인지된 위험을 매개 구성요소로 하여 개선됩니다(Featherman & Pavlou, 2003). 양방향 실패가 모두 존재합니다: 결합 제시는 과잉 신뢰를 줄이지만 과소 신뢰를 증가시킬 수 있으며(Lu, Wang, & Yin, 2024), 신뢰도 표시는 정확도보다 더 쉽게 신뢰를 보정하고(Zhang, Liao, & Bellamy, 2020), 설명은 검토를 높이지 않으면서 신뢰를 높일 수 있으며(Bansal et al., 2021), 인지적 강제 기능은 만족도 비용으로 과잉 신뢰를 줄이고(Buçinca, Malaya, & Gajos, 2021), 106개 실험의 메타분석은 인간-AI 결합이 평균적으로 인간 또는 AI 단독보다 더 나쁘게 수행됨을 발견했습니다(Vaccaro, Almaatouq, & Malone, 2024). P1은 단조 증가가 아닌 보정을 검사합니다: 표면화된 불일치는 최고 성능의 조합 설계 중 소수에 속하는 것이어야 합니다. 명제는 분할됩니다: 주효과는 확인적 주장이고, 조절 변수는 탐색적이며, 사후에 열거되지 않은 증거의 진단성에서 도출됩니다. 보정 이득은 이해관계와 돌이킬 수 없음과 과제 객관성에 따라 증가해야 합니다(객관적 질문에 대한 불일치는 오류 신호로, 주관적 질문에 대해서는 취향으로 읽힙니다; Castelo et al., 2019). 소비자 전문성은 반대 부호를 생성하도록 예측됩니다: 낮은 전문성 소비자의 경우, 표면화된 불일치는 위임 의사를 감소시켜야 하고, 높은 전문성 소비자의 경우 신뢰 보정을 개선해야 합니다; 교차점이 관찰되거나 그렇지 않으며, 이는 전문성을 탈출구가 아닌 검사로 만듭니다. 본 논문의 자체 실험은 하나의 설계 요구사항을 부과합니다. 불일치는 과제 난이도와 공변합니다(패널 합의는 쉬운 항목에 집중), 따라서 P1 설계는 난이도를 조작하거나 통계적으로 통제하거나, 보정 효과가 항목 용이성과 혼동됩니다. 진단성 설명은 또한 일반적인 투명성 이론이 하지 않는 경계 예측을 생성합니다: 불일치 공개는 소비자의 자신의 선험이 가장 약한 국경 간 또는 생소한 판매자 구매에서 가장 중요해야 합니다. 왜냐하면 그 외부에는 외부 진단 증거가 내부 경쟁자가 없기 때문입니다.
P2. 재생 가능한 의사 결정 기록에 대한 접근은 브랜드 신뢰를 초과하여 결과적으로 중요한 과제를 AI 에이전트에게 위임하려는 의사를 증가시키며, 위임된 과제의 이해관계와 돌이킬 수 없음에 따라 효과가 증가합니다. 또한 위임된 대리성 수준 자체에 따라 증가하며, 이는 신뢰-마이그레이션 가설의 비교정적 내용입니다: 실제 모델 성능을 일정하게 유지하면, 적절한 위임에 대한 검증 가능한 아키텍처 속성의 한계 효과는 소비자가 더 많은 검토와 실행 제어를 포기함에 따라 증가합니다(조언자 → 보조자 → 감독 에이전트 → 자율 에이전트). 위임 수준을 아키텍처 가시성과 교차시키는 설계는 가설을 직접 검사합니다. 가장 가까운 소비자 연구 증거는 이 종속 변수에 있습니다: AI에 구매를 위임하면 인지된 자율성을 제한할 때 도입을 줄이고(Ahmad Husairi & Rossi, 2024), 높은 자율성 보조자의 수용은 직접 연구된 결과입니다(Frank et al., 2026). P2는 이러한 확립된 선행 요소를 초과하여 기록의 효과를 예측합니다.
P3. 조율 계층의 인지된 중립성은 독립적으로 위임 의사를 예측하며, 이는 서비스 평가의 절차적 공정성 효과와 일치합니다(Tax, Brown, & Chandrashekaran, 1998). 조작된 변수는 검증 가능한 중립성 신호이고, 측정된 변수는 그것이 생성하는 인식입니다. 제 지식으로는 조율자 중립성이 행동 실험에서 운영화된 적이 없으며, 인증 봉인이 가장 가까운 검사된 유사체입니다(Cetinkaya & Krämer, 2024). 따라서 P3은 새로운 실험 변수를 도입합니다. 방향적으로, 소비자가 실질을 확인할 자신의 능력이 감소함에 따라 중립성 효과가 강화되어야 합니다. 결과 품질을 판단하기 어려울 때, 과정 신호가 평가 가중치를 전달하기 때문입니다. 조작은 검증 가능한 중립성을 중립성 주장과 분리해야 합니다: 한 조건은 이해관계가 없는 증명이 실제로 열리고 확인될 수 있는 영수증을 전달하고, 대조 조건은 동일한 인터페이스이지만 라벨만 포함하며, 양쪽에서 인지된 중립성을 확인합니다. 그 대조 없이 P3은 일반적인 과정 공정성으로 축소되고 검증에 대해 아무것도 말하지 않습니다.
P4. 에이전트 오류 후, 검사 가능한 기록을 생성하는 서비스의 소비자는 불투명한 서비스의 소비자보다 더 작은 신뢰 붕괴와 더 높은 유지를 보여줍니다: 한 번의 실수 역학은 증거로 조절됩니다. 이는 절차적으로 공정하고 증거 기반 불만 처리가 실패 후 신뢰를 회복하는 서비스 복구 연구가 식별하는 메커니즘입니다(Tax et al., 1998). 신뢰 복구 연구는 신뢰를 회복하는 것이 위반의 성격과 제시된 설명에 달려 있다는 것을 추가하며(Kim, Ferrin, Cooper, & Dirks, 2004), 요구사항 인간-기계 연구는 이제 자율 시스템을 위한 설계 문제로 취급합니다(de Visser, Pak, & Shaw, 2018), 그리고 완충은 실패의 심각성과 돌이킬 수 없음에 따라 증가해야 합니다. P4는 예측합니다: 기록 → 더 작은 신뢰 붕괴와 더 높은 유지, 실패 심각성에 의해 조절됩니다. 기록이 과정 자체가 따르지 않았음을 보여주는 경우는 조작 확인에 의해 처리되고 테스트에서 제외되며, 명제는 따른 과정에도 불구하고 발생하는 실패에 관한 것이기 때문입니다. 내구성 비교는 교환 비용과 잠금을 통제해야 하며, 유지를 혼동하고, 동반 설계는 따른 과정 기록이 서비스에서 환경으로 책임 귀속을 이동시키는지 검사합니다. 명제는 반전 절이 없으므로, 구성상 어떤 결과 패턴도 거짓이 아닙니다.
경험적 앵커: 테스트된 구성요소로서의 신뢰도 계층. 서비스가 신뢰도 신호가 무언가를 의미한다고 주장하면, 그 주장은 재판에 회부될 수 있습니다. 본 논문의 사례 연구 뒤의 배포의 신뢰도 계층은 두 개의 독립적인 모델 제품군에 대해 사전 등록된, 위약 대조, 6-팔 평가를 거쳤습니다. 시스템의 자신의 약점의 측정된 프로필은 오류 예측을 개선했으며, 위약보다 약 +0.07의 AUROC 이득을 가지며, 두 제품군 모두에서 겹치지 않는 신뢰 구간을 가집니다. 거짓 자체 프로필은 오류 예측을 동전 던지기로 붕괴시켰으며, 일반적인 "자신의 한계를 인식하십시오" 지시는 아무것도 하지 않았습니다.
두 가지 초기 버전이 실패했는데, 하나는 저자들이 교란 변수 때문에 직접 위조했고, 하나는 음성 결과였으며, 사전 등록된 설계가 확인되기 전의 일입니다. 더 엄격한 재검증은 축소된 범위에서 결정적이지 않았고, 사전 등록된 4단계 사다리가 경계 가족에서 확인 종료점을 통과하지 못했으며, 효과의 방향은 4개 중 3개 단계에서만 탐색적으로 생존했습니다. 따라서 주장은 가족별이며 제한됩니다. 측정된 자기 지식이 확인된 곳에서 오류 예측을 개선했으며, 모든 모델 클래스의 확립된 특성이 아닙니다. 약점 프로필은 프로덕션에서도 실행되며, 여기서 실시간 모델 라우팅을 조정하고 제한되며 실패-개방됩니다. 거짓 프로필 붕괴는 보안 발견으로도 작용합니다. 위조된 자기 모델은 공격 벡터이며, 자기 지식이 모델 자체 보고가 아닌 아키텍처 보관으로 필요한 또 다른 이유입니다. 설계 논리는 기술보다 오래된 소비자 연구 계보를 가지고 있습니다. 사전 약속, 내부 의지가 지속될 것으로 예상되지 않기 때문에 외부 구조를 통해 미래 행동을 구속하는 것은 정확히 소비자들이 자신의 악습을 억제하는 방식입니다(Wertenbroch, 1998). 아키텍처 신뢰는 기계로 같은 수행을 확장합니다.
전체 호(프로토콜, 사전 등록, 원본 데이터, 위조된 파일럿, 음성 반복, 확인하지 않는 확장)는 논문의 OSF 자료와 함께 https://osf.io/jtvu9/에서 공개적으로 이용 가능한 독립 실행형 아카이브로 보존됩니다(`self-calibration-archive.zip` 파일). 보정된 신뢰도는 측정 가능한 내용을 가진 아키텍처 구성 요소이며 실패할 수 있습니다. 실패는 성공과 함께 보관됩니다. 신뢰도 주장이 실험적으로 도전받은 적이 없는 신뢰 계층은 정확히 대체하려던 맹목적 신뢰를 요구하기 때문입니다. 30명 저자 입장 논문은 이 노동 분담에 공식 성명을 제공합니다. 행위자 오케스트레이션은 베이즈 일관성이어야 합니다(Papamarkou et al., 2026). 보정된 믿음은 모델이 아닌 제어 계층에 속합니다.
메커니즘 테스팅: 사전 등록된 실험. 위의 주장은 테스트 가능하며, 이 섹션은 테스트를 보고합니다. 이 섹션의 모든 실험 결과는 두 파동 모두에서 프레임워크의 기술적 선행 요건을 말하며, 독립적 동의가 모델의 자체 보고가 아닌 사실적 질문에서 정확성 신호를 전달하는지 여부입니다. 이 실험들은 소비자 신뢰, 위임 또는 상업 행동을 보여주지 않으며, 이는 P1–P5 및 6절의 행동 연구의 영역으로 남습니다. 프로토콜은 확인 데이터가 존재하기 전에 공개적으로 동결되었습니다(OSF: https://osf.io/4y9dv, 2026년 7월 23일 등록; 가설 H1–H6, 벤치마크 부분표본 시드 및 SHA-256 해시로 고정, 가설에 불리한 결과는 미리 선언됨). 설계는 의도적으로 단순합니다. 16개 모델, 9개 경계 공급업체(Anthropic, OpenAI, Google, xAI, DeepSeek, Alibaba, Moonshot, Zhipu, Mistral) 및 7개 로컬 오픈 가중치 모델이 각각 동일한 1,500개의 SimpleQA 질문에 한 번씩 답했으며, 검색이나 도구 없이 맹목적으로 답했습니다. 이것은 상관된 매개변수 오류에 대한 노출을 최대화하는 정권이며, 신호에 대한 의도적으로 어려운 경우이며, 한계에서 언급한 생태학적 비용입니다. 답변은 온도 0에서 주어졌으며, 0–100 신뢰도를 나타냅니다. 동일한 응답 내에서 단어로 표현된 불확실성, Lin, Hilton, Evans(2022)가 모델이 보정을 배울 수 있음을 보여준 형식입니다. 패널은 24,000개 명목 답변 슬롯의 단일 수집의 분석적 조합이며, 22,598개가 전달되었고, 한 로컬 모델(deepseek-r1:8b)이 사전 약정된 중지 규칙 하에서 98개 항목에서 중지했습니다. 6개의 등록된 가설은 다음과 같이 결과에 매핑됩니다. H1, 교차 모델 발산이 자신감 있는 오류의 대부분을 표시한다는 것은 지원됩니다. 동의가 등록된 파동에서 정확성을 1.9–3.2배 높입니다(표 6). 기함 파동에서 동결된 게이트는 자신감 있는 오류의 82.1%를 제거합니다(표 10). H2, 패널 신호가 응답 모델의 자체 신뢰도를 이기는 것은 CN-경계 및 교차-집단 패널에서 유지됩니다(ΔAUROC +0.287 및 +0.063). US-경계 패널에서는 반전됩니다. H3, 자신감 있는 오류의 중요하지 않은 공유가 한 잘못된 답변에 대한 만장일치로 생존한다는 것은 지원됩니다. 개방형 질문의 0.5–2.2% 및 다중 선택 부문에서 4.0–7.9%. H4(a), 블록 내 오류 상관이 교차 블록을 초과한다는 것은 지원되지 않습니다(φ 차이 +0.011, 95% CI −0.005 ~ +0.028). H4(b), 교차 블록 패널이 더 많이 포착한다는 것도 지원되지 않으며, 교차 블록 리드가 더 작은 것입니다. H5, $0 로컬 패널이 경계 자신감 있는 오류의 대부분을 표시한다는 것은 지원되지 않습니다. 로컬 계층의 동의 신호는 우연 수준에 있습니다. H6, 계통 거리 사다리는 여기서 사다리로 테스트되지 않습니다. 블록 수준 단계는 H4(a) 무효입니다.
사실적 검증은 행위자 상거래에 관련된 적절한 프록시입니다. 위임된 구매는 실행 순간에 사실적 부주장으로 분해되기 때문입니다. 항목의 현재 가격 및 가용성, 반품 정책의 조건, 제품의 사양이 소비자의 명시된 요구 사항과 일치하는지 여부, 판매자의 신원 및 평점입니다. 이들 각각은 SimpleQA 항목과 동일한 종류의 검증 가능한 근거를 가집니다. 불동의 게이트는 그 사실적 기질에서 작동하며, 선호도 가중치(어떤 거래-오프가 중요하며 얼마나)는 소비자와 함께 남으며, 소비자는 사실이 확인되는 요구 사항을 작성했습니다. 그 노동 분담은 또한 6절 설계가 참가자의 선호도가 아닌 검증의 표시를 조작하는 이유입니다. 아키텍처의 주장은 위임된 결정의 사실적 계층과 관련이 있습니다. 판단이 전혀 사실적 기질을 가지지 않는 곳에서, 검증할 근거가 없는 진정한 주관적 선택에서, 선행 요건은 더 이상 전달되지 않으며, 한계가 그 경계를 미해결 질문으로 명시합니다.
벤치마크 선택이 측정되었습니다. 2021년식 TruthfulQA(사전학습 말뭉치에 포함됨)에서 동일 업체들은 SimpleQA(예: 89% vs 28%)보다 47~61 백분포인트 높은 점수를 기록했으며, 이는 벤치마크 나이 및 노출 효과와 일치하는 격차입니다. 다만 이 설계는 오염으로 인한 것인지 벤치마크 난이도와 구성의 차이인지 구분할 수 없습니다. 따라서 더 오래된 벤치마크에 기반한 주요 수치는 없습니다. 채점은 객관적 문자열 매칭이며, 미결정 사례는 지역 오픈웨이트 모델(Qwen3-8B, 로컬 실행; 복제 패키지의 동등성 전용 프롬프트; 패널 멤버의 가족에 의해서는 절대 아님; SimpleQA가 채점자의 학습 말뭉치에 포함되어 있는지는 불명; 채점자는 진실이 아닌 두 제공된 문자열 간의 동등성을 판정하므로 노출을 제한함)과 50개 항목 인간 표본 검사(98% 일치율)로만 동등성에 대해 판정되며, 이는 규모의 제한입니다. 현재는 계층화된 300개 항목 교차 계열 감사(감사자로서의 다른 모델 계열, 시드 고정 샘플)로 확대되었으며, 채점자가 해결한 사례의 96% 일치율(288/300)을 보였고, 12개의 모든 불일치는 관대한 거짓 양성(9개는 명확함, 3개는 경계선상)으로, 모든 채점된 답변의 약 3%(채점자 해결 점유율의 4%)를 건드리는 단방향 편향입니다. 평결의 3분의 2(66.5%)는 정확한 문자열 매칭보다는 로컬 모델 채점자에서 나왔으며, 주요 수치는 채점자 오류에 견뢰합니다. 무작위로 모델 채점 평결의 10%를 뒤집으면 인증 비율이 최대 ±0.5배 이동하지만 방향은 절대 바뀌지 않습니다.
두 가지 설계 선택은 예산상 이유보다는 의도적입니다. 업체의 중간 계층이 사용된 것은 먼저 생태학적 타당성 때문입니다. 이제 소비자를 대신해 거래하는 에이전트는 압도적으로 이러한 비용 최적화 계층에서 실행되며, 이는 공개 가격표(2026년 중반; 그림 11)에서 확인할 수 있습니다. 일반적인 서비스 교환은 예산 계층에서 몇 센트 정도의 일부에서 약 1센트, 플래그십 가중치에서는 5~10센트, 수백만 세션에 응답하는 서비스는 기본 경로를 플래그십 요금으로 책정하지 않습니다. 명단은 시장을 반영합니다. 9개 업체 패널은 함께 엔터프라이즈 LLM API 지출의 88%를 차지하는 3개 공급자 전부를 포함하며, 표 6의 미국 최전선 패널이 정확히 그 3개입니다. 이는 엔터프라이즈 증거이고 소비자는 그것에 없다는 반박은 공급망을 거꾸로 봅니다. 소비자는 더 이상 모델을 선택하지 않습니다. 은행, 소매업체, 항공사를 선택하고, 서비스의 라우팅 정책이 모델을 선택합니다. 소비자가 실제로 서비스받는 통화인 토큰과 달러 기준으로, 이 그림은 선택을 확인합니다(그림 12). OpenRouter–a16z 100조 토큰 라우팅 트래픽 연구에서 오픈웨이트 모델은 대략 모든 사용량의 3분의 1에 도달했고(Aubakirova et al., 2026), 3개 최대 소비자 AI 제품의 기본 계층은 모두 플래그십 계층 아래에 있으며, 소비자 AI 사용자의 약 3%만 프리미엄 서비스를 지불합니다(Menlo Ventures, 2025c). 따라서 한계 소비자는 거의 0에 가까운 한계 비용으로 서비스받아야 합니다. API 시장 아래에는 지출 기반 조사에 보이지 않는 온디바이스 및 자체 호스팅 오픈웨이트의 바닥이 있으며, 실험의 로컬 계층은 7개 오픈웨이트 모델로 의도적으로 표본 추출합니다. 시장을 셀 수 있는 모든 통화에서, 이 연구가 표본 추출한 계층이 소비자를 서비스하는 계층입니다. (첫 당사자 장애 후, 수집의 일부는 애그리게이터를 통해 완료되었으며, 실제 서빙 인프라는 실행 매니페스트의 호출별로 기록되었습니다.)
그림 11. 소비자가 결제에서 만나는 계층
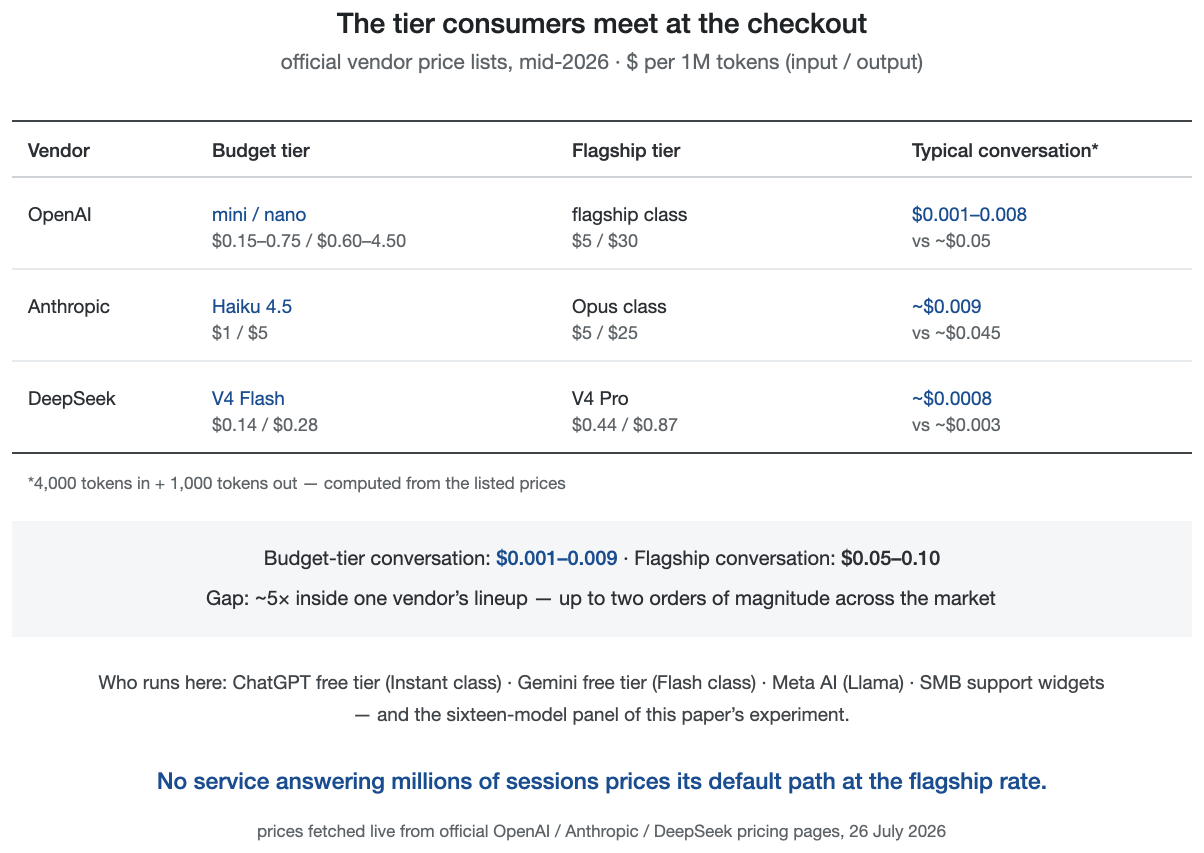
공식 업체 가격표, 2026년 중반.
그림 12. 모델 시장의 두 통화
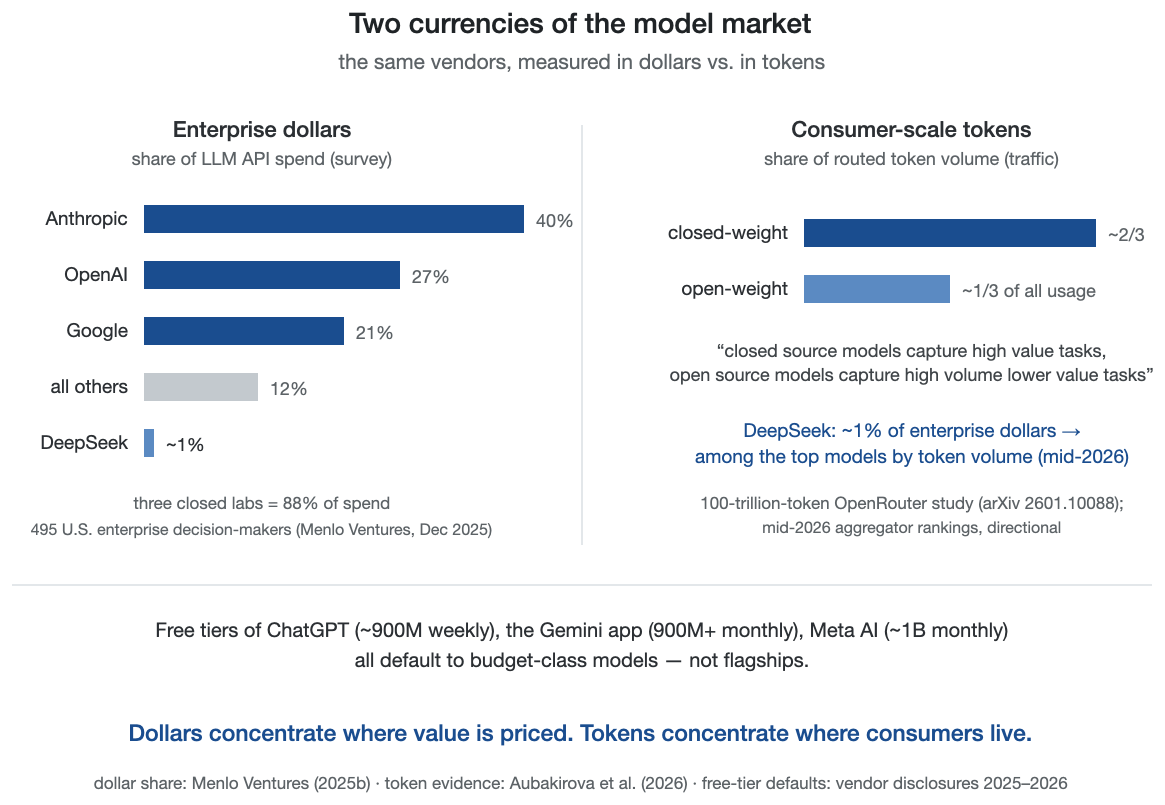
엔터프라이즈 달러 대 소비자 규모 토큰.
중간 계층도 논문의 주장에 적합했습니다. 이는 플래그십 기능이 아닌 아키텍처에 관한 것입니다. 프리미엄 가중치에서만 나타나는 효과는 모델 결과일 것입니다. 파이프라인은 API 지출 $15 미만의 상용 인프라에서 복제합니다. 검증이 모든 중요한 답변에서 실행하기에 충분히 저렴해야 한다고 주장하는 논문의 경우, 논문 자체를 검증하는 비용이 증거의 일부입니다. 파이프라인은 저자의 연구 시스템에 아무것도 요구하지 않는 독립형 복제 패키지(러너, 채점자, 분석 스크립트, 원시 채점 데이터 및 실행 매니페스트)입니다. 수집은 24,000개의 답변으로 총합하며, 벤치마크 오염 및 적합성 팔을 포함하여 대략 30,000개입니다. 가용성에 대해: 공개 사전 등록(osf.io/4y9dv)은 시드 고정 1,500개 항목 부분 표본을 아카이브합니다. 전체 패키지는 https://osf.io/jtvu9/에서 공개적으로 사용 가능하며, 등록의 소스 프로젝트의 공개 구성 요소(폴더 `replication-package-v2`)입니다.
3가지 결과가 섹션을 주도합니다. 첫째, 원시 자료는 풍부합니다: 중앙값 명시된 신뢰도는 9개 중 7개 최전선 업체에서 85~95로 실행되었고, 2개 예외(중앙값 42 및 60)는 정확히 신뢰도가 판별되는 업체인 반면, 실제 정확도는 10%에서 66%로 범위했으며, 최전선 업체당 1,500개 질문에서 289~1,212개의 자신감 많은 오류(신뢰도 ≥ 75에서 잘못됨)를 생성했습니다. 정확성 신호로, 모델 자신의 신뢰도는 업체에 따라 AUROC 0.53~0.79를 기록했고, 소비자는 외부에서 어느 업체를 받았는지 알 방법이 없습니다. 그 업체 분산은 소비자가 실제로 서비스받는 계층에서 대규모 모델이 제어된 형식에서 자체 평가에서 종종 잘 보정된다는 최전선 실험실 발견(Kadavath et al., 2022)을 적격 짓습니다. 일부 배포된 업체는 그 자체 지식을 제공하고, 다른 업체는 자신감 있는 노이즈를 제공하며, 표면상 아무것도 그들을 구분하지 않습니다.
둘째, 헤드라인: 검증은 알람이 아닌 인증으로 작동합니다. 확률론적 의미의 인증, 패널에 따라 대략 49–77%의 사후 확률이지 보장이 아닙니다. 이렇게 어려운 질문에서 순진한 신호 "어떤 패널리스트가 동의하지 않음"은 포화됩니다: 자신감 있는 오류의 85–94%에서 작동하지만 자신감 있는 올바른 답의 91–95%에서도 작동합니다(등록에서 이러한 재구성을 예상하여 사전 지정된 AUROC 종료점으로 이동). 정보 제공 방향은 반대입니다: 올바른 답은 독립적으로 재현되고, 잘못된 답은 분산됩니다. 적어도 한 명의 독립적인 패널리스트가 재현한 답은 블록 내 패널에서는 72–77%, 블록 간 패널에서는 49%의 정확도를 보였으며, 재현 없이는 18–37%입니다. 독립적 동의가 있는 답은 대략 2~3배 정도 올바를 가능성이 높았습니다(표 6의 세 패널 전반에 걸쳐 1.9–3.2×). (여기 및 전체적으로 "독립적"은 맹목적으로 별도로 생성됨을 의미하며, 잔차 오류 상관관계는 가정이 아닌 측정되고, 정확성은 항상 벤치마크의 금표준 레이블에 대해 점수화되며 다른 모델의 의견으로는 절대 점수화되지 않습니다.) 추정량은 인과관계가 아닌 연관성입니다: 재현은 답을 올바를 가능성이 더 높게 표시하며, 그것이 표시하는 것의 일부는 질문이 쉬웠다는 것이며, 선택 효과는 아래에서 정량화됩니다. 정확성 신호로서, 패널 동의는 자체 구성원의 신뢰도가 가장 약한 신호를 전달한 패널에서 AUROC 0.832에 도달했습니다(공급업체별 0.53–0.62; 풀링된 0.545). 확실한 주장은 특징적이기보다는 분포적입니다: 모든 84개의 3공급업체 패널 전반에 걸쳐 동의 AUROC는 중앙값 0.79이며 풀링된 자기 보고를 89%에서 초과합니다. 동의는 블록 간 패널에서 0.722에 도달했으며 풀링된 자신감은 0.659입니다(공급업체 간에 표준화되지 않은 언어 척도를 풀링하면 자기 보고가 왜곡됩니다. 왜냐하면 공급업체가 0–100 척도를 다르게 사용하고 아티팩트의 방향이 패널에 따라 다르기 때문이며, 이것이 공급업체별 값이 나란히 인쇄되는 이유입니다). 그 리드의 블록 간 인스턴스는 코딩 종속적입니다(대체 사전 동결 동의 코딩은 블록 간 패널의 동의 신호를 0.544–0.722에 배치하며, 관대한 미해결-동의 변형은 해당 패널의 풀링된 자신감 0.659 아래로 떨어지고, CN 패널의 신호는 같은 코딩에 걸쳐 0.719–0.894 범위이며 항상 0.545 이상입니다), 코딩 강건 패널-초과-자기 결과는 블록 내 CN 경우입니다. 자기 보고가 패널 신호를 명확히 이긴 유일한 패널(0.842 대 0.697)은 연구의 최고 판별 공급업체(Anthropic의 중간 계층, 자신감 AUROC 전체 1,500항목 수집에서 0.788)를 포함한 것이며, 잘 순위가 매겨진 공급업체의 자신 신호 자체가 자신의 패널의 동의 신호를 초과합니다. 표 7은 각 패널의 항목 모집단 내에서 계산된 패널별 값을 인쇄합니다. 쌍을 이룬 클러스터 부트스트랩(질문이 복원력으로 재샘플링되고, 질문당 모든 3개의 (항목, 기본) 단위가 함께 이동; B = 2,000)은 표 6/7 대조에 대한 신뢰 구간을 배치합니다. CN 프론티어 패널에서 패널 동의는 풀링된 자신감을 ΔAUROC = +0.287만큼 이깁니다(95% CI [+0.265; +0.308], p < .001). 블록 간 패널에서 리드는 작지만 신뢰할 수 있으며, +0.063([+0.037; +0.087], p < .001)입니다. US 프론티어 패널에서 방향이 역전되고 역전은 그 자체로 통계적으로 명확합니다: 자신감 0.842 대 패널 동의 0.697. 패널 구성은 따라서 신호 값의 1차 조절자이며, 배포 규칙은 다음과 같습니다: 동의보다 그것을 신뢰하기 전에 패널 구성원의 자신의 보정을 측정하십시오, ΔAUROC = −0.145([−0.170; −0.120], p < .001). 세 대조 모두 유의미하며, 패널 간의 이질성은 잡음이 아닌 발견입니다. US 경우는 따라서 무 영역이 아닌 확인된 역전으로 보고되며, 구성을 경계합니다: 시장의 판별 끝에서 그려진 패널에서 자신감은 동의보다 순위 신호로 더 잘 수행되므로, 다양성 구성 요소의 판별 값은 보편적으로 유지되기보다는 패널 구성에 따라 달라집니다. 아키텍처는 노출된 모델 신뢰도가 약하게 판별하는 경우 외부 정확성 신호를 제공할 수 있으며, 주장이 제시되는 경우 보정 주장을 감시합니다. 한 가지 경계가 남아있습니다: 완벽하게 보정된 모델도 자신의 역사를 공증할 수 없거나 자신의 이익 충돌을 중재할 수 없으므로, 공급업체 판별이 개선됨에 따라 다양성의 역할은 정확성 발견에서 보정 감시로 이동하며, 근거와 중립성은 보정이 할 수 없는 작업을 수행합니다.
아키텍처 검증은 공급업체가 사용 가능한 신뢰도 신호를 제공하지 못한 경우 외부 정확성 신호를 제공하며, 어느 공급업체가 하나를 제공했는지 파악하려면 아키텍처가 필요합니다. 대체 주장은 정확히 범위가 지정되며, 보정 메트릭이 아닌 AUROC에 기반합니다. 7월 웨이브의 공급업체는 동시에 판별적이고 잘 보정되지 않습니다; xAI가 가장 가깝습니다(표 7a), 그리고 플래그십 웨이브는 분리의 보정 쪽을 재현하므로, 최고 순위 신뢰도를 받기로 우연히 발생하는 소비자도 외부 참고 없이 그 수준을 확률로 현금화할 수 없습니다. 이것이 아키텍처 계층이 제공하는 것입니다. 공급업체가 결국 모든 곳에서 좋은 보정을 제공한다면, 근거와 중립성은 건드려집니다. 논거는 모델이 개선되는 세계에서도 생존합니다.
셋째, 실패 모드는 형태를 가집니다: 모든 패널리스트가 자신감 있게 같은 잘못된 답에 수렴하는 인증된 합의 오류는 개방형 질문의 0.5–2.2%에서 발생했지만, 항목을 로컬 계층의 객관식 형식으로 재배치한 동반 팔에서 4.0–7.9%에서 발생했습니다(항목 구성 및 출력은 재현 패키지에 있음). 합의는 주로 답변 공간이 제한되는 경우 오류를 인증하며, 에이전트에 옵션 메뉴를 제공하는 모든 인터페이스에 대한 설계 경고입니다.
널값(null)은 양수(positive)만큼 교시적이며, 사전등록된 결과로 발행합니다. 지정학적 블록(동일 블록 패널이 훈련 코퍼스와 증류 계통을 공유할 가능성 포함)은 이 벤치마크에서 오류 상관관계를 예측하지 못합니다(블록 내부 대 블록 간 φ 차이 +0.011, 프론티어 계층에서 95% CI −0.005 to +0.028; 로컬 계층에서는 약간 역전). 능력이 상관관계를 주도하며, 플래그가 아니며, Kim et al. (2025)을 반향합니다. 계통은 포착률을 예측하지 못합니다: 자신의 프론티어 형제를 검증하는 로컬 모델은 타인처럼 수행하며, 추론-증류 모델은 자신의 기본 가중치와 가장 오류 상관관계가 낮음을 보였습니다(φ = 0.135). 둘 다 입증된 동등성보다는 경계 널값입니다. 블록 구간은 +0.028보다 큰 φ 차이를 제외하며, 그 경계가 아닌 거부 실패가 추론적 작업을 수행합니다. 복제 데이터가 지지하는 자연스러운 연속 확장은 패널 정체성이 아닌 측정된 패널 다양성(놀라움 점수 φ) 함수로 인증 상승을 추정하는 것입니다. 그것은 분류기-앙상블 문헌이 자신의 다양성 통계에 대해 실행한 프로그램을 모델 패널에 대해 다시 실행할 것이며, 단일 측정이 앙상블 이득을 깔끔하게 예측하지 못함을 발견했습니다(Kuncheva & Whitaker, 2003).
그리고 저가 로컬 모델은 공개형 질문에 대한 프론티어 답변을 인증할 수 없었습니다(합의 여부와 관계없이 46% 정밀도): 검증자는 그 독립성이 가치 있기 전에 작업 범주에 능숙해야 합니다. 경계 조건은 다음과 같습니다: 합의는 답 공간이 제약되는 경우의 오류를 인증하고, 독립성은 가정이 아니라 측정되어야 하며, 검증자 능력이 인증 가치를 제어합니다. 실제로 다양성은 브랜드, 블록, 또는 계통에서 가정되지 않고 질문별로 측정되는 특성입니다. 표 6은 패널 지표를 요약합니다. 그림 13은 인증 상승과 신호 비교를 나란히 보여줍니다.
그림 13. 정확도 착각과 그 아키텍처적 해결책
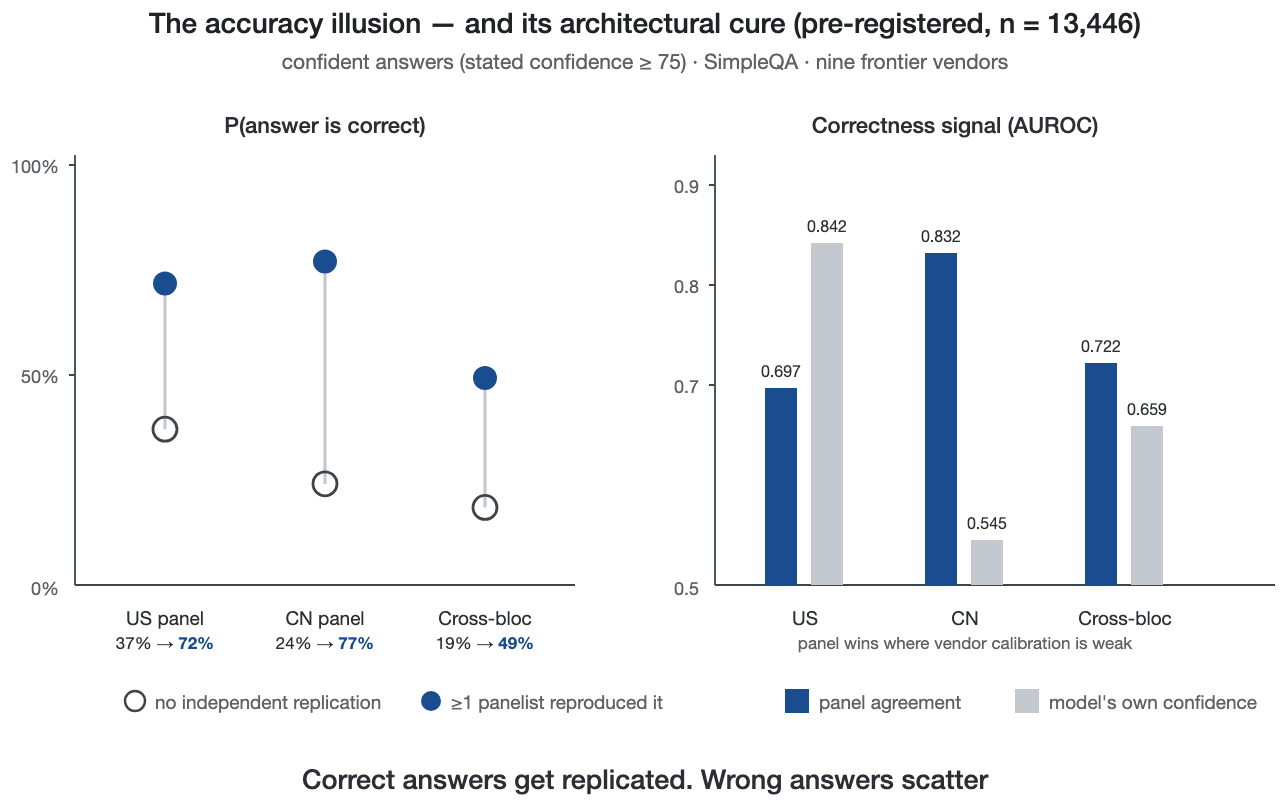
독립적 복제에 의한 인증(사전등록; n = 13,446개 채점된 답변 — 9개 프론티어 공급업체, 각각 동일한 1,500개 SimpleQA 질문에 한 번씩 답변, 54개 실패하거나 채점 불가능한 호출 제외).
동시 작업은 주의를 강화합니다: 대규모 감시는 추론 벤치마크에서 틀린 답변과 함께 발생하는 높은 자체 일관성을 발견했으며, 독립성 및 블라인드 수집 없이 합의만으로는 약하고 체제 의존적인 신호입니다(Ding, 2026). 따라서 저는 독립적이고 블라인드 복제를 인증의 단위로 취급합니다.
표 6. 자신감 있는 오류 차단 및 패널별 인증(SimpleQA, 확인; conf ≥ 75)
| 패널 | 자신감 있는 오류(n) | 오류에 대한 플래그율 [95% CI] | 정답에 대한 거짓 경보 | P(정답 | ≥1 동의) | P(정답 | 없음) | AUROC: 합의 대 자체 신뢰도 |
| US-프론티어(Anthropic·OpenAI·Google) | 1,630 | 94.3% [93.1–95.3] | 91.0% | 71.8% | 37.1% | 0.697 vs 0.842 |
| CN-프론티어(DeepSeek·Alibaba·Moonshot) | 2,128 | 85.5% [83.9–86.9] | 94.8% | 77.0% | 24.1% | 0.832 vs 0.545 |
| 블록 간(Anthropic·DeepSeek·Mistral) | 2,432 | 89.4% [88.1–90.6] | 93.4% | 49.3% | 18.5% | 0.722 vs 0.659 |
플래그 = ≥1명의 패널리스트 독립적 답변이 원본과 동등하지 않음(거부 및 겹침 없는 답변은 미동의로 계산; 더 엄격한 코딩은 복제 패키지에 있음). 60/90에서의 임계값 민감도는 결론을 변경하지 않습니다. 자체 신뢰도 AUROC는 패널의 전체 답변 모집단에 걸쳐 풀링된 명시된 신뢰도입니다; 풀링은 공급업체 간 정확도 및 신뢰도 척도의 차이를 흡수하므로 모든 구성원의 개별 값을 초과할 수 있습니다(표 7의 공급업체별 값). 답변은 질문별로 군집합니다; 질문 수준의 군집 부트스트랩은 어떤 결론도 변경하지 않으면서 구간을 대략 1.6배 확대합니다. 이 표와 표 7의 모든 AUROC는 복제 패키지 스크립트 compute_panel_vs_own_auroc.py(동점 보정이 있는 Mann–Whitney)에서 한 명령과 무작위성 없이 결정론적으로 재현됩니다.
표 7. 패널별 자체 신뢰도 AUROC: 풀링된 패널 모집단 및 공급업체별(표 6과 동일한 모집단)
| 패널 | 풀링된 자체 신뢰도 AUROC | 공급업체별 자체 신뢰도 AUROC |
| US-프론티어 | 0.842 | Anthropic 0.784 · OpenAI 0.596 · Google 0.746 |
| CN-프론티어 | 0.545 | DeepSeek 0.569 · Alibaba 0.532 · Moonshot 0.620 |
| 블록 간 | 0.659 | Anthropic 0.787 · DeepSeek 0.570 · Mistral 0.584 |
복제 패키지의 결정론적 파이프라인으로 계산됨. 두 모집단 관례가 공존하며 명시적으로 인쇄되어 명백한 불일치를 피함: 표의 공급업체별 값은 각 패널의 항목 모집단 내에서 계산되지만, 텍스트의 단일 수치 인용은 전체 컬렉션 값을 사용함 — 최고의 판별 공급업체 US-frontier 패널 내 0.784 대 전체 1,500항목 컬렉션 0.788, OpenAI의 경우 0.596 대 0.598 (두 쌍 모두 동일 파이프라인의 한 명령에서 재현). 대조적으로 통합 열은 공급업체 기본율을 혼합함 — 공급업체 간 정확도 및 신뢰도 척도 차이가 작용하므로, 통합 값이 공급업체별 범위 내에 있지 않을 수 있음 (실시간 재계산: US-frontier 통합 0.842는 모든 개별 멤버 값을 초과하며, CN-frontier 통합 0.545는 해당 패널의 공급업체별 거시 평균 0.574 아래에 위치); 공급업체별 값이 해석 가능한 수량임. 공급업체별 분산은 소비자의 문제를 수치로 표현한 것: 한 공급업체에서는 사용 가능한 판별이 존재하지만 다른 공급업체에서는 거의 확률 수준이며, 답변 외부의 어떤 것도 어느 공급업체가 생성했는지 말해주지 않음. Section 3 공급업체 범위 뒤의 소스 값, 동일한 채점 컬렉션에서 모델당 인쇄됨 (중위수 명시 신뢰도 · 정확도 · 전체 컬렉션 자체 신뢰도 AUROC): frontier — Alibaba 95 · 47.4% · 0.532; Anthropic 42 · 10.3% · 0.788; DeepSeek 90 · 35.7% · 0.570; Google 95 · 66.5% · 0.746; Mistral 90 · 16.5% · 0.584; Moonshot 85 · 51.6% · 0.619; OpenAI 85 · 16.7% · 0.598; xAI 60 · 37.9% · 0.777; Zhipu 95 · 28.4% · 0.611 — 85–95 밴드 아래의 두 중위수는 신뢰도가 사용 가능한 신호를 전달하는 두 공급업체에 속함; 지역 계층 (어려움 계층화 및 지역 계층 널값에만 포함) — gemma4:e4b 90 · 5.2% · 0.541; glm4:9b 85 · 5.0% · 0.589; llama3.2:3b 100 · 5.3% · 0.494; mistral:7b 95 · 6.3% · 0.506; phi4-mini 95 · 5.5% · 0.505; qwen3:8b 95 · 5.9% · 0.504; deepseek-r1:8b 90 · 9.2% · 0.696 (n = 98, 사전 약정된 중지 규칙).
AUROC는 공급업체의 명시된 신뢰도가 정답을 오답보다 위에 순위 매기는지 여부인 판별을 측정하며, ECE, Brier 점수, 신뢰도-정확도 간격은 명시된 수치를 확률로 읽을 수 있는지 여부인 보정을 측정하며, 이 데이터에서 두 가지는 뚜렷하게 분리됨. 연구의 최고 판별 7월 공급업체인 Anthropic의 중간 계층 (자체 신뢰도 AUROC 0.788)은 여전히 수준에서 심각하게 보정이 잘못됨: 명시된 평균 신뢰도 41.3 (중위수 42) 대 10.3% 정확도, +31.0포인트 과신뢰 간격, ECE 0.311 (15개 빈), Brier 0.206 (신뢰도 항 0.126 대 기약 불가능한 불확실성 기초값 0.093 포함). 역으로 가장 나쁜 보정은 거의 확률 수준의 판별과 공존함 (Mistral: 간격 +74.2 포인트, ECE 0.742, AUROC 0.584), xAI만이 판별과 보정 모두에 가까움 (ECE 0.111, AUROC 0.777). 거기서도 판별은 균일하게 낮은 명시된 신뢰도로 도움을 받으며, 다른 8개 7월 공급업체의 경우 두 속성은 뚜렷하게 분리됨. 동일한 분리는 기함 계층에서 지속됨: 11개 8월 기함 중 9개는 +12.5–+71.4 포인트의 과신뢰 간격 (ECE 0.125–0.714)을 지니는 반면, 2개 예외 (gpt-5.6-sol, ECE 0.031; claude-fable-5, ECE 0.043)는 정확도 척도의 반대 끝에서 보정을 달성함. 순위가 높지만 수치적으로 팽창된 신뢰도 점수를 보유한 소비자는 외부 참조 없이 이를 현금화할 수 없음. 표 7a는 판별 지표 옆에 보정 지표를 인쇄함.
표 7a. 판별 대 보정, 7월 파동 (전체 컬렉션, 해결됨; ECE 15개 빈 포함; 간격 = 명시된 평균 신뢰도 − 정확도, 백분위 포인트)
| 공급업체 | n | AUROC (자체 신뢰도) | ECE | Brier | 신뢰도 − 정확도 간격 | 평균 신뢰도 → 정확도 |
| Alibaba | 1,497 | 0.532 | 0.448 | 0.446 | +44.8 pp | 92.3 → 47.4% |
| Anthropic | 1,500 | 0.788 | 0.311 | 0.206 | +31.0 pp | 41.3 → 10.3% |
| DeepSeek | 1,500 | 0.570 | 0.536 | 0.513 | +53.4 pp | 89.1 → 35.7% |
| 1,461 | 0.746 | 0.263 | 0.271 | +26.3 pp | 92.8 → 66.5% | |
| Mistral | 1,495 | 0.584 | 0.742 | 0.686 | +74.2 pp | 90.6 → 16.5% |
| Moonshot | 1,500 | 0.619 | 0.242 | 0.292 | +24.2 pp | 75.8 → 51.6% |
| OpenAI | 1,500 | 0.598 | 0.610 | 0.531 | +60.9 pp | 77.6 → 16.7% |
| xAI | 1,500 | 0.777 | 0.111 | 0.197 | +11.1 pp | 48.9 → 37.9% |
| Zhipu | 1,493 | 0.611 | 0.642 | 0.612 | +64.2 pp | 92.6 → 28.4% |
| US-frontier 패널, 통합 단위 | 4,383 | 0.842 | 0.393 | 0.336 | +39.3 pp | — |
| CN-frontier 패널, 통합 단위 | 4,491 | 0.545 | 0.408 | 0.417 | +40.8 pp | — |
| 교차-진영 패널, 통합 단위 | 4,485 | 0.659 | 0.529 | 0.469 | +52.9 pp | — |
전체 컬렉션 AUROC 및 표 6–7과 동일한 모집단 (패널 행: 통합 (항목, 주요) 단위); 거부는 동결된 프로토콜 하에서 틀린 것으로 채점됨. Brier는 동일한 15개 빈에서 Murphy 항등식 (신뢰도 − 해결도 + 불확실성)으로 분해되며, 모든 행에서 잔차 < 0.001. 한 기함 계층 참고가 두 보정된 예외와 함께 이동: gpt-5.6-sol의 ECE 0.031은 95.4% 정확도에서 획득되었으며, Murphy 불확실성 항, 기본율이 설정하는 기초값은 0.044 — 보정은 부분적으로 표 9 오염 유의사항 (61.6% 축자 금 문자열 일치)을 지니는 기본율로 구매됨.
하나의 선택 효과는 표와 함께 이동해야 합니다: 복제는 부분적으로 질문 난이도의 표시자입니다. 질문 난이도로 계층화하면(다른 열다섯 개 모델 전체에서의 평균 정확도), 원본 인증 상향 이동은 더 쉬운 계층(2.7–4.6×)에 의해 수행되고, 두 번째로 어려운 오분위수에서 1× 미만으로 떨어지며, 이 컬렉션 내 측정에서 가장 어려운 계층에서 사라집니다. 그 계층화는 부분적으로 내생적이며, 아래의 외생적 재추정은 반전을 단조 감쇠로 완화합니다. 견고성 분석은 선택 문제를 직접 다룹니다(탐색적, 사전 등록되지 않음): 주요 모델 고정 효과를 포함한 질문 클러스터링 로지스틱 모델에서, 주요 모델 자체의 신뢰도와 항목 난이도를 제어합니다(주요 모델을 제외한 전체 열여섯 개 모델의 평균 정확도). 동의하는 각 추가 패널리스트는 여전히 정확성의 가능성을 대략 5배 곱합니다(풀링된 b = +1.65 패널리스트당, 95% CI [+1.49, +1.81], p < 10⁻⁸⁸; 모든 패널에서 양수). 난이도와 신뢰도 기준선에 동의를 추가하면 보유 AUROC를 0.859에서 0.898로 높이고 Brier 점수를 0.139에서 0.116으로 낮춥니다(질문별 이중 교차 검증 분할). 동일한 모델은 경계를 탐사하며, 계층화 자체는 주의가 필요합니다: 컬렉션 내 난이도 측정 하에서 조건부 계수는 가장 어려운 오분위수에서 음수가 됩니다(b = −0.41, p = .011). 하지만 그 측정에는 패널 자신의 구성원이 포함됩니다. 조건부 모델은 배포 주의사항을 담고 있습니다: 그 난이도 기능은 레이블이 필요하므로 진단적이지만 배포 가능하지 않으며, 배포 가능한 필터는 동의 게이트 자체입니다. 세 가지 추가 확인은 추정 및 선택 문제를 다룹니다. 모두 동결된 결정론적 프로토콜 코딩 하에서(복제 패키지가 판사 중재 헤드라인 숫자와 함께 보고하는 더 엄격한 분기). 항목 클러스터링 부트스트랩 재표본화로 인증 상향 이동을 재추정하면, 클러스터링은 난이도 구조가 요구하는 것이며, 모든 패널의 인증 상향 이동 구간은 1을 훨씬 위입니다(이 결정론적 코딩 하에서의 지점 상향 이동 2.4–4.5이며, 이는 출판된 1.9–3.2× 헤드라인 뒤의 판사 중재 쌍 코딩보다 더 적은 동의를 인증합니다; 부트스트랩 하한 2.2–4.1). 위에서 보고된 84패널 분포는 자기보고가 승리하는 미국 프론티어 패널을 예외가 아닌 규칙으로 만듭니다(중앙값 이점 +0.14, 동의 AUROC의 IQR 0.76–0.82). 난이도 계층화된 AUROC은 외생적 난이도 측정 하에서 경계를 명확히 합니다: 가장 쉬운 오분위수에서 0.87에서 가장 어려운 것으로 0.61로 떨어지며, 반전 없는 감쇠입니다. 그 측정은 leave-panel-out이며, 각 패널 외부의 열세 개 모델이며, 그것으로 재추정하면 반전을 해결합니다: 조건부 동의 계수는 가장 어려운 것을 포함한 모든 오분위수에서 양수로 유지됩니다(가장 어려운 오분위수 b = +0.97, p < 10⁻⁷; 가장 어려운 계층의 독립적으로 복제된 답변의 28%는 정확하고, 0%가 아닙니다). 따라서 컬렉션 내 반전은 부분적으로 난이도 측정의 인공산물입니다. 어느 측정 하에서든 생존하는 것은 단조 감쇠이며, 동의는 질문이 가장 어려운 곳에서 가장 약하고, 인증된 합의 오류의 현실입니다; 스크립트와 출력은 복제 패키지에 있습니다. 따라서 헤드라인 비율은 이질적 모집단에 대한 평균입니다. 신호 주장은 비율이 아닌 AUROC 끝점에 기반합니다.
실험의 가설은 내가 운영하는 연구 배포를 운영화합니다: 블라인드 수집은 그 위원회 메커니즘을 반영하며, 패널 구성은 연구가 설계되기 전에 생산 구성으로 존재했습니다. 이것은 이 연구 프로그램의 두 번째 사전 등록 연구입니다. 세 번째인 섹션 6 소비자 실험은 완료되어 보고되었으며, 네 번째(프로덕션 트래픽 상의 필드 원격 측정)는 초안 단계입니다. 복제 패키지는 누구나 상용 하드웨어에서 공용 API에 대해 실행됩니다.
플래그십 계층에서의 두 번째 웨이브: 열한 개의 실험실 — 열 개의 완전한 팔과 하나의 부분적 팔 — 하나의 보정 해자. 위의 실험은 실제로 소비자를 제공하는 비용 최적화 계층을 샘플링했습니다. 테스트할 이의: 아마도 정확성 착각은 예산 계층 인공산물이며, 플래그십, 각 공급업체가 최고로 내세우는 모델은 그 위의 아키텍처가 불필요할 정도로 충분히 보정되어 있을 수 있습니다. 두 번째 수집 웨이브(2026년 8월)는 시장 최고점에서 그 이의를 테스트합니다.
나는 미국, 중국, 유럽에 걸쳐 열 개의 주요 AI 실험실 각각에서 하나의 플래그십 모델을 평가합니다. 실험실은 이 세 지역에 걸쳐 주도적인 상용 및 오픈 웨이트 생태계를 포괄하기 위해 선택되었습니다. 각 실험실에 대해 평가 웨이브 시점에 가장 광범위하게 사용 가능한 가장 유능한 모델을 선택했습니다. 그런 다음 2026년 8월 5일 기준 공용 리더보드에 대해 이 적용 범위를 확인했습니다(LMArena Elo, Artificial Analysis Intelligence Index, Humanity's Last Exam, SWE-bench Verified): 열 개의 플래그십 중 여덟 개는 최소한 하나의 일반 기능 리더보드의 상위 계층에 배치되거나 근처에 있는 반면, 두 개(Mistral, Baidu)는 순위 근거가 아닌 실험실 및 지역 적용 범위를 유지하기 위해 포함됩니다(아래의 적용 범위 제한 사항 참조). 열한 번째 실험실인 Meta는 그 플래그십이 웨이브가 범위가 정해진 후에만 도달 가능해진 실험실로서, 웨이브 중간에 추가되었습니다; 그 수집은 접근 권리 박탈에 의해 중단되었으며 부분적으로 보고됩니다(아래 참조).
표 8. 평가된 플래그십 모델 및 리더보드 위치(2026년 8월 5일 기준)
| 실험실 | 플래그십 모델(API id) | 국가 | 리더보드 위치(2026년 8월 5일) |
| OpenAI | gpt-5.6-sol | USA | AA Index #3 (58.9); LiveBench #1 (82.4); Arena top-6 cluster |
| Anthropic | claude-fable-5 | USA | Arena #1 (~1525 Elo); AA Index #2 (59.9); SWE-bench Verified #1 (95.0) |
| gemini-3.1-pro-preview | USA | SWE-bench Verified #8 (80.6); HLE #17 (51.4); Arena 상위 클러스터 | |
| xAI | grok-4.5 | USA | AA Index #8 (53.8); Arena Elo 1499 |
| DeepSeek | deepseek-v4-pro | 중국 | SWE-bench Verified #8 (80.6, Pro-Max); HLE #23 (48.2) |
| 알리바바 | qwen-max (Qwen 3.7 Max) | 중국 | Arena #21 (1488–1496 Elo); SWE-bench Verified #11 (80.4) |
| Moonshot AI | kimi-k3 | China | AA Index #4 (57.1); HLE #9 (56.0); Arena #10 (1500) |
| Zhipu (Z.ai) | glm-5.2 | 중국 | AA Index #13 (51.1); HLE #11 (54.7) |
| Mistral | mistral-medium-3.5 | 프랑스 | 일반 순위표에서 상위 50위 이하; 지역 커버리지를 위해 포함됨 |
| Baidu | ernie-4.5-vl-424b | China | 일반 상위 30 범위 외 (ERNIE 5.0: HLE #36); ERNIE 5.1: LMArena Search Arena #4 |
| Meta (중반에 추가됨, 부분) | muse-spark-1.1 | USA | HLE #4 |
괄호 안의 점수는 스냅샷 날짜의 수집자 보고 값입니다. 순위표 위치는 수집자 및 스냅샷 날짜에 따라 약간씩 다릅니다. 스냅샷 출처는 복제 패키지와 함께 제공되는 실행 기록으로 보관됩니다.
프로토콜은 첫 번째 실험의 것이며, 고정되어 재사용됩니다. 동일한 1,500항목 SimpleQA 부분표본 (시드 및 해시로 고정), 모델당 맹검 통과 1회, 온도 0, 동일한 시스템 프롬프트 및 답변 파서, 각 답변에 대해 명시된 0–100 신뢰도입니다. 채점은 결정론적입니다 (금표준과의 정확한 문자열 일치 및 정규화된 문자열 일치; 거부는 오류로 채점; 미해결 항목은 헤드라인에서 제외되고 민감도 분석에서 오류로 재채점). 헤드라인 수치에는 LLM 판사가 관여하지 않습니다. 이는 첫 번째 물결 대비 의도적인 강화입니다. 첫 번째 물결의 채점자는 하이브리드였습니다. 목표 문자열 일치와 나머지를 해결하는 로컬 오픈웨이트 판사 (판사 발행 판결의 66.5%; 50항목 인간 점검, 98% 동의). 이 물결은 결정론적 동등성 엔진만 사용합니다 (수동 검증: 플래그된 불일치 20개 중 20개, 일치 15개 중 15개 손으로 확인됨). 따라서 이 물결의 모든 헤드라인 수치는 공개 스크립트에서 비트 단위로 재현됩니다. 절대 정확도의 크로스 웨이브 비교는 채점자 체계 간 비교이며, 모든 7월 대 8월 비교에는 채점자 체계 한정자가 포함됩니다. 웨이브 내 감시는 각 웨이브의 수치를 지원하지만, 크로스 웨이브 델타는 모델 변화와 채점자 변화를 혼동합니다. 단일 채점자를 두 개의 고정된 응답 집합에 다시 적용하지 않는 한 말입니다 (여기서는 수행되지 않음). 한 가지 노력 편차: OpenAI의 팀은 인터페이스의 기본 추론 노력 (medium)에서 수집되었습니다. 7월 프로토콜은 최소였으며, 추론 중 웹이나 도구 접근이 없었습니다 (모델에 노출된 도구를 열거하여 검증됨. 도구는 없었음). 이는 해당 공급업체의 절대 정확도를 변경합니다 (합의 메커니즘이 아님 (섹션 5)). 자신감 있는 실패는 명시된 신뢰도 ≥ 80에서 제시된 오답입니다. 임계값은 실행 전에 고정되었으며, 70과 90이 민감도로 보고됩니다. 합집합 커버리지는 11개 실험실 중 10개의 1,500/1,500 질문입니다. Meta의 수집은 액세스가 취소되기 전에 272개의 유효한 답변에 도달했습니다.
또한 크로스 체계 우려를 직접 테스트했습니다. 7월 16모델 물결을 두 번째 물결의 고정된 결정론적 엔진으로 재채점합니다 (로컬 오픈웨이트 판사로 판결의 66.5%를 중재한 하이브리드 파이프라인 대체). 해결된 판결의 2.65%를 변경합니다 (21,338 중 566개, 엔진은 추가로 4.1%에서 기권합니다). 헤드라인을 이동합니다. 단일 결정론적 코딩에서 인증 승수는 재채점 전 3.6×/4.6×/4.4×, 재채점 후 3.0–3.1×/4.5–4.6×/4.3×입니다. 둘 다 보수적인 공개 1.9–3.2× 이상입니다. LLM 중재 쌍 코딩에서 파생되며, 더 많은 합의가 인증된다는 것은 더 보수적인 승수를 의미합니다. 표 6–7의 모든 AUROC은 CN 및 크로스 집단 패널에서 최대 0.016, US 패널에서 0.046만큼 이동하여 각 패널의 합의 대 자보고 신뢰도 순서를 유지합니다.
대표 모델 라벨은 아무것도 보장하지 않습니다. 동일한 질문에 대한 해결된 정확도는 11개 대표 모델 전체에서 11.4%에서 95.4%까지 걸쳐 있습니다 (표 9). 시장 상단의 84포인트 확산은 첫 번째 실험의 중간층 확산보다 넓습니다. 정확도 착각은 이 계층에서 그대로 유지됩니다. 10개의 완전한 실험실 팔로 통합하면, 명시된 신뢰도 ≥ 80에서 제시된 모든 해결된 답변의 46.6%가 틀렸습니다 (10,540 중 4,910개; 부분 Meta 팔 포함, 46.3% 또는 10,665 중 4,935개; 미해결 항목은 여기서 제외되고 민감도에서 오류로 재채점되며, 통합된 그림은 변경되지 않습니다). 첫 번째 물결의 소비자 대면 함의는 가격으로 완화되지 않습니다. 대표 모델 배지는 소비자가 앞에 있는 신뢰할 수 있는 답변이 95% 정확한 대표 모델에서 나왔는지 11% 정확한 모델에서 나왔는지를 알려주지 않습니다.
표 9. 대표 모델 물결: 커버리지 및 정확도 (SimpleQA 부분표본, n = 실험실당 1,500, 온도 0)
| 실험실 (대표 모델) | 커버리지 | 정확도 (해결됨) | 미해결 |
| OpenAI gpt-5.6-sol | 1,500/1,500 | 95.4% (1,403/1,471) | 29 |
| Google gemini-3.1-pro | 1,500/1,500 | 71.1% (837/1,178)¹ | 46 |
| Anthropic claude-fable-5 | 1,500/1,500 | 70.3% (1,019/1,450) | 50 |
| Meta muse-spark-1.1 (부분) | 272/1,500 유효 | 61.4% (148/241)² | 10 |
| xAI grok-4.5 | 1,500/1,500 | 54.8% (794/1,448) | 52 |
| DeepSeek deepseek-v4-pro | 1,500/1,500 | 46.6% (666/1,428) | 72 |
| Moonshot kimi-k3 | 1,500/1,500 | 45.5% (645/1,418) | 82 |
| Zhipu glm-5.2 | 1,500/1,500 | 30.2% (430/1,425) | 69 |
| Baidu ernie-4.5-vl-424b | 1,500/1,500 | 28.9% (411/1,421) | 71 |
| Mistral mistral-medium-3.5 | 1,500/1,500 | 21.4% (306/1,429) | 71 |
| Alibaba qwen-max | 1,500/1,500 | 11.4% (164/1,435) | 65 |
¹ Google의 채널은 18.4%의 항목(1,500개 중 276개 — 전달 속성이며, 범위 부족이 아닙니다: 모든 1,500개가 시도됨)에서 빈 응답이나 필터링된 응답을 반환했습니다; 정확도는 파싱되고 해결된 답변으로 계산됩니다. 두 정의가 모두 보고됩니다: 답변만 계산한 경우 Google의 정확도는 71.1%(837/1,178)입니다; 276개의 미전달 응답을 오류로 계산하면 57.6%(837/1,454)이고, 해결되지 않은 항목도 오류로 점수를 매기면 55.8%(837/1,500)입니다. ² Meta 정확도는 접근 폐지 전에 수집된 답변으로 계산되었습니다; 범위 제한을 참조하세요. 표 전체의 정확도는 해결됨만 해당합니다; 해결되지 않음을 오류로 처리하는 민감도에서 상단 수치인 OpenAI의 95.4%는 93.5%(1,403/1,500)가 됩니다. 모든 실험실의 호출별 채널 출처는 실행 매니페스트에 기록됩니다. 해결되지 않음은 결정론적으로 해결되지 않은 전달된 답변을 나타냅니다; Zhipu(1,494개 답변 전달), Baidu(1,492) 및 부분 Meta 팔(251)의 경우 두 열의 합이 시도된 질문보다 적으므로, 나머지는 미전달 응답입니다.
오염 주의사항이 절대 정확도를 제한합니다. 이 파동은 공개적으로 릴리스된 원본 SimpleQA 벤치마크(2024년 10월)를 훈련 말뭉치가 출판 후 최대 2년 후인 모델에 대해 재사용하므로, 벤치마크 자체에 대한 훈련 시간 노출이 표의 상단에서 타당하며, 데이터는 구체적인 서명을 가집니다: 최고 점수의 플래그십 모델은 표준화된 정확한 일치(소수점 형식까지)로 항목의 61.6%에서 금 표준 답변 문자열을 그대로 재현하는 반면, 다른 실험실의 경우 27.9–45.3%이고, 중앙 표시 신뢰도는 99입니다. 설계는 "모델이 더 강하다"와 "모델이 벤치마크와 답안지를 봤다" 사이를 구분할 수 없습니다. 따라서 파동의 절대 정확도 수치는 이전 모델 세대에 대해 보고된 역사적 폐쇄형 상한과 비교할 수 없으며, 매개변수 메모리의 척도로 읽혀서는 안 됩니다. 첫 번째 파동의 벤치마크 연령 확인(섹션 3에서 보고된 TruthfulQA–SimpleQA 갭)은 7월 수집을 다루었습니다; 2026년 8월까지 SimpleQA 자체는 2년 된 공개 벤치마크이며, 이 주의사항이 플래그십 파동을 포함합니다. 파동의 결론은 절대 정확도에 의존하지 않습니다. 자신감 있는 실패의 구조, 표시된 신뢰도 ≥ 80에서의 유병률 및 의견 불일치 게이트에 의한 차단에 의존하며, 동일한 항목에서 평가되는 실험실 전체에서 노출 이점이 공유되는 하나의 고정된 프로토콜에서 파동 내에서 측정됩니다. 연구 기간 후에 구성된 신선한 2홉 프로브가 이 서명을 직접 확인합니다. 이 섹션의 뒷부분에 있는 "단순히 최고의 모델을 사용하지 않는 이유?"를 참조하세요.
보정 해자. 첫 번째 실험은 독립적인 의견 일치가 자체 보고 신뢰도가 하지 않는 정확성 신호를 전달함을 보여주었습니다. 플래그십 파동은 해당 신호를 측정된 필터로 바꿉니다. 메커니즘은 의견 불일치 게이트입니다: 이전 의견 불일치 분석에서 미리 고정되고 이 결과에 맞게 조정되지 않은 3개 실험실의 의회(Moonshot kimi-k3, DeepSeek deepseek-v4-pro, OpenAI gpt-5.6-sol), 그리고 자유 매개변수가 없는 규칙입니다. 답변은 3개 의회 답변이 쌍으로 동의할 때만 게이트를 통과합니다. 아무것도 추정되지 않으므로 훈련/테스트 분할이 필요하지 않습니다; 게이트는 고정된 수집에 대해 한 번 계산됩니다.
그림 17. 플래그십 게이트
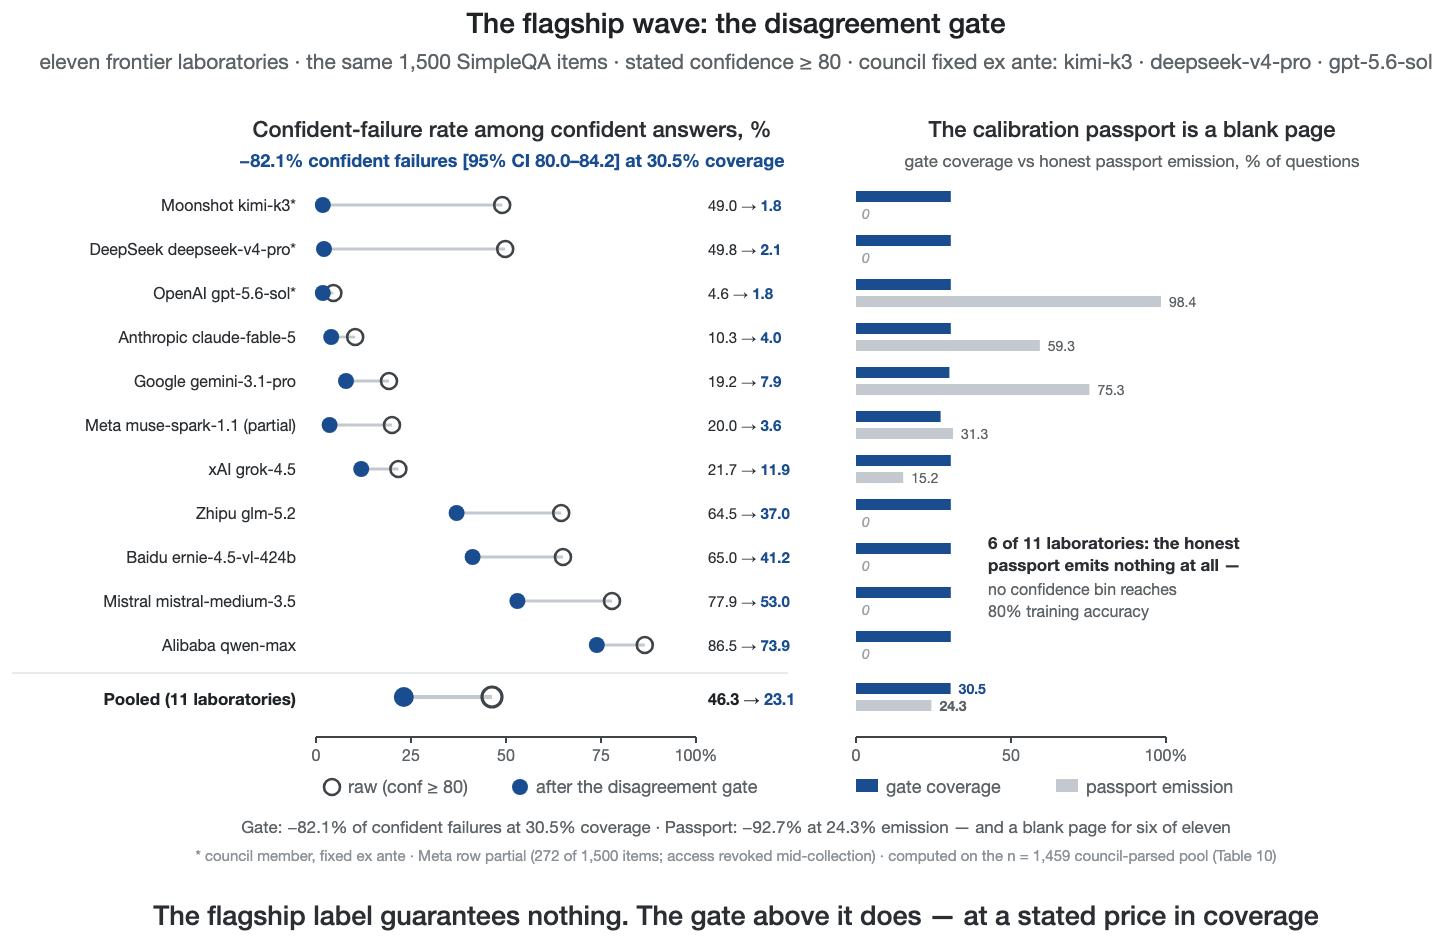
표시된 신뢰도 ≥ 80의 자신감 있는 실패 및 고정 3모델 의견 불일치 게이트에 의한 차단, 실험실별(2026년 8월 파동).
10개의 완전한 실험실 팔 전체에서 풀링됨(주 제시, 부분 Meta 팔은 별도로 보고되고 그 포함은 민감도로 처리됨), 원시 자신감 있는 실패율은 46.6%(10,540개 중 4,910개)입니다. 11개 실험실 명단 전체에서 풀링됨, 실험실별 비율이 다양함(표 9), 따라서 이 수치는 보편적 상수가 아닌 경계 명단을 특징짓습니다. 게이트는 자신감 있는 실패의 82.1%를 제거합니다 (부트스트랩 95% CI [79.9; 84.1]) 모든 풀링된 답변의 30.5%를 유지하면서 (게이트 자체는 1,459개 중 446개 질문의 30.6%에서 열립니다). 의회 외부의 완전한 실험실로 제한됨, 어떤 종류의 자기참조도 없음, 게이트는 여전히 자신감 있는 실패의 76.9%를 제거합니다(CI [74.3; 79.2]). 부분 Meta 팔을 포함하면 모든 추정치가 효과적으로 변경되지 않습니다: 11개 전체에서 풀링됨, 원시 비율은 46.3%(10,665개 중 4,935개; 신뢰 있는 답변의 35.8%가 게이트를 통과하고, 방출된 신뢰 있는 답변 중 정확도는 원시 53.7%에서 게이트 후 76.9%로 올라갑니다), 게이트는 동일한 30.5% 범위에서 82.1%(CI [80.0; 84.2])를 제거하고, 8개 실험실 비의회 수치는 77.0%(CI [74.4; 79.3])입니다. 표 10은 실험실별 수치를 제공합니다.
표 10. 의견 불일치 게이트에 의한 자신감 있는 실패 차단(conf ≥ 80; 결정론적 채점기; council = kimi-k3 · deepseek-v4-pro · gpt-5.6-sol, 미리 고정됨)
| 실험실 | 신뢰 있는 답변 | 자신감 있는 실패, 원시 | 게이트 후(방출된 것에 대한 비율) | dCF |
| Moonshot kimi-k3 [의회] | 1,056 | 517 (49.0%) | 7 (1.8%) | −98.6% |
| DeepSeek deepseek-v4-pro [의회] | 1,274 | 634 (49.8%) | 9 (2.1%) | −98.6% |
| OpenAI gpt-5.6-sol [의회] | 1,426 | 65 (4.6%) | 8 (1.8%) | −87.7% |
| Anthropic claude-fable-5 | 825 | 85 (10.3%) | 15 (4.0%) | −82.4% |
| Google gemini-3.1-pro | 966 | 185 (19.2%) | 27 (7.9%) | −85.4% |
| Meta muse-spark-1.1 (부분) | 125 | 25 (20.0%) | 2 (3.6%) | −92.0% |
| xAI grok-4.5 | 577 | 125 (21.7%) | 36 (11.9%) | −71.2% |
| Zhipu glm-5.2 | 1,128 | 727 (64.5%) | 146 (37.0%) | −79.9% |
| Baidu ernie-4.5-vl-424b | 725 | 471 (65.0%) | 107 (41.2%) | −77.3% |
| Mistral mistral-medium-3.5 | 1,354 | 1,055 (77.9%) | 224 (53.0%) | −78.8% |
| Alibaba qwen-max | 1,209 | 1,046 (86.5%) | 300 (73.9%) | −71.3% |
| 풀링(11개 실험실) | 10,665 | 4,935 (46.3%) | 881 (23.1%) | −82.1% [80.0; 84.2] |
| 풀링(8개 비의회) | 6,909 | 3,719 (53.8%) | 857 (33.5%) | −77.0% [74.4; 79.3] |
세 명의 위원회 위원이 모두 파싱되고 거부되지 않은 답변을 생성한 질문의 풀에서 계산됨 (n = 1,500 중 1,459); 게이트가 이들 중 446개를 열음 (30.6%). 메타 행은 부분적임 (수집 중 접근 권한 취소됨). 부트스트랩 CI: 5,000개 질문 수준 리샘플.
그 제목과 함께 세 가지가 따릅니다. 게이트는 또한 자신감 있는 올바른 답변의 대략 절반을 버립니다 (게이트는 자신감 있는 올바른 답변의 51.3%만 유지합니다; 게이트가 버린 답변 중 대략 41%는 실제로 맞았습니다). 거래는 확실성을 위한 범위이며, 선택적 분류의 정규적 위험–범위 거래입니다 (Geifman & El-Yaniv, 2017), 여기서 아키텍처 계층에서 실행되며, 두 숫자는 항상 쌍으로 인용되어야 합니다: 30.5% 범위에서 −82.1% 자신감 있는 실패. 시스템은 자체 바닥을 가지고 있습니다. 개방 게이트가 개별 모델의 답변이 아닌 위원회의 합의 답변을 내보내는 완전히 체계적인 모드에서, 시스템의 자신감 있는 실패율은 1.8%입니다 (해결된 합의 답변 442개 중 8개). 그 여덟 질문은 전체 위원회가 같은 잘못된 답변에 자신감 있게 동의하는 경우입니다. 이는 첫 번째 실험이 합의-실패 경계 조건을 인증하는 상관 오류 바닥입니다: 그 아래에서는 동의 확인이 도움이 되지 않습니다. 왜냐하면 동의 자체가 오류이기 때문입니다. 그리고 결과는 미리 선언된 민감도 그리드 전체에서 평탄합니다: 신뢰도 임계값 70/80/90은 풀링된 dCF를 −83.1%/−82.1%/−80.6%를 제공하며, 미해결 항목을 오류로 재채점하면 −81.8%를 제공하므로, 숫자는 선택되지 않고 측정되었습니다.
30.5% 범위 수치가 상업적으로 의미하는 바는 섹션 5의 손익분기점 경제 (Figure 14)에서 설정됩니다: 게이트가 인증을 거부하는 대략 70%의 답변은 자신감 있는 오류보다 더 저렴한 운명으로 라우팅되는 요청입니다 (인적 지원으로의 에스컬레이션, 더 깊은 검증 계층, 또는 명시적 불확실성 표시)이지, 손실된 전환이 아니므로, 범위 비용은 손실된 수요가 아닌 오류의 보험 가능한 가격입니다. 에스컬레이션 채널에 대한 비용 모델은 여기서 추정되지 않습니다. 운영 지점은 고정되어 있지 않습니다. Figure 19에 추적된 동의 사다리는 임계값의 가족을 공급하며, 서비스는 포착되지 않은 자신감 있는 실패의 예상 비용이 게이트가 유보하는 트래픽의 마진과 교차하는 곳에 위치해야 하며, 이는 비용 기반 선택을 만듭니다.
Figure 14. 졸업식 신뢰의 경제학
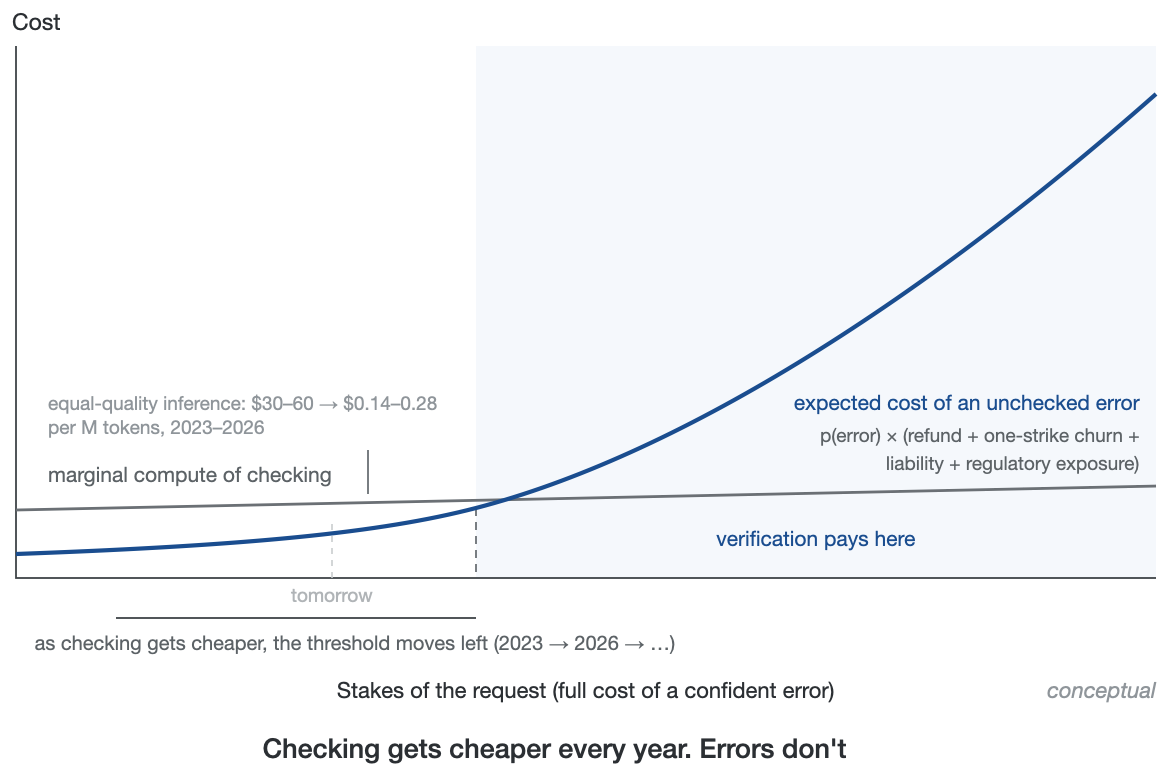
검증의 손익분기점 논리.
간단히 최고의 모델을 사용하지 않는 이유는? 웨이브가 남겨 놓은 가장 강력한 기준선은 통계적이 아닌 상업적입니다: 운영자는 아키텍처를 건너뛰고 모든 것을 웨이브의 가장 정확한 플래그십으로 라우팅할 수 있습니다. 그 기준선에는 숫자가 포함된 답변이 필요합니다. 2026년 중반 가격에서 고정된 3개 실험실 위원회는 질문당 $0.0039의 비용이 들며, 이는 웨이브의 가장 비싼 플래그십 (claude-fable-5, 목록 가격 $0.0198/질문)의 단일 답변보다 적고 가장 정확한 (gpt-5.6-sol, 공개 API 요금 $0.0027/질문)의 단일 답변보다 많습니다. "최고의 플래그십을 사면 된다"는 것은 진정한 파레토 지점입니다: gpt-5.6-sol은 단독으로 4.6% 자신감 있는 실패율로 모든 질문에 답변하며, 게이트된 어떤 구성도 어떤 가격에서든 그 범위와 일치하지 않습니다. 서비스가 대략 20개 답변 중 하나에 자신감 있는 실패를 허용하고 완전한 범위가 필요한 곳이면 어디든, 플래그십은 두 축 모두에서 승리합니다. 규칙은 순위표의 맨 위에서도 잘 일반화되지 않습니다: 웨이브의 다른 합의 우수자, claude-fable-5는 단독으로 10.3% 자신감 있는 실패율을 전달합니다. "벤치마크에서 상위인 모델을 사용하면 된다"는 것은 표본에서 두 번째로 강한 모델에서 완전히 실패하며, 이것이 아래의 식별 문제가 가설적이지 않은 이유입니다. 네 가지 고려사항이 비교를 제한합니다.
첫째, 식별 문제: 어느 모델이 현재 최고인지 아는 것은 그 자체로 외부, 교차 모델 측정의 산물입니다. 웨이브 자신의 Table 8은 공개 순위표에서 그 플래그십을 선택했으며, 연속적이고 제3자이며 교차 공급자 비교로 아무도 판매자 자체 보고서로 대체하기를 제안하지 않습니다. 이 논문의 자체 데이터는 아무도 왜 그렇지 않는지를 보여줍니다: 명시된 자신감은 공급자에 따라 AUROC 0.53–0.79에서 차별화되며, 모두 자신의 실험실의 최고로 판매되는 모델을 분리하는 84점 정확도 스프레드입니다. "최고의 모델로 라우팅"은 따라서 건축 신뢰의 응용이지, 그에 대한 대안이 아닙니다: 플래그십을 결정하는 순위표는 독립적 패널이고, 블라인드 항목이며, 섹션 3의 세 구성 요소는 시장 규모에서 운영되며 공개 기록입니다. 그리고 그 왕관은 움직입니다: 엔터프라이즈 모델 리더십은 한 봄에 손을 바꾸었고 (Kharazian, 2026), 모델은 안정적인 이름 아래에서 조용히 업데이트되며, 에이전트 구매 행동은 모델 업데이트 전체에서 극단적으로 재배열됩니다 (Allouah et al., 2026). 연속적인 외부 측정 없이, "최고의 모델"은 운영자가 지식으로 사용할 수 없습니다.
둘째, 95.4%는 부분적으로 능력보다는 메모리입니다: 최고 플래그십은 95.4% 항목의 61.6%에서 금 답변 문자열을 그대로 재현합니다 (Table 9의 오염 주의), 따라서 측정된 장점은 벤치마크가 가르칠 수 없었던 질문에서 압축됩니다. 게이트 메커니즘은 그 취약성을 상속하지 않습니다: 메모리될 가능성이 가장 낮은 계층에서 그것은 자신감 있는 실패의 89.4%를 제거하며, 이는 최악이 아닌 최고의 성능입니다 (아래 오염-계층화된 재분석), 왜냐하면 독립적으로 훈련된 실험실 간 동의는 어떤 하나의 공급자의 훈련 코퍼스에 대해 조건부가 아니기 때문입니다.
전이 가능한 지식을 벤치마크 노출에서 분리하기 위해, 나는 신선한 100개 항목 2-홉 프로브를 구성했으며, 이는 독립적으로 검증된 2023년 이전 위키데이터 사실 쌍에서 2026년 8월 6일에 기계 생성되어 오염되지 않음이 보장됩니다 (예: "[작은 건물의] 건축가가 태어난 연도는?"), 각각 단일 계산된 답변을 가지고 있으므로 구성된 질문 문자열은 어떤 훈련 코퍼스에도 나타났을 수 없습니다. 집합의 SHA-256은 첫 번째 모델 호출 전에 동결되었습니다.
파동의 동결된 프로토콜 아래(축어적 시스템 프롬프트, 온도 0, 동일한 결정론적 채점자), gpt-5.6-sol은 SimpleQA에서 95.4% 정확도와 4.6% 신뢰할 수 있는 실패율에서 33.0% [부트스트랩 95% CI 24.0–42.0]로 붕괴했으며, 신뢰할 수 있는 실패가 61.0% [51.0–70.0]에 달했습니다(신뢰할 수 있는 답변의 67.0%). 평균 명시된 신뢰도는 거의 움직이지 않았고(98.4 → 93.7), claude-fable-5는 76.0% [67.0–84.0]과 6.0% [2.0–11.0]에서 유지되었습니다. 파동의 25포인트 대표 간격은 보장되지 않은 구성에서 43포인트 적자로 반전됩니다. 파동에서 변하지 않은 평의회 관문은 이 실패를 흡수했습니다. gpt-5.6-sol의 61개 신뢰할 수 있는 실패 중 1개를 제외한 모두를 제거했습니다(60/61; n = 61에서 포인트 비율은 부정확하며, Wilson 95% CI ≈ 91–99.7%; 24.2% 커버리지; claude-fable-5: 6 → 1). 통과한 높은 신뢰도 답변 중 방출된 신뢰할 수 있는 실패율을 원본 67.0%에 대해 4.5%로 감소시켰습니다.
수준은 벤치마크 간에 포인트 비교가 불가능합니다. 2단계 구성은 본질적으로 1단계 검색보다 어렵고, n = 100에서 간격은 넓습니다. 하지만 모델 순서의 반전과 어떤 모델도 암기했을 수 없는 항목에 대한 관문의 지속성은 정확히 오염 설명이 예측하는 서명이며, 이는 더 나은 모델 선택이 아닌 아키텍처 신뢰 계층이 흡수하기 위해 구축된 실패 모드입니다.
셋째, 하한선이 있습니다. 관문은 어떤 단일 모델도 어떤 가격에서도 달성하지 않는 신뢰할 수 있는 실패율에 도달합니다. 평의회 관문 구성은 질문당 $0.0039–0.0046에서 방출된 답변에 대한 신뢰할 수 있는 실패를 1.8–2.1%로 감소시키며, 이는 최고 단독 비율보다 2.5배 이상 낮습니다. 반면 파동에서 가장 비싼 대표는 질문당 $0.0198에서 10.3% 신뢰할 수 있는 실패율을 가지며, 모든 축에서 지배적입니다. 관문은 약한 모델을 위한 구조 장치가 아닙니다. 동일한 관문 뒤의 qwen-max는 여전히 방출된 신뢰할 수 있는 답변의 73.9%에서 신뢰할 수 있게 실패하므로, 프론티어의 관문이 지어진 포인트는 약한 모델 위의 관문이 아닌 강한 모델의 평의회입니다.
넷째, 에이전트가 자율적으로 비용을 지출할 때, 운영상 질문은 "어떤 모델이 더 똑똑한가"에서 "어떤 구성이 자신이 한 일을 증명할 수 있는가"로 변합니다. 아무리 정확하더라도 단독 대표는 자신의 결정을 공증하거나 자신의 이해 충돌을 중재할 수 없습니다. 관문 구성은 답변당 검사 가능한 합의 기록을 생성합니다. 이것이 제5절의 책임 및 보험 시장이 이미 가격을 책정하고 있는 인공물이며, 여기서 적용 범위는 증거에 대해 작성되고 그 부재에 대해 제외 형태로 작성됩니다.
해결책은 승자가 아니라 프론티어입니다. 대표는 평의회의 가장 강한 구성원입니다(동결된 평의회는 이를 포함합니다). 하지만 자신의 판사로 작용할 수 없습니다. 이를 식별하는 리더보드는 아키텍처 신뢰가 운영하는 동일한 원칙, 독립적인 교차 모델 검증에 이미 기반하고 있습니다. 하지만 이는 일반적으로 모델에 대한 검증만을 합니다. 소비자 앞의 답변이 아니라 일반적으로만 공급합니다. 이 구성은 그 간격을 채우며, 그 간격은 또한 이를 제한합니다. 독립적인 검사에 기반하지 않는 주장은 아키텍처 신뢰의 인스턴스가 아니라 그 외부입니다. 운영자의 실제 선택은 위험 클래스 간입니다. 신뢰할 수 있는 실패 4.6%에서의 전체 커버리지, 또는 감사 추적과 함께 1.8%에서의 31% 커버리지, 선택적 분류 거래, 여기서 가격 책정됩니다. 전체 26개 구성 비용–커버리지–위험 프론티어(모든 단독 대표, 모든 관문 구성, 합동 합의 사다리, 포인트당 표시된 청구 대 목록 가격 기준)는 복제 패키지와 함께 CSV로 릴리스됩니다.
의견 불일치 관문에 대한 명백한 경쟁자는 단일 모델 교정 복구입니다. 각 모델의 신뢰도 대 정확도 매핑을 학습하고 매핑된 정확도가 기준을 통과하는 경우에만 방출합니다. 온도와 Platt 스케일링(Guo, Pleiss, Sun, & Weinberger, 2017)이 표준 치료법인 사후 재교정 프로그램입니다. 분리된 절반에 맞추기(히스토그램 빈 신뢰도, 짝수 인덱스 질문에 대해 학습, 홀수에 대해 평가, 20개 미만의 관찰값을 가진 빈은 방출되지 않음). 이 교정 여권은 신뢰할 수 있는 실패의 92.7%를 제거하지만 24.3% 방출에서 제거하며, 11개 대표 중 6개는 아무것도 방출하지 않습니다. 이들의 신뢰도 빈 중 어느 것도 80% 학습 정확도에 도달하지 않으므로, 이러한 모델에 대한 여권은 빈 페이지입니다. 대표 시장의 절반을 위해 단일 모델 교정은 외부에서 복구될 수 없습니다. 의견 불일치 관문은 여권이 포기한 6개를 포함하여 테이블의 모든 모델에 대해 대략 30%의 커버리지를 유지합니다. 따라서 첫 번째 실험의 결론은 이 계층에서도 유지됩니다. 아키텍처는 모델의 노출된 신뢰도가 하나로 실패하는 경우, 순위 지정이나 수준에서 외부 정확도 신호를 공급할 수 있으며, 소비자가 가장 신뢰할 수 있다고 알려진 계층에서 다시 측정됩니다.
관문 효과의 견고성. 두 가지 심판 주도 검사가 중요합니다. 순환성, 관문이 가장 강한 구성원을 탈 수 있는지 여부, 그리고 무언가 사소한 것이 동일한 작업을 수행하는지 여부입니다. 평의회의 가장 강한 구성원(gpt-5.6-sol, 95.4% 해결된 정확도)을 파동의 네 번째 사전 프론티어 실행(grok-4.5)으로 대체하면 결과는 본질적으로 변하지 않습니다. sol이 없는 평의회는 29.7% 커버리지에서 합동 신뢰할 수 있는 실패의 81.2%를 제거합니다(평의회가 아닌 대상: 77.6%). 동결된 3인조에 대해 82.1%의 30.5% 대 대비합니다. 모든 165개의 가능한 3모델 평의회에 걸쳐 메커니즘은 절대 실패하지 않습니다. 모든 평의회는 자신의 커버리지에서 무작위 기권보다 더 많은 신뢰할 수 있는 실패를 제거합니다(중앙값 초과 +8.5포인트). 사전 3인조는 그 여유로 상위 4%에 있습니다(+12.6포인트). 그 효과는 어떤 한 구성원의 정확도가 아니라 교차 모델 합의에 속합니다. 각 모델의 명시된 신뢰도를 동일한 모델당 커버리지로 임계값화하면, 사소한 기준선은 신뢰할 수 있는 실패의 66.7%만 제거합니다. 이는 같은 커버리지에서 맹목적 무작위 기권이 제거하는 69.5%보다 적습니다. 신뢰할 수 있는 실패는 정의상 높은 명시된 신뢰도에 집중되어 있기 때문입니다. 그 임계값은 또한 관문보다 더 적은 신뢰할 수 있는 정확한 답변을 유지합니다(46.4% 대 51.3%). 관문은 11개 실험실 모두에 대해 두 기준선 모두에 대해 Pareto 지배합니다. 가장 강한 모델 하나만과의 답변당 합의를 필터로 사용하는 것은 더욱 강한 선별입니다(40.7% 커버리지에서 합동 신뢰할 수 있는 실패의 97.1% 제거, 신뢰할 수 있는 정확한 답변의 97.0% 유지). 하지만 이는 기계적으로 다른 목표 조건부 규칙입니다. 검사 후에만 답변을 통과시키는 반면, 평의회 관문은 테스트 중인 답변을 보지 않고 모든 모델에 대해 동일한 고정된 질문 집합을 엽니다. 따라서 평의회 효과를 설명하지 않으면서 제한합니다. sol 없이도 3인조는 여전히 81.2%를 제거하며, 약한 단일 판사(kimi-k3, 45.5% 해결된 정확도)와의 합의도 신뢰할 수 있는 실패의 86.3%를 제거합니다. 드라이버는 교차 모델 합의 자체이며, 판사 정확도는 유지되는 것에 나타납니다(sol의 경우 신뢰할 수 있는 정확도 97.0% 대 약한 판사의 경우 20–63%).
Calibrated abstention은 더 강력한 경쟁 베이스라인을 제공하며, 이들도 실행되었습니다. 두 개의 calibrated abstention 베이스라인은 calibration passport와 동일한 분할 하에서 적합되었습니다(매개변수는 짝수 인덱스 항목에서 적합되고, 유지된 홀수 절반에서 평가되었으며, frozen gate는 30.8% 커버리지에서 자신 있는 실패의 82.2%를 제거합니다). per-model 베이스라인은 gate에 도달하지 못합니다. Platt-scaled confidence with per-model coverage를 gate에 맞추면 자신 있는 실패의 65.3%를 제거하고, split-conformal abstention(α = 0.293, P(emit | wrong) ≤ α를 보장하도록 calibrated되고 동일한 커버리지로 조정됨)은 70.8%를 제거합니다. 동일한 pooled coverage에서 raw stated-confidence top-K control도 69.4%를 제거합니다. 모든 11개 실험실의 답변을 하나의 Platt-calibrated 확률 척도에서 순위 매기는 pooled variant는 gate를 초과합니다(동일한 pooled coverage에서 89.0%). 그러나 이는 본질적으로 모든 커버리지를 well-calibrated 실험실에 재할당함으로써 이루어집니다: best-calibrated 공급업체의 답변 100%를 내보내고 11개 실험실 중 4개에 대해 0%를 내보내며, 위의 passport의 실패 모드를 더 부드러운 형태로 재현합니다. 또한 모델당 대략 700개의 등급이 매겨진 답변이 필요하며, gate는 어떤 것도 필요하지 않습니다. Calibrated confidence와 cross-model agreement는 따라서 대체물이 아닌 보완물입니다: 첫 번째는 ground-truth 레이블이 이를 훈련하기 위해 존재하는 곳에서 더 낮은 pooled 오류율을 구매하고, 두 번째는 균일한 label-free per-laboratory 보호를 구매합니다.
Figure 19는 모든 전략을 selective-prediction 평면에 배치합니다(11개 arm이 frozen 1,459-question pool에서 반환한 13,955개의 결정론적으로 해결된 답변에 걸쳐 pooled되어, 전체는 Table 9의 것보다 작으며, 이는 모든 1,500개 질문에 걸친 해결된 답변을 계산합니다; selective risk = 내보낸 답변 중 틀린 것의 비율). risk-coverage 곡선 하의 면적으로 순위 매겨지며, 낮을수록 좋습니다: Platt-calibrated confidence 0.258, stated confidence로 정제된 gate ladder 0.321, pure agreement ladder 0.356, raw stated confidence 0.367, random abstention 0.517, oracle floor 0.166에 비해; held-out-half 값은 최대 0.009만큼 다릅니다. Frozen gate 자체의 작동 지점에서(이 해결된 답변 관례에서 31.1% 커버리지, 13,955개 중 4,334개 답변이 내보내짐; 다른 곳에서 보고된 30.5%와 30.6%는 자신 있는 답변과 pool 질문의 비율입니다) gate의 위험은 24.9%이며, raw-confidence threshold의 경우 33.4%, calibrated confidence의 경우 14.0%이며, 위의 label-cost와 coverage-concentration 주의사항이 있습니다. 모든 165개 three-model councils의 클라우드는 9–59%의 커버리지와 13–38%의 위험에 걸쳐 있으므로, 보고된 gate는 조정된 이상값이 아닌 그 family의 대표 멤버입니다. Single-judge gates는 family의 퇴화된 끝을 추적하며, 여기서 "agreement"는 "가장 정확한 모델에 묻기"로 축소됩니다.
Figure 19. The risk-coverage frontier
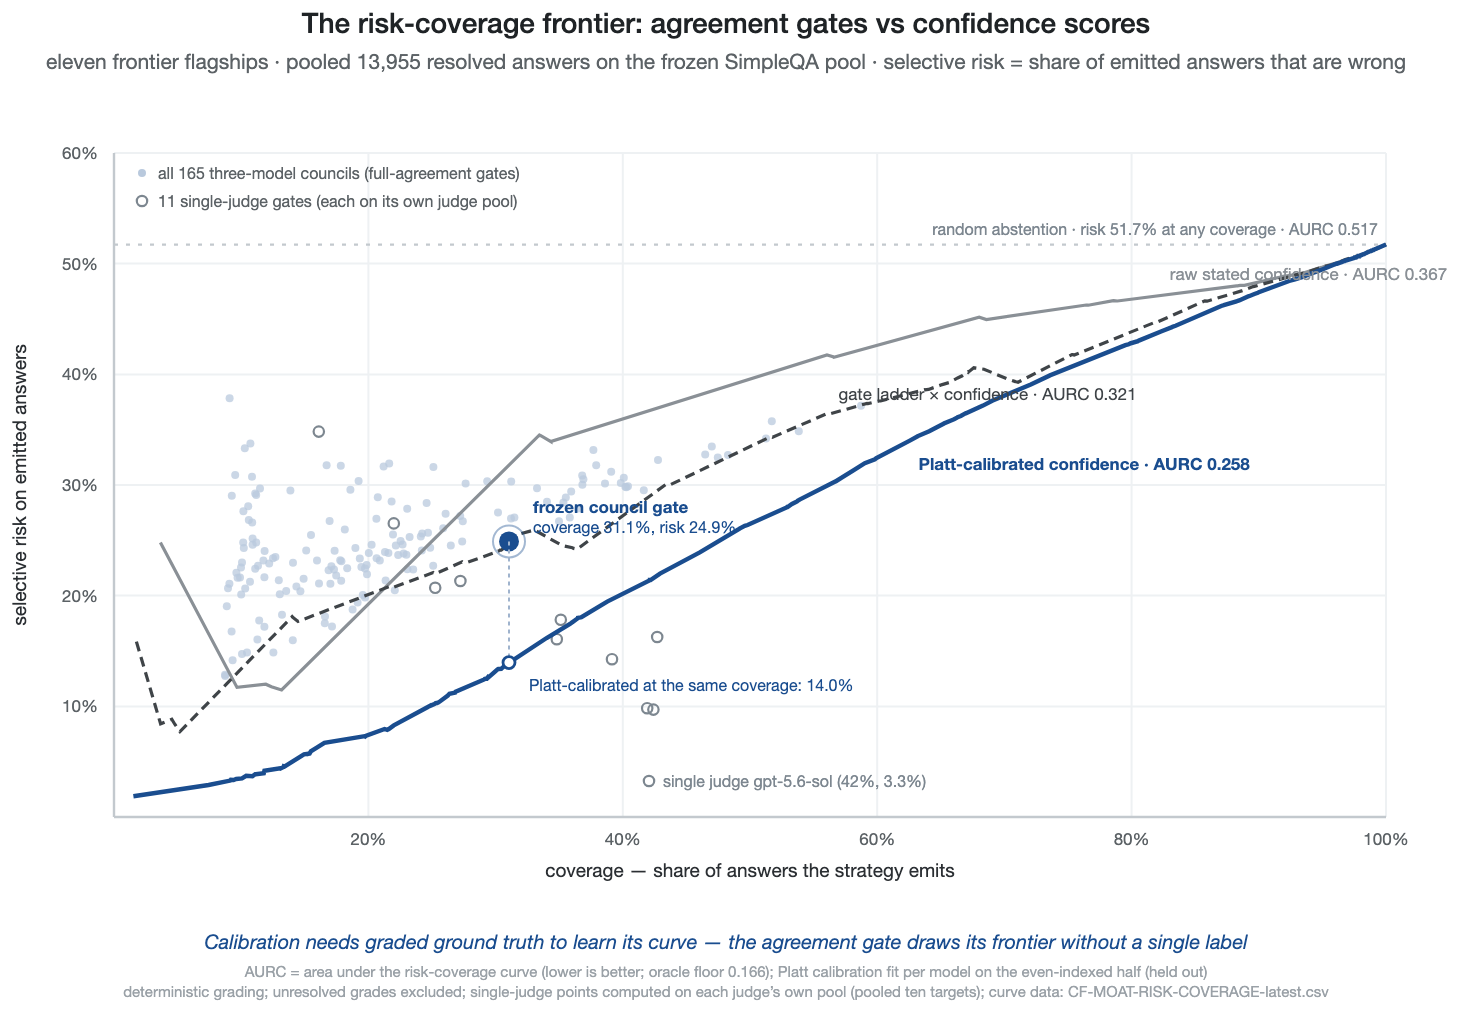
모든 abstention 전략이 selective-prediction 평면에 있으며, 커버리지와 selective risk를 대비하며, frozen 1,459-question pool에서 11개 arm이 반환한 13,955개의 결정론적으로 해결된 flagship 답변에 걸쳐 pooled됩니다(Table 9는 모든 1,500개 질문에 걸친 해결된 답변을 계산합니다): AURC 값을 포함한 raw-confidence, Platt-calibrated, gate-ladder-×-confidence 곡선, random-abstention 선, 모든 165개 three-model councils의 클라우드, 11개 single-judge gates, 그리고 frozen council의 작동 지점(해결된 답변 관례에서 31.1% 커버리지, 13,955개 중 4,334개; 24.9% 위험). 낮을수록 좋습니다; oracle floor는 0.166입니다. 모든 점은 replication package의 risk-coverage CSV에서 재계산할 수 있습니다.
Agreement는 질문 난이도를 넘어 어떤 정보도 전달하지 않을 수 있습니다. 이를 테스트하기 위해 gate agreement와 항목 난이도(그 질문에 대한 다른 모델들 사이의 틀린 답변의 비율)에 대한 답변 정확성의 로지스틱 회귀분석이 실행되었으며, laboratory 고정 효과와 question-clustered 표준 오차가 있었고, 답변은 난이도가 어떻게 측정되는지에 따라 달라집니다. Difficulty가 non-council 모델에 의해서만 측정되는 경우(fair control, 난이도 측정에 council의 자체 답변이 포함되면 구성상 gate의 신호가 내장되기 때문), agreement는 external-laboratory 대상에 대해 독립적인 기여를 유지합니다: b = +0.76, odds ratio 2.15, z = 17.2. Gate에서 내보낸 답변은 gate가 유지할 동일하게 어려운 답변과 같은 정도로 정확할 확률이 대략 두 배입니다. Council 자체의 정확성을 대신 difficulty regressor에 포함시키면 agreement 계수는 0으로 축소되며, 이는 메커니즘을 거부하기 보다는 수량화합니다: agreement와 multi-model difficulty는 동일한 잠재 수량의 두 가지 측정이며, gate는 inference 시 이를 읽기 위한 label-free 도구입니다.
Contamination-stratified 재분석은 노출 우려를 직접 해결합니다. 11개 실험실 중 3개 이상이 정규화 후 gold 문자열을 축자적으로 재현할 때 질문을 benchmark-exposed로 가능성 높게 표시하면(1,459 pool 질문 중 741개; gpt-5.6-sol의 61.6% gold-echo rate을 산출하는 동일한 signature), gate는 non-exposed 층에서 자신 있는 실패의 89.4%를 제거합니다(2,793→296; non-council 대상: 86.5%) exposed 층에서는 72.7%입니다. 따라서 메커니즘은 암기된 항목에 기반하지 않습니다. 이는 selective filter처럼 작동하며, panel이 진정으로 불확실한 곳에서 훨씬 덜 자주 열립니다(18.7% vs 41.9% 커버리지) 그리고 내보낸 자신 있는 실패율을 층에 걸쳐 거의 일정하게 유지합니다(25.9% vs 21.8%, raw rate 58.5%와 36.4%에서). 2–5개의 echoing 모델 노출 cutoff는 non-exposed dCF 87.7–89.7%를 제공하므로 발견은 threshold-robust입니다. Stratification은 설명적입니다: gold-echo는 outcome-coupled이며, contamination을 인과적으로 식별하기보다는 likely-seen 질문을 다른 질문과 분리합니다.
더 큰 추론 예산이 구매하는 것: 역량이 아닌 신뢰도. 주요 공급업체들은 이제 모델 선택 위에 두 번째 조절기를 판매하고 있습니다: 추론 예산으로, 숨겨진 숙고의 토큰당 가격입니다. 확장된 추론이 보정(calibration)을 구매한다면, 이것은 이 논문의 문제에 대한 모델 수준의 답이 될 것이고, 체크아웃에서 구매할 수 있을 것입니다. 한 주요 공급업체에 대한 쌍을 이룬 실험은 다른 것을 구매한다는 것을 보여줍니다. Google의 gemini-3.1-pro(추론을 비활성화할 수 없음)는 두 가지 예산, 낮은 추론 노력 설정과 공급업체 기본값 동적 예산에서 동일한 고정된 질문 세트에 답했으며, 온도 0, 동일한 프롬프트와 파서, 그리고 질문당 기록된 비용을 사용했습니다. 이 버전의 날짜에 두 예산 모두에서 답변한 233개 질문에서: 정확도 75.1%(낮음) 대 76.4%(기본값), 감지 가능한 차이 없음(정확한 McNemar p = .648); 기본 예산에서 진술된 신뢰도 3.1포인트 더 높음 (Wilcoxon z = 4.68, p < .0001); 기본 예산에서 보정이 약간 더 나쁨 (쌍을 이룬 ECE 0.100 대 0.082; 신뢰도-정확도 격차 +9.3 대 +7.5포인트); 질문당 가격 2.1×. 정확도 비교는 특정 종류의 무효성입니다: 이 데이터는 n = 233에서 감지 가능한 정확도 차이가 없음을 보여주고(정확한 McNemar p = .648), 동등성은 대략적인 범위에서만 공식적으로 확립됩니다. 쌍을 이룬 TOST는 정확도 차이를 ±5포인트 내에 제한하고(차이 +1.3포인트, 90% CI [−1.8; +4.4]; 양측 단측 p ≤ .024) 있지만, 이 연구는 ±2–4포인트에서 동등성을 확립하기 위해 충분한 검정력이 없으며, +3.1포인트 상승 진술된 신뢰도는 통계적으로 명확합니다(Wilcoxon p < .0001). 그 범위 내에서, 배증된 지출은 추가 진술된 신뢰도를 구매했고 측정 가능한 추가 정확성은 없었습니다: 유료 기능으로서의 과신뢰, 그리고 마이그레이션 논제의 모델 내 인스턴스. 추가 달러는 모델 계층으로 가서 소비자가 확인할 수 있는 것을 생산하지 못했으며, 그 위의 아키텍처 계층은 신뢰도를 확인 가능한 신호로 바꾸었습니다. 결과는 하나로 보고된 파일럿입니다: 비교는 233개의 쌍을 이룬 질문을 포함하고, 완전한 1,500쌍 설계는 동등성 범위를 약 2포인트로 좁힙니다; 채널 구성과 토큰 상한 검열은 복제 패키지에서 교란 변수로 문서화되어 있습니다; 수집이 계속 진행 중입니다.
그림 18. 더 큰 추론 예산이 구매하는 것
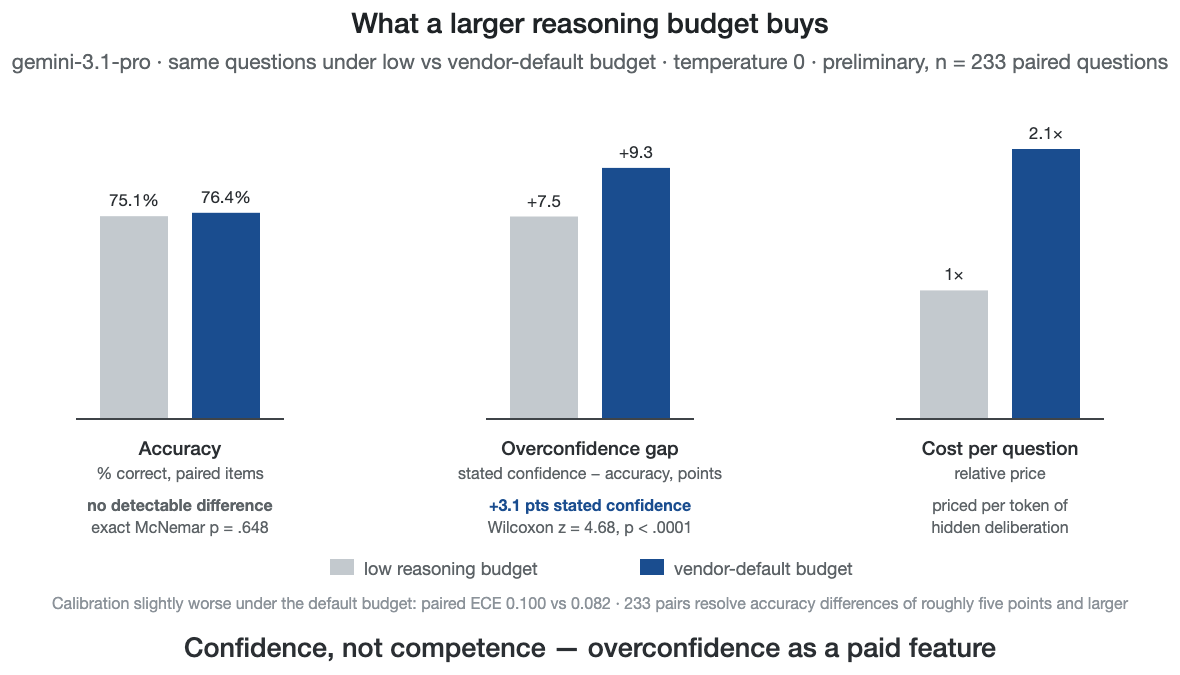
두 추론 예산에서의 쌍을 이룬 비교 — 진술된 신뢰도는 상승하지만, 정확도는 상승하지 않습니다.
표 11. 추론 예산, 쌍을 이룬 비교 (gemini-3.1-pro, 233개 질문이 두 예산에서 답변됨, 온도 0; 예비)
| 낮은 추론 예산 | 공급업체 기본값 예산 | |
| 정확도 (쌍을 이룬 항목) | 75.1% | 76.4% (McNemar p = .648) |
| 평균 진술된 신뢰도 | 기본값 대비 −3.1포인트 | +3.1포인트 (Wilcoxon p < .0001) |
| 보정 (쌍을 이룬 ECE) | 0.082 | 0.100 |
| 신뢰도 − 정확도 격차 | +7.5 | +9.3 |
| 질문당 비용 (상대값) | 1× | 2.1× |
추론 노력 설정은 팔(arm)에서 동일하지 않았습니다: 각 공급업체는 해당 인터페이스의 기본 노력에서 표준 상용 인터페이스를 통해 쿼리되었고(설정은 복제 패키지에서 모델당 기록됨), 공급업체의 절대 정확도는 노력 성분을 가질 수 있습니다. 그것은 메커니즘에 도달하지 않습니다. 정확도 순위는 부담이 없습니다(주요 공급업체 레이블은 아무것도 보장하지 않음), 게이트는 모든 구성원을 제거해도 생존합니다(무료 솔 위원회는 81.2% 제거), 그리고 더 큰 노력은 정확도가 평평할 때 진술된 신뢰도를 높입니다. 쌍을 이룬 비교가 방금 보여준 바와 같이, 게이트가 가로채는 실패인 자신감 있는 오류로 표현됩니다.
주요 공급업체 웨이브의 적용 범위 한계. 이 웨이브는 2026년 8월 5일의 고정된 스냅샷이므로, Grok 4.6(8월 12일) 및 나중의 Artificial Analysis 리더인 Claude Opus 5와 같이 그 이후에 출시된 모델은 사전 약정된 벤치마크에 들어갈 수 없습니다. 최상위 위치는 며칠 내에 전환되었습니다. 이것이 게이트가 우회하는 식별 문제입니다(합의는 모든 구성원의 제거를 생존시키는 명부에 대해 견고합니다). 포함된 두 실험실은 일반 능력 리더보드에서 현재 최신 기술을 아래에 있습니다: Mistral의 주요 공급업체는 확인된 모든 종합 지수에서 최상위 계층을 뒤지고 있으며, Baidu의 범용 ERNIE는 Humanity's Last Exam에서 상위 30 외에 있습니다(강점은 검색 강화 및 에이전트 작업이며, 여기서 ERNIE 5.1은 LMArena 검색 경기장에서 #4입니다). 유럽 생태계의 적용 범위와 모든 주요 중국 실험실을 보존하기 위해 유지되어 있습니다. 대신 웨이브의 범위를 벗어난 최상위 계층의 두 실험실 중에서, Meta Superintelligence Labs(Muse Spark 1.1; Humanity's Last Exam에서 #4)와 ByteDance(Seed 2.1; #10), 하나는 나중에 시도되고 중단됨(Meta, 아래)이고 하나는 전혀 도달할 수 없었음(ByteDance, 아래)입니다.
ByteDance의 Seed 2.1은 포함될 수 없었습니다: BytePlus ModelArk는 새로 등록된 국제 계정에 대해 "귀 국가/지역에서 사용할 수 없습니다"를 반환했고(실시간 시도, 2026년 8월 5일), 애그리게이터는 주요 공급업체를 제공하지 않으며, 국내 Volcano Ark 채널은 중국 본토 인증을 요구합니다. Baidu의 ERNIE 5.1(현재 주요 공급업체)은 마찬가지로 국내 Qianfan 플랫폼으로 제한됩니다(실시간 시도, 2026년 8월 5일). 실험실의 현재 주요 공급업체에 접근할 수 없는 경우, 폴백 규칙은 해당 실험실에서 가장 강력한 공개 출시 모델입니다. Baidu의 경우 이것은 ERNIE 4.5 VL 424B(오픈 가중치)이며, 대신 사용됩니다. 이것은 그 자체로 발견입니다: 2026년 8월 현재 6개 주요 중국 실험실 중 2개의 현재 주요 공급업체는 외부 연구자가 접근할 수 없습니다.
Meta는 파동의 세 번째 액세스 실패이며, 장애는 지리적 문제가 아니라 나의 계정이었습니다. 첫 번째(중간급) 파동에서 Meta는 문서화된 인프라 이유로 부재했습니다: 프로토콜 동결(실행 매니페스트에 기록됨) 전인 2026년 7월 6일에 자사 Llama API가 폐지되었으며, 실험실은 로컬 계층에서 오픈 가중치 Llama-3.2-3B로 대표되었는데, 이는 패널의 가장 교육적인 멤버 중 하나였습니다(전체 행렬에서 가장 낮은 오류 상관관계). 플래그십 파동의 경우, Meta의 muse-spark-1.1은 접근 가능해지자 파동 중에 추가되었으며, 수집은 순차적으로 세 가지 방식으로 실패했으며, 각각 기록되었습니다: (i) 자사 Meta Model API 키는 8월 5일에 251개의 유효한 답변이 수집된 상태에서 실행 중에 사망했으며, 개발자 콘솔은 대체품을 발급하지 않았습니다; (ii) 집계자 폴백 경로는 (iii) Meta의 공급자 엔드포인트가 공개 벤치마크의 폐쇄형 사실 회상 질문에 대해 온도 0에서 HTTP 403 `user_blocked`, "반복적인 정책 위반으로 인해 액세스가 제한되었습니다"를 반환하기 시작하기 전에 21개의 추가 답변을 생성했습니다. 순 결과는 1,500개 항목 중 272개(18.1%)가 수집되었으며 부분으로 보고되었습니다: 동결된 풀링된 분석에는 251개의 자사 답변이 포함되며(집계자 추가는 분석 동결 후에 도착했음), Meta의 실험실당 추정값(125개의 신뢰도 높은 답변에서 −92.0% dCF)은 패널과 방향 일치하지만 추론에는 너무 부정확합니다. 차단 자체는 발견입니다: 2026년 8월 현재, 독립 연구원은 승인된 채널을 통해 Meta의 플래그십에 대한 1,500개 질문의 사실 평가를 완료할 수 없습니다. 파동의 세 가지 액세스 실패, 지역 제한 플래그십(ByteDance), 국내 전용 플래그십(Baidu), 연구원 금지(Meta)는 이론적 주장을 경험적 형태로 제시합니다: 모델 계층에서의 검증 가능성은 공급업체의 은혜로 향유되며, 아키텍처 신뢰 계층은 공급업체의 은혜를 가정할 수 없습니다.
4. 극단적인 배포: 돌이킬 수 없는 이해관계를 가진 위임
소비자 신뢰를 연구하는 일반적인 방법은 설문조사 또는 실험실 작업입니다. 나는 더 가혹한 도구를 사용할 수 있었습니다: 모든 결과가 나에게 떨어지는 확대된 고위험 배포입니다. 이 섹션은 하나의 이해관계가 있는 운영자의 존재 증명이자 설계 증언이지, 일반성의 경험적 증거가 아니며, P1–P5 중 어느 것도 이에 기반하지 않습니다. 두 종류의 증거는 맞물립니다. 실험실에서 보정 효과는 위약 통제 하에서 측정되었고, 배포에서 오류가 돌이킬 수 없었을 때, 동일한 세 가지 속성은 위임이 가능한 것과 무모한 것의 차이였습니다.
배포는 클라이언트의 것이 아니며 시뮬레이션도 아닙니다: 나는 동시에 운영자, 개발자, 분석가입니다. 증거 계층은 해시 고정되어 있으며 모든 측정이 독립적으로 재계산 가능하므로, 충돌은 주장과 내가 측정하기로 선택한 것에 영향을 미치지만, 숫자가 재현되는지 여부에는 영향을 미치지 않습니다. 이 설정은 돌이킬 수 없는 이해관계와 함께 일반적인 소비자 역량을 결합하여 모든 아키텍처 약점이 빠르고 눈에 띄게 처벌됩니다.
방법론적으로 이것은 해석 및 분석-자기 민족지학 전통(Walsham, 1995; Gould, 1991; Anderson, 2006)의 극단적이고 계시적인 단일 사례(Yin, 2018)이며, 그 전통의 증거 주의를 고려합니다(Wallendorf & Brucks, 1993): 먼저 기록, 해석은 해석으로 표시됩니다. 정당성은 접근입니다: 연구원은 AI 아키텍처에 돌이킬 수 없는 실제 결과를 베팅하도록 참가자를 윤리적으로 할당할 수 없으므로, 유일하게 사용 가능한 관찰자는 자신이 내기를 선택한 참가자입니다.
분석은 동시대의 해시 고정 로그에 의존합니다. 배포의 증거 계층은 그 자체로 기록입니다: 부하 지지 단계(어떤 모델이 참조되었는지, 어디서 발산했는지, 무엇이 제어되었는지, 내가 확인한 것)는 당시에 기록되었으므로 관찰은 재생 가능한 기록에 기반하며 메모리에만 기반하지 않습니다. 사후 편향은 해석에서 제거될 수 없으므로 해석이 기록을 초과하는 각 장소를 표시합니다. 배포 기간 기록의 시스템 증거 계층은 2026년 8월 2일 현재 해시 고정되어 있습니다: 루트가 2f88a16611e51c0c12c8015754c89269e782ea167a89b5ed2a881f18eee4defc인 129개 파일(7,414,043바이트)의 파일당 SHA-256 매니페스트이며, 앵커는 이 논문과 함께 게시됩니다. 라이브 배포에서 선택적 인용은 없는 것보다 더 나쁘기 때문에 기록은 배포가 종료될 때까지 밀봉된 상태로 유지됩니다. 약속을 확인할 수 있습니다: 나중에 출시된 기록이 고정된 매니페스트와 일치하거나 일치하지 않으므로, 소급 편집, 치환 또는 역날짜는 이 페이지의 모든 판독자에 의해 감지 가능합니다. 원격 측정의 더 완전한 정량적 처리는 같은 이유로 향후 작업을 위해 남겨집니다.
이 루프 내에서 사는 것으로부터의 세 가지 관찰은 원래 설정 이상으로 전이되는 것에 대한 가설로 제공되며, 섹션 3의 제안을 제공하고, 그들이 기반하는 사건은 당시 배포에 의해 기록되었습니다.
불일치는 소비자가 사용할 수 있는 신호입니다. 독립적인 모델이 결과적인 질문에 대해 분산되었을 때, 분산 자체는 억압되지 않고 표면화되어 진정한 불확실성이 있는 곳을 알려주었습니다: 단일 모델 서비스가 제공할 수 없는 무료 조기 경고입니다.
증거는 분쟁을 변경하기 전에 동작을 변경합니다. 모든 결과적인 단계가 기록되었다는 것을 알면 위임이 심리적으로 가능했습니다; 기록은 감사 사후 작업이 아니라 신뢰의 전제 조건이었습니다.
신뢰도 게이팅은 평균 정확도보다 더 중요합니다. 실질적으로 위험한 사건은 자신감 있는 오류였으며, 평범한 출력은 절대 아닙니다. 아키텍처의 실제 기여는 높은 신뢰도를 비싸게 만드는 것이었습니다: 답변이 하나의 모델의 유창성으로 무료로 얻는 대신, 교차 모델 동의에서 벗어나야 했습니다.
5. 함의: 설득에서 인프라로
설계 및 경험
서비스 설계를 위해. 신뢰할 수 있는 AI 서비스 설계의 단위가 모델에서 파이프라인으로 전환되고 있습니다. 이는 결과적 쿼리를 독립적인 모델을 통해 라우팅하고, 의견 불일치를 1급 UX 요소로 취급하고, 기본적으로 근거를 첨부하고, 자신감 있는 오류의 비대칭 비용에 대해 다중 모델 처리 요금을 책정한다는 의미입니다. 위험이 집중된 요청을 위해 비용이 많이 드는 경로를 예약하는데, 이는 사기 심사가 위험한 거래에 대해 정밀 조사를 예약하는 방식과 같습니다. 인프라는 이미 존재합니다. 비용 중심의 캐스케이드는 어려운 요청을 비용이 많이 드는 계층으로 에스컬레이션하는데, 이는 표준 에이전트 엔지니어링이며, 이미 난이도별로 라우팅하는 서비스의 경우 결과별 라우팅의 추가 아키텍처 비용은 거의 0에 가깝습니다. 두 실험이 측정한 실패 모드는 두 가지 어려운 규칙을 제시하며, 이들은 선호도가 아닌 설계 요구사항입니다. 위치는 블라인드 상태로 수집되고 모든 크로스 모델 숙의 이전에 기록되어야 합니다. 숙의 우선 파이프라인은 아키텍처가 감시해야 하는 바로 그 합의를 제조하기 때문입니다(섹션 3의 적합성 압박). 두 번째 규칙: 제약된 옵션 집합에 대한 만장일치의 자신감 있는 합의는 실행의 녹색 신호가 아닌 검토의 빨간 신호입니다. 섹션 6의 모델 패널과 인간 참여자 모두 정확히 그러한 합의를 인증으로 취급했습니다.
경제학은 작동합니다. 에스컬레이션이 단계적이기 때문입니다. 단계적 신뢰 아키텍처: 여기에 설명된 배포에서 처리 계층은 단일 모델 답변과 완전한 다중 모델 숙의 사이의 요청당 비용에서 대략 3자리 수준을 걸칩니다(2026년 7월 현재). 따라서 비용이 많이 드는 계층은 결과가 집중된 곳에서만 구매됩니다. 손익분기점 논리는 사기 점수 책정의 것입니다(그림 14). 오케스트레이션은 자신감 있는 오류 확률 곱하기 전체 비용(환불, 일회성 허용 오차 범위 내의 이탈, 책임, 규제 위험)이 검사의 한계 계산을 초과할 때마다 비용을 지급합니다. 고위험 거래의 경우 그 부등식은 가까운 것이 아닙니다.
추론 가격의 하락(3년 동안 고정된 기능에서 대략 2자리 수준, 추적된 하락의 보수적 읽기; Appenzeller, 2024)은 비율이 아닌 절대 비용이 구조적 수량이기 때문에 논거를 해체하지 않습니다. 두 계층은 가격 곡선을 함께 타고 내려가며, 저렴한 추론은 점점 낮은 위험에서 비용이 많이 드는 계층을 합리적인 가격으로 만듭니다. 검사는 자체 두 번째 곡선을 탑니다. 약한 검증자의 앙상블은 레이블이 지정된 데이터가 없으면서 공개 70억 매개변수 구성 요소에서 최전선 추론 모델의 답변 선택 정확도에 도달합니다(Saad-Falcon 등, 2025). 일회성 소비자 허용 오차가 주어지면 비교는 "저렴한 답변 대 비용이 많이 드는 답변"이 아니라 "비용이 많이 드는 답변 대 잃어버린 고객"입니다.
두 가지 소비자 대면 원시값이 설계를 완성합니다. 의도적 마찰(비가역적 조치 전의 표시된 일시 중지)과 영수증입니다. 둘 다 위임이 어떻게 느껴지는지에 개입합니다. 소비자는 AI를 통계적으로가 아니라 사회학적으로 경험합니다(Puntoni, Reczek, Giesler, & Botti, 2021). 위임된 실행이 서비스 만남을 보기에서 제거하면서 영수증은 진실의 순간으로서의 만남의 옛 역할을 상속합니다. 그 프레임에는 위험이 함께 이동합니다. 의견 불일치를 두드러지게 만드는 것은 불확실성을 광고하고 신뢰를 보정하지 않고 침체시킬 수 있습니다(Detjen 등, 2025; Lu, Wang, & Yin, 2024). 따라서 얼마나 많은 차이를 드러낼지, 그리고 어떻게 드러낼지는 설계 변수입니다. 그것은 무료 상품이 아닙니다.
오케스트레이션 영수증은 최소한이면서도 여전히 자신의 일을 할 수 있습니다(그림 8은 목업을 보여줍니다). 세 필드가 대부분의 가치를 전달합니다. (1) 누가 행동했는가, 상담한 모델과 버전, 어떤 권한 하에 있는가. (2) 어떻게 동의했는가, 평문 발산 요약. (3) 무엇을 확인했는가, 완전히 재생 가능한 기록에 대한 포인터: 한눈에 읽을 수 있을 만큼 충분히 작으면서도 분쟁, 보험 청구 또는 감사를 정박할 수 있을 만큼 구체적입니다. 동일한 아티팩트는 운영자 자신의 장부 질문에 답하므로 영수증은 두 번 판매됩니다. 인바운드로 비용 거버넌스, 아웃바운드로 보증된 신뢰로서입니다. 그 양면성은 필요합니다. 투명성 단독에 대한 측정된 소비자의 지불 의사는 미흡합니다(유일하게 가격이 책정된 결합 분석에서 설명 가능성의 가치는 월 €1.99 미만으로 떨어졌습니다; König 등, 2022). 따라서 소비자 측만으로 자금을 조달한 신뢰 계층은 기아에 시달릴 것이고, 운영자의 비용 거버넌스 측이 그것을 지탱합니다. 영수증의 가장 가까운 엔지니어링 이웃은 환각 탐지를 위해 에이전트 프레임워크 내에 로깅되는 도구 영수증입니다(Basu, 2026). 이들은 본능을 공유하지만 청중은 공유하지 않습니다. 이들은 개별 도구 호출의 개발자 대면 기록인 반면, 오케스트레이션 영수증은 그들의 소비자 대면, 결정당 일반화입니다. 영수증은 자신의 실패 모드를 초대합니다. 검증된 것처럼 보이도록 엔지니어링되었지만 소비자가 다시 실행할 수 있는 것을 노출하지 않는 아티팩트입니다. 중요한 설계 라인은 기록이 진정으로 재생 가능한지, 단순히 영수증 모양인지입니다. 프라이버시 측면에서도 제약이 발생합니다. 무엇을 확인했는지 증명하는 아티팩트는 또한 무엇을 선호했는지 기록하므로 검증 가능성과 프라이버시는 공동으로 최적화되어야 합니다(Alavi & Nozari, 2026).
영수증 경제학의 마지막 한 가지는 검증 경제학이라는 자체 이름으로 불립니다. 위변조 방지 기록은 그것을 열려는 누군가의 인센티브만큼만 가치가 있으며, 분산 시스템의 십 년이 주의해야 할 점입니다: 공개적이고 위변조 방지된 블록체인 기록은 일반 사용자를 감시자로 만들지 못했으며, "신뢰 불필요" 아키텍처는 실제 모든 접점에서 조용히 신뢰할 수 있는 중개자를 다시 도입했습니다(Werbach, 2018). 검증자의 딜레마는 공식적 버전입니다: 검증이 비용이 많이 들고 올바른 결과가 일반적인 경우, 합리적인 검증자는 검사를 건너뜁니다. 검증 수요는 보험사, 감시자, 분쟁 절차 중 이미 개인적 검사 보상이 존재하는 곳에 집중되어야 하며, 소비자는 검증을 이러한 시장의 부산물로 상속받습니다. 영수증의 소비자 기능은 분쟁 시 이용 가능성이지, 매일 밤 읽는 것이 아닙니다. 자금 조달 문제는 같은 지점에서 따라오며, 이에 대한 두 가지 순진한 답은 모두 실패합니다: 소비자 부담 조정자는 중립성을 사치품으로 책정하고, 판매자 부담 조정자는 존재하기 위해 제거하려던 갈등을 다시 수입합니다. 그것이 영수증의 양면 경제학이 이미 암시하는 모델을 남깁니다. 계층은 감사가 지불되는 방식으로 지불됩니다. 즉, 이야기보다 위험의 가격을 매길 필요가 있는 당사자들이 지불합니다(비용 거버넌스와 책임 감소를 구매하는 운영자, 인수 가능한 위험 프로필을 구매하는 보험사, 증거를 구매하는 분쟁 절차), 그리고 이러한 시장이 수요 부족인 곳에서는 규제 하한선을 적용합니다. 소비자는 중립성이 아니라 서비스를 구매하고, 중립성을 부산물로 상속받습니다. 같은 문제는 시장 구조 버전을 가지고 있습니다. 동시에 마켓플레이스, 모델 공급업체, 광고 네트워크인 플랫폼은 중립성을 제공할 수 없는 구조적으로 지원하지 못하며, 이는 시장 형태의 이해 상충 문제이고, 알고리즘 우선순위의 역사적 기록(스폰서된 배치, 선호 파트너)은 지배적 플레이어가 라우팅을 현금화할 수 있다면 할 것이라고 말합니다. 이러한 압력이 작동하는 곳에서 중립성 하한선은 자발적이 아니라 규제적이거나 개방 프로토콜입니다. 초기 노출 소비자 증거 수요가 미약하다면, 건축 신뢰 채택은 소비자 선택보다는 규정 준수 및 보험 측면에 의해 덜 주도될 수 있으며, 선호도가 아닌 기관을 통한 마이그레이션이며, 소비자는 검증 가능한 아키텍처를 기본값으로 상속받습니다. 보정 결과는 해당 경로가 장식적이 되는 것을 방지합니다: 소비자는 건축 신호가 그들 앞에 놓이면 분명히 사용하지만, 아직 그것을 소환하기 위해 비용을 지불하지 않습니다. 여기에는 대안적 가설이 있습니다: 신뢰는 검증 가능한 아키텍처 대신 책임과 기관으로 마이그레이션할 수 있습니다. 소비자는 원장 감사가 아니라 차백 권리에 의존합니다. 카드 네트워크는 소비자가 승인 기록을 검사하는 대신 분쟁 권리를 통해 원격 상거래를 확장했습니다. 그 해석에서 결정 기록은 책임을 계산 가능하게 만드는 배관이지 소비자 신뢰의 대상이 아닙니다. 두 계정은 서로 다른 것을 예측합니다: 건축 계정에서 소비자는 검증 가능성을 볼 수 있을 때 보상합니다. 제도 계정에서는 치료가 첨부될 때만 보상하며, 소비자의 신뢰는 제도에 계속 정박되어 있고 제도의 신뢰는 건축으로 마이그레이션합니다. 아래 지정된 분쟁 시간 설계는 이를 구분합니다. 그리고 모든 기록 계층은 오라클 문제를 상속받습니다: 기록은 프로세스를 인증하고, 오직 프로세스 자신의 검사만이 사실에 도달합니다. 영수증이 반전시키는 비대칭은 플랫폼 비판 문헌이 문서화하는 것입니다: 아키텍처는 진술된 정책이 아니라 디지털 행동의 운영 규제자입니다(Lessig, 2006). 지금까지 그 도구는 소비자의 측이 아니라 소비자를 향하고 있었습니다(Zuboff, 2019; Möhlmann & Zalmanson, 2017). 영수증은 그 도구를 다른 방향으로 돌립니다.
증거 계층은 백오피스 로그에 보관되지 않고 제품 자체에 표시되어야 합니다. 소프트웨어 엔지니어링은 최근 에이전트 모델 주위의 런타임 래퍼에 대한 이름인 에이전트 하네스로 수렴했으며, 하네스는 모델이 아니라 하네스가 인증, 규제 및 신뢰될 수 있다는 인식으로 수렴했습니다. 건축 신뢰는 하네스가 그 역할을 받을 자격이 있도록 생성해야 하는 것을 명시합니다.
이 섹션이 설계하는 규모와 이것이 설계하는 반발은 이미 기록에 있습니다. Klarna의 어시스턴트는 첫 달에 230만 개의 대화를 처리했으며, 이는 회사의 고객 서비스 채팅의 3분의 2이고 700명의 정규직 에이전트의 추정 업무입니다(Klarna, 2024, 회사 보고 수치). 14개월 후 CEO는 공개적으로 방향을 바꿨습니다: 출력 품질이 저하되었고, 인력 모집이 재개되었으며, 상수 약속은 "당신이 원하면 항상 인간이 있을 것"이 되었습니다(Daly, 2025). 회사의 명시된 이유가 아니라 내 읽기로서 건축적으로 읽으면, 두 공지의 쌍은 정확히 이 논문이 명명하는 간격을 괄호로 묶습니다. 볼륨 계층은 기계 비용으로 작동하지만 졸업식 상승이나 검사 가능한 품질 신호가 없으므로 위임은 인간 기준선으로 다시 튀었습니다. 이러한 공지 사이의 위치를 안정적으로 만드는 것은 졸업식 신뢰 아키텍처입니다: 이해관계가 낮은 곳에서 저렴하고, 이해관계가 집중된 곳에서 확인되고, 확인이 실패한 곳에서 인간입니다.
시장 및 규제
국가 간 서비스용. 중립성은 모델 공급업체를 넘어 관할권으로 확장됩니다. 조정 계층은 관할권 인식 라우팅을 적용하고 적용을 기록할 수 있으며, 데이터 주권 규정 준수를 법적 표현에서 감시 가능한 런타임 속성으로 전환합니다. 그것이 대응하는 차별화는 측정되었습니다: 25개 국가에서 응답자의 중앙값 53%는 EU가 AI를 효과적으로 규제할 것으로 신뢰하는 반면, 미국은 37%, 중국은 27%입니다(Pew 데이터, Stanford HAI, 2026 보도, 기관 보고서, 동료 검토되지 않음). 신뢰가 관할권에 따라 다를 경우, 어느 관할권의 규칙이 적용되었는지 증명할 수 있는 아키텍처는 실제 가치가 있습니다.
에이전트 상거래의 경우. Visa–ChatGPT 통합은 세 가지 구성 요소를 구체적으로 만듭니다. 상한선과 화이트리스트는 정적 소비자 측 보호 장치입니다. 건축 신뢰는 동적 서비스 측 계층을 추가합니다: 독립적 모델에 의해 교차 확인된 구매(다양성), 에이전트가 이 판매자를 이 가격으로 선택한 이유를 재생 가능한 기록(증거), 그리고 매출이 어느 공급업체 또는 판매자가 이기는지에 달려 있지 않은 조정 계층(중립성)입니다.
결제 산업은 이미 이 스택의 하층부 건설을 시작했습니다. Visa의 Trusted Agent Protocol(2025년 10월, Cloudflare와 함께; Visa, 2025)은 에이전트의 정체성을 암호화 방식으로 요청에 서명합니다: 가맹점 및 목적별, 시간 제한, 재생 공격 방지 서명입니다. Google의 Agent Payments Protocol(Google Cloud, 2025)은 Mastercard의 프레임워크와 함께 2026년 FIDO Alliance에 기여했으며, 사용자의 의도를 W3C Verifiable Credentials(W3C, 2025)로 전달되는 서명된 위임으로 인코딩합니다. Mastercard의 Verifiable Intent(Google과의 공동 프레임워크; 2026년 3월 발표; Mastercard, 2026)는 이 논문이 작성했을 수 있는 목적으로 명시하며, AI 에이전트가 사용자를 대신하여 행동할 때 사용자가 승인한 내용의 변조 방지 기록입니다. 2026년 아시아 및 라틴 아메리카 시장에서 초기 파일럿이 보고되었습니다. 정체성과 의도 증거는 지금 표준화되고 있으며, 기록 형식도 마찬가지입니다: IETF의 SCITT 아키텍처(RFC 9943, 2026)는 서명된 명령문 → 추가 전용 투명성 로그 → 영수증이라는 동일한 패턴을 지정하며, 이는 이 논문의 증거 계층이 전제합니다. 위임이 일어나는 인터페이스는 도덕적으로 중립적이지 않습니다. 13개 실험에서, AI에 위임한 사람들은 덜 정직하게 행동했으며, 모호한 목표 설정 하에서 가장 심했고, 기계 에이전트는 인간 에이전트보다 완전히 부정직한 지시를 훨씬 더 자주 수행했습니다(Köbis et al., 2025). 의도를 구체적인 용어로 명시하도록 강제하는 인터페이스는 윤리적 인프라입니다.
아직 제3층인 결정 증거를 다루는 프로토콜이 없습니다: 에이전트가 이 가맹점, 이 상품, 이 가격을 선택하는 방식; 독립적인 검사가 동의했는지 여부; 신뢰도가 얼마나 가치가 있었는지(그림 15는 3개층을 나타냅니다). 이것이 이 논문이 명명하는 계층이며, "에이전트 파악(know-your-agent)"은 정확히 이 프로세스 질문으로 발전해야 하며, 감시 단위는 거래로 이동합니다. 아키텍처가 보장할 수 있는 것은 기록의 존재이지, 그 기록을 읽는 것이 아닙니다. 누군가 그러한 기록을 열지 여부는 배포만이 답할 수 있는 경험적 질문입니다.
그림 15. 증거 스택
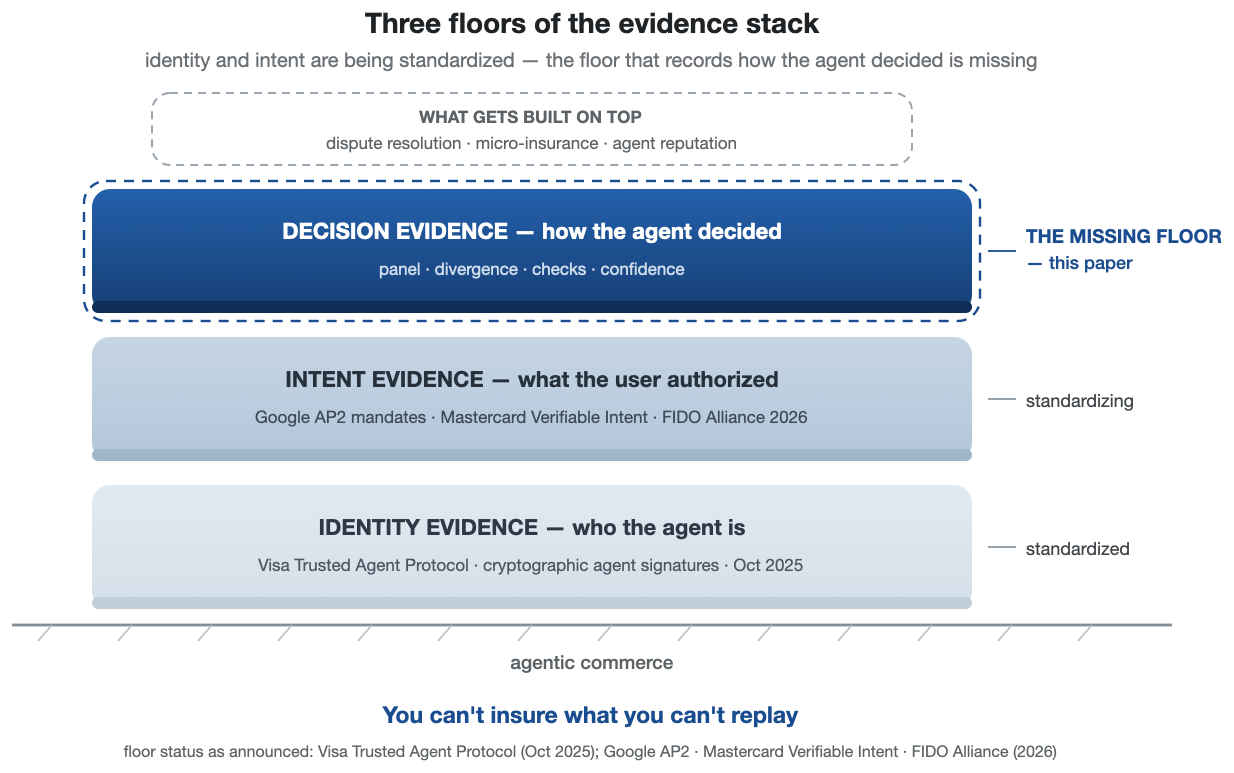
정체성과 의도 증거는 지금 표준화되고 있으며, 결정 증거는 이 논문이 명명하는 누락된 층입니다.
에이전트 구매 행동의 첫 체계적 감시는 왜 결정 증거를 미룰 수 없는지를 보여줍니다. Allouah et al.(2026)이 통제된 전자상거래 샌드박스에서 무작위 시험을 실행했을 때, 쇼핑 에이전트는 강한 위치 편향을 보이고, 몇 가지 "모달" 상품에 수요를 집중시키며, 기본 모델이 업데이트될 때 이러한 선호도를 급격히 재구성합니다. 선택이 어떻게 이루어졌는지에 대한 기록이 없으면, 이 중 어느 것도 소비자, 가맹점 또는 규제 당국에 보이지 않습니다. 다양성은 여기서 설계 답안이며, 패널은 단일 모델의 위치 특이성을 희석하고, 책임 추적성은 결정 증거가 제공하는 것입니다: 감시자들이 관찰하기 위해 샌드박스를 구축해야 했던 것을, 아키텍처적으로 신뢰할 수 있는 서비스는 프로덕션에 기록합니다.
이 프레임은 소비자를 넘어 기계 대 기계 신뢰로 확장됩니다. B2B 에이전틱 워크플로우에서는 신뢰감을 느낄 인간이 루프에 없으므로, 유일하게 가능한 기질은 검증 가능한 프로세스이며, 에이전트는 여기서 설명한 정확히 그 산출물을 교환하고 거래할지 여부를 계산합니다. 그러한 위임 체인 규모에서 신뢰가 어떻게 집계되고 전파되는지, 그리고 증거 계층의 자체 로깅 및 검증 오버헤드가 프로덕션 볼륨에서 얼마나 드는지는 여기서 해결되지 않은 문제입니다. 체인은 요구 사항을 강화합니다. 체인은 가장 증거가 불충분한 링크만큼만 신뢰할 수 있으므로, 기록은 구성되어야 합니다. 소비자가 없는 경우, 아키텍처적 신뢰는 그럴듯하게 유일한 신뢰 형태입니다.
신뢰 문헌이 따라잡지 못한 구조적 발전은 프로토콜 전쟁입니다. 경쟁하는 에이전트-상거래 스택(OpenAI와 Stripe, Agentic Commerce Protocol; Google의 Universal Commerce Protocol 연합; Perplexity와 PayPal; 기초 카드 네트워크 및 개방 표준)은 AI 서비스가 공급업체 모델 라인을 따라 단편화된 것과 정확히 같은 방식으로 상거래를 공급업체 프로토콜 라인을 따라 단편화하고 있으며, 중립성 주장은 거의 같은 말로 일반화됩니다: 한 공급업체의 프로토콜 내에서만 거래할 수 있는 소비자의 에이전트는 소비자의 에이전트가 아니라 공급업체의 에이전트입니다. 프로토콜 간에 중재하는 모든 계층은 동일한 3가지 요구사항인 독립성, 증거, 그리고 이해관계 없음에 직면할 것이며, 그러한 계층이 자리잡으면 선반에 대한 싸움은 체커에 대한 싸움이 됩니다.
증거 시장을 위해. 2026년에 이것은 더 이상 예측이 아닙니다. 책임 측면에서, 보험은 먼저 그리고 동시에 두 방향으로 움직였습니다. 생성형 AI 청구에 대한 선택적 제외 권장사항이 2026년 1월에 표준 일반 책임 툴킷에 들어갔습니다(ISO 양식 CG 40 47 및 CG 40 48, 보험사가 선택할 수 있는 권장사항, 자동 제외 아님; 몇 개월 내에 주요 보험사들이 이를 채택하거나 동등한 독점 버전을 신청했습니다). 같은 기간에 첫 AI 에이전트 정책이 반대 방향으로 작성되었습니다, 증거에 대해: AIUC-1 에이전트 표준은 레드팀 감시를 통해 보험사가 인수하기 위해 필요한 경험적 위험 프로필을 생성하기 위해 존재하며, 2026년 2월-3월은 첫 인증된 감시자, 첫 에이전트 정책, 그리고 첫 엔터프라이즈 인증을 가져왔습니다. 전면 제외와 증거 기반 인수 사이에 끼인, 기록은 책임 할당의 단위가 되었습니다: 검사 가능한 기록이 없는 에이전트는 제외 형태의 적용 범위에 직면하고, 있는 에이전트는 견적 가능한 위험입니다.
규제 측면에서, EU AI Act의 제50조 투명성 의무(소비자에게 AI 상호작용의 필수 공개 포함)는 2026년 8월 2일에 시행되며(과도기 표시 하위 의무는 2026년 12월 2일까지 실행됨), 벌금은 이 논문의 법의 페널티 조항 해석에 따르면 최대 1,500만 유로 또는 글로벌 매출의 3%입니다. 위원회는 2026년 7월 20일에 제50조 지침을 채택했습니다(유럽위원회, 2026), 그리고 병행하는 Digital Omnibus 단순화(7월 8일 서명)는 8월 의무를 지연시키지 않습니다. 기존 시스템은 기계 판독 가능 콘텐츠 표시에 대해 2026년 12월까지만 제한된 유예를 받습니다. 더 광범위한 고위험 의무는 2027-2028년을 통해 단계적으로 도입됩니다.
증거 계층은 이 의무를 변경합니다: 필수 AI 공개가 이 세션에서 이 사용자에게 표시되었다는 증명을 포함하는 위변조 방지 기록은 이 논문의 해석에 따르면 최대 €1,500만의 법적 노출을 감사 가능한 런타임 속성으로 전환하며, 아키텍처의 부산물로서 규정 준수를 달성합니다. AI 에이전트 책임을 인수하는 보험사에게는 정확히 이러한 기록이 필요하며, 추적 가능성과 책임성은 NIST AI 위험 관리 프레임워크의 핵심 특성입니다. 규제 선례는 기술보다 더 오래되었습니다. 은행의 모델 위험 지침은 2011년 이후 모델 개발자와 독립적인 당사자에 의한 독립적인 검증을 요구해 왔으며(연방준비제도 SR 11-7), 이는 조직된 패널이 자동화하고, 지속적으로 만들며, 모든 중요한 답변으로 확장하는 요구사항입니다. 소비자법은 이미 인간의 퇴출을 보유합니다: GDPR 제22조는 상당한 영향을 미치는 전적으로 자동화된 결정에 대한 인간 개입의 권리를 부여하며, 불일치 시 상향 보고는 이 논문의 해석에 따르면 기존 법적 권리의 런타임 형식입니다. AI 법은 감시 측면에서 동일한 설계에 도달합니다: 규정(EU) 2024/1689 제14조는 고위험 AI 시스템이 효과적인 인간 감시를 위해 구축되도록 요구하며, 불일치를 표면화하고 미해결 사례를 인간에게 라우팅하는 아키텍처는 규정 준수 문서가 아닌 런타임 속성으로서 감시 의무를 구현합니다.
기록이 존재하면, 두 가지 파생 상품이 따르며, 둘 다 단기 추측입니다. 거래 수준 소액 보험은 특정 에이전트 구매를 증거 기록에서 책정된 센트 단위로 보험하며, 불투명한 에이전트에 대해서는 작성 불가능하고 재생 가능한 에이전트에 대해서는 사소합니다. 다른 하나는 에이전트 평판입니다: 종단 증거 이력은 자연스럽게 에이전트 및 오케스트레이터의 평판 점수로 집계됩니다. 운영의 부산물로서 감사 등급 이력을 생성하는 서비스는 경쟁사가 개조해야 할 자산을 보유할 것입니다.
이러한 종류의 인프라가 제도적으로 어떻게 되는지는 그 자체로 가설입니다. 이 논문이 걸고 있는 궤적, 먼저 제품, 그 다음 표준, 마지막으로 의무, 은 신뢰 인프라의 역사가 전시하는 여러 궤적 중 하나입니다(공유 ATM 네트워크, 나중에 규정에 의해 비준된 카드 네트워크 규칙집, 블록체인의 검증 공급은 여전히 수요를 기다리고 있습니다). 그것은 또한 뒤에 명명된 연구 프로그램을 가지고 있습니다. Hadfield의 규제 시장 라인, 공공 당국에 의해 허가된 민간 규제자, 부하 지지 기관으로서의 독립적인 검증 조직(Hadfield, 2017; Clark & Hadfield, 2020; Hadfield & Clark, 2026)은 거버넌스의 공급 측면에서 이에 도달합니다. 이 논문은 소비자 위임의 수요 측면에서 이에 도달하며, 두 프로그램은 영수증에서 만납니다. 아래에는 영수증이 제품 기능으로 판매되는 것이 제도로 경화되는지 여부라는 더 어려운 질문이 있습니다. 그렇지 않으면 거버넌스 장식으로 남아 있으며 거버넌스 계층이 아니므로, 이 논문의 중심 주장을 반박할 것입니다. 반박 지점은 사전 등록됩니다: 최소 두 개의 산업 표준이 에이전트 거래에 대한 추적 가능한 의사 결정 기록을 요구할 때, 세 가지 구성 요소 모두를 처리하는 서비스가 높은 지분의 에이전트 거래 볼륨의 대부분을 처리할 때, 그리고 최소 하나의 국가 규제자가 책임 할당에서 그러한 기록을 인식할 때 영수증을 거버넌스 계층이라고 부릅니다. 세 가지 모두의 지속적인 실패가 "장식"이 운영적으로 의미하는 것입니다. 검증이 인프라로서 성공하면, 그것은 상품화되고, 신뢰는 현재 아키텍처를 포함한 공유 유틸리티 자체로 이동하며, 인프라가 성공했음에도 불구하고 모든 해자를 끝낼 것입니다.
조직된 의사 결정이 잘못되면 누가 책임을 지는지는 여전히 열린 질문입니다: 오케스트레이터, 모델 공급업체 또는 에이전트를 승인한 소비자입니다.
법은 쉬운 퇴출을 막기 시작했습니다. 캘리포니아의 AB 316, 2026년 1월 1일 발효, AI 시스템을 개발, 수정 또는 사용한 모든 피고인이 AI가 자율적으로 해를 야기했다고 주장하는 것을 금지하며, 일반적인 방어 및 과실의 비교 배분은 그대로 유지합니다. 그것은 엄격한 책임을 부과하지 않습니다. 이렇게 하면 할당 질문이 피할 수 없게 되며, 법리가 어느 방향으로 정착하든 재생 가능한 기록은 책임의 모든 할당이 계산될 기반입니다. 법적 학문은 동일한 목적지에 도달하고 있으며, 고전적인 대리인 법 도구 키트는 AI 에이전트로 전이되지 않으며 필요한 것은 가시성 및 책임의 새로운 인프라(Kolt, 2025)라고 주장하고 있으며, 이는 거버넌스 문헌에서 이 논문의 주장의 가장 가까운 선행자이며, 이 논문이 접근하는 감시 공급의 측면에서 접근합니다. 건축학적 신뢰는 신흥 책임 학설이 타당성 있게 실행될 수 있는 증거 기반입니다.
측정 및 연구 의제
신뢰 측정의 경우. 표준 도구는 브랜드 또는 인터페이스에 대한 태도를 측정합니다. 측정할 가치가 있는 태도는 위임 의지이며, "당신은 이 AI를 신뢰합니까?"라는 질문에 대한 답변이 아닙니다: 소비자가 각 단계를 검토하지 않고 에이전트에게 넘길 의사 결정 클래스, 위험 수준은 무엇입니까? 위임은 행동적이며, 정당한 신뢰에서 단조이며, 직접 수익에 연결됩니다. 그 옆에 소비자가 답변이 어떻게 생성되었는지 알고 있는지, 기록에 도달할 수 있는지, 표면화된 불일치가 그들의 신뢰성 조정을 개선하는지 아니면 저하시키는지에 대한 질문이 있습니다.
설문조사는 인간 시대의 영수증이었습니다: 소비자가 검색, 비교 및 선택을 수행하는 동안 소비자에게 묻는 것은 무슨 일이 일어났는지 배우는 방어 가능한 방법이었습니다. 위임은 질문지가 심문하기 위해 구축된 행위자를 제거하므로, 에피소드의 주요 추적은 아키텍처가 생성하는 아티팩트가 되며, 영수증은 정확히 그 의미에서 위임된 시대의 주요 거래 추적입니다. 두 도구는 경쟁하지 않습니다: 영수증은 기계가 한 일을 기록하고 주관적 동화, 느껴지는 자율성 또는 인지적 부하에 대해 아무것도 말하지 않으며, 이는 여전히 설문조사의 영역입니다. (이것은 섹션 1과의 겉보기 긴장을 해결하며, 그 동기 증거는 그 자체로 진술된 선호도 설문조사입니다: 설문조사는 거의 존재하지 않는 시장에 대해 소비자가 현재 느끼는 것을 측정하는 반면, 영수증은 위임된 서비스가 존재하면 실제로 한 일을 측정합니다.) 그 교량은 동일한 에피소드의 태도 측정을 아티팩트와 결과에 따라 층화하여 쌍으로 지정하고 질문지와 기록이 동의하고 어느 것이 후속 위임 행동을 더 잘 예측하는지 추정하여 테스트할 수 있습니다. 제안된 결합은 설계상 이 검증의 일부를 수행하며, 그러한 연구가 존재할 때까지 아티팩트 기반 메트릭은 설문조사를 폐기하기보다는 보완합니다.
업계 조사는 이미 행동 기준선을 보여줍니다. 2026년 5월 공개된 Gartner 소비자 조사(미국 소비자 846명, 2025년 11월~12월 실시)에서 쇼핑 중 생성형 AI를 사용한 쇼핑객의 54%가 AI가 제공한 모든 정보를 다시 확인한다고 보고했습니다. 아키텍처 신뢰는 소비자가 이미 자신을 위해 하는 일의 상품화입니다.
측정 프로그램은 전체적 평가 운동(Liang et al., 2023)과 신뢰성이 12개의 지표로 분해되는 에이전트 신뢰성의 새로운 과학에서 자연스러운 동맹을 찾습니다. 왜냐하면 단일 성공률은 중요한 실패를 숨기기 때문입니다(Rabanser et al., 2026). 아키텍처 신뢰는 행동적으로 동일한 방식으로 작동합니다: 확신 오류율, 적절한 의존, 조언 가중치 변화, 재정의 비율, 의사 결정 시간, 그리고 특히 명확한 통계인 올바른 출력과 잘못된 출력 간의 승인률 격차로, 신뢰성 보정을 행동에서 직접 읽습니다. 기록 쪽에는 증거 범위, 측정된 패널 차이, 영수증 접근 비율이 있으며, 같은 에피소드에 대해 조사, 행동 및 로그를 삼각측량합니다. 이 중 어느 것도 새로운 과학이 필요하지 않습니다. 필요한 것은 이것들이 참여가 아니라 신뢰 계층이 책임져야 할 숫자라는 결정입니다. 배포 지점에서의 제 관찰은 직관에 어긋나는 방식을 가리킵니다: 잘 제시된 불확실성은 제 적절한 의존을 증가시켰고, 시스템이 자신이 모르는 것을 눈에 띄게 알 때 저는 그 시스템을 더 신뢰했습니다.
신뢰가 위임 심리를 긴장시키는 유일한 심리는 아니기 때문에 의제에 속하는 하나의 추가 종속 변수가 있습니다. 소비자는 알고리즘이 생성한 결과에 대해 덜 긍정적으로 반응합니다. 왜냐하면 자신이 생성하지 않은 결과는 자신의 것으로 주장하기 더 어렵기 때문입니다(Yalcin, Lim, Puntoni, & van Osselaer, 2022). 위임은 의사 결정의 객관적 품질을 높이면서 그 주관적 소유권을 감소시킬 수 있습니다. 영수증은 그 갈림길에 앉아 있습니다: 한 방식으로 읽으면 저작권을 복원합니다. 다른 방식으로 읽으면 소비자가 아무것도 하지 않았음을 인증합니다. 어느 읽기가 우선하는지는 프레임워크가 이미 도구화한 설계 문제입니다: 증거 구성 요소는 무엇이 확인되었고 어떤 기준에 대해 확인되었는지 기록합니다(섹션 3). 영수증은 소비자 자신의 기준을 해당 기록에 전달하도록 구성되어 있습니다. 따라서 평가 기준의 저작권은 실험자가 발명하는 변수가 아니라 아키텍처가 노출하는 변수입니다. Yalcin et al.의 메커니즘은 자신이 생성하지 않은 결과는 자신의 것으로 주장하기 더 어렵다는 것이므로, 기준 저작권이 자연스러운 조절변수가 되고, P5는 의제의 부수적 지점이 아니라 소유권 심리에 대한 증거 구성 요소의 결과입니다. P5. 영수증 현저성은 결과 호의성과 상호 작용하여 위임된 결과의 주관적 소유권을 결정합니다: 호의적인 결과의 경우, 현저한 영수증은 소비자 저작권 기준을 인코딩할 때 소유권을 복원합니다(에이전트가 충족해야 할 기준은 내 것이었고, 그것이 충족했다는 증거가 여기 있습니다). 기준이 플랫폼의 것으로 읽힐 때 소유권을 감소시킵니다. 소비자 저작권 기준은 설계 조절변수입니다. Yalcin et al.의 효과는 소비자가 자신이 결정을 내릴 것으로 예상하는 곳에서 관찰되었으므로 P5는 그 경계로 범위가 정해졌으며 습관적 위임 하에서 반대로 될 수 있습니다. 영수증을 기존 프로세스 투명성 조작과 구별하는 것은 가정이 아니라 구현되어야 합니다. 영수증은 확인 가능하며 소비자 자신의 기준을 전달할 수 있습니다. 둘 다 생략하는 설계는 아키텍처 신뢰가 아닌 투명성을 테스트하고 있습니다.
투명성 문헌은 여기서 두 가지 주의사항을 제공합니다: 너무 많은 절차 투명성은 신뢰를 감소시킬 수 있으며(Kizilcec, 2016), AI 사용의 단순한 공개는 그것을 침식합니다(Schilke & Reimann, 2025). 두 번째는 증거 구성 요소의 경계 조건입니다: 13개의 실험에 걸쳐 AI 사용을 공개한 행위자는 그렇지 않은 행위자보다 덜 신뢰받았습니다. 이는 투명성 딜레마로, AI 관여를 더 눈에 띄게 만드는 것 자체가 신뢰를 낮춥니다. 그 페널티가 AI 관여의 신호에 부착된다면, 자신의 기계 장치를 전면에 배치하는 아키텍처는 그것을 더 확인 가능하게 만들면서도 신뢰를 감소시킬 수 있으며, 증거 구성 요소는 그것이 가장 현저한 곳에서 정확히 역효과를 낼 것입니다. 프레임워크의 답변은 입증되어야 하는 구별에 기반합니다: 검증성은 단순한 공개가 아닙니다. 영수증은 AI가 사용되었다는 선언이 아니라 답변이 어떻게 생성되었는지에 대한 확인 가능한 기록입니다. P2와 P3(H2의 사전 등록된 양측 검정, 공개 역효과를 사전에 보고 가능한 결과로 명명)은 구별이 행동적으로 그 가치를 입증하거나 실패하는 정확한 지점입니다. 확인 가능성이 신뢰를 구축합니다. 항상 존재하는 출처의 벽이 아니라 요청 시 제공됩니다. 기계 장치를 숨기거나 공고하는 것도 그 작업을 하지 않습니다. 어느 정도의 기록을 표면화할 것인지, 누구에게, 언제 표면화할 것인지는 그 자체로 설계 변수입니다.
증거가 공개 페널티를 악화시키기보다는 극복하기 위한 제안된 메커니즘은 검증성과 공개가 다른 심리 채널을 통과한다는 것입니다. 공개는 AI가 관여했다는 카테고리 레이블을 전달하며, Schilke와 Reimann의 증거는 이를 감소된 정당성과 연결합니다. 영수증은 절차를 전달하며, 이는 개방되고, 이의 제기되고, 재실행될 수 있는 기록입니다. 절차 공정성 문헌은 도전하고 확인할 수 있는 프로세스가 그것을 실행하는 행위자를 정당화한다고 합니다(Tax, Brown, & Chandrashekaran, 1998). 채널은 확인이 일어날 필요가 없습니다: 신뢰를 전달하는 것은 소비자가 확인이 존재하고 분쟁에서 개방 가능하다는 인식입니다. 검증의 가용성이 그 행사입니다. 이것은 정확히 위의 영수증이 검토 경제학에 할당한 소비자 기능입니다. 검토는 검토에 대한 비용이 존재하는 곳에 집중되며, 소비자는 검증을 부산물로 상속받으며, 기록을 문서로 읽기보다는 선택지로 보유합니다. 동일한 구별은 주관적 소유권(P5)에도 영향을 미칩니다: 공개 레이블은 결정을 기계에 귀속시키고 소유권을 감소시키지만, 소비자 저작권 기준을 인코딩하는 영수증은 에이전트가 충족해야 할 기준이 소비자 자신의 것이었음을 기록합니다. 두 채널이 실제로 분리되어 체크 가능한 절차에서 정당성이 상승하면서 단순한 공개로는 하락하는지 여부는 정확히 H2의 사전 등록된 양측 검정이 탐지하도록 구성된 것입니다.
제한 사항. 이 모델은 아키텍처 분석과 하나의 확장된 고위험 단일 운영자 배포로부터 도출되었습니다. 모든 경험적 기준점은 제가 구축하고 운영하는 그 하나의 스택에서 얻어졌습니다. 논문 자체에 적용하면, 그 보증은 자신의 격자에 의해 혼합됩니다: 한 명의 저자와 한 개의 스택(낮은 다양성), 봉인된 배포 기록 옆의 공개 재현 패키지와 출판까지 금지된 행동 등록(부분적 증거), 그리고 선언된 상업적 이해관계(손상된 중립성). 다른 스택에서의 독립적인 재현이 필요하며, 그 후에야 어떤 주장도 일반화될 수 있습니다. 배포 기록의 해시 앵커는 이후의 편집, 대체 또는 역행성 수정을 감지할 수 있도록 하므로, 봉인을 해제할 때 여기의 특성화는 확실히 변경되지 않은 증거물과 대비하여 확인할 수 있습니다. 읽자들은 봉인 해제까지 무결성은 검증할 수 있지만, 내용은 검증할 수 없습니다. 메커니즘 수치는 공개 모델 API에서 나오며, 파이프라인은 $15 이하로 수집을 종단간 재현합니다. 자극 렌더링은 인터페이스 혼동으로 남습니다: 소비자 실험의 자극, 영수증의 스타일링 포함, 은 제 자신의 UX 렌더링이며, 인터페이스 수준의 혼동은 독립적인 렌더링을 통한 재현으로만 해결됩니다. 맹검 우선 수집, 위변조 증거 기록, 그리고 무이해관계 라우팅이 구성입니다; 집계 규칙과 상향식 임계값은 공학적 선택입니다. 실험의 패널은 배포된 오케스트레이션 루프가 아닌 하나의 맹검 수집의 분석적 조합이며, 초안 현장 텔레메트리 프로토콜이 그 격차를 닫습니다. 프레임워크가 이름 지은 비모델 검증 경로(섀도우 실행, 시간적 일관성 검사)는 여기에 설명되어 있으나 테스트되지 않았습니다. 수집은 온도 0에서의 단일 실행으로, 모델 내 가변성을 억제하고 공유 계통 상관을 제자리에 남기며, 호스팅된 API도 그곳에서 엄격하게 결정론적이지 않습니다. SimpleQA의 짧은 사실 답변은 합의가 오류를 인증하는 제약 답변 공간 체제 근처에 있으며, 어려움 계층화는 가장 어려운 오분위수에서 정확히 그 패턴을 보여줍니다. 중간 계층 패널은 오류 상관이 능력과 함께 증가하므로(Kim et al., 2025) 다양성의 이점을 과대 평가할 수 있습니다. 메커니즘 실험은 검증 가능한 단일 답변을 가진 개방형 사실 질문을 테스트하며, 답변 간의 의미적 동등성 자체가 판단의 문제인 개방형 생성 과제에서, 인증 신호는 가정되지 않고 재설정되어야 합니다. 관련 경계는 답변 공간의 차원성입니다: SimpleQA 항목은 단일 검증 가능한 답변을 가지는 반면, 소비자가 실행하는 선택은 많은 방어 가능한 답변을 가진 주관적, 다중 속성 효용 판단이므로, 합의가 선호도 공간에서 어떻게 작동하는지, 그리고 독립적인 에이전트 간의 동의가 그곳에서 더 나은 선택을 식별하는지는 미해결 경험적 질문입니다(의미적 동등성은 선호도 동등성이 되고, 등급 자체가 모델링 선택이 됩니다). 한 가지 레이블 노이즈 검사가 실행됩니다: 이 연구의 부표본과 SimpleQA Verified(Google DeepMind, 2025)의 351항목 교집합에서, 수정된 금본 레이블에 대해 모든 패널 답변을 재채점하면 인증 상향은 변경되지 않거나 약간 더 강합니다(2.7 → 2.8, 4.4 → 4.4, 4.0 → 4.3 세 패널에서, 결정론적 채점자), 따라서 레이블 노이즈는 상향의 원인이 아닙니다. 모든 신뢰도 수치는 단일 프롬프트 형식으로 유도된 0–100 자기 보고 구두화이며, 유도 프로토콜에 대한 민감도 자체는 공급자에 따라 다를 수 있으므로, 공급자별 판별 및 보정 결론은 고정된 공급자 특성이 아니라 이 구성에서 이 유도 프로토콜 하에서의 속성으로 읽혀야 합니다. 16개 모델 파동의 표 6–7의 자기신뢰 기준선은 원시 진술 신뢰입니다. Guo et al.(2017)의 전통에서의 더 강한 보정된 기준선은 기함 파동에서 실행되었으며(Platt 스케일링 및 분할 등분, 섹션 3), 여기서 게이트의 대체물이 아닌 보완물로 나타나며, 첫 번째 파동의 패널 대 자기 비교는 소비자 제품이 실제로 배포하는 기준선에 대해 읽혀야 합니다. 헤드라인 게이트 추정값(−82.1% 자신감 있는 실패, 부트스트랩 95% CI [79.9; 84.1] 10개 완전한 팔에 대해, [80.0; 84.2] Meta 팔 포함)은 단일 사전 지정된 수량이며, 주변 분석(임계값 민감도 격자, 어려움 및 오염 계층, 위원회 절제 및 자명한 기준선 비교)은 다중 비교에 대한 어떤 수정 없이 보고된 기술적 견고성 검사이며, 자신의 확인 상태를 주장하지 않습니다. 논문의 유일한 가족별 오류 제어는 소비자 실험의 사전 등록된 {H1, H2}에 대한 Holm 수정입니다. 자신감 있는 추측을 보상하는 평가 체제가 수리되어 진실성을 모델에 훈련할 수 있다면(Kalai et al., 2025), 아키텍처는 더 저렴한 솔루션을 가진 문제에 대해 보호할 것이지만, 증거와 중립성은 모델 수준의 어떤 수정으로도 축소될 수 없을 것입니다. 추가 경계는 보고되는 위치에 명시됩니다: 기함 파동의 적용 범위 제한(섹션 3: 접근 불가능한 2개의 중국 기함과 1개의 중단된 Meta 수집), 그리고 예비 233쌍 추론 예산 비교로, TOST는 ±5포인트 마진에서 동등성을 제한하지만 더 좁은 범위에 대한 검정력이 없습니다. 위임 측정은 가설적 시나리오에서 나오며, 여기서 진술된 측정은 메타 분석(Schmidt & Bijmolt, 2020)에 따라 실제 의지를 약 21%만큼 과대 평가합니다; 소비자 실험은 6개의 고정 항목에 대해 200명의 등록된 참가자 중 119명의 1차 및 133명의 풀링을 달성했습니다. 상거래 기질 재현은 메커니즘을 벤치마크 이상으로 확장합니다: 신선한, 사전 동결된 267개의 Wikidata 검증 제품 사실(특정 회사가 주어진 자동차 또는 항공기를 제조하는지, 휴대폰이 무엇을 운영하는지, 어느 회사가 게임을 출판했는지, 언제 출시되었는지) 집합으로, 기함이 아닌 소비자 대면 에이전트가 실제로 운영하는 비용 최적화 계층에 대해 맹검으로 실행되며(Claude Opus, GPT-5.4, Grok, Qwen, GLM, 및 Mistral), 분열을 재현하며, 교차 모델 동의는 진술 신뢰도에 대해 0.63–0.70 대 AUROC 0.77–0.81에서 정확성을 예측하고 4–6배 인증 상향으로, 미국, 중국, 유럽 연구소를 포괄하는 3~6개 모델의 독립적으로 구성된 패널에 걸쳐 견고하며, 채점 엄격성에 대해(여기의 결정론적 문자열 일치가 주된 보수적 규칙), 상거래 스펙트럼의 주관적, 다중 속성 끝(선호도 트레이드오프, 적대적 판매자 인센티브, 그리고 변화하는 재고에 대한 도구 기반 검색)은 테스트되지 않습니다.
샘플링 하에서의 런-투-런 분산. 분산 팔(variance arm)은 단일-결정적-런 경계를 직접 조사했습니다: 어려움별 계층화된 100개 질문의 부표본(5개 어려움 분위수 × 20, seed 20260806)을 온도 0.7에서 11개의 플래그십 웨이브 패널 모델 중 9개에 대해 질문당 3개의 독립 표본으로 재실행했습니다. Meta의 엔드포인트는 접근할 수 없었고, Claude Fable 5의 API는 온도 매개변수를 노출하지 않습니다. 전반적으로 세 표본 모두 질문의 22–77%(중앙값 54%)에서 상호 동등한 답변을 생성했고, 질문당 정확도는 질문의 63–97%에서 세 표본 간에 동일했으며, 온도-0 답변은 질문의 40–85%에서 다수 온도-0.7 답변과 일치했습니다. gpt-5.6-sol의 분기에는 교란요인이 있습니다: 이는 추론 노력 없음에서 실행되었으나, 1,500개의 웨이브 레코드 중 1,486개는 기본 노력(위에서 언급한 대로 중간)을 사용했습니다. 이 부표본에서의 92.0% → 46.3% 정확도 델타는 따라서 온도와 추론 예산을 교란시키지만, 그 표본 간 일관성 수치는 영향을 받지 않습니다. 교란된 분기를 제외하고, 온도 0.7에서의 평균 표본당 정확도는 동일한 질문에서의 결정적 온도-0 정확도와 최대 14.0포인트 차이가 났으며(gemini-3.1-pro, 49.0% → 63.0%), 나머지 7개 모델은 4.4포인트 이내였습니다. 패널 수준에서 의회 게이트(kimi-k3, deepseek-v4-pro 및 gpt-5.6-sol 간의 3방향 답변 합의)는 온도 0에서 부표본의 31.0%에서 열렸으며, 3개의 온도-0.7 실행 전반에 걸쳐 25.0%, 23.7% 및 29.8%였습니다. 헤드라인 결과의 기저가 되는 합의 신호는 샘플링 노이즈 하에서 안정적입니다.
주장의 증거적 지위. 주장은 3가지 증거 수준에 있습니다. 이 데이터에 의해 확립됨: 독립적 합의가 모델의 자기 보고가 하지 않는 정확도 신호를 전달한다는 것(명시된 경계 조건 하에서: 맹검 수집, 역량 있는 검증자, 단일 검증 가능한 답변을 가진 개방형 사실 질문); 고정된 불합의 게이트가 상당한 명시된 커버리지 비용으로 자신 있는 실패의 대부분을 제거한다는 것(−82.1% at 30.5% 커버리지); 그리고 강한 경계 조건 자체: 합의는 제한된 답변 공간에서 오류를 인증하고, 원시 인증 향상은 어려움과 함께 단조롭게 감소하며(수집 내 계층화 하에서 가장 어려운 분위수에서 사라지고, 외생적 계층화 하에서 양수이지만 가장 약함), 검증자 역량이 인증 가치를 제어합니다. 행동 실험에 의해 뒷받침됨(1가지 설계, 적당한 단일 연구 규모, n = 119): 실제 교차 모델 불합의를 드러내면 양방향으로 의존 보정이 개선된다는 것(d = 0.67, Holm p = .0005; 6개 항목 중 1개가 수행; 메인 웨이브 조작 검사 88–98%; 척도 신뢰성 α = .83–.93); 그리고 등록된 결정적이지 않은 귀무가설로서, 정적 초기 노출 영수증이 위임을 감지할 수 있게 움직이지 않는다는 것. 이론적으로 제안됨, 아직 테스트되지 않음: D×E×N 상보성; 중립성 효과(P3); 증가하는 위임 하에서의 신뢰 마이그레이션; 아키텍처 기반 신뢰의 실패 후 지속성(P4); 검증 가능성에 대한 지불 의향; 그리고 섹션 7의 시장 카테고리 주장.
자연스러운 다음 단계는 실험적입니다: 단일 모델 및 조율된 조건 전반에 걸쳐 신뢰, 의존 보정, 그리고 지불 의향을 측정하고, 불합의를 교대로 드러내고 억제합니다. 섹션 6은 실현된 실험을 보고하며, 사전 등록되고 동기 양립적입니다. 표준 선택 기반 결합 분석은 부분 가치를 가법적으로 추정하고 보상적 거래를 가정하는데, 이는 상보성 가설이 부인하는 것이므로 설계 클래스는 측면별 제거 또는 거래 중단 속성을 가진 강제 선택 설계 중 어느 것이든 비보상적 구조를 허용해야 하며, 명시적 상호작용 항으로 추정됩니다. 2가지 설계 계층이 명시됩니다. 최소 계층은 대상 프로파일 연구이며, 4–5개의 프로파일이 없음, 단일 구성요소, 2개 구성요소, 그리고 전체 구성을 포함하고, 이론적 작업은 1개의 계획된 대비(전체 구성의 효과가 구성요소 효과의 합을 초과함(초가법성))로 수행되며, 가법 귀무가설에 대해 진행됩니다. 전체 계층은 구성요소당 3개의 수준(부재, 현재이지만 검사할 수 없음, 현재이고 검사 가능)을 3×3×3 피험자 간 요인설계(27개 셀; 위험은 4개 수준 전반에 걸쳐 피험자 내에서 변함)로 교차시키며, 상호작용에서 검정력 ≥ 0.85를 위해 셀당 최소 80명의 응답자(N ≥ 2,160)가 있습니다. 이진 2³ 설계는 Cobb–Douglas 지수를 복구할 수 없으며 그럴듯한 효과 크기(d ≈ 0.3–0.4)에서 검정력이 부족합니다. 3가지 자극 규율이 적용됩니다: 아키텍처 크기 자체를 변경하고 그들의 레이블만이 아니라(누락된 영수증 레이블은 증거의 부재가 아니라 증거에 대한 소비자 무지), 각 구성요소에 검증 가능한 대 단순히 주장된 대비를 부여, 그리고 선택 데이터를 영수증 필드의 프로세스 추적과 쌍을 이루므로, 이론은 증거의 사용을 예측합니다. 제 지식으로는 이것이 3가지 구성요소를 공동으로 변경하는 첫 번째 설계일 것입니다. 단일 구성요소 구성 요소는 이미 가격이 책정되었으며(König et al., 2022; Ioku et al., 2024), 인접한 번들이 실행되었으므로(Cetinkaya & Krämer, 2024, 가장 가까운 도구이자 Köbis et al., 2025)과 함께 검정력 보정 소스), 연구가 명시되고, 검정력이 있으며, 실행할 준비가 되어 있습니다. 구성의 경계 조건은 다음과 같습니다: 아키텍처 신뢰는 위험이 낮고 거래량이 많은 곳에서는 가치가 없습니다; 검증자 풀이 작업 클래스에서 역량이 있지 않은 곳에서는 거의 추가되지 않습니다; 답변 공간이 엄격히 제한된 곳에서 오류를 인증할 수 있습니다; 그리고 패널 독립성이 측정되지 않고 주장되는 곳에서는 저하되며, 개방형 레드팀 질문 조작된 영수증이 무엇처럼 보이나요?로 가장 날카롭습니다. 하이퍼링크가 권위 신호가 되면 링크 팜이 이를 제조하기 위해 나타났으며, 합의 기록은 자신의 조작을 초대할 것으로 예상되어야 합니다. 2가지 시간 경계도 적용됩니다: 신호는 주의를 얻지만 증거는 지속성을 얻으므로, 주장은 어떤 신뢰가 실패를 견디는지와 관련되며, 어떤 신뢰가 가장 빨리 탑승하는지는 아닙니다. 그리고 일하는 검사도 Chandra et al. (2026) 모델링하는 종류의 나선을 늦출 수만 있습니다. 결과가 집중되고 독립성이 실제인 곳에서, 아키텍처 신뢰는 그 비용과 그 이름을 벌어들입니다(표 12가 4가지를 수집함).
표 12. 경계 조건: 아키텍처 신뢰가 가치 있지 않은 곳
| 조건 | 왜 그 곳에서 실패하는가 | 증거 |
| 낮은 위험, 높은 거래량 | 검증 비용이 오류의 비용을 초과함; 단일 모델 서빙이 옳은 답변 | 손익분기점 논리(그림 14) |
| 작업 역량 이하의 검증자 풀 | 독립성이 역량 없이는 신호를 전달하지 않습니다 | 지역 수준 널: 합의 여부와 관계없이 46% 정확도 |
| 엄격하게 제한된 답변 공간 | 합의는 오류를 포착하기보다는 인증합니다 | 합의 오류: 객관식 4.0–7.9% vs. 개방형 0.5–2.2% |
| 주장되었지만 측정되지 않은 독립성 | 거의 복제본인 패널이 자신감을 만듭니다 | 상관된 오류; 블록 및 계보 널 |
마지막 경계는 제안된 설계 중 어떤 것이 식별할 수 있는지와 관련됩니다. 에이전트 시장에서의 신뢰는 결국 균형 객체입니다. 판매자, 플랫폼 및 경쟁 에이전트가 검증 아키텍처에 적응하면, 그 효과는 처리 셀이 아닌 적응된 시장의 속성입니다. 관찰 데이터는 선택을 상속받습니다. 신뢰가 이미 깨지고 있는 곳에서 검증이 먼저 채택되기 때문입니다. 단위 수준의 무작위화는 선택을 수정하지만 간섭에서 멈춥니다. 영수증으로 무작위화된 소비자들도 모든 사람의 영수증에 반응하는 판매자들이 있는 시장에서 거래하기 때문입니다. 균형 수량은 클러스터, 스위치백, 이부 또는 시장 수준 설계가 필요합니다. 신뢰를 측정하는 것이 아니라 아키텍처를 무작위화하는 것이 다음의 어려운 문제입니다. 초기 에이전트 상거래 코호트는 신뢰 성향에 대해 자기선택을 하므로, 초기 도입자에게서 추정된 효과는 모집단 효과를 추정하기보다는 경계합니다. 중립성은 정확히 모델에 지분이 있는 누구도 이를 공급할 수 없기 때문에 가치가 있으며, 오케스트레이션에 지분이 있는 누구도 포함됩니다. 이 논증은 제가 구축하는 시스템의 종류도 설명합니다(저자 주). 그 관심은 증거의 재현성이 아닌 옹호에 관련됩니다. 평가된 모델은 독립적이고 공개적으로 접근 가능한 최첨단 시스템이며, 모든 보고된 수치는 동결된 복제 패키지에서 제3자에 의해 재계산 가능합니다. 옹호를 완전히 할인하는 독자도 여전히 측정을 검증할 수 있습니다.
6. 소비자가 신호를 사용할 수 있습니까? 예비 행동 테스트
소비자가 메커니즘이 확립하는 정확성 신호를 사용할 수 있는지는 별개의 행동 질문이며, 이에 대한 사전 등록된 인센티브 실험을 보고합니다. 실시된 연구는 일반 효과의 테스트보다는 존재 증명이며, 소비자가 신호에 대해 전혀 행동할 수 있는지를 묻습니다. 많은 항목, 자극 표본 추출이 있는 강력하고 확증적인 복제와 항목 무작위 기울기는 계획되어 있습니다. 최종 모집 기간의 호스팅 중단으로 수집이 계획된 200명에 대해 119명의 유효한 참가자에서 종료되었습니다(소프트 런칭 코호트 133명 풀링; 미국 및 영국; 에이전트 쇼핑 보조자 주변의 피험자 간 3가지 조건; 6가지 인센티브 있는 사실 시행에서 측정된 보정 Δ = P(accept | correct) − P(accept | incorrect), Schemmer et al., 2023의 적절한 의존 판별 지수). 완전한 방법, 파일럿, 등록에서의 5가지 편차, 윤리 및 면제 공개, 그리고 모든 보조 통계는 아래의 상세 보고서(§6.1–6.2) 및 복제 패키지에 있습니다.
표시된 모델 간 불일치는 전반적인 보정을 개선했습니다(대조 Δ = 0.24 → 0.45; d = 0.67, 0.68 풀링, p = .0001). 그러나 풀링된 추정치는 취약합니다. 6개 자극 중 1개인 단일 고자신감 불일치자 항목에 의해 수행됩니다. 여기서 디스플레이는 자신감 있는 잘못된 답변의 수용을 74%에서 24%로 감소시켰습니다(풀링된 코호트, 표 18). 해당 항목을 제거하면 효과가 d = 0.09(p = .54)로 떨어지는 반면, 다른 항목을 제거하면 효과는 그대로입니다. 이점은 영국 소표본에 집중되었습니다. 미국 대조 셀(n = 16)은 이미 기준선에서 판별했습니다(상호작용 p = .002). 패널 자체가 잘못된 답변에 동의한 유일한 항목에서, 디스플레이는 두 국가 모두에서 수용을 증가시켰습니다. 이는 섹션 3의 인증된 합의 오류 모드가 인간 행동에서 재현되고 그 자체로 하나의 발견입니다. 합의를 표시하는 아키텍처는 그 하나의 체계적 실패를 사용자에게 전달합니다. P2의 증거 구성 요소인 정적 오케스트레이션 영수증의 첫 노출 테스트는 위임 의사에 대해 감지 가능한 효과를 생성하지 않았습니다(d = 0.21, 이 검정력에서 결정적이지 않음; 분쟁 시간의 라이브 드릴다운 영수증이 등록된 후속입니다).
불일치 패널 디스플레이는 소비자가 수용할 가능성이 있는 경우 자신감 있는 잘못된 권장사항의 수용을 크게 줄일 수 있으며, 패널이 공유 오류를 인증하는 곳에서 실패합니다. 따라서 보정 대비는 이 6가지 자극에서 행동 지원을 받습니다. 인지된 위험을 중재자로 하는 P1은 이 테스트에서 지원되지 않습니다. P2–P4는 개방형 프로그램으로 남아 있습니다.
6.1 행동 테스트: 방법 및 파일럿
섹션 3과 5의 명제는 테스트 가능하도록 작성되었으며, 위의 측정 의제는 어떻게 하는지 명시합니다. 실험은 P1(표시된 불일치 하에서의 의존 보정) 및 P2(재생 가능한 레코드 하에서의 위임 의사)의 사전 등록된 인센티브 호환 온라인 테스트이며, 자극은 플래그십 파동의 실제 다중 모델 출력에서 추출되고, 두 번째 의견 패러다임(Detjen et al., 2025; Chen et al., 2026)을 실제, 인센티브 있는 최첨단 모델 불일치에 건축 구조 아래에 확장합니다. 도구, 프로토콜 동결, 파일럿, 주요 파동, 및 동결된 코드 분석이 완료되고 아래에 보고됩니다. 확증적 표는 [MAIN DATA PENDING] 표시된 셀이 있는 사전 등록된 골격으로 이 논문의 이전 버전에서 수행되었으며, 이제 동결된 분석 코드로 채워집니다. 가설에 불리한 2가지 결과가 보고 가능한 주요 발견으로 사전 등록되었습니다. 표시된 불일치로 인한 보정 악화(순 과소 의존) 및 영수증으로 인한 위임 의사 감소(공개 역효과); 둘 다 실현되지 않았지만 사전 등록된 하나의 널은 실현되었습니다.
방법.
설계 및 가설. 의존성 보정은 표시된 합의를 답변 정확성과 교차시켜야 하는데, 단일 사례는 이를 수행할 수 없습니다. 따라서 설계는 하이브리드입니다. 참가자는 먼저 쇼핑 위임 사례(AI 쇼핑 에이전트 "ShopAssist"가 $1,200 예산 내에서 노트북 구매를 추천하는)를 읽으며, 이는 P2의 주요 테스트이고, 그 다음 실제 다중 모델 출력에 대한 짧은 인센티브 판단 블록을 완료하며, 이는 P1의 주요 테스트입니다. H1 (P1): 여러 독립적인 AI 시스템의 교차 모델 합의와 불일치를 표시하면 소비자의 의존성 보정을 개선합니다(에이전트의 제안된 답변을 정확할 때는 더 많이 받아들이고 부정확할 때는 더 적게 받아들입니다). 단일한 자신감 있는 답변에 비해; 양측 검정입니다. 왜냐하면 문헌에서는 공동 제시 하에서 과도한 의존 감소와 과소 의존 증가 모두를 기록했기 때문입니다. H2 (P2): 오케스트레이션 영수증(누가 행동했는지, 어떻게 합의했는지, 무엇을 확인했는지, 그리고 완전히 재검증 가능한 기록)에 대한 접근은 표시된 불일치만의 효과를 넘어 중요한 구매에 위임할 의사를 증가시킵니다; 양측 검정입니다. 왜냐하면 공개가 신뢰를 낮출 수도 있기 때문입니다.
조건. 1:1:1로 무작위 배정되고 사례와 판단 블록 전체에서 일정하게 유지되는 3가지 피험자 간 조건: (1) 통제, 단일한 자신감 있는 추천, 아키텍처 신호 없음; (2) 불일치, 동일한 추천 앞에 3개의 독립적인 AI 시스템(시스템 A, B, C로 익명화)의 패널이 명시적 합의/불일치 표시, 시스템의 대안적 답변과 명시된 신뢰도, 그리고 평문 해결 요약이 포함됨; (3) 불일치 + 증거, 불일치 화면에 누가 행동했는지 / 어떻게 합의했는지 / 무엇을 확인했는지 / 완전한 기록으로 구성된 오케스트레이션 영수증 카드가 추가됨. 하나의 사전 등록된 설계 제약이 명백한 혼동 변수를 통제합니다: 최종 추천 블록(상품, 가격, 그리고 에이전트의 명시된 최종 신뢰도)은 모든 3가지 조건에서 사례와 모든 판단 시행에서 축어적으로 동일하며, 그 주변의 아키텍처 신호만 다릅니다.
자극 및 영수증. 판단 블록 자극은 모델이 고도의 명시된 신뢰도(95–100)에서 진정으로 합의하거나 불일치한 실제 사실 질문에 대한 3개의 최첨단 모델의 실제 출력입니다; 어떤 답변이나 신뢰도도 조작되지 않았습니다. 모델 이름은 브랜드 선호 혼동을 피하기 위해 중립적인 라벨로 대체되며, 매핑은 복제 패키지에서 공개됩니다. 조건 3에 표시된 영수증(하나의 사례 영수증과 6개의 시행 영수증)은 자극 패널의 실제 출처 로그에 대한 연구 배포의 프로덕션 영수증 생성기(스키마 `decision-receipt@v1`)에 의해 만들어지며, 그들의 검증 해시는 기록에서 진정으로 재계산 가능합니다(검증 로그: 7/7 유효). 따라서 실험의 증거 조작은 섹션 3이 정의하는 아티팩트의 사례입니다. 표시된 초점 신뢰도는 정확성 셀 전체에서 밀접하게 일치했으며(부정확 항목 95/98/99; 정확 항목 99/99/100), 처리 대비에 결정적으로, 조건 전체에서 동일했습니다. 통제는 동일한 초점 신뢰도를 보았고 훨씬 덜 판별했으며, 신뢰도 신호 설명은 이를 설명할 수 없습니다.
측정. DV1 (H2): 4개 항목 위임 의사 척도(7점; 예: "나는 ShopAssist가 나 자신이 추천을 검토하지 않고 이 구매를 완료하도록 하겠습니다"), 평균화; 단일 항목 위임 사다리(0–4, "추천만"에서 "환불 불가능한 구매를 포함하여 자율적으로 행동")는 보조적입니다. DV2 (H1): 6개 판단 시행; 각 시행에서 에이전트는 하나의 답변을 제안하고 참가자는 어시스턴트가 진행하도록 할지 여부(예/아니오)를 결정하고 답변에 대한 신뢰도를 평가합니다(0–100 슬라이더). 의존성 결정은 정확성 인센티브화됩니다(각 정확한 의존성 결정에 대한 보너스, 정확한 답변 수락 또는 부정확한 답변 거부). 제안된 답변은 정확히 6개 중 3개 시행에서 정확합니다. 참가자당 보정 점수는 Δ = P(accept | correct) − P(accept | incorrect)이며, 이는 적절한 의존성 문헌의 판별 지수입니다(Schemmer et al., 2023, 그들의 RAIR/RSR 측정이 동일한 대상을 분해함); 시행 수준 혼합 효과 모델은 항목 수준 해결을 복구합니다. 인식된 위험과 인식된 과정 통제(각각 4개 항목)는 P1 및 P2 경로에 대한 사전 등록된 2차 분석에서 매개 변수로 측정됩니다; 인식된 오케스트레이터 중립성(4개 항목)은 본 연구에서 조작하지 않는 P3의 탐색적 상관으로 측정됩니다.
동결된 프로토콜. 사전등록은 주요 데이터 수집 전에 동결되었습니다(분석 코드 및 프로토콜은 2026년 8월 5일 SHA-256으로 동결됨; OSF 등록은 8월 13일에 제출되었으며, 주요 웨이브는 8월 13-14일에 현장에 진입함; 프리프린트 공개 제한으로 등록됨(사전등록, 열람 전용: https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f), 논문의 공개 OSF 컴포넌트에서 공개될 예정, https://osf.io/jtvu9/). 6문항 세트는 시드로 동결되었습니다: 디자인으로 고정된 3개의 불일치 문항과 수작업 검증, 그리고 세 시스템 모두가 명시된 신뢰도 ≥ 95에서 동일하게 응답한 풀에서 시드 셔플로 추출한 합의 문항(1개의 진정한 합의 오류 포함)으로, 표시된 일치가 진단적이지만 불완전하고 소스 데이터와 정확히 동일합니다. 6개 문항은 모든 참가자에게 동일했으며, 제시 순서는 설문지에서 무작위화되었으나, 현장 수출은 문항별 표시 순서를 유지하지 않았습니다. 현장 표시는 패널의 추정된 독립성 점수를 표시하지 않았으며, 이는 프레임워크 자체가 요구하는 측정된 다양성 공시이므로, 참가자는 불일치를 보았지만 불일치하는 시스템들이 얼마나 독립적인지는 보지 못했습니다. 패널의 독립성은 측정되었지만 표시되지 않았으며, 소스 수집에서의 값은 여기에서 사후에 보고됩니다: 평균 쌍별 오류 상관 φ = 0.22(세 쌍에서 0.10-0.44, 같은 블록 멤버 두 개는 0.44로 가장 상관관계가 높음; 연구의 동결된 결정론적 채점자에 의해 등급화되어 응답의 95-98%를 해결하며, 미해결 나머지가 어떻게 코드화되는지에 무감각), 이는 패널을 독립과 멀고 클론과도 멉니다. 이것이 다음 설문지가 참가자 앞에 놓아야 할 숫자입니다. 하나의 자극 경계: 6개의 고정 문항으로, 처리-문항 변동은 추정할 수 없으므로, 효과는 이러한 자극에 대해 확립됩니다. 세션은 정보에 입각한 동의로 시작되어 소설식 구매의 가상적 성격을 공시하는 사후 설명으로 종료되었습니다. 이 연구는 헬싱키 선언에 따라 수행되었습니다: GDPR 준수 패널의 영국 및 미국 성인과의 익명, 최소 위험 설문 조사 동의, 플랫폼 최소 이상의 보상, 사후에 공시된 가상 소설식을 넘어 기만 없음. 이러한 기준에서 완전한 윤리위원회 검토 면제 조건을 충족했으며, 면제 평가는 사전등록에 문서화되어 있습니다. 풀은 현재 종료되었으며, 축자 문항 세트, 응답 및 문항별 영수증 식별자는 동결된 사전등록의 일부이며 데이터와 함께 공개될 것입니다.
표본 및 분석 계획. 목표 N = 200명의 유효한 참가자(미국 100명, 영국 100명; 별도의 Prolific 연구; 210명으로 모집 상한선), 18세 이상, 영어 능숙, ≥ 98% 승인률, ≥ 100회 사전 제출, 지난 3개월 이내 최소 하나의 온라인 구매. 사전등록된 제외(실질적 응답을 보기 전에 적용): 3개 중 2개 이상의 주의력 검사 실패; 3분 미만의 완료; 직선 응답; 조작 검사 실패(조건 2-3의 합의 문항, 조건 3의 영수증 문항, 제품 이해 문항); 판단 블록 이해 2회 실패; 중복 ID 또는 IP; 불완전한 세션. 확증 분석: H1의 경우, 국가 공변량이 있는 대조군 대비 풀된 불일치 조건(2 및 3)의 Δ에 대한 OLS; H2의 경우, 조건 2 및 3으로 제한, 국가 공변량이 있는 조건에 대한 위임 의사 합성에 대한 OLS; {H1, H2}에 걸친 Holm 보정, 가족별 α = .05; 견고성으로 Welch t-검증; 조작 검사 게이팅이 먼저 보고됨. 코호트 순서는 여기에서 고정됩니다: 주요 확증 분석은 파일럿의 소프트 런칭 참가자를 제외한 주요 웨이브 코호트에서 계산되며, 소프트 런칭 코호트를 확증 표본에 풀링하는 분기는 견고성 분석으로 함께 보고됩니다. 파일럿의 탐색적 Δ 기술통계는 주요 웨이브 전에 확인되었으므로, 해당 코호트를 주요 추정에서 제외하면 주요 등록 소프트 런칭 포함을 보고된 분기로 유지하면서 이중 침수의 소프트 형식도 제거됩니다. 주요 보고에는 사전등록된 프로토콜당 분석과 함께 모든 무작위화된 참가자를 유지하는 의도대로 치료 분석이 포함됩니다. 조작 검사 제외는 조건별 차등 이탈 검사와 함께 보고될 것이며, 아키텍처 신호 현저성은 조건 전체에서 자체로 달라질 수 있기 때문입니다. 민감도: 이 설계는 H1에서 d ≈ 0.42, H2에서 d ≈ 0.49를 검정력 .80에서 감지하며, 인접 신뢰 및 투명성 문헌의 중간 효과에 적절합니다. 더 작은 효과는 연구 의제의 전체 인수분해에 맡겨집니다. 3개의 사전등록된 요소는 확증 대조가 단독으로 답할 수 없는 메커니즘 질문에 답합니다. 설문지는 P1 경로에서 4문항 지각된 위험 척도(파일럿 α = .881)를 포함하므로, 위험 인식은 가정이 아닌 측정된 구성으로 분석에 진입합니다. 중재는 인식된 위험이 신뢰성에 미치는 불일치 효과를 중재하고 지각된 과정 통제가 위임 의사에 미치는 영수증 효과를 중재하는 것으로 2차 분석으로 사전등록되며, 부트스트랩 경로 분석으로 추정됩니다(PROCESS 모델 4, 5,000회 리샘플링). 조건 3 자극 화면에서의 시간은 영수증 읽기에 대한 사전등록된 프록시로 수집되어 참가자가 영수증을 처리 없이 통과시키는 인지 부하 대안에 대한 직접 검사입니다. 분석 코드는 데이터 수집 전에 동결되었으며 복제 패키지와 함께 보관됩니다.
파일럿(소프트 론칭): 기준 및 결과.
사전등록된 통과 기준이 미리 고정된 최종 설문지로 실행된 n = 20(미국) 파일럿은 2026년 8월 6일에 완료되었습니다. 표 13은 모든 기준을 그 결과에 대해 보고합니다.
표 13. 파일럿 수용 기준(사전등록) 및 결과(n = 20, 미국)
| 기준 (사전에 고정됨) | 결과 | 판정 |
| 조작 감지: 일치 확인에서 80% 초과 정답 (조건 2–3) | 81.3% (13/16) | 통과 |
| 조작 감지: 수령 확인에서 80% 초과 정답 (조건 3) | 88.9% (8/9) | 통과 |
| Cronbach's α > .70, 위임 의향 (4개 항목) | .854 | 통과 (.85 목표도 달성) |
| Cronbach's α > .70, 인지된 위험 (4개 항목) | .881 | 통과 |
| Cronbach's α > .70, 프로세스 제어 (4개 항목) | .965 | 통과 |
| Cronbach's α > .70, 중립성 (4개 항목) | .851 | 통과 |
| 중앙값 완료 시간 10-15분 | 9.60분 | 빠른 방향에서 24초 차이로 불합격 |
한 가지 기준이 불합격했습니다. 중앙값이 사전 등록된 창보다 24초 빨랐으며, 이 창은 과도한 길이에 대해 구성되었지 효율성에 대해서는 아닙니다. 빠른 꼬리에서는 부주의한 응답의 증거가 없습니다: 어떤 참여자도 3분 제외 기준 이하로 떨어지지 않았으며, 5분 미만인 한 참여자는 모든 주의력, 조작 및 이해도 확인을 통과했으며, 주의력 확인 통과율은 95-100%였으며, 주요 변수에 대한 누락 셀이 없었고, 중복 ID나 IP가 없었으며, 직선형 응답이 없었습니다. 모집 플랫폼 완료 시간은 설문 타이머를 독립적으로 확인합니다(중앙값 9.74분). 도구는 예산보다 현장에서 더 짧습니다. 조건 균형(조건 1/2/3 걸친 4/7/9)은 n = 20에서 1:1:1 무작위화와 양립합니다(χ²(2) = 1.90, p = .387). 사전 등록된 분석 제외 기준에 따라, 20명의 파일럿 참여자 중 6명이 확인 분석에서 제외됩니다(5명은 조작 확인 근거로, 1명은 두 번 실패한 이해도로), 14명이 남습니다. 소프트 론칭 규칙에 따라, 파일럿 코호트는 여기에 공개된 타이밍 편차 및 OSF에 2026년 8월 14일 03:09 UTC에 제출된 등록과 함께 풀링된 샘플로 진행되며, 이는 본 수집 전에 제출되었고, 소프트 론칭 파일럿이 명시된 타이밍 편차와 함께 확인 샘플에 포함된다고 명시합니다. 본 수집 코호트를 1차 확인 추정치로, 풀링된 분기를 견고성으로 취급하는 것은 사후 등록 분석 선택이며, 파일럿 기술통계가 본 수집 전에 확인되었기 때문에 취해졌으며, 두 분기 모두 보고됩니다. 제품 이해도 여유(80% 기준 이상의 한 참여자)는 본 수집에서 모니터링하도록 표시됩니다. 한 가지 탐색적 기술통계, 파일럿 n에서 추론 없이 보고됨: 보정 점수 Δ 조건별로 +0.33(대조군, n = 4), +0.52(불일치, n = 7), +0.22(불일치 + 증거, n = 9)로 실행되어, 불일치 조건이 H1의 방향으로 이동합니다. 파일럿은 더 이상 말할 수 없습니다.
6.2 행동 테스트: 결과, 탐색적 분석 및 남은 장부
확인 결과.
본 수집은 2026년 8월 13-14일에 실행되었으며(190개 슬롯: 소프트 론칭 코호트 위에 미국 85개 + 영국 105개), 완료되지 않았습니다: 설문 호스트가 최종 모집 창 동안 기술적 중단을 겪었고, 수집은 최대 200개 유효 대상 대신 158개의 완료된 세션(본 수집 138개, 소프트 론칭 20개)으로 종료되었습니다. 관찰된 결과에 응답하지 않고 사전 등록된 선택적 중지 규칙 하에서 플랫폼 중단으로 모집이 종료되었으나, 결과는 이미 그때쯤 확인되었습니다. 그 결과는 감소된 검정력입니다. 실현된 셀에서 최소 탐지 가능 효과는 등록된 d ≈ 0.42(H1) 및 d ≈ 0.49(H2)에서 동일한 검정력에서 대략 d ≈ 0.54 및 d ≈ 0.64로 상승하며, 이는 한 방향으로만 확인 결과를 무시하며, 아래의 모든 귀무 가설 및 탐색적 대조에 적용됩니다. 코호트 순서는 §6.1의 계획을 따릅니다. 파일럿은 한 가지 통과 기준(완료 시간 창, 빠른 방향에서 24초)을 놓쳤으며, 그 탐색적 기술통계는 본 수집 전에 확인되었으므로, 1차 확인 코호트는 본 수집 단독(N = 119 유효)이며, 동일하게 필드된 소프트 론칭 코호트를 다시 풀링하는 분기(N = 133)는 견고성으로 보고됩니다. 아래의 모든 숫자는 데이터 수집 전에 SHA-256으로 고정된 분석 코드의 출력입니다. 등록으로부터의 편차, 한 곳에 수집됨: (i) N 부족(등록된 200개 중 133개 유효; 호스팅 중단); (ii) 파일럿의 완료 시간 기준이 빠른 방향에서 24초 불합격; (iii) 필드된 내보내기에서 보유되지 않은 시행별 표시 순서; (iv) 캡처되지 않은 화면 수준 타이밍; (v) 변분 근사치에서 실행된 시행 수준 혼합 모델(패키지의 최종 엔진은 다를 수 있음). 다른 것은 편차가 없습니다. 모든 확인 테스트는 등록된 대로 실행되었으며, 위의 1차 코호트 결정이 유일한 사후 등록 분석 선택입니다.
표 14. 샘플 흐름 및 제외(본 수집; 주석에 소프트 론칭 코호트)
| 미국 | 영국 | 합계 | |
| 완료된 세션 | 50 | 88 | 138 |
| 제외: 주의력(3개 중 ≥ 2개 확인) | 0 | 0 | 0 |
| 제외: 속도(< 3분) / 직선형 응답 | 0 | 0 | 0 |
| 제외: 조작 / 이해도 확인 | 10 | 9 | 19 |
| 제외: 중복 / 불완전 | 0 | 0 | 0 |
| 유효 N(조건별 1/2/3) | 40(16/15/9) | 79(26/28/25) | 119(42/43/34) |
소프트 론칭 코호트는 20개의 완료된 미국 세션을 추가하며, 이 중 14개가 동일한 제외를 생존합니다. 이는 풀링된 견고성 분기(N = 133)에만 들어갑니다. 본 수집의 모든 제외는 조작 및 이해도 확인 규칙에서 나왔습니다. 어떤 참여자도 주의산만, 속도 저하, 직선형 응답, 중복 또는 불완전성으로 제외되지 않았습니다. 조작 확인 제어는 조건 간 비대칭을 보이지 않습니다(MC1 χ²(1) = 0.12, p = .73; MC3 χ²(2) = 3.67, p = .16, 제외 전 샘플에서 계산됨).
표 15. H1(P1): 조건별 신뢰도 보정 Δ(1차 코호트, N = 119)
| 대조군 | 불일치 | 불일치 + 증거 | |
| Δ, 평균(표준편차) | 0.238(0.332) | 0.465(0.274) | 0.422(0.299) |
| 과도한 신뢰: P(수락 | 부정확) | 0.603 | 0.434 | 0.510 |
| 과소 신뢰: 1 − P(수락 | 정확) | 0.159 | 0.101 | 0.069 |
| 확인 대조: 풀링된(2,3) vs 대조군, 국가 공변량이 있는 OLS | b = +0.217, 95% CI [+0.104, +0.330], Holm 조정 p = .0005(d = 0.67) |
표 16. H2(P2): 위임 의사, 수령 vs 불일치만(1차 코호트)
| 불일치(2) | 불일치 + 증거 (3) | |
| 위임 의향 종합점수, 평균 (표준편차) | 3.09 (1.61) | 3.45 (1.79) |
| 위임 척도, 중앙값 | 2 | 2 |
| 확인적 대비: 3 대 2, 국가 공변량이 포함된 OLS | b = +0.41, 95% CI [−0.35, +1.18], Holm 조정 p = .29 |
H1은 이 설계에서 캘리브레이션 대비를 통해 지지되며, 사전 등록된 인지된 위험을 통한 중재는 무의미했으므로 이 검정에 의해 P1은 기술된 그대로 지지되지 않습니다. 자신감 있는 단일 답변에 직면했을 때 참가자들은 거의 구분하지 않았습니다. 그들은 정답에서는 에이전트가 진행되도록 허용한 비율이 84%였지만 오답에서도 60%였습니다(Δ = 0.238, 95% CI [0.14, 0.34]; 처치 조건 0.465 [0.38, 0.55]와 0.422 [0.32, 0.52]). 불일치 표시는 캘리브레이션을 거의 2배로 증가시켰습니다(통합 Δ = 0.446; b = +0.217, p = .0002, Holm 조정 p = .0005; Welch d = 0.67). 그리고 그것은 양쪽 모두에서 동시에 그렇게 했습니다. 과도한 의존은 감소했습니다(60% → 43%와 51%) 한편 과소 의존도 감소했습니다(16% → 10%와 7%)(그림 20). 그 통합 평균은 단일 항목에 의해 운반되며 견고한 평균보다는 존재 증명으로 읽히는 것이 가장 좋습니다. 통제 참가자들이 74%에서 수용하고 있던 유일한 높은 신뢰도 이의 항목에서 표시는 오답의 수용을 24%로 감소시켰으며, 그 항목을 제거하면 확인적 대비는 더 이상 유의미하지 않습니다(d = 0.09, p = .54). 다른 단일 항목을 드롭하면 그것은 그대로 유지됩니다(d = 0.47–0.89). 아래의 탐색적 분해(표 17–18)는 효과를 항목별로 위치시킵니다. 그 집중은 국가 수준에서 보고된 동일한 여유 공간 의존성입니다. 표시는 캘리브레이션 간격이 열려 있는 곳에서만 캘리브레이션 간격을 닫으며, 6개 항목 중 1개가 그것을 넓게 열었습니다.
그림 20. 불일치 표시가 의존성에 미치는 영향(1차 집단)
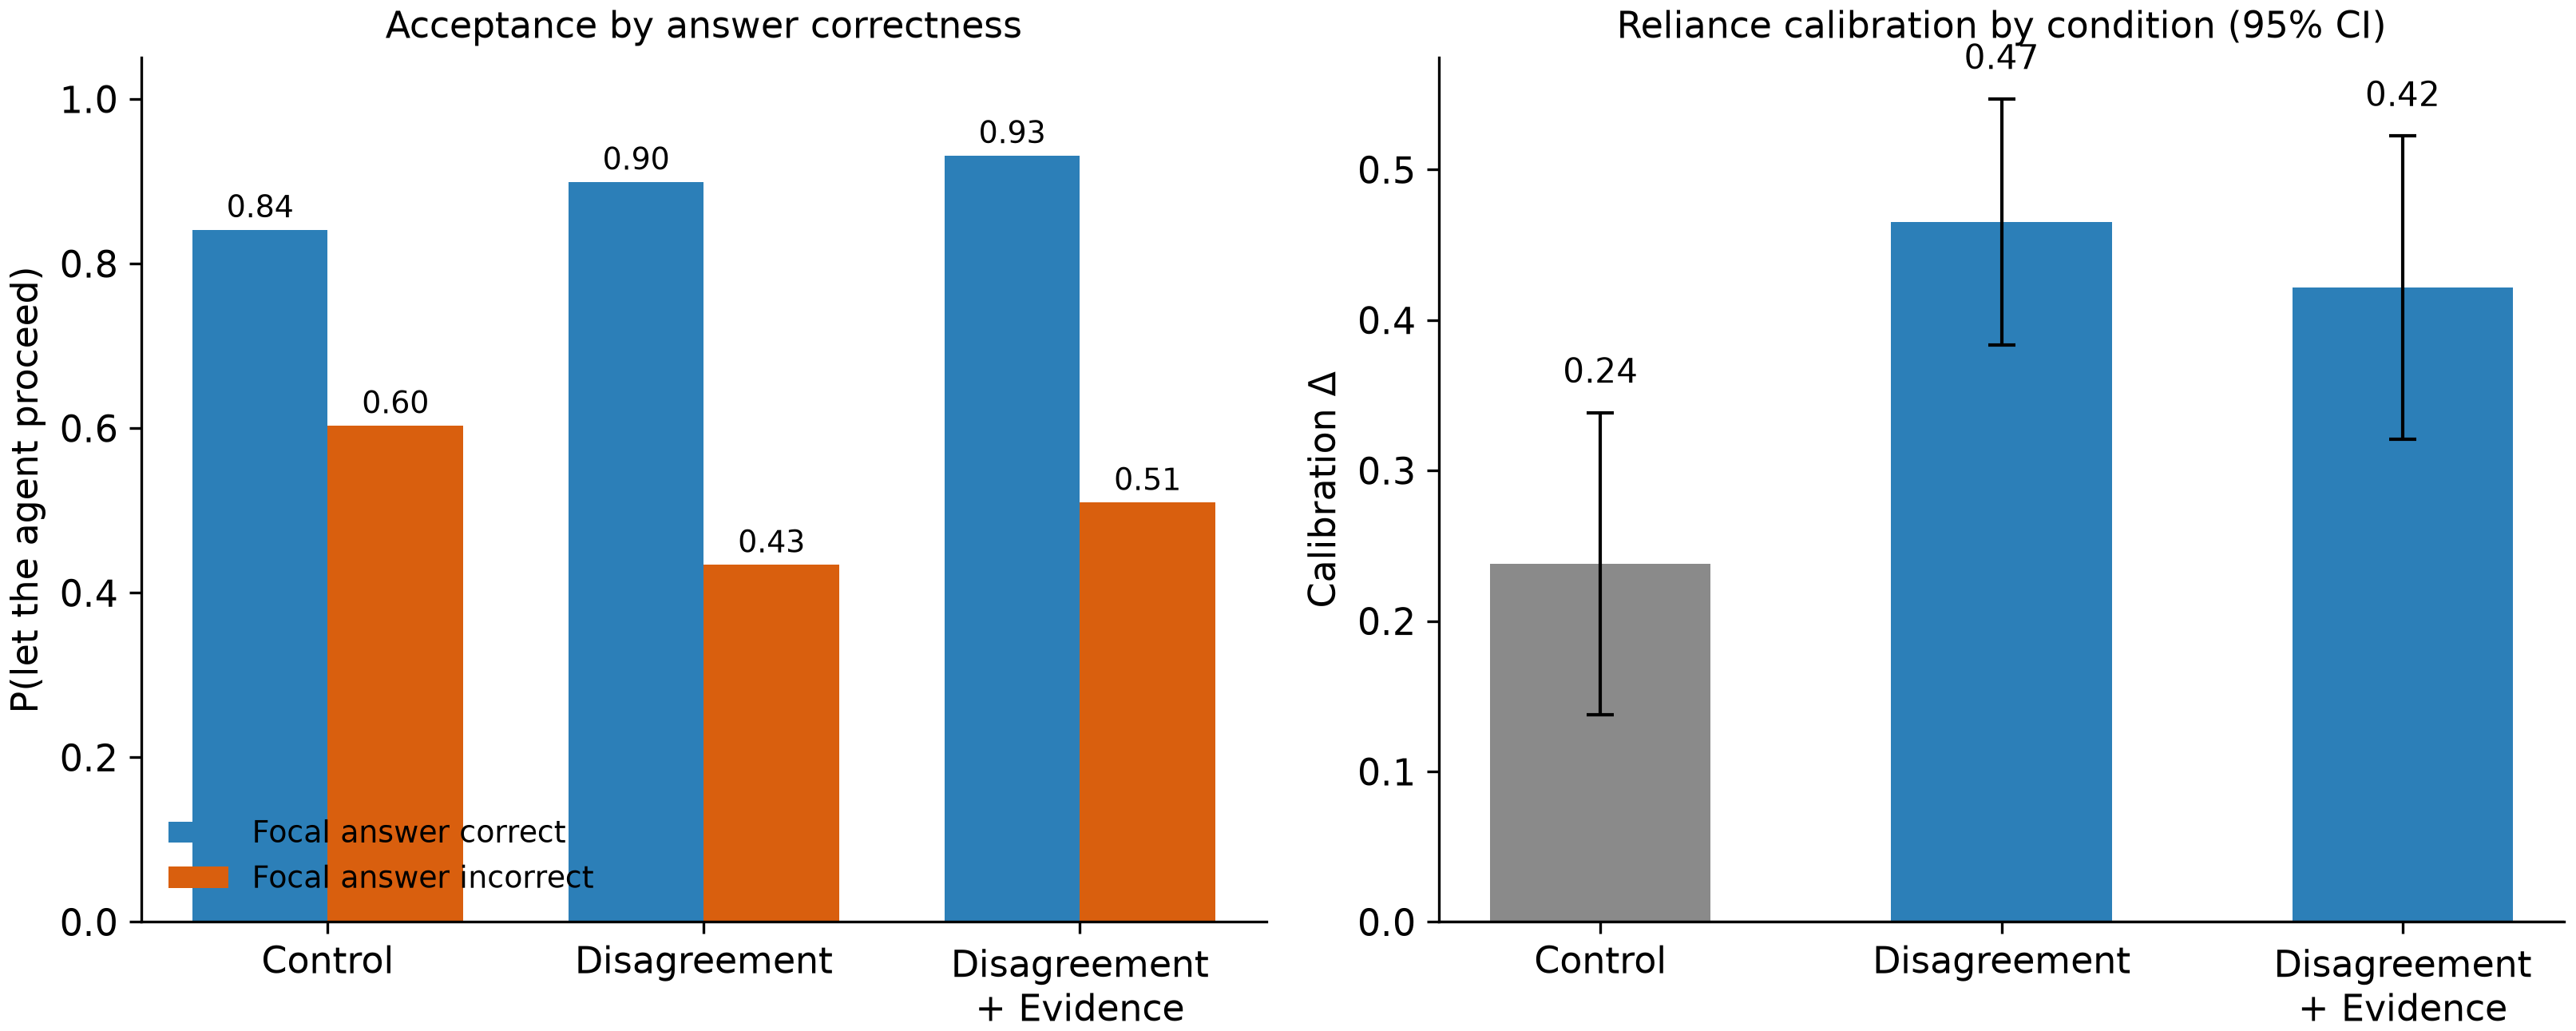
왼쪽: 조건별 수용률, 초점 답변이 정답인지 여부로 분할(캘리브레이션 = 막대 쌍 사이의 간격). 오른쪽: 조건별 참가자당 캘리브레이션 점수 Δ, 95% CI; 확인적 대비는 두 불일치 조건을 통제와 비교합니다.
사전 등록된 양측 프레이밍은 제2의견 문헌이 과도한 의존성 감소를 그 대가로 과소 의존성 증가를 구매하는 중재를 기록했기 때문에 존재했습니다. 이것은 그 대가를 지불하지 않았습니다. 신호는 참가자들을 더 회의적이지 않고 더 구분력 있게 만들었으며, 신호 탐지 분해는 집계 비율의 숫자를 붙입니다. 민감도 d′은 통제에서 0.74에서 처치 조건에서 1.44와 1.46으로 상승했습니다(반올림하지 않은 비율에서 계산). 한편 반응 기준은 거의 움직이지 않았습니다(−0.63 대 −0.56과 −0.76). 시험 수준 혼합 효과 모델은 동일한 구조를 복구합니다. 두 처치 조건 모두에서 큰 양의 정답성 × 조건 상호작용이 있습니다. 모든 등록된 분기가 동의합니다. 통합 견고성 분기(b = +0.215, p = .0001, d = 0.68), 및 점검 실패와 관계없이 모든 완료된 주요 파동 세션을 유지하는 의도-치료 분기(b = +0.2174 대 +0.2169 프로토콜당, p = .0001, n = 138). 제외는 조건 전체에서 균형을 이루었습니다(8/6/5; χ²(2) = 0.34, p = .85). 차등 손실 확인 §6.1은 약속합니다(조작 점검 제외는 치료 후 조건화입니다. Montgomery, Nyhan, & Torres, 2018 참조. 따라서 조건화되지 않은 분기의 동등한 지위). 하나의 설계 교란이 해석을 적격으로 만듭니다. 불일치 조건은 신호가 말하는 것뿐만 아니라 표시되는 양, 3개 위치와 신뢰도(1개 대신)에서 통제와 다르므로 캘리브레이션 이득은 원칙적으로 동의 신호의 내용보다는 정보 양을 반영할 수 있습니다. 두 가지 관찰은 양 해석에 반대합니다(그것을 해결하지는 못하지만). 효과는 표시된 신호 항목의 방향을 따릅니다. 항목별로, 오답 초점 항목에서 표시가 불일치를 보였을 때 수용이 감소했으며, 표시가 모든 시험에서 만장일치의 자신감 있는 동의를 보였던 유일한 항목에서 오답의 수용이 증가했습니다; 그리고 시험 수준 상호작용은 양 단독으로는 예측하지 못하는 답변 정답성입니다. 정보 양이 일정하게 유지되고 모든 시험에서 모든 시스템이 동의하는 깔끔한 구분력 있는 팔은 다음 파동에 대해 지정됩니다.
H2는 지원되지 않습니다. 이미 불일치 표시를 본 참여자들 중에서, 영수증은 실현된 힘에서 위임 복합 지표에 감지할 수 있는 영향을 미치지 않았습니다(3.45 vs 3.09; b = +0.41, p = .29; 풀링된 분기 b = +0.34, p = .33; 복합 신뢰도: 주요 파동 Cronbach α = .89). 세 가지 사전 등록된 이차 결과가 영값을 어떻게 읽어야 하는지를 결정합니다. 영수증은 수신되었습니다: 영수증 조건에서의 중앙값 세션 시간은 불일치 조건에서보다 약 1분 반 더 길었습니다(11.0 vs 9.4분; 화면 수준 타이밍은 필드 내보내기에서 캡처되지 않았으므로, 전체 기간이 등록된 자극 시간 프록시를 대신합니다). 추가 시간이 참여자들이 영수증을 사용했다는 것을 증명하지는 않습니다. 현장 영수증은 정적 카드였으며, 그 "전체 기록 보기" affordance는 설문 조사 내에서 활성화되지 않았으므로, 조작은 영수증의 존재를 테스트했으며, 사용을 테스트하지 않았습니다. 라이브 드릴다운 영수증은 다음 디자인이 포함하는 더 강력한 조작입니다. 이것은 하나의 정적 영수증 표시에 대한 영값이며, 기록, 확인 가능성 또는 P2의 작성된 대로에 대한 것이 아닙니다. 영수증은 또한 사전 등록된 매개변수를 이동했습니다. 인지된 프로세스 제어는 영수증 조건에서 증가했습니다(a = +0.60; 척도 신뢰도, 주요 파동: 프로세스 제어 α = .93, 위험 α = .83, 중립성 α = .90), 프로세스 제어는 강력하게 위임을 예측합니다(b = +0.60), 그리고 부트스트랩 간접 경로는 양수이며 0을 제외합니다(간접 = +0.35, 95% CI [+0.02, +0.78], 5,000 리샘플), 직접 경로는 거의 0입니다. 이것은 탐색적 매개변수 증거입니다: 매개변수는 처리 후 동일한 도구에서 측정되었으므로, 공통 방법 분산 및 역방향 해석이 남아 있을 수 있습니다. 민감도 한계는 이 영값이 정착할 수 있는 것입니다. 실현된 셀은 등록된 N에서만 0.80의 힘에서 d ≈ 0.49를 감지하므로, 매개변수 경로가 암시하는 크기의 영수증 효과는 정확히 이 샘플이 해결할 수 없는 크기입니다. 결과는 소형 및 중형 효과에 대해 불확실하며 더 큰 효과에 대해서만 결정적입니다. 공식적으로, 동등성 테스트는 효과를 오직 거칠게만 한정합니다(TOST는 α = .05에서 |d| < 0.64를 확립하며, |d| < 0.5는 아닙니다), JZS Bayes 계수는 BF₀₁ ≈ 2.9(풀링된 분기 3.1)를 제공하며, 표준 대역의 영값을 선호하는 일화적 증거입니다(일화/중간 경계 3에서 또는 바로 지나간 곳). 부재를 입증하지도 않고 존재를 지원하지도 않습니다. 측정 섹션은 많은 것을 예측했습니다: 확인 가능성은 온디맨드 속성이며, 그 가치는 분쟁, 청구 또는 감사의 순간에 표시되어야 하므로, 가상 구매에서 한 번 읽은 정적 영수증은 그것을 관찰하기에 잘못된 순간일 수 있습니다. 등록된 결론: P2의 첫 노출 테스트는 위임을 이동하지 못했으며, 영수증의 운영자 측 경제(섹션 5)는 이 소비자 측 결과에 달려 있지 않습니다. 두 가지 해석이 남아 있습니다: 증거 구성 요소가 결정의 순간에 프레임워크가 주장하는 것보다 덜 기여하거나, 이 조작화가 그것의 잘못된 테스트입니다. 분쟁 시간 계정은 영값의 해결이 아니라 이 섹션의 끝에서 명명된 후속 디자인으로 예약된 사후 가설입니다. 회피 문헌에서 세 번째 해석이 옵니다. 자세한 영수증은 현저함 조작이며, 정확히 위임의 순간에 소비자에게 얼마나 많은 일이 잘못될 수 있는지를 상기시키는 기계 장치의 노출이며, 절차적 세부 사항이 신뢰를 구축하기보다는 억누르는 투명성 역설입니다(Kizilcec, 2016; Dietvorst, Simmons, & Massey, 2015). 이러한 경쟁하는 해석들, 주장된 것보다 약한 구성 요소, 잘못된 순간 테스트, 그리고 현저함 역화는 다양한 예측을 하며 디자인으로 분리할 수 있습니다.
인증된 합의 오류 모드가 인간 행동에서 재현되었습니다. 하나의 인센티브 시행은 설계상 진정한 합의 오류를 수행했으며, 세 시스템 모두가 자신감 있게 동일한 잘못된 답으로 수렴하였으며, 메커니즘 연구가 측정하는 0.5–2.2% 개방형 합의 오류율을 반영했습니다. 그 시행에서, 하나의 항목과 따라서 추정치가 아닌 관찰, 불일치 표시는 누구도 보호하지 못했으며, 양국에서 방향성으로 잘못된 답의 수용을 증가시켰습니다(대조에 상대적으로 4 및 14 백분 포인트): 참여자들은 합리적으로 만장일치의 독립적 동의를 인증으로 읽었습니다. 그래서 아키텍처의 하나의 체계적 실패 모드는 높은 충실도로 그 사용자에게 전이됩니다. 섹션 3은 디자인 경고를 제공했으며, 합의는 패널의 다양성이 실패하는 정확히 그곳에서 오류를 인증하며, 프로브는 행동에서 동일한 실패를 보여줍니다.
탐색적: 보정 이점이 도착하는 곳.
다음의 모든 것은 탐색적이고 가설 생성적입니다. 국가 셀은 작으며, 아래의 모든 국가 내 p값은 설명적으로 읽어야 합니다. 보정 효과는 거의 전적으로 영국 샘플에 집중되었으며 미국 샘플에서는 부재했습니다:
표 17. 국가 및 조건별 보정 Δ(탐색적)
| 대조 Δ | 불일치(풀링된 2, 3) Δ | 국가 내 효과 크기 | |
| 영국(n = 79) | +0.103 (n = 26) | +0.447 (n = 53) | d = +1.19 |
| 미국(n = 40 주요 / 54 풀링됨) | +0.458 / +0.433 | +0.444 / +0.471 | d = −0.05 / +0.13 |
| 국가 × 조건 상호작용 | b = −0.36, p = .002 (주요); b = −0.31, p = .004 (풀링됨) |
분해는 상호작용보다 더 정보를 제공합니다. 미국 대조군 참가자들은 아키텍처 신호 없이도 이미 명확하게 판별하여 정답의 92%는 수용했지만 오답의 48%만 수용했으며, 영국 대조군 참가자들은 거의 판별하지 못했습니다(78% 대 68%). 불일치 표시 아래에서 두 국가는 항목별로 거의 구분되지 않았으며(모든 6개 시행에 걸쳐 최대 셀 차이 0.07), 중재는 두 표본을 동일한 보정 끝점으로 수렴시켰습니다(Δ ≈ +0.45). 이는 자신이 만들지 않은 기저 차이를 동일화했습니다(그림 21). 이 패턴의 일부는 기계적입니다. Δ는 제한되어 있으므로 기저 보정이 높아질수록 이용 가능한 여유가 줄어들고, "이득이 기저가 가장 약한 곳에 집중된다"는 것은 부분적으로 측정의 특성입니다. 그러나 천장만으로도 동일한 끝점이나 항목별 프로필 일치를 강제하지는 않습니다. 가장 방어 가능한 해석은 6개 항목이 한 패널이 보조 없이 판별하기에 충분히 쉬웠으므로, 디스플레이가 존재하는 보정 격차를 닫는다는 것입니다. 그 해석은 국가가 아닌 여유에 관한 것이며, 자극에 관해서도 마찬가지입니다. 항목 집합 자체는 문화적으로 편향되어 있었습니다(2개의 불일치 항목이 미국 국지적 콘텐츠를 포함했음). 따라서 수렴 프로필은 이 두 패널만큼 이 6개 항목의 특성입니다.
그림 21. 균일한 반응이 아닌 수렴(탐색적)
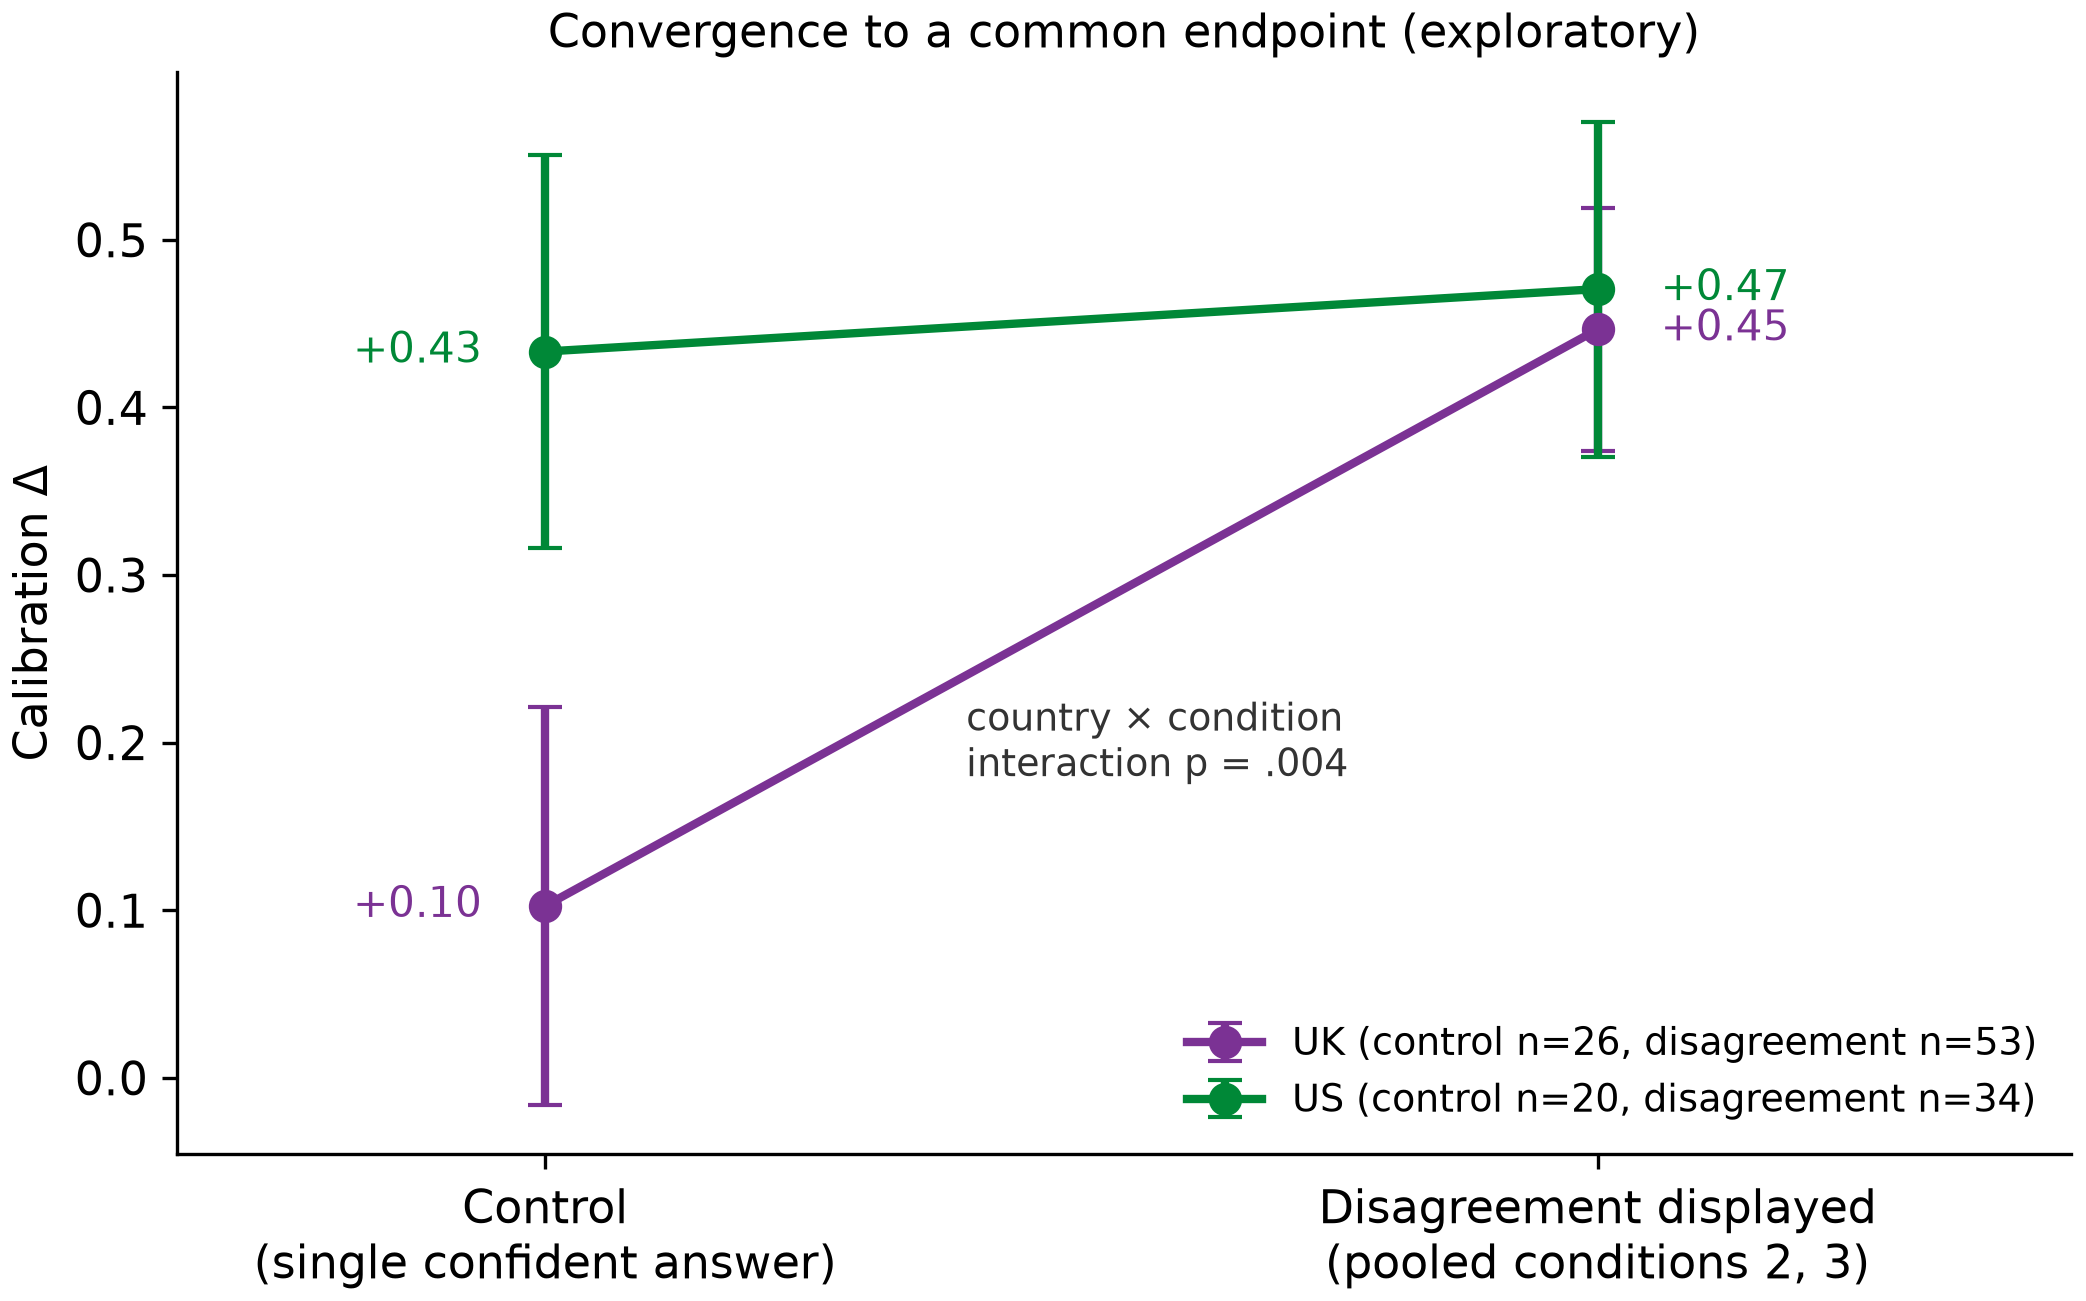
국가 및 조건별 보정 Δ: 미국 대조군은 이미 판별하며(Δ ≈ +0.45), 영국 대조군은 거의 판별하지 않습니다(Δ ≈ +0.10). 표시된 불일치 아래에서 두 국가 모두 동일한 끝점에 도달합니다(Δ ≈ +0.45). 이득은 기저 보정이 가장 약한 곳에 정확히 집중됩니다.
미국의 대조군 우위는 한편 개연성 있는 미국 국지적 콘텐츠를 가진 2개의 불일치 항목에 집중되어 있습니다. 하나는 박물관의 전제를 아는 누구에게나 오답인 "모나리자"가 터무니없는 나쁜 미술 박물관 질문입니다(미국 수용률 5% 대 영국 27%). 이 두 항목에 대한 집중은 국민 기질이 아닌 항목 수준의 친숙성을 시사합니다.
표 18. 항목 및 셀별 오답 초점에 대한 수용률(탐색적; 합계 코호트)
| 셀 | 불일치 오답, 신뢰도 95("모나리자" 항목) | 불일치 오답, 신뢰도 98(ICM-도시 항목) | 합의 오답, 신뢰도 99 |
| 영국 대조군(n = 26) | 0.27 | 0.85 | 0.92 |
| 미국 대조군(n = 20) | 0.05 | 0.60 | 0.80 |
| 영국 불일치(n = 53) | 0.21 | 0.25 | 0.96 |
| 미국 불일치(n = 34) | 0.18 | 0.24 | 0.94 |
중재의 보호 효과는 거의 전적으로 높은 신뢰도 불일치 항목(영국 −0.60, 미국 −0.36)에 있습니다. 합의 오류 항목에서 디스플레이는 두 국가 모두에서 수용을 약간 증가시킵니다. 만장일치 동의가 인증으로 읽혀지고, 메커니즘 연구의 인증된 합의 오류의 행동 이미지입니다. 보호 효과가 이 하나의 항목에 있으므로, 합계 확증적 대비는 제거 시 생존하지 않습니다(d = 0.09, p = .54). 다른 모든 단일 항목 제거 시에는 생존합니다(d = 0.47–0.89). 효과의 양적 형태는 하나의 항목에 의해 수행됩니다.
표 19. 국가별 태도 척도(탐색적; 합계 코호트): 격차는 태도가 아닌 행동적입니다
| 척도(1–7, 달리 표기되지 않은 경우) | 영국 평균 | 미국 평균 | 방향 |
| 노출 전 AI에 대한 신뢰 | 4.68 | 4.70 | 동일 |
| 위임 의향(합계) | 2.94 | 3.43 | 미국 더 높음(p = .08) |
| 위임 사다리(0–4) | 1.71 | 1.98 | 미국 더 높음(p = .08) |
| 인지된 위험 | 5.54 | 5.13 | 미국 더 낮음(p = .09) |
| 인지된 프로세스 통제 | 4.17 | 4.56 | 미국 더 높음(p = .14) |
| 인지된 중립성 | 4.75 | 4.62 | 유의하지 않음 |
존재하는 모든 태도 차이는 미국 회의론 설명에 대해 "잘못된" 방향을 가리킵니다. 미국 참가자는 위임 의향이 더 높고 위험을 덜 인지했으나 대조군에서 행동적으로 더 잘 판별했습니다. 측정된 태도는 이를 설명하지 못합니다. 기저 국가 격차를 인구통계 및 모든 5개 척도에 대해 조정하면 최대 15%만큼만 감소하며, 척도를 통한 부트스트랩 간접 경로는 유의하지 않습니다.
국제 간 조사는 태도 결론과 일치합니다. AI에 대한 신뢰 의사는 미국과 영국에서 본질적으로 동일합니다(41% 대 42%: Gillespie et al., 2025). 두 국가 모두 AI 신경과민증에 대한 동일한 고도의 경계 "영어권" 클러스터에 있습니다(Ipsos, 2025). 관찰된 방향을 가리키는 유일한 인구 수준 비대칭은 AI 리터러시입니다. 영국 응답자는 AI 사용 및 평가에서 기술과 자신감이 적다고 자보고했습니다(기술 36% 대 42%: Gillespie et al., 2025). 미국 성인은 조사된 가장 AI 노출이 많은 공중 중 하나입니다(Pew Research Center, 2025). 따라서 두 가지 설명이 탐색적 기록을 생존합니다. 친숙성 설명에서 AI 조언을 평가할 역량이 더 적은 인구가 구조적으로 평가하는 아키텍처에서 가장 많은 이득을 얻습니다. 다른 설명은 패널 구성입니다. 채용 플랫폼의 영국 지부는 더 오래되고 경험 많은 풀이며, 온라인 패널은 국가 간 추론을 위한 불완전한 도구입니다(Gvirtz & Sabherwal, 2024). 따라서 "국가" 레이블은 부분적으로 패널 재직 기간을 대리할 수 있습니다. 설계는 두 가지를 분리할 수 없으며, 어느 쪽 설명이든 실질적 발견은 보상적 프로필 자체이므로 분리할 필요가 없습니다. 셀 크기를 고려하면, 더 안전한 기본값은 통전된 복제가 말할 때까지 패턴을 이 두 패널의 특성으로 읽는 것입니다. 본 논문의 어떤 이론적 주장도 이에 의존하지 않습니다.
그 프로필은 과다 의존 개입의 기본 결과가 아닙니다. 인지적 강제 기능은 과다 의존을 줄이지만 이미 인지 필요성이 높은 사용자들 사이에 그 이점을 집중시키므로, 분석적 성향의 사람들은 더욱 분석적이 됩니다(Buçinca et al., 2021). 적응형 신뢰 보정 연구는 잘못 보정된 사람들을 대상으로 하는 것을 설계 목표로 간주하며 적극적인 모니터링이 필요합니다(Okamura & Yamada, 2020). 여기서 대상 지정은 자유로웠습니다. 표시된 불일치는 자기 촉발적입니다. 패널이 불일치할 때 정확히 나타나며 사용자에게 미리 아무것도 요구하지 않습니다. 그 이점은 기저 판별력이 가장 낮은 그룹에 정확히 도착했으며, 이미 보정된 그룹의 정확성을 훼손하지 않고 그대로 유지했습니다. 소비자 보호 메커니즘으로서 이는 사전에 지정할 수 있는 분배 프로필입니다. 도움이 오정렬이 집중된 곳에 집중되어 있고 이를 필요로 하지 않는 사람들에게는 세금이 없습니다.
사전 등록된 이차 분석: 남은 장부.
남은 사전 등록된 이차 분석은 한 곳에 있습니다(1차 코호트; 복제 패키지의 통합 분지 값). 지각된 위험을 통한 불일치 효과의 매개, 설계가 예상한 P1 경로는 무효입니다. 표시는 지각된 위험을 약간 감소시켰고(a = −0.40), 부트스트랩 간접 경로는 0과 구별할 수 없습니다(+0.006, 95% CI [−0.013, +0.029]). 보정 효과는 직접적이며, 참가자들이 불일치 패턴을 거래에 대한 일반적인 경보보다는 답변에 대한 정보로 사용함과 일치합니다. 조작된 것이 아니라 측정된 지각된 오케스트레이터 중립성은 상태와 국가를 통제하는 위임의사와 강한 상관관계가 있습니다(b = +0.47, p < .0001). P3이 예측하는 상관관계 흔적을 기다리면서 그 조작을 기다립니다. 위임 사다리는 합성물과 동일한 순서를 보여주지만 유의성에 도달하지 못합니다(순서 로짓, 영수증 대 불일치: b = +0.70, p = .11; 중앙값은 4개 중 2에서 동률). 등록되지 않은 조건 3 대 1 대비는 위임 방향으로 긍정적이고 유의하지 않습니다(b = +0.52, p = .15). 한 가지 편차: 필드된 내보내기는 화면 수준 타이밍을 캡처하지 않았으므로, 등록된 자극 영수증 읽기 프록시의 시간은 총 세션 시간으로 근사됩니다(위의 H2 아래 보고됨). 의도된 화면 수준 검사는 다음 파동의 도구에 내장되어야 합니다.
이 연구는 P1과 P2만 테스트합니다. P3은 측정되고 조작되지 않으며, P4와 섹션 5의 전체 공동 변형 결합은 지정된 다음 연구입니다. 삼부작의 행동 검증은 따라서 불완전합니다. 한 구성 요소는 지원되었고, 하나는 결론이 나지 않았으며, 하나는 측정되었지만 조작되지 않았습니다. 한 가지 종단 질문은 프로그램 위에 있습니다. 지속적인 불일치 표시는 알고리즘 감정과 일회용 혐오 사이의 진동에 대한 감쇠제로서 장기 채택을 안정화할 수도 있고, 기계 오류의 지속적인 노출을 통해 그 채택을 소진할 수도 있습니다. 단일 세션 설계로는 알 수 없습니다. 위의 결과로 동기가 부여된 두 가지 연구가 프로그램에 추가됩니다. 하나는 분쟁 시간 설계로 그 가치가 살아있을 것으로 예측되는 순간에 영수증을 다시 테스트하며, 거짓 영수증 제어, 해시가 다시 계산되지 않는 영수증을 사용하여 검증 가능성을 그 렌더링에서 분리합니다. 다른 하나는 위에서 보고된 국가 조정 복제입니다(표 17).
7. 결론
AI가 중요한 소비자 결정을 중재하고 점점 더 많이 그들을 내리면서, 나는 신뢰가 스택에서 위로 이동해야 한다고 주장했습니다. 모델에서 아키텍처로, 기록으로. 다양성, 증거, 중립성이 함께 신뢰성을 신앙으로 받아들이기보다는 확인할 수 있는 서비스를 생산합니다. 구축 중인 것은 더 나은 설득이 아니라 경제적 신뢰 인프라이며, 위임이 확장될 수 있게 하는 책임 추적 체계입니다. 주력 파동은 그것을 시장의 최상위에서 측정합니다. 파동의 10개 완전 주력 팔 전체에 걸쳐 통합되면, 각 실험실의 최고로 판매되는 모델은 명시된 신뢰도 ≥ 80에서 제공된 해결된 답변의 거의 절반에 대해 자신감 있게 틀렸습니다(46.6%. 해결되지 않은 항목이 오류로 다시 채점될 때 수치는 거의 움직이지 않습니다). 부분 Meta 팔은 별도로 보고되며, 이를 포함하면 수치는 실질적으로 변하지 않습니다. 훈련이나 조정이 없는 고정된 3모델 불일치 게이트는 명시되고 검사 가능한 커버리지 비용으로 이러한 오류의 5분의 4를 제거합니다. 여기의 기판이 순전히 사실적이기 때문에 그 비율은 혼합 상거래 작업의 상한으로 읽혀야 합니다. 상거래 자체에 대한 주장을 허락하는 것은 제한된 제품 메뉴에서 검색 근거, 도구 사용 복제이며, 여기서 합의 오류는 개방적인 사실 공간과 다르게 작동합니다. 사전 등록된 실험(섹션 6)은 동일한 아키텍처 신호를 소비자 앞에 놓았고 그들이 정확성 신호로 행동할 수 있다는 증거를 반환했습니다. 불일치 표시는 정규화 항목에서 자신감 있는 잘못된 권장 사항의 수락을 74%에서 24%로 감소시켰습니다. 탐색적 국가 분할에서 그것은 과다 의존하는 영국 셀에 집중되어 있으며 단일 항목에 달려 있습니다(통합 대비는 제거되어도 생존하지 않습니다, d = 0.09). 이는 이러한 자극에서의 존재 증명이지, 아직 일반적인 효과가 아닙니다. 자극 샘플링 확인 테스트가 계획되어 있습니다.
이 계층은 클라우드, 신원, 결제 인프라가 판매되는 방식으로 판매되어야 한다는 증거 인프라라는 시장 이름을 가집니다. 왜냐하면 동일한 종류의 질문에 답하기 때문입니다. "이것을 신뢰할 수 있으며, 우리는 어떻게 알겠습니까?" 이는 "이것이 똑똑합니까?"라는 질문과는 다른 질문입니다. 보안과 개인정보 보호는 모두 이 방향으로 갔습니다. 차별화 요인, 그 다음 기대, 그 다음 진입 요구 사항. 아키텍처 신뢰는 그럴듯하게 동일한 경로를 따를 수 있으며, 이미 보이는 규제 및 책임 압박에 의해 설정된 속도로 진행합니다.
소비자의 AI 서비스 신뢰 문제에 관해 이론적으로 제시하는 주장은 분석의 단위가 모델에서 아키텍처로 이동해야 한다는 것입니다. 신뢰와 관련된 속성들이 실제로 아키텍처에 위치하기 때문입니다: 검증의 독립성, 의사결정의 재현 가능성, 이해 상충의 부재. 모델은 모든 서비스에서 끊임없이 변화하며, 어떤 평판도 추적할 수 있을 만큼 빠르지 않습니다. 폐쇄형-개방형 성능 격차는 단 1년 사이에 8.04%에서 1.70%로 붕괴했으며(Stanford HAI, 2025), 엔터프라이즈 모델 시장의 리더십은 단 한 봄 사이에 바뀌었습니다(Kharazian, 2026). 이렇게 빠르게 상품화되는 계층은 신뢰가 닻을 내릴 수 있는 곳이 아닙니다. 소비자에게 필요한 것은 모델과 가격대를 넘어 라우팅되는 것이 점점 더 많아지고 있으며, 비용 주도적이고, 보이지 않으며, 검증되지 않는 것입니다. 그리고 선택된 최고의 모델은 점점 더 적은 수를 제공합니다. 남아있는 단계, 그리고 여기서 제시하는 단계는 최고로 라우팅되는 아키텍처에서 소비자, 보험사, 규제기관이 검사할 수 있을 정도로 충분히 오래 정지할 수 있는 검증 가능한 아키텍처로 이동하는 것입니다. 그 아래에는 AI 어시스턴트에서 AI 수탁자로의 전환이 있습니다. 수탁자는 어떤 분야에서든 그들을 구성하는 것은 재능이 아니라 의무입니다: 기록을 유지하고, 감사를 받고, 상충하는 이해가 없어야 합니다. 아키텍처 신뢰는 이러한 의무를 기계에 내장합니다.
동일한 요구 사항이 시스템 자체의 성장 방식에도 적용됩니다. 결과적 조치를 신뢰할 것을 요청하는 시스템은 검증 가능한 방식으로 성장해야 합니다. 오케스트레이션 계층에 대한 구성 변경은 보유된 증거에 대한 감사된 통계 게이트를 통해 커밋되거나 롤백되어야 하며, 자동화된 프로세스가 안전 규칙을 약화하지 않고 오직 추가하기만 해야 합니다. 사례 연구의 연구 배포는 이러한 게이트를 구현합니다.
AI 인프라는 이제 검증 계층이 필요합니다(Figure 16). 업계는 컴퓨팅 계층과 모델 계층을 구축했으며, 현재 오케스트레이션 계층을 구축하고 있습니다. 그 다음으로 검증이 옵니다. 즉, AI 시스템의 행동을 신뢰할 수 있게 하기보다는 검증 가능하게 만드는 메커니즘입니다. AI 신뢰의 근거는 평판 기반이 아닌 기계 검증 가능한 것이 되어야 합니다. 신뢰 자체는 인간의 것으로 남아있으며, 기계가 검증할 수 있는 것은 그것의 근거입니다. 이것이 맞다면, AI 인프라의 다음 필수 계층은 지능이 아니라 검증 가능성을 중심으로 구축될 것입니다.
Figure 16. 인프라 사다리
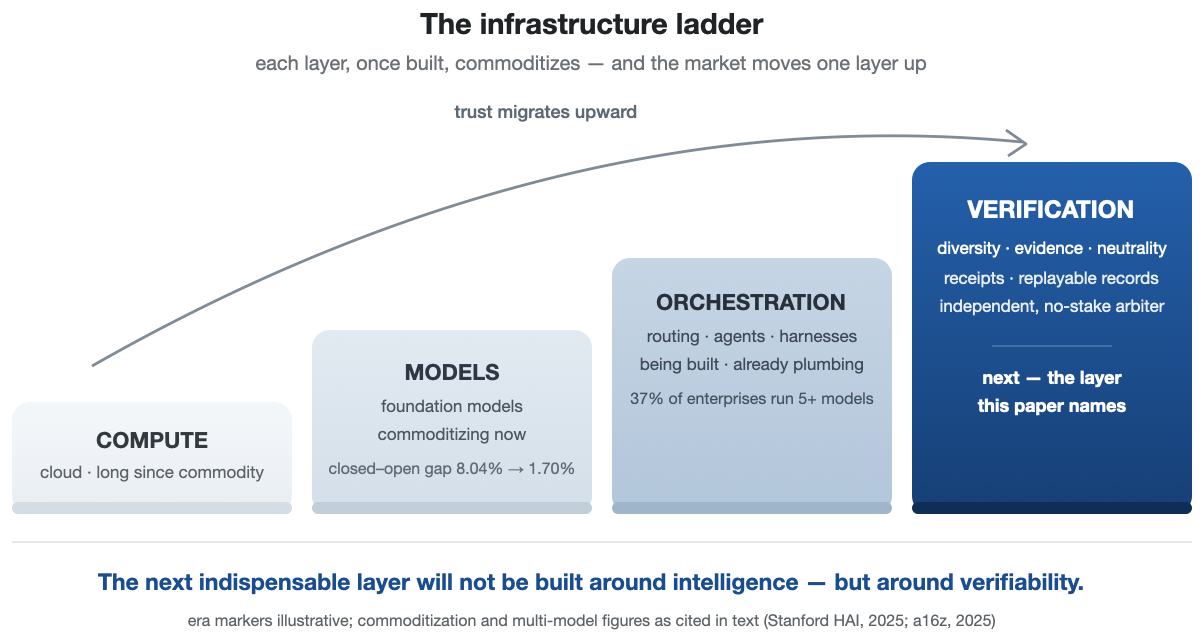
컴퓨팅, 그 다음 모델, 그 다음 오케스트레이션, 그리고 검증이 다음의 필수 계층입니다.
저자의 주석 및 공개
섹션 4에서 설명한 배포는 저자가 구축하고 운영하는 참조 구현입니다. 이것이 구현하는 방법은 공개되어 있으며, 저자는 이 논문이 검토하는 종류의 AI 오케스트레이션 및 다중 모델 검증 시스템을 다루는 미결 특허 출원(허가된 특허가 아닌)의 명명된 출원인입니다. 이것은 여기서 연구의 연구 도구로 작용하며, 저자는 이것이 구현하는 아키텍처에 개발자의 관심을 가지고 있습니다. 섹션 4는 독립적인 평가가 아닌 존재 증명 및 설계 증언으로 읽어야 합니다. 이 연구의 모든 모델은 벤더의 표준 상업 API를 통해 보통 조건으로 접근했습니다. 외부 자금은 이 작업을 지원하지 않았습니다.
도구 및 검증. AI 어시스턴트는 저자의 지시에 따라 도구로 사용되었습니다. 아이디어, 연구 및 결론은 저자의 것입니다. 부하를 견디는 사실적 주장은 가능한 경우 원본 자료와 대조하여 확인했으며 텍스트 내에 증거적 상태와 함께 기록되어 있습니다(언론 보도는 보도로, 주장은 주장으로, 사전 인쇄본은 사전 인쇄본으로). 또한 날짜가 기록된 주장 검증 로그는 원고의 작업 자료와 함께 유지됩니다. 실험의 정확성은 어떤 패널 모델에 의해서도 판단되지 않습니다(채점은 객관적인 문자열 일치 또는 로컬 오픈 가중치 등급 지정자입니다). 벤더별 차별화 및 보정 숫자는 주 텍스트에 인쇄되어 있으며(표 7 및 7a), 모든 보고된 숫자는 결정론적 복제 패키지에서 재계산 가능합니다(https://osf.io/jtvu9/에서 공개적으로 사용 가능).
데이터 및 코드 가용성
메커니즘 실험(3절)에서 보고된 모든 수치는 결정적 복제 패키지로부터 재계산할 수 있습니다. 여기에는 두 파동의 원본 모델 응답(16개 모델 컬렉션의 24,000개 답변 및 주요 파동의 채점 기록 포함), 컬렉션 실행기, 결정적 채점기, 분석 스크립트, 파생된 CSV 파일(위험-커버리지 곡선 및 26포인트 비용-정확도 경계선 포함, 각 포인트의 청구된 가격 대비 목록 가격 기준이 표시됨)이 포함됩니다. 이는 https://osf.io/jtvu9/에서 공개적으로 제공되며, 사전 등록 소스 프로젝트의 공개 구성요소입니다(폴더 `replication-package-v2`; 3절의 자체 보정 프로그램 아카이브는 이와 함께 보관됨). 고정된 SimpleQA 부분표본(시드 및 SHA-256 해시로 고정됨)은 이미 메커니즘 연구의 OSF 사전 등록에서 공개되어 있습니다(https://osf.io/4y9dv, 2026년 7월 23일 등록). 소비자 실험의 사전 등록은 OSF에 제한 공개로 등록되어 있습니다(주요 데이터 수집 전 고정됨; 등록 https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f). 참여자 풀은 폐쇄되어 있습니다. 설문 도구, 비네트 및 판단 블록 자극, 6절의 영수증 발행 기록, 고정된 분석 코드가 포함된 소비자 실험 데이터는 출판 시 동일한 OSF 구성요소로 공개될 예정입니다.
참고문헌
arXiv로 표시된 항목은 사전 인쇄본입니다. 업계 공지사항 및 2026년 보도 자료는 정착된 문헌이 아닌 동시대 보도이며 이와 같이 인용됩니다.
a16z — Andreessen Horowitz (2025). 2025년에 100명의 엔터프라이즈 CIO가 생성 AI를 구축하고 구매하는 방법. a16z.com/ai-enterprise-2025.
Accenture (2026). 내 AI 에이전트와 대화하기: 브랜드 가치의 새로운 규칙. 16개국 25,590명의 소비자 조사, 2026년 1월.
ACI Worldwide (2026). AI 기반 쇼핑 및 결제에 대한 소비자 태도. 2026년 6월 19-22일 실시한 2,080명의 영국 성인 대상 YouGov 설문. 보도 자료.
Ahmad Husairi, M., & Rossi, P. (2024). 구매 업무의 AI로의 위임: 인지된 선택과 결정 자율성의 역할. Decision Support Systems, 179, 114166. DOI 10.1016/j.dss.2023.114166.
AIUC (2025). AIUC-1: 에이전트 표준. Artificial Intelligence Underwriting Company.
Alavi, S., & Nozari, S. (2026). 에이전트가 당신을 위해 쇼핑할 때: AI 매개 시장에서의 역할 일관성. arXiv:2604.26220.
Allouah, A., Besbes, O., Figueroa, J. D., Kanoria, Y., & Kumar, A. (2026). AI 에이전트가 구매하는 것은 무엇인가? 에이전트 전자상거래의 평가, 편향, 모델 종속성 및 새로운 함의. ACM 웹 컨퍼런스 2026 논문집, 8697–8700. https://doi.org/10.1145/3774904.3792943
American Express (2026). American Express가 에이전트 상거래 경험(ACE) 개발자 키트를 공개하고 등록된 에이전트 구매에 대한 업계 최초의 보호를 발표합니다. 보도자료, 2026년 4월 14일.
Anderson, L. (2006). 분석적 자기민족지학. 현대 민족지학 저널, 35(4), 373–395.
André, Q., Carmon, Z., Wertenbroch, K., Crum, A., Frank, D., Goldstein, W., Huber, J., van Boven, L., Weber, B., & Yang, H. (2018). 인공지능과 빅데이터 시대의 소비자 선택과 자율성. 고객 니즈 및 솔루션, 5(1–2), 28–37.
Appenzeller, G. (2024). LLMflation의 시대로 환영합니다: LLM 추론 비용이 빠르게 하락하고 있습니다. Andreessen Horowitz, 2024년 11월.
Aubakirova, M., Atallah, A., Clark, C., Summerville, J., & Midha, A. (2026). AI의 상태: OpenRouter를 이용한 100조 토큰 실증 연구. arXiv:2601.10088(2025년 12월 발행 보고서).
Bain & Company (2025). 에이전트 상거래 시장 예측: 2030년까지 미국 전자상거래 3,000~5,000억 달러. 2025년 12월.
Bainbridge, L. (1983). 자동화의 아이러니. Automatica, 19(6), 775–779.
Balaskas, S. (2026). 추천에서 위임으로: 전자상거래의 에이전트 AI 매핑 및 그 소비자 효과에 대한 체계적 리뷰. 정보, 17(3), 222.
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. S. (2021). 전체가 부분의 합보다 큰가? AI 설명이 상호보완적 팀 성과에 미치는 영향. 컴퓨팅 시스템의 인간 요소에 관한 2021 CHI 컨퍼런스 논문집, 1–16.
Basu, A. (2026). 영지식 증명이 아닌 도구 영수증: AI 에이전트의 실질적인 환각 탐지. arXiv:2603.10060.
Board of Governors of the Federal Reserve System & OCC (2011). 모델 위험 관리에 대한 감독 지침 (SR Letter 11-7 / OCC 2011-12).
Buçinca, Z., Malaya, L. B., & Gajos, K. Z. (2021). 신뢰할 것인가 생각할 것인가: 인지적 강제 함수는 AI 지원 의사결정에서 AI에 대한 과도한 의존을 줄일 수 있습니다. 인간-컴퓨터 상호작용에 관한 ACM 회의록, 5(CSCW1), 1–21.
Burton, J. W., Stein, M.-K., & Jensen, T. B. (2020). 증강 의사결정에서 알고리즘 거부에 관한 체계적 리뷰. 행동 의사결정 저널, 33(2), 220–239.
California State Legislature (2025). Assembly Bill 316 (인공지능: 방어), Stats. 2025, ch. 672 (Cal. Civ. Code § 1714.46 추가), 2026년 1월 1일 발효.
Carlson, S. C. (2026). 디지털 시대의 신뢰 이동: 정보 체계와 구매자-판매자 관계의 변환. 대서양 마케팅 저널, 15(1), Article 6.
Castelo, N., Bos, M. W., & Lehmann, D. R. (2019). 과제 의존적 알고리즘 혐오. 마케팅 연구 저널, 56(5), 809–825.
Cetinkaya, N. E., & Krämer, N. (2024). 이해 대 신뢰: 결합 분석. 작업 논문, OSF 프로젝트 mw4dq.
Chandra, K., Kleiman-Weiner, M., Ragan-Kelley, J., & Tenenbaum, J. B. (2026). 아부하는 챗봇은 이상적인 베이지안에서도 망상적 소용돌이를 야기합니다. arXiv:2602.19141.
Chen, C., Sun, Y., Liao, M., & Sundar, S. S. (2026). AI가 의견이 다를 때: 두 번째 의견이 환자의 의사에 대한 신뢰에 미치는 영향. 국제 인간-컴퓨터 상호작용 연구 저널, 213, 103824.
Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026). 아부하는 AI는 친사회적 의도를 감소시키고 의존성을 증진합니다. Science, 391(6792), eaec8352. DOI: 10.1126/science.aec8352.
Choi, H. K., Zhu, X., & Li, S. (2026). 정체성이 토론을 왜곡할 때: 편향 감소 다중 에이전트 추론을 위한 익명화. 계산언어학 협회 제64차 연례 회의 논문집(제1권: 장편 논문), 14284–14311. https://doi.org/10.18653/v1/2026.acl-long.650
Choi, M., Kim, K., Chae, S., & Baek, S. (2025). 다중 에이전트 시스템에서의 집단 순응에 관한 실증 연구. 계산언어학 협회 결과: ACL 2025, 5123–5139. https://doi.org/10.18653/v1/2025.findings-acl.265
Clark, J., & Hadfield, G. K. (2020). AI 안전을 위한 규제 시장. arXiv:2001.00078.
CNBC (2026, March 24). OpenAI는 인스턴트 체크아웃 제공으로 어려움을 겪은 후 ChatGPT의 쇼핑 경험을 개편합니다(The Information의 2026년 3월 기본 결제 철회 기사 보도).
Daly, C. (2025). Klarna는 실제 인력 요청으로 AI 주도 구조조정을 둔화합니다. Bloomberg News, 2025년 5월 8일.
de Bellis, E., & Johar, G. V. (2020). 자율 쇼핑 시스템: 소비자 채택의 장벽 파악 및 극복. 소매 저널, 96(1), 74–87.
Detjen, H. H. J., Densky, L., von Kalckreuth, N., & Kopka, M. (2025). 두 번째 의견을 신뢰하는 것은 누구인가? 유방 촬영술 선별 후 생검 결정에서 의료 AI와 의사의 집단 의견 비교. CHI 2025.
de Visser, E. J., Pak, R., & Shaw, T. H. (2018). '자동화'에서 '자율성'으로: 인간-기계 상호작용에서 신뢰 복구의 중요성. 인간공학, 61(10), 1409–1427.
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). 알고리즘 혐오: 사람들은 알고리즘이 오류를 범하는 것을 본 후 오류를 범합니다. 실험 심리학 저널: 일반, 144(1), 114–126.
DigiCert (2026). AI 신뢰 아키텍처. 제품 발표, 2026년 4월.
Ding, K. (2026). LLM이 동의할 때 그들이 맞는가? 신뢰 신호로서의 자기 일관성 및 교차 모델 합의 감사. arXiv:2607.08065.
Dranove, D., & Jin, G. Z. (2010). 품질 공개 및 인증: 이론과 실제. 경제 문헌 저널, 48(4), 935–963.
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024). 다중 에이전트 토론을 통한 언어 모델의 사실성과 추론 개선. 제41회 국제 기계학습 컨퍼런스 논문집, PMLR 235, 11733–11763.
Endsley, M. R., & Kiris, E. O. (1995). 루프 밖 성능 문제와 자동화의 제어 수준. 인간 요소, 37(2), 381–394.
Errico, H. (2026). 자율 작업 런타임 관리(AARM): AI 주도 작업의 런타임 보안을 위한 시스템 사양. arXiv:2602.09433.
유럽 위원회 (2026). AI법 제50조에 따른 특정 AI 시스템의 투명성 의무 이행에 관한 지침. 2026년 7월 20일 채택.
Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). 의미론적 엔트로피를 사용한 대규모 언어 모델의 환각 탐지. Nature, 630(8017), 625–630.
Featherman, M. S., & Pavlou, P. A. (2003). 인지된 위험 측면에서의 전자상거래 서비스 채택 예측. International Journal of Human-Computer Studies, 59(4), 451–474.
Frank, D.-A., Folwarczny, M., & Otterbring, T. (2026). 온라인 쇼핑 환경에서 고자율 AI 어시스턴트의 소비자 수용은 인지된 이점에 의해 주도된다. Psychology & Marketing, 43(3), 538–555. https://doi.org/10.1002/mar.70074
Gartner (2025). Gartner, 2027년 말까지 40% 이상의 에이전틱 AI 프로젝트가 취소될 것으로 예측. 보도자료, 2025년 6월 25일.
Gartner (2026). 쇼핑에서의 생성 AI에 관한 소비자 조사 (2026년 5월 보도자료).
Gefen, D., Karahanna, E., & Straub, D. W. (2003). 온라인 쇼핑에서의 신뢰와 TAM: 통합 모형. MIS Quarterly, 27(1), 51–90.
Geifman, Y., & El-Yaniv, R. (2017). 심층 신경망을 위한 선택적 분류. Advances in Neural Information Processing Systems 30 (NeurIPS 2017), 4878–4887 (arXiv:1705.08500).
Gillespie, N., Lockey, S., Ward, T., Macdade, A., & Hassed, G. (2025). AI에 대한 신뢰, 태도 및 사용: 2025년 글로벌 연구. 멜버른 대학교 및 KPMG. https://doi.org/10.26188/28822919
Glikson, E., & Woolley, A. W. (2020). AI에 대한 인간의 신뢰: 경험적 연구 검토. Academy of Management Annals, 14(2), 627–660.
Google (2026). Universal Commerce Protocol. NRF 발표, 2026년 1월 11일; 카트, 카탈로그 및 신원 연결 확장, 2026년 3월.
Google Cloud (2025). Agent Payments Protocol (AP2). 발표, 2025년 9월 16일.
Google DeepMind (2025). SimpleQA Verified. arXiv:2509.07968.
Gorbett, M., & Jana, S. (2026). 라벨 없는 정확성 신호로서의 교차 모델 불일치. arXiv:2603.25450.
Gottweis, J., Weng, W.-H., Daryin, A., Tu, T., Sirkovic, P., Myaskovsky, A., Glowaty, G., Weissenberger, F., Orlandi, A., Popovici, D., Palepu, A., Rong, K., Tanno, R., Saab, K., Zhang, F., Blum, J., Carroll, A., Kulkarni, K., Tomašev, N., Zverinski, D., Rendulic, I., Vedadi, E., Hasler, F., Rimanic, L., Boia, M., Budiselic, I., Feinstein, B., Bellaiche, M., Sheffer, T., Freyberg, J., Ratcliff, J., Bertolli, O., Chou, K., Hassidim, A., Gokturk, B., Vahdat, A., Guan, Y., Dhillon, V., Vaishnav, E. D., Lee, B., Costa, T. R. D., Penadés, J. R., Peltz, G., Matias, Y., Manyika, J., Hassabis, D., Xu, Y., Kohli, P., Pawlosky, A., Karthikesalingam, A., & Natarajan, V. (2026). Co-Scientist로 과학적 발견 가속화. Nature, 655(8122), 487–496. https://doi.org/10.1038/s41586-026-10644-y
Gould, S. J. (1991). 제품 사용을 통한 나의 광범위하고 인지된 중요 에너지의 자기 조작: 내성적-실천적 관점. Journal of Consumer Research, 18(2), 194–207.
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). 현대 신경망의 보정. ICML 2017, PMLR 70, 1321–1330.
Gvirtz, A., & Sabherwal, A. (2024). 글로벌 교차문화 행동과학 연구의 한계. Proceedings of the National Academy of Sciences, 121(36), e2316690121.
Hadfield, G. K. (2017). 평탄한 세계를 위한 규칙: 인간이 법을 발명한 이유와 복잡한 글로벌 경제를 위해 그것을 재발명하는 방법. Oxford University Press.
Hadfield, G. K., & Clark, J. (2026). 규제 시장: AI 거버넌스의 미래. Jurimetrics, 65, 195–240 (arXiv:2304.04914).
Hansen, L. K., & Salamon, P. (1990). 신경망 앙상블. IEEE Transactions on Pattern Analysis and Machine Intelligence, 12(10), 993–1001.
Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026). 모든 변화가 동조성은 아니다: 다중 에이전트 LLM 토론에서의 입장 수렴 분해. arXiv:2606.00820.
Hoff, K. A., & Bashir, M. (2015). 자동화에 대한 신뢰: 신뢰에 영향을 미치는 요소에 관한 경험적 증거 통합. Human Factors, 57(3), 407–434.
Hong, L., & Page, S. E. (2004). 다양한 문제 해결자 집단은 높은 능력을 가진 문제 해결자 집단을 능가할 수 있습니다. Proceedings of the National Academy of Sciences, 101(46), 16385–16389.
Huang, M.-H., & Rust, R. T. (2021). 마케팅에서 AI의 전략적 틀. Journal of the Academy of Marketing Science, 49(1), 30–50.
Insurance Services Office (2026). 승인 양식 CG 40 47 및 CG 40 48: 생성 인공지능 제외. 2026년 1월 1일 발효.
Internet Engineering Task Force (2026). 신뢰할 수 있고 투명한 디지털 공급망을 위한 아키텍처 (RFC 9943; SCITT 워킹 그룹). IETF. https://datatracker.ietf.org/doc/rfc9943/
Ioku, T., Song, J., & Watamura, E. (2024). AI 어시스턴트 선택의 절충: 소비자가 AI 어시스턴트 성능보다 투명성과 지속가능성을 우선시합니까? Big Data & Society, 11(4).
Ipsos (2025). Ipsos AI 모니터 2025. Ipsos Global Advisor, 30개국 조사, 2025년 6월.
Jacovi, A., Marasović, A., Miller, T., & Goldberg, Y. (2021). 인공지능에 대한 신뢰의 형식화: AI에 대한 인간 신뢰의 전제조건, 원인 및 목표. FAccT 2021, 624–635.
Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., Schiefer, N., Hatfield-Dodds, Z., DasSarma, N., Tran-Johnson, E., Johnston, S., El-Showk, S., Jones, A., Elhage, N., Hume, T., Chen, A., Bai, Y., Bowman, S., Fort, S., ... Kaplan, J. (2022). 언어 모델은 (대부분) 자신이 아는 것을 알고 있습니다. arXiv:2207.05221.
Kalai, A. T., Nachum, O., Vempala, S., & Zhang, E. (2025). 언어 모델이 환각하는 이유. arXiv:2509.04664.
Kharazian, A. (2026). Anthropic, 비즈니스 채택에서 OpenAI를 능가합니다. Ramp Economics Lab / Ramp AI Index, 2026년 5월 13일 (5만 개 이상의 미국 기업의 기업 결제 데이터).
Kim, D., & Benbasat, I. (2010). 인터넷 스토어에서 신뢰 보증의 효과적인 구현을 위한 설계. Communications of the ACM, 53(2), 121–126.
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). 대규모 언어 모델의 상관 오류. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038–30066.
Kim, P. H., Ferrin, D. L., Cooper, C. D., & Dirks, K. T. (2004). 의심의 그림자 제거: 역량 기반 및 무결성 기반 신뢰 위반을 복구하기 위한 사과와 부인의 효과. Journal of Applied Psychology, 89(1), 104–118.
Kizilcec, R. F. (2016). 얼마나 많은 정보? 알고리즘 인터페이스에서 투명성이 신뢰에 미치는 영향. CHI 2016, 2390–2395.
Klarna (2024). Klarna AI 어시스턴트가 첫 달에 고객 서비스 채팅의 3분의 2를 처리합니다. 보도자료, 2024년 2월 27일.
Köbis, N., Rahwan, Z., Rilla, R., Supriyatno, B. I., Bersch, C., Ajaj, T., Bonnefon, J.-F., & Rahwan, I. (2025). 인공지능으로의 위임은 부정직한 행동을 증가시킬 수 있습니다. Nature, 646(8083), 126–134. DOI: 10.1038/s41586-025-09505-x.
Kolt, N. (2025). AI 에이전트 관리. Notre Dame Law Review, 101 (SSRN working paper 4772956; arXiv:2501.07913).
Komiak, S. Y. X., & Benbasat, I. (2006). The effects of personalization and familiarity on trust and adoption of recommendation agents. MIS Quarterly, 30(4), 941–960.
König, P. D., Wurster, S., & Siewert, M. B. (2022). 소비자들은 설명 가능한 AI에 대해서는 가격을 지불할 의향이 있지만 친환경 AI에 대해서는 그렇지 않습니다: 선택 기반 결합 분석의 증거. Big Data & Society, 9(1).
Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. 신경정보처리시스템의 발전, 7, 231–238.
Kroll, J. A., Huey, J., Barocas, S., Felten, E. W., Reidenberg, J. R., Robinson, D. G., & Yu, H. (2017). 설명 가능한 알고리즘. 펜실베이니아 대학교 법학 리뷰, 165(3), 633–705.
Kuncheva, L. I., & Whitaker, C. J. (2003). Classifier 앙상블의 다양성 측정 및 앙상블 정확도와의 관계. Machine Learning, 51(2), 181–207.
Lee, J. D., & See, K. A. (2004). 자동화에 대한 신뢰: 적절한 의존성을 위한 설계. Human Factors, 46(1), 50–80.
Lessig, L. (2006). Code: Version 2.0. Basic Books.
Li, M. (2025). 클라우드 네이티브에서 신뢰 기반으로: 검증 가능한 멀티 에이전트 시스템을 위한 프로토콜. arXiv:2507.22077.
Liang, P., Bommasani, R., Lee, T., Tsipras, D., Soylu, D., Yasunaga, M., Zhang, Y., Narayanan, D., Wu, Y., Kumar, A., Newman, B., Yuan, B., Yan, B., Zhang, C., Cosgrove, C., Manning, C. D., Ré, C., Acosta-Navas, D., Hudson, D. A., ... Koreeda, Y. (2023). 언어 모델의 전체적 평가. Transactions on Machine Learning Research.
Liao, Q. V., & Sundar, S. S. (2022). AI 시스템에서 책임 있는 신뢰를 위한 설계: 커뮤니케이션 관점. FAccT 2022, 1257–1268.
Lin, S., Hilton, J., & Evans, O. (2022). 모델이 말로 불확실성을 표현하도록 가르치기. arXiv:2205.14334.
Lindsey, J. (2025). 대규모 언어 모델의 자동적 내성적 인식. Anthropic / Transformer Circuits.
Liu, J., Bursztyn, V. S., Ai, L., Wang, H., Choudhary, S., Mitra, S., & Wu, Q. (2026). TeamFusion: 멀티 에이전트 시스템으로 개방형 팀워크 지원. arXiv:2604.19589 (ACL 2026; Adobe Research).
Lizzeri, A. (1999). 정보 공개와 인증 중개자. RAND Journal of Economics, 30(2), 214–231.
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Algorithm appreciation: People prefer algorithmic to human judgment. Organizational Behavior and Human Decision Processes, 151, 90–103.
Longoni, C., Bonezzi, A., & Morewedge, C. K. (2019). Resistance to medical artificial intelligence. Journal of Consumer Research, 46(4), 629–650.
Longoni, C., Cian, L., & Kyung, E. J. (2023). Algorithmic transference: People overgeneralize failures of AI in the government. Journal of Marketing Research, 60(1), 170–188.
Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020–9025. DOI: 10.1073/pnas.1008636108.
Lu, Z., Wang, D., & Yin, M. (2024). Does more advice help? The effects of second opinions in AI-assisted decision making. Proceedings of the ACM on Human-Computer Interaction, 8(CSCW1), 1–31.
Marchal, N., Chan, S., Franklin, M., Revel, M., Keeling, G., Fischli, R., Chandra, B., & Gabriel, I. (2026). Architecting trust in artificial epistemic agents. arXiv:2603.02960.
Mastercard (2026). Verifiable Intent (co-developed with Google). Newsroom announcement, 5 March 2026; early pilots reported in Asian and Latin American markets, 2026.
Mayer, R. C., Davis, J. H., & Schoorman, F. D. (1995). 조직 신뢰의 통합 모델. Academy of Management Review, 20(3), 709–734.
McKinsey & Company (2025). 에이전트 상거래 기회 (Schumacher, Roberts, & Giebel). 2025년 10월 17일.
McKnight, D. H., Choudhury, V., & Kacmar, C. (2002). 전자상거래를 위한 신뢰 척도 개발 및 검증. Information Systems Research, 13(3), 334–359.
Menlo Ventures (2025a). 2025년 중반 LLM 시장 업데이트. 2025년 7월 31일 (150명의 기술 의사결정자 대상 설문).
Menlo Ventures (2025b). 2025: 엔터프라이즈의 생성형 AI 현황. 2025년 12월 9일 (495명의 미국 엔터프라이즈 AI 의사결정자 대상 설문; Menlo Ventures는 Anthropic 투자사).
Menlo Ventures (2025c). 2025: 소비자 AI 현황. 2025년 6월 26일 (5,031명의 미국 성인 대상 설문, Morning Consult와 함께; 약 3% 유료 사용자 수치는 수익 기반 추정치).
Möhlmann, M., & Zalmanson, L. (2017). 핸들에 손을 올려놓고: 알고리즘 관리와 우버 운전자의 자율성 탐색. ICIS 2017.
Montgomery, J. M., Nyhan, B., & Torres, M. (2018). 처리 후 변수를 조건화하는 것이 실험을 망칠 수 있는 방법과 이를 해결하는 방법. American Journal of Political Science, 62(3), 760–775.
Morgan Stanley (2025). 에이전트 상거래 예측: 2030년까지 1,900억~3,850억 달러의 미국 전자상거래 지출. 2025년 12월.
Mosier, K. L., & Skitka, L. J. (1996). 인간 의사결정자와 자동화된 의사결정 보조 시스템: 서로를 위해 만들어졌을까? R. Parasuraman & M. Mouloua (Eds.), 자동화와 인간 성능: 이론 및 응용 (pp. 201–220). Lawrence Erlbaum Associates.
Mozannar, H., & Sontag, D. (2020). 전문가에게 위임하도록 학습하기 위한 일관된 추정치. ICML 2020, PMLR 119, 7076–7087.
Muchnik, L., Aral, S., & Taylor, S. J. (2013). 사회적 영향 편향: 무작위 실험. Science, 341(6146), 647–651. DOI: 10.1126/science.1240466.
Muir, B. M. (1994). Trust in automation: Part I. Theoretical issues in the study of trust and human intervention in automated systems. Ergonomics, 37(11), 1905–1922.
NIST (2023). 자동화된 시스템에서의 신뢰: 1부. 신뢰와 자동화된 시스템에 대한 인간의 개입 연구의 이론적 문제들 (NIST AI 100-1). 미국표준기술연구소.
Okamura, K., & Yamada, S. (2020). 인간-AI 협업을 위한 적응형 신뢰 보정. PLOS ONE, 15(2), e0229132.
Papamarkou, T., Alquier, P., Bauer, M., Buntine, W., Davison, A., Dziugaite, G. K., Filippone, M., Foong, A. Y. K., Fortuin, V., Fouskakis, D., Frellsen, J., Hüllermeier, E., Karaletsos, T., Khan, M. E., Kotelevskii, N., Lahlou, S., Li, Y., Liu, F., Lyle, C., Möllenhoff, T., Palla, K., Panov, M., Sale, Y., Schweighofer, K., Shelmanov, A., Swaroop, S., Trapp, M., Waegeman, W., Wilson, A. G., & Zaytsev, A. (2026). 입장: 행위 AI 오케스트레이션은 베이즈 일관성을 가져야 합니다. arXiv:2605.00742. (ICML 2026에서 채택됨.)
Parasuraman, R., & Manzey, D. H. (2010). 자동화의 인간 사용에서의 자기만족과 편향: 주의의 통합. Human Factors, 52(3), 381–410. DOI: 10.1177/0018720810376055.
Parasuraman, R., & Riley, V. (1997). 인간과 자동화: 사용, 오용, 불용, 남용. Human Factors, 39(2), 230–253.
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). 자동화와의 인간 상호작용 유형 및 수준 모델. IEEE Transactions on Systems, Man, and Cybernetics — Part A: Systems and Humans, 30(3), 286–297.
Pavlou, P. A. (2003). 전자상거래에 대한 소비자 수용: 신뢰와 위험을 기술 수용 모델과 통합. International Journal of Electronic Commerce, 7(3), 101–134.
Pew Research Center (2025). 전 세계 사람들의 AI 인식. 25개국 조사, 2025년 10월.
Piehlmaier, D. M. (2023). 원맨쇼: 공동 의사결정이 투자자 과신에 미치는 영향. Journal of Consumer Research, 50(2), 426–446. https://doi.org/10.1093/jcr/ucac054
Puntoni, S., Reczek, R. W., Giesler, M., & Botti, S. (2021). 소비자와 인공지능: 경험적 관점. Journal of Marketing, 85(1), 131–151.
Rabanser, S., Kapoor, S., Kirgis, P., Liu, K., Utpala, S., & Narayanan, A. (2026). AI 에이전트 신뢰성 과학을 향하여. arXiv:2602.16666 (ICML 2026).
Raji, I. D., Xu, P., Honigsberg, C., & Ho, D. (2022). 외부 감시: AI 거버넌스를 위한 제3자 감시 생태계 설계. AIES 2022, 557–571.
Regulation (EU) 2016/679 (일반 데이터 보호 규정), 제22조 — 자동화된 개인 의사결정.
Regulation (EU) 2024/1689 (인공지능법), 제14조 — 고위험 AI 시스템에 대한 인간 감시; 제50조 — 특정 AI 시스템의 제공자 및 배포자를 위한 투명성 의무.
Ríos-García, M., Alampara, N., Gupta, C., Mandal, I., Mannan, S., Aghajani, A. A., Krishnan, N. M. A., & Jablonka, K. M. (2026). AI 과학자는 과학적으로 추론하지 않고 결과를 생성합니다. arXiv:2604.18805.
Saad-Falcon, J., Buchanan, E. K., Chen, M. F., Huang, T.-H., McLaughlin, B., Bhathal, T., Zhu, S., Athiwaratkun, B., Sala, F., Linderman, S., Mirhoseini, A., & Ré, C. (2025). 약한 검증자로 생성-검증 격차 축소. arXiv:2506.18203.
Sabater, J., & Sierra, C. (2005). 계산 신뢰와 평판 모델 검토. Artificial Intelligence Review, 24(1), 33–60.
Schemmer, M., Kühl, N., Benz, C., Bartos, A., & Satzger, G. (2023). AI 조언에 대한 적절한 신뢰: 개념화 및 설명의 효과. IUI '23, 410–422.
Schilke, O., & Reimann, M. (2025). 투명성 딜레마: AI 공개가 신뢰를 침식하는 방법. Organizational Behavior and Human Decision Processes, 188, 104405.
Schmidt, J., & Bijmolt, T. H. A. (2020). 소비재에 대한 구매의도를 정확하게 측정: 가정적 편향에 대한 메타분석. Journal of the Academy of Marketing Science, 48, 499–518.
Shapiro, S. P. (1987). 비인격적 신뢰의 사회적 통제. American Journal of Sociology, 93(3), 623–658.
Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., Cheng, N., Durmus, E., Hatfield-Dodds, Z., Johnston, S. R., Kravec, S., Maxwell, T., McCandlish, S., Ndousse, K., Rausch, O., Schiefer, N., Yan, D., Zhang, M., & Perez, E. (2024). 언어 모델의 아부성 이해를 향하여. ICLR 2024 (arXiv:2310.13548).
Shehata, D., & Li, M. (2026). 역지혜 법칙: 행위 무리에서의 건축 부족주의와 합의 역설. arXiv:2604.27274.
Sheridan, T. B., & Verplank, W. L. (1978). 수중 원격 조종 장치의 인간과 컴퓨터 제어 (기술 보고서). MIT 인간-기계 시스템 연구소.
Smit, A. P., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). MAD를 추진해야 할까요? LLM을 위한 다중 에이전트 토론 전략 살펴보기. ICML 2024, PMLR 235, 45883–45905 (arXiv:2311.17371).
Söllner, M., Hoffmann, A., & Leimeister, J. M. (2016). 정보 시스템 사용자에게 다른 신뢰 관계가 중요한 이유. European Journal of Information Systems, 25(3), 274–287.
Spiro, T. (2026). 오라클의 지문: 상관된 AI 예측 오류와 편향 전송의 한계. arXiv:2605.00844.
Stanford HAI (2025). 인공지능 지수 보고서 2025. 스탠포드 인간중심인공지능연구소 (기술 성능 장).
Stanford HAI (2026). 인공지능 지수 보고서 2026. 스탠포드 인간중심인공지능연구소 (여론 장, Pew 25개국 조사 데이터 보고).
Tax, S. S., Brown, S. W., & Chandrashekaran, M. (1998). 서비스 불만 경험에 대한 고객 평가: 관계 마케팅에 대한 함의. Journal of Marketing, 62(2), 60–76.
Vaccaro, M., Almaatouq, A., & Malone, T. (2024). 인간과 AI의 조합이 유용한 경우: 체계적 검토 및 메타분석. Nature Human Behaviour, 8(12), 2293–2303. DOI: 10.1038/s41562-024-02024-1.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). 판사를 배심원으로 교체: 다양한 모델 패널로 LLM 생성 평가. arXiv:2404.18796.
Visa (2025). Visa는 신뢰할 수 있는 에이전트 프로토콜을 도입합니다: AI 상거래를 위한 생태계 주도 프레임워크. 보도자료 (Cloudflare와 함께), 2025년 10월 14일.
Visa (2026). Visa partners with OpenAI to power the next generation of AI commerce. 보도자료, Visa Payments Forum, 2026년 6월 10일.
W3C (2025). Verifiable Credentials Data Model v2.0. W3C Recommendation.
Wallendorf, M., & Brucks, M. (1993). 소비자 연구에서의 자기 성찰: 구현과 함축. Journal of Consumer Research, 20(3), 339–359.
Walsham, G. (1995). IS 연구에서의 해석적 사례 연구: 성질과 방법. European Journal of Information Systems, 4(2), 74–81.
Wang, W., & Benbasat, I. (2005). 온라인 추천 에이전트에 대한 신뢰 및 채택. Journal of the Association for Information Systems, 6(3), 72–101.
Wang, Y., Zhang, J., Cai, T., Liu, Z., Sun, Q., Sun, Z., Wu, Z., Dong, M., Zheng, M., Yin, X., & Zhu, Y. (2026). 에이전트 추적에서 신뢰로: LLM 에이전트의 증거 추적 및 실행 증명 검사. arXiv:2606.04990.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., & Fedus, W. (2024). 대형 언어 모델에서 단문형 사실성 측정. arXiv:2411.04368.
Werbach, K. (2018). 블록체인과 신뢰의 새로운 아키텍처. MIT Press.
Wertenbroch, K. (1998). 미덕과 악덕 구매 수량 배분을 통한 소비 자제. Marketing Science, 17(4), 317–337.
Xiao, B., & Benbasat, I. (2007). 전자상거래 제품 추천 에이전트: 사용, 특성 및 영향. MIS Quarterly, 31(1), 137–209.
Yalcin, G., Lim, S., Puntoni, S., & van Osselaer, S. M. J. (2022). 엄지손가락 위 또는 아래: 알고리즘 대 인간 결정에 대한 소비자 반응. Journal of Marketing Research, 59(4), 696–717.
Yin, R. K. (2018). 사례 연구 연구 및 응용: 설계 및 방법 (제6판). Sage.
Zhang, Y., Liao, Q. V., & Bellamy, R. K. E. (2020). AI 지원 의사결정에서 신뢰도 및 설명이 정확성 및 신뢰 보정에 미치는 영향. Proceedings of the 2020 ACM Conference on Fairness, Accountability, and Transparency, 295–305.
Zheng, J., & Zhang, J. (2026). 구조화된 전문가 판단을 통한 다중 LLM 시스템의 불확실성 인식 신뢰 추정. arXiv:2607.20529.
Zuboff, S. (2019). 감시 자본주의의 시대. PublicAffairs.
Zucker, L. G. (1986). 신뢰 생성: 경제 구조의 제도적 원천, 1840–1920. Research in Organizational Behavior, 8, 53–111.
* AI 시스템 아키텍트. 이해관계: 저자는 다중 모델 오케스트레이션 방법을 개발하고, 여기에서 설명한 아키텍처의 참조 구현을 운영하며, AI 오케스트레이션 및 다중 모델 검증 시스템의 보류 중인 특허 출원(승인된 특허 아님)에 명명된 출원인이며, 이 논문이 검토하는 종류의 아키텍처에 개발자로서의 이해관계를 가지고 있습니다. 이 종류의 필요성에 관한 규범적 주장은 이 이해관계를 염두에 두고 읽어야 합니다. 저자의 제4절 배포에서의 역할은 이 논문의 끝에 있는 저자 노트 및 공시에 명시되어 있습니다. 의견을 환영합니다: [email protected].↩︎
인용 방법
Chernets, V. (2026). 건축적 신뢰: 소비자 신뢰가 AI 모델에서 검증 가능한 아키텍처로 이동하는 이유 [사전 인쇄본]. SSRN. https://doi.org/10.2139/ssrn.7191261
@misc{chernets2026architecturaltrust,
  author       = {Chernets, Vadym},
  title        = {{Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7191261},
  url          = {https://doi.org/10.2139/ssrn.7191261}
}