Спросите несколько ИИ одновременно и посмотрите, где они расходятся
Это перевод. Основная версия — оригинал на английском; ссылайтесь на него.
Когда вы задаёте вопрос одному ИИ, вы получаете один уверенный ответ и не имеете лёгкого способа понять, правильный ли он. Обращение ко второму и третьему ИИ помогает, но только если вы видите, где их ответы расходятся, и только если вы знаете, что на самом деле стоит их согласие. After Chat — это небольшой набор бесплатных скриптов Python с открытым кодом, который отправляет один вопрос нескольким ИИ одновременно и делает оба: показывает, кто что сказал, и вычисляет, что стоит их согласие. Он работает на вашем компьютере через ИИ-инструменты, в которые вы уже вошли, без ключей API и дополнительной подписки, и сами скрипты требуют только Python.
Одного ИИ недостаточно, и четыре ИИ — это не четыре
Модели ИИ разных компаний обучаются по-разному, поэтому они не всегда делают одни и те же ошибки. Вот почему люди копируют один вопрос в ChatGPT, Claude, Gemini и Grok и сравнивают ответы вручную. Однако их ошибки совпадают больше, чем может показаться. Исследование 2025 года более 350 языковых моделей показало, что когда обе модели ошибаются, они часто дают один и тот же неправильный ответ: в наборе данных рейтинга это происходит в 60% случаев. Поэтому когда четыре ИИ согласны друг с другом, у вас есть меньше четырёх независимых подтверждений. Реальная ценность обращения к нескольким заключается в разногласиях: в пункте, который поднял только один из них, или в одном и том же утверждении с разными цифрами в нём.
Реальный пример
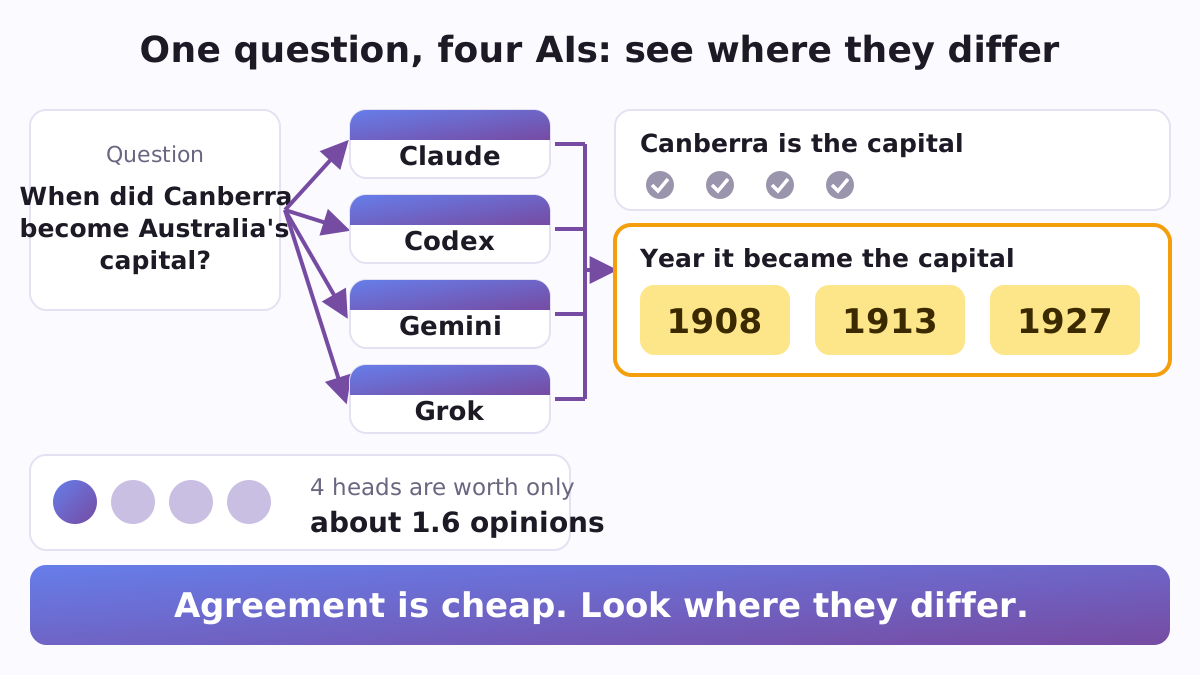
21 сентября 2026 года автор задал один вопрос четырём инструментам AI командной строки: «В одном предложении: какая столица Австралии и в каком году она стала столицей?» Все четверо ответили в течение 25 секунд, и все четверо назвали Канберру. По году мнения разошлись тремя способами: 1908, 1913 и 1927. За каждый год можно привести аргументы: место было выбрано в 1908 году, город был назван в 1913 году, а Парламент переместился туда в 1927 году. При опросе отдельно Codex дал бы 1927, а Grok — 1913, каждый как простой факт. Рядом ответы сразу показали, что у вопроса есть три честных ответа, и указали на точное место, которое нужно проверить.
Что находится внутри
- Спросите их всех сразу (
fanout.py). Сначала отправляет каждому инструменту ИИ из списка быстрый тестовый вопрос и пропускает любой инструмент, который не установлен или не отвечает. Затем ставит ваш вопрос всем активным инструментам одновременно в рамках одного выбранного вами лимита времени и передаёт каждый ответ в свой файл. Если инструмент всё ещё пишет, когда время истекает, то написанное до этого момента сохраняется и помечается как частичное, не выбрасывается. Каждый ИИ запускается в собственной пустой папке, а не в папке, из которой вы запустили программу, так что работает только на основе вашего вопроса. Длинный вопрос, например страница текста для проверки всеми инструментами, помещается в файл с--question-file. - Посмотрите, кто что сказал (
provenance.py). Разбивает каждый ответ на короткие утверждения, группирует утверждения, которые сформулированы похоже, и выводит одну таблицу: каждое утверждение и какой ИИ его сделал. Под таблицей находятся два списка, которые имеют наибольшее значение: утверждения, сделанные только одним ИИ (то, что упустили остальные, или ошибка того единственного), и утверждения, где ИИ дают разные числа, проценты или даты. Читает текстовые файлы из любой папки, поэтому вы можете также вставить ответы с веб-сайтов чатов в файлы, по одному на каждый ИИ, и сравнить их. - Определите ценность согласия (
neff.py). Дайте ей горсть вопросов с известными ответами, помеченными как правильные или неправильные для каждого ИИ, и она измеряет, как часто ваши ИИ ошибаются вместе. Из этого она вычисляет, сколько независимых мнений они на самом деле стоят. На встроенном примере четыре ИИ, чьи ошибки перекрываются, стоят около 1,6 независимых мнений, и никакое количество таких ИИ никогда не будет стоить больше 2,1. - Второе мнение внутри Claude Code (
second-opinion/SKILL.md). Готовый навык: скопируйте папку в~/.claude/skills/, и Claude Code может задать ИИ другой компании тот же вопрос, показать этот ответ в точности так, как он пришёл, и добавить короткую таблицу того, где они согласны, где расходятся, и что упоминает только один из них. Он никогда не смешивает их в один уверенный текст и обращается с ответом другого ИИ как с материалом для сравнения, никогда как с инструкциями для следования. - Безопасные настройки для агентов ИИ (
safety/). Готовый пример настроек разрешений Claude Code (settings.json), который запускает каждую сессию в режиме плана, запрещает команды типаrm -rf,sudo,curlиgit push, делает файлы.envи папкуsecretsнечитаемыми, и просит подтверждение передrm,mvи веб-запросами. Настройки для Codex позволяют ему писать только внутри своей рабочей папки, с отключённой сетью, и заставляют его просить подтверждение перед выходом за эти границы. Контрольный список из 14 пунктов охватывает практики вокруг них: работа в копии, сначала попросите план, сохраните возможность отката, знайте, как остановить длительное задание. - Инструменты для исследователей (
crossings.py,crossings.schema.json,jsonl_log.py). Формат записи со строгой проверкой для исследований того, как люди переходят от общения с ИИ к тому, чтобы позволить агентам ИИ выполнять реальную работу. Установка приложения не считается использованием, завершённый шаг требует чего-то, что агент действительно создал, и когда кто-то останавливается, запись сохраняет его собственные слова. Крошечный логгер записывает каждое решение, такое как отклонённый план или принятое второе мнение, как одну строку JSON с временной меткой.
Почему это реализовано таким образом
Многие инструменты «LLM council» завершаются одним объединённым ответом. Популярный llm-council Andrej Karpathy, например, отправляет ваш вопрос моделям через OpenRouter, API-сервис, за который вы покупаете кредиты, и позволяет модели-«председателю» написать финальный ответ. After Chat проходит через инструменты командной строки, которые вы уже используете со своими собственными учётными записями, и намеренно останавливается перед объединением: вы получаете таблицу того, кто что сказал, а решение остаётся в ваших руках. Каждый скрипт использует только стандартную библиотеку Python и умещается в один короткий файл (самый длинный составляет менее 200 строк), поэтому вы можете точно прочитать, что он делает, и изменить это.
Как начать
Скрипты работают везде, где работает Python 3; на Windows запустите fanout.py в WSL. Прямое сравнение использует два или более инструментов командной строки AI, в которые вы входите со своими учётными записями. Встроенный список включает Claude Code (claude), OpenAI Codex (codex), Antigravity CLI от Google (agy, который пришёл на смену Gemini CLI для личных учётных записей Google от 18 июня 2026 г.) и Grok Build от xAI (grok). Команда каждого инструмента — это одна строка в небольшом файле JSON, передаваемом с помощью --tools, поэтому добавление другого инструмента или адаптация к флагу, который изменился в новом выпуске, займёт минуту. Нет инструмента командной строки? Вставьте ответы с любого веб-сайта чата AI в файлы .txt, по одному на AI, и запустите provenance.py в этой папке: имя каждого файла становится столбцом таблицы.
git clone https://github.com/vadimchernets/after-chat
cd after-chat
python3 neff.py --demo                       # what four agreeing AIs are worth
python3 fanout.py "Your question" --out run  # ask every live AI at once
python3 provenance.py run                    # who said what, and where they differ
28 тестов запускаются командой python3 -m unittest tests/test_patterns.py. Код, его тесты и параметры безопасности находятся по адресу github.com/vadimchernets/after-chat.
Происхождение
After Chat — это вспомогательный код к статье After Chat: The Three Transitions Between Non-Programmers and Agentic AI авторства Vadym Chernets (сентябрь 2026, SSRN 7520019, DOI 10.2139/ssrn.7520019). В статье исследуется, почему так мало людей перешли от общения с ИИ к использованию ИИ-агентов для работы, и как измерить этот переход. Код распространяется под лицензией MIT и архивирован на Zenodo (DOI 10.5281/zenodo.22944451). Два готовых плагина Claude Code выросли из этих же паттернов: Sidecall обращается к инструментам командной строки ИИ на вашем компьютере, а Roundcall обращается к сайтам ИИ-чатов через ваш браузер.
Просмотреть after-chat на GitHub
Vadym Chernets также разрабатывает Poly A1, приложение, в котором ИИ разных компаний проверяют работу друг друга.