Sealed Before the Open: A Verifiable Standard for Measuring AI Forecasts of Financial Markets
这是译文。权威版本是英文原文,引用请以原文为准。
十四个美国和中国AI模型、十二个市场、四个时间范围:一个封存的实时联赛、每个共识背后独立声音的计数和30个已登记的预测
Vadym Chernets,博士,AI系统架构师 · PolyHelper创始人 (polyhelper.ai) · ORCID 0009-0007-4845-3163
SSRN 7653679 · DOI 10.2139/ssrn.7653679 · Zenodo 10.5281/zenodo.23552697 · OSF登记 10.17605/OSF.IO/9Q86N · 分析发布 10.5281/zenodo.23552700 · GitHub
下载本文
- SSRN (推荐引用): ssrn.com/abstract=7653679 · DOI 10.2139/ssrn.7653679
- Zenodo (存档,开放获取): doi.org/10.5281/zenodo.23552697
- OSF (第8节的已登记预测): doi.org/10.17605/OSF.IO/9Q86N
- GitHub (完整文本和附录B的验证命令): https://github.com/vadimchernets/papers/tree/main/sealed-before-the-open
- 分析发布 (本版本读取的文件,冻结版本,带SHA-256清单): doi.org/10.5281/zenodo.23552700
- 实时联赛和开放数据 (CC BY 4.0): trends.polyhelper.ai/markets/ · trends.polyhelper.ai/api/v1/
三步验证封存 (附录B): 下载该书和10月20日的时间戳,对加盖时间戳的前缀进行哈希处理,验证锚点。
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt.ots
head -n 159 council-book.jsonl | shasum -a 256   # 59673b9e...a7d9, as in 130025Z.txt
ots verify 130025Z.txt.ots # Bitcoin block 972,334没有比特币节点的情况下,ots info 130025Z.txt.ots 显示对区块 972,334 的证明,任何区块浏览器都可以显示其默克尔根(附录 B,第 6 步)。第 10 步检查 Sigstore Rekor 日志中的时间戳。
引用 SSRN 预印本。计分会话读取时间为 2026 年 10 月 20 日,数据来自 2026 年 10 月 21 日 02:42 至 05:33 UTC 期间生成的开放文件。第一次计数运行时间为 2026 年 10 月 21 日,数据来自 22:16 UTC 生成的文件。表 5 显示的合规性状态读取时间为 2026 年 10 月 21 日 15:05 UTC,需求 1 的合规性检查时间为 22:33 UTC,需求 3 的 Rekor 条目时间为 2026 年 10 月 22 日 00:00:16 UTC。
关键词:AI 预测;大型语言模型;金融市场;预测评估;布里尔评分;校准;前瞻偏差;受信任的时间戳;OpenTimestamps;有效独立声音数量;预测市场;注册预测
JEL:G17; C53; C52; G14; D84
摘要
当人工智能模型说黄金会上升时,读者可以在收盘时评分这个预测,但通常无法检查它是何时做出的。回测混合了记忆和技能,一个交易季是穿过市场的一条路径。我提出了一套编号的要求标准,用于衡量人工智能对金融市场的预测,并记录其参考实现——由PolyHelper运营的开放联盟AI Council · Markets,每项要求都有已发布的状态。十四个大型语言模型,七个来自美国实验室,七个来自中国实验室,对共享价格快照上的同一问题回答,每个都有自己的账户。其中十一个在纽约开盘前四个时间范围内预测十二个指标。每个计数答案在其参考价格前被封入SHA-256哈希链,并通过OpenTimestamps锚定在比特币中。从2026年10月21日起,计数运行提前声明,独立的RFC 3161权威机构为每条带时间戳的记录签名,这些记录也进入Sigstore Rekor透明日志。在第一个计数早晨,每个计数答案都在09:30 ET开盘前签署,其中八个在开盘前29分钟签署。所询问事件的Brier分数设定对比50%基准、气候学基准率和预测市场价格,一致性报告为独立声音的计数。在10月19日和20日的开发早晨,模型的概率图像就像约1.6个独立预测者的图像一样相似。10月20日,四个最接近的配对中有三个联合了一个美国和一个中国实验室。针对23项人工智能预测和交易努力的日期地图,该联盟是第一个在金融指标上的实时人工智能联盟,结合了这些要素。它也是第一个人工智能市场竞技场,七个美国和七个中国模型在一个协议下交易,读者随机分配一次,在查看模型之前或之后进行预测。三十个日期预测,在发布前在OSF上注册,在日期修订中评分。
执行摘要
价格预测只有在预测者不知道结果、预测在结果之前存在、且计分的预测是被计算的那一个(无论其他尝试说了什么)的情况下,才能证明预测者具有技能。AI模型在这三个方面都存在问题:它们可能在训练中读过结果、可以在几秒内被再次询问、且其记录通常由提问者保存。我将每个条件都写成了读者可以检查的要求。由PolyHelper运营的AI Council · Markets是参考实现。
每个问题都涉及一个尚未发生的结果,这使其不在模型的记忆中。市场是一个自我更新的测试:它每天早上提出一个新问题,同一天下午回答,因此没有模型能够读过答案。两个预测只有在对同一事物下注时才能比较,因此单位是一个事先确定的事件合约。每个答案在被计分的开盘价之前被密封到哈希链中,因为看到开盘变动的预测回答的是一个不同的问题。我不希望记录依赖于对其保存者的信任,因此该链被锚定在Bitcoin中,并从2026年10月21日起由独立时间戳颁发机构签署。每个会话只计算一次运行。从10月21日起,选择它的规则在提前声明并密封,其他运行保持发布并标记。
分数是所提问事件的Brier分数。它是一个恰当的分数,因此预测者通过陈述任何非其信念的东西而没有任何收益。联赛根据硬币、事件的基础率和预测市场价格来读取它,三个不同的技能衡量标准。相关模型不是独立的证人,它们之间的一致性被报告为独立声音的数量。七个美国和七个中国模型共享问题、快照、截止日期和规则,因此双方之间的任何差异都在一项任务上衡量。读者被随机分配一次,以在预测前或预测后看到模型,并保持在该组中。他们衡量模型是否帮助人们或仅仅拉动他们(F28, F29)。
两个开发早晨显示这些衡量标准读取的内容。在一天期限,在开盘前密封的模型概率图像与少于两个独立预测者的图像一样相似。它们在六个月时最具决定性,其预测最后解决,在10月20日最近的四对中的三对加入了一个美国和一个中国实验室。一个主要测试和三十个预测在OSF上注册发布前,在开放数据和代码的日期修订版本中计分。
1. 引言
周一早上,一个人问人工智能模型是否应该购买黄金。该模型以某种信心说是,并给出了理由。到收盘时,黄金已经下跌。该模型是错误的、不幸的,还是这是它那天早上给出的几个答案之一?答案是在09:00存在的,还是在中午写的?这个人无法分辨。在第7节审查的大多数评估中,预测的时间取决于操作员的记录。我在这里描述的联盟将该记录保存在操作员之外。2026年10月20日星期二,在开盘前,八个模型在Polymarket的日合约上平均给了黄金45%的收盘上涨概率,而该合约上的人群定价为29%。两个数字都在09:30 ET开盘前被封存,任何人都可以读回它们(附录B)。
模型进行真实货币交易的竞技场在2025年引起了广泛关注(Forklog, 2025a, 2025b),大型语言模型预测基准达到了主要机器学习场所:ICLR 2025的ForecastBench(Karger et al., 2025)、ICLR 2026的FutureX(Zeng et al., 2025)和Prophet Arena(Yang et al., 2025)。交易基准发现,大多数代理没有击败买入并持有策略(Y. Chen et al., 2025; Yu et al., 2025),在流动性预测市场上,一个强大的人工智能预测系统仍然落后于市场共识,而两者的组合击败了两者(Alur et al., 2025)。
这些工作共享一个依赖关系:预测先于结果的证据由运行评估的人保留。回测根本无法提供它,因为模型可能已经知道结果(Lopez-Lira et al., 2025; Paleka et al., 2026)。实时基准通过操作员的记录提供它,Prophet Arena为每个预测添加了加盐的SHA-256封印,带有可选的签名收据,由平台自己的时钟计时(Prophet Arena, 2026)。Foresight Arena将Polymarket事件的哈希预测(其中一些是资产价格)提交到Polygon区块链,在截止日期前并根据市场价格进行评分。其修订版本报告模拟结果并推迟实时结果(Nechepurenko & Shuvalov, 2026a)。Prediction Arena给前沿模型在Kalshi和Polymarket上真实资本,并保留操作员日志而不做承诺(Zhang et al., 2026)。在人工智能之外,金融泡沫的预测早在2010年就通过校验和与延迟披露进行了封存(Sornette et al., 2010),在市场之外,一个人工智能的足球概率自2026年7月以来一直锚定在比特币中(NeuPortal, 2026)。我没有找到关于固定财务指标面板的人工智能预测的实时联盟,该联盟将其记录锚定在操作员控制之外(第7节)。我的研究问题是,人工智能市场预测的测量需要什么,以便读者可以针对操作员控制之外的时钟进行检查,预测了什么、何时,以及哪个预测被计算了。
我提议了一个该测量的标准,写成MUST和SHOULD要求的检查清单(第3.13节),并记录了它的一个实现,由PolyHelper运营的开放实时联盟AI Council · Markets,地址为trends.polyhelper.ai/markets。十四个模型,七个来自美国实验室,七个来自中国实验室,在相同的问题、快照和规则上运行模拟投资组合,其中十一个在Council上并给出概率。每天早上在纽约开盘前,Council预测12个财务指标,涵盖股票指数、利率、美元、波动率、商品和比特币,时间跨度从一天到六个月。每个答案都被密封在一个哈希链书中,其首部通过OpenTimestamps锚定在比特币中。每个答案从其密封后的第一个价格开始评分,这本书与评分代码和数据一起发布。从2026年10月21日起,独立的RFC 3161时间戳机构也对每个带时间戳的记录进行签名,因此读者可以针对操作员控制之外的时钟进行检查,被计算的答案在为其评分的开盘价之前存在(第3.2节)。密封记录也是金融的一种新型开放数据:来自许多人工智能模型对相同事件的每日概率面板,在开盘前固定,可以测量它们的分歧及其价值。
事件合约以模式形式发布,其中包含任何其他联盟都可以在其自己的文件上运行的检查器(第3.13节)。我贡献的是标准和读者可以检查的实现。第一个会话显示它生成的数据,第8节的注册测试决定技能。第3节陈述标准,第4节陈述实时市场设置的评分设计。第5节测量实时数据上独立声音的有效数量,第6节设置人工智能前的人类设计,第7节绘制人工智能市场竞技场的日期地图。第8节包含注册预测,第9节包含最强异议及其规则答案,第10节包含每个声明的范围。第7.4节在三个声明和三个进一步的设计中陈述了新的内容,这些设计在所审查的人工智能市场竞技场中首次出现,以及联盟建立在什么基础之上,每个都有其最近的先例。附录E给出了逐单元的证据。
2. 为什么后见之明破坏了AI市场预测
人类预测竞赛通过注册截止日期和信任的组织者来保护执行摘要的三个条件。AI模型绕过了每一道防线。一个模型可能从训练中了解结果,它可以在一分钟内被问许多次,以及它所说的记录通常由提问者保管。前三个小节依次涉及这些问题,第四个解释了为什么交易季节不能替代预测记录。
2.1 模型的记忆
对AI模型进行金融预测评估的最便宜方法是回测,但模型的训练数据可能已经包含接下来会发生什么。Lopez-Lira等人(2025)证明了大型语言模型从训练截止前回忆宏观经济和金融时间序列的精确值,不使用更新知识的指令并不能消除这种回忆,而且回忆在截止后停止:在训练窗口内,技能和记忆无法区分。
Gao等人(2025)为前瞻偏差建立了一个测试,即前瞻倾向。在复现模型对新闻标题的评分预测股票收益的结果时(Lopez-Lira & Tang, 2023),前瞻倾向高的观察上预测能力被放大了。截止后原始信号保留,而与记忆相关的交互作用失去了显著性。Glasserman和Lin(2023)分离了GPT情绪回测的两个样本内偏差,前瞻和对模型对所命名公司的了解的分心,发现第二个更大,对大公司尤其如此。在20年的数据上,FINSABER框架发现一旦控制了幸存者偏差、数据挖掘和前瞻,LLM投资策略报告的优势急剧缩小(W. W. Li等人,2025),而基于历史模拟的基准(如InvestorBench(H. Li等人,2025))继承了相同的敞口。
文献以两种方式修复这一问题。一种限制模型:按时间顺序一致的语言模型只在每个预测日期之前可用的文本上训练(He等人,2025)。另一种限制时间:任何模型,处于全力状态并进行搜索,被问及仍未发生的结果,答案在结果存在之前可检查地固定。我选择限制时间,让模型保持全力。这两条路线是互补的,因为一个按时间顺序一致的模型可以进入一个密封联赛。
2.2 泄漏的路线
转向实时问题消除了最大的泄漏,但不是每一个泄漏。Paleka等人(2026)表明语言模型预报者评估中的时间泄漏通常是微妙的,而且对评估的表现可能不会延续到世界中的预测。FutureX报告了同一系列的失败模式,包括虚假网页和时间有效性错误的答案(Zeng等人,2025)。在宏观金融预测中,将模型的输入限制在决策时可用的范围内消除了泄漏基准报告的大部分明显技能(Guan & Chen, 2026)。一个特定的形式是跨日事件漂移:收益报告后几天的文章已经包含了市场的反应,如果它们进入较早一天的输入,结果会泄漏到预测中(Zhang & Zhang, 2026)。在参考价格之前密封的预测不能利用之后写的文本。
对于金融市场,时间问题是具体的。在09:29记录的一天预测和在09:45记录的预测是不同的对象,因为第二个可以看到开盘涨跌。如果预测何时进行的记录仅由操作员保管,读者必须相信没有较晚的答案取代了较早的答案。预注册通过在数据存在之前在公开记录中固定它来将假设的生成与其测试分开(Nosek等人,2018)。密封预测是自动且每日进行的注册,信任的时间戳让第三方检查其时间(Haber & Stornetta, 1991; Todd, 2016)。
2.3 许多运行,一个分数
竞赛中的预报者通常在截止日期前提交一个答案。一个模型可以被问十次,措辞略有不同或在略有不同的分钟,其答案会变化。一个评估者如果保留了十个中最好的,或在失败后重新运行流程并保留重新运行的结果,会在不改变单一预测的情况下增加技能,除非每个运行都被记录且计数规则在运行前固定,否则这种增加是不可见的。因此,我编写了标准来密封它发送的每个运行,通过运行前编写的规则按会话计数一个运行,并将其他运行保留为标记的参考计算(第3.4节)。
2.4 一个轨迹不是一个测量
模型交易资金的竞技场回答了哪些决策会赚钱,但投资组合在一个季节的收益是市场可能走过的路径中的一个抽取。阿尔法竞技场前两个季节的新闻报道报告了排名的反转:在第一个季节赢得的模型(在加密货币永续期货上)在第二个季节(在具有新格式和杠杆的代币化美国股票上)中排名最弱(Forklog, 2025a, 2025b; Yahoo Finance, 2025)。资产、格式和模型在季节之间改变,所以反转,正如这些报道所报道的,并不能识别运气。这是一个季节作为一个轨迹预测的东西。StockBench发现大多数交易道琼斯股票约四个月的代理没有击败买入并持有(Y. Chen等人,2025),LiveTradeBench发现在50多个实时日期一般聊天排行榜没有预测交易结果(Yu等人,2025),PredictionMarketBench发现朴素代理在重播的Kalshi订单簿上对费用和结算造成损失(Arora & Malpani, 2026)。Prediction Arena给了一队前沿模型57天的真实资本,同样的模型在Kalshi上平均收益为−22.6%,在Polymarket上平均收益为−1.1%(Zhang等人,2026):场地将平均结果移动了超过20个点。没有人能说一个模型是否了解市场的某些东西,因为一个收益将一个看涨的方向、其大小、其时机、其成本和市场的路径混合成一个数字。
概率隔离了预测的方向和置信度。说黄金今天上涨有70%概率的模型可以单独通过严格正确的规则对该陈述进行评分(Brier, 1950; Gneiting & Raftery, 2007)。十二个市场在四个时间范围上每个模型每天产生许多这样的陈述,尽管一天的十二个市场共享一个交易时段(第4.6节)。在一个受监管的预测市场上的问题中,该市场在模型训练后结算,五个前沿模型过度自信,更扩展的推理使校准变得更差(Nel, 2025)。
2.5 三个条件的要求
预测必须在模型的知识截断时间之后、针对一个尚未发生的结果进行(2.1)。其时间必须在结果之前固定在一条记录中,该记录的后续更改第三方可以检测到(2.2)。哪个预测计算的规则必须在运行之前固定(2.3)。评分必须是所提问事件的正确评分,在足够的独立交易时段上汇总以区分技能和运气路径,并对校准进行检查(2.4)。模型之间的一致性必须在考虑其误差的相关性之后才能作为证据读取(Clemen & Winkler, 1985; Kim et al., 2025; Chernets, 2026a)。第3节将这五个条件写成一份清单。
3. 协议
该协议使预测的时刻成为第三方可以检查的事实,并说明该事实的哪一层取决于谁。以下所有内容都发布在联盟的公开文件中(AI Council · Markets, 2026):协议为 arena-protocol.json,密封簿为 council-book.jsonl,问题文本在 asks/ 下,带时间戳的列表及其 OpenTimestamps 证明在每天一个页面上(/markets/proof/<day>/)。我描述的规则是 2026 年 10 月 20 日的规则(协议 arena-3,评分方法版本 2),并使用该上午的运行 2026-10-20-am 作为实际示例;其中引用的每个时间和哈希值都可以从公开文件中读回(附录 B)。每个密封都包含生效的方法论版本,规则的后续更改不会改变其之前密封的任何内容。
事件合约。标准衡量事件。模型、运行或排行榜的一行是事件的集合,我通过在问题发出前固定的合约定义每个事件(表 1)。只有当每个字段都一致时,两个预测才属于同一事件。具有自己参考的预测,例如在公开后密封的行(第 3.3 节),是对不同事件的预测。它在该事件上评分,并从每个比较模型在共同事件上的统计数据中排除(要求 4)。
单词 yield 在本联盟中命名三个独立事件。预测是针对 10 年期收益率本身(以收益率单位计),从其参考价格到东部时间 15:00 的终端价格。众筹合约(当问题列出一个时)在财政部东部时间 3:30 PM 的面值收益率上结算(收盘至收盘),并按这些条款评分(第 4.9 节)。投资组合持有一只美国国债基金(IEF),当收益率下降时上升(第 4.7 节)。10 月 20 日,众筹将收益率合约定价为 7%,对比之前的面值收益率 5.15%,这一价格已经包含了盘前跌幅;联盟自己关于收益率的问题从 09:30 参考价格开始,并提出了不同的问题。在其中一个上的正确判断本身并不能说明其他的任何信息。VIX 的分割方式相同:预测是针对指数的,普通投资组合无法持有它,专业联盟可以。
表 1。 事件合约的最小字段,以及参考实现如何固定每个字段。
| 字段 | 其用途 | 参考实现 |
|---|---|---|
| 目标 | 指标本身,而非跟踪它的工具 | 按代码的 12 个指标;交易基金仅出现在投资组合联盟中(assets、trades_as) |
| 谓词和期限 | 事件:从参考价格到终端价格的严格上升 | prob_up;1d;1w、1m、6m 分别为 5、21 和 126 个交易日(比特币 7、30 和 182 个日历日) |
| 价格来源 | 参考和终端价格的供应商、符号、柱状图大小和时间戳规则(按指标) | 每个预测行上的提供商、符号和参考规则(price_provider、price_symbol、reference_rule;对于标普 500,^GSPC 的一分钟柱在参考时间或之后),在合约架构中按指标声明;协议中投资组合价格的来源(prices) |
| 信息截止 | 预测可使用的内容:参考价格之前的任何内容,绝不包括参考本身 | 价格快照和问题哈希到运行行中(snapshot_sha256、ask_sha256) |
| 截止时间和计数运行 | 该会话中计数的答案 | 自 2026 年 10 月 21 日起,预定的上午运行,提前声明,在 asks.jsonl 中密封并在证明页上发布;其中,在参考前密封的最后一行(counted),从会话 11(2026 年 11 月 2 日)起,每个座位在参考前密封的第一个格式良好的答案行,同一座位的后续行被标记为重试,按 asks.jsonl 第 74 行、文本 SHA-256 0f42c93b…b0b6cd 中声明的规则。对于 10 月 19 日和 20 日,运行在公开前最后密封(session_run),在运行后应用;在迄今为止的每个计数运行中,每个座位密封一条答案行,因此参考前的第一行和最后一行相同 |
| 参考价格 | 每个事件一个参考价格,在密封后采取 | 东部时间 09:30 或之后的第一个价格;比特币为行密封时刻开始或之后的第一个一分钟柱的收盘(reference、btc) |
| 结算 | 终端价格、其时间及其规则 | 期限最后一个交易日的收盘价东部时间 16:00;10 年期收益率东部时间 15:00;比特币从密封分钟到评分会话东部时间 16:00 的日数据 |
| 平局规则 | 哪些小幅波动是平局以及如何评分 | 0.1 倍当日一分钟柱状图波动范围的区间,约为一个交易日标准差的 0.08;排除滚动会话(direction、noise_rolls) |
| 评分规则和基准 | 正确分数及其与什么比较 | 所有行的 Brier 分数;50% 基准;事件的固定气候学(climatology_fixed,第 4.3 节) |
| 规则版本 | 应用哪种方法论 | methodology.version,在每个运行行中密封;methodology_version 在每个预测行上 |
| 事件标识符 | "同一事件"的一个密钥 | event_id_v2,完整合约九个密钥的哈希,带有五密钥 event_id(event-contract.schema.json,第 3.13 节) |
注:括号中的字段名称是公开文件中的字段名(arena-protocol.json、每个运行行的 methodology 字段、council-stats.json、council-calibration.json 和 council-forecasts.csv 的列)。10 月 20 日收益率的 15:00 ET 窗口在该日期的密封运行行中说明。
3.1 联盟的一天
图 1 从快照追踪到评分的联盟的一天。
快照。问题发出前,引擎拍摄12个市场的一份价格快照:标普500、纳斯达克100、道琼斯、半导体指数(SOX)、美国10年收益率、美元指数(DXY)、VIX、黄金、WTI、布伦特、铜和比特币(表2)。每行包含其价格、近期变化、52周范围和读取时间;开市前,股票指数和收益率行包含前一个交易日的数据,而其他行是实时的。快照的SHA-256被写入运行行(snapshot_sha256),以便后来可以检验模型是否看到了不同的价格。
问题。十四个席位交易;其中十一个还给出概率并构成委员会,五个来自美国实验室,六个来自中国实验室,三个席位在替补席上仅进行交易(表8)。一个问题逐字逐句地发送给委员会的每个模型,除了一个为每个模型提供其自己账户的块。常见文本的SHA-256被写入运行行(ask_sha256)并在每个答案行中重复,文本以asks/<sha256>.md的形式发布。每个模型收到的文本的哈希值(包括其自己的账户)在发送时被封存(asks.jsonl)。10月20日问题在08:30 EDT开放,其发布的文件哈希值与运行行中的值77d3c627…6f07相符。它还给出了股票指数期货的盘前变化,并告知模型他们可以使用这些数据(第3.3节)。
在09:30 ET前封存。每个答案被记入一行哈希链账本。10月20日,八个计数答案的答案时间从12:31:11Z到12:42:02Z;运行行和答案在一个批次中进入账本,答案的booked_at为13:00:25Z,批次在13:00:25Z被盖章(09:00:25 ET)。一个批次印章为批次计时。要求12在收到时封存每个答案,10月21日上午的记录显示两种形式。其前八个计数答案(12:32:52Z到12:44:59Z)在13:00:19Z的一个批次中被记入,两个外部机构在其签署盖章清单的第二时刻签署了,第九个答案在13:23:37Z被记入,即在其到达后14秒,三个机构在签署下一份清单的第二时刻签署了(第3.2节)。10月20日的证明页记录"计分的流入在美国东部时间2026年10月20日星期二上午9:30(2026-10-20T13:30:00Z)关闭"。那天拍摄了四份印章,在13:00:25Z、15:00:12Z、15:36:05Z和16:52:54Z,锚定在区块972,334、972,344、972,354和972,359。第一份印章覆盖第1到159行,其中包含运行行(151)和八个计数答案(152到159)。
开放。除比特币外,每个市场的参考价格是09:30 ET时或之后的第一个价格;对于全天交易的比特币,它是在该行印章时或之后开始的第一个一分钟K线的收盘价。参考价格始终在印章之后采取(第3.3节)。
收盘后计分。在16:00 ET收盘后,引擎在同一账本中写入一行计分数据,包含每个市场的参考价、收盘价、变化、平局标志以及每个模型给出的概率。10月20日,计分行(第184行)在20:30:36Z被记入,在该日最后一份印章之后,因此被下一份印章覆盖,即10月21日的第一份印章。更长期限在其窗口关闭时计分,作为各自的行。
图1。 联赛的一天:快照、问题、封存、开放、计分。
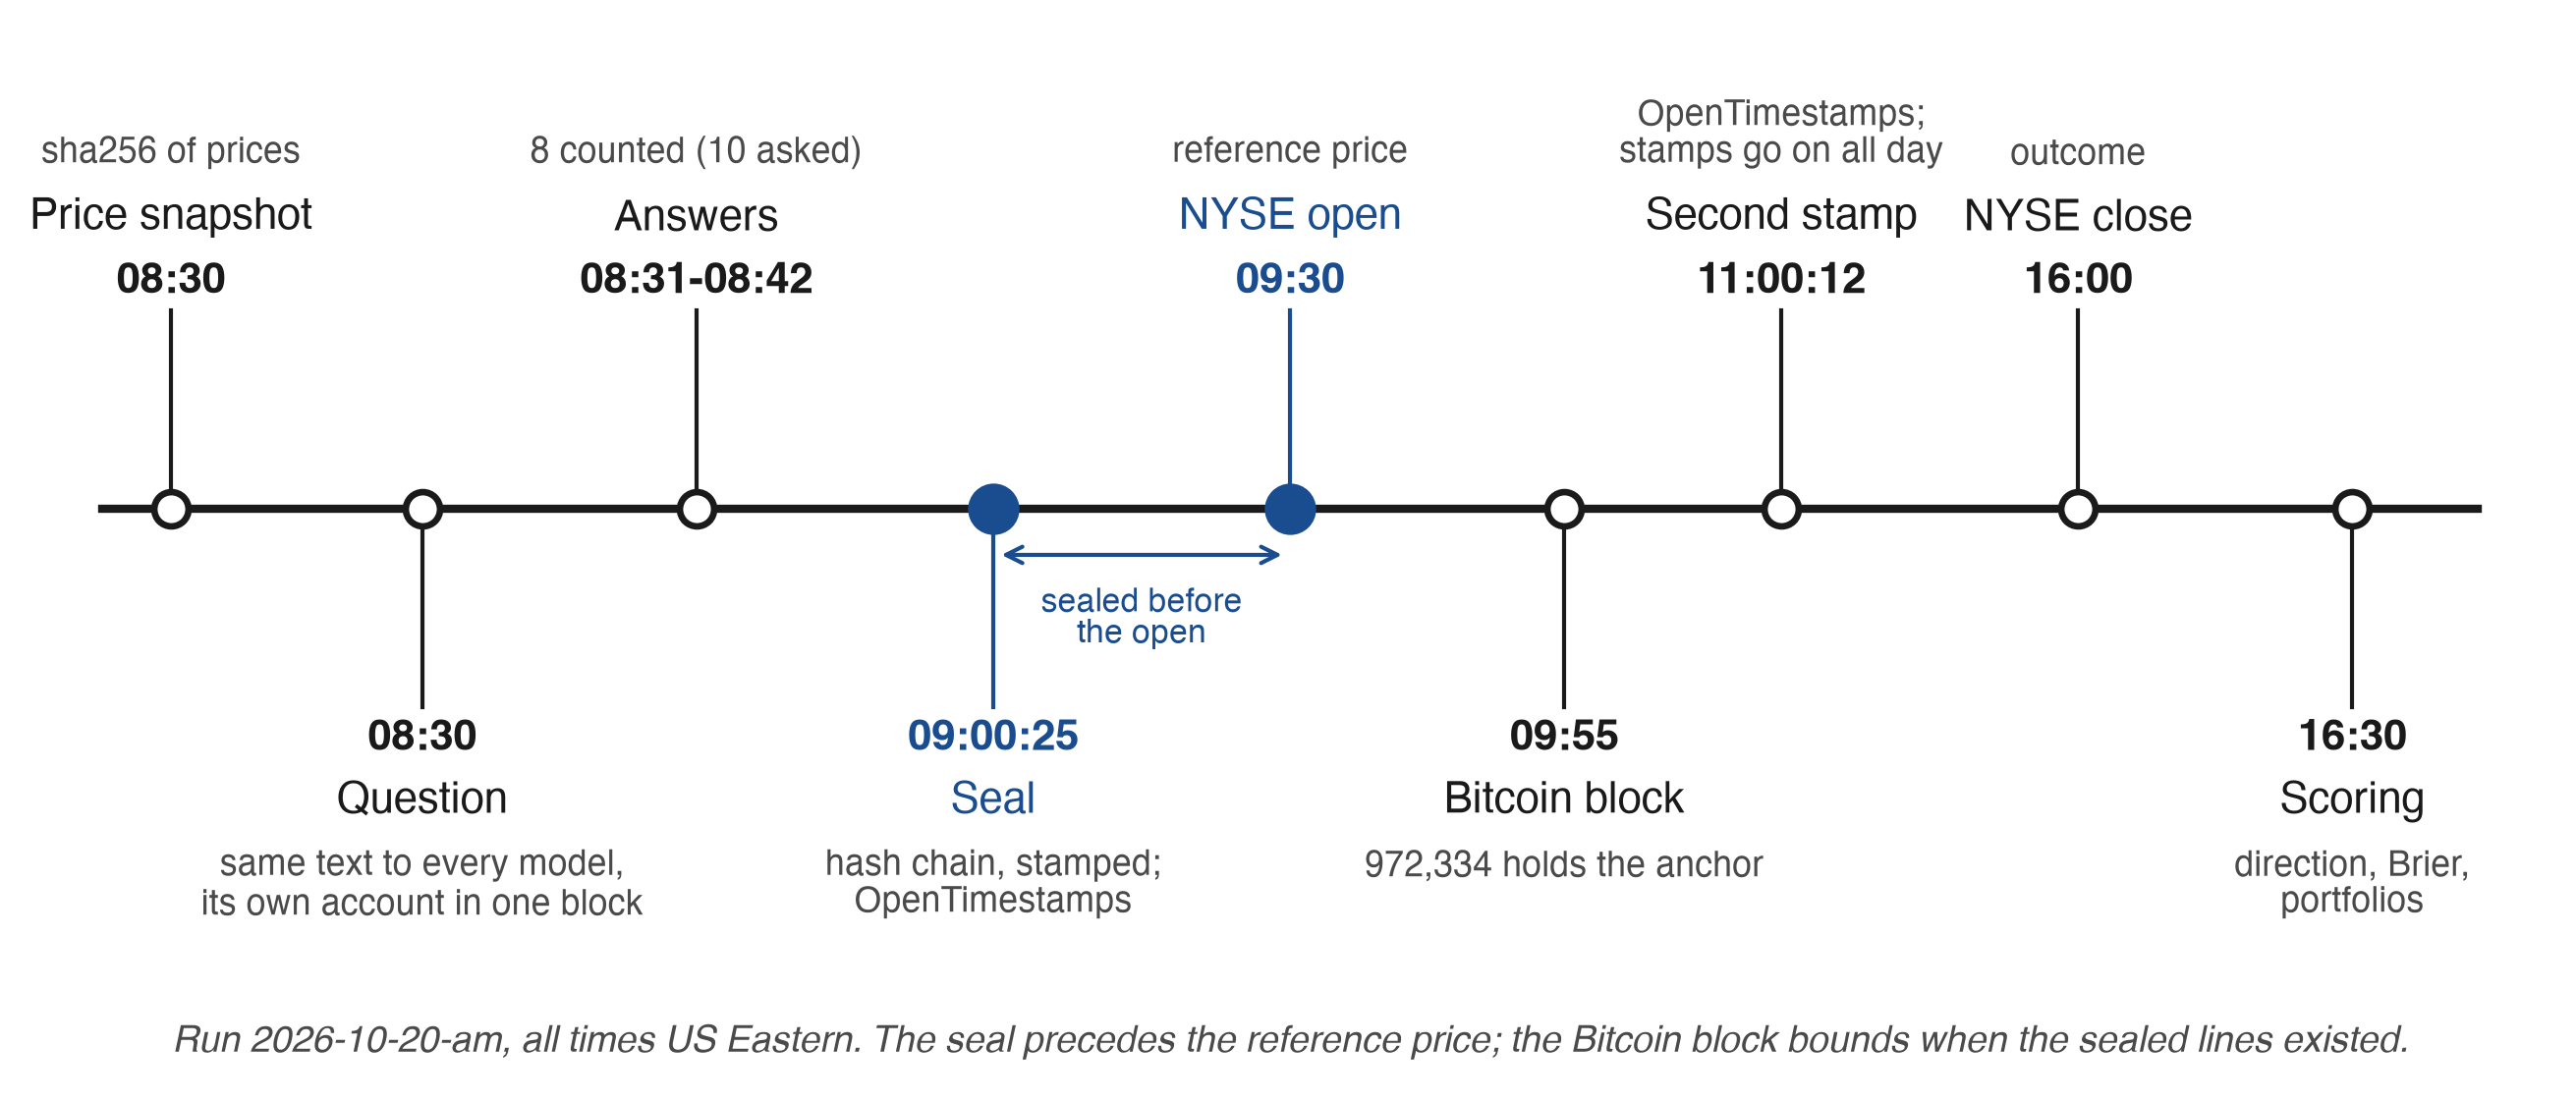
注:时间来自从council-book.jsonl读取的运行2026-10-20-am和证明页/markets/proof/2026-10-20/。ET是纽约时间。比特币区块时间是第972,334区块的头部时间,该区块包含13:00:25Z印章的锚。头部时间通过实际界限限制挖矿时间(第3.11节)。该日的第二份印章15:00:12Z(11:00:12 ET)被标记为显示整日都在进行印章;20:30:36Z的计分行被下一日的第一份印章覆盖。
在表2中,我为每个市场列出了其事件解决所依据的价格代码、一天期事件的结束、投资组合联赛中持有它的基金以及在2026年10月20日用问题一起封存的众筹合约。
表2。 十二个市场:价格代码、参考和一天期事件的结束、每个在投资组合联赛中交易的基金,以及2026年10月20日封存的众筹合约。
| 市场 | 代码 | 价格代码 | 参考 | 一天期事件的结束(ET) | 交易形式 | 众筹合约,2026年10月20日(交易场所,已封存成交量$) |
|---|---|---|---|---|---|---|
| 标普500 | SPX | ^GSPC |
09:30 ET时或之后的第一个1分钟K线 | 16:00 | SPY | Polymarket, 20,637 (Kalshi也已上市) |
| 纳斯达克100 | NDX | ^NDX |
相同 | 16:00 | QQQ | Kalshi, 1,150 |
| 道琼斯 | DJI | ^DJI |
相同 | 16:00 | DIA | Polymarket, 20 |
| 半导体 | SOX | ^SOX |
相同 | 16:00 | SOXQ | 无 |
| 美国10年收益率 | US10Y | ^TNX |
相同 | 15:00 | IEF | Kalshi, 3,199 |
| 美元指数 | DXY | DX-Y.NYB |
相同 | 16:00 | UUP | Polymarket, 4 |
| VIX | VIX | ^VIX |
相同 | 16:00 | 不持有(indicators_only) |
无 |
| 黄金 | GOLD | GC=F |
相同 | 16:00 | GLD | Polymarket, 3,112 (Kalshi也已上市) |
| WTI | WTI | CL=F |
相同 | 16:00 | USO | Polymarket, 3,736 (Kalshi也已上市) |
| 布伦特 | BRENT | BZ=F |
相同 | 16:00 | BNO | 无 |
| 铜 | COPPER | HG=F |
相同 | 16:00 | CPER | 无 |
| 比特币 | BTC | BTC-USD |
在该行印章时或之后开始的第一个1分钟K线的收盘价 | 计分会期的16:00 | BTC-USD | Polymarket, 38 |
注:来自2026年10月20日和21日运行的预测行(price_provider、price_symbol、reference_rule、event_end_at)、arena-protocol.json(assets、indicators_only)和council-book.jsonl第151行(crowd.odds、crowd.kalshi)。每一行都指定提供者yahoo_finance_chart_v8_1m和规则first_1m_bar_at_or_after_reference_at__last_1m_bar_at_or_before_end_at__v1。一周、一个月和六个月的时间跨度分别为5、21和126个交易时段(比特币为7、30和182天;表1)。波动幅度带按交易时段设置(表1),未列出。主要众议对比接纳密封成交量至少为$1,000的合约(第4.9节)。
价格在问题之前存在,问题在答案之前,答案在它们被评分的价格之前,结果在所有这些之后。每个"之前"都以哈希形式写入账本,账本的首部锚定在操作者的控制之外。
3.2 密封是什么
账本是JSON行的序列,一次写入并保持原样。每一行都有四个簿记字段:其位置n、前一行的哈希prev、其自身内容哈希seal和其链式哈希link。令为SHA-256(国家标准与技术研究所,2015年)并令为JSON对象的序列化,键排序方式完全如同Python的json.dumps(o, sort_keys=True, ensure_ascii=False)所写,编码为UTF-8(附录B,第4步)。那么对于第行,其内容为(除四个字段外的所有字段):
密封固定该行所述内容。链固定它所述的内容、它所处位置和它之前的一切。我重新计算了截至2026年10月20日账本全部211行的两个哈希:每个seal和每个link都复现无误,每个prev都等于其前一行的link。
运行行携带问题的哈希、价格快照的哈希、按方的名册、生效的评分方法以及问题发出时记录的预测市场价格。答案行携带模型、其模式及其对12个市场和四个时间跨度的完整解析答案,包括own_sha256(原始回复的哈希)和ask_sha256。评分行携带结果。三者密封方式相同。
链本身证明顺序和内容。控制文件的操作者可在一个下午重建整条链,因此我借助外部时间。在每次运行时,引擎写下一个简短的带时间戳的列表,为每个账本说明其包含的行数、恰好这些行的SHA-256和最后一行的链。本账本在2026年10月20日13:00:25Z时的列表读作"159行,sha256 59673b9e…a7d9,最后链接378273fd…7175b2c"。该列表使用OpenTimestamps(Todd,2016)进行时间戳,该服务将许多哈希聚合到Merkle树中,并通过公开日历服务器将其根提交到比特币交易中。.ots证明与列表一起发布,保存从列表的SHA-256到一个区块头Merkle根的哈希操作路径,此处为区块972,334,头部时间13:55:20Z。该构造是Haber和Stornetta(1991)的链式时间戳与比特币链(Nakamoto,2008)作为见证人的组合。
我按读者必须信任的对象来评级时间证据,从操作员的自有记录到签名时间:
- Level 1,操作员的记录。每一行被封入链中(
at、prev、link;答案行添加booked_at,其批次封的第二个),参考价格在封之后取得。链固定了顺序和内容;封的分钟数是操作员记录的。 - 提交到日历。持有链头的列表被发送到公共 OpenTimestamps 日历(证明命名
alice.btc.calendar.opentimestamps.org和bob.btc.calendar.opentimestamps.org)。待处理收据表明哈希被接受;它不包含读者可以验证的时间。 - Level 2,比特币锚。日历将哈希提交到比特币区块。锚定的前缀最晚在区块头时间之后的几小时内存在,由实际界限(第 3.11 节),持有较早证明的任何人都可以检测到对其中某行的后续重写。区块可在 09:30 ET 之后被挖矿:10 月 20 日,09:00:25 ET 的戳到达了一个区块头时间为 09:55:20 ET 的区块。
- Level 2+,签名时间。从 2026 年 10 月 21 日起,独立的 RFC 3161 时间戳颁发机构(Adams 等人,2001 年)FreeTSA 和 DigiCert,由该天第三份列表中的 Sectigo 加入,对每个带戳的列表进行签名,固定其覆盖的每一行存在的秒。读者信任一个颁发机构及其证书而不是操作员,对于独立的颁发机构,任何一个都足够。令牌对批次进行时间戳记。每个答案的到达是要求 12 的主题。
一行在进入链时被封,头在发送到日历时被戳,当它到达一个区块时被锚定。因为账簿只增长不减,在第 159 行获取的戳在任何后来的长度仍然验证:今天文件的head -n 159返回戳的字节不变并哈希到那天上午戳的值,所以前缀由行数确定,而不是会重写行的过滤器。每个带戳的列表打印它哈希的字节规则:文件按存储方式,UTF-8 无字节顺序标记且未重新编码,每行按其最后 LF 计数,最后一行在其 LF 被写入后计数一次。
披露时间和封时间。封时间是一行进入链的时间;披露时间是其文本变为公开的时间。联赛在当日比分后发布这些行的文本,座位、封和时间在之前可见(证明页)。Sornette 等人(2010 年)的延迟披露属性,阻止第三方在公开中使用封的概率。约束操作员(其持有文本以便预订它)是 P1b 和 P2 的工作(第 3.11 节)。在一个批次内,链记录预订的顺序:10 月 20 日,运行行站在其答案之前,并在它们到达后与它们一起预订。
3.3 封后的参考价格
参考价格是每个市场规则封后的第一个价格。预测仅在固定后开始的价格路径上评分。封前存在的信息是允许的:问题可以携带盘前期货(10 月 20 日,S&P 500、Nasdaq-100、道琼斯和罗素 2000 期货对前一收盘),模型可以搜索到其答案为止的新闻。协议排除的是参考价格及其之后的所有内容。
封在开盘后的行被保留。它获得其自己的参考,其自己的封之后的第一个价格,并标记为迟(评分行中的late_ref)。封在收盘后的行在该会话中不被评分(counted)。这样的行回答了不同的问题:在 10 月 20 日的账簿中,一个封在开盘后的行的自有参考在其九个一日单元格中的六个中反转了评分移动的符号。因此,我将其排除在比较模型在共同事件上的所有内容之外:共识、共享错误的计数、最接近的模型、有效声音数和每个一对一比较(要求 4)。评分行标记该行,联赛统计的计数序列将其排除(表 5)。
相同的规则为每个共同事件固定一个参考,包括比特币。在参考实现中,比特币的参考是在行的封时或之后开始的第一个一分钟柱的收盘(reference_rule,Yahoo Finance BTC-USD),所以价格总是晚于封,而开放文件将封第二个写为reference_at,定价柱的开始为reference_price_at。在后续批次中封的行获得其自己的比特币参考并是一个单独的事件。10 月 21 日,在 13:00:19Z 处封的八个答案共享参考 83,536.42,13:01Z 柱的收盘;第九个,在 13:23:37Z 处封,有其自己的,83,677.08,13:24Z 柱的收盘,并单独评分(own_event,same_event false),在共同比特币事件之外。因为reference_at等于封的秒,一个在"封在reference_at之前"处的切割会削除每个比特币行。我为所有十二个市场使用一个时钟:答案行仅在封在会话的 09:30 ET 参考之前时才进入共同事件统计。比特币行遵循相同的 09:30 ET 切割,而比特币价格本身从运行的封之后的第一分钟引用。这是已发布的计数序列的规则(n_eff.counted)和已归档的分辨率脚本。一旦答案在到达时被封(要求 12),为全天交易的市场的共同参考是运行摄入关闭时的价格,在每个计数的封之后。
3.4 每个会话一个计数运行
联盟每天要求多次运行(早上运行、傍晚运行、周末比特币运行和周日雷达),因此几次运行可以针对一个会话。每个模型和会话只计算一次,标准要求该运行由在运行前声明的规则固定(要求6)。形式为"在开盘前最后封装的运行"的规则事后应用。它使运营商可以自由地在开盘前发送后来的运行,从而在运行中进行选择。因此我制定了时间表规则。从2026年10月21日(计数记录的开始)开始,定时的早晨运行计入,所有其他运行都是参考计算。声明被封装为传出问题链的第一行(asks.jsonl,2026年10月21日04:16 UTC,在早晨运行前八小时),并在证明页面上与其SHA-256(c24b0d4f…5df5)和互联网档案馆捕获(同日05:35 UTC)一起发布;我在2026年10月21日15:05 UTC在那里读取了它。在两个开发会话中,10月19日和20日,封装的方法计算了在会话开始前最后封装的运行(session_run),这是一项事后应用的规则。这些会话构成了主要比较窗口之外的开发段(第8节)。其他运行在自己的页面(not_counted、earlier_run)上评分,保存、发布并标记,任何人都可以对封装的时间戳应用声明的规则(P3、第3.11节)。投资组合联盟的重试(asked_again、附录A)与其问题哈希一起封装,并保持在每个预测分数之外。
3.5 方向、概率和平局
模型给出prob_up,其从0到100的概率,表示指标在地平线末端高于其参考价格的概率。对于10年期收益率,"买入"是对收益率上升的押注;对于VIX,是对预期波动率上升的押注。
我通过提前固定的规则将小幅波动视为平局。区间为,其中为参考前四个分钟柱会话上的平均绝对一分钟百分比回报率;对于正常回报,这约为会话标准偏差的0.08(council-stats.json、draw_band)。对于期货(WTI、布伦特、黄金、铜),跨越记录的前月合约变化的分钟波动被排除在外,因为滚动是两份合约之间的跳跃(noise_rolls)。标准要求评分事件是被询问的事件(要求7)。主要Brier分数在所有行上计算,上升意味着变化大于零,不含平局的分数以其丢弃的行数为第二报告。模型被要求给出严格上升的概率,并且没有被告知平局规则。从10月21日的会话开始,全行分数是联盟的主要分数(字段pall)。开发会话如已发布,作为单独的段(要求15),在排除平局的分数上。这样的分数被超出区间的上升概率最小化,因此对于所提问题,它在严格意义上不是正确的。
平局区间和正确的分数可以结合在一起。一种设计要求超出区间的移动上升的条件概率,并仅在非平局行上对其评分。另一种要求三个概率:上升、平局和下降,由三结果Brier分数评分,对三元组严格正确(Brier,1950;Gneiting & Raftery,2007):
在非平局行上给平局零概率的预测评分恰好等于二元Brier分数,。均匀预测各占三分之一评分为,而二元硬币为0.25,因此三结果分数需要自己的基准。恰好50的概率不支持任何一方,仅由Brier评分。
3.6 "逢低买入"作为提前固定的水平
"逢低买入"如果没有水位就无法评分,因此我需要带有buy_dips操作的答案来给出entry,即参考水位下方一个模型会加仓的水位。如果价格在交易时段触及该水位,投资组合就在该入场点买入,否则不买。无论如何,概率都会被评分。五个允许的操作是buy_strong、buy_dips、hold、trim和sell。列表外的词会作为action_word保留,其概率和水位被评分,但不交易。
因此每个答案格子对一个事件有两个密封答案:概率和操作,在最近计数的两个早晨它们排成一列(图2)。在2026年10月20日前密封的八个席位的384个格子和2026年10月21日九个席位的432个格子中,没有操作字段为空,每个sell和trim都在50以下,hold在接近五五开的地方(两个早晨中位数均为52),中位数逐级上升到buy_strong。我发现四个格子中有逢低买入伴随概率低于50:Claude在10月20日的三个单日格子(标普500为48、纳斯达克100为47、半导体为46)和MiMo在10月21日一周的标普500(47)。逢低买入是一种只在入场水位成交的订单,该水位固定在参考价格下方,因此概率低于50伴随它是合理的。表3按时间跨度计数操作。hold在两个早晨的单日格子中填充了64个(分别占96和108个格子),在六个月时buy_dips领先(37和38个格子)。
图2。同一答案格子中密封的操作所对应的上升概率:运行2026-10-20-am(八个席位在参考前密封)和2026-10-21-am(九个席位),全部四个时间跨度。
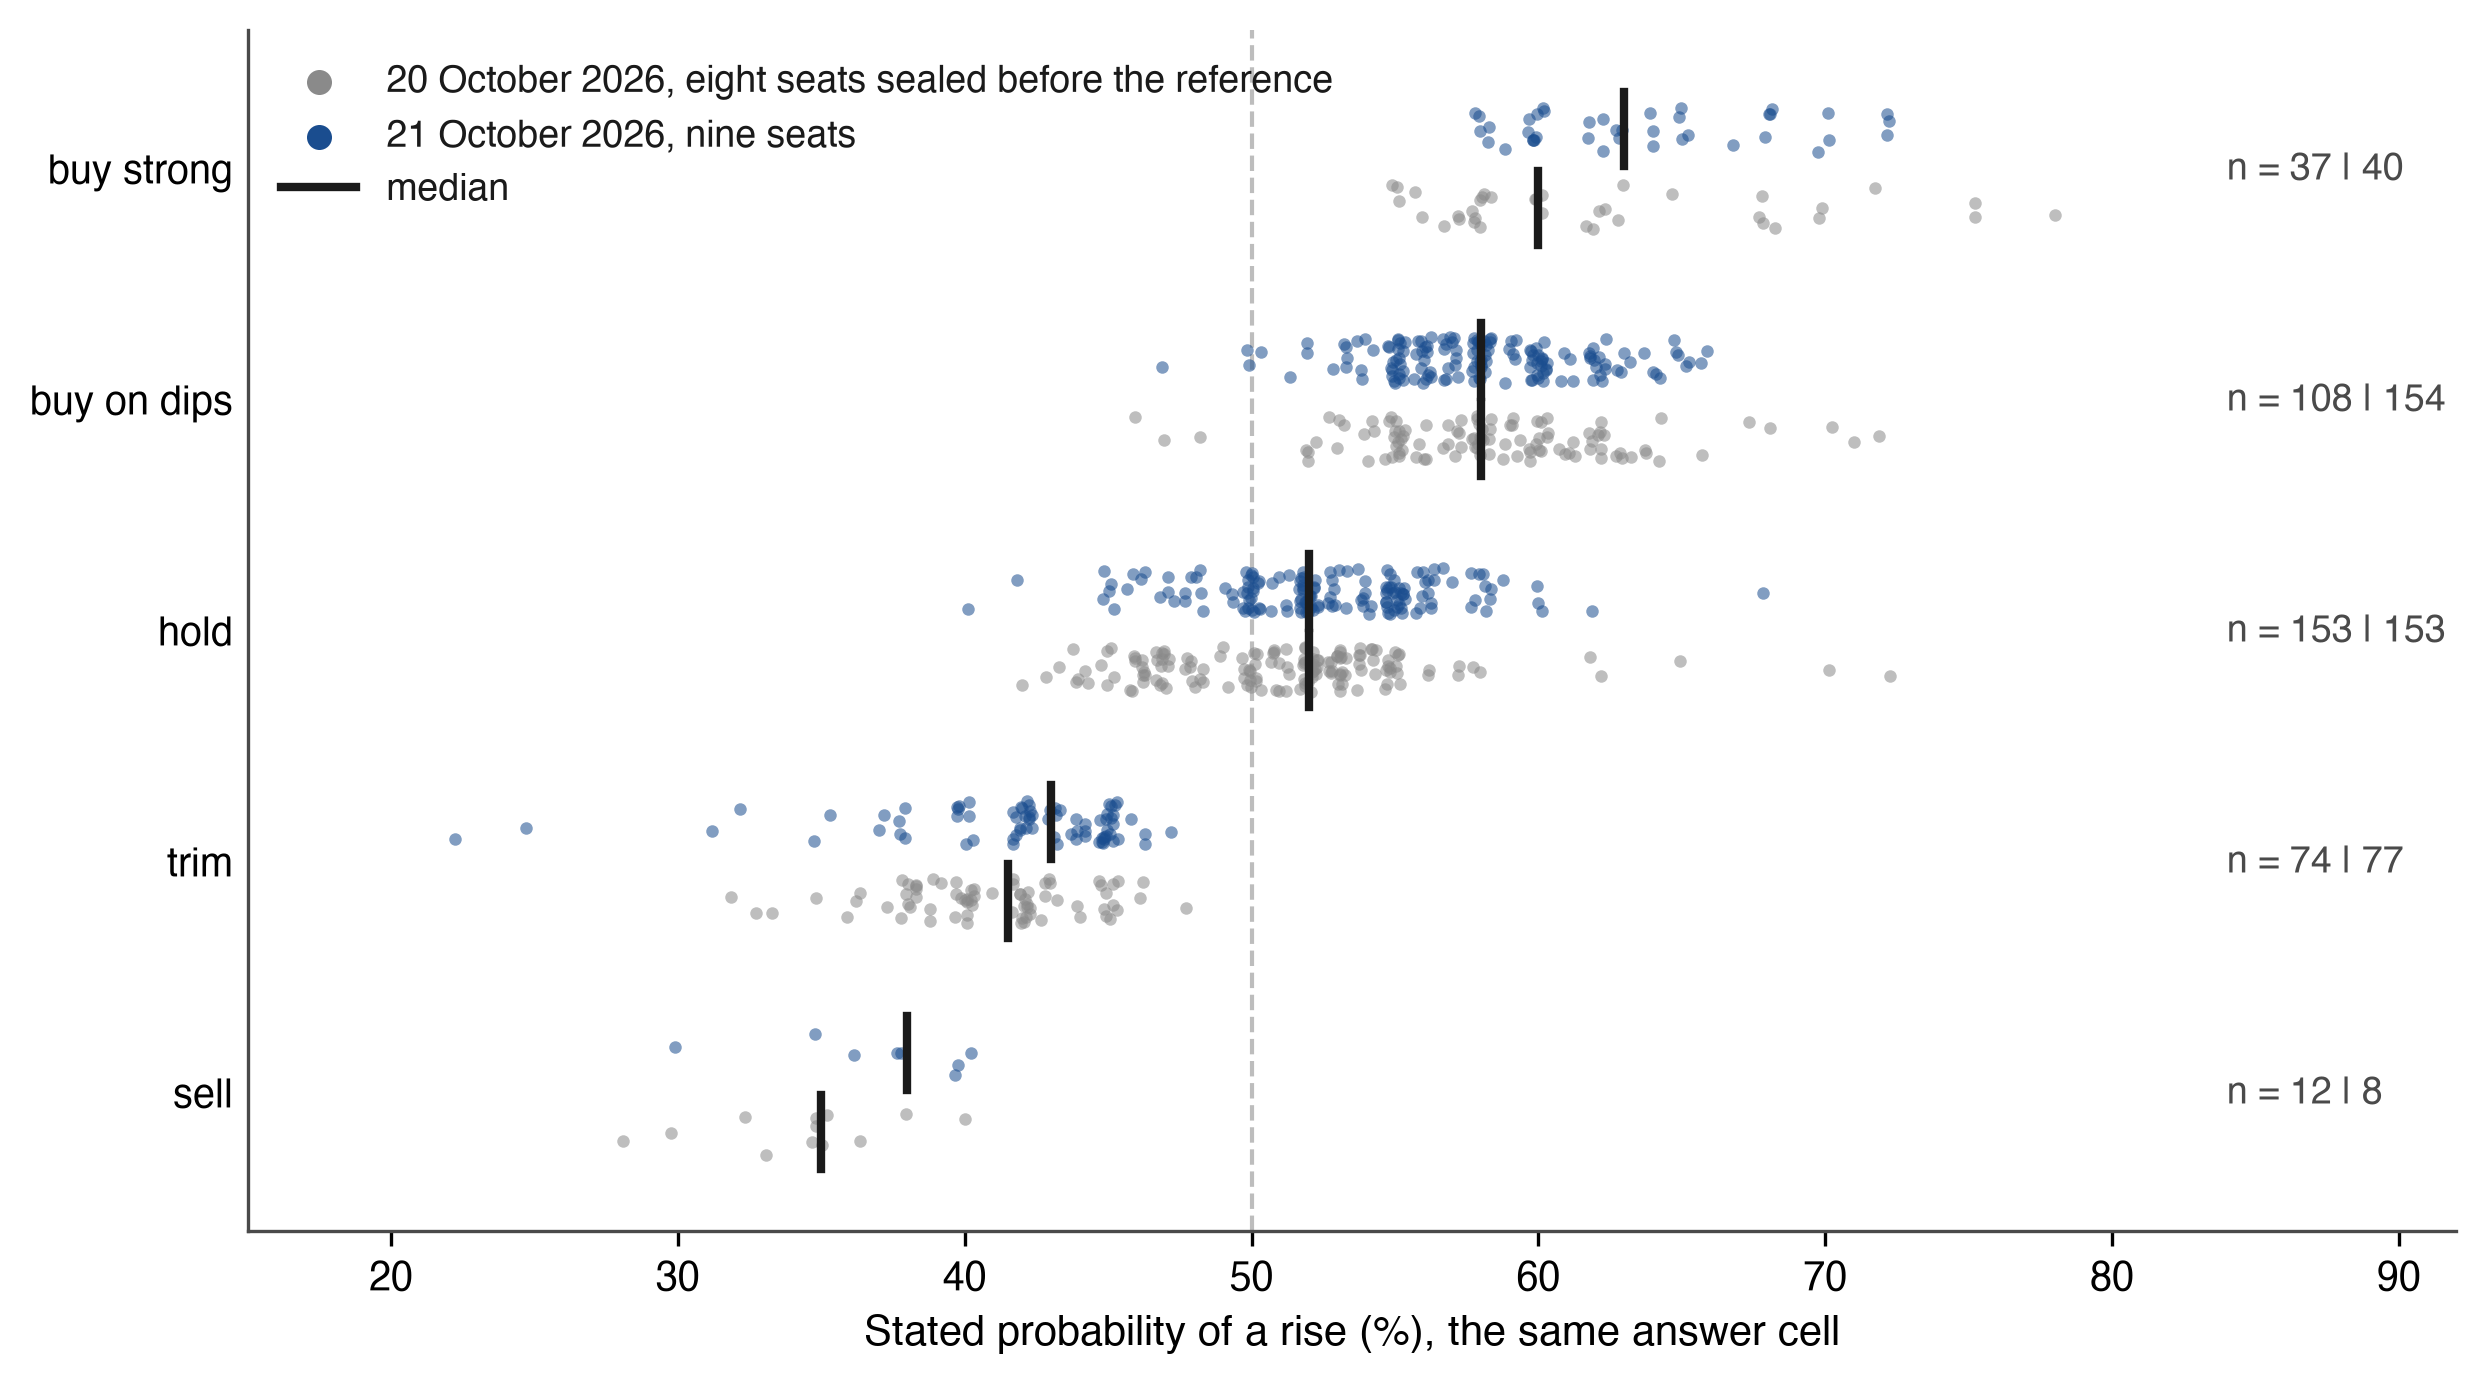
注:每个点是一个答案格子(席位×市场×时间跨度),略有抖动;柱子标记中位数(sell 35和38、trim 41.5和43、hold 52和52、逢低买入58和58、强势买入60和63);n为10月20日|21日的格子数。操作如items.<market>.<horizon>.action中密封,概率在prob_up中。来源:council-forecasts.csv存档于2026年10月22日01:32 UTC。与第3至5节中由密封答案生成的每个图表和表格一样,它不显示任何结果。
表3。按时间跨度密封的操作:运行2026-10-20-am(八个席位在参考前密封,每个时间跨度96个格子)和2026-10-21-am(九个席位,每个时间跨度108个格子)。
| 时间跨度 | 运行 | 卖出 | 减仓 | 持有 | 逢低买入 | 强势买入 |
|---|---|---|---|---|---|---|
| 1天 | 2026年10月20日 | 1 | 11 | 64 | 16 | 4 |
| 1天 | 2026年10月21日 | 0 | 12 | 64 | 26 | 6 |
| 1周 | 2026年10月20日 | 3 | 23 | 33 | 31 | 6 |
| 1周 | 2026年10月21日 | 1 | 18 | 31 | 54 | 4 |
| 1个月 | 2026年10月20日 | 2 | 15 | 42 | 24 | 13 |
| 1个月 | 2026年10月21日 | 3 | 22 | 34 | 36 | 13 |
| 6个月 | 2026年10月20日 | 6 | 25 | 14 | 37 | 14 |
| 6个月 | 2026年10月21日 | 4 | 25 | 24 | 38 | 17 |
注:按答案格子中密封的操作计数。来源:council-forecasts.csv存档于2026年10月22日01:32 UTC。
3.7 四个时间跨度和年度
每个答案对每个市场的四个时间跨度都有覆盖:下一个交易日(1d)、一周(1w)、一个月(1m)和六个月(6m),加上一句关于年度的未评分句子(years)。对于十一个交易时段市场,较长的时间跨度为5、21和126个交易时段;对于比特币,它们为7、30和182个日历日,其日从密封分钟到评分交易时段的16:00 ET收盘,早间运行约七小时。我在每个定义内比较时间跨度。一个模型在一个早晨因此给出48个概率,每个在其自己的窗口上解决,全部在一分钟内在一组信息上密封。
3.8 目标和"错误如果"
对于每个市场和时间跨度,模型也给出target,即其预期价格走向,和invalidation,显示为"错误如果",该模型会承认其看法错误的水位,以及其主要风险和什么会让它修正看法(risk、revise_if)。所有这些都与概率一起密封,因此预测在模型自己的条件下是可证伪的。一个密封答案展示了这些字段的作用。在2026年10月19日开盘前,ChatGPT(GPT-6.1 Sol)给标普500该天上升54%的机会,目标为7,678.59,"错误如果"在7,560,然后一周42%,一个月38%,六个月61%。其陈述的看法是"我对人工智能支出的直接通胀效应的权重比其最终生产率红利更大",其修正条件是"如果SPX连同改善的盈利指引突破8000,我会放弃月度看空观点"(书籍第83行)。这些水位中的每一个都可以根据价格走势检查,无需询问模型其含义。在图3中我绘制了完整答案,在每个时间跨度处的概率、操作、目标和"错误如果"水位,以及其逢低买入在六个月处的7,350入场水位会成交的地方。问题显示了前一收盘价7,659.44,该日参考价格7,700.34是在密封后取得的。
图3。一个密封答案:ChatGPT在标普500上,运行2026-10-19-am(council-book.jsonl,第83行),在每个时间跨度处的概率、操作、目标、"错误如果"水位和入场水位。
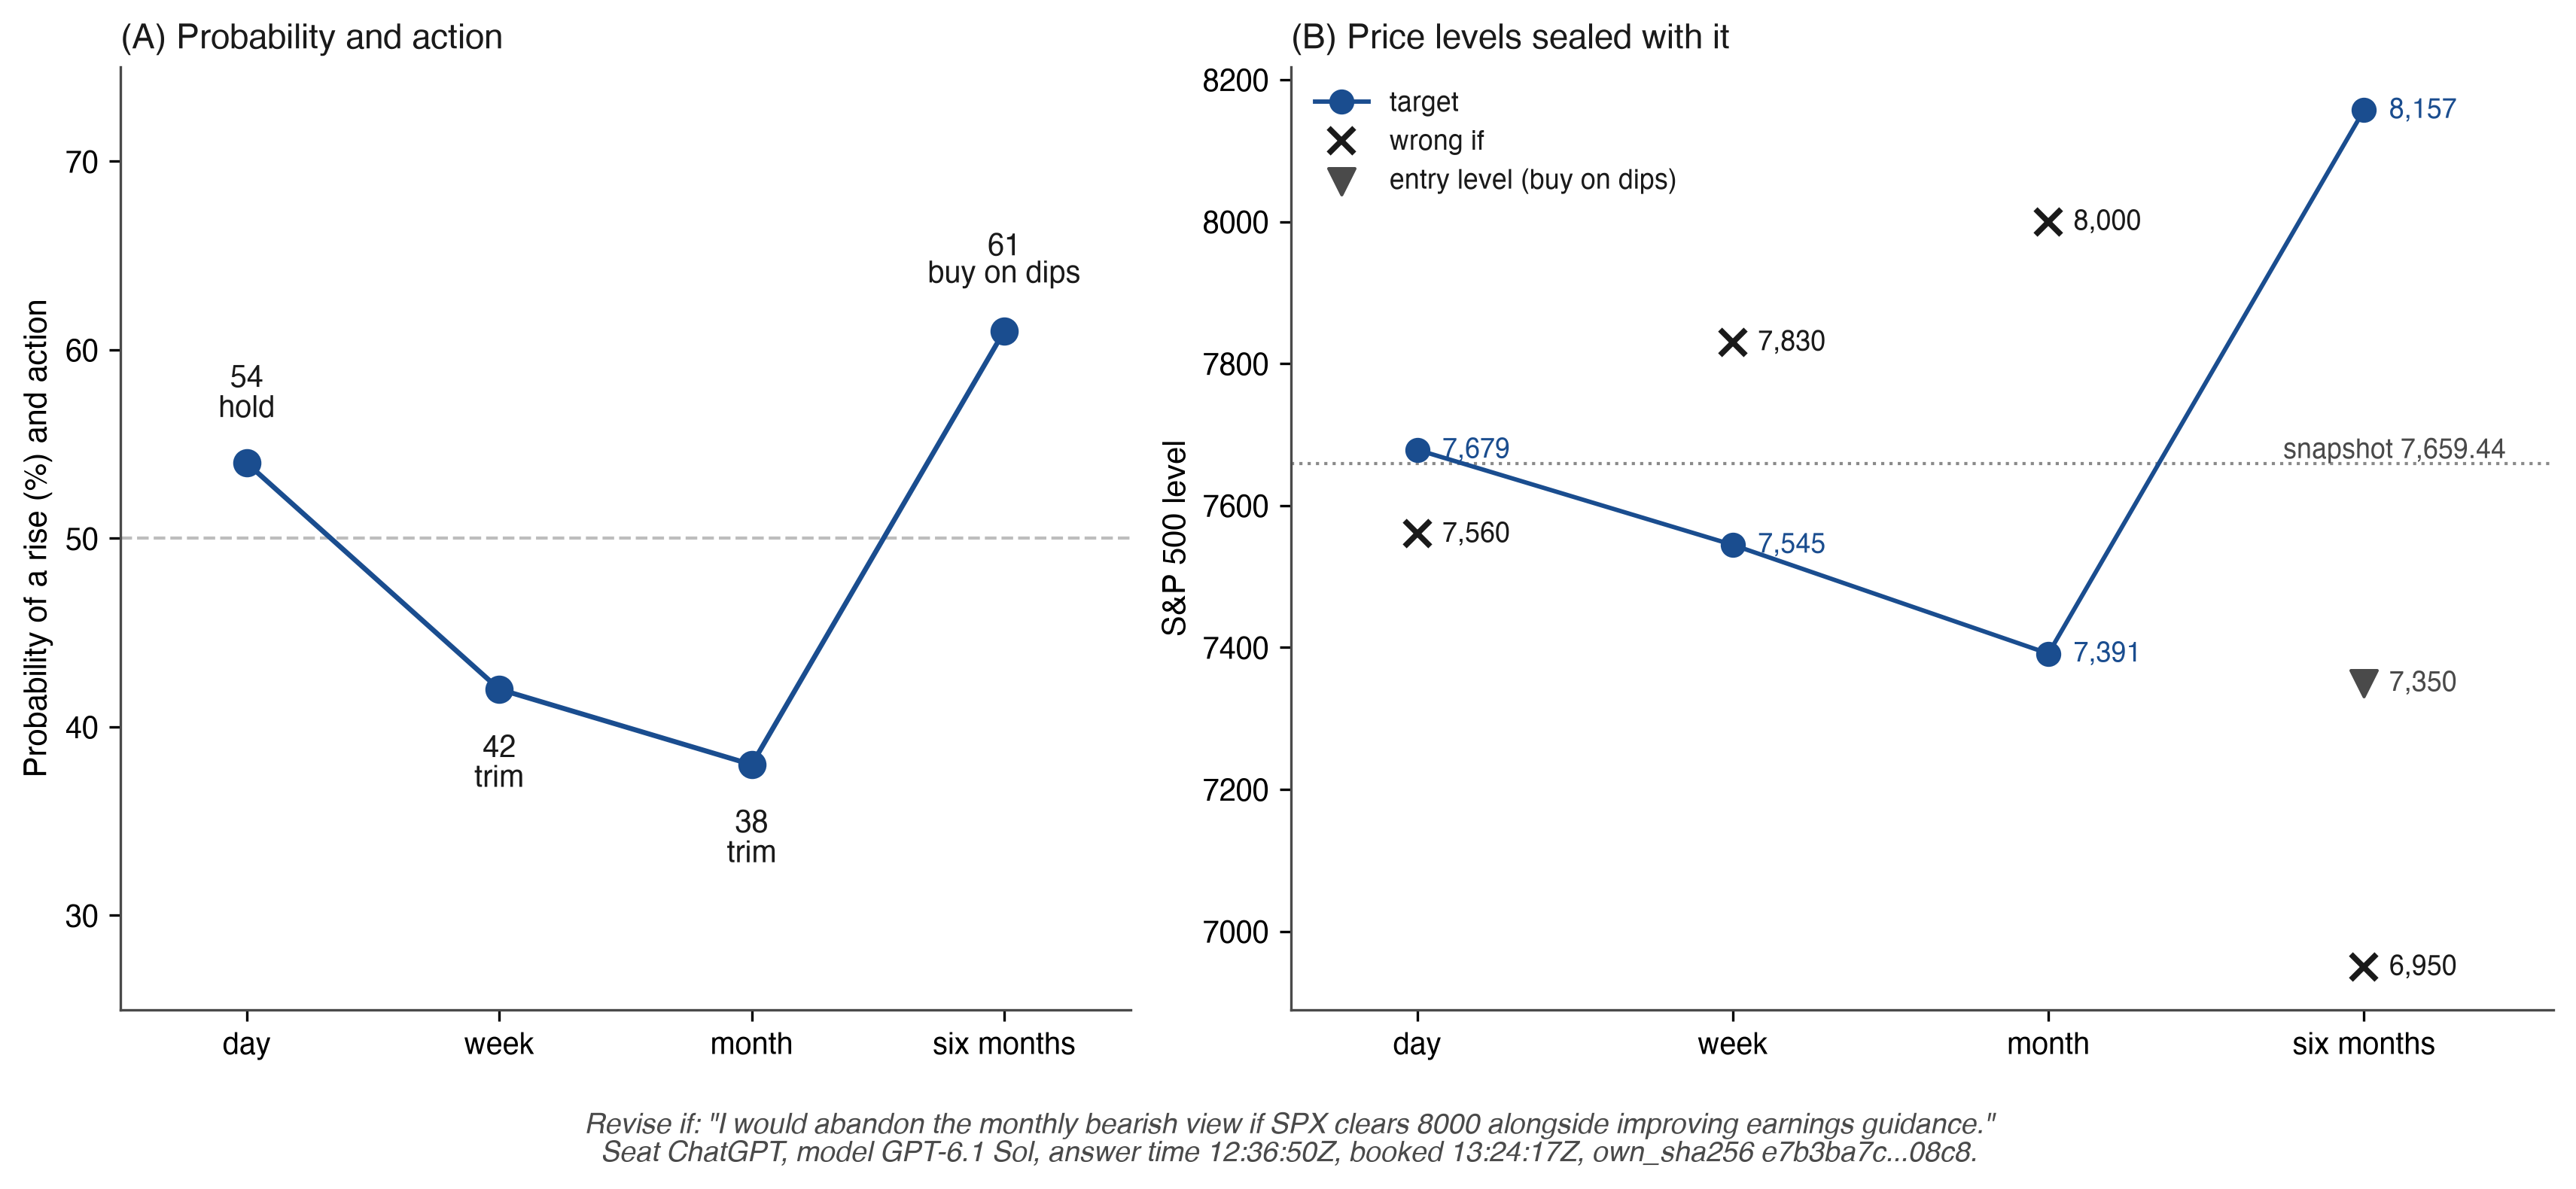
注意:所有值均已记录在答案行中(答案时间 12:36:50Z,预订时间 13:24:17Z,在 09:30 ET 参考之前)。点线是问题快照中的标准普尔 500 指数价格(asks/02577f9c….md);连接目标的线条连接了用于阅读的期限,并不是一条路径。入场水平是答案行的字段 items.SPX.6m.entry;council-forecasts.csv 的列 entry 在该单元格处为空。
3.9 空单元格
答案的每个单元格都会被评分。模型留空的单元格计为 50%,布瑞尔得分 0.25,无边界(counted_50);它无法超过随机猜测,但可以掩盖在困难市场上的低于随机猜测的表现,因此我在每个得分旁边报告空单元格的数量(要求 8)。不发送答案行的席位记录为 no_answer,并在该运行的得分中缺失。填充的 0.25 属于席位的服务得分。共识和一致计数由实际给出的概率形成,字段 of 计算它们。因此每个席位在每个期限有三个结果,各自排名:给定概率的布瑞尔得分、截止日期前答案单元格的预期比例,以及服务得分。组合投资组合是其自身表格中的第四个结果。一个统一的得分会掩盖席位是在判断、准时性还是交易方面失利。
预期单元格必须在答案之前已知。该标准要求提供预期答案的名单,包括席位、市场、期限、截止日期和重试政策,在运行的第一个问题之前密封(要求 13),以便每个预期单元格都解析为一种状态(counted、counted_50、no_answer 或拒绝)。运行行按边界携带名单,从 2026 年 10 月 21 日起,名单在运行的第一个问题之前密封,在传出问题链中(asks.jsonl)。名单根据声明的日程检查完整性。每个传出问题的哈希值在发送时密封,用于检查已发送的运行(要求 13)。
3.10 模型版本的变更、更正、规则的变更
座位是一个运营参与者;模型版本是一个特定时间的实现,记录同时保存两者。当座位的版本更改时,其账户继续运行,更改带有日期,新版本以来的结果单独显示(new_model_version),每个版本从接管之日起获得自己的账户(_ver:<model>:<n>),版本更改的运行被标记(seat_versions_in_run)。
更正是一条新行,命名其涉及的行(of),被更正的行保持原样。价格遵循相同规则:协议声明从2026年10月22日起,更正的参考价格或收盘价作为密封更正行输入,带有其来源和原因,其前面的评分行不被重写(arena-protocol.json中的price_corrections)。在10月20日,该书211行中有47行是更正:一些从运行收据中恢复首次运行中的答案模型和模式,其他记录重新密封的答案等于较早的行(same_as,council-forecasts-copies.csv中的较早副本)。该标准要求在答案行本身中包含模型、版本和模式,或者在盲季节期间,对其进行加盐承诺(要求1)。
方法论的改变改变了任务并开启一个新的测量段(requirement 15)。确认性评分、配对收益或投资组合比较在一个方法论版本内计算,或各版本报告为独立的段;在新规则下重新评分的旧预测被标记为替代性分析。基于一个2级或以上元素的声明涵盖该元素在公开文件中出现之后做出的印章。
3.11 事前证明:三个属性
我称预测记录为事前证明,当第三方使用公开文件和 Bitcoin 链可以建立下述属性时,且当该记录说明其中哪些相互依赖时。设预测 保有在账簿行 ,参考价格在时间 ,结果在时间 。设印章 承诺前 行通过摘要 ,其证明将印章列表放在块 中,标题时间为 。设 为真实挖矿时间可以跟随标题时间的边际值:在实践中为数小时,由下面讨论的界限约束。
P1a. 锚点之后无重构。对于每个计数的预测,都有一个时间戳 ,其中 。根据实际界限,带时间戳的前缀最晚存在于 ,此后对其中任何行的添加、删除或重写都会改变 ,使其不再与块 中提交的摘要相匹配。对于晚于 的每个结果,这排除了在结果之后写入的预测。
P1b. 参考之前的承诺。预测在 之前被密封。从2026年10月21日起,这对接受任一权威及其证书的任何人都在2级及以上成立:两个RFC 3161令牌在 之前在带时间戳的列表上签名,其中 。10月21日,两个权威在协调世界时13:00:19签署了包含第1至222行、运行行(214)和八个计数答案(215至222)的列表,比 早29分41秒;三个权威在协调世界时13:23:37签署了包含第九个计数答案(224)的列表,比 早6分23秒(附录B、第9步)。对于比特币,参考是每行密封后的第一个一分钟柱线的收盘,批次为13:01Z,第九个答案为13:24Z,所以顺序在构造上在那里成立。对于10月19日和20日的开发会话,本版本评分的会话,P1b在链式记录(at、booked_at、prev、link)上处于1级。10月20日,锚定块在 之后(第3.2节)。
P2. 无替换。改变 的任何字段(其中 )会改变 ,因此改变 及随后的每个链接,因此改变 。无法检测的替换需要SHA-256的第二原像或比特币链的重写,前提是验证者持有在时间戳处发布的证明(威胁模型见下文)。
P3. 不在披露的密封运行之间进行选择。对于每个模型和会话,计数行由在运行之前声明并仅应用于密封时间戳的规则固定。从2026年10月21日起,该规则是在运行之前密封的已发布日程。在运行内,从会话11开始,每个席位的第一个格式正确的答案计数(在asks.jsonl、第74行中声明)。第3.4节给出了开发会话的规则。其他每个密封的运行仍在账簿中,带有标签,读者可以重新计算哪行计数。完整形式还涵盖询问和不密封的运行:每个传出问题的哈希在发送时被密封(2级及以上)。从2026年10月21日起,这些哈希在asks.jsonl中被链接。
威胁模型。时间戳证明摘要曾存在。它对其他在其旁边带时间戳的摘要没有说明。同时托管账簿和证明的运营者可以在每次运行时为两本书打上时间戳,稍后将书和证明一起替换;替代品对比特币和时间戳颁发机构进行验证。因此,要求3使得必须在每个时间戳处,在运营者不控制的至少一个仅追加通道(存档存款、公共版本控制主机或网络存档捕获)上发布带时间戳列表的SHA-256,并在证明页面上列出这些通道。从2026年10月22日起,每个带时间戳的列表在标记时进入Sigstore Rekor透明度日志,较早日期的列表在2026年10月21日协调世界时23:45至23:47之间进入(表5)。对于日志中的列表,从其日志时间起,P1a和P2对所有人成立;在该时间之前,对任何保持或可从独立存档检索较早证明的方产生约束力。
表4针对给予该属性的协议元素和读者可以检查它的级别列出了每个属性。
表4。 之前的证明:协议的哪个要素提供每个属性,以及在哪个级别。
| 属性 | 排除的内容 | 提供该属性的要素 | 读者如何检验 |
|---|---|---|---|
| P1a 锚点后无重建(第2级,具有独立的证明副本或列表的Rekor条目) | 在锚点后写入或重写的预测 | 每本书的带时间戳的前缀哈希;Bitcoin中的OpenTimestamps锚点;独立渠道上的印章摘要 | head -n m哈希等于带时间戳的摘要;.ots证明指向区块的Merkle根;约束先于结果 |
| P1b 参考前的承诺(10月19日和20日的第1级;10月21日起的第2+级) | 在参考价格后密封但从中计分的预测 | 链中的密封分钟数(booked_at);参考在密封之后;到达时密封(必需);从10月21日起:RFC 3161令牌 |
将该行的密封时间max(at, booked_at)与会话的09:30 ET进行比较;从10月21日起:附录B,第9步 |
| P2 无替换(第2级,具有独立的证明副本或列表的Rekor条目) | 密封的预测稍后被更改 | 每行seal;链式link带prev;仅可追加的书 |
重新计算seal和link;每个prev都等于前一个link |
| P3 已披露密封运行中无选择(第1级规则;第2+级完整形式) | 多次询问并计算获胜的运行 | 每个会话一个计数运行,从2026年10月21日起事先声明;所有其他运行保持为not_counted;第2+级:传出问题哈希在发送时密封(asks.jsonl,从10月21日起) |
对该书的密封时间应用声明的规则;在council-forecasts.csv中查找所有运行(run_id, run_role) |
P1a的分辨率为小时,其边界是实际的。外部时间是网络接受的链中区块的时间,该区块的标题时间由矿工设置。共识规则从下面将其限制为前11个区块的中位数时间,从上面限制为约比接受该区块的节点的网络调整时钟提前两小时(Bitcoin开发者文档,n.d.)。两条规则都没有规定在其标题时间后多久实际挖出一个区块。在正常运行中,中位数滞后于实际时间约一小时,因此锚定摘要存在的时间不晚于之后的几小时。想要仅从共识规则获得边界的验证者使用几个确认后区块的标题时间,每个印章的带签名的日历时间仅来自时间戳颁发机构(第2+级)。对于区块972,334,前11个区块的中位数时间为12:45:12Z,比其标题时间早70分钟。IETF互联网草案规定了验证者如何检查Bitcoin锚定的时间证明(Fassbender, 2026)。10月17日、19日和20日,锚定区块(971,796、972,153和972,334)的标题时间在预订时间的一小时内,对于在16:00 ET解决的日期范围,带边界的约束在结果之前;对于更长的范围,分辨率是无关的。会话中印章和参考的顺序是P1b。
3.12 信任之梯
关于"已验证"AI预测的公开声明分为三个级别,最后一级上方还有第四步(图4)。在第0级,读者信任运营者。在第1级,运营者保留指纹或链式记录,这证明后来的文本与早期的哈希匹配,但不能证明何时制作的哈希。在第2级,指纹被锚定在运营者之外,在一个无法在不被检测到的情况下重写或后期编辑的公开记录中,并用运营者无法控制的工具检查。第2+级是第2级加上每个印章上第三方签名的时间(第3.2节)。
图4。 信任之梯:信任运营者、运营者指纹、运营者外的锚点,以及来自两个权威的签名时间(第2+级,RFC 3161,自2026年10月21日起)。
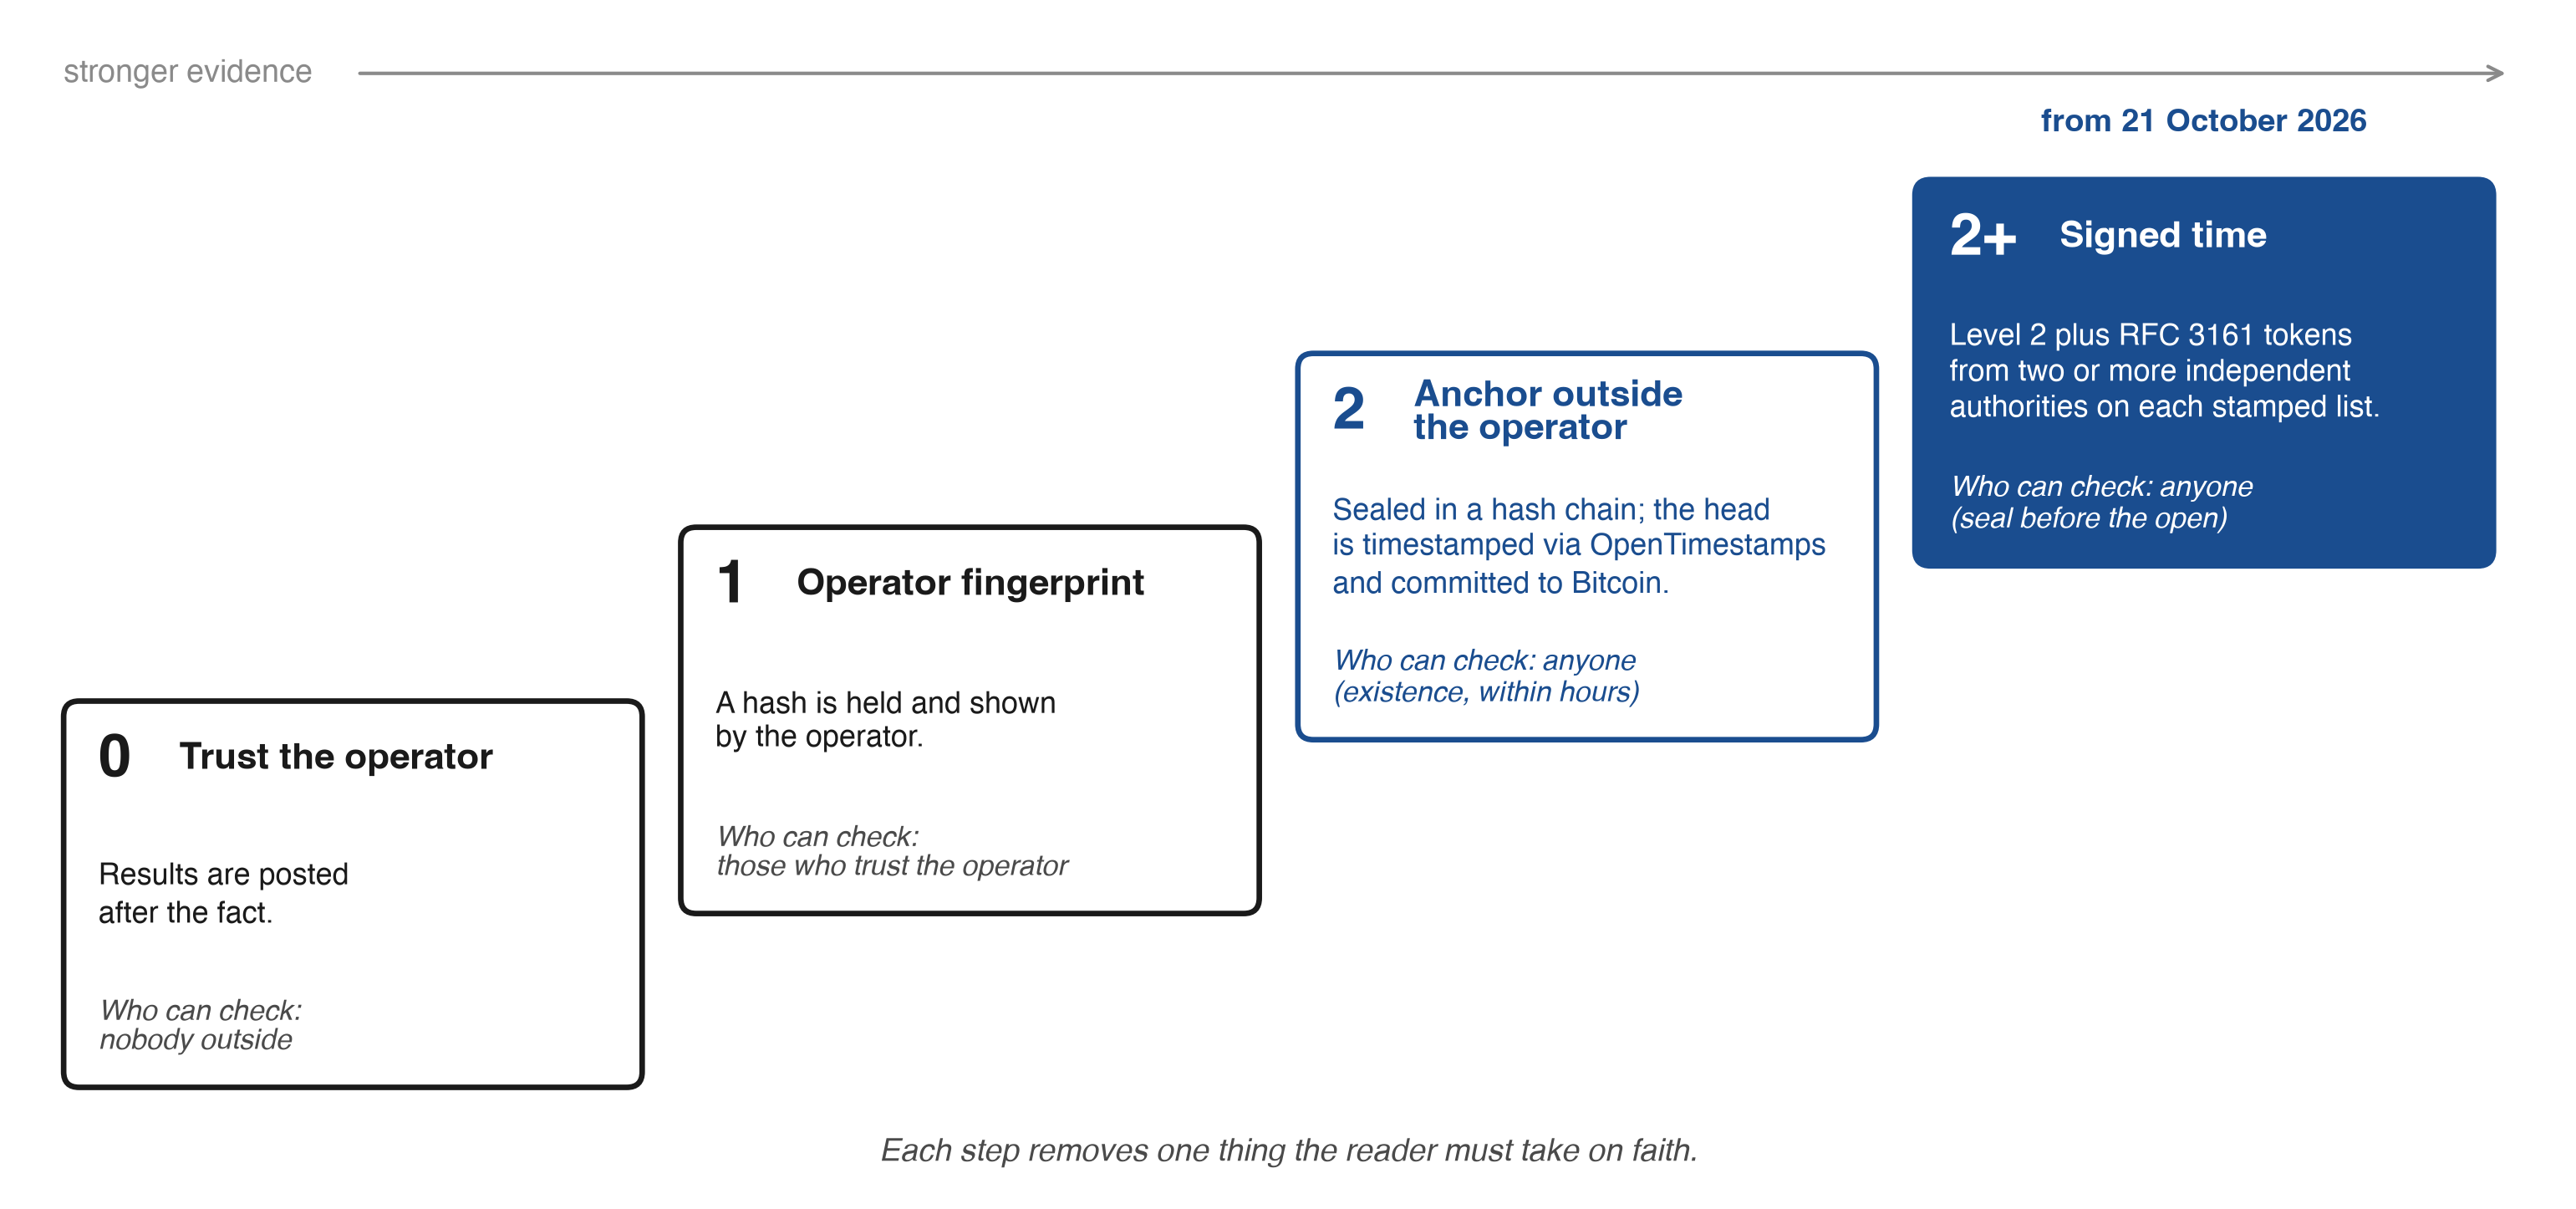
注:这些级别描述了读者必须信任的关于记录时间的内容。第2+级添加了RFC 3161令牌,在自2026年10月21日起的联赛中,当持有计数答案的记录在09:30 ET开放前被签名时。到达时密封、参考价格在密封之后,以及计数运行规则是单独的要求(第3.13节)。
在参考实现中,锚点对P1a和P2提供第2级,对抗任何持有证明独立副本的一方,以及对进入Rekor日志的每个带时间戳的列表的所有人(第3.11节)。P1b在计数记录中处于第2+级(第3.11节)。P3在运营者的链式记录上处于第1级,从2026年10月21日起,基于事先声明的计数运行规则。梯子衡量的是对时钟的信任。读者可能对价格或技能的声称上升到第二个梯子,即声称之梯(表B1,附录B):已发布的规则、重新计算的文件、已验证的外部承诺、与独立价格来源协调的结果、在其窗口前冻结的前瞻性配对评估,以及第二条管道的复制。第二个梯子在第8节的注册比较中结束。
3.13 建议标准的检查清单
我将以下要求写成竞技场、基准或基金在声称遵循该标准时采用的内容。MUST标记了没有该要求声明不成立的要求;SHOULD标记第2+级规范。
- 必须通过在问题发出前确定的事件合约来定义每个任务,至少包括表1的字段,其中包括每个指标的价格来源(供应商、代码、柱线大小和参考价及终端价的时间戳规则);预测结果应位于未来;在答案行本身中封存模型、其版本及其模式。在盲季中,该行将它们作为加盐SHA-256承诺携带,,盐值在季节结束后发布,因此身份在封存时固定,在季节结束前保持隐藏。
- 必须保持一个仅追加、哈希链式的记录,其中每一行在进入时都被封存,问题文本和价格快照被哈希到运行中,问题被发布,更正是一条命名它所涉及行的新行。
- 必须在每次运行(级别2)时将记录的头部锚定在操作员外部,发布证明,按其边界陈述界限,并在时间戳立即发布到至少一个操作员不控制的仅追加通道上的每个加盖摘要。
- 必须为每个常见事件取一个参考价格,在封存后,按每个工具的已发布规则;较晚封存的行获得其自身的参考,是一个单独的事件。预测仅在其事件合约的每个字段都一致时才被汇总(共识、一致、共享误差计数、模型间比较)。
- 必须发布每次运行,无论是否计数,并带有其标签。
- 必须通过在运行前声明的规则(例如已发布的时间表)来固定每个会话的计数运行,并应在操作员不控制的通道上发布带有其哈希的声明。事后应用于已进行的运行的规则不满足此要求。
- 必须按严格适当规则对所询问的事件进行评分:在所有行上严格上升的主要布里耶尔评分,任何过滤评分其次及其删除的行数;或者,对于有上升波段的,要么要求给定波段外移动的上升概率,要么要求三个概率并按三结果布里耶尔评分对其进行评分(第3.5节)。
- 必须报告空单元格和缺失答案在每个评分旁,将填充值排除在共识和一致计数之外,并报告所述概率、覆盖范围和任何服务评分的质量作为单独的结果。
- 必须为每个资产和时间范围报告无信息50%基准和相同事件的气候学基准率,按在季节前结束并由已发布哈希封存的固定窗口估计,具有针对其的布里耶尔技能评分;用作基准的预测市场价格与其交易量一起被封存,声明的交易量下限定义主要比较。
- 必须仅在每个时间范围内达到最少会话数后进行排名,会话内的间隔聚类,对于超过一天的时间范围,间隔应尊重重叠窗口;计划对配对的会话级Brier差异的精度进行比较,不存在差异的声称需要间隔在声明的等价边际内(第4.6节)。
- 必须发布数据和评分代码,以便任何第三方都能重新计算每个分数,并在每次论文修订中引用具有每个文件校验和的不可变分析发布版本(附录C)。
- 必须在收到答案时立即密封,无需等待批处理,且应该(第2级+)从公共时间戳证书颁发机构获得RFC 3161令牌以密封每个答案。
- 应该(第2级+)在发送每个传出问题时密封其哈希,并在运行的第一个问题之前用其截止日期和重试策略密封预期答案的名单。
- 必须在同一表面上,将任何已发布的模型共识伴随已输入的陈述概率数量、其平均两两相关性和第5.1节中该运行和时间范围的,以便读者看到有多少独立声音支持该共识。
- 必须将方法论的改变视为新测量段的开始,将更正视为保留原始内容的追加行;确认性分数在一个段内计算(第3.10节)。
- 必须,当读者与模型一起进行预测时:随机分配每个读者一次,从不重新分配;计算每个市场、标识符和会话的一次初始预测;在参考时间关闭读者预测;将重置标识符视为新读者并报告重置比例;在第一个评分预测前在数据字典中标记盲组;不存储任何读者的地址,最多只存储其加盐哈希,仅使用该天来限制重复投票,两者都不发布(第6节)。
- 应该在分数旁报告第4至6节的诊断:最大特征值的比例和相似性矩阵的参与比率、每个座位的两个独特性计数、边作为块的测试、每个进入重叠计数的引用链接的获取记录、仅价格臂、冻结数据包下的概率重复、每个众筹行的买价、卖价和最后交易时间,以及每个账户的成交量和成本与无交易阴影相比。
该清单的一部分作为代码运行。该联盟将事件合约发布为JSON模式(event-contract.schema.json)和一个仅使用Python标准库编写的独立检查器(tools/conformance.py,位于与数据相同的地址,SHA-256 e1f929a9…63db2e,于2026年10月21日22:33 UTC检索,在tools/archive/conformance-e1f929a9.py处保持不变;environment.json列出了检查器的每个版本及其日期和哈希值)。完整合约包含九个键:资产、期限、参考时间、结束时间、规则、解析器版本、参考规则、价格提供商和价格符号,其event_id_v2是ev2-后跟其规范JSON(排序的键、无空格、UTF-8)的SHA-256的前16个十六进制数字。第一个标识符event_id(ev1-,前五个键)保留在其旁边,因此任何已发布的标识符都不会改变。两个编写相同合约的联盟会得到相同的标识符,因此要求4的测试变成对固定结果的每个字段的标识符比较,评分规则由密封在同一行的方法论版本固定。检查器根据模式验证每一行,重建其标识符,检查时间、概率范围和结果字段,拒绝用于两个事件的一个标识符,并要求每一行的方法论版本(要求15)。任何联盟都可以在其自身导出上运行python3 conformance.py its.csv。在2026年10月21日22:33 UTC的联盟预测文件上,它报告"3792行,正常",两个标识符在每一行上重建。通过显示格式良好的记录,表5逐个要求读取合规性。
表5给出了参考实现相对于每个要求的状态。基于某个要求的声明自该要求得到满足的日期起成立。"已满足"意味着在我2026年10月21日15:05 UTC读取公共文件时可见(见注),"部分满足"意味着该要求的部分在那里可见,"进行中"意味着实现正在进行中,已就位的部分列在其旁边。
表5。参考实现的合规性,如2026年10月21日所读(要求3在2026年10月22日)。
| 要求 | 等级 | 状态 | 已就位 |
|---|---|---|---|
| 1 事件合约 | 必须 | 从2026年10月21日起满足 | 合约字段密封在方法论中;合约模式、检查器和两个标识符在每个预测行上,具有提供商、符号和参考规则的九键event_id_v2;模型及其版本字符串和模式密封在每个答案行中(对于首次运行由更正行恢复) |
| 2 哈希链记录 | 必须 | 已满足 | 链、问题和快照哈希、发布的问题、作为行的更正 |
| 3 外部锚点 | 必须 | 从2026年10月22日起满足 | 每次运行的OpenTimestamps锚点,发布的证明;从10月21日起,两个独立机构的RFC 3161令牌在每个带时间戳的列表上(从13:23 UTC起三个),每个列表按其SHA-256命名前一个列表;从2026年10月22日起,每个带时间戳的列表在Sigstore Rekor透明日志中输入(第一个在日志索引3,368,763,032,其00:00:11 UTC时间戳后五秒),较早的列表在10月21日23:45至23:47 UTC(10月20日的列表在日志索引3,368,351,276) |
| 4 每个公共事件一个参考 | 必须 | 进行中 | 参考之后密封的行携带它们自身的参考(late_ref);行携带reference_at、same_event和event_id;计数的n_eff系列,标记为主要系列,排除此类行;全席位n_eff,标记为"无密封时间切割",和together在其旁边发布,无切割 |
| 5 每次运行都发布 | 必须 | 已满足 | 未计数的运行标记为not_counted |
| 6 计数运行 | 必须;应该 | 必须从10月21日起满足;应该已满足 | 定时早上运行提前声明,密封为asks.jsonl的第一行(04:16 UTC)并在证明页面上发布其SHA-256和互联网档案捕获(05:35 UTC);10月19日和20日遵循第3.4节的开发规则 |
| 7 事件提出 | 必须 | 进行中 | 全行Brier从10月21日的会话声明为主要分数(main_metric,该关闭后的第一个这样的分数);10月19日和20日按发布的方式并列,作为单独的分段(method_segments) |
| 8 空单元格 | 必须 | 已满足 | counted_50、no_answer、of;三个结果单独报告 |
| 9 基准 | 必须 | 进行中 | 发布50%基准;固定气候学在从2026年10月21日08:54 UTC起的现场council-calibration.json中发布(climatology_fixed,48个市场-期限单元,内容SHA-256 2810d11e…3cabb7,sha256_ok为真);F12和F13已在其自身定义中应用$1,000下限,发布的方法论中的人群量下限完成了它 |
| 10 排名和区间 | 必须 | 进行中 | 30/10规则、会话聚类区间和配对会话级区间(pairs、council-pairs.csv)已发布;重叠窗口区间和注册中声明的边际 |
| 11 数据、代码、发布 | 必须 | 进行中 | 数据和代码与哈希一起发布;分析发布随每个修订版本存放 |
| 12 到达时密封;RFC 3161 | 必须;应该 | 部分满足 | RFC 3161令牌从10月21日起在每个带时间戳的列表上;那个早上八个答案在一个批处理中密封,第九个在它到达后14秒;在到达时密封每个答案完成了它 |
| 13 问题哈希、问题前的花名册 | 应该 | 从10月21日起部分满足 | 运行的每个步骤在其第一个问题之前密封其花名册(要求的席位、已回答的席位、备用席位),以便第二个请求可见;传出的问题哈希在asks.jsonl中链接并由带时间戳的列表覆盖;两个都在证明页面上;截止时间和重试策略加入花名册字段 |
| 14 有效声音与共识并列 | 必须 | 进行中 | n_eff 发布在 council-stats.json 中;计数序列(计数运行、在美东时间 09:30 前密封的答案)标记为主要序列,所有席位序列保留在其旁边;在每个显示的共识旁边打印完成它 |
| 15 Segments | MUST | 已满足 | 方法论版本在每条运行线和每行预测中密封(methodology_version);按段的分数(method_segments);更改日期;未重新计数 |
| 16 Readers | MUST | 进行中 | 两个永久随机组处于活跃状态(experiment.g0、g1),仅第一次预测,读者预测在美东时间 09:30 关闭,不存储地址(盐化的每日哈希限制投票);数据字典中的盲组标签和重置的比例完成它 |
| 17 Diagnostics | SHOULD | 部分满足 | 参与率(n_eff_participation)、无符号和气候学中心计数、共享源重叠和闭卷臂已发布;其他诊断已指定 |
注:状态如 2026 年 10 月 21 日 15:05 UTC 的公开文件和证明页所示(council-stats.json 生成于 14:51:50 UTC,council-book.jsonl 包含 230 行);要求 1 如同日 22:33 UTC 检查(第 3.13 节),要求 3 如 2026 年 10 月 22 日 00:00:16 UTC 输入 Rekor 日志(附录 B,第 10 步)。
4. 测量
该协议记录了说了什么以及何时说的。测量把该记录转化为分数;两者一起构成标准要求的预测评估。我描述每项测量,如在方法论(第2版)和联赛协议(arena-3,职业联赛pro-1)中发布的那样,以及在标准要求更多的地方,该要求。第5节报告了对实时数据的依赖值,准确性结果作为本文的带日期修订版到达。
4.1 方向
指标在地平线末端是否比参考时高或低,且模型的概率是否支持该方向?高于50支持上升,低于50支持下降,恰好50都不支持。51%的预测和95%的预测获得相同的命中,所以方向无法区分一个有把握的模型和一个犹豫不决的模型,主要测量是布里埃分数。
4.2 布里埃分数
对于陈述概率为(百分比)上升且结果为的预测,
模型在个已解决预测上的分数是平均值(布里埃,1950),从完美预测的0到最差的1。布里埃分数对其计算所针对的事件是严格合适的(Gneiting & Raftery,2007);对于联赛的问题,该事件是在所有行上的严格上升(第3.5节,要求7)。
4.3 无信息50%基准和气候学
总是说50%的预测者每次预测的得分都是0.25。这是无信息50%基准(联赛文件中的"硬币"),一个中性参考。知道上升基础率的预测者可以在没有任何当天技能的情况下得分低于0.25,在较长的地平线上基础率可能远非二分之一。因此我添加一个气候学基准(要求9):在每个资产和地平线上严格上升的频率相同,在季节开始前结束的固定窗口上估计,并在方法论中封存,具有布里埃技能得分
在相同的行上。相同的事件意味着合约评分的事件:对于当天,从参考价格到表1的价格源规则的终端价格(美国东部时间09:30到16:00,收益率到美国东部时间15:00,比特币从封存时间到美国东部时间16:00)。对于更长的地平线,它在相同数量的交易日或日历天上运行(第3.7节)。不同事件的基础率会使基准产生偏差。
在参考实现中,固定气候学是council-calibration.json的字段climatology_fixed:按资产和地平线,p_up,2016年至2025年严格上升的频率,每行都计算,p_up_ex_draw,相同但排除平手,计数n和n_independent,窗口和规则。主要基准是 = p_up,因为主要布里埃分数计算所有行。p_up_ex_draw用于联赛自己的技能得分,不包括平手(bss_reference)。该字段由council-clim-window.json封存,在数据地址下发布,具有2810d11e…3cabb7,其内容的SHA-256:Python的json.dumps,没有其sha256键的对象,带有排序的键和默认设置。文件脚本在读取之前重新计算此内容哈希。该字段于2026年10月21日美国东部时间08:54进入实时文件,其内容哈希检查(sha256_ok),这是主要比较的基准。如果实时窗口没有每日历史,最接近的每日事件代替:黄金、WTI、布伦特、铜和美元指数的每日条,10年期收益率的每日收盘,比特币的UTC日和一周后的移动开始。四个美国股票指数从美国东部时间09:30到16:00交易日本身的每日条中取得,这是模型回答的事件,主要测试也仅在这四个指数上报告(第8节)。近似值对产生偏差并使预测保持不变(第10节)。
4.4 校准和锐度
校准问卷预测所给概率是否以所述频率成真。联盟报告方向性信心校准:每个已解决的概率被折叠到其支持的一侧(变为,且结果翻转,而恰好50被排除),折叠后的预测落入四个区间[50, 60), [60, 70), [70, 80)和[80, 100],每个区间显示平均所述概率和实现的份额,来自20个预测的绘图(calib_min)。折叠测量对所支持一侧的信心是否与该一侧的命中率匹配。上升原始概率的校准也可从未平仓行计算。Brier分数分为校准项和分辨项(Murphy, 1973),区间是该分割的可读伴件。
区间需要许多预测,因此我为每个座位、共识和每个时间范围添加逻辑校准拟合在该事件所有询问行上(Cox, 1958)。斜率小于1意味着所述概率距离二分之一太远,大于1则太近;测量向上升或下跌的倾斜。斜率使用每个预测并带有标准误,通过会议保持在一起计算(第4.6节)。同样的拟合,间隔按事件聚类,已应用于Polymarket价格(Walker, 2026)。
校准与敏锐度一起评估,因为总是说50%的预测者既是校准的又是无信息的(Gneiting et al., 2007)。我还为每个座位、共识和时间范围要求
从0(总是50%)到100(总是确定),仅在所述概率上,以及用第4.3节的气候概率代替50。敏锐度对二分之一预期随着时间范围增长而增长,其中长期基础利率远离二分之一;敏锐度对气候学是预测者自己的。两者都不需要结果。在2026年10月20日计数运行中,参考前密封的八个座位一天内K为9.2,一周为14.1,一个月为13.9,六个月为20.3(图5;单元格本身在图6B中)。它们对于一天大约距离均匀机会五个点,在最后解决的时间范围内最有决定性,其中部分是移除的基础利率。在2026年10月21日,九个座位给出10.1, 12.5, 14.6和19.9。大多数所述概率位于40到60之间。一天内,20日有93%的概率在此范围内,21日有95%,即使六个月也有超过一半(58%和61%)。
图5。按时间范围的上升所述概率:运行2026-10-20-am(八个座位在参考前密封)和2026-10-21-am(九个座位)。
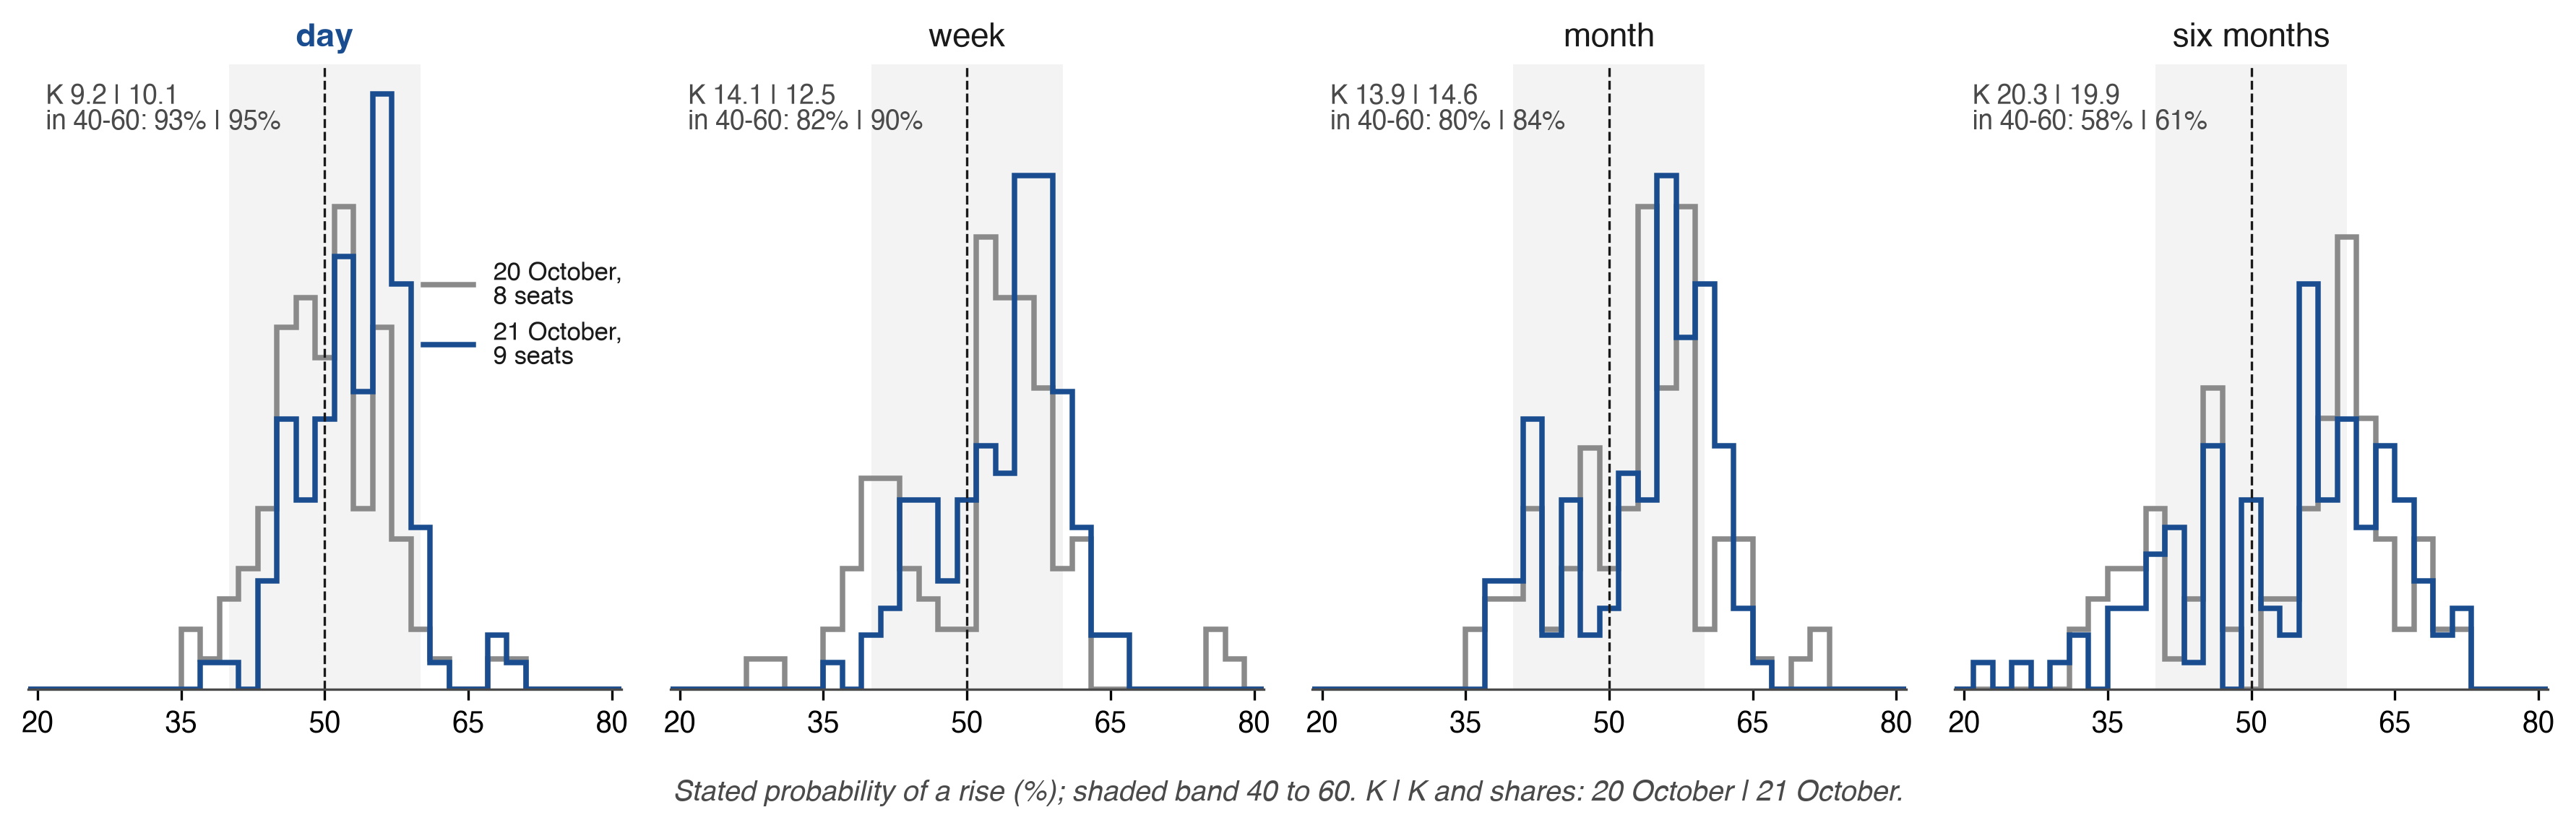
注:以2个点步长的直方图,按相等面积缩放;阴影带从40运行到60。K = (2/n)Σ|p − 50|(第4.4节)。10月21日,第九答案的四个Bitcoin单元格具有其自己的参考(第3.3节),在本运行的这次和每次其他合并读取中被排除(432个单元格中的428个)。来源:council-forecasts.csv保存于2026年10月22日,01:32 UTC。
4.5 基准
联盟根据固定基准对相同行进行评分:
- 硬币(每次预测0.25)。
- 动量:同一指标昨日方向固定为55%,在与共识相同的行上评分;联盟的已发布字段排除平局,注册的F15在所有行上评分(第8.1节)。
- 买入并持有(
_hold_all)、标普500(_spy)、60/40(_passive)、现金处于13周国债(_cash)和随机在联盟规则内(_random)。
前两个是概率分数的基准,其他五个是在与模型相同的成本和执行条件下运行的投资组合。动量检验一条平凡规则。当结果与昨天无关且机会均等时,固定55%的得分为(期望值)。气候学基准是该标准要求的门槛。该方法学还规定了一个不变基准,即没有概率的点预报,它在布赖尔比较之外。委员会的共识也是一个基准:模型概率的平均值,当五个或更多个答案时去掉最高和最低值,同一族的第二个席位加权三分之一,结果限制在2%至98%之间。
平均化带来的收益不是技能。对于一个结果为、权重为且和为1的事件,加权平均值的布赖尔分数等于成员分数的加权平均值减去其加权离散度(Krogh & Vedelsby, 1995):
因此,共识在一个共同事件上不能输给它保留的成员的平均值,无论其技能如何;将结果限制在2%至98%之间最多只能花费一行0.0004的成本。共识击败其平均成员的发现是机械上预期的。其技能通过对比硬币、气候学基准比率、群体和前一时期的最佳单一模型来判断,离散度项与共识分数一起报告(第5.3节)。
4.6 30/10规则:至少10个交易日的30个预报
一个模型仅当在该预报期限有至少30个已解决预报,且在该预报期限内至少有10个交易场次各有至少一个已解决预报时,才能进入该期限的表格。密封的方法学在一个字段中阐述该规则及其原因:"一天的12个指标共同变动:联盟在预报旁边显示交易日,模型在至少10个交易日的30个已解决预报后被排名"(independence)。该规则不限制预报在这些场次中分布的不均匀程度,因此表格在其分数旁边显示每个模型的场次数量(days),第二个条件是最具约束力的。如果一个场次内的预报具有相关系数,那么来自一个场次的个预报携带约个独立预报的信息,即整群抽样的设计效应(Kish, 1965)。当且时,一个场次相当于3.75个独立预报,三个早晨的30个预报相当于约11个。要求10个交易日迫使样本跨越不同的新闻;在一个预报期限内,重新抽样的单位是场次。30/10规则决定了资格,功效在下文讨论。第一个表格在2026年10月30日的场次之后是暂定的描述性排序,在前十个场次中遗漏任何一个的模型稍后变得合格。
统计文件发布来自5个评分会话(会话均值上的学生t检验)和20个会话自助法的区间,每天的12个指标作为一个聚类(council-stats.json、sample.note)。5个会话之前不显示区间,在行上计算的区间将一天的12个市场视为独立的,太窄。对于超过一天的预测时间跨度,连续预测共享大部分结果窗口,因此我要求,对于会话的预测时间跨度,具有异方差和自相关一致的区间,滞后为(Newey & West, 1987)或者具有至少会话块的块自助法(Künsch, 1989),并且在会话之前没有区间(要求10)。在126个会话的季度中,该规则给出从第25会话起一周的区间和从第105会话起一个月的区间,六个月没有区间,这需要630个。确认性声明基于该天、主要预测时间跨度,以及满足规则的周和月。六个月结果和每日区间在本季度是描述性的。技能声称在注册检查日期读取(第8节),无论它们之间的会话显示什么。
功效属于将被声称的比较,即配对Brier差异。对于预报员和基准在同一事件上,令是会话事件上的均值。给定会话均值的标准差和声称的最小效应,在5%的双尾检验与80%功效条件下需要约个独立会话。持续性增加数量,注册分析保持连续会话的关联(Diebold & Mariano, 1995; Künsch, 1989)。在126个会话时,文件的Brier计算(power_brier)检测到低于硬币的0.0105的下降,0.005的下降需要554个会话。它从171个两个会话的预测进行外推(文件生成于2026年10月21日05:33 UTC,基于10月20日的数据;实时字段在每次运行时重新计算),采用其预测级标准差0.062和作为代理直到五个会话被评分。在第30会话时基于会话级数据重新计算,注册检验不依赖于它。文件的命中率计算(power)需要209个会话在假定的条件下区分55%和50%。对二元预测市场问题的独立分析达到相同的数量级:约350个已解决的预测以检测相对市场0.02的Brier优势(Nechepurenko & Shuvalov, 2026a)。
否定结果需要它自己的规则。小的估计差异、太宽而无法判断的区间和无差异的证据是三个发现。我为每个确认性比较声称一个等价性边界,±0.01 Brier,只有当配对差异的90%区间(两个单侧检验,5%)完全位于其内时,才读取"没有实质差异"。我选择了边界。它接近两个会话外推说126个会话可以解决的内容(power_brier,上述),当该外推被重新计算时它不移动,它是评分容差,不同于任何经济阈值。
4.7 投资组合联赛
概率衡量判断。投资组合作为二级衡量指标,展示了模型如何运用判断。14个模型中的每一个在相同规则下管理10万美元的模拟资金:11只交易基金代表市场(VIX仅作为指标),头寸仅限多头5%至25%,现金以13周期国债收益率计息,每笔美元交易成本0.1%,决策在其时间戳后的第一个开盘时交易(美国东部时间09:30至09:45的第一个价格)。"持有"是一项不涉及交易和成本的决策。破坏规则的决策被拒绝,头寸保持不变。每个账户在收盘时标记其收益率和最大回撤,并从20个交易期计算夏普比率和索蒂诺比率(Sharpe, 1994; Sortino & Price, 1994)。完整规则见协议文件(附录A,表A1)。账户为工具评分,一支国债基金用于收益率,每个商品期货配一支基金,因此更低的布里尔分数并不能确立更高的账户价值。账户与被动基准在相同成本下进行比较,在同一规则版本内。
4.8 专业联赛
每个模型在专业联赛(pro-1)持有第二个10万美元账户,这是一个多空账户,权重为股权的5%至30%,总杠杆率为100%至200%,杠杆可达2倍;VIX可在此交易。其基准是标普500指数多头持仓和空头持仓。
4.9 AI对阵众智
对于12个市场中最多8个,预测市场交易一个与联赛相近的日度问题。每次运行的问题列出这些问题及其完整的解决规则,并要求每个模型在答题行的单独字段(crowd_up)中提供其对每个问题"上升"概率的预测。不查询Polymarket、Kalshi或任何投注赔率的指令被封存在问题中,模型搜索返回的内容位于封存范围之外。如果Polymarket列出该市场,模型回答Polymarket的问题,仅在Polymarket未列出该市场时才提出Kalshi问题(council-calibration.json、method.crowd_window)。众智的价格和交易量(vol)在问题发出时记录,并封存在运行行中(Polymarket为crowd.odds,Kalshi为crowd.kalshi)。10月20日,价格在12:30:06Z时记录,早于第一个模型开始答题。我有意隐藏价格。如果向模型展示市场价格并要求其修改答案,它在某些合约上可能击败市场(S. Kim et al., 2026),但其答案不再是独立于众智的证据。联赛将两者分开:时间戳答案对价格盲目,任何与众智的组合都是单独的策略,在评分前封存(第5.3节)。每次比较标注其信息时钟:封存价格是问题时间的众智,而校准文件将每个模型的答案与该模型自身答题分钟时的众智价格进行比较,两者都按众智的解决进行评分。解决后,联赛按问题报告模型的概率和众智的概率、各自的布里尔分数以及各方答对的情况(账簿行crowd;council-league.json,字段crowd)。
10月20日,Polymarket列出了六个日度"上升或下降"问题(标普500、道琼斯指数、黄金、WTI、美元指数和比特币),Kalshi列出了五个(标普500、纳斯达克100、10年期收益率、黄金和WTI):八个市场,其中三个在两个交易所上市。当两个交易所都列出一个市场时,我使用Polymarket合约,即模型回答的合约;否则使用Kalshi合约。每个众智概率来自一个合约。Kalshi问题在执行价设定,其价格通过两个相邻执行价之间的插值转换为"高于上一收盘价"(运行行中的lo、hi)。插值价格近似来自两个交易价格的该事件的概率,两方随后按合约指定的来源对该合成事件进行评分。当合约的封存成交量在问题发出时至少为1000美元时,我将其纳入主要比较,并单独报告较薄的合约。该阈值显示在该合约上交易的资金。要求17要求每个众智行显示买价、卖价和最后交易的时间,因为在Polymarket上,不太可能的结果的点差更宽(Dubach, 2026)。
众智的问题与联赛的相近,但时钟不同。联赛的一天从美国东部时间09:30参考时间运行至16:00(收益率至15:00);众智的问题从收盘至收盘运行,若干问题在其他时间和其他来源解决:黄金和美元指数在美国东部时间下午5:00的Pyth K线,WTI在活跃期货合约的每日收盘,收益率在美国财政部下午3:30的平价收益率,比特币在Binance从午时至午时。因此,我逐问进行比较,按众智自身条款,使用单独征询的概率。预测市场价格是强有力的基准(Wolfers & Zitzewitz, 2004; Berg et al., 2008),Kalshi的宏观经济合约的预测准确性与市场预期调查和彭博一致性相当(Diercks et al., 2026)。敏锐度(第4.4节)从crowd_up逐个模型在相同合约上进行比较,因为众智不对prob_up事件定价。
事件不匹配能够改变得分多远可以精确表述。假设某指数昨日收于100,今日开盘于98,收于99:其从前收盘下跌,又从开盘上涨。设两个版本的事件在共享行行中结果相反,概率和行数固定。在翻转的行上,预测的布赖尔评分改变量为,绝对值最多为1,因此平均布赖尔评分最多改变。预测者和之间的差距在该行改变,因此差距最多改变,其中是翻转行的集合。这些界对固定预测在固定样本上成立。由此产生两条规则。预测进入共同评分仅在一个事件上,具有一个参考价格(要求4)。每次与群体的比较都报告其市场会议共享,即两个问题以相反符号解决的会议比例;不超过的差距不被解读为任何一方的优势。
4.10 网格:模型×市场×时限
每个计数答案填充一个三维网格的一个单元:最多十一个理事会模型、12个市场和四个时限(图6)。每个单元累积其自身的布赖尔评分、命中率、校准和敏锐度。网格回答了单一排行榜无法回答的问题:哪些市场在哪个时限上可预测,模型的优势是否在一个资产类别中,以及当每个都针对其自身基础比率衡量时,一个月是否比一天更容易。边际视图发布在council-league.json(models、by_asset、by_horizon)中,完整行在council-forecasts.csv中。
图6。测量网格。(A)设计:模型×市场×时限。(B)填充的网格:某个计数早晨的密封概率,2026年10月20日。
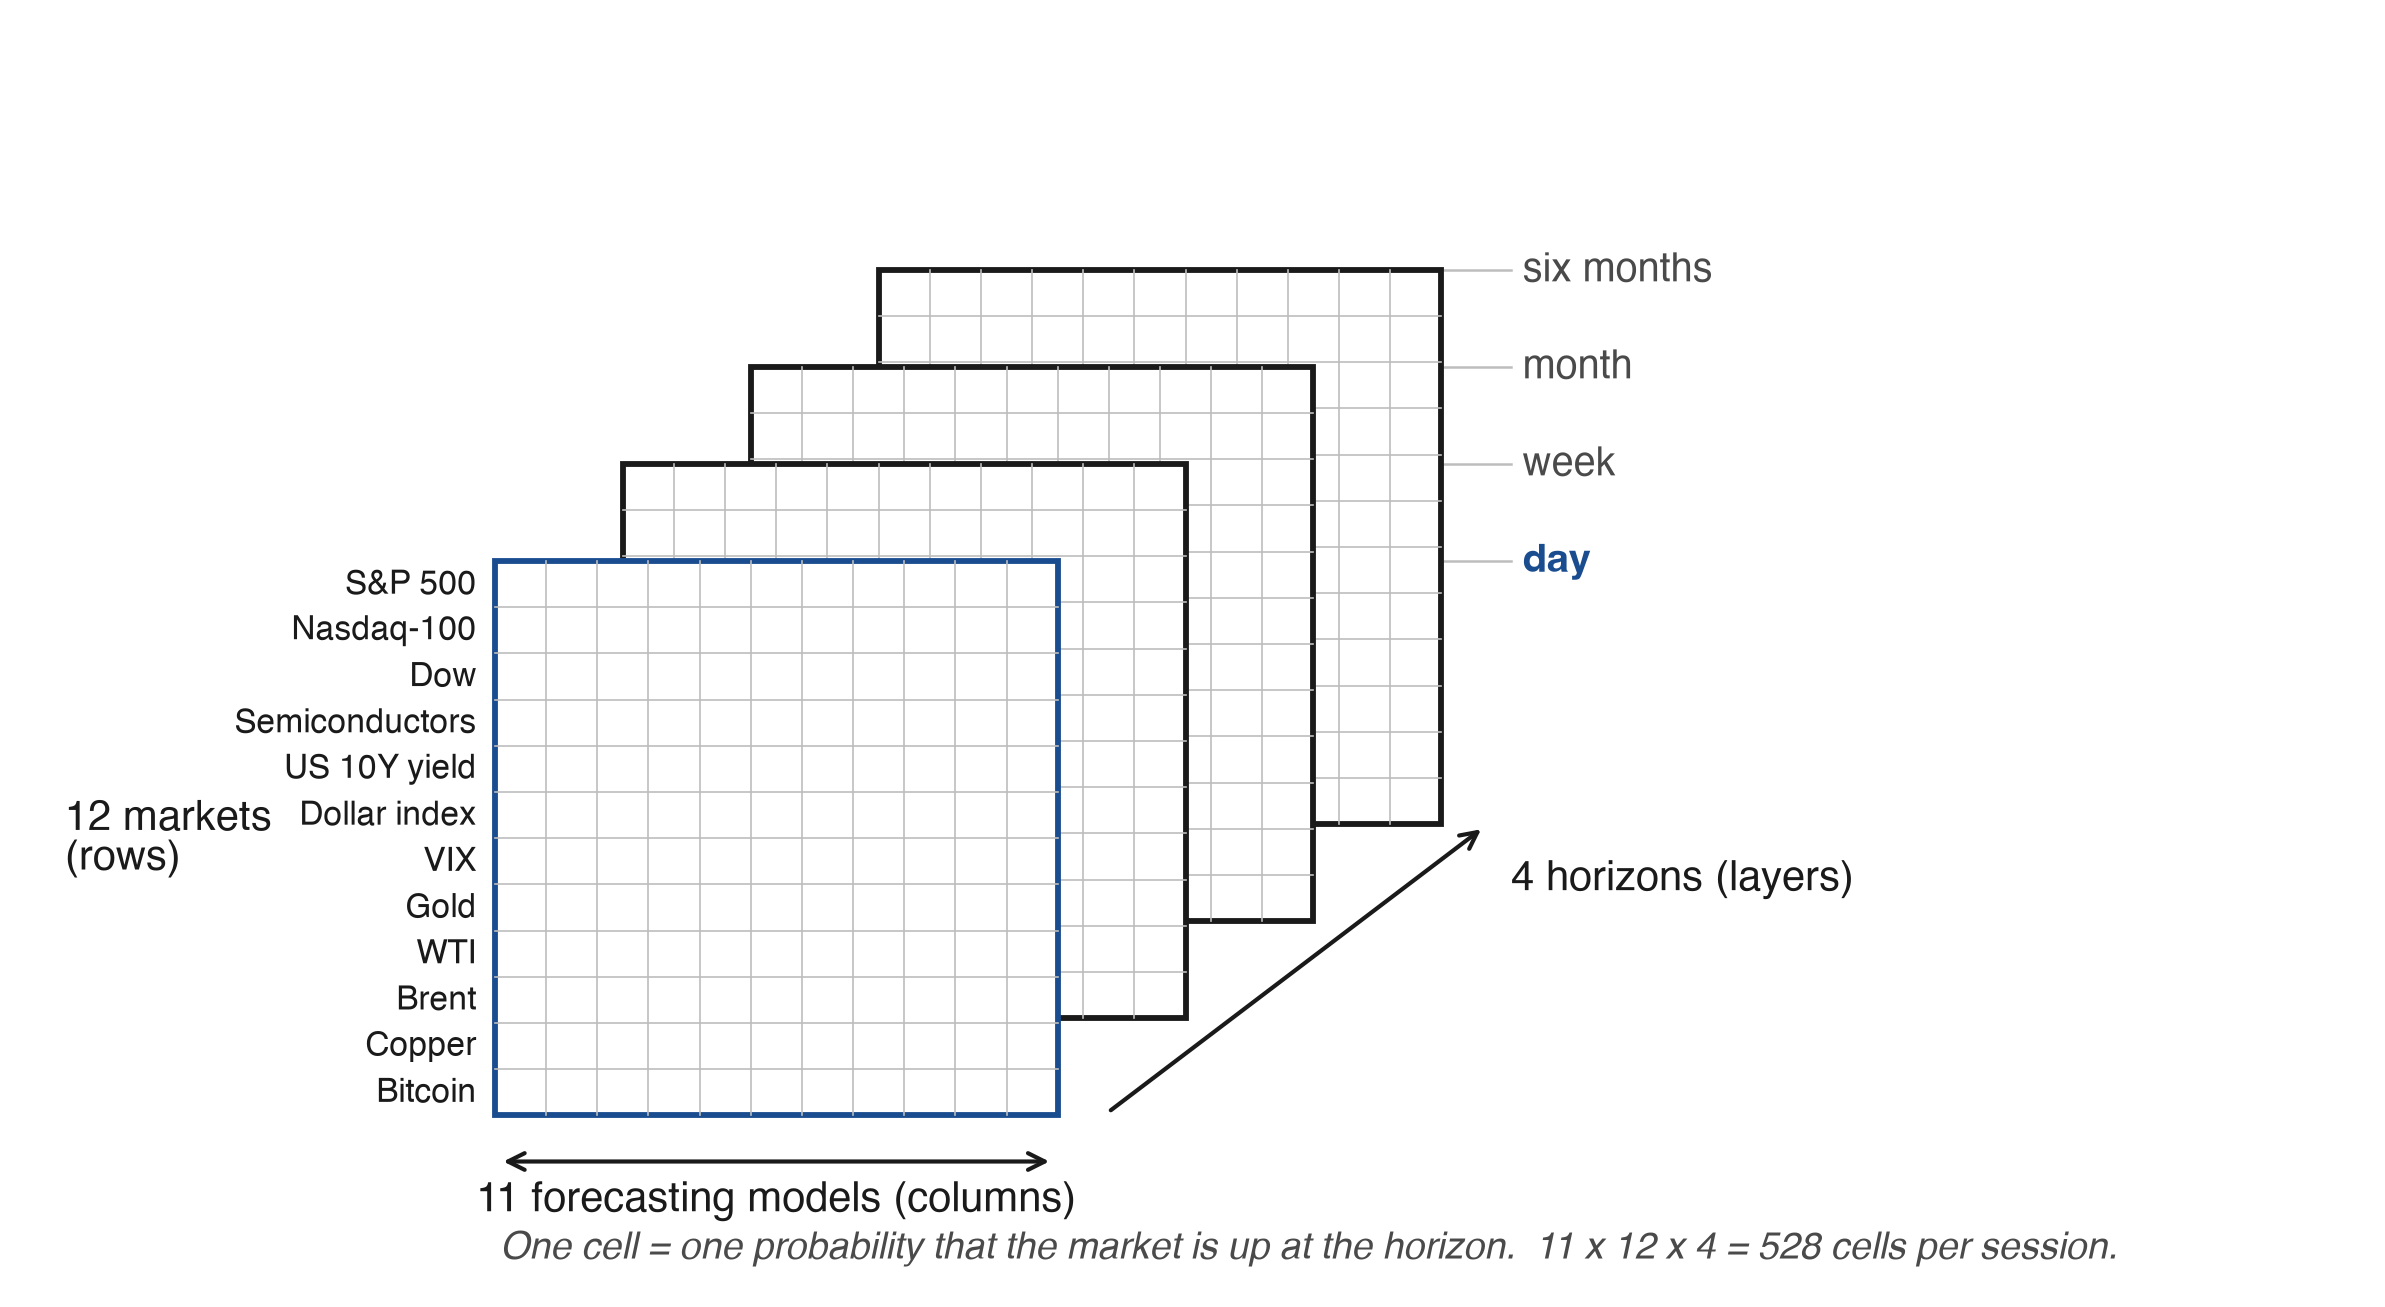
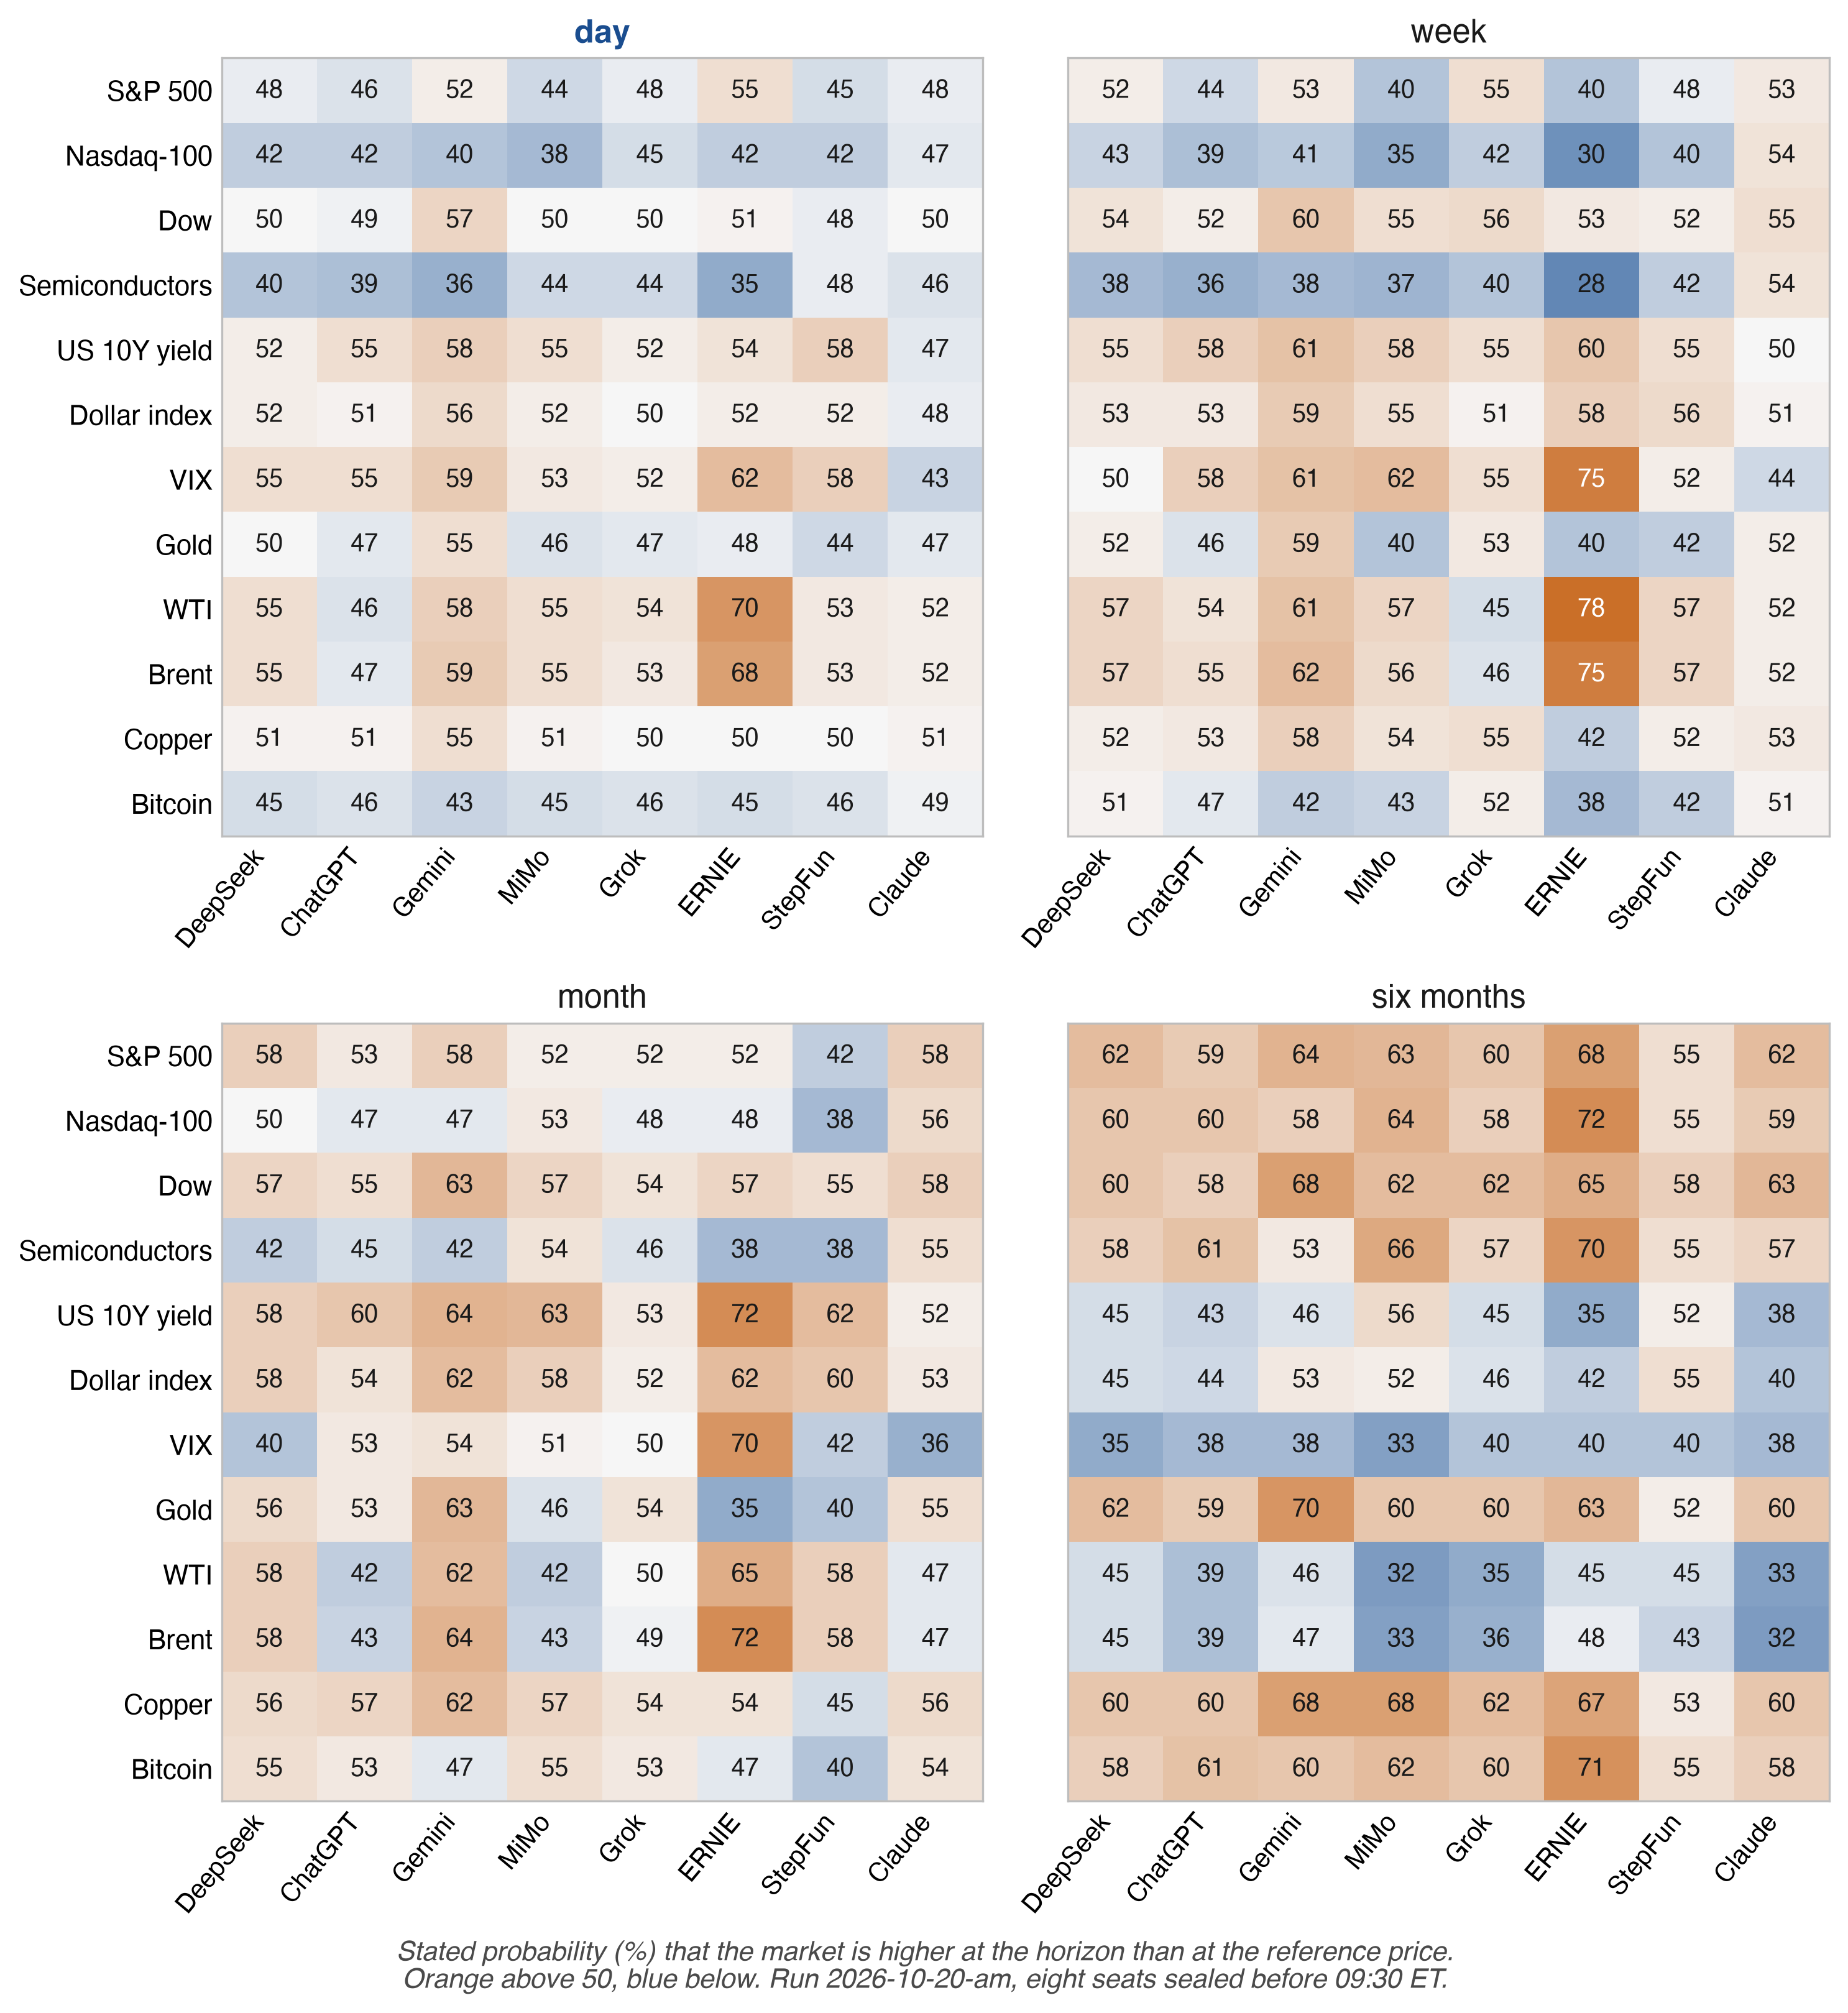
注:(A)单元格从 council-forecasts.csv 的统计行填充;单元格仅根据第4.6节的规则进行排名。(B)八个座位的答案在2026年10月20日09:30 ET参考之前被密封(运行 2026-10-20-am),每个市场和期限一个单元格,按照所述的上升概率着色,并以50%为中心。座位按其在概率图片首个主成分上的负荷排序,而非按国家排序。来源: council-forecasts.csv,读取2026年10月21日。
日度预测在每个交易时段解决;计分联赛的第一周预测从2026年10月26日解决,第一个月预测约在2026年11月19日解决,第一个六个月预测在2027年4月解决。
4.11 可复现性
每个得分都可以从开放文件重新计算。投资组合引擎的代码以文本形式发布,包含19个文件和联盟设置,每个文件都带有SHA-256(arena-code.json)。重新计算脚本(replay.py)从交易和价格重新计算每个账户的价值、现金份额、费用和权重。在2026年10月20日的文件上,它在发布舍入范围内(附录B,第7步)重现了145个账户的全部253行发布数据。第二个脚本tools/replay_brier.py位于同一地址,从council-forecasts.csv重新计算每个计数预测的Brier评分以及按席位、期限和方法版本的总计,并与发布的数据进行比较;在2026年10月22日00:09 UTC的实时文件上,它完全匹配了全部9,318个发布数字。council-forecasts.csv中的每一行预测都命名了密封它的账簿线(line),因此每个得分都可以追溯到一个密封的答案,进而追溯到一个带时间戳的前缀和一个比特币区块(附录B)。得分线由其之后的首个时间戳覆盖。
任何人都可以重新计算发布的输出。链和锚点固定了密封的答案、它们的时间和问题。原始模型调用、价格源和部署的代码与运营商提供的哈希值一起发布。将参考价格和收盘价与第二个独立来源进行协调是声明阶梯的最高级(表B1)。由于实时文件在每次运行时都会变化,每个修订都引用Zenodo上的不可变分析发布(10.5281/zenodo.23552700),包含每个文件的SHA-256、大小和检索时间的清单(附录C)。
5. 有多少个独立声音
该联盟有十一个预测席位。这样规模的委员会看起来就像有很多观点,该联盟就是为了计算它拥有多少个观点而建立的。如果N个预测者的误差在共同的ρ处相关,其平均值携带的证据相当于
N_eff = N / (1 + (N − 1)ρ)
个独立预测者,随着N增长,N_eff趋近于1/ρ并停留在那里。该公式是整群抽样的设计效应(Kish,1965),预测组合中依赖专家价值的饱和已由Clemen和Winkler(1985)证明。配套论文将其应用于AI模型面板(Chernets,2026a)。上限不取决于询问了多少个模型。在ρ = 0.5时,一千个模型的价值只相当于两个证人,一旦委员会的规模超过1/ρ,降低ρ比增加成员带来更多收益。输入是可测量的。当两个语言模型都犯错时,它们通常给出相同的错误答案,特别是在同一架构或提供商内(Kim等,2025)。三个前沿模型在568个二元问题上的预测误差平均相关系数r为0.77(Spiro,2026),前沿模型在Metaculus AI基准上做出高度相关的预测(Aitchison等,2026)。当许多决策制定者采用一种算法时,集体决策可能会变得更差,即使该算法的表现优于其中任何一个(Kleinberg & Raghavan,2021)。理论和根据机构持仓数据校准的模拟表明,广泛采用相似AI模型会缩短它们交易信号的生命周期(Meng & Chen,2026)。此类论证需要将模型的可测量相似度作为输入。市场联盟每个交易日提供一个外部基准真值,以及最多十一条关于概率的实时流,ρ可以从中估计出来。N_eff是方差的计数。所有模型共有的偏差无论模型数量多少都会留在平均值中,这就是为什么该联盟也直接计数一致错误(第5.3节)。一个没有标明其有效声音数量的模型共识就像一个没有标明样本量的民意调查:读者看到同意的比例但无法判断协议拥有多少证据。因此,要求14规定计数在显示任何共识时必须进行。10月20日,八个席位在开市前封存了一日图景,其图景的相似程度相当于1.46个独立预测者的图景(第5.2节)。
5.1 该联盟如何估计ρ
每个封存的运行为每个预测席位提供在每个时间范围内12个市场中的每一个上升的概率。对于每次运行和时间范围,该联盟计算席位对中的平均值,计算其在两个回答的市场中的概率的Pearson相关系数,并用该运行自己的n和ρ评估N_eff = n / (1 + (n − 1)ρ)。N_eff关于ρ是凸的,因此每次运行计数的平均值至少是平均ρ处的计数,ρ的抽样噪声(从十二个市场估计)也会推高每次运行的计数。平均值低于阈值,如在F1和F2中,因此是保守读数,而时间范围之间的比较是在ρ本身上读取的(F9)。对于十二个市场,一个成对的相关系数在观察范围0.38到0.64内的标准误差约为0.26到0.18;一次运行的多对共享席位和市场,因此其平均值比一对更稳定,但不是按其数量的根。间隔来自五次计数的运行。我使用每个席位的最新答案行,并留出由带日期的correction行在封存后恢复的单元格,因为它们不在封存的答案中。资格规则是估计器的一部分。我仅接受计数的运行,仅接受在参考价格之前封存的答案,以便看到开市移动的迟到答案不会被计入。开放文件council-stats.json在n_eff.counted下发布此序列,规则在文件中说明。较早的块n_eff.per_run及其平均值包括所有封存的运行、试运行和迟到的答案。附录C给出了从council-forecasts.csv和council-book.jsonl重新计算的字段。表6按照开放文件通过此规则从六次封存运行到计数记录的行。
表6。从开放文件到计数记录,按运行:行、更正、席位、在参考之前封存的行、说明的50、无效单元格和计数的一日行(council-forecasts.csv,3,792行)。
| 运行 | 角色 | 文件中的行 | 更正行 | 回答的席位 | 在参考之前封存的席位 | 在参考之前封存的行 | 说明的50 | 无效单元格 | 计数的一日行 |
|---|---|---|---|---|---|---|---|---|---|
| 2026-10-16-eve | 试运行 | 1,056 | 39 | 9 | 9 | 1,017 | 20 | 0 | 0 |
| 2026-10-17-btc | 试运行 | 864 | 32 | 9 | 9 | 832 | 40 | 0 | 0 |
| 2026-10-18-radar | 试运行 | 672 | 21 | 8 | 8 | 651 | 22 | 0 | 0 |
| 2026-10-19-am | 开发 | 336 | 11 | 7 | 7 | 325 | 4 | 0 | 83 |
| 2026-10-20-am | 开发 | 432 | 0 | 9 | 8 | 384 | 14 | 12 | 105(96在参考之前封存) |
| 2026-10-21-am | 计数记录 | 432 | 0 | 9 | 9 | 432 | 24 | 0 | 108 |
注意:修正行是由后来的修正线添加的单元格(line_kind);其他列计算答案行的单元格。当一行的线密封时间(max(at, booked_at))早于其针对的会话的09:30 ET时,该行在参考前被密封;三次试验运行针对10月19日。陈述的50和无效单元格从cell_status(explicit_50、invalid)读取,计数行从status读取。10月20日,第九个座位Meta AI在16:16:52Z密封:其12个无效单元格不包含概率,其九个计数的单日行从其自己的参考进行评分,在通用事件之外。10月21日,第九个答案的四个比特币单元格拥有自己的参考(第3.3节)。来源:council-forecasts.csv和council-book.jsonl保存于2026年10月22日01:32 UTC(CSV的SHA-256 9fa4747e…c299d)。
我在计数旁边发布伴随统计。相关性是在市场间计算的,因此包括市场一起移动的方式(三个美国股票指数、WTI和布伦特油);第二个版本每个组保留一个市场,删除纳斯达克100指数、道琼斯指数和布伦特油。市场间的相关性也取决于询问每个市场的方向:VIX上升、美元升值或收益率上升通常伴随股票下跌,而委员会询问每个市场时都是上升,在其事件合同中是固定的。我还计算了一个不受该约定约束的版本,该版本关联偏离50的偏差,而不减去每个座位在市场间的平均值,因此翻转任何市场不会改变任何内容。在一天内,它给出1.85和1.54,分别在10月19日和20日,而标题计数的值为1.74和1.46。从气候学概率而非50取得的同样偏差提供了第4.3节要求的长期视野读数。矩阵的参与比率是不同的维度计数,在等相关下两者不同,所以我在N_eff旁边读取它作为第二个计数。第三个统计数据首先删除每个市场的共识。从相同的模型中减去估计的共识在构造上使偏差呈负相关,因此这是描述性的,未被记录。要求17添加了最大特征值的份额。份额接近1表示单个共同因子承载相似性,是一个共同ρ是公平总结的结构,低份额表示单个ρ隐藏了多个因子。在2026年10月20日的计数运行中,在八个座位的所有48个单元格中(在参考前密封),最大特征值承载迹的68%(8个中的5.47)。一个共同因子掌握大部分的相似性。单日矩阵的参与比率在10月19日为2.28,10月20日为1.79,10月21日为3.28(n_eff_participation)。
标题计数概率图像的相似程度。误差的相关性,即上述公式中的ρ,是第二个计数,委员会从评分的会话计算它:座位在市场间的误差指标的平均成对相关性,以相同方式转换为N_eff(n_eff_errors)。它也包含结果的共同移动。当三个股票指数一起下跌时,无论其相似性如何,说上升的模型会一起出错。
5.2 该方法的首次阅读
我在2026年10月19日和20日的开发会议上首先阅读该方法(第8节)。在他们的两次计数的早晨运行中,仅使用在09:30 ET参考价格前密封的答案,我发现2026年10月19日一天时N_eff为1.74(n = 7个座位在参考前密封,ρ = 0.505)和2026年10月20日为1.46(n = 8,ρ = 0.64)。这两个早晨的图像与大约1.6个独立预报员的图像一样相似。每个组保留一个市场给出1.69和1.57。计数记录的第一次运行在2026年10月21日给出2.23(n = 9,ρ = 0.379),每个组一个市场时为2.09(council-stats.json、n_eff.counted.per_run,生成于2026年10月21日22:16 UTC)。
相同的规则在每个时间范围内应用,加上不需要除它之外的结果的三个描述性措施,给出表7。
表7。 按时间范围对计数的早晨运行进行描述性阅读,答案在参考前密封:概率图像的N_eff(平均成对ρ在括号中)、锐度K、40到60之间的概率份额及座位间的分布。
| 运行 | 措施 | 1天 | 1周 | 1个月 | 6个月 |
|---|---|---|---|---|---|
| 10月19日2026年(n = 7) | N_eff(ρ) | 1.74(0.51) | 2.81(0.25) | 2.39(0.32) | 1.16(0.84) |
| K | 10.7 | 14.4 | 17.9 | 25.0 | |
| [40, 60]中的份额(%) | 88 | 81 | 67 | 42 | |
| 分布(点数) | 4.2 | 6.3 | 7.4 | 5.1 | |
| 10月20日2026年(n = 8) | N_eff(ρ) | 1.46(0.64) | 1.99(0.43) | 2.68(0.28) | 1.14(0.86) |
| K | 9.2 | 14.1 | 13.9 | 20.3 | |
| [40, 60]中的份额(%) | 93 | 82 | 80 | 58 | |
| 分布(点数) | 3.5 | 5.7 | 6.2 | 4.7 | |
| 10月21日2026年(n = 9) | N_eff(ρ) | 2.23(0.38) | 2.63(0.30) | 2.41(0.34) | 1.58(0.59) |
| K | 10.1 | 12.5 | 14.6 | 19.9 | |
| [40, 60]中的份额(%) | 95 | 90 | 84 | 61 | |
| 分布(点数) | 4.3 | 4.8 | 5.7 | 6.8 |
注意:每个时间范围十二个市场。N_eff按照提交的脚本neff-horizons.py的规则(第5.1节),排除拥有自己参考的单元格(10月21日第九个答案的比特币单元格);21日的一天值等于已发布的n_eff.counted.per_run。K = (2/n)Σ|p − 50|遍历座位的单元格(第4.4节);分布是座位间的群体标准偏差,在十二个市场上平均。值来自council-forecasts.csv和council-book.jsonl保存于2026年10月22日01:32 UTC。
在全部三次运行中,六个月时的声音最少,一周和一个月时的声音比一天时更多。六个月的相似性可能来自共同的基础比率(股票和黄金在六个月内上升),所以六个月的计数也应该按气候学概率的偏差来解读。我在10月20日的运行中看到了这种模式(图6B),在图7中我按市场逐个绘制。参考前密封的八个席位使五个市场在该天的概率低于五成,六个月时接近60%。在平均概率中,标普500指数从48升至62,纳斯达克-100从42升至61,半导体从42升至60,黄金从48升至61,比特币从46升至61,而石油、VIX和10年期收益率则反向变化(WTI从55降至40,VIX从55降至38,收益率从54降至45)。该委员会看到了一个短暂冲击随后消退。六个月时它收敛到长期漂移。10月21日,短端移动而长端保持不变。九个席位给出标普500指数当天55.9和六个月时60.4,只有铜(47.9)和VIX(45.7)在该天的概率低于五成。六个月时,风险资产再次位于56.7至62.7之间,而石油、VIX、收益率和美元位于41.2至46.1之间。
图7。按市场一天和六个月时的平均陈述上升概率:(A)2026-10-20-am运行,参考前密封的八个席位;(B)2026-10-21-am运行,九个席位。
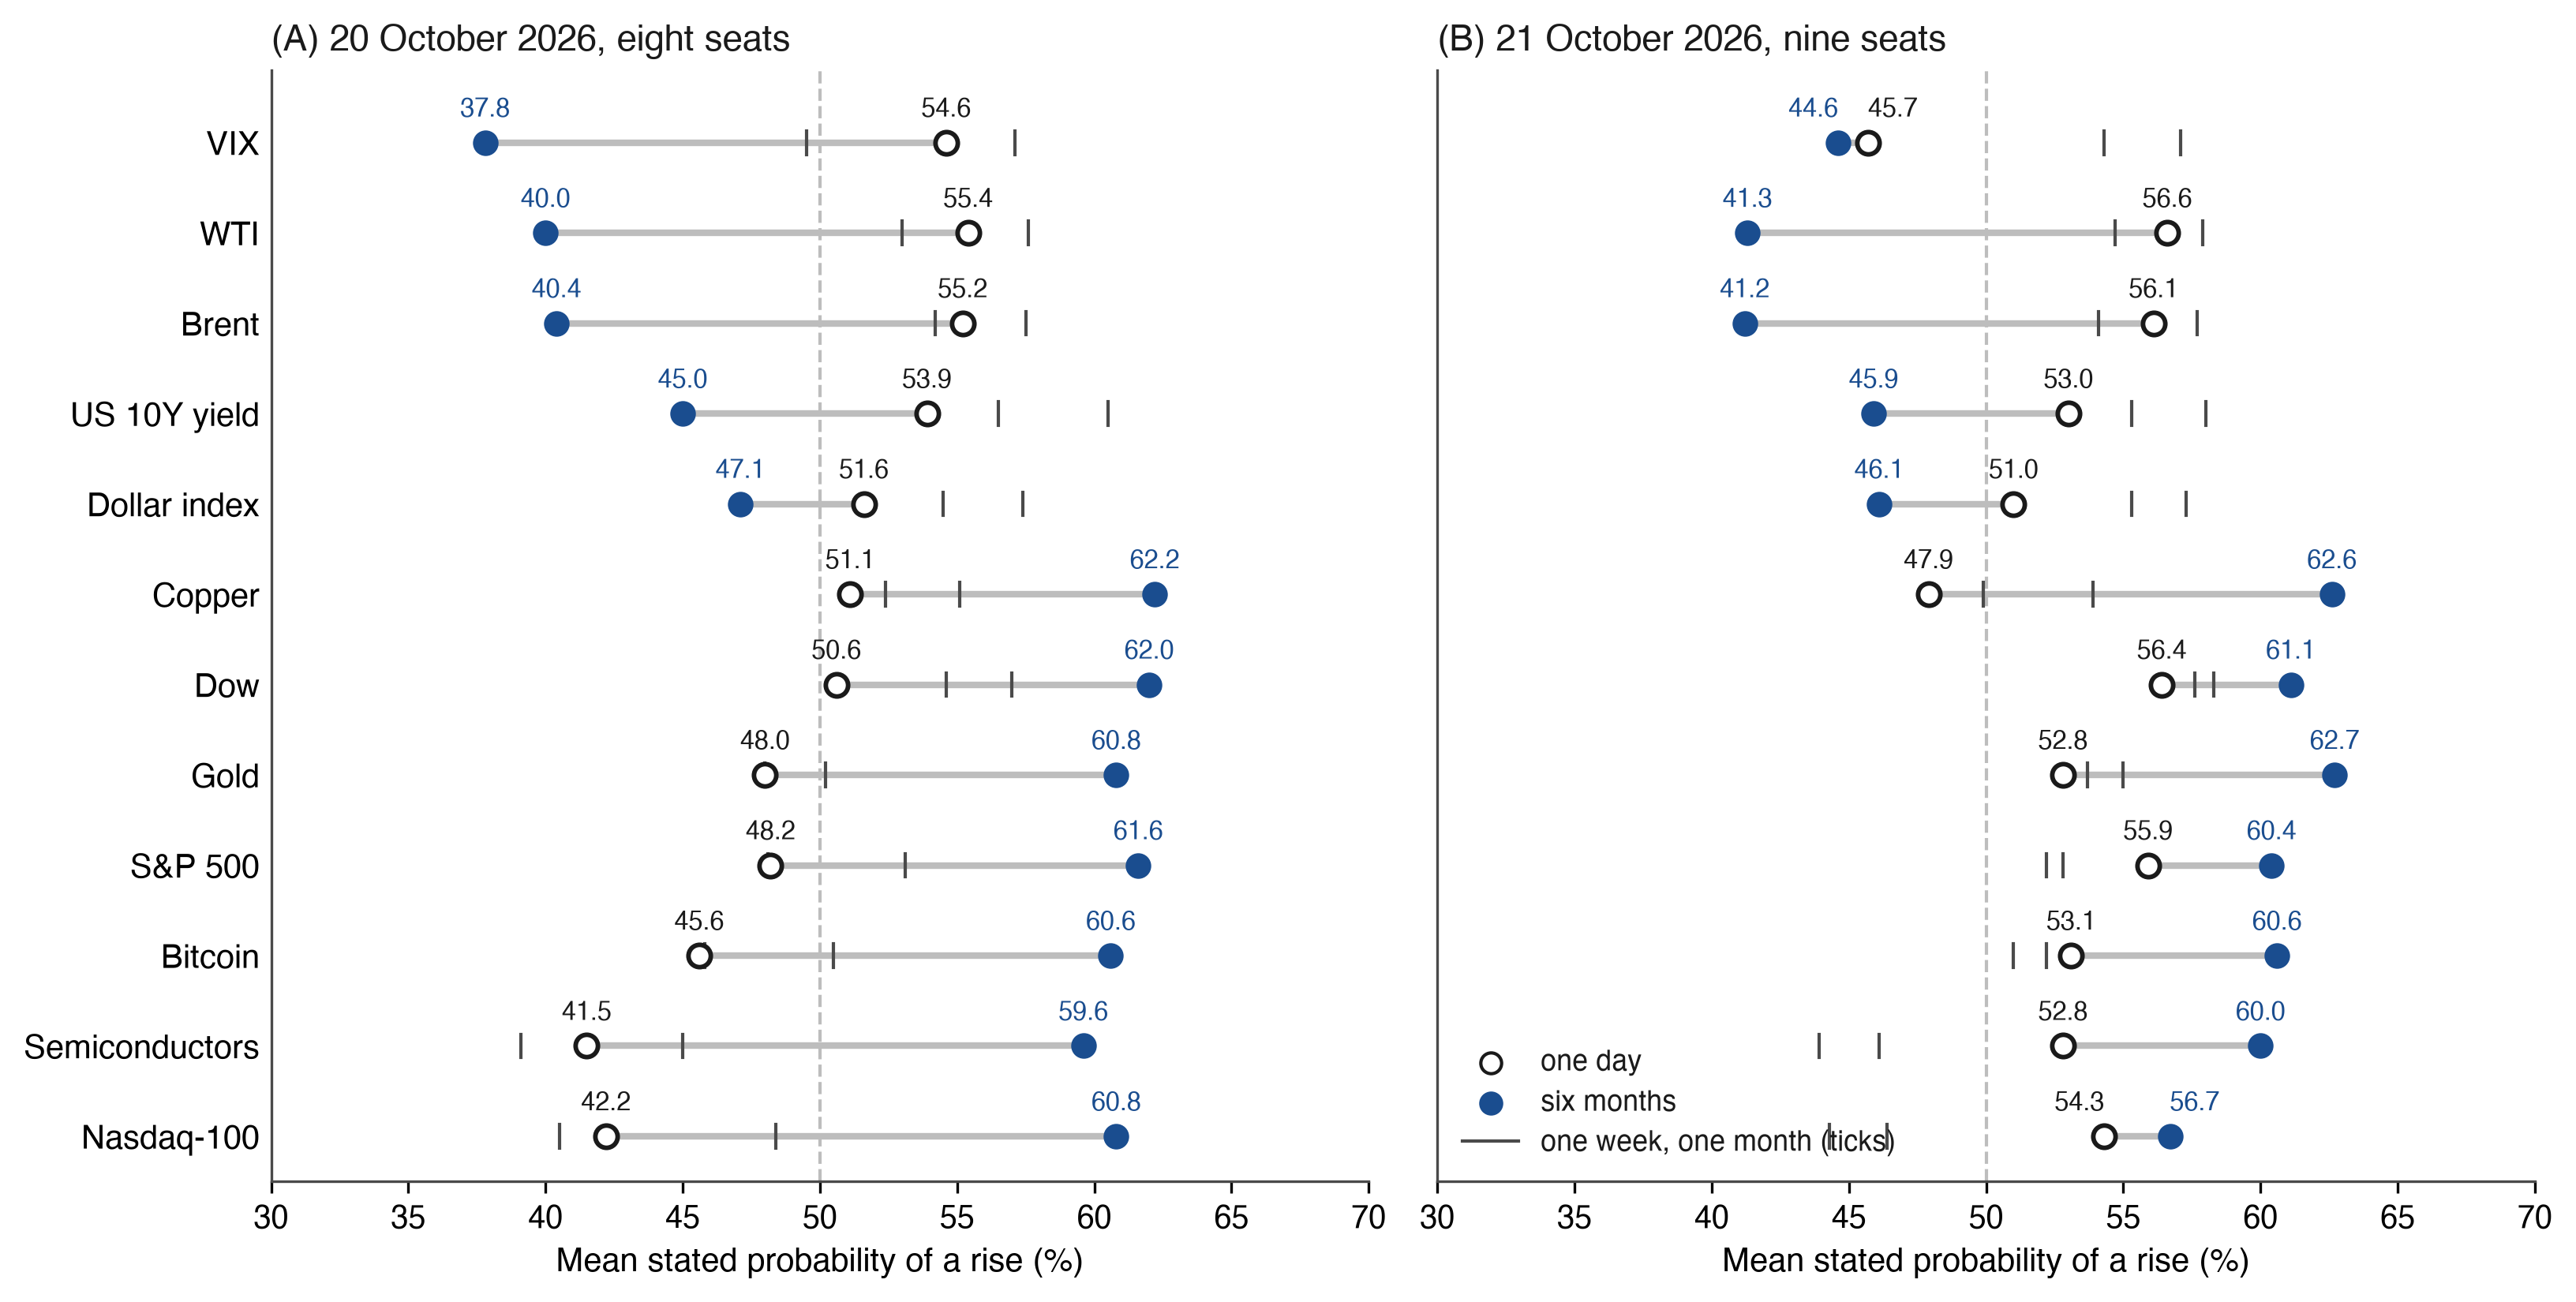
注:席位prob_up的平均值;刻度标记一周和一个月。市场按10月20日从一天到六个月的变化排序。六个月概率包括每个市场的基础比率(第4.3节);对气候学的相同读数是。10月21日,比特币平均值不包括第九个答案的单元格,这些单元格有各自的参考。来源:council-forecasts.csv保存于2026年10月22日,01:32 UTC。
相同的运行给出第8节使用的价差。在八个席位中,概率的总体标准差在一天时平均3.5个百分点,一周时5.7个,一个月时6.2个,六个月时4.7个。在一天时从铜的1.5个百分点到WTI的6.4个百分点不等,最宽的单元格是VIX和布伦特在一个月时(9.9和9.8)。10月21日,平均价差为4.3、4.8、5.7和6.8个百分点,在六个月时最宽(布伦特9.5,WTI和VIX 8.4)。图8显示了两个早晨的每个单元格。
图8。按市场和时间范围的席位间陈述概率的价差:(A)2026-10-20-am运行,参考前密封的八个席位;(B)2026-10-21-am运行,九个席位。
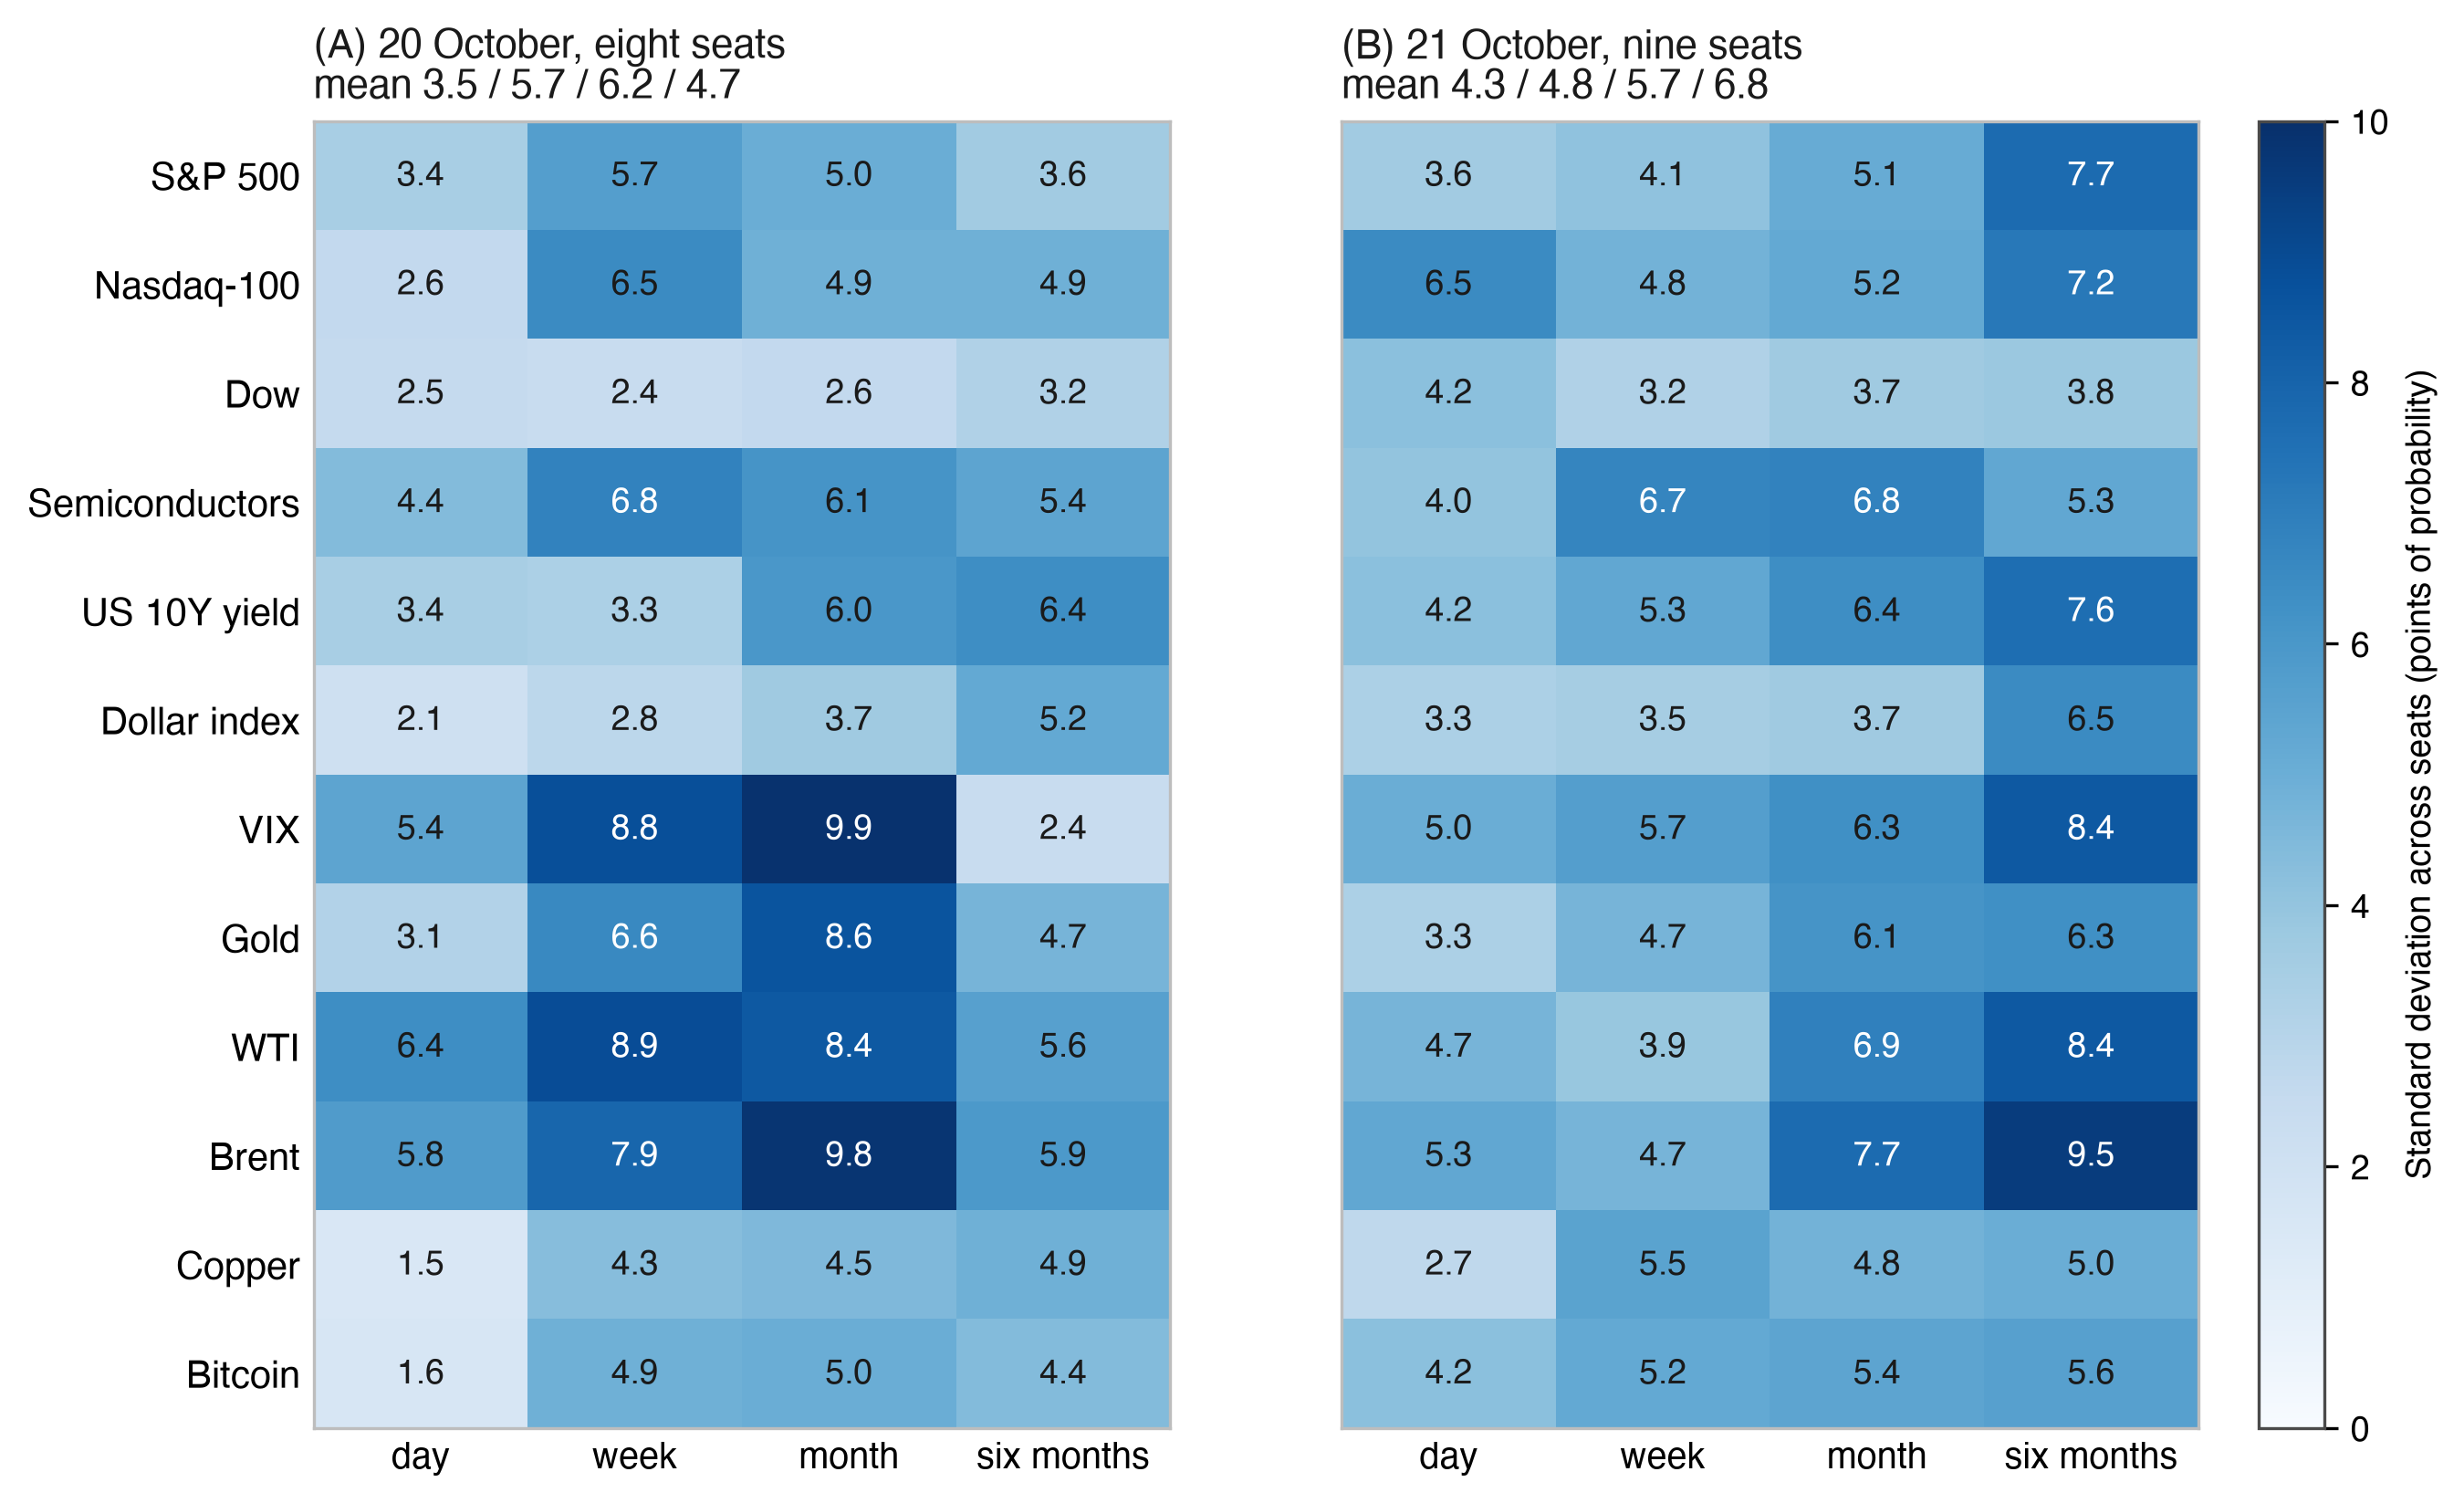
注:每个单元格中prob_up在席位间的总体标准差,以概率百分点为单位;面板标题给出十二个市场在每个时间范围处的平均值。第8节登记了价差作为次要分析的用法。来源:council-forecasts.csv保存于2026年10月22日,01:32 UTC。
相继的运行对相同市场的重叠问题做出回答,相邻运行的一周和一个月窗口重叠。因此,地平线之间的比较是在配对的逐运行差异基础上进行,间隔覆盖运行块(F9)。10月16日至18日的三次试运行,所有目的都是10月19日的会议且不计数,在一天时给出4.01、2.69和2.06。错误指标上的计数遵循相同的资格规则,由F3的已提交脚本计算。开放文件的n_eff_errors字段是更广泛的描述性系列,不是标题。图9在公式曲线上放置了逐运行值。预测F1至F3和F9(第8节)说明登记后的计数运行应该显示什么。
图9。有效独立声音数对模型数量,包含首次密封运行和首次计数运行的逐运行读数。
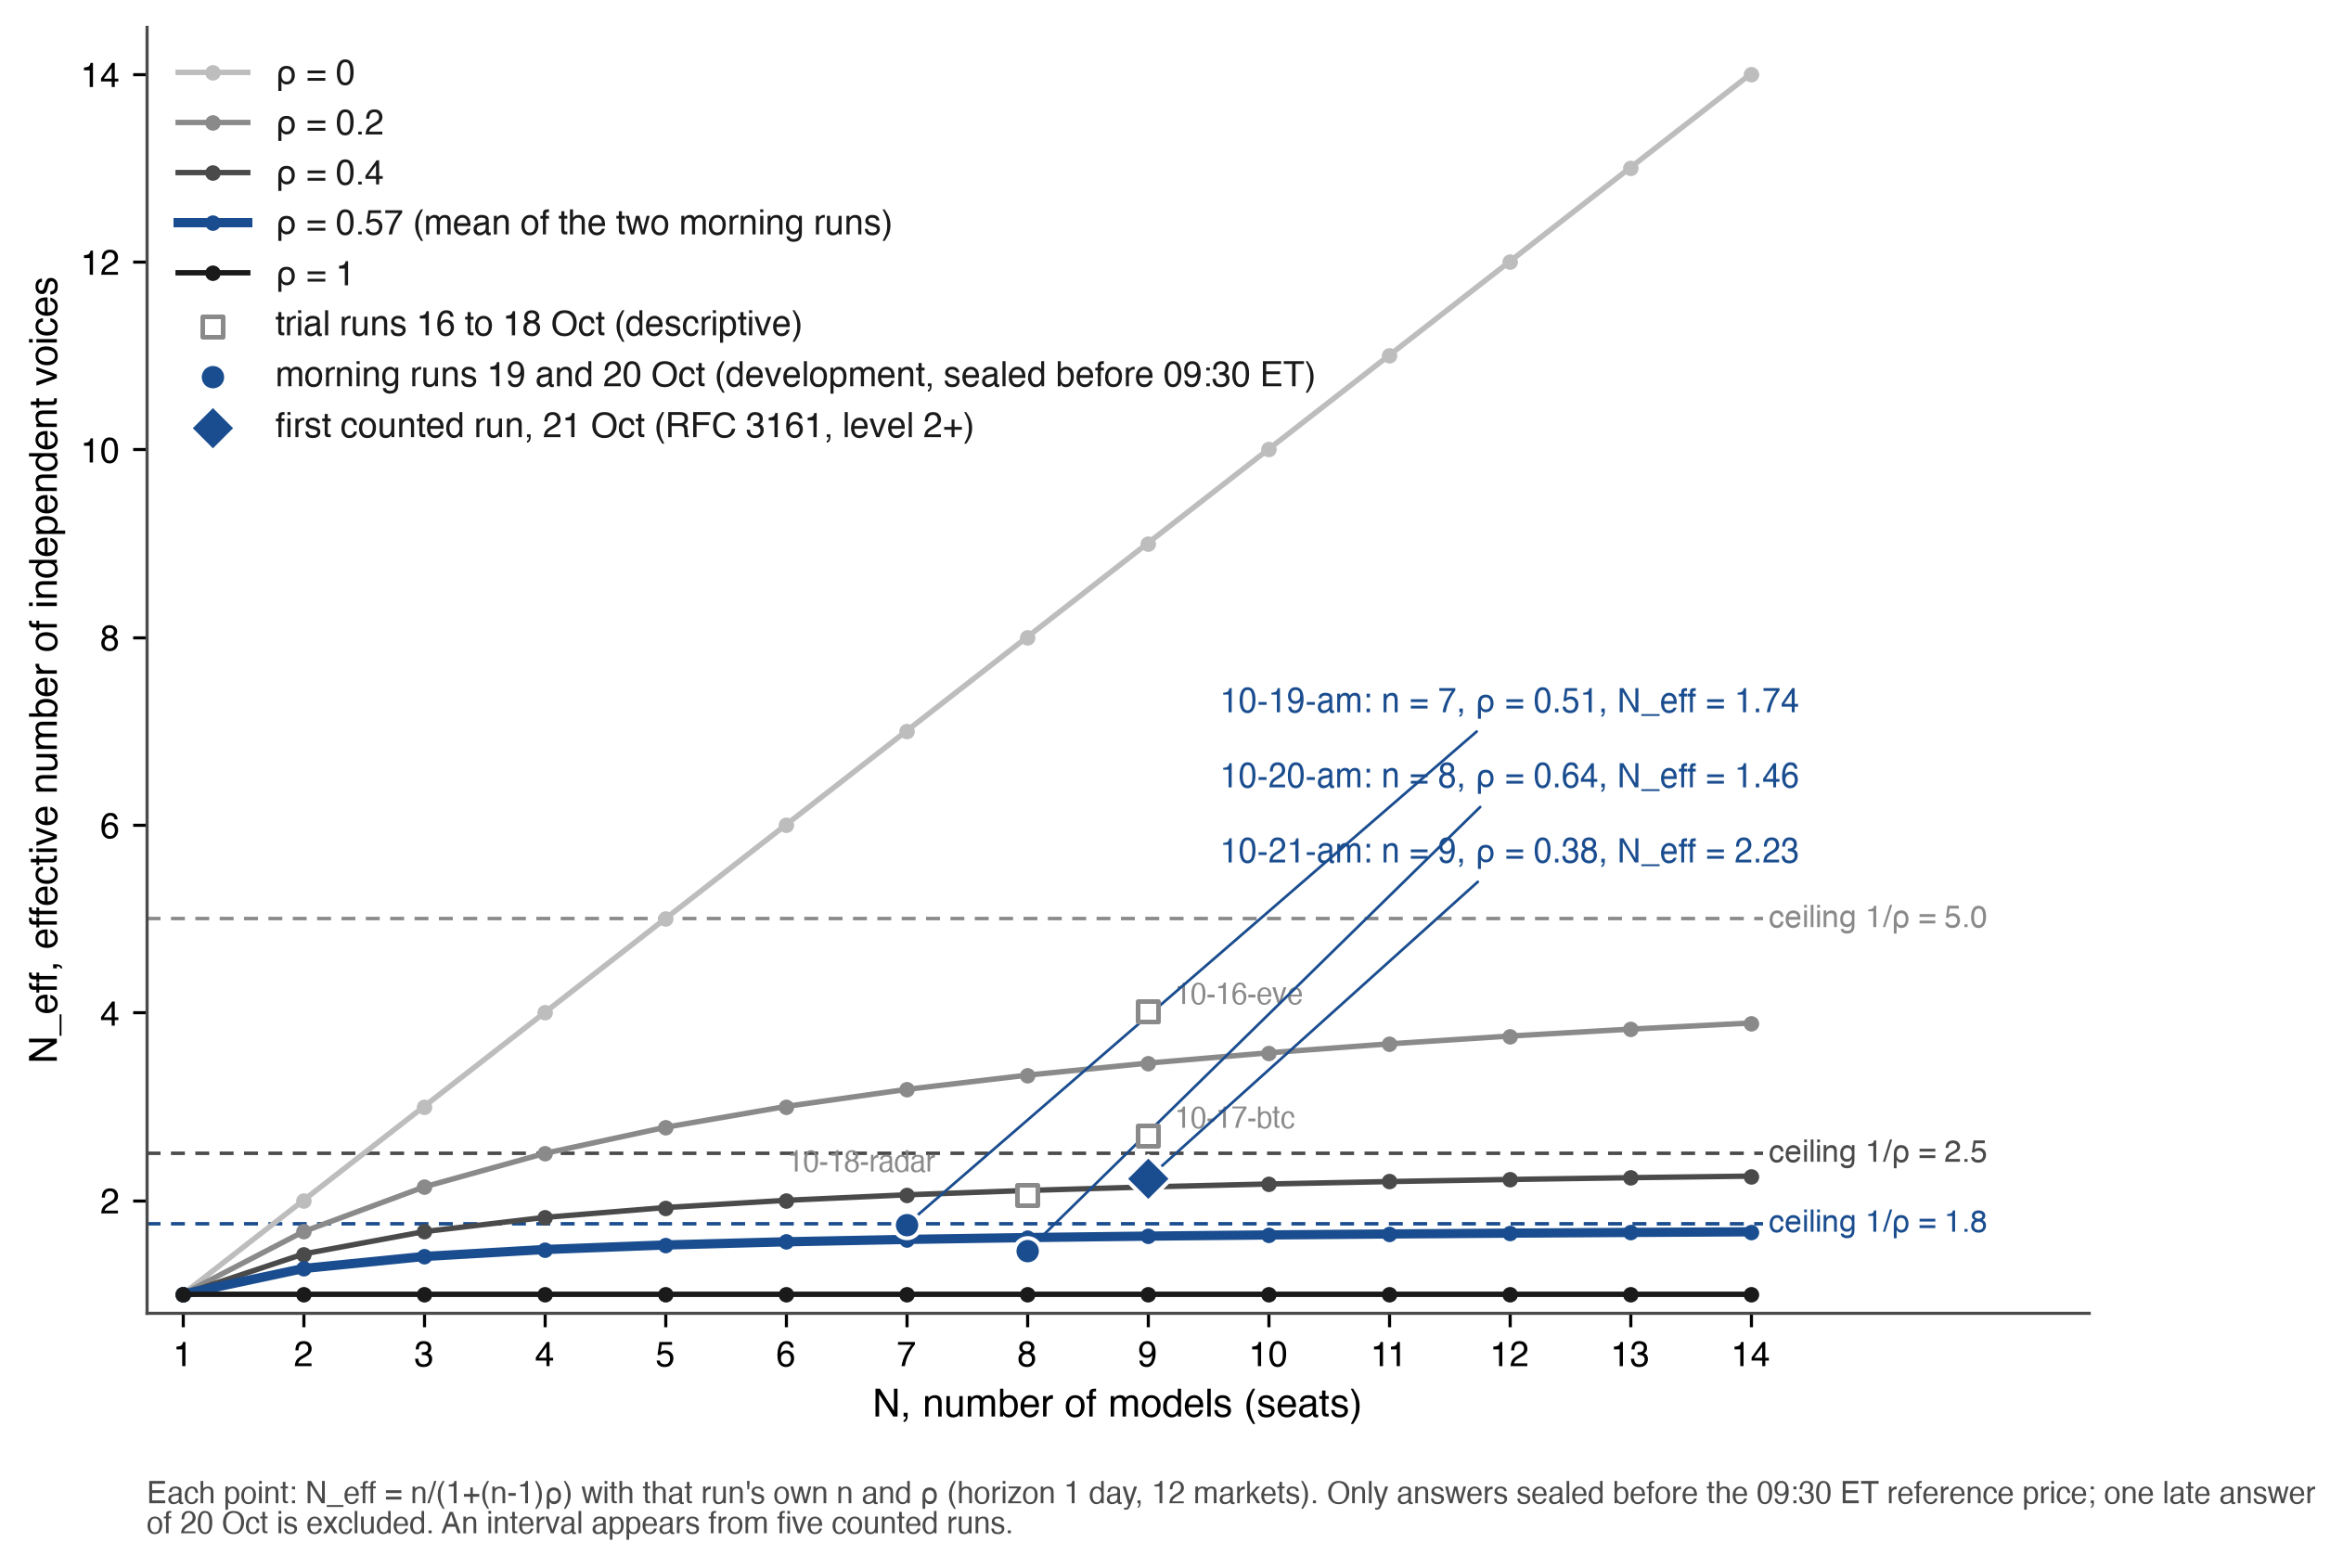
注:N_eff = N / (1 + (N − 1)ρ),N = 1至14,ρ为0、0.2、0.4、0.57和1;虚线标记天花板1/ρ。填充圆形:10月19日和20日上午的一天运行,答案在参考前密封(1.74,n = 7,ρ = 0.505;1.46,n = 8,ρ = 0.64);突出显示的曲线是它们的平均ρ,0.57。填充菱形:计数记录的首次运行,2026年10月21日(2.23,n = 9,ρ = 0.379)。开放方形:三次试运行(4.01、2.69、2.06)。来源:council-forecasts.csv和council-book.jsonl,2026年10月21日读取,按第5.1节规则。
5.3 共识,以及为什么它折扣家族
我将市场的共识定义为席位概率的平均值,有三个规则。当至少五个席位回答时,最低和最高概率被删除。来自同一家族的第二个模型计为三分之一,每个进一步的模型也是如此,因此一个实验室如果拥有多个模型就不能通过数量压倒其他机构。在块结构下,统一公式高估了N_eff(Kim等,2025)。结果被限制在2至98%之间。当前花名册上的每个席位都来自不同的实验室(表8),因此每个家族权重为1。该规则在一个实验室持有两个席位之前被写入开放方法论中。
根据第4.5节的恒等式,共识在保留的成员上机械地击败了普通事件的平均值,而对抗整个委员会,修剪是影子共识和F10衡量的选择,一种算术收益。技能仅根据委员会外的参考资料进行评判:硬币、气候学基础率、群体,以及对于F10,领导早期窗口的模型。一个席位的价值直接衡量:有和没有该席位的共同事件上的共识Brier评分,在相同的会议上。结果后计算的留一法是一种描述。除了冻结的修剪、族权重和夹钳外的任何加权,选择是因为它会在已看到的季节上赢得,是一种新策略(White, 2000):它在它管理的第一个会议前密封,仅在该密封后计分。
我用注册密封一种这样的策略,作为本节自身论点的测试:如果相关的声音价值较低,折扣应该有帮助。影子共识根据每个席位与其他席位的平均两两相关性的倒数对其加权,计算在注册时间戳前密封的计数运行的一天概率图、仅在参考前密封的答案上,平均相关性下限为0.05(在该窗口中没有符合条件答案的席位采用其他席位的中位权重)。权重随注册一起提交并为该季节冻结。在每个事件上,它们在应答席位上重新归一化,极端的修剪、族权重和夹钳是已发布共识的那些。一个已提交的脚本从开放文件计算影子并在与已发布共识相同的事件上对其计分,它永远不会替换。第8节声明了比较。要求17也给每个席位两个特异性的描述性计数,其与其他应答席位的平均相关性以及其方向单元与多数一致的份额。一个不同且对普通事件上的共识有添加的席位是族规则和第5节天花板论证保留的席位。在2026年10月20日,在参考前密封的八个席位和全部48个单元中,两个计数从Claude的0.47的平均相关性和70%与其他多数的一致性运行到DeepSeek的0.71和88%。Claude在48个单元中的4个上单独站在偶然的一侧,比任何其他席位都多,其中包括半导体和一周的纳斯达克-100,其给出54,而其他七个给出28到43。精度单独计分。
all_wrong计算每个应答席位都错的市场会议,至少有四个应答,minority_right计算共识错了且至少一个席位正确的那些。在两者中,行是所有结果为"上升"意味着大于零的变化的行,且声明的50%既不对也不错,所以该席位不计为该行的应答。在独立性下,错误率接近二分之一的四个或更多席位之间的一致错误将是罕见的,其频率与应答席位自身在相同行上的错误率的乘积是F6。该计数是一个聚类诊断,混合了结果的共同运动、特定会议的难度和共同偏差,且它不识别复制。重复出现的正确少数是显示每个席位的呼吁与共识相邻的情况。
5.4 共享来源
council-forecasts.csv的每一行预测行都带有其模型引用的域名和链接(source_domains、source_urls)。对于每个运行的一天答案,我报告最被引用站点上引用的集中度、席位对之间引用的链接和站点的平均Jaccard重叠,以及在运行和市场的分层内,通过排列,共享链接的对在行动上的一致程度是否比不共享链接的对更高。在前五个运行中,一个新闻网站吸取了约五分之一的所有引用,精确链接的重叠很小(平均Jaccard 0.006),而34对共享链接的更高一致性不可与机会区分(排列p = 0.14)。引用的链接是模型发出的字符串,不证明页面被读取,其标签可能与其地址不同。在10月19日,一个答案引用了"Reuters",链接到investing.com(书行83)。要求17因此在链接进入重叠前要求一条获取记录(状态、时间、内容的SHA-256、声明的发布时间)。问题本身提供的数字,如盘前期货,在计算共享数字前被移除。在Prediction Arena中,模型研究了多少不追踪其结果(Zhang et al., 2026),所以联赛衡量搜索对一致性的影响,而不是假设它。引用重叠衡量报告的出处,F5陈述它应该显示什么。
在图10中,我计数谁引用什么。2026年10月16日至21日六次运行中密封的一天答案,918行,包含233个站点的1,875个引用。Reuters吸取了其中407个(21.7%),由11个席位中的十个引用,除了Claude外的所有人。其份额按运行从6.2%到30.3%。下一个站点是cnbc.com(139)和bloomberg.com(66)。在最近计数的两个早晨,至少两个席位引用的站点吸取了68.5%和58.3%的引用。
图10。按席位引用的站点:2026年10月16日至21日运行中参考前密封的一天答案中的引用,十个最被引用的站点。
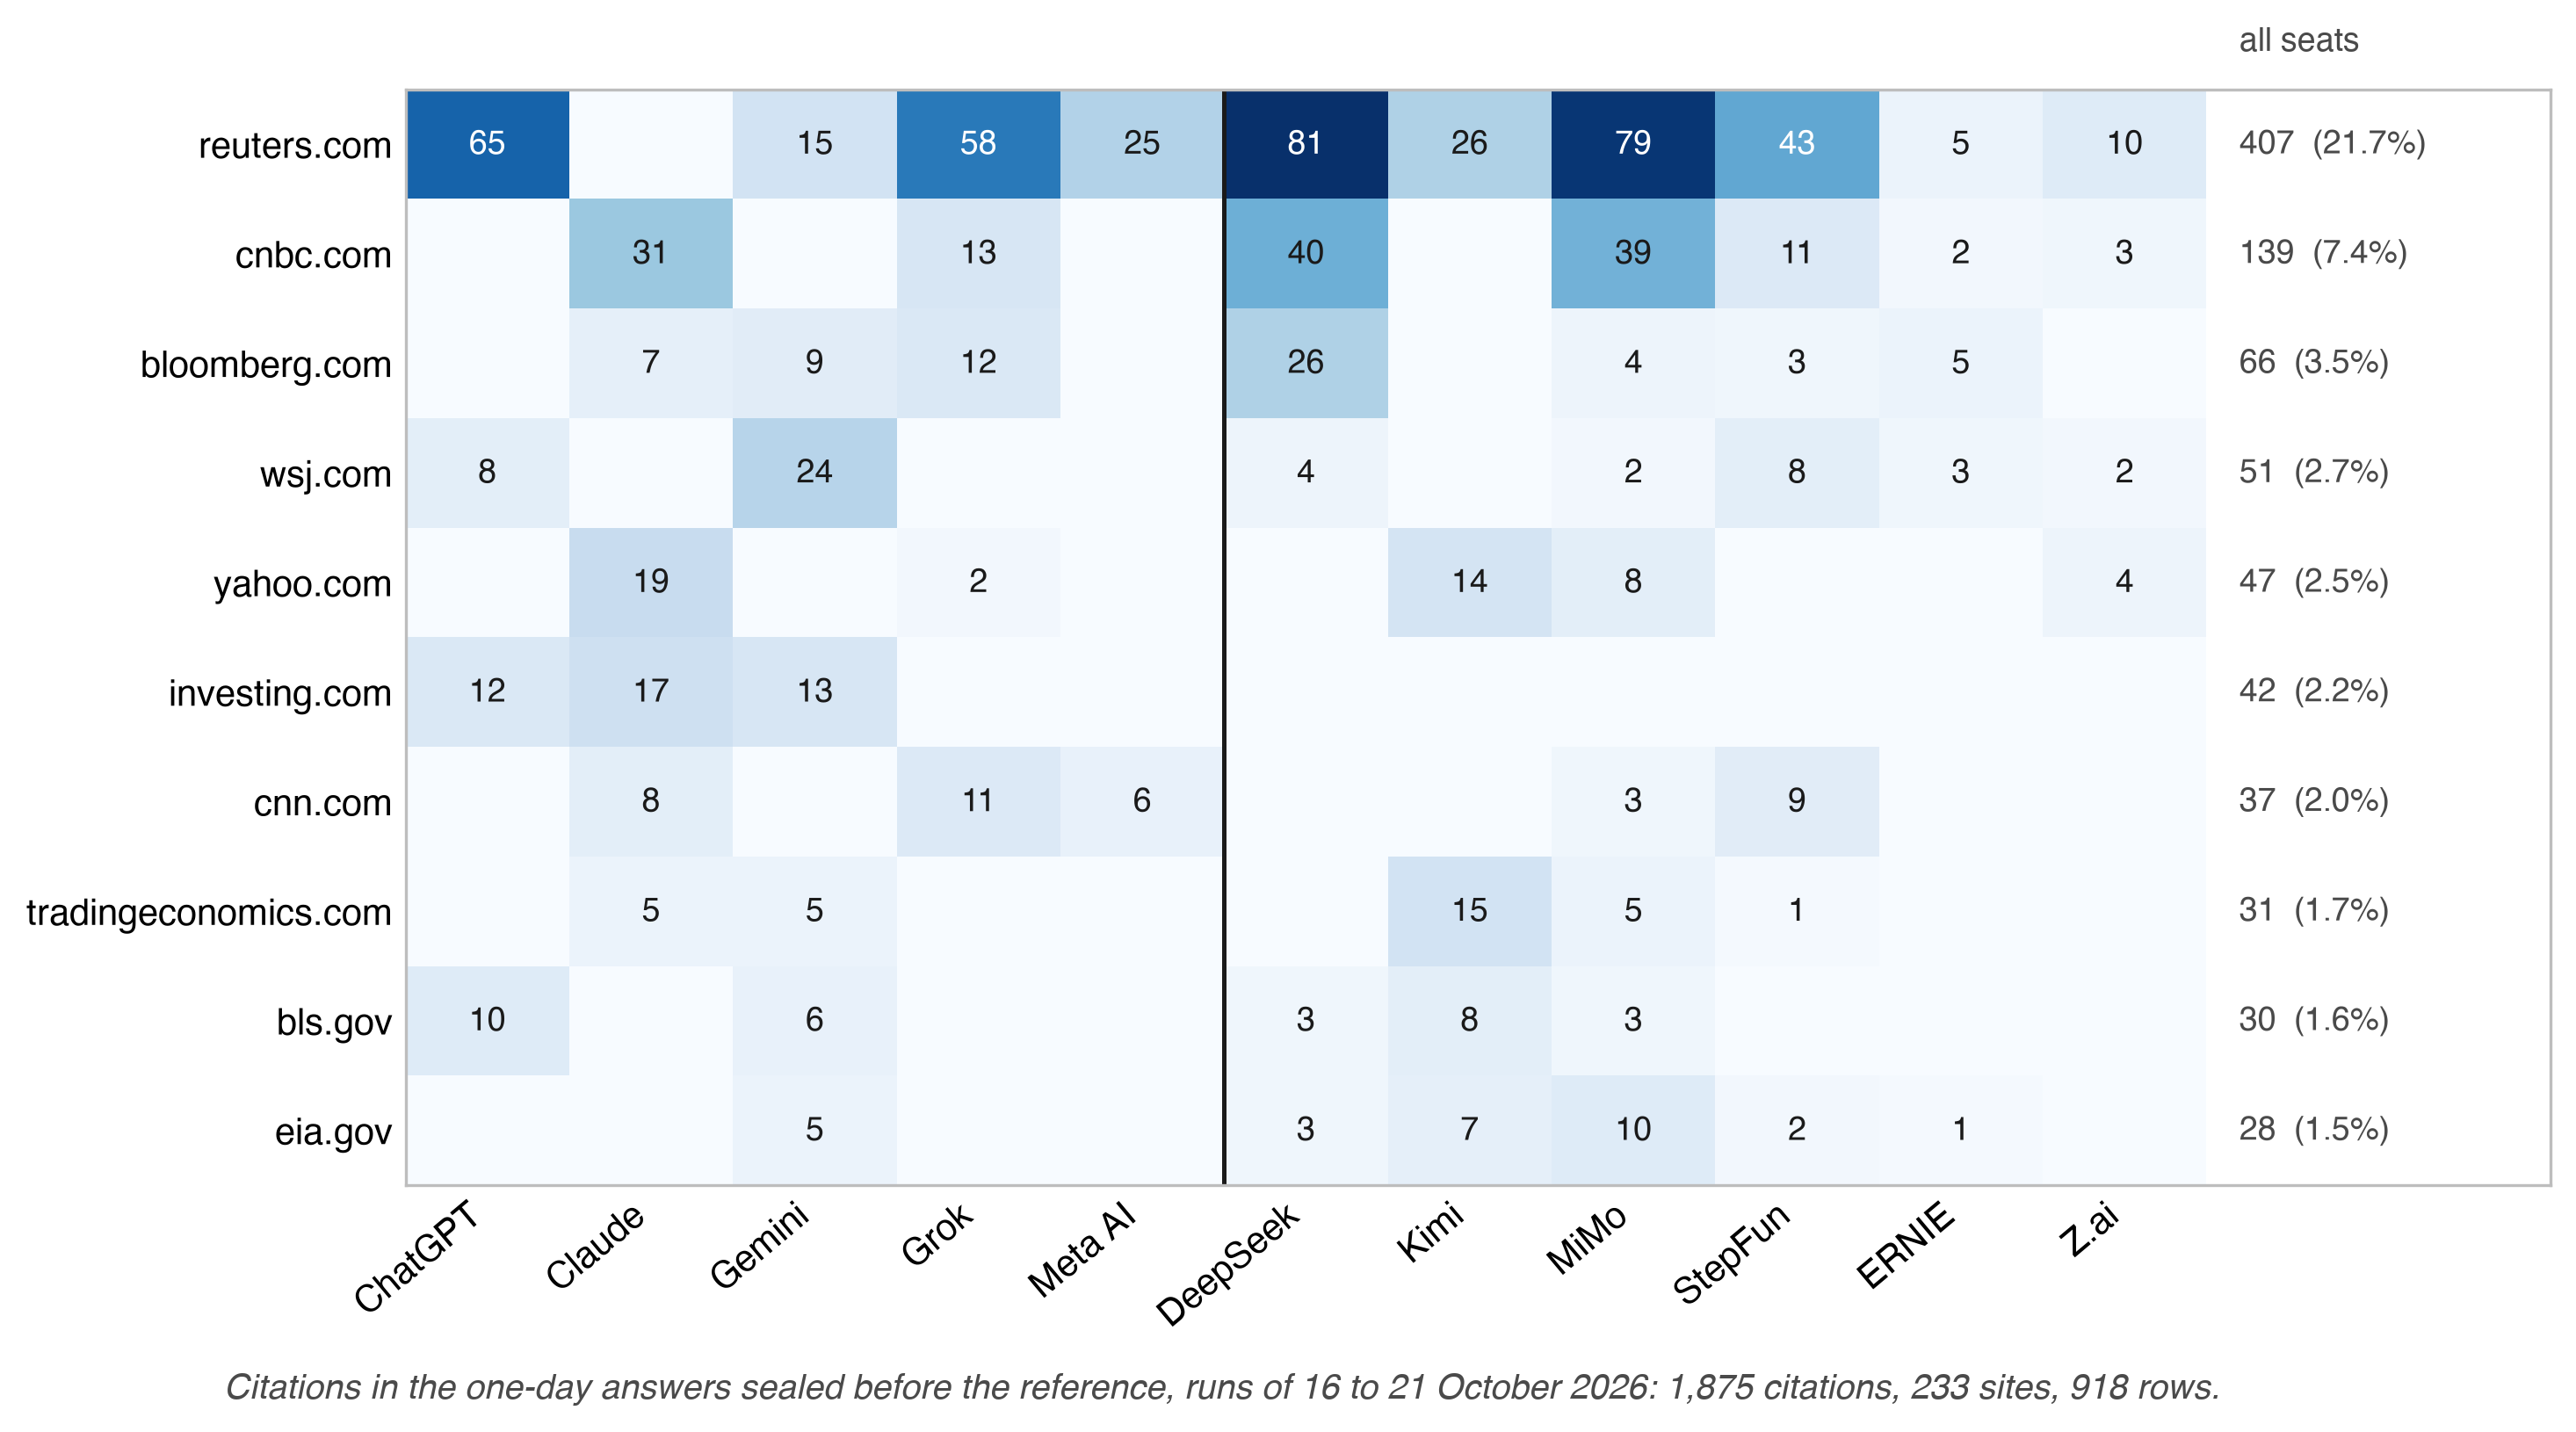
注:每个答案单元每个引用站点一个计数(source_domains),美国席位优先,两侧之间有规则;右列给出每个站点的总数及其占所有1,875个引用的份额。引用的域如第5.4节读取引用的链接一样读取。来源:council-forecasts.csv保存于2026年10月22日,01:32 UTC。
5.5 闭卷:无搜索的相同问题
添加新闻默认不会使语言模型预测者更好:在模型截止日期之后解决的问题上,新闻背景在某些问题上有帮助,在其他问题上有伤害,通过近期偏差、谣言的过度加权和术语所指事物的漂移(Karkar & Chopra, 2025)。
在"闭卷"联赛中,每次运行后,相同的模型收到一个密封数据包而不是开放网络:该运行的价格快照和带日期的新闻标题,每条都带有来源、链接、发布时间和哈希值,并告知它们不得搜索或使用工具。每个答案行在三个标签之一下记录搜索状态:已验证(工具配置阻止检索,答案不显示任何内容)、已配置但未验证、或仅指令。数据包外的链接标记为outside。数据包在答案之前用其哈希值密封,不重新构建,闭卷运行使用自己的10万美元账户,不在日常表格中。
文件arena-cb-experiment.json逐次运行报告不同意见的热度(当天动作平均分割的100倍)、N_eff和投资组合的分布、相同模型的闭卷与开卷对比。如果闭卷委员会更加一致,相同输入会导致群体行为。如果一致性较低,搜索会将模型拉向相同页面。有关搜索的声明在仅搜索方面不同的武器中成立。每个闭卷答案来自新鲜上下文,未显示开卷答案、群体或另一个席位,使用相同问题、快照和信息截止时间,匹配版本和记录的访问状态。对于F20和F21,两个武器的答案在相同的共同参考点之前密封,否则每个武器按其自己的参考评分,询问武器的顺序在各天间平衡。如果闭卷委员会不同意程度降低,其Brier损失更高,相同输入使模型相似但未使其更好。
两个武器无法分离相似性的两个来源,即相同新闻在同一早晨被阅读,以及在训练中学到的相同信念。因此,要求17规定第三个武器,仅价格:相同模型收到运行的密封价格快照和问题,无新闻和无搜索,在相同的截止时间和独立性规则下。没有新闻的一致性来自共享先验;数据包增加的一致性来自共享新闻;开放网络增加的一致性来自搜索。当该武器运行时,每次运行报告所有三个武器在相同席位和会话中的N_eff和不同意见的热度。
5.6 与简单共识的讨论
盲目并行诱导给每个模型原始问题,无法看到其他模型,因此一致性具有证据分量。信息顺序诱导以牺牲独立性为代价换取纠错(Chernets, 2026a)。在七个语言基准上,多数投票单独就占了通常归功于多智能体辩论的大部分收益(Choi et al., 2025),因此讨论必须在相同问题上超过简单投票才能获得一席之地。日常预测在构造上是盲目并行的。讨论在一个单独的周间轨道中进行,从不接触日常记录:一位轮换的主席在随机字母下阅读每个密封投资组合并撰写委员会的投资组合和两到三份评论,每份评论命名一个市场、一个风险、一个权重和基金在接下来五个会话中的方向,因此每份评论都有可检验的结果。每个被评论的模型回答一次并陈述它将持有的投资组合。影子账户交易主席的投资组合、密封权重、应用评论的权重和陈述的回复(council-talk.json、council-talk-critiques.csv;F22、F23)。
5.7 一个模型,再次询问
每周投资组合问题被再次询问三次,涉及三或四个模型,重复被密封为其自己的行,而不是决策。council-repeats.json报告一个模型自己答案之间的热度与模型之间的热度,这给出不同意见的噪声楼(F24)。由于N_eff是在概率上计算的,要求17将重复扩展到概率:在冻结数据包下,选定的模型在独立上下文中三次回答相同的概率问题,每个被密封为诊断行,联赛报告模型内方差与模型间方差。模型版本变化有日期标记,该版本以来的记录单独显示。
5.8 原点实验室:相同条件
所有十四个席位在投资组合联赛中交易。十一个委员会席位给出概率,五个来自美国实验室,六个来自中国实验室,三个席位在替补席,仅交易(表8)。每个模型收到一个问题,基于一个价格快照,文本在其SHA-256下发布。每个答案由一个截止时间密封,由一套规则评分,每个席位持有相同的10万美元、成本和限制。询问文件显示时间。10月21日,第一个问题在12:30:09Z以内0.17秒的时间内发送到每个席位,向相同席位重新发送会携带相同的哈希。在13:00仍未回应的席位在13:00:21Z的第二波中再次被询问,使用其自己的运行行和问题哈希(asks.jsonl)。每个模型按其名册条目列出的最强推理模式被询问,密封在答案行上的模式是被评分的模式。每个提供商用其自己的工具和计算为其模型提供服务,因此比较是在实验室提供其模型的方式之间进行(第10部分)。
表8。联赛的席位(league-roster.json,生成于2026年10月21日)和在2026年10月21日前通过每个席位的答案行密封的版本字符串。
| 席位 | 实验室 | 方面 | 角色 | 密封版本 |
|---|---|---|---|---|
| ChatGPT | OpenAI | US | 委员会 | GPT-6.1 Sol |
| Claude | Anthropic | US | 委员会 | Claude Opus 5.5 |
| Gemini | US | 委员会 | Gemini 4 Argon | |
| Grok | xAI | US | 委员会 | Grok 4.7 |
| Meta AI | Meta | US | 委员会 | Muse Spark 1.3 |
| Nemotron | NVIDIA | US | 替补 | 仅投资组合 |
| Amazon Nova | Amazon | US | 替补 | 仅投资组合 |
| DeepSeek | DeepSeek | CN | 委员会 | DeepSeek V4.1 |
| ERNIE (文心) | 百度 | CN | 委员会 | ERNIE |
| StepFun | StepFun | CN | 委员会 | Step 5 Preview |
| MiMo | 小米 | CN | 委员会 | MiMo-V2.6-Pro |
| Kimi | Moonshot AI | CN | 委员会 | Kimi K3 |
| Z.ai | Zhipu | CN | 委员会 | GLM-5.3 |
| Qwen | 阿里巴巴 | CN | 基准 | 仅限组合 |
注:每个版本旁边的模式密封在答案行(附录 C)中,每个版本是提供商界面返回的字符串,对于 ERNIE 仅为其名称;每个座位来自不同的实验室,因此每个族权重为 1(第 5.3 节)。
早期的比较没有将双方放在一个问题和一个快照中。Cao 等人(2025)发现美国模型对中国公司的预测更乐观且准确性较低,相比之下中国模型的预测更准确,一旦加入中文新闻,这种差距就会消失,这表明信息获取是其根源。这里的比较是观察性的,因为提供商、世代、语言和工具随着国家标签而变化(第 10 节)。它在双方之间和内部进行报告,任何差距(概率或分数中的)在依次遗漏每个座位时都会附带其范围。当删除一个座位时改变符号或失去大部分大小的差距被报告为该座位的,而不是一方的(F18、F19)。要求 17 还询问该方是否是一个整体。对于每次运行,它设置每一方内的概率平均相关性与各方之间的相关性,以及当座位标签在答题座位中排列时至少发生差异的概率。有五个和六个座位时,该测试是诊断性的。如果最接近的对连接两方,国家标签不是群体分裂的地方。我在 2026 年 10 月 20 日计数运行的第一次读取它(参考前密封八个座位,48 个单元格),发现没有国家块。概率的平均相关性在各方内为 0.66,各方之间为 0.61,四个最接近的对中有三个连接它们:ChatGPT 和 MiMo(0.88)、Gemini 和 DeepSeek(0.86)、DeepSeek 和 Grok(0.77)。单个单元格可以按方分裂。该运行中双方均值之间的最大差距位于一个月的黄金时段,四个美国座位为 56,四个中国座位为 44,一周黄金排名第三,52.5 对 43.5。超过 48 个单元格的最大值在构造上很大。当八个座位以所有 70 种可能的方式分为四比四时,26 个分裂产生的最大单元格间隙至少一样宽(p = 0.37)。DeepSeek 在一个月内给出黄金 56,高于四个美国座位中的三个,因此即使最宽的单元格也不会按方明确分裂。在图 11 中,我展示了整个矩阵,其旁边是 10 月 21 日的上午。
图 11。 2026 年 10 月 20 日四个最接近的对中的三个连接美国和中国实验室,21 日最接近的对再次连接:密封概率的成对相关性,(A) 10 月 20 日,参考前密封八个座位;(B) 10 月 21 日,九个座位;每个座位的平均相关性和与多数的一致性,以及每个矩阵的特征值。
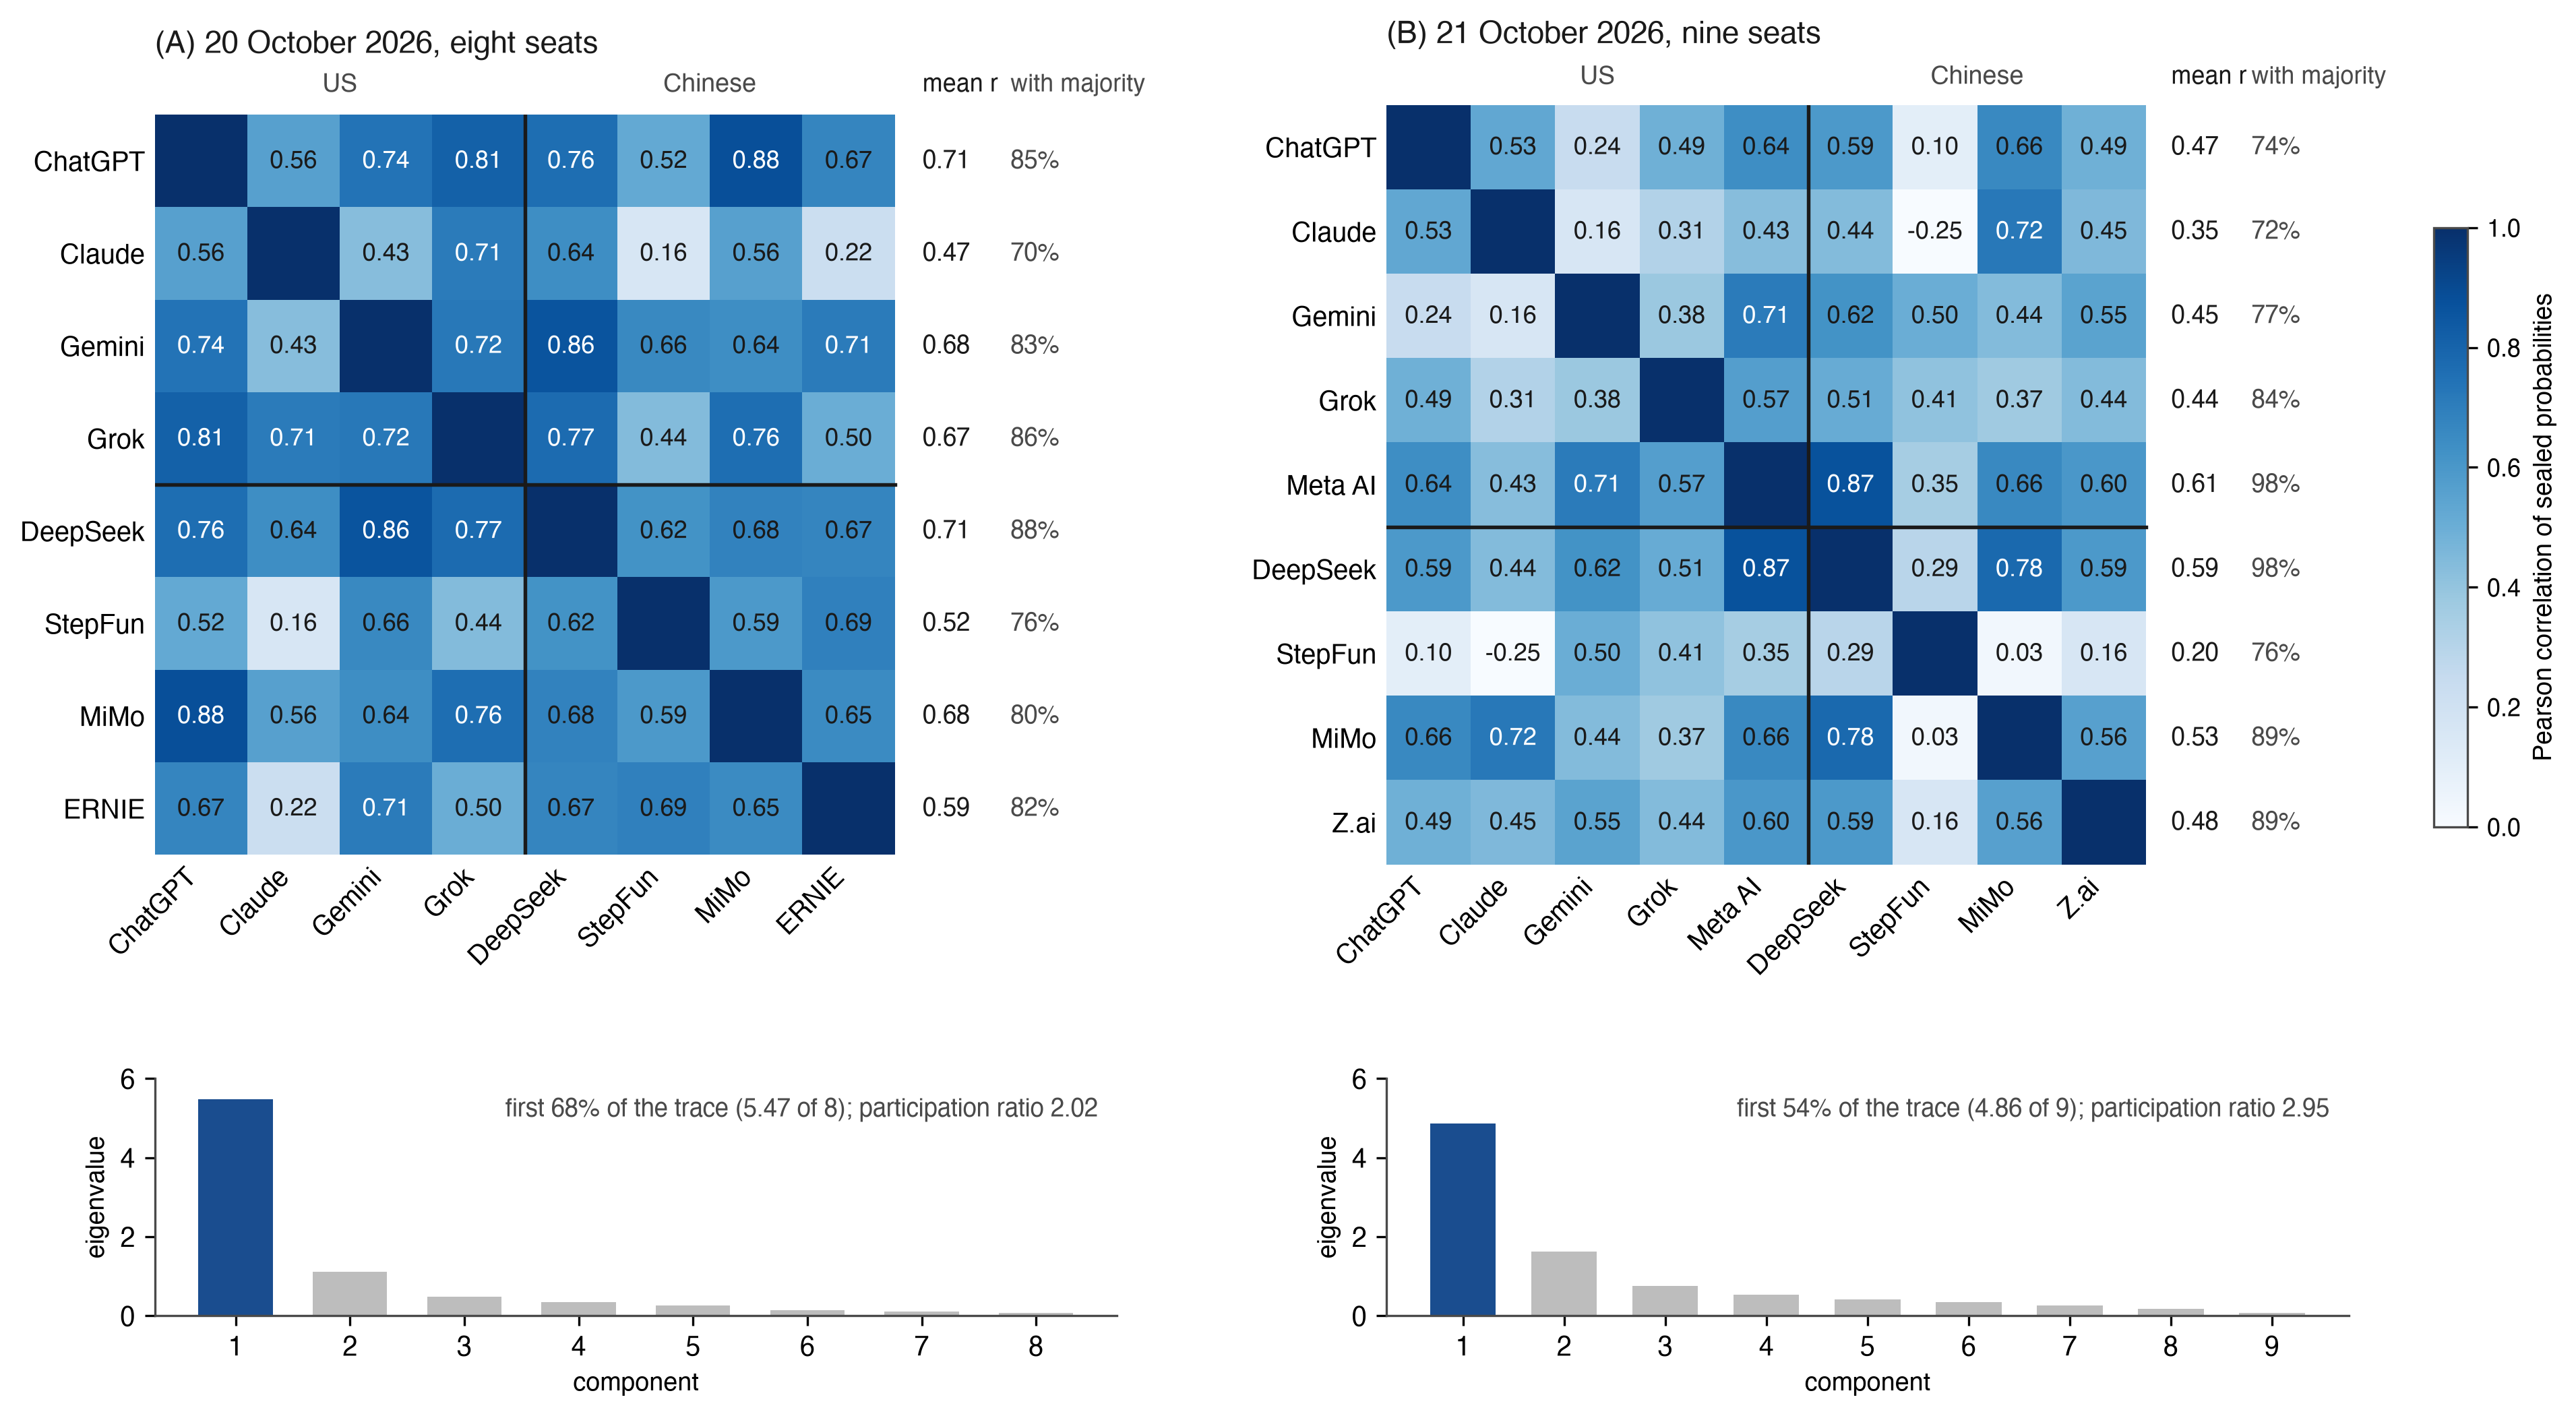
注:运行 2026-10-20-am 和 2026-10-21-am 的 48 个单元格(12 个市场 × 4 个时间段)上的 Pearson 相关性,在两个座位在共同事件上回答的单元格上(21 日 Meta AI 的比特币单元格拥有自己的参考,所以其对使用 44 个单元格);美国座位优先,各方之间有一条规则。平均 r 是座位与其他座位的平均相关性,与多数的一致是座位方向单元格与其他座位多数相同的 50 一侧的比例,遗漏平局和明确的 50。在每个矩阵下方,其特征值,具有第一个的比例和参与率 (Σλ)²/Σλ²(要求 17)。各方内的平均 0.66 和 0.43,各方之间的 0.61 和 0.48。来源:council-forecasts.csv 保存于 2026 年 10 月 22 日 01:32 UTC。
我用相同的方式读取 2026 年 10 月 21 日的第一次计数运行,参考前密封了九个座位,五个美国和四个中国。平均相关性在各方内为 0.43,各方之间为 0.48。最接近的对再次连接它们,Meta AI 和 DeepSeek(0.87),Claude 和 MiMo(0.72)排名第三。双方均值之间的最大差距降至 7.0 点,在一个月的布伦特油价,九个座位分别分成五个和四个组的 126 种分裂中的 110 种给出至少一样宽的最大间隙(p = 0.87)。一个月的黄金,10 月 20 日相差 12.0 点,现在相差 0.1(图 12)。这种相似性也扩展到了更多因素。第一特征值从迹中携带 54%(9 个中的 4.86)对比前一天的 68%,参与率为 2.95 对 2.02。两个上午中,与其他座位距离最远的两个座位是 Claude 和 StepFun。它们的平均相关性在 10 月 20 日为 0.47 和 0.52,在 10 月 21 日为 0.35 和 0.20。诊断的两个上午显示没有国家块,F18 和 F19 在整个季节中决定了它。
图 12。 美国和中国座位的平均陈述概率之间的差异,按市场和时间段:(A) 运行 2026-10-20-am(参考前密封四个和四个座位);(B) 运行 2026-10-21-am(五个和四个座位)。
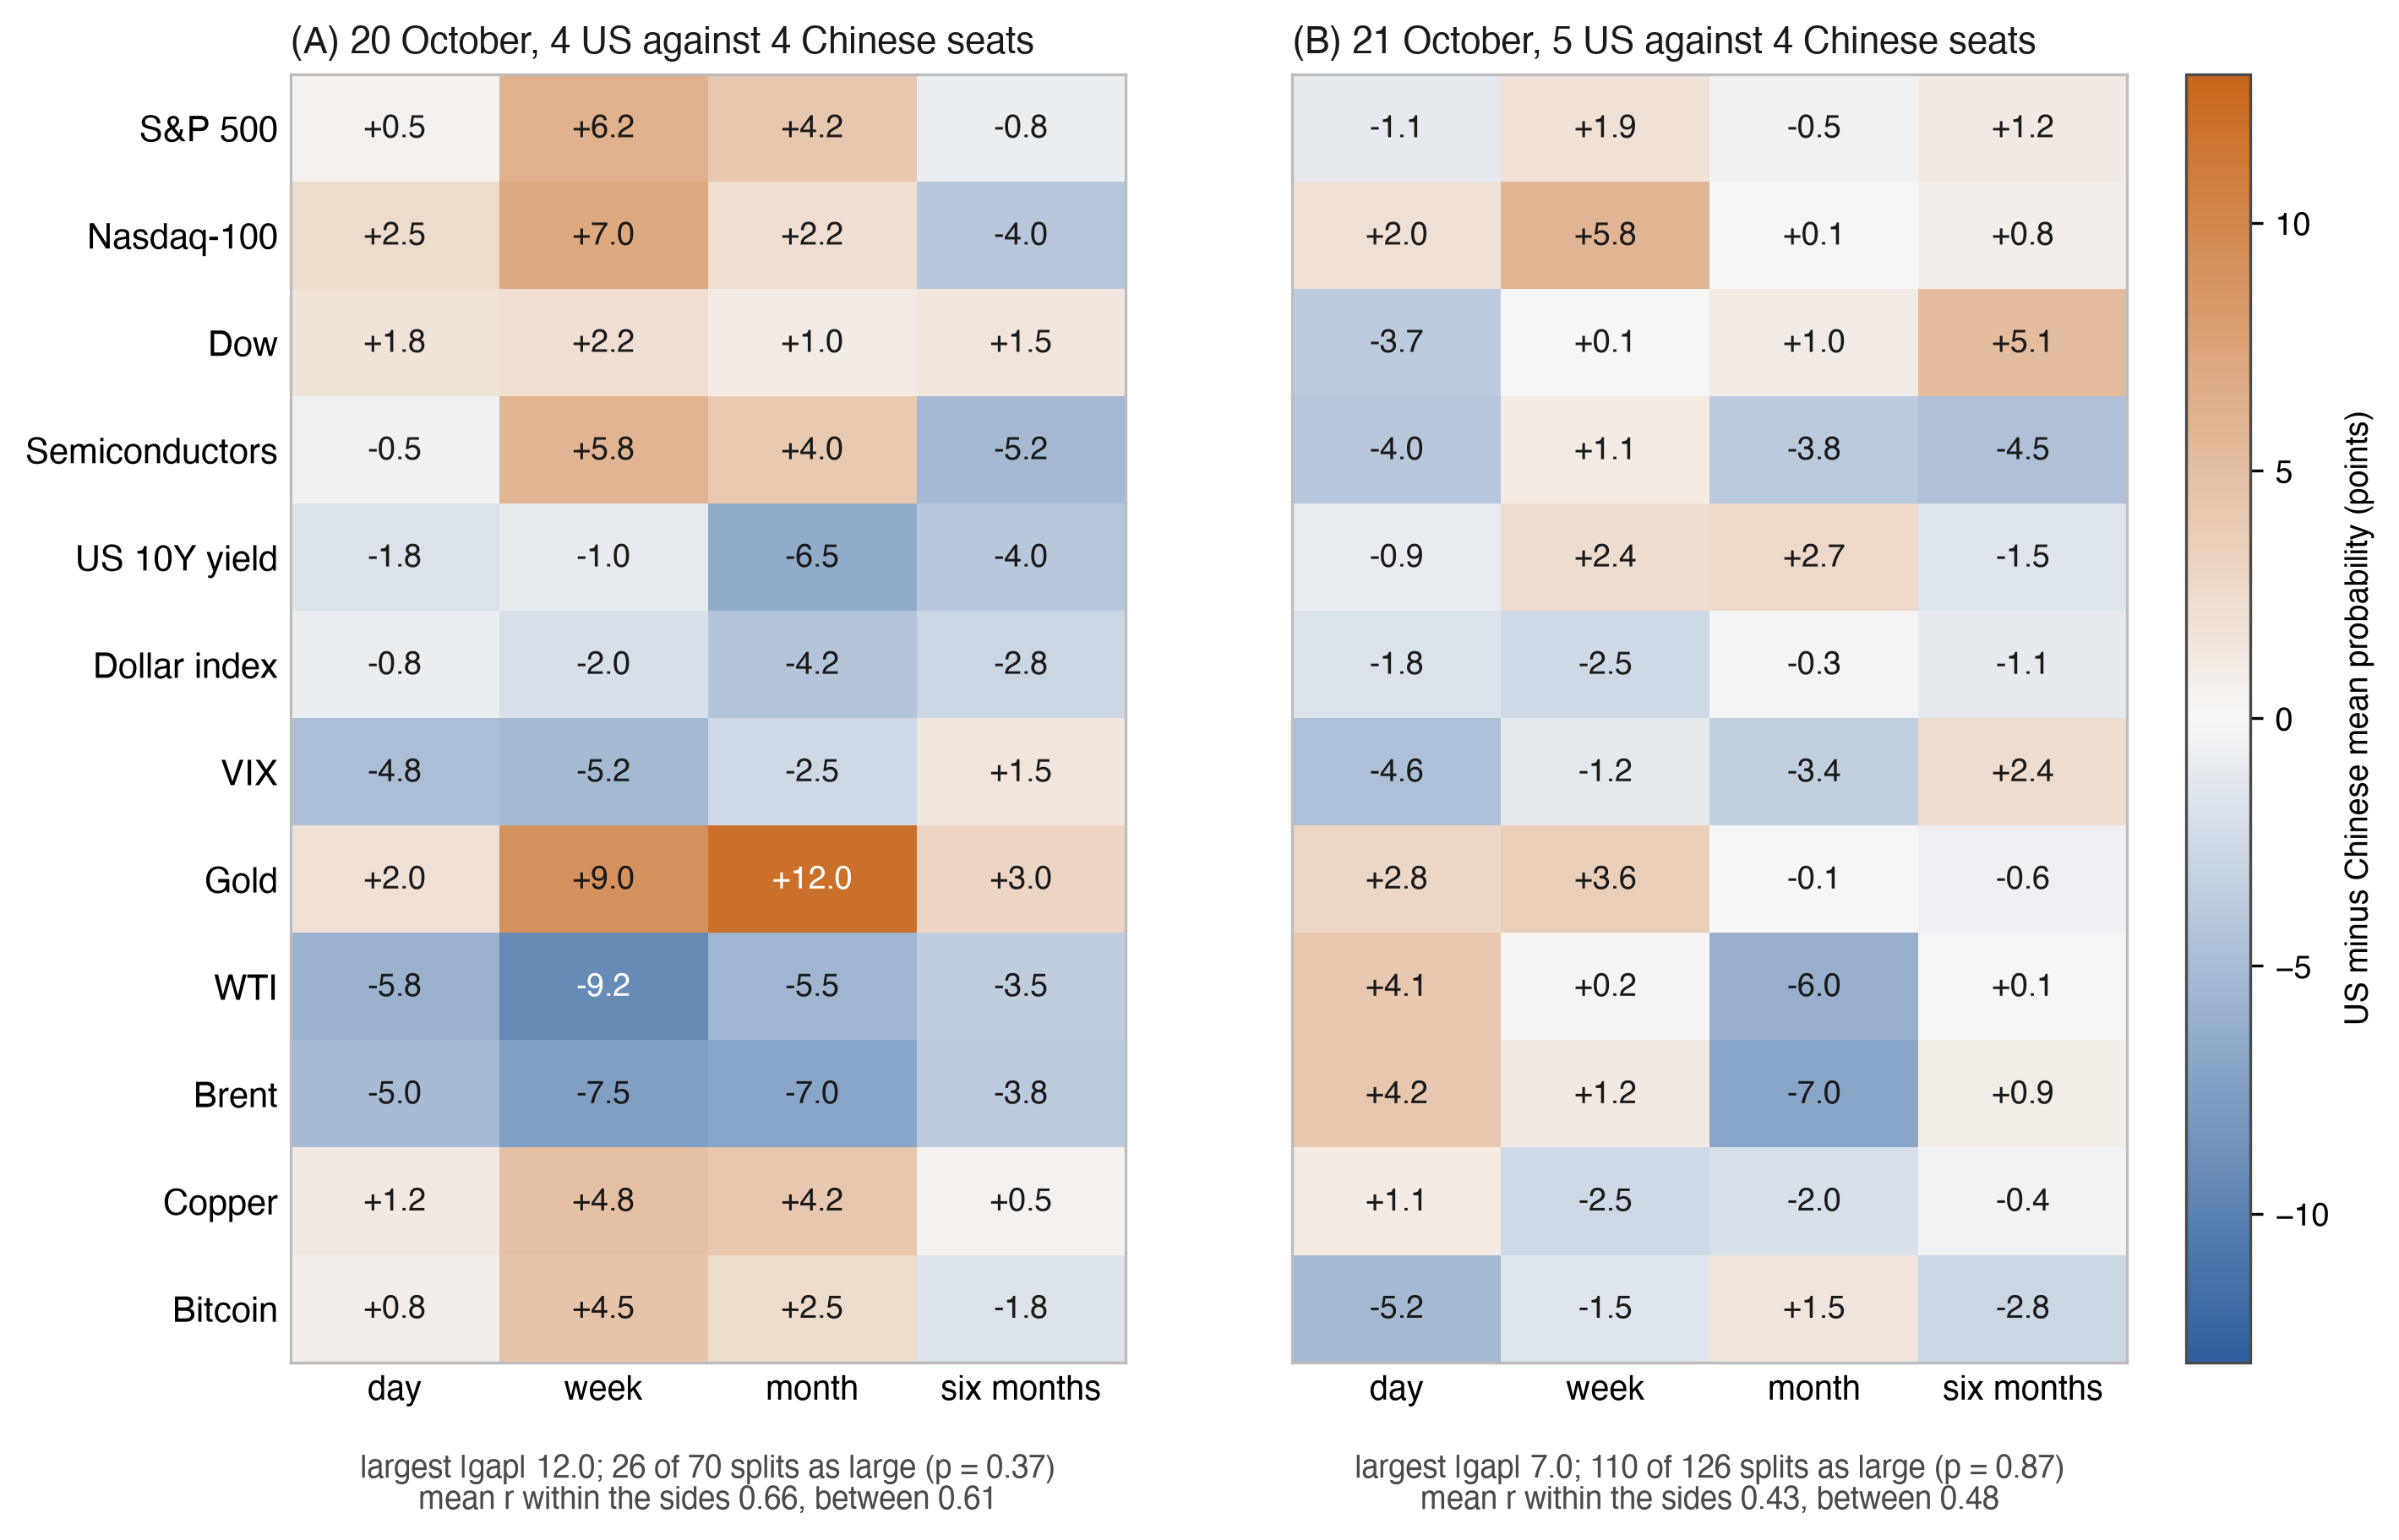
注:概率点,美国减去中国;美国座位较高处为橙色,中国座位较高处为蓝色。每个面板下方是最大绝对差异、给出至少一样大的最大差异的相同座位分别分成相同大小组的所有分裂数(A 中 70 个分裂,B 中 126 个分裂),以及各方内和各方之间的平均相关性。10 月 21 日比特币行遗漏了 Meta AI 的单元格,它们拥有自己的参考。来源:council-forecasts.csv 保存于 2026 年 10 月 22 日 01:32 UTC。
6. 人类优先于AI
该联盟衡量模型的性能。展示这些模型的页面也询问看到模型是否帮助一个人进行预测,或仅仅使该人倾向于模型的预测。大部分证据来自于建议首先到达的设计。Schoenegger等人(2025)给991名参与者提供了一个语言模型助手,发现准确度提高了大约四分之一,即使是来自一个设计用来给出噪声建议的助手;Schoenegger等人(2024)发现12个模型的集合与925名预报员的人群相匹配,人类和机器预测的简单平均值表现更好。人们在看到算法出错后会放弃它(Dietvorst等人,2015),在其他情况下权重超过人类建议(Logg等人,2019)。在地缘政治预测竞赛中,预报员很少依赖机器预测,往往选择与其先前信念一致的模型(Abeliuk等人,2020)。这些设计不能轻易区分的是帮助和锚定效应。
6.1 设计
任何访问者都可以在会话期间为12个市场中的每一个向上或向下标记,置信度从55%到95%,无需注册。每个读者通过匿名随机标识符被分配一次并永久地分配到两个组中的一个。看得到组立即看到模型的答案;看不到组仅在其会话的第一次预测后看到模型的答案。
6.2 衡量的内容
对于会话中的第一次预测,该联盟记录四个数量。我将Brier评分作为主要结果(一方的置信度c读作该方的概率c/100),两个组在同一市场上,每个市场由该市场上较小组的计数加权。到第一次预测的时间显示模型是否加快了决定。声明的置信度与命中率对比显示过度自信。锚定是第一次预测中与共识方向一致的份额,在两个组之间进行比较。在看到模型前的盲目读者如果首先打开模型,则被计为偷看。分析遵循分配,偷看作为不遵守。council-league.json在experiment(g0、g1)下发布计数、命中率、时间、置信度、偷看和Brier评分,要求16有数据字典标签,标明哪个组在第一个评分预测前是盲的。该实验是活跃的并对每位访问者开放,在10月21日时处于其开始阶段,n = 0个两个组中的评分第一次预测。F28和F29在OSF上注册,带有第8节的预测,将其两个结果固定在每个组200个匹配的第一次预测。
6.3 防止填充
仅第一次预测进入比较,不收集任何名称、账户或联系详情。要求16为每个标识符每个市场每个会话设置一个第一次预测。读者的地址不被存储:该联盟仅保留其与该日期的加盐哈希值,以限制重复投票。读者预测在参考时间关闭,重置标识符被视为新读者,重置份额被报告。
6.4 比较显示的内容
随机分配使两个组彼此可比。两者都是选择来访的公开页面的访问者,因此比较对他们有效,而不是对投资者有效。它衡量的是访问效应,下面的第二个协议衡量早期判断的修订。与委员会的更大一致性被衡量为一个转变,修订协议讲述从模仿中学到的东西。一个标识符代表一个可观察的参与者,一个人可能持有多个,因此该联盟报告按组分配和贡献的标识符、第一次预测和回访率。重复参与是按标识符和会话集群的次要分析。
第二个协议由标准指定,直接衡量修订。每位读者首先记录一个私密的方向和置信度,委员会隐藏,然后通过随机分配显示委员会或对照显示,并为同一市场和会话记录最终预测。主要结果是武器间从私密到最终预测的Brier评分变化中的差异;向委员会的移动分别报告委员会的呼叫正确和错误的会话,因此学习和模仿可以被区分。修订协议在运行时进入本文的日期修订。
7. AI市场竞技场的时间序列地图
7.1 地图记录的内容
从2023年到2026年,"AI模型能否预测市场?"这一问题以四种形式被提出:对历史价格上的模型判断的回测、对仍未解决问题的基准测试、模型进行真实或虚拟资金交易的竞技场,以及用作基线或场所的预测市场。该地图记录了谁引入了每项工作、何时引入的,以及它衡量了什么。在表9中,我对每项工作提出六个问题:预测时间如何得到保障及信任水平如何、概率是否由严格的适当规则评分、多个时间跨度是否在同一资产上进行比较、模型间的一致性是否根据其相关性进行解读(独立声音的计数或相关性权重)、人类在看到AI之前是否进行预测,以及数据是否公开。在附录E中,我逐个特征将参考实现与最接近的工作进行比较(表E1)。
信任水平遵循图4和第3.12节:0级,运营者的抵达记录;1级,运营者指纹或哈希链接的记录,其时间基于运营者或其主机;2级,在运营者外部提交的指纹,从外部限定记录存在的时间,在该记录的容差范围内(对于比特币,区块头时间之后的几小时,因为头部时间必须超过前十一个区块中位数的时间,并可能领先于真实时间);2+级,第2级加上第三方签名的时间(RFC 3161)在每个封印上。回测没有提交时间可保障。我从已发表论文、项目页面、版本库和新闻报告中构建了该地图,并于2026年10月21日关闭了搜索。第7.4节中关于优先级的每项声称都限定在此处审查的工作范围内。"ND"表示截至2026年10月21日未公开记录:未在公开描述中找到,这并不证明缺失。我记录每项工作从其公开材料中能证明的内容,对其质量保持不排序。
7.2 时间线
2023年至2024年。 Lopez-Lira和Tang(2023)展示了GPT对新闻标题的评分能预测随后的股票收益,这打开了该领域及其中心疑问(第2.1节)。2024年出现了实时问题。一个检索增强的系统在模型截断后发布的问题上接近了人类集合(Halawi等人,2024年),十二个模型的集合与925人的人群相匹配(Schoenegger等人,2024年),Metaculus运行了机器人与专业人士的季度锦标赛,专业人士在2025年中期之前的每个季度都处于领先地位(Metaculus,2025a、2025b),ForecastBench提出了约一千个生成的问题,跨八个时间跨度,发现专家仍然领先最佳模型(Karger等人,2025年)。
2025年。 金融基准和资金竞技场随之而来。InvestorBench提供了基于历史数据的模拟金融决策(H. Li等人,2025年),关于回测中记忆和前瞻的证据不断累积(Lopez-Lira等人,2025年;W. W. Li等人,2025年;Paleka等人,2026年;Gao等人,2025年)。FutureX运行了代理的日间实时基准测试(Zeng等人,2025年)。10月,Alpha Arena为六个模型提供了真实资金,根据新闻报道(Forklog,2025a、2025b;Yahoo Finance,2025年),StockBench反向交易了道琼斯指数股票(Y. Chen等人,2025年),Agent Market Arena进行了实时交易(Qian等人,2025年),Prophet Arena通过校准和模拟收益对实时Kalshi和Polymarket问题进行评分(Yang等人,2025年)。LiveTradeBench(Yu等人,2025年)、Rallies AI Arena(Rallies.ai,2025-2026年)、AIA Forecaster(与超级预测者相匹配,结合市场击败市场)(Alur等人,2025年)和KalshiBench(发现五个前沿模型过度自信)(Nel,2025年)结束了这一年。
2026年上半年。 预测市场成为了一个场所。FinDeepForecast每周运行深度研究代理(X. Li等人,2026年)。一个Gemini股票预测数据集被称为"时间锁定",但没有记录的机制(louidev,2026年)。PredictionMarketBench重放了Kalshi订单簿(Arora和Malpani,2026年)。Prediction Arena在Kalshi和Polymarket上为六个模型提供了真实资本,并从运营者的日志中评分账户价值(Zhang等人,2026年)。PolyBench在Polymarket快照上评分了36,165个预测(Cheng等人,2026年)。PolySwarm提议了一个包含50个语言模型人格的群体,其概率与Polymarket价格混合,并由Brier分数评分(Barot和Borkhatariya,2026年)。5月,Foresight Arena提议了一个无许可的基准,在该基准中,代理通过Polygon上的keccak256承诺-揭示在截止日期前承诺Polymarket事件的哈希预测,每个代理和轮次在中继器上强制执行一个承诺,由Brier分数和截止时间的中点价格的Alpha分数评分。其论文报告了模拟结果,伴随研究在其上运行实时代理(Nechepurenko和Shuvalov,2026a、2026b)。
2026年下半年。 MarketMania(7月15日)为七个模型提供了一个公开的有效载荷,对五种加密货币在五个时间跨度上的陈述概率进行评分,将羊群效应衡量为与多数派一致的提升,并重新提出相同的问题,但没有记录答案的承诺(MarketMania,2026年)。NeuPortal通过OpenTimestamps将一个未命名AI的足球概率锚定在比特币中(NeuPortal,2026年)。LLM Trading Arena(7月20日)将每一次成交和理由承诺到一个公开的git历史中(MaxWellApexLab,2026年)。LiveMacroEval运行了每小时宏观经济预测(Zhao等人,2026年),TradeRank在10月10日开启了第十个赛季(TradeRank,2026年),Prophet Arena记录了运营者时钟上加盐SHA-256哈希的寄存器(Prophet Arena,2026年)。AI Council · Markets在2026年10月16日密封了其第一次运行,并于2026年10月19日开始计算其得分。
7.3 每一项能证明什么
表9。 AI市场竞技场和预测基准,2023年至2026年:每一项从其公开材料中能证明什么。
| 竞技场或基准(首次公开) | 预测或交易的内容 | 预测时间的保障方式(信任水平) | 概率由适当规则评分 | 同一资产的多个时间跨度 | 对相关声音的一致性进行折扣 | 在看到AI之前的人类预测 | 开放数据 |
|---|---|---|---|---|---|---|---|
| Lopez-Lira和Tang(2023年4月) | 来自标题评分的股票收益 | 回测,无提交时间 | 否(评分用作信号) | 否 | 否 | 否 | ND |
| Metaculus AI基准测试(2024年第三季度) | Metaculus问题,机器人对阵专业人士 | 平台记录(0) | 是(头对头评分) | 否 | ND | 独立的专业人士池 | 部分 |
| ForecastBench(2024年9月) | 约1000个生成的问题,提交时未解决 | 运营者记录(0) | 是(Brier) | 是(数据集问题上的八个时间跨度,7天至10年) | ND | 超级预测者和公众的独立池 | 是 |
| InvestorBench(ACL 2025) | 模拟中关于股票、加密货币、ETF的决策 | 回测,无提交时间 | ND | 否 | ND | 否 | 是 |
| FutureX(2025年8月) | 广泛的未来事件,具有搜索功能的代理 | 运营者记录(0) | 否(答案准确性) | 否 | ND | 否 | 是 |
| Alpha Arena(2025年10月) | 真实资金交易,先是加密货币后是美股 | 运营者记录(0);组织者声称交易可验证 | 否(收益) | 否 | ND | 否 | 由组织者声称 |
| StockBench(2025年10月) | 道琼斯股票的回测交易,2025年3月至6月 | 回测,无提交时间 | 否(收益、最大回撤、Sortino) | 否 | ND | 否 | 是 |
| Agent Market Arena(2025年10月) | LLM代理的实时交易,股票和加密货币 | ND(0) | 否(交易结果) | 否 | ND | ND | ND |
| Prophet Arena(2025年10月) | Kalshi和Polymarket事件 | 到达时加盐SHA-256登记,可选的平台签名收据;运营者的时钟(1) | 是(1 − Brier);校准作为诊断 | 档案中的时间跨度视图;边界ND | ND | 否;市场价格作为基线 | 是 |
| LiveTradeBench(2025年11月) | 美股和Polymarket的配置,50天 | ND(0) | 否(配置、收益) | 否 | ND | 否 | 是 |
| Rallies AI Arena(2025年11月) | 美股中每个模型虚拟10万美元,八个模型(新闻稿) | ND(0) | 否(收益) | 否 | ND | ND | ND |
| AI-Trader(2025年12月) | 美股、A股和加密货币上的实时交易代理,三个中国模型和三个美国模型 | 运营者记录(0) | 否(收益) | 否 | ND | 否 | 库开放 |
| KalshiBench(2025年12月) | 截止后300个已解决的Kalshi问题 | 截止后的静态集合 | 是(Brier;针对气候学的技能评分);ECE作为诊断 | 否 | 否 | 否 | 是 |
| PredictionMarketBench(2026) | 带有费用的重放Kalshi订单簿 | 回测重放 | 否(交易损益) | 否 | ND | 否 | ND |
| Prediction Arena(2026年1月至3月) | Kalshi和Polymarket上的真实资本交易,七个类别中的金融合约 | 运营者日志(0) | 否(账户价值、收益、胜率) | 否 | 否 | 否 | ND(未提供库) |
| PolyBench(2026年4月) | Polymarket快照,2026年2月6日至12日 | ND(0) | 否(方向性准确性、置信度加权收益) | 否 | ND | 否 | 代码开放;数据集通过下载链接(未检索) |
| Foresight Arena(2026年5月) | 二元Polymarket事件,某些涉及资产价格 | 截止前,每个代理和轮次在Polygon PoS上的keccak256承诺-揭示(2;块时间);论文结果模拟,实时代理在配套研究中 | 是(Brier;针对市场中间价的Alpha) | 否 | 否(市场结果假设独立) | 否 | 合约和分析代码开放;数据链上,许可证ND |
| MarketMania(2026年7月) | 五种加密货币在五个时间跨度上,七个模型,一个披露的有效载荷 | ND(0) | 是(所述概率上的Brier;校准差) | 是(1小时至1个月) | 部分(测量羊群效应;未折扣协议) | ND | API导出,许可证ND |
| NeuPortal(2026年7月) | 一个未命名AI的足球比赛概率(非金融) | 每个预测文件的SHA-256,通过OpenTimestamps在Bitcoin中有时间戳(2) | 是(三结果Brier) | 否 | 否(一个模型) | ND;锁定时或之前的Polymarket价格作为基线 | 是(GitHub、Zenodo) |
| LLM Trading Arena(2026年7月) | 加密货币和标普100股票的纸面交易,每个模型10万美元 | 每次成交和原因的公开git历史,订单在下一个开市成交(1;时间取决于git主机) | 否(账户价值) | 否 | ND | ND | 是(MIT,完整账目,账户可重新计算) |
| LiveMacroEval(2026年8月) | 发布前16个美国宏观经济指标的每小时现势估计 | ND(0) | 否(基于收益和博彩评分) | 否 | ND | 否;机构现势估计作为比较器 | 论文CC BY 4.0;数据许可证ND |
| RockAlpha(未定) | 实时AI股票交易,六个中国模型和四个美国模型,2倍杠杆 | ND(0) | 否(收益) | 否 | ND | 否 | ND |
| TradeRank(第10季,2026年10月) | 22个模型关于加密货币和美国大型股的日决策,模拟1万美元 | ND(0) | ND | 否 | ND | ND | 开放JSON数据集,许可证ND |
| AI Council · Markets(2026年10月) | 12个金融指标的固定面板,每日 | 自2026年10月21日起,每个盖章列表至少两个RFC 3161令牌,在开市前签署(2+);SHA-256链,头部锚定在Bitcoin中(2);2026年10月19日和20日在引用之前的密封级别1(表12) | 部分(自2026年10月21日起全行Brier为主,第3.5节;针对币和基线的Brier;校准箱作为诊断) | 是(日、周、月、六个月) | 是(根据陈述的合格规则的N_eff;一个家族的第二个模型权重为三分之一) | 是(两个常设小组,第6节) | 是(CC BY 4.0,评分代码,重新计算脚本) |
注意:ND = 截至2026年10月21日未公开记录,意指该属性未在公开描述中找到且未检查代码。"恰当规则"仅计算预报概率的严格恰当评分(布赖尔、对数评分)。准确度、ECE和收益标记为"否"。"独立池"是指人类独立预报同一问题,而非人类先预报后看到AI预报。Alpha Arena和Rallies AI Arena基于新闻报道。我全文阅读了Foresight Arena和Prediction Arena(arXiv:2605.00420v2、arXiv:2604.07355v1),从其代码库阅读了NeuPortal和LLM Trading Arena,从其方法和研究页面阅读了MarketMania。NeuPortal不是市场竞技场。我列出它是因为其标志最接近此处的标准化标志。AIA Forecaster、FinDeepForecast和GlassBallAI数据集仅在时间线中。来源见第7.2节。
7.4 阅读地图
信任列显示该领域从无法确保时间的回测,发展到由运营者记录保障的实时问题,再到运营者注册的加盐哈希带签名收据的阶段(Prophet Arena)。第2级存在于固定的财务指标面板之外。Foresight Arena将Polymarket事件的预报(其中一些关于资产价格)提交到Polygon(Nechepurenko & Shuvalov,2026a、2026b)。竞争性天气预报在Zeus子网上链提交(Ørpheus AI,无日期),NeuPortal在Bitcoin中锚定足球概率。密封的财务预报带延迟披露可追溯到金融泡沫实验(Sornette等,2010),非AI预报记录锚定在Bitcoin中并由布赖尔评分评级(Jyotish,2026)。免费公开时间戳存在(Todd,2016),因此锚是便宜的。围绕它的规则使其成为公平的测试。
概率和投资组合很少相遇。大多数竞技场交易评分收益或账户价值,大多数评分概率的基准不交易。Prophet Arena通过模拟收益连接两者,MarketMania纸面交易它评分的预报,Foresight Arena根据市场价格评分概率。金融市场标准需要两者。投资组合回答用户提问的问题,概率是恰当规则可在短记录上评分的部分(第2.4节)。一列为空:表9中的任何工作都不在其公开材料中因关联声音的一致性而打折扣。MarketMania测量羊群效应但不将一致性转换为声音计数,Foresight Arena将市场结果视为独立的。在语言模型之外,Numerai竞赛通过将模型的预测中性化来对抗从所有提交构建的元模型来评分模型的贡献(Numerai,无日期)。这奖励不同信号,并留下共识持有多少独立声音的问题开放。离线模型共同出错的证据很强(第5节)。
新之处。 联赛中的六个设计在截至2026年10月21日审查的系统中无匹配(表E1、表9)。前三个将其与地图上的每个系统区分开:
- AI Council · Markets是第一个关于固定财务指标面板的AI预报实时联赛,在运营者之外锚定其预报分类账,从其密封后取得的参考价格评分每个预报,按提前声明的规则固定计数运行且每个其他运行发布并标记,并报告每日有效声音计数。在计数记录中,从2026年10月21日起,计数运行规则提前声明并密封在问题链中,至少两个独立RFC 3161权限在参考价格之前放置计数答案(第2+级)。表12给出2026年10月19日和20日开发会议每个元素的级别,密封和参考价格顺序为第1级。Foresight Arena是最接近的结合:外部锚、每个代理和轮次的一个中继强制提交和提交截止时间的基准价格,在Polymarket事件而非固定指标面板上每日预报。
- 它是第一个关于财务指标的AI预报实时联赛,报告每次运行时按陈述的合格规则的有效声音数(计数运行、在参考价格前密封的答案),以及共识中的家族权重和一致错误与正确少数的计数。公式是经典的(Kish,1965;Clemen & Winkler,1985),模型错误的相关性已在离线中确立(Kim等,2025;Spiro,2026;Aitchison等,2026),羊群效应已被实时测量(MarketMania,2026)。声明是实时联赛内的计数。
- 它提议一个标准,将内容完整性、外部有界存在、参考价格前的提交以及计数的预报的识别分开,写成编号的必须和应该要求,读者可以运行检查(第3.13节、附录B)。第3.13节给出参考实现的每个要求的状态。Foresight Arena和Prediction Arena都不为他人采纳提议标准。
其他三个将其与地图上的每个AI市场竞技场区分开:
- 读者一次分配,随机分配,从不重新分配,到与模型在同一天预报同一市场的两个组之一:一个立即看到模型,另一个仅在其首次预报后看到,因此在看到它们之前预报(第6节)。设计是实时的且对每个访问者开放,其两个结果注册为F28和F29,在每组200个首次预报处读取。较早的设计比较独立的人类池(ForecastBench、Metaculus)或先给人类AI助手(Schoenegger等,2025)。
- 来自美国实验室的七个模型和来自中国实验室的七个模型,每个来自不同实验室,回答同一问题,在一步中发送,在同一快照下在同一截止时间、规则和账户下(第5.8节、表8)。最接近的阵容是RockAlpha的,六个中国和四个美国模型,每个实验室一个,具有2倍杠杆(Rockflow,无日期),以及AI-Trader的,三个和三个,交易美国股票、A股和加密货币(Fan等,2025)。两者都不发布密封、概率评分或读者设计。其他阵容在六到八个中混合两个中国模型(Alpha Arena、Rallies AI Arena、LLM Trading Arena、MarketMania),TradeRank配备22个模型无国家设计。
- 三十个关于联赛本身的日期预测,每个都有度量、检查日期和反驳规则,由来自三个家族的模型的盲投票定价并与其解决者注册,在决定它们的数据存在之前(第8节)。
《The Closed Book》、评分评论和重复查询也在该联赛中运行,其前身出现在时间线中(第 7.2 节,表 E1)。
该联赛的基础。 在结果之前进行哈希预测承诺(Foresight Arena;通过 OpenTimestamps 的 NeuPortal 和 Jyotish)以及通过延迟披露封闭财务预测(Sornette et al., 2010)先于该联赛。最接近的封闭方案 NeuPortal 有四个差异:一个未命名的模型、足球、在锁定时或之前获取的众众基准,以及没有文档记录的计数运行规则或哈希链。早期的努力还提供了日多模型货币联赛(Alpha Arena、Agent Market Arena、Rallies AI Arena、LLM Trading Arena、TradeRank)、10 万美元虚拟账户、第三方账户或分数重新计算(LLM Trading Arena、Foresight Arena)和杠杆(Alpha Arena、RockAlpha)。它们还提供与答案时预测市场价格的比较(Foresight Arena、Prophet Arena、NeuPortal、AIA Forecaster)、带有幂分析的适当评分(Foresight Arena)、多个时间范围的概率评分和纸质交易(MarketMania;ForecastBench 的时间范围)、气候学技能评分(KalshiBench)以及锚定竞技场上的实时协调设计(Nechepurenko & Shuvalov, 2026b)。该联赛使用这些特性。事件问题、真实货币交易和数千个问题的广度是具有各自优势的其他设计,它们补充了一个固定的日常小组。
8. 注册预测
我在此声明,附带日期、阈值和概率,该联赛将显示什么,其开放文件将做出决定。本版本读取两个评分的赛次,至2026年10月20日。每项预测命名其度量、解决它的开放字段或归档脚本、检验日期、确认它的结果和反驳它的结果,以及使误差可评分的概率(Brier, 1950; Gneiting & Raftery, 2007),遵循Chernets (2026c)。在解决预测的数据之前注册预测,将预测与测试它的证据分开(Nosek et al., 2018);该设计遵循已注册报告的逻辑,其中方法和分析在结果存在之前确定(Chambers, 2013)。该协议每天早上为模型执行此操作;本节为协议执行一次。
主要终点。 一项比较是主要的,联赛的技能声明仅基于它:委员会的共识是否比基础率更好地预测了这一天?对于从赛次11(2026年11月2日)到赛次126(赛季结束)的每个赛次,配对收益为
其中是赛次的共识回答的一日市场事件集合,是发布的共识(第5.3节),仅从事件参考价格之前密封的答案构建,对于严格上升为1,否则为0,覆盖所有行,包括平局(第3.5节),是2016年至2025年事件市场一日严格上升的频率,计算所有行:council-calibration.json中climatology_fixed.table[*](horizon 1d)的字段p_up,而非联赛用作其自身技能分数参考的排除平局的p_up_ex_draw。该表由文件council-clim-window.json密封,在数据地址下发布,其内容SHA-256(JSON不含其sha256键,键已排序)为2810d11e907bbaa1f311d06622c929c69e60cc81e558fdb78f5baa04113cabb7。归档脚本读取该字段并检查密封。该字段自2026年10月21日08:54 UTC起在开放文件中,脚本无错地读取它。如果日常历史不覆盖实时窗口,频率使用最近的日常事件(第10节)。正的表示共识的损失较小。每个事件在赛次内权重相等,每个赛次在窗口中权重相等。估计是的平均值。其区间是移动块自助法覆盖赛次,块大小为5,10,000次重采样,种子20261102,百分位区间(Künsch, 1989; Diebold & Mariano, 1995)。判决将于2027年4月30日按顺序读取。如果95%区间完全位于零上方,主要声明得到确认。否则,如果90%区间完全位于标准为每项确认性比较规定的±0.01 Brier等效区间内(第4.6节),结果读作没有实际意义的收益。任何其他结果都是不确定的,不显著的收益不被解读为等效。其90%区间也位于该区间内的已确认收益报告为已确认且小于该边界。在开放文件的当前损失标准差和相关性(council-stats.json中的power_brier),126个赛次可以区分约0.01的差距,所以该区间与赛季可以解决的问题相符。报告了已注册的敏感性分析在判决旁:标普500、纳斯达克100、道琼斯指数和半导体指数单独上的相同配对收益,其基础率在事件自己的09:30到16:00 ET赛次上计算(归档脚本中的sensitivity_exact_window)。主要声明得到确认的已注册概率为0.08。该估计适用于赛季采取的路径,计分卡报告了窗口中各市场日常变化的平均值和离散度。
第11次会议之前的会议和运行构成了设计窗口。它们包括第5.2节的两个评分开发会议,它们告知了设计和一些阈值,并且没有确认性估计读取它们。下面的三十个预测是次要赌注,按自己的Brier评分一起评分,没有一个单独被读作确认技能。联盟页面上的日表是描述性的,声明在注册检查日期被读取。一个次要科学问题在没有方向的情况下被声明:分歧有帮助吗?预测者之间的离散度自Miller (1977)以来就具有经济意义:分析师预测分歧较大的股票之后收益率较低(Diether et al., 2002)。座位的价差是联盟版本的机器预测分歧,在金融中被衡量为机器学习模型的回报预测离散度,并预测较低的股票收益(Bali et al., 2023)和较低的加密货币收益(Chu et al., 2025)。这里预测者是语言模型,预测是固定事件的概率,问题涉及准确性。对注册后计数的一天事件,座位概率的价差(它们对事件的既定概率的总体标准差,以点为单位)被分成三等分,边界在第33.3百分位数和第66.7百分位数处,计算范围为第1至10次会议,由提交的脚本按预先固定的规则计算。共识与气候学的配对收益在最高和最低三等分之间进行比较,市场保持固定,双尾。统计量是市场平均值对两个三等分之间平均收益差异的平均值,带有移动块引导区间,如果任一三等分的事件少于30个,则未解决。第二个次要问题直接测试第5节的论文:贴现相关声音有帮助吗?对第11到126次会议的计数一天事件,在已发布的共识和第5.3节的影子共识之间的配对Brier差异,其权重与注册一起提交,由与主要终点相同的移动块引导估计,并根据±0.01的相同等效区域读取。两个次要问题都没有注册概率,因此预测数量保持三十。两者都在没有多重性调整的情况下报告。进一步的科学比较将是新的注册。
8.1 写预测的规则
每个预测从联盟的开放数据中解决,在CC BY 4.0下,位于https://trends.polyhelper.ai/api/v1/,没有任何需要我私下保存的数据。集合A(10个预测:F1、F2、F5、F7、F8、F20、F22、F23、F24和F28)由一个已发布的字段或两个字段的比较定义,任何人都可以在浏览器中读取;提交的脚本将该字段应用于窗口。集合B(20个预测)需要对开放原始文件的计算。对于每个,脚本在注册时以其SHA-256一起提交,在它将读取的数据存在之前,脚本就是定义。
一个窗口规则适用于每一行,除非该行命名另一个:预测在第11次会议到其检查日期的会议上计算,在会议09:30 ET参考之前密封的计数行上(相同的截断也适用于Bitcoin,其参考是行密封后的第一个一分钟条的收盘),使用Brier评分对所有行(包括平局)。当已发布的字段还覆盖早期会议时,提交的脚本将该字段的定义应用于窗口。一个会议是纽约证券交易所开放的一天:第1次会议是2026年10月19日,第10次会议是10月30日,第11次会议是11月2日,第30次会议是11月30日,第52次会议是2026年12月31日,11月26日和12月25日关闭。126次会议的赛季在2027年4月20日左右结束,在2027年4月30日进行检查。每个预测在其日期之后开放文件的第一次发布时检查。OSF脚本中的解析器(resolve.py、规则版本osf-rules-1)修正了行留下的四个细节。"排名"是在预测自己的窗口内应用的30/10规则,除了F8,它读取联盟的标志。F25的两个季度是第11至52次会议(发展期后的2026年第四季度)和2027年1月4日至3月31日的会议。F15的动量规则是指标联盟成果在前一次会议中的方向(参考价格到收盘)为55%,零移动后没有预测,在所有行上评分。用于上面三等分的价差是座位概率的标准差。
比较的是相同的:模型与硬币、动量规则、共识和众数在相同的会议和市场上。在模型之间的比较中,每个事件在会议内的权重相等,每个会议在窗口内的权重相等,在回答该会议的座位上,因此样本是可用的座位。当预测需要最小样本时,检查日期上的较小样本会使其未解决。如果字段被重命名,解析器使用数据字典(arena-dataset.json和已发布的模式)中的已记录等效项并记录映射。我在看到第一个密封的运行后设置了F1到F5和F9的阈值。它们的窗口从第11次会议开始,因此这些运行中没有一个决定它们。在最小样本中,三个预测是描述性的,具有这些标准错误:100个预测时F14校准间隙约为5点,20个批评时F22份额约为11点,每组200个第一预测时F28差异约为0.02 Brier。F15、F21和F28将点估计与0.01阈值进行比较,等效区域属于主要终点。几个预测陈述了在这些样本量中没有可测量的技能的期望。表D1给出了在没有技能的情况下预期的值,那里的成功并不表明技能不存在。每个预测涉及联盟将测量什么,而不是市场将朝哪个方向发展。
8.2 预测
表10给出了十项核心预测,表D1(附录D)给出了全部三十项。F1到F3、F5到F7和F9询问委员会的图景和错误有多相似,以及声音在哪个时间范围内分离。F4将模型的敏锐度与人群的进行对比,F8(业务运作)询问表格是否按时填充。F10到F15将共识与早期领导者、简单规则和人群进行比较。两项预测F16、F17询问任何信号在各时间范围内的位置。F18和F19涉及美国和中国方面,F20和F21涉及闭卷,F22到F24涉及讨论和重复。F25到F27询问领导者是否持久以及优秀预测者交易是否良好,F28和F29询问获取模型对读者有什么影响,F30询问隐藏名字后风格是否能暴露模型。
表10. 十项核心预测,包含阈值、检验日期和概率(所有三十项在表D1中)。
| # | 预测 | 若下列情况为真则被反驳 | 检验日期 | p |
|---|---|---|---|---|
| F1 | 委员会保持在两个独立声音以下:根据第5.1节规则,第11至30场会议的计数运行中一天N_eff的平均值低于2.0 | 平均值≥2.0,至少10次运行 | 2026年11月30日 | 0.50 |
| F3 | 错误也共享:座席一天错误指标上的N_eff,在第11场会议开始的至少30个计分会议中的平均值低于4.0 | 值≥4.0,至少30个会议 | 2026年12月31日 | 0.74 |
| F6 | 一致错误至少是回答座席在同一行上自身错误率乘积预测的两倍频繁 | 观察份额<2×预期 | 2026年12月31日 | 0.92 |
| F10 | 平均表现好于跟随领导者:在2026年12月,共识在一天内的表现优于11月的领先模型 | 共识Brier评分≥11月领导者在同一12月市场会议中的Brier评分 | 2026年12月31日 | 0.64 |
| F11 | 从第11场会议开始,没有单个模型在所有行上显示相对于随机猜测的可检测日优势 | 某个排名模型的95%会议集群区间完全低于0.25 | 2026年12月31日 | 0.79 |
| F12 | 人群在至少100个一天市场会议中击败委员会,合约密封成交量至少为1,000美元 | 人群Brier评分≥委员会Brier评分 | 2026年12月31日 | 0.83 |
| F13 | 人群和委员会的平均值在同一合约中击败人群单独表现 | 组合Brier评分≥人群Brier评分 | 2026年12月31日 | 0.30 |
| F18 | 国家是一个小因素:美国和中国方面之间的差距小于每个方面内排名模型Brier的范围 | 差距≥任一方面内的范围 | 2026年12月31日 | 0.80 |
| F20 | 相同新闻意味着更少争议:闭卷热度低于开卷热度 | 闭卷热度≥开卷热度 | 2026年11月30日 | 0.70 |
| F30 | 风格在盲审季节暴露模型:固定猜测者识别模型的准确度达到概率的三倍或更好 | 平均top-1准确度<项目上3/k的平均值 | 2027年4月30日 | 0.46 |
注:p是在预测得到解决的条件下预测为真的已注册概率:来自三个系列模型的三个盲审投票的中位数,仅根据陈述、测量、日期和阈值进行投票。六个值(F5、F7、F20、F21、F23、F25)是2026年10月20日20个模型的投票。其他二十四个和主要终点在2026年10月21日进行投票,分三个后续轮次,每轮基于该轮重写的预测文本,每个值是该轮投票的中位数(所有轮次都在档案中)。传播范围超过0.15的投票在档案中标记。Brier评分均为一天,除非另有说明;区间为95%(按会议)。第8.4节给出了未解决预测的规则。
8.3 概率
我要求来自三个系列的三个模型——Claude Opus 5.5(Anthropic)、GPT-6.1(OpenAI)和Grok(xAI;版本与投票一起归档)——对清单进行定价(仅包含陈述、测量、检验日期和阈值,不含我的估计),每个模型互不知晓其他模型的数字,每个已注册概率是这三个模型的中位数。这三个系列也持有联赛座席,F18、F19和F30涉及这些座席。每个投票者在任何记录存在之前对陈述进行了定价。模型验证者面板在成员相互看到时会以可测量的方式失败(Chernets,2026b),因此每个投票者单独对清单进行定价。所有概率均以解决为条件;解决的份额在分数旁报告。
8.4 冻结和计分
我在发布前在OSF上注册预测和主要终点(10.17605/OSF.IO/9Q86N),作为开放式注册,立即公开,包含清单、所有投票、Set B脚本和每一行的解析器、主要终点的脚本、密封气候学内容的SHA-256和每个已归档文件及其SHA-256的清单。每个检验日期和每个时间窗口都在注册时间戳之后。OSF注册无法编辑,撤回会留下带有原因的公开记录,因此预测保存在那里。SSRN在修订时替换预印本。
没有任何内容被删除。每项预测在每个计分卡上显示为真、不为真、尚未到期或未解决。在截止日期前无法通过其日期计算的预测保持未解决状态,永远不会被计为成功。每个计分卡报告已解决预测上的Brier评分、解决的份额、最坏边界(其中超过截止日期的每个未解决预测加上max[p²,(1−p)²],分母中所有超过其日期的预测),以及相对于平坦0.5的Brier技能评分。计分卡按检验日期编制(2026年11月30日、2026年12月31日、2027年4月30日),每个都作为本文在SSRN和Zenodo上的日期修订版本发布并在OSF上注册,每个裁决引用其所依据的字段或脚本。
9. 异议及其对应的规则
四项异议对设计施加最强压力。以下每项异议都由第3部分的规则或第8部分的注册测试来解答。
盘前信息引导预测。参考价格是解封后的第一个价格,因此计数答案不能使用09:30的成交,晚期答案获得其后的参考价格。参考前可用的信息,如问题中引用的盘前期货,是允许的且属于预测的一部分;读取期货的预测者可以朝正确方向倾斜,无需任何自主判断。技能衡量对标气候学基线汇率和持有相同盘前信息的市场,以及对标随机抛硬币。记忆化历史无法帮助模型预测尚未发生的收盘价(Lopez-Lira等,2025;Paleka等,2026)。
平局与所问事件。问题要求严格上升的概率,未陈述平局区间。从2026年10月21日起,主要评分计算所有行,即所问事件的评分(第3.5部分)。开发会话按已发布状态呈现,无平局,且每个注册比较在一个方法论分段内使用一个事件(第8.1部分)。
谁掌握寄存处。我运营联赛并撰写了预测(声明)。每个会话计数一次运行,其他运行发布为not_counted。从2026年10月21日的计数记录中,解封和参考价格的顺序基于至少两个独立权威机构(等级2+)的RFC 3161令牌,而10月19日和20日的开发会话则基于链式记录(等级1,表12)。标准控制通过发送时每个传出问题的哈希值在运行间进行选择,一个在发送前声明的计数运行(从2026年10月21日的问题链中密封),以及每个加盖的列表在由运营商不控制的公开透明日志中加盖时输入(Sigstore Rekor,从2026年10月22日起;第3.13部分)。预测从公开文件通过命名字段或其数据存在前提交的脚本进行结果解析,注册无法编辑,概率设置为盲目的。
压缩概率。模型的概率保持接近50%。10月20日,在参考前分别征得的八个密封座位对在八个市场上列出的合约的概率(crowd_up)平均距离50% 5.9个百分点,同一合约的市场价格距离50% 20.7个百分点(当两个交易场所都列出市场时,以Polymarket合约为准,即模型回答的合约)。市场距离的一部分已在接近收盘的合约中体现盘前走势,因此我逐个合约在每个合约结算的事件上进行比较。在密封成交量至少为$1,000的五个合约上(表11),座位的均值与市场价格每次都朝同一方向倾斜,座位平均距离50% 7.5个百分点,而市场距离28.1个百分点。市场本身是谨慎的:在188,509个已结算的Polymarket市场中,价格过于接近一半,逻辑重新校准斜率为1.112(Walker,2026)。座位距离一半更近。在联赛自有的一日问题上,同样八个座位平均距离50% 4.6个百分点(K = 9.2,第4.4部分)。联赛可区分两种压缩读法。根据Murphy分解,Brier评分为可靠性减去分辨力加上不确定性(第4.4部分)。谨慎的预测者是校准的,放弃分辨力,评分接近气候学,对更尖锐的市场损失不大,而将定性观点转化为概率不当的预测者也是未校准的,校准斜率偏离一(Cox,1958),损失超过其尖锐度的解释。F4陈述尖锐度差距,F12和F13陈述与市场的比较,F14陈述校准,各自在注册后的一个季节上。
表11。市场价格与座位在同一合约上分别征得的概率,2026年10月20日(八个座位在参考前密封;密封成交量至少为$1,000的合约)。
| 市场 | 交易场所 | 密封成交量($) | 市场价格(%) | 座位均值crowd_up(%) |
座位范围(%) |
|---|---|---|---|---|---|
| 标普500 | Polymarket | 20,637 | 34.0 | 46.4 | 42到52 |
| WTI | Polymarket | 3,736 | 83.0 | 61.6 | 47到76 |
| 10年期收益率 | Kalshi | 3,199 | 7.0 | 48.2 | 20到56 |
| 黄金 | Polymarket | 3,112 | 29.0 | 44.8 | 36到50 |
| 纳斯达克100 | Kalshi | 1,150 | 22.6 | 41.6 | 34到46 |
注:市场价格和成交量在12:30:06Z记录,在council-book.jsonl的运行行151中密封(crowd.odds、crowd.kalshi);crowd_up来自答案行152到159。Kalshi价格插值到"高于前收盘价"(第4.9部分)。合约逐日结算,因此市场价格已包含盘前走势。比特币、道琼斯指数和美元指数的成交量低于阈值。未显示结果。
在图13中,我逐个座位绘制表11。在每个座位的市场合约概率旁,它标记同一座位对联赛自有的一日事件的概率,这是一个不同的事件(表1)。我发现两者可能不同。Claude给收益率合约的概率为20,联赛收益率问题为47,WTI为74对52,Gemini给WTI 76对58。市场的合约从前收盘开始,联赛的问题从09:30参考开始,所以一个模型可以在同一个早晨对两个问题不同地回答。
图13。座位分别征得的概率和市场在同一五个合约上的价格,2026年10月20日(八个座位在参考前密封;密封成交量至少为$1,000的合约)。
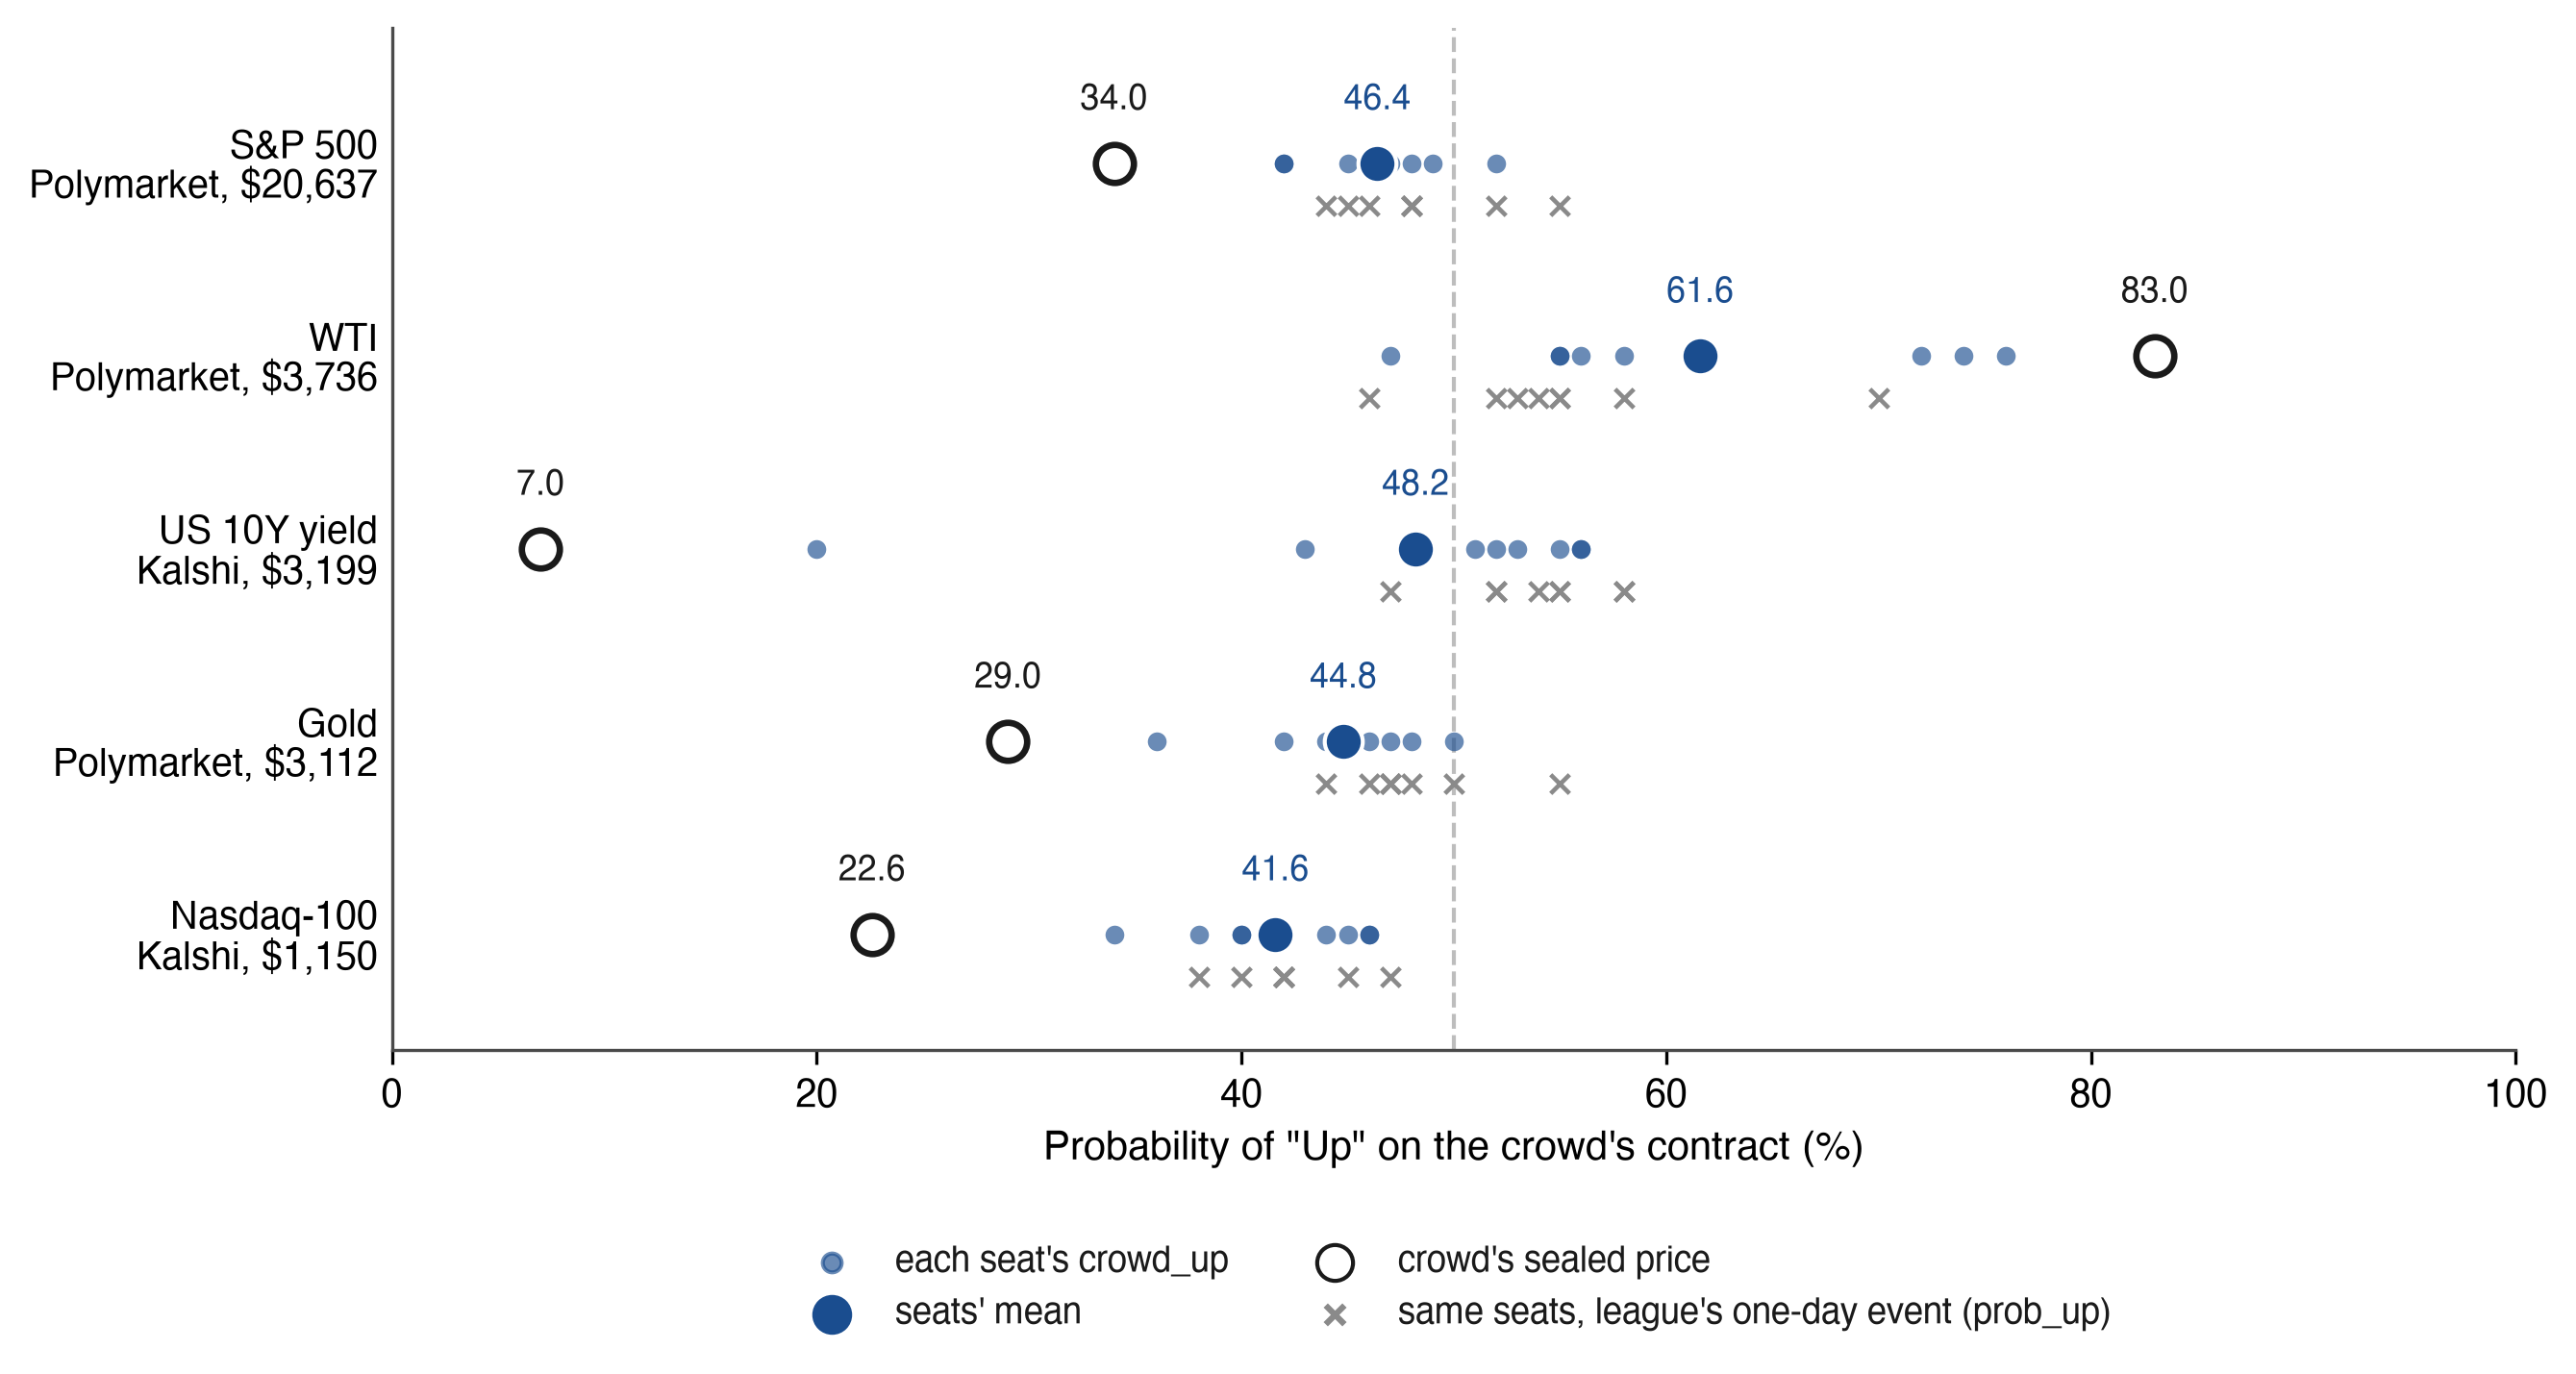
注:群众价格和交易量记录于12:30:06Z,密封在council-book.jsonl的第151行(crowd.odds、crowd.kalshi);crowd_up和prob_up来自第152至159行的答案行。Kalshi价格插值为"高于前一收盘价"(第4.9节)。灰色叉号标记相同席位在联赛自有一日事件中上升的概率,该事件为不同事件(表1)。平均值和范围如表11所示,在五份合约中,席位平均距离50相隔7.5个百分点,群众距离28.1。
10. 范围和边界条件
在表12中,我说明了每项声明的依据及其适用范围,下面的段落提供了详细信息。
表12。 每项声明的适用范围。
| 声明 | 依据 | 适用范围 |
|---|---|---|
| 封存和参考价格的顺序,2026年10月19日和20日 | 运营商的记录(第1级);线条存在时的比特币锚定边界(第2级) | 开发会话,在每个确认性估计之外 |
| 封存和参考价格的顺序,从2026年10月21日起 | 至少两个独立权威机构的RFC 3161令牌(第2+级) | 计数记录 |
| 气候基准 | 2016至2025年的日历史;四个美国股票指数的精确09:30至16:00 ET交易时段,其他地方的最近日间事件 | 影响 ,而非预测;主要测试也报告了四个精确指数 |
| 参考价格和收盘价 | 运营商的价格源,在每个预测行上命名(提供商、代码、参考规则) | 封存确定了预测;第二个价格来源是表B1的结果层级 |
| 账户 | $100,000,成本为0.1%,封存后的首次开盘 | 次要的描述性措施 |
| 首次读数(N_eff、相似度、锐度) | 至2026年10月21日的密封运行:两个评分开发会话和第一个计数运行 | 它们说明了这些措施;主要终点和第8节的记分卡承载了结论 |
| 美国和中国方面 | 所有十四个模型的相同问题、快照、截止日期和规则 | 两组实验室的比较,观测性的 |
时间。 密封运行始于2026年10月16日,评分始于2026年10月19日。本文的联赛数字读取自2026年10月21日的开放文件,2026年10月21日早间的读数读取自2026年10月22日01:32 UTC保存的副本,涵盖六次密封运行:三次试验运行、两个开发会话和第一次计数记录运行。第8节的每个记分卡都标名了它评分的市场路径。
时间证据。 对于本版本评分的开发会话,2026年10月19日和20日,运营商的记录(booked_at和前驱/链接链)表明在参考价格之前封存了一个答案(第1级)。比特币锚定将锚定前缀的存在限制在块头时间的几小时内(第2级,第3.11节)。任何持有较早证明的人都可以检测到重写,并且对于Sigstore Rekor日志中的每个带时间戳的列表(从2026年10月22日的时间戳开始,较早的列表来自2026年10月21日23:47 UTC),任何人都可以检测到。在计数记录中,从2026年10月21日起,至少两个独立的RFC 3161权威机构对每个带时间戳的列表进行签名(第2+级)。该日计数答案批次在参考价格前29分41秒签署,一个后来到达的答案在到达后14秒由三个权威机构密封并签署,仍在参考价格之前。
模型。 十一个预测席位,其中在参考价格前密封答案的席位(10月19日七个,10月20日八个)进入本版本的读数;所有十四个席位都进行交易(表8)。这些结果用答案行上密封的模式描述这些模型。
市场。 十二个指标涵盖美国股票、半导体、利率、美元、波动率、金属、石油和比特币,时间从09:30至16:00 ET,10年期收益率至15:00 ET,比特币从密封时间起。单个股票(S&P 100追踪之外)和日内交易不在范围内。气候基准在日历史上估计,并在不存在匹配窗口的地方近似实时事件:黄金、WTI、布伦特、铜和美元指数的合约日线,10年期收益率的日收盘,比特币的UTC日,以及在一周及更长时间内,从开盘的波动,其中实时合约从收盘到收盘测量其波段;近似值在字段中说明并偏向 ,而非预测。账户通过arena-protocol.json中命名的工具持有每个市场;对于石油、金属和铜,该工具是持有期货并对其进行展期的基金,因此账户可能偏离其交易的指标,这是F27比较预测和回报的排名而非其水平的原因之一。众筹行由其至少$1,000的密封成交量准入;要求17向每个众筹行添加买价、卖价和最后交易的时间,清新度和价差规则在它们管理的窗口前冻结,池化场所仅在合约在同一谓词上结算的情况下。
独立性、国家、读者、投资组合。 N_eff总结了在一个共同关联下概率图像的相似程度,逐次运行和逐地平线运行,它不对模型进行排名。读者实验比较了自选访客的随机化组。账户是模拟的,每个$100,000,成本为0.1%,执行在密封后首次开盘;它们排除了市场影响和税收。交易是表现不足的经典渠道(Barber & Odean, 2000),所以要求17在每个账户的换手率(交易价值超过平均权益)和其支付的成本旁报告一个密封的无交易影子,该影子在每次再平衡前保持持仓;换手率和回报之间的关联是描述性的。
声明的状态。 协议及其措施是提议的,AI Council · Markets是参考实现,其针对每项要求的状态在第3.13节中公布。一个确认性测试是主要终点,第8节的三十个陈述是注册的次要预测。
本文描述了一个测量协议,不构成投资建议。
11. 结论
我制定了这个标准,以便读者而非操作员可以检查金融市场预测何时被确定、该预测针对哪个事件进行评分以及哪次运行被计算在内。由PolyHelper运营的AI Council · Markets是其在十二个指标和四个时间范围上的参考实现,其对每项要求的满足情况已发布并注明日期(第3.13节)。自2026年10月21日起,计数运行将提前声明并封存,独立时间戳机构在美国东部时间09:30开盘前签署已计算答案的记录。预测和参考的顺序随后取决于操作员外的时钟。我建议其他联赛首先采用这一部分:第三方的时间戳将操作员的保证转变为读者可以检查的记录。在第7.4节中映射的竞技场中,该联赛是第一个在固定的金融指标面板上结合这些元素的,也是第一个在相同的问题、快照、截止时间和规则上将七个美国和七个中国模型放在一起的AI市场竞技场,其中读者被随机分配在看到这些模型之前或之后进行预测。除了其共识外,该联赛还报告其背后的独立声音的数量,因为模型达成一致的比例如果没有这个数量就意味着很少。在最初两天的上午,在参考文献封存前密封的概率图与少于两个独立预报员一天的概率图一样相似,计数记录的第一次运行给出了2.23。一项主要测试和三十项次要预测已在OSF上注册,发布前公开。日期修订将对其进行评分,与每项预测一起提交的解析器让任何读者首先对其评分,数据以CC BY 4.0许可开放,地址为https://trends.polyhelper.ai/api/v1/。
声明
资金。本工作未获得外部资金支持。
竞争利益(利益冲突)。我创办并运营 PolyHelper,该公司管理本文所述的 AI Council · Markets 联赛,并开发多模型编排方法,相关专利申请正在审理中(尚未授予任何专利)。
工具与验证。我使用 AI 助手作为我指导下的工具。这些想法、研究和结论都是我的。我于 2026 年 10 月 20 日针对定量声明和引文对照初级来源或存档副本进行了检查,并于 2026 年 10 月 21 日检查了第 7 节和附录 E 的先前工作。我于 2026 年 10 月 21 日从该联赛的开放文件中读取了数据(council-stats.json 生成于 03:47 和 05:33 UTC,第二个包含 n_eff.counted 和 power_brier 块,以及 22:16 UTC 生成的文件中 2026 年 10 月 21 日的每轮数据),并使用与注册一起提交的脚本从同一天的 council-forecasts.csv 和 council-book.jsonl 重新计算了第 5.2 节的每轮和每地平线独立性值。我于 2026 年 10 月 21 日 15:05 UTC 从实时文件和证明页面读取了表 5 的符合性状态和封条,并使用 OpenSSL 针对当局的证书检查了 RFC 3161 令牌。来自三个系列的三个模型设置了已注册预测的概率,每个模型对其他模型和我的估计都是盲目的(第 8.3 节)。
数据和代码可用性。已提交的脚本、事件合约检查器和两个重新计数脚本使用 Python 3.9 或更高版本,不依赖标准库之外的任何包,并在 python3 -I 下运行;我使用 macOS 上的 Python 3.15.0 运行它们。附录 B 的检查需要 shasum、OpenTimestamps 客户端(第 6 步)和 OpenSSL 3 或更高版本(第 9 步)。没有内容经过训练,因此没有结果依赖于硬件;模型在其提供商处运行,每个返回的版本和模式都在其答案行上封存(表 8)。该联赛的数据在 https://trends.polyhelper.ai/api/v1/ 下以 CC BY 4.0 开放,包括封存的账簿(council-book.jsonl)、预测(council-forecasts.csv)、其哈希值下的问题文本(asks/<sha256>.md)、统计数据(council-stats.json)、协议及其版本(arena-protocol.json)、投资组合引擎的代码及 SHA-256 哈希值(arena-code.json)、每项预测分数的重新计数(tools/replay_brier.py)以及一个重新计数脚本,可以从已发布的交易和价格在所述发布舍入容差内重新计算每个已发布的联赛账户(python3 replay.py https://trends.polyhelper.ai/api/v1/,附录 B)。实时端点每个会话都会更改,因此分析不依赖于它们:每个论文版本日期的开放文件的不可更改版本与其 SHA-256 哈希值清单一起存档在 Zenodo 上(10.5281/zenodo.23552700),论文中的每个数字都是从该版本计算的;已提交的脚本在其上离线运行(--data)。稍后下载实时文件的读者可以检查已封存账簿的存档前缀与它们的一致性(附录 B)。主端点及其脚本、已注册的预测及其各自的解析器(resolve.py)、由盲目预报员定价的干净列表(包含所有三票)、集合 B 脚本、已封存气候学的内容 SHA-256 和已提交文件的清单(包含其 SHA-256)以及列出要求和每个脚本命令的 README,已在 OSF 上注册(10.17605/OSF.IO/9Q86N)。本文存档在 Zenodo 上(10.5281/zenodo.23552697),其首选引用是 SSRN 预印本(https://ssrn.com/abstract=7653679)。
伦理。第 6 节的读者实验从公开页面访问者处收集带有所述置信度的匿名向上或向下预测。读者通过匿名随机标识符分配给一个组。该实验不收集名称、账户或联系详情。该联赛不存储或记录读者的 IP 地址。为了限制每个地址的投票,仅保留其与当天的加盐哈希值,且不发布或在分析中使用任何个人数据。结果报告为汇总计数,F29 读取的首批预测仅在匿名标识符下发布。我作为独立研究人员进行了这项工作,没有机构伦理委员会。该联赛中的预报员是软件模型。
作者贡献。独自完成。
通信。[email protected] · ORCID: 0009-0007-4845-3163
References
Abeliuk, A., Benjamin, D. M., Morstatter, F., & Galstyan, A. (2020). Quantifying machine influence over human forecasters. Scientific Reports, 10, 15940. https://doi.org/10.1038/s41598-020-72690-4
Adams, C., Cain, P., Pinkas, D., & Zuccherato, R. (2001). Internet X.509 public key infrastructure time-stamp protocol (TSP) (RFC 3161). Internet Engineering Task Force. https://doi.org/10.17487/RFC3161
AI Council · Markets. (2026). Open data of the AI Council · Markets league: sealed book, forecasts, statistics, protocol, event-contract schema and league accounts [Data set]. CC BY 4.0. Data as of 20 October 2026 (generated 21 October 2026, 02:42 UTC); conformance status read 21 October 2026, 15:05 UTC. Retrieved 20-21 October 2026, from https://trends.polyhelper.ai/api/v1/
Aitchison, M., Jeen, S., Shevlane, T., & Day, B. (2026). Diversity is the strength of the AI crowd (arXiv:2606.29661). arXiv. https://arxiv.org/abs/2606.29661
Alur, R., Stadie, B. C., Kang, D., Chen, R., McManus, M., Rickert, M., Lee, T., Federici, M., Zhu, R., Fogerty, D., Williamson, H., Lozinski, N., Linsky, A., & Sekhon, J. S. (2025). AIA Forecaster: Technical report (arXiv:2511.07678). arXiv. https://arxiv.org/abs/2511.07678
Arora, A., & Malpani, R. (2026). PredictionMarketBench: A SWE-bench-style framework for backtesting trading agents on prediction markets (arXiv:2602.00133). arXiv. https://arxiv.org/abs/2602.00133
Bali, T. G., Kelly, B. T., Mörke, M., & Rahman, J. (2023). Machine forecast disagreement (NBER Working Paper No. 31583). National Bureau of Economic Research. https://doi.org/10.3386/w31583
Barber, B. M., & Odean, T. (2000). Trading is hazardous to your wealth: The common stock investment performance of individual investors. The Journal of Finance, 55(2), 773-806. https://doi.org/10.1111/0022-1082.00226
Barot, R. M., & Borkhatariya, A. S. (2026). PolySwarm: A multi-agent large language model framework for prediction market trading and latency arbitrage (arXiv:2604.03888). arXiv. https://arxiv.org/abs/2604.03888
Berg, J., Nelson, F., & Rietz, T. (2008). Prediction market accuracy in the long run. International Journal of Forecasting, 24(2), 285-300. https://doi.org/10.1016/j.ijforecast.2008.03.007
Bitcoin Developer Documentation. (n.d.). Block chain: Block headers. Retrieved 20 October 2026, from https://developer.bitcoin.org/reference/block_chain.html
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Cao, S., Wang, C. C. Y., & Yi, X. (2025). When LLMs go abroad: Foreign bias in AI financial predictions (Harvard Business School Working Paper No. 26-013). Harvard Business School.
Chambers, C. D. (2013). Registered Reports: A new publishing initiative at Cortex. Cortex, 49(3), 609-610. https://doi.org/10.1016/j.cortex.2012.12.016
Chen, Y., Yao, Z., Liu, Y., Xin, A., Ye, J., Yu, J., Hou, L., & Li, J. (2025). StockBench: Can LLM agents trade stocks profitably in real-world markets? (arXiv:2510.02209). arXiv. https://arxiv.org/abs/2510.02209
Cheng, P., Liu, J., & Long, Y. (2026). PolyBench: Benchmarking LLM forecasting and trading capabilities on live prediction market data (arXiv:2604.14199). arXiv. https://arxiv.org/abs/2604.14199
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. Zenodo. https://doi.org/10.5281/zenodo.22683716 (also SSRN Working Paper No. 7390698, https://ssrn.com/abstract=7390698)
Chernets, V. (2026b). Verification theater: Measured failure modes of AI verifier panels. Zenodo. https://doi.org/10.5281/zenodo.23197641
Chernets, V. (2026c). After the programmer divide: One measure for people who build through AI agents (SSRN Working Paper No. 7589918). SSRN. https://ssrn.com/abstract=7589918
Choi, H. K., Zhu, X., & Li, S. (2025). Debate or vote: Which yields better decisions in multi-agent large language models? (arXiv:2508.17536). Advances in Neural Information Processing Systems 38 (NeurIPS 2025). https://arxiv.org/abs/2508.17536
Chu, G., Shen, D., & Zhu, Z. (2025). Machine forecast disagreement in the cryptocurrency market (SSRN Working Paper No. 5230677). SSRN. https://doi.org/10.2139/ssrn.5230677
Clemen, R. T., & Winkler, R. L. (1985). Limits for the precision and value of information from dependent sources. Operations Research, 33(2), 427-442. https://doi.org/10.1287/opre.33.2.427
Cox, D. R. (1958). Two further applications of a model for binary regression. Biometrika, 45(3-4), 562-565. https://doi.org/10.1093/biomet/45.3-4.562
Diebold, F. X., & Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253-263. https://doi.org/10.1080/07350015.1995.10524599
Diercks, A. M., Katz, J. D., & Wright, J. H. (2026). Kalshi and the rise of macro markets (Finance and Economics Discussion Series 2026-010). Board of Governors of the Federal Reserve System. https://doi.org/10.17016/FEDS.2026.010
Diether, K. B., Malloy, C. J., & Scherbina, A. (2002). Differences of opinion and the cross section of stock returns. The Journal of Finance, 57(5), 2113-2141. https://doi.org/10.1111/0022-1082.00490
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114-126. https://doi.org/10.1037/xge0000033
Dubach, P. D. (2026). The anatomy of a decentralized prediction market: Microstructure evidence from the Polymarket order book (arXiv:2604.24366). arXiv. https://arxiv.org/abs/2604.24366
Fan, T., Yang, Y., Jiang, Y., Zhang, Y., Chen, Y., & Huang, C. (2025). AI-Trader: Benchmarking autonomous agents in real-time financial markets (arXiv:2512.10971). arXiv. https://arxiv.org/abs/2512.10971
Fassbender, J. (2026). Bitcoin-anchored temporal proof for transparency services (Internet-Draft draft-fassbender-scitt-time-anchor-07). Internet Engineering Task Force. https://datatracker.ietf.org/doc/html/draft-fassbender-scitt-time-anchor-07
Forklog. (2025a). Four out of six AI models suffer losses in trading tournament. https://forklog.com/en/four-out-of-six-ai-models-suffer-losses-in-trading-tournament/
Forklog. (2025b). AI model Grok 4.2 triumphs in trading tournament. https://forklog.com/en/ai-model-grok-4-2-triumphs-in-trading-tournament/
Gao, Z., Jiang, W., & Yan, Y. (2025). Detecting lookahead bias in LLM forecasts (arXiv:2512.23847). arXiv. https://arxiv.org/abs/2512.23847
Glasserman, P., & Lin, C. (2023). Assessing look-ahead bias in stock return predictions generated by GPT sentiment analysis (arXiv:2309.17322). arXiv. https://arxiv.org/abs/2309.17322
Gneiting, T., Balabdaoui, F., & Raftery, A. E. (2007). Probabilistic forecasts, calibration and sharpness. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 69(2), 243-268. https://doi.org/10.1111/j.1467-9868.2007.00587.x
Gneiting, T., & Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359-378. https://doi.org/10.1198/016214506000001437
Guan, M., & Chen, Q. (2026). Leakage-aware benchmarking of LLM forecasting: Real-time nowcasts as the decision-time input for macro factor ranking (arXiv:2606.22719). arXiv. https://arxiv.org/abs/2606.22719
Haber, S., & Stornetta, W. S. (1991). How to time-stamp a digital document. Journal of Cryptology, 3(2), 99-111. https://doi.org/10.1007/BF00196791
Halawi, D., Zhang, F., Chen, Y.-H., & Steinhardt, J. (2024). Approaching human-level forecasting with language models. In Advances in Neural Information Processing Systems 37 (NeurIPS 2024). https://arxiv.org/abs/2402.18563
He, S., Lv, L., Manela, A., & Wu, J. (2025). Chronologically consistent large language models (arXiv:2502.21206). arXiv. https://arxiv.org/abs/2502.21206
Jyotish, V. (2026). Sealed before the event: A publicly verifiable, Bitcoin-anchored forecast record of 92 graded outcomes [Version 1; awaiting peer review]. F1000Research, 15, Article 1322. https://doi.org/10.12688/f1000research.186752.1
Karger, E., Bastani, H., Chen, Y.-H., Jacobs, Z., Halawi, D., Zhang, F., & Tetlock, P. E. (2025). ForecastBench: A dynamic benchmark of AI forecasting capabilities. In International Conference on Learning Representations (ICLR 2025). https://arxiv.org/abs/2409.19839
Karkar, C., & Chopra, P. (2025). Future is unevenly distributed: Forecasting ability of LLMs depends on what we're asking (arXiv:2511.18394). arXiv. https://arxiv.org/abs/2511.18394
Kim, E. M., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning (PMLR 267, pp. 30038-30066). https://proceedings.mlr.press/v267/kim25e.html
Kim, S., Kwon, J., Kim, Y., Kagan, N., Khatchadourian, R., Ahn, W., Lopez-Lira, A., Lee, J., Hwang, Y., Levy, O., Lee, Y., & Choi, C. (2026). Forecasting future language: Context design for mention markets (arXiv:2602.21229). arXiv. https://arxiv.org/abs/2602.21229
Kish, L. (1965). Survey sampling. Wiley.
Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118. https://doi.org/10.1073/pnas.2018340118
Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. In Advances in Neural Information Processing Systems 7 (NIPS 1994). https://papers.nips.cc/paper_files/paper/1994/hash/b8c37e33defde51cf91e1e03e51657da-Abstract.html
Künsch, H. R. (1989). The jackknife and the bootstrap for general stationary observations. The Annals of Statistics, 17(3), 1217-1241. https://doi.org/10.1214/aos/1176347265
Li, H., Cao, Y., Yu, Y., Javaji, S. R., Deng, Z., He, Y., Jiang, Y., Zhu, Z., Subbalakshmi, K. P., Huang, J., Qian, L., Peng, X., Suchow, J. W., & Xie, Q. (2025). INVESTORBENCH: A benchmark for financial decision-making tasks with LLM-based agent. In Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 2509-2525). https://aclanthology.org/2025.acl-long.126/
Li, W. W., Kim, H., Cucuringu, M., & Ma, T. (2025). Can LLM-based financial investing strategies outperform the market in long run? [FINSABER] (arXiv:2505.07078). arXiv. https://arxiv.org/abs/2505.07078
Li, X., Yao, X., Qi, G., Zhu, F., Koa, K. J. L., Ng, X. Y., Liu, Z., Ni, X., Liu, C., Yang, Y., Zhang, Y., Wang, W., Feng, F., Wang, C., Luan, H., Xing, X., Xu, X., Chua, T.-S., & Huang, K.-W. (2026). FinDeepForecast: A live multi-agent system for benchmarking deep research agents in financial forecasting (arXiv:2601.05039). arXiv. https://arxiv.org/abs/2601.05039
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Algorithm appreciation: People prefer algorithmic to human judgment. Organizational Behavior and Human Decision Processes, 151, 90-103. https://doi.org/10.1016/j.obhdp.2018.12.005
Lopez-Lira, A., & Tang, Y. (2023). Can ChatGPT forecast stock price movements? Return predictability and large language models (SSRN Working Paper No. 4412788). https://doi.org/10.2139/ssrn.4412788
Lopez-Lira, A., Tang, Y., & Zhu, M. (2025). The memorization problem: Can we trust LLMs' economic forecasts? (arXiv:2504.14765). arXiv. https://arxiv.org/abs/2504.14765
louidev. (2026). GlassBallAI: A dataset of LLM market predictions (made with Google Gemini models) (Version 1.2) [Data set, CC BY-NC 4.0]. Hugging Face. Retrieved 21 October 2026, from https://huggingface.co/datasets/louidev/glassballai
MarketMania. (2026). Live LLM crypto forecasting benchmark and Benchmark methodology [Web pages]. Retrieved 21 October 2026, from https://marketmania.ai/llm-financial-market-benchmark and https://marketmania.ai/benchmarks/methodology
MaxWellApexLab. (2026). llm-trading-arena: LLM Trading Arena [Computer software and live ledger, MIT licence]. GitHub. Retrieved 21 October 2026, from https://github.com/MaxWellApexLab/llm-trading-arena
Meng, S., & Chen, X. (2026). AI-driven alpha decay: Algorithmic homogenization, reflexive signal erosion, and the paradox of intelligent markets (arXiv:2605.23905). arXiv. https://arxiv.org/abs/2605.23905
Metaculus. (2025a). Q1 AI benchmarking results: Human pros crush bots. Effective Altruism Forum. https://forum.effectivealtruism.org/posts/mwcWxwdsEMexm98GF/q1-ai-benchmarking-results-human-pros-crush-bots
Metaculus. (2025b). Q2 AI benchmark results: Pros maintain clear lead. LessWrong. https://www.lesswrong.com/posts/Surnjh8A4WjgtQTkZ/q2-ai-benchmark-results-pros-maintain-clear-lead
Miller, E. M. (1977). Risk, uncertainty, and divergence of opinion. The Journal of Finance, 32(4), 1151-1168. https://doi.org/10.1111/j.1540-6261.1977.tb03317.x
Murphy, A. H. (1973). A new vector partition of the probability score. Journal of Applied Meteorology, 12(4), 595-600. https://doi.org/10.1175/1520-0450(1973)012<0595:ANVPOT>2.0.CO;2
Nakamoto, S. (2008). Bitcoin: A peer-to-peer electronic cash system. https://bitcoin.org/bitcoin.pdf
National Institute of Standards and Technology. (2015). Secure hash standard (SHS) (FIPS PUB 180-4). https://doi.org/10.6028/NIST.FIPS.180-4
Nechepurenko, M., & Shuvalov, P. (2026a). Foresight Arena: An on-chain benchmark for evaluating AI forecasting agents (arXiv:2605.00420v2). arXiv. https://arxiv.org/abs/2605.00420
Nechepurenko, M., & Shuvalov, P. (2026b). Coordination as an architectural layer for LLM-based multi-agent systems (arXiv:2605.03310). arXiv. https://arxiv.org/abs/2605.03310
Nel, L. (2025). Do large language models know what they don't know? KalshiBench: A new benchmark for evaluating epistemic calibration via prediction markets (arXiv:2512.16030). arXiv. https://arxiv.org/abs/2512.16030
NeuPortal. (2026). NeuPortal: AI forecasts vs prediction markets (Bitcoin-timestamped) (Version 1) [Data set; Zenodo record by A. Bilous]. Zenodo. https://doi.org/10.5281/zenodo.21294229 . Proofs: https://github.com/neuportalai-ui/experiment-proofs
Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703-708. https://doi.org/10.2307/1913610
Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600-2606. https://doi.org/10.1073/pnas.1708274114
Numerai. (n.d.). Meta Model Contribution (MMC) [Technical documentation]. Numerai Docs. Retrieved 21 October 2026, from https://docs.numer.ai/numerai-tournament/scoring/meta-model-contribution-mmc
Rockflow. (n.d.). RockAlpha: AI stock. Retrieved 21 October 2026, from https://rockalpha.rockflow.ai/ai-stock
Ørpheus AI. (n.d.). Zeus: Environmental forecasting subnet [Source code and README]. GitHub. Retrieved 21 October 2026, from https://github.com/Orpheus-AI/Zeus/blob/main/README.md
Paleka, D., Goel, S., Geiping, J., & Tramèr, F. (2026). Pitfalls in evaluating language model forecasters. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2506.00723
Prophet Arena. (2026). Verify a forecast, Verify (documentation) and How scoring works [Web pages]. Retrieved 20-21 October 2026, from https://www.prophetarena.co/verify , https://www.prophetarena.co/docs/verify and https://www.prophetarena.co/research/how-scoring-works
Qian, L., Peng, X., Wang, Y., Zhang, V. J., He, H., Smith, H., Han, Y., He, Y., Li, H., Cao, Y., Yu, Y., Lopez-Lira, A., Lu, P., Nie, J.-Y., Xiong, G., Huang, J., & Ananiadou, S. (2025). When agents trade: Live multi-market trading benchmark for LLM agents (arXiv:2510.11695). arXiv. https://arxiv.org/abs/2510.11695
Rallies.ai. (2025-2026). AI Arena [Website feature]. Retrieved 21 October 2026, from https://rallies.ai/
Schoenegger, P., Park, P. S., Karger, E., Trott, S., & Tetlock, P. E. (2025). AI-augmented predictions: LLM assistants improve human forecasting accuracy. ACM Transactions on Interactive Intelligent Systems, 15(1). https://doi.org/10.1145/3707649
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), Article eadp1528. https://doi.org/10.1126/sciadv.adp1528
Sharpe, W. F. (1994). The Sharpe ratio. The Journal of Portfolio Management, 21(1), 49-58. https://doi.org/10.3905/jpm.1994.409501
Sornette, D., Woodard, R., Fedorovsky, M., Reimann, S., Woodard, H., & Zhou, W.-X. (2010). The financial bubble experiment: Advanced diagnostics and forecasts of bubble terminations, volume II, master document (arXiv:1005.5675). arXiv. https://arxiv.org/abs/1005.5675
Sortino, F. A., & Price, L. N. (1994). Performance measurement in a downside risk framework. The Journal of Investing, 3(3), 59-64. https://doi.org/10.3905/joi.3.3.59
Spiro, T. (2026). The oracle's fingerprint: Correlated AI forecasting errors and the limits of bias transmission (arXiv:2605.00844). arXiv. https://arxiv.org/abs/2605.00844
Todd, P. (2016, September 15). OpenTimestamps: Scalable, trust-minimized, distributed timestamping with Bitcoin. https://petertodd.org/2016/opentimestamps-announcement
TradeRank. (2026). TradeRank.ai: Live AI trading leaderboard [Website and open JSON data set]. Retrieved 21 October 2026, from https://traderank.ai/
Walker, A. (2026). The price is (almost) right: A calibration analysis of Polymarket pricing data [Senior thesis, Princeton University]. Princeton University Senior Theses. https://theses-dissertations.princeton.edu/handle/88435/dsp01mw22v8973
White, H. (2000). A reality check for data snooping. Econometrica, 68(5), 1097-1126. https://doi.org/10.1111/1468-0262.00152
Wolfers, J., & Zitzewitz, E. (2004). Prediction markets. Journal of Economic Perspectives, 18(2), 107-126. https://doi.org/10.1257/0895330041371321
Yahoo Finance. (2025). Elon Musk's Grok 4.20 beats OpenAI, Google models in live stock trading contest. https://finance.yahoo.com/news/elon-musks-grok-4-20-123855766.html
Yang, Q., Mahns, S., Li, S., Gu, A., Wu, J., & Xu, H. (2025). LLM-as-a-prophet: Understanding predictive intelligence with Prophet Arena. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2510.17638
Yu, H., Li, F., & You, J. (2025). LiveTradeBench: Seeking real-world alpha with large language models (arXiv:2511.03628). arXiv. https://arxiv.org/abs/2511.03628
Zeng, Z., Liu, J., Chen, S., He, T., Liao, Y., Tian, Y., Wang, J., Wang, Z., Yang, Y., Yin, L., Yin, M., Zhu, Z., Cai, T., Chen, Z., Chen, J., Du, Y., Gao, X., Guo, J., Hu, L., . . . Huang, W. (2025). FutureX: An advanced live benchmark for LLM agents in future prediction. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2508.11987
Zhang, J., Liu, G., Johansson, O., Yitayew, H., Ohly, K., & Li, G. (2026). Prediction Arena: Benchmarking AI models on real-world prediction markets (arXiv:2604.07355). arXiv. https://arxiv.org/abs/2604.07355
Zhang, O., & Zhang, Z. (2026). A review of large language models for stock price forecasting from a hedge-fund perspective (arXiv:2605.05211). arXiv. https://arxiv.org/abs/2605.05211
Zhao, X., Zhang, R., Ye, L., Cao, R., Xie, P., & Chava, S. (2026). Can LLMs take the pulse of the economy? A real-time evaluation of LLM nowcasts on macroeconomic indicators (arXiv:2608.30110). arXiv. https://arxiv.org/abs/2608.30110
附录 A. 协议字段
规范是文件本身:arena-protocol.json 用于联赛(表 A1),以及在每条运行线中密封的 methodology 字段用于预测分数(表 A2)。两者都有版本控制。每项更改都有日期标记,每个密封件都包含生效的版本,因此更改不会影响任何在更改前密封的内容(要求 15)。下表列出了截至 2026 年 10 月 20 日解决分数所需的密钥。
表 A1。 解决账户所需的 arena-protocol.json 密钥(版本 arena-3,2026 年 10 月 20 日)。
| 密钥 | 它确定的内容 |
|---|---|
version、pro_version、history |
生效的规则(arena-3、专业联赛 pro-1)以及每个版本及其开始日期 |
assets、indicators_only |
每个市场交易的工具(收益率为 IEF,比特币为 BTC-USD 等);VIX 不持有 |
prices |
价格来源和账户规则:09:30-09:45 ET 的第一分钟柱用于执行,收盘价用于估值 |
execution、cost |
决策在密封后的第一个开盘时成交;每改变一美元收取 0.001 |
limits、cash |
单个头寸占 5% 到 25%,总计 100%,仅多头;现金按 13 周国债年化 360 天计 |
missing_answer、refused、asked_again |
无决策或拒绝决策使头寸保持不变;重试使用其问题的哈希值密封 |
pro_league |
有符号权重、总敞口最高 2 倍、借贷成本、保证金平仓 |
new_model_version |
账户继续运行;更改有日期标记;版本以来的结果单独显示 |
formulas |
回报、最大回撤、夏普比率、索提诺比率、除权息、配股一次性应用 |
question、replay |
投资组合问题的模板哈希;如何从公开文件重新计算每个账户 |
影子赛道(f12、closed_book、repeats、sp100、council_talk、modalities、roles)在同一文件中有其自己的规则版本,不计入预测分数。
表 A2。 在每条运行线中密封的评分方法字段(methodology,版本 2)。
| 字段 | 它确定的内容 |
|---|---|
reference |
每个指标规则后的第一个价格(ref_rule);迟到答案获得其自己的参考 |
counted |
参考前最后密封的答案线计数;从第 11 个会话(2026 年 11 月 2 日)开始,每个座位在参考前密封的第一条格式正确的答案线计数,同一座位的较晚行为标记重试(asks.jsonl,第 74 行);收盘后的行不计入该会话 |
league |
每个会话一个分数:开盘前最后密封的运行(session_run);其他单独显示。从 2026 年 10 月 21 日起,计数运行是计划好的晨间运行,在证明页面上提前声明(第 3.4 节) |
direction |
指标从参考点向上或向下;在抽签区间内的波动是平局(区间定义在 council-stats.json 中的 draw_band);50 不支持任何一方 |
brier、calibration |
,硬币 0.25;折叠到支持的一方,分箱 [50, 60)、[60, 70)、[70, 80)、[80, 100] |
independence |
至少 10 个交易日后 30 次预测排名 |
missing |
给定答案中未回答的单元格计为 50% |
btc |
比特币从密封分钟开始的当日涨跌,上限为评分会话 ET 时间 16:00 |
consensus |
平均概率;五个或更多答案时排除极值;同一家族的第二个座位权重为 1/3;维持在 2-98% 内 |
together |
all_wrong(每个模型都错,至少 4 个回答)和 minority_right(共识错,某些模型对) |
changes |
方法论的日期标记更改;更改前发布的内容不重新计算 |
附录 B. 自己验证印章
这些步骤仅使用公开文件和标准工具。我在 2026 年 10 月 20 日晚间 (ET) 运行了步骤 1 至 8,在 10 月 21 日运行了步骤 9,所示输出是我获得的结果。步骤 1 至 8 的示例是 2026 年 10 月 20 日 13:00:25Z 的时间戳,是该天四个中的一个 (第 3.1 节)。步骤 1 至 8 检查第 1 级 (链) 和第 2 级 (锚点)。步骤 9 检查第 2+ 级,即 2026 年 10 月 21 日加盖列表上的 RFC 3161 令牌。2026 年 10 月 19 日和 20 日的会话是开发会话,计数记录从 2026 年 10 月 21 日开始。
步骤 1. 下载该书和时间戳。
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt.ots
证明页面 https://trends.polyhelper.ai/markets/proof/2026-10-20/ 列出了当天的每个邮戳和运行的每条书籍行,包括其印章和链接。
第 2 步。阅读已盖章的列表。cat 130025Z.txt 显示其他书籍中的这条行:
daily/council/book.jsonl: 159 lines, sha256 59673b9e21ac6d358e7dc3b811dc3d78f5286390094f7133e3704f57cac1a7d9, last link 378273fd057fcbf364746b032f67f42cd811d281da80f39ff0792c4047175b2c第3步。检查今天的书籍是否以盖章前缀开头。
head -n 159 council-book.jsonl | shasum -a 256
# 59673b9e21ac6d358e7dc3b811dc3d78f5286390094f7133e3704f57cac1a7d9  -
sed -n 159p council-book.jsonl | python3 -c "import json,sys; print(json.load(sys.stdin)['link'])"
# 378273fd057fcbf364746b032f67f42cd811d281da80f39ff0792c4047175b2c两个值都与盖章列表匹配,所以前159行正是它承诺的行。第151行是2026-10-20-am的运行行,第152到159行是其答案行。对150012Z.txt、153605Z.txt和165254Z.txt进行相同的检查,分别涵盖165、167和173行。
每个盖章列表中打印的规则固定字节。文件按存储方式取用(UTF-8、无字节顺序标记、无重新编码或规范化),每行以LF结尾。N行的哈希涵盖第1到N行,每行都带有其LF,最后一行如果没有LF则尚未计数。重写行尾的镜像将无法通过检查。
步骤4. 重新计算每个封印和链接。
import json, hashlib
H = lambda o: hashlib.sha256(json.dumps(o, sort_keys=True, ensure_ascii=False).encode()).hexdigest()
lines = [json.loads(l) for l in open("council-book.jsonl", encoding="utf-8")]
prev = ""
for i, x in enumerate(lines, 1):
    assert x["n"] == i and x["prev"] == prev
    assert x["seal"] == H({k: v for k, v in x.items() if k not in ("seal", "link", "prev", "n")})
    assert x["link"] == H({k: v for k, v in x.items() if k != "link"})
    prev = x["link"]
print("chain ok:", len(lines), "lines")在10月20日的文件中打印了chain ok: 211 lines。
步骤5。检查问题的运行答案。
curl -s https://trends.polyhelper.ai/api/v1/asks/77d3c627c7c69d2f6e740ccd89113872b1ac08053554a4651bc2d3064b4e6f07.md | shasum -a 256
# 77d3c627c7c69d2f6e740ccd89113872b1ac08053554a4651bc2d3064b4e6f07 -第6步。验证比特币锚点。安装OpenTimestamps客户端(pip install opentimestamps-client)。使用本地比特币节点,ots verify 130025Z.txt.ots对130025Z.txt进行哈希运算,跟踪证明并根据区块头进行检查。没有节点的情况下,ots info 130025Z.txt.ots打印文件哈希(5c7d3a357f3cd8b9c27aa4c5d1e9e4750d522bd90b58ffe5193fc61356079d0f,等于shasum -a 256 130025Z.txt)、证明的操作及其证明BitcoinBlockHeaderAttestation(972334)。对文件哈希应用这些操作得到74072ae1fdee72c9a3f749462490b46f896e0fab58f7d101dc1a403d967e5c30,这是第972,334区块的默克尔根,如任何区块浏览器所示(区块头时间2026-10-20 13:55:20Z;前11个区块的中位数时间12:45:12Z)。这两个文件也可以拖放到https://opentimestamps.org上。仅显示待定日历证明的证明可以通过ots upgrade完成。待定证明不包含读者可以验证的时间。
第7步。重新计算联赛。
curl -s https://trends.polyhelper.ai/api/v1/arena-code-tools-replay.py.txt -o replay.py
python3 replay.py https://trends.polyhelper.ai/api/v1/
关于2026年10月20日的文件,脚本打印了(摘录):
replay: 253 published rows, 145 accounts, 2 sessions (2026-10-19 .. 2026-10-20), 1006 trades, rules arena-3
exact to the cent (|d| <= 0.01): 204; within the rounding of the published trades: 49; DIFFERENT: 0; not recounted (other price sets): 0
result: the published scores are reproduced
第 8 步。检查引擎的代码。 arena-code.json 列出每个代码文件及其 SHA-256 值;每个文件以 arena-code-<file>.txt 的形式发布:
curl -s https://trends.polyhelper.ai/api/v1/arena-code-council_arena.py.txt | shasum -a 256
# 9ff5575c2b5c7736fba06bec1b63a608f5f290aacdee6df6b24a51381f22686c  -
这与 council_arena.py 的条目相符。
第 9 步。验证 2026 年 10 月 21 日的签署时间(2 级及以上)。在 2026 年 10 月 21 日 09:10 ET 运行,使用 OpenSSL 3(两项检查在 OpenSSL 3.6 和 4.0 中都通过)。FreeTSA 证书被复制到 tsa/ 中并由服务发布(https://freetsa.org/files/);DigiCert 的链位于系统信任存储中。
P=https://trends.polyhelper.ai/markets/proof/2026-10-21
for f in 130019Z.txt 130019Z.txt.freetsa.tsr 130019Z.txt.digicert.tsr tsa/freetsa-cacert.pem tsa/freetsa-tsa.crt; do curl -sO $P/$f; done
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
shasum -a 256 130019Z.txt
# 986bd13907397901ceed70131a70c3674eba05dfdcb9ededbc7cbc0e57bd3714  130019Z.txt
openssl ts -verify -data 130019Z.txt -in 130019Z.txt.freetsa.tsr -CAfile freetsa-cacert.pem -untrusted freetsa-tsa.crt
# Verification: OK   (after a warning that freetsa-tsa.crt is not a CA certificate, which is expected)
openssl ts -verify -data 130019Z.txt -in 130019Z.txt.digicert.tsr -CAfile /etc/ssl/cert.pem
# Verification: OK
openssl ts -reply -in 130019Z.txt.digicert.tsr -text | grep "Time stamp"
# Time stamp: Oct 21 13:00:19 2026 GMT   (the same for the FreeTSA token)
head -n 222 council-book.jsonl | shasum -a 256
# a9359a7741ef5f7aad7436e022a60813e2fc2f9ce76e130abe21dc820e59bd8c -该列表声明包含222行哈希值。第214至222行是2026-10-21-am的运行行和答案,已在第一批中预订,两个权威机构都在UTC 13:00:19将其标记,比UTC 13:30:00的参考时间早29分钟41秒。覆盖asks.jsonl的130035Z.txt的令牌给出UTC 13:00:36。对132337Z.txt执行相同步骤会覆盖224行。第224行是在UTC 13:23:23到达的答案,在14秒后被预订,三个权威机构(FreeTSA、DigiCert和Sectigo)在UTC 13:23:37对其签名,早于参考时间。asks.jsonl的第一行声明从2026年10月21日开始的哪个运行计数。它在UTC 04:16:39被封存,早于运行的问题被发送,其文本哈希值被打印在证明页上。
这些步骤建立的内容。步骤3和4为至戳记止的每一行给出P2。步骤6将带戳记的前缀放置在不晚于区块972,334报头时间后几小时之内,这个实际界限在第3.11节中取代共识规则证明的常数,为之后的每个结果给出P1a,针对持有此证明或其独立副本的任何人。
该区块在美东时间09:30之后出现。对于10月20日,封存和参考价格的顺序(P1b)因此在第1级从该行在书中的封存时间max(at, booked_at)读取,针对会议的美东时间09:30,council-forecasts.csv的sealed_at列给出答案时间。我通过对这些封存时间应用计数运行规则来检查P3。对于开发会议,P3依赖于运营者关于每个运行都被发布和标记的记录。在计数记录中,计数运行是计划的早间运行,提前声明并在问题链中在运行之前封存(步骤9),因此读者针对在答案之前存在的声明来检查P3。步骤9为10月21日会议在第2级及以上级别给出P1b,针对接受任何一个签署权威机构及其证书的任何人。在盲季,相同步骤运行在将模型封存为加盐承诺的行上(要求1),当盐在季节后发布时检查身份。
表B1。声明的阶梯:每个检查级别支持的声明,以及它留下的开放问题。
| 检查级别 | 它支持的声明 | 它留下的开放问题 | 在本文中 |
|---|---|---|---|
| 规则已发布 | 读者可以声明事件合约、分数和计数运行规则 | 文件是否遵循规则 | 第3节;附录A |
| 文件已重新计算 | 已发布的分数和账目遵循已发布的记录 | 价格是否与独立来源匹配;命名的模型是否产生了答案 | 步骤4、7和8 |
| 外部承诺已验证(第2级;对于封存和参考的顺序为第2+级) | 承诺的字节在规定的界限内存在,该前缀的后期重写是可检测的;在第2+级(从2026年10月21日起),早于参考价格 | 是否披露了每个预期的预测;提供者的模型身份;每个答案的到达时间 | 步骤3、6和9 |
| 结果已调和 | 参考和收盘价格在规定的时间与第二个命名来源匹配 | 任何预测优势 | 标准要求;待在带日期的修订中添加 |
| 前瞻性配对评估,在其窗口前冻结 | 规定事件、权重和比较器上的损失差异 | 其他市场、时间范围和制度 | 第8节 |
| 独立复制 | 另一条在其他人手中的管道从同一版本重现分数 | 后续季节中的表现 | 对任何读者开放(附录C) |
注:锚点证明记录。与提供者的TLS会话证明(TLSNotary)可以将阶梯扩展到命名端点返回封存答案的声明,协议在答案行的字段中为其留有空间。技能由第8节的注册比较确定。
步骤10。在独立日志中检查戳记。每个带戳记的列表也被输入到Sigstore Rekor透明日志中,运营者不运行该日志;该条目保存列表的SHA-256。
shasum -a 256 130025Z.txt
# 5c7d3a357f3cd8b9c27aa4c5d1e9e4750d522bd90b58ffe5193fc61356079d0f  130025Z.txt
curl -s "https://rekor.sigstore.dev/api/v1/log/entries?logIndex=3368351276"
# the base64 body holds spec.data.hash.value, the same SHA-256; integratedTime 1792626303 is 21 October 2026, 23:45:03 UTC
2026年10月20日的列表于2026年10月21日在日志索引3,368,351,276处输入。从2026年10月22日起,每份列表都在盖章时输入,首份列表(索引3,368,763,032)于协调世界时00:00:16集成,比其盖章时间晚五秒。
附录 C. 数据字典
所有文件位于 https://trends.polyhelper.ai/api/v1/,以 CC BY 4.0 许可证发布,署名为"AI Council · Markets, trends.polyhelper.ai/markets/"。该地址的索引页列出了每个文件及其更新频率,arena-dataset.json 描述了每个文件的列;表 C1 列出了预测读取的文件,列名称如 2026 年 10 月 21 日 08:16 UTC 所示。无法打开大型文件的读取 AI 应从 markets-digest.json(小于 30 KB)或 council-forecasts-index.json 中的每次运行切片开始。
表 C1。 主要文件。
| 文件 | 内容 | 更新 |
|---|---|---|
council-book.jsonl |
密封簿:每次运行、回答、得分、投资组合和联赛线,哈希链接 | 每次运行 |
council-forecasts.csv |
每个密封预测单元格及其结果占一行 | 每次运行和计分 |
council-stats.json |
按会话的 Brier 区间、平局带、功率计算、n_eff(包含计数序列 n_eff.counted)、成对区间(pairs)、按方法论段的得分(method_segments)、共享源 |
每次构建 |
council-calibration.json |
校准、针对硬币、众数和气候学的技能得分、每个比较的方法(method);发布时的固定气候学 climatology_fixed |
每次构建 |
council-pairs.csv |
同一事件上每两个席位的成对损失 | 每次构建 |
league-roster.json |
每个模型、其阵营、理事会或替补席、其在两个联赛中的状态 | 每次构建 |
{lang}/council-league.json |
联赛:模型、基线、校准、时间范围、众数、投资组合联赛 | 每次运行和计分 |
arena-protocol.json, arena-code.json |
协议(附录 A);引擎的代码及其 SHA-256 | 每次构建 |
arena-trades.csv, arena-accounts.csv, arena-prices.json |
已执行的交易;每个会话的每个账户;执行价和平仓价 | 每次会话 |
asks/<sha256>.md, asks/index.json |
每个 ask_sha256 后面的问题文本 |
每次运行 |
event-contract.schema.json, tools/conformance.py |
作为 JSON 模式的事件合约;任何联赛都可以在其自己的预测文件上运行的检查器(第 3.13 节) | 每次合约变更时 |
council-forecasts.csv(每个模型、运行、市场和时间范围占一行):run_id;session;seat;model、mode;line(密封线的位置 n);sealed_at(UTC);status(counted、not_counted、counted_50、no_answer、refused_shape);asset、horizon;action、action_word;prob_up(0-100);exp_pct;target、invalidation;ref、close、actual_pct;draw;source_domains、source_urls;why_missing;run_role(session_run 或 earlier_run);seat_versions_in_run;line_kind(issue,即单元格如在回答线中密封的,或 correction,由后来的更正线添加的单元格);reference_at(从该行参考规则取价格的时间;对于比特币来说是密封秒,价格是从该秒开始或之后的第一个一分钟柱线的收盘价);same_event(当该行从其自己的参考得分时为 false);cell_status(elicited、explicit_50 或 invalid);attempt;event_id、event_reference_at、event_end_at(事件合约,第 3.13 节);methodology_version。sealed_at 是回答时间,即回答线的 at;该线在簿中被密封的时间是该线的 max(at, booked_at)(10 月 20 日,回答时间为 12:31Z 至 12:42Z,密封时间为 13:00:25Z),这是 council-stats.json(time_basis: book_sealed_at)和已提交脚本的时间基准。对于比特币,reference_at 是该行自己线的密封秒(10 月 21 日批次为 13:00:19Z,第九个回答为 13:23:37Z),reference_price_at 是其收盘价为参考的一分钟柱线的开始(13:01:00Z 和 13:24:00Z)。cell_status 为 explicit_50 的单元格是陈述的 50% 概率;counted_50、no_answer、refused_shape 和空的 prob_up 未陈述,不进入陈述概率的 Brier 得分,也不进入共识。模型对众数问题的回答 crowd_up 不在本文件中;它在簿的回答线中。
书籍行。每一行都有n、at、kind、prev、seal和link。承载预测的种类包括run(添加run_id、ask_sha256、snapshot_sha256、roster、methodology和crowd,其中crowd.at是Polymarket合约,crowd.odds下是Polymarket合约,crowd.kalshi下是Kalshi合约,各自带有p_up和vol)、answer(添加seat、model、mode、items、years,在后续运行中还有own_sha256、ask_sha256、booked_at;模型对众议问题的概率为items.<asset>.1d.crowd_up)、score和score_h(该天和各时间跨度的结果,带有late_ref、noise和of)、crowd(解析每份合约:Polymarket对应rows.<code>,Kalshi对应rows.<code>@kalshi,结果为up;截至2026年10月21日仅在运行2026-10-19-am中出现)和correction(在of中命名其涉及的行)。其他种类记录投资组合联赛和影子轨道。
固定气候学。在council-calibration.json中,climatology_fixed包含table[*],其中有asset、h、p_up、p_up_ex_draw、n、n_independent、window和rule,加上sha256和sha256_ok。其封签是council-clim-window.json(位于数据地址下)的内容哈希值2810d11e907bbaa1f311d06622c929c69e60cc81e558fdb78f5baa04113cabb7,按第4.3节计算;主基准在时间跨度1d处读取p_up。该字段于2026年10月21日08:54 UTC进入实时文件,因此表C1在08:16 UTC时未列出。
状态值和事件合约。counted_50标记填充为50%的单元格,用于席位的服务得分;这不是陈述的概率,不进入共识或协议计数,其贡献概率的数量为of。带有late_ref的行是对单独事件的预测(第3.3节);在共同事件上汇总模型的分析选择参考等于会话共同参考的行。
分析发布。每个修订版本都基于沉积在Zenodo上的不可变发布(10.5281/zenodo.23552700):书籍、预测、统计、协议、代码文件、重新计数的文件、发表的问题和每个带有其.ots证明的时间戳列表,包含每个文件的SHA-256、大小、检索时间的清单,以及声明的生成时间。逐一检索的文件形成已识别版本的集合,发布是原子快照。书籍只会增长,因此发布的书籍是任何后续下载的前缀(第3.2节)。
附录 D. 已注册预测(完整表格)
表 D1 一览第 8 节的三十项次级预测,表 D2 给出其已注册文本。来自三个家族的三个模型,各自单独对清单进行盲测定价,已注册的 p 是三个模型的中位数。该清单、Set B 脚本及其 SHA-256 和主要端点及其脚本已与 OSF 注册一起存档 (10.17605/OSF.IO/9Q86N)。
适用于每一行的规则。 除非一行指定另一个窗口,否则预测是根据从会话 11(2026 年 11 月 2 日)至其检查日期的会话计算的。它使用计数行(每个会话一次运行),其图书密封时间 max(at, booked_at) 在会话 09:30 ET 参考时间之前,同样的截断也适用于比特币,其参考是该行密封后第一根一分钟棒的收盘。Brier 分数为一天且覆盖所有行,包括平局。如果已发布的字段也涵盖更早的会话,则已存档的脚本将该字段的定义应用于该窗口。
字段来自 https://trends.polyhelper.ai/api/v1/ 的开放文件,如 2026 年 10 月 21 日记录的那样,已重命名的字段由其已记录的等效字段替换,映射已记录。如果一行需要的值不在任何开放字段中,则该字段将被发布,OSF 脚本中的解析器根据行的规则从 council-forecasts.csv 和 council-book.jsonl 计算该值。"已排名"表示至少 10 个交易日内的 30 个已解决预测(第 4.6 节的 30/10 规则),适用于预测的窗口内,F8 除外,其读取联赛的标志。Crowd 行是密封问题列出日常合约的市场会话(第 4.9 节),该合约是模型使用 crowd_up 回答的合约,Polymarket 列出市场时为 Polymarket 合约,否则为 Kalshi 合约,两种情况下密封成交量至少为 $1,000(准入阈值)。区间为 95%,会话作为簇,在已存档的脚本中通过 10,000 次重新采样引导,种子为 20261102。
未达到最小样本量、文件缺失或没有已记录等效的字段会导致预测未解决且不成功。没有预测被删除。p 是预测成立的已注册概率(假设已解决):三次盲投的中位数。六个值(F5、F7、F20、F21、F23、F25)是 2026 年 10 月 20 日的投票。其他二十四项和主要端点在 2026 年 10 月 21 日投票,分三个较晚的轮次,每轮根据该轮改写的预测文本投票。最后一轮之后固定的措辞指定行如何解决,未重新定价,所有轮次和投票均与注册一起存档。
表 D1。 三十项已注册预测一览。
| # | 预测(已注册陈述,至冒号为止) | Set | 检查日期 | p | 不具备技能的 P(true) |
|---|---|---|---|---|---|
| F1 | 委员会在一天内保持低于两个独立声音 | A | 2026 年 11 月 30 日 | 0.50 | |
| F2 | 市场共同运动不能解释相似性 | A | 2026 年 12 月 31 日 | 0.50 | |
| F3 | 错误也是共享的 | B | 2026 年 12 月 31 日 | 0.74 | |
| F4 | 模型不如群体敏锐 | B | 2026 年 12 月 31 日 | 0.40 | |
| F5 | 共享链接意味着共享调用 | A | 2026 年 12 月 31 日 | 0.56 | |
| F6 | 全部一起错误 | B | 2026 年 12 月 31 日 | 0.92 | |
| F7 | 正确的少数比一致的错误更常见 | A | 2026 年 12 月 31 日 | 0.63 | |
| F8 | 表格按时填充 | A | 2026 年 11 月 30 日 | 0.88 | operational |
| F9 | 月份的独立性大于日期的独立性 | B | 2026 年 12 月 31 日 | 0.30 | |
| F10 | 平均胜过跟随领导者 | B | 2026 年 12 月 31 日 | 0.64 | |
| F11 | 没有单个模型显示检测到的日度优势 | B | 2026 年 12 月 31 日 | 0.79 | 至少约 0.78 |
| F12 | 群体击败委员会 | B | 2026 年 12 月 31 日 | 0.83 | |
| F13 | 组合击败群体 | B | 2026 年 12 月 31 日 | 0.30 | |
| F14 | 模型过度自信 | B | 2026 年 12 月 31 日 | 0.80 | |
| F15 | 委员会没有以明显的优势击败简单规则 | B | 2026 年 12 月 31 日 | 0.80 | |
| F16 | 没有任何时间范围在一个季度内带来检测到的信号 | B | 2027 年 4 月 30 日 | 0.63 | 至少约 0.93 |
| F17 | 相对于气候学,日期是最难的时间范围 | B | 2027 年 4 月 30 日 | 0.37 | |
| F18 | 国家是一个小因素 | B | 2026 年 12 月 31 日 | 0.80 | |
| F19 | 美国方面在一个季度内得分更好 | B | 2027 年 4 月 30 日 | 0.57 | |
| F20 | 相同的新闻意味着更少的争议 | A | 2026 年 11 月 30 日 | 0.70 | |
| F21 | 搜索增加的准确性很少 | B | 2026 年 12 月 31 日 | 0.72 | |
| F22 | 讨论发现真正的风险 | A | 2026 年 12 月 31 日 | 0.30 | |
| F23 | 听取批评得到回报 | A | 2026 年 12 月 31 日 | 0.42 | |
| F24 | 一个模型与自己的分歧很多 | A | 2026 年 11 月 30 日 | 0.60 | |
| F25 | 领导者不会持久 | B | 2027 年 4 月 30 日 | 0.62 | 约 0.85(十一个已排名座位),0.82(十个) |
| F26 | 指数难以击败 | B | 2027 年 4 月 30 日 | 0.60 | |
| F27 | 优秀预测者不是最佳交易员 | B | 2027 年 4 月 30 日 | 0.83 | |
| F28 | 首次预测前访问模型不会将读者的布里尔评分改进0.01或更多 | A | 2026年12月31日 | 0.46 | |
| F29 | 访问使读者朝向委员会 | B | 2026年12月31日 | 0.41 | |
| F30 | 风格暴露了模型 | B | 2027年4月30日 | 0.46 |
注:每行对应一个已注册预测;完整文本及其度量、来源和裁定规则在表D2中。集合A由一至两个已发表的领域定义,集合B由随注册提交的脚本定义。p是已注册概率,表示在裁定为真的条件下预测成真的概率:三次盲投票的中位数。无技能情况下P(true)是在模型无技能条件下预测成真的概率,如表D2注中推导;空单元格表示该行未规定此值。
表D2。 全部三十个已注册预测的完整形式:陈述、度量、来源、集合、检查日期、规则和概率。
| # | 陈述 | 度量(打开文件) | 集合 | 检查日期 | 成真条件 | 被驳斥条件 | p |
|---|---|---|---|---|---|---|---|
| F1 | 委员会在一天内保持低于两个独立声音:从第11场到第30场会话的计数运行中,按第5.1节的资格规则计算的单日概率图的平均N_eff低于2.0 | n_eff.counted.per_run[*].n_eff在其run id日期为2到30 November 2026的运行上的平均值,council-stats.json |
A | 2026年11月30日 | 平均值 < 2.0,至少有10次计数运行 | 平均值 ≥ 2.0,至少有10次计数运行;少于此数量 = 未裁定 | 0.50 |
| F2 | 市场共动不能解释相似性:从第11场到第52场会话的计数运行中,按第5.1节规则计算的单日N_eff平均值(每组一个市场:纳斯达克100、道琼斯和布伦特油价已去除)低于2.5 | n_eff.counted.one_per_group.per_run[*].n_eff在其run id日期为2 November到31 December 2026的运行上的平均值,council-stats.json |
A | 2026年12月31日 | 平均值 < 2.5,至少有20次计数运行 | 平均值 ≥ 2.5,至少有20次计数运行;少于此数量 = 未裁定 | 0.50 |
| F3 | 错误也是共享的:从第11场到第52场计分会话中,在座位单日错误指标(参考前封存的答案、所有行、规定的50%被排除)上计算的N_eff,按会话平均,低于4.0(错误计数也承载结果跨市场的共动)。每场会话中,受访者是有资格行的座位,n是该会话中的数量,ρ是他们在两个都回答的市场中0/1错误指标的平均成对皮尔逊相关系数(具有常数指标的对被排除,没有可计算对的会话也被排除),会话上的平均值等权重每场会话 | 待发表字段(已发表的n_eff_errors包括后期行);OSF脚本中的解决器从council-forecasts.csv和council-book.jsonl的计数1天行中计算 |
B | 2026年12月31日 | 数值 < 4.0,至少有30次计分会话 | 数值 ≥ 4.0,至少有30次计分会话;少于此数量 = 未裁定 | 0.74 |
| F4 | 模型不如群体敏锐:在单日群体合约上(封存成交量至少为$1,000的合约,模型回答的合约:在Polymarket上列出的为Polymarket,否则为Kalshi),从第11场到第52场会话,每个座位其crowd_up答案与50%距离的平均值在这些合约上的平均值小于群体价格与50%距离的平均值的一半 |
council-book.jsonl运行行中的群体价格和vol(crowd.odds、crowd.kalshi);答案行的crowd_up封存于参考前;已提交脚本 |
B | 2026年12月31日 | 座位平均距离 < 0.5 × 群体平均距离,至少在100个合约-会话上 | 座位平均距离 ≥ 0.5 × 群体平均距离;少于100个合约-会话 = 未裁定 | 0.40 |
| F5 | 共享链接意味着共享判断:引用相同链接的模型对在行动类别上的一致性比不引用相同链接的对更频繁,在分层内至少多5个百分点,排列p < 0.05 | sources.agreement_by_shared_link.diff_within_strata和p_permutation,council-stats.json,由已提交脚本应用于窗口(定义复现在2026年10月21日的文件中) |
A | 2026年12月31日 | diff ≥ 0.05且p < 0.05 | diff < 0.05或p ≥ 0.05 | 0.56 |
| F6 | 全部错误:在至少有4个回答模型的已裁定单日市场-会话中,每个回答模型都错误的份额至少是独立假设下预期份额的两倍,其中预期份额是同一市场-会话上的平均值,是实际回答模型的错误率乘积,每个率在相同行上估算 | together.all_wrong / together.rows,council-league.json;由已提交脚本从council-forecasts.csv预期 |
B | 2026年12月31日 | 观测份额 ≥ 2 × 预期份额 | 观测份额 < 2 × 预期份额 | 0.92 |
| F7 | 少数派正确比全票错误更常见:minority_right超过all_wrong |
together定义(council-league.json),由已提交脚本按本论文规则在窗口上重新计算,从参考前封存的行和所有行;已发表字段(也计数后期行并排除平局)在其旁边显示 |
A | 2026年12月31日 | minority_right > all_wrong | minority_right ≤ all_wrong | 0.63 |
| F8 | 表格按计划填充:在第30场会议计分后(2026年11月30日),11个委员会席位中至少9个在一天达到排名规则(自2026年10月19日起计数的所有会话中30次裁定预测在至少10个交易日) | ranked标志,council-league.json by_horizon.1d |
A | 2026年11月30日 | 9个或更多委员会席位排名 | 8个或更少的委员会席位排名 | 0.88 |
| F9 | 月度独立性高于日度独立性:在第11场到第52场会话的完整运行中,日度均值两两相关系数ρ与月度均值之间的逐运行差异(均按第5.1节规则,正差值表示月度声音更独立)的均值为正,其95%移动区块自助法置信区间(5场运行的区块)完全在零以上 | 在council-forecasts.csv的1d和1m处、council-book.jsonl处计数的行;已存档的脚本 | B | 31 Dec 2026 | 置信区间完全在零以上,至少有20场计数的运行 | 置信区间不完全在零以上,至少有20场计数的运行;更少 = 未解决 | 0.30 |
| F10 | 平均预测优于跟随领导者:第31到52场会话(2026年12月1日至31日)的共识1日Brier得分低于领导者的得分,其中领导者是第11到30场会话(2026年11月2日至30日)1日Brier最低的排名委员会模型,在两者都回答的12月市场会话上 | council-forecasts.csv计数的1日行;共识由密封答案前发布的规则得出;已存档的脚本 | B | 31 Dec 2026 | 共识Brier < 领导者的Brier | 共识Brier ≥ 领导者的Brier;第11到30场会话无排名模型 = 未解决 | 0.64 |
| F11 | 没有单一模型显示检测到的日度优势:没有排名委员会模型的1日Brier在第11场会话之后的所有行中,其95%会话聚类置信区间完全在0.25以下(每个排名席位一个未校正的置信区间) | council-forecasts.csv计数的1日行;已存档的脚本 | B | 31 Dec 2026 | 无席位的上界 < 0.25 | 至少一个席位的上界 < 0.25 | 0.79 |
| F12 | 群体优于委员会:在至少100个不同的1日市场会话中(从第11场会话开始,群体合约的密封成交量至少$1,000),模型回答的合约(在Polymarket上市时为Polymarket,否则为Kalshi),群体的Brier低于委员会的crowd_up修剪共识,两者都根据该合约自身的分辨率计分 |
council-book.jsonl运行行中的群体价格和vol(Polymarket为crowd.odds、Kalshi为crowd.kalshi);其crowd行中的分辨率(rows.<code>[@kalshi].up);council-book.jsonl答案行中的crowd_up;已存档的脚本 |
B | 31 Dec 2026 | 群体Brier < 委员会Brier,在至少100个市场会话上 | 群体Brier ≥ 委员会Brier;少于100个市场会话 = 未解决 | 0.83 |
| F13 | 组合优于群体:在F12的相同合约上(至少100个市场会话,密封成交量至少$1,000),群体价格与委员会的crowd_up修剪共识的简单平均值比单独的群体具有更低的Brier,根据每个合约自身的分辨率计分 |
如F12;已存档的脚本 | B | 31 Dec 2026 | 组合Brier < 群体Brier,在至少100个市场会话上 | 组合Brier ≥ 群体Brier;少于100个市场会话 = 未解决 | 0.30 |
| F14 | 模型过度自信:在第11场会话之后的所有1日行中,在支持方的汇总60到70%分位数上(至少100个预测),观测频率比陈述概率至少低5个百分点 | council-forecasts.csv计数的1日行;已存档的脚本 | B | 31 Dec 2026 | 差异 ≥ 5个百分点,n ≥ 100 | 差异 < 5个百分点,n ≥ 100;n < 100 = 未解决 | 0.80 |
| F15 | 委员会没有以明显优势击败简单规则:在两者都计分的会话上,1日时B(consensus) − B(momentum)大于−0.01 | council-forecasts.csv的共识和动量1日Brier在公共会话上;已存档的脚本 | B | 31 Dec 2026 | B(consensus) − B(momentum) > −0.01 | B(consensus) − B(momentum) ≤ −0.01 | 0.80 |
| F16 | 没有预期期限在一个赛季内携带检测到的信号:对于1日、1周和1个月中的任何一个,共识Brier都没有95%置信区间完全在0.25以下,置信区间按第4.6节规则(1日的会话聚类;滞后为h−1的Newey-West,或至少h个会话区块的区块自助法,用于预期期限h) | council-forecasts.csv按预期期限的共识Brier;已存档的脚本 | B | 30 Apr 2027 | 无预期期限的上界 < 0.25 | 至少一个预期期限的上界 < 0.25 | 0.63 |
| F17 | 相对于气候学,日度是最困难的预期期限:在1日、1周和1个月中,委员会的共识Brier技能得分(相对于气候学基准率:2016到2025年间每个市场和预期期限的严格上升频率,所有行)在1日时最低 | council-forecasts.csv按预期期限的共识Brier;council-calibration.json的气候学climatology_fixed.table[*].p_up,已存档脚本验证的密封(第8节);字段发布于2026年10月21日 |
B | 30 Apr 2027 | 1日技能得分是三者中最低的 | 1日技能得分不是最低的 | 0.37 |
| F18 | 国家是一个小因素:美国方和中国方1日Brier之间的绝对差距(每方是其排名模型在公共会话上Brier的均值)小于每方内部的范围(最高减最低排名模型Brier) | council-league.json的by_horizon.1d、side、ranked;council-forecasts.csv;已存档的脚本 |
B | 31 Dec 2026 | 差距 < 每方内部的范围 | 差距 ≥ 任一方内部的范围;任一方的排名模型少于两个 = 未解决 | 0.80 |
| F19 | 美国方在一个赛季内得分更好:美国方的1日Brier,即其排名模型在第11场会话开始的公共会话上所有行的Brier均值,低于中国方的,计算方式相同 | council-forecasts.csv的计数1日行,council-league.json的side和ranked;已存档的脚本 |
B | 30 Apr 2027 | 美国 < 中国 | 美国 ≥ 中国;任一方的排名模型少于两个 = 未解决 | 0.57 |
| F20 | 相同的新闻意味着更少的争议:在闭卷运行(密封数据包,无搜索)中,分歧的热度低于同一模型和同一天的开放运行 | arena-cb-experiment.json中窗口内runs[*]的heat_closed − heat_open平均值 |
A | 30 Nov 2026 | closed heat < open heat | closed heat ≥ open heat | 0.70 |
| F21 | 搜索增加的准确度很少:闭合账本调用的次日Brier与相同模型和会话的开放调用相差不超过0.01 | closed_book council-book.jsonl、council-forecasts.csv 的行;已提交脚本。在公共参考点之后密封的闭合调用仅从其自身参考价格评分(第5.5节)。在2026年10月21日的文件中,每条闭合账本行在开放之后被请求(asked_after_open),并且不从其自身参考中携带任何结果,因此该行尚无法解决;一旦联盟发布密封在公共参考之前的闭合调用或为每个闭合调用发布其自身的参考价格、收盘价和结果(例如每个市场的score字段),它就会得到解决,解析器已经可以读取 |
B | 31 Dec 2026 | absolute difference ≤ 0.01 | absolute difference > 0.01; no comparable pairs = unresolved | 0.72 |
| F22 | 讨论发现真实风险:至少55%的主席已解决的5会话移动批评得到确认,"确认"意指该基金在5个会话中的回报具有批评预测的符号 | status、council-talk-critiques.csv(从批评的方向和基金的5会话回报重新计算,其中字段不同) |
A | 31 Dec 2026 | share ≥ 55% with at least 20 resolved critiques | share < 55% with at least 20 resolved critiques; fewer = unresolved | 0.30 |
| F23 | 遵守批评有回报:采纳批评的影子投资组合平均而言击败了保留的投资组合 | 在时间窗口内会话位于其中的周的批评投资组合中 weeks[*].criticised[*].heed_minus_keep_pp 的均值,council-talk.json |
A | 31 Dec 2026 | mean > 0 | mean ≤ 0 | 0.42 |
| F24 | 一个模型与自身意见不一致很多:一个模型自身重复中的平均热量至少是模型之间热量的一半 | 来自2026年11月1日雷达的周的 weeks[*].summary.noise_floor.heat_self 和 heat_between_models 的均值,council-repeats.json |
A | 30 Nov 2026 | heat_self ≥ 0.5 × heat_between_models, with heat_between_models > 0 | heat_self < 0.5 × heat_between_models; both zero = unresolved | 0.60 |
| F25 | 领导者不会持久:在2026年Q4中按1天Brier排名前三的委员会模型中,最多有一个出现在2027年Q1的前三名中。符合条件的是 league-roster.json 中位置为 council 的席位,在每个季度内满足30/10规则,2026年Q4指会话11至52(开发期之后),2027年Q1指2027年1月4日至3月31日的会话;模型版本的日期变更中,一个席位保持一个席位(第5.7节);Brier中的精确平局按席位名称按字母顺序打破 |
council-forecasts.csv,按季度计数1天行;league-roster.json;已提交脚本 | B | 30 Apr 2027 | at most one stays in the top three | two or more stay in the top three; fewer than three ranked Council seats in either quarter = unresolved | 0.62 |
| F26 | 指数很难被击败:在赛季最后一个会话,14个主联盟模型账户中的少于一半具有比S&P 500账户更高的价值 | 14个模型账户和 _spy 的 value_usd,arena-accounts.csv;已提交脚本 |
B | 30 Apr 2027 | 6 or fewer above _spy |
7 or more above _spy |
0.60 |
| F27 | 优秀的预测者不是最好的交易者:在持有主联盟账户的1天排名委员会席位中,1天Brier排名与主联盟回报排名之间的Spearman相关系数低于0.5,其中排名1为最低Brier和最高回报。席位是指按30/10规则在会话11至126中排名的席位,Brier来自该窗口中所有计数的1天行,回报来自账户在赛季最后一个会话的 value_usd;相关值取其排名的平均值 |
council-forecasts.csv的计数1天行、league-roster.json、arena-accounts.csv;已提交脚本 | B | 30 Apr 2027 | rho < 0.5 with at least 6 ranked seats | rho ≥ 0.5 with at least 6 ranked seats; fewer = unresolved | 0.83 |
| F28 | 在第一次预测之前访问模型不会将读者的Brier分数提高0.01或更多:在匹配的市场(每组至少200个首次预测)上,未显示模型的组的Brier分数超过显示模型的组的分数少于0.01(组间访问的影响;侧面上的置信度c解读为该侧面的概率c/100;命中率在其旁报告) | experiment.g0.brier 和 experiment.g1.brier,各有 n,council-league.json |
A | 31 Dec 2026 | difference < 0.01 with at least 200 per group | difference ≥ 0.01 with at least 200 per group; fewer = unresolved | 0.46 |
| F29 | 访问权限使读者走向委员会:显示模型的组的首次预测与委员会共识在方向上一致的频率至少比未显示模型的组的首次预测高10个百分点(组间访问的影响;每组至少200个首次预测) | 实验的按读者首次预测(将在arena-dataset.json中发布和记录的字段)和每次运行的共识;已提交脚本 | B | 31 Dec 2026 | difference ≥ 10 points with at least 200 per group | difference < 10 points with at least 200 per group; fewer = unresolved | 0.41 |
| F30 | 风格暴露了模型:在盲季(从2026年11月2日开始),一个固定的猜测者(模型、版本和其提示的SHA-256,命名在注册表的附录中,在2026年11月2日之前提交,温度0,来自被排除在候选之外的家族),显示每个项目一个密封答案文本和回答的k个候选席位的列表,识别模型的频率至少是机会的三倍 | 盲季答案行和赛后揭示;已提交脚本 | B | 30 Apr 2027 | mean top-1 accuracy over items ≥ mean of 3/k | mean top-1 accuracy over items < mean of 3/k | 0.46 |
注意:集合A由一个或两个已发表的字段定义。集合B由随注册提交的脚本定义,并在开放原始文件上运行,该脚本就是定义。每一行的解析器都作为resolve.py提交(规则版本osf-rules-1),其中包含第8.1节的详细信息:F15的动量规则是指标在前一个会期的联赛结果的方向,比例为55%,适用于所有行。在2026年10月21日的文件中,F21、F29和F30显示为未解决,每一行都标明了它需要的数据。我在第一批密封运行对我可见后设置了F1至F5和F9的阈值,其时间窗口从第11个会期开始。
F14、F22和F28是低功率行:F14的标准误差在100次预测时约为5个百分点,F22在20次评论时约为11个百分点,F28在每组200次时约为0.02 Brier。F15、F21和F28比较点估计值且阈值为0.01,不是等价性检验。
无技能情况下的预期值:F11,对于十个独立出错的排名模型,在单侧2.5%的情况下至少约为0.78,当它们的得分高于0.25时更高,当它们的误差相关时又更高(F3)。F16,在相同假设下三个时间范围内至少约为0.93。F25,十一个排名模型约为0.85,十个随机排名约为0.82。F10可能有任一结果:领先者在较早的时间窗口中选出,平均只能保证超过它保留的成员均值(第4.5节)。F8是关于联赛的操作预测。校准分段是半开的,支持方为[60,70)。
检查日期:2026年11月30日(第30个会期)、2026年12月31日(第52个会期)、2027年4月30日(在126个会期赛季结束后,预计在2027年4月20日左右结束)。盲赛季始于2026年11月2日。其中答案行用加盐SHA-256承诺密封模型、其版本和模式,H(salt || model || version || mode),因此要求1在不显示名称的情况下成立。盐值在赛季后发布(第3.13节),F30在承诺打开后根据密封的答案行评分。记分卡作为本文的有日期修订版本发布并在OSF上注册。
随注册声明的次要分析,不带概率。(1)分歧是否有帮助:共识相对于气候学在座位传播最高和最低三分位数的配对增益,市场固定,双侧(第8节)。(2)折扣相关声音是否有帮助:第5.3节公布的共识与影子共识的配对单日Brier差异,第11至126个会期,移动块自助法(块大小为5,10,000次重采样,种子20261102)以及±0.01的等价区间;影子权重和计算它们的脚本随注册提交。两者都不是F行,两者都不进入三十项预测的Brier得分。
附录 E. 与先前工作的功能比较(截至 2026 年 10 月 21 日)
表 E1 将参考实现的功能与最接近的工作进行了对比,按表 9 的注释中列出的内容阅读。"是"表示该属性已记录;"部分"表示一种较弱或不同的形式,如单元格中所述;"否"表示已记录的缺失或排除该功能的设计;"未记录"表示截至 2026 年 10 月 21 日未公开记录(表 9)。联盟列使用自己的三种状态,截至 2026 年 10 月 21 日:已实现表示在开放文件中可见。已指定表示在标准或开放方法中书写,在该日期不在文件中。运营商记录表示正在运行,有第三方通过依赖运营商的记录进行检查。一个单元格可能为功能的两个部分给出两种状态。
表 E1. AI Council · Markets 的功能与最接近的先前工作对比,基于截至 2026 年 10 月 21 日的公开材料。
| 功能 | 我们的(状态) | Foresight Arena | Prediction Arena | NeuPortal | LLM Trading Arena | TradeRank | MarketMania | 其他 |
|---|---|---|---|---|---|---|---|---|
| 1. 日常实时联赛 | 已实现(从 2026 年 10 月 16 日) | 部分(轮次;论文结果模拟,§6;Nechepurenko & Shuvalov, 2026b 中的实时代理) | 是(每 15 到 45 分钟一个周期,2026 年 1 月至 3 月) | 否(每场比赛) | 是(加密资产每天两次,股票每个交易日) | 是(每 24 小时) | 是(从 2026 年 7 月 15 日) | 是:Alpha Arena、Agent Market Arena、Rallies、FutureX |
| 2. 七个美国实验室和七个中国实验室的模型 | 已实现(14 个交易席位,7 个美国和 7 个中国实验室;11 个预测席位,5 个美国和 6 个中国) | 否(5 个计划,1 个中国) | 否(10 个模型,1 个中国实验室) | 否(一个未命名的 AI) | 否(6 个系列,2 个中国) | 无国家设计(22 个模型) | 否(7 个模型,2 个中国) | 否:Alpha Arena 6 中的 2 个;Rallies 8 中的 2 个 |
| 3. 来自预测席位的概率 | 已实现(11 个席位) | 是 | 否(仅交易) | 是(三个结果) | 否(订单) | 未记录 | 是(陈述概率) | 是:Prophet Arena、ForecastBench |
| 4. 跨资产类别的固定金融指标面板 | 已实现(12 个) | 否(Polymarket 事件) | 部分(Kalshi 金融合约在 7 个类别中) | 否(足球) | 部分(5 种加密资产、标普 100) | 部分(10 种加密资产、50 只美国股票) | 部分(5 种加密资产) | 部分:单个股票或加密资产(StockBench、Agent Market Arena、GlassBallAI) |
| 5. 同一资产上的四个固定时间范围 | 已实现 | 否 | 否 | 否 | 未记录 | 未记录 | 是(1 小时至 1 个月) | 是,非金融面板:ForecastBench 数据集问题上的八个时间范围;部分:GlassBallAI 一个 10 天时间范围 |
| 6. 在参考之前由哈希密封的答案 | 已实现(SHA-256 链在美国东部时间 09:30 之前预订);2026 年 10 月 19 日和 20 日的运营商记录(级别 1);从 2026 年 10 月 21 日起可公开验证(至少两个 RFC 3161 令牌,级别 2+,证明页面);在到达时密封已指定 | 部分(每个代理和轮次的 keccak256 承诺,§3.2;不是所有答案的链) | 否 | 部分(每个预测文件的 SHA-256;未记录链) | 部分(填充和理由的 git 历史记录,在下一个开放填充之前) | 未记录 | 未记录 | 部分:Prophet Arena 加盐 SHA-256 注册表、运营商时钟;Sornette et al. (2010) 校验和,非 AI |
| 7. 运营商外的锚点 | 已实现(Bitcoin、OpenTimestamps:存在不迟于区块后数小时;2026 年 10 月 20 日在开放后) | 部分(Polygon PoS,§3.2) | 否 | 是(Bitcoin;足球,一个 AI) | 否(时间取决于 git 主机) | 未记录 | 未记录 | 是,非金融:Zeus 链上天气预报承诺;Jyotish (2026),非 AI;否:Prophet Arena(运营商时钟) |
| 8. 在密封后获取的参考价格 | 已实现,从 2026 年 10 月 21 日起可公开验证(级别 2+,附录 B,第 9 步);2026 年 10 月 19 日和 20 日的运营商记录(booked_at,级别 1) |
部分(基准中间价格在截止时间后存储;二元结果,图 3) | 否 | 部分(在锁定时或之前的众包价格) | 部分(订单在下一个开放时成交) | 未记录 | 部分(在答案后的第一个 1 分钟 K 线进入) | 未记录 |
| 9. 一次由预先书写的规则计数的运行;所有运行已发布 | 已实现(每次运行已发布,其他标记为 not_counted);计数运行从 2026 年 10 月 21 日起在问题链中提前声明并密封(第 3.4 节);对于 2026 年 10 月 19 日和 20 日的开发会话,规则在运行后应用 |
部分(每个代理和轮次的一次提交,中继器强制执行,§4.3;所有提交在链上公开;离链运行未涵盖) | 否(隐藏模型的预窗口运行,附录 B.2) | 未记录 | 未记录 | 未记录 | 未记录 | 未记录 |
| 10. 严格适当的评分和校准 | 部分已实现(已发布的 Brier 下降抽取;校准柱);所有行 Brier 从 2026 年 10 月 21 日起指定为主要的,并由提交的脚本计算 | 是(Brier、Alpha、Murphy 分解,§3.3 至 §3.5) | 否(收益、胜率,§3.3) | 是(三个结果的 Brier) | 否(账户价值) | 未记录 | 是(Brier、校准差距) | 是:Prophet Arena、ForecastBench |
| 11. 无信息 50% 和气候基准 | 已实现(50%);已实现(2016 至 2025 年频率密封;从 2026 年 10 月 21 日 08:54 UTC 起在开放文件中的字段 climatology_fixed) |
部分(随机和市场基准) | 否 | 未记录 | 未记录 | 未记录 | 未记录 | 部分:ForecastBench 朴素基准;KalshiBench 针对气候的技能分数 |
| 12. 排名前的最少会话规则 | 已实现(30/10,ranked 标志) |
部分(幂分析,推荐最少轮次,§3.6.2) | 否 | 未记录 | 未记录 | 未记录 | 未记录 | 未记录 |
| 13. 每个模型 $100,000 的模拟投资组合 | 已实现 | 否 | 部分(事件合约中的真实 10,000 美元) | 否 | 是(100,000 美元,纸质) | 部分(10,000 美元模拟) | 部分(纸质期货交易) | 是:集会 100,000 美元;Alpha Arena 真实 10,000 美元 |
| 14. 卖空和 2 倍杠杆 | 已实现(Pro 联赛) | 否 | 否(无杠杆,§4.5.1) | 否 | 部分(加密杠杆,无卖空) | ND | 部分(多头或空头,纸质) | 是:Alpha Arena 杠杆永续合约(新闻稿) |
| 15. 答案时预测市场价格作为比较 | 已实现(crowd_up 对合约价格) |
是(Alpha 对中间价,§3.4) | 部分(交易对价格) | 是 | ND | ND | ND | 是:Prophet Arena、AIA Forecaster |
| 16. 一致性因相关声音实时打折 | 已实现(按既定资格规则计算 N_eff,n_eff.counted;家族权重;全错误和少数正确计数) |
否(假设市场独立,§7.5) | 否 | 否(一个模型) | ND | ND | 部分(测量羊群行为,未打折) | 仅离线:Kim et al. (2025)、Spiro (2026)、Aitchison et al. (2026) |
| 17. 闭卷考试配密封新闻包 | 已实现(密封包配哈希值);缺少搜索运算符记录在指令仅指的地方 | 否(搜索可选,未消融) | 否(所有模型搜索) | ND | ND | ND | 部分(一个公开有效负载配新闻摘要;搜索 ND) | 部分:FinDeepForecast 有搜索和无搜索、离线;MarketMania 通用有效负载 |
| 18. 委员会讨论模式 | 已实现 | 否(设计上盲目) | 否(未来工作) | ND | ND | ND | ND | 部分:协调配置,Foresight Arena 实时(Nechepurenko & Shuvalov, 2026b) |
| 19. 重复查询一个模型 | 已实现(投资组合);概率重复已指定 | 否 | 否 | ND | ND | ND | 是(稳定性运行) | 离线抽样研究(Aitchison et al., 2026) |
| 20. 读者在看到 AI 之前预测,两个永久小组 | 实时向每个访问者开放;结果注册为 F28 和 F29,每组前 200 个预测读取;小组标签已指定 | 否 | 否 | ND | ND | ND | ND | 部分:独立池(ForecastBench、Metaculus);协助试验(Schoenegger et al., 2025) |
| 21. 盲期 | 已指定(从 2026 年 11 月 2 日起;模型、版本和模式密封为加盐 SHA-256 承诺,盐在季节结束后发布) | 否 | 部分(一个隐藏标识符下的模型) | ND | ND | ND | ND | ND |
| 22. 关于联赛的日期预测,盲目定价 | 已实现(30 个,盲目定价;在发布前注册在 OSF 上) | 否 | 否 | ND | ND | ND | ND | ND |
| 23. 按既定许可证公开数据 | 已实现(CC BY 4.0) | 部分(链上,未声明数据许可证) | ND(未给出存储库) | 是(GitHub、Zenodo) | 是(MIT,完整账本) | 部分(开放 JSON,许可证未声明) | 部分(API 导出,许可证 ND) | 是:ForecastBench、LiveTradeBench、StockBench;GlassBallAI CC BY-NC |
| 24. 带哈希值的开放评分代码 | 已实现(引擎代码配哈希值、arena-code.json;预测评分重新计算、tools/replay_brier.py;解析器在 OSF 上归档) | 是(链上合约、分析存储库) | 否 | ND | 部分(代码开放) | ND | ND | 部分:PolyBench、ForecastBench 代码 |
| 25. 第三方重新计算每个账户 | 已实现(replay.py) |
是("重放完整历史",Contributions 1) | 否 | ND | 是(账本重新计算每个账户) | ND | ND | ND |
| 26. RFC 3161 令牌在密封处 | 从 2026 年 10 月 21 日起实现,公开可验证(FreeTSA 和 DigiCert;同一上午添加 Sectigo;证明页面);指定到达时密封 | 否 | 否 | ND | ND | ND | ND | 非 AI:人类预测的通用密封工具 |
注:Foresight Arena 和 Prediction Arena 列中的 § 编号引用这些论文的相应章节。第 5、10、13 至 15、19 和 25 行是联赛与早期工作共享的功能。第 7.4 节主张背后的行:主张 1:第 4 和 6 至 9 行(10 月 19 日和 20 日在第 1 级,10 月 21 日起在第 2 级以上)。主张 2:第 16 行。主张 3:第 6 至 12、16 和 26 行,与第 3.13 节的状态列一并阅读。主张 4:第 20 行。主张 5:第 2 行。主张 6:第 22 行。
如何引用
Chernets, V. (2026). Sealed Before the Open: A Verifiable Standard for Measuring AI Forecasts of Financial Markets [预印本]。SSRN。https://doi.org/10.2139/ssrn.7653679
@misc{chernets2026sealedbeforetheopen,
  author       = {Chernets, Vadym},
  title        = {{Sealed Before the Open: A Verifiable Standard for Measuring AI Forecasts of Financial Markets}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7653679},
  url          = {https://doi.org/10.2139/ssrn.7653679}
}