Sealed Before the Open: A Verifiable Standard for Measuring AI Forecasts of Financial Markets
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
Quatorze modèles d'IA américains et chinois, douze marchés, quatre horizons : une ligue en direct scellée, un décompte des voix indépendantes derrière chaque consensus et 30 prévisions enregistrées
Vadym Chernets, PhD, architecte de systèmes IA · Fondateur, PolyHelper (polyhelper.ai) · ORCID 0009-0007-4845-3163
SSRN 7653679 · DOI 10.2139/ssrn.7653679 · Zenodo 10.5281/zenodo.23552697 · Enregistrement OSF 10.17605/OSF.IO/9Q86N · Publication d'analyse 10.5281/zenodo.23552700 · GitHub
Télécharger cet article
- SSRN (citation préférée) : ssrn.com/abstract=7653679 · DOI 10.2139/ssrn.7653679
- Zenodo (archivé, accès ouvert) : doi.org/10.5281/zenodo.23552697
- OSF (les prévisions enregistrées de la section 8) : doi.org/10.17605/OSF.IO/9Q86N
- GitHub (texte complet et commandes de vérification de l'appendice B) : https://github.com/vadimchernets/papers/tree/main/sealed-before-the-open
- Publication d'analyse (les fichiers que cette version lit, gelés, avec un manifeste SHA-256) : doi.org/10.5281/zenodo.23552700
- Ligue en direct et données ouvertes (CC BY 4.0) : trends.polyhelper.ai/markets/ · trends.polyhelper.ai/api/v1/
Vérifiez un sceau en trois étapes (Appendice B) : téléchargez le livre et le timbre du 20 octobre, hashez le préfixe tamponné, vérifiez l'ancre.
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt.ots
head -n 159 council-book.jsonl | shasum -a 256   # 59673b9e...a7d9, as in 130025Z.txt
ots verify 130025Z.txt.ots                       # Bitcoin block 972,334
Sans un nœud Bitcoin, ots info 130025Z.txt.ots affiche l'attestation au bloc 972 334, dont la racine de Merkle est affichée par n'importe quel explorateur de blocs (Appendice B, étape 6). L'étape 10 vérifie l'horodatage dans le journal Sigstore Rekor.
Citez le prétirage SSRN. Les sessions notées sont lues au 20 octobre 2026, à partir des fichiers ouverts générés le 21 octobre 2026 entre 02:42 et 05:33 UTC. La première exécution comptabilisée, du 21 octobre 2026, est lue à partir des fichiers générés à 22:16 UTC. Le tableau 5 donne l'état de conformité tel que lu le 21 octobre 2026 à 15:05 UTC, la vérification de conformité de l'exigence 1 à 22:33 UTC et l'entrée Rekor de l'exigence 3 le 22 octobre 2026 à 00:00:16 UTC.
Mots-clés : prévision IA ; grands modèles de langage ; marchés financiers ; évaluation des prévisions ; score de Brier ; calibrage ; biais de regard en avant ; horodatage approuvé ; OpenTimestamps ; nombre effectif de voix indépendantes ; marchés de prédiction ; prédictions enregistrées
JEL : G17; C53; C52; G14; D84
Résumé
Lorsqu'une IA prédit que l'or augmentera, un lecteur peut évaluer cette prédiction à la fermeture du marché mais généralement ne peut pas vérifier quand elle a été faite. Un backtest mélange la mémoire avec la compétence, et une saison de trading est un chemin possible à travers le marché. Je propose une norme de requirements numérotés pour mesurer les prévisions des IA sur les marchés financiers et je documente son implémentation de référence, la ligue ouverte AI Council · Markets, gérée par PolyHelper, avec un statut publié par requirement. Quatorze grands modèles de langage, sept de laboratoires américains et sept de laboratoires chinois, répondent à la même question sur un snapshot de prix partagé, chacun avec son propre compte. Onze d'entre eux font des prévisions sur douze indicateurs à quatre horizons avant chaque ouverture à New York. Chaque réponse comptabilisée est scellée dans une chaîne de hash SHA-256 avant son prix de référence et ancrée dans Bitcoin par OpenTimestamps. À partir du 21 octobre 2026, le run comptabilisé est déclaré à l'avance, et des autorités RFC 3161 indépendantes signent chaque enregistrement horodaté, qui entre également dans le journal de transparence Sigstore Rekor. À cette première matinée comptabilisée, chaque réponse comptabilisée a été signée avant l'ouverture de 09:30 ET, huit d'entre elles 29 minutes avant elle. Le score de Brier de l'événement demandé est évalué par rapport à un benchmark de 50%, le taux climatologique de base et les prix des marchés de prédiction, et l'accord est rapporté comme un nombre de voix indépendantes. Pendant les matinées de développement des 19 et 20 octobre, les images de probabilité des modèles étaient aussi similaires à celles d'environ 1,6 prévisionnistes indépendants. Le 20 octobre, trois des quatre paires les plus proches ont réuni un laboratoire américain et un laboratoire chinois. Par rapport à une carte datée de 23 efforts de prévision et de trading en IA, la ligue est la première ligue d'IA en direct sur les indicateurs financiers à combiner ces éléments. C'est aussi la première arène de marché IA où sept modèles américains et sept modèles chinois échangent sous un protocole unique à côté de lecteurs assignés une seule fois, au hasard, pour faire des prévisions avant ou après avoir vu les modèles. Trente prédictions datées, inscrites sur OSF avant publication, sont évaluées dans des révisions datées.
Résumé exécutif
Une prévision de prix est une preuve de compétence seulement si le prévisionniste ne connaissait pas le résultat, la prévision existait avant lui, et la prévision notée est celle qui compte, quels que soient les autres essais. Les modèles IA mettent à l'épreuve tous les trois : ils peuvent avoir lu le résultat lors de l'entraînement, peuvent être interrogés à nouveau en secondes, et leurs antécédents sont généralement conservés par celui qui a posé la question. J'ai rédigé chaque condition comme une exigence qu'un lecteur peut vérifier. AI Council · Markets, géré par PolyHelper, est l'implémentation de référence.
Chaque question concerne un résultat à venir, ce qui la garde hors de la mémoire d'un modèle. Un marché est un test qui se renouvelle : il pose une nouvelle question chaque matin et y répond le même après-midi, de sorte qu'aucun modèle ne peut avoir lu la réponse. Deux prévisions ne se comparent que lorsqu'elles parient sur la même chose, et l'unité est donc un contrat d'événement fixé à l'avance. Chaque réponse est scellée dans une chaîne de hachage avant le prix d'ouverture à partir duquel elle est notée, puisqu'une prévision qui a vu le mouvement d'ouverture répond à une question différente. Je ne voulais pas que le dossier repose sur la confiance envers son conservateur, donc la chaîne est ancrée dans Bitcoin et, à partir du 21 octobre 2026, signée par des autorités d'horodatage indépendantes. Une exécution par session compte. À partir du 21 octobre, la règle qui la sélectionne est déclarée à l'avance et scellée, et les autres exécutions restent publiées et étiquetées.
Le score est le score de Brier de l'événement posé. C'est un score propre, de sorte qu'un prévisionniste ne gagne rien en déclarant autre chose que sa conviction. La ligue le lit par rapport à une pièce, le taux de base de l'événement et les prix du marché de prédiction, trois barres différentes pour la compétence. Les modèles corrélés ne sont pas des témoins distincts, et l'accord entre eux est rapporté comme un nombre de voix indépendantes. Sept modèles américains et sept modèles chinois partagent la question, l'instantané, l'échéance et les règles, de sorte que toute différence entre les côtés est mesurée sur une seule tâche. Les lecteurs sont randomisés une fois, pour voir les modèles avant ou après qu'ils prévisent, et restent dans ce groupe. Ils mesurent si les modèles aident les gens ou seulement les entraînent avec eux (F28, F29).
Les deux matins de développement montrent ce que ces mesures lisent. À l'horizon d'une journée, les images de probabilité des modèles scellés avant l'ouverture étaient aussi similaires que celles de moins de deux prévisionnistes indépendants. Elles ont été les plus décidées à six mois, où leurs prévisions se résolvent en dernier, et le 20 octobre, trois des quatre paires les plus proches ont rejoint un laboratoire américain et un laboratoire chinois. Un test primaire et trente prédictions, enregistrés sur OSF avant la publication, sont notés dans des révisions datées sur des données et du code ouverts.
1. Introduction
Lundi matin, une personne demande à un modèle IA s'il faut acheter de l'or. Le modèle répond oui, avec une certaine confiance, et donne une raison. À la clôture, l'or a baissé. Le modèle s'était-il trompé, ou avait-il été malchanceux, ou s'agissait-il l'une de plusieurs réponses qu'il a données ce matin-là ? La réponse existait-elle à 09:00, ou a-t-elle été écrite à midi ? La personne ne peut pas le dire. Dans la plupart des évaluations examinées à la section 7, le moment d'une prévision repose sur le dossier de l'opérateur. La ligue que je décris ici conserve ce dossier en dehors de l'opérateur. Le mardi 20 octobre 2026, avant l'ouverture, huit modèles ont donné à l'or une probabilité moyenne de 45 % de clôturer en hausse sur le contrat quotidien de Polymarket, et la foule sur ce contrat l'a évalué à 29 %. Les deux chiffres ont été scellés avant l'ouverture à 09:30 ET, et n'importe qui peut les relire (Appendice B).
Les arènes dans lesquelles les modèles négocient de l'argent réel ont attiré une large attention en 2025 (Forklog, 2025a, 2025b), et les benchmarks de prévision des LLM ont atteint les principaux lieux du machine learning : ForecastBench à ICLR 2025 (Karger et al., 2025), FutureX (Zeng et al., 2025) et Prophet Arena (Yang et al., 2025) à ICLR 2026. Les benchmarks de négociation ont montré que la plupart des agents n'ont pas surpassé l'achat et la conservation (Y. Chen et al., 2025 ; Yu et al., 2025), et sur les marchés de prédiction liquides, un système de prévision IA fort a encore traîné le consensus du marché tandis qu'une combinaison des deux a surpassé les deux (Alur et al., 2025).
Ces efforts partagent une dépendance : la preuve qu'une prévision a précédé son résultat est conservée par quiconque a mené l'évaluation. Les backtests ne peuvent pas la fournir du tout, car le modèle connaît peut-être déjà le résultat (Lopez-Lira et al., 2025 ; Paleka et al., 2026). Les benchmarks en direct la fournissent par les dossiers de l'opérateur, et Prophet Arena ajoute un sceau SHA-256 salé de chaque prévision, avec des reçus signés optionnels, horodatés par l'horloge de la plateforme elle-même (Prophet Arena, 2026). Foresight Arena engage les prévisions hachées des événements Polymarket, dont certaines sur les prix des actifs, dans la chaîne Polygon avant une limite et les note en fonction du prix du marché. Sa version révisée signale les résultats simulés et diffère les résultats en direct (Nechepurenko & Shuvalov, 2026a). Prediction Arena a donné aux modèles de pointe un capital réel sur Kalshi et Polymarket et a conservé les journaux des opérateurs sans engagement (Zhang et al., 2026). En dehors de l'IA, les prévisions des bulles financières ont été scellées par somme de contrôle avec divulgation retardée dès 2010 (Sornette et al., 2010), et, en dehors des marchés, les probabilités de football d'une IA sont ancrées dans Bitcoin depuis juillet 2026 (NeuPortal, 2026). Je n'ai trouvé aucune ligue en direct de prévisions IA sur un panel fixe d'indicateurs financiers qui ancre ses dossiers en dehors de l'opérateur (Section 7). Ma question de recherche est ce qu'une mesure des prévisions de marché IA doit avoir pour qu'un lecteur puisse vérifier, en fonction d'une horloge en dehors du contrôle de l'opérateur, ce qui a été prévu, à quel moment, et quelle prévision a été comptabilisée.
Je propose une norme pour cette mesure, écrite sous forme de liste de contrôle des exigences MUST et SHOULD (Section 3.13), et je documente une implémentation de celle-ci, la ligue en direct ouverte AI Council · Markets, dirigée par PolyHelper, sur trends.polyhelper.ai/markets. Quatorze modèles, sept de laboratoires américains et sept de laboratoires chinois, gèrent des portefeuilles simulés sur la même question, snapshot et règles, et onze d'entre eux siègent au Conseil et donnent des probabilités. Chaque matin avant l'ouverture de New York, le Conseil prévoit 12 indicateurs financiers, couvrant les indices boursiers, les taux, le dollar, la volatilité, les matières premières et le Bitcoin, sur quatre horizons allant d'un jour à six mois. Chaque réponse est scellée dans un livre enchaîné par hachage dont l'en-tête est ancré dans Bitcoin via OpenTimestamps. Chaque réponse est notée à partir du premier prix après son scellement, et le livre est publié avec le code de notation et les données. À partir du 21 octobre 2026, des autorités indépendantes de signature d'horodatage RFC 3161 signent également chaque dossier horodaté, pour qu'un lecteur puisse vérifier selon des horloges en dehors du contrôle de l'opérateur que les réponses comptabilisées existaient avant le prix d'ouverture auquel elles sont évaluées (Section 3.2). Le dossier scellé est également une nouvelle sorte de données ouvertes pour la finance : un panel quotidien de probabilités de nombreux modèles IA sur les mêmes événements, fixé avant l'ouverture, sur lequel leur désaccord et sa valeur peuvent être mesurés.
Le contrat d'événement est publié sous forme de schéma avec un vérificateur que toute autre ligue peut exécuter sur ses propres fichiers (Section 3.13). Ce que j'apporte est la norme et une implémentation qu'un lecteur peut vérifier. Les premières sessions montrent les données qu'elle produit, et les tests enregistrés de la section 8 décident de la compétence. La section 3 énonce la norme et la section 4 un modèle de notation pour un contexte de marché en direct. La section 5 mesure le nombre effectif de voix indépendantes sur les données en direct, la section 6 expose un modèle pour les humains avant l'IA, et la section 7 dresse une carte datée des arènes de marché IA. La section 8 contient les prédictions enregistrées, la section 9 les objections les plus fortes avec la règle qui y répond, et la section 10 la portée de chaque affirmation. La section 7.4 énonce ce qui est nouveau, en trois affirmations et trois conceptions supplémentaires en premier parmi les arènes de marché IA examinées, et ce sur lequel la ligue s'appuie, chacun avec son précédent le plus proche. L'appendice E fournit la preuve cellule par cellule.
2. Pourquoi la vision rétrospective déstabilise les prévisions du marché de l'IA
Les tournois de prévisions humaines protègent les trois conditions du résumé exécutif par des délais d'inscription et un organisateur de confiance. Les modèles IA contournent chaque garde. Un modèle peut connaître le résultat à partir de ses données d'entraînement, on peut l'interroger plusieurs fois par minute, et l'enregistrement de ce qu'il a dit est conservé, en règle générale, par la personne qui l'a interrogé. Les trois premiers sous-sections les abordent tour à tour, et la quatrième explique pourquoi une saison de trading ne peut pas se substituer à un enregistrement de prévisions.
2.1 Ce qu'un modèle retient
L'évaluation la moins coûteuse d'un modèle IA en matière de prévisions financières est un backtest, mais les données d'entraînement du modèle peuvent déjà contenir ce qui s'est passé ensuite. Lopez-Lira et al. (2025) ont montré que les grands modèles de langage retrouvent les valeurs exactes des séries macroéconomiques et financières antérieures à leur date limite d'entraînement, qu'une instruction de ne pas utiliser des connaissances ultérieures ne supprime pas cette capacité, et que celle-ci s'arrête après la limite : dans la fenêtre d'entraînement, compétence et mémoire ne sont pas distinguées.
Gao et al. (2025) ont construit un test pour la distorsion prospective, la propension à l'anticipation. Dans une réplication du résultat selon lequel les scores de modèles sur les titres d'actualité prédisent les rendements boursiers (Lopez-Lira & Tang, 2023), la puissance prédictive s'est amplifiée sur les observations ayant une forte propension à l'anticipation. Après la limite, le signal brut a persisté, tandis que l'interaction associée à la mémorisation a perdu sa significativité. Glasserman et Lin (2023) ont séparé deux biais en échantillon des backtests de sentiment GPT, la distorsion prospective et une distraction par ce que le modèle sait de l'entreprise nommée, et trouvé le second plus important, surtout pour les grandes entreprises. Sur vingt ans de données, le cadre FINSABER a constaté que les avantages rapportés pour les stratégies d'investissement LLM diminuent fortement une fois que la survivance, le data snooping et la distorsion prospective sont contrôlés (W. W. Li et al., 2025), et les indices basés sur la simulation historique, tels que InvestorBench (H. Li et al., 2025), héritent de la même exposition.
La littérature répare cela de deux façons. L'une restreint le modèle : les modèles de langage chronologiquement cohérents sont entraînés uniquement sur du texte disponible avant chaque date de prévision (He et al., 2025). L'autre restreint le temps : n'importe quel modèle, à pleine puissance et avec recherche, est interrogé sur un résultat encore à venir, et la réponse est fixée, vérifiablement, avant que le résultat n'existe. J'ai choisi de contraindre le temps et de laisser le modèle à pleine puissance. Les deux voies sont complémentaires, car un modèle chronologiquement cohérent peut entrer dans une ligue hermétique.
2.2 Routes de fuite
Passer à des questions en direct supprime la plus grande fuite mais non chaque fuite. Paleka et al. (2026) montrent que la fuite temporelle dans les évaluations de prévisionnistes de modèles de langage est souvent subtile, et que la performance sur une évaluation peut ne pas se transposer aux prévisions dans le monde réel. FutureX rapporte des modes de défaillance de la même famille, y compris des pages web contrefaites et des réponses dont la validité temporelle est incorrecte (Zeng et al., 2025). En prévisions macrofinancières, restreindre les entrées d'un modèle à ce qui était disponible au moment de la décision supprime une grande partie de la compétence apparente que les indices de fuite signalent (Guan & Chen, 2026). Une forme explicite est la dérive d'événement inter-jour : les articles des jours suivant un rapport de résultats portent déjà la réaction du marché, et s'ils entrent dans les entrées pour un jour antérieur, le résultat fuit dans la prévision (Zhang & Zhang, 2026). Une prévision hermétique avant le prix de référence ne peut pas s'appuyer sur du texte écrit après celui-ci.
Pour les marchés financiers, le problème de synchronisation est concret. Une prévision pour le jour enregistrée à 09h29 et une enregistrée à 09h45 sont des objets différents, car la seconde peut voir le mouvement d'ouverture. Si l'enregistrement du moment où une prévision a été faite est conservé uniquement par l'opérateur, un lecteur doit faire confiance au fait qu'aucune réponse ultérieure n'a remplacé une réponse antérieure. La préenregistrement sépare la génération d'une hypothèse de son test en la fixant dans un registre public avant que les données n'existent (Nosek et al., 2018). Une prévision hermétique est un enregistrement devenu automatique et quotidien, et l'horodatage de confiance permet à un tiers de vérifier son heure (Haber & Stornetta, 1991 ; Todd, 2016).
2.3 De nombreuses exécutions, un seul score
Un prévisionniste dans un tournoi soumet généralement une réponse avant une date limite. Un modèle peut être interrogé dix fois, avec une formulation légèrement différente ou à des minutes légèrement différentes, et ses réponses varient. Un évaluateur qui garde le meilleur des dix, ou qui réexécute un pipeline après une défaillance et garde la réexécution, gonfle la compétence sans changer une seule prévision, et le gonflement est invisible sauf si chaque exécution est enregistrée et la règle pour laquelle l'exécution compte est fixée à l'avance. J'ai donc écrit la norme pour sceller chaque exécution qu'elle envoie, compter une exécution par session selon une règle écrite avant les exécutions, et conserver les autres comme calculs de référence étiquetés (Section 3.4).
2.4 Une trajectoire n'est pas une mesure
Les arènes dans lesquelles les modèles échangent de l'argent répondent à la question de savoir quelles décisions auraient rapporté de l'argent, mais le rendement d'un portefeuille sur une saison est un tirage des chemins que le marché aurait pu suivre. Les comptes de presse des deux premières saisons d'Alpha Arena rapportent une inversion du classement : le modèle qui a remporté la première saison, sur les contrats perpétuels de cryptomonnaies, était parmi les plus faibles de la deuxième, sur les actions américaines tokenisées avec de nouveaux formats et effet de levier (Forklog, 2025a, 2025b ; Yahoo Finance, 2025). Les actifs, les formats et les modèles ont changé entre les saisons, donc l'inversion, telle que ces comptes la rapportent, n'identifie pas la chance. C'est ce qu'une saison en tant qu'une trajectoire prédit. StockBench a constaté que la plupart des agents négociant des actions Dow pendant environ quatre mois n'ont pas battu l'achat et la conservation (Y. Chen et al., 2025), LiveTradeBench a constaté sur plus de 50 jours en direct que les classements de discussion générale n'ont pas prédit les résultats commerciaux (Yu et al., 2025), et PredictionMarketBench a constaté que les agents naïfs perdent contre les frais et le règlement sur les carnets de commandes Kalshi rejoués (Arora & Malpani, 2026). Prediction Arena a donné à une cohorte de modèles frontières un capital réel pendant 57 jours, et les mêmes modèles ont en moyenne un rendement de −22,6 % sur Kalshi et −1,1 % sur Polymarket (Zhang et al., 2026) : le lieu a déplacé le résultat moyen de plus de vingt points. Aucun ne peut dire si un modèle savait quelque chose sur le marché, car un rendement mélange la direction d'un appel, sa taille, son calendrier, ses coûts et la trajectoire du marché en un seul nombre.
Les probabilités isolent la direction et la confiance d'une prévision. Un modèle qui déclare une probabilité de 70 % que l'or augmente aujourd'hui peut être évalué sur cette seule affirmation, selon une règle strictement appropriée (Brier, 1950 ; Gneiting & Raftery, 2007). Douze marchés à quatre horizons temporels produisent de nombreuses telles affirmations par modèle par jour, bien que les douze marchés d'un jour partagent une session (section 4.6). Sur des questions provenant d'un marché de prévision réglementé qui s'est résolu après l'entraînement des modèles, cinq modèles de pointe ont manqué de confiance, et un raisonnement plus approfondi a aggravé l'étalonnage (Nel, 2025).
2.5 Ce que les trois conditions exigent
La prévision doit être faite après la date limite du modèle concernant un résultat encore à venir (2.1). Son moment doit être fixé avant le résultat dans un enregistrement dont un tiers peut détecter toute modification ultérieure (2.2). La règle pour laquelle la prévision compte doit être fixée avant les exécutions (2.3). Le score doit être un score approprié de l'événement demandé, agrégé sur suffisamment de sessions indépendantes pour distinguer la compétence d'un chemin fortuit, avec une vérification de l'étalonnage (2.4). Et l'accord entre les modèles doit être actualisé en fonction de la corrélation de leurs erreurs avant d'être interprété comme une preuve (Clemen & Winkler, 1985 ; Kim et al., 2025 ; Chernets, 2026a). La section 3 transcrit les cinq éléments sous forme de liste de contrôle.
3. Le protocole
Le protocole rend le moment d'une prévision un fait qu'un tiers peut vérifier, et il dit quelle couche de ce fait repose sur qui. Tout ce qui suit est publié dans les fichiers ouverts de la ligue (AI Council · Markets, 2026) : le protocole sous le nom arena-protocol.json, le livre scellé sous council-book.jsonl, les textes des questions sous asks/, et les listes estampillées avec leurs preuves OpenTimestamps sur une page par jour (/markets/proof/<day>/). Je décris les règles telles qu'elles se présentaient le 20 octobre 2026 (protocole arena-3, version 2 de la méthodologie de notation) et utilise la série de ce matin-là, 2026-10-20-am, comme exemple détaillé ; chaque heure et chaque hash cité pour cela peut être relu à partir des fichiers ouverts (Appendice B). Chaque sceau porte la version de la méthodologie en vigueur, et un changement ultérieur des règles laisse tout ce qui a été scellé avant comme il était.
Le contrat d'événement. La norme mesure les événements. Un modèle, une série ou une ligne d'un classement est une collection d'entre eux, et je définis chaque événement par un contrat fixé avant que la question ne soit envoyée (Tableau 1). Deux prévisions appartiennent au même événement uniquement lorsque chaque champ est d'accord. Une prévision avec sa propre référence, comme une ligne scellée après l'ouverture (Section 3.3), est une prévision sur un événement différent. Elle est notée sur cet événement et tenue à l'écart de toute statistique qui compare les modèles sur un événement commun (exigence 4).
Le mot rendement désigne trois événements distincts dans cette ligue. La prévision porte sur le rendement à 10 ans lui-même, en unités de rendement, de sa référence à son prix terminal à 15:00 ET. Le contrat de foule, quand la question en énumère un, se résout sur le rendement nominal du Trésor à 15:30 ET, clôture à clôture, et est noté sur ces termes (Section 4.9). Le portefeuille détient un fonds obligataire du Trésor (IEF), qui augmente quand le rendement baisse (Section 4.7). Le 20 octobre, la foule a évalué le contrat de rendement à 7 % contre le rendement nominal précédent de 5,15 %, un prix qui tenait déjà compte de la baisse du marché avant ouverture ; la propre question de la ligue sur le rendement commence à partir de la référence 09:30 et demande quelque chose d'autre. Un appel correct sur l'un ne dit rien en soi sur les autres. Le VIX est divisé de la même manière : la prévision porte sur l'indice, le portefeuille ordinaire ne peut pas le détenir, la ligue Pro le peut.
Tableau 1. Champs minimaux d'un contrat d'événement, et où l'implémentation de référence fixe chacun.
| Champ | Ce qu'il fixe | Implémentation de référence |
|---|---|---|
| Cible | L'indicateur lui-même, non un instrument qui le suit | 12 indicateurs par code ; les fonds négociés n'apparaissent que dans les ligues de portefeuille (assets, trades_as) |
| Prédicat et horizon | L'événement : une hausse stricte de la référence au prix terminal | prob_up ; 1j ; 1s, 1m, 6m comme 5, 21 et 126 séances (Bitcoin 7, 30 et 182 jours calendaires) |
| Source de prix | Fournisseur, symbole, taille de la barre et règle d'horodatage pour le prix de référence et le prix terminal, par indicateur | Fournisseur, symbole et règle de référence sur chaque ligne de prévision (price_provider, price_symbol, reference_rule ; pour le S&P 500, la barre d'une minute de ^GSPC à ou après l'heure de référence), déclarée par indicateur dans le schéma de contrat ; source des prix du portefeuille dans le protocole (prices) |
| Limite d'information | Ce qu'une prévision peut utiliser : tout ce qui précède le prix de référence, jamais la référence elle-même | Snapshot des prix et question hachés dans la ligne de série (snapshot_sha256, ask_sha256) |
| Délai et série comptée | Quelle réponse compte pour la séance | À partir du 21 octobre 2026, la série programmée du matin, déclarée à l'avance, scellée dans asks.jsonl et publiée sur la page de preuve ; en son sein, la ligne scellée en dernier avant la référence (counted), et à partir de la séance 11 (2 novembre 2026) la première ligne de réponse bien formée de chaque siège scellée avant la référence, les lignes ultérieures du même siège étant étiquetées comme des tentatives, selon une règle déclarée dans asks.jsonl, ligne 74, texte SHA-256 0f42c93b…b0b6cd. Pour les 19 et 20 octobre, la série scellée en dernier avant l'ouverture (session_run), appliquée après les séries ; dans chaque série comptée à ce jour, chaque siège a scellé une ligne de réponse, donc la première et la dernière ligne avant la référence sont les mêmes |
| Prix de référence | Une référence par événement, prise après le sceau | Premier prix à ou après 09:30 ET ; Bitcoin, la clôture de la première barre d'une minute commençant à ou après le sceau de la ligne (reference, btc) |
| Résolution | Prix terminal, son heure et sa règle | Clôture de la dernière séance de l'horizon à 16:00 ET ; le rendement à 10 ans à 15:00 ET ; le jour de Bitcoin du sceau minute à 16:00 ET de la séance de notation |
| Règle de tirage | Quels petits mouvements sont des égalités et comment ils sont notés | Bande de 0,1 fois l'échelle de barre d'une minute du mouvement du jour, environ 0,08 d'un écart-type de séance ; séances de roulement exclues (direction, noise_rolls) |
| Règle de notation et références | Le score correct et avec quoi il est comparé | Score de Brier sur toutes les lignes ; référence 50 % ; climatologie fixe de l'événement (climatology_fixed, Section 4.3) |
| Version des règles | Quelle méthodologie s'applique | methodology.version, scellée dans chaque ligne de série ; methodology_version sur chaque ligne de prévision |
| Identifiant d'événement | Une clé pour « le même événement » | event_id_v2, un hash des neuf clés du contrat complet, avec la clé à cinq éléments event_id à côté (event-contract.schema.json, Section 3.13) |
Note : Les noms de champs entre parenthèses sont ceux des fichiers ouverts (arena-protocol.json, le champ methodology de chaque ligne de série, council-stats.json, council-calibration.json et les colonnes de council-forecasts.csv). La fenêtre 15:00 ET du rendement est énoncée dans la ligne de série scellée du 20 octobre.
3.1 Un jour de la ligue
La Figure 1 suit un jour de ligue de l'instantané au score.
Instantané. Avant que la question ne soit publiée, le moteur prend un instantané des prix des 12 marchés : S&P 500, Nasdaq-100, Dow Jones, l'indice des semi-conducteurs (SOX), le rendement américain à 10 ans, l'indice du dollar (DXY), VIX, l'or, le WTI, le Brent, le cuivre et le Bitcoin (tableau 2). Chaque ligne porte son prix, les changements récents, l'intervalle sur 52 semaines et la minute à laquelle il a été lu ; avant l'ouverture, les lignes d'indice boursier et de rendement contiennent la session précédente, tandis que les autres lignes sont en direct. Le SHA-256 de l'instantané est écrit dans la ligne d'exécution (snapshot_sha256), de sorte qu'une réclamation ultérieure selon laquelle les modèles auraient vu des prix différents peut être vérifiée.
Question. Quatorze sièges font du commerce ; onze d'entre eux donnent aussi des probabilités et forment le Conseil, cinq de laboratoires américains et six de laboratoires chinois, et trois sièges au banc ne font que du commerce (tableau 8). Une question va à chaque modèle du Conseil, mot pour mot sauf un bloc qui donne à chaque modèle son propre compte. Le SHA-256 du texte commun est écrit dans la ligne d'exécution (ask_sha256) et répété dans chaque ligne de réponse, et le texte est publié en tant que asks/<sha256>.md. Le hash du texte que chaque modèle a reçu, son propre compte inclus, est scellé au moment de son envoi (asks.jsonl). Le 20 octobre, la question a ouvert à 08:30 EDT, et son fichier publié correspond à la valeur dans la ligne d'exécution, 77d3c627…6f07. Il a également fourni les changements de pré-ouverture des contrats à terme des indices boursiers et a dit aux modèles qu'ils pouvaient les utiliser (section 3.3).
Sceau avant 09:30 ET. Chaque réponse est enregistrée en tant qu'une ligne du livre chaîné par hash. Le 20 octobre, les huit réponses comptabilisées ont des heures de réponse de 12:31:11Z à 12:42:02Z ; la ligne d'exécution et les réponses sont entrées dans le livre en un seul lot, les réponses avec booked_at 13:00:25Z, et le lot a été horodaté à 13:00:25Z (09:00:25 ET). Un sceau de lot horodate le lot. L'exigence 12 scelle chaque réponse à l'arrivée, et la matinée du 21 octobre montre les deux formes. Ses huit premières réponses comptabilisées (12:32:52Z à 12:44:59Z) ont été enregistrées en un seul lot à 13:00:19Z, la deuxième à laquelle deux autorités externes ont signé sa liste horodatée, et une neuvième a été enregistrée à 13:23:37Z, 14 secondes après son arrivée, la deuxième à laquelle trois autorités ont signé la liste suivante (section 3.2). La page de preuve du 20 octobre enregistre que « l'admission pour le score a fermé à mar., 20 oct. 2026, 9:30 AM ET (2026-10-20T13:30:00Z) ». Quatre sceaux ont été pris ce jour-là, à 13:00:25Z, 15:00:12Z, 15:36:05Z et 16:52:54Z, ancrés dans les blocs 972 334, 972 344, 972 354 et 972 359. Le premier couvre les lignes 1 à 159, qui contiennent la ligne d'exécution (151) et les huit réponses comptabilisées (152 à 159).
Ouverture. Le prix de référence de chaque marché sauf le Bitcoin est le premier prix à ou après 09:30 ET ; pour le Bitcoin, qui s'échange en continu, c'est la clôture de la première barre d'une minute qui commence à ou après le sceau de la ligne. La référence est toujours prise après le sceau (section 3.3).
Score après la clôture. Après la clôture à 16:00 ET, le moteur écrit une ligne de score dans le même livre avec le prix de référence, la clôture, le changement, le drapeau d'égalité et la probabilité que chaque modèle a donnée pour chaque marché. Le 20 octobre, la ligne de score (ligne 184) a été enregistrée à 20:30:36Z, après le dernier sceau de la journée, de sorte qu'elle est couverte par le sceau suivant, le premier du 21 octobre. Les horizons plus longs sont notés lorsque leurs fenêtres se ferment, comme leurs propres lignes.
Figure 1. Un jour de la ligue : instantané, question, sceau, ouverture, score.
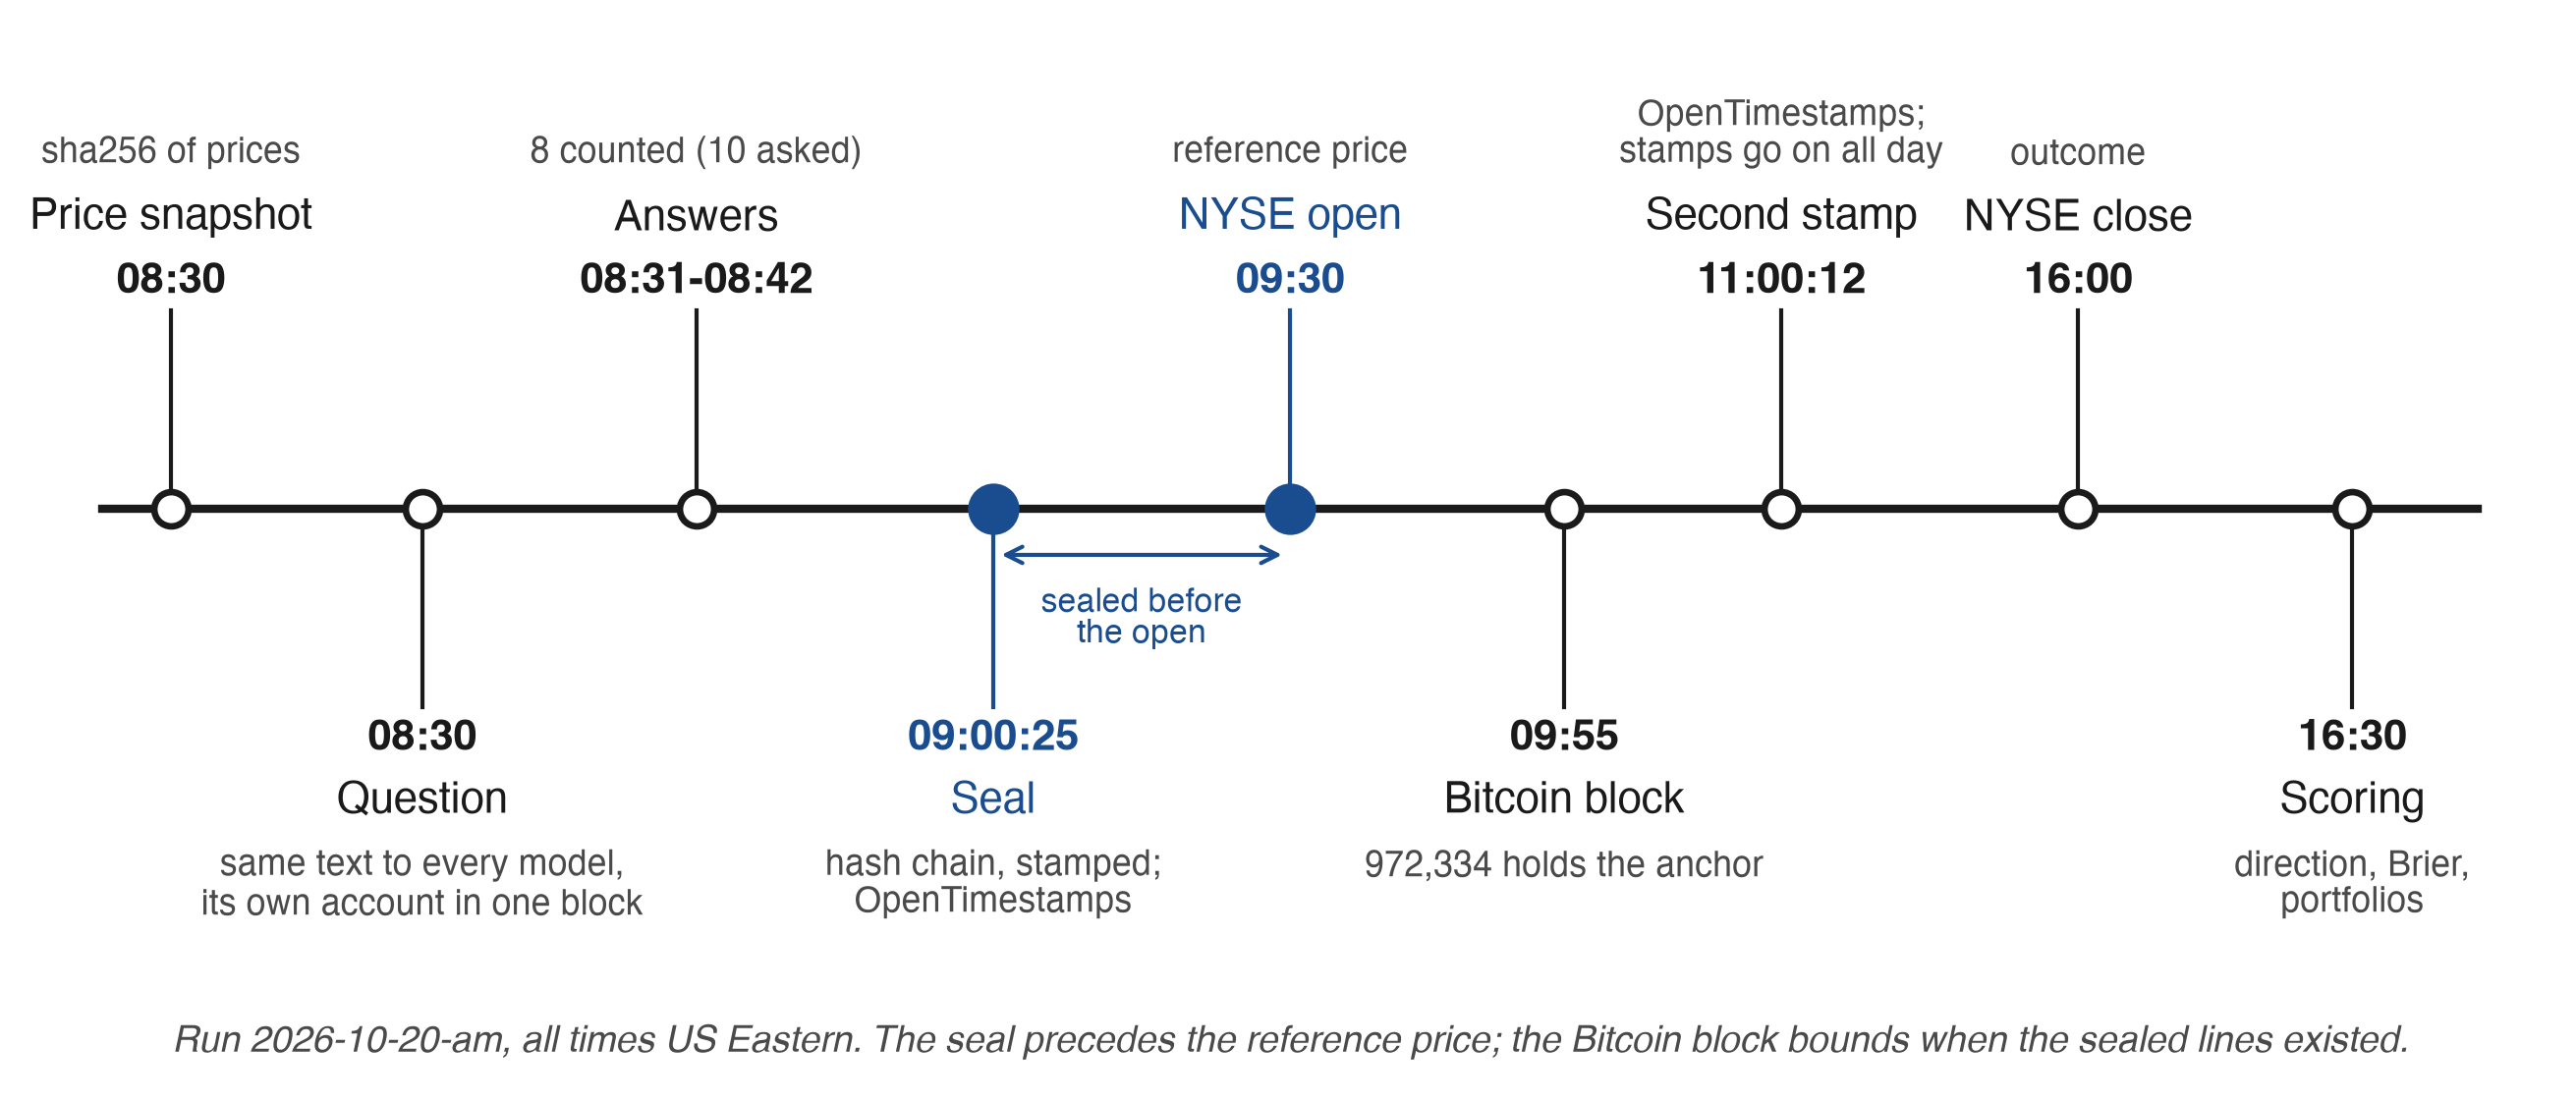
Remarque : Les heures sont celles de l'exécution 2026-10-20-am lue à partir de council-book.jsonl et de la page de preuve /markets/proof/2026-10-20/. ET est l'heure de New York. L'heure du bloc Bitcoin est l'heure d'en-tête du bloc 972 334, qui contient l'ancre du sceau 13:00:25Z. Une heure d'en-tête limite le moment du minage par la limite pratique (section 3.11). Le deuxième sceau de la journée, 15:00:12Z (11:00:12 ET), est marqué pour montrer que les sceaux se poursuivent tout au long de la journée ; la ligne de score de 20:30:36Z est couverte par le premier sceau du jour suivant.
Dans le tableau 2, je donne, pour chaque marché, le symbole de prix sur lequel son événement est résolu, la fin de son événement d'un jour, le fonds par lequel les ligues de portefeuille le détiennent et le contrat de foule scellé avec la question le 20 octobre 2026.
Tableau 2. Les douze marchés : symbole de prix, référence et fin de l'événement d'un jour, le fonds par lequel chacun se négocie dans les ligues de portefeuille, et le contrat de foule scellé le 20 octobre 2026.
| Marché | Code | Symbole de prix | Référence | Fin de l'événement d'un jour (ET) | Négocié en tant que | Contrat de foule, 20 octobre 2026 (lieu, volume scellé $) |
|---|---|---|---|---|---|---|
| S&P 500 | SPX | ^GSPC |
Première barre de 1 min à ou après 09:30 ET | 16:00 | SPY | Polymarket, 20 637 (Kalshi aussi coté) |
| Nasdaq-100 | NDX | ^NDX |
Idem | 16:00 | QQQ | Kalshi, 1 150 |
| Dow Jones | DJI | ^DJI |
Idem | 16:00 | DIA | Polymarket, 20 |
| Semi-conducteurs | SOX | ^SOX |
Idem | 16:00 | SOXQ | Aucun |
| Rendement américain à 10 ans | US10Y | ^TNX |
Idem | 15:00 | IEF | Kalshi, 3 199 |
| Indice du dollar | DXY | DX-Y.NYB |
Idem | 16:00 | UUP | Polymarket, 4 |
| VIX | VIX | ^VIX |
Idem | 16:00 | Non détenu (indicators_only) |
Aucun |
| Or | GOLD | GC=F |
Idem | 16:00 | GLD | Polymarket, 3 112 (Kalshi aussi coté) |
| WTI | WTI | CL=F |
Idem | 16:00 | USO | Polymarket, 3 736 (Kalshi aussi coté) |
| Brent | BRENT | BZ=F |
Idem | 16:00 | BNO | Aucun |
| Cuivre | COPPER | HG=F |
Idem | 16:00 | CPER | Aucun |
| Bitcoin | BTC | BTC-USD |
Clôture de la première barre d'une minute commençant à ou après le sceau de la ligne | 16:00 de la session de notation | BTC-USD | Polymarket, 38 |
Remarque : À partir des lignes de prévision des exécutions des 20 et 21 octobre 2026 (price_provider, price_symbol, reference_rule, event_end_at), arena-protocol.json (assets, indicators_only) et la ligne 151 de council-book.jsonl (crowd.odds, crowd.kalshi). Chaque ligne nomme le fournisseur yahoo_finance_chart_v8_1m et la règle first_1m_bar_at_or_after_reference_at__last_1m_bar_at_or_before_end_at__v1. Les horizons d'une semaine, d'un mois et de six mois correspondent à 5, 21 et 126 séances (Bitcoin 7, 30 et 182 jours ; Tableau 1). Les bandes de tirage sont définies par séance (Tableau 1) et ne sont pas énumérées. La comparaison de foule principale accepte les contrats avec un volume scellé d'au moins 1 000 $ (Section 4.9).
Les prix existent avant la question, la question avant les réponses, les réponses avant le prix à partir duquel elles sont notées, et le résultat après tous les éléments précédents. Chaque « avant » est inscrit dans le registre sous forme de hachage, et l'en-tête du registre est ancré en dehors du contrôle de l'opérateur.
3.2 Qu'est-ce qu'un sceau
Le registre est une séquence de lignes JSON , écrites une seule fois et conservées telles qu'écrites. Chaque ligne comporte quatre champs comptables : sa position n, le hachage de la ligne précédente prev, son hachage de contenu seal et son hachage chaîné link. Soit le SHA-256 (Institut national des normes et de la technologie, 2015) et soit la sérialisation d'un objet JSON avec clés triées exactement telle que json.dumps(o, sort_keys=True, ensure_ascii=False) de Python l'écrit, codée en UTF-8 (Annexe B, Étape 4). Alors pour la ligne avec le contenu (tous les champs sauf les quatre) :
Le sceau fixe ce que dit la ligne. Le lien fixe ce qu'elle dit, où elle se tient et tout ce qui la précède. J'ai recalculé les deux hachages pour les 211 lignes du registre en date du 20 octobre 2026 : chaque seal et chaque link se reproduisent, et chaque prev égale le link de la ligne qui la précède.
La ligne d'exécution porte le hachage de la question, le hachage de l'instantané de prix, la liste par côté, la méthodologie de notation en vigueur et les prix du marché de prédiction enregistrés au moment où la question a été envoyée. La ligne de réponse porte le modèle, son mode et sa réponse entière analysée pour les 12 marchés et quatre horizons, avec own_sha256, le hachage de la réponse brute, et ask_sha256. La ligne de score porte le résultat. Les trois sont scellées de la même manière.
Une chaîne seule prouve l'ordre et le contenu. Un opérateur qui contrôle le fichier pourrait reconstruire toute une chaîne en une après-midi, j'utilise donc le temps de l'extérieur. À chaque exécution, le moteur écrit une brève liste horodatée qui nomme, pour chaque registre, combien de lignes il contenait, le SHA-256 de exactement ces lignes et le lien du dernier. Pour ce registre le 20 octobre à 13:00:25Z, elle indique « 159 lignes, sha256 59673b9e…a7d9, dernier lien 378273fd…7175b2c ». La liste est horodatée avec OpenTimestamps (Todd, 2016), qui agrège de nombreux hachages dans un arbre de Merkle et engage sa racine dans une transaction Bitcoin par l'intermédiaire de serveurs de calendrier publics. La preuve .ots, publiée à côté de la liste, détient le chemin des opérations de hachage du SHA-256 de la liste à la racine de Merkle d'un en-tête de bloc, ici le bloc 972 334, heure d'en-tête 13:55:20Z. La construction est l'horodatage lié de Haber et Stornetta (1991) avec la chaîne Bitcoin (Nakamoto, 2008) comme témoin.
Je note les preuves de timing selon la confiance requise du lecteur, de l'enregistrement propre de l'opérateur à une signature temporelle :
- Niveau 1, l'enregistrement de l'opérateur. Chaque ligne est scellée dans la chaîne (
at,prev,link; les lignes de réponse ajoutentbooked_at, la seconde de leur sceau de lot), et le prix de référence est pris après le sceau. La chaîne fixe l'ordre et le contenu ; la minute du sceau est ce que l'opérateur a enregistré. - Soumission aux calendriers. La liste qui tient la tête de la chaîne est envoyée aux calendriers publics OpenTimestamps (les preuves nomment
alice.btc.calendar.opentimestamps.orgetbob.btc.calendar.opentimestamps.org). Un reçu en attente montre que le hash a été accepté ; il ne porte aucune heure qu'un lecteur puisse vérifier. - Niveau 2, l'ancrage Bitcoin. Les calendriers valident le hash dans un bloc Bitcoin. Le préfixe ancré n'existait pas plus tard que quelques heures après l'heure d'en-tête du bloc, par la limite pratique (section 3.11), et une réécriture ultérieure d'une ligne qu'il contient est détectable par quiconque détient une preuve antérieure. Le bloc peut être exploité après 09:30 ET : le 20 octobre, l'horodatage de 09:00:25 ET a atteint un bloc avec l'heure d'en-tête 09:55:20 ET.
- Niveau 2+, signature temporelle. À partir du 21 octobre 2026, les autorités d'horodatage RFC 3161 indépendantes (Adams et al., 2001), FreeTSA et DigiCert, rejointes par Sectigo à partir de la troisième liste de ce jour, signent chaque liste horodatée, fixant la seconde par laquelle chaque ligne qu'elle couvre existait. Le lecteur fait confiance à une autorité et son certificat au lieu de l'opérateur, et avec des autorités indépendantes, l'une quelconque suffit. Le jeton fixe le temps du lot. L'arrivée de chaque réponse fait l'objet de l'exigence 12.
Une ligne est scellée quand elle entre dans la chaîne, la tête est horodatée quand elle va aux calendriers, et elle est ancrée quand elle atteint un bloc. Parce que le registre ne fait que croître, un horodatage pris à la ligne 159 vérife toujours à n'importe quelle longueur ultérieure : head -n 159 du fichier d'aujourd'hui retourne les octets horodatés inchangés et hache à la valeur horodatée ce matin, donc le préfixe est pris par le nombre de lignes, non par un filtre qui réécrirait les lignes. Chaque liste horodatée imprime la règle d'octet qu'elle hache : le fichier tel que stocké, UTF-8 sans marque d'ordre d'octet et sans rien réencodé, chaque ligne comptée avec son LF final, et une dernière ligne comptée une fois son LF écrit.
Heure de divulgation et heure de scellement. L'heure de scellement est quand une ligne entre dans la chaîne ; l'heure de divulgation est quand son texte devient public. La ligue publie les textes des lignes après le score du jour, avec le siège, le sceau et l'heure visibles avant (page de preuve). La divulgation retardée, la propriété de Sornette et al. (2010), empêche un tiers d'utiliser une probabilité scellée ouvertement. Lier l'opérateur, qui détient le texte pour le réserver, est le travail de P1b et P2 (section 3.11). Dans un lot, la chaîne enregistre l'ordre de réservation : le 20 octobre, la ligne d'exécution précède ses réponses et a été réservée avec elles, après leur arrivée.
3.3 Prix de référence après le scellement
Le prix de référence est le premier prix après le scellement selon la règle de chaque marché. Une prévision n'est notée que sur le chemin de prix qui commence après sa fixation. L'information qui existe avant la référence est autorisée : la question peut porter les contrats à terme pré-ouverture (le 20 octobre, les contrats à terme S&P 500, Nasdaq-100, Dow et Russell 2000 contre la clôture précédente), et un modèle peut chercher des nouvelles jusqu'à sa réponse. Ce que le protocole exclut est le prix de référence et tout ce qui suit.
Une ligne scellée après l'ouverture est conservée. Elle reçoit sa propre référence, le premier prix après son propre scellement, et est marquée comme tardive (late_ref dans la ligne de score). Une ligne scellée après la clôture n'est pas notée pour cette séance (counted). Une telle ligne répond à une question différente : dans le registre du 20 octobre, la propre référence d'une ligne scellée après l'ouverture a inversé le signe du mouvement noté dans six de ses neuf cellules d'un jour. Je la laisse donc hors de tout ce qui compare les modèles sur un événement commun : le consensus, les décomptes d'erreur partagée, le modèle le plus proche, le nombre effectif de voix et chaque comparaison en tête-à-tête (exigence 4). La ligne de score marque la ligne, et la série comptée des statistiques de la ligue la laisse de côté (tableau 5).
La même règle fixe une référence par événement commun, Bitcoin inclus. Dans l'implémentation de référence, la référence Bitcoin est la clôture de la première barre d'une minute qui commence à ou après le scellement de la ligne (reference_rule, Yahoo Finance BTC-USD), donc le prix est toujours plus tardif que le scellement, tandis que les fichiers ouverts écrivent le scellement en second comme reference_at et le début de la barre tarifée comme reference_price_at. Une ligne scellée dans un lot ultérieur obtient sa propre référence Bitcoin et est un événement distinct. Le 21 octobre, les huit réponses scellées à 13:00:19Z partagent la référence 83 536,42, la clôture de la barre 13:01Z ; la neuvième, scellée à 13:23:37Z, a la sienne, 83 677,08, la clôture de la barre 13:24Z, et est notée à part (own_event, same_event faux), hors de l'événement Bitcoin commun. Parce que reference_at égale la seconde de scellement, une coupure à « scellée avant reference_at » supprimerait chaque ligne Bitcoin. J'utilise une horloge pour les douze marchés à la place : une ligne de réponse entre dans les statistiques d'événement commun seulement si elle a été scellée avant la référence 09:30 ET de la séance. Les lignes Bitcoin suivent la même coupure 09:30 ET, tandis que le prix Bitcoin lui-même est référencé à partir de la première minute après le scellement de l'exécution. C'est la règle de la série comptée publiée (n_eff.counted) et des scripts de résolution déposés. Une fois que les réponses sont scellées à l'arrivée (exigence 12), la référence commune pour un marché qui s'échange en continu est le prix à la clôture de l'entrée d'exécution, après chaque sceau comptabilisé.
3.4 Une exécution comptée par séance
La ligue demande plus d'une fois par jour (une course matinale, une course vespérale, une course Bitcoin du week-end et un radar du dimanche), de sorte que plusieurs courses peuvent viser une même session. Exactement une compte pour chaque modèle et session, et la norme exige que cette course soit fixée par une règle déclarée avant les courses (exigence 6). Une règle de la forme « la course scellée en dernier avant l'ouverture » s'applique après coup. Elle laisse à l'opérateur la liberté d'envoyer une course ultérieure avant l'ouverture, et donc de choisir parmi les courses. J'ai donc fait de l'horaire la règle. À partir du 21 octobre 2026, le début de l'enregistrement compté, la course matinale prévue compte et toute autre course est un calcul de référence. La déclaration est scellée en première ligne de la chaîne de questions sortantes (asks.jsonl, 04:16 UTC le 21 octobre 2026, huit heures avant la course matinale) et publiée sur la page de preuve avec son SHA-256 (c24b0d4f…5df5) et une capture Internet Archive (05:35 UTC le même jour) ; je l'ai lue là le 21 octobre 2026 à 15:05 UTC. Dans les deux sessions de développement, 19 et 20 octobre, la méthodologie scellée comptait la course scellée en dernier avant l'ouverture de la session (session_run), une règle appliquée après les courses. Ces sessions forment un segment de développement en dehors de la fenêtre de la comparaison primaire (section 8). Les autres courses sont notées sur leur propre page (not_counted, earlier_run), conservées, publiées et étiquetées, et chacun peut appliquer la règle déclarée aux horodatages scellés (P3, section 3.11). Les réessais des ligues de portefeuille (asked_again, appendice A) sont scellés avec leurs hachages de question et restent en dehors de chaque score de prévision.
3.5 Direction, probabilité et match nul
Le modèle donne prob_up, sa probabilité de 0 à 100 que l'indicateur soit plus élevé à la fin de l'horizon qu'à son prix de référence. Pour le rendement décennal, un « achat » est un pari que le rendement augmente ; pour le VIX, que la volatilité attendue augmente.
Je traite les petits mouvements comme des matchs nuls selon une règle fixée à l'avance. La bande est , avec la moyenne absolue du rendement en pour-cent à une minute sur les quatre sessions de barres de minute avant la référence ; pour les rendements normaux, cela représente environ 0.08 de l'écart-type d'une session (council-stats.json, draw_band). Pour les contrats à terme (WTI, Brent, or, cuivre), les mouvements à une minute au-delà d'un changement enregistré du contrat du mois courant sont laissés de côté, car un roulement est un saut entre deux contrats (noise_rolls). La norme exige que l'événement noté soit l'événement demandé (exigence 7). Le score de Brier primaire est calculé sur toutes les lignes, une augmentation signifiant un changement supérieur à zéro, et le score sans matchs nuls est rapporté en second avec le nombre de lignes qu'il supprime. Les modèles sont interrogés sur la probabilité d'une augmentation stricte et on ne leur indique pas la règle de match nul. À partir de la session du 21 octobre, le score toutes lignes est le score principal de la ligue (champ pall). Les sessions de développement restent publiées, un segment séparé (exigence 15), sur un score qui laisse les matchs nuls de côté. Un tel score est minimisé par la probabilité d'une augmentation étant donné un mouvement en dehors de la bande, donc pour la question posée, il n'est pas strictement approprié.
Une bande de match nul et un score approprié peuvent aller ensemble. Une conception demande la probabilité d'une augmentation étant donné un mouvement en dehors de la bande et la note uniquement sur les lignes qui ne sont pas des matchs nuls. L'autre demande trois probabilités, d'une augmentation, d'un match nul et d'une baisse, notées par le score de Brier à trois résultats, strictement approprié pour le triple (Brier, 1950 ; Gneiting & Raftery, 2007) :
Une prévision qui donne au match nul une probabilité zéro sur une ligne qui n'est pas un match nul obtient exactement le score de Brier binaire, . La prévision uniforme d'un tiers chacun obtient par rapport à 0.25 pour la pièce de monnaie binaire, donc le score à trois résultats a besoin de son propre repère. Une probabilité de exactement 50 ne soutient aucun côté et est notée par Brier uniquement.
3.6 « Acheter en baisse » comme niveau fixé à l'avance
« Acheter sur creux » sans niveau ne peut pas être noté, je demande donc une réponse avec l'action buy_dips pour donner entry, un niveau en dessous de la référence auquel le modèle ajouterait. Si le prix le touche pendant la séance, le portefeuille achète à l'entrée, sinon rien n'est acheté. De toute façon, la probabilité est notée. Les cinq actions autorisées sont buy_strong, buy_dips, hold, trim et sell. Un mot en dehors de la liste est conservé comme action_word, sa probabilité et ses niveaux sont notés, et il ne fait pas de transaction.
Chaque cellule de réponse porte donc deux réponses scellées sur un événement, une probabilité et une action, et sur les deux derniers matins comptés elles s'alignent (Figure 2). Sur les 384 cellules des huit sièges scellés avant la référence le 20 octobre 2026 et les 432 cellules des neuf sièges le 21 octobre 2026, aucun champ d'action n'était vide, chaque sell et trim se situaient sous 50, hold s'établissait autour d'une chance égale (médiane 52 les deux matins) et la médiane augmentait pas à pas vers buy_strong. Je trouve un achat sur creux à côté d'une probabilité inférieure à 50 dans quatre cellules : trois cellules d'un jour de Claude le 20 octobre (S&P 500 48, Nasdaq-100 47, semi-conducteurs 46) et S&P 500 de MiMo sur une semaine le 21 octobre (47). Un achat sur creux est un ordre qui ne se remplit qu'à un niveau d'entrée fixé en dessous de la référence, donc une probabilité inférieure à 50 à côté est cohérente. Le tableau 3 compte les actions par horizon. hold a rempli 64 des cellules d'un jour chaque matin (sur 96 et 108 cellules), et à six mois buy_dips a mené (37 et 38 cellules).
Figure 2. Probabilité déclarée d'une hausse selon l'action scellée dans la même cellule de réponse : exécutions 2026-10-20-am (huit sièges scellés avant la référence) et 2026-10-21-am (neuf sièges), tous les quatre horizons.
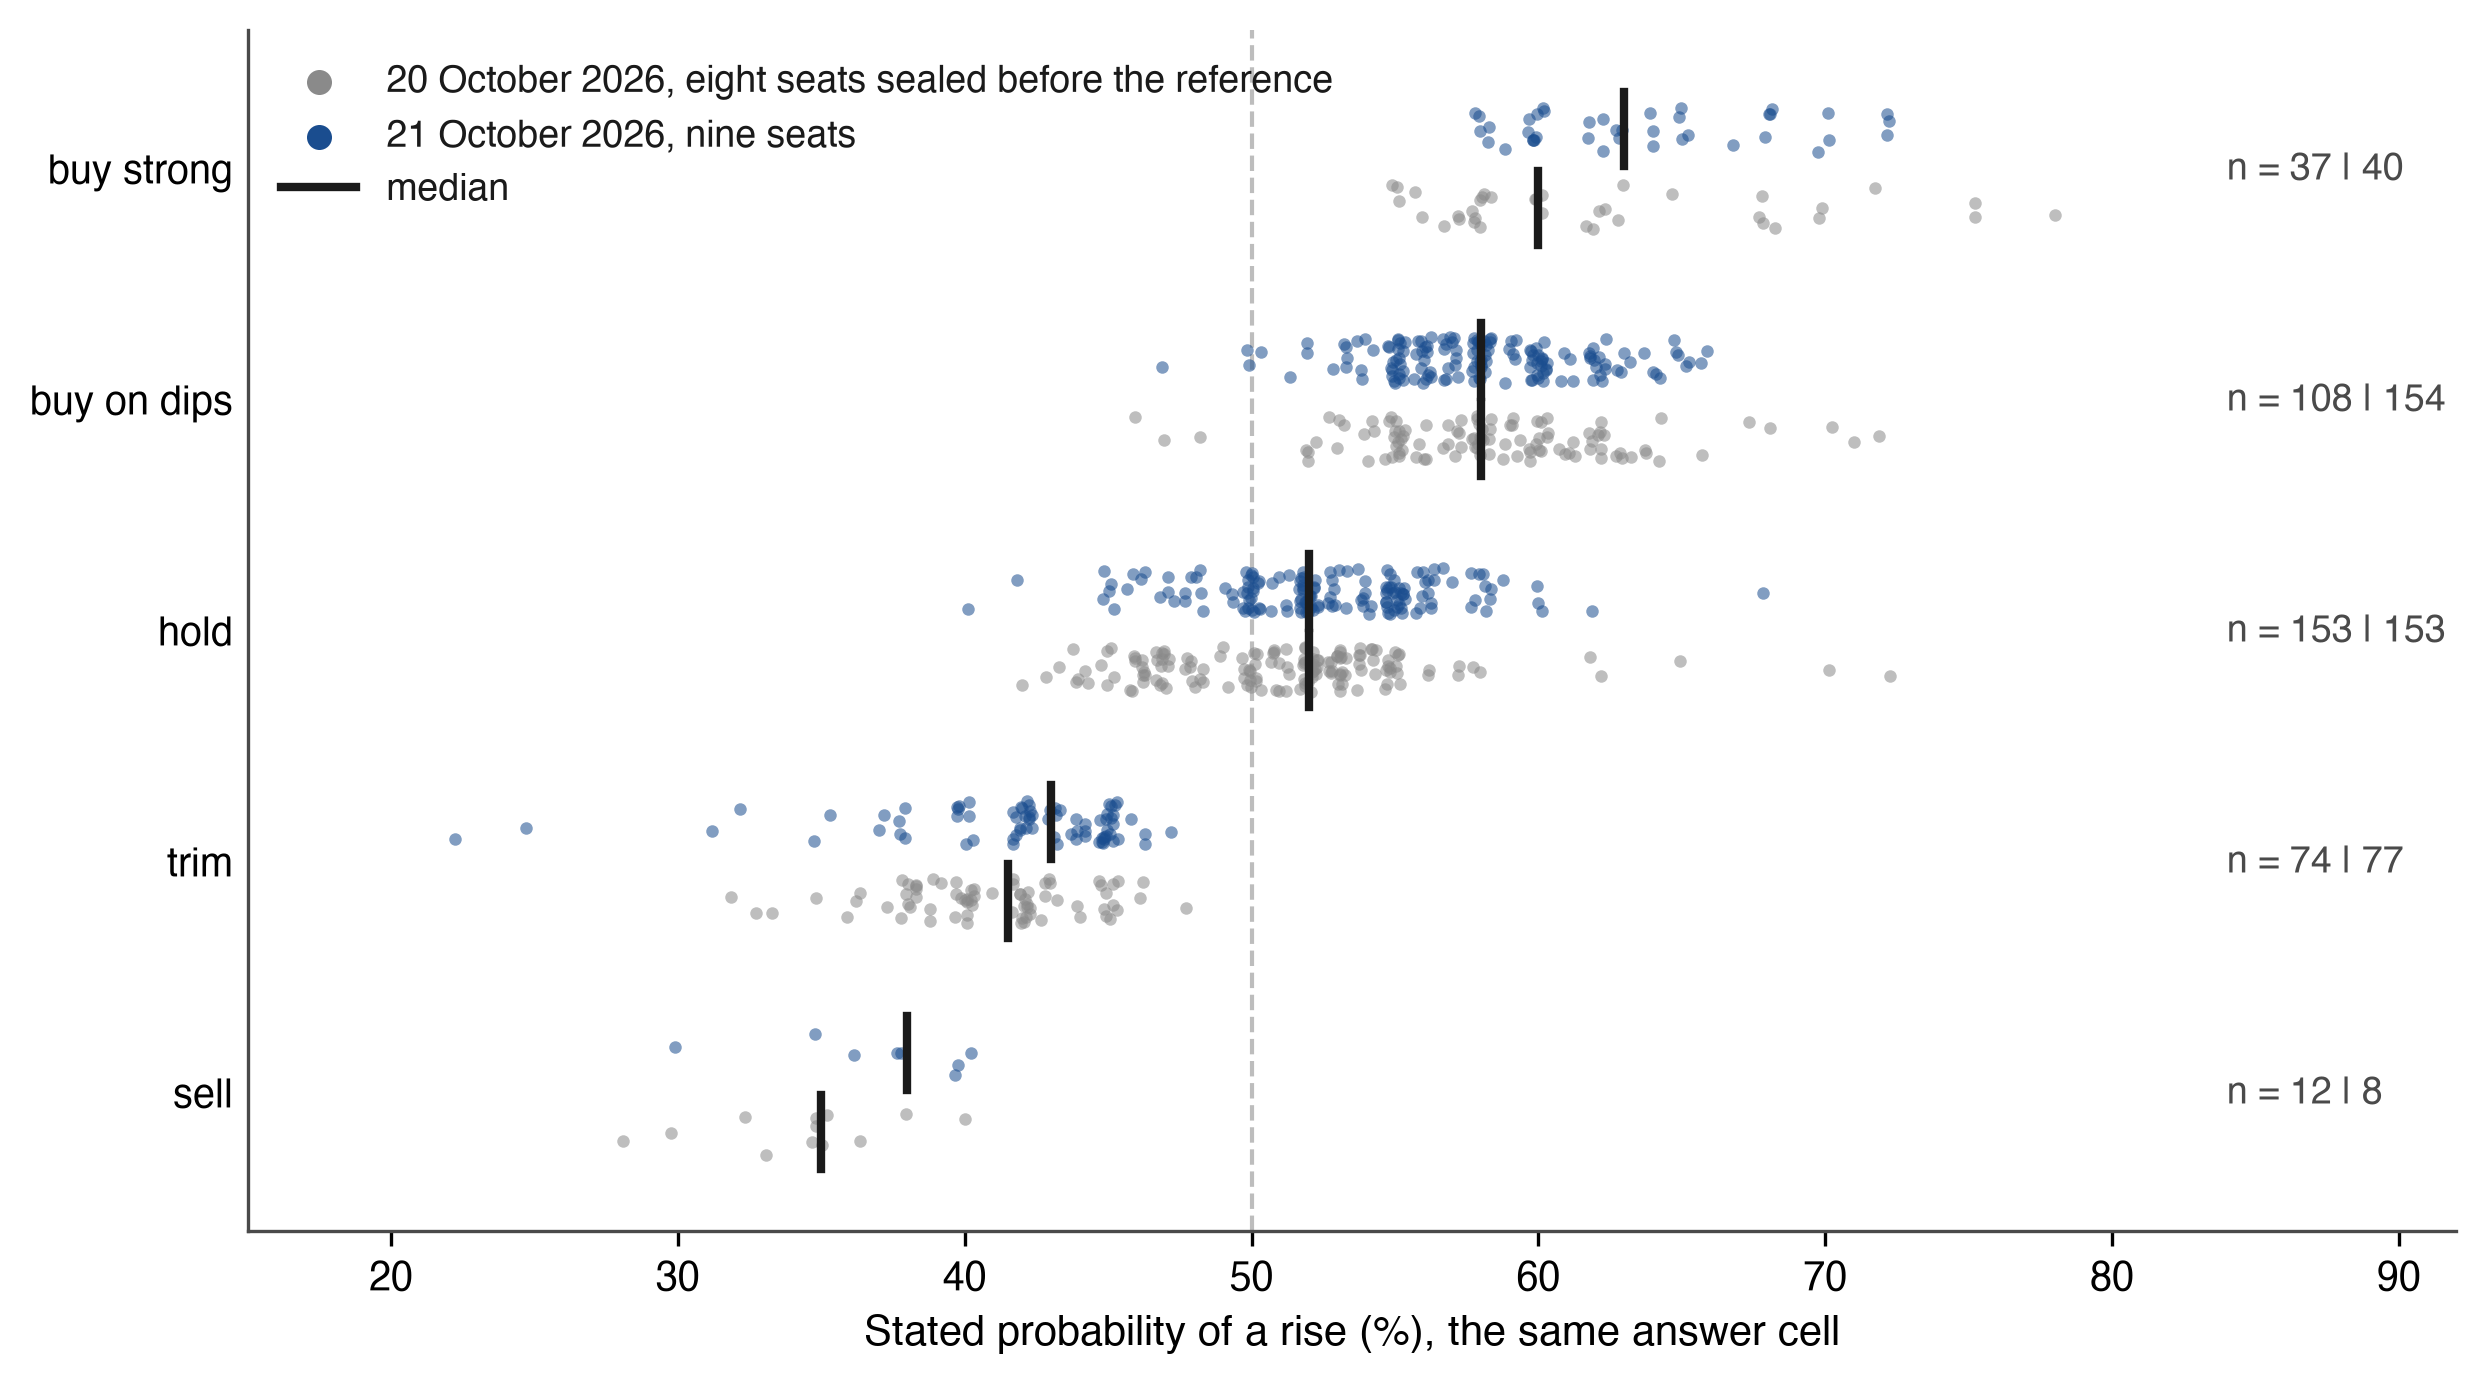
Note : Chaque point est une cellule de réponse (siège × marché × horizon), légèrement perturbée ; les barres marquent les médianes (sell 35 et 38, trim 41,5 et 43, hold 52 et 52, achat sur creux 58 et 58, buy strong 60 et 63) ; n donne les cellules de 20 | 21 octobre. Actions telles que scellées dans items.<market>.<horizon>.action, probabilités dans prob_up. Source : council-forecasts.csv sauvegardé 22 octobre 2026, 01:32 UTC. Comme chaque figure et tableau des sections 3 à 5 construits à partir de réponses scellées, il ne montre aucun résultat.
Tableau 3. Actions scellées par horizon : exécutions 2026-10-20-am (huit sièges scellés avant la référence, 96 cellules par horizon) et 2026-10-21-am (neuf sièges, 108 cellules par horizon).
| Horizon | Exécution | Vente | Réduction | Maintien | Achat sur creux | Achat fort |
|---|---|---|---|---|---|---|
| 1 jour | 20 oct 2026 | 1 | 11 | 64 | 16 | 4 |
| 1 jour | 21 oct 2026 | 0 | 12 | 64 | 26 | 6 |
| 1 semaine | 20 oct 2026 | 3 | 23 | 33 | 31 | 6 |
| 1 semaine | 21 oct 2026 | 1 | 18 | 31 | 54 | 4 |
| 1 mois | 20 oct 2026 | 2 | 15 | 42 | 24 | 13 |
| 1 mois | 21 oct 2026 | 3 | 22 | 34 | 36 | 13 |
| 6 mois | 20 oct 2026 | 6 | 25 | 14 | 37 | 14 |
| 6 mois | 21 oct 2026 | 4 | 25 | 24 | 38 | 17 |
Note : Comptage des cellules de réponse selon l'action scellée en elles. Source : council-forecasts.csv sauvegardé 22 octobre 2026, 01:32 UTC.
3.7 Quatre horizons et l'année
Chaque réponse couvre quatre horizons pour chaque marché : le prochain jour de bourse (1d), la semaine (1w), le mois (1m) et six mois (6m), plus une phrase non notée sur l'année (years). Pour les onze marchés à heure d'ouverture des échanges, les horizons plus longs sont 5, 21 et 126 séances ; pour le Bitcoin, ils sont 7, 30 et 182 jours calendaires, et son jour s'exécute de la minute de scellement à la clôture 16:00 ET de la séance de notation, environ sept heures pour l'exécution du matin. Je compare les horizons au sein de chaque définition. Un modèle un matin donne donc 48 probabilités, chacune résolue sur sa propre fenêtre et toutes scellées en une minute sur un même ensemble d'informations.
3.8 Cible et « incorrect si »
Pour chaque marché et horizon, le modèle donne également target, où il s'attend à ce que le prix aille, et invalidation, montré comme « Incorrect si », le niveau auquel il admettrait que la vue était fausse, avec son risque principal et ce qui le ferait réviser la vue (risk, revise_if). Tous sont scellés avec la probabilité, donc la prévision est réfutable selon les propres termes du modèle. Une réponse scellée montre les champs en action. Le 19 octobre 2026, avant l'ouverture, ChatGPT (GPT-6.1 Sol) a donné au S&P 500 54 % de chance de monter le jour, avec une cible de 7 678,59 et « Incorrect si » à 7 560, puis 42 % à une semaine, 38 % à un mois et 61 % à six mois. Sa vue déclarée était « Je mets davantage de poids sur les effets inflationnistes immédiats des dépenses en IA que sur son éventuel dividende de productivité », et sa condition de révision était « J'abandonnerais la vue baissière mensuelle si SPX franchit 8000 aux côtés d'une amélioration des perspectives de bénéfices » (ligne du livre 83). Chacun de ces niveaux peut être vérifié par rapport à la trajectoire des prix sans demander au modèle ce qu'il voulait dire. À la Figure 3, je dessine la réponse complète, avec la probabilité, l'action, la cible et le niveau « Incorrect si » à chaque horizon, et le niveau d'entrée de 7 350 à six mois auquel son achat sur creux se remplirait. La question avait montré la clôture précédente, 7 659,44, et le prix de référence du jour, 7 700,34, a été pris après le scellement.
Figure 3. Une réponse scellée : ChatGPT sur le S&P 500, exécution 2026-10-19-am (council-book.jsonl, ligne 83), avec probabilité, action, cible, niveau « Incorrect si » et niveau d'entrée à chaque horizon.
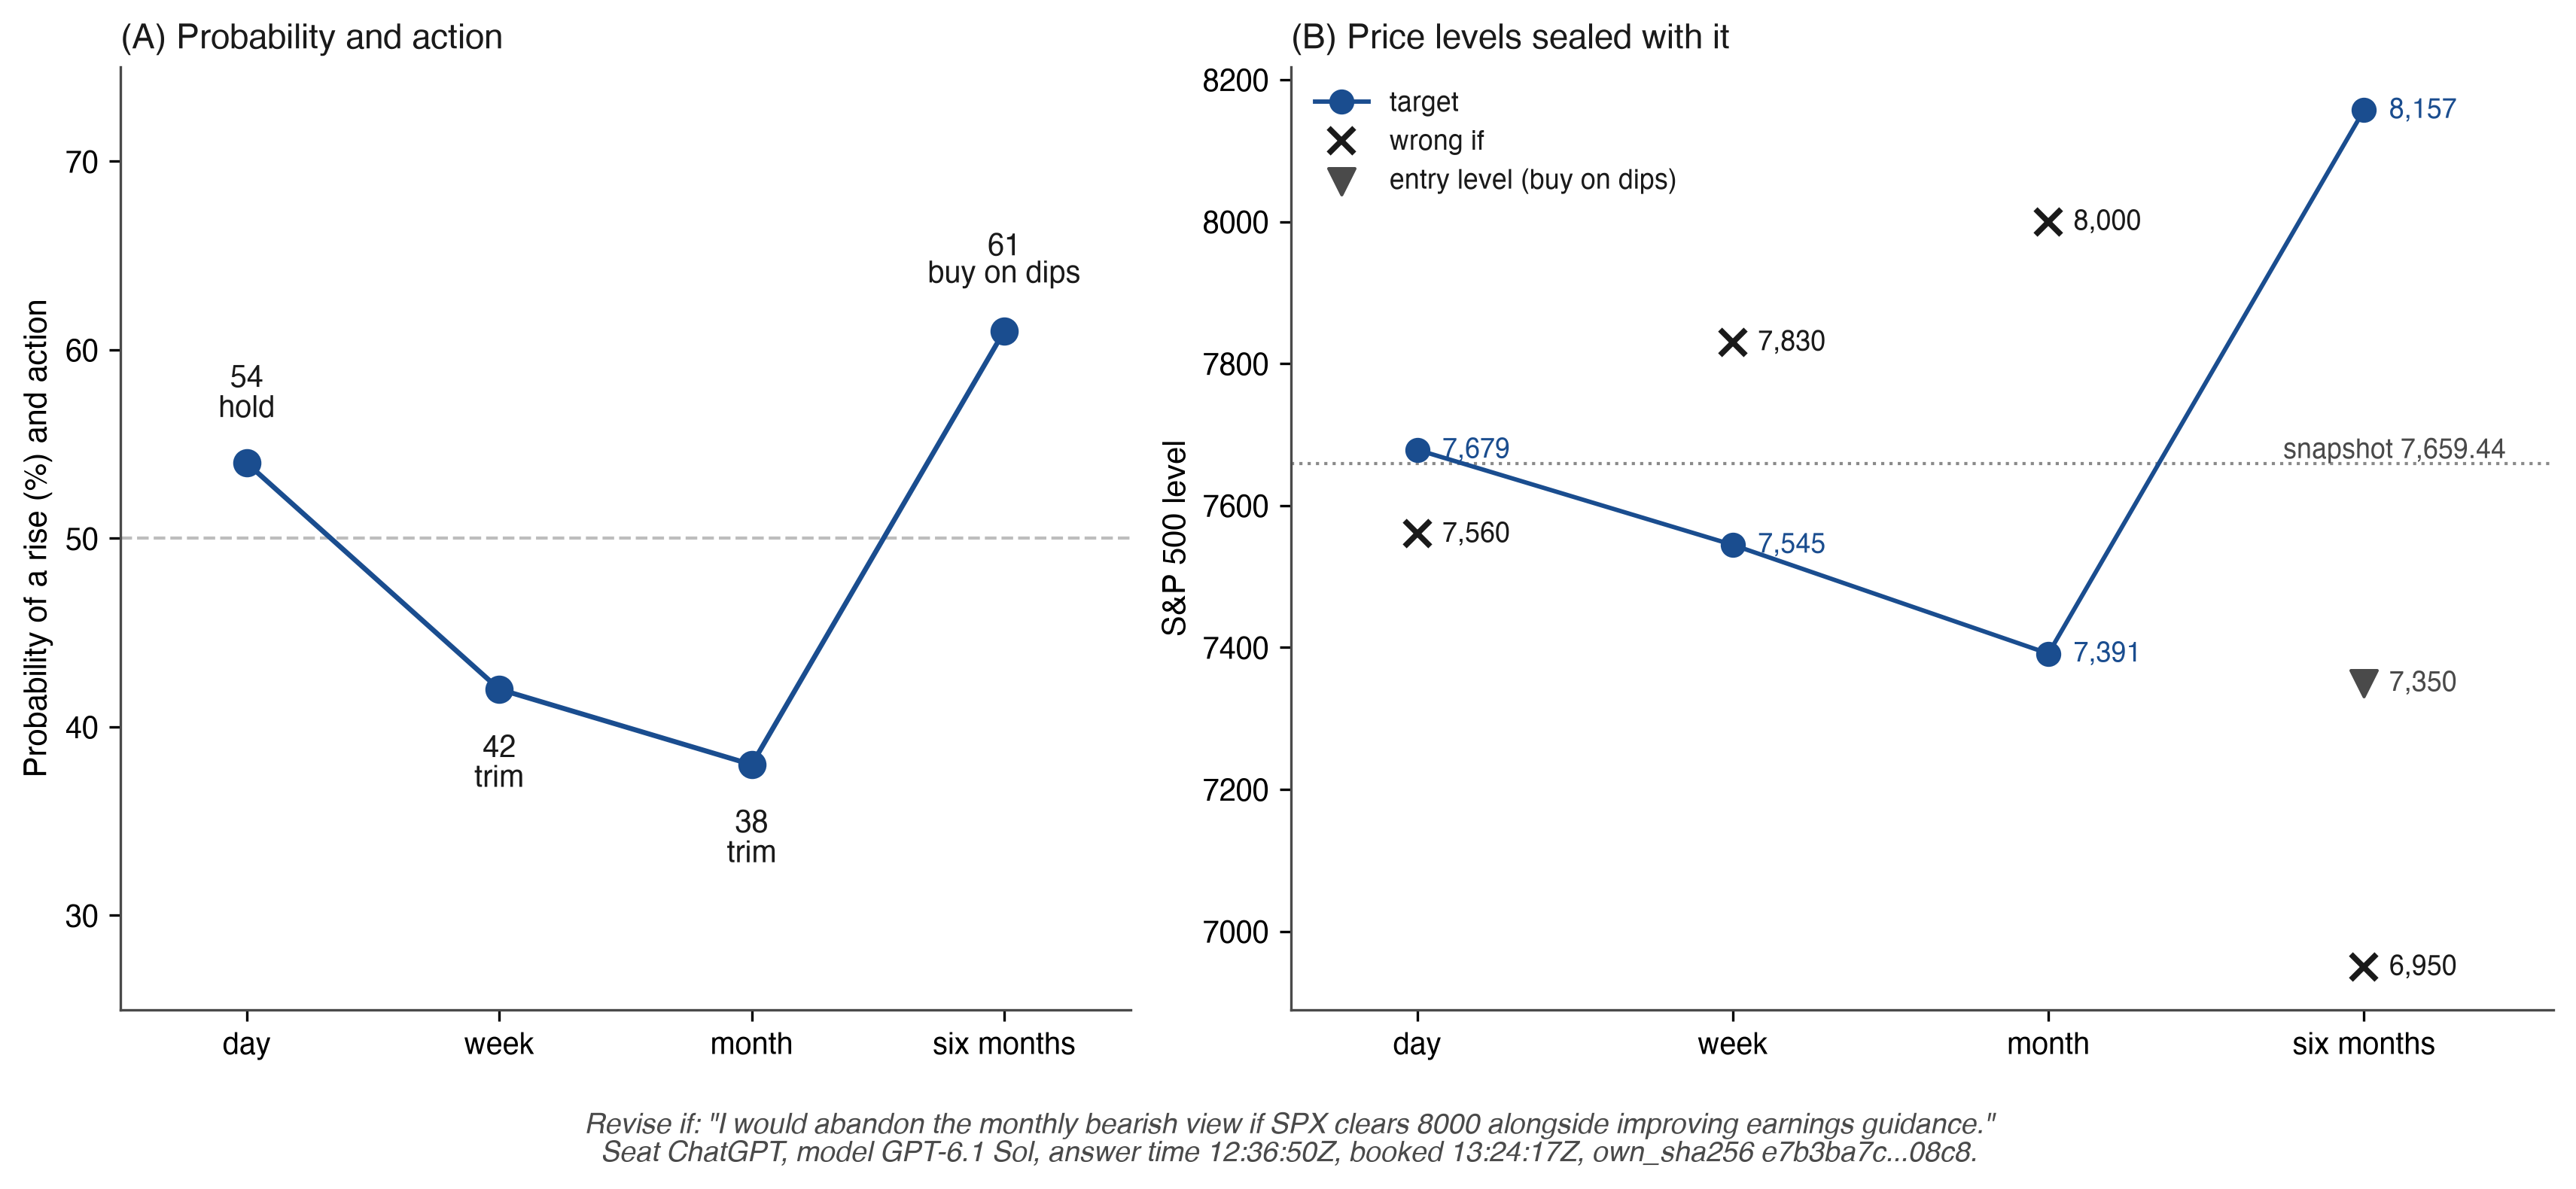
Remarque : Toutes les valeurs telles que scellées dans la ligne de réponse (heure de réponse 12:36:50Z, réservée 13:24:17Z, avant la référence 09:30 ET). La ligne pointillée est le prix S&P 500 dans l'instantané de la question (asks/02577f9c….md) ; la ligne passant par les cibles relie les horizons pour la lecture et n'est pas un chemin. Le niveau d'entrée est le champ items.SPX.6m.entry de la ligne de réponse ; la colonne entry de council-forecasts.csv est vide pour cette cellule.
3.9 Cellules vides
Chaque cellule d'une réponse est notée. Une cellule qu'un modèle laisse vide compte pour 50 %, Brier 0,25, aucun côté (counted_50) ; elle ne peut pas battre la pièce mais peut masquer une performance pire que la pièce sur un marché difficile, donc je rapporte le nombre de cellules vides à côté de chaque score (exigence 8). Un siège qui n'envoie pas de ligne de réponse est enregistré comme no_answer et est absent des scores de cette exécution. Le 0,25 rempli appartient au score de service du siège. Le consensus et les comptages d'accord sont formés à partir des probabilités réellement données, et le champ of les compte. Chaque siège a donc trois résultats à chaque horizon, classés chacun indépendamment : le score Brier sur les probabilités énoncées, la part des cellules prévues auxquelles on a répondu avant la date limite, et le score de service. Le portefeuille est un quatrième résultat dans sa propre table. Un score combiné unique cacherait si un siège avait perdu sur le jugement, sur la ponctualité ou sur la négociation.
Les cellules prévues doivent être connues avant les réponses. La norme exige une liste des réponses prévues, avec les sièges, les marchés, les horizons, la date limite et la politique de nouvelle tentative, scellée avant la première question d'une exécution (exigence 13), afin que chaque cellule prévue se résout en un statut (counted, counted_50, no_answer ou refusée). La ligne d'exécution porte la liste par côté, et à partir du 21 octobre 2026, la liste est scellée avant la première question, dans la chaîne des questions sortantes (asks.jsonl). La liste vérifie l'exhaustivité par rapport au calendrier déclaré. Le hachage de chaque question sortante, scellé lorsqu'elle est envoyée, vérifie les exécutions qui ont été envoyées (exigence 13).
3.10 Un changement de version de modèle, une correction, un changement de règles
Un siège est un participant opérationnel ; une version de modèle est une implémentation spécifique à une époque, et le registre garde les deux. Quand la version d'un siège change, son compte se poursuit, le changement est daté, le résultat depuis la nouvelle version est montré séparé (new_model_version), chaque version obtient son propre compte à partir du jour où elle a pris le relais (_ver:<model>:<n>), et une exécution dans laquelle une version a changé est marquée (seat_versions_in_run).
Une correction est une nouvelle ligne qui nomme les lignes qu'elle concerne (of), et la ligne qu'elle corrige reste telle qu'écrite. Les prix suivent la même règle : le protocole déclare qu'à partir du 22 octobre 2026, un prix de référence ou de fermeture corrigé entre comme une ligne de correction scellée avec sa source et sa raison, et la ligne de score avant elle n'est pas réécrite (price_corrections dans arena-protocol.json). Le 20 octobre, 47 des 211 lignes du livre étaient des corrections : certaines restaurent le modèle et le mode de réponses dans les premières exécutions à partir des reçus d'exécution, d'autres enregistrent qu'une réponse rescellée est égale à une ligne antérieure (same_as, anciennes copies dans council-forecasts-copies.csv). La norme exige le modèle, la version et le mode dans la ligne de réponse elle-même, ou, en saison aveugle, un engagement salé à ceux-ci (exigence 1).
Un changement de méthodologie change la tâche et ouvre un nouveau segment de mesure (exigence 15). Un score confirmatoire, un gain jumelé ou une comparaison de portefeuille est calculé au sein d'une version de méthodologie, ou les versions sont rapportées comme des segments séparés ; les anciennes prévisions rescorées selon une nouvelle règle sont étiquetées comme une analyse alternative. Une revendication qui repose sur un élément de niveau 2+ couvre les scellés effectués après que cet élément apparaît dans les fichiers publics.
3.11 Preuve-d'avant : trois propriétés
J'appelle un enregistrement de prévision preuve-d'avant quand un tiers, en utilisant les fichiers publics et la chaîne Bitcoin, peut établir les propriétés ci-dessous, et quand l'enregistrement dit lesquelles d'entre elles reposent sur qui. Soit une prévision détenue dans la ligne du livre , avec un prix de référence au moment et un résultat au moment . Soit le timbre engager les premières lignes par le résumé , et soit sa preuve placer la liste estampillée dans le bloc avec l'heure d'en-tête . Écrivez pour la marge par laquelle le vrai moment de minage peut suivre l'heure d'en-tête : quelques heures en pratique, selon la limite discutée ci-dessous.
P1a. Pas de reconstruction après l'ancrage. Pour chaque prévision comptabilisée, il existe un horodatage avec . Le préfixe horodaté a existé, selon la limite pratique, au plus tard à , et tout ajout, suppression ou réécriture ultérieure d'une ligne le change , de sorte qu'il ne correspond plus au résumé engagé dans le bloc . Pour chaque résultat ultérieur à , cela exclut une prévision écrite après le résultat.
P1b. Engagement avant la référence. La prévision a été scellée avant . À partir du 21 octobre 2026, cela vaut au niveau 2+, pour quiconque accepte l'une des autorités et son certificat : deux jetons RFC 3161 signés avant sur une liste horodatée avec . Le 21 octobre, deux autorités ont signé la liste couvrant les lignes 1 à 222, la ligne d'exécution (214) et huit réponses comptabilisées (215 à 222), à 13:00:19 UTC, 29 minutes 41 secondes avant , et trois ont signé la liste couvrant la neuvième réponse comptabilisée (224) à 13:23:37 UTC, 6 minutes 23 secondes avant (Appendix B, Step 9). Pour Bitcoin, la référence est la clôture de la première barre d'une minute après le scellement de chaque ligne, 13:01Z pour le lot et 13:24Z pour la neuvième réponse, de sorte que l'ordre s'y maintient par construction. Pour les sessions de développement des 19 et 20 octobre, les sessions que cette version évalue, P1b s'appuie au niveau 1 sur l'enregistrement chaîné (at, booked_at, prev, link). Le 20 octobre, le bloc d'ancrage est tombé après (Section 3.2).
P2. Pas de substitution. Modifier un champ quelconque de pour change , donc et tous les liens ultérieurs, donc . Une substitution indétectable exigerait une deuxième préimage de SHA-256 ou une réécriture de la chaîne Bitcoin, pourvu que le vérificateur détienne la preuve qui a été publiée à l'horodatage (modèle de menace ci-dessous).
P3. Pas de sélection parmi les exécutions scellées divulguées. Pour chaque modèle et session, la ligne comptabilisée est fixée par une règle déclarée avant les exécutions et appliquée à des horodatages scellés seulement. À partir du 21 octobre 2026, cette règle est l'agenda publié, scellé avant les exécutions. Dans l'exécution, la première réponse bien formée de chaque siège compte à partir de la session 11 (déclarée dans asks.jsonl, ligne 74). La section 3.4 donne la règle des sessions de développement. Toute autre exécution scellée reste dans le livre, étiquetée, et un lecteur peut recalculer quelle ligne compte. La forme complète couvre aussi les exécutions demandées et laissées non scellées : le hachage de chaque question sortante est scellé au moment où elle est envoyée (niveau 2+). À partir du 21 octobre 2026, ces hachages sont chaînés dans asks.jsonl.
Modèle de menace. Un horodatage prouve qu'un résumé a existé. Il ne dit rien sur d'autres résumés horodatés à côté de lui. Un opérateur qui héberge à la fois le livre et les preuves pourrait horodater deux livres à chaque exécution et remplacer ultérieurement le livre et la preuve ensemble ; le substitut se vérifie par rapport à Bitcoin, et par rapport à une autorité d'horodatage aussi. La condition 3 exige donc qu'il soit OBLIGATOIRE de publier, à chaque horodatage, le SHA-256 de la liste horodatée sur au moins un canal en ajout uniquement que l'opérateur ne contrôle pas (un dépôt archivé, un hôte de contrôle de version public ou une capture d'archive du web) et de nommer les canaux sur la page de preuve. À partir du 22 octobre 2026, chaque liste horodatée entre dans le journal de transparence Sigstore Rekor à l'horodatage, et les listes des jours antérieurs y sont entrées le 21 octobre 2026 entre 23:45 et 23:47 UTC (Table 5). Pour une liste dans le journal, P1a et P2 valent pour tous à partir de son heure d'enregistrement, et avant cette heure pour toute partie qui a gardé, ou peut récupérer à partir d'une archive indépendante, une preuve antérieure.
La table 4 confronte chaque propriété à l'élément du protocole qui la fournit et au niveau auquel un lecteur peut la vérifier.
Tableau 4. Preuve-d'avant : quel élément du protocole fournit chaque propriété, et à quel niveau.
| Propriété | Ce qu'elle exclut | Élément qui la fournit | Comment un lecteur la vérifie |
|---|---|---|---|
| P1a Aucune reconstruction après l'ancre (niveau 2, avec une copie indépendante de la preuve ou de l'entrée Rekor de la liste) | Une prévision écrite ou réécrite après l'ancre | Hachage de préfixe horodaté par livre ; ancre OpenTimestamps en Bitcoin ; condensé d'horodatage sur un canal indépendant | head -n m le hachage égale le condensé horodaté ; la preuve .ots conduit à la racine Merkle du bloc ; la borne précède le résultat |
| P1b Engagement avant la référence (niveau 1 pour les 19 et 20 octobre ; niveau 2+ à partir du 21 octobre) | Une prévision scellée après le prix de référence mais cotée à partir de lui | Minute de scellement dans la chaîne (booked_at) ; référence après le scellement ; scellement à l'arrivée (requis) ; à partir du 21 octobre : jetons RFC 3161 |
Comparer l'heure de scellement de la ligne, max(at, booked_at), avec 09:30 ET de la session ; à partir du 21 octobre : Appendice B, Étape 9 |
| P2 Aucune substitution (niveau 2, avec une copie indépendante de la preuve ou de l'entrée Rekor de la liste) | Une prévision scellée modifiée ultérieurement | Scellement par ligne (seal) ; link chaîné avec prev ; livre d'ajout seulement |
Recalculer seal et link ; chaque prev égale le link précédent |
| P3 Aucune sélection parmi les exécutions scellées divulguées (règle de niveau 1 ; forme complète niveau 2+) | Demander plusieurs fois et compter l'exécution qui a gagné | Une exécution comptée par session, déclarée à l'avance à partir du 21 octobre 2026 ; chaque autre exécution conservée comme not_counted ; niveau 2+ : hachages des questions sortantes scellés à l'envoi (asks.jsonl, à partir du 21 octobre) |
Appliquer la règle déclarée aux heures de scellement du livre ; trouver toutes les exécutions dans council-forecasts.csv (run_id, run_role) |
P1a a une résolution d'heures, et sa borne est pratique. L'heure externe est l'heure d'un bloc de la chaîne que le réseau a accepté, et l'heure d'en-tête de ce bloc est définie par le mineur. Les règles de consensus la bornent par le bas par l'heure médiane des 11 blocs précédents et par le haut d'environ deux heures avant les horloges ajustées au réseau des nœuds qui l'acceptent (Bitcoin Developer Documentation, s.d.). Aucune règle ne fixe le délai après le temps d'en-tête pendant lequel un bloc a été réellement miné. En fonctionnement normal, la médiane accuse un retard d'environ une heure sur l'heure réelle, donc le condensé ancré existait au plus tard quelques heures après . Un vérificateur qui veut une borne provenant uniquement des règles de consensus utilise l'heure d'en-tête d'un bloc plusieurs confirmations plus tard, et une heure calendaire signée sur chaque scellement ne vient que d'une autorité d'horodatage (niveau 2+). Pour le bloc 972 334, l'heure médiane des 11 blocs précédents était 12:45:12Z, 70 minutes avant son heure d'en-tête. Un Internet-Draft de l'IETF spécifie comment un vérificateur vérifie les preuves temporelles ancrées en Bitcoin (Fassbender, 2026). Les 17, 19 et 20 octobre, les blocs d'ancrage (971 796, 972 153 et 972 334) portaient des heures d'en-tête à moins d'une heure de l'heure de réservation, et pour l'horizon journalier, qui se résout à 16:00 ET, la borne avec sa marge tombait avant le résultat ; pour les horizons plus longs, la résolution est immaterielle. L'ordre du scellement et de la référence dans la session est P1b.
3.12 L'échelle de confiance
Les affirmations publiques concernant les prévisions IA « vérifiées » se situent sur trois niveaux, avec une quatrième étape au-dessus du dernier (Figure 4). Au niveau 0, le lecteur fait confiance à l'opérateur. Au niveau 1, l'opérateur conserve une empreinte ou un enregistrement chaîné, qui prouve qu'un texte ultérieur correspond à un hachage antérieur mais non quand le hachage a été créé. Au niveau 2, l'empreinte est ancrée en dehors de l'opérateur, dans un enregistrement public qui ne peut pas être réécrit ou antidaté sans détection, et vérifié avec des outils que l'opérateur ne contrôle pas. Le niveau 2+ est le niveau 2 plus une heure signée par un tiers sur chaque scellement (Section 3.2).
Figure 4. L'échelle de confiance : faire confiance à l'opérateur, empreinte de l'opérateur, ancre en dehors de l'opérateur, et heure signée par deux autorités (niveau 2+, RFC 3161, à partir du 21 octobre 2026).
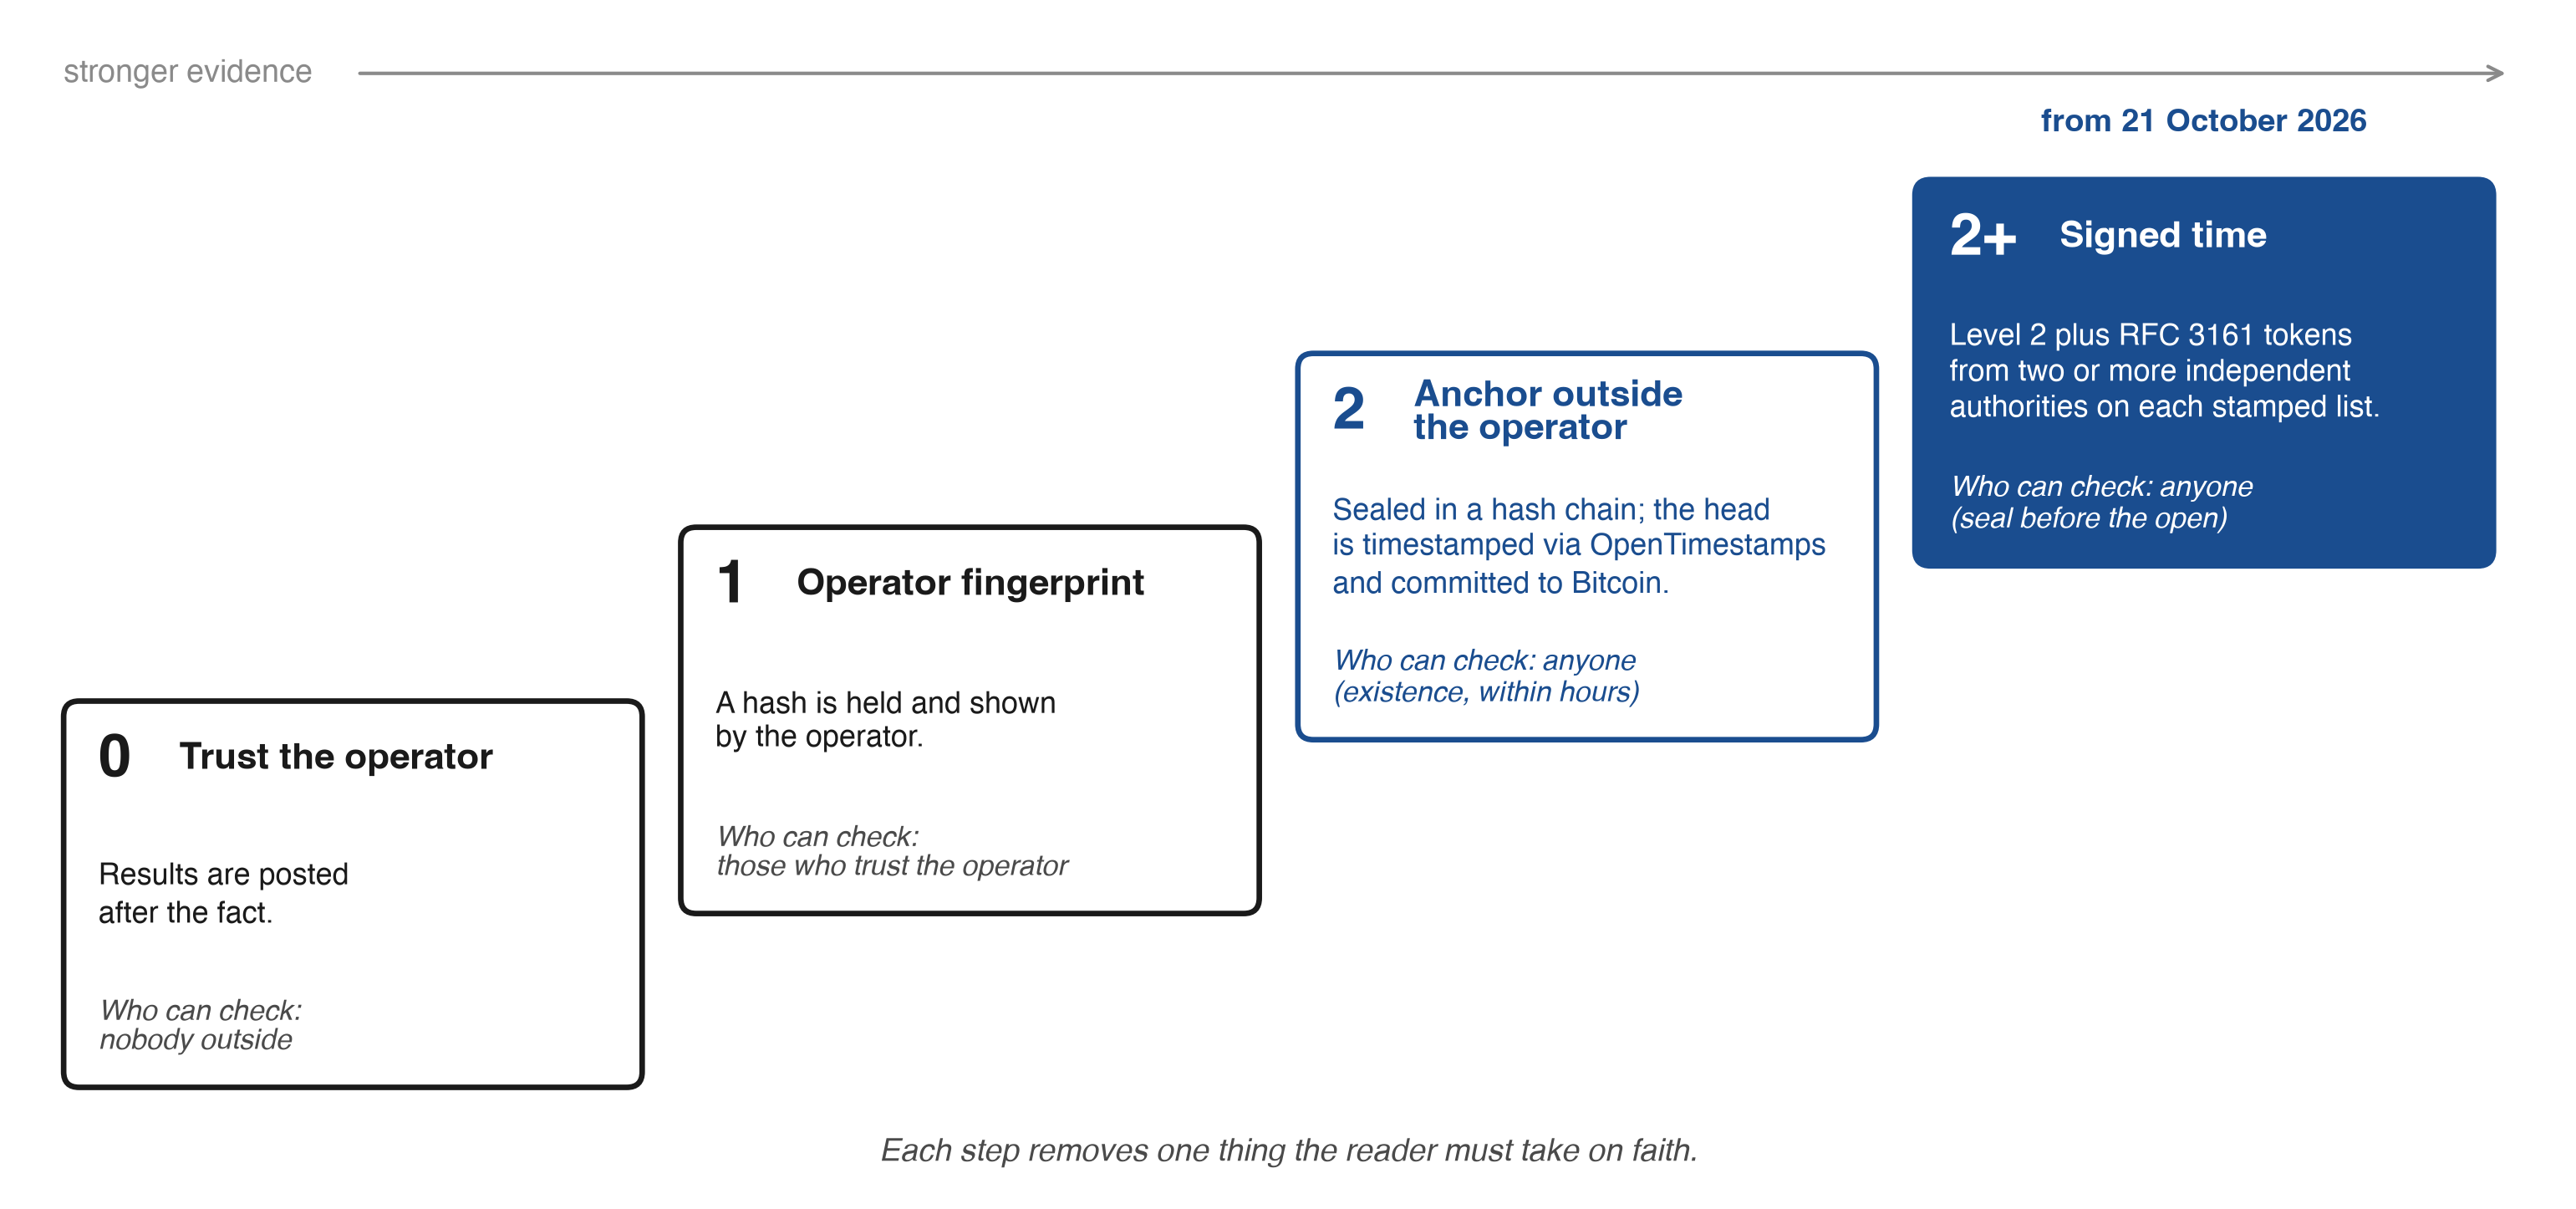
Remarque : Les niveaux décrivent ce qu'un lecteur doit faire confiance concernant l'heure d'un enregistrement. Le niveau 2+ ajoute des jetons RFC 3161, dans la ligue à partir du 21 octobre 2026, quand l'enregistrement contenant les réponses comptées a été signé avant l'ouverture à 09:30 ET. Le scellement à l'arrivée, le prix de référence après le scellement et la règle d'exécution comptée sont des exigences distinctes (Section 3.13).
Dans l'implémentation de référence, l'ancre donne le niveau 2 pour P1a et P2, contre toute partie détenant une copie indépendante d'une preuve, et contre tous pour chaque liste horodatée entrée dans le journal Rekor (Section 3.11). P1b se situe au niveau 2+ dans l'enregistrement compté (Section 3.11). P3 repose au niveau 1 sur l'enregistrement chaîné de l'opérateur et, à partir du 21 octobre 2026, sur une règle d'exécution comptée déclarée à l'avance. L'échelle mesure la confiance dans l'horloge. Ce qu'un lecteur peut affirmer sur les prix ou la compétence grimpe une deuxième échelle, l'échelle des affirmations (Tableau B1, Appendice B) : règles publiées, fichiers recalculés, engagement externe vérifié, résultats réconciliés avec une source de prix indépendante, évaluation appariée prospective gelée avant sa fenêtre, et réplication par un deuxième pipeline. Cette deuxième échelle s'achève dans les comparaisons enregistrées de la Section 8.
3.13 Liste de vérification de la norme proposée
J'écris les exigences ci-dessous comme ce qu'une arène, un repère ou un fonds adopte quand il prétend suivre la norme. DOIT marque une exigence sans laquelle la prétention ne tient pas ; DEVRAIT marque la spécification de niveau 2+.
- DOIT définir chaque tâche par un contrat d'événement fixé avant que la question ne soit lancée, avec au minimum les champs du tableau 1, incluant la source de prix de chaque indicateur (vendeur, symbole, taille de barre et règle d'horodatage pour le prix de référence et le prix terminal) ; les résultats de prévision qui se situent dans le futur ; et sceller le modèle, sa version et son mode dans la ligne de réponse elle-même. Dans une saison en aveugle, la ligne les porte sous forme d'engagement SHA-256 salé, , et les salts sont publiés après la saison, de sorte que l'identité est fixée au sceau et cachée jusqu'à la fin de la saison.
- DOIT conserver un enregistrement infalsifiable et chaîné par hachage dans lequel chaque ligne est scellée à son entrée, le texte de la question et l'instantané de prix sont hachés dans l'exécution, la question est publiée, et une correction est une nouvelle ligne qui désigne les lignes qu'elle concerne.
- DOIT ancrer la tête de l'enregistrement en dehors de l'opérateur à chaque exécution (niveau 2), publier les preuves, énoncer la limite avec sa marge, et publier chaque résumé horodaté au moment de l'horodatage sur au moins un canal infalsifiable que l'opérateur ne contrôle pas.
- DOIT prendre un prix de référence par événement commun, après le sceau, selon une règle publiée pour chaque instrument ; une ligne scellée plus tard reçoit sa propre référence et constitue un événement distinct. Les prévisions sont regroupées (consensus, accord, décomptes d'erreurs partagées, comparaisons entre modèles) uniquement lorsque chaque champ de leurs contrats d'événement s'accorde.
- DOIT publier chaque exécution, comptabilisée ou non, avec son étiquette.
- DOIT fixer l'exécution comptabilisée de chaque session par une règle déclarée avant les exécutions (par exemple, un calendrier publié), et DEVRAIT publier la déclaration avec son hachage sur un canal que l'opérateur ne contrôle pas. Une règle appliquée après coup aux exécutions qui ont été effectuées ne la satisfait pas.
- DOIT coter l'événement demandé par une règle strictement propre : le score de Brier principal d'une hausse stricte sur toutes les lignes, avec tout score filtré en second et le nombre de lignes qu'il abandonne ; ou, avec une bande de parité, soit demander la probabilité d'une hausse étant donné un mouvement en dehors de la bande, soit demander trois probabilités et les coter par le score de Brier à trois résultats (section 3.5).
- DOIT signaler les cellules vides et les réponses manquantes à côté de chaque score, tenir une valeur remplie en dehors du consensus et des décomptes d'accord, et rapporter la qualité sur les probabilités déclarées, la couverture et tout score de service comme résultats distincts.
- DOIT signaler l'indice de référence non informatif de 50 % et un taux de base climatologique du même événement pour chaque actif et horizon, estimé sur une fenêtre fixe qui se termine avant la saison et scellée par un hachage publié, avec le score d'habileté de Brier par rapport à lui ; un prix du marché de prédiction utilisé comme référence est scellé avec son volume échangé, et un plancher de volume déclaré définit la comparaison principale.
- DOIT classer uniquement après un nombre minimum de sessions par horizon, avec des intervalles regroupés par session et, pour les horizons plus longs qu'un jour, des intervalles qui respectent les fenêtres chevauchantes ; une comparaison est planifiée pour la précision sur la différence de Brier appariée au niveau de la session, et une affirmation d'absence de différence requiert un intervalle dans une marge d'équivalence déclarée (section 4.6).
- DOIT publier les données et le code de cotation afin que chaque score puisse être recalculé par un tiers, et citer dans chaque révision de l'article une version d'analyse immuable avec une somme de contrôle pour chaque fichier (appendice C).
- DOIT sceller chaque réponse à son arrivée, sans attendre un lot, et DEVRAIT (niveau 2+) obtenir un jeton RFC 3161 d'une autorité publique d'horodatage sur chaque sceau.
- DEVRAIT (niveau 2+) sceller le hachage de chaque question sortante au moment de son envoi, et sceller la liste des réponses attendues avec son délai et sa politique de retry avant la première question d'une exécution.
- DOIT accompagner tout consensus publié de modèles, sur la même surface, du nombre de probabilités déclarées qui y ont participé, leur corrélation par paire moyenne et le de la section 5.1 pour cette exécution et cet horizon, de sorte qu'un lecteur voit combien de voix indépendantes soutiennent l'accord.
- DOIT traiter un changement de méthodologie comme le début d'un nouveau segment de mesure et une correction comme une ligne ajoutée qui laisse l'original en place ; les scores confirmatoires sont calculés dans un seul segment (section 3.10).
- DOIT, où les lecteurs font des prévisions à côté des modèles : assigner chaque lecteur une fois et au hasard, jamais réassigné ; compter une première prévision par marché, identifiant et session ; clôturer les prévisions des lecteurs à l'heure de référence ; traiter un identifiant réinitialisé comme un nouveau lecteur et rapporter la part des réinitialisations ; étiqueter le groupe en aveugle dans le dictionnaire des données avant la première prévision cotée ; et ne stocker l'adresse d'aucun lecteur, au maximum un hachage salé de celle-ci avec le jour utilisé uniquement pour plafonner les votes répétés, sans publier ni l'un ni l'autre (section 6).
- DEVRAIT signaler les diagnostiques des sections 4 à 6 à côté des scores : la part de la plus grande valeur propre et le rapport de participation de la matrice de ressemblance, les deux décomptes de distinctivité de chaque siège, le test des côtés comme blocs, un enregistrement de récupération pour chaque lien cité qui entre dans un décompte de chevauchement, le bras réservé aux prix, les répétitions de probabilité sous un paquet gelé, le cours acheteur, le cours vendeur et l'heure du dernier cours sur chaque ligne de foule, et le chiffre d'affaires et les coûts de chaque compte à côté d'une ombre sans trading.
Une partie de la liste de contrôle s'exécute sous forme de code. La ligue publie le contrat d'événement en tant que schéma JSON (event-contract.schema.json) et un vérificateur autonome écrit uniquement avec la bibliothèque standard Python (tools/conformance.py, à la même adresse que les données, SHA-256 e1f929a9…63db2e tel que récupéré le 21 octobre 2026, 22:33 UTC, conservé inchangé à tools/archive/conformance-e1f929a9.py ; environment.json énumère chaque version du vérificateur avec sa date et son hash). Le contrat complet comporte neuf clés : asset, horizon, heure de référence, heure de fin, règle, version du résolveur, règle de référence, fournisseur de prix et symbole de prix, et son event_id_v2 est ev2- suivi des 16 premiers chiffres hexadécimaux du SHA-256 de leur JSON canonique (clés triées, pas d'espaces, UTF-8). Le premier identifiant, event_id (ev1-, les cinq premières clés), le côtoie, de sorte qu'aucun identifiant publié ne change jamais. Deux ligues qui rédigent le même contrat reçoivent le même identifiant, de sorte que le test de l'exigence 4 devient une comparaison d'identifiants pour chaque champ qui fixe le résultat, et les règles de notation sont fixées par la version de la méthodologie scellée dans la même ligne. Le vérificateur valide chaque ligne par rapport au schéma, reconstruit son identifiant, vérifie les heures, la plage de probabilité et les champs de résultat, rejette un identifiant utilisé pour deux événements et exige la version de méthodologie de chaque ligne (exigence 15). Toute ligue peut exécuter python3 conformance.py its.csv sur son propre export. Sur le fichier de prévisions de la ligue du 21 octobre 2026, 22:33 UTC, il a signalé « 3792 lignes, OK », avec les deux identifiants reconstruits sur chaque ligne. Une réussite montre un enregistrement bien formé, et le tableau 5 présente l'exigence de conformité exigence par exigence.
Le tableau 5 donne l'état de l'implémentation de référence par rapport à chaque exigence. Une affirmation qui repose sur une exigence s'applique à partir de la date à laquelle l'exigence est remplie. « Satisfaite » signifie visible dans les fichiers publics lorsque je les ai lus le 21 octobre 2026 à 15:05 UTC (voir la remarque), « Partiellement satisfaite » que part de l'exigence y est visible, et « En cours » que l'implémentation est en cours, les parties déjà en place étant énumérées à côté.
Tableau 5. Conformité de l'implémentation de référence, telle que lue le 21 octobre 2026 (exigence 3 le 22 octobre 2026).
| Exigence | Niveau | Statut | Ce qui est en place |
|---|---|---|---|
| 1 Contrat d'événement | MUST | Satisfaite à partir du 21 octobre 2026 | Champs de contrat scellés dans la méthodologie ; schéma de contrat, vérificateur et les deux identifiants sur chaque ligne de prévision, l'event_id_v2 à neuf clés avec fournisseur, symbole et règle de référence ; modèle avec sa chaîne de version et mode scellé dans chaque ligne de réponse (restauré par les lignes de correction pour les premières exécutions) |
| 2 Enregistrement chaîné par hash | MUST | Satisfaite | Hashes de chaîne, de question et d'instantané, questions publiées, corrections en tant que lignes |
| 3 Ancre externe | MUST | Satisfaite à partir du 22 octobre 2026 | Ancre OpenTimestamps à chaque exécution, preuves publiées ; à partir du 21 octobre, jetons RFC 3161 de deux autorités indépendantes sur chaque liste horodatée (trois à partir de 13:23 UTC), chaque liste nommant la précédente par son SHA-256 ; chaque liste horodatée entrée dans le journal de transparence Sigstore Rekor lors de l'horodatage à partir du 22 octobre 2026 (la première à l'index du journal 3 368 763 032, cinq secondes après son horodatage de 00:00:11 UTC), et les listes antérieures le 21 octobre de 23:45 à 23:47 UTC (la liste du 20 octobre à l'index du journal 3 368 351 276) |
| 4 Une référence par événement commun | MUST | En cours | Lignes scellées après la référence portent leur propre référence (late_ref) ; les lignes portent reference_at, same_event et event_id ; la série comptée de n_eff, intitulée la principale, exclut ces lignes ; l'n_eff tous les sièges, intitulée « pas de coupure au moment du scellé », et together sont publiées à côté sans la coupure |
| 5 Chaque exécution publiée | MUST | Satisfaite | Exécutions non comptées intitulées not_counted |
| 6 Exécution comptée | MUST ; SHOULD | MUST satisfaite à partir du 21 octobre ; SHOULD satisfaite | Exécution matinale programmée déclarée à l'avance, scellée comme première ligne de asks.jsonl (04:16 UTC) et publiée sur la page de preuve avec son SHA-256 et une capture de l'Internet Archive (05:35 UTC) ; 19 et 20 octobre suivent la règle de développement de la section 3.4 |
| 7 Événement demandé | MUST | En cours | Score Brier tous les sièges déclaré le score principal à partir de la session du 21 octobre (main_metric, premier tel score après cette clôture) ; 19 et 20 octobre se présentent comme publiés, un segment séparé (method_segments) |
| 8 Cellules vides | MUST | Satisfaite | counted_50, no_answer, of ; trois résultats signalés séparément |
| 9 Repères | MUST | En cours | Repère 50 % publié ; climatologie fixe publiée dans le council-calibration.json en direct à partir du 21 octobre 2026, 08:54 UTC (climatology_fixed, 48 cellules marché-horizon, contenu SHA-256 2810d11e…3cabb7, sha256_ok vrai) ; F12 et F13 appliquent déjà le plancher de 1 000 $ dans leurs propres définitions, et le plancher du volume de la foule dans la méthodologie publiée le complète |
| 10 Classement et intervalles | MUST | En cours | Règle 30/10, intervalles groupés par session et intervalles appariés au niveau de la session (pairs, council-pairs.csv) publiés ; intervalles à fenêtre chevauchante et marges déclarées dans l'enregistrement |
| 11 Données, code, version | MUST | En cours | Données et code publiés avec hashes ; publication d'analyse déposée à chaque révision |
| 12 Scellement à l'arrivée ; RFC 3161 | MUST ; SHOULD | Partiellement satisfaite | Jetons RFC 3161 sur chaque liste horodatée à partir du 21 octobre ; ce matin-là, huit réponses ont été scellées en un lot et une neuvième 14 secondes après son arrivée ; le scellement de chaque réponse à son arrivée le complète |
| 13 Hashes des questions, liste avant la question | SHOULD | Partiellement satisfaite à partir du 21 octobre | Chaque étape d'une exécution scelle sa liste (sièges demandés, sièges déjà répondus, suppléants) avant sa première question, de sorte qu'une deuxième demande est visible ; hashes des questions sortantes chaînés dans asks.jsonl et couverts par les listes horodatées ; les deux sur la page de preuve ; la date limite et la politique de relance rejoignent les champs de liste |
| 14 Voix effectives à côté du consensus | MUST | En cours | n_eff publié dans council-stats.json ; la série comptabilisée (exécutions comptabilisées, réponses scellées avant 09:30 ET) est étiquetée comme principale, la série tous sièges est conservée à côté ; l'impression à côté de chaque consensus affiché le complète |
| 15 Segments | MUST | Satisfait | Version méthodologique scellée dans chaque ligne d'exécution et sur chaque ligne de prévision (methodology_version) ; scores par segment (method_segments) ; changements datés ; rien recompté |
| 16 Lecteurs | MUST | En cours | Deux groupes aléatoires permanents actifs (experiment.g0, g1), premières prévisions uniquement, prévisions de lecteurs fermées à 09:30 ET, aucune adresse stockée (un hachage salé par jour plafonne les votes) ; l'étiquette de groupe aveugle dans le dictionnaire de données et la part des réinitialisations le complètent |
| 17 Diagnostiques | SHOULD | Partiellement satisfait | Ratio de participation (n_eff_participation), les comptages sans signe et centrés sur la climatologie, le chevauchement de source partagée et le bras Closed Book publiés ; les autres diagnostiques sont spécifiés |
Note : État tel que lu dans les fichiers publics et sur la page de preuve du 21 octobre 2026 à 15:05 UTC (council-stats.json généré 14:51:50 UTC, council-book.jsonl de 230 lignes) ; l'exigence 1 est telle que vérifiée à 22:33 UTC le même jour (Section 3.13), et l'exigence 3 telle qu'entrée dans le journal Rekor le 22 octobre 2026 à 00:00:16 UTC (Appendice B, Étape 10).
4. Mesures
Le protocole fixe ce qui a été dit et quand. Les mesures transforment cet enregistrement en scores ; ensemble, elles constituent l'évaluation des prévisions que la norme exige. Je décris chaque mesure telle que publiée dans la méthodologie (version 2) et le protocole de la ligue (arena-3, ligue Pro pro-1) et, lorsque la norme demande davantage, l'exigence. La section 5 rapporte les valeurs de dépendance sur les données en direct, et les résultats de précision arrivent sous forme de révisions datées de cet article.
4.1 Direction
L'indicateur était-il plus élevé ou plus bas à la fin de l'horizon qu'à sa référence, et la probabilité du modèle a-t-elle soutenu ce côté ? Au-dessus de 50, cela soutient une hausse ; en dessous de 50, une baisse ; exactement 50, ni l'un ni l'autre. Un appel de 51 % et un appel de 95 % obtiennent le même succès, donc la direction ne peut pas distinguer un modèle confiant d'un modèle hésitant, et la mesure principale est le score de Brier.
4.2 Score de Brier
Pour une prévision avec probabilité déclarée (en pourcentage) d'une hausse et résultat ,
et le score d'un modèle sur prévisions résolues est la moyenne (Brier, 1950), de 0 pour une prévision parfaite à 1 pour la pire. Le score de Brier est strictement propre pour l'événement sur lequel il est calculé (Gneiting & Raftery, 2007) ; pour la question de la ligue, cet événement est une hausse stricte sur toutes les lignes (section 3.5, exigence 7).
4.3 L'indice neutre de 50 % et la climatologie
Un prévisionniste qui dit toujours 50 % obtient un score de 0,25 à chaque prévision. C'est l'indice neutre de 50 % (la « pièce » des fichiers de la ligue), une référence neutre. Un prévisionniste qui connaît le taux de base des hausses peut obtenir un score inférieur à 0,25 sans compétence sur le jour, et aux horizons longs, le taux de base peut être très éloigné d'une moitié. J'ajoute donc un indice climatologique (exigence 9) : la fréquence d'une hausse stricte du même événement pour chaque actif et horizon, estimée sur une fenêtre fixe qui se termine avant la saison et scellée dans la méthodologie, avec le score de compétence de Brier
sur les mêmes lignes. Le même événement signifie l'événement que le contrat évalue : pour le jour, de la référence au prix terminal selon la règle de source de prix du tableau 1 (09:30 à 16:00 ET, le rendement à 15:00 ET, Bitcoin de la minute scellée à 16:00 ET). Pour les horizons plus longs, il s'étend sur le même nombre de séances ou de jours calendaires (section 3.7). Un taux de base d'un événement différent biaiserait l'indice.
Dans l'implémentation de référence, la climatologie fixe est le champ climatology_fixed de council-calibration.json : par actif et horizon, p_up, la fréquence 2016 à 2025 d'une hausse stricte avec chaque ligne comptée, p_up_ex_draw, la même sans les égalités, les comptages n et n_independent, la fenêtre et la règle. L'indice principal est = p_up, car le score de Brier principal compte toutes les lignes. p_up_ex_draw sert le score de compétence propre de la ligue sans égalités (bss_reference). Le champ est scellé par council-clim-window.json, publié sous l'adresse de données, avec 2810d11e…3cabb7, le SHA-256 de son contenu : json.dumps de Python de l'objet sans sa clé sha256, avec les clés triées et les paramètres par défaut. Le script de classement recalcule ce hachage de contenu avant de lire . Le champ a été saisi dans le fichier en direct le 21 octobre 2026 à 08:54 UTC, son hachage de contenu vérifie (sha256_ok), et c'est l'indice de la comparaison principale. Lorsque la fenêtre en direct n'a pas d'historique quotidien, l'événement quotidien le plus proche tient lieu : la barre quotidienne pour l'or, le WTI, le Brent, le cuivre et l'indice du dollar, la clôture quotidienne pour le rendement à 10 ans, le jour UTC pour Bitcoin et, à partir d'une semaine, les mouvements à partir de l'ouverture. Les quatre indices boursiers américains prennent les leurs de la barre quotidienne de la séance 09:30 à 16:00 ET elle-même, l'événement auquel les modèles répondent, et le test principal est également rapporté sur ces quatre seuls (section 8). Les approximations biaissent et laissent les prévisions intactes (section 10).
4.4 Calibrage et pertinence
L'étalonnage se demande si les probabilités énoncées se réalisent au taux énoncé. La ligue rapporte l'étalonnage directionnel de la confiance : chaque probabilité résolue est repliée du côté qu'elle soutient ( devient avec le résultat inversé, et exactement 50 laissé de côté), les prévisions repliées tombent dans quatre bacs, [50, 60), [60, 70), [70, 80) et [80, 100], et chaque bac affiche la probabilité énoncée moyenne et la part qui s'est réalisée, tracée à partir de 20 prévisions (calib_min). Le repliement mesure si la confiance dans le côté soutenu est assortie au taux de succès de ce côté. L'étalonnage de la probabilité brute d'une hausse peut aussi être calculé à partir des lignes ouvertes. Le score de Brier se divise en un terme d'étalonnage et un terme de résolution (Murphy, 1973), et les bacs constituent un complément lisible à cette division.
Les bacs nécessitent de nombreuses prévisions, donc j'ajoute, pour chaque siège, le consensus et chaque horizon, l'ajustement d'étalonnage logistique sur toutes les lignes de l'événement demandé (Cox, 1958). Une pente inférieure à 1 signifie que les probabilités énoncées s'écartent trop de la moitié, supérieure à 1 trop proche ; mesure une inclinaison vers les hausses ou les baisses. La pente utilise chaque prévision et porte une erreur type, calculée en gardant les sessions ensemble (Section 4.6). Le même ajustement, avec des intervalles regroupés par événement, a été appliqué aux prix de Polymarket (Walker, 2026).
L'étalonnage est jugé conjointement avec la netteté, puisqu'un prévisionniste qui dit toujours 50 % est étalonné et non informatif (Gneiting et al., 2007). Je demande aussi, par siège, consensus et horizon,
de 0 (toujours 50 %) à 100 (toujours certain), sur les probabilités énoncées uniquement, et avec la probabilité climatologique de la Section 4.3 à la place de 50. La netteté par rapport à la moitié devrait augmenter avec l'horizon où les taux de base à long terme s'écartent beaucoup de la moitié ; la netteté par rapport à la climatologie est celle du prévisionniste lui-même. Aucune des deux ne nécessite un résultat. Sur la course comptabilisée du 20 octobre 2026, les huit sièges scellés avant la référence avaient K de 9,2 à un jour, 14,1 à une semaine, 13,9 à un mois et 20,3 à six mois (Figure 5 ; les cellules elles-mêmes se trouvent à la Figure 6B). Ils se situaient environ cinq points d'une chance égale pour le jour et étaient les plus décidés à l'horizon qui se résout en dernier, dont une partie est le taux de base que élimine. Le 21 octobre 2026, les neuf sièges ont donné 10,1, 12,5, 14,6 et 19,9. La plupart des probabilités énoncées se situaient entre 40 et 60. À un jour, cela s'appliquait à 93 % d'entre elles le 20 octobre et 95 % le 21 octobre, et même à six mois pour plus de la moitié (58 % et 61 %).
Figure 5. Probabilités énoncées d'une hausse par horizon : courses 2026-10-20-am (huit sièges scellés avant la référence) et 2026-10-21-am (neuf sièges).
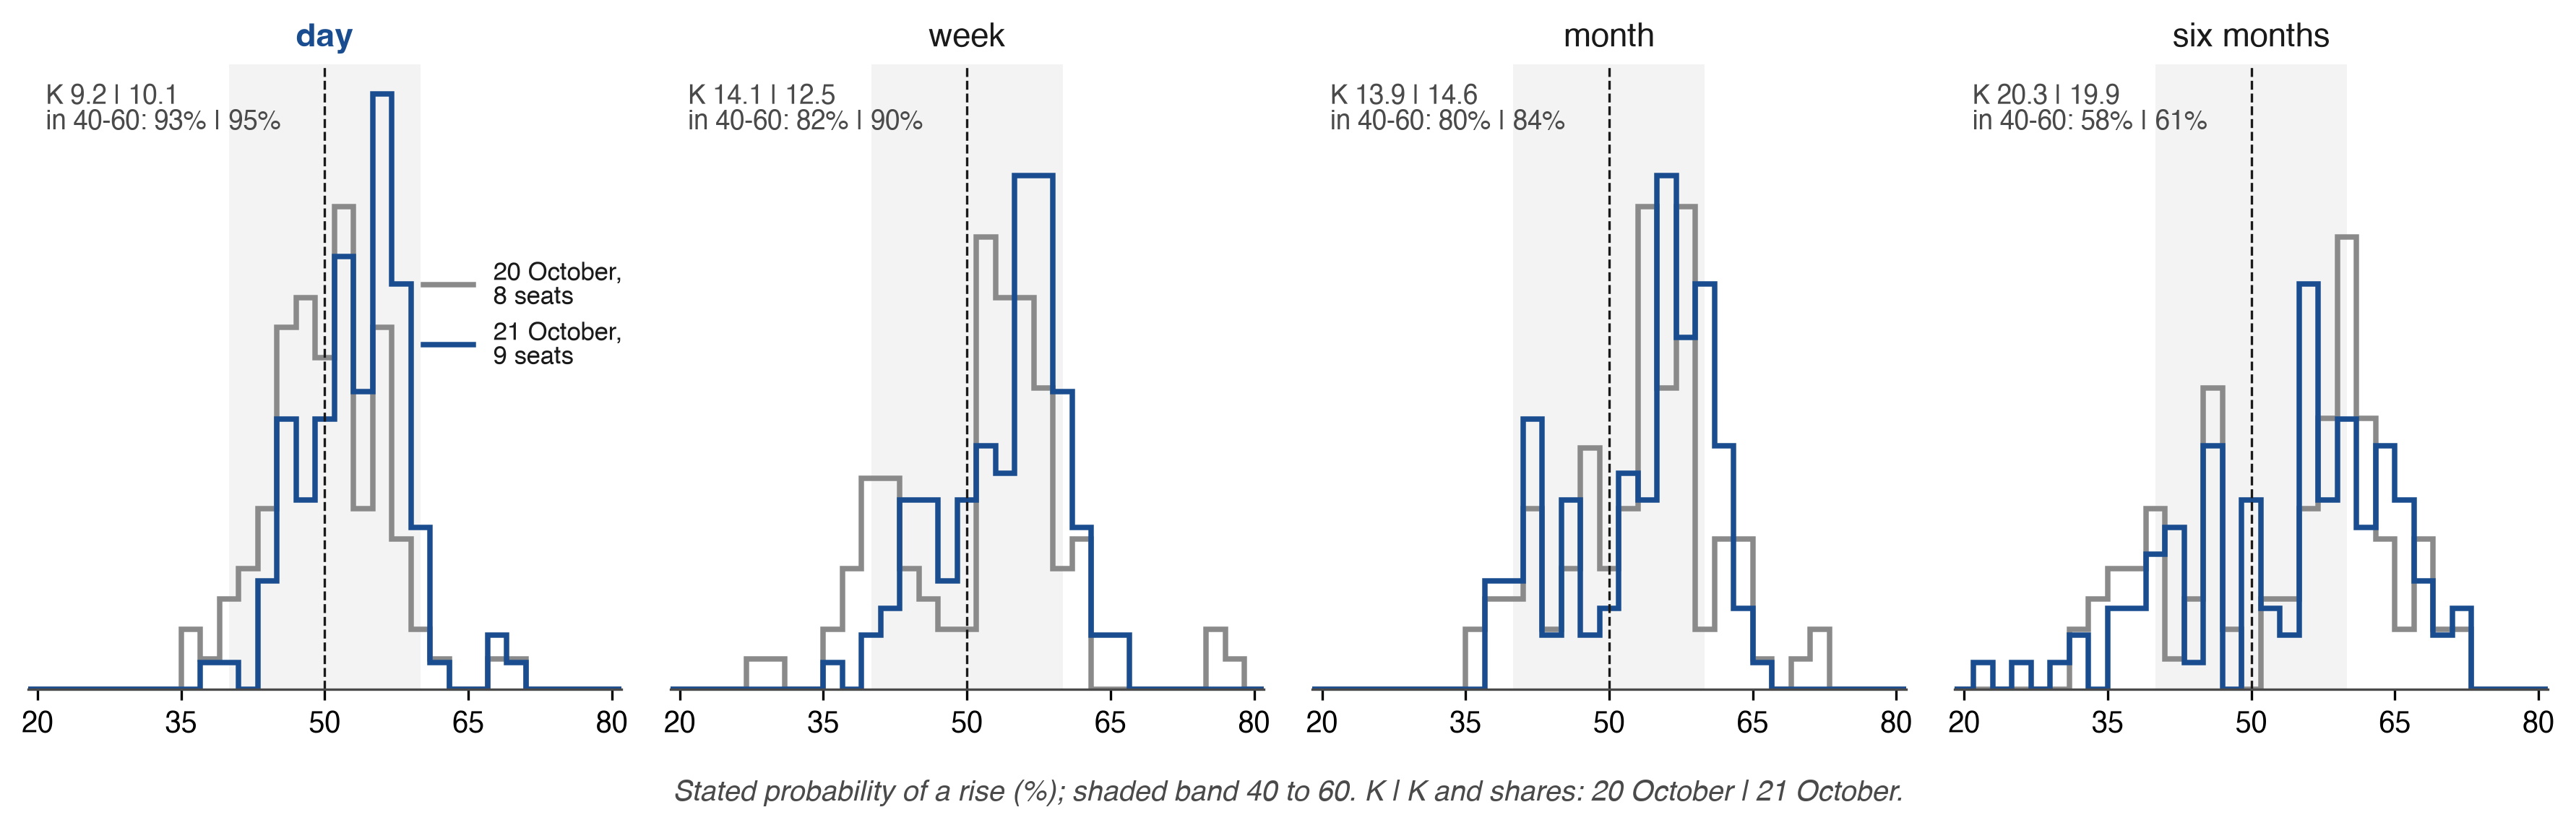
Note : Histogrammes par pas de 2 points, mis à l'échelle à surface égale ; la bande ombrée s'étend de 40 à 60. K = (2/n)Σ|p − 50| (Section 4.4). Le 21 octobre, les quatre cellules Bitcoin de la neuvième réponse comportent une référence qui leur est propre (Section 3.3) et sont exclues de cette lecture et de toute autre lecture regroupée de la course (428 sur 432 cellules). Source : council-forecasts.csv enregistré 22 octobre 2026, 01:32 UTC.
4.5 Références
La ligue évalue les mêmes lignes contre des références fixes :
- Pièce (0,25 sur chaque prévision).
- Momentum : direction d'hier du même indicateur à 55 % fixe, évalué sur les mêmes lignes que le consensus ; le champ publié de la ligue laisse de côté les égalités, et le F15 enregistré le marque sur toutes les lignes (Section 8.1).
- Acheter et conserver (
_hold_all), S&P 500 (_spy), 60/40 (_passive), Trésorerie au bon du Trésor à 13 semaines (_cash) et Aléatoire selon les règles de la ligue (_random).
Les deux premiers sont des points de référence pour les scores de probabilité, et les cinq autres sont des portefeuilles gérés dans les mêmes conditions de coûts et d'exécution que les modèles. Momentum teste une règle triviale. Quand le résultat est une chance égale indépendante d'hier, un taux fixe de 55% obtient en espérance. Le point de référence climatologique est le seuil que la norme exige. La méthodologie désigne aussi une ligne de base sans changement, une prévision ponctuelle sans probabilité, qui reste en dehors de la comparaison de Brier. Le consensus du Conseil est aussi un point de référence : la moyenne des probabilités des modèles, avec la plus élevée et la plus basse supprimées quand cinq ou plus répondent, un deuxième membre de la même famille pondéré à un tiers, et le résultat maintenu entre 2% et 98%.
La moyenne pondérée donne un gain qui n'est pas de la compétence. Pour un événement avec le résultat et les poids qui somment à un, le score de Brier de la moyenne pondérée égale la moyenne pondérée des scores des membres moins leur dispersion pondérée (Krogh & Vedelsby, 1995) :
Le consensus ne peut donc pas perdre contre la moyenne des membres qu'il conserve, sur un événement commun, quelle que soit leur compétence ; maintenir le résultat entre 2% et 98% peut coûter au maximum 0,0004 par ligne. Un constat selon lequel le consensus surpasse son membre moyen est mécaniquement attendu. Sa compétence est jugée contre la pièce, le taux de base climatologique, la foule et le meilleur modèle unique de la période précédente, et le terme de dispersion est rapporté à côté du score du consensus (Section 5.3).
4.6 La règle 30/10 : 30 prévisions sur au moins 10 jours de bourse
Un modèle entre dans le tableau d'un horizon seulement s'il a au moins 30 prévisions résolues à cet horizon et au moins 10 séances de bourse avec au moins une prévision résolue à cet horizon dans chacune. La méthodologie scellée énonce la règle et sa raison dans un champ : « les 12 indicateurs d'un jour bougent ensemble : la ligue affiche les jours de bourse à côté des prévisions, et un modèle est classé après 30 prévisions résolues sur au moins 10 jours de bourse » (independence). La règle ne limite pas comment inégalement les prévisions se répartissent sur ces séances, donc le tableau affiche le nombre de séances de chaque modèle à côté de son score (days), et la deuxième condition est celle qui prime. Si les prévisions au sein d'une séance partagent une corrélation , alors prévisions d'une séance portent l'information d'environ prévisions indépendantes, l'effet de conception de l'échantillonnage en grappes (Kish, 1965). Avec et , une séance vaut 3,75 prévisions indépendantes, et trente prévisions de trois matinées environ onze. Exiger 10 jours de bourse force l'échantillon à s'étendre sur différentes actualités ; au sein d'un horizon, l'unité de rééchantillonnage est la séance. La règle 30/10 décide l'admissibilité, et la puissance est traitée ci-dessous. Le premier tableau, après la séance du 30 octobre 2026, est un ordre descriptif provisoire, et un modèle qui a manqué l'une quelconque des dix premières séances devient admissible plus tard.
Le fichier de statistiques publie des intervalles à partir de 5 sessions cotées (test t de Student sur les moyennes de session) et à partir de 20 par un bootstrap sur les sessions, avec les 12 indicateurs d'une journée comme un cluster (council-stats.json, sample.note). Avant 5 sessions, aucun intervalle n'est affiché, et un intervalle calculé sur les lignes traite les douze marchés d'une journée comme indépendants et est trop étroit. Pour des horizons plus longs qu'une journée, les prévisions consécutives partagent la majeure partie de leur fenêtre de résultats, donc j'exige, pour l'horizon en sessions, des intervalles robustes à l'hétéroscédasticité et l'autocorrélation avec décalage (Newey & West, 1987) ou un bootstrap par blocs avec des blocs d'au moins sessions (Künsch, 1989), et aucun intervalle avant sessions (exigence 10). Dans une saison de 126 sessions, cette règle donne des intervalles à une semaine à partir de la session 25 et à un mois à partir de la session 105, et aucun à six mois, ce qui nécessiterait 630. Les affirmations confirmatoires reposent sur la journée, l'horizon primaire, et sur la semaine et le mois où la règle est satisfaite. Les résultats à six mois et les intervalles quotidiens sont descriptifs dans cette saison. Une affirmation de compétence est lue aux dates de vérification enregistrées (section 8), quelles que soient les sessions entre elles.
La puissance appartient à la comparaison qui sera affirmée, une différence Brier appariée. Pour un prévisionniste et une référence sur les mêmes événements, soit la moyenne sur les événements de la session de . Avec un écart-type des moyennes de session et un plus petit effet déclaré , un test bilatéral à 5% avec une puissance de 80% nécessite environ sessions indépendantes. La persistance augmente le nombre, et l'analyse enregistrée garde les sessions consécutives ensemble (Diebold & Mariano, 1995; Künsch, 1989). À 126 sessions, le calcul Brier du fichier (power_brier) détecte une baisse sous le hasard de 0,0105, et une baisse de 0,005 nécessite 554 sessions. Il extrapole à partir de 171 prévisions de deux sessions (le fichier généré le 21 octobre 2026, 05:33 UTC, sur les données du 20 octobre; le champ en direct est recalculé à chaque exécution), en prenant leur écart-type au niveau des prévisions de 0,062 et comme approximation jusqu'à ce que cinq sessions soient cotées. Il est recalculé à la session 30 sur des données au niveau de la session, et les tests enregistrés n'en dépendent pas. Le calcul du taux de réussite du fichier (power) nécessite 209 sessions pour distinguer 55% de 50% avec un supposé. Une analyse indépendante des questions de marché prédictif binaire atteint le même ordre : environ 350 prédictions résolues pour détecter un avantage Brier de 0,02 sur le marché (Nechepurenko & Shuvalov, 2026a).
Un résultat négatif a besoin de sa propre règle. Une petite différence estimée, un intervalle trop large pour décider et une preuve d'absence de différence sont trois résultats. Je déclare une marge d'équivalence, ±0,01 Brier, pour chaque comparaison confirmatoire, et lis « aucune différence matérielle » uniquement lorsque l'intervalle à 90% de la différence appariée (deux tests unilatéraux à 5%) se situe entièrement à l'intérieur. J'ai choisi la marge. Elle est proche de ce que l'extrapolation à deux sessions dit que 126 sessions peuvent résoudre (power_brier, ci-dessus), elle ne change pas lorsque cette extrapolation est recalculée, et c'est une tolérance de cotation, distincte de tout seuil économique.
4.7 The portfolio league
Les probabilités mesurent le jugement. Un portefeuille, une mesure secondaire, montre ce qu'un modèle en fait. Chacun des 14 modèles gère 100 000 $ simulés selon les mêmes règles : onze fonds négociés représentent les marchés (le VIX est un indicateur seulement), les positions sont longues uniquement de 5 % à 25 %, le cash rapporte le bon du Trésor à 13 semaines, chaque dollar échangé coûte 0,1 %, et une décision se négocie à la première ouverture après son sceau (le premier prix de 09:30 à 09:45 ET). « Hold » est une décision sans échange et sans coût. Une décision qui viole une règle est refusée, et les positions se maintiennent. Chaque compte est marqué à la clôture avec son rendement et sa baisse maximale, et à partir de 20 sessions avec les ratios de Sharpe et Sortino (Sharpe, 1994 ; Sortino & Price, 1994). Les règles complètes sont dans le fichier de protocole (Appendice A, Tableau A1). Le compte note l'instrument, un fonds du Trésor pour le rendement et un fonds pour chaque contrat à terme sur matières premières, donc un score de Brier plus bas n'établit pas une valeur de compte plus élevée. Le compte est comparé plutôt avec les lignes de base passives selon les mêmes coûts, dans une version de règles.
4.8 La ligue Pro
Chaque modèle tient un deuxième compte de 100 000 $ dans la ligue Pro (pro-1), un portefeuille long-short avec des poids signés de 5 % à 30 % des actions et une exposition brute de 100 % à 200 %, donc un effet de levier jusqu'à 2× ; le VIX peut être négocié ici. Ses lignes de base sont le S&P 500 détenu long et détenu short.
4.9 L'IA contre la foule
Pour jusqu'à huit des 12 marchés, les marchés de prédiction négocient une question quotidienne proche de celle de la ligue. La question de chaque passage les énumère avec leurs règles de résolution complètes et demande à chaque modèle sa propre probabilité de « Up » sur chacune, dans un champ séparé de sa ligne de réponse (crowd_up). L'instruction de ne pas consulter Polymarket, Kalshi ou aucune cote de paris est scellée dans la question, et ce qu'une recherche de modèle a renvoyé se situe en dehors du sceau. Où Polymarket énumère le marché, les modèles répondent à la question de Polymarket, et une question Kalshi est posée uniquement pour un marché que Polymarket n'énumère pas (council-calibration.json, method.crowd_window). Les prix de la foule et les volumes négociés (vol) sont enregistrés lorsque la question est posée et scellés dans la ligne d'exécution (crowd.odds pour Polymarket, crowd.kalshi pour Kalshi). Le 20 octobre, ils ont été enregistrés à 12:30:06Z, avant que le premier modèle ne commence sa réponse. Je cache le prix par conception. Un modèle qui reçoit le prix du marché et est invité à le réviser peut battre le marché sur certains contrats (S. Kim et al., 2026), mais sa réponse n'est alors plus une preuve indépendante de la foule. La ligue les tient séparés : la réponse scellée est aveugle au prix, et toute combinaison avec la foule est une stratégie séparée, scellée avant d'être notée (Section 5.3). Chaque comparaison nomme son horloge d'information : le prix scellé est la foule au moment de la question, tandis que le fichier d'étalonnage compare la réponse de chaque modèle au prix de la foule à la minute de sa propre réponse, tous deux notés sur la résolution de la foule. Après résolution, la ligue rapporte, par question, la probabilité des modèles et celle de la foule, le score de Brier de chacun et les côtés que chacun a deviné correctement (ligne de livre crowd ; council-league.json, champ crowd).
Le 20 octobre, Polymarket énumérait six questions quotidiennes « Up or Down » (S&P 500, Dow, or, WTI, l'indice du dollar et Bitcoin) et Kalshi cinq (S&P 500, Nasdaq-100, le rendement à 10 ans, or et WTI) : huit marchés, trois d'entre eux sur les deux venues. Où les deux venues énumèrent un marché, j'utilise le contrat Polymarket, celui que les modèles ont répondu ; sinon le contrat Kalshi. Chaque probabilité de foule provient d'un contrat. Une question Kalshi est définie à un strike, et son prix est converti en « au-dessus de la clôture précédente » par interpolation entre les deux strikes adjacents (lo, hi dans la ligne d'exécution). Le prix interpolé rapproche la probabilité de cet événement à partir de deux prix négociés, et les deux côtés sont alors notés sur cet événement synthétique par la source que le contrat nomme. J'admets un contrat à la comparaison primaire lorsque son volume scellé est d'au moins 1 000 $ au moment où la question est posée, et je rapporte les contrats plus fins à part. Le seuil montre l'argent négocié sur le contrat. L'exigence 17 demande l'offre, la demande et l'heure de la dernière transaction sur chaque ligne de foule, car sur Polymarket les écarts sont plus larges sur les résultats improbables (Dubach, 2026).
Les questions de la foule sont proches de celles de la ligue, et leurs horloges diffèrent. La journée de la ligue s'écoule de la référence 09:30 à 16:00 ET (le rendement à 15:00 ET) ; les questions de la foule s'écoulent de clôture à clôture et plusieurs se résolvent à d'autres heures et à partir d'autres sources : or et indice du dollar à la chandelle Pyth de 17:00 ET, WTI à la clôture quotidienne du contrat à terme actif, le rendement au taux par au pair du Trésor à 15:30 ET, Bitcoin de midi à midi sur Binance. Je fais donc la comparaison question par question, selon les propres termes de la foule, avec la probabilité séparément obtenue. Les prix des marchés de prédiction sont une ligne de base forte (Wolfers & Zitzewitz, 2004 ; Berg et al., 2008), et les contrats macroéconomiques de Kalshi prédisent environ aussi précisément que l'Enquête sur les attentes du marché et le consensus Bloomberg (Diercks et al., 2026). La netteté (Section 4.4) est comparée sur les mêmes contrats, modèle par modèle, à partir de crowd_up, car la foule ne fixe pas le prix de l'événement prob_up.
La distance sur laquelle une inadéquation d'événements peut faire bouger un score peut être énoncée exactement. Supposons qu'un indice ait fermé hier à 100, ouvre à 98 et ferme à 99 : il a baissé depuis la clôture précédente et a augmenté depuis l'ouverture. Soit deux versions d'un événement qui se résout avec des résultats opposés sur une part de lignes, avec les probabilités et les lignes fixées. Sur une ligne inversée, une prévision change son score de Brier de , au maximum 1 en valeur absolue, donc un score de Brier moyen se déplace d'au maximum . L'écart entre les prévisionnistes et change sur cette ligne de , donc l'écart se déplace d'au maximum , où est l'ensemble des lignes inversées. Les bornes valent pour les prévisions fixes sur un échantillon fixe. Deux règles en découlent. Les prévisions entrent dans un score commun seulement sur un événement, avec un seul prix de référence (exigence 4). Et chaque comparaison avec la foule rapporte sa part de sessions de marché sur lesquelles les deux questions se résolvent avec des signes opposés ; un écart pas plus grand que n'est pas lu comme un avantage d'aucun des deux côtés.
4.10 La grille : modèle × marché × horizon
Chaque réponse comptée remplit une cellule d'une grille à trois voies : jusqu'à onze modèles du Conseil, 12 marchés et quatre horizons (Figure 6). Chaque cellule accumule son propre score de Brier, taux de réussite, calibration et netteté. La grille répond à des questions qu'un seul classement ne peut pas poser : quels marchés sont prévisibles à quel horizon, si l'avantage d'un modèle se situe dans une classe d'actifs, et si le mois est plus facile que le jour une fois que chacun est mesuré par rapport à son propre taux de base. Les vues marginales sont publiées dans council-league.json (models, by_asset, by_horizon), les lignes complètes dans council-forecasts.csv.
Figure 6. La grille de mesure. (A) La conception : modèle × marché × horizon. (B) La grille remplie : les probabilités scellées d'une matinée comptée, 20 octobre 2026.
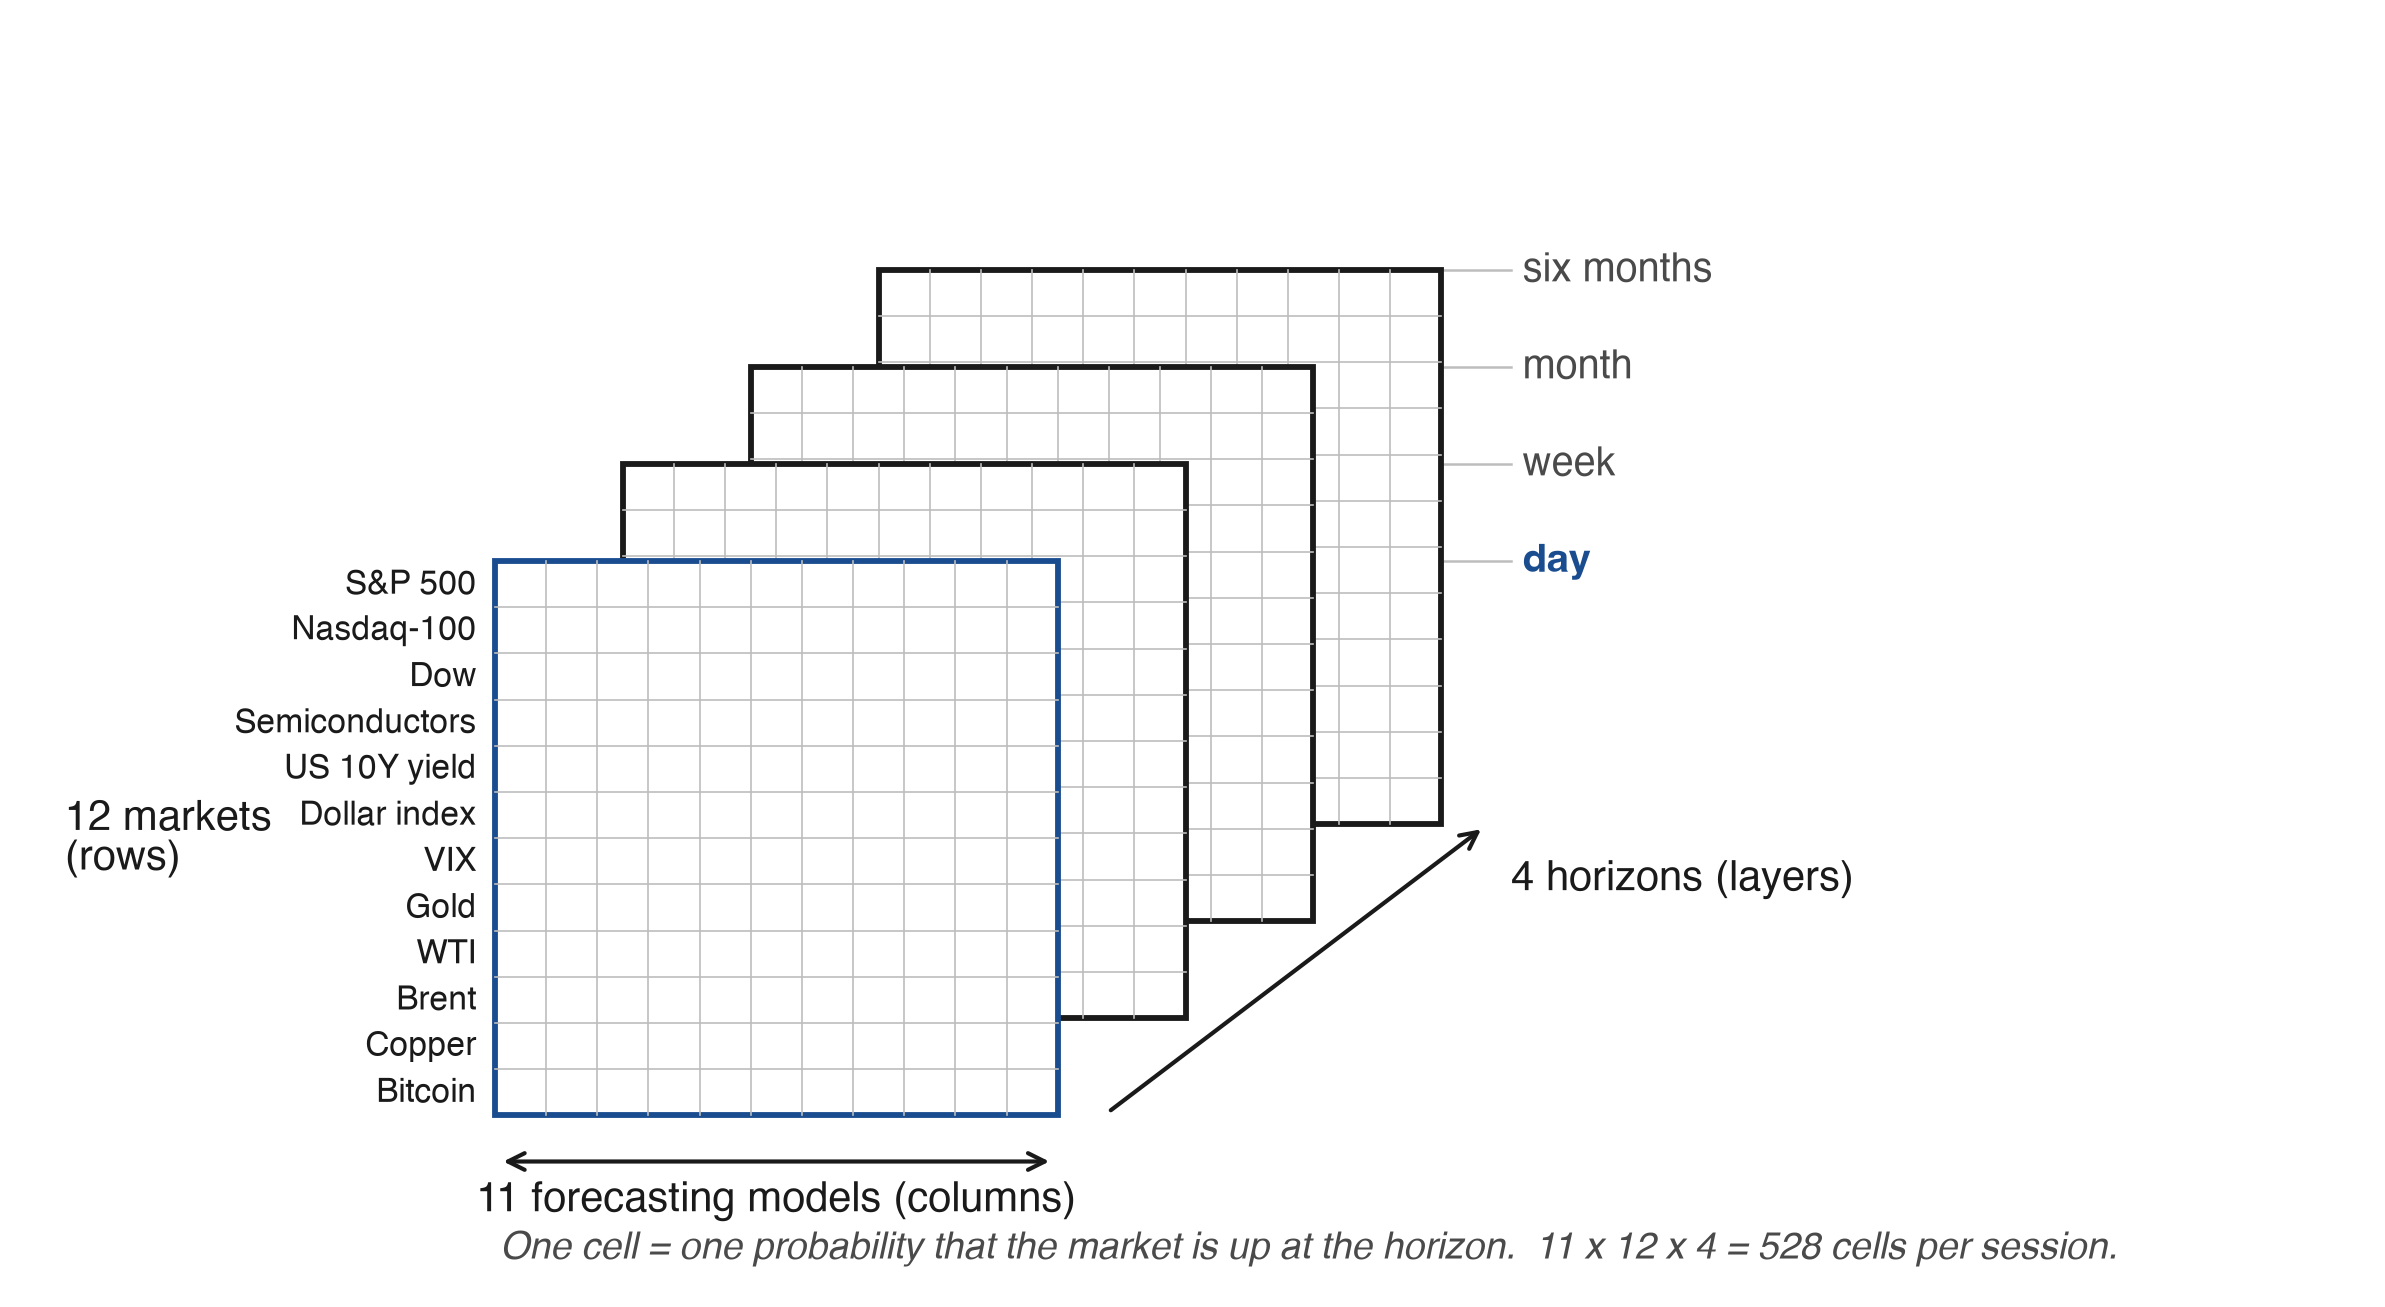
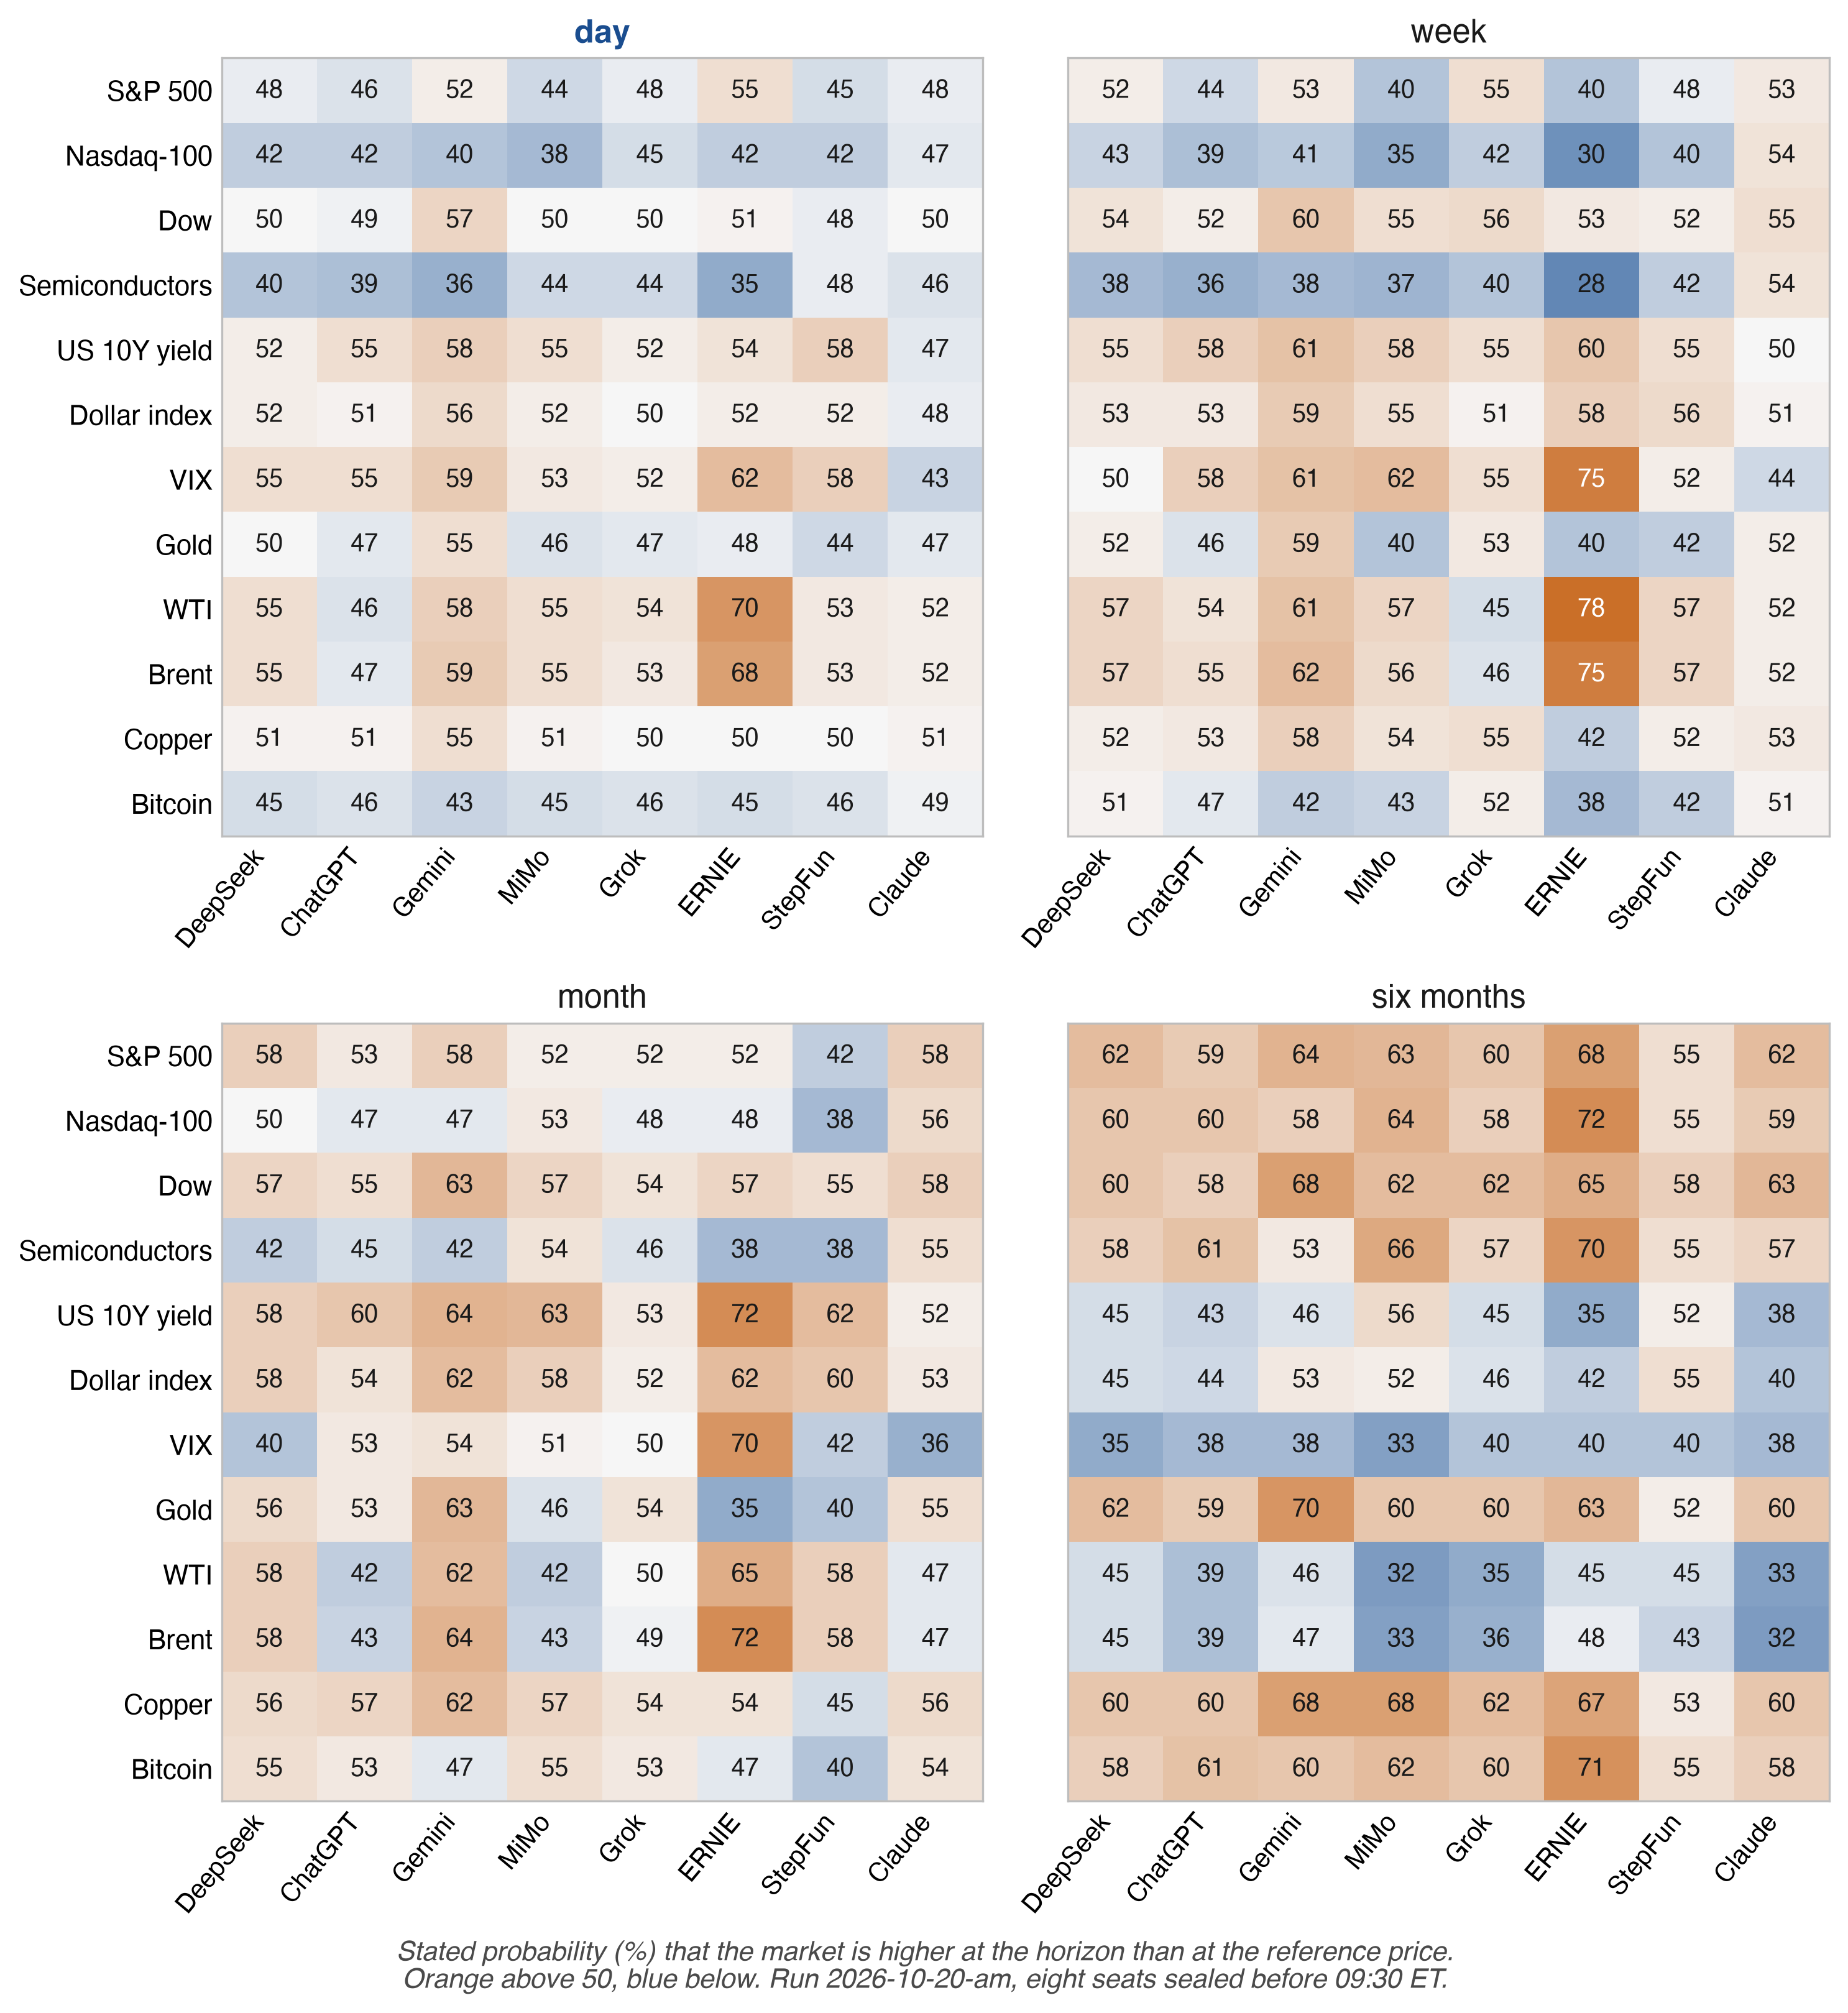
Note : (A) Les cellules sont remplies à partir des lignes comptées de council-forecasts.csv ; une cellule n'est classée que selon la règle de la section 4.6. (B) Les huit sièges dont les réponses ont été scellées avant la référence 09:30 ET du 20 octobre 2026 (exécution 2026-10-20-am), une cellule par marché et horizon, coloriées par la probabilité déclarée d'une hausse et centrées sur 50 %. Les sièges sont ordonnés selon leur charge sur la première composante principale des images de probabilité, non par pays. Source : council-forecasts.csv, lu 21 octobre 2026.
Les prévisions quotidiennes se résolvent à chaque session ; les premières prévisions hebdomadaires de la ligue notée se résolvent à partir du 26 octobre 2026, les premières prévisions mensuelles environ le 19 novembre 2026 et les premières prévisions sur six mois en avril 2027.
4.11 Reproductibilité
Chaque score peut être recalculé à partir de fichiers ouverts. Le code du moteur de portefeuille est publié en tant que texte, 19 fichiers et les paramètres de la ligue, chacun avec son SHA-256 (arena-code.json). Un script de recompte (replay.py) recalcule la valeur, la part de trésorerie, les frais et les poids de chaque compte à partir des transactions et des prix. Sur les fichiers au 20 octobre 2026, il a reproduit les 253 lignes publiées de 145 comptes dans l'arrondi de publication (Appendice B, étape 7). Un deuxième script, tools/replay_brier.py à la même adresse, recalcule à partir de council-forecasts.csv le score de Brier de chaque prévision comptée et les totaux par siège, horizon et version de méthodologie, et les compare aux chiffres publiés; sur les fichiers actifs du 22 octobre 2026, 00:09 UTC, il a correspondait exactement à tous les 9 318 nombres publiés. Chaque ligne de prévision dans council-forecasts.csv nomme la ligne de livre qui la scelle (line), ainsi chaque score se trace jusqu'à une réponse scellée et de là à un préfixe horodaté et un bloc Bitcoin (Appendice B). Une ligne de score est couverte par le premier horodatage après elle.
Quiconque peut recalculer les résultats publiés. La chaîne et l'ancre fixent les réponses scellées, leurs heures et leurs questions. Les appels de modèle bruts, le flux de prix et le code déployé sont publiés avec leurs hachages tels que l'opérateur les a fournis. Réconcilier les prix de référence et de fermeture avec une deuxième source indépendante est le barreau de résultat de l'échelle des affirmations (tableau B1). Parce que les fichiers actifs changent à chaque exécution, chaque révision cite une version d'analyse immuable sur Zenodo (10.5281/zenodo.23552700) avec un manifeste du SHA-256, de la taille et du temps de récupération de chaque fichier (Appendice C).
5. Combien de voix indépendantes
La ligue compte onze sièges de prévision. Un conseil de cette taille semble offrir autant d'opinions, et la ligue est construite pour compter combien elle en détient. Si les erreurs de N prévisionnistes sont corrélées à un ρ commun, leur moyenne porte la preuve de
N_eff = N / (1 + (N − 1)ρ)
prévisionnistes indépendants, et à mesure que N augmente, N_eff s'approche de 1/ρ et s'y arrête. La formule est l'effet de conception de l'échantillonnage en grappes (Kish, 1965), et la saturation de la valeur des experts dépendants a été démontrée pour la combinaison de prévisions par Clemen et Winkler (1985). L'article complémentaire l'applique à des panels d'IA (Chernets, 2026a). Le plafond ne dépend pas du nombre de modèles interrogés. À ρ = 0,5, mille modèles valent deux témoins, et une fois qu'un conseil est plus grand que 1/ρ, réduire ρ apporte plus que d'ajouter des membres. L'entrée est mesurée. Quand deux modèles de langage se trompent tous les deux, ils donnent souvent la même mauvaise réponse, davantage au sein d'une architecture ou d'un fournisseur (Kim et al., 2025). Les erreurs de prévision de trois modèles frontière étaient corrélées à une moyenne r de 0,77 sur 568 questions binaires (Spiro, 2026), et les modèles frontière font des prédictions hautement corrélées sur l'indice d'IA de Metaculus (Aitchison et al., 2026). Quand de nombreux décideurs adoptent un algorithme, la décision collective peut s'aggraver même si l'algorithme surpasse chacun d'eux seul (Kleinberg & Raghavan, 2021). La théorie et les simulations calibrées aux portefeuilles institutionnels suggèrent que l'adoption généralisée de modèles d'IA similaires raccourcit la durée de vie des signaux qu'ils échangent (Meng & Chen, 2026). De tels arguments exigent une mesure de la ressemblance des modèles en entrée. Une ligue de marché fournit une vérité de référence externe tous les jours de négociation et jusqu'à onze flux de probabilités en direct sur lesquels ρ peut être estimé. N_eff est un décompte de la variance. Un biais que chaque modèle partage reste dans la moyenne quel que soit le nombre de modèles, c'est pourquoi la ligue compte aussi l'erreur unanime directement (Section 5.3). Un consensus de modèles imprimé sans son nombre effectif de voix est un sondage imprimé sans sa taille d'échantillon : le lecteur voit la part qui est d'accord et ne peut pas dire combien de preuve l'accord détient. L'exigence 14 fait donc du décompte une OBLIGATION partout où un consensus est affiché. Le 20 octobre, huit sièges ont scellé une image d'une journée avant l'ouverture, et leurs images étaient aussi semblables que celles de 1,46 prévisionnistes indépendants (Section 5.2).
5.1 Comment la ligue estime ρ
Chaque exécution scellée donne, pour chaque siège de prévision, une probabilité que chacun des 12 marchés sera à la hausse à chaque horizon. Pour chaque exécution et horizon, la ligue calcule la moyenne sur les paires de sièges de la corrélation de Pearson de leurs probabilités sur les marchés tous les deux répondus, et évalue N_eff = n / (1 + (n − 1)ρ) avec le propre n et ρ de cette exécution. N_eff est convexe en ρ, donc la moyenne des décomptes par exécution est au moins égale au décompte au ρ moyen, et le bruit d'échantillonnage de ρ, estimé à partir de douze marchés, pousse aussi le décompte par exécution vers le haut. Une moyenne en dessous d'un seuil, comme en F1 et F2, est donc la lecture conservatrice, et une comparaison entre horizons se lit sur ρ lui-même (F9). Avec douze marchés, une corrélation par paires porte un écart type d'environ 0,26 à 0,18 sur la plage observée de 0,38 à 0,64 ; les paires d'une exécution partagent des sièges et des marchés, donc leur moyenne est plus stable qu'une paire mais non par la racine de leur nombre. Un intervalle provient de cinq exécutions comptées. J'utilise la dernière ligne de réponse de chaque siège et laisse de côté les cellules restaurées après le sceau par une ligne correction datée, car elles n'étaient pas dans la réponse scellée. La règle d'admissibilité fait partie de l'estimateur. Je n'admets que les exécutions comptées, et seulement les réponses scellées avant le prix de référence, de sorte qu'une réponse tardive, qui aurait pu voir le mouvement d'ouverture, n'entre pas. Le fichier ouvert council-stats.json publie cette série sous n_eff.counted, avec la règle énoncée dans le fichier. Le bloc plus ancien n_eff.per_run et sa moyenne font la moyenne de toutes les exécutions scellées, exécutions d'essai et réponses tardives incluses. L'Appendice C donne les champs pour recalculer à partir de council-forecasts.csv et council-book.jsonl. Le Tableau 6 suit les lignes du fichier ouvert par cette règle, des six exécutions scellées au registre compté.
Tableau 6. Du fichier ouvert au registre compté, par exécution : lignes, corrections, sièges, lignes scellées avant la référence, 50 affichés, cellules invalides et lignes d'une journée comptées (council-forecasts.csv, 3 792 lignes).
| Exécution | Rôle | Lignes dans le fichier | Lignes de correction | Sièges répondant | Sièges scellés avant la référence | Lignes scellées avant la référence | 50 affichés | Cellules invalides | Lignes d'une journée comptées |
|---|---|---|---|---|---|---|---|---|---|
| 2026-10-16-eve | Essai | 1 056 | 39 | 9 | 9 | 1 017 | 20 | 0 | 0 |
| 2026-10-17-btc | Essai | 864 | 32 | 9 | 9 | 832 | 40 | 0 | 0 |
| 2026-10-18-radar | Essai | 672 | 21 | 8 | 8 | 651 | 22 | 0 | 0 |
| 2026-10-19-am | Développement | 336 | 11 | 7 | 7 | 325 | 4 | 0 | 83 |
| 2026-10-20-am | Développement | 432 | 0 | 9 | 8 | 384 | 14 | 12 | 105 (96 scellés avant la référence) |
| 2026-10-21-am | Registre compté | 432 | 0 | 9 | 9 | 432 | 24 | 0 | 108 |
Note : Les lignes de correction ajoutent des cellules de correction (line_kind) ; les autres colonnes comptent les cellules des lignes de réponse. Une ligne est scellée avant la référence quand le sceau de sa ligne, max(at, booked_at), précède 09:30 ET de la session qu'elle vise ; les trois essais visent le 19 octobre. Les cellules stated 50 et invalid sont lues dans cell_status (explicit_50, invalid), les lignes comptées dans status. Le 20 octobre, le neuvième siège, Meta AI, s'est scellé à 16:16:52Z : ses 12 cellules invalid ne portent aucune probabilité, et ses neuf lignes comptées d'un jour sont notées d'après sa propre référence, en dehors de l'événement commun. Le 21 octobre, les quatre cellules Bitcoin de la neuvième réponse ont leur propre référence (section 3.3). Source : council-forecasts.csv et council-book.jsonl enregistrés 22 octobre 2026, 01:32 UTC (SHA-256 du CSV 9fa4747e…c299d).
Je publie les statistiques complémentaires à côté du décompte. La corrélation est calculée sur les marchés, de sorte qu'elle inclut la manière dont les marchés évoluent ensemble (les trois indices boursiers américains, le WTI et le Brent) ; une deuxième version conserve un marché par groupe, en excluant le Nasdaq-100, le Dow et le Brent. La corrélation sur les marchés dépend aussi de la direction dans laquelle chaque marché est interrogé : une hausse du VIX, du dollar ou du rendement va généralement de pair avec une baisse des actions, et la ligue interroge chaque marché comme une hausse, fixée dans son contrat d'événement. Je calcule aussi une version libre de cette convention, qui corréle les écarts à 50 sans soustraire la moyenne de chaque siège sur les marchés, de sorte que retourner un marché ne change rien. À un jour, cela donne 1,85 et 1,54, les 19 et 20 octobre, contre 1,74 et 1,46 pour le décompte principal. Tirée de la probabilité climatologique au lieu de 50, les mêmes écarts donnent la lecture que la section 4.3 demande pour les horizons longs. Le ratio de participation de la matrice est une dimension de décompte différente, et sous équicorrélation les deux diffèrent, de sorte que je le lis à côté de N_eff comme second décompte. Une troisième statistique soustrait d'abord le consensus de chaque marché. Soustraire un consensus estimé à partir des mêmes modèles rend les écarts négativement corrélés par construction, de sorte que celui-ci est descriptif et non enregistré. La condition 17 ajoute la part de la plus grande valeur propre. Une part proche de un dit qu'un seul facteur commun porte la ressemblance, la structure sous laquelle un seul ρ commun est un résumé équitable, et une faible part dit que le ρ unique masque plusieurs facteurs. Sur la série comptée du 20 octobre 2026, sur les 48 cellules des huit sièges scellés avant la référence, la plus grande valeur propre porte 68 % de la trace (5,47 sur 8). Un seul facteur commun porte la plupart de la ressemblance. Le ratio de participation de la matrice d'un jour était 2,28 le 19 octobre, 1,79 le 20 octobre et 3,28 le 21 octobre (n_eff_participation).
Le décompte principal mesure à quel point les images de probabilité se ressemblent. La corrélation des erreurs, le ρ de la formule ci-dessus, est le second décompte, et la ligue le calcule à partir des sessions notées : la corrélation par paire moyenne des indicateurs d'erreur des sièges sur les marchés, transformée en N_eff de la même manière (n_eff_errors). Elle porte aussi le comouvement des résultats. Quand les trois indices boursiers baissent ensemble, les modèles qui ont dit hausse se trompent ensemble, quelle que soit leur ressemblance.
5.2 Une première lecture de la méthode
Je lis la méthode d'abord sur les sessions de développement des 19 et 20 octobre 2026 (section 8). Sur leurs deux séries comptées du matin, en utilisant uniquement les réponses scellées avant le prix de référence 09:30 ET, je trouve N_eff à un jour de 1,74 le 19 octobre 2026 (n = 7 sièges scellés avant la référence, ρ = 0,505) et 1,46 le 20 octobre 2026 (n = 8, ρ = 0,64). Les images de ces deux matins étaient aussi ressemblantes que celles d'environ 1,6 prévisionnistes indépendants. En conservant un marché par groupe, on obtient 1,69 et 1,57. La première série de la série comptée, le 21 octobre 2026, a donné 2,23 (n = 9, ρ = 0,379), et 2,09 avec un marché par groupe (council-stats.json, n_eff.counted.per_run, générés 21 octobre 2026, 22:16 UTC).
La même règle à chaque horizon, avec les trois mesures descriptives qui ne nécessitent aucun résultat en dehors d'elle, donne le tableau 7.
Tableau 7. Lecture descriptive par horizon des séries comptées du matin, réponses scellées avant la référence : N_eff des images de probabilité (corrélation par paire moyenne ρ entre parenthèses), netteté K, part des probabilités entre 40 et 60, et écart entre sièges.
| Série | Mesure | 1 jour | 1 semaine | 1 mois | 6 mois |
|---|---|---|---|---|---|
| 19 oct 2026 (n = 7) | N_eff (ρ) | 1,74 (0,51) | 2,81 (0,25) | 2,39 (0,32) | 1,16 (0,84) |
| K | 10,7 | 14,4 | 17,9 | 25,0 | |
| Part en [40, 60] (%) | 88 | 81 | 67 | 42 | |
| Écart (points) | 4,2 | 6,3 | 7,4 | 5,1 | |
| 20 oct 2026 (n = 8) | N_eff (ρ) | 1,46 (0,64) | 1,99 (0,43) | 2,68 (0,28) | 1,14 (0,86) |
| K | 9,2 | 14,1 | 13,9 | 20,3 | |
| Part en [40, 60] (%) | 93 | 82 | 80 | 58 | |
| Écart (points) | 3,5 | 5,7 | 6,2 | 4,7 | |
| 21 oct 2026 (n = 9) | N_eff (ρ) | 2,23 (0,38) | 2,63 (0,30) | 2,41 (0,34) | 1,58 (0,59) |
| K | 10,1 | 12,5 | 14,6 | 19,9 | |
| Part en [40, 60] (%) | 95 | 90 | 84 | 61 | |
| Écart (points) | 4,3 | 4,8 | 5,7 | 6,8 |
Note : Douze marchés par horizon. N_eff selon la règle du script déposé neff-horizons.py (section 5.1), les cellules qui portent leur propre référence étant exclues (le 21 octobre, les cellules Bitcoin de la neuvième réponse) ; la valeur d'un jour du 21 octobre égale le n_eff.counted.per_run publié. K = (2/n)Σ|p − 50| sur les cellules des sièges (section 4.4) ; l'écart est l'écart-type de population entre les sièges, moyenné sur les douze marchés. Valeurs tirées de council-forecasts.csv et council-book.jsonl enregistrés 22 octobre 2026, 01:32 UTC.
Sur les trois exécutions, les voix sont les moins nombreuses à six mois et plus nombreuses à une semaine et un mois qu'à un jour. La ressemblance à six mois peut provenir de taux de base partagés (les actions et l'or augmentent sur six mois), donc le décompte à six mois doit aussi être lu sur les écarts par rapport à la probabilité climatologique. Je vois le motif sur l'exécution du 20 octobre (Figure 6B), et à la Figure 7 je le dessine marché par marché. Les huit sièges scellés avant la référence ont mis cinq marchés sous une chance égale pour le jour et près de 60 % à six mois. En probabilité moyenne, le S&P 500 est passé de 48 à 62, le Nasdaq-100 de 42 à 61, les semi-conducteurs de 42 à 60, l'or de 48 à 61 et Bitcoin de 46 à 61, tandis que le pétrole, le VIX et le rendement décennal ont évolué dans l'autre sens (WTI 55 à 40, VIX 55 à 38, le rendement 54 à 45). Le conseil a constaté un choc à court terme qui s'atténue. À six mois, il a convergé vers la dérive à long terme. Le 21 octobre, le court terme s'est déplacé et le long terme s'est maintenu. Les neuf sièges ont donné au S&P 500 55,9 pour le jour et 60,4 à six mois, et seul le cuivre (47,9) et le VIX (45,7) se sont tenus sous une chance égale pour le jour. À six mois, les actifs risqués se situaient à nouveau entre 56,7 et 62,7 et le pétrole, le VIX, le rendement et le dollar entre 41,2 et 46,1.
Figure 7. Probabilité moyenne déclarée d'une hausse à un jour et à six mois, par marché : (A) exécution 2026-10-20-am, huit sièges scellés avant la référence ; (B) exécution 2026-10-21-am, neuf sièges.
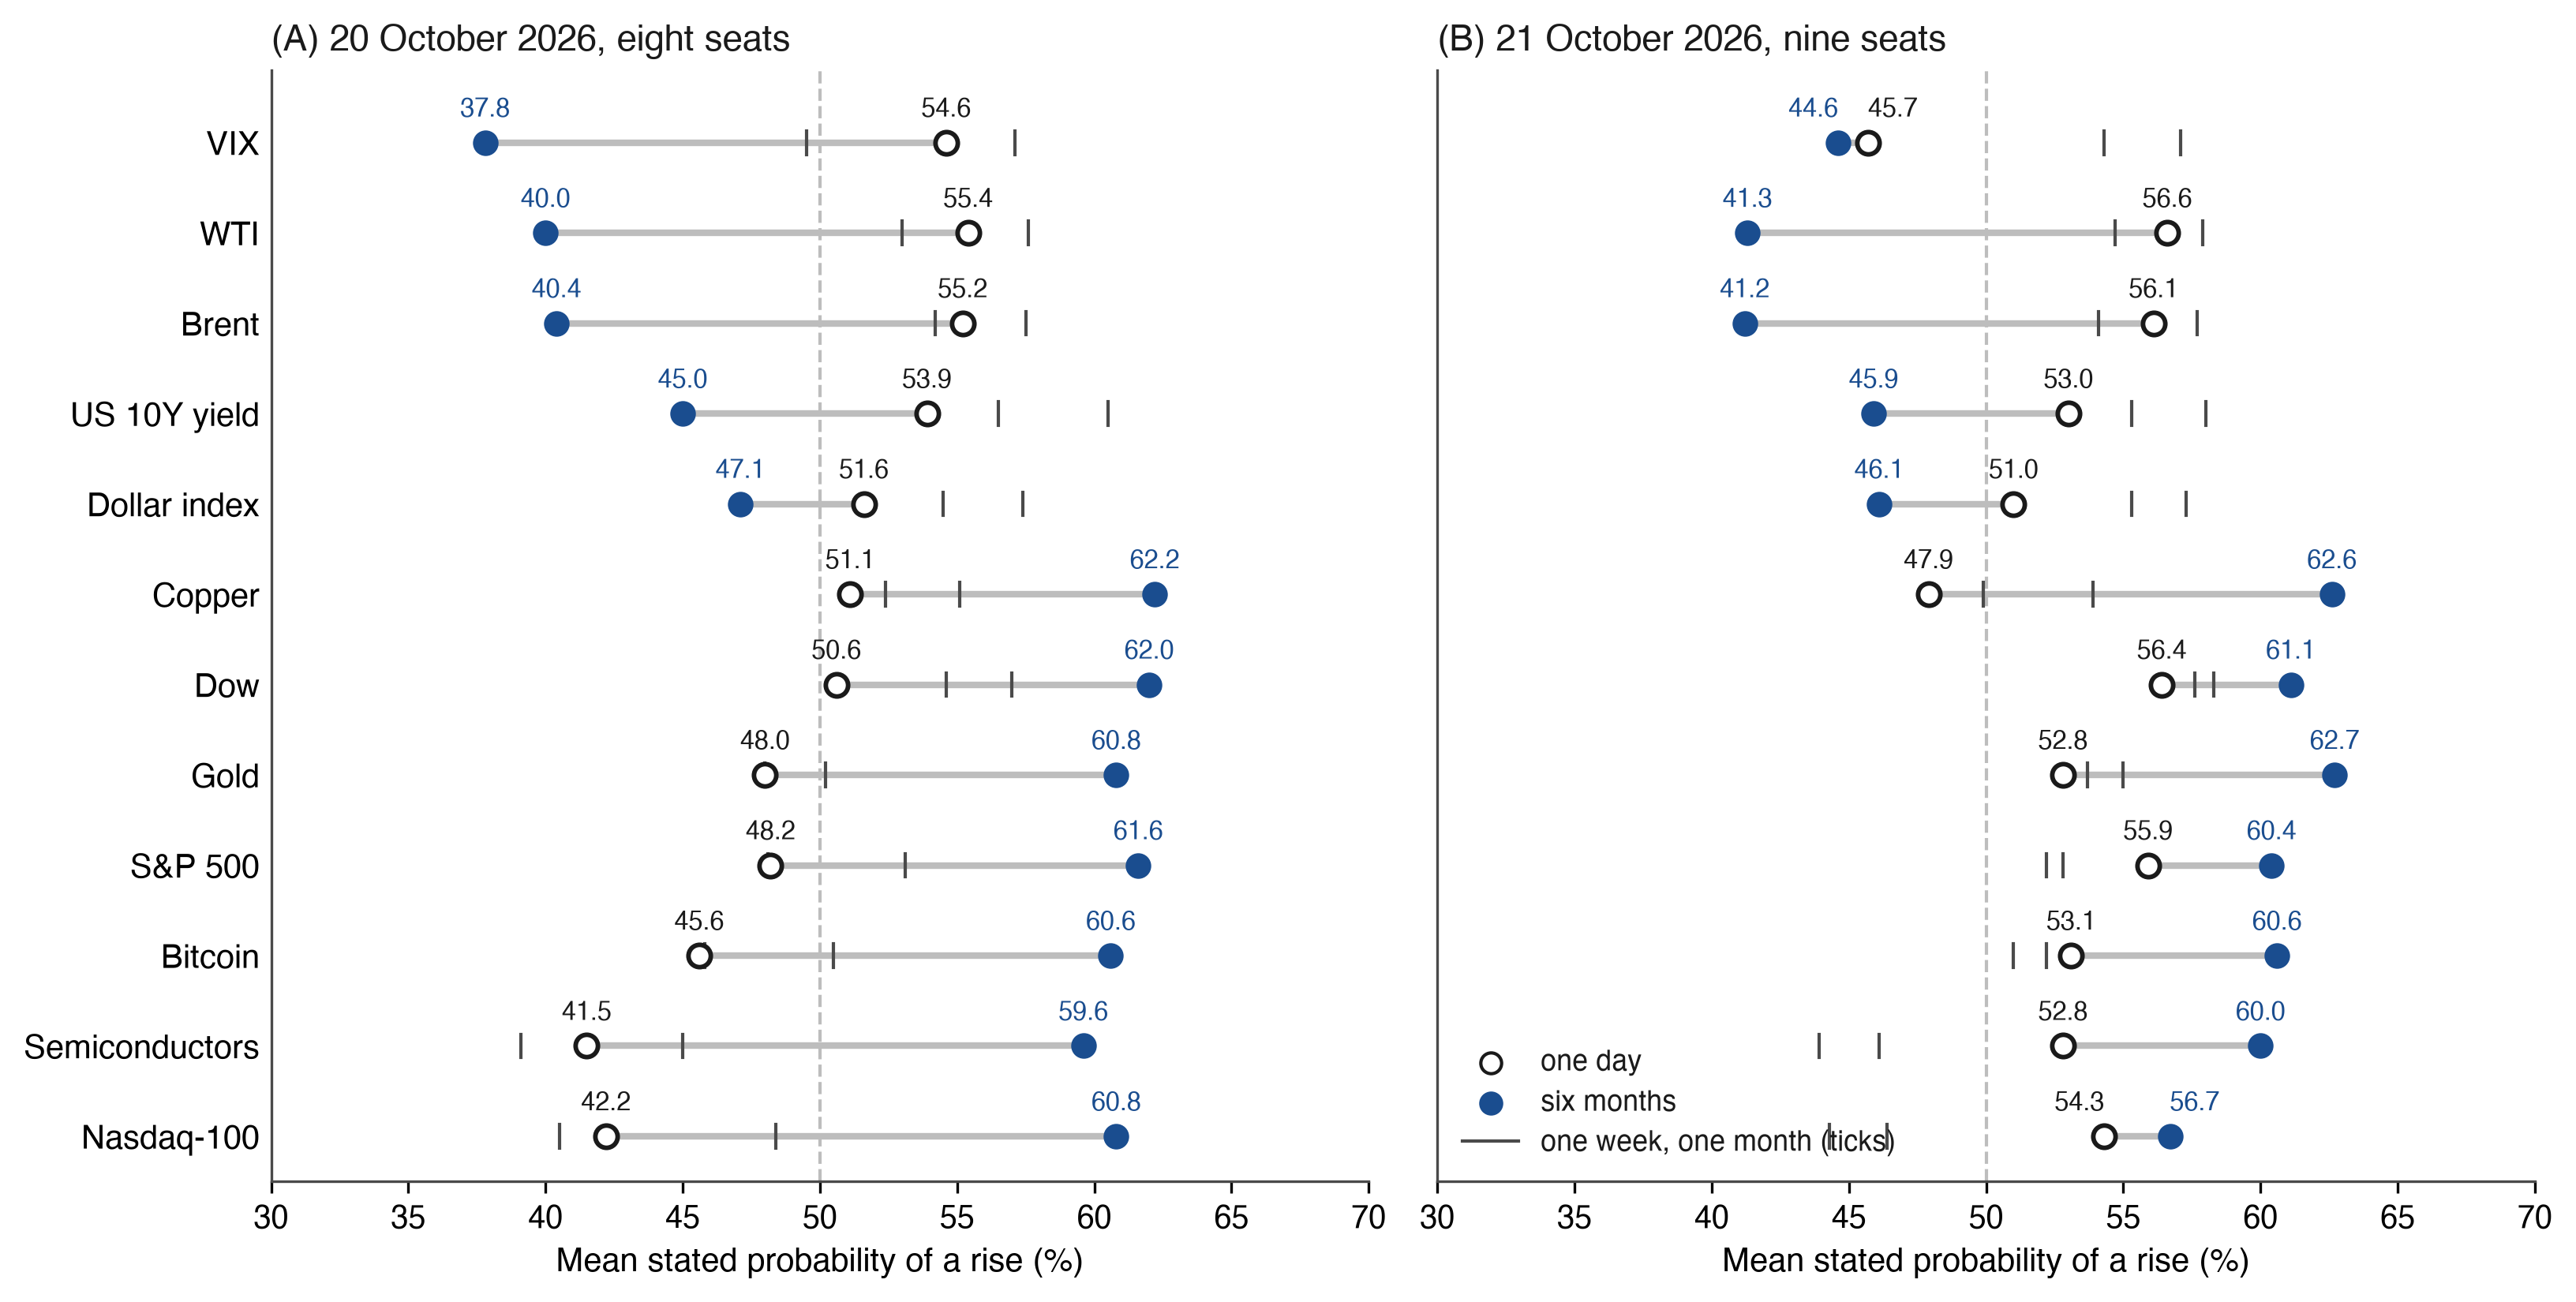
Note : Moyenne des prob_up des sièges ; les graduations marquent une semaine et un mois. Les marchés sont ordonnés par le changement d'un jour à six mois le 20 octobre. Les probabilités à six mois incluent le taux de base de chaque marché (Section 4.3) ; la même lecture par rapport à la climatologie est . Le 21 octobre, la moyenne Bitcoin omet les cellules de la neuvième réponse, qui ont leur propre référence. Source : council-forecasts.csv sauvegardé 22 octobre 2026, 01:32 UTC.
La même exécution donne l'écart que la Section 8 utilise. Sur les huit sièges, l'écart-type de population des probabilités était en moyenne de 3,5 points à un jour, 5,7 à une semaine, 6,2 à un mois et 4,7 à six mois. À un jour, il a varié de 1,5 points sur le cuivre à 6,4 sur le WTI, et les cellules les plus larges étaient le VIX et le Brent à un mois (9,9 et 9,8). Le 21 octobre, l'écart moyen était de 4,3, 4,8, 5,7 et 6,8 points, le plus large à six mois (Brent 9,5, WTI et VIX 8,4). La Figure 8 montre chaque cellule sur les deux matins.
Figure 8. Écart des probabilités déclarées entre les sièges, par marché et horizon : (A) exécution 2026-10-20-am, huit sièges scellés avant la référence ; (B) exécution 2026-10-21-am, neuf sièges.
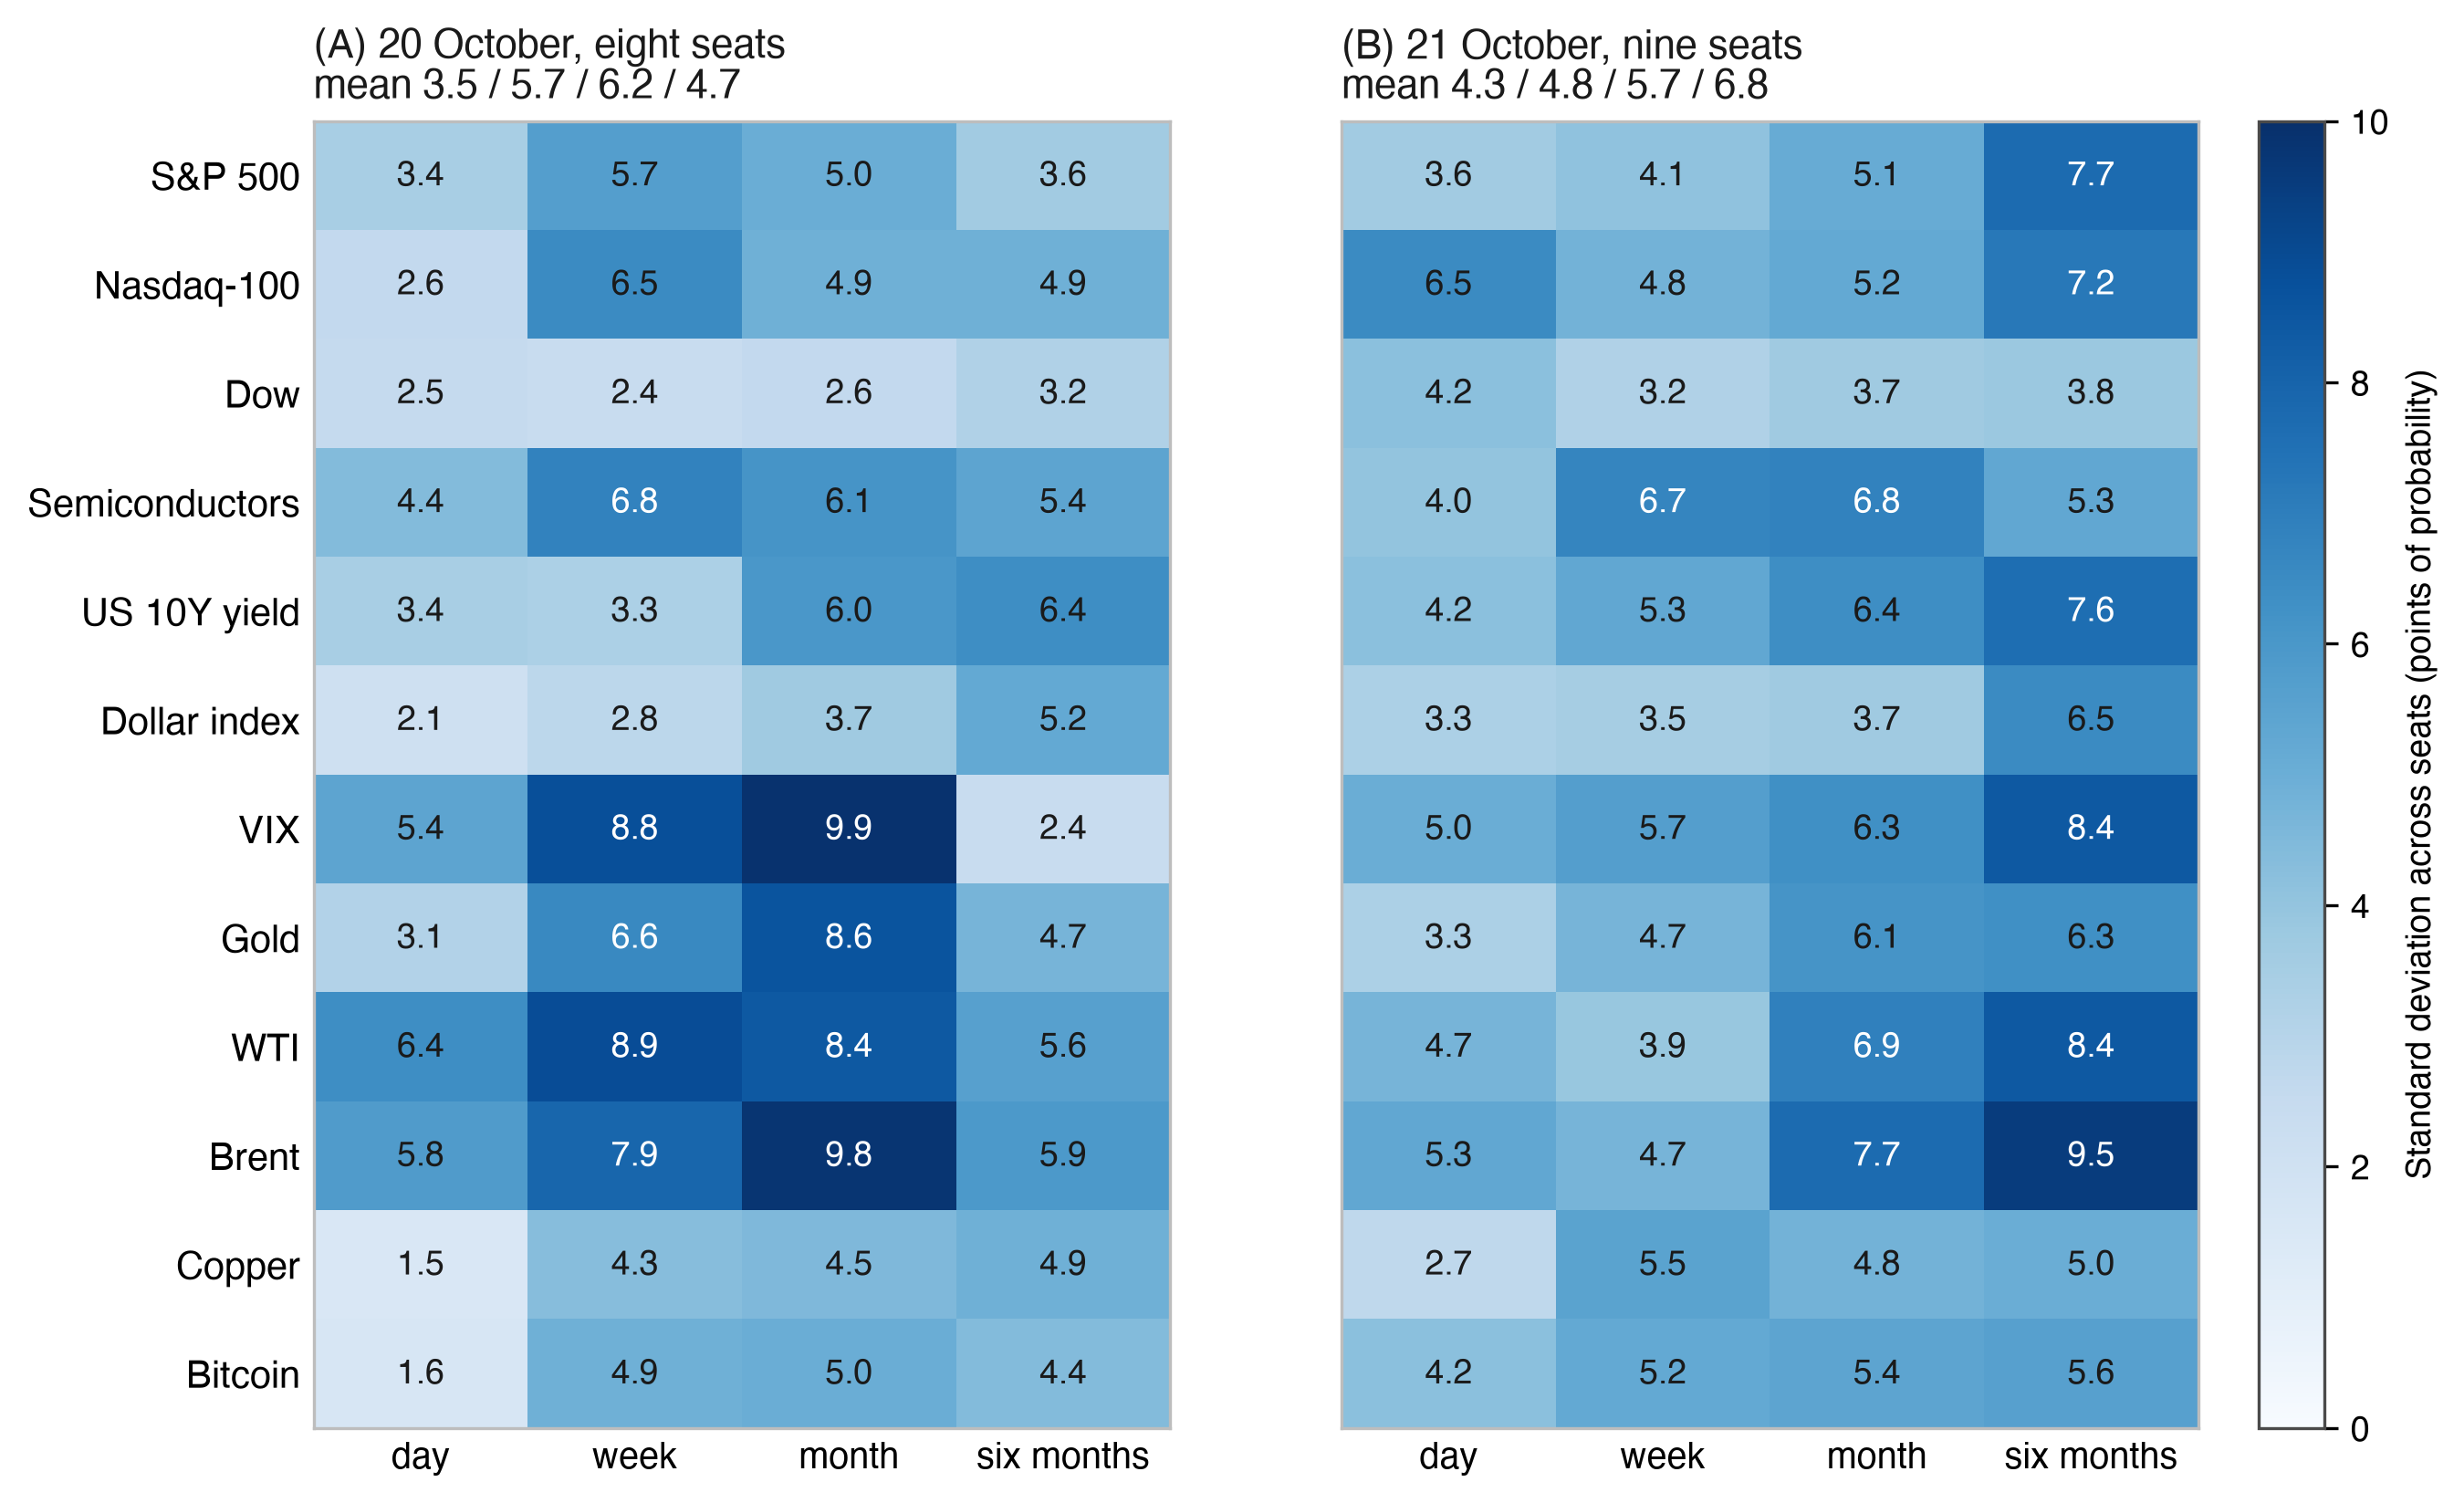
Note : Écart-type de population de prob_up entre les sièges dans chaque cellule, en points de probabilité ; les titres du panneau donnent la moyenne sur les douze marchés à chaque horizon. La Section 8 enregistre l'utilisation de l'écart comme analyse secondaire. Source : council-forecasts.csv sauvegardé 22 octobre 2026, 01:32 UTC.
Les exécutions successives répondent à des questions qui se chevauchent sur les mêmes marchés, et les fenêtres d'une semaine et d'un mois des exécutions voisines se chevauchent. Une comparaison entre les horizons est donc effectuée sur les différences appariées exécution par exécution, avec des intervalles sur les blocs d'exécutions (F9). Les trois exécutions d'essai du 16 au 18 octobre, toutes destinées à la session du 19 octobre et non comptabilisées, ont donné 4,01, 2,69 et 2,06 à un jour. Le décompte sur les indicateurs d'erreur suit la même règle d'admissibilité et est calculé par le script déposé de F3. Le champ n_eff_errors du fichier ouvert est une série descriptive plus large et n'est pas le titre. La Figure 9 place les valeurs par exécution sur les courbes de la formule. Les prédictions F1 à F3 et F9 (Section 8) indiquent ce que les exécutions comptabilisées après l'enregistrement devraient montrer.
Figure 9. Nombre effectif de voix indépendantes en fonction du nombre de modèles, avec les lectures par exécution des premières exécutions scellées et la première exécution comptabilisée.
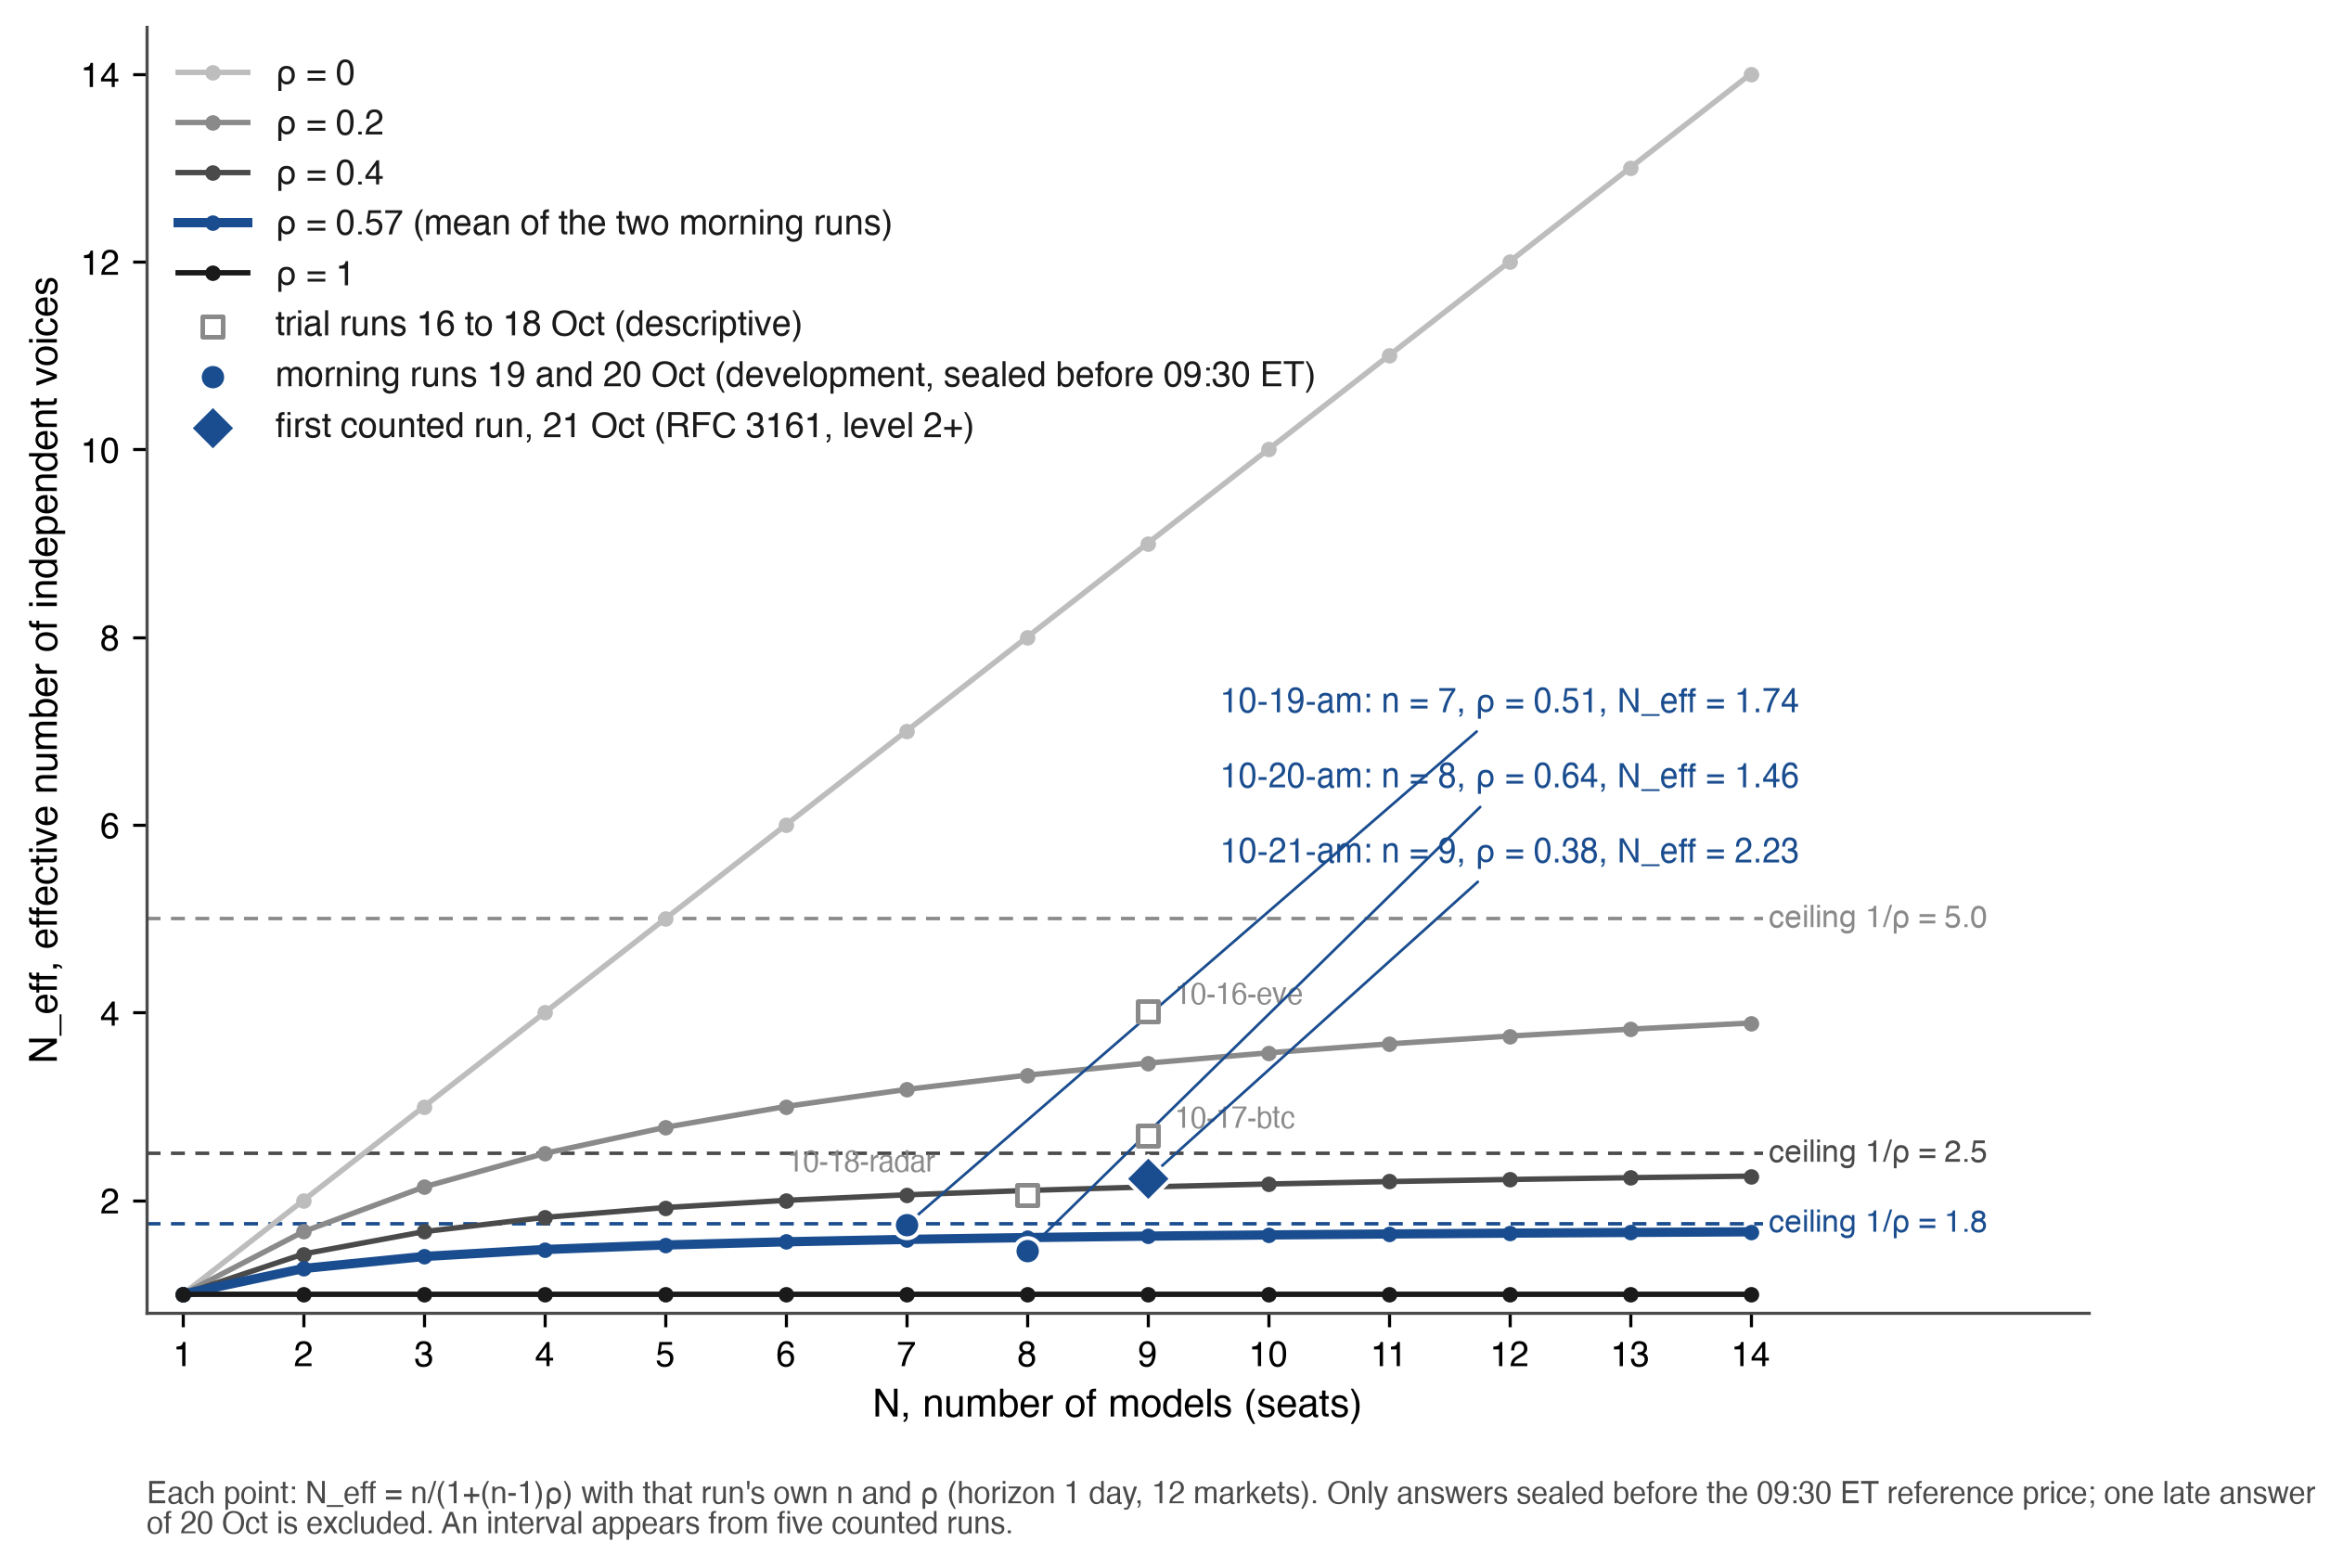
Note : N_eff = N / (1 + (N − 1)ρ) pour N = 1 à 14 et ρ de 0, 0,2, 0,4, 0,57 et 1 ; les lignes pointillées marquent les plafonds 1/ρ. Cercles pleins : les exécutions du matin des 19 et 20 octobre à un jour, réponses scellées avant la référence (1,74, n = 7, ρ = 0,505 ; 1,46, n = 8, ρ = 0,64) ; la courbe en surbrillance est leur ρ moyen, 0,57. Losange plein : la première exécution du registre comptabilisé, 21 octobre 2026 (2,23, n = 9, ρ = 0,379). Carrés ouverts : les trois exécutions d'essai (4,01, 2,69, 2,06). Source : council-forecasts.csv et council-book.jsonl, lus 21 octobre 2026, selon la règle de la Section 5.1.
5.3 Le consensus, et pourquoi il réduit les familles
Je définis le consensus pour un marché comme la moyenne des probabilités des sièges, avec trois règles. Lorsqu'au moins cinq sièges répondent, la probabilité la plus basse et la plus haute sont écartées. Un deuxième modèle de la même famille compte pour un tiers, et chaque modèle supplémentaire aussi, de sorte qu'un laboratoire qui fournit plusieurs modèles ne peut pas surpasser les autres en nombre. Sous une structure de bloc, la formule uniforme surestime N_eff (Kim et al., 2025). Le résultat est limité à 2 à 98 %. Chaque siège sur la liste actuelle provient d'un laboratoire différent (Tableau 8), donc chaque poids de famille est 1. La règle est écrite dans la méthodologie ouverte avant qu'un laboratoire n'occupe deux sièges.
Par l'identité de la section 4.5, le consensus bat la moyenne des membres qu'il conserve mécaniquement sur un événement commun, et contre le conseil complet, la troncature est un choix que le consensus fantôme et F10 mesurent, un gain arithmétique. La compétence ne se juge que contre des références extérieures au conseil : la pièce de monnaie, le taux de base climatologique, la foule et, pour F10, le modèle qui a dirigé une fenêtre antérieure. La valeur d'un siège se mesure directement : le score de Brier du consensus sur les événements communs avec et sans ce siège, sur les mêmes sessions. Une validation croisée leave-one-out calculée après les résultats est une description. Tout pondérage autre que la troncature gelée, les poids de famille et le clamp, choisis parce qu'ils auraient remporté sur des saisons déjà observées, est une nouvelle stratégie (White, 2000) : elle est scellée avant la première session qu'elle gouverne et notée uniquement après ce scellement.
Je scelle une telle stratégie avec l'enregistrement, comme test de la thèse propre de cette section : si les voix corrélées valent moins, les réduire devrait aider. Le consensus fantôme pondère chaque siège par l'inverse de sa corrélation par paires moyenne avec les autres sièges, calculée sur les images de probabilité d'un jour des exécutions comptées scellées avant l'horodatage d'enregistrement, les réponses scellées avant la référence uniquement, avec la corrélation moyenne plafonnée à 0,05 (un siège sans réponse admissible dans cette fenêtre prend le poids médian des autres). Les poids sont déposés avec l'enregistrement et gelés pour la saison. À chaque événement, ils sont renormalisés sur les sièges répondants, et la troncature des extrêmes, les poids de famille et le clamp sont ceux du consensus publié. Un script déposé calcule l'ombre à partir des fichiers ouverts et la note sur les mêmes événements que le consensus publié, qu'il ne remplace jamais. La section 8 déclare la comparaison. L'exigence 17 donne également à chaque siège deux comptages descriptifs de distinctivité, sa corrélation moyenne avec les autres sièges répondants et la part de ses cellules directionnelles qui s'accordent avec la majorité. Un siège qui est distinct et ajoute au consensus sur les événements communs est le siège que la règle de famille et le plafond de la section 5 plaident pour conserver. Le 20 octobre 2026, sur les huit sièges scellés avant la référence et les 48 cellules, les deux comptages se sont échelonnés d'une corrélation moyenne de 0,47 et 70% d'accord avec la majorité des autres (Claude) à 0,71 et 88% (DeepSeek). Claude se tenait seul de son côté d'une chance égale dans quatre des 48 cellules, plus que tout autre siège, parmi lesquels les semi-conducteurs et le Nasdaq-100 à une semaine, auquel il a donné 54 tandis que les sept autres ont donné 28 à 43. La précision est notée séparément.
all_wrong compte les sessions de marché sur lesquelles chaque siège répondant s'est trompé, avec au moins quatre répondants, et minority_right compte celles sur lesquelles le consensus s'est trompé et au moins un siège a eu raison. Dans les deux, les lignes sont toutes les lignes avec le résultat « hausse » signifiant un changement supérieur à zéro, et un 50% déclaré n'est ni juste ni faux, de sorte que ce siège ne compte pas comme répondant pour cette ligne. Sous indépendance, l'erreur unanime parmi quatre sièges ou plus avec des taux d'erreur proches d'une moitié serait rare, et sa fréquence par rapport au produit des taux d'erreur propres des sièges répondants sur les mêmes lignes est F6. Le comptage est un diagnostic de clustering qui mélange la co-évolution des résultats, la difficulté de sessions particulières et un biais partagé, et il n'identifie pas la copie. Une minorité à juste titre récurrente est le cas pour montrer l'appel de chaque siège à côté du consensus.
5.4 Sources partagées
Chaque ligne de prévision de council-forecasts.csv porte les domaines et les liens citées par son modèle (source_domains, source_urls). Pour les réponses d'un jour de chaque exécution, je rapporte la concentration des citations sur les sites les plus cités, le chevauchement moyen de Jaccard des liens et sites cités entre les paires de sièges, et si les paires qui partagent un lien s'accordent sur l'action plus souvent que les paires qui ne le font pas, au sein des strates d'exécution et de marché, par permutation. Sur les cinq premières exécutions, un site d'actualités a attiré environ un cinquième de toutes les citations, le chevauchement des liens exacts était faible (Jaccard moyen 0,006), et l'accord plus élevé des 34 paires partageant un lien n'était pas distinguable du hasard (p de permutation = 0,14). Un lien cité est une chaîne que le modèle a émise et ne prouve pas que la page a été lue, et son label peut différer de son adresse. Le 19 octobre, une réponse citait « Reuters » avec un lien vers investing.com (ligne de livre 83). L'exigence 17 demande donc un dossier de récupération (statut, heure, SHA-256 du contenu, heure de publication déclarée) avant qu'un lien n'entre dans le chevauchement. Les nombres que la question elle-même a fournis, comme les contrats à terme pré-ouverture, sont supprimés avant que les chiffres partagés ne soient comptés. Dans Prediction Arena, la quantité d'un modèle recherché n'a pas suivi son résultat (Zhang et al., 2026), donc la ligue mesure ce que la recherche fait à l'accord au lieu de l'assumer. Le chevauchement des citations mesure la provenance déclarée, et F5 indique ce qu'il devrait montrer.
À la figure 10, je compte qui cite quoi. Les réponses d'un jour scellées avant la référence dans les six exécutions du 16 au 21 octobre 2026, 918 lignes, portent 1 875 citations de 233 sites. Reuters en a attiré 407 (21,7 %) et a été cité par dix des onze sièges, tous sauf Claude. Sa part s'est échelonnée de 6,2 % à 30,3 % selon l'exécution. Les sites suivants étaient cnbc.com (139) et bloomberg.com (66). Sur les deux derniers matins comptés, les sites cités par au moins deux sièges ont attiré 68,5 % et 58,3 % des citations.
Figure 10. Sites cités par siège : citations dans les réponses d'un jour scellées avant la référence, exécutions du 16 au 21 octobre 2026, les dix sites les plus cités.
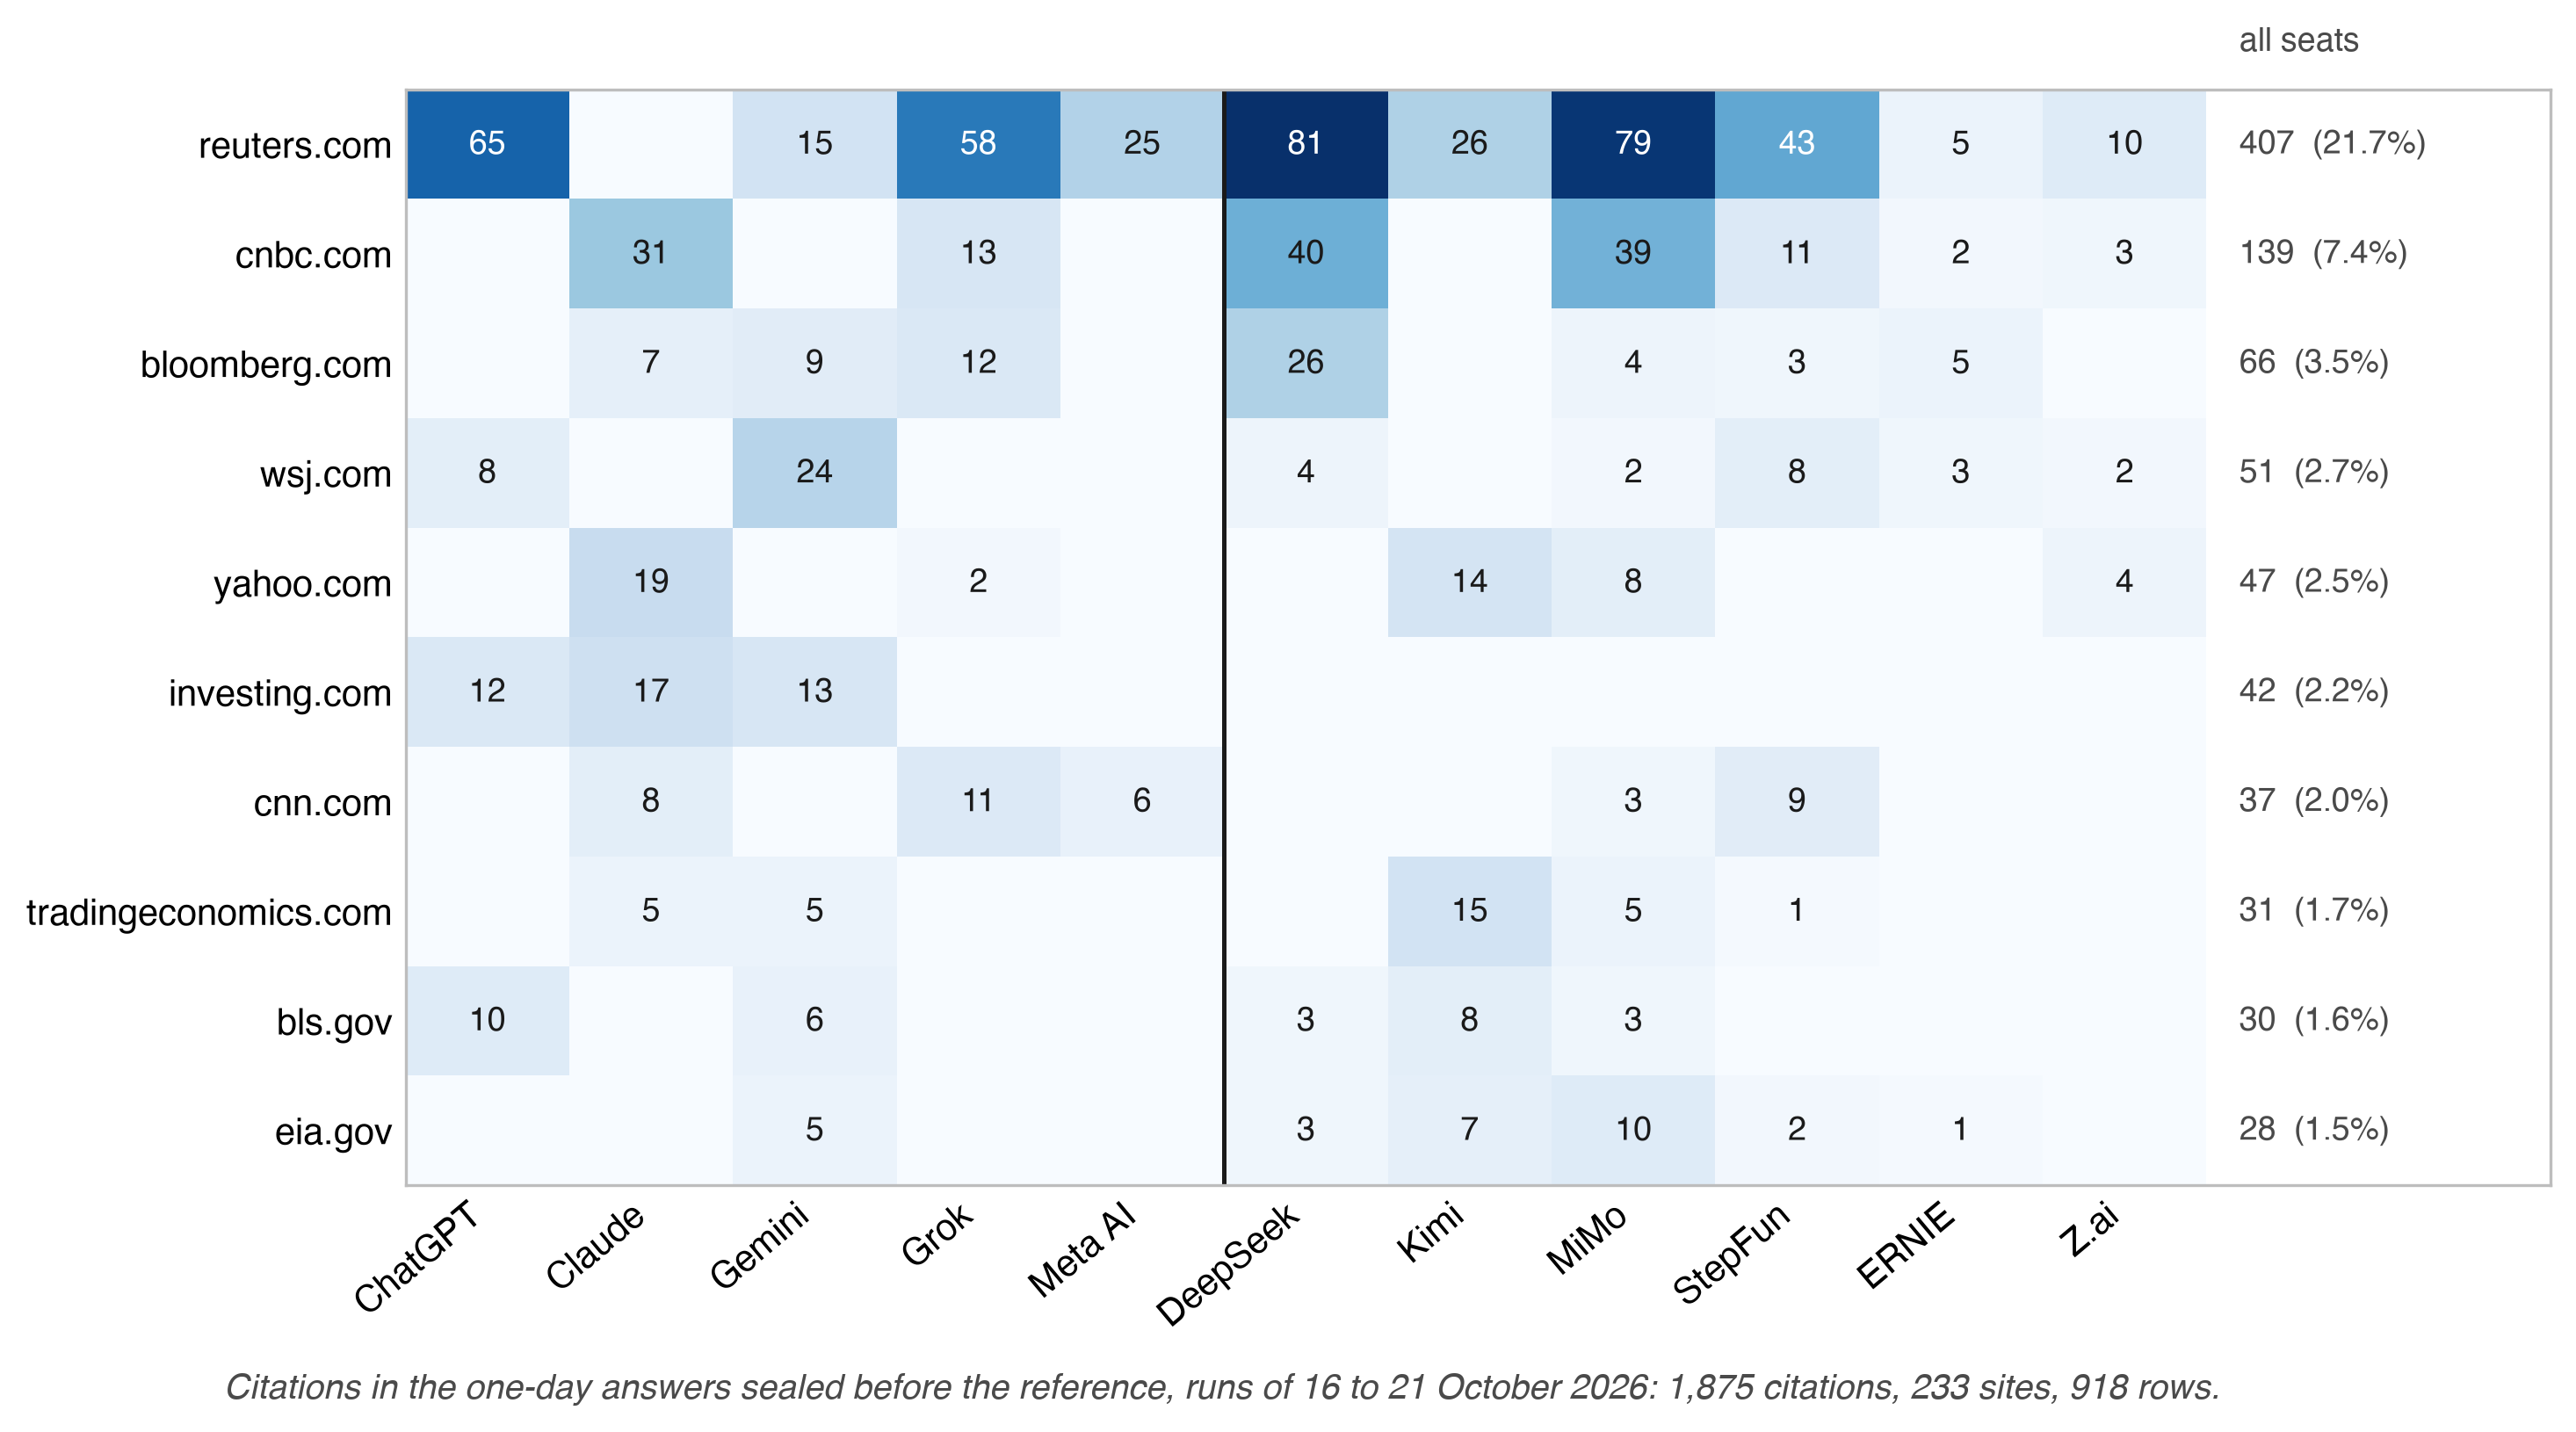
Note : Un comptage par site cité par cellule de réponse (source_domains), sièges américains d'abord, avec une règle entre les côtés ; la colonne de droite donne le total de chaque site et sa part des 1 875 citations au total. Un domaine cité se lit comme la section 5.4 lit un lien cité. Source : council-forecasts.csv sauvegardé 22 octobre 2026, 01:32 UTC.
5.5 Le livre fermé : la même question sans recherche
L'ajout d'actualités ne rend pas un prévisionniste modèle de langage meilleur par défaut : sur les questions résolues après les dates limites des modèles, le contexte des actualités a aidé sur certaines questions et nui sur d'autres, par le biais de récence, la surpondération des rumeurs et la dérive dans ce qu'un terme désigne (Karkar & Chopra, 2025).
Dans la ligue Closed Book, après chaque exécution, les mêmes modèles reçoivent un paquet scellé au lieu du web ouvert : l'instantané des prix de l'exécution et des dépêches datées, chacune avec source, lien, heure de publication et empreinte, et on leur dit de ne pas effectuer de recherches ni d'utiliser d'outils. Chaque ligne de réponse enregistre l'état de la recherche sous l'une de trois étiquettes : vérifiée (la configuration de l'outil empêche la récupération et la réponse n'en montre aucune), configurée mais non vérifiée, ou instruction uniquement. Les liens en dehors du paquet sont marqués outside. Le paquet est scellé avec son empreinte avant les réponses et n'est pas reconstruit, et les exécutions Closed Book utilisent leurs propres comptes de 100 000 $ en dehors du tableau quotidien.
Le fichier arena-cb-experiment.json rapporte, exécution par exécution, la chaleur du désaccord (100 fois la division moyenne des actions du jour), N_eff et la dispersion des portefeuilles, fermé moins ouvert sur les mêmes modèles. Si le conseil fermé s'accorde davantage, des entrées identiques créent un troupeau. Si elle s'accorde moins, la recherche tire les modèles vers les mêmes pages. Une affirmation sur la recherche tient lorsque les bras diffèrent en recherche uniquement. Chaque réponse fermée provient d'un contexte frais qui ne montre pas la réponse ouverte, la foule ou un autre siège, avec la même question, instantané et date limite d'information, des versions correspondantes et des états d'accès enregistrés. Pour F20 et F21, les réponses des deux bras sont scellées avant la même référence commune, sinon chaque bras est noté sur sa propre référence, et l'ordre dans lequel les bras sont interrogés est équilibré d'un jour à l'autre. Si le conseil fermé est en désaccord moins et sa perte Brier est plus élevée, des entrées identiques ont rendu les modèles semblables sans les améliorer.
Deux bras ne peuvent pas séparer les deux sources de ressemblance, les mêmes nouvelles lues le même matin et les mêmes croyances apprises lors de l'entraînement. L'exigence 17 spécifie donc un troisième bras, prix uniquement : les mêmes modèles reçoivent l'instantané des prix scellés de l'exécution et la question, sans dépêches ni recherche, sous la même date limite et les mêmes règles d'indépendance. L'accord qui persiste sans nouvelles provient des a priori partagés ; l'accord ajouté par le paquet provient des nouvelles partagées ; l'accord ajouté par le web ouvert provient de la recherche. Lorsque le bras s'exécute, chaque exécution rapporte N_eff et la chaleur du désaccord dans les trois bras sur les mêmes sièges et sessions.
5.6 Discussion contre le consensus simple
L'élicitation en aveugle et en parallèle donne à chaque modèle la question brute sans voir les autres, ainsi l'accord porte un poids probant. L'élicitation informée et séquentielle achète la correction d'erreurs au prix de l'indépendance (Chernets, 2026a). Sur sept tests de langue, le vote à la majorité seul représente la plupart des gains généralement attribués au débat multi-agents (Choi et al., 2025), donc une discussion doit dépasser le vote simple sur les mêmes questions avant de mériter une place. Les prévisions quotidiennes sont en aveugle et en parallèle de par leur conception. La discussion s'exécute sur une piste hebdomadaire distincte qui ne touche jamais au dossier quotidien : un président, tournant entre les côtés, lit chaque portefeuille scellé sous des lettres mélangées et écrit le portefeuille du conseil et deux ou trois critiques, chacune nommant un marché, un risque, un poids et la direction du fonds au cours des cinq prochaines sessions, ainsi chaque critique a une conséquence vérifiable. Chaque modèle critiqué répond une fois et déclare le portefeuille qu'il détiendrait. Les comptes fantômes négocient le portefeuille du président, les poids scellés, les poids avec la critique appliquée, et la réponse déclarée (council-talk.json, council-talk-critiques.csv ; F22, F23).
5.7 Un modèle, interrogé à nouveau
Une fois par semaine, la question du portefeuille est posée à nouveau, trois fois, à trois ou quatre modèles, et les répétitions sont scellées comme leurs propres lignes, non comme des décisions. council-repeats.json rapporte la chaleur parmi les propres réponses d'un modèle par rapport à la chaleur entre les modèles, ce qui donne le plancher de bruit du désaccord (F24). Parce que N_eff est calculé sur les probabilités, l'exigence 17 étend les répétitions aux probabilités : sous un paquet figé, un modèle sélectionné répond à la même question de probabilité trois fois dans des contextes indépendants, chaque scellé en tant que ligne de diagnostic, et la ligue rapporte la variance au sein du modèle par rapport à la variance entre les modèles. Un changement de version de modèle est daté, et le dossier depuis la version est montré à part.
5.8 Laboratoire d'origine : les mêmes conditions
Les quatorze sièges négocient dans la ligue de portefeuille. Onze sièges du Conseil donnent des probabilités, cinq de laboratoires américains et six de laboratoires chinois, et trois sièges sont sur le banc, ne négociant que (Tableau 8). Chaque modèle reçoit une question, construite sur un instantané des prix, avec le texte publié sous son SHA-256. Chaque réponse est scellée par une date limite et notée selon un ensemble de règles, et chaque siège détient les mêmes 100 000 $, frais et limites. Le fichier asks montre le calendrier. Le 21 octobre, la première question a été envoyée à chaque siège en 0,17 secondes, à 12:30:09Z, et un renvoi au même siège porte la même empreinte. Les sièges toujours silencieux à 13:00 ont été interrogés à nouveau dans une deuxième vague à 13:00:21Z sous sa propre ligne d'exécution et son hash de question (asks.jsonl). Chaque modèle est interrogé au mode de raisonnement le plus fort que son entrée de roster liste, et le mode scellé sur la ligne de réponse est le mode noté. Chaque fournisseur sert son modèle avec ses propres outils et calculs, ainsi la comparaison se fait entre laboratoires tels qu'ils servent leurs modèles (Section 10).
Tableau 8. Sièges de la ligue (league-roster.json, généré le 21 octobre 2026) et la chaîne de version scellée sur les lignes de réponse de chaque siège jusqu'au 21 octobre 2026.
| Siège | Laboratoire | Côté | Rôle | Version scellée |
|---|---|---|---|---|
| ChatGPT | OpenAI | US | Conseil | GPT-6.1 Sol |
| Claude | Anthropic | US | Conseil | Claude Opus 5.5 |
| Gemini | US | Conseil | Gemini 4 Argon | |
| Grok | xAI | US | Conseil | Grok 4.7 |
| Meta AI | Meta | US | Conseil | Muse Spark 1.3 |
| Nemotron | NVIDIA | US | Banc | portefeuille uniquement |
| Amazon Nova | Amazon | US | Banc | portefeuille uniquement |
| DeepSeek | DeepSeek | CN | Conseil | DeepSeek V4.1 |
| ERNIE (Wenxin) | Baidu | CN | Conseil | ERNIE |
| StepFun | StepFun | CN | Conseil | Step 5 Preview |
| MiMo | Xiaomi | CN | Conseil | MiMo-V2.6-Pro |
| Kimi | Moonshot AI | CN | Conseil | Kimi K3 |
| Z.ai | Zhipu | CN | Conseil | GLM-5.3 |
| Qwen | Alibaba | CN | Bench | portefeuille uniquement |
Note : le mode scellé à côté de chaque version se trouve dans la ligne de réponse (Appendice C), et chaque version est la chaîne que l'interface du fournisseur retourne, pour ERNIE son seul nom ; chaque siège provient d'un laboratoire différent, donc chaque poids de famille est 1 (Section 5.3).
Les comparaisons antérieures n'ont pas mis les deux côtés sur une question et un instantané. Cao et al. (2025) ont constaté qu'un modèle américain prévoyait les entreprises chinoises de manière plus optimiste et moins précise qu'un modèle chinois, et que l'écart disparaissait une fois que les informations chinoises étaient ajoutées, ce qui pointe vers l'accès à l'information comme source. La comparaison ici est observationnelle, car le fournisseur, la génération, la langue et les outils voyagent avec l'étiquette de pays (Section 10). Elle est rapportée entre et dans les côtés, et tout écart, en probabilités ou en scores, est publié avec son étendue lorsque chaque siège à son tour est exclu. Un écart qui change de signe ou perd la majeure partie de sa taille lorsqu'un siège est supprimé est rapporté comme étant celui de ce siège, non du côté (F18, F19). L'exigence 17 demande également si le côté est un bloc du tout. Pour chaque exécution, elle définit la corrélation moyenne des probabilités au sein de chaque côté par rapport à celle entre les côtés, avec la probabilité d'une différence au moins aussi grande lorsque les étiquettes de côté sont permutées parmi les sièges répondants. Avec cinq et six sièges, le test est un diagnostic. Si les paires les plus proches joignent les deux côtés, l'étiquette de pays n'est pas où le troupeau se divise. Je l'ai lu en premier sur l'exécution comptée du 20 octobre 2026 (huit sièges scellés avant la référence, 48 cellules) et je ne trouve aucun bloc par pays. La corrélation moyenne des probabilités est 0,66 au sein des côtés et 0,61 entre eux, et trois des quatre paires les plus proches les joignent : ChatGPT et MiMo (0,88), Gemini et DeepSeek (0,86), DeepSeek et Grok (0,77). Les cellules individuelles peuvent se diviser par côté. L'écart le plus large entre les moyennes des côtés lors de cette exécution se trouvait dans l'or à un mois, 56 pour les quatre sièges américains contre 44 pour les quatre sièges chinois, et l'or à une semaine venait en troisième, 52,5 contre 43,5. Un maximum sur 48 cellules est grand par construction. Lorsque les huit sièges sont divisés quatre et quatre de chacune des 70 façons possibles, 26 des divisions produisent un écart de cellule maximum au moins aussi large (p = 0,37). DeepSeek a donné de l'or à un mois 56, au-dessus de trois des quatre sièges américains, donc même la cellule la plus large ne se divise pas nettement par côté. À la Figure 11, j'affiche la matrice complète, avec le matin du 21 octobre à côté.
Figure 11. Trois des quatre paires les plus proches joignent un laboratoire américain et un laboratoire chinois le 20 octobre 2026, et la paire la plus proche le fait à nouveau le 21 octobre : corrélation par paires des probabilités scellées, (A) 20 octobre, huit sièges scellés avant la référence ; (B) 21 octobre, neuf sièges ; avec la corrélation moyenne de chaque siège et l'accord avec la majorité, et les valeurs propres de chaque matrice.
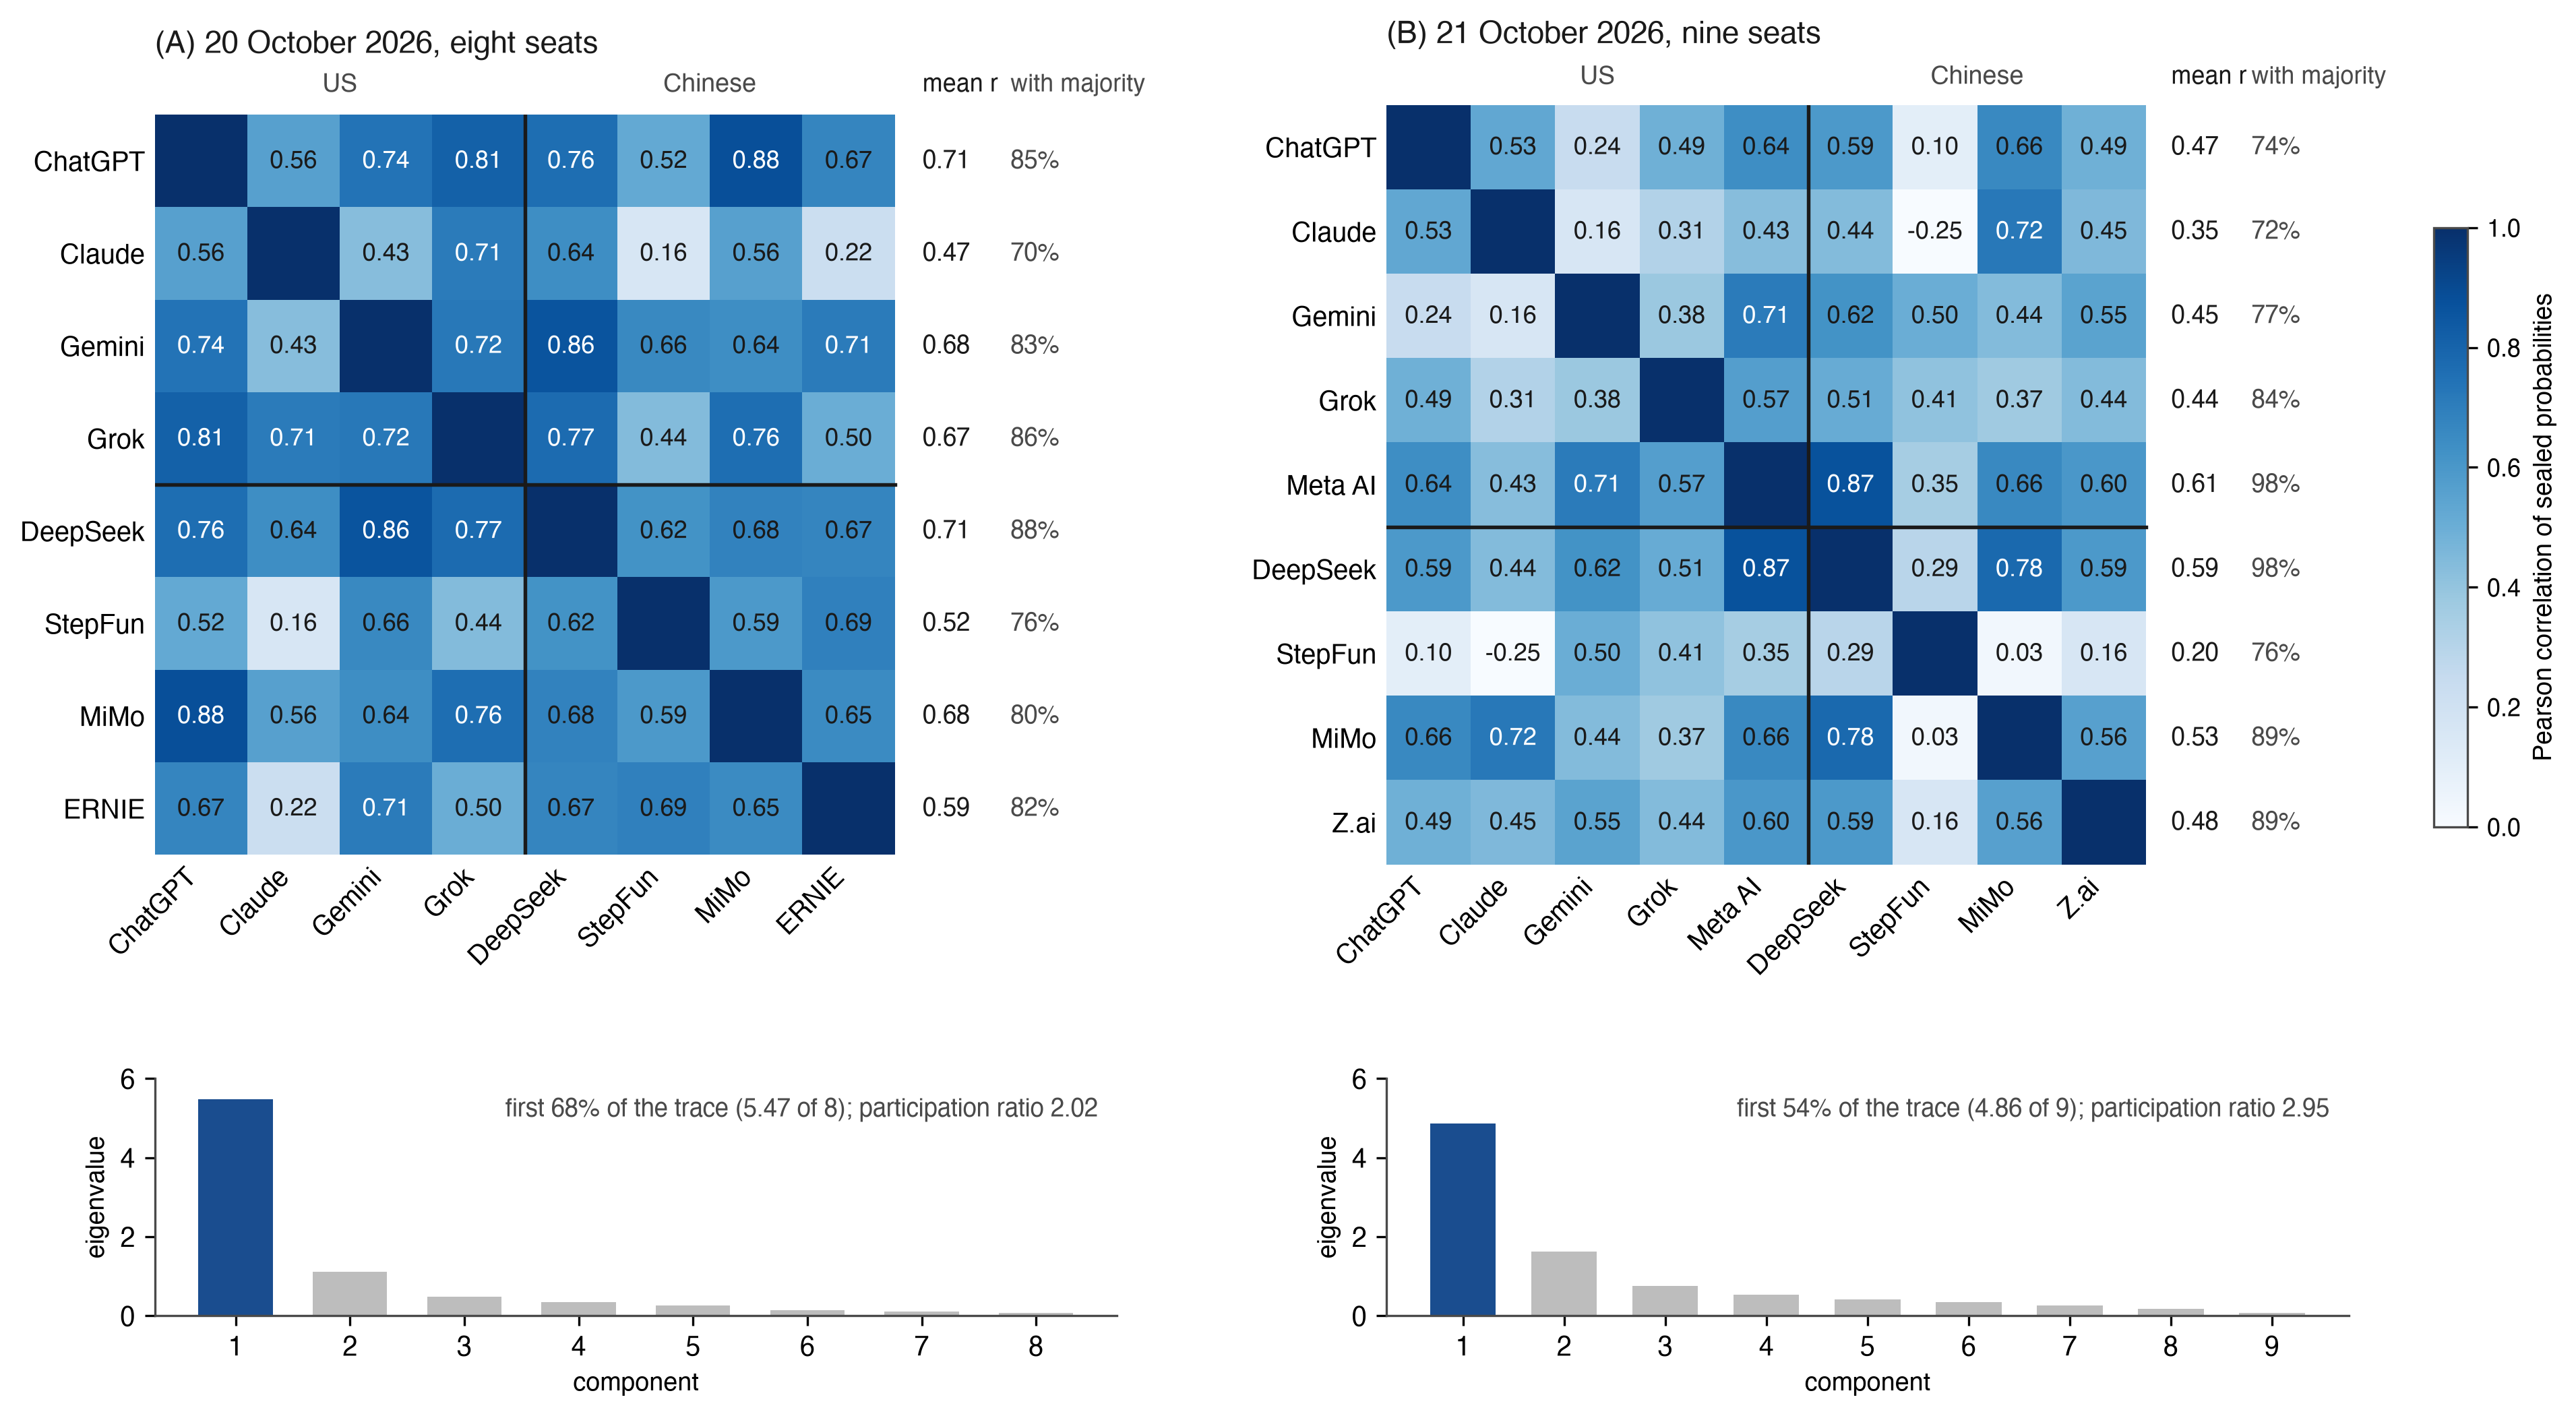
Note : corrélation de Pearson sur les 48 cellules (12 marchés × 4 horizons) des exécutions 2026-10-20-am et 2026-10-21-am, sur les cellules que les deux sièges ont tous deux répondues sur un événement commun (le 21 octobre les cellules Bitcoin de Meta AI portent leur propre référence, donc ses paires utilisent 44 cellules) ; sièges américains en premier, avec une règle entre les côtés. La moyenne r est la corrélation moyenne du siège avec les autres sièges, et avec majorité est la part des cellules directionnelles du siège du même côté de 50 que la majorité des autres sièges, les égalités et les 50 énoncés exclus. Sous chaque matrice, ses valeurs propres, avec la part de la première et le ratio de participation (Σλ)²/Σλ² (exigence 17). Moyenne au sein des côtés 0,66 et 0,43, entre eux 0,61 et 0,48. Source : council-forecasts.csv enregistré 22 octobre 2026, 01:32 UTC.
J'ai lu la première exécution comptée, le 21 octobre 2026, de la même manière avec neuf sièges scellés avant la référence, cinq américains et quatre chinois. La corrélation moyenne est 0,43 au sein des côtés et 0,48 entre eux. La paire la plus proche les joigne à nouveau, Meta AI et DeepSeek (0,87), avec Claude et MiMo (0,72) en troisième. L'écart le plus large entre les moyennes des côtés est tombé à 7,0 points, dans Brent à un mois, et 110 des 126 divisions des neuf sièges en groupes de cinq et quatre donnent un écart maximum au moins aussi large (p = 0,87). L'or à un mois, 12,0 points d'écart le 20 octobre, se tenait à 0,1 d'écart (Figure 12). La ressemblance s'est également étendue à plus de facteurs. La première valeur propre a porté 54 % de la trace (4,86 de 9) contre 68 % la veille, avec un ratio de participation de 2,95 contre 2,02. Sur les deux matins, les deux sièges les plus éloignés des autres étaient Claude et StepFun. Leurs corrélations moyennes étaient 0,47 et 0,52 le 20 octobre et 0,35 et 0,20 le 21 octobre. Deux matins du diagnostic ne montrent aucun bloc par pays, et F18 et F19 le décident sur la saison.
Figure 12. Différence entre les probabilités moyennes énoncées des sièges américains et chinois, par marché et horizon : (A) exécution 2026-10-20-am (quatre et quatre sièges scellés avant la référence) ; (B) exécution 2026-10-21-am (cinq et quatre sièges).
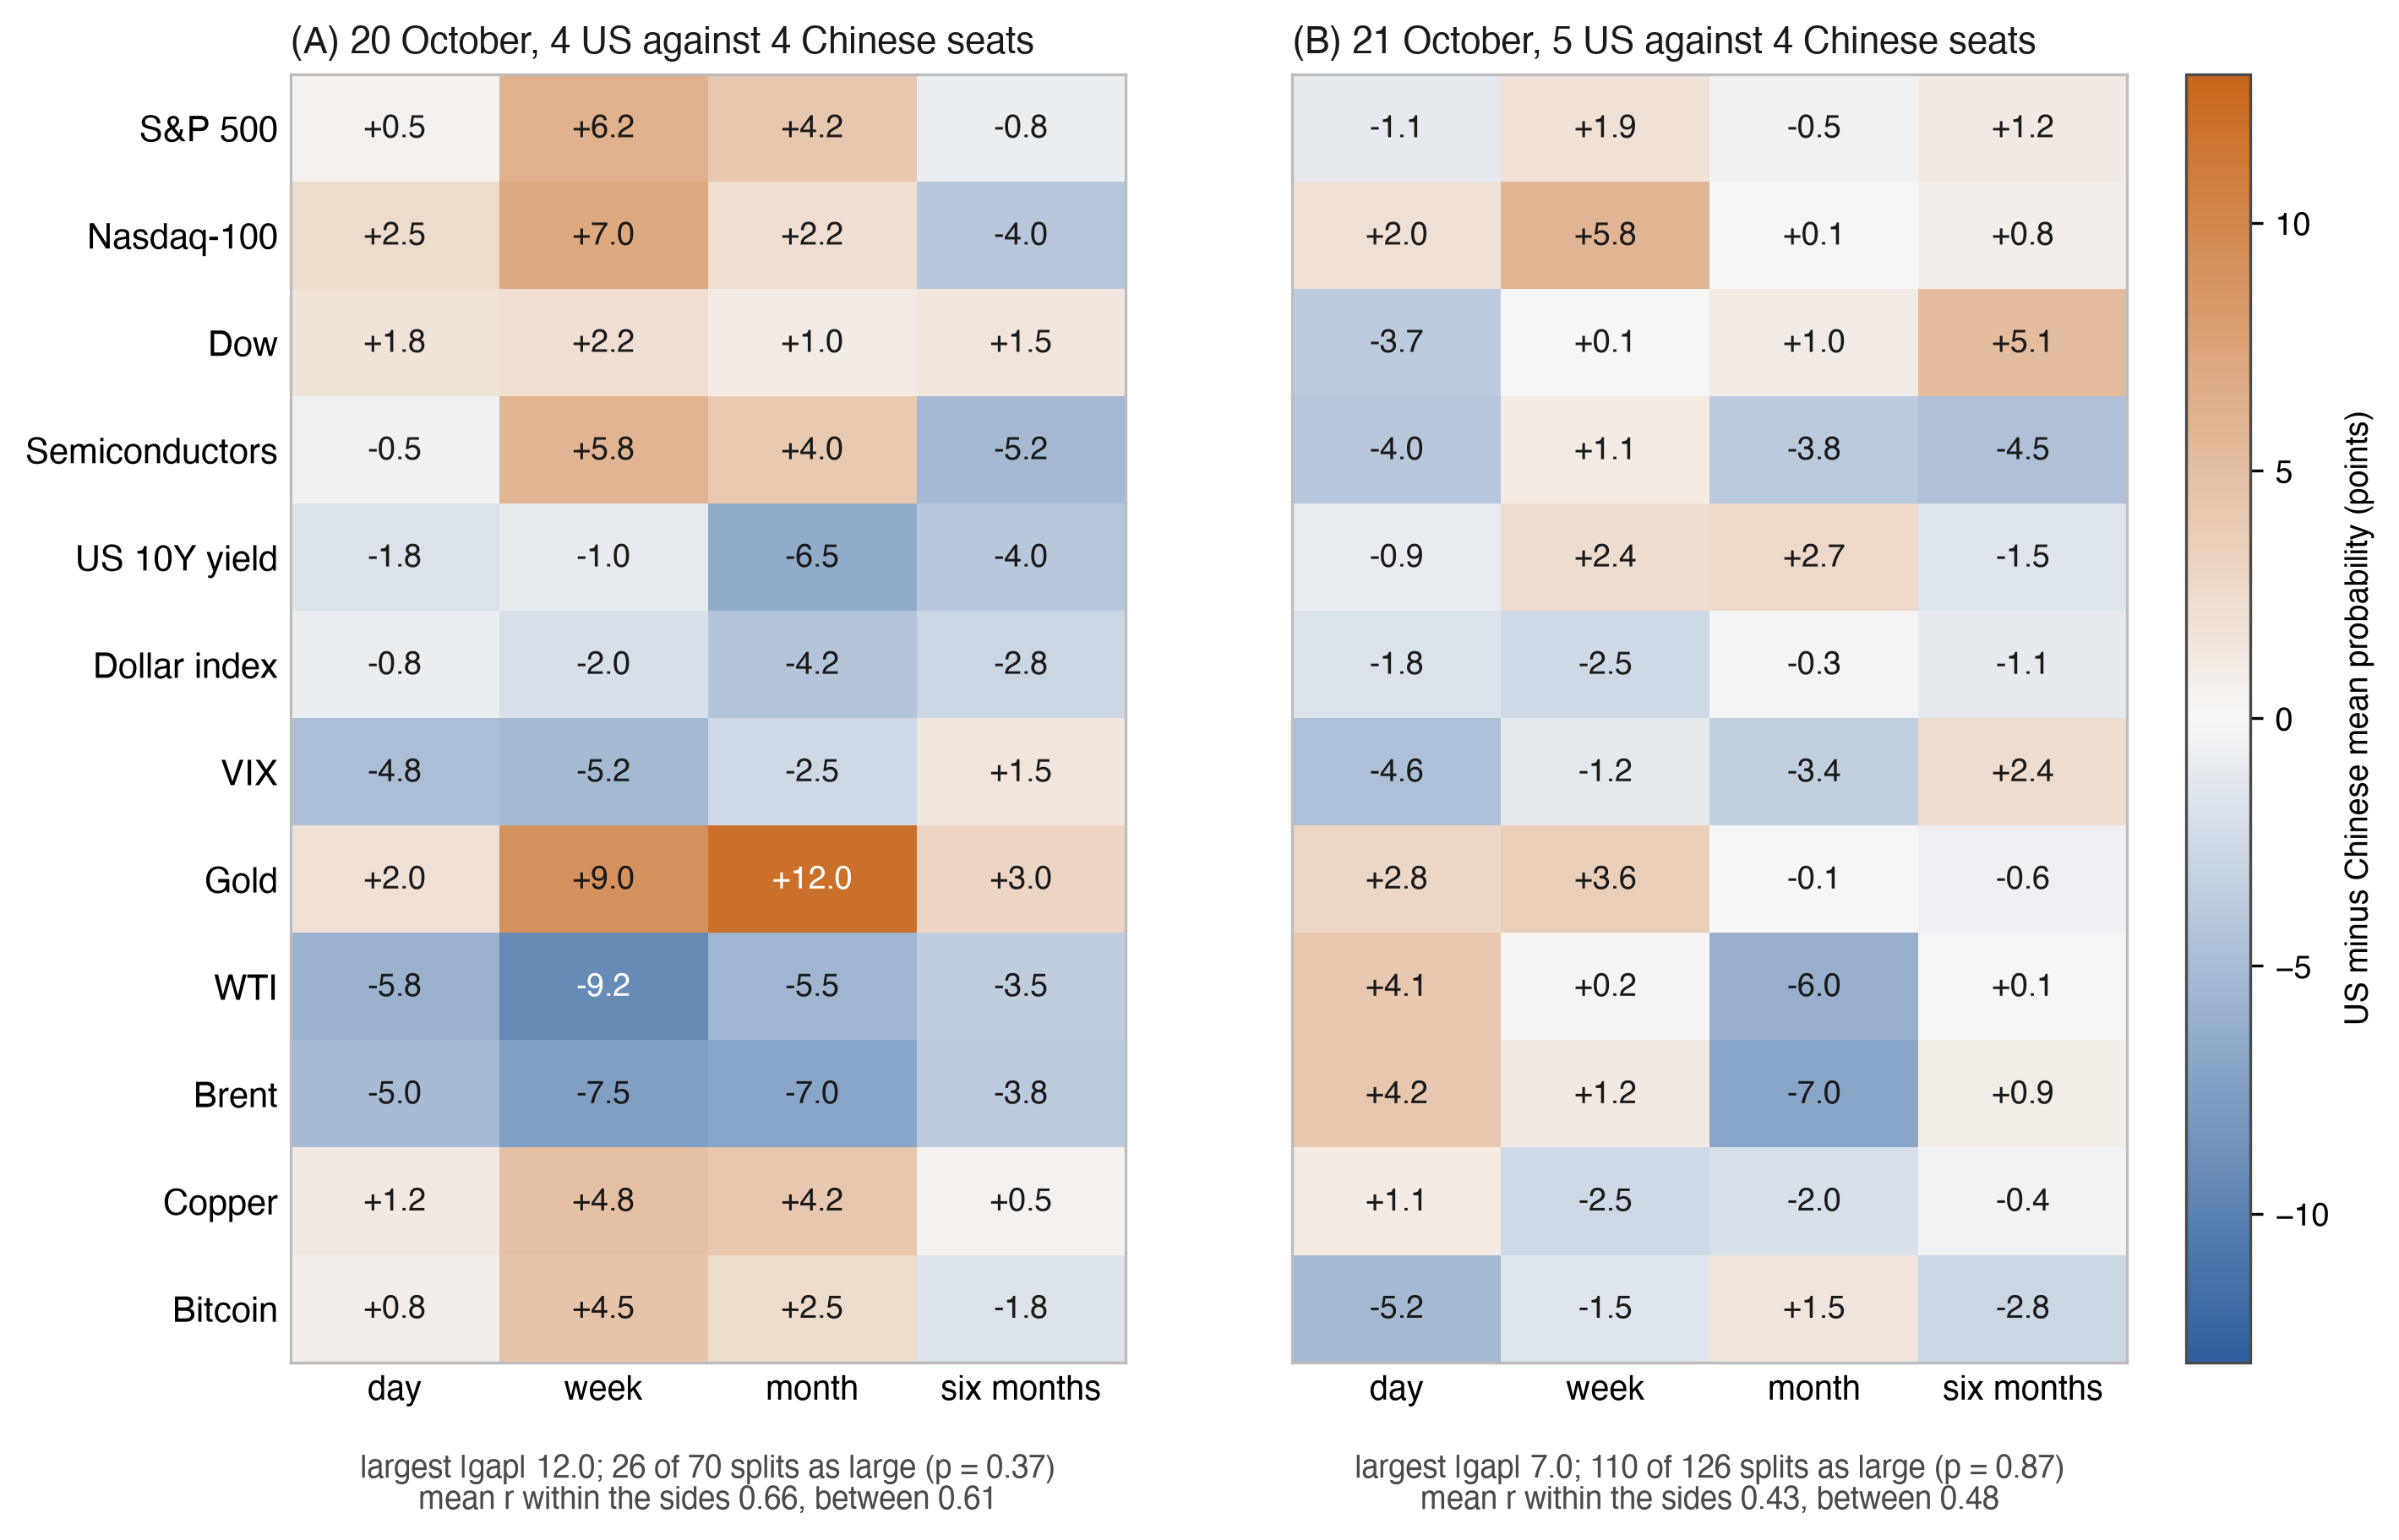
Note : Points de probabilité, américain moins chinois ; orange où les sièges américains se tiennent plus haut, bleu où les sièges chinois le font. Sous chaque panneau se trouvent la plus grande différence absolue, le nombre de toutes les divisions des mêmes sièges en groupes des mêmes tailles qui donnent une plus grande différence au moins aussi grande (70 divisions en A, 126 en B), et la corrélation moyenne au sein et entre les côtés. Le 21 octobre, la ligne Bitcoin exclut les cellules de Meta AI, qui portent leur propre référence. Source : council-forecasts.csv enregistré 22 octobre 2026, 01:32 UTC.
6. Les humains avant l'IA
La ligue mesure les modèles. La page qui les affiche demande aussi si voir les modèles aide une personne à faire des prévisions ou seulement l'oriente vers eux. La plupart des preuves proviennent de protocoles dans lesquels le conseil arrive en premier. Schoenegger et al. (2025) ont donné un assistant de modèle de langage à 991 participants et ont trouvé des gains de précision d'environ un quart, même à partir d'un assistant conçu pour donner des conseils bruyants ; Schoenegger et al. (2024) ont constaté qu'un ensemble de douze modèles correspondait à une foule de 925 prévisionnistes, et qu'une simple moyenne des prévisions humaines et automatiques réussissait encore mieux. Les gens abandonnent un algorithme après l'avoir vu se tromper (Dietvorst et al., 2015), et dans d'autres contextes le pondèrent au-dessus du conseil humain (Logg et al., 2019). Dans un tournoi de prévision géopolitique, les prévisionnistes se sont rarement appuyés sur les prévisions automatiques et ont tendu à choisir des modèles qui s'accordaient avec leurs croyances préalables (Abeliuk et al., 2020). Ce que ces protocoles ne peuvent pas facilement séparer, c'est l'aide de l'effet d'ancrage.
6.1 Protocole
Tout visiteur peut noter chacun des 12 marchés à la hausse ou à la baisse pour la session, avec une confiance de 55 à 95 %, sans s'inscrire. Chaque lecteur est assigné une fois et définitivement, par un identifiant aléatoire anonyme, à l'un de deux groupes. Le groupe voyant voit les réponses des modèles immédiatement ; le groupe aveugle ne les voit qu'après sa première prévision de la session.
6.2 Ce qui est mesuré
Pour la première prévision d'une session, la ligue enregistre quatre quantités. Je prends comme résultat principal le score de Brier (une confiance c d'un côté lue comme probabilité c/100 de ce côté), sur les mêmes marchés pour les deux groupes, chaque marché pondéré par le nombre du groupe le plus petit sur celui-ci. Le temps jusqu'à la première prévision montre si les modèles accélèrent une décision. La confiance énoncée par rapport au taux de réussite donne la surconfiance. L'ancrage est la part des premières prévisions qui s'accordent en direction avec le consensus, comparée entre groupes. Un lecteur aveugle qui ouvre les modèles en premier est compté comme un coup d'œil. L'analyse suit l'assignation, avec les coups d'œil comme non-respect. council-league.json publie les nombres, taux de réussite, temps, confiance, coups d'œil et scores de Brier sous experiment (g0, g1), et la condition 16 a l'étiquette du dictionnaire de données indiquant quel groupe est aveugle avant la première prévision notée. L'expérience est en direct et ouverte à tous les visiteurs, et le 21 octobre elle en était à son commencement, n = 0 premières prévisions notées dans les deux groupes. F28 et F29, enregistrés sur OSF avec les prévisions de la section 8, fixent ses deux résultats à 200 premières prévisions appariées par groupe.
6.3 Protection contre le remplissage
Seules les premières prévisions entrent dans la comparaison, et aucun nom, compte ou détail de contact n'est collecté. La condition 16 fixe une première prévision par marché par identifiant par session. L'adresse du lecteur n'est pas stockée : la ligue ne conserve qu'un hachage salé de celle-ci avec le jour, pour plafonner les votes répétés. Les prévisions des lecteurs se ferment à l'heure de référence, et un identifiant réinitialisé est traité comme un nouveau lecteur, la part des réinitialisations étant signalée.
6.4 Ce que la comparaison montre
L'assignation aléatoire rend les deux groupes comparables l'un avec l'autre. Les deux sont des visiteurs d'une page publique qui ont choisi de venir, de sorte que la comparaison parle pour eux et non pour les investisseurs. Elle mesure un effet d'accès, et le deuxième protocole ci-dessous mesure la révision d'un jugement antérieur. Un accord plus grand avec le conseil est mesuré comme un décalage, et le protocole de révision dit l'apprentissage par imitation. Un identifiant représente un participant observable, et une personne peut en détenir plusieurs, de sorte que la ligue signale les identifiants assignés et contributifs, les premières prévisions et les taux de retour par groupe. La participation répétée est une analyse secondaire groupée par identifiant et session.
Un deuxième protocole, spécifié par la norme, mesure la révision directement. Chaque lecteur enregistre d'abord une direction privée et une confiance avec le conseil caché, est alors montré le conseil ou un affichage de contrôle par assignation aléatoire, et enregistre une prévision finale pour le même marché et la même session. Le résultat principal est la différence entre les bras dans le changement de score de Brier de la prévision privée à la prévision finale ; le mouvement vers le conseil est signalé séparément pour les sessions sur lesquelles son appel était juste et faux, de sorte que l'apprentissage et l'imitation peuvent être distingués. Le protocole de révision entre dans les révisions datées de cet article quand il s'exécute.
7. Une carte datée des arènes de marché de l'IA
7.1 Ce que la carte enregistre
Entre 2023 et 2026, la question « les modèles d'IA peuvent-ils prévoir les marchés ? » a été posée sous quatre formes : les backtests des jugements des modèles sur les prix historiques, les benchmarks sur des questions encore ouvertes, les arènes dans lesquelles les modèles ont échangé de l'argent réel ou virtuel, et les marchés prédictifs utilisés comme base de référence ou lieu d'échange. La carte enregistre qui a présenté chaque effort, quand, et ce qu'il a mesuré. Au tableau 9, je pose six questions à chacun : comment le moment d'une prévision est assuré et à quel niveau de confiance, si les probabilités sont évaluées par une règle strictement propre, si plusieurs horizons sont comparés sur les mêmes actifs, si l'accord entre les modèles est lu par rapport à leur corrélation (un nombre de voix indépendantes ou un poids de corrélation), si un humain prévoit avant de voir l'IA, et si les données sont ouvertes. Dans l'appendice E, je compare l'implémentation de référence aux efforts les plus proches, élément par élément (tableau E1).
Les niveaux de confiance suivent la figure 4 et la section 3.12 : 0, l'enregistrement de l'arrivée par l'opérateur ; 1, une empreinte digitale de l'opérateur ou un enregistrement lié par hachage dont le moment repose sur l'opérateur ou son hôte ; 2, une empreinte digitale engagée en dehors de l'opérateur, qui délimite de l'extérieur quand l'enregistrement a existé, dans la tolérance de cet enregistrement (pour Bitcoin, quelques heures après l'heure du bloc, car une heure de bloc doit dépasser la médiane des onze précédentes et peut devancer le temps réel) ; 2+, le niveau 2 plus une heure signée par un tiers (RFC 3161) sur chaque sceau. Un backtest n'a pas de temps de soumission à assurer. J'ai construit la carte à partir de documents publiés, de pages de projet, de dépôts et de rapports de presse, et j'ai fermé la recherche le 21 octobre 2026. Chaque revendication de priorité à la section 7.4 est limitée aux efforts examinés ici. « ND » signifie non documenté publiquement au 21 octobre 2026 : non trouvé dans la description publique, ce qui ne prouve pas l'absence. J'enregistre ce que chaque effort peut prouver à partir de ses matériels publics et laisse leur qualité sans classement.
7.2 La chronologie
2023 à 2024. Lopez-Lira et Tang (2023) ont montré que les scores GPT des titres d'actualité prédisaient les rendements boursiers ultérieurs, ce qui a ouvert le domaine et son doute central (section 2.1). En 2024, les questions en direct sont arrivées. Un système augmenté par récupération s'est rapproché de l'agrégat humain sur des questions publiées après la date limite du modèle (Halawi et al., 2024), un ensemble de douze modèles a égalé une foule de 925 personnes (Schoenegger et al., 2024), Metaculus a organisé des tournois trimestriels de bots contre des professionnels, qui ont mené à chaque trimestre jusqu'au milieu de 2025 (Metaculus, 2025a, 2025b), et ForecastBench a posé environ mille questions générées à huit horizons et a constaté que les experts devançaient toujours le meilleur modèle (Karger et al., 2025).
2025. Des benchmarks financiers et des arènes monétaires ont suivi. InvestorBench a proposé des décisions financières simulées sur des données historiques (H. Li et al., 2025), et des preuves sur la mémoire et l'anticipation dans les backtests se sont accumulées (Lopez-Lira et al., 2025 ; W. W. Li et al., 2025 ; Paleka et al., 2026 ; Gao et al., 2025). FutureX a exécuté un benchmark quotidien en direct d'agents (Zeng et al., 2025). En octobre, Alpha Arena a donné de l'argent réel à six modèles, selon les rapports de presse (Forklog, 2025a, 2025b ; Yahoo Finance, 2025), StockBench a rétrotrading des actions du Dow (Y. Chen et al., 2025), Agent Market Arena a échangé en direct (Qian et al., 2025), et Prophet Arena a noté des questions Kalshi et Polymarket en direct par calibrage et rendements simulés (Yang et al., 2025). LiveTradeBench (Yu et al., 2025), Rallies AI Arena (Rallies.ai, 2025-2026), l'AIA Forecaster, qui a égalé les superforecasters et, combiné au marché, l'a dépassé (Alur et al., 2025), et KalshiBench, qui a trouvé cinq modèles frontière surconfidents (Nel, 2025), ont fermé l'année.
2026, première moitié. Les marchés prédictifs sont devenus un lieu. FinDeepForecast a exécuté des agents de recherche approfondie hebdomadairement (X. Li et al., 2026). Un ensemble de prévisions de stocks Gemini a été appelé « verrouillé dans le temps » sans mécanisme documenté (louidev, 2026). PredictionMarketBench a relu les carnets de commandes Kalshi (Arora & Malpani, 2026). Prediction Arena a donné du capital réel à six modèles sur Kalshi et Polymarket et a noté la valeur du compte à partir des journaux de l'opérateur (Zhang et al., 2026). PolyBench a noté 36 165 prédictions sur les instantanés Polymarket (Cheng et al., 2026). PolySwarm a proposé un essaim de 50 personnalités de modèles de langage dont les probabilités sont mélangées avec les prix Polymarket et notées par le score de Brier (Barot & Borkhatariya, 2026). En mai, Foresight Arena a proposé un benchmark sans permission dans lequel les agents valident les prévisions chiffrées des événements Polymarket via un commit-reveal keccak256 sur Polygon avant une échéance, un commit par agent et tour appliqué au relayeur, noté par le score de Brier et un score Alpha par rapport au mid-price à l'échéance. Son document rapporte les résultats simulés, et une étude d'accompagnement exécute les agents en direct sur celui-ci (Nechepurenko & Shuvalov, 2026a, 2026b).
2026, deuxième moitié. MarketMania (15 juillet) donne à sept modèles une charge utile divulguée, note les probabilités déclarées sur cinq cryptomonnaies à cinq horizons, mesure le troupeau comme la hausse de l'accord avec la majorité, et repose des questions identiques, sans engagement des réponses documenté (MarketMania, 2026). NeuPortal ancre les probabilités de football d'une IA non nommée en Bitcoin via OpenTimestamps (NeuPortal, 2026). LLM Trading Arena (20 juillet) valide chaque remplissage et justification dans un historique git public (MaxWellApexLab, 2026). LiveMacroEval a exécuté des nowcasts macroéconomiques horaires (Zhao et al., 2026), TradeRank a ouvert sa dixième saison le 10 octobre (TradeRank, 2026), et Prophet Arena a documenté un registre de hachages SHA-256 salés sur l'horloge de l'opérateur (Prophet Arena, 2026). AI Council · Markets a scellé sa première exécution le 16 octobre 2026 et a commencé à compter son score le 19 octobre 2026.
7.3 Ce que chacun peut prouver
Tableau 9. Arènes de marché de l'IA et benchmarks de prévision, 2023 à 2026 : ce que chacun peut prouver à partir de ses matériels publics.
| Arène ou benchmark (premiers publics) | Ce qui est prévu ou échangé | Moment de la prévision assuré par (niveau de confiance) | Probabilités notées par une règle propre | Plusieurs horizons sur les mêmes actifs | Accord remisé pour les voix corrélées | Prévisions humaines avant de voir l'IA | Données ouvertes |
|---|---|---|---|---|---|---|---|
| Lopez-Lira & Tang (avril 2023) | Rendements des actions à partir des scores de titres | Backtest, pas de temps de soumission | Non (scores utilisés comme signaux) | Non | Non | Non | ND |
| Métaculus IA benchmark (Q3 2024) | Questions de Métaculus, bots face aux professionnels | Record de plateforme (0) | Oui (scoring tête-à-tête) | Non | ND | Groupe séparé de professionnels | Partiellement |
| ForecastBench (sep 2024) | Environ 1 000 questions générées, non résolues à la soumission | Record d'opérateur (0) | Oui (Brier) | Oui (huit horizons sur les questions du ensemble de données, 7 jours à 10 ans) | ND | Groupes séparés de superprédicteurs et du public | Oui |
| InvestorBench (ACL 2025) | Décisions sur les actions, crypto-monnaies et ETF en simulation | Test rétrospectif, pas de temps de soumission | ND | Non | ND | Non | Oui |
| FutureX (août 2025) | Événements futurs généraux, agents avec recherche | Record d'opérateur (0) | Non (précision des réponses) | Non | ND | Non | Oui |
| Alpha Arena (oct 2025) | Trading avec argent réel, crypto puis actions américaines | Record d'opérateur (0) ; l'organisateur déclare que les transactions sont vérifiables | Non (rendements) | Non | ND | Non | Déclaré par l'organisateur |
| StockBench (oct 2025) | Back-trading sur les actions du Dow, mars à juin 2025 | Test rétrospectif, pas de temps de soumission | Non (rendement, drawdown, Sortino) | Non | ND | Non | Oui |
| Agent Market Arena (oct 2025) | Trading en direct par les agents LLM, actions et crypto-monnaies | ND (0) | Non (résultats de trading) | Non | ND | ND | ND |
| Prophet Arena (oct 2025) | Événements Kalshi et Polymarket | Registre SHA-256 salé à l'arrivée, reçu optionnellement signé par la plateforme ; horloge de l'opérateur (1) | Oui (1 − Brier) ; étalonnage comme diagnostic | Vues d'horizon dans l'archive ; limites ND | ND | Non ; prix du marché comme référence | Oui |
| LiveTradeBench (nov 2025) | Allocations sur actions américaines et Polymarket, 50 jours | ND (0) | Non (allocations, rendements) | Non | ND | Non | Oui |
| Rallies IA Arena (nov 2025) | 100 000 dollars virtuels par modèle en actions américaines, huit modèles (presse) | ND (0) | Non (rendements) | Non | ND | ND | ND |
| AI-Trader (déc 2025) | Agents de trading en direct sur actions américaines, actions A et crypto-monnaies, trois modèles chinois et trois modèles américains | Record d'opérateur (0) | Non (rendements) | Non | ND | Non | Dépôt ouvert |
| KalshiBench (déc 2025) | 300 questions Kalshi résolues après la date limite | Ensemble statique après la date limite | Oui (Brier ; score de compétence par rapport à la climatologie) ; ECE comme diagnostic | Non | Non | Non | Oui |
| PredictionMarketBench (2026) | Carnets d'ordres Kalshi relus avec frais | Rejeu de test rétrospectif | Non (P&L du trading) | Non | ND | Non | ND |
| Prediction Arena (jan à mar 2026) | Trading avec capital réel sur Kalshi et Polymarket, contrats financiers parmi sept catégories | Journaux d'opérateur (0) | Non (valeur du compte, rendement, taux de gain) | Non | Non | Non | ND (aucun dépôt fourni) |
| PolyBench (avr 2026) | Snapshots Polymarket, 6 au 12 fév 2026 | ND (0) | Non (précision directionnelle, rendement pondéré par la confiance) | Non | ND | Non | Code ouvert ; ensemble de données par lien de téléchargement (non récupéré) |
| Foresight Arena (mai 2026) | Événements Polymarket binaires, certains sur les prix des actifs | Engagement keccak256-reveal par agent et tour sur Polygon PoS avant l'échéance (2 ; temps de bloc) ; résultats de l'article simulés, agents en direct dans une étude complémentaire | Oui (Brier ; Alpha par rapport au prix médian du marché) | Non | Non (les résultats des marchés sont supposés indépendants) | Non | Contrats et code d'analyse ouverts ; données sur chaîne, licence ND |
| MarketMania (juil 2026) | Cinq crypto-monnaies à cinq horizons, sept modèles, une charge utile divulguée | ND (0) | Oui (Brier sur la probabilité déclarée ; écart d'étalonnage) | Oui (1 heure à 1 mois) | Partiellement (effet de troupeau mesuré ; accord non réduit) | ND | Exports d'API, licence ND |
| NeuPortal (juil 2026) | Probabilités des matchs de football d'une IA sans nom (non financier) | SHA-256 de chaque fichier de prévision, horodaté dans Bitcoin via OpenTimestamps (2) | Oui (Brier à trois résultats) | Non | Non (un modèle) | ND ; prix Polymarket à ou avant le verrouillage comme référence | Oui (GitHub, Zenodo) |
| LLM Trading Arena (juil 2026) | Trading sur papier de crypto-monnaies et actions S&P 100, 100 000 dollars par modèle | Historique git public de chaque exécution et justification, ordres exécutés à l'ouverture suivante (1 ; le temps repose sur l'hôte git) | Non (valeur du compte) | Non | ND | ND | Oui (MIT, registre complet, comptes recalculables) |
| LiveMacroEval (août 2026) | Nowcasts horaires de 16 indicateurs macroéconomiques américains avant la publication | ND (0) | Non (scores basés sur le rendement et les paris) | Non | ND | Non ; nowcasts institutionnels comme comparateurs | Article CC BY 4.0 ; licence des données ND |
| RockAlpha (s.d.) | Trading d'actions IA en direct, six modèles chinois et quatre modèles américains, effet de levier 2× | ND (0) | Non (rendements) | Non | ND | Non | ND |
| TradeRank (saison 10, oct 2026) | Décisions quotidiennes de 22 modèles sur crypto-monnaies et grandes capitalisations américaines, 10 000 dollars simulés | ND (0) | ND | Non | ND | ND | Ensemble de données JSON ouvert, licence ND |
| IA Council · Marchés (oct 2026) | Panel fixe de 12 indicateurs financiers, quotidien | À partir du 21 oct 2026, au moins deux jetons RFC 3161 par liste horodatée, signés avant l'ouverture (2+) ; chaîne SHA-256, tête ancrée dans Bitcoin (2) ; 19 et 20 oct 2026 au niveau 1 pour sceau avant la référence (tableau 12) | Partiellement (Brier sur toutes les lignes principal à partir du 21 oct 2026, section 3.5 ; Brier par rapport à pièce et bases de référence ; bacs d'étalonnage comme diagnostic) | Oui (jour, semaine, mois, six mois) | Oui (N_eff par une règle d'éligibilité déclarée ; le deuxième modèle d'une famille pèse un tiers) | Oui (deux groupes permanents, section 6) | Oui (CC BY 4.0, code de notation, script de recount) |
Remarque : ND = non documenté publiquement au 21 octobre 2026, ce qui signifie que la propriété n'a pas été trouvée dans la description publique et le code n'a pas été inspecté. « Règle appropriée » compte uniquement un score strictement approprié de la probabilité de prévision (Brier, log score). La précision, l'ECE et les rendements sont marqués Non. « Pool séparé » signifie que les humains prévoient les mêmes questions indépendamment, non qu'un humain prévoit d'abord puis voit l'IA. Alpha Arena et Rallies AI Arena reposent sur des rapports de presse. J'ai lu Foresight Arena et Prediction Arena en texte intégral (arXiv:2605.00420v2, arXiv:2604.07355v1), NeuPortal et LLM Trading Arena à partir de leurs dépôts, et MarketMania à partir de ses pages de méthodologie et de recherche. NeuPortal n'est pas une arène de marché. Je la liste parce que son sceau est le plus proche de celui normalisé ici. The AIA Forecaster, FinDeepForecast et le dataset GlassBallAI se trouvent uniquement dans la chronologie. Les sources sont données à la section 7.2.
7.4 Lire la carte
La colonne de confiance montre le domaine passant des backtests, qui ne peuvent pas sécuriser le temps, aux questions en direct sécurisées par l'enregistrement de l'opérateur, et aux registres d'opérateurs de hachages salés avec des reçus signés (Prophet Arena). Le niveau 2 existe en dehors d'un panneau fixe d'indicateurs financiers. Foresight Arena s'engage sur les prévisions d'événements Polymarket, certaines d'entre elles sur les prix des actifs, à Polygon (Nechepurenko & Shuvalov, 2026a, 2026b). Les prévisions météorologiques concurrentes sont validées on-chain dans le sous-réseau Zeus (Ørpheus AI, n.d.), et NeuPortal ancre les probabilités de football dans Bitcoin. Les prévisions financières scellées avec divulgation retardée remontent à la Financial Bubble Experiment (Sornette et al., 2010), et un enregistrement de prévision non-IA est ancré dans Bitcoin et évalué par le score de Brier (Jyotish, 2026). L'horodatage public gratuit existe (Todd, 2016), donc l'ancre est bon marché. Les règles qui l'entourent en font un test équitable.
Les probabilités et les portefeuilles se rencontrent rarement. La plupart des arènes qui négocient des rendements de score ou une valeur de compte, et la plupart des références qui évaluent les probabilités ne négocient pas. Prophet Arena réunit les deux par des rendements simulés, MarketMania négocie sur papier les prévisions qu'elle évalue, et Foresight Arena évalue les probabilités par rapport au prix du marché. Une norme pour les marchés financiers en a besoin des deux. Le portefeuille répond à la question que les utilisateurs posent, et la probabilité est la partie qu'une règle appropriée peut évaluer sur un enregistrement court (section 2.4). Une colonne est vide : aucun effort dans le tableau 9 ne tient compte de l'accord pour les voix corrélées dans ses matériaux publics. MarketMania mesure le comportement de troupeau mais ne transforme pas l'accord en un compte de voix, et Foresight Arena traite les résultats du marché comme indépendants. En dehors des modèles de langage, le tournoi Numerai évalue la contribution d'un modèle après avoir neutralisé ses prédictions par rapport au métamodèle construit à partir de toutes les soumissions (Numerai, n.d.). Cela récompense un signal distinct, et cela laisse ouverte la question du nombre de voix indépendantes qu'un consensus détient. Les preuves que les modèles font erreur ensemble sont solides hors ligne (section 5).
Ce qui est nouveau. Six conceptions de la ligue n'ont pas de correspondance parmi les systèmes examinés au 21 octobre 2026 (tableau E1, tableau 9). Les trois premiers la distinguent de tous les systèmes sur la carte :
- AI Council · Markets est la première ligue en direct de prévisions IA sur un panneau fixe d'indicateurs financiers qui ancre son registre de prévisions en dehors de l'opérateur, évalue chaque prévision à partir d'un prix de référence pris après son sceau, fixe la série comptée par une règle déclarée à l'avance avec tous les autres séries publiées et étiquetées, et rapporte un compte quotidien de voix effectif. Dans l'enregistrement comptée, à partir du 21 octobre 2026, la règle de série comptée est déclarée à l'avance et scellée dans la chaîne de questions, et au moins deux autorités RFC 3161 indépendantes placent les réponses comptées avant le prix de référence (niveau 2+). Le tableau 12 donne le niveau de chaque élément pour les sessions de développement des 19 et 20 octobre 2026, niveau 1 pour l'ordre du sceau et du prix de référence. Foresight Arena est la conjonction la plus proche : une ancre externe, un engagement par relayeur par agent et par tour et un prix de référence à la date limite d'engagement, sur des événements Polymarket plutôt qu'une prévision de panneau d'indicateurs fixes quotidienne.
- C'est la première ligue en direct de prévisions IA sur des indicateurs financiers qui rapporte, à chaque série, le nombre effectif de voix par une règle d'admissibilité déclarée (séries comptées, réponses scellées avant la référence), à côté des poids familiaux dans le consensus et des comptages d'erreur unanime et de petites minorités justes. La formule est classique (Kish, 1965 ; Clemen & Winkler, 1985), la corrélation des erreurs de modèle est établie hors ligne (Kim et al., 2025 ; Spiro, 2026 ; Aitchison et al., 2026), et le comportement de troupeau a été mesuré en direct (MarketMania, 2026). La revendication est le compte à l'intérieur d'une ligue en direct.
- Elle propose une norme qui sépare l'intégrité du contenu, l'existence bornée de manière externe, l'engagement avant le prix de référence et l'identification de la prévision qui compte, écrite sous forme d'exigences MUST et SHOULD numérotées avec des vérifications qu'un lecteur peut exécuter (section 3.13, appendice B). La section 3.13 donne le statut de chaque exigence pour l'implémentation de référence. Ni Foresight Arena ni Prediction Arena ne proposent une norme pour que d'autres l'adoptent.
Les trois autres la distinguent de tous les autres arènes de marché IA sur la carte :
- Les lecteurs sont assignés une fois, au hasard, et jamais réassignés, à l'un de deux groupes qui prévoient les mêmes marchés le même jour que les modèles : l'un voit les modèles immédiatement, l'autre seulement après sa première prévision, afin qu'il prévoie avant de les voir (section 6). La conception est en direct et ouverte à tous les visiteurs, ses deux résultats étant enregistrés sous F28 et F29 et lus aux 200 premières prévisions par groupe. Les conceptions antérieures comparent des pools séparés d'humains (ForecastBench, Metaculus) ou donnent aux gens un assistant IA en premier (Schoenegger et al., 2025).
- Sept modèles de laboratoires américains et sept de laboratoires chinois, chacun d'un laboratoire différent, répondent à la même question, envoyée en une seule étape, sur le même snapshot sous le même délai, les mêmes règles et les mêmes comptes (section 5.8, tableau 8). Les effectifs les plus proches sont ceux de RockAlpha, six modèles chinois et quatre américains, un par laboratoire, avec un effet de levier 2× (Rockflow, n.d.), et celui d'AI-Trader, trois et trois, négociant les actions américaines, les actions A et les cryptomonnaies (Fan et al., 2025). Aucun ne publie un sceau, un score de probabilité ou une conception de lecteur. D'autres effectifs mélangent deux modèles chinois parmi six à huit (Alpha Arena, Rallies AI Arena, LLM Trading Arena, MarketMania), et TradeRank déploie 22 modèles sans conception de pays.
- Trente prédictions datées sur la ligue elle-même, chacune avec une mesure, une date de vérification et une règle de réfutation, sont évaluées par des votes à l'aveugle de modèles de trois familles et enregistrées avec leurs résolveurs avant les données qui les décident (section 8).
The Closed Book, scored critiques and repeated queries run in the league as well, and their predecessors appear in the timeline (Section 7.2, Table E1).
Ce sur quoi la ligue s'appuie. L'engagement d'une prévision hachée avant le résultat (Foresight Arena ; NeuPortal et Jyotish par OpenTimestamps) et le scellage des prévisions financières avec divulgation différée (Sornette et al., 2010) précèdent cette ligue. NeuPortal, le scellage le plus proche, diffère de quatre façons : un modèle sans nom, le football, un benchmark de foule pris au moment du verrouillage ou avant, et aucune règle de série comptée ou chaîne de hachage documentée. Les efforts antérieurs fournissent également des ligues monétaires multi-modèles quotidiennes (Alpha Arena, Agent Market Arena, Rallies AI Arena, LLM Trading Arena, TradeRank), des comptes virtuels de 100 000 dollars, une recomputation tierce des comptes ou des scores (LLM Trading Arena, Foresight Arena) et un effet de levier (Alpha Arena, RockAlpha). Ils fournissent également une comparaison avec les prix du marché de prévision au moment de la réponse (Foresight Arena, Prophet Arena, NeuPortal, the AIA Forecaster), un score approprié avec une analyse de puissance (Foresight Arena), des scores de probabilité à plusieurs horizons avec des échanges papier (MarketMania ; ForecastBench pour les horizons), un score de compétence climatologique (KalshiBench) et des designs de coordination en direct sur une arène ancrée (Nechepurenko & Shuvalov, 2026b). La ligue utilise ces fonctionnalités. Les questions sur des événements, les échanges en argent réel et l'amplitude de milliers de questions sont d'autres designs avec leurs propres forces, et ils complètent un panneau quotidien fixe.
8. Prédictions enregistrées
Je déclare ici, avec des dates, des seuils et des probabilités, ce que la ligue montrera, et ses fichiers ouverts en décideront. Cette version lit deux sessions notées, jusqu'au 20 octobre 2026. Chaque prédiction nomme sa mesure, le champ ouvert ou le script déposé qui la résout, une date de vérification, le résultat qui la confirme et le résultat qui la réfute, et une probabilité qui rend une erreur scorable (Brier, 1950 ; Gneiting & Raftery, 2007), selon Chernets (2026c). L'enregistrement des prédictions avant les données qui les résolvent sépare la prévision de la preuve qui la teste (Nosek et al., 2018) ; le plan suit la logique du Rapport enregistré, dans lequel les méthodes et les analyses sont fixées avant l'existence des résultats (Chambers, 2013). Le protocole le fait pour les modèles chaque matin ; cette section le fait une fois pour le protocole.
Le point final principal. Une comparaison est principale, et la prétention de la ligue à une compétence repose sur elle seule : le consensus du conseil prévoit-il mieux la journée que le taux de base ? Pour chaque session de la session 11 (2 novembre 2026) à la session 126, la fin de la saison, le gain apparié est
où est l'ensemble des événements de marché d'une journée de la session auxquels le consensus a répondu, est le consensus publié (Section 5.3) construit uniquement à partir des réponses scellées avant le prix de référence de l'événement, est 1 pour une hausse stricte et 0 sinon sur toutes les lignes, les matchs nuls inclus (Section 3.5), et est la fréquence de 2016 à 2025 d'une hausse stricte du marché de l'événement à un jour, tous les résultats comptés : le champ p_up de climatology_fixed.table[*] (horizon 1d) dans council-calibration.json, non le p_up_ex_draw excluant les matchs nuls que la ligue utilise comme référence de son propre score de compétence. Le tableau est scellé par le fichier council-clim-window.json, publié sous l'adresse des données, dont le contenu SHA-256 (du JSON sans sa clé sha256, clés triées) est 2810d11e907bbaa1f311d06622c929c69e60cc81e558fdb78f5baa04113cabb7. Le script déposé lit le champ et vérifie le sceau. Le champ figure dans les fichiers ouverts depuis le 21 octobre 2026, 08:54 UTC, et le script le lit sans erreur. Lorsque l'historique quotidien ne couvre pas la fenêtre en direct, la fréquence utilise l'événement quotidien le plus proche (Section 10). Un positif signifie que le consensus avait la perte plus petite. Chaque événement pèse également au sein d'une session et chaque session également sur la fenêtre. L'estimation est la moyenne de . Son intervalle est un bootstrap par bloc glissant sur les sessions, blocs de cinq, 10 000 rééchantillonnages, graine 20261102, intervalles de percentiles (Künsch, 1989 ; Diebold & Mariano, 1995). Le verdict est lu dans l'ordre le 30 avril 2027. La prétention principale est confirmée si l'intervalle à 95 % se situe entièrement au-dessus de zéro. Sinon, si l'intervalle à 90 % se situe entièrement à l'intérieur de la zone d'équivalence de ±0,01 Brier, la marge que la norme déclare pour chaque comparaison confirmatoire (Section 4.6), le résultat se lit comme l'absence de gain de taille pratique. Tout autre résultat est inconclus, et un gain non significatif n'est pas lu comme une équivalence. Un gain confirmé dont l'intervalle à 90 % se situe également à l'intérieur de la zone est rapporté comme confirmé et inférieur à la marge. À l'écart-type de perte et la corrélation actuels du fichier ouvert (power_brier dans council-stats.json), 126 sessions peuvent distinguer un écart d'environ 0,01, donc la zone correspond à ce que la saison peut résoudre. Une analyse de sensibilité enregistrée est rapportée à côté du verdict : le même gain apparié sur l'indice S&P 500, Nasdaq-100, Dow et indice des semi-conducteurs seul, dont le taux de base est calculé sur la session propre de l'événement de 09:30 à 16:00 ET (sensitivity_exact_window dans le script déposé). La probabilité enregistrée que la prétention principale soit confirmée est de 0,08. L'estimation tient compte du chemin que prend la saison, et le bulletin de notes rapporte la moyenne et la dispersion des changements quotidiens par marché sur la fenêtre.
Les sessions et les exécutions antérieures à la session 11 constituent la fenêtre de conception. Elles incluent les deux sessions de développement notées de la section 5.2, elles ont informé la conception et certains seuils, et aucune estimation confirmatoire ne les lit. Les trente prédictions ci-dessous sont des paris secondaires, notés ensemble par leur propre score de Brier, et aucun n'est lu individuellement comme confirmant une compétence. Les tableaux quotidiens sur les pages de la ligue sont descriptifs, et une affirmation est lue à une date de vérification enregistrée. Une question scientifique secondaire est déclarée sans direction : le désaccord aide-t-il ? La dispersion entre les prévisionnistes a eu une signification économique depuis Miller (1977) : les actions sur lesquelles les prévisions des analystes diffèrent davantage rapportent des rendements plus faibles par la suite (Diether et al., 2002). L'écart des sièges est la version de la ligue du désaccord de prévision machine, qui en finance est mesuré comme la dispersion des prévisions de rendement entre les modèles d'apprentissage automatique et prédit des rendements boursiers plus faibles (Bali et al., 2023) et des rendements de cryptomonnaie plus faibles (Chu et al., 2025). Ici les prévisionnistes sont des modèles de langage, la prévision est la probabilité d'un événement fixe, et la question porte sur la précision. Sur les événements d'un jour comptés après enregistrement, l'écart des probabilités des sièges (l'écart-type de la population de leurs probabilités énoncées pour l'événement, en points) est divisé en terciles, avec des limites aux 33,3e et 66,7e percentiles sur les sessions 1 à 10, calculé par le script déposé selon cette règle fixée à l'avance. Le gain appairé du consensus sur la climatologie est comparé entre le tercile le plus élevé et le plus bas avec le marché maintenu fixe, bilatéral. La statistique est la moyenne sur les marchés de la différence de gain moyen entre les deux terciles, avec un intervalle de bootstrap par bloc mobile, et elle est non résolue si l'un ou l'autre tercile a moins de 30 événements. Une deuxième question secondaire teste directement la thèse de la section 5 : le dénombrement des voix corrélées aide-t-il ? Sur les événements d'un jour comptés des sessions 11 à 126, la différence appairée de Brier entre le consensus publié et le consensus fantôme de la section 5.3, dont les poids sont déposés avec l'enregistrement, est estimée par le même bootstrap par bloc mobile que le critère d'évaluation primaire et lue par rapport à la même zone d'équivalence de ±0,01. Aucune question secondaire ne porte une probabilité enregistrée, donc le nombre de prédictions reste trente. Les deux sont rapportées sans ajustement de multiplicité. Une comparaison scientifique supplémentaire serait un nouvel enregistrement.
8.1 Règles pour écrire les prédictions
Chaque prédiction se résout à partir des données ouvertes de la ligue, sous CC BY 4.0, à https://trends.polyhelper.ai/api/v1/, et aucune n'a besoin de données que je détiens en privé. L'ensemble A (10 prédictions : F1, F2, F5, F7, F8, F20, F22, F23, F24 et F28) est défini par un champ publié, ou une comparaison de deux, que n'importe qui peut lire dans un navigateur ; le script déposé applique le champ à la fenêtre. L'ensemble B (20 prédictions) nécessite un calcul sur les fichiers bruts ouverts. Pour chacun, le script est déposé avec l'enregistrement, avec son SHA-256, avant que les données qu'il lira n'existent, et le script est la définition.
Une règle de fenêtre s'applique à chaque ligne sauf si la ligne en nomme une autre : la prédiction est calculée sur les sessions de la session 11 à sa date de vérification, sur les lignes comptées scellées avant la référence 09:30 ET de la session (le même seuil s'applique au Bitcoin, dont la référence est la clôture de la première barre d'une minute après le scellage de la ligne), avec des scores de Brier sur toutes les lignes (tirages inclus). Lorsqu'un champ publié couvre également des sessions antérieures, le script déposé applique la définition du champ à la fenêtre. Une session est un jour où la Bourse de New York est ouverte : la session 1 est le 19 octobre 2026, la session 10 est le 30 octobre, la session 11 est le 2 novembre, la session 30 est le 30 novembre et la session 52 est le 31 décembre 2026, avec le 26 novembre et le 25 décembre fermés. La saison de 126 sessions se termine vers le 20 avril 2027 et est vérifiée le 30 avril 2027. Chaque prédiction est vérifiée à la première publication des fichiers ouverts après sa date. Les résolveurs dans les scripts de l'OSF (resolve.py, version des règles osf-rules-1) fixent quatre détails que les lignes laissent ouverts. « Classé » est la règle 30/10 appliquée dans la fenêtre propre de la prédiction, sauf F8, qui lit l'indicateur de la ligue. Les deux trimestres de F25 sont les sessions 11 à 52 (Q4 2026 après la période de développement) et les sessions du 4 janvier au 31 mars 2027. La règle de momentum de F15 est la direction du résultat de la ligue de l'indicateur dans la session précédente (prix de référence à la clôture) à 55 %, sans prévision après un mouvement nul, noté sur toutes les lignes. L'écart utilisé pour les terciles ci-dessus est l'écart-type des probabilités des sièges.
On compare ce qui est comparable : un modèle par rapport à la pièce, la règle de momentum, le consensus et la foule sur les mêmes sessions et marchés. Dans les comparaisons entre modèles, chaque événement a un poids égal dans une session et chaque session a un poids égal dans la fenêtre, sur les sièges qui ont répondu à cette session, donc l'échantillon est les sièges disponibles. Lorsqu'une prédiction nécessite un échantillon minimum, un échantillon plus petit à la date de vérification la laisse non résolue. Si un champ est renommé, le résolveur utilise l'équivalent documenté dans le dictionnaire des données (arena-dataset.json et les schémas publiés) et enregistre le mappage. J'ai défini les seuils de F1 à F5 et F9 après que les premières exécutions scellées m'aient été visibles. Leurs fenêtres commencent à la session 11, donc aucune de ces exécutions ne les décide. À leurs échantillons minimums, trois prédictions sont descriptives, avec ces erreurs-types : environ 5 points pour l'écart d'étalonnage F14 à 100 prévisions, environ 11 points pour la part F22 à 20 critiques et environ 0,02 Brier pour la différence F28 à 200 premières prévisions par groupe. F15, F21 et F28 comparent les estimations ponctuelles avec un seuil de 0,01, et la zone d'équivalence appartient au critère d'évaluation primaire. Plusieurs prédictions énoncent l'attente qu'aucune compétence mesurable n'existe à ces tailles d'échantillon. Le tableau D1 donne la valeur attendue sans compétence à côté d'eux, et un succès là ne montre pas que la compétence est absente. Chaque prédiction concerne ce que la ligue mesurera, non la direction dans laquelle un marché se déplacera.
8.2 Les prédictions
Le tableau 10 donne dix prédictions fondamentales et le tableau D1 (Appendice D) les trente. F1 à F3, F5 à F7 et F9 demandent à quel point les images et les erreurs du conseil se ressemblent et à quel horizon les voix se séparent. F4 oppose la netteté des modèles à celle de la foule, et F8 (opérationnel) demande si le tableau se remplit selon le calendrier. F10 à F15 comparent le consensus avec un leader antérieur, une règle simple et la foule. Deux prédictions, F16, F17, demandent où se situe tout signal parmi les horizons. F18 et F19 concernent les côtés américain et chinois, F20 et F21 le Closed Book, F22 à F24 la discussion et les répétitions. F25 à F27 demandent si les leaders durent et si les bons prévisionnistes commercent bien, F28 et F29 ce que l'accès aux modèles fait aux lecteurs, et F30 si le style trahit un modèle une fois les noms masqués.
Tableau 10. Dix prédictions fondamentales, avec seuils, dates de vérification et probabilités (les trente dans le tableau D1).
| # | Prédiction | Réfutée si | Date de vérification | p |
|---|---|---|---|---|
| F1 | Le conseil reste en dessous de deux voix indépendantes : N_eff moyen sur un jour pour les sessions comptabilisées 11 à 30, selon la règle de la section 5.1, en dessous de 2,0 | moyenne ≥ 2,0 avec au moins 10 sessions | 30 nov 2026 | 0,50 |
| F3 | Les erreurs sont aussi partagées : N_eff sur les indicateurs d'erreur sur un jour des sièges, moyenné sur au moins 30 sessions notées à partir de la session 11, en dessous de 4,0 | valeur ≥ 4,0 avec au moins 30 sessions | 31 déc 2026 | 0,74 |
| F6 | L'erreur unanime est au moins deux fois plus fréquente que le produit des taux d'erreur propres des sièges répondants sur les mêmes lignes le prédit | part observée < 2 × attendu | 31 déc 2026 | 0,92 |
| F10 | La moyenne surpasse le suivi du leader : en décembre 2026 le consensus obtient un meilleur score à un jour que le modèle qui a dirigé novembre | Brier du consensus ≥ Brier du leader de novembre sur les mêmes sessions de marché en décembre | 31 déc 2026 | 0,64 |
| F11 | Aucun modèle unique ne montre d'avantage quotidien détecté sur la pièce, sur toutes les lignes à partir de la session 11 | l'intervalle de regroupement de sessions à 95 % d'un modèle classé se situe entièrement en dessous de 0,25 | 31 déc 2026 | 0,79 |
| F12 | La foule surpasse le conseil sur au moins 100 sessions de marché sur un jour avec un contrat d'au moins 1 000 $ de volume scellé | Brier de la foule ≥ Brier du conseil | 31 déc 2026 | 0,83 |
| F13 | La moyenne de la foule et du conseil surpasse la foule seule sur les mêmes contrats | Brier de la combinaison ≥ Brier de la foule | 31 déc 2026 | 0,30 |
| F18 | Le pays est un facteur mineur : l'écart entre les côtés américain et chinois est plus petit que l'étendue du Brier des modèles classés au sein de chaque côté | écart ≥ étendue au sein de l'un ou l'autre côté | 31 déc 2026 | 0,80 |
| F20 | Les mêmes nouvelles signifient moins de désaccord : chaleur du Closed Book inférieure à la chaleur ouverte | chaleur fermée ≥ chaleur ouverte | 30 nov 2026 | 0,70 |
| F30 | Le style trahit le modèle dans la saison en aveugle : un devineur fixe identifie le modèle à trois fois la chance ou mieux | précision top-1 moyenne < moyenne de 3/k sur les items | 30 avr 2027 | 0,46 |
Note : p est la probabilité enregistrée que la prédiction se réalise, étant donné qu'elle est résolue : la médiane de trois votes en aveugle de modèles de trois familles, exprimée à partir de l'énoncé, de la mesure, de la date et du seuil seul. Six valeurs (F5, F7, F20, F21, F23, F25) sont les votes du 20 octobre 2026. Les vingt-quatre autres et le point d'arrivée principal ont été votés le 21 octobre 2026, en trois tours ultérieurs, chacun sur le texte des prédictions réécrites dans ce tour, et chaque valeur est la médiane des votes de ce tour (tous les tours sont dans l'archive). Les votes qui s'écartent de plus de 0,15 sont signalés dans l'archive. Les scores de Brier sont sur un jour sauf indication contraire ; les intervalles sont à 95 % par sessions. La section 8.4 donne la règle pour les prédictions non résolues.
8.3 Probabilités
J'ai demandé à trois modèles de trois familles, Claude Opus 5.5 (Anthropic), GPT-6.1 (OpenAI) et Grok (xAI ; la version est classée avec les votes), de fixer le prix de la liste nette (énoncé, mesure, date de vérification et seuil, sans estimation de ma part), chacun sans voir les chiffres des autres, et chaque probabilité enregistrée est la médiane des trois. Les trois familles occupent aussi des sièges à la ligue, et F18, F19 et F30 concernent ces sièges. Chaque votant a fixé le prix des énoncés avant l'existence de tout dossier. Les panels de vérificateurs de modèles échouent de manière mesurable lorsque leurs membres se voient (Chernets, 2026b), donc chaque votant a fixé le prix de la liste seul. Toutes les probabilités sont conditionnelles à la résolution ; la part résolue est rapportée à côté du score.
8.4 Gel et notation
J'enregistre les prédictions et le point d'arrivée principal sur OSF (10.17605/OSF.IO/9Q86N) avant de les publier, comme une inscription ouverte, publique immédiatement, avec la liste nette, tous les votes, les scripts de l'ensemble B et les résolveurs de chaque ligne, le script du point d'arrivée principal, le SHA-256 du contenu de la climatologie scellée et un manifeste de chaque fichier déposé avec son SHA-256. Chaque date de vérification et chaque fenêtre tombe après l'horodatage d'enregistrement. Un enregistrement OSF ne peut pas être modifié, et un retrait laisse un dossier public avec sa raison, donc les prédictions y vivent. SSRN remplace la prépublication lors de la révision.
Rien n'est supprimé. Chaque prédiction apparaît sur chaque feuille de notation telle qu'elle s'est réalisée, ne s'est pas réalisée, pas encore due, ou non résolue. Une prédiction qui n'a pas pu être calculée à sa date reste non résolue et n'est jamais comptée comme un succès. Chaque feuille de notation rapporte le score de Brier sur les prédictions résolues, la part résolue, une limite la plus mauvaise dans laquelle chaque prédiction non résolue passée sa date ajoute max[p², (1 − p)²] avec toutes les prédictions passées leur date au dénominateur, et le score de compétence de Brier par rapport à une valeur plate de 0,5. Les feuilles de notation suivent les dates de vérification (30 novembre 2026, 31 décembre 2026, 30 avril 2027), chacune publiée comme une révision datée de cet article sur SSRN et Zenodo et enregistrée sur OSF, et chaque verdict cite le champ ou le script sur lequel il repose.
9. Objections et la règle qui répond à chacun
Quatre objections pèsent le plus lourdement sur la conception. Chacune est répondée ci-dessous par une règle de la Section 3 ou par un test enregistré de la Section 8.
L'information pré-ouverture guide la prévision. Le prix de référence est le premier prix après le sceau, donc une réponse comptabilisée ne peut pas utiliser l'impression de 09:30, et une réponse tardive obtient sa propre référence ultérieure. L'information disponible avant la référence, comme les contrats à terme pré-marché cités dans la question, est autorisée et fait partie de la prévision ; un prévisionniste qui lit les contrats à terme peut pencher du bon côté sans aucun jugement de sa part. L'habileté est mesurée par rapport au taux climatologique de base et à la foule, dont les prix détiennent les mêmes informations pré-ouverture, ainsi que par rapport à la pièce. L'histoire mémorisée ne peut pas aider un modèle à prévoir une clôture qui ne s'est pas produite (Lopez-Lira et al., 2025 ; Paleka et al., 2026).
Les égalités et l'événement demandé. La question demande la probabilité d'une hausse stricte et n'énonce pas la bande d'égalité. À partir du 21 octobre 2026, le score principal compte toutes les lignes, le score de l'événement demandé (Section 3.5). Les sessions de développement sont publiées comme telles, sans égalités, et chaque comparaison enregistrée utilise un événement dans un segment de méthodologie (Section 8.1).
Qui détient le registre. J'exploite la ligue et j'ai écrit les prédictions (Déclarations). Une exécution compte par session, et les autres exécutions sont publiées comme not_counted. Dans le dossier compté à partir du 21 octobre 2026, l'ordre du sceau et du prix de référence repose sur des jetons RFC 3161 d'au moins deux autorités indépendantes (niveau 2+), et pour les sessions de développement des 19 et 20 octobre sur le dossier chaîné (niveau 1, Tableau 12). La norme contrôle la sélection parmi les exécutions avec un hachage de chaque question sortante au moment de l'envoi, une exécution comptée déclarée à l'avance (scellée dans la chaîne de questions à partir du 21 octobre 2026), et chaque liste horodatée entrée au moment de l'horodatage dans un journal de transparence public que l'opérateur ne contrôle pas (Sigstore Rekor, à partir du 22 octobre 2026 ; Section 3.13). Les prédictions se résolvent à partir de fichiers publics par un champ nommé ou un script déposé avant que ses données n'existent, l'enregistrement ne peut pas être modifié, et les probabilités ont été définies en aveugle.
Probabilités comprimées. Les probabilités des modèles restent proches de 50 %. Le 20 octobre, les probabilités séparément élicitées des huit sièges scellés avant la référence pour les contrats cotés sur huit marchés (crowd_up) s'élevaient en moyenne à 5,9 points de 50 %, et les prix de la foule sur les mêmes contrats à 20,7 points (où les deux lieux avaient coté un marché, le contrat Polymarket, qui est celui auquel les modèles ont répondu). Une partie de la distance de la foule est le mouvement pré-marché déjà dans un contrat proche de clôture, donc je compare contrat par contrat sur l'événement que chaque contrat résout. Sur les cinq contrats avec un volume scellé d'au moins 1 000 $ (Tableau 11), la moyenne des sièges penchait du même côté que le prix de la foule à chaque fois, et les sièges s'élevaient en moyenne à 7,5 points de 50 % contre 28,1 pour la foule. La foule elle-même est prudente : sur 188 509 marchés Polymarket résolus, les prix s'élevaient trop près d'une moitié, avec une pente de recalibration logistique de 1,112 (Walker, 2026). Les sièges s'élevaient encore plus près d'une moitié. Sur la propre question d'un jour de la ligue, les mêmes huit sièges s'élevaient en moyenne à 4,6 points de 50 % (K = 9,2, Section 4.4). La ligue peut distinguer deux lectures de compression. Par la décomposition de Murphy, le score de Brier est la fiabilité moins la résolution plus l'incertitude (Section 4.4). Un prévisionniste prudent est calibré et abandonne la résolution, donc il score près de la climatologie et perd peu face à une foule plus nette, tandis qu'un prévisionniste qui traduit mal une vue qualitative en probabilité est aussi mal calibré, avec une pente de calibration loin de un (Cox, 1958), et perd face à la foule de plus que sa netteté ne l'explique. F4 énonce l'écart de netteté, F12 et F13 la comparaison avec la foule, et F14 la calibration, chacun sur une saison après l'enregistrement.
Tableau 11. Prix de la foule et probabilité séparément élicitée des sièges sur le même contrat, 20 octobre 2026 (huit sièges scellés avant la référence ; contrats avec un volume scellé d'au moins 1 000 $).
| Marché | Lieu | Volume scellé ($) | Prix de la foule (%) | Moyenne des sièges crowd_up (%) |
Étendue des sièges (%) |
|---|---|---|---|---|---|
| S&P 500 | Polymarket | 20,637 | 34.0 | 46.4 | 42 à 52 |
| WTI | Polymarket | 3,736 | 83.0 | 61.6 | 47 à 76 |
| Rendement 10 ans | Kalshi | 3,199 | 7.0 | 48.2 | 20 à 56 |
| Or | Polymarket | 3,112 | 29.0 | 44.8 | 36 à 50 |
| Nasdaq-100 | Kalshi | 1,150 | 22.6 | 41.6 | 34 à 46 |
Note : Prix de la foule et volumes enregistrés à 12:30:06Z et scellés à la ligne d'exécution 151 de council-book.jsonl (crowd.odds, crowd.kalshi) ; crowd_up des lignes de réponse 152 à 159. Les prix Kalshi sont interpolés à « au-dessus de la clôture précédente » (Section 4.9). Les contrats se résolvent près de la clôture, donc le prix de la foule détient déjà le mouvement pré-marché. Bitcoin, le Dow et l'indice du dollar se sont négociés en dessous du seuil de volume. Aucun résultat n'est affiché.
À la Figure 13, je dessine le Tableau 11 siège par siège. À côté de la probabilité de chaque siège pour le contrat de la foule, elle marque la probabilité du même siège pour le propre événement d'un jour de la ligue, qui est un événement différent (Tableau 1). Je constate que les deux peuvent différer. Claude a donné au rendement du contrat 20 et à la question de rendement de la ligue 47, et au WTI 74 contre 52, et Gemini a donné au WTI 76 contre 58. Le contrat de la foule part de la clôture précédente et la question de la ligue de la référence de 09:30, donc un modèle peut répondre aux deux différemment le même matin.
Figure 13. Les probabilités séparément élicitées des sièges et le prix de la foule sur les mêmes cinq contrats, 20 octobre 2026 (huit sièges scellés avant la référence ; contrats avec un volume scellé d'au moins 1 000 $).
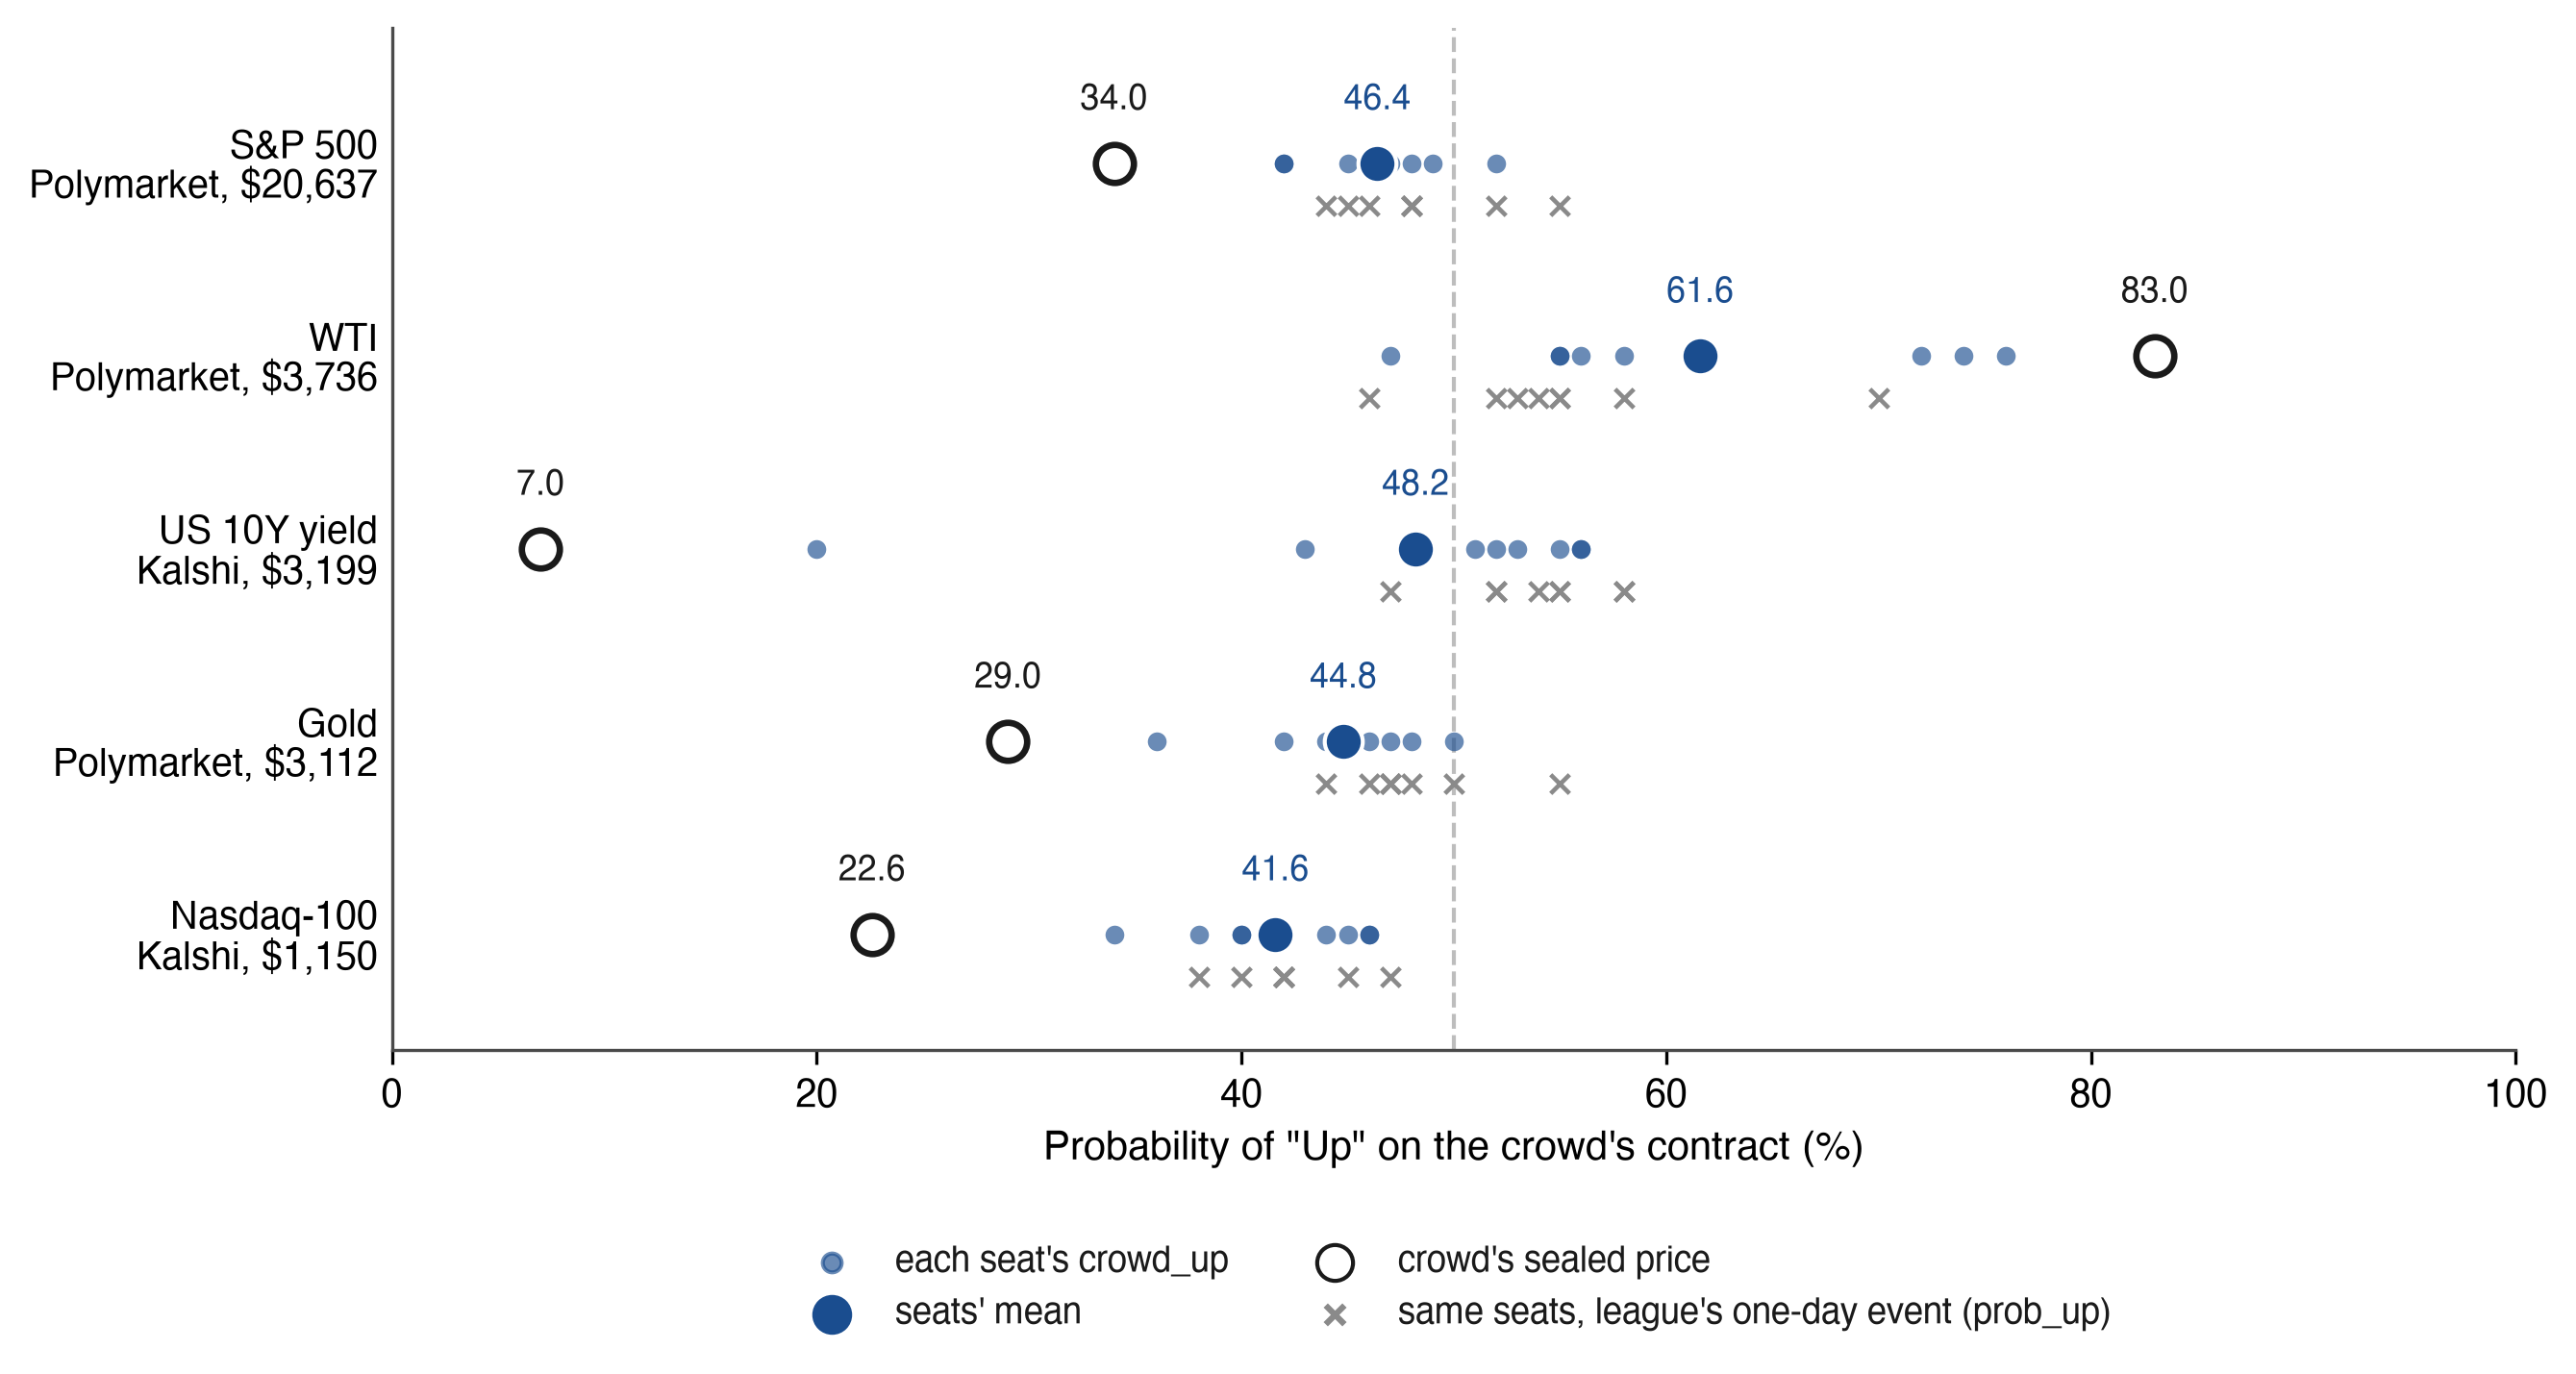
Remarque : Les prix et volumes de foule enregistrés à 12:30:06Z et scellés à la ligne 151 de council-book.jsonl (crowd.odds, crowd.kalshi) ; crowd_up et prob_up des lignes de réponse 152 à 159. Les prix Kalshi sont interpolés à « au-dessus de la clôture précédente » (section 4.9). Les croix grises marquent la probabilité de hausse des mêmes sièges lors de l'événement d'une journée propre à la ligue, un événement différent (tableau 1). Les moyennes et plages comme dans le tableau 11, et sur les cinq contrats, les sièges se tenaient en moyenne à 7,5 points de 50 et la foule à 28,1.
10. Portée et conditions limites
Le tableau 12 énonce ce sur quoi repose chaque affirmation et jusqu'où elle s'étend, et les paragraphes ci-dessous en donnent le détail.
Tableau 12. Portée de chaque affirmation.
| Affirmation | Repose sur | Portée |
|---|---|---|
| Ordre d'horodatage et prix de référence, 19 et 20 octobre 2026 | L'enregistrement de l'opérateur (niveau 1) ; les bornes d'ancrage Bitcoin au moment où les lignes existaient (niveau 2) | Séances de développement, hors chaque estimation confirmatoire |
| Ordre d'horodatage et prix de référence, à partir du 21 octobre 2026 | Jetons RFC 3161 d'au moins deux autorités indépendantes (niveau 2+) | L'enregistrement comptabilisé |
| Référence climatologique | Historique quotidien 2016 à 2025 ; la séance exacte de 09:30 à 16:00 ET pour les quatre indices boursiers américains, l'événement quotidien le plus proche ailleurs | Mouvements , non les prévisions ; le test principal est également rapporté sur les quatre indices exacts |
| Prix de référence et de clôture | Le flux de prix de l'opérateur, nommé sur chaque ligne de prévision (fournisseur, symbole, règle de référence) | L'horodatage fixe la prévision ; une seconde source de prix est l'échelon de résultat du tableau B1 |
| Comptes | 100 000 $, frais de 0,1 %, la première ouverture après l'horodatage | Une mesure secondaire, descriptive |
| Premières lectures (N_eff, ressemblance, netteté) | Les exécutions horodatées jusqu'au 21 octobre 2026 : deux séances de développement notées et la première exécution comptabilisée | Elles illustrent les mesures ; l'objectif principal et les fiches de la section 8 portent les conclusions |
| Côtés américain et chinois | La même question, instantané, délai et règles pour les quatorze modèles | Une comparaison de deux ensembles de laboratoires, observationnelle |
Temps. Les exécutions horodatées ont commencé le 16 octobre 2026 et la notation le 19 octobre 2026. Les numéros de ligue présentés ici ont été lus à partir des fichiers ouverts le 21 octobre 2026, les lectures du matin du 21 octobre à partir de copies enregistrées le 22 octobre 2026 à 01:32 UTC, et couvrent six exécutions horodatées : trois exécutions d'essai, les deux séances de développement et la première exécution de l'enregistrement comptabilisé. Chaque fiche de la section 8 nomme le chemin de marché qu'elle a noté.
Preuve de synchronisation. Pour les séances de développement que cette version note, 19 et 20 octobre, l'enregistrement de l'opérateur (booked_at et la chaîne prev/link) montre qu'une réponse a été horodatée avant le prix de référence (niveau 1). L'ancrage Bitcoin limite l'existence du préfixe ancré à quelques heures du temps d'en-tête du bloc (niveau 2, section 3.11). Une réécriture est détectable par quiconque détient une preuve antérieure, et, pour chaque liste horodatée du journal Sigstore Rekor (à partir du 22 octobre 2026 à l'horodatage, les listes antérieures du 21 octobre 2026, 23:47 UTC), par quiconque. Dans l'enregistrement comptabilisé, à partir du 21 octobre 2026, au moins deux autorités RFC 3161 indépendantes signent chaque liste horodatée (niveau 2+). Ce jour-là, le lot de réponses comptabilisées a été signé 29 minutes 41 secondes avant le prix de référence, et une réponse arrivée ultérieurement a été horodatée et signée par trois autorités 14 secondes après son arrivée, toujours avant le prix de référence.
Modèles. Onze sièges de prévision, dont les sièges dont les réponses ont été horodatées avant le prix de référence (sept le 19 octobre, huit le 20 octobre) entrent dans les lectures de cette version ; les quatorze sièges négocient tous (tableau 8). Les conclusions décrivent ces modèles dans les modes horodatés sur leurs lignes de réponse.
Marchés. Douze indicateurs couvrent les actions américaines, les semi-conducteurs, les taux, le dollar, la volatilité, les métaux, le pétrole et le Bitcoin, avec la journée de 09:30 à 16:00 ET, le rendement du 10 ans jusqu'à 15:00 ET et le Bitcoin à partir de la minute d'horodatage. Les actions individuelles, en dehors du suivi séparé du S&P 100, et le trading intrajournalier sont hors de portée. La référence climatologique est estimée sur l'historique quotidien et rapproche l'événement en direct où aucune fenêtre correspondante n'existe : la barre quotidienne du contrat pour l'or, le WTI, le Brent, le cuivre et l'indice du dollar, la clôture quotidienne pour le rendement du 10 ans, la journée UTC pour le Bitcoin, et, à une semaine et plus, les mouvements à partir de l'ouverture où le contrat en direct mesure sa bande de clôture à clôture ; les approximations sont indiquées dans le champ et biaiser , non les prévisions. Les comptes détiennent chaque marché par l'instrument nommé dans arena-protocol.json ; pour le pétrole, les métaux et le cuivre, cet instrument est un fonds qui détient des contrats à terme et les renouvelle, de sorte qu'un compte peut dériver de l'indicateur qu'il négocie, ce qui est l'une des raisons pour lesquelles F27 compare les rangs de prévision et de rendement plutôt que leurs niveaux. Une ligne de foule est admise par son volume horodaté d'au moins 1 000 $ ; l'exigence 17 ajoute enchère, demande et l'heure de la dernière transaction à chaque ligne de foule, avec des règles de fraîcheur et d'écart gelées avant la fenêtre qu'elles régissent, et un lieu mis en commun seulement où les contrats se résolvent sur le même prédicat.
Indépendance, pays, lecteurs, portefeuilles. N_eff résume à quel point les images de probabilité sont similaires sous une corrélation commune, exécution par exécution et horizon par horizon, et il ne classe pas les modèles. L'expérience de lecteur compare des groupes randomisés de visiteurs auto-sélectionnés. Les comptes sont simulés, 100 000 $ chacun, avec des frais de 0,1 % et exécution à la première ouverture après l'horodatage ; ils excluent l'impact de marché et les taxes. Le trading est un canal classique de sous-performance (Barber & Odean, 2000), de sorte que l'exigence 17 rapporte le taux de rotation de chaque compte (valeur négociée sur capitaux propres moyens) et les frais qu'il a payés à côté d'une ombre de non-trading horodatée qui maintient les participations avant chaque rééquilibrage ; une association entre taux de rotation et rendement est descriptive.
Statut des affirmations. Le protocole et ses mesures sont proposés, et AI Council · Markets est l'implémentation de référence, dont le statut par rapport à chaque exigence est publié dans la section 3.13. Le seul test confirmatoire est l'objectif principal, et les trente énoncés de la section 8 sont des prédictions secondaires enregistrées.
Cet article décrit un protocole de mesure et n'est pas un conseil en investissement.
11. Conclusion
J'ai rédigé la norme pour qu'un lecteur, et non l'opérateur, puisse vérifier quand une prévision d'un marché financier a été fixée, sur quel événement elle a été notée et quelle exécution a compté. IA Council · Markets, géré par PolyHelper, en est l'implémentation de référence sur douze indicateurs à quatre horizons, avec son statut par rapport à chaque exigence publié et daté (Section 3.13). À partir du 21 octobre 2026, l'exécution qui compte est déclarée à l'avance et scellée, et des autorités horodatage indépendantes signent l'enregistrement des réponses comptées avant l'ouverture à 09:30 ET. L'ordre de la prévision et de la référence repose alors sur des horloges extérieures à l'opérateur. C'est l'élément que je recommande aux autres ligues d'adopter en premier : l'horodatage d'un tiers transforme l'assurance d'un opérateur en un enregistrement qu'un lecteur peut vérifier. Parmi les arènes cartographiées à la Section 7.4, la ligue est la première à combiner ces éléments sur un panel fixe d'indicateurs financiers, et la première arène de marché IA à placer sept modèles américains et sept modèles chinois sur la même question, instantané, échéance et règles à côté de lecteurs aléatoirement affectés à prévoir avant ou après les avoir vus. À côté de son consensus, la ligue rapporte le nombre de voix indépendantes qui le soutiennent, car une part de modèles d'accord signifie peu sans ce décompte. Au cours des deux premiers matins, les images de probabilité des sièges scellés avant la référence étaient aussi semblables à celles de moins de deux prévisionnistes indépendants en une journée, et la première exécution de l'enregistrement compté a donné 2,23. Un test primaire et trente prédictions secondaires sont enregistrés sur OSF avant la publication. Les révisions datées les noteront, et le résolveur classé avec chaque prédiction permet à tout lecteur de la noter en premier, à partir de données ouvertes en CC BY 4.0 à https://trends.polyhelper.ai/api/v1/.
Déclarations
Financement. Aucun financement externe n'a soutenu ce travail.
Conflits d'intérêts. J'ai fondé et j'opère PolyHelper, qui gère la ligue AI Council · Markets décrite ici et développe des méthodes d'orchestration multi-modèles, avec des demandes de brevet connexes en attente (aucun brevet n'a été accordé).
Outils et vérification. J'ai utilisé des assistants IA comme instruments sous ma direction. Les idées, la recherche et les conclusions sont miennes. J'ai vérifié les affirmations quantitatives et les citations par rapport aux sources primaires ou aux copies archivées au 20 octobre 2026, ainsi que les travaux antérieurs de la section 7 et de l'annexe E au 21 octobre 2026. J'ai lu les chiffres de la ligue dans ses fichiers ouverts le 21 octobre 2026 (council-stats.json généré à 03:47 et 05:33 UTC, le second contenant les blocs n_eff.counted et power_brier, et la valeur par séance du 21 octobre 2026 du fichier généré à 22:16 UTC), et j'ai recalculé les valeurs d'indépendance par séance et par horizon de la section 5.2 à partir de council-forecasts.csv et council-book.jsonl du même jour avec un script déposé avec l'enregistrement. J'ai lu l'état de conformité du tableau 5 et les cachets du 21 octobre 2026 à partir des fichiers en direct et de la page de preuve le 21 octobre 2026 à 15:05 UTC, et j'ai vérifié les jetons RFC 3161 avec OpenSSL par rapport aux certificats des autorités. Trois modèles de trois familles ont défini les probabilités des prédictions enregistrées, chacun aveugle aux autres et à mes estimations (section 8.3).
Disponibilité des données et du code. Les scripts déposés, le vérificateur de contrats d'événements et les deux scripts de recompte utilisent Python 3.9 ou ultérieur sans paquet au-delà de sa bibliothèque standard et s'exécutent sous python3 -I ; je les ai exécutés avec Python 3.15.0 sur macOS. Les vérifications de l'annexe B nécessitent shasum, le client OpenTimestamps pour l'étape 6 et OpenSSL 3 ou ultérieur pour l'étape 9. Rien n'est entraîné, donc aucun résultat ne dépend du matériel ; les modèles s'exécutent chez leurs fournisseurs, et la version et le mode que chacun a retourné sont scellés sur sa ligne de réponse (tableau 8). Les données de la ligue sont ouvertes sous CC BY 4.0 à https://trends.polyhelper.ai/api/v1/, y compris le livre scellé (council-book.jsonl), les prévisions (council-forecasts.csv), les textes des questions selon leurs hachés (asks/<sha256>.md), les statistiques (council-stats.json), le protocole et ses versions (arena-protocol.json), le code du moteur de portefeuille avec des hachés SHA-256 (arena-code.json), un recompte de chaque score de prévision (tools/replay_brier.py) et un script de recompte qui recalcule chaque compte de ligue publié à partir des transactions et des prix publiés dans la tolérance d'arrondi de publication indiquée (python3 replay.py https://trends.polyhelper.ai/api/v1/, annexe B). Les points d'extrémité en direct changent à chaque session, donc l'analyse ne repose pas sur eux : une version immuable des fichiers ouverts au moment de chaque version de l'article, avec un manifeste de leurs hachés SHA-256, est archivée sur Zenodo (10.5281/zenodo.23552700), et chaque chiffre de l'article est calculé à partir de cette version ; les scripts déposés s'exécutent sur celle-ci hors ligne (--data). Un lecteur qui télécharge les fichiers en direct ultérieurement peut vérifier le préfixe archivé du livre scellé par rapport à eux (annexe B). Le point d'extrémité primaire avec son script, les prédictions enregistrées avec un résolveur pour chacune (resolve.py), la liste propre tarifée par les prévisionnistes aveugles avec les trois votes, les scripts de l'ensemble B, le contenu SHA-256 de la climatologie scellée et un manifeste des fichiers déposés avec leurs SHA-256, accompagnés d'un README qui énumère les exigences et la commande pour chaque script, sont enregistrés sur OSF (10.17605/OSF.IO/9Q86N). L'article est archivé sur Zenodo (10.5281/zenodo.23552697) et sa citation préférée est la prépublication SSRN (https://ssrn.com/abstract=7653679).
Éthique. L'expérience de lecture de la section 6 collecte des prévisions anonymes haut ou bas avec une confiance indiquée de la part des visiteurs d'une page publique. Les lecteurs sont assignés à un groupe par un identifiant aléatoire anonyme. L'expérience ne collecte aucun nom, compte ou coordonnées de contact. La ligue ne stocke ni ne consigne l'adresse IP d'un lecteur. Un hachage salé de celle-ci avec le jour est conservé uniquement pour plafonner les votes par adresse, et aucune donnée personnelle n'est publiée ou utilisée dans l'analyse. Les résultats sont rapportés sous forme de comptes agrégés, et les premières prévisions que F29 lit sont publiées sous le seul identifiant anonyme. J'ai mené le travail en tant que chercheur indépendant sans comité d'éthique institutionnel. Les prévisionnistes de la ligue sont des modèles logiciels.
Contributions de l'auteur. Auteur unique.
Correspondance. [email protected] · ORCID: 0009-0007-4845-3163
References
Abeliuk, A., Benjamin, D. M., Morstatter, F., & Galstyan, A. (2020). Quantifying machine influence over human forecasters. Scientific Reports, 10, 15940. https://doi.org/10.1038/s41598-020-72690-4
Adams, C., Cain, P., Pinkas, D., & Zuccherato, R. (2001). Internet X.509 public key infrastructure time-stamp protocol (TSP) (RFC 3161). Internet Engineering Task Force. https://doi.org/10.17487/RFC3161
AI Council · Markets. (2026). Open data of the AI Council · Markets league: sealed book, forecasts, statistics, protocol, event-contract schema and league accounts [Data set]. CC BY 4.0. Data as of 20 October 2026 (generated 21 October 2026, 02:42 UTC); conformance status read 21 October 2026, 15:05 UTC. Retrieved 20-21 October 2026, from https://trends.polyhelper.ai/api/v1/
Aitchison, M., Jeen, S., Shevlane, T., & Day, B. (2026). Diversity is the strength of the AI crowd (arXiv:2606.29661). arXiv. https://arxiv.org/abs/2606.29661
Alur, R., Stadie, B. C., Kang, D., Chen, R., McManus, M., Rickert, M., Lee, T., Federici, M., Zhu, R., Fogerty, D., Williamson, H., Lozinski, N., Linsky, A., & Sekhon, J. S. (2025). AIA Forecaster: Technical report (arXiv:2511.07678). arXiv. https://arxiv.org/abs/2511.07678
Arora, A., & Malpani, R. (2026). PredictionMarketBench: A SWE-bench-style framework for backtesting trading agents on prediction markets (arXiv:2602.00133). arXiv. https://arxiv.org/abs/2602.00133
Bali, T. G., Kelly, B. T., Mörke, M., & Rahman, J. (2023). Machine forecast disagreement (NBER Working Paper No. 31583). National Bureau of Economic Research. https://doi.org/10.3386/w31583
Barber, B. M., & Odean, T. (2000). Trading is hazardous to your wealth: The common stock investment performance of individual investors. The Journal of Finance, 55(2), 773-806. https://doi.org/10.1111/0022-1082.00226
Barot, R. M., & Borkhatariya, A. S. (2026). PolySwarm: A multi-agent large language model framework for prediction market trading and latency arbitrage (arXiv:2604.03888). arXiv. https://arxiv.org/abs/2604.03888
Berg, J., Nelson, F., & Rietz, T. (2008). Prediction market accuracy in the long run. International Journal of Forecasting, 24(2), 285-300. https://doi.org/10.1016/j.ijforecast.2008.03.007
Bitcoin Developer Documentation. (n.d.). Block chain: Block headers. Retrieved 20 October 2026, from https://developer.bitcoin.org/reference/block_chain.html
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3. https://doi.org/10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
Cao, S., Wang, C. C. Y., & Yi, X. (2025). When LLMs go abroad: Foreign bias in AI financial predictions (Harvard Business School Working Paper No. 26-013). Harvard Business School.
Chambers, C. D. (2013). Registered Reports: A new publishing initiative at Cortex. Cortex, 49(3), 609-610. https://doi.org/10.1016/j.cortex.2012.12.016
Chen, Y., Yao, Z., Liu, Y., Xin, A., Ye, J., Yu, J., Hou, L., & Li, J. (2025). StockBench: Can LLM agents trade stocks profitably in real-world markets? (arXiv:2510.02209). arXiv. https://arxiv.org/abs/2510.02209
Cheng, P., Liu, J., & Long, Y. (2026). PolyBench: Benchmarking LLM forecasting and trading capabilities on live prediction market data (arXiv:2604.14199). arXiv. https://arxiv.org/abs/2604.14199
Chernets, V. (2026a). Agreement is not independent evidence: Auditable multi-model synthesis without an API. Zenodo. https://doi.org/10.5281/zenodo.22683716 (also SSRN Working Paper No. 7390698, https://ssrn.com/abstract=7390698)
Chernets, V. (2026b). Verification theater: Measured failure modes of AI verifier panels. Zenodo. https://doi.org/10.5281/zenodo.23197641
Chernets, V. (2026c). After the programmer divide: One measure for people who build through AI agents (SSRN Working Paper No. 7589918). SSRN. https://ssrn.com/abstract=7589918
Choi, H. K., Zhu, X., & Li, S. (2025). Debate or vote: Which yields better decisions in multi-agent large language models? (arXiv:2508.17536). Advances in Neural Information Processing Systems 38 (NeurIPS 2025). https://arxiv.org/abs/2508.17536
Chu, G., Shen, D., & Zhu, Z. (2025). Machine forecast disagreement in the cryptocurrency market (SSRN Working Paper No. 5230677). SSRN. https://doi.org/10.2139/ssrn.5230677
Clemen, R. T., & Winkler, R. L. (1985). Limits for the precision and value of information from dependent sources. Operations Research, 33(2), 427-442. https://doi.org/10.1287/opre.33.2.427
Cox, D. R. (1958). Two further applications of a model for binary regression. Biometrika, 45(3-4), 562-565. https://doi.org/10.1093/biomet/45.3-4.562
Diebold, F. X., & Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253-263. https://doi.org/10.1080/07350015.1995.10524599
Diercks, A. M., Katz, J. D., & Wright, J. H. (2026). Kalshi and the rise of macro markets (Finance and Economics Discussion Series 2026-010). Board of Governors of the Federal Reserve System. https://doi.org/10.17016/FEDS.2026.010
Diether, K. B., Malloy, C. J., & Scherbina, A. (2002). Differences of opinion and the cross section of stock returns. The Journal of Finance, 57(5), 2113-2141. https://doi.org/10.1111/0022-1082.00490
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114-126. https://doi.org/10.1037/xge0000033
Dubach, P. D. (2026). The anatomy of a decentralized prediction market: Microstructure evidence from the Polymarket order book (arXiv:2604.24366). arXiv. https://arxiv.org/abs/2604.24366
Fan, T., Yang, Y., Jiang, Y., Zhang, Y., Chen, Y., & Huang, C. (2025). AI-Trader: Benchmarking autonomous agents in real-time financial markets (arXiv:2512.10971). arXiv. https://arxiv.org/abs/2512.10971
Fassbender, J. (2026). Bitcoin-anchored temporal proof for transparency services (Internet-Draft draft-fassbender-scitt-time-anchor-07). Internet Engineering Task Force. https://datatracker.ietf.org/doc/html/draft-fassbender-scitt-time-anchor-07
Forklog. (2025a). Four out of six AI models suffer losses in trading tournament. https://forklog.com/en/four-out-of-six-ai-models-suffer-losses-in-trading-tournament/
Forklog. (2025b). AI model Grok 4.2 triumphs in trading tournament. https://forklog.com/en/ai-model-grok-4-2-triumphs-in-trading-tournament/
Gao, Z., Jiang, W., & Yan, Y. (2025). Detecting lookahead bias in LLM forecasts (arXiv:2512.23847). arXiv. https://arxiv.org/abs/2512.23847
Glasserman, P., & Lin, C. (2023). Assessing look-ahead bias in stock return predictions generated by GPT sentiment analysis (arXiv:2309.17322). arXiv. https://arxiv.org/abs/2309.17322
Gneiting, T., Balabdaoui, F., & Raftery, A. E. (2007). Probabilistic forecasts, calibration and sharpness. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 69(2), 243-268. https://doi.org/10.1111/j.1467-9868.2007.00587.x
Gneiting, T., & Raftery, A. E. (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association, 102(477), 359-378. https://doi.org/10.1198/016214506000001437
Guan, M., & Chen, Q. (2026). Leakage-aware benchmarking of LLM forecasting: Real-time nowcasts as the decision-time input for macro factor ranking (arXiv:2606.22719). arXiv. https://arxiv.org/abs/2606.22719
Haber, S., & Stornetta, W. S. (1991). How to time-stamp a digital document. Journal of Cryptology, 3(2), 99-111. https://doi.org/10.1007/BF00196791
Halawi, D., Zhang, F., Chen, Y.-H., & Steinhardt, J. (2024). Approaching human-level forecasting with language models. In Advances in Neural Information Processing Systems 37 (NeurIPS 2024). https://arxiv.org/abs/2402.18563
He, S., Lv, L., Manela, A., & Wu, J. (2025). Chronologically consistent large language models (arXiv:2502.21206). arXiv. https://arxiv.org/abs/2502.21206
Jyotish, V. (2026). Sealed before the event: A publicly verifiable, Bitcoin-anchored forecast record of 92 graded outcomes [Version 1; awaiting peer review]. F1000Research, 15, Article 1322. https://doi.org/10.12688/f1000research.186752.1
Karger, E., Bastani, H., Chen, Y.-H., Jacobs, Z., Halawi, D., Zhang, F., & Tetlock, P. E. (2025). ForecastBench: A dynamic benchmark of AI forecasting capabilities. In International Conference on Learning Representations (ICLR 2025). https://arxiv.org/abs/2409.19839
Karkar, C., & Chopra, P. (2025). Future is unevenly distributed: Forecasting ability of LLMs depends on what we're asking (arXiv:2511.18394). arXiv. https://arxiv.org/abs/2511.18394
Kim, E. M., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning (PMLR 267, pp. 30038-30066). https://proceedings.mlr.press/v267/kim25e.html
Kim, S., Kwon, J., Kim, Y., Kagan, N., Khatchadourian, R., Ahn, W., Lopez-Lira, A., Lee, J., Hwang, Y., Levy, O., Lee, Y., & Choi, C. (2026). Forecasting future language: Context design for mention markets (arXiv:2602.21229). arXiv. https://arxiv.org/abs/2602.21229
Kish, L. (1965). Survey sampling. Wiley.
Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118. https://doi.org/10.1073/pnas.2018340118
Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. In Advances in Neural Information Processing Systems 7 (NIPS 1994). https://papers.nips.cc/paper_files/paper/1994/hash/b8c37e33defde51cf91e1e03e51657da-Abstract.html
Künsch, H. R. (1989). The jackknife and the bootstrap for general stationary observations. The Annals of Statistics, 17(3), 1217-1241. https://doi.org/10.1214/aos/1176347265
Li, H., Cao, Y., Yu, Y., Javaji, S. R., Deng, Z., He, Y., Jiang, Y., Zhu, Z., Subbalakshmi, K. P., Huang, J., Qian, L., Peng, X., Suchow, J. W., & Xie, Q. (2025). INVESTORBENCH: A benchmark for financial decision-making tasks with LLM-based agent. In Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 2509-2525). https://aclanthology.org/2025.acl-long.126/
Li, W. W., Kim, H., Cucuringu, M., & Ma, T. (2025). Can LLM-based financial investing strategies outperform the market in long run? [FINSABER] (arXiv:2505.07078). arXiv. https://arxiv.org/abs/2505.07078
Li, X., Yao, X., Qi, G., Zhu, F., Koa, K. J. L., Ng, X. Y., Liu, Z., Ni, X., Liu, C., Yang, Y., Zhang, Y., Wang, W., Feng, F., Wang, C., Luan, H., Xing, X., Xu, X., Chua, T.-S., & Huang, K.-W. (2026). FinDeepForecast: A live multi-agent system for benchmarking deep research agents in financial forecasting (arXiv:2601.05039). arXiv. https://arxiv.org/abs/2601.05039
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Algorithm appreciation: People prefer algorithmic to human judgment. Organizational Behavior and Human Decision Processes, 151, 90-103. https://doi.org/10.1016/j.obhdp.2018.12.005
Lopez-Lira, A., & Tang, Y. (2023). Can ChatGPT forecast stock price movements? Return predictability and large language models (SSRN Working Paper No. 4412788). https://doi.org/10.2139/ssrn.4412788
Lopez-Lira, A., Tang, Y., & Zhu, M. (2025). The memorization problem: Can we trust LLMs' economic forecasts? (arXiv:2504.14765). arXiv. https://arxiv.org/abs/2504.14765
louidev. (2026). GlassBallAI: A dataset of LLM market predictions (made with Google Gemini models) (Version 1.2) [Data set, CC BY-NC 4.0]. Hugging Face. Retrieved 21 October 2026, from https://huggingface.co/datasets/louidev/glassballai
MarketMania. (2026). Live LLM crypto forecasting benchmark and Benchmark methodology [Web pages]. Retrieved 21 October 2026, from https://marketmania.ai/llm-financial-market-benchmark and https://marketmania.ai/benchmarks/methodology
MaxWellApexLab. (2026). llm-trading-arena: LLM Trading Arena [Computer software and live ledger, MIT licence]. GitHub. Retrieved 21 October 2026, from https://github.com/MaxWellApexLab/llm-trading-arena
Meng, S., & Chen, X. (2026). AI-driven alpha decay: Algorithmic homogenization, reflexive signal erosion, and the paradox of intelligent markets (arXiv:2605.23905). arXiv. https://arxiv.org/abs/2605.23905
Metaculus. (2025a). Q1 AI benchmarking results: Human pros crush bots. Effective Altruism Forum. https://forum.effectivealtruism.org/posts/mwcWxwdsEMexm98GF/q1-ai-benchmarking-results-human-pros-crush-bots
Metaculus. (2025b). Q2 AI benchmark results: Pros maintain clear lead. LessWrong. https://www.lesswrong.com/posts/Surnjh8A4WjgtQTkZ/q2-ai-benchmark-results-pros-maintain-clear-lead
Miller, E. M. (1977). Risk, uncertainty, and divergence of opinion. The Journal of Finance, 32(4), 1151-1168. https://doi.org/10.1111/j.1540-6261.1977.tb03317.x
Murphy, A. H. (1973). A new vector partition of the probability score. Journal of Applied Meteorology, 12(4), 595-600. https://doi.org/10.1175/1520-0450(1973)012<0595:ANVPOT>2.0.CO;2
Nakamoto, S. (2008). Bitcoin: A peer-to-peer electronic cash system. https://bitcoin.org/bitcoin.pdf
National Institute of Standards and Technology. (2015). Secure hash standard (SHS) (FIPS PUB 180-4). https://doi.org/10.6028/NIST.FIPS.180-4
Nechepurenko, M., & Shuvalov, P. (2026a). Foresight Arena: An on-chain benchmark for evaluating AI forecasting agents (arXiv:2605.00420v2). arXiv. https://arxiv.org/abs/2605.00420
Nechepurenko, M., & Shuvalov, P. (2026b). Coordination as an architectural layer for LLM-based multi-agent systems (arXiv:2605.03310). arXiv. https://arxiv.org/abs/2605.03310
Nel, L. (2025). Do large language models know what they don't know? KalshiBench: A new benchmark for evaluating epistemic calibration via prediction markets (arXiv:2512.16030). arXiv. https://arxiv.org/abs/2512.16030
NeuPortal. (2026). NeuPortal: AI forecasts vs prediction markets (Bitcoin-timestamped) (Version 1) [Data set; Zenodo record by A. Bilous]. Zenodo. https://doi.org/10.5281/zenodo.21294229 . Proofs: https://github.com/neuportalai-ui/experiment-proofs
Newey, W. K., & West, K. D. (1987). A simple, positive semi-definite, heteroskedasticity and autocorrelation consistent covariance matrix. Econometrica, 55(3), 703-708. https://doi.org/10.2307/1913610
Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600-2606. https://doi.org/10.1073/pnas.1708274114
Numerai. (n.d.). Meta Model Contribution (MMC) [Technical documentation]. Numerai Docs. Retrieved 21 October 2026, from https://docs.numer.ai/numerai-tournament/scoring/meta-model-contribution-mmc
Rockflow. (n.d.). RockAlpha: AI stock. Retrieved 21 October 2026, from https://rockalpha.rockflow.ai/ai-stock
Ørpheus AI. (n.d.). Zeus: Environmental forecasting subnet [Source code and README]. GitHub. Retrieved 21 October 2026, from https://github.com/Orpheus-AI/Zeus/blob/main/README.md
Paleka, D., Goel, S., Geiping, J., & Tramèr, F. (2026). Pitfalls in evaluating language model forecasters. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2506.00723
Prophet Arena. (2026). Verify a forecast, Verify (documentation) and How scoring works [Web pages]. Retrieved 20-21 October 2026, from https://www.prophetarena.co/verify , https://www.prophetarena.co/docs/verify and https://www.prophetarena.co/research/how-scoring-works
Qian, L., Peng, X., Wang, Y., Zhang, V. J., He, H., Smith, H., Han, Y., He, Y., Li, H., Cao, Y., Yu, Y., Lopez-Lira, A., Lu, P., Nie, J.-Y., Xiong, G., Huang, J., & Ananiadou, S. (2025). When agents trade: Live multi-market trading benchmark for LLM agents (arXiv:2510.11695). arXiv. https://arxiv.org/abs/2510.11695
Rallies.ai. (2025-2026). AI Arena [Website feature]. Retrieved 21 October 2026, from https://rallies.ai/
Schoenegger, P., Park, P. S., Karger, E., Trott, S., & Tetlock, P. E. (2025). AI-augmented predictions: LLM assistants improve human forecasting accuracy. ACM Transactions on Interactive Intelligent Systems, 15(1). https://doi.org/10.1145/3707649
Schoenegger, P., Tuminauskaite, I., Park, P. S., Bastos, R. V. S., & Tetlock, P. E. (2024). Wisdom of the silicon crowd: LLM ensemble prediction capabilities rival human crowd accuracy. Science Advances, 10(45), Article eadp1528. https://doi.org/10.1126/sciadv.adp1528
Sharpe, W. F. (1994). The Sharpe ratio. The Journal of Portfolio Management, 21(1), 49-58. https://doi.org/10.3905/jpm.1994.409501
Sornette, D., Woodard, R., Fedorovsky, M., Reimann, S., Woodard, H., & Zhou, W.-X. (2010). The financial bubble experiment: Advanced diagnostics and forecasts of bubble terminations, volume II, master document (arXiv:1005.5675). arXiv. https://arxiv.org/abs/1005.5675
Sortino, F. A., & Price, L. N. (1994). Performance measurement in a downside risk framework. The Journal of Investing, 3(3), 59-64. https://doi.org/10.3905/joi.3.3.59
Spiro, T. (2026). The oracle's fingerprint: Correlated AI forecasting errors and the limits of bias transmission (arXiv:2605.00844). arXiv. https://arxiv.org/abs/2605.00844
Todd, P. (2016, September 15). OpenTimestamps: Scalable, trust-minimized, distributed timestamping with Bitcoin. https://petertodd.org/2016/opentimestamps-announcement
TradeRank. (2026). TradeRank.ai: Live AI trading leaderboard [Website and open JSON data set]. Retrieved 21 October 2026, from https://traderank.ai/
Walker, A. (2026). The price is (almost) right: A calibration analysis of Polymarket pricing data [Senior thesis, Princeton University]. Princeton University Senior Theses. https://theses-dissertations.princeton.edu/handle/88435/dsp01mw22v8973
White, H. (2000). A reality check for data snooping. Econometrica, 68(5), 1097-1126. https://doi.org/10.1111/1468-0262.00152
Wolfers, J., & Zitzewitz, E. (2004). Prediction markets. Journal of Economic Perspectives, 18(2), 107-126. https://doi.org/10.1257/0895330041371321
Yahoo Finance. (2025). Elon Musk's Grok 4.20 beats OpenAI, Google models in live stock trading contest. https://finance.yahoo.com/news/elon-musks-grok-4-20-123855766.html
Yang, Q., Mahns, S., Li, S., Gu, A., Wu, J., & Xu, H. (2025). LLM-as-a-prophet: Understanding predictive intelligence with Prophet Arena. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2510.17638
Yu, H., Li, F., & You, J. (2025). LiveTradeBench: Seeking real-world alpha with large language models (arXiv:2511.03628). arXiv. https://arxiv.org/abs/2511.03628
Zeng, Z., Liu, J., Chen, S., He, T., Liao, Y., Tian, Y., Wang, J., Wang, Z., Yang, Y., Yin, L., Yin, M., Zhu, Z., Cai, T., Chen, Z., Chen, J., Du, Y., Gao, X., Guo, J., Hu, L., . . . Huang, W. (2025). FutureX: An advanced live benchmark for LLM agents in future prediction. In International Conference on Learning Representations (ICLR 2026). https://arxiv.org/abs/2508.11987
Zhang, J., Liu, G., Johansson, O., Yitayew, H., Ohly, K., & Li, G. (2026). Prediction Arena: Benchmarking AI models on real-world prediction markets (arXiv:2604.07355). arXiv. https://arxiv.org/abs/2604.07355
Zhang, O., & Zhang, Z. (2026). A review of large language models for stock price forecasting from a hedge-fund perspective (arXiv:2605.05211). arXiv. https://arxiv.org/abs/2605.05211
Zhao, X., Zhang, R., Ye, L., Cao, R., Xie, P., & Chava, S. (2026). Can LLMs take the pulse of the economy? A real-time evaluation of LLM nowcasts on macroeconomic indicators (arXiv:2608.30110). arXiv. https://arxiv.org/abs/2608.30110
Annexe A. Champs du protocole
La spécification est le fichier lui-même : arena-protocol.json pour les ligues (Tableau A1) et le champ methodology scellé dans chaque ligne de run pour le score de prévision (Tableau A2). Les deux sont versionnés. Chaque modification est datée et chaque sceau porte la version en vigueur, de sorte qu'une modification ne s'applique à rien de scellé avant elle (exigence 15). Les tableaux ci-dessous énumèrent les clés nécessaires pour résoudre un score en date du 20 octobre 2026.
Tableau A1. Clés de arena-protocol.json nécessaires pour résoudre un compte (version arena-3, 20 octobre 2026).
| Clé | Ce qu'elle fixe |
|---|---|
version, pro_version, history |
Règles en vigueur (arena-3, ligue Pro pro-1) et chaque version avec sa date de début |
assets, indicators_only |
L'instrument que chaque marché négocie (le rendement comme IEF, Bitcoin comme BTC-USD et ainsi de suite) ; VIX non détenu |
prices |
Source de prix et règle des comptes : première barre minute de 09h30-09h45 ET pour l'exécution, la clôture pour la valeur |
execution, cost |
Une décision s'exécute à la première ouverture après son sceau ; 0,001 sur chaque dollar qui change |
limits, cash |
5 % à 25 % par position, somme 100 %, long uniquement ; trésorerie au bon du Trésor à 13 semaines par jours calendaires sur 360 |
missing_answer, refused, asked_again |
Pas de décision ou une décision refusée ne modifie pas les positions ; les tentatives sont scellées avec le hachage de leur question |
pro_league |
Poids signés, exposition brute jusqu'à 2×, coûts d'emprunt, réduction de marge |
new_model_version |
Le compte continue ; la modification est datée ; le résultat depuis la version est affiché à part |
formulas |
Rendement, drawdown maximal, Sharpe, Sortino, dividendes à partir de la date ex-dividende, divisions appliquées une fois |
question, replay |
Hachage de modèle de la question de portefeuille ; comment recompter chaque compte à partir des fichiers ouverts |
Les pistes fantômes (f12, closed_book, repeats, sp100, council_talk, modalities, roles) portent leurs propres versions de règles dans le même fichier et n'entrent pas dans le score de prévision.
Tableau A2. Champs de la méthodologie de notation scellée dans chaque ligne de run (methodology, version 2).
| Champ | Ce qu'il fixe |
|---|---|
reference |
Le premier prix après le sceau selon la règle de chaque indicateur (ref_rule) ; les réponses tardives obtiennent leur propre référence |
counted |
La ligne de réponse scellée en dernier avant la référence compte ; à partir de la session 11 (2 novembre 2026), la première ligne de réponse bien formée de chaque siège scellée avant la référence compte et une ligne ultérieure du même siège est une tentative étiquetée (asks.jsonl, ligne 74) ; une ligne après la clôture n'est pas notée pour cette session |
league |
Un score par session : le run scellé en dernier avant l'ouverture (session_run) ; les autres affichés à part. À partir du 21 octobre 2026, le run compté est le run matinal planifié, déclaré à l'avance sur la page de preuve (Section 3.4) |
direction |
À la hausse ou à la baisse de l'indicateur par rapport à sa référence ; un mouvement dans la bande de parité est un match nul (bande définie dans council-stats.json, draw_band) ; 50 ne soutient aucun côté |
brier, calibration |
, pièce 0,25 ; se pliant vers le côté soutenu, bacs [50, 60), [60, 70), [70, 80), [80, 100] |
independence |
Classement après 30 prévisions sur au moins 10 jours de négociation |
missing |
Une cellule non répondue dans une réponse donnée compte comme 50 % |
btc |
Jour du Bitcoin à partir de la minute du sceau, plafonné à 16h00 ET de la session de notation |
consensus |
Probabilité moyenne ; extrêmes supprimés à cinq réponses ou plus ; le deuxième siège d'une famille pèse 1/3 ; maintenu dans 2-98 % |
together |
all_wrong (chaque modèle faux, au moins 4 répondu) et minority_right (consensus faux, un modèle juste) |
changes |
Modifications datées de la méthodologie ; rien publié avant n'est recompté |
Appendice B. Vérifier un sceau vous-même
Les étapes n'utilisent que des fichiers publics et des outils standards. J'ai exécuté les étapes 1 à 8 en soirée du 20 octobre 2026 (ET) et l'étape 9 le 21 octobre, et les résultats affichés sont ceux que j'ai obtenus. L'exemple des étapes 1 à 8 est le sceau du 20 octobre 2026 à 13:00:25Z, l'un des quatre de ce jour (section 3.1). Les étapes 1 à 8 vérifient le niveau 1 (la chaîne) et le niveau 2 (l'ancrage). L'étape 9 vérifie le niveau 2+, les jetons RFC 3161 sur la liste estampillée du 21 octobre 2026. Les sessions des 19 et 20 octobre 2026 sont les sessions de développement, et l'enregistrement compté s'exécute à partir du 21 octobre 2026.
Étape 1. Télécharger le livre et le sceau.
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt
curl -sO https://trends.polyhelper.ai/markets/proof/2026-10-20/130025Z.txt.ots
La page de preuve https://trends.polyhelper.ai/markets/proof/2026-10-20/ énumère chaque timbre du jour et chaque ligne de livre de la série, avec son sceau et son lien.
Étape 2. Lire la liste horodatée. cat 130025Z.txt affiche, parmi d'autres livres, la ligne de celui-ci :
daily/council/book.jsonl: 159 lines, sha256 59673b9e21ac6d358e7dc3b811dc3d78f5286390094f7133e3704f57cac1a7d9, last link 378273fd057fcbf364746b032f67f42cd811d281da80f39ff0792c4047175b2cÉtape 3. Vérifiez que le livre d'aujourd'hui commence par le préfixe estampillé.
head -n 159 council-book.jsonl | shasum -a 256
# 59673b9e21ac6d358e7dc3b811dc3d78f5286390094f7133e3704f57cac1a7d9  -
sed -n 159p council-book.jsonl | python3 -c "import json,sys; print(json.load(sys.stdin)['link'])"
# 378273fd057fcbf364746b032f67f42cd811d281da80f39ff0792c4047175b2c
Les deux valeurs correspondent à la liste estampillée, donc les 159 premières lignes sont exactement celles auxquelles elle s'engage. La ligne 151 est la ligne d'exécution de 2026-10-20-am et les lignes 152 à 159 sont ses lignes de réponse. La même vérification avec 150012Z.txt, 153605Z.txt et 165254Z.txt couvre 165, 167 et 173 lignes.
Une règle imprimée dans chaque liste estampillée fixe les octets. Le fichier est pris tel qu'il est stocké (UTF-8, sans marque d'ordre des octets, rien réencodé ni normalisé) et chaque ligne se termine par LF. Le hachage de N lignes couvre les lignes 1 à N, chacune avec son LF, et une dernière ligne sans LF n'est pas encore comptée. Un miroir qui réécrit les fins de ligne échoue la vérification.
Étape 4. Recalculer chaque sceau et chaque lien.
import json, hashlib
H = lambda o: hashlib.sha256(json.dumps(o, sort_keys=True, ensure_ascii=False).encode()).hexdigest()
lines = [json.loads(l) for l in open("council-book.jsonl", encoding="utf-8")]
prev = ""
for i, x in enumerate(lines, 1):
    assert x["n"] == i and x["prev"] == prev
    assert x["seal"] == H({k: v for k, v in x.items() if k not in ("seal", "link", "prev", "n")})
    assert x["link"] == H({k: v for k, v in x.items() if k != "link"})
    prev = x["link"]
print("chain ok:", len(lines), "lines")
Sur le fichier du 20 octobre, ceci s'est affiché chain ok: 211 lines.
Étape 5. Vérifier la question à laquelle une exécution a répondu.
curl -s https://trends.polyhelper.ai/api/v1/asks/77d3c627c7c69d2f6e740ccd89113872b1ac08053554a4651bc2d3064b4e6f07.md | shasum -a 256
# 77d3c627c7c69d2f6e740ccd89113872b1ac08053554a4651bc2d3064b4e6f07  -
Étape 6. Vérifiez l'ancrage Bitcoin. Installez le client OpenTimestamps (pip install opentimestamps-client). Avec un nœud Bitcoin local, ots verify 130025Z.txt.ots hache 130025Z.txt, suit la preuve et la vérifie par rapport à l'en-tête du bloc. Sans nœud, ots info 130025Z.txt.ots affiche le hash du fichier (5c7d3a357f3cd8b9c27aa4c5d1e9e4750d522bd90b58ffe5193fc61356079d0f, égal à shasum -a 256 130025Z.txt), les opérations de la preuve et son attestation, BitcoinBlockHeaderAttestation(972334). L'application des opérations au hash du fichier donne 74072ae1fdee72c9a3f749462490b46f896e0fab58f7d101dc1a403d967e5c30, la racine de Merkle du bloc 972 334 comme n'importe quel explorateur de bloc l'affiche (heure d'en-tête 2026-10-20 13:55:20Z ; temps médian des 11 blocs précédents 12:45:12Z). Les deux fichiers peuvent également être déposés sur https://opentimestamps.org. Une preuve qui n'affiche qu'une attestation calendaire en attente est complétée avec ots upgrade. Une attestation en attente ne contient aucune heure qu'un lecteur peut vérifier.
Étape 7. Recomptez la ligue.
curl -s https://trends.polyhelper.ai/api/v1/arena-code-tools-replay.py.txt -o replay.py
python3 replay.py https://trends.polyhelper.ai/api/v1/
Sur les fichiers au 20 octobre 2026, le script a affiché (extrait) :
replay: 253 published rows, 145 accounts, 2 sessions (2026-10-19 .. 2026-10-20), 1006 trades, rules arena-3
exact to the cent (|d| <= 0.01): 204; within the rounding of the published trades: 49; DIFFERENT: 0; not recounted (other price sets): 0
result: the published scores are reproduced
Étape 8. Vérifiez le code du moteur. arena-code.json répertorie chaque fichier de code avec son SHA-256 ; chaque fichier est publié sous la forme arena-code-<file>.txt :
curl -s https://trends.polyhelper.ai/api/v1/arena-code-council_arena.py.txt | shasum -a 256
# 9ff5575c2b5c7736fba06bec1b63a608f5f290aacdee6df6b24a51381f22686c  -
qui correspond à l'entrée pour council_arena.py.
Étape 9. Vérifier les heures signées du 21 octobre 2026 (niveau 2+). Exécuté le 21 octobre 2026, 09:10 ET, avec OpenSSL 3 (les deux vérifications réussissent avec OpenSSL 3.6 et 4.0). Les certificats FreeTSA sont copiés sous tsa/ et publiés par le service (https://freetsa.org/files/) ; la chaîne de DigiCert se trouve dans le magasin de confiance du système.
P=https://trends.polyhelper.ai/markets/proof/2026-10-21
for f in 130019Z.txt 130019Z.txt.freetsa.tsr 130019Z.txt.digicert.tsr tsa/freetsa-cacert.pem tsa/freetsa-tsa.crt; do curl -sO $P/$f; done
curl -sO https://trends.polyhelper.ai/api/v1/council-book.jsonl
shasum -a 256 130019Z.txt
# 986bd13907397901ceed70131a70c3674eba05dfdcb9ededbc7cbc0e57bd3714  130019Z.txt
openssl ts -verify -data 130019Z.txt -in 130019Z.txt.freetsa.tsr -CAfile freetsa-cacert.pem -untrusted freetsa-tsa.crt
# Verification: OK   (after a warning that freetsa-tsa.crt is not a CA certificate, which is expected)
openssl ts -verify -data 130019Z.txt -in 130019Z.txt.digicert.tsr -CAfile /etc/ssl/cert.pem
# Verification: OK
openssl ts -reply -in 130019Z.txt.digicert.tsr -text | grep "Time stamp"
# Time stamp: Oct 21 13:00:19 2026 GMT   (the same for the FreeTSA token)
head -n 222 council-book.jsonl | shasum -a 256
# a9359a7741ef5f7aad7436e022a60813e2fc2f9ce76e130abe21dc820e59bd8c  -
La liste indique 222 lignes avec ce hash. Les lignes 214 à 222 sont la ligne d'exécution et les réponses de 2026-10-21-am enregistrées dans le premier lot, et les deux autorités les placent à 13:00:19 UTC, 29 minutes 41 secondes avant la référence à 13:30:00 UTC. Les jetons de 130035Z.txt, qui couvre asks.jsonl, donnent 13:00:36 UTC. Les mêmes étapes sur 132337Z.txt couvrent 224 lignes. La ligne 224, une réponse arrivée à 13:23:23 UTC, a été enregistrée 14 secondes plus tard, et trois autorités (FreeTSA, DigiCert et Sectigo) l'ont signée à 13:23:37 UTC, avant la référence. La première ligne de asks.jsonl déclare quelle exécution compte à partir du 21 octobre 2026. Elle a été scellée à 04:16:39 UTC, avant l'envoi de la question de l'exécution, et son hash de texte est imprimé sur la page de preuve.
Ce que les étapes établissent. Les étapes 3 et 4 donnent P2 pour chaque ligne jusqu'au timbre. L'étape 6 place le préfixe timbré au plus tard quelques heures après l'heure d'en-tête du bloc 972 334, et cette limite pratique, énoncée à la section 3.11 à la place d'une constante prouvée par les règles de consensus, donne P1a pour chaque résultat après celui-ci, contre quiconque détient cette preuve ou une copie indépendante de celle-ci.
Le bloc est tombé après 09:30 ET. Pour le 20 octobre, l'ordre du sceau et du prix de référence (P1b) est donc lu au niveau 1 à partir de l'heure de sceau de la ligne dans le livre, max(at, booked_at), par rapport à 09:30 ET de la séance, et la colonne sealed_at de council-forecasts.csv donne l'heure de la réponse. J'ai vérifié P3 en appliquant la règle d'exécution comptée à ces heures de sceau. Pour les séances de développement, P3 repose sur le dossier de l'opérateur que chaque exécution est publiée et étiquetée. Dans le dossier compté, l'exécution comptée est l'exécution matinale programmée, déclarée à l'avance et scellée dans la chaîne de questions avant l'exécution (Étape 9), afin que le lecteur vérifie P3 par rapport à une déclaration qui existait avant les réponses. L'étape 9 donne P1b au niveau 2+ pour la séance du 21 octobre, contre quiconque accepte l'une quelconque des autorités de signature et son certificat. Pendant la saison aveugle, les mêmes étapes s'exécutent sur des lignes qui scellent le modèle comme un engagement salé (exigence 1), et l'identité est vérifiée lorsque les sels sont publiés après la saison.
Tableau B1. L'échelle des réclamations : ce que chaque niveau de vérification supporte, et ce qu'il laisse ouvert.
| Niveau de vérification | Réclamation qu'il supporte | Réclamation qu'il laisse ouverte | Dans cet article |
|---|---|---|---|
| Règles publiées | Un lecteur peut énoncer le contrat d'événement, le score et la règle d'exécution comptée | Que les fichiers suivent les règles | Section 3 ; Appendice A |
| Fichiers recalculés | Les scores et comptes publiés résultent des dossiers publiés | Que les prix correspondent à une source indépendante ; que le modèle nommé a produit la réponse | Étapes 4, 7 et 8 |
| Engagement externe vérifié (niveau 2 ; niveau 2+ pour l'ordre du sceau et de la référence) | Les octets engagés existaient à la limite indiquée, et une réécriture ultérieure de ce préfixe est détectable ; au niveau 2+ (à partir du 21 octobre 2026), avant le prix de référence | Que chaque prévision attendue a été divulguée ; l'identité du modèle du fournisseur ; l'heure d'arrivée de chaque réponse | Étapes 3, 6 et 9 |
| Résultats rapprochés | Les prix de référence et de clôture correspondent à une deuxième source nommée à l'heure nommée | Tout avantage prédictif | Exigence de la norme ; à ajouter dans une révision datée |
| Évaluation prospective appariée, gelée avant sa fenêtre | Une différence de perte sur les événements indiqués, les poids et le comparateur | Autres marchés, horizons et régimes | Section 8 |
| Réplication indépendante | Un deuxième pipeline en d'autres mains reproduit les scores à partir de la même version | Performance dans les saisons ultérieures | Ouvert à tout lecteur (Appendice C) |
Note : L'ancre certifie le dossier. Une preuve de la session TLS avec le fournisseur (TLSNotary) peut étendre l'échelle à la réclamation que le point de terminaison nommé a retourné la réponse scellée, et le protocole a de la place pour cela comme champ de la ligne de réponse. L'habileté est réglée par les comparaisons enregistrées de la section 8.
Étape 10. Vérifiez le timbre dans un journal indépendant. Chaque liste timbrée est également entrée dans le journal de transparence Sigstore Rekor, que l'opérateur n'exploite pas ; l'entrée détient le SHA-256 de la liste.
shasum -a 256 130025Z.txt
# 5c7d3a357f3cd8b9c27aa4c5d1e9e4750d522bd90b58ffe5193fc61356079d0f  130025Z.txt
curl -s "https://rekor.sigstore.dev/api/v1/log/entries?logIndex=3368351276"
# the base64 body holds spec.data.hash.value, the same SHA-256; integratedTime 1792626303 is 21 October 2026, 23:45:03 UTC
La liste du 20 octobre 2026 a été enregistrée le 21 octobre 2026 à l'index de journal 3 368 351 276. À partir du 22 octobre 2026, chaque liste est enregistrée lors de l'horodatage, et la première, index 3 368 763 032, a été intégrée à 00:00:16 UTC, cinq secondes après son horodatage.
Appendice C. Dictionnaire des données
Tous les fichiers sont sous https://trends.polyhelper.ai/api/v1/, publiés sous CC BY 4.0 avec attribution « AI Council · Markets, trends.polyhelper.ai/markets/ ». La page d'index de cette adresse énumère chaque fichier et la fréquence de ses mises à jour, et arena-dataset.json décrit les colonnes de chaque fichier ; le tableau C1 énumère les fichiers que les prédictions lisent, avec les noms de colonnes tels que lus le 21 octobre 2026 à 08:16 UTC. Un lecteur-IA qui ne peut pas ouvrir de fichiers volumineux commence par markets-digest.json (moins de 30 KB) ou les tranches par exécution dans council-forecasts-index.json.
Tableau C1. Fichiers principaux.
| Fichier | Contenu | Mise à jour |
|---|---|---|
council-book.jsonl |
Le livre scellé : chaque exécution, réponse, score, ligne de portefeuille et de ligue, chaînée par hash | À chaque exécution |
council-forecasts.csv |
Une ligne par cellule de prévision scellée avec son résultat | À chaque exécution et score |
council-stats.json |
Intervalles de Brier par sessions, bande de tirage, calculs de puissance, n_eff (avec la série comptée n_eff.counted), intervalles appariés (pairs), scores par segment de méthodologie (method_segments), sources partagées |
À chaque construction |
council-calibration.json |
Calibration, scores de compétence par rapport à la pièce, à la foule et à la climatologie, la méthode de chaque comparaison (method) ; la climatologie fixe climatology_fixed lors de la publication |
À chaque construction |
council-pairs.csv |
Pertes appariées de chaque deux sièges sur les mêmes événements | À chaque construction |
league-roster.json |
Chaque modèle, son côté, Conseil ou banc, son statut dans les deux ligues | À chaque construction |
{lang}/council-league.json |
La ligue : modèles, références, calibration, horizons, la foule, la ligue de portefeuille | À chaque exécution et score |
arena-protocol.json, arena-code.json |
Le protocole (Appendice A) ; le code du moteur avec SHA-256 | À chaque construction |
arena-trades.csv, arena-accounts.csv, arena-prices.json |
Transactions exécutées ; chaque compte chaque session ; prix d'exécution et de clôture | À chaque session |
asks/<sha256>.md, asks/index.json |
Le texte de la question derrière chaque ask_sha256 |
À chaque exécution |
event-contract.schema.json, tools/conformance.py |
Le contrat d'événement sous forme de schéma JSON ; le vérificateur que chaque ligue peut exécuter sur son propre fichier de prévisions (section 3.13) | À chaque modification du contrat |
council-forecasts.csv (une ligne par modèle, exécution, marché et horizon) : run_id ; session ; seat ; model, mode ; line (position n de la ligne de scellement) ; sealed_at (UTC) ; status (counted, not_counted, counted_50, no_answer, refused_shape) ; asset, horizon ; action, action_word ; prob_up (0-100) ; exp_pct ; target, invalidation ; ref, close, actual_pct ; draw ; source_domains, source_urls ; why_missing ; run_role (session_run ou earlier_run) ; seat_versions_in_run ; line_kind (issue, la cellule telle que scellée dans la ligne de réponse, ou correction, une cellule ajoutée par une ligne de correction ultérieure) ; reference_at (heure à partir de laquelle la règle de référence de la ligne prend le prix ; pour Bitcoin la seconde de scellement, le prix étant la clôture de la première barre d'une minute commençant à partir de celle-ci ou après) ; same_event (faux quand la ligne est notée à partir de sa propre référence) ; cell_status (elicited, explicit_50 ou invalid) ; attempt ; event_id, event_reference_at, event_end_at (le contrat d'événement, section 3.13) ; methodology_version. sealed_at est l'heure de la réponse, le at de la ligne de réponse ; l'heure à laquelle la ligne a été scellée dans le livre est max(at, booked_at) de cette ligne (le 20 octobre, réponses de 12:31Z à 12:42Z, scellement à 13:00:25Z), qui est la base temporelle de council-stats.json (time_basis: book_sealed_at) et des scripts déposés. Pour Bitcoin, reference_at est la seconde de scellement de la propre ligne de la ligne (13:00:19Z pour le lot du 21 octobre, 13:23:37Z pour la neuvième réponse), et reference_price_at est le début de la barre d'une minute dont la clôture est la référence (13:01:00Z et 13:24:00Z). Une cellule avec cell_status explicit_50 est une probabilité déclarée de 50 ; counted_50, no_answer, refused_shape et un prob_up vide ne sont pas déclarés et n'entrent dans aucun score de Brier de probabilités déclarées et aucun consensus. La réponse du modèle à une question de foule, crowd_up, ne figure pas dans ce fichier ; elle se trouve dans les lignes de réponse du livre.
Lignes du registre. Chaque ligne possède n, at, kind, prev, seal et link. Les types qui portent les prévisions sont run (ajoute run_id, ask_sha256, snapshot_sha256, roster, methodology et crowd, avec crowd.at, les contrats Polymarket sous crowd.odds et les contrats Kalshi sous crowd.kalshi, chacun avec son p_up et vol), answer (ajoute seat, model, mode, items, years, et dans les exécutions ultérieures own_sha256, ask_sha256, booked_at ; la probabilité du modèle pour une question crowd est items.<asset>.1d.crowd_up), score et score_h (les résultats du jour et des horizons, avec late_ref, noise et of), crowd (résout chaque contrat : rows.<code> pour Polymarket et rows.<code>@kalshi pour Kalshi, avec le résultat up ; au 21 octobre 2026 présent pour l'exécution 2026-10-19-am uniquement), et correction (nomme les lignes qu'il concerne dans of). D'autres types enregistrent les ligues de portefeuille et les pistes fantômes.
Climatologie fixe. Dans council-calibration.json, climatology_fixed contient table[*] avec asset, h, p_up, p_up_ex_draw, n, n_independent, window et rule, plus sha256 et sha256_ok. Son sceau est le hash de contenu de council-clim-window.json (sous l'adresse des données), 2810d11e907bbaa1f311d06622c929c69e60cc81e558fdb78f5baa04113cabb7, calculé comme à la section 4.3 ; l'indice de référence principal lit p_up à l'horizon 1d. Le champ est entré dans le fichier en direct le 21 octobre 2026 à 08:54 UTC, donc le tableau C1 à 08:16 UTC ne le répertorie pas.
Valeurs de statut et le contrat d'événement. counted_50 marque une cellule remplie de 50 % pour le score de service du siège ; ce n'est pas une probabilité énoncée et n'entre pas dans les comptes de consensus ou d'accord, dont le nombre de probabilités contribuantes est of. Une ligne avec late_ref est une prévision sur un événement distinct (section 3.3) ; une analyse qui regroupe les modèles sur un événement commun sélectionne les lignes dont la référence égale la référence commune de la session.
Publication de l'analyse. Chaque révision repose sur une publication immuable déposée sur Zenodo (10.5281/zenodo.23552700) : le registre, les prévisions, les statistiques, le protocole, les fichiers de code, les fichiers du recomptage, les questions publiées et chaque liste horodatée avec sa preuve .ots, avec un manifeste du SHA-256, de la taille, de l'heure de récupération et, le cas échéant, de l'heure de génération de chaque fichier. Les fichiers récupérés un par un forment une collection de versions identifiées, et la publication est l'instantané atomique. Le registre ne fait que croître, et le registre de la publication est donc un préfixe de tout téléchargement ultérieur (section 3.2).
Annexe D. Prédictions enregistrées (tableau complet)
Le tableau D1 énumère les trente prédictions secondaires de la section 8 en un coup d'œil, et le tableau D2 donne leur texte enregistré. Trois modèles de trois familles, chacun seul, ont évalué la liste épurée en aveugle, et le p enregistré est la médiane des trois. Cette liste, les scripts de l'ensemble B avec leur SHA-256 et le point d'extrémité primaire avec son script sont déposés auprès de l'enregistrement OSF (10.17605/OSF.IO/9Q86N).
Règles qui s'appliquent à chaque ligne. Sauf si une ligne désigne une autre fenêtre, une prédiction est calculée sur les sessions de la session 11 (2 novembre 2026) à sa date de vérification. Elle utilise les lignes comptées (une exécution par session) dont l'heure de scellement du carnet, max(at, booked_at), est antérieure à la référence 09:30 ET de la session, et le même seuil s'applique à Bitcoin, dont la référence est la clôture de la première barre d'une minute après le scellement de la ligne. Les scores de Brier sont sur un jour et sur toutes les lignes, tirages inclus. Lorsqu'un champ publié couvre également des sessions antérieures, le script déposé applique la définition du champ à la fenêtre.
Les champs sont ceux des fichiers ouverts à https://trends.polyhelper.ai/api/v1/ tels que documentés le 21 octobre 2026, et un champ renommé est remplacé par son équivalent documenté avec la correspondance enregistrée. Lorsqu'une ligne a besoin d'une valeur qu'aucun champ ouvert ne contient, le champ doit être publié, et le résolveur dans les scripts OSF calcule la valeur à partir de council-forecasts.csv et council-book.jsonl selon la règle de la ligne. « Classé » signifie 30 prédictions résolues sur au moins 10 jours de négociation (la règle 30/10, section 4.6), appliquée dans la fenêtre de la prédiction, sauf F8, qui lit l'indicateur de la ligue. Les lignes de foule sont des sessions de marché sur lesquelles la liste des questions scellées énumère un contrat quotidien (section 4.9), et le contrat est celui auquel les modèles ont répondu avec crowd_up, le contrat Polymarket où Polymarket énumère le marché et sinon le contrat Kalshi, dans les deux cas avec un volume scellé d'au moins 1 000 $ (un seuil d'admission). Les intervalles sont à 95 % avec la session comme grappe, par un rééchantillonnage d'amorçage de 10 000 avec la graine 20261102 dans les scripts déposés.
Un échantillon minimum non atteint, un fichier manquant ou un champ sans équivalent documenté laisse la prédiction non résolue et non un succès. Aucune prédiction n'est supprimée. p est la probabilité enregistrée que la prédiction se réalise, étant donné qu'elle est résolue : la médiane de trois votes en aveugle. Six valeurs (F5, F7, F20, F21, F23, F25) sont les votes du 20 octobre 2026. Les vingt-quatre autres et le point d'extrémité primaire ont été votés le 21 octobre 2026, en trois rondes ultérieures, chacune sur le texte des prédictions réécrites dans cette ronde. La formulation fixée après la dernière ronde précise comment une ligne se résout et n'a pas été réévaluée, et tous les tours et les votes sont déposés auprès de l'enregistrement.
Tableau D1. Les trente prédictions enregistrées en un coup d'œil.
| # | Prédiction (énoncé enregistré, jusqu'aux deux points) | Ensemble | Date de vérification | p | P(vrai) sans compétence |
|---|---|---|---|---|---|
| F1 | Le conseil reste en dessous de deux voix indépendantes en un jour | A | 30 nov 2026 | 0.50 | |
| F2 | Le co-mouvement du marché n'explique pas la ressemblance | A | 31 déc 2026 | 0.50 | |
| F3 | Les erreurs sont aussi partagées | B | 31 déc 2026 | 0.74 | |
| F4 | Les modèles sont moins précis que la foule | B | 31 déc 2026 | 0.40 | |
| F5 | Les liens partagés signifient des appels partagés | A | 31 déc 2026 | 0.56 | |
| F6 | Tous se trompent ensemble | B | 31 déc 2026 | 0.92 | |
| F7 | Une minorité juste est plus courante qu'une erreur unanime | A | 31 déc 2026 | 0.63 | |
| F8 | Le tableau se remplit selon le calendrier | A | 30 nov 2026 | 0.88 | opérationnel |
| F9 | L'indépendance est plus grande au mois qu'au jour | B | 31 déc 2026 | 0.30 | |
| F10 | La moyenne dépasse le suivi du leader | B | 31 déc 2026 | 0.64 | |
| F11 | Aucun modèle unique ne montre un avantage quotidien détecté | B | 31 déc 2026 | 0.79 | au moins environ 0,78 |
| F12 | La foule dépasse le conseil | B | 31 déc 2026 | 0.83 | |
| F13 | La combinaison dépasse la foule | B | 31 déc 2026 | 0.30 | |
| F14 | Les modèles sont surconfiants | B | 31 déc 2026 | 0.80 | |
| F15 | Le conseil ne dépasse pas une règle simple par une marge claire | B | 31 déc 2026 | 0.80 | |
| F16 | Aucun horizon ne porte un signal détecté sur une saison | B | 30 avr 2027 | 0.63 | au moins environ 0,93 |
| F17 | Relativement à la climatologie, le jour est l'horizon le plus difficile | B | 30 avr 2027 | 0.37 | |
| F18 | Le pays est un petit facteur | B | 31 déc 2026 | 0.80 | |
| F19 | Le côté américain obtient un meilleur score sur une saison | B | 30 avr 2027 | 0.57 | |
| F20 | Les mêmes nouvelles signifient moins de dispute | A | 30 nov 2026 | 0.70 | |
| F21 | La recherche ajoute peu de précision | B | 31 déc 2026 | 0.72 | |
| F22 | La discussion trouve de vrais risques | A | 31 déc 2026 | 0.30 | |
| F23 | Suivre la critique paie | A | 31 déc 2026 | 0.42 | |
| F24 | Un modèle se contredit beaucoup | A | 30 nov 2026 | 0.60 | |
| F25 | Les leaders ne durent pas | B | 30 avr 2027 | 0.62 | environ 0,85 (onze sièges classés), 0,82 (dix) |
| F26 | L'indice est difficile à battre | B | 30 avr 2027 | 0.60 | |
| F27 | Les bons prévisionnistes ne sont pas les meilleurs commerçants | B | 30 avr 2027 | 0.83 | |
| F28 | L'accès aux modèles avant la première prévision n'améliore pas le score de Brier des lecteurs de 0,01 ou plus | A | 31 Dec 2026 | 0.46 | |
| F29 | L'accès oriente les lecteurs vers le conseil | B | 31 Dec 2026 | 0.41 | |
| F30 | Le style trahit le modèle | B | 30 Apr 2027 | 0.46 |
Note : Une ligne par prévision enregistrée ; le texte complet de chacune, avec sa mesure, sa source et ses règles de résolution, se trouve dans le tableau D2. L'ensemble A est défini par un ou deux domaines publiés, l'ensemble B par un script déposé auprès de l'enregistrement. p est la probabilité enregistrée que la prévision se réalise, étant donné qu'elle est résolue : la médiane de trois votes en aveugle. P(true) sans compétence est la probabilité que la prévision se réalise si aucun modèle n'a de compétence, telle que dérivée dans la note du tableau D2 ; une cellule vide signifie que la ligne n'énonce pas de telle valeur.
Tableau D2. Les trente prévisions enregistrées en intégralité : énoncés, mesures, sources, ensembles, dates de vérification, règles et probabilités.
| # | Énoncé | Mesure (ouvrir le fichier) | Ensemble | Date de vérification | Vraie si | Réfutée si | p |
|---|---|---|---|---|---|---|---|
| F1 | Le conseil reste en dessous de deux voix indépendantes en un jour : sur les exécutions comptées des sessions 11 à 30, la moyenne N_eff des images de probabilité d'un jour, calculée par exécution selon la règle d'admissibilité de la section 5.1, est inférieure à 2,0 | moyenne de n_eff.counted.per_run[*].n_eff sur les exécutions dont l'identifiant run est daté du 2 au 30 novembre 2026, council-stats.json |
A | 30 Nov 2026 | moyenne < 2,0 avec au moins 10 exécutions comptées | moyenne ≥ 2,0 avec au moins 10 exécutions comptées ; moins = non résolu | 0.50 |
| F2 | Le co-mouvement du marché n'explique pas la ressemblance : sur les exécutions comptées des sessions 11 à 52, la moyenne N_eff d'un jour avec un marché par groupe (Nasdaq-100, Dow et Brent supprimés), selon la règle de la section 5.1, est inférieure à 2,5 | moyenne de n_eff.counted.one_per_group.per_run[*].n_eff sur les exécutions dont l'identifiant run est daté du 2 novembre au 31 décembre 2026, council-stats.json |
A | 31 Dec 2026 | moyenne < 2,5 avec au moins 20 exécutions comptées | moyenne ≥ 2,5 avec au moins 20 exécutions comptées ; moins = non résolu | 0.50 |
| F3 | Les erreurs sont aussi partagées : sur les sessions notées des sessions 11 à 52, N_eff calculé sur les indicateurs d'erreur d'un jour des sièges (réponses scellées avant la référence, toutes les lignes, 50 % indiqué laissé de côté), moyenné sur les sessions, est inférieur à 4,0 (le décompte des erreurs porte aussi le co-mouvement des résultats entre marchés). Par session, les répondants sont les sièges avec une ligne admissible, n est leur nombre cette session, ρ est la moyenne corrélation de Pearson par paire de leurs indicateurs d'erreur 0/1 entre les marchés tous deux auxquels on a répondu (une paire avec un indicateur constant est laissée de côté, et il en est de même pour une session sans paire calculable), et la moyenne sur les sessions pèse chaque session équitablement | champ à publier (le n_eff_errors publié comprend les lignes tardives) ; le programme de résolution dans les scripts OSF le calcule à partir des lignes comptées d'un jour de council-forecasts.csv et council-book.jsonl |
B | 31 Dec 2026 | valeur < 4,0 avec au moins 30 sessions notées | valeur ≥ 4,0 avec au moins 30 sessions notées ; moins = non résolu | 0.74 |
| F4 | Les modèles sont moins précis que la foule : sur les contrats de foule d'un jour avec un volume scellé d'au moins 1 000 $ (le contrat auquel les modèles ont répondu : Polymarket où il l'énumère, sinon Kalshi), des sessions 11 à 52, la moyenne sur les sièges de la distance moyenne de chaque siège par rapport à 50 % de ses réponses crowd_up est inférieure à la moitié de la distance moyenne des prix de foule par rapport à 50 % sur les mêmes contrats |
prix de foule et vol dans les lignes d'exécution de council-book.jsonl (crowd.odds, crowd.kalshi) ; crowd_up des lignes de réponse scellées avant la référence ; script déposé |
B | 31 Dec 2026 | distance moyenne des sièges < 0,5 × distance moyenne de la foule, sur au moins 100 contrats-sessions | distance moyenne des sièges ≥ 0,5 × distance moyenne de la foule ; moins de 100 contrats-sessions = non résolu | 0.40 |
| F5 | Les liens partagés signifient les appels partagés : les paires de modèles citant le même lien s'accordent sur la classe d'action plus souvent que les paires qui ne le font pas, d'au moins 5 points dans les strates, p de permutation < 0,05 | sources.agreement_by_shared_link.diff_within_strata et p_permutation, council-stats.json, appliqués à la fenêtre par le script déposé (définition reproduite sur les fichiers du 21 octobre 2026) |
A | 31 Dec 2026 | diff ≥ 0,05 et p < 0,05 | diff < 0,05 ou p ≥ 0,05 | 0.56 |
| F6 | Tous se trompent ensemble : la proportion des sessions marché-un jour résolues avec au moins 4 modèles répondants sur lesquels chaque modèle répondant s'est trompé est au moins le double de la proportion attendue selon l'indépendance, où la proportion attendue est la moyenne, sur les mêmes sessions marché-un jour, du produit des taux d'erreur des modèles qui ont réellement répondu, chaque taux estimé sur les mêmes lignes | together.all_wrong / together.rows, council-league.json ; attente par le script déposé à partir de council-forecasts.csv |
B | 31 Dec 2026 | proportion observée ≥ 2 × proportion attendue | proportion observée < 2 × proportion attendue | 0.92 |
| F7 | Une minorité qui a raison est plus commune qu'une erreur unanime : minority_right dépasse all_wrong |
définition together (council-league.json), recalculée sur la fenêtre par le script déposé selon la règle de cet article, à partir des lignes scellées avant la référence et de toutes les lignes ; le champ publié, qui compte aussi les lignes tardives et laisse les égalités de côté, est indiqué à côté |
A | 31 Dec 2026 | minority_right > all_wrong | minority_right ≤ all_wrong | 0.63 |
| F8 | Le tableau se remplit selon le calendrier : après la notation de la session 30 (30 novembre 2026), au moins 9 des 11 sièges du Conseil satisfont la règle de classement à un jour (30 prévisions résolues sur au moins 10 jours de bourse, toutes les sessions du 19 octobre 2026 comptées) | drapeaux ranked, council-league.json by_horizon.1d |
A | 30 Nov 2026 | 9 ou plus de sièges du Conseil classés | 8 sièges ou moins au Conseil classés | 0.88 |
| F9 | L'indépendance est plus grande au mois qu'au jour : en comptant les exécutions de la session 11 à la session 52, la différence exécution par exécution entre la corrélation par paires moyenne ρ à un jour et à un mois (chacune selon la règle de la Section 5.1, de sorte qu'une différence positive signifie des voix plus indépendantes au mois) a une moyenne positive, avec un intervalle de bootstrap à bloc mobile de 95 % (blocs de cinq exécutions) entièrement au-dessus de zéro | lignes comptées de council-forecasts.csv à 1d et 1m, council-book.jsonl; script déposé | B | 31 Dec 2026 | intervalle entièrement au-dessus de zéro, avec au moins 20 exécutions comptées | intervalle non entièrement au-dessus de zéro, avec au moins 20 exécutions comptées; moins = non résolu | 0.30 |
| F10 | La moyenne surpasse le suivi du leader : le Brier 1-jour consensus sur les sessions 31 à 52 (1 à 31 décembre 2026) est inférieur à celui du leader, le modèle Conseil classé avec le Brier 1-jour le plus bas sur les sessions 11 à 30 (2 à 30 novembre 2026), sur les sessions de marché en décembre auxquelles il a répondu | lignes 1-jour comptées de council-forecasts.csv; consensus selon la règle publiée à partir des réponses scellées avant la référence; script déposé | B | 31 Dec 2026 | Brier consensus < Brier du leader | Brier consensus ≥ Brier du leader; aucun modèle classé sur les sessions 11 à 30 = non résolu | 0.64 |
| F11 | Aucun modèle unique ne montre un avantage quotidien détecté : aucun modèle Conseil classé n'a de Brier un-jour, sur toutes les lignes à partir de la session 11, dont l'intervalle de cluster de session à 95 % se situe entièrement au-dessous de 0,25 (un intervalle non corrigé par siège classé) | lignes 1-jour comptées de council-forecasts.csv; script déposé | B | 31 Dec 2026 | aucune limite supérieure de siège < 0,25 | au moins une limite supérieure de siège < 0,25 | 0.79 |
| F12 | La foule surpasse le conseil : sur au moins 100 sessions de marché un-jour distinctes à partir de la session 11 avec un contrat foule dont le volume scellé est d'au moins $1,000 (le contrat auquel les modèles ont répondu : Polymarket où il le liste, sinon Kalshi), le Brier de la foule est inférieur à celui du consensus trimé du conseil de crowd_up, tous deux notés contre la propre résolution de ce contrat |
prix de la foule et vol dans les lignes d'exécution de council-book.jsonl (crowd.odds pour Polymarket, crowd.kalshi); résolutions dans ses lignes crowd (rows.<code>[@kalshi].up); crowd_up dans les lignes de réponse de council-book.jsonl; script déposé |
B | 31 Dec 2026 | Brier foule < Brier conseil sur au moins 100 sessions de marché | Brier foule ≥ Brier conseil; moins de 100 sessions de marché = non résolu | 0.83 |
| F13 | La combinaison surpasse la foule : sur les mêmes contrats que F12 (au moins 100 sessions de marché, volume scellé d'au moins $1,000), la moyenne simple du prix de la foule et du consensus trimé du conseil de crowd_up a un Brier inférieur à celui de la foule seule, notés contre la propre résolution de chaque contrat |
comme F12; script déposé | B | 31 Dec 2026 | Brier combinaison < Brier foule sur au moins 100 sessions de marché | Brier combinaison ≥ Brier foule; moins de 100 sessions de marché = non résolu | 0.30 |
| F14 | Les modèles sont trop confiants : sur toutes les lignes un-jour à partir de la session 11, dans le bucket 60 à 70 % cumulé sur le côté soutenu (au moins 100 prévisions), la fréquence observée est d'au moins 5 points au-dessous de la probabilité indiquée | lignes 1-jour comptées de council-forecasts.csv; script déposé | B | 31 Dec 2026 | écart ≥ 5 points avec n ≥ 100 | écart < 5 points avec n ≥ 100; n < 100 = non résolu | 0.80 |
| F15 | Le conseil ne surpasse pas une règle simple par une marge claire : sur les sessions où les deux sont notés, B(consensus) − B(momentum) à un jour est supérieur à −0,01 | consensus et momentum Brier 1-jour sur les sessions communes, council-forecasts.csv; script déposé | B | 31 Dec 2026 | B(consensus) − B(momentum) > −0,01 | B(consensus) − B(momentum) ≤ −0,01 | 0.80 |
| F16 | Aucun horizon ne porte un signal détecté sur une saison : pour aucun de 1 jour, 1 semaine et 1 mois le Brier consensus n'a d'intervalle à 95 % entièrement au-dessous de 0,25, intervalles selon la règle de la Section 4.6 (clusters de session à 1 jour; Newey-West avec lag h − 1, ou un bootstrap par blocs avec des blocs d'au moins h sessions, à l'horizon h) | Brier consensus par horizon de council-forecasts.csv; script déposé | B | 30 Apr 2027 | aucune limite supérieure d'horizon < 0,25 | au moins une limite supérieure d'horizon < 0,25 | 0.63 |
| F17 | Par rapport à la climatologie, le jour est l'horizon le plus difficile : parmi 1 jour, 1 semaine et 1 mois, le score d'habileté Brier consensus par rapport au taux de base climatologique (fréquence d'une hausse stricte par marché et horizon de 2016 à 2025, toutes les lignes) est le plus bas à 1 jour | Brier consensus par horizon de council-forecasts.csv; climatologie climatology_fixed.table[*].p_up de council-calibration.json, sceau vérifié par le script déposé (Section 8); champ publié 21 octobre 2026 |
B | 30 Apr 2027 | le score d'habileté 1-jour est le plus bas des trois | le score d'habileté 1-jour n'est pas le plus bas | 0.37 |
| F18 | Le pays est un petit facteur : l'écart absolu entre le Brier 1-jour côté américain et côté chinois (chaque côté la moyenne du Brier de ses modèles classés sur les sessions communes) est plus petit que l'étendue (le Brier le plus haut moins le plus bas du modèle classé) à l'intérieur de chaque côté | by_horizon.1d, side, ranked, council-league.json; council-forecasts.csv; script déposé |
B | 31 Dec 2026 | écart < étendue à l'intérieur de chaque côté | écart ≥ étendue à l'intérieur d'un côté ou des deux; moins de deux modèles classés de chaque côté = non résolu | 0.80 |
| F19 | Le côté américain se note mieux sur une saison : le Brier un-jour du côté américain, la moyenne du Brier de ses modèles classés sur toutes les lignes sur les sessions communes à partir de la session 11, est inférieur à celui du côté chinois, calculé de la même façon | lignes 1-jour comptées de council-forecasts.csv, side et ranked dans council-league.json; script déposé |
B | 30 Apr 2027 | US < China | US ≥ China; moins de deux modèles classés de chaque côté = non résolu | 0.57 |
| F20 | La même actualité signifie moins de différend : dans les exécutions en Livre fermé (paquet scellé, aucune recherche) la chaleur du désaccord est inférieure à celle des exécutions ouvertes des mêmes modèles et jours | moyenne de heat_closed − heat_open sur runs[*] dans la fenêtre, arena-cb-experiment.json |
A | 30 Nov 2026 | chaleur fermée < chaleur ouverte | chaleur fermée ≥ chaleur ouverte | 0.70 |
| F21 | La recherche ajoute peu de précision : le Brier du lendemain des appels Closed Book se situe à moins de 0,01 des appels ouverts des mêmes modèles et sessions | lignes closed_book de council-book.jsonl, council-forecasts.csv ; script déposé. Un appel fermé scellé après la référence commune n'est noté que d'après son propre prix de référence (section 5.5). Sur les fichiers du 21 octobre 2026, chaque ligne Closed Book a été demandée après l'appel ouvert (asked_after_open) et ne porte aucun résultat de sa propre référence, de sorte que la ligne ne peut pas encore se résoudre ; elle se résout une fois que la ligue publie soit des appels fermés scellés avant la référence commune, soit, pour chaque appel fermé, son propre prix de référence, fermeture et résultat (par exemple un champ score par marché), que le résolveur lit déjà |
B | 31 Dec 2026 | différence absolue ≤ 0,01 | différence absolue > 0,01 ; pas de paires comparables = non résolu | 0.72 |
| F22 | La discussion révèle des risques réels : au moins 55 % des critiques du président ayant un mouvement de 5 sessions résolu sont confirmées, « confirmées » signifiant que le rendement du fonds sur les 5 sessions porte le signe que la critique prédisait | status, council-talk-critiques.csv (recalculé à partir de la direction de la critique et du rendement de 5 sessions du fonds où le champ diffère) |
A | 31 Dec 2026 | part ≥ 55 % avec au moins 20 critiques résolues | part < 55 % avec au moins 20 critiques résolues ; moins = non résolu | 0.30 |
| F23 | Tenir compte de la critique paie : les ombres critiques tenues surpassent en moyenne les portefeuilles conservés | moyenne de weeks[*].criticised[*].heed_minus_keep_pp sur les portefeuilles critiqués des semaines dont les sessions se situent dans la fenêtre, council-talk.json |
A | 31 Dec 2026 | moyenne > 0 | moyenne ≤ 0 | 0.42 |
| F24 | Un modèle est en désaccord avec lui-même beaucoup : la chaleur moyenne parmi les propres répétitions d'un modèle est au moins la moitié de la chaleur entre modèles | moyennes de weeks[*].summary.noise_floor.heat_self et heat_between_models sur les semaines du radar du 1er novembre 2026, council-repeats.json |
A | 30 Nov 2026 | heat_self ≥ 0,5 × heat_between_models, avec heat_between_models > 0 | heat_self < 0,5 × heat_between_models ; les deux zéro = non résolu | 0.60 |
| F25 | Les leaders ne durent pas : parmi les trois modèles Council les mieux classés selon le Brier 1 jour sur le Q4 2026, au maximum un se situe dans les trois meilleurs sur le Q1 2027. Les sièges admissibles sont ceux ayant le lieu council dans league-roster.json qui respectent la règle 30/10 au sein de chaque trimestre, Q4 2026 signifiant les sessions 11 à 52 (après la période de développement) et Q1 2027 les sessions du 4 janvier au 31 mars 2027 ; un siège reste un siège lors d'un changement daté de version de modèle (section 5.7) ; les égalités exactes au Brier sont tranchées par le nom du siège en ordre alphabétique |
council-forecasts.csv, lignes 1 jour comptées par trimestre ; league-roster.json ; script déposé | B | 30 Apr 2027 | au maximum un reste dans les trois meilleurs | deux ou plus restent dans les trois meilleurs ; moins de trois sièges Council classés dans chaque trimestre = non résolu | 0.62 |
| F26 | L'indice est difficile à battre : à la dernière session de la saison, moins de la moitié des 14 comptes de modèle de la ligue principale ont une valeur supérieure au compte S&P 500 | value_usd des 14 comptes de modèle et du compte _spy, arena-accounts.csv ; script déposé |
B | 30 Apr 2027 | 6 ou moins au-dessus de _spy |
7 ou plus au-dessus de _spy |
0.60 |
| F27 | Les bons prévisionnistes ne sont pas les meilleurs traders : sur les sièges Council classés à 1 jour qui détiennent un compte de la ligue principale, la corrélation de rang de Spearman entre le rang Brier 1 jour et le rang de rendement de la ligue principale est inférieure à 0,5, où le rang 1 est le plus bas Brier et le rendement le plus élevé. Les sièges sont ceux classés selon la règle 30/10 sur les sessions 11 à 126, Brier sur toutes leurs lignes 1 jour comptées dans cette fenêtre, rendement à partir de value_usd du compte à la dernière session de la saison ; les valeurs liées prennent la moyenne de leurs rangs |
lignes 1 jour comptées de council-forecasts.csv, league-roster.json, arena-accounts.csv ; script déposé | B | 30 Apr 2027 | rho < 0,5 avec au moins 6 sièges classés | rho ≥ 0,5 avec au moins 6 sièges classés ; moins = non résolu | 0.83 |
| F28 | L'accès aux modèles avant la première prévision n'améliore pas le score Brier des lecteurs de 0,01 ou plus : sur les marchés appariés (au moins 200 premières prévisions par groupe), le score Brier du groupe sans affichage des modèles dépasse celui du groupe auquel ils ont été montrés de moins de 0,01 (un effet d'accès entre groupes ; confiance c lue d'un côté comme probabilité c/100 de ce côté ; taux de réussite signalés à côté) | experiment.g0.brier et experiment.g1.brier, avec n de chacun, council-league.json |
A | 31 Dec 2026 | différence < 0,01 avec au moins 200 par groupe | différence ≥ 0,01 avec au moins 200 par groupe ; moins = non résolu | 0.46 |
| F29 | L'accès rapproche les lecteurs du conseil : les premières prévisions du groupe auquel les modèles ont été montrés s'accordent en direction avec le consensus du conseil au moins 10 points plus souvent que celles du groupe auquel ils n'ont pas été montrés (un effet d'accès entre groupes ; au moins 200 premières prévisions par groupe) | premières prévisions par lecteur de l'expérience (champ à publier et documenter dans arena-dataset.json) et le consensus par exécution ; script déposé | B | 31 Dec 2026 | différence ≥ 10 points avec au moins 200 par groupe | différence < 10 points avec au moins 200 par groupe ; moins = non résolu | 0.41 |
| F30 | Le style trahit le modèle : durant la saison en aveugle (à partir du 2 novembre 2026), un devineur fixe (modèle, version et SHA-256 de sa suggestion nommée dans un addendum de l'enregistrement déposé avant le 2 novembre 2026, température 0, d'une famille exclue des candidats), montré un texte de réponse scellé par article et la liste des k sièges candidats qui ont répondu, identifie le modèle au moins trois fois plus souvent que le hasard | lignes de réponse de la saison en aveugle et la révélation post-saison ; script déposé | B | 30 Apr 2027 | précision top-1 moyenne sur les articles ≥ moyenne de 3/k | précision top-1 moyenne sur les articles < moyenne de 3/k | 0.46 |
Remarque : L'ensemble A est défini par un ou deux champs publiés. L'ensemble B est défini par un script déposé avec l'enregistrement et exécuté sur les fichiers bruts ouverts, et le script est la définition. Les résolveurs de chaque ligne sont déposés sous la forme resolve.py (version des règles osf-rules-1), avec les détails de la section 8.1 : la règle de momentum de F15 est la direction du résultat de la ligue de l'indicateur dans la session précédente à 55 %, sur toutes les lignes. Sur les fichiers du 21 octobre 2026, F21, F29 et F30 se lisent non résolus, et chaque ligne nomme les données dont elle a besoin. J'ai défini les seuils de F1 à F5 et F9 après que les premières exécutions scellées m'aient été visibles, et leurs fenêtres commencent à la session 11.
F14, F22 et F28 sont les lignes de faible puissance : l'erreur-type de F14 est d'environ 5 points sur 100 prévisions, celle de F22 environ 11 points sur 20 critiques et celle de F28 environ 0,02 Brier sur 200 par groupe. F15, F21 et F28 comparent les estimations ponctuelles avec un seuil de 0,01 et ne sont pas des tests d'équivalence.
Attendu sans compétence : F11, au moins environ 0,78 pour dix modèles classés commettant des erreurs indépendamment à 2,5 % unilatéral chacun, plus élevé s'ils obtiennent un score supérieur à 0,25 et plus élevé encore lorsque leurs erreurs sont corrélées (F3). F16, au moins environ 0,93 sur trois horizons selon la même hypothèse. F25, environ 0,85 pour onze modèles classés et 0,82 pour dix selon des classements aléatoires. F10 est ouvert à l'un ou l'autre résultat : le leader est choisi sur une fenêtre antérieure, et la moyenne garantit une victoire uniquement sur la moyenne des membres qu'elle conserve (section 4.5). F8 est une prévision opérationnelle concernant la ligue. Les compartiments d'étalonnage sont semi-ouverts, [60,70) du côté couvert.
Dates de vérification : 30 novembre 2026 (session 30), 31 décembre 2026 (session 52), 30 avril 2027 (après la saison de 126 sessions, censée se terminer aux alentours du 20 avril 2027). La saison aveugle commence le 2 novembre 2026. En elle, la ligne de réponse scelle le modèle, sa version et son mode comme un engagement SHA-256 salé, H(salt || model || version || mode), de sorte que l'exigence 1 tient sans afficher le nom. Les sels sont publiés après la saison (section 3.13), et F30 est noté sur les lignes de réponse scellées une fois les engagements ouverts. Les fiches de résultats sont publiées sous forme de révisions datées de cet article et enregistrées sur OSF.
Analyses secondaires déclarées avec l'enregistrement, sans probabilité. (1) Le désaccord aide-t-il : le gain apparié du consensus sur la climatologie du tercile le plus élevé contre le tercile le plus bas de la propagation des sièges, marché fixe, bilatéral (section 8). (2) L'actualisation des voix corrélées aide-t-elle : la différence Brier unilatérale d'un jour entre le consensus publié et le consensus fantôme de la section 5.3, sessions 11 à 126, rééchantillonnage par bloc mobile (blocs de cinq, 10 000 rééchantillonnages, graine 20261102) et la zone d'équivalence de ±0,01 ; les poids fantômes et le script qui les calcule sont déposés avec l'enregistrement. Ni l'un ni l'autre n'est une ligne F, et ni l'un ni l'autre ne figure dans le score Brier des trente prédictions.
Appendice E. Comparaison des fonctionnalités avec les travaux antérieurs (au 21 octobre 2026)
Le tableau E1 compare les fonctionnalités de l'implémentation de référence avec les efforts les plus proches, listés dans la note du tableau 9. Oui signifie que la propriété est documentée ; Partiellement, une forme plus faible ou différente, comme indiqué dans la cellule ; Non, absence documentée ou conception qui l'exclut ; ND, non documenté publiquement au 21 octobre 2026 (tableau 9). La colonne pour la ligue utilise trois statuts propres, au 21 octobre 2026 : Implémenté signifie visible dans les fichiers ouverts. Spécifié signifie écrit dans la norme ou la méthodologie ouverte et absent des fichiers à cette date. Enregistré par l'opérateur signifie en cours d'exécution, avec un enregistrement qu'un tiers vérifie en se fiant à l'opérateur. Une cellule peut donner deux statuts pour deux parties d'une fonctionnalité.
Tableau E1. Fonctionnalités de AI Council · Markets par rapport aux travaux antérieurs les plus proches, d'après les matériaux publics au 21 octobre 2026.
| Fonctionnalité | Nôtre (statut) | Foresight Arena | Prediction Arena | NeuPortal | LLM Trading Arena | TradeRank | MarketMania | Autres |
|---|---|---|---|---|---|---|---|---|
| 1. Ligue quotidienne en direct | Implémenté (à partir du 16 octobre 2026) | Partiellement (manches ; résultats papier simulés, §6 ; agents en direct dans Nechepurenko & Shuvalov, 2026b) | Oui (cycles toutes les 15 à 45 minutes, janvier à mars 2026) | Non (par match) | Oui (crypto deux fois par jour, actions chaque jour de bourse) | Oui (toutes les 24 h) | Oui (à partir du 15 juillet 2026) | Oui : Alpha Arena, Agent Market Arena, Rallies, FutureX |
| 2. Sept modèles de laboratoires américains et sept de laboratoires chinois | Implémenté (14 sièges de trading, 7 laboratoires américains et 7 chinois ; 11 sièges de prévision, 5 américains et 6 chinois) | Non (5 prévus, 1 chinois) | Non (10 modèles, 1 laboratoire chinois) | Non (une IA sans nom) | Non (6 familles, 2 chinoises) | Pas de conception par pays (22 modèles) | Non (7 modèles, 2 chinois) | Non : Alpha Arena 2 sur 6 ; Rallies 2 sur 8 |
| 3. Probabilités à partir des sièges de prévision | Implémenté (11 sièges) | Oui | Non (trades seulement) | Oui (trois résultats) | Non (ordres) | ND | Oui (probabilité indiquée) | Oui : Prophet Arena, ForecastBench |
| 4. Panneau fixe d'indicateurs financiers dans les classes d'actifs | Implémenté (12) | Non (événements Polymarket) | Partiellement (contrats financiers Kalshi parmi 7 catégories) | Non (football) | Partiellement (5 cryptomonnaies, S&P 100) | Partiellement (10 cryptomonnaies, 50 actions américaines) | Partiellement (5 cryptomonnaies) | Partiellement : actions ou crypto isolées (StockBench, Agent Market Arena, GlassBallAI) |
| 5. Quatre horizons fixes sur les mêmes actifs | Implémenté | Non | Non | Non | ND | ND | Oui (1 heure à 1 mois) | Oui, pas de panneaux financiers : ForecastBench huit horizons sur des questions de données ; Partiellement : GlassBallAI un horizon de 10 jours |
| 6. Réponses scellées par hachage avant la référence | Implémenté (chaîne SHA-256 enregistrée avant 09:30 ET) ; enregistrement de l'opérateur pour 19 et 20 octobre 2026 (niveau 1) ; vérifiable publiquement à partir du 21 octobre 2026 (au moins deux jetons RFC 3161, niveau 2+, page de preuve) ; scellement à l'arrivée spécifié | Partiellement (engagement keccak256 par agent et manche, §3.2 ; pas une chaîne de toutes les réponses) | Non | Partiellement (SHA-256 de chaque fichier de prévision ; pas de chaîne documentée) | Partiellement (historique git des remplissages et justifications avant le prochain remplissage ouvert) | ND | ND | Partiellement : Prophet Arena registre SHA-256 avec salt, horloge de l'opérateur ; Sornette et al. (2010) sommes de contrôle, pas IA |
| 7. Ancrage en dehors de l'opérateur | Implémenté (Bitcoin, OpenTimestamps : existence au plus tard quelques heures après le bloc ; le 20 octobre 2026 après l'ouverture) | Partiellement (Polygon PoS, §3.2) | Non | Oui (Bitcoin ; football, une IA) | Non (l'heure repose sur l'hôte git) | ND | ND | Oui, pas financier : Zeus engagements on-chain de prévisions météorologiques ; Jyotish (2026), pas IA ; Non : Prophet Arena (horloge de l'opérateur) |
| 8. Prix de référence pris après le scellement | Implémenté et vérifiable publiquement à partir du 21 octobre 2026 (niveau 2+, Appendice B, Étape 9) ; enregistré par l'opérateur pour 19 et 20 octobre 2026 (booked_at, niveau 1) |
Partiellement (prix médian de référence stocké après la limite ; résultat binaire, Fig. 3) | Non | Partiellement (prix de foule au moment ou avant le verrouillage) | Partiellement (les ordres se remplissent à l'ouverture suivante) | ND | Partiellement (entrée à la première bougie de 1 minute après la réponse) | ND |
| 9. Une exécution comptée par une règle écrite d'avance ; toutes les exécutions publiées | Implémenté (toute exécution publiée, autres étiquetées not_counted) ; exécution comptée déclarée d'avance et scellée dans la chaîne des questions à partir du 21 octobre 2026 (Section 3.4) ; pour les sessions de développement des 19 et 20 octobre 2026, la règle a été appliquée après les exécutions |
Partiellement (un engagement par agent et manche, appliqué par le relayeur, §4.3 ; tous les engagements publics sur la chaîne ; les exécutions hors chaîne non couvertes) | Non (exécution pré-fenêtre d'un modèle caché, App. B.2) | ND | ND | ND | ND | ND |
| 10. Score strictement propre et calibration | Implémenté en partie (chutes de Brier publiées avec tirages ; bacs de calibration) ; Brier de toutes les lignes spécifié comme principal à partir du 21 octobre 2026 et calculé par les scripts déposés | Oui (Brier, Alpha, décomposition Murphy, §3.3 à §3.5) | Non (rendement, taux de victoire, §3.3) | Oui (Brier à trois résultats) | Non (valeur du compte) | ND | Oui (Brier, écart de calibration) | Oui : Prophet Arena, ForecastBench |
| 11. Références de 50% non informatifs et climatologiques | Implémenté (50%) ; implémenté (fréquences 2016 à 2025 scellées ; champ climatology_fixed dans les fichiers ouverts à partir du 21 octobre 2026, 08:54 UTC) |
Partiellement (bases aléatoires et de marché) | Non | ND | ND | ND | ND | Partiellement : ForecastBench bases naïves ; KalshiBench score de compétence par rapport à la climatologie |
| 12. Règle de session minimale avant classement | Implémenté (30/10, drapeaux ranked) |
Partiellement (analyse de puissance, manches minimales recommandées, §3.6.2) | Non | ND | ND | ND | ND | ND |
| 13. Portefeuille simulé de 100 000 $ par modèle | Implémenté | Non | Partiellement (réel 10 000 $ sur contrats d'événements) | Non | Oui (100 000 $, papier) | Partiellement (10 000 $ simulés) | Partiellement (transactions de contrats à terme papier) | Oui : Rallies 100 000 $ ; Alpha Arena réel 10 000 $ |
| 14. Vente à découvert et effet de levier 2× | Implémenté (Ligue Pro) | Non | Non (pas d'effet de levier, §4.5.1) | Non | Partiellement (effet de levier crypto, pas de vente à découvert) | ND | Partiellement (long ou court, papier) | Oui : Alpha Arena perpétuels avec effet de levier (presse) |
| 15. Prix du marché prédictif au moment de la réponse en comparaison | Implémenté (crowd_up par rapport au prix du contrat) |
Oui (Alpha par rapport au prix moyen, §3.4) | Partiellement (transactions par rapport aux prix) | Oui | ND | ND | ND | Oui : Prophet Arena, AIA Forecaster |
| 16. Accord actualisé pour les voix corrélées, en direct | Implémenté (N_eff par une règle d'admissibilité énoncée, n_eff.counted ; poids familiaux ; comptages complètement erronés et minorité juste) |
Non (indépendance du marché supposée, §7.5) | Non | Non (un modèle) | ND | ND | Partiellement (comportement grégaire mesuré, non actualisé) | Hors ligne uniquement : Kim et al. (2025), Spiro (2026), Aitchison et al. (2026) |
| 17. Livre fermé avec un paquet de nouvelles scellé | Implémenté (paquet scellé avec hachage) ; absence d'opérateur de recherche enregistrée où la ligne dit instruction uniquement | Non (recherche facultative, non supprimée) | Non (tous les modèles recherchent) | ND | ND | ND | Partiellement (une charge utile divulguée avec un résumé de nouvelles ; recherche ND) | Partiellement : FinDeepForecast avec et sans recherche, hors ligne ; charge commune MarketMania |
| 18. Mode discussion du conseil | Implémenté | Non (aveugle par conception) | Non (travail futur) | ND | ND | ND | ND | Partiellement : configurations de coordination, en direct sur Foresight Arena (Nechepurenko & Shuvalov, 2026b) |
| 19. Requêtes répétées d'un modèle | Implémenté (portefeuilles) ; répétitions de probabilité spécifiées | Non | Non | ND | ND | ND | Oui (séries de stabilité) | Études d'échantillonnage hors ligne (Aitchison et al., 2026) |
| 20. Les lecteurs font des prévisions avant de voir l'IA, deux groupes permanents | En direct et ouvert à chaque visiteur ; résultats enregistrés comme F28 et F29, lus à 200 premières prévisions par groupe ; label de groupe spécifié | Non | Non | ND | ND | ND | ND | Partiellement : groupes distincts (ForecastBench, Metaculus) ; essai d'assistance (Schoenegger et al., 2025) |
| 21. Saison aveugle | Spécifié (à partir du 2 novembre 2026 ; modèle, version et mode scellés en tant qu'engagement SHA-256 salé, sels publiés après la saison) | Non | Partiellement (un modèle sous un identifiant masqué) | ND | ND | ND | ND | ND |
| 22. Prédictions datées à propos de la ligue, au prix aveugle | Implémenté (30, au prix aveugle ; enregistré sur OSF avant la publication) | Non | Non | ND | ND | ND | ND | ND |
| 23. Données ouvertes selon une licence énoncée | Implémenté (CC BY 4.0) | Partiellement (sur la chaîne, aucune licence de données énoncée) | ND (aucun référentiel fourni) | Oui (GitHub, Zenodo) | Oui (MIT, registre complet) | Partiellement (JSON ouvert, licence non énoncée) | Partiellement (exportations API, licence ND) | Oui : ForecastBench, LiveTradeBench, StockBench ; GlassBallAI CC BY-NC |
| 24. Code de notation ouvert avec hachages | Implémenté (code du moteur avec hachages, arena-code.json ; recomptage des scores de prévision, tools/replay_brier.py ; résolveurs déposés sur OSF) | Oui (contrats sur chaîne, référentiel d'analyse) | Non | ND | Partiellement (code ouvert) | ND | ND | Partiellement : code PolyBench, ForecastBench |
| 25. Recalcul de chaque compte par des tiers | Implémenté (replay.py) |
Oui (« relire tout l'historique », Contributions 1) | Non | ND | Oui (le registre recalcule chaque compte) | ND | ND | ND |
| 26. Jeton RFC 3161 au sceau | Implémenté à partir du 21 octobre 2026, vérifiable publiquement (FreeTSA et DigiCert ; Sectigo ajouté le même matin ; page de preuve) ; scellement à l'arrivée spécifié | Non | Non | ND | ND | ND | ND | Pas une IA : un outil de scellement général pour les prévisions humaines |
Remarque : les numéros § dans les colonnes Foresight Arena et Prediction Arena font référence aux sections de ces articles. Les lignes 5, 10, 13 à 15, 19 et 25 sont des fonctionnalités que la ligue partage avec les travaux antérieurs. Les lignes derrière les affirmations de la section 7.4 : Affirmation 1 : lignes 4 et 6 à 9 (ligne 8 au niveau 1 pour 19 et 20 octobre, niveau 2+ à partir du 21 octobre). Affirmation 2 : ligne 16. Affirmation 3 : lignes 6 à 12, 16 et 26, lues avec la colonne d'état de la section 3.13. Affirmation 4 : ligne 20. Affirmation 5 : ligne 2. Affirmation 6 : ligne 22.
Comment citer
Chernets, V. (2026). Sealed Before the Open: A Verifiable Standard for Measuring AI Forecasts of Financial Markets [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7653679
@misc{chernets2026sealedbeforetheopen,
  author       = {Chernets, Vadym},
  title        = {{Sealed Before the Open: A Verifiable Standard for Measuring AI Forecasts of Financial Markets}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7653679},
  url          = {https://doi.org/10.2139/ssrn.7653679}
}