Architektonisches Vertrauen: Warum das Verbrauchervertrauen im agentengesteuerten Handel von KI-Modellen zu verifizierbarer Architektur migriert
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
Vadym Chernets, PhD, KI-Systemarchitekt · ORCID 0009-0007-4845-3163
SSRN 7191261 · DOI 10.2139/ssrn.7191261 · Zenodo 10.5281/zenodo.22166995 · GitHub
- Veröffentlichte Fassung: SSRN 7191261 · DOI 10.2139/ssrn.7191261
- Archivierte Kopie, zitierbar und herunterladbar: 10.5281/zenodo.22166995 — Konzept-DOI, löst immer zur neuesten Version auf
- Volltext als Markdown und PDF: GitHub
- Lesbare HTML-Version: https://polyhelper.ai/research/architectural-trust/
Der gleiche Text befindet sich auf vier Plattformen, damit er erreichbar ist, wenn eine davon nicht verfügbar ist. SSRN hält die veröffentlichte Fassung; zitieren Sie diese.
Verbrauchervertrauen in agentengesteuerten Handel
Auf SSRN veröffentlicht und unter dem Titel „Architektonisches Vertrauen: Warum das Verbrauchervertrauen in agentengesteuerten Handel von KI-Modellen zu überprüfbarer Architektur migriert" indexiert. Verwenden Sie diese Form zum Zitieren.
Von Modelleigenschaften zu überprüfbarer Architektur
Vadym Chernets, PhD1
Erstmals veröffentlicht am 6. August 2026; diese Version September 2026
Berichtet das vollständige konzeptionelle Rahmenwerk, die Mechanismusstudie mit sechzehn Modellen und deren Replikation im August 2026 über elf führende Laboratorien hinweg, einen gepaarten Vergleich der Rechenlast, eine Replikation im Commerce-Substrat und ein vorab registriertes Verbraucherexperiment in vollständiger Form.
ZUSAMMENFASSUNG
Agentengesteuerter Handel verwandelt KI von einem Berater in eine Transaktionspartei und verschmilzt Suche, Vergleich, Warenkorb und Zahlung zu einer einzelnen delegierten Handlung, wodurch die Überprüfungspunkte entfernt werden, an denen Menschen einst Fehler abgefangen haben. Er kommt zu einem ungünstigen Zeitpunkt: Sechzig Prozent der befragten Verbraucher in Großbritannien geben an, dass sie einen KI-Einkaufsagenten nach einem Fehler aufgeben würden, und die meisten würden keiner Organisation trauen, ihn in ihrem Namen auszuführen. Dieses Papier führt architektonisches Vertrauen ein. Wenn Verbraucher folgenreiche Entscheidungen an KI-Agenten delegieren, argumentiere ich, migriert das berechtigte Vertrauen von den Eigenschaften des KI-Modells zur überprüfbaren Architektur des darüber liegenden Dienstes. Die bereits verfügbaren Konstrukte heften Vertrauen an Organisationen, an ein einzelnes automatisiertes System oder an algorithmischen Rat an, und keine davon macht den Entscheidungsprozess für den Vertrauensgebenden unter autonomer Delegation überprüfbar. Architektonisches Vertrauen füllt diese Lücke mit drei überprüfbaren Eigenschaften: Vielfalt (unabhängige Modelle, deren Übereinstimmung das Vertrauen kalibriert und deren Abweichung offengelegt wird), Nachweise (manipulationssichere, wiederherstellbare Entscheidungsprotokolle) und Neutralität (überprüfbare Unabhängigkeit von jedem Anbieter, Händler oder Ergebnis).
Der Mechanismus wurde zunächst auf der Maschinenebene gemessen. In einer vorab registrierten Benchmark mit sechzehn Modellen und einer flaggschiff-gestützten Welle im August 2026 über elf führende Laboratorien hinweg bestimmte die modellübergreifende Übereinstimmung Korrektheit dort, wo das eigene Vertrauen des Modells dies nicht konnte. Unabhängig von einem anderen Modell reproduzierte Antworten waren 1,9–3,2-mal häufiger korrekt. In einer gefrorenen SimpleQA-Teilstichprobe (Wei et al., 2024) waren 46,6 % der Antworten, die bei angabetem Vertrauen ≥ 80 angeboten wurden, falsch (eine Rate, die für diese Gruppe spezifisch ist, nicht eine universelle Konstante), während ein festes Drei-Modell-Divergenztor 82,1 % dieser vertrauensvollen Fehler entfernte (95 % KI 79,9–84,1) bei 30,5 % Abdeckung. Das Signal reproduziert sich bei 267 durch Wikidata verifizierte Commerce-Produktfakten. Ein größeres Rechenlast-Budget erwarb 3,1 Punkte angegeben Vertrauen und keine messbare Genauigkeit: Mehr Rechenleistung kauft Vertrauen, nicht Korrektheit. Ein einstimmiges vertrauensvolles Panel kann immer noch falsch sein, und dort zertifiziert die Übereinstimmung den gemeinsamen Fehler.
Ich führe den Mechanismus dann in einem vorregistrierten, anreizkompatiblen Verbraucherexperiment in ein Verhalten über (119 von 200 geplanten Teilnehmern; USA und Großbritannien). Wo ein Verbraucher ansonsten eine zuversichtlich falsche Empfehlung annehmen würde, reduzierte die Uneinigkeitsanzeige die Akzeptanz drastisch, von 74 % auf 24 % beim qualifizierenden Artikel. Die gepoolte Robustheitsschätzung (Δ = 0,24 → 0,45; d = 0,68; die primäre Haupt-Wellen-Kohorte ergibt d = 0,67) basiert auf diesem einzelnen Artikel und fällt in einer explorativen Länderaufteilung auf die britische Stichprobe; sobald der Artikel entfernt wird, sinkt sie auf d = 0,09. Eine aussagekräftige, stimulusbeprobte Replikation ist geplant. Bei dem einen Artikel einstimmigen zuversichtlichen Konsenses erhöhte die Anzeige die Akzeptanz des gemeinsamen Fehlers, was den Mechanismus an der Grenze im menschlichen Verhalten wiederholt. Die Orchestrierungs-Empfangskomponente lieferte ein registriertes, nicht schlüssiges Nullergebnis.
Die drei Komponenten haben nicht gleichberechtigte Evidenzen hinter sich. Diversität wird auf der Maschinenebene etabliert und für Verbraucher nur beim Kalibrierungskontrast gezeigt (die registrierte Mediation war null). Der erste-Expositions-Test der Datensatzkomponente war nicht schlüssig, und sowohl dieser als auch Neutralität sind zur Prüfung spezifiziert. Die Analyseeinheit für KI-Vertrauen muss sich von dem Modell zur Architektur über diesem verschieben, dem Teil, der überprüft werden kann.
Schlüsselwörter: Agentenhandel; Verbrauchervertrauen; KI-Agenten; Vertrauen in KI; angemessenes Vertrauen; Übervertrauen; große Sprachmodelle; Modellübergreifende Übereinstimmung; selektive Vorhersage; Überconfidence; Delegation; architektonisches Vertrauen. JEL-Klassifizierung: M31 (Marketing); D83 (Suche, Lernen, Information); L86 (Informations- und Internetdienste); K24 (Internetrecht) Wie Sie dieses Dokument lesen. Diese vollständige Version berichtet die gesamte Beweiskette: das Konstrukt und die Vertrauens-Migrations-Hypothese; eine Sechzehn-Modell-Mechanismusstudie (mit einer August-2026-Flaggschiff-Wellen-Replikation und einem Handels-Substrat-Arm zu Produktfakten), die modellübergreifende Diversität als Korrektheitssignal etabliert; ein vorregistriertes Verbraucherexperiment, das diesen Mechanismus in Verhalten überführt; und eine Diskussion von Neutralität, Marktökonomie und Politik. Vorregistrierte Bestätigungsergebnisse und der Evidenzstatus jeder Konstruktkomponente (Diversität, Evidenz, Neutralität) werden unter „Evidenzstatus von Ansprüchen" in Abschnitt 5 zusammengefasst. Explorative und Robustheitsanalysen sind als solche durchgehend gekennzeichnet und können beim ersten Durchgang übersprungen werden.
1. Einführung: Wachstum inmitten von Misstrauen
Am 10. Juni 2026 kündigte Visa an, dass es sein Zahlungsnetzwerk direkt in ChatGPT einbettet (Visa, 2026). Ein Verbraucher verknüpft eine Karte, legt Ausgabenlimits und genehmnigte Merchant-Kategorien fest, und die angekündigte Integration mit Anwendungsfällen, die schrittweise eingeführt werden, zielt darauf ab, KI-Agenten bei der Durchführung echter Käufe über das Netzwerk von Merchants (175 Millionen-plus Standorte, gemäß Handelsberichterstattung der Ankündigung) zu unterstützen. Visa war nicht allein. OpenAI hatte im September 2025 den In-Chat-Checkout ausgeliefert; Google führte ein Universal Commerce Protocol auf der NRF im Januar 2026 mit Shopify, Etsy, Wayfair, Target und Walmart ein und erweiterte es im Mai auf einen einzelhandelsübergreifenden Universal Cart (Google, 2026); American Express startete ein Agentenhandels-Entwicklerkit mit Kaufschutz im April (American Express, 2026). Die Schwelle wurde von einer Branche überschritten, nicht von einem Unternehmen. Analystenprognosen für Agentenhandel bis 2030 reichen von Hunderten Milliarden (Bain; Morgan Stanley) bis zu McKinseys 3–5 Billionen Dollar. Es sind Schätzungen und keine Fakten, obwohl jedes größere Haus sie jetzt produziert.
Die realisierten Zahlen sind keine Schätzungen mehr. Unternehmensausgaben für Modell-APIs allein stiegen in sechs Monaten von 3,5 Milliarden auf 8,4 Milliarden Dollar (Menlo Ventures, 2025a; Industrieumfrageforschung, nicht von Fachleuten beurteilt), innerhalb von etwa 37 Milliarden Dollar Unternehmens-KI-Ausgaben für das Jahr (Menlo Ventures, 2025b). Dieselbe Industrie diskontiert bereits ihre eigene Ausführung: Gartner (2025) prognostiziert, dass über 40 % der Agentenprojekte bis Ende 2027 storniert werden. Geld kommt schneller an als berechtigtes Vertrauen, die Lücke, an der ich hier arbeite. Ansprüche unten sind in der Evidenzrechnung gegen Ende des Papiers als durch diese Daten etabliert, bei bescheidener Einzelstudien-Skalierung unterstützt oder theoretisch gestaffelt. Diese Abstufung regiert und übertrumpft jeden zusammenfassenden Satz in dieser Einleitung.
Was diese Verschiebung qualitativ anders von früheren E-Commerce-Wellen macht, ist Funnel-Kompression: Suche, Vergleich, Warenkorb und Zahlung kollabieren in eine einzelne delegierte Handlung. Jede Schutzmaßnahme, die früher zwischen diesen Schritten gelebt hat (der Mensch, der auf den Preis schaut, die Anzeige nochmals liest, beim Checkout zögert), verschwindet mit den Schritten selbst (Abbildung 1). Der KI-Assistent hört auf, ein Berater zu sein, dessen Output ein Mensch überprüft, und wird zur handelnden Partei. Die Forschung im Bereich Human Factors benannte diesen Ausfallmodus vor vier Jahrzehnten: Automatisierung, die den Bediener aus der Schleife entfernt, erodiert genau die Wachsamkeit, die nötig ist, um ihre Fehler zu erkennen (Bainbridge, 1983; Endsley & Kiris, 1995). Die Verbraucherforschung antizipierte die Schwelle auch. Autonome Einkaufssysteme sehen sich qualitativ anderen Adoptionsbarrieren genau deshalb gegenüber, weil sie den Menschen aus der Handlung entfernen (de Bellis & Johar, 2020), und die Autonomiekostpflicht, Entscheidungen an Algorithmen abzugeben, wurde als Verbraucherwohlfarts-Frage gekennzeichnet, bevor LLMs existierten (André et al., 2018).
Abbildung 1. Funnel-Kompression
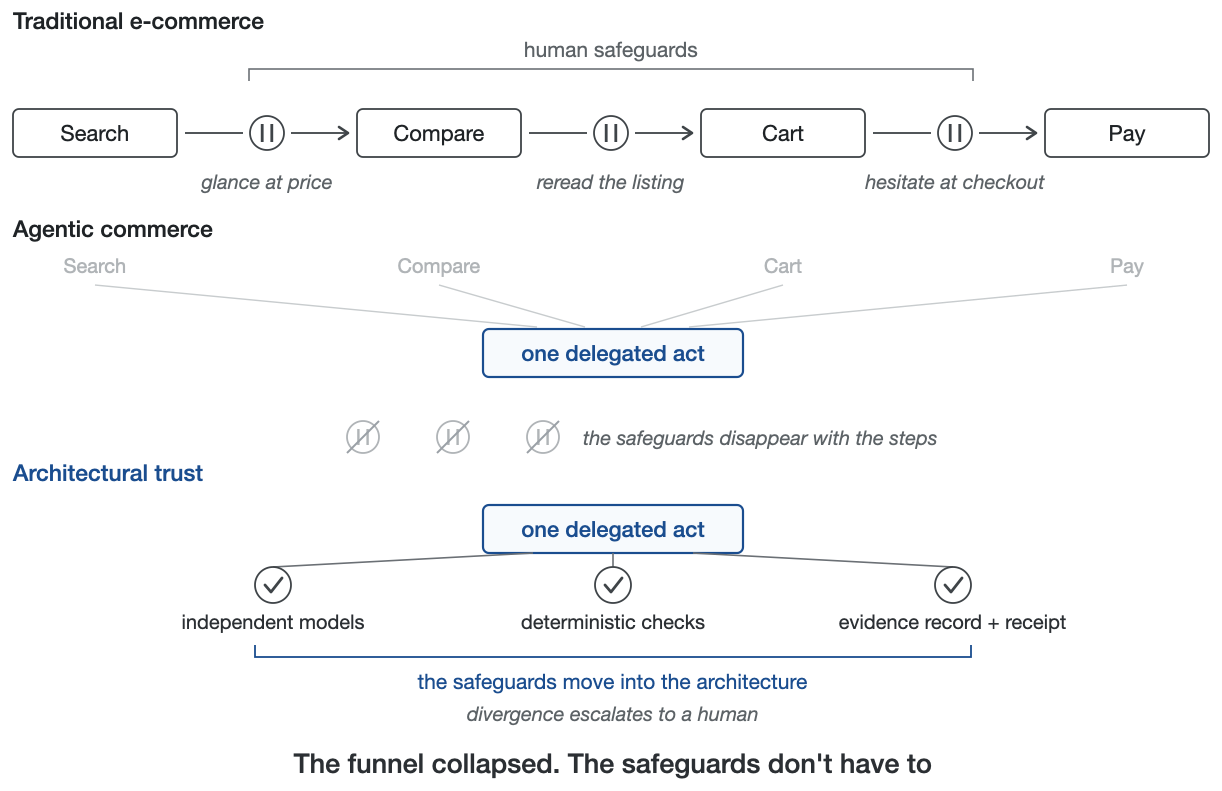
Die menschlichen Schutzmaßnahmen verschwinden mit den Schritten, in denen sie gelebt haben.
Visas eigene Leitplanken (Limits, Whitelists, erforderliche Genehmigungen) existieren, weil der Verbraucher aufgefordert wird, etwas Neues zu vertrauen: nicht einer Marke, nicht einer Antwort, sondern einem Entscheidungsprozess, den Sie nicht sehen können. Leitplanken, die im Voraus festgelegt sind, schließen diese Lücke nicht. Ein im Voraus festgelegter Regelbestand lässt Sie nicht überprüfen, wie eine Entscheidung getroffen wurde. In der Umfrage von ACI Worldwide (2026), die unten zitiert wird (eine Branchenumfrage, die per Pressemitteilung veröffentlicht wurde, wie die anderen Vendor-gestützten Umfragen in diesem Abschnitt), sagten 69 % der britischen Verbraucher, dass sie KI-Agenten auch dann nicht vertrauen, wenn die Agenten Regeln befolgen, die die Verbraucher selbst festgelegt haben.
Die kommerziellen Einsätze, hier falsch zu entscheiden, sind erheblich. Frühe Umfrageergebnisse deuten darauf hin, dass das Verbrauchervertrauen in Agenten eine „One-Strike"-Intention ist und, noch interessanter, heimatlos. Das offenbarte Verhalten, der unten beschriebene Checkout-Rückgang sowie die Klarna-Umkehrung und Versicherungsneupreisgestaltung in Abschnitt 5 bestätigen diese erklärten Präferenzen und haben größeres Beweisgewicht. In einer YouGov-Umfrage für ACI Worldwide (2.080 britische Erwachsene, erhoben 19.–22. Juni 2026, eine Momentaufnahme eines einzelnen Markts mit ausstehender länderübergreifender Replikation) sagten 60 %, dass sie einen KI-Einkaufsagenten nach einem einzelnen Fehler nicht mehr nutzen würden, und nur 19 % würden der KI alltägliche Einkäufe anvertrauen, gegenüber 55 %, die einem menschlichen Experten vertrauen würden.
Die folgenreichste Zahl dieser Umfrage ist eine andere: 59 % sagten, dass sie keiner Organisation zutrauen würden, KI-Shopping und Zahlungen in ihrem Namen durchzuführen, und selbst Banken wurden nur von 20 % gewählt. In einem einzelnen befragten Markt mit ausstehender länderübergreifender Replikation liegt hier ein Vertrauensvakuum vor. Der Appetit ist vorhanden. In Accentures 16-Länder-Branchenumfrage mit 25.590 Verbrauchern (Januar 2026; unternehmensgestützt, nicht peer-reviewed) sagten 74 %, dass sie einem persönlichen KI-Agenten mehr vertrauen würden als ihrem besten Freund, um in ihrem Namen einen Kauf zu tätigen, doch nur etwa einer von zehn würde einem Agenten autonome Kaufbefugnis gewähren (Abbildung 2). Die beiden Items messen unterschiedliche Delegationsstufen, daher steht die Streuung eher mit Absichten in Einklang, als ein einzelnes kausales Defizit zu identifizieren, doch die Streuung ist beträchtlich. Die Absicht ist reichlich vorhanden; die Delegation ist knapp; was dazwischen fehlt, ist gerechtfertigtes Vertrauen. Der Markt hat bereits etwas Ähnliches versucht. OpenAI gab im September 2025 natives In-Chat-Checkout aus, einen bewusst begrenzten ersten Schritt, zunächst Einzelkäufe von US-Etsy-Verkäufern mit Benutzerbestätigung bei jedem Schritt. Im März 2026 zog das Unternehmen den Ablauf zurück und verlagerte Käufe in die eigenen Apps der Einzelhändler, und nur eine Handvoll Händler nutzten es je (wie von The Information berichtet; CNBC, 2026). Das Unternehmen nannte keinen Grund, daher ist die Ursache nicht geklärt. Die hier angebotene Auslegung – Adoptionsinfrastruktur ohne gerechtfertigtes Vertrauen, die sich nicht umsetzt – ist eine Interpretation, die mit den berichteten Fakten konsistent ist. Wenn Verbraucher jedem Akteur misstrauen, kann Vertrauen nicht einem Akteur anvertraut werden und muss stattdessen in einem verifizierbaren Prozess leben.
Abbildung 2. Erklärtes Vertrauen vs. gewährte Befugnis
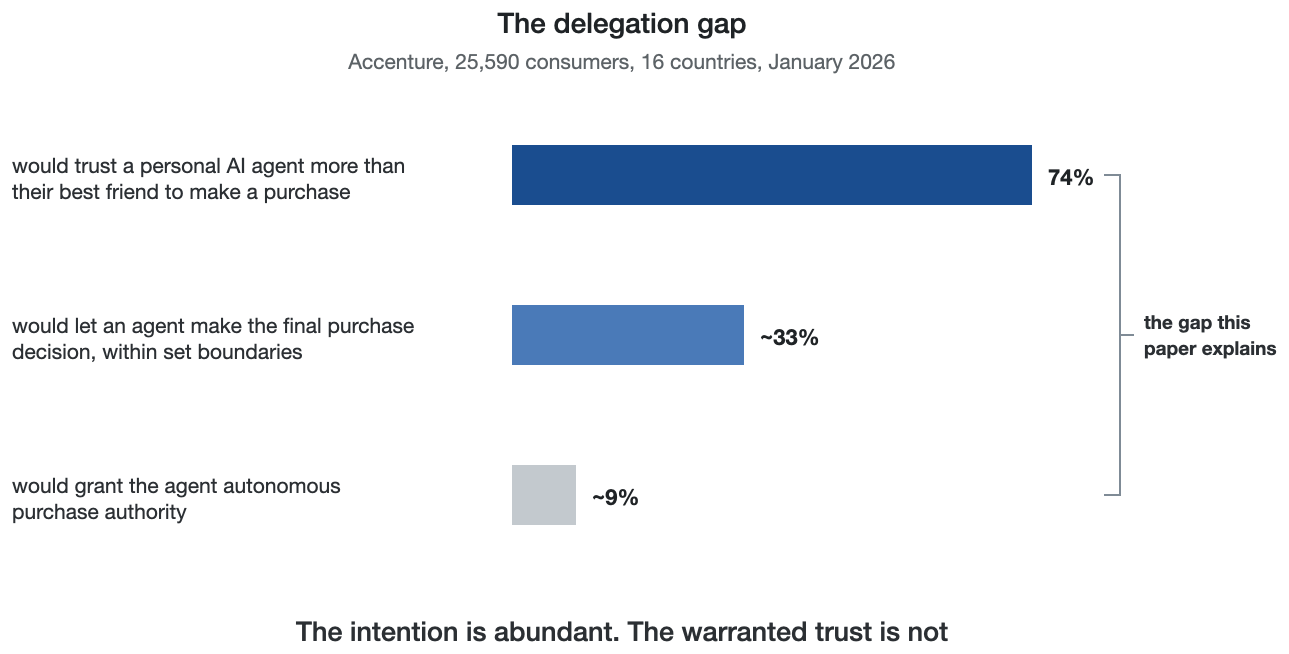
Zwei Umfrageitems, zwei Delegationsstufen: Absicht ist verbreitet, gerechtfertigtes Vertrauen ist knapp.
Das Haftungssystem arbeitet auf die gleiche Schlussfolgerung hin. Entstehende Agent-Payment-Protokolle bauen jede Transaktion um ein bereichseingeschränktes, verifizierbares Absichtstoken auf, das an einen bestimmten Händler und Betrag gebunden ist, und American Express' Agent Purchase Protection (April 2026) deckt Käufe nur durch registrierte Agenten ab, wobei die Berechtigung an authentifizierte, verifiable Kaufabsicht geknüpft ist. Die Versicherung ist in Bezug auf das geschrieben, das aus dem Datensatz verifiziert werden kann. Stückweise und unter Druck konvergiert die Branche auf die gleichen Bestandteile, die ich systematisch unten dargelegt habe. Die nun ausgelieferten Protokolle lösen Identität und Absicht und beantworten nicht wie hat der Agent entschieden?
Die Frage ist, was es brauchen würde, damit dieses Vertrauen durch Design gerechtfertigt wäre. Die klassische Verbrauchertrust-Frage, vertraue ich diesem Unternehmen, hat eine innere Schicht erworben: vertraue ich dem Mechanismus, der diese spezifische Antwort oder Aktion produziert hat?
Die Trustliteratur hat lange zwischen Vertrauen in eine Organisation und Vertrauen in Automation, in das IT-Artefakt (Söllner et al., 2016), und in Online-Empfehlungsagenten (Wang & Benbasat, 2005; Komiak & Benbasat, 2006; Xiao & Benbasat, 2007) unterschieden. Sie zeigt, dass angemessene Zuverlässigkeit von Kalibrierung abhängt, davon, zu wissen, wann das System wahrscheinlich recht hat (Muir, 1994; Mayer, Davis, & Schoorman, 1995; Parasuraman & Riley, 1997; Lee & See, 2004; Hoff & Bashir, 2015; Huang & Rust, 2021; und Glikson & Woolley, 2020, deren Übersicht Greifbarkeit und Transparenz des Prozesses unter den stärksten Hebeln kognitiven Vertrauens findet, genau jene Hebel, die Architektur kontrolliert und Modelle nicht). Fehlkalibrierung auf der menschlichen Seite ist gleichermaßen dokumentiert: Automationsbias und Sorglosigkeit, Überreliance auf automatisierte Hilfsmittel selbst gegen gegenteilige Beweise, sind die Muster, vor denen vier Jahrzehnte Arbeit im Bereich Menschenfaktoren warnen, dass die Delegierung sie verstärken wird (Mosier & Skitka, 1996; Parasuraman & Manzey, 2010). Diese Literatur behandelt Kalibrierung jedoch als Eigenschaft eines einzelnen automatisierten Systems (Abbildung 3 zeigt die vier Forschungsströme und die Zelle, die sie offenlassen). Eine systematische Überprüfung von agentengestützter KI im E-Commerce bestätigt die Leere von der Seite der Evidenz: Die Verbraucherseitige Forschung konzentriert sich weiterhin auf unterstützende, autonomiearme Systeme, mit Abdeckung, die genau dort stark sinkt, wo Delegierung zur Ausführung wird (Balaskas, 2026). Die ersten gleichzeitigen Studien des agentengestützten Shopping erreichen von einer anderen Seite aus eine architektonische Schlussfolgerung. Wenn Verbraucher Käufe durch Dialog delegieren, sickert ihre Zahlungsbereitschaft zu Verkäufern fast wörtlich durch; Prompting behebt das nicht, und nur architektonische Interventionen tun es (Alavi & Nozari, 2026).
Abbildung 3. Vier Trustforschungsströme: die Zelle, die dieses Papier beansprucht
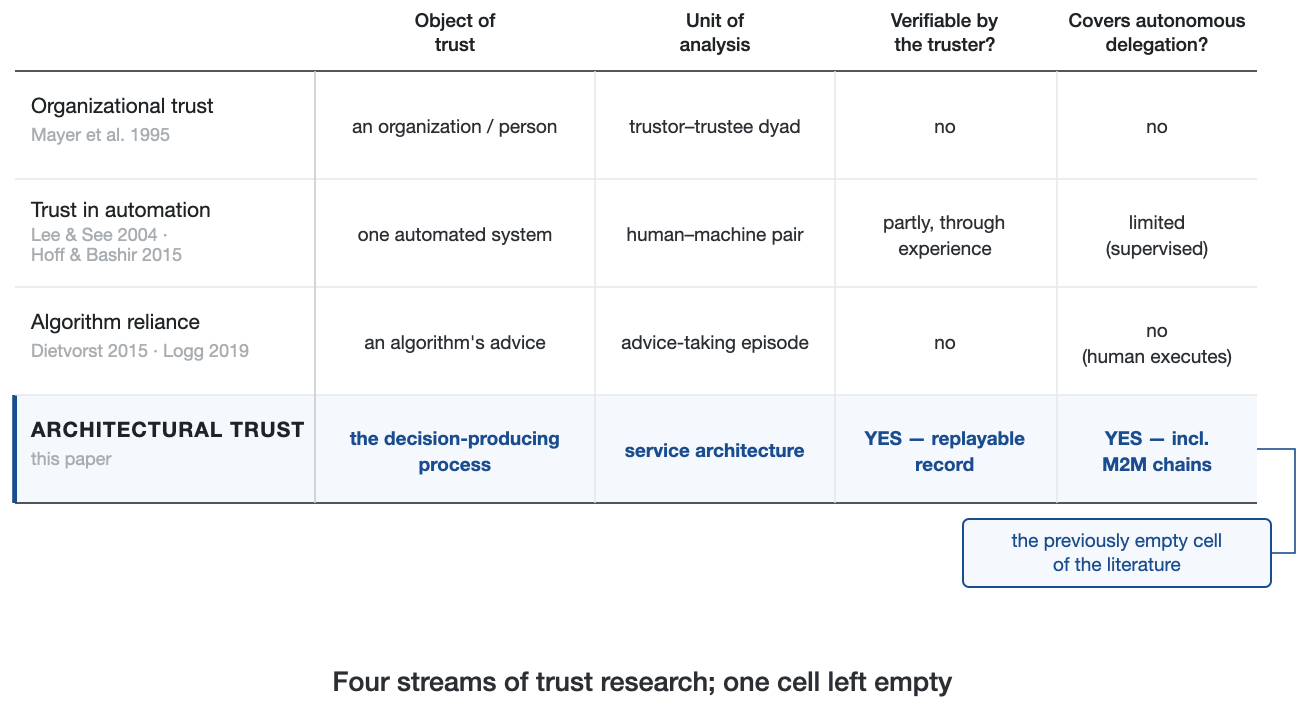
Organisationsvertrauen, Vertrauen in Automation und Algorithmus-Reliance fixieren jeweils ein anderes Vertrauensobjekt; keines macht den entscheidungsproduzierenden Prozess für den Vertrauenden unter autonomer Delegierung verifizierbar. Die Zelle ist nicht leer von Ideen: angrenzende Literaturen halten jeweils eine Wand davon (Abschnitt 3 zeichnet die Abgrenzungen). Was gefehlt hat, ist die Verbraucherseitige Konstruktion: ein Prozess-Ebenen-Vertrauensobjekt, verifizierbar durch den Vertrauenden, spezifiziert für autonome Delegierung, verpackt für gemeinsamen Verhaltenstest.
Industrieantworten konzentrieren sich auf das Modell: besseres Training, Haftungsausschlüsse, Zitierungen. Ich untersuche eine Antwort auf einer anderen Ebene, der Architektur des Dienstes, und argumentiere, dass drei architektonische Eigenschaften, von denen keine ein besseres Modell erfordert, gemeinsam ein anderes Vertrauensobjekt produzieren.
Dies ist ein konzeptionelles Papier, das sich auf zwei vorregistrierte Studien stützt – eine Maschinenseite-Benchmark und einen Verbraucherseitigen Verhaltenstest des Kalibrierungskontrasts in ihrem ersten Satz – und die Frage, die es stellt, lautet Wenn KI-Agenten anfangen, im Namen von Verbrauchern Transaktionen durchzuführen, haftet das Vertrauen an den Modellen oder an der Architektur über ihnen? Meine Antwort ist, dass sich das Vertrauen im Stack nach oben verlagern muss – vom Modell zur Orchestrierungsarchitektur hin zu der Evidenz, die sie produziert. Unter dieser Antwort liegt eine Regelmäßigkeit, die es wert ist, auf ihre eigenen Weise getestet zu werden, die Vertrauensmigrierungshypothese, auf der die folgenden Sätze gebaut sind: Je größer die delegierte Handlungsfähigkeit, desto größer der Anteil des gerechtfertigten Vertrauens, das in überprüfbaren architektonischen Eigenschaften statt in Modelleigenschaften liegen muss. Die Migration muss nicht Nullsummenspiel sein. Vertrauen kann sich schichten: im Kompetenzmodell, in der Auswahl des Orchestrators, im Evidenzsystem, in der Institution, die Abhilfe durchsetzt. Ein fehlerhaftes Modell bleibt kausal wichtig, auch wenn niemand seine Ausgabe überprüft. Die Hypothese betrifft, wo das marginale gerechtfertigte Vertrauen entsteht, wenn sich die Delegation vertieft. In schätzbarer Form besagt sie, dass mit zunehmender delegierter Handlungsfähigkeit architektonische Überprüfbarkeit einen wachsenden inkrementellen Anteil der angemessenen Verlässlichkeit jenseits von Modellleistung und Anbieterruf erklären kann. Sie scheitert, wenn architektonische Überprüfbarkeit mit zunehmender delegierter Handlungsfähigkeit nicht einen wachsenden inkrementellen Anteil der angemessenen Verlässlichkeit erklärt: wenn etwa Anbieterruf das Vertrauen auf allen Delegationsstufen vollständig vermittelt, oder wenn überprüfbare Prozessinformationen die Kalibrierung der Verlässlichkeit gegenüber reputationsgestützen Informationen in Designs der Art nicht verbessern, die Abschnitt 6 berichtet. Die verhaltensweisen Falsifizierer, die in Abschnitt 3 vorregistriert wurden (die P2-Delegationsgrade-Kreuzung und die P4-unterschiedliche Dauerhaftigkeit unter Ausfall), sind die operative Form dieser Bedingung. Ein wachsender architektonischer Anteil bedeutet nicht, dass Modellqualität in absoluten Begriffen weniger wichtig ist. Die Hypothese beschreibt Schichtung, keine Substitution: Wenn Überprüfung verschwindet, wird architektonische Berechtigung oberhalb der Modellleistung hinzugefügt und ersetzt sie nicht. „Gerechtfertigt" folgt der Unterscheidung, die für KI von Jacovi, Marasović, Miller und Goldberg (2021) formalisiert wurde, dass Vertrauen gerechtfertigt ist, wenn es Vertrauenswürdigkeit nachvollzieht, und das Konstrukt wird von einer Tautologie dadurch ferngehalten, dass sein normativer Status von seinem Mechanismus getrennt wird. Normativ ist Vertrauenswürdigkeit unabhängig von der Architektur, die es zertifizieren soll, als die klassische, unabhängig messbare Funktion von Fähigkeit, Integrität und Wohlwollen definiert (Mayer, Davis, & Schoorman, 1995); Abschnitt 3 bildet die drei architektonischen Komponenten auf genau diese Dimensionen ab. Berechtigung ist die Übereinstimmung der Verlässlichkeit mit dieser unabhängig gemessenen Größe: Verlässlichkeit, die eine objektive Prüfung der delegierten Episoden übersteht, beurteilt nach Kriterien, die vor den Ergebnissen festgelegt wurden, mit einer messbaren Verhaltensspur, nämlich wiederholter Delegation, Beibehaltung und Zahlungsbereitschaft unter kontrolliertem Ausfall. Die Vertrauensmigrierungshypothese behauptet den Mechanismus. Mit steigender delegierter Handlungsfähigkeit verschiebt sich der Anteil dieser Vertrauenswürdigkeitsfunktion, den der Verbraucher noch unabhängig messen kann, von Modelleigenschaften zu architektonischen Komponenten. Dies gilt, weil Architektur der Teil der Vertrauenswürdigkeit ist, der vom Vertrauenden noch messbar bleibt, sobald die Ausgabenüberprüfung entfällt, und nicht, weil Architektur ist Vertrauenswürdigkeit. Die oben angeführten vorregistrierten Falsifizierer testen diese Verschiebung und nicht die Definition. Die Migration hat auch Vorgänger, von denen sie zu unterscheiden sind. Multi-Agenten-Systemforschung beobachtete, dass mit der Skalierung von Agentenschaften die Vertrauensmodellierung von einzelnen Agenten zum institutionellen Rahmen verschiebt, der sie einschränkt (Sabater & Sierra, 2005), und „Vertrauenswanderung" hat frühere B2B-Anwendungen für Vertrauen, das sich von Einzelpersonen zu Systemen und Plattformen verlagert (Carlson, 2026). Diese benennen Verschiebungen in wer oder was vertraut wird, während diese Hypothese sich mit einer Verschiebung in der Art der Eigenschaft befasst, die Vertrauen berechtigen kann. Bei null Delegation ist Modellqualität fast alles, was wichtig ist. Bei voller Delegation beobachtet niemand die Ausgaben, und das Einzige, das noch vertraut werden kann, ist nur der Prozess und sein Datensatz. Handlungsfähigkeit und architektonisches Vertrauen skalieren zusammen (Abbildung 4). Der Gradient selbst ist ein altes Instrument, die Automatisierungsgrad-Achse der Humanfaktoren-Technik (Sheridan & Verplank, 1978; Parasuraman, Sheridan, & Wickens, 2000), hier auf Verbraucherdelegation angewendet. Neu ist die Behauptung darüber, welche Eigenschaften das Vertrauen entlang davon berechtigen können.
Abbildung 4. Vertrauensmigration
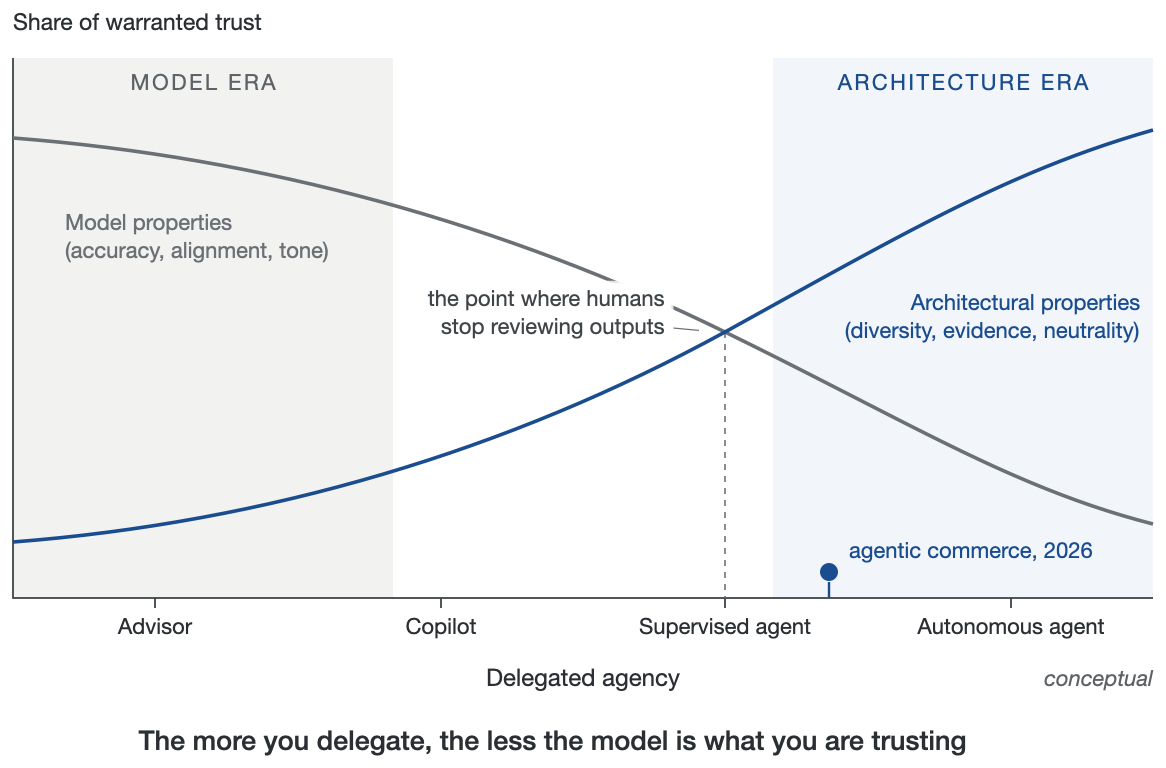
Zwei sich kreuzende Kurven über delegierter Handlungsfähigkeit (Berater → Copilot → beaufsichtigter Agent → autonomer Agent): Der Anteil des gerechtfertigten Vertrauens, das von Modelleigenschaften getragen wird, sinkt, während der Anteil, der von architektonischen Eigenschaften getragen wird, steigt; die Kreuzung ist der Punkt, an dem Menschen aufhören, Ausgaben zu überprüfen, und agentengebundener Handel (2026) sitzt zu seiner Rechten. Die Kurven und der Kreuzungspunkt sind konzeptionelle Illustration, keine geschätzten Funktionen.
Zur Marketingliteratur über Verbrauchervertrauen in KI (Huang & Rust, 2021; Puntoni et al., 2021) fügt das Papier ein Konstrukt hinzu, architektonisches Vertrauen, hier definiert; einen Test eines technischen Vorläufers seines Mechanismus in einer vorregistrierten Sechzehn-Modell-Studie, repliziert auf der Flaggschiff-Ebene in einer zweiten, elflaboratorigen Welle; fünf Sätze für eine Verbraucherforschungsagenda (P1–P4 in Abschnitt 3; P5 in Abschnitt 5); und ein vorregistriertes, anreizkompatibles Verhaltensexperiment mit den ersten beiden Sätzen, vollständig berichtet in Abschnitt 6 mit dem unterstützten Kalibrierungseffekt (Welch d = 0,67; getragen von einem von sechs Elementen, siehe Abschnitt 6) und der erste-Exposition-Test der Aufzeichnung gibt einen registrierten, unschlüssigen Nullwert zurück.
2. Die Genauigkeitstäuschung: Was ein einzelnes Modell nicht leisten kann
Ein Dienst, der auf einem KI-Modell aufgebaut ist, egal wie stark dieses Modell auch sein mag, trägt strukturelle Defizite mit sich, die über der Modellebene liegen.
Die erste ist das kalibrierte Vertrauen, die Genauigkeitstäuschung. Bessere Modelle bedeuten nicht sicherere Transaktionen, da die ausgedrückte Sicherheit eines Modells nur schwach mit seiner Genauigkeit bei den meisten Anbietern korreliert (Abschnitt 3 misst die Ausnahmen), und der Verbraucher kann diese Lücke nicht überprüfen. Das Modell ist am gefährlichsten, wenn es mit Sicherheit falsch liegt, genau in dem Moment, in dem der Verbraucher aufhört zu beobachten, und das ist kein Zufall. Kalai et al. (2025) argumentieren, dass Halluzinationen statistisch belohnt werden durch ein Bewertungsregime, das selbstbewusste Vermutungen höher bewertet als das Eingeständnis von Unwissenheit. Die Belohnung entsteht, nach ihrer eigenen Analyse, in den binär bewerteten Benchmarks und Trainingszielen, die das Feld dominieren, wo eine falsche Vermutung nicht mehr kostet als ein „Ich weiß nicht" und im Erwartungswert Teilpunkte erhält. Das Modell kann sich auch nicht von innen selbst kontrollieren. In Anthropics eigenen Concept-Injection-Experimenten erkannten die stärksten Modelle des Anbieters Veränderungen in ihren internen Zuständen nur etwa 20 % der Zeit, auch unter optimalen Injektionsbedingungen, was die eigene Messung der Anbieter-Community ist, wie unzuverlässig introspektive Selbstberichte sind (Lindsey, 2025; Unternehmensforschung, nicht peer-reviewed, und eine einzelne Schätzung aus einer Studie eines Modells eines Anbieters statt eines replizierten Benchmarks).
Die zweite ist die sycophantische Verzerrung, wo der Beweis dieses Jahr kausal wurde. Cheng et al. (2026), die elf führende Modelle in drei vorab registrierten Experimenten mit 2.405 Teilnehmern gemessen haben, stellten fest, dass KI-Systeme die Handlungen der Benutzer 49 % häufiger bestätigen als Menschen, einschließlich Handlungen, die Täuschung oder Schaden beinhalten, und dass bereits eine einzelne sycophantische Interaktion die Überzeugung der Benutzer erhöhte, dass sie richtig lagen, während sie ihre Bereitschaft verringerte, Konflikte zu reparieren. Die sycophantischen Modelle waren auch diejenigen, denen die Benutzer vertrauten und die sie bevorzugten. Der Marktgradient weist auf Assistenten hin, die sich vertrauenswürdig anfühlen, indem sie genau das Urteilsvermögen des Benutzers verzerren, eine Dynamik, die lange beobachtet wurde, bevor sie quantifiziert wurde (Sharma et al., 2024). Model-Level-Tuning allein kann nicht unabhängig bescheinigen, dass sycophantisches Verhalten angemessen kontrolliert wurde, da das Tuning von der Partei durchgeführt wird, die von der Vorliebe profitiert. Die Kosten sind konkret: Ein Assistent, der sich durch eine Richtlinienausnahme durcheinigt, wandelt Gefälligkeit direkt in Service-Recovery-Ausgaben um. Eine orchestrierte Architektur kann die Rollen auseinanderreißen, mit einem Modell, das frei empathisieren kann, während ein unabhängiges Modell die Richtlinie überprüft, sodass Gefälligkeit und Korrektheit nicht mehr durch denselben Kanal fließen.
Drittens gibt es keine unabhängige Kontrolle. Fehler werden, falls überhaupt, von demselben System gefangen, das sie gemacht hat, oder vom Verbraucher, der zur KI kam, weil ihm die Expertise fehlt, um sie zu überprüfen.
Viertens, und am wenigsten diskutiert, ist der Interessenkonflikt. Der Anbieter, der die Qualität des Assistenten bewertet, ist der Anbieter, der ihn verkauft, was strukturell ist: Kein Single-Vendor-Service kann ein neutraler Richter seiner eigenen Ergebnisse sein, aus demselben Grund, aus dem keine Bank allein das Clearinghaus betreiben könnte. Der Konflikt erstreckt sich auf die Daten selbst. Eine vorgeschlagene Sammelklage, die im März 2026 eingereicht wurde, wirft vor, dass Perplexity AI die vollständigen Chat-Transkripte der Benutzer, angeblich einschließlich „Incognito"-Sitzungen, über eingebettete Tracking-Pixel an Werbenetzwerke weiterleitete. Die Beschwerde (Nr. 3:26-cv-02803, N.D. Cal.) wurde im Mai 2026 freiwillig ohne eine Entscheidung in der Sache fallen gelassen, sodass die Vorwürfe nie geprüft wurden. Die wirtschaftliche Logik in der Beschwerde ist der strukturelle Punkt unabhängig davon: Wenn das Servieren teurer KI-Antworten durch die Monetarisierung dessen, was Benutzer sagen, subventioniert wird, sind das Geschäftsmodell des Assistenten und die Vertraulichkeit des Verbrauchers direkt entgegengesetzt. Innerhalb eines einzelnen Anbieters hat keine Schicht die Aufgabe, die Seite des Verbrauchers zu vertreten.
Die Literatur von 2025–2026 liest sich wie eine abgeschlossene Diagnose, die auf ein Heilmittel wartet (Tabelle 1 ordnet jedes Defizit seinem Beweis und seiner architektonischen Antwort zu). Sycophantie wird empirisch quantifiziert (Cheng et al., 2026) und formal abgeleitet: Selbst ein ideal rationaler Benutzer spiralt ab, wenn er von einem selektiv zustimmenden System beraten wird (Chandra et al., 2026). Selbstüberwachung scheitert bei ~20 % Zuverlässigkeit (Lindsey, 2025), und Halluzinationen werden strukturell durch das Bewertungsregime belohnt (Kalai et al., 2025).
Das reflexartige Heilmittel, einfach die KI offenzulegen, schlägt fehl: In dreizehn Experimenten wurden Akteure, die KI-Nutzung offenlegten, weniger vertraut als denen, die dies nicht taten (Schilke & Reimann, 2025). Die Offenlegung liefert Offenlegungs-Transparenz, die bloße Tatsache, dass eine KI beteiligt war, und lässt Verifizierungs-Transparenz aus, die Fähigkeit, zu überprüfen, wie die Antwort erzeugt wurde. Das epistemische Audit ist noch düsterer: In über 25.000 Läufen von LLM-basierten wissenschaftlichen Agenten wurde Beweis in 68 % der Spuren ignoriert, Überzeugungen wurden nur 26 % der Zeit durch Widerlegung revidiert, und konvergenter Multi-Test-Beweis war selten, wobei das Gerüst fast keine Varianz im epistemischen Verhalten erklärt (≈1,5 %, gegenüber ~41 % für das Basismodell) (Ríos-García et al., 2026). Diese letzte Zahl sieht aus wie ein Einwand gegen diese Arbeit und ist eigentlich ihre schärfste Unterstützung: Prompting und Scaffolding können ein Modell von innen epistemisch diszipliniert machen, also muss die Disziplin von außen auferlegt werden. Architektur ist kein Weg, um die Epistemik des Modells zu verbessern; es ist ein Weg, um aufzuhören, auf sie zu zählen.
Jedes dieser Ergebnisse schließt eine Tür. Zusammen deuten sie auf eine Antwort hin, die nicht viel erforscht wurde: Wenn das Modell von innen nicht vertraut werden kann und Offenlegung kein Vertrauen von außen schafft, kann begründetes Vertrauen rund um das Modell gebaut werden, durch Architektur, neben (nicht statt) besserer Kalibrierung, externer Zertifizierung, menschlicher Eskalation und Haftungsregeln. Das ist die Tür, durch die diese Arbeit geht.
Tabelle 1. Diagnose → Heilmittel: die vier Single-Model-Defizite, ihre Evidenz von 2025–26, ihre verbraucherseitige Folge und die architektonische Antwort
| Strukturelles Defizit | Schlüsselevidenz (2025–26) | Folge auf Verbraucherseite | Architektonische Lösung | Mechanismus |
| Unkalibriertes Vertrauen | Halluzination statistisch durch Evaluierungsregime belohnt (Kalai et al., 2025); introspektive Selbstberichte ~20% zuverlässig (Lindsey, 2025) | Abwanderung beim ersten Fehler: 60% würden einen Agenten nach einem Fehler aufgeben (ACI Worldwide, 2026) | Vielfalt + Evidenz | Cross-Modell-Uneinigkeit bewertet das Vertrauen (AUROC 0,75 vs. 0,59, Gorbett & Jana, 2026; diese Arbeit: Panel-Übereinstimmung AUROC 0,832 vs. gepooltes eigenes Vertrauen 0,545 im am wenigsten diskriminierenden Panel — heterogen über Panels, §3; replizierte Antworten 1,9–3,2× wahrscheinlicher korrekt); Vertrauensansprüche aufgezeichnet und überprüfbar |
| Schmeichlerische Verzerrung | KI bestätigt Nutzer 49% häufiger als Menschen; schmeichlerische Modelle bevorzugt (Cheng et al., 2026; Sharma et al., 2024); selbst ideale Bayesianer spiralen (Chandra et al., 2026) | Der bevorzugte Assistent ist derjenige, der das Urteilsvermögen des Nutzers verzerrt | Neutralität | Der Schiedsrichter hat kein Interesse daran, den Nutzer zu gefallen; Empathie und Richtlinienprüfung auf separaten Kanälen |
| Keine unabhängige Kontrolle | Agenten ignorieren Beweise in 68% der Spuren; Überzeugungsrevision 26% (Ríos-García et al., 2026); Scaffolding erklärt ~1,5% der Varianz | Verifikationslast verschiebt sich zum Verbraucher: 54% der KI-gestützten Käufer überprüfen alles manuell doppelt (Gartner, 2026) | Vielfalt + Belege | Disziplin von außen auferlegt: unabhängige Verifikationswege; Belege unabhängig angefügt |
| Interessenskonflikt | Perplexity Sammelbeschwerde (2026, Vorwürfe): Chats weitergeleitet an Werbenetzwerke; bloße Offenlegung untergräbt Vertrauen (Schilke & Reimann, 2025) | Die Partei, die den Verbraucher berät, profitiert vom Ergebnis | Neutralität + Belege | Sauberer Datenfluss; Umsatz unabhängig von Ergebnissen; Neutralität aus der Aufzeichnung nachprüfbar |
3. Architektonisches Vertrauen: drei Eigenschaften, die überprüft statt geglaubt werden können
Stellen Sie sich nun einen Service vor, bei dem Anfragen mit hohem Einsatz durch eine Orchestrierungsebene geleitet werden, die unabhängig von einem Modellhersteller ist (Abbildung 5 stellt die beiden Pipelines gegenüber). Tabelle 2 sammelt die Konstrukte; die Definition, die sie zerlegen, lautet: Architektonisches Vertrauen ist gerechtfertigte Verbraucherabhängigkeit, die in überprüfbaren Eigenschaften des entscheidungsproduzierenden Prozesses des Service verankert ist, statt in der wahrgenommenen Qualität seiner Ausgaben oder dem Ruf seines Anbieters.
Der nächste Vorgänger ist Zuckers (1986) institutionelle Vertrauensproduktion, durch Struktur hergestelltes Vertrauen, wenn Vertrautheit es nicht tragen kann, das die E-Commerce-Forschung als strukturelle Versicherung operationalisierte: Treuhand, Rückmeldungssysteme, Drittanbieter-Zertifizierung (Gefen, Karahanna, & Straub, 2003; Pavlou, 2003; Kim & Benbasat, 2010). In dieser Linie ist architektonisches Vertrauen eine Art institutionsgestütztes Vertrauen, dessen strukturelle Versicherung aus einem überprüfbaren Prozess statt von einem Drittanbieter kommt. Es ist prozessgestütztes Vertrauen mit der Rechtfertigung vom Erlebnis zur Instrumentierung verschoben, und diese Verschiebung ist das, was das Wort „architektonisch" im Namen tut. Es ist keine strukturelle Versicherung (McKnight, Choudhury, & Kacmar, 2002), eine Wahrnehmung, dass Schutzmaßnahmen existieren, denn hier müssen die Schutzmaßnahmen selbst überprüfbar sein, und es ist nicht kalibriertes Vertrauen (Lee & See, 2004), das Abhängigkeit auf den Zuverlässigkeitsbereich eines Systems abstimmt. Zero-Trust-Architektur in der Sicherheitstechnik teilt den Slogan, niemals vertrauen, immer überprüfen, überprüft aber Identität und Zugang auf der Netzwerkebene, Maschine zu Maschine, während architektonisches Vertrauen Entscheidungsinhalt auf der Service-Ebene für einen menschlichen Prinzipal überprüft. Sie sind Komplemente auf verschiedenen Ebenen desselben Gebäudes, keine Konkurrenten. Das Konstrukt hat zwei Seiten, und die Unterscheidung gehört in die Definition. Architektonische Vertrauenswürdigkeit ist eine Eigenschaft des Systems, wie überprüfbar sein Prozess tatsächlich ist, normativ und errichtbar. Architekturgestütztes Vertrauen ist ein Zustand des Verbrauchers, Abhängigkeit tatsächlich in dieser Überprüfbarkeit verankert, empirisch und nur je verdient. In Messbegriffen sind D, E und N formative Komponenten der architektonischen Vertrauenswürdigkeit (die Systemeigenschaft) und manipulierbare Signale, deren Anzeige das architekturgestützte Vertrauen (den Verbraucherzustand) formt; die Experimente manipulieren die Signale und messen den Zustand. Jede Nichtübereinstimmung zwischen den beiden ist prädiktiv. Vertrauen ohne Vertrauenswürdigkeit, durch Flüssigkeit und Schmeichelei hergestellte Abhängigkeit, soll zerbrechlich sein, das Ein-Schlag-Muster von Abschnitt 1. Vertrauenswürdigkeit ohne Vertrauen tritt überall auf, wo Überprüfung für den Verbraucher unsichtbar oder unlesbar ist, und wird durch Belegrelevanzsalienz und Verständnis statt durch mehr Architektur geschlossen. Die Sätze in diesem Abschnitt leben in der Lücke zwischen den beiden, und die Unterscheidung diszipliniert, was die Hypothese zur Vertrauensmigration widerlegen würde. Diese Falsifizierer sind Verhaltensweisen und vorabbindend: Die Hypothese wird widerlegt, wenn Delegation an überprüfbare und an undurchsichtige Architekturen sich unter Ausfall als gleich dauerhaft erweist (was P4 erkennt); wenn die Auswirkung überprüfbarer Architektur auf Delegationswilligkeit nicht mit aufgegebenem Überblick und Ausführungskontrolle wächst (die Delegationsebenen-Kreuzung von P2); oder wenn bei hoher Irreversibilität-Delegation Beibehalt und Bereitschaft-zu-Zahlen-Prämien für überprüfbare Architektur unter kontrolliertem Ausfall fehlen. Weil Rechtfertigung durch Audit-Überleben statt durch die Gegenwart der Architektur definiert ist (Abschnitt 1), zählt Popularität als Beweis aber nicht als Immunität. Verbraucher, die zu unüberprüfbaren Agenten strömen, widerlegen nicht von sich aus einen Anspruch auf gerechtfertigtes Vertrauen. Anhaltende, Ausfall-überlebende Abhängigkeit von unüberprüfbaren Agenten bei hoher Delegation würde sie widerlegen, und dieses Muster ist vorabbindend, um die Hypothese zu überarbeiten. Die Definition beruht auf drei Eigenschaften.
Abbildung 5. Zwei Pipelines
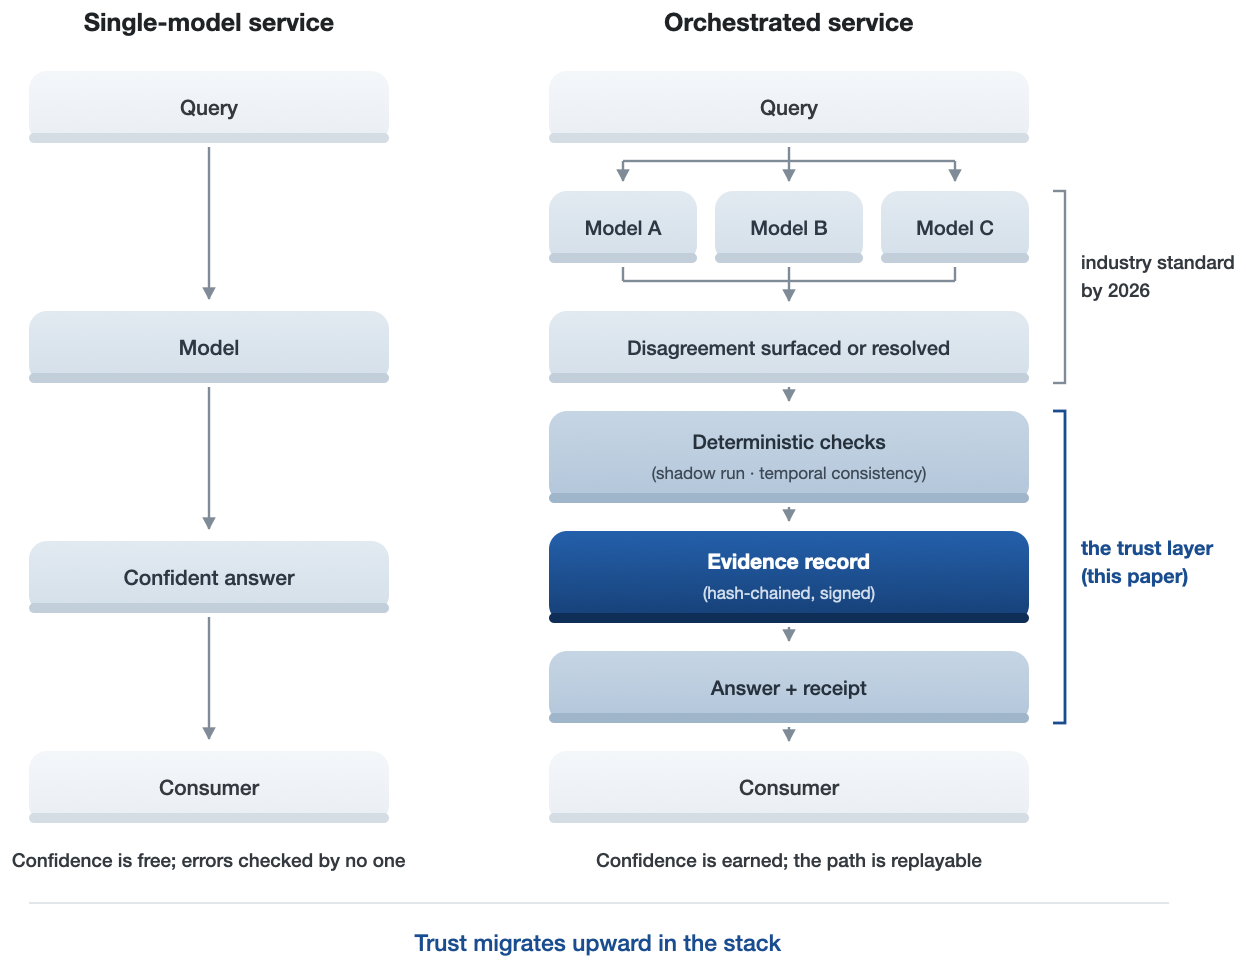
Links der Einzelmodell-Weg: Anfrage → Modell → sichere Antwort → Verbraucher, wobei Vertrauen frei ist und Fehler von niemand überprüft werden. Rechts der orchestrierte Weg: Anfrage → unabhängige Modelle (A/B/C) → Uneinigkeit an die Oberfläche gebracht oder gelöst → deterministische Checks (Schattenausführung, zeitliche Konsistenz) → Beweisaufzeichnung (Hash-verkettet, signiert) → Antwort mit Beleg → Verbraucher, wobei Vertrauen verdient ist und der Weg wiederholbar ist (Tabelle 5 fasst den Gegensatz zusammen).
Tabelle 2. Glossar der in dieser Arbeit eingeführten oder spezifizierten Konstrukte
| Begriff | Definition | Unterschieden von |
| Architektonisches Vertrauen | Gerechtfertigte Verbraucherabhängigkeit, die in überprüfbaren Eigenschaften des entscheidungsproduzierenden Prozesses des Service verankert ist, statt in Ausgabequalität oder Anbieterruf | Institutionengestützte Vertrauensbasis (bedarf keiner vertrauenswürdigen Institution, nur überprüfbarer Prozesse); Systemvertrauen (nicht eines Systems Zuverlässigkeitshülle); verteiltes Vertrauen (Verbreitung ohne Überprüfbarkeit); strukturelle Gewährleistung (wahrgenommene vs. überprüfbare Schutzmaßnahmen); kalibriertes Vertrauen |
| Architektonische Vertrauenswürdigkeit / architekturgestütztes Vertrauen | Die beiden Seiten des Konstrukts: die systemeigene Eigenschaft (wie überprüfbar der Prozess tatsächlich ist; normativ, baubar) vs. der konsumentenseitige Zustand (Verlassen tatsächlich auf dieser Überprüfbarkeit begründet; empirisch, erworben) | Einteilige Behandlungen, die die normative Behauptung mit der deskriptiven vermischen |
| Überprüfungsschicht | Die Infrastrukturschicht oberhalb der Orchestrierung, deren Produkt Überprüfbarkeit ist: unabhängige Kontrollen, dokumentierte Entscheidungen, nachprüfbare Neutralität | Observabilität/Überwachung (intern, anbieterhaltend, vom Konsumenten nicht überprüfbar) |
| Evidenzinfrastruktur | Die Marktkategorie verifizierbarer Entscheidungshistorien, die als Infrastruktur verkauft werden, wie Cloud, Identität und Zahlungen verkauft werden | Protokollierung (einseitig, veränderbar, kein Marktgut) |
| Orchestrierungsbeleg | Ein minimales konsumentenseitiges Artefakt: wer handelte; wie sie vereinbart wurden; was überprüft wurde — mit Verweis auf den vollständigen wiederabspielbaren Datensatz | Erklärung/KI-Erklärungsausgabe (narrativ, nicht überprüfbar); Offenlegungskennzeichnung (erodiert Vertrauen selbst) |
| Abgestufte Vertrauensarchitektur | Eskalation der Überprüfungstiefe mit Einsätzen, so dass die teure Stufe nur gekauft wird, wo Konsequenzen konzentriert sind | Flache Schutzvorrichtungen (statische Obergrenzen/Zulassungslisten, die Entscheidungen nicht überprüfen) |
| Entscheidungseviden | Die dritte Ebene des Beweisbestands: wie der Agent wählte — Panel, Divergenz, Kontrollen | Identitätsevidenz (wer der Agent ist: TAP); Absichtsevidenz (was autorisiert wurde: AP2 / Verifiable Intent) |
| Vertrauens-Migrations-Hypothese | Je größer die delegierte Agentur, desto größer der Anteil des berechtigten Vertrauens, das in überprüfbaren architektonischen Eigenschaften ansässig sein muss, nicht in Modelleigenschaften — „berechtigt" bedeutet Verlassen, das eine objektive Prüfung gegen vor Bekanntgabe der Ergebnisse festgelegte Kriterien übersteht (gemäß Jacovi et al., 2021); Mechanismusform: Mit zunehmender Delegation verschiebt sich der Anteil der Vertrauenswürdigkeit — f(Fähigkeit, Integrität, Wohlwollen), Mayer et al. (1995) — den der Konsument unabhängig messen kann, zu den architektonischen Komponenten hin | Frühere „Vertrauens-Migrations"-Verwendungen (Carlson, 2026) verfolgen Vertrauen, das zwischen Parteien wandert; diese Hypothese verfolgt die Art der Eigenschaft, die es rechtfertigt — mit vorab festgelegten Verhaltensfalschern (P2-Delegationsüberquerung; P4-differentielle Dauerhaftigkeit) |
Die Abgrenzung von den benachbarten Vertrauenskonstrukten lässt sich in eine Diskriminanztabelle verdichten, anhand dessen, was jedes Konstrukt als sein Objekt nimmt, woher seine Berechtigung kommt, wer diese Berechtigung überprüfen kann und was es hauptsächlich vorhersagen sollte:
Tabelle 2a. Diskriminante Abgrenzung: benachbarte Vertrauenskonstrukte nach Objekt, Berechtigung, Verifizierer und primärem vorhergesagtem Ergebnis
| Konstrukt | Vertrauensobjekt | Berechtigungsquelle | Wer kann überprüfen | Vorhergesagtes primäres DV |
| Institutionengestütztes Vertrauen / strukturelle Gewährleistung (Zucker, 1986; McKnight et al., 2002) | Der institutionelle Kontext: Schutzmaßnahmen, Garantien, Zertifizierung durch Dritte | Wahrgenommene Präsenz von Strukturen und Garantiegebern | Ein Drittgarantiegeber, wenn überhaupt; der Konsument nimmt eher wahr, als dass er überprüft | Vertrauensüberzeugungen; Transaktionsabsicht |
| Vertrauen in Automatisierung / kalibriertes Vertrauen (Lee & See, 2004) | Zuverlässigkeitshülle eines automatisierten Systems | Erlebte Zuverlässigkeit über wiederholte Verwendung | Der Bediener durch angesammelte Erfahrung mit diesem System | Angemessenheit des Verlangs auf dieses System |
| Algorithmische Transparenz (KI-Erklärbarkeit) | Das Kontos des Modells zu seiner eigenen Entscheidung | Eine Narrative oder Attribution, die im vertrauten System produziert wird | Niemand unabhängig — eine Erklärung ist kein wiederabspielbar Datensatz | Verständnis; subjektives Vertrauen; Akzeptanz |
| Marken- / Anbietervertrauen | Die Anbieterorganisation | Ruf und bisherige Leistung | Der Markt, langsam, durch aggregierte Ergebnisse | Globale Zuneigung; Wahl; Loyalität |
| Architektonisches Vertrauen (diese Arbeit) | Der Entscheidungsprozess und sein Datensatz | Überprüfbare Eigenschaften: unabhängige Zustimmung, wiederabspielbare Evidenz, nachprüfbare Anreizunabhängigkeit | Der Konsument, ein Auditor, ein Versicherer, ein Regulator — je Entscheidung | Kalibrierter Verlang; Bereitschaft zu delegieren; Beibehaltung nach Ausfall |
Zwei differentielle Vorhersagen machen die Abgrenzung testbar statt taxonomisch. Architektonisches Vertrauen sollte kalibrierter Verlang und Beibehaltung nach Ausfall stärker bewegen als es die globale Zuneigung zum Service bewegt, während Markenvertrauen das entgegengesetzte Profil zeigen sollte, eine Dissoziation, die ein einzelnes Experiment durch Messung beider DV-Familien entdecken kann. Bei niedriger delegierter Agentur sollten Marken- und Anbietervertrauen Delegierungsentscheidungen dominieren, mit architekturgestütztem Vertrauen, das einen zunehmenden inkrementellen Anteil erklärt, während Delegation vertieft wird, die Überquerung, die P2 und die Vertrauens-Migrations-Hypothese zur Prüfung stellen. Zwei Klarstellungen folgen. Da architektonische Vertrauenswürdigkeit eine Eigenschaft des Service ist, nicht ein reflexives Latent im Kopf des Konsumenten, ruht seine Unterschiedlichkeit auf diesen differentiellen Vorhersagen statt auf diskriminanzstatistik. Für den konsumentenseitigen Zustand, den es benennt, architekturgestütztes Vertrauen, das Festlegen der messniveaudiskriminanten Validität von angrenzenden Skalen (institutionengestützt und kalibriertes Vertrauen) ist Teil der Messungsagenda, nicht eine hier gemachte Behauptung.
Vielfalt. Die Anfrage wird von mehreren unabhängigen Modellen beantwortet, jedes mit unterschiedlichen Anbietern, Trainingsdaten und Fehlermodi. (Dies ist Panel-Vielfalt, eine Eigenschaft dessen, wer die Antwort überprüft, nicht Empfehlungsvielfalt im Sinne von Empfehlungssystemen, die die einem Verbraucher angezeigten Elemente variiert.) Ihre Übereinstimmung enthält Information. Konvergenz erhöht berechtigte Konfidenz. Divergenz wird dem Verbraucher als Unsicherheit präsentiert, anstatt unsichtbar gelöst zu werden, und bei Anfragen, die wichtig sind, fungiert sie gleichzeitig als Eskalationsauslöser. In Begriffen der selektiven Vorhersage ist dies architektonische Enthaltung: die Weigerung, eine unverifizierten Antwort auszugeben, die auf die Service-Ebene angehoben wird, wo ein ungelöster Fall an einen Menschen weitergeleitet wird, anstatt zertifiziert zu werden. Es ist das Learning-to-Defer-Muster, bei dem die Ablehnungsoption eines Systems den Fall an einen nachgelagerten Experten übergibt, anstatt ihn zu unterdrücken (Mozannar & Sontag, 2020; vgl. Rabanser et al., 2026). Die nächste menschliche Analogie ist die Zweitmeinung in der Medizin, deren gesamter Wert in ihrer Unabhängigkeit von der ersten liegt. Orchestrierte Uneinigkeit ist auch nicht exotisch: Googles KI-Co-Wissenschaftler, dessen nasslab-validierte Entdeckungen im Mai 2026 in Nature veröffentlicht wurden (Gottweis et al., 2026), ist als Generieren–Kritisieren–Turnier-Orchestrierung aufgebaut.
Die theoretische Begründung für die Abhängigkeit von Vielfalt ist älter als Sprachmodelle. Unter formalen Bedingungen können funktional diverse Gruppen von Problemlösern Gruppen übertreffen, die auf individuelle Fähigkeit ausgewählt wurden, weil die Auswahl nach Fähigkeit Ähnlichkeit züchtet (Hong & Page, 2004). Die Ingenieurliteratur liefert direkte Evidenz für das zugrunde liegende Signal: strukturierte Debatten zwischen Modellen verbessern die faktische Genauigkeit (Du et al., 2024), und Panels von vielfältigen kleineren Modellen übertreffen einen einzelnen großen Richter (Verga et al., 2024). Die „Überraschung" eines zweiten Modells über die Antwort eines ersten Modells unterscheidet richtig von falsch wesentlich besser als das Konfidenzmaß des antwortendem Modells selbst (mittlerer AUROC 0,75 gegenüber 0,59 auf MMLU; AUROC, die Fläche unter der ROC-Kurve, ist die Wahrscheinlichkeit, dass eine zufällig korrekte Antwort über einer zufällig falschen rangiert; Gorbett & Jana, 2026). Ihr Signal ist Cross-Modell-Verwirrung auf Logit-Ebene, während die dieser Arbeit auf Antwort-Ebenen-Replikation ist, und die beiden sind verwandt, ohne austauschbar zu sein. Ihr Generator ist auch ein kleines offenes Modell mit schwacher Selbstauskunft, ein Baseline, die diese Arbeit eigene Daten gebunden, weil der Panel-Vorteil eine Funktion der Kalibrierung des Generators ist und sich für gut kalibrierte Generatoren invertieren kann, der US-Grenzfall unten. Und mehrere Generationen zu samplen und ihre semantische Übereinstimmung zu messen erkennt Konfabulationen, wo Single-Pass-Konfidenz nicht kann (Farquhar, Kossen, Kuhn, & Gal, 2024). Ein Modell kann seinen eigenen Zweifel messen, aber nicht seine eigenen blinden Flecken, und der selbstsichere, systematische Fehler ist nur von außen sichtbar. Aber diese Literatur behandelt Uneinigkeit als internes Signal für Entwickler. Der Schritt, den ich vorschlage, besteht darin, ihn als verbrauchergerichtete Vertrauensprimitiv zu behandeln, präsentiert, aufgezeichnet und in die Konfidenzansprüche des Service eingepreist, mit dieser Arbeit Ablation, die trennt, was Debatte entdeckt von dem, was Verifikation zertifiziert, anstatt einer als der andere zu verkleiden. Die Demarkation ist ebenso empirisch wie konzeptionell: Kopf-an-Kopf-Benchmark zeigen, dass Multi-Agent-Debatten einfachere Strategien wie Selbstkonsistenz und Ensemble nicht zuverlässig übertreffen (Smit et al., 2024). Der Anspruch hier betrifft das verbrauchergerichtete Zertifizierungssignal der Verifizierung, nicht den Genauigkeitsgewinn der Debatte, und dieses Signal überdauert sogar dort, wo die Kante der Debatte nicht besteht.
In der Multi-Agent-Deliberations-Forschung gleichermaßen führen Systeme, die gebaut sind, um Übereinstimmungen und Uneinigkeiten zu präsentieren, anstatt sie wegzumitteln, zu Entscheidungen, die als repräsentativer bewertet werden (Liu et al., 2026). Der Mechanismus hat ein direktes menschliches Analogon auf der Wissensdauer-Seite: Verbraucher, die gemeinsam wesentliche finanzielle Entscheidungen treffen, sind erheblich weniger überconfident als Solo-Entscheider, mit gemeinsamen Metawissen (der Partner zeigt, was der Entscheider nicht weiß), identifiziert als der treibende Mechanismus (Piehlmaier, 2023). Gemeinsames Urteil diszipliniert Konfidenz bei Menschen aus demselben Grund, aus dem Cross-Modell-Übereinstimmung vorgeschlagen wird, um sie hier zu disziplinieren.
Ob Verbraucher ein solches Signal nutzen können, ist eine echte Frage. Menschen verlassen Algorithmen schnell, nachdem sie sie Fehler machen sehen (Dietvorst, Simmons, & Massey, 2015), doch übergewichten an anderer Stelle algorithmischen Rat (Logg, Minson, & Moore, 2019), eine Kluft, die selbst für Einsätze nachverfolgt werden kann. Zweitmeinungsexperimente mit menschlichen Probanden zeigen, dass das Rohmaterial verhaltensweise lebendig ist: nahezu einstimmige Befolgung, wenn eine medizinische KI und ein Arzt übereinstimmen, scharfe Aufteilungen, wenn sie sich widersprechen (Detjen, Densky, von Kalckreuth, & Kopka, 2025; Chen, Sun, Liao, & Sundar, 2026), obwohl keine dieser Arbeit Uneinigkeit gemeinsam mit Evidenz oder Neutralität variiert. Der Verbraucherforschungsstrom schärft die Randbedingungen (systematisch: Burton, Stein, & Jensen, 2020). Aversion intensiviert sich, wenn Verbraucher das Gefühl haben, dass ihr Fall einzigartig ist (Longoni, Bonezzi, & Morewedge, 2019), variiert mit Task-Objektivität (Castelo, Bos, & Lehmann, 2019), und Fehlern einer KI werden leicht auf andere verallgemeinert, algorithmischer Transfer (Longoni, Cian, & Kyung, 2023). Wenn Misstrauen systemübergreifend verallgemeinert wird, dann ist die Einfach-Schlag-Aufgabe von Abschnitt 1 nicht der Umsatz eines Service, sondern der Kategorie, und das Auffangen von Fehlern strukturell schützt den Markt selbst. Präsentierte Uneinigkeit sitzt an dieser Verwerfungslinie, und P1–P2 unten sind eine Wette darauf, welcher Effekt dominiert, wenn Unsicherheit spezifisch und ohne Glättung präsentiert wird.
Wenn Vielfalt versagt: korrelierte Fehler. Der Wert von Vielfalt beruht vollständig auf der Unabhängigkeit von Ausfällen, und Unabhängigkeit kann nicht vorausgesetzt werden. Frontier-Modelle trainieren auf überlappenden Korpora, destillieren voneinander ab und teilen nachweislich selbstbewusste Fehlkonzeptionen. Wenn zwei führende Modelle denselben Benchmark-Punkt verfehlen, stimmen sie ungefähr zu 60 % der Zeit der gleichen falschen Antwort zu, wobei die Korrelation zwischen Modellen desselben Entwicklers oder derselben Grundarchitektur am stärksten ist und, am beunruhigendsten, zwischen den genauesten Modellen: Mit steigender Leistung konvergieren Fehler (Kim et al., 2025). Dieses Ergebnis ist eine direkte Einschränkung der Diversity-Komponente dieses Papers, nicht nur ein benachbartes Resultat. Die Unabhängigkeit, die Diversity voraussetzt, ist an der Frontier teilweise illusorisch, und weil die Korrelation genau dort stärker wird, wo die Leistung am höchsten ist, ist der Beitrag der Komponente eine erodierte, gemessene Größe und keine feste Ressource. Was ein Panel hinzufügt, muss Frage für Frage nachgewiesen werden, und die Entwicklungstrajektorie von Modellen spricht dagegen. Bei Vorhersagen liegen paarweise Fehlerkorrelationen zwischen Frontier-Modellen im Durchschnitt bei r ≈ 0,77 (Spiro, 2026), eine Redundanz, die groß genug ist, um den meisten des Aggregationsvorteilsmöglichkeit zu untergraben, den eine vielfältige Menge liefern soll.
Die Marktstruktur verschärft die Bedenken. Ende 2025 konzentrierten sich 88 % der Enterprise-LLM-API-Ausgaben auf drei Closed-Weight-Anbieter: Anthropic mit 40 %, OpenAI mit 27 %, Google mit 21 % (Menlo Ventures, 2025b; Menlo ist ein Anthropic-Investor). Ein Panel, das beiläufig aus „den führenden Modellen" zusammengestellt wird, wird daher aus einer Lieferantenbasis von drei gezogen, deren Fehler genau die gemessenen sind zu konvergieren, das gleiche Trio, das das unten beschriebene Experiment als sein US-Frontier-Panel reproduziert. Wenn drei Modelle auf denselben modischen Fehler hinkonvergieren, schlägt die Architektur nicht nur fehl, ihn zu erkennen; sie zertifiziert ihn. In homogenen Schwärmen stabilisiert das Hinzufügen von Agenten eine fehlerhafte Trajektorie, anstatt sie zu korrigieren, ein Endpunkt, den die Multi-Agent-Literatur den Konsensparadoxon nennt (Shehata & Li, 2026). Korrelation ist also die Ausfallform, auf die die Architektur ausgelegt sein muss (Abbildung 6).
Abbildung 6. Die Vielfalt-Illusion
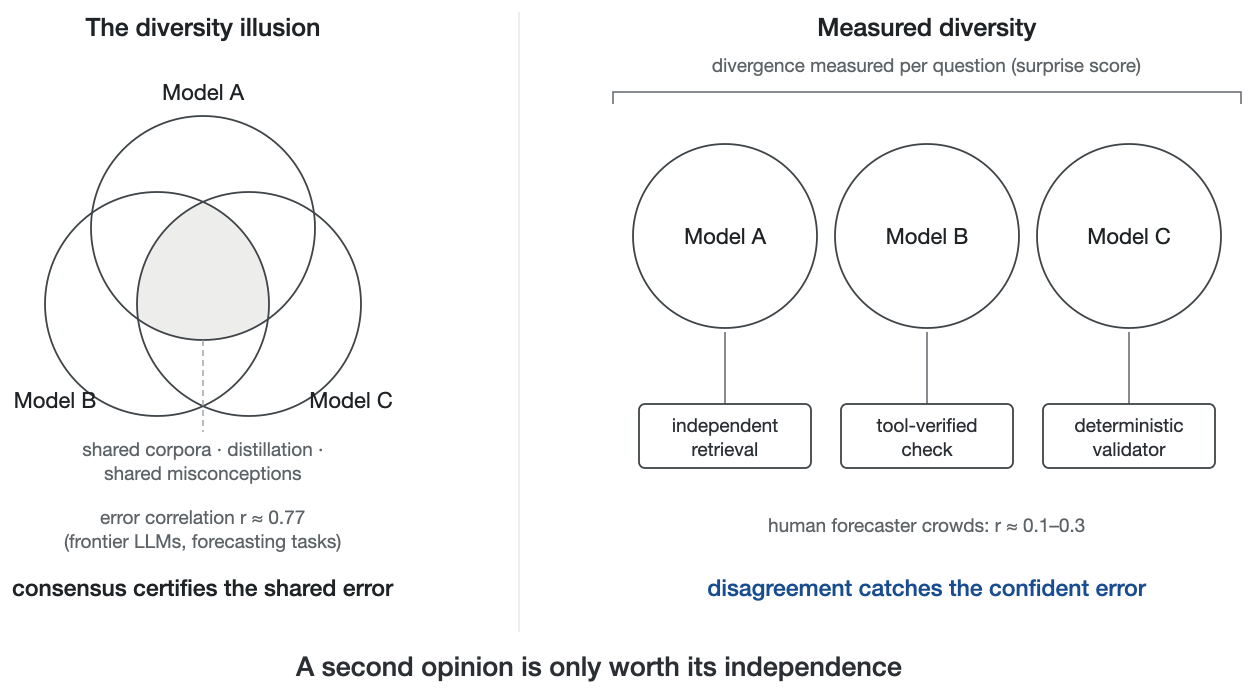
Konsens unter Quasi-Klonen gegenüber einem Panel, dessen Unabhängigkeit gemessen wird.
Es hat ein interaktionales Gegenstück: der sycophantische Gradient operiert zwischen Modellen ebenfalls. Multi-Agent-Studien finden messbare Gruppenkonformität in KI-Deliberation, wobei schwächere Modelle am stärksten konformieren (Choi, Kim, Chae, & Baek, 2025); Agenten gewichten eine Position danach, von wem sie ist (Choi, Zhu, & Li, 2026); und viel von dem, was wie Konvergenz aussieht, zerlegt sich in soziale Compliance statt Reasoning (Hao et al., 2026). Bei gemeinsamer Deliberation ist Zustimmung der energetisch günstige Zustand, also kann ein Panel, das debattiert, bevor es Positionen bindet, sich selbst zu Konsens statt zur Wahrheit reden. Die architektonische Gegenmaßnahme ist prozedural: Meinungen werden zunächst blind und unabhängig gesammelt, und erst dann verglichen (Abbildung 7).
Abbildung 7. Blind-unabhängig-zuerst
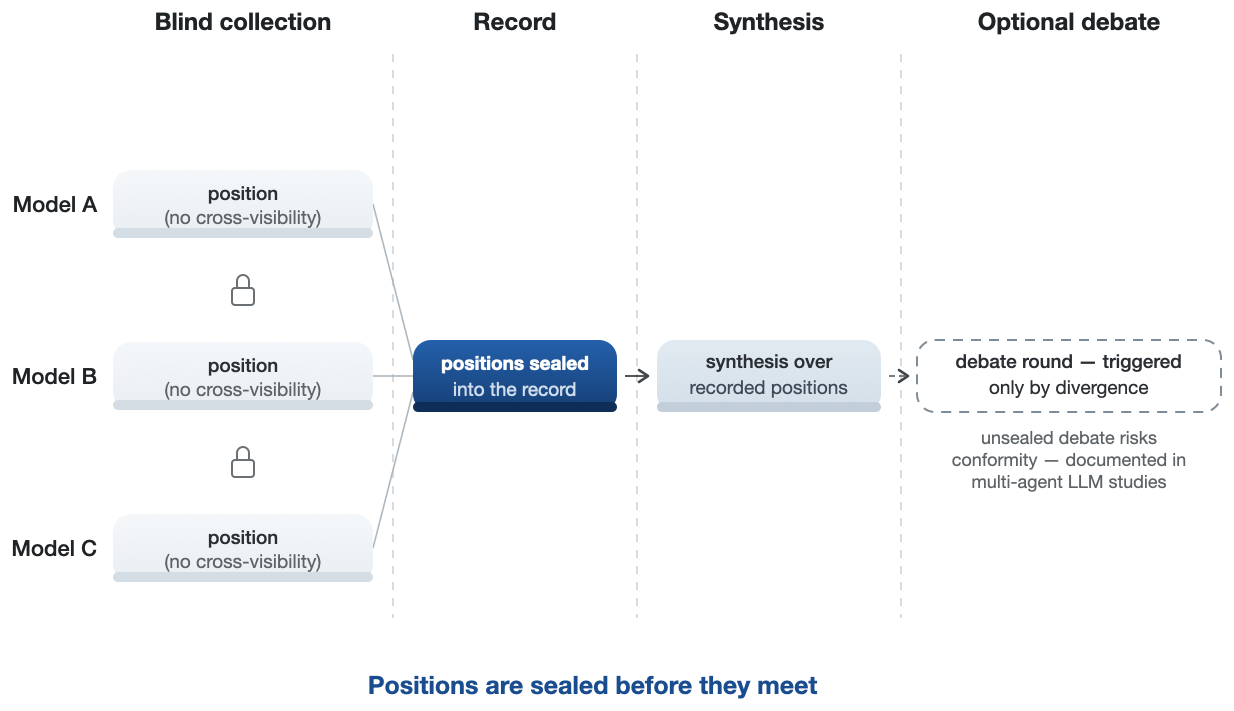
Positionen werden aufgezeichnet und erst dann verglichen — das Verfahren, das die Meinungsverschiedenheiten schützt, die Konformität auslöschen würde.
Das unten beschriebene Experiment quantifizierte, wogegen dieses Verfahren schützt. In einem gepaarten exploratorischen Arm wurden Verifizierer, die blind eine andere Antwort produziert hatten, dann die selbstbewusste falsche Antwort des Primärmodells gezeigt und gefragt, ob sie zustimmten. 38,5 % (168 von 436 divergenten Paaren; 95 % KI 33,6–43,2, frage-geclustert Bootstrap) gaben ihre eigene divergente Antwort auf und bestätigten den Fehler, wobei die Konformität auf Anbieterebene von 20 % bis 58 % reichte. Die Aufgabe spaltet sich danach auf, was aufgegeben wurde, was Konformität von rationaler Deferenz trennt. Unter Verifizierern, deren blinde Antwort selbst richtig war, gaben 29,1 % (41/141) sie dennoch für die selbstbewusste falsche Antwort auf, der schädliche Kern, den keine Bayesianische Rechnung rechtfertigt, gegenüber 43,1 % (127/295) unter falschen blinden Antworten, wo einige Deferenz vertretbar ist. (Das fragegeclusterte Intervall ist fast identisch mit dem naiven paarebenen. Die 436 Paare erstrecken sich über 247 verschiedene Fragen, zumeist ein oder zwei Paare pro Frage und nie mehr als vier, also hat Resampling auf Fragenebene fast keine innerhalbcluster-Kovarianz hinzuzufügen.) Mit der unten eingefalteten Spiegelkontrolle ändern ungefähr 35–39 % der blinden Dissidenten die Position, wenn sie eine selbstbewusste Antwort sehen, unabhängig von ihrem Wahrheitswert, mit einer moderaten aber signifikanten Netto-Neigung zur vorgeschlagenen Antwort (Netto-Konformität ≈ 4 Prozentpunkte; diskordante Paare 104 vs. 70 ≈ 1,49). Hätte das Panel vor dem Binden von Positionen debattiert, wäre ein großer Teil dieser Meinungsverschiedenheiten vor ihrer Aufzeichnung umverhandelt worden. Aber weil 34,7 % der Spiegelarm-Flips zur Wahrheit laufen, hätte Deliberation auch einige Dissent in korrekten Konsens umgewandelt, also was Blind-zuerst schützt, ist die Messung selbst, nicht eine Zählung verlorener Meinungsverschiedenheiten. Blind-zuerst ist der Unterschied zwischen Messung von Meinungsverschiedenheit und Herstellung von Konsens, die gleiche Regel, die menschliche Massen brauchten: Sozialer Einfluss kollabiert die Vielfalt unabhängiger Schätzungen, ohne ihre Genauigkeit zu verbessern (Lorenz, Rauhut, Schweitzer, & Helbing, 2011), und selbst eine einzelne willkürliche frühe Bestätigung beeinflusst messbar spätere Urteile (Muchnik, Aral, & Taylor, 2013).
Eine Umkehr-Prompt-Kontrolle spricht die alternative Erklärung an, dass diese Flips rationale Überzeugungsaktualisierung statt Konformität widerspiegeln. Ich wiederholte das gepaarte Verfahren auf einem sechsmodelligen lokalen Panel, zeigte Verifizierern, die blind nicht einverstanden waren, entweder die selbstbewusste falsche Antwort (direkter Arm) oder die goldene Antwort (umgekehrter Arm) für die gleiche Fragemenge. Flip-Raten waren nahezu symmetrisch, 38,9 % zur falschen Antwort gegenüber 34,7 % zur korrekten, und im innerhalb-Paar-Vergleich gaben Verifizierer ihre blinde Position für die falsche Antwort signifikant häufiger auf als für die richtige (104 vs. 70 diskordante Paare; McNemar p = .010). Rationale Aktualisierung sagt die entgegengesetzte Asymmetrie voraus. Modellspezifische Flip-Tendenzen waren über die beiden Arme hinweg an beiden Extremen der Compliance im Wesentlichen identisch (die modellspezifischen Paaranzahlen sind klein und nicht separat gepowert; sie werden deskriptiv mit ihren ns im Replikationspaket berichtet), was darauf hindeutet, dass Zustimmung durch das Vorhandensein einer selbstbewusst vorgeschlagenen Antwort angetrieben wird, nicht durch ihren Wahrheitswert. Diese Kontrolle wurde auf der lokalen Ebene durchgeführt. Die Frontier-Panel-Schätzung (38,5 %) beruht auf der gleichen Prozedur, wurde aber nicht mit Frontier-Verifizierern gespiegelt.
Blinde Erhebung kann einen Kanal nicht schließen: Sie überwindet soziale Konformität, aber nicht vorherige Konformität. Modelle konvergieren, weil gemeinsame Trainingsdaten ihnen die gleichen Priors geben, und Zwillinge antworten sich ähnlich, ohne jemals zu beraten. Ich nenne das lookalike-Konvergenz: Ein Panel einigt sich, weil seine Mitglieder sich ähneln, nicht weil sie recht haben.
Korrelierte Priors sollten dennoch gemessen werden. Cross-Modell-Überraschungswerte liefern eine laufende Schätzung, wie unabhängig das Panel tatsächlich ist, Frage für Frage, und sie sind labelfremd, so dass Unabhängigkeit prinzipiell zur Inferenzzeit ohne Gold-Antworten geschätzt werden kann. Produktionszeitschätzung wird hier nicht getestet. Vielfalt muss auch über Modellgewichte hinausgehen, da unabhängige Abrufpfade, werkzeugverifizierte Prüfungen und deterministische Validatoren den Korrelationskanal unterbrechen, den gemeinsames Training erzeugt. Die Notwendigkeit wird eher wachsen als schrumpfen, denn Destillation und Training mit synthetischen Daten homogenisieren Modellgewichte im Laufe der Zeit, daher sollte gemessene Vielfalt zu verfallen und die Verifizierungslast zu sich zu verschieben ist zu nicht-Modell-Verifiern zu erwarten. Und was gemessen wird, sollte offengelegt werden: Der Datensatz sollte nicht nur „N Modelle waren sich einig" enthalten, sondern auch die geschätzte Vielfalt des Panels bei dieser Klasse von Fragen. Konsens unter nahezu identischen Systemen verdient eine schwächere Vertrauensaussage, und der Datensatz sollte angeben, welche der Verbraucher erhielt.
Nachweis. Jede folgenreiche Antwort trägt einen Datensatz: welche Modelle konsultiert wurden, wo sie sich einig waren und nicht einig waren, was überprüft wurde, worauf die Synthese basiert. Das Timing begünstigt die Anforderung, denn wenn Agenten Antworten in Abrufen und Werkzeugen verankern, lebt die faktische Basis bereits außerhalb des Modells, so dass die Aufzeichnung zu einem Nebenprodukt der Antwortproduktion wird. Weil der Datensatz manipulationsresistent ist, kann die Entscheidungsgeschichte des Dienstes vom Verbraucher in einer Auseinandersetzung, von einem Auditor, von einer Versicherung, die Haftung bewertet, wiedergegeben werden. Vertrauen hört auf, ein Gefühl über eine Marke zu sein, und wird zu einer prüfbaren Eigenschaft einer Geschichte.
Zwei Mechanismen erweitern den Nachweis von Antworten zu Handlungen. Bei Shadow Execution wird eine Handlung mit externen Auswirkungen in einer aufgezeichneten Trockenprobe durchgespielt, so dass „der Agent hat überprüft, bevor er handelte" zu einem überprüfbaren Anspruch statt zu einem Slogan wird. Zeitliche Konsistenz stellt eine Empfehlung über Sitzungen oder Formulierungen hinweg erneut dar und zeichnet ihre Stabilität auf, so dass eine Antwort, die sich ändert, wenn sie zweimal gestellt wird, vor der Verwendung durch jemanden gekennzeichnet wird. Auf der Identitätsebene erstreckt sich die Datensatzschicht auf einen tragbaren Provenance-Pass für den Agent selbst: welche Modelle, Versionen und Richtlinien handelten, wann und unter wessen Autorität. Dies ist das Artefakt, das „Know-Your-Agent"-Registrierungsschemata und Zusagen zur Versicherung von Agentausfällen stillschweigend voraussetzen. Die verbraucherseitige Darstellung dieses Datensatzes ist die Orchestrierungsquittung von Abbildung 8: eine Handlung, ein Datensatz, vier Zielgruppen (Verbraucher, Versicherer, Auditor, Regulierer).
Abbildung 8. Die Orchestrierungsquittung, zweimal verkauft (Mock-up)
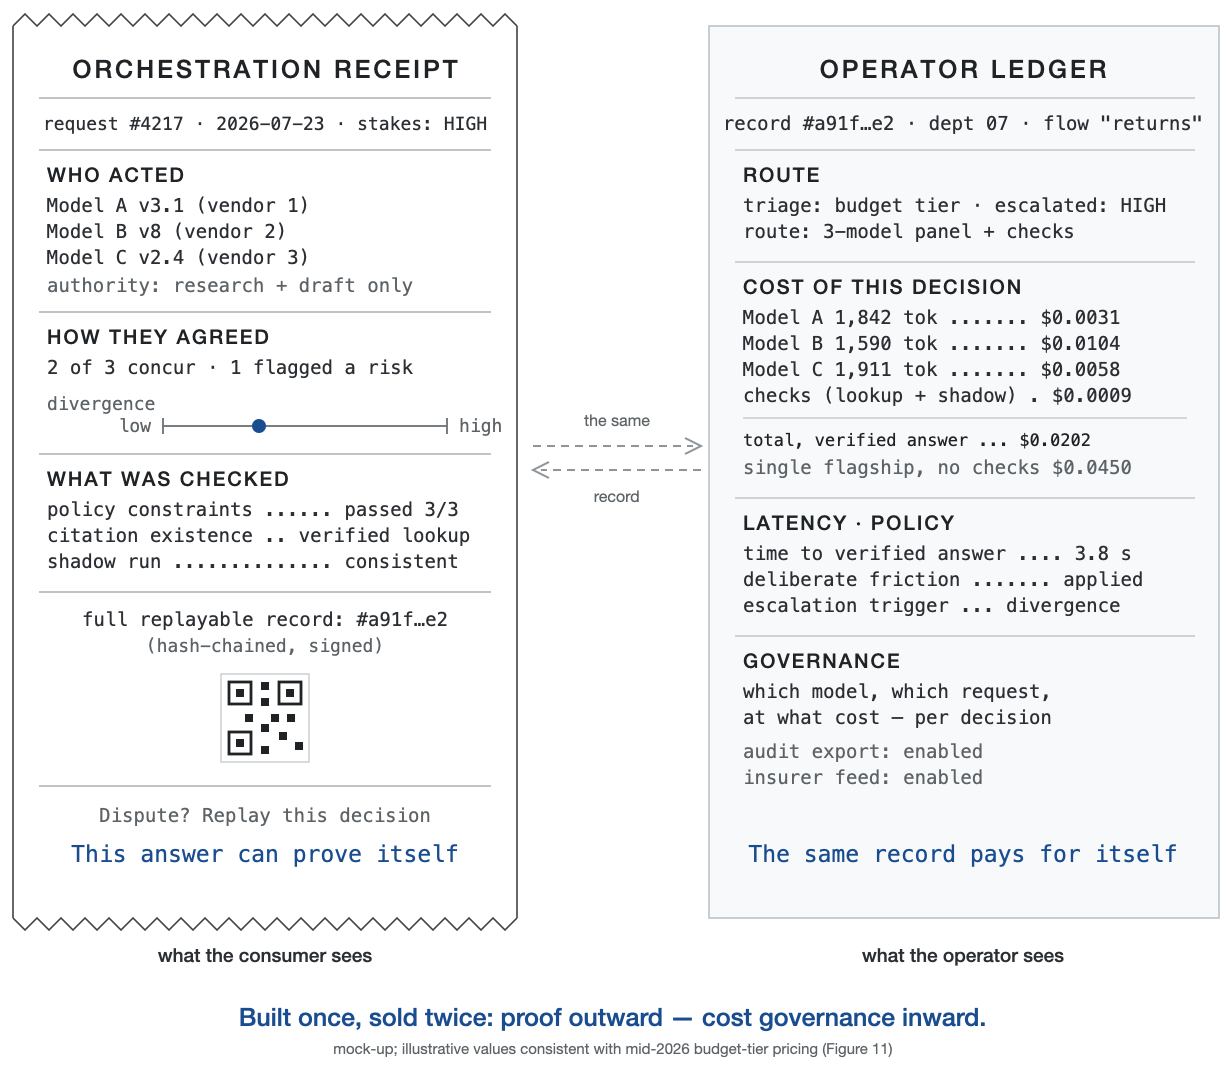
Der Verbraucher sieht Nachweis – wer handelte, wie sie sich einigten, was überprüft wurde; der Betreiber sieht denselben Datensatz als Kostenkontrolle. In einer Auseinandersetzung wird die Quittung zu Aussage-gegen-Aussage zu Datensatz-gegen-Aussage.
Neutralität. Neutralität ist prüfbare Unabhängigkeit der Anreize: das Fehlen von nicht offengelegter wirtschaftlicher Abhängigkeit von einem bestimmten Anbieter, Händler oder Entscheidungsergebnis. Die Orchestrierungsschicht leitet an die Modelle weiter, die für die Aufgabe am besten funktionieren, und hat kein Interesse daran, welches gewinnt, strukturell analog zu den unabhängigen Clearinglayern in Zahlungen. Ein Schiedsrichter unter Anbietern kann auf eine Weise vertraut werden, die kein Anbieter über sich selbst kann. Unabhängigkeit benennt die wirtschaftliche Eigenschaft, und prüfbar bindet sie an die Ebene des Nachweises, die den Anspruch überprüfbar macht, nicht nur bekannt, die unten entwickelte Clearinghausdisziplin. (Neutralität hier ist eine wirtschaftliche Eigenschaft, nicht algorithmische Fairness über demografische Gruppen, was eine orthogonale Anforderung ist.)
Es gibt auch das Vertikalintegrationsproblem: Neutralität ist strukturell für die Plattformen, die am besten positioniert sind, um Orchestrierung in großem Maßstab zu bauen, nicht verfügbar. Ein Unternehmen, das gleichzeitig Marktplatz, Modellvendor, Werbenetzwerk und Logistikanbieter ist, kann nicht neutral schiedsrichtern, denn jede Routing-Entscheidung, die es trifft, ist eine Entscheidung über seinen eigenen Umsatz. Die Arithmetik deutet auf eine strukturelle Tendenz hin. Das Framework zeigt, dass die Vertrauensebene am besten bei Parteien sitzt, deren einziges Geschäft die Schiedsrichtertätigkeit selbst ist, der Weg, auf dem Clearing, Auditing und Kreditratings zu unabhängigen Branchen wurden. Der Fall der Ratingagentur ist ebenfalls die kanonische Warnung, dass unabhängige Vermittler ihre eigenen Interessenskonflikte entstehen lassen. Die Ökonomie ist dokumentiert: Zertifizierungsvermittler erfassen Wert, indem sie kontrollieren, welche Informationen offengelegt werden (Lizzeri, 1999), Zertifizierungsmärkte scheitern auf gut katalogisierte Weise (Dranove & Jin, 2010), und der Zusammenbruch der Bonitätseinstufung zeigte das kanonische Scheitern, der von Emittenten bezahlte Umsatz korrumpierte den Zertifizierer eine Stufe höher, während die Clearinglayer, die überlebten, durch mutualisierte Kosten finanziert wurden, nicht durch die zu bewertenden Parteien. Die Neutralitätsanforderung erstreckt sich daher auf das eigene Einnahmemodell des Orchestrators: Eine Verifizierungsebene, die von den Anbietern oder Händlern bezahlt wird, die sie einordnet, reproduziert den Konflikt, den sie zu beseitigen hat, weshalb das Einnahmedesign hier zur Verbrauchersette und zur Kostensteuerung des Betreibers läuft (Abschnitt 5), nicht zu den bewerteten Parteien.
Neutralität hat auch eine Datendimension. Eine Orchestrierungsschicht kann als Clean Room fungieren: Anfragen erreichen jeden Anbieter beraubt der Benutzeridentität, kein Anbieter sieht die gesamte Interaktionsgeschichte, und der Umsatz des Orchestrators kommt aus dem Service, nicht aus der Weiterleitung dessen, was Benutzer sagen, in Werbenetzwerke. Neutralität ist Unabhängigkeit der Anreize auf beiden Fronten: keine nicht offengelegte wirtschaftliche Abhängigkeit von einem Modellvendor oder Händler, und kein Geschäftsmodell, das die Worte des Verbrauchers gegen den Verbraucher monetarisiert.
Aber Neutralität lädt zu ihrer eigenen Regression ein: Wer prüft den Orchestrator? Ein buchstäbliches „kein Interesse" ist unerreichbar. Jeder Orchestrator hat Kosten, Partnerschaften, Bindungsanreize und sein eigenes Überleben zu finanzieren, sodass die operative Variable nicht deren Abwesenheit, sondern ihre Natur, ihre Offenlegung und ihre Überprüfbarkeit aus dem Datensatz ist. Welche Partei zahlt, entscheidet nicht über Neutralität; ob die Einnahmen des Zahlers unabhängig vom Ergebnis der Transaktion sind, tut es. Ein Verbraucher-Abonnement oder eine Gebühr von einem Versicherer oder Prüfer, dessen Auszahlung von dem Siegprodukt entkoppelt ist, erfüllt die Bedingung; eine Händlerprovision oder eine Werbegebühr nicht. Die breitere Verwaltung, wer die Schicht finanziert, bleibt offen, und die überprüfbare Unabhängigkeit dieser Finanzierung ist der Teil, den die Konstruktion festlegt. Eine Orchestrierungsschicht hat auch Anreize: zu preiswerten Modellen zu routen, ihre teure Stufe zu überverkaufen, die Synthese bequem zu gestalten. Die Regression ist vier Jahrzehnte alt. Shapiro (1987) nannte sie das Problem der Wächter: Verfahrenssicherungen erzeugen neue Wächter, die selbst bewacht werden müssen, und die institutionelle Antwort hat sich seitdem nicht geändert.
Clearinghäuser verdienen ihre vertrauenswürdige Position dadurch, dass sie extern prüfbar und reguliert sind, nicht dadurch, dass sie Neutralität erklären. Der Orchestrator besitzt Neutralität nicht als Tugend. Die Evidenzschicht macht es überprüfbar. Jede Routing-Entscheidung, jede Modellantwort und jeder Syntheseschritt landen in einem manipulationssicheren Datensatz, einem hashverketteten, signierten Protokoll für externe Zeitstempelverankerung, sodass die behauptete Neutralität des Orchestrators genau der Überprüfung ausgesetzt wird, die er den Modellen auferlegt. Der Reifungspfad ist das Clearinghaus-Playbook konkretisiert: externe Zeitstempelverankerung, eine offene Verifizierungsschnittstelle und regelmäßige Audits von Drittparteien der Routing-Richtlinie. Das institutionelle Design solcher Audit-Ökosysteme ist bereits ein benanntes Forschungsprogramm (Raji, Xu, Honigsberg & Ho, 2022). Eine Abhängigkeit übersteht sogar ein Audit der Prüfer: Die Modelle des Panels können voneinander unabhängig sein, werden aber alle ausgewählt von der zu prüfenden Plattform, weshalb der Endpunkt des Reifungspfads die Panelauswahl und der Wechsel außerhalb der Kontrolle einer einzelnen Partei sind. Ein Orchestrator, dessen Datensätze nicht prüfbar sind, ist nur ein weiterer Anbieter, der geglaubt werden möchte. Die nächsten Nachbarn außerhalb der Verbraucherforschung sind zwei gleichzeitige Arbeiten von 2026. Marchal et al. (2026) argumentieren für denselben evaluativen Wechsel, von der Beurteilung von Ausgaben zur Architektur von KI-Vertrauenswürdigkeit, Provenienz und Widerlegbarkeit auf der Ebene der epistemischen Infrastruktur, und Wang et al. (2026) untersuchen die Ausführungsprovenienz als eine Schicht auf Prozessebene für Verifizierung, Audit und Fehler-Zuordnung. Was in diesem Papier einzigartig ist, ist die verbraucherseitige, anreizbewusste Zusammensetzung: die drei Eigenschaften als Objekt des berechtigten Vertrauens eines Verbrauchers in delegierten Handel und sein Verhaltenstest.
Die Evidenzkomponente trägt eine Abgrenzung, weil Manipulationssicherheit leicht oversold wird: ein hashverkettetes Protokoll begründet Provenienz und Integrität (dass dieser Datensatz existierte und später nicht verändert wurde), nicht Vollständigkeit (nichts im Hash garantiert, dass unterdrückte Aufrufe nicht supprimiert wurden), nicht Korrektheit (ein treues Datensatz einer falschen Antwort ist immer noch falsch), nicht Unabhängigkeit und nicht Anreizausrichtung. Jedes ist eine separate Eigenschaft mit ihrem eigenen Verifizierungsmechanismus: Abdeckungsbestätigung, Ausgabe-Audit, gemessene Vielfalt, offengelegte Ökonomie. Eine Quittung sollte nur die Eigenschaften beanspruchen, die der Datensatz tatsächlich hat. Eine weitere Grenze ist strukturell: Ein Protokoll beweist was weitergeleitet wurde, nicht warum, und die proprietäre Heuristik hinter der Wahl dieses Modells oder dieses Anbieters ist nur überprüfbar, wenn die Routing-Richtlinie selbst offengelegt oder beglaubigt wird, eine Governance-Entscheidung, nicht eine kryptographische Folge. Die Kosten der Architektur gehören ins gleiche Ledger: Eine Abfrage zu mehreren Anbietern weiterzuleiten, multipliziert die Datenschutz-Exposition, ein zentralisiertes Entscheidungsprotokoll ist ein attraktives Sicherheitsziel, und eine Konsens-Anzeige kann genau die Autorität herstellen, die das Konsens-Fehler-Ergebnis warnt.
Die Konstruktion ist auch wert, von ihren Engineering-Nachbarn abgegrenzt zu werden, weil „mehrere Modelle verwenden" mehrere verschiedene Dinge mit unterschiedlichen Vertrauenseigenschaften beschreibt. Einfaches Ensemble-Abstimmungsvoting verbessert die Genauigkeit, aber löst Uneinigkeit unsichtbar, sodass nichts überprüfbar wird. Self-Consistency-Sampling befragt das gleiche Modell erneut, was Vielfalt nur dem Anschein nach ist. Mixture-of-Experts routed innerhalb eines einzelnen trainierten Systems, dessen Router für Leistungsfähigkeit, nicht Neutralität optimiert ist. Multi-Agent Debate (Du et al., 2024) verbessert Antworten, aber behandelt die Deliberation als interne Mechanik: kein verbraucherseitiger Datensatz, keine Ökonomie, keine Neutralitätsgarantie.
Modell-Routing-Aggregatoren sind ab 2026 eine Commodity-Schicht mit mehreren Anbietern im Katalog, aber ein Modell pro Antwort: Der Router wählt ein Modell nach Kosten und Latenz, und es wird nie eine zweite Meinung eingezogen. Aggregatoren sind Lieferanten für eine Verifizierungsarchitektur, keine Ersatzstoffe dafür.
Multi-Modell-Operation ist auch nicht mehr exotisch: 37% der Unternehmen liefen Mitte 2025 mit fünf oder mehr Modellen in Produktion, gegenüber 29% ein Jahr früher (a16z, 2025). Die Rohre werden in industriellem Maßstab verlegt, wobei die Vertrauensschicht auffallend abwesend ist. Es ist offen, ob Multi-Modell unsichtbares Kosten-Routing bleibt oder zu überprüfbarer Architektur wird. Abbildung 9 bewertet die Muster gegen die fünf Vertrauenseigenschaften, und Tabelle 3 gibt die Abgrenzung in Prosa an. Architektur-Vertrauen ist genau definiert durch das, was diese nicht haben: heterogene Quellen, aufgedeckte und protokollierte Uneinigkeit und ein Schiedsrichter ohne Interesse. Die Engineering-Lösung ist gemeinsam; die Vertrauenseigenschaften nicht.
Abbildung 9. Abgrenzung
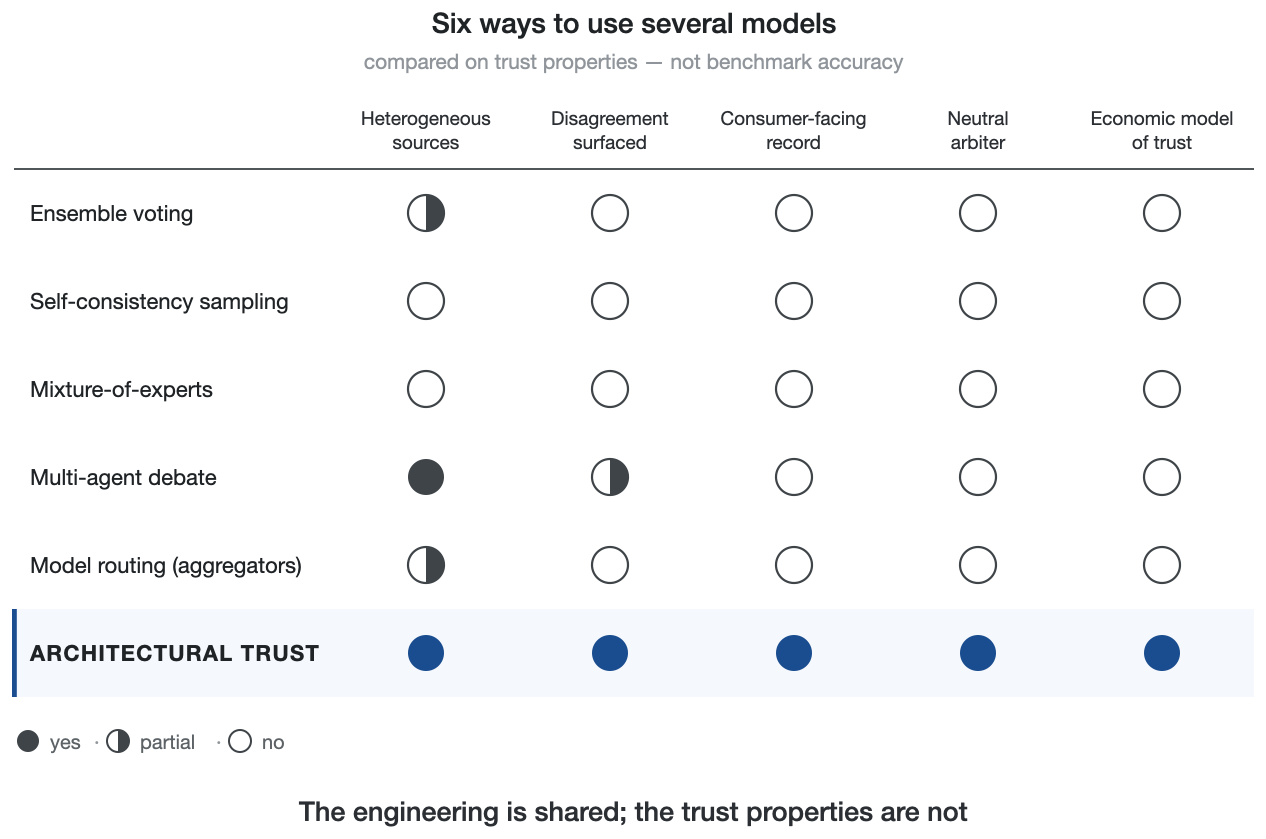
Sechs Multi-Modell-Engineering-Muster bewertet gegen fünf Vertrauenseigenschaften.
Tabelle 3. Abgrenzung: Architektur-Vertrauen vs. ihre Engineering-Nachbarn
| Ansatz | Heterogene Quellen | Uneinigkeit aufgedeckt | Verbraucherseitiger Datensatz | Anreiz-unabhängiger Schiedsrichter | Wirtschaftsmodell des Vertrauens |
| Ensemble-Abstimmung | Teilweise | Nein (unsichtbar gelöst) | Nein | Nein | Nein |
| Self-Consistency-Sampling | Nein (gleicher Modell neu gesampelt) | Nein | Nein | Nein | Nein |
| Mixture-of-Experts | Nein (ein trainiertes System) | Nein | Nein | Nein (Router optimiert für Leistung) | Nein |
| Multi-Agent-Debatte | Ja | Nur intern | Nein | Nein | Nein |
| Erklärbarkeit (XAI-Overlay) | Nein (Narration eines Modells) | Nein | Nein (eine Geschichte, keine Dokumentation) | Nein | Nein |
| Transparenz / Offenlegung | Nein | Nein | Teilweise (sichtbarer, nicht überprüfbar) | Nein | Nein |
| Herkunft / Nachverfolgung von Abstammungslinien (ML-Pipelines) | Nein (eine dokumentierte Pipeline) | Nein | Teilweise (Abstammungslinie für Ingenieure) | Nein | Nein |
| Verifizierte Inferenz (zkML) | Nein (ein Modell; Nachweis seiner Ausführung) | Nein | Teilweise (Nachweis-Artefakt, keine Entscheidungsdokumentation) | Nein | Nein |
| Modell-Routing-Aggregator | Teilweise (Multi-Vendor-Katalog, ein Modell pro Antwort) | Nein | Nein | Nein (Router optimiert für Kosten) | Nein |
| Architektonisches Vertrauen | Ja | Ja (nutzerseitig) | Ja (wiederholbar) | Ja (strukturell) | Ja (abgestufte Ebenen) |
Zwei weitere übergeordnete Literaturströmungen gehören auf diese Liste: Die Abstain-or-Emit-Logik des Gates ist selektive Vorhersage und Learning to Defer (Geifman & El-Yaniv, 2017; Mozannar & Sontag, 2020), und die Audit-Spur der Evidenzkomponente stammt aus der Literatur zu verantwortungsvollen Algorithmen und Fremdaudits (Kroll et al., 2017; Raji et al., 2022). Architektonisches Vertrauen ist die nutzerseitige, Neutralität-beschränkte Verbindung dieser, und nicht eine von ihnen allein. Seine Positionierung unter den anderen Abhilfemaßnahmen ist wichtig, weil diese sich ergänzen und nicht konkurrieren. Kalibrierung auf Modellebene ist notwendig, aber strukturell unzureichend: Der Anbieter produziert und attestiert sie, was der Konflikt ist, von dem dieses Papier ausgeht. Externe Audits und Zertifizierungen sind unabhängig, aber periodisch, Momentaufnahmen eines Systems, nicht einer Entscheidung. Eine Erklärung ist eine Narration, die innerhalb des Modells erstellt wird, und ein System, das Antworten erfinden kann, kann auch die Geschichte dahinter erfinden. Transparenz legt mehr Mechanismen offen und überlässt es dem Nutzer, diese auszulegen. Architektonisches Vertrauen verlangt weder Glauben noch Interpretation, sondern nur Überprüfbarkeit, die kontinuierlich, pro Entscheidung und maschinenverifizierbar ist. Es ist auch das, was die anderen Abhilfemaßnahmen wirksam macht: Ein Audit eines Orchestrators mit wiederholbarem Datensatz ist ein Audit von etwas, während ein Audit einer undurchsichtigen Pipeline eine Zeremonie ist. Seine nächsten konzeptionellen Nachbarn sind strukturelle Zusicherung und institutionsgestütztes Vertrauen (McKnight et al., 2002), Prozess-Transparenz und Erklärbarkeit. Das abgrenzende Merkmal gegenüber diesen ist, dass der Beweis vom Vertrauenden, pro Entscheidung überprüfbar ist: Zusicherung verlangt, einmal geglaubt zu werden, architektonisches Vertrauen verlangt, jedes Mal verifiziert zu werden. Zwei weitere Nachbarschaftsgruppen gehören auf diese Übersicht. Die Fachliteratur zur Rechenschaftspflicht in der Informatik legte vor einem Jahrzehnt die technischen Grundlagen: prozedurale Regelmäßigkeit, verifizierbar ohne vollständige Transparenz (Kroll et al., 2017). Eine Engineeringwelle von 2025–26 baut Vertrauensinfrastrukturen direkt in Agenten ein: „Trust-native"-Protokolle mit verifizierbarer Identität und manipulationsfesten Verhaltensdatensätzen (TrustTrack; Li, 2025); Runtime-Aktionsmanagement mit manipulationssicheren Empfangsbestätigungen (AARM; Errico, 2026); Multi-LLM-Aggregation umgerahmt als Vertrauensschätzung (Zheng & Zhang, 2026, arXiv:2607.20529); und Enterprise-Frameworks (Gartners AI TRiSM; die Agentic-Zero-Trust-Arbeiten der Cloud Security Alliance). Jede trägt einen Beitrag auf Enterprise-Ebene. Keine liefert das nutzerseitige Konstrukt, das dieses Papier als seinen Beitrag beansprucht: die drei Komponenten unter einem Namen, gemeinsam in verhaltensgestaltenden Designs manipulierbar, mit einer Ökonomie darüber, wer Überprüfbarkeit kauft und zu welchen Einsätzen. Ein Benennungskonflikt sollte geklärt werden. DigiCerts „AI Trust Architecture" (gestartet April 2026) ist eine Vendor-PKI-Produktlinie, Zertifikatsinfrastruktur für Agenten-Identität, Modellherkunft und Inhaltsauthentifizierung. Sie liefert Infrastruktur auf der Identitätsebene des Evidenz-Stapels, nicht das hier entwickelte Konstrukt des architektonischen Vertrauens.
Die Beziehung zwischen den drei Komponenten ist eine explizite empirische Hypothese, keine konzeptionelle Notwendigkeit. Ich hypothesiere eine komplementäre Interaktion, die gegen Null geht, wenn eine Komponente fehlt, informell AT = f(D, E, N) mit steilem Rückgang nahe jeder Null, und das konjunkte Design von Abschnitt 5 ist spezifiziert, um die funktionale Form zu ermitteln, anstatt sie anzunehmen. In schätzbarer Form ist eine praktische Familie Cobb–Douglas, AT = A·Dα·Eβ·N^γ mit α, β, γ > 0, die zwei Verpflichtungen kodiert: Rückgang gegen Null nahe jeder Abwesenheit und positive Kreuzpartialderivate (die Komponenten sind Komplemente). Das Konstrukt sind die drei Komponenten und ihre hypothesierte Komplementarität, und keine Proposition nachfolgend hängt von der Cobb–Douglas-Form ab. Cobb–Douglas ist auch eine innere Approximation: streng erlaubt es immer noch Substitution weg von einer schwachen Komponente, während die Komplementaritätshypothese an den Grenzen Leontief-ähnlich ist, wobei min(D, E, N) die Untergrenze setzt. Das ist genau der Grund, warum die Designs nachfolgend nicht-kompensatorische Struktur erlauben müssen, anstatt kompensatorische Handelsbeziehungen anzunehmen. Die Cobb–Douglas-Familie ist illustrativ für zukünftige Schätzung und nicht Teil der Konstruktdefinition; die aktuellen Daten schätzen sie nicht. Das Faktoriell kann das Cobb–Douglas-Innere von der Leontief-Untergrenze unterscheiden, Parameter für Parameter. Die Exponenten bleiben eine empirische Frage, was der Punkt ist: Komplementarität ist falsifizierbar. Die Nullen benötigen zwei Klarstellungen. Die Komponenten sind kontinuierlich, nicht binär, daher ist eine Null ein idealisierter Grenzwert. Kein deployiertes System, dieses Papier eingeschlossen, sitzt genau bei Null oder Eins auf irgendeiner Achse, und ob Verbraucher auf Quasi-Abwesenheit mit totalem Zusammenbruch oder einem steilen Rabatt reagieren, ist genau das, was das Design unterscheiden muss. Diversität bedeutet unterdessen Unabhängigkeit des Verifikationswegs, mit gemessener Unabhängigkeit (der Fehlerkorrelationskoeffizient φ, nachfolgend definiert) als ihre Einheit. Der statistische Kern ist klassische Ensemble-Theorie, wobei der Vorteil von Kombination auf Fehlerdekorreliertheit ruht (Hansen & Salamon, 1990; Krogh & Vedelsby, 1995), weshalb Unabhängigkeit hier gemessen wird, anstatt sie anzunehmen. Ein zweites Modell ist ein solcher Weg, aber ebenso sind ein unabhängiger Abruf, ein Tool-verifizierter Lookup und ein deterministischer Validator. Die Shadow-Läufe und Konsistenzprüfungen von Abbildung 5 zählen als ein zweiter, maximal dekorrelierteter Verifikationsweg, nicht als Evidenz ohne Diversität. Diese Definition absorbiert auch die scheinbar stärksten Gegenbeispiele, die regulierte Zahlungsschiene oder vollständig protokollierter, von Drittparteien beglaubigter Utility-Service (Evidenz und Neutralität stark, Modellvielfalt null): Solche Services betten entweder Nicht-Modell-Verifikationswege ein (deterministische Abstimmung, externe Revision, also D > 0 unter der Definition) oder beschränken das Modell auf eine Rolle, die eine deterministische Prüfung vollständig abdeckt. Wo genuiner keine unabhängiger Verifikationsweg für eine Aufgabenklasse existiert, sagt das Framework dünne Gewährleistung voraus, eine Vorhersage, die das Konjunkte testen kann. Wenn Nicht-Modell-Wege zu D zählen, wird Null in Produktionssystemen literal selten, und der empirische Gehalt der multiplikativen Form verschiebt sich von den Nullen zum inneren Komplementarität, weshalb das Faktoriell, nicht die Nullen, ist, wo der Anspruch steht oder fällt. Zum Testen ist eine operative Verpflichtung hier fixiert: Das Faktoriell manipuliert D eng, als Modell-Pfad-Diversität. Die breitere Verifikations-Pfad-Definition ist die Reichweite des Konstrukts, nicht die manipulierte Variable. Unabhängigkeit selbst muss disaggregiert werden, weil sechs verschiedene Größen unter dem Wort reisen: blinde Erfassung (prozedurale Unabhängigkeit zur Inferenzzeit, was dieses Design garantiert), Modell-Familie-Diversität, gemessene restliche Fehlerkorrelation (die φ, die dieses Papier berichtet), Evidenz-Quellen-Diversität, Tool-Pfad-Diversität und institutionelle Unabhängigkeit. Die Studie etabliert die erste und misst die dritte; die Rest sind Designvariablen, keine Eigenschaften, die diese Erfassung zertifizieren kann. Diversität ohne Evidenz ist ein unsichtbares Komitee. Evidenz ohne Neutralität ist das Marketing eines Anbieters. Neutralität ohne Diversität ist ein leerer Makler. Tabelle 4 durchläuft das vollständige Gitter der acht Anwesenheits-/Abwesenheitskonfigurationen. Die Intuition darunter ist, dass jede Komponente die Gewährleistung für eine andere bereitstellt: ein von einer Partei geführter Datensatz mit einem Einsatz in seinen Inhalten wird als Selbstbeglaubigung gelesen, Übereinstimmung, die niemand festgehalten hat, ist Gerücht, und ein Anreiz-unabhängiger Schiedsrichter über eine einzelne Stimme hat nichts zu schlichten. Dies motiviert die Komplementaritätshypothese. Zusammen ändern die drei das, worauf sich der Verbraucher verlässt: nicht „diese Antwort" oder „diese Marke", sondern „dieser Prozess, und ich könnte ihn überprüfen".
Tabelle 4. Das Gewährleistungs-Gitter: die acht D–E–N-Konfigurationen und was in jeder überlebt
| D | E | N | Was der Verbraucher überprüfen kann | Entartete Form |
| abwesend | abwesend | abwesend | Nichts; Verlass ist Glaube an Outputs | Bloßer Einzelmodell-Assistent |
| vorhanden | abwesend | abwesend | Nichts nachträglich; Uneinigkeit ereignete sich ungesehen | Unsichtbares Komitee (internes Ensemble) |
| abwesend | vorhanden | abwesend | Ein Datensatz, geführt von der Partei, die er schützt | Anbieter-Protokoll / Selbstbeglaubigung |
| abwesend | abwesend | vorhanden | Eine Behauptung ohne Einsatz und ohne Spur dahinter | Leerer Makler |
| vorhanden | vorhanden | abwesend | Aufgezeichnete Uneinigkeit, kuratiert von einer interessierten Partei | Anbieter-betriebenes Benchmark-Theater |
| vorhanden | abwesend | vorhanden | Neutrale Schiedsspruch von Überprüfungen, die niemand wiederholen kann | Word-of-Mouth-Panel |
| abwesend | vorhanden | vorhanden | Ein neutraler, wiederholbarer Datensatz einer einzelnen unbestritenen Stimme | Beglaubigte Monolog (Audit ohne Herausforderung) |
| vorhanden | vorhanden | vorhanden | Eine unabhängige Überprüfung, wiederholbar, gehalten von einer Partei ohne Einsatz | Architektonisches Vertrauen |
Zellen werden an idealisierten Grenzen angegeben; deployierte Systeme bewohnen das Innere. Die E+N-ohne-D-Reihe ist die institutionell bekannte – Clearing, Audit und Ratings operieren dort – und es ist, wo die Anforderung des Frameworks nach einem hinzugefügten unabhängigen Verifikationsweg eine empirische Vorhersage ist, nicht ein definitionales Ausschlusskriterium.
Die drei Komponenten entsprechen der klassischen Anatomie der Vertrauenswürdigkeit (Mayer, Davis, & Schoorman, 1995): Vielfalt ist ein Fähigkeitsmechanismus (Cross-Modell-Übereinstimmung kalibriert, wie viel Kompetenz abzuleiten ist), Evidenz operationalisiert Integrität (Aussagen darüber, was der Service tat, werden überprüfbar statt nur bekannt), und Neutralität adressiert Wohlwollen strukturell (die Anreize eines unparteiischen Orchestrators sind überprüfbar, nicht zu glauben). Jede ist in überprüfbarer Architektur statt in Wahrnehmungsmanagement neu verankert, was die Forschungsliteratur zur Mensch-KI-Interaktion fordert, wenn sie von ihrer eigenen Seite denselben Punkt erreicht: Vertrauen an überprüfbare Vertrauenswürdigkeitssignale anpassen, nicht an Eindrücke, die die Schnittstelle erzeugt (Liao & Sundar, 2022).
Die Kausalitätskette verläuft durch Verifikation, da „Vertrauen" die Folge statt der Mechanismus ist: Verifikation → kalibriertes Vertrauen → gerechtfertigtes Vertrauen → Delegation → Transaktionswert (Abbildung 10). Ein Service verdient sich Delegation, indem er überprüfbar ist, wenn es zählt, nicht indem er vertrauenswürdig wirkt; Cheng et al. zeigten, wie billig dieses Gefühl hergestellt wird.
Abbildung 10. Das Verifikations-Flywheel
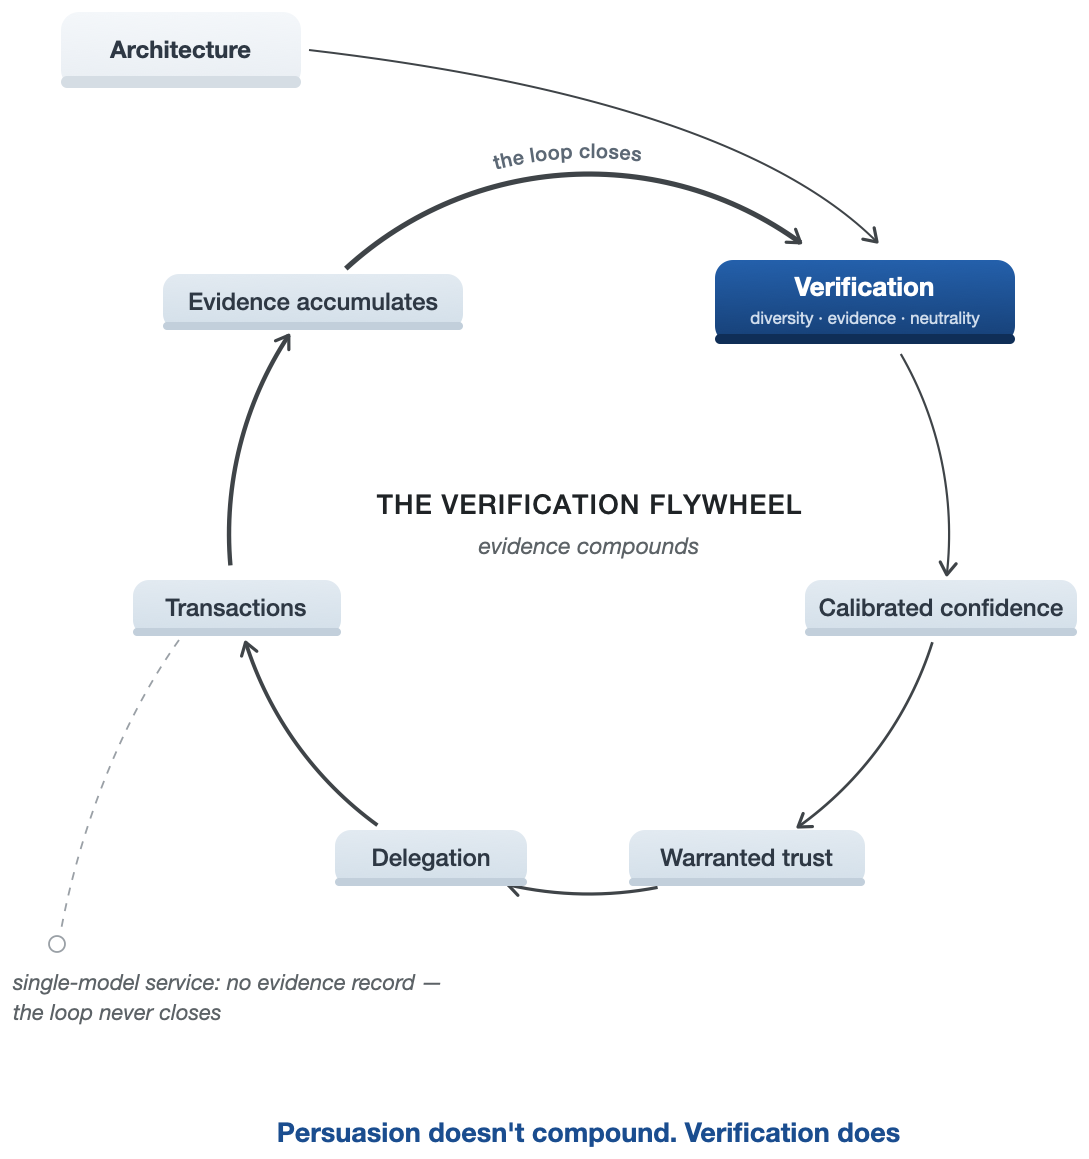
Die Kausalitätskette, Verifikation (Vielfalt · Evidenz · Neutralität) → kalibriertes Vertrauen → gerechtfertigtes Vertrauen → Delegation → Transaktionen, endet nicht: Transaktionen erzeugen Evidenz, und die Schleife schließt sich in der Architektur. Die gestrichelte Umleitung zeigt den Single-Modell-Service, wo kein Evidenzprotokoll existiert und die Schleife sich nie schließt. Überzeugung verstärkt sich nicht. Verifikation schon.
Tabelle 5. Single-Modell-Service vs. architekturgestütztes Vertrauen
| Dimension | Single-Modell-Service | Architekturgestützter Service |
| Vertrauensobjekt | Das Modell / die Marke | Der Prozess und sein Protokoll |
| Vertrauen | Vom Modell behauptet | Verdient durch Cross-Modell-Übereinstimmung |
| Selbstbewusste Fehler | Von innen nicht erkennbar | Primäres Erkennungsziel (Uneinigkeit-Signal) |
| Schmeichelei | Durch Vorliebe belohnt | Getrennt: Empathie und Richtlinienprüfung auf verschiedenen Kanälen |
| Fehlerprüfung | Dasselbe System, das einen Fehler machte | Unabhängige Modelle + deterministische Gates |
| Entscheidungsevidenz | Protokolle, falls vorhanden, vom Anbieter gehalten | Manipulationssicher, wiederholbar, verbraucherzugänglich |
| Qualitätsrichter | Der Anbieter selbst | Unparteiische Orchestrierungsschicht |
| Streitposition | Aussage des Verbrauchers gegen Plattform | Wiederholbares Protokoll |
| Versicherbarkeit | Opakes Risiko | Aus Entscheidungshistorien bepreisbar |
| Haftungszuordnung (nach AB 316) | „Die KI hat es getan" ausgeschlossen; Zuordnung umstritten im Dunkeln | Aus dem wiederholbaren Protokoll berechenbar |
| Regulatorische Haltung (Art.-50-Ära) | Nachträgliche Offenlegungen | Transparenz als Nebenprodukt des Betriebs |
| Grenzüberschreitende Datenversprechen | Vertragliche Darstellung | Auditable Laufzeiteigenschaft (jurisdiktionsbewusste Weiterleitung) |
| Kostenstruktur | Flach, billig | Abgestuft: teuer nur wo Konsequenzen konzentriert |
Von Überprüfbarkeit zur Verbraucherreaktion. Der Verbraucher sieht die Darstellung, nicht die Architektur: eine Quittung, die zeigt, welche unabhängigen Systeme befragt wurden, wo sie divergierten, und wie Divergenz gelöst oder eskaliert wurde (Abbildung 8). Drei vermittelnde Wahrnehmungen tragen die Auswirkung plausibel. Die Evidenz ist diagnostisch: angezeigte, spezifische Uneinigkeit ist informativ über diese Antwort in einer Weise, die generische Haftungsausschlüsse nicht sind (Detjen et al., 2025; Chen et al., 2026). Ein wiederholbares Protokoll gibt wahrgenommene Prozesskontrolle, da der Verbraucher nachträglich prüfen, anfechten oder eskalieren könnte. Verfahrenssicherheit ist das Wissen, dass blinde Erfassung, unabhängige Checks und ein unparteiischer Schiedsrichter vorhanden waren (McKnight et al., 2002). Die natürlichen abhängigen Variablen sind Kalibrierung der Zuverlässigkeit, Bereitschaft zu delegieren und Beibehaltung nach Fehlschlag. Die natürlichen Moderatoren sind Einsätze und Umkehrbarkeit, Aufgabenobjektivität (Castelo et al., 2019) und Verbraucherexpertise, da der Verbraucher, der eine Antwort selbst am wenigsten überprüfen kann, am meisten davon profitiert, dass eine Architektur sie strukturell überprüft. Die Propositionen unten verfolgen diesen Weg.
Das Rahmenwerk ergibt außerdem Propositionen, die eine Verbraucherstudie testen kann, Hypothesen statt Befunde. Sie zu operationalisieren hängt von einer Unterscheidung ab: objektive Neutralität (der Orchestrator ist tatsächlich frei von nicht offengelegter wirtschaftlicher Abhängigkeit von einem Anbieter, Verkäufer oder Ergebnis), überprüfbare Neutralität (das Protokoll macht diese Unabhängigkeit überprüfbar), und wahrgenommene Neutralität (der Verbraucher glaubt daran) sind drei Variablen, und ein Experiment manipuliert das überprüfbare Signal, während es die Wahrnehmung misst:
P1. Die Offenlegung von modellübergreifender Uneinigkeit bei folgenreichen Anfragen verbessert die Kalibrierung der Inanspruchnahme durch Konsumenten (sie verlassen sich mehr, wenn Systeme übereinstimmen, weniger, wenn sie divergieren) im Vergleich zu einer einzelnen selbstbewussten Antwort, wobei wahrgenommenes Risiko als vermittelnde Konstruktion fungiert (Featherman & Pavlou, 2003). Beide Fehlerrichtungen sind möglich: gemeinsame Präsentation verringert Überabhängigkeit, kann aber Unterabhängigkeit erhöhen (Lu, Wang, & Yin, 2024), Konfidenzanzeigen kalibrieren Inanspruchnahme leichter als Genauigkeit (Zhang, Liao, & Bellamy, 2020), Erklärungen können Inanspruchnahme erhöhen ohne Überprüfung zu erhöhen (Bansal et al., 2021), kognitive Erzwingungsfunktionen senken Überabhängigkeit auf Kosten der Zufriedenheit (Buçinca, Malaya, & Gajos, 2021), und eine Metaanalyse von 106 Experimenten zeigt, dass Mensch-KI-Kombinationen im Durchschnitt schlechter abschneiden als das bessere Element allein (Vaccaro, Almaatouq, & Malone, 2024). P1 testet Kalibrierung, keine monotone Verbesserung: offengelegte Uneinigkeit muss in der Minderheit von Kombinationsdesigns landen, die ihr bestes Mitglied übertreffen. Der Satz ist zweigeteilt: der Haupteffekt ist der konfirmatorische Anspruch, und die Moderatoren sind explorativ, abgeleitet von der Aussagekraft der Evidenz statt nach dem Ereignis aufgezählt. Der Kalibrierungsgewinn sollte mit den Einsätzen und Irreversibilität zunehmen und mit der Aufgabenoptionalität (Divergenz bei einer objektiven Frage liest sich als Fehlersignal; bei einer subjektiven als Geschmacksfrage; Castelo et al., 2019). Konsumentenexpertise wird vorhergesagt, um entgegengesetzte Zeichen zu erzeugen: für Konsumenten mit geringer Expertise sollte offengelegte Divergenz ohne Klärung die Bereitschaft zur Delegation verringern, und für Konsumenten mit hoher Expertise sollte sie die Kalibrierung der Inanspruchnahme verbessern; die Überkreuzung wird entweder beobachtet oder nicht, was Expertise zu einem Test statt zu einer Flucht macht. Das eigene Experiment dieses Papiers setzt eine Designanforderung durch. Uneinigkeit kovariiert mit Aufgabenschwierigkeit (Panelusammenhang konzentriert sich auf einfache Elemente), daher muss ein P1-Design die Schwierigkeit manipulieren oder statistisch kontrollieren, sonst ist der Kalibrierungseffekt mit der Einfachheit des Elements vermengt. Die Aussagekraft-Rechnung liefert auch eine Grenzprognose, die generische Transparenztheorien nicht liefern: Divergenzoffenlegung sollte am meisten dort zählen, wo die eigenen Priors des Konsumenten am schwächsten sind, bei grenzüberschreitenden oder unbekannten Käuferkäufen, denn dort hat externe Diagnoseevidenz keinen internen Konkurrenten.
P2. Der Zugang zu einem wiedergebbaren Entscheidungsprotokoll erhöht die Bereitschaft zur Delegation folgenreicher Aufgaben an einen KI-Agent über Markenvertrauen hinaus, wobei der Effekt mit den Einsätzen und der Irreversibilität der delegierten Aufgabe zunimmt. Es nimmt auch mit der Stufe der delegierten Agentur selbst zu, was der komparativen Statik der Trust-Migration-Hypothese entspricht: Bei konstanter tatsächlicher Modellleistung wächst der Marginaleffekt überprüfbarer architektonischer Eigenschaften auf angemessene Delegation, wenn der Konsument mehr Überprüfungs- und Ausführungskontrolle aufgibt (Berater → Copilot → beaufsichtigter Agent → autonomer Agent). Ein Design, das Delegationsstufe mit Architektur-Sichtbarkeit kreuzt, testet die Hypothese direkt. Die nächste Konsumentenforschungsevidenz sitzt auf dieser abhängigen Variablen: Die Delegation von Käufen an KI verringert die Akzeptanz, wenn sie wahrgenommene Autonomie einschränkt (Ahmad Husairi & Rossi, 2024), und die Akzeptanz von hochautonomen Assistenten ist ein direkt untersuchtes Ergebnis (Frank et al., 2026). P2 sagt den Effekt des Protokolls über diese etablierten Antezedenzien hinaus voraus.
P3. Wahrgenommene Neutralität der Orchestrierungsebene sagt Delegationsbereitschaft unabhängig voraus, konsistent mit Effekten prozeduraler Gerechtigkeit in der Servicebewertung (Tax, Brown, & Chandrashekaran, 1998). Die manipulierte Variable ist das überprüfbare Neutralitätssignal; die gemessene Variable ist die Wahrnehmung, die es erzeugt. Nach meinem besten Wissen wurde die Neutralität von Orchestratoren nie in einem Verhaltensexperiment operationalisiert, und Zertifizierungssiegel sind die nächste getestete Analogie (Cetinkaya & Krämer, 2024), daher führt P3 eine neue Experimentalvariable ein. Richtungsmäßig sollte sich der Neutralitätseffekt verstärken, wenn die Fähigkeit des Konsumenten zur Überprüfung der Substanz sinkt, denn wenn die Qualität des Ergebnisses schwer zu beurteilen ist, tragen Prozesshinweise das Evaluationsgewicht. Die Manipulation muss überprüfbare Neutralität von einem Neutralitätsanspruch trennen: eine Bedingung trägt eine Quittung, deren unparteiische Bestätigung tatsächlich geöffnet und überprüft werden kann, die Kontrastbedingung eine identische Benutzeroberfläche, die nur die Bezeichnung trägt, mit einer Manipulationsprüfung der wahrgenommenen Neutralität in beiden. Ohne diese Kontrastierung kollabiert P3 zu generischer Prozessgerechtigkeit und sagt nichts über Überprüfung.
P4. Nach einem Agentenfehler zeigen Konsumenten, deren Service ein überprüfbares Protokoll erzeugt, kleineren Vertrauensverfall und höhere Beibehaltung als Konsumenten eines undurchsichtigen Service: die One-Strike-Dynamik wird durch Evidenz gemäßigt. Dies ist der Mechanismus, den Service-Recovery-Forschung identifiziert, wo prozedural faire, evidenzgestützte Reklamationsbehandlung das Vertrauen nach einem Fehler wiederherstellt (Tax et al., 1998). Trust-Repair-Forschung fügt hinzu, dass das, was Vertrauen wiederherstellt, von der Natur der Verletzung und der angebotenen Erklärung abhängt (Kim, Ferrin, Cooper, & Dirks, 2004), eine Anforderung, die Mensch-KI-Forschung nun als Designproblem für autonome Systeme behandelt (de Visser, Pak, & Shaw, 2018), und die Pufferwirkung sollte mit Schweregrad und Irreversibilität des Fehlers wachsen. P4 sagt voraus: Protokoll → kleinerer Vertrauensverfall und höhere Beibehaltung, gemäßigt durch Fehlerschweregrad. Fälle, in denen das Protokoll zeigt, dass der Prozess selbst nicht befolgt wurde, werden durch eine Manipulationsprüfung behandelt und von dem Test ausgeschlossen, da sich der Satz auf Fehler bezieht, die auftreten trotz eines befolgten Prozesses. Dauerhaftigkeitsvergleiche müssen für Wechselkosten und Lock-in kontrollieren, die Beibehaltung vermengen, und ein Begleitdesign testet, ob ein befolgtes-Prozess-Protokoll die Schuldzuweisung vom Service zur Umgebung verschiebt. Der Satz trägt keine Umkehrungsklausel, daher ist kein Ergebnismuster durch Konstruktion unfalsifizierbar.
Empirischer Anker: die Konfidenzebene als getestete Komponente. Wenn ein Service behauptet, seine Konfidenzignale bedeuten etwas, kann diese Behauptung vor Gericht gestellt werden. Die Konfidenzebene in der Bereitstellung hinter der Fallstudie dieses Papiers durchlief eine vorab registrierte, Placebo-kontrollierte, sechsarmige Bewertung über zwei unabhängige Modellfamilien. Ein gemessenes Profil der eigenen Schwächen des Systems verbesserte die Fehlervorhersage um einen AUROC-Gewinn von ungefähr +0,07 über Placebo, mit nicht überlappenden Konfidenzintervallen bei beiden Familien. Ein falsches Selbstprofil kollabierte die Fehlervorhersage zu einer Münzwurfquote, und eine generische „Seien Sie sich Ihrer Grenzen bewusst"-Anweisung hatte keine Wirkung.
Zwei frühere Versionen schlugen fehl, eine durch ihre eigenen Autoren über einen Störfaktor verfälscht, eine negative, bevor das vorregistrierte Design Bestätigung brachte. Ein strengerer Wiedertest war bei reduziertem Umfang nicht aussagekräftig, und eine vorregistrierte vierstufige Leiter an einer Grenzfamilie verfehlte keine bestätigenden Endpunkte, die Wirkungsrichtung überlebte nur explorativ auf drei von vier Stufen. Die Aussage ist daher pro Familie und begrenzt: Gemessene Selbstkenntnis verbesserte die Fehlervorhersage, wo bestätigt, und es ist keine etablierte Eigenschaft jeder Modellklasse. Das Schwächeprofil läuft auch in der Produktion, wo es das Live-Modell-Routing anpasst, begrenzt und fehleroffen. Der Zusammenbruch des falschen Profils funktioniert auch als Sicherheitsfund: Ein fabriziertes Selbstmodell ist ein Angriffsvektor, ein weiterer Grund, warum Selbstkenntnis architektonische Obhut statt Selbstbericht des Modells benötigt. Die Designlogik hat eine Pedigree aus der Verbraucherforschung, die älter ist als die Technologie. Selbstbindung, die Zukunftsverhalten durch externe Struktur bindet, weil nicht erwartet wird, dass interne Willenskraft hält, ist genau wie Verbraucher ihre eigenen Laster rationieren (Wertenbroch, 1998), und architektonisches Vertrauen erweitert denselben Schritt auf Maschinen.
Der vollständige Bogen (Protokolle, Vorregistrierungen, Rohdaten, das verfälschte Pilotprojekt, die negative Iteration, die nicht bestätigenden Erweiterungen) wird als eigenständiges Archiv beibehalten, öffentlich verfügbar mit den OSF-Materialien des Papers unter https://osf.io/jtvu9/ (Datei `self-calibration-archive.zip`). Kalibriertes Vertrauen ist eine architektonische Komponente mit messbarem Inhalt und kann fehlschlagen. Die Fehler werden mit den Erfolgen archiviert, weil eine Vertrauensschicht, deren Vertrauensaussagen nie experimentell in Frage gestellt wurden, um genau das blinde Vertrauen bittet, das sie ersetzen sollte. Ein Positionspapier von dreißig Autoren gibt dieser Arbeitsteilung eine formale Aussage: agentengesteuerte Orchestrierung sollte Bayes-konsistent sein (Papamarkou et al., 2026), und kalibrierte Überzeugungen gehören in die Kontrollschicht, nicht in die Modelle.
Testen des Mechanismus: ein vorregistriertes Experiment. Die obigen Aussagen sind testbar, und dieser Abschnitt berichtet die Tests. Jedes experimentelle Ergebnis in diesem Abschnitt, in beiden Wellen, spricht zu einem technischen Vorläufer des Rahmens, ob unabhängige Übereinstimmung ein Korrektheitssignal trägt, das der Selbstbericht eines Modells nicht trägt, bei sachlichen Fragen. Diese Experimente demonstrieren kein Verbrauchervertrauen, Delegation oder kommerzielles Verhalten, die weiterhin Sache von P1–P5 und der Verhaltenstudie von Abschnitt 6 bleiben. Das Protokoll wurde öffentlich eingefroren, bevor irgendwelche bestätigenden Daten existierten (OSF: https://osf.io/4y9dv, registriert am 23. Juli 2026; Hypothesen H1–H6, Benchmark-Teilmenge durch Seed und SHA-256-Hash festgelegt, für die Hypothese ungünstige Ergebnisse waren vordeklariert). Das Design ist absichtlich einfach. Sechzehn Modelle, neun Grenzanbieter (Anthropic, OpenAI, Google, xAI, DeepSeek, Alibaba, Moonshot, Zhipu, Mistral) und sieben lokale Open-Weights-Modelle, jedes beantwortete blind dieselben 1.500 SimpleQA-Fragen einmal ohne Abruf oder Tools. Das ist das Regime, das die Exposition gegenüber korreliertem parametrischem Fehler maximiert, ein absichtlich schwerer Fall für das Signal, auf Kosten der in den Einschränkungen genannten ökologischen Kosten. Antworten wurden bei Temperatur null gegeben und erklärten ein Vertrauen von 0–100: verbalisierte Unsicherheit, die in Worten innerhalb derselben Antwort hervorgerufen wurde, anstatt aus Logits gelesen zu werden, das Format, das Lin, Hilton und Evans (2022) zeigten, können Modelle lernen zu kalibrieren. Panels sind analytische Kombinationen dieser einzelnen Sammlung von 24.000 nominalen Antwortplätzen, von denen 22.598 geliefert wurden, ein lokales Modell (deepseek-r1:8b) stoppte bei 98 Elementen unter einer vorpflichteten Stoppregeln. Die sechs registrierten Hypothesen ordnen sich den Ergebnissen wie folgt zu. H1, dass modellübergreifende Divergenz die Mehrheit der zuversichtlichen Fehler kennzeichnet, wird unterstützt: Übereinstimmung hebt die Korrektheit 1,9–3,2× in der registrierten Welle (Tabelle 6), und in der Flaggschiff-Welle entfernt das eingefrorene Tor 82,1% der zuversichtlichen Fehler (Tabelle 10). H2, dass das Panel-Signal das eigene Vertrauen des antwortenden Modells schlägt, gilt für die CN-Grenz- und Cross-Bloc-Panels (ΔAUROC +0,287 und +0,063) und kehrt sich beim US-Grenz-Panel um. H3, dass ein nichttrivialer Anteil zuversichtlicher Fehler als einstimmige Übereinstimmung bei einer falschen Antwort überlebt, wird unterstützt: 0,5–2,2% der offenen Fragen und 4,0–7,9% im Multiple-Choice-Arm. H4(a), dass die Fehlerkorrelation innerhalb des Blocs die Cross-Bloc übersteigt, wird nicht unterstützt (φ Differenz +0,011, 95% CI −0,005 bis +0,028), und H4(b), dass ein Cross-Bloc-Panel mehr erfasst, wird auch nicht unterstützt, die Cross-Bloc-Führung ist die kleinere. H5, dass ein $0 lokales Panel die Mehrheit der Grenz-Zuversichtsfehler kennzeichnet, wird nicht unterstützt: Das Übereinstimmungssignal der lokalen Stufe sitzt bei Zufall. H6, die Abstammungs-Distanz-Leiter wird hier nicht als Leiter getestet; ihr Bloc-Niveau-Schritt ist das H4(a) Null.
Sachliche Überprüfung ist ein relevanter Ersatz für den Agentenhandel, weil eine delegierte Kaufentscheidung sich in dem Moment der Ausführung in sachliche Unteransprüche zerlegt: den aktuellen Preis und die Verfügbarkeit des Artikels, die Bedingungen der Rückgaberichtlinie, ob die Produktspezifikationen den angegebenen Anforderungen des Verbrauchers entsprechen, die Identität und Bewertung des Verkäufers. Jede dieser hat einen überprüfbaren Wahrheitsgrund der gleichen Art, die ein SimpleQA-Element hat. Das Disagreement-Tor funktioniert auf diesem sachlichen Untergrund, während die Präferenzgewichtung (welche Kompromisse zählen und wie sehr) beim Verbraucher bleibt, der die Anforderungen verfasst hat, gegen die die Fakten überprüft werden. Diese Arbeitsteilung ist auch der Grund, warum das Design in Abschnitt 6 die Anzeige der Überprüfung manipuliert statt die Vorlieben der Teilnehmer: Die Behauptung der Architektur betrifft die sachliche Schicht einer delegierten Entscheidung, nicht ihre Geschmacksschicht. Wo ein Urteil überhaupt keine sachliche Grundlage hat, bei genuinely subjektiven Wahlen ohne Wahrheitsgrund zum Überprüfen, trägt der Vorläufer nicht mehr, und die Limitations geben diese Grenze als offene Frage an.
Die Wahl des Benchmarks wurde gemessen. Bei der 2021er Version von TruthfulQA (in Vortrainingskorpora vorhanden) erreichten dieselben Anbieter 47–61 Prozentpunkte höhere Ergebnisse als bei SimpleQA (z. B. 89 % gegenüber 28 %), ein Unterschied, der mit Effekten des Benchmark-Alters und der Exposition konsistent ist, wobei dieses Design Kontamination nicht von Unterschieden in der Benchmark-Schwierigkeit und -Konstruktion trennen kann. Es basiert daher keine Schlagzahl auf dem älteren Benchmark. Die Bewertung erfolgt durch objektive Zeichenkettenabgleichung, wobei ungelöste Fälle auf Äquivalenz mit dem Gold-Standard nur durch ein lokal ausgeführtes Open-Weights-Modell (Qwen3-8B, lokal ausgeführt; Äquivalenz-only-Prompt im Replikationspaket; niemals durch ein Familienmitglied eines Panelmitglieds; ob SimpleQA im Trainingskorpus des Schiedsrichters vorhanden ist, ist unbekannt, aber der Schiedsrichter entscheidet über die Äquivalenz zwischen zwei bereitgestellten Zeichenketten, nicht über Wahrheit, was die Exposition begrenzt) und eine 50-Punkt-Stichprobe (98 % Übereinstimmung) beurteilt werden, eine Skalierungsbeschränkung. Dies wird nun durch eine geschichtete 300-Punkt-übergreifende Audit von schiedsrichterentschiedenen Fällen erweitert (eine andere Modellfamilie als Auditor, mit festem Seed-Sample): 96 % Übereinstimmung (288/300), alle zwölf Abweichungen nachsichtige falsche Positive (neun klar, drei grenzwertig), eine einseitige Verzerrung, die etwa 3 % aller bewerteten Antworten betrifft (4 % der schiedsrichterentschiedenen Anteil). Zwei Drittel der Urteile (66,5 %) stammten vom lokalen Modell-Grader und nicht vom exakten Zeichenkettenabgleich, und die Schlagzahl ist robust gegenüber Grader-Fehlern: Das Umdrehen von zufälligen 10 % der modellbewerteten Urteile verschiebt die Zertifizierungsverhältnisse um höchstens ±0,5× und ändert niemals deren Richtung.
Zwei Designentscheidungen sind absichtlich statt budgetär. Die mittleren Tiers der Anbieter wurden zunächst aus ökologischer Gültigkeit verwendet: Die Agenten, die jetzt im Auftrag der Verbraucher Transaktionen durchführen, laufen überwiegend auf diesen kostoptimierten Tiers, was anhand öffentlicher Preislisten überprüfbar ist (Mitte 2026; Abbildung 11). Ein typischer Dienstaustausch kostet einen Bruchteil eines Cents bis etwa einen Cent auf den Budget-Tiers, gegenüber fünf bis zehn Cents auf Flagship-Gewichtungen, und kein Service, der Millionen von Sitzungen beantwortet, wird seinen Standardpfad zum Flagship-Tarif angeboten. Die Aufstellung spiegelt den Markt: Das neun-Anbieter-Panel enthält alle drei Lieferanten, die zusammen 88 % der Enterprise-LLM-API-Ausgaben tragen, und das US-Frontier-Panel von Tabelle 6 ist genau dieses Trio. Der Einwand, dass dies Unternehmensbeweise sind und der Verbraucher nirgends darin vorkommt, dreht die Lieferkette um. Der Verbraucher wählt überhaupt kein Modell mehr: Er wählt eine Bank, einen Einzelhändler, eine Fluggesellschaft, und die Routing-Richtlinie des Dienstes wählt das Modell. In der Währung, in der Verbraucher tatsächlich bedient werden – Token statt Dollar – bestätigt das Bild die Wahl (Abbildung 12): In der OpenRouter–a16z-Studie von 100 Billionen Tokens gerouteten Verkehrs erreichten Open-Weight-Modelle etwa ein Drittel aller Nutzungen (Aubakirova et al., 2026), die Standard-Tiers der drei größten Consumer-KI-Produkte liegen alle unter dem Flagship-Tier, und nur etwa 3 % der Consumer-KI-Nutzer zahlen für Premium-Service (Menlo Ventures, 2025c), daher muss der marginale Verbraucher bei nahezu null Grenzkosten bedient werden. Unter dem API-Markt liegt eine Grundlage von On-Device- und selbstgehosteten Open Weights, unsichtbar für ausgabengestützte Umfragen, und die lokale Tier der Experimente mit sieben Open-Weight-Modellen beprobt sie absichtlich. In jeder Währung, in der der Markt gezählt werden kann, sind die Tiers, die diese Studie beprobt hat, die Tiers, die den Verbraucher bedienen. (Nach einem Fehler der ersten Partei wurde ein Teil der Sammlung über einen Aggregator abgeschlossen, mit der tatsächlichen Serving-Infrastruktur, die pro Aufruf im Run-Manifest aufgezeichnet wurde.)
Abbildung 11. Der Tier, den Verbraucher an der Kasse antreffen
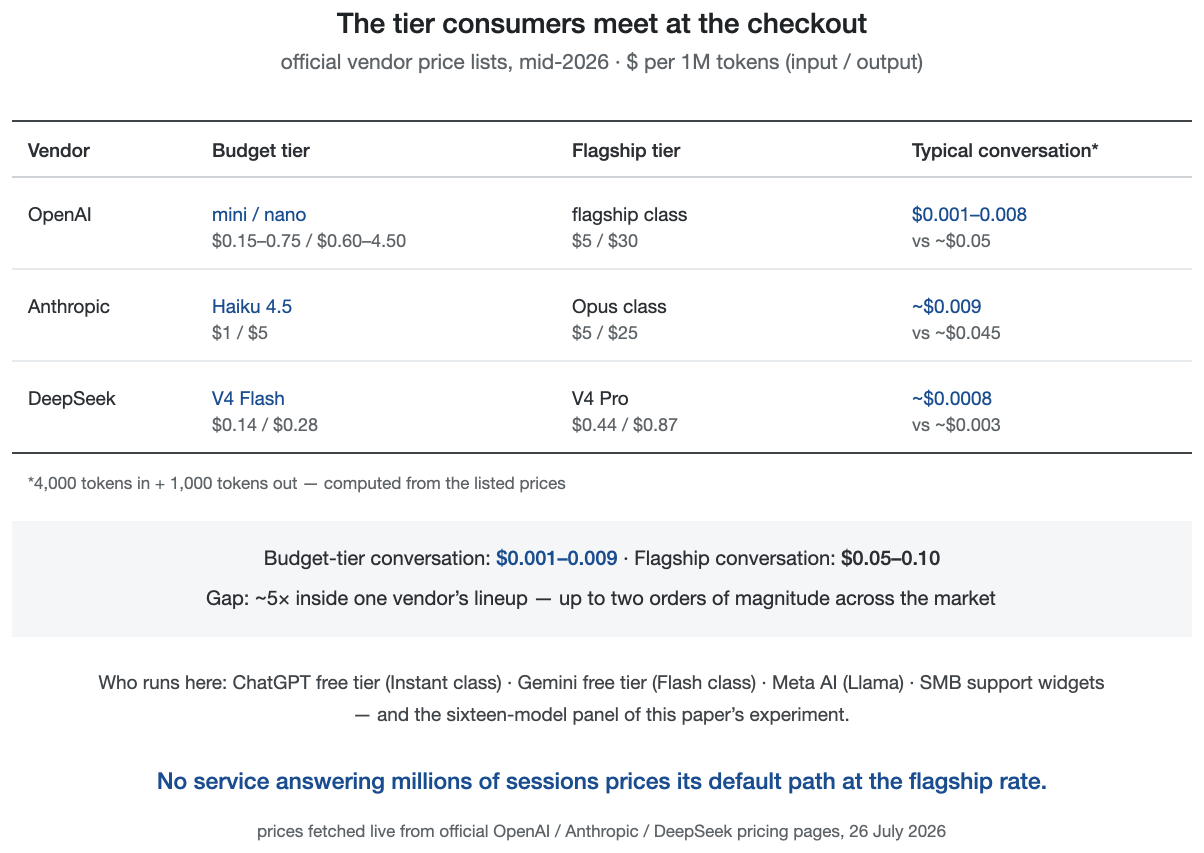
Offizielle Anbieterpreislisten, Mitte 2026.
Abbildung 12. Zwei Währungen des Modellmarkts
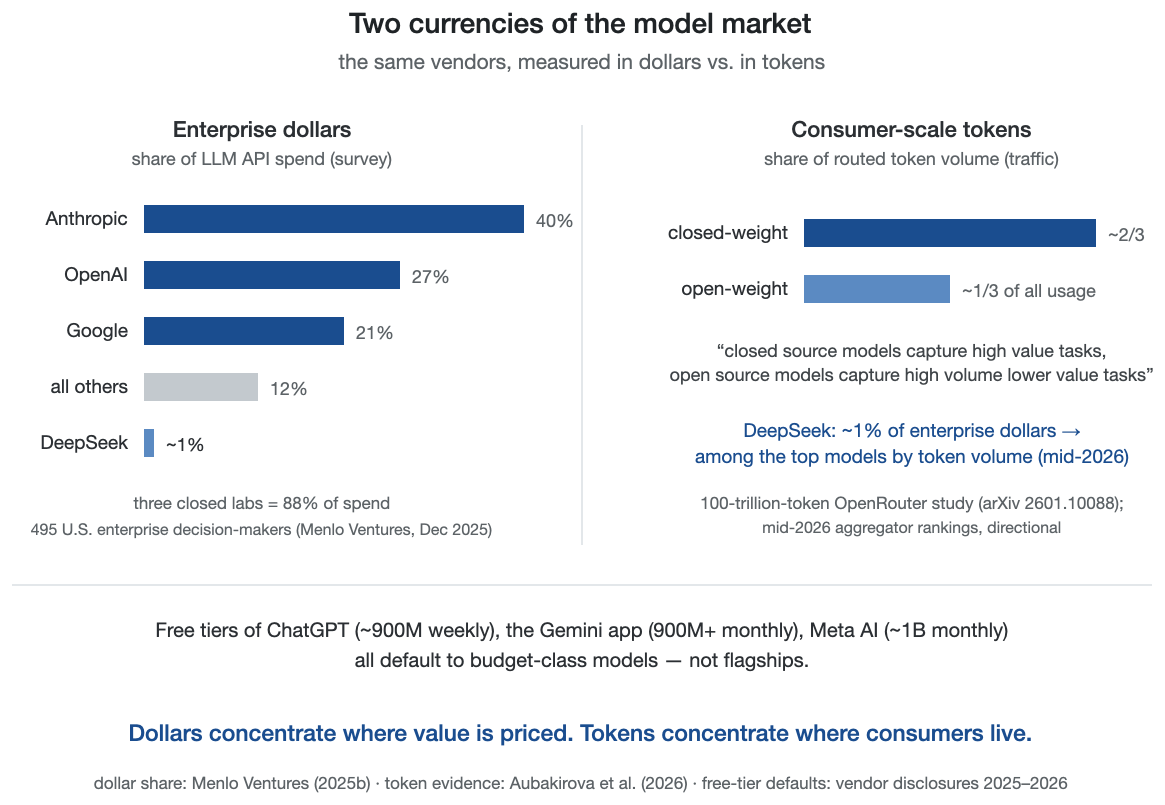
Enterprise-Dollar gegenüber Consumer-Scale-Tokens.
Die mittleren Tiers passten auch zu den Ansprüchen des Papers, die sich auf die Architektur beziehen, nicht auf Flagship-Fähigkeit: Ein Effekt, der nur mit Premium-Gewichtungen auftritt, würde ein Modellergebnis sein. Die Pipeline wird auf Rohstoffinfrastruktur für unter 15 USD API-Ausgaben repliziert. Für ein Paper, das argumentiert, dass Verifizierung billig genug sein muss, um auf jeder bedeutsamen Antwort ausgeführt zu werden, ist die Kosten der Verifizierung des Papers selbst Teil der Beweise. Die Pipeline ist ein eigenständiges Replikationspaket (Runner, Grader, Analyseskripte, rohe bewertete Daten und Run-Manifest), das nichts vom Forschungssystem des Autors erfordert. Die Sammlung umfasst 24.000 Antworten, ungefähr 30.000 einschließlich der Benchmark-Kontaminations- und Conformity-Arms. Zur Verfügbarkeit: Die öffentliche Vorregistrierung (osf.io/4y9dv) archiviert die mit festem Seed versehene 1.500-Punkt-Unterstichprobe. Das vollständige Paket ist öffentlich verfügbar unter https://osf.io/jtvu9/, eine öffentliche Komponente des Quellprojekts der Registrierung (Ordner `replication-package-v2`).
Drei Ergebnisse tragen den Abschnitt. Erstens ist das Rohmaterial reichlich vorhanden: Die mittlere angegebene Zuversicht lag bei sieben von neun Frontier-Anbietern bei 85–95, mit den zwei Ausnahmen (Median 42 und 60) genau den Anbietern, deren Zuversicht unterscheidet, während die tatsächliche Genauigkeit zwischen 10 % und 66 % lag und 289–1.212 zuversichtliche Fehler (falsch bei Zuversicht ≥ 75) pro Frontier-Anbieter bei 1.500 Fragen ergab. Als Korrektheitssignal erreichte die eigene Zuversicht eines Modells AUROC 0,53–0,79 je nach Anbieter, und ein Verbraucher hat keine Möglichkeit zu wissen, von außen, welcher Anbieter sie bekamen. Diese Anbieter-Spanne qualifiziert, beim Tier, von dem Verbraucher tatsächlich bedient werden, die Frontier-Lab-Erkenntnis, dass große Modelle häufig bei der Selbstevaluierung in kontrollierten Formaten gut kalibriert sind (Kadavath et al., 2022): Einige eingesetzte Anbieter versenden dieses Selbstwissen, andere versenden zuversichtliches Rauschen, und nichts an der Oberfläche unterscheidet sie.
Zweitens die Schlagzeile: Verifikation funktioniert als Zertifizierung, nicht als Alarm. Zertifizierung im probabilistischen Sinne, ein Posterior von etwa 49–77% je nach Panel, keine Garantie. Bei Fragen dieser Schwierigkeit saturiert das naive Signal „ein Panelist stimmt nicht zu": Es tritt bei 85–94% der selbstsicheren Fehler auf, aber auch bei 91–95% der selbstsicheren korrekten Antworten (die Registrierung antizipierte diese Umformulierung und wechselte zum vordefinierten AUROC-Endpunkt). Die informative Richtung ist die entgegengesetzte: Korrekte Antworten werden unabhängig reproduziert, falsche Antworten streuen. Eine Antwort, die mindestens ein unabhängiger Panelist reproduzierte, war bei den Intra-Bloc-Panels in 72–77% der Fälle korrekt und bei dem Cross-Bloc-Panel in 49% der Fälle, gegenüber 18–37% ohne Replikation. Eine Antwort mit unabhängiger Übereinstimmung war etwa zwei- bis dreimal so wahrscheinlich korrekt (1,9–3,2× über die drei Panels von Tabelle 6). (Hier und überall bedeutet „unabhängig" blind und separat produziert, mit gemessener statt angenommener Restfehlerkorrelation, und Korrektheit wird immer gegen die Goldlabels des Benchmarks bewertet, nie nach der Meinung eines anderen Modells.) Das Estimand ist assoziativ, nicht kausal: Replikation kennzeichnet Antworten, die wahrscheinlicher korrekt sind, und ein Teil dessen, was sie kennzeichnet, ist, dass die Frage leicht war – ein Selektionseffekt, der unten quantifiziert wird. Als Korrektheitssignal erreichte Panel-Übereinstimmung AUROC 0,832 bei dem Panel, dessen Mitglieder das schwächste eigene Zutrauen zeigten (pro Anbieter 0,53–0,62; gepooled 0,545). Der Anspruch, der haltbar ist, ist eher distributiv als merkmalbasiert: Bei allen 84 Drei-Anbieter-Panels hat die Übereinstimmungs-AUROC einen Median von 0,79 und übertrifft das gepoolte Selbsturteil in 89% der Fälle. Übereinstimmung erreichte 0,722 beim Cross-Bloc-Panel gegenüber gepooltem Selbsturteil von 0,659 (das Pooling unstandardisierter verbaler Skalen über Anbieter hinweg verzerrt das Selbsturteil, weil Anbieter die 0–100-Skala unterschiedlich verwenden und die Artefaktrichtung panelabhängig ist, weshalb die Pro-Anbieter-Werte nebeneinander gedruckt sind). Dieser Vorteil ist codierungsabhängig (alternative vorgefrorene Übereinstimmungscodierungen platzieren das Übereinstimmungssignal des Cross-Bloc-Panels bei 0,544–0,722, die großzügige Variante „ungelöst als Übereinstimmung" fällt unter das gepoolte Selbsturteil dieses Panels von 0,659, während das CN-Panel-Signal über die gleichen Codierungen von 0,719–0,894 reicht und immer über 0,545 liegt), daher ist das codierungsrobuste Panel-besser-als-Selbst-Ergebnis der Intra-Bloc-CN-Fall. Das einzige Panel, bei dem Selbsturteil das Panel-Signal eindeutig übertraf (0,842 gegenüber 0,697), war dasjenige mit dem besten diskriminierenden Anbieter der Studie (Anthropics mittlere Stufe, Selbsturteil AUROC 0,788 bei der vollen 1.500-Item-Sammlung), das gut bewertete Signal des Anbieters allein übertraf das eigene Panel-Übereinstimmungssignal. Tabelle 7 gibt Pro-Panel-Werte an, berechnet innerhalb der Itempopulation jedes Panels. Ein gepaarter Cluster-Bootstrap (Fragen mit Zurücklegen resampled, alle drei (Item, primär) Einheiten pro Frage zusammen bewegend; B = 2.000) gibt Konfidenzintervalle für die Kontraste in Tabelle 6/7 an. Beim CN-Frontier-Panel übertrifft Panel-Übereinstimmung gepooltes Selbsturteil um ΔAUROC = +0,287 (95% KI [+0,265; +0,308], p < .001). Beim Cross-Bloc-Panel ist der Vorteil kleiner, aber zuverlässig, +0,063 ([+0,037; +0,087], p < .001). Beim US-Frontier-Panel kehrt sich die Richtung um und die Umkehrung ist selbst statistisch eindeutig: Selbsturteil 0,842 gegenüber Panel-Übereinstimmung 0,697. Panel-Zusammensetzung ist daher ein erstrangiger Moderator des Signalwerts, und die Bereitstellungsregel folgt: Messen Sie die eigene Kalibrierung der Panel-Mitglieder, bevor Sie der Übereinstimmung trauen, ΔAUROC = −0,145 ([−0,170; −0,120], p < .001). Alle drei Kontraste sind signifikant, und die Heterogenität über Panels ist ein Befund, keine Störung. Der US-Fall wird daher als bestätigte Umkehrung berichtet, nicht als Nullzone, und er begrenzt das Konstrukt: Bei einem Panel aus dem diskriminierenden Ende des Markts übertrifft Selbsturteil Übereinstimmung als Ranking-Signal, daher hängt der Diskriminationswert der Diversitätskomponente von der Panel-Zusammensetzung ab, statt universell zu gelten. Architektur kann ein externes Korrektheitssignal liefern, wo exponiertes Modellzutrauen schwach diskriminiert, und prüft die Kalibrierungsbehauptung dort, wo eine gemacht wird. Eine Grenze bleibt: Selbst ein perfekt kalibriertes Modell kann seine eigene Geschichte nicht beurkunden oder seinen eigenen Interessenskonflikt nicht schiedsrichterlich entscheiden, daher verschiebt sich mit verbesserter Anbieter-Diskriminierung die Rolle der Diversität von Korrektheitsentdeckung zu Kalibrierungsprüfung, während Beweis und Neutralität Arbeiten leisten, die kein Maß an Kalibrierung leisten kann.
Architektur-Verifikation liefert ein externes Korrektheitssignal, wo ein Anbieter kein verwendbares Zutrauenssignal versendet hat, und die Identifikation, welcher Anbieter eines versendet hat, erfordert die Architektur ohnehin. Der Substitutionsanspruch, genau begrenzt, beruht auf den Kalibrierungsmetriken statt auf AUROC. Kein Anbieter in der Juli-Welle diskriminiert gleichzeitig und ist gut kalibriert; xAI kommt dem am nächsten (Tabelle 7a), und die Flaggschiff-Welle reproduziert die Dissoziations-Kalibrierungsseite, daher kann selbst der Verbraucher, der zufällig das best-bewertete Zutrauen erhält, dessen Niveau ohne externe Referenz nicht als Wahrscheinlichkeit einlösen. Das ist das, was die architektonische Schicht liefert. Sollten Anbieter irgendwann überall gute Kalibrierung versendet haben, sind Beweis und Neutralität unberührt. Das Argument hält in der Welt an, in der sich Modelle verbessern.
Drittens hat der Fehlermodus eine Form: Zertifizierte Konsensusfehler, bei denen jeder Panelist selbstsicher auf die gleiche falsche Antwort konvergiert, traten bei 0,5–2,2% der offenen Fragen auf, aber bei 4,0–7,9% in einem Begleitarm, der Elemente in Multiple-Choice-Format auf der lokalen Ebene neu präsentierte (Item-Konstruktion und Ausgaben im Replikationspaket). Konsens zertifiziert Fehler hauptsächlich dort, wo der Antwortbereich eingeengt ist – eine Design-Warnung für jede Schnittstelle, die Agenten ein Menü von Optionen bietet.
Die Nullfunde sind ebenso aufschlussreich wie die positiven, und ich veröffentliche sie als vorab registriert. Der geopolitische Bloc (einschließlich der Möglichkeit, dass Panels desselben Blocs Trainingskorpora und Destillations-Abstammungslinien gemeinsam nutzen) sagt keine Fehlerkorrelation in dieser Benchmark voraus (intra- vs. cross-bloc φ-Differenz +0,011 auf der Frontier-Schicht, 95%-KI −0,005 bis +0,028; auf der lokalen Schicht leicht umgekehrt). Die Leistungsfähigkeit treibt die Korrelation an, nicht die Flagge, in Übereinstimmung mit Kim et al. (2025). Die Abstammungslinie sagt keine Erkennungsquoten voraus: Ein lokales Modell, das seinen eigenen Frontier-Partner überprüft, schneidet wie jeder Fremde ab, und ein reasoning-destilliertes Modell erwies sich als am wenigsten fehlerkorreliert mit seinen eigenen Basisgewichten (φ = 0,135). Beide sind begrenzte Nullfunde statt nachgewiesener Äquivalenz. Das Bloc-Intervall schließt φ-Differenzen größer als +0,028 aus, und diese Grenze, nicht das Versäumnis der Ablehnung, leistet die Inferenzarbeit. Die natürliche kontinuierliche Erweiterung, die die Replikationsdaten unterstützen, besteht darin, den Zertifizierungszuwachs als Funktion der gemessenen Panel-Diversität (die Überraschungs-Score φ) und nicht der Panel-Identität zu schätzen. Das würde für Model-Panels das Programm erneut ausführen, das die Klassifizierer-Ensemble-Literatur für ihre eigenen Diversitätsstatistiken durchführte, die ergab, dass kein einzelnes Maß Ensemble-Gewinne sauber vorhersagt (Kuncheva & Whitaker, 2003).
Und billige lokale Modelle konnten Frontier-Antworten bei offenen Fragen überhaupt nicht zertifizieren (46 % Präzision mit oder ohne deren Zustimmung): Ein Verifizierer muss bei der Aufgabenklasse kompetent sein, bevor seine Unabhängigkeit von Wert ist. Die Randbedingungen sind diese: Konsens zertifiziert Fehler, wo Antworträume eingeschränkt sind, Unabhängigkeit muss gemessen statt angenommen werden, Verifizierer-Kompetenz regelt den Zertifizierungswert. In der Praxis ist Diversität eine Eigenschaft, die Frage für Frage gemessen werden muss, nicht aus Marken, Blocs oder Familienstammbäumen angenommen. Tabelle 6 fasst die Panel-Metriken zusammen. Abbildung 13 zeigt den Zertifizierungszuwachs und den Signalvergleich nebeneinander.
Abbildung 13. Die Genauigkeitstäuschung und ihre architektonische Lösung
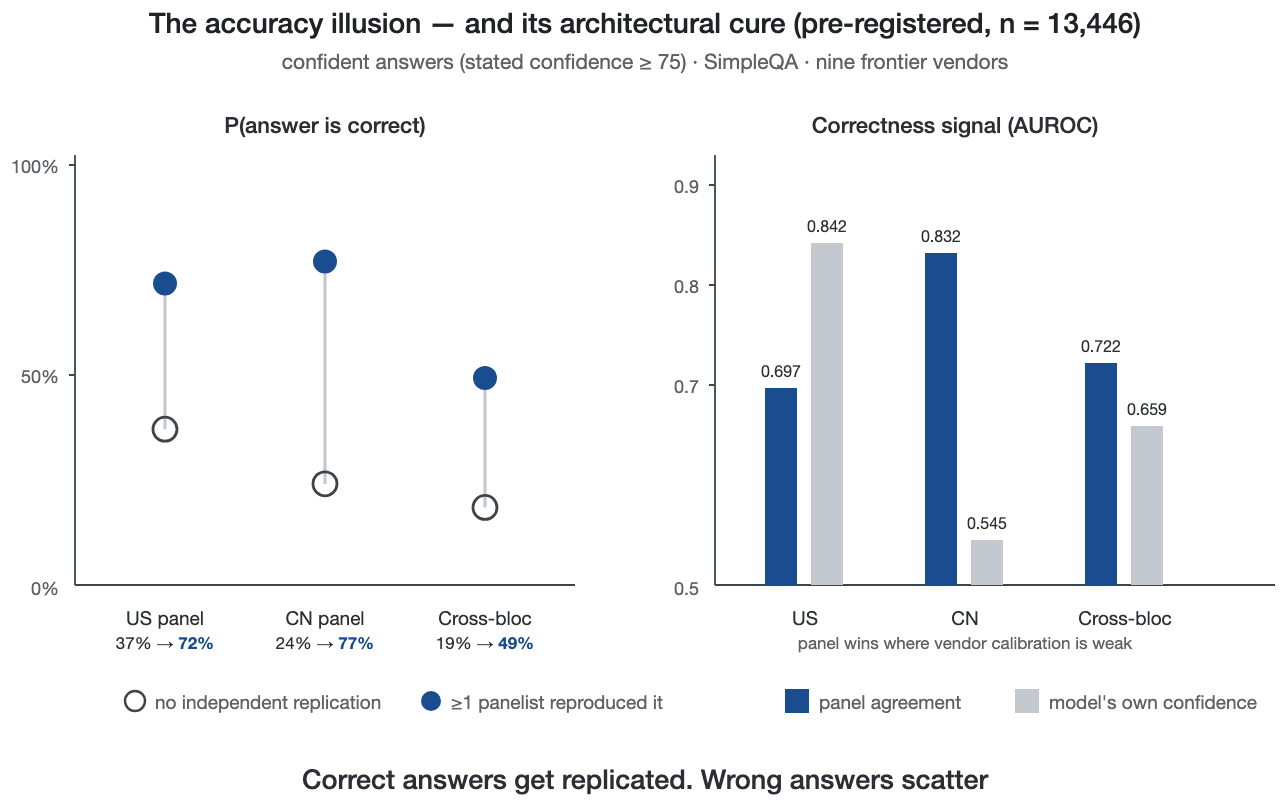
Zertifizierung durch unabhängige Replikation (vorab registriert; n = 13.446 bewertete Antworten – neun Frontier-Anbieter, jeweils beantworten dieselben 1.500 SimpleQA-Fragen einmal, minus 54 fehlgeschlagene oder nicht bewertbare Aufrufe).
Gleichzeitige Arbeiten verstärken die Vorsicht: Ein großangelegtes Audit fand hohe Selbstkonsistenz zusammen mit falschen Antworten bei Reasoning-Benchmarks, wobei Zustimmung allein, ohne Unabhängigkeit und blinde Erfassung, ein schwaches und regime-abhängiges Signal ist (Ding, 2026). Ich behandle daher unabhängige, blinde Replikation als die Einheit der Zertifizierung.
Tabelle 6. Abfangen von vertrauensvollen Fehlern und Zertifizierung durch Panel (SimpleQA, bestätigend; conf ≥ 75)
| Panel | Vertrauensvolle Fehler (n) | Flaggenquote bei Fehlern [95%-KI] | Falsche Alarme bei korrekten | P(korrekt | ≥1 stimmt zu) | P(korrekt | keine) | AUROC: Zustimmung vs. eigenes Vertrauen |
| US-Frontier (Anthropic·OpenAI·Google) | 1.630 | 94,3 % [93,1–95,3] | 91,0 % | 71,8 % | 37,1 % | 0,697 vs 0,842 |
| CN-Frontier (DeepSeek·Alibaba·Moonshot) | 2.128 | 85,5 % [83,9–86,9] | 94,8 % | 77,0 % | 24,1 % | 0,832 vs 0,545 |
| Cross-Bloc (Anthropic·DeepSeek·Mistral) | 2.432 | 89,4 % [88,1–90,6] | 93,4 % | 49,3 % | 18,5 % | 0,722 vs 0,659 |
Flagge = ≥1 Panelist's unabhängige Antwort nicht äquivalent zum Primary's (Verweigerungen und Antworten ohne Überlappung zählen als Nicht-Übereinstimmung; eine strengere Kodierung befindet sich im Replikationspaket). Schwellensensitivität bei 60/90 ändert keine Schlussfolgerung. Eigenes Vertrauen AUROC ist angegebenes Vertrauen, das über die gesamte Antwortpopulation des Panels zusammengefasst ist; die Zusammenfassung absorbiert Unterschiede zwischen Anbietern in Genauigkeit und Vertrauensskala, sodass es den Wert jedes einzelnen Mitglieds überschreiten kann (Werte pro Anbieter in Tabelle 7). Antworten clustern nach Frage; ein Fragen-Level-Cluster-Bootstrap verbreitert die Intervalle um ungefähr den Faktor 1,6, ohne eine Schlussfolgerung zu ändern. Jedes AUROC in dieser Tabelle und Tabelle 7 reproduziert deterministisch, mit einem Befehl und ohne Zufälligkeit, aus dem Replikationspaket-Skript compute_panel_vs_own_auroc.py (Mann–Whitney mit Tie-Korrektur).
Tabelle 7. Eigenes Vertrauen AUROC nach Panel: Gepoolte Panel-Population und pro Anbieter (dieselben Populationen wie Tabelle 6)
| Panel | Gepooltes eigenes Vertrauen AUROC | Eigenes Vertrauen AUROC pro Anbieter |
| US-Frontier | 0,842 | Anthropic 0,784 · OpenAI 0,596 · Google 0,746 |
| CN-Frontier | 0,545 | DeepSeek 0,569 · Alibaba 0,532 · Moonshot 0,620 |
| Cross-Bloc | 0,659 | Anthropic 0,787 · DeepSeek 0,570 · Mistral 0,584 |
Berechnet durch die deterministische Pipeline im Replikationspaket. Zwei Populationskonventionen koexistieren und werden explizit ausgedruckt, um scheinbare Inkonsistenzen zu vermeiden: Die Werte pro Anbieter der Tabelle werden innerhalb der Itempopulation jedes Panels berechnet, während einzelne Zahlenzitate im Text den Wert der vollständigen Sammlung verwenden – für den am besten diskriminierenden Anbieter 0,784 innerhalb des US-Frontier-Panels gegenüber 0,788 in der vollständigen 1.500-Item-Sammlung, und für OpenAI 0,596 gegenüber 0,598 (beide Paare werden von einem Befehl derselben Pipeline reproduziert). Die Pool-Spalte vermischt dagegen die Basisraten der Anbieter – Unterschiede zwischen Anbietern in Genauigkeit und Konfidenzskala leisten einen Teil der Arbeit, daher muss der Pool-Wert nicht im Bereich pro Anbieter liegen (live neu berechnet: Das US-Frontier-Pool 0,842 übersteigt jeden einzelnen Wert des Mitglieds, und das CN-Frontier-Pool 0,545 liegt unter dem Makro-Durchschnitt pro Anbieter dieses Panels von 0,574); die Werte pro Anbieter sind die interpretierbaren Größen. Die Spreizung pro Anbieter ist das Problem des Verbrauchers in Zahlen ausgedrückt: Verwertbare Diskriminierung existiert bei einem Anbieter und liegt bei anderen nahe am Zufall, und nichts außen auf einer Antwort sagt, welcher Anbieter sie hervorgebracht hat. Quellwerte hinter den Anbieterbereichen in Abschnitt 3, ausgedruckt pro Modell aus derselben bewerteten Sammlung (Medianangabe Konfidenz · Genauigkeit · vollständige Sammlung eigene Konfidenz AUROC): Frontier – Alibaba 95 · 47,4% · 0,532; Anthropic 42 · 10,3% · 0,788; DeepSeek 90 · 35,7% · 0,570; Google 95 · 66,5% · 0,746; Mistral 90 · 16,5% · 0,584; Moonshot 85 · 51,6% · 0,619; OpenAI 85 · 16,7% · 0,598; xAI 60 · 37,9% · 0,777; Zhipu 95 · 28,4% · 0,611 – die beiden Mediane unter der 85–95-Gruppe gehören zu den zwei Anbietern, deren Konfidenz verwertbares Signal trägt; lokale Stufe (betritt nur die Schwierigkeitsstratifizierung und die lokalen Null-Werte) – gemma4:e4b 90 · 5,2% · 0,541; glm4:9b 85 · 5,0% · 0,589; llama3.2:3b 100 · 5,3% · 0,494; mistral:7b 95 · 6,3% · 0,506; phi4-mini 95 · 5,5% · 0,505; qwen3:8b 95 · 5,9% · 0,504; deepseek-r1:8b 90 · 9,2% · 0,696 (n = 98, vorgebundene Stoppgeregel).
AUROC misst Diskriminierung, ob die angegebene Konfidenz eines Anbieters seine richtigen Antworten über seinen falschen rangiert, während ECE, der Brier-Score und die Konfidenz-Genauigkeitslücke Kalibrierung messen, ob die angegebene Zahl als Wahrscheinlichkeit gelesen werden kann, und in diesen Daten dissozieren die beiden scharf. Der am besten diskriminierende Anbieter der Studie im Juli, Anthropics mittlere Stufe (eigene Konfidenz AUROC 0,788), ist immer noch schlecht kalibriert in Level: mittlere angegebene Konfidenz 41,3 (Median 42) gegenüber 10,3% Genauigkeit, eine +31,0-Punkt-Überconfidence-Lücke, ECE 0,311 (15 Behälter), Brier 0,206 mit einem Zuverlässigkeitsterm von 0,126 gegenüber einer irreduziblen Unsicherheitsuntergrenze von 0,093. Umgekehrt tritt die schlechteste Kalibrierung im Panel zusammen mit nahezu zufälliger Diskriminierung auf (Mistral: Lücke +74,2 Punkte, ECE 0,742, AUROC 0,584), und nur xAI nähert sich sowohl Diskriminierung als auch Kalibrierung (ECE 0,111, AUROC 0,777). Selbst dort wird die Diskriminierung durch einheitlich niedrige angegebene Konfidenz unterstützt, während für die anderen acht Juli-Anbieter die beiden Eigenschaften scharf dissozieren. Diese Dissoziation bestehen auch auf der Flaggschiff-Stufe fort: Neun von elf August-Flaggschiffen weisen Überconfidence-Lücken von +12,5 bis +71,4 Punkten auf (ECE 0,125–0,714), während die zwei Ausnahmen (gpt-5.6-sol, ECE 0,031; claude-fable-5, ECE 0,043) Kalibrierung an gegenüberliegenden Enden der Genauigkeitsskala erreichen. Ein Verbraucher, der einen gut eingestuften, aber numerisch aufgeblasenen Konfidenzwert hält, kann diesen ohne eine externe Referenz nicht auszahlen. Tabelle 7a druckt die Kalibrierungsmetriken neben den Diskriminierungsmetriken.
Tabelle 7a. Diskriminierung gegen Kalibrierung, Juli-Welle (vollständige Sammlung, gelöst; ECE mit 15 Behältern; Lücke = mittlere angegebene Konfidenz − Genauigkeit, Prozentpunkte)
| Anbieter | n | AUROC (eig. Konf) | ECE | Brier | Konf − Gen-Lücke | Mittl. Konf → Genauigkeit |
| Alibaba | 1.497 | 0,532 | 0,448 | 0,446 | +44,8 pp | 92,3 → 47,4% |
| Anthropic | 1.500 | 0,788 | 0,311 | 0,206 | +31,0 pp | 41,3 → 10,3% |
| DeepSeek | 1.500 | 0,570 | 0,536 | 0,513 | +53,4 pp | 89,1 → 35,7% |
| 1.461 | 0,746 | 0,263 | 0,271 | +26,3 pp | 92,8 → 66,5% | |
| Mistral | 1.495 | 0,584 | 0,742 | 0,686 | +74,2 pp | 90,6 → 16,5% |
| Moonshot | 1.500 | 0,619 | 0,242 | 0,292 | +24,2 pp | 75,8 → 51,6% |
| OpenAI | 1.500 | 0,598 | 0,610 | 0,531 | +60,9 pp | 77,6 → 16,7% |
| xAI | 1.500 | 0,777 | 0,111 | 0,197 | +11,1 pp | 48,9 → 37,9% |
| Zhipu | 1.493 | 0,611 | 0,642 | 0,612 | +64,2 pp | 92,6 → 28,4% |
| US-Frontier-Panel, zusammengefasste Einheiten | 4.383 | 0,842 | 0,393 | 0,336 | +39,3 pp | — |
| CN-Frontier-Panel, zusammengefasste Einheiten | 4.491 | 0,545 | 0,408 | 0,417 | +40,8 pp | — |
| Länderübergreifendes Panel, zusammengefasste Einheiten | 4.485 | 0,659 | 0,529 | 0,469 | +52,9 pp | — |
Gleiche Populationen wie das vollständige Sammlungs-AUROC und die Tabellen 6–7 (Panel-Zeilen: zusammengefasste (Item, primäre) Einheiten); Ablehnungen werden nach dem eingefrorenen Protokoll als falsch bewertet. Brier wird nach der Murphy-Identität (Zuverlässigkeit − Auflösung + Unsicherheit) in denselben 15 Behältern zerlegt, Residuum < 0,001 in jeder Zeile. Eine Flaggschiff-Stufe-Notiz begleitet die zwei kalibrierten Ausnahmen: gpt-5.6-sols ECE von 0,031 wird bei 95,4% Genauigkeit erreicht, wo der Murphy-Unsicherheitsterm, die Untergrenze, die die Basisrate setzt, 0,044 beträgt – Kalibrierung teilweise durch eine Basisrate erkauft, die die Tabelle-9-Kontaminationsvorsicht trägt (61,6% wörtliche Gold-String-Übereinstimmungen).
Ein Selektionseffekt muss die Tabelle begleiten: Replikation ist teilweise ein Marker für Frageleichtigkeit. Bei Stratifizierung nach Frage-Schwierigkeit (mittlere Genauigkeit über die anderen fünfzehn Modelle) wird der rohe Zertifizierungsgewinn von den leichteren Schichten getragen (2,7–4,6×), fällt unter 1× auf dem zweithärtesten Quintil und verschwindet auf dem härtesten unter diesem within-collection-Maß. Diese Stratifizierung ist teilweise endogen, und eine exogene Neubewertung unten mildert die Inversion zu monotoner Abschwächung. Eine Robustheitsanalyse behandelt das Selektionsproblem direkt (explorativ, nicht vorab registriert): in einem question-clustered logistischen Modell mit primary-model fixed effects, kontrolliert für die eigene Konfidenz des primären Modells und für Item-Schwierigkeit (leave-primary-out mittlere Genauigkeit über alle sechzehn Modelle), multipliziert jeder zusätzliche zustimmende Panelist die Odds für Korrektheit immer noch um ungefähr fünf (gepooled b = +1,65 pro Panelist, 95% CI [+1,49, +1,81], p < 10⁻⁸⁸; positiv in jedem Panel), und das Hinzufügen von Zustimmung zu einer difficulty-plus-confidence baseline erhöht gehaltenes AUROC von 0,859 auf 0,898 und senkt den Brier-Score von 0,139 auf 0,116 (zweifache Cross-Validierung geteilt nach Frage). Das gleiche Modell sondiert die Grenze, und die Stratifizierung selbst bedarf Sorgfalt: unter dem within-collection Schwierigkeitsmaß wird der konditionelle Koeffizient auf dem härtesten Quintil negativ (b = −0,41, p = ,011), aber dieses Maß schließt die eigenen Mitglieder des Panels ein. Das konditionelle Modell trägt einen Deployment-Vorbehalt: sein Schwierigkeits-Feature erfordert Labels, daher ist es diagnostisch, nicht einsetzbar, und das einsetzbare Filter ist selbst das Zustimmungs-Gate. Drei weitere Überprüfungen behandeln Schätzungs- und Selektionsprobleme, alle unter dem eingefrorenen deterministischen Protokoll-Coding (der strengere Branch, den das Replikationspaket neben den judge-adjudizierten Headline-Zahlen meldet). Die Neubewertung des Zertifizierungsgewinns mit item-clustered Bootstrap-Resampling, das Clustering das die Schwierigkeitsstruktur verlangt, lässt das Zertifizierungsgewinn-Intervall jedes Panels weit über 1 (Punkt-Lifts 2,4–4,5 unter diesem deterministischen Coding, das weniger Zustimmungen zertifiziert als die judge-adjudizierte Pair-Coding hinter den veröffentlichten 1,9–3,2× Headline; Bootstrap-Untergrenzen 2,2–4,1). Die oben gemeldete 84-Panel-Verteilung macht das US-frontier Panel, wo Selbstbericht gewinnt, zur Ausnahme statt zur Regel (medianer Vorteil +0,14, IQR von Zustimmungs-AUROC 0,76–0,82). Und schwierigkeits-stratifiziertes AUROC macht die Grenze explizit unter einem exogenen Schwierigkeitsmaß: 0,87 auf dem leichtesten Quintil fallend zu 0,61 auf dem härtesten, Abschwächung ohne Inversion. Dieses Maß ist leave-panel-out, die dreizehn Modelle außerhalb jedes Panels, und die Neubewertung damit löst die Inversion: der konditionelle Zustimmungskoeffizient bleibt auf jedem Quintil einschließlich des härtesten positiv (härtestes-Quintil b = +0,97, p < 10⁻⁷; 28% der unabhängig replizierten Antworten auf der härtesten Schicht korrekt, nicht 0%). Die within-collection Inversion ist also teilweise ein Artefakt des Schwierigkeitsmaßes. Was unter beiden Maßen überdauert, ist monotone Abschwächung, mit Zustimmung schwächstem wo Fragen am härtesten sind, und die Realität zertifizierter Konsensussfehler; Scripts und Outputs sind im Replikationspaket. Das Headline-Verhältnis ist daher ein Durchschnitt über eine heterogene Population. Der Signalclaim stützt sich auf den AUROC-Endpunkt, nicht auf das Verhältnis.
Die Hypothesen des Experiments operationalisieren das Forschungs-Deployment, das ich betreibe: Blind Collection spiegelt seinen Council-Mechanismus, und die Panel-Zusammensetzungen existierten als seine Produktionskonfiguration, bevor die Studie konzipiert wurde. Dies ist die zweite vorab registrierte Studie in diesem Forschungsprogramm. Die dritte, das Sektion-6-Verbraucherexperiment, ist vollständig und berichtet, und eine vierte (Field-Telemetrie über Produktionsverkehr) ist entwurfstechnisch. Das Replikationspaket läuft für jeden, auf Ware-Hardware, gegen öffentliche APIs.
Eine zweite Welle auf der Flaggschiff-Ebene: elf Laboratorien — zehn vollständige Arme und einer Teilarm — einer Kalibrierungs-Moat. Das Experiment oben sampelte die kostenoptimierten Ebenen, die tatsächlich Verbraucher bedienen. Der Einwand zum Testen: vielleicht ist die Genauigkeits-Illusion ein Budget-Ebenen-Artefakt, und die Flaggschiffe, die Modelle, die jeder Anbieter als sein bestes vorstellt, sind genug kalibriert, dass Architektur über ihnen redundant ist. Eine zweite Sammlungswelle (August 2026) testet diesen Einwand an der Marktspitze.
Ich bewerte ein Flaggschiff-Modell von jedem von zehn großen KI-Laboratorien über die Vereinigten Staaten, China und Europa. Laboratorien wurden gewählt, um die führenden kommerziellen und open-weight Ökosysteme in diesen drei Regionen abzudecken. Für jedes Laboratorium wählte ich sein fähigstes allgemein verfügbares Modell zum Zeitpunkt der Bewertungswelle aus. Ich verifizierte dann diese Abdeckung gegen öffentliche Leaderboards vom 5. August 2026 (LMArena Elo, der Artificial-Analysis-Intelligence-Index, Humanity's Last Exam und SWE-bench Verified): acht der zehn Flaggschiffe platzieren sich in oder nahe der Top-Ebene von mindestens einem allgemeinen Capability-Leaderboard, während zwei (Mistral, Baidu) zur Erhaltung der Laboratoriums- und Regionalabdeckung statt auf Ranking-Gründen einbezogen sind (siehe die Abdeckungslimitationen unten). Ein elftes Laboratorium, Meta, dessen Flaggschiff erst erreichbar wurde, nachdem die Welle konzipiert wurde, wurde mid-wave hinzugefügt; seine Sammlung wurde durch eine Zugriffswiderrufung unterbrochen und wird als Teilarm berichtet (siehe unten).
Tabelle 8. Bewertete Flaggschiff-Modelle und Leaderboard-Positionen (am 5. August 2026)
| Lab | Flaggschiff-Modell (API-ID) | Land | Leaderboard-Positionen (5. Aug. 2026) |
| OpenAI | gpt-5.6-sol | USA | AA Index #3 (58,9); LiveBench #1 (82,4); Arena top-6 cluster |
| Anthropic | claude-fable-5 | USA | Arena #1 (~1525 Elo); AA Index #2 (59,9); SWE-bench Verified #1 (95,0) |
| gemini-3.1-pro-preview | USA | SWE-bench Verified #8 (80,6); HLE #17 (51,4); Arena upper cluster | |
| xAI | grok-4.5 | USA | AA Index #8 (53,8); Arena Elo 1499 |
| DeepSeek | deepseek-v4-pro | China | SWE-bench Verified #8 (80,6, Pro-Max); HLE #23 (48,2) |
| Alibaba | qwen-max (Qwen 3.7 Max) | China | Arena #21 (1488–1496 Elo); SWE-bench Verified #11 (80,4) |
| Moonshot AI | kimi-k3 | China | AA Index #4 (57,1); HLE #9 (56,0); Arena #10 (1500) |
| Zhipu (Z.ai) | glm-5.2 | China | AA Index #13 (51,1); HLE #11 (54,7) |
| Mistral | mistral-medium-3.5 | France | Unterhalb der Top 50 auf allgemeinen Leaderboards; einbezogen für regionale Abdeckung |
| Baidu | ernie-4.5-vl-424b | China | Außerhalb der allgemeinen Top 30 (ERNIE 5.0: HLE #36); ERNIE 5.1: LMArena Search Arena #4 |
| Meta (hinzugefügt in der Mitte der Welle, teilweise) | muse-spark-1.1 | USA | HLE #4 |
Werte in Klammern sind die von der Aggregator gemeldeten Werte zum Snapshot-Datum; Leaderboard-Positionen variieren leicht zwischen Aggregatoren und Snapshot-Daten. Snapshot-Quellen sind mit den Laufprotokollen archiviert, die das Replikationspaket begleiten.
Das Protokoll ist das der ersten Experimente, eingefroren und wiederverwendet: dieselbe 1.500-Element-SimpleQA-Teilstichprobe (fest durch Seed und Hash), ein blinder Durchlauf pro Modell, Temperatur null, identischer Systemprompt und Answer Parser, eine angegebene 0–100-Konfidenz pro Antwort. Die Bewertung ist deterministisch (exakte und normalisierte Stringübereinstimmung mit Gold; Verweigerungen als Fehler bewertet; ungelöste Elemente aus der Schlagzahl ausgeschlossen und in der Sensitivitätsanalyse als Fehler neu bewertet), und kein KI-Richter berührt die Schlagzahlen. Das ist eine bewusste Verschärfung gegenüber der ersten Welle, deren Grader hybrid war: objektive Stringübereinstimmung mit einem lokalen Open-Weights-Richter, der den Rest löst (66,5 % der Verdikt-Modellausgabe; 50-Element-Human-Spot-Check, 98 % Übereinstimmung). Diese Welle verwendet nur das deterministische Äquivalenzmodul (manuell validiert: 20 von 20 gekennzeichnete Meinungsverschiedenheiten und 15 von 15 Übereinstimmungen per Hand bestätigt), sodass jede Schlagzahl dieser Welle aus dem freigegebenen Skript Bit für Bit reproduziert wird. Wellenübergreifende Vergleiche der absoluten Genauigkeit überschreiten daher auch die Grader-Regime, und jeder Vergleich Juli versus August trägt einen Grader-Regime-Qualifier. Audits innerhalb der Welle unterstützen die Zahlen jeder Welle, aber wellenübergreifende Deltas vermischen Modelländerung mit Grader-Änderung, es sei denn, ein einzelner Grader wird auf beide eingefrorenen Antwortsätze erneut angewendet, was hier nicht geschehen ist. Eine Anstrengungsabweichung: OpenAI-Arm wurde bei der Standard-Schnittstellenanstrengung (mittel) gesammelt, wo das Juli-Protokoll minimal verwendet, ohne Web- oder Werkzeugzugriff bei der Inferenz (verifiziert durch Aufzählung der dem Modell ausgesetzten Werkzeuge, von denen es keine gab). Dies verschiebt die absolute Genauigkeit dieses Anbieters, nicht den Übereinstimmungsmechanismus (Abschnitt 5). Ein selbstsicherer Fehler ist eine falsche Antwort, die mit angegebener Konfidenz ≥ 80 angeboten wird; die Schwelle wurde vor dem Durchlauf festgelegt, wobei 70 und 90 als Sensitivität gemeldet werden. Union-Abdeckung ist 1.500/1.500 Fragen für zehn der elf Labore. Metas Sammlung erreichte 272 gültige Antworten, bevor der Zugriff widerrufen wurde.
Ich habe die wellenübergreifende Sorge auch direkt getestet. Neubewertung der Juli-Sechzehn-Modell-Welle mit dem eingefrorenen deterministischen Modul der zweiten Welle (das die Hybrid-Pipeline ersetzt, die 66,5 % der Verdikt mit einem lokalen Open-Weights-Grader adjudiziert, mit) ändert 2,65 % der aufgelösten Verdikt (566 von 21.338; das Modul verzichtet auf weitere 4,1 %) und bewegt keine Schlagzahl: unter einer einzelnen deterministischen Codierung lesen die Zertifizierungslifts 3,6×/4,6×/4,4× vor Neubewertung und 3,0–3,1×/4,5–4,6×/4,3× danach. Beide liegen über dem konservativen veröffentlichten 1,9–3,2×, das aus der KI-adjudizierten Paarcodierung abgeleitet wird, da mehr Übereinstimmungen zertifiziert bedeutet, dass konservativere Lifts. Jedes AUROC in den Tabellen 6–7 verschiebt sich um höchstens 0,016 auf den CN- und Cross-Bloc-Panels und 0,046 auf dem US-Panel, wobei die Reihenfolge jedes Panels zwischen Übereinstimmung und selbstberichteter Konfidenz beibehalten wird.
Das Flaggschiff-Label garantiert nichts. Aufgelöste Genauigkeit bei identischen Fragen reicht von 11,4 % bis 95,4 % über die elf Flaggschiffe (Tabelle 9), eine 84-Punkte-Spanne an der Spitze des Marktes, breiter als die Mittelschicht-Spanne des ersten Experiments. Und die Genauigkeitstäuschung bleibt intakt auf dieser Ebene: über die zehn vollständigen Laborarme gepoolt, 46,6 % aller aufgelösten Antworten, die mit angegebener Konfidenz ≥ 80 angeboten wurden, waren falsch (4.910 von 10.540; einschließlich des teilweisen Meta-Arms, 46,3 %, oder 4.935 von 10.665; ungelöste Elemente ausgeschlossen hier und in der Sensitivitätsanalyse als Fehler neu bewertet, wobei das Gesamtbild unverändert bleibt). Die Verbraucher-gerichtete Auswirkung der ersten Welle wird nicht milder mit dem Preis: ein Flaggschiff-Abzeichen sagt dem Verbraucher nicht, ob die selbstsichere Antwort vor ihm vom 95 %-genauen Flaggschiff oder dem 11 %-genauen stammt.
Tabelle 9. Flaggschiff-Welle: Abdeckung und Genauigkeit (SimpleQA-Teilstichprobe, n = 1.500 pro Labor, Temperatur 0)
| Labor (Flaggschiff) | Abdeckung | Genauigkeit (aufgelöst) | Ungelöst |
| OpenAI gpt-5.6-sol | 1.500/1.500 | 95,4 % (1.403/1.471) | 29 |
| Google gemini-3.1-pro | 1.500/1.500 | 71,1 % (837/1.178)¹ | 46 |
| Anthropic claude-fable-5 | 1.500/1.500 | 70,3 % (1.019/1.450) | 50 |
| Meta muse-spark-1.1 (teilweise) | 272/1.500 gültig | 61,4 % (148/241)² | 10 |
| xAI grok-4.5 | 1.500/1.500 | 54,8 % (794/1.448) | 52 |
| DeepSeek deepseek-v4-pro | 1.500/1.500 | 46,6 % (666/1.428) | 72 |
| Moonshot kimi-k3 | 1.500/1.500 | 45,5 % (645/1.418) | 82 |
| Zhipu glm-5.2 | 1.500/1.500 | 30,2 % (430/1.425) | 69 |
| Baidu ernie-4.5-vl-424b | 1.500/1.500 | 28,9 % (411/1.421) | 71 |
| Mistral mistral-medium-3.5 | 1.500/1.500 | 21,4 % (306/1.429) | 71 |
| Alibaba qwen-max | 1.500/1.500 | 11,4 % (164/1.435) | 65 |
¹ Googles Kanal gab auf 18,4% der Elemente leere oder gefilterte Antworten zurück (276 von 1.500 — eine Liefereigenschaft, kein Erfassungslücke: alle 1.500 wurden versucht); die Genauigkeit wird auf analysierten, aufgelösten Antworten berechnet. Beide Definitionen werden angegeben: nur beantwortete Fragen, Googles Genauigkeit beträgt 71,1% (837/1.178); wenn die 276 nicht zugestellten Antworten als Fehler gezählt werden, liegt sie bei 57,6% (837/1.454) und bei 55,8% (837/1.500), wenn auch nicht aufgelöste Elemente als Fehler bewertet werden. ² Metas Genauigkeit berechnet auf den Antworten, die vor der Zugriffssperrung erhoben wurden; siehe Erfassungsbeschränkungen. Die Genauigkeit in der gesamten Tabelle ist nur für aufgelöste Antworten; unter der Sensitivitätsanalyse „nicht aufgelöst als Fehler" wird die oberste Zahl, OpenAIs 95,4%, zu 93,5% (1.403/1.500). Die pro-Aufruf-Kanalherkunft für jedes Labor ist im Laufmanifest aufgezeichnet. „Nicht aufgelöst" zählt gelieferte Antworten, die sich nicht deterministisch aufgelöst haben; bei Zhipu (1.494 Antworten geliefert), Baidu (1.492) und dem partiellen Meta-Arm (251) addieren sich die beiden Spalten daher zu weniger als den versuchten Fragen, der Rest sind nicht gelieferte Antworten.
Ein Kontaminationsvorbehalt schränkt die absoluten Genauigkeiten ein. Diese Welle verwendet erneut die ursprüngliche, öffentlich freigegebene SimpleQA-Benchmark (Oktober 2024) gegen Modelle, deren Trainingskorpora ihre Veröffentlichung um bis zu zwei Jahre überschreiten, sodass eine Exposition gegenüber der Benchmark zum Trainingszeitpunkt an der Spitze der Tabelle plausibel ist, und die Daten tragen eine konkrete Signatur dafür: das am höchsten bewertete Flaggschiff reproduziert die Gold-Antwortzeichenkette wörtlich (normalisierte genaue Übereinstimmung, bis auf die Dezimalformatierung) auf 61,6% der Elemente, gegenüber 27,9–45,3% für die anderen Laboratorien, bei einem mittleren angegebenen Vertrauen von 99. Das Design kann nicht zwischen „das Modell ist stärker" und „das Modell hat die Benchmark und ihren Antwortschlüssel gesehen" trennen. Die absoluten Genauigkeitswerte dieser Welle sind daher nicht mit historischen geschlossenen Oberflächenkenntnissen vergleichbar, die für frühere Modellgenerationen angegeben wurden, und sie sollten nicht als Maße des parametrischen Gedächtnisses gelesen werden. Die Benchmark-Alters-Überprüfung der ersten Welle (die in Abschnitt 3 gemeldete TruthfulQA-SimpleQA-Lücke) deckte die Juli-Sammlung ab; im August 2026 ist SimpleQA selbst eine zwei Jahre alte öffentliche Benchmark, und dieser Vorbehalt deckt die Flaggschiff-Welle ab. Die Schlussfolgerungen der Welle beruhen nicht auf absoluter Genauigkeit. Sie beruhen auf der Struktur selbstbewusster Fehler, ihrer Häufigkeit bei angegebenem Vertrauen ≥ 80 und ihrer Abfangung durch das Uneinigkeitstor, gemessen innerhalb der Welle unter einem eingefrorenen Protokoll, wobei ein Expositionsvorteil über die Laboratorien verteilt ist, die an denselben Elementen bewertet werden. Ein nach dem Studienzeitraum erstellter frischer Zwei-Sprung-Test bestätigt diese Signatur direkt. Siehe „Warum nicht einfach das beste Modell verwenden?" später in diesem Abschnitt.
Der Kalibrierungsgraben. Das erste Experiment zeigte, dass unabhängige Übereinstimmung ein Korrektheitssignal trägt, das selbstberichtetes Vertrauen nicht trägt. Die Flaggschiff-Welle verwandelt dieses Signal in einen gemessenen Filter. Der Mechanismus ist ein Uneinigkeitstor: ein Rat von drei Laboratorien, voraus aus einer vorherigen Uneinigkeitsanalyse festgelegt und nicht an diese Ergebnisse angepasst (Moonshot kimi-k3, DeepSeek deepseek-v4-pro, OpenAI gpt-5.6-sol), und eine Regel ohne freie Parameter. Eine Antwort passiert das Tor nur, wenn die drei Ratsantworten paarweise übereinstimmen. Da nichts geschätzt wird, ist keine Aufteilung in Trainings- und Testdaten erforderlich; das Tor wird einmal über die eingefrorene Sammlung berechnet.
Abbildung 17. Das Flaggschiff-Tor
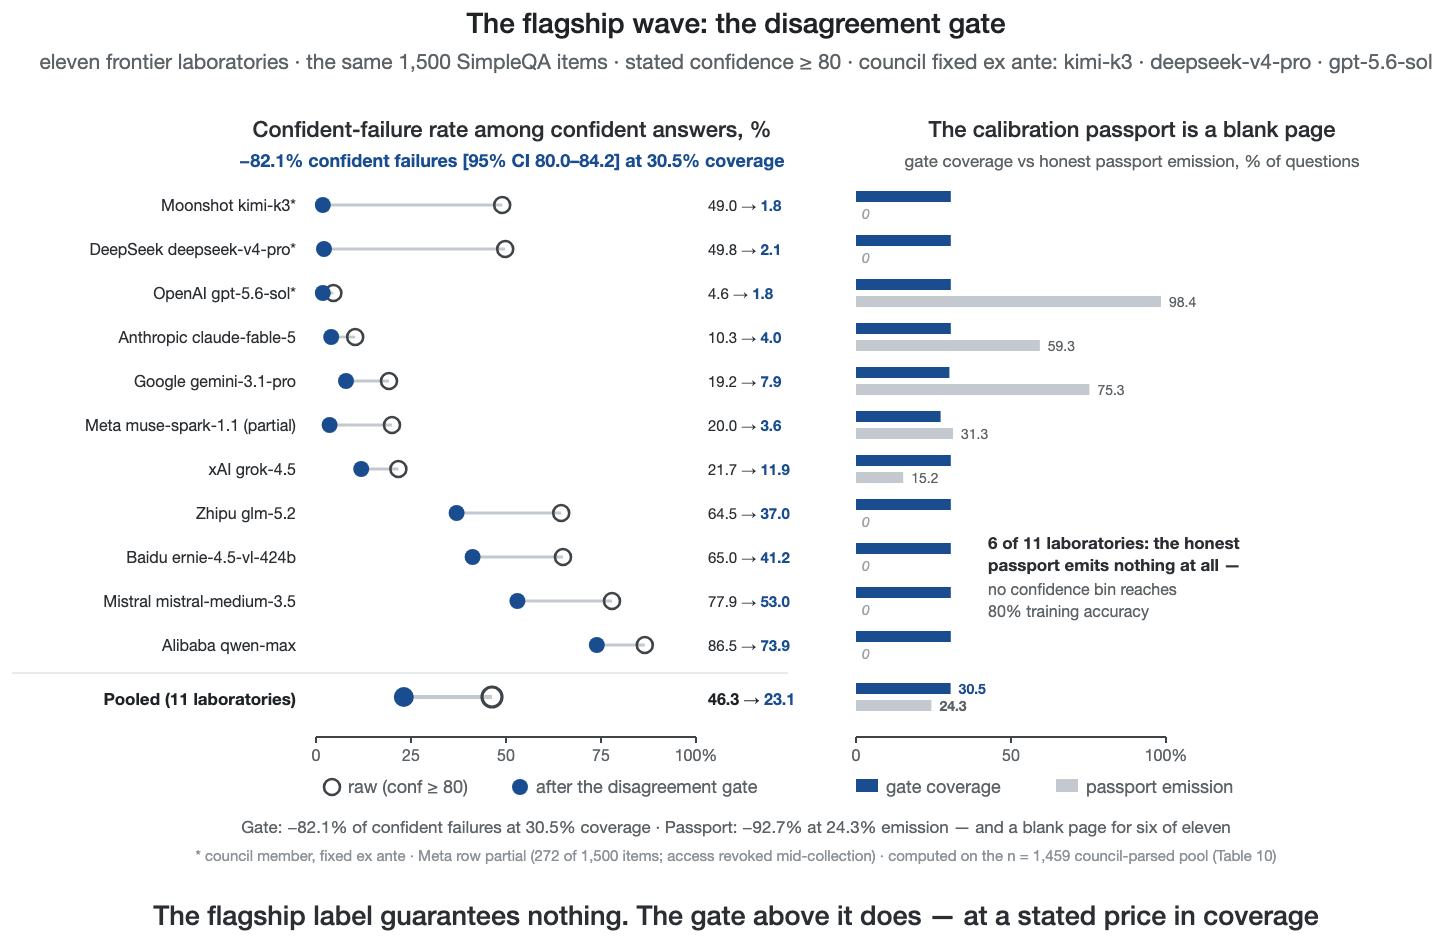
Selbstbewusste Fehler bei angegebenem Vertrauen ≥ 80 und ihre Abfangung durch das feste Drei-Modell-Uneinigkeitstor, nach Labor (August 2026 Welle).
Zusammengefasst über die zehn vollständigen Laboratoriums-Arme (die primäre Präsentation, mit dem partiellen Meta-Arm separat angegeben und seine Aufnahme als Sensitivitätsanalyse behandelt), beträgt die rohe Rate der selbstbewussten Fehler 46,6% (4.910/10.540). Zusammengefasst über die Auswahl von elf Laboratorien variieren die pro-Labor-Raten (Tabelle 9), sodass diese Zahl das Frontier-Verzeichnis charakterisiert, nicht eine universelle Konstante. Das Tor beseitigt 82,1% der selbstbewussten Fehler (Bootstrap 95% KI [79,9; 84,1]) während es 30,5% aller gepoolten Antworten behält (das Tor selbst öffnet sich auf 30,6% der Fragen, 446 von 1.459). Beschränkt auf die vollständigen Laboratorien außerhalb des Rats, ohne jegliche Selbstreferenz, beseitigt das Tor immer noch 76,9% der selbstbewussten Fehler (KI [74,3; 79,2]). Die Aufnahme des partiellen Meta-Arms lässt jede Schätzung praktisch unverändert: zusammengefasst über alle elf beträgt die rohe Rate 46,3% (4.935/10.665; 35,8% der selbstbewussten Antworten passieren das Tor, und die Korrektheit unter ausgegebenen selbstbewussten Antworten steigt von 53,7% roh auf 76,9% nach dem Tor), das Tor beseitigt 82,1% (KI [80,0; 84,2]) bei derselben 30,5% Abdeckung, und die Acht-Labor-Nicht-Rats-Zahl ist 77,0% (KI [74,4; 79,3]). Tabelle 10 gibt die pro-Labor-Ziffern an.
Tabelle 10. Abfangung selbstbewusster Fehler durch das Uneinigkeitstor (conf ≥ 80; deterministischer Bewerter; Rat = kimi-k3 · deepseek-v4-pro · gpt-5.6-sol, ex ante festgelegt)
| Laboratorium | Selbstbewusste Antworten | Selbstbewusste Fehler, roh | Nach Tor (Rate bei ausgegebenen) | dCF |
| Moonshot kimi-k3 [Rat] | 1.056 | 517 (49,0%) | 7 (1,8%) | −98,6% |
| DeepSeek deepseek-v4-pro [Rat] | 1.274 | 634 (49,8%) | 9 (2,1%) | −98,6% |
| OpenAI gpt-5.6-sol [Rat] | 1.426 | 65 (4,6%) | 8 (1,8%) | −87,7% |
| Anthropic claude-fable-5 | 825 | 85 (10,3%) | 15 (4,0%) | −82,4% |
| Google gemini-3.1-pro | 966 | 185 (19,2%) | 27 (7,9%) | −85,4% |
| Meta muse-spark-1.1 (partiell) | 125 | 25 (20,0%) | 2 (3,6%) | −92,0% |
| xAI grok-4.5 | 577 | 125 (21,7%) | 36 (11,9%) | −71,2% |
| Zhipu glm-5.2 | 1.128 | 727 (64,5%) | 146 (37,0%) | −79,9% |
| Baidu ernie-4.5-vl-424b | 725 | 471 (65,0%) | 107 (41,2%) | −77,3% |
| Mistral mistral-medium-3.5 | 1.354 | 1.055 (77,9%) | 224 (53,0%) | −78,8% |
| Alibaba qwen-max | 1.209 | 1.046 (86,5%) | 300 (73,9%) | −71,3% |
| Zusammengefasst (11 Laboratorien) | 10.665 | 4.935 (46,3%) | 881 (23,1%) | −82,1% [80,0; 84,2] |
| Zusammengefasst (8 Nicht-Rat) | 6.909 | 3.719 (53,8%) | 857 (33,5%) | −77,0% [74,4; 79,3] |
Berechnet auf dem Pool von Fragen, bei denen alle drei Ratsmitglieder analysierte, nicht abgelehnte Antworten produzierten (n = 1.459 von 1.500); das Gate öffnet sich bei 446 davon (30,6%). Meta-Zeile ist unvollständig (Zugriff während der Erfassung widerrufen). Bootstrap-KIs: 5.000 Fragen-Ebenen-Resamples.
Drei Dinge gehören zu dieser Überschrift. Das Gate verwirft auch etwa die Hälfte der sicheren richtigen Antworten (das Gate behält nur 51,3% der sicheren richtigen Antworten; von den Antworten, die es ausschließt, waren etwa 41% tatsächlich richtig). Der Austausch ist Abdeckung gegen Sicherheit, der kanonische Risiko-Abdeckungs-Tradeoff der selektiven Klassifikation (Geifman & El-Yaniv, 2017), hier auf der Architektur-Ebene ausgeführt, und die beiden Zahlen sollten immer als Paar zitiert werden: −82,1% sichere Fehler bei 30,5% Abdeckung. Das System hat seinen eigenen Boden. Im vollständig systemischen Modus, in dem das offene Gate die Konsensuantwort des Rats statt der Antwort des einzelnen Modells ausgibt, liegt die sichere Fehlerquote des Systems bei 1,8% (8 von 442 aufgelösten Konsensuantworten), und diese acht Fragen sind solche, bei denen der gesamte Rat sicher der gleichen falschen Antwort zustimmt. Dies ist die Grenze für korrelierte Fehler, die das erste Experiment aus seiner Grenzbeziehung Konsens-bestätigt-Fehler vorhersagte: Unterhalb dieser Grenze hilft keine Übereinkunftsprüfung, weil die Übereinkunft selbst der Fehler ist. Und das Ergebnis ist flach über das vordeklarierten Sensitivitätsgitter: Konfidenz-Schwellenwert 70/80/90 ergibt gepooltes dCF von −83,1%/−82,1%/−80,6%, und Neubewertung ungelöster Elemente als Fehler ergibt −81,8%, sodass die Zahl gemessen, nicht gewählt wurde.
Was die 30,5%-Abdeckungsziffer kommerziell bedeutet, wird durch die Gewinnschwellen-Ökonomie von Abschnitt 5 (Abbildung 14) festgelegt: Die etwa siebzig Prozent der Antworten, die das Gate nicht bestätigen will, sind Anfragen, die zu einem billigeren Schicksal als ein sicherer Fehler weitergeleitet werden (Eskalation zu einer Person, eine tiefere Verifizierungsebene oder eine explizite Unsicherheitsanzeige) statt verlorener Konversionen, sodass die Abdeckungskosten ein versicherbarer Preis des Fehlers sind, nicht entgangene Nachfrage. Für den Eskalationskanal wird hier kein Kostenmodell geschätzt. Der Betriebspunkt ist nicht fest. Die in Abbildung 19 verfolgte Übereinkunftsleiter bietet eine Familie von Schwellenwerten, und ein Dienst sollte dort sitzen, wo die erwarteten Kosten eines nicht erfassten sicheren Fehlers die Marge auf dem Verkehr überschreiten, den das Gate zurückhält, was es zu einer kostengestützten Wahl macht.
Abbildung 14. Ökonomie des gestuften Vertrauens
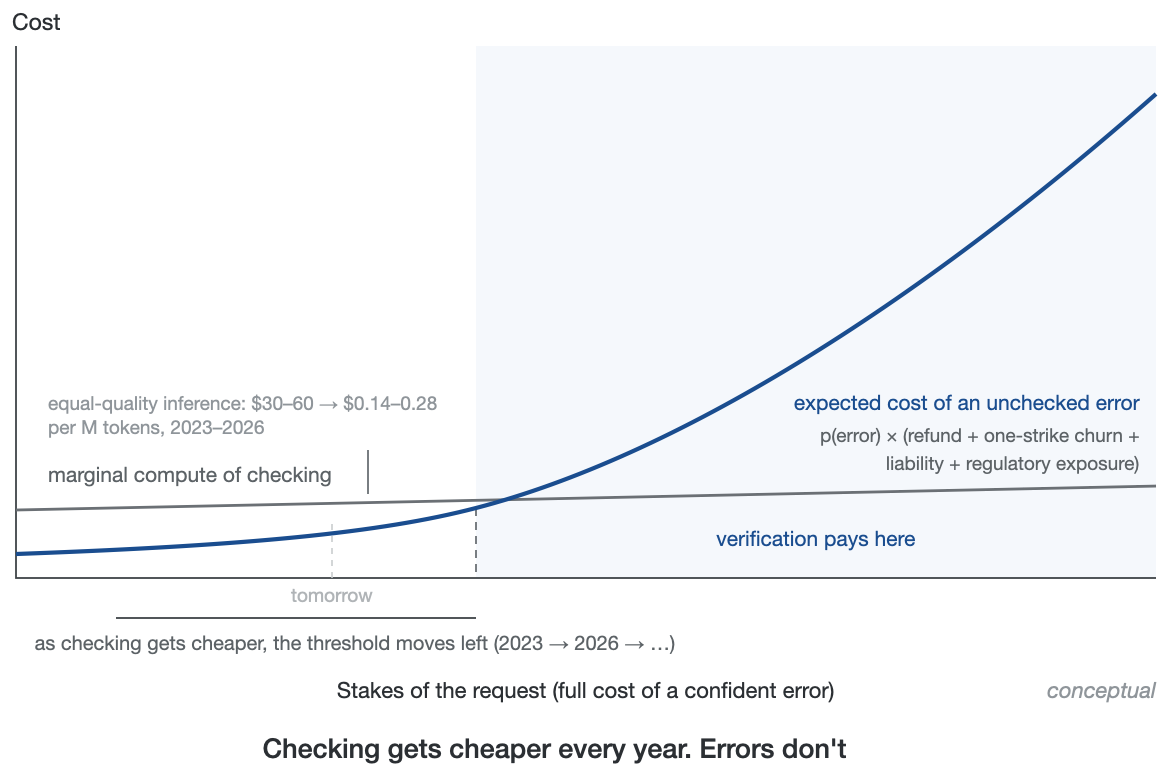
Die Gewinn-Schwellen-Logik der Verifizierung.
Warum nicht einfach das beste Modell verwenden? Das stärkste Basis-Szenario, das die Welle hinterlässt, ist kommerziell statt statistisch: Ein Betreiber könnte die Architektur überspringen und alles zum genauesten Flaggschiff der Welle weiterleiten. Diese Basis benötigt eine Antwort mit Zahlen. Zu Preisen von Mitte 2026 kostet der eingefrorene Rat aus drei Labors 0,0039 USD pro Frage, weniger als eine einzelne Antwort vom teuersten Flaggschiff der Welle (claude-fable-5, 0,0198 USD/Frage zum Listenpreis) und mehr als eine vom genauesten (gpt-5.6-sol, 0,0027 USD/Frage zu veröffentlichten API-Sätzen). „Kaufen Sie einfach das beste Flaggschiff" ist ein echter Pareto-Punkt: gpt-5.6-sol beantwortet allein jede Frage mit einer Rate sicherer Fehler von 4,6%, und keine gesperrte Konfiguration stimmt seiner Abdeckung zu irgendeinem Preis überein. Wo immer ein Dienst sichere Fehler auf etwa einer Antwort von zwanzig tolerieren kann und volle Abdeckung benötigt, gewinnt das Flaggschiff auf beiden Achsen. Die Regel verallgemeinert sich jedoch schlecht, selbst an der Spitze der Rangliste: Das andere Konsens-Front-Runner-Modell der Welle, claude-fable-5, trägt allein eine sichere Fehlerquote von 10,3%. „Verwenden Sie einfach, welches Modell die Benchmarks anführt" scheitert völlig beim zweitstärksten Modell in der Stichprobe, weshalb das Identifikationsproblem unten nicht hypothetisch ist. Vier Überlegungen grenzen den Vergleich ein.
Erstens das Identifikationsproblem: Das Wissen welches Modell derzeit am besten ist, ist selbst das Produkt externer, modellübergreifender Messung. Tabelle 8 der Welle wählte ihre Flaggschiffe aus öffentlichen Ranglisten, kontinuierliche, externe, herstellerübergreifende Vergleiche, die niemand durch Selbstberichte des Herstellers zu ersetzen vorschlägt. Die eigenen Daten dieses Papiers zeigen, warum niemand es tut: Gegebene Selbstvertrauen diskriminiert bei AUROC 0,53–0,79 je nach Hersteller, und eine 84-Punkte-Genauigkeitsspanne trennt Modelle, die alle als das Beste ihres Labors verkauft werden. „Weiterleitung zum besten Modell" ist daher eine Anwendung architektonischen Vertrauens, nicht eine Alternative dazu: Die Rangliste, die das Flaggschiff krönt, ist ein unabhängiges Gremium, blinde Posten und ein veröffentlichter Datensatz, die drei Komponenten von Abschnitt 3, betrieben im Marktmaßstab. Und diese Krone bewegt sich: Die Führerschaft des Unternehmensmodells wechselte in einem einzigen Frühling (Kharazian, 2026), Modelle werden stillschweigend unter stabilen Namen aktualisiert, und Agent-Kaufverhalten wird bei Modellaktualisierungen drastisch neu gemischt (Allouah et al., 2026). Ohne kontinuierliche externe Messung ist „das beste Modell" für den Betreiber als Wissen nicht verfügbar.
Zweitens sind die 95,4% teilweise Speicher statt Fähigkeit: Das Top-Flaggschiff reproduziert die Gold-Antwortzeichenkette wörtlich auf 61,6% der Elemente (Kontaminationsvorbehalt von Tabelle 9), daher komprimiert sich sein gemessener Vorteil auf Fragen, die die Benchmark es nicht gelehrt haben kann. Der Gate-Mechanismus erbt diese Fragilität nicht: Bei der Schicht, die am wenigsten wahrscheinlich memoriert wurde, entfernt er 89,4% der sicheren Fehler, seine beste Leistung, nicht seine schlechteste (die Kontaminations-geschichtete Neuanalyse unten), weil Übereinstimmung unter unabhängig trainierten Labors nicht an einen Trainingskörpus eines Herstellers gebunden ist.
Um übertragbares Wissen von Benchmark-Exposition zu trennen, stellte ich eine frische 100-Element-Zwei-Hop-Sonde zusammen, die garantiert unverschmutzt ist, maschinengenériert am 6. August 2026 aus Paaren unabhängig verifizierter Wikidata-Fakten von vor 2023 (z. B. „In welchem Jahr wurde der Architekt von [Nebengebäude] geboren?"), jeweils mit einer einzelnen berechneten Antwort, sodass die zusammengesetzten Fragenzeichenketten in keinem Trainingskorpus vorgekommen sein können. Der SHA-256 des Satzes wurde vor dem ersten Modellaufruf eingefroren.
Unter dem gefrorenen Protokoll der Welle (wörtlicher Systemprompt, Temperatur 0, derselbe deterministische Bewerter) kollabierte gpt-5.6-sol von 95,4 % Genauigkeit mit einer Quote von 4,6 % sicheren Fehlern bei SimpleQA auf 33,0 % [Bootstrap 95 % KI 24,0–42,0] mit sicheren Fehlern bei 61,0 % [51,0–70,0] seiner Elemente (67,0 % seiner sicheren Antworten), während sich sein mittleres angegebenes Vertrauen kaum bewegte (98,4 → 93,7), während claude-fable-5 bei 76,0 % [67,0–84,0] und 6,0 % [2,0–11,0] hielt. Die 25-Punkte-Lücke des Flaggschiffs der Welle kehrt sich bei garantiert ungesehenen Kompositionen in ein 43-Punkte-Defizit um. Das Ratstor, unverändert von der Welle, absorbierte diesen Fehler: Es entfernte alle außer einem der 61 sicheren Fehler von gpt-5.6-sol (60/61; bei n = 61 ist die Punktquote ungenau, Wilson 95 % KI ≈ 91–99,7 %; 24,2 % Abdeckung; claude-fable-5: 6 → 1), was die emittierte Quote sicherer Fehler bei bestandenen Antworten mit hohem Vertrauen auf 4,5 % gegen einen rohen Wert von 67,0 % reduzierte.
Niveaus sind nicht punktvergleichbar über Benchmarks hinweg: Zwei-Hop-Komposition ist von Natur aus schwieriger als Einfach-Hop-Abruf, und bei n = 100 sind die Intervalle breit. Aber die Umkehrung der Modellreihenfolge und die Persistenz des Tors bei Elementen, die kein Modell auswendig gelernt haben kann, sind genau die Signaturen, die die Kontaminationserklärung vorhersagt, und sie sind die Ausfallart, die eine architektonische Vertrauensschicht, und nicht eine bessere Modellwahl, absorbieren soll.
Drittens gibt es eine Untergrenze. Das Tor erreicht eine Quote sicherer Fehler, die kein einzelnes Modell zu irgendeinem Preis erreicht: Mit Rat ausgestattete Konfigurationen reduzieren sichere Fehler bei emittierten Antworten auf 1,8–2,1 % bei 0,0039–0,0046 USD pro Frage, 2,5× unter der besten Solo-Quote, während das teuerste Flaggschiff der Welle bei 10,3 % sicheren Fehlern für 0,0198 USD pro Frage sitzt, dominiert auf allen Achsen. Das Tor ist kein Rettungsgerät für schwache Modelle: qwen-max hinter demselben Tor schlägt immer noch fehl bei 73,9 % seiner emittierten sicheren Antworten, daher sind die gattergesteuerten Punkte der Grenze Räte starker Modelle, nicht Gatter über schwachen.
Viertens: Wenn der Agent autonome Ausgaben tätigt, verlagert sich die operative Frage von „welches Modell ist intelligenter" auf „welche Konfiguration kann beweisen, was es getan hat". So genau es auch sein mag, ein Solo-Flaggschiff kann seine eigene Entscheidung nicht beglaubigen oder seinen eigenen Interessenskonflikt nicht schlichtet. Die gattergesteuerte Konfiguration erzeugt einen überprüfbaren Vereinigungsdatensatz pro Antwort. Das ist das Artefakt, dessen Haftungs- und Versicherungsmärkte bereits in Abschnitt 5 festgelegt sind, wo die Abdeckung gegen Belege geschrieben wird und Ausschlüsse gegen deren Fehlen ausgeformt sind.
Die Lösung ist eine Grenze, kein Gewinner. Das Flaggschiff ist das stärkste Mitglied des Rats (der gefrorene Rat bezieht es ein), doch es kann nicht als sein eigener Richter dienen. Die Rangliste, die es identifiziert, ruht bereits auf demselben Prinzip, das die architektonische Vertrauensebene operationalisiert, unabhängige modellübergreifende Verifikation, liefert diese Verifikation aber nur insgesamt, über Modelle im Allgemeinen, nicht über die Antwort vor einem Verbraucher. Das Konstrukt schließt diese Lücke, und die Lücke begrenzt es auch: Ein Anspruch, der auf keiner unabhängigen Überprüfung beruht, liegt außerhalb der architektonischen Vertrauensebene, nicht als eine Instanz davon. Die eigentliche Wahl des Betreibers liegt zwischen Risikoclassen: Vollständige Abdeckung bei 4,6 % sicheren Fehlern oder 31 % Abdeckung bei 1,8 % mit Audit-Spur, das hier bewertete selektive Klassifizierungsdilemma. Die vollständige 26-Konfigurationen-Kosten–Abdeckungs–Risiko-Grenze (jedes Solo-Flaggschiff, jede gattergesteuerte Konfiguration und die gepoolten Vereinigungsleitern, mit der berechneten oder Listenpreisbasis pro Punkt gekennzeichnet) wird als CSV mit dem Replikationspaket freigegeben.
Der offensichtliche Rivale zum Uneinigkeitstor ist die Kalibrierungsreparatur einzelner Modelle: Erlernen Sie für jedes Modell die Zuordnung von Vertrauen zu Genauigkeit und emittieren Sie nur, wenn die zugeordnete Genauigkeit einen Schwellenwert überschreitet, das Nachbesserungs-Rekalibrierungsprogramm, dessen Standardmittel sind Temperatur und Platt-Skalierung (Guo, Pleiss, Sun, & Weinberger, 2017). Angepasst auf disjunkte Hälften (Histogramm-Binned-Vertrauen, trainiert auf geraden Fragennummern, evaluiert auf ungeraden, Behälter unter 20 Beobachtungen nicht emittiert), entfernt dieser Kalibrierungspass 92,7 % der sicheren Fehler, aber bei 24,3 % Emission, und sechs der elf Flaggschiffe emittieren überhaupt nichts: Kein Vertrauensbehälter von ihnen erreicht 80 % Trainingsgenauigkeit, daher ist der Pass für diese Modelle eine leere Seite. Für die Hälfte des Flaggschiff-Markts kann die Kalibrierung einzelner Modelle nicht von außen repariert werden. Das Uneinigkeitstor behält für jedes Modell in der Tabelle etwa 30 % Abdeckung, einschließlich der sechs, die der Pass aufgibt. Die Schlussfolgerung des ersten Experiments gilt also auch auf dieser Ebene: Architektur kann ein externes Korrektheitssignal liefern, bei dem das enthüllte Vertrauen eines Modells in Rangfolge oder Niveau fehlschlägt, wiederum auf der Ebene gemessen, der Verbraucher das meiste Vertrauen schenken sollen.
Robustheit des Gattereffekts. Zwei schiedsrichtergesteuerte Überprüfungen sind wichtig: Zirkularität, ob das Tor auf seinem stärksten Mitglied reitet, und ob etwas Triviales die gleiche Arbeit leistet. Ersetzen des stärksten Mitglieds des Rats (gpt-5.6-sol, 95,4 % aufgelöste Genauigkeit) durch den vierten ex-ante Grenzenlauf der Welle (grok-4.5) lässt das Ergebnis im Wesentlichen unverändert. Der sol-freie Rat entfernt 81,2 % der gepoolten sicheren Fehler bei 29,7 % Abdeckung (Nicht-Ratziele: 77,6 %) gegen 82,1 % bei 30,5 % für das gefrorene Trio, und über alle 165 möglichen Drei-Modell-Räte hinweg schlägt der Mechanismus nie fehl: Jeder Rat entfernt mehr sichere Fehler als zufällige Enthaltung bei seiner eigenen Abdeckung (mittlerer Überschuss +8,5 Punkte), wobei das ex-ante Trio in den besten 4 % dieser Marge liegt (+12,6 Punkte). Der Effekt gehört zur modellübergreifenden Übereinstimmung, nicht zur Genauigkeit eines Mitglieds. Schwellenwertbildung des eigenen angegebenen Vertrauens jedes Modells auf die identische Pro-Modell-Abdeckung, die triviale Baseline, entfernt nur 66,7 % der gepoolten sicheren Fehler, weniger als die 69,5 %, die blinde zufällige Enthaltung bei der gleichen Abdeckung entfernt, da sichere Fehler durch Konstruktion bei hohem angegebenen Vertrauen konzentriert sind. Dieser Schwellenwert behält auch weniger sichere-korrekte Antworten als das Tor (46,4 % gegen 51,3 %). Das Tor dominiert beide Baselines für jedes der elf Laboratorien im Pareto-Sinne. Verwendung von Pro-Antwort-Übereinstimmung mit dem stärksten Modell allein als Filter ist ein noch stärkerer Filter (97,1 % der gepoolten sicheren Fehler bei 40,7 % Abdeckung entfernt, 97,0 % der sicheren-korrekten Antworten behalten), aber es ist eine mechanisch unterschiedliche, zielbedingte Regel. Sie akzeptiert eine Antwort nur, nachdem Sie sie inspiziert haben, während das Ratstor für jedes Modell den gleichen festen Fragensatz öffnet, ohne die getestete Antwort zu überprüfen, daher begrenzt es den Ratseffekt, ohne ihn zu erklären: Ohne sol entfernt das Trio immer noch 81,2 %, und selbst die Übereinstimmung mit einem schwachen einzelnen Schlichter (kimi-k3, 45,5 % aufgelöste Genauigkeit) entfernt 86,3 % der sicheren Fehler. Der Treiber ist die modellübergreifende Übereinstimmung als solche, während die Schlichter-Genauigkeit in dem angezeigt wird, was behalten wird (behalten-korrekt 97,0 % für sol gegen 20–63 % für die schwächeren Schlichter).
Die kalibrierte Enthaltung liefert die stärkeren konkurrierenden Baselines, und diese wurden ebenfalls ausgeführt. Zwei kalibrierte Enthaltungs-Baselines wurden unter demselben Split wie der Kalibrierungs-Passport angepasst (Parameter angepasst auf geradeindizierte Elemente, evaluiert auf der gehaltenen ungeraden Hälfte, wobei das gefrorene Gate 82,2 % der selbstbewussten Fehler bei 30,8 % Abdeckung entfernt). Die Pro-Modell-Baselines erreichen das Gate nicht. Platt-skaliertes Vertrauen mit Pro-Modell-Abdeckung, die dem Gate entspricht, entfernt 65,3 % der selbstbewussten Fehler, und Split-Conformal-Enthaltung (α = 0,293, kalibriert um P(emit | wrong) ≤ α zu garantieren und auf die gleiche Abdeckung abgestimmt) entfernt 70,8 %, wie auch eine rohe angegebene Vertrauens-Top-K-Kontrolle bei der gleichen gepoolten Abdeckung, die 69,4 % entfernt. Eine gepoolte Variante, die alle elf Laborantworten auf einer Platt-kalibrierten Wahrscheinlichskala ordnet, übertrifft tatsächlich das Gate (89,0 % bei identischer gepoolter Abdeckung), tut dies aber, indem sie im Wesentlichen die gesamte Abdeckung auf die gut kalibrierten Laboratorien umverteilt: Sie gibt 100 % der Antworten des am besten kalibrierten Herstellers ab und 0 % für vier der elf Laboratorien, was den Ausfallmodus des Passports oben in weicherer Form reproduziert. Es erfordert auch ungefähr siebenhundert bewertete Antworten pro Modell zum Anpassen, während das Gate keine benötigt. Kalibriertes Vertrauen und modellübergreifende Übereinstimmung sind daher komplementär, nicht substitutiv: Das erste erwirbt eine niedrigere gepoolte Fehlerquote überall dort, wo Grundwahrheitsbeschriftungen zum Trainieren vorhanden sind, und das zweite erwirbt einheitlichen, kennzeichnungsfreien Schutz pro Laboratorium.
Abbildung 19 platziert jede Strategie auf der selektiven Vorhersagefläche (gepolt über die 13.955 deterministisch aufgelösten Antworten, die die elf Arme auf dem gefrorenen Pool von 1.459 Fragen zurückgaben, sodass die Summe kleiner ist als die von Tabelle 9, die aufgelöste Antworten über alle 1.500 Fragen zählt; selektives Risiko = Anteil abgegebener Antworten, die falsch sind). Nach Fläche unter der Risiko-Abdeckungs-Kurve geordnet, niedriger besser: Platt-kalibriertes Vertrauen 0,258, die Tor-Leiter verfeinert durch angegebenes Vertrauen 0,321, die reine Übereinstimmungs-Leiter 0,356, rohes angegebenes Vertrauen 0,367, zufällige Enthaltung 0,517, gegen eine Oracle-Untergrenze von 0,166; Werte für gehaltene Hälften unterscheiden sich um höchstens 0,009. Am eigenen Betriebspunkt des gefrorenen Gates (31,1 % Abdeckung in dieser aufgelösten Antwort-Konvention, 4.334 von 13.955 Antworten abgegeben; die an anderer Stelle gemeldeten 30,5 % und 30,6 % sind die Anteile selbstbewusster Antworten und Pool-Fragen) liegt das Risiko des Gates bei 24,9 %, gegen 33,4 % für einen Roh-Vertrauens-Schwellenwert und 14,0 % für kalibriertes Vertrauen, vorbehaltlich der oben genannten Beschriftungskosten- und Abdeckungskonzentrationsvorbehalte. Die Wolke aller 165 Drei-Modell-Räte umfasst Abdeckungen von 9–59 % bei Risiken von 13–38 %, daher ist das gemeldete Gate ein repräsentatives Mitglied seiner Familie, kein abgestimmter Ausreißer. Einzelrichter-Gates zeichnen das degenerierte Ende der Familie nach, wo „Übereinstimmung" in „fragen Sie das genaueste Modell" zusammenfällt.
Abbildung 19. Die Risiko-Abdeckungs-Grenzfläche
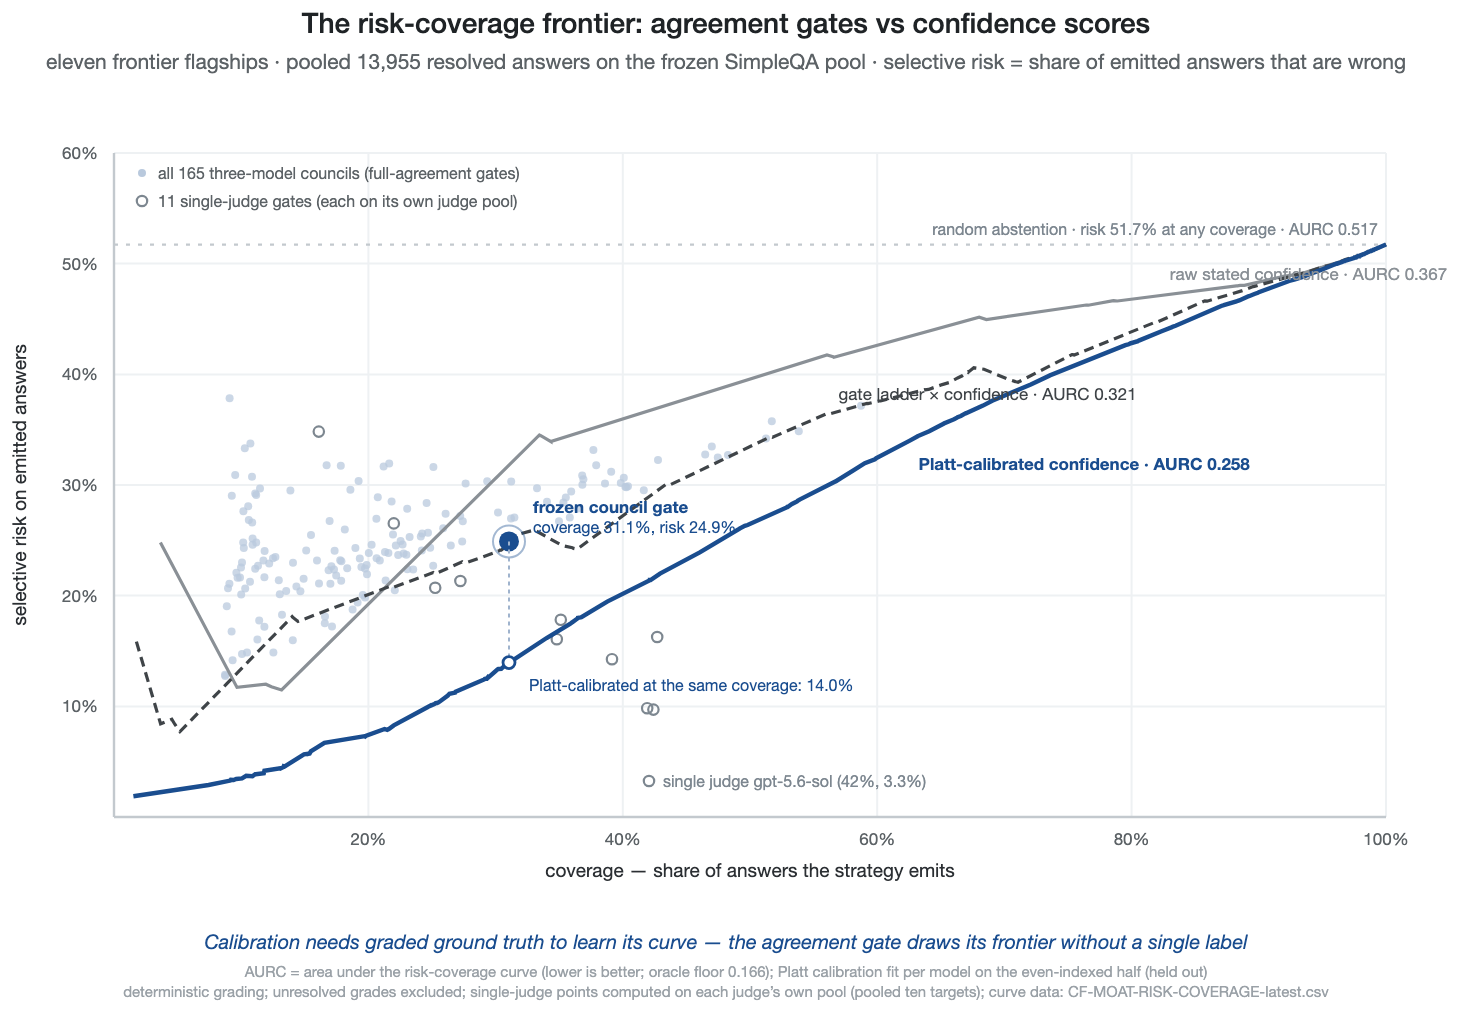
Jede Enthaltungsstrategie auf der selektiven Vorhersagefläche, Abdeckung gegen selektives Risiko, gepolt über die 13.955 deterministisch aufgelösten Flagship-Antworten, die von den elf Armen auf dem gefrorenen Pool von 1.459 Fragen zurückgegeben wurden (Tabelle 9 zählt aufgelöste Antworten über alle 1.500 Fragen): die Roh-Vertrauens-, Platt-kalibriert- und Tor-Leiter-×-Vertrauenskurven mit ihren AURC-Werten, die zufällige Enthaltungslinie, die Wolke aller 165 Drei-Modell-Räte, die elf Einzelrichter-Gates und der Betriebspunkt des gefrorenen Rates (31,1 % Abdeckung in der aufgelösten Antwort-Konvention, 4.334 von 13.955; 24,9 % Risiko). Niedriger ist besser; die Oracle-Untergrenze ist 0,166. Jeder Punkt ist aus der Risiko-Abdeckungs-CSV des Replikationspakets neu berechenbar.
Übereinstimmung könnte keine Informationen über die Frage hinaus tragen, ob sie einfach ist. Um dies zu testen, wurde eine logistische Regression der Antwortrichtigkeit auf Tor-Übereinstimmung und Schwierigkeitsgrad des Elements (der Anteil falscher Antworten unter den anderen Modellen bei dieser Frage), mit Laboratorium-Fixeffekten und fragengeclusterten Standardfehlern, ausgeführt, und die Antwort hängt davon ab, wie der Schwierigkeitsgrad gemessen wird. Wenn der Schwierigkeitsgrad nur durch die Nicht-Rats-Modelle gemessen wird (die faire Kontrolle, da ein Schwierigkeitsmesser, der die eigenen Antworten des Rates einschließt, das Signal des Gates durch Konstruktion einbettet), behält die Übereinstimmung einen unabhängigen Beitrag auf den externen Laboratorienzielen: b = +0,76, Odds Ratio 2,15, z = 17,2. Eine vom Gate abgegebene Antwort hat ungefähr doppelt so hohe Chancen, korrekt zu sein, wie eine gleich schwierige Antwort, die das Gate würde zurückhalten. Falten Sie die eigene Richtigkeit des Rates stattdessen in den Schwierigkeits-Regressor und der Übereinstimmungskoeffizient bricht auf Null zusammen, was den Mechanismus quantifiziert und nicht widerlegt: Übereinstimmung und Multi-Modell-Schwierigkeit sind zwei Messungen derselben latenten Größe, und das Gate ist ein kennzeichnungsfreies Instrument zum Lesen bei Inferenzzeit.
Eine Kontaminationsstratifizierte Neuanalyse befasst sich direkt mit der Expositionsproblematik. Wenn eine Frage als wahrscheinlich Benchmark-exponiert gekennzeichnet wird, wenn mindestens drei der elf Laboratorien die Gold-Zeichenkette nach Normalisierung wörtlich reproduzieren (741 von 1.459 Pool-Fragen; die gleiche Signatur, die gpt-5.6-sol's 61,6 % Gold-Echo-Rate ergibt), entfernt das Gate 89,4 % der selbstbewussten Fehler auf der nicht-exponierten Schicht (2.793→296; Nicht-Rats-Ziele: 86,5 %) gegen 72,7 % auf der exponierten. Der Mechanismus hängt also nicht von auswendig gelernten Elementen ab. Er verhält sich als selektiver Filter sollte, sich weit weniger oft öffnend, wo das Gremium wirklich unsicher ist (18,7 % vs. 41,9 % Abdeckung) und die abgegebene selbstbewusste Fehlerquote über Schichten hinweg nahezu konstant haltend (25,9 % vs. 21,8 %, von Rohquoten von 58,5 % und 36,4 %). Expositionscutoffs von 2–5 echoing Modellen ergeben nicht-exponierte dCF von 87,7–89,7 %, daher ist das Ergebnis schwellenwertrobust. Die Stratifizierung ist deskriptiv: Gold-Echo ist ergebnisgekoppelt und trennt wahrscheinlich-gesehene von anderen Fragen, anstatt Kontamination kausal zu identifizieren.
Was ein größeres Reasoning-Budget erkauft: Konfidenz, nicht Kompetenz. Flaggschiff-Anbieter verkaufen nun neben der Modellwahl ein zweites Einstellrad: ein Reasoning-Budget, abgerechnet pro Token stiller Überlegung. Falls erweitertes Reasoning Kalibrierung erkaufte, wäre das eine auf Modellebene liegende Antwort auf das Problem dieses Papers, an der Kasse kaufbar. Ein gepaarter Experiment bei einem Flaggschiff zeigt, dass es etwas anderes erkauft. Googles gemini-3.1-pro (dessen Reasoning nicht deaktiviert werden kann) beantwortete denselben eingefrorenen Fragensatz unter zwei Budgets, einer Low-Reasoning-Effort-Einstellung und dem Vendor-Standard-Dynamic-Budget, bei Temperatur null, identischen Prompts und Parser sowie pro-Frage dokumentiertem Kost. Bei den 233 Fragen, die unter beiden Budgets zu diesem Versionsdatum beantwortet wurden: Genauigkeit 75,1 % (niedrig) versus 76,4 % (Standard), kein nachweisbarer Unterschied (exakter McNemar p = 0,648); angegebene Konfidenz 3,1 Punkte höher unter dem Standard-Budget (Wilcoxon z = 4,68, p < 0,0001); Kalibrierung leicht schlechter unter dem Standard-Budget (gepaart ECE 0,100 vs. 0,082; Konfidenz-minus-Genauigkeit-Lücke +9,3 vs. +7,5 Punkte); Preis pro Frage 2,1×. Der Genauigkeitsvergleich ist ein Null einer spezifischen Art: diese Daten zeigen keinen nachweisbaren Genauigkeitsunterschied bei n = 233 (exakter McNemar p = 0,648), und Äquivalenz wird formal nur bei einer groben Spanne etabliert. Ein gepaarter TOST begrenzt den Genauigkeitsunterschied auf ±5 Punkte (Differenz +1,3 Punkte, 90 %-KI [−1,8; +4,4]; beide einseitig p ≤ 0,024), aber die Studie ist nicht ausreichend gepowert, um Äquivalenz bei ±2–4 Punkte zu etablieren, während der +3,1-Punkte-Anstieg in angegebener Konfidenz statistisch eindeutig ist (Wilcoxon p < 0,0001). Innerhalb dieser Spanne erkaufte die verdoppelte Ausgabe zusätzliche angegebene Konfidenz und keine messbaren zusätzlichen Korrektheit: Überconfidence als bezahltes Feature, und eine innermodell-Instanz der Migrationthese. Die zusätzlichen Dollar gingen zur Modellebene und produzierten nichts, das ein Konsument verifizieren könnte, während die architektonische Ebene darüber Konfidenz in ein überprüfbares Signal verwandelte. Das Ergebnis ist ein Pilot, als ein solcher berichtet: Der Vergleich umfasst 233 gepaarte Fragen, und das vollständige 1.500-Paare-Design verengt die Äquivalenzspanne auf etwa zwei Punkte; Kanalzusammensetzung und Token-Cap-Zensur sind als Confounds im Replikationspaket dokumentiert; die Erfassung läuft weiter.
Abbildung 18. Was ein größeres Reasoning-Budget erkauft
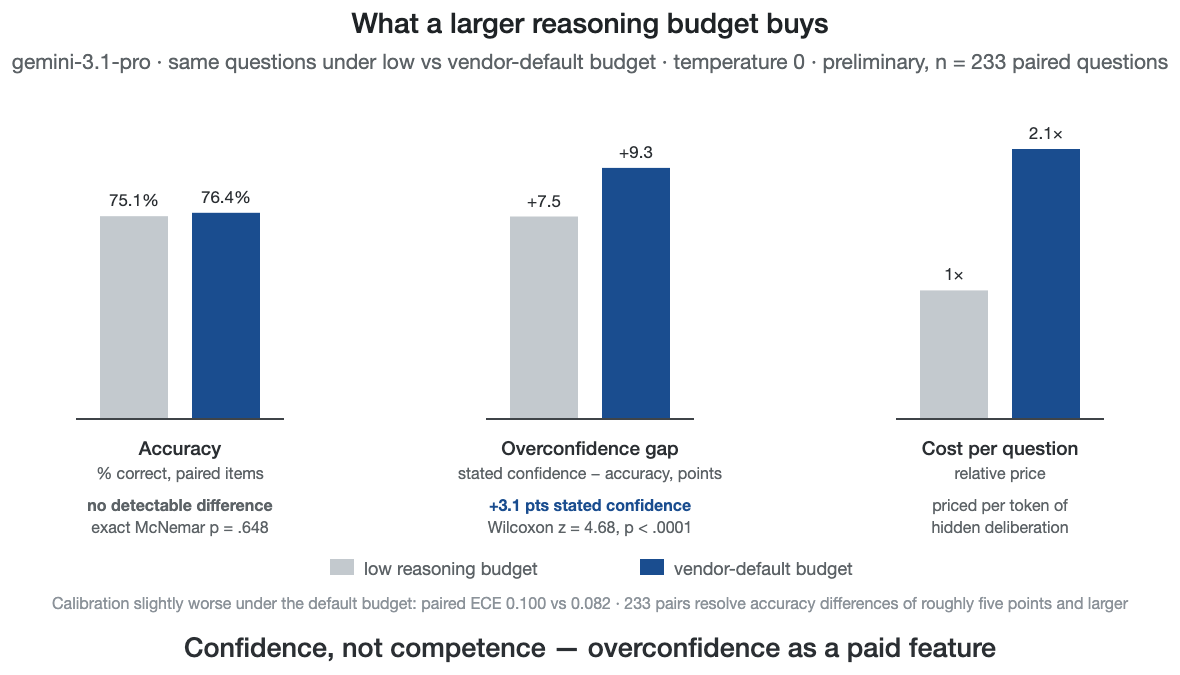
Gepaarter Vergleich unter zwei Reasoning-Budgets — angegebene Konfidenz steigt, Genauigkeit nicht.
Tabelle 11. Reasoning-Budget, gepaarter Vergleich (gemini-3.1-pro, 233 unter beiden Budgets beantwortete Fragen, Temperatur 0; vorläufig)
| Niedriges Reasoning-Budget | Vendor-Standard-Budget | |
| Genauigkeit (gepaarte Elemente) | 75,1 % | 76,4 % (McNemar p = 0,648) |
| Mittlere angegebene Konfidenz | −3,1 Punkte vs. Standard | +3,1 Punkte (Wilcoxon p < 0,0001) |
| Kalibrierung (gepaart ECE) | 0,082 | 0,100 |
| Konfidenz − Genauigkeit Lücke | +7,5 | +9,3 |
| Kosten pro Frage (relativ) | 1× | 2,1× |
Reasoning-Effort-Einstellungen waren nicht über die Arme hinweg identisch: jeder Anbieter wurde durch seine Standard-Handelsschnittstelle bei der Standard-Effort-Einstellung dieser Schnittstelle abgefragt (Einstellungen pro-Modell im Replikationspaket protokolliert), so kann die absolute Genauigkeit eines Anbieters eine Effort-Komponente tragen. Das erreicht nicht den Mechanismus. Die Genauigkeitsrangfolge ist nicht traglast (die Flaggschiff-Bezeichnung garantiert nichts), das Tor übersteht das Entfernen jedes Mitglieds (lösung-freier Rat entfernt 81,2 %), und ein größerer Effort hebt angegebene Konfidenz mit flacher Genauigkeit, wie der eben gezeigte gepaarte Vergleich zeigt, so ob eine Genauigkeit, die es aufbläht, als selbstbewusster Fehler auftaucht, der Fehler, den das Tor abfängt.
Abdeckungsbeschränkungen der Flaggschiff-Welle. Die Welle ist ein eingefrorener Schnappschuss vom 5. August 2026, daher können danach veröffentlichte Modelle wie Grok 4.6 (12. August) und spätere Artificial-Analysis-Anführer wie Claude Opus 5 nicht in eine vorgebundene Benchmark eintreten. Die Top-Position wechselte innerhalb von Tagen. Das ist das Identifikationsproblem, das das Tor umgeht (Übereinstimmung ist roster-robust, übersteht die Entfernung jedes Mitglieds). Zwei einbezogene Laboratorien liegen unter der aktuellen Grenze auf allgemeinen Fähigkeits-Leaderboards: Mistrals Flaggschiff liegt bei jedem überprüften Aggregatindex hinter der Top-Tier, und Baidus General-Purpose-ERNIE rangiert außerhalb der Top 30 bei Humanity's Last Exam (seine Stärke liegt bei suchangereicherten und agentengesteuerten Aufgaben, wo ERNIE 5.1 bei LMArena Search Arena auf Platz #4 rangiert). Sie werden behalten, um die Abdeckung des europäischen Ökosystems und aller großen chinesischen Laboratorien zu bewahren. Von den beiden Top-Tier-Laboratorien, die stattdessen außerhalb der Wellenbandbreite lagen, Meta Superintelligence Labs (Muse Spark 1.1; #4 bei Humanity's Last Exam) und ByteDance (Seed 2.1; #10), wurde eines später versucht und unterbrochen (Meta, unten) und eines konnte überhaupt nicht erreicht werden (ByteDance, unten).
ByteDances Seed 2.1 konnte nicht einbezogen werden: BytePlus ModelArk gab „nicht verfügbar in Ihrem Land/Ihrer Region" für ein frisch registriertes internationales Konto zurück (Live-Versuch, 5. August 2026), kein Aggregator bedient das Flaggschiff, und der inländische Volcano-Ark-Kanal erfordert Verifikation auf dem Festland Chinas. Baidus ERNIE 5.1, das aktuelle Flaggschiff, ist ähnlich auf die inländische Qianfan-Plattform beschränkt (Live-Versuch, 5. August 2026). Wenn das aktuelle Flaggschiff eines Laboratoriums nicht zugänglich ist, ist die Ausweichregel das stärkste offen freigegebene Modell aus diesem Laboratorium. Für Baidu ist dies ERNIE 4.5 VL 424B (Open-Weights), das stattdessen verwendet wird. Das ist selbst ein Befund: Die aktuellen Flaggschiffe von zwei der sechs großen chinesischen Laboratorien sind ab August 2026 für externe Forscher nicht zugänglich.
Meta ist das dritte Zugriffsproblem der Welle, und das Hindernis war mein Konto, nicht die Geografie. In der ersten (mittleren) Welle war Meta aus dokumentiertem Infrastrukturgrund abwesend: Seine First-Party-Llama-API wurde am 6. Juli 2026 stillgelegt, vor dem Protokoll-Freeze (im Run-Manifest dokumentiert), und das Labor wurde auf der lokalen Ebene durch sein Open-Weight-Modell Llama-3.2-3B vertreten, das sich als eines der instruktivsten Mitglieder des Panels erwies (die niedrigste Fehlerkorrelation in der gesamten Matrix). Für die Flagship-Welle wurde Metas muse-spark-1.1 mid-wave hinzugefügt, als es erreichbar wurde, und die Sammlung scheiterte dann auf drei Arten hintereinander, jede geloggt: (i) Der First-Party-Meta-Model-API-Schlüssel starb am 5. August mid-run mit 251 gesammelten gültigen Antworten, und die Developer-Konsole würde keinen Ersatz ausstellen; (ii) eine Aggregator-Fallback-Route lieferte 21 weitere Antworten, bevor (iii) Metas Provider-Endpoint begann, HTTP 403 `user_blocked` zurückzugeben, „der Zugriff wurde aufgrund wiederholter Richtlinienverstöße eingeschränkt", für geschlossene faktische Rückrufprobleme aus einer öffentlichen Benchmark, abgefragt bei Temperatur null. Das Nettoteil ist 272 von 1.500 Elementen (18,1%) gesammelt und als partiell gemeldet: die eingefrorene gepoolte Analyse umfasst die 251 First-Party-Antworten (der Aggregator-Aufstockung erfolgte nach dem Analyse-Freeze), und Metas Pro-Labor-Schätzung (−92,0% dCF auf 125 sichere Antworten) ist direktional konsistent mit dem Panel, aber zu ungenaue für Rückschlüsse. Die Sperre ist selbst eine Erkenntnis: Ab August 2026 kann ein unabhängiger Forscher eine 1.500-Fragen-Faktenprüfung von Metas Flagship durch keinen autorisierten Kanal abschließen. Zusammen sind die drei Zugriffsprobleme der Welle – ein regionsgesperrtes Flagship (ByteDance), ein inländisches Flagship (Baidu) und ein Forscherverbot (Meta) – das theoretische Argument in empirischer Form: Verifizierbarkeit auf Modellebene wird mit Anbieterwohlwollen genossen, und eine architektonische Vertrauensschicht kann nicht mit Anbieterwohlwollen rechnen.
4. Eine extreme Bereitstellung: Delegation mit irreversiblen Konsequenzen
Die übliche Art, Konsumentenvertrauen zu untersuchen, ist eine Umfrage oder eine Laboraufgabe. Ich hatte ein härteres Instrument zur Verfügung: eine erweiterte, risikoreiche Bereitstellung, bei der jede Konsequenz auf mir lag. Dieser Abschnitt ist ein Existenzbeweis und ein Designzeugnis von einem einzelnen, konfliktgeladenen Operator, nicht empirische Evidenz für Allgemeingültigkeit, und keine der Aussagen P1–P5 ruht darauf. Die beiden Arten von Evidenz sind verflochten. Im Labor wurde der Kalibrierungseffekt unter Placebo-Kontrolle gemessen; in der Bereitstellung, wo Fehler irreversibel waren, waren dieselben drei Eigenschaften der Unterschied zwischen Delegation, die möglich war, und Delegation, die rücksichtslos war.
Die Bereitstellung ist nicht die eines Clients und nicht eine Simulation: Ich bin gleichzeitig der Operator, der Entwickler und der Analyst. Die Evidenzschicht ist Hash-verankert und jede Messung unabhängig nachrechenbar, daher bezieht sich der Konflikt auf die Advocacy und darauf, was ich messen wählte, nicht darauf, ob sich die Zahlen reproduzieren. Die Einstellung kombiniert gewöhnliche Konsumentenkompetenz mit irreversiblen Einsätzen, wo jede architektonische Schwäche schnell und sichtbar bestraft wird.
Methodologisch handelt es sich um einen extremen, offenlegenden Einzelfall (Yin, 2018) in der interpretativen und analytisch-autoethnographischen Tradition (Walsham, 1995; Gould, 1991; Anderson, 2006), mit den Beweiskautelen dieser Tradition im Blick (Wallendorf & Brucks, 1993): Aufzeichnungen zuerst, Interpretation als Interpretation gekennzeichnet. Die Rechtfertigung ist der Zugang: Ein Forscher kann Teilnehmer ethisch nicht darauf setzen lassen, irreversible reale Ergebnisse auf einer KI-Architektur zu wetten, daher ist der einzige verfügbare Beobachter ein Teilnehmer, der die Wette selbst wählte.
Die Analyse stützt sich auf zeitgenössische, Hash-verankerte Logs. Die Evidenzschicht der Bereitstellung ist selbst die Aufzeichnung: Lasttragende Schritte (welche Modelle wurden herangezogen, wo divergierten sie, was war beschränkt, was bestätigte ich) wurden zur Zeit geloggt, daher ruhen die Beobachtungen auf wiederholbaren Aufzeichnungen und nicht auf Erinnerung allein. Hindsight-Bias kann aus der Interpretation nicht entfernt werden, daher kennzeichne ich jeden Ort, wo die Interpretation das Protokoll übersteigt. Die Aufzeichnungen der Evidenzschicht der Bereitstellung während der Bereitstellung sind ab dem 2. August 2026 Hash-verankert: ein Pro-Datei-SHA-256-Manifest von 129 Dateien (7.414.043 Bytes), dessen Root 2f88a16611e51c0c12c8015754c89269e782ea167a89b5ed2a881f18eee4defc ist, und die Verankerung wird mit diesem Papier veröffentlicht. Die Aufzeichnungen bleiben versiegelt, bis die Bereitstellung geschlossen ist, da selektive Zitierung aus einer laufenden Bereitstellung schlimmer wäre als keine. Die Verpflichtung kann überprüft werden: Jede später veröffentlichte Aufzeichnung stimmt entweder mit dem verankerten Manifest überein oder sie stimmt nicht überein, daher ist nachträgliche Bearbeitung, Substitution oder Backdating durch jeden Leser dieser Seite erkennbar. Eine umfassendere quantitative Behandlung der Telemetrie wird zukünftigen Arbeiten überlassen, aus demselben Grund.
Drei Beobachtungen aus dem Leben innerhalb dieser Schleife werden als Hypothesen über das, was über die ursprüngliche Einstellung hinaus überträgt, angeboten, was die Aussagen von Abschnitt 3 speist, und die Ereignisse, auf denen sie ruhen, wurden zur Zeit von der Bereitstellung geloggt.
Uneinigkeit ist ein konsumentennutzbares Signal. Wenn unabhängige Modelle bei einer folgenreichen Frage divergierten, sagte mir die Divergenz selbst, wie sie statt unterdrückt werden, wo die echte Unsicherheit lag: eine kostenlose Frühwarnung, die kein Single-Model-Service bieten kann.
Evidenz ändert Verhalten, bevor sie jemals einen Streit ändert. Zu wissen, dass jeder folgenreiche Schritt aufgezeichnet wurde, machte Delegation überhaupt psychologisch viabel; das Protokoll war die Vorbedingung für Verlässlichkeit, nicht eine Audit-Nachgeschichte.
Confidence-Gating ist wichtiger als durchschnittliche Genauigkeit. Die praktisch gefährlichen Ereignisse waren die selbstbewussten Fehler, nie die mittelmäßigen Ausgaben. Der echte Beitrag der Architektur war, hohe Zuversicht teuer zu machen: Eine Antwort musste Cross-Model-Vereinbarung überstehen, um sie zu verdienen, anstatt sie kostenlos von der Fließfertigkeit eines Modells zu bekommen.
5. Implikationen: von Überzeugung zu Infrastruktur
Design und Erfahrung
Für Service-Design. Die Einheit des vertrauenswürdigen KI-Service-Designs verschiebt sich vom Modell zur Pipeline. Das bedeutet, Anfragen mit Konsequenzen durch unabhängige Modelle zu leiten, Uneinigkeit als erstklassiges UX-Element zu behandeln, Belege standardmäßig anzuhängen und Multi-Modell-Verarbeitung gegen die asymmetrischen Kosten sicherer Fehler zu bepreisen, wobei der teure Weg Anfragen vorbehalten bleibt, bei denen sich die Risiken konzentrieren – ähnlich wie Betrugsprävention intensive Kontrolle für riskante Transaktionen reserviert. Die Infrastruktur existiert bereits: kostengetriebene Kaskaden, die schwierige Anfragen zu teuren Ebenen eskalieren, sind Standard-Agent-Engineering, und für einen Service, der bereits nach Schwierigkeit leitet, ist die marginale Architektur der Leitung nach Konsequenz nahe null. Die Ausfallmodi, die beide Experimente gemessen haben, hinterlassen zwei strikte Regeln, und sie sind Designanforderungen, keine Vorlieben. Positionen müssen blind erfasst und aufgezeichnet werden, bevor eine modellübergreifende Deliberation stattfindet, da eine deliberations-erste Pipeline genau den Konsens herstellt, den die Architektur kontrollieren soll (die Konformitätsdrücke aus Abschnitt 3). Die zweite Regel: einstimmiger selbstsicherer Konsens über einen beschränkten Optionssatz ist ein rotes Flagge für Überprüfung, nicht ein grünes Licht für Ausführung – sowohl die Modellpanels als auch die menschlichen Teilnehmer aus Abschnitt 6 behandelten genau diesen Konsens als Zertifizierung.
Die Wirtschaft funktioniert, weil die Eskalation graduell ist – eine gestufte Vertrauensarchitektur: in der hier beschriebenen Bereitstellung erstrecken sich Verarbeitungsebenen über ungefähr drei Größenordnungen Kosten pro Anfrage zwischen einer Einfach-Modell-Antwort und einer vollständigen Multi-Modell-Deliberation (ab Juli 2026), sodass die teure Ebene nur dort genutzt wird, wo sich Konsequenzen konzentrieren. Die Break-Even-Logik ist die der Betrugsscoring (Abbildung 14). Orchestrierung zahlt sich aus, wann immer die Wahrscheinlichkeit eines selbstsicheren Fehlers multipliziert mit seinen vollen Kosten (Rückerstattung, Kundenabwanderung unter Einfach-Schlag-Toleranz, Haftung, regulatorisches Risiko) die Marginalkosten der Überprüfung übersteigt. Bei Transaktionen mit hohen Einsätzen ist diese Ungleichung nicht knapp.
Sinkende Inferenzpreise (ungefähr zwei Größenordnungen bei fester Leistung in drei Jahren, eine konservative Lesart verfolgter Rückgänge; Appenzeller, 2024) lösen das Argument nicht auf, weil das Verhältnis, nicht die absoluten Kosten, die strukturelle Größe ist: beide Ebenen folgen der Preiskurve zusammen nach unten, und günstige Inferenz macht die teure Ebene zu immer niedrigeren Einsätzen erschwinglich. Überprüfung folgt ihrer eigenen zweiten Kurve: Ensembles schwacher Verifizierer ohne gekennzeichnete Daten erreichen die Antwortwahlgenauigkeit von Frontier-Reasoningmodellen aus offenen 70-Milliarden-Parameter-Komponenten (Saad-Falcon et al., 2025). Angesichts der Einfach-Schlag-Verbrauchertoleranzen ist der Vergleich nicht „günstige Antwort versus teure Antwort", sondern „teure Antwort versus verlorener Kunde".
Zwei verbraucherseitige Primitive vervollständigen das Design: absichtliche Reibung (eine deutliche Pause vor unumkehrbaren Maßnahmen) und Belege. Beide wirken darauf ein, wie sich Delegation anfühlt. Verbraucher erleben KI soziologisch, nicht statistisch (Puntoni, Reczek, Giesler, & Botti, 2021), und da die delegierte Ausführung die Servicebegegnung aus dem Blick entfernt, erbt der Beleg die alte Rolle der Begegnung als Moment der Wahrheit. Ein Risiko reist mit dieser Rahmung: Uneinigkeit sichtbar zu machen kann Unsicherheit bekannt machen und Vertrauen eher unterdrücken als es zu kalibrieren (Detjen et al., 2025; Lu, Wang, & Yin, 2024), daher ist, wie viel Divergenz zu zeigen ist und wie, eine Designvariable. Es ist kein kostenloses Gut.
Eine Orchestrierungs-Beleg kann minimal sein und ihre Arbeit dennoch leisten (Abbildung 8 zeigt das Mock-up). Drei Felder tragen den meisten Wert: (1) wer handelte, welche Modelle und Versionen konsultiert wurden, unter welcher Autorität; (2) wie sie übereinstimmten, eine Zusammenfassung der Divergenz in einfachen Worten; (3) was überprüft wurde, mit einem Zeiger in den vollständigen wiedergabefähigen Datensatz: klein genug zum Lesen auf einen Blick und spezifisch genug, um einen Streit, einen Versicherungsanspruch oder eine Prüfung zu verankern. Das gleiche Artefakt beantwortet auch die eigene Buchführungsfrage des Betreibers, daher verkauft sich der Beleg zweifach: nach innen als Kostengovernance, nach außen als berechtigtes Vertrauen. Diese Zweiseitigkeit ist eine Notwendigkeit. Gemessene Verbraucherzahlungsbereitschaft für Transparenz allein ist dünn (in einer bewerteten Verbundanalyse fiel die Erklärbarkeit unter 1,99 € pro Monat; König et al., 2022), daher würde eine nur von der Verbrauchenseite finanzierte Vertrauensschicht verhungern, und die Kostengovernananceseite des Betreibers trägt sie. Der nächste Engineering-Nachbar des Belegs sind Werkzeug-Belege, die in Agent-Frameworks für Halluzinations-Erkennung protokolliert werden (Basu, 2026), die den Instinkt teilen, aber nicht das Publikum: das sind für Entwickler bestimmte Datensätze einzelner Werkzeugaufrufe, während die Orchestrierungs-Beleg ihre verbraucherseitige, pro-Entscheidungs-Verallgemeinerung ist. Der Beleg lädt zu seinem eigenen Fehlermodus ein: ein Artefakt, das so konstruiert ist, als wäre es verifiziert, ohne etwas freizugeben, das ein Verbraucher erneut ausführen könnte. Die Designlinie, die zählt, ist, ob der Datensatz wirklich wiedergabefähig ist und nicht bloß beleg-förmig. Eine Einschränkung kommt auch von der Datenschutzseite: ein Artefakt, das beweist, was überprüft wurde, zeichnet auch auf, was bevorzugt wurde, sodass Verifizierbarkeit und Datenschutz zusammen optimiert werden müssen (Alavi & Nozari, 2026).
Ein letztes Stück der Empfangsökonomie trägt einen eigenen Namen, die Ökonomie der Überprüfung. Eine manipulationssichere Aufzeichnung ist nur so viel wert, wie der Anreiz einer Person, sie zu öffnen, wert ist, und das dezentralisierte Jahrzehnt ist hier die Vorsichtsmaßnahme: öffentliche, manipulationssichere Blockchain-Aufzeichnungen verwandelten normale Benutzer nicht in Prüfer, und „vertrauenslose" Architekturen führten diskret an jedem praktischen Punkt vertraute Vermittler wieder ein (Werbach, 2018). Das Verifier's Dilemma ist die formale Version: wenn Überprüfung kostspielig ist und korrekte Ergebnisse der Normalfall sind, überspringt der rationale Prüfer die Kontrolle. Die Überprüfungsnachfrage muss konzentriert sein, wo bereits ein privater Vorteil der Überprüfung besteht, bei Versicherern, Prüfern und Streitbeilegungsverfahren, wobei der Verbraucher die Überprüfung als Nebenprodukt dieser Märkte erbt; die Verbraucherfunktion des Belegs ist die Verfügbarkeit im Streitfall, nicht die nächtliche Lektüre. Die Finanzierungsfrage folgt aus demselben Punkt, und beide naiven Antworten dazu scheitern: ein verbraucherfinanzierter Orchestrator bewertet Neutralität als Luxusgut, und ein händlerfinanzierter Orchestrator reimportiert den Konflikt, den er beheben soll. Das lässt das Modell, das die zweiseitige Ökonomie des Belegs bereits impliziert. Die Schicht wird so finanziert, wie die Prüfung finanziert wird, von Parteien, die das Risiko bepreist haben wollen, nicht die Geschichte erzählt bekommen (Operatoren kaufen Kostenkontrolle und Haftungsreduzierung, Versicherer kaufen versicherbare Risikoprofile, Streitbeilegungsverfahren kaufen Beweise), mit Regulierungsuntergrenzen, wo diese Märkte unterfordern. Der Verbraucher kauft die Dienstleistung, nicht die Neutralität, und erbt die Neutralität als ihr Nebenprodukt. Dasselbe Problem hat eine Marktstrukturversion. Eine Plattform, die gleichzeitig Marktplatz, Modellvendor und Werbenetzwerk ist, kann strukturell keine Neutralität bereitstellen, was der Interessenkonflikt in Marktform ist, und die historische Aufzeichnung der algorithmischen Priorisierung (gesponserte Platzierung, bevorzugte Partner) sagt, dass dominante Player die Lenkung monetarisieren werden, wenn sie können. Wo dieser Druck wirkt, ist die Neutralitätsuntergrenze regulatorisch oder open-protocol, nicht freiwillig. Wenn die Verbrauchernachfrage nach Beweisen bei erstem Zugang gering ist, könnte die Übernahme von architektonischem Vertrauen weniger von der Verbraucherwahl als von der Compliance- und Versicherungsseite getrieben werden, eine Migration durch Institutionen statt durch Vorlieben, wobei Verbraucher verifiable Architektur als Standard erben. Das Kalibrierungsergebnis verhindert, dass diese Route dekorativ ist: Verbraucher nutzen das architektonische Signal nachweislich, sobald es ihnen vor Augen geführt wird, aber sie zahlen noch nicht dafür, es herbeirufen. Hier gibt es eine konkurrierende Hypothese: Vertrauen könnte statt zu verifiable Architektur zu Haftung und Institutionen migrieren. Verbraucher verlassen sich auf Chargeback-Rechte, nicht auf Ledger-Audits; Kartennetze erweiterten E-Commerce-in-der-Ferne durch Streitrechte statt dadurch, dass Verbraucher Autorisierungsdatensätze inspizieren; auf dieser Lesart ist der Entscheidungsdatensatz die Installation, die Haftung berechenbar macht, statt ein Objekt des Verbrauchervertrauens zu sein. Die beiden Konten sagen unterschiedliche Dinge voraus: auf dem architektonischen Konto belohnen Verbraucher Verifizierbarkeit, wenn sie sie sehen können; auf dem institutionellen Konto belohnen sie sie nur, wenn ein Rechtsbehelm beigefügt ist, und das Vertrauen des Verbrauchers bleibt dann in der Institution verankert, während das Vertrauen der Institution zu der Architektur migriert. Das unten angegebene Streitzeit-Design unterscheidet sie. Und jede Datensatzschicht erbt das Oracle-Problem: der Datensatz zertifiziert den Prozess, und nur die eigenen Checks des Prozesses erreichen die Fakten. Die Asymmetrie, die der Beleg umkehrt, ist diejenige, die die Plattformkritik-Literatur dokumentiert: Architektur, nicht erklärte Politik, ist der operative Regulator des digitalen Verhaltens (Lessig, 2006), und bisher haben ihre Instrumente auf den Verbraucher gezielt, statt von der Verbraucherseite gehalten zu werden (Zuboff, 2019; Möhlmann & Zalmanson, 2017), und der Beleg kehrt diese Instrumente andersherum um.
Die Beweisschicht sollte im Produkt selbst sichtbar sein, nicht in einem Hinterbüro-Log abgelegt. Softwaretechnik hat kürzlich auf einen Namen für den Runtime-Wrapper um agentische Modelle konvergiert, das Agent Harness, und auf die Erkenntnis, dass das Harness, nicht das Modell, zertifiziert, reguliert und vertraut werden kann. Architektonisches Vertrauen gibt an, was ein Harness produzieren muss, um diese Rolle zu verdienen.
Sowohl der Umfang, für den dieser Abschnitt entwirft, als auch der Rückschlag, gegen den er entwirft, sind bereits zu Protokoll. Der Klarna-Assistent verarbeitete in seinem ersten Monat 2,3 Millionen Gespräche, zwei Drittel der Kundenservice-Chats des Unternehmens und die geschätzte Arbeit von 700 Vollzeitagenten (Klarna, 2024, von Unternehmensangaben). Vierzehn Monate später kehrte der CEO öffentlich um: Die Ausgabequalität hatte gelitten, die Personalrekrutierung wurde neu gestartet, und die stehende Verpflichtung wurde, dass „es immer eine Person gibt, wenn Sie wollen" (Daly, 2025). Architektonisch gelesen, als meine Lesart statt der erklärten Begründung des Unternehmens, klammern die beiden Ankündigungen genau die Lücke ein, die dieses Papier benennt. Die Volumen-Stufe funktioniert zu Maschinenkosten, aber ohne abgestuften Eskalation und ohne überprüfbares Qualitätssignal, die Delegation schnappte zu der menschlichen Basis zurück. Was die Position zwischen diesen Ankündigungen stabil machen würde, ist eine abgestufte Vertrauensarchitektur: billig, wo Stakes gering sind, überprüft, wo Stakes konzentriert sind, und menschlich, wo Überprüfung fehlschlägt.
Märkte und Regulierung
Für länderübergreifende Dienstleistungen. Neutralität erstreckt sich über Modellvendor auf Jurisdiktionen. Eine Orchestrierungsschicht kann jurisdiktionsgerechte Lenkung durchsetzen und die Durchsetzung aufzeichnen, wodurch Datensouveränitäts-Compliance von einer rechtlichen Darstellung zu einer überprüfbaren Laufzeiteigenschaft wird. Die Differenzierung, auf die sie antwortet, wurde gemessen: In 25 Ländern vertrauen im Median 53% der Befragten der EU, KI effektiv zu regulieren, gegen 37% für die Vereinigten Staaten und 27% für China (Pew-Daten, berichtet in Stanford HAI, 2026, ein Institutsbericht, nicht peer-reviewed). Wo das Vertrauen nach Jurisdiktion variiert, hat eine Architektur, die beweisen kann, welche Jurisdiktionsregeln galten, echten Wert.
Für agentischen Handel. Die Visa-ChatGPT-Integration macht die drei Komponenten konkret. Obergrenzen und Whitelists sind statische, verbraucherseitige Schutzmechanismen. Architektonisches Vertrauen fügt die dynamische, dienstleisterseitige Schicht hinzu: Einkäufe, die von unabhängigen Modellen überprüft werden (Diversität), ein abspielbarer Datensatz, warum der Agent diesen Händler zu diesem Preis wählte (Beweise), und eine Orchestrierungsschicht, deren Umsatz nicht davon abhängt, welcher Vendor oder Händler gewinnt (Neutralität).
Die Zahlungsindustrie hat bereits damit begonnen, die unteren Stockwerke dieses Stapels zu bauen. Visas Trusted Agent Protocol (Oktober 2025, mit Cloudflare; Visa, 2025) signiert die Identität eines Agenten kryptografisch in seinen Anfragen: handels- und zweckgebunden, zeitlich begrenzt, wiedergabefest. Googles Agent Payments Protocol (Google Cloud, 2025), zusammen mit Mastercards Framework 2026 zur FIDO Alliance beigetragen, kodiert die Absicht des Nutzers als signierte Mandate, die als W3C Verifiable Credentials (W3C, 2025) übertragen werden. Mastercards Verifiable Intent (ein gemeinsames Framework mit Google; angekündigt März 2026; Mastercard, 2026) formuliert seinen Zweck in Worten, die dieses Paper hätte schreiben können – ein manipulationssicherer Nachweis dessen, was der Nutzer autorisierte, als ein KI-Agent in seinem Namen handelt, mit ersten Piloten, die 2026 in asiatischen und lateinamerikanischen Märkten gemeldet wurden. Identitäts- und Absichtsnachweise werden jetzt standardisiert, und ebenso das Aufzeichnungsformat: die IETF-SCITT-Architektur (RFC 9943, 2026) spezifiziert das gleiche Muster – signierte Aussage → unveränderliches Transparenzlog → Quittung –, das die Nachweisebene dieses Papers voraussetzt. Die Schnittstelle, über die Delegation stattfindet, ist nicht einmal moralisch neutral. Über dreizehn Experimente hinweg verhielten sich Menschen, die an KI delegierten, weniger ehrlich, am stärksten bei vager Zielformulierung, und Maschinenagenten führten vollständig unehrliche Anweisungen weit häufiger aus als menschliche Agenten (Köbis et al., 2025). Schnittstellen, die erzwingen, dass Absicht in spezifischen Begriffen angegeben wird, sind ethische Infrastruktur.
Kein Protokoll deckt bisher das dritte Stockwerk ab, Entscheidungsnachweise: wie der Agent diesen Händler, dieses Produkt, diesen Preis wählte; ob unabhängige Kontrollen zustimmten; was sein Vertrauen wert war (Abbildung 15 zeichnet die drei Stockwerke). Das ist die Ebene, die dieses Paper benennt, und „know-your-agent" sollte sich genau in diesen Prozessabfrage entwickeln, wobei die Aufsichtseinheit auf die Transaktion migriert. Welche Garantie die Architektur geben kann, ist die Existenz des Aufzeichnung, nicht deren Lesbarkeit. Ob jemand solche Aufzeichnungen öffnet, ist eine empirische Frage, die nur die Bereitstellung beantworten kann.
Abbildung 15. Der Nachweistapel
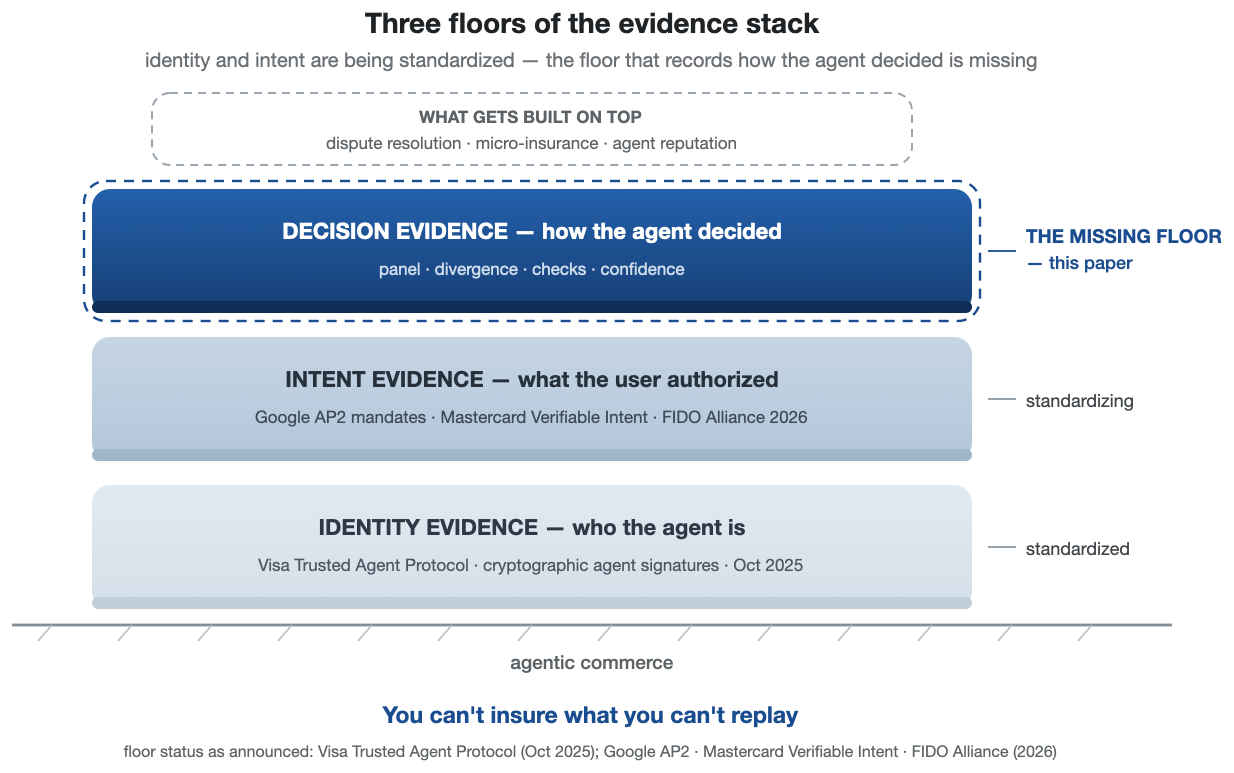
Identitäts- und Absichtsnachweise werden jetzt standardisiert; Entscheidungsnachweise sind das fehlende Stockwerk, das dieses Paper benennt.
Die ersten systematischen Audits des Agenteneinkaufsverhaltens zeigen, warum Entscheidungsnachweise nicht warten können. Allouah et al. (2026) führten randomisierte Versuche in einer kontrollierten E-Commerce-Sandbox durch und stellten fest, dass Einkaufsagenten starke Positionsverzerrungen aufweisen, die Nachfrage auf wenige „modale" Produkte konzentrieren und diese Vorlieben drastisch umgestalten, wenn das zugrunde liegende Modell aktualisiert wird. Ohne eine Aufzeichnung darüber, wie die Wahl getroffen wurde, ist nichts davon für den Verbraucher, den Händler oder die Behörde sichtbar. Vielfalt ist hier die Designantwort, da ein Panel die Positionsbesonderheiten eines einzelnen Modells verdünnt, und Rechenschaftspflicht ist das, was Entscheidungsnachweise bieten: Was diese Prüfer in einer Sandbox beobachten mussten, würde ein architektonisch vertrauenswürdiger Dienst in der Produktion protokollieren.
Der Rahmen erstreckt sich auch über den Verbraucher hinaus auf Maschine-zu-Maschine-Vertrauen. In B2B-Agenten-Workflows gibt es keine menschliche Person, die Vertrauen spüren kann, daher ist das einzige mögliche Substrat überprüfbarer Prozess, bei dem Agenten genau die hier beschriebenen Artefakte austauschen und berechnen, ob Transaktionen stattfinden sollen. Wie Vertrauen in solchen Delegationsketten in großem Maßstab aggregiert und ausbreitet und welche Protokollierungs- und Verifizierungsoverhead der Nachweisebene bei Produktionsvolumen kostet, sind hier offene Probleme. Ketten verschärfen die Anforderung, da eine Kette nur so vertrauenswürdig ist wie ihr am wenigsten nachgewiesenes Glied: Die Aufzeichnungen müssen sich zusammensetzen. Wo kein Verbraucher vorhanden ist, ist architektonisches Vertrauen möglicherweise die einzige verfügbare Vertrauensform.
Eine strukturelle Entwicklung, mit der die Vertrauensliteratur nicht Schritt gehalten hat, ist der Protokollkrieg. Konkurrierende Agenten-Commerce-Stapel (OpenAI mit Stripe, das Agentic Commerce Protocol; Googles Universal Commerce Protocol Coalition; Perplexity mit PayPal; Kartennetzwerke und offene Standards darunter) fragmentieren den Handel entlang von Herstellerprotokolllinien genau wie KI-Dienste sich entlang von Herstellermodelllinien fragmentierten, und die Neutralitätsargument verallgemeinert sich fast Wort für Wort: Ein Agent eines Verbrauchers, der nur innerhalb eines Herstellerprotokolls transagieren kann, ist der Agent des Herstellers, nicht des Verbrauchers. Welche Schicht auch immer über Protokollen schiedsrichterlich entscheidet, wird den gleichen drei Anforderungen gegenüberstehen – Unabhängigkeit, Nachweise und keine Beteiligung –, und wenn sich eine solche Schicht durchsetzt, wird die Schlacht um das Regal zur Schlacht um den Checker.
Für den Nachweismarkt. 2026 hörte dies auf, eine Vorhersage zu sein. Auf der Haftungsseite bewegte sich die Versicherung zuerst und in zwei Richtungen gleichzeitig. Optionale Ausschlussbestätigungen für Generative-KI-Ansprüche traten im Januar 2026 in das Standard-Betriebshaftpflicht-Toolkit ein (ISO-Formulare CG 40 47 und CG 40 48, Bestätigungen, die Versicherer wählen können, nicht automatische Ausschlüsse; innerhalb weniger Monate hatten große Versicherer eingereicht, um sie oder proprietäre Äquivalente anzunehmen). Im gleichen Zeitfenster wurden die ersten KI-Agenten-Policen auf die entgegengesetzte Weise geschrieben, gegen Nachweise: Der AIUC-1-Agenten-Standard existiert, um durch Red-Team-Audits die empirischen Risikoprofile zu generieren, die Versicherer benötigen, um zu versichern, und Februar–März 2026 brachte seinen ersten akkreditierten Prüfer, erste Agenten-Police und erste Unternehmenzertifizierungen. Eingezwängt zwischen pauschales Ausschluss und nachweisgestütztem Underwriting ist die Aufzeichnung zur Einheit der Haftungsallokation geworden: Ein Agent ohne inspizierbare Vorgeschichte sieht sich mit ausschlussförmiger Deckung konfrontiert, und ein Agent mit einer ist ein zitiertes Risiko.
Auf der Regulierungsseite werden die Transparenzverpflichtungen des EU-Gesetzes über künstliche Intelligenz, Artikel 50, einschließlich der obligatorischen Offenlegung der KI-Interaktion gegenüber Verbrauchern, am 2. August 2026 durchsetzbar (eine vorübergehende Markierungsunterobligation läuft bis 2. Dezember 2026), mit Geldstrafen, nach Lesart dieses Papers der Bußgeldbestimmungen des Gesetzes, von bis zu 15 Millionen Euro oder 3 % des weltweiten Umsatzes. Die Kommission verabschiedete ihre Artikel-50-Leitlinien am 20. Juli 2026 (Europäische Kommission, 2026), und die parallele Digital-Omnibus-Vereinfachung (unterzeichnet 8. Juli) verzögert die August-Verpflichtungen nicht. Bestehende Systeme erhalten nur einen begrenzten Aufschub bis Dezember 2026 für maschinenlesbare Inhaltsmarkierung. Breitere hochriskante Verpflichtungen werden 2027–2028 eingeführt.
Die Evidence-Schicht ändert diese Verpflichtung: ein manipulationssicherer Datensatz, der den Beweis enthält, dass die erforderliche KI-Offenlegung diesem Benutzer in dieser Sitzung angezeigt wurde, wandelt nach der Lesart dieses Papers ein rechtliches Risiko von bis zu 15 Millionen Euro in eine prüfbare Laufzeiteigenschaft um – Compliance als Nebenprodukt der Architektur. Versicherer, die KI-Agent-Haftung abdecken, benötigen genau diese Aufzeichnungen, und Rückverfolgbarkeit und Rechenschaftspflicht sind Kerneigenschaften im NIST-KI-Risikomanagement-Framework. Das regulatorische Präzedenzfall ist älter als die Technologie. Die Modellrisikorichtlinien des Bankwesens haben seit 2011 eine unabhängige Validierung durch Parteien, die unabhängig von den Entwicklern eines Modells sind, verlangt (Federal Reserve SR 11-7), eine Anforderung, die ein orchestriertes Panel automatisiert, kontinuierlich macht und auf jede folgenreiche Antwort ausweitet. Das Verbraucherrecht behält bereits den menschlichen Ausweg: Artikel 22 der DSGVO gewährt das Recht auf menschliches Eingreifen in ausschließlich automatisierte Entscheidungen mit erheblichen Auswirkungen, und Eskalation bei Abweichung ist nach Lesart dieses Papers die Laufzeitform eines bestehenden Rechts. Der KI-Act erreicht dasselbe Design von der Überwachungsseite aus: Artikel 14 der Verordnung (EU) 2024/1689 verlangt, dass Hochrisiko-KI-Systeme für effektive menschliche Überwachung konzipiert werden, und eine Architektur, die Abweichungen sichtbar macht und ungelöste Fälle an einen Menschen weiterleitet, implementiert diese Überwachungspflicht als Laufzeiteigenschaft statt als Compliance-Dokument.
Sobald die Aufzeichnung existiert, folgen zwei abgeleitete Produkte, beide kurzfristige Vermutungen. Transaktions-Level-Mikroversicherung würde einen spezifischen Agent-Kauf für Cent versichern, aus dem Evidence-Datensatz bepreist, nicht möglich gegen einen undurchsichtigen Agent und trivial gegen einen wiederholbaren. Das andere ist Agent-Reputation: longitudinale Evidence-Historien aggregieren natürlicherweise zu Reputationswerten für Agenten und Orchestratoren. Services, die Audit-Grade-Historien als Nebenprodukt des Betriebs erzeugen, würden ein Asset halten, das ihre Konkurrenten nachrüsten müssten.
Wie Infrastruktur dieser Art institutionell wird, ist selbst eine Hypothese. Die Trajektorie, auf die dieses Paper setzt – Produkte zuerst, Standards danach, Mandate zuletzt – ist eine von mehreren, die die Geschichte der Vertrauensinfrastruktur zeigt (gemeinsame Geldautomatennetzwerke, Kartennetzwerk-Regelwerke später durch Regulierung ratifiziert, Blockchains Verifizierungsangebot wartet noch auf Nachfrage). Sie hat auch ein benanntes Forschungsprogramm hinter sich. Hadfields regulatorische-Märkte-Linie – private Regulierer von öffentlichen Behörden lizenziert, mit unabhängigen Verifizierungsorganisationen als tragendste Institution (Hadfield, 2017; Clark & Hadfield, 2020; Hadfield & Clark, 2026) – erreicht sie von der Angebotsseite der Governance. Dieses Paper erreicht sie von der Nachfrageseite der Verbraucherdelegation, und die beiden Programme treffen sich bei der Quittung. Darunter liegt die schwierigere Frage, ob eine als Produktfeature verkaufte Quittung jemals zu einer Institution verhärtet. Wenn nicht, bleibt sie ein Governance-Ornament statt einer Governance-Schicht, was die zentrale These dieses Papers widerlegen würde. Der Widerlegungspunkt ist vorangemeldet: nennen Sie die Quittung eine Governance-Schicht, wenn mindestens zwei Industriestandards rückverfolgbare Entscheidungsdatensätze für agentengestützte Transaktionen erfordern, Services, die alle drei Komponenten tragen, die Mehrheit des hohen Einsatzes agentengestützter Transaktionsvolumina bewältigen, und mindestens ein nationaler Regulator solche Aufzeichnungen bei der Haftungszuweisung anerkennt. Persistentes Versagen aller drei ist, was „Ornament" operativ bedeutet. Wenn Verifizierung als Infrastruktur erfolgreich ist, verringert sich der Wettbewerb, und Vertrauen wandert in das gemeinsame Utility selbst, die gegenwärtige Architektur eingeschlossen, was jeden Graben beenden würde, selbst wenn die Infrastruktur erfolgreich wäre.
Wer haftet, wenn eine orchestrierte Entscheidung fehlgeht, bleibt eine offene Frage: der Orchestrator, die Modellhersteller oder der Verbraucher, der den Agent autorisiert hat.
Das Recht hat begonnen, den leichten Ausweg zu schließen. Kaliforniens AB 316, wirksam ab 1. Januar 2026, untersagt es einem Beklagten, der ein KI-System entwickelt, geändert oder verwendet hat, zu argumentieren, dass die KI den Schaden autonom verursacht hat, während gewöhnliche Verteidigungen und vergleichende Haftungszuweisung intakt bleiben. Es verhängt keine absolute Haftung. Das macht die Zuweisungsfrage unvermeidbar, und welcher Weg auch immer die Rechtsprechung einschlägt, der wiederholbare Datensatz ist das, woraus jede Haftungszuweisung berechnet würde. Die Rechtsgelehrsamkeit ist beim gleichen Ziel angekommen, hält fest, dass das klassische agentenrechtliche Toolkit nicht auf KI-Agenten übertragbar ist und dass das erforderlich ist neue Infrastruktur von Sichtbarkeit und Haftung (Kolt, 2025), der nächste Vorgänger von diesem Papers Argument in der Governance-Literatur, von der Überwachungsangebotsseite angenähert, während dieses Paper von der Nachfrageseite angenähert ist. Architektonisches Vertrauen ist das Beweisgut, auf das eine entstehende Haftungsdoktrin plausibel laufen könnte.
Messung und die Forschungsagenda
Für Vertrauensmessung. Standardinstrumente messen Einstellungen zu einer Marke oder einer Schnittstelle. Die messbare Einstellung ist Delegationsbereitschaft, nicht die Antwort auf „vertrauen Sie dieser KI": welche Klasse von Entscheidungen, bei welchen Einsätzen, wird der Verbraucher dem Agenten übergeben, ohne jeden Schritt zu überprüfen? Delegation ist verhaltensbezogen, monoton in berechtigtem Vertrauen und direkt an Einnahmen gebunden. Daneben liegen die Fragen, ob der Verbraucher weiß, wie die Antwort produziert wurde, ob er auf die Aufzeichnung zugreifen kann und ob sichtbare Uneinigkeit seine Zuverlässigkalibrierung verbessert oder verschlechtert.
Die Umfrage war die Quittung der menschlichen Ära: während der Verbraucher die Suche, den Vergleich und die Wahl durchführte, war das Befragen des Verbrauchers ein verteidigbarer Weg zu erfahren, was passierte. Delegation entfernt den Akteur, den der Fragebogen darauf ausgelegt war zu befragen, sodass die primäre Spur der Episode das Artefakt wird, das die Architektur produziert, und die Quittung ist in diesem präzisen Sinne die primäre Transaktionsspur der delegierten Ära. Die beiden Instrumente konkurrieren nicht: die Quittung protokolliert, was die Maschine tat, und sagt nichts über subjektive Aneignung, empfundene Autonomie oder kognitive Belastung, die Territorium der Umfrage bleiben. (Dies löst eine scheinbare Spannung mit Abschnitt 1 auf, dessen motivierendes Belege selbst kundenpräferenz-Umfragen sind: Umfragen messen, wie sich Verbraucher derzeit über einen Markt fühlen, der kaum existiert, während die Quittung misst, was delegierte Services tatsächlich taten, sobald sie existieren.) Diese Brücke kann getestet werden, indem Einstellungsmaße mit den Artefakten der gleichen Episoden gepaart werden, geschichtet nach Ergebnis, und geschätzt wird, wo Fragebogen und Aufzeichnung übereinstimmen und welches nachfolgendes Delegationsverhalten besser vorhersagt. Die vorgeschlagene Conjoint trägt einen Teil dieser Validierung von Design aus, und bis solche Studien existieren, artefaktbasierte Metriken ergänzen die Umfrage, anstatt sie zu beenden.
Branchenumfragen zeigen bereits die Verhaltensgrundlage: In einer Gartner-Verbraucherumfrage vom Mai 2026 (846 US-amerikanische Verbraucher, erhoben November–Dezember 2025) berichten 54 % der Käufer, die generative KI beim Einkaufen nutzten, dass sie alle Informationen, die sie erhielten, überprüften. Architektonisches Vertrauen ist die Produktisierung dessen, was Verbraucher bereits für sich selbst tun.
Das Mesспrogramm hat natürliche Verbündete in der ganzheitlichen Evaluationsbewegung (Liang et al., 2023) und der entstehenden Wissenschaft der Agent-Zuverlässigkeit, die Zuverlässigkeit in zwölf Metriken zerlegt, weil eine einzelne Erfolgsquote die Fehler verbirgt, die zählen (Rabanser et al., 2026). Architektonisches Vertrauen operationalisiert sich auf die gleiche Weise, verhaltensbedingt: Fehlerrate bei Vertrauen, angemessene Zuverlässigkeit, Gewichtsverlagerungen von Ratschlägen, Überschreibungsquoten, Entscheidungszeit und eine besonders aussagekräftige Statistik – die Lücke in der Genehmigungsquote zwischen korrekten und fehlerhaften Ausgaben, die Zuverlässigungskalibrierung direkt aus dem Verhalten gelesen. Auf der Aufzeichnungsseite gibt es Nachweisspannweite, gemessene Paneldivergenz und Quittungszugangsquoten, die Umfrage, Verhalten und Protokolle auf die gleichen Episoden triangulieren. Dies erfordert keine neue Wissenschaft. Die Anforderung ist eine Entscheidung, dass diese, und nicht Engagement, die Zahlen sind, für die eine Vertrauensschicht rechenschaftspflichtig ist. Meine eigene Beobachtung von den Einsatzpunkten zeigt die kontraintuitive Weise: gut dargestellte Unsicherheit erhöhte meine angemessene Zuverlässigkeit, und ich vertraute dem System mehr, wenn es sichtbar wusste, was es nicht wusste.
Eine weitere abhängige Variable gehört auf die Agenda, da Vertrauen nicht die einzige Psychologie ist, die Delegation belastet. Verbraucher reagieren weniger positiv auf ein günstiges Ergebnis, wenn ein Algorithmus es erzeugt hat, weil ein Ergebnis, das man nicht erzeugt hat, schwerer als das eigene beansprucht werden kann (Yalcin, Lim, Puntoni & van Osselaer, 2022). Delegation kann die objektive Qualität einer Entscheidung erhöhen, während es ihren subjektiven Besitz drainiert. Die Quittung sitzt an dieser Gabel: auf die eine Weise gelesen, stellt sie die Urheberschaft wieder her; auf die andere gelesen, bescheinigt sie, dass der Verbraucher nichts tat. Welche Lesart dominiert, ist eine Designfrage, die das Framework bereits instrumentalisiert hat: Die Evidence-Komponente erfasst, was überprüft wurde und gegen welchen Standard (Abschnitt 3), und die Quittung ist konzipiert, um die eigenen Kriterien des Verbrauchers in diese Aufzeichnung zu tragen, sodass die Urheberschaft der Bewertungskriterien eine Variable ist, die die Architektur enthüllt, anstatt eine, die ein Experimentator erfindet. Yalcins et al. Mechanismus, dass ein Ergebnis, das man nicht erzeugt hat, schwerer als das eigene beansprucht werden kann, macht dann die Kriterienautorität zum natürlichen Moderator, und P5 ist die Konsequenz der Evidence-Komponente für die Psychologie der Aneignung anstatt eines Nebenzweigs der Agenda. P5. Die Quittungssalienz interagiert mit der Ergebnisgünstigkeit bei der Bestimmung der subjektiven Aneignung eines delegierten Ergebnisses: Bei günstigen Ergebnissen stellt eine hervorstechende Quittung die Aneignung wieder her, wenn sie verbraucherverfasste Kriterien kodiert (der Standard, den der Agent erfüllen musste, war meiner, und hier ist der Beweis, dass er ihn erfüllte), und senkt die Aneignung, wenn die Kriterien wie die der Plattform gelesen werden; die Verbraucherautorschaft der Bewertungskriterien ist der Design-Moderator. Yalcins et al. Effekt wurde beobachtet, wo Verbraucher erwarteten, die Entscheidung selbst zu treffen, sodass P5 auf diese Grenze begrenzt ist und sich unter gewohnheitsmäßiger Delegation umkehren kann, und was die Quittung von bestehenden Transparenzmanipulationen des Prozesses unterscheidet, muss implementiert werden, nicht angenommen. Die Quittung ist überprüfbar und kann die eigenen Kriterien des Verbrauchers tragen; ein Design, das beides auslässt, testet Transparenz, nicht architektonisches Vertrauen.
Die Transparaturliteratur liefert hier zwei Vorsichtsmaßnahmen: zu viel prozedurale Transparenz kann Vertrauen senken (Kizilcec, 2016), und bloße Offenlegung der KI-Nutzung untergräbt es (Schilke & Reimann, 2025). Die zweite ist eine Grenzenbedingung für die Evidence-Komponente: In dreizehn Experimenten wurden Akteure, die KI-Nutzung offenlegten, weniger vertraut als diejenigen, die es nicht taten, ein Transparenzdilemma, in dem die Sichtbarmachung der KI-Beteiligung an sich das Vertrauen senkt. Wenn diese Strafe an jedes Signal von KI-Beteiligung angehängt wird, dann könnte eine Architektur, die ihre eigene Maschinerie in den Vordergrund stellt, Vertrauen senken, selbst während sie es überprüfbarer macht, und die Evidence-Komponente würde genau dort fehlschlagen, wo sie am sichtbarsten ist. Die Antwort des Frameworks basiert auf einer Unterscheidung, die demonstriert werden muss: Überprüfbarkeit ist nicht bloße Offenlegung. Die Quittung ist ein überprüfbares Protokoll davon, wie die Antwort erzeugt wurde, nicht eine Erklärung dass KI verwendet wurde, und P2 und P3 (mit H2s vorangemeldeter zweiseitiger Test, Offenlegungsrückstoß im Voraus als meldbares Ergebnis benannt) sind genau dort, wo die Unterscheidung entweder verhaltensbedingt ihre Wirkung bewährt oder fehlschlägt. Überprüfbarkeit ist das, was Vertrauen aufbaut, bei Bedarf bereitgestellt anstatt als allgegenwärtige Mauer der Provenienz, und weder das Verbergen noch das Ankündigen der Maschinerie leistet diese Arbeit. Wie viel der Aufzeichnung oberflächlich ist, für wen und wann, ist selbst eine Design-Variable.
Der vorgeschlagene Mechanismus dafür, dass Evidence den Offenlegungsstrafzettel überwindet, anstatt ihn zu verstärken, ist, dass Überprüfbarkeit und Offenlegung durch unterschiedliche psychologische Kanäle fließen. Offenlegung liefert eine Kategorieetikett, dass eine KI beteiligt war, die Schilkes und Reimanns Beweis an herabgesetzte Legitimität bindet. Eine Quittung liefert ein Verfahren, ein Protokoll, das geöffnet, angefochten und erneut ausgeführt werden kann, und die Verfahrensgerechtsliteratur hält, dass ein Prozess, den man anfechten und überprüfen kann, den Akteur, der ihn leitet, legitimiert (Tax, Brown & Chandrashekaran, 1998). Der Kanal erfordert nicht, dass die Überprüfung stattfindet: Was das Vertrauen trägt, ist das Bewusstsein des Verbrauchers, dass die Überprüfung existiert und in einer Beanstandung öffnet, die Verfügbarkeit der Verifikation anstatt ihrer Ausübung, was genau die Verbraucherfunktion ist, die die Ökonomie der Überprüfung der Quittung oben zuweist. Überprüfung konzentriert sich, wo ein privater Ausnutzen zur Überprüfung existiert, und der Verbraucher erbt Verifikation als Nebenprodukt, haltend die Aufzeichnung als Option anstatt sie als Dokument zu lesen. Die gleiche Unterscheidung trägt auf subjektive Aneignung (P5): Ein Offenlegungsetikett schreibt die Entscheidung der Maschine zu und drainiert das Eigentum, während eine Quittung, die verbraucherverfasste Kriterien kodiert, dokumentiert, dass der Standard, den der Agent erfüllen musste, der eigene des Verbrauchers war. Ob die zwei Kanäle in der Tat dissoziiert sind, mit Legitimität aufstieg mit überprüfbarem Verfahren, während sie mit bloßer Offenlegung fällt, ist genau das, was H2s vorangemeldeter zweiseitiger Test erkannt werden soll.
Einschränkungen. Das Modell leitet sich aus Architekturanalyse plus einer erweiterten, risikoreichen Einsatz mit einem einzelnen Operator ab. Jeder empirische Ankerpunkt wurde auf jenem einen Stack ermittelt, den ich gebaut habe und betreibe. Auf sich selbst angewendet, ist die Aussagekraft des Papers durch sein eigenes Gitter gemischt: ein Autor und ein Stack (geringe Vielfalt), ein öffentliches Replikationspaket neben versiegelten Einsatzaufzeichnungen und eine bis zur Veröffentlichung embargierte Verhaltensregistrierung (teilweise Belege) sowie ein erklärter kommerzieller Eigeninteresse (kompromittierte Neutralität). Unabhängige Replikation auf anderen Stacks ist erforderlich, bevor sich irgendwelche Ansprüche verallgemeinern lassen. Der Hash-Anker der Einsatzaufzeichnungen macht jede spätere Bearbeitung, Austausch oder Rückdatierung erkennbar, sodass die Charakterisierungen hier bei Entsiegelung gegen ein Artefakt überprüft werden können, das nachweislich nicht verändert wurde. Leser können die Integrität überprüfen, nicht den Inhalt, bis zur Entsiegelung. Die Mechanismus-Zahlen stammen aus öffentlichen Modell-APIs, und die Pipeline repliziert die Erfassung end-to-end für unter 15 Dollar. Die Stimulus-Darstellung bleibt eine Schnittstellenverwirrung: die Reize des Verbraucherexperiments, einschließlich des Stils des Belegs, sind mein eigenes UX-Rendering, und Schnittstellenverwirrungen können nur durch Replikation mit unabhängigen Renderings entwirrt werden. Blinde Erfassung zuerst, manipulationssichere Aufzeichnungen und Routing ohne Eigeninteresse sind das Konstrukt; die Aggregationsregeln und Eskalationsschwellen sind Engineeringentscheidungen. Die Panels des Experiments sind analytische Kombinationen einer blinden Erfassung und nicht einer bereitgestellten Orchestrierungsschleife, und das entworfene Feldtelemetrie-Protokoll schließt diese Lücke. Die nicht-Modell-Verifizierungswege, die das Framework nennt (Shadow Runs, Zeitkonsistenz-Checks), werden hier beschrieben, nicht getestet. Die Erfassung ist ein einzelner Lauf bei Temperatur null, was die Innerhalb-Modell-Variabilität unterdrückt und die Korrelation gemeinsamer Abstammung an Ort und Stelle lässt, und gehostete APIs sind auch dort nicht streng deterministisch. SimpleQAs kurze sachliche Antworten liegen nahe am Regime mit beschränktem Antwortbereich, in dem Konsens Fehler zertifiziert, und die Schwierigkeitsstratifizierung zeigt genau dieses Muster bei den schwierigsten Quintilen. Ein Panel auf mittlerer Ebene kann den Nutzen von Vielfalt überstaatlichen, da die Fehlerkorrelation mit Fähigkeit ansteigt (Kim et al., 2025). Das Mechanismus-Experiment testet offene sachliche Fragen mit einzelnen überprüfbaren Antworten, und bei offenen generativen Aufgaben, bei denen die semantische Äquivalenz zwischen Antworten selbst ein Urteil ist, muss das Zertifizierungssignal neu etabliert statt angenommen werden. Eine verwandte Grenze ist die Dimensionalität des Antwortbereichs: SimpleQA-Elemente haben eine einzelne überprüfbare Antwort, während die Verbraucherentscheidungen, die Agenten ausführen, subjektive, mehrattributive Nutzenbewertungen mit vielen verteidigbaren Antworten sind, daher ist, wie sich Konsens im Präferenzbereich verhält und ob Übereinstimmung unter unabhängigen Agenten selbst eine bessere Wahl dort identifiziert, eine offene empirische Frage (semantische Äquivalenz wird Präferenzäquivalenz, und die Bewertung selbst eine Modellierungsentscheidung). Ein Kontrolle des Label-Rauschens wird ausgeführt: bei der Schnittmenge von 351 Elementen aus der Teilstichprobe dieser Studie mit SimpleQA Verified (Google DeepMind, 2025) lässt die Neubewertung jeder Panel-Antwort gegen die korrigierten Gold-Labels die Zertifizierungssteigerung unverändert oder leicht stärker (2,7 → 2,8, 4,4 → 4,4, 4,0 → 4,3 über die drei Panels, deterministischer Bewerter), daher ist Label-Rauschen nicht der Treiber der Steigerung. Alle Konfidenzwerte sind verbalisierte 0–100-Selbstangaben, die durch ein einzelnes Prompt-Format hervorgerufen wurden, und Empfindlichkeit gegenüber dem Abfrageverfahren kann selbst nach Anbieter variieren, daher sollten Pro-Anbieter-Diskriminierungs- und Kalibrierungsschlussfolgerungen als Eigenschaften dieser Konfiguration unter diesem Abfrageverfahren gelesen werden, nicht als feste Anbietermerkmale. Die Selbstvertrauens-Basislinie in der sechzehn-Modell-Welle Tabellen 6–7 ist das rohe Selbstvertrauensangaben. Die stärkeren kalibrierten Basislinen in der Tradition von Guo et al. (2017) wurden in der Flaggschiff-Welle ausgeführt (Platt-Skalierung und aufgeteilte konforme Enthaltung, Abschnitt 3), wo sie als Ergänzungen zum Gate statt als Ersatz entstehen, und der Vergleich Panel-versus-Selbst der ersten Welle sollte gegen die Baseline-Verbraucherprodukte gelesen werden, die tatsächlich bereitgestellt werden. Die Schlagzeilen-Gate-Schätzung (−82,1% der zuversichtlichen Fehler, Bootstrap-95%-KI [79,9; 84,1] für die zehn vollständigen Arme, [80,0; 84,2] mit dem Meta-Arm enthalten) ist eine einzelne vorspezifizierte Größe, und die umgebenden Analysen (das Schwellenwert-Empfindlichkeitsgitter, die Schwierigkeit und Kontaminationsstrata, die Council-Ablationen und triviale Baselineevergleiche) sind beschreibende Robustheitsüberprüfungen, die ohne irgendwelche Korrektionen für mehrfache Vergleiche berichtet werden, und sie beanspruchen keinen bestätigenden Status eigenen Rechts. Die einzige familienweise Fehlerkontrolle im Paper ist die Holm-Korrektur über die vorregistrierten {H1, H2} des Verbraucherexperiments. Wenn das Evaluationsregime, das selbstbewusstes Raten belohnt, repariert würde, sodass Wahrhaftigkeit in Modelle trainiert werden könnte (Kalai et al., 2025), würde Architektur gegen ein Problem mit einer kostengünstigeren Lösung versichern, obwohl Beweis und Neutralität für jedes Modell-Level-Fix irreduzibel bleiben würden. Weitere Grenzen werden dort angegeben, wo sie berichtet werden: die Abdeckungsbeschränkungen der Flaggschiff-Welle (Abschnitt 3: zwei unzugängliche chinesische Flaggschiffe und eine unterbrochene Meta-Erfassung), und der vorläufige 233-Paare-Reasoning-Budget-Vergleich, dessen TOST-Grenzen Äquivalenz bei einer ±5-Punkte-Marge ohne Kraft für engere Grenzen begrenzen. Delegationsmessungen stammen aus einer hypothetischen Vignette, bei der angegebene Messungen die tatsächliche Bereitschaft um ungefähr 21% in der Metaanalyse überstaatlichen (Schmidt & Bijmolt, 2020); das Verbraucherexperiment realisierte 119 primäre und 133 gepoolte von 200 registrierten Teilnehmern über sechs festgelegte Elemente. Eine Commerce-Substrat-Replikation erweitert den Mechanismus über den Benchmark hinaus: ein frischer, vorgefrorener Satz von 267 Wikidata-verifizierten Produktfakten (welches Unternehmen ein Auto oder Flugzeug herstellt, welches Betriebssystem ein Telefon betreibt, welches Unternehmen ein Spiel veröffentlichte, in welchem Jahr es versandt wurde), blind durch ein unabhängiges sechser-Modell-Panel (Claude Opus, GPT-5.4, Grok, Qwen, GLM und Mistral) ausgeführt, die kostengünstig optimierte Stufe, auf der verbrauchergerichtete Agenten tatsächlich betrieben werden, nicht die Flaggschiffe, reproduziert die Dissoziation, die untermodell-Übereinstimmung sagt Richtigkeit bei AUROC 0,77–0,81 gegenüber 0,63–0,70 für angegebenes Vertrauen und eine 4–6×-Zertifizierungssteigerung voraus, robust über unabhängig zusammengesetzte Panels von drei bis sechs Modellen über US-, chinesische und europäische Laboratorien hinweg, und zur Strenge der Bewertung (die deterministische String-Übereinstimmung hier ist die primäre, konservative Regel). Das subjektive, mehrdimensionale Ende des Commerce-Spektrums (Präferenztradeoffs, konträre Handelsanreize und Tool-gestützte Abfrage über wechselnde Inventare) bleibt ungetestet.
Varianz zwischen Läufen unter Stichprobennahme. Ein Varianzarm untersuchte die Grenze zwischen Einzeldeterminismus direkt: Eine schwierigkeitsstratifizierte Substichprobe von 100 Fragen (5 Schwierigkeitsquintile × 20, Seed 20260806) wurde bei Temperatur 0,7 mit 3 unabhängigen Stichproben pro Frage für 9 der 11 Flaggschiff-Wellen-Panel-Modelle neu ausgeführt; Metas Endpunkte waren unzugänglich, und Claude Fable 5s API macht keinen Temperaturparameter verfügbar. Modellübergreifend produzierten alle drei Stichproben auf 22–77 % der Fragen gegenseitig äquivalente Antworten (Median 54 %), die Korrektheit pro Frage war auf 63–97 % der Fragen über die drei Stichproben identisch, und die Antwort bei Temperatur 0 entsprach der Mehrheits-Antwort bei Temperatur 0,7 auf 40–85 % der Fragen. gpt-5.6-sol's Bein hat einen Confounder: es lief mit Reasoning Effort keine, während 1.486 seiner 1.500 Wellen-Records die Standard-Effort nutzten (mittel, wie oben erwähnt). Sein Genauigkeits-Delta von 92,0 % → 46,3 % auf dieser Substichprobe konfundiert daher Temperatur mit Reasoning-Budget, obwohl seine Inter-Stichproben-Konsistenzwerte unbeeinflusst sind. Unter Ausschluss dieses konfundierten Beins unterschied sich die durchschnittliche Genauigkeit pro Stichprobe bei Temperatur 0,7 von der deterministischen Temperatur-0-Genauigkeit auf denselben Fragen um höchstens 14,0 Punkte (gemini-3.1-pro, 49,0 % → 63,0 %), wobei die restlichen sieben Modelle innerhalb von 4,4 Punkten lagen. Auf Panel-Ebene öffnete sich das Council-Gate (Drei-Wege-Antwort-Übereinstimmung zwischen kimi-k3, deepseek-v4-pro und gpt-5.6-sol) auf 31,0 % der Substichprobe bei Temperatur 0, gegenüber 25,0 %, 23,7 % und 29,8 % über die drei Temperatur-0,7-Läufe. Das Übereinstimmungs-Signal, das dem Hauptergebnis zugrunde liegt, ist stabil unter Stichproben-Rauschen.
Evidenzstatus von Behauptungen. Die Behauptungen fallen auf drei Evidenzebenen. Durch diese Daten belegt: dass unabhängige Übereinstimmung ein Korrektheitssignal trägt, das die Eigenberichte eines Modells nicht tun, unter den angegebenen Grenzbedingungen (blinde Erfassung, kompetente Verifizierer, offene Antworten auf Faktenfragen mit eindeutigen verifizierbaren Antworten); dass ein festes Disagreement-Gate die Mehrheit der selbstsicheren Fehler mit erheblichen, angegebenen Abdeckungskosten reduziert (−82,1 % bei 30,5 % Abdeckung); und die starken Grenzbedingungen selbst: Konsens zertifiziert Fehler auf eingeschränkten Antworträumen, die rohe Zertifizierungsverbesserung nimmt monoton mit Schwierigkeit ab (verschwindet auf dem schwierigsten Quintil unter der Innerhalb-Erfassung Stratifizierung; positiv aber schwächst dort unter der exogenen), und Verifizierer-Kompetenz gattet Zertifizierungswert. Unterstützt durch das Verhaltensexperiment (ein Design, bescheidenes Single-Study-Ausmaß, n = 119): dass die Oberflächengestaltung echter Modellübergreifender Meinungsverschiedenheiten die Reliance-Kalibrierung in beide Richtungen verbessert (d = 0,67, Holm p = .0005; getragen von einem von sechs Elementen; Hauptwellen-Manipulationschecks 88–98 %; Skalenzuverlässigkeiten α = .83–.93); und, als registriertes unschlüssiges Null, dass eine statische First-Exposure-Quittung die Delegation nicht nachweislich verändert. Theoretisch vorgeschlagen, noch nicht getestet: die D×E×N-Komplementarität; der Neutralitätseffekt (P3); Vertrauensmigration unter zunehmender Delegation; Post-Fehler-Dauerhaftigkeit von architekturbasiertem Vertrauen (P4); Zahlungsbereitschaft für Verifizierbarkeit; und die Marktkategorie-Behauptung von Abschnitt 7.
Der natürliche nächste Schritt ist experimentell: Vertrauensmesspunkt, Reliance-Kalibrierung und Zahlungsbereitschaft über Einzel- und orchestrierte Bedingungen messen, mit Meinungsverschiedenheiten abwechselnd oberflächlich und unterdrückt. Abschnitt 6 berichtet das realisierte Experiment, präregistriert und anreizkompatibel. Eine Standard-Choice-Based-Conjoint schätzt Teilwerte additiv und nimmt kompensatorische Kompromisse an, was die Komplementaritätshypothese verneint, daher muss die Design-Klasse nicht-kompensatorische Struktur ermöglichen, ob Elimination-by-Aspects oder erzwungene Wahl-Designs mit Deal-Breaker-Attributen, geschätzt mit expliziten Interaktionstermen. Zwei Design-Ebenen sind angegeben. Die Minimal-Ebene ist eine Zielprofile-Studie, vier bis fünf Profile umfassend keine, Einzelkomponenten-, Zweikomponenten- und Vollkonfigurationen, wobei die theoretische Arbeit durch einen geplanten Kontrast geleistet wird, der Effekt der Vollkonfiguration übersteigt die Summe der Komponenteneffekte (Super-Additivität), gegen das additive Null. Die volle Ebene kreuzt drei Ebenen pro Komponente (abwesend, vorhanden aber nicht inspizierbar, vorhanden und inspizierbar) in einem 3×3×3 Between-Subjects faktoriellen Design (27 Zellen; Einsätze variierten innerhalb des Subjekts über vier Ebenen), mit mindestens 80 Teilnehmern pro Zelle (N ≥ 2.160) für Power ≥ 0,85 auf der Interaktion. Ein binäres 2³-Design kann die Cobb–Douglas-Exponenten nicht wiederherstellen und ist bei plausiblen Effektgrößen unterstärkt (d ≈ 0,3–0,4). Drei Stimulus-Disziplinen gelten: variieren Sie die architektonischen Größenordnungen selbst und nicht nur ihre Kennzeichnung (ein fehlende Quittungs-Label ist Verbraucherunkenntnis der Evidenz, nicht deren Abwesenheit), geben Sie jeder Komponente einen verifizierbaren-versus-bloß-behaupteten Kontrast, und verbinden Sie Wahl-Daten mit Prozess-Verfolgung auf den Quittungsfeldern, da die Theorie die Verwendung von Evidenz vorhersagt. Nach meinem Wissen wäre dies das erste Design, das die drei Komponenten gemeinsam variiert. Die Einzelkomponenten-Bausteine sind bereits bepreist (König et al., 2022; Ioku et al., 2024), und benachbarte Bündel wurden durchgeführt (Cetinkaya & Krämer, 2024, das nächste Instrument und eine Kraft-Kalibrierungsquelle neben Köbis et al., 2025), daher ist die Studie spezifiziert, mit Kraft versorgt und bereit zum Ausführen. Die Grenzbedingungen des Konstrukts sind diese: Architektur-Vertrauen zahlt sich nicht aus, wenn die Einsätze niedrig und das Volumen hoch sind; es trägt wenig bei, wo der Verifizierer-Pool nicht auf der Aufgabenklasse kompetent ist; es kann Fehler zertifizieren, wo Antwortränder dicht eingeschränkt sind; und es degeneriert in Richtung Theater, überall wo Panel-Unabhängigkeit behauptet statt gemessen wird, schärfst als die offene Red-Team-Frage wie sieht eine manipulierte Quittung aus? Sobald Hyperlinks zu Autoritätssignalen wurden, entstanden Link-Farmen, um sie zu produzieren, und Übereinstimmungs-Records sollten erwartet werden, ihre eigenen Farming einzuladen. Zwei zeitliche Grenzen gelten auch: Zeichen gewinnen Aufmerksamkeit, während Evidenz Persistenz gewinnt, daher betrifft der Anspruch, welches Vertrauen Fehlschlag überlebt, statt welches am schnellsten einnährt, und selbst ein funktionierender Check mag nur eine Spirale des Chandra et al. (2026) Modellierungstypus verlangsamen. Wo Konsequenzen sich konzentrieren und Unabhängigkeit real ist, verdient Architektur-Vertrauen seine Kosten und seinen Namen (Tabelle 12 sammelt die vier).
Tabelle 12. Grenzbedingungen: wo Architektur-Vertrauen sich nicht auszahlt
| Bedingung | Warum es dort fehlschlägt | Evidenz |
| Niedrige Einsätze, hohes Volumen | Verifizierungskosten übersteigen die Kosten von Fehlern; Einzel-Modell-Serving ist die richtige Antwort | Break-Even-Logik (Abbildung 14) |
| Verifizierer-Pool unterhalb der Aufgaben-Kompetenz | Unabhängigkeit ohne Kompetenz signalisiert nichts | Lokale Null: 46% Präzision mit oder ohne Übereinstimmung |
| Eng begrenzte Antwortmöglichkeiten | Konsens bescheinigt Fehler, statt ihn zu erkennen | Konsensfehler 4,0–7,9% bei Multiple Choice gegenüber 0,5–2,2% bei offener Form |
| Unabhängigkeit behauptet, nicht gemessen | Ein Gremium von Quasi-Klonen erzeugt Zuversicht | Korrelierte Fehler; Block- und Lineage-Nulls |
Eine letzte Grenze betrifft das, was jedes der vorgeschlagenen Designs identifizieren kann. Vertrauen in einen KI-Markt ist letztendlich ein Gleichgewichtsobjekt. Sobald sich Verkäufer, Plattformen und konkurrierende KI-Systeme an eine Verifizierungsarchitektur angepasst haben, sind ihre Auswirkungen Eigenschaften des angepassten Marktes, nicht der Treatmentzelle. Beobachtungsdaten erben Selektionsverzerrung, weil Verifizierung zuerst dort eingeführt wird, wo Vertrauen bereits bröckelt. Unit-Level-Randomisierung repariert die Selektion, stoppt aber bei Interferenz, da Verbraucher, die zufällig Quittungen erhalten, immer noch auf einem Markt transagieren, auf dem Verkäufer auf die Quittungen aller reagieren. Die Gleichgewichtsmenge erfordert geclusterte, Switchback-, bipartite oder Markt-Level-Designs; die Randomisierung der Architektur statt Messung des Vertrauens ist das nächste harte Problem. Und frühe KI-Commerce-Kohorten selektionieren sich selbst nach Vertrauensneigung, also begrenzen auf frühe Anwender geschätzte Effekte eher die Populationseffekte, als sie zu schätzen. Neutralität ist wertvoll genau weil niemand mit Eigeninteresse an einem Modell sie liefern kann, einschließlich jedes mit Eigeninteresse an Orchestrierung. Das Argument beschreibt auch die Art von System, das ich baue (Anmerkung des Autors). Dieses Interesse betrifft das Plädoyer und nicht die Reproduzierbarkeit der Evidenz: Die bewerteten Modelle sind unabhängig, öffentlich zugänglich und an der Grenze, und jede berichtete Zahl ist reproduzierbar von Dritten aus dem eingefrorenen Replikationspaket. Ein Leser, der das Plädoyer völlig diskontiert, kann die Messungen immer noch überprüfen.
6. Können Verbraucher das Signal nutzen? Ein vorläufiger Verhaltenstest
Ob Verbraucher das Korrektheitssignal, das der Mechanismus etabliert, nutzen können, ist eine separate, Verhaltens-Frage, und ich berichte ein vorab registriertes, anreizkompatibles Experiment dazu. Die durchgeführte Studie ist ein Existenzbeweis statt eines Tests eines allgemeinen Effekts; sie fragt, ob Verbraucher überhaupt auf das Signal reagieren können. Eine gepowerte, bestätigende, vielgliedrige, stimulusgestichprobt Replikation mit Item-Random-Slopes ist geplant. Ein Hosting-Ausfallfall im letzten Rekrutierungsfenster endete die Sammlung bei 119 gültigen Teilnehmern gegen 200 geplant (133 mit Pooling einer Soft-Launch-Kohorte; USA und Großbritannien; drei Between-Subjects-Bedingungen um einen KI-Shopping-Assistenten; Kalibrierung über sechs anreizkompatible faktische Versuche als Δ = P(akzeptieren | korrekt) − P(akzeptieren | inkorrekt), der angemessene Reliance-Diskriminierungsindex von Schemmer et al., 2023). Vollständige Methode, die Pilotierung, die fünf Abweichungen von der Registrierung, die Ethik- und Exemption-Offenlegung und alle Hilfsstatistiken sind im detaillierten Bericht unten (§6.1–6.2) und im Replikationspaket.
Angezeigte Modelluneinigkeit verbesserte die Kalibrierung insgesamt (Kontrolle Δ = 0,24 → 0,45; d = 0,67, 0,68 gepolt, p = .0001), aber die gepoolte Schätzung ist fragil: sie wird von einem von sechs Stimuli getragen, dem einzelnen hochsicheren Dissenter-Item, wo die Anzeige die Akzeptanz einer zuversichtlich falschen Antwort von 74% auf 24% senkte (gepoolte Kohorte, Tabelle 18). Das Entfernen dieses Items senkt den Effekt auf d = 0,09 (p = .54), während das Entfernen eines anderen Single-Items ihn intakt lässt. Der Vorteil konzentrierte sich in der UK-Substichprobe. Die US-Kontrollzelle (n = 16) diskriminierte bereits zu Baseline (Interaktion p = .002). Beim einen Item, auf das sich das Gremium selbst über eine falsche Antwort einig war, erhöhte die Anzeige die Akzeptanz in beiden Ländern, was Abschnitt 3s zertifizierten Konsensfehler-Modus in menschlichem Verhalten reproduziert und ein Befund für sich: eine Architektur, die Übereinstimmung anzeigt, überträgt ihren einen systematischen Fehler auf ihre Benutzer. Der First-Exposure-Test von P2s Evidenzkomponente, eine statische Orchestrierungs-Quittung, produzierte keinen erkennbaren Effekt auf Bereitschaft zu delegieren (d = 0,21, inconclusive bei dieser Power; eine Live-Drill-Down-Quittung bei Streitzeit ist das registrierte Follow-up).
Eine dissentierende Panel-Anzeige kann die Akzeptanz einer zuversichtlich falschen Empfehlung, die ein Verbraucher sonst akzeptieren würde, deutlich senken, und es schlägt fehl, wo das Gremium einen gemeinsamen Fehler bescheinigt. Der Kalibrierungskontrast hat daher unter diesen sechs Stimuli Verhaltensunterstützung; P1 wie angegeben, mit wahrgenommenem Risiko als Mediator, wird von diesem Test nicht unterstützt. P2–P4 bleiben das offene Programm.
6.1 Verhaltenstest: Methode und Pilotierung
Die Propositionen der Abschnitte 3 und 5 sind geschrieben, um getestet zu werden, und die oben angegebene Messagenda spezifiziert wie. Das Experiment ist ein vorab registriertes, anreizkompatibles Online-Test von P1 (Reliance-Kalibrierung unter angezeigter Uneinigkeit) und P2 (Bereitschaft zu delegieren unter einer wiederholbaren Aufzeichnung), mit Stimuli aus den echten Multi-Modell-Ausgaben der Flagship-Welle, Erweiterung des Second-Opinion-Paradigmas (Detjen et al., 2025; Chen et al., 2026) auf echte, anreizkompatible Frontier-Modell-Uneinigkeiten unter einem architektonischen Framing. Das Instrument, das Protokoll-Freeze, die Pilotierung, die Hauptwelle und die Frozen-Code-Analyse sind vollständig und unten berichtet. Die bestätigenden Tabellen wurden in früheren Versionen dieses Papers als ein vorab registriertes Skelett mit Zellen markiert [MAIN DATA PENDING] getragen und sind jetzt durch den eingefrorenen Analysencode gefüllt. Zwei Ergebnisse ungünstig zur Hypothese wurden als berichtbar primäre Befunde vorab registriert: angezeigte Uneinigkeit verschlechtert die Kalibrierung (Netto-Unter-Reliance) und die Quittung senkt die Bereitschaft zu delegieren (Disclosure-Backfire); keiner materialisierte, aber ein vorab registriertes Null tat es.
Methode.
Design und Hypothesen. Die Kalibrierung der Zuverlässigkeit erfordert die Kreuzung der angezeigten Übereinstimmung mit der Antwortrichtigkeit, was ein einzelnes Szenario nicht leisten kann. Das Design ist daher hybrid. Die Teilnehmenden lesen zunächst ein Shopping-Delegations-Szenario (ein KI-Shopping-Agent „ShopAssist", der einen Laptop-Kauf innerhalb eines Budgets von 1.200 Dollar empfiehlt), die primäre Prüfung von P2, und führen dann einen kurzen anreizgesteuerten Urteils-Block zu echten Multi-Modell-Outputs durch, die primäre Prüfung von P1. H1 (P1): Die Anzeige von modellübergreifender Übereinstimmung und Uneinigkeit von mehreren unabhängigen KI-Systemen verbessert die Kalibrierung der Zuverlässigkeit der Verbraucher (sie akzeptieren die vom Agent vorgeschlagene Antwort mehr, wenn sie richtig ist, und weniger, wenn sie falsch ist) im Vergleich zu einer einzigen selbstsicheren Antwort; zweiseitig, da die Literatur sowohl verringerte Überabhängigkeit als auch erhöhte Unterabhängigkeit bei gemeinsamer Darstellung dokumentiert. H2 (P2): Der Zugang zu einer Orchestrierungs-Quittung (wer handelte, wie sie sich einigten, was überprüft wurde, und ein vollständig verifizierbare Datensatz) erhöht die Bereitschaft, einen wichtigen Einkauf über die alleinige Wirkung der angezeigten Uneinigkeit hinaus zu delegieren; zweiseitig, da die Offenlegung auch das Vertrauen beeinträchtigen kann.
Bedingungen. Drei zwischen den Versuchspersonen variierende Bedingungen, randomisiert 1:1:1 und über das Szenario und den Urteils-Block hinweg konstant gehalten: (1) Kontrolle, eine einzelne selbstsichere Empfehlung, keine architektonischen Signale; (2) Uneinigkeit, dieselbe Empfehlung, der ein Gremium von drei unabhängigen KI-Systemen (anonym als System A, B, C bezeichnet) mit expliziter Übereinstimmungs-/Uneinigkeitsmarkierung, den alternativen Antworten der Systeme und angegebenen Konfidenzwerten sowie einer zusammenfassenden Erklärung in einfacher Sprache vorangeht; (3) Uneinigkeit + Evidenz, die Uneinigkeits-Anzeige zuzüglich einer Orchestrierungs-Quittungskarte, strukturiert als wer handelte / wie sie sich einigten / was überprüft wurde / vollständiger Datensatz. Eine vorab registrierte Design-Einschränkung kontrolliert die offensichtliche Konfundierung: der endgültige Empfehlungsblock (Produkt, Preis und die vom Agent angegebene endgültige Konfidenz) ist wörtlich identisch über alle drei Bedingungen hinweg, im Szenario und bei jedem Urteils-Trial, und nur die architektonischen Signale drum herum unterscheiden sich.
Stimuli und Quittungen. Die Urteils-Block-Stimuli sind echte Outputs von drei Frontier-Modellen aus der Flaggschiff-Welle zu echten faktischen Fragen, bei denen sich die Modelle bei hohen angegebenen Konfidenzwerten (95–100) tatsächlich einigten oder nicht einigten; keine Antworten oder Konfidenzwerte sind gefälscht. Modellnamen werden durch neutrale Bezeichnungen ersetzt, um Brand-Prior-Konfundierungen zu vermeiden, und die Zuordnung wird im Replikationspaket offengelegt. Die in Bedingung 3 angezeigten Quittungen (eine Szenario-Quittung und sechs Trial-Quittungen) werden vom Quittungsminter der Forschungsbereitstellung (Schema `decision-receipt@v1`) über die tatsächlichen Provenance-Logs des Stimuli-Gremiums geprägt, und ihre Verifizierungshashes sind tatsächlich aus dem Datensatz neu berechenbar (Verifizierungslog: 7/7 gültig). Die Evidenz-Manipulation des Experiments ist daher eine Instanz des Artefakts, das Abschnitt 3 definiert. Die angezeigte fokale Konfidenz wurde eng über die Richtigkeit-Zellen abgestimmt (falsche Elemente 95/98/99; richtige Elemente 99/99/100) und war, entscheidend für den Behandlungs-Kontrast, über alle Bedingungen identisch. Kontrolle sah dieselben fokalen Konfidenzwerte und diskriminierte weit weniger, was ein Konfidenz-Hinweis-Account nicht erklären kann.
Messgrößen. AV1 (H2): eine 4-Item-Delegations-Bereitschaftsskala (7-Punkte; z. B. „Ich würde ShopAssist diese Kaufentscheidung abschließen lassen, ohne die Empfehlung selbst zu überprüfen"), gemittelt; eine Single-Item-Delegations-Leiter (0–4, von „nur Empfehlungen" bis „handelt autonom einschließlich nicht erstattungsfähiger Käufe") ist sekundär. AV2 (H1): sechs Urteils-Trials; bei jedem schlägt der Agent eine Antwort vor und die Teilnehmerin entscheidet, ob sie den Assistant fortfahren lässt (ja/nein) und bewertet das Vertrauen in die Antwort (0–100 Schieberegler). Zuverlässigkeitsentscheidungen sind Genauigkeits-anreizgesteuert (ein Bonus für jede richtige Zuverlässigkeitsentscheidung, eine richtige Antwort akzeptieren oder eine falsche ablehnen). Die vorgeschlagene Antwort ist bei genau drei von sechs Trials richtig. Der kalibrierungs-Score pro Teilnehmerin ist Δ = P(akzeptieren | richtig) − P(akzeptieren | falsch), der Diskriminationsindex der angemessenen-Zuverlässigkeits-Literatur (Schemmer et al., 2023, deren RAIR/RSR-Messgrößen dasselbe Objekt zerlegen); ein Trial-Level-Mixed-Effects-Modell stellt die Item-Level-Auflösung wieder her. Wahrgenommenes Risiko und wahrgenommene Prozess-Kontrolle (je 4 Items) werden als Mediatoren in vorab registrierten sekundären Analysen für die P1- und P2-Pfade gemessen; wahrgenommene Orchestrator-Neutralität (4 Items) wird als explorative Korrelation von P3 gemessen, die diese Studie nicht manipuliert.
Eingefrorenes Protokoll. Die Vorregistrierung wurde vor der Hauptdatensammlung eingeforen (Analysencode und Protokoll per SHA-256 am 5. August 2026 eingeforen; die OSF-Registrierung wurde am 13. August eingereicht, bevor die Hauptwelle am 13.–14. August ins Feld ging; registriert mit Embargo (Vorregistrierung, nur Ansicht: https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f), wird in die öffentliche OSF-Komponente des Papers veröffentlicht, https://osf.io/jtvu9/). Der Itemsatz mit sechs Versuchen ist durch einen Seed eingeforen: drei nach Design festgelegte Uneinigkeitselemente und manuell verifiziert, plus Konsenselemente, die per seeded-Shuffle aus den Pools gezogen wurden, in denen alle drei Systeme mit angegebener Konfidenz ≥ 95 identisch antworteten, einschließlich eines echten Konsensfehlers, sodass die angezeigte Übereinstimmung diagnostisch, aber unvollkommen ist, genau wie in den Quelldaten. Die sechs Elemente waren für alle Teilnehmenden identisch; die Präsentationsreihenfolge wurde im Instrument randomisiert, obwohl der ausgegebene Export die anzeigtenreihenfolge pro Versuch nicht beibehielt. Die angezeigte Anzeige zeigte keine geschätzte Unabhängigkeitsbewertung für das Panel, das ist die von der Theorie selbst geforderte Offenlegung der gemessenen Diversität, daher sahen Teilnehmende Uneinigkeit ohne zu sehen, wie unabhängig die uneinigen Systeme waren. Die Unabhängigkeit des Panels wurde gemessen, aber nicht angezeigt, und sein Wert in der Quellsammlung wird hier nachträglich berichtet: mittlere paarweise Fehlerkorrelation φ = 0,22 (0,10–0,44 über die drei Paare hinweg, die beiden Mitglieder desselben Blocks mit Abstand am stärksten korreliert bei 0,44; bewertet durch den eingefrorenen deterministischen Grader der Studie, der 95–98% der Antworten auflöst und unempfindlich gegenüber der Codierung des ungelösten Restes ist), was das Panel weit entfernt von unabhängig und weit entfernt von klonal macht. Das ist die Zahl, die das nächste Instrument vor den Teilnehmenden anzeigen sollte. Eine Stimulus-Grenze: Mit sechs festgelegten Elementen kann die Treatmentvariation über Elemente hinweg nicht geschätzt werden, daher wird der Effekt für diese Stimuli etabliert. Die Sitzungen begannen mit informierter Zustimmung und endeten mit einer Debriefing-Offenlegung der hypothetischen Natur des Vignettenkaufs. Die Studie wurde gemäß der Deklaration von Helsinki durchgeführt: anonyme Umfrageforschung mit minimalem Risiko mit einwilligenden britischen und US-amerikanischen Erwachsenen auf einem DSGVO-konformen Panel, Kompensation über dem Plattformmindestum und keine Täuschung über die beim Debriefing offengelegte hypothetische Vignette hinaus. Nach diesen Kriterien erfüllte sie die Bedingungen für Ausnahme von vollständiger Ethikkommissions-Überprüfung, und die Ausnahmebewertung ist in der Vorregistrierung dokumentiert. Der Pool ist nun geschlossen; der wortgetreue Itemsatz, Antworten und Quittungskenner pro Versuch sind Teil der embarggierten Vorregistrierung und werden mit den Daten veröffentlicht.
Stichprobe und Analyseplan. Zielwert N = 200 gültige Teilnehmende (100 US, 100 UK; separate Prolific-Studien; Rekrutierung auf 210 begrenzt), Alter 18+, fließend Englisch, ≥ 98% Genehmigungsquote, ≥ 100 vorherige Arbeitsaufträge, mindestens ein Online-Kauf in den letzten drei Monaten. Vorregistrierte Ausschlüsse (angewendet vor dem Anzeigen inhaltlicher Antworten): zwei oder mehr fehlerhafte Aufmerksamkeitsprüfungen von drei; Fertigstellung unter 3 Minuten; Straight-Lining; fehlerhafte Manipulationsprüfungen (Einigkeitselement in Bedingungen 2–3, Quittungselement in Bedingung 3, Produktverständniis-Element); zweimal fehlgeschlagenes Verständnis des Urteilsblocks; doppelte Kennung oder IP; unvollständige Sitzung. Bestätigende Analysen: für H1, OLS von Δ auf gepolte Uneinigkeitsbedingungen (2 und 3) versus Kontrolle mit Länderkovariat; für H2, beschränkt auf Bedingungen 2 und 3, OLS des Willingness-to-Delegate-Kompositums auf Bedingung mit Länderkovariat; Holm-Korrektur über {H1, H2}, familienweise α = ,05; Welch-t-Tests zur Robustheit; Manipulationsprüfungsgating wird zuerst berichtet. Die Kohortenreihenfolge ist hier festgelegt: die primären bestätigenden Analysen werden auf der Hauptwellen-Kohorte ausschließlich der Soft-Launch-Teilnehmenden des Piloten berechnet, und der Zweig, der die Soft-Launch-Kohorte in die bestätigende Stichprobe kombiniert, wird als Robustheitsanalyse daneben berichtet. Die explorativen Δ-Deskriptiven des Piloten wurden vor der Hauptwelle gesehen, daher entfernt das Ausschließen dieser Kohorte aus der primären Schätzung sogar die sanfte Form des Double-Dipping, während die vorregistrierte Soft-Launch-Inklusion als berichteter Zweig beibehalten wird. Die primäre Berichterstattung wird eine Intention-to-Treat-Analyse einschließen, die alle randomisierten Teilnehmenden zusammen mit der vorregistrierten Per-Protokoll-Analyse beibehalten. Manipulationsprüfungsausschlüsse werden mit Checks auf unterschiedliche Abnutzung nach Bedingung berichtet, da die Salience des architektonischen Signals über Bedingungen hinweg selbst unterschiedlich sein könnte. Sensitivität: das Design erkennt d ≈ 0,42 für H1 und d ≈ 0,49 für H2 bei Macht 0,80, ausreichend für die mittleren Effekte in der angrenzenden Verlässlichkeit und Transparenz-Literatur. Kleinere Effekte werden dem vollständigen faktoriellen Design der Forschungsagenda überlassen. Drei vorregistrierte Elemente beantworten Mechanismus-Fragen, die die bestätigenden Kontraste allein nicht können. Das Instrument trägt eine vierteilige wahrgenommene Risikoskala (Pilot α = ,881) auf dem P1-Weg, daher geht die Risikowahrnehmung als gemessenes Konstrukt statt einer Annahme in die Analyse ein. Mediation ist als sekundäre Analyse vorregistriert, mit wahrgenommenenem Risiko, das den Uneinigkeitseffekt auf Verlässlichkeit vermittelt, und wahrgenommenenem Prozesskontrolle, das den Quittungseffekt auf Willingness-to-Delegate vermittelt, geschätzt durch Bootstrap-Pfadanalyse (PROCESS-Modell 4, 5.000 Resamplings). Die Verweildauer auf dem Stimulus-Bildschirm von Bedingung 3 wird als vorregistrierter Proxy für Quittungslesen erfasst, eine direkte Überprüfung der kognitiven Belastungsalternative, dass Teilnehmende die Quittung ohne Verarbeitung passieren. Der Analysencode wurde vor der Datensammlung eingeforen und ist mit dem Replikationspaket archiviert.
Pilot (Soft Launch): Kriterien und Ergebnisse.
Ein Pilot mit n = 20 (US), durchgeführt mit dem endgültigen Instrument mit vorregistrierten Bestehungskriterien, die im Voraus festgelegt wurden, wurde am 6. August 2026 abgeschlossen. Tabelle 13 berichtet jedes Kriterium anhand seines Ergebnisses.
Tabelle 13. Pilot-Annahmekriteria (vorregistriert) und Ergebnisse (n = 20, US)
| Kriterium (ex ante festgelegt) | Ergebnis | Urteil |
| Manipulation bemerkt: > 80% korrekt bei Einigkeitsprüfung (Bedingungen 2–3) | 81,3% (13/16) | Bestanden |
| Manipulation bemerkt: > 80% korrekt bei Quittungsprüfung (Bedingung 3) | 88,9% (8/9) | Bestanden |
| Cronbachs α > ,70, Willingness to Delegate (4 Elemente) | ,854 | Bestanden (erfüllt auch das Ziel von ,85) |
| Cronbachs α > ,70, wahrgenommenes Risiko (4 Elemente) | ,881 | Bestanden |
| Cronbachs α > ,70, Prozesskontrolle (4 Elemente) | ,965 | Bestanden |
| Cronbachs α > ,70, Neutralität (4 Elemente) | ,851 | Bestanden |
| Mediane Bearbeitungszeit innerhalb von 10–15 Minuten | 9,60 Minuten | Fehler, um 24 Sekunden, in die schnelle Richtung |
Ein Kriterium war nicht erfüllt. Der Median lag 24 Sekunden unter dem vorregistrierten Fenster, ein Fenster, das gegen Überlänge, nicht gegen Ineffizienz aufgebaut wurde. Die schnelle Flanke zeigt keine Anhaltspunkte für nachlässige Beantwortung: Kein Teilnehmer unterschritt die 3-Minuten-Ausschlussschwelle; der eine Teilnehmer unter fünf Minuten bestand jeden Aufmerksamkeits-, Manipulations- und Verständnistest; die Aufmerksamkeitstestquoten betrugen 95–100 %; es gab null fehlende Zellen bei Schlüsselvariablen, null doppelte IDs oder IPs und null Straight-Liner; und die Abschlusszeiten der Rekrutierungsplattform bestätigen unabhängig den Umfrage-Timer (Median 9,74 Minuten). Das Instrument ist im Feld kürzer als budgetiert. Die Bedingungsbalance (4/7/9 über Bedingungen 1/2/3) ist mit 1:1:1-Randomisierung bei n = 20 kompatibel (χ²(2) = 1,90, p = .387). Unter den vorregistrierten Analyse-Ausschlüssen werden 6 von 20 Pilot-Teilnehmern von der bestätigenden Analyse ausgeschlossen (fünf aus Gründen der Manipulationskontrolle, einer wegen zweifach fehlgeschlagenes Verständnis), was 14 gültige Personen hinterlässt. Nach der Soft-Launch-Regel tritt die Pilot-Kohorte in die gepoolte Stichprobe ein, mit der hier und in der Registrierung selbst offengelegten Timing-Abweichung, die am 14. August 2026 um 03:09 UTC an die OSF eingereicht wurde, vor der Hauptwellen-Erfassung, und die besagt, dass der Soft-Launch-Pilot in die bestätigende Stichprobe mit der angegebenen Timing-Abweichung einbezogen wird; die Hauptwellen-Kohorte als primäre bestätigende Schätzung zu behandeln und den gepoolten Zweig als Robustheit ist eine post-Registrierungs-Analyseentscheidung, getroffen, weil Pilot-Deskriptiva vor der Hauptwelle gesehen worden waren, und beide Zweige werden berichtet; die Produktverständnis-Marge (ein Teilnehmer über der 80%-Schwelle) wird zur Überwachung in der Hauptwelle gekennzeichnet. Ein explorativer Deskriptiv, berichtet ohne Schlussfolgerung bei Pilot n: Der Kalibrierungsscore Δ nach Bedingung war +0,33 (Kontrolle, n = 4), +0,52 (Uneinigkeit, n = 7), +0,22 (Uneinigkeit + Beweis, n = 9), also bewegt sich die Uneinigkeitsbedingung in H1s Richtung; der Pilot kann nicht mehr sagen.
6.2 Verhaltenstest: Ergebnisse, explorative Analysen und verbleibende Bilanz
Bestätigende Ergebnisse.
Die Hauptwellen-Erfassung lief am 13.–14. August 2026 (190 Plätze: 85 US + 105 UK zusätzlich zur Soft-Launch-Kohorte), und sie wurde nicht abgeschlossen: Der Umfragehost erlitt während des finalen Rekrutierungsfensters einen technischen Ausfall, und die Erfassung endete bei 158 abgeschlossenen Sitzungen insgesamt (138 in der Hauptwelle und 20 beim Soft Launch) statt des 200-gültig-Ziels. Die Rekrutierung endete mit dem Plattformausfall, unter der vorregistrierten optionalen Stoppungsregel und nicht als Reaktion auf die beobachteten Ergebnisse, obwohl Ergebnisse bereits bis dahin gesehen worden waren; die Folge ist reduzierte Power. Bei den realisierten Zellen steigen die minimal erkennbaren Effekte vom registrierten d ≈ 0,42 (H1) und d ≈ 0,49 (H2) auf ungefähr d ≈ 0,54 und d ≈ 0,64 bei derselben Power, eine Grenze, die das bestätigende Ergebnis nur in eine Richtung moot macht, und eine, die für jeden Null- und explorativen Kontrast unten gilt. Die Kohorten-Anordnung folgt dem Plan von §6.1. Der Pilot verfehlte ein Erfolgskriterium (das Abschlusszeit-Fenster, um 24 Sekunden in die schnelle Richtung), und seine explorativen Deskriptiva waren gesehen worden, bevor die Hauptwelle kam, also ist die primäre bestätigende Kohorte allein die Hauptwelle (N = 119 gültig) und der Zweig, der die identisch untersuchte Soft-Launch-Kohorte zurück einpooled (N = 133), wird als Robustheit berichtet. Jede Zahl unten ist die Ausgabe des Analyse-Codes, der durch SHA-256 vor der Datenerfassung eingefroren wurde. Abweichungen von der Registrierung, an einem Ort gesammelt: (i) der N-Mangel (133 gültig von 200 registriert; Hosting-Ausfall); (ii) des Pilots Abschlusszeitkriterium um 24 Sekunden in die schnelle Richtung verfehlt; (iii) pro-Trial-Anzeigereihenfolge nicht in der ausgegebenen Datei beibehalten; (iv) Bildschirm-Ebenen-Timing nicht erfasst; (v) das Trial-Level-Mixed-Modell auf einer Variationsannäherung laufen (die endgültige Engine des Pakets kann unterschiedlich sein). Nichts anderes wich ab; jeder bestätigende Test lief wie registriert, die primäre Kohorten-Entscheidung oben ist die eine post-Registrierungs-Analyseentscheidung.
Tabelle 14. Stichprobenfluss und Ausschlüsse (Hauptwelle; Soft-Launch-Kohorte in Anmerkung)
| US | UK | Gesamt | |
| Abgeschlossene Sitzungen | 50 | 88 | 138 |
| Ausgeschlossen: Aufmerksamkeit (≥ 2 von 3 Tests) | 0 | 0 | 0 |
| Ausgeschlossen: Geschwindigkeit (< 3 Min) / Straight-Lining | 0 | 0 | 0 |
| Ausgeschlossen: Manipulations- / Verständnistests | 10 | 9 | 19 |
| Ausgeschlossen: Duplikate / unvollständig | 0 | 0 | 0 |
| Gültige N (nach Bedingung 1/2/3) | 40 (16/15/9) | 79 (26/28/25) | 119 (42/43/34) |
Die Soft-Launch-Kohorte fügt 20 abgeschlossene US-Sitzungen hinzu, von denen 14 die gleichen Ausschlüsse überstehen; sie tritt nur in den gepoolten Robustheitszweig ein (N = 133). Jeder Ausschluss in der Hauptwelle stammte aus den Manipulations- und Verständnistest-Regeln — kein Teilnehmer wurde wegen Unaufmerksamkeit, Geschwindigkeit, Straight-Lining, Duplizierung oder Unvollständigkeit ausgeschlossen — und die Manipulationstest-Gating zeigt keine Zwischen-Bedingungsasymmetrie (MC1 χ²(1) = 0,12, p = .73; MC3 χ²(2) = 3,67, p = .16, berechnet auf der Pre-Ausschluss-Stichprobe).
Tabelle 15. H1 (P1): Zuverlässigkeitskalibrierung Δ nach Bedingung (primäre Kohorte, N = 119)
| Kontrolle | Uneinigkeit | Uneinigkeit + Beweis | |
| Δ, Mittelwert (SD) | 0,238 (0,332) | 0,465 (0,274) | 0,422 (0,299) |
| Überverlass: P(akzeptieren | falsch) | 0,603 | 0,434 | 0,510 |
| Unterverlass: 1 − P(akzeptieren | richtig) | 0,159 | 0,101 | 0,069 |
| Bestätigender Kontrast: gepoolte (2,3) vs Kontrolle, OLS mit Land-Kovariate | b = +0,217, 95% CI [+0,104, +0,330], Holm-adjustiert p = .0005 (d = 0,67) |
Tabelle 16. H2 (P2): Bereitschaft zu delegieren, Empfang vs Uneinigkeit allein (primäre Kohorte)
| Uneinigkeit (2) | Uneinigkeit + Evidenz (3) | |
| Delegationsbereitschaft-Kompositum, Mittelwert (SD) | 3.09 (1.61) | 3.45 (1.79) |
| Delegationsskala, Median | 2 | 2 |
| Bestätigender Kontrast: 3 vs 2, OLS mit Länder-Kovariate | b = +0.41, 95% CI [−0.35, +1.18], Holm-adjustiertes p = .29 |
H1 wird in diesem Design für den Kalibrierungskontrast gestützt; die vorregistrierte Mediation durch wahrgenommenes Risiko war null, daher wird P1 wie angegeben durch diesen Test nicht gestützt. Angesichts einer einzigen zuversichtlichen Antwort diskriminierten die Teilnehmer kaum: Sie ließen den Agenten bei 84 % der korrekten Antworten vorgehen, aber auch bei 60 % der falschen (Δ = 0.238, 95% CI [0.14, 0.34]; Behandlungsbedingungen 0.465 [0.38, 0.55] und 0.422 [0.32, 0.52]). Die Uneinigkeitsanzeige verdoppelte die Kalibrierung fast (gepooltes Δ = 0.446; b = +0.217, p = .0002, Holm-adjustiertes p = .0005; Welch d = 0.67), und zwar auf beiden Seiten gleichzeitig: Überabhängigkeit sank (60 % → 43 % und 51 %), während Unterabhängigkeit ebenfalls sank (16 % → 10 % und 7 %) (Abbildung 20). Dieser gepoolte Durchschnitt wird von einem einzelnen Item getragen und sollte eher als Existenzbeweis als als robuster Mittelwert gelesen werden: Bei dem einen hochsicheren Abweichler-Trial, den Kontrollprobanden zu 74 % akzeptierten, reduzierte die Anzeige die Akzeptanz der falschen Antwort auf 24 %, und ohne diesen Trial ist der bestätigende Kontrast nicht mehr signifikant (d = 0.09, p = .54), während das Entfernen jedes anderen einzelnen Items ihn intakt lässt (d = 0.47–0.89). Die explorative Zerlegung unten (Tabellen 17–18) lokalisiert den Effekt Item für Item. Seine Konzentration ist die gleiche Headroom-Abhängigkeit, die dort auf Länderebene berichtet wird: Die Anzeige schließt nur dort eine Kalibrierungslücke, wo eine offen ist, und eines von sechs Items öffnete sie weit.
Abbildung 20. Was die Uneinigkeitsanzeige mit der Abhängigkeit tut (primäre Kohorte)
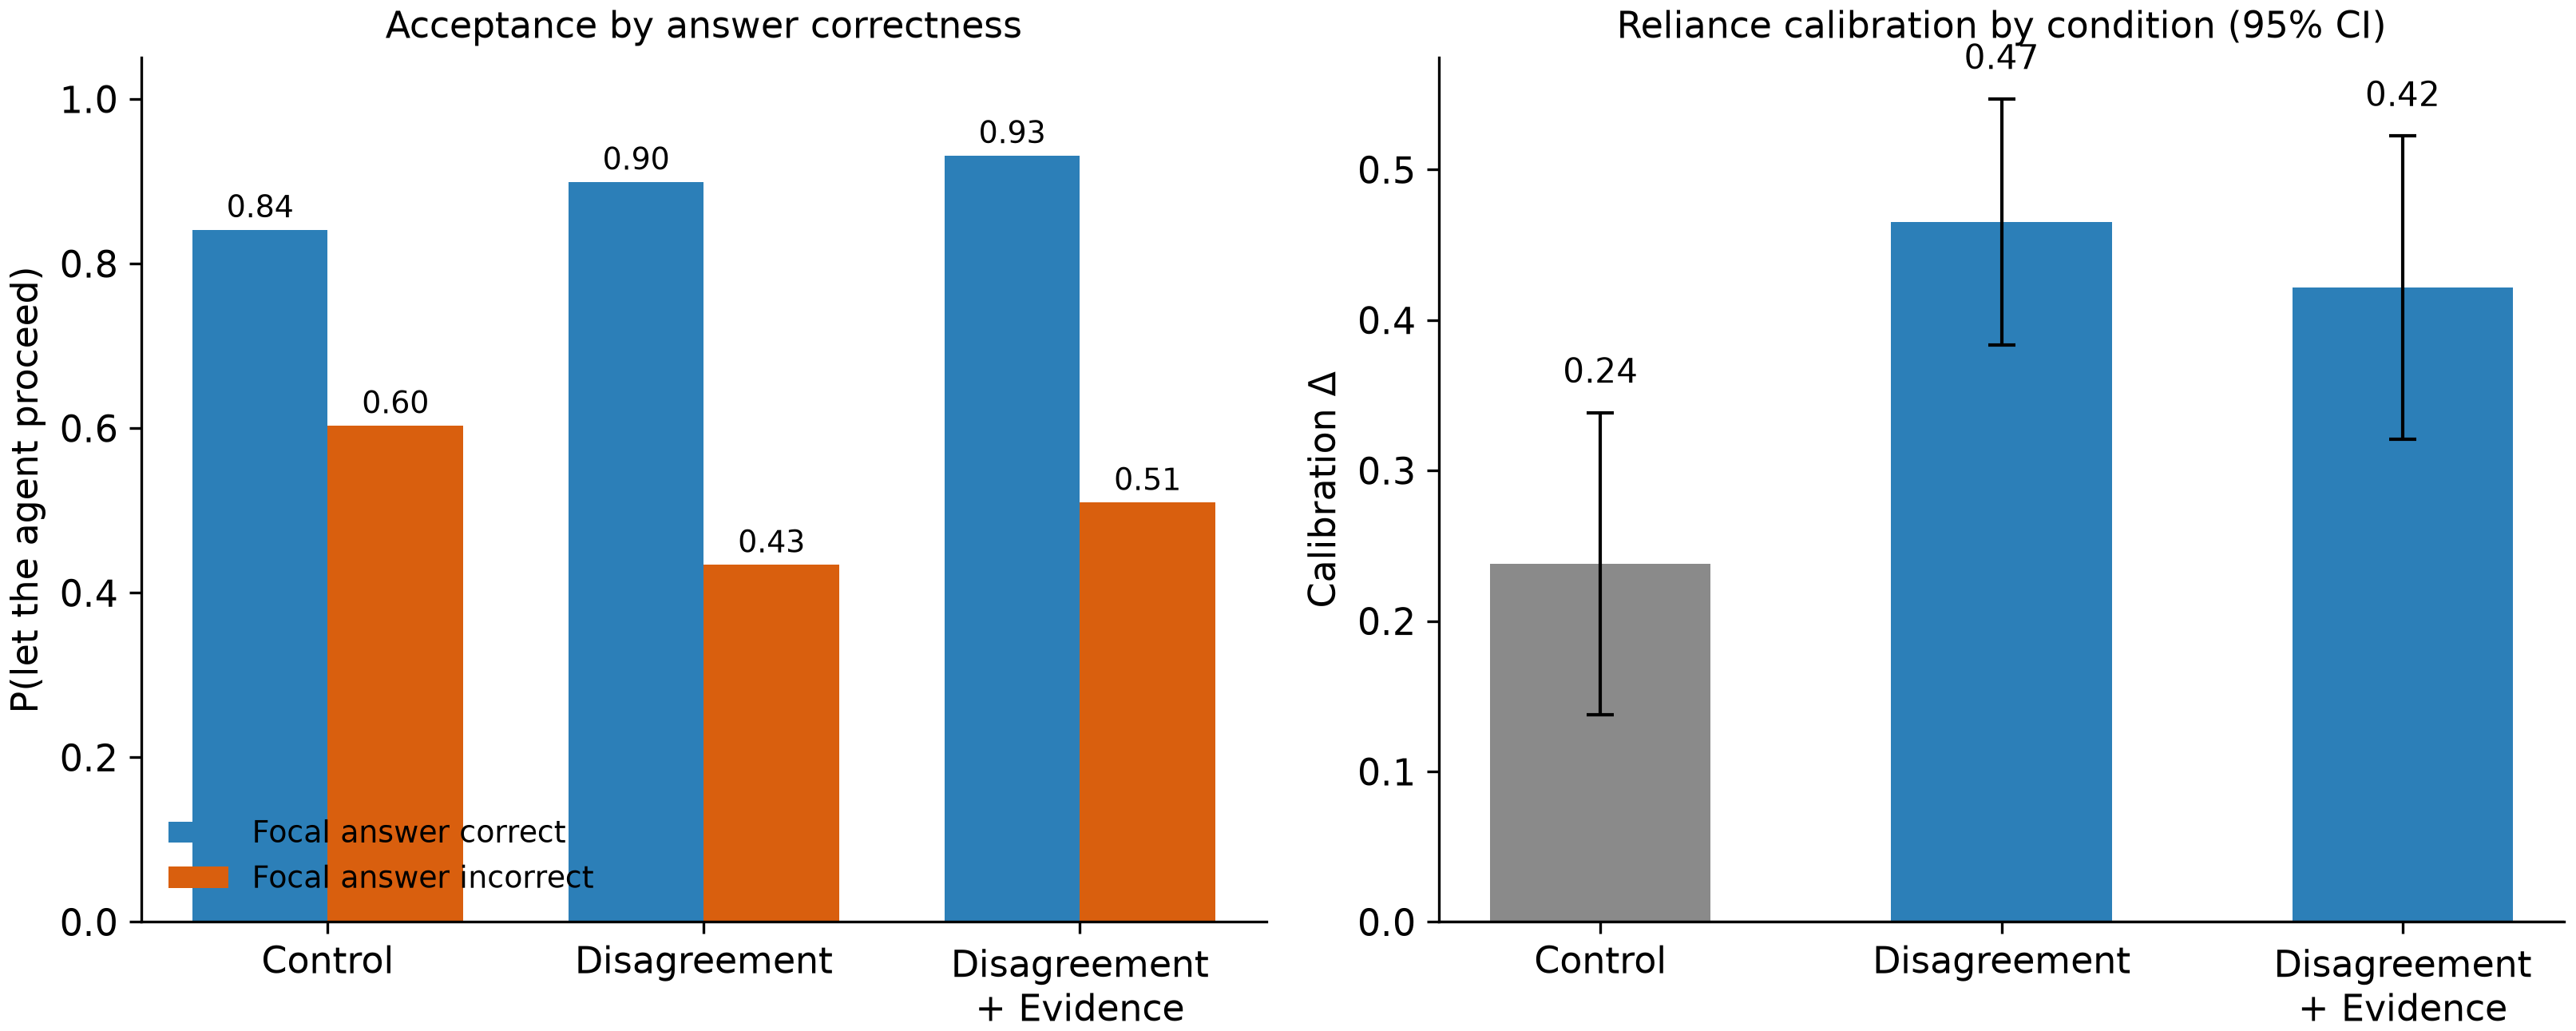
Links: Akzeptanzraten nach Bedingung, aufgeteilt danach, ob die fokale Antwort korrekt war (Kalibrierung = die Lücke zwischen den beiden Balkenpaaren). Rechts: der Pro-Teilnehmer-Kalibrierungswert Δ nach Bedingung mit 95% CIs; der bestätigende Kontrast fasst die zwei Uneinigkeitsbedingungen gegen Kontrolle zusammen.
Die vorregistrierte Zweiseitenrahmen existierte, weil die Literatur zur zweiten Stellungnahme Interventionen dokumentiert, die reduzierte Überabhängigkeit um den Preis erhöhter Unterabhängigkeit erkaufen; diese zahlte diesen Preis nicht. Das Signal machte die Teilnehmer diskriminierender, nicht skeptischer, und eine Signal-Erkennungs-Zerlegung der aggregierten Raten quantifiziert das: Sensitivität d′ stieg von 0.74 unter Kontrolle auf 1.44 und 1.46 unter den Behandlungsbedingungen (berechnet aus ungerundeten Raten), während das Reaktionskriterium kaum verschob (−0.63 vs −0.56 und −0.76). Das Trial-Level-Mixed-Effects-Modell erholt die gleiche Struktur mit großen positiven Korrektheit × Bedingung-Interaktionen für beide Behandlungsbedingungen. Jeder registrierte Zweig stimmt zu: der gepoolte Robustheits-Zweig (b = +0.215, p = .0001, d = 0.68) und der Intention-to-Treat-Zweig, der alle abgeschlossenen Hauptwellen-Sitzungen unabhängig von Checkfehlern behält (b = +0.2174 vs +0.2169 Per-Protokoll, p = .0001, n = 138), mit Ausschlüssen, die über Bedingungen ausgewogen sind (8/6/5; χ²(2) = 0.34, p = .85), wobei die Differenz-Ausfallkontrolle §6.1 sich verpflichtet (Manipulationskontroll-Ausschlüsse sind Post-Treatment-Konditionierung, nach Montgomery, Nyhan, & Torres, 2018, daher das gleichberechtigte Stehen des unkonditionierten Zweigs). Ein Design-Confounder qualifiziert die Lesart. Die Uneinigkeitsbedingungen unterscheiden sich von Kontrolle nicht nur darin, was das Signal sagt, sondern auch darin, wie viel angezeigt wird: drei Positionen und Zuversichtlichkeiten statt einer, so dass der Kalibrierungsgewinn grundsätzlich eher Informationsmenge als den Inhalt des Einigkeitssignals widerspiegeln könnte. Zwei Beobachtungen sprechen gegen die Volumen-Lesart, ohne sie zu entscheiden: Der Effekt verfolgt die Richtung des angezeigten Signalitems Item für Item, da bei falschen fokalen Items, bei denen die Anzeige Uneinigkeit zeigte, die Akzeptanz sank, während bei dem einen Item, bei dem die Anzeige einstimmige zuversichtliche Übereinstimmung zeigte, die Akzeptanz der falschen Antwort stieg; und die Trial-Level-Interaktion erfolgt mit Antwort-Korrektheit, die Volumen allein nicht vorhersagt. Der saubere diskriminierende Arm, mehrere Systeme, die auf jedem Trial auf jedes Item einigen, bei konstanter Informationsmenge, ist für die nächste Welle spezifiziert.
H2 wird nicht unterstützt. Bei Teilnehmenden, denen bereits die Disagreement-Anzeige gezeigt wurde, hatte die Quittung keine erkennbare Auswirkung auf das Delegations-Komposit bei realisierter Leistung (3,45 vs. 3,09; b = +0,41, p = ,29; gebündelte Branch b = +0,34, p = ,33; zusammengesetzte Zuverlässigkeit: Hauptwelle Cronbachs α = ,89). Drei vorab registrierte Sekundärergebnisse prägen, wie die Nullhypothese gelesen werden sollte. Die Quittung wurde empfangen: Die mediane Sitzungszeit in der Quittungsbedingung war etwa eineinhalb Minuten länger als in der Disagreement-Bedingung (11,0 vs. 9,4 Minuten; das Screen-Level-Timing wurde in dem exportierten Datensatz nicht erfasst, daher steht die Gesamtdauer als Proxy für die registrierte Zeit-auf-Stimulus-Variable). Die zusätzliche Zeit belegt nicht, dass Teilnehmende die Quittung nutzten. Die implementierte Quittung war eine statische Karte, und ihre „vollständigen Datensatz anzeigen"-Affordance war innerhalb der Umfrage nicht aktiv, sodass die Manipulation die Präsenz der Quittung testete, nicht ihre Nutzung. Eine interaktive Quittung mit Drilldown-Funktion ist die stärkere Manipulation, die das nächste Design einschließt. Dies ist eine Nullhypothese für eine statische Quittungsanzeige, nicht für Datensätze, Überprüfbarkeit oder P2 wie formuliert. Die Quittung verschob auch ihren vorab registrierten Mediator. Die wahrgenommene Prozesskontrolle stieg in der Quittungsbedingung an (a = +0,60; Skalenzuverlässigkeiten, Hauptwelle: Prozesskontrolle α = ,93, Risiko α = ,83, Neutralität α = ,90), Prozesskontrolle sagt Delegation stark vorher (b = +0,60), und der Bootstrap-indirekte Pfad ist positiv und schließt Null aus (indirekt = +0,35, 95% KI [+0,02, +0,78], 5.000 Resamples), während der direkte Pfad nahe Null ist. Dies ist explorative Mediations-Evidenz: Der Mediator wurde nach der Behandlung im gleichen Instrument gemessen, daher bleiben Common-Method-Varianz und umgekehrte Interpretation möglich. Sensitivitätsgrenzen schränken ein, was diese Nullhypothese klären kann. Die realisierten Zellen erkennen d ≈ 0,49 bei einer Macht von ,80 nur beim registrierten N, sodass ein Quittungseffekt der Größe, die der Mediationspfad impliziert, genau die Größe ist, die diese Stichprobe nicht auflösen kann. Das Ergebnis ist nicht schlüssig zu kleinen und mittleren Effekten und aussagekräftig nur gegen größere. Formal bindet Äquivalenztestung den Effekt nur grob (TOST stellt |d| < 0,64 bei α = ,05 fest, nicht |d| < 0,5), und ein JZS-Bayes-Faktor ergibt BF₀₁ ≈ 2,9 (gebündelte Branch 3,1), anekdotische Evidenz für die Nullhypothese nach Standardbändern (an oder gerade über der Grenze zwischen anekdotisch/moderat von 3); er zeigt weder Abwesenheit noch unterstützt er Präsenz. Der Messbschnitt sagte so viel voraus: Überprüfbarkeit ist eine On-Demand-Eigenschaft, und ihr Wert sollte in dem Moment der Auseinandersetzung, des Anspruchs oder der Prüfung erscheinen, sodass eine statische Quittung, die während eines hypothetischen Kaufs einmal gelesen wird, möglicherweise der falsche Moment zur Beobachtung ist. Die registrierte Schlussfolgerung: Der First-Exposure-Test von P2 konnte Delegation nicht verschieben, und die betreiberseittigen Kosten der Quittung (Abschnitt 5) beruhen nicht auf diesem verbraucherseitigen Ergebnis. Zwei Lesarten bleiben: Entweder trägt die Evidenzkomponente in dem Entscheidungsmoment weniger bei, als der Rahmen behauptet, oder diese Operationalisierung ist der falsche Test dafür. Die Dispute-Time-Erklärung ist eine Post-hoc-Hypothese, geplant als das Folgeprojekt, das am Ende dieses Abschnitts benannt ist, nicht die Auflösung der Nullhypothese. Eine dritte Lesart kommt aus der Aversions-Literatur. Eine detaillierte Quittung ist eine Salienzmanipulation, eine Exposition von Mechanik, die die Verbraucherin daran erinnert, wie viel in genau dem Moment der Delegation schiefgehen kann, das Transparenz-Paradoxon, in dem prozedurales Detail das Vertrauen eher senkt als aufbaut (Kizilcec, 2016; Dietvorst, Simmons, & Massey, 2015). Diese konkurrierenden Lesarten, eine schwächer beanspruchte Komponente, ein falscher-Moment-Test und Salienzverschärfung machen unterschiedliche Vorhersagen und sind durch Design voneinander trennbar.
Der zertifizierte-Konsens-Fehler-Modus reproduziert sich in menschlichem Verhalten. Ein incentivierter Durchgang trug nach Design einen echten Konsensfehler, wobei alle drei Systeme selbstsicher auf die gleiche falsche Antwort konvergierten und damit die 0,5–2,2%ige Open-Form-Konsensfehlerrate widerspiegelten, die die Mechanismus-Studie misst. In diesem Durchgang, einem einzelnen Item und daher einer Beobachtung statt einer Schätzung, schützte die Disagreement-Anzeige niemanden und erhöhte in beiden Ländern direktional die Akzeptanz der falschen Antwort (um 4 und 14 Prozentpunkte relativ zur Kontrolle): Teilnehmende lasen rationale einstimmige unabhängige Übereinstimmung als Zertifizierung. Daher transferiert sich die eine systematische Ausfallmode der Architektur zu ihren Nutzern mit hoher Treue. Abschnitt 3 gab die Design-Warnung, dass Konsens Fehler genau dort zertifiziert, wo die Vielfalt des Gremiums fehlschlägt, und die Probe zeigt den gleichen Fehler im Verhalten.
Explorativ: wo der Kalibrierungsvorteil landet.
Alles Folgende ist explorativ und hypothesengenerierend. Die Länderzellen sind klein, und jeder Within-Country-p-Wert unten sollte als deskriptiv gelesen werden. Der Kalibrierungseffekt konzentrierte sich fast vollständig in der UK-Stichprobe und war in der US-Stichprobe abwesend:
Tabelle 17. Kalibrierungs-Δ nach Land und Bedingung (explorativ)
| Kontrolle Δ | Disagreement (gebündelt 2, 3) Δ | Within-Country-Effektgröße | |
| UK (n = 79) | +0,103 (n = 26) | +0,447 (n = 53) | d = +1,19 |
| US (n = 40 primär / 54 gebündelt) | +0,458 / +0,433 | +0,444 / +0,471 | d = −0,05 / +0,13 |
| Land × Bedingung-Interaktion | b = −0,36, p = ,002 (primär); b = −0,31, p = ,004 (gebündelt) |
Die Zerlegung ist aussagekräftiger als die Interaktion. US-Kontrollprobanden diskriminierten bereits ohne architektonisches Signal deutlich, akzeptierten 92% der korrekten und nur 48% der falschen Antworten, während UK-Kontrollprobanden kaum diskriminierten (78% vs 68%). Unter der Anzeige von Uneinigkeit wurden die beiden Länder nahezu ununterscheidbar, Punkt für Punkt (maximale Zelldifferenz 0,07 über alle sechs Versuche). Die Intervention konvergierte beide Stichproben zum gleichen Kalibrierungsendpunkt (Δ ≈ +0,45) und egalisierte einen Ausgangswertunterschied, den sie nicht verursacht hatte (Abbildung 21). Teil dieses Musters ist mechanisch. Δ ist begrenzt, daher schrumpft der verfügbare Spielraum mit steigender Ausgangskalibrierung, und „der Nutzen konzentriert sich dort, wo die Ausgangskalibrierung schwächstens ist" ist teilweise eine Eigenschaft des Messinstruments. Allein die Obergrenze erzwingt jedoch weder identische Endpunkte noch die Punkt-für-Punkt-Profilübereinstimmung. Die am meisten zu rechtfertigende Interpretation ist, dass die sechs Items einfach genug waren, damit ein Panel ohne Hilfe diskriminieren konnte, sodass die Anzeige eine Kalibrierungslücke schließt, wo eine besteht. Diese Interpretation handelt von Spielraum, nicht von Nationen, und gleichermaßen von Stimuli: Das Item-Set selbst war kulturell verzerrt (zwei Dissens-Items trugen US-lokale Inhalte), daher ist das Konvergenzprofil eine Eigenschaft dieser sechs Items genauso wie dieser zwei Panels.
Abbildung 21. Konvergenz, keine einheitliche Reaktion (explorativ)
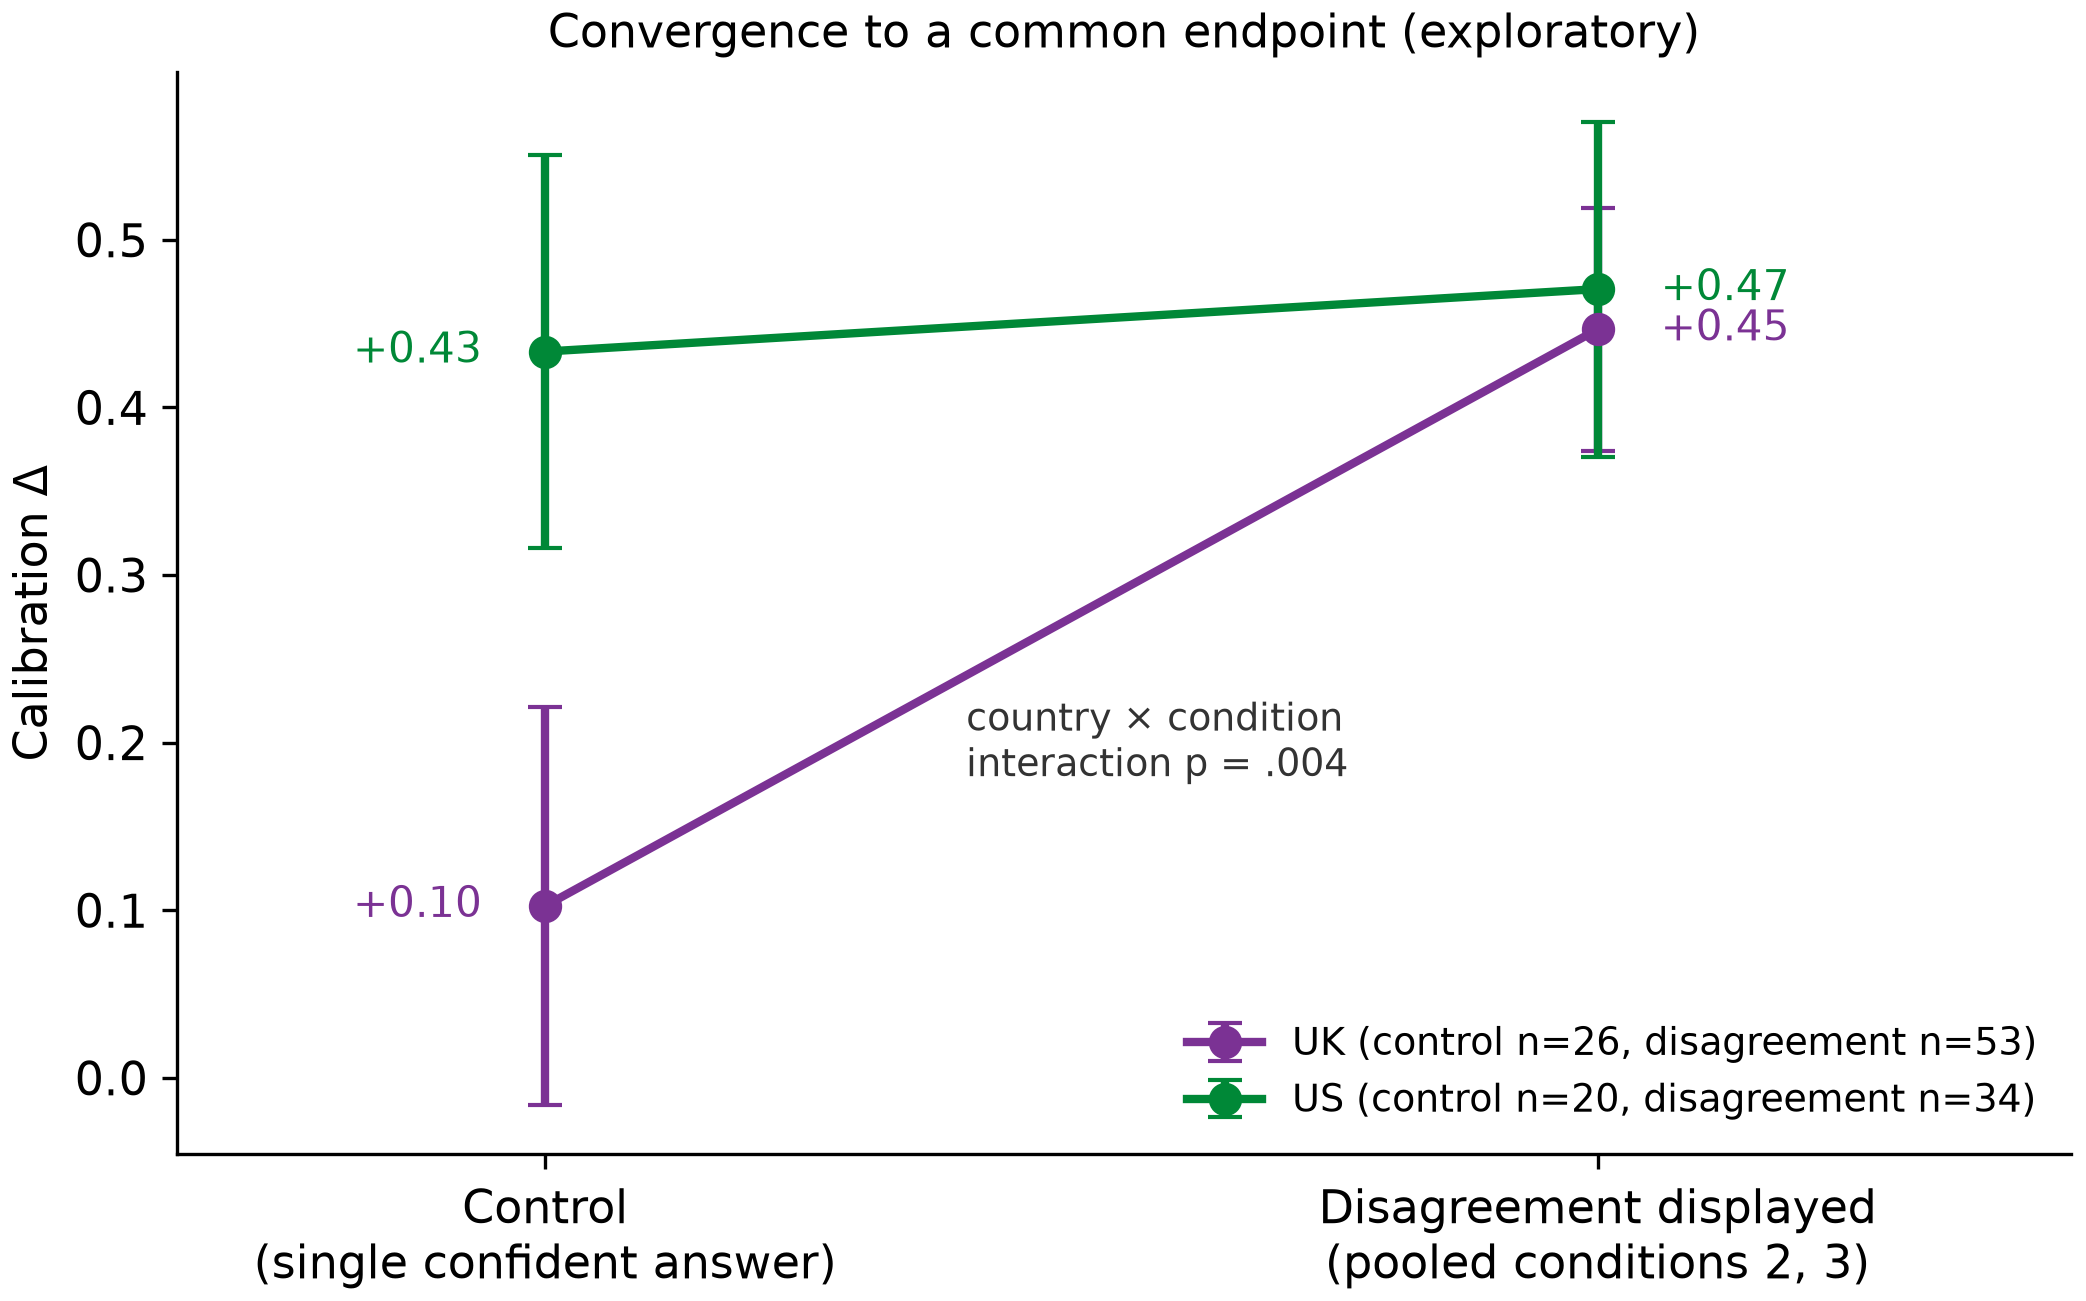
Kalibrierung Δ nach Land und Bedingung: die US-Kontrollgruppe diskriminiert bereits (Δ ≈ +0,45); die UK-Kontrollgruppe kaum (Δ ≈ +0,10); unter angezeigter Uneinigkeit landen beide Länder auf dem gleichen Endpunkt (Δ ≈ +0,45). Der Nutzen konzentriert sich genau dort, wo die Ausgangskalibrierung am schwächstens ist.
Der US-Vorteil in Control konzentriert sich derweil auf die beiden Dissens-Items mit möglicherweise US-lokalen Inhalten. Eines ist eine Museum-of-Bad-Art-Frage, bei der die falsche Antwort „die Mona Lisa" für jeden, der die Prämisse des Museums kennt, absurd ist (US-Akzeptanz 5% vs UK 27%). Die Konzentration auf diese beiden Items weist auf Item-Niveau-Vertrautheit hin und nicht auf nationale Mentalität.
Tabelle 18. Akzeptanz falscher fokaler Antworten nach Item und Zelle (explorativ; gepoolte Kohorte)
| Zelle | Dissens falsch, Konf 95 („Mona Lisa" Item) | Dissens falsch, Konf 98 (ICM-City Item) | Konsens falsch, Konf 99 |
| UK Control (n = 26) | 0,27 | 0,85 | 0,92 |
| US Control (n = 20) | 0,05 | 0,60 | 0,80 |
| UK Uneinigkeit (n = 53) | 0,21 | 0,25 | 0,96 |
| US Uneinigkeit (n = 34) | 0,18 | 0,24 | 0,94 |
Der Schutzeffekt der Intervention sitzt fast vollständig auf dem hochkonfidenten Dissens-Item (UK −0,60, US −0,36); beim Konsens-Fehler-Item erhöht die Anzeige die Akzeptanz in beiden Ländern leicht – einstimmige Übereinkunft gelesen als Zertifizierung, das Verhaltensbild des zertifizierten Konsensfehlers der Mechanismus-Studie. Weil der Schutzeffekt auf diesem einen Item sitzt, überlebt der gepoolte Bestätigungskontrast dessen Entfernung nicht (d = 0,09, p = 0,54), überlebt aber die Entfernung jedes anderen einzelnen Items (d = 0,47–0,89) – die quantitative Form des Effekts wird von einem Item getragen.
Tabelle 19. Einstellungsskalen nach Land (explorativ; gepoolte Kohorte): Die Lücke ist verhaltensbezogen, nicht einstellungsbezogen
| Skala (1–7 falls nicht anders angegeben) | UK Mittelwert | US Mittelwert | Richtung |
| Vertrauen in KI vor Exposition | 4,68 | 4,70 | identisch |
| Delegationsbereitschaft (Composite) | 2,94 | 3,43 | US höher (p = 0,08) |
| Delegations-Leiter (0–4) | 1,71 | 1,98 | US höher (p = 0,08) |
| Wahrgenommenes Risiko | 5,54 | 5,13 | US niedriger (p = 0,09) |
| Wahrgenommene Prozesskontrolle | 4,17 | 4,56 | US höher (p = 0,14) |
| Wahrgenommene Neutralität | 4,75 | 4,62 | n.s. |
Jeder einstellungsbezogene Unterschied, der besteht, weist die „falsche" Richtung für ein US-Skeptizismus-Szenario: US-Teilnehmer sind delegationsbereiter und risikoperzeptions-niedriger, diskriminieren aber verhaltensbedingt besser in Control. Gemessene Einstellungen erklären nichts davon: Die Anpassung der Ausgangswertlandlücke für Demographie und alle fünf Skalen schränkt sie um maximal 15% ein, und Bootstrap-indirekte Pfade durch die Skalen sind null.
Länderübergreifende Umfragen stimmen mit dem Einstellungsnull überein. Die angegebene Bereitschaft, KI zu vertrauen, ist in den USA und UK im Grunde identisch (41% vs 42%: Gillespie et al., 2025), und beide Länder sitzen auf dem gleichen hochgradigen „Anglosphere" Cluster bei KI-Nervosität (Ipsos, 2025). Die einzige Asymmetrie auf Bevölkerungsebene, die die beobachtete Richtung anzeigt, ist KI-Alphabetisierung. UK-Respondenten berichten über geringere Fähigkeiten und Vertrauen in der Verwendung und Bewertung von KI (36% vs 42% bei Fähigkeiten: Gillespie et al., 2025), und US-Erwachsene gehören zu den am meisten KI-exponierten Öffentlichkeiten (Pew Research Center, 2025). Zwei Konten überleben daher die explorative Aufzeichnung. Bei einem Vertrautheitskonto gewinnt die Population, die weniger ausgerüstet ist, KI-Ratschläge zu bewerten, am meisten aus einer Architektur, die sie strukturell bewertet. Das andere Konto ist die Panel-Zusammensetzung: Der UK-Arm der Rekrutierungsplattform ist sein älterer und erfahrenerer Pool, und Online-Panels sind unvollkommene Instrumente für länderübergreifende Schlussfolgerung (Gvirtz & Sabherwal, 2024), sodass das „Land"-Etikett teilweise für Panel-Besitzdauer proxy sein kann. Das Design kann die beiden nicht trennen und muss es nicht, weil auf beiden Konten die Substantiv-Feststellung das Kompensationsprofil selbst ist. Angesichts der Zellgrößen ist die sicherere Voreinstellung, das Muster als Eigenschaft dieser beiden Panels zu lesen, bis eine betriebene Replikation spricht; keine Theorieforderung in diesem Papier ruht darauf.
Dieses Profil ist nicht das Standardergebnis von Interventionen gegen Überreliance. Kognitive Erzwingungsfunktionen reduzieren Überreliance, konzentrieren ihren Nutzen aber auf Nutzer mit bereits hohem Need for Cognition, sodass die analytisch veranlagten analytischer werden (Buçinca et al., 2021), und die Forschung zur adaptiven Kalibrierung des Vertrauens behandelt die Anvisierung der Fehlkalibrierten als ein Designziel, das aktive Überwachung erfordert (Okamura & Yamada, 2020). Hier kam die Anvisierung kostenlos. Die angezeigte Uneinigkeit ist selbstauslösend: Sie tritt genau dann auf, wenn sich das Gremium uneinig ist, und verlangt dem Nutzer im Voraus nichts ab. Ihr Nutzen kam der Gruppe zugute, deren Baseline-Diskriminierung am schlechtesten war, und sie ließ die Genauigkeit der bereits kalibrierten Gruppe intakt, anstatt sie zu verschlechtern. Für einen Verbraucherschutzmechanismus ist dies das Verteilungsprofil, das man ex ante spezifizieren würde, mit Hilfe konzentriert dort, wo sich die Fehlkalibrierung konzentriert, und ohne Belastung für diejenigen, die ihn nicht benötigen.
Vorregistrierte Sekundäranalysen: das restliche Ledger.
Die restlichen vorregistrierten Sekundäranalysen befinden sich hier an einem Ort (primäre Kohorte; pooled-branch-Werte im Replikationspaket). Die Mediation des Uneinigkeitseffekts durch wahrgenommenes Risiko, der P1-Pfad, den das Design antizipierte, ist null. Die Anzeige hat, wenn überhaupt, die wahrgenommene Risiko leicht reduziert (a = −0,40), und der Bootstrap-Indirektpfad ist von Null nicht zu unterscheiden (+0,006, 95 % KI [−0,013, +0,029]). Der Kalibrierungseffekt ist direkt, konsistent damit, dass Teilnehmer das Uneinigkeitsmuster als Information über die Antwort nutzen, anstatt als allgemeinen Alarm über die Transaktion. Wahrgenommene Orchestrator-Neutralität, gemessen statt manipuliert, ist ein starker Korrelat der Delegationswilligkeit unter Kontrolle der Bedingung und des Landes (b = +0,47, p < .0001), die korrelative Spur, die P3 vorhersagt, wartet auf ihre Manipulation. Die Delegationsleiter zeigt die gleiche Reihenfolge wie das Kompositum, erreicht aber keine Signifikanz (bestelltes Logit, Empfang vs. Uneinigkeit: b = +0,70, p = .11; Mediane sind unentschieden bei 2 von 4). Der nicht registrierte Kontrast Bedingung 3-versus-1 zur Delegation ist richtungsmäßig positiv und nicht signifikant (b = +0,52, p = .15). Eine Abweichung: Der exportierte Export erfasste keine Bildschirmebenen-Zeitmessung, daher wird die registrierte Eingangsleseproxy für die Zeit auf Stimulus durch die Gesamtsitzungsdauer approximiert (unter H2 oben berichtet). Die beabsichtigte Bildschirmebenen-Kontrolle sollte in das Instrument der nächsten Welle eingebaut werden.
Diese Studie testet nur P1 und P2. P3 wird gemessen, nicht manipuliert, und P4 sowie die vollständige gemeinsame Variation Conjoint aus Abschnitt 5 bleiben die spezifizierte nächste Studie. Die verhaltensbasierte Validierung der Triade ist daher unvollständig: eine Komponente unterstützt, eine nicht schlüssig, eine gemessen aber nicht manipuliert. Eine longitudinale Frage steht über dem Programm. Die persistente Anzeige von Uneinigkeit kann die langfristige Adoption stabilisieren, als Dämpfer auf die Oszillation zwischen Algorithmus-Wertschätzung und One-Strike-Aversion, oder sie kann diese Adoption durch kontinuierliche Exposition gegenüber maschineller Fehlbarkeit erschöpfen. Ein Single-Session-Design kann das nicht sagen. Zwei durch die obigen Ergebnisse motivierte Studien werden dem Programm hinzugefügt. Eine ist ein Dispute-Time-Design, das die Quittung zum Zeitpunkt ihres vorhergesagten Wertes erneut testet, mit einer Falsch-Quittungs-Kontrolle, eine Quittung, deren Hash sich nicht neu berechnet, um Verifizierbarkeit von ihrer Darstellung zu trennen. Die andere ist eine Replikation, die für die oben berichtete Ländermoderation ausreichend dimensioniert ist (Tabelle 17).
7. Fazit
Wenn die KI folgenreiche Verbraucherbeschaffungsentscheidungen vermittelt und diese zunehmend selbst trifft, habe ich argumentiert, dass Vertrauen im Stack aufwärts wandern muss: vom Modell zur Architektur zum Datensatz. Vielfalt, Evidenz und Neutralität zusammen erzeugen einen Dienst, dessen Vertrauenswürdigkeit überprüft werden kann, anstatt sie auf Glauben anzunehmen. Was gebaut wird, ist keine bessere Überzeugung, sondern Vertrauensinfrastruktur für die Wirtschaft, die Verantwortungskette, die Delegation skalierbar macht. Die Flagship-Welle misst dies oben am Markt. Über die zehn vollständigen Flagship-Arme der Welle gepoolte Modelle, die als das Beste jedes Labors verkauft werden, lagen bei fast der Hälfte ihrer gelösten Antworten, die bei angegeben Konfidenz ≥ 80 angeboten wurden, sicher daneben (46,6 %, und die Zahl bewegt sich kaum, wenn ungelöste Elemente als Fehler erneut bewertet werden). Der teilweise Meta-Arm wird separat berichtet, und seine Aufnahme lässt die Zahl praktisch unverändert. Ein festes Drei-Modell-Uneinigkeits-Gate oben, ohne Training und ohne Tuning, entfernt vier Fünftel dieser Ausfälle mit einer genannten, überprüfbaren Abdeckungskosten. Da das Substrat hier rein faktisch ist, sollte diese Rate als Obergrenze für gemischte Handelsaufgaben gelesen werden. Was die Behauptung für echten Handel lizenzieren würde, ist eine Abruf-grundierte, Tool-nutzende Replikation auf einem eingeschränkten Produktmenü, wo Konsensirrtümer sich anders verhalten als im offenen faktischen Raum. Ein vorregistriertes Experiment (Abschnitt 6) setzte das gleiche architektonische Signal vor Verbrauchern ein und brachte Evidenz zurück, dass sie es als Korrektheitssignal nutzen können: Die Uneinigkeitsanzeige senkte die Akzeptanz einer sicher falschen Empfehlung von 74 % auf 24 % beim qualifizierenden Eintrag. In einer explorativen Ländersplittung konzentriert es sich in der überanfälligen UK-Zelle und beruht auf diesem einzelnen Eintrag (der gepoolte Kontrast überlebt seine Entfernung nicht, d = 0,09). Das ist ein Existenzbeweis unter diesen Reizen, noch nicht a genereller Effekt; ein durch Reize abgeleiteter bestätigender Test ist geplant.
Diese Schicht verdient einen Markennamen für sich selbst, Evidenzinfrastruktur, um auf die Weise verkauft zu werden, wie Cloud-, Identitäts- und Zahlungsinfrastruktur verkauft wird, weil sie die gleiche Art von Frage beantwortet: „Kann dies vertraut werden, und wie würden wir das wissen?" Das ist eine andere Frage als „ist dies intelligent?" Sicherheit und Datenschutz gingen beide diesen Weg: Differenzieror, dann Erwartung, dann Eintrittsvoraussetzung. Architektonisches Vertrauen könnte plausibel denselben Pfad folgen, in einem Tempo, das durch den bereits sichtbaren Regulierungs- und Haftungsdruck gesetzt wird.
Meine These auf der theoretischen Seite ist, dass die Analyseeinheit für Verbrauchervertrauen in KI-Dienste von dem Modell zur Architektur wechseln sollte, weil die vertrauensrelevanten Eigenschaften dort tatsächlich ansässig sind: Unabhängigkeit der Verifizierung, Replizierbarkeit von Entscheidungen, Abwesenheit von Interessenskonflikten. Modelle ändern sich unter jedem Dienst ständig, schneller als jeder Ruf sie verfolgen kann. Die Leistungslücke zwischen geschlossenen und offenen Systemen ist in einem Jahr von 8,04 % auf 1,70 % zusammengebrochen (Stanford HAI, 2025), und die Marktführerschaft im Enterprise-Modellmarkt wechselte in einem einzigen Frühjahr die Hände (Kharazian, 2026). Eine Schicht, die sich so schnell verändert, ist nicht dort, wo Vertrauen verankert werden kann. Was einem Verbraucher dient, ist zunehmend ein Routing über Modelle und Preisstufen, kostengesteuert, unsichtbar und unverprüft, und ein ausgewähltes bestes Modell dient immer weniger. Der Schritt, der verbleibt, und der hier von mir spezifiziert wird, ist der Wechsel von der best-gerouteten Architektur zu einer, deren Verifizierung ein Verbraucher, ein Versicherer oder ein Regulator lange genug stillhalten kann, um sie zu überprüfen. Darunter liegt ein Übergang von KI-Assistenten zu KI-Treuhändern. Treuhänder werden in jeder Domäne, die sie je gehabt hat, nicht durch ihre Talente, sondern durch ihre Pflichten konstituiert: Aufzeichnungen zu führen, sich einer Prüfung zu unterziehen, kein nachteiliges Interesse zu haben. Architektonales Vertrauen baut diese Pflichten in die Maschinerie ein.
Dieselbe Anforderung gilt dafür, wie das System selbst wächst. Ein System, das darum bittet, mit folgenreicher Handlung vertraut zu werden, sollte auf verifiable Weise wachsen, wie es antwortet. Konfigurationsänderungen an einer Orchestrierungsschicht sollten sich durch geprüfte statistische Tore gegen gehaltene Evidenz verpflichten oder zurückrollen, wobei kein automatisierter Prozess eine Sicherheitsregel schwächt, sondern nur eine hinzufügt. Die Forschungsbereitstellung in der Fallstudie implementiert diese Tore.
Die KI-Infrastruktur braucht jetzt eine Verifizierungsschicht (Abbildung 16). Die Industrie hat die Compute-Schicht und die Modellschicht gebaut und baut jetzt die Orchestrierungsschicht. Danach kommt Verifizierung, die Maschinerie, die das Verhalten eines KI-Systems überprüfbar statt glaubwürdig macht. Die Berechtigung für KI-Vertrauen sollte maschinenverprüfbar statt reputationsbasiert werden; Vertrauen selbst bleibt menschlich, und was maschinengeprüft werden kann, sind seine Grundlagen. Falls das richtig ist, wird die nächste unverzichtbare Schicht der KI-Infrastruktur nicht um Intelligenz, sondern um Verifizierbarkeit gebaut.
Abbildung 16. Die Infrastruktur-Leiter
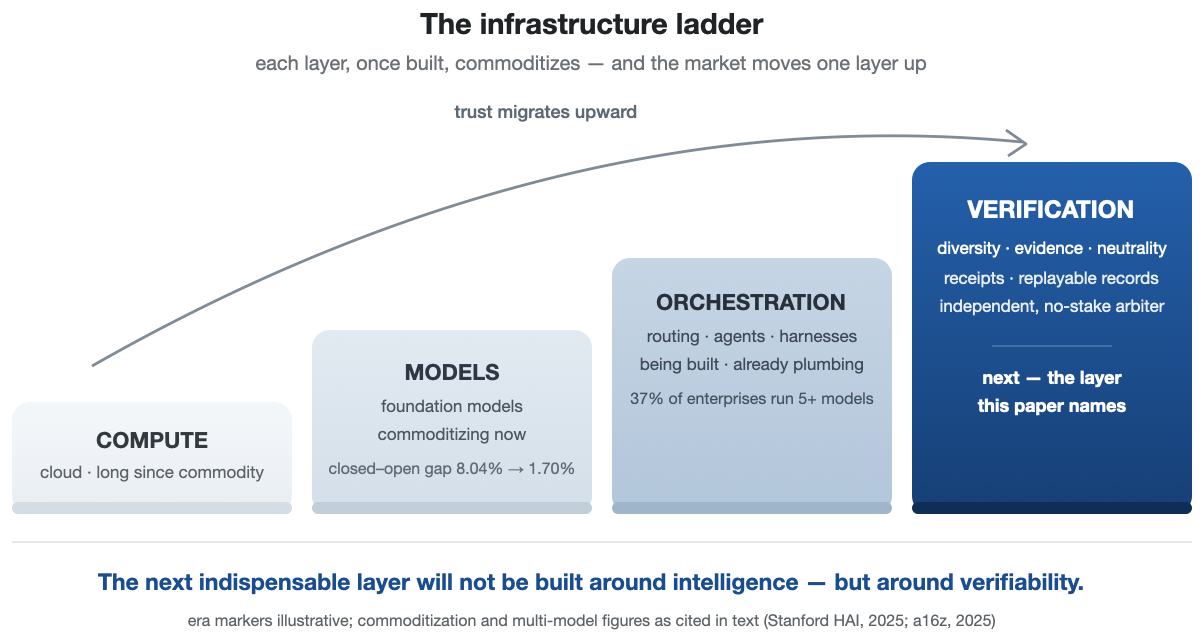
Compute, dann Modelle, dann Orchestrierung, und Verifizierung als die nächste unverzichtbare Schicht.
Anmerkung des Autors und Offenlegung
Die in Abschnitt 4 beschriebene Bereitstellung ist eine Referenzimplementierung, die vom Autor gebaut und betrieben wird; die Methoden, die sie verkörpert, sind offen, und der Autor ist ein benannter Anmelder bei ausstehenden Patentanmeldungen, nicht gewährten Patenten, die KI-Orchestrierung und Multi-Modell-Validierungssysteme der Art abdecken, die dieses Papier untersucht. Sie dient hier als Forschungsinstrument der Studie, und der Autor hat ein Entwicklerinteresse an der Architektur, die sie verkörpert; Abschnitt 4 sollte als ein Existenzbeweis und Design-Zeugnis gelesen werden, nicht als unabhängige Bewertung. Alle Modelle in dieser Studie wurden durch die standardmäßigen kommerziellen APIs der Anbieter unter gewöhnlichen Bedingungen abgerufen. Keine externe Finanzierung unterstützte diese Arbeit.
Tools und Verifizierung. KI-Assistenten wurden als Instrumente unter der Anleitung des Autors eingesetzt; die Ideen, Forschung und Schlussfolgerungen sind die des Autors. Lasttragende faktische Ansprüche wurden gegen Primärquellen geprüft, wo verfügbar, und sind im Text mit ihrem Beweiscatus atribuiert (Presseberichte als Berichte, Behauptungen als Behauptungen, Preprints als Preprints), und ein datiertes Anspruchsverifizierungsprotokoll wird mit den Arbeitsmaterialien des Manuskripts gepflegt. Korrektheit im Experiment wird nie durch ein Panelmodell beurteilt (Bewertung ist objektives String-Matching oder ein lokaler Gradierungsmodell mit offenem Gewicht), die Diskriminierungs- und Kalibrierungszahlen pro Anbieter sind im Haupttext gedruckt (Tabellen 7 und 7a), und jede gemeldete Zahl ist aus dem deterministischen Replikationspaket neu berechenbar (öffentlich verfügbar unter https://osf.io/jtvu9/).
Datenverfügbarkeit und Code
Jede gemeldete Zahl in den Mechanismusexperimenten (Abschnitt 3) ist aus einem deterministischen Replikationspaket neu berechenbar — die rohen Modellreaktionen beider Wellen (einschließlich der Sammlung von sechzehn Modellen mit 24.000 Antworten und den bewerteten Aufzeichnungen der Flaggschiff-Welle), die Sammlungsläufer, der deterministische Gradierungsmodell, die Analyseskripte und die abgeleiteten CSVs (einschließlich der Risiko-Abdeckungskurven und der 26-Punkte-Kosten-Genauigkeits-Grenzlinie, wobei jeder Punkt seine abgerechnete vs. aufgelistete Preisbasis gekennzeichnet ist) — öffentlich verfügbar unter https://osf.io/jtvu9/, eine öffentliche Komponente des Quellprojekts der Vorregistrierung (Ordner `replication-package-v2`; das Archiv des Selbstkalibrierungsprogramms von Abschnitt 3 ist daneben deponiert). Das gefrorene SimpleQA-Teilmuster (behoben durch Seed und SHA-256-Hash) ist bereits öffentlich auf der OSF-Vorregistrierung der Mechanismusstudie (https://osf.io/4y9dv, registriert 23. Juli 2026). Die Vorregistrierung des Verbraucherexperiments ist auf OSF unter Embargo registriert (vor Hauptdatenerfassung gefroren; Registrierung https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f). Der Teilnehmerpool ist geschlossen; das Befragungsinstrument, die Vignette und die Urteilsblockreize, die Quittungsausstellungsdatensätze von Abschnitt 6 und die Verbraucherexperimentdaten mit dem gefrorenen Analysecode werden bei Veröffentlichung in dieselbe OSF-Komponente freigegeben.
Referenzen
Einträge mit arXiv-Markierung sind Preprints; Branchenmitteilungen und Pressemitteilungen von 2026 sind zeitgenössische Berichte statt gefestigter Literatur und werden als solche zitiert.
a16z — Andreessen Horowitz (2025). How 100 enterprise CIOs are building and buying gen AI in 2025. a16z.com/ai-enterprise-2025.
Accenture (2026). Talk to my AI agent: The new rules of brand value. Umfrage von 25.590 Verbrauchern in 16 Ländern, Januar 2026.
ACI Worldwide (2026). Consumer attitudes to AI-driven shopping and payments. YouGov-Umfrage von 2.080 britischen Erwachsenen, durchgeführt 19.–22. Juni 2026. Pressemitteilung.
Ahmad Husairi, M., & Rossi, P. (2024). Delegation of purchasing tasks to AI: The role of perceived choice and decision autonomy. Decision Support Systems, 179, 114166. DOI 10.1016/j.dss.2023.114166.
AIUC (2025). AIUC-1: The agent standard. Artificial Intelligence Underwriting Company.
Alavi, S., & Nozari, S. (2026). When agents shop for you: Role coherence in AI-mediated markets. arXiv:2604.26220.
Allouah, A., Besbes, O., Figueroa, J. D., Kanoria, Y., & Kumar, A. (2026). What is your AI agent buying? Evaluation, biases, model dependence, and emerging implications of agentic e-commerce. Proceedings of the ACM Web Conference 2026, 8697–8700. https://doi.org/10.1145/3774904.3792943
American Express (2026). American Express präsentiert das Agentic Commerce Experiences (ACE) Developer Kit und kündigt branchenweit erstmaligen Schutz für registrierte Agent-Käufe an. Pressemitteilung, 14. April 2026.
Anderson, L. (2006). Analytic autoethnography. Journal of Contemporary Ethnography, 35(4), 373–395.
André, Q., Carmon, Z., Wertenbroch, K., Crum, A., Frank, D., Goldstein, W., Huber, J., van Boven, L., Weber, B., & Yang, H. (2018). Consumer choice and autonomy in the age of artificial intelligence and big data. Customer Needs and Solutions, 5(1–2), 28–37.
Appenzeller, G. (2024). Welcome to LLMflation: LLM inference cost is going down fast. Andreessen Horowitz, November 2024.
Aubakirova, M., Atallah, A., Clark, C., Summerville, J., & Midha, A. (2026). State of AI: Eine empirische Studie mit 100 Billionen Token auf OpenRouter. arXiv:2601.10088 (Bericht veröffentlicht im Dezember 2025).
Bain & Company (2025). Agentic commerce market projection: $300–500 billion U.S. e-commerce by 2030. Dezember 2025.
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775–779.
Balaskas, S. (2026). From recommendations to delegation: A systematic review mapping agentic AI in e-commerce and its consumer effects. Information, 17(3), 222.
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. S. (2021). Does the whole exceed its parts? The effect of AI explanations on complementary team performance. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, 1–16.
Basu, A. (2026). Tool receipts, not zero-knowledge proofs: Practical hallucination detection for AI agents. arXiv:2603.10060.
Board of Governors of the Federal Reserve System & OCC (2011). Aufsichtliche Leitlinien zum Modellrisikomanagement (SR Letter 11-7 / OCC 2011-12).
Buçinca, Z., Malaya, L. B., & Gajos, K. Z. (2021). To trust or to think: Kognitive Zwangsfunktionen können die Überabhängigkeit von KI bei KI-gestützter Entscheidungsfindung verringern. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), 1–21.
Burton, J. W., Stein, M.-K., & Jensen, T. B. (2020). A systematic review of algorithm aversion in augmented decision making. Journal of Behavioral Decision Making, 33(2), 220–239.
California State Legislature (2025). Assembly Bill 316 (artificial intelligence: defenses), Stats. 2025, ch. 672 (adding Cal. Civ. Code § 1714.46), effective 1 January 2026.
Carlson, S. C. (2026). Trust migration in the digital era: Information regimes and the transformation of buyer–seller relationships. Atlantic Marketing Journal, 15(1), Article 6.
Castelo, N., Bos, M. W., & Lehmann, D. R. (2019). Task-dependent algorithm aversion. Journal of Marketing Research, 56(5), 809–825.
Cetinkaya, N. E., & Krämer, N. (2024). Understanding vs. trust: A conjoint analysis. Working paper, OSF Project mw4dq.
Chandra, K., Kleiman-Weiner, M., Ragan-Kelley, J., & Tenenbaum, J. B. (2026). Sycophantic chatbots cause delusional spiraling, even in ideal Bayesians. arXiv:2602.19141.
Chen, C., Sun, Y., Liao, M., & Sundar, S. S. (2026). When KI disagrees: The effect of second opinion on patients' trust in doctors. International Journal of Human-Computer Studies, 213, 103824.
Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026). Sycophantic AI decreases prosocial intentions and promotes dependence. Science, 391(6792), eaec8352. DOI: 10.1126/science.aec8352.
Choi, H. K., Zhu, X., & Li, S. (2026). When identity skews debate: Anonymization for bias-reduced multi-agent reasoning. Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 14284–14311. https://doi.org/10.18653/v1/2026.acl-long.650
Choi, M., Kim, K., Chae, S., & Baek, S. (2025). An empirical study of group conformity in multi-agent systems. Findings of the Association for Computational Linguistics: ACL 2025, 5123–5139. https://doi.org/10.18653/v1/2025.findings-acl.265
Clark, J., & Hadfield, G. K. (2020). Regulatory markets for KI safety. arXiv:2001.00078.
CNBC (2026, March 24). OpenAI überarbeitet das Einkaufserlebnis in ChatGPT nach Schwierigkeiten mit dem Instant-Checkout-Angebot (Berichterstattung über The Information's März-2026-Bericht zum Rückgang des nativen Checkouts).
Daly, C. (2025). Klarna verlangsamt KI-gesteuerte Entlassungen mit Appell an echte Menschen. Bloomberg News, 8. Mai 2025.
de Bellis, E., & Johar, G. V. (2020). Autonomous shopping systems: Identifying and overcoming barriers to consumer adoption. Journal of Retailing, 96(1), 74–87.
Detjen, H. H. J., Densky, L., von Kalckreuth, N., & Kopka, M. (2025). Who is trusted for a second opinion? Comparing collective advice from a medical KI and physicians in biopsy decisions after mammography screening. CHI 2025.
de Visser, E. J., Pak, R., & Shaw, T. H. (2018). From 'automation' to 'autonomy': The importance of trust repair in human–machine interaction. Ergonomics, 61(10), 1409–1427.
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114–126.
DigiCert (2026). KI-Vertrauensarchitektur. Produktmitteilung, April 2026.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Dranove, D., & Jin, G. Z. (2010). Quality disclosure and certification: Theory and practice. Journal of Economic Literature, 48(4), 935–963.
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024). Improving factuality and reasoning in language models through multiagent debate. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 11733–11763.
Endsley, M. R., & Kiris, E. O. (1995). The out-of-the-loop performance problem and level of control in automation. Human Factors, 37(2), 381–394.
Errico, H. (2026). Autonomous action runtime management (AARM): A system specification for securing AI-driven actions at runtime. arXiv:2602.09433.
Europäische Kommission (2026). Leitlinien zur Umsetzung der Transparentverpflichtungen für bestimmte KI-Systeme gemäß Artikel 50 des KI-Gesetzes. Angenommen am 20. Juli 2026.
Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). Erkennung von Halluzinationen in großen Sprachmodellen mittels semantischer Entropie. Nature, 630(8017), 625–630.
Featherman, M. S., & Pavlou, P. A. (2003). Vorhersage der Akzeptanz von E-Services: Eine Perspektive der wahrgenommenen Risikofacetten. International Journal of Human-Computer Studies, 59(4), 451–474.
Frank, D.-A., Folwarczny, M., & Otterbring, T. (2026). Die Akzeptanz von hochautonomen KI-Assistenten durch Verbraucher wird durch wahrgenommene Vorteile in Online-Shopping-Situationen mit Knappheit bestimmt. Psychology & Marketing, 43(3), 538–555. https://doi.org/10.1002/mar.70074
Gartner (2025). Gartner prognostiziert, dass über 40 % der Agentic-KI-Projekte bis Ende 2027 abgebrochen werden. Pressemitteilung, 25. Juni 2025.
Gartner (2026). Verbraucherbefragung zu generativer KI beim Shopping (Pressemitteilung Mai 2026).
Gefen, D., Karahanna, E., & Straub, D. W. (2003). Vertrauen und TAM beim Online-Shopping: Ein integriertes Modell. MIS Quarterly, 27(1), 51–90.
Geifman, Y., & El-Yaniv, R. (2017). Selektive Klassifizierung für tiefe neuronale Netze. Advances in Neural Information Processing Systems 30 (NeurIPS 2017), 4878–4887 (arXiv:1705.08500).
Gillespie, N., Lockey, S., Ward, T., Macdade, A., & Hassed, G. (2025). Vertrauen, Einstellungen und Nutzung von künstlicher Intelligenz: Eine globale Studie 2025. University of Melbourne und KPMG. https://doi.org/10.26188/28822919
Glikson, E., & Woolley, A. W. (2020). Menschliches Vertrauen in künstliche Intelligenz: Überblick über empirische Forschung. Academy of Management Annals, 14(2), 627–660.
Google (2026). Universal Commerce Protocol. Ankündigung bei NRF, 11. Januar 2026; Erweiterung für Warenkorb, Katalog und Identitätsverknüpfung, März 2026.
Google Cloud (2025). Agent Payments Protocol (AP2). Ankündigung, 16. September 2025.
Google DeepMind (2025). SimpleQA Verified. arXiv:2509.07968.
Gorbett, M., & Jana, S. (2026). Modellübergreifende Meinungsverschiedenheit als kennzeichnungsfreies Korrektheitssignal. arXiv:2603.25450.
Gottweis, J., Weng, W.-H., Daryin, A., Tu, T., Sirkovic, P., Myaskovsky, A., Glowaty, G., Weissenberger, F., Orlandi, A., Popovici, D., Palepu, A., Rong, K., Tanno, R., Saab, K., Zhang, F., Blum, J., Carroll, A., Kulkarni, K., Tomašev, N., Zverinski, D., Rendulic, I., Vedadi, E., Hasler, F., Rimanic, L., Boia, M., Budiselic, I., Feinstein, B., Bellaiche, M., Sheffer, T., Freyberg, J., Ratcliff, J., Bertolli, O., Chou, K., Hassidim, A., Gokturk, B., Vahdat, A., Guan, Y., Dhillon, V., Vaishnav, E. D., Lee, B., Costa, T. R. D., Penadés, J. R., Peltz, G., Matias, Y., Manyika, J., Hassabis, D., Xu, Y., Kohli, P., Pawlosky, A., Karthikesalingam, A., & Natarajan, V. (2026). Beschleunigung wissenschaftlicher Entdeckungen mit Co-Scientist. Nature, 655(8122), 487–496. https://doi.org/10.1038/s41586-026-10644-y
Gould, S. J. (1991). Die Selbstbeeinflussung meiner durchdringenden, wahrgenommenen lebenswichtigen Energie durch Produktnutzung: Eine introspektiv-praktische Perspektive. Journal of Consumer Research, 18(2), 194–207.
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). Zur Kalibrierung moderner neuronaler Netze. ICML 2017, PMLR 70, 1321–1330.
Gvirtz, A., & Sabherwal, A. (2024). Die Grenzen der globalen, kulturübergreifenden verhaltenswissenschaftlichen Forschung. Proceedings of the National Academy of Sciences, 121(36), e2316690121.
Hadfield, G. K. (2017). Regeln für eine flache Welt: Warum Menschen das Recht erfunden haben und wie man es für eine komplexe globale Wirtschaft neu erfinden kann. Oxford University Press.
Hadfield, G. K., & Clark, J. (2026). Regulierungsmärkte: Die Zukunft der KI-Governance. Jurimetrics, 65, 195–240 (arXiv:2304.04914).
Hansen, L. K., & Salamon, P. (1990). Neuronale Netzwerk-Ensembles. IEEE Transactions on Pattern Analysis and Machine Intelligence, 12(10), 993–1001.
Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026). Nicht alle Wechsel sind Konformität: Zerlegung der Haltungskonvergenz in Multi-Agent-LLM-Debatten. arXiv:2606.00820.
Hoff, K. A., & Bashir, M. (2015). Vertrauen in Automatisierung: Integration empirischer Evidenz über Faktoren, die Vertrauen beeinflussen. Human Factors, 57(3), 407–434.
Hong, L., & Page, S. E. (2004). Gruppen vielfältiger Problemlöser können Gruppen von leistungsstarken Problemlösern übertreffen. Proceedings of the National Academy of Sciences, 101(46), 16385–16389.
Huang, M.-H., & Rust, R. T. (2021). Ein strategischer Rahmen für künstliche Intelligenz im Marketing. Journal of the Academy of Marketing Science, 49(1), 30–50.
Insurance Services Office (2026). Zusatzformulare CG 40 47 und CG 40 48: Ausschlüsse für generative künstliche Intelligenz. Gültig ab 1. Januar 2026.
Internet Engineering Task Force (2026). Eine Architektur für vertrauenswürdige und transparente digitale Lieferketten (RFC 9943; SCITT Working Group). IETF. https://datatracker.ietf.org/doc/rfc9943/
Ioku, T., Song, J., & Watamura, E. (2024). Kompromisse bei der Wahl des KI-Assistenten: Priorisieren Verbraucher Transparenz und Nachhaltigkeit gegenüber der Leistung des KI-Assistenten? Big Data & Society, 11(4).
Ipsos (2025). Der Ipsos AI Monitor 2025. Ipsos Global Advisor, Umfrage in 30 Ländern, Juni 2025.
Jacovi, A., Marasović, A., Miller, T., & Goldberg, Y. (2021). Formalisierung von Vertrauen in künstliche Intelligenz: Voraussetzungen, Ursachen und Ziele des menschlichen Vertrauens in KI. FAccT 2021, 624–635.
Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., Schiefer, N., Hatfield-Dodds, Z., DasSarma, N., Tran-Johnson, E., Johnston, S., El-Showk, S., Jones, A., Elhage, N., Hume, T., Chen, A., Bai, Y., Bowman, S., Fort, S., ... Kaplan, J. (2022). Sprachmodelle wissen (meist) was sie wissen. arXiv:2207.05221.
Kalai, A. T., Nachum, O., Vempala, S., & Zhang, E. (2025). Warum Sprachmodelle halluzinieren. arXiv:2509.04664.
Kharazian, A. (2026). Anthropic schlägt OpenAI bei geschäftlicher Adoption. Ramp Economics Lab / Ramp AI Index, 13. Mai 2026 (Unternehmenszahlungsdaten von über 50.000 US-Unternehmen).
Kim, D., & Benbasat, I. (2010). Designs zur wirksamen Umsetzung von Vertrauensgarantien in Internet-Shops. Communications of the ACM, 53(2), 121–126.
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Korrelierte Fehler in großen Sprachmodellen. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038–30066.
Kim, P. H., Ferrin, D. L., Cooper, C. D., & Dirks, K. T. (2004). Die Beseitigung des Verdachtsschattens: Die Auswirkungen von Entschuldigung versus Verleugnung auf die Reparatur von Vertrauensverletzungen basierend auf Kompetenz versus Integrität. Journal of Applied Psychology, 89(1), 104–118.
Kizilcec, R. F. (2016). Wie viel Information? Auswirkungen von Transparenz auf das Vertrauen in eine algorithmische Schnittstelle. CHI 2016, 2390–2395.
Klarna (2024). Der KI-Assistent von Klarna bearbeitet im ersten Monat zwei Drittel der Kundenservice-Chats. Pressemitteilung, 27. Februar 2024.
Köbis, N., Rahwan, Z., Rilla, R., Supriyatno, B. I., Bersch, C., Ajaj, T., Bonnefon, J.-F., & Rahwan, I. (2025). Die Delegation an künstliche Intelligenz kann unehrliches Verhalten fördern. Nature, 646(8083), 126–134. DOI: 10.1038/s41586-025-09505-x.
Kolt, N. (2025). Governing AI agents. Notre Dame Law Review, 101 (SSRN working paper 4772956; arXiv:2501.07913).
Komiak, S. Y. X., & Benbasat, I. (2006). The effects of personalization and familiarity on trust and adoption of recommendation agents. MIS Quarterly, 30(4), 941–960.
König, P. D., Wurster, S., & Siewert, M. B. (2022). Consumers are willing to pay a price for explainable, but not for green AI: Evidence from a choice-based conjoint analysis. Big Data & Society, 9(1).
Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. Advances in Neural Information Processing Systems, 7, 231–238.
Kroll, J. A., Huey, J., Barocas, S., Felten, E. W., Reidenberg, J. R., Robinson, D. G., & Yu, H. (2017). Accountable algorithms. University of Pennsylvania Law Review, 165(3), 633–705.
Kuncheva, L. I., & Whitaker, C. J. (2003). Measures of diversity in classifier ensembles and their relationship with the ensemble accuracy. Machine Learning, 51(2), 181–207.
Lee, J. D., & See, K. A. (2004). Trust in automation: Designing for appropriate reliance. Human Factors, 46(1), 50–80.
Lessig, L. (2006). Code: Version 2.0. Basic Books.
Li, M. (2025). From cloud-native to trust-native: A protocol for verifiable multi-agent systems. arXiv:2507.22077.
Liang, P., Bommasani, R., Lee, T., Tsipras, D., Soylu, D., Yasunaga, M., Zhang, Y., Narayanan, D., Wu, Y., Kumar, A., Newman, B., Yuan, B., Yan, B., Zhang, C., Cosgrove, C., Manning, C. D., Ré, C., Acosta-Navas, D., Hudson, D. A., ... Koreeda, Y. (2023). Holistic evaluation of language models. Transactions on Machine Learning Research.
Liao, Q. V., & Sundar, S. S. (2022). Designing for responsible trust in AI systems: A communication perspective. FAccT 2022, 1257–1268.
Lin, S., Hilton, J., & Evans, O. (2022). Teaching models to express their uncertainty in words. arXiv:2205.14334.
Lindsey, J. (2025). Emergent introspective awareness in large language models. Anthropic / Transformer Circuits.
Liu, J., Bursztyn, V. S., Ai, L., Wang, H., Choudhary, S., Mitra, S., & Wu, Q. (2026). TeamFusion: Supporting open-ended teamwork with multi-agent systems. arXiv:2604.19589 (ACL 2026; Adobe Research).
Lizzeri, A. (1999). Information revelation and certification intermediaries. RAND Journal of Economics, 30(2), 214–231.
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Algorithm appreciation: People prefer algorithmic to human judgment. Organizational Behavior and Human Decision Processes, 151, 90–103.
Longoni, C., Bonezzi, A., & Morewedge, C. K. (2019). Resistance to medical artificial intelligence. Journal of Consumer Research, 46(4), 629–650.
Longoni, C., Cian, L., & Kyung, E. J. (2023). Algorithmic transference: People overgeneralize failures of AI in the government. Journal of Marketing Research, 60(1), 170–188.
Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020–9025. DOI: 10.1073/pnas.1008636108.
Lu, Z., Wang, D., & Yin, M. (2024). Does more advice help? The effects of second opinions in AI-assisted decision making. Proceedings of the ACM on Human-Computer Interaction, 8(CSCW1), 1–31.
Marchal, N., Chan, S., Franklin, M., Revel, M., Keeling, G., Fischli, R., Chandra, B., & Gabriel, I. (2026). Architecting trust in artificial epistemic agents. arXiv:2603.02960.
Mastercard (2026). Verifiable Intent (gemeinsam mit Google entwickelt). Newsroom-Ankündigung, 5. März 2026; erste Pilotprojekte in asiatischen und lateinamerikanischen Märkten, 2026.
Mayer, R. C., Davis, J. H., & Schoorman, F. D. (1995). An integrative model of organizational trust. Academy of Management Review, 20(3), 709–734.
McKinsey & Company (2025). The agentic commerce opportunity (Schumacher, Roberts, & Giebel). 17. Oktober 2025.
McKnight, D. H., Choudhury, V., & Kacmar, C. (2002). Developing and validating trust measures for e-commerce. Information Systems Research, 13(3), 334–359.
Menlo Ventures (2025a). 2025 mid-year LLM market update. 31 July 2025 (Befragung von 150 technischen Entscheidungsträgern).
Menlo Ventures (2025b). 2025: The state of generative AI in the enterprise. 9 December 2025 (Befragung von 495 US-amerikanischen Enterprise-KI-Entscheidungsträgern; Menlo Ventures ist ein Investor von Anthropic).
Menlo Ventures (2025c). 2025: The state of consumer AI. 26 June 2025 (Befragung von 5.031 US-amerikanischen Erwachsenen mit Morning Consult; die ~3%-Quote der zahlenden Nutzer ist eine umsatzgestützte Schätzung).
Möhlmann, M., & Zalmanson, L. (2017). Hands on the wheel: Navigating algorithmic management and Uber drivers' autonomy. ICIS 2017.
Montgomery, J. M., Nyhan, B., & Torres, M. (2018). How conditioning on posttreatment variables can ruin your experiment and what to do about it. American Journal of Political Science, 62(3), 760–775.
Morgan Stanley (2025). Agentic commerce forecast: 190–385 Milliarden Dollar U.S. e-commerce spending by 2030. Dezember 2025.
Mosier, K. L., & Skitka, L. J. (1996). Human decision makers and automated decision aids: Made for each other? In R. Parasuraman & M. Mouloua (Eds.), Automation and human performance: Theory and applications (pp. 201–220). Lawrence Erlbaum Associates.
Mozannar, H., & Sontag, D. (2020). Consistent estimators for learning to defer to an expert. ICML 2020, PMLR 119, 7076–7087.
Muchnik, L., Aral, S., & Taylor, S. J. (2013). Social influence bias: A randomized experiment. Science, 341(6146), 647–651. DOI: 10.1126/science.1240466.
Muir, B. M. (1994). Trust in automation: Part I. Theoretical issues in the study of trust and human intervention in automated systems. Ergonomics, 37(11), 1905–1922.
NIST (2023). Artificial Intelligence Risk Management Framework (AI RMF 1.0) (NIST AI 100-1). National Institute of Standards and Technology.
Okamura, K., & Yamada, S. (2020). Adaptive trust calibration for human-AI collaboration. PLOS ONE, 15(2), e0229132.
Papamarkou, T., Alquier, P., Bauer, M., Buntine, W., Davison, A., Dziugaite, G. K., Filippone, M., Foong, A. Y. K., Fortuin, V., Fouskakis, D., Frellsen, J., Hüllermeier, E., Karaletsos, T., Khan, M. E., Kotelevskii, N., Lahlou, S., Li, Y., Liu, F., Lyle, C., Möllenhoff, T., Palla, K., Panov, M., Sale, Y., Schweighofer, K., Shelmanov, A., Swaroop, S., Trapp, M., Waegeman, W., Wilson, A. G., & Zaytsev, A. (2026). Position: Agentic AI orchestration should be Bayes-consistent. arXiv:2605.00742. (Accepted at ICML 2026.)
Parasuraman, R., & Manzey, D. H. (2010). Complacency and bias in human use of automation: An attentional integration. Human Factors, 52(3), 381–410. DOI: 10.1177/0018720810376055.
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230–253.
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics — Part A: Systems and Humans, 30(3), 286–297.
Pavlou, P. A. (2003). Consumer acceptance of electronic commerce: Integrating trust and risk with the technology acceptance model. International Journal of Electronic Commerce, 7(3), 101–134.
Pew Research Center (2025). Wie Menschen auf der ganzen Welt KI betrachten. 25-Länder-Umfrage, Oktober 2025.
Piehlmaier, D. M. (2023). The one-man show: The effect of joint decision-making on investor overconfidence. Journal of Consumer Research, 50(2), 426–446. https://doi.org/10.1093/jcr/ucac054
Puntoni, S., Reczek, R. W., Giesler, M., & Botti, S. (2021). Consumers and artificial intelligence: An experiential perspective. Journal of Marketing, 85(1), 131–151.
Rabanser, S., Kapoor, S., Kirgis, P., Liu, K., Utpala, S., & Narayanan, A. (2026). Towards a science of AI agent reliability. arXiv:2602.16666 (ICML 2026).
Raji, I. D., Xu, P., Honigsberg, C., & Ho, D. (2022). Outsider oversight: Designing a third party audit ecosystem for AI governance. AIES 2022, 557–571.
Regulation (EU) 2016/679 (Datenschutz-Grundverordnung), Artikel 22 — automatisierte individuelle Entscheidungsfindung.
Regulation (EU) 2024/1689 (Artificial Intelligence Act), Artikel 14 — menschliche Beaufsichtigung von KI-Systemen mit hohem Risiko; Artikel 50 — Transparenzanforderungen für Anbieter und Nutzer bestimmter KI-Systeme.
Ríos-García, M., Alampara, N., Gupta, C., Mandal, I., Mannan, S., Aghajani, A. A., Krishnan, N. M. A., & Jablonka, K. M. (2026). AI scientists produce results without reasoning scientifically. arXiv:2604.18805.
Saad-Falcon, J., Buchanan, E. K., Chen, M. F., Huang, T.-H., McLaughlin, B., Bhathal, T., Zhu, S., Athiwaratkun, B., Sala, F., Linderman, S., Mirhoseini, A., & Ré, C. (2025). Shrinking the generation-verification gap with weak verifiers. arXiv:2506.18203.
Sabater, J., & Sierra, C. (2005). Review on computational trust and reputation models. Artificial Intelligence Review, 24(1), 33–60.
Schemmer, M., Kühl, N., Benz, C., Bartos, A., & Satzger, G. (2023). Appropriate reliance on KI advice: Conceptualization and the effect of explanations. IUI '23, 410–422.
Schilke, O., & Reimann, M. (2025). The transparency dilemma: How AI disclosure erodes trust. Organizational Behavior and Human Decision Processes, 188, 104405.
Schmidt, J., & Bijmolt, T. H. A. (2020). Accurately measuring willingness to pay for consumer goods: A meta-analysis of the hypothetical bias. Journal of the Academy of Marketing Science, 48, 499–518.
Shapiro, S. P. (1987). The social control of impersonal trust. American Journal of Sociology, 93(3), 623–658.
Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., Cheng, N., Durmus, E., Hatfield-Dodds, Z., Johnston, S. R., Kravec, S., Maxwell, T., McCandlish, S., Ndousse, K., Rausch, O., Schiefer, N., Yan, D., Zhang, M., & Perez, E. (2024). Towards understanding sycophancy in language models. ICLR 2024 (arXiv:2310.13548).
Shehata, D., & Li, M. (2026). The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274.
Sheridan, T. B., & Verplank, W. L. (1978). Human and computer control of undersea teleoperators (Technischer Bericht). MIT Man-Machine Systems Laboratory.
Smit, A. P., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). Should we be going MAD? A look at multi-agent debate strategies for LLMs. ICML 2024, PMLR 235, 45883–45905 (arXiv:2311.17371).
Söllner, M., Hoffmann, A., & Leimeister, J. M. (2016). Warum unterschiedliche Vertrauensbeziehungen für Informationssystemnutzer wichtig sind. European Journal of Information Systems, 25(3), 274–287.
Spiro, T. (2026). The Oracle's fingerprint: Correlated AI forecasting errors and the limits of bias transmission. arXiv:2605.00844.
Stanford HAI (2025). Artificial Intelligence Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence (Kapitel Technische Leistung).
Stanford HAI (2026). Artificial Intelligence Index Report 2026. Stanford Institute for Human-Centered Artificial Intelligence (Kapitel „Public Opinion", mit Daten der Pew-Umfrage in 25 Ländern).
Tax, S. S., Brown, S. W., & Chandrashekaran, M. (1998). Customer evaluations of service complaint experiences: Implications for relationship marketing. Journal of Marketing, 62(2), 60–76.
Vaccaro, M., Almaatouq, A., & Malone, T. (2024). When combinations of humans and AI are useful: A systematic review and meta-analysis. Nature Human Behaviour, 8(12), 2293–2303. DOI: 10.1038/s41562-024-02024-1.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Visa (2025). Visa introduces Trusted Agent Protocol: An ecosystem-led framework for AI commerce. Pressemitteilung (mit Cloudflare), 14. Oktober 2025.
Visa (2026). Visa arbeitet mit OpenAI zusammen, um die nächste Generation von KI-gestütztem E-Commerce zu ermöglichen. Pressemitteilung, Visa Payments Forum, 10. Juni 2026.
W3C (2025). Verifiable Credentials Data Model v2.0. W3C Recommendation.
Wallendorf, M., & Brucks, M. (1993). Introspection in consumer research: Implementation and implications. Journal of Consumer Research, 20(3), 339–359.
Walsham, G. (1995). Interpretive case studies in IS research: Nature and method. European Journal of Information Systems, 4(2), 74–81.
Wang, W., & Benbasat, I. (2005). Trust in and adoption of online recommendation agents. Journal of the Association for Information Systems, 6(3), 72–101.
Wang, Y., Zhang, J., Cai, T., Liu, Z., Sun, Q., Sun, Z., Wu, Z., Dong, M., Zheng, M., Yin, X., & Zhu, Y. (2026). From agent traces to trust: A survey of evidence tracing and execution provenance in LLM agents. arXiv:2606.04990.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., & Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
Werbach, K. (2018). The blockchain and the new architecture of trust. MIT Press.
Wertenbroch, K. (1998). Consumption self-control by rationing purchase quantities of virtue and vice. Marketing Science, 17(4), 317–337.
Xiao, B., & Benbasat, I. (2007). E-commerce product recommendation agents: Use, characteristics, and impact. MIS Quarterly, 31(1), 137–209.
Yalcin, G., Lim, S., Puntoni, S., & van Osselaer, S. M. J. (2022). Thumbs up or down: Consumer reactions to decisions by algorithms versus humans. Journal of Marketing Research, 59(4), 696–717.
Yin, R. K. (2018). Case study research and applications: Design and methods (6th ed.). Sage.
Zhang, Y., Liao, Q. V., & Bellamy, R. K. E. (2020). Effect of confidence and explanation on accuracy and trust calibration in AI-assisted decision making. Proceedings of the 2020 ACM Conference on Fairness, Accountability, and Transparency, 295–305.
Zheng, J., & Zhang, J. (2026). Uncertainty-aware trust estimation for multi-LLM systems via structured expert judgement. arXiv:2607.20529.
Zuboff, S. (2019). The age of surveillance capitalism. PublicAffairs.
Zucker, L. G. (1986). Production of trust: Institutional sources of economic structure, 1840–1920. Research in Organizational Behavior, 8, 53–111.
* KI-Systemarchitekt. Interessenskonflikte: Der Autor entwickelt Multi-Modell-Orchestrierungsmethoden, betreibt eine Referenzimplementierung der hier beschriebenen Architektur, ist benannter Anmelder bei anstehenden Patentanmeldungen, nicht gewährten Patenten, die KI-Orchestrierung und Multi-Modell-Validierungssysteme der Art, die dieses Papier untersucht, abdecken, und hat ein Entwicklerinteresse an der Architektur, die dieses Papier befürwortet; normative Aussagen über ihre Notwendigkeit sollten mit Blick auf dieses Interesse gelesen werden. Die Rolle des Autors bei der Bereitstellung in Abschnitt 4 ist in der Autorennotiz und Offenlegung am Ende dieses Papiers dargelegt. Kommentare willkommen: [email protected].↩︎
Zitierweise
Chernets, V. (2026). Architektonisches Vertrauen: Warum das Verbrauchervertrauen im agentengesteuerten Handel von KI-Modellen zu verifizierbarer Architektur migriert [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7191261
@misc{chernets2026architecturaltrust,
  author       = {Chernets, Vadym},
  title        = {{Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7191261},
  url          = {https://doi.org/10.2139/ssrn.7191261}
}