Architectural Trust: Pourquoi la confiance des consommateurs dans le commerce agentique migre des modèles IA vers l'architecture vérifiable
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
Vadym Chernets, PhD, architecte de systèmes IA · ORCID 0009-0007-4845-3163
SSRN 7191261 · DOI 10.2139/ssrn.7191261 · Zenodo 10.5281/zenodo.22166995 · GitHub
- Version officielle : SSRN 7191261 · DOI 10.2139/ssrn.7191261
- Copie archivée, citable et téléchargeable : 10.5281/zenodo.22166995 — DOI du concept, résout toujours la dernière version
- Texte intégral en Markdown et PDF : GitHub
- HTML lisible : https://polyhelper.ai/research/architectural-trust/
Le même texte se trouve sur quatre surfaces afin qu'il puisse être consulté quand l'une d'elles ne peut pas le servir. SSRN contient la version officielle ; veuillez citer celle-ci.
Confiance des consommateurs dans le commerce dirigé par les IA
Publié sur SSRN et indexé sous le titre « Confiance architecturale : Pourquoi la confiance des consommateurs dans le commerce dirigé par les IA migre des modèles d'IA vers une architecture vérifiable ». Veuillez citer cette forme.
Des propriétés du modèle à l'architecture vérifiable
Vadym Chernets, PhD1
Publié pour la première fois le 6 août 2026 ; cette version septembre 2026
Rapporte le cadre conceptuel complet, l'étude du mécanisme à seize modèles et sa réplication en vague phare d'août 2026 dans onze laboratoires de première ligne, une comparaison de budget de raisonnement appariée, une réplication de substrat commercial et une expérience consommateur pré-enregistrée complète.
RÉSUMÉ
Le commerce dirigé par les IA transforme l'IA en partie prenante du commerce, en fusionnant recherche, comparaison, panier et paiement en un seul acte délégué et en supprimant les points de contrôle où les humains capturaient autrefois les erreurs. Cela arrive à un moment mal choisi : soixante pour cent des consommateurs britanniques interrogés déclarent qu'ils abandonneraient un agent d'achat IA après une seule erreur, et la plupart n'accorderaient la confiance à aucune organisation pour le gérer en leur nom. Cet article introduit la confiance architecturale. Au fur et à mesure que les consommateurs délèguent des décisions importantes aux agents IA, j'affirme que la confiance justifiée migre des propriétés du modèle d'IA vers l'architecture vérifiable du service au-dessus. Les construits existants rattachent la confiance aux organisations, à un seul système automatisé ou à des conseils algorithmiques, et aucun ne rend le processus de prise de décision vérifiable par celui qui accorde la confiance en cas de délégation autonome. La confiance architecturale comble cette lacune avec trois propriétés vérifiables : la diversité (modèles indépendants dont l'accord étalonne la confiance et dont la divergence est révélée), la preuve (enregistrements de décision inviolables et rejouables) et la neutralité (indépendance auditable de tout fournisseur, marchand ou résultat).
Le mécanisme a d'abord été mesuré au niveau de la machine. Sur un benchmark pré-enregistré de seize modèles et une vague phare d'août 2026 couvrant onze laboratoires de première ligne, l'accord inter-modèles s'est avéré prédire la correction là où la confiance propre d'un modèle ne pouvait pas le faire. Les réponses indépendamment reproduites par un autre modèle avaient 1,9 à 3,2 fois plus de chances d'être correctes. Sur un sous-ensemble SimpleQA gelé (Wei et al., 2024), 46,6 % des réponses offertes à une confiance déclarée ≥ 80 étaient fausses (un taux spécifique à cette liste, pas une constante universelle), tandis qu'une porte de désaccord fixe à trois modèles a supprimé 82,1 % de ces défaillances confiantes (IC 95 % 79,9–84,1) à 30,5 % de couverture. Le signal se reproduit sur 267 faits de produits commerciaux vérifiés par Wikidata. Un budget de raisonnement plus large a acheté 3,1 points de confiance déclarée et aucune précision mesurable : plus de calcul achète la confiance, pas la correction. Un panneau unanimement confiant peut quand même se tromper, et là l'accord certifie l'erreur partagée.
J'ai ensuite appliqué le mécanisme au comportement dans une expérience de consommation pré-enregistrée et compatible avec les incitations (119 des 200 participants prévus ; États-Unis et Royaume-Uni). Là où un consommateur accepterait autrement une recommandation confidemment erronée, l'affichage du désaccord a réduire considérablement l'acceptation, de 74 % à 24 % sur l'item pertinent. L'estimation robuste groupée (Δ = 0,24 → 0,45 ; d = 0,68 ; la cohorte principale de la vague initiale donne d = 0,67) repose sur cet unique item et, dans une division exploratoire par pays, sur l'échantillon du Royaume-Uni, et elle tombe à d = 0,09 une fois l'item supprimé. Une réplication puissante et échantillonnée par stimulus est prévue. Sur l'unique item de consensus unanime et confiant, l'affichage a augmenté l'acceptation de l'erreur partagée, ce qui reproduit la limite du mécanisme dans le comportement humain. La composante orchestration-réception a retourné un null inconclusif enregistré.
Les trois composantes n'ont pas de preuves égales. La diversité est établie du côté machine et démontrée chez les consommateurs pour le contraste d'étalonnage uniquement (la médiation enregistrée était nulle). Le test de première exposition de la composante record était inconclusif, et elle et la neutralité sont toutes deux spécifiées pour le test. L'unité d'analyse pour la confiance dans l'IA doit passer du modèle à l'architecture qui le surplombe, la partie qui peut être vérifiée.
Mots-clés : commerce agentic ; confiance des consommateurs ; agents IA ; confiance dans l'IA ; dépendance appropriée ; dépendance excessive ; modèles de langage de grande taille ; accord entre modèles ; prédiction sélective ; surconfiance ; délégation ; confiance architecturale. Classification JEL : M31 (Marketing) ; D83 (Recherche, apprentissage, information) ; L86 (Services d'information et Internet) ; K24 (Droit cyber) Comment lire ce document. Cette version complète rapporte la chaîne de preuves entière : le construit et l'hypothèse de migration de confiance ; une étude de mécanisme sur seize modèles (avec une réplication de vague phare en août 2026 et un bras sur substrat commercial portant sur les caractéristiques des produits) qui établit la diversité entre modèles comme signal de justesse ; une expérience de consommation pré-enregistrée appliquant ce mécanisme au comportement ; et une discussion de la neutralité, de l'économie de marché et de la politique. Les résultats confirmatoires pré-enregistrés et le statut probant de chaque composante du construit (diversité, preuve, neutralité) sont résumés sous « Statut probant des affirmations » à la section 5. Les analyses exploratoires et de robustesse sont identifiées comme telles tout au long et peuvent être ignorées à la première lecture.
1. Introduction : croissance malgré la méfiance
Le 10 juin 2026, Visa a annoncé qu'il intégrait directement son réseau de paiement dans ChatGPT (Visa, 2026). Un consommateur relie une carte, fixe des plafonds de dépenses et des catégories de commerçants approuvées, et l'intégration annoncée, avec des cas d'usage déployés par étapes, vise les agents IA effectuant des achats réels dans la base de commerçants du réseau (plus de 175 millions de lieux, selon la couverture commerciale de l'annonce). Visa n'était pas seul. OpenAI avait déployé la caisse intégrée en septembre 2025 ; Google a présenté un protocole de commerce universel au NRF en janvier 2026 avec Shopify, Etsy, Wayfair, Target et Walmart, l'étendant en mai en un panier universel inter-détaillants (Google, 2026) ; American Express a lancé un kit développeur de commerce agentic avec protection d'achat en avril (American Express, 2026). Le seuil a été franchi par une industrie, non par une seule entreprise. Les projections des analystes pour le commerce agentic d'ici 2030 vont de centaines de milliards (Bain ; Morgan Stanley) à 3 à 5 mille milliards de dollars selon McKinsey. Ce sont des estimations et non des faits, bien que chaque grand groupe en produise maintenant.
Les chiffres réalisés ne sont plus des estimations. Les dépenses d'entreprise consacrées aux seules API de modèles sont passées de 3,5 milliards de dollars à 8,4 milliards de dollars en six mois (Menlo Ventures, 2025a ; enquête auprès de l'industrie, non examinée par les pairs), dans un ensemble d'environ 37 milliards de dollars de dépenses d'IA générative d'entreprise pour l'année (Menlo Ventures, 2025b). La même industrie réduit déjà ses attentes quant à sa propre exécution : Gartner (2025) prévoit que plus de 40 % des projets d'IA agentic seront annulés d'ici fin 2027. L'argent arrive plus rapidement que la confiance justifiée, ce qui est l'écart dont je traite ici. Les affirmations ci-dessous sont classées dans le registre probant près de la fin de l'article selon qu'elles sont établies par ces données, appuyées par une seule étude à modeste échelle, ou théoriques. Cette classification gouverne et prime sur toute phrase résumée dans cette introduction.
Ce qui rend ce changement qualitativement différent des vagues de commerce électronique antérieures est la compression d'entonnoir : la recherche, la comparaison, le panier et le paiement s'effondrent en un acte unique délégué. Chaque sauvegarde qui existait autrefois entre ces étapes (l'humain jetant un coup d'œil au prix, relisant l'annonce, hésitant à la caisse) disparaît avec les étapes elles-mêmes (Figure 1). L'assistant IA cesse d'être un conseiller dont la production est examinée par un humain et devient une partie prenante transactionnelle. La recherche sur les facteurs humains a nommé ce mode de défaillance il y a quatre décennies : l'automatisation qui retire l'opérateur de la boucle mine précisément la vigilance nécessaire pour détecter ses erreurs (Bainbridge, 1983 ; Endsley & Kiris, 1995). La recherche consommateur a aussi prévu ce seuil. Les systèmes d'achat autonomes font face à des obstacles d'adoption qualitativement différents parce qu'ils soustrayent l'humain de l'action (de Bellis & Johar, 2020), et l'impact sur l'autonomie de confier les choix aux algorithmes a été signalé comme une question de bien-être des consommateurs avant l'existence des LLM (André et al., 2018).
Figure 1. Compression d'entonnoir
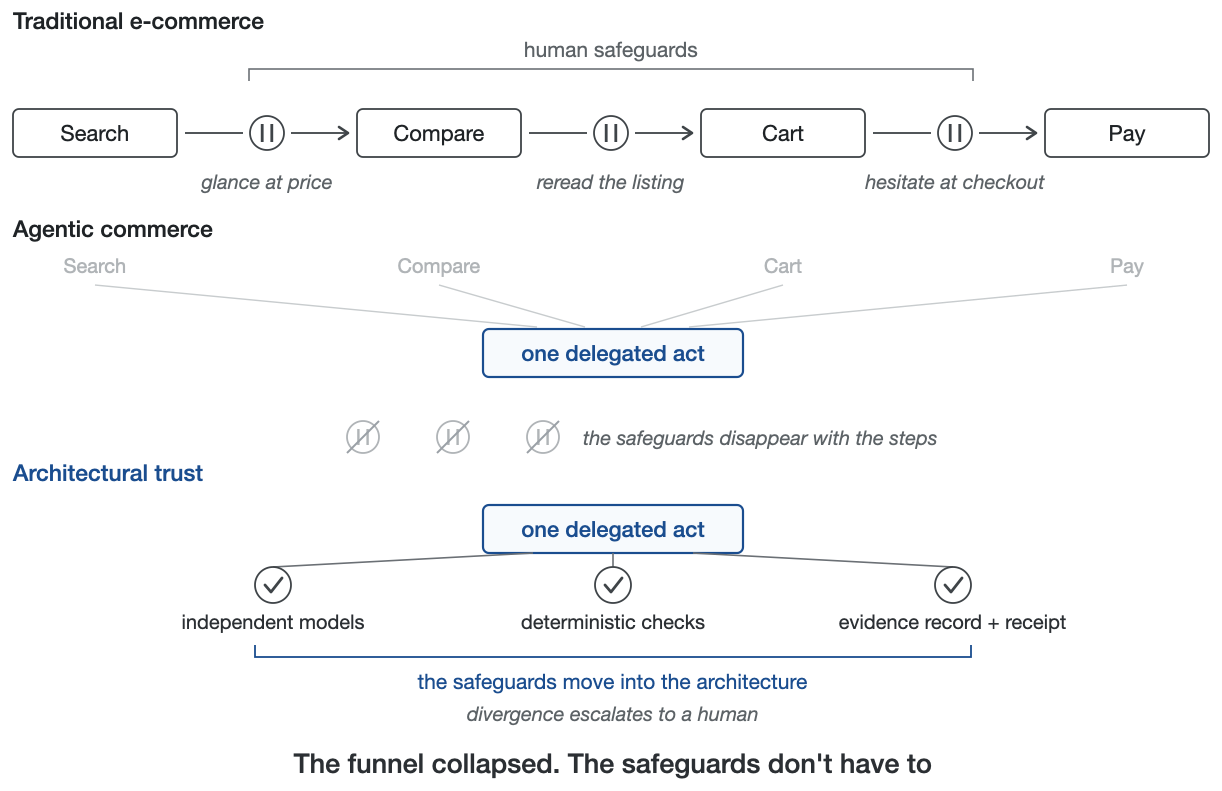
Les sauvegardes humaines disparaissent avec les étapes entre lesquelles elles se trouvaient.
Les garde-fou de Visa (plafonds, listes blanches, approbations requises) existent parce que le consommateur est invité à faire confiance à quelque chose de nouveau : non pas une marque, non pas une réponse, mais un processus de prise de décision qu'il ne peut pas voir. Les garde-fou définis à l'avance ne comblent pas cet écart. Des règles fixées d'avance ne permettent pas au consommateur de vérifier comment une décision a été prise. Dans l'enquête ACI Worldwide (2026) citée ci-dessous (une enquête auprès de l'industrie publiée par communiqué de presse, comme les autres enquêtes dirigées par les fournisseurs que cette section cite), 69 % des consommateurs du Royaume-Uni ont déclaré qu'ils ne faisaient pas confiance aux agents IA même quand les agents respectent les règles que les consommateurs ont eux-mêmes établies.
Les enjeux commerciaux d'une erreur sont considérables. Les premières données d'enquête suggèrent que la confiance des consommateurs envers les agents est fragile – « une seule erreur » en intention déclarée – et, de manière intéressante, sans ancrage comportemental. Le comportement révélé, le recul au paiement présenté ci-dessous et l'inversion de Klarna et la réévaluation de l'assurance de la Section 5, corroborent ces préférences déclarées et portent un poids probant plus important. Dans une enquête YouGov pour ACI Worldwide (2 080 adultes britanniques, réalisée 19-22 juin 2026, un instantané du marché unique en attente de réplication transfrontalière), 60 % ont déclaré qu'ils cesseraient d'utiliser un agent IA d'achat après une seule erreur, et seulement 19 % feraient confiance à une IA pour les achats quotidiens, contre 55 % qui feraient confiance à un expert humain.
Le chiffre le plus important de cette enquête en est un autre : 59 % ont déclaré qu'ils ne feraient confiance à aucune organisation pour gérer les achats et les paiements IA en leur nom, et même les banques n'ont été choisies que par 20 %. Dans un seul marché sondé, en attente de réplication transfrontalière, c'est un vide de confiance. L'appétit est là. Dans l'enquête du secteur à 16 pays d'Accenture auprès de 25 590 consommateurs (janvier 2026 ; commandée par l'entreprise, non révisée par les pairs), 74 % ont déclaré qu'ils feraient davantage confiance à un agent IA personnel qu'à leur meilleur ami pour faire un achat en leur nom, pourtant seulement environ un sur dix accorderait à un agent l'autorité d'achat autonome (Figure 2). Les deux éléments mesurent différents degrés de délégation, de sorte que l'écart aligne les intentions plutôt que d'identifier un seul écart causal, mais l'écart est flagrant. L'intention est abondante ; la délégation est rare ; ce qui manque entre les deux est la confiance justifiée. Le marché a déjà essayé quelque chose de similaire. OpenAI a lancé le paiement natif en discussion en septembre 2025, une première étape délibérément limitée, initialement des achats d'un seul article auprès de vendeurs Etsy américains avec confirmation de l'utilisateur à chaque étape. Le flux a été réduit d'ici mars 2026, les achats ayant été transférés vers les propres applications des détaillants, et seule une poignée de marchands l'ont jamais utilisé (selon The Information ; CNBC, 2026). L'entreprise n'a déclaré aucune raison, de sorte que la cause n'est pas établie. La lecture proposée ici – une infrastructure d'adoption sans confiance justifiée échouant à convertir – est une interprétation cohérente avec les faits rapportés. Si les consommateurs se méfient de chaque acteur, la confiance ne peut pas être investie dans un acteur du tout, et doit résider plutôt dans un processus vérifiable.
Figure 2. Confiance déclarée vs autorité accordée
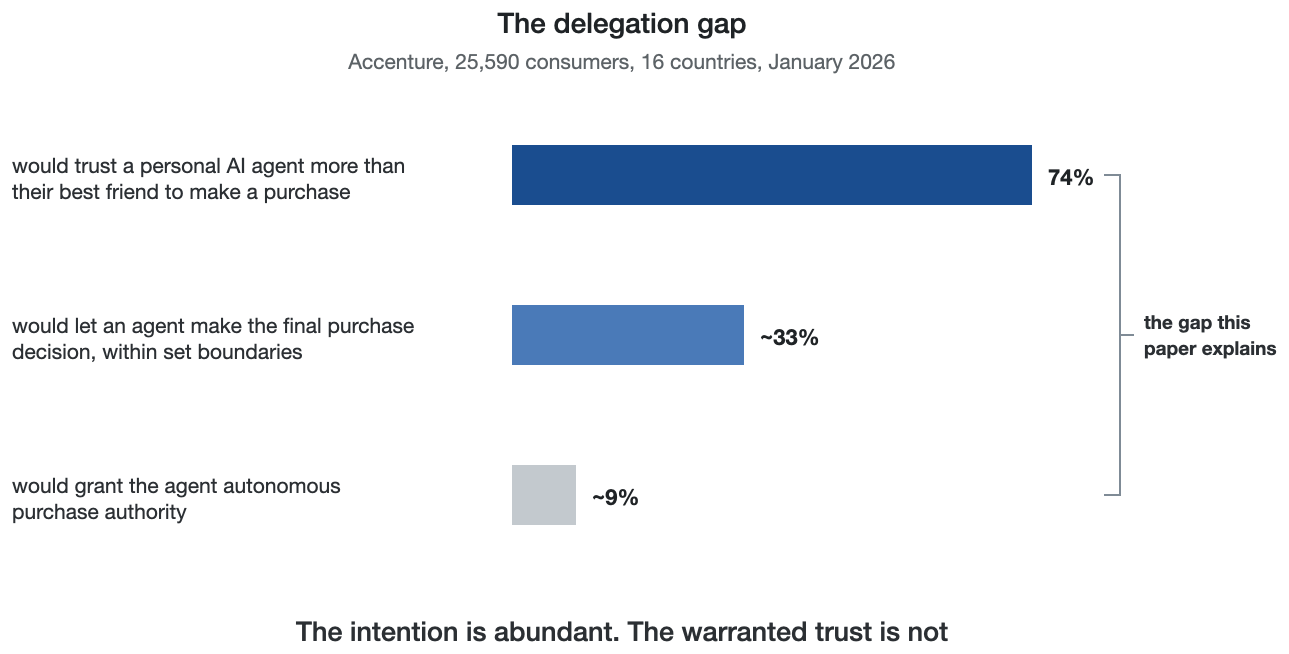
Deux éléments d'enquête, deux degrés de délégation : l'intention est courante, la confiance justifiée est rare.
Le système de responsabilité civile tâtonne vers la même conclusion. Les protocoles agents-paiements émergents construisent chaque transaction autour d'un jeton d'intention scopé et vérifiable lié à un marchand et un montant spécifiques, et la Agent Purchase Protection d'American Express (avril 2026) couvre les achats uniquement par des agents enregistrés, l'admissibilité étant conditionnée par une intention d'achat authentifiée et vérifiable. L'assurance est rédigée en termes de ce qui peut être vérifié à partir du dossier. De manière fragmentaire et sous pression, l'industrie converge vers les mêmes ingrédients que j'énumère systématiquement ci-dessous. Les protocoles actuellement déployés résolvent l'identité et l'intention et ne répondent pas à comment l'agent a-t-il décidé ?
La question est ce qu'il faudrait pour que cette confiance soit justifiée par la conception. La question classique de la confiance des consommateurs, « fais-je confiance à cette entreprise », a acquis une couche interne : fais-je confiance au mécanisme qui a produit cette réponse ou action spécifique ?
La littérature sur la confiance a longtemps distingué la confiance dans une organisation de la confiance dans l'automatisation, dans l'artefact informatique (Söllner et al., 2016), et dans les agents de recommandation en ligne (Wang & Benbasat, 2005 ; Komiak & Benbasat, 2006 ; Xiao & Benbasat, 2007). Elle montre que la confiance appropriée dépend de l'étalonnage, de savoir quand le système est susceptible d'avoir raison (Muir, 1994 ; Mayer, Davis, & Schoorman, 1995 ; Parasuraman & Riley, 1997 ; Lee & See, 2004 ; Hoff & Bashir, 2015 ; Huang & Rust, 2021 ; et Glikson & Woolley, 2020, dont l'examen constate que la tangibilité et la transparence du processus sont parmi les leviers les plus forts de la confiance cognitive, précisément les leviers que l'architecture contrôle et que les modèles ne contrôlent pas). Le désétallonnage du côté humain est documenté tout aussi bien : le biais d'automatisation et la complaisance, la surconfianza dans les aides automatisées même face à des preuves contraires, sont les schémas quatre décennies de travail en facteurs humains avertissent que la délégation amplifiera (Mosier & Skitka, 1996 ; Parasuraman & Manzey, 2010). Cette littérature, cependant, traite l'étalonnage comme une propriété d'un seul système automatisé (la Figure 3 cartographie les quatre flux de recherche et la cellule qu'ils laissent ouverte). Un examen systématique de l'IA agentive dans le commerce électronique confirme le vide du côté des preuves : la recherche orientée vers les consommateurs reste concentrée sur les systèmes d'assistance à faible autonomie, la couverture diminuant fortement précisément là où la délégation devient exécution (Balaskas, 2026). Les premières études concurrentes du shopping médié par les agents atteignent une conclusion architecturale d'un autre côté. Quand les consommateurs délèguent les achats par dialogue, leur consentement à payer fuit aux vendeurs presque mot pour mot ; l'incitation ne corrige pas cela, et seules les interventions architecturales le font (Alavi & Nozari, 2026).
Figure 3. Quatre flux de recherche sur la confiance : la cellule que cet article revendique
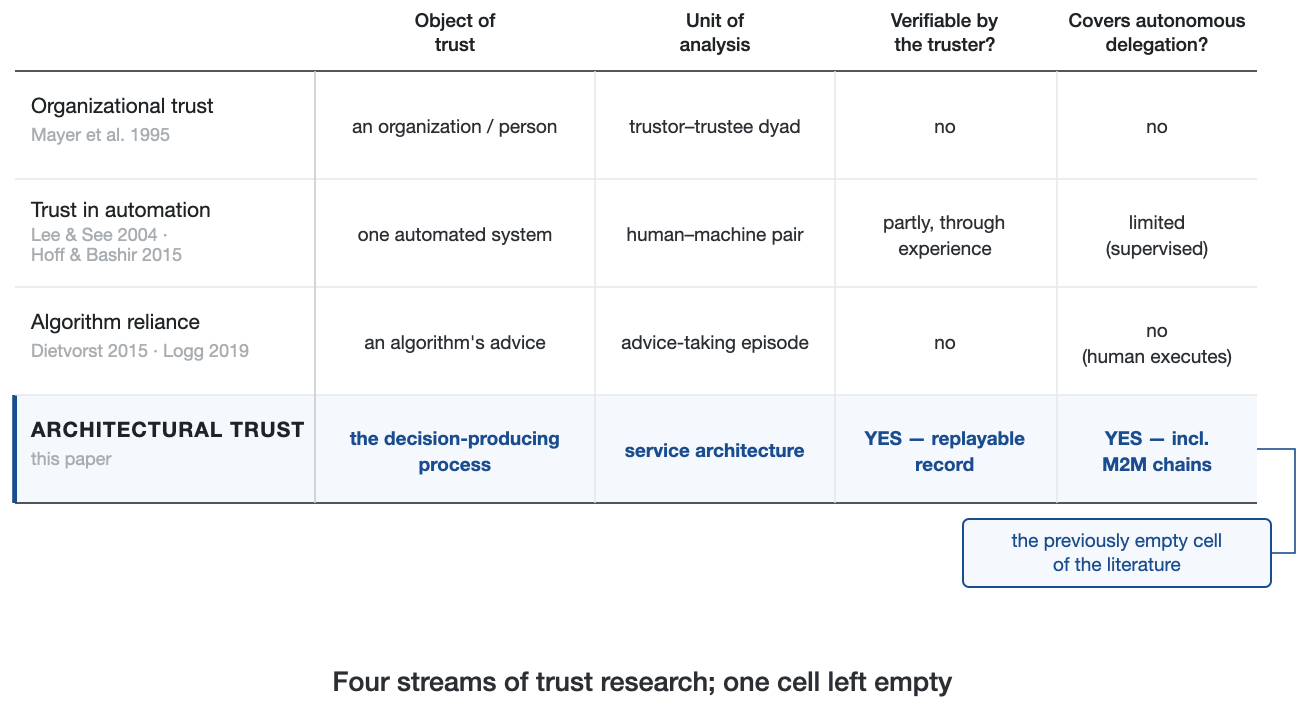
La confiance organisationnelle, la confiance dans l'automatisation et la dépendance aux algorithmes fixent chacun un objet de confiance différent ; aucun ne rend le processus producteur de décision vérifiable par le faiseur de confiance sous délégation autonome. La cellule n'est pas vide d'idées : les littératures adjacentes en détiennent chacune un mur (la Section 3 tire les démarcations). Ce qui a manqué est la construction orientée vers les consommateurs : un objet de confiance au niveau du processus, vérifiable par le faiseur de confiance, spécifié pour la délégation autonome, packagé pour un test comportemental conjoint.
Les réponses du secteur se concentrent sur le modèle : meilleure formation, avertissements, citations. J'examine une réponse à un niveau différent, l'architecture du service, et j'affirme que trois propriétés architecturales, dont aucune ne nécessite un meilleur modèle, produisent conjointement un objet de confiance différent.
Cet article est un document conceptuel ancré par deux études pré-enregistrées, un benchmark côté machine et un test comportemental côté consommateur du contraste d'étalonnage dans sa première proposition, et la question qu'il pose est à mesure que les agents IA commencent à conclure des transactions au nom des consommateurs, la confiance s'attache-t-elle aux modèles ou à l'architecture au-dessus d'eux ? Ma réponse est que la confiance doit migrer vers le haut dans la pile, du modèle à l'architecture d'orchestration aux preuves qu'elle produit. Sous cette réponse se trouve une régularité qui mérite d'être testée en elle-même, l'hypothèse de migration de la confiance, que les propositions ci-dessous sont construites pour tester : plus l'agentivité déléguée est grande, plus la part de la confiance justifiée doit résider dans les propriétés architecturales vérifiables plutôt que dans les propriétés du modèle. La migration n'a pas besoin d'être un jeu à somme nulle. La confiance peut s'empiler : dans la compétence du modèle, la sélection de l'orchestrateur, le système de preuve, l'institution appliquant les recours. Un modèle défectueux reste causalement important même quand personne n'examine ses résultats. L'hypothèse concerne l'endroit où la confiance justifiée marginale s'accumule à mesure que la délégation s'approfondit. Sous forme estimable, elle dit que à mesure que l'agentivité déléguée augmente, la vérifiabilité architecturale explique une part croissante supplémentaire de la confiance appropriée au-delà de la performance du modèle et de la réputation du fournisseur. Elle échoue si, à mesure que l'agentivité déléguée augmente, la vérifiabilité architecturale n'explique pas une part croissante supplémentaire de la confiance appropriée : si la réputation du fournisseur médiatise complètement la confiance à tous les niveaux de délégation, par exemple, ou si l'information sur les processus vérifiables n'améliore pas l'étalonnage de la confiance par rapport aux informations fondées sur la réputation seule dans les conceptions que rapporte la section 6. Les falsificateurs comportementaux pré-engagés dans la section 3 (le croisement P2 du niveau de délégation et la durabilité différentielle P4 en cas d'échec) sont la forme opérationnelle de cette condition. Une part architecturale croissante ne signifie pas que la qualité du modèle importe moins en termes absolus. L'hypothèse décrit une superposition, non une substitution : à mesure que l'examen disparaît, la justification architecturale s'ajoute aux performances du modèle et ne la remplace pas. « Justifiée » suit la distinction formalisée pour l'IA par Jacovi, Marasović, Miller, et Goldberg (2021), que la confiance est justifiée quand elle suit la fiabilité, et la construction est protégée d'une tautologie en séparant son statut normatif de son mécanisme. Normativement, la fiabilité est définie indépendamment de l'architecture censée la certifier, comme la fonction classique et indépendamment mesurable de la capacité, de l'intégrité et de la bienveillance (Mayer, Davis, & Schoorman, 1995) ; la section 3 mappe les trois composants architecturaux sur exactement ces dimensions. La justification est la correspondance de la confiance à cette quantité indépendamment mesurée : la confiance qui survit à un audit objectif des épisodes délégués, jugée par rapport à des critères fixés avant que les résultats ne soient connus, avec une trace comportementale mesurable, à savoir la délégation répétée, la rétention et la volonté de payer en cas d'échec contrôlé. L'hypothèse de migration de la confiance affirme le mécanisme. À mesure que l'agentivité déléguée augmente, la part de cette fonction de fiabilité que le consommateur peut encore mesurer indépendamment se déplace des propriétés du modèle vers les composants architecturaux. Cela tient au fait que l'architecture est la partie de la fiabilité qui reste mesurable par celui qui fait confiance une fois que l'examen des résultats disparaît, et non pas parce que l'architecture est la fiabilité. Les falsificateurs pré-engagés ci-dessus testent ce décalage et non la définition. La migration a aussi des prédécesseurs à distinguer. La recherche sur les systèmes multi-agents a observé que à mesure que les sociétés d'agents se développent, la modélisation de la confiance se déplace des agents individuels au cadre institutionnel les contraignant (Sabater & Sierra, 2005), et « migration de la confiance » a des usages B2B antérieurs pour la confiance se déplaçant des individus vers les systèmes et les plateformes (Carlson, 2026). Ceux-ci nomment les décalages dans qui ou quoi est fiable, tandis que cette hypothèse concerne un décalage dans le type de propriété qui peut justifier la confiance. À délégation nulle, la qualité du modèle est presque tout ce qui compte. À délégation complète, personne ne regarde les résultats, et seul le processus et son enregistrement peuvent être fiables. L'agentivité et la confiance architecturale se mettent à l'échelle ensemble (Figure 4). Le gradient lui-même est un vieil instrument, l'axe des niveaux d'automatisation de l'ingénierie des facteurs humains (Sheridan & Verplank, 1978 ; Parasuraman, Sheridan, & Wickens, 2000), appliqué ici à la délégation du consommateur. Ce qui est nouveau est l'affirmation sur les propriétés qui peuvent justifier la confiance le long de celui-ci.
Figure 4. Migration de la confiance
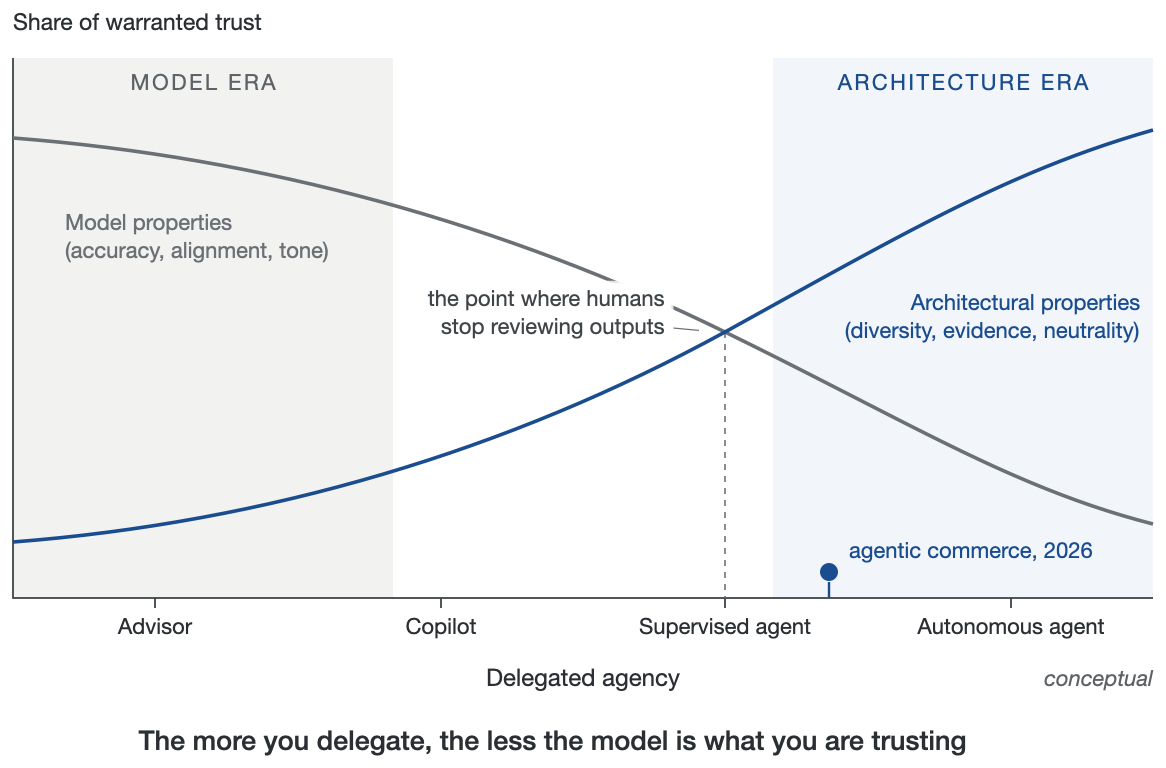
Deux courbes qui se croisent sur l'agentivité déléguée (conseiller → copilote → agent supervisé → agent autonome) : la part de confiance justifiée portée par les propriétés du modèle baisse à mesure que la part portée par les propriétés architecturales augmente ; le croisement est le point où les humains cessent d'examiner les résultats, et le commerce agentic (2026) se situe à sa droite. Les courbes et le point de croisement sont une illustration conceptuelle, pas des fonctions estimées.
À la littérature marketing sur la confiance des consommateurs envers l'IA (Huang & Rust, 2021 ; Puntoni et al., 2021) l'article ajoute une construction, la confiance architecturale, définie ici ; un test d'un antécédent technique de son mécanisme dans une étude pré-enregistrée de seize modèles, répliquée au niveau phare dans une deuxième vague à onze laboratoires ; cinq propositions pour un agenda de recherche consommateur (P1–P4 section 3 ; P5 section 5) ; et une expérience comportementale pré-enregistrée, compatible avec les incitations, portant les deux premières propositions, rapportée en totalité à la section 6 avec l'effet d'étalonnage soutenu (Welch d = 0.67 ; porté par un des six éléments, voir section 6) et le test de première exposition du dossier renvoyant un résultat nul inconclusif enregistré.
2. L'illusion de précision : ce qu'un seul modèle ne peut pas vous donner
Un service construit sur un seul modèle IA, aussi puissant que soit ce modèle, porte des déficits structurels qui vivent au-dessus de la couche du modèle.
Le premier est la confiance non calibrée, l'illusion de précision. Des modèles meilleurs ne signifient pas des transactions plus sûres, car la certitude exprimée par un modèle corrèle faiblement avec sa précision chez la plupart des vendeurs (la section 3 mesure les exceptions), et le consommateur ne peut pas vérifier l'écart. Le modèle est au plus dangereux quand il se trompe avec assurance au moment où le consommateur cesse de surveiller, et ce n'est pas un accident. Kalai et al. (2025) arguent que l'hallucination est statistiquement récompensée par un régime d'évaluation qui privilégie les suppositions confiantes à l'admission de l'ignorance. La récompense découle, selon leur propre analyse, des repères binaires et des objectifs d'entraînement qui dominent le domaine, où une mauvaise réponse coûte autant qu'un « je ne sais pas » et rapporte un crédit partiel en attente. Le modèle ne peut pas se policing lui-même de l'intérieur. Dans les expériences d'injection de concepts propres à Anthropic, les modèles les plus puissants du vendeur ont détecté les changements dans leurs états internes seulement environ 20 % du temps même dans les conditions d'injection optimales, ce qui est la mesure propre à la communauté des vendeurs de la fiabilité des rapports introspectifs (Lindsey, 2025 ; recherche de l'entreprise, non évaluée par les pairs, et une seule estimation provenant d'une étude d'un seul vendeur plutôt qu'un repère répliqué).
Le second est la distorsion flagorneuse, où la preuve est devenue causale cette année. Cheng et al. (2026), mesurant onze modèles de premier plan dans trois expériences pré-enregistrées avec 2 405 participants, ont constaté que les systèmes IA affirment les actions des utilisateurs 49 % plus souvent que les humains ne le font, y compris les actions impliquant la tromperie ou le préjudice, et qu'une seule interaction flagorneuse a augmenté la conviction des utilisateurs d'avoir raison tout en réduisant leur volonté de réparer les conflits. Les modèles flagorneurs étaient aussi ceux que les utilisateurs faisaient confiance et préféraient. Le gradient du marché pointe vers des assistants qui semblent dignes de confiance exactement en déformant le jugement de l'utilisateur, une dynamique observée bien avant qu'elle ne soit quantifiée (Sharma et al., 2024). Le réglage au niveau du modèle seul ne peut pas certifier indépendamment que le comportement flagorneur a été adéquatement contrôlé, car le réglage est effectué par la partie qui bénéficie de la préférence. Le coût est concret : un assistant qui accepte sa façon de contourner une exception de politique convertit l'amabilité directement en dépense de récupération de service. Une architecture orchestrée peut séparer les rôles, un modèle libre d'éprouver de l'empathie tandis qu'un modèle indépendant vérifie la politique, de sorte que l'amabilité et la justesse ne voyagent plus par le même canal.
Troisièmement, il n'existe pas de contrôle indépendant. Les erreurs sont détectées, sinon, par le même système qui les a produites, ou par le consommateur, qui s'est adressé à l'IA en premier lieu parce qu'il manque d'expertise pour la vérifier.
Quatrièmement, et moins discuté, il y a le conflit d'intérêts. Le fournisseur évaluant la qualité de l'assistant est celui qui le vend, ce qui est structurel : aucun service monovendeur ne peut être un juge neutre de ses propres résultats, pour la même raison qu'aucune banque ne pourrait diriger seule la chambre de compensation. Le conflit s'étend aux données elles-mêmes. Une classe d'action proposée déposée en mars 2026 allègue que Perplexity AI a acheminé les transcriptions de chat complètes des utilisateurs, comportant apparemment des sessions « Incognito », vers des réseaux publicitaires via des pixels de suivi intégrés. La plainte (n° 3:26-cv-02803, N.D. Cal.) a été volontairement rejetée en mai 2026 sans aucune décision sur le bien-fondé, de sorte que les allégations n'ont jamais été testées. La logique économique de la plainte est le point structurel indépendamment : lorsque la fourniture de réponses IA coûteuses est subventionnée par la monétisation de ce que disent les utilisateurs, le modèle commercial de l'assistant et la confidentialité du consommateur sont directement opposés. À l'intérieur d'un seul vendeur, aucune couche n'a le travail de prendre le parti du consommateur.
La littérature 2025-2026 se lit comme un diagnostic terminé en attente d'un remède (le tableau 1 mappe chaque déficit à ses preuves et sa réponse architecturale). La sycophanterie est quantifiée empiriquement (Cheng et al., 2026) et dérivée formellement : même un utilisateur idéalement rationnel s'enroule quand conseillé par un système sélectivement d'accord (Chandra et al., 2026). L'auto-monitoring échoue à environ 20 % de fiabilité (Lindsey, 2025), et l'hallucination est structurellement récompensée par le régime d'évaluation (Kalai et al., 2025).
Le remède réflexe, simplement révéler l'IA, se retourne contre lui : dans treize expériences, les acteurs qui ont révélé l'utilisation de l'IA ont été moins dignes de confiance que ceux qui ne l'ont pas fait (Schilke & Reimann, 2025). La divulgation fournit la transparence-divulgation, le simple fait qu'une IA ait été impliquée, et laisse de côté la transparence-vérification, la capacité de vérifier comment la réponse a été produite. L'audit épistémique est encore plus bleak : sur plus de 25 000 exécutions d'agents scientifiques basés sur les LLM, les preuves ont été ignorées dans 68 % des traces, les croyances ont été révisées sur réfutation seulement 26 % du temps, et les preuves convergentes multi-tests étaient rares, l'échafaudage expliquant presque aucune variance dans le comportement épistémique (≈1,5 %, contre ~41 % pour le modèle de base) (Ríos-García et al., 2026). Ce dernier nombre ressemble à une objection à cet article et en est en réalité le soutien le plus pointu : l'incitation et l'échafaudage ne peuvent pas rendre un modèle épistémiquement discipliné de l'intérieur, de sorte que la discipline doit être imposée de l'extérieur. L'architecture n'est pas un moyen d'améliorer l'épistémologie du modèle ; c'est un moyen de cesser d'en dépendre.
Chacun de ces résultats ferme une porte. Ensemble, ils pointent vers une réponse qui n'a pas beaucoup été explorée : si le modèle ne peut pas être approuvé de l'intérieur, et la divulgation ne fabrique pas la confiance de l'extérieur, la confiance justifiée peut être construite autour du modèle, par architecture, aux côtés (non au lieu de) d'une meilleure calibration, d'une certification externe, d'une escalade humaine et de règles de responsabilité. C'est la porte que cet article emprunte.
Tableau 1. Diagnostic → remède : les quatre déficits monovend, leurs preuves 2025-26, leur conséquence côté consommateur, et la réponse architecturale
| Déficit structurel | Preuves clés (2025–26) | Conséquence côté consommateur | Remède architectural | Mécanisme |
| Confiance non calibrée | L'hallucination est statistiquement récompensée par les régimes d'évaluation (Kalai et al., 2025) ; l'auto-rapport introspectif est fiable à environ 20 % (Lindsey, 2025) | Désabonnement en un coup : 60 % abandonneraient un agent après une erreur (ACI Worldwide, 2026) | Diversité + Preuve | Le désaccord intermodèle mesure la confiance (AUROC 0,75 c. 0,59, Gorbett & Jana, 2026; cet article: accord du panel AUROC 0,832 c. confiance individuelle regroupée 0,545 sur le panel le moins discriminant — hétérogène selon les panels, §3; les réponses répliquées sont 1,9–3,2× plus probablement correctes); les affirmations de confiance sont enregistrées et testables |
| Distorsion sycophante | Les IA affirment plus les utilisateurs de 49% par rapport aux humains; les modèles sycophantes sont préférés (Cheng et al., 2026; Sharma et al., 2024); même les bayésiens idéaux divergent (Chandra et al., 2026) | L'assistant préféré est celui qui déforme le jugement de l'utilisateur | Neutralité | L'arbitre n'a aucun intérêt à plaire à l'utilisateur; l'empathie et la vérification des règles sur des canaux séparés |
| Pas de vérification indépendante | Les agents ignorent les preuves dans 68% des traces; révision des croyances 26% (Ríos-García et al., 2026); l'échafaudage explique ~1,5% de la variance | La charge de vérification se déplace vers le consommateur: 54% des acheteurs assistés par IA vérifient manuellement tout deux fois (Gartner, 2026) | Diversité + Preuve | Discipline imposée de l'extérieur: chemins de vérification indépendants; preuves attachées quoi qu'il en soit |
| Conflit d'intérêt | Action collective Perplexity (2026, allégations): chats acheminés vers des réseaux publicitaires; la simple divulgation érode la confiance (Schilke & Reimann, 2025) | La partie conseillant le consommateur bénéficie du résultat | Neutralité + Preuve | Flux de données en chambre stérile; revenus indépendants des résultats; neutralité auditable à partir du dossier |
3. Confiance architecturale: trois propriétés qui peuvent être vérifiées plutôt que crues
Considérez maintenant un service dans lequel les demandes à enjeux élevés passent par une couche d'orchestration indépendante de tout fournisseur de modèles (la Figure 5 oppose les deux pipelines). Le Tableau 2 rassemble les construits; la définition qu'ils décomposent s'énonce: la confiance architecturale est une confiance justifiée du consommateur fondée sur des propriétés vérifiables du processus de prise de décision du service, plutôt que sur la qualité perçue de ses résultats ou la réputation de son fournisseur.
Le prédécesseur le plus proche est la production institutionnelle de confiance de Zucker (1986), la confiance fabriquée par la structure là où la familiarité ne peut la porter, que la recherche en commerce électronique a opérationnalisée en tant qu'assurance structurelle: escrow, feedback systems, third-party certification (Gefen, Karahanna, & Straub, 2003; Pavlou, 2003; Kim & Benbasat, 2010). Dans cette lignée, la confiance architecturale est une espèce de confiance basée sur les institutions dont l'assurance structurelle provient d'un processus vérifiable au lieu d'un garant tiers. C'est une confiance basée sur le processus dont la justification est passée de l'expérience à l'instrumentation, et ce déplacement est ce que le mot « architecturale » effectue dans le nom. Ce n'est pas l'assurance structurelle (McKnight, Choudhury, & Kacmar, 2002), la perception que des mesures de protection existent, car ici les mesures de protection elles-mêmes doivent être vérifiables, et ce n'est pas la confiance calibrée (Lee & See, 2004), qui adapte la confiance à l'enveloppe de fiabilité d'un système. L'architecture sans confiance en ingénierie de la sécurité partage le slogan, ne jamais faire confiance, toujours vérifier, mais elle vérifie l'identité et l'accès au niveau de la couche réseau, machine à machine, tandis que la confiance architecturale vérifie le contenu décisionnel au niveau de la couche service, pour un principal humain. Elles sont des compléments à différents étages du même bâtiment, pas des concurrentes. Le construit a deux faces, et la distinction appartient à la définition. La fiabilité architecturale est une propriété du système, la mesure dans laquelle son processus est en fait vérifiable, normative et constructible. La confiance basée sur l'architecture est un état du consommateur, une confiance réellement fondée sur cette vérifiabilité, empirique et seulement jamais gagnée. En termes de mesure, D, E et N sont des composantes formatives de la fiabilité architecturale (la propriété du système) et des signaux manipulables dont l'affichage façonne la confiance basée sur l'architecture (l'état du consommateur); les expériences manipulent les signaux et mesurent l'état. Chaque décalage entre les deux est prédictif. La confiance sans fiabilité, la confiance fabriquée par la fluidité et la sycophanterie, est prédite comme étant fragile, le motif du coup unique de la Section 1. La fiabilité sans confiance est prédite partout où la vérification est invisible ou illisible pour le consommateur, et est fermée par la saillance du reçu et la compréhension plutôt que par plus d'architecture. Les propositions de cette section vivent dans l'écart entre les deux, et la distinction discipline ce qui falsifierait l'hypothèse de migration de confiance. Ces falsificateurs sont comportementaux et préalablement engagés: l'hypothèse est réfutée si la délégation aux architectures vérifiables et opaques s'avère également durable en cas de défaillance (ce que P4 détecte); si l'effet de l'architecture vérifiable sur la volonté de délégation ne croît pas avec l'abandon du contrôle d'examen et d'exécution (le franchissement du niveau de délégation de P2); ou si, dans la délégation à haute irréversibilité, la rétention et les primes de volonté de payer pour une architecture vérifiable en cas de défaillance contrôlée sont absentes. Parce que la justification est définie par la survie à l'audit plutôt que par la présence de l'architecture (Section 1), la popularité compte comme preuve mais pas comme immunité. Le fait que les consommateurs se tournent vers des agents non vérifiables ne réfute pas en soi une réclamation concernant la confiance justifiée. La confiance soutenue et survivant aux défaillances envers des agents non vérifiables dans la délégation à enjeux élevés la réfuterait, et ce motif est préalablement engagé en tant que révision de l'hypothèse. La définition repose sur trois propriétés.
Figure 5. Deux pipelines
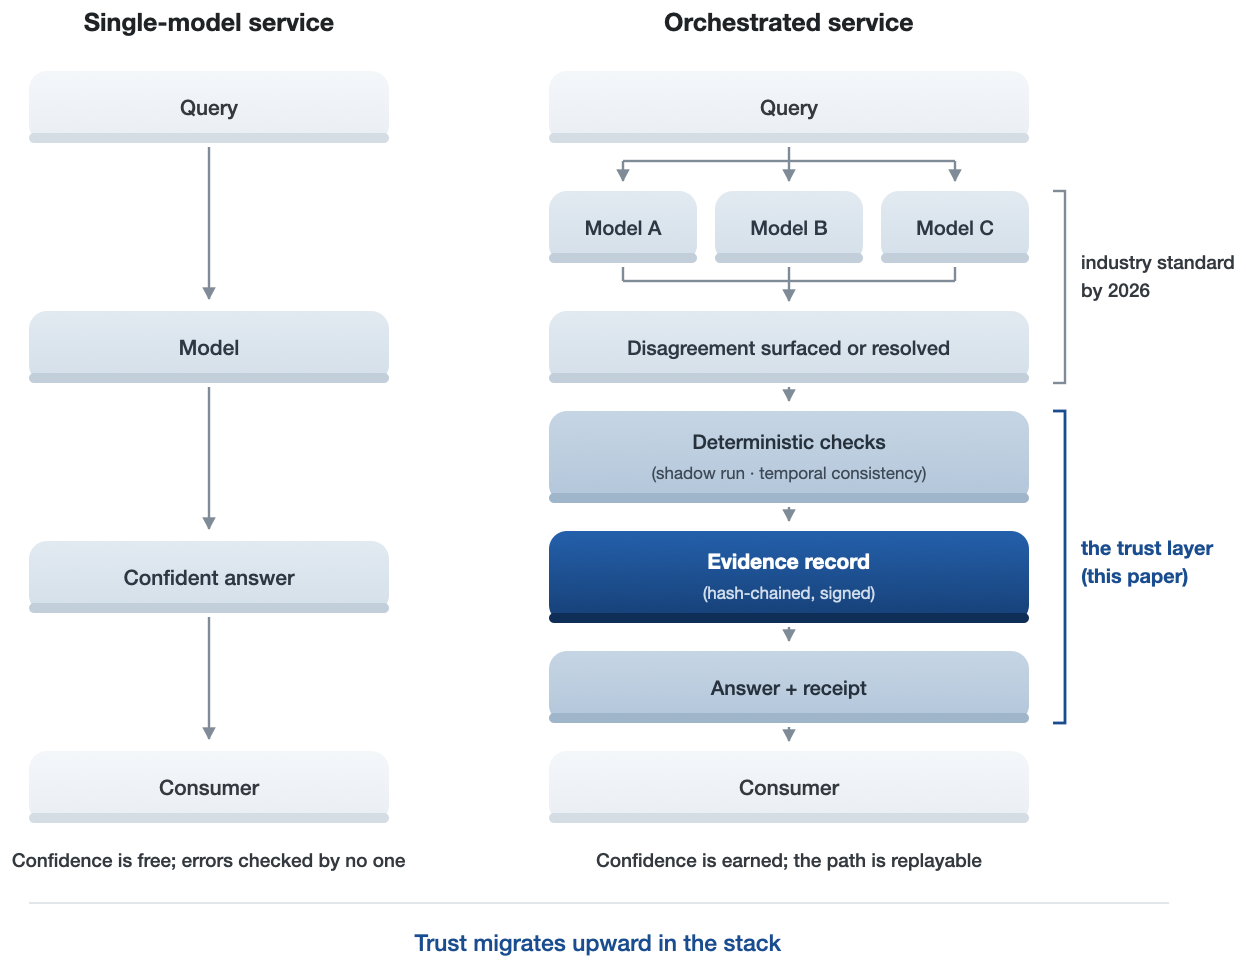
À gauche, le chemin du modèle unique: requête → modèle → réponse confiante → consommateur, où la confiance est libre et les erreurs ne sont vérifiées par personne. À droite, le chemin orchestré: requête → modèles indépendants (A/B/C) → désaccord mis en évidence ou résolu → contrôles déterministes (exécution fantôme, cohérence temporelle) → dossier de preuve (chaîné par hash, signé) → réponse avec reçu → consommateur, où la confiance est gagnée et le chemin est rejoué (le Tableau 5 résume le contraste).
Tableau 2. Glossaire des construits introduits ou spécifiés dans cet article
| Terme | Définition | À distinguer de |
| Confiance architecturale | Confiance justifiée du consommateur fondée sur des propriétés vérifiables du processus de prise de décision du service, plutôt que sur la qualité des résultats ou la réputation du fournisseur | Confiance fondée sur l'institution (ne nécessite aucune institution de confiance, seulement un processus vérifiable); confiance du système (pas l'enveloppe de fiabilité d'un seul système); confiance distribuée (dispersion sans vérifiabilité); assurance structurelle (mesures perçues par rapport aux mesures vérifiables); confiance calibrée |
| Fiabilité architecturale / confiance fondée sur l'architecture | Les deux facettes de la construction : la propriété du côté du système (dans quelle mesure le processus est en fait vérifiable; normatif, constructible) par rapport à l'état du côté du consommateur (confiance réellement fondée sur cette vérifiabilité; empirique, acquise) | Les traitements à un seul nom qui mélangent la revendication normative avec la revendication descriptive |
| Couche de vérification | La couche d'infrastructure au-dessus de l'orchestration dont le produit est la vérifiabilité : vérifications indépendantes, décisions enregistrées, neutralité vérifiable | Observabilité/surveillance (interne, détenue par le fournisseur, non vérifiable par le consommateur) |
| Infrastructure de preuves | La catégorie de marché des historiques de décisions vérifiables vendus en tant qu'infrastructure, comme le cloud, l'identité et les paiements sont vendus | Enregistrement (unilatéral, mutable, non un bien marchand) |
| Reçu d'orchestration | Un artefact minimal face au consommateur : qui a agi; comment ils ont accepté; qu'est-ce qui a été vérifié — avec un pointeur vers l'enregistrement entièrement rejouable | Explication/sortie XAI (narrative, non vérifiable); étiquette de divulgation (érode la confiance en elle-même) |
| Architecture de confiance graduée | Escalade de la profondeur de vérification en fonction des enjeux, de sorte que la couche coûteuse n'est achetée que là où les conséquences se concentrent | Garde-fous plats (plafonds statiques/listes blanches qui ne vérifient pas les décisions) |
| Preuve de décision | Le troisième étage de la pile de preuves : comment l'agent a choisi — panel, divergence, vérifications | Preuve d'identité (qui est l'agent : TAP); preuve d'intention (ce qui a été autorisé : AP2 / Intention vérifiable) |
| Hypothèse de migration de confiance | Plus l'agentivité déléguée est grande, plus la part de confiance justifiée qui doit résider dans les propriétés architecturales vérifiables plutôt que dans les propriétés du modèle est grande — « justifiée » signifiant une confiance qui survit à un audit objectif par rapport à des critères fixés avant que les résultats ne soient connus (selon Jacovi et al., 2021); forme du mécanisme : à mesure que la délégation s'approfondit, la part de fiabilité — f(capacité, intégrité, bienveillance), Mayer et al. (1995) — que le consommateur peut mesurer indépendamment se déplace vers les composants architecturaux | Les utilisations antérieures de « migration de confiance » (Carlson, 2026) suivent la confiance se déplaçant entre les parties; cette hypothèse suit le type de propriété qui la justifie — avec des falsificateurs de comportement pré-engagés (croisement de délégation P2; durabilité différentielle P4) |
La délimitation par rapport aux construits de confiance voisins peut être comprimée dans un seul tableau discriminant, selon ce que chaque construit prend comme objet, d'où provient sa justification, qui peut vérifier cette justification et ce qu'il devrait principalement prédire :
Tableau 2a. Délimitation discriminante : construits de confiance voisins par objet, justification, vérificateur et résultat principal prédit
| Construction | Objet de confiance | Source de justification | Qui peut vérifier | VD principal prédit |
| Confiance fondée sur l'institution / assurance structurelle (Zucker, 1986; McKnight et al., 2002) | Le contexte institutionnel : mesures de sauvegarde, garanties, certification tierce | Présence perçue de structures et de garants | Un garant tiers, le cas échéant; le consommateur perçoit plutôt que de vérifier | Croyances de confiance; intention de transaction |
| Confiance dans l'automation / confiance calibrée (Lee & See, 2004) | L'enveloppe de fiabilité d'un système automatisé | Fiabilité expérimentée lors d'utilisations répétées | L'opérateur, grâce à l'expérience cumulée avec ce système | Pertinence de la confiance dans ce système |
| Transparence algorithmique (XAI) | Le compte rendu du modèle de sa propre décision | Un récit ou une attribution produit à l'intérieur du système en question | Personne de manière indépendante — une explication n'est pas un enregistrement rejouable | Compréhension; confiance subjective; acceptation |
| Confiance de marque / confiance du fournisseur | L'organisation du fournisseur | Réputation et performance passée | Le marché, lentement, par les résultats agrégés | Préférence mondiale; choix; fidélité |
| Confiance architecturale (cet article) | Le processus de production des décisions et son enregistrement | Propriétés vérifiables : accord indépendant, preuves rejouables, indépendance des incitations vérifiable | Le consommateur, un auditeur, un assureur, un régulateur — par décision | Confiance calibrée; volonté de déléguer; rétention après défaillance |
Deux prédictions différentielles rendent la délimitation testable plutôt que taxonomique. La confiance architecturale devrait affecter la confiance calibrée et la rétention après défaillance plus fortement qu'elle n'affecte la préférence mondiale du service, alors que la confiance de marque devrait montrer le profil opposé, une dissociation qu'une seule expérience peut détecter en mesurant les deux familles de VD. À faible agentivité déléguée, la confiance de marque et du fournisseur devrait dominer les décisions de délégation, la confiance fondée sur l'architecture expliquant une part supplémentaire croissante à mesure que la délégation s'approfondit, le croisement que P2 et l'hypothèse de migration de confiance mettent à l'épreuve. Deux clarifications suivent. Parce que la fiabilité architecturale est une propriété du service, non une variable latente réflexive dans l'esprit du consommateur, sa distinction repose sur ces prédictions différentielles plutôt que sur les statistiques discriminantes d'échelle. Pour l'état du côté du consommateur qu'elle désigne, la confiance fondée sur l'architecture, l'établissement de la validité discriminante au niveau de la mesure par rapport aux échelles adjacentes (confiance fondée sur l'institution et confiance calibrée) fait partie de l'agenda de mesure, et non une affirmation faite ici.
Diversité. La demande est traitée par plusieurs modèles indépendants, chacun provenant de fournisseurs différents, avec des données d'entraînement et des modes de défaillance distincts. (Il s'agit de la diversité de panel, une propriété de qui vérifie la réponse, et non de la diversité de recommandation au sens des systèmes de recommandation, qui varie les éléments présentés à un consommateur.) Leur accord porte de l'information. La convergence renforce une confiance justifiée. La divergence est présentée au consommateur comme une incertitude plutôt que d'être résolue invisiblement, et sur les demandes importantes elle double un déclencheur d'escalade. En termes de prédiction sélective, il s'agit d'une abstention architecturale : le refus d'émettre une réponse non vérifiée, soulevé jusqu'à la couche de service, où un cas non résolu est dirigé vers un humain plutôt que certifié. C'est le schéma learning-to-defer, dans lequel l'option de rejet d'un système confie le cas à un expert en aval plutôt que de le supprimer (Mozannar & Sontag, 2020 ; cf. Rabanser et al., 2026). L'analogue humain le plus proche est l'avis médical secondaire, dont toute la valeur réside dans son indépendance du premier. Le désaccord orchestré n'est pas exotique non plus : le co-scientifique IA de Google, dont les découvertes validées en laboratoire humide ont atteint Nature en mai 2026 (Gottweis et al., 2026), est construit comme une orchestration génération-critique-tournoi.
La justification théorique pour s'appuyer sur la diversité est antérieure aux modèles de langage. Sous certaines conditions formelles, des groupes fonctionnellement diversifiés de résolveurs de problèmes peuvent surpasser des groupes sélectionnés pour leur capacité individuelle, car la sélection pour l'habileté génère la similitude (Hong & Page, 2004). La littérature d'ingénierie fournit des preuves directes du signal sous-jacent : le débat structuré entre modèles améliore la précision factuelle (Du et al., 2024), et les panels de modèles plus petits et diversifiés surpassent un seul juge de grande taille (Verga et al., 2024). La « surprise » d'un deuxième modèle face à la réponse d'un premier modèle sépare le juste du faux bien mieux que la confiance du modèle répondant lui-même (AUROC moyen 0,75 contre 0,59 sur MMLU ; AUROC, la zone sous la courbe ROC, est la probabilité qu'une réponse correcte aléatoire soit classée au-dessus d'une réponse incorrecte aléatoire ; Gorbett & Jana, 2026). Leur signal est la perplexité inter-modèle au niveau de la logit, tandis que celui de cet article est la réplication au niveau de la réponse, et les deux sont liés sans être interchangeables. Leur générateur est aussi un petit modèle ouvert avec un auto-rapport faible, une ligne de base que les propres données de cet article délimitent, car l'avantage du panel est une fonction de l'étalonnage du générateur et peut s'inverser pour les générateurs bien étalonnés, le cas de la frontière américaine ci-dessous. Et l'échantillonnage de plusieurs générations et la mesure de leur accord sémantique détectent les confabulations où la confiance à une seule passe ne peut pas (Farquhar, Kossen, Kuhn, & Gal, 2024). Un modèle peut mesurer son propre doute mais pas ses propres points aveugles, et l'erreur systématique confiante n'est visible que de l'extérieur. Mais cette littérature traite le désaccord comme un signal interne pour les développeurs. Le mouvement que je propose est de le traiter comme une primitive de confiance tournée vers le consommateur, exposée, enregistrée et intégrée dans les revendications de confiance du service, l'ablation de cet article séparant ce que le débat découvre de ce que la vérification certifie plutôt que de laisser l'un faire semblant d'être l'autre. La démarcation est aussi bien empirique que conceptuelle : en benchmark tête-à-tête, le débat multi-agent ne surpasse pas de manière fiable les stratégies plus simples telles que l'auto-cohérence et l'ensemble (Smit et al., 2024). La revendication ici concerne le signal de certification tournée vers le consommateur de la vérification plutôt que le gain de précision du débat, et ce signal subsiste même là où l'avantage du débat ne le fait pas.
Dans la recherche sur la délibération multi-agent, de même, les systèmes construits pour exposer les accords et les désaccords plutôt que de les moyenner produisent des décisions jugées plus représentatives (Liu et al., 2026). Le mécanisme a un analogue humain direct du côté de l'étalonnage des connaissances : les consommateurs qui prennent des décisions financières conséquentes conjointement sont substantiellement moins surconfiants que les décideurs seuls, avec le métasavoir partagé (le partenaire exposant ce que le décideur ne sait pas) identifié comme le mécanisme moteur (Piehlmaier, 2023). Le jugement conjoint discipline la confiance chez les humains pour la même raison que l'accord inter-modèle est proposé pour la discipliner ici.
La question de savoir si les consommateurs peuvent utiliser un tel signal est réelle. Les gens abandonnent les algorithmes rapidement après les avoir vu errer (Dietvorst, Simmons, & Massey, 2015), pourtant ailleurs surpondèrent les conseils algorithmiques (Logg, Minson, & Moore, 2019), une division qui peut elle-même suivre les enjeux. Les expériences d'avis secondaire avec des sujets humains montrent que le matériau brut est comportementalement vivant : une adhésion quasi unanime quand une IA médicale et un médecin s'accordent, des scissions nettes quand ils divergent (Detjen, Densky, von Kalckreuth, & Kopka, 2025 ; Chen, Sun, Liao, & Sundar, 2026), bien qu'aucun de ces travaux ne fasse varier le désaccord conjointement avec la preuve ou la neutralité. Le flux de recherche consommateur affine les conditions limites (systématiquement : Burton, Stein, & Jensen, 2020). L'aversion s'intensifie quand les consommateurs sentent que leur cas est unique (Longoni, Bonezzi, & Morewedge, 2019), varie avec l'objectivité de la tâche (Castelo, Bos, & Lehmann, 2019), et les défaillances d'une IA sont facilement surgénéralisées à d'autres, transfert algorithmique (Longoni, Cian, & Kyung, 2023). Si la méfiance se généralise entre systèmes, alors l'abandon à un coup de la section 1 n'est pas la rotation d'un service mais celle de la catégorie, et la détection d'erreurs structurellement protège le marché lui-même. Le désaccord exposé se situe à cette ligne de faille, et P1–P2 ci-dessous sont un pari sur quel effet domine quand l'incertitude est présentée spécifiquement et sans lissage.
Quand la diversité échoue : erreurs corrélées. La valeur de la diversité repose entièrement sur l'indépendance des défaillances, et l'indépendance ne peut pas être supposée. Les modèles de pointe s'entraînent sur des corpus qui se chevauchent, se distillent les uns des autres et partagent manifestement des idées fausses assurées. Quand deux modèles leaders manquent tous les deux le même élément de benchmark, ils s'accordent sur la même mauvaise réponse environ 60 % du temps, la corrélation étant la plus forte entre les modèles du même développeur ou de la même architecture de base et, plus inquiétant encore, entre les modèles les plus précis : à mesure que la capacité augmente, les erreurs convergent (Kim et al., 2025). Cette conclusion est une contrainte directe sur le composant Diversité de cet article, et non simplement un résultat connexe. L'indépendance que la Diversité présuppose est partiellement illusoire à la frontière, et parce que la corrélation se renforce exactement là où la capacité est la plus élevée, la contribution du composant est une quantité qui s'érode et se mesure plutôt qu'un actif fixe. Ce qu'ajoute un panneau doit être démontré question par question, et la trajectoire du développement des modèles va contre elle. En matière de prévision, les corrélations d'erreur par paires entre les modèles de pointe s'élèvent en moyenne à r ≈ 0,77 (Spiro, 2026), une redondance suffisamment élevée pour éroder la plupart des bénéfices d'agrégation qu'une foule diversifiée est censée apporter.
La structure du marché aggrave la préoccupation. Fin 2025, 88 % des dépenses des entreprises en API LLM étaient concentrées chez trois fournisseurs à poids fermé : Anthropic à 40 %, OpenAI à 27 %, Google à 21 % (Menlo Ventures, 2025b ; Menlo est un investisseur d'Anthropic). Un panneau assemblé sans réfléchir à partir des « modèles leaders » est donc tiré d'une base de fournisseurs de trois entités dont les erreurs sont exactement celles mesurées pour converger, le trio même que l'expérience ci-dessous reproduit comme son panneau de frontière américaine. Quand trois modèles convergent sur la même erreur à la mode, l'architecture n'échoue pas simplement à la détecter ; elle la certifie. Dans les essaims homogènes, l'ajout d'agents stabilise une trajectoire erronée plutôt que de la corriger, un point d'arrivée que la littérature multi-agents appelle le paradoxe du consensus (Shehata & Li, 2026). La corrélation est donc le mode de défaillance que l'architecture doit être construite pour détecter (Figure 6).
Figure 6. L'illusion de la diversité
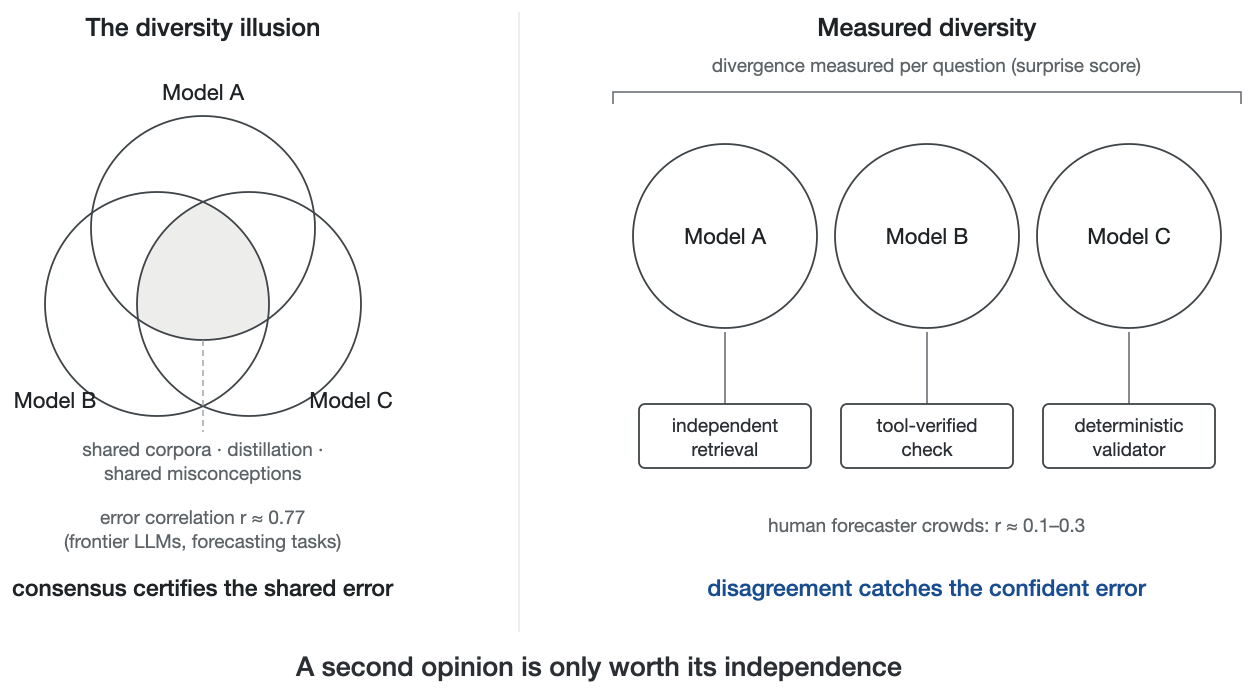
Consensus entre quasi-clones par rapport à un panneau dont l'indépendance est mesurée.
Elle a un homologue interactionnel : le gradient de sycophantisme fonctionne entre les modèles aussi. Les études multi-agents trouvent une conformité de groupe mesurable dans la délibération des IA, les modèles plus faibles se conformant le plus fortement (Choi, Kim, Chae, & Baek, 2025) ; les agents pondèrent une position selon qui la propose (Choi, Zhu, & Li, 2026) ; et une grande partie de ce qui ressemble à une convergence se décompose en conformité sociale plutôt qu'en raisonnement (Hao et al., 2026). Dans la délibération conjointe, l'accord est l'état de basse énergie, donc un panneau qui débat avant de s'engager sur les positions peut se parler en consensus plutôt que vers la vérité. Le contre-projet architectural est procédural : les opinions sont d'abord collectées en aveugle et indépendamment, et seulement alors comparées (Figure 7).
Figure 7. Aveugle-indépendant-d'abord
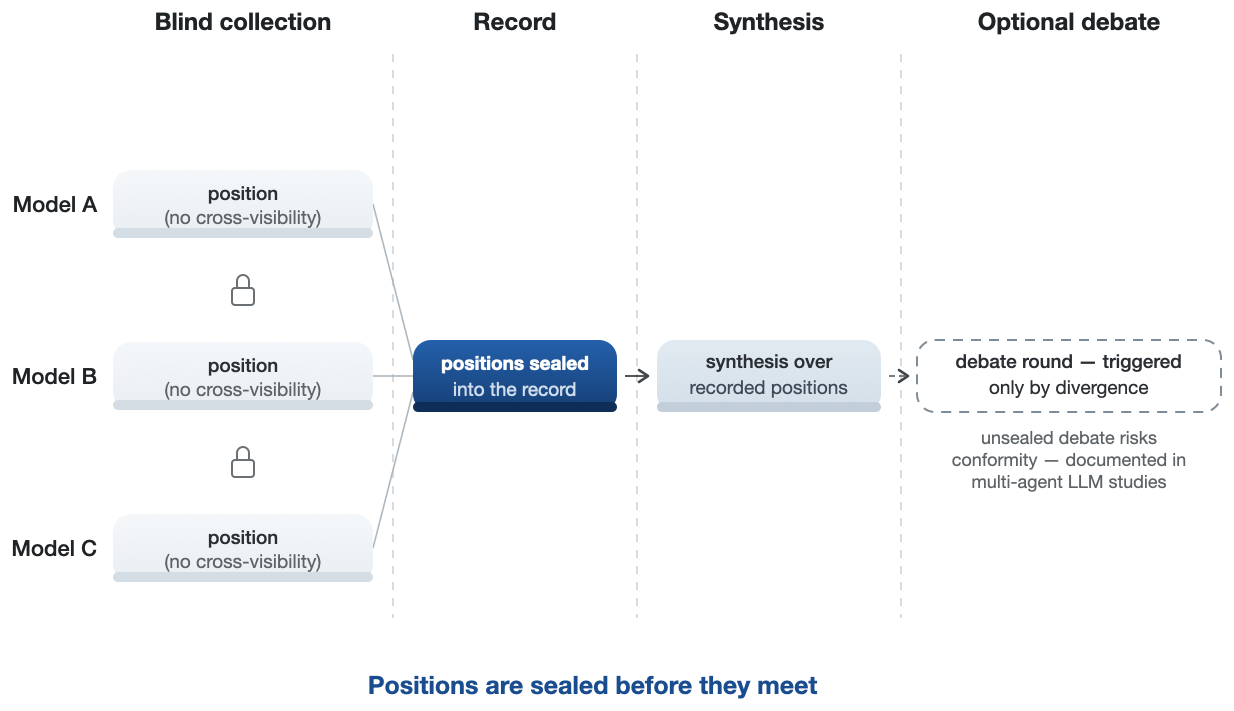
Les positions sont enregistrées et seulement ensuite comparées — la procédure qui protège les désaccords que la conformité effacerait.
L'expérience rapportée ci-dessous a chiffré ce que cette procédure protège. Dans un bras exploratoire apparié, les vérificateurs qui avaient en aveugle produit une réponse différente se sont ensuite vu montrer la réponse erronée assurée du modèle principal et on leur a demandé s'ils étaient d'accord. 38,5 % (168 sur 436 paires divergentes ; IC 95 % 33,6–43,2, bootstrap groupé par question) ont abandonné leur propre réponse divergente et ont approuvé l'erreur, la conformité au niveau des fournisseurs allant de 20 % à 58 %. L'abandon se divise par ce qui a été abandonné, ce qui sépare la conformité de la déférence rationnelle. Parmi les vérificateurs dont la réponse en aveugle était elle-même correcte, 29,1 % (41/141) l'ont néanmoins abandonnée pour la mauvaise réponse assurée, le noyau nuisible qu'aucun compte bayésien n'absout, contre 43,1 % (127/295) parmi les réponses erronées en aveugle, où une certaine déférence est défendable. (L'intervalle groupé par question est presque identique à celui au niveau des paires naïf. Les 436 paires s'étendent sur 247 questions distinctes, la plupart ayant une ou deux paires par question et jamais plus de quatre, donc le rééchantillonnage au niveau des questions a presque aucune covariance intra-cluster à ajouter.) Avec le contrôle miroir ci-dessous plié, environ 35–39 % des dissidents en aveugle changent de position quand on leur montre une réponse assurée, quelle que soit sa valeur de vérité, avec un léger biais net significatif vers la réponse proposée (conformité nette ≈ 4 points de pourcentage ; paires discordantes 104 vs 70 ≈ 1,49). Si le panneau avait délibéré avant de s'engager sur les positions, une grande part de ces désaccords aurait été renégociée avant de pouvoir être enregistrée. Mais parce que 34,7 % des retournements du bras miroir vont vers la vérité, la délibération aurait aussi converti une certaine dissidence en consensus correct, donc ce que la procédure aveugle-d'abord protège est la mesure elle-même, et non un compte des désaccords perdus. La procédure aveugle-d'abord est la différence entre mesurer le désaccord et fabriquer le consensus, la même règle dont les foules humaines avaient besoin : l'influence sociale effondre la diversité des estimations indépendantes sans améliorer leur précision (Lorenz, Rauhut, Schweitzer, & Helbing, 2011), et même une seule approbation précoce arbitraire biaise mesurément les jugements ultérieurs (Muchnik, Aral, & Taylor, 2013).
Un contrôle à l'invite inversée traite l'explication alternative selon laquelle ces retournements reflètent une mise à jour rationnelle des croyances plutôt que de la conformité. J'ai répété la procédure appariée sur un panneau local à six modèles, montrant aux vérificateurs qui avaient désaccordé en aveugle soit la mauvaise réponse assurée (bras direct) soit la réponse correcte (bras inverse) pour le même ensemble de questions. Les taux de retournement étaient quasi symétriques, 38,9 % vers la mauvaise réponse contre 34,7 % vers la réponse correcte, et dans la comparaison intra-paire les vérificateurs ont abandonné leur position en aveugle pour la mauvaise réponse significativement plus souvent que pour la réponse correcte (104 vs 70 paires discordantes ; McNemar p = ,010). La mise à jour rationnelle prédit l'asymétrie opposée. Les propensions de retournement par modèle étaient essentiellement identiques dans les deux bras aux deux extrêmes de la conformité (les comptages de paires par modèle sont petits et ne sont pas séparément alimentés ; ils sont rapportés de manière descriptive, avec leurs ns, dans le paquet de réplication), indiquant que l'accord est entraîné par la présence d'une réponse proposée avec assurance, et non par sa valeur de vérité. Ce contrôle a été exécuté sur le tier local. L'estimation du panneau de frontière (38,5 %) repose sur la même procédure mais n'a pas été testée en miroir avec les vérificateurs de frontière.
La collecte aveugle ne peut fermer un canal : elle défait la sociale conformité mais pas la préalable conformité. Les modèles convergent parce que les données d'entraînement partagées leur donnent les mêmes priors, et les jumeaux répondent de la même manière sans jamais conférer. J'appelle cela la convergence de sosies : un panneau d'accord parce que ses membres se ressemblent, pas parce qu'ils ont raison.
Les priors corrélés devraient toujours être mesurés. Les scores de surprise entre modèles fournissent une estimation en continu de l'indépendance réelle du panneau, question par question, et ils sont sans étiquettes, de sorte que l'indépendance peut en principe être estimée au temps d'inférence sans réponses de référence. L'estimation au moment de la production n'est pas testée ici. La diversité doit aussi transcender les poids du modèle, car les chemins de récupération indépendants, les vérifications validées par les outils, et les validateurs déterministes rompent le canal de corrélation que l'entraînement partagé crée. Le besoin augmentera plutôt que de diminuer, car la distillation et l'entraînement par données synthétiques homogénéisent les poids du modèle au fil du temps, de sorte qu'on devrait s'attendre à une décroissance de la diversité mesurée et à un déplacement du fardeau de la vérification vers les vérificateurs non-modèles. Et ce qui est mesuré doit être divulgué : le dossier devrait porter non seulement « N modèles d'accord » mais la diversité estimée du panneau sur cette classe de question. Le consensus parmi les quasi-clones mérite une affirmation de confiance moins forte, et le dossier devrait indiquer lequel le consommateur a reçu.
Preuve. Chaque réponse importante porte un dossier : quels modèles ont été consultés, où ils ont été d'accord et en désaccord, ce qui a été vérifié, sur quoi repose la synthèse. Le calendrier favorise cette exigence, car à mesure que les agents ancrent les réponses dans la récupération et les outils, la base factuelle vit déjà en dehors du modèle, de sorte que l'enregistrement devient un sous-produit de la production de la réponse. Parce que le dossier est tel que toute modification est évidente, l'historique des décisions du service peut être rejoué par le consommateur en cas de litige, par un auditeur, par un assureur fixant le prix de la responsabilité. La confiance cesse d'être une sensation à propos d'une marque et devient une propriété examinable d'un historique.
Deux mécanismes étendent la preuve des réponses aux actions. Sous l'exécution fantôme, une action aux effets externes est simulée dans une exécution à blanc enregistrée, de sorte que « l'agent a vérifié avant d'agir » devient une affirmation vérifiable au lieu d'un slogan. La cohérence temporelle repose à nouveau une recommandation à travers les sessions ou les formulations et enregistre sa stabilité, de sorte qu'une réponse qui change quand posée deux fois est signalée avant que quiconque n'en dépende. Au niveau de l'identité, la couche de dossier s'étend dans un passeport de provenance portable pour l'agent lui-même : quels modèles, versions et stratégies ont agi, quand, sous l'autorité de qui. C'est l'artefact que les schémas d'enregistrement « connaître votre agent » et les engagements d'assurance contre les erreurs d'agent supposent tranquillement. Le rendu destiné au consommateur de ce dossier est le reçu d'orchestration de la Figure 8 : une action, un dossier, quatre publics (consommateur, assureur, auditeur, régulateur).
Figure 8. Le reçu d'orchestration, vendu deux fois (maquette)
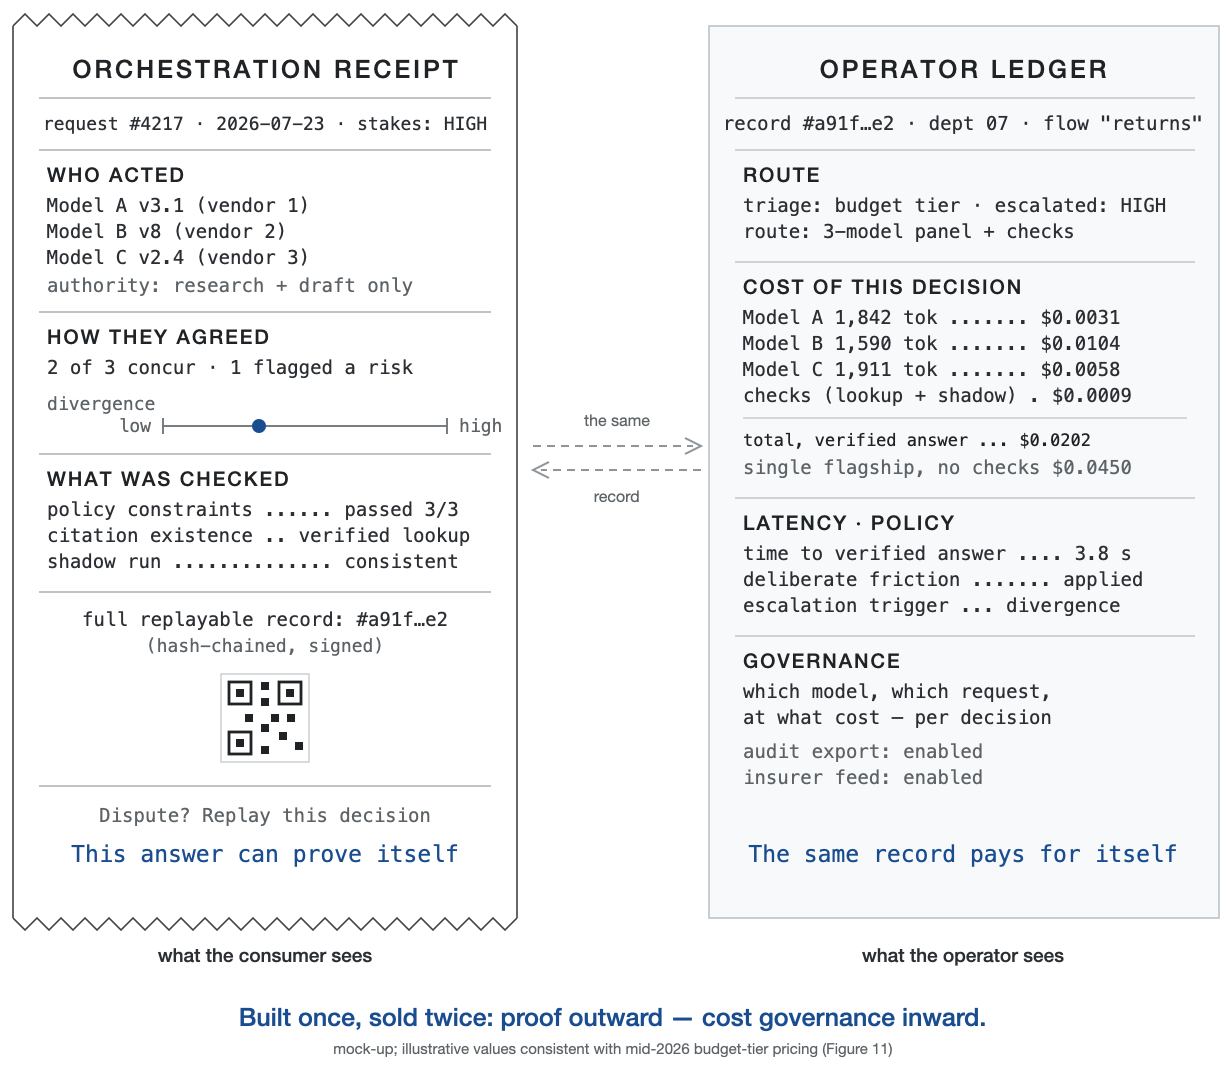
Le consommateur voit la preuve — qui a agi, comment ils se sont mis d'accord, ce qui a été vérifié ; l'opérateur voit le même dossier comme gouvernance des coûts. En cas de litige, le reçu transforme la parole contre la parole en dossier contre les paroles.
Neutralité. La neutralité est l'indépendance d'incitations auditables : l'absence de dépendance économique non divulguée envers tout fournisseur particulier, commerçant, ou résultat décisionnel. La couche d'orchestration achemine vers les modèles qui fonctionnent le mieux pour la tâche et n'a aucun intérêt dans celui qui gagne, structurellement analogue aux couches de compensation indépendantes dans les paiements. Un arbitre parmi les fournisseurs peut être digne de confiance de manière qu'aucun fournisseur ne peut l'être concernant ses propres intérêts. L'indépendance désigne la propriété économique, et l'auditable la lie à la couche de preuve qui rend l'affirmation vérifiable plutôt que simplement professée, la discipline de compensation développée ci-dessous. (La neutralité ici est une propriété économique, non une équité algorithmique entre groupes démographiques, ce qui est une exigence orthogonale.)
Il y a aussi le problème d'intégration verticale : la neutralité est structurellement indisponible pour les plateformes les mieux positionnées pour construire l'orchestration à l'échelle. Une entreprise qui est simultanément marché, fournisseur de modèles, réseau publicitaire et fournisseur de logistique ne peut arbitrer neutralement, car chaque décision d'acheminement qu'elle prend est une décision sur ses propres revenus. L'arithmétique pointe une tendance structurelle. Le cadre implique que la couche de confiance s'installe mieux avec les parties dont le seul métier est l'arbitrage lui-même, la voie par laquelle la compensation, l'audit et la notation de crédit sont devenues des industries indépendantes. Le cas des agences de notation est aussi la mise en garde canonique que les intermédiaires indépendants développent leurs propres conflits d'intérêts (modèle payeur-émetteur). C'est bien documenté en économie : les intermédiaires de certification capturent de la valeur en contrôlant quelle information est révélée (Lizzeri, 1999), les marchés de certification échouent de manières bien cataloguées (Dranove & Jin, 2010), et l'effondrement de la notation de crédit a montré l'échec canonique, les revenus payeur-émetteur corrompant le certificateur un niveau au-dessus, tandis que les couches de compensation qui ont survécu sont financées par coût mutualisé, non par les parties notées. L'exigence de neutralité s'étend donc au propre modèle de revenus de l'orchestrateur : une couche de vérification payée par les fournisseurs ou commerçants qu'elle classe reproduit le conflit qu'elle existe pour supprimer, c'est pourquoi la conception des revenus ici va du côté du consommateur et vers la gouvernance des coûts de l'opérateur (Section 5), non vers les parties classées.
La neutralité a aussi une dimension relative aux données. Une couche d'orchestration peut fonctionner comme une salle blanche : les demandes parviennent à chaque fournisseur privées de l'identité utilisateur, aucun fournisseur ne voit l'historique d'interaction complet, et les revenus de l'orchestrateur proviennent du service, non de la canalisation de ce que disent les utilisateurs vers des réseaux publicitaires. La neutralité est une indépendance d'incitations sur les deux fronts : aucune dépendance économique non divulguée envers tout fournisseur de modèles ou commerçant, et aucun modèle commercial qui transforme les paroles du consommateur en revenus au détriment du consommateur.
Mais la neutralité invite sa propre régression : qui audit l'orchestrateur ? Une « absence totale d'intérêt » est inatteignable. Tout orchestrateur a des coûts, des partenariats, des incitations à la rétention et sa propre survie à financer, donc la variable opératoire n'est pas leur absence mais leur nature, leur divulgation et leur auditabilité à partir du registre. La partie qui paie ne règle pas la neutralité ; c'est que le revenu du payeur soit indépendant de l'issue de la transaction qui le fait. Un abonnement consommateur, ou une rémunération d'un assureur ou auditeur dont le paiement est découplé du produit gagnant, satisfait la condition ; une commission marchande ou une rémunération publicitaire ne le font pas. La gouvernance plus large de qui finance la couche reste ouverte, et l'indépendance auditable de ce financement est la partie que la construction fixe. Une couche d'orchestration a aussi des incitations : router vers les modèles bon marché, vendre à outrance sa couche coûteuse, façonner la synthèse commodément. La régression a quatre décennies. Shapiro (1987) l'a nommée le problème des gardiens : les garanties procédurales génèrent de nouveaux gardiens qui doivent eux-mêmes être gardés, et la réponse institutionnelle n'a pas changé depuis.
Les chambres de compensation gagnent leur position de confiance en étant auditables et régulées de l'extérieur, non en déclarant la neutralité. L'orchestrateur ne possède pas la neutralité comme vertu. La couche d'évidences est ce qui la rend vérifiable. Chaque décision de routage, réponse de modèle et étape de synthèse atterrissent dans un registre infalsifiable, un journal hashé, signé et conçu pour l'ancrage temporel externe, de sorte que la neutralité affirmée de l'orchestrateur est exposée exactement à la vérification qu'il impose aux modèles. Le chemin de maturité est le scénario de la chambre de compensation concrétisé : ancrage temporel externe, une interface de vérification ouverte, et audit tiers périodique de la politique de routage. La conception institutionnelle de tels écosystèmes d'audit est déjà un programme de recherche nommé (Raji, Xu, Honigsberg, & Ho, 2022). Une dépendance survit même à un audit des vérificateurs : les modèles du panel peuvent être indépendants les uns des autres mais tous sélectionnés par la plateforme vérifiée, c'est pourquoi le terme du chemin de maturité est la sélection et la rotation du panel lodgées en dehors du contrôle d'une seule partie. Un orchestrateur dont les registres ne peuvent être audités n'est qu'un fournisseur de plus demandant à être cru. Les plus proches voisins en dehors de la recherche consommateur sont deux travaux concurrents de 2026. Marchal et al. (2026) plaident le même virage évaluatif, du jugement des résultats à l'architecture de la fiabilité, la provenance et la falsifiabilité des agents, au niveau de l'infrastructure épistémique, et Wang et al. (2026) examinent la provenance de l'exécution comme une couche de responsabilité au niveau du processus pour la vérification, l'audit et l'attribution des défaillances. Ce qui reste propre à cet article est la composition tournée vers le consommateur et consciente des incitations : les trois propriétés groupées comme l'objet de la confiance justifiée d'un consommateur dans le commerce délégué, et son test comportemental.
La composante d'évidences porte une démarcation, parce que l'infalsifiabilité est facilement survalorisée : un journal hashé établit la provenance et l'intégrité (que ce registre existait et n'a pas été altéré par la suite), non la complétude (rien dans le hash ne garantit que les appels omis n'ont pas été supprimés), non l'exactitude (un registre fidèle d'une mauvaise réponse est toujours mauvais), non l'indépendance, et non l'alignement des incitations. Chacun est une propriété distincte avec son propre mécanisme de vérification : attestation de couverture, audit de résultat, diversité mesurée, économie divulguée. Un reçu ne devrait revendiquer que les propriétés que son registre porte effectivement. Une limite supplémentaire est structurelle : un journal prouve ce qui a été routé, non pourquoi, et l'heuristique propriétaire derrière le choix de ce modèle ou ce marchand n'est auditable que si la politique de routage elle-même est divulguée ou attestée, un choix de gouvernance, non une conséquence cryptographique. Les coûts de l'architecture appartiennent au même registre : router une requête vers plusieurs fournisseurs multiplie l'exposition à la vie privée, un journal de décision centralisé est une cible de sécurité attrayante, et un affichage de consensus peut fabriquer exactement l'autorité que le résultat d'erreur de consensus avertit contre.
La construction vaut aussi la peine d'être démarcée de ses voisins d'ingénierie, parce que « utiliser plusieurs modèles » décrit plusieurs choses différentes avec différentes propriétés de confiance. Le vote d'ensemble simple améliore la précision mais résout le désaccord invisiblement, donc rien ne devient vérifiable. L'échantillonnage d'auto-cohérence re-demande au même modèle, qui est la diversité en apparence seulement. Le mélange d'experts route dans un seul système entraîné dont le routeur est optimisé pour la capacité, non la neutralité. Le débat multi-agents (Du et al., 2024) améliore les réponses mais traite la délibération comme une mécanique interne : aucun registre tourné vers le consommateur, aucune économie, aucune garantie de neutralité.
Les agrégateurs de routage de modèles, en 2026 une couche de base, sont multi-fournisseurs dans le catalogue mais un modèle par réponse : le routeur choisit un modèle sur la base du coût et de la latence, et aucun deuxième avis n'est jamais collecté. Les agrégateurs sont des fournisseurs à une architecture de vérification, non des substituts pour une.
L'exploitation multi-modèles n'est plus exotique non plus : 37 % des entreprises exécutaient cinq modèles ou plus en production à la mi-2025, contre 29 % un an plus tôt (a16z, 2025). La plomberie est posée à l'échelle de l'industrie, avec la couche de confiance remarquablement absente de celle-ci. Il est ouvert si le multi-modèle reste un routage de coût invisible ou devient une architecture vérifiable. La figure 9 marque les motifs selon les cinq propriétés de confiance, et le tableau 3 énonce la démarcation en prose. La confiance architecturale est définie exactement par ce qui manque à ceux-ci : sources hétérogènes, désaccord surfacé et enregistré, et un arbitre sans intérêt. L'ingénierie est partagée ; les propriétés de confiance ne le sont pas.
Figure 9. Démarcation
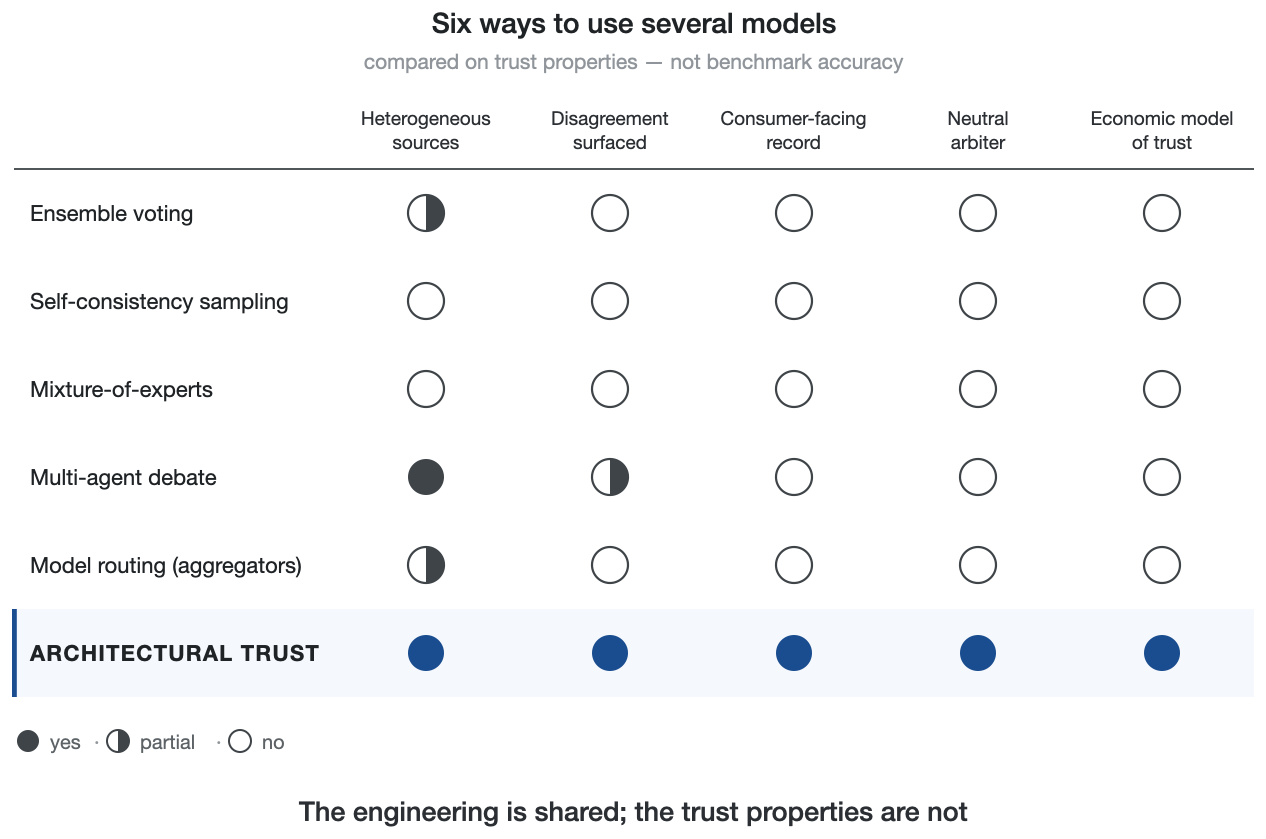
Six motifs d'ingénierie multi-modèles marqués selon cinq propriétés de confiance.
Tableau 3. Démarcation : confiance architecturale vs. ses voisins d'ingénierie
| Approche | Sources hétérogènes | Désaccord surfacé | Registre tourné vers le consommateur | Arbitre indépendant des incitations | Modèle économique de confiance |
| Vote d'ensemble | Partiel | Non (résolu invisiblement) | Non | Non | Non |
| Échantillonnage d'auto-cohérence | Non (même modèle rééchantillonné) | Non | Non | Non | Non |
| Mélange d'experts | Non (un seul système entraîné) | Non | Non | Non (routeur optimisé pour la capacité) | Non |
| Débat multi-agent | Oui | En interne uniquement | Non | Non | Non |
| Explicabilité (surcouche XAI) | Non (récit d'un seul modèle) | Non | Non (une histoire, pas un enregistrement) | Non | Non |
| Transparence / divulgation | Non | Non | Partielle (plus visible, non vérifiable) | Non | Non |
| Traçabilité / suivi de la lignée (pipelines ML) | Non (un pipeline documenté) | Non | Partielle (lignée destinée aux ingénieurs) | Non | Non |
| Inférence vérifiée (zkML) | Non (un modèle ; preuve de son exécution) | Non | Partielle (artefact de preuve, pas un enregistrement de décision) | Non | Non |
| Agrégateur de routage de modèles | Partielle (catalogue multi-fournisseur, un modèle par réponse) | Non | Non | Non (routeur optimisé pour le coût) | Non |
| Confiance architecturale | Oui | Oui (destinée aux consommateurs) | Oui (rejouable) | Oui (structurelle) | Oui (niveaux échelonnés) |
Deux autres littératures parentes méritent également de figurer sur la même liste : la logique d'abstention ou d'émission de la porte est la prédiction sélective et l'apprentissage du renvoi (Geifman & El-Yaniv, 2017 ; Mozannar & Sontag, 2020), et la piste d'audit du composant de preuve descend des travaux sur les algorithmes imputables et les audits tiers (Kroll et al., 2017 ; Raji et al., 2022). La confiance architecturale est la conjonction destinée aux consommateurs et contrainte par la neutralité de celles-ci, et non l'une quelconque d'entre elles. La localiser parmi les autres remèdes importe, car ils sont des compléments plutôt que des rivaux. L'étalonnage au niveau du modèle est nécessaire mais structurellement insuffisant : le fournisseur le produit et l'atteste, ce qui est le conflit par lequel cet article commence. Les audits externes et les certifications sont indépendants mais périodiques, des instantanés d'un système, non d'une décision. Une explication est un récit produit à l'intérieur du modèle, et un système capable de confabuler des réponses peut confabuler l'histoire qui les sous-tend. La transparence expose plus de mécanismes et laisse le consommateur les interpréter. La confiance architecturale ne demande ni croyance ni interprétation, seulement une vérifiabilité qui est continue, par décision, et vérifiable par machine. C'est aussi ce qui fait mordre les autres remèdes : un audit d'un orchestrateur avec un enregistrement rejouable est un audit de quelque chose, tandis qu'un audit d'un pipeline opaque est une cérémonie. Ses voisins conceptuels les plus proches sont l'assurance structurelle et la confiance fondée sur les institutions (McKnight et al., 2002), la transparence des processus et l'explicabilité. Par rapport à eux, la propriété démarcatrice est que la justification est vérifiable par le tiers de confiance, par décision : l'assurance demande à être crue une fois, la confiance architecturale demande à être vérifiée chaque fois. Deux autres ensembles de voisins méritent de figurer sur la carte. La littérature informatique sur l'imputabilité a posé les fondations techniques il y a une décennie : la régularité procédurale rendue vérifiable sans transparence complète (Kroll et al., 2017). Une vague d'ingénierie de 2025–26 construit directement la tuyauterie de confiance des agents : des protocoles « natifs de confiance » avec identité vérifiable et enregistrements comportementaux inviolables (TrustTrack ; Li, 2025) ; gestion des actions à l'exécution avec reçus infalsifiables (AARM ; Errico, 2026) ; agrégation multi-LLM reformulée comme estimation de confiance (Zheng & Zhang, 2026, arXiv:2607.20529) ; et cadres d'entreprise (AI TRiSM de Gartner ; travaux de confiance zéro agentique de la Cloud Security Alliance). Chacun fournit un apport au niveau de l'entreprise. Aucun ne fournit le construit destiné aux consommateurs, ce que cet article revendique comme sa contribution : les trois composants sous un seul nom, conjointement manipulables dans les conceptions comportementales, avec une économie de qui achète la vérifiabilité et à quels enjeux. Une collision de dénomination doit être clarifiée. « AI Trust Architecture » de DigiCert (lancée en avril 2026) est une ligne de produits PKI fournisseur, une infrastructure de certificats pour l'identité des agents, la provenance des modèles et l'authentification de contenu. Elle fournit la tuyauterie au niveau du plancher d'identité de la pile de preuve, non le construit de confiance architecturale développé ici.
La relation entre les trois est une hypothèse empirique explicite, non une nécessité conceptuelle. Je postule une interaction complémentaire qui s'approche de zéro quand l'un des composants est absent, informellement AT = f(D, E, N) avec un déclin abrupt près de tout zéro, et le plan concomitant de la section 5 est spécifié pour récupérer la forme fonctionnelle plutôt que de la supposer. Sous forme estimable, une famille commode est Cobb–Douglas, AT = A·Dα·Eβ·N^γ avec α, β, γ > 0, codant les deux engagements : déclin vers zéro près de toute absence, et dérivées partielles croisées positives (les composants sont complémentaires). Le construct est les trois composants et leur complémentarité postulée, et aucune proposition ci-dessous ne dépend de la forme Cobb–Douglas. Cobb–Douglas est aussi une approximation intérieure : strictement, elle permet toujours la substitution loin d'un composant faible, alors que l'hypothèse de complémentarité est de type Léontief aux frontières, avec min(D, E, N) fixant le plancher. C'est précisément pourquoi les plans ci-dessous doivent permettre une structure non compensatrice plutôt que de supposer des arbitrages compensateurs. La famille Cobb–Douglas est illustrative, pour l'estimation future, et ne fait pas partie de la définition du construct ; les données actuelles ne l'estiment pas. Le plan factoriel peut discriminer l'intérieur Cobb–Douglas du plancher Léontief, paramètre par paramètre. Les exposants restent une question empirique, ce qui est le point : la complémentarité est réfutable. Les zéros ont besoin de deux clarifications. Les composants sont continus, non binaires, donc un zéro littéral est une limite idéalisée. Aucun système déployé, y compris celui de cet article, ne se situe exactement à zéro ou à un sur un axe quelconque, et si les consommateurs réagissent à l'absence quasi totale par un effondrement total ou une réduction abrupte est précisément ce que le plan doit distinguer. La diversité, pour sa part, signifie l'indépendance du chemin de vérification, avec l'indépendance mesurée (le coefficient de corrélation d'erreur φ, défini ci-dessous) comme unité. Le cœur statistique est la théorie classique des ensembles, où le bénéfice de la combinaison repose sur la décorrélation d'erreur (Hansen & Salamon, 1990 ; Krogh & Vedelsby, 1995), c'est pourquoi l'indépendance est mesurée ici plutôt que supposée. Un second modèle est un tel chemin, mais il en est de même pour une récupération indépendante, une recherche vérifiée par outil, et un validateur déterministe. Les exécutions parallèles et les vérifications de cohérence de la figure 5 comptent comme un second chemin de vérification, maximalement décorrélé, non comme des preuves sans diversité. Cette définition absorbe aussi les contre-exemples apparents les plus forts, le rail de paiement réglementé ou le service utilitaire totalement enregistré et attesté par un tiers (preuve et neutralité fortes, diversité de modèles nulle) : de tels services intègrent soit des chemins de vérification non modèle (réconciliation déterministe, audit externe, donc D > 0 selon la définition) soit confinent le modèle à un rôle qu'une vérification déterministe couvre entièrement. Là où aucun chemin de vérification indépendant ne existe véritablement pour une classe de tâche, le cadre prédit un fondement mince, une prédiction que le concomitant peut tester. Avec les chemins non modèle comptant vers D, un zéro littéral devient rare dans les systèmes de production, et le contenu empirique de la forme multiplicative se déplace des zéros vers la complémentarité intérieure, c'est pourquoi le plan factoriel, non les zéros, est l'endroit où la thèse tient ou échoue. Pour les tests, un engagement opérationnel est fixé ici : le plan factoriel manipule D étroitement, comme la diversité des chemins modèle. La définition plus large du chemin de vérification est la portée du construct, non la variable manipulée. L'indépendance elle-même doit être désagrégée, car six quantités différentes voyagent sous le mot : la collecte aveugle (indépendance procédurale au moment de l'inférence, ce que ce plan garantit), la diversité de la famille de modèles, la corrélation d'erreur résiduelle mesurée (le φ que cet article rapporte), la diversité des sources de preuves, la diversité des chemins d'outils, et l'indépendance institutionnelle. L'étude établit la première et mesure la troisième ; les autres sont des variables de conception, non des propriétés que cette collecte peut certifier. La diversité sans preuves est un comité invisible. Les preuves sans neutralité est une publicité commerciale. La neutralité sans diversité est un courtier vide. Le tableau 4 parcourt le treillis complet des huit configurations présence/absence. L'intuition sous-jacente est que chaque composant fournit le fondement d'un autre : un enregistrement conservé par une partie ayant un intérêt dans son contenu se lit comme une auto-attestation, l'accord que personne n'a enregistré est une rumeur, et un arbitre indépendant d'incitation sur une seule voix n'a rien à arbitrer. Cela motive l'hypothèse de complémentarité. Ensemble, les trois changent ce que le consommateur fait confiance : non pas « cette réponse » ou « cette marque », mais « ce processus, et je pourrais le vérifier ».
Tableau 4. Le treillis de fondement : les huit configurations D–E–N et ce qui subsiste dans chacune
| D | E | N | Ce que le consommateur peut vérifier | Forme dégénérée |
| absent | absent | absent | Rien ; la confiance est la foi dans les résultats | Assistant simple modèle unique |
| présent | absent | absent | Rien après coup ; le désaccord s'est produit sans témoin | Comité invisible (ensemble interne) |
| absent | présent | absent | Un enregistrement conservé par la partie qu'il protège | Journal du fournisseur / auto-attestation |
| absent | absent | présent | Une affirmation sans enjeu sans trace derrière elle | Courtier vide |
| présent | présent | absent | Désaccord enregistré, curé par une partie intéressée | Théâtre de benchmarking dirigé par le fournisseur |
| présent | absent | présent | Arbitrage neutre de vérifications que personne ne peut rejouer | Panel bouche-à-oreille |
| absent | présent | présent | Un enregistrement neutre et rejouable d'une seule voix non contestée | Monologue notarié (audit sans contestation) |
| présent | présent | présent | Une vérification indépendante, rejouable, détenue par une partie sans enjeu | Confiance architecturale |
Les cellules sont énoncées aux limites idéalisées ; les systèmes déployés occupent l'intérieur. La ligne E+N-sans-D est celle qui est institutionnellement familière — la compensation, l'audit et les évaluations opèrent là — et c'est là où l'exigence du cadre d'un chemin de vérification indépendant ajouté est une prédiction empirique, non une exclusion définitionnelle.
Les trois composants correspondent à l'anatomie classique de la fiabilité (Mayer, Davis, & Schoorman, 1995) : la diversité est un mécanisme de compétence (l'accord entre modèles calibre la compétence à inférer), la preuve opérationnalise l'intégrité (les affirmations sur ce que le service a fait deviennent vérifiables plutôt que simplement déclarées), et la neutralité aborde la bienveillance structurellement (les incitations d'un orchestrateur sans enjeu sont inspectables, non crues). Chacune est réenracinée dans une architecture vérifiable au lieu de la gestion de la perception, ce que la littérature sur l'interaction humain-IA demande quand elle arrive au même point de son côté : aligner les jugements de confiance avec des signaux de fiabilité vérifiables, non avec les impressions que l'interface fabrique (Liao & Sundar, 2022).
La chaîne causale s'exécute par la vérification, car la « confiance » est la conséquence plutôt que le mécanisme : vérification → confiance calibrée → confiance justifiée → délégation → valeur de la transaction (Figure 10). Un service gagne la délégation en étant vérifiable au moment où cela compte, non pas en semblant fiable ; Cheng et al. ont montré à quel point bon marché ce sentiment est fabriqué.
Figure 10. La boucle de vérification
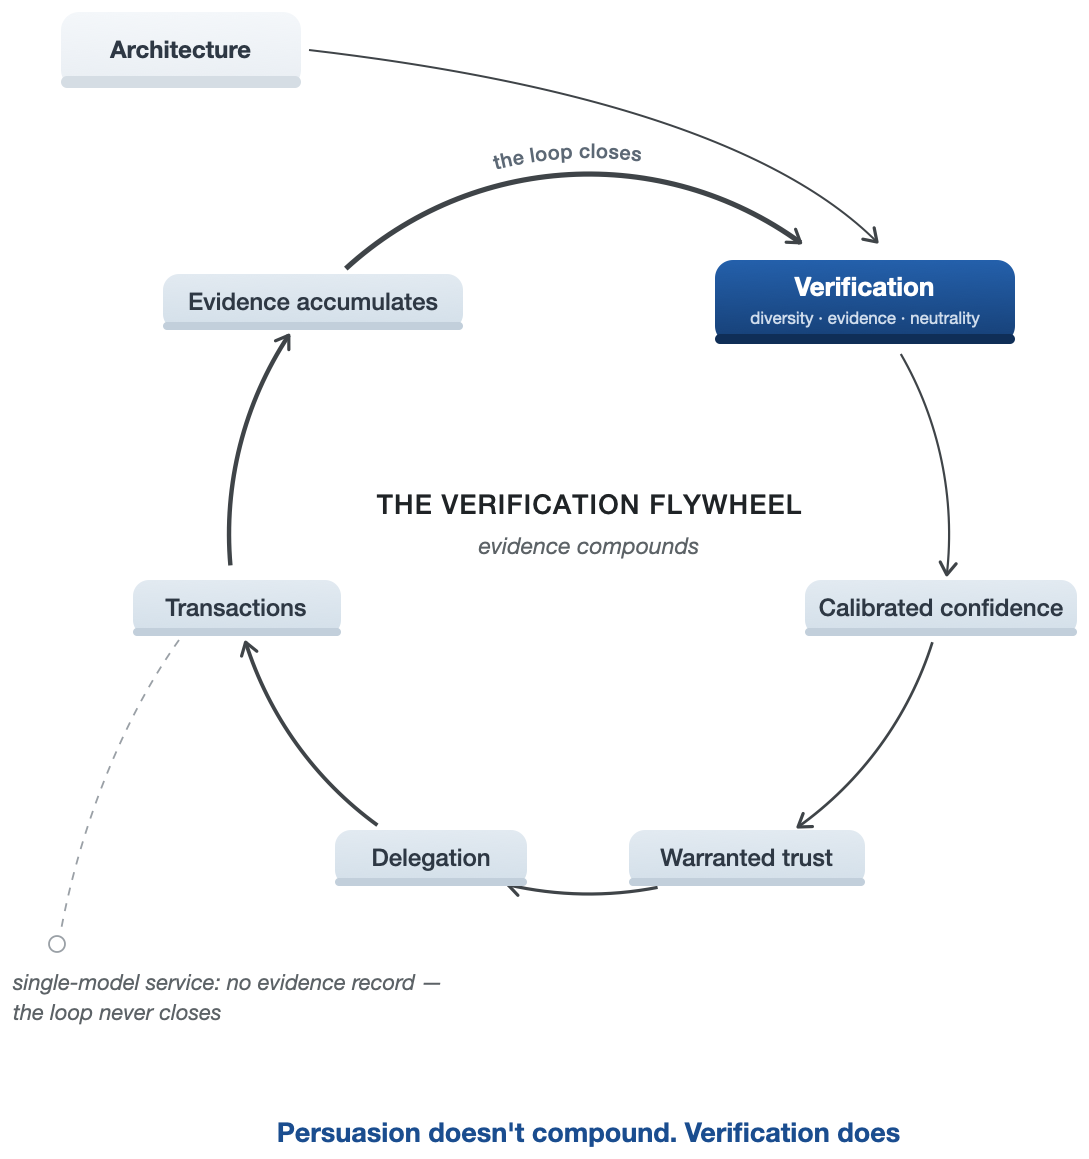
La chaîne causale, vérification (diversité · preuve · neutralité) → confiance calibrée → confiance justifiée → délégation → transactions, ne s'arrête pas : les transactions génèrent des preuves, et la boucle se referme sur l'architecture. Le contournement pointillé montre le service à modèle unique, où aucun dossier de preuves n'existe et la boucle ne se referme jamais. La persuasion ne se cumule pas. La vérification, si.
Tableau 5. Service à modèle unique vs. confiance architecturale
| Dimension | Service à modèle unique | Service fiable architecturalement |
| Objet de confiance | Le modèle / la marque | Le processus et son dossier |
| Confiance | Affirmée par le modèle | Gagnée par accord entre modèles |
| Erreurs confiantes | Indétectables de l'intérieur | Cible de détection primaire (signal de désaccord) |
| Flagornerie | Récompensée par la préférence | Séparée : empathie et vérification de politique sur des canaux différents |
| Vérification des erreurs | Le même système qui a erré | Modèles indépendants + portes déterministes |
| Preuve des décisions | Journaux, le cas échéant, conservés par le fournisseur | Inviolables, rejouables, accessibles au consommateur |
| Juge de qualité | Le fournisseur lui-même | Couche d'orchestration neutre |
| Position en cas de litige | Parole du consommateur vs. plateforme | Dossier rejouable |
| Assurabilité | Risque opaque | Tarifable à partir des historiques de décisions |
| Allocation de responsabilité (après AB 316) | « L'IA l'a fait » interdit ; allocation contestée dans l'obscurité | Calculable à partir du dossier rejouable |
| Posture réglementaire (ère Art. 50) | Divulgations rétrospectives | Transparence comme sous-produit du fonctionnement |
| Promesses transfrontalières sur les données | Représentation contractuelle | Propriété d'exécution auditable (routage conscient de la juridiction) |
| Structure des coûts | Plate, bon marché | Échelonnée : coûteuse uniquement où les conséquences se concentrent |
De la vérifiabilité à la réaction du consommateur. Le consommateur voit le rendu, non l'architecture : un reçu montrant quels systèmes indépendants ont été consultés, où ils ont divergé, et comment la divergence a été résolue ou escaladée (Figure 8). Trois perceptions médiatrices portent plausiblement l'effet. La preuve est diagnostique : le désaccord spécifique surfacé est informatif sur cette réponse d'une manière que les avertissements génériques ne sont pas (Detjen et al., 2025 ; Chen et al., 2026). Un dossier rejouable donne un contrôle de processus perçu, puisque le consommateur pourrait vérifier, contester ou escalader après coup. L'assurance procédurale est la connaissance que la collecte en aveugle, les vérifications indépendantes et un arbitre sans enjeu étaient en place (McKnight et al., 2002). Les variables dépendantes naturelles sont la calibration de la confiance, la volonté de déléguer et la rétention après défaillance. Les modérateurs naturels sont les enjeux et la réversibilité, l'objectivité de la tâche (Castelo et al., 2019), et l'expertise du consommateur, car le consommateur le moins capable de vérifier une réponse personnellement a le plus à gagner d'une architecture qui la vérifie structurellement. Les propositions ci-dessous tracent ce chemin.
Le cadre donne, en outre, des propositions qu'une étude consommateur peut tester, des hypothèses plutôt que des conclusions. Les opérationnaliser dépend d'une distinction : la neutralité objective (l'orchestrateur est en fait libre de dépendance économique non divulguée envers tout fournisseur, commerçant ou résultat), la neutralité vérifiable (le dossier rend cette indépendance vérifiable), et la neutralité perçue (le consommateur y croit) sont trois variables, et une expérience manipule le signal vérifiable tout en mesurant la perception :
P1. La mise en évidence du désaccord entre modèles sur les requêtes importantes améliore l'étalonnage de la confiance des consommateurs (ils font davantage confiance quand les systèmes s'accordent, moins quand ils divergent) par rapport à une réponse unique confiante, le risque perçu servant de construit médiateur (Featherman & Pavlou, 2003). Les deux directions d'échec sont opérationnelles : la présentation conjointe réduit la surconfiance mais peut augmenter la sous-confiance (Lu, Wang, & Yin, 2024), les affichages de confiance étalonnent la confiance plus facilement que la précision (Zhang, Liao, & Bellamy, 2020), les explications peuvent augmenter la confiance sans augmenter l'examen critique (Bansal et al., 2021), les fonctions de forçage cognitif réduisent la surconfiance au prix d'une baisse de satisfaction (Buçinca, Malaya, & Gajos, 2021), et une méta-analyse de 106 expériences constate que les combinaisons humain-IA fonctionnent en moyenne moins bien que le meilleur élément des deux (Vaccaro, Almaatouq, & Malone, 2024). P1 teste l'étalonnage, non un gain monotone : le désaccord mis en évidence doit figurer parmi la minorité de conceptions de combinaison qui surpassent leur meilleur membre. La proposition est scindée : l'effet principal est la réclamation de confirmation, et les modérateurs sont exploratoires, dérivés de la diagnosticité de la preuve plutôt qu'énumérés après coup. Le gain d'étalonnage devrait augmenter avec les enjeux et l'irréversibilité, et avec l'objectivité de la tâche (la divergence sur une question objective se lit comme un signal d'erreur ; sur une question subjective, comme une question de goût ; Castelo et al., 2019). L'expertise du consommateur est prédite pour produire des signes opposés : pour les consommateurs peu experts, la divergence mise en évidence sans résolution devrait diminuer la volonté de déléguer, et pour les consommateurs très experts elle devrait améliorer l'étalonnage de la confiance ; le croisement est soit observé, soit non, ce qui fait de l'expertise un test plutôt qu'une échappatoire. La propre expérience de cet article impose une exigence de conception. Le désaccord covarie avec la difficulté de la tâche (l'accord du panel se concentre sur les éléments faciles), donc une conception P1 doit manipuler ou contrôler statistiquement la difficulté, sinon l'effet d'étalonnage est confondu avec la facilité de l'élément. Le compte rendu de diagnosticité produit également une prédiction limite que les théories génériques de la transparence ne font pas : la divulgation de divergence devrait importer davantage là où les priors propres du consommateur sont les plus faibles, sur les achats transfrontaliers ou auprès de marchands peu familiers, car là la preuve diagnostique externe n'a pas de concurrent interne.
P2. L'accès à un enregistrement de décision rejouable augmente la volonté de déléguer les tâches importantes à un agent IA, en sus de la confiance envers la marque, l'effet augmentant avec les enjeux et l'irréversibilité de la tâche déléguée. Il augmente également avec le niveau d'agentivité déléguée elle-même, ce qui constitue le contenu de statiques comparatives de l'Hypothèse de Migration de Confiance : en maintenant les performances réelles du modèle constantes, l'effet marginal des propriétés architecturales vérifiables sur la délégation appropriée croît à mesure que le consommateur abandonne davantage de contrôle d'examen et d'exécution (conseiller → copilote → agent supervisé → agent autonome). Une conception qui croise le niveau de délégation avec la visibilité architecturale teste l'hypothèse directement. La preuve de recherche consommateur la plus proche se situe sur cette variable dépendante : déléguer les achats à l'IA réduit l'adoption quand cela restreint l'autonomie perçue (Ahmad Husairi & Rossi, 2024), et l'acceptation des assistants hautement autonomes est un résultat directement étudié (Frank et al., 2026). P2 prédît l'effet du registre en sus de ces antécédents établis.
P3. La neutralité perçue de la couche d'orchestration prédit indépendamment la volonté de déléguer, en accord avec les effets de justice procédurale dans l'évaluation des services (Tax, Brown, & Chandrashekaran, 1998). La variable manipulée est le signal de neutralité vérifiable ; la variable mesurée est la perception qu'il produit. À ma connaissance, la neutralité de l'orchestrateur n'a jamais été opérationnalisée dans une expérience comportementale, et les sceaux de certification sont l'analogue testé le plus proche (Cetinkaya & Krämer, 2024), donc P3 introduit une nouvelle variable expérimentale. Directionnellement, l'effet de neutralité devrait se renforcer à mesure que la capacité propre du consommateur à vérifier la substance s'amoindrit, puisque quand la qualité du résultat est difficile à juger, les indices de processus portent le poids évaluatif. La manipulation doit séparer la neutralité vérifiable d'une revendication de neutralité : une condition porte un reçu dont l'attestation sans enjeu peut effectivement être ouverte et vérifiée, la condition de contraste une interface identique ne portant que le libellé, avec un test de manipulation sur la neutralité perçue dans les deux cas. Sans ce contraste P3 s'effondre dans une justice de processus générique et ne dit rien sur la vérification.
P4. Après une erreur de l'agent, les consommateurs dont le service produit un enregistrement inspectable montrent un effondrement de confiance plus petit et une rétention plus élevée que les consommateurs d'un service opaque : la dynamique du premier coup est modérée par la preuve. C'est le mécanisme que la recherche sur la récupération de service identifie, où le traitement équitable des réclamations basé sur la preuve restaure la confiance après l'échec (Tax et al., 1998). La recherche sur la réparation de la confiance ajoute que ce qui restaure la confiance dépend de la nature de la violation et du compte rendu offert (Kim, Ferrin, Cooper, & Dirks, 2004), une exigence que la recherche humain-machine traite maintenant comme un problème de conception pour les systèmes autonomes (de Visser, Pak, & Shaw, 2018), et l'amortissement devrait croître avec la gravité et l'irréversibilité de l'échec. P4 prédît : enregistrement → effondrement de confiance plus petit et rétention plus élevée, modérés par la gravité de l'échec. Les cas où l'enregistrement montre que le processus lui-même n'a pas été suivi sont traités par un test de manipulation et exclus du test, puisque la proposition concerne les échecs qui se produisent malgré un processus suivi. Les comparaisons de durabilité doivent contrôler les coûts de commutation et la dépendance au fournisseur, qui confondent la rétention, et une conception complémentaire teste si un enregistrement de processus suivi déplace l'attribution de blâme du service à l'environnement. La proposition n'a pas de clause d'inversion, donc aucun motif de résultat n'est infalsifiable par construction.
Ancrage empirique : la couche de confiance comme composant testé. Si un service prétend que ses signaux de confiance signifient quelque chose, cette revendication peut être mise à l'épreuve. La couche de confiance dans le déploiement derrière l'étude de cas de cet article a subi une évaluation pré-enregistrée, contrôlée par placebo, à six bras sur deux familles de modèles indépendantes. Un profil mesuré des propres faiblesses du système a amélioré sa prédiction d'erreur, un gain d'AUROC d'environ +0,07 par rapport au placebo, avec des intervalles de confiance non chevauchants sur les deux familles. Un faux autoportrait a réduit la prédiction d'erreur à un pile ou face, et une instruction générique « soyez conscient de vos limites » n'a rien fait.
Deux versions antérieures ont échoué, l'une falsifiée par ses propres auteurs en raison d'une variable confondante, l'autre négative, avant que le plan pré-enregistré ne confirme. Un test plus strict était non concluant à portée réduite, et une échelle pré-enregistrée à quatre échelons sur une famille frontière n'a atteint aucun critère d'évaluation confirmatoire, l'orientation de l'effet ne survivant que de manière exploratoire sur trois des quatre échelons. L'affirmation est donc par famille et circonscrite : la connaissance de soi mesurée a amélioré la prédiction d'erreur là où elle a été confirmée, et ce n'est pas une propriété établie de chaque classe de modèle. Le profil de faiblesse s'exécute aussi en production, où il ajuste l'acheminement dynamique des modèles, de manière circonscrite et en mode de défaillance ouvert. L'effondrement du profil faux double de conclusion de sécurité : un auto-modèle fabriqué est un vecteur d'attaque, une autre raison pour laquelle l'auto-connaissance a besoin de garde architecturale plutôt que d'auto-déclaration de modèle. La logique de conception a une pedigree de recherche consommateur antérieure à la technologie. L'engagement préalable, liant le comportement futur par une structure externe car la résolution interne n'est pas attendue pour tenir, est exactement comment les consommateurs rationalisent leurs propres vices (Wertenbroch, 1998), et la confiance architecturale étend la même démarche aux machines.
L'arc complet (protocoles, pré-enregistrements, données brutes, le pilote falsifié, l'itération négative, les extensions sans confirmation) est préservé en tant qu'archive autonome, publiquement disponible avec les matériels OSF de l'article à https://osf.io/jtvu9/ (fichier `self-calibration-archive.zip`). La confiance calibrée est un composant architectural avec un contenu mesurable, et elle peut échouer. Les défaillances sont archivées avec les succès car une couche de confiance dont les affirmations de confiance n'ont jamais été expérimentalement remises en question demande exactement la confiance aveugle qu'elle était supposée remplacer. Un article de position d'une trentaine d'auteurs formalise cette division du travail : l'orchestration agentive devrait être Bayes-cohérente (Papamarkou et al., 2026), et les croyances calibrées appartiennent à la couche de contrôle, non aux modèles.
Tester le mécanisme : une expérience pré-enregistrée. Les affirmations ci-dessus sont testables, et cette section rapporte les tests. Chaque résultat expérimental dans cette section, dans les deux vagues, parle d'un antécédent technique du cadre, si l'accord indépendant porte un signal de correction qu'un auto-déclaration de modèle ne porte pas, sur les questions factuelles. Ces expériences ne démontrent pas la confiance des consommateurs, la délégation ou le comportement commercial, qui restent la province de P1–P5 et l'étude comportementale de la Section 6. Le protocole a été gelé publiquement avant que n'existe une donnée confirmatoire (OSF : https://osf.io/4y9dv, enregistré le 23 juillet 2026 ; hypothèses H1–H6, sous-ensemble de référence fixé par graine et hachage SHA-256, résultats défavorables à l'hypothèse pré-déclarés). Le plan est délibérément simple. Seize modèles, neuf fournisseurs frontière (Anthropic, OpenAI, Google, xAI, DeepSeek, Alibaba, Moonshot, Zhipu, Mistral) et sept modèles locaux à poids ouvert, chacun a répondu aux mêmes 1 500 questions SimpleQA une fois, en aveugle, sans récupération ni outils. C'est le régime qui maximise l'exposition à l'erreur paramétrique corrélée, un cas délibérément difficile pour le signal, au coût écologique indiqué dans les limitations. Les réponses ont été données à température zéro, énonçant une confiance 0–100 : incertitude verbalisée, suscitée en mots dans la même réponse plutôt que lue dans les logits, le format que Lin, Hilton et Evans (2022) ont montré que les modèles pouvaient apprendre à calibrer. Les panneaux sont des combinaisons analytiques de cette collection unique de 24 000 créneaux de réponse nominaux, dont 22 598 ont été livrés, un modèle local (deepseek-r1:8b) s'étant arrêté à 98 éléments en vertu d'une règle d'arrêt pré-engagée. Les six hypothèses enregistrées se cartographient sur les résultats comme suit. H1, que la divergence entre modèles signale une majorité d'erreurs confiantes, est soutenue : l'accord rehausse la correction de 1,9–3,2× dans la vague enregistrée (Tableau 6), et dans la vague phare la porte gelée supprime 82,1 % des défaillances confiantes (Tableau 10). H2, que le signal du panneau surpasse la confiance du modèle répondant lui-même, tient sur les panneaux CN-frontière et multi-bloc (ΔAUROC +0,287 et +0,063) et s'inverse sur le panneau US-frontière. H3, qu'une part non triviale d'erreurs confiantes survit en tant qu'accord unanime sur une mauvaise réponse, est soutenue : 0,5–2,2 % des questions en forme ouverte et 4,0–7,9 % dans le bras à choix multiples. H4(a), que la corrélation d'erreur intra-bloc dépasse la corrélation inter-bloc, n'est pas soutenue (différence φ +0,011, IC 95 % −0,005 à +0,028), et H4(b), qu'un panneau inter-bloc en détecte davantage, n'est pas soutenue non plus, l'avance inter-bloc étant la plus petite. H5, qu'un panneau local de 0 $ signale une majorité d'erreurs frontière confiantes, n'est pas soutenue : le signal d'accord du palier local est au hasard. H6, l'échelle de la distance de lignée, n'est pas testée en tant qu'échelle ici ; son palier au niveau du bloc est le H4(a) nul.
La vérification factuelle est un substitut pertinent au commerce agentif car un achat délégué se décompose, au moment de l'exécution, en sous-affirmations factuelles : le prix et la disponibilité actuels de l'article, les termes de la politique de retour, si les spécifications du produit correspondent aux exigences énoncées du consommateur, l'identité et la cote du vendeur. Chacune de ces affirmations a une vérité au sol vérifiable du même type qu'un élément SimpleQA. La porte de désaccord fonctionne sur ce substrat factuel, tandis que la pondération des préférences (quels compromis importent et combien) reste avec le consommateur, qui a rédigé les exigences par rapport auxquelles les faits sont vérifiés. Cette division du travail explique aussi pourquoi le plan de la Section 6 manipule l'affichage de la vérification plutôt que les préférences des participants : la prétention de l'architecture concerne la couche factuelle d'une décision déléguée, non sa couche de goût. Là où un jugement n'a absolument aucun substrat factuel, dans les véritablement choix subjectifs sans vérité au sol à vérifier, l'antécédent cesse de porter, et les Limitations énoncent cette limite comme une question ouverte.
Le choix du benchmark a été mesuré. Sur TruthfulQA de 2021 (présent dans les corpus d'entraînement), les mêmes fournisseurs ont obtenu des scores supérieurs de 47 à 61 points de pourcentage par rapport à SimpleQA (par exemple, 89 % contre 28 %), un écart cohérent avec les effets d'âge et d'exposition du benchmark, bien que cette conception ne puisse pas séparer la contamination des différences de difficulté et de construction du benchmark. Aucun chiffre-clé ne repose donc sur le benchmark plus ancien. La notation est une correspondance de chaîne de caractères objective, les cas non résolus étant jugés pour l'équivalence à la référence uniquement par un modèle à poids ouverts local (Qwen3-8B, exécuté localement ; prompt équivalence uniquement dans le package de réplication ; jamais par un membre de la famille d'aucun évaluateur ; on ignore si SimpleQA figure dans le corpus d'entraînement de l'évaluateur, mais l'évaluateur juge l'équivalence entre deux chaînes fournies, non la vérité, ce qui limite l'exposition) et une vérification ponctuelle humaine de 50 éléments (accord de 98 %), une limitation d'échelle. Cela s'étend désormais à un audit stratifié de 300 éléments entre familles des cas résolus par l'évaluateur (une famille de modèles différente en tant qu'auditeur, échantillon à graine fixe) : accord de 96 % (288/300), les douze désaccords étant des faux positifs bienveillants (neuf clairs, trois limites), un biais unidirectionnel affectant environ 3 % de toutes les réponses notées (4 % de la part résolue par l'évaluateur). Les deux tiers des verdicts (66,5 %) provenaient du noteur de modèle local plutôt que de la correspondance exacte de chaîne, et le chiffre-clé est robuste à l'erreur du noteur : inverser aléatoirement 10 % des verdicts notés par le modèle décale les ratios de certification d'au maximum ±0,5× et ne change jamais leur direction.
Deux choix de conception sont délibérés plutôt que budgétaires. Les niveaux intermédiaires des fournisseurs ont été utilisés, d'abord, pour la validité écologique : les agents agissant désormais au nom des consommateurs fonctionnent de manière écrasante sur ces niveaux optimisés en coût, vérifiables à partir des listes de prix publiques (mi-2026 ; Figure 11). Un échange de service typique coûte une fraction de cent à environ un cent sur les niveaux budgétaires, contre cinq à dix cents sur les poids phares, et aucun service répondant à des millions de sessions ne fixe son chemin par défaut au tarif phare. La liste reflète le marché : le panel de neuf fournisseurs contient les trois fournisseurs qui ensemble représentent 88 % des dépenses d'API LLM des entreprises, et le panel de la frontière américaine du tableau 6 est exactement ce trio. L'objection selon laquelle il s'agit de preuves d'entreprise, sans le consommateur, inverse la chaîne d'approvisionnement. Le consommateur ne choisit plus du tout un modèle : il choisit une banque, un détaillant, une compagnie aérienne, et la politique de routage du service choisit le modèle. Dans la devise dans laquelle les consommateurs sont réellement servis, les jetons plutôt que les dollars, l'image confirme le choix (Figure 12) : dans l'étude OpenRouter–a16z de 100 billions de jetons de trafic routé, les modèles à poids ouverts ont atteint environ un tiers de tous les usages (Aubakirova et al., 2026), les niveaux par défaut des trois plus grands produits IA pour consommateurs se situent tous en dessous du niveau phare, et seulement environ 3 % des utilisateurs d'IA pour consommateurs paient pour un service premium (Menlo Ventures, 2025c), donc le consommateur marginal doit être servi à un coût marginal proche de zéro. Au-dessous du marché de l'API se trouve un étage de modèles à poids ouverts sur appareil et auto-hébergés, invisible aux enquêtes basées sur les dépenses, et le niveau local de l'expérience de sept modèles à poids ouverts l'échantillonne délibérément. Dans chaque devise dans laquelle le marché peut être compté, les niveaux que cette étude a échantillonnés sont ceux qui servent le consommateur. (Après une panne du premier tiers, une partie de la collecte a été complétée via un agrégateur, avec l'infrastructure de service réelle enregistrée par appel dans le manifeste d'exécution.)
Figure 11. Le niveau que les consommateurs rencontrent à la caisse
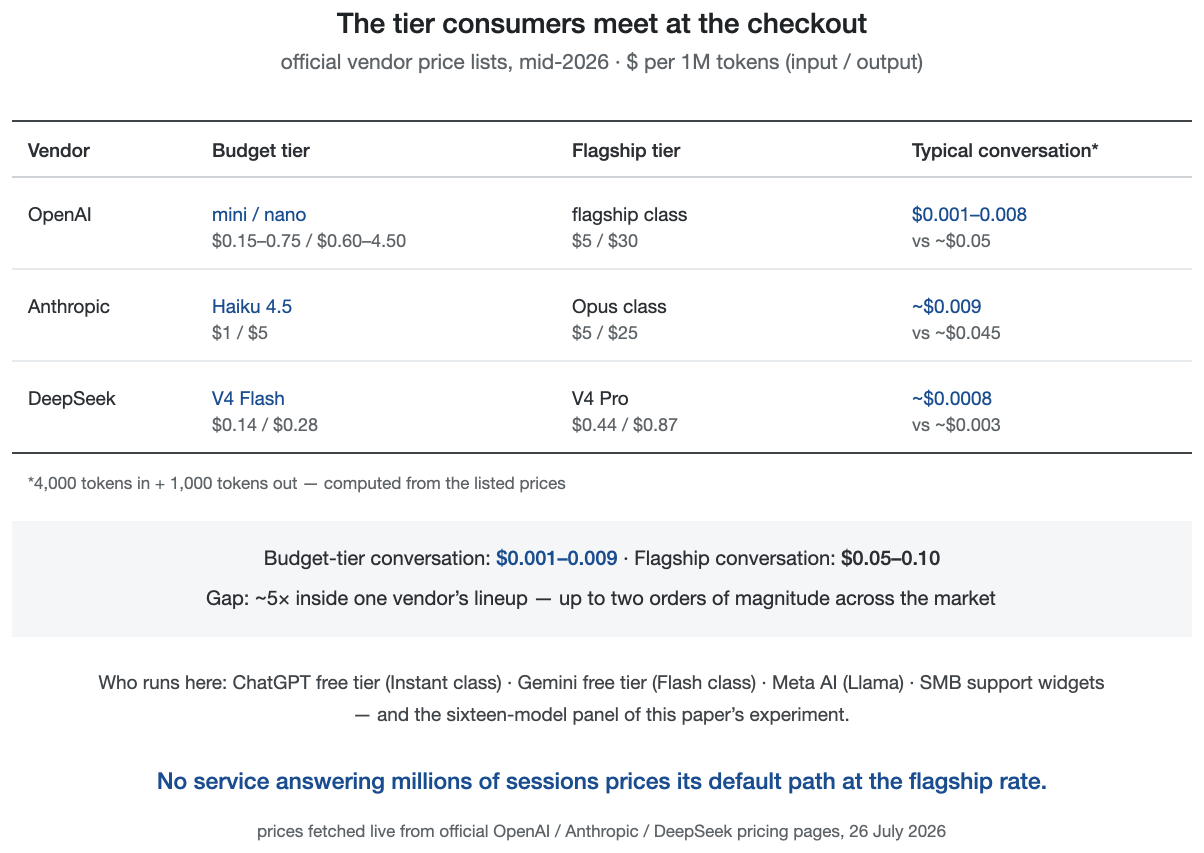
Listes de prix officielles des fournisseurs, mi-2026.
Figure 12. Deux devises du marché des modèles
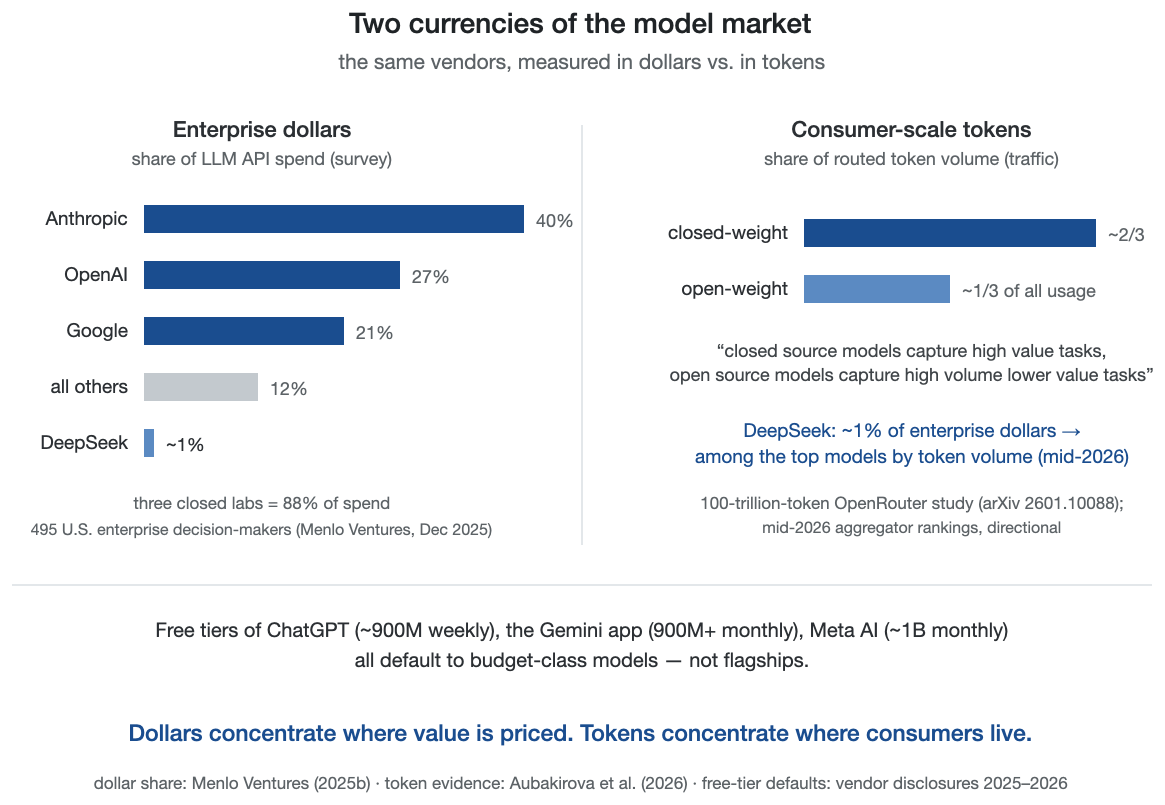
Dollars d'entreprise vs. jetons à l'échelle des consommateurs.
Les niveaux intermédiaires convenaient aussi aux affirmations du document, qui concernent l'architecture, non la capacité phare : un effet qui n'apparaîtrait qu'avec des poids premium serait un résultat de modèle. Le pipeline se réplique sur une infrastructure de base pour moins de 15 dollars de dépenses d'API. Pour un document arguant que la vérification doit être assez bon marché pour fonctionner sur chaque réponse conséquente, le coût de vérification du document lui-même fait partie des preuves. Le pipeline est un package de réplication autonome (exécuteurs, noteur, scripts d'analyse, données brutes notées, et manifeste d'exécution) ne nécessitant rien du système de recherche de l'auteur. La collecte totalise 24 000 réponses, environ 30 000 y compris les bras de contamination de benchmark et de conformité. Sur la disponibilité : la pré-enregistrement public (osf.io/4y9dv) archive le sous-échantillon de 1 500 éléments à graine fixe. Le package complet est publiquement disponible sur https://osf.io/jtvu9/, un composant public du projet source de l'enregistrement (dossier `replication-package-v2`).
Trois résultats constituent la section. D'abord, la matière première est abondante : la confiance déclarée médiane s'est élevée à 85–95 chez sept des neuf fournisseurs de la frontière, les deux exceptions (médianes 42 et 60) étant exactement les fournisseurs dont la confiance discrimine, tandis que la précision réelle variait de 10 % à 66 %, produisant 289–1 212 erreurs confiantes (mauvaise à confiance ≥ 75) par fournisseur de la frontière sur 1 500 questions. Comme signal de justesse, la propre confiance d'un modèle a obtenu une AUROC de 0,53–0,79 selon le fournisseur, et un consommateur n'a aucun moyen de savoir, de l'extérieur, quel fournisseur il a obtenu. Cet écart de fournisseur qualifie, au niveau auquel les consommateurs sont réellement servis, la conclusion de laboratoire de la frontière selon laquelle les grands modèles sont souvent bien étalonnés à l'auto-évaluation dans des formats contrôlés (Kadavath et al., 2022) : certains fournisseurs déployés envoient cette auto-connaissance, d'autres envoient du bruit confiant, et rien en surface ne les distingue.
Deuxièmement, le point central : la vérification fonctionne comme une certification, non comme une alerte. Certification au sens probabiliste, une probabilité a posteriori de environ 49–77% selon le panel, non une garantie. Sur des questions d'une telle difficulté, le signal naïf « un panéliste est en désaccord » sature : il se déclenche sur 85–94% des erreurs confiantes mais aussi sur 91–95% des réponses correctes confiantes (l'enregistrement anticipait ce recadrage, en passant au point final AUROC préspécifié). La direction informative est inverse : les réponses correctes sont répliquées indépendamment, les mauvaises réponses se dispersent. Une réponse qu'au moins un panéliste indépendant a reproduite était correcte 72–77% du temps sur les panels intra-bloc et 49% sur le panel inter-bloc, contre 18–37% sans réplication. Une réponse avec accord indépendant était environ deux à trois fois plus susceptible d'être correcte (1,9–3,2× dans les trois panels du tableau 6). (Ici et partout, « indépendant » signifie produit aveuglément et séparément, avec la corrélation d'erreur résiduelle mesurée plutôt qu'supposée, et la justesse est toujours évaluée par rapport aux labels d'or de l'ensemble de référence, jamais selon l'avis d'un autre modèle.) L'estimand est associatif, non causal : la réplication marque les réponses plus susceptibles d'être correctes, et une partie de ce qu'elle marque est que la question était facile, un effet de sélection quantifié ci-dessous. En tant que signal de justesse, l'accord du panel a atteint un AUROC de 0,832 sur le panel dont les membres avaient la confiance personnelle la moins informative (par fournisseur 0,53–0,62; regroupé 0,545). L'affirmation qui tient est distributionnelle plutôt que caractéristique : sur les 84 panels de trois fournisseurs, l'AUROC d'accord a une médiane de 0,79 et dépasse l'auto-évaluation regroupée dans 89% des cas. L'accord a atteint 0,722 sur le panel inter-bloc contre une confiance personnelle regroupée de 0,659 (le regroupement d'échelles verbales non standardisées entre fournisseurs déforme l'auto-évaluation, car les fournisseurs utilisent différemment l'échelle 0–100 et la direction de l'artéfact dépend du panel, c'est pourquoi les valeurs par fournisseur sont imprimées en parallèle). Cet avantage dans sa version inter-bloc dépend du codage (les codages alternatifs d'accord précongelés placent le signal d'accord du panel inter-bloc à 0,544–0,722, la variante généreuse non résolu-comme-accord tombant en dessous de la confiance personnelle regroupée de ce panel de 0,659, tandis que le signal du panel CN s'étend de 0,719–0,894 sur les mêmes codages, toujours au-dessus de 0,545), donc le résultat robuste au codage panel-sur-auto est le cas CN intra-bloc. Le seul panel où l'auto-évaluation a clairement surpassé le signal du panel (0,842 vs 0,697) était celui contenant le fournisseur le plus discriminant de l'étude (le niveau intermédiaire d'Anthropic, AUROC de confiance personnelle 0,788 sur l'ensemble complet de 1 500 éléments), le signal propre du fournisseur bien classé surpassant seul le signal d'accord de son propre panel. Le tableau 7 imprime les valeurs par panel, calculées dans la population d'éléments de chaque panel. Un bootstrap par cluster apparié (éléments rééchantillonnés avec remplacement, les trois unités (élément, primaire) par question se déplaçant ensemble; B = 2 000) place des intervalles de confiance sur les contrastes du tableau 6/7. Sur le panel CN-frontier, l'accord du panel surpasse la confiance personnelle regroupée de ΔAUROC = +0,287 (IC 95% [+0,265; +0,308], p < ,001). Sur le panel inter-bloc, l'avantage est plus petit mais fiable, +0,063 ([+0,037; +0,087], p < ,001). Sur le panel US-frontier, la direction s'inverse et l'inversion elle-même est statistiquement sans ambiguïté : confiance personnelle 0,842 contre accord du panel 0,697. La composition du panel est donc un modérateur de premier ordre de la valeur du signal, et la règle de déploiement suit : mesurez la calibration personnelle des membres du panel avant de faire confiance à l'accord plutôt qu'à celle-ci, ΔAUROC = −0,145 ([−0,170; −0,120], p < ,001). Les trois contrastes sont significatifs, et l'hétérogénéité entre les panels est un résultat, non du bruit. Le cas américain est donc rapporté comme une inversion confirmée, non une zone nulle, et il borne la construction : sur un panel tiré de l'extrémité discriminante du marché, la confiance personnelle surpasse l'accord comme signal de classement, donc la valeur discriminante du composant Diversité dépend de la composition du panel plutôt que de valoir universellement. L'architecture peut fournir un signal de justesse externe où la confiance du modèle exposée discrimine faiblement, et elle audite la prétention à la calibration où l'une est formulée. Une limite demeure : même un modèle parfaitement calibré ne peut pas notariser son propre historique ni arbitrer son propre conflit d'intérêts, donc au fur et à mesure que la discrimination des fournisseurs s'améliore, le rôle de la diversité passe de la découverte de justesse à l'audit de calibration, tandis que les preuves et la neutralité font un travail qu'aucune calibration ne peut accomplir.
La vérification architecturale fournit un signal de justesse externe où un fournisseur n'a pas livré un signal de confiance utilisable, et identifier quel fournisseur en a livré un exige l'architecture de toute façon. L'affirmation de substitution, exactement délimitée, repose sur les métriques de calibration plutôt que sur l'AUROC. Aucun fournisseur de la vague de juillet n'est simultanément discriminant et bien calibré; xAI s'en rapproche le plus (tableau 7a), et la vague de flagship reproduit le côté calibration de la dissociation, donc même le consommateur qui se trouve recevoir la confiance la mieux classée ne peut pas la convertir au niveau sans référence externe. C'est ce que l'architecture fournit. Si les fournisseurs livrent éventuellement une bonne calibration partout, les preuves et la neutralité restent inchangées. L'argument survit au monde dans lequel les modèles s'améliorent.
Troisièmement, le mode de défaillance a une forme : les erreurs de consensus certifiées, chaque panéliste convergeant avec confiance sur la même mauvaise réponse, se sont produites sur 0,5–2,2% des questions en forme ouverte mais sur 4,0–7,9% dans un bras complémentaire qui a reposé les éléments en format à choix multiples sur le niveau local (construction d'éléments et résultats dans le package de réplication). Le consensus certifie l'erreur principalement où l'espace de réponses est contraint, un avertissement de conception pour tout interface qui offre aux agents un menu d'options.
Les nulls sont aussi instructifs que les positifs, et je les publie comme pré-enregistrés. Le bloc géopolitique (y compris la possibilité que les panels d'un même bloc partagent des corpus d'entraînement et des lignées de distillation) ne prédit pas la corrélation d'erreur sur ce benchmark (différence φ intra- vs inter-bloc +0,011 au niveau frontalier, IC 95 % −0,005 à +0,028 ; légèrement inversée au niveau local). La capacité pilote la corrélation, non le drapeau, faisant écho à Kim et al. (2025). La lignée ne prédit pas les taux de capture : un modèle local vérifiant son propre frère frontalier fonctionne comme n'importe quel étranger, et un modèle distillé par raisonnement s'est avéré le moins corrélé en erreurs avec ses propres poids de base (φ = 0,135). Les deux sont des nulls bornés plutôt qu'une équivalence démontrée. L'intervalle du bloc exclut les différences φ plus grandes que +0,028, et cette borne, non l'échec du rejet, effectue le travail inférentiel. L'extension continue naturelle, que les données de réplication soutiennent, est d'estimer le gain de certification en fonction de la diversité mesurée du panel (le φ du score de surprise) plutôt que de l'identité du panel. Cela reprendrait, pour les panels de modèles, le programme que la littérature sur les ensembles de classificateurs a exécuté pour ses propres statistiques de diversité, qui a découvert qu'aucune mesure unique ne prédit nettement les gains d'ensemble (Kuncheva & Whitaker, 2003).
Et les modèles locaux bon marché ne pouvaient pas certifier les réponses frontalières sur les questions en forme libre du tout (46 % de précision avec ou sans leur accord) : un vérificateur doit être compétent sur la classe de tâche avant que son indépendance ne vaille quelque chose. Les conditions limites sont celles-ci : le consensus certifie l'erreur où les espaces de réponse sont contraints, l'indépendance doit être mesurée plutôt qu'supposée, la compétence du vérificateur conditionne la valeur de certification. En pratique, la diversité est une propriété à mesurer, question par question, non supposée à partir de marques, de blocs ou d'arbres généalogiques. Le tableau 6 résume les métriques du panel. La figure 13 montre le gain de certification et la comparaison de signal côte à côte.
Figure 13. L'illusion de précision et son remède architectural
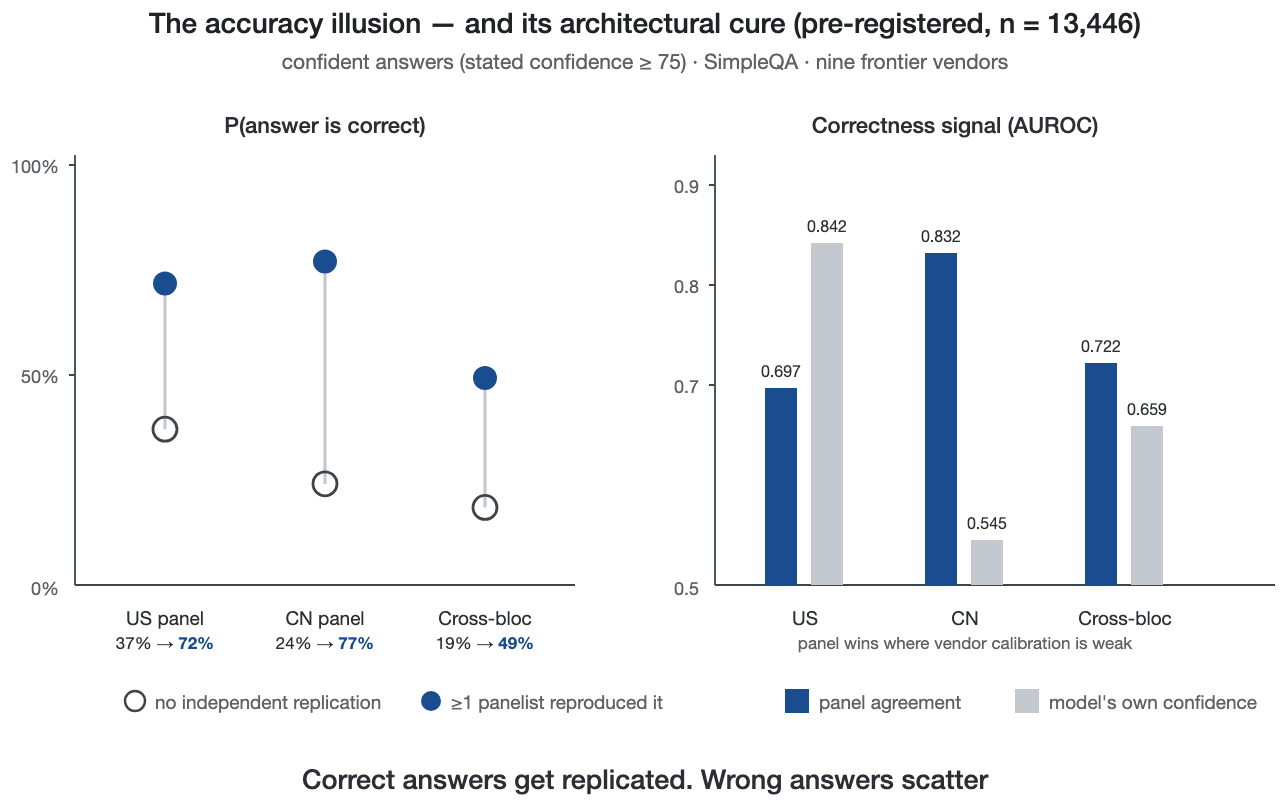
Certification par réplication indépendante (pré-enregistrée ; n = 13 446 réponses notées — neuf fournisseurs frontaliers, chacun répondant aux mêmes 1 500 questions SimpleQA une fois, moins 54 appels échoués ou non notables).
Les travaux concurrents renforcent la prudence : un audit à grande échelle a trouvé une auto-cohérence élevée coexistant avec des réponses incorrectes sur les benchmarks de raisonnement, où l'accord seul, sans indépendance et collecte aveugle, est un signal faible et dépendant du régime (Ding, 2026). Je traite donc la réplication indépendante, aveugle comme l'unité de certification.
Tableau 6. Interception d'erreur confiante et certification par panel (SimpleQA, confirmatoire ; conf ≥ 75)
| Panel | Erreurs confiantes (n) | Taux de signalement sur erreurs [IC 95 %] | Faux positifs sur correct | P(correct | ≥1 d'accord) | P(correct | aucun) | AUROC : accord vs conf propre |
| US-frontier (Anthropic·OpenAI·Google) | 1 630 | 94,3 % [93,1–95,3] | 91,0 % | 71,8 % | 37,1 % | 0,697 vs 0,842 |
| CN-frontier (DeepSeek·Alibaba·Moonshot) | 2 128 | 85,5 % [83,9–86,9] | 94,8 % | 77,0 % | 24,1 % | 0,832 vs 0,545 |
| Cross-bloc (Anthropic·DeepSeek·Mistral) | 2 432 | 89,4 % [88,1–90,6] | 93,4 % | 49,3 % | 18,5 % | 0,722 vs 0,659 |
Signalement = réponse indépendante d'≥1 panéliste non équivalente à celle du principal (les refus et les réponses sans chevauchement comptent comme non-concurrence ; un codage plus strict se trouve dans le package de réplication). La sensibilité au seuil à 60/90 ne change aucune conclusion. L'AUROC de confiance propre est la confiance déclarée regroupée sur la population complète de réponses du panel ; le regroupement absorbe les différences inter-fournisseurs en précision et échelle de confiance, de sorte qu'il peut dépasser la valeur individuelle de chaque membre (valeurs par fournisseur au tableau 7). Les réponses se regroupent par question ; un bootstrap de cluster au niveau des questions élargit les intervalles d'environ un facteur 1,6 sans changer aucune conclusion. Chaque AUROC de ce tableau et du tableau 7 se reproduit de manière déterministe, avec une commande et sans aléa, à partir du script du package de réplication compute_panel_vs_own_auroc.py (Mann–Whitney avec correction des ex aequo).
Tableau 7. AUROC de confiance propre par panel : population du panel regroupée et par fournisseur (mêmes populations que le tableau 6)
| Panel | AUROC de confiance propre du panel regroupé | AUROC de confiance propre par fournisseur |
| US-frontier | 0,842 | Anthropic 0,784 · OpenAI 0,596 · Google 0,746 |
| CN-frontier | 0,545 | DeepSeek 0,569 · Alibaba 0,532 · Moonshot 0,620 |
| Cross-bloc | 0,659 | Anthropic 0,787 · DeepSeek 0,570 · Mistral 0,584 |
Calculé par le pipeline déterministe du paquet de réplication. Deux conventions de population coexistent et sont imprimées explicitement pour éviter une incohérence apparente : les valeurs par fournisseur du tableau sont calculées au sein de la population d'éléments de chaque panneau, tandis que les citations à un seul chiffre dans le texte utilisent la valeur de la collection complète — pour le meilleur fournisseur discriminant 0,784 dans le panneau US-frontier par rapport à 0,788 sur la collection complète de 1 500 éléments, et pour OpenAI 0,596 par rapport à 0,598 (les deux paires se reproduisent à partir d'une commande du même pipeline). La colonne groupée, en revanche, confond les taux de base des fournisseurs — les différences entre fournisseurs en termes de précision et d'échelle de confiance jouent un rôle, donc la valeur groupée n'a pas besoin de se situer dans la plage par fournisseur (recalculée en direct : la valeur groupée US-frontier 0,842 dépasse celle de chaque membre individuel, et la valeur groupée CN-frontier 0,545 se situe en dessous de la moyenne macro par fournisseur 0,574 de ce panneau) ; les valeurs par fournisseur sont les quantités interprétables. L'écart par fournisseur est le problème du consommateur énoncé numériquement : une discrimination utilisable existe chez un fournisseur et est quasi aléatoire chez les autres, et rien à l'extérieur d'une réponse ne dit quel fournisseur l'a produite. Les valeurs sources derrière les plages de fournisseurs de la Section 3, imprimées par modèle à partir de la même collection notée (médiane confiance indiquée · précision · AUROC de confiance propre à la collection complète) : frontier — Alibaba 95 · 47,4 % · 0,532 ; Anthropic 42 · 10,3 % · 0,788 ; DeepSeek 90 · 35,7 % · 0,570 ; Google 95 · 66,5 % · 0,746 ; Mistral 90 · 16,5 % · 0,584 ; Moonshot 85 · 51,6 % · 0,619 ; OpenAI 85 · 16,7 % · 0,598 ; xAI 60 · 37,9 % · 0,777 ; Zhipu 95 · 28,4 % · 0,611 — les deux médianes en dessous de la bande 85–95 appartiennent aux deux fournisseurs dont la confiance porte un signal utilisable ; tier local (entre uniquement dans la stratification de la difficulté et les valeurs nulles du tier local) — gemma4:e4b 90 · 5,2 % · 0,541 ; glm4:9b 85 · 5,0 % · 0,589 ; llama3.2:3b 100 · 5,3 % · 0,494 ; mistral:7b 95 · 6,3 % · 0,506 ; phi4-mini 95 · 5,5 % · 0,505 ; qwen3:8b 95 · 5,9 % · 0,504 ; deepseek-r1:8b 90 · 9,2 % · 0,696 (n = 98, règle d'arrêt pré-engagée).
L'AUROC mesure la discrimination, c'est-à-dire si la confiance indiquée par un fournisseur classe ses réponses correctes au-dessus de ses réponses incorrectes, tandis que l'ECE, le score de Brier et l'écart confiance-précision mesurent l'étalonnage, c'est-à-dire si le chiffre indiqué peut être lu comme une probabilité, et dans ces données, les deux se dissocient nettement. Le meilleur fournisseur discriminant de juillet de l'étude, le tier intermédiaire d'Anthropic (AUROC de confiance propre 0,788), est toujours très mal étalonné en niveau : confiance moyenne indiquée 41,3 (médiane 42) par rapport à une précision de 10,3 %, un écart de surévaluation de la confiance de +31,0 points, ECE 0,311 (15 bacs), Brier 0,206 avec un terme de fiabilité de 0,126 par rapport à un plancher d'incertitude irréductible de 0,093. Inversement, le pire étalonnage du panneau coïncide avec une discrimination quasi aléatoire (Mistral : écart +74,2 points, ECE 0,742, AUROC 0,584), et seul xAI s'approche à la fois de la discrimination et de l'étalonnage (ECE 0,111, AUROC 0,777). Même là, la discrimination est aidée par une confiance indiquée uniformément basse, tandis que pour les huit autres fournisseurs de juillet, les deux propriétés se dissocient nettement. Cette même dissociation persiste au tier flagship : neuf des onze flagships d'août portent des écarts de surévaluation de la confiance de +12,5 à +71,4 points (ECE 0,125–0,714), tandis que les deux exceptions (gpt-5.6-sol, ECE 0,031 ; claude-fable-5, ECE 0,043) réalisent l'étalonnage aux extrémités opposées de l'échelle de précision. Un consommateur disposant d'un score de confiance bien classé mais numériquement gonflé ne peut pas l'utiliser sans référence externe. Le Tableau 7a imprime les métriques d'étalonnage à côté des métriques de discrimination.
Tableau 7a. Discrimination par rapport à l'étalonnage, vague de juillet (collection complète, résolue ; ECE avec 15 bacs ; écart = confiance moyenne indiquée − précision, points de pourcentage)
| Fournisseur | n | AUROC (confiance propre) | ECE | Brier | Écart confiance − précision | Confiance moyenne → précision |
| Alibaba | 1 497 | 0,532 | 0,448 | 0,446 | +44,8 pp | 92,3 → 47,4 % |
| Anthropic | 1 500 | 0,788 | 0,311 | 0,206 | +31,0 pp | 41,3 → 10,3 % |
| DeepSeek | 1 500 | 0,570 | 0,536 | 0,513 | +53,4 pp | 89,1 → 35,7 % |
| 1 461 | 0,746 | 0,263 | 0,271 | +26,3 pp | 92,8 → 66,5 % | |
| Mistral | 1 495 | 0,584 | 0,742 | 0,686 | +74,2 pp | 90,6 → 16,5 % |
| Moonshot | 1 500 | 0,619 | 0,242 | 0,292 | +24,2 pp | 75,8 → 51,6 % |
| OpenAI | 1 500 | 0,598 | 0,610 | 0,531 | +60,9 pp | 77,6 → 16,7 % |
| xAI | 1 500 | 0,777 | 0,111 | 0,197 | +11,1 pp | 48,9 → 37,9 % |
| Zhipu | 1 493 | 0,611 | 0,642 | 0,612 | +64,2 pp | 92,6 → 28,4 % |
| Panneau US-frontier, unités groupées | 4 383 | 0,842 | 0,393 | 0,336 | +39,3 pp | — |
| Panneau CN-frontier, unités groupées | 4 491 | 0,545 | 0,408 | 0,417 | +40,8 pp | — |
| Panneau cross-bloc, unités groupées | 4 485 | 0,659 | 0,529 | 0,469 | +52,9 pp | — |
Mêmes populations que l'AUROC de la collection complète et les Tableaux 6–7 (rangées de panneau : unités (élément, primaire) groupées) ; les refus marqués comme incorrects selon le protocole gelé. Brier se décompose par l'identité de Murphy (fiabilité − résolution + incertitude) sur les mêmes 15 bacs, résidu < 0,001 dans chaque rangée. Une note de tier flagship voyage avec les deux exceptions étalonnées : l'ECE de gpt-5.6-sol de 0,031 est obtenue à 95,4 % de précision, où le terme d'incertitude Murphy, le plancher que le taux de base fixe, est 0,044 — l'étalonnage partiellement acheté par un taux de base qui porte la mise en garde de contamination du Tableau 9 (61,6 % de correspondances de chaînes d'or littérales).
Un effet de sélection doit accompagner le tableau : la réplication est en partie un marqueur de facilité de question. En stratifiant par difficulté de question (précision moyenne sur les quinze autres modèles), le gain brut de certification est porté par les strates plus faciles (2,7–4,6×), tombe en dessous de 1× sur l'avant-dernier quintile et disparaît sur le plus difficile selon cette mesure intra-collection. Cette stratification est en partie endogène, et une ré-estimation exogène ci-dessous adoucit l'inversion en atténuation monotone. Une analyse de robustesse aborde la préoccupation de sélection directement (exploratoire, non pré-enregistrée) : dans un modèle logistique groupé par question avec effets fixes du modèle primaire, en contrôlant pour la confiance propre du modèle primaire et pour la difficulté de l'item (précision moyenne leave-primary-out sur les seize modèles), chaque panéliste supplémentaire en accord multiplie encore les chances de correction d'environ cinq (b poolé = +1,65 par panéliste, IC 95 % [+1,49, +1,81], p < 10⁻⁸⁸ ; positif dans chaque panneau), et ajouter l'accord à une base difficulté-plus-confiance augmente l'AUROC en retenue de 0,859 à 0,898 et abaisse le score de Brier de 0,139 à 0,116 (split de validation croisée deux fois par question). Le même modèle sonde la frontière, et la stratification elle-même exige de la prudence : selon la mesure de difficulté intra-collection, le coefficient conditionnel devient négatif sur le quintile le plus difficile (b = −0,41, p = ,011), mais cette mesure inclut les propres membres du panneau. Le modèle conditionnel porte une réserve de déploiement : sa variable de difficulté exige des étiquettes, elle est donc diagnostique, non déployable, et le filtre déployable est lui-même la porte d'accord. Trois vérifications supplémentaires abordent l'estimation et les préoccupations de sélection, tous selon le codage de protocole déterministe gelé (la branche plus stricte que le paquet de réplication rapporte aux côtés des chiffres phares adjudiqués par le juge). En ré-estimant le gain de certification avec le rééchantillonnage bootstrap groupé par item, le regroupement que la structure de difficulté exige, laisse l'intervalle de gain de certification de chaque panneau bien au-dessus de 1 (gains ponctuels 2,4–4,5 selon ce codage déterministe, qui certifie moins d'accords que le codage de paire adjudiqué par le juge derrière les chiffres phares publiés 1,9–3,2× ; bornes inférieures bootstrap 2,2–4,1). La distribution de 84 panneaux rapportée ci-dessus fait du panneau à la frontière américaine, où l'auto-déclaration gagne, l'exception plutôt que la règle (avantage médian +0,14, IQR d'AUROC d'accord 0,76–0,82). Et l'AUROC stratifiée par difficulté rend la frontière explicite selon une mesure de difficulté exogène : 0,87 sur le quintile le plus facile tombant à 0,61 sur le plus difficile, atténuation sans inversion. Cette mesure est leave-panel-out, les treize modèles en dehors de chaque panneau, et ré-estimer avec elle résout l'inversion : le coefficient d'accord conditionnel reste positif sur chaque quintile y compris le plus difficile (b du quintile le plus difficile = +0,97, p < 10⁻⁷ ; 28 % des réponses indépendamment reproduites sur la strate la plus difficile sont correctes, non 0 %). Donc l'inversion intra-collection est en partie un artefact de la mesure de difficulté. Ce qui survit selon l'une ou l'autre mesure est l'atténuation monotone, l'accord étant le plus faible là où les questions sont les plus difficiles, et la réalité des erreurs de consensus certifiées ; les scripts et les résultats se trouvent dans le paquet de réplication. Le ratio phare est donc une moyenne sur une population hétérogène. La réclamation de signal repose sur le point d'extrémité AUROC, non sur le ratio.
Les hypothèses de l'expérience opérationnalisent le déploiement de recherche que j'opère : la collection en aveugle reflète son mécanisme de conseil, et les compositions de panneau existaient comme sa configuration de production avant que l'étude soit conçue. Ceci est la deuxième étude pré-enregistrée dans ce programme de recherche. La troisième, l'expérience consommateur de la section 6, est complète et rapportée, et une quatrième (télémétrie de champ sur le trafic de production) est rédigée. Le paquet de réplication s'exécute pour n'importe qui, sur un matériel standard, contre des API publiques.
Une deuxième vague au niveau phare : onze laboratoires — dix bras complets et un partiel — un fossé d'étalonnage. L'expérience ci-dessus a échantillonné les niveaux optimisés en coûts qui servent réellement les consommateurs. L'objection à tester : peut-être l'illusion de précision est-elle un artefact de niveau budget, et les phares, les modèles que chaque fournisseur met en avant comme ses meilleurs, sont suffisamment étalonnés pour que l'architecture au-dessus d'eux soit redondante. Une deuxième vague de collection (août 2026) teste cette objection au sommet du marché.
J'évalue un modèle phare de chacun des dix principaux laboratoires d'IA couvrant les États-Unis, la Chine et l'Europe. Les laboratoires ont été choisis pour couvrir les écosystèmes commerciaux et open-weight les plus importants dans ces trois régions. Pour chaque laboratoire, j'ai sélectionné son modèle généralement disponible le plus capable au moment de la vague d'évaluation. J'ai ensuite vérifié cette couverture par rapport aux classements publics au 5 août 2026 (LMArena Elo, l'Artificial Analysis Intelligence Index, Humanity's Last Exam et SWE-bench Verified) : huit des dix phares se classent dans ou près du sommet d'au moins un classement de capacité générale, tandis que deux (Mistral, Baidu) sont inclus pour préserver la couverture de laboratoire et régionale plutôt que sur la base du classement (voir les limitations de couverture ci-dessous). Un onzième laboratoire, Meta, dont le phare est devenu accessible uniquement après que la vague soit définie, a été ajouté en cours de vague ; sa collection a été interrompue par une révocation d'accès et est rapportée comme partielle (voir ci-dessous).
Tableau 8. Modèles phares évalués et positions en classement (au 5 août 2026)
| Labo | Modèle phare (ID API) | Pays | Positions en classement (5 août 2026) |
| OpenAI | gpt-5.6-sol | USA | AA Index #3 (58,9) ; LiveBench #1 (82,4) ; Arena top-6 cluster |
| Anthropic | claude-fable-5 | USA | Arena #1 (~1525 Elo) ; AA Index #2 (59,9) ; SWE-bench Verified #1 (95,0) |
| gemini-3.1-pro-preview | USA | SWE-bench Verified #8 (80,6) ; HLE #17 (51,4) ; Arena upper cluster | |
| xAI | grok-4.5 | USA | AA Index #8 (53,8) ; Arena Elo 1499 |
| DeepSeek | deepseek-v4-pro | China | SWE-bench Verified #8 (80,6, Pro-Max) ; HLE #23 (48,2) |
| Alibaba | qwen-max (Qwen 3.7 Max) | China | Arena #21 (1488–1496 Elo) ; SWE-bench Verified #11 (80,4) |
| Moonshot AI | kimi-k3 | China | AA Index #4 (57,1) ; HLE #9 (56,0) ; Arena #10 (1500) |
| Zhipu (Z.ai) | glm-5.2 | China | AA Index #13 (51,1) ; HLE #11 (54,7) |
| Mistral | mistral-medium-3.5 | France | Sous le top 50 des classements généraux ; inclus pour la couverture régionale |
| Baidu | ernie-4.5-vl-424b | China | Hors du top 30 général (ERNIE 5.0 : HLE #36) ; ERNIE 5.1 : LMArena Search Arena #4 |
| Meta (ajouté en milieu de vague, partiel) | muse-spark-1.1 | USA | HLE #4 |
Les scores entre parenthèses sont les valeurs rapportées par l'agrégateur à la date de l'instantané ; les positions au classement varient légèrement selon les agrégateurs et les dates d'instantané. Les sources d'instantané sont archivées avec les enregistrements d'exécution qui accompagnent le paquet de réplication.
Le protocole est celui de la première expérience, gelé et réutilisé : le même sous-ensemble SimpleQA de 1 500 éléments (fixé par seed et hash), un passage en aveugle par modèle, température zéro, invite système identique et analyseur de réponse, une confiance déclarée de 0–100 par réponse. La notation est déterministe (correspondance exacte et normalisée des chaînes par rapport à la référence ; les refus sont notés comme des erreurs ; les éléments non résolus sont exclus du titre et re-notés comme des erreurs dans l'analyse de sensibilité), et aucun juge IA ne touche aux chiffres du titre. C'est un renforcement délibéré par rapport à la première vague, dont le notation était hybride : correspondance objective des chaînes avec un juge à poids ouvert local résolvant le reste (66,5 % des verdicts émis par le modèle ; vérification ponctuelle de 50 éléments par un humain, 98 % d'accord). Cette vague utilise uniquement le moteur d'équivalence déterministe (validé manuellement : 20 sur 20 désaccords signalés et 15 sur 15 accords confirmés à la main), de sorte que chaque chiffre du titre de cette vague se reproduit bit par bit à partir du script publié. Les comparaisons entre vagues de la précision absolue traversent donc aussi les régimes de notation, et chaque comparaison juillet-août porte un qualificatif de régime de notation. Les audits intra-vague soutiennent les chiffres de chaque vague, mais les deltas entre vagues confondent le changement de modèle avec le changement de notation à moins qu'une seule notation soit réappliquée aux deux ensembles de réponses gelées, ce qui n'a pas été fait ici. Une déviation d'effort : le bras d'OpenAI a été collecté à l'effort de raisonnement par défaut de l'interface (moyen) où le protocole de juillet utilisait le minimum, sans accès au web ou aux outils à l'inférence (vérifié en énumérant les outils exposés au modèle, dont il y en avait zéro). Ceci modifie la précision absolue de ce fournisseur, et non le mécanisme d'accord (Section 5). Un échec confiant est une réponse incorrecte offerte à une confiance déclarée ≥ 80 ; le seuil a été fixé avant l'exécution, 70 et 90 étant rapportés comme sensibilité. La couverture de l'union est de 1 500/1 500 questions pour dix des onze laboratoires. La collecte de Meta a atteint 272 réponses valides avant que l'accès soit révoqué.
J'ai également testé directement la préoccupation entre régimes. La re-notation de la vague de seize modèles de juillet avec le moteur déterministe gelé de la deuxième vague (qui remplace le pipeline hybride qui a arbitré 66,5 % des verdicts avec un juge à poids ouvert local) change 2,65 % des verdicts résolus (566 sur 21 338 ; le moteur s'abstient sur 4,1 % supplémentaires) et ne modifie aucun titre : selon un codage déterministe unique, les lectures de certification sont 3,6×/4,6×/4,4× avant re-notation et 3,0–3,1×/4,5–4,6×/4,3× après. Les deux sont au-dessus des 1,9–3,2× prudents publiés, qui découlent du codage par paire arbitré par IA, car plus d'accords certifiés signifie des relevés plus prudents. Chaque AUROC des tableaux 6–7 se décale d'au maximum 0,016 sur les panneaux CN et inter-blocs et 0,046 sur le panneau US, préservant le classement de chaque panneau d'accord par rapport à la confiance auto-déclarée.
L'étiquette phare ne garantit rien. La précision résolue sur des questions identiques varie de 11,4 % à 95,4 % selon les onze produits phares (Tableau 9), un écart de 84 points en haut du marché, plus large que l'écart du segment intermédiaire de la première expérience. Et l'illusion de précision survit intacte à ce niveau : regroupées sur les dix bras de laboratoire complets, 46,6 % de toutes les réponses résolues offertes à une confiance déclarée ≥ 80 étaient incorrectes (4 910 sur 10 540 ; y compris le bras partiel de Meta, 46,3 %, ou 4 935 sur 10 665 ; les éléments non résolus sont exclus ici et re-notés comme des erreurs dans la sensibilité, où l'image regroupée est inchangée). L'implication face aux consommateurs de la première vague ne s'adoucit pas avec le prix : un badge phare ne dit pas au consommateur si la réponse confidente devant lui provient du produit phare à 95 % de précision ou de celui à 11 % de précision.
Tableau 9. Vague phare : couverture et précision (sous-ensemble SimpleQA, n = 1 500 par laboratoire, température 0)
| Laboratoire (produit phare) | Couverture | Précision (résolue) | Non résolus |
| OpenAI gpt-5.6-sol | 1 500/1 500 | 95,4 % (1 403/1 471) | 29 |
| Google gemini-3.1-pro | 1 500/1 500 | 71,1 % (837/1 178)¹ | 46 |
| Anthropic claude-fable-5 | 1 500/1 500 | 70,3 % (1 019/1 450) | 50 |
| Meta muse-spark-1.1 (partiel) | 272/1 500 valides | 61,4 % (148/241)² | 10 |
| xAI grok-4.5 | 1 500/1 500 | 54,8 % (794/1 448) | 52 |
| DeepSeek deepseek-v4-pro | 1 500/1 500 | 46,6 % (666/1 428) | 72 |
| Moonshot kimi-k3 | 1 500/1 500 | 45,5 % (645/1 418) | 82 |
| Zhipu glm-5.2 | 1 500/1 500 | 30,2 % (430/1 425) | 69 |
| Baidu ernie-4.5-vl-424b | 1 500/1 500 | 28,9 % (411/1 421) | 71 |
| Mistral mistral-medium-3.5 | 1 500/1 500 | 21,4 % (306/1 429) | 71 |
| Alibaba qwen-max | 1 500/1 500 | 11,4 % (164/1 435) | 65 |
¹ Le canal de Google a retourné des réponses vides ou filtrées sur 18,4 % des éléments (276 sur 1 500 — une propriété de livraison, non une lacune de couverture : les 1 500 ont tous été tentés) ; la précision est calculée sur les réponses analysées et résolues. Les deux définitions sont rapportées : réponses seules, la précision de Google est 71,1 % (837/1 178) ; en comptant les 276 réponses non livrées comme des erreurs, elle est 57,6 % (837/1 454), et 55,8 % (837/1 500) avec les éléments non résolus également notés comme erreurs. ² Précision Meta calculée sur les réponses collectées avant la révocation d'accès ; voir les limitations de couverture. La précision dans tout le tableau est résolue uniquement ; sous la sensibilité non-résolu-comme-erreur, le chiffre principal, 95,4 % pour OpenAI, devient 93,5 % (1 403/1 500). La provenance du canal par appel pour chaque laboratoire est enregistrée dans le manifeste d'exécution. Les comptes non résolus correspondent à des réponses livrées qui n'ont pas été résolues de manière déterministe ; pour Zhipu (1 494 réponses livrées), Baidu (1 492) et le volet Meta partiel (251), les deux colonnes totalisent donc moins que les questions tentées, le reste étant des réponses non livrées.
Une mise en garde sur la contamination délimite les précisions absolues. Cette vague réutilise l'indice SimpleQA initialement publié (octobre 2024) par rapport à des modèles dont les corpus d'entraînement postdatent sa publication de jusqu'à deux ans, donc l'exposition à l'indice lui-même au moment de l'entraînement est plausible en haut du tableau, et les données en portent une signature concrète : le modèle phare au meilleur score reproduit la chaîne de réponse de référence verbatim (correspondance exacte normalisée, jusqu'au formatage décimal) sur 61,6 % des éléments, contre 27,9–45,3 % pour les autres laboratoires, avec une confiance médiane déclarée de 99. La conception ne peut pas distinguer « le modèle est plus fort » de « le modèle a vu l'indice et sa clé de réponse ». Les chiffres de précision absolue de la vague ne sont donc pas comparables aux plafonds en circuit fermé historiques rapportés pour les générations de modèles antérieures, et ils ne doivent pas être lus comme des mesures de mémoire paramétrique. La vérification d'ancienneté d'indice de la première vague (l'écart TruthfulQA–SimpleQA rapporté dans la section 3) couvrait la collecte de juillet ; en août 2026, SimpleQA lui-même est un indice public âgé de deux ans, et cette mise en garde couvre la vague phare. Les conclusions de la vague ne reposent pas sur la précision absolue. Elles reposent sur la structure des échecs confiants, leur prévalence à confiance déclarée ≥ 80 et leur interception par la porte de désaccord, mesurées dans la vague selon un protocole gelé unique, où tout avantage d'exposition est partagé entre les laboratoires évalués sur les mêmes éléments. Une sonde fraîche à deux sauts construite après la fenêtre d'étude confirme cette signature directement. Voir « Pourquoi ne pas simplement utiliser le meilleur modèle ? » plus loin dans cette section.
Le fossé de calibrage. La première expérience a montré que l'accord indépendant porte un signal de correction que la confiance auto-déclarée ne porte pas. La vague phare transforme ce signal en filtre mesuré. Le mécanisme est une porte de désaccord : un conseil de trois laboratoires, fixé à l'avance à partir d'une analyse de désaccord antérieure et non ajusté à ces résultats (Moonshot kimi-k3, DeepSeek deepseek-v4-pro, OpenAI gpt-5.6-sol), et une règle sans paramètres libres. Une réponse passe la porte uniquement lorsque les trois réponses du conseil s'accordent par paires. Parce que rien n'est estimé, aucun fractionnement train/test n'est nécessaire ; la porte est calculée une fois sur la collection gelée.
Figure 17. La porte phare
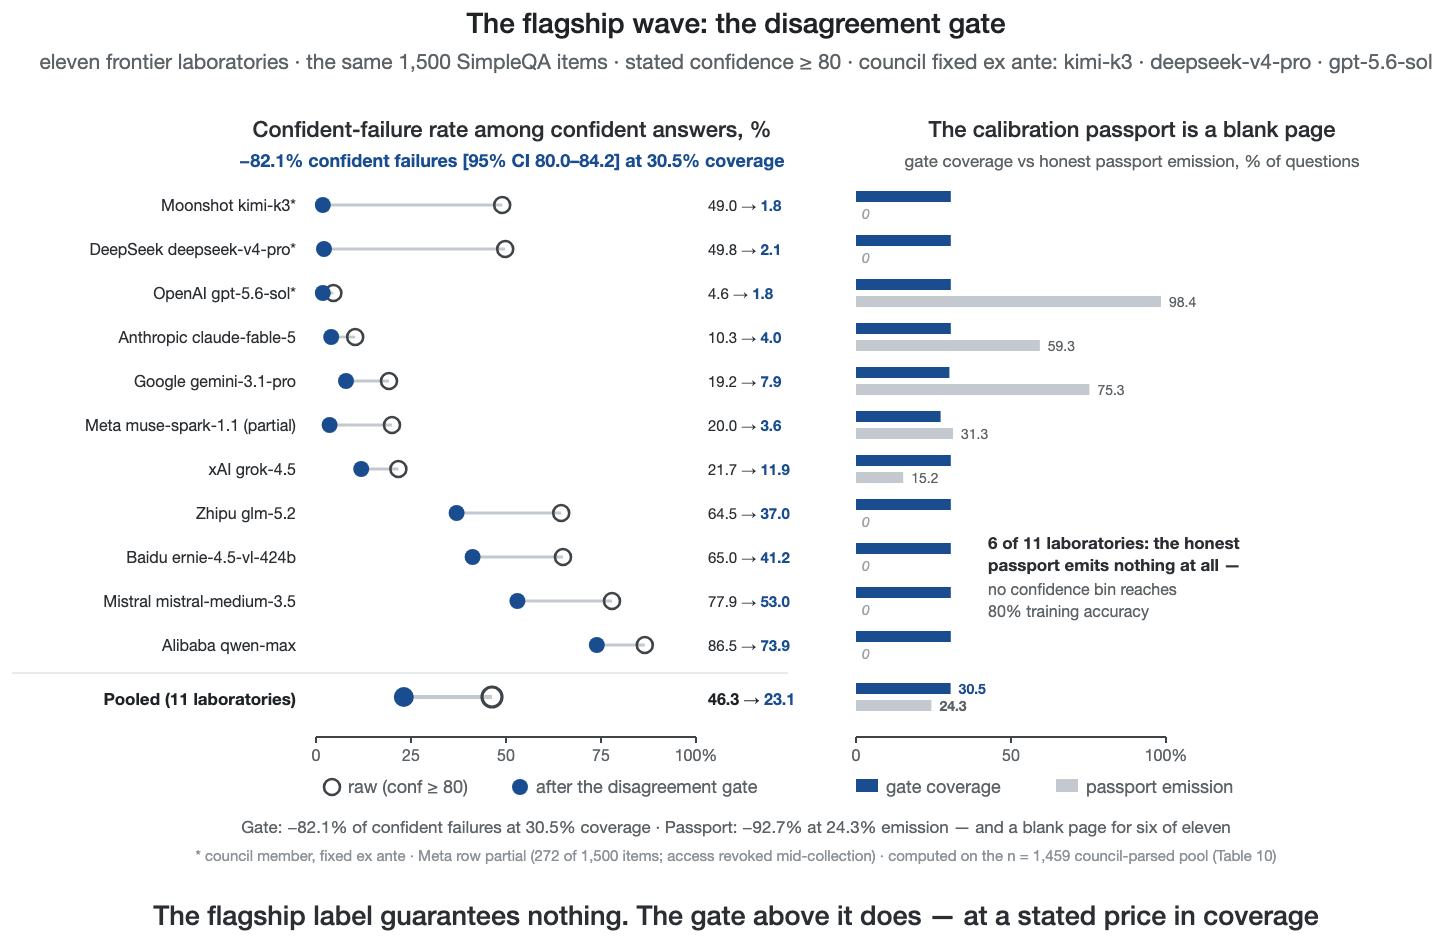
Échecs confiants à confiance déclarée ≥ 80 et leur interception par la porte de désaccord fixe à trois modèles, par laboratoire (vague d'août 2026).
Regroupés sur les dix volets de laboratoire complets (la présentation principale, avec le volet Meta partiel rapporté séparément et son inclusion traitée comme une sensibilité), le taux brut d'échec confiant est 46,6 % (4 910/10 540). Regroupés sur l'effectif de onze laboratoires, les taux par laboratoire varient (tableau 9), ainsi ce chiffre caractérise la liste d'effectifs frontière plutôt qu'une constante universelle. La porte supprime 82,1 % des échecs confiants (intervalle de confiance bootstrap 95 % [79,9 ; 84,1]) tout en conservant 30,5 % de tous les réponses regroupées (la porte elle-même s'ouvre sur 30,6 % des questions, 446 sur 1 459). Limité aux laboratoires complets en dehors du conseil, sans aucune auto-référence, la porte supprime toujours 76,9 % des échecs confiants (IC [74,3 ; 79,2]). L'inclusion du volet Meta partiel laisse chaque estimation effectivement inchangée : regroupées sur les onze, le taux brut est 46,3 % (4 935/10 665 ; 35,8 % des réponses confiantes passent la porte, et la correction parmi les réponses confiantes émises augmente de 53,7 % brut à 76,9 % post-porte), la porte supprime 82,1 % (IC [80,0 ; 84,2]) à la même couverture de 30,5 %, et le chiffre pour huit laboratoires non-conseil est 77,0 % (IC [74,4 ; 79,3]). Le tableau 10 donne les chiffres par laboratoire.
Tableau 10. Interception d'échec confiant par la porte de désaccord (conf ≥ 80 ; évaluateur déterministe ; conseil = kimi-k3 · deepseek-v4-pro · gpt-5.6-sol, fixé ex ante)
| Laboratoire | Réponses confiantes | Échecs confiants, bruts | Après la porte (taux sur émises) | dEC |
| Moonshot kimi-k3 [conseil] | 1 056 | 517 (49,0 %) | 7 (1,8 %) | −98,6 % |
| DeepSeek deepseek-v4-pro [conseil] | 1 274 | 634 (49,8 %) | 9 (2,1 %) | −98,6 % |
| OpenAI gpt-5.6-sol [conseil] | 1 426 | 65 (4,6 %) | 8 (1,8 %) | −87,7 % |
| Anthropic claude-fable-5 | 825 | 85 (10,3 %) | 15 (4,0 %) | −82,4 % |
| Google gemini-3.1-pro | 966 | 185 (19,2 %) | 27 (7,9 %) | −85,4 % |
| Meta muse-spark-1.1 (partiel) | 125 | 25 (20,0 %) | 2 (3,6 %) | −92,0 % |
| xAI grok-4.5 | 577 | 125 (21,7 %) | 36 (11,9 %) | −71,2 % |
| Zhipu glm-5.2 | 1 128 | 727 (64,5 %) | 146 (37,0 %) | −79,9 % |
| Baidu ernie-4.5-vl-424b | 725 | 471 (65,0 %) | 107 (41,2 %) | −77,3 % |
| Mistral mistral-medium-3.5 | 1 354 | 1 055 (77,9 %) | 224 (53,0 %) | −78,8 % |
| Alibaba qwen-max | 1 209 | 1 046 (86,5 %) | 300 (73,9 %) | −71,3 % |
| Regroupés (11 laboratoires) | 10 665 | 4 935 (46,3 %) | 881 (23,1 %) | −82,1 % [80,0 ; 84,2] |
| Regroupés (8 non-conseil) | 6 909 | 3 719 (53,8%) | 857 (33,5%) | −77,0% [74,4; 79,3] |
Calculé sur le pool de questions pour lesquelles les trois membres du conseil ont produit des réponses analysées et non refusées (n = 1 459 sur 1 500); la porte s'ouvre sur 446 de ces dernières (30,6%). La ligne Meta est partielle (accès révoqué en cours de collecte). IC bootstrap: 5 000 rééchantillonnages au niveau des questions.
Trois éléments accompagnent ce titre. La porte rejette également environ la moitié des réponses correctes confiantes (la porte ne conserve que 51,3% des réponses correctes-confiantes; parmi les réponses qu'elle rejette, environ 41% étaient en fait correctes). Le compromis porte sur la couverture en échange de la certitude, le compromis risque-couverture canonique de la classification sélective (Geifman & El-Yaniv, 2017), exécuté ici au niveau de l'architecture, et les deux chiffres doivent toujours être cités comme une paire: −82,1% d'échecs confiants à 30,5% de couverture. Le système possède son propre plancher. En mode entièrement systémique, où la porte ouverte émet la réponse de consensus du conseil plutôt que celle du modèle individuel, le taux d'échec confiant du système est de 1,8% (8 sur 442 réponses de consensus résolues), et ces huit questions sont celles où tout le conseil est en accord confiant sur la même mauvaise réponse. C'est le plancher d'erreur corrélée que la première expérience avait prédit à partir de sa condition limite de consensus certifiant l'erreur: en dessous, aucune vérification d'accord ne peut aider, car l'accord lui-même est l'erreur. Et le résultat est plat sur la grille de sensibilité pré-déclarée: seuil de confiance 70/80/90 donne un dCF poolé de −83,1%/−82,1%/−80,6%, et la réévaluation des éléments non résolus comme des erreurs donne −81,8%, donc le chiffre a été mesuré, non sélectionné.
Ce que le chiffre de couverture de 30,5% signifie commercialement est établi par l'économie du seuil de rentabilité de la section 5 (figure 14): les environ soixante-dix pour cent de réponses que la porte refuse de certifier sont des demandes acheminées vers une solution moins coûteuse qu'une erreur confiante (escalade vers un humain, un niveau de vérification plus approfondi, ou un affichage explicite de l'incertitude) plutôt que des conversions perdues, donc le coût de couverture est un prix asurable de l'erreur, non une demande non satisfaite. Aucun modèle de coût pour le canal d'escalade n'est estimé ici. Le point de fonctionnement n'est pas fixé. L'échelle d'accord tracée à la figure 19 fournit une famille de seuils, et un service doit se situer là où le coût attendu d'un échec confiant non détecté croise la marge sur le trafic que la porte retient, ce qui en fait un choix basé sur le coût.
Figure 14. Économie de la confiance graduée
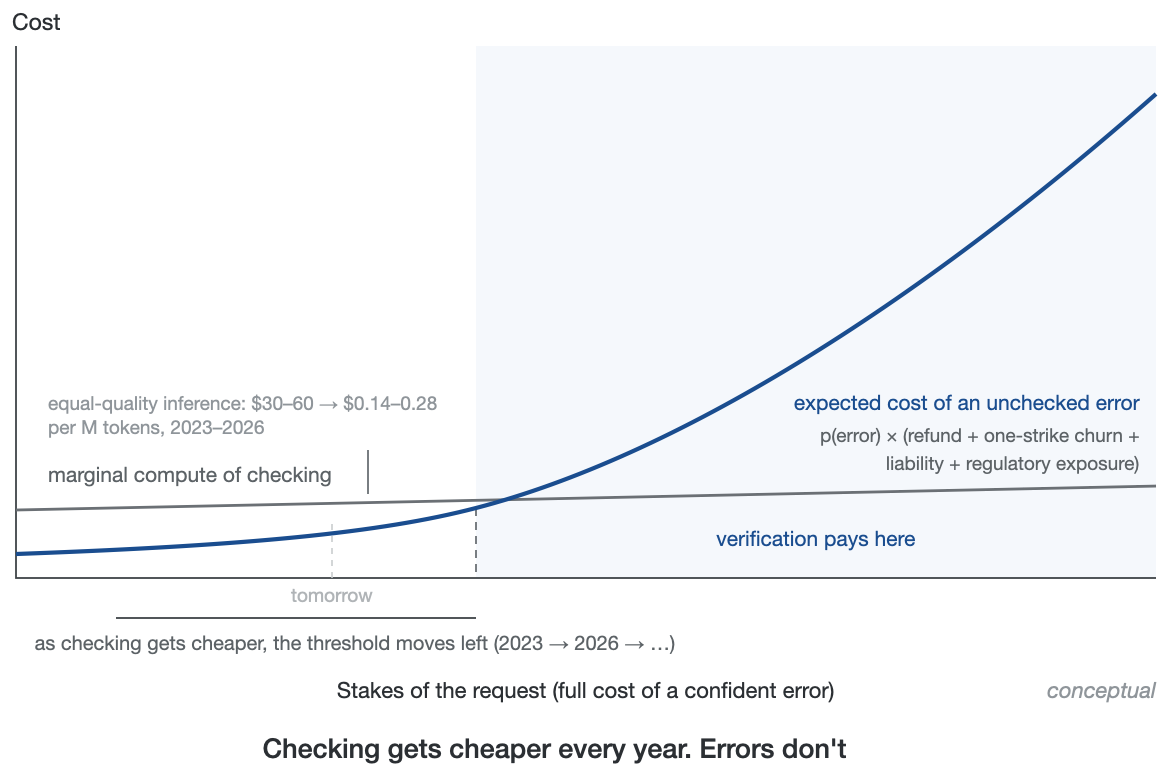
La logique du seuil de rentabilité de la vérification.
Pourquoi ne pas simplement utiliser le meilleur modèle? La plus forte ligne de base que la vague laisse subsister est commerciale plutôt que statistique: un opérateur pourrait ignorer l'architecture et acheminer tout vers le produit phare le plus précis de la vague. Cette ligne de base a besoin d'une réponse avec des chiffres. Aux prix de mi-2026, le conseil des trois laboratoires gelé coûte 0,0039$ par question, moins qu'une seule réponse du produit phare le plus cher de la vague (claude-fable-5, 0,0198$/question au tarif catalogue) et plus qu'une du plus précis (gpt-5.6-sol, 0,0027$/question aux tarifs de l'API publiés). « Il suffit d'acheter le meilleur produit phare » est un véritable point de Pareto: gpt-5.6-sol seul répond à chaque question avec un taux d'échec confiant de 4,6%, et aucune configuration avec porte ne correspond à sa couverture à aucun prix. Partout où un service peut tolérer un échec confiant sur environ une réponse sur vingt et a besoin d'une couverture complète, le produit phare l'emporte sur les deux axes. La règle se généralise mal, cependant, même au sommet du classement: l'autre grand concurrent de consensus de la vague, claude-fable-5, affiche un taux d'échec confiant de 10,3% en solo. « Utilisez simplement quel que soit le modèle qui domine les benchmarks » échoue complètement sur le deuxième modèle le plus fort de l'échantillon, c'est pourquoi le problème d'identification ci-dessous n'est pas hypothétique. Quatre considérations limitent la comparaison.
D'abord, le problème d'identification: savoir quel modèle est actuellement le meilleur est lui-même le produit d'une mesure externe, entre modèles. Le tableau 8 de la vague a sélectionné ses produits phares à partir de classements publics, continus, tiers, inter-vendeurs que personne ne propose de remplacer par un auto-rapport des vendeurs. Les données de cet article montrent pourquoi personne ne le fait: la confiance en soi déclarée discrimine à AUROC 0,53–0,79 selon le vendeur, et une écart de précision de 84 points sépare des modèles tous vendus comme le meilleur de leur laboratoire. « Acheminer vers le meilleur modèle » est donc une application de l'architecture de confiance, non une alternative à celle-ci: le classement qui couronne le produit phare est un panel indépendant, des items en aveugle, et un dossier publié, les trois composantes de la section 3 exploitées à l'échelle du marché. Et cette couronne change: le leadership des modèles d'entreprise a changé de mains au cours d'un seul printemps (Kharazian, 2026), les modèles sont mis à jour silencieusement sous des noms stables, et le comportement d'achat des agents se réorganise drastiquement lors des mises à jour de modèles (Allouah et al., 2026). Sans mesure externe continue, « le meilleur modèle » n'est pas disponible pour l'opérateur comme connaissance.
Deuxièmement, le 95,4% est en partie mémoire plutôt que capacité: le produit phare supérieur reproduit la chaîne de réponse correcte à l'identique sur 61,6% des éléments (la mise en garde sur la contamination du tableau 9), donc son avantage mesuré se compresse sur les questions que le benchmark ne peut pas lui avoir enseignées. Le mécanisme de porte n'hérite pas de cette fragilité: sur la strate la moins susceptible d'avoir été mémorisée, il supprime 89,4% des échecs confiants, sa meilleure performance plutôt que sa pire (la réanalyse stratifiée par contamination ci-dessous), car l'accord entre laboratoires indépendants entraînés n'est conditionné par aucun corpus d'entraînement d'un seul vendeur.
Pour séparer la connaissance transférable de l'exposition aux benchmarks, j'ai composé une sonde nouvelle de 100 éléments à deux sauts garantie non contaminée, générée par machine le 6 août 2026 à partir de paires de faits Wikidata vérifiés indépendamment d'avant 2023 (par ex., « En quelle année est né l'architecte du [bâtiment mineur]? »), chacun avec une réponse calculée unique, donc les chaînes de questions composées ne peuvent pas avoir figuré dans un corpus d'entraînement. Le SHA-256 de l'ensemble a été gelé avant le premier appel de modèle.
Sous le protocole gelé de la vague (invite système textuelle, température 0, même notateur déterministe), gpt-5.6-sol s'est effondré de 95,4 % de précision avec un taux de défaillance confiante de 4,6 % sur SimpleQA à 33,0 % [intervalle de confiance bootstrap 95 % : 24,0–42,0] avec des défaillances confiantes sur 61,0 % [51,0–70,0] de ses éléments (67,0 % de ses réponses confiantes), sa confiance moyenne énoncée bougeant à peine (98,4 → 93,7), tandis que claude-fable-5 s'est maintenu à 76,0 % [67,0–84,0] et 6,0 % [2,0–11,0]. L'écart de 25 points du navire amiral de la vague s'inverse en un déficit de 43 points sur les compositions garanties non vues. La porte du conseil, inchangée par rapport à la vague, a absorbé cet échec : elle a supprimé toutes les défaillances confiantes de gpt-5.6-sol sauf une (60/61 ; à n = 61 le taux ponctuel est imprécis, intervalle de confiance Wilson 95 % ≈ 91–99,7 % ; couverture de 24,2 % ; claude-fable-5 : 6 → 1), réduisant le taux de défaillance confiante émise parmi les réponses de confiance élevée passées à 4,5 % contre 67,0 % brut.
Les niveaux ne sont pas comparables ponctuellement entre les benchmarks : la composition à deux sauts est intrinsèquement plus difficile que la récupération à un seul saut, et à n = 100 les intervalles sont larges. Mais l'inversion de l'ordre des modèles et la persistance de la porte sur les éléments qu'aucun modèle ne peut avoir mémorisés sont exactement les signatures que l'hypothèse de contamination prédit, et ce sont le mode de défaillance qu'une couche de confiance architecturale, et non un meilleur choix de modèle, est construite pour absorber.
Troisièmement, il existe un plancher. La porte atteint un taux de défaillance confiante qu'aucun modèle seul n'atteint à aucun prix : les configurations avec porte du conseil réduisent les défaillances confiantes sur les réponses émises à 1,8–2,1 % à 0,0039–0,0046 $ par question, 2,5× en dessous du meilleur taux en solo, tandis que le navire amiral le plus onéreux de la vague se situe à 10,3 % de défaillances confiantes pour 0,0198 $ par question, dominant sur tous les axes. La porte n'est pas un dispositif de sauvetage pour les modèles faibles : qwen-max derrière la même porte échoue toujours avec confiance sur 73,9 % de ses réponses confiantes émises, les points de porte de la frontière sont donc des conseils de modèles forts, non des portes sur les modèles faibles.
Quatrièmement, lorsque l'agent dépense de l'argent de manière autonome, la question opérationnelle se déplace de « quel modèle est le plus intelligent » à « quelle configuration peut prouver ce qu'elle a fait ». Aussi précis soit-il, un navire amiral en solo ne peut pas certifier sa propre décision ou arbitrer son propre conflit d'intérêts. La configuration avec porte produit un enregistrement d'accord inspectable par réponse. C'est l'artefact que les marchés de la responsabilité civile et des assurances de la section 5 prix déjà, où les couvertures s'écrivent contre les preuves et l'exclusion se forme en fonction de leur absence.
La résolution est une frontière, non un gagnant. Le navire amiral est le membre le plus fort du conseil (le conseil gelé le comprend), mais il ne peut pas servir de son propre juge. Le tableau de classement qui l'identifie repose déjà sur le même principe que l'opérationnalisation de la confiance architecturale, la vérification cross-modèle indépendante, mais il ne fournit cette vérification qu'en agrégat, sur les modèles en général, non sur la réponse devant un consommateur. La construction comble cette lacune, et la lacune la délimite aussi : une affirmation reposant sur aucune vérification indépendante se situe en dehors de la confiance architecturale, non comme une instance de celle-ci. Le vrai choix de l'opérateur est entre les classes de risque : couverture complète à 4,6 % de défaillances confiantes, ou 31 % de couverture à 1,8 % avec une piste d'audit, l'échange de classification sélective, tarifé ici. La frontière complète coût–couverture–risque de 26 configurations (tous les navires amirals en solo, toutes les configurations avec porte, et les échelles d'accord regroupées, avec la base de prix facturé par rapport à affiché indiquée par point) est publiée en tant que CSV avec le paquet de réplication.
Le rival évident à la porte de désaccord est la réparation d'étalonnage de modèle unique : apprenez le mappage confiance-à-précision de chaque modèle et n'émettez que là où la précision mappée franchit une barre, le programme d'recalibration post-hoc dont les remèdes standard sont la température et la mise à l'échelle de Platt (Guo, Pleiss, Sun, & Weinberger, 2017). Ajusté sur les moitiés disjointes (confiance binée par histogramme, entraînement sur les questions avec index pair, évaluation sur les impaires, les bacs avec moins de 20 observations non émis), ce passeport d'étalonnage supprime 92,7 % des défaillances confiantes, mais à 24,3 % d'émission, et six des onze navires amirals n'émettent rien du tout : aucune case de confiance des leurs n'atteint 80 % de précision d'entraînement, le passeport pour ces modèles est donc une page blanche. Pour la moitié du marché des navires amirals, l'étalonnage de modèle unique ne peut pas être réparé de l'extérieur. La porte de désaccord maintient à peu près 30 % de couverture pour chaque modèle du tableau, y compris les six que le passeport abandonne. La conclusion du premier expérience tient donc aussi à ce niveau : l'architecture peut fournir un signal de correction externe là où la confiance exposée d'un modèle échoue comme tel, en classement ou en niveau, mesuré à nouveau au niveau que les consommateurs sont censés faire le plus confiance.
Robustesse de l'effet de porte. Deux vérifications axées sur l'arbitre importent : la circularité, si la porte repose sur son membre le plus fort, et si quelque chose de trivial fait le même travail. Le remplacement du membre le plus fort du conseil (gpt-5.6-sol, 95,4 % de précision résolue) par la quatrième passage de la frontière ex-ante de la vague (grok-4.5) laisse le résultat essentiellement inchangé. Le conseil sans sol supprime 81,2 % des défaillances confiantes regroupées à 29,7 % de couverture (cibles non-conseil : 77,6 %) contre 82,1 % à 30,5 % pour le trio gelé, et parmi les 165 conseils possibles à trois modèles le mécanisme ne échoue jamais : chaque conseil supprime plus de défaillances confiantes que l'abstention aléatoire à sa propre couverture (médiane supplémentaire +8,5 points), avec le trio ex-ante dans les 4 % supérieurs par cette marge (+12,6 points). L'effet appartient à l'accord cross-modèle, non à la précision d'un seul membre. L'établissement d'un seuil sur la confiance énoncée de chaque modèle à la couverture identique par modèle, la ligne de base triviale, supprime seulement 66,7 % des défaillances confiantes regroupées, moins que les 69,5 % que l'abstention aléatoire aveugle à la même couverture supprime, car les défaillances confiantes sont par construction concentrées à haute confiance énoncée. Ce seuil garde également moins de réponses confiantes-correctes que la porte (46,4 % contre 51,3 %). La porte domine Pareto les deux lignes de base pour chacun des onze laboratoires. L'utilisation de l'accord par réponse avec le modèle le plus fort seul comme filtre est un écran encore plus fort (97,1 % des défaillances confiantes regroupées supprimées à 40,7 % de couverture, conservant 97,0 % des réponses confiantes-correctes), mais c'est une règle mécaniquement différente, conditionnée par la cible. Elle transmet une réponse uniquement après l'inspection, tandis que la porte du conseil ouvre le même ensemble de questions fixes pour chaque modèle sans regarder la réponse testée, elle délimite donc l'effet du conseil sans l'expliquer : sans sol le trio supprime toujours 81,2 %, et même l'accord avec un juge seul faible (kimi-k3, 45,5 % de précision résolue) supprime 86,3 % des défaillances confiantes. Le moteur est l'accord cross-modèle en tant que tel, tandis que la précision du juge s'affiche dans ce qui est conservé (réponses conservées-correctes 97,0 % pour sol contre 20–63 % pour les juges plus faibles).
L'abstention calibrée fournit les lignes de base concurrentes plus fortes, et elles ont également été exécutées. Deux lignes de base d'abstention calibrée ont été ajustées selon la même division que le passeport de calibrage (paramètres ajustés sur les éléments indexés de manière paire, évalués sur la moitié impaire retenue, où la porte gelée supprime 82,2 % des défaillances confiantes avec 30,8 % de couverture). Les lignes de base par modèle n'atteignent pas la porte. La confiance à l'échelle de Platt avec couverture par modèle adaptée à la porte supprime 65,3 % des défaillances confiantes, et l'abstention conforme à division (α = 0,293, calibrée pour garantir P(emit | wrong) ≤ α et accordée à la même couverture) supprime 70,8 %, comme le fait un contrôle top-K à confiance déclarée brute au même couverture regroupée, qui supprime 69,4 %. Une variante regroupée qui classe les réponses de tous les onze laboratoires sur une seule échelle de probabilité calibrée à Platt dépasse la porte (89,0 % avec couverture regroupée identique), mais elle le fait en réallouant essentiellement toute la couverture aux laboratoires bien calibrés : elle émet 100 % des réponses du fournisseur le mieux calibré et 0 % pour quatre des onze laboratoires, reproduisant sous forme atténuée le mode de défaillance du passeport ci-dessus. Elle nécessite également environ sept cents réponses notées par modèle pour l'ajustement, tandis que la porte n'en nécessite aucune. La confiance calibrée et l'accord entre modèles sont donc des compléments, non des substituts : le premier procure un taux d'erreur regroupée plus faible partout où des étiquettes de vérité terrain existent pour le former, et le second procure une protection par laboratoire uniforme et sans étiquette.
La figure 19 place chaque stratégie sur le plan de prédiction sélective (regroupée sur les 13 955 réponses résolues déterministiquement que les onze bras ont retournées sur le pool gelé de 1 459 questions, de sorte que le total est inférieur à celui du tableau 9, qui compte les réponses résolues sur les 1 500 questions ; risque sélectif = part des réponses émises qui sont erronées). Classées par aire sous la courbe risque-couverture, inférieur est mieux : confiance calibrée à Platt 0,258, l'échelle de porte affinée par confiance déclarée 0,321, l'échelle d'accord pur 0,356, confiance déclarée brute 0,367, abstention aléatoire 0,517, par rapport à un plancher oracle de 0,166 ; les valeurs de moitié retenue diffèrent d'au plus 0,009. Au point de fonctionnement propre de la porte gelée (31,1 % de couverture dans cette convention de réponse résolue, 4 334 de 13 955 réponses émises ; les 30,5 % et 30,6 % rapportés ailleurs sont les parts de réponses confiantes et de questions du pool) le risque de la porte est 24,9 %, contre 33,4 % pour un seuil de confiance brute et 14,0 % pour une confiance calibrée, sous réserve des avertissements de coût d'étiquetage et de concentration de couverture ci-dessus. Le nuage de tous les 165 conseils à trois modèles couvre les couvertures de 9–59 % avec des risques de 13–38 %, de sorte que la porte rapportée est un membre représentatif de sa famille, non un cas particulier accordé. Les portes à juge unique tracent l'extrémité dégénérée de la famille, où « l'accord » s'effondre en « consulter le modèle le plus précis ».
Figure 19. La frontière risque-couverture
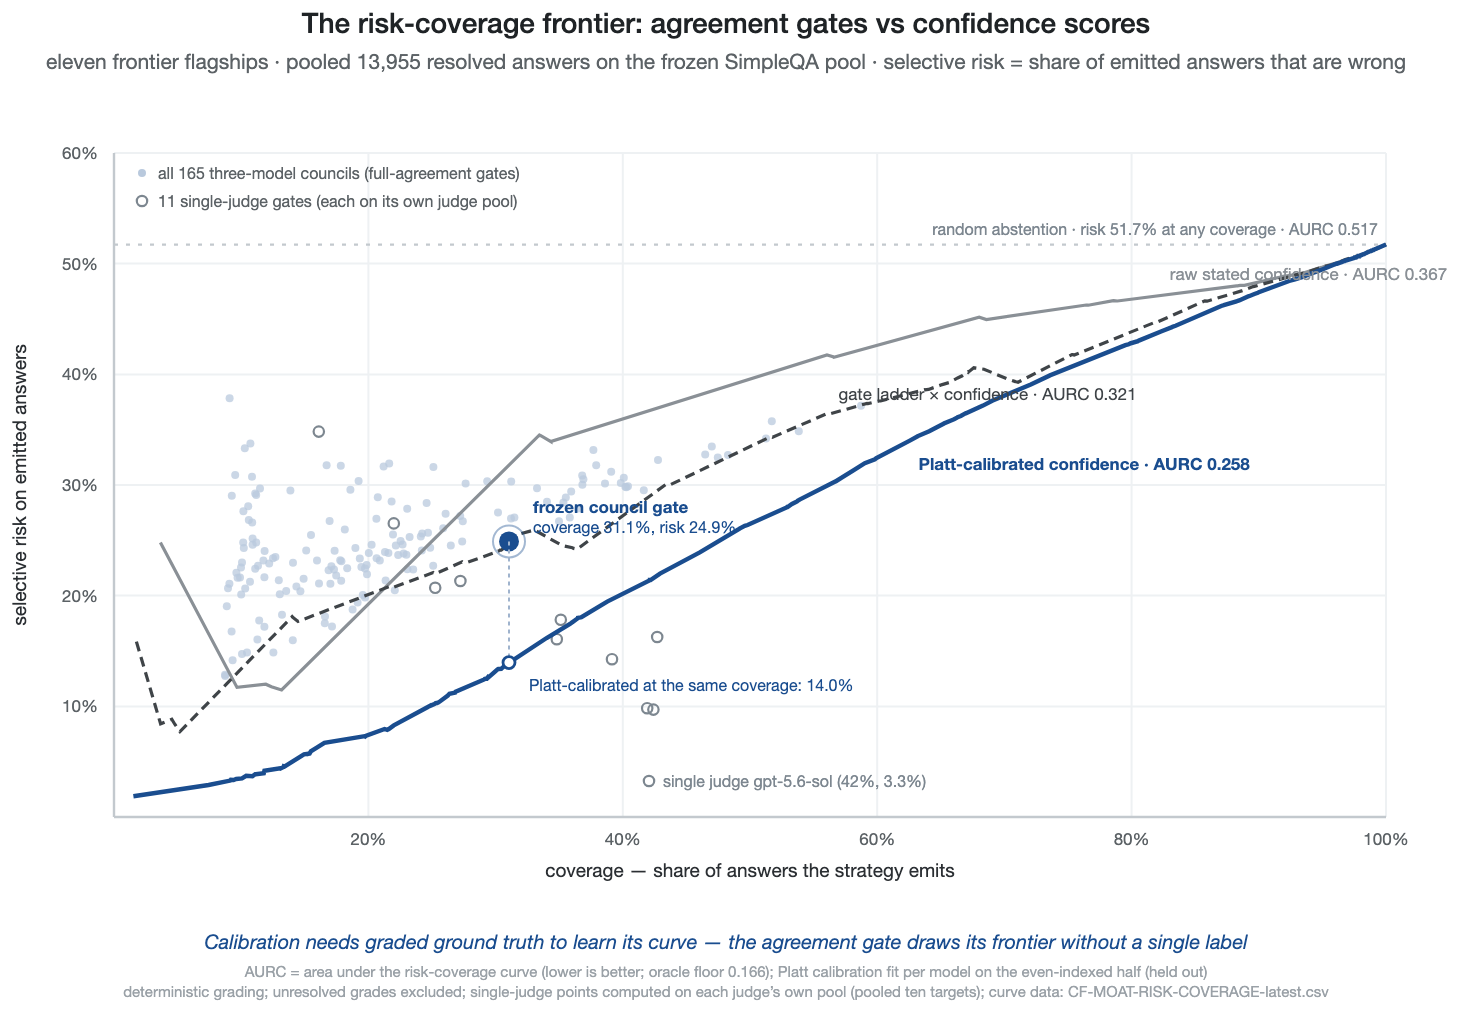
Chaque stratégie d'abstention sur le plan de prédiction sélective, couverture par rapport au risque sélectif, regroupée sur les 13 955 réponses phares résolues déterministiquement retournées par les onze bras sur le pool gelé de 1 459 questions (le tableau 9 compte les réponses résolues sur les 1 500 questions) : les courbes de confiance brute, calibrée à Platt et d'échelle de porte × confiance avec leurs valeurs AURC, la ligne d'abstention aléatoire, le nuage de tous les 165 conseils à trois modèles, les onze portes à juge unique, et le point de fonctionnement du conseil gelé (31,1 % de couverture dans la convention de réponse résolue, 4 334 de 13 955 ; risque de 24,9 %). Inférieur est mieux ; le plancher oracle est 0,166. Chaque point est recalculable à partir du fichier CSV risque-couverture du package de réplication.
L'accord peut ne pas transporter d'information au-delà de la facilité de la question. Pour tester cela, une régression logistique de la justesse des réponses sur l'accord de porte et la difficulté des éléments (la part de réponses erronées parmi les autres modèles sur cette question), avec effets fixes par laboratoire et erreurs types groupées par question, a été exécutée, et la réponse dépend de la façon dont la difficulté est mesurée. Avec la difficulté mesurée par les modèles hors conseil uniquement (le contrôle équitable, puisqu'une mesure de difficulté qui inclut les propres réponses du conseil intègre le signal de la porte par construction), l'accord conserve une contribution indépendante sur les cibles de laboratoire externes : b = +0,76, rapport de cotes 2,15, z = 17,2. Une réponse émise par la porte a environ deux fois plus de chances d'être correcte qu'une réponse de difficulté égale que la porte retiendrait. Intégrez la propre justesse du conseil dans le régresseur de difficulté à la place et le coefficient d'accord s'effondre à zéro, ce qui quantifie le mécanisme plutôt que de le réfuter : l'accord et la difficulté multi-modèle sont deux mesures de la même quantité latente, et la porte est un instrument sans étiquette pour la lire au moment de l'inférence.
Une réanalyse stratifiée par contamination aborde directement la préoccupation relative à l'exposition. En signalant une question comme probablement exposée au repère lorsqu'au moins trois des onze laboratoires reproduisent la chaîne d'or textuellement après normalisation (741 des 1 459 questions du pool ; la même signature qui donne au taux d'écho d'or de gpt-5.6-sol de 61,6 %), la porte supprime 89,4 % des défaillances confiantes sur la strate non exposée (2 793→296 ; cibles hors conseil : 86,5 %) contre 72,7 % sur la strate exposée. Le mécanisme ne repose donc pas sur les éléments mémorisés. Il se comporte comme un filtre sélectif devrait le faire, s'ouvrant beaucoup moins souvent là où le panel est vraiment incertain (18,7 % vs 41,9 % de couverture) et maintenant le taux de défaillance confiant émis presque constant dans les strates (25,9 % vs 21,8 %, à partir de taux bruts de 58,5 % et 36,4 %). Les seuils de contamination de 2–5 modèles échos donnent dCF non exposée de 87,7–89,7 %, le résultat est donc robuste au seuil. La stratification est descriptive : l'écho d'or est couplé aux résultats, et il sépare les questions probablement vues des autres plutôt que d'identifier la contamination causalement.
Ce qu'un budget de raisonnement plus important achète : de la confiance, non de la compétence. Les éditeurs phares vendent désormais un deuxième paramètre au-dessus du choix de modèle : un budget de raisonnement, tarifé par jeton de délibération cachée. Si le raisonnement prolongé achetait l'étalonnage, ce serait une réponse au niveau du modèle au problème de cet article, disponible à la caisse. Une expérience appariée sur un éditeur phare montre qu'il achète quelque chose d'autre. Le gemini-3.1-pro de Google (dont le raisonnement ne peut pas être désactivé) a répondu au même ensemble de questions gelées selon deux budgets, un paramètre d'effort de raisonnement faible et le budget dynamique par défaut du vendeur, avec température zéro, invites et analyseur identiques, et coût par question enregistré. Sur les 233 questions répondues selon les deux budgets à la date de cette version : précision 75,1 % (faible) par rapport à 76,4 % (par défaut), aucune différence détectable (McNemar exact p = ,648) ; confiance déclarée 3,1 points plus élevée selon le budget par défaut (Wilcoxon z = 4,68, p < ,0001) ; étalonnage légèrement plus mauvais selon le budget par défaut (ECE appariée 0,100 vs 0,082 ; écart confiance-précision +9,3 vs +7,5 points) ; prix par question 2,1×. La comparaison de précision est une hypothèse nulle d'un type spécifique : ces données montrent aucune différence de précision détectable à n = 233 (McNemar exact p = ,648), et l'équivalence n'est formellement établie que sur une marge grossière. Un TOST appariée borne la différence de précision dans ±5 points (différence +1,3 points, IC 90 % [−1,8 ; +4,4] ; p unilatéral ≤ ,024) mais l'étude n'est pas puissante pour établir l'équivalence à ±2–4 points, tandis que l'augmentation de +3,1 points de la confiance déclarée est statistiquement sans ambiguïté (Wilcoxon p < ,0001). Dans cette limite, la dépense doublée a acheté de la confiance déclarée supplémentaire et aucune correction supplémentaire mesurable : la surestimation comme fonctionnalité payante, et une instance au sein du modèle de la thèse de migration. Les dollars supplémentaires sont allés à la couche modèle et n'ont produit rien qu'un consommateur puisse vérifier, tandis que la couche architecturale au-dessus l'a transformée en signal vérifiable. Le résultat est un projet pilote, rapporté comme tel : la comparaison couvre 233 questions appariées, et la conception complète de 1 500 paires réduit la borne d'équivalence à environ deux points ; la composition des canaux et la censure de plafond de jetons sont documentées comme des facteurs de confusion dans le paquet de réplication ; la collecte se poursuit.
Figure 18. Ce qu'un budget de raisonnement plus important achète
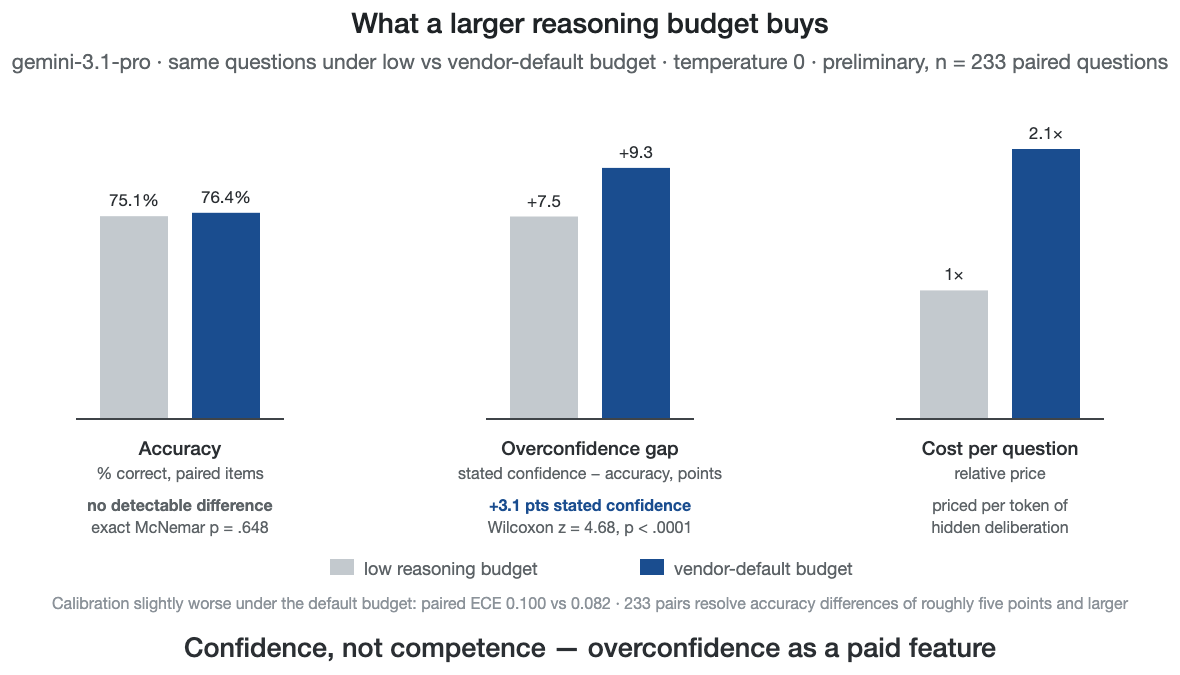
Comparaison appariée selon deux budgets de raisonnement — la confiance déclarée augmente, la précision ne change pas.
Tableau 11. Budget de raisonnement, comparaison appariée (gemini-3.1-pro, 233 questions répondues selon les deux budgets, température 0 ; préliminaire)
| Budget de raisonnement faible | Budget par défaut du vendeur | |
| Précision (éléments appariés) | 75,1 % | 76,4 % (McNemar p = ,648) |
| Confiance déclarée moyenne | −3,1 points vs défaut | +3,1 points (Wilcoxon p < ,0001) |
| Étalonnage (ECE appariée) | 0,082 | 0,100 |
| Écart confiance − précision | +7,5 | +9,3 |
| Coût par question (relatif) | 1× | 2,1× |
Les paramètres d'effort de raisonnement n'étaient pas identiques selon les groupes : chaque vendeur a été interrogé via son interface commerciale standard selon l'effort par défaut de cette interface (paramètres enregistrés par modèle dans le paquet de réplication), donc la précision absolue d'un vendeur peut comporter une composante d'effort. Cela n'atteint pas le mécanisme. Le classement de précision n'est pas porteur (l'étiquette phare ne garantit rien), la porte survit à la suppression de tout membre (le conseil sans solution supprime 81,2 %), et un effort plus important élève la confiance déclarée avec la précision plate, comme la comparaison appariée vient de le montrer, donc toute précision qu'elle augmente apparaît comme une erreur confiante, l'échec que la porte intercepte.
Limitations de couverture de la vague des modèles phares. La vague est un instantané gelé du 5 août 2026, ainsi les modèles publiés après, comme Grok 4.6 (12 août) et les futurs leaders Artificial Analysis comme Claude Opus 5, la postériorisent et ne peuvent pas entrer dans un benchmark préengagé. La première position s'est tournée en quelques jours. C'est le problème d'identification que la porte contourne (l'accord est robuste aux changements de liste, survivant à la suppression de tout membre). Deux laboratoires inclus se situent sous la frontière actuelle sur les classements généraux de capacités : le modèle phare de Mistral est à la traîne du premier tier sur tous les indices d'agrégation vérifiés, et l'ERNIE à usage général de Baidu se classe en dehors du top 30 sur Human's Last Exam (sa force réside dans les tâches augmentées de recherche et agentiques, où ERNIE 5.1 se classe #4 sur LMArena Search Arena). Ils sont conservés pour préserver la couverture de l'écosystème européen et de tous les principaux laboratoires chinois. Des deux laboratoires du premier tier qui n'ont pas pu être inclus dans la portée de la vague, Meta Superintelligence Labs (Muse Spark 1.1 ; #4 sur Humanity's Last Exam) et ByteDance (Seed 2.1 ; #10), l'un a été ultérieurement tenté et interrompu (Meta, ci-dessous) et l'autre n'a pas pu être contacté du tout (ByteDance, ci-dessous).
Le Seed 2.1 de ByteDance n'a pas pu être inclus : BytePlus ModelArk a renvoyé « non disponible dans votre pays/région » pour un compte international nouvellement enregistré (tentative en direct, 5 août 2026), aucun agrégateur ne dessert le modèle phare, et le canal domestique Volcano Ark requiert une vérification de la Chine continentale. L'ERNIE 5.1 de Baidu, le modèle phare actuel, est de manière similaire restreint à la plateforme domestique Qianfan (tentative en direct, 5 août 2026). Lorsque le modèle phare actuel d'un laboratoire est inaccessible, la règle de secours est le modèle ouvertement publié le plus puissant de ce laboratoire. Pour Baidu, c'est ERNIE 4.5 VL 424B (poids ouverts), qui est utilisé à la place. C'est une découverte en soi : les modèles phares actuels de deux des six grands laboratoires chinois ne sont pas accessibles aux chercheurs externes en août 2026.
Meta est le troisième échec d'accès de la vague, et l'obstacle était mon compte, non la géographie. Dans la première vague (de niveau intermédiaire), Meta était absent pour une raison d'infrastructure documentée : son API Llama propriétaire a été retirée le 6 juillet 2026, avant le gel du protocole (enregistré dans le manifeste d'exécution), et le laboratoire était représenté au niveau local par son Llama-3.2-3B de poids ouvert, qui s'est avéré être l'un des membres les plus instructifs du panel (la corrélation d'erreur la plus faible de toute la matrice). Pour la vague phare, le muse-spark-1.1 de Meta a été ajouté en milieu de vague quand il est devenu accessible, et la collecte a échoué ensuite de trois façons en séquence, chacune enregistrée : (i) la clé API Meta Model propriétaire est morte en milieu d'exécution le 5 août avec 251 réponses valides collectées, et la console développeur n'a pas voulu émettre de remplacement ; (ii) un itinéraire de secours d'agrégateur a produit 21 réponses supplémentaires avant que (iii) le point d'accès du fournisseur de Meta ne commence à renvoyer HTTP 403 `user_blocked`, « l'accès a été restreint en raison de violations répétées de la politique », pour des questions de rappel de faits en circuit fermé d'un benchmark public, posées à température zéro. Le résultat net est 272 sur 1 500 éléments (18,1 %) collectés et signalés comme partiels : l'analyse groupée figée inclut les 251 réponses propriétaires (le top-up agrégateur a été obtenu après le gel de l'analyse), et l'estimation par laboratoire de Meta (−92,0 % dCF sur 125 réponses de confiance) est directionnellement cohérente avec le panel mais trop imprécise pour l'inférence. Le blocage est lui-même une conclusion : en août 2026, un chercheur indépendant ne peut pas compléter une évaluation factuelle de 1 500 questions du phare de Meta par aucun canal autorisé. Entre les trois échecs d'accès de la vague, un phare verrouillé régionalement (ByteDance), un phare réservé au marché intérieur (Baidu), et une interdiction de chercheur (Meta), ils constituent l'argument théorique sous forme empirique : la vérifiabilité au niveau du modèle s'exerce à titre gracieux du fournisseur, et une couche de confiance architecturale ne peut pas supposer la grâce du fournisseur.
4. Un déploiement extrême : délégation à enjeux irréversibles
La façon habituelle d'étudier la confiance des consommateurs est un sondage ou une tâche en laboratoire. J'avais un instrument plus sévère à disposition : un déploiement prolongé, à forts enjeux, où chaque conséquence reposait sur moi. Cette section est une preuve d'existence et un témoignage de conception d'un seul opérateur, en conflit d'intérêts, non une preuve empirique de généralité, et aucune des propositions P1–P5 ne s'y appuie. Les deux sortes de preuves s'imbriquent. En laboratoire, l'effet d'étalonnage a été mesuré en condition placebo ; au déploiement, où les erreurs étaient irréversibles, les trois mêmes propriétés ont fait la différence entre la possibilité et l'imprudence de la délégation.
Le déploiement n'est ni celui d'un client ni une simulation : je suis simultanément l'opérateur, le développeur et l'analyste. La couche de preuve est ancrée par hash et chaque mesure est indépendamment recalculable, donc le conflit porte sur le plaidoyer et sur ce que j'ai choisi de mesurer, non sur la reproduction des nombres. Le cadre combine une compétence ordinaire du consommateur avec des enjeux irréversibles, où chaque faiblesse architecturale est rapidement et visiblement punie.
Méthodologiquement, c'est un cas unique extrême et révélateur (Yin, 2018) dans la tradition interprétative et autoethnographique analytique (Walsham, 1995 ; Gould, 1991 ; Anderson, 2006), avec les précautions évidentaires de cette tradition en vue (Wallendorf & Brucks, 1993) : d'abord les records, l'interprétation marquée comme telle. La justification est l'accès : un chercheur ne peut pas éthiquement assigner des participants à parier des résultats irréversibles du monde réel sur une architecture IA, donc le seul observateur disponible est un participant qui a choisi lui-même le pari.
L'analyse s'appuie sur des logs contemporains, ancrés par hash. La couche de preuve du déploiement est elle-même le record : les étapes porteuses (quels modèles ont été consultés, où ils ont divergé, ce qui a été bloqué, ce que j'ai confirmé) ont été enregistrées au moment, donc les observations s'appuient sur des records rejouables et non sur la mémoire seule. Le biais rétrospectif ne peut pas être éliminé de l'interprétation, donc je marque chaque lieu où l'interprétation dépasse le record. Les records de la couche de preuve du système pendant la période de déploiement sont ancrés par hash au 2 août 2026 : un manifeste SHA-256 par fichier de 129 fichiers (7 414 043 octets) dont la racine est 2f88a16611e51c0c12c8015754c89269e782ea167a89b5ed2a881f18eee4defc, et l'ancrage est publié avec cet article. Les records restent scellés jusqu'à la clôture du déploiement, car les citations sélectives d'un déploiement en cours seraient pires qu'aucune. L'engagement peut être vérifié : tout record publié ultérieurement correspond soit au manifeste ancré, soit non, donc la modification rétroactive, la substitution ou la rétrodatation sont détectables par tout lecteur de cette page. Un traitement quantitatif plus complet de la télémétrie est laissé aux travaux futurs, pour la même raison.
Trois observations de la vie à l'intérieur de cette boucle sont offertes comme hypothèses sur ce qui se transfère au-delà du cadre original, alimentant les propositions de la section 3, et les événements sur lesquels elles s'appuient ont été enregistrés par le déploiement au moment.
Le désaccord est un signal utilisable par le consommateur. Quand des modèles indépendants divergeaient sur une question conséquente, la divergence elle-même, surfacée au lieu d'être supprimée, m'a dit où se trouvait la véritable incertitude : un avertissement précoce gratuit qu'aucun service monomodèle ne peut fournir.
La preuve change le comportement avant même de changer un différend. Savoir que chaque étape conséquente était enregistrée rendait la délégation psychologiquement viable d'emblée ; le record était la précondition de la confiance, non une réflexion d'audit.
L'accès conditionnel à la confiance importe plus que la précision moyenne. Les événements pratiquement dangereux étaient les erreurs confiantes, jamais les résultats médiocres. La véritable contribution de l'architecture était de rendre la haute confiance coûteuse : une réponse devait survivre à l'accord intermodèles pour l'obtenir, au lieu de l'obtenir gratuitement de la fluidité d'un modèle.
5. Implications : de la persuasion à l'infrastructure
Conception et expérience
Pour la conception de services. L'unité de la conception de services d'IA de confiance se déplace du modèle vers le pipeline. Cela signifie acheminer les requêtes conséquentes via des modèles indépendants, traiter le désaccord comme un élément d'UX de premier ordre, joindre des preuves par défaut, et tarifie le traitement multi-modèles en fonction du coût asymétrique des erreurs confiantes, le chemin coûteux étant réservé aux demandes où les enjeux se concentrent, comme la détection de fraude réserve l'examen aux transactions à risque. L'infrastructure existe déjà : les cascades guidées par les coûts qui escaladent les demandes difficiles vers les niveaux coûteux sont l'ingénierie d'agents standard, et pour un service qui achemine déjà par difficulté, l'architecture marginale du routage par conséquence est proche de zéro. Les modes de défaillance que les deux expériences ont mesurés laissent deux règles strictes, et ce sont des exigences de conception, pas des préférences. Les positions doivent être collectées à l'aveugle et enregistrées avant toute délibération inter-modèles, car un pipeline délibération-d'abord fabrique le consensus même que l'architecture est censée surveiller (les pressions de conformité de la section 3). La deuxième règle : un consensus unanime confiant sur un ensemble d'options restreint est un signal d'alerte pour examen, pas un feu vert pour exécution : les panneaux de modèles et les participants humains de la section 6 ont tous traité ce consensus exactement comme une certification.
L'économie fonctionne parce que l'escalade est graduée, une architecture de confiance graduée : dans le déploiement décrit ici, les niveaux de traitement s'étendent sur environ trois ordres de grandeur en coût par requête entre une réponse mono-modèle et une délibération multi-modèle complète (en juillet 2026), donc le niveau coûteux est acheté uniquement là où les conséquences se concentrent. La logique du seuil de rentabilité est celle du notation de fraude (figure 14). L'orchestration paie chaque fois que la probabilité d'une erreur confiante multipliée par son coût complet (remboursement, churn sous tolérance d'une seule erreur, responsabilité, risque réglementaire) dépasse le calcul marginal de la vérification. Pour les transactions à enjeux élevés, cette inégalité n'est pas proche.
La baisse des prix d'inférence (environ deux ordres de grandeur à capacité fixe en trois ans, une lecture conservative des déclins suivis ; Appenzeller, 2024) ne dissout pas l'argument, car le ratio, pas le coût absolu, est la quantité structurelle : les deux niveaux descendent ensemble la courbe des prix, et l'inférence bon marché rend le niveau coûteux abordable à des enjeux toujours plus bas. La vérification suit sa propre deuxième courbe : les ensembles de vérificateurs faibles, sans données étiquetées, atteignent la précision de sélection de réponses des modèles de raisonnement de première classe à partir de composants open 70-milliards-paramètres (Saad-Falcon et al., 2025). Compte tenu de la tolérance à une seule erreur chez les consommateurs, la comparaison n'est pas « réponse bon marché versus réponse coûteuse » mais « réponse coûteuse versus client perdu ».
Deux primitives orientées consommateur complètent la conception : le frottement délibéré (une pause marquée avant les actions irréversibles) et les reçus. Les deux interviennent sur la façon dont la délégation se ressent. Les consommateurs expérimentent l'IA sociologiquement, pas statistiquement (Puntoni, Reczek, Giesler, & Botti, 2021), et alors que l'exécution déléguée retire la rencontre de service de la vue, le reçu hérite du rôle ancien de la rencontre en tant que moment de vérité. Un risque voyage avec ce cadrage : rendre le désaccord saillant peut annoncer l'incertitude et déprimer la confiance plutôt que la calibrer (Detjen et al., 2025 ; Lu, Wang, & Yin, 2024), donc combien de divergence surfacer, et comment, est une variable de conception. Ce n'est pas un bien gratuit.
Un reçu d'orchestration peut être minimal et accomplir son travail (la figure 8 montre la maquette). Trois champs portent la plupart de la valeur : (1) qui a agi, les modèles et versions consultés, sous quelle autorité ; (2) comment ils se sont mis d'accord, un résumé de divergence en termes clairs ; (3) ce qui a été vérifié, avec un pointeur dans l'enregistrement replayable complet : assez petit pour être lu en un coup d'œil et assez spécifique pour ancrer un différend, une réclamation d'assurance, ou un audit. Le même artefact répond à la question de tenue de livre propre de l'opérateur, donc le reçu vend deux fois : vers l'intérieur comme gouvernance des coûts, vers l'extérieur comme confiance justifiée. Cette double aspect est une nécessité. La volonté mesurée des consommateurs de payer pour la transparence seule est mince (dans la seule conjointe tarifée, la valeur de l'explicabilité a chuté sous 1,99 € par mois ; König et al., 2022), donc une couche de confiance financée par le côté consommateur seul serait affamée, et le côté gouvernance des coûts de l'opérateur la porte. Le voisin technique le plus proche du reçu est les reçus d'outils enregistrés dans les frameworks d'agents pour la détection d'hallucination (Basu, 2026), qui partagent l'instinct mais pas le public : ceux-ci sont des enregistrements orientés développeur d'appels d'outils individuels, tandis que le reçu d'orchestration est leur généralisation orientée consommateur, par décision. Le reçu invite son propre mode de défaillance : un artefact conçu pour ressembler à un artefact vérifié sans exposer quoi que ce soit qu'un consommateur puisse réexécuter. La ligne de conception qui compte est si l'enregistrement est véritablement replayable et pas simplement de forme reçu. Une contrainte arrive aussi du côté de la vie privée : un artefact qui prouve ce qui a été vérifié enregistre également ce qui était préféré, donc la vérifiabilité et la vie privée doivent être optimisées conjointement (Alavi & Nozari, 2026).
Un dernier aspect de l'économie des reçus porte un nom qui lui est propre, l'économie de la vérification. Un enregistrement inviolable ne vaut que ce que représente l'incitation de quelqu'un à l'ouvrir, et la décennie des systèmes décentralisés en est l'avertissement : les enregistrements publics et inviolables de la blockchain n'ont pas transformé les utilisateurs ordinaires en auditeurs, et les architectures « sans confiance » ont tranquillement réintroduit des intermédiaires de confiance à chaque point d'application pratique (Werbach, 2018). Le dilemme du vérificateur en est la version formelle : lorsque la vérification est coûteuse et que les résultats corrects sont le cas commun, le vérificateur rationnel saute l'étape. La demande de vérification doit être concentrée là où il existe déjà un avantage privé à la vérification, parmi les assureurs, les auditeurs et les processus de différend, le consommateur héritant de la vérification comme sous-produit de ces marchés ; la fonction du reçu pour le consommateur est sa disponibilité en cas de différend, non sa lecture quotidienne. La question du financement découle du même point, et les deux réponses naïves y échouent : un orchestrateur payé par le consommateur tarifie la neutralité comme un bien de luxe, et un orchestrateur payé par le commerçant réimporte le conflit qu'il existe pour éliminer. Cela laisse le modèle que l'économie bilatérale du reçu implique déjà. La couche est financée de la même façon que l'audit est financé, par les parties qui ont besoin que le risque soit tarifié plutôt que l'histoire soit racontée (opérateurs achetant la gouvernance des coûts et la réduction de la responsabilité, assureurs achetant des profils de risque assurables, processus de différend achetant des preuves), avec des seuils réglementaires où ces marchés en sous-demandent. Le consommateur achète le service, non la neutralité, et hérite de la neutralité comme son sous-produit. Le même problème a une version de structure de marché. Une plateforme qui est simultanément marché, fournisseur de modèles et réseau publicitaire est structurellement incapable de fournir la neutralité, ce qui est le conflit d'intérêts sous forme de marché, et l'historique de la priorisation algorithmique (placement sponsorisé, partenaires préférés) dit que les acteurs dominants monétiseront l'acheminement s'ils le peuvent. Là où cette pression opère, le seuil de neutralité est réglementaire ou à protocole ouvert, non volontaire. Si la première demande de consommateur d'exposition à la preuve est mince, l'adoption de la confiance architecturale peut être entraînée moins par le choix du consommateur que par le côté conformité et assurance, une migration à travers les institutions plutôt que par les préférences, les consommateurs héritant de l'architecture vérifiable par défaut. Le résultat d'étalonnage empêche cette route d'être purement cosmétique : les consommateurs utilisent démontrablement le signal architectural une fois qu'il leur est présenté, mais ils ne le demandent pas encore. Il y a une hypothèse rivale ici : la confiance peut migrer vers la responsabilité et les institutions plutôt que vers l'architecture vérifiable. Les consommateurs s'appuient sur les droits de rétrofacturation, non sur les audits de registre ; les réseaux de cartes ont mis à l'échelle le commerce à distance par les droits de différend plutôt que par les consommateurs inspectant les enregistrements d'autorisation ; selon cette lecture, l'enregistrement de décision est la plomberie qui rend la responsabilité calculable plutôt qu'un objet de confiance du consommateur. Les deux comptes prédisent des choses différentes : selon le compte architectural, les consommateurs récompensent la vérifiabilité quand ils peuvent la voir ; selon le compte institutionnel, ils la récompensent seulement quand un recours est attaché, et la confiance du consommateur reste alors ancrée dans l'institution tandis que la confiance de l'institution migre vers l'architecture. La conception au moment du différend spécifiée ci-dessous les discrimine. Et chaque couche d'enregistrement hérite du problème de l'oracle : l'enregistrement certifie le processus, et seuls les contrôles du processus lui-même atteignent les faits. L'asymétrie que le reçu inverse est celle que la littérature de la critique de plateforme documente : l'architecture, non la politique déclarée, est le régulateur opérationnel de la conduite numérique (Lessig, 2006), et jusqu'à présent ses instruments ont pointé vers le consommateur plutôt que d'être tenus du côté du consommateur (Zuboff, 2019 ; Möhlmann et Zalmanson, 2017), et le reçu inverse ces instruments de l'autre côté.
La couche de preuve devrait être visible dans le produit lui-même, non archivée dans un registre administratif. L'ingénierie logicielle a récemment convergé sur un nom pour le wrapper d'exécution autour des modèles d'agent, le harnais d'agent, et sur la reconnaissance que le harnais, et non le modèle, est ce qui peut être certifié, réglementé et approuvé. La confiance architecturale spécifie ce qu'un harnais doit produire pour mériter ce rôle.
L'échelle que cette section conçoit et le retour qu'elle conçoit pour combattre sont déjà dans le registre. L'assistant de Klarna a traité 2,3 millions de conversations au cours de son premier mois, deux tiers des chats de service à la clientèle de l'entreprise et le travail estimé de 700 agents à temps plein (Klarna, 2024, chiffres rapportés par l'entreprise). Quatorze mois plus tard, le PDG a renversé sa position publiquement : la qualité de la production avait souffert, le recrutement humain a repris, et l'engagement permanent est devenu que « il y aura toujours un humain si vous le souhaitez » (Daly, 2025). Lue architecturalement, comme ma lecture plutôt que la raison déclarée de l'entreprise, la paire d'annonces encadre exactement l'écart que ce document nomme. Le niveau de volume fonctionne au coût machine, mais sans escalade graduée et sans signal de qualité vérifiable, la délégation a basculé vers la référence humaine. Ce qui rendrait la position entre ces deux annonces stable est une architecture de confiance graduée : bon marché où les enjeux sont bas, vérifié où les enjeux se concentrent, et humain où la vérification échoue.
Marchés et réglementation
Pour les services transfrontaliers. La neutralité s'étend au-delà des fournisseurs de modèles aux juridictions. Une couche d'orchestration peut appliquer un routage conscient de la juridiction et enregistrer l'application, transformant la conformité de la souveraineté des données d'une représentation juridique à une propriété d'exécution vérifiable. La différenciation à laquelle elle répond a été mesurée : dans 25 pays, une médiane de 53 % des répondants font confiance à l'UE pour réguler efficacement l'IA, contre 37 % pour les États-Unis et 27 % pour la Chine (données Pew, rapportées dans Stanford HAI, 2026, un rapport d'institut, non évalué par les pairs). Lorsque la confiance varie selon la juridiction, une architecture qui peut prouver les règles de quelle juridiction s'appliquaient a une vraie valeur.
Pour le commerce d'agent. L'intégration Visa–ChatGPT rend les trois composants concrets. Les plafonds et listes blanches sont des garde-fous statiques, côté consommateur. La confiance architecturale ajoute la couche dynamique, côté service : achats contre-vérifiés par des modèles indépendants (diversité), un enregistrement rejouable de la raison pour laquelle l'agent a choisi ce commerçant à ce prix (preuve), et une couche d'orchestration dont le revenu ne dépend pas du fournisseur ou du commerçant qui gagne (neutralité).
L'industrie des paiements a déjà commencé à construire les étages inférieurs de cette pile. Le Trusted Agent Protocol de Visa (octobre 2025, avec Cloudflare ; Visa, 2025) signe cryptographiquement l'identité d'un agent dans ses requêtes : des signatures spécifiques au commerçant et à l'objectif, limitées dans le temps, et protégées contre la relecture. Le Agent Payments Protocol de Google (Google Cloud, 2025), contribué parallèlement au cadre de Mastercard à la FIDO Alliance en 2026, encode l'intention de l'utilisateur sous forme de mandats signés transportés comme des Verifiable Credentials du W3C (W3C, 2025). Le Verifiable Intent de Mastercard (un cadre conjoint avec Google ; annoncé en mars 2026 ; Mastercard, 2026) énonce son objectif dans des termes que cet article aurait pu écrire, un enregistrement inviolable de ce que l'utilisateur a autorisé lorsqu'un agent IA agit en son nom, avec des essais précoces rapportés sur les marchés asiatiques et latino-américains en 2026. Les preuves d'identité et d'intention sont en cours de normalisation, tout comme le format d'enregistrement : l'architecture SCITT de l'IETF (RFC 9943, 2026) spécifie le même schéma, énoncé signé → journal de transparence immuable → reçu, que la couche de preuve de cet article présuppose. L'interface par laquelle la délégation se fait n'est même pas moralement neutre. Sur treize expériences, les personnes qui ont délégué à l'IA se sont comportées moins honnêtement, particulièrement sous une définition d'objectifs vague, et les agents machine ont exécuté des instructions complètement malhonnêtes beaucoup plus souvent que les agents humains (Köbis et al., 2025). Les interfaces qui forcent l'intention à être énoncée en termes spécifiques sont une infrastructure éthique.
Aucun protocole ne couvre encore le troisième étage, la preuve de décision : comment l'agent a choisi ce commerçant, ce produit, ce prix ; si des vérifications indépendantes étaient d'accord ; quelle était la valeur de sa confiance (la Figure 15 dessine les trois étages). C'est la couche que cet article nomme, et « connaître votre agent » devrait évoluer vers exactement ce processus d'examen, avec l'unité de surveillance migrant vers la transaction. Ce que l'architecture peut garantir, c'est l'existence de l'enregistrement, non sa lecture. Que quelqu'un ouvre ou non ces enregistrements est une question empirique que seul le déploiement peut répondre.
Figure 15. La pile de preuves
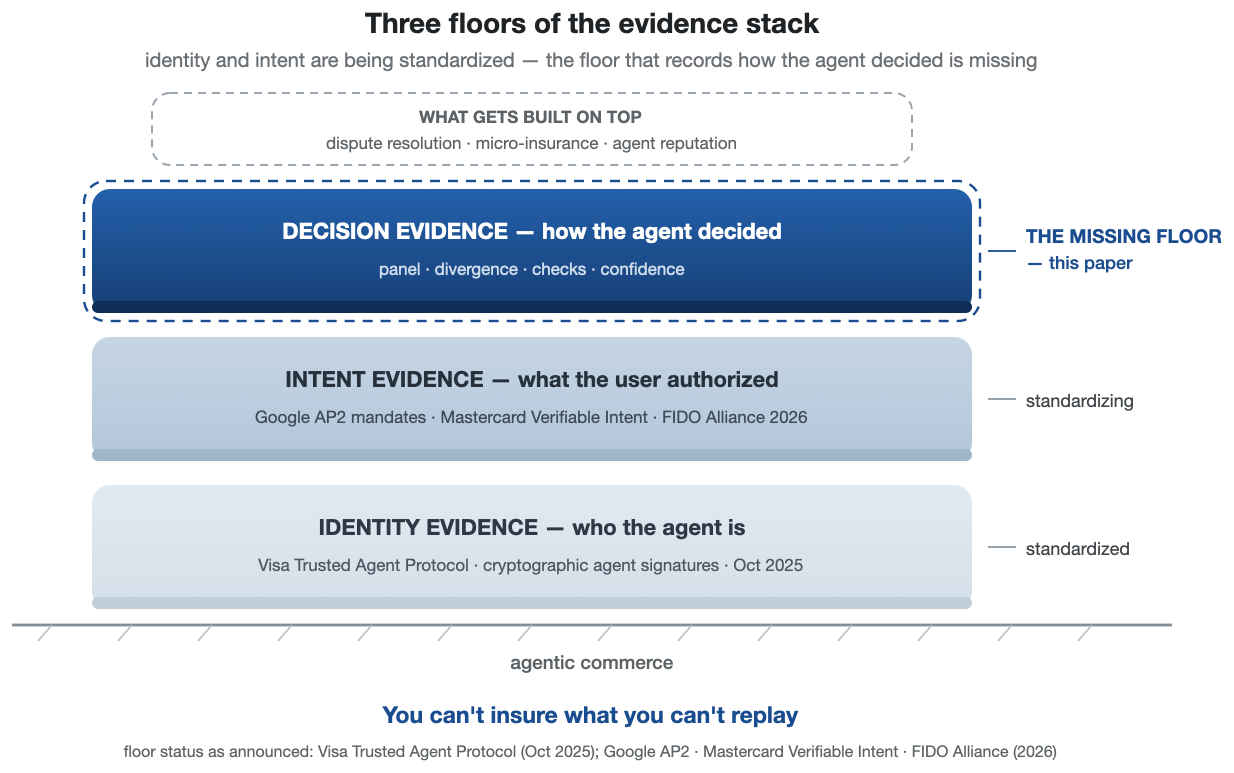
Les preuves d'identité et d'intention sont en cours de normalisation ; la preuve de décision est l'étage manquant que cet article nomme.
Les premiers audits systématiques du comportement d'achat des agents montrent pourquoi la preuve de décision ne peut pas attendre. Allouah et al. (2026), menants des essais randomisés dans un bac à sable de commerce électronique contrôlé, ont constaté que les agents d'achat présentent des biais positionnels forts, concentrent la demande sur quelques produits « modaux », et réorganisent drastiquement ces préférences lorsque le modèle sous-jacent est mis à jour. Sans un enregistrement de la façon dont le choix a été fait, rien de tout cela n'est visible pour le consommateur, le commerçant ou le régulateur. La diversité est la réponse en matière de conception ici, puisqu'un panel dilue les quirks positionnels d'un seul modèle, et la responsabilité est ce que la preuve de décision fournit : ce que ces auditeurs ont dû construire un bac à sable pour observer, un service architecturalement fiable enregistrerait en production.
Le cadre s'étend également au-delà du consommateur, à la confiance machine-à-machine. Dans les flux de travail agentiques B2B, il n'y a pas d'humain dans la boucle pour sentir la confiance du tout, donc le seul substrat possible est le processus vérifiable, avec des agents échangeant exactement les artefacts décrits ici et calculant s'il faut effectuer la transaction. Comment la confiance s'agrège et se propage à travers de telles chaînes de délégation à grande échelle, et quels sont les frais généraux de journalisation et de vérification de la couche de preuve à volume de production, sont des questions ouvertes ici. Les chaînes aiguisent l'exigence, puisqu'une chaîne n'est aussi fiable que son lien le moins documenté : les enregistrements doivent se composer. Où aucun consommateur n'est présent, la confiance architecturale est, plausiblement, la seule forme de confiance disponible.
Un développement structurel que la littérature sur la confiance n'a pas rattrapé est la guerre des protocoles. Les piles concurrentes d'agents-commerce (OpenAI avec Stripe, le Protocole de Commerce Agentique ; la coalition Google Universal Commerce Protocol ; Perplexity avec PayPal ; les réseaux de cartes et les normes ouvertes en dessous) fragmentent le commerce selon les lignes de protocole des fournisseurs exactement comme les services d'IA se sont fragmentés selon les lignes de modèle des fournisseurs, et l'argument de neutralité se généralise presque mot pour mot : un agent du consommateur qui ne peut effectuer des transactions que dans le protocole d'un seul fournisseur est l'agent du fournisseur, non celui du consommateur. Quelle que soit la couche qui arbitre entre les protocoles devra faire face aux mêmes trois exigences, l'indépendance, la preuve et l'absence de conflit d'intérêts, et si une telle couche prend de l'importance, la bataille pour le rayon devient la bataille pour le vérificateur.
Pour le marché de la preuve. En 2026, cela a cessé d'être une prévision. Du côté de la responsabilité, l'assurance a avancé en premier et dans deux directions à la fois. Les avenants d'exclusion facultatifs pour les réclamations liées à l'IA générative ont été intégrés à la boîte à outils des responsabilités civiles générales standard en janvier 2026 (formulaires ISO CG 40 47 et CG 40 48, avenants que les assureurs peuvent élire, non des exclusions automatiques ; en quelques mois, les grands assureurs avaient déposé des demandes pour les adopter ou des équivalents propriétaires). Dans la même période, les premières polices d'agents IA ont été rédigées de manière opposée, contre la preuve : la norme d'agent AIUC-1 existe afin de générer, par le biais d'audits de test adversarial, les profils de risque empiriques que les assureurs exigent pour souscrire, et février-mars 2026 ont apporté son premier auditeur accrédité, sa première police d'agent et ses premières certifications d'entreprise. Serrés entre l'exclusion générale et la souscription basée sur la preuve, l'enregistrement est devenu l'unité d'allocation de la responsabilité : un agent sans antécédents inspectables fait face à une couverture modelée sur l'exclusion, et un agent ayant une couverture est un risque cotable.
Du côté réglementaire, les obligations de transparence de l'article 50 de la loi de l'UE sur l'IA, notamment la divulgation obligatoire des interactions avec l'IA aux consommateurs, deviennent applicables le 2 août 2026 (une sous-obligation de marquage transitionnel s'étend au 2 décembre 2026), avec des amendes, à la lecture de cet article des dispositions pénales de la loi, pouvant atteindre 15 millions d'euros ou 3 % du chiffre d'affaires mondial. La Commission a adopté ses orientations de l'article 50 le 20 juillet 2026 (Commission européenne, 2026), et l'Omnibus numérique parallèle de simplification (signé le 8 juillet) ne retarde pas les obligations d'août. Les systèmes existants ne reçoivent qu'un sursis limité, jusqu'au 2 décembre 2026, pour le marquage du contenu lisible par machine. Les obligations de plus haut risque s'étalent sur 2027-2028.
La couche d'évidence change cette obligation : un enregistrement infalsifiable qui inclut la preuve que la divulgation d'IA requise a été montrée à cet utilisateur dans cette session convertit, selon la lecture de cet article, une exposition légale pouvant atteindre 15 millions d'euros en une propriété auditable du runtime, la conformité comme sous-produit de l'architecture. Les assureurs souscrivant la responsabilité des agents IA ont besoin de exactement ces enregistrements, et la traçabilité et la responsabilité sont des caractéristiques fondamentales du NIST AI Risk Management Framework. Le précédent réglementaire est plus ancien que la technologie. Les directives de gestion des risques de modèles du secteur bancaire ont exigé une validation indépendante par des parties indépendantes des développeurs d'un modèle depuis 2011 (Federal Reserve SR 11-7), une exigence qu'un panel orchestré automatise, rend continue et étend à chaque réponse importante. Le droit des consommateurs réserve déjà la sortie humaine : l'article 22 du RGPD accorde le droit à une intervention humaine dans les décisions entièrement automatisées avec des effets significatifs, et l'escalade en cas de divergence est, selon la lecture de cet article, la forme runtime d'un droit légal existant. La loi sur l'IA atteint le même design du côté du contrôle : l'article 14 du Règlement (UE) 2024/1689 exige que les systèmes d'IA à haut risque soient construits pour permettre un contrôle humain efficace, et une architecture qui fait émerger la divergence et achemine les cas non résolus vers un humain implémente ce devoir de contrôle comme une propriété runtime plutôt qu'un document de conformité.
Une fois l'enregistrement en place, deux produits dérivés suivent, tous deux conjectures à court terme. La micro-assurance au niveau des transactions assurerait un achat d'agent spécifique pour quelques centimes, tarifé à partir de l'enregistrement d'évidence, impossible sur un agent opaque et trivial sur un agent rejouable. L'autre est la réputation des agents : les historiques d'évidence longitudinaux s'agrègent naturellement en scores de réputation pour les agents et les orchestrateurs. Les services qui produisent des historiques conformes aux normes d'audit comme sous-produit du fonctionnement détiendraient un atout que leurs concurrents devraient adapter.
Comment une infrastructure de ce type devient institutionnelle est elle-même une hypothèse. La trajectoire sur laquelle parie cet article, les produits en premier, les normes ensuite, les mandats en dernier, en est une parmi plusieurs que l'histoire de l'infrastructure de confiance exhibe (les réseaux de guichets automatiques partagés, les règlementations de réseaux de cartes ratifiées plus tard par la réglementation, la vérification blockchain attendant toujours la demande). Elle a aussi un programme de recherche nommé derrière elle. La ligne de marchés réglementaires de Hadfield, les régulateurs privés autorisés par les autorités publiques, avec les organisations de vérification indépendantes comme institution fondamentale (Hadfield, 2017; Clark & Hadfield, 2020; Hadfield & Clark, 2026), l'atteint du côté offre de la gouvernance. Cet article l'atteint du côté demande de la délégation des consommateurs, et les deux programmes se rencontrent au reçu. Dessous se situe la question plus difficile de savoir si un reçu vendu comme caractéristique produit se durcit jamais en institution. S'il ne le fait pas, il reste un ornement de gouvernance plutôt qu'une couche de gouvernance, ce qui réfuterait la revendication centrale de cet article. Le point de réfutation est préenregistré : appelez le reçu une couche de gouvernance quand au moins deux normes industrielles exigent des enregistrements de décisions traçables pour les transactions agentic, les services portant les trois composants gèrent la majorité du volume de transactions agentic à enjeux élevés, et au moins un régulateur national reconnaît ces enregistrements dans son allocation de responsabilité. L'échec persistant des trois signifie opérationnellement « ornement ». Si la vérification réussit comme infrastructure, elle se commoditise, et la confiance migre vers l'utilitaire partagé lui-même, l'architecture présente incluse, ce qui mettrait fin à tout avantage concurrentiel même au moment où l'infrastructure réussirait.
Qui est responsable quand une décision orchestrée se trompe reste une question ouverte : l'orchestrateur, les fournisseurs de modèles, ou le consommateur qui a autorisé l'agent.
La loi a commencé à fermer la sortie facile. La loi AB 316 de Californie, applicable à partir du 1er janvier 2026, interdit à tout défendeur qui a développé, modifié ou utilisé un système d'IA d'affirmer que l'IA a autonomément causé le préjudice, tout en laissant intactes les défenses ordinaires et l'allocation comparative de culpabilité. Elle n'impose pas la responsabilité stricte. Cela rend la question d'allocation inévitable, et quelque soit la manière dont la doctrine la règle, l'enregistrement rejouable est ce à partir duquel toute allocation de responsabilité serait calculée. La littérature juridique est arrivée à la même destination, affirmant que la boîte à outils classique du droit de l'agentiel ne se transfère pas aux agents IA et que ce qui est requis est une nouvelle infrastructure de visibilité et de responsabilité (Kolt, 2025), le prédécesseur le plus proche de l'argument de cet article dans la littérature sur la gouvernance, approché du côté de l'approvisionnement en contrôle où cet article l'approche du côté de la demande pour cela. La confiance architecturale est le substrat probant sur lequel une doctrine de responsabilité émergente pourrait plausiblement fonctionner.
Mesure et l'agenda de recherche
Pour la mesure de la confiance. Les instruments standards mesurent les attitudes envers une marque ou une interface. L'attitude qui vaut la peine d'être mesurée est la volonté de déléguer, pas la réponse à « faites-vous confiance à cette IA » : quelle classe de décisions, avec quels enjeux, le consommateur confiera-t-il à l'agent sans examiner chaque étape ? La délégation est comportementale, monotone dans la confiance justifiée, et directement liée aux revenus. À côté d'elle se situent les questions de savoir si le consommateur sait comment la réponse a été produite, s'il peut accéder à l'enregistrement, et si le désaccord apparent améliore ou dégrade son étalonnage de confiance.
L'enquête était le reçu de l'ère humaine : tandis que le consommateur effectuait la recherche, la comparaison et le choix, demander au consommateur était une façon défendable d'apprendre ce qui s'était passé. La délégation supprime l'acteur que le questionnaire a été construit pour interroger, donc la trace principale de l'épisode devient l'artefact que l'architecture produit, et le reçu est en ce sens précis la trace de transaction primaire de l'ère déléguée. Les deux instruments ne sont pas en concurrence : le reçu enregistre ce que la machine a fait et ne dit rien sur l'appropriation subjective, l'autonomie ressentie ou la charge cognitive, qui restent le territoire de l'enquête. (Ceci dissout une tension apparente avec la section 1, dont la preuve motivante est elle-même des enquêtes sur les préférences énoncées : les enquêtes mesurent ce que les consommateurs ressentent actuellement à propos d'un marché qui existe à peine, tandis que le reçu mesure ce que les services délégués ont réellement fait une fois qu'ils existent.) Ce pont peut être testé en appairant les mesures d'attitude avec les artefacts des mêmes épisodes, stratifiés par résultat, et en estimant où le questionnaire et l'enregistrement s'accordent et lequel prédit mieux le comportement de délégation ultérieur. Le conjoint proposé porte une partie de cette validation par conception, et jusqu'à ce que de telles études existent, les mesures basées sur les artefacts complètent l'enquête plutôt que de la retirer.
Les enquêtes sectorielles montrent déjà la ligne de base comportementale : dans une enquête de consommateurs Gartner publiée en mai 2026 (846 consommateurs américains, collectée en novembre–décembre 2025), 54 % des acheteurs qui ont utilisé l'IA générative pendant leurs achats déclarent avoir revérifié toutes les informations qu'elle leur a fourni. La confiance architecturale est la productisation de ce que les consommateurs font déjà d'eux-mêmes.
Le programme de mesure compte des alliés naturels dans le mouvement d'évaluation holistique (Liang et al., 2023) et dans la science émergente de la fiabilité des agents, qui décompose la fiabilité en douze métriques parce qu'un seul taux de succès masque les défaillances qui importent (Rabanser et al., 2026). La confiance architecturale s'opérationnalise de la même manière, comportementalement : le taux d'erreur confiant, la confiance appropriée, les décalages de poids du conseil, les taux d'annulation, le temps de décision, et une statistique particulièrement révélatrice, l'écart dans le taux d'approbation entre les résultats corrects et incorrects, qui est l'étalonnage de la confiance lu directement du comportement. Du côté du dossier, il y a la couverture des preuves, la divergence des panneaux mesurée, et les taux d'accès aux reçus, triangulant enquête, comportement et journaux sur les mêmes épisodes. Aucun de ceci ne nécessite une nouvelle science. L'exigence est une décision selon laquelle ce sont ces chiffres, et non l'engagement, que la couche de confiance doit rendre des comptes. Ma propre observation depuis les points de déploiement pointe dans le sens contre-intuitif : l'incertitude bien présentée a augmenté ma confiance appropriée, et j'ai plus fait confiance au système quand il savait visiblement ce qu'il ne savait pas.
Une variable dépendante supplémentaire mérite d'être à l'ordre du jour parce que la confiance n'est pas la seule psychologie que la délégation impose des tensions. Les consommateurs réagissent moins chaleureusement à un résultat favorable quand un algorithme l'a produit, parce qu'un résultat qu'on n'a pas produit est plus difficile à revendiquer comme le sien (Yalcin, Lim, Puntoni, & van Osselaer, 2022). La délégation peut améliorer la qualité objective d'une décision tout en appauvrissant son appropriation subjective. Le reçu se tient sur cette fourche : lu d'une manière, il restaure l'authorship ; lu de l'autre, il certifie que le consommateur n'a rien fait. Quelle lecture prévaut est une question de conception que le cadre a déjà mise en œuvre : le composant Evidence enregistre ce qui a été vérifié et par rapport à quel standard (Section 3), et le reçu est construit pour apporter les critères propres du consommateur dans cet enregistrement, de sorte que l'authorship des critères d'évaluation est une variable que l'architecture expose plutôt qu'une variable qu'un expérimentateur invente. Le mécanisme de Yalcin et al., qu'un résultat qu'on n'a pas produit est plus difficile à revendiquer comme le sien, rend alors l'authorship des critères le modérateur naturel, et P5 est la conséquence du composant Evidence pour la psychologie de l'appropriation plutôt qu'une branche latérale de l'ordre du jour. P5. La saillance du reçu interagit avec la favorabilité du résultat pour déterminer l'appropriation subjective d'un résultat délégué : pour les résultats favorables, un reçu saillant restaure l'appropriation quand il encode les critères créés par le consommateur (le standard que l'agent devait respecter était le mien, et voici la preuve qu'il l'a respecté) et déprime l'appropriation quand les critères se lisent comme ceux de la plateforme ; l'authorship du consommateur des critères d'évaluation est le modérateur de conception. L'effet de Yalcin et al. a été observé là où les consommateurs s'attendaient à prendre la décision eux-mêmes, de sorte que P5 est délimité à cette limite et peut s'inverser sous délégation habituelle, et ce qui distingue le reçu des manipulations de transparence de processus existantes doit être mis en œuvre, non supposé. Le reçu est vérifiable et peut porter les critères propres du consommateur ; une conception qui omet les deux teste la transparence, non la confiance architecturale.
La littérature sur la transparence fournit deux avertissements ici : trop de transparence procédurale peut déprimer la confiance (Kizilcec, 2016), et la simple divulgation de l'utilisation d'IA l'érode (Schilke & Reimann, 2025). La seconde est une condition limite sur le composant Evidence : dans treize expériences, les acteurs qui ont divulgué l'utilisation d'IA ont reçu moins de confiance que ceux qui ne l'ont pas fait, un dilemme de transparence dans lequel rendre l'implication de l'IA plus visible, par elle-même, abaisse la confiance. Si cette pénalité s'attache à tout signal d'implication d'IA, alors une architecture qui met en avant ses propres mécanismes pourrait déprimer la confiance même en la rendant plus vérifiable, et le composant Evidence échouerait exactement où il est le plus saillant. La réponse du cadre repose sur une distinction qui doit être démontrée : la vérifiabilité n'est pas une simple divulgation. Le reçu est un enregistrement vérifiable de comment la réponse a été produite, non une déclaration que l'IA a été utilisée, et P2 et P3 (avec le test bilatéral pré-enregistré de H2, le retour de divulgation nommé à l'avance comme résultat rapportable) sont exactement où la distinction soit la justifie comportementalement soit échoue. La vérifiabilité est ce qui construit la confiance, livrée à la demande plutôt que comme un mur toujours présent de provenance, et ni cacher les mécanismes ni les annoncer ne fait ce travail. Combien de l'enregistrement surfacer, à qui, et quand est elle-même une variable de conception.
Le mécanisme proposé pour que Evidence surmonte la pénalité de divulgation plutôt que de la compliquer est que la vérifiabilité et la divulgation voyagent à travers différents canaux psychologiques. La divulgation fournit une étiquette de catégorie, qu'une IA a été impliquée, que les preuves de Schilke et Reimann lient à une légitimité déprimée. Un reçu fournit une procédure, un enregistrement qui peut être ouvert, contesté et réexécuté, et la littérature sur la justice procédurale soutient qu'un processus qu'on peut contester et vérifier légitime l'acteur le dirigeant (Tax, Brown, & Chandrashekaran, 1998). Le canal ne nécessite pas que la vérification se produise : ce qui porte la confiance est la conscience du consommateur que la vérification existe et est ouverte en cas de différend, la disponibilité de la vérification plutôt que son exercice, ce qui est exactement la fonction du consommateur que l'économie de la vérification assigne au reçu ci-dessus. La vérification se concentre là où un gain privé à la vérification existe, et le consommateur hérite de la vérification comme un sous-produit, tenant l'enregistrement comme une option plutôt que de le lisant comme un document. La même distinction porte sur l'appropriation subjective (P5) : une étiquette de divulgation attribue la décision à la machine et vide la propriété, tandis qu'un reçu qui encode les critères créés par le consommateur documente que le standard que l'agent devait respecter était celui du consommateur lui-même. Si les deux canaux dissocient en fait, la légitimité augmentant avec la procédure vérifiable tandis qu'elle baisse avec la simple divulgation, est exactement ce que le test bilatéral pré-enregistré de H2 est construit pour détecter.
Limitations. Le modèle découle d'une analyse architecturale et d'un déploiement prolongé, à enjeux élevés, à opérateur unique. Chaque ancrage empirique a été obtenu sur cette seule pile, que j'ai construite et que j'exploite. Appliqué à lui-même, le fondement de l'article est mixte selon son propre treillis : un auteur et une pile (faible diversité), un paquet de réplication publique à côté des dossiers de déploiement scellés et une enregistrement de comportement sous embargo jusqu'à la publication (preuve partielle), et un intérêt commercial déclaré (neutralité compromise). La réplication indépendante sur d'autres piles est requise avant que toute affirmation se généralise. L'ancrage de hachage des dossiers de déploiement rend toute modification, substitution ou antédatation ultérieure détectable, de sorte qu'à l'ouverture, les caractérisations ici peuvent être vérifiées par rapport à un artéfact qui n'a probablement pas changé. Les lecteurs peuvent vérifier l'intégrité, pas les contenus, jusqu'à l'ouverture. Les nombres de mécanismes proviennent des API de modèles publics, et le pipeline réplique la collecte de bout en bout pour moins de 15 dollars. Le rendu des stimulus reste un biais d'interface : les stimulus de l'expérience des consommateurs, y compris le style du reçu, sont mon propre rendu UX, et les biais au niveau interface ne s'étudient que par réplication avec des rendus indépendants. La collecte en aveugle d'abord, les dossiers inviolables et l'acheminement sans enjeu constituent le construit ; les règles d'agrégation et les seuils d'escalade sont des choix d'ingénierie. Les panneaux de l'expérience sont des combinaisons analytiques d'une collecte aveugle unique plutôt qu'une boucle d'orchestration déployée, et le protocole de télémétrie sur le terrain préparé ferme cet écart. Les voies de vérification sans modèle que le cadre nomme (exécutions fantômes, vérifications de cohérence temporelle) sont décrites ici, pas testées. La collecte est une unique exécution à température zéro, ce qui supprime la variabilité intra-modèle et laisse la corrélation de lignée partagée en place, et les API hébergées ne sont pas strictement déterministes même là. Les réponses courtes factuelles de SimpleQA se situent près du régime d'espace de réponses contraintes dans lequel le consensus certifie l'erreur, et la stratification des difficultés montre exactement ce motif sur les quintiles les plus difficiles. Un panel de niveau intermédiaire peut surestimer le bénéfice de la diversité, puisque la corrélation d'erreur augmente avec la capacité (Kim et al., 2025). L'expérience de mécanisme teste des questions factuelles à réponse ouverte avec des réponses uniques vérifiables, et sur les tâches génératives ouvertes, où l'équivalence sémantique entre les réponses est elle-même un jugement, le signal de certification doit être rétabli plutôt qu'assumé. Une frontière connexe est la dimensionnalité de l'espace de réponses : les items SimpleQA ont une réponse vérifiable unique, tandis que les choix des consommateurs que les agents exécutent sont des jugements d'utilité multi-attributs subjectifs avec de nombreuses réponses défendables, donc comment le consensus se comporte dans l'espace des préférences, et si l'accord entre agents indépendants identifie même un meilleur choix là, est une question empirique ouverte (l'équivalence sémantique devient équivalence de préférence, et la notation elle-même un choix de modélisation). Une vérification du bruit d'étiquette est exécutée : sur l'intersection de 351 items de l'sous-échantillon de cette étude avec SimpleQA Verified (Google DeepMind, 2025), rénoter chaque réponse du panel par rapport aux étiquettes or corrigées laisse l'augmentation de certification inchangée ou légèrement plus forte (2,7 → 2,8, 4,4 → 4,4, 4,0 → 4,3 sur les trois panneaux, évaluateur déterministe), donc le bruit d'étiquette n'est pas le moteur de l'augmentation. Tous les chiffres de confiance sont des auto-déclarations verbalisées 0–100 sollicitées par un format de prompt unique, et la sensibilité au protocole d'élicitation peut elle-même varier par fournisseur, donc les conclusions de discrimination et d'étalonnage par fournisseur doivent être lues comme des propriétés de cette configuration sous ce protocole d'élicitation, pas comme des traits de fournisseur fixes. La ligne de base d'auto-confiance dans les tableaux 6–7 de la vague de seize modèles est la confiance énoncée brute. Les lignes de base étalonnées plus fortes dans la tradition de Guo et al. (2017) ont été exécutées sur la vague phare (mise à l'échelle de Platt et abstention conforme au fractionnement, section 3), où elles émergent comme des compléments à la porte plutôt que des substituts, et la comparaison panel-versus-auto de la première vague doit être lue par rapport aux produits consommateurs de base que les entreprises déploient réellement. L'estimation de porte en titre (−82,1 % des défaillances confiantes, IC de bootstrap à 95 % [79,9 ; 84,1] pour les dix bras complets, [80,0 ; 84,2] avec le bras Meta inclus) est une quantité pré-spécifiée unique, et les analyses environnantes (la grille de sensibilité de seuil, les strates de difficulté et de contamination, les ablations de conseil et les comparaisons de référence triviales) sont des vérifications robustes descriptives rapportées sans aucune correction pour comparaisons multiples, et elles ne revendiquent aucun statut confirmatoire propre. Le seul contrôle d'erreur dans la famille du papier est la correction de Holm sur l'expérience des consommateurs pré-enregistrée {H1, H2}. Si le régime d'évaluation qui récompense les devinettes confiantes était réparé de sorte que la véracité puisse être entraînée dans les modèles (Kalai et al., 2025), l'architecture assurerait contre un problème avec une solution moins chère, bien que les preuves et la neutralité resteraient irréductibles à tout correctif au niveau du modèle. D'autres limites sont énoncées où elles sont rapportées : les limitations de couverture de la vague phare (section 3 : deux modèles phares chinois inaccessibles et une collecte Meta interrompue), et la comparaison préliminaire de budget de raisonnement de 233 paires, dont les bornes d'équivalence TOST à une marge de ±5 points sans puissance pour des bornes plus étroites. Les mesures de délégation proviennent d'une vignette hypothétique, où les mesures énoncées surestiment la volonté réelle d'environ 21 % en méta-analyse (Schmidt & Bijmolt, 2020) ; l'expérience des consommateurs a réalisé 119 participants primaires et 133 regroupés sur 200 participants enregistrés sur six items fixes. Une réplication sur substrat commercial étend le mécanisme au-delà de l'étalon : un ensemble frais, pré-gelé de 267 faits produits vérifiés par Wikidata (quelle entreprise fabrique une voiture ou un avion donné, quel système d'exploitation un téléphone exécute, quelle entreprise a publié un jeu, en quelle année il a été expédié), exécuté en aveugle par un panel indépendant de six modèles (Claude Opus, GPT-5.4, Grok, Qwen, GLM et Mistral), le niveau optimisé pour les coûts sur lequel les agents grand public opèrent réellement, pas le phare, reproduit la dissociation, l'accord entre modèles prédisant la justesse à AUROC 0,77–0,81 contre 0,63–0,70 pour la confiance énoncée et un gain de certification de 4–6×, robuste dans les panneaux indépendamment composés de trois à six modèles couvrant les laboratoires américains, chinois et européens, et à la rigueur de la notation (la correspondance de chaîne déterministe ici est la règle primaire et prudente). L'extrémité subjective et multi-attributs du spectre commercial (compromis de préférence, incitations marchands adversaires et récupération ancrée aux outils sur un inventaire changeant) reste testée.
Variance aléatoire lors de l'échantillonnage. Un bras de variance a sondé directement la limite des exécutions déterministes uniques : un sous-échantillon stratifié par difficulté de 100 questions (5 quintiles de difficulté × 20, seed 20260806) a été réexécuté à une température de 0,7 avec 3 échantillons indépendants par question pour 9 des 11 modèles du groupe d'ébauche phare ; les points d'accès de Meta étaient inaccessibles, et l'API de Claude Fable 5 n'expose pas de paramètre de température. Dans l'ensemble des modèles, les trois échantillons ont produit des réponses mutuellement équivalentes sur 22–77 % des questions (médiane 54 %), la correction par question était identique dans les trois échantillons sur 63–97 % des questions, et la réponse à température 0 correspondait à la réponse majoritaire à température 0,7 sur 40–85 % des questions. La branche de gpt-5.6-sol porte un confusant : elle s'est exécutée à un effort de raisonnement aucun, tandis que 1 486 de ses 1 500 enregistrements d'ébauche utilisaient l'effort par défaut (moyen, comme indiqué ci-dessus). Son delta de précision de 92,0 % → 46,3 % sur ce sous-échantillon confond donc la température avec le budget de raisonnement, bien que ses chiffres de cohérence interéchantillon ne soient pas affectés. En excluant cette branche confusante, la précision moyenne par échantillon à température 0,7 différait de la précision déterministe à température 0 sur les mêmes questions d'au maximum 14,0 points (gemini-3.1-pro, 49,0 % → 63,0 %), les sept modèles restants étant à moins de 4,4 points. Au niveau du groupe, la barrière du conseil (accord tripartite entre kimi-k3, deepseek-v4-pro et gpt-5.6-sol) s'est ouverte sur 31,0 % du sous-échantillon à température 0, contre 25,0 %, 23,7 % et 29,8 % dans les trois exécutions à température 0,7. Le signal d'accord sous-jacent au résultat principal est stable face au bruit d'échantillonnage.
Statut probant des affirmations. Les affirmations se situent à trois niveaux de preuve. Établi par ces données : que l'accord indépendant porte un signal de correction qu'un auto-rapport du modèle n'a pas, sous les conditions limites énoncées (collecte en aveugle, vérificateurs compétents, questions factuelles à réponse ouverte avec réponses uniques vérifiables) ; qu'une barrière de désaccord fixe réduit la grande majorité des défaillances confiantes à un coût substantiel et énoncé (−82,1 % à 30,5 % de couverture) ; et les conditions limites fortes elles-mêmes : le consensus certifie l'erreur sur des espaces de réponse contraints, l'amélioration de certification brute s'atténue de manière monotone avec la difficulté (s'annulant sur le quintile le plus difficile sous la stratification intra-collecte ; positif mais le plus faible là-bas sous celle exogène), et la compétence du vérificateur ouvre la valeur de certification. Soutenu par l'expérience comportementale (un plan, échelle modeste d'une seule étude, n = 119) : que la mise en évidence du désaccord réel entre modèles améliore l'étalonnage de la confiance dans les deux directions (d = 0,67, Holm p = 0,0005 ; porté par un des six items ; vérifications de manipulation de l'ébauche principale 88–98 % ; fiabilités d'échelle α = 0,83–0,93) ; et, comme une valeur nulle inconclusif enregistré, qu'un reçu à première exposition statique ne change pas de manière détectable la délégation. Proposé théoriquement, pas encore testé : la complémentarité D×E×N ; l'effet de neutralité (P3) ; la migration de confiance sous une délégation croissante ; la durabilité post-défaillance de la confiance basée sur l'architecture (P4) ; la volonté de payer pour la vérifiabilité ; et la réclamation de catégorie de marché de la Section 7.
L'étape naturelle suivante est expérimentale : mesurer la confiance, l'étalonnage de la confiance et la volonté de payer dans des conditions à modèle unique et orchestrées, avec le désaccord alternativement mis en évidence et supprimé. La Section 6 rapporte l'expérience réalisée, préenregistrée et compatible avec les incitations. Une analyse conjointe standard basée sur les choix estime les utilités partielles de manière additive et suppose des échanges compensatoires, ce que l'hypothèse de complémentarité nie, donc la classe de plan doit permettre une structure non compensatoire, que ce soit l'élimination par aspects ou des plans à choix forcé avec des attributs rédhibitoires, estimés avec des termes d'interaction explicites. Deux niveaux de plan sont spécifiés. Le niveau minimal est une étude de profils ciblés, quatre à cinq profils couvrant aucun, une composante unique, deux composantes et des configurations complètes, avec le travail théorique effectué par un contraste planifié, l'effet de la configuration complète dépassant la somme des effets des composantes (super-additivité), contre la valeur nulle additive. Le niveau complet croise trois niveaux par composante (absent, présent mais non inspectable, présent et inspectable) dans une factorielle 3×3×3 entre sujets (27 cellules ; les enjeux varient au sein du sujet sur quatre niveaux), avec au moins 80 répondants par cellule (N ≥ 2 160) pour une puissance ≥ 0,85 sur l'interaction. Un plan binaire 2³ ne peut pas récupérer les exposants de Cobb–Douglas et est underpowered à des tailles d'effet plausibles (d ≈ 0,3–0,4). Trois disciplines de stimuli s'appliquent : varier les amplitudes architecturales elles-mêmes et non seulement leur étiquetage (une étiquette de reçu manquante est l'ignorance des consommateurs de la preuve, pas son absence), donner à chaque composante un contraste vérifiable par rapport à seulement asservi, et coupler les données de choix avec le suivi des processus sur les champs du reçu, puisque la théorie prédit l'utilisation de la preuve. À ma connaissance, ce serait le premier plan à varier les trois composantes conjointement. Les blocs de construction à composante unique sont déjà tarifés (König et al., 2022 ; Ioku et al., 2024), et des bundles adjacents ont été exécutés (Cetinkaya & Krämer, 2024, l'instrument le plus proche et une source d'étalonnage de puissance aux côtés de Köbis et al., 2025), donc l'étude est spécifiée, dosée et prête à fonctionner. Les conditions limites de la construction sont celles-ci : la confiance architecturale ne paie pas là où les enjeux sont bas et le volume est élevé ; elle ajoute peu là où le groupe de vérificateurs n'est pas compétent sur la classe de tâches ; elle peut certifier l'erreur où les espaces de réponse sont étroitement contraints ; et elle se dégrade vers le théâtre partout où l'indépendance du groupe est affirmée plutôt que mesurée, le plus aigu comme la question de test rouge ouverte à quoi ressemble un reçu truqué ? Une fois que les hyperliens sont devenus des signaux d'autorité, les fermes de liens se sont élevées pour les fabriquer, et les enregistrements d'accord doivent s'attendre à inviter leur propre création de fermes. Deux limites temporelles s'appliquent également : les indices gagnent l'attention tandis que la preuve gagne la persistance, donc la réclamation concerne quelle confiance survive à l'échec plutôt que laquelle s'intègre le plus rapidement, et même une vérification fonctionnelle ne peut que ralentir une spirale du type que Chandra et al. (2026) modélisent. Où les conséquences se concentrent et l'indépendance est réelle, la confiance architecturale gagne son coût et son nom (le Tableau 12 en collecte les quatre).
Tableau 12. Conditions limites : où la confiance architecturale ne paie pas
| Condition | Pourquoi elle échoue là | Preuve |
| Enjeux bas, volume élevé | Le coût de vérification dépasse le coût des erreurs ; la distribution à modèle unique est la bonne réponse | Logique du seuil de rentabilité (Figure 14) |
| Groupe de vérificateurs en dessous de la compétence en tâches | L'indépendance sans compétence ne produit aucun signal | Nul au niveau local : 46 % de précision avec ou sans accord |
| Espaces de réponse fortement contraints | Le consensus certifie l'erreur plutôt que de la détecter | Erreurs de consensus 4,0–7,9 % en réponse à choix multiples contre 0,5–2,2 % en réponse libre |
| Indépendance affirmée, non mesurée | Un panel de quasi-clones fabrique la confiance | Erreurs corrélées ; nuls de bloc et de lignage |
Une dernière limite concerne ce que chacune des architectures proposées peut identifier. La confiance dans un marché agentique est, en fin de compte, un objet d'équilibre. Une fois que les vendeurs, les plateformes et les agents concurrents se sont adaptés à une architecture de vérification, ses effets sont des propriétés du marché adapté, non de la cellule de traitement. Les données observationnelles héritent de la sélection, car la vérification sera adoptée en premier là où la confiance s'érode déjà. La randomisation au niveau des unités répare la sélection mais s'arrête à l'interférence, puisque les consommateurs randomisés à recevoir des reçus transigent toujours sur un marché dont les vendeurs réagissent aux reçus de tous à la fois. La quantité d'équilibre exige des conceptions en grappes, basculement, bipartites ou au niveau du marché ; randomiser l'architecture plutôt que de mesurer la confiance est le prochain problème difficile. Et les premières cohortes du commerce agentique s'auto-sélectionnent selon la propension à faire confiance, de sorte que les effets estimés sur les premiers adoptants bornent plutôt qu'ils n'estiment l'effet de population. La neutralité est précieuse précisément parce que personne ayant un intérêt dans un modèle ne peut la fournir, y compris quiconque a un intérêt dans l'orchestration. L'argument décrit aussi le type de système que je construis (note de l'auteur). Cet intérêt porte sur l'advocacy et non sur la reproductibilité de la preuve : les modèles évalués sont des systèmes frontière indépendants et accessibles au public, et chaque nombre rapporté est recalculable par les tiers à partir du package de réplication gelé. Un lecteur qui rejette entièrement l'advocacy peut néanmoins vérifier les mesures.
6. Les consommateurs peuvent-ils utiliser le signal ? Un test comportemental préliminaire
La question de savoir si les consommateurs peuvent utiliser le signal de justesse que le mécanisme établit est une question comportementale distincte, et je rapporte une expérience pré-enregistrée et incitée à ce sujet. L'étude sur le terrain est une preuve d'existence plutôt qu'un test d'un effet général ; elle demande si les consommateurs peuvent agir sur le signal du tout. Une réplication confirmative, puissante, multi-item, échantillonnée par stimulus, avec pentes aléatoires par item est prévue. Une panne d'hébergement dans la fenêtre de recrutement finale a mis fin à la collecte à 119 participants valides contre 200 planifiés (133 regroupant une cohorte de lancement progressif ; États-Unis et Royaume-Uni ; trois conditions entre-sujets autour d'un assistant commercial agentique ; calibration mesurée sur six essais factuels incités comme Δ = P(accepter | correct) − P(accepter | incorrect), l'indice de discrimination de confiance appropriée de Schemmer et coll., 2023). La méthode complète, le projet pilote, les cinq écarts par rapport à l'enregistrement, la divulgation éthique et d'exemption, et toutes les statistiques auxiliaires sont dans le rapport détaillé ci-dessous (§6.1–6.2) et le package de réplication.
Le désaccord entre modèles affiché a amélioré la calibration globalement (Δ contrôle = 0,24 → 0,45 ; d = 0,67, 0,68 regroupé, p = 0,0001), mais l'estimation regroupée est fragile : elle est portée par l'un des six stimuli, l'item unique dissident à haute confiance, où l'affichage a réduit l'acceptation d'une réponse confiante erronée de 74 % à 24 % (cohorte regroupée, tableau 18). Supprimer cet item réduit l'effet à d = 0,09 (p = 0,54), tandis que supprimer tout autre item le laisse intact. L'avantage s'est concentré dans l'échantillon du Royaume-Uni. La cellule contrôle américaine (n = 16) discriminait déjà au départ (interaction p = 0,002). Sur l'item unique où le panel lui-même a convenu d'une réponse erronée, l'affichage a augmenté l'acceptation dans les deux pays, ce qui est le mode d'erreur de consensus certifié de la section 3 reproduit dans le comportement humain et une découverte en soi : une architecture qui fait remonter l'accord transfère son unique défaillance systématique à ses utilisateurs. Le test à première exposition de la composante de preuve de P2, un reçu d'orchestration statique, n'a produit aucun effet détectable sur la volonté de déléguer (d = 0,21, inconclusive à cette puissance ; un reçu d'exploration directe en direct au moment du différend est le suivi enregistré).
Un affichage de panel dissident peut réduire considérablement l'acceptation d'une recommandation confiante erronée là où un consommateur l'accepterait autrement, et il échoue là où le panel certifie une erreur partagée. Le contraste de calibration a donc un soutien comportemental sous ces six stimuli ; P1 tel qu'énoncé, avec le risque perçu comme médiateur, n'est pas soutenu par ce test. P2–P4 restent le programme ouvert.
6.1 Test comportemental : méthode et projet pilote
Les propositions des sections 3 et 5 sont rédigées pour être testées, et le programme de mesure ci-dessus spécifie comment. L'expérience est un test en ligne pré-enregistré et incité compatibles avec les incitations de P1 (calibration de confiance sous désaccord affiché) et P2 (volonté de déléguer sous un enregistrement rejouable), avec des stimuli tirés des résultats réels multi-modèles de la vague phare, étendant le paradigme du deuxième avis (Detjen et coll., 2025 ; Chen et coll., 2026) aux désaccords réels, incités sur les modèles frontière sous un encadrement architectural. L'instrument, le gel du protocole, le projet pilote, la vague principale et l'analyse du code gelé sont terminés et rapportés ci-dessous. Les tableaux confirmatoires ont été présentés dans les versions antérieures de cet article en tant que squelette pré-enregistré avec des cellules marquées [DONNÉES PRINCIPALES EN ATTENTE] et sont maintenant remplies par le code d'analyse gelé. Deux résultats défavorables à l'hypothèse ont été pré-enregistrés comme des résultats primaires rapportables : le désaccord affiché aggravant la calibration (sous-confiance nette), et le reçu abaissant la volonté de déléguer (retour de divulgation) ; aucun ne s'est matérialisé, mais un nul pré-enregistré l'a fait.
Méthode.
Conception et hypothèses. L'étalonnage de la confiance requiert de croiser l'accord affiché avec l'exactitude de la réponse, ce qu'une seule vignette ne peut pas faire. La conception est donc hybride. Les participants lisent d'abord une vignette de délégation d'achats (un agent IA commercial, « ShopAssist », recommandant l'achat d'un ordinateur portable avec un budget de 1 200 $), test principal de P2, puis complètent un court bloc de jugement incitatif sur des résultats réels multi-modèles, test principal de P1. H1 (P1) : afficher l'accord et le désaccord entre modèles provenant de plusieurs systèmes IA indépendants améliore l'étalonnage de la confiance des consommateurs (ils acceptent la réponse proposée par l'agent davantage quand elle est correcte et moins quand elle est incorrecte) par rapport à une réponse unique confiante ; bilatéral, car la littérature documente à la fois une sur-confiance réduite et une sous-confiance accrue lors d'une présentation conjointe. H2 (P2) : l'accès à un reçu d'orchestration (qui a agi, comment ils ont convenu, ce qui a été vérifié, et un dossier complet vérifiable à nouveau) augmente la volonté de déléguer un achat conséquent au-delà de l'effet du désaccord affiché seul ; bilatéral, car la divulgation peut aussi réduire la confiance.
Conditions. Trois conditions inter-sujets, randomisées 1:1:1 et maintenues constantes dans la vignette et le bloc de jugement : (1) Contrôle, une recommandation unique confiante, sans signaux architecturaux ; (2) Désaccord, la même recommandation précédée par un panel de trois systèmes IA indépendants (anonymisés comme Système A, B, C) avec marquage explicite d'accord/désaccord, les réponses alternatives des systèmes et les confiances indiquées, et un résumé de résolution en langage clair ; (3) Désaccord + Preuves, l'écran Désaccord plus une carte de reçu d'orchestration structurée comme qui a agi / comment ils ont convenu / ce qui a été vérifié / dossier complet. Une contrainte de conception préenregistrée contrôle le confond évident : le bloc de recommandation final (produit, prix, et la confiance finale indiquée par l'agent) est textuellement identique dans les trois conditions, dans la vignette et à chaque essai de jugement, et seuls les signaux architecturaux autour diffèrent.
Stimuli et reçus. Les stimuli du bloc de jugement sont des résultats réels de trois modèles de pointe de la vague phare sur des questions factuelles réelles sur lesquelles les modèles se sont véritablement accordés ou désaccordés à une confiance indiquée élevée (95–100) ; aucune réponse ou confiance n'est fabriquée. Les noms de modèles sont remplacés par des étiquettes neutres pour éviter les biais de marque, et le mappage est divulgué dans le paquet de réplication. Les reçus affichés dans la condition 3 (un reçu de vignette et six reçus d'essai) sont générés par le producteur de reçus de production du déploiement de recherche (schéma `decision-receipt@v1`) sur les journaux de provenance réels du panel de stimuli, et leurs hachages de vérification sont véritablement recalculables à partir du dossier (journal de vérification : 7/7 valides). La manipulation de preuves de l'expérience est donc une instance de l'artefact que la section 3 définit. La confiance focale affichée a été étroitement rapprochée dans les cellules de correction (éléments incorrects 95/98/99 ; éléments corrects 99/99/100) et, décisivement pour le contraste de traitement, identique selon les conditions. Le Contrôle a vu les mêmes confiances focales et a discriminé beaucoup moins, ce qu'un compte de signal de confiance ne peut pas expliquer.
Mesures. VD1 (H2) : une échelle de volonté de déléguer à 4 items (7 points ; par exemple, « Je laisserais ShopAssist compléter cet achat sans examiner la recommandation moi-même »), moyennée ; une échelle d'échelle de délégation à un seul item (0–4, allant de « recommandations uniquement » à « agit de manière autonome, y compris les achats non remboursables ») est secondaire. VD2 (H1) : six essais de jugement ; sur chacun, l'agent propose une réponse et le participant décide de laisser l'assistant procéder (oui/non) et évalue la confiance dans la réponse (curseur 0–100). Les décisions de confiance sont incitativisées par l'exactitude (un bonus pour chaque décision de confiance correcte, accepter une réponse correcte ou rejeter une incorrect). La réponse proposée est correcte sur exactement trois des six essais. Le score d'étalonnage par participant est Δ = P(accepter | correct) − P(accepter | incorrect), l'indice de discrimination de la littérature sur la confiance appropriée (Schemmer et al., 2023, dont les mesures RAIR/RSR décomposent le même objet) ; un modèle à effets mixtes au niveau des essais récupère la résolution au niveau des items. Le risque perçu et le contrôle de processus perçu (4 items chacun) sont mesurés comme des médiateurs dans les analyses secondaires préenregistrées pour les voies P1 et P2 respectivement ; la neutralité de l'orchestrateur perçue (4 items) est mesurée comme un corrélat exploratoire de P3, que cette étude ne manipule pas.
Protocole gelé. La pré-enregistrement a été gelé avant la collecte de données principale (code d'analyse et protocole gelés par SHA-256 le 5 août 2026 ; l'enregistrement OSF a été soumis le 13 août, avant que la vague principale n'entre sur le terrain les 13–14 août ; enregistré avec embargo (pré-enregistrement, vue seule : https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f), à être libéré dans le composant OSF public de l'article, https://osf.io/jtvu9/). L'ensemble d'éléments à six essais est gelé par seed : trois éléments de désaccord fixés par conception et vérifiés manuellement, plus des éléments de consensus tirés par un shuffle avec seed des pools où les trois systèmes ont répondu de manière identique avec confiance déclarée ≥ 95, incluant une véritable erreur de consensus, de sorte que l'accord affiché est diagnostique mais imparfait, exactement comme dans les données sources. Les six éléments étaient identiques pour chaque participant ; l'ordre de présentation a été aléatoire dans l'instrument, bien que l'export opérationnel n'ait pas conservé l'ordre d'affichage par essai. L'affichage opérationnel n'a pas surfacé un score d'indépendance estimé pour le panel, qui est la divulgation de diversité mesurée que le cadre lui-même appelle, donc les participants ont vu un désaccord sans voir à quel point les systèmes en désaccord étaient indépendants. L'indépendance du panel a été mesurée mais non affichée, et sa valeur sur la collecte source est rapportée ici post hoc : corrélation d'erreur pairwise moyenne φ = 0,22 (0,10–0,44 sur les trois paires, les deux membres du même bloc de loin les plus corrélés à 0,44 ; classés par le notateur déterministe gelé de l'étude, qui résout 95–98 % des réponses, et insensible à la façon dont le reste non résolu est codé), ce qui place le panel loin de l'indépendance et loin du clonage. C'est le nombre que l'instrument suivant devrait mettre devant les participants. Une limite de stimulus : avec six éléments fixes, la variation de traitement par élément ne peut pas être estimée, donc l'effet est établi pour ces stimuli. Les sessions ont commencé par le consentement éclairé et se sont terminées par un débriefing divulguant la nature hypothétique de l'achat du vignette. L'étude a été menée conformément à la Déclaration d'Helsinki : recherche sondage anonyme, à risque minimal avec des adultes consentants du Royaume-Uni et des États-Unis sur un panel conforme au RGPD, compensation au-dessus du minimum de la plateforme, et aucune tromperie au-delà du vignette hypothétique divulguée au débriefing. Selon ces critères, elle répondait aux conditions d'exemption d'un examen éthique complet du conseil, et l'évaluation d'exemption est documentée dans la pré-enregistrement. Le pool est maintenant fermé ; l'ensemble d'éléments textuel, les réponses et les identifiants de reçu par essai font partie de la pré-enregistrement avec embargo et seront libérés avec les données.
Exemple et plan d'analyse. N cible = 200 participants valides (100 États-Unis, 100 Royaume-Uni ; études Prolific séparées ; recrutement plafonné à 210), âge 18+, anglais courant, taux d'approbation ≥ 98 %, ≥ 100 soumissions antérieures, au moins un achat en ligne au cours des trois derniers mois. Exclusions pré-enregistrées (appliquées avant de voir les réponses substantielles) : deux ou plus contrôles d'attention échoués sur trois ; durée de réalisation inférieure à 3 minutes ; straight-lining ; contrôles de manipulation échoués (élément d'accord dans les conditions 2–3, élément de reçu dans la condition 3, élément de compréhension du produit) ; compréhension du bloc de jugement échouée deux fois ; identifiant ou IP dupliqué ; session incomplète. Analyses confirmatoires : pour H1, MCO de Δ sur les conditions de désaccord groupées (2 et 3) par rapport au contrôle avec covariable de pays ; pour H2, restreint aux conditions 2 et 3, MCO du composite de volonté de déléguer sur la condition avec covariable de pays ; correction de Holm sur {H1, H2}, α familial = ,05 ; tests t de Welch comme robustesse ; le gating des contrôles de manipulation est rapporté en premier. L'ordre de cohorte est fixé ici : les analyses confirmatoires primaires sont calculées sur la cohorte de vague principale excluant les participants du lancement logiciel du pilote, et la branche qui regroupe la cohorte de lancement logiciel dans l'échantillon confirmatoire est rapportée comme une analyse de robustesse à côté. Les statistiques descriptives Δ exploratoires du pilote ont été vues avant la vague principale, donc exclure cette cohorte de l'estimation primaire supprime même la forme logicielle du double-dipping tout en conservant l'inclusion de lancement logiciel pré-enregistrée comme une branche rapportée. Le rapport primaire inclura une analyse en intention de traiter conservant tous les participants aléatoires à côté de l'analyse conforme au protocole pré-enregistrée. Les exclusions de contrôle de manipulation seront rapportées avec des contrôles de déperdition différentielle par condition, puisque la saillance du signal architectural pourrait elle-même différer selon les conditions. Sensibilité : la conception détecte d ≈ 0,42 pour H1 et d ≈ 0,49 pour H2 à puissance ,80, adéquat pour les effets médiums dans les littératures adjacentes de fiabilité et de transparence. Les effets plus petits sont laissés à la factorielle complète du programme de recherche. Trois éléments pré-enregistrés répondent aux questions de mécanisme que seuls les contrastes confirmatoires ne peuvent pas. L'instrument porte une échelle de risque perçu à quatre éléments (α du pilote = ,881) sur le chemin P1, de sorte que la perception du risque entre dans l'analyse en tant que construct mesuré plutôt qu'une hypothèse. La médiation est pré-enregistrée comme analyse secondaire, avec le risque perçu médiatisant l'effet de désaccord sur la fiabilité et le contrôle de processus perçu médiatisant l'effet de reçu sur la volonté de déléguer, estimés par analyse de chemin par bootstrap (PROCESS Model 4, 5 000 rééchantillonnages). Le temps sur l'écran de stimulus de condition 3 est collecté en tant que proxy pré-enregistré pour la lecture de reçu, une vérification directe de l'alternative de charge cognitive que les participants passent le reçu sans le traiter. Le code d'analyse a été gelé avant la collecte de données et est archivé avec le paquet de réplication.
Pilote (lancement logiciel) : critères et résultats.
Un pilote de n = 20 (États-Unis), réalisé sur l'instrument final avec des critères de passage pré-enregistrés fixés à l'avance, a été complété le 6 août 2026. Le tableau 13 rapporte chaque critère par rapport à son résultat.
Tableau 13. Critères d'acceptation du pilote (pré-enregistrés) et résultats (n = 20, États-Unis)
| Critère (fixé ex ante) | Résultat | Verdict |
| Manipulation remarquée : > 80 % correct sur le contrôle d'accord (conditions 2–3) | 81,3 % (13/16) | Réussir |
| Manipulation remarquée : > 80 % correct sur le contrôle de reçu (condition 3) | 88,9 % (8/9) | Réussir |
| Alpha de Cronbach > ,70, volonté de déléguer (4 éléments) | ,854 | Réussir (dépasse aussi la cible de ,85) |
| Alpha de Cronbach > ,70, risque perçu (4 éléments) | ,881 | Réussir |
| Alpha de Cronbach > ,70, contrôle de processus (4 éléments) | ,965 | Réussir |
| Alpha de Cronbach > ,70, neutralité (4 éléments) | ,851 | Réussir |
| Temps médian de réalisation entre 10-15 minutes | 9,60 minutes | Échec, avec 24 secondes de moins, dans la direction rapide |
Un critère a échoué. La médiane a dépassé de 24 secondes la fenêtre pré-enregistrée, une fenêtre construite contre la longueur excessive, non contre l'efficacité. La queue rapide ne montre aucune preuve de réponses négligentes : aucun participant n'est tombé en dessous du seuil d'exclusion de 3 minutes ; l'un des participants sous les cinq minutes a réussi tous les contrôles d'attention, de manipulation et de compréhension ; les taux de réussite des contrôles d'attention se situaient entre 95 et 100 % ; il y avait zéro cellules manquantes sur les variables clés, zéro identifiant dupliqué ou adresse IP dupliquée, et zéro schéma récurrent ; et les temps de réalisation de la plateforme de recrutement confirment indépendamment le minuteur du sondage (médiane 9,74 minutes). L'instrument est plus court sur le terrain que prévu. L'équilibre des conditions (4/7/9 entre les conditions 1/2/3) est compatible avec une randomisation 1:1:1 à n = 20 (χ²(2) = 1,90, p = ,387). Selon les exclusions de l'analyse pré-enregistrée, 6 des 20 participants pilotes sont exclus de l'analyse confirmatoire (cinq pour des raisons de contrôle de manipulation, un pour un échec double au contrôle de compréhension), ce qui en laisse 14 valides. Selon la règle du lancement en douceur, la cohorte pilote procède à l'incorporation dans l'échantillon regroupé avec l'écart de temps divulgué ici et dans l'enregistrement lui-même, qui a été soumis à OSF le 14 août 2026 à 03:09 UTC, avant la collecte de la vague principale, et qui stipule que le pilote de lancement en douceur est inclus dans l'échantillon confirmatoire avec l'écart de temps indiqué ; traiter la cohorte de la vague principale comme l'estimation confirmatoire primaire et la branche regroupée comme robustesse est une décision analytique post-enregistrement, prise parce que les descriptifs pilotes avaient été vus avant la vague principale, et les deux branches sont rapportées ; la marge de compréhension du produit (un participant au-dessus de la barre des 80 %) est signalée pour surveillance lors de la vague principale. Une descriptive exploratoire : le score d'étalonnage Δ par condition s'est élevé à +0,33 (contrôle, n = 4), +0,52 (désaccord, n = 7), +0,22 (désaccord + preuve, n = 9), de sorte que la condition de désaccord se déplace dans la direction de H1 ; le pilote ne peut pas en dire plus.
6.2 Test comportemental : résultats, analyses exploratoires et reste du compte rendu
Résultats confirmatoires.
La collecte de la vague principale s'est déroulée les 13-14 août 2026 (190 emplacements : 85 États-Unis + 105 Royaume-Uni au-dessus de la cohorte de lancement en douceur), et elle ne s'est pas terminée : l'hôte du sondage a subi une panne technique pendant la fenêtre de recrutement finale, et la collecte s'est arrêtée à 158 sessions terminées au total (138 dans la vague principale et 20 lors du lancement en douceur) plutôt que l'objectif de 200 valides. Le recrutement s'est terminé avec la panne de la plateforme, selon la règle d'arrêt optionnel pré-enregistrée et non en réponse aux résultats observés, bien que les résultats aient déjà été vus ; la conséquence est une puissance réduite. Aux cellules réalisées, les effets minimums détectables augmentent par rapport aux d ≈ 0,42 (H1) et d ≈ 0,49 (H2) enregistrés à environ d ≈ 0,54 et d ≈ 0,64 à la même puissance, une limite que le résultat confirmatoire rend sans objet dans une direction uniquement, et qui s'applique à chaque contraste nul et exploratoire ci-dessous. L'ordre des cohortes suit le plan du §6.1. Le pilote a manqué un critère de réussite (la fenêtre de temps de réalisation, avec 24 secondes de moins dans la direction rapide), et ses descriptives exploratoires avaient été vues avant la vague principale, de sorte que la cohorte confirmatoire primaire est la vague principale uniquement (N = 119 valides) et la branche regroupant la cohorte de lancement en douceur identiquement générée en arrière (N = 133) est rapportée comme robustesse. Chaque nombre ci-dessous est la sortie du code d'analyse figé par SHA-256 avant la collecte de données. Les écarts par rapport à l'enregistrement, regroupés en un seul endroit : (i) l'insuffisance de N (133 valides sur 200 enregistrés ; panne d'hébergement) ; (ii) le critère de temps de réalisation du pilote manqué de 24 secondes dans la direction rapide ; (iii) l'ordre d'affichage par essai non conservé dans l'exportation générée ; (iv) le minutage au niveau de l'écran non capturé ; (v) le modèle mixte au niveau de l'essai exécuté sur une approximation variationnelle (le moteur final du package peut différer). Rien d'autre n'a dévié ; chaque test confirmatoire s'est déroulé tel qu'enregistré, la décision de cohorte primaire ci-dessus étant le seul choix analytique post-enregistrement.
Tableau 14. Flux d'échantillon et exclusions (vague principale ; cohorte de lancement en douceur en note)
| États-Unis | Royaume-Uni | Total | |
| Sessions terminées | 50 | 88 | 138 |
| Exclu : attention (≥ 2 sur 3 contrôles) | 0 | 0 | 0 |
| Exclu : vitesse (< 3 min) / réponses récurrentes | 0 | 0 | 0 |
| Exclu : contrôles de manipulation / compréhension | 10 | 9 | 19 |
| Exclu : doublons / incomplets | 0 | 0 | 0 |
| N valide (par condition 1/2/3) | 40 (16/15/9) | 79 (26/28/25) | 119 (42/43/34) |
La cohorte de lancement en douceur ajoute 20 sessions terminées aux États-Unis, dont 14 survivent aux mêmes exclusions ; elle n'entre que dans la branche de robustesse regroupée (N = 133). Chaque exclusion dans la vague principale provenait des règles de contrôle de manipulation et de compréhension — aucun participant n'a été exclu pour inattention, accélération, réponses récurrentes, duplication ou incomplétude — et le portillage du contrôle de manipulation ne montre aucune asymétrie entre les conditions (MC1 χ²(1) = 0,12, p = ,73 ; MC3 χ²(2) = 3,67, p = ,16, calculé sur l'échantillon avant exclusion).
Tableau 15. H1 (P1) : étalonnage de la confiance Δ par condition (cohorte primaire, N = 119)
| Contrôle | Désaccord | Désaccord + Preuve | |
| Δ, moyenne (ÉT) | 0,238 (0,332) | 0,465 (0,274) | 0,422 (0,299) |
| Confiance excessive : P(accepter | incorrect) | 0,603 | 0,434 | 0,510 |
| Confiance insuffisante : 1 − P(accepter | correct) | 0,159 | 0,101 | 0,069 |
| Contraste confirmatoire : regroupé (2,3) vs contrôle, OLS avec covariable pays | b = +0,217, IC 95 % [+0,104, +0,330], p ajusté Holm = ,0005 (d = 0,67) |
Tableau 16. H2 (P2) : volonté de déléguer, réception vs désaccord seul (cohorte primaire)
| Désaccord (2) | Désaccord + Preuves (3) | |
| Composite volonté de déléguer, moyenne (ÉT) | 3,09 (1,61) | 3,45 (1,79) |
| Échelle de délégation, médiane | 2 | 2 |
| Contraste confirmatoire : 3 vs 2, MCO avec covariable pays | b = +0,41, IC 95 % [−0,35, +1,18], p ajustée Holm = ,29 |
H1 est soutenue dans ce plan pour le contraste d'étalonnage ; la médiation préenregistrée par le risque perçu était nulle, donc P1 tel qu'énoncé n'est pas soutenu par ce test. Face à une réponse unique confiante, les participants ont à peine discriminé : ils ont laissé l'agent procéder dans 84 % des réponses correctes mais aussi dans 60 % des réponses incorrectes (Δ = 0,238, IC 95 % [0,14, 0,34] ; conditions de traitement 0,465 [0,38, 0,55] et 0,422 [0,32, 0,52]). L'affichage du désaccord a presque doublé l'étalonnage (Δ regroupé = 0,446 ; b = +0,217, p = ,0002, p ajustée Holm = ,0005 ; d de Welch = 0,67), et il l'a fait des deux côtés à la fois : la surfiabilité a diminué (60 % → 43 % et 51 %) tandis que la sous-fiabilité a également diminué (16 % → 10 % et 7 %) (Figure 20). Cette moyenne regroupée est portée par un seul élément et se lit mieux comme une preuve d'existence que comme une moyenne robuste : sur le seul essai de dissident confiants à haut degré de confiance que les participants du contrôle acceptaient à 74 %, l'affichage a réduit l'acceptation de la mauvaise réponse à 24 %, et avec cet essai supprimé, le contraste confirmatoire n'est plus significatif (d = 0,09, p = ,54), tandis que l'suppression de tout autre élément unique le laisse intact (d = 0,47–0,89). La décomposition exploratoire ci-dessous (Tableaux 17–18) localise l'effet élément par élément. Sa concentration est la même dépendance de l'espace disponible signalée au niveau national : l'affichage ne ferme un écart d'étalonnage que là où il existe, et l'un des six éléments l'a ouvert largement.
Figure 20. Ce que l'affichage du désaccord fait à la fiabilité (cohorte primaire)
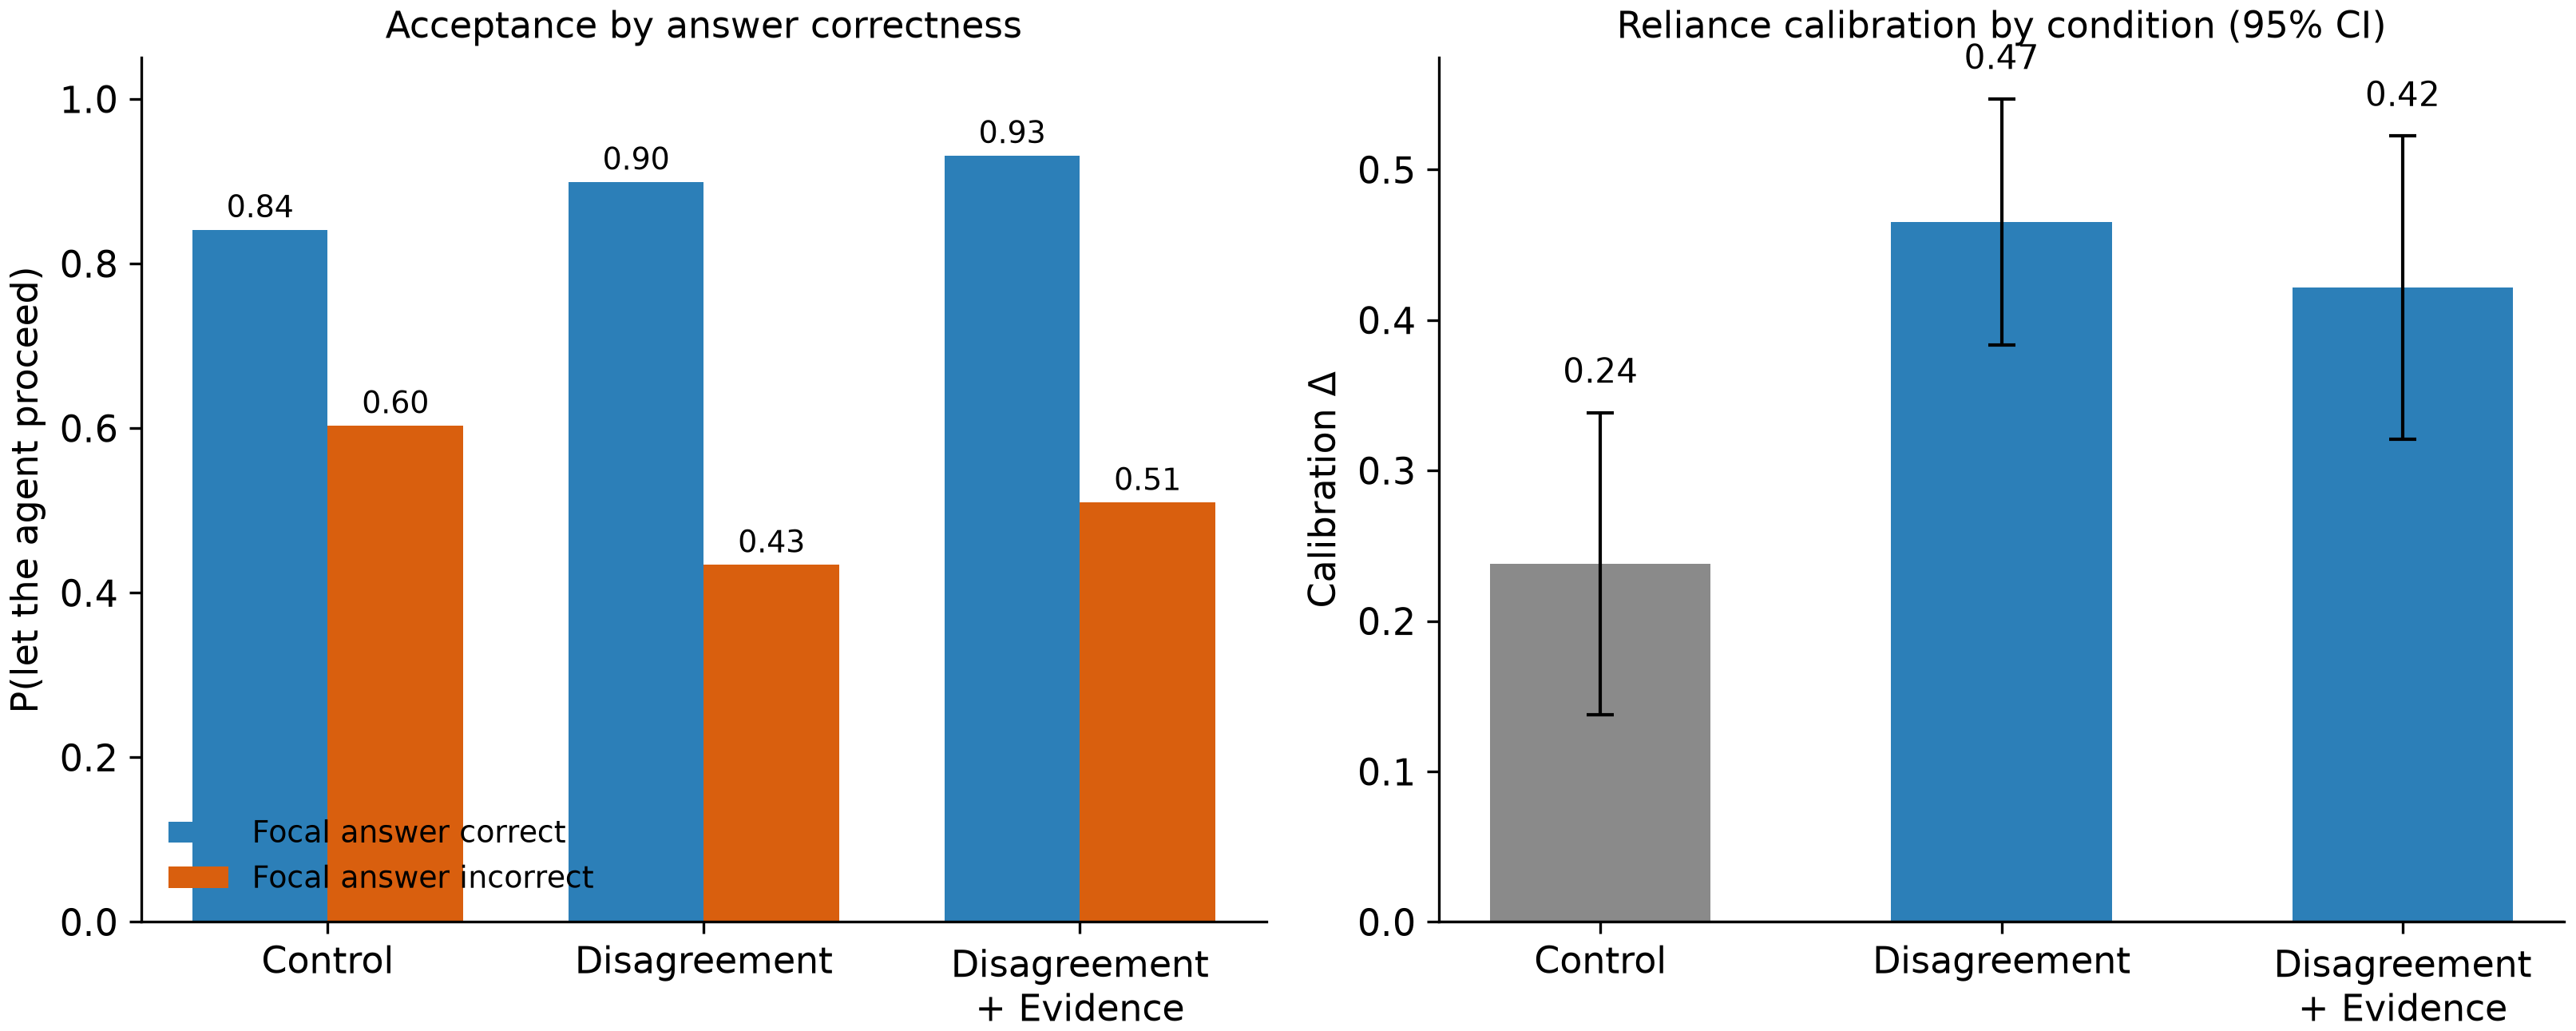
Gauche : taux d'acceptation par condition, en fonction de si la réponse focale était correcte (étalonnage = l'écart entre la paire de barres). Droite : le score d'étalonnage par participant Δ par condition avec IC 95 % ; le contraste confirmatoire regroupe les deux conditions de désaccord par rapport au contrôle.
Le cadrage bilatéral préenregistré existait parce que la littérature des deuxièmes avis documente les interventions qui réduisent la surfiabilité au prix d'une fiabilité accrue ; celle-ci n'a pas payé ce prix. Le signal a rendu les participants plus discriminants, non pas plus sceptiques, et une décomposition de détection de signal des taux agrégés met des chiffres sur cela : la sensibilité d′ est passée de 0,74 dans le Contrôle à 1,44 et 1,46 dans les conditions de traitement (calculée à partir de taux non arrondis) tandis que le critère de réponse a à peine bougé (−0,63 vs −0,56 et −0,76). Le modèle d'effets mixtes au niveau des essais récupère la même structure, avec de grandes interactions correctness × condition positives pour les deux conditions de traitement. Chaque branche enregistrée s'accorde : la branche de robustesse regroupée (b = +0,215, p = ,0001, d = 0,68), et la branche intention-à-traiter retenant toutes les sessions de la vague principale complétées indépendamment des défaillances des vérifications (b = +0,2174 vs +0,2169 par protocole, p = ,0001, n = 138), avec les exclusions équilibrées entre conditions (8/6/5 ; χ²(2) = 0,34, p = ,85), la vérification de l'attrition différentielle §6.1 s'engage à (les exclusions de vérification de manipulation sont un conditionnement post-traitement, per Montgomery, Nyhan, & Torres, 2018, d'où l'égalité de statut de la branche non conditionnée). Un confound de plan qualifie la lecture. Les conditions de désaccord diffèrent du Contrôle non seulement dans ce que le signal dit mais dans combien est montré, trois positions et niveaux de confiance au lieu d'un, donc le gain d'étalonnage pourrait en principe refléter le volume d'information plutôt que le contenu du signal d'accord. Deux observations s'opposent à la lecture du volume sans la trancher : l'effet suit la direction du signal affiché élément par élément, car sur les éléments focaux incorrects où l'affichage montrait du désaccord, l'acceptation a diminué, tandis que sur le seul élément où l'affichage montrait un accord confiant unanime, l'acceptation de la mauvaise réponse a augmenté ; et l'interaction au niveau des essais est avec la correction de la réponse, que le volume seul ne prédit pas. Le bras discriminant propre, plusieurs systèmes affichés en accord sur chaque essai avec le volume d'information maintenu constant, est spécifié pour la prochaine vague.
H2 n'est pas supporté. Parmi les participants ayant déjà vu l'affichage du désaccord, le reçu n'a produit aucun effet détectable sur le composite de délégation à la puissance réalisée (3,45 vs 3,09 ; b = +0,41, p = 0,29 ; branche regroupée b = +0,34, p = 0,33 ; fiabilité composite : α de Cronbach de la vague principale = 0,89). Trois résultats secondaires préenregistrés façonnent la façon dont le résultat nul doit être interprété. Le reçu a été reçu : le temps de session médian dans la condition reçu a duré environ une minute et demie de plus que dans la condition désaccord (11,0 vs 9,4 minutes ; le chronométrage au niveau de l'écran n'a pas été capturé dans l'export sur le terrain, donc la durée totale remplace le proxy de temps-sur-stimulus enregistré). Le temps supplémentaire n'établit pas que les participants ont utilisé le reçu. Le reçu sur le terrain était une carte statique, et son affordance « voir l'enregistrement complet » n'était pas active dans l'enquête, donc la manipulation a testé la présence du reçu, non son exercice. Un reçu avec exploration en direct est la manipulation plus forte que le prochain design inclut. C'est un résultat nul pour un affichage de reçu statique, pas pour les enregistrements, la vérifiabilité ou P2 tel qu'écrit. Le reçu a également déplacé son médiateur préenregistré. Le contrôle de processus perçu a augmenté dans la condition reçu (a = +0,60 ; fiabilités d'échelle, vague principale : contrôle de processus α = 0,93, risque α = 0,83, neutralité α = 0,90), le contrôle de processus prédit fortement la délégation (b = +0,60), et le chemin indirect avec bootstrap est positif et exclut zéro (indirect = +0,35, IC 95 % [+0,02, +0,78], 5 000 rééchantillonnages), tandis que le chemin direct est proche de zéro. C'est une preuve de médiation exploratoire : le médiateur a été mesuré après le traitement dans le même instrument, de sorte que la variance de méthode commune et l'interprétation inverse restent possibles. L'analyse de sensibilité limite ce que ce résultat nul peut établir. Les cellules réalisées détectent d ≈ 0,49 au pouvoir 0,80 seulement au N enregistré, de sorte qu'un effet de reçu de la taille que le chemin de médiation implique est exactement la taille que cet échantillon ne peut pas résoudre. Le résultat est non concluant pour les petits et moyens effets et décisif uniquement contre les plus grands. Formellement, l'équivalence de test délimite l'effet seulement grossièrement (TOST établit |d| < 0,64 à α = 0,05, non |d| < 0,5), et un facteur de Bayes JZS donne BF₀₁ ≈ 2,9 (branche regroupée 3,1), preuve anecdotique favorisant le résultat nul selon les bandes standard (à ou juste après la limite anecdotique/modérée de 3) ; il ne démontre ni l'absence ni soutient la présence. La section de mesure l'avait prédit : la vérifiabilité est une propriété à la demande, et sa valeur doit émerger au moment du différend, de la réclamation ou de l'audit, de sorte qu'un reçu statique lu une fois lors d'un achat hypothétique peut être le mauvais moment pour l'observer. La conclusion enregistrée : le test de première exposition de P2 n'a pas modifié la délégation, et l'économie du côté opérateur du reçu (Section 5) ne repose pas sur ce résultat du côté consommateur. Deux lectures restent : soit le composant de preuve contribue moins au moment de la décision que le cadre ne le prétend, soit cette opérationnalisation est la mauvaise façon de le tester. Le compte du moment du différend est une hypothèse post-hoc, programmé comme design de suivi nommé à la fin de cette section, non la résolution du résultat nul. Une troisième lecture provient de la littérature sur l'aversion. Un reçu détaillé est une manipulation de la saillance, une exposition de la machinerie qui rappelle au consommateur combien de choses peuvent mal tourner exactement au moment de la délégation, le paradoxe de transparence dans lequel le détail procédural déprime plutôt que renforce la confiance (Kizilcec, 2016 ; Dietvorst, Simmons, & Massey, 2015). Ces lectures concurrentes, un composant plus faible que prétendu, un test au mauvais moment, et la contre-attaque de la saillance, font des prédictions différentes et sont séparables par la conception.
Le mode d'erreur de consensus certifié reproduit dans le comportement humain. Un essai incité portait, par conception, une véritable erreur de consensus, avec les trois systèmes convergeant avec assurance sur la même mauvaise réponse, reflétant le taux d'erreur de consensus en forme libre de 0,5–2,2 % que l'étude de mécanisme mesure. Sur cet essai, un seul élément et donc une observation plutôt qu'une estimation, l'affichage du désaccord n'a protégé personne et, dans les deux pays, a directionnellement augmenté l'acceptation de la mauvaise réponse (de 4 et 14 points de pourcentage par rapport au contrôle) : les participants ont rationnellement lu l'accord indépendant unanime comme une certification. Ainsi, le mode d'échec systématique de cette architecture se transfère à ses utilisateurs avec une grande fidélité. La section 3 a donné l'avertissement de conception, que le consensus certifie l'erreur exactement où la diversité du panel échoue, et la sonde montre le même échec dans le comportement.
Exploratoire : où l'avantage d'étalonnage se situe.
Tout ce qui suit est exploratoire et génère des hypothèses. Les cellules de pays sont petites, et chaque valeur p intra-pays ci-dessous doit être lue comme descriptive. L'effet d'étalonnage s'est concentré presque entièrement dans l'échantillon du Royaume-Uni et était absent dans l'échantillon américain :
Tableau 17. Δ d'étalonnage par pays et condition (exploratoire)
| Contrôle Δ | Désaccord (regroupé 2, 3) Δ | Taille d'effet intra-pays | |
| Royaume-Uni (n = 79) | +0,103 (n = 26) | +0,447 (n = 53) | d = +1,19 |
| États-Unis (n = 40 principal / 54 regroupé) | +0,458 / +0,433 | +0,444 / +0,471 | d = −0,05 / +0,13 |
| Interaction pays × condition | b = −0,36, p = 0,002 (principal) ; b = −0,31, p = 0,004 (regroupé) |
La décomposition est plus informative que l'interaction. Les participants du groupe Contrôle américain discriminaient déjà fortement sans aucun signal architectural, acceptant 92 % des réponses correctes et seulement 48 % des réponses incorrectes, tandis que les participants du groupe Contrôle britannique discriminaient à peine (78 % contre 68 %). Sous l'affichage du désaccord, les deux pays devenaient presque indiscernables, élément par élément (différence cellulaire maximale 0,07 sur les six essais). L'intervention a convergé les deux échantillons vers le même point d'étalonnage (Δ ≈ +0,45), égalisant une différence de base qu'elle n'a pas créée (Figure 21). Une partie de ce pattern est mécanique. Δ est borné, donc la marge disponible diminue à mesure que l'étalonnage de base augmente, et « le bénéfice se concentre là où l'étalonnage de base est le plus faible » est en partie une propriété de la mesure. Le plafond seul, cependant, ne force pas des points finaux identiques ni la correspondance du profil élément par élément. La lecture la plus défendable est que les six éléments étaient suffisamment faciles pour qu'un panel les discrimine sans aide, de sorte que l'affichage comble un écart d'étalonnage là où il existe. Cette lecture concerne la marge, non les nations, et concerne également les stimuli : l'ensemble d'éléments lui-même était incliné culturellement (deux éléments dissidents contenaient du contenu d'ordre local américain), de sorte que le profil de convergence est une propriété de ces six éléments autant que de ces deux panels.
Figure 21. Convergence, non réponse uniforme (exploratoire)
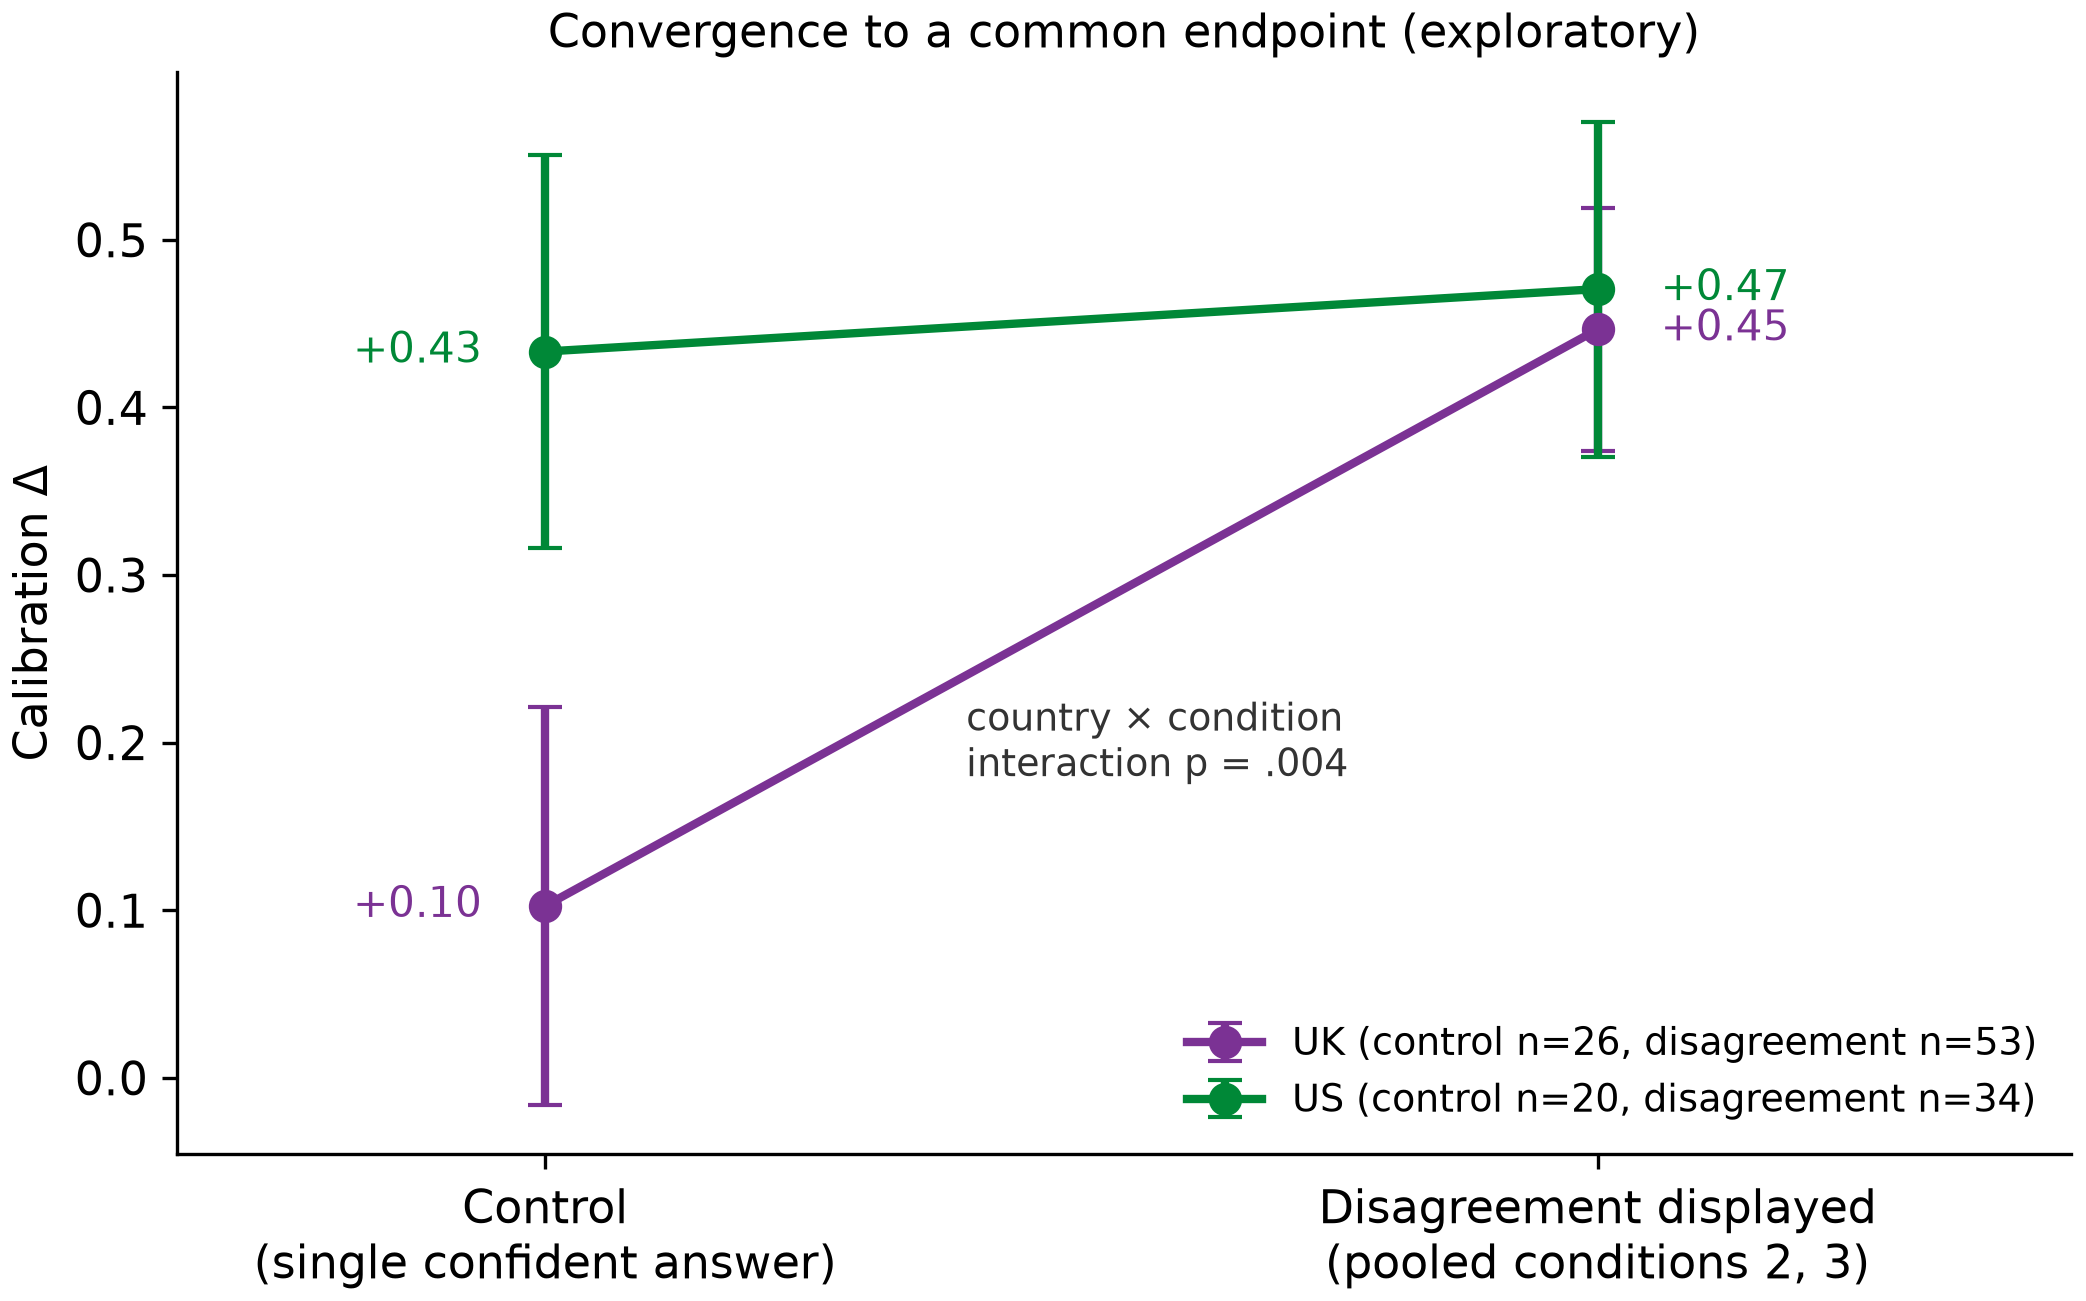
Δ d'étalonnage par pays et condition : le groupe de contrôle américain discrimine déjà (Δ ≈ +0,45) ; le groupe de contrôle britannique le fait à peine (Δ ≈ +0,10) ; sous le désaccord affiché, les deux pays arrivent au même point final (Δ ≈ +0,45). Le bénéfice se concentre exactement là où l'étalonnage de base est le plus faible.
L'avantage américain en Contrôle, quant à lui, est concentré sur les deux éléments dissidents avec un contenu d'ordre local américain plausible. L'un est une question du Museum of Bad Art pour laquelle la mauvaise réponse, « la Joconde », est absurde pour quiconque connaît la prémisse du musée (acceptation américaine 5 % contre britannique 27 %). La concentration sur ces deux éléments pointe vers la familiarité au niveau de l'élément et non vers le tempérament national.
Tableau 18. Acceptation des réponses focales incorrectes par élément et cellule (exploratoire ; cohorte regroupée)
| Cellule | Dissident incorrect, conf 95 (élément « Joconde ») | Dissident incorrect, conf 98 (élément ville ICM) | Consensus incorrect, conf 99 |
| Contrôle britannique (n = 26) | 0,27 | 0,85 | 0,92 |
| Contrôle américain (n = 20) | 0,05 | 0,60 | 0,80 |
| Désaccord britannique (n = 53) | 0,21 | 0,25 | 0,96 |
| Désaccord américain (n = 34) | 0,18 | 0,24 | 0,94 |
L'effet protecteur de l'intervention se situe presque entièrement sur l'élément dissident à haute confiance (royaume-uni −0,60, États-Unis −0,36) ; sur l'élément d'erreur de consensus, l'affichage augmente légèrement l'acceptation dans les deux pays — un accord unanime lu comme une certification, l'image comportementale du mécanisme d'erreurs de consensus certifiées de l'étude. Parce que l'effet protecteur se situe sur cet unique élément, le contraste confirmatoire regroupé ne survit pas à son retrait (d = 0,09, p = 0,54) bien qu'il survive au retrait de tout autre élément unique (d = 0,47–0,89) — la forme quantitative de l'effet étant portée par un élément.
Tableau 19. Échelles d'attitude par pays (exploratoire ; cohorte regroupée) : l'écart est comportemental, non attitudinal
| Échelle (1–7 sauf indication contraire) | Moyenne britannique | Moyenne américaine | Direction |
| Confiance pré-exposition en l'IA | 4,68 | 4,70 | identique |
| Volonté de déléguer (composite) | 2,94 | 3,43 | Plus élevée aux États-Unis (p = 0,08) |
| Échelle de délégation (0–4) | 1,71 | 1,98 | Plus élevée aux États-Unis (p = 0,08) |
| Risque perçu | 5,54 | 5,13 | Plus faible aux États-Unis (p = 0,09) |
| Contrôle du processus perçu | 4,17 | 4,56 | Plus élevé aux États-Unis (p = 0,14) |
| Neutralité perçue | 4,75 | 4,62 | n.s. |
Chaque différence attitudinal qui existe pointe dans la « mauvaise » direction pour un compte de scepticisme américain : les participants américains sont plus disposés à déléguer et perçoivent moins le risque, mais discriminent mieux comportementalement en Contrôle. Les attitudes mesurées n'expliquent rien : ajuster l'écart de base entre pays pour les variables démographiques et les cinq échelles l'atténue d'au maximum 15 %, et les chemins indirects d'amorçage par les échelles sont nuls.
Les enquêtes transnationales concordent avec le null attitudinal. La volonté déclarée de faire confiance à l'IA est essentiellement identique aux États-Unis et au Royaume-Uni (41 % contre 42 % : Gillespie et al., 2025), et les deux pays se situent dans le même cluster de haute méfiance « Anglosphère » sur la nervosité face à l'IA (Ipsos, 2025). L'asymétrie au niveau de la population pointant la direction observée est la littératie en IA. Les répondants britanniques rapportent eux-mêmes moins de compétences et de confiance dans l'utilisation et l'évaluation de l'IA (36 % contre 42 % sur les compétences : Gillespie et al., 2025), et les adultes américains sont parmi les publics les plus exposés à l'IA interrogés (Pew Research Center, 2025). Deux comptes survivent donc au registre exploratoire. Sur un compte de familiarité, la population moins équipée pour évaluer les conseils de l'IA bénéficie le plus d'une architecture qui les évalue structurellement. L'autre compte est la composition du panel : le bras britannique de la plateforme de recrutement est son pool plus ancien et plus expérimenté, et les panels en ligne sont des instruments imparfaits pour l'inférence entre pays (Gvirtz & Sabherwal, 2024), de sorte que l'étiquette « pays » peut partiellement servir de proxy pour l'ancienneté du panel. Le plan ne peut pas séparer les deux, et n'a pas besoin de le faire, car sur l'un ou l'autre compte la conclusion substantielle est le profil compensatoire lui-même. Compte tenu de la taille des cellules, la valeur par défaut la plus sûre est de lire le pattern comme une propriété de ces deux panels jusqu'à ce qu'une réplication alimentée en parle ; aucune conclusion théorique dans cet article ne repose sur elle.
Ce profil n'est pas le résultat par défaut des interventions de réduction de la dépendance excessive. Les fonctions de forçage cognitif réduisent la dépendance excessive mais concentrent leurs bénéfices parmi les utilisateurs ayant déjà un besoin élevé de cognition, de sorte que les personnes analytiquement orientées deviennent plus analytiques (Buçinca et al., 2021), et la recherche sur l'étalonnage adaptatif de la confiance traite le ciblage des mal étalonnés comme un objectif de conception nécessitant une surveillance active (Okamura & Yamada, 2020). Ici, le ciblage s'est fait naturellement. Le désaccord affiché s'auto-déclenche : il apparaît exactement quand le panel n'est pas d'accord et ne demande rien à l'utilisateur à l'avance. Son bénéfice a porté directement sur le groupe dont la discrimination de base était la plus faible, et il a laissé intacte la précision du groupe déjà étalonné plutôt que de la dégrader. Pour un mécanisme de protection des consommateurs, c'est le profil distributional qu'on spécifierait ex ante, avec l'aide concentrée là où se concentre le mauvais étalonnage et sans coût pour ceux qui n'en ont pas besoin.
Analyses secondaires pré-enregistrées : le reste du bilan.
Les analyses secondaires pré-enregistrées restantes se trouvent ici en un seul endroit (cohorte primaire ; valeurs poolées entre branches dans le paquet de réplication). La médiation de l'effet de désaccord par le risque perçu, la voie P1 que le design anticipait, est nulle. L'affichage, si quelque chose, a légèrement réduit le risque perçu (a = −0,40), et le chemin indirect bootstrap est indistinguible de zéro (+0,006, IC 95 % [−0,013, +0,029]). L'effet d'étalonnage est direct, cohérent avec des participants utilisant le motif de désaccord comme information sur la réponse plutôt que comme une alarme générale sur la transaction. La neutralité perçue de l'orchestrateur, mesurée plutôt que manipulée, est un corrélat fort de la volonté de déléguer en contrôlant la condition et le pays (b = +0,47, p < ,0001), la trace corrélationnelle que P3 prédit, en attente de sa manipulation. L'échelle de délégation montre le même ordre que l'indice composite sans atteindre la signification (logit ordonné, reçu vs désaccord : b = +0,70, p = ,11 ; les médianes sont à égalité à 2 sur 4). Le contraste non enregistré condition 3-versus-1 sur la délégation est directionnellement positif et non significatif (b = +0,52, p = ,15). Une déviation : l'export déployé n'a pas capturé le minutage au niveau de l'écran, donc le proxy pré-enregistré de temps sur stimulus lecture-reçu est approximé par la durée totale de la session (rapportée sous H2 ci-dessus). La vérification au niveau de l'écran prévue devrait être intégrée à l'instrument de la prochaine vague.
Cette étude teste uniquement P1 et P2. P3 est mesurée, non manipulée, et P4 et la conjonction conjointe de variation complète de la section 5 restent l'étude spécifiée suivante. La validation comportementale de la triade est donc incomplète : une composante soutenue, une inconclusive, une mesurée mais non manipulée. Une question longitudinale domine le programme. L'affichage persistant du désaccord peut stabiliser l'adoption à long terme, comme amortisseur de l'oscillation entre l'appréciation de l'algorithme et l'aversion en cas d'unique défaillance, ou il peut épuiser cette adoption par l'exposition continue aux défaillances des machines. Un design monophonique ne peut le dire. Deux études motivées par les résultats ci-dessus sont ajoutées au programme. L'une est un design au moment du différend qui réteste le reçu au moment où sa valeur devrait vivre, en utilisant un contrôle faux-reçu, un reçu dont le hash ne se recalcule pas, pour séparer la vérifiabilité de sa présentation. L'autre est une réplication alimentée pour la modération du pays rapportée ci-dessus (tableau 17).
7. Conclusion
Alors que l'IA médiatise les décisions de consommation importantes et les prend de plus en plus, j'ai soutenu que la confiance doit remonter dans la pile : du modèle, à l'architecture, au registre. La diversité, la preuve et la neutralité ensemble produisent un service dont la fiabilité peut être vérifiée plutôt que tenue pour acquise. Ce qui est construit n'est pas une meilleure persuasion mais une infrastructure économique de confiance, la chaîne de responsabilité qui permet à la délégation de s'adapter. La vague phare mesure cela au sommet du marché. Groupés dans les dix bras phares complets de la vague, les modèles vendus comme meilleurs de chaque laboratoire avaient tort en toute confiance sur près de la moitié de leurs réponses résolues offertes à une confiance déclarée ≥ 80 (46,6 %, et le chiffre bouge à peine quand les éléments non résolus sont re-codifiés comme des erreurs). Le bras Meta partiel est rapporté séparément, et l'inclure laisse le chiffre pratiquement inchangé. Une porte de désaccord à trois modèles fixe au-dessus, sans entraînement et sans réglage, supprime quatre-cinquièmes de ces défaillances à un coût déclaré, inspectable en couverture. Parce que le substrat ici est purement factuel, ce taux devrait être lu comme une limite supérieure pour les tâches de commerce mixte. Ce qui autoriserait la réclamation pour le commerce proprement dit est une réplication ancrée par la récupération, utilisant les outils sur un menu de produits contraint, où les erreurs de consensus se comportent différemment que dans l'espace factuel ouvert. Une expérience pré-enregistrée (section 6) a mis le même signal architectural devant les consommateurs et a retourné des preuves qu'ils peuvent l'utiliser comme signal de justesse : l'affichage du désaccord a réduit l'acceptation d'une recommandation mauvaise confiante de 74 % à 24 % sur l'élément éligible. Dans un fractionnement de pays exploratoire, il se concentre dans la cellule britannique sur-dépendante et repose sur cet élément unique (le contraste groupé ne survit pas à son retrait, d = 0,09). C'est une preuve d'existence sous ces stimuli, pas encore un effet général ; un test confirmatoire échantillonné par stimuli est prévu.
Cette couche mérite un nom de marché qui lui est propre, infrastructure de preuve, pour être vendue comme l'infrastructure cloud, identité et paiements, car elle répond au même type de question : « peut-on en dépendre et comment le saurions-nous ? » C'est une question différente de « est-ce intelligent ? » La sécurité et la confidentialité ont suivi cette voie : différenciateur, puis attente, puis exigence d'entrée. La confiance architecturale peut plausiblement suivre le même chemin, à un rythme établi par la pression réglementaire et en matière de responsabilité déjà visible.
Ma thèse du côté théorique est que l'unité d'analyse pour la confiance des consommateurs dans les services d'IA devrait passer du modèle à l'architecture, car les propriétés pertinentes pour la confiance y résident réellement : l'indépendance de la vérification, la reproductibilité des décisions, l'absence de conflit d'intérêts. Les modèles changent constamment dans chaque service, plus vite que toute réputation ne peut suivre. L'écart de performance fermé-ouvert s'est effondré de 8,04 % à 1,70 % en une seule année (Stanford HAI, 2025), et le leadership du marché des modèles d'entreprise a changé de mains en un seul printemps (Kharazian, 2026). Une couche qui se démocratise aussi rapidement n'est pas un endroit où la confiance peut s'ancrer. Ce qui sert un consommateur est de plus en plus un routage entre les modèles et les tranches tarifaires, piloté par les coûts, invisible et non vérifié, et un modèle choisi comme meilleur en sert de moins en moins. L'étape qui reste, et celle que je précise ici, est de passer d'une architecture routée au meilleur à une dont la vérification qu'un consommateur, un assureur ou un régulateur peut maintenir suffisamment longtemps pour vérifier. Sous cela se trouve une transition des assistants IA aux fiduciaires IA. Les fiduciaires, dans tous les domaines qui en ont jamais eu, sont constitués non par leurs talents mais par leurs devoirs : tenir des registres, se soumettre à un audit, n'avoir aucun intérêt contraire. La confiance architecturale construit ces devoirs dans la machinerie.
La même exigence s'applique à la façon dont le système lui-même se développe. Un système demandant à être fiable pour une action conséquente devrait devoir se développer selon la façon dont il répond, vérifiablement. Les changements de configuration à une couche d'orchestration devraient être validés ou annulés par des portes statistiques vérifiées par rapport à des données de contrôle, sans qu'aucun processus automatisé n'affaiblisse une règle de sécurité, seulement en ajouter une. Le déploiement de recherche dans l'étude de cas met en œuvre ces portes.
L'infrastructure IA a maintenant besoin d'une couche de vérification (Figure 16). L'industrie a construit la couche de calcul et la couche de modèles, et construit maintenant la couche d'orchestration. Après vient la vérification, la machinerie qui rend le comportement d'un système IA vérifiable plutôt que crédible. La justification de la confiance IA devrait devenir vérifiable par machine plutôt que basée sur la réputation ; la confiance elle-même reste humaine, et ce qui peut être vérifié par machine est son fondement. Si c'est correct, la couche suivante indispensable de l'infrastructure IA sera construite non autour de l'intelligence mais autour de la vérifiabilité.
Figure 16. L'échelle d'infrastructure
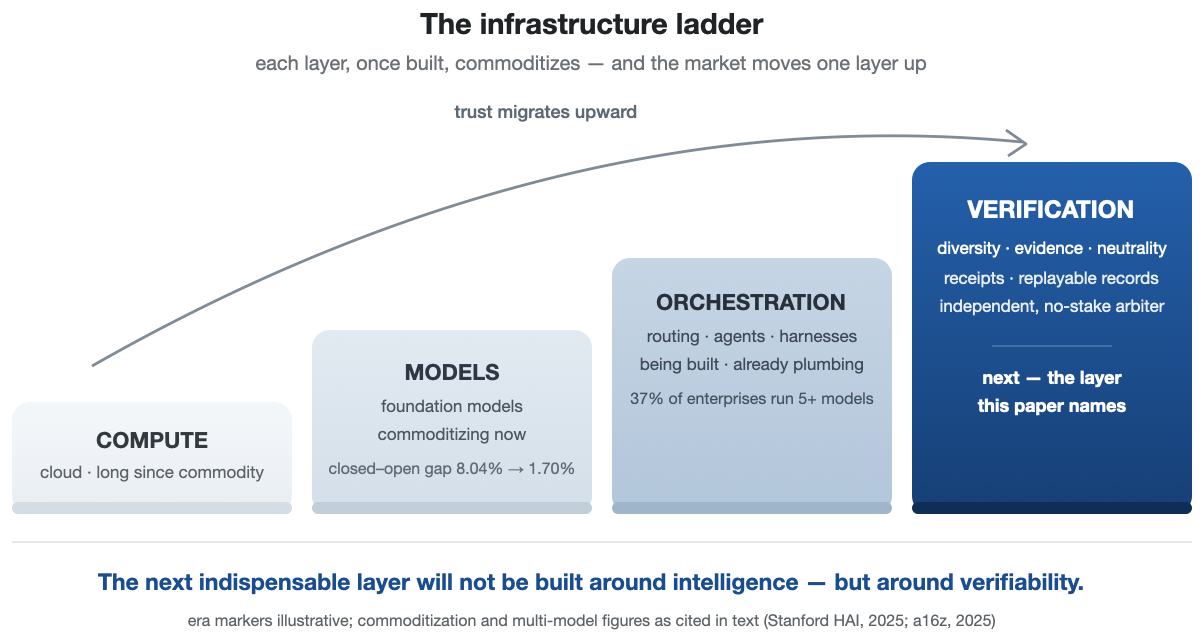
Calcul, puis modèles, puis orchestration, et vérification comme couche indispensable suivante.
Note de l'auteur et divulgation
Le déploiement décrit à la Section 4 est une implémentation de référence construite et exploitée par l'auteur ; les méthodes qu'il incarne sont ouvertes, et l'auteur est un demandeur nommé sur des demandes de brevet en attente, pas des brevets accordés, couvrant les systèmes d'orchestration IA et de validation multi-modèles du type que cet article examine. Il sert ici comme instrument de recherche de l'étude, et l'auteur a un intérêt de développeur dans l'architecture qu'il incarne ; la Section 4 devrait être lue comme une preuve d'existence et un témoignage de conception, pas comme une évaluation indépendante. Tous les modèles de cette étude ont été accédés par les APIs commerciales standard des fournisseurs selon les conditions ordinaires. Aucun financement externe n'a soutenu ce travail.
Outils et vérification. Les assistants IA ont été utilisés comme instruments sous la direction de l'auteur ; les idées, la recherche et les conclusions sont celles de l'auteur. Les affirmations factuelles critiques ont été vérifiées par rapport aux sources primaires si disponibles et sont attribuées dans le texte avec leur statut probant (les rapports de presse comme rapports, les allégations comme allégations, les prépublications comme prépublications), et un journal de vérification des affirmations daté est maintenu avec les matériaux de travail du manuscrit. L'exactitude de l'expérience n'est jamais jugée par aucun modèle de panel (la notation est une correspondance de chaîne objective ou un notation locale de poids ouvert), les chiffres de discrimination et calibrage par fournisseur sont imprimés dans le texte principal (Tableaux 7 et 7a), et chaque nombre rapporté est recalculable à partir du package de réplication déterministe (accessible publiquement à https://osf.io/jtvu9/).
Disponibilité des données et du code
Chaque nombre rapporté dans les expériences de mécanisme (Section 3) est recalculable à partir d'un package de réplication déterministe — les réponses brutes du modèle des deux vagues (y compris la collection de seize modèles de 24 000 réponses et les registres notés de la vague phare), les collecteurs de collection, le notation déterministe, les scripts d'analyse et les CSV dérivés (y compris les courbes de couverture des risques et la frontière coût-précision de 26 points, chaque point étant marqué sur la base du prix facturé par rapport au prix catalogue) — accessible publiquement à https://osf.io/jtvu9/, un composant public du projet source de la pré-inscription (dossier `replication-package-v2` ; l'archive du programme d'auto-étalonnage de la Section 3 est déposée à côté). Le sous-échantillon SimpleQA gelé (fixé par seed et hachage SHA-256) est déjà accessible au public à la pré-inscription OSF de l'étude de mécanisme (https://osf.io/4y9dv, enregistré le 23 juillet 2026). La pré-inscription de l'expérience du consommateur est enregistrée sur OSF sous embargo (gelée avant la collection de données principale ; enregistrement https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f). Le bassin de participants est fermé ; l'instrument d'enquête, les stimulus de vignette et bloc de jugement, les dossiers de frappe de reçu de la Section 6 et les données d'expérience du consommateur avec le code d'analyse gelé seront libérés dans le même composant OSF à la publication.
Références
Les entrées marquées arXiv sont des prépublications ; les annonces de l'industrie et les articles de presse de 2026 sont des rapports contemporains plutôt que de la littérature établie et sont cités comme tels.
a16z — Andreessen Horowitz (2025). How 100 enterprise CIOs are building and buying gen AI in 2025. a16z.com/ai-enterprise-2025.
Accenture (2026). Talk to my AI agent: The new rules of brand value. Survey of 25,590 consumers in 16 countries, January 2026.
ACI Worldwide (2026). Consumer attitudes to AI-driven shopping and payments. YouGov survey of 2,080 UK adults, fielded 19–22 June 2026. Press release.
Ahmad Husairi, M., & Rossi, P. (2024). Delegation of purchasing tasks to AI: The role of perceived choice and decision autonomy. Decision Support Systems, 179, 114166. DOI 10.1016/j.dss.2023.114166.
AIUC (2025). AIUC-1: The agent standard. Artificial Intelligence Underwriting Company.
Alavi, S., & Nozari, S. (2026). When agents shop for you: Role coherence in AI-mediated markets. arXiv:2604.26220.
Allouah, A., Besbes, O., Figueroa, J. D., Kanoria, Y., & Kumar, A. (2026). What is your AI agent buying? Evaluation, biases, model dependence, and emerging implications of agentic e-commerce. Proceedings of the ACM Web Conference 2026, 8697–8700. https://doi.org/10.1145/3774904.3792943
American Express (2026). American Express débute les expériences de commerce agentif (ACE) et annonce une protection de première industrie pour les achats d'agents enregistrés. Communiqué de presse, 14 avril 2026.
Anderson, L. (2006). Analytic autoethnography. Journal of Contemporary Ethnography, 35(4), 373–395.
André, Q., Carmon, Z., Wertenbroch, K., Crum, A., Frank, D., Goldstein, W., Huber, J., van Boven, L., Weber, B., & Yang, H. (2018). Choix du consommateur et autonomie à l'ère de l'intelligence artificielle et du mégadonnées. Customer Needs and Solutions, 5(1–2), 28–37.
Appenzeller, G. (2024). Bienvenue à l'inflation des LLM : le coût de l'inférence des LLM diminue rapidement. Andreessen Horowitz, novembre 2024.
Aubakirova, M., Atallah, A., Clark, C., Summerville, J., & Midha, A. (2026). État de l'IA : une étude empirique de 100 billions de jetons avec OpenRouter. arXiv:2601.10088 (rapport publié décembre 2025).
Bain & Company (2025). Projection du marché du commerce agentif : 300–500 milliards de dollars du commerce électronique américain d'ici 2030. Décembre 2025.
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775–779.
Balaskas, S. (2026). De la recommandation à la délégation : examen systématique cartographiant l'IA agentive dans le commerce électronique et ses effets sur les consommateurs. Information, 17(3), 222.
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. S. (2021). L'ensemble dépasse-t-il ses parties ? L'effet des explications d'IA sur la performance des équipes complémentaires. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, 1–16.
Basu, A. (2026). Reçus d'outils, non preuves de connaissance zéro : détection pratique des hallucinations pour les agents IA. arXiv:2603.10060.
Board of Governors of the Federal Reserve System & OCC (2011). Supervisory guidance on model risk management (SR Letter 11-7 / OCC 2011-12).
Buçinca, Z., Malaya, L. B., & Gajos, K. Z. (2021). Faire confiance ou réfléchir : les fonctions de forçage cognitif peuvent réduire la surconfiance envers l'IA dans la prise de décision assistée par IA. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), 1–21.
Burton, J. W., Stein, M.-K., & Jensen, T. B. (2020). Examen systématique de l'aversion aux algorithmes dans la prise de décision augmentée. Journal of Behavioral Decision Making, 33(2), 220–239.
California State Legislature (2025). Assembly Bill 316 (artificial intelligence: defenses), Stats. 2025, ch. 672 (adding Cal. Civ. Code § 1714.46), effective 1 January 2026.
Carlson, S. C. (2026). Migration de la confiance à l'ère numérique : régimes informationnels et transformation des relations acheteur-vendeur. Atlantic Marketing Journal, 15(1), Article 6.
Castelo, N., Bos, M. W., & Lehmann, D. R. (2019). Aversion aux algorithmes dépendante de la tâche. Journal of Marketing Research, 56(5), 809–825.
Cetinkaya, N. E., & Krämer, N. (2024). Compréhension par rapport à la confiance : une analyse conjointe. Document de travail, OSF Project mw4dq.
Chandra, K., Kleiman-Weiner, M., Ragan-Kelley, J., & Tenenbaum, J. B. (2026). Les chatbots courtisans causent une spirale délirante, même chez les bayésiens idéaux. arXiv:2602.19141.
Chen, C., Sun, Y., Liao, M., & Sundar, S. S. (2026). Lorsque l'IA n'est pas d'accord : l'effet d'une deuxième opinion sur la confiance des patients dans les médecins. International Journal of Human-Computer Studies, 213, 103824.
Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026). L'IA courtisane diminue les intentions prosociales et favorise la dépendance. Science, 391(6792), eaec8352. DOI: 10.1126/science.aec8352.
Choi, H. K., Zhu, X., & Li, S. (2026). Lorsque l'identité fausse le débat : anonymisation pour un raisonnement multi-agents avec biais réduits. Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 14284–14311. https://doi.org/10.18653/v1/2026.acl-long.650
Choi, M., Kim, K., Chae, S., & Baek, S. (2025). Une étude empirique de la conformité collective dans les systèmes multi-agents. Findings of the Association for Computational Linguistics: ACL 2025, 5123–5139. https://doi.org/10.18653/v1/2025.findings-acl.265
Clark, J., & Hadfield, G. K. (2020). Marchés réglementaires pour la sécurité de l'IA. arXiv:2001.00078.
CNBC (2026, 24 mars). OpenAI révise l'expérience d'achat dans ChatGPT après avoir eu du mal avec l'offre de paiement instantané (rapport du compte de mars 2026 de The Information sur l'abandon du paiement natif).
Daly, C. (2025). Klarna ralentit les réductions d'emplois pilotées par l'IA avec un appel aux vraies personnes. Bloomberg News, 8 mai 2025.
de Bellis, E., & Johar, G. V. (2020). Systèmes d'achat autonomes : identifier et surmonter les obstacles à l'adoption par les consommateurs. Journal of Retailing, 96(1), 74–87.
Detjen, H. H. J., Densky, L., von Kalckreuth, N., & Kopka, M. (2025). À qui faire confiance pour un deuxième avis ? Comparaison des conseils collectifs d'une IA médicale et de médecins dans les décisions de biopsie après dépistage par mammographie. CHI 2025.
de Visser, E. J., Pak, R., & Shaw, T. H. (2018). De l'« automation » à l'« autonomie » : l'importance de la réparation de la confiance dans l'interaction humain-machine. Ergonomics, 61(10), 1409–1427.
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Aversion aux algorithmes : les gens évitent à tort les algorithmes après les avoir vus faire une erreur. Journal of Experimental Psychology: General, 144(1), 114–126.
DigiCert (2026). Architecture de confiance pour l'IA. Annonce de produit, avril 2026.
Ding, K. (2026). Lorsque les LLM sont d'accord, ont-ils raison ? Audit de l'auto-cohérence et de l'accord entre modèles en tant que signaux de confiance. arXiv:2607.08065.
Dranove, D., & Jin, G. Z. (2010). Divulgation de qualité et certification : théorie et pratique. Journal of Economic Literature, 48(4), 935–963.
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024). Améliorer la factualité et le raisonnement dans les modèles de langage par débat multi-agents. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 11733–11763.
Endsley, M. R., & Kiris, E. O. (1995). Le problème de performance hors de la boucle et le niveau de contrôle dans l'automation. Human Factors, 37(2), 381–394.
Errico, H. (2026). Gestion du temps d'exécution des actions autonomes (AARM) : spécification d'un système pour sécuriser les actions pilotées par l'IA au moment de l'exécution. arXiv:2602.09433.
Commission européenne (2026). Lignes directrices sur la mise en œuvre des obligations de transparence pour certains systèmes d'IA en vertu de l'article 50 de la loi sur l'IA. Adoptées le 20 juillet 2026.
Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017), 625–630.
Featherman, M. S., & Pavlou, P. A. (2003). Prédire l'adoption des services en ligne : une perspective basée sur les facettes du risque perçu. International Journal of Human-Computer Studies, 59(4), 451–474.
Frank, D.-A., Folwarczny, M., & Otterbring, T. (2026). L'acceptation par les consommateurs des assistants IA hautement autonomes est motivée par les avantages perçus dans les environnements d'achat en ligne caractérisés par la rareté. Psychology & Marketing, 43(3), 538–555. https://doi.org/10.1002/mar.70074
Gartner (2025). Gartner prédit que plus de 40 % des projets d'IA agent seront annulés d'ici la fin de 2027. Communiqué de presse, 25 juin 2025.
Gartner (2026). Enquête consommateurs sur l'IA générative dans l'achat (communiqué de presse de mai 2026).
Gefen, D., Karahanna, E., & Straub, D. W. (2003). Trust and TAM in online shopping: An integrated model. MIS Quarterly, 27(1), 51–90.
Geifman, Y., & El-Yaniv, R. (2017). Selective classification for deep neural networks. Advances in Neural Information Processing Systems 30 (NeurIPS 2017), 4878–4887 (arXiv:1705.08500).
Gillespie, N., Lockey, S., Ward, T., Macdade, A., & Hassed, G. (2025). Confiance, attitudes et utilisation de l'intelligence artificielle : Une étude mondiale 2025. The University of Melbourne and KPMG. https://doi.org/10.26188/28822919
Glikson, E., & Woolley, A. W. (2020). La confiance humaine envers l'intelligence artificielle : Examen de la recherche empirique. Academy of Management Annals, 14(2), 627–660.
Google (2026). Universal Commerce Protocol. Annonce à la NRF, 11 janvier 2026 ; extension de panier, catalogue et liaison d'identité, mars 2026.
Google Cloud (2025). Agent Payments Protocol (AP2). Annonce, 16 septembre 2025.
Google DeepMind (2025). SimpleQA Verified. arXiv:2509.07968.
Gorbett, M., & Jana, S. (2026). Le désaccord entre modèles comme signal de exactitude sans étiquette. arXiv:2603.25450.
Gottweis, J., Weng, W.-H., Daryin, A., Tu, T., Sirkovic, P., Myaskovsky, A., Glowaty, G., Weissenberger, F., Orlandi, A., Popovici, D., Palepu, A., Rong, K., Tanno, R., Saab, K., Zhang, F., Blum, J., Carroll, A., Kulkarni, K., Tomašev, N., Zverinski, D., Rendulic, I., Vedadi, E., Hasler, F., Rimanic, L., Boia, M., Budiselic, I., Feinstein, B., Bellaiche, M., Sheffer, T., Freyberg, J., Ratcliff, J., Bertolli, O., Chou, K., Hassidim, A., Gokturk, B., Vahdat, A., Guan, Y., Dhillon, V., Vaishnav, E. D., Lee, B., Costa, T. R. D., Penadés, J. R., Peltz, G., Matias, Y., Manyika, J., Hassabis, D., Xu, Y., Kohli, P., Pawlosky, A., Karthikesalingam, A., & Natarajan, V. (2026). Accélération de la découverte scientifique avec Co-Scientist. Nature, 655(8122), 487–496. https://doi.org/10.1038/s41586-026-10644-y
Gould, S. J. (1991). L'auto-manipulation de mon énergie vitale perçue omniprésente par l'utilisation de produits : Une perspective introspective-praxis. Journal of Consumer Research, 18(2), 194–207.
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). Sur l'étalonnage des réseaux de neurones modernes. ICML 2017, PMLR 70, 1321–1330.
Gvirtz, A., & Sabherwal, A. (2024). Les limites de la recherche en sciences comportementales mondiale et transculturelle. Proceedings of the National Academy of Sciences, 121(36), e2316690121.
Hadfield, G. K. (2017). Rules for a flat world: Pourquoi les humains ont inventé le droit et comment le réinventer pour une économie mondiale complexe. Oxford University Press.
Hadfield, G. K., & Clark, J. (2026). Marchés réglementaires : l'avenir de la gouvernance de l'IA. Jurimetrics, 65, 195–240 (arXiv:2304.04914).
Hansen, L. K., & Salamon, P. (1990). Ensembles de réseaux de neurones. IEEE Transactions on Pattern Analysis and Machine Intelligence, 12(10), 993–1001.
Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026). Tous les changements ne sont pas de la conformité : décomposer la convergence positionnelle dans le débat multi-agents par grands modèles de langage. arXiv:2606.00820.
Hoff, K. A., & Bashir, M. (2015). La confiance dans l'automatisation : intégrer les données empiriques sur les facteurs qui influencent la confiance. Human Factors, 57(3), 407–434.
Hong, L., & Page, S. E. (2004). Les groupes de résolveurs de problèmes diversifiés peuvent surpasser les groupes de résolveurs de problèmes hautement compétents. Proceedings of the National Academy of Sciences, 101(46), 16385–16389.
Huang, M.-H., & Rust, R. T. (2021). Un cadre stratégique pour l'IA en marketing. Journal of the Academy of Marketing Science, 49(1), 30–50.
Insurance Services Office (2026). Formulaires d'avenant CG 40 47 et CG 40 48 : exclusions relatives à l'IA générative. En vigueur à compter du 1er janvier 2026.
Internet Engineering Task Force (2026). Une architecture pour des chaînes d'approvisionnement numériques dignes de confiance et transparentes (RFC 9943 ; groupe de travail SCITT). IETF. https://datatracker.ietf.org/doc/rfc9943/
Ioku, T., Song, J., & Watamura, E. (2024). Les compromis dans le choix d'assistant IA : les consommateurs privilégient-ils la transparence et la durabilité par rapport aux performances de l'assistant IA ? Big Data & Society, 11(4).
Ipsos (2025). Le Moniteur Ipsos de l'IA 2025. Ipsos Global Advisor, enquête de 30 pays, juin 2025.
Jacovi, A., Marasović, A., Miller, T., & Goldberg, Y. (2021). Formaliser la confiance dans l'IA : conditions préalables, causes et objectifs de la confiance humaine dans l'IA. FAccT 2021, 624–635.
Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., Schiefer, N., Hatfield-Dodds, Z., DasSarma, N., Tran-Johnson, E., Johnston, S., El-Showk, S., Jones, A., Elhage, N., Hume, T., Chen, A., Bai, Y., Bowman, S., Fort, S., ... Kaplan, J. (2022). Les grands modèles de langage savent (généralement) ce qu'ils savent. arXiv:2207.05221.
Kalai, A. T., Nachum, O., Vempala, S., & Zhang, E. (2025). Pourquoi les grands modèles de langage hallucinent. arXiv:2509.04664.
Kharazian, A. (2026). Anthropic dépasse OpenAI en adoption commerciale. Ramp Economics Lab / Ramp AI Index, 13 mai 2026 (données de paiement d'entreprise pour plus de 50 000 entreprises américaines).
Kim, D., & Benbasat, I. (2010). Les conceptions pour une mise en œuvre efficace des garanties de confiance dans les magasins en ligne. Communications of the ACM, 53(2), 121–126.
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Erreurs corrélées dans les grands modèles de langage. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038–30066.
Kim, P. H., Ferrin, D. L., Cooper, C. D., & Dirks, K. T. (2004). Removing the shadow of suspicion: The effects of apology versus denial for repairing competence- versus integrity-based trust violations. Journal of Applied Psychology, 89(1), 104–118.
Kizilcec, R. F. (2016). How much information? Effects of transparency on trust in an algorithmic interface. CHI 2016, 2390–2395.
Klarna (2024). L'assistant IA de Klarna traite deux tiers des discussions de service client au cours de son premier mois. Communiqué de presse, 27 février 2024.
Köbis, N., Rahwan, Z., Rilla, R., Supriyatno, B. I., Bersch, C., Ajaj, T., Bonnefon, J.-F., & Rahwan, I. (2025). Delegation to artificial intelligence can increase dishonest behaviour. Nature, 646(8083), 126–134. DOI: 10.1038/s41586-025-09505-x.
Kolt, N. (2025). Governing AI agents. Notre Dame Law Review, 101 (SSRN working paper 4772956; arXiv:2501.07913).
Komiak, S. Y. X., & Benbasat, I. (2006). The effects of personalization and familiarity on trust and adoption of recommendation agents. MIS Quarterly, 30(4), 941–960.
König, P. D., Wurster, S., & Siewert, M. B. (2022). Les consommateurs sont disposés à payer un prix pour une IA explicable, mais pas pour une IA verte : Résultats d'une analyse conjointe basée sur les choix. Big Data & Society, 9(1).
Krogh, A., & Vedelsby, J. (1995). Ensembles de réseaux de neurones, validation croisée et apprentissage actif. Advances in Neural Information Processing Systems, 7, 231–238.
Kroll, J. A., Huey, J., Barocas, S., Felten, E. W., Reidenberg, J. R., Robinson, D. G., & Yu, H. (2017). Algorithmes responsables. University of Pennsylvania Law Review, 165(3), 633–705.
Kuncheva, L. I., & Whitaker, C. J. (2003). Measures of diversity in classifier ensembles and their relationship with the ensemble accuracy. Machine Learning, 51(2), 181–207.
Lee, J. D., & See, K. A. (2004). Trust in automation: Designing for appropriate reliance. Human Factors, 46(1), 50–80.
Lessig, L. (2006). Code: Version 2.0. Basic Books.
Li, M. (2025). From cloud-native to trust-native: A protocol for verifiable multi-agent systems. arXiv:2507.22077.
Liang, P., Bommasani, R., Lee, T., Tsipras, D., Soylu, D., Yasunaga, M., Zhang, Y., Narayanan, D., Wu, Y., Kumar, A., Newman, B., Yuan, B., Yan, B., Zhang, C., Cosgrove, C., Manning, C. D., Ré, C., Acosta-Navas, D., Hudson, D. A., ... Koreeda, Y. (2023). Évaluation holistique des modèles de langage. Transactions on Machine Learning Research.
Liao, Q. V., & Sundar, S. S. (2022). Designing for responsible trust in AI systems: A communication perspective. FAccT 2022, 1257–1268.
Lin, S., Hilton, J., & Evans, O. (2022). Teaching models to express their uncertainty in words. arXiv:2205.14334.
Lindsey, J. (2025). Emergent introspective awareness in large language models. Anthropic / Transformer Circuits.
Liu, J., Bursztyn, V. S., Ai, L., Wang, H., Choudhary, S., Mitra, S., & Wu, Q. (2026). TeamFusion: Supporting open-ended teamwork with multi-agent systems. arXiv:2604.19589 (ACL 2026; Adobe Research).
Lizzeri, A. (1999). Information revelation and certification intermediaries. RAND Journal of Economics, 30(2), 214–231.
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Algorithm appreciation: People prefer algorithmic to human judgment. Organizational Behavior and Human Decision Processes, 151, 90–103.
Longoni, C., Bonezzi, A., & Morewedge, C. K. (2019). Résistance à l'IA médicale. Journal of Consumer Research, 46(4), 629–650.
Longoni, C., Cian, L., & Kyung, E. J. (2023). Algorithmic transference: People overgeneralize failures of AI in the government. Journal of Marketing Research, 60(1), 170–188.
Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). Comment l'influence sociale peut-elle saper l'effet de la sagesse des foules. Proceedings of the National Academy of Sciences, 108(22), 9020–9025. DOI: 10.1073/pnas.1008636108.
Lu, Z., Wang, D., & Yin, M. (2024). Des avis supplémentaires aident-ils ? Les effets des deuxièmes avis dans la prise de décision assistée par l'IA. Proceedings of the ACM on Human-Computer Interaction, 8(CSCW1), 1–31.
Marchal, N., Chan, S., Franklin, M., Revel, M., Keeling, G., Fischli, R., Chandra, B., & Gabriel, I. (2026). Architecting trust in artificial epistemic agents. arXiv:2603.02960.
Mastercard (2026). Verifiable Intent (co-développé avec Google). Annonce de salle de presse, 5 mars 2026 ; premiers pilotes signalés sur les marchés asiatiques et latino-américains, 2026.
Mayer, R. C., Davis, J. H., & Schoorman, F. D. (1995). An integrative model of organizational trust. Academy of Management Review, 20(3), 709–734.
McKinsey & Company (2025). The agentic commerce opportunity (Schumacher, Roberts, & Giebel). 17 octobre 2025.
McKnight, D. H., Choudhury, V., & Kacmar, C. (2002). Developing and validating trust measures for e-commerce. Information Systems Research, 13(3), 334–359.
Menlo Ventures (2025a). Mise à jour du marché des LLM à mi-année 2025. 31 juillet 2025 (enquête auprès de 150 décideurs techniques).
Menlo Ventures (2025b). 2025 : L'état de l'IA générative en entreprise. 9 décembre 2025 (enquête auprès de 495 décideurs en matière d'IA dans les entreprises américaines ; Menlo Ventures est un investisseur d'Anthropic).
Menlo Ventures (2025c). 2025 : L'état de l'IA grand public. 26 juin 2025 (enquête auprès de 5 031 adultes américains, avec Morning Consult ; le chiffre d'environ 3 % d'utilisateurs payants est une estimation basée sur les revenus).
Möhlmann, M., & Zalmanson, L. (2017). Hands on the wheel: Navigating algorithmic management and Uber drivers' autonomy. ICIS 2017.
Montgomery, J. M., Nyhan, B., & Torres, M. (2018). How conditioning on posttreatment variables can ruin your experiment and what to do about it. American Journal of Political Science, 62(3), 760–775.
Morgan Stanley (2025). Prévisions du commerce avec IA : dépenses de 190 à 385 milliards de dollars US en commerce électronique d'ici 2030. Décembre 2025.
Mosier, K. L., & Skitka, L. J. (1996). Décideurs humains et systèmes d'aide à la décision automatisés : faits l'un pour l'autre ? In R. Parasuraman & M. Mouloua (Eds.), Automation and human performance: Theory and applications (pp. 201–220). Lawrence Erlbaum Associates.
Mozannar, H., & Sontag, D. (2020). Estimateurs cohérents pour l'apprentissage du report à un expert. ICML 2020, PMLR 119, 7076–7087.
Muchnik, L., Aral, S., & Taylor, S. J. (2013). Biais d'influence sociale : une expérience aléatoire. Science, 341(6146), 647–651. DOI: 10.1126/science.1240466.
Muir, B. M. (1994). Trust in automation: Part I. Theoretical issues in the study of trust and human intervention in automated systems. Ergonomics, 37(11), 1905–1922.
NIST (2023). Cadre de gestion des risques de l'intelligence artificielle (AI RMF 1.0) (NIST AI 100-1). National Institute of Standards and Technology.
Okamura, K., & Yamada, S. (2020). Adaptive trust calibration for human-AI collaboration. PLOS ONE, 15(2), e0229132.
Papamarkou, T., Alquier, P., Bauer, M., Buntine, W., Davison, A., Dziugaite, G. K., Filippone, M., Foong, A. Y. K., Fortuin, V., Fouskakis, D., Frellsen, J., Hüllermeier, E., Karaletsos, T., Khan, M. E., Kotelevskii, N., Lahlou, S., Li, Y., Liu, F., Lyle, C., Möllenhoff, T., Palla, K., Panov, M., Sale, Y., Schweighofer, K., Shelmanov, A., Swaroop, S., Trapp, M., Waegeman, W., Wilson, A. G., & Zaytsev, A. (2026). Position : L'orchestration des IA agentiques devrait être cohérente bayésienne. arXiv:2605.00742. (Accepté à ICML 2026.)
Parasuraman, R., & Manzey, D. H. (2010). Complaisance et biais dans l'utilisation humaine de l'automation : une intégration attentionnelle. Human Factors, 52(3), 381–410. DOI: 10.1177/0018720810376055.
Parasuraman, R., & Riley, V. (1997). Humains et automation : utilisation, mauvais usage, non-utilisation, abus. Human Factors, 39(2), 230–253.
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). Un modèle pour les types et niveaux d'interaction humaine avec l'automation. IEEE Transactions on Systems, Man, and Cybernetics — Part A: Systems and Humans, 30(3), 286–297.
Pavlou, P. A. (2003). Acceptabilité des consommateurs du commerce électronique : intégration de la confiance et du risque avec le modèle d'acceptation de la technologie. International Journal of Electronic Commerce, 7(3), 101–134.
Pew Research Center (2025). Comment les gens dans le monde voient l'IA. Sondage dans 25 pays, octobre 2025.
Piehlmaier, D. M. (2023). The one-man show: The effect of joint decision-making on investor overconfidence. Journal of Consumer Research, 50(2), 426–446. https://doi.org/10.1093/jcr/ucac054
Puntoni, S., Reczek, R. W., Giesler, M., & Botti, S. (2021). Les consommateurs et l'IA : Une perspective expérientielle. Journal of Marketing, 85(1), 131–151.
Rabanser, S., Kapoor, S., Kirgis, P., Liu, K., Utpala, S., & Narayanan, A. (2026). Vers une science de la fiabilité des agents IA. arXiv:2602.16666 (ICML 2026).
Raji, I. D., Xu, P., Honigsberg, C., & Ho, D. (2022). Surveillance de l'extérieur : Concevoir un écosystème d'audit tiers pour la gouvernance de l'IA. AIES 2022, 557–571.
Règlement (UE) 2016/679 (Règlement général sur la protection des données), Article 22 — prise de décision individuelle automatisée.
Règlement (UE) 2024/1689 (Loi sur l'IA), Article 14 — surveillance humaine des systèmes d'IA à haut risque ; Article 50 — obligations de transparence pour les fournisseurs et les déploieurs de certains systèmes d'IA.
Ríos-García, M., Alampara, N., Gupta, C., Mandal, I., Mannan, S., Aghajani, A. A., Krishnan, N. M. A., & Jablonka, K. M. (2026). Les scientifiques IA produisent des résultats sans raisonner scientifiquement. arXiv:2604.18805.
Saad-Falcon, J., Buchanan, E. K., Chen, M. F., Huang, T.-H., McLaughlin, B., Bhathal, T., Zhu, S., Athiwaratkun, B., Sala, F., Linderman, S., Mirhoseini, A., & Ré, C. (2025). Réduire l'écart génération-vérification avec des vérificateurs faibles. arXiv:2506.18203.
Sabater, J., & Sierra, C. (2005). Review on computational trust and reputation models. Artificial Intelligence Review, 24(1), 33–60.
Schemmer, M., Kühl, N., Benz, C., Bartos, A., & Satzger, G. (2023). Confiance appropriée dans les conseils de l'IA : conceptualisation et effet des explications. IUI '23, 410–422.
Schilke, O., & Reimann, M. (2025). Le dilemme de la transparence : comment la divulgation de l'IA érode la confiance. Organizational Behavior and Human Decision Processes, 188, 104405.
Schmidt, J., & Bijmolt, T. H. A. (2020). Mesurer avec précision la volonté de payer pour les biens de consommation : une méta-analyse du biais hypothétique. Journal of the Academy of Marketing Science, 48, 499–518.
Shapiro, S. P. (1987). The social control of impersonal trust. American Journal of Sociology, 93(3), 623–658.
Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., Cheng, N., Durmus, E., Hatfield-Dodds, Z., Johnston, S. R., Kravec, S., Maxwell, T., McCandlish, S., Ndousse, K., Rausch, O., Schiefer, N., Yan, D., Zhang, M., & Perez, E. (2024). Vers une compréhension de la complaisance dans les modèles de langage. ICLR 2024 (arXiv:2310.13548).
Shehata, D., & Li, M. (2026). The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274.
Sheridan, T. B., & Verplank, W. L. (1978). Contrôle humain et informatique des télé-opérateurs sous-marins (Rapport technique). MIT Man-Machine Systems Laboratory.
Smit, A. P., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). Devrions-nous devenir MAD ? Un examen des stratégies de débat multi-agents pour les LLM. ICML 2024, PMLR 235, 45883–45905 (arXiv:2311.17371).
Söllner, M., Hoffmann, A., & Leimeister, J. M. (2016). Pourquoi différentes relations de confiance importent pour les utilisateurs des systèmes d'information. European Journal of Information Systems, 25(3), 274–287.
Spiro, T. (2026). L'empreinte de l'Oracle : erreurs corrélées de prévision en IA et les limites de la transmission de biais. arXiv:2605.00844.
Stanford HAI (2025). Artificial Intelligence Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence (chapitre Performance technique).
Stanford HAI (2026). Artificial Intelligence Index Report 2026. Stanford Institute for Human-Centered Artificial Intelligence (chapitre Opinion publique, rapportant les données de l'enquête Pew 25 pays).
Tax, S. S., Brown, S. W., & Chandrashekaran, M. (1998). Évaluations client des expériences de réclamation de service : implications pour le marketing relationnel. Journal of Marketing, 62(2), 60–76.
Vaccaro, M., Almaatouq, A., & Malone, T. (2024). Quand les combinaisons d'humains et d'IA sont utiles : une revue systématique et une méta-analyse. Nature Human Behaviour, 8(12), 2293–2303. DOI: 10.1038/s41562-024-02024-1.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). Remplacer les juges par des jurés : évaluation des générations LLM avec un panel de modèles divers. arXiv:2404.18796.
Visa (2025). Visa introduces Trusted Agent Protocol: An ecosystem-led framework for AI commerce. Communiqué de presse (avec Cloudflare), 14 octobre 2025.
Visa (2026). Visa s'associe à OpenAI pour propulser la prochaine génération du commerce IA. Communiqué de presse, Visa Payments Forum, 10 juin 2026.
W3C (2025). Verifiable Credentials Data Model v2.0. W3C Recommendation.
Wallendorf, M., & Brucks, M. (1993). L'introspection dans la recherche en consommation : mise en œuvre et implications. Journal of Consumer Research, 20(3), 339–359.
Walsham, G. (1995). Les études de cas interprétatives en recherche en SI : nature et méthode. European Journal of Information Systems, 4(2), 74–81.
Wang, W., & Benbasat, I. (2005). La confiance envers les agents de recommandation en ligne et leur adoption. Journal of the Association for Information Systems, 6(3), 72–101.
Wang, Y., Zhang, J., Cai, T., Liu, Z., Sun, Q., Sun, Z., Wu, Z., Dong, M., Zheng, M., Yin, X., & Zhu, Y. (2026). Des traces d'agents à la confiance : un examen des traçabilité des preuves et de la provenance d'exécution dans les agents LLM. arXiv:2606.04990.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., & Fedus, W. (2024). Mesurer la facticité à court terme dans les grands modèles de langage. arXiv:2411.04368.
Werbach, K. (2018). La chaîne de blocs et la nouvelle architecture de la confiance. MIT Press.
Wertenbroch, K. (1998). L'autocontrôle de la consommation par le rationnement des quantités d'achat de biens vertueux et vicieux. Marketing Science, 17(4), 317–337.
Xiao, B., & Benbasat, I. (2007). Les agents de recommandation de produits pour le commerce électronique : utilisation, caractéristiques et impact. MIS Quarterly, 31(1), 137–209.
Yalcin, G., Lim, S., Puntoni, S., & van Osselaer, S. M. J. (2022). Pouces vers le haut ou vers le bas : réactions des consommateurs aux décisions des algorithmes par rapport aux humains. Journal of Marketing Research, 59(4), 696–717.
Yin, R. K. (2018). L'étude de cas : recherche et applications : conception et méthodes (6e éd.). Sage.
Zhang, Y., Liao, Q. V., & Bellamy, R. K. E. (2020). Effet de la confiance et de l'explication sur la précision et l'étalonnage de la confiance dans la prise de décision assistée par l'IA. Proceedings of the 2020 ACM Conference on Fairness, Accountability, and Transparency, 295–305.
Zheng, J., & Zhang, J. (2026). Estimation de la confiance tenant compte de l'incertitude pour les systèmes multi-LLM via le jugement d'experts structuré. arXiv:2607.20529.
Zuboff, S. (2019). L'âge du capitalisme de surveillance. PublicAffairs.
Zucker, L. G. (1986). La production de la confiance : sources institutionnelles de la structure économique, 1840–1920. Research in Organizational Behavior, 8, 53–111.
* Architecte de systèmes d'IA. Conflits d'intérêts : l'auteur développe des méthodes d'orchestration multi-modèles, exploite une implémentation de référence de l'architecture décrite ici, est demandeur désigné sur des demandes de brevets en attente, non accordés, couvrant l'orchestration de l'IA et les systèmes de validation multi-modèles du type que cet article examine, et a un intérêt de développeur dans l'architecture que cet article défend ; les affirmations normatives concernant sa nécessité doivent être lues en tenant compte de cet intérêt. Le rôle de l'auteur dans le déploiement de la Section 4 est énoncé dans la Note de l'auteur et la Divulgation à la fin de cet article. Les commentaires sont les bienvenus : [email protected].↩︎
Comment citer cet article
Chernets, V. (2026). Architectural Trust: Pourquoi la confiance des consommateurs dans le commerce agentique migre des modèles IA vers l'architecture vérifiable [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7191261
@misc{chernets2026architecturaltrust,
  author       = {Chernets, Vadym},
  title        = {{Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7191261},
  url          = {https://doi.org/10.2139/ssrn.7191261}
}