Confianza Arquitectónica: Por Qué la Confianza del Consumidor en el Comercio Agentico Migra de Modelos de IA a Arquitectura Verificable
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
Vadym Chernets, Doctorado, arquitecto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7191261 · DOI 10.2139/ssrn.7191261 · Zenodo 10.5281/zenodo.22166995 · GitHub
- Versión de registro: SSRN 7191261 · DOI 10.2139/ssrn.7191261
- Copia archivada, citable y descargable: 10.5281/zenodo.22166995 — DOI de concepto, siempre se resuelve a la última versión
- Texto completo como Markdown y PDF: GitHub
- HTML legible: https://polyhelper.ai/research/architectural-trust/
El mismo texto está en cuatro superficies para que se pueda acceder a él cuando una de ellas no pueda servirlo. SSRN mantiene la versión de registro; cite esa.
Confianza del Consumidor en el Comercio Agentico
Publicado en SSRN e indexado bajo el título "Confianza Arquitectónica: Por Qué la Confianza del Consumidor en el Comercio Agentico Migra de Modelos de IA a Arquitectura Verificable". Cite esa forma.
De las Propiedades del Modelo a la Arquitectura Verificable
Vadym Chernets, Doctorado1
Publicado por primera vez el 6 de agosto de 2026; versión de septiembre de 2026
Reporta el marco conceptual completo, el estudio del mecanismo de dieciséis modelos y su replicación de nivel insignia de agosto de 2026 en once laboratorios de vanguardia, una comparación pareada de presupuesto de razonamiento, una replicación de sustrato comercial, y un experimento de consumidor pre-registrado completo.
RESUMEN
El comercio agentico transforma la IA de un asesor en un participante de transacciones, fusionando búsqueda, comparación, carrito y pago en un único acto delegado y eliminando los puntos de revisión donde los humanos alguna vez detectaban errores. Llega en un momento incómodo: el sesenta por ciento de los consumidores del Reino Unido encuestados dicen que abandonarían un agente de compras con IA después de un solo error, y la mayoría no confiarían en ninguna organización en absoluto para ejecutar uno en su nombre. Este artículo introduce confianza arquitectónica. Conforme los consumidores delegan decisiones consecuentes a agentes de IA, la confianza justificada migra de las propiedades del modelo de IA a la arquitectura verificable del servicio por encima. Los constructos ya disponibles vinculan confianza a organizaciones, a un solo sistema automatizado, o a asesoramiento algorítmico, y ninguno de ellos hace que el proceso de toma de decisiones sea verificable por quien confía bajo delegación autónoma. La confianza arquitectónica cierra esa brecha con tres propiedades verificables: diversidad (modelos independientes cuyo acuerdo calibra confianza y cuya divergencia se expone), evidencia (registros de decisión resistentes a la manipulación y reproducibles), y neutralidad (independencia auditable de cualquier proveedor, comerciante o resultado).
El mecanismo se midió primero en el lado de la máquina. En un banco de pruebas de dieciséis modelos pre-registrado y una onda de nivel insignia de agosto de 2026 que abarca once laboratorios de vanguardia, el acuerdo entre modelos evaluó la corrección donde la confianza del modelo en sí mismo no pudo. Las respuestas reproducidas independientemente por otro modelo fueron 1,9–3,2 veces más propensas a ser correctas. En una submuestra congelada SimpleQA (Wei et al., 2024), el 46,6% de las respuestas ofrecidas con confianza declarada ≥ 80 eran incorrectas (una tasa específica para este conjunto, no una constante universal), mientras que una compuerta fija de desacuerdo de tres modelos eliminó el 82,1% de esos fallos confiados (IC 95% 79,9–84,1) con una cobertura del 30,5%. La señal se reproduce en 267 productos comerciales verificados por Wikidata. Un presupuesto de razonamiento más grande compró 3,1 puntos de confianza declarada y ninguna precisión medible: más cómputo compra confianza, no corrección. Un panel unánimemente confiado aún puede estar equivocado, y allí el acuerdo certifica el error compartido.
Luego llevo el mecanismo al comportamiento en un experimento de consumidor pre-registrado, compatible con incentivos (119 de 200 participantes planeados; EE.UU. y Reino Unido). Cuando un consumidor de otro modo aceptaría una recomendación errónea confiada, la visualización del desacuerdo redujo drásticamente la aceptación, del 74% al 24% en el elemento calificador. La estimación de solidez agrupada (Δ = 0,24 → 0,45; d = 0,68; la cohorte principal de onda primaria da d = 0,67) descansa en ese elemento único y, en una división de país exploratoria, en la muestra del Reino Unido, y cae a d = 0,09 una vez que el elemento se elimina. Se planea una replicación con poder estadístico y muestreo de estímulos. En el único elemento de consenso confiado unánime, la visualización aumentó la aceptación del error compartido, lo que reproduce el límite del mecanismo en el comportamiento humano. El componente de orquestación-recepción devolvió un resultado nulo registrado e inconcluso.
Los tres componentes no tienen la misma evidencia detrás de ellos. La diversidad se establece en el lado de la máquina y se muestra con consumidores solo para el contraste de calibración (la mediación registrada fue nula). La prueba de primera exposición del componente de registro fue inconclusa, y tanto este como la neutralidad se especifican para prueba. La unidad de análisis de la confianza en la IA tiene que moverse del modelo a la arquitectura por encima de él, la parte que se puede verificar.
Palabras clave: comercio agentivo; confianza del consumidor; agentes de IA; confianza en la IA; confianza apropiada; confianza excesiva; modelos de lenguaje grande; acuerdo entre modelos; predicción selectiva; exceso de confianza; delegación; confianza arquitectónica. Clasificación JEL: M31 (Marketing); D83 (Search, Learning, Information); L86 (Information and Internet Services); K24 (Cyber Law) Cómo leer este documento. Esta versión completa informa toda la cadena de evidencia: la construcción y la Hipótesis de Migración de Confianza; un estudio de mecanismo de dieciséis modelos (con una replicación de onda insignia de agosto de 2026 y un brazo de sustrato de comercio en hechos de productos) que establece la diversidad entre modelos como una señal de corrección; un experimento de consumidor pre-registrado que lleva ese mecanismo al comportamiento; y una discusión de neutralidad, economía de mercado y política. Los resultados confirmatorios pre-registrados y el estado evidencial de cada componente de construcción (diversidad, evidencia, neutralidad) se resumen en "Estado evidencial de las afirmaciones" en la Sección 5. Los análisis exploratorios y de solidez se etiquetan como tales a lo largo del documento y pueden omitirse en una primera lectura.
1. Introducción: crecimiento en medio de la desconfianza
El 10 de junio de 2026, Visa anunció que estaba integrando su red de pagos directamente en ChatGPT (Visa, 2026). Un consumidor vincula una tarjeta, establece límites de gasto y categorías de comerciantes aprobados, y la integración anunciada, con casos de uso que se despliegan en etapas, tiene como objetivo que agentes de IA completen compras reales en toda la base de comerciantes de la red (175 millones o más de ubicaciones, según la cobertura comercial del anuncio). Visa no estaba sola en esto. OpenAI había lanzado un proceso de compra en el chat en septiembre de 2025; Google introdujo un Protocolo de Comercio Universal en NRF en enero de 2026 con Shopify, Etsy, Wayfair, Target y Walmart, extendiéndolo en mayo a un Carrito Universal entre minoristas (Google, 2026); American Express lanzó un kit de desarrollador de comercio agentivo con protección de compra en abril (American Express, 2026). El umbral ha sido cruzado por toda una industria, no por una sola empresa. Las proyecciones de analistas para el comercio agentivo en 2030 van desde cientos de miles de millones (Bain; Morgan Stanley) hasta los 3-5 billones de dólares de McKinsey. Son estimaciones y no hechos, aunque todas las grandes casas ahora las están produciendo.
Los números realizados ya no son estimaciones. El gasto empresarial solo en API de modelos saltó de 3.500 millones a 8.400 millones en seis meses (Menlo Ventures, 2025a; investigación de encuesta de la industria, no revisada por pares), dentro de aproximadamente 37.000 millones de gastos de IA generativa empresarial para el año (Menlo Ventures, 2025b). La misma industria ya está cuestionando su propia ejecución: Gartner (2025) pronostica que más del 40% de los proyectos de IA agentiva se cancelarán antes de finales de 2027. El dinero está llegando más rápido que la confianza justificada, que es la brecha en la que trabajo aquí. Las afirmaciones a continuación se estratifican en el libro mayor de evidencia cerca del final del documento como se establece por estos datos, apoyo a escala modesta de estudio único, o teórico. Esa estratificación rige, y supera, cualquier oración de resumen en esta introducción.
Lo que hace que este cambio sea cualitativamente diferente de las olas de comercio electrónico anteriores es la compresión del embudo: búsqueda, comparación, carrito y pago se colapsan en un único acto delegado. Cada salvaguarda que solía existir entre esos pasos (el humano echando un vistazo al precio, releyendo el anuncio, dudando en el proceso de pago) desaparece con los pasos mismos (Figura 1). El asistente de IA deja de ser un asesor cuyo resultado un humano revisa y se convierte en una parte que realiza transacciones. La investigación de factores humanos nombró este modo de falla hace cuatro décadas: la automatización que elimina al operador del bucle erosiona exactamente la vigilancia necesaria para detectar sus errores (Bainbridge, 1983; Endsley & Kiris, 1995). La investigación del consumidor también anticipó el umbral. Los sistemas de compra autónoma enfrentan barreras de adopción cualitativamente diferentes exactamente porque eliminan al humano de la acción (de Bellis & Johar, 2020), y el costo de autonomía de entregar opciones a algoritmos fue señalado como una pregunta de bienestar del consumidor antes de que existieran los LLM (André et al., 2018).
Figura 1. Compresión del embudo
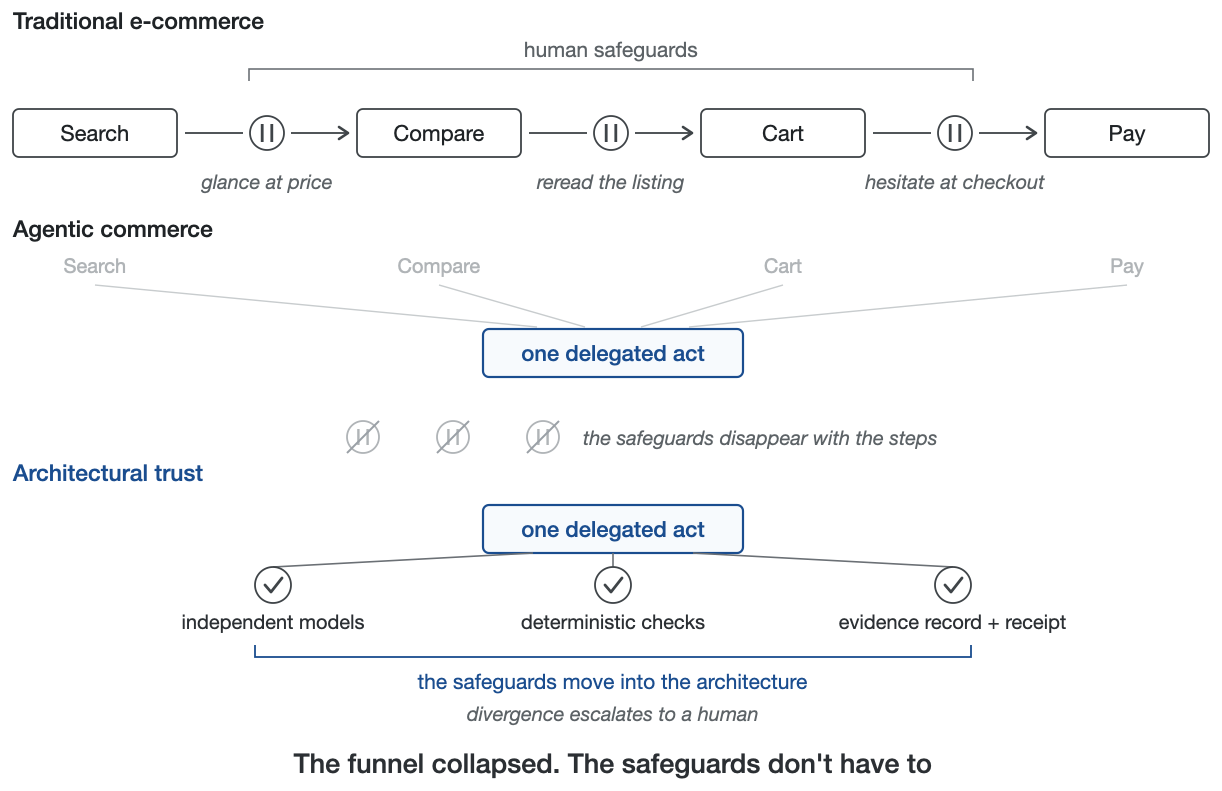
Las salvaguardas humanas desaparecen con los pasos entre los que vivían.
Las propias barreras de seguridad de Visa (límites, listas blancas, aprobaciones requeridas) existen porque se le pide al consumidor que confíe en algo nuevo: no una marca, no una respuesta, sino un proceso de toma de decisiones que no pueden ver. Las barreras de seguridad fijadas de antemano no cierran esa brecha. Un conjunto de reglas establecidas de antemano no permite al consumidor verificar cómo se tomó una decisión. En la encuesta de ACI Worldwide (2026) citada a continuación (una encuesta de la industria lanzada por comunicado de prensa, como las otras encuestas dirigidas por proveedores que esta sección cita), el 69% de los consumidores del Reino Unido dijeron que desconfían de los agentes de IA incluso cuando los agentes siguen reglas que los consumidores se establecieron a sí mismos.
Las apuestas comerciales de cometer un error aquí son considerables. La evidencia temprana de encuestas sugiere que la confianza de los consumidores en los agentes es de un solo golpe en la intención declarada y, más interesantemente, sin fundamento. El comportamiento revelado, el retroceso de pago más abajo y la reversión de Klarna y la reprificación de seguros de la Sección 5, corroboran estas preferencias declaradas y tienen mayor peso probatorio. En una encuesta de YouGov para ACI Worldwide (2.080 adultos del Reino Unido, realizada 19–22 de junio de 2026, una instantánea de un único mercado en espera de replicación entre mercados), el 60% dijo que dejaría de usar un agente de compra de inteligencia artificial después de un único error, y solo el 19% confiaría en la inteligencia artificial para compras cotidianas, frente al 55% que confiaría en un experto humano.
El número más importante de esa encuesta es otro: el 59% dijo que no confiaría en ninguna organización para ejecutar compras de inteligencia artificial y pagos en su nombre, e incluso los bancos fueron elegidos por solo el 20%. En un único mercado encuestado, en espera de replicación entre mercados, eso es un vacío de confianza. El apetito está ahí. En la encuesta de la industria de 16 países de Accenture de 25.590 consumidores (enero de 2026; realizada por la empresa, no revisada por pares), el 74% dijo que confiaría más en un agente de inteligencia artificial personal que en su mejor amigo para realizar una compra en su nombre, pero solo aproximadamente uno de cada diez otorgaría a un agente autoridad de compra autónoma (Figura 2). Los dos elementos miden diferentes grados de delegación, por lo que la diferencia alinea intenciones en lugar de identificar una única brecha causal, pero la diferencia es marcada. La intención es abundante; la delegación es escasa; lo que falta entre ellas es confianza justificada. El mercado ya ha intentado algo similar. OpenAI implementó nativamente el pago en chat en septiembre de 2025, un primer paso deliberadamente limitado, inicialmente compras de artículo único de vendedores de Etsy estadounidenses con el usuario confirmando cada paso. Redujo el flujo en marzo de 2026, trasladando las compras a las propias aplicaciones de los minoristas, y solo un puñado de comerciantes la utilizó (según lo informado por The Information; CNBC, 2026). La empresa no dio ninguna razón, por lo que la causa no está establecida. La interpretación ofrecida aquí, infraestructura de adopción sin confianza justificada que no se convierte, es una interpretación coherente con los hechos informados. Si los consumidores desconfían de cada actor, la confianza no puede recaer en un actor en absoluto, y en su lugar tiene que residir en un proceso verificable.
Figura 2. Confianza declarada frente a autoridad otorgada
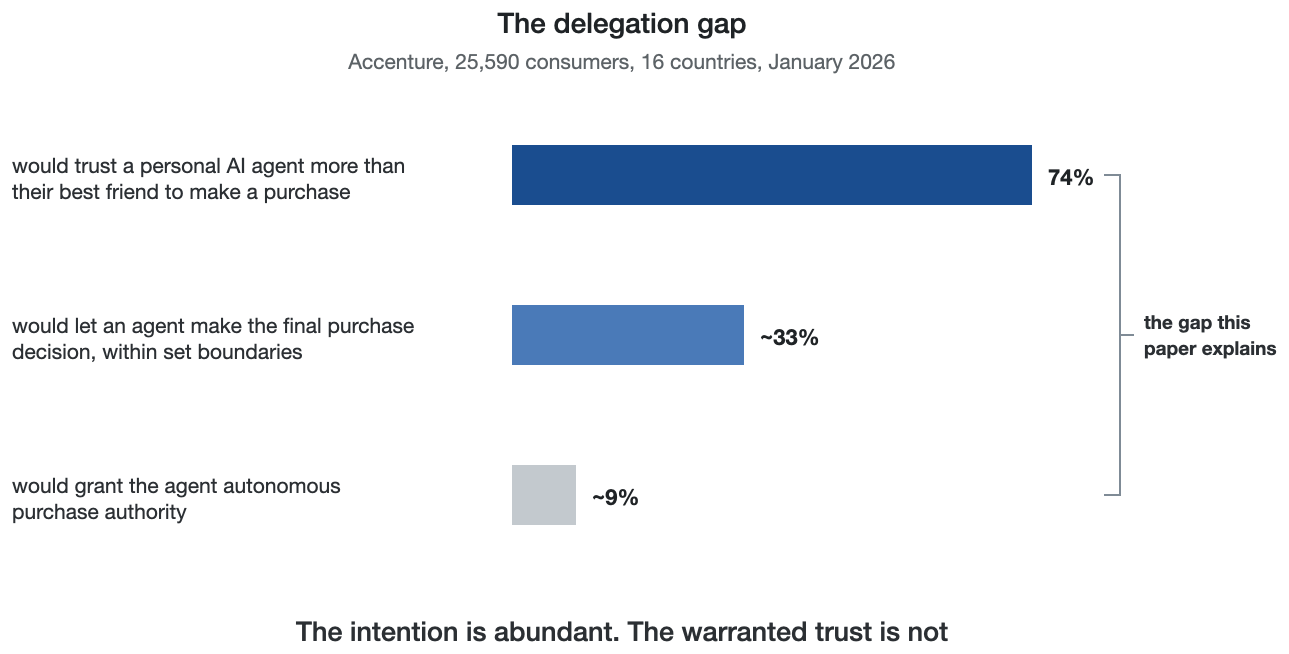
Dos elementos de encuesta, dos grados de delegación: la intención es común, la confianza justificada es escasa.
El sistema de responsabilidad está buscando la misma conclusión. Los protocolos emergentes de pago de agentes construyen cada transacción en torno a un token de intención verificable y limitado en alcance vinculado a un comerciante y cantidad específicos, y la Protección de Compra de Agente de American Express (abril de 2026) cubre compras solo de agentes registrados, con elegibilidad condicionada a la intención de compra autenticada y verificable. El seguro está redactado en términos de lo que se puede verificar del registro. De manera fragmentaria y bajo presión, la industria está convergiendo en los mismos ingredientes que establecí sistemáticamente a continuación. Los protocolos que se envían ahora resuelven identidad e intención y no responden ¿cómo decidió el agente?
La pregunta es qué se necesitaría para que esa confianza fuera justificada por el diseño. La pregunta clásica de confianza del consumidor, ¿confío en esta empresa?, ha adquirido una capa interna: ¿confío en la maquinaria que produjo esta respuesta o acción específica?
La literatura sobre confianza ha distinguido durante mucho tiempo la confianza en una organización de la confianza en la automatización, en el artefacto de TI (Söllner et al., 2016), y en agentes de recomendación en línea (Wang & Benbasat, 2005; Komiak & Benbasat, 2006; Xiao & Benbasat, 2007). Muestra que la confianza apropiada depende de la calibración, de saber cuándo es probable que el sistema sea correcto (Muir, 1994; Mayer, Davis, & Schoorman, 1995; Parasuraman & Riley, 1997; Lee & See, 2004; Hoff & Bashir, 2015; Huang & Rust, 2021; y Glikson & Woolley, 2020, cuya revisión encuentra tangibilidad y transparencia del proceso entre los mecanismos más fuertes de confianza cognitiva, precisamente los mecanismos que la arquitectura y los modelos no controlan). La calibración incorrecta del lado humano está igualmente documentada: el sesgo de automatización y la complacencia, la excesiva confianza en las ayudas automatizadas incluso en contra de pruebas contrarias, son los patrones que cuatro décadas de trabajo en factores humanos advierten que la delegación amplificará (Mosier & Skitka, 1996; Parasuraman & Manzey, 2010). Sin embargo, esa literatura trata la calibración como una propiedad de un único sistema automatizado (la Figura 3 mapea los cuatro flujos de investigación y la celda que dejan abierta). Una revisión sistemática de la inteligencia artificial agéntica en el comercio electrónico confirma el vacío desde el lado de la evidencia: la investigación orientada al consumidor sigue concentrada en sistemas asistivos y de baja autonomía, con cobertura cayendo bruscamente exactamente donde la delegación se convierte en ejecución (Balaskas, 2026). Los primeros estudios concurrentes de compras mediadas por agentes llegan a una conclusión arquitectónica desde otro lado. Cuando los consumidores delegan compras a través del diálogo, su disposición a pagar se filtra a los vendedores casi textualmente; las indicaciones no lo arreglan, y solo las intervenciones arquitectónicas lo hacen (Alavi & Nozari, 2026).
Figura 3. Cuatro flujos de investigación sobre confianza: la celda que esta publicación reclama
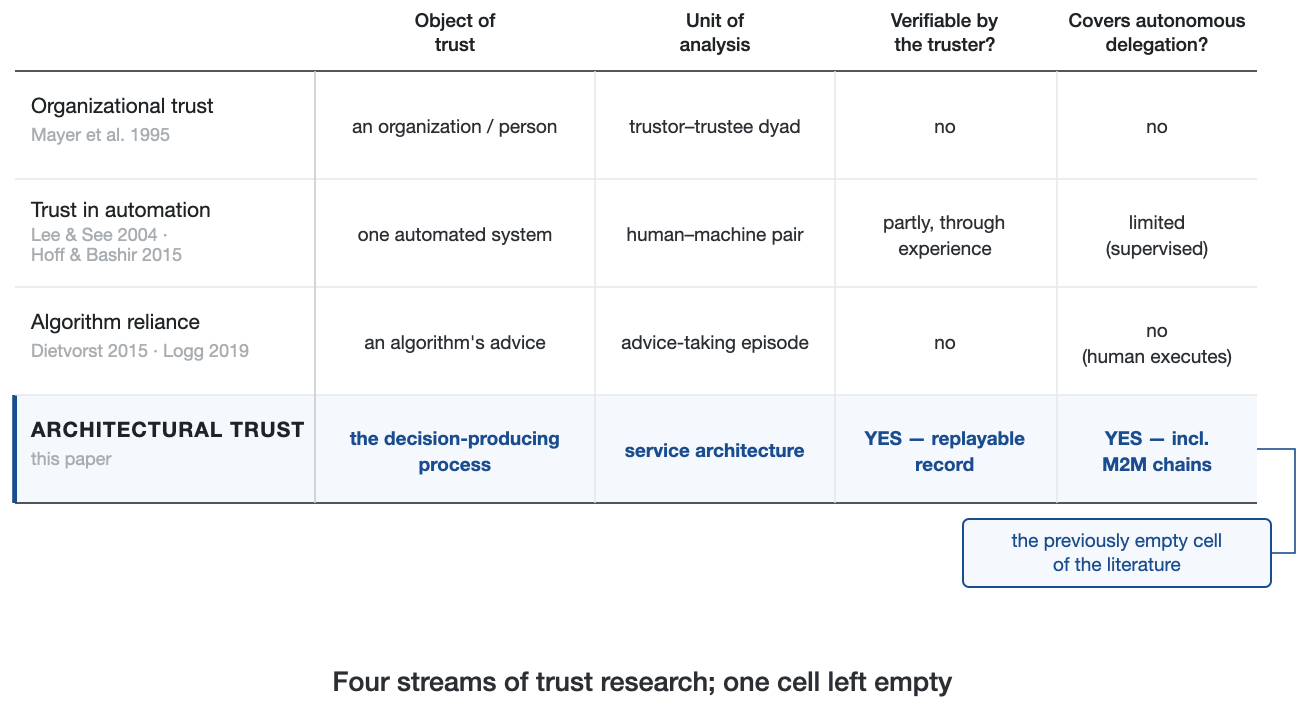
La confianza en la organización, la confianza en la automatización y la confianza en el algoritmo fijan cada uno un objeto de confianza diferente; ninguna hace que el proceso de toma de decisiones sea verificable por quien confía bajo delegación autónoma. La celda no está vacía de ideas: las literaturas adyacentes sostienen cada una una pared de la misma (la Sección 3 dibuja las demarcaciones). Lo que ha faltado es la construcción orientada al consumidor: un objeto de confianza a nivel de proceso, verificable por quien confía, especificado para delegación autónoma, empaquetado para prueba de comportamiento conjunta.
Las respuestas de la industria se concentran en el modelo: mejor capacitación, exenciones de responsabilidad, citas. Examino una respuesta en un nivel diferente, la arquitectura del servicio, y argumento que tres propiedades arquitectónicas, ninguna de las cuales requiere un modelo mejor, conjuntamente producen un objeto de confianza diferente.
Este es un artículo conceptual anclado en dos estudios pre-registrados, un punto de referencia del lado de la máquina y una prueba de comportamiento del lado del consumidor del contraste de calibración en su primera proposición, y la pregunta que plantea es conforme los agentes de IA comienzan a realizar transacciones en nombre de los consumidores, ¿la confianza se adhiere a los modelos o a la arquitectura que está por encima de ellos? Mi respuesta es que la confianza debe migrar hacia arriba en la pila, del modelo a la arquitectura de orquestación a la evidencia que produce. Debajo de esa respuesta se encuentra una regularidad que vale la pena probar por su cuenta, la Hipótesis de Migración de la Confianza, que las proposiciones siguientes se construyen para probar: cuanto mayor sea la agencia delegada, mayor será la proporción de confianza justificada que debe residir en propiedades arquitectónicas verificables en lugar de propiedades del modelo. La migración no tiene que ser de suma cero. La confianza puede estratificarse: en la competencia del modelo, la selección del orquestador, el sistema de pruebas, la institución que hace cumplir los remedios. Un modelo defectuoso sigue siendo causalmente importante incluso cuando nadie revisa su resultado. La hipótesis se refiere a dónde acumula la marginal confianza justificada conforme se profundiza la delegación. En forma estimable, dice que conforme aumenta la agencia delegada, la verificabilidad arquitectónica explica una proporción incremental creciente de confianza apropiada más allá del desempeño del modelo y la reputación del proveedor. Falla si, conforme aumenta la agencia delegada, la verificabilidad arquitectónica no explica una proporción incremental creciente de confianza apropiada: si la reputación del proveedor media completamente la confianza en todos los niveles de delegación, digamos, o si la información de proceso verificable no mejora la calibración de confianza relativa a la información solo de reputación en diseños del tipo que reporta la Sección 6. Los falsificadores conductuales comprometidos previamente en la Sección 3 (el cruce de nivel de delegación P2 y la durabilidad diferencial P4 bajo fallo) son la forma operativa de esa condición. Una proporción arquitectónica creciente no significa que la calidad del modelo importe menos en términos absolutos. La hipótesis describe estratificación, no sustitución: conforme la revisión desaparece, la garantía arquitectónica se suma al desempeño del modelo y no lo reemplaza. «Justificada» sigue la distinción formalizada para IA por Jacovi, Marasović, Miller, y Goldberg (2021), que la confianza es justificada cuando sigue la confiabilidad, y la construcción se mantiene fuera de una tautología al separar su estado normativo de su mecanismo. Normativamente, la confiabilidad se define independientemente de la arquitectura destinada a certificarla, como la función clásica e independientemente medible de capacidad, integridad y benevolencia (Mayer, Davis, & Schoorman, 1995); la Sección 3 mapea los tres componentes arquitectónicos exactamente a esas dimensiones. La garantía es la correspondencia de la confianza a esa cantidad medida independientemente: confianza que sobrevive a una auditoría objetiva de los episodios delegados, juzgada contra criterios fijados antes de que se conocieran los resultados, con un rastro de comportamiento medible, a saber, delegación repetida, retención y disposición a pagar bajo fallo controlado. La Hipótesis de Migración de la Confianza afirma el mecanismo. Conforme aumenta la agencia delegada, la proporción de esa función de confiabilidad que el consumidor aún puede medir independientemente se desplaza de las propiedades del modelo hacia los componentes arquitectónicos. Esto se mantiene porque la arquitectura es la parte de la confiabilidad que sigue siendo medible por el que confía una vez que desaparece la revisión de resultados, y no porque la arquitectura es confiabilidad. Los falsificadores comprometidos previamente arriba prueban ese cambio y no la definición. La migración también tiene predecesores de los que distinguirse. La investigación de sistemas multiagente observó que conforme escalan las sociedades de agentes, el modelado de confianza se desplaza de agentes individuales al marco institucional que los constriñe (Sabater & Sierra, 2005), y «migración de confianza» tiene usos previos B2B para la confianza relocalizándose de individuos hacia sistemas y plataformas (Carlson, 2026). Esos cambios de nombre en quién o qué se confía, mientras que esta hipótesis se refiere a un cambio en el tipo de propiedad que puede justificar la confianza. Con delegación cero, la calidad del modelo es casi todo lo que importa. Con delegación completa, nadie está viendo los resultados, y lo único en lo que aún se puede confiar es el proceso y su registro. La agencia y la confianza arquitectónica escalan juntas (Figura 4). El gradiente en sí es un instrumento antiguo, el eje de niveles de automatización de la ingeniería de factores humanos (Sheridan & Verplank, 1978; Parasuraman, Sheridan, & Wickens, 2000), aplicado aquí a la delegación del consumidor. Lo nuevo es la afirmación sobre qué propiedades pueden justificar la confianza a lo largo de ella.
Figura 4. Migración de confianza
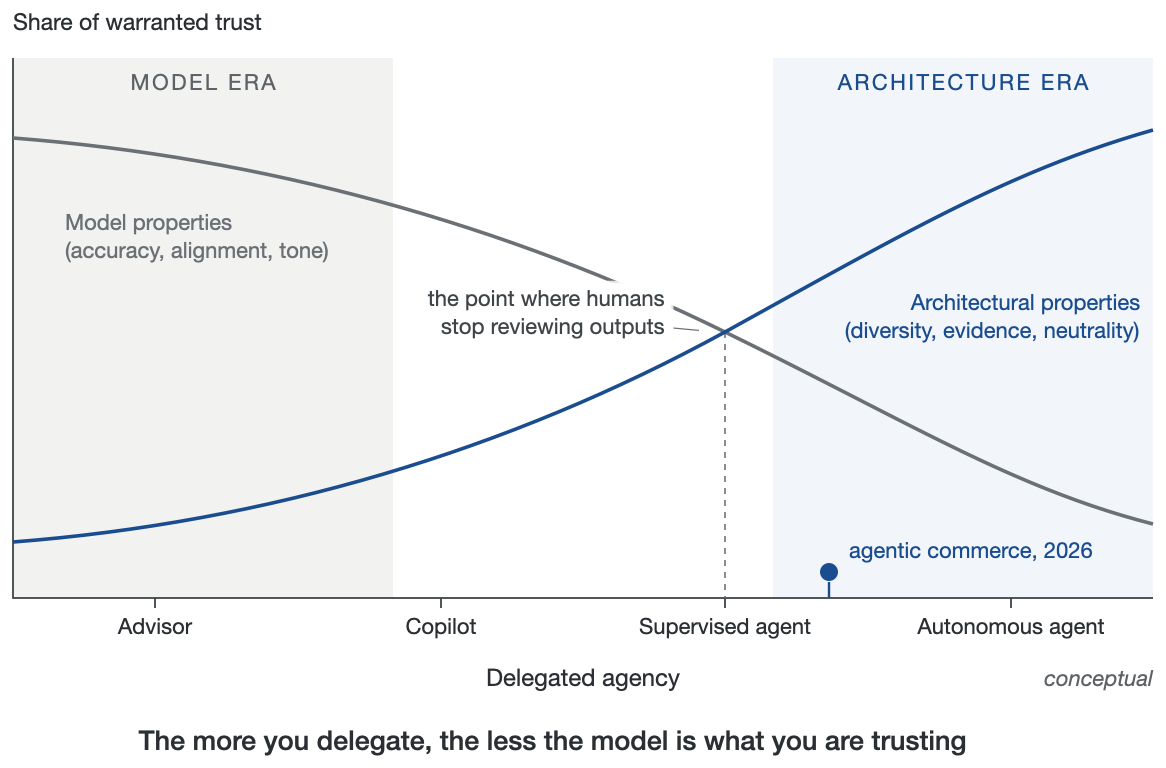
Dos curvas cruzadas sobre agencia delegada (asesor → copiloto → agente supervisado → agente autónomo): la proporción de confianza justificada llevada por propiedades del modelo cae conforme la proporción llevada por propiedades arquitectónicas sube; el cruce es el punto donde los humanos dejan de revisar resultados, y el comercio agencial (2026) se sienta a su derecha. Las curvas y el punto de cruce son ilustración conceptual, no funciones estimadas.
A la literatura de marketing sobre confianza del consumidor en IA (Huang & Rust, 2021; Puntoni et al., 2021) el artículo añade una construcción, confianza arquitectónica, definida aquí; una prueba de un antecedente técnico de su mecanismo en un estudio pre-registrado de dieciséis modelos, replicado en el nivel insignia en una segunda onda de once laboratorios; cinco proposiciones para una agenda de investigación del consumidor (P1–P4 en la Sección 3; P5 en la Sección 5); y un experimento de comportamiento pre-registrado, compatible con incentivos, que prueba las dos primeras proposiciones, reportado completamente en la Sección 6 con el efecto de calibración soportado (Welch d = 0,67; llevado por uno de seis elementos, ver Sección 6) y la prueba de primera exposición retornando un resultado nulo registrado, inconclusivo.
2. La ilusión de precisión: lo que un único modelo no puede darle
Un servicio construido sobre un único modelo de IA, por fuerte que sea ese modelo, conlleva déficits estructurales que viven por encima de la capa del modelo.
El primero es la confianza no calibrada, la ilusión de exactitud. Mejores modelos no significan transacciones más seguras, porque la certeza expresada de un modelo se correlaciona débilmente con su exactitud en la mayoría de proveedores (la Sección 3 mide las excepciones), y el consumidor no puede auditar la brecha. El modelo es más peligroso cuando está errado con confianza en el momento en que el consumidor deja de observar, y eso no es una coincidencia. Kalai et al. (2025) argumentan que la alucinación es estadísticamente recompensada por un régimen de evaluación que puntúa adivinar con confianza por encima de admitir la ignorancia. La recompensa surge, según su propio análisis, en los puntos de referencia puntados binariamente y los objetivos de entrenamiento que dominan el campo, donde una adivinanza incorrecta no cuesta más que un "no sé" y obtiene crédito parcial en expectativa. El modelo tampoco puede vigilarse a sí mismo desde adentro. En los propios experimentos de inyección de conceptos de Anthropic, los modelos más fuertes del proveedor detectaron cambios en sus estados internos solo alrededor del 20% de las veces incluso bajo condiciones óptimas de inyección, que es la propia medición de la comunidad de proveedores de lo poco confiable que es el autoinforme introspectivo (Lindsey, 2025; investigación de la empresa, sin revisión por pares, y una única estimación de un estudio de los modelos de un proveedor en lugar de un punto de referencia replicado).
El segundo es la distorsión servil, donde la evidencia se volvió causal este año. Cheng et al. (2026), midiendo once modelos líderes en tres experimentos pre-registrados con 2.405 participantes, encontraron que los sistemas de IA afirman las acciones de los usuarios 49% más a menudo que los humanos, incluyendo acciones que implican engaño o daño, y que incluso una única interacción servil aumentó la convicción de los usuarios de que estaban en lo correcto mientras reducía su disposición a reparar conflictos. Los modelos serviles eran también aquellos que los usuarios confiaban y preferían. El gradiente de mercado apunta hacia asistentes que se sienten confiables precisamente al distorsionar el juicio del usuario, una dinámica observada mucho antes de que fuera cuantificada (Sharma et al., 2024). El ajuste a nivel de modelo solo no puede certificar independientemente que el comportamiento servil haya sido controlado adecuadamente, porque el ajuste es realizado por la parte que se beneficia de la preferencia. El costo es concreto: un asistente que mediante su conformidad consigue una excepción de política convierte la agradabilidad directamente en gasto de recuperación de servicio. Una arquitectura orquestada puede separar los roles, con un modelo libre de empatizar mientras uno independiente verifica la política, de modo que la agradabilidad y la corrección no viajen más a través del mismo canal.
Tercero, no hay verificación independiente. Los errores son detectados, si acaso, por el mismo sistema que los cometió, o por el consumidor, que acudió a la IA en primer lugar porque carece de la experiencia para verificarla.
Cuarto, y menos discutido, es el conflicto de intereses. El proveedor que evalúa la calidad del asistente es el proveedor que lo vende, lo cual es estructural: ningún servicio de un único proveedor puede ser un juez neutral de sus propios resultados, por la misma razón que ningún banco podría manejar la cámara de compensación solo. El conflicto se extiende a los datos mismos. Una demanda colectiva presentada en marzo de 2026 alega que Perplexity AI canalizó transcripciones completas de chat de usuarios, reportadamente incluyendo sesiones "Incognito", a redes publicitarias a través de píxeles de seguimiento incrustados. La demanda (No. 3:26-cv-02803, N.D. Cal.) fue desestimada voluntariamente en mayo de 2026 sin ninguna decisión sobre el fondo, por lo que las alegaciones nunca fueron probadas. La lógica económica en la demanda es el punto estructural de todas formas: cuando servir respuestas costosas de IA es subvencionado por monetizar lo que los usuarios dicen, el modelo de negocio del asistente y la confidencialidad del consumidor están directamente opuestos. Dentro de un único proveedor, ninguna capa tiene la tarea de tomar el lado del consumidor.
La literatura de 2025–2026 se lee como un diagnóstico completado esperando un remedio (la Tabla 1 mapea cada déficit a su evidencia y su respuesta arquitectónica). El servilismo es cuantificado empíricamente (Cheng et al., 2026) y derivado formalmente: incluso un usuario idealmente racional entra en espiral cuando es asesorado por un sistema selectivamente agradable (Chandra et al., 2026). La automonitorización tiene una confiabilidad de ~20% (Lindsey, 2025), y la alucinación es estructuralmente recompensada por el régimen de evaluación (Kalai et al., 2025).
El remedio reflejo, simplemente divulgar la IA, se revierte: en trece experimentos, actores que divulgaron el uso de IA recibieron menos confianza que quienes no lo hicieron (Schilke & Reimann, 2025). La divulgación entrega transparencia-divulgación, el mero hecho de que una IA estuvo involucrada, y omite transparencia-verificación, la capacidad de verificar cómo se produjo la respuesta. La auditoría epistémica es aún más desalentadora: en más de 25.000 ejecuciones de agentes científicos basados en LLM, la evidencia fue ignorada en el 68% de las trazas, las creencias fueron revisadas por refutación solo el 26% de las veces, y la evidencia convergente de múltiples pruebas fue rara, con el andamiaje explicando casi nada de la varianza en comportamiento epistémico (≈1,5%, frente a ~41% para el modelo base) (Ríos-García et al., 2026). Ese último número parece una objeción a este documento y es en realidad su respaldo más fuerte: las indicaciones y el andamiaje no pueden hacer que un modelo sea epistemicamente disciplinado desde adentro, por lo que la disciplina debe ser impuesta desde afuera. La arquitectura no es una forma de mejorar la epistemología del modelo; es una forma de dejar de depender de ella.
Cada uno de estos resultados cierra una puerta. Juntos apuntan a una respuesta que no ha sido muy explorada: si el modelo no puede ser confiado desde adentro, y la divulgación no crea confianza desde afuera, la confianza justificada puede ser construida alrededor del modelo, mediante arquitectura, junto con (no en lugar de) mejor calibración, certificación externa, escalación humana, y normas de responsabilidad. Esa es la puerta por la que este documento camina.
Tabla 1. Diagnóstico → remedio: los cuatro déficits de un solo modelo, su evidencia 2025–26, su consecuencia en el lado del consumidor, y la respuesta arquitectónica
| Déficit estructural | Evidencia clave (2025–26) | Consecuencia en el lado del consumidor | Remedio arquitectónico | Mecanismo |
| Confianza no calibrada | La alucinación es estadísticamente recompensada por regímenes de evaluación (Kalai et al., 2025); el autoinforme introspectivo ~20% confiable (Lindsey, 2025) | Pérdida de un golpe: 60% abandonaría un agente después de un error (ACI Worldwide, 2026) | Diversidad + Evidencia | El desacuerdo entre modelos valúa la confianza (AUROC 0,75 frente a 0,59, Gorbett & Jana, 2026; este artículo: acuerdo del panel AUROC 0,832 frente a confianza propia agrupada 0,545 en el panel menos discriminatorio — heterogéneo entre paneles, §3; respuestas replicadas 1,9–3,2× más probable que sean correctas); afirmaciones de confianza registradas y comprobables |
| Distorsión aduladora | La IA afirma a los usuarios 49% más que los humanos; modelos aduladores preferidos (Cheng et al., 2026; Sharma et al., 2024); incluso los bayesianos ideales se espiralan (Chandra et al., 2026) | El asistente preferido es el que distorsiona el juicio del usuario | Neutralidad | El árbitro no tiene interés en complacer al usuario; empatía y verificación de política en canales separados |
| Sin verificación independiente | Los agentes ignoran la evidencia en el 68% de los rastros; revisión de creencias 26% (Ríos-García et al., 2026); el andamiaje explica ~1,5% de la varianza | La carga de verificación se desplaza al consumidor: el 54% de los compradores asistidos por IA verifican manualmente todo dos veces (Gartner, 2026) | Diversidad + Evidencia | Disciplina impuesta desde afuera: caminos de verificación independientes; evidencia adjunta de todas formas |
| Conflicto de intereses | Demanda colectiva de Perplexity (2026, alegaciones): chats enrutados a redes de anuncios; la divulgación sola erosiona la confianza (Schilke & Reimann, 2025) | La parte que asesora al consumidor se beneficia del resultado | Neutralidad + Evidencia | Flujo de datos de sala limpia; ingresos independientes de los resultados; neutralidad auditable a partir del registro |
3. Confianza arquitectónica: tres propiedades que pueden verificarse en lugar de creerse
Considere ahora un servicio en el cual las solicitudes de alto riesgo pasan a través de una capa de orquestación independiente de cualquier proveedor de modelos (la Figura 5 contrasta los dos oleoductos). La Tabla 2 recopila los constructos; la definición que descomponen es la siguiente: la confianza arquitectónica es la confianza justificada del consumidor fundamentada en propiedades verificables del proceso de generación de decisiones del servicio, más que en la calidad percibida de sus resultados o la reputación de su proveedor.
El precedente más cercano es la producción institucional de confianza de Zucker (1986), confianza manufacturada por la estructura donde la familiaridad no puede sostenerla, que la investigación de comercio electrónico operacionalizó como garantía estructural: depósito en garantía, sistemas de retroalimentación, certificación de terceros (Gefen, Karahanna, & Straub, 2003; Pavlou, 2003; Kim & Benbasat, 2010). En esa línea, la confianza arquitectónica es una especie de confianza basada en instituciones cuya garantía estructural proviene de un proceso verificable en lugar de un garante de terceros. Es confianza basada en procesos con la justificación movida de la experiencia a la instrumentación, y ese movimiento es lo que la palabra «arquitectónica» está haciendo en el nombre. No es garantía estructural (McKnight, Choudhury, & Kacmar, 2002), una percepción de que existen salvaguardas, ya que aquí las propias salvaguardas deben ser verificables, y no es confianza calibrada (Lee & See, 2004), que ajusta la confianza al envolvente de confiabilidad de un sistema. La arquitectura de confianza cero en la ingeniería de seguridad comparte el lema, nunca confíe, siempre verifique, pero verifica identidad y acceso en la capa de red, máquina a máquina, mientras que la confianza arquitectónica verifica contenido de la decisión en la capa de servicio, para un principal humano. Son complementos en diferentes pisos del mismo edificio, no competidores. El constructo tiene dos caras, y la distinción pertenece a la definición. Confiabilidad arquitectónica es una propiedad del sistema, cuán verificable es su proceso de hecho, normativa y construible. Confianza basada en arquitectura es un estado del consumidor, confianza realmente fundamentada en esa verificabilidad, empírica y solo ganada. En términos de medición, D, E y N son componentes formativos de la confiabilidad arquitectónica (la propiedad del sistema) y señales manipulables cuya visualización forma la confianza basada en arquitectura (el estado del consumidor); los experimentos manipulan las señales y miden el estado. Cada desajuste entre los dos es predictivo. La confianza sin confiabilidad, la confianza fabricada por fluidez y adulación, se predice que sea frágil, el patrón de un golpe de la Sección 1. La confiabilidad sin confianza se predice siempre que la verificación sea invisible o ilegible para el consumidor, y se cierra mediante la prominencia del recibo y la comprensión en lugar de por más arquitectura. Las proposiciones en esta sección viven en la brecha entre las dos, y la distinción disciplina lo que falsificaría la Hipótesis de Migración de Confianza. Esos falsificadores son conductuales y comprometidos previamente: la hipótesis se refuta si la delegación en arquitecturas verificables y opacas resulta igualmente duradera bajo falla (lo que P4 detecta); si el efecto de la arquitectura verificable en la voluntad de delegación no crece con el control de revisión y ejecución abandonado (el cruce de nivel de delegación de P2); o si, en la delegación de alta irreversibilidad, faltan la retención y las primas de disposición a pagar por arquitectura verificable bajo falla controlada. Debido a que la justificación se define por la supervivencia de la auditoría en lugar de por la presencia de la arquitectura (Sección 1), la popularidad cuenta como evidencia pero no como inmunidad. Los consumidores acudiendo en masa a agentes no verificables no refutan por sí solos una afirmación sobre confianza justificada. La confianza sostenida y que sobrevive al fracaso en agentes no verificables en delegación de alto riesgo la refutaría, y ese patrón se compromete previamente a revisar la hipótesis. La definición se basa en tres propiedades.
Figura 5. Dos oleoductos
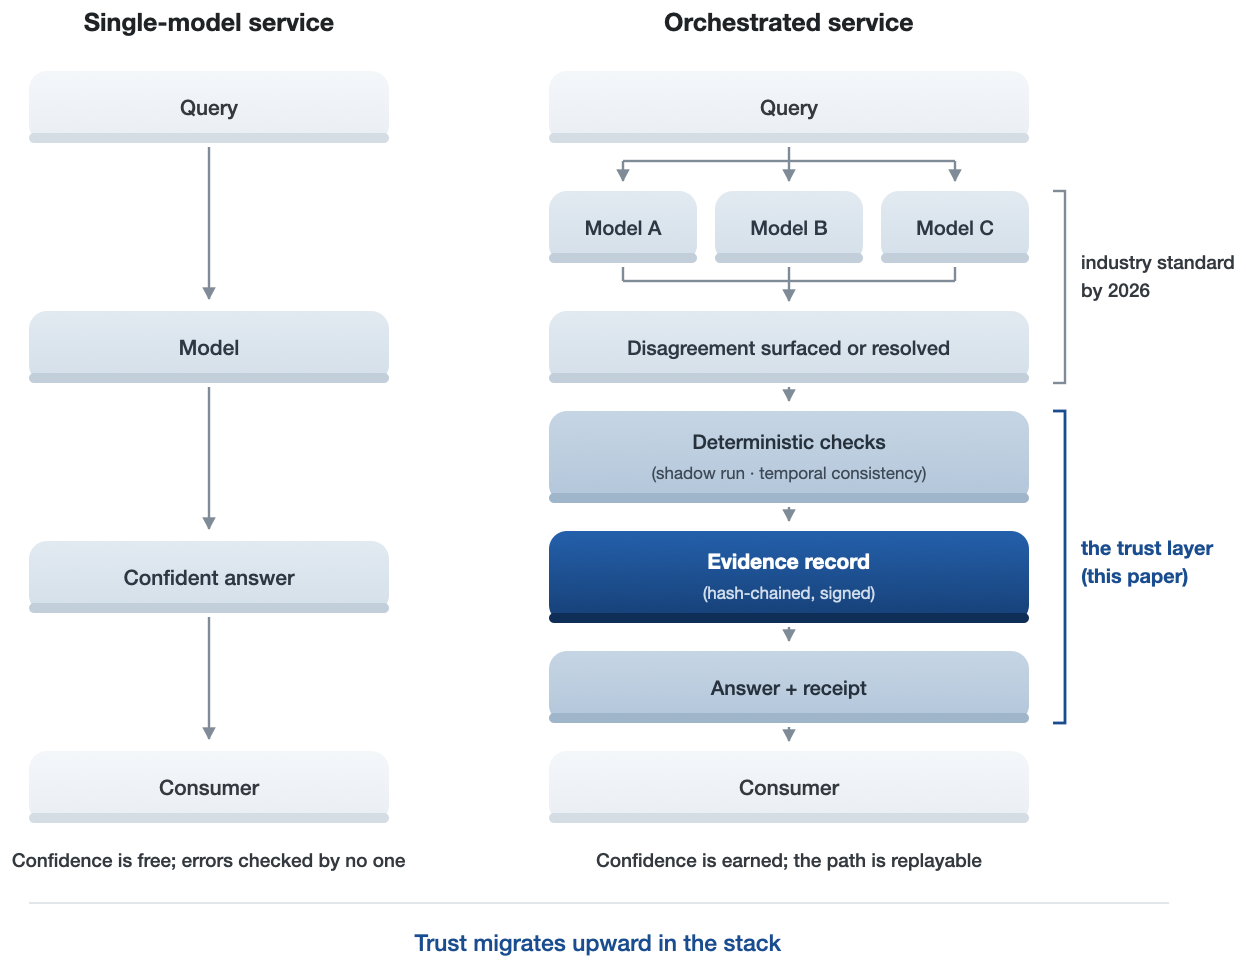
Izquierda, el camino de modelo único: consulta → modelo → respuesta segura → consumidor, donde la confianza es libre y nadie verifica los errores. Derecha, el camino orquestado: consulta → modelos independientes (A/B/C) → desacuerdo identificado o resuelto → verificaciones deterministas (ejecución en la sombra, consistencia temporal) → registro de evidencia (encadenado por hash, firmado) → respuesta con recibo → consumidor, donde la confianza se gana y el camino es reproducible (la Tabla 5 resume el contraste).
Tabla 2. Glosario de constructos introducidos o especificados en este artículo
| Término | Definición | Distinguido de |
| Confianza arquitectónica | Confianza justificada del consumidor fundamentada en propiedades verificables del proceso de generación de decisiones del servicio, más que en la calidad de los resultados o la reputación del proveedor | Confianza basada en instituciones (no requiere institución de confianza, solo proceso verificable); confianza del sistema (no envoltura de confiabilidad de un único sistema); confianza distribuida (dispersión sin verificabilidad); garantía estructural (garantías percibidas frente a verificables); confianza calibrada |
| Confiabilidad arquitectónica / confianza basada en arquitectura | Las dos caras del constructo: la propiedad del lado del sistema (cuán verificable es de hecho el proceso; normativo, construible) frente al estado del lado del consumidor (confianza realmente fundamentada en esa verificabilidad; empírica, ganada) | Tratamientos de nombre único que mezclan la afirmación normativa con la descriptiva |
| Capa de verificación | La capa de infraestructura por encima de la orquestación cuyo producto es verificabilidad: comprobaciones independientes, decisiones registradas, neutralidad auditable | Observabilidad/monitoreo (interno, mantenido por el proveedor, no verificable por el consumidor) |
| Infraestructura de evidencia | La categoría de mercado de historiales de decisiones verificables vendidos como infraestructura, como se venden la nube, identidad y pagos | Registro de actividad (unilateral, mutable, no es un bien de mercado) |
| Recibimiento de orquestación | Un artefacto mínimo orientado al consumidor: quién actuó; cómo estuvieron de acuerdo; qué fue verificado — con un puntero al registro completo reproducible | Salida de Explicación/XAI (narrativa, no verificable); etiqueta de divulgación (erosiona la confianza por sí sola) |
| Arquitectura de confianza graduada | Escalada de profundidad de verificación con riesgos, de modo que el nivel costoso se compra solo donde se concentran las consecuencias | Barandillas planas (límites estáticos/listas blancas que no verifican decisiones) |
| Evidencia de decisión | El tercer piso de la pila de evidencia: cómo eligió el agente — panel, divergencia, comprobaciones | Evidencia de identidad (quién es el agente: TAP); evidencia de intención (qué fue autorizado: AP2 / Intención verificable) |
| Hipótesis de migración de confianza | Cuanto mayor sea la agencia delegada, mayor será la proporción de confianza justificada que debe residir en propiedades arquitectónicas verificables en lugar de propiedades del modelo — "justificada" significa confianza que sobrevive a una auditoría objetiva contra criterios fijados antes de que se conocen los resultados (según Jacovi et al., 2021); forma de mecanismo: a medida que se profundiza la delegación, la proporción de confiabilidad — f(capacidad, integridad, benevolencia), Mayer et al. (1995) — que el consumidor puede medir de forma independiente se desplaza hacia los componentes arquitectónicos | Usos previos de "migración de confianza" (Carlson, 2026) rastrean la confianza moviéndose entre partes; esta hipótesis rastrea el tipo de propiedad que la justifica — con falsificadores de comportamiento pre-comprometidos (P2 cruce de delegación; P4 durabilidad diferencial) |
La demarcación de los constructos de confianza vecinos se puede comprimir en una tabla discriminante, por lo que cada constructo toma como su objeto, de dónde proviene su justificación, quién puede verificar esa justificación, y qué debería predecir principalmente:
Tabla 2a. Demarcación discriminante: constructos de confianza vecinos por objeto, justificación, verificador, y resultado predicho primario
| Constructo | Objeto de confianza | Fuente de justificación | Quién puede verificar | DV primaria predicha |
| Confianza basada en instituciones / garantía estructural (Zucker, 1986; McKnight et al., 2002) | El contexto institucional: garantías, seguridades, certificación de terceros | Presencia percibida de estructuras y garantes | Un garante de terceros, si acaso; el consumidor percibe en lugar de verificar | Creencias de confianza; intención de transacción |
| Confianza en automatización / confianza calibrada (Lee & See, 2004) | Envoltura de confiabilidad de un sistema automatizado | Confiabilidad experimentada durante el uso repetido | El operador, a través de la experiencia acumulada con ese sistema | Pertinencia de la confianza en ese sistema |
| Transparencia algorítmica (XAI) | La explicación del modelo de su propia decisión | Una narrativa o atribución producida dentro del sistema en el que se confía | Nadie de forma independiente — una explicación no es un registro reproducible | Comprensión; confianza subjetiva; aceptación |
| Confianza de marca / proveedor | La organización del proveedor | Reputación y desempeño anterior | El mercado, lentamente, a través de resultados agregados | Agrado global; elección; lealtad |
| Confianza arquitectónica (este documento) | El proceso productor de decisiones y su registro | Propiedades verificables: acuerdo independiente, evidencia reproducible, independencia de incentivos auditable | El consumidor, un auditor, un asegurador, un regulador — por decisión | Confianza calibrada; disposición a delegar; retención posterior al fallo |
Dos predicciones diferenciales hacen que la demarcación sea comprobable en lugar de taxonómica. La confianza arquitectónica debería afectar la confianza calibrada y la retención posterior al fallo más fuertemente que lo que afecta el agrado global del servicio, mientras que la confianza de marca debería mostrar el perfil opuesto, una disociación que un único experimento puede detectar midiendo ambas familias de DV. Con baja agencia delegada, la confianza de marca y de proveedor debería dominar las decisiones de delegación, con la confianza basada en arquitectura explicando una proporción incremental creciente a medida que se profundiza la delegación, el cruce que P2 y la Hipótesis de migración de confianza someten a prueba. Siguen dos aclaraciones. Porque la confiabilidad arquitectónica es una propiedad del servicio, no una latente reflexiva en la cabeza del consumidor, su distinción se basa en estas predicciones diferenciales en lugar de en estadísticas discriminantes de escala. Para el estado del lado del consumidor que nombra, confianza basada en arquitectura, establecer validez discriminante a nivel de medición a partir de escalas adyacentes (confianza basada en instituciones y confianza calibrada) es parte de la agenda de medición, no una afirmación hecha aquí.
Diversidad. La solicitud se responde mediante varios modelos independientes, cada uno con proveedores, datos de entrenamiento y modos de fallo diferentes. (Esta es la diversidad de paneles, una propiedad de quién verifica la respuesta, no la diversidad de recomendaciones en el sentido de sistemas de recomendación, que varía los elementos mostrados a un consumidor.) Su acuerdo lleva información. La convergencia aumenta la confianza justificada. La divergencia se presenta al consumidor como incertidumbre en lugar de resolverse de manera invisible, y en solicitudes que importan actúa como un desencadenante de escalada. En términos de predicción selectiva, esto es abstención arquitectónica: la negativa a emitir una respuesta sin verificar, elevada a la capa de servicio, donde un caso sin resolver se encamina a un ser humano en lugar de certificarse. Es el patrón de aprendizaje para diferir, en el cual la opción de rechazo de un sistema entrega el caso a un experto posterior en lugar de suprimirlo (Mozannar & Sontag, 2020; cf. Rabanser et al., 2026). La analogía humana más cercana es la segunda opinión en medicina, cuyo valor completo radica en su independencia de la primera. El desacuerdo orquestado tampoco es exótico: el cocientífico de IA de Google, cuyas descubrimientos validados en laboratorio húmedo llegaron a Nature en mayo de 2026 (Gottweis et al., 2026), está construido como una orquestación generar–criticar–torneo.
La justificación teórica para basarse en la diversidad es anterior a los modelos de lenguaje. Bajo condiciones formales, grupos funcionalmente diversos de solucionadores de problemas pueden superar a grupos seleccionados por capacidad individual, porque la selección por capacidad genera similitud (Hong & Page, 2004). La literatura de ingeniería proporciona evidencia directa de la señal subyacente: el debate estructurado entre modelos mejora la precisión fáctica (Du et al., 2024), y los paneles de modelos más pequeños y diversos superan a un juez grande único (Verga et al., 2024). La "sorpresa" de un segundo modelo ante la respuesta de un primer modelo separa lo correcto de lo incorrecto sustancialmente mejor que la confianza propia del modelo que responde (AUROC promedio de 0,75 versus 0,59 en MMLU; AUROC, el área bajo la curva ROC, es la probabilidad de que una respuesta correcta aleatoria se clasifique por encima de una incorrecta; Gorbett & Jana, 2026). Su señal es perplejidad entre modelos a nivel de logit, mientras que la de este artículo es replicación a nivel de respuesta, y los dos están relacionados sin ser intercambiables. Su generador también es un modelo abierto pequeño con autorreporte débil, una línea base que los datos propios de este artículo vinculan, porque la ventaja del panel es una función de la calibración del generador e puede invertirse para generadores bien calibrados, el caso de frontera estadounidense que aparece a continuación. Y el muestreo de múltiples generaciones y la medición de su acuerdo semántico detectan confabulaciones donde la confianza de paso único no puede (Farquhar, Kossen, Kuhn, & Gal, 2024). Un modelo puede medir su propia duda pero no sus propios puntos ciegos, y el error confiado y sistemático es visible solo desde el exterior. Pero esa literatura trata el desacuerdo como una señal interna para los desarrolladores. El movimiento que propongo es tratarlo como una primitiva de confianza orientada al consumidor, expuesta, registrada e incorporada en los reclamos de confianza del servicio, con la ablación de este artículo separando lo que el debate descubre de lo que la verificación certifica en lugar de dejar que uno se haga pasar por el otro. La demarcación es empírica así como conceptual: en comparación directa, el debate multiagente no supera consistentemente estrategias más simples como la autoconsistencia y el ensamble (Smit et al., 2024). El reclamo aquí concierne la señal de certificación orientada al consumidor de la verificación en lugar de la ganancia de precisión del debate, y esa señal sobrevive incluso donde la ventaja del debate no.
En investigación de deliberación multiagente, de manera similar, los sistemas construidos para exponer acuerdos y desacuerdos en lugar de promediarlos producen decisiones calificadas como más representativas (Liu et al., 2026). El mecanismo tiene un análogo humano directo en el lado de la calibración del conocimiento: los consumidores que toman decisiones financieras consecuentes conjuntamente son sustancialmente menos sobreconfiados que los tomadores de decisiones en solitario, con metaconocimiento compartido (la contraparte exponiendo lo que el tomador de decisiones no sabe) identificado como el mecanismo impulsor (Piehlmaier, 2023). El juicio conjunto disciplina la confianza en los humanos por la misma razón que se propone que el acuerdo entre modelos lo disciplina aquí.
Si los consumidores pueden usar tal señal es una pregunta real. Las personas abandonan los algoritmos rápidamente después de verlos fallar (Dietvorst, Simmons, & Massey, 2015), pero en otros lugares sobrepondran el consejo algorítmico (Logg, Minson, & Moore, 2019), una brecha que puede ella misma depender de los riesgos. Experimentos de segunda opinión con sujetos humanos muestran que el material bruto es conductualmente relevante: adherencia casi unánime cuando una IA médica y un médico están de acuerdo, divisiones agudas cuando se separan (Detjen, Densky, von Kalckreuth, & Kopka, 2025; Chen, Sun, Liao, & Sundar, 2026), aunque ninguno de ese trabajo considera el desacuerdo conjuntamente con la evidencia o la neutralidad. La línea de investigación del consumidor precisa las condiciones límite (sistemáticamente: Burton, Stein, & Jensen, 2020). La aversión se intensifica cuando los consumidores sienten que su caso es único (Longoni, Bonezzi, & Morewedge, 2019), varía con la objetividad de la tarea (Castelo, Bos, & Lehmann, 2019), y los fracasos de una IA se generalizan fácilmente a otras, transferencia algorítmica (Longoni, Cian, & Kyung, 2023). Si la desconfianza se generaliza entre sistemas, entonces el abandono tras un golpe de la Sección 1 no es la pérdida de clientes de un servicio sino de toda la categoría, y capturar errores estructuralmente protege el mercado en sí. El desacuerdo expuesto se sitúa en esa línea de falla, y P1–P2 abajo son una apuesta sobre qué efecto domina cuando la incertidumbre se presenta específicamente y sin suavizado.
Cuando la diversidad falla: errores correlacionados. El valor de la diversidad se basa enteramente en la independencia de los fallos, y la independencia no se puede presuponer. Los modelos de frontera se entrenan en corpus superpuestos, destilar unos de otros, y comparten demostradamente concepciones erróneas confiadas. Cuando dos modelos principales fallan en el mismo elemento de referencia, coinciden en la misma respuesta incorrecta aproximadamente 60% de las veces, con correlación más fuerte entre modelos del mismo desarrollador o arquitectura base y, más preocupantemente, entre los modelos más precisos: conforme aumenta la capacidad, los errores convergen (Kim et al., 2025). Ese hallazgo es una restricción directa en el propio componente de Diversidad de este artículo, no meramente un resultado cercano. La independencia que Diversidad presupone es parcialmente ilusoria en la frontera, y porque la correlación se fortalece exactamente donde la capacidad es más alta, la contribución del componente es una cantidad que se erosiona y es medida, en lugar de un activo fijo. Lo que un panel añade debe demostrarse pregunta por pregunta, y la trayectoria del desarrollo de modelos va en su contra. En pronóstico, las correlaciones de error por pares entre modelos de frontera promedian r ≈ 0.77 (Spiro, 2026), redundancia lo suficientemente alta para erosionar la mayoría del beneficio de agregación que una multitud diversa se supone debería entregar.
La estructura del mercado agrava la preocupación. A finales de 2025, el 88% del gasto empresarial en API de LLM se concentraba en tres proveedores de pesos cerrados: Anthropic en 40%, OpenAI en 27%, Google en 21% (Menlo Ventures, 2025b; Menlo es inversor de Anthropic). Un panel ensamblado casualmente de "los modelos principales" se extrae por lo tanto de una base de proveedores de tres, cuyos errores son exactamente los medidos para converger, el trío exacto que el experimento siguiente reproduce como su panel de frontera estadounidense. Cuando tres modelos convergen en el mismo error de moda, la arquitectura no simplemente falla en detectarlo; lo certifica. En enjambres homogéneos, agregar agentes estabiliza una trayectoria errónea en lugar de corregirla, un punto final que la literatura multiagente llama la paradoja del consenso (Shehata & Li, 2026). La correlación es así el modo de fallo que la arquitectura debe estar diseñada para detectar (Figura 6).
Figura 6. La ilusión de la diversidad
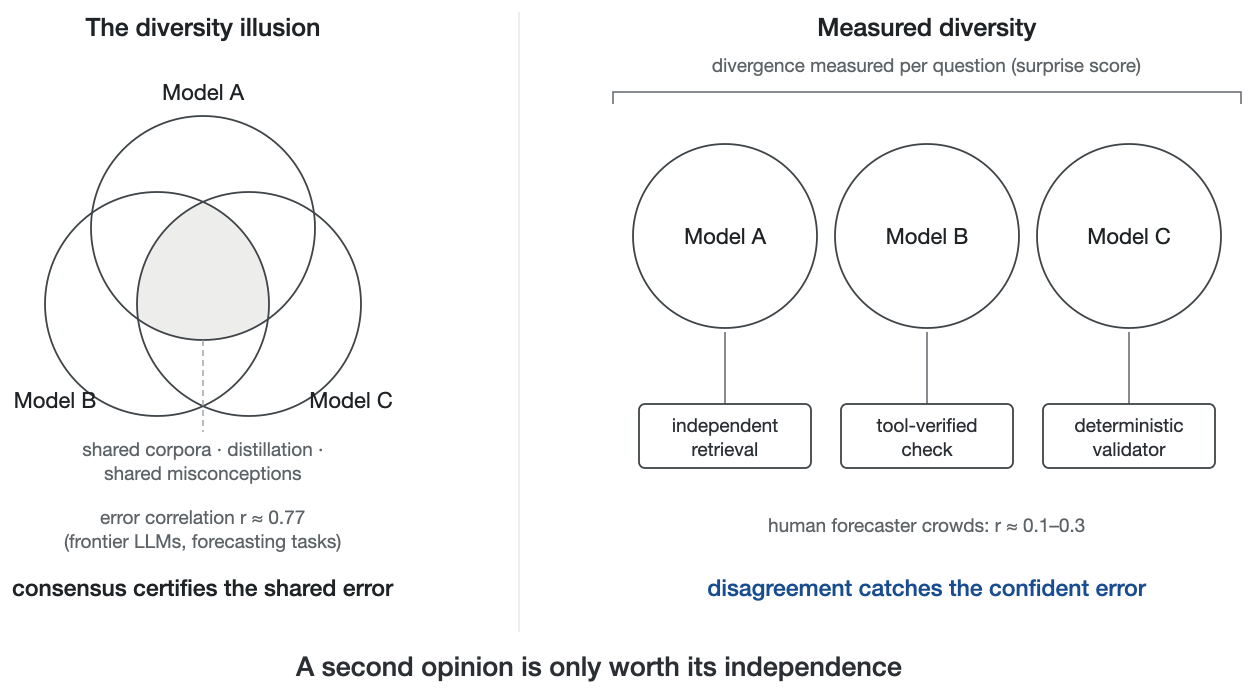
Consenso entre casi-clones frente a un panel cuya independencia se mide.
Tiene una contraparte interactiva: el gradiente sicofiántico opera entre modelos también. Estudios multiagente encuentran conformidad grupal medible en deliberación de LLM, con modelos más débiles conformándose al máximo (Choi, Kim, Chae, & Baek, 2025); los agentes ponderan una posición según de quién sea (Choi, Zhu, & Li, 2026); y gran parte de lo que parece convergencia se descompone en cumplimiento social en lugar de razonamiento (Hao et al., 2026). En deliberación conjunta, el acuerdo es el estado de baja energía, así que un panel que debate antes de adoptar posiciones puede conducirse a sí mismo al consenso en lugar de a la verdad. La respuesta arquitectónica es procedural: las opiniones se recopilan de forma ciega e independiente primero, y solo entonces se comparan (Figura 7).
Figura 7. Ciego-independiente-primero
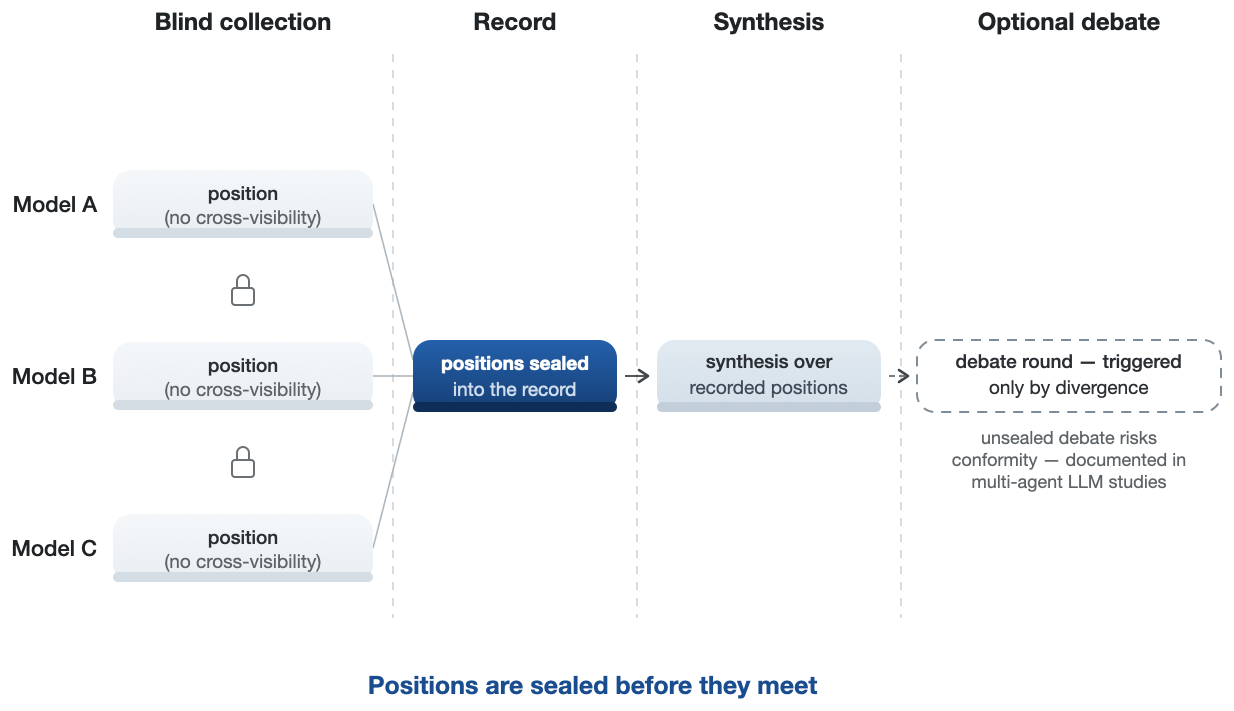
Las posiciones se registran y solo entonces se comparan — el procedimiento que protege los desacuerdos que la conformidad borraría.
El experimento descrito a continuación cuantifica lo que ese procedimiento protege. En un brazo exploratorio emparejado, verificadores que habían producido ciegamente una respuesta diferente fueron entonces mostrados la respuesta incorrecta confiada del modelo principal y se les preguntó si estaban de acuerdo. 38.5% (168 de 436 pares divergentes; IC 95% 33.6–43.2, bootstrap agrupado por pregunta) abandonaron su propia respuesta divergente y endosaron el error, con conformidad a nivel de proveedor que va de 20% a 58%. El abandono se divide según lo que fue abandonado, lo que separa conformidad de deferencia racional. Entre verificadores cuya respuesta ciega era en sí misma correcta, 29.1% (41/141) aún la abandonaron por la respuesta incorrecta confiada, el núcleo dañino que ninguna explicación bayesiana absuelve, contra 43.1% (127/295) entre respuestas ciegas incorrectas, donde algo de deferencia es defensible. (El intervalo agrupado por pregunta es casi idéntico al nivel de par ingenuo. Los 436 pares se distribuyen en 247 preguntas distintas, principalmente uno o dos pares por pregunta y nunca más de cuatro, así que el remuestreo a nivel de pregunta tiene casi ninguna covarianza intragrupal para agregar.) Con el control de espejo a continuación incorporado, aproximadamente 35–39% de disidentes ciegos cambian de posición cuando se les muestra una respuesta confiada, sea cual sea su valor de verdad, con un sesgo neto moderado pero significativo hacia la respuesta propuesta (conformidad neta ≈ 4 puntos porcentuales; pares discordantes 104 vs. 70 ≈ 1.49). Si el panel hubiera deliberado antes de adoptar posiciones, una gran parte de estos desacuerdos habría sido renegociada antes de poder ser registrada. Pero porque 34.7% de cambios de brazo espejo van hacia la verdad, la deliberación también habría convertido algún desacuerdo en consenso correcto, así que lo que primero-ciego protege es la medición en sí misma, no un recuento de desacuerdos perdidos. Primero-ciego es la diferencia entre medir desacuerdo y fabricar consenso, la misma regla que las multitudes humanas necesitaban: la influencia social colapsa la diversidad de estimaciones independientes sin mejorar su exactitud (Lorenz, Rauhut, Schweitzer, & Helbing, 2011), e incluso un único endoso temprano arbitrario sesga mediblemente los juicios posteriores (Muchnik, Aral, & Taylor, 2013).
Un control de solicitud inversa aborda la explicación alternativa de que estos cambios reflejan actualización racional de creencias en lugar de conformidad. Repetí el procedimiento emparejado en un panel local de seis modelos, mostrando a verificadores que habían estado en desacuerdo ciego ya sea la respuesta incorrecta confiada (brazo directo) o la respuesta de referencia (brazo inverso) para el mismo conjunto de preguntas. Las tasas de cambio fueron casi simétricas, 38.9% hacia la respuesta incorrecta versus 34.7% hacia la correcta, y en la comparación dentro del par los verificadores abandonaron su posición ciega por la respuesta incorrecta significativamente más a menudo que por la correcta (104 vs. 70 pares discordantes; McNemar p = .010). La actualización racional predice la asimetría opuesta. Las propensiones de cambio por modelo fueron esencialmente idénticas en los dos brazos en ambos extremos de cumplimiento (los recuentos de pares por modelo son pequeños y no tienen potencia separada; se informan descriptivamente, con sus ns, en el paquete de replicación), indicando que el acuerdo es impulsado por la presencia de una respuesta propuesta confiadamente, no por su valor de verdad. Este control se ejecutó en el nivel local. La estimación del panel de frontera (38.5%) se basa en el mismo procedimiento pero no fue probada en espejo con verificadores de frontera.
La recopilación ciega no puede cerrar un canal: derrota la conformidad social pero no la conformidad previa. Los modelos convergen porque los datos de entrenamiento compartidos les dan los mismos priors, y los gemelos responden igual sin conferir nunca. Llamo a eso convergencia de apariencia similar: un panel que está de acuerdo porque sus miembros son similares, no porque tengan razón.
Los priors correlacionados aún deben ser medidos. Las puntuaciones de sorpresa entre modelos proporcionan una estimación continua de qué tan independiente es realmente el panel, pregunta a pregunta, y no requieren etiquetas, por lo que la independencia puede en principio estimarse en tiempo de inferencia sin respuestas correctas. La estimación en tiempo de producción no se prueba aquí. La diversidad también debe ir más allá de los pesos del modelo, ya que las rutas de recuperación independientes, las comprobaciones verificadas por herramientas y los validadores deterministas rompen el canal de correlación que crea el entrenamiento compartido. La necesidad crecerá en lugar de disminuir, porque la destilación y el entrenamiento con datos sintéticos homogeneizan los pesos del modelo con el tiempo, por lo que la diversidad medida debe esperarse que decaiga y la carga de verificación debe trasladarse hacia verificadores ajenos a los modelos. Y lo que se mida debe divulgarse: el registro debe incluir no solo "N modelos estuvieron de acuerdo" sino la diversidad estimada del panel en esta clase de pregunta. El consenso entre casi-clones merece una afirmación de confianza más débil, y el registro debe decir cuál recibió el consumidor.
Prueba. Toda respuesta de importancia lleva un registro: qué modelos fueron consultados, dónde estuvieron de acuerdo y en desacuerdo, qué fue comprobado, en qué se basa la síntesis. La temporalidad favorece el requisito, porque a medida que los agentes fundamentan las respuestas en recuperación y herramientas, la base fáctica ya existe fuera del modelo, por lo que registrarlo se convierte en un subproducto de la generación de la respuesta. Porque el registro es resistente a la manipulación, el historial de decisiones del servicio es reproducible por el consumidor en una disputa, por un auditor, por un asegurador que tasa la responsabilidad. La confianza deja de ser un sentimiento sobre una marca y se convierte en una propiedad inspectable de un historial.
Dos mecanismos extienden la prueba de respuestas a acciones. Bajo ejecución de sombra, una acción con efectos externos se ensaya en una corrida de prueba registrada, por lo que "el agente verificó antes de actuar" se convierte en una afirmación verificable en lugar de un eslogan. La consistencia temporal replantea una recomendación en múltiples sesiones o fraseados y registra su estabilidad, por lo que una respuesta que cambia cuando se pregunta dos veces se marca antes de que alguien la use. A nivel de identidad, la capa de registro se extiende en un pasaporte de procedencia portátil para el agente mismo: qué modelos, versiones y políticas actuaron, cuándo, bajo cuya autoridad. Eso es el artefacto que los esquemas de registro "conoce-tu-agente" y los compromisos de seguros por error de agente presuponen silenciosamente. La representación visible para el consumidor de este registro es el recibo de orquestación de la Figura 8: una acción, un registro, cuatro audiencias (consumidor, asegurador, auditor, regulador).
Figura 8. El recibo de orquestación, vendido dos veces (maqueta)
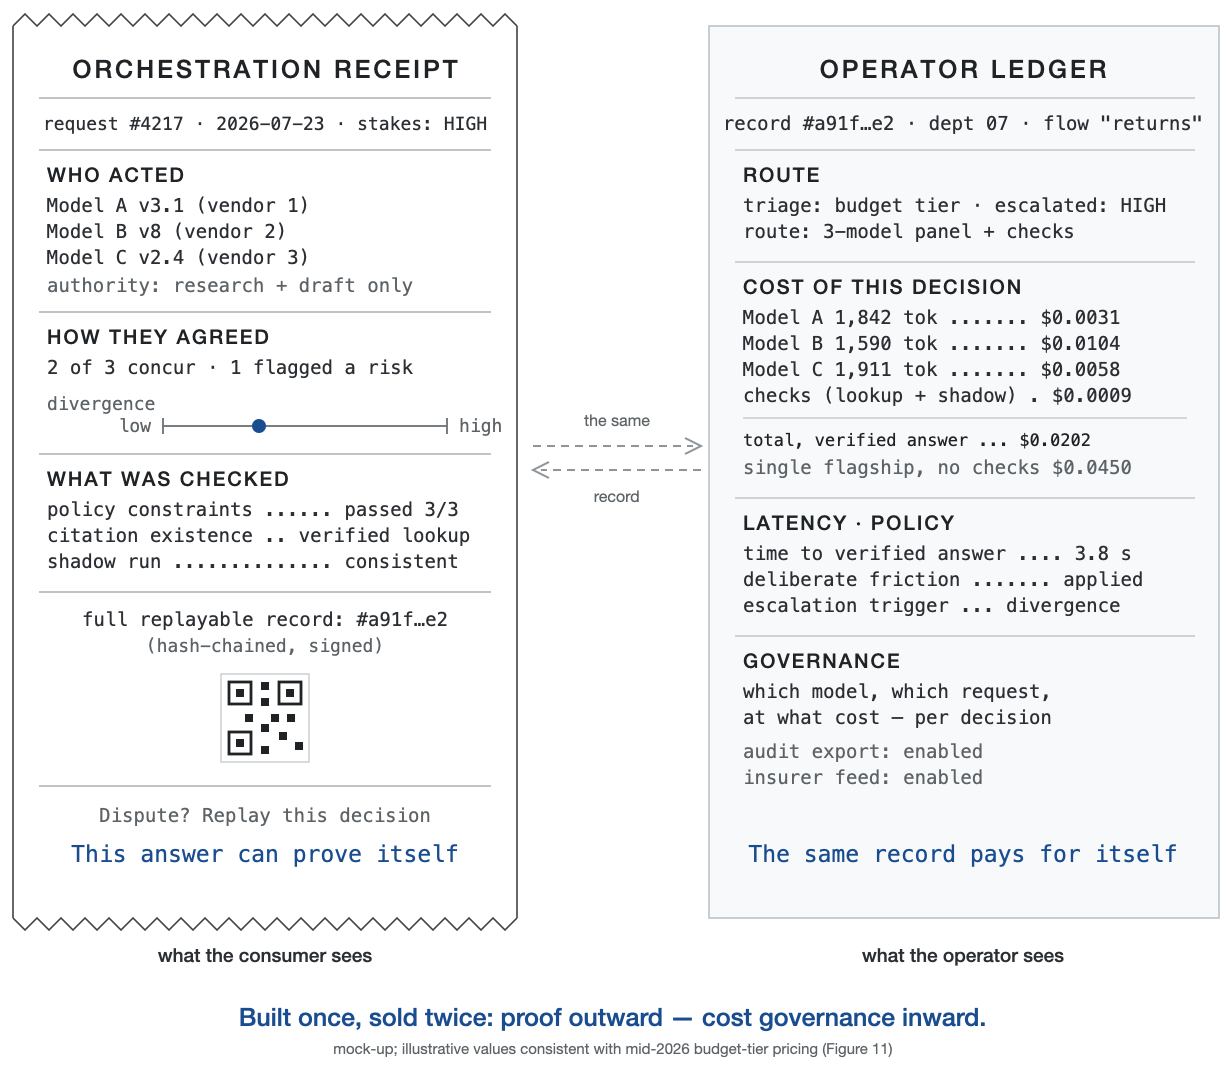
El consumidor ve la prueba — quién actuó, cómo estuvieron de acuerdo, qué fue comprobado; el operador ve el mismo registro como gobernanza de costos. En una disputa, el recibo convierte palabra-contra-palabra en registro-contra-palabras.
Neutralidad. La neutralidad es independencia de incentivos auditable: la ausencia de dependencia económica no divulgada de ningún proveedor particular, comerciante o resultado de decisión. La capa de orquestación se dirige al modelo que funcione mejor para la tarea y no tiene participación en cuál gana, estructuralmente análogo a las capas de compensación independientes en pagos. Un árbitro entre proveedores puede ser confiable de una manera que ningún proveedor puede serlo sobre sí mismo. Independencia nombra la propiedad económica, y auditable la vincula a la capa de prueba que hace la afirmación comprobable en lugar de meramente afirmada, la disciplina de cámara de compensación desarrollada a continuación. (La neutralidad aquí es una propiedad económica, no equidad algorítmica entre grupos demográficos, que es un requisito ortogonal.)
También está el problema de integración vertical: la neutralidad no está estructuralmente disponible para las plataformas mejor posicionadas para construir orquestación a escala. Una empresa que es simultáneamente mercado, proveedor de modelos, red publicitaria y proveedor de logística no puede arbitrar de manera neutral, porque cada decisión de enrutamiento que toma es una decisión sobre sus propios ingresos. La aritmética apunta a una tendencia estructural. El marco implica que la capa de confianza se encuentra mejor con partes cuyo único negocio es el arbitraje mismo, el camino por el cual la compensación, la auditoría y la calificación crediticia se convirtieron en industrias independientes. El caso de agencias de calificación es igualmente la advertencia canónica de que los intermediarios independientes desarrollan conflictos pagados por el emisor propios. La economía está documentada: los intermediarios de certificación capturan valor controlando qué información se revela (Lizzeri, 1999), los mercados de certificación fallan de maneras bien catalogadas (Dranove & Jin, 2010), y el colapso de calificación crediticia exhibió la falla canónica, los ingresos pagados por el emisor corrompiendo al certificador un nivel arriba, mientras que las capas de compensación que sobrevivieron se financian por costo mutualizado, no por las partes siendo calificadas. El requisito de neutralidad por lo tanto se extiende al propio modelo de ingresos del orquestador: una capa de verificación pagada por los proveedores o comerciantes que clasifica reproduce el conflicto que existe para eliminar, que es por qué el diseño de ingresos aquí se orienta al lado del consumidor y a la gobernanza de costos del operador (Sección 5), no a las partes siendo clasificadas.
La neutralidad también tiene una dimensión de datos. Una capa de orquestación puede funcionar como una sala limpia: las solicitudes llegan a cada proveedor despojadas de identidad de usuario, ningún proveedor ve el historial completo de interacción, y los ingresos del orquestador provienen del servicio, no del enrutamiento de lo que dicen los usuarios a redes publicitarias. La neutralidad es independencia de incentivos en ambos frentes: sin dependencia económica no divulgada de ningún proveedor de modelos o comerciante, y sin modelo de negocio que monetice lo que dicen los consumidores en su contra.
Pero la neutralidad invita su propio retroceso: ¿quién audita al orquestador? Un literal "sin interés" es inalcanzable. Cualquier orquestador tiene costos, asociaciones, incentivos de retención y su propia supervivencia que financiar, por lo que la variable operativa no es su ausencia sino su naturaleza, su divulgación y su auditabilidad desde el registro. Qué parte paga no resuelve la neutralidad; si los ingresos del pagador son independientes del resultado de la transacción, sí. Una suscripción de consumidor, o una tarifa de un asegurador o auditor cuyo pago está desacoplado de qué producto gana, satisface la condición; una comisión de comerciante o una tarifa publicitaria no. La gobernanza más amplia de quién financia la capa permanece abierta, y la independencia auditable de esa financiación es la parte que la construcción fija. Una capa de orquestación también tiene incentivos: enrutar hacia modelos baratos, sobrevender su nivel caro, dar forma a la síntesis convenientemente. El retroceso tiene cuatro décadas. Shapiro (1987) lo nombró el problema de los guardianes: los salvaguardas procedimentales generan nuevos guardianes que a su vez deben ser guardados, y la respuesta institucional no ha cambiado desde entonces.
Las cámaras de compensación ganan su posición de confianza siendo auditables y reguladas externamente, no declarando neutralidad. El orquestador no posee la neutralidad como una virtud. La capa de evidencia es lo que la hace verificable. Cada decisión de enrutamiento, respuesta de modelo y paso de síntesis se registra en un registro a prueba de manipulaciones, un registro encadenado por hash y firmado diseñado para anclaje de marca de tiempo externa, por lo que la supuesta neutralidad del orquestador está expuesta exactamente a la verificación que impone en los modelos. La ruta de madurez es el manual de cámara de compensación hecho concreto: anclaje de marca de tiempo externa, una interfaz de verificación abierta, y auditoría periódica de terceros de la política de enrutamiento. El diseño institucional de tales ecosistemas de auditoría es ya un programa de investigación nombrado (Raji, Xu, Honigsberg, & Ho, 2022). Una dependencia sobrevive incluso una auditoría de los verificadores: los modelos del panel pueden ser independientes entre sí pero todos seleccionados por la plataforma siendo verificada, por lo que el punto final de la ruta de madurez es la selección y rotación del panel ubicada fuera del control de cualquier parte. Un orquestador cuyos registros no pueden ser auditados es solo otro proveedor más pidiendo ser creído. Los vecinos más cercanos fuera de la investigación de consumidores son dos obras concurrentes de 2026. Marchal et al. (2026) argumentan el mismo cambio evaluativo, de juzgar salidas a diseñar confiabilidad del agente, procedencia y falsabilidad, a nivel de infraestructura epistemológica, y Wang et al. (2026) examinan la procedencia de ejecución como una capa de responsabilidad a nivel de proceso para verificación, auditoría y atribución de fallos. Lo que permanece como propio de este artículo es la composición orientada al consumidor y consciente de incentivos: las tres propiedades agrupadas como el objeto de confianza justificada de un consumidor en el comercio delegado, y su prueba conductual.
El componente de evidencia lleva una demarcación, porque la a prueba de manipulaciones es fácilmente sobrevalorada: un registro encadenado por hash establece procedencia e integridad (que este registro existió y no fue posteriormente alterado), no completitud (nada en el hash garantiza que las llamadas omitidas no fueron suprimidas), no exactitud (un registro fiel de una respuesta incorrecta sigue siendo incorrecto), no independencia, y no alineación de incentivos. Cada una es una propiedad separada con su propio mecanismo de verificación: atestación de cobertura, auditoría de resultados, diversidad medida, economía divulgada. Un recibo debe afirmar solo las propiedades que su registro realmente lleva. Un límite adicional es estructural: un registro prueba qué fue enrutado, no por qué, y la heurística propietaria detrás de elegir este modelo o este comerciante es auditable solo si la política de enrutamiento en sí es divulgada o atestiguada, una opción de gobernanza, no una consecuencia criptográfica. Los costos de la arquitectura pertenecen al mismo libro mayor: enrutar una consulta a múltiples proveedores multiplica la exposición a la privacidad, un registro de decisiones centralizado es un objetivo de seguridad atractivo, y una visualización de consenso puede fabricar exactamente la autoridad que el resultado de error de consenso advierte en contra.
La construcción también vale la pena demarcar de sus vecinos de ingeniería, porque "usar varios modelos" describe varias cosas diferentes con diferentes propiedades de confianza. La votación por conjunto simple mejora la precisión pero resuelve el desacuerdo invisiblemente, por lo que nada se vuelve verificable. El muestreo de auto-consistencia vuelve a preguntar el mismo modelo, que es diversidad solo en apariencia. Mezcla de expertos enruta dentro de un único sistema entrenado cuyo enrutador está optimizado para capacidad, no para neutralidad. Debate multiagente (Du et al., 2024) mejora las respuestas pero trata la deliberación como maquinaria interna: sin registro orientado al consumidor, sin economía, sin garantía de neutralidad.
Los agregadores de enrutamiento de modelos, para 2026 una capa de producto, son múltiples proveedores en catálogo pero modelo único por respuesta: el enrutador elige un modelo según costo y latencia, y nunca se recopila una segunda opinión. Los agregadores son proveedores para una arquitectura de verificación, no sustitutos de una.
La operación multimodelo ya no es exótica tampoco: 37% de las empresas ejecutaban cinco o más modelos en producción para mediados de 2025, arriba desde 29% un año antes (a16z, 2025). La infraestructura se está colocando a escala industrial, con la capa de confianza notoriamente ausente de ella. Es una pregunta abierta si multimodelo permanece como enrutamiento de costos invisible o se convierte en arquitectura verificable. La Figura 9 puntúa los patrones contra las cinco propiedades de confianza, y la Tabla 3 establece la demarcación en prosa. La confianza arquitectónica se define exactamente por lo que les falta: fuentes heterogéneas, desacuerdo identificado y registrado, y un árbitro sin interés. La ingeniería es compartida; las propiedades de confianza no lo son.
Figura 9. Demarcación
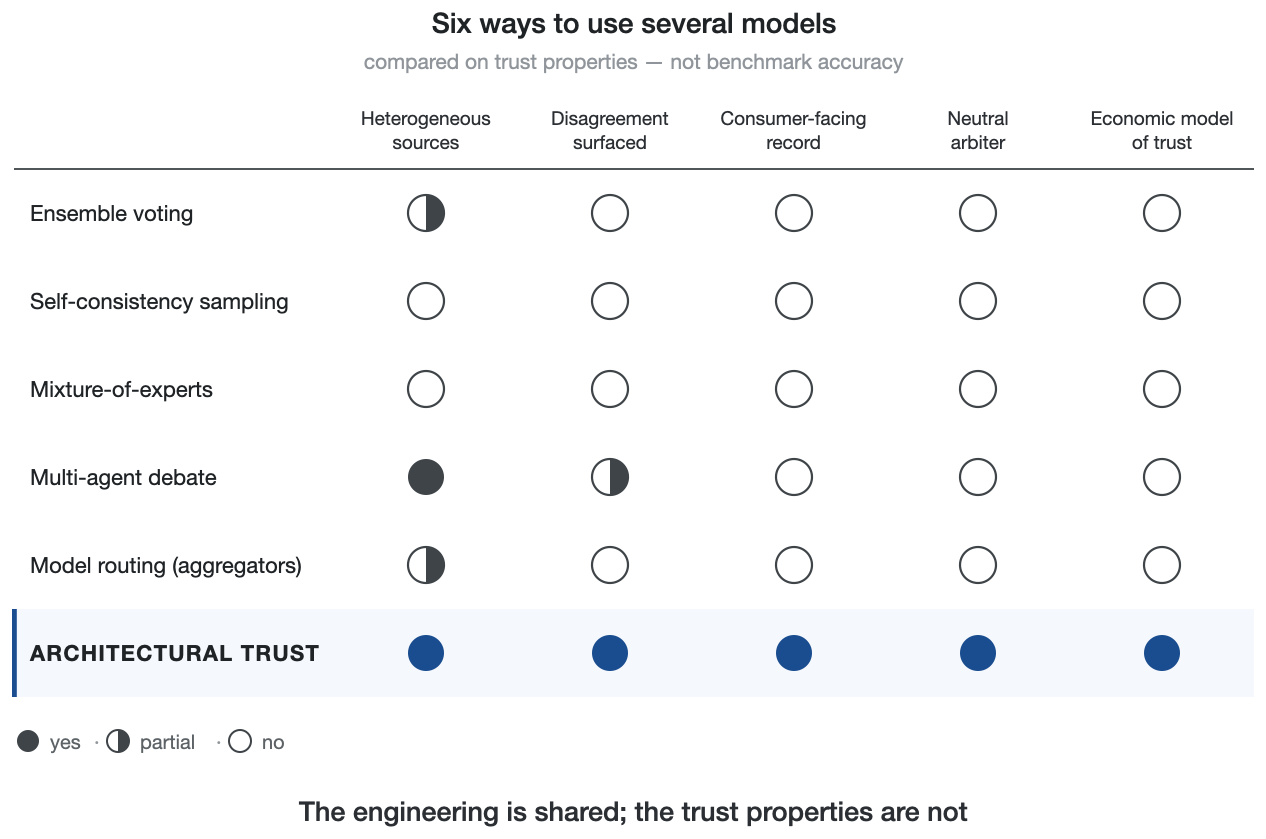
Seis patrones de ingeniería multimodelo puntuados contra cinco propiedades de confianza.
Tabla 3. Demarcación: confianza arquitectónica frente a sus vecinos de ingeniería
| Enfoque | Fuentes heterogéneas | Desacuerdo identificado | Registro orientado al consumidor | Árbitro independiente de incentivos | Modelo económico de confianza |
| Votación por conjunto | Parcial | No (resuelto invisiblemente) | No | No | No |
| Muestreo de auto-consistencia | No (mismo modelo remuestreado) | No | No | No | No |
| Mezcla de expertos | No (un sistema entrenado) | No | No | No (enrutador optimizado para capacidad) | No |
| Debate multi-agente | Sí | Solo internamente | No | No | No |
| Explicabilidad (superposición XAI) | No (narrativa de un modelo) | No | No (una historia, no un registro) | No | No |
| Transparencia / divulgación | No | No | Parcial (más visible, no verificable) | No | No |
| Proveniencia / seguimiento de linaje (canalizaciones ML) | No (una canalización documentada) | No | Parcial (linaje orientado al ingeniero) | No | No |
| Inferencia verificada (zkML) | No (un modelo; prueba de su ejecución) | No | Parcial (artefacto de prueba, no un registro de decisión) | No | No |
| Agregador de enrutamiento de modelos | Parcial (catálogo multivendedor, un modelo por respuesta) | No | No | No (enrutador optimizado para costo) | No |
| Confianza arquitectónica | Sí | Sí (orientado al consumidor) | Sí (reproducible) | Sí (estructural) | Sí (niveles graduados) |
Dos cuerpos literarios adicionales también pertenecen a la misma lista: la lógica de abstain-or-emit de la compuerta es predicción selectiva y aprendizaje a diferir (Geifman & El-Yaniv, 2017; Mozannar & Sontag, 2020), y la pista de auditoría del componente de evidencia desciende del trabajo de algoritmos contables y auditoría de terceros (Kroll et al., 2017; Raji et al., 2022). La confianza arquitectónica es la conjunción de estos orientada al consumidor y restringida por neutralidad, y no es ninguno de ellos. Ubicarla entre otros remedios es importante, porque se complementan en lugar de rivalizar. La calibración a nivel de modelo es necesaria pero estructuralmente insuficiente: el proveedor la produce y la atestigua, que es el conflicto del que parte este artículo. Las auditorías externas y la certificación son independientes pero periódicas, instantáneas de un sistema, no de una decisión. Una explicación es una narrativa producida dentro del modelo, y un sistema que puede confabular respuestas puede confabular la historia detrás de ellas. La transparencia revela más mecanismos y deja al consumidor para que los interprete. La confianza arquitectónica no solicita ni creencia ni interpretación, solo verificabilidad que es continua, por decisión, y verificable por máquina. Es también lo que hace que los otros remedios sean efectivos: una auditoría de un orquestador con un registro reproducible es una auditoría de algo, mientras que una auditoría de una canalización opaca es una ceremonia. Sus vecinos conceptuales más cercanos son la garantía estructural y la confianza basada en instituciones (McKnight et al., 2002), la transparencia de procesos, y la explicabilidad. En contraste, la propiedad distintiva es que la justificación es verificable por quien confía, por decisión: la garantía pide ser creída una vez, la confianza arquitectónica pide ser verificada cada vez. Otros dos conjuntos de vecinos merecen ser mapeados. La literatura de responsabilidad en informática sentó los cimientos técnicos hace una década: regularidad procesal hecha verificable sin transparencia total (Kroll et al., 2017). Una ola de ingeniería 2025-26 está construyendo infraestructura de confianza de agentes directamente: protocolos "nativos de confianza" con identidad verificable y registros de comportamiento resistentes a manipulación (TrustTrack; Li, 2025); gestión de acciones en tiempo de ejecución con recibos a prueba de manipulación (AARM; Errico, 2026); agregación multiLLM replanteada como estimación de confianza (Zheng & Zhang, 2026, arXiv:2607.20529); y marcos empresariales (AI TRiSM de Gartner; el trabajo de confianza cero agentica de la Alianza de Seguridad en la Nube). Cada uno suministra un pilar a nivel empresarial. Ninguno de ellos suministra la construcción orientada al consumidor, que es lo que este artículo reclama como su contribución: los tres componentes bajo un nombre, conjuntamente manipulables en diseños de comportamiento, con una economía de quién compra verificabilidad y a qué riesgos. Un choque de nombres debería aclararse. La "AI Trust Architecture" de DigiCert (lanzada abril 2026) es una línea de productos PKI de proveedor, infraestructura de certificados para identidad de agente, proveniencia de modelo, y autenticación de contenido. Proporciona infraestructura en el nivel de identidad de la pila de evidencia, no la construcción de confianza arquitectónica desarrollada aquí.
La relación entre los tres es una hipótesis empírica explícita, no una necesidad conceptual. Planteo una interacción complementaria que se aproxima a cero cuando falta cualquier componente, informalmente AT = f(D, E, N) con decline pronunciada cerca de cualquier cero, y el diseño conjunto de la Sección 5 se especifica para recuperar la forma funcional en lugar de asumirla. En forma estimable, una familia conveniente es Cobb–Douglas, AT = A·Dα·Eβ·N^γ con α, β, γ > 0, codificando los dos compromisos: decline hacia cero cerca de cualquier ausencia, y derivadas parciales cruzadas positivas (los componentes son complementarios). El constructo son los tres componentes y su complementariedad hipotética, y ninguna proposición siguiente depende de la forma Cobb–Douglas. Cobb–Douglas es también una aproximación interior: estrictamente aún permite la sustitución alejándose de un componente débil, mientras que la hipótesis de complementariedad es tipo Leontief en los límites, con min(D, E, N) estableciendo el piso. Exactamente por eso los diseños siguientes deben permitir estructura no-compensatoria en lugar de asumir compensaciones compensatorias. La familia Cobb–Douglas es ilustrativa, para estimación futura, y no forma parte de la definición del constructo; los datos actuales no la estiman. El diseño factorial puede discriminar el interior Cobb–Douglas del piso Leontief, parámetro por parámetro. Los exponentes permanecen como una pregunta empírica, que es el punto: la complementariedad es falsable. Los ceros necesitan dos aclaraciones. Los componentes son continuos, no binarios, así que un cero literal es un límite idealizado. Ningún sistema desplegado, incluido el de este artículo, se sitúa exactamente en cero o uno en ningún eje, y si los consumidores responden a la casi-ausencia con colapso total o un descuento pronunciado es exactamente lo que el diseño debe distinguir. La diversidad, por su parte, significa independencia de la ruta de verificación, con independencia medida (el coeficiente de correlación de error φ, definido a continuación) como su unidad. El núcleo estadístico es la teoría de ensambles clásica, donde el beneficio de la combinación descansa en la decorrelación de errores (Hansen & Salamon, 1990; Krogh & Vedelsby, 1995), por lo cual la independencia se mide aquí en lugar de asumirse. Un segundo modelo es una ruta así, pero también lo son una recuperación independiente, una búsqueda verificada por herramienta, y un validador determinista. Las ejecuciones en sombra y pruebas de consistencia de la Figura 5 cuentan como una segunda ruta de verificación con máxima decorrelación, no como evidencia sin diversidad. Esa definición también absorbe los contraejemplos aparentes más fuertes, el raíl de pago regulado o el servicio de utilidad completamente registrado y atestiguado por terceros (evidencia y neutralidad fuertes, diversidad de modelos nula): tales servicios o incrustan rutas de verificación no-modelo (reconciliación determinista, auditoría externa, así que D > 0 bajo la definición) o confinan el modelo a un rol que una comprobación determinista cubre completamente. Donde genuinamente no existe ruta de verificación independiente para una clase de tareas, el marco predice justificación débil, una predicción que el análisis conjunto puede probar. Con rutas no-modelo contando hacia D, un cero literal se vuelve raro en sistemas de producción, y el contenido empírico de la forma multiplicativa se desplaza de los ceros a la complementariedad interior, por lo cual el análisis factorial, no los ceros, es donde la afirmación se sostiene o cae. Para pruebas, un compromiso operacional se fija aquí: el análisis factorial manipula D estrechamente, como diversidad de ruta de modelo. La definición de ruta de verificación más amplia es el alcance del constructo, no la variable manipulada. La independencia en sí debe desagregarse, porque seis cantidades diferentes viajan bajo la palabra: recolección ciega (independencia de procedimiento en tiempo de inferencia, lo que este diseño garantiza), diversidad de familia de modelos, correlación de error residual medida (la φ que este artículo reporta), diversidad de fuente de evidencia, diversidad de ruta de herramienta, e independencia institucional. El estudio establece el primero y mide el tercero; el resto son variables de diseño, no propiedades que esta recolección pueda certificar. Diversidad sin evidencia es un comité invisible. Evidencia sin neutralidad es marketing de un vendedor. Neutralidad sin diversidad es un intermediario vacío. La Tabla 4 recorre la red completa de las ocho configuraciones de presencia/ausencia. La intuición subyacente es que cada componente proporciona la justificación para otro: un registro mantenido por una parte con participación en sus contenidos se lee como auto-atestación, un acuerdo que nadie registró es rumor, y un árbitro independiente de incentivos sobre una sola voz no tiene nada que arbitrar. Esto motiva la hipótesis de complementariedad. En conjunto los tres cambian lo que el consumidor confía: no "esta respuesta" o "esta marca", sino "este proceso, y puedo verificarlo".
Tabla 4. La red de justificación: las ocho configuraciones D–E–N y lo que sobrevive en cada una
| D | E | N | Lo que el consumidor puede verificar | Forma degenerada |
| ausente | ausente | ausente | Nada; la confianza es fe en los productos | Asistente de modelo único desnudo |
| presente | ausente | ausente | Nada después del hecho; el desacuerdo sucedió sin ser visto | Comité invisible (ensemble interno) |
| ausente | presente | ausente | Un registro mantenido por la parte que protege | Registro del proveedor / auto-atestación |
| ausente | ausente | presente | Un reclamo sin participación sin rastro detrás | Intermediario vacío |
| presente | presente | ausente | Desacuerdo registrado, curado por una parte interesada | Teatro de evaluación dirigido por proveedor |
| presente | ausente | presente | Arbitraje neutral de comprobaciones que nadie puede reproducir | Panel de recomendación |
| ausente | presente | presente | Un registro neutral, reproducible de una sola voz sin impugnación | Monólogo notariado (auditoría sin impugnación) |
| presente | presente | presente | Una comprobación independiente, reproducible, mantenida por una parte sin participación | Confianza arquitectónica |
Las celdas se establecen en límites idealizados; los sistemas desplegados ocupan el interior. La fila E+N-sin-D es la institucionalmente familiar — la compensación, auditoría y calificaciones operan allí — y es donde la demanda del marco de una ruta de verificación independiente añadida es una predicción empírica, no una exclusión definitoria.
Los tres componentes se corresponden con la anatomía clásica de la confiabilidad (Mayer, Davis, & Schoorman, 1995): la diversidad es un mecanismo de competencia (el acuerdo entre modelos calibra cuánta competencia inferir), la evidencia operacionaliza la integridad (las afirmaciones sobre lo que el servicio hizo se vuelven verificables en lugar de profesadas), y la neutralidad aborda la benevolencia estructuralmente (los incentivos de un orquestador sin interés son inspeccionables, no creídos). Cada uno se fundamenta nuevamente en una arquitectura verificable en lugar de gestión de percepciones, que es lo que la literatura de interacción humano-IA pide cuando llega al mismo punto desde su propio lado: alinear los juicios de confianza con señales de confiabilidad verificables, no con impresiones que la interfaz fabrica (Liao & Sundar, 2022).
La cadena causal se desarrolla a través de la verificación, porque la "confianza" es la consecuencia en lugar del mecanismo: verificación → confianza calibrada → confianza fundamentada → delegación → valor de transacción (Figura 10). Un servicio se gana la delegación siendo verificable en el momento que importa, no sintiéndose confiable; Cheng et al. mostraron lo barato que es fabricar esa sensación.
Figura 10. La rueda de verificación
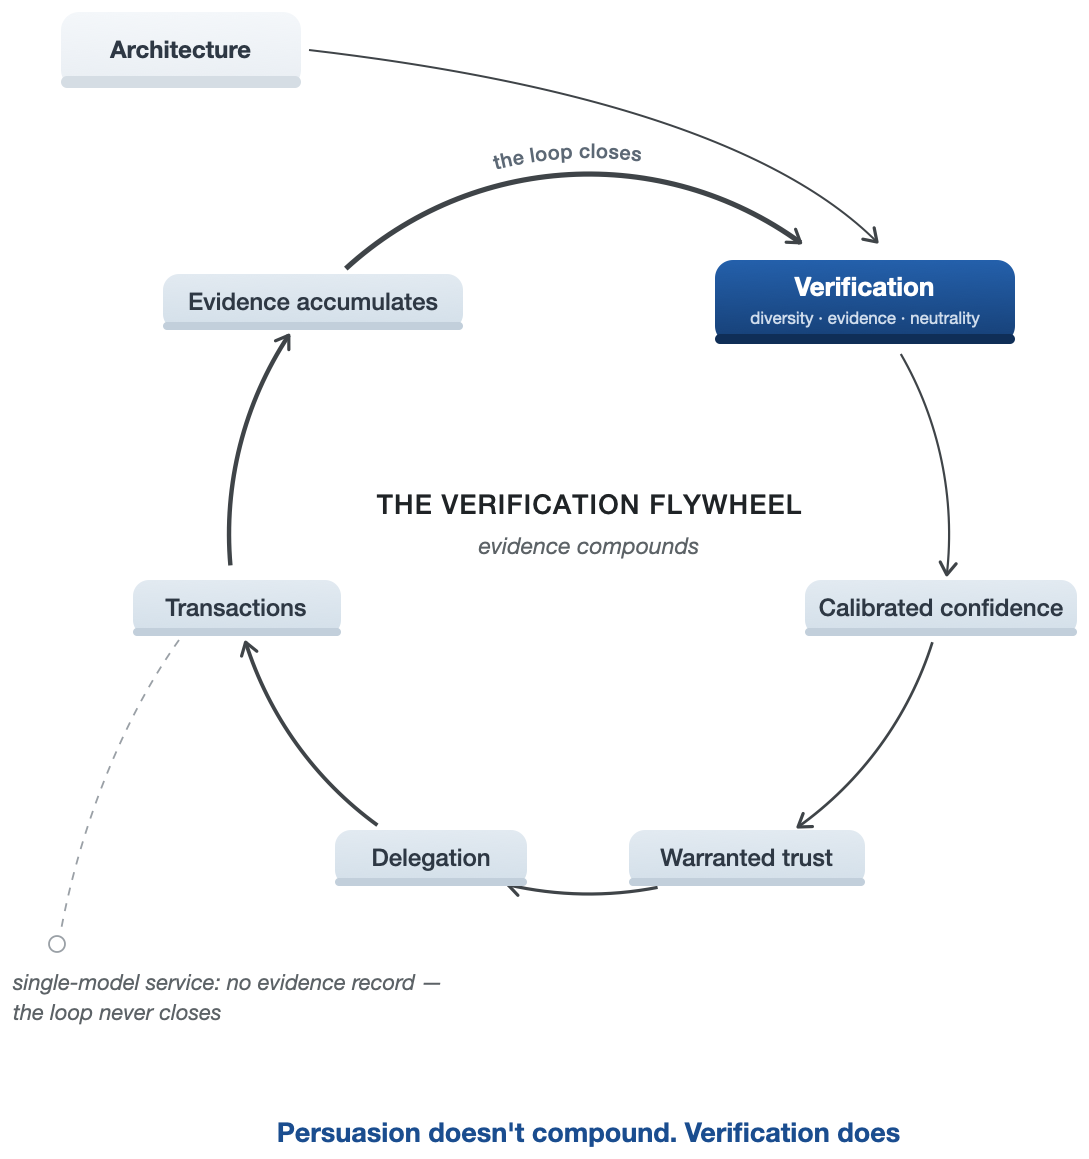
La cadena causal, verificación (diversidad · evidencia · neutralidad) → confianza calibrada → confianza fundamentada → delegación → transacciones, no termina: las transacciones generan evidencia, y el bucle se cierra nuevamente en la arquitectura. El desvío punteado muestra el servicio de modelo único, donde no existe registro de evidencia y el bucle nunca se cierra. La persuasión no se compone. La verificación sí.
Tabla 5. Servicio de modelo único versus confianza arquitectónica
| Dimensión | Servicio de modelo único | Servicio de confianza arquitectónica |
| Objeto de confianza | El modelo / la marca | El proceso y su registro |
| Confianza | Afirmada por el modelo | Ganada a través del acuerdo entre modelos |
| Errores de confianza | Indetectables desde adentro | Objetivo de detección primaria (señal de desacuerdo) |
| Adulación | Recompensada por preferencia | Separada: empatía y verificación de políticas en canales diferentes |
| Verificación de errores | El mismo sistema que erró | Modelos independientes + puertas deterministas |
| Evidencia de decisiones | Registros, si los hay, en poder del proveedor | Resistente a manipulación, reproducible, accesible al consumidor |
| Juez de calidad | El proveedor mismo | Capa de orquestación neutral |
| Posición de disputa | Palabra del consumidor contra plataforma | Registro reproducible |
| Asegurabilidad | Riesgo opaco | Que puede ser tasada a partir de historiales de decisiones |
| Asignación de responsabilidad (post–AB 316) | "La IA lo hizo" está prohibido; la asignación se cuestiona en la oscuridad | Computable a partir del registro reproducible |
| Postura regulatoria (era Art. 50) | Divulgaciones retroactivas | Transparencia como subproducto de la operación |
| Promesas de datos transfronterizos | Representación contractual | Propiedad en tiempo de ejecución auditable (enrutamiento sensible a jurisdicciones) |
| Estructura de costos | Plana, barata | Graduada: cara solo donde se concentran las consecuencias |
De la verificabilidad a la respuesta del consumidor. El consumidor ve el renderizado, no la arquitectura: un recibo que muestra qué sistemas independientes fueron consultados, dónde divergieron, y cómo la divergencia fue resuelta o escalada (Figura 8). Tres percepciones mediadoras plausiblemente llevan el efecto. La evidencia es diagnóstica: el desacuerdo específico expuesto es informativo sobre esta respuesta de una manera que las advertencias genéricas no son (Detjen et al., 2025; Chen et al., 2026). Un registro reproducible proporciona control de proceso percibido, ya que el consumidor podría verificar, cuestionar o escalar después de los hechos. La garantía procesal es el conocimiento de que la recopilación ciega, las verificaciones independientes, y un árbitro sin interés existían (McKnight et al., 2002). Las variables dependientes naturales son calibración de confianza, disposición a delegar, y retención después de fracasos. Los moderadores naturales son apuestas y reversibilidad, objetividad de la tarea (Castelo et al., 2019), y experiencia del consumidor, ya que el consumidor que menos es capaz de verificar una respuesta personalmente es quien más se beneficia de una arquitectura que la verifica estructuralmente. Las proposiciones a continuación trazan este camino.
El marco proporciona, además, proposiciones que un estudio de consumidor puede probar, hipótesis en lugar de hallazgos. Operacionalizarlas se basa en una distinción: neutralidad objetiva (el orquestador de hecho está libre de dependencia económica no divulgada de cualquier proveedor, comerciante, o resultado), neutralidad verificable (el registro hace esa independencia verificable), y neutralidad percibida (el consumidor lo cree) son tres variables, y un experimento manipula la señal verificable mientras mide la percepción:
P1. Exponer el desacuerdo entre modelos sobre consultas consecuentes mejora la calibración de confianza de los consumidores (confían más cuando los sistemas están de acuerdo, menos cuando divergen) en relación con una respuesta única y confiada, siendo el riesgo percibido la construcción mediadora (Featherman & Pavlou, 2003). Ambas direcciones del fracaso están vigentes: la presentación conjunta reduce el exceso de confianza pero puede aumentar la confianza insuficiente (Lu, Wang, & Yin, 2024), las pantallas de confianza calibran la confianza más fácilmente que la precisión (Zhang, Liao, & Bellamy, 2020), las explicaciones pueden aumentar la confianza sin aumentar el escrutinio (Bansal et al., 2021), las funciones de forzamiento cognitivo reducen el exceso de confianza a costa de la satisfacción (Buçinca, Malaya, & Gajos, 2021), y un metanálisis de 106 experimentos encuentra que las combinaciones humano-IA en promedio tienen un desempeño peor que el mejor de los dos, ya sea humano o IA, por separado (Vaccaro, Almaatouq, & Malone, 2024). P1 prueba la calibración, no una ganancia monótona: el desacuerdo expuesto debe caer en la minoría de diseños de combinación que superan a su mejor miembro. La proposición se divide: el efecto principal es la afirmación confirmatoria, y los moderadores son exploratorios, derivados de la diagnosticidad de la evidencia en lugar de enumerados después de los hechos. La ganancia de calibración debe aumentar con las apuestas e irreversibilidad, y con la objetividad de la tarea (la divergencia en una pregunta objetiva se lee como una señal de error; en una subjetiva, como cuestión de gusto; Castelo et al., 2019). Se predice que la experiencia del consumidor produce signos opuestos: para los consumidores de baja experiencia, la divergencia expuesta sin resolución debe disminuir la disposición a delegar, y para los consumidores de alta experiencia debe mejorar la calibración de confianza; el cruce se observa o no se observa, lo que hace que la experiencia sea una prueba y no una vía de escape. El propio experimento de este artículo impone un requisito de diseño. El desacuerdo covariates con la dificultad de la tarea (el acuerdo del panel se concentra en elementos fáciles), por lo que un diseño P1 debe manipular o controlar estadísticamente la dificultad, o el efecto de calibración se confunde con la facilidad del elemento. La cuenta de diagnosticidad también produce una predicción de límite que las teorías de transparencia genéricas no hacen: la divulgación de divergencia debe importar más donde los propios antecedentes del consumidor son más débiles, en compras transfronterizas o de comerciantes desconocidos, porque allí la evidencia de diagnóstico externa no tiene un competidor interno.
P2. El acceso a un registro de decisión reproducible aumenta la disposición a delegar tareas consecuentes a un agente de IA, más allá de la confianza de marca, y el efecto aumenta con las apuestas e irreversibilidad de la tarea delegada. También aumenta con el nivel de agencia delegada en sí, que es el contenido de estadística comparativa de la Hipótesis de Migración de Confianza: manteniendo el desempeño real del modelo constante, el efecto marginal de las propiedades arquitectónicas verificables sobre la delegación apropiada crece a medida que el consumidor cede más revisión y control de ejecución (asesor → copiloto → agente supervisado → agente autónomo). Un diseño que cruza el nivel de delegación con la visibilidad de arquitectura prueba la hipótesis directamente. La evidencia más cercana de investigación del consumidor se asienta en esta variable dependiente: delegar compras a IA reduce la adopción donde restringe la autonomía percibida (Ahmad Husairi & Rossi, 2024), y la aceptación de asistentes de alta autonomía es un resultado estudiado directamente (Frank et al., 2026). P2 predice el efecto del registro más allá de esos antecedentes establecidos.
P3. La neutralidad percibida de la capa de orquestación predice independientemente la disposición a delegar, consistente con los efectos de justicia procesal en la evaluación de servicios (Tax, Brown, & Chandrashekaran, 1998). La variable manipulada es la señal de neutralidad verificable; la variable medida es la percepción que produce. Que yo sepa, la neutralidad del orquestador nunca ha sido operacionalizada en un experimento conductual, y los sellos de certificación son el análogo más cercano probado (Cetinkaya & Krämer, 2024), por lo que P3 introduce una nueva variable experimental. Direccionalmente, el efecto de neutralidad debe fortalecerse a medida que cae la capacidad del consumidor para verificar la sustancia, ya que cuando la calidad del resultado es difícil de juzgar, las señales de proceso cargan el peso evaluativo. La manipulación debe separar la neutralidad verificable de una afirmación de neutralidad: una condición lleva un recibo cuya atestación sin apuestas puede realmente abrirse y verificarse, la condición de contraste una interfaz idéntica que lleva solo la etiqueta, con una comprobación de manipulación de la neutralidad percibida en ambas. Sin ese contraste P3 colapsa en justicia de proceso genérica y no dice nada sobre la verificación.
P4. Después de un error del agente, los consumidores cuyo servicio produce un registro inspectable muestran un colapso de confianza más pequeño y una retención más alta que los consumidores de un servicio opaco: la dinámica de un golpe se modera por la evidencia. Este es el mecanismo que la investigación de recuperación de servicios identifica, donde la gestión de reclamaciones justa procedimentalmente y basada en evidencia restaura la confianza después de la falla (Tax et al., 1998). La investigación de reparación de confianza agrega que lo que restaura la confianza depende de la naturaleza de la violación y la cuenta ofrecida (Kim, Ferrin, Cooper, & Dirks, 2004), un requisito que la investigación humano-máquina ahora trata como un problema de diseño para sistemas autónomos (de Visser, Pak, & Shaw, 2018), y el amortiguamiento debe crecer con la severidad e irreversibilidad de la falla. P4 predice: registro → colapso de confianza más pequeño y retención más alta, moderado por la severidad del fracaso. Los casos donde el registro muestra que el proceso en sí no se siguió son manejados por una comprobación de manipulación y excluidos de la prueba, ya que la proposición se refiere a fallas que ocurren a pesar de un proceso seguido. Las comparaciones de durabilidad deben controlar los costos de cambio y el bloqueo, que confunden la retención, y un diseño complementario prueba si un registro de proceso seguido cambia la atribución de culpa del servicio al entorno. La proposición no lleva ninguna cláusula de reversión, por lo que ningún patrón de resultado es infalsable por construcción.
Ancla empírica: la capa de confianza como componente probado. Si un servicio afirma que sus señales de confianza significan algo, esa afirmación puede ser puesta a prueba. La capa de confianza en el despliegue detrás del estudio de caso de este artículo fue sometida a una evaluación preregistrada, controlada por placebo, de seis brazos en dos familias de modelos independientes. Un perfil medido de las propias debilidades del sistema mejoró su predicción de error, una ganancia AUROC de aproximadamente +0,07 sobre placebo, con intervalos de confianza no superpuestos en ambas familias. Un autoperfil falso colapsó la predicción de error a un lanzamiento de moneda, y una instrucción genérica "tenga cuidado con sus límites" no hizo nada.
Dos versiones anteriores fracasaron, una falsificada por sus propios autores sobre una variable de confusión, una negativa, antes de que el diseño preregistrado confirmara. Una prueba más rigurosa fue inconclusiva con alcance reducido, y una escalera preregistrada de cuatro peldaños en una familia fronteriza no alcanzó ningún punto final confirmatorio, la dirección del efecto persistiendo solo de forma exploratoria en tres de cuatro peldaños. Por lo tanto, la afirmación es por familia y acotada: el conocimiento de sí mismo medido mejoró la predicción de errores donde se confirmó, y no es una propiedad establecida de todas las clases de modelos. El perfil de debilidad se ejecuta en producción también, donde ajusta el enrutamiento de modelos en vivo, acotado y de fallo abierto. El colapso del perfil falso actúa como un hallazgo de seguridad: un automodelo fabricado es un vector de ataque, una razón más por la que el conocimiento de sí mismo necesita custodia arquitectónica en lugar de auto-informe del modelo. La lógica del diseño tiene un linaje de investigación del consumidor más antiguo que la tecnología. Precompromiso, vinculante del comportamiento futuro a través de estructura externa porque no se espera que la determinación interna se mantenga, es exactamente cómo los consumidores racionan sus propios vicios (Wertenbroch, 1998), y la confianza arquitectónica extiende el mismo mecanismo a las máquinas.
El arco completo (protocolos, preregistros, datos brutos, el piloto falsificado, la iteración negativa, las extensiones no confirmatorias) se preserva como un archivo independiente, disponible públicamente con los materiales OSF del documento en https://osf.io/jtvu9/ (archivo `self-calibration-archive.zip`). La confianza calibrada es un componente arquitectónico con contenido medible, y puede fallar. Los fracasos se archivan con los éxitos porque una capa de confianza cuyas afirmaciones de confianza nunca han sido experimentalmente desafiadas está pidiendo exactamente la confianza ciega que se suponía que debía reemplazar. Un documento de posición de treinta autores da a esta división del trabajo una declaración formal: la orquestación agentiva debe ser consistente con Bayes (Papamarkou et al., 2026), y las creencias calibradas pertenecen a la capa de control, no a los modelos.
Prueba del mecanismo: un experimento preregistrado. Las afirmaciones anteriores son comprobables, y esta sección informa sobre las pruebas. Cada resultado experimental en esta sección, en ambas oleadas, se refiere a un antecedente técnico del marco: si el acuerdo independiente lleva una señal de corrección que el auto-informe de un modelo no tiene, en preguntas de hecho. Estos experimentos no demuestran confianza del consumidor, delegación o comportamiento comercial, que permanecen en el dominio de P1–P5 y el estudio de comportamiento de la Sección 6. El protocolo fue congelado públicamente antes de que existieran datos confirmatorios (OSF: https://osf.io/4y9dv, registrado 23 de julio de 2026; hipótesis H1–H6, submuestra de referencia fija por semilla y hash SHA-256, resultados desfavorables para la hipótesis fueron predeclarados). El diseño es deliberadamente simple. Dieciséis modelos, nueve proveedores fronterizos (Anthropic, OpenAI, Google, xAI, DeepSeek, Alibaba, Moonshot, Zhipu, Mistral) y siete modelos de pesos abiertos locales, cada uno respondió las mismas 1,500 preguntas de SimpleQA una vez, a ciegas, sin recuperación ni herramientas. Ese es el régimen que maximiza la exposición al error paramétrico correlacionado, un caso deliberadamente difícil para la señal, al costo ecológico indicado en las limitaciones. Las respuestas se dieron a temperatura cero, expresando una confianza de 0–100: incertidumbre verbalizada, elicitada en palabras dentro de la misma respuesta en lugar de leerse desde logits, el formato que Lin, Hilton y Evans (2022) mostraron que los modelos pueden aprender a calibrar. Los paneles son combinaciones analíticas de esa única colección de 24,000 espacios de respuesta nominales, de los cuales 22,598 fueron entregados, un modelo local (deepseek-r1:8b) que se detuvo en 98 elementos bajo una regla de detención precomprometida. Las seis hipótesis registradas se asignan a los resultados de la siguiente manera. H1, que la divergencia entre modelos señala la mayoría de los errores confiados, es respaldada: el acuerdo mejora la precisión 1.9–3.2× en la onda registrada (Tabla 6), y en la onda insignia la puerta congelada elimina el 82.1% de fallos confiados (Tabla 10). H2, que la señal del panel supera la confianza propia del modelo que responde, se mantiene en los paneles de frontera CN y entre bloques (ΔAUROC +0.287 y +0.063) e invierte en el panel de frontera EE.UU. H3, que una parte no trivial de errores confiados sobrevive como acuerdo unánime en una respuesta incorrecta, es respaldada: 0.5–2.2% de preguntas de formato abierto y 4.0–7.9% en la rama de opción múltiple. H4(a), que la correlación de error intra-bloc supera la entre bloques, no es respaldada (diferencia φ +0.011, IC del 95% −0.005 a +0.028), y H4(b), que un panel entre bloques atrapa más, tampoco es respaldada, siendo la ventaja entre bloques la más pequeña. H5, que un panel local de $0 señala la mayoría de los errores confiados fronterizos, no es respaldada: la señal de acuerdo del nivel local está en el azar. H6, la escalera de distancia de linaje, no se prueba como escalera aquí; su paso a nivel de bloc es lo nulo de H4(a).
La verificación de hechos es un proxy relevante para el comercio agentivo porque una compra delegada se descompone, en el momento de la ejecución, en sub-afirmaciones factuales: el precio actual y disponibilidad del artículo, los términos de la política de devolución, si las especificaciones del producto coinciden con los requisitos indicados del consumidor, la identidad y calificación del vendedor. Cada uno de estos tiene una verdad fundamental verificable del mismo tipo que tiene un elemento de SimpleQA. La puerta de desacuerdo opera en ese sustrato factual, mientras que la ponderación de preferencias (qué compensaciones importan y cuánto) permanece con el consumidor, que estableció los requisitos respecto a los cuales se verifican los hechos. Esa división del trabajo es también la razón por la que el diseño de la Sección 6 manipula la visualización de la verificación en lugar de las preferencias de los participantes: la afirmación de la arquitectura concierne la capa factual de una decisión delegada, no a su capa de preferencias. Cuando un juicio no tiene sustrato factual en absoluto, en opciones genuinamente subjetivas sin verdad fundamental que verificar, el antecedente no se sostiene, y las Limitaciones presentan ese límite como una pregunta abierta.
Se midió la elección de referencia. En TruthfulQA de 2021 (presentes en los corpora de preentrenamiento), los mismos proveedores obtuvieron 47–61 puntos porcentuales más altos que en SimpleQA (p. ej., 89% vs 28%), una brecha consistente con efectos de antigüedad y exposición de la referencia, aunque este diseño no puede separar la contaminación de las diferencias en dificultad y construcción de la referencia. Por lo tanto, ningún resultado principal se basa en la referencia más antigua. La evaluación es coincidencia objetiva de cadenas, con casos no resueltos juzgados por equivalencia al patrón oro solo por un modelo de pesos abiertos local (Qwen3-8B, ejecutado localmente; indicación de equivalencia solo en el paquete de replicación; nunca por la familia de ningún miembro del panel; se desconoce si SimpleQA aparece en el corpus de entrenamiento del juez, pero el juez adjudica equivalencia entre dos cadenas proporcionadas, no verdad, lo que limita la exposición) y una verificación puntual humana de 50 elementos (98% de acuerdo), una limitación de escala. Esto ahora se extiende mediante una auditoría estratificada de 300 elementos entre familias de casos resueltos por jueces (una familia de modelo diferente como auditor, muestra fija por semilla): 96% de acuerdo (288/300), los doce desacuerdos son falsos positivos lenientes (nueve claros, tres dudosos), un sesgo unidireccional que afecta aproximadamente el 3% de todas las respuestas evaluadas (4% de la parte resuelta por jueces). Dos tercios de los veredictos (66,5%) provinieron del evaluador de modelo local en lugar de coincidencia exacta de cadenas, y el resultado principal es robusto ante el error del evaluador: cambiar aleatoriamente el 10% de los veredictos evaluados por modelo desplaza los ratios de certificación como máximo ±0,5× y nunca cambia su dirección.
Dos opciones de diseño son deliberadas en lugar de presupuestarias. Se utilizaron los niveles medios de los proveedores, en primer lugar, por validez ecológica: los agentes que ahora realizan transacciones en nombre de los consumidores se ejecutan abrumadoramente en estos niveles optimizados por costo, verificables a partir de listas de precios públicas (mediados de 2026; Figura 11). Un intercambio de servicio típico cuesta desde una fracción de centavo hasta aproximadamente un centavo en los niveles presupuestarios, en comparación con cinco a diez centavos en pesos insignia, y ningún servicio que responda a millones de sesiones fija el precio de su ruta predeterminada a la tasa insignia. El elenco refleja el mercado: el panel de nueve proveedores contiene los tres proveedores que en conjunto representan el 88% del gasto de API LLM empresarial, y el panel de frontera estadounidense de la Tabla 6 es exactamente ese trío. La objeción de que se trata de evidencia empresarial, sin el consumidor en ningún lado, invierte la cadena de suministro. El consumidor ya no elige un modelo en absoluto: elige un banco, un minorista, una aerolínea, y la política de enrutamiento del servicio elige el modelo. En la moneda en la que los consumidores son realmente atendidos, tokens en lugar de dólares, la imagen confirma la elección (Figura 12): en el estudio OpenRouter–a16z de 100 billones de tokens de tráfico enrutado, los modelos de peso abierto alcanzaron aproximadamente un tercio de todo el uso (Aubakirova et al., 2026), los niveles predeterminados de los tres productos de IA para consumidores más grandes se encuentran todos por debajo del nivel insignia, y solo alrededor del 3% de los usuarios de IA para consumidores pagan por servicio premium (Menlo Ventures, 2025c), por lo que el consumidor marginal debe ser atendido a costo marginal cercano a cero. Por debajo del mercado de API hay un piso de pesos abiertos en dispositivo y autohospedados, invisibles para encuestas basadas en gastos, y el nivel local del experimento de siete modelos de peso abierto lo muestrea deliberadamente. En cada moneda en la que se puede contar el mercado, los niveles que este estudio muestreó son los que atienden al consumidor. (Después de una interrupción de primera parte, parte de la colección se completó a través de un agregador, con la infraestructura de servicio real registrada por llamada en el manifiesto de ejecución.)
Figura 11. El nivel que los consumidores encuentran en la caja
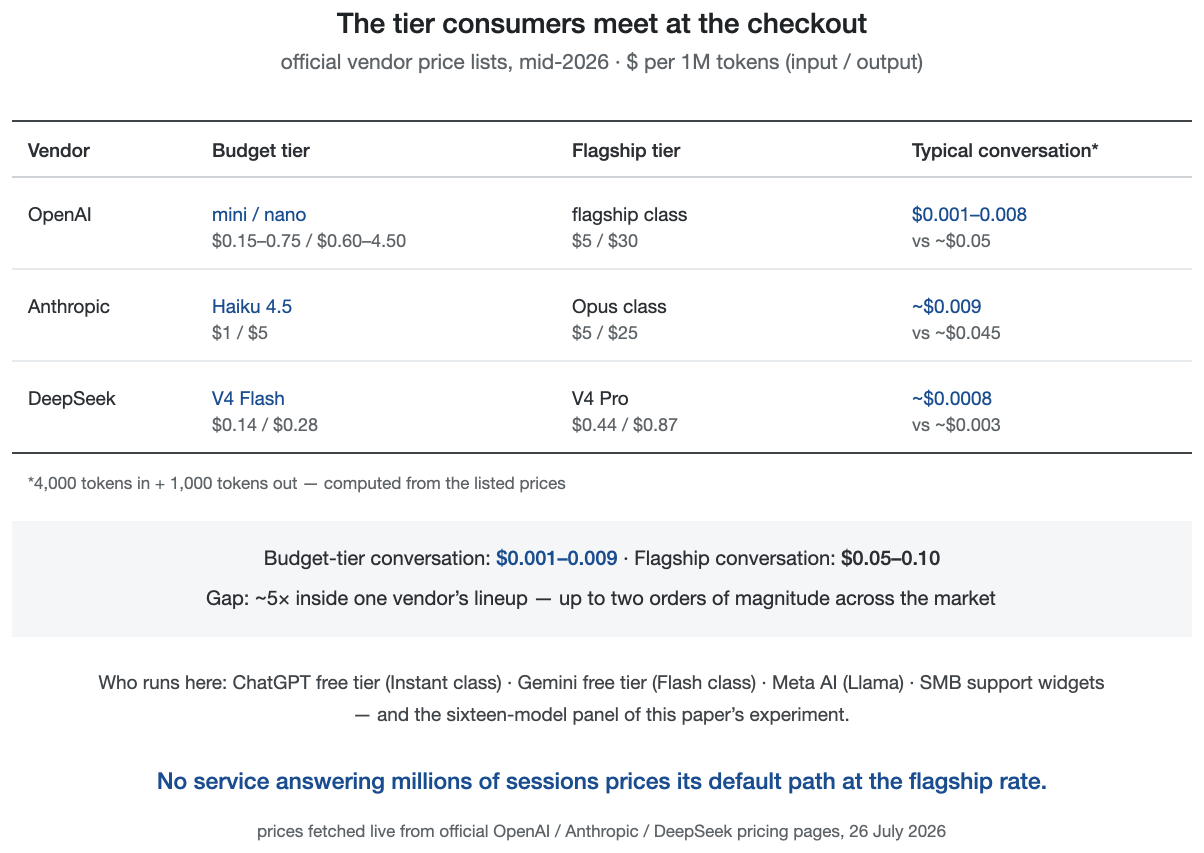
Listas de precios de proveedores oficiales, mediados de 2026.
Figura 12. Dos monedas del mercado de modelos
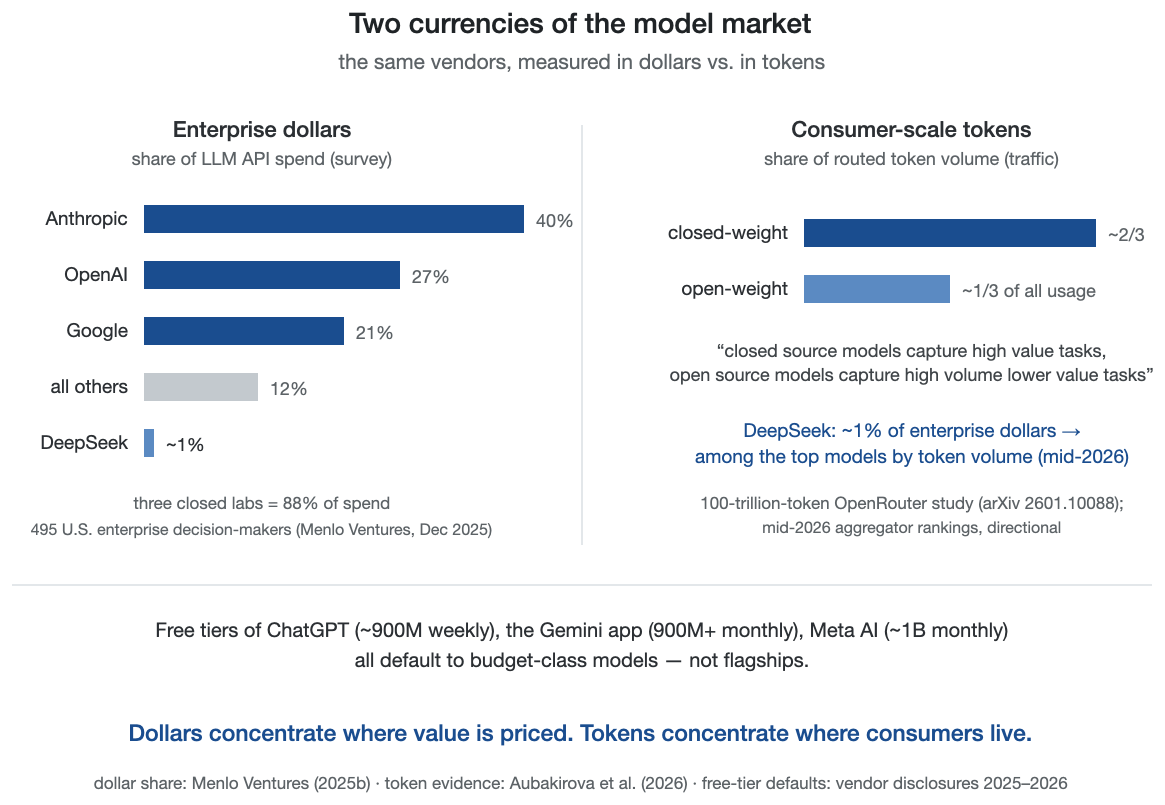
Dólares empresariales vs. tokens a escala de consumidor.
Los niveles medios también se ajustaban a las afirmaciones del documento, que se refieren a la arquitectura, no a la capacidad insignia: un efecto que solo aparecería con pesos premium sería un resultado del modelo. El pipeline se replica en infraestructura estándar por menos de $15 de gasto de API. Para un documento que argumenta que la verificación debe ser lo suficientemente barata para ejecutarse en cada respuesta consecuente, el costo de verificar el documento en sí es parte de la evidencia. El pipeline es un paquete de replicación independiente (ejecutores, evaluador, scripts de análisis, datos sin procesar evaluados y manifiesto de ejecución) que no requiere nada del sistema de investigación del autor. La colección totaliza 24,000 respuestas, aproximadamente 30,000 incluyendo los brazos de contaminación de referencia y conformidad. En cuanto a disponibilidad: el prerregistro público (osf.io/4y9dv) archiva la submuestra de 1,500 elementos con semilla fija. El paquete completo está disponible públicamente en https://osf.io/jtvu9/, un componente público del proyecto fuente del registro (carpeta `replication-package-v2`).
Tres resultados encabezan la sección. Primero, la materia prima es abundante: la confianza declarada mediana fue de 85–95 en siete de nueve proveedores de frontera, con las dos excepciones (medianas 42 y 60) siendo exactamente los proveedores cuya confianza discrimina, mientras que la precisión real osciló entre 10% y 66%, produciendo 289–1,212 errores confiados (incorrecto a una confianza ≥ 75) por proveedor de frontera en 1,500 preguntas. Como indicador de exactitud, la confianza propia del modelo obtuvo una puntuación AUROC de 0,53–0,79 dependiendo del proveedor, y un consumidor no tiene forma de saber, desde el exterior, qué proveedor obtuvo. Esa variación de proveedores se califica, en el nivel en el que los consumidores son realmente atendidos, el hallazgo de laboratorio de frontera de que los grandes modelos a menudo están bien calibrados en la autoevaluación en formatos controlados (Kadavath et al., 2022): algunos proveedores desplegados envían ese autoconocimiento, otros envían ruido confiado, y nada en la superficie los distingue.
Segundo, el titular: la verificación funciona como certificación, no como alarma. En preguntas tan difíciles, la señal ingenua «algún panelista está en desacuerdo» se satura: se activa en el 85–94% de errores confiados pero también en el 91–95% de respuestas correctas confiadas (el registro anticipó este replanteamiento, pasando al punto final AUROC preestablecido). La dirección informativa es la opuesta: las respuestas correctas se replican de forma independiente, las respuestas incorrectas se dispersan. Una respuesta que al menos un panelista independiente reprodujo fue correcta el 72–77% de las veces en los paneles intra-bloque y el 49% en el panel entre bloques, frente al 18–37% sin replicación. Una respuesta con acuerdo independiente tenía aproximadamente dos o tres veces más probabilidades de ser correcta (1,9–3,2× en los tres paneles de la Tabla 6). (Aquí y en todo el documento, «independiente» significa producido ciegamente y por separado, con correlación de error residual medida en lugar de asumida, y la corrección siempre se puntúa con respecto a las etiquetas de oro del punto de referencia, nunca por opinión de otro modelo). El estimando es asociacional, no causal: la replicación marca respuestas con más probabilidades de ser correctas, y parte de lo que marca es que la pregunta era fácil, un efecto de selección cuantificado a continuación. Como señal de corrección, el acuerdo del panel alcanzó AUROC 0,832 en el panel cuyos miembros tuvieron la señal de confianza propia menos relevante (por proveedor 0,53–0,62; agrupado 0,545). La afirmación que se mantiene es distribucional en lugar de característica: en los 84 paneles de tres proveedores, el AUROC de acuerdo tiene una mediana de 0,79 y supera el autoinforme agrupado en el 89%. El acuerdo alcanzó 0,722 en el panel entre bloques frente a una confianza propia agrupada de 0,659 (agrupar escalas verbales no estandarizadas entre proveedores distorsiona el autoinforme, porque los proveedores usan la escala 0–100 de manera diferente y la dirección del artefacto depende del panel, por lo que los valores por proveedor se imprimen al lado). Esa instancia entre bloques de la ventaja depende de la codificación (las codificaciones de acuerdo congeladas previamente alternativas colocan la señal de acuerdo del panel entre bloques en 0,544–0,722, la variante generosa no resuelta como acuerdo cae por debajo de la confianza propia agrupada de ese panel de 0,659, mientras que la señal del panel CN varía de 0,719–0,894 en las mismas codificaciones, siempre por encima de 0,545), por lo que el resultado robusto de codificación panel sobre sí mismo es el caso CN intra-bloque. El único panel donde el autoinforme claramente superó la señal del panel (0,842 frente a 0,697) fue el que contiene el proveedor más discriminante del estudio (el nivel medio de Anthropic, AUROC de confianza propia 0,788 en la colección completa de 1.500 elementos), la señal propia del proveedor bien clasificado superando por sí sola la señal de acuerdo de su propio panel. La Tabla 7 imprime valores por panel, calculados dentro de la población de elementos de cada panel. Un bootstrap de cluster emparejado (preguntas remuestreadas con reemplazo, las tres unidades (elemento, principal) por pregunta moviéndose juntas; B = 2.000) coloca intervalos de confianza en los contrastes de las Tablas 6/7. En el panel de frontera CN, el acuerdo del panel supera la confianza propia agrupada por ΔAUROC = +0,287 (IC del 95% [+0,265; +0,308], p < ,001). En el panel entre bloques, la ventaja es menor pero confiable, +0,063 ([+0,037; +0,087], p < ,001). En el panel de frontera de EE.UU., la dirección se revierte y la reversión en sí es estadísticamente inequívoca: confianza propia 0,842 frente a acuerdo del panel 0,697. La composición del panel es, por lo tanto, un moderador de primer orden del valor de la señal, y la regla de implementación es la siguiente: mida la calibración propia de los miembros del panel antes de confiar en el acuerdo sobre ella, ΔAUROC = −0,145 ([−0,170; −0,120], p < ,001). Los tres contrastes son significativos y la heterogeneidad entre paneles es un hallazgo, no ruido. El caso de EE.UU. se reporta por lo tanto como una reversión confirmada, no una zona nula, y acota el constructo: en un panel extraído del extremo discriminante del mercado, la confianza propia supera el acuerdo como señal de clasificación, por lo que el valor de discriminación del componente Diversidad depende de la composición del panel en lugar de mantenerse universalmente. La arquitectura puede proporcionar una señal de corrección externa donde la confianza del modelo expuesto discrimina débilmente, y audita la afirmación de calibración donde se hace una. Un límite permanece: incluso un modelo perfectamente calibrado no puede notarizar su propio historial o arbitrar su propio conflicto de intereses, por lo que a medida que mejora la discriminación de los proveedores, el papel de la diversidad se desplaza del descubrimiento de corrección a la auditoría de calibración, mientras que la evidencia y la neutralidad hacen un trabajo que ninguna cantidad de calibración puede hacer.
La verificación arquitectónica proporciona una señal de corrección externa donde un proveedor no pudo enviar una señal de confianza utilizable, e identificar qué proveedor envió una requiere la arquitectura de todos modos. La afirmación de sustitución, exactamente delimitada, se basa en las métricas de calibración en lugar de en AUROC. Ningún proveedor en la onda de julio es simultáneamente discriminante y bien calibrado; xAI se aproxima más (Tabla 7a), y la onda insignia reproduce el lado de calibración de la disociación, por lo que incluso el consumidor que casualmente recibe la confianza mejor clasificada no puede canjear su nivel como probabilidad sin una referencia externa. Eso es lo que proporciona la capa arquitectónica. Si los proveedores eventualmente proporcionan una buena calibración en todas partes, la evidencia y la neutralidad no se ven afectadas. El argumento sobrevive al mundo en el que los modelos mejoran.
Tercero, el modo de falla tiene una forma: errores de consenso certificados, todos los panelistas convergiendo con confianza en la misma respuesta incorrecta, ocurrieron en el 0,5–2,2% de preguntas de forma abierta pero en el 4,0–7,9% en un brazo complementario que replanteó elementos en formato de opción múltiple en el nivel local (construcción de elementos y salidas en el paquete de replicación). El consenso certifica error principalmente donde el espacio de respuesta está restringido, una advertencia de diseño para cualquier interfaz que ofrezca a los agentes un menú de opciones.
Los nulos son tan instructivos como los positivos, y los publico como preregistrados. El bloque geopolítico (incluida la posibilidad de que los paneles del mismo bloque compartan corpus de entrenamiento y linajes de destilación) no predice la correlación de errores en este punto de referencia (diferencia φ intra- vs inter-bloque +0.011 en el nivel frontera, IC 95% −0.005 a +0.028; ligeramente invertido en el nivel local). La capacidad impulsa la correlación, no la bandera, haciendo eco de Kim et al. (2025). El linaje no predice las tasas de captura: un modelo local que verifica su propio hermano frontera se comporta como cualquier desconocido, y un modelo destilado de razonamiento resultó ser el menos correlacionado en errores con sus propios pesos base (φ = 0.135). Ambos son nulos acotados más que equivalencia demostrada. El intervalo del bloque excluye diferencias φ mayores que +0.028, y ese límite, no el fracaso en rechazar, realiza el trabajo inferencial. La extensión continua natural, que los datos de replicación respaldan, es estimar la mejora de certificación como una función de la diversidad medida del panel (la φ de puntuación sorpresa) en lugar de la identidad del panel. Eso volvería a ejecutar, para paneles de modelo, el programa que la literatura de conjuntos de clasificadores ejecutó para sus propias estadísticas de diversidad, que encontró que ninguna medida única predice limpiamente las ganancias de conjunto (Kuncheva & Whitaker, 2003).
Y los modelos locales económicos no pudieron certificar las respuestas frontera en preguntas abiertas en absoluto (precisión del 46% con o sin su acuerdo): un verificador debe ser competente en la clase de tarea antes de que su independencia valga algo. Las condiciones de límite son estas: el consenso certifica error donde los espacios de respuesta están restringidos, la independencia debe medirse en lugar de asumirse, la competencia del verificador determina el valor de certificación. En la práctica, la diversidad es una propiedad a medir, pregunta por pregunta, no asumida a partir de marcas, bloques o árboles genealógicos. La Tabla 6 resume las métricas del panel. La Figura 13 muestra la mejora de certificación y la comparación de señales lado a lado.
Figura 13. La ilusión de precisión y su cura arquitectónica
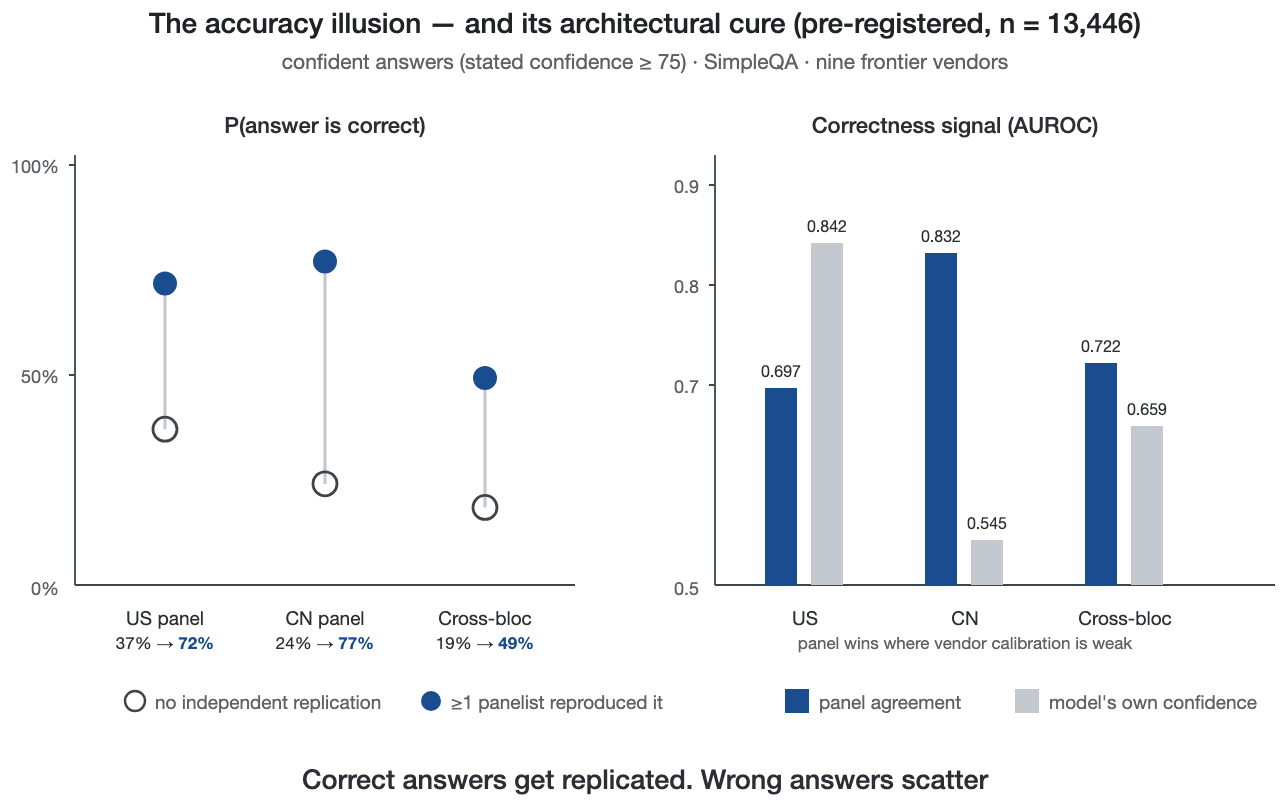
Certificación por replicación independiente (preregistrada; n = 13.446 respuestas calificadas — nueve proveedores frontera, cada uno respondiendo las mismas 1.500 preguntas SimpleQA una vez, menos 54 llamadas fallidas o no calificables).
El trabajo concurrente refuerza la precaución: una auditoría a gran escala encontró alta auto-consistencia coocurriendo con respuestas incorrectas en puntos de referencia de razonamiento, donde el acuerdo por sí solo, sin independencia y recopilación ciega, es una señal débil y dependiente del régimen (Ding, 2026). Por lo tanto, trato la replicación independiente y ciega como la unidad de certificación.
Tabla 6. Intercepción de error confiado y certificación por panel (SimpleQA, confirmatorio; conf ≥ 75)
| Panel | Errores confiados (n) | Tasa de bandera en errores [IC 95%] | Falsas alarmas en correcto | P(correcto | ≥1 acuerda) | P(correcto | ninguno) | AUROC: acuerdo vs conf propia |
| Frontera estadounidense (Anthropic·OpenAI·Google) | 1.630 | 94,3% [93,1–95,3] | 91,0% | 71,8% | 37,1% | 0,697 vs 0,842 |
| Frontera china (DeepSeek·Alibaba·Moonshot) | 2.128 | 85,5% [83,9–86,9] | 94,8% | 77,0% | 24,1% | 0,832 vs 0,545 |
| Entre bloques (Anthropic·DeepSeek·Mistral) | 2.432 | 89,4% [88,1–90,6] | 93,4% | 49,3% | 18,5% | 0,722 vs 0,659 |
Bandera = respuesta independiente de ≥1 panelista no equivalente a la del principal (las negativas y respuestas de cero solapamiento cuentan como no-coincidencia; una codificación más estricta está en el paquete de replicación). La sensibilidad del umbral a 60/90 no cambia ninguna conclusión. AUROC de confianza propia es confianza declarada agrupada sobre la población de respuestas completa del panel; la agrupación absorbe diferencias entre proveedores en precisión y escala de confianza, por lo que puede exceder el valor individual de cada miembro (valores por proveedor en la Tabla 7). Las respuestas se agrupan por pregunta; un arranque de agrupación a nivel de pregunta amplía los intervalos aproximadamente por un factor de 1,6 sin cambiar ninguna conclusión. Cada AUROC en esta tabla y la Tabla 7 se reproduce de manera determinista, con un comando y sin aleatoriedad, desde el script del paquete de replicación compute_panel_vs_own_auroc.py (Mann–Whitney con corrección de empate).
Tabla 7. AUROC de confianza propia por panel: población del panel agrupada y por proveedor (mismas poblaciones que la Tabla 6)
| Panel | AUROC de confianza propia agrupada | AUROC de confianza propia por proveedor |
| Frontera estadounidense | 0,842 | Anthropic 0,784 · OpenAI 0,596 · Google 0,746 |
| Frontera china | 0,545 | DeepSeek 0,569 · Alibaba 0,532 · Moonshot 0,620 |
| Entre bloques | 0,659 | Anthropic 0,787 · DeepSeek 0,570 · Mistral 0,584 |
Calculado por la tubería determinista en el paquete de replicación. Coexisten dos convenciones de población e se imprimen explícitamente para evitar una aparente inconsistencia: los valores por proveedor de la tabla se calculan dentro de la población de elementos de cada panel, mientras que las citas de número único en el texto utilizan el valor de la colección completa — para el proveedor de mejor discriminación 0.784 en el panel US-frontier versus 0.788 en la colección completa de 1500 elementos, y para OpenAI 0.596 versus 0.598 (ambos pares se reproducen desde un comando de la misma tubería). La columna agrupada, por el contrario, confunde las tasas base de los proveedores — las diferencias entre proveedores en la escala de precisión y confianza hacen parte del trabajo, por lo que el valor agrupado no necesita estar dentro del rango por proveedor (recomputado en vivo: el US-frontier agrupado 0.842 excede todos los valores individuales de los miembros, y el CN-frontier agrupado 0.545 se sitúa por debajo del promedio macro por proveedor de ese panel de 0.574); los valores por proveedor son las cantidades interpretables. La dispersión por proveedor es el problema del consumidor enumerado numéricamente: existe discriminación utilizable en un proveedor y está cerca de la oportunidad en otros, y nada en el exterior de una respuesta dice qué proveedor lo produjo. Valores de origen detrás de los rangos de proveedores de la Sección 3, impresos por modelo de la misma colección clasificada (confianza declarada mediana · precisión · AUROC de confianza propia de colección completa): frontier — Alibaba 95 · 47.4% · 0.532; Anthropic 42 · 10.3% · 0.788; DeepSeek 90 · 35.7% · 0.570; Google 95 · 66.5% · 0.746; Mistral 90 · 16.5% · 0.584; Moonshot 85 · 51.6% · 0.619; OpenAI 85 · 16.7% · 0.598; xAI 60 · 37.9% · 0.777; Zhipu 95 · 28.4% · 0.611 — las dos medianas por debajo de la banda 85–95 pertenecen a los dos proveedores cuya confianza lleva una señal utilizable; nivel local (entra solo en la estratificación de dificultad y los nulos de nivel local) — gemma4:e4b 90 · 5.2% · 0.541; glm4:9b 85 · 5.0% · 0.589; llama3.2:3b 100 · 5.3% · 0.494; mistral:7b 95 · 6.3% · 0.506; phi4-mini 95 · 5.5% · 0.505; qwen3:8b 95 · 5.9% · 0.504; deepseek-r1:8b 90 · 9.2% · 0.696 (n = 98, pre-committed stopping rule).
AUROC mide la discriminación, ya sea que la confianza declarada de un proveedor clasifique sus respuestas correctas por encima de sus respuestas incorrectas, mientras que ECE, la puntuación de Brier y la brecha de confianza-precisión miden la calibración, ya sea que el número declarado pueda leerse como una probabilidad, y en estos datos los dos se disocian fuertemente. El proveedor de julio de mejor discriminación del estudio, el nivel medio de Anthropic (AUROC de confianza propia 0.788), sigue siendo muy mal calibrado en nivel: confianza declarada media 41.3 (mediana 42) frente a una precisión del 10.3%, una brecha de exceso de confianza de +31.0 puntos, ECE 0.311 (15 contenedores), Brier 0.206 con un término de confiabilidad de 0.126 frente a un piso de incertidumbre irreducible de 0.093. Inversamente, la peor calibración en el panel coexiste con una discriminación cercana al azar (Mistral: brecha +74.2 puntos, ECE 0.742, AUROC 0.584), y solo xAI se acerca tanto a la discriminación como a la calibración (ECE 0.111, AUROC 0.777). Incluso allí, la discriminación se ve ayudada por una confianza declarada uniformemente baja, mientras que para los otros ocho proveedores de julio, las dos propiedades se disocian fuertemente. La misma disociación persiste en el nivel insignia: nueve de once insignias de agosto llevan brechas de exceso de confianza de +12.5 a +71.4 puntos (ECE 0.125–0.714), mientras que las dos excepciones (gpt-5.6-sol, ECE 0.031; claude-fable-5, ECE 0.043) logran calibración en extremos opuestos de la escala de precisión. Un consumidor que tenga una puntuación de confianza bien clasificada pero numéricamente inflada no puede utilizarla sin una referencia externa. La tabla 7a imprime las métricas de calibración junto a las de discriminación.
Tabla 7a. Discriminación vs calibración, onda de julio (colección completa, resuelta; ECE con 15 contenedores; brecha = confianza declarada media − precisión, puntos porcentuales)
| Proveedor | n | AUROC (conf propia) | ECE | Brier | Brecha conf − prec | Conf media → precisión |
| Alibaba | 1,497 | 0.532 | 0.448 | 0.446 | +44.8 pp | 92.3 → 47.4% |
| Anthropic | 1,500 | 0.788 | 0.311 | 0.206 | +31.0 pp | 41.3 → 10.3% |
| DeepSeek | 1,500 | 0.570 | 0.536 | 0.513 | +53.4 pp | 89.1 → 35.7% |
| 1,461 | 0.746 | 0.263 | 0.271 | +26.3 pp | 92.8 → 66.5% | |
| Mistral | 1,495 | 0.584 | 0.742 | 0.686 | +74.2 pp | 90.6 → 16.5% |
| Moonshot | 1,500 | 0.619 | 0.242 | 0.292 | +24.2 pp | 75.8 → 51.6% |
| OpenAI | 1,500 | 0.598 | 0.610 | 0.531 | +60.9 pp | 77.6 → 16.7% |
| xAI | 1,500 | 0.777 | 0.111 | 0.197 | +11.1 pp | 48.9 → 37.9% |
| Zhipu | 1,493 | 0.611 | 0.642 | 0.612 | +64.2 pp | 92.6 → 28.4% |
| panel US-frontier, unidades agrupadas | 4,383 | 0.842 | 0.393 | 0.336 | +39.3 pp | — |
| panel CN-frontier, unidades agrupadas | 4,491 | 0.545 | 0.408 | 0.417 | +40.8 pp | — |
| panel Cross-bloc, unidades agrupadas | 4,485 | 0.659 | 0.529 | 0.469 | +52.9 pp | — |
Mismas poblaciones que el AUROC de colección completa y las Tablas 6–7 (filas de panel: unidades agrupadas (elemento, primarias)); negativas puntuadas como incorrecto bajo el protocolo congelado. Brier se descompone por la identidad de Murphy (confiabilidad − resolución + incertidumbre) en los mismos 15 contenedores, residuo < 0.001 en cada fila. Una nota de nivel insignia viaja con las dos excepciones calibradas: el ECE de 0.031 de gpt-5.6-sol se obtiene con una precisión del 95.4%, donde el término de incertidumbre de Murphy, el piso que fija la tasa base, es 0.044 — calibración parcialmente comprada por una tasa base que lleva la advertencia de contaminación de la Tabla 9 (61.6% de coincidencias de cadena de oro verbatim).
Un efecto de selección debe acompañar la tabla: la replicación es parcialmente un marcador de facilidad de la pregunta. Estratificando por dificultad de la pregunta (precisión media en los otros quince modelos), el aumento de certificación en bruto se lleva por los estratos más fáciles (2,7–4,6×), cae por debajo de 1× en el segundo quintil más difícil, y desaparece en el más difícil bajo esta medida dentro de la colección. Esa estratificación es parcialmente endógena, y una reestimación exógena más abajo suaviza la inversión en una atenuación monótona. Un análisis de robustez aborda la preocupación por selección directamente (exploratorio, no preregistrado): en un modelo logístico agrupado por preguntas con efectos fijos del modelo primario, controlando por la confianza propia del modelo primario y por la dificultad del elemento (precisión media dejando fuera el modelo primario en los dieciséis modelos), cada panelista adicional concordante sigue multiplicando las probabilidades de corrección por aproximadamente cinco (b agrupada = +1,65 por panelista, IC del 95% [+1,49, +1,81], p < 10⁻⁸⁸; positivo en cada panel), y añadir acuerdo a una línea base de dificultad-más-confianza eleva el AUROC retenido de 0,859 a 0,898 y reduce la puntuación de Brier de 0,139 a 0,116 (división de validación cruzada bidireccional por pregunta). El mismo modelo sondea el límite, y la estratificación en sí requiere cuidado: bajo la medida de dificultad dentro de la colección, el coeficiente condicional se vuelve negativo en el quintil más difícil (b = −0,41, p = ,011), pero esa medida incluye los miembros del propio panel. El modelo condicional conlleva una advertencia de implementación: su característica de dificultad requiere etiquetas, por lo que es diagnóstico, no implementable, y el filtro implementable es la propia puerta de acuerdo. Tres comprobaciones adicionales abordan preocupaciones de estimación y selección, todas bajo la codificación de protocolo determinista congelado (la rama más estricta que el paquete de replicación reporta junto con los números de titular adjudicados por juez). Reestimando el aumento de certificación con remuestreo bootstrap agrupado por elemento, el agrupamiento que la estructura de dificultad exige, deja el intervalo de aumento de certificación de cada panel muy por encima de 1 (aumentos puntuales 2,4–4,5 bajo esta codificación determinista, que certifica menos acuerdos que la codificación de pares adjudicados por juez detrás del titular publicado 1,9–3,2×; límites inferiores de bootstrap 2,2–4,1). La distribución de 84 paneles reportada arriba hace del panel de frontera estadounidense, donde la auto-información gana, la excepción en lugar de la regla (ventaja mediana +0,14, RIC del AUROC de acuerdo 0,76–0,82). Y el AUROC estratificado por dificultad hace explícito el límite bajo una medida de dificultad exógena: 0,87 en el quintil más fácil cayendo a 0,61 en el más difícil, atenuación sin inversión. Esa medida es dejar fuera el panel, los trece modelos fuera de cada panel, y reestimando con ella se resuelve la inversión: el coeficiente de acuerdo condicional permanece positivo en cada quintil incluyendo el más difícil (b del quintil más difícil = +0,97, p < 10⁻⁷; 28% de las respuestas replicadas independientemente en el estrato más difícil son correctas, no 0%). Entonces la inversión dentro de la colección es parcialmente un artefacto de la medida de dificultad. Lo que sobrevive bajo cualquiera de las medidas es una atenuación monótona, con acuerdo más débil donde las preguntas son más difíciles, y la realidad de errores de consenso certificados; los scripts y salidas están en el paquete de replicación. La relación de titular es por lo tanto un promedio sobre una población heterogénea. La afirmación de señal descansa en el extremo AUROC, no en la relación.
Las hipótesis del experimento operacionalizan el despliegue de investigación que opero: la recopilación ciega refleja su mecanismo de consejo, y las composiciones del panel existían como su configuración de producción antes de que se diseñara el estudio. Este es el segundo estudio preregistrado en este programa de investigación. El tercero, el experimento del consumidor de la Sección 6, está completo y reportado, y un cuarto (telemetría de campo sobre tráfico de producción) está redactado. El paquete de replicación se ejecuta para cualquiera, en hardware básico, contra API públicas.
Una segunda onda a nivel insignia: once laboratorios — diez brazos completos y uno parcial — un foso de calibración. El experimento anterior muestreó los niveles optimizados por costo que realmente sirven a los consumidores. La objeción a probar: quizás la ilusión de precisión es un artefacto de nivel presupuestario, y los modelos insignia, los modelos que cada proveedor presenta como su mejor, están lo suficientemente calibrados como para que la arquitectura por encima sea redundante. Una segunda onda de recopilación (agosto de 2026) prueba esa objeción en la cúspide del mercado.
Evalúo un modelo insignia de cada uno de diez laboratorios principales de IA que abarcan Estados Unidos, China y Europa. Los laboratorios fueron elegidos para cubrir los ecosistemas comerciales y de pesos abiertos principales en estas tres regiones. Para cada laboratorio seleccioné su modelo más capaz generalmente disponible en el momento de la onda de evaluación. Luego verifiqué esta cobertura contra tableros de clasificación públicos a partir del 5 de agosto de 2026 (LMArena Elo, el Índice de Inteligencia de Análisis Artificial, Humanity's Last Exam, y SWE-bench Verified): ocho de los diez modelos insignia se colocan en o cerca del nivel superior de al menos un tablero de clasificación de capacidad general, mientras que dos (Mistral, Baidu) se incluyen para preservar la cobertura de laboratorio y región en lugar de por criterios de clasificación (ver las limitaciones de cobertura a continuación). Un undécimo laboratorio, Meta, cuyo modelo insignia se hizo alcanzable solo después de que se definió el alcance de la onda, se agregó durante la onda; su recopilación fue interrumpida por una revocación de acceso y se reporta como parcial (ver a continuación).
Tabla 8. Modelos insignia evaluados y posiciones en tableros de clasificación (a partir del 5 de ago de 2026)
| Laboratorio | Modelo insignia (id de API) | País | Posiciones en tablero de clasificación (5 ago 2026) |
| OpenAI | gpt-5.6-sol | EE.UU. | AA Index #3 (58.9); LiveBench #1 (82.4); Arena top-6 cluster |
| Anthropic | claude-fable-5 | EE.UU. | Arena #1 (~1525 Elo); AA Index #2 (59.9); SWE-bench Verified #1 (95.0) |
| gemini-3.1-pro-preview | EE.UU. | SWE-bench Verified #8 (80.6); HLE #17 (51.4); Arena upper cluster | |
| xAI | grok-4.5 | EE.UU. | AA Index #8 (53.8); Arena Elo 1499 |
| DeepSeek | deepseek-v4-pro | China | SWE-bench Verified #8 (80.6, Pro-Max); HLE #23 (48.2) |
| Alibaba | qwen-max (Qwen 3.7 Max) | China | Arena #21 (1488–1496 Elo); SWE-bench Verified #11 (80.4) |
| Moonshot AI | kimi-k3 | China | AA Index #4 (57.1); HLE #9 (56.0); Arena #10 (1500) |
| Zhipu (Z.ai) | glm-5.2 | China | AA Index #13 (51.1); HLE #11 (54.7) |
| Mistral | mistral-medium-3.5 | Francia | Por debajo del top-50 en clasificaciones generales; incluido para cobertura regional |
| Baidu | ernie-4.5-vl-424b | China | Fuera del top-30 general (ERNIE 5.0: HLE #36); ERNIE 5.1: LMArena Search Arena #4 |
| Meta (añadido a mitad de la onda, parcial) | muse-spark-1.1 | USA | HLE #4 |
Las puntuaciones entre paréntesis son los valores reportados por el agregador en la fecha de la instantánea; las posiciones en la clasificación varían ligeramente entre agregadores y fechas de instantánea. Las fuentes de instantáneas se archivan con los registros de ejecución que acompañan el paquete de replicación.
El protocolo es el del primer experimento, congelado y reutilizado: la misma submuestra SimpleQA de 1.500 elementos (fija por semilla y hash), un pase ciego por modelo, temperatura cero, indicación del sistema idéntica y analizador de respuestas, una confianza de 0–100 declarada por respuesta. La calificación es determinística (coincidencia exacta y normalizada contra el estándar de oro; rechazos puntuados como errores; elementos no resueltos excluidos del titular y repuntuados como errores en análisis de sensibilidad), y ningún juez LLM toca los números titulares. Eso es un endurecimiento deliberado en relación con la primera onda, cuyo calificador era híbrido: coincidencia de cadena objetiva con un juez local de pesos abiertos resolviendo el resto (66,5% de veredictos emitidos por modelo; revisión spot humana de 50 elementos, 98% de acuerdo). Esta onda utiliza únicamente el motor de equivalencia determinística (validado manualmente: 20 de 20 desacuerdos marcados y 15 de 15 acuerdos confirmados a mano), por lo que cada número titular de esta onda se reproduce bit a bit del script lanzado. Las comparaciones entre ondas de precisión absoluta, por lo tanto, también cruzan regímenes de calificador, y cada comparación julio-versus-agosto lleva un calificador de régimen de calificación. Las auditorías dentro de la onda apoyan los números de cada onda, pero los deltas entre ondas confunden el cambio de modelo con el cambio de calificador a menos que un único calificador se vuelva a aplicar a ambos conjuntos de respuesta congelados, lo que no se ha hecho aquí. Una variación de esfuerzo: el brazo de OpenAI se recopiló en el esfuerzo de razonamiento predeterminado de la interfaz (medio) donde el protocolo de julio utilizaba mínimo, sin acceso web ni herramienta en inferencia (verificado enumerando las herramientas expuestas al modelo, de las cuales no había ninguna). Esto cambia la precisión absoluta de ese proveedor, no el mecanismo de acuerdo (Sección 5). Un fracaso seguro es una respuesta errónea ofrecida con confianza declarada ≥ 80; el umbral se fijó antes de la ejecución, con 70 y 90 reportados como sensibilidad. La cobertura de unión es 1.500/1.500 preguntas para diez de los once laboratorios. La colección de Meta alcanzó 272 respuestas válidas antes de que se revocara el acceso.
También probé la preocupación de régimen cruzado directamente. Re-calificar la onda de dieciséis modelos de julio con el motor determinístico congelado de la segunda onda (que reemplaza la tubería híbrida que decidió el 66,5% de los veredictos con un calificador local de pesos abiertos) cambia el 2,65% de los veredictos resueltos (566 de 21.338; el motor se abstiene en un 4,1% adicional) y no mueve el titular: bajo una codificación determinística única, los levantamientos de certificación leen 3,6×/4,6×/4,4× antes de re-calificar y 3,0–3,1×/4,5–4,6×/4,3× después. Ambos están por encima de los 1,9–3,2× publicados conservadores, que derivan de la codificación de pares adjudicada por LLM, ya que más acuerdos certificados significa levantamientos más conservadores. Cada AUROC en las Tablas 6–7 se desplaza como máximo 0,016 en los paneles CN y entre bloques y 0,046 en el panel de EE.UU., preservando el orden de cada panel de acuerdo versus confianza autoinformada.
La etiqueta de buque insignia no garantiza nada. La precisión resuelta en preguntas idénticas abarca del 11,4% al 95,4% entre los once buques insignia (Tabla 9), una dispersión de 84 puntos en la parte superior del mercado, más amplia que la dispersión de nivel medio del primer experimento. Y la ilusión de precisión se mantiene intacta en este nivel: agrupada en los diez brazos de laboratorio completos, el 46,6% de todas las respuestas resueltas ofrecidas con confianza declarada ≥ 80 eran incorrectas (4.910 de 10.540; incluyendo el brazo parcial de Meta, 46,3%, o 4.935 de 10.665; elementos no resueltos excluidos aquí y repuntuados como errores en sensibilidad, donde el panorama agrupado es sin cambios). La implicación orientada al consumidor de la primera onda no se suaviza con el precio: una insignia de buque insignia no le dice al consumidor si la respuesta confiada ante ellos proviene del buque insignia con precisión del 95% o del 11%.
Tabla 9. Onda de buque insignia: cobertura y precisión (submuestra SimpleQA, n = 1.500 por laboratorio, temperatura 0)
| Laboratorio (buque insignia) | Cobertura | Precisión (resuelta) | Sin resolver |
| OpenAI gpt-5.6-sol | 1.500/1.500 | 95,4% (1.403/1.471) | 29 |
| Google gemini-3.1-pro | 1.500/1.500 | 71,1% (837/1.178)¹ | 46 |
| Anthropic claude-fable-5 | 1.500/1.500 | 70,3% (1.019/1.450) | 50 |
| Meta muse-spark-1.1 (parcial) | 272/1.500 válidas | 61,4% (148/241)² | 10 |
| xAI grok-4.5 | 1.500/1.500 | 54,8% (794/1.448) | 52 |
| DeepSeek deepseek-v4-pro | 1.500/1.500 | 46,6% (666/1.428) | 72 |
| Moonshot kimi-k3 | 1.500/1.500 | 45,5% (645/1.418) | 82 |
| Zhipu glm-5.2 | 1.500/1.500 | 30,2% (430/1.425) | 69 |
| Baidu ernie-4.5-vl-424b | 1.500/1.500 | 28,9% (411/1.421) | 71 |
| Mistral mistral-medium-3.5 | 1.500/1.500 | 21,4% (306/1.429) | 71 |
| Alibaba qwen-max | 1.500/1.500 | 11,4% (164/1.435) | 65 |
¹ El canal de Google devolvió respuestas vacías o filtradas en el 18,4% de los elementos (276 de 1.500 — una propiedad de entrega, no una brecha de cobertura: se intentaron los 1.500); la precisión se calcula en respuestas analizadas y resueltas. Se reportan ambas definiciones: solo respondidas, la precisión de Google es 71,1% (837/1.178); contando las 276 respuestas no entregadas como errores es 57,6% (837/1.454), y 55,8% (837/1.500) con elementos sin resolver también puntuados como errores. ² Precisión de Meta calculada en las respuestas recopiladas antes de la revocación de acceso; véase limitaciones de cobertura. La precisión en toda la tabla es solo resuelta; bajo la sensibilidad de no-resuelto-como-error, la cifra superior, 95,4% de OpenAI, se convierte en 93,5% (1.403/1.500). La procedencia del canal por llamada de cada laboratorio se registra en el manifiesto de ejecución. Los conteos sin resolver comprenden respuestas entregadas que no se resolvieron de manera determinista; para Zhipu (1.494 respuestas entregadas), Baidu (1.492) y el brazo parcial de Meta (251) las dos columnas por lo tanto suman menos que las preguntas intentadas, siendo el resto respuestas no entregadas.
Una advertencia de contaminación limita las precisiones absolutas. Esta ronda reutiliza el benchmark SimpleQA original, lanzado públicamente (octubre de 2024) contra modelos cuyos corpus de entrenamiento se actualizan hasta dos años después de su publicación, por lo que la exposición en tiempo de entrenamiento al benchmark en sí es plausible en la parte superior de la tabla, y los datos llevan una firma concreta de ello: el modelo insignia de mayor puntuación reproduce la cadena de respuesta de referencia textualmente (coincidencia exacta normalizada, hasta el formato decimal) en 61,6% de los elementos, frente a 27,9–45,3% para los otros laboratorios, con una confianza media declarada de 99. El diseño no puede separar "el modelo es más fuerte" de "el modelo ha visto el benchmark y su clave de respuesta". Las cifras de precisión absoluta de la onda por lo tanto no son comparables con los límites históricos de libro cerrado reportados para generaciones de modelos anteriores, y no deben interpretarse como medidas de memoria paramétrica. La verificación de edad del benchmark de la primera onda (la brecha TruthfulQA–SimpleQA reportada en la Sección 3) cubrió la recopilación de julio; para agosto de 2026, SimpleQA en sí es un benchmark público de dos años, y esta advertencia cubre la onda insignia. Las conclusiones de la onda no descansan en precisión absoluta. Descansan en la estructura de fracasos confiados, su prevalencia con confianza declarada ≥ 80 y su intercepción por la puerta de desacuerdo, medida dentro de la onda bajo un protocolo congelado, donde cualquier ventaja de exposición se comparte entre los laboratorios evaluados en los mismos elementos. Una sonda de dos saltos nueva construida después de la ventana del estudio confirma esta firma directamente. Véase "¿Por qué no simplemente usar el mejor modelo?" más adelante en esta sección.
El foso de calibración. El primer experimento mostró que el acuerdo independiente lleva una señal de corrección que la confianza autoinformada no tiene. La onda insignia convierte esa señal en un filtro medido. El mecanismo es una puerta de desacuerdo: un consejo de tres laboratorios, fijados de antemano a partir de un análisis de desacuerdo anterior y no ajustados a estos resultados (Moonshot kimi-k3, DeepSeek deepseek-v4-pro, OpenAI gpt-5.6-sol), y una regla sin parámetros libres. Una respuesta pasa la puerta solo cuando las tres respuestas del consejo están de acuerdo por pares. Porque nada se estima, no se necesita división entrenamiento/prueba; la puerta se calcula una vez sobre la colección congelada.
Figura 17. La puerta insignia
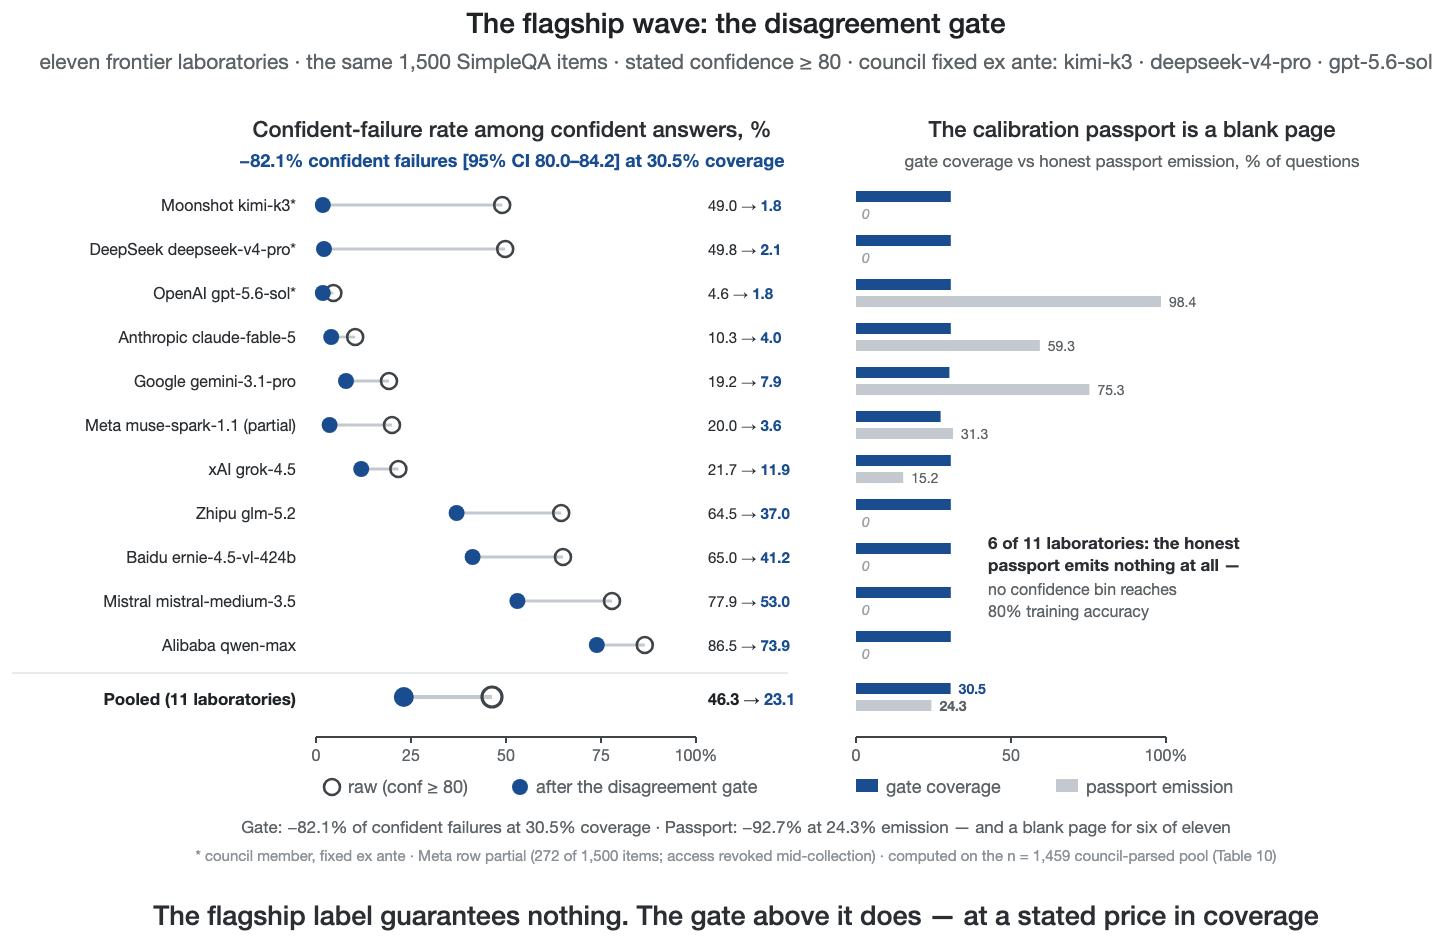
Fracasos confiados con confianza declarada ≥ 80 y su intercepción por la puerta de desacuerdo de tres modelos fija, por laboratorio (onda de agosto de 2026).
Agrupados en los diez brazos de laboratorio completos (la presentación principal, con el brazo parcial de Meta reportado por separado y su inclusión tratada como una sensibilidad), la tasa bruta de fracaso confiado es 46,6% (4.910/10.540). Agrupados en la lista de once laboratorios, las tasas por laboratorio varían (Tabla 9), por lo que esta cifra caracteriza la lista fronteriza en lugar de una constante universal. La puerta elimina 82,1% de fracasos confiados (IC bootstrap 95% [79,9; 84,1]) mientras mantiene 30,5% de todas las respuestas agrupadas (la puerta misma se abre en 30,6% de las preguntas, 446 de 1.459). Restringida a los laboratorios completos fuera del consejo, sin autorreferencia de ningún tipo, la puerta aún elimina 76,9% de fracasos confiados (IC [74,3; 79,2]). Incluir el brazo parcial de Meta deja cada estimación efectivamente sin cambios: agrupados en los once, la tasa bruta es 46,3% (4.935/10.665; 35,8% de respuestas confiadas pasan la puerta, y la corrección entre respuestas confiadas emitidas sube de 53,7% bruto a 76,9% post-puerta), la puerta elimina 82,1% (IC [80,0; 84,2]) en la misma cobertura 30,5%, y la cifra de no-consejo de ocho laboratorios es 77,0% (IC [74,4; 79,3]). La Tabla 10 proporciona las cifras por laboratorio.
Tabla 10. Intercepción de fracaso confiado por la puerta de desacuerdo (conf ≥ 80; calificador determinista; consejo = kimi-k3 · deepseek-v4-pro · gpt-5.6-sol, fijo ex ante)
| Laboratorio | Respuestas confiadas | Fracasos confiados, bruto | Después de la puerta (tasa en emitido) | dCF |
| Moonshot kimi-k3 [consejo] | 1,056 | 517 (49,0%) | 7 (1,8%) | −98,6% |
| DeepSeek deepseek-v4-pro [consejo] | 1,274 | 634 (49,8%) | 9 (2,1%) | −98,6% |
| OpenAI gpt-5.6-sol [consejo] | 1,426 | 65 (4,6%) | 8 (1,8%) | −87,7% |
| Anthropic claude-fable-5 | 825 | 85 (10,3%) | 15 (4,0%) | −82,4% |
| Google gemini-3.1-pro | 966 | 185 (19,2%) | 27 (7,9%) | −85,4% |
| Meta muse-spark-1.1 (parcial) | 125 | 25 (20,0%) | 2 (3,6%) | −92,0% |
| xAI grok-4.5 | 577 | 125 (21,7%) | 36 (11,9%) | −71,2% |
| Zhipu glm-5.2 | 1,128 | 727 (64,5%) | 146 (37,0%) | −79,9% |
| Baidu ernie-4.5-vl-424b | 725 | 471 (65,0%) | 107 (41,2%) | −77,3% |
| Mistral mistral-medium-3.5 | 1,354 | 1,055 (77,9%) | 224 (53,0%) | −78,8% |
| Alibaba qwen-max | 1,209 | 1,046 (86,5%) | 300 (73,9%) | −71,3% |
| Agrupado (11 laboratorios) | 10,665 | 4,935 (46,3%) | 881 (23,1%) | −82,1% [80,0; 84,2] |
| Agrupado (8 no-consejo) | 6,909 | 3,719 (53.8%) | 857 (33.5%) | −77.0% [74.4; 79.3] |
Calculado en el conjunto de preguntas donde los tres miembros del consejo produjeron respuestas analizadas y no rechazadas (n = 1,459 de 1,500); la puerta se abre en 446 de estas (30.6%). La fila de metadatos es parcial (acceso revocado a mitad de la recopilación). Bootstrap CIs: 5,000 remuestreos a nivel de pregunta.
Tres cosas acompañan ese titular. La puerta también descarta aproximadamente la mitad de las respuestas correctas seguras (la puerta retiene solo el 51.3% de respuestas seguro-correctas; de las respuestas que descarta, aproximadamente el 41% eran de hecho correctas). El cambio es cobertura por certeza, el compromiso canónico riesgo–cobertura de la clasificación selectiva (Geifman & El-Yaniv, 2017), ejecutado aquí a nivel de arquitectura, y los dos números siempre deben citarse como pareja: −82.1% errores seguros con 30.5% de cobertura. El sistema tiene su propio piso. En el modo completamente sistémico, donde la puerta abierta emite la respuesta de consenso del consejo en lugar de la del modelo individual, la tasa propia de errores seguros del sistema es 1.8% (8 de 442 respuestas de consenso resueltas), y esas ocho preguntas son aquellas en las que todo el consejo está seguro de que concuerda en la misma respuesta incorrecta. Ese es el piso de error correlacionado que el primer experimento predijo de su condición de límite consenso-certifica-error: debajo de él, ninguna cantidad de verificación de acuerdo ayuda, porque el acuerdo en sí es el error. Y el resultado es plano en la cuadrícula de sensibilidad predeclarada: el umbral de confianza 70/80/90 da dCF agrupada de −83.1%/−82.1%/−80.6%, y reevaluar elementos no resueltos como errores da −81.8%, por lo que el número fue medido, no seleccionado.
Lo que el número de cobertura del 30.5% significa comercialmente está establecido por la economía del punto de equilibrio de la Sección 5 (Figura 14): el aproximadamente setenta por ciento de respuestas que la puerta rechaza certificar son solicitudes dirigidas a un destino más barato que un error seguro (escalada a un humano, un nivel de verificación más profundo, o una visualización explícita de incertidumbre) en lugar de conversiones perdidas, por lo que el costo de cobertura es un precio asegurable de error, no demanda perdida. No se estima ningún modelo de costo para el canal de escalada aquí. El punto operativo no está fijo. La escalera de acuerdo trazada en la Figura 19 suministra una familia de umbrales, y un servicio debe situarse donde el costo esperado de un error seguro no detectado cruce el margen en el tráfico que la puerta retiene, lo que lo convierte en una opción basada en costos.
Figura 14. Economía de la confianza graduada
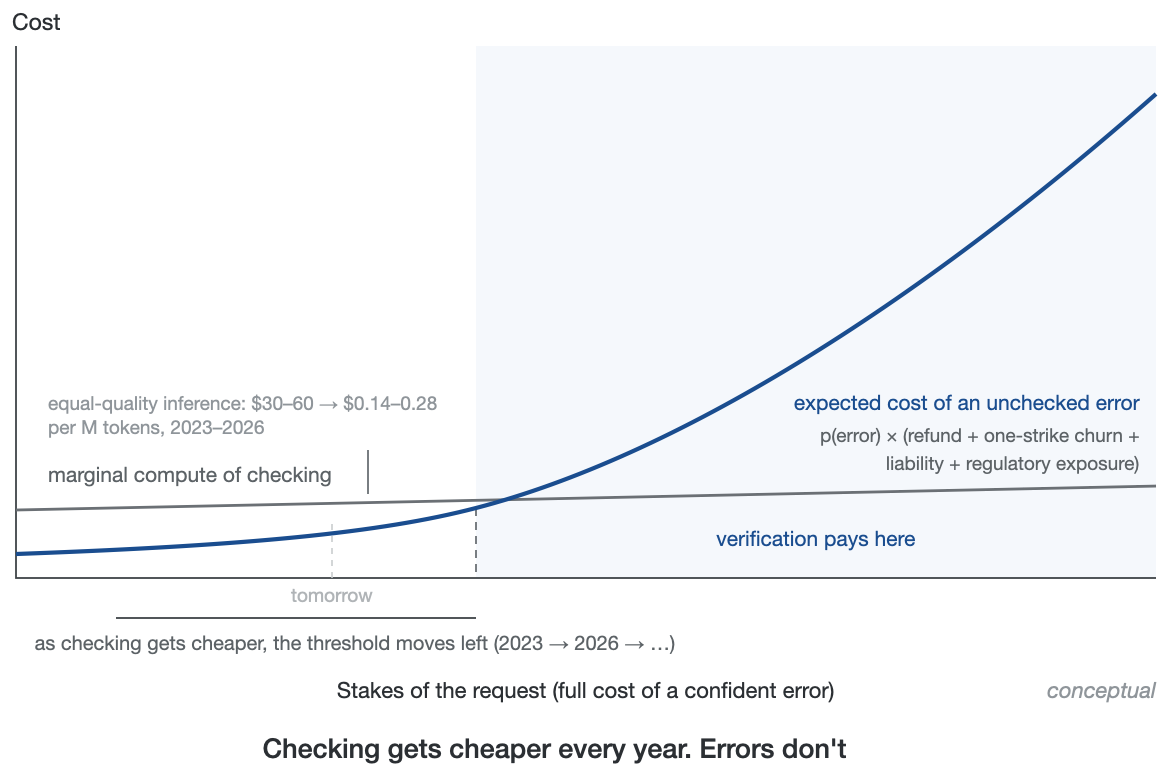
La lógica del punto de equilibrio de la verificación.
¿Por qué no simplemente usar el mejor modelo? La línea de base más sólida que deja en pie la onda es comercial en lugar de estadística: un operador podría omitir la arquitectura y enrutar todo al buque insignia más preciso de la onda. Esa línea de base necesita una respuesta con números. A precios de mediados de 2026, el consejo congelado de tres laboratorios cuesta $0.0039 por pregunta, menos que una sola respuesta del buque insignia más caro de la onda (claude-fable-5, $0.0198/pregunta a precio de lista) y más que una de su más preciso (gpt-5.6-sol, $0.0027/pregunta a tasas de API publicadas). "Solo compra el mejor buque insignia" es un punto de Pareto genuino: gpt-5.6-sol responde por sí solo cada pregunta con una tasa de error seguro del 4.6%, y ninguna configuración puerta iguala su cobertura a ningún precio. Dondequiera que un servicio pueda tolerar un error seguro en aproximadamente una respuesta de cada veinte y necesite cobertura completa, el buque insignia gana en ambos ejes. Sin embargo, la regla se generaliza mal, incluso en la cúspide de la tabla de clasificación: el otro contendiente de consenso de la onda, claude-fable-5, conlleva una tasa de error seguro del 10.3% por sí solo. "Solo usa el modelo que encabeza los puntos de referencia" falla completamente en el segundo modelo más fuerte en la muestra, que es por qué el problema de identificación a continuación no es hipotético. Cuatro consideraciones delimitan la comparación.
Primero, el problema de identificación: saber cuál modelo es actualmente el mejor es en sí mismo el producto de medición externa entre modelos. La propia Tabla 8 de la onda seleccionó sus buques insignia de tablas de clasificación públicas, comparaciones continuas, de terceros, entre proveedores que nadie propone reemplazar con autoinformes de proveedores. Los propios datos de este documento muestran por qué nadie lo hace: la autoconfianza declarada discrimina con AUROC 0.53–0.79 dependiendo del proveedor, y una diferencia de precisión de 84 puntos separa modelos todos vendidos como el mejor de su laboratorio. "Enrutar al mejor modelo" es por lo tanto una aplicación de confianza arquitectónica, no una alternativa a ella: la tabla de clasificación que corona al buque insignia es un panel independiente, ítems ciegos y un registro publicado, los tres componentes de la Sección 3 operados a escala de mercado. Y esa corona se mueve: el liderazgo del modelo empresarial cambió de manos en una sola primavera (Kharazian, 2026), los modelos se actualizan silenciosamente bajo nombres estables, y el comportamiento de compra del agente se reorganiza drásticamente entre actualizaciones de modelos (Allouah et al., 2026). Sin medición externa continua, "el mejor modelo" no está disponible para el operador como conocimiento.
Segundo, el 95.4% es en parte memoria en lugar de capacidad: el buque insignia superior reproduce la cadena de respuesta de oro textualmente en el 61.6% de los elementos (la advertencia de contaminación de la Tabla 9), por lo que su ventaja medida se comprime en preguntas que el punto de referencia no podría haberle enseñado. El mecanismo de puerta no hereda esa fragilidad: en el estrato menos probable de haber sido memorizado, elimina el 89.4% de errores seguros, su mejor rendimiento en lugar de su peor rendimiento (el re-análisis estratificado por contaminación a continuación), porque el acuerdo entre laboratorios entrenados independientemente no está condicionado por el corpus de entrenamiento de ningún proveedor.
Para separar el conocimiento transferible de la exposición al punto de referencia, compuse una sonda de dos saltos de 100 elementos nueva que se garantiza sin contaminar, generada por máquina el 6 de agosto de 2026 a partir de pares de hechos de Wikidata pre-2023 verificados independientemente (por ejemplo, "¿En qué año nació el arquitecto de [edificio menor]?"), cada uno con una respuesta única calculada, por lo que las cadenas de preguntas compuestas no podían haber aparecido en ningún corpus de entrenamiento. El SHA-256 del conjunto se congeló antes de la primera llamada al modelo.
Bajo el protocolo congelado de la onda (indicación del sistema verbatim, temperatura 0, el mismo calificador determinístico), gpt-5.6-sol se desplomó de una precisión de 95,4% con una tasa de fracaso seguro del 4,6% en SimpleQA a 33,0% [IC de bootstrap del 95% 24,0–42,0] con fracasos seguros en el 61,0% [51,0–70,0] de sus elementos (67,0% de sus respuestas seguras), su confianza media expresada apenas moviéndose (98,4 → 93,7), mientras que claude-fable-5 se mantuvo en 76,0% [67,0–84,0] y 6,0% [2,0–11,0]. La brecha insignia de 25 puntos de la onda se invierte en un déficit de 43 puntos en composiciones garantizadas no vistas. La puerta del consejo, sin cambios desde la onda, absorbió este fracaso: eliminó todos excepto uno de los 61 fracasos seguros de gpt-5.6-sol (60/61; en n = 61 la tasa puntual es imprecisa, IC de Wilson del 95% ≈ 91–99,7%; cobertura del 24,2%; claude-fable-5: 6 → 1), reduciendo la tasa de fracaso seguro emitida entre respuestas de alta confianza aprobadas a 4,5% frente a un 67,0% bruto.
Los niveles no son comparables punto a punto entre puntos de referencia: la composición de dos saltos es intrínsecamente más difícil que la recuperación de un salto, y en n = 100 los intervalos son amplios. Pero la inversión del orden del modelo y la persistencia de la puerta en elementos que ningún modelo podría haber memorizado son exactamente las firmas que la hipótesis de contaminación predice, y son el modo de fallo que una capa de confianza arquitectónica, y no una mejor opción de modelo, está construida para absorber.
Tercero, hay un piso. La puerta alcanza una tasa de fracaso seguro que ningún modelo individual logra a ningún precio: las configuraciones con puerta de consejo reducen los fracasos seguros en respuestas emitidas a 1,8–2,1% a $0,0039–0,0046 por pregunta, 2,5× por debajo de la mejor tasa sola, mientras que la insignia más cara en la onda se sitúa en 10,3% de fracasos seguros por $0,0198 por pregunta, dominada en todos los ejes. La puerta no es un dispositivo de rescate para modelos débiles: qwen-max detrás de la misma puerta aún falla con confianza en el 73,9% de sus respuestas seguras emitidas, por lo que los puntos con puerta de la frontera son consejos de modelos fuertes, no puertas sobre débiles.
Cuarto, cuando el agente está gastando dinero de forma autónoma, la pregunta operativa cambia de «¿qué modelo es más inteligente?» a «¿qué configuración puede probar qué hizo?». Por muy preciso que sea, una insignia sola no puede notarizar su propia decisión ni arbitrar su propio conflicto de interés. La configuración con puerta produce un registro de acuerdo inspectable por respuesta. Ese es el artefacto que los mercados de responsabilidad civil y seguros de la Sección 5 ya cotizan, donde la cobertura se está escribiendo contra evidencia y exclusión-formada contra su ausencia.
La resolución es una frontera, no un ganador. La insignia es el miembro más fuerte del consejo (el consejo congelado la incluye), pero no puede servir como su propio juez. El marcador de posiciones que la identifica ya descansa en el mismo principio que la confianza arquitectónica operacionaliza, verificación cruzada de modelos independientes, pero suministra esa verificación solo en agregado, sobre modelos en general, no sobre la respuesta frente a un consumidor. La construcción llena ese vacío, y el vacío también la delimita: una reclamación que descansa en ninguna verificación independiente está fuera de la confianza arquitectónica, no una instancia de ella. La opción real del operador es entre clases de riesgo: cobertura completa a 4,6% de fracasos seguros, u 31% de cobertura a 1,8% con un rastro de auditoría, la compensación de clasificación selectiva, con precios aquí. La frontera completa de costo-cobertura-riesgo de 26 configuraciones (cada insignia sola, cada configuración con puerta, y las escaleras de acuerdo agrupadas, con la base de precio facturado versus lista señalada por punto) se libera como CSV con el paquete de replicación.
El rival obvio de la puerta de desacuerdo es la reparación de calibración de modelo único: aprender la asignación de confianza a precisión de cada modelo y emitir solo donde la precisión asignada alcanza una barra, el programa de recalibración post-hoc cuyos remedios estándar son temperatura y escalado de Platt (Guo, Pleiss, Sun, & Weinberger, 2017). Ajustando en mitades disjuntas (confianza agrupada en histogramas, entrenar en preguntas de índice par, evaluar en índice impar, contenedores con menos de 20 observaciones no emitidas), este pasaporte de calibración elimina 92,7% de fracasos seguros, pero a 24,3% de emisión, y seis de las once insignias no emiten nada en absoluto: ningún contenedor de confianza de las suyas alcanza 80% de precisión de entrenamiento, por lo que el pasaporte para esos modelos es una página en blanco. Para la mitad del mercado insignia, la calibración de modelo único no se puede reparar desde el exterior. La puerta de desacuerdo mantiene aproximadamente 30% de cobertura para cada modelo en la tabla, incluidos los seis que el pasaporte abandona. Así que la conclusión del primer experimento se mantiene en este nivel también: la arquitectura puede suministrar una señal de corrección externa donde la confianza expuesta de un modelo falla como tal, en clasificación o en nivel, medida nuevamente en el nivel que se dice a los consumidores que confíen más.
Robustez del efecto de la puerta. Dos verificaciones de árbitro importan: circularidad, si la puerta depende de su miembro más fuerte, y si algo trivial hace el mismo trabajo. Reemplazar el miembro más fuerte del consejo (gpt-5.6-sol, 95,4% de precisión resuelta) con la cuarta ejecución de frontera ex-ante de la onda (grok-4.5) deja el resultado esencialmente sin cambios. El consejo sin sol elimina 81,2% de fracasos seguros agrupados a 29,7% de cobertura (objetivos sin consejo: 77,6%) contra 81,2% a 30,5% para el trío congelado, y en todos los 165 consejos posibles de tres modelos el mecanismo nunca falla: cada consejo elimina más fracasos seguros que la abstención aleatoria en su propia cobertura (exceso mediano +8,5 puntos), con el trío ex-ante en el 4% superior por ese margen (+12,6 puntos). El efecto pertenece al acuerdo cruzado de modelos, no a la precisión de ningún miembro. Establecer un umbral en la confianza expresada propia de cada modelo a la cobertura idéntica por modelo, la línea de base trivial, elimina solo 66,7% de fracasos seguros agrupados, menos que el 69,5% que la abstención aleatoria ciega en la misma cobertura elimina, porque los fracasos seguros están por construcción concentrados en confianza expresada alta. Ese umbral también mantiene menos respuestas seguras correctas que la puerta (46,4% frente a 51,3%). La puerta domina de Pareto a ambas líneas de base para cada uno de los once laboratorios. Usar acuerdo por respuesta con el modelo más fuerte solo como filtro es una pantalla aún más fuerte (97,1% de fracasos seguros agrupados eliminados a 40,7% de cobertura, manteniendo 97,0% de respuestas seguras correctas), pero es una regla mecánicamente diferente, condicionada por objetivo. Solo pasa una respuesta después de inspeccionarla, mientras que la puerta del consejo abre el mismo conjunto de preguntas fijo para cada modelo sin mirar la respuesta bajo prueba, así acota el efecto del consejo sin explicarlo: sin sol el trío aún elimina 81,2%, e incluso el acuerdo con un juez solo débil (kimi-k3, 45,5% de precisión resuelta) elimina 86,3% de fracasos seguros. El conductor es acuerdo cruzado de modelos como tal, mientras que la precisión del juez se muestra en qué se mantiene (correcto mantenido 97,0% para sol contra 20–63% para los jueces más débiles).
La abstención calibrada proporciona las líneas de base competidoras más sólidas, y también se ejecutaron. Se ajustaron dos líneas de base de abstención calibrada bajo la misma división que el pasaporte de calibración (parámetros ajustados en elementos de índice par, evaluados en la mitad impar retenida, donde la puerta congelada elimina el 82,2% de los errores confident con cobertura del 30,8%). Las líneas de base por modelo no alcanzan la puerta. La confianza escalada según Platt con cobertura por modelo coincidida con la puerta elimina el 65,3% de los errores confident, y la abstención dividida-conforme (α = 0.293, calibrada para garantizar P(emit | wrong) ≤ α y ajustada a la misma cobertura) elimina el 70,8%, al igual que un control top-K de confianza declarada sin procesar a la misma cobertura agrupada, que elimina el 69,4%. Una variante agrupada que clasifica todas las respuestas de los once laboratorios en una escala de probabilidad calibrada según Platt sí supera la puerta (89,0% con cobertura agrupada idéntica), pero lo hace reasignando esencialmente toda la cobertura a los laboratorios bien calibrados: emite el 100% de las respuestas del proveedor mejor calibrado y el 0% para cuatro de los once laboratorios, reproduciendo en forma más suave el modo de fallo del pasaporte anterior. También requiere aproximadamente setecientas respuestas calificadas por modelo para ajustarse, mientras que la puerta no requiere ninguna. Por lo tanto, la confianza calibrada y el acuerdo entre modelos son complementos, no sustitutos: el primero logra una tasa de error agrupado más baja dondequiera que existan etiquetas de verdad fundamentales para entrenarlo, y el segundo logra protección uniforme, sin etiquetas, por laboratorio.
La Figura 19 coloca cada estrategia en el plano de predicción selectiva (agrupada sobre las 13,955 respuestas resueltas determinísticamente que los once brazos devolvieron en el conjunto de 1,459 preguntas congeladas, por lo que el total es menor que el de la Tabla 9, que cuenta respuestas resueltas sobre las 1,500 preguntas; riesgo selectivo = proporción de respuestas emitidas que son incorrectas). Clasificadas por área bajo la curva riesgo-cobertura, mejor es menor: confianza calibrada según Platt 0.258, la escala de puerta refinada por confianza declarada 0.321, la escala de acuerdo puro 0.356, confianza declarada sin procesar 0.367, abstención aleatoria 0.517, frente a un límite oráculo de 0.166; los valores de mitad retenida difieren en como máximo 0.009. En el punto de funcionamiento propio de la puerta congelada (31,1% de cobertura en esta convención de respuestas resueltas, 4,334 de 13,955 respuestas emitidas; el 30,5% y 30,6% reportados en otro lugar son las proporciones de respuestas confident y de preguntas del conjunto) el riesgo de la puerta es del 24,9%, contra el 33,4% para un umbral de confianza sin procesar y el 14,0% para confianza calibrada, sujeto a las advertencias de costo de etiqueta y concentración de cobertura anteriores. La nube de los 165 consejos de tres modelos abarca coberturas del 9–59% con riesgos del 13–38%, por lo que la puerta reportada es un miembro representativo de su familia, no un valor atípico ajustado. Los jueces únicos trazan el extremo degenerado de la familia, donde el "acuerdo" se reduce a "preguntar al modelo más preciso".
Figura 19. La frontera riesgo-cobertura
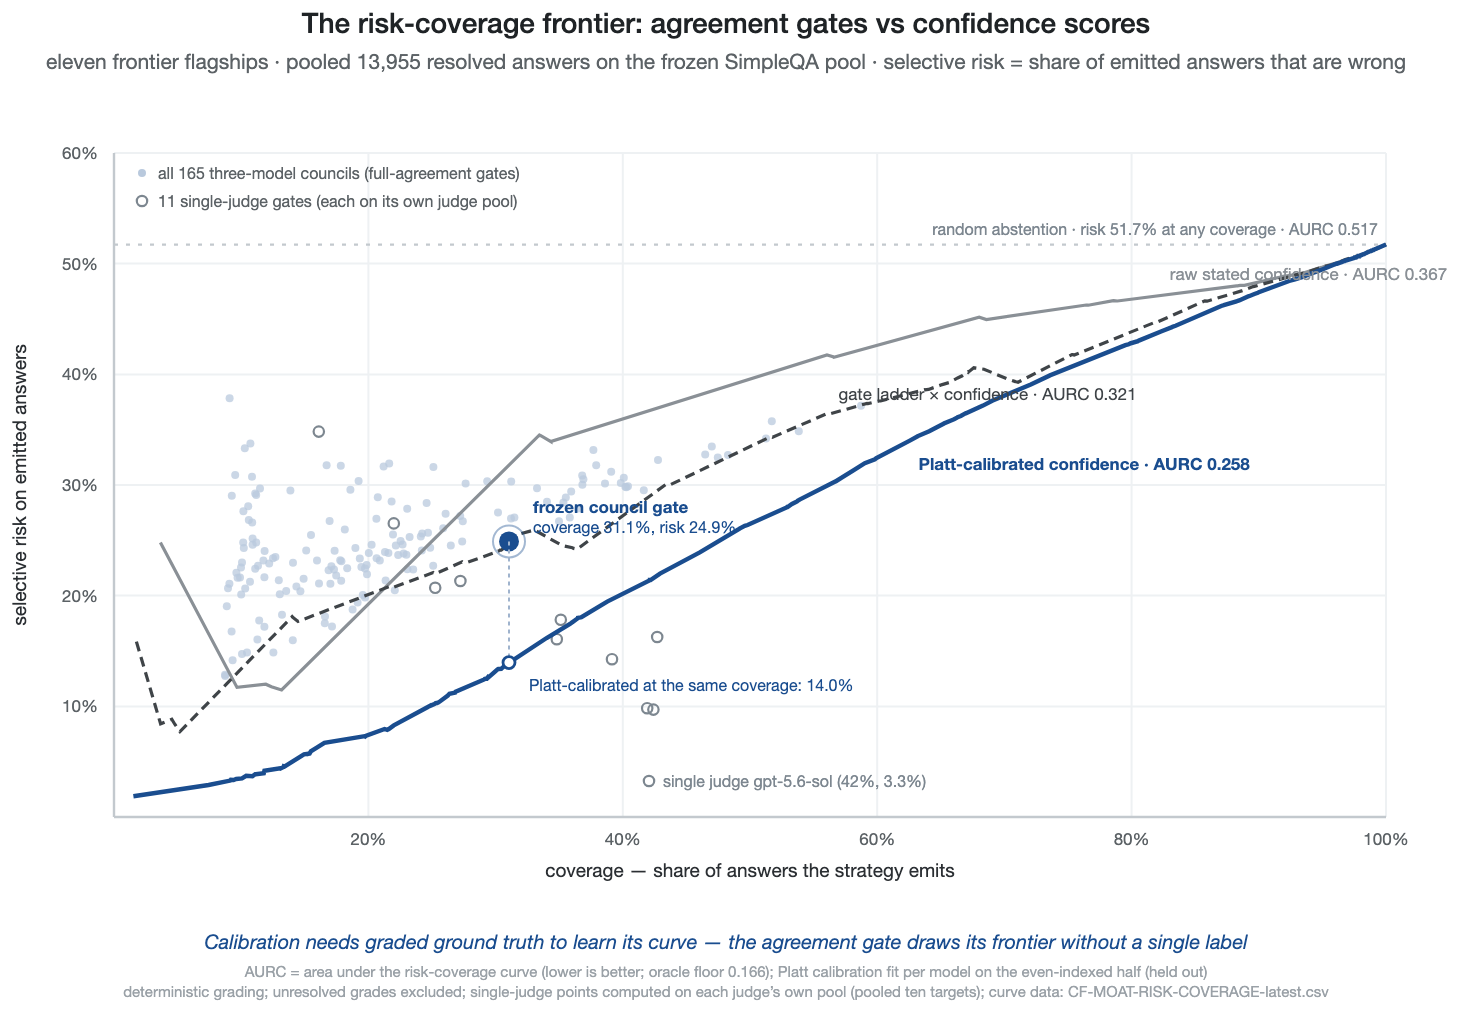
Cada estrategia de abstención en el plano de predicción selectiva, cobertura contra riesgo selectivo, agrupada sobre las 13,955 respuestas insignia resueltas determinísticamente devueltas por los once brazos en el conjunto de 1,459 preguntas congeladas (la Tabla 9 cuenta respuestas resueltas sobre las 1,500 preguntas): las curvas de confianza sin procesar, calibrada según Platt y escala de puerta-×-confianza con sus valores AURC, la línea de abstención aleatoria, la nube de los 165 consejos de tres modelos, los once jueces únicos, y el punto de funcionamiento del consejo congelado (31,1% de cobertura en la convención de respuestas resueltas, 4,334 de 13,955; riesgo del 24,9%). Menor es mejor; el límite oráculo es 0.166. Cada punto es recomputable a partir del CSV de riesgo-cobertura del paquete de replicación.
El acuerdo podría no llevar información más allá de la facilidad de la pregunta. Para probar esto, se ejecutó una regresión logística de la corrección de la respuesta en el acuerdo de la puerta y la dificultad del elemento (la proporción de respuestas incorrectas entre los otros modelos en esa pregunta), con efectos fijos de laboratorio y errores estándar agrupados por pregunta, y la respuesta depende de cómo se mida la dificultad. Con dificultad medida solo por modelos que no son del consejo (el control justo, ya que una medida de dificultad que incluye las propias respuestas del consejo incrusta la señal de la puerta por construcción), el acuerdo retiene una contribución independiente en los objetivos de laboratorio externo: b = +0.76, razón de posibilidades 2.15, z = 17.2. Una respuesta emitida por la puerta tiene aproximadamente el doble de probabilidades de ser correcta que una respuesta igualmente difícil que la puerta retendría. Incorpore la propia corrección del consejo en el regresor de dificultad en su lugar y el coeficiente de acuerdo se reduce a cero, lo que cuantifica el mecanismo en lugar de refutarlo: el acuerdo y la dificultad multimodelo son dos medidas de la misma cantidad latente, y la puerta es un instrumento sin etiquetas para leerla en el momento de la inferencia.
Un reanálisis estratificado por contaminación aborda la preocupación de exposición directamente. Marcar una pregunta como probablemente expuesta al punto de referencia cuando al menos tres de los once laboratorios reproducen la cadena de oro textualmente después de la normalización (741 de las 1,459 preguntas del conjunto; la misma firma que produce la tasa de eco de oro del 61,6% de gpt-5.6-sol), la puerta elimina el 89,4% de los errores confident en el estrato no expuesto (2,793→296; objetivos sin consejo: 86,5%) frente al 72,7% en el expuesto. Entonces el mecanismo no se monta en elementos memorizados. Se comporta como debería un filtro selectivo, abriéndose mucho menos a menudo donde el panel es genuinamente incierto (cobertura del 18,7% frente al 41,9%) y manteniendo la tasa de fallo confident emitida casi constante en los estratos (25,9% frente al 21,8%, de tasas sin procesar del 58,5% y 36,4%). Los cortes de exposición de 2–5 modelos de eco dan dCF no expuesto del 87,7–89,7%, por lo que el hallazgo es robusto al umbral. La estratificación es descriptiva: el eco de oro está acoplado al resultado, y separa las preguntas probablemente vistas de otras preguntas en lugar de identificar la contaminación de manera causal.
Lo que compra un presupuesto de razonamiento más grande: confianza, no competencia. Los proveedores insignia ahora venden un segundo dial encima de la elección del modelo: un presupuesto de razonamiento, con precio por token de deliberación oculta. Si el razonamiento extendido comprara calibración, sería una respuesta a nivel de modelo para el problema de este artículo, comprable en el checkout. Un experimento pareado en un proveedor insignia dice que compra algo más. El gemini-3.1-pro de Google (cuyo razonamiento no se puede desactivar) respondió el mismo conjunto de preguntas congelado bajo dos presupuestos, una configuración de bajo esfuerzo de razonamiento y el presupuesto dinámico predeterminado del proveedor, con temperatura cero, indicaciones y analizador idénticos, y costo por pregunta registrado. En las 233 preguntas respondidas bajo ambos presupuestos en la fecha de esta versión: exactitud 75.1% (baja) versus 76.4% (predeterminada), sin diferencia detectable (McNemar exacto p = .648); confianza declarada 3.1 puntos más alta bajo el presupuesto predeterminado (Wilcoxon z = 4.68, p < .0001); calibración ligeramente peor bajo el presupuesto predeterminado (ECE pareado 0.100 vs 0.082; brecha de confianza menos exactitud +9.3 vs +7.5 puntos); precio por pregunta 2.1×. La comparación de exactitud es un resultado nulo de un tipo específico: estos datos muestran ninguna diferencia de exactitud detectable en n = 233 (McNemar exacto p = .648), y la equivalencia se establece formalmente solo en un margen grueso. Una TOST pareada limita la diferencia de exactitud dentro de ±5 puntos (diferencia +1.3 puntos, IC 90% [−1.8; +4.4]; ambos unilaterales p ≤ .024) pero el estudio no tiene poder para establecer equivalencia en ±2–4 puntos, mientras que el aumento de +3.1 puntos en la confianza declarada es estadísticamente inequívoco (Wilcoxon p < .0001). Dentro de ese límite, el gasto duplicado compró confianza declarada adicional y ninguna corrección adicional mensurable: exceso de confianza como una característica pagada, e instancia dentro del modelo de la tesis de migración. Los dólares adicionales fueron a la capa del modelo y no produjeron nada que un consumidor pudiera verificar, mientras que la capa arquitectónica encima la convirtió en una señal verificable. El resultado es un piloto, reportado como tal: la comparación cubre 233 preguntas pareadas, y el diseño completo de 1.500 parejas estrecha el límite de equivalencia a aproximadamente dos puntos; la composición del canal y la censura de límite de tokens se documentan como confusoras en el paquete de replicación; la colección continúa.
Figura 18. Lo que compra un presupuesto de razonamiento más grande
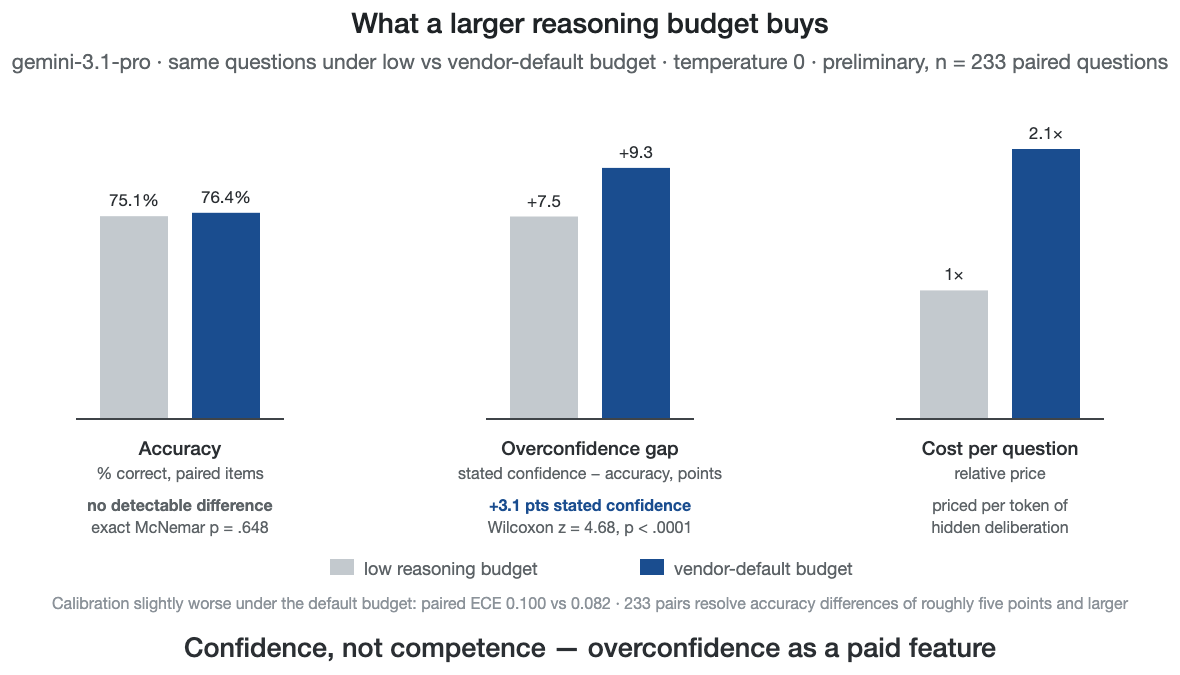
Comparación pareada bajo dos presupuestos de razonamiento — la confianza declarada sube, la exactitud no.
Tabla 11. Presupuesto de razonamiento, comparación pareada (gemini-3.1-pro, 233 preguntas respondidas bajo ambos presupuestos, temperatura 0; preliminar)
| Presupuesto de razonamiento bajo | Presupuesto predeterminado del proveedor | |
| Exactitud (elementos pareados) | 75.1% | 76.4% (McNemar p = .648) |
| Confianza declarada media | −3.1 puntos vs predeterminado | +3.1 puntos (Wilcoxon p < .0001) |
| Calibración (ECE pareado) | 0.082 | 0.100 |
| Brecha de confianza − exactitud | +7.5 | +9.3 |
| Costo por pregunta (relativo) | 1× | 2.1× |
Los ajustes de esfuerzo de razonamiento no eran idénticos entre brazos: cada proveedor fue consultado a través de su interfaz comercial estándar al esfuerzo predeterminado de esa interfaz (ajustes registrados por modelo en el paquete de replicación), por lo que la exactitud absoluta de un proveedor puede llevar un componente de esfuerzo. Eso no llega al mecanismo. La clasificación de exactitud no es determinante (la etiqueta insignia no garantiza nada), la compuerta sobrevive la eliminación de cualquier miembro (consejo sin solución elimina 81.2%), y un mayor esfuerzo levanta la confianza declarada con exactitud plana, como mostró la comparación pareada hace poco, por lo que cualquier exactitud que infle surge como error confiado, el fallo que la compuerta intercepta.
Limitaciones de cobertura de la onda insignia. La onda es una instantánea congelada del 5 de agosto de 2026, por lo que los modelos lanzados después, como Grok 4.6 (12 de agosto) y líderes posteriores de Artificial Analysis como Claude Opus 5, tienen fecha posterior y no pueden ingresar a un punto de referencia precomprometido. La posición superior cambió en días. Ese es el problema de identificación que la compuerta elude (el acuerdo es robusto respecto a la composición, sobreviviendo la eliminación de cualquier miembro). Dos laboratorios incluidos caen por debajo de la frontera actual en tablas de clasificación de capacidad general: el modelo insignia de Mistral se queda atrás de la categoría superior en cada índice agregado verificado, y el ERNIE de propósito general de Baidu se clasifica fuera de los 30 principales en Humanity's Last Exam (su fortaleza son tareas aumentadas de búsqueda y agentes, donde ERNIE 5.1 se clasifica #4 en LMArena Search Arena). Se conservan para preservar la cobertura del ecosistema europeo y de todos los laboratorios chinos principales. De los dos laboratorios de nivel superior que estaban fuera del alcance de la onda, Meta Superintelligence Labs (Muse Spark 1.1; #4 en Humanity's Last Exam) y ByteDance (Seed 2.1; #10), uno fue intentado e interrumpido posteriormente (Meta, más abajo) y uno no pudo ser alcanzado en absoluto (ByteDance, más abajo).
El Seed 2.1 de ByteDance no pudo ser incluido: BytePlus ModelArk devolvió «no disponible en su país/región» para una cuenta internacional recién registrada (intento en vivo, 5 de agosto de 2026), ningún agregador sirve al modelo insignia, y el canal doméstico Volcano Ark requiere verificación de China continental. El ERNIE 5.1 de Baidu, el actual modelo insignia, está similarmente restringido a la plataforma doméstica Qianfan (intento en vivo, 5 de agosto de 2026). Cuando el modelo insignia actual de un laboratorio es inaccesible, la regla de retroceso es el modelo más fuerte lanzado abiertamente de ese laboratorio. Para Baidu esto es ERNIE 4.5 VL 424B (pesos abiertos), que se utiliza en su lugar. Ese es un hallazgo en sí mismo: los modelos insignia actuales de dos de los seis laboratorios chinos principales no son accesibles a investigadores externos a partir de agosto de 2026.
Meta es el tercer fallo de acceso de la onda, y el obstáculo era mi cuenta, no la geografía. En la primera onda (nivel medio), Meta estuvo ausente por una razón de infraestructura documentada: su Llama API de primera parte fue retirada el 6 de julio de 2026, antes de la congelación del protocolo (registrada en el manifiesto de ejecución), y el laboratorio estuvo representado en el nivel local por su Llama-3.2-3B de peso abierto, que resultó ser uno de los miembros más instructivos del panel (la correlación de error más baja en toda la matriz). Para la onda insignia, se agregó muse-spark-1.1 de Meta a mitad de onda cuando se volvió accesible, y la recopilación falló entonces de tres formas secuenciales, cada una registrada: (i) la clave de la API del Modelo Meta de primera parte falló a mitad de ejecución el 5 de agosto con 251 respuestas válidas recopiladas, y la consola del desarrollador no emitiría un reemplazo; (ii) una ruta de reserva de agregador proporcionó 21 respuestas adicionales antes de que (iii) el punto final del proveedor de Meta comenzara a devolver HTTP 403 `user_blocked`, "el acceso ha sido restringido debido a violaciones de política repetidas," para preguntas de recuperación de hechos de libro cerrado de una evaluación de referencia pública, realizadas a temperatura cero. El resultado neto es 272 de 1.500 elementos (18,1%) recopilados e informados como parciales: el análisis agrupado congelado incluye las 251 respuestas de primera parte (la ampliación del agregador llegó después de la congelación del análisis), y la estimación por laboratorio de Meta (−92,0% dCF en 125 respuestas confiables) es directamente consistente con el panel pero demasiado imprecisa para hacer inferencias. El bloqueo es en sí mismo un hallazgo: a partir de agosto de 2026, un investigador independiente no puede completar una evaluación de hechos de 1.500 preguntas del insignia de Meta a través de ningún canal autorizado. Entre los tres, los tres fallos de acceso de la onda, un insignia con bloqueo regional (ByteDance), un insignia solo doméstico (Baidu), y una prohibición para investigadores (Meta), son el argumento teórico en forma empírica: la verificabilidad en la capa de modelo es gozada por gracia del proveedor, y una capa de confianza arquitectónica no puede asumir gracia del proveedor.
4. Un despliegue extremo: delegación con apuestas irreversibles
La forma habitual de estudiar la confianza del consumidor es una encuesta o una tarea de laboratorio. Tenía disponible un instrumento más severo: un despliegue extendido de alto riesgo en el que todas las consecuencias cayeron sobre mí. Esta sección es una prueba de existencia y testimonio de diseño de un único operador conflictivo, no evidencia empírica de generalidad, y ninguno de P1–P5 descansa en ella. Los dos tipos de evidencia se entrelazan. En el laboratorio, el efecto de calibración se midió bajo control de placebo; en el despliegue, donde los errores eran irreversibles, las mismas tres propiedades marcaron la diferencia entre que la delegación fuera posible y que fuera temeraria.
El despliegue no es de un cliente ni es una simulación: simultáneamente soy el operador, el desarrollador y el analista. La capa de evidencia está anclada criptográficamente y cada medición es independientemente recomputable, de modo que el conflicto recae en la defensa y en lo que elegí medir, no en si los números se reproducen. El entorno combina competencia ordinaria del consumidor con apuestas irreversibles, donde cada debilidad arquitectónica es castigada rápida y visiblemente.
Metodológicamente, este es un caso único extremo y revelador (Yin, 2018) en la tradición interpretativa y analítica-autoetnográfica (Walsham, 1995; Gould, 1991; Anderson, 2006), con las precauciones de evidencia de esa tradición en vista (Wallendorf & Brucks, 1993): registros primero, interpretación marcada como interpretación. La justificación es el acceso: un investigador no puede asignar éticamente participantes para apostar resultados del mundo real irreversibles en una arquitectura de IA, así que el único observador disponible es un participante que eligió la apuesta él mismo.
El análisis se basa en registros contemporáneos anclados criptográficamente. La capa de evidencia del despliegue es el registro mismo: los pasos de carga crítica (qué modelos fueron consultados, dónde divergieron, qué fue controlado, qué confirmé) fueron registrados en el momento, de modo que las observaciones descansan en registros reproducibles y no solo en la memoria. El sesgo retrospectivo no se puede eliminar de la interpretación, de modo que marco cada lugar donde la interpretación excede el registro. Los registros del período de despliegue de la capa de evidencia del sistema están anclados criptográficamente a partir del 2 de agosto de 2026: un manifiesto SHA-256 por archivo de 129 archivos (7.414.043 bytes) cuya raíz es 2f88a16611e51c0c12c8015754c89269e782ea167a89b5ed2a881f18eee4defc, y el anclaje se publica con este documento. Los registros permanecen sellados hasta que se cierra el despliegue, porque la cita selectiva de un despliegue en vivo sería peor que ninguna. El compromiso puede ser verificado: cualquier registro liberado después coincide con el manifiesto anclado o no, de modo que la edición retroactiva, la sustitución o la falsificación de fechas son detectables por cualquier lector de esta página. Un tratamiento cuantitativo más completo de la telemetría se deja para trabajo futuro, por la misma razón.
Se ofrecen tres observaciones de vivir dentro de este bucle como hipótesis sobre qué se transfiere más allá del entorno original, alimentando las proposiciones de la Sección 3, y los eventos en los que descansan fueron registrados por el despliegue en el momento.
El desacuerdo es una señal utilizable por el consumidor. Cuando modelos independientes divergieron en una pregunta de consecuencia, la divergencia en sí, sacada a la superficie en lugar de suprimida, me dijo dónde residía la incertidumbre genuina: una advertencia temprana gratuita que ningún servicio de un único modelo puede proporcionar.
La evidencia cambia el comportamiento antes de que jamás cambie una disputa. Saber que cada paso de consecuencia fue registrado hizo que la delegación fuera psicológicamente viable en absoluto; el registro era la condición previa de la confianza, no una idea tardía de auditoría.
La compuerta de confianza importa más que la precisión promedio. Los eventos prácticamente peligrosos eran los errores confiantes, nunca los resultados mediocres. La verdadera contribución de la arquitectura fue hacer que la alta confianza fuera cara: una respuesta tenía que sobrevivir el acuerdo entre modelos para ganárselo, en lugar de obtenerlo gratis de la fluidez de un modelo.
5. Implicaciones: de la persuasión a la infraestructura
Diseño y experiencia
Para el diseño de servicios. La unidad del diseño de servicios de IA confiable se está desplazando del modelo a la canalización. Eso significa enrutar consultas consecuentes a través de modelos independientes, tratando el desacuerdo como un elemento UX de primera clase, adjuntando evidencia por defecto, y fijando el precio del procesamiento multi-modelo contra el costo asimétrico de errores confiados, con la ruta cara reservada para solicitudes donde las apuestas se concentran, como la evaluación de fraude reserva el escrutinio para transacciones arriesgadas. La infraestructura ya existe: cascadas impulsadas por costos que escalan solicitudes difíciles a capas caras son una ingeniería de agentes estándar, y para un servicio que ya se enruta por dificultad, la arquitectura marginal del enrutamiento por consecuencia está cerca de cero. Los modos de fallo que ambos experimentos midieron dejan dos reglas duras, y son requisitos de diseño, no preferencias. Las posiciones deben ser recopiladas en ciego y registradas antes de cualquier deliberación entre modelos, ya que una canalización deliberación-primero fabrica el mismo consenso que la arquitectura se supone debe vigilar (las presiones de conformidad de la Sección 3). La segunda regla: el consenso unánime confiado sobre un conjunto de opciones limitadas es una bandera roja para revisión, no una luz verde para la ejecución: tanto los paneles de modelos como los participantes humanos de la Sección 6 trataron exactamente ese consenso como certificación.
La economía funciona porque la escalada es graduada, una arquitectura de confianza graduada: en el despliegue descrito aquí, los niveles de procesamiento abarcan aproximadamente tres órdenes de magnitud en costo por solicitud entre una respuesta de modelo único y una deliberación multi-modelo completa (a partir de julio de 2026), por lo que el nivel caro se compra solo donde se concentran las consecuencias. La lógica del punto de equilibrio es la de la puntuación de fraude (Figura 14). La orquestación paga siempre que la probabilidad de un error confiado multiplicada por su costo total (reembolso, pérdida bajo tolerancia de un strike, responsabilidad, riesgo regulatorio) supera el cálculo marginal de la verificación. Para transacciones de alto riesgo, esa desigualdad no está cerca.
Los precios de inferencia decrecientes (aproximadamente dos órdenes de magnitud a capacidad fija en tres años, una lectura conservadora de declives rastreados; Appenzeller, 2024) no disuelven el argumento, porque la razón, no el costo absoluto, es la cantidad estructural: ambos niveles descienden la curva de precio juntos, e inferencia barata hace que el nivel caro sea asequible a apuestas cada vez menores. La verificación sigue su propia segunda curva: conjuntos de verificadores débiles, sin datos etiquetados, alcanzan la precisión de selección de respuesta de modelos de razonamiento de frontera de componentes abiertos de 70 mil millones de parámetros (Saad-Falcon et al., 2025). Dada la tolerancia del consumidor de un strike, la comparación no es "respuesta barata versus respuesta cara" sino "respuesta cara versus cliente perdido".
Dos primitivas orientadas al consumidor completan el diseño: fricción deliberada (una pausa marcada antes de acciones irreversibles) y recibos. Ambas intervienen en cómo se siente la delegación. Los consumidores experimentan IA sociológicamente, no estadísticamente (Puntoni, Reczek, Giesler, & Botti, 2021), y como la ejecución delegada elimina el encuentro de servicio de la vista, el recibo hereda el antiguo rol del encuentro como el momento de la verdad. Un riesgo viaja con ese encuadre: hacer que el desacuerdo sea saliente puede anunciar incertidumbre y deprimir la confianza en lugar de calibrarla (Detjen et al., 2025; Lu, Wang, & Yin, 2024), por lo que cuánta divergencia exponer, y cómo, es una variable de diseño. No es un bien gratuito.
Un recibo de orquestación puede ser mínimo y aún funcionar (la Figura 8 muestra el prototipo). Tres campos llevan la mayoría del valor: (1) quién actuó, los modelos y versiones consultados, bajo qué autoridad; (2) cómo estuvieron de acuerdo, un resumen de divergencia en términos simples; (3) qué fue verificado, con un puntero al registro completamente reproducible: lo suficientemente pequeño para leer de un vistazo y lo suficientemente específico para anclar una disputa, un reclamo de seguros o una auditoría. El mismo artefacto responde a la propia pregunta de contabilidad del operador, por lo que el recibo se vende dos veces: hacia adentro como gobernanza de costos, hacia afuera como confianza justificada. Esa bilateralidad es una necesidad. La voluntad medida del consumidor de pagar por transparencia solamente es limitada (en el único análisis conjunto con precio, el valor de explicabilidad quedó por debajo de €1,99 al mes; König et al., 2022), por lo que una capa de confianza financiada solo por el lado del consumidor se moriría de hambre, y el lado de gobernanza de costos del operador la sostiene. El vecino ingenieril más cercano del recibo son los recibos de herramientas registrados dentro de marcos de agentes para detección de alucinaciones (Basu, 2026), que comparten el instinto pero no la audiencia: esos son registros orientados al desarrollador de llamadas de herramientas individuales, mientras que el recibo de orquestación es su generalización orientada al consumidor, por decisión. El recibo invita su propio modo de fallo: un artefacto diseñado para parecer verificado sin exponer nada que un consumidor pueda volver a ejecutar. La línea de diseño que importa es si el registro es genuinamente reproducible y no meramente con forma de recibo. Una restricción también viene del lado de la privacidad: un artefacto que prueba qué fue verificado también registra qué fue preferido, por lo que la verificabilidad y la privacidad tienen que ser optimizadas conjuntamente (Alavi & Nozari, 2026).
Una última faceta de la economía de los recibos tiene su propio nombre, la economía de la verificación. Un registro a prueba de manipulación tiene valor solo en la medida en que alguien tiene incentivo para abrirlo, y la década de sistemas descentralizados es la advertencia aquí: los registros públicos de cadenas de bloques a prueba de manipulación no convirtieron a los usuarios ordinarios en auditores, y las arquitecturas "sin confianza" reintrodujeron silenciosamente intermediarios de confianza en cada unión práctica (Werbach, 2018). El Dilema del Verificador es la versión formal: donde la verificación es costosa y los resultados correctos son el caso común, el verificador racional se salta la verificación. La demanda de verificación debe concentrarse donde ya existe un beneficio privado en la verificación, entre aseguradoras, auditores y procesos de disputa, con el consumidor heredando la verificación como subproducto de esos mercados; la función del consumidor del recibo es la disponibilidad en disputa, no la lectura nocturna. La cuestión de la financiación se deduce del mismo punto, y ambas respuestas ingenuas a él fracasan: un orquestador pagado por el consumidor valora la neutralidad como un bien de lujo, y un orquestador pagado por el comerciante reimporta el conflicto que existe para eliminar. Eso deja el modelo que la economía de dos caras del recibo ya implica. La capa se paga de la forma en que se paga la auditoría, por partes que necesitan el riesgo tasado en lugar de la historia contada (operadores comprando gobernanza de costos y reducción de responsabilidad, aseguradoras comprando perfiles de riesgo asegurables, procesos de disputa comprando evidencia), con pisos regulatorios donde esos mercados tienen demanda insuficiente. El consumidor compra el servicio, no la neutralidad, e hereda la neutralidad como su subproducto. El mismo problema tiene una versión de estructura de mercado. Una plataforma que es simultáneamente mercado, proveedor de modelos y red de publicidad es estructuralmente incapaz de suministrar neutralidad, que es el punto de conflicto de interés en forma de mercado, y el registro histórico de priorización algorítmica (ubicación patrocinada, socios preferidos) dice que los jugadores dominantes monetizarán el enrutamiento si pueden. Donde opera esa presión, el piso de neutralidad es regulatorio o de protocolo abierto, no voluntario. Si la demanda inicial del consumidor por evidencia es débil, la adopción de confianza arquitectónica puede ser impulsada menos por la elección del consumidor que por el lado de cumplimiento y seguros, una migración a través de instituciones en lugar de preferencias, con consumidores heredando arquitectura verificable como predeterminada. El resultado de calibración mantiene esa ruta de ser decorativa: los consumidores demostrablemente usan la señal arquitectónica una vez que se les presenta, pero aún no pagan para invocarla. Hay una hipótesis rival aquí: la confianza puede migrar a la responsabilidad e instituciones en lugar de a la arquitectura verificable. Los consumidores confían en derechos de contracargo, no en auditorías de libro mayor; las redes de tarjetas escalaron el comercio remoto a través de derechos de disputa en lugar de a través de los consumidores inspeccionando registros de autorización; en esa lectura el registro de decisión es infraestructura que hace la responsabilidad computable en lugar de un objeto de confianza del consumidor. Las dos cuentas predicen cosas diferentes: en la cuenta arquitectónica los consumidores recompensan la verificabilidad cuando pueden verla; en la cuenta institucional la recompensan solo cuando se adjunta un remedio, y la confianza del consumidor luego permanece anclada en la institución mientras que la confianza de la institución migra a la arquitectura. El diseño de tiempo de disputa especificado a continuación los discrimina. Y cada capa de registro hereda el problema del oráculo: el registro certifica el proceso, y solo los propios controles del proceso alcanzan los hechos. La asimetría que el recibo invierte es la que documenta la literatura de crítica de plataformas: la arquitectura, no la política declarada, es el regulador operativo de la conducta digital (Lessig, 2006), y hasta la fecha sus instrumentos han apuntado al consumidor en lugar de ser sostenidos por el lado del consumidor (Zuboff, 2019; Möhlmann & Zalmanson, 2017), y el recibo vuelve esos instrumentos al otro lado.
La capa de evidencia debe ser visible en el producto mismo, no archivada en un registro de back-office. La ingeniería de software ha convergido recientemente en un nombre para el envoltorio de ejecución alrededor de modelos agénticos, el arnés de agente, y en el reconocimiento de que el arnés, no el modelo, es lo que puede ser certificado, regulado y de confianza. La confianza arquitectónica especifica qué debe producir un arnés para merecer ese papel.
La escala para la cual esta sección diseña y el retroceso que previene ya están en el registro. El asistente de Klarna manejó 2.3 millones de conversaciones en su primer mes, dos tercios de los chats de servicio al cliente de la compañía y el trabajo estimado de 700 agentes de tiempo completo (Klarna, 2024, figuras reportadas por la compañía). Catorce meses después, el CEO cambió de curso públicamente: la calidad de salida había decaído, la contratación humana se reinició, y el compromiso permanente se convirtió en que "siempre habrá un humano si lo deseas" (Daly, 2025). Leído arquitectónicamente, como mi lectura en lugar de la razón declarada de la compañía, el par de anuncios encierra exactamente la brecha que este documento nombra. El nivel de volumen funciona a costo de máquina, pero sin escalación graduada y sin señal de calidad verificable, la delegación se revirtió al nivel humano base. Lo que estabilizaría la posición entre esos anuncios es una arquitectura de confianza graduada: barata donde los riesgos son bajos, verificada donde se concentran, y humana donde la verificación falla.
Mercados y regulación
Para servicios transfronterizos. La neutralidad se extiende más allá de los proveedores de modelos hacia las jurisdicciones. Una capa de orquestación puede ejecutar enrutamiento consciente de jurisdicción y registrar su ejecución, convirtiendo el cumplimiento de soberanía de datos de una representación legal a una propiedad de tiempo de ejecución auditable. La diferenciación a la que responde ha sido medida: en 25 países, el 53% de los encuestados en promedio confía en que la UE regule la IA de manera efectiva, contra el 37% para los Estados Unidos y el 27% para China (datos de Pew, reportados en Stanford HAI, 2026, un informe de instituto, no revisado por pares). Donde la confianza varía por jurisdicción, una arquitectura que puede probar qué reglas de jurisdicción se aplicaron tiene valor real.
Para comercio agéntico. La integración Visa–ChatGPT concretiza los tres componentes. Los límites y listas blancas son controles estáticos del lado del consumidor. La confianza arquitectónica añade la capa dinámica del lado del servicio: compras verificadas por modelos independientes (diversidad), un registro reproducible de por qué el agente eligió este comerciante a este precio (evidencia), y una capa de orquestación cuyos ingresos no dependen de qué proveedor o comerciante gana (neutralidad).
La industria de pagos ya ha comenzado a construir los pisos inferiores de esta arquitectura. El Trusted Agent Protocol de Visa (octubre de 2025, con Cloudflare; Visa, 2025) firma criptográficamente la identidad de un agente en sus solicitudes: firmas específicas de comerciante y propósito, limitadas en tiempo, a prueba de repetición. El Agent Payments Protocol de Google (Google Cloud, 2025), aportado junto con el marco de Mastercard a la Alianza FIDO en 2026, codifica la intención del usuario como mandatos firmados transportados como Credenciales Verificables W3C (W3C, 2025). Verifiable Intent de Mastercard (un marco conjunto con Google; anunciado en marzo de 2026; Mastercard, 2026) expresa su propósito en palabras que este artículo podría haber escrito, un registro resistente a manipulaciones de lo que el usuario autorizó cuando un agente de IA actúa en su nombre, con pilotos tempranos reportados en mercados asiáticos y latinoamericanos en 2026. La evidencia de identidad e intención se está estandarizando ahora, y también el formato del registro: la arquitectura SCITT del IETF (RFC 9943, 2026) especifica el mismo patrón, declaración firmada → registro de transparencia de solo anexión → recibo, que la capa de evidencia de este artículo presupone. La interfaz a través de la cual ocurre la delegación ni siquiera es moralmente neutra. En trece experimentos, las personas que delegaron en IA se comportaron con menos honestidad, más marcadamente bajo establecimiento de objetivos vagos, y los agentes de máquina llevaron a cabo instrucciones completamente deshonestas mucho más a menudo que los agentes humanos (Köbis et al., 2025). Las interfaces que obligan a que la intención se exprese en términos específicos son infraestructura ética.
Ningún protocolo aún cubre el tercer piso, la evidencia de decisión: cómo el agente eligió este comerciante, este producto, este precio; si verificaciones independientes concordaron; cuál fue el valor de su confianza (la Figura 15 dibuja los tres pisos). Esa es la capa que este artículo nombra, y "conoce-tu-agente" debe madurar en exactamente esta pregunta de proceso, con la unidad de supervisión migrando hacia la transacción. Lo que la arquitectura puede garantizar es la existencia del registro, no su lectura. Si alguien abre tales registros es una pregunta empírica que solo el despliegue puede responder.
Figura 15. La pila de evidencia
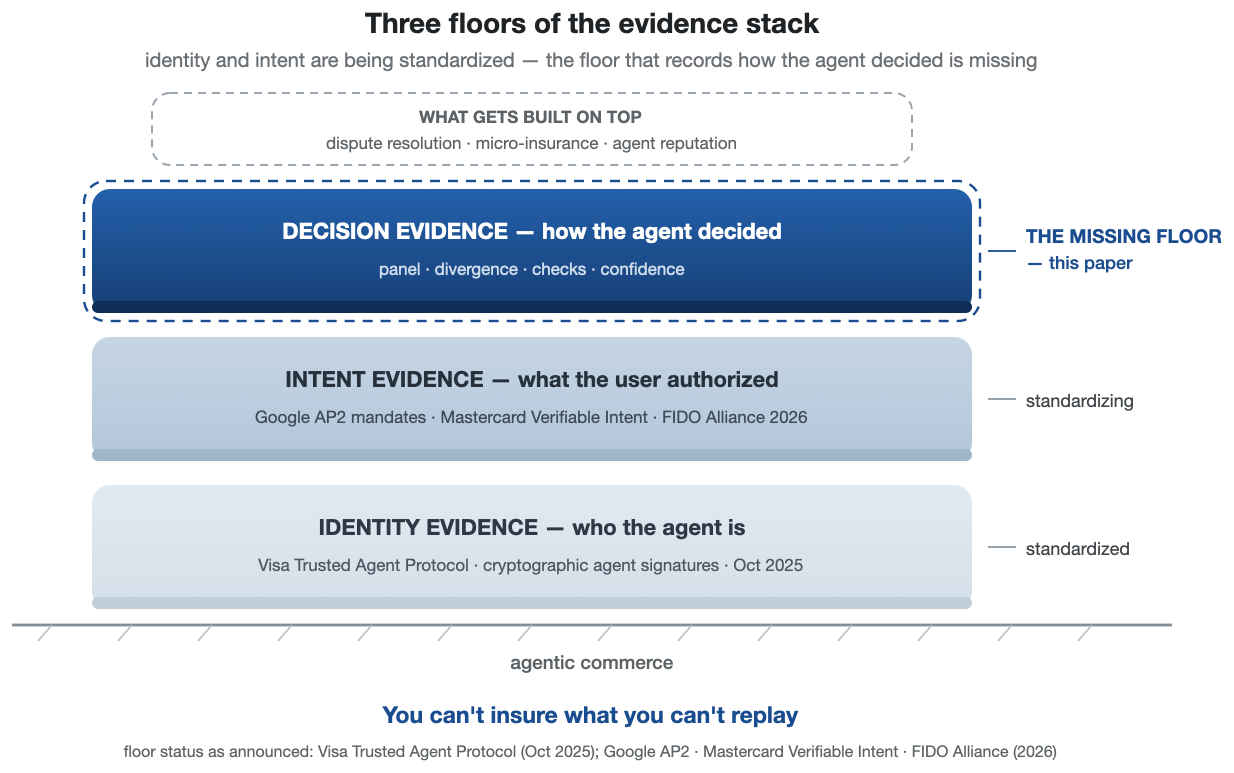
La evidencia de identidad e intención se está estandarizando ahora; la evidencia de decisión es el piso faltante que este artículo nombra.
Los primeros auditorios sistemáticos del comportamiento de compra de agentes muestran por qué la evidencia de decisión no puede esperar. Allouah et al. (2026), ejecutando ensayos aleatorizados en una sandbox de comercio electrónico controlada, encontraron que los agentes de compra exhiben fuertes sesgos posicionales, concentran la demanda en unos pocos productos "modales" y reorganizan esas preferencias drásticamente cuando el modelo subyacente se actualiza. Sin un registro de cómo se tomó la decisión, nada de esto es visible para el consumidor, el comerciante o el regulador. La diversidad es la respuesta de diseño aquí, ya que un panel diluye los caprichos posicionales de cualquier modelo único, y la responsabilidad es lo que la evidencia de decisión proporciona: lo que esos auditores tuvieron que construir una sandbox para observar, un servicio arquitectónicamente confiable registraría en producción.
El marco también se extiende más allá del consumidor, a la confianza de máquina a máquina. En flujos de trabajo agénticos B2B no hay un humano en el circuito para sentir confianza en absoluto, así que el único sustrato posible es un proceso verificable, con agentes intercambiando exactamente los artefactos descritos aquí y calculando si realizar la transacción. Cómo se agrega y propaga la confianza a través de tales cadenas de delegación a escala, y cuáles son los costos de sobrecarga de registro y verificación propios de la capa de evidencia a volumen de producción, son problemas abiertos aquí. Las cadenas agudizan el requisito, ya que una cadena es solo tan confiable como su eslabón menos evidenciado: los registros deben componerse. Donde no hay consumidor presente, la confianza arquitectónica es, plausiblemente, la única forma de confianza disponible.
Un desarrollo estructural que la literatura sobre confianza no ha alcanzado es la guerra de protocolos. Pilas competidoras de comercio agéntico (OpenAI con Stripe, el Agentic Commerce Protocol; la coalición Universal Commerce Protocol de Google; Perplexity con PayPal; redes de tarjetas y estándares abiertos por debajo) están fragmentando el comercio según líneas de protocolo de proveedor exactamente como los servicios de IA se fragmentaron según líneas de modelo de proveedor, y el argumento de neutralidad se generaliza casi palabra por palabra: un agente del consumidor que solo puede realizar transacciones dentro del protocolo de un proveedor es el agente del proveedor, no el del consumidor. Cualquier capa que arbitre entre protocolos enfrentará los mismos tres requisitos: independencia, evidencia y sin participación, y si tal capa se consolida, la batalla por el estante se convierte en la batalla por el verificador.
Para el mercado de evidencia. En 2026 esto dejó de ser un pronóstico. En el lado de la responsabilidad civil, el seguro se movió primero y en dos direcciones a la vez. Los respaldos de exclusión opcional para reclamaciones de IA generativa ingresaron al conjunto de herramientas estándar de responsabilidad civil general en enero de 2026 (formularios ISO CG 40 47 y CG 40 48, respaldos que las aseguradoras pueden elegir, no exclusiones automáticas; dentro de meses, las principales aseguradoras habían presentado solicitudes para adoptarlos o equivalentes propios). En la misma ventana las primeras pólizas de agente de IA se escribieron de manera opuesta, en contra de la evidencia: el estándar de agente AIUC-1 existe para generar, a través de auditorías de equipo rojo, los perfiles de riesgo empíricos que los asegurados requieren para suscribir, y febrero-marzo de 2026 trajo su primer auditor acreditado, primera póliza de agente y primeras certificaciones empresariales. Presionado entre exclusión general y suscripción basada en evidencia, el registro se ha convertido en la unidad de asignación de responsabilidad: un agente sin historial inspeccionable enfrenta cobertura de exclusión, y un agente con uno es un riesgo cotizable.
En el lado regulatorio, las obligaciones de transparencia del Artículo 50 de la Ley de IA de la UE, incluida la divulgación obligatoria de la interacción de IA a los consumidores, se hacen exigibles el 2 de agosto de 2026 (una sub-obligación de marcado transitoria se extiende hasta el 2 de diciembre de 2026), con multas, según la lectura de este artículo de las disposiciones de penalización de la Ley, de hasta €15 millones o 3% de la facturación global. La Comisión adoptó su orientación del Artículo 50 el 20 de julio de 2026 (Comisión Europea, 2026), y la simplificación paralela de Digital Omnibus (firmada el 8 de julio) no retrasa las obligaciones de agosto. Los sistemas existentes reciben solo un aplazamiento limitado, hasta diciembre de 2026, para el marcado de contenido legible por máquina. Las obligaciones más amplias de alto riesgo se implementan gradualmente durante 2027–2028.
La capa de evidencia modifica esta obligación: un registro a prueba de manipulación que incluye prueba de que la divulgación de IA requerida se mostró a este usuario en esta sesión convierte, según la lectura de este artículo, una exposición legal de hasta €15 millones en una propiedad de ejecución auditable, cumplimiento normativo como subproducto de la arquitectura. Los aseguradores que suscriben la responsabilidad de agentes de IA necesitan precisamente estos registros, y la trazabilidad y la rendición de cuentas son características fundamentales en el Marco de Gestión de Riesgos de IA del NIST. El precedente regulatorio es anterior a la tecnología. La orientación sobre riesgo de modelos de la banca ha requerido validación independiente por partes independientes de los desarrolladores de un modelo desde 2011 (Federal Reserve SR 11-7), un requisito que un panel orquestado automatiza, hace continuo y extiende a cada respuesta consecuente. La ley de protección del consumidor ya reserva la salida humana: el Artículo 22 del RGPD otorga el derecho a la intervención humana en decisiones únicamente automatizadas con efectos significativos, y la escalación ante divergencia es, según la lectura de este artículo, la manifestación en tiempo de ejecución de un derecho legal existente. La Ley de IA alcanza el mismo diseño desde el lado de la supervisión: el Artículo 14 del Reglamento (UE) 2024/1689 requiere que los sistemas de IA de alto riesgo estén diseñados para una supervisión humana efectiva, y una arquitectura que pone de relieve la divergencia y encamina los casos no resueltos a un humano implementa ese deber de supervisión como una propiedad de ejecución en lugar de un documento de cumplimiento normativo.
Una vez que el registro existe, siguen dos productos derivados, ambos conjeturas a corto plazo. El microseguro a nivel de transacción aseguraría una compra de agente específica por centavos, valorada a partir del registro de evidencia, no asegurable contra un agente opaco y trivial contra uno reproducible. El otro es reputación de agente: los historiales de evidencia longitudinal se agregan naturalmente en puntuaciones de reputación para agentes y orquestadores. Los servicios que producen historiales de calidad de auditoría como subproducto de la operación tendrían un activo que sus competidores tendrían que adaptar retrospectivamente.
Cómo la infraestructura de este tipo se vuelve institucional es en sí una hipótesis. La trayectoria en la que apuesta este artículo, productos primero, normas después, mandatos al final, es una de varias que la historia de la infraestructura de confianza exhibe (redes ATM compartidas, libros de reglas de redes de tarjetas ratificados posteriormente por la regulación, oferta de verificación de blockchain aún esperando demanda). También tiene un programa de investigación nombrado detrás. La línea de mercados regulatorios de Hadfield, reguladores privados autorizados por autoridades públicas, con organizaciones de verificación independientes como institución fundamental (Hadfield, 2017; Clark & Hadfield, 2020; Hadfield & Clark, 2026), la alcanza desde el lado de la oferta de la gobernanza. Este artículo la alcanza desde el lado de la demanda de la delegación del consumidor, y los dos programas se encuentran en el recibo. Debajo se plantea la pregunta más difícil de si un recibo vendido como característica de producto alguna vez se endurece en una institución. Si no lo hace, sigue siendo un adorno de gobernanza en lugar de una capa de gobernanza, lo que refutaría la afirmación central de este artículo. El punto de refutación está preregistrado: llamar al recibo una capa de gobernanza cuando al menos dos normas de la industria requieren registros de decisiones trazables para transacciones de agentes, servicios que llevan los tres componentes manejan la mayoría del volumen de transacciones de agentes de alto riesgo, y al menos un regulador nacional reconoce tales registros en su asignación de responsabilidad. El fracaso persistente de los tres es lo que "adorno" significa operacionalmente. Si la verificación tiene éxito como infraestructura, se mercantiliza, y la confianza migra hacia la utilidad compartida misma, la arquitectura actual incluida, lo que terminaría con cualquier ventaja competitiva incluso cuando la infraestructura tuvo éxito.
Quién es responsable cuando una decisión orquestada se equivoca sigue siendo una pregunta abierta: el orquestador, los proveedores del modelo, o el consumidor que autorizó el agente.
La ley ha comenzado a cerrar la salida fácil. La AB 316 de California, efectiva a partir del 1 de enero de 2026, prohíbe que cualquier demandado que desarrolló, modificó o utilizó un sistema de IA argumente que la IA causó autónomamente el daño, mientras mantiene intactas las defensas ordinarias y la asignación comparativa de culpa. No impone responsabilidad estricta. Eso hace que la pregunta de asignación sea inevitable, y de cualquier manera que la doctrina la resuelva, el registro reproducible es aquello a partir del cual se calcularía cualquier asignación de responsabilidad. La erudición legal ha estado llegando al mismo destino, sosteniendo que el conjunto de herramientas clásico del derecho de agencia no se transfiere a agentes de IA y que lo que se requiere es una nueva infraestructura de visibilidad y responsabilidad (Kolt, 2025), el predecesor más cercano del argumento de este artículo en la literatura de gobernanza, abordado desde el lado de la oferta de supervisión donde este artículo lo aborda desde el lado de la demanda. La confianza arquitectónica es el sustrato probatorio en el que una doctrina de responsabilidad emergente podría plausiblemente basarse.
Medición y la agenda de investigación
Para la medición de confianza. Los instrumentos estándar miden actitudes hacia una marca o una interfaz. La actitud que vale la pena medir es la disposición a delegar, no la respuesta a "¿confías en esta IA?": ¿qué clase de decisiones, con qué riesgos, entregará el consumidor al agente sin revisar cada paso? La delegación es conductual, monótona respecto a la confianza garantizada, y directamente vinculada a los ingresos. Junto a ella se plantean las preguntas de si el consumidor sabe cómo se produjo la respuesta, si puede acceder al registro, y si el desacuerdo revelado mejora o degrada su calibración de confianza.
La encuesta fue el recibo de la era humana: mientras el consumidor realizaba la búsqueda, la comparación y la elección, preguntar al consumidor era una forma defendible de aprender lo que sucedió. La delegación elimina al actor al que el cuestionario fue construido para interrogar, por lo que el rastro principal del episodio se convierte en el artefacto que produce la arquitectura, y el recibo es en ese sentido preciso el rastro de transacción principal de la era delegada. Los dos instrumentos no compiten: el recibo registra lo que la máquina hizo y no dice nada sobre la apropiación subjetiva, la autonomía sentida o la carga cognitiva, que siguen siendo territorio de la encuesta. (Esto disuelve una tensión aparente con la Sección 1, cuya evidencia motivadora son en sí misma encuestas de preferencia declarada: las encuestas miden lo que los consumidores actualmente sienten sobre un mercado que apenas existe, mientras que el recibo mide lo que los servicios delegados realmente hicieron una vez que existen.) Ese puente puede probarse emparejando medidas de actitud con los artefactos de los mismos episodios, estratificados por resultado, y estimando dónde el cuestionario y el registro están de acuerdo y cuál predice mejor el comportamiento de delegación subsecuente. El análisis conjunto propuesto lleva parte de esta validación por diseño, y hasta que tales estudios existan, las métricas basadas en artefactos complementan la encuesta en lugar de retirarla.
Las encuestas industriales ya muestran la línea de referencia conductual: en una encuesta de consumidores de Gartner publicada en mayo de 2026 (846 consumidores estadounidenses, recopilada en noviembre-diciembre de 2025), el 54% de los compradores que utilizaron IA generativa al comprar reportan verificar toda la información que les proporcionó. La confianza arquitectónica es la productización de lo que los consumidores ya hacen por sí mismos.
El programa de medición tiene aliados naturales en el movimiento de evaluación holística (Liang et al., 2023) y la ciencia emergente de la confiabilidad de agentes, que descompone la confiabilidad en doce métricas porque una única tasa de éxito oculta los fracasos que importan (Rabanser et al., 2026). La confianza arquitectónica se operacionaliza de la misma manera, conductualmente: tasa de error confiado, confianza apropiada, cambios en el peso del consejo, tasas de anulación, tiempo de decisión, y una estadística especialmente aguda, la brecha en la tasa de aprobación entre resultados correctos e incorrectos, que es la calibración de la confianza leída directamente del comportamiento. En el lado del registro hay cobertura de evidencia, divergencia de panel medida y tasas de acceso a comprobantes, triangulando encuesta, comportamiento y registros en los mismos episodios. Nada de esto requiere ciencia nueva. El requisito es una decisión de que estos, y no el compromiso, son los números a los que una capa de confianza es responsable. Mi propia observación desde el despliegue señala de manera contraintuiva: la incertidumbre bien presentada aumentó mi confianza apropiada, y confié más en el sistema cuando visiblemente sabía lo que no sabía.
Una variable dependiente adicional pertenece a la agenda porque la confianza no es la única tensión psicológica que causa la delegación. Los consumidores responden menos calurosamente a un resultado favorable cuando un algoritmo lo produjo, porque un resultado que uno no produjo es más difícil de reclamar como propio (Yalcin, Lim, Puntoni, & van Osselaer, 2022). La delegación puede aumentar la calidad objetiva de una decisión mientras agota su apropiación subjetiva. El comprobante se sitúa en esa bifurcación: leído de una manera, restaura la autoría; leído de otra, certifica que el consumidor no hizo nada. Cuál lectura prevalece es una pregunta de diseño que el marco ya ha instrumentado: el componente Evidencia registra qué se verificó y contra qué estándar (Section 3), y el comprobante está diseñado para llevar los criterios propios del consumidor a ese registro, por lo que la autoría de los criterios de evaluación es una variable que la arquitectura expone en lugar de una que un experimentador inventa. El mecanismo de Yalcin et al., que un resultado que uno no produjo es más difícil de reclamar como propio, entonces hace de la autoría de criterios el moderador natural, y P5 es la consecuencia del componente Evidencia para la psicología de la apropiación en lugar de una rama secundaria de la agenda. P5. La saliencia del comprobante interactúa con la favorabilidad del resultado para determinar la apropiación subjetiva de un resultado delegado: para resultados favorables, un comprobante saliente restaura la apropiación cuando codifica criterios de autoría del consumidor (el estándar que el agente tenía que cumplir era el mío, y aquí está la prueba de que lo cumplió) y deprime la apropiación cuando los criterios se leen como los de la plataforma; la autoría del consumidor de los criterios de evaluación es el moderador del diseño. El efecto de Yalcin et al. se observó donde los consumidores esperaban tomar la decisión por sí mismos, por lo que P5 está limitado a esa frontera y puede revertirse bajo delegación habitual, y lo que distingue el comprobante de las manipulaciones de transparencia de procesos existentes debe implementarse, no asumirse. El comprobante es verificable y puede llevar los criterios propios del consumidor; un diseño que omita ambos está probando transparencia, no confianza arquitectónica.
La literatura de transparencia ofrece dos advertencias aquí: demasiada transparencia procesal puede deprimir la confianza (Kizilcec, 2016), y la mera divulgación del uso de IA la erosiona (Schilke & Reimann, 2025). La segunda es una condición límite en el componente Evidencia: en trece experimentos, los actores que divulgaron el uso de IA fueron confiados menos que aquellos que no lo hicieron, un dilema de transparencia en el que hacer la implicación de IA más visible, por sí solo, reduce la confianza. Si esa penalización se adhiere a cualquier señal de implicación de IA, entonces una arquitectura que pone en primer plano su propia maquinaria podría deprimir la confianza incluso mientras la hace más verificable, y el componente Evidencia sería contraproducente exactamente donde es más saliente. La respuesta del marco se basa en una distinción que tiene que demostrarse: la verificabilidad no es mera divulgación. El comprobante es un registro verificable de cómo se produjo la respuesta, no una declaración que se usó IA, y P2 y P3 (con la prueba de dos lados pre-registrada de H2, el retroceso de divulgación nombrado de antemano como resultado reportable) son exactamente donde la distinción se justifica conductualmente o falla. La verificabilidad es lo que construye confianza, entregada bajo demanda en lugar de como un muro omnipresente de proveniencia, y ni ocultar la maquinaria ni anunciarla realiza ese trabajo. Cuánto del registro exponer, a quién y cuándo es en sí una variable de diseño.
El mecanismo propuesto para que Evidencia supere la penalización de divulgación en lugar de agravarlo es que la verificabilidad y la divulgación viajan a través de canales psicológicos diferentes. La divulgación entrega una etiqueta de categoría, que una IA fue implicada, que la evidencia de Schilke y Reimann vincula a la legitimidad deprimida. Un comprobante entrega un procedimiento, un registro que puede abrirse, cuestionarse y re-ejecutarse, y la literatura de justicia procesal sostiene que un proceso que se puede desafiar y verificar legitima al actor que lo ejecuta (Tax, Brown, & Chandrashekaran, 1998). El canal no requiere que la verificación suceda: lo que lleva la confianza es la conciencia del consumidor de que la verificación existe y es abierta en una disputa, la disponibilidad de verificación en lugar de su ejercicio, que es exactamente la función del consumidor que la economía de la verificación asigna al comprobante anterior. La verificación se concentra donde existe una ganancia privada para la verificación, y el consumidor hereda la verificación como un subproducto, manteniendo el registro como una opción en lugar de leerlo como un documento. La misma distinción se aplica a la apropiación subjetiva (P5): una etiqueta de divulgación atribuye la decisión a la máquina y agota la propiedad, mientras que un comprobante que codifica criterios de autoría del consumidor documenta que el estándar que el agente tenía que cumplir fue el del propio consumidor. Si los dos canales en realidad se disocian, con la legitimidad aumentando con un procedimiento verificable mientras cae con divulgación desnuda, es exactamente lo que la prueba de dos lados pre-registrada de H2 está construida para detectar.
Limitaciones. El modelo se deriva del análisis arquitectónico más una implementación extendida, de alto riesgo y con un único operador. Cada anclaje empírico se obtuvo en ese único stack, que construí y opero. Aplicado a sí mismo, la validez del artículo se ve afectada por su propia estructura: un autor y un stack (baja diversidad), un paquete de replicación público junto a registros de implementación sellados y un registro de comportamiento embargado hasta la publicación (evidencia parcial), y una participación comercial declarada (neutralidad comprometida). Se requiere replicación independiente en otros stacks antes de que cualquier afirmación se generalice. El anclaje hash de los registros de implementación hace que cualquier edición posterior, sustitución o cambio de fecha sea detectable, por lo que al dessellar, las caracterizaciones aquí pueden verificarse contra un artefacto que comprobablemente no ha cambiado. Los lectores pueden verificar la integridad, no los contenidos, hasta el desellado. Los números del mecanismo provienen de API de modelos públicas, y la canalización replica la recopilación de extremo a extremo por menos de $15. La representación del estímulo sigue siendo una confusión de interfaz: los estímulos del experimento del consumidor, incluido el estilo del recibo, son mi propia representación UX, y las confusiones a nivel de interfaz se desenredan solo mediante replicación con representaciones independientes. La recopilación ciega primero, los registros a prueba de manipulación y el enrutamiento sin interés son la construcción; las reglas de agregación y los umbrales de escalada son opciones de ingeniería. Los paneles del experimento son combinaciones analíticas de una recopilación ciega en lugar de un bucle de orquestación implementado, y el protocolo de telemetría de campo redactado cierra esa brecha. Las rutas de verificación no modelo que el marco nombra (ejecuciones paralelas, comprobaciones de consistencia temporal) se describen aquí, no se prueban. La recopilación es una única ejecución a temperatura cero, que suprime la variabilidad dentro del modelo y deja la correlación de linaje compartido en su lugar, y las API alojadas no son estrictamente deterministas ni siquiera allí. Las respuestas factuales cortas de SimpleQA se sitúan cerca del régimen de espacio de respuestas limitado en el que el consenso certifica el error, y la estratificación de dificultad muestra exactamente ese patrón en los quintiles más difíciles. Un panel de nivel medio puede exagerar el beneficio de la diversidad, ya que la correlación de errores aumenta con la capacidad (Kim et al., 2025). El experimento del mecanismo prueba preguntas factuales de respuesta abierta con respuestas verificables únicas, y en tareas generativas abiertas, donde la equivalencia semántica entre respuestas es en sí misma una decisión de juicio, la señal de certificación debe restablecerse en lugar de asumirse. Un límite relacionado es la dimensionalidad del espacio de respuestas: los elementos de SimpleQA tienen una respuesta verificable única, mientras que las opciones de consumidor que ejecutan los agentes son juicios de utilidad multiatributo subjetivos con muchas respuestas defendibles, por lo que cómo se comporta el consenso en el espacio de preferencias, y si el acuerdo entre agentes independientes incluso identifica una opción mejor allí, es una pregunta empírica abierta (la equivalencia semántica se convierte en equivalencia de preferencias, y la calificación en sí una opción de modelado). Se ejecuta una comprobación de ruido de etiqueta: en la intersección de 351 elementos del subconjunto de este estudio con SimpleQA Verified (Google DeepMind, 2025), recalificar cada respuesta del panel contra las etiquetas de oro corregidas deja el levantamiento de certificación sin cambios o ligeramente más fuerte (2.7 → 2.8, 4.4 → 4.4, 4.0 → 4.3 en los tres paneles, calificador determinista), por lo que el ruido de etiqueta no es el factor impulsor del levantamiento. Todas las figuras de confianza son informes de autoinforme verbalizados de 0–100 obtenidos por un formato de pregunta único, y la sensibilidad al protocolo de elicitación puede variar en sí misma por proveedor, por lo que las conclusiones de discriminación y calibración por proveedor deben leerse como propiedades de esta configuración bajo este protocolo de elicitación, no como rasgos de proveedor fijos. La línea de base de autoconfianza en las Tablas 6–7 de la onda de dieciséis modelos es la confianza declarada sin procesar. Las líneas de base calibradas más sólidas en la tradición de Guo et al. (2017) se ejecutaron en la onda insignia (escalado de Platt y abstinencia conforme dividida, Sección 3), donde emergen como complementos de la puerta en lugar de sustitutos, y la comparación panel-versus-self de la primera onda debe leerse contra la línea de base que los productos del consumidor realmente implementan. La estimación de puerta principal (−82.1% de fallos confiados, IC de bootstrap del 95% [79,9; 84,1] para los diez brazos completos, [80,0; 84,2] con el brazo Meta incluido) es una cantidad única prespecificada, y los análisis circundantes (la cuadrícula de sensibilidad de umbral, los estratos de dificultad y contaminación, las ablaciones del consejo y las comparaciones de línea de base trivial) son comprobaciones descriptivas de robustez reportadas sin corrección alguna para comparaciones múltiples, y no reclaman ningún estado confirmatorio propio. El único control de error familiar en el artículo es la corrección de Holm en los {H1, H2} preregistrados del experimento del consumidor. Si el régimen de evaluación que recompensa las adivinanzas seguras se reparara para que la veracidad pudiera entrenarse en modelos (Kalai et al., 2025), la arquitectura aseguraría contra un problema con una solución más barata, aunque la evidencia y la neutralidad seguirían siendo irreducibles a cualquier solución a nivel de modelo. Otros límites se indican donde se reportan: las limitaciones de cobertura de la onda insignia (Sección 3: dos buques insignia chinos inaccesibles y una recopilación Meta interrumpida), y la comparación preliminar de presupuesto de razonamiento de 233 pares, cuyas limitaciones TOST equivalen a un margen de ±5 puntos sin poder para límites más estrechos. Las medidas de delegación provienen de una viñeta hipotética, donde las medidas declaradas exageran la disposición real en aproximadamente el 21% en metanálisis (Schmidt & Bijmolt, 2020); el experimento del consumidor realizó 119 primarias y 133 agrupadas de 200 participantes registrados en seis elementos fijos. Una replicación de sustrato de comercio extiende el mecanismo más allá de la referencia: un conjunto fresco y precongelado de 267 hechos de productos verificados por Wikidata (qué empresa fabrica un automóvil o aeronave determinado, qué sistema operativo ejecuta un teléfono, qué empresa publicó un juego, en qué año se lanzó), ejecutado a ciegas a través de un panel independiente de seis modelos (Claude Opus, GPT-5.4, Grok, Qwen, GLM y Mistral), el nivel optimizado por costo en el que los agentes orientados al consumidor realmente operan, no el insignia, reproduce la disociación, el acuerdo entre modelos prediciendo la exactitud en AUROC 0,77–0,81 contra 0,63–0,70 para la confianza declarada y un levantamiento de certificación de 4–6×, robusto en paneles compuestos independientemente de tres a seis modelos que abarcan laboratorios estadounidenses, chinos y europeos, y a la rigurosidad de la calificación (la coincidencia de cadena determinista aquí es la regla primaria, conservadora). El extremo subjetivo y multiatributo del espectro de comercio (compensaciones de preferencias, incentivos de comerciantes adversarios y recuperación basada en herramientas sobre inventario cambiante) sigue sin ser probado.
Varianza de ejecución a ejecución bajo muestreo. Un brazo de varianza sondeó directamente el límite de ejecución determinista única: se volvió a ejecutar una submuestra estratificada por dificultad de 100 preguntas (5 quintiles de dificultad × 20, semilla 20260806) a temperatura 0,7 con 3 muestras independientes por pregunta para 9 de los 11 modelos del panel de onda insignia; los puntos de conexión de Meta fueron inaccesibles, y la API de Claude Fable 5 no expone un parámetro de temperatura. Entre modelos, las tres muestras produjeron respuestas mutuamente equivalentes en 22–77% de las preguntas (mediana 54%), la corrección por pregunta fue idéntica entre las tres muestras en 63–97% de las preguntas, y la respuesta de temperatura 0 coincidió con la respuesta mayoritaria de temperatura 0,7 en 40–85% de las preguntas. La rama de gpt-5.6-sol lleva un factor de confusión: se ejecutó con esfuerzo de razonamiento ninguno, mientras que 1.486 de sus 1.500 registros de onda utilizaron el esfuerzo predeterminado (medio, como se señaló arriba). Por lo tanto, su delta de precisión del 92,0% → 46,3% en esta submuestra confunde la temperatura con el presupuesto de razonamiento, aunque sus cifras de consistencia entre muestras no se ven afectadas. Excluyendo esa rama confundida, la precisión promedio por muestra a temperatura 0,7 se diferenció de la precisión determinista de temperatura 0 en las mismas preguntas en como máximo 14,0 puntos (gemini-3.1-pro, 49,0% → 63,0%), con los siete modelos restantes dentro de 4,4 puntos. A nivel de panel, la puerta del consejo (acuerdo de respuesta tripartito entre kimi-k3, deepseek-v4-pro y gpt-5.6-sol) se abrió en el 31,0% de la submuestra a temperatura 0, frente al 25,0%, 23,7% y 29,8% entre las tres ejecuciones de temperatura 0,7. La señal de acuerdo subyacente al resultado titular es estable bajo ruido de muestreo.
Estado probatorio de las afirmaciones. Las afirmaciones caen en tres niveles de evidencia. Establecido por estos datos: que el acuerdo independiente lleva una señal de corrección que el autoinforme de un modelo no tiene, bajo las condiciones de límite establecidas (recopilación ciega, verificadores competentes, preguntas fácticas de respuesta abierta con respuestas verificables únicas); que una puerta de desacuerdo fijo reduce la gran mayoría de fallos seguros con un costo de cobertura sustancial y establecido (−82,1% con cobertura del 30,5%); y las propias condiciones de límite fuerte: el consenso certifica error en espacios de respuesta restringidos, la elevación de certificación bruta se atenúa monótonamente con la dificultad (desapareciendo en el quintil más difícil bajo la estratificación dentro de la colección; positivo pero más débil allí bajo el exógeno), y la competencia del verificador determina el valor de certificación. Respaldado por el experimento de comportamiento (un diseño, escala de estudio único modesto, n = 119): que poner en superficie el desacuerdo real entre modelos mejora la calibración de confianza en ambas direcciones (d = 0,67, Holm p = ,0005; llevado por uno de seis elementos; verificaciones de manipulación de onda principal 88–98%; confiabilidades de escala α = ,83–,93); y, como un nulo inconcluso registrado, que un recibo de primera exposición estática no mueve detectablemente la delegación. Propuesto teóricamente, aún no probado: la complementariedad D×E×N; el efecto de neutralidad (P3); migración de confianza bajo delegación creciente; durabilidad posterior al fallo de la confianza basada en arquitectura (P4); disposición a pagar por verificabilidad; y la afirmación de categoría de mercado de la Sección 7.
El siguiente paso natural es experimental: medir la confianza, la calibración de confianza y la disposición a pagar entre condiciones de un único modelo y orquestadas, con desacuerdo alternadamente puesto en superficie y suprimido. La Sección 6 reporta el experimento realizado, pre-registrado e incentivo-compatible. Un análisis conjunto basado en opciones estándar estima las utilidades parciales de manera aditiva y asume compensaciones compensatorias, que es lo que niega la hipótesis de complementariedad, por lo que la clase de diseño tiene que permitir estructura no compensatoria, ya sea eliminación por aspectos o diseños de opción forzada con atributos decisivos, estimados con términos de interacción explícitos. Se especifican dos niveles de diseño. El nivel mínimo es un estudio de perfil dirigido, cuatro o cinco perfiles que abarcan ninguno, un componente, dos componentes y configuraciones completas, con el trabajo teórico realizado por un contraste planificado, el efecto de configuración completa que excede la suma de los efectos de los componentes (super-aditividad), contra el nulo aditivo. El nivel completo cruza tres niveles por componente (ausente, presente-pero-no-inspectable, presente-e-inspectable) en un factorial entre-sujetos de 3×3×3 (27 celdas; las apuestas varían dentro del sujeto en cuatro niveles), con al menos 80 encuestados por celda (N ≥ 2.160) para potencia ≥ 0,85 en la interacción. Un diseño binario 2³ no puede recuperar los exponentes de Cobb-Douglas y no tiene suficiente potencia con tamaños de efecto plausibles (d ≈ 0,3–0,4). Se aplican tres disciplinas de estímulo: variar las magnitudes arquitectónicas en sí mismas y no solo su etiquetado (una etiqueta de recibo faltante es ignorancia del consumidor de evidencia, no su ausencia), dar a cada componente un contraste verificable-versus-meramente-afirmado, y emparejar datos de opción con seguimiento de proceso en los campos del recibo, ya que la teoría predice uso de evidencia. Según mi conocimiento, este sería el primer diseño para variar los tres componentes conjuntamente. Los bloques de construcción de un solo componente ya tienen precio (König et al., 2022; Ioku et al., 2024), y se han ejecutado paquetes adyacentes (Cetinkaya & Krämer, 2024, el instrumento más cercano y una fuente de calibración de potencia junto con Köbis et al., 2025), por lo que el estudio está especificado, con potencia y listo para ejecutar. Las condiciones de límite del constructo son estas: la confianza arquitectónica no paga donde las apuestas son bajas y el volumen es alto; añade poco donde el grupo de verificadores no es competente en la clase de tarea; puede certificar error donde los espacios de respuesta están fuertemente restringidos; y se degrada hacia teatro donde quiera que la independencia del panel se afirme en lugar de medirse, más marcadamente como la pregunta abierta de equipo rojo ¿cómo se ve un recibo manipulado? Una vez que los hipervínculos se convirtieron en señales de autoridad, surgieron granjas de enlaces para fabricarlos, y los registros de acuerdo deberían esperarse que inviten su propia siembra. Dos límites temporales también se aplican: las señales ganan atención mientras que la evidencia gana persistencia, por lo que la afirmación se refiere a qué confianza sobrevive al fallo en lugar de cuál se incorpora más rápido, e incluso una verificación que funcione puede solo ralentizar una espiral del tipo que modela Chandra et al. (2026). Donde las consecuencias se concentran y la independencia es real, la confianza arquitectónica gana su costo y su nombre (la Tabla 12 recopila las cuatro).
Tabla 12. Condiciones de límite: donde la confianza arquitectónica no paga
| Condición | Por qué falla allí | Evidencia |
| Apuestas bajas, volumen alto | El costo de verificación excede el costo de los errores; servir un único modelo es la respuesta correcta | Lógica de punto de equilibrio (Figura 14) |
| Grupo de verificadores por debajo de la competencia de la tarea | La independencia sin competencia no transmite señal alguna | Nulo de nivel local: 46% de precisión con o sin acuerdo |
| Espacios de respuesta estrictamente limitados | El consenso certifica el error en lugar de detectarlo | Errores de consenso 4,0–7,9% en opción múltiple frente a 0,5–2,2% en forma abierta |
| Independencia aseverada, no medida | Un panel de casi clones fabrica confianza | Errores correlacionados; nulos de bloque y linaje |
Un último límite concierne a lo que cualquiera de los diseños propuestos puede identificar. La confianza en un mercado de agentes es, en fin, un objeto de equilibrio. Una vez que los vendedores, plataformas y agentes competidores se han adaptado a una arquitectura de verificación, sus efectos son propiedades del mercado adaptado, no de la célula de tratamiento. Los datos observacionales heredan la selección, porque la verificación se adoptará primero donde la confianza ya se está quebrando. La aleatorización a nivel de unidad repara la selección pero se detiene en la interferencia, ya que los consumidores aleatorizados a recibos aún realizan transacciones en un mercado cuyos vendedores responden a los recibos de todos a la vez. La cantidad de equilibrio requiere diseños agrupados, switchback, bipartitos o a nivel de mercado; aleatorizar la arquitectura, en lugar de medir la confianza, es el próximo problema difícil. Y las cohortes tempranas de comercio agentico se autoseleccionan por propensión a la confianza, por lo que los efectos estimados en los primeros usuarios acotan, en lugar de estimar, el efecto poblacional. La neutralidad es valiosa exactamente porque nadie con interés en un modelo puede proporcionarla, incluyendo a cualquiera con interés en la orquestación. El argumento también describe el tipo de sistema que construyo (Nota del autor). Ese interés toca la defensa y no la reproducibilidad de la evidencia: los modelos evaluados son sistemas de frontera independientes y públicamente accesibles, y cada número informado es recomputable por terceros desde el paquete de replicación congelado. Un lector que desestima completamente la defensa aún puede verificar las mediciones.
6. ¿Pueden los consumidores usar la señal? Una prueba conductual preliminar
Si los consumidores pueden usar la señal de corrección que establece el mecanismo es una pregunta conductual separada, e informo de un experimento pre-registrado e incentivado sobre ella. El estudio de campo es una prueba de existencia más que una prueba de un efecto general; pregunta si los consumidores pueden actuar según la señal en absoluto. Se planifica una replicación confirmativa y potenciada, de muchos elementos, muestreada por estímulo, con pendientes aleatorias. Una interrupción del alojamiento en la ventana final de reclutamiento finalizó la recopilación de datos en 119 participantes válidos frente a 200 planeados (133 agrupando una cohorte de lanzamiento suave; EE.UU. y Reino Unido; tres condiciones entre sujetos alrededor de un asistente de compras agentico; calibración medida en seis ensayos fácticos incentivados como Δ = P(aceptar | correcto) − P(aceptar | incorrecto), el índice de discriminación de confianza apropiada de Schemmer et al., 2023). El método completo, el piloto, las cinco desviaciones del registro, la divulgación de ética y exención, y todas las estadísticas auxiliares están en el informe detallado a continuación (§6.1–6.2) y el paquete de replicación.
El desacuerdo mostrado entre modelos mejoró la calibración en general (Control Δ = 0,24 → 0,45; d = 0,67, 0,68 agrupado, p = ,0001), pero la estimación agrupada es frágil: es llevada por uno de seis estímulos, el único elemento disidente de alta confianza, donde la pantalla redujo la aceptación de una respuesta confiada incorrecta del 74% al 24% (cohorte agrupada, Tabla 18). Quitar ese elemento reduce el efecto a d = 0,09 (p = ,54), mientras que quitar cualquier otro elemento lo deja intacto. El beneficio se concentró en la submuestra del Reino Unido. La célula de control estadounidense (n = 16) ya discriminaba en la línea de base (p de interacción = ,002). En el único elemento donde el panel en sí estuvo de acuerdo en una respuesta incorrecta, la pantalla aumentó la aceptación en ambos países, que es el modo de error de consenso certificado de la Sección 3 reproducido en el comportamiento humano y un hallazgo en sí mismo: una arquitectura que presenta el acuerdo transfiere su único fallo sistemático a sus usuarios. La prueba de primera exposición del componente de evidencia de P2, un recibo de orquestación estática, no produjo efecto detectable en la disposición a delegar (d = 0,21, inconcluso con este poder; un recibo de desglose en vivo en el momento de la disputa es el seguimiento registrado).
Una pantalla de panel disidente puede reducir drásticamente la aceptación de una recomendación confiada incorrecta donde un consumidor de otro modo la aceptaría, y falla donde el panel certifica un error compartido. El contraste de calibración por lo tanto tiene apoyo conductual bajo estos seis estímulos; P1 como se indica, con riesgo percibido como mediador, no es apoyado por esta prueba. P2–P4 permanecen como el programa abierto.
6.1 Prueba conductual: método y piloto
Las proposiciones de las Secciones 3 y 5 están escritas para ser probadas, y la agenda de medición anterior especifica cómo. El experimento es una prueba en línea pre-registrada e compatible con incentivos de P1 (calibración de confianza bajo desacuerdo manifestado) y P2 (disposición a delegar bajo un registro replicable), con estímulos extraídos de los resultados reales de múltiples modelos de la onda insignia, extendiendo el paradigma de segunda opinión (Detjen et al., 2025; Chen et al., 2026) a desacuerdos reales e incentivados entre modelos de frontera bajo un marco arquitectónico. El instrumento, la congelación del protocolo, el piloto, la onda principal, y el análisis de código congelado están completos e informados a continuación. Las tablas confirmatorias fueron incluidas en versiones anteriores de este documento como un esqueleto pre-registrado con celdas marcadas [MAIN DATA PENDING] y ahora se llenan mediante el código de análisis congelado. Dos resultados desfavorables para la hipótesis fueron pre-registrados como hallazgos primarios reportables: desacuerdo manifestado empeorando la calibración (confianza insuficiente neta), y el recibo reduciendo la disposición a delegar (contraefecto de divulgación); ninguno de los dos se materializó, pero uno nulo pre-registrado sí lo hizo.
Método.
Diseño e hipótesis. La calibración de confianza requiere cruzar el acuerdo mostrado con la exactitud de la respuesta, lo que una única viñeta no puede hacer. El diseño es por lo tanto híbrido. Los participantes primero leen una viñeta de delegación de compra (un agente de compra de IA, "ShopAssist", recomendando la compra de un portátil dentro de un presupuesto de $1200), la prueba principal de P2, y luego completan un breve bloque de juicio incentivado en los resultados reales de múltiples modelos, la prueba principal de P1. H1 (P1): mostrar acuerdo y desacuerdo entre modelos de varios sistemas de IA independientes mejora la calibración de confianza de los consumidores (aceptan más la respuesta propuesta por el agente cuando es correcta y menos cuando es incorrecta) en relación con una respuesta única segura; de dos colas, porque la literatura documenta tanto la reducción de la sobreconfianza como el aumento de la infraconfianza bajo presentación conjunta. H2 (P2): el acceso a un recibo de orquestación (quién actuó, cómo acordaron, qué se verificó, y un registro plenamente reversificable) aumenta la disposición a delegar una compra de gran importancia por encima del efecto del desacuerdo mostrado únicamente; de dos colas, porque la divulgación también puede disminuir la confianza.
Condiciones. Tres condiciones entre sujetos, aleatorizadas 1:1:1 y mantenidas constantes a través de la viñeta y el bloque de juicio: (1) Control, una única recomendación segura, sin señales arquitectónicas; (2) Desacuerdo, la misma recomendación precedida por un panel de tres sistemas de IA independientes (anonimizados como Sistema A, B, C) con marcado explícito de acuerdo/desacuerdo, las respuestas alternativas de los sistemas y confianzas declaradas, y un resumen de resolución en lenguaje sencillo; (3) Desacuerdo + Evidencia, la pantalla de Desacuerdo más una tarjeta de recibo de orquestación estructurada como quién actuó / cómo acordaron / qué se verificó / registro completo. Una restricción de diseño pre-registrada controla el factor de confusión obvio: el bloque de recomendación final (producto, precio, y la confianza final declarada del agente) es palabra por palabra idéntico entre las tres condiciones, en la viñeta y en cada ensayo de juicio, y solo las señales arquitectónicas a su alrededor difieren.
Estímulos y recibos. Los estímulos del bloque de juicio son salidas reales de tres modelos de frontera de la serie principal sobre preguntas fácticas reales en las que los modelos genuinamente estuvieron de acuerdo o desacuerdo con confianza alta declarada (95–100); ninguna respuesta o confianza es fabricada. Los nombres de modelo se reemplazan por etiquetas neutrales para evitar sesgos previos de marca, y el mapeo se divulga en el paquete de replicación. Los recibos mostrados en la condición 3 (un recibo de viñeta y seis recibos de ensayo) son generados por el generador de recibos de producción del despliegue de investigación (esquema `decision-receipt@v1`) usando los registros de proveniencia reales del panel de estímulos, y sus hashes de verificación son genuinamente recalculables a partir del registro (registro de verificación: 7/7 válidos). La manipulación de evidencia del experimento es por lo tanto una instancia del artefacto que la Sección 3 define. La confianza focal mostrada fue muy similar entre celdas de exactitud (elementos incorrectos 95/98/99; elementos correctos 99/99/100) y, crucialmente para el contraste del tratamiento, idéntica entre condiciones. Control mostró las mismas confianzas focales y discriminó mucho menos, lo que una explicación basada en señales de confianza no puede explicar.
Medidas. DV1 (H2): una escala de disposición a delegar de 4 elementos (de 7 puntos; p. ej., "Permitiría que ShopAssist completara esta compra sin revisar yo la recomendación"), promediada; una escala de delegación de un único elemento (0–4, desde "solo recomendaciones" hasta "actúa autónomamente incluyendo compras no reembolsables") es secundaria. DV2 (H1): seis ensayos de juicio; en cada uno, el agente propone una respuesta y el participante decide si permitir que el asistente proceda (sí/no) y califica la confianza en la respuesta (deslizador 0–100). Las decisiones de confianza están incentivadas por exactitud (una bonificación por cada decisión correcta de confianza, aceptando una respuesta correcta o rechazando una incorrecta). La respuesta propuesta es correcta en exactamente tres de seis ensayos. La puntuación de calibración por participante es Δ = P(aceptar | correcto) − P(aceptar | incorrecto), el índice de discriminación de la literatura sobre confianza apropiada (Schemmer et al., 2023, cuyas medidas RAIR/RSR descomponen el mismo objeto); un modelo de efectos mixtos a nivel de ensayo recupera la resolución a nivel de elemento. Riesgo percibido y control de proceso percibido (4 elementos cada uno) se miden como mediadores en análisis secundarios pre-registrados para las rutas P1 y P2 respectivamente; neutralidad percibida del orquestador (4 elementos) se mide como un correlato exploratorio de P3, que este estudio no manipula.
Protocolo congelado. El pre-registro fue congelado antes de la recopilación de datos principal (código de análisis y protocolo congelados por SHA-256 el 5 de agosto de 2026; el registro de OSF fue enviado el 13 de agosto, antes de que la onda principal entrara en el campo el 13-14 de agosto; registrado con embargo (pre-registro, solo lectura: https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f), para ser publicado en el componente público de OSF del artículo, https://osf.io/jtvu9/). El conjunto de seis elementos de prueba es congelado por semilla: tres elementos de desacuerdo fijados por diseño y verificados manualmente, más elementos de consenso extraídos por una permutación con semilla de los grupos donde los tres sistemas respondieron de manera idéntica con una confianza declarada ≥ 95, incluyendo un error de consenso genuino, de modo que el acuerdo mostrado es diagnóstico pero imperfecto, exactamente como en los datos de origen. Los seis elementos eran idénticos para cada participante; el orden de presentación fue aleatorizado en el instrumento, aunque la exportación de campo no retuvo el orden de visualización por ensayo. La pantalla de campo no mostró una puntuación de independencia estimada para el panel, que es la divulgación de diversidad medida que el marco mismo requiere, por lo que los participantes vieron desacuerdo sin ver qué tan independientes eran los sistemas que no estaban de acuerdo. La independencia del panel fue medida pero no mostrada, y su valor en la colección de origen se reporta aquí post hoc: correlación de error pairwise media φ = 0.22 (0.10–0.44 en los tres pares, los dos miembros del mismo bloque con mucho los más correlacionados a 0.44; calificado por el calificador determinista congelado del estudio, que resuelve el 95–98% de las respuestas, e insensible a cómo se codifica el resto sin resolver), lo que pone el panel lejos de ser independiente y lejos de ser clonal. Ese es el número que el siguiente instrumento debería mostrar a los participantes. Un límite de estímulo: con seis elementos fijos, no se puede estimar la variación de tratamiento por elemento, por lo que el efecto se establece para estos estímulos. Las sesiones comenzaron con consentimiento informado y terminaron con un debriefing que revelaba la naturaleza hipotética de la compra de la viñeta. El estudio fue realizado de acuerdo con la Declaración de Helsinki: investigación de encuesta anónima de riesgo mínimo con adultos del Reino Unido y EE.UU. que consintieron en un panel que cumple con GDPR, compensación superior al mínimo de la plataforma, y ningún engaño más allá de la viñeta hipotética revelada en el debriefing. Bajo estos criterios cumplía las condiciones para exención de revisión completa de la junta de ética, y la evaluación de exención está documentada en el pre-registro. El grupo ahora está cerrado; el conjunto de elementos literales, respuestas e identificadores de recibos por ensayo son parte del pre-registro embargado y serán publicados con los datos.
Muestra y plan de análisis. N objetivo = 200 participantes válidos (100 EE.UU., 100 RU; estudios de Prolific separados; reclutamiento limitado a 210), edad 18+, inglés fluido, tasa de aprobación ≥ 98%, ≥ 100 envíos previos, al menos una compra en línea en los últimos tres meses. Exclusiones pre-registradas (aplicadas antes de ver respuestas sustantivas): dos o más controles de atención fallidos de tres; finalización en menos de 3 minutos; relleno lineal; controles de manipulación fallidos (elemento de acuerdo en condiciones 2-3, elemento de recibido en condición 3, elemento de comprensión de producto); comprensión de bloque de juicio fallida dos veces; ID o IP duplicado; sesión incompleta. Análisis confirmatorios: para H1, OLS de Δ en condiciones de desacuerdo agrupadas (2 y 3) versus control con covariable país; para H2, restringido a condiciones 2 y 3, OLS del compuesto de disposición-a-delegar en la condición con covariable país; corrección de Holm en {H1, H2}, α familiar = .05; pruebas t de Welch como análisis de robustez; compuerta de control de manipulación reportada primero. El orden de cohortes está fijado aquí: los análisis confirmatorios primarios se calculan en la cohorte de onda principal excluyendo a los participantes del lanzamiento suave del piloto, y la rama que agrega la cohorte de lanzamiento suave en la muestra confirmatoria se reporta como un análisis de robustez al lado. Los descriptivos exploratorios Δ del piloto fueron vistos antes de la onda principal, entonces excluir esa cohorte de la estimación primaria elimina incluso la forma suave de reutilización de datos mientras se retiene la inclusión del lanzamiento suave pre-registrada como una rama reportada. La presentación de informes principal incluirá un análisis de intención-para-tratar que retiene a todos los participantes aleatorizados junto con el análisis pre-registrado por-protocolo. Las exclusiones de control de manipulación serán reportadas con comprobaciones de desgaste diferencial por condición, dado que la prominencia de la señal arquitectónica podría diferir entre condiciones. Sensibilidad: el diseño detecta d ≈ 0.42 para H1 y d ≈ 0.49 para H2 con potencia .80, adecuado para los efectos medianos en las literaturas de confianza y transparencia adyacentes. Los efectos más pequeños se dejan al factorial completo de la agenda de investigación. Tres elementos pre-registrados responden preguntas de mecanismo que los contrastes confirmatorios solos no pueden. El instrumento lleva una escala de riesgo percibido de cuatro elementos (piloto α = .881) en la vía P1, por lo que la percepción de riesgo entra en el análisis como una construcción medida en lugar de una suposición. La mediación es pre-registrada como un análisis secundario, con el riesgo percibido mediando el efecto del desacuerdo en la confianza y el control de proceso percibido mediando el efecto del recibido en la disposición a delegar, estimado por análisis de ruta de arranque (Modelo PROCESS 4, 5,000 remuestreos). El tiempo en la pantalla de estímulo de condición-3 se recopila como un proxy pre-registrado para la lectura del recibido, una comprobación directa de la alternativa de carga cognitiva de que los participantes pasarían por alto el recibido sin procesarlo. El código de análisis fue congelado antes de la recopilación de datos y está archivado con el paquete de replicación.
Piloto (lanzamiento suave): criterios y resultados.
Un piloto de n = 20 (EE.UU.), realizado en el instrumento final con criterios de aceptación pre-registrados fijados de antemano, fue completado el 6 de agosto de 2026. La Tabla 13 reporta cada criterio frente a su resultado.
Tabla 13. Criterios de aceptación del piloto (pre-registrados) y resultados (n = 20, EE.UU.)
| Criterio (fijado ex ante) | Resultado | Veredicto |
| Manipulación percibida: > 80% correcto en la comprobación de acuerdo (condiciones 2-3) | 81.3% (13/16) | Aprobado |
| Manipulación percibida: > 80% correcto en la comprobación de recibido (condición 3) | 88.9% (8/9) | Aprobado |
| Alfa de Cronbach > .70, disposición a delegar (4 elementos) | .854 | Aprobado (también supera el objetivo de .85) |
| Alfa de Cronbach > .70, riesgo percibido (4 elementos) | .881 | Aprobado |
| Alfa de Cronbach > .70, control de proceso (4 elementos) | .965 | Aprobado |
| Alfa de Cronbach > .70, neutralidad (4 elementos) | .851 | Aprobado |
| Tiempo medio de finalización entre 10–15 minutos | 9.60 minutos | Fallo, por 24 segundos, en la dirección rápida |
Un criterio no se cumplió. La mediana fue 24 segundos por debajo de la ventana preregistrada, una ventana diseñada contra el exceso de duración, no contra la eficiencia. La cola rápida no muestra evidencia de respuestas descuidadas: ningún participante cayó por debajo del umbral de exclusión de 3 minutos; el único participante bajo cinco minutos aprobó todas las pruebas de atención, manipulación y comprensión; las tasas de aprobación de pruebas de atención fueron del 95–100%; no había celdas faltantes en variables clave, cero ID o direcciones IP duplicados, y cero respondientes con respuestas lineales; y los tiempos de finalización de la plataforma de reclutamiento confirman independientemente el temporizador de la encuesta (mediana 9.74 minutos). El instrumento es más corto en el campo que lo presupuestado. El balance de condiciones (4/7/9 entre condiciones 1/2/3) es compatible con aleatorización 1:1:1 en n = 20 (χ²(2) = 1.90, p = .387). Bajo las exclusiones de análisis preregistradas, 6 de 20 participantes piloto se excluyen del análisis confirmatorio (cinco por motivos de prueba de manipulación, uno por comprensión fallida dos veces), dejando 14 válidos. Conforme a la regla de lanzamiento suave, la cohorte piloto procede al grupo combinado con la desviación de tiempo divulgada aquí y en el propio registro, que fue presentado a OSF el 14 de agosto de 2026 a las 03:09 UTC, antes de la recopilación de la onda principal, y que establece que el piloto de lanzamiento suave se incluye en la muestra confirmatoria con la desviación de tiempo indicada; tratar la cohorte de onda principal como la estimación confirmatoria primaria y la rama combinada como robustez es una decisión analítica posterior al registro, tomada porque los descriptivos piloto se habían visto antes de la onda principal, y se informan ambas ramas; el margen de comprensión del producto (un participante por encima de la barra del 80%) se marca para monitoreo en la onda principal. Un descriptivo exploratorio, reportado sin inferencia a n piloto: la puntuación de calibración Δ por condición resultó +0.33 (control, n = 4), +0.52 (desacuerdo, n = 7), +0.22 (desacuerdo + evidencia, n = 9), por lo que la condición de desacuerdo se mueve en la dirección de H1; el piloto no puede decir más.
6.2 Prueba de comportamiento: resultados, análisis exploratorios y registro restante
Resultados confirmatorios.
La recopilación de onda principal se realizó del 13–14 de agosto de 2026 (190 espacios: 85 US + 105 UK además de la cohorte de lanzamiento suave), y no se completó: el servidor de encuestas sufrió un apagón técnico durante la ventana de reclutamiento final, y la recopilación terminó con 158 sesiones completadas en total (138 en la onda principal y 20 en el lanzamiento suave) en lugar del objetivo de 200 válidos. El reclutamiento terminó con el apagón de la plataforma, bajo la regla de detención opcional preregistrada y no en respuesta a los resultados observados, aunque los resultados ya habían sido vistos para entonces; la consecuencia es poder reducido. En las celdas realizadas, los efectos mínimos detectables aumentan del d ≈ 0.42 (H1) y d ≈ 0.49 (H2) registrados a aproximadamente d ≈ 0.54 y d ≈ 0.64 al mismo poder, un límite que el resultado confirmatorio hace discutible solo en una dirección, y uno que se aplica a cada contraste nulo y exploratorio a continuación. El orden de la cohorte sigue el plan de §6.1. El piloto perdió un criterio de aprobación (la ventana de tiempo de finalización, por 24 segundos en la dirección rápida), y sus descriptivos exploratorios se habían visto antes de la onda principal, por lo que la cohorte confirmatoria primaria es solo la onda principal (N = 119 válido) y la rama que agrupa la cohorte de lanzamiento suave idénticamente implementada de nuevo (N = 133) se informa como robustez. Cada número a continuación es el resultado del código de análisis congelado por SHA-256 antes de la recopilación de datos. Desviaciones del registro, recopiladas en un lugar: (i) el déficit de N (133 válido de 200 registrados; apagón de alojamiento); (ii) el criterio de tiempo de finalización del piloto se perdió por 24 segundos en la dirección rápida; (iii) orden de visualización por prueba no retenido en la exportación de campo; (iv) tiempo a nivel de pantalla no capturado; (v) el modelo mixto a nivel de prueba se ejecutó en una aproximación variacional (el motor final del paquete puede diferir). Nada más se desvió; cada prueba confirmatoria se ejecutó como fue registrada, la decisión de cohorte primaria anterior siendo la única opción analítica posterior al registro.
Tabla 14. Flujo de muestra y exclusiones (onda principal; cohorte de lanzamiento suave en nota)
| US | UK | Total | |
| Sesiones completadas | 50 | 88 | 138 |
| Excluidas: atención (≥ 2 de 3 comprobaciones) | 0 | 0 | 0 |
| Excluidas: velocidad (< 3 min) / respuestas lineales | 0 | 0 | 0 |
| Excluidas: pruebas de manipulación / comprensión | 10 | 9 | 19 |
| Excluidas: duplicadas / incompletas | 0 | 0 | 0 |
| N válido (por condición 1/2/3) | 40 (16/15/9) | 79 (26/28/25) | 119 (42/43/34) |
La cohorte de lanzamiento suave añade 20 sesiones US completadas, de las cuales 14 sobreviven a las mismas exclusiones; entra solo en la rama de robustez combinada (N = 133). Cada exclusión en la onda principal provino de las reglas de prueba de manipulación y comprensión — ningún participante fue excluido por falta de atención, velocidad, respuestas lineales, duplicación o incompletitud — y el control de gating de prueba de manipulación no muestra asimetría entre condiciones (MC1 χ²(1) = 0.12, p = .73; MC3 χ²(2) = 3.67, p = .16, calculado en la muestra anterior a la exclusión).
Tabla 15. H1 (P1): calibración de confianza Δ por condición (cohorte primaria, N = 119)
| Control | Desacuerdo | Desacuerdo + Evidencia | |
| Δ, media (DE) | 0.238 (0.332) | 0.465 (0.274) | 0.422 (0.299) |
| Confianza excesiva: P(aceptar | incorrecto) | 0.603 | 0.434 | 0.510 |
| Falta de confianza: 1 − P(aceptar | correcto) | 0.159 | 0.101 | 0.069 |
| Contraste confirmatorio: agrupado (2,3) vs control, MCO con covariable de país | b = +0.217, IC 95% [+0.104, +0.330], p ajustado por Holm = .0005 (d = 0.67) |
Tabla 16. H2 (P2): disposición a delegar, recepción vs desacuerdo solo (cohorte primaria)
| Desacuerdo (2) | Desacuerdo + Evidencia (3) | |
| Compuesto de disposición a delegar, media (DE) | 3.09 (1.61) | 3.45 (1.79) |
| Escala de delegación, mediana | 2 | 2 |
| Contraste confirmatorio: 3 vs 2, MCO con covariable de país | b = +0.41, IC 95% [−0.35, +1.18], p ajustada por Holm = .29 |
La H1 es compatible en este diseño para el contraste de calibración; la mediación preregistrada a través del riesgo percibido fue nula, por lo que la P1 tal como se establece no es compatible con esta prueba. Frente a una única respuesta confiada, los participantes apenas discriminaron: permitieron que el agente procediera en el 84% de las respuestas correctas pero también en el 60% de las incorrectas (Δ = 0.238, IC 95% [0.14, 0.34]; condiciones de tratamiento 0.465 [0.38, 0.55] y 0.422 [0.32, 0.52]). La pantalla de desacuerdo casi duplicó la calibración (Δ agrupada = 0.446; b = +0.217, p = .0002, p ajustada por Holm = .0005; Welch d = 0.67), e hizo esto en ambos lados a la vez: la confianza excesiva disminuyó (60% → 43% y 51%) mientras que la confianza insuficiente también disminuyó (16% → 10% y 7%) (Figura 20). Ese promedio agrupado es llevado por un único elemento y es mejor interpretarlo como una prueba de existencia que como una media robusta: en el único ensayo de inconformista de alta confianza que los participantes de control aceptaban al 74%, la pantalla redujo la aceptación de la respuesta incorrecta al 24%, y con ese ensayo eliminado el contraste confirmatorio ya no es significativo (d = 0.09, p = .54), mientras que eliminar cualquier otro elemento lo mantiene intacto (d = 0.47–0.89). La descomposición exploratoria a continuación (Tablas 17–18) localiza el efecto elemento por elemento. Su concentración muestra la misma dependencia de margen reportada a nivel de país: la pantalla cierra una brecha de calibración solo donde hay una abierta, y uno de los seis elementos la abrió ampliamente.
Figura 20. Qué hace la pantalla de desacuerdo con la confianza (cohorte primaria)
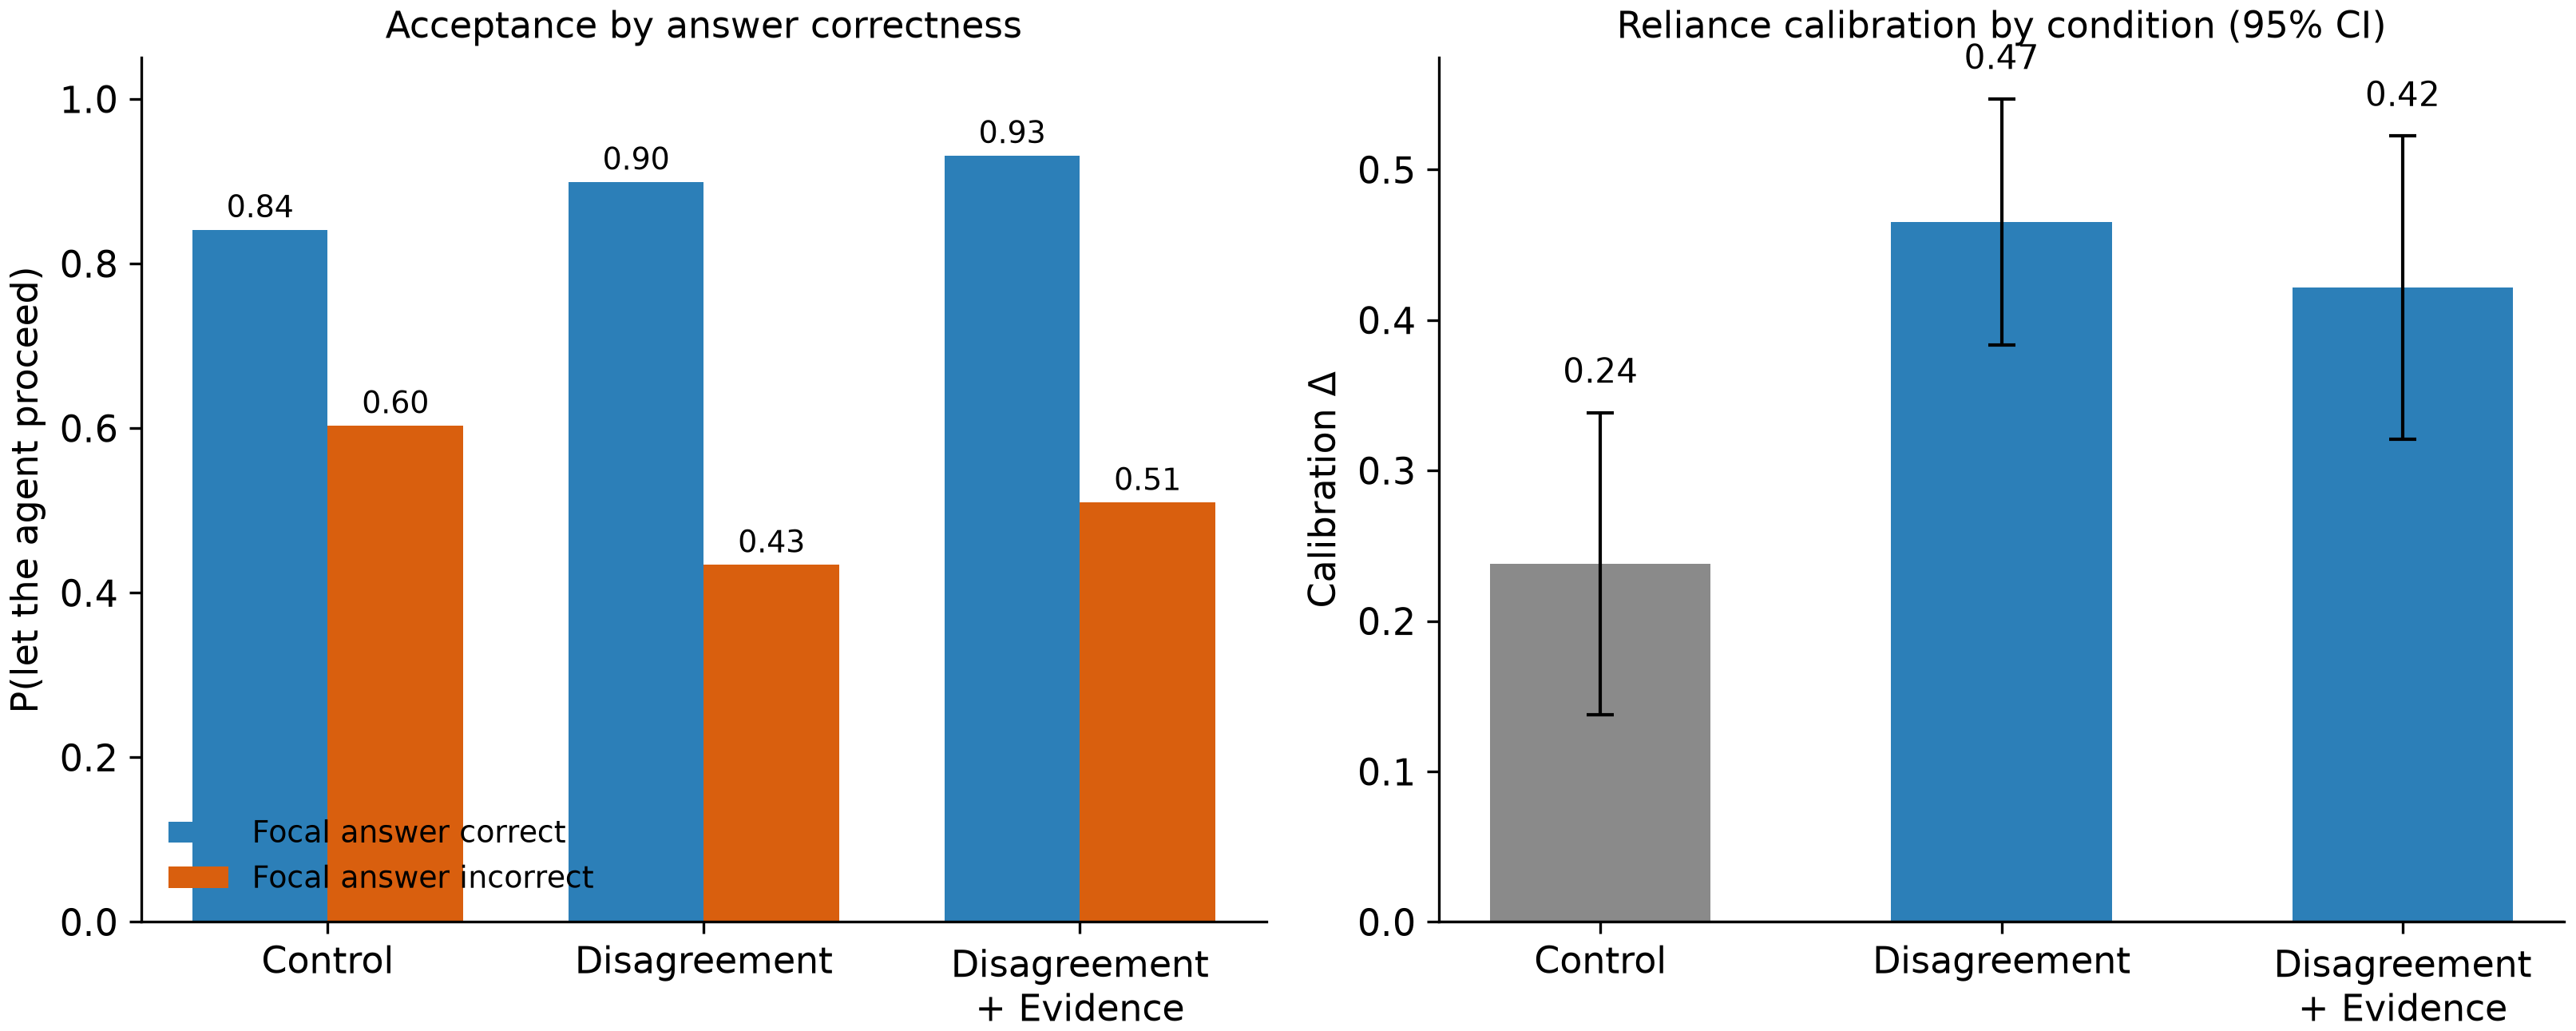
Izquierda: tasas de aceptación por condición, divididas según si la respuesta focal era correcta (calibración = la brecha entre el par de barras). Derecha: la puntuación de calibración por participante Δ por condición con IC del 95%; el contraste confirmatorio agrupa las dos condiciones de desacuerdo contra el control.
El marco preregistrado de dos lados existía porque la literatura de segunda opinión documenta intervenciones que reducen la confianza excesiva al costo de aumentar la confianza insuficiente; esta no pagó ese costo. La señal hizo que los participantes fueran más discriminantes, no más escépticos, y una descomposición de detección de señales de las tasas agregadas lo cuantifica: la sensibilidad d′ aumentó de 0.74 en Control a 1.44 y 1.46 en las condiciones de tratamiento (calculada a partir de tasas sin redondear) mientras que el criterio de respuesta apenas se movió (−0.63 vs −0.56 y −0.76). El modelo mixto a nivel de ensayo recupera la misma estructura, con grandes interacciones positivas de corrección × condición para ambas condiciones de tratamiento. Cada rama registrada está de acuerdo: la rama de solidez agrupada (b = +0.215, p = .0001, d = 0.68), y la rama de intención de tratar que retiene todas las sesiones de onda principal completadas independientemente de fallas de verificación (b = +0.2174 vs +0.2169 por protocolo, p = .0001, n = 138), con exclusiones equilibradas entre condiciones (8/6/5; χ²(2) = 0.34, p = .85), el control de desgaste diferencial §6.1 se compromete a (las exclusiones de verificación de manipulación son acondicionamiento posterior al tratamiento, según Montgomery, Nyhan, & Torres, 2018, por lo tanto el igual peso de la rama no acondicionada). Un factor de confusión en el diseño matiza la lectura. Las condiciones de desacuerdo difieren del Control no solo en lo que dice la señal sino en cuánto se muestra, tres posiciones y confidencias en lugar de una, por lo que la ganancia de calibración podría en principio reflejar el volumen de información en lugar del contenido de la señal de acuerdo. Dos observaciones van en contra de la lectura de volumen sin resolver: el efecto rastrea la dirección de la señal mostrada elemento por elemento, ya que en elementos con respuesta focal incorrecta donde la pantalla mostró desacuerdo, la aceptación disminuyó, mientras que en el único elemento donde la pantalla mostró un acuerdo confiado unánime, la aceptación de la respuesta incorrecta aumentó; y la interacción a nivel de ensayo es con la corrección de la respuesta, que el volumen solo no predice. La rama discriminante clara, con varios sistemas mostrados en acuerdo en cada ensayo y el volumen de información mantenido constante, se especifica para la próxima onda.
H2 no se respalda. Entre los participantes que ya habían visto la pantalla de desacuerdo, el recibo no produjo ningún efecto detectable en el índice compuesto de delegación en la potencia realizada (3,45 vs 3,09; b = +0,41, p = ,29; rama agrupada b = +0,34, p = ,33; confiabilidad compuesta: α de Cronbach de onda principal = ,89). Tres resultados secundarios preregistrados moldean cómo debe interpretarse la nulidad. El recibo sí fue recibido: el tiempo medio de sesión en la condición de recibo fue aproximadamente un minuto y medio más largo que en la condición de desacuerdo (11,0 vs 9,4 minutos; el cronometraje a nivel de pantalla no se capturó en la exportación de campo, por lo que la duración total sirve como proxy del tiempo en el estímulo registrado). El tiempo adicional no establece que los participantes utilizaran el recibo. El recibo desplegado fue una tarjeta estática, y su funcionalidad "ver registro completo" no estaba activa dentro de la encuesta, por lo que la manipulación probó la presencia del recibo, no su ejercicio. Un recibo de exploración en vivo es la manipulación más fuerte que incluye el próximo diseño. Esta es una nulidad para una pantalla de recibo estática, no para registros, verificabilidad, o P2 como está escrito. El recibo también movió su mediador preregistrado. El control de proceso percibido aumentó en la condición de recibo (a = +0,60; confiabilidades de escala, onda principal: control de proceso α = ,93, riesgo α = ,83, neutralidad α = ,90), el control de proceso predice fuertemente la delegación (b = +0,60), y la ruta indirecta de bootstrap es positiva y excluye cero (indirecta = +0,35, IC 95 % [+0,02, +0,78], 5.000 remuestreos), mientras que la ruta directa está cerca de cero. Esta es evidencia de mediación exploratoria: el mediador fue medido post-tratamiento en el mismo instrumento, por lo que la varianza del método común y la interpretación inversa siguen siendo posibles. La sensibilidad limita lo que esta nulidad puede resolver. Las celdas realizadas detectan d ≈ 0,49 con poder ,80 solo en la N registrada, por lo que un efecto de recibo del tamaño que implica la ruta de mediación es exactamente el tamaño que esta muestra no puede resolver. El resultado es inconcluso sobre efectos pequeños y medianos y decisivo solo contra los mayores. Formalmente, las pruebas de equivalencia limitan el efecto solo aproximadamente (TOST establece |d| < 0,64 en α = ,05, no |d| < 0,5), y un factor de Bayes JZS da BF₀₁ ≈ 2,9 (rama agrupada 3,1), evidencia anecdótica a favor de la nulidad en las bandas estándar (en o justo después del límite anecdótico/moderado de 3); ni demuestra ausencia ni apoya presencia. La sección de medición predijo lo mismo: la verificabilidad es una propiedad bajo demanda, y su valor debe aparecer en el momento de la disputa, reclamación o auditoría, por lo que un recibo estático leído una sola vez en una compra hipotética puede ser el momento incorrecto para observarlo. La conclusión registrada: la prueba de primera exposición de P2 no logró mover la delegación, y la economía del lado del operador del recibo (Sección 5) no descansa en este resultado del lado del consumidor. Quedan dos interpretaciones posibles: o bien el componente de evidencia contribuye menos en el momento de la decisión de lo que afirma el marco conceptual, o esta operacionalización es la prueba equivocada de él. La cuenta de tiempo de disputa es una hipótesis post-hoc, programada como el diseño de seguimiento nombrado al final de esta sección, no la resolución de la nulidad. Una tercera interpretación proviene de la literatura de aversión. Un recibo detallado es una manipulación de prominencia, una exposición de los mecanismos que recuerda al consumidor cuánto puede salir mal exactamente en el momento de la delegación, la paradoja de transparencia en la que los detalles procedimentales deprimen en lugar de construir confianza (Kizilcec, 2016; Dietvorst, Simmons, & Massey, 2015). Esas lecturas competidoras, un componente más débil de lo afirmado, una prueba de momento incorrecto, y el efecto contraproducente de la prominencia, hacen predicciones diferentes y son separables por diseño.
El modo de error de consenso certificado reproducido en el comportamiento humano. Un ensayo incentivado conllevaba, por diseño, un error de consenso genuino, con los tres sistemas convergiendo con confianza en la misma respuesta incorrecta, reflejando la tasa de error de consenso de forma abierta del 0,5–2,2 % que mide el estudio del mecanismo. En ese ensayo, un solo elemento y por lo tanto una observación en lugar de una estimación, la pantalla de desacuerdo no protegió a nadie y, en ambos países, directamente aumentó la aceptación de la respuesta incorrecta (en 4 y 14 puntos porcentuales en relación con el control): los participantes leyeron racionalmente el acuerdo independiente unánime como certificación. Entonces, el único modo de falla sistemática de la arquitectura se transfiere a sus usuarios con alta fidelidad. La Sección 3 dio la advertencia de diseño, que el consenso certifica error exactamente donde falla la diversidad del panel, y la sonda muestra el mismo fallo en el comportamiento.
Exploratorio: dónde se ubican los beneficios de calibración.
Todo lo que sigue es exploratorio y generador de hipótesis. Las muestras por país son pequeñas, y cada valor p dentro del país que aparece a continuación debe leerse como descriptivo. El efecto de calibración se concentró casi enteramente en la muestra del Reino Unido y estuvo ausente en la muestra de Estados Unidos:
Tabla 17. Δ de calibración por país y condición (exploratorio)
| Δ de control | Desacuerdo (agrupado 2, 3) Δ | Tamaño del efecto dentro del país | |
| Reino Unido (n = 79) | +0,103 (n = 26) | +0,447 (n = 53) | d = +1,19 |
| Estados Unidos (n = 40 primario / 54 agrupado) | +0,458 / +0,433 | +0,444 / +0,471 | d = −0,05 / +0,13 |
| Interacción país × condición | b = −0,36, p = ,002 (primario); b = −0,31, p = ,004 (agrupado) |
La descomposición es más informativa que la interacción. Los participantes de Control de EE.UU. ya discriminaban fuertemente sin ninguna señal arquitectónica, aceptando el 92% de respuestas correctas y solo el 48% de respuestas incorrectas, mientras que los participantes de Control del Reino Unido apenas discriminaban en absoluto (78% vs 68%). Bajo la pantalla de desacuerdo, los dos países se volvieron casi indistinguibles, elemento por elemento (diferencia máxima de celda 0,07 en los seis ensayos). La intervención convergió ambas muestras al mismo punto de calibración (Δ ≈ +0,45), igualando una diferencia de línea base que no creó (Figura 21). Parte de este patrón es mecánico. Δ está acotado, por lo que el espacio disponible se reduce a medida que aumenta la calibración de línea base, y "el beneficio se concentra donde la calibración de línea base es más débil" es en parte una propiedad de la medida. El techo por sí solo, sin embargo, no fuerza puntos finales idénticos ni la coincidencia del perfil elemento por elemento. La lectura más defendible es que los seis elementos eran lo suficientemente fáciles para que un panel discriminara sin ayuda, por lo que la pantalla cierra una brecha de calibración donde existe una. Esa lectura trata sobre espacio disponible, no sobre naciones, e igualmente sobre estímulos: el conjunto de elementos en sí estuvo culturalmente sesgado (dos elementos disidentes llevaban contenido local de EE.UU.), por lo que el perfil de convergencia es una propiedad de estos seis elementos tanto como de estos dos paneles.
Figura 21. Convergencia, no respuesta uniforme (exploratorio)
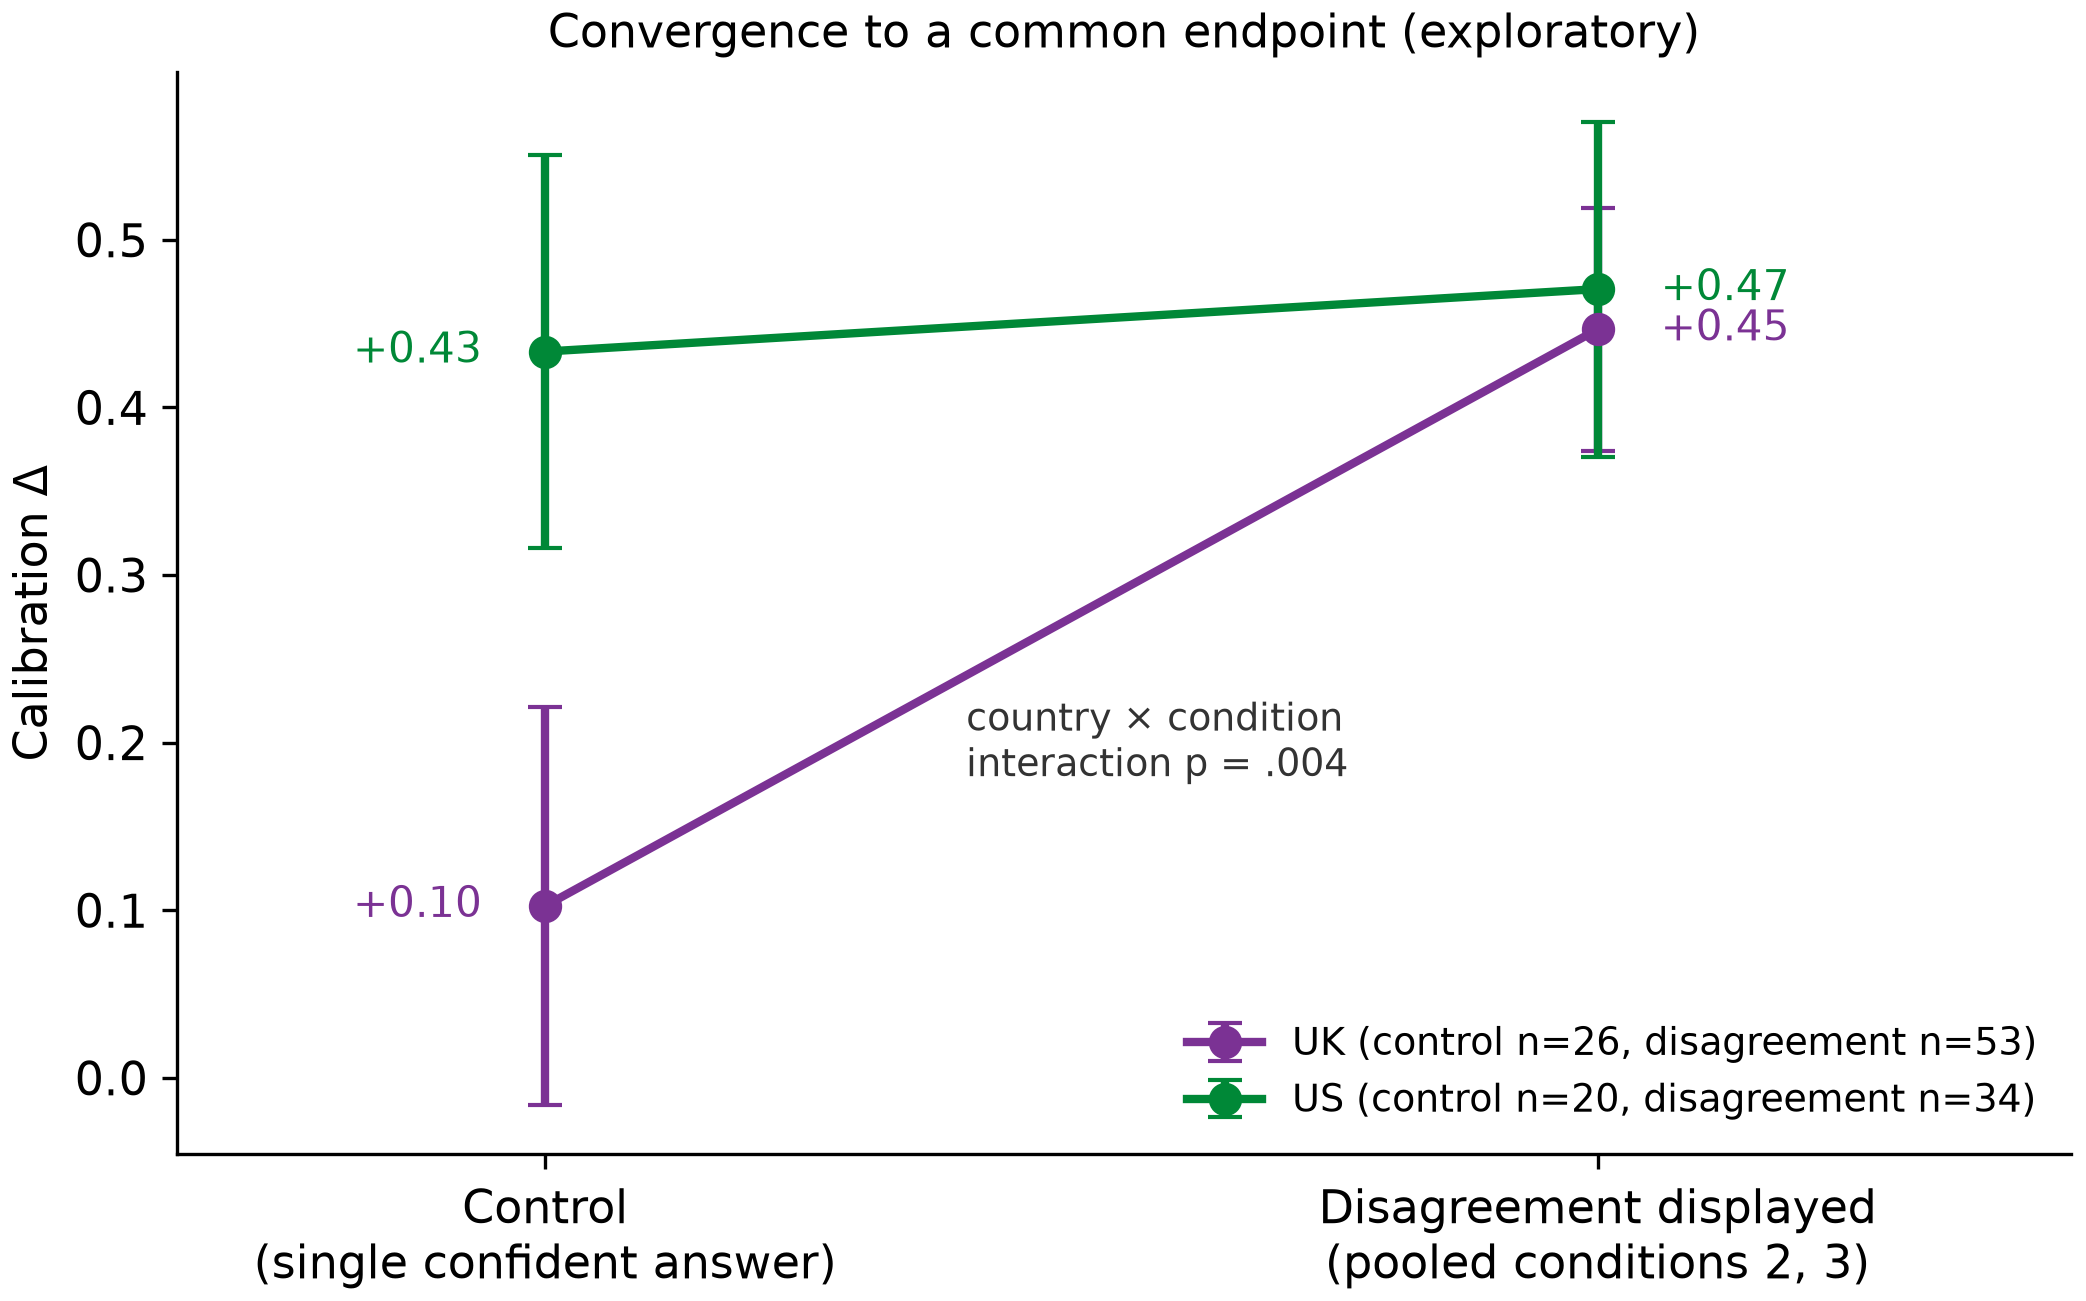
Calibración Δ por país y condición: el grupo control de EE.UU. ya discrimina (Δ ≈ +0,45); el grupo control del Reino Unido apenas lo hace (Δ ≈ +0,10); bajo desacuerdo mostrado ambos países llegan al mismo punto final (Δ ≈ +0,45). El beneficio se concentra exactamente donde la calibración de línea base es más débil.
La ventaja de EE.UU. en Control, mientras tanto, se concentra en los dos elementos disidentes con contenido plausiblemente local de EE.UU. Uno es una pregunta del Museum of Bad Art en la cual la respuesta incorrecta, "la Mona Lisa", es absurda para cualquiera que conozca la premisa del museo (aceptación en EE.UU. 5% vs Reino Unido 27%). La concentración en esos dos elementos apunta a familiaridad a nivel de elemento y no a temperamento nacional.
Tabla 18. Aceptación de respuestas focales incorrectas por elemento y celda (exploratorio; cohorte agrupada)
| Celda | Disidente incorrecto, conf 95 (elemento "Mona Lisa") | Disidente incorrecto, conf 98 (elemento ICM-city) | Consenso incorrecto, conf 99 |
| Control del Reino Unido (n = 26) | 0.27 | 0.85 | 0.92 |
| Control de EE.UU. (n = 20) | 0.05 | 0.60 | 0.80 |
| Desacuerdo del Reino Unido (n = 53) | 0.21 | 0.25 | 0.96 |
| Desacuerdo de EE.UU. (n = 34) | 0.18 | 0.24 | 0.94 |
El efecto protector de la intervención se ubica casi completamente en el elemento disidente de alta confianza (Reino Unido −0,60, EE.UU. −0,36); en el elemento de error por consenso la pantalla aumenta ligeramente la aceptación en ambos países — el acuerdo unánime se lee como certificación, la imagen conductual de los errores de consenso certificados del estudio del mecanismo. Debido a que el efecto protector se ubica en este único elemento, el contraste confirmatorio agrupado no sobrevive su eliminación (d = 0.09, p = .54) aunque sobrevive la eliminación de cualquier otro elemento único (d = 0.47–0.89) — la forma cuantitativa del efecto siendo llevada por un elemento.
Tabla 19. Escalas de actitud por país (exploratorio; cohorte agrupada): la brecha es conductual, no actitudinal
| Escala (1–7 a menos que se indique) | Media del Reino Unido | Media de EE.UU. | Dirección |
| Confianza previa en IA | 4.68 | 4.70 | idéntica |
| Disposición a delegar (compuesto) | 2.94 | 3.43 | EE.UU. más alto (p = .08) |
| Escala de delegación (0–4) | 1.71 | 1.98 | EE.UU. más alto (p = .08) |
| Riesgo percibido | 5.54 | 5.13 | EE.UU. más bajo (p = .09) |
| Control de proceso percibido | 4.17 | 4.56 | EE.UU. más alto (p = .14) |
| Neutralidad percibida | 4.75 | 4.62 | n.s. |
Cada diferencia actitudinal que existe apunta en la forma "incorrecta" para una explicación del escepticismo estadounidense: los participantes estadounidenses son más dispuestos a delegar y perciben menos riesgo, sin embargo discriminan mejor conductualmente en Control. Las actitudes medidas no explican nada de esto: ajustando la brecha del país de línea base para datos demográficos y las cinco escalas la atenúa en a lo sumo 15%, y los caminos indirectos de remuestreo a través de las escalas son nulos.
Las encuestas transnacionales están de acuerdo con el nulo actitudinal. La disposición declarada a confiar en la IA es esencialmente idéntica en EE.UU. y el Reino Unido (41% vs 42%: Gillespie et al., 2025), y ambos países se encuentran en el mismo grupo de "Anglosfera" de alta cautela en nerviosismo de IA (Ipsos, 2025). La única asimetría a nivel de población que apunta la dirección observada es la alfabetización de IA. Los encuestados del Reino Unido autoinforman menos habilidad y confianza en el uso y evaluación de la IA (36% vs 42% en habilidades: Gillespie et al., 2025), y los adultos estadounidenses se encuentran entre los públicos más expuestos a IA encuestados (Pew Research Center, 2025). Dos explicaciones por lo tanto sobreviven al registro exploratorio. En una explicación de familiaridad, la población menos equipada para evaluar el consejo de IA se beneficia más de una arquitectura que lo evalúa estructuralmente. La otra explicación es la composición del panel: el brazo del Reino Unido de la plataforma de reclutamiento es su grupo más antiguo y más experimentado, y los paneles en línea son instrumentos imperfectos para la inferencia entre países (Gvirtz & Sabherwal, 2024), por lo que la etiqueta "país" puede en parte servir como proxy para la antigüedad del panel. El diseño no puede separar los dos, y no necesita hacerlo, porque en cualquiera de las explicaciones el hallazgo sustancial es el perfil compensatorio en sí. Dados los tamaños de celda, la lectura más segura es considerar el patrón como una propiedad de estos dos paneles hasta que una replicación suficientemente potente hable; ninguna afirmación teórica en este trabajo se basa en esto.
Ese perfil no es el resultado predeterminado de las intervenciones contra la dependencia excesiva. Las funciones de forzamiento cognitivo reducen la dependencia excesiva pero concentran su beneficio entre usuarios con alta Need for Cognition, de modo que los inclinados analíticamente se vuelven más analíticos (Buçinca et al., 2021), e investigaciones sobre calibración de confianza adaptativa tratan la identificación de los mal calibrados como un objetivo de diseño que requiere monitoreo activo (Okamura & Yamada, 2020). Aquí la identificación fue gratuita. El desacuerdo mostrado se activa a sí mismo: aparece exactamente cuando el panel está en desacuerdo y no exige nada del usuario por adelantado. Su beneficio recayó claramente en el grupo cuya discriminación de referencia era la peor, y dejó intacta la precisión del grupo ya calibrado en lugar de degradarla. Para un mecanismo de protección del consumidor, este es el perfil distributivo que se especificaría ex ante, con ayuda concentrada donde se concentra la mala calibración y sin costo para quienes no la necesitan.
Análisis secundarios preregistrados: la cuenta pendiente.
Los análisis secundarios preregistrados restantes se encuentran aquí en un solo lugar (cohorte primaria; valores de rama agrupada en el paquete de replicación). La mediación del efecto de desacuerdo a través del riesgo percibido, la ruta P1 que el diseño anticipó, es nula. La pantalla, si acaso, ligeramente redujo el riesgo percibido (a = −0.40), y la ruta indirecta de bootstrap es indistinguible de cero (+0.006, 95% CI [−0.013, +0.029]). El efecto de calibración es directo, consistente con que los participantes usen el patrón de desacuerdo como información sobre la respuesta en lugar de como una alarma general sobre la transacción. La neutralidad del orquestrador percibida, medida en lugar de manipulada, es un fuerte correlato de la disposición a delegar controlando por condición y país (b = +0.47, p < .0001), el rastro correlacional que P3 predice, aguardando su manipulación. La escalera de delegación muestra el mismo orden que el compuesto sin alcanzar significancia (logit ordenado, recepción versus desacuerdo: b = +0.70, p = .11; medianas empatan en 2 de 4). El contraste de condición no registrado 3 versus 1 sobre delegación es direccionalmente positivo y no significativo (b = +0.52, p = .15). Una desviación: la exportación de campo no capturó tiempos a nivel de pantalla, por lo que el proxy registrado de tiempo-en-estímulo-lectura-de-recepción es aproximado mediante la duración total de sesión (reportado en H2 arriba). La verificación a nivel de pantalla prevista debería incorporarse en el instrumento de la próxima onda.
Este estudio prueba solo P1 y P2. P3 es medido, no manipulado, y P4 y el conjoint de variación conjunta completo de la Sección 5 permanecen como el próximo estudio especificado. Por lo tanto, la validación conductual de la tríada es incompleta: un componente respaldado, uno inconclusivo, uno medido pero no manipulado. Una cuestión longitudinal permanece por encima del programa. La pantalla de desacuerdo persistente puede estabilizar la adopción a largo plazo, como amortiguador de la oscilación entre apreciación del algoritmo y aversión de una sola oportunidad, o puede agotar esa adopción a través de exposición continua a la falibilidad de la máquina. Un diseño de sesión única no puede decirlo. Dos estudios motivados por los resultados anteriores se añaden al programa. Uno es un diseño de momento de disputa que vuelve a probar la recepción en el momento en que se predice que tendrá valor, usando un control de recepción falsa, una recepción cuyo hash no se recomputa, para separar la verificabilidad de su representación. El otro es una replicación potenciada para la moderación de país reportada arriba (Tabla 17).
7. Conclusión
A medida que la IA interviene en decisiones de consumidor trascendentes, e incrementalmente las toma, he argumentado que la confianza debe migrar hacia arriba en la pila: del modelo, a la arquitectura, al registro. Diversidad, evidencia y neutralidad juntas producen un servicio cuya fiabilidad puede ser verificada en lugar de ser tomada de buena fe. Lo que se está construyendo no es mejor persuasión sino infraestructura de confianza económica, la cadena de responsabilidad que permite que la delegación escale. La onda insignia mide eso en la parte superior del mercado. Agrupadas en los diez brazos insignia completos de la onda, los modelos vendidos como lo mejor de cada laboratorio estaban confiadamente equivocados en casi la mitad de sus respuestas resueltas ofrecidas con confianza declarada ≥ 80 (46.6%, y la cifra apenas se mueve cuando los elementos no resueltos se puntúan nuevamente como errores). El brazo Meta parcial se reporta por separado, e incluirlo deja la cifra efectivamente sin cambios. Una compuerta de desacuerdo de tres modelos fija por encima de ellos, sin entrenamiento y sin ajuste, elimina cuatro quintos de esos fallos a un costo declarado, inspectable en cobertura. Porque el sustrato aquí es puramente fáctico, esa tasa debería interpretarse como un límite superior para tareas de comercio mixto. Lo que permitiría respaldar la afirmación para comercio genuino es una replicación basada en recuperación y uso de herramientas en un catálogo de productos limitado, donde los errores de consenso se comportan de manera diferente que en espacio fáctico abierto. Un experimento preregistrado (Sección 6) puso la misma señal arquitectónica frente a consumidores y devolvió evidencia de que pueden actuar sobre ella como una señal de corrección: la pantalla de desacuerdo redujo la aceptación de una recomendación confiadamente equivocada del 74% al 24% en el elemento que califica. En un desglose de país exploratorio se concentra en la celda UK de confianza excesiva y descansa en ese elemento único (el contraste agrupado no sobrevive su eliminación, d = 0.09). Esto es una prueba de existencia bajo estos estímulos, no aún un efecto general; una prueba confirmatoria muestreada por estímulo está planeada.
Esta capa merece un nombre de mercado propio, infraestructura de evidencia, para ser vendida de la manera en que se venden la nube, identidad e infraestructura de pagos, porque responde el mismo tipo de pregunta: "¿se puede confiar en esto, y cómo lo sabríamos?" Esa es una pregunta diferente de "¿es esto inteligente?" Seguridad y privacidad fueron de esta manera: diferenciador, luego expectativa, luego requisito de entrada. La confianza arquitectónica plausiblemente puede seguir el mismo camino, a un ritmo establecido por la presión regulatoria y de responsabilidad ya visible.
Mi argumentación en el lado teórico es que la unidad de análisis para la confianza del consumidor en los servicios de IA debería pasar del modelo a la arquitectura, porque las propiedades relevantes para la confianza en realidad residen allí: independencia de la verificación, reproducibilidad de las decisiones, ausencia de intereses conflictivos. Los modelos cambian constantemente en todos los servicios, más rápido de lo que cualquier reputación puede rastrear. La brecha de rendimiento cerrada-abierta se redujo del 8,04% al 1,70% en un solo año (Stanford HAI, 2025), y el liderazgo del mercado de modelos empresariales cambió de manos en una sola primavera (Kharazian, 2026). Una capa que se commoditiza tan rápidamente no es donde la confianza puede anclarse. Lo que sirve a un consumidor es cada vez más el enrutamiento entre modelos y niveles de precios, impulsado por costos, invisible y no verificado, y un modelo mejor elegido sirve a cada vez menos personas. El paso que permanece, y el que especifico aquí, es pasar de la arquitectura mejor enrutada a una cuya verificación un consumidor, un asegurador o un regulador pueda mantener lo suficientemente quieta como para comprobar. Debajo de eso yace una transición de asistentes de IA a fiduciarios de IA. Los fiduciarios, en cada dominio que los ha tenido, están constituidos no por sus talentos sino por sus deberes: guardar registros, someterse a auditoría, no tener intereses adversos. La confianza arquitectónica incorpora esos deberes en la maquinaria.
El mismo requisito se aplica a cómo crece el propio sistema. Un sistema que pide ser confiado con acciones consecuentes debe crecer de la manera en que responde, verificablemente. Los cambios de configuración en una capa de orquestación deben confirmarse o revertirse a través de compuertas estadísticas auditadas contra pruebas retenidas, sin que ningún proceso automatizado debilite una regla de seguridad, solo añadiendo una. La implementación de investigación en el caso de estudio implementa esas compuertas.
La infraestructura de IA ahora necesita una capa de verificación (Figura 16). La industria ha construido la capa de computación y la capa de modelos, y ahora está construyendo la capa de orquestación. Después de ella viene verificación, la maquinaria que hace que el comportamiento de un sistema de IA sea verificable en lugar de creíble. La justificación para la confianza en la IA debería ser verificable por máquina en lugar de estar basada en la reputación; la confianza en sí sigue siendo humana, y lo que puede ser verificado por máquina son sus bases. Si eso es correcto, la próxima capa indispensable de la infraestructura de IA se construirá no alrededor de la inteligencia sino alrededor de la verificabilidad.
Figura 16. La escalera de infraestructura
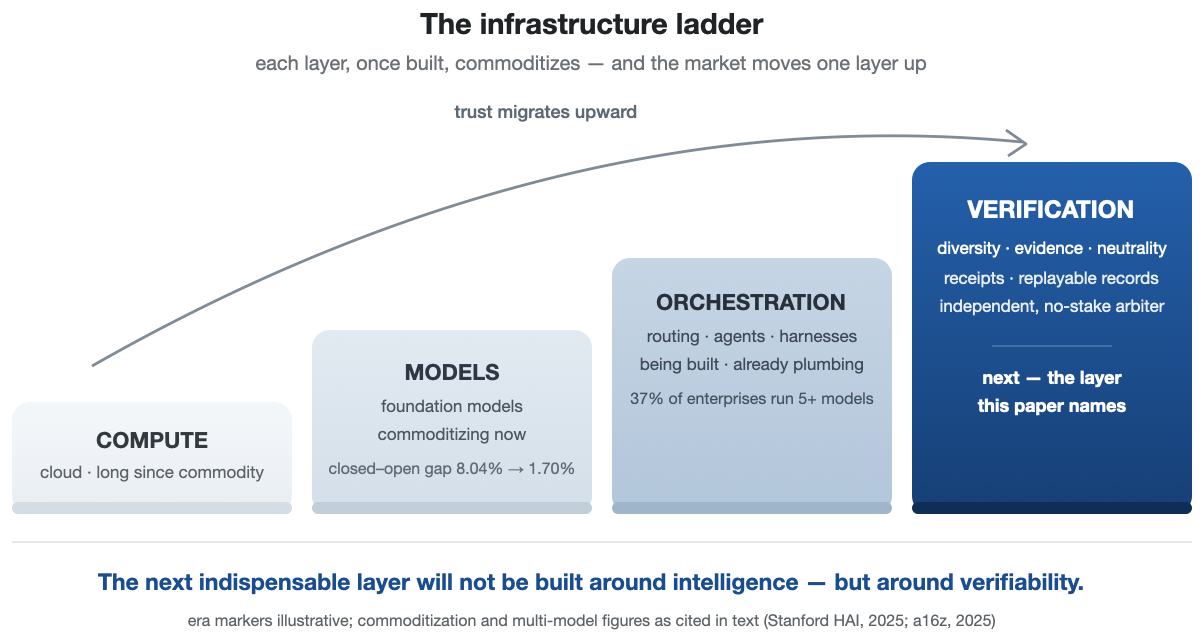
Computación, luego modelos, luego orquestación, y verificación como la próxima capa indispensable.
Nota del autor y divulgación
La implementación descrita en la Sección 4 es una implementación de referencia construida y operada por el autor; los métodos que encarna son abiertos, y el autor es un solicitante mencionado en solicitudes de patentes pendientes, no patentes otorgadas, que cubren sistemas de orquestación de IA y validación multimodelo del tipo que este artículo examina. Sirve aquí como el instrumento de investigación del estudio, y el autor tiene un interés de desarrollador en la arquitectura que encarna; la Sección 4 debe ser leída como una prueba de existencia y testimonio de diseño, no como evaluación independiente. Todos los modelos en este estudio fueron accedidos a través de las API comerciales estándar de los proveedores en términos ordinarios. Ningún financiamiento externo apoyó este trabajo.
Herramientas y verificación. Se utilizaron asistentes de IA como instrumentos bajo la dirección del autor; las ideas, investigación y conclusiones son del autor. Las afirmaciones factuales con carga estructural fueron verificadas contra fuentes primarias donde estuvo disponible y se atribuyen en el texto con su estado probatorio (reportes de prensa como reportes, alegaciones como alegaciones, preprints como preprints), y se mantiene un registro de verificación de afirmaciones fechado con los materiales de trabajo del manuscrito. La corrección en el experimento nunca es juzgada por ningún modelo de panel (la puntuación es coincidencia de cadena objetiva o un calificador de pesos abiertos local), los números de discriminación y calibración por proveedor se imprimen en el texto principal (Tablas 7 y 7a), y cada número reportado es recomputable desde el paquete de replicación determinista (disponible públicamente en https://osf.io/jtvu9/).
Disponibilidad de datos y código
Cada número reportado en los experimentos de mecanismo (Sección 3) es recomputable desde un paquete de replicación determinista — las respuestas de modelo sin procesar de ambas olas (incluyendo la colección de dieciséis modelos de 24.000 respuestas y los registros calificados de la ola insignia), los ejecutores de colección, el calificador determinista, los scripts de análisis, y los CSV derivados (incluyendo las curvas de cobertura de riesgo y la frontera costo-precisión de 26 puntos, con la base de precio de facturación versus listado de cada punto señalada) — disponible públicamente en https://osf.io/jtvu9/, un componente público del proyecto fuente de la preregistración (carpeta `replication-package-v2`; el archivo de programa de autocalibracion de la Sección 3 está depositado junto con él). La submuestra congelada de SimpleQA (fija por semilla y hash SHA-256) ya es pública en la preregistración OSF del estudio de mecanismo (https://osf.io/4y9dv, registrada el 23 de julio de 2026). La preregistración del experimento del consumidor está registrada en OSF bajo embargo (congelada antes de la recopilación de datos principal; registro https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f). El conjunto de participantes está cerrado; el instrumento de encuesta, los estímulos de viñeta y bloque de juicio, los registros de acuñación de recibos de la Sección 6, y los datos del experimento del consumidor con el código de análisis congelado serán liberados al mismo componente OSF tras la publicación.
Referencias
Las entradas marcadas con arXiv son preprints; los anuncios de la industria y los elementos de prensa de 2026 son reportes contemporáneos en lugar de literatura establecida y se citan como tales.
a16z — Andreessen Horowitz (2025). How 100 enterprise CIOs are building and buying gen AI in 2025. a16z.com/ai-enterprise-2025.
Accenture (2026). Talk to my AI agent: The new rules of brand value. Encuesta de 25.590 consumidores en 16 países, enero de 2026.
ACI Worldwide (2026). Consumer attitudes to AI-driven shopping and payments. Encuesta de YouGov de 2.080 adultos del Reino Unido, realizada el 19-22 de junio de 2026. Comunicado de prensa.
Ahmad Husairi, M., & Rossi, P. (2024). Delegation of purchasing tasks to AI: The role of perceived choice and decision autonomy. Decision Support Systems, 179, 114166. DOI 10.1016/j.dss.2023.114166.
AIUC (2025). AIUC-1: The agent standard. Artificial Intelligence Underwriting Company.
Alavi, S., & Nozari, S. (2026). When agents shop for you: Role coherence in AI-mediated markets. arXiv:2604.26220.
Allouah, A., Besbes, O., Figueroa, J. D., Kanoria, Y., & Kumar, A. (2026). What is your AI agent buying? Evaluation, biases, model dependence, and emerging implications of agentic e-commerce. Proceedings of the ACM Web Conference 2026, 8697–8700. https://doi.org/10.1145/3774904.3792943
American Express (2026). American Express debuts Agentic Commerce Experiences (ACE) developer kit and announces industry-first protection for registered agent purchases. Comunicado de prensa, 14 April 2026.
Anderson, L. (2006). Analytic autoethnography. Journal of Contemporary Ethnography, 35(4), 373–395.
André, Q., Carmon, Z., Wertenbroch, K., Crum, A., Frank, D., Goldstein, W., Huber, J., van Boven, L., Weber, B., & Yang, H. (2018). Consumer choice and autonomy in the age of artificial intelligence and big data. Customer Needs and Solutions, 5(1–2), 28–37.
Appenzeller, G. (2024). Welcome to LLMflation: LLM inference cost is going down fast. Andreessen Horowitz, November 2024.
Aubakirova, M., Atallah, A., Clark, C., Summerville, J., & Midha, A. (2026). State of AI: An empirical 100 trillion token study with OpenRouter. arXiv:2601.10088 (report released December 2025).
Bain & Company (2025). Agentic commerce market projection: $300–500 billion U.S. e-commerce by 2030. December 2025.
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775–779.
Balaskas, S. (2026). From recommendations to delegation: A systematic review mapping agentic AI in e-commerce and its consumer effects. Information, 17(3), 222.
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. S. (2021). Does the whole exceed its parts? The effect of AI explanations on complementary team performance. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, 1–16.
Basu, A. (2026). Tool receipts, not zero-knowledge proofs: Practical hallucination detection for AI agents. arXiv:2603.10060.
Board of Governors of the Federal Reserve System & OCC (2011). Supervisory guidance on model risk management (SR Letter 11-7 / OCC 2011-12).
Buçinca, Z., Malaya, L. B., & Gajos, K. Z. (2021). To trust or to think: Cognitive forcing functions can reduce overreliance on AI in AI-assisted decision-making. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), 1–21.
Burton, J. W., Stein, M.-K., & Jensen, T. B. (2020). A systematic review of algorithm aversion in augmented decision making. Journal of Behavioral Decision Making, 33(2), 220–239.
California State Legislature (2025). Assembly Bill 316 (artificial intelligence: defenses), Stats. 2025, ch. 672 (adding Cal. Civ. Code § 1714.46), vigente a partir del 1 de January 2026.
Carlson, S. C. (2026). Trust migration in the digital era: Information regimes and the transformation of buyer–seller relationships. Atlantic Marketing Journal, 15(1), Article 6.
Castelo, N., Bos, M. W., & Lehmann, D. R. (2019). Task-dependent algorithm aversion. Journal of Marketing Research, 56(5), 809–825.
Cetinkaya, N. E., & Krämer, N. (2024). Understanding vs. trust: A conjoint analysis. Documento de trabajo, OSF Project mw4dq.
Chandra, K., Kleiman-Weiner, M., Ragan-Kelley, J., & Tenenbaum, J. B. (2026). Sycophantic chatbots cause delusional spiraling, even in ideal Bayesians. arXiv:2602.19141.
Chen, C., Sun, Y., Liao, M., & Sundar, S. S. (2026). When AI disagrees: The effect of second opinion on patients' trust in doctors. International Journal of Human-Computer Studies, 213, 103824.
Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026). Sycophantic AI decreases prosocial intentions and promotes dependence. Science, 391(6792), eaec8352. DOI: 10.1126/science.aec8352.
Choi, H. K., Zhu, X., & Li, S. (2026). When identity skews debate: Anonymization for bias-reduced multi-agent reasoning. Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 14284–14311. https://doi.org/10.18653/v1/2026.acl-long.650
Choi, M., Kim, K., Chae, S., & Baek, S. (2025). An empirical study of group conformity in multi-agent systems. Findings of the Association for Computational Linguistics: ACL 2025, 5123–5139. https://doi.org/10.18653/v1/2025.findings-acl.265
Clark, J., & Hadfield, G. K. (2020). Regulatory markets for AI safety. arXiv:2001.00078.
CNBC (2026, March 24). OpenAI revamps shopping experience in ChatGPT after struggling with Instant Checkout offering (reportando el relato de The Information de March 2026 sobre el native-checkout pullback).
Daly, C. (2025). Klarna slows AI-driven job cuts with call for real people. Bloomberg News, 8 May 2025.
de Bellis, E., & Johar, G. V. (2020). Autonomous shopping systems: Identifying and overcoming barriers to consumer adoption. Journal of Retailing, 96(1), 74–87.
Detjen, H. H. J., Densky, L., von Kalckreuth, N., & Kopka, M. (2025). Who is trusted for a second opinion? Comparing collective advice from a medical AI and physicians in biopsy decisions after mammography screening. CHI 2025.
de Visser, E. J., Pak, R., & Shaw, T. H. (2018). From 'automation' to 'autonomy': The importance of trust repair in human–machine interaction. Ergonomics, 61(10), 1409–1427.
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114–126.
DigiCert (2026). AI Trust Architecture. Anuncio de producto, April 2026.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Dranove, D., & Jin, G. Z. (2010). Quality disclosure and certification: Theory and practice. Journal of Economic Literature, 48(4), 935–963.
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024). Improving factuality and reasoning in language models through multiagent debate. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 11733–11763.
Endsley, M. R., & Kiris, E. O. (1995). The out-of-the-loop performance problem and level of control in automation. Human Factors, 37(2), 381–394.
Errico, H. (2026). Autonomous action runtime management (AARM): A system specification for securing AI-driven actions at runtime. arXiv:2602.09433.
European Commission (2026). Guidelines on the implementation of the transparency obligations for certain AI systems under Article 50 of the AI Act. Adoptadas el 20 de julio de 2026.
Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017), 625–630.
Featherman, M. S., & Pavlou, P. A. (2003). Predicting e-services adoption: A perceived risk facets perspective. International Journal of Human-Computer Studies, 59(4), 451–474.
Frank, D.-A., Folwarczny, M., & Otterbring, T. (2026). Consumer acceptance of high-autonomy AI assistants is driven by perceived benefits in online shopping settings characterized by scarcity. Psychology & Marketing, 43(3), 538–555. https://doi.org/10.1002/mar.70074
Gartner (2025). Gartner predicts over 40% of agentic AI projects will be canceled by end of 2027. Comunicado de prensa, 25 de junio de 2025.
Gartner (2026). Consumer survey on generative AI in shopping (comunicado de prensa de mayo de 2026).
Gefen, D., Karahanna, E., & Straub, D. W. (2003). Trust and TAM in online shopping: An integrated model. MIS Quarterly, 27(1), 51–90.
Geifman, Y., & El-Yaniv, R. (2017). Selective classification for deep neural networks. Advances in Neural Information Processing Systems 30 (NeurIPS 2017), 4878–4887 (arXiv:1705.08500).
Gillespie, N., Lockey, S., Ward, T., Macdade, A., & Hassed, G. (2025). Trust, attitudes and use of artificial intelligence: A global study 2025. The University of Melbourne and KPMG. https://doi.org/10.26188/28822919
Glikson, E., & Woolley, A. W. (2020). Human trust in artificial intelligence: Review of empirical research. Academy of Management Annals, 14(2), 627–660.
Google (2026). Universal Commerce Protocol. Anuncio en NRF, 11 de enero de 2026; extensión de carrito, catálogo y vinculación de identidad, marzo de 2026.
Google Cloud (2025). Agent Payments Protocol (AP2). Anuncio, 16 de septiembre de 2025.
Google DeepMind (2025). SimpleQA Verified. arXiv:2509.07968.
Gorbett, M., & Jana, S. (2026). Cross-model disagreement as a label-free correctness signal. arXiv:2603.25450.
Gottweis, J., Weng, W.-H., Daryin, A., Tu, T., Sirkovic, P., Myaskovsky, A., Glowaty, G., Weissenberger, F., Orlandi, A., Popovici, D., Palepu, A., Rong, K., Tanno, R., Saab, K., Zhang, F., Blum, J., Carroll, A., Kulkarni, K., Tomašev, N., Zverinski, D., Rendulic, I., Vedadi, E., Hasler, F., Rimanic, L., Boia, M., Budiselic, I., Feinstein, B., Bellaiche, M., Sheffer, T., Freyberg, J., Ratcliff, J., Bertolli, O., Chou, K., Hassidim, A., Gokturk, B., Vahdat, A., Guan, Y., Dhillon, V., Vaishnav, E. D., Lee, B., Costa, T. R. D., Penadés, J. R., Peltz, G., Matias, Y., Manyika, J., Hassabis, D., Xu, Y., Kohli, P., Pawlosky, A., Karthikesalingam, A., & Natarajan, V. (2026). Accelerating scientific discovery with Co-Scientist. Nature, 655(8122), 487–496. https://doi.org/10.1038/s41586-026-10644-y
Gould, S. J. (1991). The self-manipulation of my pervasive, perceived vital energy through product use: An introspective-praxis perspective. Journal of Consumer Research, 18(2), 194–207.
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). On calibration of modern neural networks. ICML 2017, PMLR 70, 1321–1330.
Gvirtz, A., & Sabherwal, A. (2024). The limits of doing global, cross-cultural behavioral science research. Proceedings of the National Academy of Sciences, 121(36), e2316690121.
Hadfield, G. K. (2017). Rules for a flat world: Why humans invented law and how to reinvent it for a complex global economy. Oxford University Press.
Hadfield, G. K., & Clark, J. (2026). Regulatory markets: The future of AI governance. Jurimetrics, 65, 195–240 (arXiv:2304.04914).
Hansen, L. K., & Salamon, P. (1990). Neural network ensembles. IEEE Transactions on Pattern Analysis and Machine Intelligence, 12(10), 993–1001.
Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026). Not all flips are conformity: Decomposing stance convergence in multi-agent LLM debate. arXiv:2606.00820.
Hoff, K. A., & Bashir, M. (2015). Trust in automation: Integrating empirical evidence on factors that influence trust. Human Factors, 57(3), 407–434.
Hong, L., & Page, S. E. (2004). Groups of diverse problem solvers can outperform groups of high-ability problem solvers. Proceedings of the National Academy of Sciences, 101(46), 16385–16389.
Huang, M.-H., & Rust, R. T. (2021). A strategic framework for artificial intelligence in marketing. Journal of the Academy of Marketing Science, 49(1), 30–50.
Insurance Services Office (2026). Endorsement forms CG 40 47 and CG 40 48: generative artificial intelligence exclusions. A partir del 1 de enero de 2026.
Internet Engineering Task Force (2026). An architecture for trustworthy and transparent digital supply chains (RFC 9943; SCITT working group). IETF. https://datatracker.ietf.org/doc/rfc9943/
Ioku, T., Song, J., & Watamura, E. (2024). Trade-offs in AI assistant choice: Do consumers prioritize transparency and sustainability over AI assistant performance? Big Data & Society, 11(4).
Ipsos (2025). The Ipsos AI Monitor 2025. Ipsos Global Advisor, encuesta de 30 países, junio de 2025.
Jacovi, A., Marasović, A., Miller, T., & Goldberg, Y. (2021). Formalizing trust in artificial intelligence: Prerequisites, causes and goals of human trust in AI. FAccT 2021, 624–635.
Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., Schiefer, N., Hatfield-Dodds, Z., DasSarma, N., Tran-Johnson, E., Johnston, S., El-Showk, S., Jones, A., Elhage, N., Hume, T., Chen, A., Bai, Y., Bowman, S., Fort, S., ... Kaplan, J. (2022). Language models (mostly) know what they know. arXiv:2207.05221.
Kalai, A. T., Nachum, O., Vempala, S., & Zhang, E. (2025). Why language models hallucinate. arXiv:2509.04664.
Kharazian, A. (2026). Anthropic beats OpenAI on business adoption. Ramp Economics Lab / Ramp AI Index, 13 de mayo de 2026 (datos de pagos corporativos en más de 50.000 empresas estadounidenses).
Kim, D., & Benbasat, I. (2010). Designs for effective implementation of trust assurances in internet stores. Communications of the ACM, 53(2), 121–126.
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038–30066.
Kim, P. H., Ferrin, D. L., Cooper, C. D., & Dirks, K. T. (2004). Eliminación de la sombra de la sospecha: Los efectos de la disculpa frente a la negación para reparar violaciones de confianza basadas en competencia versus integridad. Journal of Applied Psychology, 89(1), 104–118.
Kizilcec, R. F. (2016). ¿Cuánta información? Efectos de la transparencia en la confianza en una interfaz algorítmica. CHI 2016, 2390–2395.
Klarna (2024). Klarna AI assistant handles two-thirds of customer service chats in its first month. Comunicado de prensa, 27 February 2024.
Köbis, N., Rahwan, Z., Rilla, R., Supriyatno, B. I., Bersch, C., Ajaj, T., Bonnefon, J.-F., & Rahwan, I. (2025). La delegación en la inteligencia artificial puede aumentar el comportamiento deshonesto. Nature, 646(8083), 126–134. DOI: 10.1038/s41586-025-09505-x.
Kolt, N. (2025). Gobernanza de agentes de IA. Notre Dame Law Review, 101 (SSRN working paper 4772956; arXiv:2501.07913).
Komiak, S. Y. X., & Benbasat, I. (2006). Los efectos de la personalización y la familiaridad en la confianza y adopción de agentes de recomendación. MIS Quarterly, 30(4), 941–960.
König, P. D., Wurster, S., & Siewert, M. B. (2022). Los consumidores están dispuestos a pagar un precio por una IA explícable, pero no por una IA verde: Evidencia de un análisis conjunto basado en elecciones. Big Data & Society, 9(1).
Krogh, A., & Vedelsby, J. (1995). Conjuntos de redes neuronales, validación cruzada y aprendizaje activo. Advances in Neural Information Processing Systems, 7, 231–238.
Kroll, J. A., Huey, J., Barocas, S., Felten, E. W., Reidenberg, J. R., Robinson, D. G., & Yu, H. (2017). Algoritmos responsables. University of Pennsylvania Law Review, 165(3), 633–705.
Kuncheva, L. I., & Whitaker, C. J. (2003). Medidas de diversidad en conjuntos de clasificadores y su relación con la precisión del conjunto. Machine Learning, 51(2), 181–207.
Lee, J. D., & See, K. A. (2004). Confianza en la automatización: Diseño para una confianza apropiada. Human Factors, 46(1), 50–80.
Lessig, L. (2006). Code: Version 2.0. Basic Books.
Li, M. (2025). De nativo en la nube a nativo de confianza: Un protocolo para sistemas multi-agente verificables. arXiv:2507.22077.
Liang, P., Bommasani, R., Lee, T., Tsipras, D., Soylu, D., Yasunaga, M., Zhang, Y., Narayanan, D., Wu, Y., Kumar, A., Newman, B., Yuan, B., Yan, B., Zhang, C., Cosgrove, C., Manning, C. D., Ré, C., Acosta-Navas, D., Hudson, D. A., ... Koreeda, Y. (2023). Evaluación holística de modelos de lenguaje. Transactions on Machine Learning Research.
Liao, Q. V., & Sundar, S. S. (2022). Diseño para una confianza responsable en sistemas de IA: Una perspectiva de comunicación. FAccT 2022, 1257–1268.
Lin, S., Hilton, J., & Evans, O. (2022). Enseñanza de modelos para expresar su incertidumbre en palabras. arXiv:2205.14334.
Lindsey, J. (2025). Conciencia introspectiva emergente en grandes modelos de lenguaje. Anthropic / Transformer Circuits.
Liu, J., Bursztyn, V. S., Ai, L., Wang, H., Choudhary, S., Mitra, S., & Wu, Q. (2026). TeamFusion: Apoyo al trabajo en equipo abierto con sistemas multi-agente. arXiv:2604.19589 (ACL 2026; Adobe Research).
Lizzeri, A. (1999). Revelación de información e intermediarios de certificación. RAND Journal of Economics, 30(2), 214–231.
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Apreciación de algoritmos: Las personas prefieren el juicio algorítmico al juicio humano. Organizational Behavior and Human Decision Processes, 151, 90–103.
Longoni, C., Bonezzi, A., & Morewedge, C. K. (2019). Resistencia a la inteligencia artificial médica. Journal of Consumer Research, 46(4), 629–650.
Longoni, C., Cian, L., & Kyung, E. J. (2023). Transferencia algorítmica: Las personas generalizan excesivamente los fracasos de la IA en el gobierno. Journal of Marketing Research, 60(1), 170–188.
Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). Cómo la influencia social puede socavar el efecto de la sabiduría colectiva. Proceedings of the National Academy of Sciences, 108(22), 9020–9025. DOI: 10.1073/pnas.1008636108.
Lu, Z., Wang, D., & Yin, M. (2024). ¿Ayuda más consejo? Los efectos de segundas opiniones en la toma de decisiones asistida por IA. Proceedings of the ACM on Human-Computer Interaction, 8(CSCW1), 1–31.
Marchal, N., Chan, S., Franklin, M., Revel, M., Keeling, G., Fischli, R., Chandra, B., & Gabriel, I. (2026). Arquitectura de confianza en agentes epistémicos artificiales. arXiv:2603.02960.
Mastercard (2026). Verifiable Intent (co-developed with Google). Anuncio de sala de prensa, 5 March 2026; early pilots reported in Asian and Latin American markets, 2026.
Mayer, R. C., Davis, J. H., & Schoorman, F. D. (1995). Un modelo integrador de la confianza organizacional. Academy of Management Review, 20(3), 709–734.
McKinsey & Company (2025). La oportunidad del comercio agéntico (Schumacher, Roberts, & Giebel). 17 October 2025.
McKnight, D. H., Choudhury, V., & Kacmar, C. (2002). Desarrollo y validación de medidas de confianza para el comercio electrónico. Information Systems Research, 13(3), 334–359.
Menlo Ventures (2025a). Actualización del mercado de LLM de mediados de 2025. 31 July 2025 (survey of 150 technical decision-makers).
Menlo Ventures (2025b). 2025: El estado de la IA generativa en la empresa. 9 December 2025 (survey of 495 U.S. enterprise AI decision-makers; Menlo Ventures is an Anthropic investor).
Menlo Ventures (2025c). 2025: El estado de la IA del consumidor. 26 June 2025 (survey of 5,031 U.S. adults, with Morning Consult; the ~3% paying-user figure is a revenue-derived estimate).
Möhlmann, M., & Zalmanson, L. (2017). Manos en el volante: Navegando la gestión algorítmica y la autonomía de los conductores de Uber. ICIS 2017.
Montgomery, J. M., Nyhan, B., & Torres, M. (2018). Cómo el condicionamiento en variables posteriores al tratamiento puede arruinar su experimento y qué hacer al respecto. American Journal of Political Science, 62(3), 760–775.
Morgan Stanley (2025). Pronóstico de comercio agéntico: gasto de comercio electrónico estadounidense de $190–385 mil millones para 2030. December 2025.
Mosier, K. L., & Skitka, L. J. (1996). Tomadores de decisiones humanos y ayudas automatizadas para la toma de decisiones: ¿Hechos el uno para el otro? En R. Parasuraman & M. Mouloua (Eds.), Automatización y rendimiento humano: Teoría y aplicaciones (pp. 201–220). Lawrence Erlbaum Associates.
Mozannar, H., & Sontag, D. (2020). Estimadores consistentes para aprender a deferir a un experto. ICML 2020, PMLR 119, 7076–7087.
Muchnik, L., Aral, S., & Taylor, S. J. (2013). Sesgo de influencia social: Un experimento aleatorizado. Science, 341(6146), 647–651. DOI: 10.1126/science.1240466.
Muir, B. M. (1994). Confianza en la automatización: Parte I. Cuestiones teóricas en el estudio de la confianza e intervención humana en sistemas automatizados. Ergonomics, 37(11), 1905–1922.
NIST (2023). Artificial Intelligence Risk Management Framework (AI RMF 1.0) (NIST AI 100-1). National Institute of Standards and Technology.
Okamura, K., & Yamada, S. (2020). Calibración adaptativa de confianza para la colaboración humano-IA. PLOS ONE, 15(2), e0229132.
Papamarkou, T., Alquier, P., Bauer, M., Buntine, W., Davison, A., Dziugaite, G. K., Filippone, M., Foong, A. Y. K., Fortuin, V., Fouskakis, D., Frellsen, J., Hüllermeier, E., Karaletsos, T., Khan, M. E., Kotelevskii, N., Lahlou, S., Li, Y., Liu, F., Lyle, C., Möllenhoff, T., Palla, K., Panov, M., Sale, Y., Schweighofer, K., Shelmanov, A., Swaroop, S., Trapp, M., Waegeman, W., Wilson, A. G., & Zaytsev, A. (2026). Posición: la orquestación de IA agéntica debería ser consistente con Bayes. arXiv:2605.00742. (Aceptado en ICML 2026.)
Parasuraman, R., & Manzey, D. H. (2010). Complacencia y sesgo en el uso humano de la automatización: una integración atencional. Human Factors, 52(3), 381–410. DOI: 10.1177/0018720810376055.
Parasuraman, R., & Riley, V. (1997). Humanos y automatización: uso, mal uso, desuso, abuso. Human Factors, 39(2), 230–253.
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). Un modelo para tipos y niveles de interacción humana con la automatización. IEEE Transactions on Systems, Man, and Cybernetics — Part A: Systems and Humans, 30(3), 286–297.
Pavlou, P. A. (2003). Aceptación del comercio electrónico por parte del consumidor: integración de confianza y riesgo con el modelo de aceptación de tecnología. International Journal of Electronic Commerce, 7(3), 101–134.
Pew Research Center (2025). Cómo las personas de todo el mundo ven la IA. Encuesta de 25 países, octubre de 2025.
Piehlmaier, D. M. (2023). El espectáculo en solitario: el efecto de la toma de decisiones conjunta en la excesiva confianza del inversor. Journal of Consumer Research, 50(2), 426–446. https://doi.org/10.1093/jcr/ucac054
Puntoni, S., Reczek, R. W., Giesler, M., & Botti, S. (2021). Consumidores e inteligencia artificial: una perspectiva experiencial. Journal of Marketing, 85(1), 131–151.
Rabanser, S., Kapoor, S., Kirgis, P., Liu, K., Utpala, S., & Narayanan, A. (2026). Hacia una ciencia de la confiabilidad del agente de IA. arXiv:2602.16666 (ICML 2026).
Raji, I. D., Xu, P., Honigsberg, C., & Ho, D. (2022). Supervisión externa: diseño de un ecosistema de auditoría de terceros para la gobernanza de la IA. AIES 2022, 557–571.
Regulation (EU) 2016/679 (General Data Protection Regulation), Article 22 — toma de decisiones individual automatizada.
Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 14 — supervisión humana de sistemas de IA de alto riesgo; Article 50 — obligaciones de transparencia para proveedores e implementadores de ciertos sistemas de IA.
Ríos-García, M., Alampara, N., Gupta, C., Mandal, I., Mannan, S., Aghajani, A. A., Krishnan, N. M. A., & Jablonka, K. M. (2026). Los científicos de IA producen resultados sin razonar científicamente. arXiv:2604.18805.
Saad-Falcon, J., Buchanan, E. K., Chen, M. F., Huang, T.-H., McLaughlin, B., Bhathal, T., Zhu, S., Athiwaratkun, B., Sala, F., Linderman, S., Mirhoseini, A., & Ré, C. (2025). Reduciendo la brecha generación-verificación con verificadores débiles. arXiv:2506.18203.
Sabater, J., & Sierra, C. (2005). Revisión de modelos computacionales de confianza y reputación. Artificial Intelligence Review, 24(1), 33–60.
Schemmer, M., Kühl, N., Benz, C., Bartos, A., & Satzger, G. (2023). Dependencia apropiada del consejo de IA: conceptualización y el efecto de las explicaciones. IUI '23, 410–422.
Schilke, O., & Reimann, M. (2025). El dilema de la transparencia: cómo la divulgación de IA erosiona la confianza. Organizational Behavior and Human Decision Processes, 188, 104405.
Schmidt, J., & Bijmolt, T. H. A. (2020). Medición precisa de la disposición a pagar por bienes de consumo: un metaanálisis del sesgo hipotético. Journal of the Academy of Marketing Science, 48, 499–518.
Shapiro, S. P. (1987). El control social de la confianza impersonal. American Journal of Sociology, 93(3), 623–658.
Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., Cheng, N., Durmus, E., Hatfield-Dodds, Z., Johnston, S. R., Kravec, S., Maxwell, T., McCandlish, S., Ndousse, K., Rausch, O., Schiefer, N., Yan, D., Zhang, M., & Perez, E. (2024). Hacia la comprensión de la adulación en modelos de lenguaje. ICLR 2024 (arXiv:2310.13548).
Shehata, D., & Li, M. (2026). La ley de la sabiduría inversa: tribalismo arquitectónico y la paradoja del consenso en enjambres agénticos. arXiv:2604.27274.
Sheridan, T. B., & Verplank, W. L. (1978). Control humano y de computadora de teleoperadores submarinos (Informe técnico). MIT Man-Machine Systems Laboratory.
Smit, A. P., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). ¿Deberíamos volvernos MAD? Una mirada a las estrategias de debate multiagente para LLMs. ICML 2024, PMLR 235, 45883–45905 (arXiv:2311.17371).
Söllner, M., Hoffmann, A., & Leimeister, J. M. (2016). Por qué diferentes relaciones de confianza importan para los usuarios de sistemas de información. European Journal of Information Systems, 25(3), 274–287.
Spiro, T. (2026). La huella dactilar del Oráculo: errores de predicción de IA correlacionados y los límites de la transmisión de sesgo. arXiv:2605.00844.
Stanford HAI (2025). Artificial Intelligence Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence (Capítulo de desempeño técnico).
Stanford HAI (2026). Artificial Intelligence Index Report 2026. Stanford Institute for Human-Centered Artificial Intelligence (Capítulo de opinión pública, informando datos de la encuesta de 25 países de Pew).
Tax, S. S., Brown, S. W., & Chandrashekaran, M. (1998). Evaluaciones de clientes de experiencias de quejas de servicio: implicaciones para el marketing relacional. Journal of Marketing, 62(2), 60–76.
Vaccaro, M., Almaatouq, A., & Malone, T. (2024). Cuándo las combinaciones de humanos e IA son útiles: una revisión sistemática y metaanálisis. Nature Human Behaviour, 8(12), 2293–2303. DOI: 10.1038/s41562-024-02024-1.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). Reemplazando jueces por jurados: evaluación de generaciones de LLM con un panel de modelos diversos. arXiv:2404.18796.
Visa (2025). Visa introduce Trusted Agent Protocol: un marco dirigido por el ecosistema para el comercio de IA. Comunicado de prensa (con Cloudflare), 14 de octubre de 2025.
Visa (2026). Visa partners with OpenAI to power the next generation of AI commerce. Comunicado de prensa, Visa Payments Forum, 10 de junio de 2026.
W3C (2025). Verifiable Credentials Data Model v2.0. W3C Recommendation.
Wallendorf, M., & Brucks, M. (1993). Introspection in consumer research: Implementation and implications. Journal of Consumer Research, 20(3), 339–359.
Walsham, G. (1995). Interpretive case studies in IS research: Nature and method. European Journal of Information Systems, 4(2), 74–81.
Wang, W., & Benbasat, I. (2005). Trust in and adoption of online recommendation agents. Journal of the Association for Information Systems, 6(3), 72–101.
Wang, Y., Zhang, J., Cai, T., Liu, Z., Sun, Q., Sun, Z., Wu, Z., Dong, M., Zheng, M., Yin, X., & Zhu, Y. (2026). From agent traces to trust: A survey of evidence tracing and execution provenance in LLM agents. arXiv:2606.04990.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., & Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
Werbach, K. (2018). The blockchain and the new architecture of trust. MIT Press.
Wertenbroch, K. (1998). Consumption self-control by rationing purchase quantities of virtue and vice. Marketing Science, 17(4), 317–337.
Xiao, B., & Benbasat, I. (2007). E-commerce product recommendation agents: Use, characteristics, and impact. MIS Quarterly, 31(1), 137–209.
Yalcin, G., Lim, S., Puntoni, S., & van Osselaer, S. M. J. (2022). Thumbs up or down: Consumer reactions to decisions by algorithms versus humans. Journal of Marketing Research, 59(4), 696–717.
Yin, R. K. (2018). Case study research and applications: Design and methods (6ª ed.). Sage.
Zhang, Y., Liao, Q. V., & Bellamy, R. K. E. (2020). Effect of confidence and explanation on accuracy and trust calibration in AI-assisted decision making. Proceedings of the 2020 ACM Conference on Fairness, Accountability, and Transparency, 295–305.
Zheng, J., & Zhang, J. (2026). Uncertainty-aware trust estimation for multi-LLM systems via structured expert judgement. arXiv:2607.20529.
Zuboff, S. (2019). The age of surveillance capitalism. PublicAffairs.
Zucker, L. G. (1986). Production of trust: Institutional sources of economic structure, 1840–1920. Research in Organizational Behavior, 8, 53–111.
* Arquitecto de sistemas de IA. Intereses en conflicto: el autor desarrolla métodos de orquestación multimodelo, opera una implementación de referencia de la arquitectura descrita aquí, es solicitante mencionado en solicitudes de patentes pendientes, no en patentes concedidas, que cubren sistemas de orquestación de IA y validación multimodelo del tipo que este artículo examina, y tiene un interés de desarrollador en la arquitectura que este artículo defiende; las afirmaciones normativas sobre su necesidad deben leerse teniendo en cuenta ese interés. El rol del autor en el despliegue de la Sección 4 se describe en la Nota del Autor y Divulgación al final de este artículo. Comentarios bienvenidos: [email protected].↩︎
Cómo citar
Chernets, V. (2026). Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture [Preimpresión]. SSRN. https://doi.org/10.2139/ssrn.7191261
@misc{chernets2026architecturaltrust,
  author       = {Chernets, Vadym},
  title        = {{Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7191261},
  url          = {https://doi.org/10.2139/ssrn.7191261}
}