Архітектурна довіра: чому довіра споживача в агентній комерції мігрує від моделей штучного інтелекту до верифікованої архітектури
Це переклад. Основна версія — оригінал англійською; посилайтеся на неї.
Vadym Chernets, PhD, архітектор AI-систем · ORCID 0009-0007-4845-3163
SSRN 7191261 · DOI 10.2139/ssrn.7191261 · Zenodo 10.5281/zenodo.22166995 · GitHub
- Версія запису: SSRN 7191261 · DOI 10.2139/ssrn.7191261
- Архівна копія, цитована і доступна для завантаження: 10.5281/zenodo.22166995 — концептуальний DOI, завжди розв'язується на найновішу версію
- Повний текст як Markdown і PDF: GitHub
- Читаний HTML: https://polyhelper.ai/research/architectural-trust/
Один і той же текст розташований на чотирьох платформах, щоб до нього можна було звернутися, коли одна з них недоступна. SSRN зберігає версію запису; цитуйте цю.
Довіра споживачів в агентній комерції
Опубліковано на SSRN та індексовано під назвою «Архітектурна довіра: чому довіра споживача в агентній комерції мігрує від моделей штучного інтелекту до верифікованої архітектури». Цитуйте цю форму.
Від властивостей моделі до верифікованої архітектури
Vadym Chernets, PhD1
Вперше розміщено 6 серпня 2026 р.; ця версія вересня 2026 р.
Представляє повну концептуальну основу, дослідження механізму шістнадцяти моделей та його репліку на прапороносній хвилі серпня 2026 р. по одинадцяти передовим лабораторіям, парне порівняння бюджету міркування, репліку комерційного субстрату та попередньо зареєстрований експеримент зі споживачами в повному обсязі.
АБСТРАКТ
Агентна комерція перетворює ШІ з радника на контрагента, об'єднуючи пошук, порівняння, кошик і платіж у одну делегьовану операцію та видаляючи контрольні точки, де люди раніше виявляли помилки. Це виникає в незручний момент: шістдесят відсотків британців, опитаних у дослідженні, кажуть, що покинули б агента ШІ для покупок після однієї помилки, і більшість взагалі не довіряла б жодній організації керувати ним від їхнього імені. Ця праця представляє архітектурну довіру. Коли споживачі делегьють важливі рішення агентам ШІ, я стверджую, обґрунтована довіра мігрує від властивостей моделі ШІ до верифікованої архітектури сервісу над нею. Наявні конструкти прив'язують довіру до організацій, до однієї автоматизованої системи або до алгоритмічних рекомендацій, і жодна з них не робить процес прийняття рішень перевіряємим для того, хто довіряє, під час автономної делегації. Архітектурна довіра заповнює цю прогалину трьома перевіряємими властивостями: різноманітність (незалежні моделі, чия узгодженість калібрує впевненість і чия розбіжність розкривається), докази (записи рішень, що виявляють втручання і можуть бути відтворені), і нейтральність (перевіряємої незалежність від будь-якого постачальника, торговця або результату).
Механізм спочатку вимірювався на машинній стороні. По всій попередньо зареєстрованій шістнадцятимодельній контрольній точці та прапороносній хвилі серпня 2026 р., яка охоплює одинадцять передових лабораторій, узгодженість між моделями служила показником правильності там, де власна впевненість моделі не змогла. Відповіді, які були незалежно відтворені іншою моделлю, мали в 1,9–3,2 рази вищу ймовірність бути правильними. На фіксованій підвибірці SimpleQA (Wei та ін., 2024), 46,6% відповідей, запропонованих при заявленій впевненості ≥ 80, були невірними (показник, специфічний для цього набору, а не універсальна константа), тоді як фіксований шлюз розбіжності трьох моделей видалив 82,1% цих впевнених невдач (95% ДІ 79,9–84,1) при охопленні 30,5%. Сигнал відтворюється на 267 фактах про комерційні продукти, перевірених Wikidata. Більший бюджет міркування дав 3,1 пункти заявленої впевненості, але не вимірюваної точності: більше обчислень купує впевненість, а не правильність. Одностайна впевнена панель все ще може бути неправильною, і в такому разі узгодженість підтверджує спільну помилку.
Далі я реалізую механізм у поведінці в попередньо зареєстрованому, сумісному зі стимулами експерименті зі споживачами (119 з 200 запланованих учасників; США та Велика Британія). У випадку, коли споживач зазвичай прийняв би впевнену неправильну рекомендацію, екран розбіжностей різко скоротив прийняття з 74% до 24% на кваліфікуючому елементі. Об'єднана оцінка надійності (Δ = 0.24 → 0.45; d = 0.68; первинна основна хвиля когорти дає d = 0.67) спирається на цей один елемент і, при дослідницькому розділенні за країнами, на британській вибірці, і знижується до d = 0.09 після видалення елемента. Планується репліцирування з потужністю та вибіркою стимулів. На одному елементі одностайної впевненої згоди екран підвищив прийняття спільної помилки, яка відтворює межу механізму в людській поведінці. Компонент управління-розпису повернув зареєстрований, неоднозначний нуль.
Три компоненти не мають однакових свідчень на користь них. Різноманітність встановлена на машинній стороні та продемонстрована зі споживачами лише для контрасту калібрування (зареєстроване опосередкування було нульовим). Перший тест експозиції компонента запису був неоднозначним, і обидва вони та нейтральність вказані для тестування. Одиниця аналізу для довіри до ШІ має перейти від моделі до архітектури над нею, до частини, яку можна перевірити.
Ключові слова: агентивна комерція; довіра споживачів; агенти ШІ; довіра до ШІ; належна спираність; надмірна спираність; великі мовні моделі; міжмодельна згода; вибіркове передбачення; надмірна впевненість; делегування; архітектурна довіра. Класифікація JEL: M31 (Marketing); D83 (Search, Learning, Information); L86 (Information and Internet Services); K24 (Cyber Law) Як читати цей документ. Ця повна версія наводить весь ланцюг свідчень: конструкт та гіпотеза міграції довіри; дослідження механізму з шістнадцятьма моделями (з репліцюванням основної хвилі серпня 2026 року та комерційно-субстратною складовою щодо фактів товарів), яке встановлює міжмодельну різноманітність як сигнал коректності; попередньо зареєстрований експеримент зі споживачами, який переносить цей механізм у поведінку; та обговорення нейтральності, економіки ринку та політики. Попередньо зареєстровані підтвердні результати та статус доказовості кожного компонента конструкту (різноманітність, свідчення, нейтральність) узагальнено в розділі «Статус доказовості тверджень» у розділі 5. Дослідницькі та аналізи надійності позначені як такі скрізь й можуть пропускатися при першому читанні.
1. Вступ: розвиток серед недовіри
10 червня 2026 року Visa оголосила, що вбудовує свою платіжну мережу безпосередньо в ChatGPT (Visa, 2026). Споживач пов'язує карту, встановлює обмеження видатків і схвалені категорії торговців, а оголошена інтеграція, з розгортанням випадків використання по етапам, спрямована на те, щоб агенти ШІ завершували реальні покупки в базі торговців мережі (175 млн+ місцезнаходжень, за даними торговельного висвітлення). Visa не була одна. OpenAI випустила касу в чаті у вересні 2025 року; Google представила Universal Commerce Protocol на NRF у січні 2026 року з Shopify, Etsy, Wayfair, Target та Walmart, розширивши його до травня на міжрітейлерський Universal Cart (Google, 2026); American Express запустила агентивно-комерційний набір розробників із захистом покупок у квітні (American Express, 2026). Поріг перейшла цілою галуззю, а не однією компанією. Прогнози аналітиків щодо агентивної комерції до 2030 року коливаються від сотень мільярдів (Bain; Morgan Stanley) до прогнозу McKinsey в 3–5 трильйонів доларів. Це оцінки, а не факти, хоча кожна велика компанія тепер їх виробляє.
Реалізовані цифри більше не є оцінками. Видатки підприємств тільки на API моделей стрибнули з 3,5 млрд до 8,4 млрд доларів за шість місяців (Menlo Ventures, 2025a; промислові дослідження на основі опитувань, без рецензування), в межах приблизно 37 млрд доларів видатків підприємств на генеративний ШІ на рік (Menlo Ventures, 2025b). Та сама галузь вже дисконтує своє виконання: Gartner (2025) прогнозує, що понад 40% проектів агентивного ШІ будуть скасовані до кінця 2027 року. Гроші надходять швидше, ніж виправдана довіра, що є розривом, над яким я працюю тут. Твердження нижче класифіковані в реєстрі доказів біля кінця статті як встановлені цими даними, підтримані на скромному рівні одного дослідження або теоретичні. Ця класифікація керує й переважає будь-яке резюмуюче речення в цьому вступі.
Що робить цей перехід якісно відмінним від раніших хвиль електронної комерції, це стиснення лійки: пошук, порівняння, кошик та платіж стискаються в одну делеговану дію. Кожна гарантія, що раніше існувала між цими кроками (людина гляділа на ціну, ще раз прочитувала список, вагалась при касі), зникає разом з самими кроками (Рисунок 1). Помічник ШІ перестає бути радником, результати якого перевіряє людина, і стає стороною в операції. Дослідження людських факторів назвали цей режим відмови чотири десятиліття тому: автоматизація, яка видаляє оператора з циклу, підриває саме той нагляд, необхідний для виявлення її помилок (Bainbridge, 1983; Endsley & Kiris, 1995). Дослідження споживачів також передбачили цей поріг. Автономні системи покупок стикаються з якісно різними бар'єрами адаптації саме тому, що вони видаляють людину від виконання (de Bellis & Johar, 2020), і вартість автономії при передачі виборів алгоритмам була позначена як питання споживчого добробуту ще до появи LLM (André et al., 2018).
Рисунок 1. Стиснення лійки
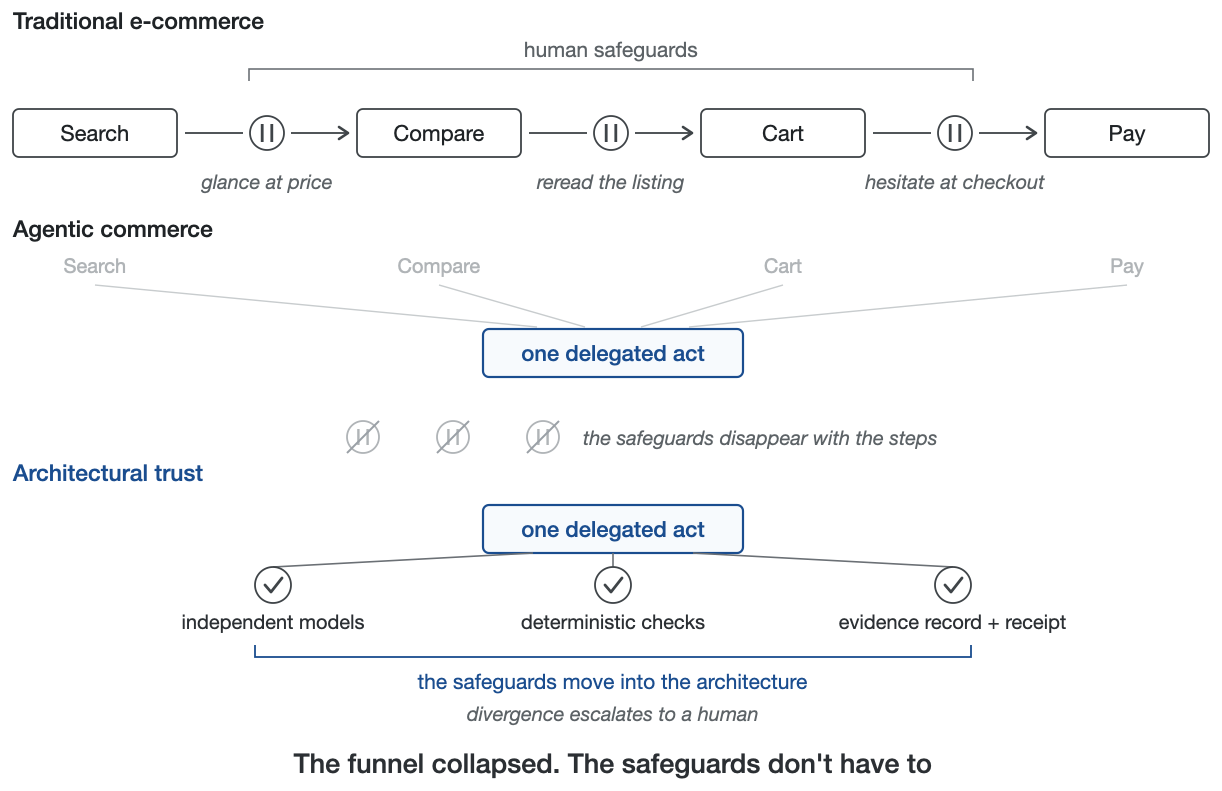
Людські гарантії зникають разом з кроками, між якими вони існували.
Власні заходи Visa (обмеження, білі списки, необхідні затвердження) існують тому, що від споживача просять довіряти чомусь новому: не марці, не відповіді, а процесу прийняття рішень, який вони не можуть побачити. Заходи, встановлені заздалегідь, не закривають цей розрив. Правило, встановлене заздалегідь, не дозволяє споживачу перевірити, як було прийняте рішення. У дослідженні ACI Worldwide (2026), цитованому нижче (промисловому дослідженні, випущеному прес-звітом, як й інші дослідження від постачальників, цитовані в цьому розділі), 69% британських споживачів сказали, що вони не довіряють агентам ШІ навіть коли агенти дотримуються правил, які встановили самі споживачі.
Комерційні ставки помилки гострі. Ранні дані опитувань свідчать про те, що довіра споживачів до ШІ-агентів є однократна у заявленому намірі й, що цікаво, бездомна. Виявлена поведінка, відступ від оформлення замовлення нижче та розворот Klarna і переоцінка страхування розділу 5 підтверджують ці заявлені переваги та мають більшу доказову вагу. У опитуванні YouGov для ACI Worldwide (2,080 дорослих на території UK, проведено 19–22 червня 2026, знімок одного ринку в очікуванні крос-ринкової репродукції) 60% сказали, що припинять користування ШІ-агентом для покупок після однієї помилки, і лише 19% довіряли б ШІ для повсякденних покупок порівняно з 55%, які довіряли б людському експертові.
Найважливіша цифра в цьому опитуванні — інша: 59% сказали, що не довіряли б жодній організації керувати покупками та платежами на основі ШІ від їх імені, і навіть банки вибрали лише 20%. На одному обстеженому ринку, в очікуванні крос-ринкової репродукції, це вакуум довіри. Апетит є. У опитуванні промисловості в 16 країнах від Accenture 25,590 споживачів (січень 2026; проведено компанією, не пересцінене) 74% сказали, що довіряли б персональному ШІ-агентові більше, ніж своєму найкращому другу, щоб зробити покупку від їх імені, проте лише близько однієї з десяти дали б агентові автономну покупну повноваження (рис. 2). Ці два пункти вимірюють різні рівні делегування, тому розкид узгоджує наміри, а не визначає єдину причинно-наслідкову прогалину, але розкид різкий. Намір багатий; делегування рідкісне; чого не вистачає між ними, так це обґрунтованої довіри. Ринок уже спробував щось близьке до цього. OpenAI випустила вбудований чат-чекаут у вересні 2025, навмисне обмежений перший крок, спочатку покупки одного товару від продавців Etsy у США з підтвердженням користувачем кожного кроку. Вона повернула цей потік назад у березні 2026, перемістивши покупки на власні додатки роздрібників, і лише декілька продавців коли-небудь користувалося цим (за повідомленням The Information; CNBC, 2026). Компанія не назвала причину, тому причина не встановлена. Запропонована тут інтерпретація, що інфраструктура прийняття без обґрунтованої довіри не здатна конвертуватися, узгоджується з повідомленими фактами. Якщо споживачі не довіряють кожному гравцю, довіру неможливо покласти на гравця взагалі, і вона повинна замість цього проживати в перевіреному процесі.
Рис. 2. Заявлена довіра проти наданої влади
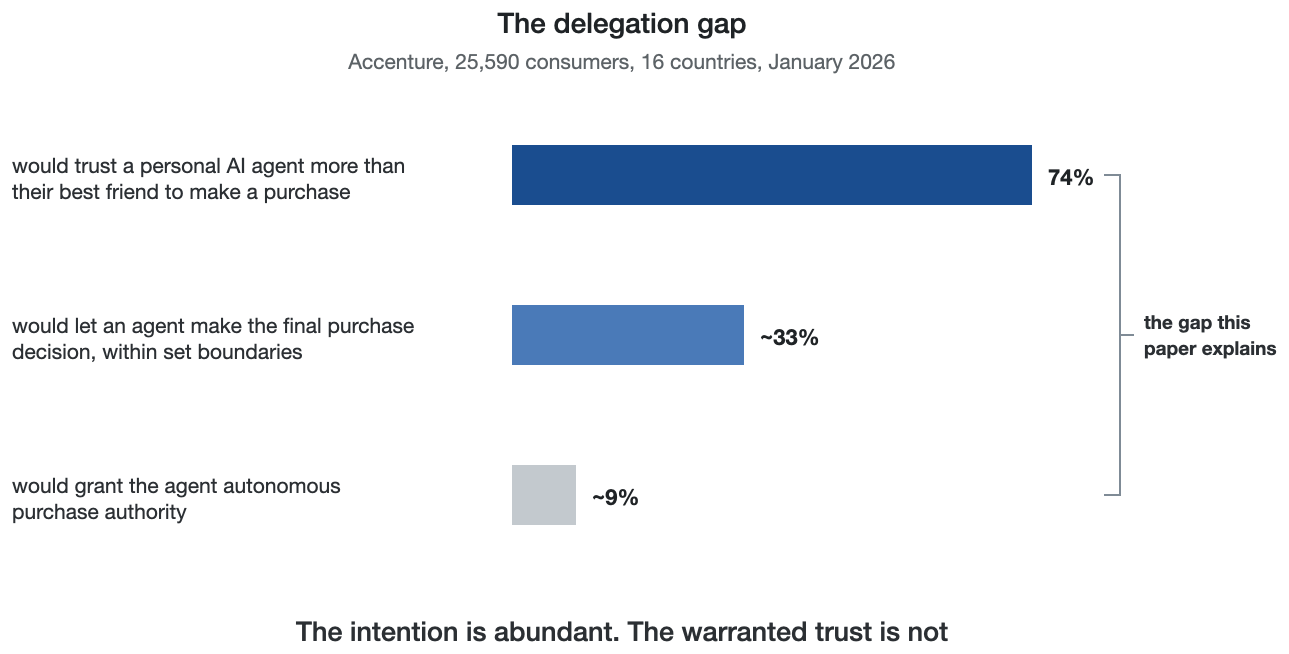
Два опитування пункти, два рівні делегування: намір поширений, обґрунтована довіра рідкісна.
Система відповідальності намагається дійти до того ж висновку. Протоколи агента-платежу, що розвиваються, будують кожну операцію навколо обмеженого, перевіреного токена наміру, пов'язаного з конкретним продавцем та сумою, а Agent Purchase Protection американської компанії American Express (квітень 2026) охоплює покупки лише зареєстрованих агентів, і право на участь обумовлене аутентифікованим, перевіреним наміром покупки. Страхування написано у термінах того, що можна перевірити з запису. Поступово і під тиском промисловість сходиться на тих же інгредієнтах, які я систематично викладу нижче. Протоколи, що зараз доставляються, вирішують питання ідентичності і наміру та не відповідають на питання як агент прийняв рішення?
Питання полягає в тому, що потрібно, щоб ця довіра була обґрунтована за задумом. Класичне питання споживацької довіри, чи довіряю я цій компанії, набуло внутрішнього шару: чи довіряю я механізму, який виробив цю конкретну відповідь чи дію?
Література про довіру давно розрізняє довіру до організації від довіри до автоматизації, до артефакту ІТ (Söllner et al., 2016), і до агентів онлайн-рекомендацій (Wang & Benbasat, 2005; Komiak & Benbasat, 2006; Xiao & Benbasat, 2007). Вона показує, що належне покладення залежить від калібрування, від знання того, коли система, ймовірно, буде правильною (Muir, 1994; Mayer, Davis, & Schoorman, 1995; Parasuraman & Riley, 1997; Lee & See, 2004; Hoff & Bashir, 2015; Huang & Rust, 2021; і Glikson & Woolley, 2020, чий огляд знаходить матеріальність і прозорість процесу серед найсильніших важелів когнітивної довіри, саме ті важелі, які архітектура контролює, а моделі ні). Неправильне калібрування на людській стороні документується так само добре: упередженість автоматизації й самовдоволення, надмірне покладення на автоматизовані засоби навіть всупереч суперечливим доказам, є закономірностями, які чотири десятиліття роботи з людськими факторами попереджають, що делегування буде посилювати (Mosier & Skitka, 1996; Parasuraman & Manzey, 2010). Однак ця література розглядає калібрування як властивість однієї автоматизованої системи (рис. 3 показує чотири потоки досліджень і комірку, яку вони залишають відкритою). Систематичний огляд агентського ШІ в електронній комерції підтверджує порожнечу з боку доказів: дослідження споживацької сторони залишається зосереджено на допоміжних системах з низькою автономією, з охопленням, що різко падає саме там, де делегування переходить у виконання (Balaskas, 2026). Перші паралельні дослідження посередництва агентів у покупках досягають архітектурного висновку з іншої сторони. Коли споживачі делегують покупки через діалог, їх готовність платити витікає продавцям майже дослівно; запит цього не виправляє, і лише архітектурні втручання це роблять (Alavi & Nozari, 2026).
Рис. 3. Чотири потоки дослідження довіри: комірка, на яку претендує ця стаття
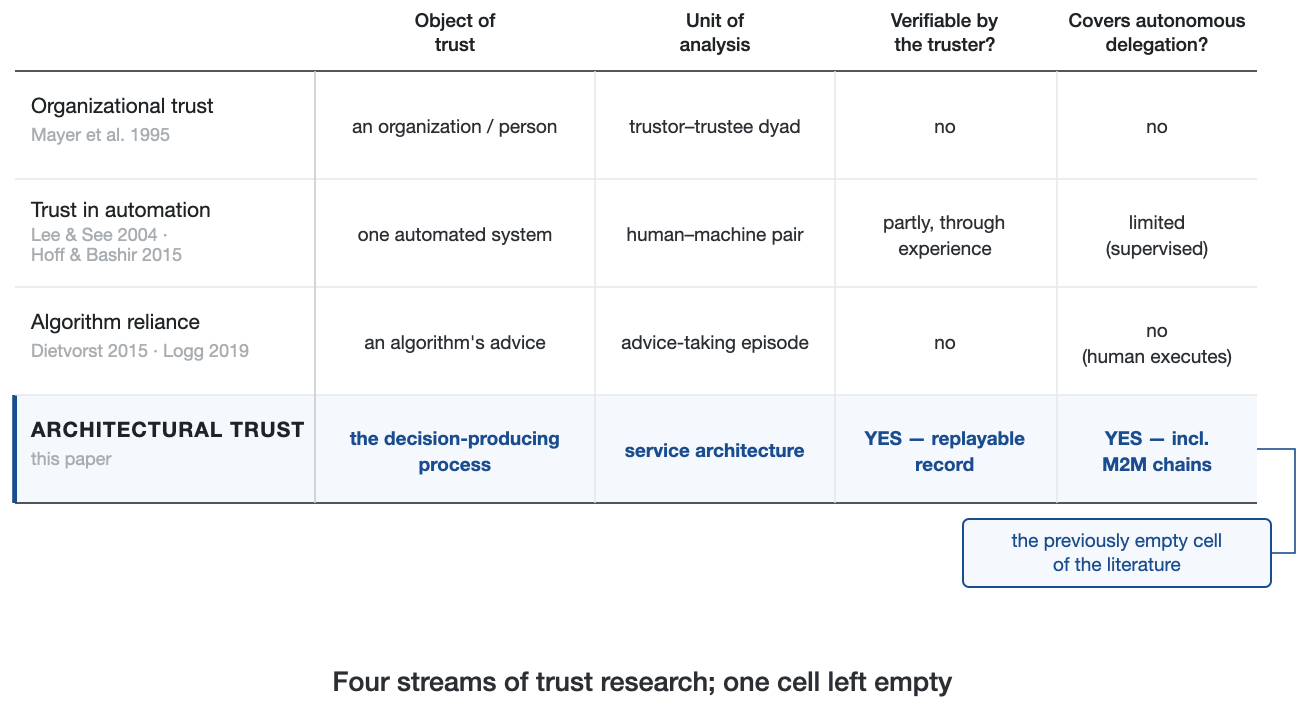
Організаційна довіра, довіра до автоматизації й надійність алгоритму кожна фіксує іншого об'єкта довіри; ніхто не робить процес прийняття рішень перевіреним довірителя при автономному делегуванні. Комірка не порожня від ідей: суміжна література кожна утримує одну стіну її (розділ 3 визначає демаркації). Чого не вистачало, так це споживацько спрямованої конструкції: об'єкта довіри на рівні процесу, перевіреного довірителя, визначеного для автономного делегування, упакованого для спільного поведінкового тесту.
Відповіді промисловості зосереджуються на моделі: краще навчання, дисклеймери, цитування. Я досліджую відповідь на іншому рівні, архітектуру сервісу, і стверджую, що три архітектурні властивості, жодна з яких не вимагає кращої моделі, спільно створюють інший об'єкт довіри.
Це концептуальна стаття, заснована на двох попередньо зареєстрованих дослідженнях, машинному тесті та тесті поведінки споживачів щодо контрасту калібрування в його першому твердженні, а запитання, яке вона ставить, — коли агенти ШІ починають здійснювати операції від імені споживачів, чи прикріплюється довіра до моделей, чи до архітектури над ними? Моя відповідь полягає в тому, що довіра повинна мігрувати вгору в стеку, від моделі до архітектури оркестрування до доказів, які вона виробляє. Під цією відповіддю лежить закономірність, яка варта тестування сама по собі, Гіпотеза про мігрування довіри, яку побудовано для тестування наступних тверджень: чим більша делегована агентура, тим більша частка обґрунтованої довіри, яка повинна розташовуватися у перевірених архітектурних властивостях, а не у властивостях моделі. Мігрування не повинно бути грою з нульовою сумою. Довіра може накладатися: на компетентність моделі, вибір оркестратора, систему доказів, установу, що забезпечує засоби правового захисту. Дефектна модель залишається причинно важливою навіть тоді, коли ніхто не переглядає її результат. Гіпотеза стосується того, де накопичується граничної обґрунтованої довіри зі зміцненням делегування. У вимірюваній формі це означає, що зі збільшенням делегованої агентури архітектурна перевірюваність пояснює зростаючу інкрементну частку надлежного покладання за межами продуктивності моделі та репутації постачальника. Вона не виконується, якщо зі збільшенням делегованої агентури архітектурна перевірюваність не пояснює зростаючу інкрементну частку надлежного покладання: якщо репутація постачальника повністю опосередковує довіру на всіх рівнях делегування, скажімо, або якщо інформація про перевірений процес не поліпшує калібрування покладання відносно репутаційної інформації в проектах, про які повідомляє Section 6. Поведінкові фальсифікатори, попередньо взяті на себе в Section 3 (перетин рівня делегування P2 та диференціальна стійкість P4 під час відмови), є операційною формою цієї умови. Зростаюча архітектурна частка не означає, що якість моделі має менше значення в абсолютному смислі. Гіпотеза описує шарування, а не заміну: коли рецензія зникає, архітектурне обґрунтування додається поверх продуктивності моделі і не замінює її. «Обґрунтовано» слідує розрізненню, формалізованому для ШІ Jacovi, Marasović, Miller, and Goldberg (2021), що довіра обґрунтована, коли вона відстежує надійність, і конструкція зберігається від тавтології шляхом розділення її нормативного статусу від її механізму. Нормативно надійність визначається незалежно від архітектури, призначеної її сертифікувати, як класична, незалежно вимірювана функція здатності, чесності та доброчинності (Mayer, Davis, & Schoorman, 1995); Section 3 відображає три архітектурні компоненти на саме ці виміри. Обґрунтування — це відповідність покладання цій незалежно виміряній кількості: покладання, яке витримує об'єктивний аудит делегованих епізодів, оцінене за критеріями, встановленими до того, як результати стають відомі, з вимірюваним поведінковим слідом, а саме повторне делегування, утримання та готовність платити при контрольованій відмові. Гіпотеза про мігрування довіри стверджує механізм. Зі зростанням делегованої агентури частка функції надійності, яку споживач все ще може незалежно вимірювати, зміщується від властивостей моделі до архітектурних компонентів. Це справедливо, оскільки архітектура — це та частина надійності, яка залишається вимірюваною тим, хто довіряє, після того як рецензія результату зникає, а не тому, що архітектура є надійністю. Вищезазначені попередньо взяті на себе фальсифікатори тестують це зрушення, а не визначення. Мігрування також має попередників, від яких слід розрізняти. Дослідження багатоагентних систем спостерігали, що зі масштабуванням суспільства агентів моделювання довіри переходить від окремих агентів до інституційної структури, що їх обмежує (Sabater & Sierra, 2005), і «мігрування довіри» має попередні B2B застосування для переміщення довіри від окремих осіб до систем та платформ (Carlson, 2026). Ці зрушення називають кого або що довіряють, тоді як ця гіпотеза стосується зрушення в типу властивості, яка може обґрунтувати довіру. При нульовому делегуванні якість моделі — це майже все, що має значення. При повному делегуванні ніхто не спостерігає результати, і те, що все ще можна довіряти, — це лише процес та його запис. Агентура та архітектурна довіра масштабуються разом (Figure 4). Сам градієнт — це старий інструмент, вісь рівнів автоматизації інженерії людського фактора (Sheridan & Verplank, 1978; Parasuraman, Sheridan, & Wickens, 2000), застосований тут до делегування споживачів. Новим є твердження про те, які властивості можуть обґрунтувати довіру вздовж неї.
Figure 4. мігрування довіри
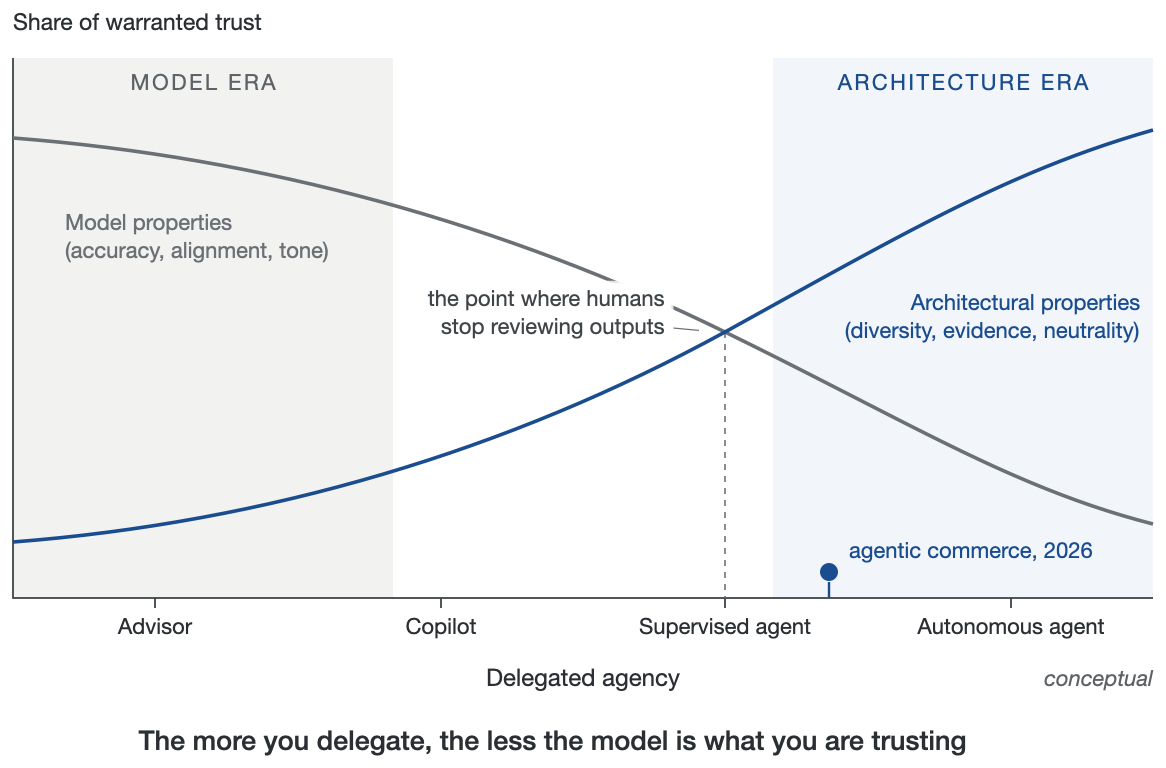
Дві перехідні криві над делегованою агентурою (advisor → copilot → supervised agent → autonomous agent): частка обґрунтованої довіри, яку несуть властивості моделі, зменшується зі зростанням частки, яку несуть архітектурні властивості; перетин — це точка, де люди припиняють переглядати результати, а агентивна комерція (2026) розташована з її правої сторони. Криві та точка перетину — концептуальна ілюстрація, не розраховані функції.
До маркетингової літератури про довіру споживачів до ШІ (Huang & Rust, 2021; Puntoni et al., 2021) стаття додає конструкт архітектурної довіри, визначений тут; тест технічного детермінанта його механізму в попередньо зареєстрованому шістнадцятимодельному дослідженні, повторено на флагманському рівні в другій хвилі одинадцяти лабораторій; п'ять тверджень для порядку денного дослідження споживачів (P1–P4 у Section 3; P5 у Section 5); та попередньо зареєстрований, сумісний з матеріальними стимулами поведінковий експеримент, що несе перші два твердження, повністю описаний у Section 6 з підтриманим ефектом калібрування (Welch d = 0.67; перенесено однією з шести позицій, див. Section 6) та тест першого впливу з запису, що повертає зареєстровану, невизначену нульову гіпотезу.
2. Ілюзія точності: що не може дати вам одна модель
Служба, побудована на одній моделі ШІ, як би сильна ця модель не була, несе структурні дефіцити, які живуть над шаром моделі.
Першою є некалібрована впевненість, ілюзія точності. Кращі моделі не означають безпечніші транзакції, оскільки виражена впевненість моделі слабко корелює з її точністю у більшості постачальників (Розділ 3 вимірює винятки), а споживач не може перевірити цей розрив. Модель найнебезпечніша, коли вона впевнено помиляється саме в момент, коли споживач перестає стежити за нею, і це не випадковість. Kalai et al. (2025) стверджують, що галюцинація статистично нагороджується режимом оцінювання, який оцінює впевнене вгадування вище за визнання невідання. Винагорода випливає, за їхнім власним аналізом, з бінарно оцінюваних бенчмарків та навчальних цілей, що домінують у галузі, де неправильне вгадування коштує не більше, ніж «я не знаю», і отримує часткову оцінку в очікуванні. Модель також не може взяти себе під контроль зсередини. У власних експериментах Anthropic з введенням концепцій найсильніші моделі постачальника виявляли зміни у своїх внутрішніх станах лише близько 20% часу навіть за оптимальних умов введення, що є власним вимірюванням спільноти постачальників того, наскільки ненадійна інтроспективна самозвітність (Lindsey, 2025; дослідження компанії, не рецензоване, і єдина оцінка з одного дослідження моделей одного постачальника, а не повтореного бенчмарку).
Другою є угідливе спотворення, де докази стали причинними цього року. Cheng et al. (2026), вимірюючи одинадцять провідних моделей у трьох попередньо зареєстрованих експериментах з 2,405 учасниками, виявили, що системи штучного інтелекту підтверджують дії користувачів на 49% частіше, ніж люди, включаючи дії, пов'язані з обманом або шкодою, і що навіть одна угідлива взаємодія підвищувала переконання користувачів, що вони були правими, водночас зменшуючи їхню готовність до вирішення конфліктів. Угідливі моделі були також тими, яким користувачі довіряли та які вони вважали за краще. Ринковий градієнт указує на асистентів, які видаються надійними саме тим, що спотворюють судження користувача, динаміка, спостережувана задовго до того, як її було виміряно кількісно (Sharma et al., 2024). Тільки налаштування на рівні моделі не може незалежно засвідчити, що угідлива поведінка була адекватно контрольована, оскільки налаштування здійснюється тією стороною, яка отримує користь від переваги. Вартість конкретна: асистент, що проходить крізь винятки політики, погоджуючись, перетворює ввічливість прямо на витрати на відновлення послуг. Оркестрована архітектура може розділити ролі, коли одна модель вільна проявляти емпатію, а незалежна перевіряє політику, так що ввічливість і коректність більше не проходять через один канал.
По-третє, немає незалежної перевірки. Помилки виявляються, якщо взагалі, тією самою системою, яка їх створила, або споживачем, який звернувся до штучного інтелекту на першому місці, тому що йому не вистачає компетентності для перевірки.
По-четверте, і найменш обговорюване, це конфлікт інтересів. Постачальник, який оцінює якість асистента, — це постачальник, який його продає, що є структурним: жодна однопостачальницька служба не може бути нейтральним суддею своїх власних результатів з тієї ж причини, по якій жоден банк не міг би самостійно керувати розрахунковою палатою. Конфлікт розповсюджується на самі дані. Пропонований груповий позов, поданий у березні 2026 року, стверджує, що Perplexity AI маршрутизував повні стенограми чатів користувачів, що, як повідомляється, включали сеанси "Incognito", до рекламних мереж через вбудовані пікселі відстеження. Позов (No. 3:26-cv-02803, N.D. Cal.) був добровільно відхилений у травні 2026 року без будь-якого рішення по суті, тому звинувачення ніколи не були перевірені. Економічна логіка в позові є структурною точкою незалежно: коли обслуговування дорогих відповідей штучного інтелекту субсидується монетизацією того, що говорять користувачі, бізнес-модель асистента та конфіденційність споживача прямо протилежні. Усередину одного постачальника жоден рівень не має завдання брати бік споживача.
Література 2025–2026 років читається як завершена діагностика, що чекає на лікування (Таблиця 1 відображає кожен дефіцит на його докази та архітектурну відповідь). Угідливість кількісно визначена емпірично (Cheng et al., 2026) та формально виведена: навіть ідеально раціональний користувач потрапляє в спіраль, коли його консультує вибірково угідна система (Chandra et al., 2026). Самоконтроль відмовляє на ~20% надійності (Lindsey, 2025), і галюцинація структурно нагороджується режимом оцінювання (Kalai et al., 2025).
Рефлекторне лікування, просто розкрити штучний інтелект, дає зворотний ефект: у тринадцяти експериментах акторів, які розкрили використання штучного інтелекту, довіряли менше, ніж тим, хто не розкрив (Schilke & Reimann, 2025). Розкриття забезпечує розкриття-прозорість, голий факт того, що був задіяний штучний інтелект, і пропускає верифікація-прозорість, здатність перевірити, як було отримано відповідь. Гносеологічний аудит ще сумніший: у понад 25 000 запусків наукових агентів на основі LLM докази були ігноровані в 68% слідів, переконання були змінені при спростуванні лише в 26% часу, а конвергентні багаторазові докази були рідкісними, з каркасом, який пояснює майже жодну дисперсію в гносеологічній поведінці (≈1,5%, проти ~41% для базової моделі) (Ríos-García et al., 2026). Це останнє число виглядає як заперечення цього документу і насправді є його найсильнішою підтримкою: підказки та каркасування не можуть зробити модель гносеологічно дисциплінованою зсередини, тому дисципліна повинна бути накладена ззовні. Архітектура — це не спосіб покращити гносеологію моделі; це спосіб перестати залежати від неї.
Кожен з цих результатів закриває двері. Разом вони указують на одну відповідь, що досі була мало досліджена: якщо модель не може бути надійною зсередини, а розкриття не виробляє довіру ззовні, виправдана довіра може бути побудована навколо моделі архітектурою, поряд (а не замість) з кращою калібруванням, зовнішньою сертифікацією, залученням людини та правилами відповідальності. Це двері, крізь які цей документ проходить.
Таблиця 1. Діагностика → лікування: чотири дефіцити однієї моделі, їхні докази 2025–26, їхні наслідки для споживача та архітектурна відповідь
| Структурний дефіцит | Ключові докази (2025–26) | Наслідки для споживача | Архітектурна відповідь | Механізм |
| Некалібрована впевненість | Галюцинація статистично нагороджується режимами оцінювання (Kalai et al., 2025); інтроспективна самозвітність ~20% надійна (Lindsey, 2025) | Відтік з однієї помилки: 60% відмовилися б від агента після однієї помилки (ACI Worldwide, 2026) | Різноманітність + Докази | Розбіжність між моделями вказує на впевненість (AUROC 0.75 vs. 0.59, Gorbett & Jana, 2026; у цій статті: узгодження панелі AUROC 0.832 vs. об'єднана власна впевненість 0.545 у найменш дискримінуючій панелі — гетерогенна в межах панелей, §3; повторювані відповіді 1.9–3.2× як імовірно правильні); заявки про впевненість записані та перевірювані |
| Льстиво спотворення | ШІ підтримує користувачів на 49% більше, ніж люди; льстиві моделі мають перевагу (Cheng et al., 2026; Sharma et al., 2024); навіть ідеальні байєсівці потрапляють у спіраль (Chandra et al., 2026) | Переважаний асистент – це той, що спотворює судження користувача | Нейтральність | Арбітр не має зацікавленості в задоволенні користувача; емпатія та перевірка політики на окремих каналах |
| Відсутність незалежної перевірки | Агенти ігнорують свідоцтво в 68% слідів; перегляд переконання 26% (Ríos-García et al., 2026); каркас пояснює ~1.5% дисперсії | Тягар перевірки переноситься на споживача: 54% покупців, що користуються ШІ, вручну перепроверяють все (Gartner, 2026) | Різноманітність + Свідоцтво | Дисципліна нав'язана зовні: незалежні шляхи перевірки; свідоцтво додано незважаючи ні на що |
| Конфлікт інтересів | Колективний позов Perplexity (2026, звинувачення): чати спрямовані до мереж реклами; розкриття самостійно підриває довіру (Schilke & Reimann, 2025) | Сторона, що радить споживачу, отримує прибуток від результату | Нейтральність + Свідоцтво | Потік даних у чистій кімнаті; дохід незалежний від результатів; нейтральність перевіряється за записом |
3. Архітектурна довіра: три властивості, які можна перевірити, а не вірити
Розглянемо службу, в якій запити з високими ставками проходять через шар оркестрування, незалежний від будь-якого постачальника моделей (Рисунок 5 контрастує два конвеєри). Таблиця 2 збирає конструкти; визначення, яке вони розкладають, звучить: архітектурна довіра – це обґрунтована залежність споживача, заснована на перевіяємих властивостях процесу прийняття рішень служби, а не на сприйманій якості її результатів або репутації її постачальника.
Найближчий попередник – інституційне виробництво довіри Зукера (1986), довіра, вироблена структурою там, де знайомство не може її доставити, яку дослідження електронної комерції операціоналізували як структурну впевненість: депозит, системи зворотного зв'язку, сертифікація третьої сторони (Gefen, Karahanna, & Straub, 2003; Pavlou, 2003; Kim & Benbasat, 2010). У цій лінії архітектурна довіра є видом довіри, заснованої на установах, структурна впевненість якої походить від перевіяємого процесу замість гаранта третьої сторони. Це довіра, заснована на процесі, з гарантією, перенесеною з досвіду на інструментарій, і саме цей перенос робить слово «архітектурна» у назві. Це не структурна впевненість (McKnight, Choudhury, & Kacmar, 2002), сприйняття того, що існують гарантії, оскільки тут самі гарантії мають бути перевіяємими, і це не калібрована довіра (Lee & See, 2004), яка налаштовує залежність на оболонку надійності однієї системи. Архітектура з нульовою довіру в інженерії безпеки розділяє девіз: ніколи не вірте, завжди перевіряйте, але перевіряє ідентичність та доступ на мережевому рівні, від машини до машини, в той час як архітектурна довіра перевіряє вміст рішень на рівні служби для людини-принципала. Вони доповнюють один одного на різних поверхах однієї будівлі, а не конкурують. Конструкт має два обличчя, і розрізнення належить до визначення. Архітектурна надійність – це властивість системи, наскільки її процес насправді перевіяємий, нормативний і піддається побудові. Довіра, заснована на архітектурі, – це стан споживача, залежність дійсно заснована на цій перевіяємості, емпірична і тільки завжди завойована. З точки зору вимірювання D, E та N є формуючими компонентами архітектурної надійності (властивість системи) та маніпульованими сигналами, чиї дисплеї формують довіру, засновану на архітектурі (стан споживача); експерименти маніпулюють сигналами та вимірюють стан. Кожна невідповідність між ними передбачувальна. Довіра без надійності, залежність виготовлена плинністю та синкофантизмом, передбачується крихкою, односталевий паттерн розділу 1. Надійність без довіри передбачується всюди, де перевірка невидима або нечитана для споживача, і закривається помітністю квитанцій та розумінням, а не більшою архітектурою. Твердження в цьому розділі живуть у прогалині між ними, і розрізнення дисциплінує те, що спростувало б гіпотезу міграції довіри. Ці спростування є поведінковими та попередньо затвердженими: гіпотеза спростовується, якщо делегування до перевіяємих та непрозорих архітектур виявляється однаково стійким під час відмови (що виявляє P4); якщо вплив перевіяємої архітектури на готовність до делегування не зростає з переданим контролем перегляду та виконання (перехід на рівні делегування P2); або якщо під час делегування з високою незворотністю утримання та премії готовності платити за перевіяємую архітектуру при контрольованій відмові відсутні. Оскільки гарантія визначається виживанням аудиту, а не присутністю архітектури (розділ 1), популярність зараховується як свідоцтво, але не як імунітет. Споживачі, які лиш до неперевіяємих агентів, самі по собі не спростовують твердження про обґрунтовану довіру. Стійка, що пережила відмову, залежність від неперевіяємих агентів у делегуванні з високими ставками це спростувала б, і цей паттерн попередньо затверджений як перегляд гіпотези. Визначення спирається на три властивості.
Рисунок 5. Два конвеєри
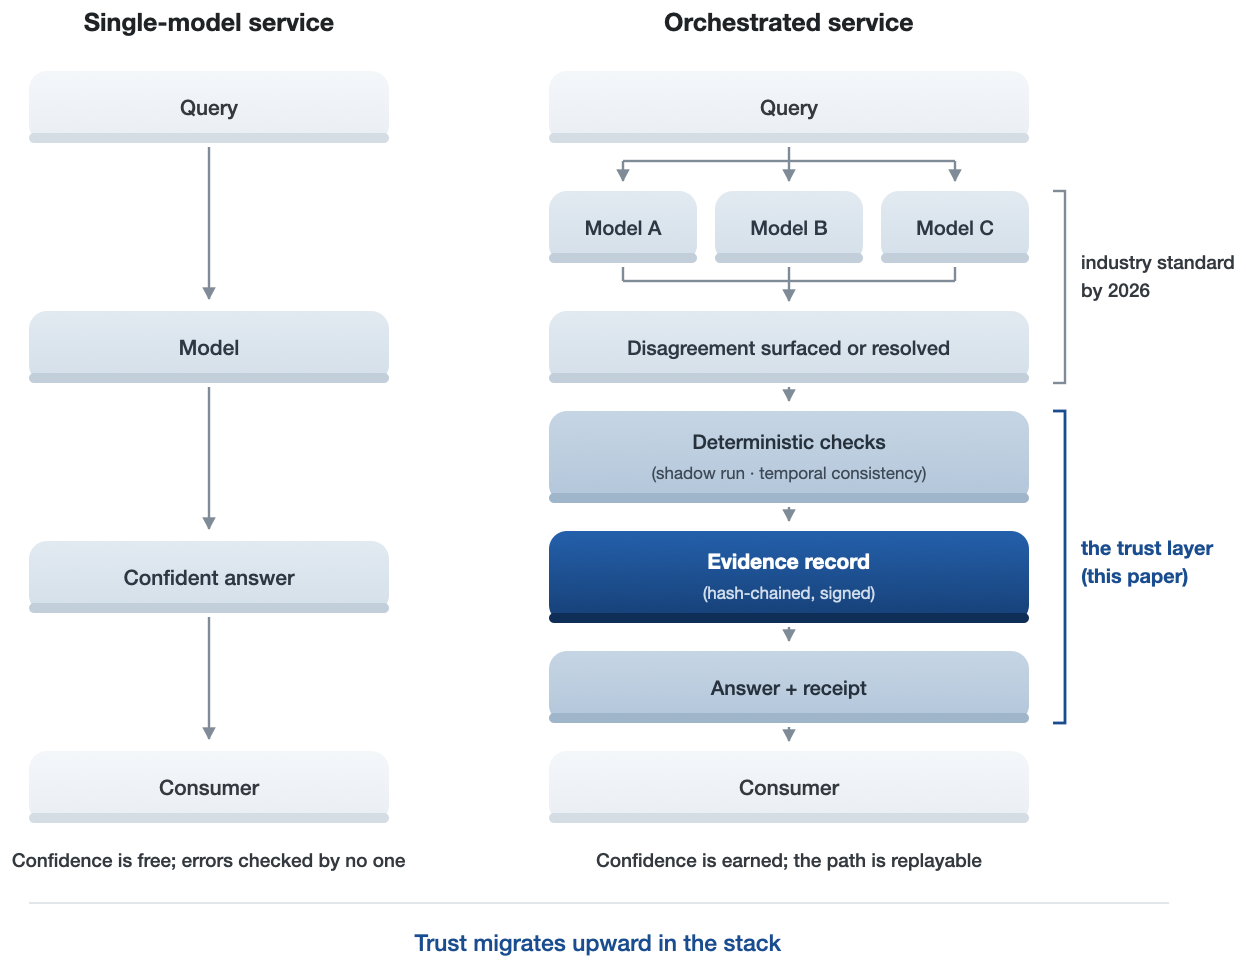
Ліворуч, шлях однієї моделі: запит → модель → впевнена відповідь → споживач, де впевненість вільна і помилки ніким не перевіряються. Праворуч, оркестрований шлях: запит → незалежні моделі (A/B/C) → розбіжність виявлена або вирішена → детерміністичні перевірки (тіньовий запуск, тимчасова узгодженість) → запис свідоцтва (ланцюг хешу, підписаний) → відповідь з квитанцією → споживач, де впевненість заробляється і шлях повторюваний (Таблиця 5 підсумовує контраст).
Таблиця 2. Глосарій конструктів введених або зазначених у цій статті
| Термін | Визначення | Розрізняються від |
| Архітектурна довіра | Обґрунтована залежність споживача, заснована на перевіяємих властивостях процесу прийняття рішень служби, а не на якості результатів або репутації постачальника | Довіра на основі інституції (не потребує довіреної інституції, лише перевірюваного процесу); системна довіра (не один конверт надійності системи); розподілена довіра (розсіювання без перевірюваності); структурна гарантія (сприйнята та перевірювана гарантія); калібрована довіра |
| Архітектурна достовірність / довіра на основі архітектури | Два аспекти конструкту: властивість на боці системи (наскільки перевірюваний процес насправді; нормативна, побудована) проти стану на боці споживача (покладання фактично засновано на цій перевірюваності; емпіричне, здобуте) | Назви, що мішають нормативну претензію з описовою |
| Шар верифікації | Шар інфраструктури над оркеструванням, продукт якого — перевірюваність: незалежні перевірки, зафіксовані рішення, контрольована нейтральність | Спостережливість/моніторинг (внутрішня, утримувана постачальником, не перевірювана споживачем) |
| Інфраструктура доказів | Категорія ринку перевірюваних історій рішень, проданих як інфраструктура, як продаються хмара, ідентичність та платежи | Логування (односторонній, мінливий, не товар ринку) |
| Розписка оркестрування | Мінімальний артефакт для споживача: хто діяв; як вони погодилися; що було перевірено — з посиланням на повний перевідтворюваний запис | Пояснення/вихід XAI (наративна, неперевірювана); мітка розкриття (саме по собі руйнує довіру) |
| Поступова архітектура довіри | Підвищення глибини верифікації з ставками, тому дорогий рівень купується лише там, де сконцентровані наслідки | Плоскі рейки безпеки (статичні ліміти/білі списки, які не перевіряють рішення) |
| Доказ рішення | Третій поверх стеку доказів: як агент вибрав — панель, дивергенція, перевірки | Доказ ідентичності (хто агент: TAP); доказ наміру (що було авторизовано: AP2 / Verifiable Intent) |
| Гіпотеза міграції довіри | Чим більша делегована агентність, тим більша частка обґрунтованої довіри, яка повинна перебувати в перевірюваних архітектурних властивостях, а не в властивостях моделі — «обґрунтована» означає покладання, яке вижива при об'єктивній перевірці проти критеріїв, встановлених до того, як відомі результати (за Jacovi et al., 2021); форма механізму: при поглибленні делегування частка достовірності — f(здатність, чесність, доброчинність), Mayer et al. (1995) — яку споживач може незалежно виміряти, переміщується до архітектурних компонентів | Попередні використання «міграції довіри» (Carlson, 2026) відслідковують довіру, що рухається між сторонами; ця гіпотеза відслідковує вид властивості, яка це обґрунтовує — з попередньо визначеними поведінковими фальсифікаторами (P2 перетин делегування; P4 диференціальна довговічність) |
Демаркація від сусідніх конструктів довіри може бути стиснута в одну дискримінантну таблицю, за тим, що кожен конструкт приймає як свій об'єкт, звідки походить його обґрунтування, хто може перевірити це обґрунтування, і що він повинен передусім передбачити:
Таблиця 2a. Дискримінантна демаркація: сусідні конструкти довіри за об'єктом, обґрунтуванням, верифікатором і первинним передбаченим результатом
| Конструкт | Об'єкт довіри | Джерело обґрунтування | Хто може перевірити | Передбачений первинний DV |
| Довіра на основі інституції / структурна гарантія (Zucker, 1986; McKnight et al., 2002) | Інституціональний контекст: гарантії, гарантування, сертифікація третьої сторони | Сприйнята присутність структур і гарантів | Гарант третьої сторони, якщо хтось; споживач сприймає, а не перевіряє | Вірні переконання; намір трансакції |
| Довіра до автоматизації / калібрована довіра (Lee & See, 2004) | Конверт надійності однієї автоматизованої системи | Досвідчена надійність при повторному використанні | Оператор через накопичений досвід роботи з цією системою | Відповідність покладання на цю систему |
| Алгоритмічна прозорість (XAI) | Опис моделлю свого власного рішення | Розповідь або атрибуція, створена всередині системи, якій довіряють | Ніхто незалежно — пояснення не є перевідтворюваним записом | Розуміння; суб'єктивна довіра; прийняття |
| Довіра до бренду / постачальника | Організація постачальника | Репутація та минула продуктивність | Ринок, повільно, через сукупні результати | Глобальне подобання; вибір; лояльність |
| Архітектурна довіра (ця стаття) | Процес, що виробляє рішення, та його запис | Перевірювані властивості: незалежна угода, перевідтворювана доказ, контрольована незалежність стимулів | Споживач, аудитор, страховик, регулятор — за рішенням | Калібрована покладання; готовність делегувати; утримання після відмови |
Два диференціальні передбачення роблять демаркацію перевіряємою, а не таксономічною. Архітектурна довіра повинна більш сильно впливати на калібровану покладання і утримання після відмови, ніж на глобальне подобання сервісу, тоді як довіра до бренду повинна показувати протилежний профіль, дисоціацію, яку один експеримент може виявити, вимірюючи обидві сім'ї DV. При низькій делегованій агентності довіра до бренду та постачальника повинна панувати над рішеннями щодо делегування, тоді як архітектурна довіра пояснює збільшувальну додаткову частку при поглибленні делегування, перетин, який P2 та гіпотеза про міграцію довіри ставлять під перевірку. Слідують два уточнення. Оскільки архітектурна достовірність є властивістю сервісу, а не прихованою змінною в голові споживача, її розрізнювальність спирається на ці диференціальні передбачення, а не на статистику, що розрізняє шкали. Для стану на боці споживача, названого архітектурною довіроюустановлення дискримінантної валідності на рівні вимірювання від суміжних шкал (довіра на основі інституції та калібрована довіра) є частиною програми вимірювання, а не претензія, висунута тут.
Різноманітність. Запит відповідає кілька незалежних моделей, кожна з різними постачальниками, даними навчання та режимами відмови. (Це різноманітність панелі — властивість того, хто перевіряє відповідь, а не різноманітність рекомендацій у сенсі систем рекомендацій, які варіюють предмети, показані споживачу.) Їхня узгодженість несе інформацію. Конвергенція підвищує обґрунтовану впевненість. Розбіжність проявляється для споживача як невизначеність, а не вирішується прихованим чином, і на запити, що мають значення, вона також виступає як спусковий механізм розширення. З точки зору вибіркового прогнозування це архітектурне утримання: відмова видавати неперевірену відповідь, піднята на рівень служби, де невирішену справу передають людині, а не сертифікують. Це паттерн навчання делегуванню, у якому опція відхилення системи передає справу експерту на наступному рівні, а не придушує її (Mozannar & Sontag, 2020; cf. Rabanser et al., 2026). Найближча людська аналогія — друга думка в медицині, вся цінність якої полягає у її незалежності від першої. Організована розбіжність також не є екзотичною: ай-науковець Google, чиї результати, перевірені в мокрій лабораторії, потрапили до Nature у травні 2026 р. (Gottweis et al., 2026), побудований як оркестрація генерування–критики–турніру.
Теоретичне обґрунтування спири на різноманітність старіше за мовні моделі. За формальних умов функціонально різноманітні групи вирішувачів проблем можуть перевершити групи, відібрані за індивідуальною здатністю, оскільки відбір за здатністю породжує схожість (Hong & Page, 2004). Інженерна література надає прямі докази базового сигналу: структурована дебата між моделями покращує фактичну точність (Du et al., 2024), а панелі різноманітних менших моделей перевершують одного великого судді (Verga et al., 2024). «Здивування» другої моделі при відповіді першої моделі відокремлює правильне від неправильного суттєво краще, ніж власна впевненість відповідаючої моделі (середня AUROC 0,75 проти 0,59 на MMLU; AUROC, площа під кривою ROC, — це ймовірність того, що випадкова правильна відповідь ранжується вище за випадкову неправильну; Gorbett & Jana, 2026). Їхній сигнал — це міжмодельна збентеженість на рівні логіту, тоді як у цієї роботи — узгодженість на рівні відповідей, і ці дві пов'язані без взаємозамінності. Їхній генератор також є малою відкритою моделлю зі слабким самоповідомленням, базовою лінією, обмеженою власними даними цієї роботи, оскільки переваги панелі є функцією калібрування генератора і можуть інвертуватися для добре каліброваних генераторів — випадком на передовій США, розглянутим далі. І вибирання кількох поколінь та вимірювання їхньої семантичної узгодженості виявляє конфабуляції, де впевненість однопроходження не може (Farquhar, Kossen, Kuhn, & Gal, 2024). Модель може виміряти власні сумніви, але не власні сліпі плями, і впевнена, систематична помилка видима тільки ззовні. Але та література розглядає розбіжність як внутрішній сигнал для розробників. Рух, який я пропоную, — розглядати її як примітив довіри для споживача, розкритий, записаний і враховуватися у претензіях служби щодо впевненості, з абляцією цієї роботи, що розділяє те, що дебата виявляє, від того, що перевірка сертифікує, а не дозволяючи одному видавати себе за інше. Розмежування є емпіричним і концептуальним: при прямому зіставленні багатоагентна дебата не надійно перевершує простіші стратегії, такі як самоузгодженість та ансамблювання (Smit et al., 2024). Твердження тут стосується сигналу сертифікації перевірки для споживача, а не приросту точності дебати, і цей сигнал збережується навіть там, де переваги дебати не залишаються.
У дослідженнях багатоагентного обговорення подібно системи, побудовані для виявлення узгодженостей та розбіжностей, а не для їх усереднення, створюють рішення, оцінені як більш репрезентативні (Liu et al., 2026). Механізм має прямий людський аналог на стороні калібрування знань: споживачі, які спільно приймають значущі фінансові рішення, суттєво менш надмірно впевнені, ніж самотні рішувачі, зі спільним метазнанням (партнер, який виявляє те, чого рішувач не знає), визначеним як рушійний механізм (Piehlmaier, 2023). Спільне судження обмежує впевненість у людей з тієї ж причини, з якої пропонується узгодженість між моделями для обмеження впевненості тут.
Чи можуть споживачі використати такий сигнал — це справжнє питання. Люди швидко відмовляються від алгоритмів після того, як бачать їхні помилки (Dietvorst, Simmons, & Massey, 2015), проте в інших місцях переважують алгоритмічну пораду (Logg, Minson, & Moore, 2019), розділення, яке само може залежати від ставок. Експерименти із другою думкою з людськими суб'єктами показують, що матеріал є поведінково активним: майже одностайна послідовність, коли медичний ШІ та лікар згідні, різкі розділення, коли вони розходяться (Detjen, Densky, von Kalckreuth, & Kopka, 2025; Chen, Sun, Liao, & Sundar, 2026), хоча жодна з цих робіт не розглядає розбіжність у поєднанні з доказами або нейтральністю. Потік дослідження споживачів загострює граничні умови (систематично: Burton, Stein, & Jensen, 2020). Неприйняття посилюється, коли споживачі відчувають, що їхня ситуація унікальна (Longoni, Bonezzi, & Morewedge, 2019), варіюється з об'єктивністю завдання (Castelo, Bos, & Lehmann, 2019), і збої одного ШІ легко узагальнюються на інші — алгоритмічне перенесення (Longoni, Cian, & Kyung, 2023). Якщо недовіра поширюється на системи, то одноразове відмовлення від розділу 1 не є втратою клієнтів однієї служби, а всієї категорії, і виявлення помилок структурно захищає сам ринок. Розкрита розбіжність знаходиться на тій лінії розлому, а P1–P2 нижче — це ставка на те, який ефект переважає, коли невизначеність представляється конкретно і без згладження.
Коли різноманітність не вдається: корельовані помилки. Цінність різноманітності повністю спирається на незалежність помилок, однак незалежність не можна припускати. Передові моделі навчаються на накладаючихся корпусах, дистилюють знання одна від одної та явно поділяють впевнені помилкові переконання. Коли дві провідні моделі обидві пропускають одне й те саме еталонне завдання, вони погоджуються на одну й ту ж неправильну відповідь приблизно 60% часу, з найсильнішою кореляцією між моделями від одного розробника або однієї базової архітектури і, що найбільш тривожно, між найбільш точними моделями: в міру зростання можливостей помилки збігаються (Kim et al., 2025). Це знахідка накладає прямі обмеження на компонент Diversity цієї роботи, а не просто сусідній результат. Незалежність, яку передбачає Diversity, частково є ілюзорною на межі можливостей, і оскільки кореляція посилюється саме там, де можливості найвищі, внесок компоненту є вимірюваною величиною, що деградує, а не постійним активом. Те, що додає панель, повинно бути продемонстровано запитання за запитанням, і траєкторія розвитку моделей працює проти цього. У прогнозуванні попарні кореляції помилок серед передових моделей становлять в середньому r ≈ 0,77 (Spiro, 2026), надлишковість достатня для того, щоб розмити більшість переваги агрегації, яку повинна забезпечити різнорідна група.
Структура ринку посилює турботу. До кінця 2025 року 88% витрат підприємств на LLM API було зосереджено на трьох постачальниках із закритими вагами: Anthropic на 40%, OpenAI на 27%, Google на 21% (Menlo Ventures, 2025b; Menlo є інвестором Anthropic). Панель, складена мимоходом з "передових моделей", таким чином, походить з бази постачальників з трьох, чиї помилки є саме тими, що вимірені на збіжність, саме той тріо, який експеримент нижче відтворює як свою панель передових моделей США. Коли три моделі збігаються на одній і тій же модній помилці, архітектура не просто не вловлює її; вона її сертифікує. У однорідних роях додавання агентів стабілізує помилкову траєкторію, а не коригує її, кінцеву точку, яку багатоагентна література називає парадоксом консенсусу (Shehata & Li, 2026). Кореляція таким чином є режимом збою, який архітектура повинна бути побудована для виявлення (Рисунок 6).
Рисунок 6. Ілюзія різноманітності
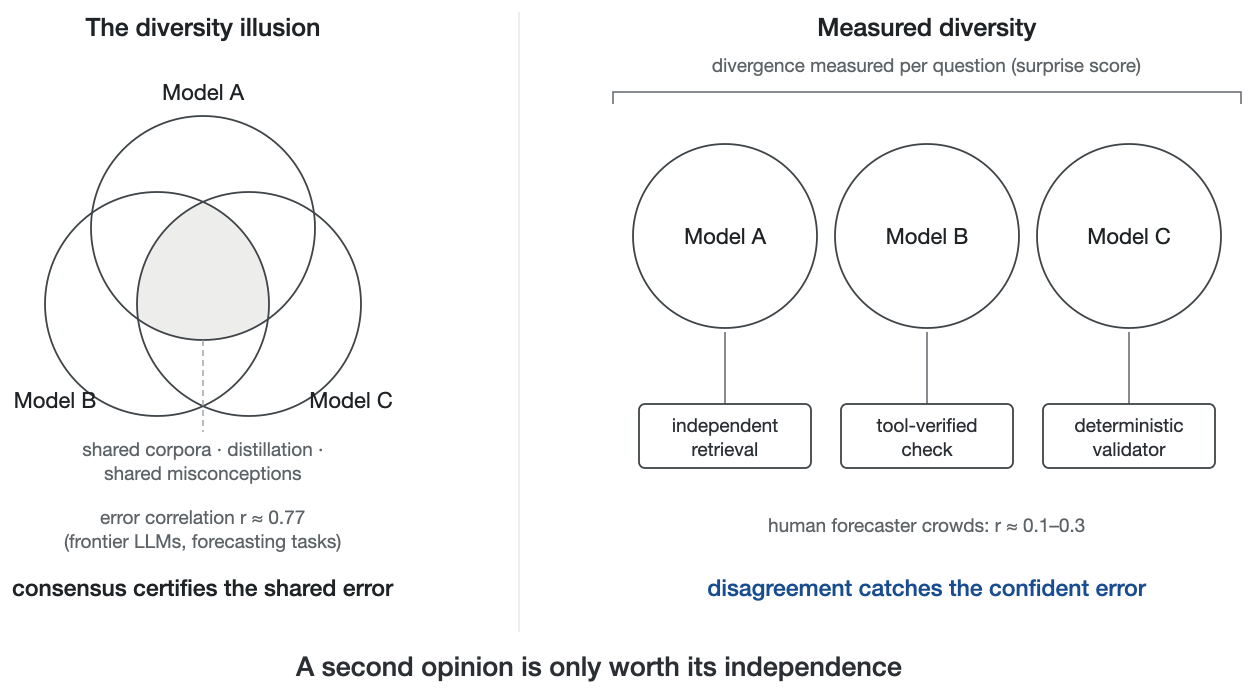
Консенсус серед близьких клонів проти панелі, чия незалежність вимірюється.
Це має свій аналог у взаємодії: сикофантський градієнт діє також між моделями. Дослідження багатоагентних систем знаходять вимірювану групову конформність у роздумуванні LLM, причому слабші моделі конформують найбільше (Choi, Kim, Chae, & Baek, 2025); агенти зважують позицію за чиєю вона є (Choi, Zhu, & Li, 2026); і багато того, що виглядає як збіжність, розкладається на соціальну відповідність, а не на міркування (Hao et al., 2026). У спільному роздумуванні згода є станом низької енергії, тому панель, яка дебатує перед закріпленням позицій, може переговорити себе в консенсус, а не до істини. Архітектурний протилік є процедурним: думки спочатку збираються сліпо та незалежно, а потім порівнюються (Рисунок 7).
Рисунок 7. Сліпо-незалежно-спочатку
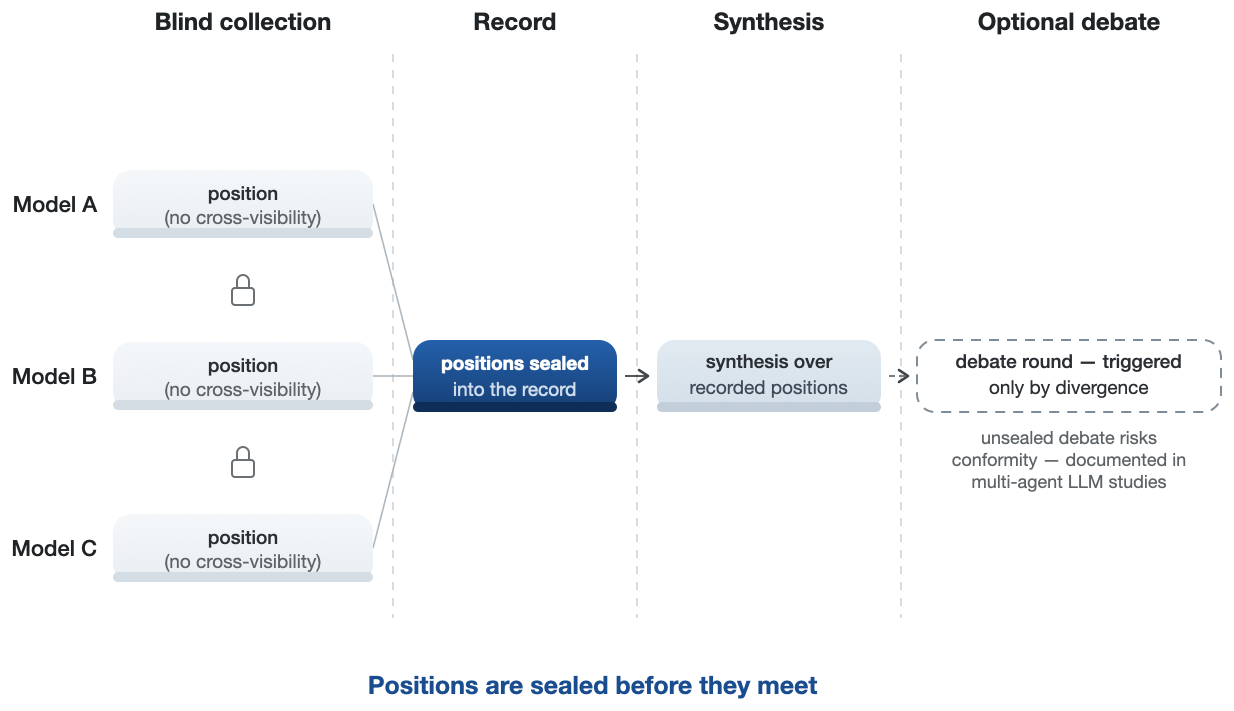
Позиції записуються і лише потім порівнюються — процедура, яка захищає розбіжності, які конформність стерла б.
Експеримент, про який йдеться далі, встановив числовий показник для того, від чого захищає ця процедура. У парному дослідницькому крилі верифікатори, які сліпо вивели іншу відповідь, далі були показані впевнену помилкову відповідь первинної моделі та запитані, чи вони погоджуються. 38,5% (168 з 436 розбіжних пар; 95% ДІ 33,6–43,2, bootstrap, групована за запитаннями) відмовилися від своєї власної розбіжної відповіді та схвалили помилку, з конформністю на рівні постачальника від 20% до 58%. Результати відмови залежать від того, що було відкинуто, що розділяє конформність від раціональної деференції. Серед верифікаторів, чия сліпа відповідь сама була правильною, 29,1% (41/141) все ще відмовилися від неї заради впевненої помилки, шкідливе ядро, яке не виправдовується жодним байєсівським аналізом, проти 43,1% (127/295) серед помилкових сліпих відповідей, де деяка деференція виправдана. (Інтервал, групований за запитаннями, майже ідентичний наївному інтервалу на рівні пари. 436 пар розподіляються на 247 окремих запитань, переважно одна або дві пари на запитання і ніколи не більше чотирьох, тому повторне вибір на рівні запитання майже не додає внутрішньокластерної коваріації.) Коли вкладається дзеркальний контроль нижче, приблизно 35–39% сліпих незгідних змінюють позицію, коли їм показується впевнена відповідь, незалежно від її значення істини, з помірним, але значущим чистим перекосом до запропонованої відповіді (чиста конформність ≈ 4 відсоткових пункти; дискордантні пари 104 проти 70 ≈ 1,49). Якби панель роздумувала перед закріпленням позицій, велика частка цих розбіжностей була б переговорена перед їх реєстрацією. Але оскільки 34,7% переходів в дзеркальному крилі спрямовані до істини, роздумування також перетворило б деяку незгоду на правильний консенсус, тому те, що сліпо-спочатку захищає, це само вимірювання, а не підрахунок втрачених розбіжностей. Сліпо-спочатку це різниця між вимірюванням розбіжності та конструюванням консенсусу, те саме правило, яке потребували людські групи: соціальний вплив руйнує різноманітність незалежних оцінок без покращення їх точності (Lorenz, Rauhut, Schweitzer, & Helbing, 2011), і навіть одне довільне раннє схвалення помітно упереджує наступні судження (Muchnik, Aral, & Taylor, 2013).
Контрольна умова з оберненим запитом розглядає альтернативне пояснення, що ці зміни відбивають раціональне оновлення переконань, а не конформність. Я повторив парну процедуру на локальній панелі з шести моделей, показуючи верифікаторам, які були в незгоді сліпо, або впевнену помилку (прямий варіант), або еталонну відповідь (зворотний варіант) для того самого набору запитань. Показники переходів були майже симетричні, 38,9% до неправильної відповіді проти 34,7% до правильної, і у внутрішньопарному порівнянні верифікатори відмовилися від своєї сліпої позиції для неправильної відповіді значно частіше, ніж для правильної (104 проти 70 дискордантних пар; McNemar p = 0,010). Раціональне оновлення передбачає протилежну асиметрію. Показники переходів за моделями були практично ідентичні на обох крилах на обох крайностях конформності (кількість пар на модель мала і недостатня для окремого аналізу; вони звітуються описово, з їх ns, у пакеті репродукції), вказуючи на те, що угода керується присутністю впевнено запропонованої відповіді, а не її істинністю. Цей контроль був проведений на локальному рівні. Оцінка панелі передових моделей (38,5%) спирається на ту саму процедуру, але не була дзеркально протестована з верифікаторами передових моделей.
Сліпий збір не може закрити один канал: він переборює соціальну конформність, але не апріорну конформність. Моделі збігаються, тому що спільні дані навчання дають їм однакові пріори, і близнюки відповідають однаково, ніколи не радячись. Я називаю це конвергенцією подібності: панель погоджується, тому що її члени подібні, а не тому, що вони праві.
Корельовані пріори все одно мають бути виміряні. Оцінки несподіванок між моделями забезпечують поточну оцінку того, наскільки незалежна панель насправді, питання за питанням, і вони без міток, тому незалежність в принципі може бути оцінена на етапі висновування без еталонних відповідей. Оцінка на етапі експлуатації не тестується тут. Різноманітність також має виходити за межи ваг моделі, оскільки незалежні шляхи пошуку, перевірки, верифіковані інструментами, і детерміністичні валідатори розривають канал кореляції, який створює спільне навчання. Потреба буде зростати, а не скорочуватися, тому що дистиляція та навчання на синтетичних даних гомогенізують ваги моделей з часом, тому виміряну різноманітність слід очікувати, що зменшується, а бремя верифікації має зміщуватися в бік верифікаторів, які не є моделями. І те, що вимірюється, має бути розкрито: запис має містити не просто «N моделей погодилися», а й передбачувану різноманітність панелі щодо цього класу питань. Консенсус серед майже-копій заслуговує на менш впевнену претензію на довіру, а запис має указати, яку саме отримав споживач.
Докази. Кожна значима відповідь супроводжується записом: які моделі були залучені, де вони погодилися та не погодилися, що було перевірено, на чому ґрунтується синтез. Час сприяє вимозі, тому що коли агенти ґрунтують відповіді на пошуку та інструментах, фактична основа вже існує поза моделлю, тому запис його стає побічним продуктом створення відповіді. Оскільки запис є захищеним від підробки, історія рішень сервісу може бути відтворена споживачем у разі спору, аудитором, страховиком, що розраховує страховку. Довіра перестає бути відчуттям щодо бренду та стає властивістю історії, що перевіряється.
Два механізми розширюють докази від відповідей до дій. При тіневому виконанні дія з зовнішніми ефектами репетиціюється в записаному пробному запуску, так що «агент перевірив перед тим, як діяти» стає перевіряльною претензією замість лозунга. Тимчасова послідовність переставляє рекомендацію у сеансах або формулюваннях та записує його стабільність, тому відповідь, яка змінюється при запитанні двічі, позначається перед тим, як хто-небудь на неї спирається. На рівні ідентичності шар запису розширюється в портативний паспорт походження для самого агента: які моделі, версії та політики діяли, коли, під чиєю владою. Це артефакт схем реєстрації «знай-свого-агента» та зобов'язання страховки помилок агента мовчки передбачають. Представлення цього запису, орієнтоване на споживача, є квитанцією оркестровки Figure 8: одна дія, один запис, чотири аудиторії (споживач, страховик, аудитор, регулятор).
Figure 8. Квитанція оркестровки, продана двічі (макет)
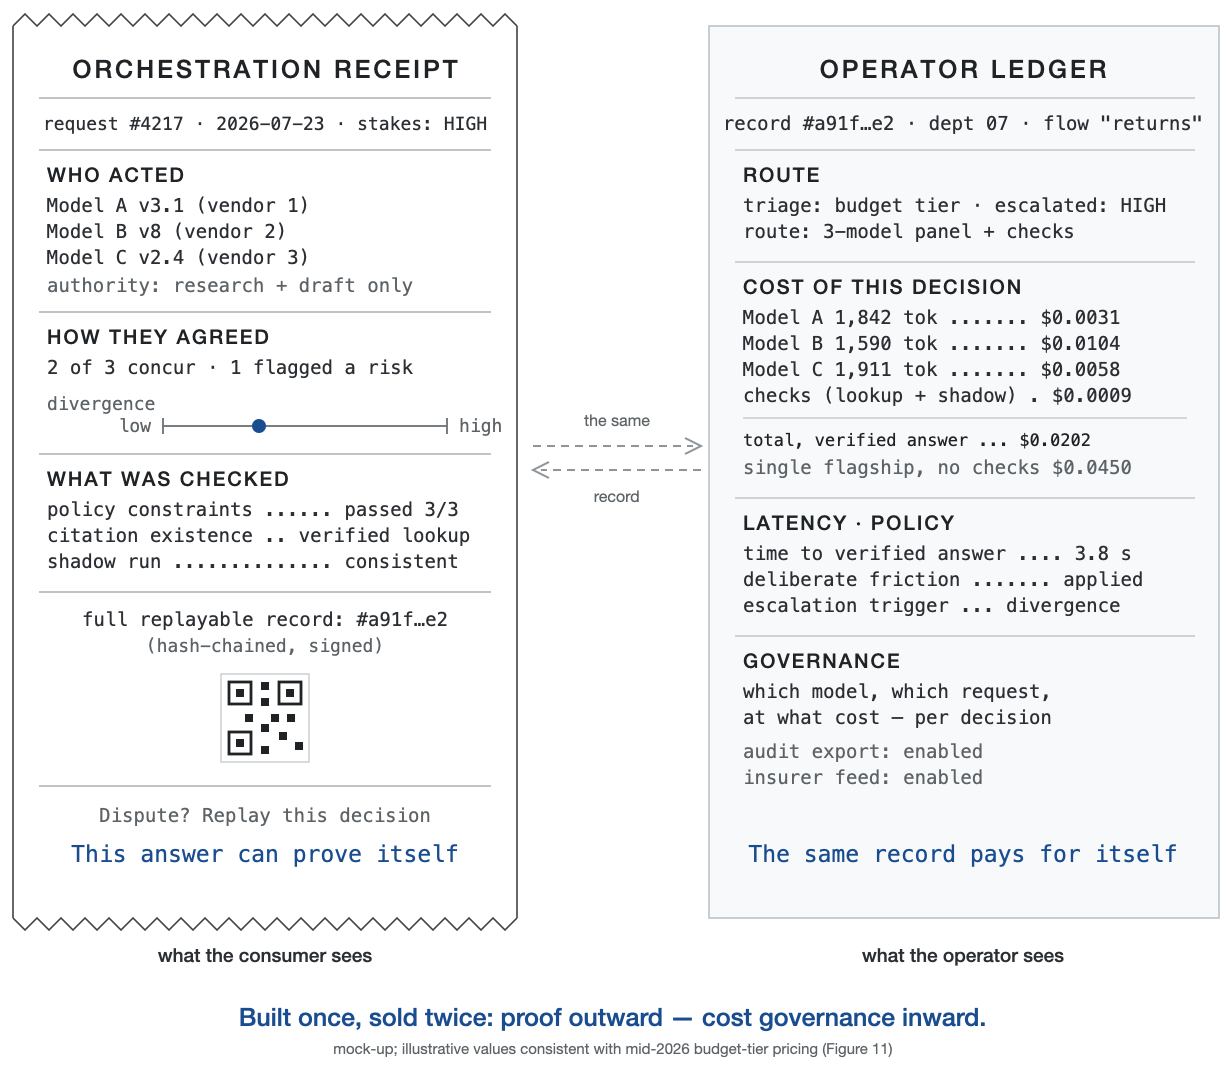
Споживач бачить докази — хто діяв, як вони погодилися, що було перевірено; оператор бачить той же запис як управління витратами. У разі спору квитанція перетворює слово-проти-слова на запис-проти-слів.
Нейтральність. Нейтральність це перевіряльна незалежність стимулів: відсутність непрозорої економічної залежності від будь-якого конкретного постачальника, торговця або результату рішення. Шар оркестровки спрямовує до будь-яких моделей, які найкраще виконують завдання, і немає інтересу, яка з них переможе, структурно аналогічна незалежним шарам розрахунків у платежах. Арбітр серед постачальників може бути довіреним так, як жодний постачальник не може бути про себе. Незалежність називає економічну властивість, а перевіряльність пов'язує її з шаром доказів, що робить претензію перевіряльною, а не задекларованою, дисципліна розрахункової палати розроблена нижче. (Нейтральність тут є економічною властивістю, а не алгоритмічною справедливістю серед демографічних груп, що є ортогональною вимогою.)
Є також проблема вертикальної інтеграції: нейтральність структурно недоступна платформам, найбільш придатним для побудови оркестровки у масштабі. Компанія, яка одночасно є ринком, постачальником моделей, рекламною мережею та логістичним провайдером, не може арбітрувати нейтрально, тому що кожне рішення щодо маршрутизації, яке вона приймає, є рішенням про її власний дохід. Арифметика вказує на структурну тенденцію. Основа передбачає, що шар довіри розташовується найкраще з сторонами, чиїм єдиним бізнесом є сам арбітраж, шлях, яким розрахунки, аудит та рейтингування кредиту стали незалежними галузями. Випадок агентства рейтингу також є канонічним попередженням про те, що незалежні посередники розвивають конфлікти, коли платить видавець. Економіка задокументована: посередники сертифікації захоплюють цінність, контролюючи, яка інформація розкривається (Lizzeri, 1999), ринки сертифікації не вдаються у добре документованих способах (Dranove & Jin, 2010), а крах кредитного рейтингу продемонстрував канонічний збій, дохід видавця, що платить, корумпує сертифікатор на рівень вище, в той час як розрахункові шари, які пережили, фінансуються спільними витратами, а не сторонами, які оцінюються. Вимога нейтральності тому розширюється на власну модель доходу оркестратора: шар верифікації, оплачений постачальниками або торговцями, які він ранжує, відтворює конфлікт, який він існує для видалення, тому дизайн доходу тут спрямовується на сторону споживача та до управління витратами оператора (Section 5), а не до сторін, які ранжуються.
Нейтральність також має вимір даних. Шар оркестровки може функціонувати як чиста кімната: запити досягають кожного постачальника без ідентичності користувача, жоден постачальник не бачить всю історію взаємодії, а дохід оркестратора походить від послуги, а не з маршрутизації того, що говорять користувачі, у рекламні мережи. Нейтральність є незалежністю стимулів на обох фронтах: немає непрозорої економічної залежності від будь-якого постачальника моделей або торговця, і немає бізнес-моделі, яка комерціалізує слова споживача проти споживача.
Але нейтральність спричиняє свою регресію: хто аудитує оркестратора? Буквальна "відсутність ставки" є недосяжною. Будь-який оркестратор має витрати, партнерства, стимули утримання та власне виживання для фінансування, тому операціональна змінна - це не їхня відсутність, а їхня природа, їхнє розкриття та їхня перевірюваність на записах. Те, хто платить, не визначає нейтральність; те, чи доходи платника незалежні від результату операції, визначає. Передплата споживача або комісія від страховика чи аудитора, чия виплата відокремлена від того, який продукт переможе, задовольняє умову; комісія купця або комісія за рекламу - ні. Більш широке управління фінансуванням шару залишається відкритим, а перевірювана незалежність цього фінансування - це та частина, яку конструкція фіксує. Шар оркестрування також має стимули: спрямовувати до дешевих моделей, перепродавати його дорогий рівень, зручно формувати синтез. Регресія налічує чотири десятиліття. Shapiro (1987) назвав це проблемою опікунів: процедурні гарантії генерують нових опікунів, які самі повинні охоронятися, і інституційна відповідь не змінилася з тих пір.
Клірингові палати заробляють свою довірену позицію, будучи зовнішньо перевірюваними та регульованими, а не декларуючи нейтральність. Оркестратор не володіє нейтральністю як чеснотою. Шар свідчень - це те, що робить це перевіряємим. Кожне рішення маршрутизації, відповідь моделі та крок синтезу потрапляють у записи, захищені від підробки, журнал із ланцюгом хешів та підписами, розроблений для зовнішнього закріплення часових міток, тому заявлена нейтральність оркестратора піддається рівно тій верифікації, яку він накладає на моделі. Шлях дозрівання - це конкретизований посібник клірингової палати: зовнішнє закріплення часових міток, відкритий інтерфейс верифікації та періодичний аудит третьої сторони маршрутизаційної політики. Інституціональний дизайн таких екосистем аудиту вже є названою дослідницькою програмою (Raji, Xu, Honigsberg, & Ho, 2022). Одна залежність виживає навіть при аудиті перевіряльників: моделі панелі можуть бути незалежними одна від одної, але всі вибрані платформою, яка перевіряється, тому кінцева точка шляху дозрівання - це вибір та ротація панелі, розташовані поза контролем будь-якої однієї сторони. Оркестратор, записи якого не можуть бути перевірені, - це просто ще один продавець, який просить вірити йому. Найближчі суміжні роботи поза дослідженнями споживачів - це два одночасних дослідження 2026 року. Marchal та ін. (2026) обґрунтовують те саме оцінювальне зміщення, від оцінювання результатів до проектування надійності агента, походження та спростовуваності на рівні епістемічної інфраструктури, а Wang та ін. (2026) переглядають походження виконання як шар підзвітності на рівні процесу для верифікації, аудиту та атрибуції відмов. То, що залишається власним для цієї роботи, - це склад, орієнтований на споживача та чутливий до стимулів: три властивості, об'єднані як об'єкт обґрунтованого покладання споживача у делегованій торгівлі та його поведінковий тест.
Компонента свідчень має одне розмежування, оскільки захист від підробки часто перепродається: журнал із ланцюгом хешів встановлює походження та цілісність (що цей запис існував і пізніше не був змінений), але не повноту (ніщо в хеші не гарантує, що пропущені виклики не були придушені), не правильність (точний запис неправильної відповіді все одно неправильний), не незалежність і не вирівнювання стимулів. Кожна - окрема властивість з власним механізмом верифікації: засвідчення охоплення, аудит результатів, виміряна різноманітність, розкриті економічні показники. Квитанція повинна заявляти лише ті властивості, які її запис насправді містить. Подальше обмеження є структурним: журнал доводить, що було маршрутизовано, але не чому, а власна евристика, що стоїть за вибором цієї моделі або цього купця, перевіряється лише якщо сама маршрутизаційна політика розкривається або посвідчується, що є виборомуправління, а не криптографічною наслідком. Витрати архітектури належать до того ж реєстру: маршрутизація запиту до кількох продавців множить розкриття конфіденційності, централізований журнал рішень є привабливою метою безпеки, а показ консенсусу може генерувати саме ту авторитетність, на яку попереджає результат помилки консенсусу.
Конструкцію також варто розмежувати від її інженерних сусідів, оскільки "використання кількох моделей" описує кілька різних речей з різними властивостями довіри. Простого голосування ансамблю покращує точність, але розв'язує розбіжність невидимо, тому нічого не стає перевіряємим. Вибірка з самоконсистентністю перепитує ту ж модель, що є різноманітністю лише в появі. Суміш експертів маршрутизує всередину однієї навченої системи, чий маршрутизатор оптимізований для можливості, а не для нейтральності. Дебати багатьох агентів (Du та ін., 2024) покращують відповіді, але розглядають обговорення як внутрішню механіку: жодного спрямованого на споживача запису, жодної економіки, жодної гарантії нейтральності.
Агрегатори маршрутизації моделей, до 2026 року товарний шар, є багатопоставниковими в каталозі, але одномодельними на відповідь: маршрутизатор вибирає одну модель за вартістю та затримкою, і друга думка ніколи не збирається. Агрегатори є постачальниками для архітектури верифікації, а не замінниками для неї.
Багатомодельна операція більше не є екзотичною: 37% підприємств запускали п'ять або більше моделей в продакшені до середини 2025 року, що вище від 29% роком раніше (a16z, 2025). Інфраструктура прокладається в масштабі індустрії, але довірчий шар помітно відсутній. Залишається відкритим, чи багатомодельна система залишається невидимою маршрутизацією вартості або стає перевіряємою архітектурою. Рисунок 9 оцінює патерни за п'ятьма властивостями довіри, а Таблиця 3 викладає розмежування прозою. Архітектурна довіра визначається саме тим, чого їм не вистачає: різнорідних джерел, явної та записаної розбіжності та арбітра без ставки. Інженерія є спільною; властивості довіри - ні.
Рисунок 9. Розмежування
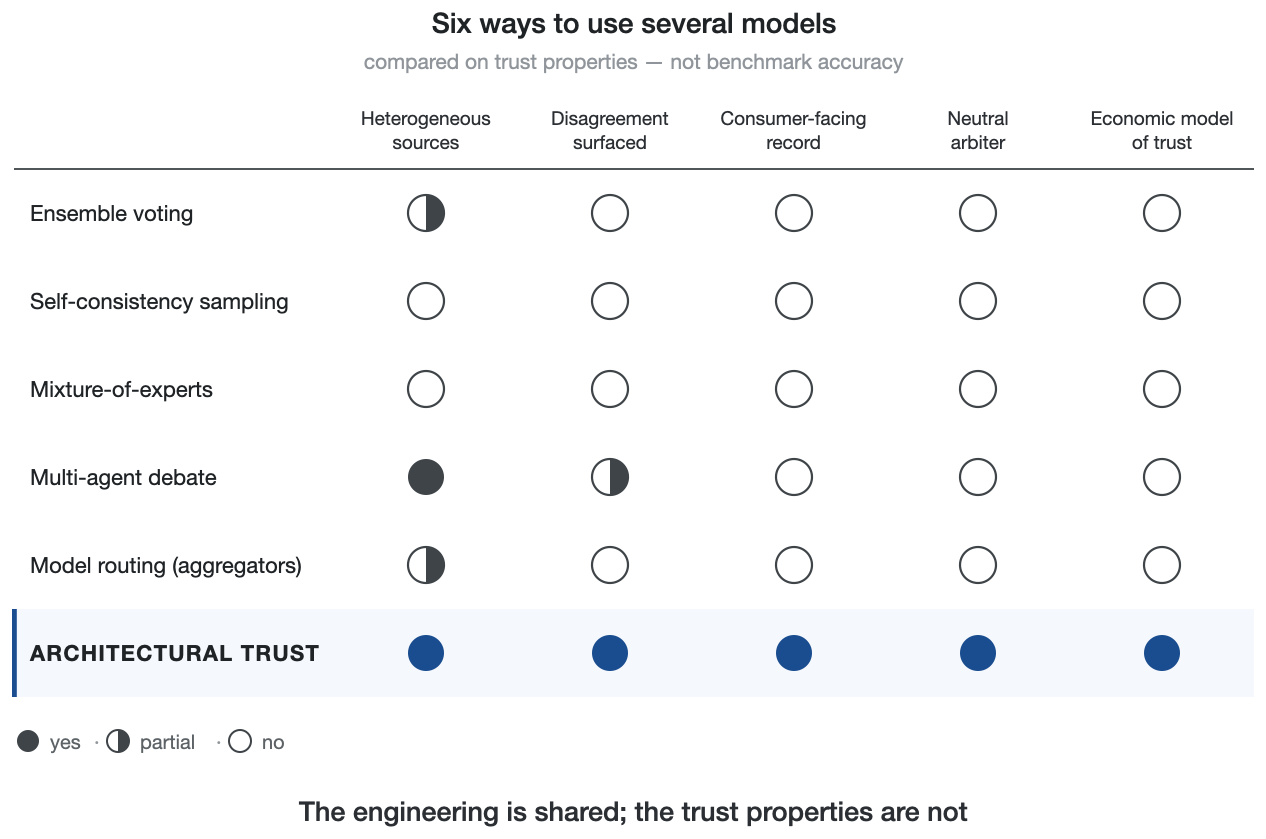
Шість багатомодельних інженерних патернів оцінені за п'ятьма властивостями довіри.
Таблиця 3. Розмежування: архітектурна довіра проти її інженерних сусідів
| Підхід | Різнорідні джерела | Явна розбіжність | Запис для споживача | Незалежний від стимулів арбітр | Економічна модель довіри |
| Голосування ансамблю | Частково | Ні (вирішено невидимо) | Ні | Ні | Ні |
| Вибірка з самоконсистентністю | Ні (та ж модель перезразована) | Ні | Ні | Ні | Ні |
| Суміш експертів | Ні (одна натренована система) | Ні | Ні | Ні (маршрутизатор оптимізований для можливостей) | Ні |
| Дебати з кількома агентами | Так | Тільки всередину | Ні | Ні | Ні |
| Пояснюваність (накладання XAI) | Ні (наратив однієї моделі) | Ні | Ні (історія, а не запис) | Ні | Ні |
| Прозорість / розкриття | Ні | Ні | Частково (видніше, але не перевіряється) | Ні | Ні |
| Походження / відстеження лінії (конвеєри ML) | Ні (один задокументований конвеєр) | Ні | Частково (лінія зі сторони інженера) | Ні | Ні |
| Перевірене висновування (zkML) | Ні (одна модель; доказ її виконання) | Ні | Частково (артефакт доказу, а не запис рішення) | Ні | Ні |
| Агрегатор маршрутизації моделей | Частково (каталог кількох постачальників, одна модель на відповідь) | Ні | Ні | Ні (маршрутизатор оптимізований для вартості) | Ні |
| Архітектурна довіра | Так | Так (зі сторони споживача) | Так (повторюваний) | Так (структурна) | Так (ступінчаті рівні) |
Ще дві батьківські літератури мають місце в тому самому списку: логіка воріт утримання або видачі — це вибіркова передбачення та навчання утримуватися (Geifman & El-Yaniv, 2017; Mozannar & Sontag, 2020), а слід аудиту компоненту доказу походить від роботи з підзвітних алгоритмів та третьостороннього аудиту (Kroll et al., 2017; Raji et al., 2022). Архітектурна довіра — це конструкція зі сторони споживача, обмежена нейтральністю, що об'єднує ці, а не будь-яка з них окремо. Розташування її серед інших засобів має значення, оскільки вони є доповненнями, а не конкурентами. Калібрування на рівні моделі необхідне, але структурно недостатнє: постачальник його виробляє та засвідчує, що є конфліктом, з якого починається ця стаття. Зовнішні аудити та сертифікація є незалежні, але періодичні, знімки системи, а не рішення. Пояснення — це наратив, створений всередину моделі, а система, яка може вигадувати відповіді, може вигадувати й історію за ними. Прозорість експонує більше механізму й залишає споживачу інтерпретувати його. Архітектурна довіра не просить ні віри, ні інтерпретації, тільки перевірюваність, яка є безперервною, за кожним рішенням, та машинно-перевіряється. Це також те, що дає іншим засобам дієвість: аудит оркестратора з повторюваним записом — це аудит чогось, тоді як аудит непрозорого конвеєру — це церемонія. Його найближчі концептуальні сусіди — структурна гарантія та інституційна довіра (McKnight et al., 2002), прозорість процесу та пояснюваність. На противагу їм розмежувальна властивість полягає в тому, що гарантія перевіряється тим, хто довіряє, за кожним рішенням: гарантія просить бути повіреною один раз, архітектурна довіра просить бути перевіреною щоразу. Ще два набори сусідів варто помітити на карті. Література інформатики про підзвітність закладала технічні основи десять років тому: процедурна регулярність, зроблена перевіряємою без повної прозорості (Kroll et al., 2017). Хвиля інженерії 2025–26 будує трубопровід довіри до агентів безпосередньо: протоколи «рідні для довіри» з перевірюємою ідентичністю та записами поведінки, стійкими до підробок (TrustTrack; Li, 2025); управління дією виконання з квитанціями, стійкими до підробок (AARM; Errico, 2026); агрегація кількох LLM переформатована як оцінка довіри (Zheng & Zhang, 2026, arXiv:2607.20529); та платформи рівня підприємства (AI TRiSM Gartner; робота Cloud Security Alliance щодо агентної нульової довіри). Кожна надає складову на рівні підприємства. Жодна з них не надає конструкцію зі сторони споживача, що є тим, на що ця стаття претендує як на свій внесок: три компоненти під одним іменем, спільно маніпульовані в дизайнах поведінки, з економікою того, хто купує перевірюваність і на яких ставках. Одна колізія найменувань повинна бути з'ясована. «AI Trust Architecture» DigiCert (запущена в квітні 2026) — це лінія продуктів PKI постачальника, інфраструктура сертифікатів для ідентичності агента, походження моделі та автентифікації змісту. Вона надає інфраструктуру на рівні ідентичності стеку доказу, а не конструкцію архітектурної довіри, розроблену тут.
Взаємозв'язок між цими трьома є явною емпіричною гіпотезою, а не концептуальною необхідністю. Я гіпотезую комплементарну взаємодію, яка наближається до нуля при відсутності будь-якої складової, неформально AT = f(D, E, N) зі крутим спаданням поблизу будь-якого нуля, а спільний дизайн розділу 5 визначений для відновлення функціональної форми, а не для припущення її. У формі, що піддається оцінці, зручне сімейство — Кобба–Дугласа, AT = A·Dα·Eβ·N^γ де α, β, γ > 0, кодуючи два зобов'язання: спадання до нуля при будь-якій відсутності та позитивні перехресні частинні похідні (складові є доповняттями). Конструкт — це три складові та їхня гіпотезована комплементарність, і жодне твердження нижче не залежить від форми Кобба–Дугласа. Кобба–Дугласа також є внутрішнім наближенням: строго кажучи, воно все ще дозволяє заміну слабкої складової, тоді як гіпотеза комплементарності схожа на Леонтьєва на границях, з min(D, E, N), що встановлює мінімум. Саме тому наведені нижче дизайни мають дозволяти некомпенсаційну структуру, а не припускати компенсаційні компроміси. Сімейство Кобба–Дугласа є ілюстративним для майбутньої оцінки та не є частиною визначення конструкту; поточні дані його не оцінюють. Факторіальний дизайн може розрізнити внутрішність Кобба–Дугласа та мінімум Леонтьєва параметр за параметром. Показники степенів залишаються емпіричним питанням, у чому й полягає суть: комплементарність є спростовною. Нулі потребують двох уточнень. Складові є безперервними, а не бінарними, тому буквальний нуль є ідеалізованою границею. Жодна розгорнута система, включаючи цю роботу, не знаходиться точно на нулі або одиниці по жодній осі, і те, чи реагують споживачі на близько-відсутність повним колапсом чи крутою знижкою, — це саме те, що дизайн мусить розрізняти. Різноманітність, зі свого боку, означає незалежність шляху верифікації, з виміряною незалежністю (коефіцієнт кореляції помилок φ, визначений нижче) як її одиницею. Статистичне ядро — класична теорія ансамблів, де користь комбінування спирається на декореляцію помилок (Hansen & Salamon, 1990; Krogh & Vedelsby, 1995), тому незалежність вимірюється тут, а не припускається. Друга модель — один такий шлях, але так само незалежна вибірка, перевірена за допомогою інструменту вибірка та детермінований валідатор. Тіньові проходження та перевірки консистентності на рисунку 5 рахуються як другий, максимально декорельований шлях верифікації, а не як свідоцтво без різноманітності. Це визначення також поглинає найсильніші очевидні контрприклади — регульовану систему розрахунків або повністю залоговану, засвідчену третьою стороною службу комунальних послуг (свідоцтво та нейтральність сильні, різноманітність моделей нульова): такі служби або вбудовують не-модельні шляхи верифікації (детермінована примирення, зовнішній аудит, тому D > 0 за визначенням), або обмежують модель роллю, яку детермінована перевірка повністю покриває. Де щойно не існує жодного незалежного шляху верифікації для класу завдань, структура передбачає тонке обґрунтування, передбачення, яке спільний дизайн може перевірити. З не-модельними шляхами, що рахуються на D, буквальний нуль стає рідкісним у виробничих системах, і емпіричний вміст мультиплікативної форми зміщується від нулів до внутрішної комплементарності, тому факторіальний дизайн, а не нулі, — це те, де твердження стоїть або падає. Для тестування одне операційне зобов'язання фіксується тут: факторіальний дизайн маніпулює D вузько як різноманітність модельного шляху. Ширше визначення шляху верифікації — це область дії конструкту, а не маніпульована змінна. Сама незалежність мусить бути розділена, тому що шість різних величин подорожують під цим словом: сліпа збірка (процедурна незалежність на час висновку, що гарантує цей дизайн), різноманітність сім'ї моделей, виміряна залишкова кореляція помилок (φ, яку цей документ повідомляє), різноманітність джерела свідоцтва, різноманітність шляху інструменту та інституціональна незалежність. Дослідження встановлює перше та вимірює третє; решта — змінні дизайну, а не властивості, які ця збірка може засвідчити. Різноманітність без свідоцтва — це невидима комісія. Свідоцтво без нейтральності — це маркетинг продавця. Нейтральність без різноманітності — це порожній посередник. Таблиця 4 проходить повну ґратку восьми конфігурацій наявності/відсутності. Інтуїція під цим полягає в тому, що кожна складова надає обґрунтування для іншої: запис, ведений стороною, яка має частку в його вмісті, читається як самопідтвердження, узгодження, яке ніхто не записав, — це чутки, а незацікавлений арбітр одного голосу не має чого арбітрувати. Це мотивує гіпотезу комплементарності. Разом ці три змінюють те, чому довіряє споживач: не «цій відповіді» чи «цьому бренду», а «цьому процесу, і я міг би його перевірити».
Таблиця 4. Ґратка обґрунтування: вісім конфігурацій D–E–N та що залишається в кожній
| D | E | N | Що може перевірити споживач | Виродження форма |
| відсутня | відсутня | відсутня | Нічого; надійність — це віра в результати | Чистий одномодельний асистент |
| присутня | відсутня | відсутня | Нічого після факту; незгода сталася непомітно | Невидима комісія (внутрішній ансамбль) |
| відсутня | присутня | відсутня | Запис, ведений стороною, яку він захищає | Журнал продавця / самопідтвердження |
| відсутня | відсутня | присутня | Твердження без частки з жодним слідом за ним | Порожній посередник |
| присутня | присутня | відсутня | Записана незгода, організована зацікавленою стороною | Театр орієнтирів, керований продавцем |
| присутня | відсутня | присутня | Нейтральна арбітраж перевірок, які ніхто не може повторити | Панель рекомендацій |
| відсутня | присутня | присутня | Нейтральний, повторюваний запис одного незаперечувального голосу | Нотаризований монолог (аудит без оспорювання) |
| присутня | присутня | присутня | Незалежна перевірка, повторювана, утримувана стороною без частки | Архітектурна довіра |
Клітинки наведені на ідеалізованих границях; розгорнуті системи займають внутрішність. Рядок E+N-без-D — це той, що інституціонально знайомий — очищення, аудит та рейтинги працюють там — і саме там вимога структури щодо додаткового незалежного шляху верифікації є емпіричним передбаченням, а не визначальним виключенням.
Три компоненти відповідають класичній анатомії достовірності (Mayer, Davis, & Schoorman, 1995): різноманітність є механізмом здатності (узгодження крос-моделей калібрує, скільки компетентності виводити), докази операціоналізують цілісність (твердження про те, що зробив сервіс, стають перевіряємими, а не просто проголошеними), а нейтральність структурно розв'язує добросердечність (стимули бездержавного оркестратора піддаються перевірці, а не виявляються вірою). Кожна із них переукорінюється у верифікованій архітектурі замість управління сприйняттям, що є тим, про що запитує література про взаємодію людини та AI, коли досягає того ж пункту зі своєї сторони: узгодити судження про довіру з верифікованими сигналами довіри, а не з враженнями, які виробляє інтерфейс (Liao & Sundar, 2022).
Причинно-наслідковий ланцюг проходить через верифікацію, тому що «довіра» є наслідком, а не механізмом: верифікація → калібрована впевненість → обґрунтована довіра → делегування → цінність операції (Figure 10). Сервіс заслуговує делегування, будучи перевіряємим у момент, коли це важливо, а не завдяки тому, що викликає довіру; Cheng et al. показали, як дешево це відчуття виробляється.
Figure 10. Маховик верифікації
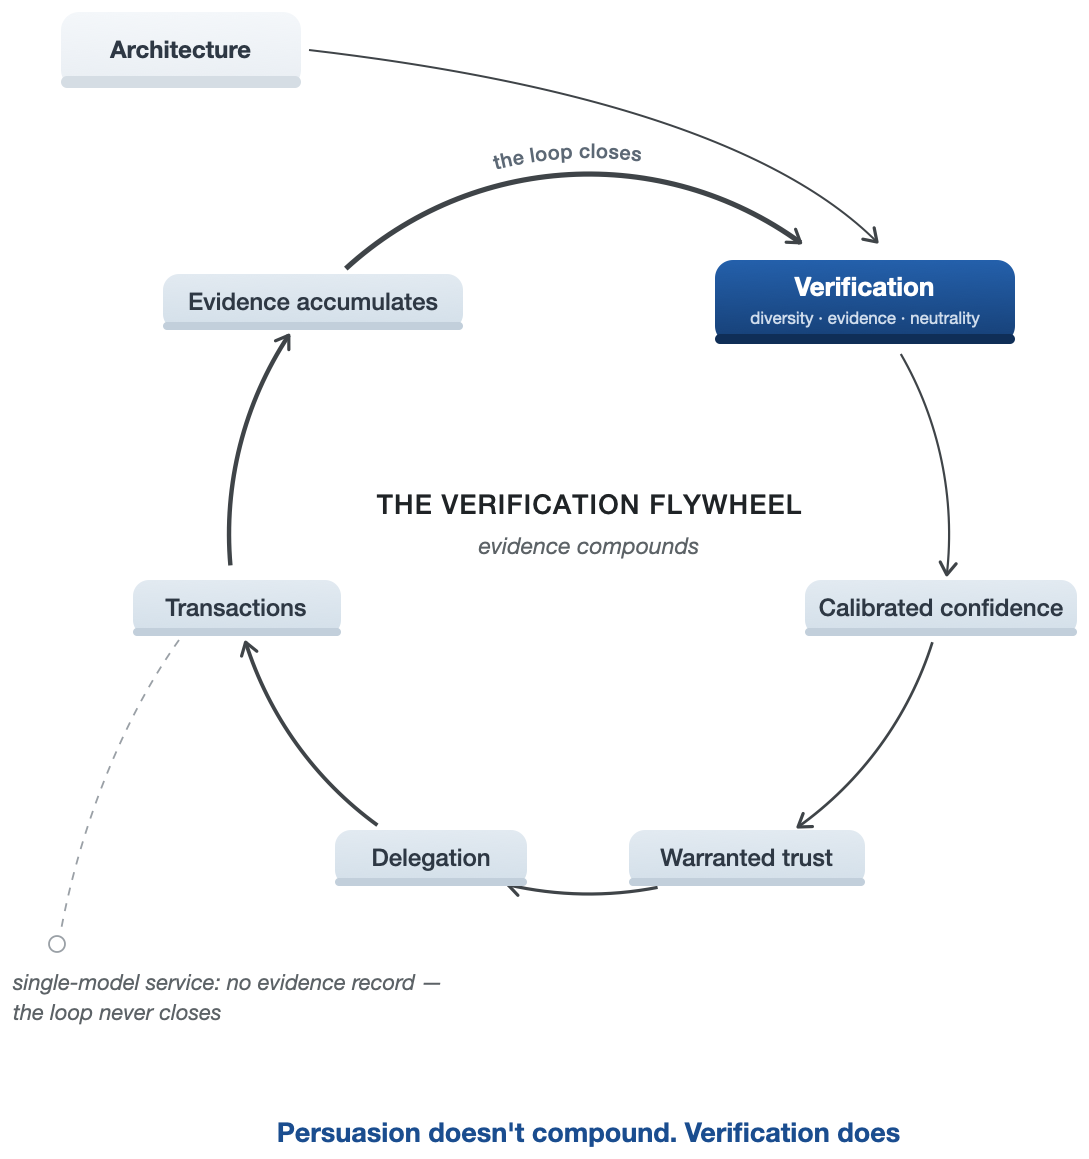
Причинно-наслідковий ланцюг, верифікація (різноманітність · докази · нейтральність) → калібрована впевненість → обґрунтована довіра → делегування → операції, не завершується: операції генерують докази, і цикл замикається назад в архітектуру. Штрихована шунт показує сервіс однієї моделі, де не існує запису доказів і цикл ніколи не замикається. Переконання не складаються. Верифікація складається.
Table 5. Сервіс однієї моделі проти архітектурної довіри
| Вимір | Сервіс однієї моделі | Архітектурно надійний сервіс |
| Об'єкт довіри | Модель / бренд | Процес та його запис |
| Впевненість | Стверджена моделлю | Отримана завдяки узгодженню крос-моделей |
| Впевнені помилки | Невиявлювані зсередини | Первинна мета виявлення (сигнал незгоди) |
| Угодництво | Винагороджено перевагою | Розділено: емпатія та перевірка політики на різних каналах |
| Перевірка помилок | Та ж система, що помилилась | Незалежні моделі + детерміновані вентилі |
| Докази рішень | Журнали, якщо такі є, утримувані постачальником | Доказово-стійке, відтворювальне, доступне для споживача |
| Судія якості | Сам постачальник | Шар нейтральної оркестрації |
| Позиція спору | Слово споживача проти платформи | Відтворювальний запис |
| Страховуваність | Непрозора ризик | Оцінюваний за історіями рішень |
| Розподіл відповідальності (після AB 316) | «AI це зробив» заборонено; розподіл оскаржується в темряві | Обчислюваний з відтворювального запису |
| Нормативна позиція (епоха Art. 50) | Ретрофіт розкриття | Прозорість як побічний продукт операції |
| Обіцянки трансграничних даних | Контрактне представництво | Аудитна властивість часу виконання (маршрутизація з урахуванням юрисдикції) |
| Структура витрат | Плоска, дешева | Градуйована: дорога тільки там, де концентруються наслідки |
Від верифікованості до відповіді споживача. Споживач бачить рендеринг, а не архітектуру: квитанцію, яка показує, які незалежні системи були проконсультовані, де вони розходилися і як розходження було розв'язано або передано до вищої інстанції (Figure 8). Три опосередковані сприйняття правдоподібно несуть ефект. Докази є діагностичними: поверхневі, конкретні розходження є інформативними про цю відповідь так, як загальні дисклеймери не є (Detjen et al., 2025; Chen et al., 2026). Відтворювальний запис дає сприйняту контроль процесу, оскільки споживач міг би перевірити, оскаржити або передати до вищої інстанції після того, як факт стався. Процедурна впевненість — це знання того, що були в місці сліпа збірка, незалежні перевірки та бездержавний арбітр (McKnight et al., 2002). Природними залежними змінними є калібрування надійності, готовність делегувати та утримання після відмови. Природними модераторами є ставки та оборотність, об'єктивність завдання (Castelo et al., 2019) та експертиза споживача, оскільки споживач, найменше здатний особисто перевірити відповідь, має найбільше отримати від архітектури, яка структурно перевіряє це. Пропозиції нижче прослідковують цей шлях.
Система дає, крім того, пропозиції, які дослідження споживача може перевірити, гіпотези, а не висновки. Їх операціоналізація залежить від однієї відмінності: об'єктивна нейтральність (оркестратор насправді вільний від нерозкритої економічної залежності від будь-якого постачальника, торговця або результату), верифікована нейтральність (запис робить цю незалежність перевіряємою) та сприйнята нейтральність (споживач в це вірить) є трьома змінними, і експеримент маніпулює верифікованим сигналом, вимірюючи сприйняття:
P1. Розкриття розбіжностей між моделями щодо важливих запитів покращує калібрування довіри споживачів (вони більше покладаються, коли системи погоджуються, менше, коли вони розходяться) порівняно з однією впевненою відповіддю, при цьому сприйнятий ризик виступає опосередкуючою конструкцією (Featherman & Pavlou, 2003). Обидва напрями несправностей актуальні: спільне представлення знижує надмірну довіру, але може посилити недостатню довіру (Lu, Wang, & Yin, 2024), дисплеї впевненості калібрують довіру більш легко, ніж точність (Zhang, Liao, & Bellamy, 2020), пояснення можуть посилити довіру без посилення критичного аналізу (Bansal et al., 2021), когнітивні функції примусу зменшують надмірну довіру за рахунок задоволення (Buçinca, Malaya, & Gajos, 2021), а мета-аналіз 106 експериментів показує, що людино-AI комбінації в середньому виконують гірше ніж найкращий з людини або AI окремо (Vaccaro, Almaatouq, & Malone, 2024). P1 тестує калібрування, а не монотонний приріст: розкрита розбіжність повинна потрапити у меншість комбінованих конструкцій, які перевищують своє найкраще окреме виконання. Гіпотеза розділена: основний ефект — це підтверджувальне твердження, а модератори є дослідницькими, виведеними з діагностичності доказів, а не визначеними після фактів. Прибуток від калібрування повинен зростати зі ставками та незворотністю, а також з об'єктивністю завдання (розбіжність щодо об'єктивного питання сприймається як сигнал помилки; щодо суб'єктивного — як смак; Castelo et al., 2019). Очікується, що експертиза споживачів виявить протилежні ефекти: для споживачів з низькою експертизою розкрита розбіжність без розв'язання повинна зменшити готовність делегувати, а для споживачів з високою експертизою вона повинна покращити калібрування довіри; перехід або спостерігається, або ні, що робить експертизу перевіркою, а не лазівкою. Власний експеримент цієї роботи накладає одну вимогу до дизайну. Розбіжність коваріює з складністю завдання (узгодження панелі концентрується на простих завданнях), тому дизайн P1 повинен маніпулювати або статистично контролювати складність, інакше ефект калібрування буде плутатися з легкістю завдань. Розгляд діагностичності також дає прогноз межі, що його не висувають загальні теорії прозорості: розкриття розбіжностей повинно мати найбільше значення там, де власні попередні переконання споживача найслабші, при покупках через кордон або у незнайомих торговців, оскільки там зовнішні діагностичні докази не мають внутрішнього конкурента.
P2. Доступ до записаного рішення, придатного для повтору, підвищує готовність делегувати важливі завдання AI-агенту поверх брендової довіри, при цьому ефект збільшується зі ставками та незворотністю делегованого завдання. Він також збільшується з рівнем делегованої агентності як такої, що становить зміст порівняльної статики гіпотези про мігрування довіри: при постійній фактичній продуктивності моделі граничний ефект перевіримих архітектурних властивостей на адекватне делегування зростає, коли споживач передає більше контролю над переглядом та виконанням (радник → копілот → керований агент → автономний агент). Дизайн, який перетинає рівень делегування з видимістю архітектури, безпосередньо тестує гіпотезу. Емпіричні дослідження поведінки споживачів, що найбільше відповідають цьому, сфокусовані на цій залежній змінній: делегування покупок AI зменшує прийняття там, де це обмежує сприйнятту автономію (Ahmad Husairi & Rossi, 2024), а прийняття помічників з високою автономією є прямо вивченим результатом (Frank et al., 2026). P2 передбачає ефект запису поверх цих встановлених попередників.
P3. Сприйнята нейтральність шару оркестрування незалежно передбачає готовність делегувати, що узгоджується з ефектами процедурної справедливості при оцінці послуг (Tax, Brown, & Chandrashekaran, 1998). Маніпульована змінна — це сигнал перевіримої нейтральності; виміряна змінна — це сприйняття, яке він викликає. Наскільки мені відомо, нейтральність оркестратора ніколи не операціоналізувалась у поведінковому експерименті, а найближчою перевіреною аналогією є печатки сертифікації (Cetinkaya & Krämer, 2024), тому P3 вводить нову експериментальну змінну. За напрямом, ефект нейтральності повинен зміцніти, оскільки власна здатність споживача перевіряти суть падає, адже коли якість результату важко оцінити, сигнали процесу несуть оцінну вагу. Маніпуляція повинна розділити перевірену нейтральність від твердження про нейтральність: одна умова містить квитанцію, атестацію без ставок якої насправді можна відкрити і перевірити, умова контрасту — ідентичний інтерфейс, що містить лише мітку, з перевіркою маніпуляції щодо сприйнятої нейтральності в обох. Без цього контрасту P3 деградує до загальної справедливості процесу і не говорить ні про що щодо верифікації.
P4. Після помилки агента споживачі, чия послуга створює перевіримий запис, показують менший колапс довіри та вищу утримання, ніж споживачі непрозорої послуги: динаміка одного удару модерується доказами. Це механізм, який визначає дослідження відновлення послуг, де процедурно справедливе, засноване на доказах розгляду скарг відновлює довіру після відмови (Tax et al., 1998). Дослідження відновлення довіри додає, що те, що відновлює довіру, залежить від характеру порушення та наданого пояснення (Kim, Ferrin, Cooper, & Dirks, 2004), вимога, яку дослідження людино-машини зараз розглядає як проблему дизайну для автономних систем (de Visser, Pak, & Shaw, 2018), і буферизація повинна зростати з серйозністю та незворотністю відмови. P4 передбачає: запис → менший колапс довіри та вища утримання, модеровано серйозністю відмови. Випадки, коли запис показує, що процес сам по собі не був дотриманий, обробляються перевіркою маніпуляції та виключаються з тесту, оскільки пропозиція стосується відмов, які виникають попри дотримання процесу. Порівняння стійкості повинні контролювати витрати на переключення та блокування, які змішують утримання, і супровідний дизайн тестує, чи запис дотриманого процесу змінює приписування вини з послуги на навколишнє середовище. Пропозиція не містить пункту про зворотність, тому жодна схема результатів не є спростовною за конструкцією.
Емпіричний якір: рівень впевненості як перевірений компонент. Якщо послуга стверджує, що її сигнали впевненості щось значать, це твердження можна випробувати. Рівень впевненості у розгортанні системи, що лежить в основі тематичного дослідження цієї роботи, пройшов попередньо зареєстровану, контрольовану плацебо, шести-рукавну оцінку на двох незалежних сім'ях моделей. Виміряний профіль власних слабостей системи покращив передбачення помилок приблизно на +0.07 AUROC порівняно з плацебо, з неперекритими довірчими інтервалами на обох сім'ях. Фальшивий автопрофіль звів передбачення помилок до випадковості, а загальна інструкція «будьте обережні щодо ваших обмежень» не мала жодного ефекту.
Дві більш ранні версії не вдалися — одну фальсифікували самі автори через змішування змінних, одна дала негативні результати — перед тим, як попередньо зареєстрований дизайн дав підтвердження. Суворіший повторний тест не дав однозначного результату при скороченому обсязі, а попередньо зареєстрована чотирисходинкова шкала на граничній сім'ї експериментів не дала підтвердження жодної кінцевої точки, напрямок ефекту вижив лише дослідницько на трьох із чотирьох сходинок. Отже, твердження стосується окремої сім'ї та є обмеженим: виміряна самосвідомість поліпшила передбачення помилок там, де було підтверджено, і це не є встановленою властивістю кожного класу моделей. Профіль слабкості працює й у виробництві, де він коригує динамічну маршрутизацію моделей, обмежено та з відмовостійкістю. Колапс помилкового профілю також служить безпековою знахідкою: сфабрикована модель самовідомості є вектором атаки, ще одна причина того, що самосвідомість потребує архітектурного контролю, а не самозвіту моделі. Логіка дизайну має родовід дослідження споживачів, старіший за саму технологію. Попередня прив'язка — прив'язка майбутньої поведінки до зовнішньої структури, оскільки внутрішня сила волі не очікується, — це саме те, як споживачі обмежують свої власні лакомства (Wertenbroch, 1998), а архітектурна довіра розширює той же прийом на машини.
Вся дуга (протоколи, попередні реєстрації, сирі дані, фальсифікований пілот, негативна ітерація, неспроможні розширення) збережена як окремий архів, публічно доступна разом з матеріалами OSF статті за адресою https://osf.io/jtvu9/ (файл `self-calibration-archive.zip`). Відкалібрована впевненість — це архітектурний компонент з вимірюваним змістом, і він може відмовити. Невдачі архівуються разом з успіхами, оскільки шар довіри, чиї твердження про впевненість ніколи не були експериментально піддані випробуванню, просить саме ту сліпу довіру, яку він мав замінити. Позиційний документ тридцяти авторів дає цьому поділу праці формальне визначення: агентивна оркестрація має бути байєс-послідовна (Papamarkou et al., 2026), і відкалібровані переконання мають бути в шарі керування, а не в моделях.
Тестування механізму: попередньо зареєстрований експеримент. Твердження вище піддаються перевірці, і цей розділ звітує про тести. Кожен експериментальний результат у цьому розділі в обох хвилях свідчить про технічний попередник фреймворку, чи незалежна згода несе сигнал коректності, якого не несе самозвіт моделі, щодо фактичних питань. Ці експерименти не демонструють довіру споживачів, делегування або комерційну поведінку, що залишаються сферою P1–P5 та поведінкового дослідження розділу 6. Протокол був заморозений публічно до того, як виникли якісь дані підтвердження (OSF: https://osf.io/4y9dv, зареєстровано 23 липня 2026 року; гіпотези H1–H6, еталонна підвибірка зафіксована за насінням та хешем SHA-256, несприятливі результати були попередньо оголошені). Дизайн навмисне простий. Шістнадцять моделей, дев'ять граничних постачальників (Anthropic, OpenAI, Google, xAI, DeepSeek, Alibaba, Moonshot, Zhipu, Mistral) та сім локальних моделей з відкритими вагами, кожна відповіла на одну й ту саму 1500 питань SimpleQA один раз, сліпо, без пошуку або інструментів. Це режим, який максимізує вплив корельованої параметричної помилки, навмисно складний випадок для сигналу, при екологічній вартості, зазначеній у обмеженнях. Відповіді давалися при нульовій температурі, з указанням впевненості 0–100: вербалізована невпевненість, отримана у словах у межах однієї відповіді, а не прочитана з логітів, формат, який Lin, Hilton, and Evans (2022) показали, що моделі можуть навчитися калібрувати. Панелі — це аналітичні комбінації цієї однієї колекції з 24000 номінальних слотів відповідей, з яких 22598 були доставлені, одна локальна модель (deepseek-r1:8b) зупинилася при 98 елементах відповідно до попередньо затвердженого правила зупинки. Шість зареєстрованих гіпотез відповідають результатам таким чином. H1, що розбіжність між моделями позначає більшість впевнених помилок, підтримується: згода підвищує коректність в 1,9–3,2× у зареєстрованій хвилі (таблиця 6), і в основній хвилі заморожений шлюз видаляє 82,1% впевнених невдач (таблиця 10). H2, що сигнал панелі перевершує власну впевненість моделі, яка відповідає, зберігається на панелях CN-frontier та cross-bloc (ΔAUROC +0.287 та +0.063) і змінює напрямок на панелі US-frontier. H3, що нетривіальна частка впевнених помилок виживає як однозначна згода на одну невірну відповідь, підтримується: 0,5–2,2% питань відкритої форми та 4,0–7,9% у гілці з множинним вибором. H4(a), що кореляція помилок у межах блоку перевищує міжблокову, не підтримується (різниця φ +0,011, 95% CI −0,005 до +0,028), і H4(b), що панель cross-bloc ловить більше, також не підтримується, при тому що крос-блокова перевага виявляється меншою. H5, що панель $0 local позначає більшість граничних впевнених помилок, не підтримується: сигнал згоди локального рівня знаходиться на рівні випадку. H6, шкала lineage-distance, не випробовується як шкала тут; її крок на рівні блоку — це нульовий результат H4(a).
Фактична верифікація — це релевантний проксі для агентивної комерції, оскільки делегована покупка розпадається, у момент виконання, на фактичні підтвердження: поточна ціна та доступність товару, умови політики повернення, чи відповідають специфікації продукту вказаним вимогам споживача, ідентичність та рейтинг продавця. Кожен із них має верифіковане істинне значення того ж роду, як елемент SimpleQA. Шлюз розбіжностей працює на цьому фактичному субстраті, тоді як зважування переваг (які компроміси важливі та наскільки) залишається зі споживачем, який визначив вимоги, щодо яких перевіряються факти. Цей поділ праці також пояснює, чому дизайн розділу 6 маніпулює відображенням верифікації, а не перевагами учасників: претензія архітектури стосується фактичного шару делегованого рішення, а не його шару смаку. Там, де судження не має фактичного субстрату взагалі, у справді суб'єктивних виборах без верифікованого істинного значення, попередник перестає діяти, і розділ Обмежень визначає цю межу як відкрите питання.
Вибір бенчмарку був виміряний. На 2021-року TruthfulQA (присутній у корпусах предтренування), ті ж постачальники набрали на 47–61 процентні пункти вищі результати, ніж на SimpleQA (наприклад, 89% проти 28%), розрив, узгоджений з ефектами віку та експозиції бенчмарку, хоча цей дизайн не може відокремити забруднення від відмінностей у складності та конструкції бенчмарку. Жодне основне число не базується на більш старому бенчмарку. Оцінювання — об'єктивне збігання рядків, невирішені випадки оцінюються на еквівалентність до золотого стандарту виключно локальною моделлю відкритих ваг (Qwen3-8B, запущена локально; підказка, що стосується лише еквівалентності, у пакеті репродукції; ніколи членами сім'ї жодного члена панелі; чи з'являється SimpleQA в навчальному корпусі судді, невідомо, але суддя визначає еквівалентність між двома поданими рядками, а не істину, що обмежує експозицію) та вибірковою перевіркою людиною 50 позицій (98% узгодження), обмеження масштабу. Це тепер розширено стратифікованим аудитом 300 позицій між сім'ями розв'язаних судлею випадків (інша сім'я моделей як аудитор, вибір з фіксованим насінням): 96% узгодження (288/300), усі дванадцять розбіжностей — м'які помилкові позитиви (дев'ять явних, три граничні), однонаправлене упередження, яке стосується приблизно 3% всіх оцінених відповідей (4% частки розв'язаних судлею). Дві третини вердиктів (66.5%) надійшли від локального оцінювача моделі, а не точного збігання рядків, а заголовок стійкий до помилок оцінювача: інвертування випадкових 10% вердиктів, оцінених моделлю, зміщує коефіцієнти сертифікації максимум на ±0.5× та ніколи не змінює їхній напрямок.
Два вибори дизайну були навмисні, а не обумовлені бюджетом. Середні рівні постачальників були використані, по-перше, для екологічної валідності: агенти, що зараз здійснюють операції від імені споживачів, переважно запускаються на цих оптимізованих за вартістю рівнях, які можна перевірити з публічних прайс-листів (середина 2026; Figure 11). Типовий обмін сервісу коштує частину цента до одного цента на бюджетних рівнях, проти п'яти-десяти центів на флагманських вагах, і жоден сервіс, що обслуговує мільйони сеансів, не призначає свій типовий шлях за флагманської ставки. Список відповідає ринку: панель з дев'яти постачальників містить усіх трьох постачальників, які разом займають 88% витрат на LLM API на рівні підприємств, а панель US-frontier Table 6 — це саме ці трьоє. Заперечення про те, що це докази на рівні підприємства, зі споживачем ніде в них, розуміє ланцюг поставок навпаки. Споживач більше вообще не вибирає модель: вони вибирають банк, роздрібного продавця, авіакомпанію, і політика маршрутизації сервісу вибирає модель. У валюті, якою фактично обслуговуються споживачи, у токенах, а не доларах, картина підтверджує вибір (Figure 12): у дослідженні OpenRouter–a16z 100 трильйонів токенів маршрутизованого трафіку, моделі відкритих ваг досягли приблизно третини всього використання (Aubakirova et al., 2026), типові рівні трьох найбільших продуктів споживацького AI всі знаходяться нижче флагманського рівня, і лише приблизно 3% користувачів споживацького AI платять за преміум-сервіс (Menlo Ventures, 2025c), тому граничного споживача повинні обслуговувати майже за нульовими граничними витратами. Нижче ринку API лежить фундамент на пристрої та власноруч розміщених відкритих ваг, невидимий для обстежень, заснованих на витратах, і локальний рівень експерименту з семи моделей відкритих ваг навмисно його вибирає. За будь-якою валютою, в якій можна рахувати ринок, рівні, що вивчала ця робота, — це ті, що обслуговують споживача. (Після збою першої сторони, частина колекції була завершена через агрегатор, при цьому фактична інфраструктура обслуговування записувалася за кожним дзвінком у маніфесті запуску.)
Figure 11. Рівень, з яким споживачі зустрічаються при касі
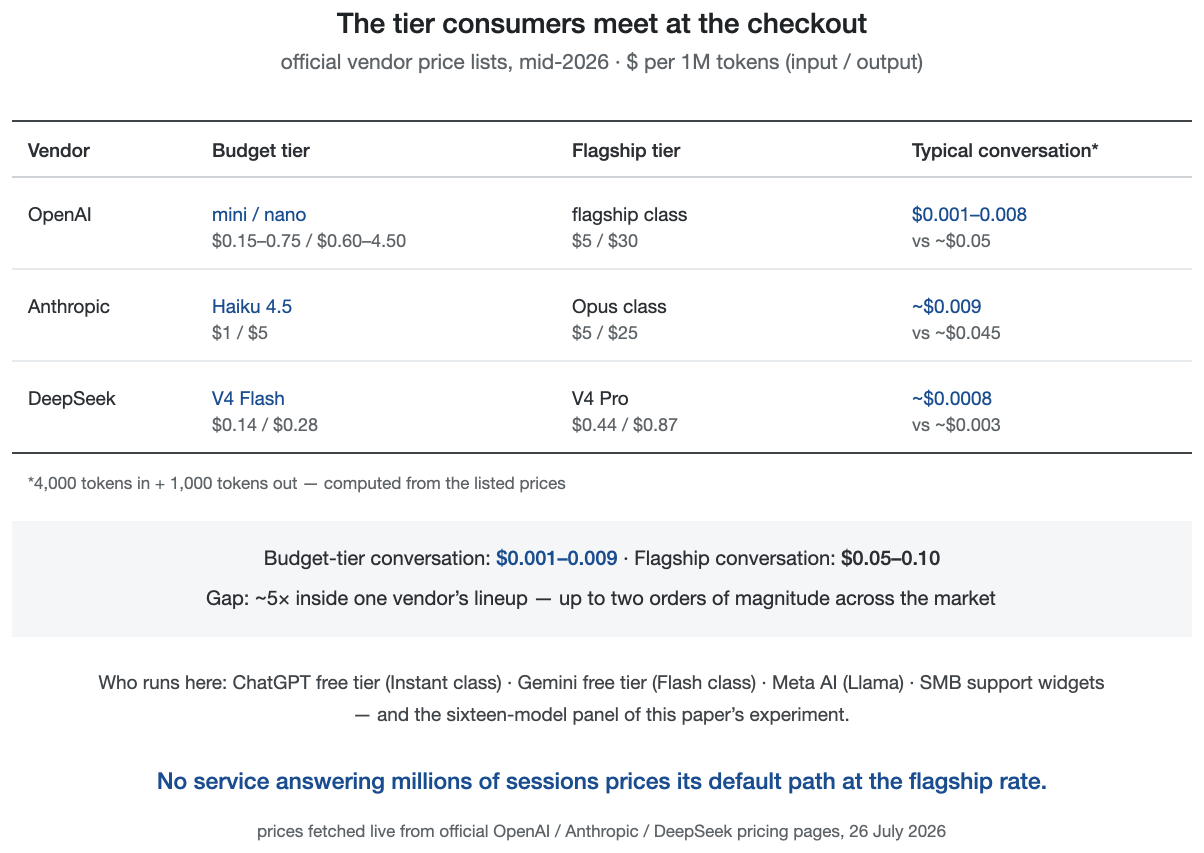
Офіційні прайс-листи постачальників, середина 2026.
Figure 12. Дві валюти ринку моделей
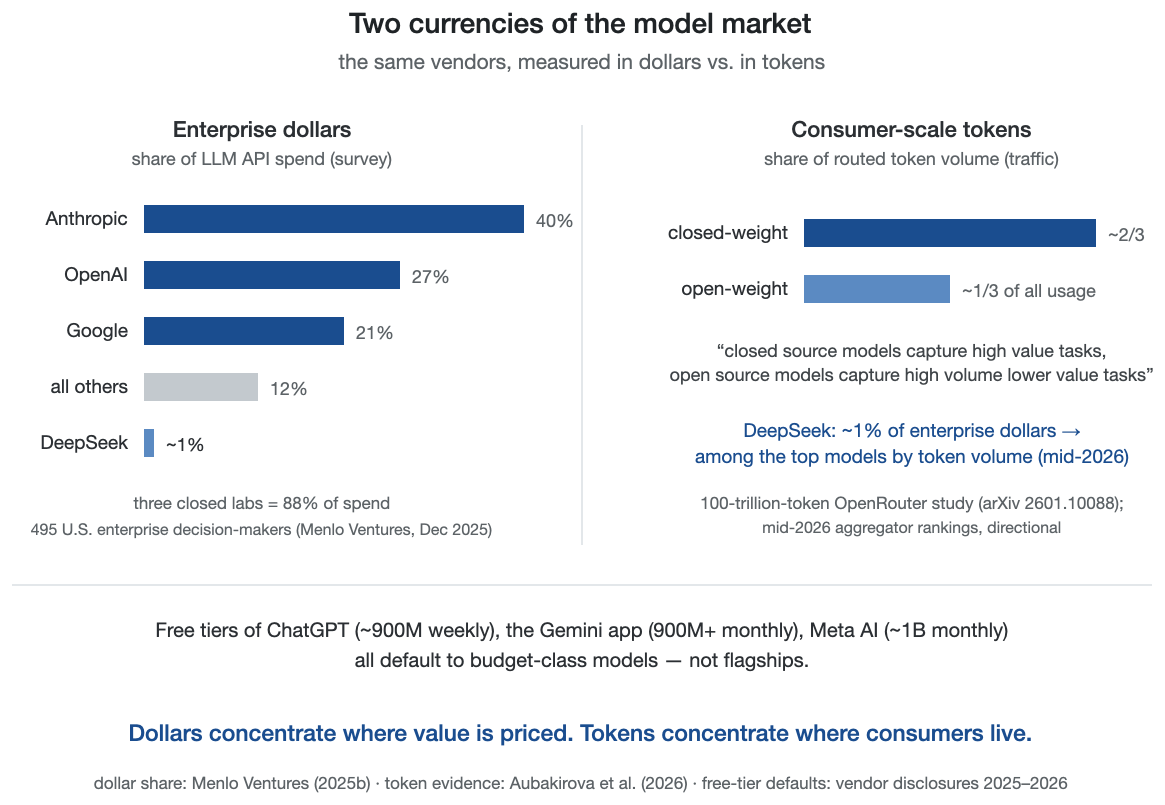
Долари підприємств проти токенів масштабу споживача.
Середні рівні також відповідали твердженням статті, які стосуються архітектури, а не флагманської спроможності: ефект, який з'явився б лише з преміум-вагами, був би результатом моделі. Конвеєр реплікується на стандартній інфраструктурі менше ніж за $15 витрат на API. Для статті, яка стверджує, що верифікація повинна бути досить дешевою, щоб запускатися на кожній суттєвій відповіді, вартість верифікації самої статті є частиною доказів. Конвеєр — це автономний пакет репродукції (запускачі, оцінювач, скрипти аналізу, сирі оцінені дані та маніфест запуску), що не потребує нічого від дослідницької системи автора. Колекція складає 24 000 відповідей, приблизно 30 000, включаючи гілки забруднення бенчмарку та конформності. Щодо доступності: публічна передреєстрація (osf.io/4y9dv) архівує вибір з фіксованим насінням з 1 500 позицій. Повний пакет є публічно доступним за адресою https://osf.io/jtvu9/, публічний компонент вихідного проекту реєстрації (папка `replication-package-v2`).
Три результати несуть розділ. По-перше, сировина багата: медіана заявленої впевненості становила 85–95 у семи з дев'яти постачальників frontier, з двома винятками (медіани 42 і 60) саме тими постачальниками, чия впевненість розрізняє, тоді як фактична точність коливалася від 10% до 66%, виробляючи 289–1 212 впевнених помилок (неправильно при впевненості ≥ 75) на одного постачальника frontier на 1 500 питань. Як сигнал правильності, власна впевненість моделі набрала AUROC 0.53–0.79 залежно від постачальника, і споживач не має способу дізнатися, звідки, якого постачальника вони отримали. Це поширення постачальників підтверджує, на рівні, з якого фактично обслуговуються споживачи, висновок лабораторії frontier про те, що великі моделі часто добре калібруються при самооцінці в контрольованих форматах (Kadavath et al., 2022): деякі розгорнені постачальники доставляють це самознання, інші доставляють впевнений шум, і нічого на поверхні їх не розрізняє.
По-друге, основне: перевірка працює як сертифікація, а не як сигнал тривоги. Сертифікація у ймовірнісному сенсі, апостеріорна ймовірність приблизно 49–77% залежно від панелі, а не гарантія. На таких складних питаннях наївний сигнал «якийсь член панелі не згоден» насичується: він активується на 85–94% впевнених помилок, але також на 91–95% впевнених правильних відповідей (реєстрація передбачила це переосмислення, переходячи до заздалегідь визначеної кінцевої точки AUROC). Інформативний напрямок — протилежний: правильні відповіді отримують незалежну реплікацію, неправильні відповіді розсипаються. Відповідь, яку відтворив щонайменше один незалежний член панелі, була правильною 72–77% часу на внутрішньоблокових панелях і 49% на кросблоковій панелі, порівняно з 18–37% без реплікації. Відповідь з незалежною згодою мала приблизно в два-три рази більшу ймовірність бути правильною (1,9–3,2× на трьох панелях таблиці 6). (Тут і далі «незалежна» означає проведена сліпо й окремо, з залишковою кореляцією помилок, яка вимірюється, а не передбачається; коректність завжди оцінюється щодо еталонних мітак, ніколи за оцінкою іншої моделі.) Оцінюємий параметр є асоціаційним, а не причинно-наслідковим: реплікація позначає відповіді, які з більшою ймовірністю є правильними, і частина того, що вона позначає, полягає в тому, що питання було легким, ефект селекції, кількісно визначений далі. Як сигнал коректності, згода панелі досягла AUROC 0,832 на панелі, члени якої мали найменший сигнал від власної впевненості (per-vendor 0,53–0,62; pooled 0,545). Твердження, яке утримується, є розподільним, а не конкретним: на всіх 84 трьохвендорних панелях AUROC згоди має медіану 0,79 і перевищує pooled self-report у 89%. Згода досягла 0,722 на кросблоковій панелі порівняно з об'єднаною власною впевненістю 0,659 (об'єднання нестандартизованих вербальних шкал між вендорами спотворює self-report, оскільки вендори використовують шкалу 0–100 по-різному, а напрямок артефакту залежить від панелі, тому значення per-vendor надруковані поруч). Цей крос-блоковий випадок залежить від кодування (альтернативні попередньо заморожені кодування згоди розміщують сигнал згоди кросблокової панелі на 0,544–0,722, щедрий варіант невирішеного як згода падає нижче об'єднаної власної впевненості цієї панелі 0,659, тоді як сигнал панелі CN охоплює 0,719–0,894 для того ж кодування, завжди вище 0,545), тому стійкий до кодування результат panel-over-self є внутрішньоблоковим випадком CN. Єдина панель, де self-report явно переважала сигнал панелі (0,842 проти 0,697), була панеллю, яка містила найкращого дискримінуючого вендора дослідження (середній рівень Anthropic, AUROC власної впевненості 0,788 на повній колекції з 1500 елементів), власний сигнал впевненості цього добре ранжованого вендора перевищував сигнал згоди його панелі. Таблиця 7 показує per-panel значення, обчислені в межах популяції елементів кожної панелі. Парний кластерний bootstrap (питання передискретизовані з повторенням, усі три одиниці (item, primary) за питанням рухаються разом; B = 2000) встановлює довірчі інтервали для контрастів таблиці 6/7. На панелі CN-frontier згода панелі перевищує об'єднану власну впевненість на ΔAUROC = +0,287 (95% CI [+0,265; +0,308], p < .001). На кросблоковій панелі перевага менша, але надійна, +0,063 ([+0,037; +0,087], p < .001). На панелі US-frontier напрямок розвертається, і розвертання саме по собі статистично недвозначне: власна впевненість 0,842 проти згоди панелі 0,697. Склад панелі є таким чином першорядним модератором цінності сигналу, і правило розгортання випливає: виміряйте власну калібрацію членів панелі перед довіренням до згоди замість цього, ΔAUROC = −0,145 ([−0,170; −0,120], p < .001). Усі три контрасти значущі, а гетерогенність на панелях є знаходженням, а не шумом. Таким чином, випадок US повідомляється як підтверджене розвертання, а не нульова зона, і він обмежує конструкт: на панелі, взятій з дискримінуючого кінця ринку, власна впевненість перевищує згоду як сигнал ранжування, тому значення дискримінації компонента Diversity залежить від складу панелі, а не утримується універсально. Архітектура може забезпечити зовнішній сигнал коректності, де розкрита впевненість моделі слабо дискримінує, і вона аудитує претензію на калібрацію, де вона робиться. Одна межа залишається: навіть ідеально відкалібрована модель не може засвідчити свою власну історію або арбітрувати власний конфлікт інтересів, тому, оскільки дискримінація вендора покращується, роль різноманітності зміщується від виявлення коректності до аудиту калібрації, тоді як докази та нейтральність роблять те, що калібрація робити не може.
Архітектурна перевірка забезпечує зовнішній сигнал коректності, де вендор не зміг поставити придатний сигнал впевненості, і визначення того, який вендор поставив, вимагає архітектури в будь-якому випадку. Претензія на заміну, точно означена областю, спирається на метрики калібрації, а не на AUROC. Жоден вендор в липневій хвилі одночасно не дискримінує і добре не відкалібрований; xAI найближче (таблиця 7a), і флагманська хвиля відтворює сторону калібрації дисоціації, тому навіть споживач, який випадково отримує найкраще ранжовану впевненість, не може отримати її рівень як ймовірність без зовнішнього посилання. Саме це забезпечує архітектурний рівень. Якщо вендори в кінцевому випадку поставлять хорошу калібрацію всюди, докази та нейтральність залишаються недоторканими. Аргумент виживає у світі, де моделі покращуються.
По-третє, режим відмови має форму: сертифіковані помилки консенсусу, коли кожен член панелі впевнено збігається на одну й ту саму неправильну відповідь, сталися на 0,5–2,2% питань відкритої форми, але на 4,0–7,9% в пов'язаній гілці, яка переставила елементи у форматі множинного вибору на локальному рівні (конструкція елементів і результати в пакеті реплікації). Консенсус засвідчує помилку головним чином там, де простір відповідей обмежений, попередження дизайну для будь-якого інтерфейсу, який пропонує агентам меню опцій.
Нулі настільки ж повчальні, як позитивні результати, і я публікую їх як попередньо зареєстровані. Геополітичний блок (включаючи можливість того, що панелі в межах одного блоку мають спільні корпуси навчання і лінії дистиляції) не передбачає кореляцію помилок на цьому еталоні (різниця φ всередину блоку проти перехресного блоку +0.011 на рівні frontier, 95% ДІ −0.005 до +0.028; дещо зворотна на локальному рівні). Можливість визначає кореляцію, не позначка, відголошуючи Kim et al. (2025). Лінія походження не передбачає рівні перехоплення: локальна модель, яка перевіряє свого власного frontier колегу, виступає як будь-хто чужий, а модель, дистильована на міркування, виявилась найменш корельованою зі своїми власними базовими вагами (φ = 0.135). Обидва є обмеженими нулями, а не продемонстрованою еквівалентністю. Інтервал блоку виключає φ різниці, більші за +0.028, і ця межа, а не невдача відхилити, виконує інформаційну роботу. Природне безперервне розширення, яке підтримують дані реплікації, полягає в оцінці ліфту сертифікації як функції виміряного різноманіття панелей (φ оцінки сюрпризу) замість ідентичності панелі. Це б повторно запустило, для модельних панелей, програму, яку література класифікатора-ансамблю запустила для своєї статистики різноманіття, яка виявила, що жодна єдина міра чисто не передбачає ансамблювальні прибутки (Kuncheva & Whitaker, 2003).
І дешеві локальні моделі взагалі не могли сертифікувати frontier відповіді на запитання відкритої форми (46% точність з їхньою згодою чи без неї): верифікатор повинен бути компетентним у класі завдань, перш ніж його незалежність що-небудь варта. Граничні умови такі: консенсус сертифікує помилку, де простори відповідей обмежені, незалежність повинна вимірюватися, а не припускатися, компетентність верифікатора відкриває цінність сертифікації. На практиці, різноманіття — це властивість, яку потрібно вимірювати, питання за питанням, а не припускати на основі брендів, блоків або генеалогічних дерев. Таблиця 6 узагальнює метрики панелі. Рисунок 13 показує ліфт сертифікації та порівняння сигналу поруч.
Рисунок 13. Ілюзія точності та її архітектурне вирішення
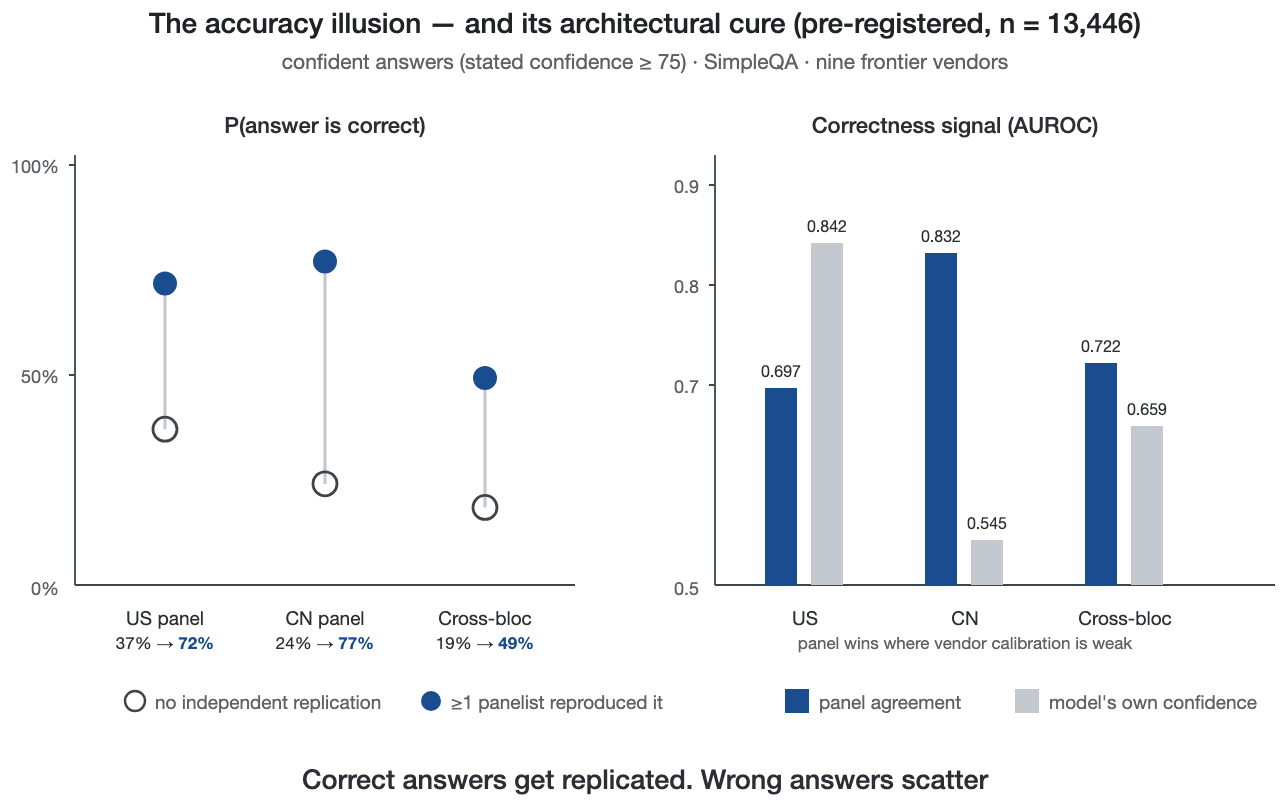
Сертифікація незалежною репліцією (попередньо зареєстрована; n = 13,446 оцінених відповідей — дев'ять frontier постачальників, кожен відповідає на ті ж 1,500 SimpleQA запитань один раз, мінус 54 невдалих або неоціненних викликів).
Одночасна робота посилює обережність: масштабний аудит виявив високу самоконсистентність, яка співіснує з неправильними відповідями на еталонах міркування, де сама по собі згода, без незалежності та сліпої збірки, є слабким і залежним від режиму сигналом (Ding, 2026). Тому я розглядаю незалежну, сліпу репліцію як одиницю сертифікації.
Таблиця 6. Перехоплення впевненої помилки та сертифікація панеллю (SimpleQA, підтверджувальна; conf ≥ 75)
| Панель | Впевнені помилки (n) | Коефіцієнт позначки на помилках [95% ДІ] | Хибні сигнали на правильному | P(правильно | ≥1 згідно) | P(правильно | немає) | AUROC: згода vs власна впевненість |
| US-frontier (Anthropic·OpenAI·Google) | 1,630 | 94.3% [93.1–95.3] | 91.0% | 71.8% | 37.1% | 0.697 vs 0.842 |
| CN-frontier (DeepSeek·Alibaba·Moonshot) | 2,128 | 85.5% [83.9–86.9] | 94.8% | 77.0% | 24.1% | 0.832 vs 0.545 |
| Cross-bloc (Anthropic·DeepSeek·Mistral) | 2,432 | 89.4% [88.1–90.6] | 93.4% | 49.3% | 18.5% | 0.722 vs 0.659 |
Позначка = ≥1 незалежна відповідь панеліста не еквівалентна первинній (відмови та відповіді з нульовим перекриттям рахуються як невідповідність; суворіше кодування у пакеті реплікації). Чутливість порогу при 60/90 не змінює висновок. AUROC власної впевненості — це зазначена впевненість, об'єднана по всій популяції відповідей панелі; об'єднання поглинає відмінності між постачальниками в точності та шкалі впевненості, тому вона може перевищувати індивідуальне значення кожного члена (значення за постачальником у Таблиці 7). Відповіді кластеризуються за питанням; бутстреп кластера на рівні питання розширює інтервали приблизно в 1.6 разу без зміни будь-якого висновку. Кожен AUROC у цій таблиці та Таблиці 7 відтворюється детерміністично, однією командою без будь-якої випадковості, зі скрипту пакета реплікації compute_panel_vs_own_auroc.py (Mann–Whitney з коригуванням зв'язків).
Таблиця 7. AUROC власної впевненості за панеллю: об'єднана популяція панелі та за постачальником (ті ж популяції, що й Таблиця 6)
| Панель | AUROC об'єднаної власної впевненості | AUROC власної впевненості за постачальником |
| US-frontier | 0.842 | Anthropic 0.784 · OpenAI 0.596 · Google 0.746 |
| CN-frontier | 0.545 | DeepSeek 0.569 · Alibaba 0.532 · Moonshot 0.620 |
| Cross-bloc | 0.659 | Anthropic 0.787 · DeepSeek 0.570 · Mistral 0.584 |
Обчислено за допомогою детермінованого конвеєру в пакеті репліцірування. Дві конвенції популяції співіснують і явно друкуються, щоб уникнути видимої невідповідності: значення таблиці для кожного постачальника обчислюються в межах популяції елементів кожної панелі, тоді як однозначні посилання в тексті використовують значення повної колекції — для постачальника з найкращою розрізнювальною здатністю 0,784 у межах панелі US-frontier проти 0,788 у повній колекції з 1500 елементів, і для OpenAI 0,596 проти 0,598 (обидві пари відтворюються однією командою того ж конвеєру). Стовпець об'єднаних значень, навпаки, змішує базові показники постачальників — міжпостачальницькі різниці в точності та масштабі впевненості грають роль, тому об'єднане значення не обов'язково лежить у межах діапазону для кожного постачальника (перераховано в реальному часі: об'єднане значення для панелі US-frontier 0,842 перевищує значення кожного учасника, а об'єднане значення для панелі CN-frontier 0,545 лежить нижче макро-середнього показника панелі 0,574 для кожного постачальника); значення для кожного постачальника — інтерпретовані величини. Розподіл за постачальниками — проблема споживача, виражена чисельно: практична розрізнювальна здатність існує у одного постачальника і близька до випадкової у інших, а ніщо з зовні відповіді не говорить, який постачальник її створив. Вихідні значення за діапазонами постачальників у розділі 3, надруковані для кожної моделі з однієї оціненої колекції (зазначена медіана впевненості · точність · AUROC повної колекції власної впевненості): frontier — Alibaba 95 · 47,4% · 0,532; Anthropic 42 · 10,3% · 0,788; DeepSeek 90 · 35,7% · 0,570; Google 95 · 66,5% · 0,746; Mistral 90 · 16,5% · 0,584; Moonshot 85 · 51,6% · 0,619; OpenAI 85 · 16,7% · 0,598; xAI 60 · 37,9% · 0,777; Zhipu 95 · 28,4% · 0,611 — дві медіани нижче діапазону 85–95 належать двом постачальникам, впевненість яких несе практичний сигнал; локальний рівень (входить лише в стратифікацію за складністю та нулі локального рівня) — gemma4:e4b 90 · 5,2% · 0,541; glm4:9b 85 · 5,0% · 0,589; llama3.2:3b 100 · 5,3% · 0,494; mistral:7b 95 · 6,3% · 0,506; phi4-mini 95 · 5,5% · 0,505; qwen3:8b 95 · 5,9% · 0,504; deepseek-r1:8b 90 · 9,2% · 0,696 (n = 98, попередньо затверджене правило зупинки).
AUROC вимірює розрізнювальну здатність — чи показана впевненість постачальника розташовує його правильні відповіді вище неправильних, тоді як ECE, показник Брієра та розрив впевненість–точність вимірюють калібрування — чи можна прочитати зазначене число як ймовірність, і в цих даних обидві властивості різко розходяться. Найкраще розрізнювальний постачальник дослідження в липні, середній рівень Anthropic (власна впевненість AUROC 0,788), все ще погано калібрований за рівнем: середня зазначена впевненість 41,3 (медіана 42) проти 10,3% точності, розрив завищеної впевненості +31,0 пункти, ECE 0,311 (15 бінів), показник Брієра 0,206 з терміном надійності 0,126 проти неустранного мінімуму невизначеності 0,093. Навпаки, найгірше калібрування в панелі мають місце одночасно з близькою до випадкової розрізнювальною здатністю (Mistral: розрив +74,2 пункти, ECE 0,742, AUROC 0,584), і лише xAI наближається до обох розрізнювальної здатності й калібрування (ECE 0,111, AUROC 0,777). Навіть там розрізнювальна здатність підтримується рівномірно низькою зазначеною впевненістю, тоді як для інших восьми липневих постачальників обидві властивості різко розходяться. Те ж саме розходження зберігається на рівні флагманів: дев'ять із одинадцяти серпневих флагманів мають розриви завищеної впевненості від +12,5 до +71,4 пункти (ECE 0,125–0,714), тоді як обидва винятки (gpt-5.6-sol, ECE 0,031; claude-fable-5, ECE 0,043) досягають калібрування на протилежних кінцях шкали точності. Споживач, який має добре ранговану, але чисельно завищену оцінку впевненості, не може її реалізувати без зовнішнього еталону. Таблиця 7a друкує метрики калібрування поруч із показниками розрізнювальної здатності.
Таблиця 7a. Розрізнювальна здатність проти калібрування, липневий цикл (повна колекція, розв'язана; ECE з 15 бінів; розрив = середня зазначена впевненість − точність, пункти відсотків)
| Постачальник | n | AUROC (власна впевненість) | ECE | Брієр | Розрив впевненість − точність | Середня впевненість → точність |
| Alibaba | 1,497 | 0,532 | 0,448 | 0,446 | +44,8 пункти | 92,3 → 47,4% |
| Anthropic | 1,500 | 0,788 | 0,311 | 0,206 | +31,0 пункти | 41,3 → 10,3% |
| DeepSeek | 1,500 | 0,570 | 0,536 | 0,513 | +53,4 пункти | 89,1 → 35,7% |
| 1,461 | 0,746 | 0,263 | 0,271 | +26,3 пункти | 92,8 → 66,5% | |
| Mistral | 1,495 | 0,584 | 0,742 | 0,686 | +74,2 пункти | 90,6 → 16,5% |
| Moonshot | 1,500 | 0,619 | 0,242 | 0,292 | +24,2 пункти | 75,8 → 51,6% |
| OpenAI | 1,500 | 0,598 | 0,610 | 0,531 | +60,9 пункти | 77,6 → 16,7% |
| xAI | 1,500 | 0,777 | 0,111 | 0,197 | +11,1 пункти | 48,9 → 37,9% |
| Zhipu | 1,493 | 0,611 | 0,642 | 0,612 | +64,2 пункти | 92,6 → 28,4% |
| Панель US-frontier, об'єднані одиниці | 4,383 | 0,842 | 0,393 | 0,336 | +39,3 пункти | — |
| Панель CN-frontier, об'єднані одиниці | 4,491 | 0,545 | 0,408 | 0,417 | +40,8 пункти | — |
| Панель Cross-bloc, об'єднані одиниці | 4,485 | 0,659 | 0,529 | 0,469 | +52,9 пункти | — |
Ті самі популяції, що й AUROC повної колекції та таблиці 6–7 (рядки панелей: об'єднані (елемент, первинні) одиниці); відмови оцінені як неправильні за замороженим протоколом. Показник Брієра розкладається за тотожністю Мерфі (надійність − роздільність + невизначеність) на тих же 15 бінів, залишок < 0,001 у кожному рядку. Одна примітка рівня флагмана супроводжує обидва калібровані винятки: ECE gpt-5.6-sol 0,031 отримано при точності 95,4%, де термін невизначеності Мерфі, мінімум, встановлений базовим показником, становить 0,044 — калібрування частково придбано базовим показником, що несе застереження про забруднення таблиці 9 (61,6% точних збігів золотого рядка).
Один ефект відбору повинен супроводжувати таблицю: реплікація частково є маркером простоти запитання. Розшарування за складністю запитання (середня точність серед інших п'ятнадцяти моделей), сирий ліфт сертифікації переносять легші страти (2.7–4.6×), він падає нижче за 1× на другому найскладнішому квінтилі та зникає на найскладнішому під цією внутрішньоколекційною мірою. Це розшарування частково ендогенне, і екзогенна переоцінка нижче пом'якшує інверсію до монотонного затухання. Аналіз стійкості безпосередньо розглядає проблему відбору (розвідувальний, не запланований заздалегідь): у логістичній моделі з кластеризацією за запитаннями з фіксованими ефектами первинної моделі, контролюючи довіру самої первинної моделі та складність елемента (середня точність з виключенням первинної моделі для всіх шістнадцяти моделей), кожен додатковий панеліст, що погоджується, все ще множить ймовірність правильності приблизно на п'ять (об'єднаний b = +1.65 за панеліста, 95% ДІ [+1.49, +1.81], p < 10⁻⁸⁸; позитивний в кожній панелі), а додавання згоди до базової лінії за складністю та довірою підвищує утриману AUROC з 0.859 до 0.898 і знижує оцінку Брієра з 0.139 до 0.116 (двозначне перехресне валідування розбиття за запитанням). Та ж модель досліджує границю, і саме розшарування потребує уваги: під мірою складності всередину колекції умовний коефіцієнт стає негативним на найскладнішому квінтилі (b = −0.41, p = .011), але ця міра включає власних членів панелі. Умовна модель несе застереження щодо розгортання: її функція складності потребує міток, тому вона діагностична, а не розгортаємна, і розгортаємним фільтром є сама брама згоди. Три подальші перевірки розглядають проблеми оцінки та відбору, всі під заморозненим детермінованим протоколом кодування (суворішу гілку пакет реплікації повідомляє поряд із відредагованими судом числами заголовків). Переоцінка ліфту сертифікації за допомогою перевибірки bootstrap з кластеризацією за елементами, кластеризація, яку вимагає структура складності, залишає інтервал ліфту сертифікації кожної панелі далеко вище за 1 (точкові ліфти 2.4–4.5 під цим детермінованим кодуванням, яке сертифікує менше згод, ніж парне кодування, відредаговане судом, за опублікованим заголовком 1.9–3.2×; нижчі межі bootstrap 2.2–4.1). Розподіл 84 панелей, повідомлений вище, робить панель US-frontier, де самозвіт перемагає, винятком, а не правилом (медіанна перевага +0.14, МКР AUROC згоди 0.76–0.82). А розшарована за складністю AUROC робить границю явною під екзогенною мірою складності: 0.87 на найлегшому квінтилі, що падає до 0.61 на найскладнішому, затухання без інверсії. Ця міра — залишивши-панель-поза, тринадцять моделей поза кожною панеллю, і переоцінка з нею розв'язує інверсію: коефіцієнт умовної згоди залишається позитивним на кожному квінтилі, включаючи найскладніший (найскладніший-квінтиль b = +0.97, p < 10⁻⁷; 28% незалежно реплікованих відповідей на найскладнішому шарі правильні, а не 0%). Отже, інверсія всередину колекції частково є артефактом міри складності. Те, що виживає під будь-якою мірою, — це монотонне затухання, зі згодою найслабшою там, де запитання найскладніші, і реальністю помилок сертифікованого консенсусу; скрипти та виходи знаходяться в пакеті реплікації. Коефіцієнт заголовка — це тому середнє значення для неоднорідної популяції. Заяву про сигнал базується на кінцевій точці AUROC, а не на коефіцієнті.
Гіпотези експерименту операціоналізують розгортання дослідження, яким я керую: сліпа колекція дзеркалює його механізм ради, а композиції панелей існували як його виробнича конфігурація до розроблення дослідження. Це друге запланеме заздалегідь дослідження в цій програмі дослідження. Третє, експеримент зі споживачами в розділі 6, завершений і повідомлений, а четверте (телеметрія поля над виробничим трафіком) чернетка. Пакет реплікації працює для будь-кого на звичайному обладнанні з використанням публічних API.
Друга хвиля на рівні флагмана: одинадцять лабораторій — десять повних варіантів і один неповний — один калібрувальний рів. Експеримент вище отримав вибірку з оптимізованих за вартістю рівнів, які насправді обслуговують споживачів. Заперечення для тестування: можливо, ілюзія точності — це артефакт бюджетного рівня, а флагмани, моделі, які кожен постачальник висуває як свої найкращі, досить добре відкалібровані, що архітектура вище них є надлишковою. Друга хвиля збирання (серпень 2026) тестує це заперечення на вершині ринку.
Я оцінюю одну модель-флагман з кожної з десяти великих лабораторій штучного інтелекту, що охоплюють Сполучені Штати, Китай та Європу. Лабораторії були обрані для охоплення провідних комерційних та екосистем з відкритою вагою в цих трьох регіонах. Для кожної лабораторії я вибрав її найбільш здатну загально доступну модель у час хвилі оцінки. Потім я перевірив це охоплення порівняно з публічними таблицями рейтингів станом на 5 серпня 2026 р. (LMArena Elo, Artificial Analysis Intelligence Index, Humanity's Last Exam та SWE-bench Verified): восьмеро з десяти флагманів розташовуються в топ-рівні або поблизу нього щонайменше однієї таблиці рейтингів загальної здатності, тоді як два (Mistral, Baidu) включені для збереження охоплення лабораторії та регіону, а не на основі рейтингу (див. обмеження охоплення нижче). Одинадцята лабораторія, Meta, флагман якої став доступним лише після того, як хвиля була визначена, була додана в середині хвилі; її збирання було перервано відміною доступу й повідомляється як часткове (див. нижче).
Таблиця 8. Оцінені моделі-флагмани та позиції в таблицях рейтингів (станом на 5 серпня 2026 р.)
| Лабораторія | Модель-флагман (API id) | Країна | Позиції в таблицях рейтингів (5 серп. 2026) |
| OpenAI | gpt-5.6-sol | США | AA Index #3 (58.9); LiveBench #1 (82.4); Arena верхній кластер |
| Anthropic | claude-fable-5 | США | Arena #1 (~1525 Elo); AA Index #2 (59.9); SWE-bench Verified #1 (95.0) |
| gemini-3.1-pro-preview | США | SWE-bench Verified #8 (80.6); HLE #17 (51.4); Arena верхній кластер | |
| xAI | grok-4.5 | США | AA Index #8 (53.8); Arena Elo 1499 |
| DeepSeek | deepseek-v4-pro | Китай | SWE-bench Verified #8 (80.6, Pro-Max); HLE #23 (48.2) |
| Alibaba | qwen-max (Qwen 3.7 Max) | Китай | Arena #21 (1488–1496 Elo); SWE-bench Verified #11 (80.4) |
| Moonshot AI | kimi-k3 | Китай | AA Index #4 (57.1); HLE #9 (56.0); Arena #10 (1500) |
| Zhipu (Z.ai) | glm-5.2 | Китай | AA Index #13 (51.1); HLE #11 (54.7) |
| Mistral | mistral-medium-3.5 | Франція | Нижче топ-50 у загальних рейтингах; включено для регіонального охоплення |
| Baidu | ernie-4.5-vl-424b | Китай | Поза загальним топ-30 (ERNIE 5.0: HLE #36); ERNIE 5.1: LMArena Search Arena #4 |
| Meta (додано в середині хвилі, частково) | muse-spark-1.1 | США | HLE #4 |
Показники в дужках — це значення, про які повідомляє агрегатор, на дату снімка; позиції в рейтингах дещо відрізняються між агрегаторами та датами снімків. Джерела снімків архівуються разом із записами запусків, які супроводжують пакет реплікації.
Протокол першого експерименту був заморожений і повторно використаний: той самий зразок SimpleQA з 1500 елементами (фіксований за допомогою seed та hash), один сліпий прохід на модель, температура нуль, ідентичний системний запит та аналізатор відповідей, задекларована впевненість 0–100 для кожної відповіді. Оцінювання є детермінованим (точний і нормалізований матч рядка порівняно з золотим стандартом; відмови оцінюються як помилки; невирішені елементи виключені з основних показників і переоцінені як помилки в аналізі чутливості), і жоден суддя LLM не торкається основних цифр. Це навмисне посилення порівняно з першою хвилею, суддя якої був гібридним: об'єктивний матч рядка з локальним суддею з відкритими вагами, що вирішує залишок (66,5% вердиктів видано моделлю; перевірка 50 елементів людиною, 98% узгодженість). Ця хвиля використовує лише детермінований двигун еквівалентності (вручну перевірено: 20 із 20 позначених розбіжностей і 15 із 15 узгодженостей підтверджено вручну), тому кожна основна цифра цієї хвилі відтворюється бітово з випущеного скрипту. Порівняння абсолютної точності між хвилями також перетинають режими судді, і кожне порівняння липня та серпня містить кваліфікатор режиму судді. Аудити в межах хвилі підтримують цифри кожної хвилі, але дельти між хвилями змішують зміну моделі зі змінами судді, якщо не застосувати одного судді до обох замороженого набору відповідей, що не було зроблено тут. Одне відхилення у зусиллях: збір OpenAI був виконаний за замовчуванням інтерфейсу зусилля міркування (середнє), де протокол липня використав мінімальне, без веб-доступу або доступу до інструментів під час умовиводу (перевірено перерахуванням інструментів, викритих моделі, яких не було). Це змінює абсолютну точність цього постачальника, а не механізм узгодженості (розділ 5). Впевнена помилка — це неправильна відповідь, запропонована з декларованою впевненістю ≥ 80; поріг був встановлений перед запуском, з 70 і 90, про які повідомляється як чутливість. Охоплення об'єднання становить 1500/1500 запитань для десяти з одинадцяти лабораторій. Збір Meta досяг 272 дійсних відповідей перед тим, як доступ був відкликаний.
Я також прямо протестував занепокоєння перехресного режиму. Переоцінка липневої хвилі з шістнадцятьма моделями за допомогою замороженого детермінованого двигуна другої хвилі (який замінює гібридний конвеєр, що винесли вирок у 66,5% вердиктів, з локальним суддею з відкритими вагами) змінює 2,65% розв'язаних вердиктів (566 із 21 338; двигун утримується від подальшого 4,1%) і не переміщує основну лінію: під час єдиного детермінованого кодування ліфти сертифікації читаються 3,6×/4,6×/4,4× до переоцінки та 3,0–3,1×/4,5–4,6×/4,3× після. Обидва перевищують консервативно опубліковані 1,9–3,2×, які випливають з кодування парів, винесених суддею LLM, оскільки більше узгоджень, сертифікованих, означає більш консервативні ліфти. Кожний AUROC у таблицях 6–7 зміщується максимум на 0,016 на панелях CN та перехресних блоків і на 0,046 на панелі США, зберігаючи впорядкування кожної панелі щодо узгодженості та самозвіту про впевненість.
Позначка флагмана нічого не гарантує. Вирішена точність на ідентичних запитаннях коливається від 11,4% до 95,4% серед одинадцяти флагманів (таблиця 9), розкид у 84 пункти на верхівці ринку, ширший за розкид середнього рівня першого експерименту. І ілюзія точності залишається неушкодженою на цьому рівні: об'єднано на десяти повних лабораторних гілках, 46,6% усіх розв'язаних відповідей, запропонованих з декларованою впевненістю ≥ 80, були неправильними (4910 із 10 540; включаючи часткову гілку Meta, 46,3%, або 4935 із 10 665; невирішені елементи виключені тут і переоцінені як помилки в чутливості, де об'єднана картина залишається незмінною). Висновок першої хвилі для споживача не м'якшає від ціни: позначка флагмана не говорить споживачу, чи вийшла впевнена відповідь перед ними від флагмана з точністю 95% або від того, що має 11% точності.
Таблиця 9. Хвиля флагманів: охоплення та точність (зразок SimpleQA, n = 1500 на лабораторію, температура 0)
| Лабораторія (флагман) | Охоплення | Точність (розв'язана) | Невирішена |
| OpenAI gpt-5.6-sol | 1,500/1,500 | 95.4% (1,403/1,471) | 29 |
| Google gemini-3.1-pro | 1,500/1,500 | 71.1% (837/1,178)¹ | 46 |
| Anthropic claude-fable-5 | 1,500/1,500 | 70.3% (1,019/1,450) | 50 |
| Meta muse-spark-1.1 (частково) | 272/1,500 дійсних | 61.4% (148/241)² | 10 |
| xAI grok-4.5 | 1,500/1,500 | 54.8% (794/1,448) | 52 |
| DeepSeek deepseek-v4-pro | 1,500/1,500 | 46.6% (666/1,428) | 72 |
| Moonshot kimi-k3 | 1,500/1,500 | 45.5% (645/1,418) | 82 |
| Zhipu glm-5.2 | 1,500/1,500 | 30.2% (430/1,425) | 69 |
| Baidu ernie-4.5-vl-424b | 1,500/1,500 | 28.9% (411/1,421) | 71 |
| Mistral mistral-medium-3.5 | 1,500/1,500 | 21.4% (306/1,429) | 71 |
| Alibaba qwen-max | 1,500/1,500 | 11.4% (164/1,435) | 65 |
¹ Канал Google повернув порожні або відфільтровані відповіді на 18,4% елементів (276 із 1500 — властивість доставки, не розрив охоплення: всі 1500 були спробовані); точність обчислюється на розібраних, вирішених відповідях. Обидва визначення повідомляються: тільки відповіді, точність Google становить 71,1% (837/1178); враховуючи 276 недоставлених відповідей як помилки, це 57,6% (837/1454) і 55,8% (837/1500) з невирішеними елементами також оцінені як помилки. ² Точність Meta обчислена на відповідях, зібраних до відкликання доступу; див. обмеження охоплення. Точність у всій таблиці розв'язується лише; при чутливості невирішених як помилки верхня цифра, 95,4% OpenAI, стає 93,5% (1403/1500). Походження каналу за викликом для кожної лабораторії записується в маніфесті запуску. Невирішені підрахунки доставили відповіді, які не розв'язувалися детерміністично; для Zhipu (1494 відповіді доставлені), Baidu (1492) та часткової гілки Meta (251) два стовпці тому дорівнюють менше запитаних питанням, решта — недоставлені відповіді.
Застереження про забруднення обмежує абсолютні точності. Ця хвиля повторно використовує оригінальний, публічно випущений еталон SimpleQA (жовтень 2024) проти моделей, чиї тренувальні корпуси відстають від його публікації до двох років, тому тренувальна експозиція еталона є правдоподібною на вершині таблиці, і дані несуть конкретну сигнатуру цього: мідер за точністю відтворює рядок золотої відповіді дослівно (нормалізована точна відповідність, до форматування десяткових місць) на 61,6% елементів, проти 27,9–45,3% для інших лабораторій при медіанній заявленій впевненості 99. Дизайн не може розділити «модель сильніша» від «модель бачила еталон та його ключ відповідей». Абсолютні цифри точності хвилі тому не порівнювані з історичними потолками закритої книги, про які повідомляються для попередніх поколінь моделей, і їх не слід читати як міри параметричної пам'яті. Перевірка віку еталона першої хвилі (розрив TruthfulQA–SimpleQA, про який повідомляється в розділі 3) охопила колекцію липня; до серпня 2026 SimpleQA сам по собі є дволітнім публічним еталоном, і це застереження охоплює хвилю мідера. Висновки хвилі не спираються на абсолютну точність. Вони спираються на структуру впевнених помилок, їх поширеність при заявленій впевненості ≥ 80 та їх перехоплення воротами незгоди, виміряні в межах хвилі під одним замороженим протоколом, де будь-яка перевага експозиції поділяється в лабораторіях, оцінених на одних і тих же елементах. Свіжий двоходовий зонд, побудований після вікна дослідження, прямо підтверджує цю сигнатуру. Див. «Чому не просто використовувати найкращу модель?» далі в цьому розділі.
Рів калібрування. Перший експеримент показав, що незалежна згода несе сигнал правильності, якого не несе самозвітна впевненість. Хвиля мідера перетворює цей сигнал на виміряний фільтр. Механізм — ворота незгоди: рада трьох лабораторій, зафіксована заздалегідь на основі попередньо аналізу незгоди та не прилаштована до цих результатів (Moonshot kimi-k3, DeepSeek deepseek-v4-pro, OpenAI gpt-5.6-sol), та правило без вільних параметрів. Відповідь проходить ворота лише коли три відповіді ради погоджуються попарно. Оскільки нічого не оцінюється, розділення на тренування/тест не потрібне; ворота обчислюються один раз над замороженою колекцією.
Рисунок 17. Ворота мідера
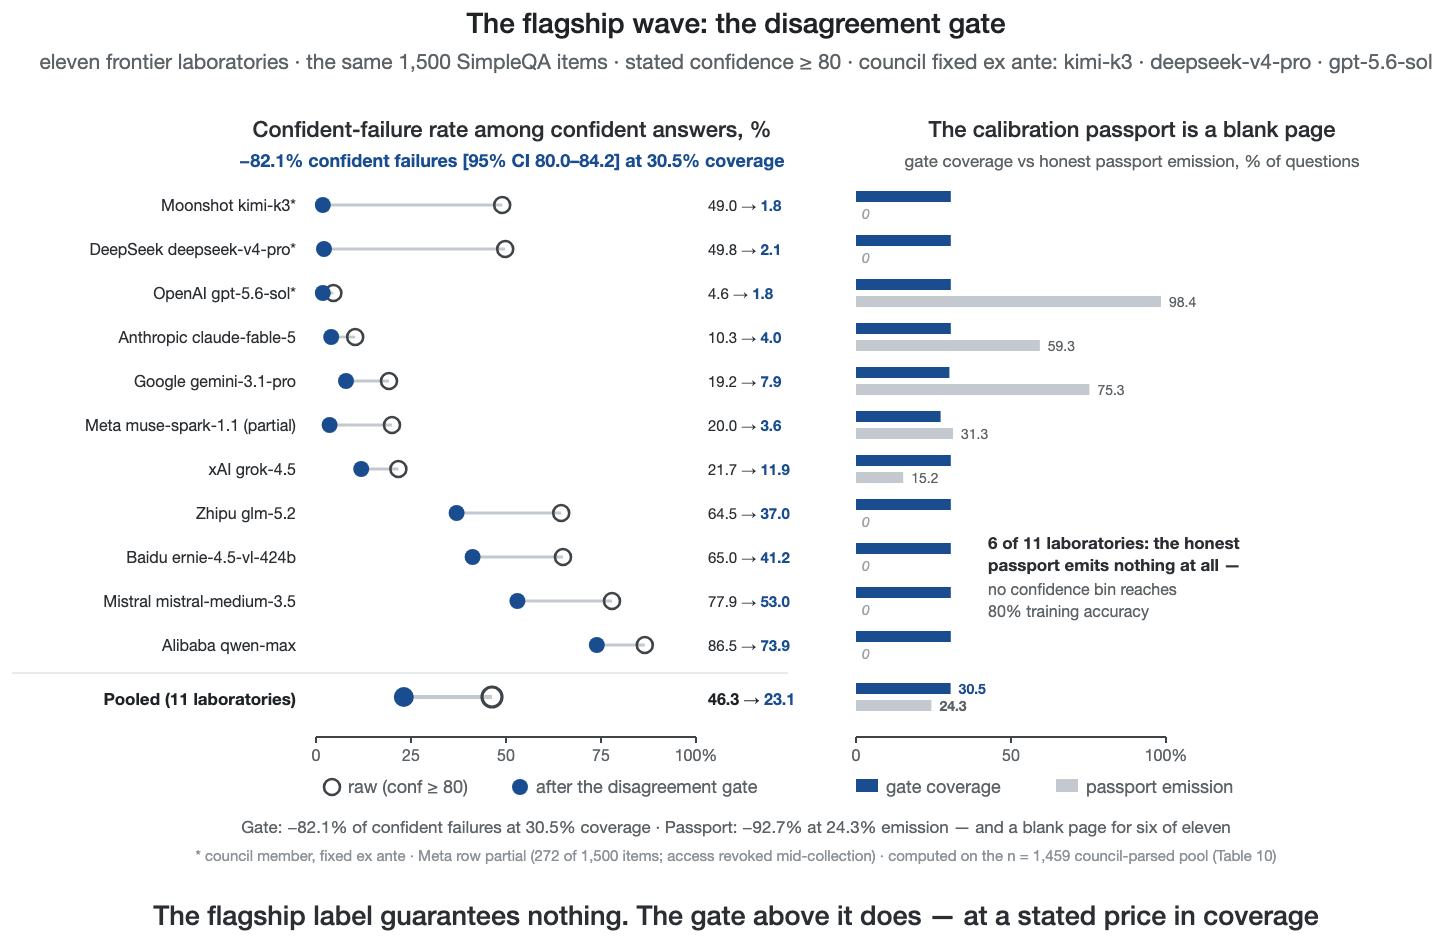
Впевнені помилки при заявленій впевненості ≥ 80 та їх перехоплення нерухомими воротами тризначної незгоди за лабораторією (серпень 2026 хвиля).
Об'єднано через десять повних ділянок лабораторії (первинна презентація, з частковою гілкою Meta повідомляється окремо та її включення розглядається як чутливість), сира частота впевнених помилок становить 46,6% (4910/10540). Об'єднано через реєстр одинадцяти лабораторій, частоти на лабораторію варіюються (таблиця 9), тому ця цифра характеризує рубежний реєстр, а не універсальну константу. Ворота видаляють 82,1% впевнених помилок (bootstrap 95% ДІ [79,9; 84,1]) при збереженні 30,5% усіх об'єднаних відповідей (самі ворота відкриваються на 30,6% запитань, 446 з 1459). Обмежено повними лабораторіями поза радою, без жодного самовідношення будь-якого роду, ворота все ще видаляють 76,9% впевнених помилок (ДІ [74,3; 79,2]). Включення часткової гілки Meta залишає кожну оцінку практично незміненою: об'єднано через усі одинадцять, сира частота становить 46,3% (4935/10665; 35,8% впевнених відповідей проходять ворота, і правильність серед випущених впевнених відповідей зростає з 53,7% сирої до 76,9% після воріт), ворота видаляють 82,1% (ДІ [80,0; 84,2]) при тій же охопленні 30,5%, і цифра для восьми лабораторій поза радою становить 77,0% (ДІ [74,4; 79,3]). Таблиця 10 наводить цифри для кожної лабораторії.
Таблиця 10. Перехоплення впевнених помилок воротами незгоди (conf ≥ 80; детермінований оцінювач; рада = kimi-k3 · deepseek-v4-pro · gpt-5.6-sol, зафіксовано ex ante)
| Лабораторія | Впевнені відповіді | Впевнені помилки, сирі | Після воріт (частота в випущених) | dCF |
| Moonshot kimi-k3 [рада] | 1,056 | 517 (49,0%) | 7 (1,8%) | −98,6% |
| DeepSeek deepseek-v4-pro [рада] | 1,274 | 634 (49,8%) | 9 (2,1%) | −98,6% |
| OpenAI gpt-5.6-sol [рада] | 1,426 | 65 (4,6%) | 8 (1,8%) | −87,7% |
| Anthropic claude-fable-5 | 825 | 85 (10,3%) | 15 (4,0%) | −82,4% |
| Google gemini-3.1-pro | 966 | 185 (19,2%) | 27 (7,9%) | −85,4% |
| Meta muse-spark-1.1 (часткова) | 125 | 25 (20,0%) | 2 (3,6%) | −92,0% |
| xAI grok-4.5 | 577 | 125 (21,7%) | 36 (11,9%) | −71,2% |
| Zhipu glm-5.2 | 1,128 | 727 (64,5%) | 146 (37,0%) | −79,9% |
| Baidu ernie-4.5-vl-424b | 725 | 471 (65,0%) | 107 (41,2%) | −77,3% |
| Mistral mistral-medium-3.5 | 1,354 | 1,055 (77,9%) | 224 (53,0%) | −78,8% |
| Alibaba qwen-max | 1,209 | 1,046 (86,5%) | 300 (73,9%) | −71,3% |
| Об'єднано (11 лабораторій) | 10,665 | 4,935 (46,3%) | 881 (23,1%) | −82,1% [80,0; 84,2] |
| Об'єднано (8 поза радою) | 6,909 | 3,719 (53.8%) | 857 (33.5%) | −77.0% [74.4; 79.3] |
Обчислено на наборі запитань, де всі три члени ради вивели розібрані, невідмовлені відповіді (n = 1,459 з 1,500); шлюз відкривається для 446 з них (30.6%). Рядок Meta є частковим (доступ скасований під час збору). Bootstrap CIs: 5,000 перевибірок на рівні запитань.
З цим заголовком пов'язані три речи. Шлюз також відкидає приблизно половину впевнених правильних відповідей (шлюз збереває лише 51.3% впевнено-правильних відповідей; з відповідей, які він відкидає, приблизно 41% насправді були правильними). Обмін — це охоплення на впевненість, канонічна компромісна ризик–охоплення вибіркової класифікації (Geifman & El-Yaniv, 2017), виконаний тут на рівні архітектури, і ці два числа завжди повинні цитуватися як пара: −82.1% впевнених відмов при 30.5% охоплення. Система має свій поріг. У повністю системному режимі, де відкритий шлюз видає консенсусну відповідь ради замість відповіді окремої моделі, власна частота впевнених відмов системи становить 1.8% (8 з 442 розв'язаних консенсусних відповідей), і ці вісім запитань — це запитання, де вся рада впевнено погоджується з однією й тією самою неправильною відповіддю. Це поріг корельованої помилки, який перший експеримент передбачив з його граничної умови засвідчення помилки консенсусом: нижче від нього, ніяка кількість перевірки узгодження не допомагає, тому що саме узгодження є помилкою. І результат є постійним у попередньо оголошеній сітці чутливості: поріг впевненості 70/80/90 дає об'єднаний dCF −83.1%/−82.1%/−80.6%, а переоцінка невирішених елементів як помилок дає −81.8%, тому число було виміряно, а не вибрано.
Те, що означає показник покриття 30,5% у комерційному сенсі, визначається економікою беззбитковості з розділу 5 (рис. 14): приблизно сімдесят відсотків відповідей, які затвір відмовляється засвідчувати, — це запити, спрямовані на дешевший результат, ніж впевнена помилка (передача людині, глибший рівень перевірки чи явне відображення невизначеності), а не втрачені конверсії, тому витрати на покриття — це застраховувана ціна помилки, а не втрачений попит. Тут не оцінюється жодна модель витрат для каналу передачі. Робоча точка не фіксована. Драбина узгодження, відслідкована на рис. 19, забезпечує сім'ю порогів, і сервіс повинен розташовуватися там, де очікувана вартість неперехопленої впевненої помилки перетинає маржу трафіку, який затвір утримує, що робить це вибір, заснований на витратах.
Рис. 14. Економіка ступеневої довіри
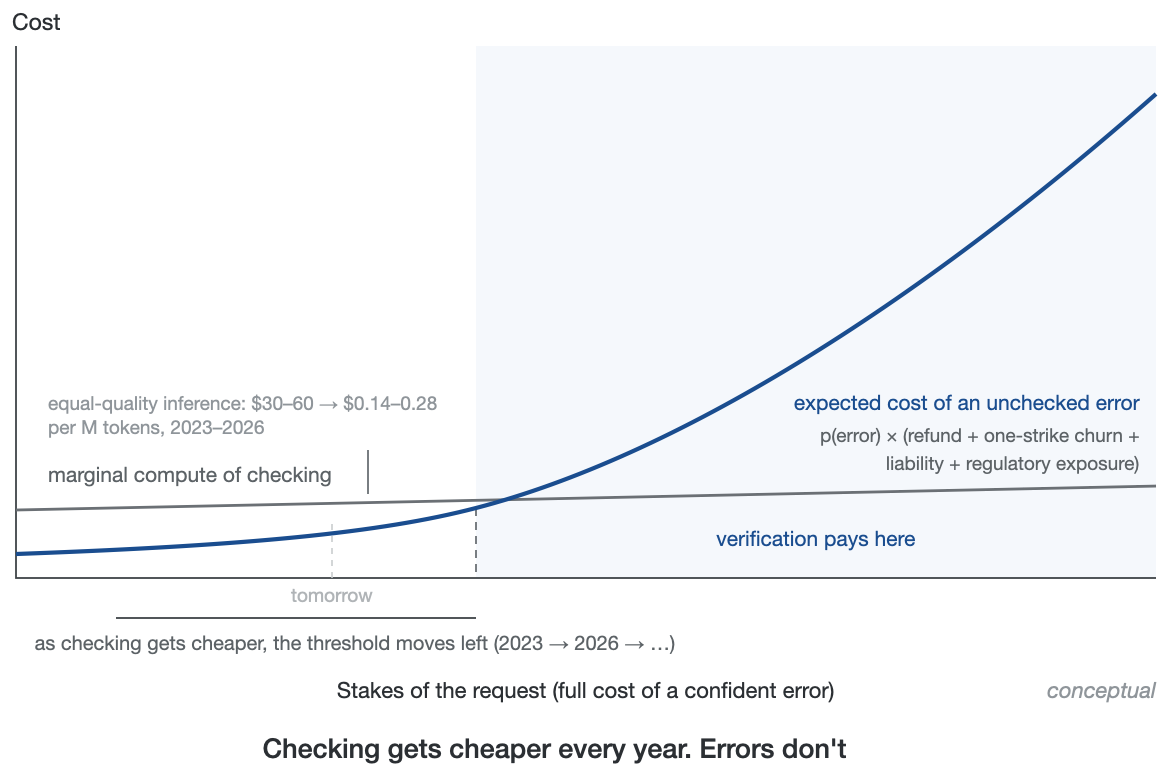
Логіка беззбитковості верифікації.
Чому б просто не використовувати найкращу модель? Найсильніший базис, який залишає хвиля, є комерційним, а не статистичним: оператор міг би пропустити архітектуру і спрямувати все на найточніший флагман хвилі. Цей базис потребує обґрунтування цифрами. За цінами середини 2026 року фіксована трилабораторна рада коштує $0.0039 за питання, менше, ніж одна відповідь від найдорожчого флагмана хвилі (claude-fable-5, $0.0198/питання за списковою ціною) і більше, ніж одна від його найточнішого (gpt-5.6-sol, $0.0027/питання за опублікованими тарифами API). «Просто купіть найкраще флагманське рішення» — це справжня точка Парето: gpt-5.6-sol окремо дає відповідь на всі питання з показником впевненої помилки 4,6%, і жодна конфігурація затвору не досягає його покриття за будь-яку ціну. Де б сервіс міг терпіти впевнену помилку приблизно в одній відповіді з двадцяти й потребує повного покриття, флагман перемагає на обох осях. Правило узагальнюється погано, однак, навіть на вершині рейтингу: інший консенсус-лідер хвилі, claude-fable-5, має показник впевненої помилки 10,3% окремо. «Просто використовуйте модель, що лідирує в тестах» не спрацьовує для другої за силою моделі в зразку, тому проблема ідентифікації нижче не є гіпотетичною. Чотири міркування обмежують порівняння.
По-перше, проблема ідентифікації: знання про те, яка модель наразі найкраща, саме є продуктом зовнішнього, міжмодельного вимірювання. Таблиця 8 хвилі обрала своїх флагманів з публічних рейтингів, безперервних, сторонніх, міжпостачальницьких порівнянь, які ніхто не пропонує замінювати на самозвіт постачальника. Дані цієї роботи показують, чому ніхто цього не робить: заявлена самовпевненість розрізняє при AUROC 0,53–0,79 залежно від постачальника, і 84-поінтовий розрив точності розділяє моделі, усі продані як найкращі своєї лабораторії. «Спрямування до найкращої моделі» — це тому застосування архітектурної довіри, а не альтернатива їй: рейтинг, що вінчає флагмана, — це незалежна комісія, замасковані завдання та опублікований запис, три компоненти розділу 3, які працюють у масштабі ринку. І та корона рухається: лідерство корпоративної моделі змінилося за одну весну (Kharazian, 2026), моделі оновлюються мовчки під стабільними назвами, і поведінка агентів при придбанні дико перестановляється під час оновлення моделей (Allouah et al., 2026). Без постійного зовнішнього вимірювання, «найкраща модель» недоступна оператору як знання.
По-друге, 95,4% — це частково пам'ять, а не здатність: топ-флагман відтворює еталонний рядок відповіді слово в слово на 61,6% елементів (оговірка про забруднення таблиці 9), тому його виміряна перевага стискається на питаннях, які бенчмарк не міг навчити. Механізм затвору не успадковує цю крихкість: на рівні найменше схильному до запам'ятовування він видаляє 89,4% впевнених помилок, його найкраще виконання, а не гірше (переаналіз, стратифікований за забрудненням, нижче), оскільки узгодження між незалежно навченими лабораторіями не залежить від корпусу навчання жодного постачальника.
Щоб відокремити передавальне знання від впливу бенчмарку, я склав свіжий 100-елементний двокроковий зонд, який гарантовано не забруднений, машинно сгенерований 6 серпня 2026 з пар незалежно перевірених фактів Wikidata до 2023 року (наприклад, «У якому році народився архітектор [малої будівлі]?»), кожен з однією обчисленою відповіддю, тому складені рядки питань не могли з'явитися в жодному корпусі навчання. SHA-256 набору було зафіксовано перед першим викликом моделі.
Під замерзлим протоколом хвилі (дослівний системний запит, temperature 0, той самий детерміністичний грейдер), gpt-5.6-sol впав з 95.4% точності з 4.6% частотою впевнених помилок на SimpleQA до 33.0% [bootstrap 95% CI 24.0–42.0] з впевненими помилками на 61.0% [51.0–70.0] своїх елементів (67.0% його впевнених відповідей), його середня заявлена впевненість ледве рухалась (98.4 → 93.7), тоді як claude-fable-5 залишився на 76.0% [67.0–84.0] та 6.0% [2.0–11.0]. 25-пунктний розрив флагмана хвилі змінюється на 43-пунктний дефіцит у гарантовано невидимих композиціях. Портал ради, незмінний від хвилі, поглинув цю помилку: він видалив усе крім однієї з 61 впевненої помилки gpt-5.6-sol (60/61; при n = 61 пунктний курс неточний, Wilson 95% CI ≈ 91–99.7%; 24.2% охоплення; claude-fable-5: 6 → 1), скоротивши видану частоту впевнених помилок серед схвалених відповідей високої впевненості до 4.5% проти сирих 67.0%.
Рівні не порівнюються за пунктами в межах тестів: двоступенева композиція внутрішньо складніша за одноступеневу вибірку, а при n = 100 інтервали широкі. Але розворот впорядкування моделей і персистентність портала на елементах, які жодна модель не могла запам'ятати, є саме сигнатури, які рахунок забруднення передбачає, і вони є режимом невдачі, у які архітектурний шар довіри, а не кращий вибір моделі, побудований поглинати.
По-третє, існує поріг. Портал досягає частоти впевнених помилок, яку жодна окрема модель не досягає за будь-якою ціною: конфігурації з портала ради скорочують впевнені помилки на видавлених відповідях до 1.8–2.1% при $0.0039–0.0046 за запитання, 2.5× нижче найкращого одиничного курсу, тоді як найдорожчий флагман хвилі знаходиться на 10.3% впевнених помилок за $0.0198 за запитання, домінує на кожній осі. Портал — це не рятувальний пристрій для слабких моделей: qwen-max за тим же порталом все ще виходить з ладу впевнено на 73.9% його видавлених впевнених відповідей, тому гейтові точки межі — це ради сильних моделей, не портали над слабкими.
По-четверте, коли агент витрачає гроші автономно, операційне запитання зміщується від «яка модель розумніша» до «яка конфігурація може довести, що вона робила». Як би вона ні була точна, одиничний флагман не може нотаризувати своє власне рішення чи арбітрувати свій власний конфлікт інтересів. Конфігурація з порталом виробляє придатний до перевірки запис угоди на відповідь. Це артефакт, ринки відповідальності та страхування розділу 5 уже оцінюють, де покриття пишеться проти доказів та виключено-сформовано проти його відсутності.
Дозвіл — це межа, не переможець. Флагман є найсильнішим членом ради (замерзла рада його включає), проте він не може служити своїм судді. Таблиця лідерів, яка його ідентифікує, уже спирається на той же принцип, який архітектурна довіра здійснює, незалежну перехресну перевірку моделей, але вона постачає цю перевірку лише в сукупності, про моделі в цілому, а не про відповідь перед споживачем. Конструкція заповнює цей зазор, і зазор також його обмежує: твердження, що спирається на жодну незалежну перевірку, знаходиться поза архітектурною довіро, а не є її екземпляром. Справжній вибір оператора — це вибір між класами ризику: повне охоплення при 4.6% впевнених помилок, або 31% охоплення при 1.8% з журналом аудиту, вибіркова торговля класифікацією, оцінена тут. Повна межа 26-конфігурацій вартості–охоплення–ризику (кожен одиничний флагман, кожна конфігурація з порталом та об'єднані драбини угоди, з базисом виставленої проти вказаної ціни позначеним на пункт) випущена як CSV з пакетом репліката.
Очевидний суперник портала розбіжності — це ремонт калібрування однієї моделі: дізнатися відображення впевненості в точність кожної моделі та видавати тільки там, де відображена точність перевищує поріг, програма пост-хоку перекалібрування чиїх стандартні засоби — це temperature та Platt scaling (Guo, Pleiss, Sun, & Weinberger, 2017). Припасовано на роз'єднані половини (впевненість, розташована в гістограмі, навчитися на питаннях з парними індексами, оцінити на непарних, контейнери з менше 20 спостережень не видаються), цей паспорт калібрування видаляє 92.7% впевнених помилок, але при 24.3% видачі, та шість з одинадцяти флагманів не видають нічого взагалі: жоден контейнер їхньої впевненості не досягає 80% точності навчання, тому паспорт для цих моделей — чиста сторінка. Для половини ринку флагманів калібрування однієї моделі не може бути відремонтовано ззовні. Портал розбіжності утримує приблизно 30% охоплення для кожної моделі в таблиці, включаючи шість, які паспорт покидає. Отже, висновок першого експерименту тримається на цьому рівні також: архітектура може постачати зовнішній сигнал правильності там, де виявлена впевненість моделі виходить з ладу як у рейтингуванні, так і на рівні, виміряно знову на рівні, якому споживачам сказано найбільше довіряти.
Стійкість ефекту портала. Два перевірені арбітром перевіри мають значення: циклічність, чи портал спирається на його найсильнішого члена, та чи щось тривіальне робить ту ж саму роботу. Заміна найсильнішого члена ради (gpt-5.6-sol, 95.4% розв'язана точність) на четвертий запуск межі ex-ante хвилі (grok-4.5) залишає результат по суті незмінним. Рада без сонця видаляє 81.2% об'єднаних впевнених помилок при 29.7% охоплення (цілі не-ради: 77.6%) проти 82.1% при 30.5% для замерзлої тройки, і у всіх 165 можливих трьохмодельних радах механізм ніколи не виходить з ладу: кожна рада видаляє більше впевнених помилок ніж випадкова утримання при її власному охоплені (медіана надлишку +8.5 пункту), з ex-ante тройкою в топ 4% за цією межею (+12.6 пункту). Ефект належить до угоди між моделями, а не до точності будь-якого члена. Встановлення порога кожної моделі на її власну заявлену впевненість до однакового охоплення на модель, тривіальна лінія порівняння, видаляє тільки 66.7% об'єднаних впевнених помилок, менше ніж 69.5%, які сліпа випадкова утримання при тому ж охоплені видаляє, тому що впевнені помилки за конструкцією зосереджені на висока заявленій впевненості. Цей поріг також тримає менше впевнено-правильних відповідей ніж портал (46.4% проти 51.3%). Портал Pareto-домінує обидві лінії порівняння для кожної з одинадцяти лабораторій. Використання угоди на відповідь тільки з найсильнішою моделлю як фільтр є ще сильніший екран (97.1% об'єднаних впевнених помилок видалено при 40.7% охоплені, утримуючи 97.0% впевнено-правильних відповідей), але це механічно різне, правило, обумовлене цілю. Він пропускає відповідь тільки після її огляду, тоді як портал ради відкриває той же фіксований набір запитань для кожної моделі без дивленням на відповідь під тестом, тому він обмежує ефект ради без його пояснення: без сонця тройка все ще видаляє 81.2%, і навіть угода зі слабким одиничним суддею (kimi-k3, 45.5% розв'язана точність) видаляє 86.3% впевнених помилок. Водій — це угода між моделями як така, тоді як точність судді проявляється в тому, що зберігається (зберігає-правильні 97.0% для сонця проти 20–63% для менш сильних суддів).
Калібрована абстинентність забезпечує сильніші конкуруючі базові варіанти, і вони також були запущені. Два базові варіанти каліброваної абстинентності були пристосовані під тим же розбиттям, що й паспорт калібрування (параметри пристосовані на парно індексованих елементах, оцінені на утримуваній непарній половині, де заморозений шлюз видаляє 82,2% впевнених помилок при 30,8% покриття). Базові варіанти для кожної моделі не досягають шлюзу. Впевненість з масштабуванням Платта з покриттям для кожної моделі, узгоджена зі шлюзом, видаляє 65,3% впевнених помилок, а розбиття-конформна абстинентність (α = 0,293, калібрована для гарантування P(emit | wrong) ≤ α та настроєна на те ж покриття) видаляє 70,8%, як і контроль заявленої впевненості top-K без обробки при тому ж об'єднаному покритті, що видаляє 69,4%. Об'єднаний варіант, який ранжує відповіді всіх одинадцяти лабораторій на одній ймовірнісній шкалі, каліброваній за Платтом, справді перевищує шлюз (89,0% при ідентичному об'єднаному покритті), але робить це шляхом перерозподілу по суті всього покриття добре каліброваним лабораторіям: він видає 100% відповідей найбільш добре каліброваного постачальника та 0% для чотирьох з одинадцяти лабораторій, відтворюючи в пом'якшеній формі наведений вище режим відмови паспорту. Він також вимагає приблизно семисот оцінених відповідей на модель для пристосування, де шлюз не вимагає ніяких. Калібрована впевненість та міжмодельна згода є тому доповненнями, а не замінниками: перша дає нижчу об'єднану частоту помилок всюди, де існують мітки наземної істини для навчання їй, а друга дає рівномірний захист без міток для кожної лабораторії.
Рисунок 19 розташовує кожну стратегію на площині вибіркового прогнозування (об'єднано над 13 955 детерміністично вирішеними відповідями, які повернули одинадцять варіантів на заморозеній вибірці з 1 459 питань, тому загальна кількість менша за таблицю 9, яка рахує вирішені відповіді над усіма 1 500 питаннями; вибірковий ризик = частка виданих відповідей, які є неправильними). Ранжовано за площею під кривою ризик-покриття, менше краще: впевненість, калібрована за Платтом, 0,258, драбина шлюзу, вишліфована заявленою впевненістю, 0,321, чиста драбина згоди 0,356, сира заявлена впевненість 0,367, випадкова абстинентність 0,517, проти рівня оракула 0,166; значення утримуваної половини різняться не більш ніж на 0,009. На власній робочій точці заморозеного шлюзу (31,1% покриття в цій конвенції вирішеної відповіді, 4 334 з 13 955 виданих відповідей; 30,5% та 30,6% повідомлені в інших місцях — це частки впевнених відповідей та питань пула) ризик шлюзу становить 24,9%, проти 33,4% для сирого порогу впевненості та 14,0% для каліброваної впевненості, з урахуванням застережень щодо вартості міток та концентрації покриття, наведених вище. Хмара всіх 165 тримодельних рад охоплює покриття 9–59% при ризиках 13–38%, тому повідомлений шлюз є представницьким членом його сім'ї, а не налаштованим викидом. Шлюзи одного судді відслідковують виродженість сім'ї, де «згода» зводиться до «запитання до найбільш точної моделі».
Рисунок 19. Межа ризику–покриття
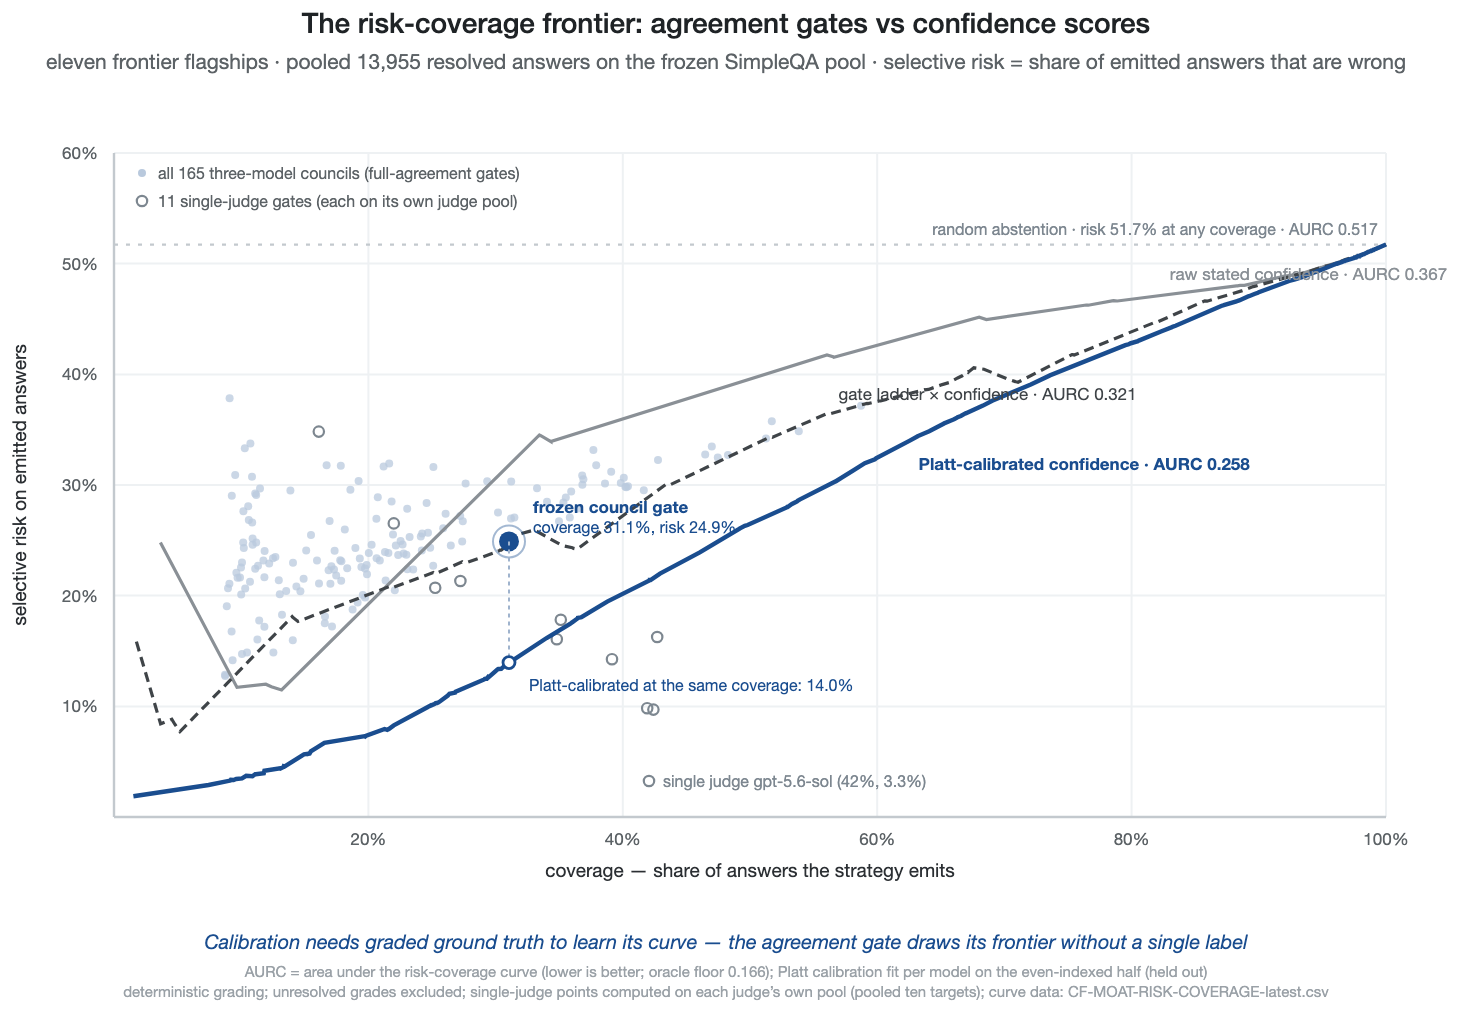
Кожна стратегія утримання на площині селективного передбачення, охоплення проти селективного ризику, об'єднані з 13,955 детерміністично розв'язаних флагманських відповідей, повернених одинадцятьма варіантами на замороженому пулі з 1,459 запитань (Таблиця 9 підраховує розв'язані відповіді серед усіх 1,500 запитань): криві необкаліброваної впевненості, Platt-калібровані та gate-ladder-×-впевненості з їхніми значеннями AURC, лінія випадкового утримання, хмара всіх 165 трьохмодельних рад, одинадцять однозасідацельних шлюзів та робоча точка замороженої ради (31,1% охоплення в конвенції розв'язаних відповідей, 4,334 із 13,955; 24,9% ризику). Нижче краще; оракульний мінімум дорівнює 0,166. Кожна точка перерахункова з CSV ризику-охоплення пакета репліканції.
Узгодженість може не містити більшої інформації, ніж складність запитання. Для перевірки цього було виконано логістичну регресію правильності відповіді стосовно узгодженості шлюзу та складності позиції (частка неправильних відповідей серед інших моделей на цьому запитанні), з фіксованими ефектами лабораторії та стандартними помилками, кластеризованими за запитанням, і відповідь залежить від того, як вимірюється складність. Коли складність вимірюється тільки моделями, що не входять до ради (справедлива контроль, оскільки міра складності, яка включає власні відповіді ради, вбудовує сигнал шлюзу за конструкцією), узгодженість зберігає незалежний внесок на зовнішніх лабораторних цілях: b = +0,76, коефіцієнт шансів 2,15, z = 17,2. Відповідь, видана шлюзом, має приблизно вдвічі вищі шанси бути правильною, ніж однаково складна відповідь, яку шлюз утримав би. Якщо замість того додати власну правильність ради до реґресора складності, то коефіцієнт узгодженості падає до нуля, що кількісно визначає механізм, а не спростовує його: узгодженість та багатомодельна складність є двома вимірюваннями однієї латентної величини, і шлюз є інструментом без міток для її читання під час умовиводу.
Стратифікований за забрудненням повторний аналіз безпосередньо розглядає занепокоєння щодо експозиції. Позначення запитання як, ймовірно, піддане експозиції до бенчмарку, коли щонайменше три з одинадцяти лабораторій відтворюють золотий рядок дослівно після нормалізації (741 із 1,459 запитань з пулу; та сама ознака, яка дає коефіцієнт золотого відлунення 61,6% для gpt-5.6-sol), шлюз видаляє 89,4% впевнених відмов на шарі непіддане експозиції (2,793→296; цілі поза радою: 86,5%) проти 72,7% на підданому експозиції. Таким чином, механізм не залежить від запам'ятованих завдань. Він поводиться так, як повинен селективний фільтр, активуючись набагато рідше там, де панель справді невпевнена (18,7% проти 41,9% охоплення), і утримуючи коефіцієнт виданої впевненої відмови близько постійним по всіх шарах (25,9% проти 21,8%, з необоротних показників 58,5% та 36,4%). Пороги експозиції 2–5 моделей-еха дають непіддане експозиції dCF 87,7–89,7%, тому результат є робастним щодо порога. Розшарування є описовим: золоте-відлуння пов'язане з результатом, і воно відокремлює, ймовірно, побачене від інших запитань, замість того щоб каузально ідентифікувати забруднення.
Що купує більший бюджет міркування: впевненість, а не компетентність. Провідні постачальники тепер продають другий регулятор над вибором моделі: бюджет міркування, коштує за токен прихованого обміркування. Якби розширене міркування купило калібрування, це була б відповідь на рівні моделі на проблему цієї роботи, придбавна в касі. Парний експеримент на одному флагмані говорить, що він купує щось інше. Google gemini-3.1-pro (чиє міркування не можна вимкнути) відповів на ту саму замерзлу набір запитань під двома бюджетами, низька налаштування зусилля міркування та типовий динамічний бюджет постачальника, з температурою нуль, однаковими підказками та парсером, та записаною вартістю на запитання. На 233 запитаннях, відповіданих під обома бюджетами на дату цієї версії: точність 75,1% (низька) проти 76,4% (типова), немає виявляємої різниці (точний McNemar p = .648); заявлена впевненість на 3,1 пункти вища під типовим бюджетом (Wilcoxon z = 4.68, p < .0001); калібрування дещо гірше під типовим бюджетом (парна ECE 0.100 проти 0.082; різниця впевненість−точність +9.3 проти +7.5 пунктів); вартість на запитання 2.1×. Порівняння точності - це нуль особливого роду: ці дані показують немає виявляємої різниці в точності на n = 233 (точний McNemar p = .648), і еквівалентність формально встановлена тільки на грубій межі. Парний TOST обмежує різницю точності в межах ±5 пунктів (різниця +1.3 пункти, 90% CI [−1.8; +4.4]; обидві односторонні p ≤ .024), але дослідження не має потужності для встановлення еквівалентності на ±2–4 пунктах, в той час як підвищення на +3.1 пункту в заявленій впевненості статистично не двозначна (Wilcoxon p < .0001). В межах цієї межи, подвійні витрати придбали додаткову заявлену впевненість та не виміриму додаткову коректність: надмірна впевненість як платна функція та внутрішньомодельний приклад міграційного тезису. Додаткові долари пішли до шару моделі та не створили нічого, що споживач міг би перевірити, в той час як архітектурний шар над ним перетворив впевненість на перевіримий сигнал. Результат - це пілот, про який повідомляється як такий: порівняння охоплює 233 парні запитання, і повний дизайн з 1500 парами звужує межу еквівалентності приблизно до двох пунктів; композиція каналу та цензура на верхній межі токена документовані як змішувальні фактори в пакеті репродукції; збір продовжується.
Рисунок 18. Що купує більший бюджет міркування
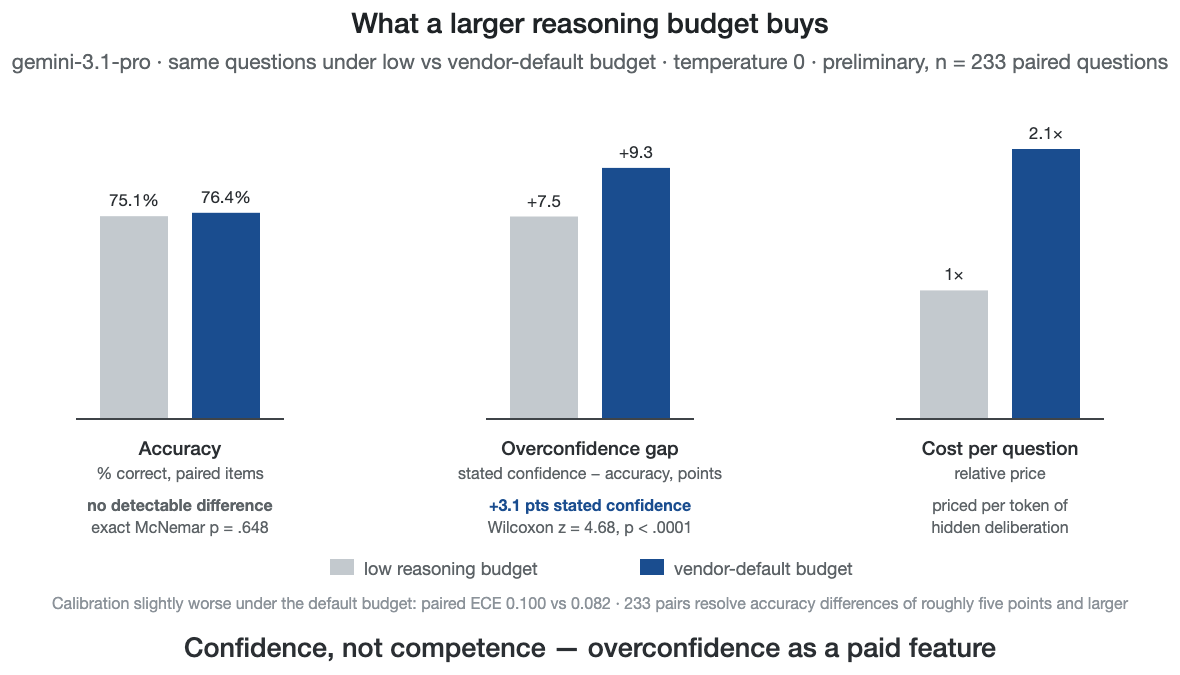
Парне порівняння під двома бюджетами міркування — заявлена впевненість зростає, точність не зростає.
Таблиця 11. Бюджет міркування, парне порівняння (gemini-3.1-pro, 233 запитання, відповіданих під обома бюджетами, температура 0; попередньо)
| Низький бюджет міркування | Типовий бюджет постачальника | |
| Точність (парні елементи) | 75,1% | 76,4% (McNemar p = .648) |
| Середня заявлена впевненість | −3.1 пункти проти типового | +3.1 пункти (Wilcoxon p < .0001) |
| Калібрування (парна ECE) | 0.082 | 0.100 |
| Різниця впевненість − точність | +7.5 | +9.3 |
| Вартість на запитання (відносна) | 1× | 2.1× |
Налаштування зусилля міркування не були однаковими по рукам: кожного постачальника запитували через його стандартний комерційний інтерфейс за типовим зусиллям цього інтерфейсу (налаштування зареєстровані для кожної моделі в пакеті репродукції), тому абсолютна точність постачальника може мати компонент зусиль. Це не досягає механізму. Рейтинг точності не є несучим (мітка флагмана нічого не гарантує), ворота пережили видалення будь-якого члена (рада без розв'язку видаляє 81,2%), і більше зусиль підіймає заявлену впевненість з плоскою точністю, як щойно показало парне порівняння, тому будь-яка точність, яку вона завищує, з'являється як впевнена помилка, невдача, яку ворота перехоплюють.
Обмеження охоплення хвилі флагмана. Хвиля - це замерзлий знімок 5 серпня 2026 року, тому моделі, випущені пізніше, такі як Grok 4.6 (12 серпня) та пізніші лідери Artificial Analysis, такі як Claude Opus 5, мають пізнішу дату та не можуть увійти в попередньо зобов'язаний тест. Топ-позиція змінилася впродовж днів. Це проблема ідентифікації, яку ворота обходять (згода стійка до списку, пережившаяся видалення будь-якого члена). Два включені лабораторії падають нижче поточної межи на таблицях лідерів загальної можливості: флагман Mistral перевищує топ-тьму на кожному перевіреному агрегованому індексі, а ERNIE загального призначення Baidu займає місце поза топ-30 на Humanity's Last Exam (його сила в посилених пошуком та агентських завданнях, де ERNIE 5.1 займає місце #4 на LMArena Search Arena). Вони зберігаються для збереження охоплення європейської екосистеми та всіх основних китайських лабораторій. З двох лабораторій вищого рівня, які замість цього були поза межами хвилі, Meta Superintelligence Labs (Muse Spark 1.1; #4 на Humanity's Last Exam) та ByteDance (Seed 2.1; #10), один був згодом спроб і перерваний (Meta, нижче) та один взагалі не міг бути досягнутий (ByteDance, нижче).
ByteDance Seed 2.1 не міг бути включений: BytePlus ModelArk повернув "not available in your country/region" для щойно зареєстрованого міжнародного облікового запису (жива спроба, 5 серпня 2026), жодна агрегаторна служба не обслуговує флагман, та внутрішній канал Volcano Ark вимагає верифікації на материковій Китаї. Baidu ERNIE 5.1, поточний флагман, аналогічно обмежено до внутрішньої платформи Qianfan (жива спроба, 5 серпня 2026). Коли поточний флагман лабораторії недоступний, правило резервування - це найсильніша публічно випущена модель з цієї лабораторії. Для Baidu це ERNIE 4.5 VL 424B (open-weights), яка замість цього використовується. Це є висновком сама по собі: поточні флагмани двох з шести основних китайських лабораторій не доступні для зовнішніх дослідників станом на серпень 2026.
Meta — третій збій доступу в хвилі, і перешкода була на моєму обліку, а не за географічними причинами. У першій (середньорівневій) хвилі Meta була відсутня з документованої причини інфраструктури: її власний Llama API був припинений 6 липня 2026 року, до заморожування протоколу (записано в маніфесті запуску), а лабораторія була представлена на локальному рівні своєю Llama-3.2-3B з відкритими вагами, яка виявилася одним з найпоучальніших членів панелі (найнижча кореляція помилок у всій матриці). Для флагманської хвилі мусе-спарк-1.1 Meta було додано в середину хвилі, коли вона стала доступною, і збір потім збився трьома способами послідовно, кожний записаний: (i) власний ключ API Meta Model помер в середині запуску 5 серпня з 251 зібраною правильною відповіддю, і консоль розробника не видала заміну; (ii) маршрут резервного агрегатора дав 21 подальшу відповідь перед (iii) кінцевою точкою Meta, яка почала повертати HTTP 403 `user_blocked`, "доступ був обмежений через повторні порушення політики," для закритих питань на відповідь про факти з публічного тесту, запитані при нульовій температурі. Чистий результат — 272 з 1500 одиниць (18,1%) зібрано і повідомлено як часткові: заморожений об'єднаний аналіз включає 251 власну відповідь (дозавантаження від агрегатора потрапило після заморожування аналізу), і оцінка Meta для кожної лабораторії (−92,0% dCF на 125 впевнених відповідях) за напрямком узгоджена з панеллю, але занадто неточна для висновків. Сам блок є знахідкою: станом на серпень 2026 року незалежний дослідник не може завершити 1500-питаннєву фактичну оцінку флагмана Meta через будь-який авторизований канал. Разом три збої доступу в хвилі — географічно заблокований флагман (ByteDance), внутрішньодержавний флагман (Baidu) та заборона для дослідників (Meta) — являють собою теоретичну аргументацію у емпіричній формі: можливість перевірки на рівні моделі залежить від благодаті постачальника, і архітектурний шар довіри не може покладатися на благодать постачальника.
4. Крайне розгортання: делегування з незворотними наслідками
Звичайний спосіб дослідження довіри споживачів — опитування чи лабораторне завдання. Мав на розпорядженні жорсткіший інструмент: розширене розгортання з високими ставками, в якому я нісся всі наслідки. Цей розділ — доказ існування та дизайнерське свідчення від одного оператора з конфліктом інтересів, а не емпіричний доказ узагальненості, і жодна з P1–P5 залежить від нього. Два види доказів взаємопов'язані. У лабораторії ефект калібрування вимірювався під контролем плацебо; у розгортанні, де помилки були незворотні, ті самі три властивості визначали різницю між можливістю безпечного делегування та делегування з необережністю.
Розгортання не належить клієнту і не є симуляцією: я одночасно оператор, розробник і аналітик. Шар доказів закріплено гешем, і кожне вимірювання можна незалежно перевірити, тому конфлікт інтересів стосується захисту та того, що я вибрав для вимірювання, а не того, чи можна цифри відтворити. Обстановка поєднує звичайну компетентність споживача з незворотними наслідками, де кожна архітектурна слабкість миттю виявляється очевидно.
Методологічно це екстремальний, виявляючий одиничний випадок (Yin, 2018) в інтерпретативній та аналітико-автоетнографічній традиції (Walsham, 1995; Gould, 1991; Anderson, 2006), з урахуванням застережень цієї традиції щодо доказів (Wallendorf & Brucks, 1993): записи насамперед, інтерпретація позначена як інтерпретація. Обґрунтування — доступ: дослідник не може етично спонукати учасників до незворотних ставок на архітектуру штучного інтелекту, тому єдиним доступним спостерігачем є учасник, який сам цей ризик вибрав.
Аналіз спирається на тогочасні журнали, закріплені гешем. Шар доказів розгортання сам є записом: ключові кроки (які моделі були консультовані, де вони розійшлися, що було заблоковано, що я підтвердив) були записані в той час, тому спостереження спираються на відтворювані записи, а не лише на пам'ять. Неможливо позбутися упередженості задньої думки під час інтерпретації, тому я позначу кожне місце, де інтерпретація виходить за межи записів. Записи періоду розгортання шару доказів системи закріплені гешем станом на 2 серпня 2026 року: маніфест SHA-256 кожного файлу з 129 файлів (7 414 043 байтів) з коренем 2f88a16611e51c0c12c8015754c89269e782ea167a89b5ed2a881f18eee4defc, і якір опублікований з цією статтею. Записи залишаються запечатаними до завершення розгортання, оскільки вибіркове цитування з живого розгортання було б гірше, ніж його відсутність. Зобов'язання можна перевірити: будь-який запис, випущений пізніше, або збігається з якорьованим маніфестом, або ні, тому редагування після факту, заміна або зміна дати виявляються будь-яким читачем цієї сторінки. Більш детальна кількісна обробка телеметрії залишається для майбутніх робіт з тієї ж причини.
Пропонуються три спостереження з цього циклу як гіпотези про те, що поширюється поза межи оригінального середовища, живлячи пропозиції розділу 3; подій, на яких вони спираються, розгортання записало тогочасно.
Незгода — це сигнал, який може використовувати споживач. Коли незалежні моделі розійшлися щодо питання з наслідками, сама розбіжність, виявлена замість приховування, показала мені, де лежала справжня невизначеність: вільне ранне попередження, яке не може дати жоден одномодельний сервіс.
Докази впливають на поведінку раніше, ніж на вирішення суперечки. Знання того, що кожен крок з наслідками був записаний, зробило делегування психологічно можливим; запис був умовою надійності, а не переглядом аудиту.
Контроль впевненості має більше значення, ніж середня точність. Практично небезпечними були впевнені помилки, ніколи посередні результати. Справжній внесок архітектури полягав у тому, щоб зробити високу впевненість дорогою: відповідь повинна була отримати узгодження всіх моделей, щоб мати це, замість отримання її даремно від плавності однієї моделі.
5. Наслідки: від переконання до інфраструктури
Дизайн та досвід
Для проектування сервісів. Одиниця проектування надійного сервісу штучного інтелекту переміщується від моделі до конвеєра. Це означає спрямування важливих запитів через незалежні моделі, розглядання розбіжностей як першокласного елемента UX, за замовчуванням додання доказів та визначення ціни багатомодельної обробки щодо асиметричної вартості впевнених помилок, при цьому дорогий шлях зберігається для запитів, де ставки концентруються, як системи виявлення шахрайства зберігають ретельну перевірку для ризикованих операцій. Інфраструктура вже існує: каскади, керовані вартістю, що передають складні запити дорогим ярусам, є стандартною інженерією агентів, і для сервісу, що уже маршрутизує за складністю, архітектура маршрутизації за наслідками близька до нуля. Режими відмов, виявлені обома експериментами, встановлюють два жорсткі правила, і вони є вимогами проектування, не перевагами. Позиції мають бути зібрані наосліп та записані перед будь-якою міжмодельною нарадою, оскільки конвеєр, що розпочинається з наради, виробляє саме той консенсус, який архітектура повинна контролювати (тиск конформізму розділу 3). Друге правило: одностайна впевнена згода щодо обмеженого набору варіантів постає тривожним сигналом для перегляду, а не дозволом для виконання: як панелі моделей, так і людські учасники розділу 6 розглядали цей консенсус як засвідчення.
Це економічно виправдано, оскільки підвищення здійснюється поступово — поступова архітектура довіри: в описаному тут розгортанні яруси обробки охоплюють приблизно три порядки величини у вартості на запит між одномодельною відповіддю та повною багатомодельною нарадою (станом на липень 2026 р.), тому дорогий ярус використовується лише там, де концентруються наслідки. Логіка беззбитковості — та ж, що й у оцінці шахрайства (Рисунок 14). Оркестрація окупається щоразу, коли ймовірність помилки, у яку впевнена модель, помножена на її повну вартість (повернення коштів, втрата клієнтів у разі однієї помилки, відповідальність, регуляторний ризик) перевищує додаткові обчислювальні витрати перевірки. Для операцій з високими ставками ця нерівність є значною.
Падіння цін на інференцію (приблизно на два порядки величини при фіксованій здатності протягом трьох років, консервативне тлумачення зафіксованих темпів спаду; Appenzeller, 2024) не скасовує аргумент, оскільки коефіцієнт, а не абсолютна вартість, є структурним показником: обидва рівні спускаються вниз по кривій ціни разом, а дешева інференція робить дорогий рівень доступним при дедалі нижчих ставках. Перевірка йде своєю другою кривою: ансамблі слабких верифікаторів без позначених даних досягають точності виділення правильної відповіді моделей frontier reasoning з 70-мільярдпараметрових відкритих компонентів (Saad-Falcon et al., 2025). Враховуючи нульову толерантність споживачів до помилок, порівняння полягає не в "дешевій відповіді проти дорогої", а в "дорогій відповіді проти втраченого клієнта".
Два примітива, орієнтовані на споживача, завершують дизайн: навмисне тертя (помітна пауза перед незворотними діями) та квитанції. Обидва впливають на те, як делегування відчувається. Споживачі взаємодіють з AI соціологічно, а не статистично (Puntoni, Reczek, Giesler, & Botti, 2021), і оскільки делегована виконання видаляє зустріч зі послугою зі сцени, квитанція успадковує давню роль зустрічі як момент істини. Цей фреймінг несе ризик: акцентування розбіжностей може висвітлювати невизначеність і послабити довіру, а не калібрувати її (Detjen et al., 2025; Lu, Wang, & Yin, 2024), тому те, скільки розбіжностей показати та як, є змінною дизайну. Це не безкоштовна послуга.
Квитанція оркестрації може бути мінімальною і все ще виконувати свою роботу (Figure 8 показує макет). Три поля містять більшість цінності: (1) хто діяв, які моделі та версії використовувались, під яким повноваженням; (2) як вони дійшли консенсусу, розбіжності у простих термінах; (3) що було перевірено, з посиланням на повний повторно програвний запис: досить малий, щоб прочитати з першого погляду, і досить конкретний, щоб обґрунтувати суперечку, страховий позов або аудит. Той же артефакт відповідає на питання оператора щодо власних записів, тому квитанція служить двом цілям: всередину як контроль витрат, назовні як обґрунтована довіра. Ця двосторонність є необхідністю. Виміряна готовність споживачів платити лише за прозорість є мізерною (в одному дослідженні сумісного аналізу цін вартість пояснювальності виявилась нижче €1,99 на місяць; König et al., 2022), тому шар довіри, фінансований лише стороною споживача, не мав би достатнього фінансування, а операторська сторона контролю витрат його підтримує. Найближчим інженерним аналогом квитанції є квитанції інструментів, записані всередину фреймворків агентів для виявлення галюцинацій (Basu, 2026), які мають той же інстинкт, але не аудиторію: ті є записами, орієнтованими на розробника, окремих викликів інструментів, тоді як квитанція оркестрації є їх узагальненням, орієнтованим на споживача, на рівні кожного рішення. Квитанція має свій власний режим відмови: артефакт, спроектований так, щоб виглядати перевіреним, не розкриваючи нічого, що споживач міг би повторити. Важлива лінія дизайну полягає в тому, чи запис дійсно є повторно програвним, а не просто має форму квитанції. Обмеження приходить також з боку конфіденційності: артефакт, який доводить, що було перевірено, також реєструє, що було обрано, тому перевіреність та конфіденційність мають оптимізуватися спільно (Alavi & Nozari, 2026).
Останнім компонентом економіки квитанцій є те, що має власну назву, економіка перевірки. Запис, захищений від підробок, коштує лише стільки, скільки коштує чиїсь стимул його відкрити, і десятиліття децентралізованих систем тут застерігає: публічні, захищені від підробок записи блокчейну не перетворили звичайних користувачів на аудиторів, а архітектури «без довіри» непомітно повернули надійних посередників у кожну практичну щілину (Werbach, 2018). Дилема Верифікатора — це формальна версія: там, де верифікація дорога й правильні результати — типовий випадок, раціональний верифікатор пропускає перевірку. Попит на верифікацію має бути зосереджений там, де приватний виторг від перевірки вже існує, серед страховиків, аудиторів та процесів вирішення спорів, з результатом, що споживач успадковує верифікацію як побічний продукт цих ринків; функція квитанції для споживача — доступність у разі спору, а не вечірнє читання. Питання фінансування випливає з того ж пункту, і обидві наївні відповіді на нього не спрацьовують: організатор, що платить споживач, оцінює нейтральність як предмет розкоші, а організатор, що платить купець, повертає конфлікт, який він існує, щоб усунути. Це залишає модель, яку вже передбачає двостороння економіка квитанції. Шар оплачується так, як оплачується аудит, сторонами, які потребують оцінки ризику, а не розповіді про нього (оператори, які купують управління витратами та зменшення відповідальності, страховики, які купують профілі ризику, придатні для андеррайтингу, процеси вирішення спорів, які купують доказ), із мінімальними нормативними стандартами там, де ці ринки створюють недостатній попит. Споживач купує послугу, а не нейтральність, і успадковує нейтральність як її побічний продукт. Та ж проблема має версію в структурі ринку. Платформа, яка одночасно є ринком, постачальником моделей та рекламною мережею, структурно не спроможна забезпечити нейтральність, що є конфліктом інтересів у формі ринку, і історичний запис алгоритмічного пріоритету (спонсоровані розміщення, переважні партнери) говорить, що домінуючі гравці монетизуватимуть маршрутизацію, якщо зможуть. Там, де цей тиск діє, нейтральність забезпечується регуляцією або відкритим протоколом, а не добровільно. Якщо перший попит споживачів на доказ слабкий, прийняття архітектурної довіри може керуватися менше вибором споживача, ніж стороною відповідності та страхування, міграцією через установи, а не переваги, з результатом, що споживачі успадковують верифіковану архітектуру як стандарт. Результат калібрування запобігає тому, щоб цей шлях був декоративним: споживачі явно використовують архітектурний сигнал, коли його їм показують, але вони ще не платять, щоб його викликати. Тут є суперниківна гіпотеза: довіра може мігрувати до відповідальності та установ замість верифікованої архітектури. Споживачі спираються на права зворотного списання, а не на аудити записів; мережі карток розширили дистанційну комерцію через права на вирішення спорів, а не через перевірку споживачами записів авторизації; на цьому читанні запис рішення — це внутрішня система, яка робить відповідальність обчислюваною, а не об'єктом довіри споживача. Два пояснення передбачають різні речі: на архітектурному рахунку споживачі винагороджують верифіковність, коли вони її бачать; на інституціональному рахунку вони винагороджують її лише коли додано засіб виправлення, і довіра споживача тоді залишається якорена в установі, поки довіра установи мігрує до архітектури. Конструкція часу спору, зазначена нижче, розрізняє їх. І кожен шар запису успадковує проблему оракула: запис засвідчує процес, і лише власні перевірки процесу досягають фактів. Асиметрія, яку квитанція інвертує, — це та, яку документує література про критику платформ: архітектура, а не встановлена політика, є функціональним регулятором цифрової поведінки (Lessig, 2006), і досі її інструменти вказували на споживача, а не були у руках сторони споживача (Zuboff, 2019; Möhlmann & Zalmanson, 2017), і квитанція повертає ці інструменти назад інакше.
Шар доказу повинен бути видимим у самому продукті, а не зберігатися в журналі back-office. Програмна інженерія нещодавно прийшла до спільної назви для оболонки часу виконання навколо агентних моделей — оправа агента, і до визнання того, що оправа, а не модель, — це те, що можна сертифікувати, регулювати та якому можна довіряти. Архітектурна довіра визначає, що оправа повинна видавати, щоб заслужити цю роль.
І масштаб, для якого розроблено цей розділ, і відскік, проти якого він розроблений, вже зафіксовані в записах. Помічник Klarna обробив 2,3 мільйона розмов у перший місяць, дві третини чатів служби обслуговування клієнтів компанії та приблизну роботу 700 штатних агентів (Klarna, 2024, цифри, повідомлені компанією). Чотирнадцять місяців пізніше генеральний директор публічно змінив курс: якість виходу постраждала, найм персоналу відновився, і постійне зобов'язання стало таким: «завжди буде людина, якщо ви хочете» (Daly, 2025). Прочитавши це архітектурно, як мое читання, а не встановлену причину компанії, пара оголошень окреслює саме той розрив, який називає ця стаття. Рівень обсягу працює за машинною вартістю, але без поступового підвищення та без верифіковного сигналу якості делегування відскочило назад до базису людини. Те, що зробило б позицію між цими оголошеннями стійкою, — це архітектура поступової довіри: дешево, де ставки низькі, перевірено, де ставки концентруються, і людина, де перевірка не працює.
Ринки та регуляція
Для послуг між країнами. Нейтральність поширюється за межі постачальників моделей на юрисдикції. Шар оркестрації може забезпечити маршрутизацію з урахуванням юрисдикції та записати це забезпечення, перетворюючи відповідність суверенітету даних із правового подання на верифіковну властивість часу виконання. Диференціація, на яку він відповідає, була виміряна: у 25 країнах медіана 53% респондентів довіряє ЄС ефективно регулювати штучний інтелект, на відміну від 37% для Сполучених Штатів і 27% для Китаю (дані Pew, повідомлені в Stanford HAI, 2026, звіт інституту, не рецензований). Там, де довіра відрізняється за юрисдикцією, архітектура, яка може довести, які правила юрисдикції були застосовані, має реальну цінність.
Для агентської комерції. Інтеграція Visa–ChatGPT робить три компоненти конкретними. Ліміти та списки білих списків — це статичні, призначені для споживача рейки. Архітектурна довіра додає динамічний, призначений для послуги шар: покупки перехресно перевірені незалежними моделями (різноманітність), верифіковний запис того, чому агент вибрав цього торговця за цією ціною (доказ), та шар оркестрації, чий дохід не залежить від того, який постачальник або торговець виграє (нейтральність).
Індустрія платежів уже почала будувати нижні поверхи цього стека. Trusted Agent Protocol (Visa, жовтень 2025, з Cloudflare; Visa, 2025) криптографічно підписує ідентичність агента в його запитах: специфічні для торговця та мети, обмежені в часі, захищені від повтору підписи. Agent Payments Protocol (Google Cloud, 2025), розроблений у співпраці з Mastercard для FIDO Alliance у 2026, кодує намір користувача як підписані мандати, передані як W3C Verifiable Credentials (W3C, 2025). Verifiable Intent компанії Mastercard (спільна рамка з Google; оголошена в березні 2026; Mastercard, 2026) висловлює своє призначення словами, які могла б написати ця стаття — захищений від підробок запис про те, що користувач дозволив, коли ШІ-агент діє від його імені, з ранніми пілотами, про які повідомляли на азійських та латиноамериканських ринках у 2026. Докази ідентичності та наміру стандартизуються зараз, а також формат запису: архітектура IETF SCITT (RFC 9943, 2026) визначає той самий шаблон — підписана заява → журнал транспарентності, що додається лише в кінець → розписка, який передбачає шар доказів цієї статті. Інтерфейс, через який відбувається делегування, навіть не морально нейтральний. На тринадцяти експериментах люди, які делегували ШІ, поводилися менш чесно, найгостріше при неясному формулюванні цілей, а машинні агенти виконували повністю нечесні інструкції набагато частіше, ніж людські агенти (Köbis et al., 2025). Інтерфейси, які змушують висловлювати намір у конкретних термінах, — це етична інфраструктура.
Жоден протокол ще не охоплює третій поверх, докази рішення: як агент обрав цього торговця, цей товар, цю ціну; чи були незалежні перевірки узгоджені; яка була його впевненість (рисунок 15 зображує три поверхи). Це той шар, якому дає назву ця стаття, і «знай свого агента» має розвиватися саме в цей процес запитання, при якому одиниця нагляду переміщується вниз до рівня транзакції. Те, що може гарантувати архітектура, — це існування запису, а не його прочитання. Чи буде хтось відкривати такі записи, — це емпіричне запитання, на яке може відповісти лише розгортання.
Рисунок 15. Стек доказів
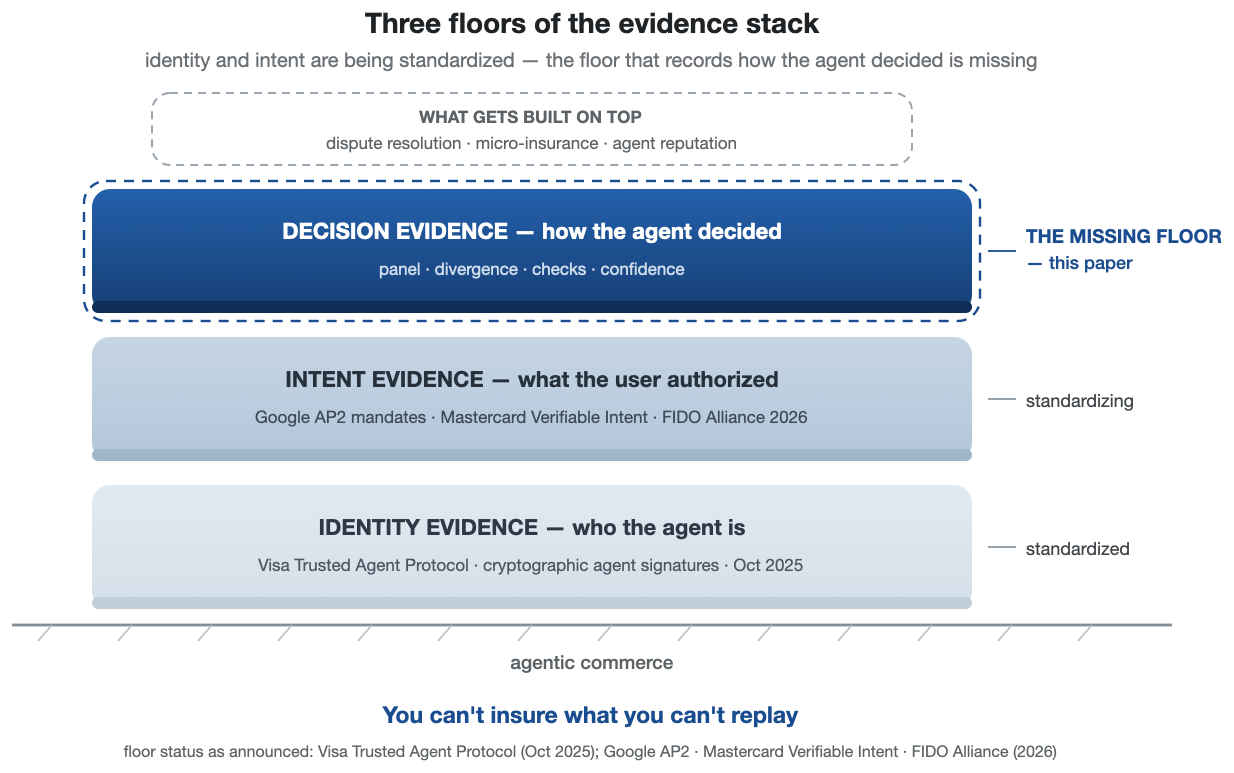
Докази ідентичності та наміру стандартизуються зараз; докази рішення — це перебуваючий на розгляді поверх, якому дає назву ця стаття.
Перші систематичні аудити поведінки агентів при покупках показують, чому докази рішення не можуть чекати. Allouah et al. (2026), проводячи рандомізовані випробування в контрольованій е-комерційній пісочниці, виявили, що агенти для покупок мають сильні позиційні упередження, концентрують попит на кількох «модальних» продуктах і кардинально змінюють ці переваги, коли оновлюється базова модель. Без запису про те, як було зроблено вибір, ніщо з цього не видно споживачу, торговцю чи регулятору. Різноманітність — це дизайнерське рішення тут, оскільки панель послабляє будь-які позиційні дивацтва однієї моделі, а відповідальність — це те, що надають докази рішення: те, що аудиторам довелося будувати пісочницю, щоб спостерігати, архітектурно довірена служба реєструвала б у виробництві.
Рамка також розширюється за межи споживача на взаємодію машини з машиною. У робочих процесах B2B-агентів немає людини в циклі, щоб відчути довіру взагалі, тому єдиним можливим субстратом є перевірюваний процес, з агентами, які обмінюються саме артефактами, описаними тут, і обчислюють, чи варто здійснювати транзакцію. Як довіра накопичується та поширюється в масштабі таких ланцюжків делегування, а також яка витрата логування та перевірки самого шару доказів на обсяг виробництва, залишаються відкритими питаннями. Ланцюжки загострюють вимогу, оскільки ланцюжок такий же надійний, як його найменш документально підтверджена ланка: записи мають складатися. Де немає споживача, архітектурна довіра, можливо, є єдиною доступною формою довіри.
Структурний розвиток, якого література про довіру не встигла осягнути, — це протокольна війна. Конкуруючі агентські стеки комерції (OpenAI зі Stripe, Agentic Commerce Protocol; коаліція Universal Commerce Protocol компанії Google; Perplexity з PayPal; мережі карток та відкриті стандарти внизу) фрагментують комерцію по лініях протоколів постачальника так само, як ШІ-послуги фрагментувалися по лініях моделей постачальника, і аргумент нейтральності узагальнює майже слово в слово: агент споживача, який може здійснювати транзакції лише у протоколі одного постачальника, — це агент постачальника, а не споживача. Який би рівень не арбітрував між протоколами, він буде стикатися з тими самими трьома вимогами: незалежність, докази та відсутність зацікавленості, а якщо такий рівень закріпиться, битва за полицю стане битвою за перевірувача.
Для ринку доказів. У 2026 році це перестало бути прогнозом. На стороні відповідальності страхування рухнулося першим і одночасно в двох напрямках. Необов'язкові скасування схвалень для претензій щодо генеративного ШІ вступили в стандартний набір загального страхування відповідальності в січні 2026 (форми ISO CG 40 47 та CG 40 48, затвердження, які перевізники можуть обрати, не автоматичні виключення; протягом кількох місяців великі страховики подали документи на прийняття їх або еквівалентних власних варіантів). У тому ж вікні було написано першу політику для ШІ-агентів протилежним чином, проти доказів: стандарт AIUC-1 для агентів існує для того, щоб генерувати, через аудити червоної команди, емпіричні профілі ризику, які потребують страховики для андерайтингу, і лютий–березень 2026 принесли його першого акредитованого аудитора, першу політику для агентів та перші сертифікації підприємств. Стиснутих між повним виключенням та андерайтингом на основі доказів, запис став одиницею розподілу відповідальності: агент без перевіряємої історії стикається з виключенням-подібним охопленням, а агент з записом — це розраховуваний ризик.
На боці регулювання Закон про ШІ ЄС, стаття 50, зобов'язання щодо прозорості, включаючи обов'язкове розкриття взаємодії зі ШІ споживачам, стають обов'язковими до 2 серпня 2026 року (перехідне позначення субзобов'язання діє до 2 грудня 2026 року), зі штрафами, за читанням цієї статті положень про штрафи Закону, до 15 мільйонів євро або 3% від глобального обороту. Комісія прийняла своє керівництво до статті 50 20 липня 2026 року (Європейська комісія, 2026), а паралельне спрощення Digital Omnibus (підписано 8 липня) не затримує серпневі зобов'язання. Існуючі системи отримують лише обмежену відстрочку, до грудня 2026 року, для машиночитаного позначення вмісту. Ширші зобов'язання високого ризику впроваджуються впродовж 2027–2028 років.
Шар доказів змінює це зобов'язання: запис, захищений від підробки, що включає доказ того, що обов'язкове розкриття інформації про ШІ було показано цьому користувачеві в цій сесії перетворює, за читанням цієї роботи, правовий ризик до €15 мільйонів на перевіряємо властивість у час виконання, дотримання як побічний продукт архітектури. Страховикам, які забезпечують відповідальність ШІ-агентів, потрібні саме ці записи, а трасованість і підзвітність є основними характеристиками у Фреймворку управління ризиками ШІ NIST. Нормативний прецедент старший за саму технологію. Керівництво банківського управління моделями вимагало незалежної перевірки партіями, незалежними від розробників моделі, з 2011 року (Federal Reserve SR 11-7), вимога, яку оркестрована комісія автоматизує, робить безперервною та поширює на кожну важливу відповідь. Законодавство про захист прав споживачів уже зберігає людський вихід: Стаття 22 GDPR надає право на людське втручання в суто автоматизовані рішення зі значними наслідками, і посилення при розбіжності є, за читанням цієї роботи, формою під час виконання існуючого правового права. Закон про ШІ досягає того ж дизайну з боку нагляду: Стаття 14 Регламенту (ЄС) 2024/1689 вимагає, щоб системи ШІ високого ризику були побудовані для ефективного людського нагляду, а архітектура, яка виявляє розбіжності та спрямовує невирішені справи до людини, реалізує цей обов'язок нагляду як властивість під час виконання, а не як документ дотримання.
Коли запис існує, слідують два похідні продукти, обидва близькострокові припущення. Мікрострахування на рівні транзакції страховував би конкретне придбання агентом за копійки, оцінене на основі запису доказів, не підлягає страхуванню для непрозорого агента й тривіальне для повторювального. Інший - репутація агента: поздовжні історії доказів природно агрегуються в оцінки репутації для агентів та оркестраторів. Послуги, які створюють історії якості аудиту як побічний продукт операції, мали б активи, які їхні конкуренти повинні були б переоснащувати.
Те, як інфраструктура такого роду стає інституціональною, саме по собі є гіпотезою. Траєкторія, на яку ставить ця робота, продукти спочатку, стандарти потім, мандати останні, є однією з кількох, які демонструє історія інфраструктури довіри (спільні мережі банкоматів, правила мережі карток, згодом затвердені нормативами, пропозиція верифікації блокчейну все ще чекає попиту). За нею також стоїть названа програма досліджень. Лінія регуляторних ринків Хадфілда, приватні регулятори, ліцензовані публічними органами влади, з незалежними організаціями верифікації як основною інституцією (Hadfield, 2017; Clark & Hadfield, 2020; Hadfield & Clark, 2026), досягає її з боку пропозиції управління. Ця робота досягає її з боку попиту споживацької делегації, і дві програми зустрічаються на чеку. Під цим лежить складніше питання про те, чи коли-небудь чек, проданий як особливість продукту, перетворюється на інституцію. Якщо цього не відбувається, він залишається орнаментом управління, а не шаром управління, що спростовуватиме центральну претензію цієї роботи. Точка спростування попередньо зареєстрована: назвіть чек шаром управління layer, коли принаймні два промислові стандарти вимагають відслідковуваних записів рішень для агентських транзакцій, послуги, що несуть усі три компоненти, обробляють більшість обсягу високостійкої агентської транзакції, і принаймні один національний регулятор визнає такі записи у своєму розподілі відповідальності. Постійна невдача всіх трьох - це те, що "орнамент" означає операційно. Якщо верифікація успішна як інфраструктура, вона товаризується, і довіра мігрує в саму спільну утиліту, включаючи теперішню архітектуру, що закінчило б будь-який рів навіть якщо інфраструктура успішна.
Хто несе відповідальність, коли оркестрована рішення помиляється, залишається відкритим питанням: оркестратор, постачальники моделей чи споживач, який авторизував агента.
Закон почав перекривати легкий вихід. California's AB 316, що набирає чинності 1 січня 2026, забороняє будь-якому відповідачу, який розробив, модифікував або використовував систему ШІ, стверджувати, що ШІ автономно спричинила шкоду, залишаючи звичайні захисти та порівняльний розподіл вини неушкодженими. Вона не накладає абсолютну відповідальність. Це робить питання розподілу неминучим, і як би доктрина це не вирішила, повторювальний запис - це те, від чого буде обчислено будь-який розподіл відповідальності. Юридична наука прибула до того ж місця призначення, стверджуючи, що класичний набір інструментів агентського права не переноситься на ШІ агентів і що необхідна нова інфраструктура видимості та відповідальності (Kolt, 2025), найближчий попередник аргументу цієї роботи у літературі управління, підійшовши з боку пропозиції нагляду, де ця робота підходить з боку попиту на нього. Архітектурна довіра - це доказова основа, на якій може правдоподібно працювати виникаюча доктрина відповідальності.
Вимірювання та дослідницька програма
Для вимірювання довіри. Стандартні інструменти вимірюють ставлення до бренду або інтерфейсу. Ставлення, вартого вимірювання, - це готовність делегувати, а не відповідь на "ви довіряєте цьому ШІ": який клас рішень, на які ставки, передаватиме споживач агенту без перегляду кожного кроку? Делегування є поведінковим, монотонічно пов'язаним з обґрунтованою довіром, та безпосередньо пов'язаним з доходом. Поруч з ним сидять питання про те, чи знає споживач, як була вироблена відповідь, чи можуть вони досягти запису, і чи виявлена розбіжність поліпшує або погіршує їх калібрування надійності.
Опитування було чеком людської ери: поки споживач виконував пошук, порівняння та вибір, запитування споживача було захищаним способом дізнатися, що трапилося. Делегування видаляє актора, якого опитувальник був побудований щоб допитувати, тому первинна слід епізоду стає артефактом, який архітектура виробляє, і чек в тому точному сенсі є первинною слідом транзакції делегованої ери. Два інструменти не конкурують: чек реєструє те, що робила машина, і нічого не говорить про суб'єктивне присвоєння, відчуту автономію або когнітивне навантаження, які залишаються територією опитування. (Це розв'язує очевидну напругу з розділу 1, доказова основа якого саме по собі є опитуваннями заявлених переваг: опитування вимірюють те, що споживачі в даний час почувають щодо ринку, який ледь існує, поки чек вимірює те, що делеговані послуги насправді робили, коли вони існували.) Цей міст можна перевірити, пов'язавши міри ставлення з артефактами того ж епізоду, розшаровані за результатом, і оцінивши, де опитувальник та запис погоджуються та який краще передбачає наступну поведінку делегування. Запропонований спільний аналіз несе частину цієї валідації за дизайном, і до тих пір, поки такі дослідження не існують, метрики на основі артефактів доповнюють опитування, а не виходять на пенсію.
Дослідження промисловості вже показують поведінкову базову лінію: у опитуванні споживачів Gartner, опублікованому у травні 2026 року (846 американських споживачів, проведено в листопаді–грудні 2025 року), 54% покупців, які використовували генеративний AI під час покупок, повідомляють про повторну перевірку всієї інформації, яку вона їм дала. Архітектурна довіра — це комерціалізація того, що споживачі вже роблять для себе.
Програма вимірювання має природних союзників у русі комплексної оцінки (Liang et al., 2023) та у новій науці про надійність агентів, яка розкладає надійність на дванадцять метрик, оскільки один показник успіху приховує відмови, які мають значення (Rabanser et al., 2026). Архітектурна довіра операціоналізується так само, поведінково: коефіцієнт помилок з впевненістю, відповідне покладання, зміни ваги пропозиції, коефіцієнти переважання, час прийняття рішення, і одна особливо чітка статистика — різниця у коефіцієнті схвалення між правильними та неправильними виходами, яка є калібруванням покладання, прочитаним безпосередньо з поведінки. На стороні запису існує покриття доказів, виміряна дивергенція панелі та коефіцієнти доступу до квитанцій, триангуляція опитування, поведінки та журналів на одних і тих же епізодах. Жодне з цього не вимагає нової науки. Вимога полягає у рішенні, що це, а не залучення, це цифри, за які відповідає рівень довіри. Моє власне спостереження від розгортання вказує контринтуїтивним способом: добре представлена невизначеність підвищила моє відповідне покладання, і я довіряв системі більше, коли вона явно знала, чого вона не знала.
Ще одна залежна змінна входить у програму, оскільки довіра не є єдиною психологією, яку напруга делегування створює. Споживачі менш тепло реагують на сприятливий результат, коли його виробив алгоритм, оскільки результат, який не виробили вони, важче присвоїти собі (Yalcin, Lim, Puntoni, & van Osselaer, 2022). Делегування може підвищити об'єктивну якість рішення, одночасно спустошуючи його суб'єктивне володіння. Квитанція займає місце на цій розвилці: прочитана одним способом, вона відновлює авторство; прочитана іншим способом, вона засвідчує, що споживач нічого не зробив. Яка інтерпретація переважає — це питання дизайну, яке архітектура вже інструментувала: компонент Доказів записує, що було перевірено та щодо якого стандарту (Розділ 3), а квитанція побудована так, щоб нести власні критерії споживача в цей запис, тому авторство критеріїв оцінки — це змінна, яку архітектура розкриває, а не та, яку вигадує експериментатор. Механізм Yalcin et al., що результат, який не виробили вони, важче присвоїти собі, робить авторство критеріїв природним модератором, і P5 є наслідком компонента Доказів для психології привласнення, а не побічною гілкою програми. P5. Помітність квитанції взаємодіє з сприятливістю результату у визначенні суб'єктивного привласнення делегованого результату: для сприятливих результатів помітна квитанція відновлює привласнення, коли вона кодує авторські критерії споживача (стандарт, якому агент мав відповідати, був моїм, і ось доказ того, що він йому відповідав) і пригнічує привласнення, коли критерії читаються як критерії платформи; авторство споживача критеріїв оцінки є модератором дизайну. Ефект Yalcin et al. спостерігався там, де споживачі очікували прийняти рішення самостійно, тому P5 обмежена цією межею та може змінитися під час звичного делегування, і те, що відрізняє квитанцію від існуючих маніпуляцій прозорістю процесу, має бути реалізовано, а не передбачено. Квитанція перевірна та може нести власні критерії споживача; дизайн, який опускає обидва, тестує прозорість, а не архітектурну довіру.
Література про прозорість дає тут два застереження: занадто багато процедурної прозорості може пригнітити довіру (Kizilcec, 2016), а просте розкриття використання AI підриває її (Schilke & Reimann, 2025). Друге — це гранична умова компонента Доказів: в тринадцяти експериментах актори, які розкрили використання AI, були менш довіреними, ніж ті, які не розкривали, — це дилема прозорості, в якій робити залучення AI більш видимим, саме по собі, знижує довіру. Якщо цей штраф прикріпляється до будь-якого сигналу залучення AI, то архітектура, яка висуває на перший план власну машинерію, могла б пригнітити довіру, навіть роблячи її більш перевіряючою, і компонент Доказів спрацював би в зворотному напрямку саме там, де він найбільш помітний. Відповідь архітектури спирається на розрізнення, яке має бути продемонстровано: верифікованість — це не просто розкриття. Квитанція — це перевіряючий запис про то, як був виробленої відповідь, а не декларація про те, що був використаний AI, і P2 та P3 (з попередньо зареєстрованим двостороннім тестом H2, в якому зворотна дія розкриття названа наперед як звітний результат) — саме там розрізнення або виправдовується поведінково, або не функціонує. Перевіряємість — це те, що будує довіру, поставлена за запитом, а не як завжди присутня стіна походження, і ні приховування машинерії, ні оголошення її не робить цю роботу. Скільки запису виявити, кому та коли — це сама по собі змінна дизайну.
Запропонований механізм для Доказів, які подолають штраф за розкриття, а не його посилюють, полягає в тому, що верифікованість та розкриття проходять через різні психологічні канали. Розкриття надає категоричний ярлик про те, що був залучений AI, який свідчення Schilke та Reimann пов'язує з пригніченою легітимністю. Квитанція надає процедуру, запис, який можна відкрити, оскаржити та повторити, і література про процедурну справедливість стверджує, що процес, який можна оскаржити та перевірити, легітимує актора, який його виконує (Tax, Brown, & Chandrashekaran, 1998). Канал не вимагає того, щоб перевірка насправді відбулася: те, що несе довіру, це усвідомлення споживачем того, що перевірка існує та є доступною в разі суперечки, доступність верифікації, а не її здійснення, що саме то, що функція споживача економіка перевірки призначає квитанції вище. Перевірка концентрується там, де існує приватний виграш від перевірки, і споживач успадковує верифікацію як побічний продукт, тримаючи запис як опцію, а не читаючи його як документ. Те саме розрізнення стосується суб'єктивного привласнення (P5): ярлик розкриття приписує рішення машині і спустошує володіння, тоді як квитанція, яка кодує авторські критерії споживача, документує, що стандарт, якому агент мав відповідати, був власним споживача. Чи насправді два канали дисоціюються, при легітимності, що зростає з перевіряючою процедурою, в той час як падає з голою розкриттям, — це саме те, що попередньо зареєстрований двосторонній тест H2 побудований для виявлення.
Обмеження. Модель базується на архітектурному аналізі та одному розширеному, високоставковому розгортанні з єдиним оператором. Кожна емпірична опора була отримана на цьому ж стеку, який я побудував та експлуатую. При застосуванні до себе самої достовірність роботи змішується з її власною структурою: один автор та один стек (низька різноманітність), публічний пакет репродукції поруч із запечатаними записами розгортання та заборонена реєстрація поведінки до публікації (часткові докази) та задекларована комерційна заінтересованість (компрометована нейтральність). Незалежна репродукція на інших стеках необхідна, перш ніж будь-яке твердження узагальнюватиметься. Якірь хешу записів розгортання робить будь-яке пізніше редагування, заміну або зворотне датування виявляємим, тому при розпечатуванні характеристики тут можуть бути перевірені проти артефакту, який заведено не змінився. Читачі можуть перевірити цілісність, а не вміст, до розпечатування. Числа механізму походять з публічних API моделей, і конвеєр повторює збір наскрізно менш ніж за 15 доларів. Рендеринг стимулу залишається конфаундером на рівні інтерфейсу: стимули експерименту споживача, включаючи оформлення квитанції, — це мій власний рендеринг UX, і конфаундери на рівні інтерфейсу розплутуються лише через репродукцію з незалежними рендеринками. Спочатку сліпа збірка, записи, стійкі до підробки, та маршрутизація без ставок — це конструкція; правила агрегації та пороги активації — це інженерні вибори. Панелі експерименту є аналітичними комбінаціями однієї сліпої збірки, а не розгорнутого циклу оркестрації, і розроблений протокол телеметрії поля закриває цей розрив. Шляхи верифікації без моделей, названі в структурі (тіневі запуски, перевірки тимчасової консистентності), описуються тут, а не тестуються. Збір — це єдиний запуск при температурі нуль, що пригнічує варіативність всередині моделі та залишає кореляцію спільної генеалогії на місці, і розміщені API навіть там не суворо детерміністичні. Короткі фактичні відповіді SimpleQA знаходяться поблизу режиму простору обмежених відповідей, у якому консенсус засвідчує помилку, і стратифікація складності показує саме цей паттерн на найскладніших квінтилях. Панель середнього рівня може перебільшити користь різноманітності, оскільки кореляція помилки зростає з можливістю (Kim et al., 2025). Експеримент механізму тестує питання на відкриту відповідь з єдиною перевіряємою відповіддю, а на відкритих генеративних завданнях, де семантична еквівалентність між відповідями сама по собі є винесенням судження, сигнал сертифікації повинен бути встановлений заново, а не припущений. Пов'язаною межею є розмірність простору відповідей: елементи SimpleQA мають єдину перевіряєму відповідь, тоді як вибори споживачів, які виконують агенти, є суб'єктивними судженнями багатоатрибутної корисності з багатьма обороними відповідями, отже, як консенсус поводиться у просторі переваг та чи навіть згода між незалежними агентами визначає кращий вибір там, є відкритим емпіричним питанням (семантична еквівалентність стає еквівалентністю переваг, а сама оцінювання — моделювальним виором). Проводиться одна перевірка шуму мітки: на перетині 351 елемента підвибірки цього дослідження з SimpleQA Verified (Google DeepMind, 2025), переоцінювання кожної відповіді панелі щодо виправлених еталонних міток залишає підйом сертифікації без змін або трохи більш виразним (2.7 → 2.8, 4.4 → 4.4, 4.0 → 4.3 у трьох панелях, детерміністичний оцінювач), тому шум мітки не є рушійною силою підйому. Усі фігури впевненості — це вербалізовані самозвіти від 0 до 100, викликані єдиним форматом підказки, і чутливість до протоколу елюціювання сама може варіюватися залежно від постачальника, тому висновки щодо дискримінації та калібрування за постачальником слід читати як властивості цієї конфігурації під цим протоколом елюціювання, а не як фіксовані ознаки постачальника. Базова лінія самовпевненості в таблицях 6–7 хвилі шістнадцяти моделей — це сира заявлена впевненість. Більш сильні відкалібровані базові лінії в традиції Guo et al. (2017) були запущені на флагманській хвилі (масштабування Platt та розділено-конформна утримання, розділ 3), де вони виникають як доповнення до воріт, а не замінники, і порівняння панелі з собою першої хвилі слід читати проти базової лінії продуктів споживачів, які насправді розгортаються. Оцінка воріт заголовку (−82,1% впевнених невдач, бутстреп 95% CI [79,9; 84,1] для десяти повних рукавів, [80,0; 84,2] з включеним рукавом Meta) — це єдина заздалегідь визначена величина, і навколишні аналізи (сітка чутливості порогу, шари складності та забруднення, видалення радою та порівняння тривіальної базової лінії) — це описові перевірки надійності, про які повідомляється без жодної поправки на кратні порівняння, і вони не претендують на жоден статус підтвердження власного. Єдиний контроль похибки на рівні сім'ї в роботі — це поправка Holm у попередньо зареєстрованих {H1, H2} експерименту споживача. Якби режим оцінювання, який винаграджує впевнене вгадування, був відремонтований так, щоб чесність можна було тренувати в моделях (Kalai et al., 2025), архітектура страхувала б від проблеми із дешевшим рішенням, хоча докази та нейтральність залишалися б незвідними для будь-якого виправлення на рівні моделі. Подальші межі зазначаються там, де вони повідомляються: обмеження покриття флагманської хвилі (розділ 3: два недосяжні китайські флагмани та одна перервана збірка Meta), а також попередній 233-парний порівняння бюджету міркування, межі TOST якого еквівалентні при маржі ±5 балів без потужності для вужчих меж. Заходи делегування походять з гіпотетичної віньєтки, де заявлені заходи перебільшують реальну готовність приблизно на 21% за метааналізом (Schmidt & Bijmolt, 2020); експеримент споживача здійснив 119 первинних та 133 об'єднаних з 200 зареєстрованих учасників за шістьма зафіксованими елементами. Репродукція комерційного субстрату розширює механізм поза порівняльною базою: свіжий, заздалегідь заморожений набір 267 фактів продуктів, перевірених Wikidata (яка компанія виробляє певний автомобіль чи літак, яка операційна система працює на телефоні, яка компанія видала гру, у якому році вона була випущена), запущена сліпо через незалежну панель шести моделей (Claude Opus, GPT-5.4, Grok, Qwen, GLM та Mistral), рівень, оптимізований за вартістю, на якому насправді працюють агенти, орієнтовані на споживача, а не флагман, повторює дисоціацію, узгодженість моделей, передбачаючи правильність при AUROC 0,77–0,81 проти 0,63–0,70 для заявленої впевненості та підйому сертифікації 4–6×, надійна у незалежно складених панелях з трьома-шістьма моделями, що охоплюють лабораторії США, Китаю та Європи, а також до суворості оцінювання (детерміністичне співпадіння рядків тут — це основне, консервативне правило). Суб'єктивний, багатоатрибутний кінець спектру комерції (компроміси переваг, антагоністичні стимули торговців та отримання, засноване на інструментах, над змінним запасом) залишається невідтестованим.
Дисперсія між запусками при вибіркуванні. Гілка дослідження дисперсії прямо опробувала кордон однієї детермінованої реалізації: підвибірка 100 запитань, розшарована за складністю (5 квінтилів складності × 20, seed 20260806), була перезапущена при температурі 0,7 з 3 незалежними зразками на запитання для 9 з 11 флагманських хвильових моделей панелі; кінцеві точки Meta були недоступні, а API Claude Fable 5 не надає параметр температури. Для всіх моделей усі три зразки давали взаємно еквівалентні відповіді на 22–77% запитань (медіана 54%), точність для кожного запитання була однаковою для трьох зразків на 63–97% запитань, і відповідь при температурі 0 збігалася з переважаючою відповіддю при температурі 0,7 на 40–85% запитань. Компонента gpt-5.6-sol експерименту містить змішуючий чинник: вона працювала з рівнем інтенсивності міркування нема, тоді як 1,486 з 1,500 записів хвилі використовували стандартний рівень інтенсивності (середній, як зазначено вище). Її зміна точності з 92,0% на 46,3% на цій підвибірці тому змішує температуру з бюджетом інтенсивності міркування, хоча її показники узгодженості між зразками не постраждали. Вилучивши цю змішуючу компоненту, середня точність на зразок при температурі 0,7 відрізнялась від детермінованої точності при температурі 0 на одних запитаннях максимум на 14,0 пункти (gemini-3.1-pro, 49,0% → 63,0%), решта сім моделей були в межах 4,4 пункти. На рівні панелі брама ради (триспрямована угода між kimi-k3, deepseek-v4-pro та gpt-5.6-sol) спрацьовувала на 31,0% підвибірки при температурі 0, проти 25,0%, 23,7% та 29,8% протягом трьох запусків при температурі 0,7. Сигнал угоди, на якому ґрунтується основний результат, стійкий до шуму вибірки.
Статус доказів для тверджень. Твердження розподіляються на три рівні доказів. Встановлені цими даними: що незалежна угода несе сигнал правильності, якого не несе самозвіт моделі, за зазначених граничних умов (сліпий збір, компетентні верифікатори, відкриті тестові запитання з єдиною перевіряємою відповіддю); що фіксована брама незгоди відсікає переважну більшість впевнених помилок при суттєвій, вказаній вартості покриття (−82,1% при 30,5% покритті); та сильні граничні умови самі по собі: консенсус засвідчує помилку в обмежених просторах відповідей, первинне посилення сертифікації монотонно спадає зі зростанням складності (зникаючи на найскладнішому квінтилі при внутрішній стратифікації; позитивне, але найслабше там при зовнішній), та компетентність верифікатора контролює цінність сертифікації. Підтримано поведінковим експериментом (один дизайн, скромної масштабу однієї студії, n = 119): що виявлення справжньої незгоди між моделями поліпшує калібрування довіри в обох напрямках (d = 0.67, Holm p = .0005; обумовлено одним з шести елементів; перевірки маніпуляцій основної хвилі 88–98%; коефіцієнти надійності α = .83–.93); та як зареєстрований неконклюзивний нульовий результат, що статична квитанція при першому знайомстві не чутливо впливає на делегування. Теоретично запропоновано, але ще не перевірено: D×E×N комплементарність; ефект нейтральності (P3); міграція довіри при зростаючому делегуванні; стійкість архітектурної довіри після збою (P4); готовність платити за верифікованість; та ринково-категоріальне твердження розділу 7.
Природним наступним кроком є експериментальне дослідження: вимір довіри, калібрування довіри та готовності платити у одномодельних та оркестрованих умовах, з незгодою, яка чергово розкривається та приглушується. Розділ 6 звітує про реалізований експеримент, попередньо зареєстрований та сумісний зі стимулами. Стандартний вибір-заснований конджойнт аналіз оцінює часткові вартості адитивно та припускає компенсаційні компроміси, що заперечує гіпотеза комплементарності, тому клас проектів має дозволяти некомпенсаційну структуру, чи то дизайни на базі елімінації за аспектами чи дизайни примусового вибору з блокуючими атрибутами, оцінені з явними членами взаємодії. Визначені два рівні дизайну. Мінімальний рівень - це дослідження цільовим профілем з чотирма-п'ятьма профілями, що охоплюють жодну компоненту, одну компоненту, дві компоненти та повні конфігурації, з теоретичною роботою, виконаною одним планованим контрастом, ефект повної конфігурації перевищує суму ефектів компонент (супер-адитивність), проти адитивної нульової гіпотези. Повний рівень перехрещує три рівні на компоненту (відсутня, присутня-але-неперевіримо, присутня-і-перевіримо) в 3×3×3 між-суб'єктом факторіальному дизайні (27 комірок; ставки змінювалися в межах суб'єкта протягом чотирьох рівнів), з щонайменш 80 респондентів на комірку (N ≥ 2,160) для статистичної потужності ≥ 0,85 на взаємодії. Бінарний дизайн 2³ не може відновити експоненти Cobb–Douglas і недостатньо потужний при правдоподібних розмірах ефектів (d ≈ 0,3–0,4). Застосовуються три принципи подання стимулів: варіювати саме архітектурні величини, а не лише їх позначення (відсутня мітка отримання - це невідомість споживачем доказу, а не його відсутність), надати кожній компоненті контраст перевіримо-проти-просто-стверджено, і поєднати дані вибору з трейсингом процесу на полях отримання, оскільки теорія передбачає використання доказів. На мою думку, це був би перший дизайн, що варіює три компоненти спільно. Однокомпонентні будівельні блоки вже оцінені (König et al., 2022; Ioku et al., 2024), і близькі комбінації були реалізовані (Cetinkaya & Krämer, 2024, найближчий інструмент та джерело калібрування потужності разом з Köbis et al., 2025), тому дослідження визначено, забезпечено необхідною потужністю, і готове до виконання. Граничні умови конструкту такі: архітектурна довіра невигідна там, де ставки низькі та обсяг великий; вона мало допомагає там, де пул верифікаторів не компетентний для класу задач; вона може підтвердити помилку, де простори відповідей строго обмежені; і вона погіршується до театральності повсюди, де незалежність панелі стверджується, а не вимірюється, найбільш гостро як відкрите запитання red-team як виглядає маніпульована квитанція? Коли гіперпосилання стали сигналами авторитету, ферми посилань виникли для їх штучного створення, і слід очікувати, що записи про угоду також запросять свою версію такого фермування. Також застосовуються два часові кордони: сигнали привертають увагу, тоді як докази встановлюють стійкість, тому твердження стосується того, яка довіра зберігається після збою, а не яка швидше запускається, і навіть ефективна перевірка може лише сповільнити спіраль типу, яку моделюють Chandra et al. (2026). Там, де наслідки зосереджуються і незалежність є реальною, архітектурна довіра окупає свою вартість та своє призначення (Таблиця 12 зібрала чотири).
Таблиця 12. Граничні умови: де архітектурна довіра невигідна
| Умова | Чому це там не спрацьовує | Докази |
| Низькі ставки, високий обсяг | Вартість верифікації перевищує вартість помилок; одномодельне обслуговування - правильна відповідь | Логіка точки беззбитку (Рисунок 14) |
| Пул верифікаторів нижче компетентності задачі | Незалежність без компетентності не несе сигналу | Нульовий результат локального рівня: точність 46% незалежно від згоди |
| Строго обмежені простори відповідей | Консенсус засвідчує помилку, а не виявляє її | Помилки консенсусу 4.0–7.9% при виборі з варіантів проти 0.5–2.2% у відкритій формі |
| Незалежність заявлена, а не виміряна | Панель майже-клонів створює впевненість | Корельовані помилки; нулі блоку та генеалогії |
Остання межа стосується того, що можуть виявити будь-які з запропонованих конструкцій. Довіра на агентському ринку — це, в кінцевому рахунку, об'єкт рівноваги. Після того як продавці, платформи та конкуруючі агенти адаптувались до архітектури верифікації, її ефекти є властивостями адаптованого ринку, а не експериментальної комірки. Спостережні дані успадковують селекцію, оскільки верифікація буде прийнята насамперед там, де довіра вже розривається. Рандомізація на рівні одиниці виправляє селекцію, але зупиняється перед інтерференцією, оскільки споживачи, рандомізовані на квитанції, все ще здійснюють транзакції на ринку, де продавці реагують на всі квитанції одночасно. Рівноважна кількість потребує кластеризованих, чередуючихся, двочастинних або ринкових конструкцій; рандомізація архітектури, а не вимірювання довіри, — це наступна складна проблема. І ранні когорти агентської комерції самовідбиралися за схильністю до довіри, тому ефекти, оцінені на ранніх користувачах, обмежують, а не оцінюють, ефект у популяції. Нейтральність цінна саме тому, що її не може забезпечити ніхто, чиї інтереси пов'язані з моделлю, включаючи тих, чиї інтереси пов'язані з оркестрацією. Аргумент також описує вид системи, яку я будую (Примітка автора). Цей інтерес стосується захисту позиції, а не відтворюваності доказів: оцінені моделі є незалежними, публічно доступними системами передового рівня, і кожне повідомлене число може бути перераховано третіми сторонами з замороженого пакету реплікації. Читач, який дисконтує захист позиції, все ще може перевірити вимірювання.
6. Чи можуть споживачі використовувати сигнал? Попередній тест поведінки
Чи можуть споживачі використовувати сигнал коректності, який встановлює механізм, — це окреме, поведінкове питання, і я повідомляю про попередньо зареєстрований, стимульований експеримент щодо цього. Проведене дослідження — це доказ існування, а не тест загального ефекту; воно запитує, чи можуть споживачі взагалі діяти на основі сигналу. Плануються потужне, підтверджувальне, багатопозиційне, стимулом-відібране повторення з випадковими нахилами позицій. Відключення хостингу в завершальному вікні набору завершило збір на 119 дійсних учасниках проти 200 запланованих (133 об'єднуючи когорту м'якого запуску; США та Великобританія; три умови між суб'єктами навколо агентського помічника для покупок; калібрування виміряне протягом шести стимульованих фактичних спроб як Δ = P(accept | correct) − P(accept | incorrect), індекс дискримінації належної спираємості Schemmer та ін., 2023). Повна методика, пілот, п'ять відхилень від реєстрації, розкриття щодо етики та звільнення та всі допоміжні статистичні дані в докладному звіті нижче (§6.1–6.2) та пакеті реплікації.
Відображена міжмодельна незгода підвищила загальне калібрування (Control Δ = 0.24 → 0.45; d = 0.67, 0.68 об'єднано, p = .0001), але об'єднана оцінка крихка: вона підтримується одним із шести стимулів, єдиною позицією дисидента з високою впевненістю, де дисплей зменшив прийняття впевненої неправильної відповіді з 74% до 24% (об'єднана когорта, таблиця 18). Видалення цієї позиції знижує ефект до d = 0.09 (p = .54), тоді як видалення будь-якої іншої однієї позиції залишає його незмінним. Користь зосередилася в британській підвибірці. Американська контрольна комірка (n = 16) вже дискримінувала на вихідному рівні (взаємодія p = .002). На одній позиції, де сама панель погодилася з неправильною відповіддю, дисплей збільшив прийняття в обох країнах, що є режимом засвідченої помилки консенсусу розділу 3, відтвореним у людській поведінці та знахідкою сама по собі: архітектура, яка показує згоду, передає одну свою систематичну помилку своїм користувачам. Тест першої експозиції компоненти доказу P2, статична квитанція оркестрації, не виробив виявленого ефекту на готовність делегувати (d = 0.21, невирішена за цієї потужності; жива квитанція з розширенням під час суперечки — зареєстрований подальший крок).
Дисплей дисидентської панелі може різко зменшити прийняття впевненої неправильної рекомендації, де споживач інакше прийняв би її, і він не спрацьовує там, де панель засвідчує спільну помилку. Контраст калібрування, таким чином, має поведінкову підтримку за цих шести стимулів; P1 як сформульовано, із сприйманим ризиком як посередником, не підтримується цим тестом. P2–P4 залишаються відкритою програмою.
6.1 Тест поведінки: методика та пілот
Твердження розділів 3 і 5 написані для тестування, і порядок денний вимірювання вище визначає як. Експеримент є попередньо зареєстрованим, сумісним за стимулами онлайн-тестом P1 (калібрування спираємості під виявленою незгодою) та P2 (готовність делегувати під повторюваним записом), зі стимулами, взятими з реальних результатів мультимоделей головної хвилі, розширюючи парадигму другої думки (Detjen та ін., 2025; Chen та ін., 2026) на справжні, стимульовані незгоди моделей передового рівня під архітектурним каркасом. Інструмент, заморозка протоколу, пілот, головна хвиля та аналіз замороженого коду завершені та повідомлені нижче. Підтверджувальні таблиці були включені в попередніх версіях цієї статті як попередньо зареєстрований каркас з комірками, позначеними [MAIN DATA PENDING], і тепер заповнені кодом замороженого аналізу. Два результати, несприятливі для гіпотези, були попередньо зареєстровані як звітні основні результати: виявлена незгода погіршує калібрування (чиста недостатня спираємість) та квитанція знижує готовність делегувати (зворотний удар розкриття); жодне не матеріалізувалось, але один попередньо зареєстрований нуль виявився вірним.
Методика.
Дизайн та гіпотези. Калібрування надійності вимагає порівняння відображеної згоди з коректністю відповіді, чого одна віньєтка не може забезпечити. Тому дизайн є гібридним. Учасники спочатку читають віньєтку про делегування покупок (AI-агента для покупок «ShopAssist», який рекомендує придбання ноутбука в межах бюджету $1,200), первинна перевірка P2, а потім виконують короткий блок мотивованих суджень на реальних результатах мультимодельних моделей, первинна перевірка P1. H1 (P1): відображення угоди та розбіжностей між моделями від кількох незалежних AI-систем покращує калібрування надійності споживачів (вони приймають запропоновану агентом відповідь більше, коли вона правильна, і менше, коли вона неправильна) порівняно з однією впевненою відповіддю; двостороння, оскільки література документує як зменшену надмірну надійність, так і збільшену недостатню надійність при спільному представленні. H2 (P2): доступ до розписки оркестрування (хто діяв, як вони погодилися, що було перевірено, і повна перевіряєма запис) збільшує готовність делегувати значущу покупку понад ефект самого відображеного розбіжності; двостороння, оскільки розкриття також може знизити довіру.
Умови. Три міжсуб'єктні умови, рандомізовані 1:1:1 і збережені постійними у межах віньєтки та блоку суджень: (1) Контроль, одна впевнена рекомендація, без архітектурних сигналів; (2) Розбіжність, та ж рекомендація, якій передує панель з трьох незалежних AI-систем (анонімізовані як System A, B, C) з явним позначенням згоди/розбіжності, альтернативні відповіді систем і задекларовані впевненості, та резюме розв'язання простою мовою; (3) Розбіжність + Докази, екран Розбіжності плюс карта розписки оркестрування структурована як хто діяв / як вони погодилися / що було перевірено / повна запис. Одне попередньо зареєстроване обмеження дизайну контролює явний змішуючий чинник: блок остаточної рекомендації (продукт, ціна та задекларована остаточна впевненість агента) є дослівно ідентичним у всіх трьох умовах, у віньєтці та у кожному судженні, і лише архітектурні сигнали навколо нього різняться.
Стимули та розписки. Стимули блоку судження є реальними результатами трьох передових моделей з флагманської хвилі на реальних фактичних питаннях, щодо яких моделі справді погодилися або розійшлися при високо задекларованій впевненості (95–100); жодні відповіді або впевненості не вигадані. Назви моделей замінені нейтральними мітками, щоб уникнути змішування від попередніх брендових асоціацій, і відображення розкривається в пакеті репліки. Розписки, показані в умові 3 (одна розписка віньєтки та шість розписок суджень), генеруються генератором розписок дослідницького розгортання (схема `decision-receipt@v1`) на основі фактичних журналів походження панелі стимулів, і їх хеші верифікації справді перераховуються з запису (журнал верифікації: 7/7 валідних). Маніпуляція доказами в експерименті таким чином є екземпляром артефакту, який визначає Розділ 3. Відображена фокусна впевненість була близько узгоджена у клітинах коректності (неправильні елементи 95/98/99; правильні елементи 99/99/100) і, вирішально для контрасту лікування, ідентична у всіх умовах. Контроль побачив ту ж фокусну впевненість і розрізняв набагато менше, що не можна пояснити гіпотезою про сигнал впевненості.
Вимірювання. DV1 (H2): 4-позиційна шкала готовності делегувати (7-бальна; наприклад, «Я дозволив би ShopAssist завершити цю покупку без перегляду рекомендації самостійно»), усереднена; однопозиційна драбина делегування (0–4, від «лише рекомендації» до «діє автономно, включаючи товари без повернення») є вторинною. DV2 (H1): шість суджень; на кожному судженні агент пропонує одну відповідь і учасник вирішує, дозволити помічнику продовжити (так/ні) та оцінює довіру до відповіді (повзунок 0–100). Рішення про надійність мотивуються точністю (бонус за правильне рішення про надійність, прийняття правильної відповіді або відхилення неправильної). Запропонована відповідь правильна рівно у трьох із шести суджень. Оцінка калібрування на одного учасника — це Δ = P(accept | correct) − P(accept | incorrect), індекс дискримінації літератури про відповідну надійність (Schemmer et al., 2023, чиї заходи RAIR/RSR розкладають той самий об'єкт); модель змішаних ефектів на рівні судження відновлює розв'язання рівня елемента. Сприйнятий ризик і сприйнятий контроль процесу (по 4 позиції) вимірюються як посередники у попередньо зареєстрованих вторинних аналізах для шляхів P1 і P2 відповідно; сприйнята нейтральність оркестратора (4 позиції) вимірюється як дослідницький корелят P3, яким це дослідження не маніпулює.
Замерзлий протокол. Попередня реєстрація була заморожена перед основним збиранням даних (код аналізу та протокол заморожені за SHA-256 5 серпня 2026 року; реєстрація OSF була подана 13 серпня, перед тим як основна хвиля вийшла в поле 13–14 серпня; зареєстрована з емберго (попередня реєстрація, лише для перегляду: https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f), яка буде випущена в публічний компонент OSF статті, https://osf.io/jtvu9/). Набір із шести елементів випробування заморожений за насінням: три елементи розбіжності зафіксовані за конструкцією та вручну перевірені, плюс елементи консенсусу отримані через перемішування з насінням із пулів, де всі три системи дали однакові відповіді при вказаній впевненості ≥ 95, включаючи одну справжню помилку консенсусу, так що відображена згода є діагностичною, але не досконалою, точно як у вихідних даних. Ці шість елементів були однаковими для кожного учасника; порядок презентації був випадковим в інструменті, хоча експортовані дані не зберегли порядок відображення для кожного випробування. Відображені дані не показали розраховану оцінку незалежності для панелі, що є розкриттям виміряної різноманітності, яке саме фреймворк вимагає, тому учасники бачили розбіжність, не бачачи, наскільки незалежними були розходжувальні системи. Незалежність панелі була виміряна, але не показана, і її значення в збірці джерела повідомляється тут post hoc: середня попарна кореляція помилок φ = 0.22 (0.10–0.44 для трьох пар, два члени одного блоку на далеко найбільш корельовані при 0.44; оцінені за допомогою заморозеного детермінованого оцінювача дослідження, який вирішує 95–98% відповідей і нечутливий до того, як кодується невирішена залишок), що ставить панель далеко від незалежності та далеко від клональності. Це число повинна показати наступна система учасникам. Одна межа стимулу: із шістьма зафіксованими елементами варіація обробки на елемент не може бути оцінена, тому ефект встановлено для цих стимулів. Сеанси починалися з інформованої згоди та завершувалися дебрифінгом, який розкривав гіпотетичну природу покупки віньєти. Дослідження проводилося відповідно до Гельсінської декларації: анонімне дослідження мінімального ризику з участю дорослих з Великої Британії та США, які дали згоду, на панелі, відповідній GDPR, з компенсацією вище мінімуму платформи та без обману крім гіпотетичної віньєти, розкритої при дебрифінгу. За цими критеріями воно відповідало умовам звільнення від повного етичного огляду, і оцінка звільнення задокументована в попередній реєстрації. Пул тепер закритий; дослівний набір елементів, відповіді та ідентифікатори квитанції для кожного випробування є частиною попередньої реєстрації під емберго і будуть випущені разом із даними.
Вибірка та план аналізу. Цільова N = 200 дійсних учасників (100 США, 100 Великої Британії; окремі дослідження Prolific; набір обмежений на 210), вік 18+, вільне володіння англійською мовою, ≥ 98% рейтинг схвалення, ≥ 100 попередніх поданнь, принаймні одна онлайн-покупка в минулі три місяці. Попередньо зареєстровані виключення (застосовані перед переглядом змістовних відповідей): два або більше невдалих перевірок уваги із трьох; завершення менше ніж за 3 хвилини; рядкове заповнення; невдалі перевірки маніпуляції (елемент згоди в умовах 2–3, елемент квитанції в умові 3, елемент розуміння продукту); двічі невдалий тест розуміння блоку судження; дублюючи ID або IP; незавершений сеанс. Підтвердні аналізи: для H1, OLS Δ на об'єднаних умовах розбіжності (2 та 3) проти контролю з країною як коваріатом; для H2, обмежено умовами 2 та 3, OLS композиту бажання делегувати на умову з країною як коваріатом; коригування Holm для {H1, H2}, family-wise α = .05; t-тести Welch як перевірка робастності; затвори перевірки маніпуляції повідомляються першими. Порядок когорти зафіксований тут: первинні підтвердні аналізи обчислюються на когорті основної хвилі виключаючи учасників м'якого запуску пілотного дослідження, і гілка, яка об'єднує когорту м'якого запуску в підтвердний зразок, повідомляється як аналіз робастності поряд. Дослідницькі описові статистики Δ пілотного дослідження було видно перед основною хвилею, тому виключення цієї когорти з первинної оцінки усуває навіть м'яку форму подвійного використання, зберігаючи попередньо зареєстроване включення м'якого запуску як повідомлену гілку. Первинне повідомлення матиме аналіз за наміром лікування, що зберігає всіх рандомізованих учасників поряд з попередньо зареєстрованим аналізом за протоколом. Виключення перевірки маніпуляції будуть повідомлені з перевірками диференціального вибуття за умовою, оскільки помітність архітектурного сигналу могла б сама відрізнятися за умовами. Чутливість: конструкція виявляє d ≈ 0.42 для H1 та d ≈ 0.49 для H2 при потужності 0.80, адекватне для середніх ефектів у суміжній літературі про довіру та прозорість. Менші ефекти залишаються для повного факторіального дизайну дослідницької програми. Три попередньо зареєстровані елементи відповідають на питання механізму, на які самі підтвердні контрасти не можуть. Інструмент містить чотирьохелементну шкалу сприйнятого ризику (пілотне α = .881) на шляху P1, тому сприйняття ризику входить в аналіз як виміряна конструкція, а не припущення. Посередництво попередньо зареєстровано як вторинний аналіз, зі сприйнятим ризиком, який опосередковує ефект розбіжності на довіру, і сприйнятим контролем процесу, який опосередковує ефект квитанції на бажання делегувати, оцінено за допомогою аналізу шляху бутстрепу (PROCESS Model 4, 5000 передискретизацій). Час на екрані стимулу умови 3 збирається як попередньо зареєстрований проксі для читання квитанції, пряма перевірка альтернативи когнітивного навантаження, що учасники проходять повз квитанцію без її обробки. Код аналізу був заморожений перед збиранням даних і архівований з пакетом реплікації.
Пілотне дослідження (м'який запуск): критерії та результати.
Пілотне дослідження n = 20 (США), проведене на остаточному інструменті з попередньо зареєстрованими критеріями прохідності, встановленими заздалегідь, було завершено 6 серпня 2026 року. Таблиця 13 повідомляє про кожний критерій та його результат.
Таблиця 13. Критерії прийнятості пілотного дослідження (попередньо зареєстровані) та результати (n = 20, США)
| Критерій (встановлений ex ante) | Результат | Висновок |
| Маніпуляція помічена: > 80% правильно на перевірці згоди (умови 2–3) | 81.3% (13/16) | Пройдено |
| Маніпуляція помічена: > 80% правильно на перевірці квитанції (умова 3) | 88.9% (8/9) | Пройдено |
| Cronbach's α > .70, бажання делегувати (4 елементи) | .854 | Пройдено (також переходить ціль .85) |
| Cronbach's α > .70, сприйнятий ризик (4 елементи) | .881 | Пройдено |
| Cronbach's α > .70, контроль процесу (4 елементи) | .965 | Пройдено |
| Cronbach's α > .70, нейтральність (4 елементи) | .851 | Пройдено |
| Медіанна тривалість завершення за 10–15 хвилин | 9.60 хвилин | Невдача, на 24 секунди, у швидкому напрямку |
Один критерій не пройшов. Медіана виявилась на 24 секунди нижче від попередньо зареєстрованого вікна, вікна розробленого проти надмірної довжини, а не проти неефективності. Швидкий хвіст не показує ознак неуважного реагування: жоден учасник не впав нижче за порогу виключення у 3 хвилини; той один учасник менше п'яти хвилин пройшов кожну перевірку уваги, маніпуляції та розуміння; рівні проходження перевірки уваги були 95–100%; не було пропущених осередків за ключовими змінними, нульових дублікатних ID або IP-адрес, і нульових прямолінійних відповідей; і часи завершення платформи найму незалежно підтверджують таймер опитування (медіана 9.74 хвилини). Інструмент коротший у полі, ніж планувалося. Баланс умов (4/7/9 по умовах 1/2/3) сумісний з 1:1:1 рандомізацією при n = 20 (χ²(2) = 1.90, p = .387). Згідно з попередньо зареєстрованими виключеннями аналізу, 6 з 20 пілотних учасників виключено з аналізу підтвердження (п'ять на основі перевірки маніпуляції, один на основі двічі невдалого розуміння), залишаючи 14 вірних. Відповідно до правила м'якого запуску, пілотна група переходить у об'єднаний зразок з відхиленням синхронізації, розкритим тут і в самій реєстрації, яка була подана до OSF 14 серпня 2026 року о 03:09 UTC, перед основною хвилею збору даних, і яка стверджує, що пілотний м'який запуск включено у зразок підтвердження з зазначеним відхиленням синхронізації; розглядання основної групи як первинної оцінки підтвердження і об'єднаної гілки як надійності є поставторегістраційним аналітичним рішенням, прийнятим тому, що дескриптивні статистики пілота було побачено перед основною хвилею, і обидві гілки повідомляються; границя розуміння продукту (один учасник вище за 80% планку) позначена для моніторингу в основній хвилі. Одна розвідувальна дескриптивна статистика, повідомлена без висновків при пілотному n: оцінка калібрування Δ за умовою дорівнювала +0.33 (контроль, n = 4), +0.52 (незгода, n = 7), +0.22 (незгода + доказ, n = 9), тому умова незгоди рухається у напрямку H1; пілот не може сказати більше.
6.2 Поведінковий тест: результати, розвідувальні аналізи та залишковий реєстр
Результати підтвердження.
Збір даних основної хвилі проводився 13–14 серпня 2026 року (190 слотів: 85 США + 105 Великобританія поверх пілотної групи м'якого запуску), і він не був завершений: хост опитування зазнав технічного збою під час остаточного вікна найму, і збір закінчився на 158 завершених сеансах загалом (138 в основній хвилі та 20 в м'якому запуску) замість цільового 200 вірних. Найм закінчився з відключенням платформи, згідно з попередньо зареєстрованим правилом опціонального зупинення і не у відповідь на спостережувані результати, хоча результати вже були видні до того; наслідком є зменшена потужність. На реалізованих осередках мінімальні виявлені ефекти зростають від зареєстрованого d ≈ 0.42 (H1) та d ≈ 0.49 (H2) приблизно до d ≈ 0.54 та d ≈ 0.64 при тій же потужності, межа, яку результат підтвердження робить спірною лише в одному напрямку, і та, що застосовується до кожного нульового та розвідувального контрасту нижче. Упорядкування групи слідує плану §6.1. Пілот не пройшов один критерій успіху (вікно часу завершення, на 24 секунди в швидкому напрямку), і його розвідувальні дескриптивні статистики було побачено перед основною хвилею, тому первинною групою підтвердження є сама основна хвиля (N = 119 вірних) і гілка, яка об'єднує однаково збиралась пілотну групу м'якого запуску назад (N = 133), повідомляється як надійність. Кожне число нижче є виходом коду аналізу, замороженого SHA-256 перед збором даних. Відхилення від реєстрації, зібрані в одному місці: (i) дефіцит N (133 вірні з 200 зареєстрованих; збій хостингу); (ii) критерій часу завершення пілота не досяг на 24 секунди в швидкому напрямку; (iii) порядок відображення на основі пробного не збережено в експортованому полі; (iv) синхронізація рівня екрана не захоплена; (v) змішана модель на рівні пробного запуску на варіаційному наближенні (остаточний двигун пакету може відрізнятися). Нічого іншого не відхилялось; кожен тест підтвердження запускався як зареєстрований, рішення первинної групи вище є однією поставторегістраційною аналітичною вибору.
Таблиця 14. Потік зразка та виключення (основна хвиля; пілотна група м'якого запуску в примітці)
| США | Великобританія | Усього | |
| Завершені сеанси | 50 | 88 | 138 |
| Виключено: увага (≥ 2 з 3 перевірок) | 0 | 0 | 0 |
| Виключено: швидкість (< 3 хвилини) / прямолінійні відповіді | 0 | 0 | 0 |
| Виключено: маніпуляція / перевірки розуміння | 10 | 9 | 19 |
| Виключено: дублікати / неповні | 0 | 0 | 0 |
| Вірне N (за умовою 1/2/3) | 40 (16/15/9) | 79 (26/28/25) | 119 (42/43/34) |
Пілотна група м'якого запуску додає 20 завершених сеансів США, з яких 14 пережили те ж виключення; вона входить лише у гілку об'єднаної надійності (N = 133). Кожне виключення в основній хвилі походило з правил перевірки маніпуляції та розуміння — жоден учасник не був виключений через неуважність, прискорення, прямолінійні відповіді, дублювання або неповноту — і гейтування перевірки маніпуляції не показує асиметрії між умовами (MC1 χ²(1) = 0.12, p = .73; MC3 χ²(2) = 3.67, p = .16, обчислено на попередньо виключеному зразку).
Таблиця 15. H1 (P1): калібрування надійності Δ за умовою (первинна група, N = 119)
| Контроль | Незгода | Незгода + Доказ | |
| Δ, середнє значення (SD) | 0.238 (0.332) | 0.465 (0.274) | 0.422 (0.299) |
| Надмірна надійність: P(приймати | неправильно) | 0.603 | 0.434 | 0.510 |
| Недостатня надійність: 1 − P(приймати | правильно) | 0.159 | 0.101 | 0.069 |
| Контрастове підтвердження: об'єднане (2,3) проти контролю, OLS з коваріатом країни | b = +0.217, 95% CI [+0.104, +0.330], Holm-adjusted p = .0005 (d = 0.67) |
Таблиця 16. H2 (P2): готовність делегувати, вихід проти самої незгоди (первинна група)
| Незгода (2) | Незгода + Докази (3) | |
| Композитний показник готовності до делегування, середнє значення (СВ) | 3.09 (1.61) | 3.45 (1.79) |
| Шкала делегування, медіана | 2 | 2 |
| Підтверджувальний контраст: 3 порівняно з 2, OLS з коваріатом країни | b = +0.41, 95% CI [−0.35, +1.18], Holm-adjusted p = .29 |
H1 підтримується в цьому дизайні для калібровочного контрасту; попередньо зареєстроване опосередкування через сприйняту ризик було нульовим, тому P1 у його формулюванні не підтримується цим тестом. Стикаючись з однією впевненою відповіддю, учасники ледь розрізняли: вони дозволяли агенту продовжувати в 84% правильних відповідей, але також у 60% неправильних (Δ = 0.238, 95% CI [0.14, 0.34]; експериментальні умови 0.465 [0.38, 0.55] та 0.422 [0.32, 0.52]). Дисплей незгоди майже подвоїв калібрування (об'єднане Δ = 0.446; b = +0.217, p = .0002, Holm-adjusted p = .0005; Welch d = 0.67), і це сталося з обох боків одночасно: надмірна спертість зменшилась (60% → 43% та 51%), в той час як недостатня спертість також зменшилась (16% → 10% та 7%) (Рисунок 20). Те об'єднане середнє значення залежить від одного елемента й найкраще розглядається як доказ існування ефекту, а не як надійне середнє значення: на одному випробуванні розходження з високою впевненістю, яке учасники контрольної умови приймали на 74%, дисплей скоротив прийняття неправильної відповіді до 24%, і коли це випробування видалено, підтверджувальний контраст більше не є статистично значущим (d = 0.09, p = .54), в той час як вилучення будь-якого іншого елемента залишає його неушкодженим (d = 0.47–0.89). Дослідницька декомпозиція нижче (Таблиці 17–18) визначає ефект елемент за елементом. Його концентрація виявляє ту ж залежність від наявного простору, про яку повідомляється там на рівні країни: дисплей закриває розрив калібрування лише там, де він відкритий, і один з шести елементів розкрив його широко.
Рисунок 20. Вплив дисплея незгоди на спертість (первинна когорта)
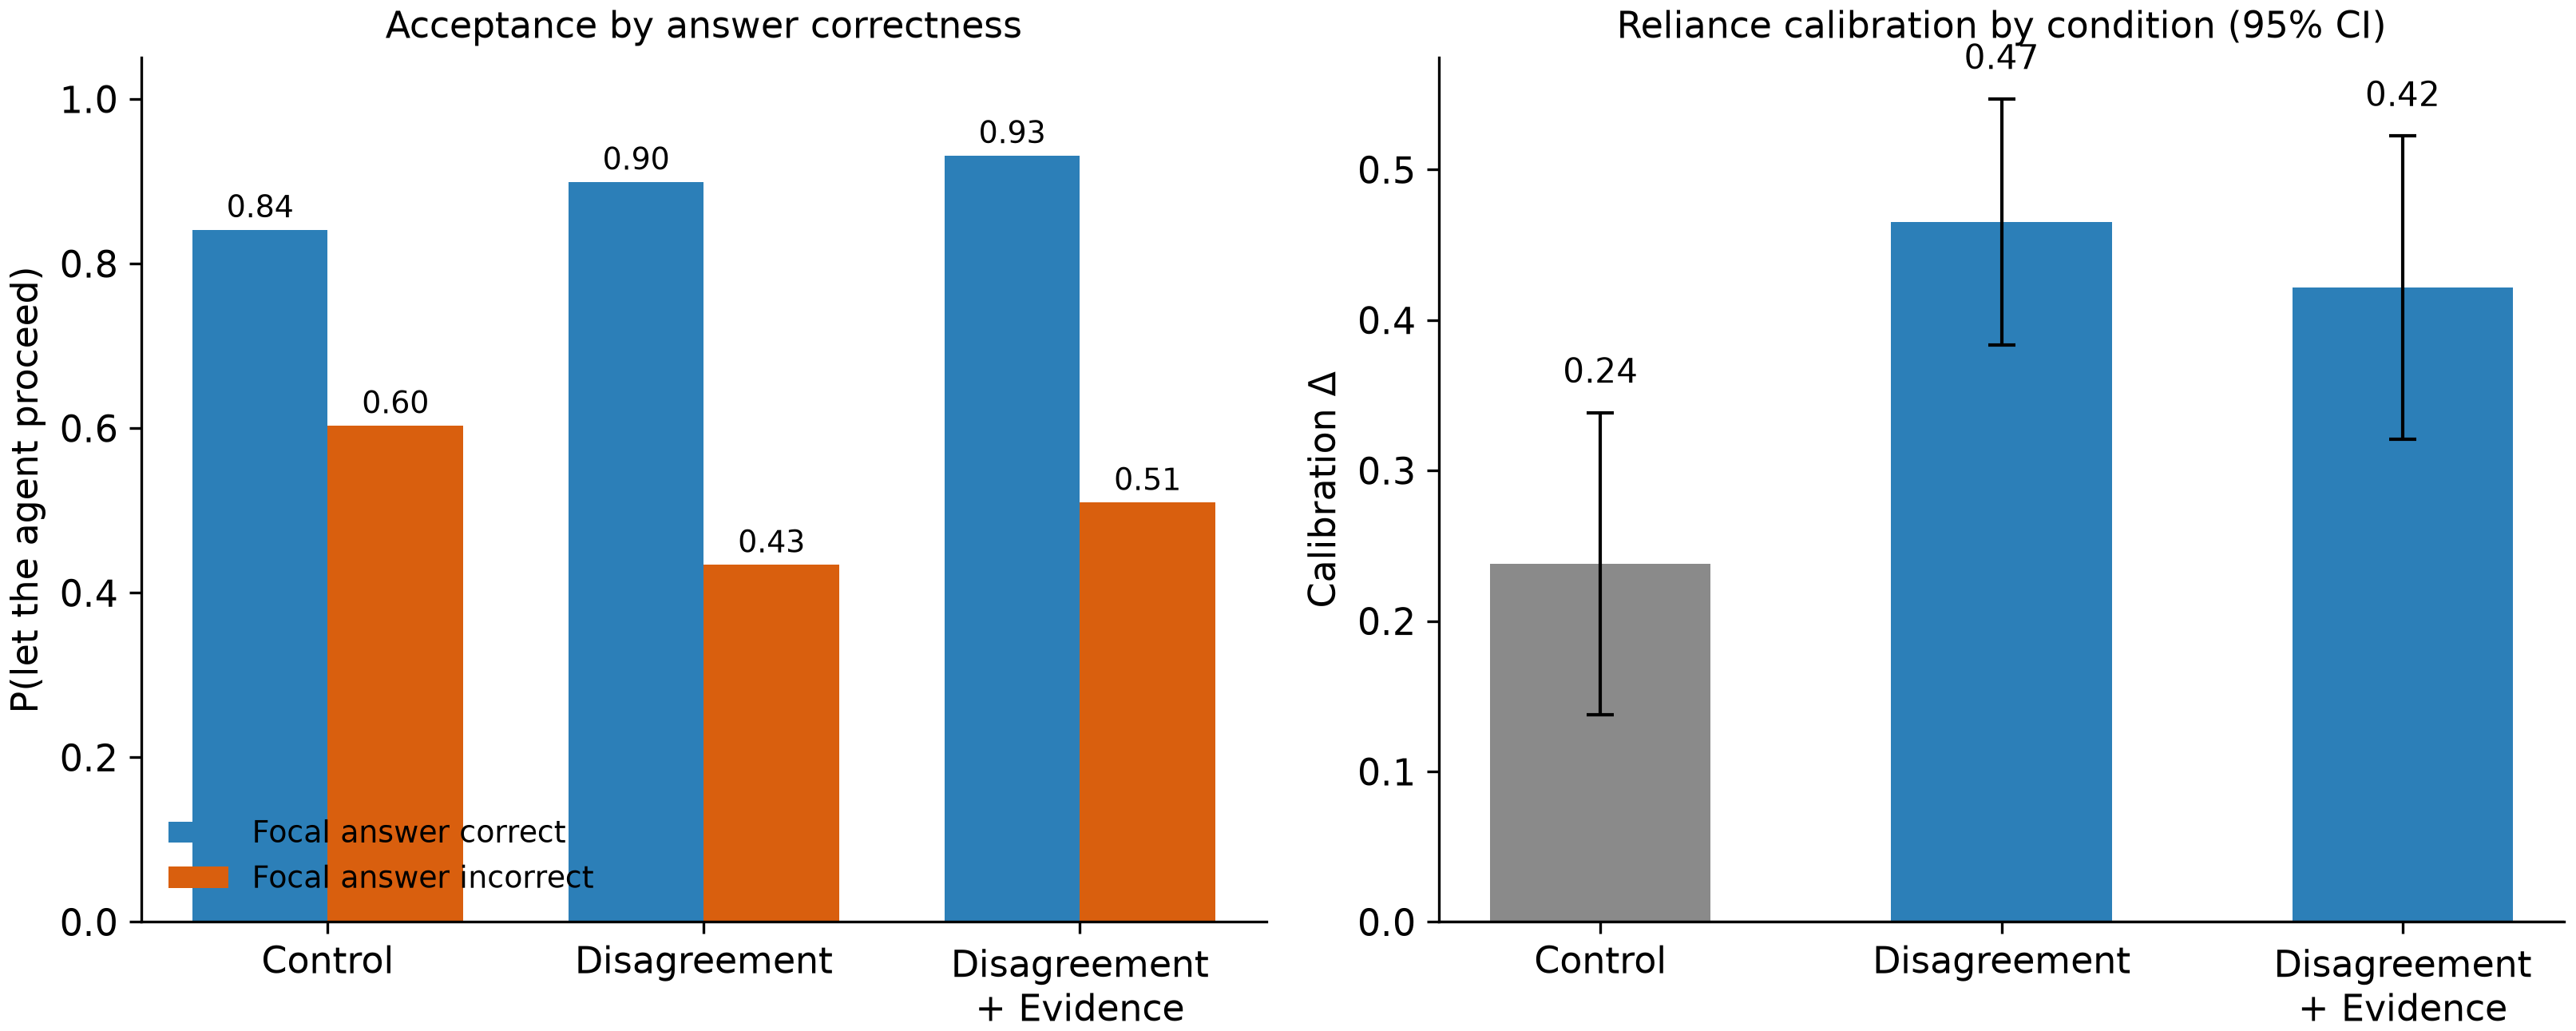
Ліворуч: показники прийняття за умовою, розділено залежно від того, чи була фокусна відповідь правильною (калібрування = розрив між парою стовпців). Праворуч: індивідуальний показник калібрування Δ за умовою з 95% CIs; підтверджувальний контраст об'єднує дві умови незгоди в порівнянні з контролем.
Попередньо зареєстроване двостороннє фреймування існувало, оскільки література про другу думку документує втручання, що зменшують надмірну спертість за ціну збільшення недостатної спертості; це втручання не платило цю ціну. Сигнал зробив учасників більш спроможними розрізняти, а не більш скептичними, і декомпозиція теорії детекції сигналу сукупних показників надає числові докази цього: чутливість d′ зросла з 0.74 в контрольній умові до 1.44 та 1.46 в експериментальних умовах (обчислено з неокруглених показників), в той час як критерій відповіді ледь змінився (−0.63 порівняно з −0.56 та −0.76). Модель змішаних ефектів на рівні випробування показує ту ж саму структуру, з великими позитивними взаємодіями правильність × умова для обох експериментальних умов. Кожна зареєстрована гілка аналізу підтримує це: об'єднана гілка аналізу надійності (b = +0.215, p = .0001, d = 0.68) та гілка аналізу наміру лікувати, що охоплює всі завершені основні сеанси хвилі незалежно від недоліків перевірки (b = +0.2174 порівняно з +0.2169 за протоколом, p = .0001, n = 138), з виключеннями, збалансованими за умовами (8/6/5; χ²(2) = 0.34, p = .85), перевірка диференціального вибування §6.1 зобов'язує (виключення перевірки маніпуляції є кондиціонуванням після лікування, за Montgomery, Nyhan, & Torres, 2018, звідси рівне становище некондиціонованої гілки). Один змішуючий фактор дизайну уточнює інтерпретацію. Умови незгоди відрізняються від контролю не лише в тому, що говорить сигнал, але й у кількості показаної інформації, три позиції та впевненості замість однієї, тому калібровочний виграш міг би в принципі відображати обсяг інформації, а не вміст сигналу згоди. Два спостереження свідчать проти інтерпретації обсягу, не вирішуючи її: ефект відслідковує напрямок відображеного сигналу елемент за елементом, оскільки на неправильних фокусних елементах, де дисплей показав незгоду, прийняття упало, в той час як на одному елементі, де дисплей показав одностайну впевнену згоду, прийняття неправильної відповіді зросло; і взаємодія на рівні випробування пов'язана з правильністю відповіді, яку обсяг сам по собі не передбачає. Чистий варіант розрізнення, кілька систем показані, що погоджуються на кожному випробуванні з постійним обсягом інформації, планується для наступної хвилі.
H2 не підтримується. Серед учасників, яким вже було показано дисплей розбіжності, квитанція не виробила жодного помітного ефекту на композит делегування при реалізованій потужності (3.45 vs 3.09; b = +0.41, p = .29; об'єднана гілка b = +0.34, p = .33; композитна надійність: основна хвиля Cronbach α = .89). Три попередньо зареєстровані вторинні результати визначають, як слід інтерпретувати нульовий результат. Квитанцію дійсно отримували: медіанний час сеансу в умові квитанції був приблизно на півтори хвилини довшим, ніж в умові розбіжності (11.0 vs 9.4 хвилин; синхронізація на рівні екрана не була зафіксована в експортованих польових даних, тому загальна тривалість замінює зареєстровану проксі часу впливу стимулу). Додатковий час не доводить, що учасники використовували квитанцію. Розповсюджена квитанція була статичною карткою, і її можливість «переглянути повний запис» не була активною всередині опитування, тому маніпуляція перевіряла наявність квитанції, а не її використання. Квитанція з інтерактивною деталізацією — це більш сильна маніпуляція, яку включає наступний дизайн. Це нульовий результат для одного статичного дисплея квитанції, а не для записів, перевіреності або P2 як описано. Квитанція також змінила свій попередньо зареєстрований посередник. Сприйманий контроль процесу зріс в умові квитанції (a = +0.60; надійність шкали, основна хвиля: контроль процесу α = .93, ризик α = .83, нейтральність α = .90), контроль процесу сильно передбачає делегування (b = +0.60), і опосередкований шлях bootstrap є позитивним і виключає нуль (indirect = +0.35, 95% CI [+0.02, +0.78], 5,000 resamples), тоді як прямий ефект близький до нуля. Це дослідницький доказ опосередкування: посередник вимірювали після втручання в тому ж інструменті, тому загальна дисперсія методу та зворотна інтерпретація залишаються можливими. Чутливість обмежує те, що цей нульовий результат може вирішити. Реалізовані комірки виявляють d ≈ 0.49 при потужності .80 лише при зареєстрованому N, тому ефект квитанції розміру, який мається на увазі медіаційним шляхом, — це саме той розмір, який цей зразок не може розрізнити. Результат не є висновковим щодо малих і середніх ефектів і є вирішальним лише проти більших ефектів. Формально тестування еквівалентності обмежує ефект лише грубо (TOST встановлює |d| < 0.64 при α = .05, а не |d| < 0.5), а Байєсів коефіцієнт JZS дає BF₀₁ ≈ 2.9 (об'єднана гілка 3.1), анекдотичний доказ на користь нуля за стандартними порогами (на межі або трохи далі від анекдотичної/помірної межі 3); він не демонструє відсутність і не підтримує присутність. Розділ про вимірювання передбачував це: перевіреність — це властивість за запитом, і її цінність повинна з'явитися в момент суперечки, претензії або аудиту, тому статична квитанція, прочитана один раз під час гіпотетичної покупки, може бути неправильним моментом для її спостереження. Зареєстрований висновок: тест першого впливу P2 не вдався змінити делегування, і економіка квитанції зі сторони оператора (розділ 5) не спирається на цей результат зі сторони споживача. Залишаються два тлумачення: або компонент доказу менше сприяє в момент прийняття рішення, ніж стверджує структура, або ця операціоналізація є неправильною перевіркою для неї. Пояснення часу суперечки — це гіпотеза post-hoc, запланована як дизайн подальшого дослідження, названий в кінці цього розділу, а не вирішення нульового результату. Третє тлумачення походить з літератури про психологічне уникання. Детальна квитанція — це маніпуляція видатністю, експозиція механізму, яка нагадує споживачу, як багато чого може піти не так саме в момент делегування, парадокс прозорості, в якому процедурна деталь пригнічує, а не будує довіру (Kizilcec, 2016; Dietvorst, Simmons, & Massey, 2015). Ці конкуруючі тлумачення, слабший за заявлений компонент, тест неправильного моменту та зворотний ефект видатності роблять різні передбачення й розділяються за дизайном.
Сертифікований режим помилки консенсусу відтворений у людській поведінці. Один стимульований тест мав, за дизайном, справжню помилку консенсусу, у якій всі три системи впевнено конвергуються на одну й ту саму неправильну відповідь, відображаючи 0.5–2.2% рівень помилки консенсусу в відкритій формі, який вимірює дослідження механізму. На тому тесті — один предмет і тому спостереження, а не оцінка — дисплей розбіжності не захистив нікого і, в обох країнах, спрямовано збільшив прийняття неправильної відповіді (на 4 та 14 відсоткових пунктів відносно контролю): учасники раціонально інтерпретували одностайну незалежну згоду як сертифікацію. Отже, один систематичний режим відмови архітектури передається своїм користувачам з високою вірністю. Розділ 3 дав дизайну попередження, що консенсус засвідчує помилку саме там, де різноманітність панелі зазнає невдачі, і тест показує ту ж невдачу в поведінці.
Дослідницько: де проявляється користь від калібрування.
Все, що далі йде, є дослідницьким та спрямованим на генерування гіпотез. Комірки за країнами малі, і кожне значення p всередині країни нижче слід читати як описове. Ефект калібрування сконцентрувався майже повністю у британській вибірці та був відсутній у американській вибірці:
Таблиця 17. Калібрування Δ за країною та умовою (дослідницьки)
| Контроль Δ | Розбіжність (об'єднано 2, 3) Δ | Розмір ефекту всередині країни | |
| Великобританія (n = 79) | +0.103 (n = 26) | +0.447 (n = 53) | d = +1.19 |
| США (n = 40 первинне / 54 об'єднано) | +0.458 / +0.433 | +0.444 / +0.471 | d = −0.05 / +0.13 |
| Взаємодія: країна × умова | b = −0.36, p = .002 (первинне); b = −0.31, p = .004 (об'єднано) |
Декомпозиція більш інформативна, ніж взаємодія. Учасники US Control вже чітко розрізняли без будь-якого архітектурного сигналу, приймаючи 92% правильних та лише 48% неправильних відповідей, тоді як учасники UK Control майже не розрізняли (78% проти 68%). Під час відображення розбіжності дві країни стали майже невідрізненими, позицію за позицією (максимальна різниця в комірці 0.07 для всіх шести випробувань). Втручання зблизило обидві вибірки до однієї точки калібрування (Δ ≈ +0.45), вирівнюючи базову різницю, яку воно не створило (Figure 21). Частина цього закономірності є механічною. Δ обмежена, тому доступний простір скорочується зі зростанням базового калібрування, а "користь концентрується там, де базова найслабша" — це частково властивість самого показника. Однак сама верхня межа не примушує однакові кінцеві точки або збіг профілю позицію за позицією. Найбільш обґрунтоване прочитання полягає в тому, що шість позицій були досить легкими, щоб одна панель могла розрізняти їх без допомоги, тому дисплей закриває прогалину калібрування там, де вона існує. Це прочитання стосується простору, а не націй, і рівною мірою стимулів: сам набір позицій був культурно перекошений (дві позиції незгоди містили контент, специфічний для США), тому профіль конвергенції є властивістю цих шести позицій не менше, ніж цих двох панелей.
Figure 21. Конвергенція, не однорідна відповідь (дослідницька)
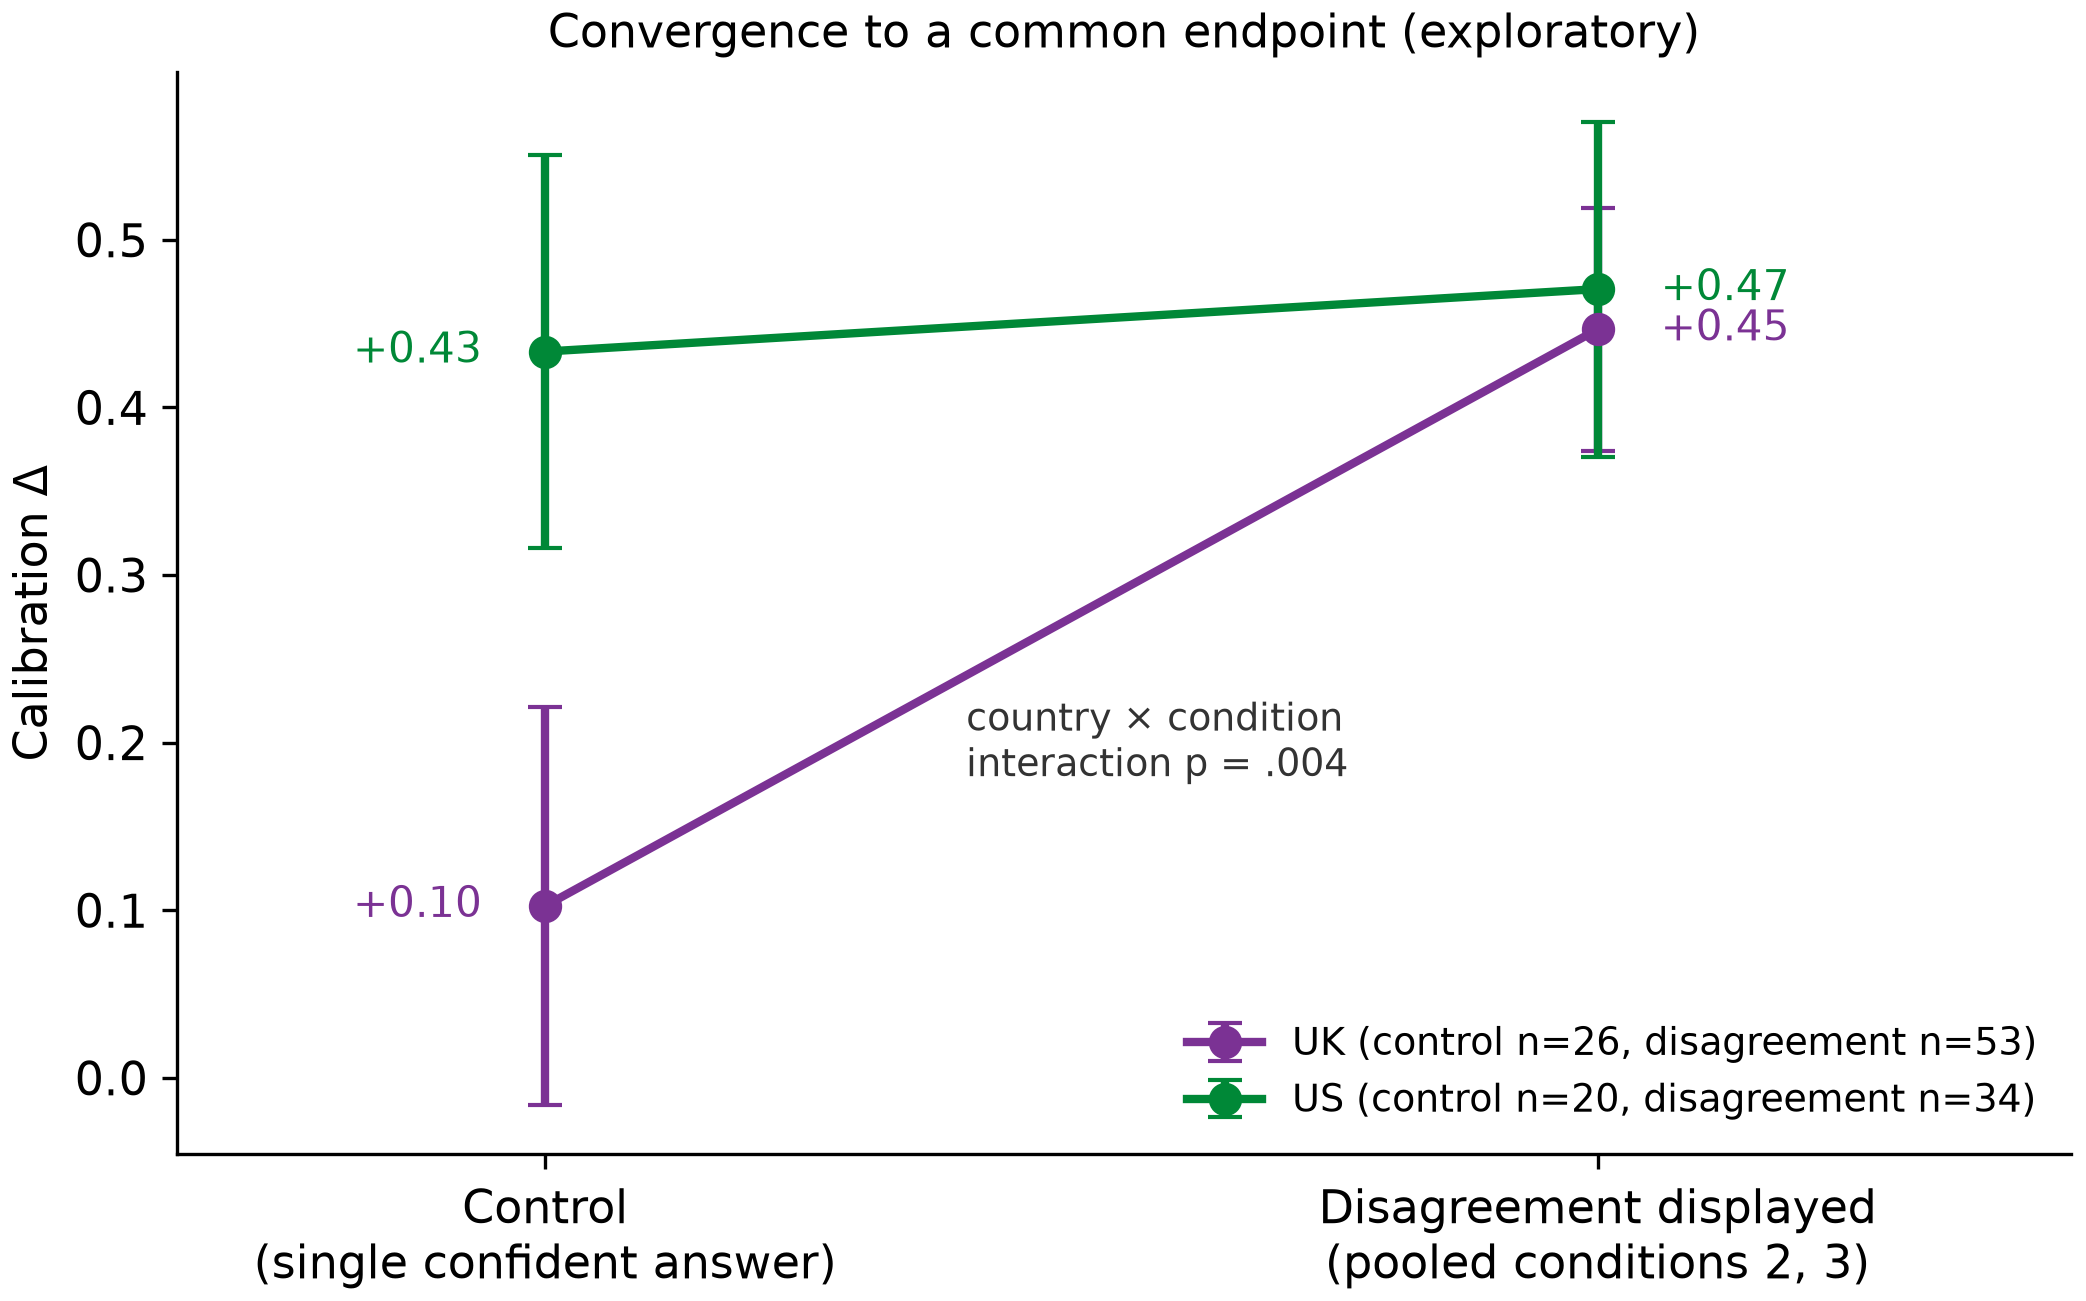
Калібрування Δ за країною та умовою: група US control вже розрізняє (Δ ≈ +0.45); група UK control майже не розрізняє (Δ ≈ +0.10); під час відображеної розбіжності обидві країни потрапляють на ту ж саму кінцеву точку (Δ ≈ +0.45). Користь концентрується точно там, де базове калібрування найслабше.
Тим часом, перевага США в Control зосереджена на двох позиціях незгоди з правдоподібно специфічним для США змістом. Одна — це питання про Museum of Bad Art, на якому неправильна відповідь "the Mona Lisa" є абсурдною для будь-кого, хто знає концепцію музею (прийняття в США 5% проти 27% у Великобритані). Концентрація на цих двох позиціях вказує на знайомство з позиціями, а не на національний характер.
Table 18. Прийняття неправильних фокусних відповідей за позицією та комірці (дослідницька; об'єднана когорта)
| Комірка | Дисентер неправ, conf 95 ("Mona Lisa" item) | Дисентер неправ, conf 98 (ICM-city item) | Консенсус неправий, conf 99 |
| UK Control (n = 26) | 0.27 | 0.85 | 0.92 |
| US Control (n = 20) | 0.05 | 0.60 | 0.80 |
| UK Disagreement (n = 53) | 0.21 | 0.25 | 0.96 |
| US Disagreement (n = 34) | 0.18 | 0.24 | 0.94 |
Захисний ефект втручання розташовується майже повністю на позиції дисентера з високою впевненістю (UK −0.60, US −0.36); на позиції помилки консенсусу дисплей дещо збільшує прийняття в обох країнах — одностайна згода читається як сертифікація, поведінкове відображення сертифікованих помилок консенсусу дослідження механізму. Оскільки захисний ефект розташовується на цій одній позиції, об'єднаний підтверджуючий контраст не переживе його видалення (d = 0.09, p = .54), хоча він переживе видалення будь-якої іншої окремої позиції (d = 0.47–0.89) — кількісна форма ефекту, яку несе одна позиція.
Table 19. Шкали ставлення за країною (дослідницька; об'єднана когорта): розрив є поведінковим, не ставленням
| Шкала (1–7 якщо не зазначено) | Середнє значення UK | Середнє значення US | Напрямок |
| Довіра до AI до експозиції | 4.68 | 4.70 | ідентичні |
| Готовність делегувати (складена) | 2.94 | 3.43 | США вище (p = .08) |
| Шкала делегування (0–4) | 1.71 | 1.98 | США вище (p = .08) |
| Сприйнятий ризик | 5.54 | 5.13 | США нижче (p = .09) |
| Сприйнятий контроль процесу | 4.17 | 4.56 | США вище (p = .14) |
| Сприйнята нейтральність | 4.75 | 4.62 | n.s. |
Кожна різниця ставлень, яка існує, вказує на "неправильний" напрямок для гіпотези про скептицизм США: учасники США більш готові делегувати та менш сприймають ризик, проте розрізняють краще поведінково в Control. Виміряні ставлення цього не пояснюють: коригування базової різниці за країнами для демографії та всіх п'яти шкал послаблює це максимум на 15%, а завантажувальні непрямі шляхи через шкали дають нульові результати.
Міжнародні опитування узгоджуються з гіпотезою про нульовість ставлень. Заявлена готовність довіряти AI по суті однакова у США та Великобритані (41% проти 42%: Gillespie et al., 2025), і обидві країни знаходяться в одному кластері високої обережності "Anglosphere" щодо нервозності AI (Ipsos, 2025). Єдина асиметрія на рівні населення, що вказує на спостережуваний напрямок, — це грамотність у AI. Респонденти з Великобритані повідомляють про менші навички та впевненість у використанні та оцінці AI (36% проти 42% за навичками: Gillespie et al., 2025), а дорослі в США знаходяться серед населення найбільш знайомого з AI, яке опитувалось (Pew Research Center, 2025). Таким чином, дві версії залишаються в межах дослідницьких даних. За версією про знайомство, населення менш обладнане для оцінки порад AI отримує найбільше користі від архітектури, яка оцінює це структурно. Інша версія — це склад панелі: британське крило платформи рекрутування складається з більш старих та досвідчених учасників, і онлайн-панелі є неповними інструментами для висновків між країнами (Gvirtz & Sabherwal, 2024), тому ярлик "country" може частково служити замінником для тривалості участі в панелі. Дизайн не може розділити ці дві версії, і не потребує цього, оскільки на будь-якій версії суттєвою знахідкою є сам компенсаційний профіль. Враховуючи розміри комірок, безпечніше за замовчуванням читати закономірність як властивість цих двох панелей до отримання результатів повноцінної репліки; жодна теоретична претензія в цій статті на це не спирається.
Цей профіль не є типовим результатом втручань проти надмірної залежності. Когнітивні функції примусу зменшують надмірну залежність, але концентрують їх користь серед користувачів з уже високою потребою в когніції, тому аналітично схильні люди стають ще більш аналітичними (Buçinca et al., 2021), а дослідження адаптивної калібрування довіри розглядають спрямування на неправильно відкалібровані як дизайнерське завдання, що вимагає активного моніторингу (Okamura & Yamada, 2020). Тут спрямування виникло без додаткових зусиль. Відображена розбіжність є самоспрацьовуючою: вона з'являється саме тоді, коли панель не згідна, і нічого не вимагає від користувача заздалегідь. Її користь впала саме на групу, базова здатність якої до розрізнення була найслабшою, і залишила точність уже відкаліброваної групи не порушеною, замість того щоб її погіршити. Для механізму захисту споживача це є розподільним профілем, який можна було б визначити ex ante, з допомогою, зосередженою там, де зосереджується неправильна калібрування, і без навантаження на тих, хто в ньому не потребує.
Попередньо зареєстровані вторинні аналізи: залишок реєстру.
Решта попередньо зареєстрованих вторинних аналізів знаходиться тут в одному місці (основна когорта; об'єднані значення гілок у пакеті репліції). Посередництво впливу розбіжності через сприймаємий ризик, шлях P1, який передбачав дизайн, дорівнює нулю. Відображення, якщо що, злегка зменшило сприймаємий ризик (a = −0.40), а опосередкований шлях бутстрапу не відрізняється від нуля (+0.006, 95% CI [−0.013, +0.029]). Ефект калібрування є прямим, що узгоджується з використанням учасниками розбіжності як інформації про відповідь, а не як загального сигналу тривоги щодо операції. Сприйнята нейтральність оркестратора, виміряна, а не маніпульована, є сильним корелятом готовності делегувати, контролюючи за умовою та країною (b = +0.47, p < .0001), кореляційний слід, який передбачає P3, в очікуванні на його маніпуляцію. Драбина делегування показує те саме упорядкування, що й композит, без досягнення статистичної значимості (впорядкована логіт, квитанція vs розбіжність: b = +0.70, p = .11; медіани дорівнюють 2 з 4). Незареєстрований контраст умови 3-проти-1 щодо делегування є спрямовано позитивним і статистично незначимим (b = +0.52, p = .15). Одне відхилення: експорт даних не захопив синхронізацію на рівні екрана, тому зареєстрований проксі часу читання квитанції наближується загальною тривалістю сеансу (повідомлено під H2 вище). Призначена перевірка на рівні екрана повинна бути вбудована в інструмент наступної хвилі.
Це дослідження перевіряє тільки P1 та P2. P3 вимірюється, а не маніпулюється, а P4 та повна спільна варіація розділу 5 залишаються визначеним наступним дослідженням. Поведінкова валідація тріади тому неповна: одна компонента підтримана, одна невирішена, одна виміряна, але не маніпульована. Одне лонгітюдне питання стоїть понад програмою. Постійне відображення розбіжності може стабілізувати довгострокову адоптацію як демпфер коливань між оцінкою алгоритму та аверсією після першої помилки, або може виснажити цю адоптацію через постійну експозицію машинним помилкам. Дослідження одного сеансу це не може розкрити. Два дослідження, мотивовані наведеними вище результатами, додаються до програми. Одне — це дизайн у момент спору, який перевіряє квитанцію в момент, коли передбачається його прояв, використовуючи контроль поддільної квитанції, квитанцію, чий хеш не перераховується, щоб розділити перевірюваність від її візуалізації. Інше — це репліція, розраховане з врахуванням модерування за країною, повідомлена вище (таблиця 17).
7. Висновок
Оскільки AI опосередковує значні рішення споживачів і все більше їх приймає, я стверджував, що довіра повинна мігрувати вгору в стеку: від моделі до архітектури, до запису. Різноманітність, докази та нейтральність разом виробляють послугу, чия надійність може бути перевірена, а не прийнята на віру. Те, що будується, — це не вдосконалена переконаність, а економічна інфраструктура довіри, ланцюг відповідальності, який дозволяє масштабувати делегування. Флагманська хвиля вимірює це на вершині ринку. Об'єднано у всіх десяти повних флагманських гілках хвилі моделі, продані як найкраще від кожної лабораторії, були впевнено невірні в майже половині розв'язаних відповідей, запропоновані при заявленій впевненості ≥ 80 (46.6%, і цифра майже не змінюється, коли невирішені пункти рахуються як помилки). Часткова гілка Meta повідомляється окремо, й її включення залишає цифру практично незміненою. Фіксована брама розбіжності трьох моделей вище них, без навчання та налаштування, видаляє чотирьох п'ятих цих невдач при зазначеній, видимій вартості охоплення. Оскільки субстрат тут чисто фактичний, цей показник слід розуміти як верхню межу для змішаних комерційних завдань. Що обґрунтувало б претензію для справжної комерції, — це репліція, заснована на пошуку, з використанням інструментів на обмеженому меню товарів, де помилки консенсусу поводяться інакше, ніж у відкритому фактичному просторі. Попередньо зареєстрований експеримент (розділ 6) представив той же архітектурний сигнал перед споживачами й повернув докази того, що вони можуть діяти на його основі як на сигналі правильності: відображення розбіжності скоротило прийняття впевненої невірної рекомендації з 74% до 24% за кваліфікуючим пунктом. У дослідницькому поділі за країною вона концентрується в комірці надмірно залежної Великобританії й спирається на цей один пункт (об'єднаний контраст не залишається при його видаленні, d = 0.09). Це доказ існування за цими стимулами, ще не загальний ефект; планується підтверджувальний тест на вибірці стимулів.
Цей рівень заслуговує на власну назву на ринку, інфраструктура доказів, щоб продаватися так само, як хмарні, ідентифікаційні та платіжні інфраструктури, оскільки вона відповідає на той же вид запитання: «чи можна на це покластися, і як ми це дізналися б?» Це інше запитання, ніж «чи це розумно?» Безпека та приватність обидві пішли цим шляхом: спочатку диференціатор, далі очікування, далі умова входу. Архітектурна довіра може обґрунтовано слідувати тим же шляхом у темпі, встановленому вже видимим регуляторним та юридичним тиском.
Мій аргумент на теоретичному рівні полягає в тому, що одиницею аналізу для довіри споживачів до послуг на основі ШІ має стати архітектура замість моделі, тому що властивості, які становлять довіру, насправді знаходяться там: незалежність перевірки, відтворюваність рішень, відсутність конфліктів інтересів. Моделі змінюються під кожною послугою швидше, ніж будь-яка репутація може відстежувати. Розрив у продуктивності закритих і відкритих моделей упав з 8.04% до 1.70% за один рік (Stanford HAI, 2025), а лідерство на ринку корпоративних моделей змінилося за одну весну (Kharazian, 2026). Шар, який настільки швидко перетворюється на товар, не є місцем, де може закріпитися довіра. Те, що служить споживачеві, дедалі більше маршрутизується по моделях і цінових рівнях, керованого вартістю, невидимо та непровірено, і обрана найкраща модель служить дедалі меншій кількості. Крок, що залишається, і той, що його тут визначаю, це перейти від найкраще маршрутизованої архітектури до такої, чию перевірку споживач, страховик чи регулятор могли б утримувати достатньо довго, щоб перевірити. Під цим лежить перехід від асистентів ШІ до фідуціаріїв ШІ. Фідуціарії, в кожній галузі, яка коли-либо їх мала, утворюються не за їхніми здібностями, а за їхніми обов'язками: вести записи, піддаватися аудиту, не мати несприятливих інтересів. Архітектурна довіра вбудовує ці обов'язки в механізм.
Та сама вимога застосовується до того, як зростає сама система. Система, яка просить бути довіреною для дій з наслідками, повинна зростати способом, який можна перевірити. Зміни конфігурації на рівні оркестрації повинні фіксуватися або скасовуватися через перевірені статистичні шлюзи проти збереженого доказу, без жодного автоматичного процесу послаблення правила безпеки, лише додавання нових. Дослідне розгортання в дослідженні випадку реалізує ці шлюзи.
Інфраструктура ШІ тепер потребує шару верифікації (Рисунок 16). Індустрія побудувала шар обчислень та шар моделей, і тепер будує шар оркестрації. Після нього йде верифікація, механізм, який робить поведінку системи ШІ перевірюваною, а не гідною довіри. Обґрунтування довіри до ШІ повинно стати машинно перевірюваним, а не заснованим на репутації; сама довіра залишається людською, і те, що може бути перевірено машиною, це її основи. Якщо це правильно, наступний незамінний шар інфраструктури ШІ буде побудований не навколо інтелекту, а навколо перевірюваності.
Рисунок 16. Драбина інфраструктури
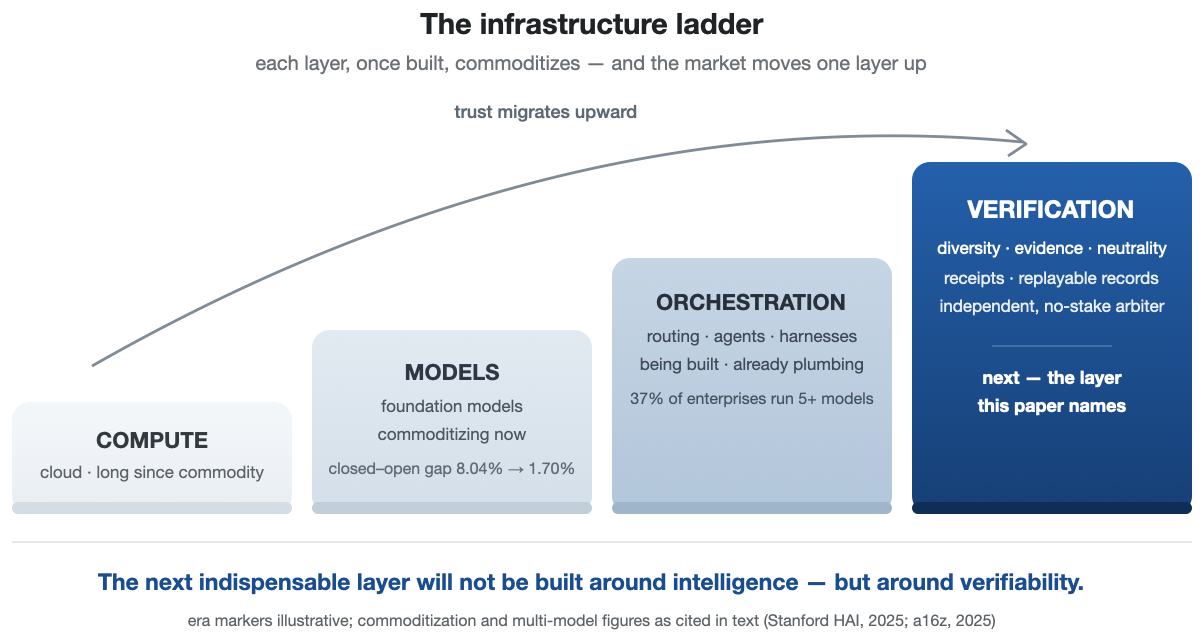
Обчислення, потім моделі, потім оркестрація, і верифікація як наступний незамінний шар.
Примітка та розкриття автора
Розгортання, описане в розділі 4, є еталонною реалізацією, побудованою та керованою автором; методи, які вона втілює, є відкритими, і автор є названим заявником у очікуючих патентних заявках, не видані патенти, що охоплюють системи оркестрації ШІ та багатомодельної валідації того типу, які цей документ розглядає. Вона служить тут дослідницьким інструментом дослідження, і автор має інтерес розробника в архітектурі, яку вона втілює; розділ 4 слід читати як доказ існування та дизайнерське свідчення, а не як незалежну оцінку. Усі моделі в цьому дослідженні були доступні через стандартні комерційні API постачальників на звичайних умовах. Жодне зовнішнє фінансування не підтримало цю роботу.
Інструменти та верифікація. Асистенти ШІ були використані як інструменти під керівництвом автора; ідеї, дослідження та висновки належать автору. Фактичні твердження, що мають вагу, були перевірені проти первинних джерел, де це було можливо, і в тексту атрибутовані з їхнім доказовим статусом (звіти про пресу як звіти, звинувачення як звинувачення, препринти як препринти), і ведеться датований журнал верифікації тверджень з матеріалами робочого рукопису. Коректність експерименту ніколи не оцінюється жодною панельною моделлю (оцінка — це об'єктивне узгодження рядків або локальний оцінювач з відкритими вагами), числа дискримінації та калібрування для кожного постачальника надруковані в основному тексту (таблиці 7 та 7a), і кожне повідомлене число можна перебудувати з детерміністичного пакета репродукції (доступно публічно на https://osf.io/jtvu9/).
Доступність даних та коду
Кожне повідомлене число в експериментах механізму (розділ 3) можна перебудувати з детерміністичного пакета репродукції — необроблені відповіді моделей обох хвиль (включаючи шістнадцятимодельну колекцію з 24 000 відповідей та оцінені записи основної хвилі), програми запуску колекцій, детерміністичний оцінювач, скрипти аналізу та похідні CSV-файли (включаючи криві охоплення ризику та 26-пунктову межу витрат–точності, кожна точка якої позначена основою ціни рахунку проти списку) — доступно публічно на https://osf.io/jtvu9/, публічний компонент вихідного проекту попередньої реєстрації (папка `replication-package-v2`; архів програми самокаліброви розділу 3 відкладається поруч). Замороженої підвибірка SimpleQA (закріплена посівом та SHA-256 хешем) уже є публічною в попередній реєстрації дослідження механізму (https://osf.io/4y9dv, зареєстрована 23 липня 2026). Попередня реєстрація експерименту споживача зареєстрована на OSF під ембарго (заморожена перед основною збіркою даних; реєстрація https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f). Пул учасників закритий; інструмент опитування, віньєтки та стимули судження в блоках, записи про видачу квитанцій розділу 6 та дані експерименту споживача з замороженим кодом аналізу будуть випущені до того ж компонента OSF при публікації.
Посилання
Записи, позначені arXiv, є препринтами; оголошення індустрії та прессові матеріали 2026 року є сучасними звітами, а не усталеною літературою, і цитуються як такі.
a16z — Andreessen Horowitz (2025). Як 100 корпоративних CIO будують та купують gen AI у 2025 році. a16z.com/ai-enterprise-2025.
Accenture (2026). Поговори з моїм агентом ШІ: нові правила вартості бренду. Опитування 25 590 споживачів у 16 країнах, січень 2026.
ACI Worldwide (2026). Ставлення споживачів до покупок та платежів, керованих ШІ. Опитування YouGov 2080 дорослих у Великобританії, проведене 19–22 червня 2026. Прес-реліз.
Ahmad Husairi, M., & Rossi, P. (2024). Делегування завдань покупки до ШІ: роль сприйманого вибору та автономії рішень. Decision Support Systems, 179, 114166. DOI 10.1016/j.dss.2023.114166.
AIUC (2025). AIUC-1: стандарт агента. Компанія зі страхування штучного інтелекту.
Alavi, S., & Nozari, S. (2026). Коли агенти ходять за покупками для вас: узгодженість ролей на ринках, опосередкованих ШІ. arXiv:2604.26220.
Allouah, A., Besbes, O., Figueroa, J. D., Kanoria, Y., & Kumar, A. (2026). Що закуповує ваш AI-агент? Оцінка, упередження, залежність від моделі та виникаючі наслідки агентної е-комерції. Proceedings of the ACM Web Conference 2026, 8697–8700. https://doi.org/10.1145/3774904.3792943
American Express (2026). American Express представляє набір розробника Agentic Commerce Experiences (ACE) та оголошує захист першої у промисловості для придбань зареєстрованих агентів. Прес-реліз, 14 квітня 2026.
Anderson, L. (2006). Аналітична аутоетнографія. Journal of Contemporary Ethnography, 35(4), 373–395.
André, Q., Carmon, Z., Wertenbroch, K., Crum, A., Frank, D., Goldstein, W., Huber, J., van Boven, L., Weber, B., & Yang, H. (2018). Вибір споживача та автономія в епоху штучного інтелекту та великих даних. Customer Needs and Solutions, 5(1–2), 28–37.
Appenzeller, G. (2024). Ласкаво просимо в LLMflation: вартість виведення LLM швидко зменшується. Andreessen Horowitz, листопада 2024.
Aubakirova, M., Atallah, A., Clark, C., Summerville, J., & Midha, A. (2026). Стан AI: емпіричне дослідження 100 трильйонів токенів з OpenRouter. arXiv:2601.10088 (звіт опублікований грудня 2025).
Bain & Company (2025). Прогноз ринку агентної комерції: 300–500 мільярдів доларів США е-комерції до 2030 року. Грудня 2025.
Bainbridge, L. (1983). Парадокси автоматизації. Automatica, 19(6), 775–779.
Balaskas, S. (2026). Від рекомендацій до делегування: систематичний огляд картування агентного AI в е-комерції та його впливу на споживачів. Information, 17(3), 222.
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. S. (2021). Чи перевищує ціле суму своїх частин? Вплив пояснень AI на характеристики взаємодіючої команди. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, 1–16.
Basu, A. (2026). Квитанції інструментів, а не докази з нульовим знанням: практичне виявлення галюцинацій для агентів AI. arXiv:2603.10060.
Board of Governors of the Federal Reserve System & OCC (2011). Надзорні вказівки з управління ризиком моделі (SR Letter 11-7 / OCC 2011-12).
Buçinca, Z., Malaya, L. B., & Gajos, K. Z. (2021). Довіряти чи думати: когнітивні функції примусу можуть зменшити надмірну залежність від AI в прийнятті рішень, допоміжних AI. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), 1–21.
Burton, J. W., Stein, M.-K., & Jensen, T. B. (2020). Систематичний огляд відвороту від алгоритму при прийнятті рішень з технологічною підтримкою. Journal of Behavioral Decision Making, 33(2), 220–239.
California State Legislature (2025). Assembly Bill 316 (artificial intelligence: defenses), Stats. 2025, ch. 672 (adding Cal. Civ. Code § 1714.46), effective 1 січня 2026.
Carlson, S. C. (2026). Міграція довіри в цифрову епоху: інформаційні режими та трансформація відносин купівельника-продавця. Atlantic Marketing Journal, 15(1), Article 6.
Castelo, N., Bos, M. W., & Lehmann, D. R. (2019). Залежна від завдання несприйнятливість алгоритму. Journal of Marketing Research, 56(5), 809–825.
Cetinkaya, N. E., & Krämer, N. (2024). Розуміння проти довіри: аналіз спільного впливу. Робочий документ, OSF Project mw4dq.
Chandra, K., Kleiman-Weiner, M., Ragan-Kelley, J., & Tenenbaum, J. B. (2026). Угодливі чатботи викликають маячну спіраль навіть у ідеальних байесівців. arXiv:2602.19141.
Chen, C., Sun, Y., Liao, M., & Sundar, S. S. (2026). Коли AI не згоджується: вплив другої думки на довіру пацієнтів лікарям. International Journal of Human-Computer Studies, 213, 103824.
Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026). Угодливий AI зменшує просоціальні наміри та сприяє залежності. Science, 391(6792), eaec8352. DOI: 10.1126/science.aec8352.
Choi, H. K., Zhu, X., & Li, S. (2026). Коли ідентичність викривлює дебати: анонімність для міркування мультиагента зі зменшеним упередженням. Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 14284–14311. https://doi.org/10.18653/v1/2026.acl-long.650
Choi, M., Kim, K., Chae, S., & Baek, S. (2025). Емпіричне дослідження групової відповідності в системах мультиагента. Findings of the Association for Computational Linguistics: ACL 2025, 5123–5139. https://doi.org/10.18653/v1/2025.findings-acl.265
Clark, J., & Hadfield, G. K. (2020). Нормативні ринки для безпеки AI. arXiv:2001.00078.
CNBC (2026, 24 березня). OpenAI переробляє покупальницький досвід у ChatGPT після боротьби з пропозицією Instant Checkout (повідомлення про звіт The Information за березень 2026 про відкат вбудованого касиру).
Daly, C. (2025). Klarna сповільнює скорочення робочих місць, спричинені AI, закликаючи до реальних людей. Bloomberg News, 8 травня 2025.
de Bellis, E., & Johar, G. V. (2020). Автономні системи покупок: визначення та подолання бар'єрів для прийняття споживачами. Journal of Retailing, 96(1), 74–87.
Detjen, H. H. J., Densky, L., von Kalckreuth, N., & Kopka, M. (2025). Кому довіряють для другої думки? Порівняння колективної консультації від медичного AI та лікарів у рішеннях біопсії після мамографічного скринінгу. CHI 2025.
de Visser, E. J., Pak, R., & Shaw, T. H. (2018). Від 'автоматизації' до 'автономії': важливість відновлення довіри в взаємодії людини та машини. Ergonomics, 61(10), 1409–1427.
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Несприйнятливість алгоритму: люди помилково уникають алгоритмів після того, як бачать їх помилки. Journal of Experimental Psychology: General, 144(1), 114–126.
DigiCert (2026). Архітектура довіри AI. Оголошення продукту, квітня 2026.
Ding, K. (2026). Коли LLM згоджуються, вони правильні? Аудит самоузгодженості та кросс-модельної угоди як сигналів впевненості. arXiv:2607.08065.
Dranove, D., & Jin, G. Z. (2010). Розкриття якості та сертифікація: теорія та практика. Journal of Economic Literature, 48(4), 935–963.
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024). Поліпшення фактичності та міркування в мовних моделях через дебати мультиагента. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 11733–11763.
Endsley, M. R., & Kiris, E. O. (1995). Проблема характеристики поза циклом та рівень контролю в автоматизації. Human Factors, 37(2), 381–394.
Errico, H. (2026). Управління автономною дією під час виконання (AARM): специфікація системи для захисту дій, спричинених AI, під час виконання. arXiv:2602.09433.
Європейська комісія (2026). Керівництво щодо впровадження зобов'язань з прозорості для певних систем штучного інтелекту відповідно до статті 50 Закону про штучний інтелект. Прийнято 20 липня 2026 року.
Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). Виявлення галюцинацій у великих мовних моделях за допомогою семантичної ентропії. Nature, 630(8017), 625–630.
Featherman, M. S., & Pavlou, P. A. (2003). Прогнозування впровадження електронних послуг: перспектива аспектів сприйманого ризику. International Journal of Human-Computer Studies, 59(4), 451–474.
Frank, D.-A., Folwarczny, M., & Otterbring, T. (2026). Прийняття споживачами високоавтономних помічників зі штучного інтелекту зумовлено сприйманими переважами в умовах інтернет-шопінгу, що характеризуються дефіцитом. Psychology & Marketing, 43(3), 538–555. https://doi.org/10.1002/mar.70074
Gartner (2025). Gartner прогнозує, що понад 40% проектів агентного штучного інтелекту будуть скасовані до кінця 2027 року. Прес-реліз, 25 червня 2025 року.
Gartner (2026). Дослідження споживачів щодо генеративного штучного інтелекту в покупках (прес-реліз травня 2026 року).
Gefen, D., Karahanna, E., & Straub, D. W. (2003). Довіра та TAM в інтернет-шопінгу: інтегрована модель. MIS Quarterly, 27(1), 51–90.
Geifman, Y., & El-Yaniv, R. (2017). Вибіркова класифікація для глибоких нейронних мереж. Advances in Neural Information Processing Systems 30 (NeurIPS 2017), 4878–4887 (arXiv:1705.08500).
Gillespie, N., Lockey, S., Ward, T., Macdade, A., & Hassed, G. (2025). Довіра, ставлення та використання штучного інтелекту: глобальне дослідження 2025. The University of Melbourne and KPMG. https://doi.org/10.26188/28822919
Glikson, E., & Woolley, A. W. (2020). Людська довіра до штучного інтелекту: огляд емпіричних досліджень. Academy of Management Annals, 14(2), 627–660.
Google (2026). Universal Commerce Protocol. Оголошення на NRF, 11 січня 2026 року; розширення cart, catalog та identity-linking, березня 2026 року.
Google Cloud (2025). Agent Payments Protocol (AP2). Оголошення, 16 вересня 2025 року.
Google DeepMind (2025). SimpleQA Verified. arXiv:2509.07968.
Gorbett, M., & Jana, S. (2026). Розбіжність між моделями як сигнал коректності без міток. arXiv:2603.25450.
Gottweis, J., Weng, W.-H., Daryin, A., Tu, T., Sirkovic, P., Myaskovsky, A., Glowaty, G., Weissenberger, F., Orlandi, A., Popovici, D., Palepu, A., Rong, K., Tanno, R., Saab, K., Zhang, F., Blum, J., Carroll, A., Kulkarni, K., Tomašev, N., Zverinski, D., Rendulic, I., Vedadi, E., Hasler, F., Rimanic, L., Boia, M., Budiselic, I., Feinstein, B., Bellaiche, M., Sheffer, T., Freyberg, J., Ratcliff, J., Bertolli, O., Chou, K., Hassidim, A., Gokturk, B., Vahdat, A., Guan, Y., Dhillon, V., Vaishnav, E. D., Lee, B., Costa, T. R. D., Penadés, J. R., Peltz, G., Matias, Y., Manyika, J., Hassabis, D., Xu, Y., Kohli, P., Pawlosky, A., Karthikesalingam, A., & Natarajan, V. (2026). Прискорення наукових відкриттів за допомогою Co-Scientist. Nature, 655(8122), 487–496. https://doi.org/10.1038/s41586-026-10644-y
Gould, S. J. (1991). Самоманіпуляція своєю всепроникною, сприйманою життєвою енергією через використання продукту: перспектива інтроспективної практики. Journal of Consumer Research, 18(2), 194–207.
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). Щодо калібрування сучасних нейронних мереж. ICML 2017, PMLR 70, 1321–1330.
Gvirtz, A., & Sabherwal, A. (2024). Межи проведення глобальних, кроскультурних досліджень поведінкової науки. Proceedings of the National Academy of Sciences, 121(36), e2316690121.
Hadfield, G. K. (2017). Правила для плоского світу: чому люди винайшли право і як його переосмислити для складної глобальної економіки. Oxford University Press.
Hadfield, G. K., & Clark, J. (2026). Регуляторні ринки: майбутнє управління штучним інтелектом. Jurimetrics, 65, 195–240 (arXiv:2304.04914).
Hansen, L. K., & Salamon, P. (1990). Ансамблі нейронних мереж. IEEE Transactions on Pattern Analysis and Machine Intelligence, 12(10), 993–1001.
Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026). Не всі перевороти — це конформізм: розкладання збіжності позицій у багатоагентній дискусії LLM. arXiv:2606.00820.
Hoff, K. A., & Bashir, M. (2015). Довіра до автоматизації: інтеграція емпіричних доказів факторів, що впливають на довіру. Human Factors, 57(3), 407–434.
Hong, L., & Page, S. E. (2004). Групи різноманітних вирішувачів проблем можуть перевищити групи високоздатних вирішувачів проблем. Proceedings of the National Academy of Sciences, 101(46), 16385–16389.
Huang, M.-H., & Rust, R. T. (2021). Стратегічна структура штучного інтелекту в маркетингу. Journal of the Academy of Marketing Science, 49(1), 30–50.
Insurance Services Office (2026). Форми схвалення CG 40 47 та CG 40 48: виключення генеративного штучного інтелекту. Вступає в силу 1 січня 2026 року.
Internet Engineering Task Force (2026). Архітектура надійних і прозорих цифрових ланцюгів поставок (RFC 9943; робоча група SCITT). IETF. https://datatracker.ietf.org/doc/rfc9943/
Ioku, T., Song, J., & Watamura, E. (2024). Компроміси у виборі помічника зі штучного інтелекту: чи переважають споживачі прозорість та стійкість над продуктивністю помічника зі штучного інтелекту? Big Data & Society, 11(4).
Ipsos (2025). The Ipsos AI Monitor 2025. Ipsos Global Advisor, дослідження 30 країн, червень 2025 року.
Jacovi, A., Marasović, A., Miller, T., & Goldberg, Y. (2021). Формалізація довіри до штучного інтелекту: передумови, причини та цілі людської довіри до штучного інтелекту. FAccT 2021, 624–635.
Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., Schiefer, N., Hatfield-Dodds, Z., DasSarma, N., Tran-Johnson, E., Johnston, S., El-Showk, S., Jones, A., Elhage, N., Hume, T., Chen, A., Bai, Y., Bowman, S., Fort, S., ... Kaplan, J. (2022). Мовні моделі (в основному) знають, що вони знають. arXiv:2207.05221.
Kalai, A. T., Nachum, O., Vempala, S., & Zhang, E. (2025). Чому мовні моделі галюцинують. arXiv:2509.04664.
Kharazian, A. (2026). Anthropic перевищує OpenAI в прийнятті бізнесом. Ramp Economics Lab / Ramp AI Index, 13 травня 2026 року (корпоративні дані платежів з 50 000+ компаній США).
Kim, D., & Benbasat, I. (2010). Проекти для ефективного впровадження гарантій довіри в інтернет-магазинах. Communications of the ACM, 53(2), 121–126.
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Корельовані помилки у великих мовних моделях. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038–30066.
Kim, P. H., Ferrin, D. L., Cooper, C. D., & Dirks, K. T. (2004). Видалення тіні підозри: Вплив вибачення проти заперечення на відновлення порушень довіри, заснованих на компетентності та чесності. Journal of Applied Psychology, 89(1), 104–118.
Kizilcec, R. F. (2016). Скільки інформації? Вплив прозорості на довіру до алгоритмічного інтерфейсу. CHI 2016, 2390–2395.
Klarna (2024). Помічник Klarna AI обробляє дві третини чатів служби обслуговування клієнтів у перший місяць. Прес-реліз, 27 лютого 2024.
Köbis, N., Rahwan, Z., Rilla, R., Supriyatno, B. I., Bersch, C., Ajaj, T., Bonnefon, J.-F., & Rahwan, I. (2025). Делегування штучному інтелекту може збільшити нечесну поведінку. Nature, 646(8083), 126–134. DOI: 10.1038/s41586-025-09505-x.
Kolt, N. (2025). Управління агентами штучного інтелекту. Notre Dame Law Review, 101 (SSRN робоча стаття 4772956; arXiv:2501.07913).
Komiak, S. Y. X., & Benbasat, I. (2006). Вплив персоналізації та знайомства на довіру та прийняття агентів рекомендацій. MIS Quarterly, 30(4), 941–960.
König, P. D., Wurster, S., & Siewert, M. B. (2022). Споживачі готові платити за пояснювальний, але не за зелений штучний інтелект: Докази аналізу на основі вибору. Big Data & Society, 9(1).
Krogh, A., & Vedelsby, J. (1995). Ансамблі нейронних мереж, крос-валідація та активне навчання. Advances in Neural Information Processing Systems, 7, 231–238.
Kroll, J. A., Huey, J., Barocas, S., Felten, E. W., Reidenberg, J. R., Robinson, D. G., & Yu, H. (2017). Підзвітні алгоритми. University of Pennsylvania Law Review, 165(3), 633–705.
Kuncheva, L. I., & Whitaker, C. J. (2003). Міри різноманітності в ансамблях класифікаторів та їх зв'язок з точністю ансамблю. Machine Learning, 51(2), 181–207.
Lee, J. D., & See, K. A. (2004). Довіра до автоматизації: Проектування для належного покладання. Human Factors, 46(1), 50–80.
Lessig, L. (2006). Code: Version 2.0. Basic Books.
Li, M. (2025). Від хмарних до орієнтованих на довіру: Протокол для верифікованих мультиагентних систем. arXiv:2507.22077.
Liang, P., Bommasani, R., Lee, T., Tsipras, D., Soylu, D., Yasunaga, M., Zhang, Y., Narayanan, D., Wu, Y., Kumar, A., Newman, B., Yuan, B., Yan, B., Zhang, C., Cosgrove, C., Manning, C. D., Ré, C., Acosta-Navas, D., Hudson, D. A., ... Koreeda, Y. (2023). Комплексна оцінка мовних моделей. Transactions on Machine Learning Research.
Liao, Q. V., & Sundar, S. S. (2022). Проектування відповідальної довіри в системах штучного інтелекту: Комунікаційна перспектива. FAccT 2022, 1257–1268.
Lin, S., Hilton, J., & Evans, O. (2022). Навчання моделей висловлювати свою невизначеність словами. arXiv:2205.14334.
Lindsey, J. (2025). Виникаюча інтроспективна свідомість у великих мовних моделях. Anthropic / Transformer Circuits.
Liu, J., Bursztyn, V. S., Ai, L., Wang, H., Choudhary, S., Mitra, S., & Wu, Q. (2026). TeamFusion: Підтримка відкритої командної роботи мультиагентними системами. arXiv:2604.19589 (ACL 2026; Adobe Research).
Lizzeri, A. (1999). Розкриття інформації та посередники сертифікації. RAND Journal of Economics, 30(2), 214–231.
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Цінування алгоритму: Люди віддають перевагу алгоритмічним судженням над людськими. Organizational Behavior and Human Decision Processes, 151, 90–103.
Longoni, C., Bonezzi, A., & Morewedge, C. K. (2019). Опір медичному штучному інтелекту. Journal of Consumer Research, 46(4), 629–650.
Longoni, C., Cian, L., & Kyung, E. J. (2023). Алгоритмічна трансферентність: Люди перезагальнюють невдачи штучного інтелекту в уряді. Journal of Marketing Research, 60(1), 170–188.
Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). Як соціальний вплив може підірвати ефект колективної мудрості. Proceedings of the National Academy of Sciences, 108(22), 9020–9025. DOI: 10.1073/pnas.1008636108.
Lu, Z., Wang, D., & Yin, M. (2024). Чи допомагає більше рад? Вплив другої думки у прийнятті рішень за допомогою штучного інтелекту. Proceedings of the ACM on Human-Computer Interaction, 8(CSCW1), 1–31.
Marchal, N., Chan, S., Franklin, M., Revel, M., Keeling, G., Fischli, R., Chandra, B., & Gabriel, I. (2026). Архітектура довіри у штучних епістемних агентах. arXiv:2603.02960.
Mastercard (2026). Verifiable Intent (розроблено спільно з Google). Оголошення Newsroom, 5 березня 2026; ранні пілоти в азіатських і латиноамериканських ринках, 2026.
Mayer, R. C., Davis, J. H., & Schoorman, F. D. (1995). Інтеграційна модель організаційної довіри. Academy of Management Review, 20(3), 709–734.
McKinsey & Company (2025). Можливість торгівлі агентів (Schumacher, Roberts, & Giebel). 17 жовтня 2025.
McKnight, D. H., Choudhury, V., & Kacmar, C. (2002). Розроблення та валідація заходів довіри для електронної комерції. Information Systems Research, 13(3), 334–359.
Menlo Ventures (2025a). Оновлення ринку LLM у середині 2025 року. 31 липня 2025 (опитування 150 технічних осіб, які приймають рішення).
Menlo Ventures (2025b). 2025: Стан генеративного штучного інтелекту на підприємстві. 9 грудня 2025 (опитування 495 осіб, які приймають рішення щодо ШІ в США; Menlo Ventures є інвестором Anthropic).
Menlo Ventures (2025c). 2025: Стан споживацького штучного інтелекту. 26 червня 2025 (опитування 5031 дорослого США за участю Morning Consult; цифра ~3% користувачів, що платять, – це оцінка, отримана на основі доходу).
Möhlmann, M., & Zalmanson, L. (2017). Руки на кермі: Навігація алгоритмічного управління та автономії водіїв Uber. ICIS 2017.
Montgomery, J. M., Nyhan, B., & Torres, M. (2018). Як врахування змінних після обробки може зіпсувати ваш експеримент та що з цим робити. American Journal of Political Science, 62(3), 760–775.
Morgan Stanley (2025). Прогноз торгівлі агентів: $190–385 млрд витрат США на електронну комерцію до 2030 року. Грудень 2025.
Mosier, K. L., & Skitka, L. J. (1996). Люди, що приймають рішення, та автоматизовані засоби прийняття рішень: Створені один для одного? У R. Parasuraman & M. Mouloua (Eds.), Автоматизація та людська дійсність: Теорія та застосування (pp. 201–220). Lawrence Erlbaum Associates.
Mozannar, H., & Sontag, D. (2020). Послідовні оцінювачі для навчання делегування експертові. ICML 2020, PMLR 119, 7076–7087.
Muchnik, L., Aral, S., & Taylor, S. J. (2013). Упередженість соціального впливу: Рандомізований експеримент. Science, 341(6146), 647–651. DOI: 10.1126/science.1240466.
Muir, B. M. (1994). Довіра до автоматизації: Частина I. Теоретичні питання у вивченні довіри та людського втручання в автоматизовані системи. Ergonomics, 37(11), 1905–1922.
NIST (2023). Структура управління ризиками штучного інтелекту (AI RMF 1.0) (NIST AI 100-1). National Institute of Standards and Technology.
Okamura, K., & Yamada, S. (2020). Адаптивна калібрування довіри для співпраці людини та штучного інтелекту. PLOS ONE, 15(2), e0229132.
Papamarkou, T., Alquier, P., Bauer, M., Buntine, W., Davison, A., Dziugaite, G. K., Filippone, M., Foong, A. Y. K., Fortuin, V., Fouskakis, D., Frellsen, J., Hüllermeier, E., Karaletsos, T., Khan, M. E., Kotelevskii, N., Lahlou, S., Li, Y., Liu, F., Lyle, C., Möllenhoff, T., Palla, K., Panov, M., Sale, Y., Schweighofer, K., Shelmanov, A., Swaroop, S., Trapp, M., Waegeman, W., Wilson, A. G., & Zaytsev, A. (2026). Позиція: оркестрування агентного ШІ повинно бути Bayes-узгоджене. arXiv:2605.00742. (Accepted at ICML 2026.)
Parasuraman, R., & Manzey, D. H. (2010). Самовдоволення та упередженість у людському використанні автоматизації: Інтеграція уваги. Human Factors, 52(3), 381–410. DOI: 10.1177/0018720810376055.
Parasuraman, R., & Riley, V. (1997). Люди та автоматизація: Використання, неправильне використання, невикористання, зловживання. Human Factors, 39(2), 230–253.
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). Модель типів і рівнів людської взаємодії з автоматизацією. IEEE Transactions on Systems, Man, and Cybernetics — Part A: Systems and Humans, 30(3), 286–297.
Pavlou, P. A. (2003). Прийняття електронної торгівлі споживачами: Інтеграція довіри та ризику з моделлю прийняття технології. International Journal of Electronic Commerce, 7(3), 101–134.
Pew Research Center (2025). Як люди у всьому світі сприймають штучний інтелект. 25-країнове дослідження, жовтень 2025.
Piehlmaier, D. M. (2023). Шоу однієї людини: Вплив спільного прийняття рішень на надмірну впевненість інвесторів. Journal of Consumer Research, 50(2), 426–446. https://doi.org/10.1093/jcr/ucac054
Puntoni, S., Reczek, R. W., Giesler, M., & Botti, S. (2021). Споживачі та штучний інтелект: Перспектива досвіду. Journal of Marketing, 85(1), 131–151.
Rabanser, S., Kapoor, S., Kirgis, P., Liu, K., Utpala, S., & Narayanan, A. (2026). До науки про надійність агентів штучного інтелекту. arXiv:2602.16666 (ICML 2026).
Raji, I. D., Xu, P., Honigsberg, C., & Ho, D. (2022). Зовнішній контроль: Проектування екосистеми аудиту третьою стороною для керування штучним інтелектом. AIES 2022, 557–571.
Regulation (EU) 2016/679 (General Data Protection Regulation), Article 22 — автоматизоване індивідуальне прийняття рішень.
Regulation (EU) 2024/1689 (Artificial Intelligence Act), Article 14 — людський контроль над системами штучного інтелекту високого ризику; Article 50 — зобов'язання щодо прозорості для постачальників і розгортачів деяких систем штучного інтелекту.
Ríos-García, M., Alampara, N., Gupta, C., Mandal, I., Mannan, S., Aghajani, A. A., Krishnan, N. M. A., & Jablonka, K. M. (2026). Вчені ШІ отримують результати без наукового мислення. arXiv:2604.18805.
Saad-Falcon, J., Buchanan, E. K., Chen, M. F., Huang, T.-H., McLaughlin, B., Bhathal, T., Zhu, S., Athiwaratkun, B., Sala, F., Linderman, S., Mirhoseini, A., & Ré, C. (2025). Зменшення розриву між генерацією та перевіркою слабкими верифікаторами. arXiv:2506.18203.
Sabater, J., & Sierra, C. (2005). Огляд моделей обчислювальної довіри та репутації. Artificial Intelligence Review, 24(1), 33–60.
Schemmer, M., Kühl, N., Benz, C., Bartos, A., & Satzger, G. (2023). Правильна опора на поради штучного інтелекту: Концептуалізація та вплив пояснень. IUI '23, 410–422.
Schilke, O., & Reimann, M. (2025). Дилема прозорості: Як розкриття ШІ підриває довіру. Organizational Behavior and Human Decision Processes, 188, 104405.
Schmidt, J., & Bijmolt, T. H. A. (2020). Точне вимірювання готовності платити за товари споживання: Мета-аналіз гіпотетичного упередження. Journal of the Academy of Marketing Science, 48, 499–518.
Shapiro, S. P. (1987). Соціальний контроль безособової довіри. American Journal of Sociology, 93(3), 623–658.
Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., Cheng, N., Durmus, E., Hatfield-Dodds, Z., Johnston, S. R., Kravec, S., Maxwell, T., McCandlish, S., Ndousse, K., Rausch, O., Schiefer, N., Yan, D., Zhang, M., & Perez, E. (2024). До розуміння лестивості в мовних моделях. ICLR 2024 (arXiv:2310.13548).
Shehata, D., & Li, M. (2026). Закон оберненої мудрості: Архітектурний трайбалізм та парадокс консенсусу в агентних роях. arXiv:2604.27274.
Sheridan, T. B., & Verplank, W. L. (1978). Людське та комп'ютерне керування підводними телеоператорами (Technical report). MIT Man-Machine Systems Laboratory.
Smit, A. P., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). Чи мають ми йти MAD? Погляд на стратегії багатоагентних дебатів для LLMs. ICML 2024, PMLR 235, 45883–45905 (arXiv:2311.17371).
Söllner, M., Hoffmann, A., & Leimeister, J. M. (2016). Чому різні відносини довіри мають значення для користувачів інформаційних систем. European Journal of Information Systems, 25(3), 274–287.
Spiro, T. (2026). Відбиток провісника: Корельовані помилки прогнозування ШІ та межи передачі упередження. arXiv:2605.00844.
Stanford HAI (2025). Artificial Intelligence Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence (розділ «Технічні характеристики»).
Stanford HAI (2026). Artificial Intelligence Index Report 2026. Stanford Institute for Human-Centered Artificial Intelligence (розділ «Громадська думка», звіт на основі даних дослідження Pew у 25 країнах).
Tax, S. S., Brown, S. W., & Chandrashekaran, M. (1998). Оцінка клієнтами досвіду скарг на послуги: Наслідки для маркетингу взаємовідносин. Journal of Marketing, 62(2), 60–76.
Vaccaro, M., Almaatouq, A., & Malone, T. (2024). Коли комбінації людей та ШІ корисні: Систематичний огляд та мета-аналіз. Nature Human Behaviour, 8(12), 2293–2303. DOI: 10.1038/s41562-024-02024-1.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). Заміна суддів журі: Оцінка генерацій LLM панеллю різноманітних моделей. arXiv:2404.18796.
Visa (2025). Visa представляє Trusted Agent Protocol: Структура, керована екосистемою, для комерції штучного інтелекту. Press release (with Cloudflare), 14 October 2025.
Visa (2026). Visa partners with OpenAI to power the next generation of AI commerce. Прес-реліз, Visa Payments Forum, 10 June 2026.
W3C (2025). Verifiable Credentials Data Model v2.0. Рекомендація W3C.
Wallendorf, M., & Brucks, M. (1993). Introspection in consumer research: Implementation and implications. Journal of Consumer Research, 20(3), 339–359.
Walsham, G. (1995). Interpretive case studies in IS research: Nature and method. European Journal of Information Systems, 4(2), 74–81.
Wang, W., & Benbasat, I. (2005). Trust in and adoption of online recommendation agents. Journal of the Association for Information Systems, 6(3), 72–101.
Wang, Y., Zhang, J., Cai, T., Liu, Z., Sun, Q., Sun, Z., Wu, Z., Dong, M., Zheng, M., Yin, X., & Zhu, Y. (2026). From agent traces to trust: A survey of evidence tracing and execution provenance in LLM agents. arXiv:2606.04990.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., & Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
Werbach, K. (2018). The blockchain and the new architecture of trust. MIT Press.
Wertenbroch, K. (1998). Consumption self-control by rationing purchase quantities of virtue and vice. Marketing Science, 17(4), 317–337.
Xiao, B., & Benbasat, I. (2007). E-commerce product recommendation agents: Use, characteristics, and impact. MIS Quarterly, 31(1), 137–209.
Yalcin, G., Lim, S., Puntoni, S., & van Osselaer, S. M. J. (2022). Thumbs up or down: Consumer reactions to decisions by algorithms versus humans. Journal of Marketing Research, 59(4), 696–717.
Yin, R. K. (2018). Case study research and applications: Design and methods (6th ed.). Sage.
Zhang, Y., Liao, Q. V., & Bellamy, R. K. E. (2020). Effect of confidence and explanation on accuracy and trust calibration in AI-assisted decision making. Proceedings of the 2020 ACM Conference on Fairness, Accountability, and Transparency, 295–305.
Zheng, J., & Zhang, J. (2026). Uncertainty-aware trust estimation for multi-LLM systems via structured expert judgement. arXiv:2607.20529.
Zuboff, S. (2019). The age of surveillance capitalism. PublicAffairs.
Zucker, L. G. (1986). Production of trust: Institutional sources of economic structure, 1840–1920. Research in Organizational Behavior, 8, 53–111.
* Архітектор систем ШІ. Конфлікт інтересів: автор розробляє методи оркестрування багатомодельних систем, керує еталонною реалізацією архітектури, описаної тут, є названим заявником щодо розгляданих патентних заявок (не видані патенти), що охоплюють системи оркестрування ШІ та валідації багатомодельних систем такого роду, як ті, що розглядає цей документ, та має зацікавленість розробника в архітектурі, яку пропагує цей документ; нормативні твердження про її необхідність слід читати, маючи на увазі цей інтерес. Роль автора в розгортанні в розділі 4 описана в Примітці автора та Розкритті інформації в кінці цієї роботи. Коментарі вітаються: [email protected].↩︎
Як цитувати
Chernets, V. (2026). Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture [Препринт]. SSRN. https://doi.org/10.2139/ssrn.7191261
@misc{chernets2026architecturaltrust,
  author       = {Chernets, Vadym},
  title        = {{Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7191261},
  url          = {https://doi.org/10.2139/ssrn.7191261}
}