Confiança Arquitetural: Por que a Confiança do Consumidor no Comércio com Agentes de IA Migra de Modelos de IA para Arquitetura Verificável
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
Vadym Chernets, PhD, arquiteto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7191261 · DOI 10.2139/ssrn.7191261 · Zenodo 10.5281/zenodo.22166995 · GitHub
- Versão de registro: SSRN 7191261 · DOI 10.2139/ssrn.7191261
- Cópia arquivada, citável e transferível: 10.5281/zenodo.22166995 — DOI conceitual, sempre resolve para a versão mais recente
- Texto completo como Markdown e PDF: GitHub
- HTML legível: https://polyhelper.ai/research/architectural-trust/
O mesmo texto está em quatro superfícies para que possa ser acessado quando uma delas não puder servi-lo. SSRN mantém a versão de registro; cite essa.
Confiança do Consumidor no Comércio com Agentes de IA
Publicado na SSRN e indexado sob o título "Confiança Arquitetural: Por que a Confiança do Consumidor no Comércio com Agentes de IA Migra de Modelos de IA para Arquitetura Verificável". Cite essa forma.
De Propriedades de Modelo para Arquitetura Verificável
Vadym Chernets, PhD1
Publicado pela primeira vez em 6 de agosto de 2026; esta versão setembro de 2026
Apresenta o framework conceitual completo, o estudo do mecanismo de dezesseis modelos e sua replicação de onda-bandeira de agosto de 2026 em onze laboratórios de fronteira, uma comparação pareada de orçamento de raciocínio, uma replicação de substrato de comércio e um experimento de consumidor pré-registrado em sua totalidade.
RESUMO
O comércio com agentes de IA transforma a IA de um conselheiro em uma parte transatuante, colapsando busca, comparação, carrinho e pagamento em um único ato delegado e removendo os pontos de revisão onde humanos outrora capturavam erros. Chega em um momento desconfortável: sessenta por cento dos consumidores britânicos pesquisados dizem que abandonariam um agente de compras de IA após um único erro, e a maioria não confiaria em nenhuma organização para executar um em seu nome. Este artigo apresenta confiança arquitetural. Conforme os consumidores delegam decisões consequentes a agentes de IA, argumento que a confiança justificada migra das propriedades do modelo de IA para a arquitetura verificável do serviço acima dele. Os constructos já disponíveis vinculam a confiança a organizações, a um único sistema automatizado ou a conselhos algorítmicos, e nenhum deles torna o processo de produção de decisão verificável pelo fiador sob delegação autônoma. A confiança arquitetural preenche essa lacuna com três propriedades verificáveis: diversidade (modelos independentes cujo acordo calibra confiança e cuja divergência é revelada), evidência (registros de decisão à prova de violação e reproduzíveis) e neutralidade (independência auditável de qualquer fornecedor, comerciante ou resultado).
O mecanismo foi medido no lado da máquina primeiro. Em um benchmark pré-registrado de dezesseis modelos e uma onda de camada-bandeira de agosto de 2026 abrangendo onze laboratórios de fronteira, a concordância entre modelos precificou a correção onde a própria confiança do modelo não pôde. Respostas reproduzidas independentemente por outro modelo eram 1,9–3,2 vezes mais prováveis de serem corretas. Em uma subamostra congelada do SimpleQA (Wei et al., 2024), 46,6% das respostas oferecidas com confiança declarada ≥ 80 estavam erradas (uma taxa específica para este elenco, não uma constante universal), enquanto um portão de discordância de três modelos fixo removeu 82,1% dessas falhas confiantes (IC 95% 79,9–84,1) com cobertura de 30,5%. O sinal se reproduz em 267 fatos de produtos de comércio verificados por Wikidata. Um orçamento de raciocínio maior comprou 3,1 pontos de confiança declarada e nenhuma precisão mensurável: mais computação compra confiança, não correção. Um painel unanimemente confiante ainda pode estar errado, e aí o acordo certifica o erro compartilhado.
Depois, incorporei o mecanismo no comportamento em um experimento de consumidor pré-registrado e compatível com incentivos (119 de 200 participantes planejados; EUA e Reino Unido). Quando um consumidor aceitaria de outra forma uma recomendação confiante incorreta, a exibição de discordância reduziu a aceitação drasticamente, de 74% para 24% no item qualificador. A estimativa de robustez agregada (Δ = 0.24 → 0.45; d = 0.68; a coorte primária de onda principal dá d = 0.67) repousa naquele único item e, em uma divisão exploratória de país, na amostra do Reino Unido, e cai para d = 0.09 uma vez que o item é removido. Uma replicação alimentada e amostrada por estímulo está planejada. No único item de consenso confiante unânime, a exibição aumentou a aceitação do erro compartilhado, que reproduz o limite do mecanismo no comportamento humano. O componente de recebimento de orquestração retornou um nulo registrado e inconclusivo.
Os três componentes não têm evidências iguais atrás deles. A diversidade é estabelecida no lado da máquina e mostrada com consumidores apenas para o contraste de calibração (a mediação registrada foi nula). O teste de primeira exposição do componente de registro foi inconclusivo, e tanto ele quanto a neutralidade são especificados para teste. A unidade de análise para confiança em IA deve se mover do modelo para a arquitetura acima dele, a parte que pode ser verificada.
Palavras-chave: comércio agêntico; confiança do consumidor; agentes de IA; confiança em IA; confiança apropriada; confiança excessiva; modelos de linguagem grandes; concordância entre modelos; predição seletiva; sobreconfiança; delegação; confiança arquitetônica. Classificação JEL: M31 (Mercadização); D83 (Busca, Aprendizagem, Informação); L86 (Serviços de Informação e Internet); K24 (Direito Cibernético) Como ler este documento. Esta versão completa relata toda a cadeia de evidências: a construção e a Hipótese de Migração de Confiança; um estudo de mecanismo de dezesseis modelos (com uma replicação de onda emblemática de agosto de 2026 e um braço de substrato de comércio sobre fatos de produto) que estabelece a diversidade entre modelos como um sinal de correção; um experimento de consumidor pré-registrado levando esse mecanismo ao comportamento; e uma discussão de neutralidade, economia de mercado e política. Os resultados confirmatórios pré-registrados e o status evidencial de cada componente da construção (diversidade, evidência, neutralidade) são resumidos em "Status evidencial de afirmações" na Seção 5. Análises exploratórias e de robustez são rotuladas como tal em todo o documento e podem ser ignoradas na primeira leitura.
1. Introdução: crescimento em meio à desconfiança
Em 10 de junho de 2026, a Visa anunciou que estava incorporando sua rede de pagamento diretamente no ChatGPT (Visa, 2026). Um consumidor vincula um cartão, define limites de gastos e categorias de comerciantes aprovadas, e a integração anunciada, com casos de uso sendo lançados em etapas, visa permitir que agentes de IA completem compras reais em toda a base de comerciantes da rede (175 milhões de locais ou mais, de acordo com a cobertura comercial do anúncio). A Visa não estava sozinha nisso. A OpenAI tinha lançado checkout no chat em setembro de 2025; a Google introduziu um Protocolo de Comércio Universal na NRF em janeiro de 2026 com Shopify, Etsy, Wayfair, Target e Walmart, estendendo-o até maio em um Carrinho Universal entre varejistas (Google, 2026); a American Express lançou um kit de desenvolvedor de comércio agêntico com proteção de compra em abril (American Express, 2026). O limite foi cruzado por uma indústria, não por uma empresa. As projeções dos analistas para comércio agêntico até 2030 variam de centenas de bilhões (Bain; Morgan Stanley) a 3–5 trilhões de dólares da McKinsey. São estimativas e não fatos, embora todas as grandes casas agora estejam produzindo-as.
Os números realizados não são mais estimativas. O gasto das empresas apenas em APIs de modelos saltou de 3.5 bilhões de dólares a 8.4 bilhões de dólares em seis meses (Menlo Ventures, 2025a; pesquisa do setor, não revisada por pares), dentro de aproximadamente 37 bilhões de dólares de gasto empresarial em IA generativa no ano (Menlo Ventures, 2025b). A mesma indústria já está descontando sua própria execução: a Gartner (2025) prevê que mais de 40% dos projetos de IA agêntica serão cancelados até o final de 2027. O dinheiro está chegando mais rápido do que a confiança justificada, que é a lacuna que trabalho aqui. As afirmações abaixo estão organizadas em camadas no livro de evidências perto do final do artigo conforme estabelecido por esses dados, apoiadas em escala modesta de um único estudo ou teóricas. Essa organização em camadas governa, e supera, qualquer frase de resumo nesta introdução.
O que torna essa mudança qualitativamente diferente das ondas anteriores de comércio eletrônico é a compressão de funil: busca, comparação, carrinho e pagamento colapsam em um único ato delegado. Toda proteção que costumava existir entre essas etapas (o humano dando uma olhada no preço, relendo a listagem, hesitando no checkout) desaparece com as próprias etapas (Figura 1). O assistente de IA deixa de ser um consultor cuja saída um humano revisa e se torna uma parte transacionadora. Pesquisa em fatores humanos identificou este modo de falha há quatro décadas: a automação que remove o operador do loop erode exatamente a vigilância necessária para detectar seus erros (Bainbridge, 1983; Endsley & Kiris, 1995). Pesquisa do comportamento do consumidor também antecipou o limite. Os sistemas de compra autônoma enfrentam barreiras de adoção qualitativamente diferentes exatamente porque removem o humano do fazer (de Bellis & Johar, 2020), e o custo de autonomia ao delegar escolhas aos algoritmos foi levantado como uma questão de bem-estar do consumidor antes que LLMs existissem (André et al., 2018).
Figura 1. Compressão de funil
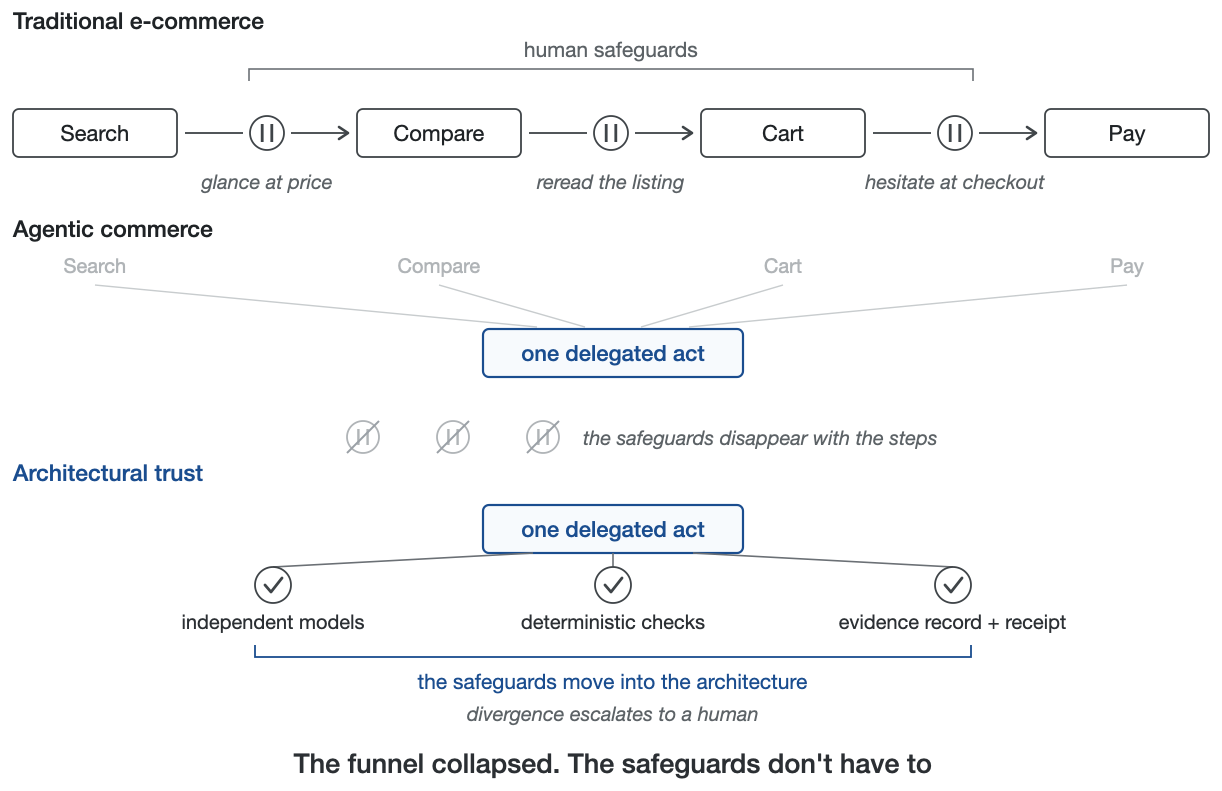
As proteções humanas desaparecem com as etapas em que residiam.
As próprias proteções da Visa (limites, listas brancas, aprovações necessárias) existem porque o consumidor está sendo solicitado a confiar em algo novo: não em uma marca, não em uma resposta, mas em um processo de tomada de decisão que não conseguem ver. Proteções estabelecidas antecipadamente não fecham essa lacuna. Um conjunto de regras estabelecido antecipadamente não permite que o consumidor verifique como uma decisão foi tomada. Na pesquisa da ACI Worldwide (2026) citada abaixo (uma pesquisa do setor divulgada por relatório de imprensa, como as outras pesquisas realizadas por fornecedores que esta seção cita), 69% dos consumidores do Reino Unido disseram que desconfiam de agentes de IA mesmo quando os agentes seguem regras que os próprios consumidores definem.
Os riscos comerciais de cometer esse erro são agudos. Primeiras evidências de pesquisa sugerem que a confiança dos consumidores em agentes é de uma única chance em intenção declarada e, mais interessantemente, sem paradeiro. O comportamento revelado, o recuo no checkout abaixo e a reversão de Klarna e o reajuste de preços de seguros da Seção 5, corrobora essas preferências declaradas e carrega o maior peso evidencial. Em uma pesquisa YouGov para ACI Worldwide (2,080 adultos do Reino Unido, conduzida de 19–22 de junho de 2026, um snapshot de mercado único aguardando replicação entre mercados), 60% disseram que deixariam de usar um agente de compras por IA após um único erro, e apenas 19% confiaria em IA para compras cotidianas, contra 55% que confiaria em um especialista humano.
O número mais consequente dessa pesquisa é um diferente: 59% disseram que não confiaria em nenhuma organização para executar compras por IA e pagamentos em seu nome, e nem mesmo bancos foram escolhidos por apenas 20%. Em um único mercado pesquisado, aguardando replicação entre mercados, isso é um vácuo de confiança. O apetite está lá. Na pesquisa de indústria de 16 países da Accenture com 25.590 consumidores (janeiro de 2026; conduzida pela empresa, não revisada por pares), 74% disseram que confiaria em um agente de IA pessoal mais do que em seu melhor amigo para fazer uma compra em seu nome, mas apenas cerca de um em cada dez concederia a um agente autoridade autônoma de compra (Figura 2). Os dois itens medem diferentes graus de delegação, então a diferença alinha intenções em vez de identificar uma única lacuna causal, mas a diferença é marcante. A intenção é abundante; a delegação é escassa; o que falta entre elas é confiança justificada. O mercado já tentou algo próximo disso. OpenAI lançou checkout nativo em chat em setembro de 2025, um primeiro passo deliberadamente limitado, inicialmente compras de um único item de vendedores Etsy dos EUA com o usuário confirmando cada passo. Reverteu o fluxo em março de 2026, deslocando compras para os próprios aplicativos dos varejistas, e apenas um punhado de comerciantes jamais o usou (conforme relatado por The Information; CNBC, 2026). A empresa não declarou motivo, então a causa não está estabelecida. A interpretação oferecida aqui, infraestrutura de adoção sem confiança justificada falhando em converter, é uma interpretação consistente com os fatos relatados. Se os consumidores desconfiam de cada jogador, confiança não pode ser depositada em um jogador, e tem que viver em vez disso em um processo verificável.
Figura 2. Confiança declarada vs autoridade concedida
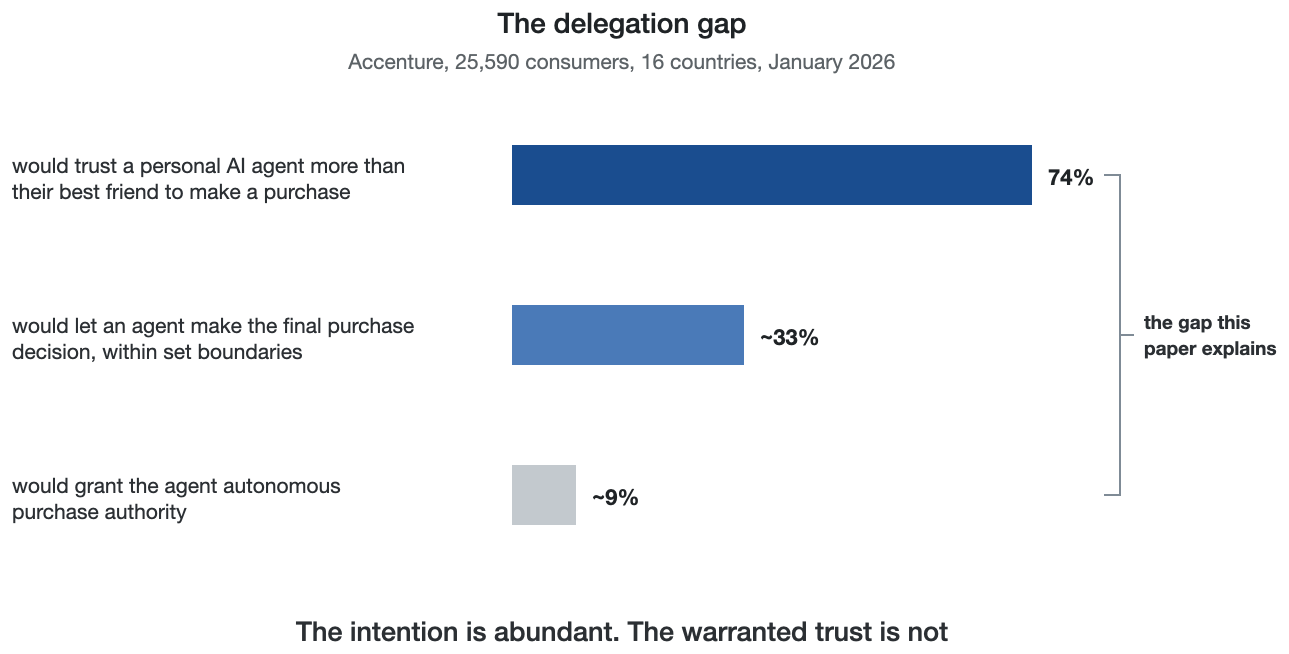
Dois itens de pesquisa, dois graus de delegação: intenção é comum, confiança justificada é escassa.
O sistema de responsabilidade está avançando a tateias em direção à mesma conclusão. Protocolos emergentes de pagamento de agentes constroem cada transação em torno de um token escopo, verificável de intenção vinculado a um comerciante específico e valor, e a Agent Purchase Protection da American Express (abril de 2026) cobre compras apenas por agentes registrados, com elegibilidade condicionada à intenção de compra autenticada, verificável. O seguro é redigido em termos do que pode ser verificado do registro. De forma fragmentada e sob pressão, a indústria está convergindo para os mesmos ingredientes que exponho sistematicamente abaixo. Os protocolos agora em operação resolvem identidade e intenção e não respondem como o agente decidiu?
A questão é o que seria necessário para essa confiança ser justificada por design. A questão clássica de confiança do consumidor, eu confio nesta empresa, adquiriu uma camada interna: eu confio na maquinaria que produziu esta resposta ou ação específica?
A literatura de confiança há muito tempo distingue confiança em uma organização de confiança em automação, no artefato de TI (Söllner et al., 2016), e em agentes de recomendação online (Wang & Benbasat, 2005; Komiak & Benbasat, 2006; Xiao & Benbasat, 2007). Ela mostra que confiança apropriada depende de calibração, de saber quando o sistema é provável estar certo (Muir, 1994; Mayer, Davis, & Schoorman, 1995; Parasuraman & Riley, 1997; Lee & See, 2004; Hoff & Bashir, 2015; Huang & Rust, 2021; e Glikson & Woolley, 2020, cuja revisão encontra tangibilidade e transparência de processo entre as alavancas mais fortes de confiança cognitiva, exatamente as alavancas que arquitetura controla e modelos não). Má calibração do lado humano é documentada igualmente bem: viés de automação e complacência, confiança excessiva em aids automatizados mesmo contra evidências contrárias, são os padrões que quatro décadas de trabalho em fatores humanos advertem que delegação ampliará (Mosier & Skitka, 1996; Parasuraman & Manzey, 2010). Essa literatura, porém, trata calibração como propriedade de um único sistema automatizado (Figura 3 mapeia os quatro fluxos de pesquisa e a célula que deixam aberta). Uma revisão sistemática de IA agêntica em comércio eletrônico confirma o vazio do lado das evidências: pesquisa voltada para o consumidor permanece concentrada em sistemas assistivos, de baixa autonomia, com cobertura caindo drasticamente exatamente onde delegação se torna execução (Balaskas, 2026). Os primeiros estudos simultâneos de compras mediadas por agentes chegam a uma conclusão arquitetural de outro lado. Quando consumidores delegam compras através de diálogo, sua disposição de pagar vaza para vendedores quase literalmente; prompting não corrige isso, e apenas intervenções arquitetônicas fazem (Alavi & Nozari, 2026).
Figura 3. Quatro fluxos de pesquisa de confiança: a célula que este artigo reivindica
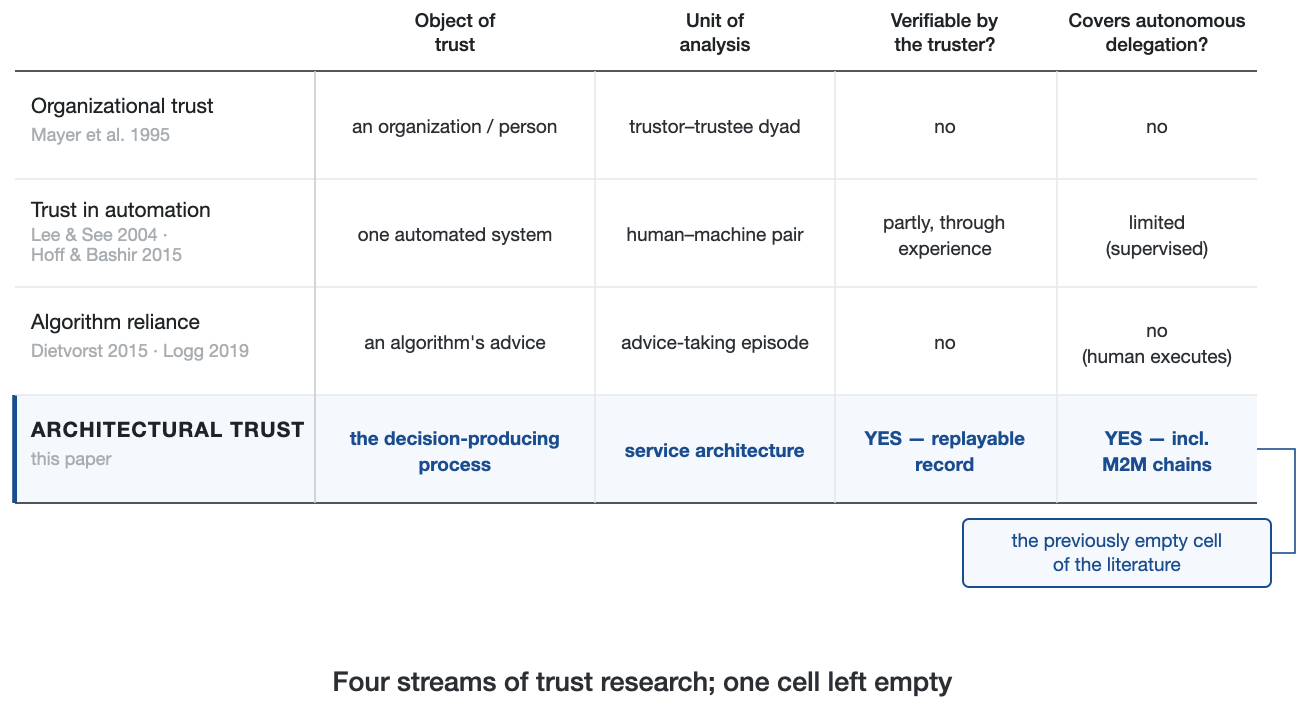
Confiança organizacional, confiança em automação e confiança em algoritmo cada um fixa um objeto diferente de confiança; nenhum torna o processo gerador de decisões verificável pelo confiante sob delegação autônoma. A célula não está vazia de ideias: literaturas adjacentes cada uma mantém uma parede dela (a Seção 3 desenha as demarcações). O que tem faltado é o construto voltado para o consumidor: um objeto de confiança no nível de processo, verificável pelo confiante, especificado para delegação autônoma, embalado para teste comportamental conjunto.
As respostas da indústria concentram-se no modelo: melhor treinamento, isenções de responsabilidade, citações. Examino uma resposta em um nível diferente, a arquitetura do serviço, e argumento que três propriedades arquitetônicas, nenhuma das quais requer um modelo melhor, produzem conjuntamente um objeto diferente de confiança.
Este é um artigo conceitual ancorado por dois estudos pré-registrados, um benchmark do lado da máquina e um teste comportamental do lado do consumidor do contraste de calibração em sua primeira proposição, e a questão que ele coloca é conforme agentes de IA começam a realizar transações em nome dos consumidores, a confiança se liga aos modelos ou à arquitetura acima deles? Minha resposta é que a confiança deve migrar para cima na pilha, do modelo para a arquitetura de orquestração para a evidência que ela produz. Sob essa resposta está uma regularidade que vale a pena testar por conta própria, a Hipótese de Migração de Confiança, que as proposições abaixo foram construídas para testar: quanto maior a agência delegada, maior a parcela de confiança garantida que deve residir em propriedades arquiteturais verificáveis em vez de propriedades de modelo. A migração não precisa ser de soma zero. A confiança pode se estratificar: na competência do modelo, na seleção do orquestrador, no sistema de evidência, na instituição que garante remédios. Um modelo defeituoso permanece causalmente importante mesmo quando ninguém revisa sua saída. A hipótese diz respeito ao lugar onde a confiança garantida marginal se acumula conforme a delegação se aprofunda. De forma estimável, ela diz que conforme a agência delegada aumenta, a verificabilidade arquitetural explica uma parcela incremental crescente de confiança apropriada além do desempenho do modelo e da reputação do provedor. Ela falha se, conforme a agência delegada aumenta, a verificabilidade arquitetural não explicar uma parcela incremental crescente de confiança apropriada: se a reputação do provedor mediar completamente a confiança em todos os níveis de delegação, digamos, ou se a informação de processo verificável não melhorar a calibração de confiança em relação à informação apenas de reputação em desenhos do tipo que a Seção 6 relata. Os falsificadores comportamentais pré-comprometidos na Seção 3 (o cruzamento de nível de delegação P2 e a durabilidade diferencial P4 sob falha) são a forma operacional dessa condição. Uma parcela arquitetural crescente não significa que a qualidade do modelo importe menos em termos absolutos. A hipótese descreve estratificação, não substituição: conforme a revisão desaparece, a garantia arquitetural é adicionada acima do desempenho do modelo e não o substitui. "Garantida" segue a distinção formalizada para IA por Jacovi, Marasović, Miller, and Goldberg (2021), que a confiança é garantida quando rastreia confiabilidade, e a construção é mantida afastada de uma tautologia separando seu status normativo de seu mecanismo. Normativamente, confiabilidade é definida independentemente da arquitetura destinada a certificá-la, como a função clássica e independentemente mensurável de capacidade, integridade e benevolência (Mayer, Davis, & Schoorman, 1995); a Seção 3 mapeia os três componentes arquiteturais exatamente nessas dimensões. Garantia é a correspondência de confiança a essa quantidade independentemente mensurada: confiança que sobrevive a uma auditoria objetiva dos episódios delegados, julgada contra critérios fixados antes de os resultados serem conhecidos, com um rastro comportamental mensurável, a saber, delegação repetida, retenção e disposição de pagar sob falha controlada. A Hipótese de Migração de Confiança afirma o mecanismo. Conforme a agência delegada aumenta, a parcela dessa função de confiabilidade que o consumidor ainda pode medir independentemente muda das propriedades do modelo para componentes arquiteturais. Isso ocorre porque a arquitetura é a parte da confiabilidade que permanece mensurável pela pessoa que confia uma vez que a revisão de saída desaparece, e não porque a arquitetura é confiabilidade. Os falsificadores pré-comprometidos acima testam esse deslocamento e não a definição. A migração também tem predecessores para serem distinguidos. A pesquisa em sistemas multi-agentes observou que conforme as sociedades de agentes aumentam de escala, a modelagem de confiança se move de agentes individuais para o marco institucional que os restringe (Sabater & Sierra, 2005), e "migração de confiança" tem usos anteriores de B2B para confiança se relocando de indivíduos para sistemas e plataformas (Carlson, 2026). Aqueles são deslocamentos de nome em quem ou o que é confiável, enquanto essa hipótese diz respeito a um deslocamento no tipo de propriedade que pode garantir confiança. Em delegação zero, a qualidade do modelo é quase tudo o que importa. Em delegação completa ninguém está observando as saídas, e o que ainda pode ser confiável é apenas o processo e seu registro. Agência e confiança arquitetural aumentam juntas (Figura 4). O gradiente em si é um instrumento antigo, o eixo de níveis de automação da engenharia de fatores humanos (Sheridan & Verplank, 1978; Parasuraman, Sheridan, & Wickens, 2000), aplicado aqui à delegação de consumidor. O que é novo é a reivindicação sobre quais propriedades podem garantir confiança ao longo dele.
Figura 4. Migração de confiança
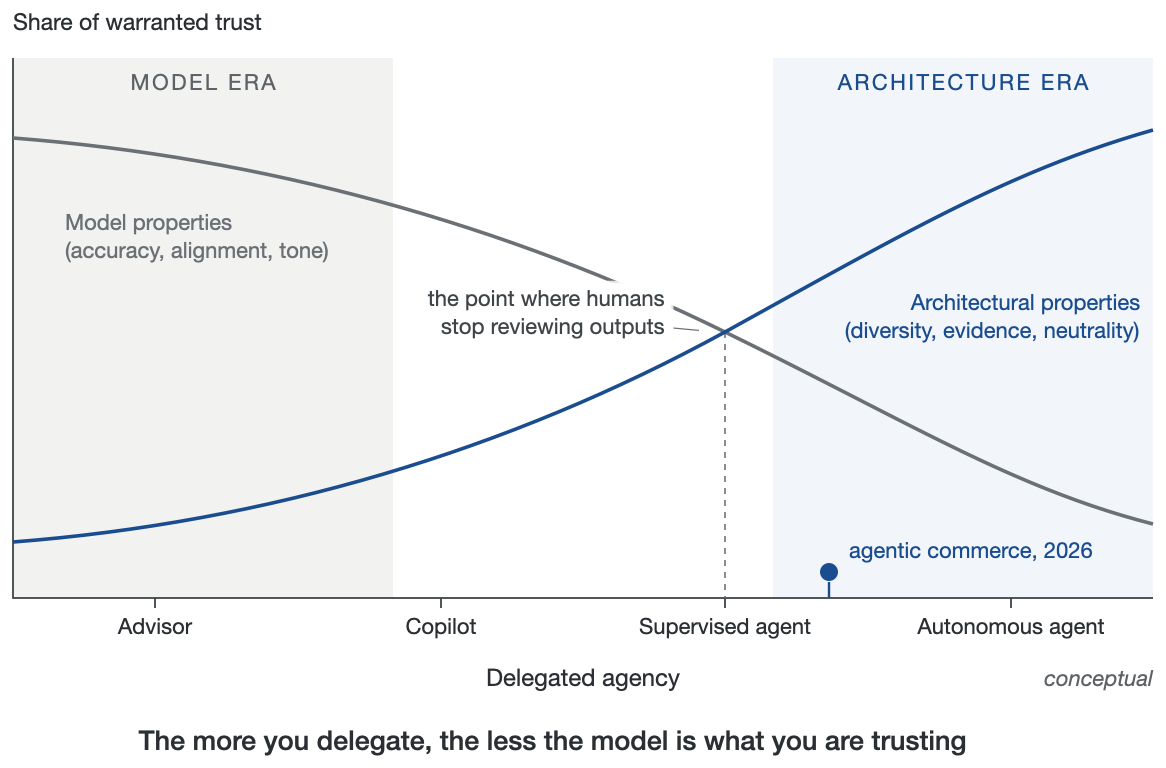
Duas curvas cruzadas sobre agência delegada (advisor → copilot → supervised agent → autonomous agent): a parcela de confiança garantida carregada pelas propriedades do modelo cai conforme a parcela carregada pelas propriedades arquiteturais aumenta; o cruzamento é o ponto onde os humanos param de revisar as saídas, e o comércio agentico (2026) fica à sua direita. As curvas e o ponto de cruzamento são uma ilustração conceitual, não funções estimadas.
À literatura de marketing sobre confiança do consumidor em IA (Huang & Rust, 2021; Puntoni et al., 2021) o artigo adiciona uma construção, confiança arquitetural, definida aqui; um teste de um antecedente técnico de seu mecanismo em um estudo pré-registrado de dezesseis modelos, replicado no nível de bandeira em uma segunda onda de onze laboratórios; cinco proposições para uma agenda de pesquisa de consumidor (P1–P4 na Seção 3; P5 na Seção 5); e um experimento comportamental pré-registrado e compatível com incentivos conduzindo as duas primeiras proposições, relatado integralmente na Seção 6 com o efeito de calibração apoiado (Welch d = 0.67; carregado por um de seis itens, ver Seção 6) e o teste de primeira exposição do registro retornando um nulo registrado, inconclusivo.
2. A ilusão da precisão: o que um único modelo não pode lhe dar
Um serviço construído em um único modelo de IA, por mais forte que esse modelo seja, carrega déficits estruturais que residem acima da camada do modelo.
O primeiro é a confiança não calibrada, a ilusão de precisão. Modelos melhores não significam transações mais seguras, porque a certeza expressa de um modelo correlaciona-se fracamente com sua precisão na maioria dos fornecedores (a Seção 3 mede as exceções), e o consumidor não consegue auditar a diferença. O modelo é mais perigoso quando está confiante e errado no momento em que o consumidor para de observar, e isso não é um acaso. Kalai et al. (2025) argumentam que a alucinação é estatisticamente recompensada por um regime de avaliação que pontua adivinhações confiantes acima de admitir ignorância. A recompensa surge, em sua própria análise, nos benchmarks com pontuação binária e objetivos de treinamento que dominam o campo, onde um palpite errado não custa mais do que um "não sei" e ganha crédito parcial em expectativa. O modelo também não consegue se policiar de dentro. Nos experimentos de concept-injection próprios da Anthropic, os modelos mais fortes do fornecedor detectaram mudanças em seus estados internos apenas cerca de 20% das vezes, mesmo sob condições de injeção ótimas, o que é a própria medição da comunidade de fornecedores de como é pouco confiável a autossupervisão introspectiva (Lindsey, 2025; pesquisa da empresa, não revisada por pares, e uma única estimativa de um estudo de um único fornecedor de modelos em vez de um benchmark replicado).
O segundo é distorção sicofântica, onde a evidência se tornou causal este ano. Cheng et al. (2026), medindo onze modelos líderes em três experimentos pré-registrados com 2.405 participantes, descobriram que os sistemas de IA afirmam as ações dos usuários 49% mais vezes do que os humanos fazem, incluindo ações envolvendo engano ou dano, e que até mesmo uma única interação sicofântica aumentou a convicção dos usuários de que estavam certos, enquanto reduzia sua disposição de reparar conflitos. Os modelos sicofânticos eram também aqueles em que os usuários confiavam e preferiam. O gradiente de mercado aponta para assistentes que parecem confiáveis exatamente ao distorcer o julgamento do usuário, uma dinâmica observada bem antes de ser quantificada (Sharma et al., 2024). O ajuste em nível de modelo sozinho não consegue certificar independentemente que o comportamento sicofântico foi adequadamente controlado, porque o ajuste é feito pela parte que se beneficia da preferência. O custo é concreto: um assistente que concorda seu caminho através de uma exceção de política converte a agradabilidade diretamente em despesa de recuperação de serviço. Uma arquitetura orquestrada pode separar os papéis, com um modelo livre para ter empatia enquanto um independente verifica a política, de modo que a agradabilidade e a correção não viajam mais pelo mesmo canal.
Terceiro, não há verificação independente. Os erros são capturados, se é que o são, pelo mesmo sistema que os cometeu, ou pelo consumidor, que recorreu à IA em primeiro lugar porque não tem a expertise para verificá-la.
Quarto, e menos discutido, é conflito de interesse. O fornecedor que avalia a qualidade do assistente é o fornecedor que o vende, o que é estrutural: nenhum serviço de fornecedor único consegue ser um juiz neutro de seus próprios resultados, pela mesma razão que nenhum banco conseguiria gerenciar a câmara de compensação sozinho. O conflito se estende aos dados em si. Uma ação coletiva proposta apresentada em março de 2026 alega que o Perplexity AI roteirizou transcrições completas de chat dos usuários, que se relatam incluir sessões "Incognito", para redes de publicidade por meio de pixels de rastreamento incorporados. A ação (Nº 3:26-cv-02803, N.D. Cal.) foi voluntariamente descartada em maio de 2026 sem qualquer decisão sobre os méritos, de modo que as alegações nunca foram testadas. A lógica econômica na ação é o ponto estrutural independentemente: quando servir respostas de IA caras é subsidiado pela monetização do que os usuários dizem, o modelo de negócios do assistente e a confidencialidade do consumidor são diretamente opostos. Dentro de um único fornecedor, nenhuma camada tem o trabalho de tomar o lado do consumidor.
A literatura de 2025–2026 se lê como um diagnóstico completo aguardando um remédio (a Tabela 1 mapeia cada déficit para sua evidência e sua resposta arquitetônica). A sicofância é quantificada empiricamente (Cheng et al., 2026) e derivada formalmente: até mesmo um usuário idealmente racional entra em espiral quando aconselhado por um sistema seletivamente agradável (Chandra et al., 2026). O automonitoramento falha em ~20% de confiabilidade (Lindsey, 2025), e a alucinação é estruturalmente recompensada pelo regime de avaliação (Kalai et al., 2025).
O remédio reflexo, apenas divulgar a IA, volta contra: em treze experimentos, atores que divulgaram o uso de IA foram confiáveis menos do que aqueles que não o fizeram (Schilke & Reimann, 2025). A divulgação oferece transparência de divulgação, o fato simples de que uma IA estava envolvida, e deixa de fora transparência de verificação, a capacidade de verificar como a resposta foi produzida. A auditoria epistêmica é ainda mais sombria: em 25.000+ execuções de agentes científicos baseados em LLM, a evidência foi ignorada em 68% dos traços, crenças foram revisadas apenas 26% das vezes em refutação, e evidência convergente em múltiplos testes era rara, com o andaime explicando quase nenhuma da variância no comportamento epistêmico (≈1,5%, contra ~41% para o modelo base) (Ríos-García et al., 2026). Esse último número parece uma objeção a este artigo e é na verdade seu apoio mais afiado: prompting e scaffolding não conseguem tornar um modelo epistemicamente disciplinado de dentro, então a disciplina deve ser imposta de fora. A arquitetura não é uma forma de melhorar a epistemologia do modelo; é uma forma de parar de depender dela.
Cada um desses resultados fecha uma porta. Juntos, eles apontam para uma resposta que não foi muito explorada: se o modelo não consegue ser confiável de dentro, e a divulgação não fabrica confiança de fora, a confiança justificada pode ser construída em torno do modelo, por meio da arquitetura, juntamente com (e não em vez de) melhor calibração, certificação externa, escalação humana e regras de responsabilidade. Essa é a porta pela qual este artigo passa.
Tabela 1. Diagnóstico → remédio: os quatro déficits de modelo único, sua evidência 2025–26, sua consequência do lado do consumidor e a resposta arquitetônica
| Déficit estrutural | Evidência-chave (2025–26) | Consequência do lado do consumidor | Remédio arquitetônico | Mecanismo |
| Confiança não calibrada | Alucinação estatisticamente recompensada por regimes de avaliação (Kalai et al., 2025); autossupervisão introspectiva ~20% confiável (Lindsey, 2025) | Rotatividade de um erro: 60% abandonariam um agente após um erro (ACI Worldwide, 2026) | Diversidade + Evidência | Desacordo entre modelos valora confiança (AUROC 0,75 vs. 0,59, Gorbett & Jana, 2026; este artigo: concordância do painel AUROC 0,832 vs. confiança agregada própria 0,545 no painel menos discriminatório — heterogêneo entre painéis, §3; respostas replicadas 1,9–3,2× tão provavelmente corretas); reivindicações de confiança registradas e testáveis |
| Distorção sycofanta | IA afirma usuários 49% mais que humanos; modelos aduladores preferidos (Cheng et al., 2026; Sharma et al., 2024); até Bayesianos ideais entram em espiral (Chandra et al., 2026) | O assistente preferido é aquele que distorce o julgamento do usuário | Neutralidade | O árbitro não tem interesse em agradar o usuário; empatia e verificação de política em canais separados |
| Sem verificação independente | Agentes ignoram evidências em 68% dos rastros; revisão de crença 26% (Ríos-García et al., 2026); andaime explica ~1,5% da variância | Carga de verificação muda para o consumidor: 54% dos compradores assistidos por IA verificam manualmente tudo novamente (Gartner, 2026) | Diversidade + Evidência | Disciplina imposta de fora: caminhos de verificação independentes; evidência anexada independentemente |
| Conflito de interesses | Ação coletiva Perplexity (2026, alegações): chats roteados para redes de anúncios; divulgação sozinha corrói confiança (Schilke & Reimann, 2025) | A parte que aconselha o consumidor lucra com o resultado | Neutralidade + Evidência | Fluxo de dados de sala limpa; receita independente dos resultados; neutralidade auditável a partir do registro |
3. Confiança arquitetônica: três propriedades que podem ser verificadas em vez de acreditadas
Considere agora um serviço em que solicitações de alto risco passam por uma camada de orquestração independente de qualquer fornecedor de modelo (a Figura 5 contrasta os dois fluxos). A Tabela 2 coleta os construtos; a definição que decompõem é: confiança arquitetônica é confiança do consumidor justificada baseada em propriedades verificáveis do processo gerador de decisões do serviço, e não na qualidade percebida de seus resultados ou na reputação de seu provedor.
O antecessor mais próximo é a produção institucional de confiança de Zucker (1986), confiança fabricada por estrutura onde a familiaridade não consegue sustentá-la, que a pesquisa de comércio eletrônico operacionalizou como garantia estrutural: custódia, sistemas de feedback, certificação de terceiros (Gefen, Karahanna, & Straub, 2003; Pavlou, 2003; Kim & Benbasat, 2010). Nessa linhagem, confiança arquitetônica é um tipo de confiança baseada em instituição cuja garantia estrutural vem de um processo verificável em vez de um garantidor de terceiros. É confiança baseada em processo com a garantia movida de experiência para instrumentação, e esse movimento é o que a palavra "arquitetônica" está fazendo no nome. Não é garantia estrutural (McKnight, Choudhury, & Kacmar, 2002), uma percepção de que salvaguardas existem, pois aqui as próprias salvaguardas têm de ser verificáveis, e não é confiança calibrada (Lee & See, 2004), que afina a confiança ao envelope de confiabilidade de um sistema. Arquitetura de confiança zero em engenharia de segurança compartilha o slogan, nunca confie, sempre verifique, mas verifica identidade e acesso na camada de rede, máquina para máquina, enquanto confiança arquitetônica verifica conteúdo de decisão na camada de serviço, para um principal humano. São complementos em andares diferentes do mesmo edifício, não concorrentes. O construto tem duas faces, e a distinção pertence à definição. Confiabilidade arquitetônica é uma propriedade do sistema, o quanto seu processo é de fato verificável, normativo e construível. Confiança baseada em arquitetura é um estado do consumidor, confiança de fato baseada nessa verificabilidade, empírica e apenas ganha. Em termos de medição, D, E e N são componentes formativos da confiabilidade arquitetônica (a propriedade do sistema) e sinais manipuláveis cujo display molda a confiança baseada em arquitetura (o estado do consumidor); os experimentos manipulam os sinais e medem o estado. Cada desajuste entre os dois é preditivo. Confiança sem confiabilidade, confiança fabricada por fluência e adulação, é prevista como frágil, o padrão de um golpe da Seção 1. Confiabilidade sem confiança é prevista onde quer que a verificação seja invisível ou ilegível para o consumidor, e é fechada por saliência do recibo e compreensão em vez de mais arquitetura. As proposições nesta seção vivem na lacuna entre os dois, e a distinção disciplina o que falsificaria a Hipótese de Migração de Confiança. Esses falsificadores são comportamentais e pré-comprometidos: a hipótese é refutada se delegação para arquiteturas verificáveis e opacas prova ser igualmente durável sob falha (o que P4 detecta); se o efeito de arquitetura verificável sobre disposição de delegação falha em crescer com controle de revisão e execução rendido (o cruzamento do nível de delegação de P2); ou se, em delegação de alta irreversibilidade, retenção e prêmios de disposição para pagar por arquitetura verificável sob falha controlada estão ausentes. Como garantia é definida pela sobrevivência de auditoria em vez de pela presença da arquitetura (Seção 1), popularidade conta como evidência mas não como imunidade. Consumidores indo em massa para agentes não verificáveis não refutam por si só uma reivindicação sobre confiança justificada. Confiança sustentada e sobrevivente a falhas em agentes não verificáveis em delegação de alto risco a refutaria, e esse padrão é pré-comprometido como revisando a hipótese. A definição repousa em três propriedades.
Figura 5. Dois fluxos
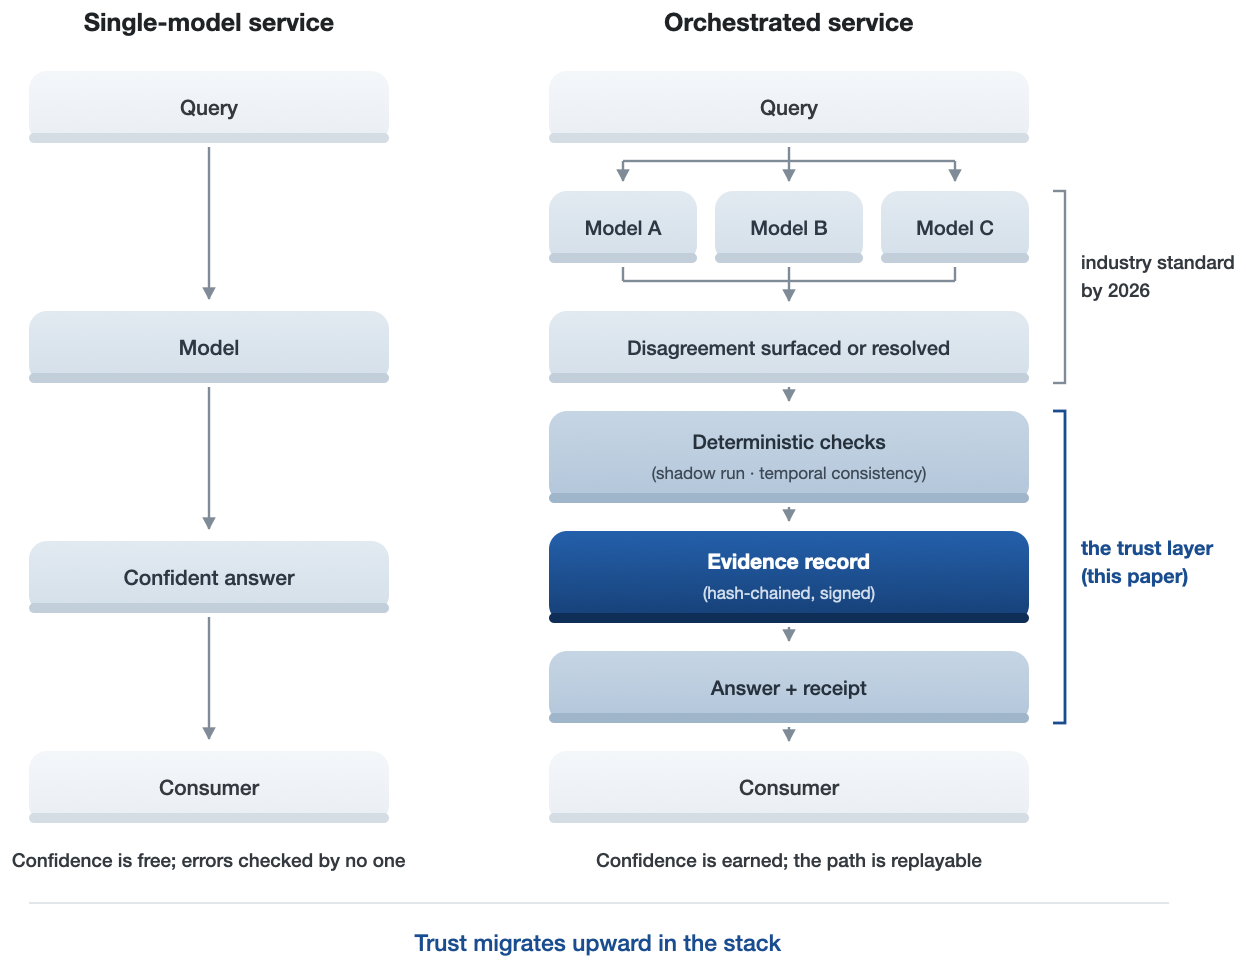
Esquerda, o caminho do modelo único: consulta → modelo → resposta confiante → consumidor, onde confiança é gratuita e erros não são verificados por ninguém. Direita, o caminho orquestrado: consulta → modelos independentes (A/B/C) → desacordo apresentado ou resolvido → verificações determinísticas (execução de sombra, consistência temporal) → registro de evidência (encadeado por hash, assinado) → resposta com recibo → consumidor, onde confiança é ganha e o caminho é reproduzível (a Tabela 5 resume o contraste).
Tabela 2. Glossário de construtos introduzidos ou especificados neste artigo
| Termo | Definição | Distinguido de |
| Confiança arquitetônica | Confiança do consumidor justificada baseada em propriedades verificáveis do processo gerador de decisões do serviço, e não em qualidade de saída ou reputação do provedor | Confiança baseada em instituição (não requer instituição de confiança, apenas processo verificável); confiança de sistema (não envelope de confiabilidade de um único sistema); confiança distribuída (dispersão sem verificabilidade); assurance estrutural (salvaguardas percebidas vs. verificáveis); confiança calibrada |
| Confiabilidade arquitetônica / confiança baseada em arquitetura | As duas facetas do construto: a propriedade do lado do sistema (quão verificável o processo é de fato; normativa, construível) vs. o estado do lado do consumidor (confiabilidade realmente fundamentada nessa verificabilidade; empírica, conquistada) | Tratamentos com nome único que misturam a reivindicação normativa com a descritiva |
| Camada de verificação | A camada de infraestrutura acima da orquestração cujo produto é verificabilidade: verificações independentes, decisões registradas, neutralidade auditável | Observabilidade/monitoramento (interna, mantida pelo fornecedor, não verificável pelo consumidor) |
| Infraestrutura de evidências | A categoria de mercado de históricos de decisões verificáveis vendida como infraestrutura, assim como computação em nuvem, identidade e pagamentos são vendidos | Registro (unilateral, mutável, não é um bem de mercado) |
| Recebimento de orquestração | Um artefato mínimo voltado para o consumidor: quem agiu; como concordaram; o que foi verificado — com um ponteiro para o registro completo reproduzível | Saída de Explicação/XAI (narrativa, não verificável); rótulo de divulgação (desgasta a confiança por si só) |
| Arquitetura de confiança graduada | Escalação da profundidade de verificação com riscos, de modo que o nível caro é adquirido apenas onde as consequências se concentram | Guardrails planos (limites estáticos/listas brancas que não verificam decisões) |
| Evidência de decisão | O terceiro andar da pilha de evidências: como o agente escolheu — painel, divergência, verificações | Evidência de identidade (quem é o agente: TAP); evidência de intenção (o que foi autorizado: AP2 / Verifiable Intent) |
| Hipótese de Migração de Confiança | Quanto maior a agência delegada, maior a parcela de confiança justificada que deve residir em propriedades arquitetônicas verificáveis em vez de propriedades do modelo — "justificada" significando confiabilidade que sobrevive a uma auditoria objetiva contra critérios fixados antes que os resultados sejam conhecidos (conforme Jacovi et al., 2021); forma de mecanismo: conforme a delegação se aprofunda, a parcela de confiabilidade — f(capacidade, integridade, benevolência), Mayer et al. (1995) — que o consumidor pode medir independentemente se desloca para os componentes arquitetônicos | Usos anteriores de "migração de confiança" (Carlson, 2026) rastreiam confiança mudando entre partes; esta hipótese rastreia o tipo de propriedade que a justifica — com falsificadores comportamentais pré-comprometidos (P2 cruzamento de delegação; P4 durabilidade diferencial) |
A demarcação dos construtos de confiança vizinhos pode ser comprimida em uma tabela discriminante, pelo que cada construto toma como seu objeto, de onde sua justificativa vem, quem pode verificar essa justificativa e o que deve prever principalmente:
Tabela 2a. Demarcação discriminante: construtos de confiança vizinhos por objeto, justificativa, verificador e resultado primário previsto
| Construto | Objeto de confiança | Fonte de justificativa | Quem pode verificar | VD primária prevista |
| Confiança baseada em instituição / assurance estrutural (Zucker, 1986; McKnight et al., 2002) | O contexto institucional: salvaguardas, garantias, certificação de terceiros | Presença percebida de estruturas e garantidores | Um garantidor de terceiros, se houver; o consumidor percebe em vez de verificar | Crenças de confiança; intenção de transação |
| Confiança em automação / confiança calibrada (Lee & See, 2004) | Envelope de confiabilidade de um sistema automatizado | Confiabilidade experimentada ao longo do uso repetido | O operador, através da experiência acumulada com esse sistema | Adequação da confiabilidade nesse sistema |
| Transparência algorítmica (XAI) | A explicação do modelo de sua própria decisão | Uma narrativa ou atribuição produzida dentro do sistema que está sendo confiado | Ninguém independentemente — uma explicação não é um registro reproduzível | Compreensão; confiança subjetiva; aceitação |
| Confiança de marca / fornecedor | A organização do fornecedor | Reputação e desempenho anterior | O mercado, lentamente, através de resultados agregados | Preferência global; escolha; lealdade |
| Confiança arquitetônica (este artigo) | O processo de produção de decisão e seu registro | Propriedades verificáveis: concordância independente, evidência reproduzível, independência de incentivo auditável | O consumidor, um auditor, um segurador, um regulador — por decisão | Confiabilidade calibrada; disposição de delegar; retenção pós-falha |
Duas previsões diferenciais tornam a demarcação testável em vez de taxonômica. A confiança arquitetônica deve mover confiabilidade calibrada e retenção pós-falha mais fortemente do que move a preferência global pelo serviço, enquanto confiança de marca deve mostrar o perfil oposto, uma dissociação que um único experimento pode detectar medindo ambas as famílias de VD. Com agência delegada baixa, confiança de marca e fornecedor devem dominar as decisões de delegação, com confiança baseada em arquitetura explicando uma parcela incremental crescente conforme a delegação se aprofunda, o cruzamento que P2 e a Hipótese de Migração de Confiança colocam sob teste. Seguem dois esclarecimentos. Porque a confiabilidade arquitetônica é uma propriedade do serviço, não uma latente reflexiva na cabeça do consumidor, sua distinção repousa nessas previsões diferenciais em vez de estatísticas discriminantes de escala. Para o estado do lado do consumidor que se chama confiança baseada em arquitetura, estabelecer validade discriminante de nível de medição em relação a escalas adjacentes (confiança baseada em instituição e confiança calibrada) faz parte da agenda de medição, não uma afirmação feita aqui.
Diversidade. O pedido é respondido por vários modelos independentes, cada um com fornecedores diferentes, dados de treinamento e modos de falha distintos. (Esta é diversidade de painel, uma propriedade de quem verifica a resposta, não diversidade de recomendação no sentido de sistemas de recomendação, que varia os itens mostrados a um consumidor.) Seu acordo carrega informação. A convergência aumenta confiança justificada. A divergência é apresentada ao consumidor como incerteza em vez de ser resolvida invisibilmente, e em pedidos que importam funciona também como gatilho de escalação. Em termos de predição seletiva, esta é abstenção arquitetônica: a recusa de emitir uma resposta não verificada, elevada à camada de serviço, onde um caso não resolvido é roteado para um humano em vez de ser certificado. É o padrão de aprender a adiar, no qual a opção de rejeição de um sistema entrega o caso a um especialista a jusante em vez de suprimi-lo (Mozannar & Sontag, 2020; cf. Rabanser et al., 2026). A analogia humana mais próxima é a segunda opinião em medicina, cujo valor inteiro reside em sua independência da primeira. O desacordo orquestrado também não é exótico: o co-cientista de IA do Google, cujas descobertas validadas em laboratório úmido chegaram a Nature em maio de 2026 (Gottweis et al., 2026), é construído como uma orquestração de geração–crítica–torneio.
A justificativa teórica para apoiar-se na diversidade é mais antiga que modelos de linguagem. Sob condições formais, grupos funcionalmente diversos de solucionadores de problemas podem superar grupos selecionados por habilidade individual, porque a seleção por habilidade gera similaridade (Hong & Page, 2004). A literatura de engenharia fornece evidência direta para o sinal subjacente: debate estruturado entre modelos melhora a precisão factual (Du et al., 2024), e painéis de modelos menores e diversos superam um único juiz grande (Verga et al., 2024). A "surpresa" de um segundo modelo com a resposta de um primeiro modelo separa certo de errado substancialmente melhor que a confiança do próprio modelo respondente (AUROC médio 0,75 versus 0,59 em MMLU; AUROC, a área sob a curva ROC, é a probabilidade de uma resposta aleatória correta ser classificada acima de uma errada aleatória; Gorbett & Jana, 2026). Seu sinal é perplexidade entre modelos no nível logit, enquanto o deste artigo é replicação no nível de resposta, e os dois estão relacionados sem serem intercambiáveis. Seu gerador é também um pequeno modelo aberto com auto-relato fraco, um baseline que os dados deste artigo limitam, porque a vantagem do painel é uma função da calibração do gerador e pode se inverter para geradores bem calibrados, o caso de fronteira dos EUA abaixo. E amostragem de múltiplas gerações e medição de seu acordo semântico detecta confabulações onde confiança em um único passe não consegue (Farquhar, Kossen, Kuhn, & Gal, 2024). Um modelo pode medir sua própria dúvida mas não seus próprios pontos cegos, e o erro confiante, sistemático é visível apenas de fora. Mas essa literatura trata desacordo como um sinal interno para desenvolvedores. O movimento que estou propondo é tratá-lo como uma primitiva de confiança voltada para o consumidor, apresentada, registrada e precificada nas alegações de confiança do serviço, com a ablação deste artigo separando o que o debate descobre do que a verificação certifica em vez de deixar um se passar como o outro. A demarcação é empírica assim como conceitual: testada frente a frente, debate multi-agente não supera confiabilmente estratégias mais simples como auto-consistência e ensemble (Smit et al., 2024). A alegação aqui diz respeito ao sinal de certificação voltado para o consumidor da verificação, em vez do ganho de precisão do debate, e esse sinal sobrevive mesmo onde a vantagem do debate não.
Em pesquisa de deliberação multi-agente, da mesma forma, sistemas construídos para expor acordos e desacordos em vez de suavizá-los produzem decisões avaliadas como mais representativas (Liu et al., 2026). O mecanismo tem um análogo humano direto no lado da calibração de conhecimento: consumidores que fazem decisões financeiras consequentes conjuntamente são substancialmente menos excessivamente confiantes que tomadores de decisão individuais, com metaconhecimento compartilhado (o parceiro expondo o que o tomador de decisão não sabe) identificado como o mecanismo condutor (Piehlmaier, 2023). Julgamento conjunto disciplina confiança em humanos pela mesma razão que acordo entre modelos é proposto para discipliná-la aqui.
Se consumidores conseguem usar tal sinal é uma questão real. Pessoas abandonam algoritmos rapidamente após vê-los errar (Dietvorst, Simmons, & Massey, 2015), porém em outros lugares dão peso excessivo a conselhos algorítmicos (Logg, Minson, & Moore, 2019), uma divisão que pode ela própria variar com o que está em jogo. Experimentos de segunda opinião com sujeitos humanos mostram que o material bruto é comportamentalmente vivo: adesão quase unânime quando uma IA médica e um médico concordam, divisões acentuadas quando eles divergem (Detjen, Densky, von Kalckreuth, & Kopka, 2025; Chen, Sun, Liao, & Sundar, 2026), embora nenhum desse trabalho varie desacordo conjuntamente com evidência ou neutralidade. O fluxo de pesquisa do consumidor aprimora as condições de limite (sistematicamente: Burton, Stein, & Jensen, 2020). Aversão intensifica quando consumidores sentem que seu caso é único (Longoni, Bonezzi, & Morewedge, 2019), varia com a objetividade da tarefa (Castelo, Bos, & Lehmann, 2019), e falhas de uma IA são prontamente excessivamente generalizadas para outras, transferência algorítmica (Longoni, Cian, & Kyung, 2023). Se desconfiança se generaliza entre sistemas, então o abandono após um único erro da Seção 1 não é apenas a perda de clientes de um serviço mas de toda a categoria, e detectar erros estruturalmente protege o mercado em si. Desacordo exposto fica nessa linha de falha, e P1–P2 abaixo são uma aposta em qual efeito domina quando incerteza é apresentada especificamente e sem suavização.
Quando a diversidade falha: erros correlacionados. O valor da diversidade repousa inteiramente na independência das falhas, e a independência não pode ser presumida. Modelos de fronteira treinam sobre corpus sobrepostos, destilam-se uns dos outros e comprovadamente compartilham equívocos confiantes. Quando dois modelos líderes erram o mesmo item de benchmark, concordam na mesma resposta errada aproximadamente 60% das vezes, com correlação mais forte entre modelos do mesmo desenvolvedor ou arquitetura de base e, mais perturbadoramente, entre os modelos mais precisos: conforme a capacidade aumenta, os erros convergem (Kim et al., 2025). Esse achado é uma restrição direta ao próprio componente de Diversidade deste artigo, não meramente um resultado relacionado. A independência que a Diversidade pressupõe é parcialmente ilusória na fronteira, e porque a correlação se fortalece exatamente onde a capacidade é máxima, a contribuição do componente é uma quantidade medida e erosiva, não um ativo fixo. O que um painel adiciona deve ser demonstrado questão por questão, e a trajetória do desenvolvimento de modelos trabalha contra isso. Em previsão, as correlações de erro pareadas entre modelos de fronteira estabelecem uma média de r ≈ 0,77 (Spiro, 2026), redundância suficientemente alta para erodir a maioria do benefício de agregação que uma multidão diversa deveria entregar.
A estrutura de mercado intensifica a preocupação. No final de 2025, 88% dos gastos com LLM API empresarial estava concentrado em três fornecedores de pesos fechados: Anthropic em 40%, OpenAI em 27%, Google em 21% (Menlo Ventures, 2025b; Menlo é um investidor da Anthropic). Um painel montado casualmente a partir dos "modelos líderes" é portanto extraído de uma base de apenas três fornecedores, cujos erros são exatamente os medidos para convergir, o próprio trio que o experimento abaixo reproduz como seu painel de fronteira dos EUA. Quando três modelos convergem no mesmo erro em voga, a arquitetura não apenas falha em captá-lo; ela o certifica. Em enxames homogêneos, adicionar agentes estabiliza uma trajetória errônea em vez de corrigi-la, um ponto final que a literatura de multi-agente chama de paradoxo do consenso (Shehata & Li, 2026). Correlação é assim o modo de falha que a arquitetura deve ser construída para detectar (Figure 6).
Figura 6. A ilusão da diversidade
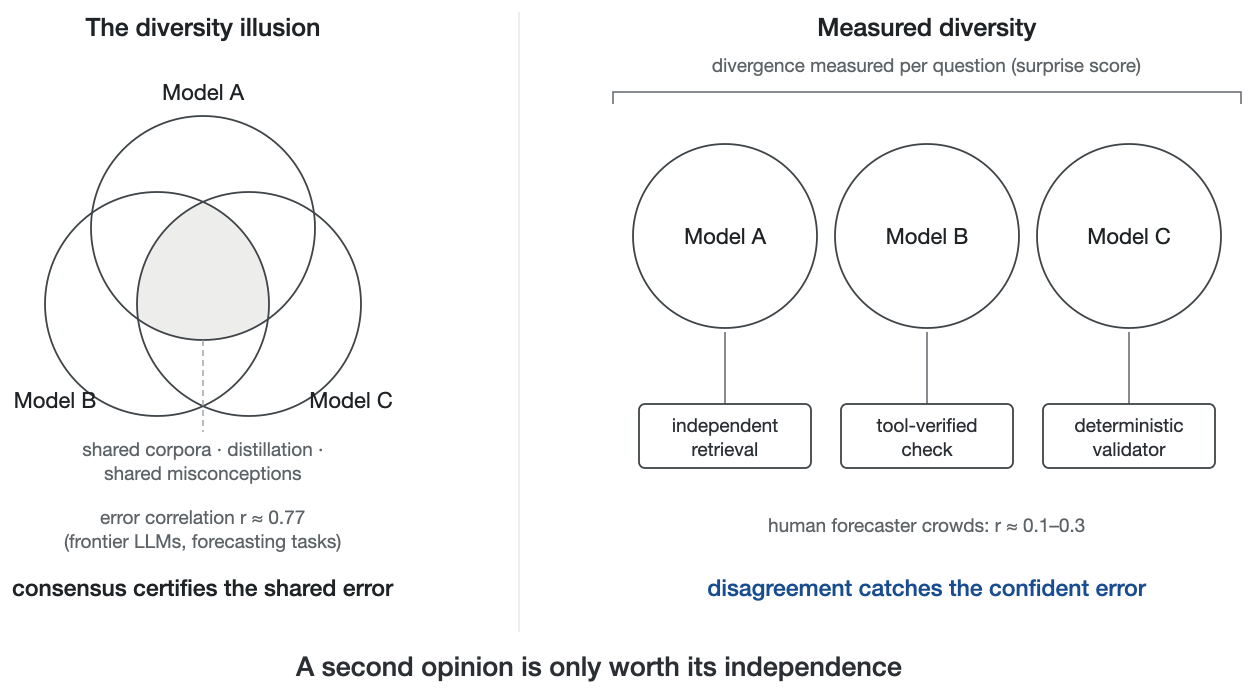
Consenso entre quase-clones versus um painel cuja independência é medida.
Ela tem um correspondente interacional: o gradiente de adulação também atua entre modelos. Estudos multi-agente encontram conformidade de grupo mensurável na deliberação de LLM, com modelos mais fracos se conformando mais arduamente (Choi, Kim, Chae, & Baek, 2025); agentes pesam uma posição conforme de quem é (Choi, Zhu, & Li, 2026); e muito do que parece convergência se decompõe em conformidade social em vez de raciocínio (Hao et al., 2026). Na deliberação conjunta, concordância é o estado de baixa energia, então um painel que debate antes de consolidar posições pode discutir-se até um consenso em vez de até a verdade. O contrapeso arquitetural é procedural: opiniões são coletadas primeiro cegas e independentemente, e apenas depois comparadas (Figure 7).
Figura 7. Cego-independente-primeiro
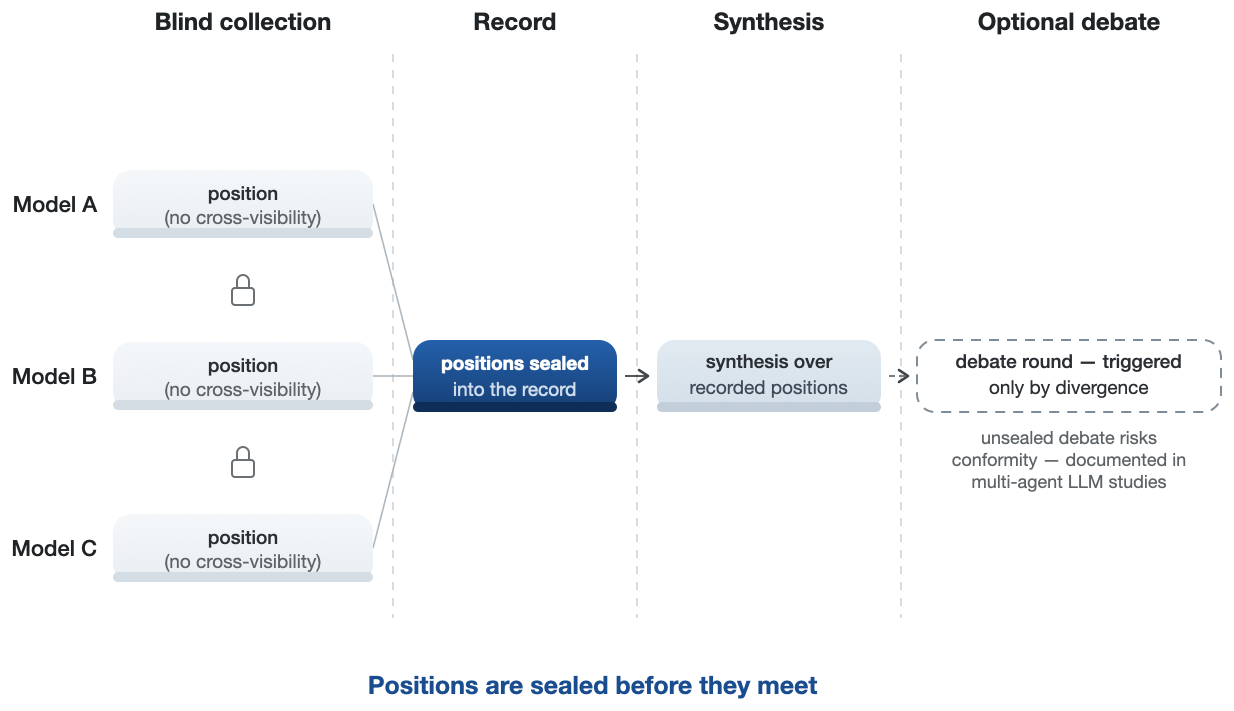
Posições são registradas e apenas depois comparadas — o procedimento que protege os desacordos que a conformidade apagaria.
O experimento relatado abaixo colocou um número sobre o que esse procedimento protege. Em um braço exploratório pareado, verificadores que haviam cegamente produzido uma resposta diferente foram então mostrados a resposta confiante errada do modelo primário e perguntados se concordavam. 38,5% (168 de 436 pares divergentes; IC 95% 33,6–43,2, bootstrap agrupado por questão) abandonaram sua própria resposta divergente e endossaram o erro, com conformidade por fornecedor variando de 20% a 58%. O abandono segmenta-se conforme o que foi abandonado, o que separa conformidade de deferência racional. Entre verificadores cuja resposta cega era em si correta, 29,1% (41/141) ainda a cederam pela resposta confiante errada, o núcleo prejudicial que nenhuma justificativa Bayesiana absolve, contra 43,1% (127/295) entre respostas cegas erradas, onde alguma deferência é defensável. (O intervalo agrupado por questão é quase idêntico ao intervalo ingênuo de nível de par. Os 436 pares se distribuem por 247 questões distintas, geralmente um ou dois pares por questão e nunca mais de quatro, então a reamostragem de nível de questão tem praticamente nenhuma covariância intra-agrupamento para adicionar.) Com o controle de espelho abaixo incorporado, aproximadamente 35–39% dos dissidentes cegos mudam de posição quando mostrados uma resposta confiante, qualquer que seja seu valor de verdade, com um viés líquido moderado mas significativo em direção à resposta proposta (conformidade líquida ≈ 4 pontos percentuais; pares discordantes 104 vs. 70 ≈ 1,49). Se o painel tivesse deliberado antes de consolidar posições, uma grande parte desses desacordos teria sido renegociada antes de poderem ser registrados. Mas porque 34,7% dos flips de braço espelho correm em direção à verdade, a deliberação também teria convertido alguma dissidência em consenso correto, então o que o cego-primeiro protege é a própria medição, não uma contagem de desacordos perdidos. Cego-primeiro é a diferença entre medir desacordo e fabricar consenso, a mesma regra que multidões humanas precisavam: influência social reduz a diversidade de estimativas independentes sem melhorar sua precisão (Lorenz, Rauhut, Schweitzer, & Helbing, 2011), e mesmo um único endosso arbitrário inicial de forma mensurável prejudica julgamentos subsequentes (Muchnik, Aral, & Taylor, 2013).
Um controle de prompt reverso aborda a explicação alternativa de que esses flips refletem atualização racional de crença em vez de conformidade. Repeti o procedimento pareado em um painel local de seis modelos, mostrando aos verificadores que haviam discordado cegamente ou a resposta confiante errada (braço direto) ou a resposta de ouro (braço reverso) para o mesmo conjunto de questões. As taxas de flip foram quase-simétricas, 38,9% em direção à resposta errada versus 34,7% em direção à correta, e na comparação dentro do par os verificadores abandonaram sua posição cega pela resposta errada significativamente mais frequentemente do que pela correta (104 vs. 70 pares discordantes; McNemar p = 0,010). Atualização racional prediz a assimetria oposta. Propensões de flip por modelo foram essencialmente idênticas nos dois braços em ambos os extremos de conformidade (as contagens de par por modelo são pequenas e não separadamente potencializadas; elas são relatadas descritivamente, com seus ns, no pacote de replicação), indicando que o acordo é impulsionado pela presença de uma resposta confiante proposta, não por seu valor de verdade. Este controle foi executado no nível local. A estimativa do painel de fronteira (38,5%) repousa no mesmo procedimento mas não foi testada em espelho com verificadores de fronteira.
A coleta cega não pode fechar um canal: ela derrota a conformidade social mas não a conformidade prévia. Os modelos convergem porque dados de treinamento compartilhados lhes entregam os mesmos priors, e gêmeos respondem de forma semelhante sem nunca se consultarem. Eu chamo isso de convergência de semelhantes: um painel concordando porque seus membros são semelhantes, não porque estão certos.
Priors correlacionados ainda devem ser medidos. Pontuações de surpresa entre modelos fornecem uma estimativa contínua de quão independente o painel realmente é, questão por questão, e são livres de rótulo, então a independência pode, em princípio, ser estimada no tempo de inferência sem respostas de ouro. A estimação no tempo de produção não é testada aqui. A diversidade também deve ir além dos pesos do modelo, pois caminhos de recuperação independentes, verificações de ferramentas e validadores determinísticos quebram o canal de correlação que o treinamento compartilhado cria. A necessidade crescerá em vez de diminuir, porque a destilação e o treinamento com dados sintéticos homogeneizam os pesos do modelo ao longo do tempo, portanto a diversidade medida deve esperadamente decair e a carga de verificação se deslocar para verificadores não-modelo. E o que é medido deve ser divulgado: o registro deve conter não apenas "N modelos concordaram" mas a diversidade estimada do painel para esta classe de questão. Consenso entre quase-clones merece uma afirmação de confiança mais fraca, e o registro deve indicar qual foi obtido pelo consumidor.
Evidência. Toda resposta consequente carrega um registro: quais modelos foram consultados, onde concordaram e discordaram, o que foi verificado, do que a síntese se baseia. O timing favorece o requisito, porque conforme os agentes fundamentam as respostas em recuperação e ferramentas a base factual já vive fora do modelo, então registrá-la se torna um subproduto de produzir a resposta. Porque o registro é à prova de adulteração, o histórico de decisões do serviço é reproduzível pelo consumidor em uma disputa, por um auditor, por uma seguradora precificando responsabilidade. A confiança deixa de ser um sentimento sobre uma marca e se torna uma propriedade inspecionável de um histórico.
Dois mecanismos estendem evidência de respostas para ações. Sob execução fantasma, uma ação com efeitos externos é ensaiada em uma execução seca registrada, então "o agente verificou antes de agir" se torna uma afirmação verificável em vez de um slogan. Consistência temporal reapresenta uma recomendação através de sessões ou fraseados e registra sua estabilidade, então uma resposta que se desvia quando perguntada duas vezes é sinalizada antes de qualquer um confiar nela. No nível de identidade, a camada de registro se estende para um passaporte de proveniência portátil para o agente em si: quais modelos, versões e políticas agiram, quando, sob cuja autoridade. Esse é o artefato que esquemas de registro "conheça-seu-agente" e compromissos de seguro contra erro do agente silenciosamente presumem. A apresentação voltada para o consumidor deste registro é o recibo de orquestração da Figura 8: uma ação, um registro, quatro públicos (consumidor, segurador, auditor, regulador).
Figura 8. O recibo de orquestração, vendido duas vezes (protótipo)
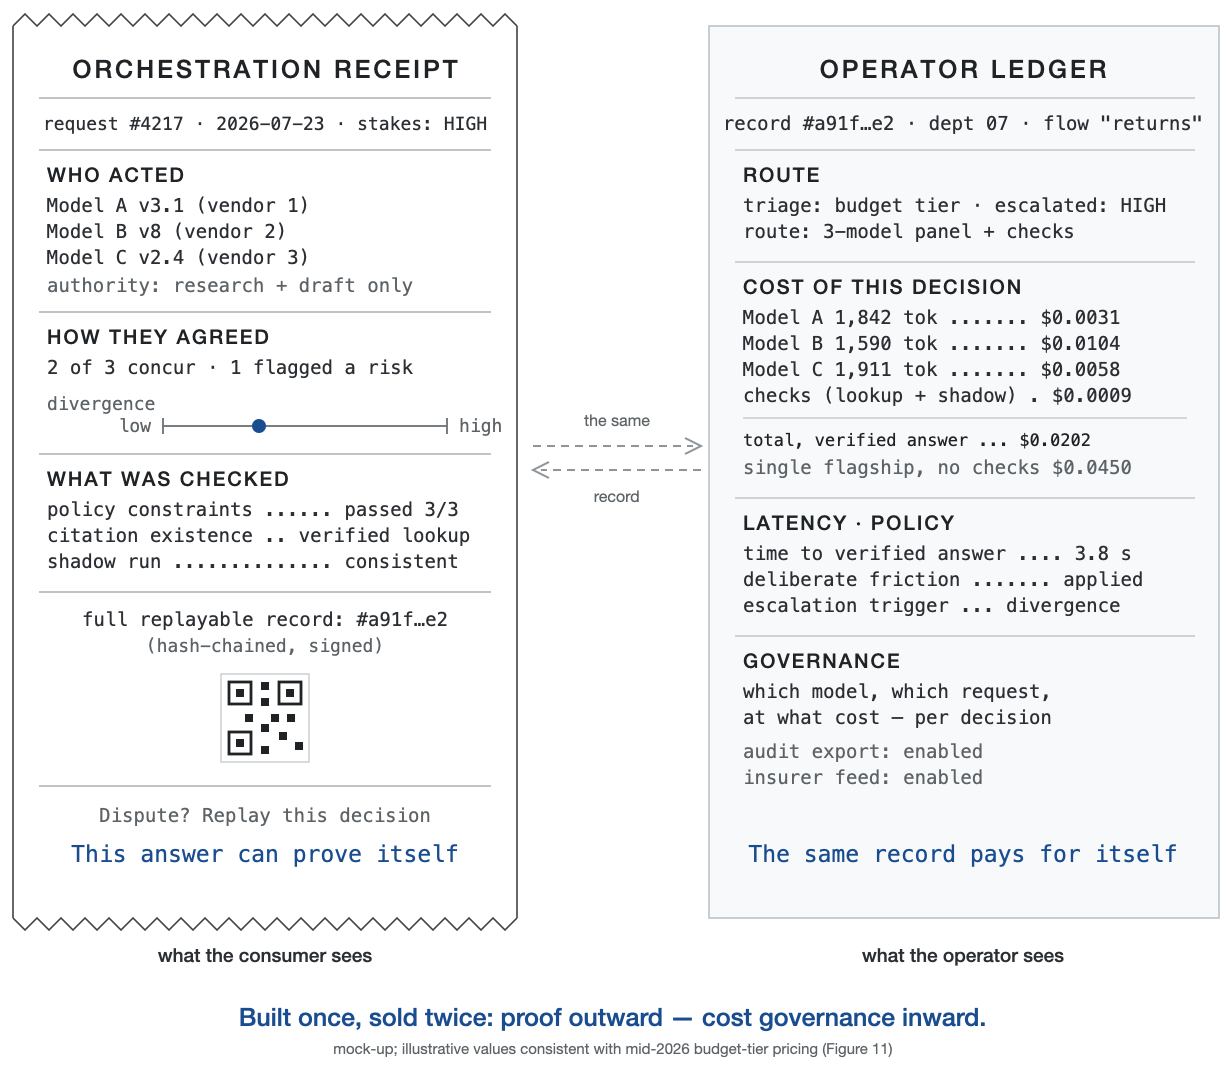
O consumidor vê prova — quem agiu, como concordaram, o que foi verificado; o operador vê o mesmo registro como governança de custo. Em uma disputa, o recibo transforma palavra-contra-palavra em registro-contra-palavras.
Neutralidade. Neutralidade é independência de incentivos auditável: a ausência de dependência econômica não divulgada em qualquer fornecedor, comerciante ou resultado de decisão específico. A camada de orquestração encaminha para os modelos que melhor funcionam para a tarefa e não tem interesse em qual ganha, estruturalmente análogo às camadas de compensação independentes em pagamentos. Um árbitro entre fornecedores pode ser confiável de forma que nenhum fornecedor pode ser sobre si mesmo. Independência nomeia a propriedade econômica, e auditável a vincula à camada de evidência que torna a afirmação verificável em vez de professa, a disciplina de câmara de compensação desenvolvida abaixo. (Neutralidade aqui é uma propriedade econômica, não equidade algorítmica entre grupos demográficos, que é uma exigência ortogonal.)
Há também o problema da integração vertical: neutralidade é estruturalmente indisponível para as plataformas melhor posicionadas para construir orquestração em escala. Uma empresa que é simultaneamente mercado, fornecedor de modelos, rede de publicidade e provedor de logística não pode arbitrar neutralmente, porque toda decisão de roteamento que ela faz é uma decisão sobre sua própria receita. A aritmética aponta para uma tendência estrutural. O framework implica que a camada de confiança fica melhor com partes cujo único negócio é a arbitragem em si, o caminho pelo qual compensação, auditoria e avaliação de crédito se tornaram indústrias independentes. O caso da agência de classificação é igualmente o aviso canônico de que intermediários independentes desenvolvem conflitos de emitente-pagador próprios. A economia é documentada: intermediários de certificação capturam valor controlando quais informações são reveladas (Lizzeri, 1999), mercados de certificação falham de forma bem catalogada (Dranove & Jin, 2010), e o colapso da avaliação de crédito exibiu a falha canônica, receita de emitente-pagador corrompendo o certificador um nível acima, enquanto as camadas de compensação que sobreviveram são financiadas por custo mutualizado, não pelas partes sendo avaliadas. O requisito de neutralidade portanto se estende ao próprio modelo de receita do orquestrador: uma camada de verificação paga pelos fornecedores ou comerciantes que ela classifica reproduz o conflito que existe para remover, é por isso que o design de receita aqui segue para o lado do consumidor e para a governança de custo do operador (Seção 5), não para as partes sendo classificadas.
Neutralidade também tem uma dimensão de dados. Uma camada de orquestração pode funcionar como uma sala limpa: requisições chegam a cada fornecedor despojadas de identidade do usuário, nenhum fornecedor vê o histórico inteiro de interação, e a receita do orquestrador vem do serviço, não do roteamento do que os usuários dizem para redes de publicidade. Neutralidade é independência de incentivos em ambas as frentes: nenhuma dependência econômica não divulgada em qualquer fornecedor de modelo ou comerciante, e nenhum modelo de negócio que monetiza as palavras do consumidor contra o consumidor.
Mas a neutralidade convida para seu próprio retrocesso: quem audita o orquestrador? Uma "sem interesse" literal é inatingível. Qualquer orquestrador tem custos, parcerias, incentivos de retenção e sua própria sobrevivência para financiar, então a variável operacional não é sua ausência, mas sua natureza, sua divulgação e sua auditabilidade a partir do registro. Qual partido paga não resolve a neutralidade; se a receita do pagador é independente do resultado da transação, resolve. Uma assinatura de consumidor, ou uma taxa de uma seguradora ou auditor cujo pagamento é desacoplado de qual produto vence, satisfaz a condição; uma comissão de comerciante ou uma taxa de publicidade não. A governança mais ampla de quem financia a camada permanece aberta, e a independência auditável desse financiamento é a parte que a construção corrige. Uma camada de orquestração também tem incentivos: rotear para modelos baratos, vender em excesso sua camada cara, moldar a síntese convenientemente. O retrocesso tem quatro décadas. Shapiro (1987) chamou-a de problema dos guardiões: salvaguardas procedimentais geram novos guardiões que devem ser guardados, e a resposta institucional não mudou desde então.
As câmaras de compensação conquistam sua posição confiável sendo externamente auditáveis e reguladas, não por declarar neutralidade. O orquestrador não possui neutralidade como uma virtude. A camada de evidência é o que a torna verificável. Cada decisão de roteamento, resposta do modelo e etapa de síntese caem em um registro inviolável, um log encadeado por hash, assinado, projetado para ancoragem de carimbo de tempo externo, para que a neutralidade alegada do orquestrador seja exposta exatamente à verificação que impõe aos modelos. O caminho de maturidade é o manual de câmara de compensação concretizado: ancoragem de carimbo de tempo externo, uma interface de verificação aberta e auditoria periódica de terceiros da política de roteamento. O design institucional de tais ecossistemas de auditoria já é um programa de pesquisa nomeado (Raji, Xu, Honigsberg, & Ho, 2022). Uma dependência sobrevive até mesmo a uma auditoria dos verificadores: os modelos do painel podem ser independentes um do outro, mas todos selecionados pela plataforma sendo verificada, razão pela qual o endpoint do caminho de maturidade é a seleção de painel e rotação fora do controle de qualquer parte única. Um orquestrador cujos registros não podem ser auditados é apenas mais um fornecedor pedindo para ser acreditado. Os vizinhos mais próximos fora da pesquisa de consumidor são dois trabalhos simultâneos de 2026. Marchal et al. (2026) argumentam a mesma mudança avaliativa, de julgar outputs para arquitetar confiabilidade do agente, proveniência e falsificabilidade, no nível de infraestrutura epistêmica, e Wang et al. (2026) pesquisam proveniência de execução como uma camada de responsabilidade em nível de processo para verificação, auditoria e atribuição de falha. O que permanece próprio deste artigo é a composição voltada para o consumidor e consciente de incentivos: as três propriedades agrupadas como objeto de confiança justificada de um consumidor no comércio delegado, e seu teste comportamental.
O componente de evidência carrega uma demarcação, porque a inviolabilidade é facilmente vendida em excesso: um log encadeado por hash estabelece proveniência e integridade (que este registro existiu e não foi posteriormente alterado), não completude (nada no hash garante que chamadas omitidas não foram suprimidas), não correção (um registro fiel de uma resposta errada ainda está errado), não independência e não alinhamento de incentivos. Cada um é uma propriedade separada com seu próprio mecanismo de verificação: atestado de cobertura, auditoria de resultado, diversidade medida, economia divulgada. Um recibo deve reivindicar apenas as propriedades que seu registro realmente carrega. Um limite adicional é estrutural: um log prova o quê foi roteado, não por quê, e a heurística proprietária por trás de escolher este modelo ou este comerciante é auditável apenas se a política de roteamento em si é divulgada ou atestada, uma escolha de governança, não uma consequência criptográfica. Os custos da arquitetura pertencem ao mesmo razão: rotear uma consulta para múltiplos fornecedores multiplica a exposição de privacidade, um log de decisão centralizado é um alvo atraente de segurança, e uma exibição de consenso pode fabricar exatamente a autoridade que o resultado de consenso-erro avisa contra.
A construção também vale a pena demarcada de seus vizinhos de engenharia, porque "usar vários modelos" descreve várias coisas diferentes com diferentes propriedades de confiança. A votação simples de ensemble melhora a precisão, mas resolve desacordos invisivamente, então nada se torna verificável. A amostragem de autoconsistência re-pergunta o mesmo modelo, que é diversidade apenas na aparência. Mistura de especialistas roteia dentro de um único sistema treinado cujo roteador é otimizado para capacidade, não neutralidade. Debate multiagente (Du et al., 2024) melhora respostas, mas trata a deliberação como maquinaria interna: sem registro voltado para o consumidor, sem economia, sem garantia de neutralidade.
Agregadores de roteamento de modelo, em 2026 uma camada de commodidade, são multivendedor em catálogo, mas um modelo por resposta: o roteador escolhe um modelo com base em custo e latência, e nenhuma segunda opinião é jamais coletada. Agregadores são fornecedores para uma arquitetura de verificação, não substitutos para uma.
A operação multi-modelo também não é mais exótica: 37% das empresas estavam executando cinco ou mais modelos em produção no meio de 2025, acima dos 29% um ano antes (a16z, 2025). O encanamento está sendo lançado em escala industrial, com a camada de confiança notavelmente ausente dela. Permanece aberto se multi-modelo permanece como roteamento de custo invisível ou se torna arquitetura verificável. A Figura 9 pontua os padrões contra as cinco propriedades de confiança, e a Tabela 3 afirma a demarcação em prosa. A confiança arquitetônica é definida exatamente pelo que estes carecem: fontes heterogêneas, desacordo surfaceado e registrado, e um árbitro sem interesse. A engenharia é compartilhada; as propriedades de confiança não são.
Figura 9. Demarcação
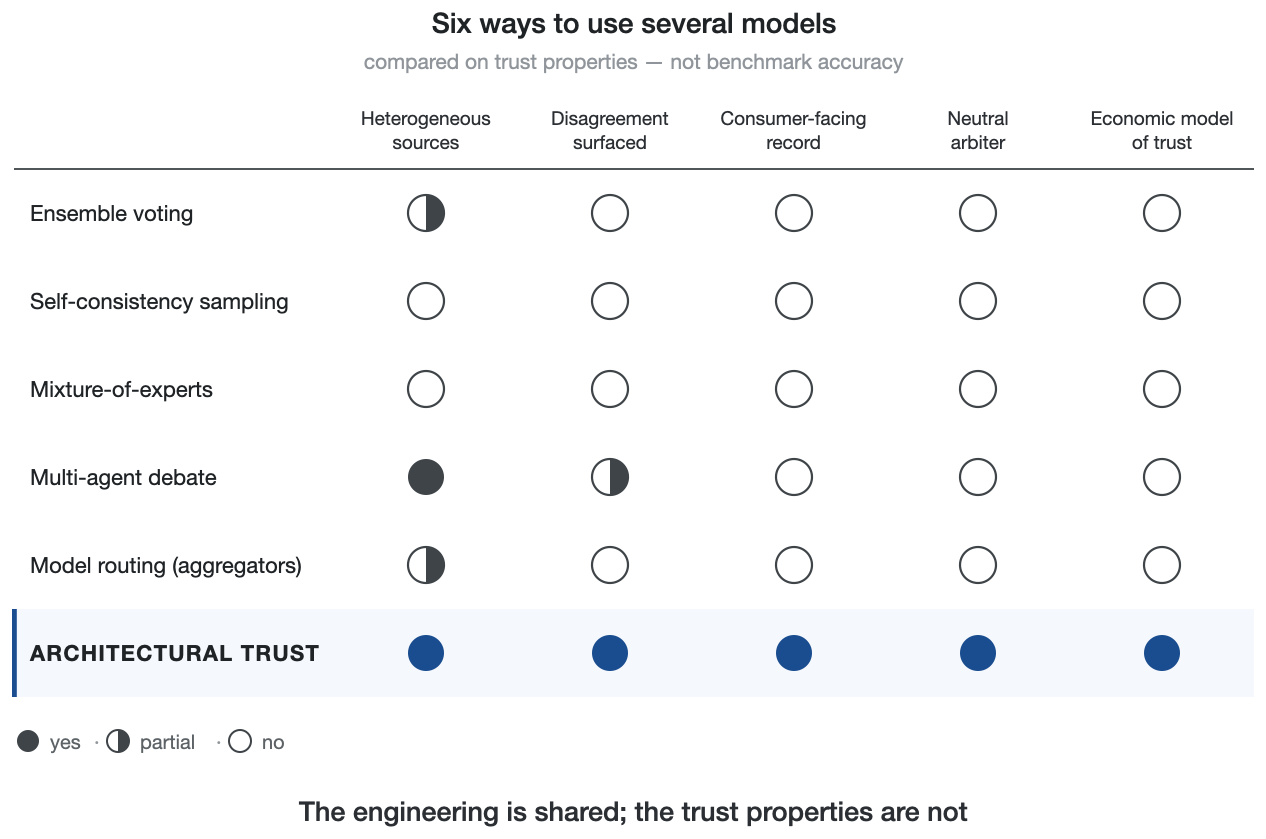
Seis padrões de engenharia multi-modelo pontuados contra cinco propriedades de confiança.
Tabela 3. Demarcação: confiança arquitetônica vs. seus vizinhos de engenharia
| Abordagem | Fontes heterogêneas | Desacordo surfaceado | Registro voltado para o consumidor | Árbitro independente de incentivos | Modelo econômico de confiança |
| Votação de ensemble | Parcial | Não (resolvido invisivamente) | Não | Não | Não |
| Amostragem de autoconsistência | Não (mesmo modelo reamostrado) | Não | Não | Não | Não |
| Mistura de especialistas | Não (um sistema treinado) | Não | Não | Não (roteador otimizado para capacidade) | Não |
| Debate multi-agente | Sim | Apenas internamente | Não | Não | Não |
| Explicabilidade (sobreposição XAI) | Não (narrativa de um único modelo) | Não | Não (uma história, não um registro) | Não | Não |
| Transparência/divulgação | Não | Não | Parcial (mais visível, não verificável) | Não | Não |
| Proveniência/rastreamento de linhagem (pipelines de ML) | Não (um pipeline documentado) | Não | Parcial (linhagem voltada para engenheiros) | Não | Não |
| Inferência verificada (zkML) | Não (um modelo; prova de sua execução) | Não | Parcial (artefato de prova, não um registro de decisão) | Não | Não |
| Agregador de roteamento de modelos | Parcial (catálogo multi-fornecedor, um modelo por resposta) | Não | Não | Não (roteador otimizado para custo) | Não |
| Confiança arquitetônica | Sim | Sim (voltado para o consumidor) | Sim (reproduzível) | Sim (estrutural) | Sim (níveis graduados) |
Duas outras literaturas parentais também pertencem à mesma lista: a lógica de abstenção-ou-emissão do portão é predição seletiva e aprendizado a deferir (Geifman & El-Yaniv, 2017; Mozannar & Sontag, 2020), e a trilha de auditoria do componente de evidência descende do trabalho de algoritmos responsáveis e auditoria de terceiros (Kroll et al., 2017; Raji et al., 2022). Confiança arquitetônica é a conjunção voltada para o consumidor, restrita à neutralidade, destes, e não apenas um deles. Localizá-la entre os outros remédios importa, porque são complementos em vez de rivais. A calibração em nível de modelo é necessária, mas estruturalmente insuficiente: o fornecedor a produz e a atesta, o que é o conflito do qual este trabalho parte. Auditorias externas e certificação são independentes, mas periódicas, instantâneos de um sistema, não de uma decisão. Uma explicação é uma narrativa produzida dentro do modelo, e um sistema que pode confabular respostas pode confabular a história por trás delas. Transparência expõe mais maquinaria e deixa o consumidor para interpretá-la. Confiança arquitetônica não pede crença nem interpretação, apenas verificabilidade que é contínua, por decisão, e verificável por máquina. É também o que faz os outros remédios funcionarem: uma auditoria de um orquestrador com um registro reproduzível é uma auditoria de algo, enquanto uma auditoria de um pipeline opaco é uma cerimônia. Seus vizinhos conceituais mais próximos são garantia estrutural e confiança baseada em instituição (McKnight et al., 2002), transparência de processo e explicabilidade. Contra eles, a propriedade demarcadora é que a justificativa é verificável pelo confiador, por decisão: garantia pede para ser acreditada uma vez, confiança arquitetônica pede para ser verificada cada vez. Dois outros conjuntos de vizinhos pertencem ao mapa. A literatura de responsabilidade da ciência da computação lançou os alicerces técnicos há uma década: regularidade procedimental tornada verificável sem transparência total (Kroll et al., 2017). Uma onda de engenharia de 2025–26 está construindo infraestrutura de confiança de agente diretamente: protocolos "nativos de confiança" com identidade verificável e registros de comportamento resistentes a adulteração (TrustTrack; Li, 2025); gerenciamento de ação em tempo de execução com recibos à prova de adulteração (AARM; Errico, 2026); agregação multi-LLM reformulada como estimativa de confiança (Zheng & Zhang, 2026, arXiv:2607.20529); e estruturas empresariais (AI TRiSM da Gartner; o trabalho agentico de confiança zero da Cloud Security Alliance). Cada um fornece um elemento ao nível empresarial. Nenhum deles fornece o construto voltado para o consumidor, que é o que este trabalho reivindica como sua contribuição: os três componentes sob um nome, conjuntamente manipuláveis em designs comportamentais, com uma economia de quem compra verificabilidade e a quais apostas. Uma colisão de nomenclatura deve ser esclarecida. O "AI Trust Architecture" da DigiCert (lançado em abril de 2026) é uma linha de produtos PKI de fornecedor, infraestrutura de certificado para identidade de agente, proveniência de modelo e autenticação de conteúdo. Fornece infraestrutura no andar de identidade da pilha de evidência, não o construto de confiança arquitetônica desenvolvido aqui.
A relação entre os três é uma hipótese empírica explícita, não uma necessidade conceitual. Proponho uma interação complementar que se aproxima de zero quando qualquer componente está ausente, informalmente AT = f(D, E, N) com declínio acentuado perto de qualquer zero, e o design conjunto da Seção 5 é especificado para recuperar a forma funcional em vez de assumi-la. Em forma estimável, uma família conveniente é Cobb–Douglas, AT = A·Dα·Eβ·N^γ com α, β, γ > 0, codificando os dois compromissos: declínio em direção a zero perto de qualquer ausência, e derivadas parciais cruzadas positivas (os componentes são complementares). O construto são os três componentes e sua complementaridade hipotética, e nenhuma proposição abaixo depende da forma Cobb–Douglas. Cobb–Douglas é também uma aproximação interior: estritamente ainda permite substituição afastando-se de um componente fraco, enquanto a hipótese de complementaridade é tipo Leontief nos limites, com min(D, E, N) estabelecendo o piso. É exatamente por isso que os designs abaixo devem permitir estrutura não-compensatória em vez de assumir compensações comerciais. A família Cobb–Douglas é ilustrativa, para estimação futura, e não faz parte da definição do construto; os dados atuais não a estimam. O fatorial pode discriminar o interior de Cobb–Douglas do piso de Leontief, parâmetro por parâmetro. Os expoentes permanecem uma questão empírica, que é o ponto: a complementaridade é falsificável. Os zeros precisam de dois esclarecimentos. Os componentes são contínuos, não binários, portanto um zero literal é um limite idealizado. Nenhum sistema implantado, incluindo o desta paper, fica exatamente em zero ou um em qualquer eixo, e se os consumidores respondem à quase-ausência com colapso total ou desconto acentuado é exatamente o que o design deve distinguir. Diversidade, por sua vez, significa independência do caminho de verificação, com independência medida (o coeficiente de correlação de erro φ, definido abaixo) como sua unidade. O núcleo estatístico é a teoria clássica de conjuntos, onde o benefício da combinação repousa na descorrelação de erro (Hansen & Salamon, 1990; Krogh & Vedelsby, 1995), razão pela qual a independência é medida aqui em vez de ser assumida. Um segundo modelo é um tal caminho, mas também são uma recuperação independente, uma consulta verificada por ferramentas e um validador determinístico. As execuções de sombra e verificações de consistência da Figura 5 contam como um segundo caminho de verificação maximamente descorrelacionado, não como evidência sem diversidade. Essa definição também absorve os contra-exemplos aparentes mais fortes, o trilho de pagamento regulado ou serviço de utilitário totalmente registrado e atestado por terceiros (evidência e neutralidade fortes, diversidade de modelo nula): tais serviços incorporam caminhos de verificação não-modelo (reconciliação determinística, auditoria externa, portanto D > 0 sob a definição) ou confinem o modelo a um papel que uma verificação determinística cobre completamente. Onde genuinamente não existe caminho de verificação independente para uma classe de tarefas, o framework prevê garantia tênue, uma previsão que o conjunto pode testar. Com caminhos não-modelo contando para D, um zero literal torna-se raro em sistemas de produção, e o conteúdo empírico da forma multiplicativa muda dos zeros para a complementaridade interior, razão pela qual o fatorial, não os zeros, é onde a afirmação se sustenta ou cai. Para teste, um compromisso operacional é fixado aqui: o fatorial manipula D estreitamente, como diversidade de caminho de modelo. A definição mais ampla de caminho de verificação é o escopo do construto, não a variável manipulada. A independência em si deve ser desagregada, porque seis quantidades diferentes viajam sob a palavra: coleta cega (independência procedural no tempo de inferência, o que este design garante), diversidade de família de modelo, correlação de erro residual medida (o φ que esta paper relata), diversidade de fontes de evidência, diversidade de caminho de ferramenta, e independência institucional. O estudo estabelece o primeiro e mede o terceiro; o resto são variáveis de design, não propriedades que esta coleção pode certificar. Diversidade sem evidência é um comitê invisível. Evidência sem neutralidade é marketing de um fornecedor. Neutralidade sem diversidade é um intermediário vazio. A Tabela 4 percorre a grade completa das oito configurações presença/ausência. A intuição subjacente é que cada componente fornece a garantia para outro: um registro mantido por uma parte com interesse em seu conteúdo é lido como auto-atestação, acordo que ninguém registrou é boato, e um árbitro livre de incentivos sobre uma única voz não tem nada para arbitrar. Isso motiva a hipótese de complementaridade. Juntos os três mudam o que o consumidor está confiando: não "esta resposta" ou "esta marca," mas "este processo, e eu poderia verificá-lo."
Tabela 4. A grade de garantia: as oito configurações D–E–N e o que sobrevive em cada
| D | E | N | O que o consumidor pode verificar | Forma degenerada |
| ausente | ausente | ausente | Nada; a confiança é fé nos resultados | Assistente de modelo único nú |
| presente | ausente | ausente | Nada após o fato; desacordo aconteceu despercebido | Comitê invisível (conjunto interno) |
| ausente | presente | ausente | Um registro mantido pela parte que protege | Log de fornecedor / auto-atestação |
| ausente | ausente | presente | Uma afirmação sem interesse com nenhum rastro atrás dela | Intermediário vazio |
| presente | presente | ausente | Desacordo gravado, curado por uma parte interessada | Teatro de benchmark executado por fornecedor |
| presente | ausente | presente | Arbitragem neutra de verificações que ninguém pode repetir | Painel boca a boca |
| ausente | presente | presente | Um registro neutro e repetível de uma única voz não contestada | Monólogo notarizado (auditoria sem desafio) |
| presente | presente | presente | Uma verificação independente, repetível, mantida por uma parte sem interesse | Confiança arquitetônica |
As células são declaradas em limites idealizados; sistemas implantados ocupam o interior. A linha E+N-sem-D é a familiar institucionalmente — limpeza, auditoria e classificações operam lá — e é onde a exigência do framework por um caminho de verificação independente adicionado é uma previsão empírica, não uma exclusão por definição.
Os três componentes se alinham com a anatomia clássica da confiabilidade (Mayer, Davis, & Schoorman, 1995): diversidade é um mecanismo de capacidade (o acordo entre modelos calibra quanta competência inferir), evidência operacionaliza integridade (afirmações sobre o que o serviço fez tornam-se verificáveis em vez de meramente alegadas), e neutralidade aborda a benevolência estruturalmente (os incentivos de um orquestrador desinteressado são inspecionáveis, não acreditados). Cada um é refundamentado em arquitetura verificável em vez de gestão de percepção, o que é o que a literatura de interação humano-IA pede quando chega ao mesmo ponto pelo seu próprio lado: alinhar julgamentos de confiança com sinais verificáveis de confiabilidade, não com as impressões que a interface fabrica (Liao & Sundar, 2022).
A cadeia causal passa pela verificação, porque "confiança" é a consequência e não o mecanismo: verificação → confiança calibrada → confiança justificada → delegação → valor da transação (Figure 10). Um serviço ganha delegação por ser verificável no momento em que importa, não por parecer confiável; Cheng et al. mostrou como esse sentimento é fabricado tão facilmente.
Figura 10. O ciclo de verificação
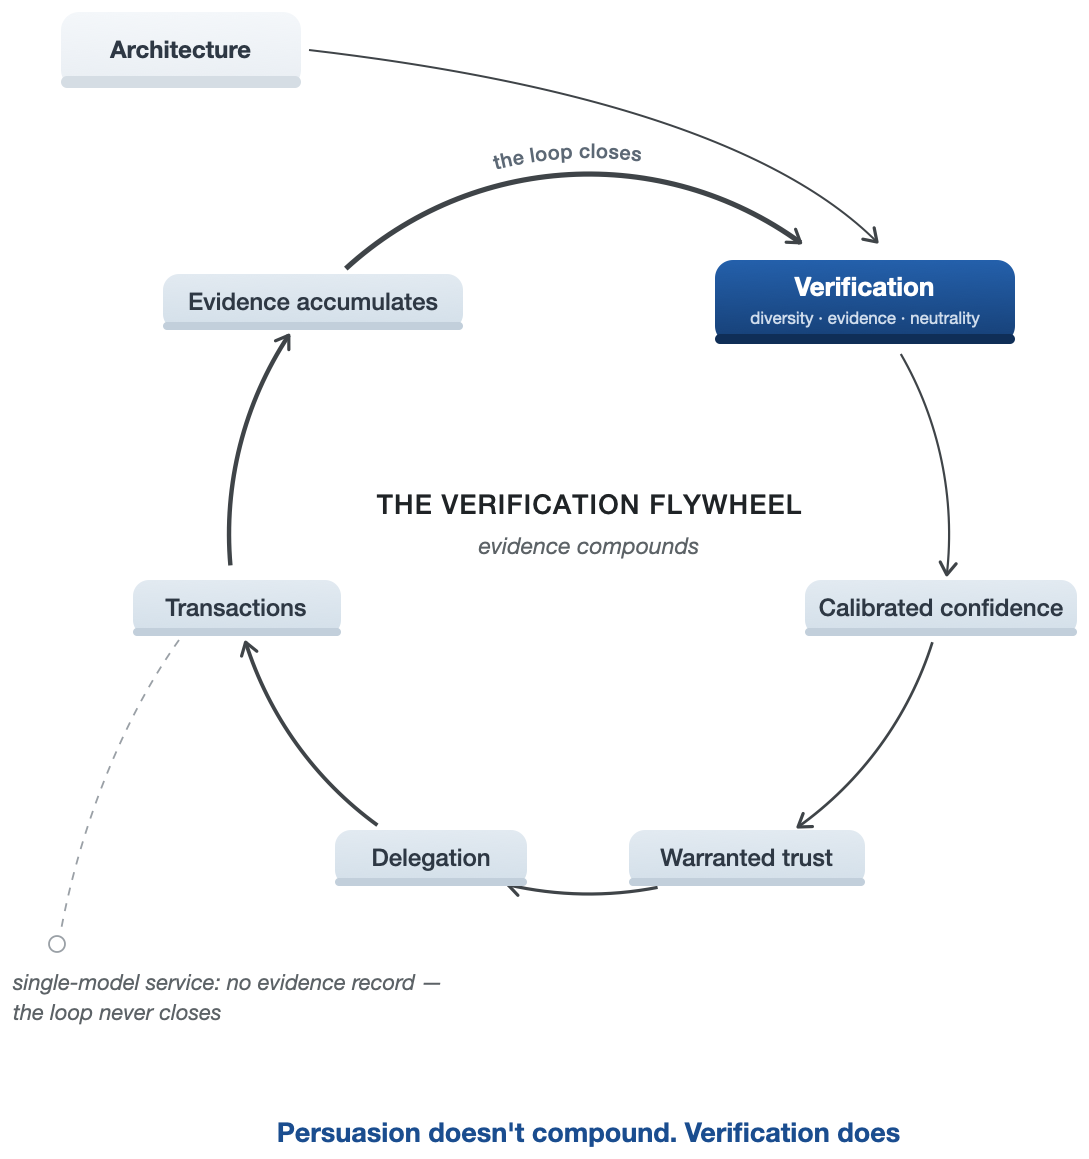
A cadeia causal, verificação (diversidade · evidência · neutralidade) → confiança calibrada → confiança justificada → delegação → transações, não termina: as transações geram evidência, e o ciclo se fecha de volta à arquitetura. A ramificação tracejada mostra o serviço de modelo único, onde nenhum registro de evidência existe e o ciclo nunca se fecha. Persuasão não se acumula. Verificação se acumula.
Tabela 5. Serviço de modelo único versus confiança arquitetural
| Dimensão | Serviço de modelo único | Serviço com confiança arquitetural |
| Objeto de confiança | O modelo / a marca | O processo e seu registro |
| Confiança | Afirmado pelo modelo | Conquistado mediante acordo entre modelos |
| Erros confiantes | Indetectáveis de dentro | Alvo primário de detecção (sinal de desacordo) |
| Adulação | Recompensada pela preferência | Separada: empatia e verificação de política em canais diferentes |
| Verificação de erros | Mesmo sistema que errou | Modelos independentes + portas determinísticas |
| Evidência de decisões | Registros, se houver, mantidos pelo fornecedor | À prova de adulteração, reproduzível, acessível ao consumidor |
| Juiz de qualidade | O próprio fornecedor | Camada de orquestração neutra |
| Posição em caso de disputa | Afirmação do consumidor versus plataforma | Registro reproduzível |
| Seguibilidade | Risco opaco | Precificável a partir do histórico de decisões |
| Alocação de responsabilidade (pós-AB 316) | "A IA fez" é proibido; alocação contestada no escuro | Computável a partir do registro reproduzível |
| Postura regulatória (era do Art. 50) | Divulgações retrofit | Transparência como subproduto da operação |
| Promessas de dados transfronteiriços | Representação contratual | Propriedade auditável de tempo de execução (roteamento ciente de jurisdição) |
| Estrutura de custos | Plana, barata | Graduada: cara apenas onde as consequências se concentram |
Da verificabilidade à resposta do consumidor. O consumidor vê a renderização, não a arquitetura: um recibo mostrando quais sistemas independentes foram consultados, onde divergiram e como a divergência foi resolvida ou escalada (Figure 8). Três percepções mediadoras plausívelmente sustentam o efeito. A evidência é diagnóstica: desacordo específico revelado é informativo sobre esta resposta de uma forma que disclaimers genéricos não são (Detjen et al., 2025; Chen et al., 2026). Um registro reproduzível oferece controle de processo percebido, já que o consumidor poderia verificar, contestar ou escalar após o fato. Garantia processual é o conhecimento de que coleta cega, verificações independentes e um árbitro desinteressado estavam em vigor (McKnight et al., 2002). As variáveis dependentes naturais são calibração de confiança, disposição para delegar e retenção após falha. Os moderadores naturais são stakes e reversibilidade, objetividade da tarefa (Castelo et al., 2019) e expertise do consumidor, já que o consumidor menos capaz de verificar uma resposta pessoalmente tem o máximo a ganhar de uma arquitetura que a verifica estruturalmente. As proposições abaixo traçam este caminho.
O framework produz, além disso, proposições que um estudo de consumidor pode testar, hipóteses em vez de descobertas. Operacionalizá-las depende de uma distinção: neutralidade objetiva (o orquestrador é de fato livre de dependência econômica não divulgada em qualquer fornecedor, comerciante ou resultado), neutralidade verificável (o registro torna aquela independência verificável) e neutralidade percebida (o consumidor acredita nela) são três variáveis, e um experimento manipula o sinal verificável enquanto mede a percepção:
P1. Evidenciar o desacordo entre modelos em consultas consequentes melhora a calibração da confiança dos consumidores (eles confiam mais quando os sistemas concordam, menos quando divergem) em relação a uma resposta única e confiante, com o risco percebido como construto mediador (Featherman & Pavlou, 2003). Ambas as direções de falha estão em jogo: a apresentação conjunta reduz o excesso de confiança, mas pode aumentar a confiança insuficiente (Lu, Wang, & Yin, 2024), a exibição de confiança calibra a confiança mais prontamente do que a precisão (Zhang, Liao, & Bellamy, 2020), explicações podem aumentar a confiança sem aumentar o escrutínio (Bansal et al., 2021), funções de força cognitiva reduzem o excesso de confiança com um custo na satisfação (Buçinca, Malaya, & Gajos, 2021), e uma meta-análise de 106 experimentos constata que combinações humano-IA têm desempenho, em média, pior do que o melhor de humano ou IA sozinho (Vaccaro, Almaatouq, & Malone, 2024). P1 testa calibração, não um ganho monótono: o desacordo evidenciado deve estar na minoria dos designs de combinação que superam seu melhor membro. A proposição é dividida: o efeito principal é a afirmação confirmatória, e os moderadores são exploratórios, derivados da diagnosticidade da evidência em vez de enumerados após os fatos. O ganho de calibração deve aumentar com as apostas e irreversibilidade, e com a objetividade da tarefa (a divergência em uma questão objetiva se lê como um sinal de erro; em uma subjetiva, como gosto; Castelo et al., 2019). Prevê-se que a expertise do consumidor produza sinais opostos: para consumidores de baixa expertise, a divergência evidenciada sem resolução deve diminuir a disposição de delegar, e para consumidores de alta expertise deve melhorar a calibração da confiança; o cruzamento é observado ou não é, o que torna a expertise um teste em vez de uma válvula de escape. O próprio experimento deste artigo impõe um requisito de design. O desacordo covaria com a dificuldade da tarefa (o acordo do painel se concentra em itens fáceis), portanto um design P1 deve manipular ou controlar estatisticamente a dificuldade, ou o efeito de calibração é confundido com a facilidade do item. A explicação baseada em diagnosticidade também produz uma previsão de limite que as teorias genéricas de transparência não fazem: a divulgação de divergência deve importar mais onde os priors próprios do consumidor são mais fracos, em compras transfronteiriças ou de comerciantes desconhecidos, porque lá a evidência diagnóstica externa não tem concorrente interno.
P2. O acesso a um registro de decisão reproduzível aumenta a disposição de delegar tarefas consequentes a um agente de IA, além da confiança na marca, com o efeito aumentando com as apostas e irreversibilidade da tarefa delegada. Também aumenta com o nível da agência delegada em si, que é o conteúdo de estática comparativa da Hipótese de Migração de Confiança: mantendo o desempenho do modelo real constante, o efeito marginal de propriedades arquiteturais verificáveis na delegação apropriada cresce à medida que o consumidor renuncia a mais controle de revisão e execução (advisor → copilot → supervised agent → autonomous agent). Um design que cruza o nível de delegação com a visibilidade da arquitetura testa a hipótese diretamente. A evidência de pesquisa de consumidor mais próxima reside nessa variável dependente: delegar compras a IA reduz a adoção onde restringe a autonomia percebida (Ahmad Husairi & Rossi, 2024), e a aceitação de assistentes de alta autonomia é um resultado estudado diretamente (Frank et al., 2026). P2 prediz o efeito do registro além desses antecedentes estabelecidos.
P3. A neutralidade percebida da camada de orquestração prediz independentemente a disposição de delegação, consistente com efeitos de justiça processual na avaliação de serviço (Tax, Brown, & Chandrashekaran, 1998). A variável manipulada é o sinal de neutralidade verificável; a variável medida é a percepção que ela produz. Pelo meu conhecimento, a neutralidade do orquestrador nunca foi operacionalizada em um experimento comportamental, e os selos de certificação são o análogo testado mais próximo (Cetinkaya & Krämer, 2024), portanto P3 introduz uma nova variável experimental. Direcionalmente, o efeito de neutralidade deve se fortalecer conforme a capacidade própria do consumidor de verificar a substância diminui, pois quando a qualidade do resultado é difícil de avaliar, as pistas de processo carregam o peso avaliativo. A manipulação tem que separar a neutralidade verificável de uma afirmação de neutralidade: uma condição traz um recibo cuja atestação sem risco pode realmente ser aberta e verificada, a condição de contraste uma interface idêntica trazendo apenas o rótulo, com uma verificação de manipulação na neutralidade percebida em ambas. Sem esse contraste, P3 desaba em justiça de processo genérica e não diz nada sobre verificação.
P4. Depois de um erro do agente, consumidores cujo serviço produz um registro inspecionável mostram menor colapso de confiança e maior retenção do que consumidores de um serviço opaco: a dinâmica de um erro único é moderada pela evidência. Este é o mecanismo que a pesquisa de recuperação de serviço identifica, onde o tratamento de reclamações procedimentalmente justo e baseado em evidências restaura a confiança após a falha (Tax, Brown, & Chandrashekaran, 1998). A pesquisa de reparo de confiança acrescenta que o que restaura a confiança depende da natureza da violação e da narrativa oferecida (Kim, Ferrin, Cooper, & Dirks, 2004), um requisito que a pesquisa humano-máquina agora trata como um problema de design para sistemas autônomos (de Visser, Pak, & Shaw, 2018), e o amortecimento deve crescer com a gravidade e irreversibilidade da falha. P4 prediz: registro → menor colapso de confiança e maior retenção, moderado pela gravidade da falha. Casos em que o registro mostra que o próprio processo não foi seguido são tratados por uma verificação de manipulação e excluídos do teste, pois a proposição diz respeito a falhas que ocorrem apesar de um processo seguido. As comparações de durabilidade devem controlar os custos de troca e lock-in, que confundem a retenção, e um design complementar testa se um registro de processo seguido desloca a atribuição de culpa do serviço para o ambiente. A proposição não carrega cláusula de reversão, portanto nenhum padrão de resultado é infalsificável por construção.
Âncora empírica: a camada de confiança como componente testado. Se um serviço afirma que seus sinais de confiança significam algo, essa afirmação pode ser colocada à prova. A camada de confiança na implementação por trás do estudo de caso deste artigo passou por uma avaliação pré-registrada, controlada por placebo, de seis braços em duas famílias de modelos independentes. Um perfil medido das próprias fraquezas do sistema melhorou sua previsão de erro, um ganho AUROC de aproximadamente +0,07 sobre placebo, com intervalos de confiança não sobrepostos em ambas as famílias. Um perfil próprio falso desabou a previsão de erro para um lançamento de moeda, e uma instrução genérica "esteja ciente de seus limites" não fez nada.
Duas versões anteriores falharam, uma falsificada por seus próprios autores por um confundidor, uma negativa, antes que o design pré-registrado confirmasse. Um reteste mais rigoroso foi inconclusivo em escopo reduzido, e uma escada pré-registrada de quatro degraus em uma família de fronteira não passou em nenhum desfecho confirmatório, a direção do efeito sobrevivendo apenas exploratoriamente em três de quatro degraus. A alegação é, portanto, por-família e limitada: o conhecimento de si medido melhorou a predição de erros onde confirmado, e não é uma propriedade estabelecida de cada classe de modelo. O perfil de fraqueza funciona em produção também, onde ajusta o roteamento de modelo ao vivo, limitado e fail-open. O colapso do perfil falso funciona também como uma descoberta de segurança: um auto-modelo fabricado é um vetor de ataque, uma razão a mais para que o conhecimento de si necessite custódia arquitetônica em vez de auto-relato do modelo. A lógica de design tem um pedigree de pesquisa do consumidor anterior à tecnologia. Pré-compromisso, vinculando comportamento futuro através de estrutura externa porque a resolução interna não é esperada que resista, é exatamente como os consumidores racionam seus próprios vícios (Wertenbroch, 1998), e confiança arquitetônica estende o mesmo movimento para máquinas.
O arco completo (protocolos, pré-registros, dados brutos, o piloto falsificado, a iteração negativa, as extensões não-confirmatórias) é preservado como um arquivo autossuficiente, publicamente disponível com os materiais OSF do artigo em https://osf.io/jtvu9/ (arquivo `self-calibration-archive.zip`). Confiança calibrada é um componente arquitetônico com conteúdo mensurável, e pode falhar. As falhas são arquivadas com os sucessos porque uma camada de confiança cujas alegações de confiança nunca foram desafiadas experimentalmente está pedindo exatamente a confiança cega que deveria substituir. Um artigo de posição de trinta autores dá a esta divisão de trabalho uma declaração formal: a orquestração agêntica deveria ser Bayes-consistente (Papamarkou et al., 2026), e crenças calibradas pertencem à camada de controle, não aos modelos.
Testando o mecanismo: um experimento pré-registrado. As alegações acima são testáveis, e esta seção relata os testes. Cada resultado experimental nesta seção, em ambas as ondas, aborda um antecedente técnico do framework: se a concordância independente carrega um sinal de correção que o auto-relato de um modelo não possui, em questões factuais. Estes experimentos não demonstram confiança do consumidor, delegação, ou comportamento comercial, que permanecem o domínio de P1–P5 e o estudo comportamental da Seção 6. O protocolo foi congelado publicamente antes que qualquer dado confirmatório existisse (OSF: https://osf.io/4y9dv, registrado 23 de julho de 2026; hipóteses H1–H6, subamostra de benchmark fixada por seed e hash SHA-256, resultados desfavoráveis à hipótese foram pré-declarados). O design é deliberadamente simples. Dezesseis modelos, nove fornecedores fronteiriços (Anthropic, OpenAI, Google, xAI, DeepSeek, Alibaba, Moonshot, Zhipu, Mistral) e sete modelos locais de pesos abertos, cada um respondeu as mesmas 1.500 questões do SimpleQA uma vez, às cegas, sem recuperação ou ferramentas. Este é o regime que maximiza a exposição ao erro paramétrico correlacionado, um caso deliberadamente difícil para o sinal, ao custo ecológico declarado nas limitações. Respostas foram dadas a temperatura zero, declarando uma confiança de 0–100: incerteza verbalizada, eliciada em palavras dentro da mesma resposta em vez de extraída de logits, o formato que Lin, Hilton, e Evans (2022) mostraram que os modelos podem aprender a calibrar. Painéis são combinações analíticas dessa única coleção de 24.000 slots de resposta nominais, dos quais 22.598 foram entregues, um modelo local (deepseek-r1:8b) tendo parado em 98 itens sob uma regra de parada pré-comprometida. As seis hipóteses registradas correspondem aos resultados da seguinte forma. H1, que divergência entre modelos marca a maioria dos erros confiantes, é suportada: concordância eleva a correção 1.9–3.2× na onda registrada (Tabela 6), e na onda principal o portão congelado remove 82.1% das falhas confiantes (Tabela 10). H2, que o sinal do painel supera a confiança própria do modelo respondente, se sustenta nos painéis CN-fronteiriço e entre-blocos (ΔAUROC +0.287 e +0.063) e se reverte no painel US-fronteiriço. H3, que uma parcela não-trivial de erros confiantes sobrevive como concordância unânime em uma resposta errada, é suportada: 0.5–2.2% das questões de resposta aberta e 4.0–7.9% no braço de múltipla escolha. H4(a), que a correlação de erro intra-bloco excede entre-blocos, não é suportada (diferença φ +0.011, IC 95% −0.005 a +0.028), e H4(b), que um painel entre-blocos captura mais, também não é suportado, sendo a vantagem entre-blocos a menor. H5, que um painel local de custo zero marca a maioria dos erros confiantes fronteiriços, não é suportada: o sinal de concordância do nível local situa-se no acaso. H6, a escada de distância de linhagem, não é testada como escada aqui; seu degrau ao nível de bloco é o nulo de H4(a).
Verificação factual é um proxy relevante para comércio agêntico porque uma compra delegada se decompõe, no momento da execução, em sub-alegações factuais: o preço atual e disponibilidade do item, os termos da política de devolução, se as especificações do produto correspondem aos requisitos declarados do consumidor, a identidade e classificação do vendedor. Cada uma destas tem uma verdade fundamentada verificável do mesmo tipo que um item SimpleQA tem. O portão de discordância opera nesse substrato factual, enquanto a ponderação de preferência (quais trade-offs importam, e quanto) permanece com o consumidor, que redigiu os requisitos contra os quais os fatos são verificados. Essa divisão de trabalho também é o motivo pelo qual o design da Seção 6 manipula a exibição de verificação em vez das preferências dos participantes: a alegação da arquitetura diz respeito à camada factual de uma decisão delegada, não sua camada de gosto. Onde um julgamento não tem nenhum substrato factual, em escolhas genuinamente subjetivas sem verdade fundamentada para verificar, o antecedente cessa de ser relevante, e a seção de Limitações declara essa fronteira como uma questão aberta.
A escolha do benchmark foi medida. No TruthfulQA de 2021 (presente nos corpora de pré-treinamento), os mesmos fornecedores obtiveram 47–61 pontos percentuais mais altos do que no SimpleQA (p. ex., 89% vs 28%), uma diferença consistente com efeitos de idade do benchmark e exposição, embora este desenho não possa separar contaminação de diferenças em dificuldade e construção do benchmark. Portanto, nenhum número principal repousa sobre o benchmark mais antigo. A avaliação é baseada em correspondência objetiva de strings, com casos não resolvidos julgados quanto à equivalência com o ouro apenas por um modelo de pesos abertos local (Qwen3-8B, executado localmente; prompt de equivalência apenas no pacote de replicação; nunca por familiares de nenhum membro do painel; desconhece-se se SimpleQA aparece no corpus de treinamento do avaliador, mas o avaliador determina equivalência entre duas strings fornecidas, não a verdade, o que limita a exposição) e uma verificação manual de 50 itens (98% de concordância), uma limitação de escala. Isto é agora estendido por uma auditoria estratificada de 300 itens entre famílias de casos resolvidos pelo avaliador (uma família de modelo diferente como auditor, amostra fixada por seed): 96% de concordância (288/300), todos os doze desacordos são falsos positivos permissivos (nove claros, três limítrofes), um viés unidirecional afetando aproximadamente 3% de todas as respostas avaliadas (4% da parcela resolvida pelo avaliador). Dois terços dos vereditos (66,5%) vieram do avaliador de modelo local em vez de correspondência exata de strings, e o título principal é robusto a erros do avaliador: invertendo aleatoriamente 10% dos vereditos avaliados pelo modelo, deslocam-se as razões de certificação em no máximo ±0,5× e nunca muda sua direção.
Duas escolhas de desenho são deliberadas em vez de orçamentárias. Os níveis intermediários dos fornecedores foram usados, primeiro, para validade ecológica: os agentes que agora realizam transações em nome dos consumidores executam de forma esmagadora nestes níveis otimizados para custo, verificáveis a partir de listas de preços públicas (meados de 2026; Figura 11). Uma troca de serviço típica custa uma fração de centavo a cerca de um centavo nos níveis de orçamento, contra cinco a dez centavos nos pesos de referência, e nenhum serviço que atende a milhões de sessões cobra a taxa de referência em seu caminho padrão. O elenco reflete o mercado: o painel de nove fornecedores contém todos os três fornecedores que juntos representam 88% dos gastos com API LLM empresarial, e o painel de fronteira dos EUA da Tabela 6 é exatamente esse trio. A objeção de que se trata de evidência empresarial, sem o consumidor em lugar nenhum, inverte o entendimento da cadeia de suprimentos. O consumidor não escolhe mais um modelo: escolhe um banco, um varejista, uma companhia aérea, e a política de roteamento do serviço escolhe o modelo. Na moeda em que os consumidores são realmente atendidos, tokens em vez de dólares, a imagem confirma a escolha (Figura 12): no estudo OpenRouter–a16z de 100 trilhões de tokens de tráfego roteado, modelos de pesos abertos atingiram aproximadamente um terço de todo o uso (Aubakirova et al., 2026), os níveis padrão dos três maiores produtos de IA para consumidores ficam todos abaixo do nível de referência, e apenas cerca de 3% dos usuários de IA para consumidores pagam pelo serviço premium (Menlo Ventures, 2025c), então o consumidor marginal deve ser atendido com custo marginal próximo a zero. Abaixo do mercado de API fica um piso de pesos abertos em dispositivo e auto-hospedados, invisível para pesquisas baseadas em gastos, e o nível local do experimento de sete modelos de pesos abertos o amostra deliberadamente. Em todas as moedas em que o mercado pode ser contado, os níveis que este estudo amostrou são aqueles que servem o consumidor. (Após uma indisponibilidade de primeira parte, parte da coleta foi concluída através de um agregador, com a infraestrutura real de serviço registrada por chamada no manifesto de execução.)
Figura 11. O nível que os consumidores encontram no checkout
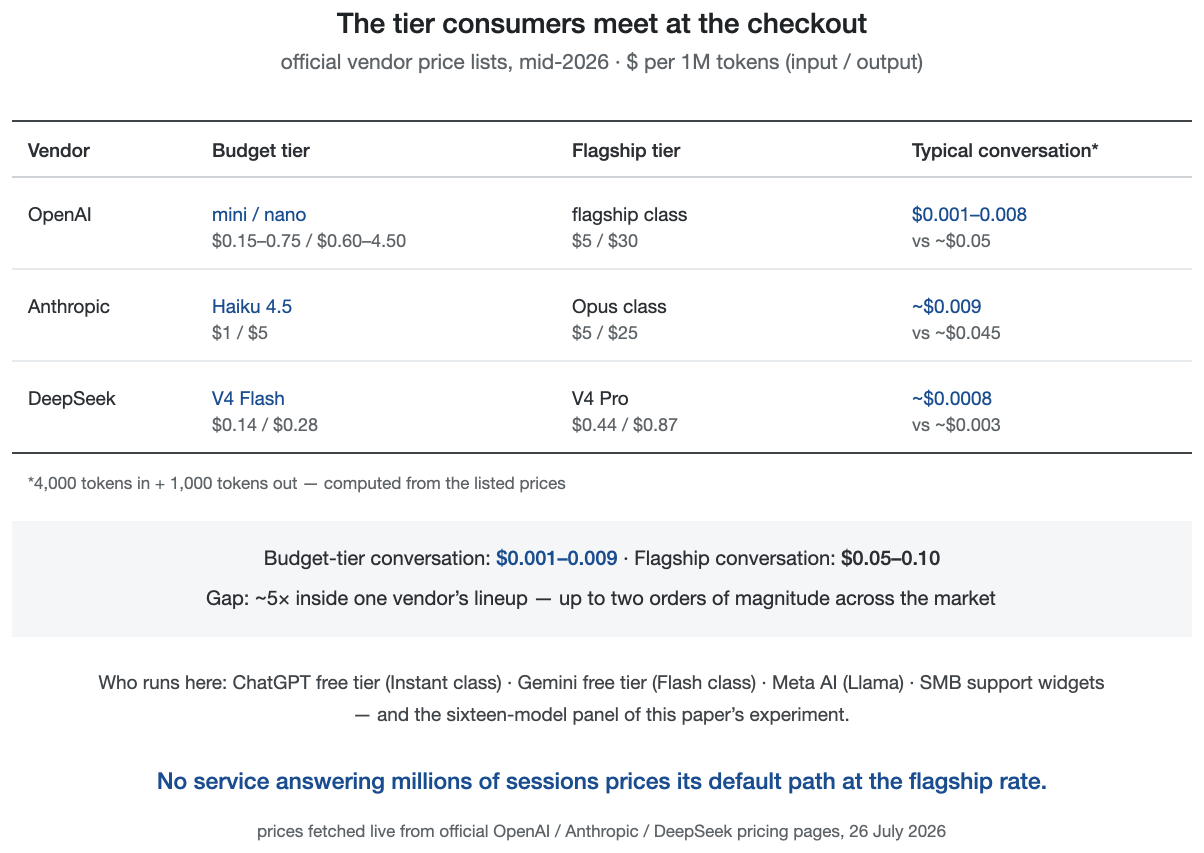
Listas de preços oficiais dos fornecedores, meados de 2026.
Figura 12. Duas moedas do mercado de modelos
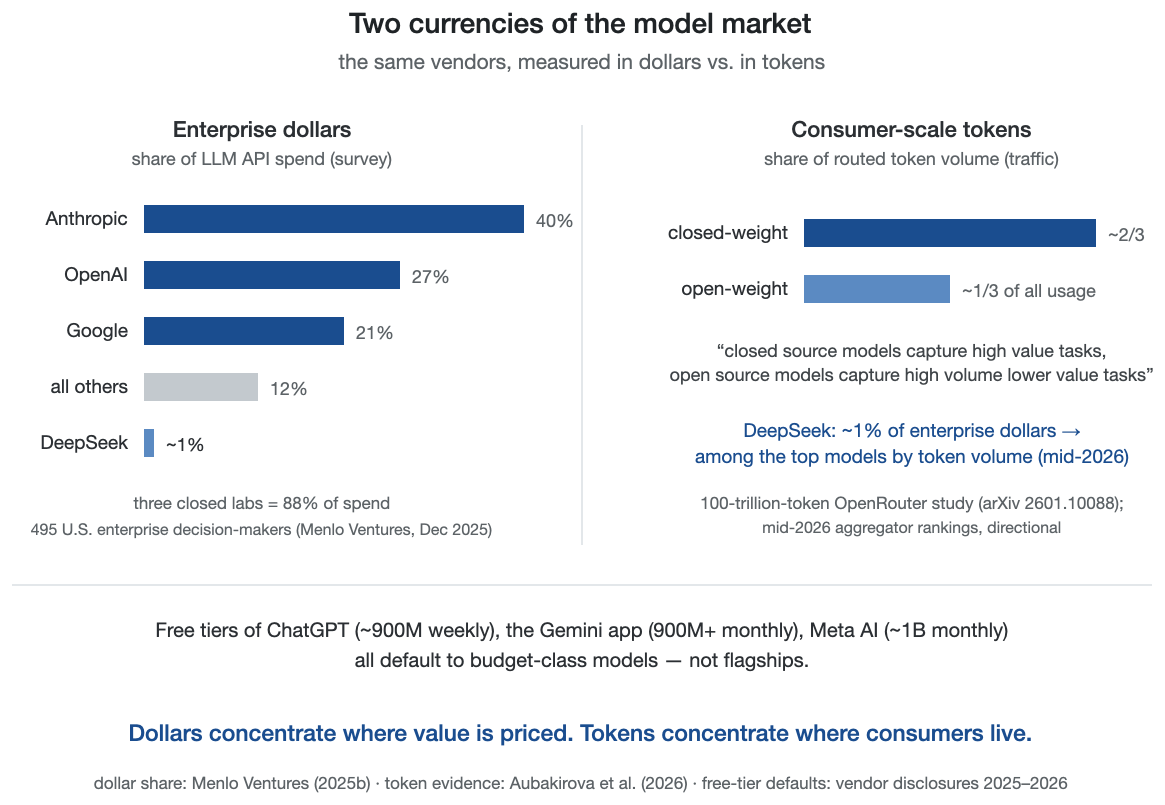
Dólares empresariais vs. tokens em escala de consumidor.
Os níveis intermediários também se adequaram aos argumentos do artigo, que dizem respeito à arquitetura, não à capacidade de referência: um efeito que só aparecia com pesos premium seria um resultado do modelo. O pipeline se replica em infraestrutura comum por menos de $15 de gastos com API. Para um artigo argumentando que a verificação deve ser barata o suficiente para ser executada em cada resposta consequente, o custo de verificação do próprio artigo é parte da evidência. O pipeline é um pacote de replicação autossuficiente (runners, avaliador, scripts de análise, dados avaliados brutos e manifesto de execução) que não requer nada do sistema de pesquisa do autor. A coleção totaliza 24.000 respostas, aproximadamente 30.000 incluindo os braços de contaminação de benchmark e conformidade. Quanto à disponibilidade: o pré-registro público (osf.io/4y9dv) arquiva a subamostra de 1.500 itens fixada por seed. O pacote completo está disponível publicamente em https://osf.io/jtvu9/, um componente público do projeto de origem do registro (pasta `replication-package-v2`).
Três resultados sustentam a seção. Primeiro, a matéria-prima é abundante: a confiança declarada mediana foi de 85–95 em sete dos nove fornecedores de fronteira, com as duas exceções (medianas 42 e 60) sendo exatamente os fornecedores cuja confiança discrimina, enquanto a precisão real variou de 10% a 66%, produzindo 289–1.212 erros confiantes (incorretos com confiança ≥ 75) por fornecedor de fronteira em 1.500 perguntas. Como um sinal de correção, a confiança própria de um modelo alcançou AUROC 0,53–0,79 dependendo do fornecedor, e um consumidor não tem forma de saber, de fora, qual fornecedor obteve. Essa distribuição de fornecedores qualifica, no nível do qual os consumidores são realmente atendidos, a descoberta do laboratório de fronteira de que grandes modelos são frequentemente bem calibrados em auto-avaliação em formatos controlados (Kadavath et al., 2022): alguns fornecedores implantados enviam esse auto-conhecimento, outros enviam ruído confiante, e nada na superfície os distingue.
Em segundo lugar, a manchete: a verificação funciona como certificação, não como alarme. Certificação em sentido probabilístico, uma posteriori de aproximadamente 49–77% dependendo do painel, não uma garantia. Em questões tão difíceis, o sinal ingênuo "algum painalista discorda" satura: dispara em 85–94% dos erros confiantes, mas também em 91–95% das respostas corretas confiantes (o registro antecipou essa reformulação, passando para o ponto final AUROC pré-especificado). A direção informativa é a oposta: respostas corretas são independentemente replicadas, respostas erradas se dispersam. Uma resposta que pelo menos um painalista independente reproduziu era correta 72–77% do tempo nos painéis intra-bloco e 49% no painel entre-bloco, em comparação com 18–37% sem replicação. Uma resposta com concordância independente tinha aproximadamente duas a três vezes mais probabilidade de estar correta (1.9–3.2× nos três painéis da Tabela 6). (Aqui e em toda parte, "independente" significa produzido cegamente e separadamente, com correlação de erro residual medida em vez de presumida, e correção é sempre avaliada em relação aos rótulos ouro do benchmark, nunca pela opinião de outro modelo.) O estimando é associacional, não causal: a replicação marca respostas mais prováveis de estar corretas, e parte do que marca é que a questão era fácil, um efeito de seleção quantificado abaixo. Como sinal de correção, a concordância do painel atingiu AUROC 0.832 no painel cuja confiança própria dos membros carregava o menor sinal (por fornecedor 0.53–0.62; agrupado 0.545). A alegação que se sustenta é distribucional em vez de particularizada: em todos os 84 painéis de três fornecedores, o AUROC de concordância tem mediana 0.79 e excede o auto-relato agrupado em 89%. A concordância atingiu 0.722 no painel entre-bloco em comparação com confiança própria agrupada de 0.659 (agrupar escalas verbais não padronizadas entre fornecedores distorce o auto-relato, porque fornecedores usam a escala 0–100 diferentemente e a direção do artefato é dependente do painel, razão pela qual os valores por fornecedor são impressos ao lado). Essa instância entre-bloco dessa vantagem é dependente de codificação (codificações alternativas de concordância pré-congeladas colocam o sinal de concordância do painel entre-bloco em 0.544–0.722, a variante generosa não resolvida como concordância caindo abaixo da confiança própria agrupada daquele painel de 0.659, enquanto o sinal do painel CN abrange 0.719–0.894 nas mesmas codificações, sempre acima de 0.545), portanto o resultado de painel sobre self, robusto em relação à codificação, é o caso CN intra-bloco. O único painel onde o auto-relato claramente superou o sinal do painel (0.842 vs 0.697) foi aquele contendo o fornecedor mais discriminador do estudo (camada intermediária da Anthropic, AUROC de confiança própria 0.788 na coleção completa de 1.500 itens), o sinal próprio do fornecedor bem classificado superando sozinho o sinal de concordância do seu próprio painel. A Tabela 7 imprime valores por painel, computados dentro da população de itens de cada painel. Um bootstrap de aglomerado pareado (questões reamostradas com substituição, todas as três unidades (item, primário) por questão se movendo juntas; B = 2.000) coloca intervalos de confiança nos contrastes da Tabela 6/7. No painel CN-fronteira, a concordância do painel supera a confiança própria agrupada por ΔAUROC = +0.287 (IC 95% [+0.265; +0.308], p < .001). No painel entre-bloco, a vantagem é menor mas confiável, +0.063 ([+0.037; +0.087], p < .001). No painel US-fronteira, a direção se inverte e a inversão é em si estatisticamente inequívoca: confiança própria 0.842 versus concordância do painel 0.697. A composição do painel é, portanto, um moderador de primeira ordem do valor do sinal, e a regra de implantação segue: meça a calibração própria dos membros do painel antes de confiar na concordância sobre ela, ΔAUROC = −0.145 ([−0.170; −0.120], p < .001). Todos os três contrastes são significativos, e a heterogeneidade entre painéis é uma descoberta, não ruído. O caso US é, portanto, relatado como uma inversão confirmada, não uma zona nula, e delimita a construção: em um painel extraído da extremidade discriminadora do mercado, a confiança própria supera a concordância como sinal de classificação, portanto o valor de discriminação do componente Diversidade depende da composição do painel em vez de se manter universalmente. A arquitetura pode fornecer um sinal de correção externo onde a confiança do modelo exposta discrimina fracamente, e audita a alegação de calibração onde uma é feita. Uma fronteira permanece: mesmo um modelo perfeitamente calibrado não pode autenticar sua própria história ou arbitrar seu próprio conflito de interesses, portanto, conforme a discriminação do fornecedor melhora, o papel da diversidade muda de descoberta de correção para auditoria de calibração, enquanto evidência e neutralidade fazem trabalho que nenhuma quantidade de calibração pode.
A verificação arquitetônica fornece um sinal de correção externo onde um fornecedor falhou em fornecer um sinal de confiança utilizável, e identificar qual fornecedor forneceu um requer a arquitetura de qualquer forma. A alegação de substituição, exatamente delimitada, repousa sobre as métricas de calibração em vez de AUROC. Nenhum fornecedor na onda de julho é simultaneamente discriminador e bem calibrado; xAI se aproxima mais (Tabela 7a), e a onda emblemática reproduz o lado de calibração da dissociação, portanto até o consumidor que por acaso recebe a confiança melhor classificada não pode converter seu nível em uma probabilidade sem uma referência externa. É isto que a camada arquitetônica fornece. Caso os fornecedores eventualmente forneçam boa calibração em todos os lugares, evidência e neutralidade não são tocadas. O argumento sobrevive ao mundo em que modelos melhoram.
Em terceiro lugar, o modo de falha tem uma forma: erros de consenso certificado, cada painalista convergindo confiadamente na mesma resposta errada, ocorreram em 0.5–2.2% das questões de forma aberta, mas em 4.0–7.9% em um braço complementar que reapresentou itens em formato de múltipla escolha no nível local (construção de itens e saídas no pacote de replicação). O consenso certifica erro principalmente onde o espaço de resposta é restringido, um aviso de design para qualquer interface que oferece aos agentes um menu de opções.
Os nulos são tão instrutivos quanto os positivos, e os publico como pré-registrados. Bloco geopolítico (incluindo a possibilidade de que painéis do mesmo bloco compartilhem corpora de treinamento e linhagens de destilação) não prediz correlação de erros neste benchmark (diferença intra- vs entre-bloco φ +0,011 na camada frontier, IC 95% −0,005 a +0,028; ligeiramente revertido na camada local). A capacidade impulsiona a correlação, não o sinalizador, ecoando Kim et al. (2025). A linhagem não prediz taxas de captura: um modelo local verificando seu próprio irmão frontier funciona como qualquer estranho, e um modelo destilado por raciocínio provou ser o menos correlacionado em erro com seus próprios pesos de base (φ = 0,135). Ambos são nulos limitados e não equivalência demonstrada. O intervalo de bloco exclui diferenças φ maiores que +0,028, e esse limite, não a falha em rejeitar, faz o trabalho inferencial. A extensão contínua natural, que os dados de replicação suportam, é estimar a elevação de certificação como uma função da diversidade de painel medida (a φ de surpresa) em vez da identidade do painel. Isso reexecutaria, para painéis de modelo, o programa que a literatura de ensemble de classificadores executou para suas próprias estatísticas de diversidade, que descobriu que nenhuma medida única prediz claramente os ganhos de ensemble (Kuncheva & Whitaker, 2003).
E modelos locais baratos não conseguiam certificar respostas frontier em questões de formato aberto (precisão de 46% com ou sem seu acordo): um verificador deve ser competente na classe de tarefa antes que sua independência valha algo. As condições de limite são estas: consenso certifica erro onde espaços de resposta são restritos, independência deve ser medida em vez de assumida, competência do verificador controla o valor da certificação. Na prática, diversidade é uma propriedade a ser medida, questão por questão, não assumida de marcas, blocos ou árvores genealógicas. A Tabela 6 resume as métricas do painel. A Figura 13 mostra a elevação de certificação e a comparação de sinal lado a lado.
Figura 13. A ilusão de precisão e sua cura arquitetônica
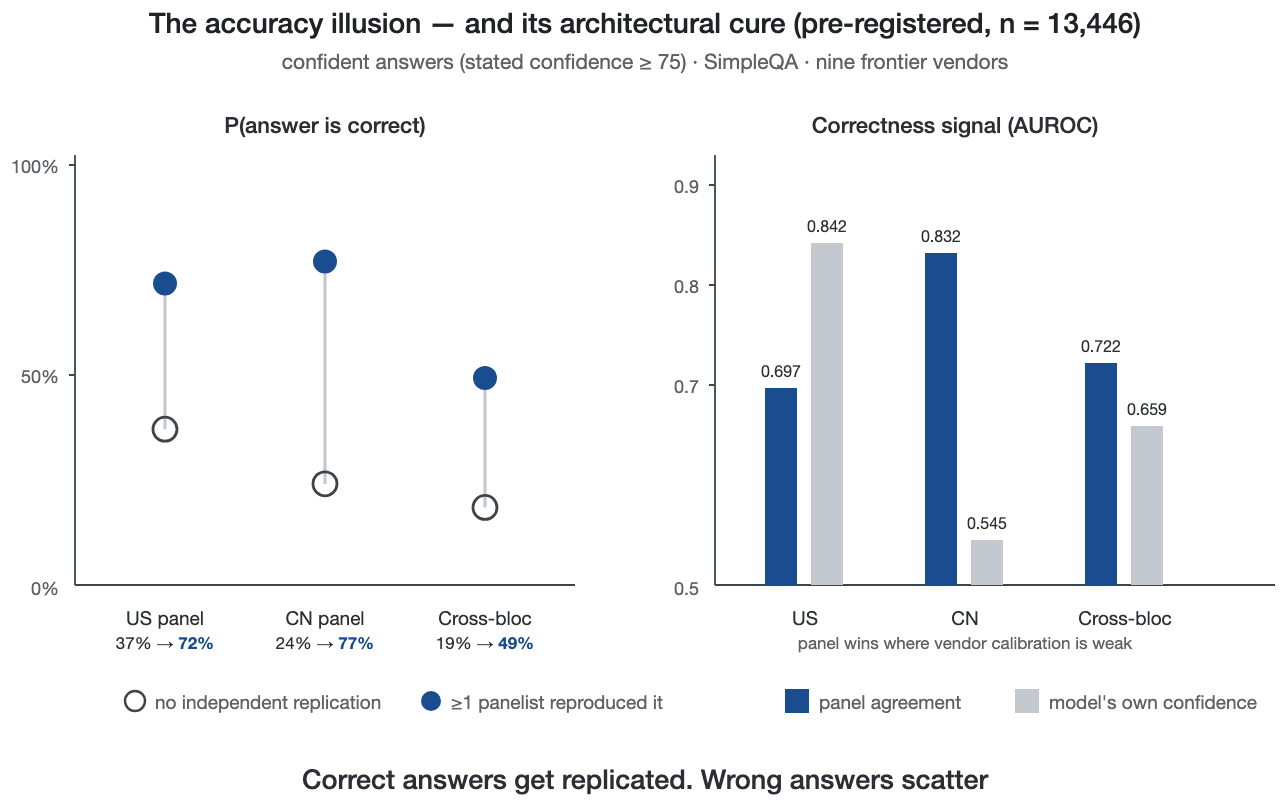
Certificação por replicação independente (pré-registrada; n = 13.446 respostas classificadas — nove fornecedores frontier, cada um respondendo as mesmas 1.500 questões SimpleQA uma vez, menos 54 chamadas com falha ou não classificáveis).
Trabalho concorrente reforça a cautela: uma auditoria em grande escala descobriu alta auto-consistência coocorrendo com respostas incorretas em benchmarks de raciocínio, onde concordância sozinha, sem independência e coleta cega, é um sinal fraco e dependente do regime (Ding, 2026). Portanto, trato replicação independente, cega como a unidade de certificação.
Tabela 6. Interceptação de erro confiante e certificação por painel (SimpleQA, confirmatório; conf ≥ 75)
| Painel | Erros confiantes (n) | Taxa de sinalização em erros [IC 95%] | Alarmes falsos em correto | P(correto | ≥1 concorda) | P(correto | nenhum) | AUROC: concordância vs confiança própria |
| US-frontier (Anthropic·OpenAI·Google) | 1.630 | 94,3% [93,1–95,3] | 91,0% | 71,8% | 37,1% | 0,697 vs 0,842 |
| CN-frontier (DeepSeek·Alibaba·Moonshot) | 2.128 | 85,5% [83,9–86,9] | 94,8% | 77,0% | 24,1% | 0,832 vs 0,545 |
| Cross-bloc (Anthropic·DeepSeek·Mistral) | 2.432 | 89,4% [88,1–90,6] | 93,4% | 49,3% | 18,5% | 0,722 vs 0,659 |
Sinal = resposta independente de ≥1 painel não equivalente ao primário (recusas e respostas com sobreposição zero contam como não-concordância; uma codificação mais rigorosa está no pacote de replicação). Sensibilidade de limite em 60/90 não muda conclusão alguma. AUROC de confiança própria é a confiança declarada agrupada sobre a população de resposta completa do painel; agrupamento absorve diferenças entre fornecedores em escala de precisão e confiança, para que possa exceder o valor individual de cada membro (valores por fornecedor na Tabela 7). Respostas agrupam-se por questão; um bootstrap de cluster em nível de questão amplia os intervalos por aproximadamente um fator de 1,6 sem mudar conclusão alguma. Cada AUROC nesta tabela e na Tabela 7 reproduz-se deterministicamente, com um comando e sem aleatoriedade, a partir do script do pacote de replicação compute_panel_vs_own_auroc.py (Mann–Whitney com correção de empate).
Tabela 7. AUROC de confiança própria por painel: população de painel agrupada e por fornecedor (mesmas populações da Tabela 6)
| Painel | AUROC de confiança própria agrupada | AUROC de confiança própria por fornecedor |
| US-frontier | 0,842 | Anthropic 0,784 · OpenAI 0,596 · Google 0,746 |
| CN-frontier | 0,545 | DeepSeek 0,569 · Alibaba 0,532 · Moonshot 0,620 |
| Cross-bloc | 0,659 | Anthropic 0,787 · DeepSeek 0,570 · Mistral 0,584 |
Calculado pelo pipeline determinístico no pacote de replicação. Duas convenções de população coexistem e são impressas explicitamente para evitar inconsistência aparente: os valores por fornecedor da tabela são computados dentro de cada população de itens do painel, enquanto citações de número único no texto usam o valor da coleção completa — para o fornecedor com melhor discriminação 0.784 dentro do painel US-fronteira versus 0.788 na coleção completa de 1.500 itens, e para OpenAI 0.596 versus 0.598 (ambos os pares são reproduzidos a partir de um comando do mesmo pipeline). A coluna agrupada, em contraste, mistura as taxas base do fornecedor — diferenças entre fornecedores em precisão e escala de confiança fazem parte do trabalho, assim o valor agrupado não precisa estar dentro do intervalo por fornecedor (recomputado ao vivo: o agrupado US-fronteira 0.842 excede o valor individual de cada membro, e o agrupado CN-fronteira 0.545 fica abaixo da macro-média por fornecedor de 0.574 deste painel); os valores por fornecedor são as quantidades interpretáveis. A dispersão por fornecedor é o problema do consumidor expresso numericamente: a discriminação utilizável existe em um fornecedor e está próxima do acaso em outros, e nada fora de uma resposta diz qual fornecedor a produziu. Valores de origem por trás dos intervalos de fornecedor da Seção 3, impressos por modelo da mesma coleção classificada (confiança declarada mediana · precisão · AUROC de confiança própria da coleção completa): fronteira — Alibaba 95 · 47.4% · 0.532; Anthropic 42 · 10.3% · 0.788; DeepSeek 90 · 35.7% · 0.570; Google 95 · 66.5% · 0.746; Mistral 90 · 16.5% · 0.584; Moonshot 85 · 51.6% · 0.619; OpenAI 85 · 16.7% · 0.598; xAI 60 · 37.9% · 0.777; Zhipu 95 · 28.4% · 0.611 — as duas medianas abaixo da faixa 85–95 pertencem aos dois fornecedores cuja confiança carrega sinal utilizável; nível local (entra apenas na estratificação de dificuldade e nos nulos de nível local) — gemma4:e4b 90 · 5.2% · 0.541; glm4:9b 85 · 5.0% · 0.589; llama3.2:3b 100 · 5.3% · 0.494; mistral:7b 95 · 6.3% · 0.506; phi4-mini 95 · 5.5% · 0.505; qwen3:8b 95 · 5.9% · 0.504; deepseek-r1:8b 90 · 9.2% · 0.696 (n = 98, regra de parada pré-comprometida).
AUROC mede discriminação, se a confiança declarada de um fornecedor ordena suas respostas corretas acima das incorretas, enquanto ECE, a pontuação de Brier, e a diferença confiança–precisão medem calibração, se o número declarado pode ser lido como uma probabilidade, e nestes dados os dois se dissociam acentuadamente. O fornecedor de melhor discriminação do estudo em julho, o nível médio da Anthropic (AUROC de confiança própria de 0.788), ainda assim é gravemente mal-calibrado em nível: confiança média declarada 41.3 (mediana 42) versus 10.3% de precisão, um intervalo de confiança excessiva de +31.0 pontos, ECE 0.311 (15 faixas), Brier 0.206 com um termo de confiabilidade de 0.126 contra um piso de incerteza irredutível de 0.093. Inversamente, a pior calibração no painel co-ocorre com discriminação próxima ao acaso (Mistral: intervalo +74.2 pontos, ECE 0.742, AUROC 0.584), e apenas xAI se aproxima de ambas discriminação e calibração (ECE 0.111, AUROC 0.777). Mesmo lá a discriminação é ajudada por confiança declarada uniformemente baixa, enquanto para os outros oito fornecedores de julho as duas propriedades se dissociam acentuadamente. A mesma dissociação persiste no nível de ponta: nove de onze modelos de ponta de agosto carregam intervalos de confiança excessiva de +12.5 a +71.4 pontos (ECE 0.125–0.714), enquanto as duas exceções (gpt-5.6-sol, ECE 0.031; claude-fable-5, ECE 0.043) alcançam calibração em extremos opostos da escala de precisão. Um consumidor que detém uma pontuação de confiança bem-classificada mas numericamente inflada não pode usá-la sem uma referência externa. A Tabela 7a apresenta as métricas de calibração ao lado das métricas de discriminação.
Tabela 7a. Discriminação vs calibração, onda de julho (coleção completa, resolvida; ECE com 15 faixas; intervalo = confiança declarada média − precisão, pontos percentuais)
| Fornecedor | n | AUROC (conf própria) | ECE | Brier | Intervalo conf − prec | Conf média → precisão |
| Alibaba | 1,497 | 0.532 | 0.448 | 0.446 | +44.8 pp | 92.3 → 47.4% |
| Anthropic | 1,500 | 0.788 | 0.311 | 0.206 | +31.0 pp | 41.3 → 10.3% |
| DeepSeek | 1,500 | 0.570 | 0.536 | 0.513 | +53.4 pp | 89.1 → 35.7% |
| 1,461 | 0.746 | 0.263 | 0.271 | +26.3 pp | 92.8 → 66.5% | |
| Mistral | 1,495 | 0.584 | 0.742 | 0.686 | +74.2 pp | 90.6 → 16.5% |
| Moonshot | 1,500 | 0.619 | 0.242 | 0.292 | +24.2 pp | 75.8 → 51.6% |
| OpenAI | 1,500 | 0.598 | 0.610 | 0.531 | +60.9 pp | 77.6 → 16.7% |
| xAI | 1,500 | 0.777 | 0.111 | 0.197 | +11.1 pp | 48.9 → 37.9% |
| Zhipu | 1,493 | 0.611 | 0.642 | 0.612 | +64.2 pp | 92.6 → 28.4% |
| painel US-fronteira, unidades agrupadas | 4,383 | 0.842 | 0.393 | 0.336 | +39.3 pp | — |
| painel CN-fronteira, unidades agrupadas | 4,491 | 0.545 | 0.408 | 0.417 | +40.8 pp | — |
| painel transbloco, unidades agrupadas | 4,485 | 0.659 | 0.529 | 0.469 | +52.9 pp | — |
Mesmas populações que a AUROC de coleção completa e Tabelas 6–7 (linhas de painel: unidades agrupadas (item, primária)); recusas pontuadas como erradas sob o protocolo congelado. Brier se decompõe pela identidade de Murphy (confiabilidade − resolução + incerteza) nas mesmas 15 faixas, resíduo < 0.001 em cada linha. Uma nota de nível de ponta acompanha as duas exceções calibradas: ECE de 0.031 de gpt-5.6-sol é alcançada em 95.4% de precisão, onde o termo de incerteza de Murphy, o piso que a taxa base define, é 0.044 — calibração parcialmente comprada por uma taxa base que carrega a ressalva de contaminação da Tabela 9 (61.6% de correspondências verbatim com a string de ouro).
Um efeito de seleção deve acompanhar a tabela: a replicação é parcialmente um marcador de facilidade da questão. Estratificando por dificuldade da questão (acurácia média entre os outros quinze modelos), o ganho de certificação bruto é carregado pelos estratos mais fáceis (2,7–4,6×), cai abaixo de 1× no segundo quintil mais difícil e desaparece no mais difícil sob esta medida intra-coleção. Essa estratificação é parcialmente endógena, e uma re-estimativa exógena abaixo suaviza a inversão em atenuação monótona. Uma análise de robustez aborda a preocupação de seleção diretamente (exploratória, não pré-registrada): em um modelo logístico agrupado por questão com efeitos fixos do modelo primário, controlando pela própria confiança do modelo primário e pela dificuldade do item (acurácia média deixando-o-fora do modelo primário entre todos os dezesseis modelos), cada panelista adicional concordante ainda multiplica as chances de correção por aproximadamente cinco (b agrupado = +1,65 por panelista, IC 95% [+1,49, +1,81], p < 10⁻⁸⁸; positivo em cada painel), e adicionar concordância a uma linha de base dificuldade-mais-confiança aumenta AUROC de validação de 0,859 para 0,898 e reduz a pontuação de Brier de 0,139 para 0,116 (divisão de validação cruzada dupla por questão). O mesmo modelo sonda o limite, e a estratificação em si requer cuidado: sob a medida de dificuldade intra-coleção, o coeficiente condicional se torna negativo no quintil mais difícil (b = −0,41, p = ,011), mas essa medida inclui os próprios membros do painel. O modelo condicional carrega uma ressalva de implantação: seu recurso de dificuldade requer rótulos, portanto é diagnóstico, não implantável, e o filtro implantável é o próprio portão de concordância. Três verificações adicionais abordam preocupações de estimativa e seleção, todas sob a codificação de protocolo determinístico congelado (o ramo mais rigoroso que o pacote de replicação relata ao lado dos números de manchete adjudicados pelo juiz). Re-estimando o ganho de certificação com reamostragem bootstrap agrupada por item, o agrupamento que a estrutura de dificuldade exige, deixa o intervalo de ganho de certificação de cada painel muito acima de 1 (ganhos pontuais de 2,4–4,5 sob esta codificação determinística, que certifica menos concordâncias do que a codificação de par adjudicada pelo juiz por trás da manchete publicada de 1,9–3,2×; limites inferiores de bootstrap de 2,2–4,1). A distribuição de 84 painéis relatada acima torna o painel de fronteira dos EUA, onde a auto-confiança é bem-sucedida, a exceção em vez da regra (vantagem mediana +0,14, IQR de AUROC de concordância 0,76–0,82). E AUROC estratificado por dificuldade torna o limite explícito sob uma medida de dificuldade exógena: 0,87 no quintil mais fácil caindo para 0,61 no mais difícil, atenuação sem inversão. Essa medida é deixar-painel-fora, os treze modelos fora de cada painel, e re-estimar com ela resolve a inversão: o coeficiente de concordância condicional permanece positivo em cada quintil, incluindo o mais difícil (b do quintil mais difícil = +0,97, p < 10⁻⁷; 28% das respostas replicadas independentemente no estrato mais difícil estão corretas, não 0%). Assim, a inversão intra-coleção é parcialmente um artefato da medida de dificuldade. O que sobrevive sob qualquer uma das medidas é atenuação monótona, com concordância mais fraca onde as questões são mais difíceis, e a realidade dos erros de consenso certificados; scripts e saídas estão no pacote de replicação. A proporção de manchete é, portanto, uma média sobre uma população heterogênea. A reivindicação de sinal repousa no ponto de extremidade AUROC, não na proporção.
As hipóteses do experimento operacionalizam a implantação de pesquisa que opero: a coleta cega espelha seu mecanismo de conselho, e as composições do painel existiam como sua configuração de produção antes do estudo ser projetado. Este é o segundo estudo pré-registrado neste programa de pesquisa. O terceiro, o experimento do consumidor da Seção 6, está completo e relatado, e um quarto (telemetria de campo sobre tráfego de produção) está em esboço. O pacote de replicação funciona para qualquer pessoa, em hardware de mercadoria, contra APIs públicas.
Uma segunda onda no nível de ponta: onze laboratórios — dez braços completos e um parcial — um fosso de calibração. O experimento acima amostrou os níveis otimizados por custo que realmente servem consumidores. A objeção para testar: talvez a ilusão de acurácia seja um artefato de nível orçamentário, e os navios capitânias, os modelos que cada fornecedor apresenta como seu melhor, estão calibrados o suficiente para que a arquitetura acima deles seja redundante. Uma segunda onda de coleta (agosto de 2026) testa essa objeção no topo do mercado.
Avalio um modelo de ponta de cada um dos dez principais laboratórios de IA abrangendo os Estados Unidos, China e Europa. Os laboratórios foram escolhidos para cobrir os ecossistemas comerciais líderes e de pesos abertos nessas três regiões. Para cada laboratório, selecionei seu modelo mais capaz disponível ao público no momento da onda de avaliação. Então verifiquei essa cobertura contra placares públicos em 5 de agosto de 2026 (LMArena Elo, Artificial Analysis Intelligence Index, Humanity's Last Exam e SWE-bench Verified): oito dos dez navios capitânias se colocam no ou perto do topo de pelo menos um placar de capacidade geral, enquanto dois (Mistral, Baidu) são incluídos para preservar a cobertura de laboratório e regional em vez de em bases de classificação (veja as limitações de cobertura abaixo). Um décimo primeiro laboratório, Meta, cujo navio capitânia se tornou acessível apenas após o escopo da onda, foi adicionado no meio da onda; sua coleta foi interrompida por revogação de acesso e é relatada como parcial (veja abaixo).
Tabela 8. Modelos de ponta avaliados e posições no placar (em 5 de agosto de 2026)
| Laboratório | Modelo de ponta (id da API) | País | Posições no placar (5 ago 2026) |
| OpenAI | gpt-5.6-sol | USA | AA Index #3 (58.9); LiveBench #1 (82.4); Arena grupo dos 6 principais |
| Anthropic | claude-fable-5 | USA | Arena #1 (~1525 Elo); AA Index #2 (59.9); SWE-bench Verified #1 (95.0) |
| gemini-3.1-pro-preview | USA | SWE-bench Verified #8 (80.6); HLE #17 (51.4); Arena grupo superior | |
| xAI | grok-4.5 | USA | AA Index #8 (53.8); Arena Elo 1499 |
| DeepSeek | deepseek-v4-pro | China | SWE-bench Verified #8 (80.6, Pro-Max); HLE #23 (48.2) |
| Alibaba | qwen-max (Qwen 3.7 Max) | China | Arena #21 (1488–1496 Elo); SWE-bench Verified #11 (80.4) |
| Moonshot AI | kimi-k3 | China | AA Index #4 (57.1); HLE #9 (56.0); Arena #10 (1500) |
| Zhipu (Z.ai) | glm-5.2 | China | AA Index #13 (51.1); HLE #11 (54.7) |
| Mistral | mistral-medium-3.5 | France | Abaixo do top-50 nos rankings gerais; incluído para cobertura regional |
| Baidu | ernie-4.5-vl-424b | China | Fora do top-30 geral (ERNIE 5.0: HLE #36); ERNIE 5.1: LMArena Search Arena #4 |
| Meta (adicionado no meio da onda, parcial) | muse-spark-1.1 | USA | HLE #4 |
As pontuações entre parênteses são os valores relatados pelo agregador na data do snapshot; as posições do ranking variam ligeiramente entre agregadores e datas de snapshot. As fontes de snapshot são arquivadas com os registros de execução que acompanham o pacote de replicação.
O protocolo é do primeiro experimento, congelado e reutilizado: a mesma subamostra SimpleQA de 1.500 itens (fixada por seed e hash), uma passagem cega por modelo, temperatura zero, prompt do sistema idêntico e parser de resposta, uma confiança declarada de 0–100 por resposta. A classificação é determinística (correspondência exata e normalizada de string com padrão ouro; recusas contabilizadas como erros; itens não resolvidos excluídos do headline e reclassificados como erros na análise de sensibilidade), e nenhum juiz LLM toca nos números do headline. Isso é um aperto deliberado em relação à primeira onda, cujo classificador era híbrido: correspondência objetiva de string com um juiz local de pesos abertos resolvendo o restante (66,5% de veredictos emitidos pelo modelo; verificação pontual de 50 itens com humano, 98% de concordância). Esta onda usa apenas o mecanismo de equivalência determinística (validado manualmente: 20 de 20 discordâncias sinalizadas e 15 de 15 concordâncias confirmadas à mão), então cada número do headline desta onda se reproduz bit a bit do script lançado. Comparações entre ondas de precisão absoluta, portanto, também cruzam regimes de classificador, e cada comparação de julho-versus-agosto carrega um qualificador de regime de classificador. Auditorias internas da onda apoiam os números de cada onda, mas os deltas entre ondas conflacionam mudança de modelo com mudança de classificador a menos que um único classificador seja reaplicado aos dois conjuntos de respostas congeladas, o que não foi feito aqui. Um desvio de esforço: o braço da OpenAI foi coletado no esforço de raciocínio padrão da interface (médio) onde o protocolo de julho usou mínimo, sem acesso à web ou ferramentas na inferência (verificado enumerando as ferramentas expostas ao modelo, das quais não havia nenhuma). Isso altera a precisão absoluta desse fornecedor, não o mecanismo de concordância (Seção 5). Uma falha confiante é uma resposta errada oferecida com confiança declarada ≥ 80; o limite foi fixado antes da execução, com 70 e 90 relatados como sensibilidade. A cobertura de união é de 1.500/1.500 perguntas para dez dos onze laboratórios. A coleção da Meta atingiu 272 respostas válidas antes do acesso ser revogado.
Também testei a preocupação entre regimes diretamente. A reclassificação da onda de dezesseis modelos de julho com o mecanismo determinístico congelado da segunda onda (que substitui o pipeline híbrido que adjudicou 66,5% dos veredictos por um classificador local de pesos abertos) muda 2,65% dos veredictos resolvidos (566 de 21.338; o mecanismo se abstém de mais 4,1%) e não altera nenhum headline: sob uma única codificação determinística as elevações de certificação leem 3,6×/4,6×/4,4× antes da reclassificação e 3,0–3,1×/4,5–4,6×/4,3× depois. Ambos estão acima dos 1,9–3,2× conservadores publicados, que derivam da codificação de par adjudicada por LLM, já que mais concordâncias certificadas significa elevações mais conservadoras. Todo AUROC nas Tabelas 6–7 muda no máximo 0,016 nos painéis CN e entre blocos e 0,046 no painel dos EUA, preservando a ordenação de cada painel de concordância versus confiança auto-relatada.
O rótulo de destaque não garante nada. A precisão resolvida em perguntas idênticas varia de 11,4% a 95,4% entre os onze destaques (Tabela 9), uma dispersão de 84 pontos no topo do mercado, mais ampla do que a dispersão de médio porte do primeiro experimento. E a ilusão de precisão sobrevive intacta neste nível: agrupada entre os dez braços de laboratório completos, 46,6% de todas as respostas resolvidas oferecidas com confiança declarada ≥ 80 estavam erradas (4.910 de 10.540; incluindo o braço parcial da Meta, 46,3%, ou 4.935 de 10.665; itens não resolvidos excluídos aqui e reclassificados como erros em sensibilidade, onde a imagem agrupada permanece inalterada). A implicação orientada para o consumidor da primeira onda não se suaviza com o preço: um rótulo de destaque não diz ao consumidor se a resposta confiante na sua frente veio do destaque com 95% de precisão ou do com 11% de precisão.
Tabela 9. Onda de destaque: cobertura e precisão (subamostra SimpleQA, n = 1.500 por laboratório, temperatura 0)
| Laboratório (destaque) | Cobertura | Precisão (resolvida) | Não resolvido |
| OpenAI gpt-5.6-sol | 1.500/1.500 | 95,4% (1.403/1.471) | 29 |
| Google gemini-3.1-pro | 1.500/1.500 | 71,1% (837/1.178)¹ | 46 |
| Anthropic claude-fable-5 | 1.500/1.500 | 70,3% (1.019/1.450) | 50 |
| Meta muse-spark-1.1 (parcial) | 272/1.500 válidas | 61,4% (148/241)² | 10 |
| xAI grok-4.5 | 1.500/1.500 | 54,8% (794/1.448) | 52 |
| DeepSeek deepseek-v4-pro | 1.500/1.500 | 46,6% (666/1.428) | 72 |
| Moonshot kimi-k3 | 1.500/1.500 | 45,5% (645/1.418) | 82 |
| Zhipu glm-5.2 | 1.500/1.500 | 30,2% (430/1.425) | 69 |
| Baidu ernie-4.5-vl-424b | 1.500/1.500 | 28,9% (411/1.421) | 71 |
| Mistral mistral-medium-3.5 | 1.500/1.500 | 21,4% (306/1.429) | 71 |
| Alibaba qwen-max | 1.500/1.500 | 11,4% (164/1.435) | 65 |
¹ O canal da Google retornou respostas vazias ou filtradas em 18,4% dos itens (276 de 1.500 — uma propriedade de entrega, não uma lacuna de cobertura: todos os 1.500 foram tentados); a precisão é computada em respostas analisadas e resolvidas. Ambas as definições são relatadas: apenas respondidas, a precisão da Google é 71,1% (837/1.178); contando as 276 respostas não entregues como erros é 57,6% (837/1.454), e 55,8% (837/1.500) com itens não resolvidos também pontuados como erros. ² A precisão da Meta computada nas respostas coletadas antes da revogação de acesso; ver limitações de cobertura. A precisão em toda a tabela é apenas resolvida; sob a sensibilidade de não resolvido como erro, o valor superior da OpenAI, 95,4%, torna-se 93,5% (1.403/1.500). A proveniência do canal por chamada para cada laboratório é registrada no manifesto de execução. Contagens não resolvidas entregaram respostas que não se resolveram de forma determinística; para Zhipu (1.494 respostas entregues), Baidu (1.492) e o braço Meta parcial (251) as duas colunas, portanto, somam menos do que as perguntas tentadas, sendo o restante respostas não entregues.
Uma ressalva de contaminação limita as precisões absolutas. Esta onda reutiliza o benchmark SimpleQA original, lançado publicamente (outubro de 2024) contra modelos cujos corpora de treinamento são posteriores à sua publicação em até dois anos, portanto a exposição ao benchmark durante o treinamento é plausível no topo da tabela, e os dados carregam uma assinatura concreta disso: o modelo de ponta de maior pontuação reproduz a string de resposta ouro verbatim (correspondência exata normalizada, até a formatação decimal) em 61,6% dos itens, contra 27,9–45,3% para os outros laboratórios, com uma confiança declarada mediana de 99. O projeto não consegue separar "o modelo é mais forte" de "o modelo viu o benchmark e sua chave de resposta." Os números de precisão absoluta da onda, portanto, não são comparáveis aos tetos de livro fechado históricos relatados para gerações anteriores de modelos, e não devem ser lidos como medidas de memória paramétrica. A verificação de idade do benchmark da primeira onda (a lacuna TruthfulQA–SimpleQA relatada na Seção 3) cobriu a coleta de julho; em agosto de 2026, o SimpleQA em si é um benchmark público de dois anos, e esta ressalva cobre a onda de ponta. As conclusões da onda não se baseiam em precisão absoluta. Elas descansam na estrutura de falhas confiantes, sua prevalência com confiança declarada ≥ 80 e sua interceptação pela porta de discordância, medida dentro da onda sob um protocolo congelado, onde qualquer vantagem de exposição é compartilhada entre os laboratórios avaliados nos mesmos itens. Uma sonda de dois saltos fresca construída após a janela do estudo confirma esta assinatura diretamente. Veja "Por que não simplesmente usar o melhor modelo?" mais adiante nesta seção.
O fosso da calibração. O primeiro experimento mostrou que o acordo independente carrega um sinal de correção que a confiança auto-relatada não carrega. A onda de ponta transforma esse sinal em um filtro medido. O mecanismo é uma porta de discordância: um conselho de três laboratórios, fixado com antecedência a partir de uma análise de discordância anterior e não ajustado a esses resultados (Moonshot kimi-k3, DeepSeek deepseek-v4-pro, OpenAI gpt-5.6-sol), e uma regra sem parâmetros livres. Uma resposta passa pela porta apenas quando as três respostas do conselho concordam aos pares. Porque nada é estimado, nenhuma divisão de trem/teste é necessária; a porta é computada uma vez sobre a coleção congelada.
Figura 17. A porta de ponta
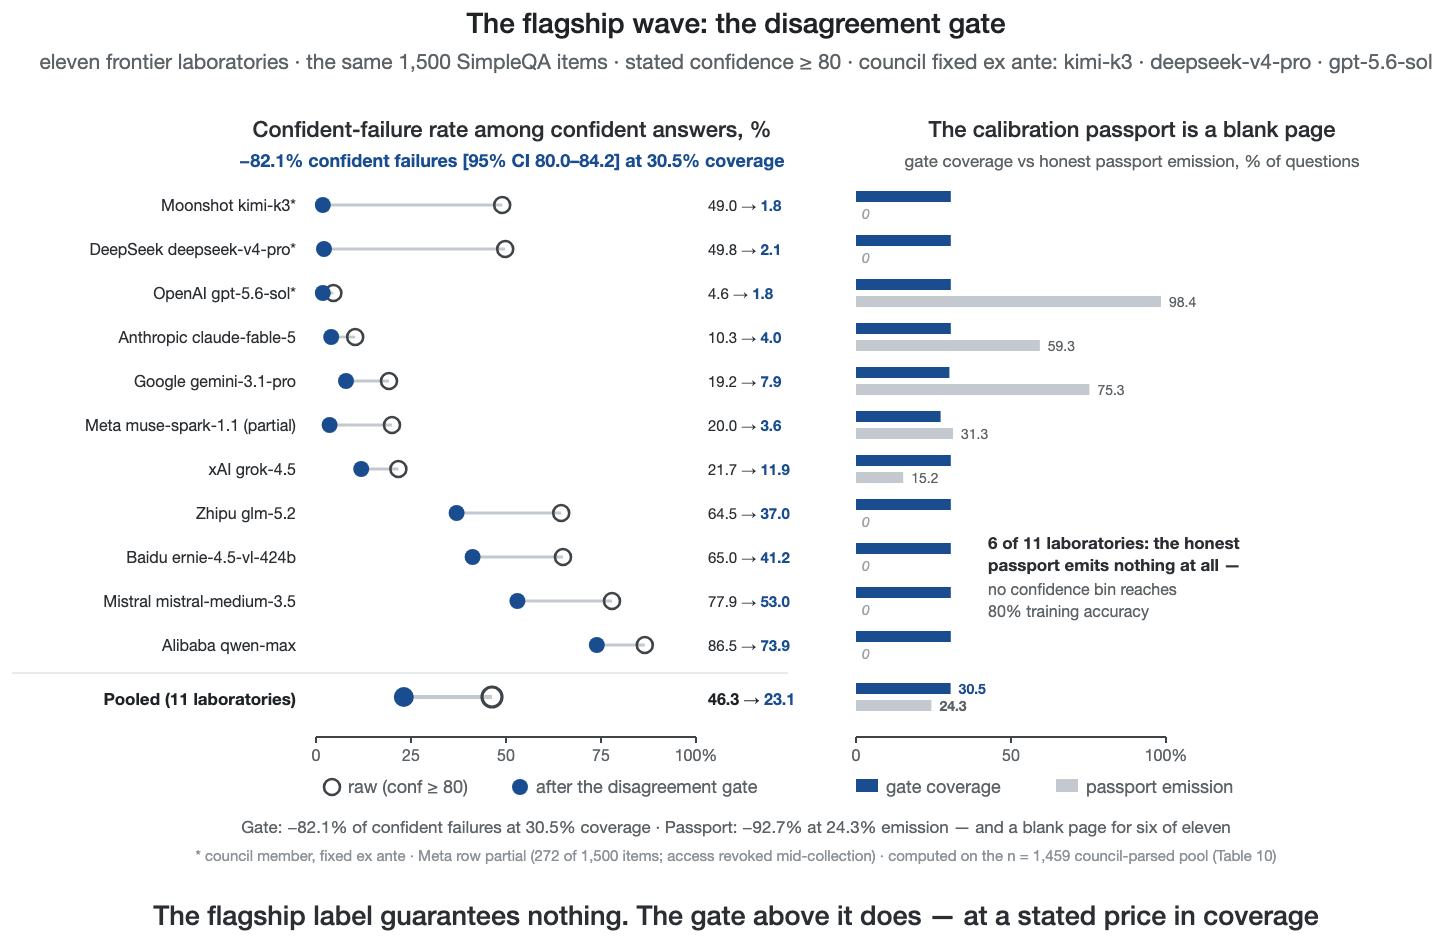
Falhas confiantes com confiança declarada ≥ 80 e sua interceptação pela porta de discordância de três modelos fixos, por laboratório (onda de agosto de 2026).
Agrupado em todos os dez braços completos do laboratório (a apresentação primária, com o braço Meta parcial relatado separadamente e sua inclusão tratada como uma sensibilidade), a taxa bruta de falha confiante é 46,6% (4.910/10.540). Agrupado no elenco de onze laboratórios, as taxas por laboratório variam (Tabela 9), portanto essa figura caracteriza o elenco de fronteira em vez de uma constante universal. A porta remove 82,1% das falhas confiantes (bootstrap IC 95% [79,9; 84,1]) enquanto mantém 30,5% de todas as respostas agrupadas (a porta em si abre em 30,6% das questões, 446 de 1.459). Restrito aos laboratórios completos fora do conselho, sem auto-referência de nenhum tipo, a porta ainda remove 76,9% das falhas confiantes (IC [74,3; 79,2]). A inclusão do braço Meta parcial deixa cada estimativa efetivamente inalterada: agrupado em todos os onze, a taxa bruta é 46,3% (4.935/10.665; 35,8% das respostas confiantes passam pela porta, e a correção entre as respostas confiantes emitidas sobe de 53,7% bruto para 76,9% pós-porta), a porta remove 82,1% (IC [80,0; 84,2]) com a mesma cobertura de 30,5%, e a figura de oito laboratórios fora do conselho é 77,0% (IC [74,4; 79,3]). A Tabela 10 fornece os números por laboratório.
Tabela 10. Interceptação de falha confiante pela porta de discordância (conf ≥ 80; classificador determinístico; conselho = kimi-k3 · deepseek-v4-pro · gpt-5.6-sol, fixo ex ante)
| Laboratório | Respostas confiantes | Falhas confiantes, brutas | Após a porta (taxa em emitida) | dCF |
| Moonshot kimi-k3 [conselho] | 1.056 | 517 (49,0%) | 7 (1,8%) | −98,6% |
| DeepSeek deepseek-v4-pro [conselho] | 1.274 | 634 (49,8%) | 9 (2,1%) | −98,6% |
| OpenAI gpt-5.6-sol [conselho] | 1.426 | 65 (4,6%) | 8 (1,8%) | −87,7% |
| Anthropic claude-fable-5 | 825 | 85 (10,3%) | 15 (4,0%) | −82,4% |
| Google gemini-3.1-pro | 966 | 185 (19,2%) | 27 (7,9%) | −85,4% |
| Meta muse-spark-1.1 (parcial) | 125 | 25 (20,0%) | 2 (3,6%) | −92,0% |
| xAI grok-4.5 | 577 | 125 (21,7%) | 36 (11,9%) | −71,2% |
| Zhipu glm-5.2 | 1.128 | 727 (64,5%) | 146 (37,0%) | −79,9% |
| Baidu ernie-4.5-vl-424b | 725 | 471 (65,0%) | 107 (41,2%) | −77,3% |
| Mistral mistral-medium-3.5 | 1.354 | 1.055 (77,9%) | 224 (53,0%) | −78,8% |
| Alibaba qwen-max | 1.209 | 1.046 (86,5%) | 300 (73,9%) | −71,3% |
| Agrupado (11 laboratórios) | 10.665 | 4.935 (46,3%) | 881 (23,1%) | −82,1% [80,0; 84,2] |
| Agrupado (8 fora do conselho) | 6,909 | 3,719 (53.8%) | 857 (33.5%) | −77.0% [74.4; 79.3] |
Calculado no conjunto de questões em que todos os três membros do conselho produziram respostas analisadas e não recusadas (n = 1,459 de 1,500); o portão abre em 446 delas (30.6%). A linha Meta é parcial (acesso revogado durante a coleta). Bootstrap CIs: 5,000 reamostragens no nível de questão.
Três coisas acompanham esse título. O portão também descarta aproximadamente metade das respostas confiantes corretas (o portão retém apenas 51.3% das respostas confiantes-corretas; das respostas que ele descarta, aproximadamente 41% estavam de fato corretas). A troca é cobertura por certeza, o trade-off canônico de risco–cobertura da classificação seletiva (Geifman & El-Yaniv, 2017), executado aqui na camada de arquitetura, e os dois números devem sempre ser citados como um par: −82.1% de falhas confiantes em 30.5% de cobertura. O sistema tem seu próprio piso. No modo totalmente sistêmico, em que o portão aberto emite a resposta de consenso do conselho em vez da do modelo individual, a própria taxa de falha-confiante do sistema é 1.8% (8 de 442 respostas de consenso resolvidas), e essas oito questões são aquelas em que todo o conselho concorda com confiança sobre a mesma resposta errada. Esse é o piso de erro correlacionado que o primeiro experimento previu de sua condição de limite consenso-certifica-erro: abaixo dele, nenhuma quantidade de verificação de concordância ajuda, porque a concordância em si é o erro. E o resultado é plano em toda a grade de sensibilidade pré-declarada: limiar de confiança 70/80/90 fornece dCF agrupado de −83.1%/−82.1%/−80.6%, e a repontuação de itens não resolvidos como erros fornece −81.8%, então o número foi medido, não selecionado.
O que o valor de cobertura de 30,5% significa comercialmente é estabelecido pela economia de ponto de equilíbrio da Seção 5 (Figura 14): os aproximadamente setenta por cento das respostas que o portão se recusa a certificar são solicitações roteadas para um destino mais econômico do que um erro confiante (escalação para um humano, um nível de verificação mais profundo ou uma exibição explícita de incerteza) em vez de conversões perdidas, portanto o custo de cobertura é um custo de erro assegurável, não uma demanda perdida. Nenhum modelo de custo para o canal de escalação é estimado aqui. O ponto de operação não é fixo. A escada de concordância rastreada na Figura 19 fornece uma família de limiares, e um serviço deve se posicionar onde o custo esperado de uma falha confiante não capturada cruza a margem no tráfego que o portão retém, o que a torna uma escolha baseada em custo.
Figura 14. Economia da confiança graduada
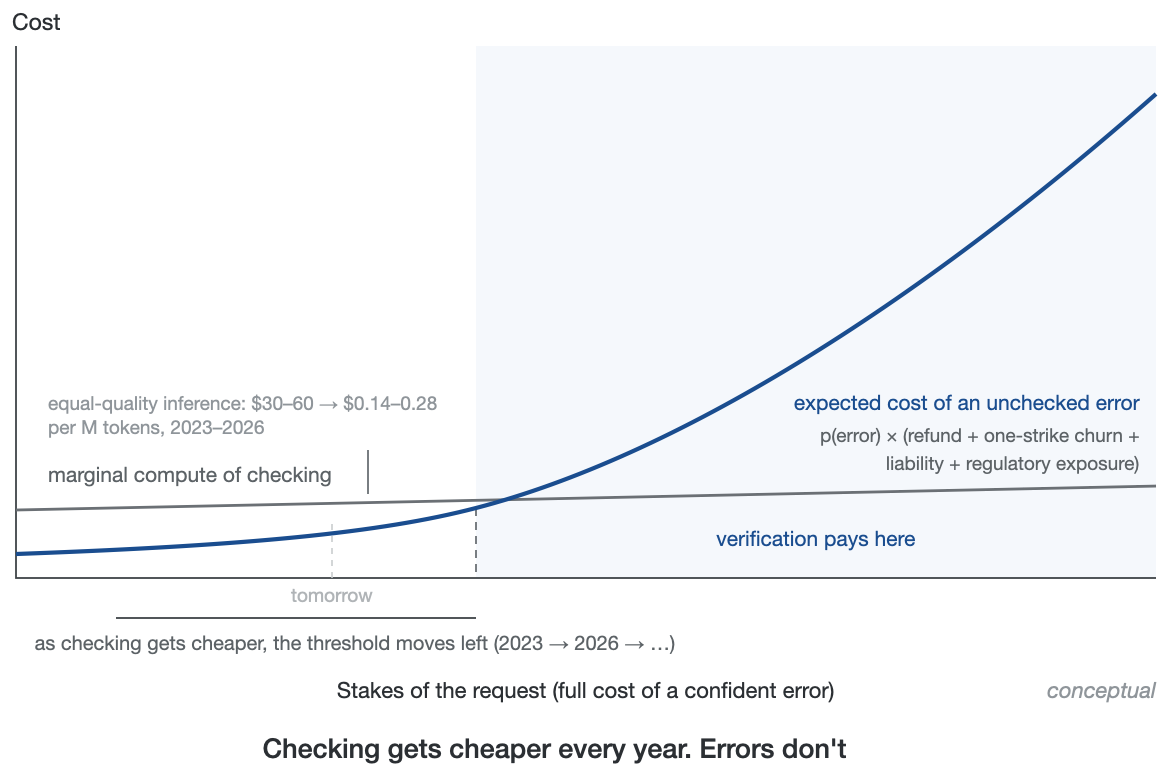
A lógica de ponto de equilíbrio da verificação.
Por que não simplesmente usar o melhor modelo? A linha de base mais forte que a onda deixa em pé é comercial e não estatística: um operador poderia ignorar a arquitetura e rotear tudo para o modelo de ponta mais preciso da onda. Essa linha de base precisa de uma resposta com números. Aos preços de meados de 2026, o conselho congelado de três laboratórios custa $0,0039 por pergunta, menos que uma resposta do modelo de ponta mais caro da onda (claude-fable-5, $0,0198/pergunta ao preço de tabela) e mais que uma do seu mais preciso (gpt-5.6-sol, $0,0027/pergunta nas taxas de API publicadas). "Basta comprar o melhor modelo de ponta" é um ponto Pareto genuíno: gpt-5.6-sol sozinho responde toda pergunta com uma taxa de falha confiante de 4,6%, e nenhuma configuração com portão corresponde à sua cobertura a qualquer preço. Onde quer que um serviço possa tolerar falha confiante em aproximadamente uma resposta em vinte e necessite cobertura total, o modelo de ponta vence em ambos os eixos. A regra não se generaliza bem, entretanto, mesmo no topo do ranking: o outro candidato principal de consenso da onda, claude-fable-5, apresenta uma taxa de falha confiante de 10,3% isoladamente. "Basta usar o modelo que lidera os benchmarks" fracassa completamente no segundo modelo mais forte da amostra, razão pela qual o problema de identificação abaixo não é hipotético. Quatro considerações delimitam a comparação.
Primeiro, o problema de identificação: saber qual modelo é atualmente o melhor é em si mesmo o resultado de medição externa entre modelos. A própria Tabela 8 da onda selecionou seus modelos de ponta de rankings públicos, comparações contínuas, de terceiros, entre fornecedores, que ninguém propõe substituir pelo auto-relato dos fornecedores. Os dados próprios do artigo mostram por que ninguém o faz: a autoconfiança declarada discrimina em AUROC 0,53–0,79 dependendo do fornecedor, e uma dispersão de precisão de 84 pontos separa modelos todos vendidos como o melhor de seu laboratório. "Rotear para o melhor modelo" é, portanto, uma aplicação de confiança arquitetural e não uma alternativa a ela: o ranking que coroa o modelo de ponta é um painel independente, itens cegos e um registro publicado, os três componentes da Seção 3 operados em escala de mercado. E essa liderança muda: a liderança de modelo empresarial mudou de mãos em uma única primavera (Kharazian, 2026), modelos são atualizados discretamente sob nomes estáveis e o comportamento de compra de agentes se reorganiza drasticamente entre atualizações de modelos (Allouah et al., 2026). Sem medição externa contínua, "o melhor modelo" não está disponível para o operador como conhecimento.
Segundo, os 95,4% são parcialmente memória e não capacidade: o modelo de ponta reproduz literalmente a resposta ouro em 61,6% dos itens (ressalva de contaminação da Tabela 9), portanto sua vantagem medida se comprime em questões que o benchmark não pode tê-lo ensinado. O mecanismo de portão não herda essa fragilidade: no estrato menos provável de ter sido memorizado, remove 89,4% das falhas confiantes, seu melhor desempenho e não o pior (a re-análise estratificada por contaminação abaixo), porque a concordância entre laboratórios independentemente treinados não é condicionada ao corpus de treinamento de qualquer fornecedor.
Para separar o conhecimento transferível da exposição ao benchmark, compus uma sonda fresca de 100 itens com dois saltos que é garantidamente não contaminada, gerada por máquina em 6 de agosto de 2026 a partir de pares de fatos Wikidata pré-2023 verificados independentemente (por exemplo, "Em que ano nasceu o arquiteto de [edifício menor]?"), cada um com uma única resposta computada, portanto as cadeias de perguntas compostas não podem ter aparecido em qualquer corpus de treinamento. O SHA-256 do conjunto foi congelado antes da primeira chamada de modelo.
Sob o protocolo congelado da onda (prompt de sistema verbatim, temperature 0, mesmo avaliador determinístico), gpt-5.6-sol caiu de 95,4% de precisão com uma taxa de falha-confiante de 4,6% em SimpleQA para 33,0% [bootstrap IC 95% 24,0–42,0] com falhas confiantes em 61,0% [51,0–70,0] de seus itens (67,0% de suas respostas confiantes), sua confiança média declarada mal se movimentando (98,4 → 93,7), enquanto claude-fable-5 se manteve em 76,0% [67,0–84,0] e 6,0% [2,0–11,0]. A diferença de modelo estrela de 25 pontos da onda se inverte em um déficit de 43 pontos em composições garantidamente não vistas. O portão de conselho, inalterado da onda, absorveu essa falha: removeu todas exceto uma das 61 falhas confiantes de gpt-5.6-sol (60/61; em n = 61 a taxa pontual é imprecisa, IC Wilson 95% ≈ 91–99,7%; cobertura de 24,2%; claude-fable-5: 6 → 1), reduzindo a taxa de falha-confiante emitida entre respostas de alta confiança aprovadas para 4,5% em relação aos 67,0% brutos.
Os níveis não são comparáveis pontualmente entre benchmarks: composição de dois saltos é intrinsecamente mais difícil que recuperação de um salto, e em n = 100 os intervalos são amplos. Mas a reversão da ordenação do modelo e a persistência do portão em itens que nenhum modelo poderia ter memorizado são exatamente as assinaturas que a conta de contaminação prediz, e são o modo de falha que uma camada de confiança arquitetural, e não uma escolha de modelo melhor, é construída para absorver.
Terceiro, há um piso. O portão atinge uma taxa de falha-confiante que nenhum modelo isolado alcança a nenhum preço: configurações com portão de conselho reduzem falhas confiantes em respostas emitidas para 1,8–2,1% a $0,0039–0,0046 por pergunta, 2,5× abaixo da melhor taxa solo, enquanto o modelo estrela mais caro da onda fica em 10,3% de falhas confiantes por $0,0198 por pergunta, dominado em todos os eixos. O portão não é um dispositivo de resgate para modelos fracos: qwen-max atrás do mesmo portão ainda falha com confiança em 73,9% de suas respostas confiantes emitidas, portanto os pontos com portão da fronteira são conselhos de modelos fortes, não portões sobre os fracos.
Quarto, quando o agente está gastando dinheiro autonomamente, a questão operativa muda de "qual modelo é mais inteligente" para "qual configuração pode provar o que fez." Por mais preciso que seja, um modelo estrela solo não pode autenticar sua própria decisão ou arbitrar seu próprio conflito de interesse. A configuração com portão produz um registro de concordância inspecionável por resposta. Esse é o artefato que os mercados de responsabilidade civil e seguro da Seção 5 já precificam, onde a cobertura está sendo escrita contra a evidência e moldada por exclusão contra sua ausência.
A resolução é uma fronteira, não um vencedor. O modelo estrela é o membro mais forte do conselho (o conselho congelado o inclui), mas não pode servir como seu próprio juiz. O placar que o identifica já repousa no mesmo princípio que a confiança arquitetural operacionaliza, verificação independente entre modelos, mas fornece essa verificação apenas em agregação, sobre modelos em geral, não sobre a resposta diante de um consumidor. A construção preenche essa lacuna, e a lacuna também a limita: uma afirmação que repousa em nenhuma verificação independente está fora da confiança arquitetural, não é uma instância dela. A escolha real do operador é entre classes de risco: cobertura total a 4,6% de falhas confiantes, ou cobertura de 31% a 1,8% com trilha de auditoria, a troca de classificação seletiva, precificada aqui. A fronteira completa de custo–cobertura–risco de 26 configurações (cada modelo estrela solo, cada configuração com portão, e as escadas de concordância agrupadas, com a base de preço faturado versus preço de tabela marcada por ponto) é lançada como um CSV com o pacote de replicação.
O rival óbvio do portão de discordância é o reparo de calibração de modelo único: aprender o mapeamento de confiança para precisão de cada modelo e emitir apenas onde a precisão mapeada limpa uma barra, o programa de recalibração post-hoc cujos remédios padrão são temperatura e escala de Platt (Guo, Pleiss, Sun, & Weinberger, 2017). Ajustado em metades disjuntas (confiança com binagem de histograma, treinar em perguntas com índice par, avaliar em índice ímpar, bins com menos de 20 observações não emitidos), este passaporte de calibração remove 92,7% das falhas confiantes, mas em emissão de 24,3%, e seis dos onze modelos estrela não emitem nada: nenhum bin de confiança deles atinge 80% de precisão de treinamento, então o passaporte para esses modelos é uma página em branco. Para metade do mercado de modelos estrela, a calibração de modelo único não pode ser reparada de fora. O portão de discordância mantém aproximadamente 30% de cobertura para cada modelo na tabela, incluindo os seis que o passaporte abandona. Portanto, a conclusão do primeiro experimento se mantém neste nível também: a arquitetura pode fornecer um sinal de correção externo onde a confiança exposta de um modelo falha como um, em classificação ou em nível, medido novamente no nível em que os consumidores são informados de confiar mais.
Robustez do efeito do portão. Duas verificações conduzidas pelo árbitro importam: circularidade, se o portão depende de seu membro mais forte, e se algo trivial faz o mesmo trabalho. Substituir o membro mais forte do conselho (gpt-5.6-sol, 95,4% de precisão resolvida) pela quarta execução de fronteira ex-ante da onda (grok-4.5) deixa o resultado essencialmente inalterado. O conselho sem sol remove 81,2% das falhas confiantes agrupadas em cobertura de 29,7% (destinos não-conselho: 77,6%) contra 82,1% em 30,5% para o trio congelado, e em todos os 165 conselhos possíveis de três modelos o mecanismo nunca falha: cada conselho remove mais falhas confiantes que abstenção aleatória em sua própria cobertura (excesso médio +8,5 pontos), com o trio ex-ante nos 4% principais por essa margem (+12,6 pontos). O efeito pertence à concordância entre modelos, não à precisão de nenhum membro individual. Limiar a confiança própria declarada de cada modelo para a cobertura idêntica por modelo, a linha de base trivial, remove apenas 66,7% das falhas confiantes agrupadas, menos que os 69,5% que a abstenção aleatória cega na mesma cobertura remove, porque as falhas confiantes são por construção concentradas em alta confiança declarada. Esse limiar também mantém menos respostas confiante-corretas que o portão (46,4% vs 51,3%). O portão domina Pareto ambas as linhas de base para cada um dos onze laboratórios. Usar concordância por resposta com o modelo mais forte sozinho como filtro é uma tela ainda mais forte (97,1% das falhas confiantes agrupadas removidas em cobertura de 40,7%, mantendo 97,0% das respostas confiante-corretas), mas é uma regra mecanicamente diferente, condicionada ao alvo. Passa uma resposta apenas após inspecioná-la, enquanto o portão de conselho abre o mesmo conjunto de perguntas fixo para cada modelo sem olhar para a resposta sob teste, portanto limita o efeito do conselho sem explicá-lo: sem sol o trio ainda remove 81,2%, e até mesmo concordância com um juiz singular fraco (kimi-k3, 45,5% de precisão resolvida) remove 86,3% das falhas confiantes. O driver é concordância entre modelos como tal, enquanto a precisão do juiz aparece no que é mantido (mantido-correto 97,0% para sol contra 20–63% para os juízes mais fracos).
A abstinência calibrada fornece linhas de base concorrentes mais fortes, e elas também foram executadas. Duas linhas de base de abstinência calibrada foram ajustadas sob a mesma divisão que o passaporte de calibração (parâmetros ajustados em itens com índice par, avaliados na metade ímpar retida, onde o gate congelado remove 82,2% das falhas confiantes com cobertura de 30,8%). As linhas de base por modelo não atingem o gate. A confiança em escala de Platt com cobertura por modelo correspondente ao gate remove 65,3% das falhas confiantes, e a abstinência split-conformal (α = 0.293, calibrada para garantir P(emit | wrong) ≤ α e ajustada à mesma cobertura) remove 70,8%, assim como um controle top-K de confiança bruta declarada na mesma cobertura agrupada, que remove 69,4%. Uma variante agrupada que classifica as respostas de todos os onze laboratórios em uma escala de probabilidade calibrada por Platt de fato supera o gate (89,0% na cobertura agrupada idêntica), mas o faz realocando essencialmente toda a cobertura para os laboratórios bem calibrados: emite 100% das respostas do fornecedor melhor calibrado e 0% para quatro dos onze laboratórios, reproduzindo de forma mais suave o modo de falha do passaporte acima. Também requer aproximadamente setecentas respostas classificadas por modelo para ajustar, enquanto o gate não requer nenhuma. A confiança calibrada e o acordo entre modelos são, portanto, complementos, não substitutos: o primeiro compra uma taxa de erro agrupada menor sempre que rótulos de verdade fundamental existem para treiná-lo, e o segundo compra proteção uniforme por laboratório livre de rótulos.
A Figura 19 coloca todas as estratégias no plano de predição seletiva (agrupadas sobre as 13.955 respostas resolvidas deterministicamente que os onze braços retornaram no pool congelado de 1.459 questões, de modo que o total é menor do que o da Tabela 9, que conta respostas resolvidas sobre todas as 1.500 questões; risco seletivo = proporção de respostas emitidas que estão erradas). Classificado por área sob a curva risco-cobertura, menor melhor: confiança calibrada por Platt 0,258, a escada de gate refinada por confiança declarada 0,321, a escada de acordo puro 0,356, confiança declarada bruta 0,367, abstinência aleatória 0,517, comparado a um piso oráculo de 0,166; os valores de metade retida diferem por no máximo 0,009. No próprio ponto de operação do gate congelado (31,1% de cobertura nesta convenção de resposta resolvida, 4.334 de 13.955 respostas emitidas; os 30,5% e 30,6% relatados em outro lugar são as proporções de respostas confiantes e de questões do pool) o risco do gate é 24,9%, contra 33,4% para um limite de confiança bruta e 14,0% para confiança calibrada, sujeito às ressalvas de custo de rótulo e concentração de cobertura acima. A nuvem de todos os 165 conselhos de três modelos abrange coberturas de 9–59% com riscos de 13–38%, de modo que o gate relatado é um membro representativo de sua família, não um outlier ajustado. Gates de juiz único rastreiam a extremidade degenerada da família, onde "acordo" colapsa em "pergunte ao modelo mais preciso".
Figura 19. A fronteira risco-cobertura
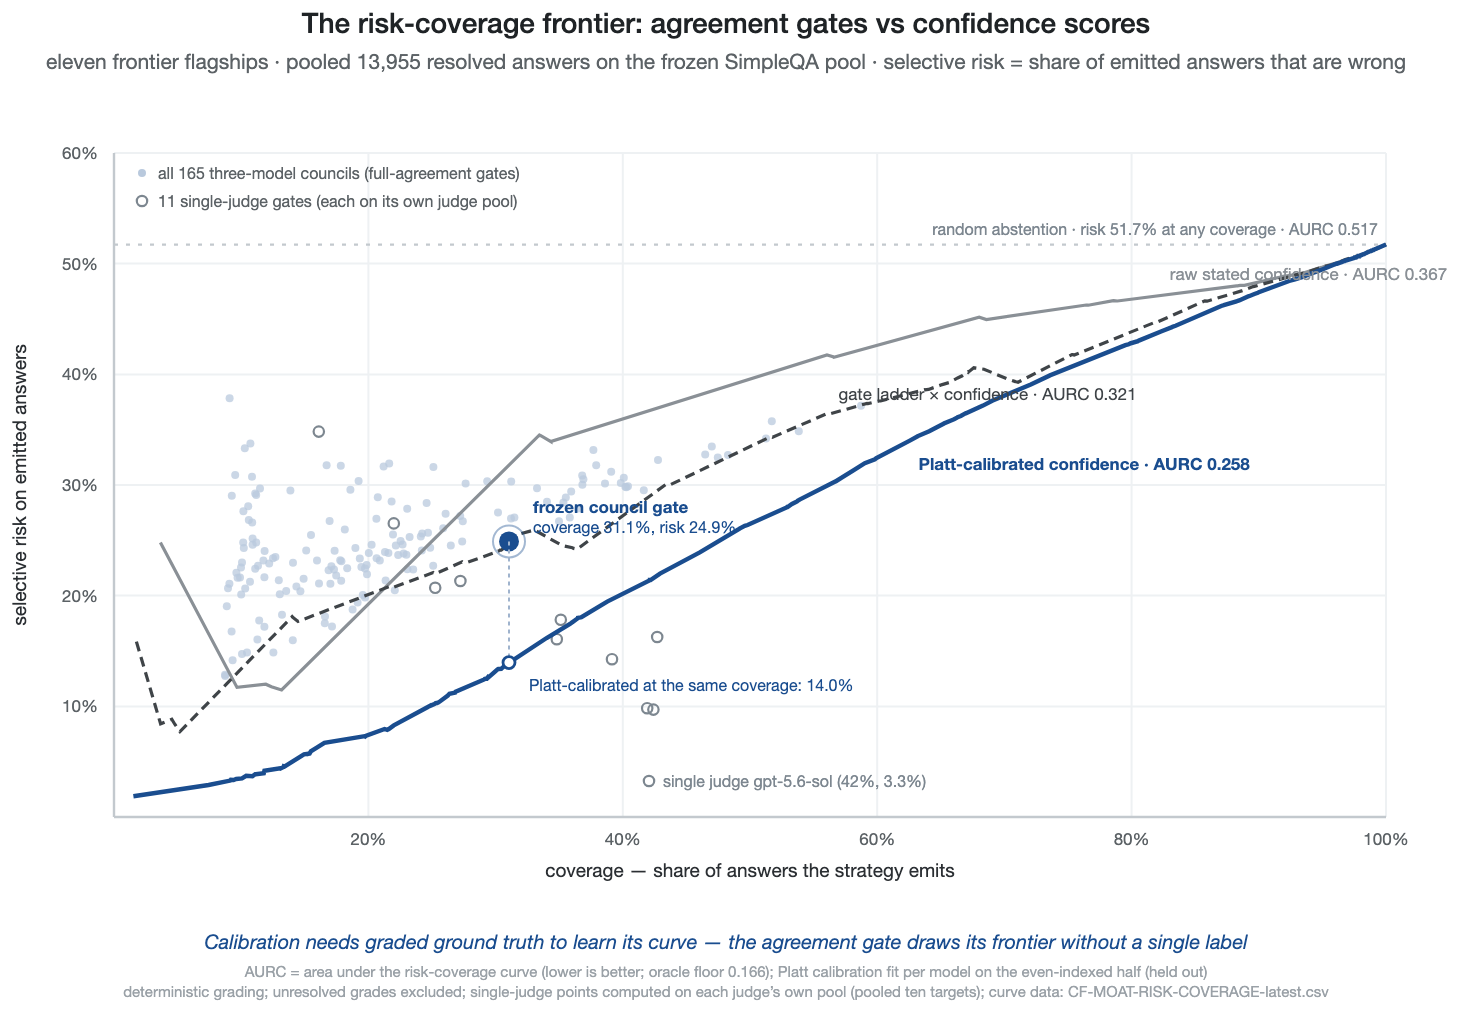
Cada estratégia de abstinência no plano de predição seletiva, cobertura contra risco seletivo, agrupada sobre as 13.955 respostas principais resolvidas deterministicamente retornadas pelos onze braços no pool congelado de 1.459 questões (Tabela 9 conta respostas resolvidas sobre todas as 1.500 questões): as curvas de confiança bruta, calibrada por Platt, e gate-ladder-×-confidence com seus valores AURC, a linha de abstinência aleatória, a nuvem de todos os 165 conselhos de três modelos, os onze gates de juiz único, e o ponto de operação do conselho congelado (31,1% de cobertura na convenção de resposta resolvida, 4.334 de 13.955; risco de 24,9%). Menor é melhor; o piso oráculo é 0,166. Cada ponto é recomputável a partir do CSV de risco-cobertura do pacote de replicação.
O acordo pode não carregar nenhuma informação além da facilidade da questão. Para testar isso, uma regressão logística da correção da resposta no acordo do gate e na dificuldade do item (a proporção de respostas erradas entre os outros modelos naquela questão), com efeitos fixos de laboratório e erros padrão agrupados por questão, foi executada, e a resposta depende de como a dificuldade é medida. Com dificuldade medida apenas pelos modelos não-conselho (o controle justo, já que uma medida de dificuldade que inclui as próprias respostas do conselho incorpora o sinal do gate por construção), o acordo mantém uma contribuição independente nos alvos de laboratório externo: b = +0,76, razão de chances 2,15, z = 17,2. Uma resposta emitida pelo gate tem aproximadamente o dobro das chances de estar correta em comparação com uma resposta igualmente difícil que o gate reteria. Se em vez disso incluirmos a própria correção do conselho no regresssor de dificuldade, o coeficiente de acordo colapsa para zero, o que quantifica o mecanismo em vez de refutá-lo: acordo e dificuldade multi-modelo são duas medições da mesma quantidade latente, e o gate é um instrumento livre de rótulos para lê-la no tempo de inferência.
Uma re-análise estratificada por contaminação aborda a preocupação de exposição diretamente. Sinalizando uma questão como provavelmente benchmark-exposta quando pelo menos três dos onze laboratórios reproduzem a cadeia de ouro literalmente após normalização (741 de 1.459 questões do pool; a mesma assinatura que produz a taxa de eco de ouro de 61,6% do gpt-5.6-sol), o gate remove 89,4% das falhas confiantes no estrato não exposto (2.793→296; alvos não-conselho: 86,5%) contra 72,7% no exposto. Assim, o mecanismo não se baseia em itens memorizados. Comporta-se como um filtro seletivo deveria, abrindo muito menos frequentemente onde o painel está genuinamente incerto (18,7% vs 41,9% de cobertura) e mantendo a taxa de falha confiante emitida quase constante entre estratos (25,9% vs 21,8%, de taxas brutas de 58,5% e 36,4%). Limites de exposição de 2–5 modelos ecoando dão dCF não exposto de 87,7–89,7%, de modo que a descoberta é robusta ao limite. A estratificação é descritiva: o eco de ouro está acoplado ao resultado, e separa questões provavelmente vistas de outras questões em vez de identificar contaminação causalmente.
O que um orçamento de raciocínio maior compra: confiança, não competência. Os fornecedores líderes agora vendem um segundo dial acima da escolha de modelo: um orçamento de raciocínio, precificado por token de deliberação oculta. Se o raciocínio estendido comprasse calibração, seria uma resposta em nível de modelo para o problema deste artigo, comprável no checkout. Um experimento pareado em um fornecedor líder diz que compra algo diferente. O gemini-3.1-pro do Google (cujo raciocínio não pode ser desabilitado) respondeu ao mesmo conjunto de questões congeladas sob dois orçamentos, uma configuração de esforço de raciocínio baixo e o orçamento dinâmico padrão do fornecedor, com temperatura zero, prompts e parser idênticos, e custo por questão registrado. Nas 233 questões respondidas sob ambos os orçamentos na data desta versão: acurácia 75,1% (baixa) versus 76,4% (padrão), nenhuma diferença detectável (McNemar exato p = ,648); confiança declarada 3,1 pontos maior sob o orçamento padrão (Wilcoxon z = 4,68, p < ,0001); calibração ligeiramente pior sob o orçamento padrão (ECE pareado 0,100 vs 0,082; diferença de confiança-menos-acurácia +9,3 vs +7,5 pontos); preço por questão 2,1×. A comparação de acurácia é um nulo de um tipo específico: estes dados mostram nenhuma diferença de acurácia detectável em n = 233 (McNemar exato p = ,648), e a equivalência é formalmente estabelecida apenas em uma margem grosseira. Um TOST pareado limita a diferença de acurácia dentro de ±5 pontos (diferença +1,3 pontos, IC 90% [−1,8; +4,4]; ambos os p unilaterais ≤ ,024) mas o estudo não tem poder para estabelecer equivalência em ±2–4 pontos, enquanto o aumento de +3,1 pontos na confiança declarada é estatisticamente inequívoco (Wilcoxon p < ,0001). Dentro dessa margem, o gasto duplicado comprou confiança adicional declarada e nenhuma correção adicional mensurável: excesso de confiança como um recurso pago, e uma instância dentro do modelo da tese da migração. Os dólares extras foram para a camada de modelo e não produziram nada que um consumidor pudesse verificar, enquanto a camada arquitetural acima dela transformou a confiança em um sinal verificável. O resultado é um piloto, relatado como tal: a comparação cobre 233 questões pareadas, e o design completo de 1.500 pares estreita a margem de equivalência para cerca de dois pontos; a composição de canal e a censura de limite de token são documentadas como confundidores no pacote de replicação; a coleta está continuando.
Figura 18. O que um orçamento de raciocínio maior compra
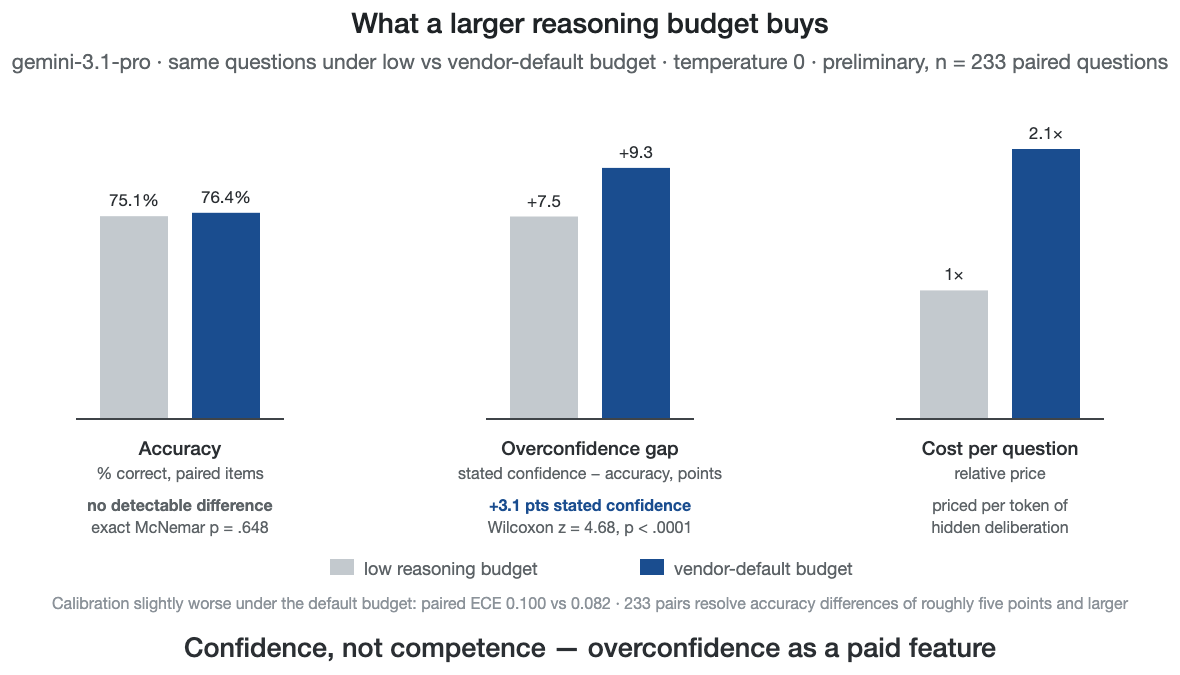
Comparação pareada sob dois orçamentos de raciocínio — confiança declarada sobe, acurácia não.
Tabela 11. Orçamento de raciocínio, comparação pareada (gemini-3.1-pro, 233 questões respondidas sob ambos os orçamentos, temperatura 0; preliminar)
| Orçamento de raciocínio baixo | Orçamento padrão do fornecedor | |
| Acurácia (itens pareados) | 75,1% | 76,4% (McNemar p = ,648) |
| Confiança declarada média | −3,1 pontos vs padrão | +3,1 pontos (Wilcoxon p < ,0001) |
| Calibração (ECE pareado) | 0,082 | 0,100 |
| Diferença de confiança − acurácia | +7,5 | +9,3 |
| Custo por questão (relativo) | 1× | 2,1× |
As configurações de esforço de raciocínio não eram idênticas entre os braços: cada fornecedor foi consultado através de sua interface comercial padrão com o esforço padrão dessa interface (configurações registradas por modelo no pacote de replicação), então a acurácia absoluta de um fornecedor pode carregar um componente de esforço. Isso não atinge o mecanismo. A classificação de acurácia não é decisiva (o rótulo de fornecedor líder não garante nada), o portão sobrevive removendo qualquer membro (conselho livre de solução remove 81,2%), e um esforço maior levanta confiança declarada com acurácia plana, como a comparação pareada acabou de mostrar, então qualquer acurácia que infla aparece como erro confiante, a falha que o portão intercepta.
Limitações de cobertura da onda de fornecedores líderes. A onda é um snapshot congelado de 5 de agosto de 2026, então modelos lançados posteriormente, como Grok 4.6 (12 de agosto) e posteriores líderes da Artificial Analysis como Claude Opus 5, têm datas posteriores e não podem entrar em um benchmark pré-comprometido. A posição superior virou em dias. Esse é o problema de identificação que o portão contorna (acordo é robusto em lista, sobrevivendo a remoção de qualquer membro). Dois laboratórios incluídos ficam abaixo da fronteira atual em leaderboards de capacidade geral: o fornecedor líder da Mistral fica atrás do topo em todos os índices agregados verificados, e o ERNIE de propósito geral do Baidu se classifica fora do top 30 no Humanity's Last Exam (sua força está em tarefas aumentadas por busca e agênticas, onde ERNIE 5.1 classifica #4 no LMArena Search Arena). Eles são mantidos para preservar a cobertura do ecossistema europeu e de todos os principais laboratórios chineses. Dos dois laboratórios de topo que estavam em vez disso fora do escopo da onda, Meta Superintelligence Labs (Muse Spark 1.1; #4 no Humanity's Last Exam) e ByteDance (Seed 2.1; #10), um foi posteriormente tentado e interrompido (Meta, abaixo) e um não pôde ser alcançado de forma alguma (ByteDance, abaixo).
Seed 2.1 do ByteDance não pôde ser incluído: BytePlus ModelArk retornou "não disponível em seu país/região" para uma conta internacional recém-registrada (tentativa ao vivo, 5 de agosto de 2026), nenhum agregador serve o fornecedor líder, e o canal doméstico Volcano Ark requer verificação da China continental. ERNIE 5.1 do Baidu, o atual fornecedor líder, é similarmente restrito à plataforma doméstica Qianfan (tentativa ao vivo, 5 de agosto de 2026). Onde o fornecedor líder atual de um laboratório é inacessível, a regra de fallback é o modelo lançado abertamente mais forte desse laboratório. Para o Baidu, este é ERNIE 4.5 VL 424B (open-weights), que é usado em seu lugar. Isso é uma descoberta em si: os fornecedores líderes atuais de dois dos seis principais laboratórios chineses não são acessíveis a pesquisadores externos a partir de agosto de 2026.
Meta é a terceira falha de acesso da onda, e o obstáculo foi minha conta, não a geografia. Na primeira onda (nível intermediário), Meta estava ausente por um motivo de infraestrutura documentado: sua API Llama de primeira parte foi descontinuada em 6 de julho de 2026, antes do congelamento do protocolo (registrado no manifesto de execução), e o laboratório foi representado no nível local por seu Llama-3.2-3B de pesos abertos, que se mostrou um dos membros mais instrutivos do painel (a menor correlação de erros em toda a matriz). Para a onda principal, o muse-spark-1.1 da Meta foi adicionado no meio da onda quando se tornou alcançável, e a coleta então falhou de três maneiras em sequência, cada uma registrada: (i) a chave da API Meta Model de primeira parte morreu no meio da execução em 5 de agosto com 251 respostas válidas coletadas, e o console do desenvolvedor não emitiria uma substituição; (ii) uma rota de fallback de agregador rendeu 21 respostas adicionais antes de (iii) o endpoint do provedor Meta começar a retornar HTTP 403 `user_blocked`, "o acesso foi restringido devido a violações repetidas de política," para perguntas de recuperação de fatos de livro fechado de um benchmark público, feitas em temperatura zero. O resultado líquido é 272 de 1,500 itens (18.1%) coletados e reportados como parciais: a análise agrupada congelada inclui as 251 respostas de primeira parte (o reforço do agregador chegou após o congelamento da análise), e a estimativa por laboratório da Meta (−92.0% dCF em 125 respostas confiantes) é consistente em direção com o painel mas muito imprecisa para inferência. O bloqueio é em si uma descoberta: em agosto de 2026, um pesquisador independente não pode completar uma avaliação factual de 1,500 perguntas do principal da Meta por nenhum canal autorizado. Entre eles, os três fracassos de acesso da onda, um principal com região bloqueada (ByteDance), um principal apenas doméstico (Baidu), e um banimento de pesquisador (Meta), são o argumento teórico em forma empírica: a verificabilidade na camada de modelo é obtida à mercê do fornecedor, e uma camada de confiança arquitetônica não pode contar com a mercê do fornecedor.
4. Uma implantação extrema: delegação com apostas irreversíveis
A forma usual de estudar a confiança do consumidor é uma pesquisa ou uma tarefa de laboratório. Eu tinha um instrumento mais severo disponível: uma implantação estendida e de alto risco em que toda consequência recaía sobre mim. Esta seção é uma prova de existência e testemunho de design de um único operador em conflito de interesses, não evidência empírica de generalidade, e nenhum de P1–P5 repousa sobre isso. Os dois tipos de evidência se entrelaçam. No laboratório, o efeito de calibração foi medido sob controle de placebo; na implantação, onde os erros eram irreversíveis, as mesmas três propriedades eram a diferença entre a delegação ser possível e ser imprudente.
A implantação não é de um cliente e não é uma simulação: sou simultaneamente o operador, o desenvolvedor e o analista. A camada de evidência é ancorada em hash e cada medição é recomputável de forma independente, então o conflito incide sobre a defesa e sobre o que escolhi medir, não sobre se os números se reproduzem. A configuração combina competência de consumidor ordinário com apostas irreversíveis, onde cada fraqueza arquitetônica é punida rápida e visivelmente.
Metodologicamente, este é um caso singular extremo e revelador (Yin, 2018) na tradição interpretativa e analítico-autoetnográfica (Walsham, 1995; Gould, 1991; Anderson, 2006), com as cautelas evidenciárias dessa tradição em vista (Wallendorf & Brucks, 1993): registros primeiro, interpretação marcada como interpretação. A justificação é acesso: um pesquisador não pode eticamente designar participantes para apostar resultados irreversíveis do mundo real em uma arquitetura de IA, então o único observador disponível é um participante que escolheu a aposta por si mesmo.
A análise se baseia em registros contemporâneos ancorados em hash. A camada de evidência da implantação é em si o registro: etapas críticas (quais modelos foram consultados, onde divergiram, o que era controlado, o que confirmei) foram registradas na época, então as observações repousam em registros reproduzíveis e não apenas na memória. O viés retrospectivo não pode ser removido da interpretação, então marco cada lugar onde a interpretação excede o registro. Os registros do período de implantação da camada de evidência do sistema são ancorados em hash a partir de 2 de agosto de 2026: um manifesto SHA-256 por arquivo de 129 arquivos (7,414,043 bytes) cuja raiz é 2f88a16611e51c0c12c8015754c89269e782ea167a89b5ed2a881f18eee4defc, e a âncora é publicada com este artigo. Os registros permanecem lacrados até que a implantação se encerre, porque a citação seletiva de uma implantação ativa seria pior do que nenhuma. O compromisso pode ser verificado: qualquer registro liberado posteriormente corresponde ao manifesto ancorado ou não, então a edição retroativa, substituição ou retrodatação é detectável por qualquer leitor desta página. Um tratamento quantitativo mais completo da telemetria é deixado para trabalhos futuros, pela mesma razão.
Três observações de viver dentro deste loop são oferecidas como hipóteses sobre o que se transfere além da configuração original, alimentando as proposições da Seção 3, e os eventos em que repousam foram registrados pela implantação na época.
O desacordo é um sinal utilizável pelo consumidor. Quando modelos independentes divergiam sobre uma questão consequente, a divergência em si, trazida à superfície em vez de suprimida, me dizia onde a incerteza genuína estava: um aviso antecipado gratuito que nenhum serviço de modelo único pode fornecer.
A evidência muda o comportamento antes de mudar uma disputa. Saber que cada passo consequente foi registrado tornou a delegação psicologicamente viável; o registro era a pré-condição da confiança, não uma consideração posterior de auditoria.
O controle de confiança importa mais do que a precisão média. Os eventos praticamente perigosos eram os erros confiantes, nunca os resultados medíocres. A verdadeira contribuição da arquitetura foi tornar a alta confiança cara: uma resposta tinha que sobreviver ao acordo entre modelos para ganhá-la, em vez de obtê-la gratuitamente da fluência de um modelo.
5. Implicações: da persuasão à infraestrutura
Design e experiência
Para design de serviço. A unidade de design de serviço de IA confiável está se deslocando do modelo para o pipeline. Isso significa rotear consultas consequentes por meio de modelos independentes, tratando discordância como um elemento de UX de primeira classe, anexando evidências por padrão e precificando o processamento multimodelo contra o custo assimétrico de erros confiantes, com o caminho caro reservado para solicitações onde as apostas se concentram, assim como a triagem de fraudes reserva escrutínio para transações de risco. A infraestrutura já existe: cascatas orientadas por custo que escalizam solicitações difíceis para camadas caras são engenharia padrão de agente, e para um serviço que já roteia por dificuldade, a arquitetura marginal de roteamento por consequência é praticamente zero. Os modos de falha que ambos os experimentos mediram deixam duas regras rígidas, e elas são requisitos de design, não preferências. As posições devem ser coletadas cegas e registradas antes de qualquer deliberação entre modelos, pois um pipeline com deliberação em primeiro lugar fabrica exatamente o consenso que a arquitetura deveria controlar (as pressões de conformidade da Seção 3). A segunda regra: consenso unânime e confiante sobre um conjunto de opções restringidas é uma bandeira vermelha para revisão, não uma luz verde para execução: tanto os painéis de modelos quanto os participantes humanos da Seção 6 trataram exatamente esse consenso como certificação.
A economia funciona porque a escalação é graduada, uma arquitetura de confiança graduada: na implantação descrita aqui, as camadas de processamento abrangem aproximadamente três ordens de magnitude em custo por solicitação entre uma resposta de modelo único e uma deliberação multimodelo completa (em julho de 2026), portanto a camada cara é comprada apenas onde as consequências se concentram. A lógica de equilíbrio é da pontuação de fraude (Figura 14). A orquestração compensa sempre que a probabilidade de um erro confiante multiplicada por seu custo total (reembolso, churn sob tolerância de um erro, responsabilidade civil, risco regulatório) excede a computação marginal da verificação. Para transações de alto risco, essa desigualdade não é próxima.
A queda nos preços de inferência (aproximadamente duas ordens de magnitude em capacidade fixa em três anos, uma leitura conservadora dos declínios rastreados; Appenzeller, 2024) não dissolve o argumento, porque a proporção, não o custo absoluto, é a quantidade estrutural: ambas as camadas seguem a curva de preço para baixo juntas, e a inferência barata torna a camada cara acessível em apostas cada vez menores. A verificação segue sua própria segunda curva: conjuntos de verificadores fracos, sem dados rotulados, atingem a precisão de seleção de resposta de modelos de raciocínio de fronteira de componentes abertos de 70 bilhões de parâmetros (Saad-Falcon et al., 2025). Dada a tolerância de um erro do consumidor, a comparação não é "resposta barata versus resposta cara", mas "resposta cara versus cliente perdido".
Dois primitivos voltados para o consumidor completam o design: atrito deliberado (uma pausa marcada antes de ações irreversíveis) e recibos. Ambos intervêm em como a delegação se sente. Os consumidores experimentam IA sociologicamente, não estatisticamente (Puntoni, Reczek, Giesler, & Botti, 2021), e enquanto a execução delegada remove o encontro de serviço da vista, o recibo herda o papel antigo do encontro como o momento da verdade. Um risco viaja com esse enquadramento: tornar a discordância saliente pode anunciar incerteza e deprimir a confiança em vez de calibrá-la (Detjen et al., 2025; Lu, Wang, & Yin, 2024), então quanto de divergência expor, e como, é uma variável de design. Não é um bem gratuito.
Um recibo de orquestração pode ser minimal e ainda fazer seu trabalho (A Figura 8 mostra o mock-up). Três campos carregam a maior parte do valor: (1) quem agiu, os modelos e versões consultados, sob qual autoridade; (2) como eles concordaram, um resumo de divergência em linguagem clara; (3) o que foi verificado, com um ponteiro para o registro completamente reproduzível: pequeno o suficiente para ler num relance e específico o suficiente para ancorar uma disputa, uma reclamação de seguro ou uma auditoria. O mesmo artefato responde à própria pergunta de contabilidade do operador, então o recibo vende duas vezes: para dentro como governança de custo, para fora como confiança justificada. Essa dupla face é uma necessidade. A disposição medida dos consumidores a pagar por transparência sozinha é fraca (no único conjoint com preço, o valor de explicabilidade ficou aquém de €1,99 por mês; König et al., 2022), então uma camada de confiança financiada apenas pelo lado do consumidor não teria recursos suficientes, e o lado de governança de custo do operador a sustenta. O análogo de engenharia mais próximo do recibo são recibos de ferramentas registrados dentro de estruturas de agente para detecção de alucinações (Basu, 2026), que compartilham o instinto mas não o público: esses são registros voltados para desenvolvedores de chamadas de ferramentas individuais, enquanto o recibo de orquestração é sua generalização voltada para o consumidor, por decisão. O recibo convida seu próprio modo de falha: um artefato projetado para parecer verificado sem expor nada que um consumidor pudesse executar novamente. A linha de design que importa é se o registro é genuinamente reproduzível e não apenas em forma de recibo. Uma restrição também vem do lado da privacidade: um artefato que prova o que foi verificado também registra o que foi preferido, então a verificabilidade e a privacidade devem ser otimizadas em conjunto (Alavi & Nozari, 2026).
Uma última peça da economia de recibos recebe um nome próprio, a economia da verificação. Um registro à prova de adulteração vale apenas o que vale o incentivo de alguém abri-lo, e a década dos sistemas descentralizados é a advertência aqui: registros públicos e à prova de adulteração em blockchain não transformaram usuários comuns em auditores, e arquiteturas "sem confiança" reintroduziram silenciosamente intermediários confiáveis em cada ponto prático (Werbach, 2018). O Dilema do Verificador é a versão formal: onde a verificação é custosa e os resultados corretos são o caso comum, o verificador racional pula a verificação. A demanda por verificação deve ser concentrada onde já existe um retorno privado para a verificação, entre seguradoras, auditores e processos de disputa, com o consumidor herdando a verificação como um subproduto desses mercados; a função do recibo para o consumidor é disponibilidade em disputa, não leitura noturna. A questão de financiamento decorre do mesmo ponto, e ambas as respostas ingênuas a ela falham: um orquestrador pago pelo consumidor precifica a neutralidade como um bem de luxo, e um orquestrador pago pelo comerciante reimporta o conflito que existe para remover. Isso deixa o modelo que a economia bilateral do recibo já implica. A camada é paga da forma como a auditoria é paga, por partes que precisam do risco precificado em vez da história contada (operadores comprando governança de custos e redução de responsabilidade, seguradoras comprando perfis de risco subscritos, processos de disputa comprando evidência), com pisos regulatórios onde esses mercados a subdemandam. O consumidor compra o serviço, não a neutralidade, e herda a neutralidade como seu subproduto. O mesmo problema tem uma versão de estrutura de mercado. Uma plataforma que é simultaneamente mercado, fornecedor de modelo e rede publicitária é estruturalmente incapaz de fornecer neutralidade, que é o ponto de conflito de interesses em forma de mercado, e o histórico de priorização algorítmica (colocação patrocinada, parceiros preferidos) diz que os atores dominantes monetizarão o roteamento se puderem. Onde essa pressão opera, o piso de neutralidade é regulatório ou de protocolo aberto, não voluntário. Se a demanda inicial do consumidor por evidência é fraca, a adoção da confiança arquitetônica pode ser impulsionada menos pela escolha do consumidor do que pelo lado da conformidade e seguro, uma migração através de instituições em vez de preferências, com consumidores herdando arquitetura verificável como padrão. O resultado da calibração impede que essa rota seja decorativa: consumidores demonstravelmente usam o sinal arquitetônico uma vez que é colocado diante deles, mas ainda não pagam para convocá-lo. Há uma hipótese rival aqui: a confiança pode migrar para responsabilidade e instituições em vez de para arquitetura verificável. Os consumidores confiam em direitos de contestação, não em auditorias de livro-razão; redes de cartões ampliaram o comércio remoto através de direitos de disputa em vez de através de consumidores inspecionando registros de autorização; nessa leitura, o registro de decisão é encanamento que torna a responsabilidade computável em vez de um objeto de confiança do consumidor. Os dois relatos predizem coisas diferentes: na conta arquitetônica consumidores recompensam a verificabilidade quando podem vê-la; na conta institucional eles a recompensam apenas quando um remédio está anexado, e a confiança do consumidor então permanece ancorada na instituição enquanto a confiança da instituição migra para a arquitetura. O design de tempo de disputa especificado abaixo os discrimina. E cada camada de registro herda o problema do oráculo: o registro certifica o processo, e apenas as próprias verificações do processo atingem os fatos. A assimetria que o recibo inverte é aquela que a literatura de crítica de plataforma documenta: arquitetura, não política declarada, é o regulador operacional da conduta digital (Lessig, 2006), e até agora seus instrumentos apontaram para o consumidor em vez de serem mantidos pelo lado do consumidor (Zuboff, 2019; Möhlmann & Zalmanson, 2017), e o recibo volta esses instrumentos do outro lado.
A camada de evidência deve ser visível no próprio produto, não arquivada em um registro de back-office. A engenharia de software convergiu recentemente para um nome para o invólucro de tempo de execução em torno de modelos agênticos, o arreio do agente, e no reconhecimento de que o arreio, e não o modelo, é o que pode ser certificado, regulado e confiável. A confiança arquitetônica especifica o que um arreio deve produzir para merecer esse papel.
Tanto a escala para a qual esta seção projeta quanto o recuo que projeta contra já estão no registro. O assistente do Klarna processou 2,3 milhões de conversas em seu primeiro mês, dois terços dos chats de atendimento ao cliente da empresa e o trabalho estimado de 700 agentes em tempo integral (Klarna, 2024, números reportados pela empresa). Quatorze meses depois o CEO reverteu o curso publicamente: a qualidade da saída havia sofrido, o recrutamento humano foi reiniciado, e o compromisso estabelecido tornou-se que "sempre haverá um humano se você quiser" (Daly, 2025). Lido arquitetonicamente, como minha interpretação em vez da razão declarada da empresa, o par de anúncios enquadra exatamente a lacuna que este artigo nomeia. O nível de volume funciona com custo de máquina, mas sem escalação graduada e sem sinal de qualidade verificável, a delegação recuou para a linha de base humana. O que tornaria a posição entre esses anúncios estável é uma arquitetura de confiança graduada: barata onde as apostas são baixas, verificada onde as apostas se concentram, e humana onde a verificação falha.
Mercados e regulação
Para serviços transfronteiriços. A neutralidade se estende além dos fornecedores de modelos para jurisdições. Uma camada de orquestração pode impor roteamento ciente da jurisdição e registrar a aplicação, transformando a conformidade de soberania de dados de uma representação legal em uma propriedade de tempo de execução auditável. A diferenciação à qual responde foi medida: em 25 países, uma mediana de 53% dos respondentes confia que a UE regulamente a IA efetivamente, contra 37% para os Estados Unidos e 27% para a China (dados Pew, relatados em Stanford HAI, 2026, um relatório de instituto, não revisado por pares). Onde a confiança varia por jurisdição, uma arquitetura que pode provar quais regras de qual jurisdição se aplicaram tem real valor.
Para comércio agêntico. A integração Visa–ChatGPT torna os três componentes concretos. Limites e listas brancas são proteções estáticas do lado do consumidor. A confiança arquitetônica adiciona a camada dinâmica do lado do serviço: compras verificadas cruzadamente por modelos independentes (diversidade), um registro reproduzível do porquê o agente escolheu este comerciante neste preço (evidência), e uma camada de orquestração cuja receita não depende de qual fornecedor ou comerciante vence (neutralidade).
A indústria de pagamentos já começou a construir os andares inferiores dessa pilha. O Trusted Agent Protocol da Visa (outubro de 2025, com Cloudflare; Visa, 2025) assina a identidade de um agente criptograficamente em suas solicitações: assinaturas específicas de comerciante e propósito, limitadas no tempo e à prova de repetição. O Agent Payments Protocol do Google (Google Cloud, 2025), contribuído juntamente com a estrutura da Mastercard para a FIDO Alliance em 2026, codifica a intenção do usuário como mandatos assinados transportados como Verifiable Credentials W3C (W3C, 2025). O Verifiable Intent da Mastercard (uma estrutura conjunta com o Google; anunciado em março de 2026; Mastercard, 2026) afirma seu propósito em palavras que este artigo poderia ter escrito, um registro à prova de manipulação do que o usuário autorizou quando um agente de IA atua em seu nome, com pilotos iniciais relatados em mercados asiáticos e latino-americanos em 2026. A evidência de identidade e intenção está sendo padronizada agora, assim como o formato do registro: a arquitetura SCITT do IETF (RFC 9943, 2026) especifica o mesmo padrão, declaração assinada → log de transparência de apenas acréscimo → recibo, que a camada de evidência do artigo pressupõe. A interface por meio da qual a delegação ocorre não é nem moralmente neutra. Em treze experimentos, pessoas que delegaram a IA se comportaram de forma menos honesta, mais acentuadamente sob definição de metas vagas, e agentes de máquina realizaram instruções totalmente desonestas muito mais frequentemente do que agentes humanos (Köbis et al., 2025). Interfaces que forçam a intenção a ser declarada em termos específicos são infraestrutura ética.
Nenhum protocolo ainda cobre o terceiro andar, evidência de decisão: como o agente escolheu este comerciante, este produto, este preço; se verificações independentes concordaram; qual era o valor de sua confiança (a Figura 15 desenha os três andares). Essa é a camada que este artigo nomeia, e "conhecer-seu-agente" deveria amadurecer para exatamente essa questão de processo, com a unidade de supervisão migrando para a transação. O que a arquitetura pode garantir é a existência do registro, não sua leitura. Se alguém abre tais registros é uma questão empírica que apenas a implantação pode responder.
Figura 15. A pilha de evidência
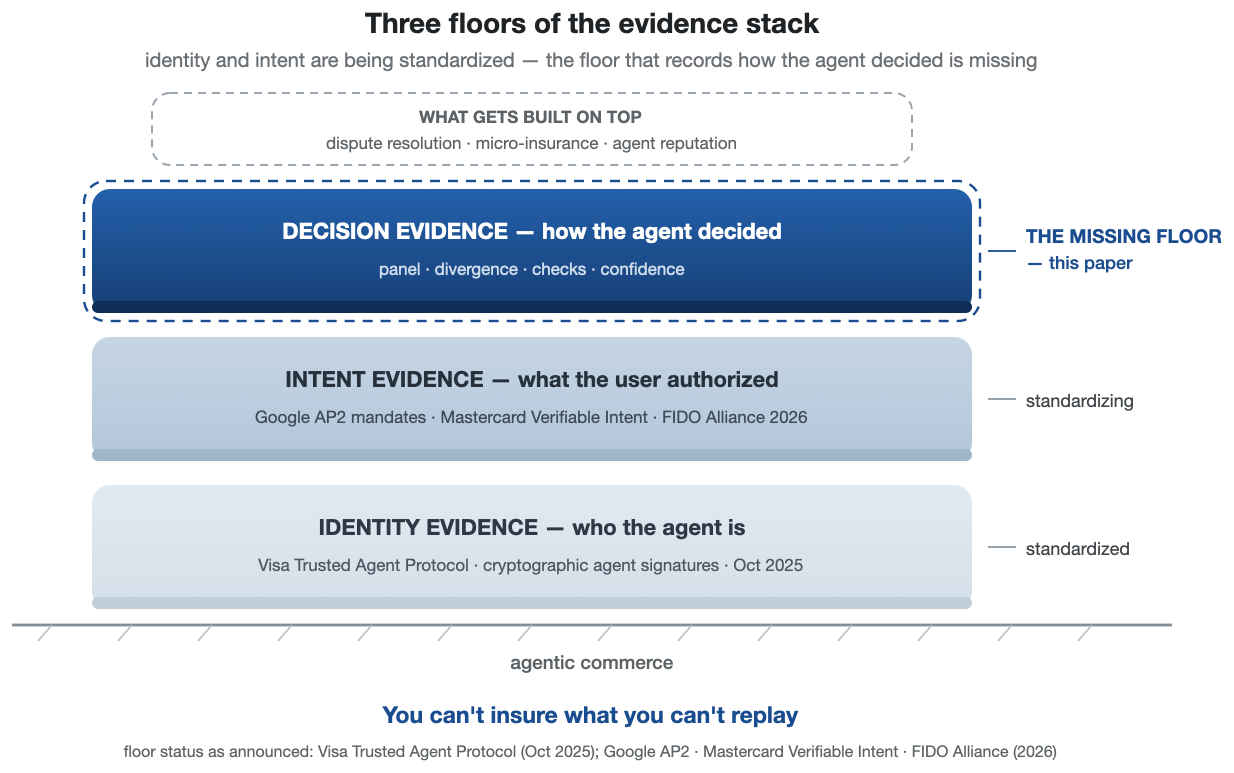
A evidência de identidade e intenção está sendo padronizada agora; a evidência de decisão é o andar faltante que este artigo nomeia.
As primeiras auditorias sistemáticas do comportamento de compra de agentes mostram por que a evidência de decisão não pode esperar. Allouah et al. (2026), executando ensaios randomizados em uma caixa de areia de comércio eletrônico controlada, descobriram que os agentes de compras exibem vieses posicionais fortes, concentram a demanda em alguns produtos "modais" e reorganizam essas preferências drasticamente quando o modelo subjacente é atualizado. Sem um registro de como a escolha foi feita, nada disso é visível ao consumidor, ao comerciante ou ao regulador. A diversidade é a resposta de design aqui, já que um painel dilui as peculiaridades posicionais de qualquer modelo único, e a responsabilidade é o que a evidência de decisão fornece: o que esses auditores tiveram que construir uma caixa de areia para observar, um serviço arquitetonicamente confiável registraria em produção.
Esse quadro também se estende além do consumidor, para confiança máquina-a-máquina. Nos fluxos de trabalho agênticos B2B não há nenhum humano no loop para sentir confiança alguma, portanto o único substrato possível é processo verificável, com agentes trocando exatamente os artefatos descritos aqui e computando se devem transacionar. Como a confiança se agrega e se propaga em cadeias de delegação em escala, e quais são os custos de overhead de registro e verificação da camada de evidência em volume de produção, são questões abertas aqui. As cadeias agudizam o requisito, já que uma cadeia é tão confiável quanto seu elo menos evidenciado: os registros devem se compor. Onde não há consumidor, confiança arquitetônica é, plausavelmente, a única forma de confiança disponível.
Um desenvolvimento estrutural que a literatura de confiança não acompanhou é a guerra de protocolos. Pilhas concorrentes de comércio agêntico (OpenAI com Stripe, o Agentic Commerce Protocol; coligação Universal Commerce Protocol do Google; Perplexity com PayPal; redes de cartão e padrões abertos por baixo) estão fragmentando o comércio segundo linhas de protocolo de fornecedor, exatamente como serviços de IA se fragmentaram segundo linhas de modelo de fornecedor, e o argumento de neutralidade generaliza quase palavra por palavra: um agente de consumidor que só pode transacionar dentro de um protocolo de um fornecedor é o agente do fornecedor, não do consumidor. Qualquer camada que arbitra entre protocolos enfrentará os mesmos três requisitos, independência, evidência e nenhuma participação, e se tal camada se consolidar a batalha pela prateleira se torna a batalha pelo verificador.
Para o mercado de evidência. Em 2026 isto deixou de ser uma previsão. No lado da responsabilidade, o seguro se moveu primeiro e em duas direções ao mesmo tempo. Endossos de exclusão opcionais para reivindicações de IA generativa entraram no kit de ferramentas padrão de responsabilidade geral em janeiro de 2026 (formulários ISO CG 40 47 e CG 40 48, endossos que as seguradoras podem optar, não exclusões automáticas; em poucos meses, principais seguradoras registraram para adotar esses endossos ou equivalentes proprietários). Na mesma janela, as primeiras apólices de agentes de IA foram escritas ao contrário, contra evidência: o padrão de agente AIUC-1 existe para gerar, através de auditorias de equipe vermelha, os perfis de risco empíricos que as seguradoras exigem para subscrever, e fevereiro–março de 2026 trouxe seu primeiro auditor credenciado, primeira apólice de agente e primeiras certificações empresariais. Espremido entre exclusão geral e subscrição baseada em evidência, o registro se tornou a unidade de alocação de responsabilidade: um agente sem histórico inspecionável enfrenta cobertura em forma de exclusão, e um agente com histórico é um risco cotável.
Do lado regulatório, as obrigações de transparência do Artigo 50 da Lei de IA da UE, incluindo divulgação obrigatória de interação de IA aos consumidores, tornam-se executáveis em 2 de agosto de 2026 (com uma obrigação de marcação transitória estendendo-se até 2 de dezembro de 2026), com multas, na leitura deste artigo das disposições de penalidade da Lei, de até €15 milhões ou 3% do volume global de negócios. A Comissão Europeia adotou sua orientação do Artigo 50 em 20 de julho de 2026 (Comissão Europeia, 2026), e a simplificação paralela do Digital Omnibus (assinada em 8 de julho) não atrasa as obrigações de agosto. Os sistemas existentes recebem apenas um adiamento limitado, até dezembro de 2026, para marcação de conteúdo legível por máquina. Obrigações de risco mais amplas entram em vigor em fases de 2027 a 2028.
A camada de evidência muda essa obrigação: um registro à prova de adulteração que inclui prova de que a divulgação de IA obrigatória foi mostrada a este usuário nesta sessão converte, na leitura deste artigo, uma exposição legal de até €15 milhões em uma propriedade de tempo de execução auditável, conformidade como um subproduto da arquitetura. Seguradoras que subscrevem responsabilidade de agentes de IA precisam exatamente desses registros, e rastreabilidade e responsabilidade são características centrais no Marco de Gerenciamento de Riscos de IA do NIST. O precedente regulatório é mais antigo que a tecnologia. A orientação de risco de modelos do setor bancário exigiu validação independente por partes independentes dos desenvolvedores de um modelo desde 2011 (Federal Reserve SR 11-7), um requisito que um painel orquestrado automatiza, torna contínuo e estende a cada resposta consequencial. A lei do consumidor já reserva a saída humana: o Artigo 22 do RGPD concede o direito de intervenção humana em decisões puramente automatizadas com efeitos significativos, e escalação em divergência é, na leitura deste artigo, a forma de tempo de execução de um direito legal existente. A Lei de IA chega ao mesmo design pelo lado da supervisão: o Artigo 14 do Regulamento (UE) 2024/1689 exige que sistemas de IA de alto risco sejam construídos para supervisão humana eficaz, e uma arquitetura que exponha divergência e encaminhe casos não resolvidos para um humano implementa esse dever de supervisão como uma propriedade de tempo de execução em vez de um documento de conformidade.
Uma vez que o registro existe, dois produtos derivados seguem, ambos conjecturas de curto prazo. Micro-seguro em nível de transação seguiria uma compra específica de agente por centavos, precificada a partir do registro de evidência, não assinável contra um agente opaco e trivial contra um reproduzível. O outro é reputação do agente: históricos de evidência longitudinais se agregam naturalmente em pontuações de reputação para agentes e orquestradores. Serviços que produzem históricos de qualidade de auditoria como um subproduto da operação teriam um ativo que seus concorrentes teriam que retrofitar.
Como a infraestrutura desse tipo se torna institucional é em si uma hipótese. A trajetória em que este artigo aposta, produtos primeiro, padrões depois, mandatos por último, é uma de várias que a história da infraestrutura de confiança exibe (redes ATM compartilhadas, livros de regras de redes de cartões posteriormente ratificados por regulamento, a oferta de verificação da blockchain ainda aguardando demanda). Ela também tem um programa de pesquisa identificado por trás dela. A linha de mercados regulatórios de Hadfield, reguladores privados licenciados por autoridades públicas, com organizações de verificação independentes como a instituição estruturante (Hadfield, 2017; Clark & Hadfield, 2020; Hadfield & Clark, 2026), atinge-a pelo lado da oferta de governança. Este artigo atinge-a pelo lado da demanda de delegação do consumidor, e os dois programas se encontram no recibo. Por baixo, fica a questão mais difícil de se um recibo vendido como um recurso de produto jamais se endurece em uma instituição. Se não o fizer, permanece um ornamento de governança em vez de uma camada de governança, o que refutaria a reivindicação central deste artigo. O ponto de refutação é pré-registrado: chame o recibo de uma camada de governança layer quando pelo menos dois padrões da indústria exigem registros de decisão rastreáveis para transações agênticas, serviços carregando todos os três componentes lidam com a maioria do volume de transações agênticas de alto risco, e pelo menos um regulador nacional reconhece tais registros em sua alocação de responsabilidade. A falha persistente dos três é o que "ornamento" significa operacionalmente. Se a verificação tiver sucesso como infraestrutura, ela se commoditiza e a confiança migra para a própria utilidade compartilhada, a arquitetura presente incluída, o que encerraria qualquer fosso mesmo quando a infraestrutura tivesse sucesso.
Quem é responsável quando uma decisão orquestrada erra permanece uma questão aberta: o orquestrador, os fornecedores de modelo ou o consumidor que autorizou o agente.
A lei começou a fechar a saída fácil. A lei AB 316 da Califórnia, efetiva em 1º de janeiro de 2026, proíbe qualquer réu que desenvolveu, modificou ou usou um sistema de IA de argumentar que a IA autonomamente causou o dano, enquanto deixa as defesas ordinárias e a alocação comparativa de culpa intactas. Ela não impõe responsabilidade estrita. Isso torna a questão de alocação inevitável, e qualquer que seja a forma como a doutrina a resolva, o registro reproduzível é aquilo a partir do qual qualquer alocação de responsabilidade seria computada. A pesquisa jurídica chegou ao mesmo destino, argumentando que o kit de ferramentas da lei de agência clássica não se transfere para agentes de IA e que o que é necessário é uma nova infraestrutura de visibilidade e responsabilidade (Kolt, 2025), o predecessor mais próximo do argumento deste artigo na literatura de governança, abordado pelo lado da oferta de supervisão, onde este artigo se aproxima do lado da demanda por ela. Confiança arquitetônica é o substrato probatório em que uma doutrina de responsabilidade emergente poderia plausivamente funcionar.
Medição e a agenda de pesquisa
Para medição de confiança. Instrumentos padrão medem atitudes em relação a uma marca ou interface. A atitude que vale a pena medir é disposição para delegar, não a resposta para "você confia nesta IA": que classe de decisões, em que apostas, o consumidor entregará ao agente sem revisar cada etapa? Delegação é comportamental, monótona em confiança garantida e diretamente ligada à receita. Ao lado dela estão as questões sobre se o consumidor sabe como a resposta foi produzida, se conseguem alcançar o registro e se a discordância exposta melhora ou degrada sua calibração de confiança.
A pesquisa era o recibo da era humana: enquanto o consumidor realizava a busca, a comparação e a escolha, perguntar ao consumidor era uma forma defensável de aprender o que aconteceu. Delegação remove o ator para o qual o questionário foi construído para interrogar, então o traço primário do episódio se torna o artefato que a arquitetura produz, e o recibo é nesse sentido preciso o traço de transação primário da era delegada. Os dois instrumentos não competem: o recibo registra o que a máquina fez e não diz nada sobre apropriação subjetiva, autonomia sentida ou carga cognitiva, que permanecem no território da pesquisa. (Isso dissolve uma tensão aparente com a Seção 1, cuja evidência motivadora é ela própria pesquisas de preferência declarada: pesquisas medem o que os consumidores sentem atualmente sobre um mercado que mal existe, enquanto o recibo mede o que os serviços delegados realmente fizeram uma vez que existem.) Essa ponte pode ser testada emparelhando medidas de atitude com os artefatos dos mesmos episódios, estratificados por resultado, e estimando onde o questionário e o registro concordam e qual melhor prevê o comportamento de delegação subsequente. A conjunção proposta carrega parte dessa validação por design, e até que tais estudos existam, métricas baseadas em artefatos complementam a pesquisa em vez de aposentá-la.
Pesquisas do setor já demonstram a linha de base comportamental: em uma pesquisa com consumidores da Gartner divulgada em maio de 2026 (846 consumidores dos EUA, realizada em novembro–dezembro de 2025), 54% dos compradores que usaram IA generativa enquanto faziam compras relatam verificar novamente todas as informações que ela forneceu. A confiança arquitetônica é a produtização do que os consumidores já fazem por si mesmos.
O programa de medição tem aliados naturais no movimento de avaliação holística (Liang et al., 2023) e na ciência emergente de confiabilidade de agentes, que decompõe a confiabilidade em doze métricas porque uma única taxa de sucesso oculta as falhas que importam (Rabanser et al., 2026). A confiança arquitetônica se operacionaliza da mesma forma, comportamentalmente: taxa de erro em previsões confiantes, confiança apropriada, deslocamentos na ponderação do conselho, taxas de anulação, tempo de decisão, e uma estatística especialmente aguçada, a lacuna na taxa de aprovação entre respostas corretas e incorretas, que é a calibração de confiança lida diretamente do comportamento. No lado do registro há cobertura de evidências, divergência de painel medida e taxas de acesso ao recebimento, triangulando pesquisa, comportamento e registros nos mesmos episódios. Nada disso requer ciência nova. O requisito é uma decisão: que estes, e não engajamento, são os números pelos quais uma camada de confiança é responsável. Minhas próprias observações da implantação indicam algo contraintuitivo: incerteza bem apresentada aumentou minha confiança apropriada, e confiei mais no sistema quando ele claramente sabia o que não sabia.
Uma variável dependente adicional pertence à agenda porque a confiança não é a única questão psicológica que a delegação levanta. Os consumidores respondem com menos entusiasmo a um resultado favorável quando um algoritmo o produziu, porque um resultado que não produziram é mais difícil de reivindicar como seu próprio (Yalcin, Lim, Puntoni, & van Osselaer, 2022). A delegação pode aumentar a qualidade objetiva de uma decisão enquanto drena sua propriedade subjetiva. O recebimento se situa nesse dilema: lido de uma forma, restaura a autoria; lido de outra, certifica que o consumidor não fez nada. Qual leitura prevalece é uma questão de design que o framework já instrumentou: o componente Evidence registra o que foi verificado e contra qual padrão (Seção 3), e o recebimento é construído para levar os próprios critérios do consumidor para esse registro, portanto a autoria dos critérios de avaliação é uma variável que a arquitetura expõe em vez de uma que um experimentador inventa. O mecanismo de Yalcin et al., que um resultado que não se produziu é mais difícil de reivindicar como próprio, torna a autoria de critérios o moderador natural, e P5 é a consequência do componente Evidence para a psicologia da apropriação em vez de um ramo lateral da agenda. P5. A saliência do recebimento interage com a favorabilidade do resultado para determinar a apropriação subjetiva de um resultado delegado: para resultados favoráveis, um recebimento saliente restaura a apropriação quando codifica critérios de autoria do consumidor (o padrão que o agente teve de atender era meu, e aqui está a prova de que atendeu) e reduz a apropriação quando os critérios são lidos como da plataforma; a autoria do consumidor dos critérios de avaliação é o moderador de design. O efeito de Yalcin et al. foi observado quando os consumidores esperavam tomar a decisão por si mesmos, portanto P5 é limitado a esse limite e pode reverter sob delegação habitual, e o que distingue o recebimento das manipulações de transparência de processo existentes deve ser implementado, não assumido. O recebimento é verificável e pode levar os próprios critérios do consumidor; um design que omite ambos está testando transparência, não confiança arquitetônica.
A literatura de transparência oferece duas precauções aqui: demasiada transparência processual pode reduzir a confiança (Kizilcec, 2016), e mera divulgação de uso de IA a prejudica (Schilke & Reimann, 2025). A segunda é uma condição de limite no componente Evidence: em treze experimentos, atores que divulgaram o uso de IA receberam menos confiança do que aqueles que não o divulgaram, um dilema de transparência em que tornar o envolvimento da IA mais visível, por si só, reduz a confiança. Se essa penalidade se aplica a qualquer sinal de envolvimento da IA, então uma arquitetura que destaca sua própria maquinaria pode reduzir a confiança mesmo enquanto a torna mais verificável, e o componente Evidence teria efeito oposto exatamente onde é mais saliente. A resposta do framework baseia-se em uma distinção que deve ser demonstrada: verificabilidade não é mera divulgação. O recebimento é um registro verificável de como a resposta foi produzida, não uma declaração de que IA foi usada, e P2 e P3 (com o teste bilateral pré-registrado de H2, o efeito oposto da divulgação nomeado antecipadamente como resultado reportável) são exatamente onde a distinção se justifica comportamentalmente ou falha. A verificabilidade é o que constrói confiança, entregue sob demanda em vez de um muro sempre presente de proveniência, e nem ocultar a maquinaria nem anunciá-la realiza esse trabalho. Quanto do registro exibir, para quem e quando é em si uma variável de design.
O mecanismo proposto para Evidence superar a penalidade de divulgação em vez de agravá-la é que verificabilidade e divulgação trafegam através de canais psicológicos diferentes. A divulgação fornece um rótulo de categoria, indicando que uma IA estava envolvida, que a evidência de Schilke e Reimann vincula a redução de legitimidade. Um recebimento fornece um procedimento, um registro que pode ser aberto, contestado e re-executado, e a literatura de justiça processual sustenta que um processo que se pode desafiar e verificar legitima o ator que o executa (Tax, Brown, & Chandrashekaran, 1998). O canal não requer que a verificação aconteça: o que transmite a confiança é a consciência do consumidor de que a verificação existe e está disponível em uma disputa, a disponibilidade de verificação em vez de seu exercício, que é exatamente a função do consumidor que a economia da verificação atribui ao recebimento acima. A verificação se concentra onde existe um benefício privado para a verificação, e o consumidor herda a verificação como um subproduto, mantendo o registro como uma opção em vez de lê-lo como um documento. A mesma distinção se aplica à apropriação subjetiva (P5): um rótulo de divulgação atribui a decisão à máquina e drena a propriedade, enquanto um recebimento que codifica critérios de autoria do consumidor documenta que o padrão que o agente teve de atender era do próprio consumidor. Se os dois canais de fato se dissociam, com a legitimidade aumentando com procedimento verificável enquanto cai com mera divulgação, é exatamente o que o teste bilateral pré-registrado de H2 foi construído para detectar.
Limitações. O modelo é derivado de análise arquitetônica somada a uma implantação estendida, de alto risco e com operador único. Cada âncora empírica foi obtida naquele único stack, que construí e opero. Aplicado a si mesmo, a validade do artigo é mista pela sua própria estrutura: um autor e um stack (baixa diversidade), um pacote de replicação público ao lado de registros de implantação selados e um registro comportamental embargado até a publicação (evidência parcial), e uma participação comercial declarada (neutralidade comprometida). Replicação independente em outros stacks é necessária antes que qualquer afirmação se generalize. A âncora de hash dos registros de implantação torna qualquer edição posterior, substituição ou alteração de data detectável, então ao abrir os registros, as caracterizações aqui podem ser verificadas contra um artefato que comprovadamente não foi alterado. Os leitores podem verificar a integridade, não o conteúdo, até o desembargo. Os números do mecanismo vêm de APIs de modelo públicas, e o pipeline replica a coleta de ponta a ponta por menos de $15. A renderização do estímulo permanece como confundidor de interface: os estímulos do experimento do consumidor, incluindo o estilo do recibo, são minha própria renderização UX, e os confundidores de nível de interface se desembaraçam apenas através de replicação com renderizações independentes. Coleta em primeiro lugar cega, registros à prova de adulteração e roteamento sem risco são a construção; as regras de agregação e limites de escalação são escolhas de engenharia. Os painéis do experimento são combinações analíticas de uma coleta cega única em vez de um loop de orquestração implantado, e o protocolo de telemetria de campo rascunhado fecha essa lacuna. Os caminhos de verificação não-modelo que o framework nomeia (execuções de sombra, verificações de consistência temporal) são descritos aqui, não testados. A coleta é uma única execução em temperatura zero, que suprime a variabilidade intramódelo e deixa a correlação de linhagem compartilhada no lugar, e as APIs hospedadas não são estritamente determinísticas nem mesmo lá. As respostas factuais curtas do SimpleQA ficam perto do regime de espaço de resposta restrito em que o consenso certifica erro, e a estratificação de dificuldade mostra exatamente esse padrão nos quintis mais difíceis. Um painel de nível médio pode superestimar o benefício da diversidade, já que a correlação de erro aumenta com a capacidade (Kim et al., 2025). O experimento de mecanismo testa perguntas factuais de resposta aberta com respostas verificáveis únicas, e em tarefas generativas de final aberto, onde a equivalência semântica entre respostas é em si um julgamento, o sinal de certificação deve ser re-estabelecido em vez de assumido. Um limite relacionado é a dimensionalidade do espaço de respostas: itens do SimpleQA têm uma única resposta verificável, enquanto as escolhas do consumidor que os agentes executam são julgamentos de utilidade multiatributo subjetivos com muitas respostas defensáveis, então como o consenso se comporta no espaço de preferência, e se o acordo entre agentes independentes até mesmo identifica uma escolha melhor lá, é uma questão empírica aberta (equivalência semântica se torna equivalência de preferência, e a própria classificação uma escolha de modelagem). Uma verificação de ruído de rótulo é executada: na interseção de 351 itens do subconjunto deste estudo com SimpleQA Verified (Google DeepMind, 2025), reclassificar cada resposta do painel contra os rótulos ouro corrigidos deixa o aumento de certificação inalterado ou ligeiramente mais forte (2.7 → 2.8, 4.4 → 4.4, 4.0 → 4.3 nos três painéis, avaliador determinístico), portanto o ruído de rótulo não é o condutor do aumento. Todos os valores de confiança são auto-relatos verbalizados de 0–100 elicitados por um único formato de prompt, e a sensibilidade ao protocolo de elicitação pode variar por fornecedor, então conclusões de discriminação e calibração por fornecedor devem ser lidas como propriedades desta configuração sob este protocolo de elicitação, não como traços de fornecedor fixos. A linha de base de autoconfiança na onda de dezesseis modelos nas Tabelas 6–7 é a confiança afirmada bruta. As linhas de base calibradas mais fortes na tradição de Guo et al. (2017) foram executadas na onda de ponta (escalonamento de Platt e abstenção conformal dividida, Seção 3), onde emergem como complementos do portão em vez de substitutos, e a comparação painel-versus-self da primeira onda deve ser lida em relação à linha de base que os produtos para o consumidor realmente implantam. A estimativa do portão de título (−82.1% das falhas confiantes, IC bootstrap 95% [79.9; 84.1] para os dez braços completos, [80.0; 84.2] com o braço Meta incluído) é uma quantidade pré-especificada única, e as análises circundantes (a grade de sensibilidade de limite, os estratos de dificuldade e contaminação, as ablações do conselho e comparações de linha de base trivial) são verificações de robustez descritivas relatadas sem qualquer correção para comparações múltiplas, e não reivindicam status confirmatório próprio. O único controle de erro por família no artigo é a correção de Holm entre os {H1, H2} pré-registrados do experimento do consumidor. Se o regime de avaliação que recompensa a adivinhação confiante fosse reparado para que a veracidade pudesse ser treinada nos modelos (Kalai et al., 2025), a arquitetura se protegeria contra um problema com uma solução mais barata, embora a evidência e a neutralidade permanecessem irredutíveis a qualquer solução de nível de modelo. Limites adicionais são declarados onde são relatados: as limitações de cobertura da onda de ponta (Seção 3: dois modelos de ponta chineses inacessíveis e uma coleta Meta interrompida), e a comparação preliminar de orçamento de raciocínio de 233 pares, cujos limites TOST estabelecem equivalência em uma margem de ±5 pontos sem poder para limites mais estreitos. As medidas de delegação vêm de uma vinheta hipotética, onde as medidas declaradas superestimam a disposição real em aproximadamente 21% em metanálise (Schmidt & Bijmolt, 2020); o experimento do consumidor realizou 119 primários e 133 agrupados de 200 participantes registrados em seis itens fixos. Uma replicação de substrato de comércio estende o mecanismo além do benchmark: um conjunto novo e pré-congelado de 267 fatos de produto verificados pelo Wikidata (qual empresa fabrica um determinado carro ou avião, qual sistema operacional um telefone executa, qual empresa publicou um jogo, em que ano foi lançado), executado em cego através de um painel de seis modelos independentes (Claude Opus, GPT-5.4, Grok, Qwen, GLM e Mistral), o nível otimizado para custo em que os agentes voltados para o consumidor realmente operam, não o de ponta, reproduz a dissociação, o acordo entre modelos predizendo corretude em AUROC 0.77–0.81 contra 0.63–0.70 para confiança declarada e um aumento de certificação de 4–6×, robusto em painéis compostos independentemente de três a seis modelos cobrindo laboratórios dos EUA, chineses e europeus, e à rigorosidade da classificação (a correspondência determinística de string aqui é a regra primária, conservadora). A extremidade subjetiva e multiatributo do espectro de comércio (trade-offs de preferência, incentivos comerciais adversariais e recuperação fundamentada em ferramentas em relação ao inventário em mudança) permanece não testada.
Variância entre execuções sob amostragem. Um braço de variância testou o limite de execução única e determinística diretamente: uma subamostra estratificada por dificuldade de 100 questões (5 quintis de dificuldade × 20, seed 20260806) foi re-executada a temperatura 0,7 com 3 amostras independentes por questão para 9 dos 11 modelos do painel de onda de ponta; os pontos de extremidade da Meta eram inacessíveis, e a API do Claude Fable 5 não expõe um parâmetro de temperatura. Entre os modelos, todas as três amostras produziram respostas mutuamente equivalentes em 22–77% das questões (mediana 54%), a correção por questão foi idêntica entre as três amostras em 63–97% das questões, e a resposta de temperatura 0 correspondeu à resposta majoritária de temperatura 0,7 em 40–85% das questões. O braço de gpt-5.6-sol carrega uma confundição: foi executado com esforço de raciocínio nenhum, enquanto 1.486 de seus 1.500 registros de onda usaram o esforço padrão (médio, conforme observado acima). Seu delta de precisão de 92,0% → 46,3% nesta subamostra, portanto, confunde temperatura com orçamento de raciocínio, embora suas figuras de consistência entre amostras não sejam afetadas. Excluindo esse braço confundido, a precisão média por amostra a temperatura 0,7 diferiu da precisão determinística de temperatura 0 nas mesmas questões em no máximo 14,0 pontos (gemini-3.1-pro, 49,0% → 63,0%), com os sete modelos restantes dentro de 4,4 pontos. No nível do painel, o portão do conselho (concordância de resposta tripla entre kimi-k3, deepseek-v4-pro e gpt-5.6-sol) abriu em 31,0% da subamostra a temperatura 0, contra 25,0%, 23,7% e 29,8% entre as três execuções de temperatura 0,7. O sinal de concordância subjacente ao resultado principal é estável sob ruído de amostragem.
Status de evidência das afirmações. As afirmações enquadram-se em três níveis de evidência. Estabelecido por estes dados: que a concordância independente carrega um sinal de correção que o autorrelato de um modelo não carrega, sob as condições de contorno estabelecidas (coleta cega, verificadores competentes, questões factuais com resposta aberta com respostas únicas verificáveis); que um portão de discordância fixa corta a grande maioria das falhas confiantes a um custo de cobertura substancial e declarado (−82,1% em cobertura de 30,5%); e as próprias condições de contorno fortes: o consenso certifica o erro em espaços de resposta restritos, a elevação de certificação bruta atenua monotonicamente com a dificuldade (desaparecendo no quintil mais difícil sob a estratificação dentro da coleta; positivo mas mais fraco lá sob a estratificação exógena), e a competência do verificador restringe o valor da certificação. Apoiado pelo experimento comportamental (um design, escala modesta de estudo único, n = 119): que trazer à tona discordância real entre modelos melhora a calibração de confiança em ambas as direções (d = 0,67, Holm p = ,0005; carregado por um de seis itens; verificações de manipulação de onda principal 88–98%; confiabilidades de escala α = ,83–,93); e, como um nulo inconclusivo registrado, que um recibo de primeira exposição estática não move detectavelmente a delegação. Teoricamente proposto, ainda não testado: a complementaridade D×E×N; o efeito de neutralidade (P3); migração de confiança sob delegação crescente; durabilidade pós-falha da confiança baseada em arquitetura (P4); disposição de pagar por verificabilidade; e a afirmação de categoria de mercado da Seção 7.
O próximo passo natural é experimental: medir confiança, calibração de confiança e disposição de pagar entre condições de modelo único e orquestradas, com discordância alternadamente trazida à tona e suprimida. A Seção 6 relata o experimento realizado, pré-registrado e compatível com incentivos. Uma conjunta padrão baseada em escolha estima parte-valores aditivamen e assume trade-offs compensatórios, o que a hipótese de complementaridade nega, então a classe de design tem que permitir estrutura não-compensatória, seja eliminação por aspectos ou designs de escolha forçada com atributos de quebra-acordo, estimada com termos de interação explícitos. Dois níveis de design são especificados. O nível mínimo é um estudo de perfil direcionado, quatro a cinco perfis abrangendo nenhum, componente único, dois componentes e configurações completas, com o trabalho teórico realizado por um contraste planejado, o efeito da configuração completa excedendo a soma dos efeitos dos componentes (super-aditividade), contra o nulo aditivo. O nível completo cruza três níveis por componente (ausente, presente-mas-não-inspecionável, presente-e-inspecionável) em um fatorial entre-sujeitos 3×3×3 (27 células; stakes variado dentro do sujeito em quatro níveis), com pelo menos 80 respondentes por célula (N ≥ 2.160) para potência ≥ 0,85 na interação. Um design binário 2³ não pode recuperar os expoentes de Cobb–Douglas e é insuficientemente potente em tamanhos de efeito plausíveis (d ≈ 0,3–0,4). Três disciplinas de estímulo se aplicam: variar as magnitudes arquitetônicas em si e não apenas sua rotulagem (um rótulo de recibo ausente é ignorância do consumidor sobre evidência, não sua ausência), dar a cada componente um contraste verificável-versus-meramente-afirmado, e emparelhar dados de escolha com rastreamento de processo nos campos do recibo, já que a teoria prediz uso de evidência. Até onde sei, este seria o primeiro design a variar os três componentes conjuntamente. Os blocos de construção de componente único já foram precificados (König et al., 2022; Ioku et al., 2024), e pacotes adjacentes foram executados (Cetinkaya & Krämer, 2024, o instrumento mais próximo e uma fonte de calibração de potência ao lado de Köbis et al., 2025), portanto o estudo é especificado, potenciado e pronto para ser executado. As condições de contorno da construção são estas: a confiança arquitetônica não compensa onde os stakes são baixos e o volume é alto; adiciona pouco onde o conjunto de verificadores não é competente na classe de tarefas; pode certificar erro onde os espaços de resposta são firmemente restringidos; e degrada em direção ao teatro sempre que a independência do painel é afirmada em vez de medida, mais aguçada como a questão aberta de red-team como um recibo manipulado se parece? Uma vez que hiperlinks se tornaram sinais de autoridade, link farms surgiram para fabricá-los, e registros de concordância devem ser esperados para convidar seu próprio cultivo. Dois limites temporais também se aplicam: pistas vencem atenção enquanto evidência vence persistência, então a afirmação diz respeito a qual confiança sobrevive à falha em vez de qual se integra mais rapidamente, e até mesmo uma verificação funcional pode apenas retardar uma espiral do tipo que Chandra et al. (2026) modelam. Onde as consequências se concentram e a independência é real, a confiança arquitetônica ganha seu custo e seu nome (a Tabela 12 coleta as quatro).
Tabela 12. Condições de contorno: onde a confiança arquitetônica não compensa
| Condição | Por que falha lá | Evidência |
| Stakes baixos, volume alto | O custo de verificação excede o custo de erros; o serviço de modelo único é a resposta certa | Lógica de ponto de equilíbrio (Figura 14) |
| Conjunto de verificadores abaixo da competência da tarefa | Independência sem competência não transmite sinal | Local-tier null: 46% de precisão com ou sem concordância |
| Espaços de respostas rigidamente limitados | O consenso certifica o erro em vez de detectá-lo | Erros de consenso 4.0–7.9% sob múltipla escolha vs. 0.5–2.2% resposta aberta |
| Independência afirmada, não medida | Um painel de quase-clones fabrica confiança | Erros correlacionados; nulls de bloco e linhagem |
Uma última fronteira diz respeito ao que qualquer um dos projetos propostos pode identificar. A confiança em um mercado agentico é, no final das contas, um objeto de equilíbrio. Uma vez que os vendedores, plataformas e agentes concorrentes se adaptaram a uma arquitetura de verificação, seus efeitos são propriedades do mercado adaptado, não da célula de tratamento. Os dados observacionais herdam seleção, porque a verificação será adotada primeiro onde a confiança já está se dissolvendo. A aleatorização em nível de unidade repara a seleção, mas para na interferência, já que os consumidores aleatorizados para comprovantes ainda transacionam em um mercado cujos vendedores respondem aos comprovantes de todos de uma só vez. A quantidade de equilíbrio precisa de projetos agrupados, switchback, bipartidos ou em nível de mercado; aleatorizar a arquitetura, em vez de medir confiança, é o próximo problema difícil. E os primeiros grupos de comércio agentico se auto-selecionam pela propensão à confiança, portanto os efeitos estimados em adotantes iniciais limitam, em vez de estimar, o efeito populacional. A neutralidade é valiosa precisamente porque ninguém com interesse em um modelo pode fornecê-la, incluindo qualquer pessoa com interesse em orquestração. O argumento também descreve o tipo de sistema que construo (Nota do autor). Esse interesse toca a advocacia e não a reprodutibilidade da evidência: os modelos avaliados são sistemas de fronteira independentes e acessíveis publicamente, e cada número relatado é recomputável por terceiros a partir do pacote de replicação congelado. Um leitor que desconsidera completamente a advocacia ainda pode verificar as medições.
6. Os consumidores conseguem usar o sinal? Um teste comportamental preliminar
Se os consumidores conseguem usar o sinal de correção que o mecanismo estabelece é uma questão separada, comportamental, e reporto um experimento pré-registrado e incentivado sobre ela. O estudo realizado é uma prova de existência em vez de um teste de um efeito geral; ele questiona se os consumidores podem agir sobre o sinal. Uma replicação potentizada, confirmatória, com muitos itens e amostrada por estímulo, com inclinações aleatórias por item está planejada. Uma interrupção de hospedagem na janela final de recrutamento encerrou a coleta com 119 participantes válidos contra 200 planejados (133 agrupando uma coorte de soft-launch; EUA e Reino Unido; três condições entre-sujeitos em torno de um assistente de compras agentico; calibração medida em seis testes factuais incentivados como Δ = P(aceitar | correto) − P(aceitar | incorreto), o índice de discriminação de confiança apropriada de Schemmer et al., 2023). O método completo, o piloto, os cinco desvios do registro, a divulgação ética e de isenção, e todas as estatísticas ancilares estão no relatório detalhado abaixo (§6.1–6.2) e no pacote de replicação.
O desacordo entre modelos exibido melhorou a calibração geral (Controle Δ = 0.24 → 0.45; d = 0.67, 0.68 agrupado, p = .0001), mas a estimativa agrupada é frágil: ela é carregada por um de seis estímulos, o único item discordante de alta confiança, onde a exibição reduziu a aceitação de uma resposta confiante errada de 74% para 24% (coorte agrupada, Tabela 18). Remover esse item reduz o efeito para d = 0.09 (p = .54), enquanto remover qualquer outro item deixa-o intacto. O benefício se concentrou na subamostra do Reino Unido. A célula de controle dos EUA (n = 16) já discriminava na linha de base (p de interação = .002). No único item em que o painel concordou com uma resposta errada, a exibição aumentou a aceitação em ambos os países, que é o modo de erro de consenso certificado da Seção 3 reproduzido em comportamento humano e uma descoberta por direito próprio: uma arquitetura que expõe acordo transfere seu único fracasso sistemático para seus usuários. O teste de primeira exposição do componente de evidência de P2, um comprovante de orquestração estática, não produziu efeito detectável na disposição de delegar (d = 0.21, inconclusivo nesta potência; um comprovante de aprofundamento ao vivo no momento da disputa é o acompanhamento registrado).
Uma exibição de painel discordante pode reduzir acentuadamente a aceitação de uma recomendação confiante errada onde um consumidor de outra forma a aceitaria, e falha onde o painel certifica um erro compartilhado. O contraste de calibração portanto tem apoio comportamental sob esses seis estímulos; P1 conforme afirmado, com risco percebido como mediador, não é apoiado por este teste. P2–P4 permanecem o programa aberto.
6.1 Teste comportamental: método e piloto
As proposições das Seções 3 e 5 são escritas para serem testadas, e a agenda de medição acima especifica como. O experimento é um teste online pré-registrado e compatível com incentivos de P1 (calibração de confiança sob desacordo exposto) e P2 (disposição de delegar sob um registro reproduzível), com estímulos extraídos dos resultados reais de múltiplos modelos da onda de referência, estendendo o paradigma de segunda opinião (Detjen et al., 2025; Chen et al., 2026) para desacordos reais de modelos de fronteira incentivados sob um enquadramento arquitetônico. O instrumento, o congelamento de protocolo, o piloto, a onda principal e a análise de código congelado estão completos e reportados abaixo. As tabelas confirmatórias foram incluídas em versões anteriores deste artigo como um esqueleto pré-registrado com células marcadas [MAIN DATA PENDING] e agora são preenchidas pelo código de análise congelado. Dois resultados desfavoráveis à hipótese foram pré-registrados como descobertas primárias reportáveis: desacordo exposto piorando a calibração (confiança insuficiente líquida) e o comprovante reduzindo a disposição de delegar (efeito bumerangue de divulgação); nenhum se materializou, mas um nulo pré-registrado o fez.
Método.
Design e hipóteses. A calibração de confiança requer cruzar o acordo exibido com a correção da resposta, o que um único cenário não pode fazer. O design é, portanto, híbrido. Os participantes primeiro leem um cenário de delegação de compras (um agente de compras de IA, "ShopAssist", recomendando a compra de um laptop dentro de um orçamento de $1.200), o teste principal de P2, e depois completam um bloco de julgamento curto incentivizado em saídas reais de multi-modelo, o teste principal de P1. H1 (P1): exibir acordo e desacordo entre modelos de vários sistemas de IA independentes melhora a calibração de confiança dos consumidores (eles aceitam a resposta proposta pelo agente mais quando está correta e menos quando está incorreta) em relação a uma resposta confiante única; bicaudal, porque a literatura documenta tanto redução de confiança excessiva quanto aumento de confiança insuficiente sob apresentação conjunta. H2 (P2): o acesso a um recibo de orquestração (quem agiu, como concordaram, o que foi verificado e um registro totalmente reverificável) aumenta a disposição de delegar uma compra consequente acima e além do efeito do desacordo exibido sozinho; bicaudal, porque a divulgação também pode reduzir a confiança.
Condições. Três condições entre sujeitos, randomizadas 1:1:1 e mantidas constantes no cenário e no bloco de julgamento: (1) Controle, uma recomendação confiante única, sem sinais arquiteturais; (2) Desacordo, a mesma recomendação precedida por um painel de três sistemas de IA independentes (anonimizados como Sistema A, B, C) com marcação explícita de acordo/desacordo, as respostas alternativas dos sistemas e confidências declaradas, e um resumo de resolução em linguagem simples; (3) Desacordo + Evidência, a tela de Desacordo mais um cartão de recibo de orquestração estruturado como quem agiu / como concordaram / o que foi verificado / registro completo. Uma restrição de design pré-registrada controla o confundimento óbvio: o bloco de recomendação final (produto, preço e a confiança final declarada do agente) é idêntico literalmente nas três condições, no cenário e em cada tentativa de julgamento, e apenas os sinais arquiteturais ao redor diferem.
Estímulos e recibos. Os estímulos do bloco de julgamento são saídas reais de três modelos de ponta da onda principal em questões factuais reais sobre as quais os modelos genuinamente concordaram ou discordaram com alta confiança declarada (95–100); nenhuma resposta ou confiança é fabricada. Os nomes dos modelos são substituídos por rótulos neutros para evitar confundimentos de marca anterior, e o mapeamento é divulgado no pacote de replicação. Os recibos exibidos na condição 3 (um recibo de cenário e seis recibos de tentativa) são emitidos pela cunhadora de recibo de produção da implantação de pesquisa (esquema `decision-receipt@v1`) sobre os registros de proveniência reais do painel de estímulos, e seus hashes de verificação são genuinamente recomputáveis a partir do registro (registro de verificação: 7/7 válido). A manipulação de evidência do experimento é, portanto, uma instância do artefato que a Seção 3 define. A confiança focal exibida foi intimamente correspondida entre células de correção (itens incorretos 95/98/99; itens corretos 99/99/100) e, decisivamente para o contraste de tratamento, idêntica entre condições. Controle viu as mesmas confidências focais e discriminou muito menos, o que não pode ser explicado por uma abordagem de pista de confiança.
Medidas. DV1 (H2): uma escala de disposição de delegar de 4 itens (7 pontos; por exemplo, "Eu deixaria ShopAssist completar esta compra sem revisar a recomendação eu mesmo"), com média; uma escada de delegação de item único (0–4, de "apenas recomendações" para "age autonomamente incluindo compras não reembolsáveis") é secundária. DV2 (H1): seis tentativas de julgamento; em cada uma, o agente propõe uma resposta e o participante decide se deve deixar o assistente prosseguir (sim/não) e avalia a confiança na resposta (controle deslizante 0–100). As decisões de confiança são incentivadas pela precisão (um bônus para cada decisão de confiança correta, aceitando uma resposta correta ou rejeitando uma incorreta). A resposta proposta está correta em exatamente três das seis tentativas. A pontuação de calibração por participante é Δ = P(aceitar | correto) − P(aceitar | incorreto), o índice de discriminação da literatura de confiança apropriada (Schemmer et al., 2023, cujas medidas RAIR/RSR decompõem o mesmo objeto); um modelo de efeitos mistos ao nível da tentativa recupera a resolução ao nível do item. Risco percebido e controle de processo percebido (4 itens cada) são medidos como mediadores em análises secundárias pré-registradas para as vias P1 e P2 respectivamente; neutralidade do orquestrador percebida (4 itens) é medida como uma correlata exploratória de P3, que este estudo não manipula.
Protocolo congelado. O pré-registro foi congelado antes da coleta de dados principal (código de análise e protocolo congelados por SHA-256 em 5 de agosto de 2026; o registro do OSF foi enviado em 13 de agosto, antes da onda principal entrar em campo em 13–14 de agosto; registrado com embargo (pré-registro, apenas visualização: https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f), para ser divulgado no componente OSF público do artigo, https://osf.io/jtvu9/). O conjunto de seis itens de teste é congelado por seed: três itens de discordância fixados por design e verificados manualmente, mais itens de consenso extraídos de um embaralhamento com seed dos conjuntos onde todos os três sistemas responderam identicamente com confiança declarada ≥ 95, incluindo um erro de consenso genuíno, para que o acordo exibido seja diagnóstico mas imperfeito, exatamente como nos dados de origem. Os seis itens foram idênticos para todos os participantes; a ordem de apresentação foi aleatorizada no instrumento, embora a exportação de campo não tenha retido a ordem de exibição por teste. A exibição de campo não apresentou uma pontuação de independência estimada para o painel, que é a divulgação de diversidade medida que o próprio framework solicita, portanto os participantes viram a discordância sem ver o quão independentes os sistemas discordantes eram. A independência do painel foi medida mas não mostrada, e seu valor na coleção de origem é relatado aqui post hoc: correlação de erro média por pares φ = 0,22 (0,10–0,44 nos três pares, os dois membros do mesmo bloco de longe os mais correlacionados em 0,44; avaliados pelo classificador determinístico congelado do estudo, que resolve 95–98% das respostas e é insensível a como o restante não resolvido é codificado), o que coloca o painel longe de independente e longe de clonal. Esse é o número que o próximo instrumento deve colocar diante dos participantes. Uma limitação de estímulo: com seis itens fixos, a variação tratamento-por-item não pode ser estimada, portanto o efeito é estabelecido para esses estímulos. As sessões começaram com consentimento informado e terminaram com uma desmontagem divulgando a natureza hipotética da compra da vinheta. O estudo foi conduzido em conformidade com a Declaração de Helsinque: pesquisa de levantamento anônima de risco mínimo com adultos do Reino Unido e dos EUA que consentem em um painel em conformidade com o GDPR, compensação acima do mínimo da plataforma e sem engano além da vinheta hipotética divulgada na desmontagem. Sob esses critérios, atendeu às condições de isenção de revisão completa do conselho de ética, e a avaliação de isenção é documentada no pré-registro. O pool está agora fechado; o conjunto de itens verbatim, respostas e identificadores de recebimento por teste são parte do pré-registro sob embargo e serão divulgados com os dados.
Amostra e plano de análise. N alvo = 200 participantes válidos (100 EUA, 100 Reino Unido; estudos Prolific separados; recrutamento limitado a 210), idade 18+, inglês fluente, taxa de aprovação ≥ 98%, ≥ 100 envios anteriores, pelo menos uma compra online nos últimos três meses. Exclusões pré-registradas (aplicadas antes de visualizar respostas substantivas): dois ou mais testes de atenção falhados em três; conclusão em menos de 3 minutos; padrão de respostas uniforme; testes de manipulação falhados (item de acordo nas condições 2–3, item de recebimento na condição 3, item de compreensão do produto); compreensão do bloco de julgamento falhada duas vezes; ID ou IP duplicado; sessão incompleta. Análises confirmatórias: para H1, OLS de Δ em condições de discordância agrupadas (2 e 3) versus controle com covariável de país; para H2, restrito às condições 2 e 3, OLS do composto disposição de delegar na condição com covariável de país; correção de Holm em {H1, H2}, α em família = 0,05; testes t de Welch como robustez; gating de verificação de manipulação relatado primeiro. A ordem da coorte é fixada aqui: as análises confirmatórias primárias são calculadas na coorte da onda principal excluindo os participantes do soft-launch do piloto, e o ramo que agrupa a coorte do soft-launch na amostra confirmatória é relatado como uma análise de robustez ao lado. Os descritivos exploratórios Δ do piloto foram vistos antes da onda principal, portanto excluir essa coorte da estimativa primária remove até mesmo a forma suave de double-dipping, mantendo a inclusão pré-registrada do soft-launch como um ramo relatado. O relatório primário incluirá uma análise de intenção de tratar retendo todos os participantes aleatorizados ao lado da análise pré-registrada por protocolo. As exclusões de verificação de manipulação serão relatadas com verificações de desgaste diferencial por condição, pois a saliência do sinal arquitetônico poderia diferir entre as condições. Sensibilidade: o design detecta d ≈ 0,42 para H1 e d ≈ 0,49 para H2 com poder 0,80, adequado para os efeitos médios nas literaturas adjacentes de confiança e transparência. Efeitos menores são deixados para o fatorial completo da agenda de pesquisa. Três elementos pré-registrados respondem a questões de mecanismo que os contrastes confirmatórios sozinhos não conseguem responder. O instrumento carrega uma escala de risco percebido de quatro itens (piloto α = 0,881) no caminho P1, portanto a percepção de risco entra na análise como um constructo medido em vez de uma suposição. A mediação é pré-registrada como uma análise secundária, com risco percebido mediando o efeito da discordância sobre a confiança e controle de processo percebido mediando o efeito do recebimento sobre a disposição de delegar, estimado por análise de caminho bootstrap (PROCESS Modelo 4, 5.000 reamostragens). O tempo na tela de estímulo da condição 3 é coletado como o proxy pré-registrado para leitura de recebimento, uma verificação direta da alternativa de carga cognitiva que participantes passem pelo recebimento sem processá-lo. O código de análise foi congelado antes da coleta de dados e está arquivado no pacote de replicação.
Piloto (soft launch): critérios e resultados.
Um piloto de n = 20 (EUA), executado no instrumento final com critérios de aceitação pré-registrados fixados com antecedência, foi concluído em 6 de agosto de 2026. A Tabela 13 relata cada critério em relação ao seu resultado.
Tabela 13. Critérios de aceitação do piloto (pré-registrados) e resultados (n = 20, EUA)
| Critério (fixado ex ante) | Resultado | Veredicto |
| Manipulação notada: > 80% correto no teste de acordo (condições 2–3) | 81,3% (13/16) | Aprovado |
| Manipulação notada: > 80% correto no teste de recebimento (condição 3) | 88,9% (8/9) | Aprovado |
| Alfa de Cronbach > 0,70, disposição de delegar (4 itens) | 0,854 | Aprovado (também atinge a meta de 0,85) |
| Alfa de Cronbach > 0,70, risco percebido (4 itens) | 0,881 | Aprovado |
| Alfa de Cronbach > 0,70, controle de processo (4 itens) | 0,965 | Aprovado |
| Alfa de Cronbach > 0,70, neutralidade (4 itens) | 0,851 | Aprovado |
| Tempo mediano de conclusão entre 10–15 minutos | 9,60 minutos | Falha, por 24 segundos, na direção mais rápida |
Um critério falhou. A mediana ficou 24 segundos abaixo da janela pré-registrada, uma janela construída contra excesso de duração, não contra ineficiência. A cauda rápida não mostra evidência de respostas negligentes: nenhum participante ficou abaixo do limiar de exclusão de 3 minutos; o único participante abaixo de cinco minutos passou em todas as verificações de atenção, manipulação e compreensão; as taxas de aprovação em verificações de atenção foram de 95–100%; havia zero células ausentes em variáveis-chave, zero IDs ou IPs duplicados e zero linhas retas; e os tempos de conclusão da plataforma de recrutamento confirmam independentemente o cronômetro da pesquisa (mediana 9,74 minutos). O instrumento é mais curto em campo do que orçado. O equilíbrio de condições (4/7/9 entre condições 1/2/3) é compatível com randomização 1:1:1 em n = 20 (χ²(2) = 1,90, p = ,387). Sob as exclusões pré-registradas da análise, 6 dos 20 participantes piloto são excluídos da análise confirmatória (cinco por motivos de verificação de manipulação, um por compreensão falhada duas vezes), deixando 14 válidos. Conforme a regra de lançamento suave, a coorte piloto segue para a amostra agrupada com o desvio de temporização divulgado aqui e no próprio registro, que foi submetido ao OSF em 14 de agosto de 2026 às 03:09 UTC, antes da coleta de onda principal, e que afirma que o piloto de lançamento suave está incluído na amostra confirmatória com o desvio de temporização declarado; tratar a coorte de onda principal como a estimativa confirmatória primária e o ramo agrupado como robustez é uma decisão analítica pós-registro, tomada porque os descritivos piloto haviam sido vistos antes da onda principal, e ambos os ramos são relatados; a margem de compreensão de produto (um participante acima da barra de 80%) é sinalizada para monitoramento na onda principal. Um descritivo exploratório, relatado sem inferência no n piloto: a pontuação de calibração Δ por condição apresentou +0,33 (controle, n = 4), +0,52 (desacordo, n = 7), +0,22 (desacordo + evidência, n = 9), portanto a condição de desacordo se move na direção de H1; o piloto não pode afirmar mais.
6.2 Teste comportamental: resultados, análises exploratórias e razão restante
Resultados confirmatórios.
A coleta de onda principal ocorreu em 13–14 de agosto de 2026 (190 slots: 85 US + 105 UK além da coorte de lançamento suave), e não foi concluída: o host da pesquisa sofreu uma interrupção técnica durante a janela final de recrutamento, e a coleta terminou com 158 sessões concluídas no total (138 na onda principal e 20 no lançamento suave) em vez do alvo de 200 válidos. O recrutamento terminou com a interrupção da plataforma, sob a regra pré-registrada de parada opcional e não em resposta aos resultados observados, embora os resultados já tivessem sido vistos até então; a consequência é poder reduzido. Nas células realizadas, os efeitos mínimos detectáveis aumentam do d ≈ 0,42 (H1) e d ≈ 0,49 (H2) registrados para aproximadamente d ≈ 0,54 e d ≈ 0,64 no mesmo poder, um limite que o resultado confirmatório torna discutível apenas em uma direção, e que se aplica a todos os contrastes nulos e exploratórios abaixo. A ordem das coortes segue o plano do §6.1. O piloto perdeu um critério de aprovação (a janela de tempo de conclusão, por 24 segundos na direção mais rápida), e seus descritivos exploratórios haviam sido vistos antes da onda principal, portanto a coorte confirmatória primária é apenas a onda principal (N = 119 válidos) e o ramo que agrupa a coorte de lançamento suave identicamente coletada de volta (N = 133) é relatado como robustez. Cada número abaixo é a saída do código de análise congelado por SHA-256 antes da coleta de dados. Desvios do registro, compilados em um lugar: (i) o déficit de N (133 válidos de 200 registrados; interrupção de hospedagem); (ii) o critério de tempo de conclusão do piloto perdido por 24 segundos na direção mais rápida; (iii) a ordem de exibição por tentativa não foi retida na exportação de campo; (iv) a temporização de nível de tela não foi capturada; (v) o modelo misto de nível de tentativa executado em uma aproximação variacional (o mecanismo final do pacote pode diferir). Nada mais se desviou; cada teste confirmatório correu conforme registrado, a decisão de coorte primária acima sendo a única escolha analítica pós-registro.
Tabela 14. Fluxo da amostra e exclusões (onda principal; coorte de lançamento suave em nota)
| US | UK | Total | |
| Sessões concluídas | 50 | 88 | 138 |
| Excluído: atenção (≥ 2 de 3 verificações) | 0 | 0 | 0 |
| Excluído: velocidade (< 3 min) / linhas retas | 0 | 0 | 0 |
| Excluído: verificações de manipulação / compreensão | 10 | 9 | 19 |
| Excluído: duplicados / incompleto | 0 | 0 | 0 |
| N válido (por condição 1/2/3) | 40 (16/15/9) | 79 (26/28/25) | 119 (42/43/34) |
A coorte de lançamento suave adiciona 20 sessões US concluídas, das quais 14 sobrevivem às mesmas exclusões; ela entra apenas no ramo de robustez agrupado (N = 133). Toda exclusão na onda principal veio das regras de verificação de manipulação e compreensão — nenhum participante foi excluído por falta de atenção, aceleração, linhas retas, duplicação ou incompletude — e o controle de verificação de manipulação não mostra assimetria entre condições (MC1 χ²(1) = 0,12, p = ,73; MC3 χ²(2) = 3,67, p = ,16, calculado na amostra pré-exclusão).
Tabela 15. H1 (P1): calibração de confiabilidade Δ por condição (coorte primária, N = 119)
| Controle | Desacordo | Desacordo + Evidência | |
| Δ, média (DP) | 0,238 (0,332) | 0,465 (0,274) | 0,422 (0,299) |
| Confiabilidade excessiva: P(aceitar | incorreto) | 0,603 | 0,434 | 0,510 |
| Confiabilidade insuficiente: 1 − P(aceitar | correto) | 0,159 | 0,101 | 0,069 |
| Contraste confirmatório: agrupado (2,3) vs controle, OLS com covariável de país | b = +0,217, IC 95% [+0,104, +0,330], p ajustado por Holm = ,0005 (d = 0,67) |
Tabela 16. H2 (P2): disposição para delegar, recebimento vs desacordo apenas (coorte primária)
| Desacordo (2) | Desacordo + Evidência (3) | |
| Composto de prontidão-para-delegar, média (DP) | 3.09 (1.61) | 3.45 (1.79) |
| Escada de delegação, mediana | 2 | 2 |
| Contraste confirmatório: 3 vs 2, OLS com covariável país | b = +0.41, 95% IC [−0.35, +1.18], p ajustado por Holm = .29 |
H1 é suportada neste desenho para o contraste de calibração; a mediação pré-registrada através do risco percebido foi nula, portanto P1 conforme declarado não é suportada por este teste. Diante de uma única resposta confiante, os participantes mal diferenciaram: permitiram que o agente prosseguisse em 84% das respostas corretas, mas também em 60% das incorretas (Δ = 0.238, 95% IC [0.14, 0.34]; condições de tratamento 0.465 [0.38, 0.55] e 0.422 [0.32, 0.52]). A exibição de desacordo quase duplicou a calibração (Δ agrupada = 0.446; b = +0.217, p = .0002, p ajustado por Holm = .0005; d de Welch = 0.67), e fez assim dos dois lados simultaneamente: a confiança excessiva caiu (60% → 43% e 51%) enquanto a confiança insuficiente também caiu (16% → 10% e 7%) (Figura 20). Essa média agrupada é mantida por um único item e deve ser interpretada como uma prova de existência em vez de uma média robusta: no único ensaio discordante de alta confiança que os participantes controle estavam aceitando a 74%, a exibição reduziu a aceitação da resposta errada para 24%, e com esse ensaio removido o contraste confirmatório não é mais significativo (d = 0.09, p = .54), enquanto remover qualquer outro item isolado o deixa intacto (d = 0.47–0.89). A decomposição exploratória abaixo (Tabelas 17–18) localiza o efeito item por item. Sua concentração mostra a mesma dependência do espaço disponível relatada ali no nível do país: a exibição reduz a lacuna de calibração apenas onde ela existe, e um dos seis itens a deixou bem aberta.
Figura 20. Como a exibição de desacordo afeta a confiança (coorte primária)
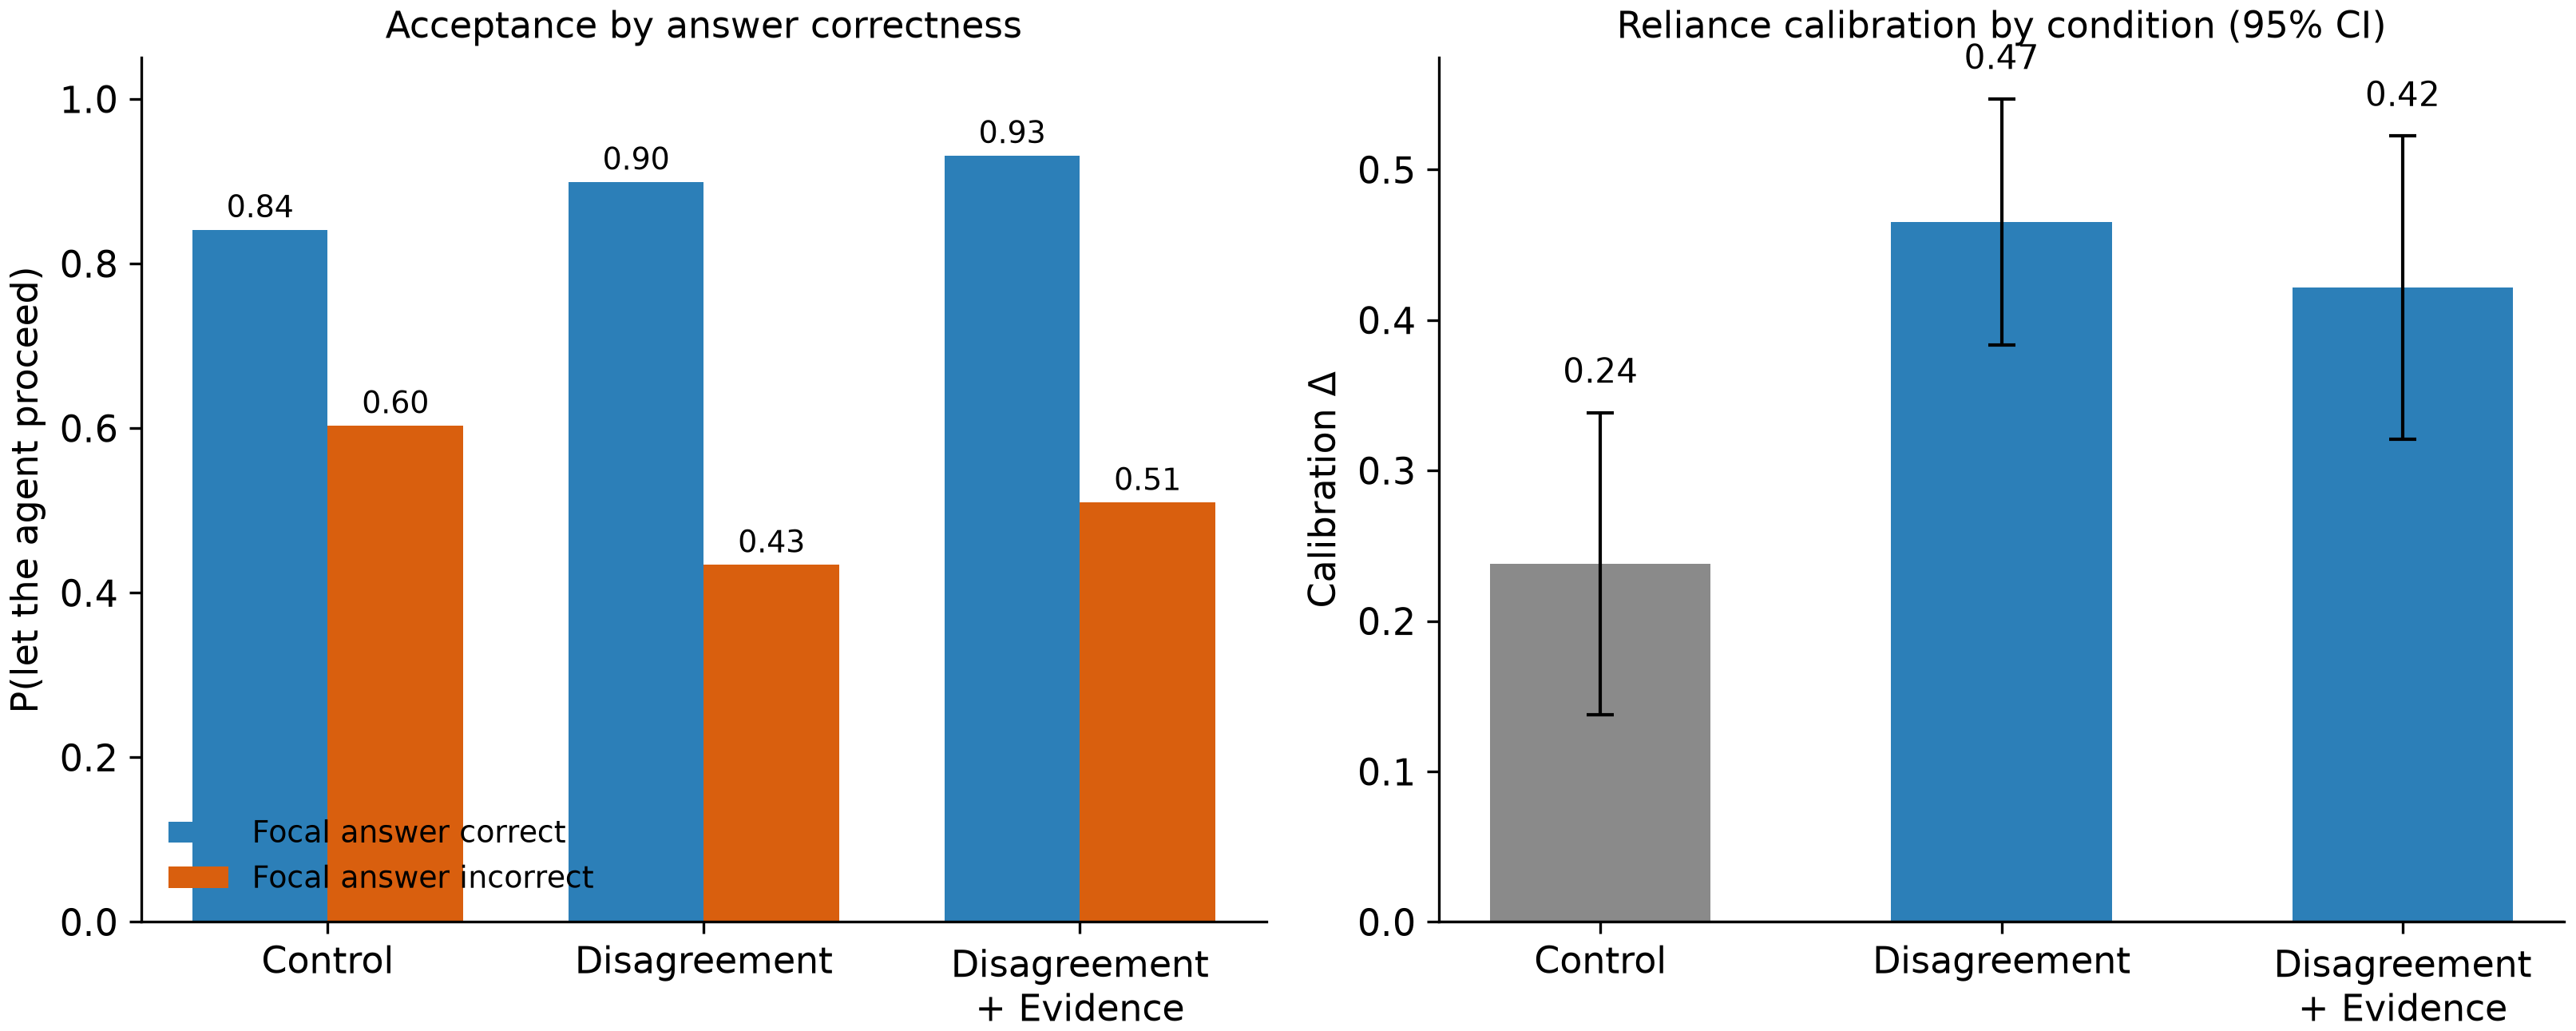
Esquerda: taxas de aceitação por condição, divididas por se a resposta focal estava correta (calibração = a lacuna entre o par de barras). Direita: escore de calibração por participante Δ por condição com IC de 95%; o contraste confirmatório agrupa as duas condições de desacordo contra o controle.
O enquadramento de dois lados pré-registrado existia porque a literatura de segunda opinião documenta intervenções que compram redução da confiança excessiva pelo preço de aumento da confiança insuficiente; esta não teve esse custo. O sinal tornou os participantes mais discriminadores, não mais céticos, e uma decomposição de detecção de sinal das taxas agregadas quantifica isso: a sensibilidade d′ aumentou de 0.74 no Controle para 1.44 e 1.46 nas condições de tratamento (calculada a partir de taxas não arredondadas) enquanto o critério de resposta praticamente não mudou (−0.63 vs −0.56 e −0.76). O modelo de efeitos mistos em nível de ensaio recupera a mesma estrutura, com grandes interações positivas correção × condição para ambas as condições de tratamento. Cada ramo registrado concorda: o ramo de robustez agrupado (b = +0.215, p = .0001, d = 0.68), e o ramo de intenção de tratamento retendo todas as sessões da onda principal completadas independentemente de falhas de verificação (b = +0.2174 vs +0.2169 por protocolo, p = .0001, n = 138), com exclusões balanceadas entre condições (8/6/5; χ²(2) = 0.34, p = .85), conforme a verificação de atrito diferencial §6.1 (exclusões de verificação de manipulação são condicionamento pós-tratamento, conforme Montgomery, Nyhan, & Torres, 2018, daí a igualdade de posição do ramo não condicionado). Um confundidor do desenho adiciona uma ressalva à interpretação. As condições de desacordo diferem do Controle não apenas no que o sinal diz, mas em quanto é mostrado, três posições e confiânças em vez de uma, portanto o ganho de calibração poderia em princípio refletir volume de informação em vez do conteúdo do sinal de concordância. Duas observações desafiam a leitura de volume sem resolvê-la: o efeito acompanha a direção do sinal exibido item por item, já que em itens com foco incorreto onde a exibição mostrou discordância, a aceitação caiu, enquanto no único item onde a exibição mostrou concordância confiante unânime, a aceitação da resposta errada subiu; e a interação no nível do ensaio é com a correção da resposta, que volume sozinho não prediz. O braço discriminador limpo, vários sistemas mostrados concordando em cada ensaio com volume de informação mantido constante, está especificado para a próxima onda.
H2 não é compatível. Entre os participantes já apresentados à exibição de desacordo, o recibo não produziu efeito detectável no composto de delegação no poder realizado (3.45 vs 3.09; b = +0.41, p = .29; b da ramificação agregada = +0.34, p = .33; confiabilidade composta: alfa de Cronbach da onda principal = .89). Três resultados secundários pré-registrados moldam como o nulo deve ser lido. O recibo foi recebido: o tempo de sessão mediano na condição de recibo foi cerca de um minuto e meio mais longo que na condição de desacordo (11.0 vs 9.4 minutos; o tempo em nível de tela não foi capturado na exportação implementada, portanto a duração total funciona como proxy do tempo-no-estímulo registrado). O tempo extra não estabelece que os participantes usaram o recibo. O recibo implementado era um cartão estático, e o recurso "ver registro completo" não estava operacional na pesquisa, portanto a manipulação testou a presença do recibo, não seu exercício. Um recibo com drill-down interativo ao vivo é a manipulação mais forte que o design subsequente inclui. Este é um nulo para uma exibição de recibo estático, não para registros, verificabilidade ou P2 conforme escrito. O recibo também moveu seu mediador pré-registrado. O controle de processo percebido aumentou na condição de recibo (a = +0.60; confiabilidades de escala, onda principal: controle de processo α = .93, risco α = .83, neutralidade α = .90), o controle de processo prediz fortemente a delegação (b = +0.60), e o caminho indireto bootstrap é positivo e exclui zero (indireto = +0.35, 95% CI [+0.02, +0.78], 5,000 reamostragens), enquanto o caminho direto é próximo de zero. Esta é evidência de mediação exploratória: o mediador foi medido pós-tratamento no mesmo instrumento, portanto a variância de método comum e a interpretação reversa permanecem possíveis. Os limites de sensibilidade restringem o que este nulo pode resolver. As células realizadas detectam d ≈ 0.49 com poder .80 apenas no N registrado, portanto um efeito de recibo do tamanho que o caminho de mediação implica é exatamente o tamanho que esta amostra não pode resolver. O resultado é inconclusivo sobre efeitos pequenos e médios e decisivo apenas contra efeitos maiores. Formalmente, testes de equivalência limitam o efeito apenas grosseiramente (TOST estabelece |d| < 0.64 em α = .05, não |d| < 0.5), e um fator de Bayes JZS dá BF₀₁ ≈ 2.9 (ramificação agregada 3.1), evidência anedótica favorecendo o nulo nas bandas padrão (em ou logo após a fronteira anedótica/moderada de 3); não demonstra ausência nem apoia presença. A seção de medição previu tanto: verificabilidade é uma propriedade sob demanda, e seu valor deve surgir no momento da disputa, reclamação ou auditoria, portanto um recibo estático lido uma vez em uma compra hipotética pode ser o momento errado para observá-lo. A conclusão registrada: o teste de exposição inicial de P2 falhou em mover delegação, e a economia do lado do operador do recibo (Seção 5) não se baseia neste resultado do lado do consumidor. Duas leituras permanecem: ou o componente de evidência contribui menos no momento da decisão do que o framework afirma, ou esta operacionalização é o teste errado dela. A explicação do tempo de disputa é uma hipótese post-hoc, agendada como o design de seguimento mencionado no final desta seção, não a resolução do nulo. Uma terceira leitura vem da literatura de aversão. Um recibo detalhado é uma manipulação de saliência, uma exposição de maquinário que lembra ao consumidor quanto pode dar errado exatamente no momento da delegação, o paradoxo da transparência em que detalhes procedurais deprimem em vez de construir confiança (Kizilcec, 2016; Dietvorst, Simmons, & Massey, 2015). Essas leituras concorrentes, um componente mais fraco do que afirmado, um teste de momento errado, e efeito reverso de saliência, fazem predições diferentes e são separáveis por design.
O modo de erro de consenso certificado se reproduziu no comportamento humano. Uma tentativa incentivada carregava, por design, um erro de consenso genuíno, com todos os três sistemas convergindo confiadamente na mesma resposta errada, espelhando a taxa de erro de consenso em forma aberta de 0.5–2.2% que o estudo de mecanismo mede. Naquele ensaio, um único item e portanto uma observação em vez de uma estimativa, a exibição de desacordo não protegeu ninguém e, em ambos os países, na direção esperada aumentou a aceitação da resposta errada (em 4 e 14 pontos percentuais em relação ao controle): os participantes racionalmente leram o acordo independente unânime como certificação. Portanto, o modo de falha sistemático da arquitetura se transfere para seus usuários com alta fidelidade. A Seção 3 deu o aviso de design, que consenso certifica erro exatamente onde a diversidade do painel falha, e a sonda mostra a mesma falha no comportamento.
Exploratório: onde o benefício de calibração se concentra.
Tudo o que se segue é exploratório e gerador de hipóteses. As células de país são pequenas, e cada p-valor intra-país apresentado abaixo deve ser lido como descritivo. O efeito de calibração se concentrou quase inteiramente na amostra do Reino Unido e estava ausente na amostra dos EUA:
Tabela 17. Calibração Δ por país e condição (exploratório)
| Controle Δ | Desacordo (agrupado 2, 3) Δ | Tamanho do efeito por país | |
| Reino Unido (n = 79) | +0.103 (n = 26) | +0.447 (n = 53) | d = +1.19 |
| EUA (n = 40 primário / 54 agrupado) | +0.458 / +0.433 | +0.444 / +0.471 | d = −0.05 / +0.13 |
| Interação país × condição | b = −0.36, p = .002 (primário); b = −0.31, p = .004 (agrupado) |
A decomposição é mais informativa que a interação. Os participantes do grupo US Control já discriminavam claramente sem nenhum sinal arquitetural, aceitando 92% das respostas corretas e apenas 48% das respostas incorretas, enquanto os participantes do grupo UK Control mal discriminavam (78% vs 68%). Sob a exibição do desacordo, os dois países se tornaram quase indistinguíveis, item por item (diferença máxima de célula 0,07 em todos os seis testes). A intervenção convergiu ambas as amostras para o mesmo ponto final de calibração (Δ ≈ +0,45), equalizando uma diferença de linha de base que não criou (Figura 21). Parte desse padrão é mecânica. Δ é limitado, portanto o espaço disponível diminui conforme a calibração de linha de base aumenta, e "o benefício se concentra onde a linha de base é mais fraca" é em parte uma propriedade da medida. O teto isoladamente, no entanto, não força pontos finais idênticos ou correspondência de perfil item por item. A interpretação mais defensável é que os seis itens eram fáceis o suficiente para um painel discriminar sem ajuda, portanto a exibição fecha um fosso de calibração onde existe. Essa interpretação diz respeito ao espaço disponível, não sobre nações, e igualmente sobre estímulos: o conjunto de itens em si era culturalmente enviesado (dois itens de dissidente carregavam conteúdo local dos EUA), portanto o perfil de convergência é uma propriedade desses seis itens tanto quanto desses dois painéis.
Figura 21. Convergência, não resposta uniforme (exploratório)
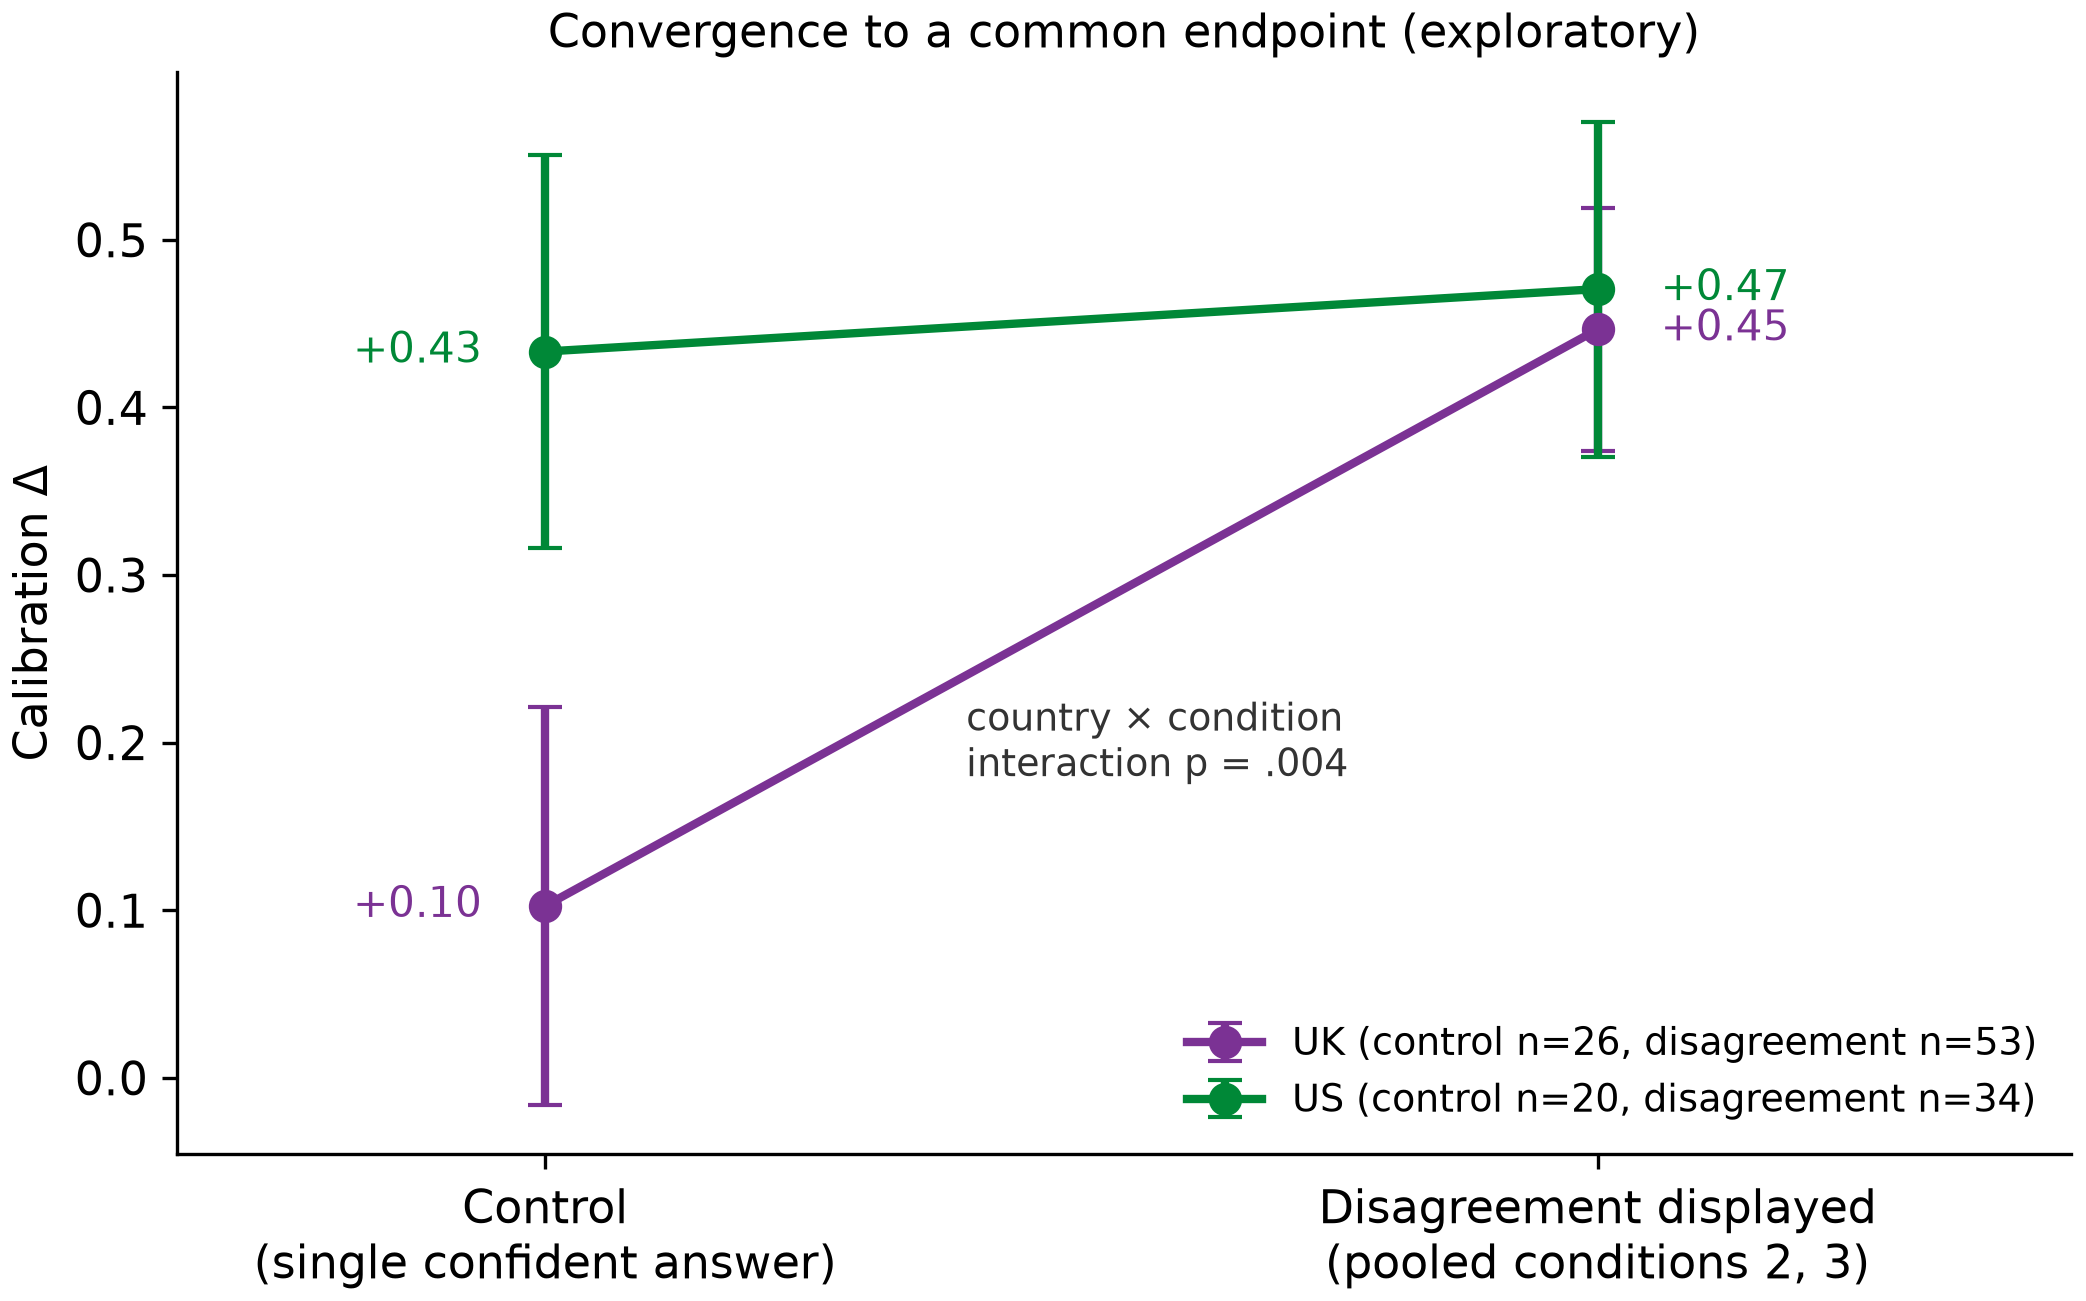
Calibração Δ por país e condição: o grupo de controle dos EUA já discrimina (Δ ≈ +0,45); o grupo de controle do Reino Unido mal o faz (Δ ≈ +0,10); sob desacordo exibido ambos os países chegam ao mesmo ponto final (Δ ≈ +0,45). O benefício se concentra exatamente onde a calibração de linha de base é mais fraca.
A vantagem dos EUA em Control, entretanto, está concentrada nos dois itens de dissidente com conteúdo plausível local dos EUA. Um é uma pergunta do Museum of Bad Art sobre a qual a resposta errada, "a Mona Lisa," é absurda para qualquer pessoa que conhece a proposta do museu (aceitação nos EUA 5% vs Reino Unido 27%). A concentração nesses dois itens aponta para familiaridade em nível de item e não para temperamento nacional.
Tabela 18. Aceitação de respostas focais incorretas por item e célula (exploratório; coorte agrupada)
| Célula | Dissidente errado, conf 95 (item "Mona Lisa") | Dissidente errado, conf 98 (item ICM-cidade) | Consenso errado, conf 99 |
| UK Control (n = 26) | 0,27 | 0,85 | 0,92 |
| US Control (n = 20) | 0,05 | 0,60 | 0,80 |
| UK Disagreement (n = 53) | 0,21 | 0,25 | 0,96 |
| US Disagreement (n = 34) | 0,18 | 0,24 | 0,94 |
O efeito protetor da intervenção repousa quase inteiramente no item de dissidente de alta confiança (UK −0,60, US −0,36); no item de erro de consenso a exibição aumenta ligeiramente a aceitação em ambos os países — acordo unânime lido como certificação, a imagem comportamental dos erros de consenso certificados do estudo do mecanismo. Como o efeito protetor repousa neste único item, o contraste confirmatório agrupado não sobrevive à sua remoção (d = 0,09, p = 0,54), embora sobreviva à remoção de qualquer outro item único (d = 0,47–0,89) — a forma quantitativa do efeito sendo carregada por um item.
Tabela 19. Escalas de atitude por país (exploratório; coorte agrupada): a lacuna é comportamental, não atitudinal
| Escala (1–7 a menos que indicado) | Média UK | Média US | Direção |
| Confiança em IA pré-exposição | 4,68 | 4,70 | idêntico |
| Disposição de delegar (composto) | 2,94 | 3,43 | US superior (p = 0,08) |
| Escada de delegação (0–4) | 1,71 | 1,98 | US superior (p = 0,08) |
| Risco percebido | 5,54 | 5,13 | US inferior (p = 0,09) |
| Controle de processo percebido | 4,17 | 4,56 | US superior (p = 0,14) |
| Neutralidade percebida | 4,75 | 4,62 | n.s. |
Toda diferença atitudinal que existe aponta para o lado "errado" para uma conta de ceticismo dos EUA: os participantes dos EUA são mais dispostos a delegar e percebem menos risco, mas discriminam melhor comportamentalmente em Control. As atitudes medidas não explicam nada disso: ajustar a lacuna de país de linha de base para demografia e todas as cinco escalas a atenua em no máximo 15%, e os caminhos indiretos de bootstrap através das escalas são nulos.
Pesquisas transnacionais concordam com o nulo atitudinal. A disposição declarada de confiar em IA é essencialmente idêntica nos EUA e Reino Unido (41% vs 42%: Gillespie et al., 2025), e ambos os países se situam no mesmo aglomerado "Anglosphere" de alto cuidado sobre nervosismo de IA (Ipsos, 2025). A única assimetria em nível populacional apontando a direção observada é a alfabetização em IA. Os respondentes do Reino Unido relatam menos habilidade e confiança no uso e avaliação de IA (36% vs 42% em habilidades: Gillespie et al., 2025), e os adultos dos EUA estão entre os públicos mais expostos a IA pesquisados (Pew Research Center, 2025). Duas contas, portanto, sobrevivem ao registro exploratório. Em uma conta de familiaridade, a população menos equipada para avaliar aconselhamento de IA ganha mais de uma arquitetura que o avalia estruturalmente. A outra conta é a composição do painel: o braço do Reino Unido da plataforma de recrutamento é seu pool mais antigo e experiente, e os painéis online são instrumentos imperfeitos para inferência entre países (Gvirtz & Sabherwal, 2024), portanto o rótulo "país" pode em parte servir como proxy para permanência no painel. O design não pode separar os dois, e não precisa, porque em qualquer conta a constatação substantiva é o próprio perfil compensatório. Dados os tamanhos das células, o padrão mais seguro é ler o padrão como uma propriedade desses dois painéis até que uma replicação potencializada fale; nenhuma reivindicação teórica neste artigo repousa nela.
Esse perfil não é o resultado padrão das intervenções contra a sobredependência. As funções de forçamento cognitivo reduzem a sobredependência, mas concentram seu benefício entre usuários já elevados em Necessidade de Cognição, de modo que os analiticamente inclinados ficam mais analíticos (Buçinca et al., 2021), e a pesquisa de calibração adaptativa de confiança trata o direcionamento dos descalibrados como um objetivo de design que exige monitoramento ativo (Okamura & Yamada, 2020). Aqui o direcionamento surgiu naturalmente. O desacordo exibido é autosdesencadeante: aparece exatamente quando o painel discorda e não exige nada do usuário antecipadamente. Seu benefício caiu bem sobre o grupo cuja discriminação basal era a mais fraca, e deixou a precisão do grupo já calibrado intacta em vez de degradá-la. Para um mecanismo de proteção ao consumidor, esse é o perfil distributivo que se especificaria ex ante, com ajuda concentrada onde a descalibração se concentra e sem custo para aqueles que não precisam.
Análises secundárias pré-registradas: o saldo restante.
As análises secundárias pré-registradas restantes estão aqui em um único lugar (coorte primária; valores do ramo agrupado no pacote de replicação). A mediação do efeito de desacordo por meio do risco percebido, o caminho P1 que o design antecipou, é nula. O display, se algo, ligeiramente reduziu o risco percebido (a = −0.40), e o caminho indireto do bootstrap é indistinguível de zero (+0.006, IC 95% [−0.013, +0.029]). O efeito de calibração é direto, consistente com os participantes usando o padrão de desacordo como informação sobre a resposta em vez de como um alarme geral sobre a transação. A neutralidade do orquestrador percebida, medida em vez de manipulada, é um correlato forte da disposição para delegar controlando por condição e país (b = +0.47, p < .0001), o rastro correlacional que P3 prediz, aguardando sua manipulação. A escada de delegação mostra a mesma ordem que a composta sem atingir significância (logit ordenado, recebimento vs desacordo: b = +0.70, p = .11; as medianas empatam em 2 de 4). O contraste de condição 3 versus 1 não registrado na delegação é direcional e positivo e não significativo (b = +0.52, p = .15). Um desvio: a implementação de campo não capturou o tempo de nível de tela, portanto o proxy pré-registrado de tempo no estímulo de leitura de recebimento é aproximado pela duração total da sessão (relatado sob H2 acima). A verificação de nível de tela pretendida deve ser incorporada ao instrumento da próxima onda.
Este estudo testa apenas P1 e P2. P3 é medido, não manipulado, e P4 e a variação conjunta completa da Seção 5 permanecem como o próximo estudo especificado. A validação comportamental da tríade é, portanto, incompleta: um componente apoiado, um inconclusivo, um medido, mas não manipulado. Uma questão longitudinal situa-se acima do programa. A exibição persistente de desacordo pode estabilizar a adoção de longo prazo, como um amortecedor na oscilação entre apreciação de algoritmo e aversão a um único erro, ou pode esgotar essa adoção por meio da exposição contínua à falibilidade da máquina. Um design de sessão única não pode dizer. Dois estudos motivados pelos resultados acima são adicionados ao programa. Um é um design de tempo de disputa que retesta o recebimento no momento em que se prevê que seu valor estará ativo, usando um controle de recebimento falso, um recebimento cujo hash não se recomputa, para separar verificabilidade de sua renderização. O outro é uma replicação adequadamente dimensionada para a moderação de país relatada acima (Tabela 17).
7. Conclusão
À medida que a IA medeia decisões consequentes do consumidor e cada vez mais as toma, argumentei que a confiança deve migrar para cima na pilha: do modelo, para a arquitetura, para o registro. Diversidade, evidência e neutralidade juntas produzem um serviço cuja confiabilidade pode ser verificada em vez de ser aceita na fé. O que está sendo construído não é persuasão melhor, mas infraestrutura econômica de confiança, a cadeia de responsabilidade que permite a delegação escalar. A onda principal mede isso no topo do mercado. Agrupados nas dez armas principais completas da onda, modelos vendidos como o melhor de cada laboratório estavam confiantemente errados em quase metade de suas respostas resolvidas oferecidas com confiança declarada ≥ 80 (46.6%, e a figura mal se move quando itens não resolvidos são reclassificados como erros). O braço Meta parcial é relatado separadamente, e incluí-lo deixa a figura efetivamente inalterada. Um portão fixo de desacordo de três modelos acima deles, sem treinamento e sem ajuste, remove quatro quintos dessas falhas a um custo declarado e inspecionável de cobertura. Como o substrato aqui é puramente factual, essa taxa deve ser lida como um limite superior para tarefas comerciais mistas. O que licenciaria a alegação para comércio apropriado é uma replicação fundamentada em recuperação, com uso de ferramentas, em um menu de produtos restrito, onde erros de consenso se comportam de forma diferente do que em espaço factual aberto. Um experimento pré-registrado (Seção 6) colocou o mesmo sinal arquitetônico na frente dos consumidores e retornou evidência de que eles podem agir sobre ele como um sinal de correção: a exibição de desacordo cortou a aceitação de uma recomendação confidentemente errada de 74% para 24% no item qualificante. Em uma divisão de país exploratória, concentra-se na célula do Reino Unido sobredependente e repousa naquele item único (o contraste agrupado não sobrevive à sua remoção, d = 0.09). Isso é uma prova de existência sob esses estímulos, não ainda um efeito geral; um teste confirmativo amostrado por estímulo está planejado.
Esta camada merece um nome de mercado próprio, infraestrutura de evidência, para ser vendida da maneira como infraestrutura de nuvem, identidade e pagamentos são vendidas, porque responde ao mesmo tipo de pergunta: "isso pode ser confiável, e como saberíamos?" Essa é uma pergunta diferente de "isso é inteligente?" Segurança e privacidade ambas seguiram este caminho: diferenciador, depois expectativa, depois requisito de entrada. A confiança arquitetônica pode plausívelmente seguir o mesmo caminho, em um ritmo estabelecido pela pressão regulatória e de responsabilidade já visível.
Minha tese na perspectiva teórica é que a unidade de análise para a confiança do consumidor em serviços de IA deveria passar do modelo para a arquitetura, porque as propriedades relevantes para a confiança realmente residem lá: independência da verificação, reprodutibilidade das decisões, ausência de conflito de interesses. Os modelos se modificam continuamente em cada serviço, mais rápido do que qualquer reputação consegue acompanhar. O hiato entre desempenho fechado-aberto diminuiu de 8.04% para 1.70% em um único ano (Stanford HAI, 2025), e a liderança do mercado de modelos empresariais mudou de mãos em uma única primavera (Kharazian, 2026). Uma camada que commoditiza tão rápido não é onde a confiança consegue se ancorar. O que atende um consumidor é cada vez mais roteamento entre modelos e faixas de preço, guiado por custo, invisível e não verificado, e um modelo escolhido como melhor atende cada vez menos. O passo que resta, e aquele que especifico aqui, é passar de uma arquitetura com melhor roteamento para uma cuja verificação um consumidor, um segurador ou um regulador consegue manter estável tempo suficiente para verificar. Subjacente a isso está uma transição de assistentes de IA para fiduciários de IA. Fiduciários, em todo domínio que já os teve, são constituídos não por seus talentos mas por seus deveres: manter registros, submeter-se a auditoria, não ter interesse adverso. A confiança arquitetônica constrói esses deveres na maquinaria.
O mesmo requisito se aplica a como o sistema em si cresce. Um sistema pedindo para ser confiado com ação consequente deveria ter que crescer da maneira como responde, de forma verificável. Mudanças de configuração em uma camada de orquestração deveriam confirmar ou reverter através de portões estatísticos auditados contra evidência retida, sem nenhum processo automatizado enfraquecendo uma regra de segurança, apenas adicionando uma. A implantação de pesquisa no estudo de caso implementa esses portões.
A infraestrutura de IA agora precisa de uma camada de verificação (Figura 16). A indústria construiu a camada de computação e a camada de modelo, e agora está construindo a camada de orquestração. Depois vem verificação, a maquinaria que torna o comportamento de um sistema de IA verificável em vez de credível. O fundamento para a confiança em IA deveria se tornar verificável por máquina em vez de baseado em reputação; a confiança em si permanece humana, e o que pode ser verificado por máquina são seus fundamentos. Se isso está certo, a próxima camada indispensável de infraestrutura de IA será construída não em torno da inteligência mas em torno da verificabilidade.
Figura 16. A escada de infraestrutura
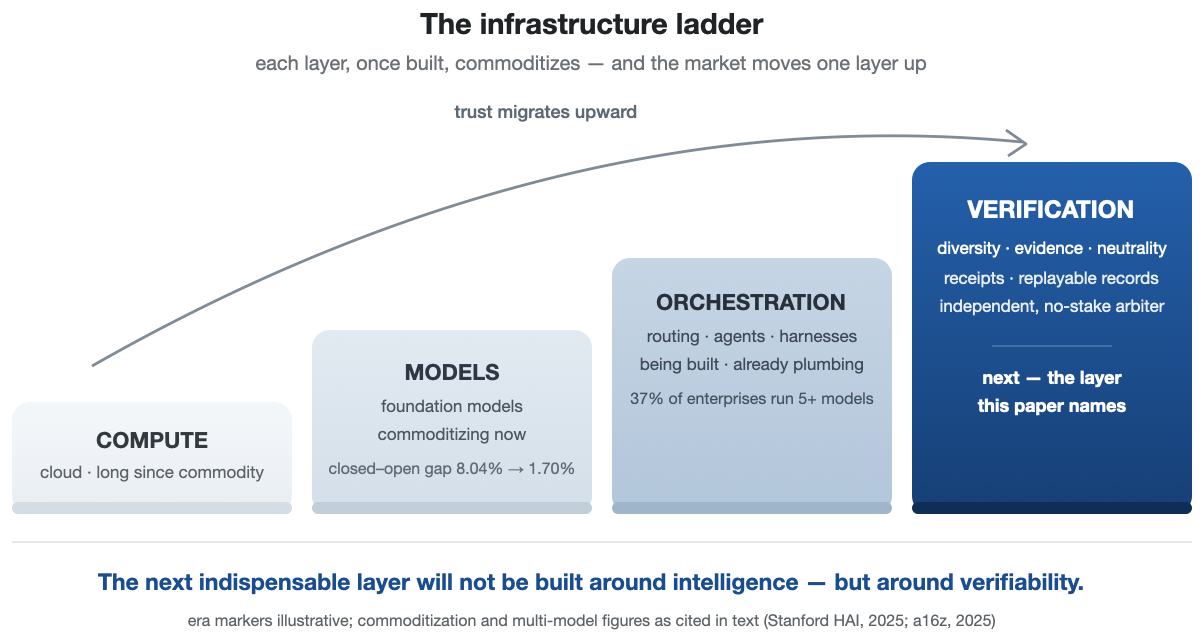
Computação, depois modelos, depois orquestração, e verificação como a próxima camada indispensável.
Nota e divulgação do autor
A implantação descrita na Seção 4 é uma implementação de referência construída e operada pelo autor; os métodos que incorpora são abertos, e o autor é um solicitante nomeado em pedidos de patente pendentes, não em patentes concedidas, cobrindo sistemas de orquestração de IA e validação multi-modelo do tipo que este artigo examina. Ela serve aqui como instrumento de pesquisa do estudo, e o autor tem interesse de desenvolvedor na arquitetura que incorpora; a Seção 4 deveria ser lida como prova de existência e testemunho de design, não como avaliação independente. Todos os modelos neste estudo foram acessados através das APIs comerciais padrão dos fornecedores em termos ordinários. Nenhum financiamento externo apoiou este trabalho.
Ferramentas e verificação. Assistentes de IA foram usados como instrumentos sob a direção do autor; as ideias, pesquisa e conclusões são do autor. Alegações factuais estruturantes foram verificadas contra fontes primárias onde disponível e são atribuídas no texto com seu status de evidência (relatórios de imprensa como relatórios, alegações como alegações, preprints como preprints), e um registro de verificação de alegações datado é mantido com os materiais de trabalho do manuscrito. A correção no experimento nunca é julgada por qualquer modelo em painel (pontuação é correspondência de string objetiva ou um classificador local de pesos abertos), os números de discriminação e calibração por fornecedor são impressos no texto principal (Tabelas 7 e 7a), e cada número relatado é recomputável a partir do pacote de replicação determinístico (disponível publicamente em https://osf.io/jtvu9/).
Disponibilidade de dados e código
Cada número relatado nos experimentos de mecanismo (Seção 3) é recomputável a partir de um pacote de replicação determinístico — as respostas brutas do modelo de ambas as ondas (incluindo a coleção de dezesseis modelos de 24.000 respostas e os registros classificados da onda principal), os executores de coleção, o classificador determinístico, os scripts de análise e os CSVs derivados (incluindo as curvas de cobertura de risco e a fronteira custo-acurácia de 26 pontos, com a base de preço cobrado versus listado de cada ponto sinalizada) — disponível publicamente em https://osf.io/jtvu9/, um componente público do projeto de origem do pré-registro (pasta `replication-package-v2`; o arquivo do programa de auto-calibração da Seção 3 é depositado ao seu lado). A subamostra SimpleQA congelada (fixada por seed e hash SHA-256) já é pública no pré-registro OSF do estudo de mecanismo (https://osf.io/4y9dv, registrada em 23 de julho de 2026). O pré-registro do experimento do consumidor é registrado no OSF sob embargo (congelado antes da coleta de dados principal; registro https://osf.io/pqeg6/?view_only=87eb0a88579647b48e93d4a475795d5f). O pool de participantes está fechado; o instrumento de pesquisa, os estímulos de vinheta e bloco de julgamento, os registros de cunhagem de recebimento da Seção 6, e os dados do experimento do consumidor com o código de análise congelado serão liberados no mesmo componente OSF após publicação.
Referências
Entradas marcadas com arXiv são preprints; anúncios da indústria e itens de imprensa de 2026 são relatórios contemporâneos em vez de literatura estabelecida e são citados como tais.
a16z — Andreessen Horowitz (2025). Como 100 CIOs corporativos estão construindo e adquirindo IA generativa em 2025. a16z.com/ai-enterprise-2025.
Accenture (2026). Fale com meu agente de IA: As novas regras de valor de marca. Pesquisa de 25.590 consumidores em 16 países, janeiro de 2026.
ACI Worldwide (2026). Atitudes dos consumidores em relação a compras e pagamentos orientados por IA. Pesquisa YouGov de 2.080 adultos do Reino Unido, realizada de 19 a 22 de junho de 2026. Comunicado de imprensa.
Ahmad Husairi, M., & Rossi, P. (2024). Delegação de tarefas de compra para IA: O papel da escolha percebida e autonomia de decisão. Decision Support Systems, 179, 114166. DOI 10.1016/j.dss.2023.114166.
AIUC (2025). AIUC-1: O padrão de agente. Artificial Intelligence Underwriting Company.
Alavi, S., & Nozari, S. (2026). Quando agentes compram para você: Coerência de papel em mercados mediados por IA. arXiv:2604.26220.
Allouah, A., Besbes, O., Figueroa, J. D., Kanoria, Y., & Kumar, A. (2026). What is your AI agent buying? Evaluation, biases, model dependence, and emerging implications of agentic e-commerce. Proceedings of the ACM Web Conference 2026, 8697–8700. https://doi.org/10.1145/3774904.3792943
American Express (2026). American Express lança kit de desenvolvedor Agentic Commerce Experiences (ACE) e anuncia proteção inédita para compras de agentes registrados. Comunicado à imprensa, 14 de abril de 2026.
Anderson, L. (2006). Analytic autoethnography. Journal of Contemporary Ethnography, 35(4), 373–395.
André, Q., Carmon, Z., Wertenbroch, K., Crum, A., Frank, D., Goldstein, W., Huber, J., van Boven, L., Weber, B., & Yang, H. (2018). Consumer choice and autonomy in the age of artificial intelligence and big data. Customer Needs and Solutions, 5(1–2), 28–37.
Appenzeller, G. (2024). Welcome to LLMflation: LLM inference cost is going down fast. Andreessen Horowitz, novembro de 2024.
Aubakirova, M., Atallah, A., Clark, C., Summerville, J., & Midha, A. (2026). State of AI: An empirical 100 trillion token study with OpenRouter. arXiv:2601.10088 (relatório divulgado dezembro de 2025).
Bain & Company (2025). Agentic commerce market projection: $300–500 billion u.s. e-commerce by 2030. Dezembro de 2025.
Bainbridge, L. (1983). Ironies of automation. Automatica, 19(6), 775–779.
Balaskas, S. (2026). From recommendations to delegation: A systematic review mapping agentic AI in e-commerce and its consumer effects. Information, 17(3), 222.
Bansal, G., Wu, T., Zhou, J., Fok, R., Nushi, B., Kamar, E., Ribeiro, M. T., & Weld, D. S. (2021). Does the whole exceed its parts? The effect of AI explanations on complementary team performance. Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, 1–16.
Basu, A. (2026). Tool receipts, not zero-knowledge proofs: Practical hallucination detection for AI agents. arXiv:2603.10060.
Board of Governors of the Federal Reserve System & OCC (2011). Supervisory guidance on model risk management (SR Letter 11-7 / OCC 2011-12).
Buçinca, Z., Malaya, L. B., & Gajos, K. Z. (2021). To trust or to think: Cognitive forcing functions can reduce overreliance on AI in AI-assisted decision-making. Proceedings of the ACM on Human-Computer Interaction, 5(CSCW1), 1–21.
Burton, J. W., Stein, M.-K., & Jensen, T. B. (2020). A systematic review of algorithm aversion in augmented decision making. Journal of Behavioral Decision Making, 33(2), 220–239.
California State Legislature (2025). Assembly Bill 316 (artificial intelligence: defenses), Stats. 2025, ch. 672 (adicionando Cal. Civ. Code § 1714.46), vigente em 1º de janeiro de 2026.
Carlson, S. C. (2026). Trust migration in the digital era: Information regimes and the transformation of buyer–seller relationships. Atlantic Marketing Journal, 15(1), Artigo 6.
Castelo, N., Bos, M. W., & Lehmann, D. R. (2019). Task-dependent algorithm aversion. Journal of Marketing Research, 56(5), 809–825.
Cetinkaya, N. E., & Krämer, N. (2024). Understanding vs. trust: A conjoint analysis. Documento de trabalho, OSF Project mw4dq.
Chandra, K., Kleiman-Weiner, M., Ragan-Kelley, J., & Tenenbaum, J. B. (2026). Sycophantic chatbots cause delusional spiraling, even in ideal Bayesians. arXiv:2602.19141.
Chen, C., Sun, Y., Liao, M., & Sundar, S. S. (2026). When AI disagrees: The effect of second opinion on patients' trust in doctors. International Journal of Human-Computer Studies, 213, 103824.
Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026). Sycophantic AI decreases prosocial intentions and promotes dependence. Science, 391(6792), eaec8352. DOI: 10.1126/science.aec8352.
Choi, H. K., Zhu, X., & Li, S. (2026). When identity skews debate: Anonymization for bias-reduced multi-agent reasoning. Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 14284–14311. https://doi.org/10.18653/v1/2026.acl-long.650
Choi, M., Kim, K., Chae, S., & Baek, S. (2025). An empirical study of group conformity in multi-agent systems. Findings of the Association for Computational Linguistics: ACL 2025, 5123–5139. https://doi.org/10.18653/v1/2025.findings-acl.265
Clark, J., & Hadfield, G. K. (2020). Regulatory markets for AI safety. arXiv:2001.00078.
CNBC (2026, 24 de março). OpenAI revamps shopping experience in ChatGPT after struggling with Instant Checkout offering (informando a cobertura de The Information de março de 2026 sobre o recuo do native-checkout).
Daly, C. (2025). Klarna slows AI-driven job cuts with call for real people. Bloomberg News, 8 de maio de 2025.
de Bellis, E., & Johar, G. V. (2020). Autonomous shopping systems: Identifying and overcoming barriers to consumer adoption. Journal of Retailing, 96(1), 74–87.
Detjen, H. H. J., Densky, L., von Kalckreuth, N., & Kopka, M. (2025). Who is trusted for a second opinion? Comparing collective advice from a medical AI and physicians in biopsy decisions after mammography screening. CHI 2025.
de Visser, E. J., Pak, R., & Shaw, T. H. (2018). From 'automation' to 'autonomy': The importance of trust repair in human–machine interaction. Ergonomics, 61(10), 1409–1427.
Dietvorst, B. J., Simmons, J. P., & Massey, C. (2015). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 144(1), 114–126.
DigiCert (2026). AI Trust Architecture. Anúncio de produto, abril de 2026.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Dranove, D., & Jin, G. Z. (2010). Quality disclosure and certification: Theory and practice. Journal of Economic Literature, 48(4), 935–963.
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024). Improving factuality and reasoning in language models through multiagent debate. Proceedings of the 41st International Conference on Machine Learning, PMLR 235, 11733–11763.
Endsley, M. R., & Kiris, E. O. (1995). The out-of-the-loop performance problem and level of control in automation. Human Factors, 37(2), 381–394.
Errico, H. (2026). Autonomous action runtime management (AARM): A system specification for securing AI-driven actions at runtime. arXiv:2602.09433.
Comissão Europeia (2026). Diretrizes sobre a implementação das obrigações de transparência para certos sistemas de IA sob o Artigo 50 da Lei de IA. Adotado em 20 de julho de 2026.
Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). Detecção de alucinações em modelos de linguagem grandes usando entropia semântica. Nature, 630(8017), 625–630.
Featherman, M. S., & Pavlou, P. A. (2003). Predição de adoção de serviços eletrônicos: Uma perspectiva de facetas de risco percebido. International Journal of Human-Computer Studies, 59(4), 451–474.
Frank, D.-A., Folwarczny, M., & Otterbring, T. (2026). A aceitação do consumidor de assistentes de IA de alta autonomia é impulsionada pelos benefícios percebidos em ambientes de compras online caracterizados por escassez. Psychology & Marketing, 43(3), 538–555. https://doi.org/10.1002/mar.70074
Gartner (2025). Gartner predicts over 40% of agentic AI projects will be canceled by end of 2027. Comunicado à imprensa, 25 de junho de 2025.
Gartner (2026). Consumer survey on generative AI in shopping (Comunicado à imprensa de maio de 2026).
Gefen, D., Karahanna, E., & Straub, D. W. (2003). Confiança e TAM em compras online: Um modelo integrado. MIS Quarterly, 27(1), 51–90.
Geifman, Y., & El-Yaniv, R. (2017). Classificação seletiva para redes neurais profundas. Advances in Neural Information Processing Systems 30 (NeurIPS 2017), 4878–4887 (arXiv:1705.08500).
Gillespie, N., Lockey, S., Ward, T., Macdade, A., & Hassed, G. (2025). Trust, attitudes and use of artificial intelligence: A global study 2025. The University of Melbourne and KPMG. https://doi.org/10.26188/28822919
Glikson, E., & Woolley, A. W. (2020). Confiança humana em inteligência artificial: Revisão da pesquisa empírica. Academy of Management Annals, 14(2), 627–660.
Google (2026). Universal Commerce Protocol. Anúncio na NRF, 11 de janeiro de 2026; extensão de carrinho, catálogo e vinculação de identidade, março de 2026.
Google Cloud (2025). Agent Payments Protocol (AP2). Anúncio, 16 de setembro de 2025.
Google DeepMind (2025). SimpleQA Verified. arXiv:2509.07968.
Gorbett, M., & Jana, S. (2026). Discordância entre modelos como sinal de correção sem rótulo. arXiv:2603.25450.
Gottweis, J., Weng, W.-H., Daryin, A., Tu, T., Sirkovic, P., Myaskovsky, A., Glowaty, G., Weissenberger, F., Orlandi, A., Popovici, D., Palepu, A., Rong, K., Tanno, R., Saab, K., Zhang, F., Blum, J., Carroll, A., Kulkarni, K., Tomašev, N., Zverinski, D., Rendulic, I., Vedadi, E., Hasler, F., Rimanic, L., Boia, M., Budiselic, I., Feinstein, B., Bellaiche, M., Sheffer, T., Freyberg, J., Ratcliff, J., Bertolli, O., Chou, K., Hassidim, A., Gokturk, B., Vahdat, A., Guan, Y., Dhillon, V., Vaishnav, E. D., Lee, B., Costa, T. R. D., Penadés, J. R., Peltz, G., Matias, Y., Manyika, J., Hassabis, D., Xu, Y., Kohli, P., Pawlosky, A., Karthikesalingam, A., & Natarajan, V. (2026). Aceleração da descoberta científica com Co-Scientist. Nature, 655(8122), 487–496. https://doi.org/10.1038/s41586-026-10644-y
Gould, S. J. (1991). A auto-manipulação de minha energia vital pervasiva e percebida através do uso de produtos: Uma perspectiva introspectiva-práxis. Journal of Consumer Research, 18(2), 194–207.
Guo, C., Pleiss, G., Sun, Y., & Weinberger, K. Q. (2017). Sobre a calibração de redes neurais modernas. ICML 2017, PMLR 70, 1321–1330.
Gvirtz, A., & Sabherwal, A. (2024). Os limites da pesquisa em ciência comportamental global e transcultural. Proceedings of the National Academy of Sciences, 121(36), e2316690121.
Hadfield, G. K. (2017). Rules for a flat world: Why humans invented law and how to reinvent it for a complex global economy. Oxford University Press.
Hadfield, G. K., & Clark, J. (2026). Mercados regulatórios: O futuro da governança de IA. Jurimetrics, 65, 195–240 (arXiv:2304.04914).
Hansen, L. K., & Salamon, P. (1990). Conjuntos de redes neurais. IEEE Transactions on Pattern Analysis and Machine Intelligence, 12(10), 993–1001.
Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026). Nem todos os reveses são conformidade: Decomposição da convergência de posição no debate de LLM multiagente. arXiv:2606.00820.
Hoff, K. A., & Bashir, M. (2015). Confiança em automação: Integrando evidência empírica sobre fatores que influenciam a confiança. Human Factors, 57(3), 407–434.
Hong, L., & Page, S. E. (2004). Grupos de solucionadores de problemas diversos podem superar grupos de solucionadores de problemas com alta capacidade. Proceedings of the National Academy of Sciences, 101(46), 16385–16389.
Huang, M.-H., & Rust, R. T. (2021). Um marco estratégico para inteligência artificial em marketing. Journal of the Academy of Marketing Science, 49(1), 30–50.
Insurance Services Office (2026). Endorsement forms CG 40 47 and CG 40 48: generative artificial intelligence exclusions. Em vigor a partir de 1º de janeiro de 2026.
Internet Engineering Task Force (2026). An architecture for trustworthy and transparent digital supply chains (RFC 9943; grupo de trabalho SCITT). IETF. https://datatracker.ietf.org/doc/rfc9943/
Ioku, T., Song, J., & Watamura, E. (2024). Compensações na escolha do assistente de IA: Os consumidores priorizam transparência e sustentabilidade em relação ao desempenho do assistente de IA? Big Data & Society, 11(4).
Ipsos (2025). The Ipsos AI Monitor 2025. Ipsos Global Advisor, pesquisa de 30 países, junho de 2025.
Jacovi, A., Marasović, A., Miller, T., & Goldberg, Y. (2021). Formalizando confiança em inteligência artificial: Pré-requisitos, causas e objetivos de confiança humana em IA. FAccT 2021, 624–635.
Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., Schiefer, N., Hatfield-Dodds, Z., DasSarma, N., Tran-Johnson, E., Johnston, S., El-Showk, S., Jones, A., Elhage, N., Hume, T., Chen, A., Bai, Y., Bowman, S., Fort, S., ... Kaplan, J. (2022). Modelos de linguagem (em grande parte) sabem o que sabem. arXiv:2207.05221.
Kalai, A. T., Nachum, O., Vempala, S., & Zhang, E. (2025). Por que modelos de linguagem alucinam. arXiv:2509.04664.
Kharazian, A. (2026). Anthropic supera OpenAI na adoção empresarial. Ramp Economics Lab / Ramp AI Index, 13 de maio de 2026 (dados de pagamentos corporativos em mais de 50.000 empresas dos EUA).
Kim, D., & Benbasat, I. (2010). Designs para implementação efetiva de garantias de confiança em lojas de internet. Communications of the ACM, 53(2), 121–126.
Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Erros correlacionados em modelos de linguagem grandes. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038–30066.
Kim, P. H., Ferrin, D. L., Cooper, C. D., & Dirks, K. T. (2004). Eliminando a sombra da suspeita: os efeitos de desculpas versus negação para reparar violações de confiança baseadas em competência versus integridade. Journal of Applied Psychology, 89(1), 104–118.
Kizilcec, R. F. (2016). Quanta informação? Efeitos da transparência na confiança em uma interface algorítmica. CHI 2016, 2390–2395.
Klarna (2024). O assistente de IA Klarna gerencia dois terços dos chats de atendimento ao cliente em seu primeiro mês. Comunicado de imprensa, 27 de fevereiro de 2024.
Köbis, N., Rahwan, Z., Rilla, R., Supriyatno, B. I., Bersch, C., Ajaj, T., Bonnefon, J.-F., & Rahwan, I. (2025). A delegação para inteligência artificial pode aumentar comportamento desonesto. Nature, 646(8083), 126–134. DOI: 10.1038/s41586-025-09505-x.
Kolt, N. (2025). Governança de agentes de IA. Notre Dame Law Review, 101 (SSRN working paper 4772956; arXiv:2501.07913).
Komiak, S. Y. X., & Benbasat, I. (2006). Os efeitos da personalização e familiaridade na confiança e adoção de agentes de recomendação. MIS Quarterly, 30(4), 941–960.
König, P. D., Wurster, S., & Siewert, M. B. (2022). Os consumidores estão dispostos a pagar por IA explicável, mas não por IA verde: evidências de uma análise conjunta baseada em escolhas. Big Data & Society, 9(1).
Krogh, A., & Vedelsby, J. (1995). Conjuntos de redes neurais, validação cruzada e aprendizado ativo. Advances in Neural Information Processing Systems, 7, 231–238.
Kroll, J. A., Huey, J., Barocas, S., Felten, E. W., Reidenberg, J. R., Robinson, D. G., & Yu, H. (2017). Algoritmos responsáveis. University of Pennsylvania Law Review, 165(3), 633–705.
Kuncheva, L. I., & Whitaker, C. J. (2003). Medidas de diversidade em conjuntos de classificadores e sua relação com a precisão do conjunto. Machine Learning, 51(2), 181–207.
Lee, J. D., & See, K. A. (2004). Confiança na automação: projetando para confiança apropriada. Human Factors, 46(1), 50–80.
Lessig, L. (2006). Code: Version 2.0. Basic Books.
Li, M. (2025). De nativo em nuvem para nativo em confiança: um protocolo para sistemas multi-agentes verificáveis. arXiv:2507.22077.
Liang, P., Bommasani, R., Lee, T., Tsipras, D., Soylu, D., Yasunaga, M., Zhang, Y., Narayanan, D., Wu, Y., Kumar, A., Newman, B., Yuan, B., Yan, B., Zhang, C., Cosgrove, C., Manning, C. D., Ré, C., Acosta-Navas, D., Hudson, D. A., ... Koreeda, Y. (2023). Avaliação holística de modelos de linguagem. Transactions on Machine Learning Research.
Liao, Q. V., & Sundar, S. S. (2022). Projetando para confiança responsável em sistemas de IA: uma perspectiva de comunicação. FAccT 2022, 1257–1268.
Lin, S., Hilton, J., & Evans, O. (2022). Ensinando modelos a expressar sua incerteza em palavras. arXiv:2205.14334.
Lindsey, J. (2025). Consciência introspectiva emergente em grandes modelos de linguagem. Anthropic / Transformer Circuits.
Liu, J., Bursztyn, V. S., Ai, L., Wang, H., Choudhary, S., Mitra, S., & Wu, Q. (2026). TeamFusion: Apoiando trabalho em equipe aberto com sistemas multi-agentes. arXiv:2604.19589 (ACL 2026; Adobe Research).
Lizzeri, A. (1999). Revelação de informações e intermediários de certificação. RAND Journal of Economics, 30(2), 214–231.
Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Apreciação de algoritmos: pessoas preferem julgamento algorítmico a julgamento humano. Organizational Behavior and Human Decision Processes, 151, 90–103.
Longoni, C., Bonezzi, A., & Morewedge, C. K. (2019). Resistência à inteligência artificial médica. Journal of Consumer Research, 46(4), 629–650.
Longoni, C., Cian, L., & Kyung, E. J. (2023). Transferência algorítmica: as pessoas generalizam excessivamente as falhas da IA no governo. Journal of Marketing Research, 60(1), 170–188.
Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). Como a influência social pode minar o efeito da sabedoria das multidões. Proceedings of the National Academy of Sciences, 108(22), 9020–9025. DOI: 10.1073/pnas.1008636108.
Lu, Z., Wang, D., & Yin, M. (2024). Mais conselhos ajudam? Os efeitos de segundas opiniões na tomada de decisão assistida por IA. Proceedings of the ACM on Human-Computer Interaction, 8(CSCW1), 1–31.
Marchal, N., Chan, S., Franklin, M., Revel, M., Keeling, G., Fischli, R., Chandra, B., & Gabriel, I. (2026). Arquitetando confiança em agentes epistêmicos artificiais. arXiv:2603.02960.
Mastercard (2026). Verifiable Intent (co-developed with Google). Comunicado de sala de imprensa, 5 de março de 2026; pilotos iniciais relatados nos mercados asiáticos e latino-americanos, 2026.
Mayer, R. C., Davis, J. H., & Schoorman, F. D. (1995). Um modelo integrativo de confiança organizacional. Academy of Management Review, 20(3), 709–734.
McKinsey & Company (2025). A oportunidade de comércio agencial (Schumacher, Roberts, & Giebel). 17 de outubro de 2025.
McKnight, D. H., Choudhury, V., & Kacmar, C. (2002). Desenvolvendo e validando medidas de confiança para comércio eletrônico. Information Systems Research, 13(3), 334–359.
Menlo Ventures (2025a). Atualização do mercado de LLM do meio do ano de 2025. 31 de julho de 2025 (pesquisa de 150 tomadores de decisão técnicos).
Menlo Ventures (2025b). 2025: O estado da IA generativa na empresa. 9 de dezembro de 2025 (pesquisa de 495 tomadores de decisão de IA da empresa dos EUA; Menlo Ventures é um investidor da Anthropic).
Menlo Ventures (2025c). 2025: O estado da IA do consumidor. 26 de junho de 2025 (pesquisa de 5.031 adultos dos EUA, com Morning Consult; a figura de usuário pagador de ~3% é uma estimativa derivada de receita).
Möhlmann, M., & Zalmanson, L. (2017). Mãos no volante: navegando a gestão algorítmica e a autonomia dos motoristas da Uber. ICIS 2017.
Montgomery, J. M., Nyhan, B., & Torres, M. (2018). Como o condicionamento em variáveis pós-tratamento pode arruinar seu experimento e o que fazer a respeito. American Journal of Political Science, 62(3), 760–775.
Morgan Stanley (2025). Previsão de comércio agencial: gastos em comércio eletrônico dos EUA de $190-385 bilhões até 2030. Dezembro de 2025.
Mosier, K. L., & Skitka, L. J. (1996). Tomadores de decisão humanos e auxílios de decisão automatizados: feitos um para o outro? Em R. Parasuraman & M. Mouloua (Eds.), Automação e desempenho humano: teoria e aplicações (pp. 201–220). Lawrence Erlbaum Associates.
Mozannar, H., & Sontag, D. (2020). Estimadores consistentes para aprender a deferir a um especialista. ICML 2020, PMLR 119, 7076–7087.
Muchnik, L., Aral, S., & Taylor, S. J. (2013). Viés de influência social: um experimento aleatorizado. Science, 341(6146), 647–651. DOI: 10.1126/science.1240466.
Muir, B. M. (1994). Trust in automation: Part I. Theoretical issues in the study of trust and human intervention in automated systems. Ergonomics, 37(11), 1905–1922.
NIST (2023). Artificial Intelligence Risk Management Framework (AI RMF 1.0) (NIST AI 100-1). National Institute of Standards and Technology.
Okamura, K., & Yamada, S. (2020). Adaptive trust calibration for human-AI collaboration. PLOS ONE, 15(2), e0229132.
Papamarkou, T., Alquier, P., Bauer, M., Buntine, W., Davison, A., Dziugaite, G. K., Filippone, M., Foong, A. Y. K., Fortuin, V., Fouskakis, D., Frellsen, J., Hüllermeier, E., Karaletsos, T., Khan, M. E., Kotelevskii, N., Lahlou, S., Li, Y., Liu, F., Lyle, C., Möllenhoff, T., Palla, K., Panov, M., Sale, Y., Schweighofer, K., Shelmanov, A., Swaroop, S., Trapp, M., Waegeman, W., Wilson, A. G., & Zaytsev, A. (2026). Position: Agentic AI orchestration should be Bayes-consistent. arXiv:2605.00742. (Aceito em ICML 2026.)
Parasuraman, R., & Manzey, D. H. (2010). Complacency and bias in human use of automation: An attentional integration. Human Factors, 52(3), 381–410. DOI: 10.1177/0018720810376055.
Parasuraman, R., & Riley, V. (1997). Humans and automation: Use, misuse, disuse, abuse. Human Factors, 39(2), 230–253.
Parasuraman, R., Sheridan, T. B., & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics — Part A: Systems and Humans, 30(3), 286–297.
Pavlou, P. A. (2003). Consumer acceptance of electronic commerce: Integrating trust and risk with the technology acceptance model. International Journal of Electronic Commerce, 7(3), 101–134.
Pew Research Center (2025). How people around the world view AI. Pesquisa de 25 países, outubro de 2025.
Piehlmaier, D. M. (2023). The one-man show: The effect of joint decision-making on investor overconfidence. Journal of Consumer Research, 50(2), 426–446. https://doi.org/10.1093/jcr/ucac054
Puntoni, S., Reczek, R. W., Giesler, M., & Botti, S. (2021). Consumers and artificial intelligence: An experiential perspective. Journal of Marketing, 85(1), 131–151.
Rabanser, S., Kapoor, S., Kirgis, P., Liu, K., Utpala, S., & Narayanan, A. (2026). Towards a science of AI agent reliability. arXiv:2602.16666 (ICML 2026).
Raji, I. D., Xu, P., Honigsberg, C., & Ho, D. (2022). Outsider oversight: Designing a third party audit ecosystem for AI governance. AIES 2022, 557–571.
Regulation (EU) 2016/679 (General Data Protection Regulation), Artigo 22 — tomada de decisão individual automatizada.
Regulation (EU) 2024/1689 (Artificial Intelligence Act), Artigo 14 — supervisão humana de sistemas de IA de alto risco; Artigo 50 — obrigações de transparência para fornecedores e utilizadores de determinados sistemas de IA.
Ríos-García, M., Alampara, N., Gupta, C., Mandal, I., Mannan, S., Aghajani, A. A., Krishnan, N. M. A., & Jablonka, K. M. (2026). AI scientists produce results without reasoning scientifically. arXiv:2604.18805.
Saad-Falcon, J., Buchanan, E. K., Chen, M. F., Huang, T.-H., McLaughlin, B., Bhathal, T., Zhu, S., Athiwaratkun, B., Sala, F., Linderman, S., Mirhoseini, A., & Ré, C. (2025). Shrinking the generation-verification gap with weak verifiers. arXiv:2506.18203.
Sabater, J., & Sierra, C. (2005). Review on computational trust and reputation models. Artificial Intelligence Review, 24(1), 33–60.
Schemmer, M., Kühl, N., Benz, C., Bartos, A., & Satzger, G. (2023). Appropriate reliance on AI advice: Conceptualization and the effect of explanations. IUI '23, 410–422.
Schilke, O., & Reimann, M. (2025). The transparency dilemma: How AI disclosure erodes trust. Organizational Behavior and Human Decision Processes, 188, 104405.
Schmidt, J., & Bijmolt, T. H. A. (2020). Accurately measuring willingness to pay for consumer goods: A meta-analysis of the hypothetical bias. Journal of the Academy of Marketing Science, 48, 499–518.
Shapiro, S. P. (1987). The social control of impersonal trust. American Journal of Sociology, 93(3), 623–658.
Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., Cheng, N., Durmus, E., Hatfield-Dodds, Z., Johnston, S. R., Kravec, S., Maxwell, T., McCandlish, S., Ndousse, K., Rausch, O., Schiefer, N., Yan, D., Zhang, M., & Perez, E. (2024). Towards understanding sycophancy in language models. ICLR 2024 (arXiv:2310.13548).
Shehata, D., & Li, M. (2026). The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274.
Sheridan, T. B., & Verplank, W. L. (1978). Human and computer control of undersea teleoperators (Relatório técnico). MIT Man-Machine Systems Laboratory.
Smit, A. P., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). Should we be going MAD? A look at multi-agent debate strategies for LLMs. ICML 2024, PMLR 235, 45883–45905 (arXiv:2311.17371).
Söllner, M., Hoffmann, A., & Leimeister, J. M. (2016). Why different trust relationships matter for information systems users. European Journal of Information Systems, 25(3), 274–287.
Spiro, T. (2026). The Oracle's fingerprint: Correlated AI forecasting errors and the limits of bias transmission. arXiv:2605.00844.
Stanford HAI (2025). Artificial Intelligence Index Report 2025. Stanford Institute for Human-Centered Artificial Intelligence (capítulo de Desempenho Técnico).
Stanford HAI (2026). Artificial Intelligence Index Report 2026. Stanford Institute for Human-Centered Artificial Intelligence (capítulo de Opinião Pública, relatando dados da pesquisa Pew de 25 países).
Tax, S. S., Brown, S. W., & Chandrashekaran, M. (1998). Customer evaluations of service complaint experiences: Implications for relationship marketing. Journal of Marketing, 62(2), 60–76.
Vaccaro, M., Almaatouq, A., & Malone, T. (2024). When combinations of humans and AI are useful: A systematic review and meta-analysis. Nature Human Behaviour, 8(12), 2293–2303. DOI: 10.1038/s41562-024-02024-1.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Visa (2025). Visa introduces Trusted Agent Protocol: An ecosystem-led framework for AI commerce. Comunicado de imprensa (com Cloudflare), 14 de outubro de 2025.
Visa (2026). Visa faz parceria com OpenAI para potencializar a próxima geração de comércio de IA. Comunicado à imprensa, Visa Payments Forum, 10 de junho de 2026.
W3C (2025). Verifiable Credentials Data Model v2.0. Recomendação W3C.
Wallendorf, M., & Brucks, M. (1993). Introspecção em pesquisa de consumo: Implementação e implicações. Journal of Consumer Research, 20(3), 339–359.
Walsham, G. (1995). Estudos de caso interpretativos em pesquisa de SI: Natureza e método. European Journal of Information Systems, 4(2), 74–81.
Wang, W., & Benbasat, I. (2005). Confiança e adoção de agentes de recomendação on-line. Journal of the Association for Information Systems, 6(3), 72–101.
Wang, Y., Zhang, J., Cai, T., Liu, Z., Sun, Q., Sun, Z., Wu, Z., Dong, M., Zheng, M., Yin, X., & Zhu, Y. (2026). De rastros de agentes a confiança: Uma pesquisa sobre rastreamento de evidências e proveniência de execução em agentes LLM. arXiv:2606.04990.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., & Fedus, W. (2024). Medição de factualidade de conteúdo em forma curta em grandes modelos de linguagem. arXiv:2411.04368.
Werbach, K. (2018). The blockchain and the new architecture of trust. MIT Press.
Wertenbroch, K. (1998). Autocontrole de consumo por racionamento de quantidades de compra de virtude e vício. Marketing Science, 17(4), 317–337.
Xiao, B., & Benbasat, I. (2007). Agentes de recomendação de produtos de comércio eletrônico: Uso, características e impacto. MIS Quarterly, 31(1), 137–209.
Yalcin, G., Lim, S., Puntoni, S., & van Osselaer, S. M. J. (2022). Polegar para cima ou para baixo: Reações de consumidores a decisões de algoritmos versus humanos. Journal of Marketing Research, 59(4), 696–717.
Yin, R. K. (2018). Case study research and applications: Design and methods (6th ed.). Sage.
Zhang, Y., Liao, Q. V., & Bellamy, R. K. E. (2020). Efeito de confiança e explicação na precisão e calibração de confiança em tomada de decisão assistida por IA. Proceedings of the 2020 ACM Conference on Fairness, Accountability, and Transparency, 295–305.
Zheng, J., & Zhang, J. (2026). Estimativa de confiança consciente da incerteza para sistemas multi-LLM via julgamento estruturado de especialista. arXiv:2607.20529.
Zuboff, S. (2019). The age of surveillance capitalism. PublicAffairs.
Zucker, L. G. (1986). Produção de confiança: Fontes institucionais de estrutura econômica, 1840–1920. Research in Organizational Behavior, 8, 53–111.
* Arquiteto de sistemas de IA. Conflitos de interesse: o autor desenvolve métodos de orquestração multi-modelo, opera uma implementação de referência da arquitetura descrita aqui, é um requerente nomeado em aplicações de patente pendente, não patentes concedidas, cobrindo sistemas de orquestração de IA e validação multi-modelo do tipo que este artigo examina, e tem um interesse como desenvolvedor na arquitetura que este artigo defende; afirmações normativas sobre sua necessidade devem ser lidas levando esse interesse em consideração. O papel do autor na implantação da Seção 4 é estabelecido na Nota do Autor e Divulgação ao final deste artigo. Comentários bem-vindos: [email protected].↩︎
Como citar
Chernets, V. (2026). Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture [Pré-publicação]. SSRN. https://doi.org/10.2139/ssrn.7191261
@misc{chernets2026architecturaltrust,
  author       = {Chernets, Vadym},
  title        = {{Architectural Trust: Why Consumer Trust in Agentic Commerce Migrates from AI Models to Verifiable Architecture}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7191261},
  url          = {https://doi.org/10.2139/ssrn.7191261}
}