验证剧院:人工智能验证小组的可度量失败模式
这是译文。权威版本是英文原文,引用请以原文为准。
Vadym Chernets,独立研究员 · ORCID 0009-0007-4845-3163
Zenodo DOI 10.5281/zenodo.23197641 · GitHub
被接收为 NeurIPS 2026"Who Verifies the Agents? Toward Reliable Agent Development"工作坊的海报(非存档)。 存档副本:10.5281/zenodo.23197641。PDF:verification-theater.pdf。以下图表转换自 LaTeX 源代码;PDF 是权威版本。
摘要
多模型验证正在成为默认的信任机制:一个答案之所以值得信任,是因为独立模型对其达成了共识。使用一个预先注册的、盲测的、温度为零的数据集,其中十六个模型(来自九个前沿厂商的模型、七个本地开源权重模型)回答了相同的1,500个事实问题(另外还包括一个750问题多选臂和一个探索对话臂),我们测量了面板验证何时停止有效,同时仍然看起来有效——我们称之为验证剧场。我们报告了四种失败模式。首先,难度反转:独立共识的认证提升——2.7–4.6在较容易的三个五分位数问题上——下降到0.82在第二难的五分位数上,在最难的五分位数上降至零,其中复制答案在342个案例中有0个正确(在独立假设下预期约13个)。一个面板外重新分层(难度由13个非面板模型排列)消除了汇总反转(78/354正确,提升2.36),而零对跨集团面板持续存在(0/116);我们始终将两种编码一起报告:在已部署群体认为最难的问题上,共识充当错误认证的功能。第二,受限答案空间:在多选题(本地层级)下,面板一致认证了4.0–7.9%的问题中的错误答案,相比之下同一层级的开放式答案为1.5–4.6%,前沿开放式为0.3–4.9%。第三,用作独立性代理的标签在经验上失效:地缘政治集团不能预测错误相关性(平均集团内 0.285对跨集团0.274,差异),而从与其面板配对相同基础蒸馏出的推理模型与其面板配对是测量中相关性最低的模型对之一(;在15个美中集团本地对中排名第14,在所有21个本地对中排名第20)。第四,从众性:一个之前不同意某答案的验证者,当被告知该答案来自同事时,在38.5%的情况下赞同了相同答案;反向提示对照显示这些翻转跟踪一个自信提案的存在,而非其准确性(向错误答案38.9%对向正确答案34.7%;McNemar精确)。我们主张这些模式共享一个经济根源,并推导出一个将验证与其剧场分开的测量规范。
导言:剧院问题
由相互检验的AI模型组成的面板被部署为信任基础设施,它们之间的一致性越来越多地被视为证据。安全研究早已为那些产生保护的外观而无其实质的机制取名(Schneier, 2003);我们用测量而非隐喻来询问,面板验证在何时应得此名。核心发现是反转:一致性的认证价值集中在简单问题上,而在验证最重要的地方消失——或反转。我们不将这视为单一异常,而是视为验证面板保持检验的外观同时丧失其实质的四种不同制度之一,并将这四种制度与一个共同的经济原因和一个共同的补救联系起来。
具体来说,本文的贡献如下:(C1) 一项分难度的认证增益测量,显示独立一致性的认证价值集中在简单问题上,且在总体难度度量下的最难五分位上反转(342个复制答案中0个正确;在面板独立难度下,汇总反转消失,跨集团面板中零值持续,0/116)——两种编码在全文中一起报告;(C2) 证据表明受限制(多选)答案空间将一致认证错误推高至4.0–7.9%,远高于开放形式的0.3–4.9%区间;(C3) 两项预注册的零假设结果,显示日常用作独立代理的标签——地缘政治集团和模型谱系——不能预测错误相关性,因此独立性必须逐对测量为矩阵,而非假设自品牌或系谱;以及(C4) 一项带反向提示对照的一致性测量,证明对话模式验证器跟踪的是自信提案的存在,而非其真实性。盲采集协议和信任结构在配套论文中充分说明,此处仅在测量所需范围内总结;本论文中报告的一切结果(C1–C4)在此处测量,不从彼处重述。从这些推导出(C5) 一种测量规范——按任务类别发布的矩阵、分难度的认证主张、盲优先诱发和困难情景升级——在操作上将验证与其剧院分开。
现有技术与框架
容错共识(BFT)假设独立失败——我们测试并发现这一假设是不成立的。共识悖论文献已经描述了同质群体中协议固化的错误(Shehata and Li,2026)。zkML 验证计算确实运行了,而非其答案的真实性——二者互补而非竞争。验证者困境提供了激励分析;(Raji et al.,2022)提供了审计人员选择问题;(Du et al.,2024)、(Farquhar et al.,2024)和(Ding,2026)提供了本文压力测试的协议信号文献。信任构造本身在配套论文中介绍(Chernets,2026);本文指出了该构造的验证引擎在看似运行时失败的位置。测试时计算工作从构造角度得出互补结论:多样化验证者的集合优于任何单一验证者(Lifshitz et al.,2025),来自互不相交族群的小裁判面板以更低成本优于单一大型裁判(Verga et al.,2024),对多代理辩论的系统重新评估将模型异质性识别为唯一可靠的改进因素(Zhang et al.,2025);辩论路线展示了结构化对抗论证如何帮助较弱的裁判获得更真实的答案(Khan et al.,2024)。同行评审证据已经记录了大量的跨提供商错误相关性——尤其在最准确的模型中最大,甚至跨越不同的架构和提供商(Kim et al.,2025)——这独立地激励了测量依赖性而非从标签推断的方法。该文献因多样性选择面板;本文测量所选属性在验证中的价值——及其缺失的隐性成本。
数据和测量
一项预先注册的、盲法收集(在确认性数据收集之前协议公开冻结;公开注册地址为 https://osf.io/4y9dv):十六个模型 SimpleQA 的 4,326 个项目中预先注册的 1,500 个随机子样本(固定种子,在任何收集之前抽取;子样本 CSV 及其 SHA-256 附加到冻结注册)在温度零处进行,置信度为 0–100(13,446 个干净的前沿答案;8,802 个本地层答案);本地层的 750 项 TruthfulQA MC1 臂,源自官方存储库文件的冻结副本(790 个项目,与规范 CSV 字节相同)通过预先注册的构造函数产生,要求每个项目至少两个不同的错误选项(固定洗牌种子;695 个项目由全部七个模型完全回答);一个探索性的主动与盲对话臂。SimpleQA 是针对前沿模型对抗性收集的,每个问题只有一个无可争议的答案(Wei et al., 2024):因此硬层探测真正的参数知识边界,评级简化为与黄金标准的等价性。TruthfulQA 提供约束答案空间臂(Lin et al., 2022)。面板是单一盲收集的分析组合;所有重新分析都是确定性的(字符串等价编码,拒绝和零重叠计为不同意;不确定对报告为括号)。难度在观察上被操作化为 16 个模型的平均准确度,分为 300 个问题的等级五分位数。相同的原始收集为配套论文奠定基础(Chernets, 2026),其报告合并的认证比率和本文详细分析的简要总结;难度分层提升阶梯、鲁棒性套件、-矩阵和一致性分解仅出现在本文中,并且每个剩余重叠在文本中被交叉标记。
开放式评级分为两个阶段:一个确定性字符串等价通过(前沿等级的 26.8%)加上拒绝检测(6.6%),其余 66.5% 由 LLM 评分器评级;人类抽查在随机样本的 98% 上与评分器一致()。因为三分之二的等级是由模型生成的,所有主要结果都伴有评分器误差灵敏度重新采样(10% 的模型评级结果翻转,200 个有种子的重新采样;第 4 节和附录 A)。
失效体制 I:难度反演
三个预先指定的前沿面板是单一盲集合中的分析性三模型组合:美国阵营(Anthropic、OpenAI、Google)、中国阵营(DeepSeek、Alibaba、Moonshot)和跨阵营(Anthropic、DeepSeek、Mistral);当初级面板的两个伙伴中至少有一个在第3节的冻结确定性编码下独立产生了等效答案时,答案被计为已复制,且提升倍数为。汇总三个面板,已复制答案正确的概率从最难五分位的0.0%(0/342,CI 0.0–1.1)上升,经过12.8%、57.5%和81.0%,至最容易的95.1%;非复制答案对应的提升倍数为0.00/ 0.82/ 2.68/ 3.09/ 4.56。在最难的20%的问题中,每一个观察到的一致都证实了错误答案;在下一个五分位,点估计使一致性低于与分歧的对等(0.82,CI [0.51, 1.21]);最难五分位的零复制在各面板中分别出现(美国0.00–4.25,中国0.00–9.76,跨阵营0.00–4.04);第二五分位的次对等结果在中国和跨阵营面板中成立,而美国面板的第二五分位提升倍数为1.20。汇总的认证提升倍数主要由简单问题承载,因此未分层的提升倍数主张高估了验证在必要之处所能提供的价值。第一五分位的零是针对活态基础率而非下限进行测量的:未复制的第一五分位答案正确的概率为3.9%(89/2286),因此独立性预测个正确的已复制答案——观察到的0(上限1.1%)显著低于该阶层自身的基础率。独立性基准在此是保守的,而非宽松的:一个保留完整测得的模型间相关结构的零假设——该阶层问题中正确性标签的一个常见排列,复制结构冻结(2,000次排列)——预期11.7–12.4个正确的已复制答案且从未产生观察到的0(;最小值3);将测得的成对并入分析二元零假设会进一步提高预期,因为正相关的错误意味着正相关的正确答案。该阶层的构成本身是信息性的:342个单元跨越106个问题——普通的狭义事实性问题(中位数17个单词),而非措辞模糊,模型很少对其回避(每个问题9个答案中的0.5个)。它们的错误答案聚集:在这些问题的70.8%中,九个前沿模型中至少三个产生了相同的错误答案;在被多个面板复制的67.4%的问题中,独立组成的面板证实了相同的错误共识——通常是一个著名相似答案取代了正确但知名度较低的实体。对全部106个金牌标签的手动学科专家评审发现2个有争议的和0个明显错误的;认可一个明确可维护的面板答案和两个部分可维护的答案,会将最难五分位的计数从0/342移至最多13/342(3.8%),因此接近零的结论成立,同时从字面零有所软化(一个标记的标签:2010年皇家学院选举针对该学院不颁授的荣誉头衔评分)。该主张是直接可测试的:它预测第一五分位提升倍数在任何按已部署人口自身准确度分层的复制中(在面板独立分层下,预测是跨阵营零,而非汇总提升倍数)。该零也不是评分者伪影:来自任何面板和原始评分者之外的供应商族系的独立第二评分者(温度零,相同的冻结等价至金标准提示)重新评分了全部342个第一五分位已复制裁定,并在342/342上一致(翻转至正确0/342,上限1.1%);合成翻转10%的模型评分标签同样在每次重采样中将认证错误份额保持在86.5%或以上(附录)。
留出面板重新分层。
由于面板成员对总体困难指数有所贡献,最难的五分位数在一定程度上受制于面板自身的失败。仅按13个非面板模型重新分层,最难五分位数上有78/354个复制答案是正确的(22.0%,汇总提升2.36,高于33/354在独立性假设下的预期),该零仅在跨阵营面板中持续(0/116;在所有13个非面板模型都失败的层中为0/88)。现存的零本身具有以下特征:该层的基础率为31/778 = 3.98%(Wilson 2.8–5.6%),给出116个中预期4.6个正确答案;保相关性排列零假设(2,000个排列)得出,95%范围,和——明显低于零假设,尽管在零假设下并非无法达到。因此,上述反演声明的是验证在已部署总体认为困难的地方相对失败,而非相对于独立于面板的困难。作为第二个灵敏度检查,我们在完全无标签复制编码(仅对盲答案进行确定性字符串比较,从不查阅正确性标签)下重新推导了阶梯:Q1结果基本没有变化(2/344个复制答案正确,0.6% [0.2–2.1];提升0.15),两个最难五分位数上的低于1的提升持续存在,而最高五分位数的提升减弱(4.56到2.33),因为纯字符串匹配会错过相同正确答案的表面变体;多选结果不受影响,因为那里的一致性由答案字母编码,按构造是无标签的。
三个稳健性检查支持该反演。(i)问题级别自助法(每个五分位数内2,000个有种子重采样)给出五个提升的95% CIs分别为[0.00, 0.00], [0.51, 1.21], [2.32, 3.09], [2.84, 3.35], 和[4.16, 5.03]:困难区间完全排除容易区间。(ii)评分者错误灵敏度:翻转10%的模型评分判决(200个有种子重采样;342个最难五分位数复制答案的97.1%由模型评分,因此可翻转),使最难五分位数的认证错误份额在每个重采样中保持在或高于86.5%,92%的重采样中Q1提升保持低于1(中位数0.82),且Q1–Q2提升永不接近Q3–Q5提升,这些在所有200个重采样中均保持高于2。(iii)七模型本地层使用独立的模型和面板复制了困难–容易对比,呈非单调性(Q3):提升分别为0.00 / 0.94 / 0.00 / 1.89 / 4.37跨相同的五分位数,最难五分位数上0/166个复制答案正确;该层94.8%由LLM评分,由与(ii)相同的评分者灵敏度重采样覆盖。
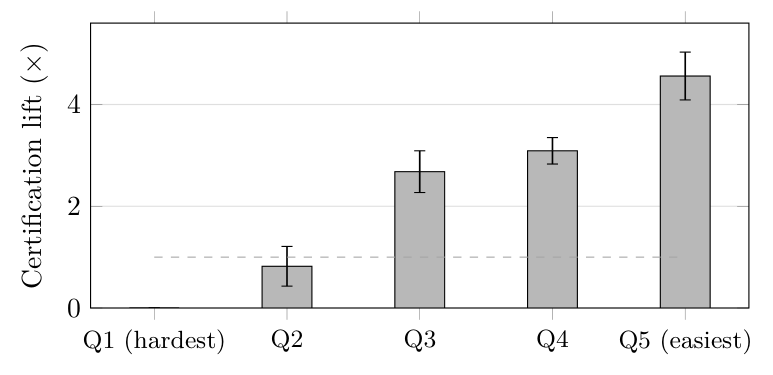 按困难五分位数的认证提升,在三个前沿面板上汇总,具有问题级别自助法95%区间(2,000个有种子重采样;附录A.1)。虚线标记提升 = 1,表示与非复制答案的奇偶性:两个最难五分位数按点估计位于其处或以下(Q1 0.00×——实测的零,不是缺失数据;Q2 0.82×,其CI穿过奇偶线),三个最容易的五分位数远高于它。
失效情景二:受限答案空间
在多项选择题中,四个预先指定的本地层级小组在695个完全回答的问题的4.0–7.9%上一致选择了错误选项(各小组分别为:4.0、5.9、6.6、7.9),而前沿层对开放式形式下有把握的一致错误答案的确定性范围为0.3–4.9%。在本地层级自身的开放式答案(8,802个经评分的SimpleQA回答)上重新计算相同的认证指标,消除了层级-格式混淆:相同的本地小组在严格的确定性编码下,仅在1.5–4.6%的开放式项目上认证一致的有把握的错误(包括不确定范围时达到9.8%),与前沿开放式范围一致——这一模式与受限答案空间而非模型层级驱动错误认证相符;然而,仍存在一个混淆因素:多项选择题分支和开放式分支是不同的问题集(TruthfulQA MC1对比SimpleQA),因此格式和问题集在这里未被分离,因果形式的声称仅通过相同问题的格式交换才能确定,而我们未进行此交换。1按小组引导法在有显著性的间隙处给出区间:多项选择题减去开放式认证共识错误为 pp [2.9, 6.8](试点)、 pp [3.9, 8.1](美国本地)及 pp [2.6, 6.3](跨联盟),各均排除零;中国本地小组,其开放式单元基于脚注的87项集,未能解决此问题。菜单将分散的错误转换为共享的错误:当答案空间很小时,相似的模型落在相同的干扰项上,小组的一致性就成了错误放大器。这些比率无法通过独立错误解释:若每个成员在其边际比率下独立出错,且错误分散在个错误选项上(),四个小组的期望一致同一错误选项比率为0.49–0.92%——观察到的4.0–7.9%是独立性基线的4.9–13.5倍。设计启示,表述为可检验的规则:任何向代理提供固定选项集的界面应预期比相同内容的开放式引出高出实质性的认证共识错误。
要求全部三位小组成员陈述的置信度几乎不影响该效应:认证共识错误范围从4.0–7.9%移动到4.0–7.2%(各小组4.0、5.2、6.0、7.2),即几乎所有一致的错误答案也都是有把握的答案。该失败也不局限于某一专题领域:在至少有20项的十个TruthfulQA类别中,合并的认证共识错误跨越1.0%(阴谋论)至8.6%(经济学),其间还有法律、健康和社会学(附录A)。
失败模式III:独立性标签无法预测独立性
在36个前沿供应商对(1,448个共享问题)中,成对错误相关性的范围为 0.123–0.395,且该范围并非由人们倾向采用的标签来组织的:相关性最高和最低的对都是块内对(googlexai 0.395对比googleopenai 0.123),块内对比块间的平均 相差,且同源系列对在695个完全回答的多选项目中由六个美国/中国-块本地模型形成的15对中排名第14(;第七个本地模型是欧盟-块的,不在预先注册的块/系列设计范围内——包括它产生21对,其中系列对排名第20)。两个预先注册的零假设(块、系列)在重新分析中仍然成立;保持预测性的是测量得到的相关性本身。实用原则:独立性是一个按对、按任务类别的量,需要被测量(一个-矩阵),而不是从品牌、国旗或系族推断的——仅凭标签组装面板是武断的,而非验证。成对的 测量经验错误依赖性,而非完全统计独立性:低 不排除三个或更多面板中的高阶依赖性,这是将独立性视为测量得到的、任务条件化的量而非假设性质的进一步理由。
对所有630个块标签分配到九个供应商的精确排列检验没有发现块效应的证据:观察到的块内减块间差异 被630次重新标记中的132次超过或等于(单侧;差异的聚类自举法95%置信区间为)。该检验对该声明的范围进行了界定——不排除存在小的块效应——且操作结论成立:该标签没有可用来代替按对测量的信号。由于当对的基础错误率不同时 有上界,我们对边际归一化比率 重新进行了分析:两个预先注册的零假设都仍然成立(块差异,排列;系列对仍为15对中的第14),这种范围仍然存在(跨前沿对0.278–0.821),极端值重新定位到两个块间对(anthropicmoonshot 0.821, mistralopenai 0.278)——在两种度量下,都没有标签能够组织这种范围。将矩阵扩展到所有16个模型:在所有模型都回答的81个问题上,成对 的范围从 到 (120对;分块平均值:前沿–前沿0.320、本地–本地0.350、前沿–本地0.210)——这是一个任何标签分类法都无法预测的范围(图2)。在81个共同项上,单个单元格的估计具有较宽的置信区间;结果是该范围本身,而不是任何单个单元格。
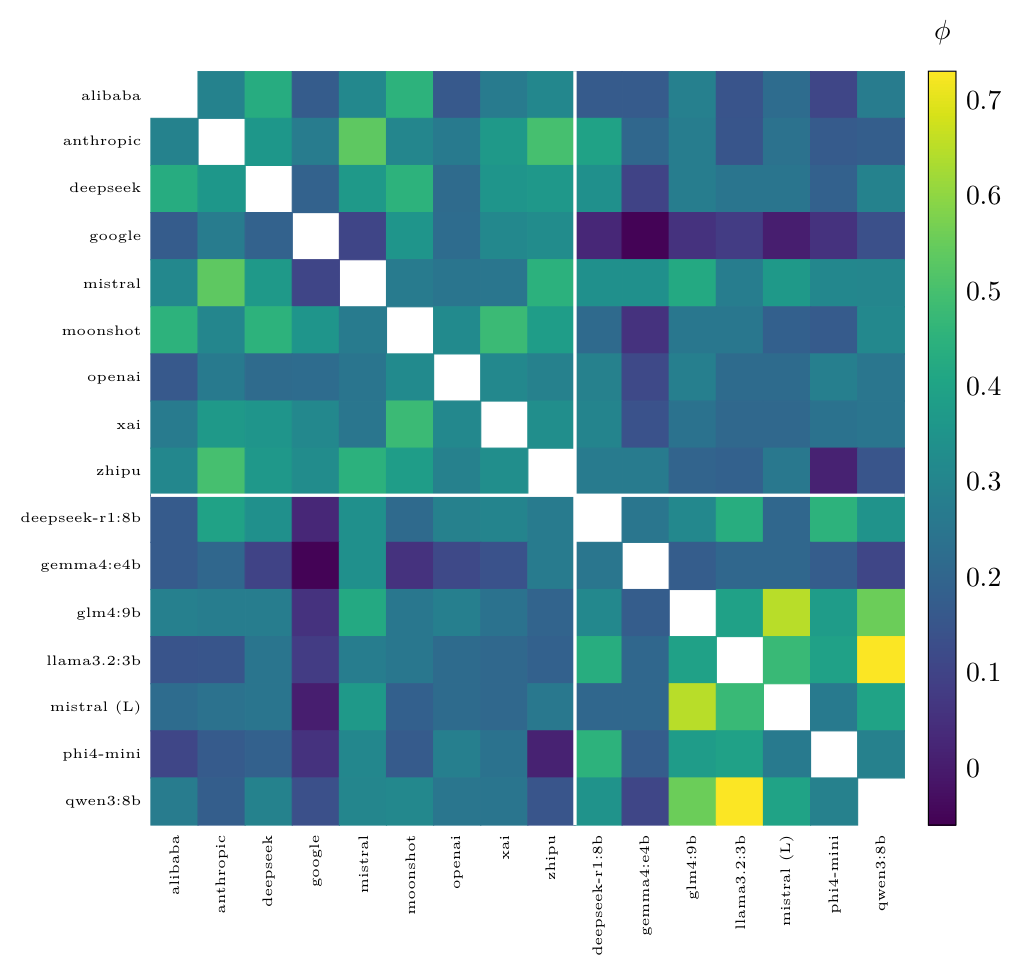 所有十六个模型在81个问题上的成对误差相关系数(ϕ)(该81个问题由每个模型均回答;包含九个前沿供应商,随后是七个本地开源权重;前沿/本地分区由白色规则线标记)。每个非对角线单元格代表120个唯一对中的一个;对角线(自相关 = 1.0)因设计而留空,以免压缩色标。ϕ的范围为−0.05到0.73(平均值0.27):任意两个验证器的误差相关程度的数量级差异,无法由我们数据中的任何阵营或谱系标签预测。值由emit_phi_matrix.py(重用analysis_week1.py第W5部分)确定性地生成;均非手工输入。
失败机制 IV:屈服的验证(探索性)
当一个在盲评中不同意的验证者被展示与同事提案相同的答案时,它在38.5%的情况下屈服了(168/436);当它在盲评中产生了正确的答案时,它在30.9%的情况下放弃该答案而接受错误答案(46/149),各供应商的放弃率从13.1%到51.6%不等(各供应商在完整的盲评-不同意子集上的屈服率跨度为20.4–58.1%)。
这些翻转可能是理性的信念更新而不是从众吗?反向提示对照论证反对了这一点。在一个六模型本地小组上,我们用翻转的曝光方向重新运行了配对程序:一个在盲评中不同意的验证者被展示相同的问题集,要么显示自信的错误答案(直接条件),要么显示标准答案(反向条件)。这两个条件在提示上相同——共享一个模板("提议的答案:…"),所显示的答案仅在内容上有所不同,不显示置信度值或来源属性——因此对比隔离了所显示答案的真值。如果验证者是基于证据进行更新,那么接触正确答案应该对他们的影响更大;相反,这两个条件产生了几乎相同的翻转率——38.9%向错误答案翻转,34.7%向正确答案翻转——而配对内的比较与更新的叙述方向相反:在174个不一致的配对中,验证者为了错误答案放弃其盲评立场104次,为了正确答案放弃70次(McNemar 精确 )。在模型层面,这两个条件是无法区分的(最顺从的验证者的翻转倾向为89.9% vs. 89.9%,最不顺从的为1.5% vs. 1.5%):触发同意的是自信提案的存在,而非其真值——偏好训练谄媚在面板验证中的表现(Sharma et al., 2024)。不对称性也不取决于最顺从的验证者:排除它留下835个配对项目,不一致计数为94 vs. 60(精确 )。两个进一步的分解强化了这一理解(附录 A):在任一条件中记录的每个翻转都伴随有曝光后置信度 (低于该阈值的翻转为0,),并且在直接条件中,在盲评中正确的验证者在40.8%的情况下放弃了正确答案(20/49),反映了前沿发现。该对照在本地层级上运行(见局限性)。该对照的文字总结也出现在相关论文中(Chernets, 2026);每模型分解、置信度门分割和正确-盲放弃分析仅在此处报告。
这界定了一个设计主张:当目标是测量独立的分歧时,启发必须是盲评优先的——一个在提交立场之前进行审议的小组不会测量其分歧,而是消除它。
讨论:剧院经济学(推测,非证据)
本节为讨论而非证据:它不报告新的测量,其中任何内容都不应被视为与上述四个已测量的制度等同。既然如此,这四个制度之所以可能持续存在,是因为没有任何参与方被付费去注意它们:消费者无法对验证质量定价,平台因信心而获得报酬,而非因怀疑,每个验证者最低成本的策略就是同意。加上审计员选择问题(独立性是选择检查员者的属性)和链接农场这一先例(任何具有商业分量的同意信号都会诱发农场化),剧院就成为一种均衡,而非偶然——这是测量所激励但未检验的推测。激励因素与工程惯性和测量标准缺失相补充,而非相排斥;它被突出强调是因为它是可证伪的成分。本节做出可证伪的市场预测而非规范性主张——例如,未经审计的小组应随时间推移趋向于最小多样性组成,因为相关小组成本更低,更容易达成共识。
从表演到测量
补救是一种规范,而不是一个组件:(1) 发布面板按任务类别的测量-矩阵,而不是其品牌名单(每个任务类别一个盲收集就足够了—本论文的16模型矩阵来自1,500项的单次通过);(2) 按难度对每个认证声明进行分层,并单独报告困难条件提升(难度按任务类别从校准集合操作化,而不是在推理时按项);(3) 总是先进行盲征求—面板验证的承诺-揭示方案,重新排序征求而不是增加计算,因为盲答案可以并行处理;(4) 将最困难的条件视为升级触发器—对于面板的测量提升为的问题,共识必须路由到人工或弃权,绝不认证。每条规则的表述方式使得部署的系统可以针对其进行审计。
作为一个实际例子,将该方法应用于本论文自有的前沿面板。规则(1):其独立性被报告为第6节的测量-矩阵(跨度0.123–0.395),而不是作为供应商名册—这将隐蔽最相关的对是集团内部的(googlexai)。规则(2):其认证提升被报告为分层的(Table 1),困难条件提升(Q1上,Q2上)单独陈述,而不是折叠到单个汇总标题中。规则(3):这里的每个答案都是在组建任何面板之前盲征求的,这正是使符合性分支(Section 7)可测量而不是受混淆影响的原因。规则(4):因为面板的测量提升在两个最困难的五分位数上为,同一面板的经审计部署将这些问题路由到弃权或人工审查,而不是共识认证。因此这一规范并非假设:它就是本论文自有数字生成所遵循的规程。
限制
每层级单一基准族(SimpleQA开放式前沿;TruthfulQA MC本地),因此等级边界是基准相对的;每个前沿厂商由一个预算/中层模型代表,因此不做厂商能力的声明。难度分层是观察得出的(对预先注册集合的事后分析),五分位分配与所评估的模型共享数据。一致性臂是探索性的,在上较为适度;其反向提示控制使用了本地模型,因此转移到前沿面板是通过类比而非测量。大约三分之二的开放式评分来自LLM评分器(人工抽查一致率98%;对所有342个最难五分位复制裁决的跨族重新评分实现了342/342的一致;灵敏度重新采样见附录)。两个基准都是公开的,因此无法排除训练集泄露;在SimpleQA上,其方向有利于已记忆的正确答案,这收缩了难层且使得困难等级的结果保守;在TruthfulQA上,公开语料库本身包含这些误解,因此那里的方向并不明确——备选解读已由第5部分的格式内容警告所限;没有就为什么在难问题上一致性失败做出因果主张——机制候选(共享先验、共享盲点、共享训练数据)被列出但未被区分。
结论
一致性仅在独立性和能力被测量之后才成为证据,而且测量成本低廉——整个重新分析在商用硬件上从公开原始文件运行,仅需数秒钟。在面板配备其矩阵和分层提升之前,"共识验证"应该如安全工程师解读手提包搜查那样来解读。
References
B. Schneier. Beyond Fear: Thinking Sensibly About Security in an Uncertain World. Copernicus Books, 2003.
D. Shehata and M. Li. The inverse-wisdom law: Architectural tribalism and the consensus paradox in agentic swarms. arXiv:2604.27274, 2026.
I. D. Raji, P. Xu, C. Honigsberg, and D. Ho. Outsider oversight: Designing a third party audit ecosystem for AI governance. In AIES, pages 557–571, 2022.
Y. Du, S. Li, A. Torralba, J. B. Tenenbaum, and I. Mordatch. Improving factuality and reasoning in language models through multiagent debate. In ICML, 2024. arXiv:2305.14325.
S. Farquhar, J. Kossen, L. Kuhn, and Y. Gal. Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017):625–630, 2024.
Kaihua Ding. When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv preprint arXiv:2607.08065, 2026.
E. Kim, A. Garg, K. Peng, and N. Garg. Correlated errors in large language models. In ICML, 2025. arXiv:2506.07962.
M. Sharma, M. Tong, T. Korbak, D. Duvenaud, et al. Towards understanding sycophancy in language models. In ICLR, 2024. arXiv:2310.13548.
A. Khan, J. Hughes, D. Valentine, L. Ruis, et al. Debating with more persuasive LLMs leads to more truthful answers. In ICML, 2024. arXiv:2402.06782.
J. Wei, K. Nguyen, H. W. Chung, Y. J. Jiao, S. Papay, A. Glaese, J. Schulman, and W. Fedus. Measuring short-form factuality in large language models. arXiv:2411.04368, 2024.
S. Lin, J. Hilton, and O. Evans. TruthfulQA: Measuring how models mimic human falsehoods. In ACL, 2022. arXiv:2109.07958.
S. Lifshitz, S. A. McIlraith, and Y. Du. Multi-agent verification: Scaling test-time compute with multiple verifiers. arXiv:2502.20379, 2025.
P. Verga, S. Hofstätter, S. Althammer, Y. Su, A. Piktus, A. Arkhangorodsky, M. Xu, N. White, and P. Lewis. Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796, 2024.
H. Zhang, Z. Cui, J. Chen, et al. Stop overvaluing multi-agent debate—we must rethink evaluation and embrace model heterogeneity. arXiv:2502.08788, 2025.
Vadym Chernets. Architectural trust: Verifiable decision architecture for agentic commerce. SSRN working paper 7191261, 2026. https://doi.org/10.2139/ssrn.7191261 (cited for the trust construct and for its summary treatment of the shared blind collection; overlapping analyses are cross-flagged where they occur).
可复现性附录
在给定原始分级JSONL文件和两个固定种子脚本的情况下,所有重新分析都是确定性的(一个基线脚本重现每个标题数字,一个第1周附加产生下面的自助法、灵敏度和分解表);完整重新计算在普通硬件上花费不到15秒,无需GPU、网络或模型调用。冻结的预注册和复制包(公共OSF注册):https://osf.io/4y9dv。
提升阶梯的自助法置信区间
问题级重新采样在五分位数内,2,000次播种抽取,汇总到三个前沿小组上。
| 五分位数 | Wilson 95% | Boot 95% | 提升 | 提升自助法95% | |
|---|---|---|---|---|---|
| Q1(最难) | 0/342 = 0.0% | [0.0, 1.1] | [0.0, 0.0] | 0.00 | [0.00, 0.00] |
| Q2 | 46/359 = 12.8% | [9.7, 16.7] | [8.2, 18.2] | 0.82 | [0.51, 1.21] |
| Q3 | 272/473 = 57.5% | [53.0, 61.9] | [50.7, 64.6] | 2.68 | [2.32, 3.09] |
| Q4 | 732/904 = 81.0% | [78.3, 83.4] | [76.6, 85.1] | 3.09 | [2.84, 3.35] |
| Q5(最简单) | 1700/1788 = 95.1% | [94.0, 96.0] | [93.4, 96.6] | 4.56 | [4.16, 5.03] |
按难度五分位数的认证提升,带有Wilson和自助法95%区间(的百分比,提升的比率)。在留出小组难度(由13个非小组模型排列)下,汇总Q1单元格为78/354(22.0%,提升2.36),零值对跨集团小组持续存在(0/116);第4部分。基率按五分位数:3.9 / 15.6 / 21.5 / 26.2 / 20.8%( = 2286 / 2308 / 2209 / 1778 / 912)。
评分者误差灵敏度
翻转8,948个模型评分的前沿裁定中的10%(200次播种重新采样;一致性编码和五分位数分配冻结在原始确定性协议编码处,因此只有正确性标签移动):最难五分位数的"认证正确"单元格从0/342上升到中位数33/342(9.6%;95%范围23–46),因此Q1一致性的认证误差份额在每次重新采样中保持在或高于86.5%;Q1提升在92%的重新采样中保持在1以下(中位数0.82,95%范围0.56–1.08),而Q3–Q5提升永不低于2(中位数2.17 / 2.51 / 3.42)。在342个Q1复制的答案中,332个(97.1%)是模型评分的,因此在此练习中可以翻转。超越综合翻转,跨系列审计使用独立第二评分者(一个供应商系列在每个小组之外且在原始评分者的系列之外;温度0;字节相同冻结提示)重新评分了所有342个Q1复制的裁定:一致性342/342(翻转到正确0/342,Wilson上界1.1%),在模型评分(332)和字符串/拒绝编码(10)单元格中一致。因为342个单元格跨越106个唯一问题,集群保守阅读将问题视为单位:0/106给出Wilson上界3.4%;第4部分的问题级排列零假设已经在集群级别运行。
反向提示控制:按模型分解
六个本地模型,2,399 对有效配对观察;flip = 验证者放弃其盲法答案,转而采用所示答案。
| 验证器 | 直接(到错误) | 反向(到正确) | 差异 |
|---|---|---|---|
| qwen3:8b | 204/227 = 89.9% | 196/218 = 89.9% | 个百分点 |
| mistral | 132/213 = 62.0% | 113/203 = 55.7% | 个百分点 |
| glm4:9b | 66/213 = 31.0% | 39/200 = 19.5% | 个百分点 |
| llama3.2:3b | 40/234 = 17.1% | 38/227 = 16.7% | 个百分点 |
| gemma4:e4b | 33/202 = 16.3% | 19/195 = 9.7% | 个百分点 |
| phi4-mini | 2/137 = 1.5% | 2/130 = 1.5% | 个百分点 |
| 汇总 | 477/1226 = 38.9% | 407/1173 = 34.7% | 个百分点 |
按验证器和臂的翻转率。没有模型向正确答案翻转的频率高于向自信错误答案翻转的频率。成对重新计数:1,028 项在两个臂中都存在(296 个在两个臂中都翻转,558 个在两个臂中都未翻转);不一致对 104 个(仅错误)对比 70 个(仅正确),精确二项 McNemar (渐近 )。所有 884 个记录的翻转都带有陈述的暴露后置信度 ;该阈值以下的翻转率为 0/547。
MC 认证共识误差(按 TruthfulQA 类别)
在四个预先指定的本地面板上汇总(每项-面板的事件;至少 20 个项目的类别):经济学 8.6%、虚构 6.2%、超自然 6.0%、法律 5.9%、迷信 5.7%、刻板印象 5.4%、社会学 4.9%、健康 4.9%、误解 2.6%、阴谋论 1.0%。所有三个成员置信度都 时的每面板率:4.0%(CN-本地)、5.2%(跨集团)、6.0%(试点)、7.2%(US-本地)。
4.6% 的上限取决于仅共享 87 个项目的一个本地面板与推理模型的 98 个可评分答案;排除该面板,严格的本地开放形式范围为 1.5–1.8%。↩︎
如何引用
Chernets, V. (2026). Verification Theater: Measured Failure Modes of AI Verifier Panels [论文报告]。NeurIPS 2026 Workshop: Who Verifies the Agents?。Zenodo. https://doi.org/10.5281/zenodo.23197641
@misc{chernets2026verificationtheater,
  author       = {Chernets, Vadym},
  title        = {{Verification Theater: Measured Failure Modes of AI Verifier Panels}},
  year         = {2026},
  howpublished = {Zenodo; NeurIPS 2026 Workshop: Who Verifies the Agents?},
  doi          = {10.5281/zenodo.23197641},
  url          = {https://doi.org/10.5281/zenodo.23197641}
}