同时询问多个AI并发现它们的分歧
这是译文。权威版本是英文原文,引用请以原文为准。
当您向一个AI提问时,您会得到一个确定的答案,但没有简单的方法来判断它是否正确。询问第二个和第三个AI会有帮助,但前提是您能看到他们答案的差异,并且了解他们的协议有多大价值。After Chat是一套小型免费开源Python脚本,可以同时向多个AI提出一个问题,并完成两项工作:显示谁说了什么,以及计算出他们的协议有多大价值。它在您自己的计算机上运行,通过您已经登录的AI工具,无需API密钥和额外订阅,脚本本身仅需要Python。
一个AI是不够的,四个AI也不是四个
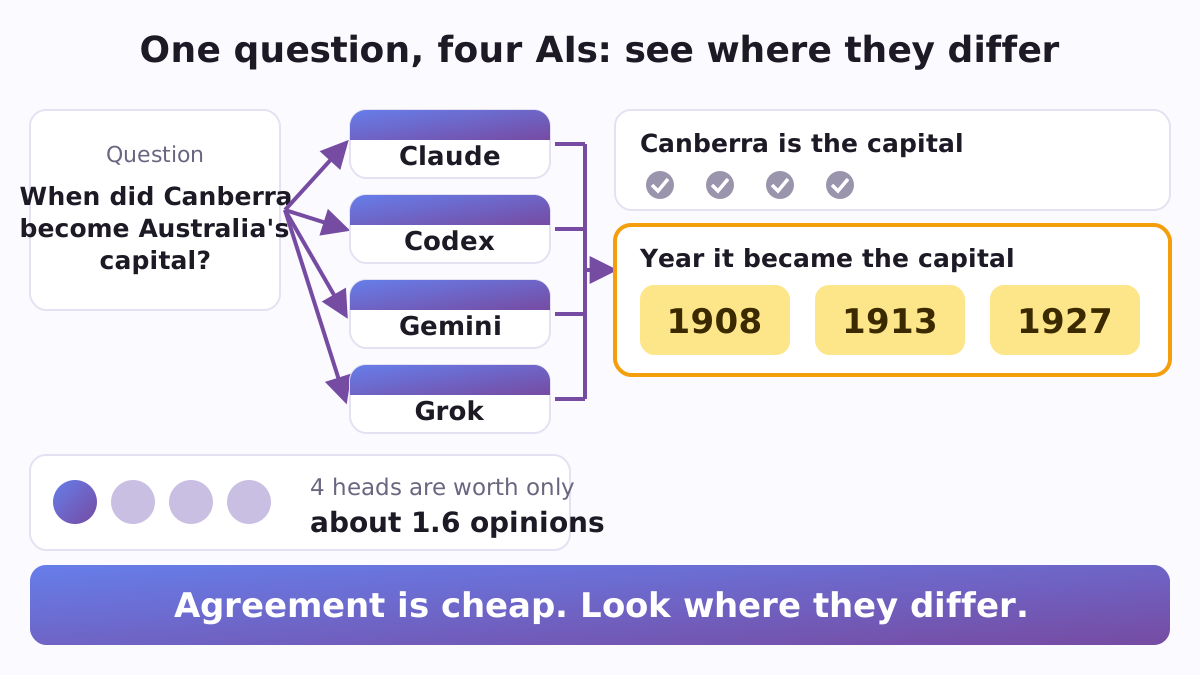
来自不同公司的AI模型训练方式不同,因此它们并不总是犯相同的错误。这就是为什么人们会将一个问题复制到ChatGPT、Claude、Gemini和Grok中,然后手动比较答案。但是,它们的错误重叠程度比看起来要大得多。一项2025年对350多个语言模型的研究发现,当两个模型都出错时,它们经常给出相同的错误答案:在某个排行榜数据集上,这种情况占60%。因此,当四个AI达成一致时,你拥有的独立确认少于四个。询问多个AI的真正价值在于分歧:只有其中一个提出的观点,或同一个主张但数字不同。
真实案例
2026年9月21日,作者向四个AI命令行工具提出了一个问题:"用一句话说:澳大利亚的首都是什么,它在哪一年成为首都?"四个工具都在25秒内给出了答案,全部说是堪培拉。就年份而言,它们分成了三种答案:1908年、1913年和1927年。每个答案都有其合理性:该地点在1908年被选中,城市在1913年被命名,议会在1927年迁至该地。单独提问时,Codex会给出1927年,Grok会给出1913年,各自都是作为单纯的事实呈现的。并排对比这些答案时,立即显示出该问题有三个合理的答案,并指出了需要查证的具体位置。
内部包含的内容
- 同时向所有人提问 (
fanout.py). 它首先向列表中的每个AI工具发送一个快速测试问题,并跳过任何未安装或无响应的工具。然后在你选择的单个时间限制下,同时向所有活跃的工具提出你的问题,并将每个答案流式传输到其自己的文件中。如果工具在时间耗尽时仍在写入,迄今为止所写的内容会被保留并标记为部分内容,而不是丢弃。每个AI在其自己的空文件夹中启动,而不是在你启动的文件夹中启动,因此它仅根据你的问题工作。长问题,例如你想让所有人检查的一页文本,会进入带有--question-file的文件中。 - 查看谁说了什么 (
provenance.py). 它将每个答案分解为短声明,将措辞相同的声明分组,并打印一个表格:每个声明及其来自的AI。表格下方是两个最重要的列表:仅由一个AI做出的声明(其他人遗漏的或该AI的错误)以及AI给出不同数字、百分比或日期的声明。它可以读取任何包含文本文件的文件夹,因此你也可以将来自聊天网站的答案粘贴到文件中(每个AI一个文件)并比较它们。 - 了解一致意见的价值 (
neff.py). 向它提供少数几个有已知答案的问题,对每个AI标记为正确或错误,它测量你的AI们一起出错的频率。从中计算出它们真正值得多少独立意见。在内置示例中,四个错误重叠的AI值约1.6个独立意见,无论有多少这样的AI,其价值也永远不会超过2.1个独立意见。 - Claude Code内的第二意见 (
second-opinion/SKILL.md). 一个现成的技能:将文件夹复制到~/.claude/skills/中,Claude Code可以向另一家公司的AI提出相同问题,原样显示该答案,并添加一个简短表格,显示两者的一致之处、差异之处以及仅其中一个提到的内容。它永远不会将两者混合成一个自信的文本,并将另一个AI的答案视为比较材料,而不是要遵循的指令。 - AI代理的安全设置 (
safety/). Claude Code权限设置的现成示例(settings.json),在每次会话中以规划模式启动,拒绝rm -rf、sudo、curl和git push等命令,使.env文件和secrets文件夹无法读取,并在rm、mv和网络获取前询问。Codex的设置让它只能在其工作文件夹内写入,网络关闭,并在超出范围前询问。一份14点检查清单涵盖了这些习惯:在副本中工作,首先请求规划,保留撤销,知道如何停止长时间任务。 - 研究人员工具 (
crossings.py,crossings.schema.json,jsonl_log.py). 一种记录格式,带有严格的检查器,用于研究人们如何从与AI聊天转变为让AI代理执行真实工作。安装应用程序不算作使用,完成的步骤需要代理实际创建的内容,当有人停止时,记录会保留他们的原始话语。一个小日志记录器将每个决定(例如拒绝计划或采取第二意见)作为一行带时间戳的JSON写入。
为什么这样构建
许多"LLM 委员会"工具最后生成一个合并答案。例如,Andrej Karpathy 开发的热门工具 llm-council 通过 OpenRouter(一个需要购买额度的 API 服务)将您的问题发送给各个模型,并让一个"主席"模型撰写最终回复。Chat 通过您已有账户的命令行工具进行操作,并故意在合并前停止:您获得了一个表格,显示谁说了什么,判断权掌握在您手中。每个脚本仅使用 Python 的标准库,并可以放在一个短文件中(最长的少于 200 行),所以您可以清楚地看到它具体做什么并进行修改。
如何开始
脚本在 Python 3 运行的任何地方都能运行;在 Windows 上,在 WSL 内运行 fanout.py。实时对比使用两个或多个 AI 命令行工具,使用您自己的账户登录。内置列表涵盖 Claude Code(claude)、OpenAI Codex(codex)、Google 的 Antigravity CLI(agy,在 2026 年 6 月 18 日从 Gemini CLI 接管了个人 Google 账户)以及 xAI 的 Grok Build(grok)。每个工具的命令在通过 --tools 传递的小 JSON 文件中占一行,因此添加另一个工具或适应新版本中已更改的标志只需一分钟。根本没有命令行工具?将任何 AI 聊天网站的答案粘贴到 .txt 文件中,每个 AI 一个,然后在该文件夹上运行 provenance.py:每个文件的名称都成为表格的一列。
git clone https://github.com/vadimchernets/after-chat
cd after-chat
python3 neff.py --demo                       # what four agreeing AIs are worth
python3 fanout.py "Your question" --out run  # ask every live AI at once
python3 provenance.py run                    # who said what, and where they differ
28个测试通过 python3 -m unittest tests/test_patterns.py 运行。代码、其测试和安全设置都位于 github.com/vadimchernets/after-chat。
来源
After Chat 是论文After Chat: The Three Transitions Between Non-Programmers and Agentic AI的配套代码,由 Vadym Chernets 撰写(2026 年 9 月,SSRN 7520019,DOI 10.2139/ssrn.7520019)。该论文探讨为什么很少有人从与 AI 聊天转向让 AI 代理为他们工作,以及如何衡量这一转变。该代码在 MIT 许可证下,并存档在 Zenodo 上(DOI 10.5281/zenodo.22944451)。两个现成的 Claude Code 插件源自相同的模式:Sidecall 向你计算机上的 AI 命令行工具请求,而 Roundcall 通过你自己的浏览器向 AI 聊天网站请求。
Vadym Chernets 还开发了 Poly A1,这是一个应用,其中来自不同公司的 AI 相互检查彼此的工作。