Pregunta a Múltiples IAs a la Vez y Observa Dónde Discrepan
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
Cuando le haces una pregunta a una IA, obtienes una respuesta confiada y ninguna forma fácil de saber si es correcta. Preguntarle a una segunda y una tercera IA ayuda, pero solo si puedes ver dónde difieren sus respuestas, y solo si sabes cuánto realmente vale su acuerdo. After Chat es un pequeño conjunto de scripts de Python gratuitos y de código abierto que presenta una pregunta a varios IAs a la vez y hace ambas cosas: muestra quién dijo qué, y calcula cuánto vale su acuerdo. Se ejecuta en tu propia computadora, a través de las herramientas de IA en las que ya has iniciado sesión, sin claves API y sin suscripción adicional, y los scripts en sí no necesitan nada más que Python.
Un IA no es suficiente, y cuatro IAs no son cuatro
Los modelos de IA de diferentes empresas se entrenan de manera diferente, por lo que no siempre cometen los mismos errores. Por eso la gente copia una pregunta en ChatGPT, Claude, Gemini y Grok y compara las respuestas a mano. Sin embargo, sus errores se solapan más de lo que parece. Un estudio de 2025 de más de 350 modelos de lenguaje encontró que cuando dos modelos están ambos equivocados, a menudo dan la misma respuesta incorrecta: en un conjunto de datos de la tabla de clasificación, el 60% de las veces. Así que cuando cuatro IAs coinciden, tienes menos de cuatro confirmaciones independientes. El valor real de preguntar a varios es el desacuerdo: un punto que solo uno de ellos planteó, o la misma afirmación con números diferentes.
Un ejemplo real
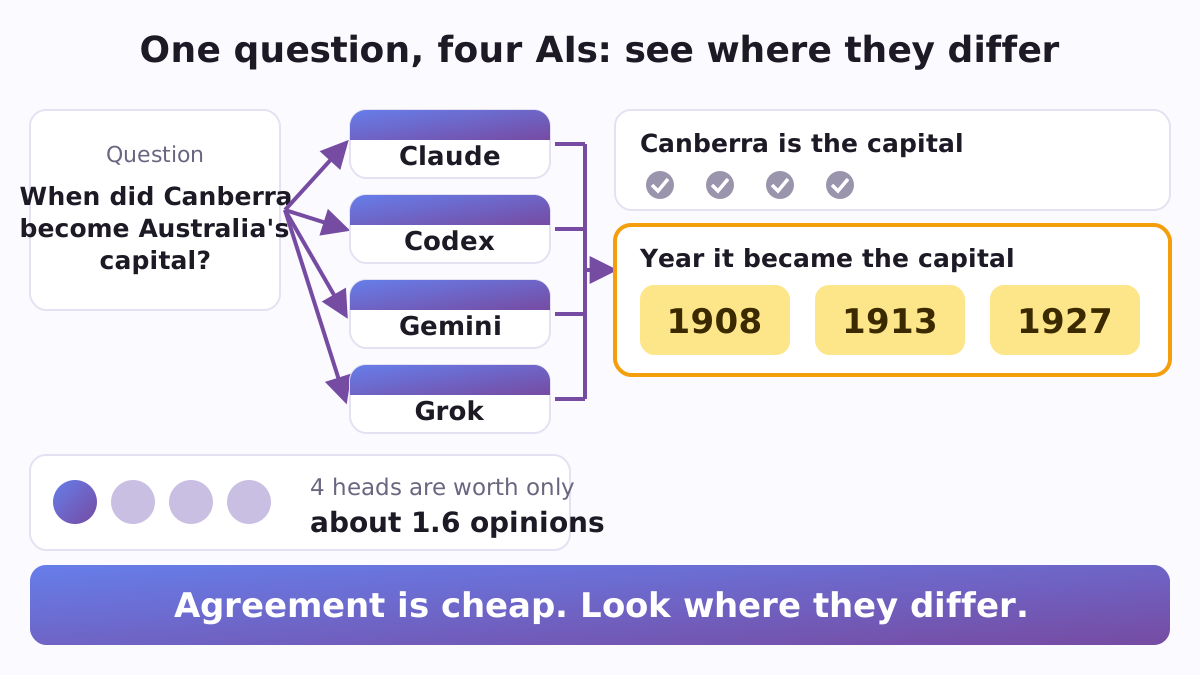
El 21 de septiembre de 2026, el autor formuló una pregunta a cuatro herramientas de IA de línea de comandos: "En una oración: ¿cuál es la capital de Australia y en qué año se convirtió en la capital?" Los cuatro respondieron dentro de 25 segundos, y los cuatro dijeron Canberra. En cuanto al año, divergieron de tres maneras: 1908, 1913 y 1927. Cada año puede defenderse: el sitio fue elegido en 1908, la ciudad fue nombrada en 1913 y el Parlamento se trasladó allí en 1927. Preguntados por separado, Codex habría dado 1927 y Grok 1913, cada uno como un hecho simple. Uno al lado del otro, las respuestas mostraron de inmediato que la pregunta tiene tres respuestas honestas y señalaron la línea exacta que una persona necesita verificar.
Qué contiene
- Pregúntale a todos a la vez (
fanout.py). Primero envía a cada herramienta de IA en su lista una pregunta de prueba rápida y omite cualquier herramienta que no esté instalada o que no responda. Luego coloca tu pregunta a todos los activos al mismo tiempo, bajo un límite de tiempo que elijas, y transmite cada respuesta a su propio archivo. Si una herramienta sigue escribiendo cuando se agota el tiempo, lo que ha escrito hasta ahora se conserva y se marca como parcial, no se descarta. Cada IA se inicia en su propia carpeta vacía en lugar de en la carpeta desde la que iniciaste, por lo que funciona solo a partir de tu pregunta. Una pregunta larga, como una página de texto que deseas que todos verifiquen, se coloca en un archivo con--question-file. - Ver quién dijo qué (
provenance.py). Desglosa cada respuesta en afirmaciones breves, agrupa las afirmaciones que están redactadas de manera similar e imprime una tabla: cada afirmación y qué IA la realizó. Debajo de la tabla vienen las dos listas que más importan: afirmaciones hechas por solo una IA (algo que los demás no vieron, o ese error de uno) y afirmaciones donde las IA dan números, porcentajes o fechas diferentes. Lee cualquier carpeta de archivos de texto, por lo que también puedes pegar respuestas de sitios web de chat en archivos, uno por IA, y compararlos. - Saber qué vale el acuerdo (
neff.py). Dale un puñado de preguntas con respuestas conocidas, marcadas como correctas o incorrectas para cada IA, y mide con qué frecuencia tus IA se equivocan juntas. A partir de eso, calcula cuántas opiniones independientes realmente valen. En el ejemplo integrado, cuatro IA cuyos errores se superponen valen aproximadamente 1,6 opiniones independientes, y ninguna cantidad de tales IA valdría más de 2,1. - Una segunda opinión dentro de Claude Code (
second-opinion/SKILL.md). Una habilidad lista para usar: copia la carpeta en~/.claude/skills/, y Claude Code puede hacer la misma pregunta a una IA de otra empresa, mostrar esa respuesta exactamente como llegó, y añadir una tabla breve de dónde coinciden los dos, dónde difieren y qué menciona solo uno de ellos. Nunca mezcla los dos en un texto confiado, y trata la respuesta de la otra IA como material para comparar, nunca como instrucciones a seguir. - Configuración segura para agentes de IA (
safety/). Un ejemplo listo de los ajustes de permisos de Claude Code (settings.json) que inicia cada sesión en modo de plan, niega comandos comorm -rf,sudo,curlygit push, mantiene los archivos.envy una carpetasecretsilegibles, y pregunta antes derm,mvy descargas web. Los ajustes para Codex le permiten escribir solo dentro de su carpeta de trabajo, con la red desconectada, y le hacen preguntar antes de ir más allá. Una lista de comprobación de 14 puntos cubre los hábitos alrededor de ellos: trabajar en una copia, pedir un plan primero, mantener un deshacer, saber cómo detener un trabajo largo. - Herramientas para investigadores (
crossings.py,crossings.schema.json,jsonl_log.py). Un formato de registro, con un verificador estricto, para estudios de cómo la gente se mueve desde chatear con IA hasta permitir que los agentes de IA hagan trabajo real. Instalar una aplicación no cuenta como usarla, un paso terminado necesita algo que el agente realmente hizo, y cuando alguien se detiene, el registro mantiene sus propias palabras. Un registrador diminuto escribe cada decisión, como un plan rechazado o una segunda opinión tomada, como una línea JSON con marca de tiempo.
Por qué está construido de esta manera
Muchas herramientas "LLM council" terminan con una respuesta fusionada. El popular llm-council de Andrej Karpathy, por ejemplo, envía tu pregunta a los modelos a través de OpenRouter, un servicio de API por el que compras créditos, y permite que un modelo "presidente" escriba la respuesta final. Después de que Chat pasa por las herramientas de línea de comandos que ya usas con tus propias cuentas, y se detiene antes de la fusión a propósito: obtienes la tabla de quién dijo qué, y el juicio se mantiene contigo. Cada script utiliza solo la biblioteca estándar de Python y cabe en un archivo corto (el más largo tiene menos de 200 líneas), para que puedas leer exactamente qué hace y cambiarlo.
Cómo comenzar
Los scripts se ejecutan donde se ejecuta Python 3; en Windows, ejecute fanout.py dentro de WSL. Una comparación en vivo utiliza dos o más herramientas de línea de comandos de IA, iniciando sesión con sus propias cuentas. La lista integrada cubre Claude Code (claude), OpenAI Codex (codex), Antigravity CLI de Google (agy, que reemplazó a Gemini CLI para cuentas personales de Google el 18 de junio de 2026) y Grok Build de xAI (grok). El comando de cada herramienta es una línea en un archivo JSON pequeño pasado con --tools, por lo que añadir otra herramienta, o actualizar un parámetro que cambió en una nueva versión, lleva un minuto. ¿Ninguna herramienta de línea de comandos en absoluto? Pegue las respuestas de cualquier sitio web de chat de IA en archivos .txt, uno por IA, y ejecute provenance.py en esa carpeta: el nombre de cada archivo se convierte en una columna de la tabla.
git clone https://github.com/vadimchernets/after-chat
cd after-chat
python3 neff.py --demo                       # what four agreeing AIs are worth
python3 fanout.py "Your question" --out run  # ask every live AI at once
python3 provenance.py run                    # who said what, and where they differ
Las 28 pruebas se ejecutan con python3 -m unittest tests/test_patterns.py. El código, sus pruebas y la configuración de seguridad están todos en github.com/vadimchernets/after-chat.
De dónde proviene
After Chat es el código complementario del artículo After Chat: The Three Transitions Between Non-Programmers and Agentic AI de Vadym Chernets (September 2026, SSRN 7520019, DOI 10.2139/ssrn.7520019). El artículo pregunta por qué tan pocas personas han pasado de charlar con IA a permitir que agentes de IA trabajen para ellas, y cómo medir ese cambio. El código está bajo la licencia MIT y archivado en Zenodo (DOI 10.5281/zenodo.22944451). Dos complementos listos para usar de Claude Code surgieron de los mismos patrones: Sidecall consulta las herramientas de línea de comandos de IA en tu computadora, y Roundcall consulta sitios de chat de IA a través de tu propio navegador.
Vadym Chernets también desarrolla Poly A1, una aplicación en la que IAs de diferentes empresas verifican el trabajo de los demás.