Pergunte a Múltiplos IAs de Uma Vez e Veja Onde Eles Discordam
Esta é uma tradução. A versão de referência é o original em inglês; cite essa.
Quando você faz uma pergunta a uma IA, obtém uma resposta confiante e não há uma maneira fácil de saber se está correta. Perguntar a uma segunda e uma terceira IA ajuda, mas apenas se você conseguir ver onde suas respostas diferem, e apenas se souber quanto realmente vale o acordo deles. After Chat é um pequeno conjunto de scripts Python gratuitos e de código aberto que faz uma pergunta a várias IAs de uma vez e realiza os dois: mostra quem disse o quê e calcula quanto vale o acordo deles. Ele é executado no seu próprio computador, através das ferramentas de IA nas quais você já está conectado, sem chaves de API e sem assinatura extra, e os próprios scripts só precisam de Python.
Uma IA não é suficiente, e quatro IAs não são quatro
Modelos de IA de diferentes empresas são treinados de forma diferente, então nem sempre cometem os mesmos erros. Por isso, as pessoas copiam uma pergunta em ChatGPT, Claude, Gemini e Grok e comparam as respostas manualmente. Mas seus erros se sobrepõem mais do que parece. Um estudo de 2025 com mais de 350 modelos de linguagem descobriu que quando dois modelos estão errados, frequentemente dão a mesma resposta incorreta: em um conjunto de dados de leaderboard, 60% das vezes. Portanto, quando quatro IAs concordam, você tem menos de quatro confirmações independentes. O verdadeiro valor de questionar vários é o desacordo: um ponto que apenas um deles levantou, ou a mesma afirmação com números diferentes.
Um exemplo real
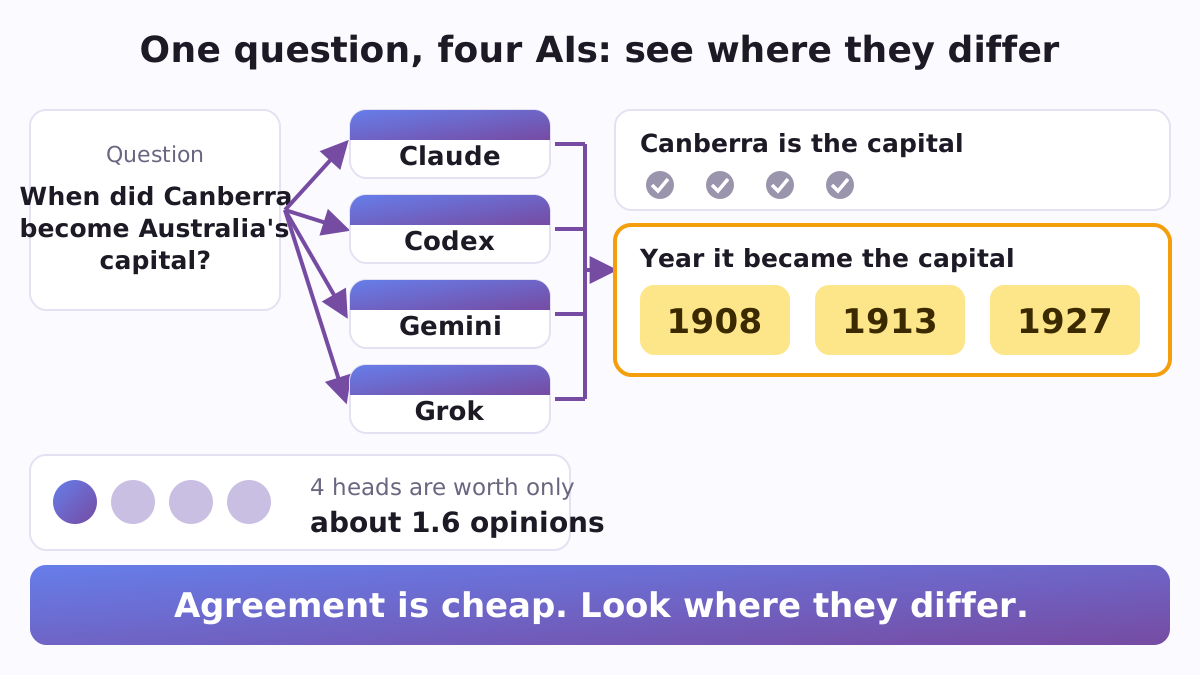
Em 21 de setembro de 2026, o autor formulou uma pergunta a quatro ferramentas de linha de comando de IA: "Em uma frase: qual é a capital da Austrália e em que ano ela se tornou a capital?" Todos os quatro responderam em 25 segundos, e todos os quatro disseram Canberra. Quanto ao ano, dividiram-se de três maneiras: 1908, 1913 e 1927. Cada ano pode ser defendido: o local foi escolhido em 1908, a cidade foi nomeada em 1913, e o Parlamento se mudou para lá em 1927. Quando interrogados isoladamente, Codex teria dado 1927 e Grok 1913, cada um como um fato puro. Lado a lado, as respostas mostraram de imediato que a pergunta tem três respostas honestas e apontaram para a linha exata que uma pessoa precisa verificar.
O que há dentro
- Pergunte a todos de uma vez (
fanout.py). Primeiro, envia a cada ferramenta de IA em sua lista uma pergunta de teste rápida e pula qualquer ferramenta que não está instalada ou não responde. Em seguida, coloca sua pergunta para todos os ativos ao mesmo tempo, sob um limite de tempo que você escolhe, e transmite cada resposta para seu próprio arquivo. Se uma ferramenta ainda estiver escrevendo quando o tempo se esgotar, o que ela escreveu até agora é mantido e marcado como parcial, não descartado. Cada IA começa em sua própria pasta vazia em vez da pasta de onde você lançou, portanto funciona apenas a partir de sua pergunta. Uma pergunta longa, como uma página de texto que você deseja que todos verifiquem, vai para um arquivo com--question-file. - Veja quem disse o quê (
provenance.py). Ela quebra cada resposta em afirmações curtas, agrupa as afirmações que são redigidas de forma semelhante e imprime uma tabela: cada afirmação e qual IA a fez. Abaixo da tabela vêm as duas listas mais importantes: afirmações feitas apenas por uma IA (algo que as outras perderam ou que foi erro dessa) e afirmações em que as IAs fornecem números, porcentagens ou datas diferentes. Ela lê qualquer pasta de arquivos de texto, portanto você também pode colar respostas de sites de chat em arquivos, um por IA, e comparar esses. - Saiba o valor do acordo (
neff.py). Dê a ela um punhado de perguntas com respostas conhecidas, marcadas como certas ou erradas para cada IA, e ela mede com que frequência suas IAs estão erradas juntas. A partir disso, calcula quantas opiniões independentes elas realmente valem. No exemplo integrado, quatro IAs cujos erros se sobrepõem valem cerca de 1,6 opiniões independentes, e nenhuma quantidade de tais IAs jamais valeria mais de 2,1. - Uma segunda opinião dentro do Claude Code (
second-opinion/SKILL.md). Uma habilidade pronta: copie a pasta em~/.claude/skills/, e o Claude Code pode fazer a mesma pergunta a uma IA de outra empresa, mostrar essa resposta exatamente como veio e adicionar uma tabela curta de onde os dois concordam, onde diferem e o que apenas um deles menciona. Nunca mescla os dois em um texto confiante único, e trata a resposta da outra IA como material para comparação, nunca como instruções a seguir. - Configurações seguras para agentes de IA (
safety/). Um exemplo pronto de configurações de permissão do Claude Code (settings.json) que inicia cada sessão no modo de plano, nega comandos comorm -rf,sudo,curlegit push, mantém arquivos.enve uma pastasecretsilegíveis, e pergunta antes derm,mve buscas na web. As configurações para o Codex permitem que ele escreva apenas dentro de sua pasta de trabalho, com a rede desligada, e o fazem perguntar antes de ir além disso. Uma lista de verificação de 14 pontos abrange os hábitos em torno deles: trabalhe em uma cópia, peça um plano primeiro, mantenha um desfazer, saiba como parar um trabalho longo. - Ferramentas para pesquisadores (
crossings.py,crossings.schema.json,jsonl_log.py). Um formato de registro, com um verificador rigoroso, para estudos de como as pessoas passam de conversar com IA para deixar agentes de IA fazerem trabalho real. Instalar um aplicativo não conta como usá-lo, uma etapa concluída requer algo que o agente realmente criou, e quando alguém para, o registro mantém suas próprias palavras. Um pequeno registrador escreve cada decisão, como um plano recusado ou uma segunda opinião obtida, como uma linha de JSON com marca de tempo.
Por que é construído dessa forma
Muitas ferramentas de "conselho LLM" terminam com uma resposta mesclada. O popular llm-council de Andrej Karpathy, por exemplo, envia sua pergunta aos modelos através do OpenRouter, um serviço de API em que você compra créditos, e deixa um modelo "presidente" escrever a resposta final. After Chat funciona com as ferramentas de linha de comando que você já usa com suas próprias contas, e ele para antes da mesclagem propositalmente: você obtém a tabela de quem disse o quê, e o julgamento fica com você. Cada script usa apenas a biblioteca padrão do Python e cabe em um único arquivo curto (o mais longo tem menos de 200 linhas), então você pode ler exatamente o que faz e modificá-lo.
Como começar
Os scripts funcionam em qualquer lugar onde Python 3 funciona; no Windows, execute fanout.py no WSL. Uma comparação em tempo real usa duas ou mais ferramentas de linha de comando de IA, autenticadas com suas próprias contas. A lista integrada cobre Claude Code (claude), OpenAI Codex (codex), Google's Antigravity CLI (agy, que substituiu o Gemini CLI para contas Google pessoais em 18 de junho de 2026) e xAI's Grok Build (grok). O comando de cada ferramenta é uma linha em um pequeno arquivo JSON passado com --tools, portanto, adicionar outra ferramenta ou acompanhar um sinalizador que mudou em uma nova versão leva um minuto. Nenhuma ferramenta de linha de comando? Cole as respostas de qualquer site de bate-papo com IA em arquivos .txt, um por IA, e execute provenance.py nessa pasta: o nome de cada arquivo se torna uma coluna da tabela.
git clone https://github.com/vadimchernets/after-chat
cd after-chat
python3 neff.py --demo                       # what four agreeing AIs are worth
python3 fanout.py "Your question" --out run  # ask every live AI at once
python3 provenance.py run                    # who said what, and where they differ
Os 28 testes rodam com python3 -m unittest tests/test_patterns.py. O código, seus testes e as configurações de segurança estão todos em github.com/vadimchernets/after-chat.
De onde vem
After Chat é o código complementar do artigo After Chat: The Three Transitions Between Non-Programmers and Agentic AI de Vadym Chernets (setembro de 2026, SSRN 7520019, DOI 10.2139/ssrn.7520019). O artigo questiona por que tão poucas pessoas passaram de conversar com IA para deixar agentes de IA trabalharem para eles e como medir essa transição. O código está sob a licença MIT e arquivado no Zenodo (DOI 10.5281/zenodo.22944451). Dois plugins Claude Code prontos surgiram dos mesmos padrões: Sidecall consulta as ferramentas de linha de comando de IA no seu computador, e Roundcall consulta sites de chat de IA através do seu próprio navegador.
Vadym Chernets também constrói Poly A1, um aplicativo no qual IAs de diferentes empresas verificam o trabalho uns dos outros.