Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7682960 · DOI 10.2139/ssrn.7682960 · Zenodo 10.5281/zenodo.24090580 · Analysis release 10.5281/zenodo.24090584 · GitHub
Prépublication, 9 novembre 2026. SSRN : 7682960. Copie archivée : 10.5281/zenodo.24090580. Données et code : 10.5281/zenodo.24090584. PDF : agreement-inversion.pdf. Le PDF fait autorité.
Résumé
Lorsque deux modèles phares, interrogés séparément, donnent la même réponse à l'une des questions SimpleQA les plus difficiles, cette réponse est généralement incorrecte. Sur les 106 questions SimpleQA où les panels de niveau intermédiaire de juillet ont échoué, 45 paires de modèles phares sans le bras GPT servi par le client, où la recherche web ne peut être exclue, sont justes sur 96 des 691 accords (13,9 %). Répondre uniquement lorsqu'un second modèle est d'accord ne nécessite pas d'étiquettes ni de paramètres, et les travaux antérieurs ont attribué les défaillances de cette règle aux modèles de niveau intermédiaire. Sur les deux niveaux que j'ai mesurés, la précision des réponses approuvées suit la précision de la paire, donc l'inversion n'est pas une propriété de niveau intermédiaire. Dans le quintile le plus difficile, défini de la même manière pour chaque niveau, la précision est de 17,3 % en juillet et 15,5 % en août ; dans les cinq quintiles, à la précision attendue des deux précisions de chaque paire, les paires de modèles phares diffèrent des paires de niveau intermédiaire de -0,2 points [-3,1, +2,7]. Les données sont SimpleQA, des questions fraîches à deux sauts et des faits de produits, collectés en juillet, août et octobre 2026 avec des modèles phares de onze laboratoires. Un partenaire d'un second laboratoire détecte plus d'erreurs mais ouvre la porte moins souvent : pour un modèle publié, un partenaire du même laboratoire détecte 2 des 29 erreurs et un partenaire d'un autre laboratoire 20 des 29 (-62,1 points [-79,3, -43,8]), la porte étant ouverte sur 96 % et 61 % des questions. Lorsque la porte plus large est affinée par la confiance déclarée pour une couverture égale, cet avantage ne persiste que lorsque le modèle du partenaire est beaucoup plus précis. Un petit modèle alimenté par les précisions mesurées prédit la précision hors échantillon avec une erreur absolue moyenne de 0,037 contre 0,099 pour le meilleur modèle unique, au niveau d'une base de référence aux erreurs indépendantes de 0,032, et obtient des résultats élevés sur les faits de produits et les données publiques. Sur les mêmes 100 questions, l'identifiant gpt-5.6-sol obtient 92,0 % dans sa vague servie par le client et 46,3 % via l'API avec un autre paramètre d'effort, tandis que huit autres modèles se déplacent d'au plus 4 points.
1. Introduction
Posez la même courte question factuelle à deux grands modèles de langage (IA) issus de laboratoires différents, séparément, et ne révélez la réponse que si les deux concordent. La porte n'a besoin d'aucune étiquette, seuil ou arbitre, seulement deux appels en aveugle. Les modèles phares rendent cela attrayant, car leur confiance affichée offre peu de protection : sur dix bras phares en août 2026, 4 910 des 10 540 réponses affirmées avec une confiance d'au moins 80 étaient incorrectes (Chernets, 2026b).
Ma mesure antérieure sur les modèles propriétaires, une collection de juillet 2026 de modèles de gamme moyenne, a trouvé des réponses de panel répliquées sur le quintile le plus difficile de SimpleQA correct en 0 occasions sur 342 (Chernets, 2026a). Cela suggère que l'accord s'inverse pour les modèles faibles, de sorte que les réponses convenues sont plus souvent incorrectes que correctes, et que les modèles forts s'en échappent. Une paire phare semblait le confirmer : gpt-5.6-sol avec claude-fable-5 avait raison sur 34 des 37 accords sur ces mêmes questions (les 106 de la section 3).
Au niveau phare, cette lecture ne tient pas. Sans le bras unique derrière les 34 des 37, gpt-5.6-sol servi via le client du fournisseur, l'inversion revient, et avec difficulté définie de la même manière pour les deux niveaux, les deux courbes se rencontrent à l'extrémité difficile. Sur tous les quintiles, une fois que les deux précisions de chaque paire sont prises en compte, les paires phares et de gamme moyenne diffèrent de -0,2 points [-3,1, +2,7]. La précision suit la précision des deux modèles sur la strate, quel que soit leur niveau.
Le tableau 1 résume quatre contributions. La section 5.1 donne un compte rendu au niveau de la porte des phares, construit autant que possible sans le bras qui domine la plage de précision. La section 5.2 mesure ce qu'un deuxième laboratoire apporte, en faisant varier le modèle libéré et le partenaire, avec GPT et sans lui. Les sections 4 et 5.3 donnent un modèle descriptif de la porte avec cinq constantes et le testent hors échantillon par rapport aux lignes de base affichées, et la section 5.4 compare les clients du fournisseur avec l'accès direct via l'API pour le même identifiant sur les mêmes questions.
Tableau 1. Affirmations, preuves et limite.
| Affirmation | Preuves | Limite |
|---|---|---|
| La précision des réponses convenues suit la précision de la paire sur les deux niveaux | 96/691 sur les 106 ; quintile le plus difficile 17,3 % juillet, 15,5 % août ; niveau à précision appariée -0,2 [-3,1, +2,7] | Association ; un seul quintile seul s'étend sur -1,8 [-22,1, +20,2] |
| Un deuxième laboratoire détecte plus d'erreurs au prix de la couverture | 20/29 contre 2/29 erreurs détectées, -62,1 [-79,3, -43,8] ; couverture 61 % contre 96 % | À couverture égale, par confiance, il a besoin d'un partenaire beaucoup plus précis ; deux laboratoires en octobre |
| Un petit modèle décrit la précision hors échantillon | Erreur 0,037 contre 0,099 pour le meilleur modèle, -0,062 [-0,085, -0,035] | Au niveau des erreurs indépendantes, +0,005 [-0,003, +0,012] ; 13 points élevés sur les faits produits |
| Le mode d'accès déplace un identifiant | 92,0 % client contre 46,3 % API, mêmes 100 questions | Mode, effort et recherche possibles changent ensemble |
2. Travaux connexes
La question la plus proche de la mienne est celle posée par Goel et al. (2025), qui introduisent CAPA, une mesure d'accord ajustée en fonction du hasard entre les distributions de résultats des modèles, et montrent sur 130 modèles à poids ouvert sur MMLU-Pro et BBH que les erreurs deviennent plus similaires avec la capacité, ce qui, selon eux, met la surveillance de l'IA, y compris les jurys de modèles de langage, en danger. Je mesure, pour les modèles propriétaires de différents laboratoires, ce que certifie l'accord aveugle quand il conditionne la publication d'une réponse brève en forme libre : la précision des réponses convenues, la part des erreurs du modèle publié que le désaccord expose, et le plancher des erreurs confiantes partagées. Les résultats sont compatibles : dans mes données, le coût de la similarité croissante se manifeste dans le rappel du désaccord, tandis que la précision reste élevée là où la précision est élevée (Annexe L). La mise en cascade basée sur l'accord (Kolawole et al., 2025) utilise l'accord d'ensemble comme règle de report sans apprentissage avec une condition sur le taux conjoint d'erreurs acceptées, et mes résultats stratifiés localisent où ces erreurs se concentrent.
Les erreurs corrélées entre fournisseurs sont documentées par Kim et al. (2025), et Hossain et al. (2026) les trouvent plus fortes parmi les juges LLM de première ligne. Les jurys de petits juges divers apparaissent dans Verga et al. (2024), et le biais d'un modèle jugeant son propre résultat dans Panickssery et al. (2024), qui favorise la comparaison de deux réponses aveugles. L'accord entre les échantillons d'un modèle est un signal de confiance dans l'auto-cohérence (Wang et al., 2023), SelfCheckGPT (Manakul et al., 2023) et l'incertitude sémantique (Kuhn et al., 2023), et une règle de report dans Yue et al. (2024) ; je le compare avec l'accord entre laboratoires (Section 5.2). La porte est un prédicteur sélectif (Geifman & El-Yaniv, 2017), donc je compare les portes à couverture égale. Les prépublications récentes divergent sur la question de savoir si l'agrégation aide (Annexe E). Je ne connais pas de travaux qui rapportent une porte de publication au niveau de la paire sur des faits brefs en forme libre pour les navires amiraux propriétaires, le rappel à couverture égale avec un modèle publié maintenu fixe, ou un identificateur mesuré dans deux modes d'accès sur les mêmes questions.
3. Données et protocole
Mes travaux antérieurs ont rapporté les panels de juillet (Chernets, 2026a) et les agrégats d'août et octobre pour les paires sélectionnées (Chernets, 2026c). Les nouveautés ici sont les paires phares sans GPT, la définition symétrique de la difficulté, les paires du même laboratoire, les comparaisons à couverture égale, les tests hors échantillon et externes et la comparaison des modes d'accès.
Collections. Toutes les réponses ont été collectées en aveugle : un appel par question, aucune IA ne voyant la réponse d'une autre. Le système d'invite demande un objet JSON avec une réponse courte et une confiance de 0 à 100 et ne demande pas les sources. Le tableau A1 liste les modèles, dates et modes d'accès, et l'Appendice F les collections en intégralité. Neuf modèles API et sept modèles locaux ont répondu à 1 500 questions SimpleQA (Wei et al., 2024) du 24 au 28 juillet, enregistrées sur OSF avant la collecte de données (Chernets, 2026a). Un navire amiral de chacun de onze laboratoires a répondu aux mêmes questions du 3 au 6 août, 1 459 communes à tous, et neuf d'entre eux ont répondu à 100 de celles-ci à température 0,7 avec trois échantillons (le bras variance). Ont été ajoutées 100 questions à deux sauts composées automatiquement à partir de Wikidata, avec le hash du fichier fixé avant le premier appel de modèle, et 267 faits de produit. En octobre, gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 et claude-fable-5-1 ont répondu à 300 questions SimpleQA stratifiées par quintile de juillet, les 106 ci-dessous et l'ensemble frais, trois ensembles disjoints avec 503 questions communes à tous les cinq modèles (chaque paire sur celles-ci figure au tableau A2).
Les 106. Ce sont les questions du quintile le plus difficile sur lesquelles un panel de juillet a répliqué une réponse (Chernets, 2026a). Elles ont été sélectionnées sur l'échec des modèles de juillet, de sorte que la précision de juillet sur celles-ci est en partie un produit de la sélection, et la Section 5.1 les apparie avec une définition symétrique de la difficulté qui ne porte pas cette propriété.
Modes d'accès. En août, claude-fable-5, gpt-5.6-sol et mistral-medium-3.5 ont fonctionné par le client propriétaire du vendeur, l'agent de ligne de commande officiel que les utilisateurs finaux déploient, et en octobre chaque bras l'a fait, de sorte que les mesures incluent les invites système côté vendeur et les valeurs par défaut de service telles qu'un utilisateur du client les reçoit. La vague de juillet et les bras d'août restants ont utilisé des routes API directes ou d'agrégateur épinglées au vendeur. Le tableau 2 énonce les conditions de mesure des bras clients. J'appelle un bras recherche-possible quand son utilisation de la recherche web ne peut pas être exclue, et je rapporte les résultats principaux avec de tels bras et sans eux.
Tableau 2. Conditions de mesure par bras. Note : la température n'est pas définie dans les clients Codex et Claude ; les flux d'événements Codex n'ont pas été conservés. Les bras API des vagues de juillet et août ont fonctionné à température 0. Un tiret marque l'absence de paramètre ou d'entrée dans les dossiers.
| Bras | Atteint par | Effort | Recherche possible |
|---|---|---|---|
| gpt-5.6-sol, août | Client Codex | valeur par défaut du client, non enregistrée | non exclue |
| claude-fable-5, août | Client Claude | - | non, 0 demande de recherche enregistrée |
| mistral-medium-3.5, août | Client du vendeur | - | non, liste d'outils vide |
| gpt-6.1-sol, gpt-6-astra, gpt-6-sol, octobre | Client Codex | moyen | non exclue |
| claude-opus-5-5, claude-fable-5-1, octobre | Client Claude | - | non, outils interdits |
| kimi-k3, gemini-3.8-flash, ensemble frais | Client du vendeur | - | outils non désactivés, invite interdit |
| gpt-5.6-sol, bras variance | API directe | aucun | - |
Portail et mesures. Le portail s'ouvre quand les deux modèles répondent, aucun ne refuse, et un moteur d'équivalence déterministe, le même pour chaque vague ici, trouve les deux réponses équivalentes. La notation applique le même moteur à la réponse et à la réponse de référence : correspondance exacte normalisée, contenance de chaînes de quatre caractères ou plus, et règles pour les dates, nombres et identifiants (Appendice D, avec une rescoring au tableau A3). Une cellule est une paire de modèles sur une strate de questions. La couverture compte les portails ouverts parmi les questions auxquelles les deux modèles ont répondu. La précision, PPV, est la part correcte parmi les réponses ouvertes que l'évaluateur résout comme juste ou fausse (K/O), et Delta est la précision moins la précision du modèle diffusé sur toutes les questions résolues de la cellule. Le rappel est la part des erreurs du modèle diffusé sur lesquelles le portail reste fermé, rapportée comme erreurs détectées. L'effet élévateur divise la précision du modèle diffusé avec le portail ouvert par celle avec le portail fermé, et le plancher compte les questions sur lesquelles les deux modèles énoncent une confiance d'au moins 80, s'accordent, et ont tort. J'appelle l'accord inversé quand le PPV est inférieur à la moitié. Le modèle diffusé est le premier membre de la paire, ou celui plus précis quand les paires sont regroupées. Pour comparer les portails à couverture égale, j'amincis le portail plus large : les réponses ouvertes sont classées par le plus petit des deux niveaux de confiance énoncés et coupées à la couverture cible, les égalités brisées au hasard.
Inférence. Les proportions uniques portent des intervalles de Wilson. Les différences et les quantités dérivées portent des intervalles de bootstrap à 95 %, bilatéraux sur la question et le modèle pour les résultats regroupés (Owen, 2007 ; B = 2000, graine fixée, avec le modèle réajusté dans chaque réplique) et sur la question pour une seule paire. Les comparaisons de précision appariées utilisent le test exact de McNemar, et l'équivalence un test deux unilatéraux (Schuirmann, 1987) avec une marge de 2 points. Les cellules sont dépendantes, elles portent des intervalles et pas de valeurs p.
4. Un modèle de la porte
Soit et les précisions mesurées de deux IA sur une cellule et . Soit la probabilité que les deux se trompent et la probabilité que les deux aient raison :
Ici amplifie le taux indépendant d'erreur conjointe. Deux bonnes réponses concordent avec la probabilité . Deux mauvaises réponses concordent avec la probabilité , où sur le 106, dont les mauvaises réponses se heurtent plus souvent, et 1 ailleurs. Alors
Ajusté sur 335 paires de cellules provenant de différents laboratoires (juillet, août et octobre, dont 106 d'entre elles ; est le taux de correspondance de deux bonnes réponses sur toutes les cellules ajustées), les constantes sont , , , (22 536 sur 22 785) et .
Le modèle prend en entrée les précisions mesurées de la cellule et retourne la couverture, la précision et la part des mauvaises réponses convenues, , dont le seuil de la section 3 est la partie ayant une confiance d'au moins 80. Données deux précisions, il retourne ce qu'ajoute la porte, et il montre pourquoi la précision doit suivre la justesse en tête : avec et les bonnes réponses correspondant, la précision des réponses convenues ne peut pas descendre en dessous de , même si chaque erreur est partagée, puisque les deux modèles ont raison ensemble sur au moins des questions et se trompent ensemble sur au plus (0,947 à ). À , il n'y a pas de borne, et peut dépasser dès que les mauvaises réponses se concentrent sur la même chaîne.
Je la compare avec deux lignes de base. La ligne de base erreurs-indépendantes fixe et réajuste le reste, elle conserve donc . La ligne de base meilleur-modèle prédit . Le critère était que le modèle surpasse les deux, avec l'intervalle de la différence en dessous de zéro, sous validation croisée sans laboratoire (LOLO), sans modèle (LOMO) et une séparation temporelle de juillet et août à octobre.
5. Résultats
5.1 L'inversion n'est pas une propriété de niveau intermédiaire
Le tableau 3 donne la porte sans les bras GPT fournis par le client. Sur l'ensemble de SimpleQA, les deux niveaux se ressemblent : précision de 72,1 % en juillet et 80,6 % en août, avec un Delta de +28,6 et +26,0 points par rapport au modèle commercialisé. Sur les 106, la précision est faible dans les deux vagues : 5 sur 717 en juillet et 96 sur 691 en août sans GPT. L'exclusion du bras GPT du côté juillet donne également 4 sur 581, et la différence août moins juillet est de +13,2 points [+2,6, +30,8]. La précision d'août est plus élevée et reste bien inférieure à une moitié, donc l'accord est inversé dans les deux vagues. Elle est également inférieure au meilleur bras unique sur la strate, de -9,5 points [-16,3, -3,2] en juillet et -43,2 [-67,6, -16,1] en août. Le lift est de 0,13 [0,00, 1,21] en juillet et 0,65 [0,23, 1,22] en août sans GPT.
Tableau 3. La porte sans bras GPT fournis par le client. Remarque : groupé par paires de laboratoires différents sauf indication contraire ; la couverture s'étend aux questions auxquelles les deux modèles ont répondu, K/O sur les réponses ouvertes que l'évaluateur résout ; intervalle sur PPV : bootstrap bidirectionnel. Faits produit : les quatre bras sans possibilité de recherche.
| Niveau, questions | Paires | Couverture | PPV (K/O) [95%] | Précision du modèle commercialisé | Delta, points [95%] |
|---|---|---|---|---|---|
| Intermédiaire, juillet, 106 | 36 | 19,8% | 0,7 % (5/717) [0,0, 3,7] | 4,6% | -3,9 [-8,3, +0,3] |
| Intermédiaire, juillet, tout SimpleQA | 36 | 20,6% | 72,1 % (7743/10745) [53,2, 82,3] | 43,4% | +28,6 [+22,3, +32,4] |
| Phare, août, 106, pas de bras avec recherche possible | 45 | 19,1% | 13,9 % (96/691) [3,3, 31,8] | 19,9% | -6,0 [-14,1, +2,9] |
| Phare, août, tout SimpleQA, pas de bras avec recherche possible | 45 | 29,1% | 80,6 % (12357/15322) [69,6, 87,9] | 54,7% | +26,0 [+19,9, +30,7] |
| Phare, août, ensemble frais 100 (GPT par API) | 6 | 37,5% | 88,9 % (200/225) [75,6, 97,4] | 66,8% | +22,1 [+7,9, +47,4] |
| Même laboratoire, octobre, fable-5-1 + opus-5-5, 106 | 1 | 39,6% | 47,5 % (19/40) | 30,0% | +17,5 [+6,2, +29,7] |
| Octobre, kimi-k3 + gemini-3.8-flash, ensemble frais 100 (outils non désactivés) | 1 | 72,0% | 95,8 % (69/72) | 74,0% | +21,8 [+14,1, +30,0] |
| Faits produit, 267, pas de bras avec recherche possible | 6 | 63,6% | 75,0 % (423/564) [66,4, 82,7] | 62,7% | +12,3 [+5,8, +20,4] |
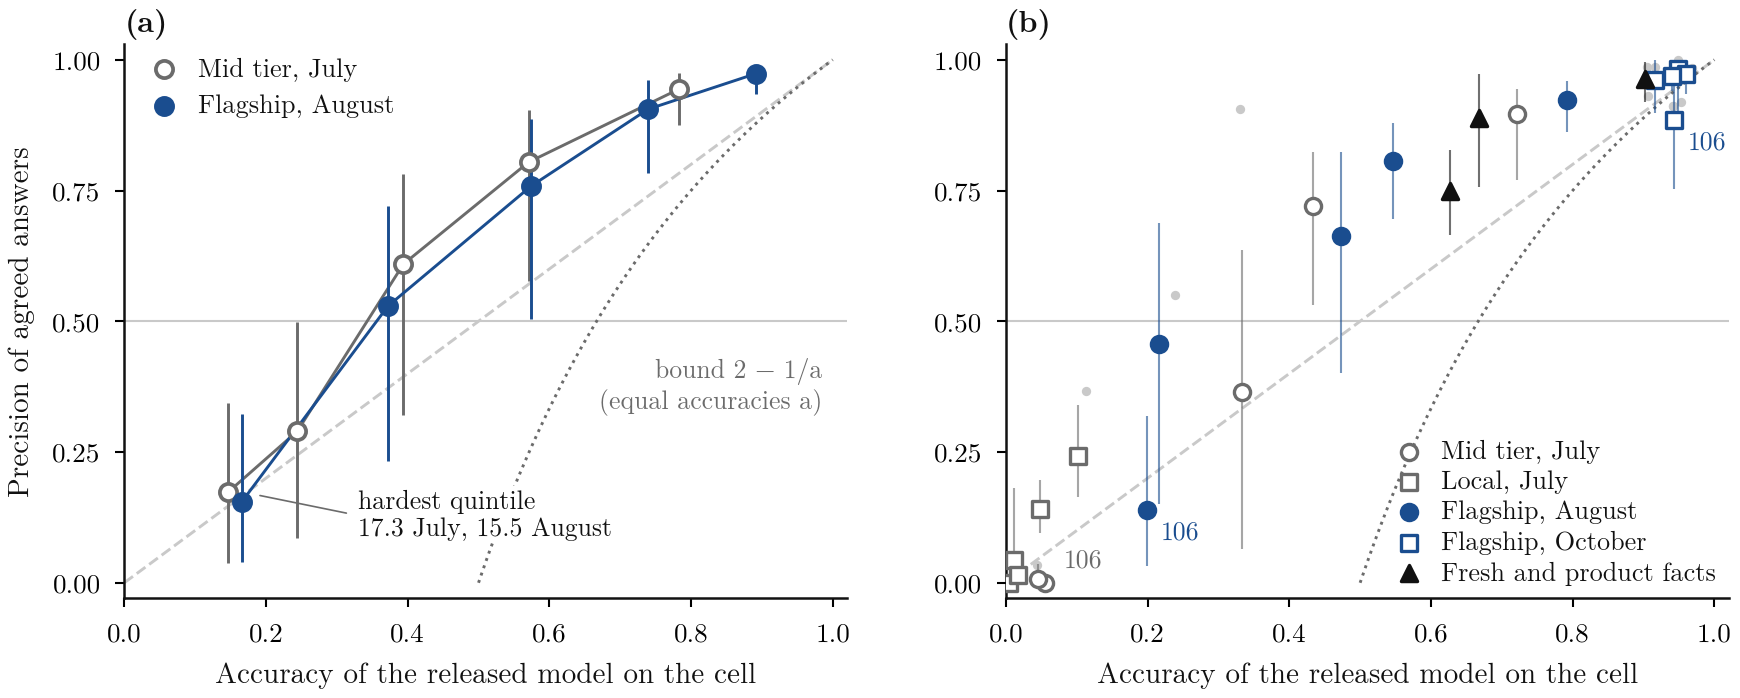
Figure 1. La précision des réponses concordantes suit la précision de la paire. Remarque : (a) quintiles de difficulté définis dans chaque niveau, niveau intermédiaire juillet et phares août sans les bras GPT fournis par le client. (b) Chaque bande de chaque niveau, juillet à octobre, par rapport à la précision du modèle commercialisé ; les cellules étiquetées sont les 106. Les moustaches sont des intervalles bootstrap à 95 %, et les petits points gris en (b) sont des paires uniques ; la ligne pointillée est l'égalité, la ligne pointillée la borne 2 - 1/a pour des précisions égales a.
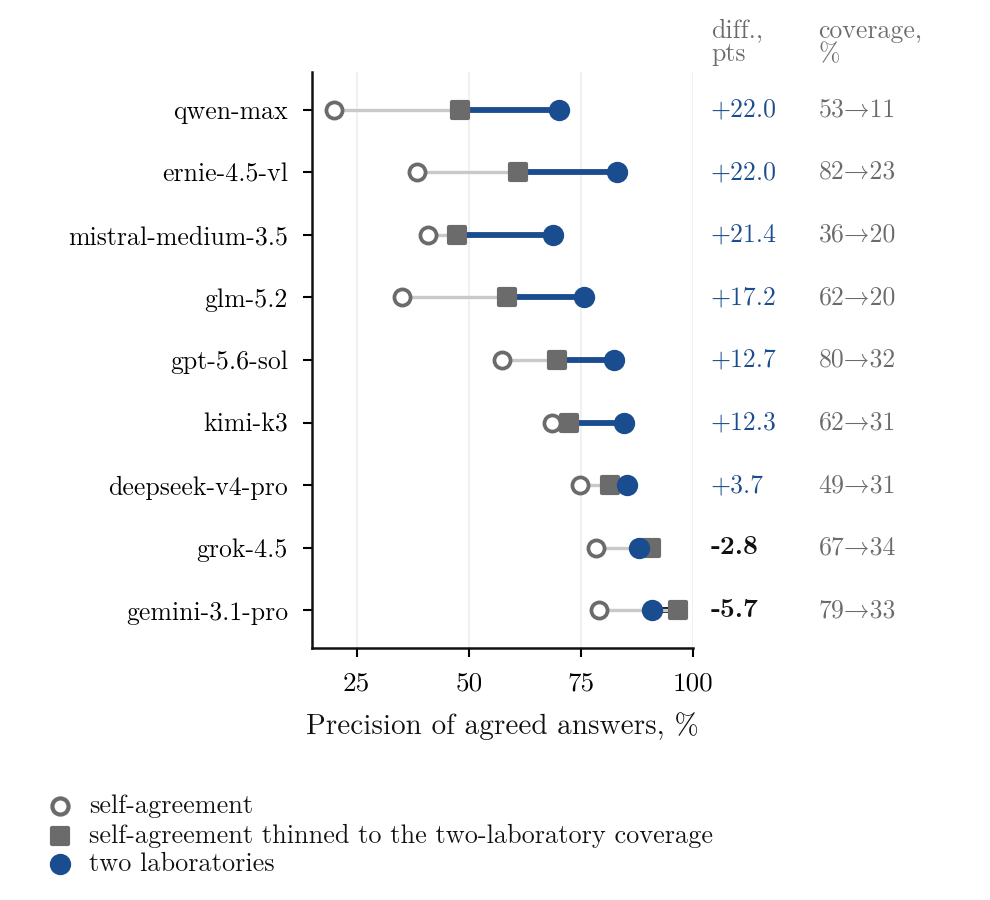
Figure 2. Auto-accord par rapport à deux laboratoires, par modèle. Remarque : bras de variance, neuf modèles, 100 questions. Cercle ouvert, deux appels à un modèle ; carré, le même réduit par confiance à la couverture de la porte deux-laboratoires ; cercle rempli, deux laboratoires, moyenne sur les partenaires. Les colonnes de droite donnent la différence à couverture égale, en points, et la couverture des deux portes, en pourcentage.
Les panneaux de trois modèles sans le bras GPT fourni par le client donnent le même résultat. Sur les 106 sous mon moteur, les panneaux juillet donnent 0 sur 318 (les 0 sur 342 de la section 1 sont la quintile la plus difficile selon la règle d'appariement antérieure ; les 5 sur 717 ci-dessus comptent les paires). En août, le panneau de DeepSeek, Qwen et Kimi donne 0 sur 76 et le panneau entre blocs de Claude, DeepSeek et Mistral 11 sur 78 (14,1 % [2,7, 26,3]), tandis que le panneau de Claude, GPT et Gemini, qui détient le bras GPT, donne 106 sur 131 (80,9 %). Les paires phares s'alignent sur leur précision sur la strate, de 4 sur 21 pour fable-5 avec deepseek-v4-pro à 15 sur 24 (62,5 % [42,6, 82,6]) pour fable-5 avec gemini-3.1-pro, dont les membres dominent ce groupe là.
Parce que les 106 ont été choisis sur l'échec juillet, ce qui abaisse la précision juillet sur eux et favorise août, la figure 1a établit la difficulté au sein de chaque niveau. Pour chaque niveau, les questions sont classées en quintiles par la précision du même niveau sans la paire en évaluation, de sorte que la quintile la plus difficile détient le même rang pour chacune, et la précision du modèle commercialisé y est proche, 15,3 % en juillet et 16,0 % en août. La précision y est de 159 sur 917 (17,3 % [3,8, 34,3]) en juillet et 203 sur 1 308 (15,5 % [4,0, 32,4]) en août sans GPT, une différence de -1,8 points [-22,1, +20,2]. Le regroupement de l'ensemble des cinq quintiles donne un test plus tranchant. Le modèle de la section 4 n'a pas de terme de niveau. Compte tenu des deux précisions de chaque cellule, il fournit la précision attendue là, et un effet de niveau se manifesterait comme une différence dans les résidus. Les cellules phares se situent à -0,2 points [-3,1, +2,7] des cellules de niveau intermédiaire, et à -0,5 [-3,6, +2,4] lorsque les constantes sont ajustées uniquement sur les cellules juillet, de sorte qu'août est hors échantillon. kimi-k3 appartient aux deux collections ; sans lui la différence est de +0,1 [-3,6, +3,8]. Sur les réponses or nettoyées, la précision reste faible : sur les 24 des 106 qui survivent dans SimpleQA Verified (Haas et al., 2025), les paires août sans GPT sont justes sur 18,7 % des accords [0,0, 57,1] (Appendice G).
Dans chaque bande de chaque niveau (figure 1b), la précision augmente avec la précision du modèle commercialisé dans chaque vague et se situe au-dessus de la diagonale dans 17 des 23 cellules. Des six en dessous, trois sont des cellules 106 et trois sont des bandes avec une précision commercialisée inférieure à 0,06. Au sommet, kimi-k3 avec gemini-3.8-flash atteignent 95,8 % sur l'ensemble frais (Appendice G).
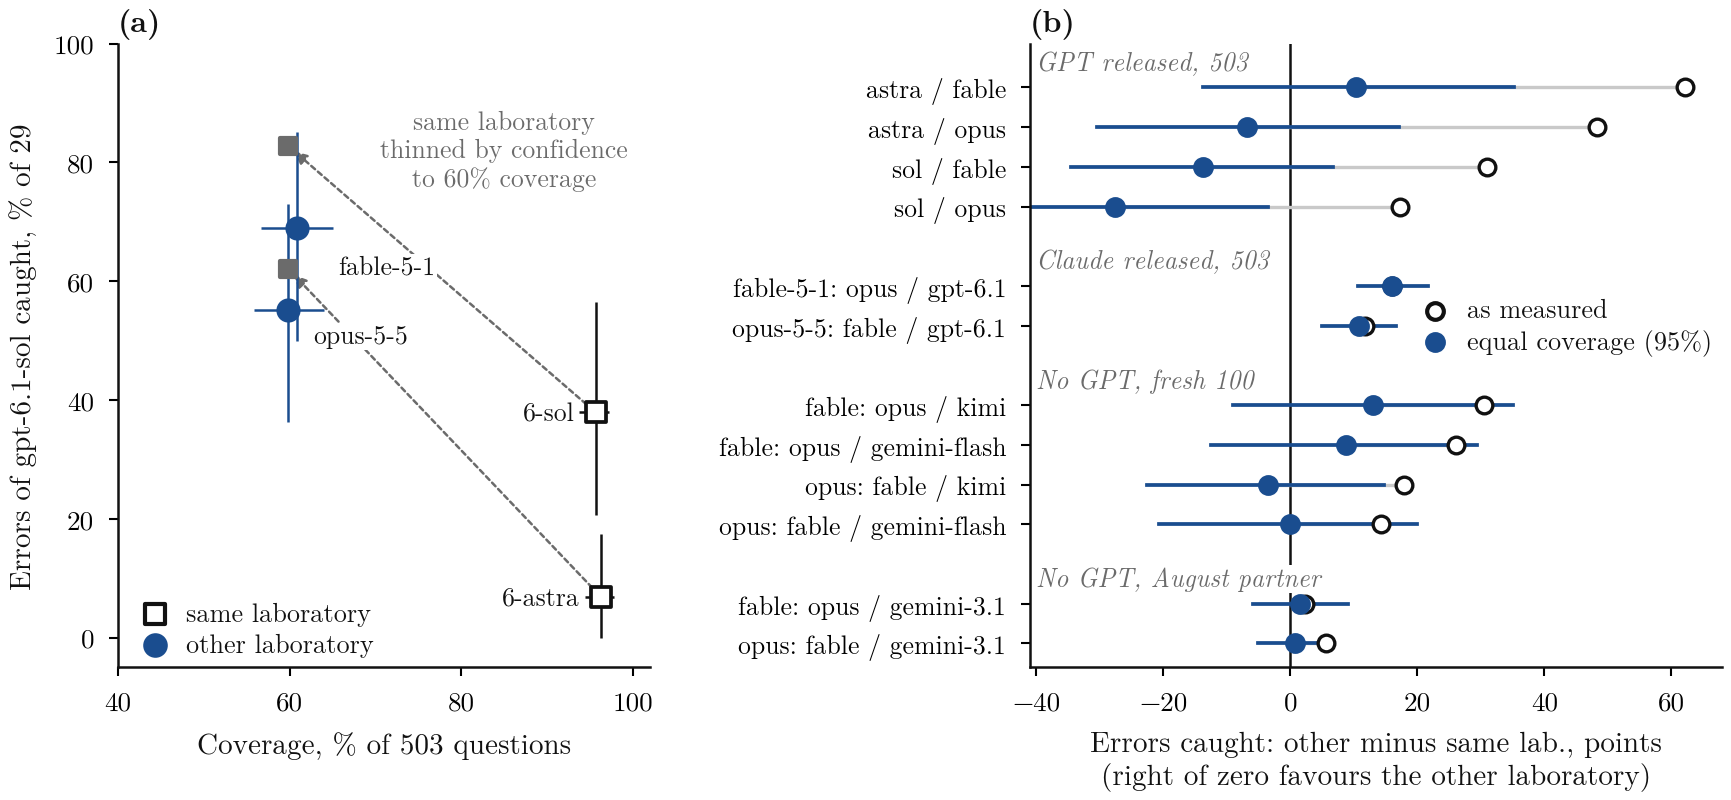
Figure 3. Un deuxième laboratoire : couverture et erreurs détectées. Note : (a) gpt-6.1-sol sur 503 questions communes, 29 erreurs, quatre partenaires du tableau A4, intervalles bootstrap à 95 % ; les flèches vont de la même porte de laboratoire à la même porte affinée par confiance à 60 % de couverture. (b) Les douze comparaisons du tableau A5 : erreurs détectées par l'autre laboratoire moins le même laboratoire, mesurées (ouvert) et à couverture égale (rempli, bootstrap à 95 % des questions).
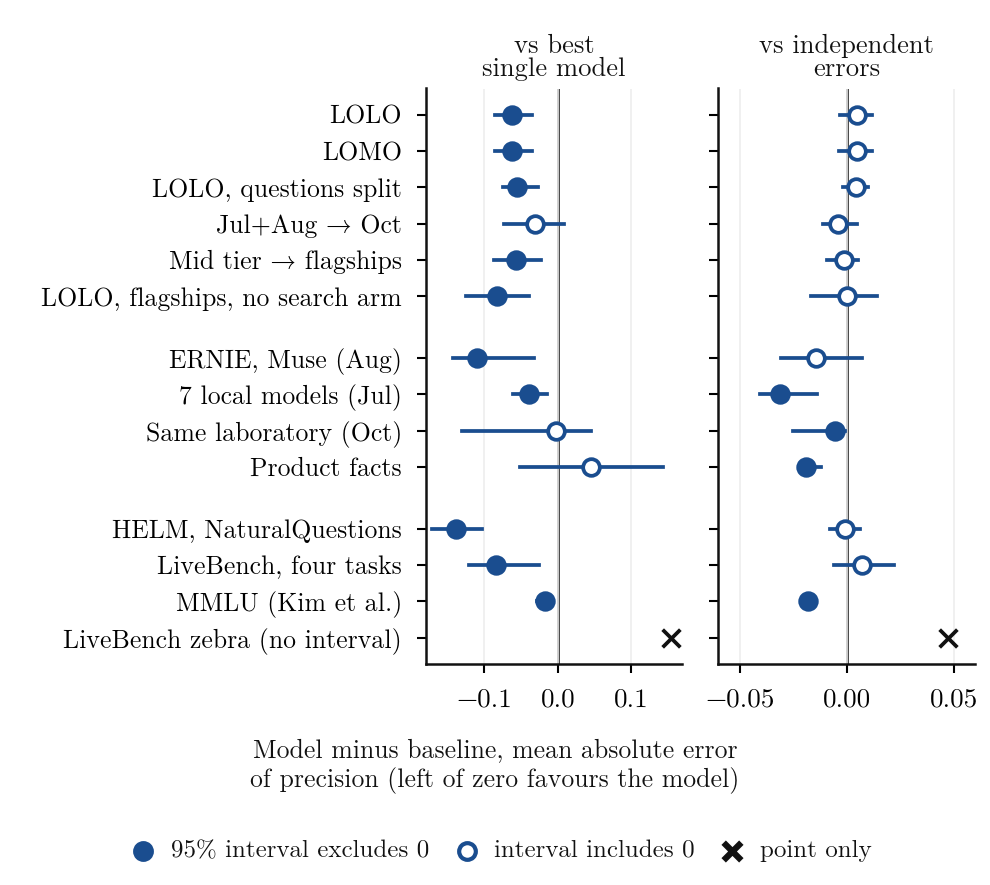
Figure 4. Le modèle par rapport à deux bases de référence, hors échantillon. Note : modèle moins base de référence en erreur absolue moyenne de la précision prédite, au-dessous de zéro favorise le modèle, avec intervalles bootstrap à 95 % bidirectionnels (tableaux A6 et A8). Groupe du haut, schémas d'ajustement ; milieu, ensembles en dehors de l'ajustement avec constantes gelées ; bas, données publiques (section 5.5). Marqueur rempli, l'intervalle à 95 % exclut zéro ; ouvert, il inclut zéro ; croix, une estimation ponctuelle (la tâche zèbre LiveBench).
5.2 Un deuxième laboratoire détecte plus d'erreurs, au prix de la couverture
La précision seule ne peut pas séparer les cas, car les paires précises d'un laboratoire ont aussi une précision élevée. Le rappel doit être lu avec la couverture, car une porte qui s'ouvre moins souvent bloque plus d'erreurs par construction.
Je commence par le bras variance : deux appels à un modèle à température 0,7, par rapport à deux appels à différents laboratoires (Figure 2). Regroupés sur neuf modèles et 100 questions, l'accord intra couvre 63,5 % à une précision de 56,1 %, et deux laboratoires couvrent 26,1 % à 82,9 %. La différence de précision est de +26,8 points [+16,6, +34,6] mesurée et +9,0 [+0,5, +17,4] à couverture égale, où l'accord intra est affiné par confiance, ce qui le favorise. Par modèle, la porte à deux laboratoires est en tête pour sept sur neuf. Le bras ne contient aucun modèle Claude et a GPT par API sans effort. Sans GPT, sur huit modèles, la différence à couverture égale est de +7,7 points [-1,9, +16,5].
La vague d'octobre contient deux modèles chacun de deux laboratoires, ce qui donne un test direct sur 503 questions communes (Figure 3a). Un modèle lancé, gpt-6.1-sol, garde les mêmes 29 erreurs dans chaque ligne et change uniquement le partenaire. Son partenaire du même laboratoire gpt-6-astra en détecte 2 et fable-5-1 en détecte 20, une différence de -62,1 points [-79,3, -43,8] ; par rapport à opus-5-5 la différence est -48,3 [-66,7, -29,6]. Le prix est la couverture, 60 à 61 % par rapport à 96 %. La précision est similaire sur les lignes : 94,3 et 96,2 % pour le même laboratoire, 95,6 et 97,0 % entre laboratoires (tableau A4). Les partenaires du même laboratoire diffèrent largement : gpt-6-sol en détecte 11 sur 29 (annexe H).
Pour voir si c'est plus qu'un mouvement le long de la courbe de couverture, et si cela nécessite GPT, chaque ligne de la Figure 3b garde un modèle lancé et compare ses deux partenaires, mesurés et à couverture égale (tableau A5). Mesurés, l'autre laboratoire détecte plus d'erreurs dans chaque ligne. À couverture égale son avantage ne tient que lorsque Claude est lancé avec gpt-6.1-sol comme partenaire, un partenaire à 93,9 % de précision par rapport à 66,6 à 69,2 % pour celui du même laboratoire sur l'ensemble stratifié. Avec GPT lancé, la porte du même laboratoire affinée par confiance est à niveau ou en avance, et sans GPT la différence est à niveau, ou favorise le même laboratoire par rapport aux partenaires faibles. Avec deux laboratoires en octobre, je ne détecte aucun effet du laboratoire au-delà de la précision du partenaire et de la couverture, et HELM, avec 20 développeurs, n'en montre aucun une fois les deux appariés (section 5.5).
5.3 Le modèle hors échantillon
Hors échantillon, le modèle s'améliore clairement par rapport à la lecture du meilleur modèle et est à niveau avec la base de référence des erreurs indépendantes (Figure 4, tableau A6). Sous LOLO son erreur est 0,037 par rapport à 0,099 pour la meilleure base de référence (-0,062 [-0,085, -0,035]), et cet intervalle se situe au-dessous de zéro sous LOMO, la division des questions et dans sept des dix lignes du tableau A6. La division temporelle donne 0,019 par rapport à 0,050, -0,031 [-0,074, +0,008], au-dessous de zéro lors du regroupement par question ou par modèle seul (annexe I). Par rapport aux erreurs indépendantes le modèle est à niveau selon les trois schémas et meilleur sur trois des quatre ensembles en dehors de l'ajustement, avec constantes gelées, donc le critère de la section 4 est respecté par rapport à la meilleure base de référence.
La précision est portée par les précisions mesurées et par : supprimer augmente l'erreur LOLO à 0,323, et la maintenir constante donne 0,046. Le multiplicateur n'ajoute rien à la précision dans les schémas principaux et aide sur la couverture et la perte logarithmique.
Sur les faits de produits le modèle s'exécute haut. Son erreur est 0,130 par rapport à 0,086 pour le meilleur modèle, tout cela surstatement (13 points), et 0,190 par rapport à 0,067 avec le correcteur natif de ce domaine, à nouveau tout surstatement (19 points). L'annexe I trie les cellules en classes de résultats.
5.4 Accès au modèle et les bras GPT
Sur un ensemble de 100 questions SimpleQA, gpt-5.6-sol obtient 92 sur 100 (92,0 %) dans la vague principale, 99 d'entre elles via le client Codex, et 139 sur 300 échantillons (46,3 %) via l'API directe dans le bras variance, un écart de 45,7 points (Figure 5). La reproduction verbatim de la chaîne de référence diminue avec elle, de 64,0 % à 26,0 %. Le client s'exécute à son paramètre d'effort par défaut sous ses propres instructions, avec température non configurable, tandis que l'API s'exécute sans effort et à température 0,7.
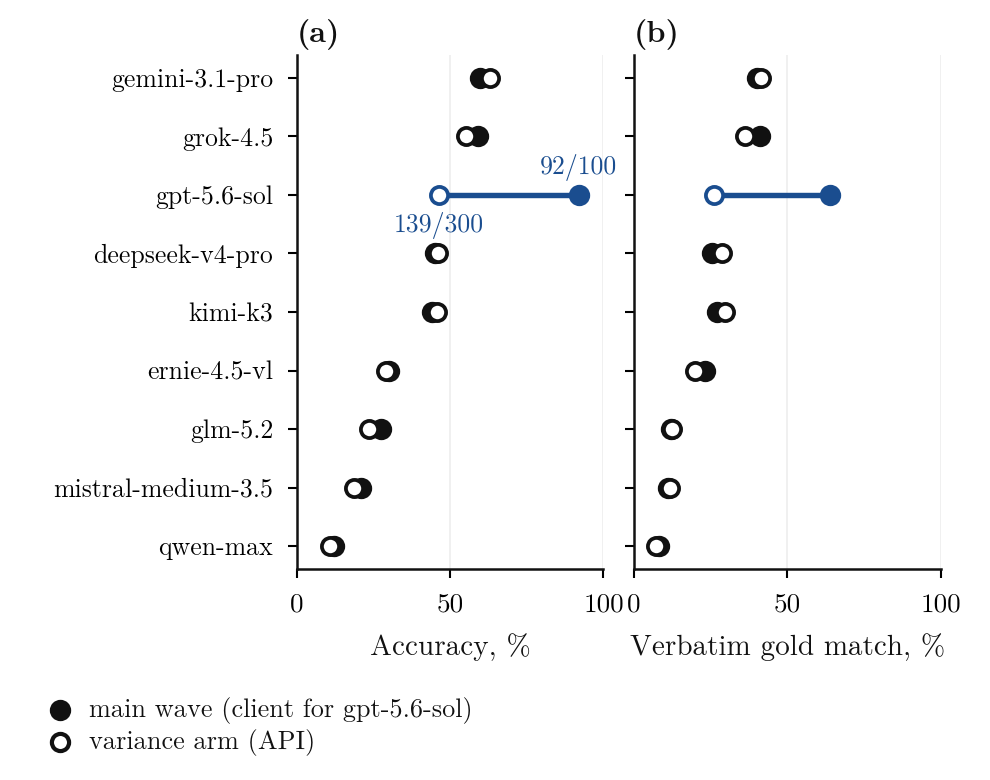
Figure 5. Un ensemble de 100 questions, deux bras, neuf modèles. Note : (a) précision, (b) correspondance verbatim avec la chaîne de référence. Rempli, vague principale (servi par client pour gpt-5.6-sol, 92/100) ; ouvert, bras variance via l'API (139/300). Pour gpt-5.6-sol les bras diffèrent aussi dans le paramètre d'effort.
Les huit autres modèles, dont la température change aussi entre les deux colonnes, se déplacent d'au maximum 4,0 points dans l'une ou l'autre direction. L'effort est un candidat, bien qu'une mesure de budget de raisonnement par paires sur gemini-3.1-pro ait laissé la précision pratiquement inchangée (Chernets, 2026c). La recherche Web est l'autre : les réponses d'octobre du même client contiennent des liens que l'invite ne demande pas, dans 3 réponses sur 506 pour gpt-6.1-sol et 18 sur 506 pour gpt-6-astra, et l'utilisation médiane de jetons par appel client en août est de 4 829.
Le chiffre du client est ce qu'une personne utilisant le produit reçoit, et le chiffre de l'API est ce qu'un harnais d'évaluation à effort nul lit. Sur des questions nouvelles en août, avec GPT via l'API, gpt-5.6-sol et fable-5 ont raison sur 29 accords sur 32, Delta +57,6 points [+46,3, +69,7]. En octobre, avec une version plus récente de GPT via le client sur les mêmes questions, la paire avec opus-5-5 a raison sur 72 sur 74, Delta +2,3 [-0,7, +6,0]. Les deux comparaisons diffèrent aussi dans le modèle GPT et la date, et dans les deux cas la valeur de la porte suit la précision du bras publié, comme à la section 5.1.
Les bras GPT servis par le client, exclus du tableau 3, sont précis : le bras d'août avec fable-5 a raison sur 997 accords sur 1 016 (98,1 %) et sur 34 sur 37 sur les 106, héritant de la précision du bras (Delta -3,3 [-10,3, +2,6] ; tableau A7 et appendice J).
5.5 Vérification externe sur données publiques
J'ai appliqué les constantes figées, sans réajustement, à des données publiques qui ne partagent ni modèles ni ajustement avec les miennes : HELM Lite (Liang et al., 2023), 95 modèles de 20 développeurs répondant à 1 000 questions NaturalQuestions en livre fermé ; LiveBench (White et al., 2025), 70 modèles de 11 laboratoires sur 346 questions avec une réponse finale brève ; et les agrégats de paires de Kim et al. (2025) pour 70 modèles sur MMLU à choix multiples (tableau A8). Les résultats correspondent à la section 5.3 (figure 4, groupe inférieur). Le modèle dépasse la lecture du meilleur modèle dans les trois sources et est égal aux erreurs indépendantes dans HELM et LiveBench. Il fonctionne haut de 5,3 à 6,6 points et échoue sur les énigmes zèbre (0,231 contre 0,076).
Dans HELM, la courbe observée s'aplatit là où le modèle continue de monter (figure 6) : à une précision de paire entre 0,5 et 0,6, la précision est de 74,6 % pour les modèles de 2023 et début 2024 et de 75,9 % pour les plus récents, contre 84,4 % prédits au milieu du bac. Sur MMLU, la probabilité médiane que deux réponses incorrectes correspondent est de 0,621 contre 0,368 de , car quatre options forcent les collisions. La précision augmente avec la précision des paires (Spearman +0,575 dans HELM et +0,786 sur MMLU, sur cellules dépendantes).
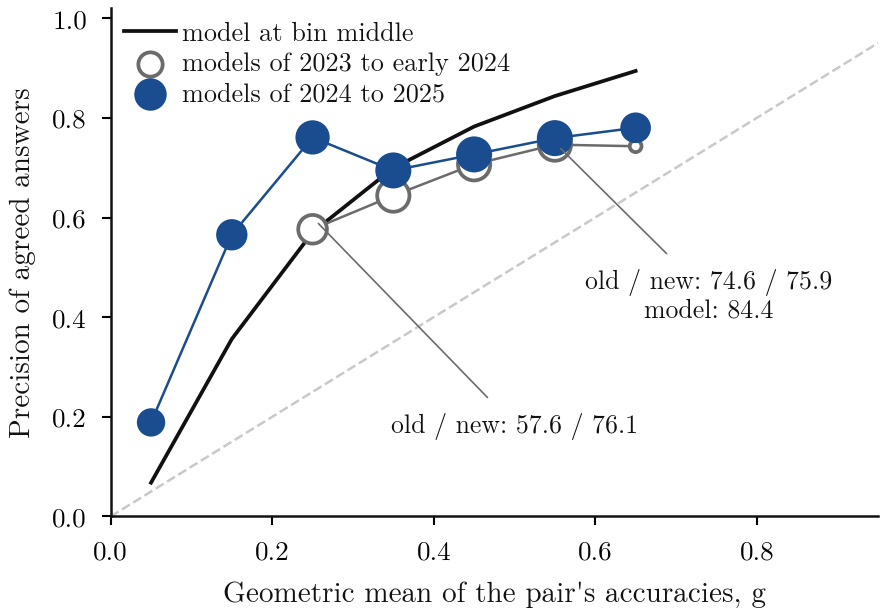
Figure 6. HELM Lite : précision des réponses concordantes par précision de paire, modèles plus anciens et plus récents. Note : bacs de la moyenne géométrique g des précisions de la paire, paires de laboratoires différents ; la taille du marqueur augmente avec le nombre de paires. La ligne est le modèle figé au milieu de chaque bac.
HELM permet aussi le test de la section 5.2 avec de nombreux laboratoires et aucune dépendance GPT. Avec un modèle publié et des partenaires dans les 3 points de précision, un autre laboratoire capture 75,5 % des erreurs contre 72,3 % pour le même laboratoire, -3,2 points [-4,2, -2,3], à une couverture supérieure de 2,7 points. Ajouter une correspondance sur couverture dans les 3 points l'annule : 75,7 contre 75,9 %, -0,2 [-0,6, +0,2].
6. Discussion
L'exécution du portail ne nécessite pas d'étiquettes, mais sa vérification en a besoin. Mesurez la précision des deux modèles sur un échantillon étiqueté de la strate pertinente, dans le mode d'accès qui sera déployé. Dans ces données, une réponse convenue par deux modèles phares sur une question au-delà de leurs capacités n'est pas plus sûre qu'une réponse convenue par deux modèles de niveau intermédiaire. L'appariement de deux laboratoires est un défaut raisonnable quand aucune valeur de confiance n'est disponible, mais il doit être vérifié sur la strate : une paire du même laboratoire affinée par la confiance, ou la confiance du modèle publié lui-même, peut faire aussi bien (section 5.2, appendice J).
La similarité ajustée du hasard (Goel et coll., 2025) et la précision des réponses convenues sont des quantités différentes, et Han (2026) nomme la décorrélation comme le levier où je place la précision et la couverture en premier (appendice L). Pour la communication des résultats, une étude de l'accord entre les modèles devrait indiquer le mode d'accès, l'effort, les conditions des outils et les journaux d'événements conservés pour chaque bras.
7. Portée et conditions aux limites
Les niveaux sont comparés sur deux vagues à des dates et des voies d'accès différentes, et la comparaison des niveaux est précise à environ 3 points à la précision appariée, beaucoup moins sur le quintile le plus difficile seul. La nouvelle preuve est un ensemble de 100 questions et huit modèles à deux dates, et October Delta sur celui-ci en inclut zéro. La précision et l'exactitude des paires évoluent ensemble selon les dates et selon les paramètres de raisonnement qui diffèrent entre les vagues, et la conception n'isole pas la capacité comme cause.
Le fait que les clients Codex, kimi et gemini-3.8-flash aient effectué des recherches ne peut être établi à partir des fichiers conservés, donc leurs exactitudes mesurent le client tel que déployé, pas la mémoire du modèle. Les sections 5.1 et 5.3 présentent les résultats principaux sans ces bras.
Des paires du même laboratoire existent en octobre, pour deux laboratoires, et sans GPT la comparaison de même vague est les 100 nouvelles questions. Les cellules d'octobre s'appuient sur cinq modèles de deux laboratoires, donc la dimension de modèle du bootstrap bidirectionnel a peu de niveaux et les intervalles regroupés sont des bornes inférieures de l'incertitude. Les comparaisons à couverture égale utilisent la confiance déclarée, que la porte nue ne fait pas, et la rupture des égalités aléatoires déplace la ligne la plus large entre 0,0 et +20,7 points (Appendice H).
Le moteur est basé sur des règles, et ses vérifications ici sont l'or nettoyé de SimpleQA Verified (section 5.1) et une réévaluation des parties de réponse. Il évalue l'ensemble de la réponse, et les réponses longues peuvent attirer un « faux » mauvais; le scoring de seulement la première partie déplace la précision des paires de référence d'au maximum 3 points, et gpt-6-astra avec opus-5-5 sur les 106 de 80,0 à 88,9% (tableau A3).
Le modèle prend les exactitudes mesurées pour chaque cellule comme entrée, il décrit donc une vérification étiquetée de la porte et n'en remplace pas une. Il fonctionne bien sur les faits de produits et les données publiques. HELM, LiveBench et les agrégats de Kim et al. maintiennent les anciens modèles dans des formats few-shot ou à choix multiples, ils testent donc la relation sur d'autres modèles, pas sur les navires amiraux de 2026.
8. Conclusion
La précision des réponses convenues augmente avec l'exactitude de la paire sur la strate en question, sur les deux niveaux et à environ 3 points d'exactitude appariée. L'inversion est apparue partout où j'ai mesuré une paire faible, les navires amiraux compris. Un partenaire d'un deuxième laboratoire détecte plus d'erreurs principalement en ouvrant la porte moins souvent, et à couverture égale, il a conservé son avantage uniquement là où son modèle était beaucoup plus exact. Un petit modèle de la porte décrit la précision hors échantillon bien mieux que le meilleur modèle et aussi bien que les erreurs indépendantes. Un identifiant mesuré par deux configurations d'accès diffère de 45,7 points, donc une affirmation sur l'exactitude d'un modèle devrait préciser le mode d'accès.
Déclaration d'impact
Cet article étudie le moment où l'accord entre deux modèles de langage peut être considéré comme une règle fiable pour publier des réponses factuelles brèves. Les praticiens peuvent vérifier, sur la strate qui compte et dans le mode d'accès qu'ils déploient, si un filtre à deux modèles est suffisamment précis pour leur utilisation, au lieu de supposer que des modèles plus puissants ou un deuxième fournisseur suffisent. Le risque principal est une confiance excessive dans l'accord sur les questions difficiles, et les résultats montrent les strates où les réponses convenues sont généralement erronées. L'étude utilise uniquement des repères publics et des questions composées par machine.
References
Chen, J. (2026). When does combining language models help? A co-failure ceiling on routing, voting, and mixture-of-agents across 67 frontier models. arXiv:2606.27288.
Chernets, V. (2026a). Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop: Who Verifies the Agents?
Chernets, V. (2026b). Weakly discriminative, not repaired by profile injection, and manipulable: Self-confidence in LLM evaluation. NeurIPS 2026 Workshop: Can We Trust AI Evaluation? Robustness, Causality, and Risk in Modern AI Assessment.
Chernets, V. (2026c). Architectural trust: When an AI agent buys for you, does trust belong to the model, or the architecture above it? SSRN 7191261.
Denisov-Blanch, Y., Kazdan, J., Chudnovsky, J., Schaeffer, R., Guan, S., Adeshina, S., and Koyejo, S. (2026). Consensus is not verification: Why crowd wisdom strategies fail for LLM truthfulness. arXiv:2603.06612.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Geifman, Y. and El-Yaniv, R. (2017). Selective classification for deep neural networks. In Advances in Neural Information Processing Systems 30. arXiv:1705.08500.
Goel, S., Strüber, J., Auzina, I. A., Chandra, K. K., Kumaraguru, P., Kiela, D., Prabhu, A., Bethge, M., and Geiping, J. (2025). Great models think alike and this undermines AI oversight. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267. arXiv:2502.04313.
Han, J. (2026). Partially correlated verifier cascades in LLM harnesses: Concave log-odds, polynomial reliability, and blind-spot ceilings. arXiv:2607.13918.
Haas, L., Yona, G., D'Antonio, G., Goldshtein, S., and Das, D. (2025). SimpleQA Verified: A reliable factuality benchmark to measure parametric knowledge. arXiv:2509.07968.
Hossain, E., Yousefi, N., and Lim, S.-N. (2026). Agreement overstates evidence: Error dependence in LLM judge consensus. arXiv:2609.22512.
Kim, D. (2026). Are diversity metrics measuring diversity? A capability-controlled audit of majority-vote gain in LLM ensembles. arXiv:2607.20768.
Kim, E., Garg, A., Peng, K., and Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267:30038-30066. arXiv:2506.07962.
Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
Kolawole, S., Dennis, D., Talwalkar, A., and Smith, V. (2025). Agreement-based cascading for efficient inference. Transactions on Machine Learning Research, 07/2025. arXiv:2407.02348.
Kuhn, L., Gal, Y., and Farquhar, S. (2023). Semantic uncertainty: Linguistic invariances for uncertainty estimation in natural language generation. In International Conference on Learning Representations. arXiv:2302.09664.
Liang, P., Bommasani, R., Lee, T., et al. (2023). Holistic evaluation of language models. Transactions on Machine Learning Research. arXiv:2211.09110.
Liu, N. (2026). LLMs as a jury: Cross-model consensus can outperform process reward models for LLM reasoning. arXiv:2607.10139.
Manakul, P., Liusie, A., and Gales, M. J. F. (2023). SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models. In Proceedings of EMNLP 2023. arXiv:2303.08896.
Naik, N. (2024). Probabilistic consensus through ensemble validation: A framework for LLM reliability. arXiv:2411.06535.
Owen, A. B. (2007). The pigeonhole bootstrap. The Annals of Applied Statistics, 1(2), 386-411.
Panickssery, A., Bowman, S. R., and Feng, S. (2024). LLM evaluators recognize and favor their own generations. In Advances in Neural Information Processing Systems 37.
Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657-680.
Tan, H., Sun, F., Liu, S., Su, D., Cao, Q., Chen, X., Wang, J., Cai, X., Wang, Y., Shen, H., and Cheng, X. (2025). Too consistent to detect: A study of self-consistent errors in LLMs. In Proceedings of EMNLP 2025. arXiv:2505.17656.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., and Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., and Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. In International Conference on Learning Representations.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., and Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
White, C., Dooley, S., Roberts, M., et al. (2025). LiveBench: A challenging, contamination-limited LLM benchmark. In International Conference on Learning Representations. arXiv:2406.19314.
Xue, Y., Greenewald, K., Mroueh, Y., and Mirzasoleiman, B. (2026). Verify when uncertain: Beyond self-consistency in black box hallucination detection. arXiv:2502.15845.
Yue, M., Zhao, J., Zhang, M., Du, L., and Yao, Z. (2024). Large language model cascades with mixture of thought representations for cost-efficient reasoning. In International Conference on Learning Representations. arXiv:2310.03094.
Déclarations
Conflits d'intérêts. L'auteur est demandeur nommé dans des demandes de brevet en attente, non des brevets accordés, portant sur les systèmes d'orchestration d'IA et de validation multi-modèles du type examiné dans cet article.
Données et code. Les réponses par appel, les scripts d'analyse et la correspondance entre chaque nombre rapporté et sa table source sont archivés sur Zenodo, doi:10.5281/zenodo.24090584 (CC BY 4.0).
Appendice A. Modèles et modes d'accès
Tableau A1. Collections et modes d'accès, par vague.
| Collection | Dates | Modèles | Accès |
|---|---|---|---|
| Juillet milieu de gamme | 24 à 28 juillet 2026 | claude-haiku-4-5, gpt-5-mini, gemini-3.6-flash, grok-4-fast, deepseek-chat, qwen-plus, kimi-k3, glm-4.5, mistral-small | API directe |
| Juillet local | 24 à 28 juillet 2026 | sept modèles locaux de poids ouvert | Inférence locale |
| Août navires amiraux | 3 à 6 août 2026 | claude-fable-5, gpt-5.6-sol, mistral-medium-3.5 | Client du fournisseur ; gpt-5.6-sol au paramètre d'effort par défaut du client, 14 des 1 500 enregistrements par secours API |
| glm-5.2 | Point d'accès du fournisseur | ||
| deepseek-v4-pro, grok-4.5, kimi-k3, qwen-max | API directe | ||
| gemini-3.1-pro, ernie-4.5-vl-424b, muse-spark-1.1 | API directe ou itinéraire d'agrégateur épinglé au fournisseur ; muse-spark-1.1 partiel (251 réponses) | ||
| Bras variance | 6 août 2026 | Neuf navires amiraux, pas de Claude | gpt-5.6-sol par API directe, effort aucun ; mistral-medium-3.5 via son client du fournisseur, qui enregistre la température demandée ; autres comme dans la vague d'août ; température 0,7, trois échantillons |
| Frais, août | 6 août 2026 | gpt-5.6-sol (effort aucun), claude-fable-5, deepseek-v4-pro, kimi-k3 | gpt-5.6-sol et deepseek-v4-pro par API directe, claude-fable-5 par client du fournisseur, kimi-k3 par itinéraire d'agrégateur |
| Faits produits | 15 août 2026 | Six modèles, 15 paires ; quatre sans possibilité de recherche, 6 paires | Mixte ; gpt-5.4 et grok via des clients |
| Octobre | 26 et 27 octobre 2026 | gpt-6.1-sol, gpt-6-astra, gpt-6-sol | Client Codex, effort moyen, pas de drapeau de recherche, flux d'événements non conservé |
| claude-opus-5-5, claude-fable-5-1 | Client Claude, outils non autorisés | ||
| kimi-k3, gemini-3.8-flash (frais seulement) | Clients des fournisseurs, outils non désactivés |
Dans la vague d'août, 19 réponses du bras claude-fable-5 ont été servies par d'autres modèles Claude. Les 34 des 37 de la vague sur les 106 n'en dépendent pas (Chernets, 2026a).
Annexe B. Paires sur les 503 questions communes
Tableau A2. Toutes les paires de laboratoires différents, premier membre publié, 503 questions communes.
| Paire | Couverture | VPP (K/O) | Delta, points [95%] | Erreurs détectées |
|---|---|---|---|---|
| gpt-6.1-sol + opus-5-5 | 59,8% | 95,6% (285/298) | +1,5 [-0,2, +3,3] | 16/29 |
| gpt-6.1-sol + fable-5-1 | 60,8% | 97,0% (294/303) | +2,9 [+1,1, +4,8] | 20/29 |
| gpt-6-astra + opus-5-5 | 58,3% | 94,8% (275/290) | +2,5 [+0,5, +4,7] | 23/38 |
| gpt-6-astra + fable-5-1 | 61,4% | 95,4% (291/305) | +3,1 [+1,1, +5,3] | 24/38 |
| gpt-6-sol + opus-5-5 | 61,6% | 95,4% (291/305) | -0,7 [-1,9, +0,6] | 5/19 |
| gpt-6-sol + fable-5-1 | 62,8% | 97,1% (301/310) | +1,0 [-0,4, +2,5] | 10/19 |
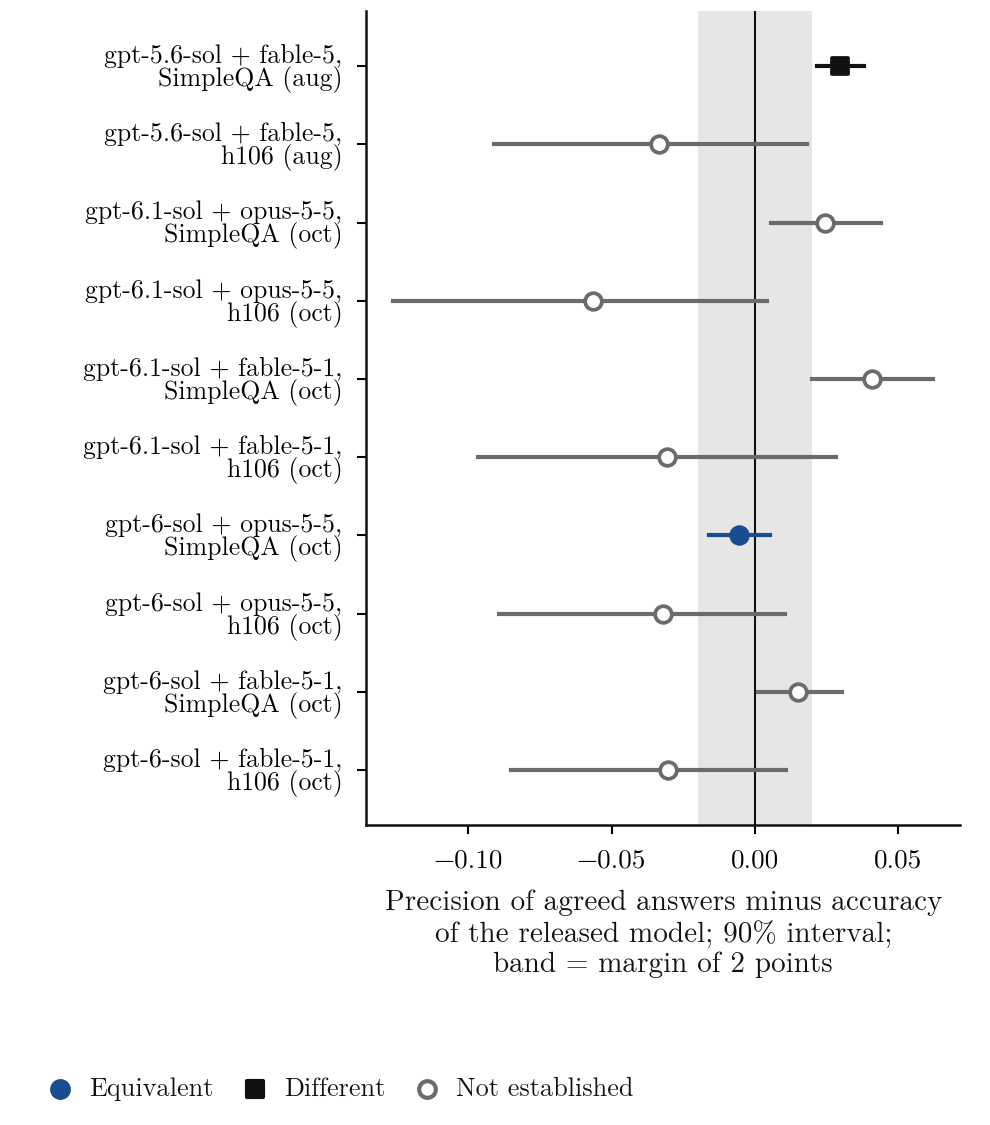
Figure A1. Test d'équivalence de la précision des paires par rapport au modèle publié. Note : amorçage de 90 % des questions, marge de 2 points en surbrillance. Paires avec un bras client Codex publié.
Appendix C. Correspondance verbatim avec la chaîne de référence
La correspondance verbatim présente une corrélation de rang parfaite avec la précision SimpleQA sur les neuf modèles disposant à la fois d'une mesure SimpleQA et d'une mesure nouvelle, puisqu'une réponse correcte est souvent la chaîne de référence. Sa corrélation avec l'écart SimpleQA moins nouveau est de +0,47 (permutation exacte p = 0,21, n = 9), ou +0,29 (p = 0,50) sans gpt-5.6-sol, dont les deux précisions proviennent de modes d'accès différents (Figure A2). Restreinte aux réponses correctes, elle est de +0,10 (p = 0,81). Parmi les réponses correctes, le taux est de 65,7 % pour gpt-5.6-sol, 66,4 % pour fable-5, 68,6 % pour deepseek-v4-pro et 64,9 % pour kimi-k3. Le résidu du modèle n'en dépend pas, avec une pente de +0,064 [-0,072, +0,167] sur 112 cellules phares. L'écart lui-même est proche de zéro ou négatif pour la plupart des modèles, à -3,0 points pour fable-5, -20,5 pour deepseek-v4-pro, -5,4 pour opus-5-5 et -7,8 pour fable-5-1, et il est important seulement pour gpt-5.6-sol (+62,4), où le mode d'accès diffère entre les deux mesures.
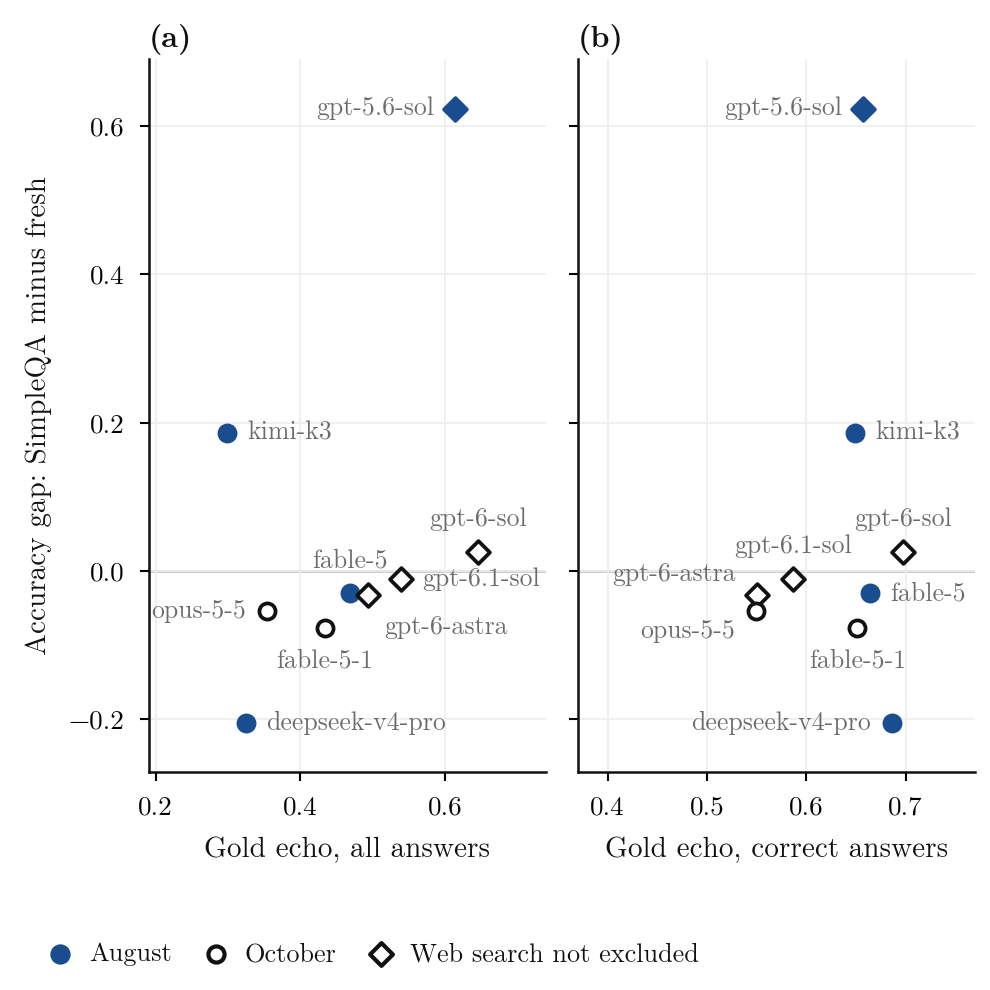
Figure A2. Correspondance verbatim avec la chaîne de référence par rapport à l'écart de précision. Note : (a) toutes les réponses, (b) réponses correctes uniquement. Bleu rempli, vague d'août ; vide, vague d'octobre. Les losanges marquent les bras pour lesquels la recherche web n'est pas exclue.
Annexe D. Sensibilité du correcteur
Le moteur normalise la casse, les articles et la ponctuation, accepte les correspondances exactes et l'inclusion de chaînes de quatre caractères ou plus, compare les dates, les nombres et les identifiants alphanumériques selon les règles, et compare autrement les mots de contenu ; une réponse qu'il ne peut pas trancher par rapport à la référence reste non résolue. Dans le tableau A3, la première partie de chaque réponse, sans parenthèses ni explication supplémentaire, est utilisée à la fois pour la correspondance et la notation, ainsi le nombre ouvert change aussi.
Tableau A3. Notation de la réponse complète par rapport à la notation de sa première partie. Le premier membre est publié.
| Paire, ensemble | VPP, réponse complète | VPP, première partie |
|---|---|---|
| gpt-5.6-sol + fable-5, tous, août | 997/1016 | 997/1019 |
| gpt-6.1-sol + opus-5-5, 106, octobre | 31/35 | 30/34 |
| gpt-6.1-sol + fable-5-1, 106, octobre | 31/34 | 31/35 |
| gpt-6-astra + opus-5-5, 106, October | 28/35 | 32/36 |
| gpt-6.1-sol + opus-5-5, strat, octobre | 183/190 | 189/195 |
| gpt-6.1-sol + fable-5-1, strat, octobre | 187/191 | 198/201 |
| gpt-6.1-sol + opus-5-5, fresh, octobre | 72/74 | 72/74 |
Appendice E. Travaux connexes supplémentaires
Des prépublications récentes pointent dans deux directions. Du côté sceptique, Denisov-Blanch et al. (2026) constatent que l'agrégation de style sondage sur cinq repères de référence et modèles ne produit aucun gain de précision cohérent à 25 fois le coût d'inférence, car les erreurs sont corrélées. Ding (2026) contrôle 265 000 échantillons sur GPQA Diamond et AIME et constate que l'accord est un prédicteur positif mais faible (Spearman 0,20 à 0,59), avec 48 % des entrées GPQA à accord élevé du modèle frontalier le plus cohérent étant erronées. Dans une vérification exploratoire sur 46 éléments, les taux de même mauvaise réponse entre gpt-4.1 et les niveaux Claude dépassent une valeur nulle préservant la marge pour deux des trois niveaux. Kohli (2026) constate que neuf juges frontaliers sur trois ensembles de données d'inférence comportent environ deux votes indépendants, et que le meilleur juge unique égale ou surpasse le groupe. Kim (2026) contrôle 31 900 sous-ensembles de 30 modèles sur MMLU-Pro : le vote surpasse le membre le plus fort dans 9,98 % des sous-ensembles de taille 3, et une mesure de diversité stricte est presque colinéaire avec un moins la précision moyenne (Spearman +0,991). Hossain et al. (2026) constatent une corrélation d'erreur appariée moyenne de 0,21 sur dix juges, qui comportent environ autant d'information que 3,5 juges indépendants, avec une dépendance plus forte parmi les juges frontaliers de différents fournisseurs. Chen (2026) montre que toute politique qui produit la réponse d'un membre ne peut pas dépasser un moins le taux auquel tous les modèles se trompent ensemble, et constate que vaut 0,052 sur les mathématiques en réponse libre sur 67 modèles contre 0,023 selon une copule gaussienne, et 0,127 sur GPQA-Diamond en réponse libre. De l'autre côté, Naik (2024) rapporte que la précision passe de 73,1 % à 93,9 % avec deux modèles et à 95,6 % avec trois sur 78 cas au format à choix multiples, et Liu (2026) montre qu'un groupe de quatre modèles sélectionne les réponses mieux que l'auto-cohérence sur sept repères de référence, avec une loi en forme fermée dans la précision du membre, la corrélation d'erreur et un taux de malentendu partagé qui prédisent la précision du consensus avec une erreur absolue moyenne de 0,028. Xue et al. (2026) rapportent que la cohérence intermodèles avec un vérificateur améliore le plafond de l'auto-cohérence pour la détection d'hallucination sur les repères de référence QA, et Tan et al. (2025) que les erreurs auto-cohérentes ne rétrécissent pas avec l'échelle du modèle, tendent à être spécifiques au modèle, et sont mieux détectées avec un deuxième modèle. Han (2026) donne une théorie des portes de vérification en série dans laquelle une masse de point aveugle plafonne la fiabilité et nomme la décorrélation, en changeant la famille de modèles, la modalité ou la source d'évidence, comme le levier pratique. Deux des travaux de la section 2 contiennent des détails qui portent sur la porte. Goel et al. (2025) définissent CAPA de sorte que des options erronées distinctes comptent comme un désaccord, et en plus de la tendance avec la capacité, ils montrent que neuf juges d'IA générative en accès ouvert notent les modèles plus similaires à eux-mêmes plus haut, et que les gains faibles vers fort sont plus importants sur les tâches où le superviseur et l'étudiant font des erreurs moins similaires (12 paires de modèles). Kolawole et al. (2025) énoncent une condition de déférence sécurisée sur le taux conjoint d'erreurs acceptées sur la distribution de test, avec un seuil estimé sur un petit ensemble de validation. Une condition sur le taux conjoint permet aux erreurs acceptées de se concentrer sur une strate, et la section 5.1 trouve une telle strate : sur les 106, les groupes de niveaux intermédiaires certifient l'erreur, tout comme les paires de navire amiral sans le bras à la plus haute précision.
Aucun de ces travaux ne rapporte, comme noté à la section 2, la porte de publication au niveau des paires, le rappel à couverture égale avec un modèle libéré maintenu fixe, ou un identifiant mesuré en deux modes d'accès.
Appendice F. Données et détails du protocole
Collections. Le protocole est celui de la section 3, et les collections suivent intégralement. Le tableau A1 énumère les modèles, les dates et les modes d'accès.
- Milieu juillet (24 à 28 juillet). Neuf modèles API et sept modèles locaux sur 1 500 questions SimpleQA (Wei et al., 2024), un sous-échantillon aléatoire fixe des 4 326 questions de l'ensemble de référence. La collection a été enregistrée sur OSF avant la collecte de données (Chernets, 2026a).
- Modèles phares d'août (3 à 6 août). Un modèle phare de chacun des onze laboratoires sur les mêmes 1 500 questions, dont 1 459 forment le groupe commun.
- Bras de variance (6 août). Neuf des modèles phares sur 100 de ces questions, 20 par quintile, à une température de 0,7 avec trois échantillons par question.
- Nouvelles questions (6 août et 26 octobre). 100 questions à deux bonds composées par machine à partir de Wikidata selon huit modèles, avec le hash du fichier fixé avant le premier appel au modèle.
- Faits de produits (15 août). 267 questions sur des produits commerciaux, également composées à partir de Wikidata, sur six modèles, quatre d'entre eux sans possibilité de recherche.
- Modèles phares d'octobre (26 et 27 octobre). gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 et claude-fable-5-1 sur 300 questions SimpleQA stratifiées par quintile de juillet (60, 120, 120 ; 297 communes à tous les cinq ; « strat » dans les tableaux), les 106 questions ci-dessous et l'ensemble de nouvelles questions, 503 questions communes au total. kimi-k3 et gemini-3.8-flash ont répondu à l'ensemble de nouvelles questions.
Modes d'accès. Les modèles ont été atteints des deux manières décrites à la section 3. gpt-5.6-sol a également fonctionné via API directe dans le bras de variance et sur l'ensemble de nouvelles questions d'août. Les identifiants de modèle et les versions du client sont enregistrés par appel.
Comme les clients définissent les conditions de mesure, je les énonce en détail. La température ne peut pas être définie dans ceux-ci. Le bras Codex d'août a fonctionné selon le paramètre par défaut du client pour l'effort de raisonnement, que l'appel ne définit pas et que les enregistrements ne précisent pas. Les bras Codex d'octobre ont fonctionné avec l'effort défini au niveau moyen dans chaque appel. Les enregistrements du manifeste d'août indiquent zéro demande de recherche Web pour le bras Claude et une liste d'outils vide pour le bras Mistral, et les bras Claude d'octobre ont fonctionné avec les outils désactivés. Les bras Codex ont été lancés sans l'indicateur de recherche, et leurs flux d'événements n'ont pas été conservés, de sorte que le fait qu'ils aient effectué une recherche ne peut pas être déterminé à partir des fichiers. Dans les clients kimi et gemini-3.8-flash, les outils n'ont pas été désactivés et l'invite les interdit.
Appendice G. Le 106 et les niveaux
La figure A3 montre les panneaux et les paires de la section 5.1 sur le 106 et deux paires supplémentaires : fable-5 avec grok-4.5 a raison sur 7 de 28 accords et gemini-3.1-pro avec grok-4.5 sur 8 de 25.
Le 0 de 342 de la section 1 dépend de la façon dont la difficulté est classée. Lorsque les propres réponses de chaque panneau sont exclues du classement de difficulté, le compte devient 78 de 354, et le panneau entre les blocs reste à 0 de 116.
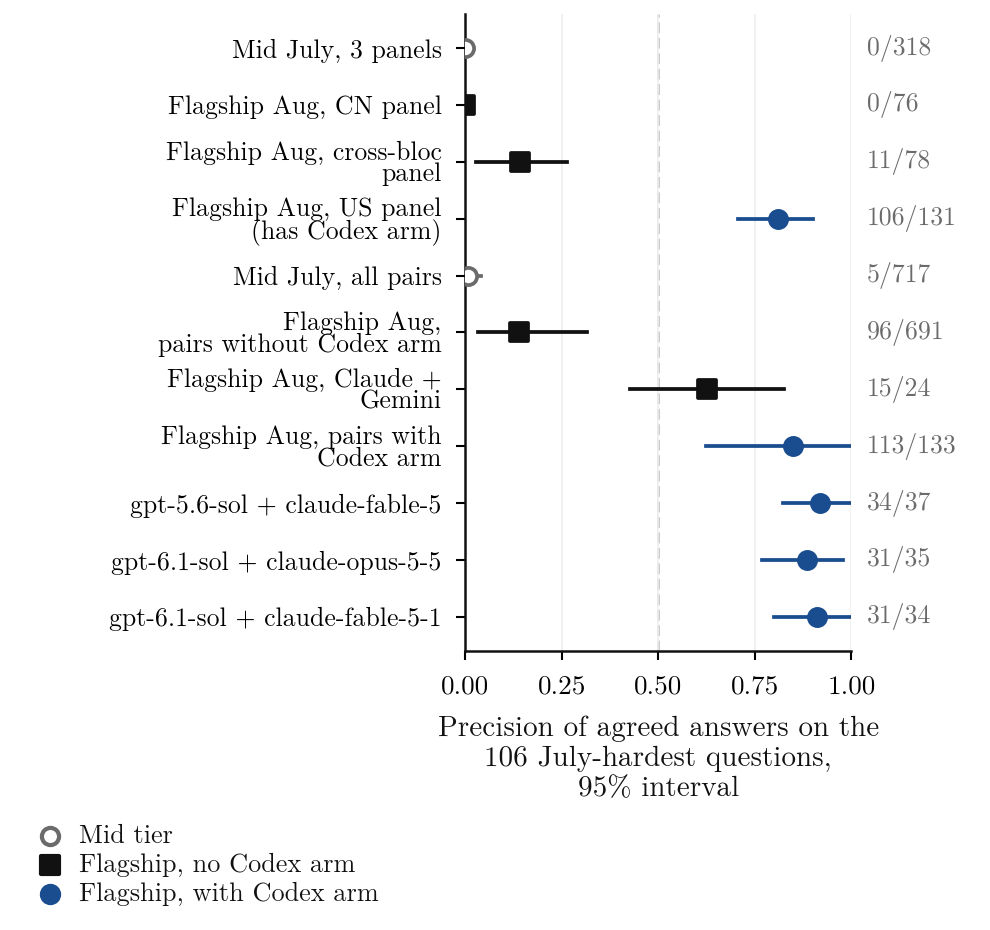
Figure A3. Précision des réponses d'accord sur les 106 questions. Remarque : bootstrap bidirectionnel à 95 % pour les lignes regroupées, bootstrap par question pour les panneaux et les paires uniques. Les lignes bleues contiennent un bras client Codex. Collections d'août et d'octobre.
La figure A4 donne les quintiles de niveau propre de la section 5.1 en totalité. Avec tous les bras, août atteint 26,6 % [6,7, 53,4] dans le quintile le plus difficile, une différence de +9,3 [-18,1, +39,8] par rapport à juillet. Sans kimi-k3, qui appartient aux deux collections, le quintile le plus difficile donne 147 de 675 (21,8 %) en juillet et 192 de 995 (19,3 %) en août, -2,5 points [-29,7, +28,2]. Le test regroupé de la section 5.1 utilise les cinq quintiles, 180 cellules par niveau ; les cellules de niveau intermédiaire se situent à +0,3 points [-2,4, +2,9] et les cellules de pointe à +0,0 [-1,4, +1,6] par rapport au modèle gelé. L'amélioration du quintile le plus difficile est de 1,15 [0,39, 1,90] en juillet et 0,97 [0,42, 1,49] en août. Sur les quintiles, août sans GPT donne 15,5, 52,9, 75,8, 90,5 et 97,3 % et juillet 17,3, 29,0, 60,9, 80,4 et 94,4 %, tandis que la précision du modèle publié s'élève à 16,0, 36,6, 56,8, 73,3 et 88,5 % contre 15,3, 25,0, 40,0, 57,7 et 78,9 %.
La précision reste faible sur les réponses d'or nettoyées. Haas et al. (2025) ont reconstruit SimpleQA en un ensemble nettoyé de 1 000 questions, et 24 des 106 y survivent, contre 24,5 attendues à partir de la part de l'indice de référence conservée, la réponse d'or identique sur 21. Le nettoyage ne supprime pas ces questions plus souvent que d'autres, bien que sa sélection favorise également les questions difficiles. Selon la même statistique et le bootstrap, les paires d'août sans GPT ont raison sur 28 de 150 accords sur ces 24 questions (18,7 % [0,0, 57,1]) et sur 67 de 538 sur les autres 82 (12,5 % [2,8, 28,1] ; le membre le plus précis est publié sur chaque sous-ensemble, donc les parties n'ont pas besoin de totaliser 96 de 691), et les paires de juillet sur 4 de 157 (2,5 % [0,0, 15,2]).
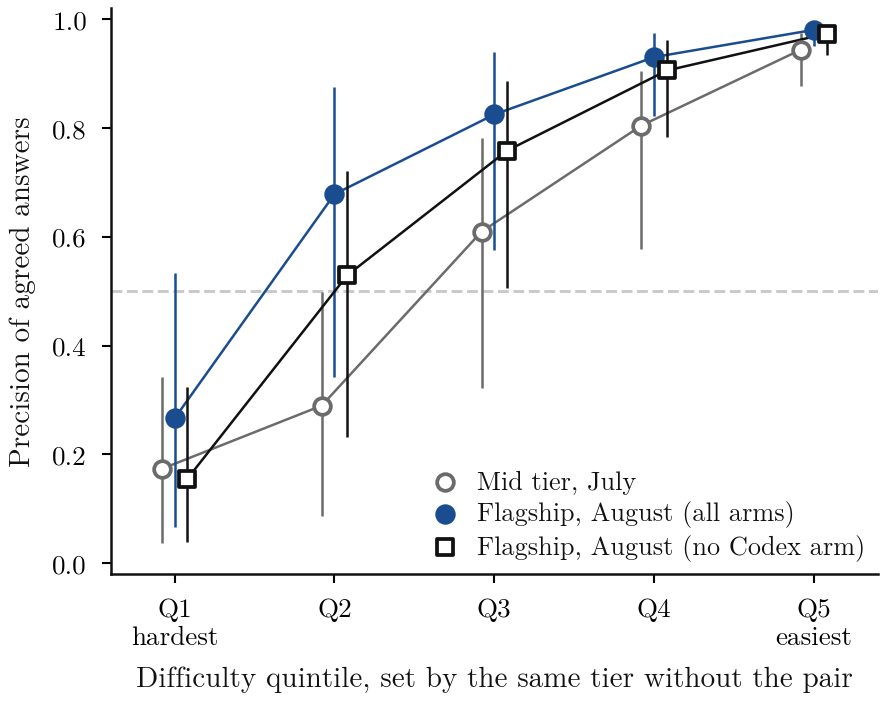
Figure A4. Précision des réponses d'accord par quintile de difficulté de niveau propre. Remarque : bootstrap bidirectionnel à 95 %. La difficulté pour chaque paire est définie par le même niveau sans cette paire. Ligne pointillée à 0,5.
Les paires les plus précises suivent la même relation. La paire kimi-k3 et gemini-3.8-flash atteignent 95,8 % sur l'ensemble frais, avec 23 de 26 erreurs du modèle publié détectées et une amélioration de 5,37 [2,86, 21,36]. Le modèle, compte tenu uniquement de leurs précisions de 0,74 et 0,82, retourne 95,1 %. Et les deux pointes de Claude ensemble, sans possibilité de recherche dans l'un ou l'autre bras, atteignent 47,5 % sur le 106, où la précision du modèle publié est de 30,0 %, et 86,2 % sur les 503 questions. La figure A5 trace chaque bande de chaque niveau par rapport à la précision du modèle publié, avec une précision au-dessus de la diagonale dans 17 de 23 cellules.
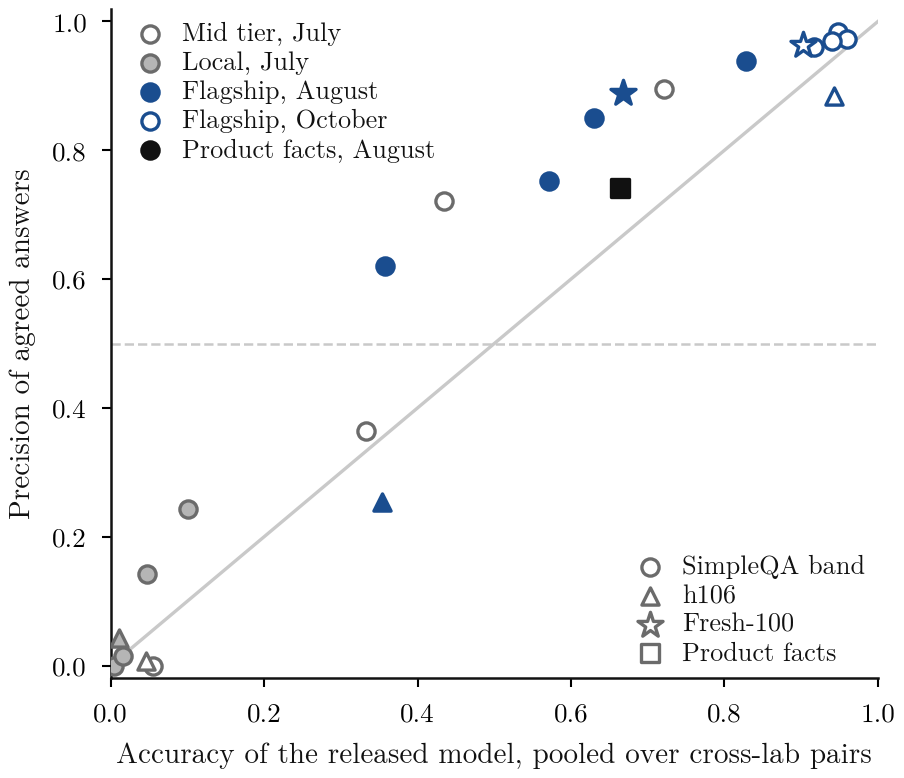
Figure A5. Précision des réponses d'accord par rapport à la précision du modèle publié. Remarque : regroupées sur les paires de différents laboratoires, par niveau et bande. La couleur et le remplissage donnent le niveau, la forme du marqueur l'ensemble. Ligne pointillée à 0,5, ligne continue est l'égalité.
Appendice H. Le deuxième laboratoire en détail
Le bras de variance. Par modèle à couverture égale (Figure 2), la porte à deux laboratoires est en tête pour sept des neuf et à la traîne pour gemini-3.1-pro (-5,7 points) et grok-4.5 (-2,8). Sans GPT, sur huit modèles, l'auto-accord couvre 61,4 % avec une précision de 55,9 % et deux laboratoires 24,4 % avec 83,3 %. La différence de précision est de +27,4 points [+16,0, +35,7] selon les mesures et +7,7 [-1,9, +16,5] à couverture égale, et les erreurs détectées diffèrent de +38,3 points [+26,0, +50,9] selon les mesures et +3,0 [-1,5, +8,4] à couverture égale. Octobre n'a pas d'appels répétés, donc l'auto-accord est mesuré en août uniquement.
Quatre partenaires d'un modèle commercialisé. Le tableau A4 donne les quatre partenaires de la Figure 3a : un modèle commercialisé, gpt-6.1-sol, donc les 29 erreurs en jeu sont les mêmes dans chaque ligne.
Tableau A4. Un modèle commercialisé, quatre partenaires : gpt-6.1-sol sur 503 questions communes (29 erreurs parmi 495 résolues, rééchantillonnage de questions à 95 %).
| Partenaire | Laboratoire | Couverture [95 %] | VPP (K/O) | Delta, points [95 %] | Erreurs détectées [95 %] |
|---|---|---|---|---|---|
| gpt-6-astra | même | 96,2 % [94,4, 97,8] | 94,3 % (449/476) | +0,2 [-0,2, +0,8] | 2/29 = 6,9 % [0,0, 17,4] |
| gpt-6-sol | même | 95,6 % [93,6, 97,2] | 96,2 % (457/475) | +2,1 [+0,9, +3,4] | 11/29 = 37,9 % [20,7, 56,5] |
| claude-opus-5-5 | différent | 59,8 % [55,9, 64,0] | 95,6 % (285/298) | +1,5 [-0,2, +3,3] | 16/29 = 55,2 % [36,4, 73,0] |
| claude-fable-5-1 | différent | 60,8 % [56,7, 65,0] | 97,0 % (294/303) | +2,9 [+1,1, +4,8] | 20/29 = 69,0 % [50,0, 85,2] |
L'autre partenaire du même laboratoire, gpt-6-sol, détecte 11 des 29, ce qui représente -31,0 points [-50,0, -10,7] par rapport à fable-5-1 et -17,2 [-37,0, +3,0] par rapport à opus-5-5. La paire Claude, sans possibilité de recherche dans aucun bras, couvre 60,6 % et détecte 140 des 181 erreurs de fable-5-1 avec une précision de 86,2 % et un Delta de +23,5 points [+19,6, +27,2]. Deux modèles d'un même laboratoire, tous deux loin du plafond, peuvent donc diverger assez souvent pour détecter la plupart des erreurs.
Le tableau A5 teste si cela représente plus qu'un déplacement le long de la courbe de couverture, et si cela nécessite GPT. Chaque ligne conserve un modèle commercialisé et compare son partenaire du même laboratoire avec un partenaire d'un autre laboratoire, d'abord selon les mesures puis à couverture égale, atteinte en affinant la porte plus large par confiance (Section 3).
Tableau A5. Erreurs détectées avec un partenaire du même laboratoire et avec un partenaire d'un autre laboratoire. Les différences sont même moins autre, en points, avec un rééchantillonnage de questions à 95 %, donc négatif favorise l'autre laboratoire ; les différences selon les mesures dans les quatre premières lignes partagent le rééchantillonnage du tableau A4.
| Commercialisé | Partenaire même/autre | Questions | Détectées, selon mesures | Différence [95 %] | Détectées, couverture égale | Différence [95 %] |
|---|---|---|---|---|---|---|
| gpt-6.1-sol | astra / fable-5-1 | 503 | 2/29, 20/29 | -62,1 [-79,3, -43,8] | 17/29, 20/29 | -10,3 [-35,3, +13,8] |
| gpt-6.1-sol | astra / opus-5-5 | 503 | 2/29, 16/29 | -48,3 [-66,7, -29,6] | 18/29, 16/29 | +6,9 [-17,1, +30,4] |
| gpt-6.1-sol | gpt-6-sol / fable-5-1 | 503 | 11/29, 20/29 | -31,0 [-50,0, -10,7] | 24/29, 20/29 | +13,8 [-6,7, +34,6] |
| gpt-6.1-sol | gpt-6-sol / opus-5-5 | 503 | 11/29, 16/29 | -17,2 [-37,0, +3,0] | 24/29, 16/29 | +27,6 [+3,4, +51,6] |
| fable-5-1 | opus-5-5 / gpt-6.1-sol | 503 | 140/181, 169/181 | -16,0 [-21,7, -10,6] | 140/181, 169/181 | -16,0 [-21,7, -10,6] |
| opus-5-5 | fable-5-1 / gpt-6.1-sol | 503 | 154/195, 177/195 | -11,8 [-17,8, -5,9] | 156/195, 177/195 | -10,8 [-16,7, -5,0] |
| fable-5-1 | opus-5-5 / kimi-k3 | 100 nouveaux | 13/23, 20/23 | -30,4 [-50,0, -12,5] | 17/23, 20/23 | -13,0 [-35,0, +9,1] |
| fable-5-1 | opus-5-5 / gemini-3.8-flash | 100 nouveaux | 13/23, 19/23 | -26,1 [-45,5, -8,7] | 17/23, 19/23 | -8,7 [-29,4, +12,5] |
| opus-5-5 | fable-5-1 / kimi-k3 | 100 nouveaux | 18/28, 23/28 | -17,9 [-38,5, +0,0] | 24/28, 23/28 | +3,6 [-14,7, +22,6] |
| opus-5-5 | fable-5-1 / gemini-3.8-flash | 100 nouveaux | 18/28, 22/28 | -14,3 [-33,3, +4,5] | 22/28, 22/28 | +0,0 [-20,0, +20,7] |
| fable-5-1 | opus-5-5 / gemini-3.1-pro (août) | 344 | 107/130, 110/130 | -2,3 [-9,8, +5,3] | 108/130, 110/130 | -1,5 [-9,1, +5,8] |
| opus-5-5 | fable-5-1 / gemini-3.1-pro (août) | 344 | 118/141, 126/141 | -5,7 [-12,1, +0,8] | 125/141, 126/141 | -0,7 [-6,4, +5,1] |
Les lignes d'août sont la seule comparaison SimpleQA sans GPT, et elles appareillent des modèles de dates différentes. gemini-3.1-pro est le bras d'août le plus proche en précision des modèles Claude sur ces questions (65,4 % par rapport à 60,6 et 57,7 % sur ces questions). Agrégés sur les sept partenaires d'août, dont la plupart sont beaucoup plus faibles, la différence est de -5,1 points [-10,1, -0,3] pour fable-5-1 et -6,0 [-10,6, -1,2] pour opus-5-5 selon les mesures, et elle devient +7,9 [+4,8, +11,2] et +6,8 [+3,6, +10,2] à couverture égale, en faveur du même laboratoire. Les égalités de confiance sont brisées au hasard, et sur 200 tirages la ligne la plus large se déplace entre 0,0 et +20,7 points.
Appendice I. Le modèle hors échantillon en détail
Le tableau A6 présente les erreurs hors échantillon qui sous-tendent la section 5.3. La division temporelle donne 0,019 contre 0,050 pour la référence du meilleur modèle, une différence de -0,031 [-0,074, +0,008] selon le bootstrap bivarié, et l'intervalle se situe en dessous de zéro lorsqu'il est regroupé par question seule ou par modèle seul. Avec 9 et 23 plis, LOLO et LOMO donnent la même erreur à trois décimales.
Tableau A6. Erreur absolue moyenne de la VPP prédite, cellules avec au moins 20 réponses ouvertes. Bootstrap bivarié, question par modèle.
| Schéma | Modèle [95 %] | Indép. | Meilleur | Modèle moins meilleur [95 %] | Modèle moins indép. [95 %] |
|---|---|---|---|---|---|
| LOLO | 0,037 [0,033, 0,055] | 0,032 | 0,099 | -0,062 [-0,085, -0,035] | +0,005 [-0,003, +0,012] |
| LOMO | 0,037 [0,033, 0,055] | 0,032 | 0,099 | -0,062 [-0,085, -0,036] | +0,005 [-0,004, +0,012] |
| LOLO, division des questions | 0,054 [0,052, 0,088] | 0,050 | 0,109 | -0,055 [-0,075, -0,027] | +0,004 [-0,002, +0,010] |
| Juillet et août à octobre | 0,019 [0,008, 0,041] | 0,023 | 0,050 | -0,031 [-0,074, +0,008] | -0,004 [-0,011, +0,005] |
| Gamme intermédiaire aux modèles phares | 0,030 [0,025, 0,053] | 0,031 | 0,087 | -0,057 [-0,087, -0,022] | -0,001 [-0,009, +0,005] |
| LOLO, modèles phares, sans bras de recherche possible | 0,037 [0,029, 0,071] | 0,038 | 0,120 | -0,083 [-0,125, -0,039] | -0,000 [-0,017, +0,014] |
| Non inclus : ERNIE et Muse, août | 0,019 [0,015, 0,055] | 0,033 | 0,128 | -0,110 [-0,143, -0,032] | -0,014 [-0,031, +0,007] |
| Non inclus : 7 modèles locaux, juillet | 0,037 [0,018, 0,072] | 0,068 | 0,077 | -0,040 [-0,061, -0,015] | -0,031 [-0,041, -0,014] |
| Non inclus : même laboratoire, octobre | 0,038 [0,017, 0,083] | 0,043 | 0,041 | -0,003 [-0,130, +0,045] | -0,006 [-0,025, -0,001] |
| Non inclus : données de produits | 0,130 [0,077, 0,187] | 0,149 | 0,086 | +0,045 [-0,051, +0,143] | -0,019 [-0,021, -0,012] |
Le gain pratique par rapport à la lecture du meilleur modèle est important, y compris le transfert de la gamme intermédiaire aux modèles phares et deux des quatre ensembles qui n'ont pas participé à l'ajustement (figure A6). Le multiplicateur n'ajoute rien à la précision dans les schémas principaux, et le travail est effectué par les précisions mesurées et par . L'élimination de augmente entièrement l'erreur LOLO à 0,323, et la maintenir constante donne 0,046. Sur la couverture et la perte logarithmique, aide : sous LOLO, les différences par rapport aux erreurs indépendantes sont -0,0079 [-0,0111, -0,0020] et -0,0024 [-0,0045, -0,0003]. Sur trois des quatre ensembles non inclus, l'intervalle par rapport aux erreurs indépendantes se situe en dessous de zéro, avec les constantes figées. Le terme d'erreur conjointe importe donc pour la couverture, tandis que la précision repose sur les précisions mesurées et .
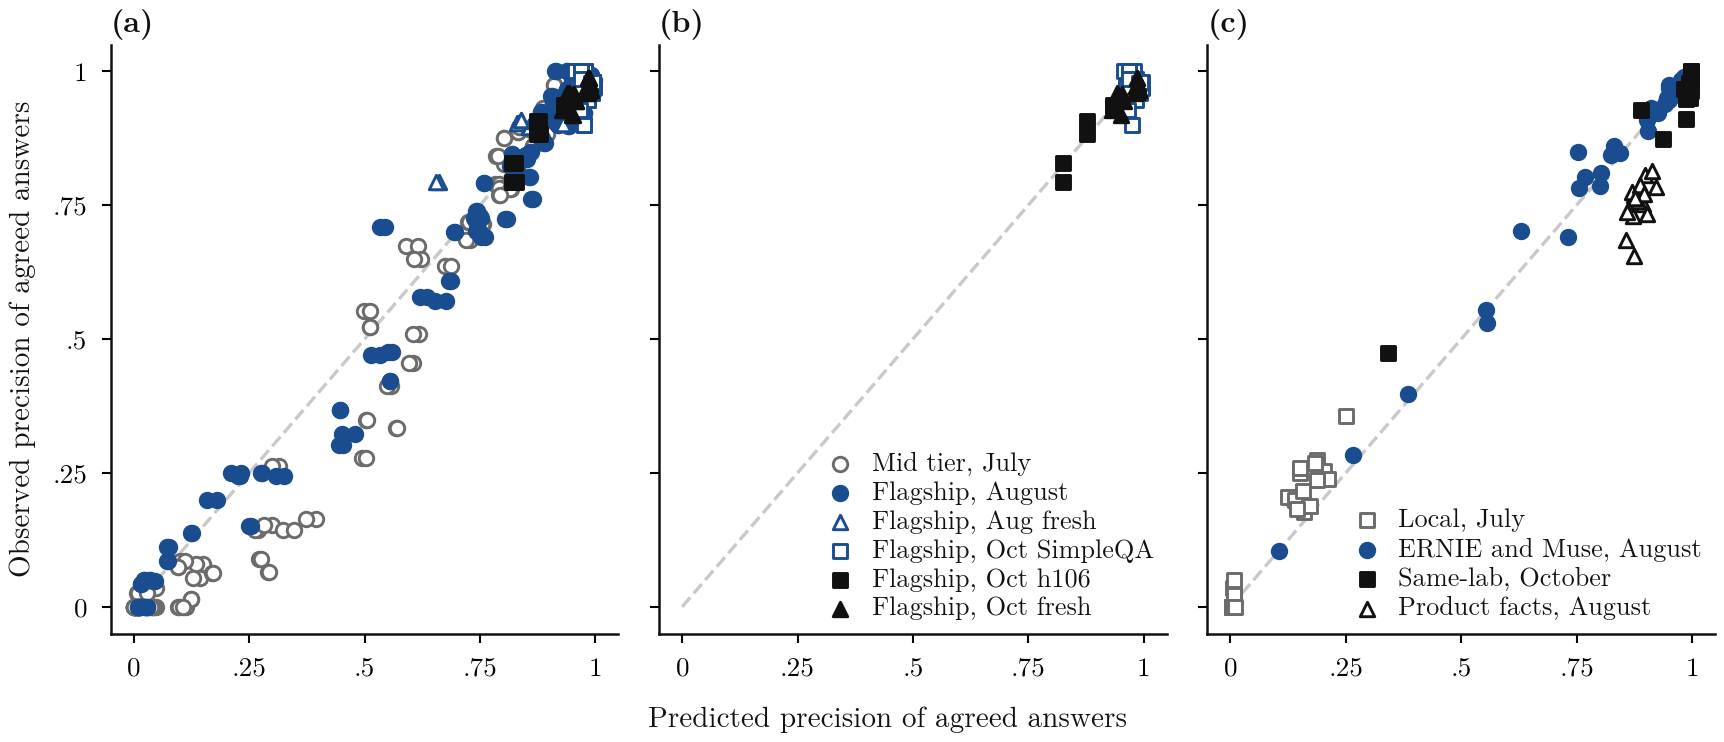
Figure A6. Précision prédite par rapport à celle observée des réponses concordantes. Note : (a) laisser sortir un laboratoire. (b) Ajuster sur juillet et août et prédire octobre. (c) Ensembles en dehors de l'ajustement, constantes figées. La ligne en pointillés est l'égalité.
Sur les données de produits, le modèle s'exécute haut. L'erreur est 0,130 contre 0,086 pour le meilleur modèle, avec une surestimation moyenne de 13 points. Avec l'évaluateur natif de ce domaine, la surestimation monte à 19 points (0,190 contre 0,067). Les données de produits se situent en dehors du domaine sur lequel les constantes ont été ajustées.
En triant les cellules en trois classes de résultats (inversée à VPP en dessous de 0,5, aucun gain à Delta jusqu'à +2 points, gain au-delà), la division temporelle correspond à 28 des 39 cellules, et neuf des erreurs prédisent aucun gain là où le gain a été observé. Le modèle est fiable pour la taille de la précision et plus faible pour trier les cellules de part et d'autre de la ligne +2 points.
Annexe J. Modes d'accès et les bras GPT en détail
Même identifiant, mêmes questions. Sur un ensemble de 100 questions SimpleQA, gpt-5.6-sol obtient un score de 92 sur 100 (92,0 %) dans la vague principale, où 99 des 100 enregistrements proviennent du client Codex et une mauvaise réponse via un repli API, et 139 des 300 échantillons (46,3 %) via l'API directe dans le bras de variance, un écart de 45,7 points (Figure 5). Sur les 99 enregistrements du client seuls, les chiffres sont 92 sur 99 (92,9 %) et 139 sur 297 (46,8 %), un écart de 46,1 points. La reproduction textuelle de la chaîne de référence diminue avec lui, de 64,0 % à 26,0 %. Les conditions diffèrent comme suit : le client s'exécute avec son paramètre d'effort par défaut selon ses propres instructions, la température n'étant pas configurable, tandis que l'API s'exécute avec un effort nul et une température de 0,7.
Sur les deux colonnes, les huit autres modèles du bras, dont la température change également, se déplacent d'au maximum 4,0 points de chaque côté. L'effort est un candidat pour gpt-5.6-sol, bien qu'une mesure d'effort de raisonnement appariée sur gemini-3.1-pro ait laissé la précision pratiquement inchangée (Chernets, 2026c). La recherche web est l'autre. Les réponses d'octobre du même client contiennent des liens que l'invite ne demande pas, dans 3 des 506 réponses de gpt-6.1-sol et dans 18 des 506 de gpt-6-astra, dont un véritable identifiant MusicBrainz. L'utilisation médiane de jetons par appel client en août est de 4 829, avec 36,4 % des appels au-dessus de 6 000. Ces jetons peuvent provenir du raisonnement ou de la recherche, et le flux d'événements qui les séparerait n'a pas été conservé.
Un harnais d'évaluation et une personne utilisant le produit peuvent ainsi voir des précisions écartées de 45,7 points sur un identifiant et un ensemble de questions, et une étude du « modèle » doit indiquer lequel elle a mesuré. À l'intérieur de la vague d'août, le bras client obtient 1 392 sur 1 457 (95,5 %), et les 14 enregistrements servis par API après une défaillance du client en obtiennent 11 (78,6 %), sur des questions sélectionnées par cette défaillance. Sur l'ensemble nouveau, gpt-5.6-sol via l'API obtient 33 sur 100, où fable-5 obtient 76, tandis que gpt-6.1-sol via le client obtient 95 en octobre. Et le modèle de la section 4 conserve sa forme selon cette question, car il prend les précisions mesurées en entrée : sur les navires amiraux sans bras où la recherche web est possible, son erreur LOLO est de 0,037 contre 0,120 pour le meilleur modèle.
Valeur de porte selon le mode d'accès. Sur des questions nouvelles en août, avec GPT via l'API, la paire gpt-5.6-sol et fable-5 a raison sur 29 des 32 accords, Delta +57,6 points [+46,3, +69,7], capturant 64 des 67 erreurs, et les erreurs confiantes du bras GPT passent de 61 sur 91 à 2 sur 29. En octobre, avec un GPT plus récent via le client sur les mêmes questions, la paire avec opus-5-5 a raison sur 72 des 74, et la paire avec fable-5-1 sur 76 des 78, avec un Delta de +2,3 [-0,7, +6,0] et +2,4 [-0,5, +6,3] et 3 des 5 erreurs capturées. La valeur de porte ici suit la précision du bras publié, comme dans la section 5.1.
Bras client sur SimpleQA. Le tableau A7 rapporte les bras mis de côté dans la section 5.1. En août, la paire gpt-5.6-sol et fable-5 a raison sur 997 des 1 016 accords (98,1 %) contre 95,4 % seule, Delta +2,8 points [+1,9, +3,7], avec le plancher à 15 sur 1 459. Sur les 106, elle obtient 34 sur 37 (91,9 %), et toutes les paires avec le bras GPT obtiennent 113 sur 133 (85,0 % [62,2, 100,0]), contre 96 sur 691 sans lui. Le bras seul a raison sur 100 sur 105. Ces accords héritent de cette précision : le Delta sur les 106 est de -3,3 points [-10,3, +2,6] en août et -5,7 [-13,7, +1,2] avec opus-5-5 en octobre. En contraste, la paire de milieu de gamme des mêmes deux fournisseurs, gpt-5-mini et claude-haiku-4-5, a raison sur 45 des 123 accords (36,6 % [28,6, 45,4]) globalement et 0 des 13 sur les 106, avec son premier membre à 163 sur 1 435.
Tableau A7. Paires de bras client. Le premier membre est publié. Intervalle de Wilson sur VPP, amorçage de questions sur Delta.
| Paire, ensemble | Couverture | VPP (K/O) [95 %] | Publié seul | Delta, points [95 %] | Erreurs capturées |
|---|---|---|---|---|---|
| gpt-5.6-sol + fable-5, tous SimpleQA, août | 1028/1500 | 98,1 % (997/1016) [97,1, 98,8] | 1403/1471 | +2,8 [+1,9, +3,7] | 49/68 |
| gpt-5.6-sol + fable-5, 106, août | 37/106 | 91,9 % (34/37) [78,7, 97,2] | 100/105 | -3,3 [-10,3, +2,6] | 2/5 |
| gpt-6.1-sol + opus-5-5, strat, octobre | 192/300 | 96,3 % (183/190) [92,6, 98,2] | 276/294 | +2,4 [+0,2, +4,9] | 11/18 |
| gpt-6.1-sol + fable-5-1, strat, octobre | 193/297 | 97,9 % (187/191) [94,7, 99,2] | 273/291 | +4,1 [+1,6, +6,7] | 14/18 |
| gpt-6.1-sol + opus-5-5, 106, octobre | 36/106 | 88,6 % (31/35) [74,0, 95,5] | 98/104 | -5,7 [-13,7, +1,2] | 2/6 |
| gpt-6.1-sol + fable-5-1, 106, octobre | 35/106 | 91,2 % (31/34) [77,0, 97,0] | 98/104 | -3,1 [-10,9, +3,5] | 3/6 |
| gpt-6.1-sol + opus-5-5, nouveau, octobre | 74/100 | 97,3 % (72/74) [90,7, 99,3] | 95/100 | +2,3 [-0,7, +6,0] | 3/5 |
| gpt-6.1-sol + fable-5-1, nouveau, octobre | 78/100 | 97,4 % (76/78) [91,1, 99,3] | 95/100 | +2,4 [-0,5, +6,3] | 3/5 |
Valeur de porte près du plafond. Sur des questions familières, la paire ajoute toujours un peu (Figure A1). En août sur SimpleQA sans les 106, son Delta est +3,0 points [+2,0, +4,0], une différence en faveur de la paire. En octobre, les paires strat se situent au-dessus de zéro, à +2,4 [+0,2, +4,9] et +4,1 [+1,6, +6,7], et en deçà d'une décision contre la marge. L'équivalence unique est gpt-6-sol avec opus-5-5 à -0,6 (intervalle à 90 % -1,6 à +0,5, p = 0,020), qui ne survit pas à la correction de Holm (0,277). Sur les 106, chaque paire avec gpt-6.1-sol et gpt-5.6-sol est indécise avec une direction vers le bas. En dehors de ce bras, l'effet est important : sur le même ensemble d'août, fable-5 avec gemini-3.1-pro est à +19,3 points et fable-5 avec grok-4.5 à +18,0.
La confiance propre du bras est un concurrent dans cette plage. Amincie par sa propre confiance à la couverture de la paire avec opus-5-5, gpt-6.1-sol est à 34 à 36 sur 36 sur les 106, selon la façon dont les égalités sont tranchées, contre 31 sur 35 pour la paire, et 74 sur 74 sur nouveau contre 72 sur 74. Sur strat, la paire est en avance, de +1,6 points [-1,4, +4,7] avec opus-5-5 et de +3,2 [+0,6, +6,2] avec fable-5-1.
Quel GPT et quel partenaire. Sur les questions communes que les deux modèles résolvent, gpt-6.1-sol surpasse gpt-6-astra 10 à 1 sur les paires discordantes (p = 0,012, +1,83 points [+0,61, +3,26]), et gpt-6-sol surpasse gpt-6-astra 21 à 5 (p = 0,002, +3,29 [+1,23, +5,34]). gpt-6.1-sol contre gpt-6-sol s'établit à 5 à 12 (p = 0,143). opus-5-5 contre fable-5-1 s'établit à 29 à 44 (p = 0,101, -3,12 [-6,65, +0,21]). Les paires des deux GPT les plus puissants avec les deux Claude se situent entre 95,4 et 97,1 % sur 503 questions (Tableau A2), avec fable-5-1 capturant davantage d'erreurs dans chaque comparaison. Et kimi-k3 avec gemini-3.8-flash, la paire sans GPT, n'est pas distinguable d'eux sur l'ensemble nouveau : sa différence par rapport à gpt-6.1-sol avec opus-5-5 est de -1,5 points [-6,3, +2,8] en précision et -2,0 [-10,0, +6,0] en couverture.
Annexe K. Données externes en détail
La vérification externe de la section 5.5 utilise les constantes gelées sans réajustement. HELM Lite (Liang et al., 2023) contient les réponses courtes ouvertes de 95 modèles provenant de 20 développeurs, publiés entre 2023 et 2025, à 1 000 questions fermées NaturalQuestions, évaluées ici par mon moteur. LiveBench (White et al., 2025) contient les réponses de 70 modèles provenant de 11 laboratoires à 346 questions avec une réponse finale courte, évaluées par rapport à sa vérité de référence. Kim et al. (2025) publient des agrégats de paires pour 70 modèles sur le MMLU à choix multiple, qui donnent la précision observée comme le taux de fois où les deux sont corrects sur le taux d'accord. Le tableau A8 donne le résultat. Les exactitudes du tableau 7 de Haas et al. (2025) ne comportent aucun résultat d'accord, donc elles donnent des prédictions et pas de test.
Tableau A8. Le modèle gelé sur d'autres modèles et questions. Erreur absolue moyenne de PPV prédite pour les paires de laboratoires différents, cellules avec au moins 20 réponses ouvertes dans les deux premières sources. Bootstrap bidirectionnel, par modèle uniquement pour MMLU. Le décalage est prédit moins observé.
| Source | Cellules | Modèle [95%] | Indép. | Meilleur | Modèle moins meilleur [95%] | Modèle moins indép. [95%] | Décalage |
|---|---|---|---|---|---|---|---|
| HELM, NaturalQuestions | 4,088 | 0.069 [0.054, 0.087] | 0.070 | 0.208 | -0.139 [-0.171, -0.103] | -0.001 [-0.008, +0.006] | +0.053 |
| LiveBench, quatre tâches | 952 | 0.114 [0.101, 0.150] | 0.107 | 0.198 | -0.084 [-0.121, -0.026] | +0.007 [-0.006, +0.022] | +0.056 |
| LiveBench, math_comp | 431 | 0.075 | 0.096 | 0.279 | -0.034 | ||
| LiveBench, zebra_puzzle | 203 | 0.231 | 0.184 | 0.076 | +0.230 | ||
| LiveBench, spatial | 161 | 0.148 | 0.114 | 0.167 | +0.148 | ||
| LiveBench, web_of_lies_v2 | 157 | 0.036 | 0.031 | 0.166 | -0.017 | ||
| Kim et al., MMLU (agrégats) | 2,189 | 0.066 [0.060, 0.072] | 0.084 | 0.084 | -0.018 [-0.028, -0.010] | -0.018 [-0.019, -0.017] | +0.066 |
Comme à la section 5.3, le modèle surpasse la simple lecture du meilleur modèle dans les trois sources prises dans leur ensemble, et il échoue sur les énigmes zebra, à 0.231 contre 0.076. Il n'améliore pas les erreurs indépendantes dans HELM ou LiveBench. Il s'élève fortement, de 5,3 à 6,6 points dans l'ensemble. Dans HELM, la courbe observée s'aplatit là où le modèle continue à monter : à la précision d'appariement entre 0,5 et 0,6, la précision est de 74,6 % pour les modèles de 2023 et début 2024 et 75,9 % pour les plus récents, contre 84,4 % prédit au milieu du bac. Sur MMLU, la chance médiane que deux réponses fausses correspondent est de 0,621 contre 0,368 de , puisque quatre options forcent les collisions.
Sur ces modèles, la précision augmente avec la précision d'appariement (Spearman +0,575 dans HELM et +0,786 sur MMLU, sur les cellules dépendantes). Les modèles plus anciens et plus récents ayant une précision similaire donnent une précision similaire entre une précision d'appariement de 0,4 et 0,6 (70,7 et 72,7 %, 74,6 et 75,9 %), et ils diffèrent davantage entre 0,2 et 0,3 (57,6 et 76,1 %). La borne inférieure de la section 4 tient dans les 4 088 cellules HELM. Les paires en dessous d'une demi-unité sont rares, 24 sur 4 088, car ces cellules ne sont pas stratifiées par difficulté.
HELM permet également le test de la section 5.2 avec de nombreux laboratoires et sans dépendance à GPT, car la précision du partenaire peut être appariée sans valeurs de confiance. Avec un modèle publié et des partenaires à moins de 3 points de précision, un partenaire du même laboratoire détecte 72,3 % des erreurs et celui d'un autre laboratoire 75,5 %, une différence de -3,2 points [-4,2, -2,3], avec une couverture supérieure de 2,7 points [+2,1, +3,4]. L'ajout d'une correspondance sur la couverture à moins de 3 points l'élimine : 75,7 contre 75,9 %, -0,2 [-0,6, +0,2], avec une précision de -0,5 [-1,4, +0,1]. Deux réponses fausses correspondent dans 31,6 % des cas au sein d'un laboratoire et 27,0 % entre laboratoires.
Les erreurs partagées se situent également bien au-dessus du hasard dans les collections de la section 3. Selon l'hypothèse nulle de permutation d'étiquettes de Ding (2026), qui conserve les réponses fausses de chaque modèle et les mélange entre les questions, deux réponses fausses qui ne sont pas des refus correspondent dans 14,0 % des cas en juillet et 15,4 % en août sans GPT, contre une hypothèse nulle de 0,1 %. Sur les 106, les taux sont de 25,7 % et 22,8 % contre 0,4 % et 0,5 %, et sur les questions nouvelles 14,5 % en août et 32,7 % en octobre contre 0,8 % et 3,8 %. Les réponses ouvertes entrent rarement en collision par hasard, donc le partage observé dépasse largement cette hypothèse nulle, sur les questions composées après la publication des modèles aussi bien.
Annexe L. Discussion supplémentaire
Relation avec Goel et al. (2025). Leur tendance concerne la similarité ajustée au hasard, et la mienne concerne la précision des réponses convenues, donc les résultats ne sont pas en conflit. Les données le montrent par la part conditionnelle d'erreur partagée, F/W, la probabilité que deux réponses incorrectes soient identiques, sur les questions où les deux réponses sont notées et les refus comptés comme incorrects. Pour les paires de référence, elle passe de 63 sur 1 088 (0,058) pour la paire de milieu de gamme à 15 sur 42 (0,357) pour la paire phare, environ sixfois. Regroupées sur toutes les paires, IA incluse, l'augmentation est plus petite et l'intervalle inclut zéro : 0,097 en juillet et 0,132 en août, une différence de +0,034 [-0,006, +0,084]. Sur l'ensemble stratifié d'octobre, F/W est 0,493 [0,179, 0,840], une différence par rapport à août de +0,361 [+0,041, +0,712]. À couverture égale, bac par bac, le rappel phare est inférieur de 0,7 à 2,5 points, un petit effet, et est 0,140 [0,092, 0,192] contre 0,113 [0,082, 0,146]. La direction s'accorde donc avec la leur, bien que l'intervalle regroupé inclue zéro. La lecture directe de leur avertissement, selon lequel la similarité menace la porte, apparaît bien dans le rappel : les paires clientes d'octobre attrapent 66,3 % des erreurs avec une couverture de 65,3 %, où les 55 paires d'août attrapent 88,2 % avec 32,5 %, un contraste que la couverture explique en partie. La précision reste élevée largement parce que, à ces précisions, la limite de la section 4 lui laisse peu de marge pour baisser.
Relation avec Han (2026). Han désigne la décorrélation comme le levier pratique. Mes mesures placent d'abord la précision et la couverture. À couverture égale avec un modèle publié, l'avantage d'un deuxième laboratoire disparaît à moins que son modèle soit bien plus précis (section 5.2). Dans HELM, avec la précision appariée, un deuxième laboratoire ajoute 3,2 points de rappel pour 2,7 points de couverture, et rien une fois la couverture appariée aussi. La décorrélation est visible là, à 27,0 contre 31,6 % des réponses incorrectes correspondantes, et elle est petite. La théorie de Han concerne la profondeur des portes en série et la mienne une seule porte, donc les deux ne se rencontrent qu'à la première étape. Liu (2026) sépare les deux mêmes choses : la précision de sélection suit la décorrélation, avec les panels multi-modèles en avant du rééchantillonnage de 12,5 à 16,7 points sur AIME-2024 à précision de membre appariée, tandis que l'étalonnage du signal d'accord suit la précision de membre. La précision des réponses convenues mesurée ici est la deuxième de celles-ci.
Les deux côtés de la section 2. Les nombres publiés réconcilient partiellement les deux côtés. Le panel unanime de Liu a raison sur 100,0 % d'AIME-2025 avec une précision de réponse complète de 0,433, et sur 70,2 % de MMLU-Pro à 0,458. Les neuf juges unanimes de Kohli, chacun près de 68 %, ont raison sur 90,9 %. Des précisions similaires donnent une précision 30 points à part, donc la précision seule ne rapproche pas ces résultats. La taille de l'espace de réponse en explique davantage. La probabilité que deux réponses incorrectes correspondent est 0,621 sur MMLU à quatre options, 0,270 sur NaturalQuestions et 0,132 sur SimpleQA pour les IA phares d'août. Ce sont des panels et des paires sur des tâches différentes, sans calcul conjoint entre les articles, et ils sont cohérents avec la précision suivant la précision dans une tâche et un format de réponse.
Familiarité. Un écart entre SimpleQA et la précision nouvelle invite à une explication par l'exposition aux repères, et la correspondance verbatim avec la chaîne de référence ressemble à sa signature. Mes données ne soutiennent pas cela en tant que covariable (annexe C). Parmi les réponses correctes, la correspondance verbatim est proche d'une valeur sur les modèles, et elle n'explique pas le résidu du modèle. F/W sur l'ensemble nouveau en août, 0,145 [0,033, 0,402], ne montre aucune distance visible de 0,132 sur SimpleQA, dans un intervalle large.
Comment citer
Chernets, V. (2026). Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy [Prépublication]. SSRN. https://doi.org/10.2139/ssrn.7682960
@misc{chernets2026agreementinversion,
  author       = {Chernets, Vadym},
  title        = {{Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7682960},
  url          = {https://doi.org/10.2139/ssrn.7682960}
}