समझौता स्वतंत्र साक्ष्य नहीं है: API के बिना ऑडिटेबल मल्टी-मॉडल सिंथेसिस
यह एक अनुवाद है। प्रामाणिक संस्करण मूल अंग्रेज़ी पाठ है; कृपया उसी का हवाला दें।
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7390698 · DOI 10.2139/ssrn.7390698 · Zenodo 10.5281/zenodo.22683716 · GitHub
- रिकॉर्ड का संस्करण: SSRN 7390698 · DOI 10.2139/ssrn.7390698
- संग्रहीत प्रति, उद्धृत और डाउनलोड करने योग्य: 10.5281/zenodo.22683716 — अवधारणा DOI, हमेशा नवीनतम संस्करण को हल करता है
- Markdown और PDF के रूप में पूर्ण पाठ: GitHub
- पठनीय HTML: https://polyhelper.ai/research/agreement-not-evidence/
समान पाठ चार सतहों पर है ताकि जब उनमें से एक इसे प्रदान नहीं कर सके तो इसे पहुँचा जा सके। SSRN रिकॉर्ड का संस्करण रखता है; उसे उद्धृत करें।
कीवर्ड: बड़े भाषा मॉडल; सहसंबद्ध त्रुटियाँ; भीड़ की बुद्धिमत्ता; Condorcet जूरी प्रमेय; एल्गोरिदमिक मोनोकल्चर; बहु-एजेंट बहस; प्रभावी नमूना आकार; डिज़ाइन प्रभाव; पहनावा; प्रमाण। JEL वर्गीकरण: C11; C18; D71; D83; L86; O33
सारांश
जो कोई भी एक भाषा मॉडल से कोई प्रश्न पूछता है, वह आत्मविश्वास से गलत उत्तर को आत्मविश्वास से सही उत्तर से अलग नहीं बता सकता। ये दोनों एक गैर-विशेषज्ञ के लिए उपलब्ध हर सतही संकेत पर समान होते हैं। कई मॉडल से पूछने से यह समस्या हल हो जाती है, लेकिन यह ज्यादातर इसे फिर से स्थापित करता है: कई उत्तरों को सुलझाना फिर से एक आत्मविश्वासी पाठ तैयार करता है, और यह पाठ अब "उनमें से दस सहमत हैं" का उधार अधिकार रखता है।
यहाँ औपचारिक किया गया प्रोटोकॉल उपयोगकर्ता के अपने ब्राउज़र या फ़ोन के माध्यम से कई उपभोक्ता चैट मॉडल से उत्तर एकत्र करता है, कोई API कुंजी नहीं, कोई स्थापना नहीं और कोई मध्यस्थ सर्वर नहीं। यह उन्हें एंकर-और-समृद्ध करके सुलझाता है: सबसे मजबूत उपलब्ध उत्तर आधार बन जाता है, और बाकी के सभी केवल वह योगदान देते हैं जो आधार में कमी है। प्रत्येक योगदान उसे प्रदान करने वाले मॉडल के साथ हस्ताक्षरित होता है। असहमतियों को औसतन दूर करने के बजाय अपने स्वयं के अनुभाग में रखा जाता है।
यह पत्र चार योगदान देता है। पहला प्रोटोकॉल स्वयं है, जो एक एल्गोरिथ्म के रूप में कहा गया है जो प्रमाण संरक्षित करता है और मूक विलोपन को प्रतिबंधित करता है, साथ ही पाँच तरीकों की एक वर्गीकरण है कि एक विलय कैसे विफल हो सकता है। उनमें से चार भोली पूलिंग के दोष हैं; पाँचवाँ विधि के बजाय ऑपरेटर की विफलता है: एक संश्लेषण जो एक एकल मॉडल के आउटपुट को एक सहयोगी परिणाम के रूप में प्रस्तुत करता है। दूसरा प्रोटोकॉल डिज़ाइन पर सहसंबंधित-गवाह अंकगणित का अनुप्रयोग है। वह अंकगणित यहाँ दावा नहीं किया जाता। कोहली (2026) ने नौ सीमांत न्यायाधीशों के पैनल पर वही किश सुधार लागू किया और लगभग दो प्रभावी वोट मापे, और किम एट अल। (2025) ने 350 से अधिक मॉडलों में अंतर्निहित त्रुटि सहसंबंध स्थापित किया। एन मॉडलों की एक परिषद जिसकी त्रुटियाँ इंट्राक्लास सहसंबंध ρ ले जाती हैं, = N / (1 + (N−1)ρ) स्वतंत्र गवाहों के लायक है, और यह मात्रा कितने भी मॉडल जोड़े जाएँ, 1/ρ पर संतृप्त होती है। एक बार जब कोई परिषद 1/ρ से बड़ी हो जाती है, तो ρ को आधा करना N को दोगुना करने से बेहतर होता है, और दो प्रयोगशालाओं से निकाली गई एक जोड़ी एक से निकाली गई पाँच को पछाड़ सकती है। किम एट अल। (2025) उस नियम को जटिल करते हैं: बड़े और अधिक सटीक मॉडल सबसे सहसंबंधित त्रुटियाँ ले जाते हैं भले ही आर्किटेक्चर और प्रदाता भिन्न हों, इसलिए दो प्रयोगशालाएँ ρ के बारे में एक पूर्व अनुमान हैं न कि इसका माप, जो कि अनुभाग 5.5 की अनुमान प्रक्रिया के लिए है। तीसरा तीन परिनियोजन स्तरों का एक विवरण है, मैनुअल, एक-टैप मोबाइल और ब्राउज़र-एजेंट, और उस अक्ष का कि जो उन्हें महामारी विज्ञान से अलग करता है: चाहे दूसरा मॉडल पहले मॉडल का उत्तर देखे। दूसरे मॉडल को कंडीशनिंग करना त्रुटि सुधार के बदले ρ बढ़ाता है। चौथा पाँच मॉडलों में जाली-परिषद विफलता का एक छोटा नमूना अवलोकन है, वह एक-वाक्य हस्तक्षेप जिसने इसे एक तीन-मॉडल पुनरावृत्ति में हटाया, और एक अंधा तीन-बांह मूल्यांकन डिज़ाइन एक निर्दिष्ट मिथ्याकरण स्थिति के साथ।
यहाँ सहसंबंधित सहमति को एक खोज के रूप में नहीं, बल्कि स्थापित के रूप में माना जाता है। कि मॉडलों का एक पैनल इसके सदस्यों की तुलना में बहुत कम स्वतंत्र गवाह होने के लायक है, सीधे मापा गया है: सात परिवारों से निकाले गए नौ सीमांत न्यायाधीश लगभग दो प्रभावी वोट आपूर्ति करते हैं (कोहली, 2026), और त्रुटि सहसंबंध प्रदाताओं और आर्किटेक्चर में भी मॉडल क्षमता के साथ बढ़ता है (किम एट अल।, 2025)। अनुभाग 5 उन मापों के पीछे डिज़ाइन-प्रभाव अंकगणित को फिर से बताता है, क्योंकि प्रोटोकॉल के तीन नियम इससे व्युत्पन्न हैं और इसके बिना fastidiousness के रूप में पढ़ते हैं। प्रोटोकॉल तब उसी समस्या का दूसरा पक्ष लेता है। वह साहित्य सहसंबंध को मापता है; यह प्रोटोकॉल इसे कम करने के लिए बनाया गया है, वंशावली में रचना करके, औसतन इसे दूर करने के बजाय असहमति रखकर, इसे प्रदान करने वाले मॉडल के साथ हर योगदान पर हस्ताक्षर करके, और एक दोहराए गए स्रोत को एक बार गिनकर।
यह दावा कि एक विलीनित उत्तर सर्वोत्तम एकल उत्तर को मारता है, डिज़ाइन से और आसन्न साहित्य से तर्क दिया जाता है; अनुभाग 9 मूल्यांकन निर्दिष्ट करता है, जो नहीं चलाया गया है।
विषयवस्तु
- परिचय
- संबंधित कार्य
- पाँच तरीके जिनसे एक मर्ज विफल होता है
- एंकर-एंड-एनरिच प्रोटोकॉल
- सहसंबद्ध समझौता
- तीन स्तर, एक प्रोटोकॉल
- प्रायोगिक अनुभाग
- पेस्ट फाइल: कोल्ड-स्टार्ट मार्गदर्शन के लिए एक इंटरफेस पैटर्न
- एक प्रस्तावित मूल्यांकन
- सीमाएँ
- नैतिकता, गोपनीयता और कानूनी संरचना
- निष्कर्ष
घोषणाएँ · संदर्भ · परिशिष्ट A, रसीद टेम्पलेट · परिशिष्ट B, स्वतंत्र साक्षियों की प्रभावी संख्या · परिशिष्ट C, मोबाइल स्तर कार्यान्वयन संदर्भ
आकृतियों और तालिकाओं की सूची
- आकृति 1. एक परिषद् 1/ρ पर संतृप्त होती है, और दस सहमत मॉडल कितने मूल्यवान हैं (खंड 5.3)
- आकृति 2. एंकर-और-समृद्ध प्रोटोकॉल, चरण दर चरण (खंड 4.2)
- आकृति 3. तीन स्तर एक विलंबता–व्यापकता वक्र पर बिंदु के रूप में (खंड 6.4)
- आकृति 4. अंध-समानांतर और सूचित-अनुक्रमिक निष्कर्षण की तुलना (खंड 6.5)
- तालिका 1. प्रोटोकॉल नियम और वे विफलताएं जिन्हें वे संबोधित करते हैं (खंड 4.5)
- तालिका 2. स्वतंत्र साक्षियों की प्रभावी संख्या, चयनित मान (खंड 5.2)
- तालिका 3. मोबाइल स्तर के तीन तरीके (खंड 6.2)
- तालिका 4. तीन स्तरों में विलंबता–व्यापकता सीमांत (खंड 6.4)
- तालिका 5. कोल्ड-स्टार्ट प्रोब, बेसलाइन रन, n = 5 (खंड 7.2)
- तालिका 6. भूमिका-असाइनमेंट हस्तक्षेप के बाद कोल्ड-स्टार्ट प्रोब, n = 3 (खंड 7.3)
- तालिका 7. उपभोक्ता ऐप-इरादा पाइपलाइन की देखी गई विफलता के तरीके (खंड 7.5)
- तालिका 8. स्वतंत्र साक्षियों की प्रभावी संख्या, पूरी तालिका (परिशिष्ट B)
- तालिका 9. मोबाइल स्तर कार्यान्वयन संदर्भ (परिशिष्ट C)
1. परिचय
1.1 समस्या
एक ऐसा सवाल लीजिए जहाँ गलत होना महँगा पड़े: स्कूल चुनना, इलाज चुनना, सप्लायर चुनना, किसी अनुबंध में एक खंड चुनना। उपयोगकर्ता एक भाषा मॉडल से सवाल पूछते हैं और उन्हें कुछ सुसंगत, आत्मविश्वासी और अच्छी तरह से स्वरूपित जवाब मिलता है, और कठिनाई वहीं से शुरू होती है। एक आत्मविश्वासी गलत जवाब और एक आत्मविश्वासी सही जवाब एक जैसे लगते हैं। न तो टोन उन्हें अलग करता है, न ही संरचना, न ही लंबाई, न ही उद्धरणों की मौजूदगी। मॉडल के द्वारा व्यक्त किया गया आत्मविश्वास अधिकतर अतिशयोक्तिपूर्ण और खराब रूप से अंशांकित माना जाता है (Kadavath et al., 2022; Xiong et al., 2024)। मॉडल की प्रश्नकर्ता के ढाँचे को अपनाने की प्रवृत्ति झूठे समर्थन की एक दूसरी परत जोड़ती है (Sharma et al., 2023)।
स्पष्ट समाधान एक दूसरी राय है। एक मॉडल की गलती आत्मविश्वास जैसी दिखती है। वही गलती जब एक दूसरे मॉडल के जवाब के बगल में रखी जाती है तो वह एक बहस जैसी दिखती है। एक बहस किसी भी व्यक्ति को दिखाई देती है जिसके पास विषय में कोई विशेषज्ञता नहीं है; आत्मविश्वास ऐसा नहीं है। नीचे सब कुछ उसी विषमता पर निर्भर करता है।
समाधान का एक मूल्य और एक जाल है। मूल्य पढ़ना है: एक सवाल के दस जवाब दस लंबे पाठ हैं जिन्हें एक साथ दिमाग में रखना है और यह याद रखना है कि किसने क्या कहा। लगभग कोई भी ऐसा नहीं करता है। व्यवहार में एक पाठक पहले जवाब को पढ़ता है, दूसरे को स्किम करता है और बाकी को बंद कर देता है। कई जवाब इकट्ठा करना वर्षों से एक हल की गई समस्या है, एकत्रकर्ता सदस्यताओं, साथ-साथ पैनलों और API गेटवे के माध्यम से। उनके साथ समाप्त करना हल नहीं हुआ है।
जाल मिलाना है। दस जवाबों को एक में कम करने का कोई भी तरीका एक बार फिर से एक एकल आत्मविश्वासी पाठ तैयार करता है, और अगर कमी अपारदर्शी है तो पाठक वहीं पर वापस आ जाता है, सिवाय इसके कि पाठ अब एक ऐसा अधिकार रखता है जिसे वे सत्यापित नहीं कर सकते। सरल पूलिंग सही अल्पसंख्यक बिंदुओं को भी मिटा देता है, सबसे जोरदार शब्दावली की ओर बढ़ता है, और वहाँ जहाँ कोई सहमति नहीं है वहाँ सहमति का रूप तैयार करता है।
एक तीसरी समस्या वह है जो पूरे व्यायाम को गैर-तुच्छ बनाती है। मॉडलों के बीच समझौता स्वतंत्र पुष्टि नहीं है, क्योंकि ओवरलैपिंग कॉर्पस पर प्रशिक्षित मॉडल ढाँचे साझा करते हैं, एक ही लेख उद्धृत करते हैं और एक ही अंधे धब्बे विरासत में लेते हैं। "दस में से नौ सहमत हुए" और "नौ स्वतंत्र विशेषज्ञ सहमत हुए" अलग-अलग कथन हैं, और उनके बीच का अंतर परिमाणात्मक और बड़ा है। अनुभाग 5 दिखाता है कि यह पूरे निर्माण पर एक सीमा डालता है।
1.2 प्रणाली
प्रोटोकॉल इसे सादे पाठ में लिखा गया है, इसे निष्पादित करने के तीन तरीकों के साथ। तीनों ही एक समान दस्तावेज़ बनाते हैं, और वे इसमें भिन्न होते हैं कि कौन क्लिक करता है और कितने मॉडल से पूछा जाता है।
मुफ्त पथ पर उपयोगकर्ता साइटें खोलता है, जवाब कॉपी करता है, और उन्हें निर्देशों के एक अनुच्छेद के तहत किसी भी चैट मॉडल में चिपकाता है। स्थापित करने के लिए कुछ नहीं, भुगतान करने के लिए कुछ नहीं, और यह एक फोन पर काम करता है।
मोबाइल स्तर पर होम स्क्रीन पर एक आइकन है। इसे टैप करें, सवाल टाइप करें, एक तरीका चुनें, और लगभग एक मिनट बाद समाप्त जवाब स्क्रीन पर और क्लिपबोर्ड में है। यह पहले से ही डिवाइस पर स्थापित सदस्यताओं के खिलाफ ऑपरेटिंग-सिस्टम ऐप इरादों के माध्यम से दो मॉडलों तक पहुँचता है, कोई API कुंजी नहीं।
एजेंट पथ पर एक मॉडल जो एक ब्राउज़र चला सकता है उपयोगकर्ता के मौजूदा लॉगिन किए गए सत्रों में नामित साइटें खोलता है, सवाल जमा करता है, प्रतीक्षा करता है, प्रत्येक जवाब को एक फाइल में सहेजता है और दस्तावेज़ बनाता है।
आर्किटेक्चरल रूप से निर्णायक तथ्य यह है कि कोई सर्वर नहीं है। एक सुरक्षित सर्वर नहीं, और न ही कोई कोई-प्रतिधारण नीति वाला सर्वर: कोई ऐसा घटक मौजूद नहीं है, इसलिए सवाल मेरे तक नहीं पहुँच सकता। यह उन मॉडल सेवाओं तक पहुँचता है जिनका नाम उपयोगकर्ता ने दिया, जो व्यायाम का बिंदु है, और यह कहीं और नहीं जाता है। उसी अनुपस्थिति से एक दूसरा परिणाम निकलता है: प्रोटोकॉल को वापस नहीं लिया जा सकता, क्योंकि यह एक अनुमतिपूर्ण लाइसेंस के तहत पाठ का एक अनुच्छेद है, और उपयोगकर्ता के नोट्स में एक प्रति आगे के किसी भी मॉडल के साथ काम करती रहती है।
1.3 योगदान
अनुभाग 3 पाँच तरीके सेट करता है जिनसे एक मर्ज विफल होता है और अनुभाग 4 उन्हें आधार-और-समृद्ध करने को औपचारिक बनाता है। अनुभाग 5 सहसंबद्ध-साक्षी मॉडल विकसित करता है, = N/(1+(N−1)ρ) इसकी सीमा 1/ρ पर, और निकालता है कि इसका क्या मतलब है कि एक परिषद को कैसे बना होना चाहिए। अनुभाग 6 तीन स्तरों, विलंबता-चौड़ाई सीमांत को वर्णित करता है जो वे पता लगाते हैं, और अंधा-समानांतर विरुद्ध सूचित-क्रमिक भेद जो उन्हें ज्ञानमीमांसात्मक रूप से अलग करता है। अनुभाग 7 नकली-परिषद अवलोकन और मोबाइल निर्माण से क्षेत्र निष्कर्ष रिपोर्ट करता है; अनुभाग 8 ठंड-शुरुआत मार्गदर्शन के लिए एक इंटरफेस पैटर्न वर्णित करता है; अनुभाग 9 एक अंधा मूल्यांकन निर्दिष्ट करता है जिसमें एक विकृतिकरण शर्त पहले से निश्चित है। यह दावा कि एक मर्ज किया हुआ जवाब सर्वश्रेष्ठ एकल जवाब से बेहतर है यहाँ निपटाया नहीं गया है, और वह मूल्यांकन वह तुलना है जो इसे निपटाएगी, उस परिणाम सहित जो मुझे इसे वापस लेने के लिए बाध्य करेगी।
अभिविन्यास सादे शब्दों में बताने लायक है, क्योंकि यह वह है जो इस पत्र को उस माप साहित्य से अलग करता है जिस पर यह निर्भर करता है। Kohli (2026), Kim et al. (2025) और Ding (2026) मापते हैं कि एक परिषद की त्रुटियाँ कितनी सहसंबद्ध हैं। यह पत्र उस सहसंबंध को डिज़ाइन लक्ष्य के रूप में लेता है और पूछता है कि एक एकल व्यक्ति, कोई API कुंजी और कोई सर्वर नहीं के साथ साधारण उपभोक्ता चैट इंटरफेस के माध्यम से काम करते हुए, इसे कैसे कम कर सकता है और एक रिकॉर्ड छोड़ सकता है जो दिखाता है कि उन्होंने ऐसा किया। उस साहित्य में एक अंतराल नाम के लायक है क्योंकि यह पहुँच के भीतर है: माप API के माध्यम से, बेंचमार्क पर, नौ मॉडलों के साथ या तीन सौ के साथ किए गए थे। किसी ने इस प्रोटोकॉल में सहसंबंध का अनुमान नहीं लगाया है जिसमें यह व्याप्त है, जहाँ एक व्यक्ति चार चैट उत्पादों को क्वेरी करता है जिनके लिए उन्हें पहले से कुछ नहीं भुगतान करना पड़ता है। अनुभाग 5.5 प्रक्रिया देता है और अनुभाग 9.6 डिज़ाइन देता है।
2. संबंधित कार्य
समूह और विविधता। शास्त्रीय समूह सिद्धांत पहले से ही बताता है कि यहाँ क्या आवश्यक है: एक समूह को जो लाभ मिलता है वह इस बात पर निर्भर करता है कि इसके सदस्य कितनी अलग तरीके से गलती करते हैं, न कि वे औसतन कितने अच्छे हैं। अस्पष्टता विघटन, जिसमें समूह की त्रुटि औसत सदस्य की त्रुटि माइनस औसत अस्पष्टता के बराबर होती है (Krogh & Vedelsby, 1995), और पूर्वाग्रह–विचरण–सहप्रसरण विघटन (Ueda & Nakano, 1996) दोनों दिखाते हैं कि एक समूह एक एकल सदस्य की ओर सिकुड़ता है क्योंकि त्रुटि सहप्रसरण बढ़ता है। Dietterich (2000) इस स्थिति को आवश्यक बताते हैं। खंड 5 इसे भाषा मॉडल की परिषदों में ले जाता है और इसका उल्लंघन करने की लागत को संख्या देता है।
भाषा मॉडल के लिए बहु-मॉडल योजनाएँ। Self-consistency (Wang, X., et al., 2023) एक मॉडल के कई नमूनों में मतदान करता है, जो विचरण को कम करता है बिना स्वतंत्रता उत्पन्न किए। Multi-agent debate (Du et al., 2023) रिपोर्ट करता है कि जब कई उदाहरण तर्कों का आदान-प्रदान करते हैं तो तथ्यात्मकता में लाभ होता है। Mixture-of-agents (Wang, J., et al., 2024) एक परत के आउटपुट को एकीकारक को खिलाता है और कई बेंचमार्क पर सबसे मजबूत एकल मॉडल पर सुधार की रिपोर्ट करता है। वह साहित्य उसी तरफ इंगित करता है जिस तरफ यह प्रोटोकॉल करता है। उसके परिणाम API पर और बेंचमार्क पर प्राप्त किए गए थे, हालांकि, तो मैं उन्हें ब्राउज़र-माध्यस्थता की परिषद तक स्थानांतरित नहीं करता हूँ उपभोक्ता इंटरफेस के बिना मापन के, जो खंड 9 निर्दिष्ट करता है।
न्यायाधीश मॉडल। एक मॉडल न्यायाधीश द्वारा मूल्यांकन अच्छी तरह से इसके दोषों के साथ चिन्हित है: स्थिति पूर्वाग्रह, वर्बोसिटी पूर्वाग्रह, और एक परिचित गृह शैली की ओर खिंचाव (Zheng et al., 2023)। यह यहाँ एक डिज़ाइन बाधा है, एक पक्ष नहीं, क्योंकि अनब्लाइंडेड स्कोरिंग आंशिक रूप से उन पूर्वाग्रहों को मापना होगा। खंड 9.4 इसे संभालता है।
Monoculture। Kleinberg और Raghavan (2021) दिखाते हैं कि जब कई एजेंट एक एल्गोरिदम पर निर्भर करते हैं, तो सामूहिक परिणाम खराब हो सकते हैं यहां तक कि जब व्यक्तिगत गुणवत्ता में सुधार होता है। Bommasani et al. (2022) समान प्रभाव को परिणाम समरूपीकरण के रूप में वर्णित करते हैं। भाषा मॉडल की परिषद के लिए यह वह तंत्र है जो पहली जगह में ρ > 0 उत्पन्न करता है। उत्पन्न डेटा पर प्रशिक्षण के तहत अवक्रमण पर कार्य (Shumailov et al., 2024) सुझाव देता है कि ρ समय के साथ ऊपर की ओर बढ़ता है।
भीड़। शास्त्रीय wisdom-of-crowds तर्क (Surowiecki, 2004) निर्णयों के स्वतंत्र होने पर निर्भर करता है। Lorenz et al. (2011) ने प्रायोगिक रूप से दिखाया कि यहां तक कि हल्का सामाजिक प्रभाव, बस लोगों को दूसरों के अनुमान देखने देना, प्रसार को संकीर्ण करता है बिना इसे सत्य की ओर ले जाए: भीड़ अधिक आत्मविश्वासी हो जाती है बिना अधिक सटीक हुए। खंड 6.5 इसे सटीक रूप से informed-sequential elicitation द्वारा स्वीकार किए गए व्यापार के रूप में पहचानता है।
Condorcet और संबंधित मत। Condorcet jury theorem (Condorcet, 1785) मानता है कि एक आधे से ऊपर की व्यक्तिगत सटीकता के साथ, एक सही बहुमत की संभावना N बढ़ने के साथ एक की ओर जाती है। Ladha (1992) ने दिखाया कि संबंधित मत गारंटी को नष्ट करते हैं। खंड 5 design effect (Kish, 1965) के माध्यम से उस चेतावनी का एक मात्रात्मक संस्करण देता है।
संबंधित त्रुटियाँ, मापी गई। खंड 5 जो अंकगणित पुनः बताता है वह तब से मॉडल पैनलों पर सीधे मापा गया है, और माप विश्लेषण की तुलना में तीव्र हैं। Kohli (2026) सात मॉडल परिवारों से खींचे गए नौ सीमांत न्यायाधीशों के एक पैनल पर Kish प्रभावी नमूना आकार लागू करता है और पाता है कि यह लगभग दो स्वतंत्र मतों के लायक है: पैनल की नाममात्र स्वतंत्रता का लगभग तीन-चौथाई साझा गलतियों में खो जाता है, पैनल की सटीकता स्वतंत्र मतदान द्वारा प्रदान की जाने वाली तुलना में 8 से 22 प्रतिशत बिंदु कम गिरती है, और सर्वश्रेष्ठ एकल न्यायाधीश पूरे पैनल से मेल खाते या बेहतर हैं। न तो अधिक न्यायाधीश और न ही बेहतर एकीकरण इसे ठीक करते हैं, जो एल्गोरिदम के बजाय न्यायाधीशों में बाधा को स्थित करता है। Kim et al. (2025), 350 से अधिक मॉडल में, पर्याप्त त्रुटि सहसंबंध खोजते हैं और, महत्वपूर्ण रूप से कि परिषद कैसे बनाई जानी चाहिए, पाते हैं कि बड़े और अधिक सटीक मॉडलों में सबसे अधिक सहसंबंधित त्रुटियाँ होती हैं यहां तक कि जब आर्किटेक्चर और प्रदाता भिन्न हों। Ding (2026) 265,000 नमूनों पर एक आत्मविश्वास संकेत के रूप में समझौते का ऑडिट करता है और इसे एक सकारात्मक लेकिन कमजोर भविष्यद्वाणी के रूप में पाता है, 0.20 और 0.59 के बीच सहसंबंध के साथ, और बिल्कुल वहाँ सबसे खराब जहाँ यह सबसे आत्मविश्वासी है: सबसे सुसंगत सीमांत मॉडल पर, 0.8 पर या उससे अधिक समझौते ने कठिन बेंचमार्क की 77% प्रविष्टियों को कवर किया और उनमें से 48% गलत थे।
इस पत्र के लिए तीन चीजें अनुसरण करती हैं। पहला, खंड 5 में डिज़ाइन-प्रभाव परिणाम मेरा योगदान नहीं है। Kohli के पेपर ने इस के पहले पोस्टिंग को पूर्वतर किया और एक ही सुधार का उपयोग किया; अनुभाग यह के लिए रखा जाता है कि प्रोटोकॉल इससे क्या व्युत्पन्न करता है, और यह जहाँ दिखाई देता है वहाँ लेबल किया जाता है। दूसरा, संरचना सलाह जो अनुसरण करती है, गणना के बजाय विविधता पर खर्च करें, अब अनुभवजन्य रूप से समर्थित है बजाय केवल तर्क किए गए। तीसरा, Kim et al. की खोज उस सलाह को इस तरीके से जटिल करती है जो बताने योग्य है: यदि सक्षमता और त्रुटि सहसंबंध एक साथ बढ़ते हैं, तो दो प्रयोगशालाओं से खींची गई जोड़ी स्वचालित रूप से विविध जोड़ी नहीं है, और lineage को ब्रांड को पढ़ने के बजाय मापा जाना चाहिए। यह खंड 5.5 की अनुमान प्रक्रिया के लिए एक तर्क है, संरचना नियम के खिलाफ नहीं।
सहायक प्रणालियाँ। कई परियोजनाएँ बहु-मॉडल परिषदें बनाती हैं। एक प्रसिद्ध खुली कार्यान्वयन, llm-council (Karpathy, 2025), मॉडल को समानांतर में क्वेरी करता है, उन्हें एक दूसरे को गुमनाम रूप से समीक्षा करता है, और एक अध्यक्ष मॉडल को अंतिम उत्तर लिखने देता है। इसे एक एकीकारक API कुंजी और प्रति-टोकन भुगतान की आवश्यकता है। वाणिज्यिक परिषद उत्पाद एक न्यायाधीश, एक सर्वसम्मत दृश्य और एक विरोध प्रदर्शन प्रदान करते हैं। खुले-स्रोत मोबाइल अनुप्रयोग मतदान और बहु-दौर बहस जोड़ते हैं। परिपक्व बहु-मॉडल मुखपृष्ठ समूह विशेषताएँ शिप करते हैं, और मुक्त पक्ष-दर-पक्ष पैनल उपयोगकर्ता पहले से लॉग इन किए गए आधिकारिक साइटों का उपयोग करते हैं। एकीकारक सदस्यपद कई मॉडलों को एक बिल के पीछे रखते हैं। इन संपत्तियों में से प्रत्येक अन्यत्र अपने आप पर मौजूद है। उनका संयोजन, एक बार में दस, अन्यत्र अनुपलब्ध प्रतीत होता है: कोई API कुंजी नहीं, कोई स्थापना नहीं, फोन-संगत, उपयोगकर्ता द्वारा पहले से रखे गए खातों पर चल रहा है मुक्त स्तर सहित, कोई नई भुगतान की गई मध्यस्थ नहीं, एक विलय विधि सादे पाठ में लिखी गई है और इसलिए संपादन योग्य है, असहमति संरक्षित है, प्रत्येक योगदान हस्ताक्षरित है, एक दोहराया स्रोत एक स्रोत के रूप में ध्वजांकित है, और एक विधि या तो हाथ से या एजेंट के तहत निष्पादन योग्य है।
स्थिति खुली रहने का एक संरचनात्मक कारण है। एक प्रयोगशाला के पास अपने प्रतिद्वंद्वी को उपयोगकर्ता के प्रश्न को रूट करने के लिए कम प्रोत्साहन है, क्योंकि प्रत्येक प्रतिभागी का उद्देश्य यह है कि उसका अपना उत्तर वह हो जो उपयोगकर्ता रखता है। तीसरे पक्ष क्रॉस-मॉडल उपकरण बेचते हैं, लेकिन सादे पाठ में लिखी गई विधि संपादकीय भूमिका को उपयोगकर्ता के साथ छोड़ देती है, जो उनमें से किसी भी व्यवस्था से एक अलग व्यवस्था है।
कार्यक्षेत्र। यह प्रोटोकॉल एक व्यक्ति द्वारा एक सावधानीपूर्वक दस्तावेज़ तैयार करने के लिए है, बिना अनुसंधान दल के बुनियादी ढांचे को एकत्रित किए: कोई कुंजियाँ नहीं, कोई स्थापना नहीं, कोई सर्वर नहीं। पुनः प्रयास, गारंटीकृत निष्पादन, लागत और त्रुटि निगरानी, ऑडिट लॉग, परीक्षण समूहों पर मूल्यांकन, पहुँच नियंत्रण, एकल साइन-ऑन, प्रतिधारण नीति, प्रॉम्प्ट संस्करण, और सेवा-स्तर समझौते एंटरप्राइज़ ऑर्केस्ट्रेशन फ्रेमवर्क के क्षेत्र हैं।
3. पाँच तरीके जिनसे एक मर्ज विफल होता है
इन पाँच में से चार भोली पूलिंग के गुण हैं, जिससे मेरा मतलब किसी भी निर्देश से है जैसे "इन उत्तरों को संयोजित करें और परिणाम को अनुकूलित करें।" पाँचवाँ ऑपरेटर के पास है, और यह सबसे अधिक महत्वपूर्ण है, क्योंकि पाठक इसे पहचान नहीं सकता।
F1, संश्लेषण में निर्माण। आउटपुट में ऐसे दावे होते हैं जो किसी भी इनपुट में नहीं थे। संश्लेषक स्वयं एक भाषा मॉडल है, और स्रोतों के बीच सीमाओं को सुचारू करते समय यह संयोजक सामग्री उत्पन्न करता है जो बिल्कुल स्रोत सामग्री जैसी दिखती है।
F2, अल्पसंख्यक विलोपन। वह एक उत्तर जो एक भौतिक आपत्ति को देखता है वह विलीन हो जाता है क्योंकि बहुमत ने अन्यथा कहा। यह वह मामला है जिसके लिए परिषद को इकट्ठा किया गया था, और यह पहली चीज़ है जो भोली मर्ज खो देती है।
F3, आत्मविश्वास की गतिविधि। जहाँ दो शब्द विरोध करते हैं, अधिक निश्चित बेहतर समर्थित को हरा देता है। यह वही तंत्र है जो न्यायाधीश मॉडल में स्थिति और शैली पूर्वाग्रह उत्पन्न करता है (Zheng et al., 2023)।
F4, निर्मित सर्वसम्मति। एक वास्तविक असहमति को एक योग्य हाँ में औसत किया जाता है। पाठक को एक ऐसा दस्तावेज़ मिलता है जिसमें विवादास्पद और निपटे हुए को अलग नहीं किया जा सकता और वह यह भी नहीं सीख सकता कि एक विवाद मौजूद था।
F5, नकली परिषद। एक मॉडल जिसे एक सौहार्दपूर्ण पास चलाने के लिए कहा गया है के पास अन्य मॉडल तक कोई पहुँच नहीं है। इसे कहने के बजाय, यह साधारण वेब अनुसंधान करता है और परिणाम को सौहार्दपूर्ण आकार में प्रारूपित करता है, जिसमें एक रसीद, सहमति और असहमति अनुभाग, और दाता एट्रिब्यूशन होते हैं। दस्तावेज़ एक सत्यनिष्ठ दस्तावेज़ से बेहतर दिखता है, बिल्कुल इसलिए क्योंकि कोई वास्तविक विरोध रास्ते में नहीं आता। पाठक इसे पकड़ नहीं सकता, क्योंकि उसके पास स्रोत उत्तरों तक कोई पहुँच नहीं है।
F5 पेपर की प्रारंभिक समस्या को एक स्तर ऊपर उठाया गया है: एक आत्मविश्वास से गलत उत्तर एक सही उत्तर से अलग नहीं किया जा सकता, और एक परिषद की तरह आकृति लेकिन एक मॉडल द्वारा लिखा गया दस्तावेज़ एक परिषद से अलग नहीं किया जा सकता। अनुभाग 7 एक अंधे रन में पाँच में से दो मॉडल में इसकी घटना की रिपोर्ट करता है।
4. एंकर-और-समृद्ध प्रोटोकॉल
4.1 सिद्धांत
उत्तरों को पूलिंग और अनुकूलित करने के बजाय, यह प्रोटोकॉल एक मजबूत उत्तर को वृद्धिशील रूप से विकसित करता है, जबकि स्रोत और असहमति दृश्यमान रहती है।
4.2 नियम
चित्र 2 प्रोटोकॉल को पूरी तरह दिखाता है।
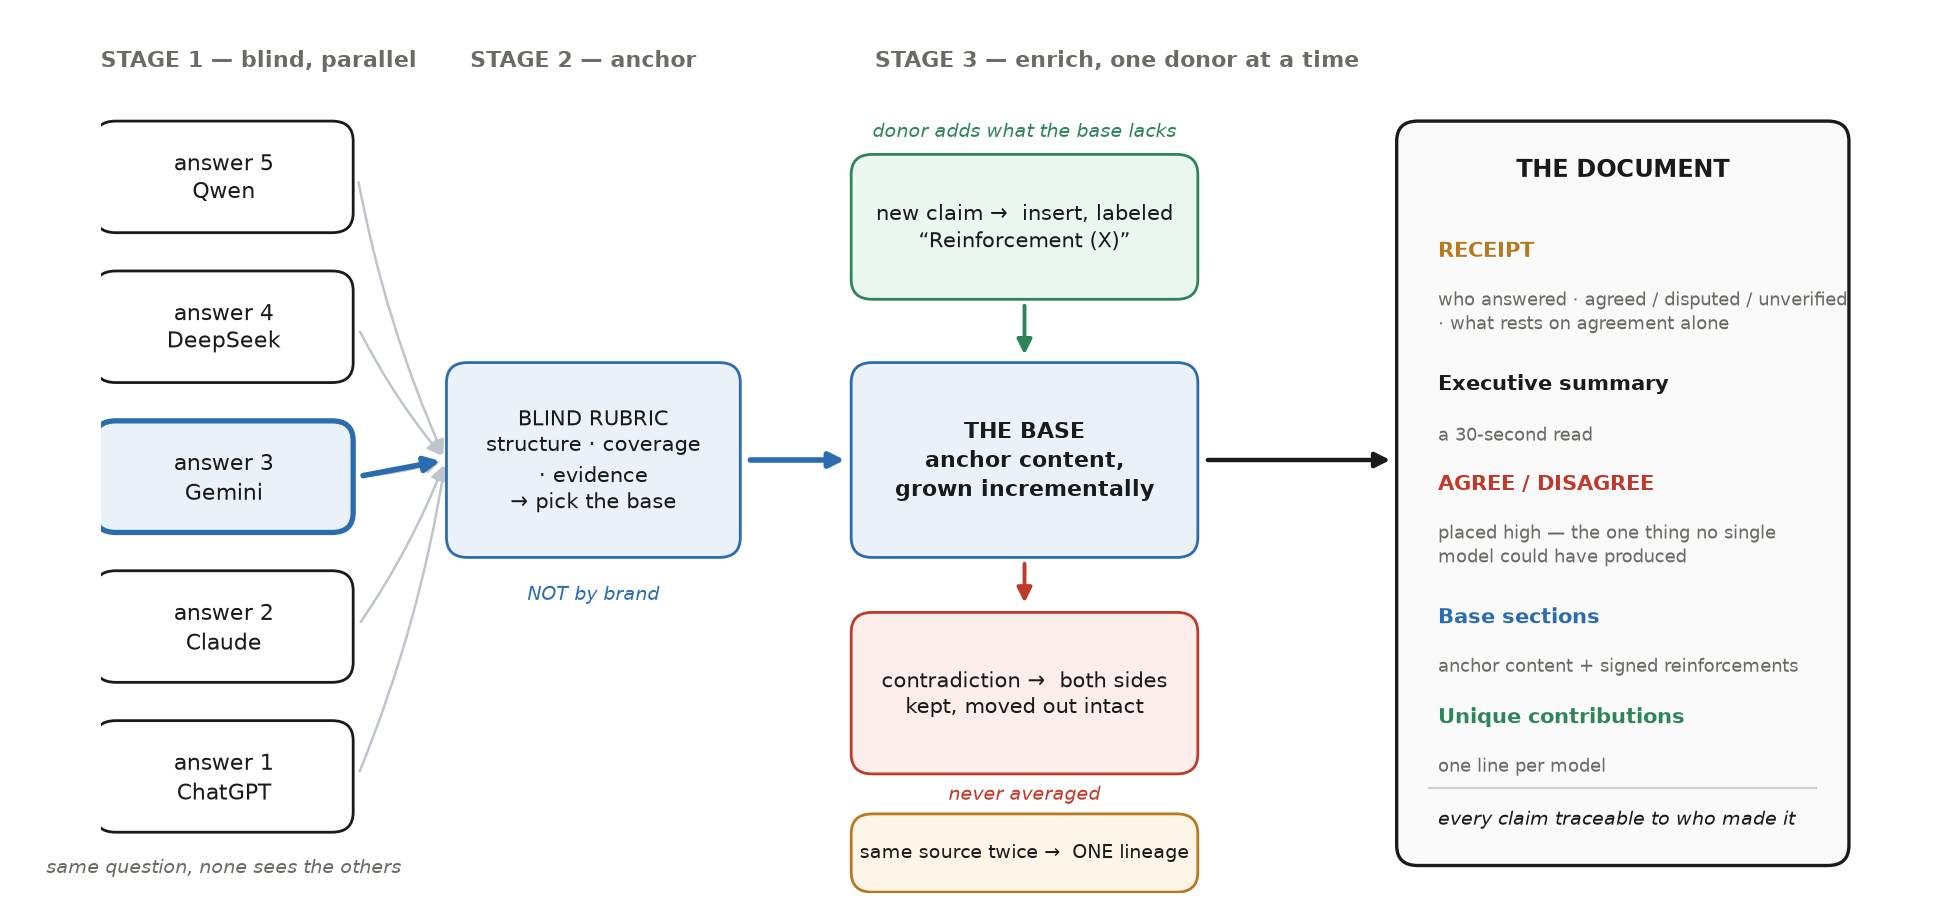
अंध रूब्रिक द्वारा एंकर चुनें, ब्रांड द्वारा नहीं। सबसे मजबूत तैयार उत्तर, अर्थात् सबसे पूर्ण और सर्वश्रेष्ठ स्रोत वाला, आधार बन जाता है। सामग्री पर निर्णय लें: संरचना, कवरेज, साक्ष्य। एक पसंदीदा मॉडल को पहले से सेट करना एक व्यवस्थित पूर्वाग्रह है, और यह सबसे बुरा उस स्थिति में है जहां एक मॉडल को संयोग से दूसरों की तुलना में अधिक संदर्भ प्राप्त हुआ हो। एंकर चुने जाने के बाद, निर्माण तुरंत शुरू होता है। पिछड़े हुए मॉडलों की प्रतीक्षा नहीं की जाती।
एक बार में एक दाता को समृद्ध करें। प्रत्येक शेष उत्तर से केवल वह लें जो आधार में कमी है या जो पहले से मौजूद किसी चीज़ को मजबूत करे: एक पूर्वदृष्टांत, एक आंकड़ा, एक तुलनीय, एक दृष्टिकोण, एक प्राथमिक-स्रोत लिंक। इसे मिलान वाले अनुभाग में लेबल सुदृढ़ीकरण (मॉडल नाम) के साथ डालें।
स्रोत को संरक्षित करें। हर योगदान अपने दाता का चिह्न वहन करता है। मॉडल स्रोत साक्ष्य स्रोत नहीं है, और जहां मूल स्रोत लिंक उपलब्ध है वह भी किया जाता है, केवल वर्णन नहीं।
खुले तौर पर सुधार करें। आधार सामग्री को प्राथमिकता से बनाए रखा जाता है। जहां एक दाता एंकर में एक त्रुटि को सुधारता है, सुधार करें और एक पंक्ति की नोट छोड़ें कि क्या बदला और क्यों। एक ज्ञात एंकर त्रुटि को आधार को स्पर्श न करने के नियम के प्रति सम्मान से सीमेंट करना इसे स्पर्श करने से भी बदतर है। नियंत्रक नियम यह है कि जानकारी चुप्पी से खोई नहीं जाती, न कि यह कि आधार अपरिवर्तनीय है।
असहमति को सामने लाएं। एक समर्पित अनुभाग सहमति को विचलन से अलग करता है। विरोधाभासी दावों को कभी भी एक मध्यवर्ती स्थिति में औसत नहीं किया जाता।
सहसंबद्ध साक्ष्य को चिह्नित करें। कई मॉडल एक ही लेख का हवाला देते हैं तो यह एक साक्ष्य लाइनज है, कई स्वतंत्र पुष्टियां नहीं। यह संरचना के स्तर पर भी लागू होता है। यदि सहमत मॉडल समान प्रकार की कंपनियों द्वारा या एक ही अधिक्षेत्र में बनाए गए थे, और विभाजन उस लाइन के साथ गिरता है, तो ऐसा कहें।
अनन्य योगदानों को श्रेय दें, प्रति मॉडल एक पंक्ति।
ऑर्केस्ट्रेटर का अपना दृष्टिकोण जोड़ें एक अंतिम अनुभाग के रूप में जहां उपयोगकर्ता ने इसके लिए कहा हो।
भार वहन करने वाले तथ्यों का नाम दें। दो या तीन तथ्यों की पहचान करें जिन पर सिफारिश वास्तव में निर्भर करती है, आमतौर पर संख्याएं, और प्रत्येक को एक जांचने योग्य स्रोत द्वारा समर्थित के रूप में या केवल मॉडल की सहमति पर आराम करने के रूप में चिह्नित करें। जहां वे एक आंकड़े पर सहमत होते हैं और उनमें से कोई भी नहीं दिखाता कि यह कहां से आया, यह एक पुष्टि नहीं, एक चेतावनी है।
4.3 एल्गोरिदम
INPUT   Q — the question
        A = {a_1 … a_N} — answers, arriving asynchronously
OUTPUT  D — a document with a receipt, provenance, and
        a disagreement section

R ← ∅            // receipt: who answered, who did not, why
D ← ⊥            // the base (anchor)

on arrival of a_i:
    R ← R ∪ {source(a_i), timestamp, mode}

    if D = ⊥ and enough_candidates():
        D ← argmax_{a ∈ A_ready} rubric(a)
        anchor ← source(D)         // recorded and disclosed
        // rubric = structure, coverage, sourcing

    else:
        for each claim c ∈ a_i:

            if c ∉ D:                              // new
                insert c into the matching section of D,
                    labeled "Reinforcement (source(a_i))"

            else if c contradicts c' ∈ D:
                if c corrects a factual error in c':
                    replace c' with c, plus a one-line
                    note of what changed
                else:
                    move (c, c') into DISAGREEMENTS,
                    both sides intact

            else:                            // agreement
                if evidence_source(c) = evidence_source(c'):
                    mark as ONE evidentiary lineage,
                    not as confirmation

after all:
    identify the load-bearing facts
    mark each [sourced] or [agreement only]
    assemble RECEIPT, SUMMARY, AGREE/DISAGREE (placed high),
             UNIQUE CONTRIBUTIONS
    emit in a readable and a double-clickable format
संग्रह और संश्लेषण एक साथ चलते हैं। एंकर जैसे ही पहुँचता है वैसे ही आधार बन जाता है, और प्रत्येक बाद का उत्तर जैसे ही आता है वैसे ही मिलाया जाता है। तेज प्रदाता एक या दो मिनट में प्रतिक्रिया देते हैं जबकि गहन-अनुसंधान मोड पाँच से पच्चीस मिनट लेते हैं, इसलिए दोनों चरणों को अनुक्रमिक करने से किसी लाभ के बिना एक रन को आधे घंटे के ब्लॉक में बदल देता।
4.4 आउटपुट आकार
अनुभाग क्रम प्रोटोकॉल का हिस्सा है, प्रस्तुति का नहीं।
रसीद शीर्ष पर बैठती है: किसने उत्तर दिया, किसने नहीं और क्यों, क्या सहमत है और विवादास्पद है और अपरीक्षित है, कहाँ सबूत सहसंबद्ध है, और मोटे तौर पर रन में समय और कोटा में क्या खर्च हुआ। फिर एक तीस-सेकंड की कार्यकारी सारांश, फिर विषय-सूची।
सहमति और असहमति सारांश के तुरंत बाद आती है: वे एक घटक हैं जो कोई भी एकल मॉडल उत्पन्न नहीं कर सकता था, और विधि को चलाने का कारण है। अंत में रखा जाए, आरामदायक सर्वसम्मति के नीचे, एक उपयोगी दस्तावेज़ स्पष्ट दिखने लगता है, और फिर इसे पढ़ा जाना बंद हो जाता है।
इसके बाद मूल अनुभाग आते हैं, प्रत्येक एंकर सामग्री प्लस हस्ताक्षरित सुदृढीकरण से युक्त; एक सूची जिसमें प्रत्येक मॉडल ने अद्वितीय रूप से क्या योगदान दिया; और, जहाँ उपयोगकर्ता ने इसके लिए कहा है, ऑर्केस्ट्रेटर का अपना दृष्टिकोण।
4.5 नियम और जिन विफलताओं को वे संबोधित करते हैं
तालिका 1. प्रोटोकॉल नियम और जिन विफलताओं को वे संबोधित करते हैं
| नियम | संबोधित विफलता |
|---|---|
| ब्रांड द्वारा नहीं, रूब्रिक द्वारा एंकर करें | एक पसंदीदा मॉडल की ओर व्यवस्थित पूर्वाग्रह |
| दाताओं को केवल वह जोड़ें जो अनुपस्थित है | F1: आधार को फिर से नहीं लिखा जाता है, इसलिए कम सीमें उत्पन्न होती हैं |
| प्रत्येक योगदान पर वंशावली | F1, और ऑडिटेबिलिटी: पाठक विश्वास करने के बजाय जांच सकते हैं |
| एक व्याख्यात्मक पंक्ति के साथ सुधार | एंकर त्रुटि को दृढ़ करना |
| असहमति अपने अनुभाग में, उच्च स्थान पर | F2, F4 |
| साझा साक्ष्य वंशावली को चिह्नित किया गया | झूठी स्वतंत्रता (अनुभाग 5) |
| भार-वहन तथ्यों को स्रोत या केवल-सहमति के रूप में चिह्नित किया गया | साक्ष्य के रूप में सहमति का इलाज |
| गैर-रन कभी भी रन के रूप में प्रस्तुत नहीं किए जाते | F5 |
यह एक डिज़ाइन तर्क है, और अनुभाग 9 निर्दिष्ट करता है कि इसका परीक्षण क्या होगा।
4.6 एक व्यावहारिक उदाहरण
इस तरह का प्रोटोकॉल इसके विवरण के मुकाबले इसके आउटपुट के विरुद्ध आंकलन करना आसान है। जो निम्नलिखित है वह 31 अगस्त 2026 को मुक्त पथ का एक वास्तविक रन से एक अंश है: एक प्रश्न, चार अलग सत्रों में चार उपभोक्ता चैट मॉडल से पूछा गया, फिर उपरोक्त नियमों द्वारा मिलाया गया। दाता के नाम यहाँ दिखाई देते हैं, अनुभाग 7 में नहीं, क्योंकि वंशावली वह संपत्ति है जिसका प्रदर्शन किया जा रहा है और एक अनामी उदाहरण कुछ भी प्रदर्शित नहीं करेगा।
RECEIPT — 4 models asked · 4 answered
Agreed:    3-2-1 redundancy · JPEG is the safe everyday format ·
           migrate every ~5 years · never let a proprietary app
           be a photograph's only home
Disputed:  how many copies (3 vs 4) · what the archival master
           should be (TIFF/PNG vs original plus JPEG)
To check:  media lifespan figures · whether your export tool
           strips EXIF

— Section 1 of the merged document: how many copies, and where —

Base.  The 3-2-1 rule: three copies, on two kinds of storage,
with one off-site. The off-site copy is what survives a fire,
a flood or a theft.

⚠ Disagreement — is there a fourth copy?
ChatGPT and Gemini both extend this to 3-2-1-1, adding one copy
that is immutable or offline. Their reasoning differs: ChatGPT
frames it as geographic independence, Gemini as protection from
ransomware and from a mass deletion that syncs everywhere.
Claude and DeepSeek stayed at three and did not argue against a
fourth; they simply did not call for one.

(added by Claude)  Whatever you choose, treat cloud as one leg
of the tripod and never the whole thing: it is tied to an
account that can be locked, closed, or repriced.

— Worth checking yourself —

The lifespan figures come from Gemini alone. No other model
gave numbers, so treat them as one source rather than as a
consensus.
उस अंश में चार चीजें प्रोटोकॉल के काम करने की हैं, न कि प्रोटोकॉल के वर्णन की। चौथी प्रति पर असहमति दोनों पक्षों के साथ बरकरार रखी गई है और दोनों मॉडलों के अलग-अलग कारणों के साथ, इसे एक सुविधाजनक "तीन या चार, आपकी जोखिम सहनशीलता के आधार पर" में हल करने के बजाय, जो यह छिपा देता कि एक पाठक किस बारे में परवाह कर सकता है। क्लाउड स्टोरेज के बारे में सुदृढीकरण उस मॉडल का नाम रखता है जिसने इसे प्रदान किया, इसलिए एक पाठक जो उस मॉडल पर संदेह करता है वह उस पंक्ति को छोड़ सकता है और कोई अन्य नहीं। समापन नोट नियम 6 है जो एक लाइव रन में काम कर रहा है: एक मॉडल ने दस्तावेज़ में एकमात्र संख्याएं प्रदान कीं, और मर्ज ने उन्हें एक एकल स्रोत के रूप में चिह्नित किया, न कि चार-मॉडल दस्तावेज़ में उनकी उपस्थिति को सहमति के रूप में पढ़ने की अनुमति दी।
चौथा वह है जो अंश में नहीं है: यह नियम 9 से पहले का है, इसलिए इसके भार-वहन तथ्य स्रोत और केवल-सहमति में अलग नहीं हैं, और यह उसी तरह पुनः प्रस्तुत किया गया है जैसे यह बाहर आया, क्योंकि नियमों को संतुष्ट करने के लिए संपादित एक उदाहरण जो वह चित्रित करता है, अब यह साक्ष्य नहीं रह जाता कि वे काम करते हैं।
5. सहसंबद्ध सहमति
प्राथमिकता नोट। इस खंड का अंकगणित नया नहीं है और इसे योगदान के रूप में दावा नहीं किया जाता है। कोहली (2026) ने नौ सीमांत न्यायाधीशों के एक पैनल पर एक ही किश सुधार लागू किया और लगभग दो प्रभावी वोट मापे, इस पत्र को पहली बार पोस्ट किए जाने से तीन महीने पहले, और किम एट अल। (2025) ने त्रुटि सहसंबंध स्थापित किया जो इसे 350 से अधिक मॉडलों में चलाता है। खंड को तीन कारणों से रखा जाता है: प्रोटोकॉल के तीन नियम इससे व्युत्पन्न हैं, एक पाठक जिसने अंकगणित नहीं देखी है वह उन नियमों को सावधानी के बजाय आवश्यकता के रूप में पढ़ेगा, और खंड 5.5 में अनुमान प्रक्रिया वह है जिसकी प्रोटोकॉल को एक ऐसी स्थिति में आवश्यकता है जिसे किसी ने मापा नहीं है। जहाँ वह साहित्य सहसंबंध को मापता है, यह प्रोटोकॉल इसे कम करने का प्रयास करता है।
यदि दस मॉडल सहमत हैं, तो दावा संभवतः आखिरकार सत्य है। यह खंड 4 का सबसे मजबूत सहज आपत्ति है और यह महसूस होने से कमजोर है; कितना कमजोर है इसके बारे में काम करना भी नियम 6 और 9 को अच्छी प्रथा से अंकगणित में बदल देता है।
5.1 सेटअप
मान लीजिए N मॉडल एक बाइनरी दावे का उत्तर देते हैं, और मान लीजिए कि e_i ∈ {0,1} मॉडल i द्वारा एक त्रुटि को दर्शाता है। स्वतंत्रता के तहत, व्यक्तिगत सटीकता p > 1/2 के साथ, N मॉडलों के बीच समझौता ऐसा साक्ष्य है जो N में घातांकी रूप से बढ़ता है। यह कॉन्डोरसेट प्रमेय की सामग्री है (कॉन्डोरसेट, 1785)।
अधिव्यापी कॉर्पोरा पर प्रशिक्षित मॉडल साझा रूप को विरासत में देते हैं, समान माध्यमिक स्रोतों का उद्धरण देते हैं और अपनी अवधि के अंधे बिंदुओं को साझा करते हैं, इसलिए उनकी त्रुटियाँ सहसंबद्ध होती हैं। एक अदालत दस गवाहों की स्थिति में होती है जो सभी एक ही सुरक्षा रिकॉर्डिंग देखते हैं: दस बयान, एक अवलोकन, और गवाहों की संख्या कहती है कि कितना स्वतंत्र रूप से देखा गया। उस अंतराल को एक संख्या दी जा सकती है, और इस खंड का बाकी हिस्सा इसे करता है। त्रुटियों के इंट्राक्लास सहसंबंध को इस प्रकार परिभाषित करें
5.2 गवाहों की प्रभावी संख्या
सहसंबद्ध मॉडलों की परिषद संरचनात्मक रूप से एक क्लस्टर नमूना है। एक क्लस्टर के अंदर इंट्राक्लास सहसंबंध ρ वाले N अवलोकन N इकाइयों की जानकारी नहीं रखते हैं, और मानक सुधार डिज़ाइन प्रभाव है (किश, 1965):
जो एक प्रभावी नमूना आकार देता है
तो एक परिषद जिसके N मॉडलों की त्रुटियाँ ρ पर सहसंबद्ध हैं, स्वतंत्र गवाहों के बराबर मूल्य रखती है। तालिका 2 चयनित मानों देती है, और परिशिष्ट B में तालिका 8 पूर्ण श्रेणी देती है।
तालिका 2। स्वतंत्र गवाहों की प्रभावी संख्या, , चयनित N और ρ के लिए
| ρ (नीचे) / N (पार) | 2 | 3 | 5 | 10 | 20 | सीमा N→∞ |
|---|---|---|---|---|---|---|
| 0 (स्वतंत्र) | 2.00 | 3.00 | 5.00 | 10.00 | 20.00 | ∞ |
| 0.1 | 1.82 | 2.50 | 3.57 | 5.26 | 6.90 | 10.0 |
| 0.2 | 1.67 | 2.14 | 2.78 | 3.57 | 4.17 | 5.0 |
| 0.3 | 1.54 | 1.88 | 2.27 | 2.70 | 2.99 | 3.33 |
| 0.5 | 1.33 | 1.50 | 1.67 | 1.82 | 1.90 | 2.0 |
| 0.7 | 1.18 | 1.25 | 1.32 | 1.37 | 1.40 | 1.43 |
5.3 छत
सबसे दाहिना स्तंभ इस खंड का मुख्य परिणाम है। जैसे N → ∞,
एक परिषद की एक छत होती है, और यह इस बात पर निर्भर नहीं करता है कि कितने मॉडल पूछे गए थे। चित्र 1 का पैनल (a) संतृप्ति को सीधे दिखाता है। ρ = 0.5 पर एक हजार मॉडलों की परिषद दो स्वतंत्र गवाहों के बराबर है, और ρ = 0.7 पर यह डेढ़ से कम है। ρ = 0.3 पर दस में एक ग्यारहवाँ मॉडल जोड़ना लगभग 0.05 गवाह खरीदता है। एक ही पाँच मॉडलों के साथ ρ = 0.3 से ρ = 0.15 तक जाना लगभग 0.85 खरीदता है।
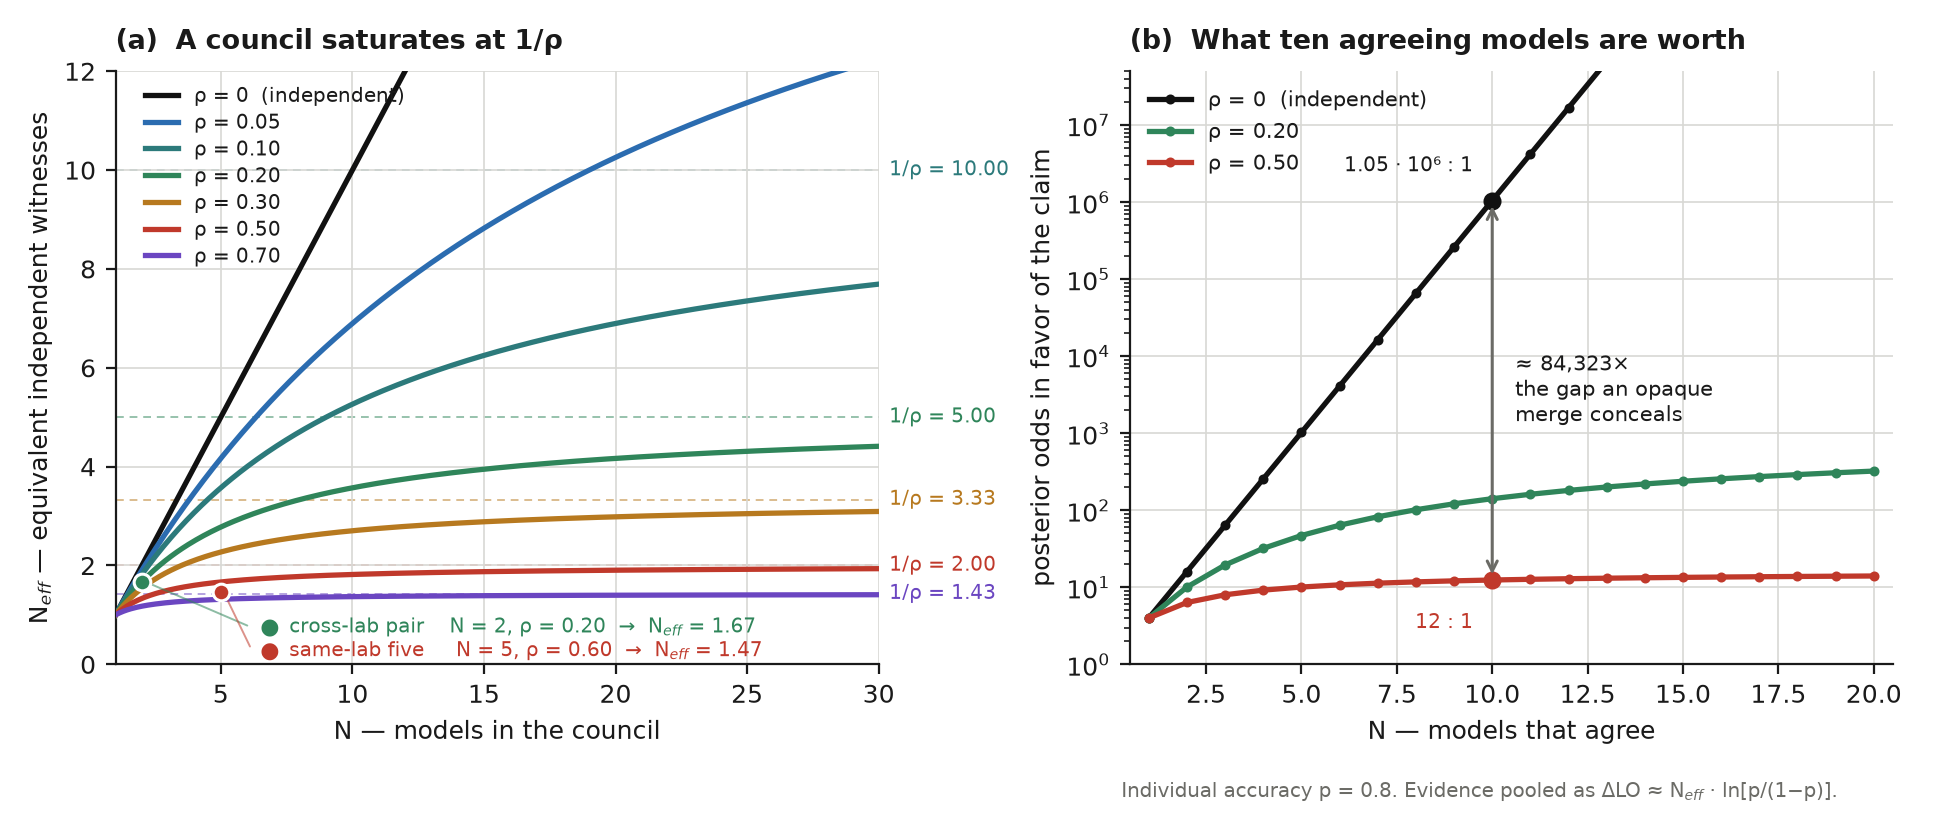
चित्र 1 — एक परिषद् 1/ρ पर संतृप्त होती है। (a) विभिन्न अंतःश्रेणी त्रुटि सहसंबंध ρ के मानों के लिए परिषद् आकार N के विरुद्ध Neff। प्रत्येक वक्र अपनी छत 1/ρ पर संतृप्त होता है, जिसे एक धराशायी अनंतस्पर्शी के रूप में खींचा जाता है; ρ = 0.20 पर एक क्रॉस-लैब जोड़ी ρ = 0.60 पर एक समान-लैब पंचक को पछाड़ देती है। (b) पश्च अंतर के रूप में वही परिणाम (धारा 5.4 में दिए गए सन्निकटन के तहत एक चित्रमय प्रॉक्सी), व्यक्तिगत सटीकता p = 0.8 के साथ और साक्ष्य को ΔLO ≈ Neff · ln[p/(1−p)] के रूप में संयोजित किया गया है। दस स्वतंत्र सहमत मॉडल लगभग दस लाख से एक तक के अंतर देते हैं; दस मॉडल ρ = 0.5 पर सहसंबद्ध बारह से एक देते हैं।
व्यावहारिक परिणाम इस अंतर्ज्ञान के विरुद्ध चलता है कि आपको बस अधिक मॉडल मांगने चाहिए। एक बार जब परिषद् 1/ρ से बड़ी हो जाती है, तो ρ को आधा करना N को दोगुना करने से बेहतर है। वह परिणाम कोहली (2026) का उतना ही है जितना किसी और का, और उनका पैनल यह अंकगणित क्षेत्र में देखा गया है: नौ न्यायाधीश लगभग दो प्रभावी वोटों के बराबर हैं जो ρ ≈ 0.44 के अनुरूप है। ρ को आधा करना N को दोगुना करने से बेहतर है, और नीचे दो तुलनाएं धारा 6 पर ध्यान केंद्रित करती हैं।
विभिन्न प्रयोगशालाओं से दो मॉडल ρ ≈ 0.2 पर ≈ 1.67 देते हैं, जबकि एक प्रयोगशाला या वंशावली से पांच ρ ≈ 0.6 पर 5/(1 + 4·0.6) ≈ 1.47 देते हैं, इसलिए क्रॉस-प्रयोगशाला जोड़ी पांच से अधिक वजन ले जाती है।
चौड़ाई भी तीव्र घटते प्रतिफल से ग्रस्त है जहां विविधता नहीं है: तालिका 2 की एक पंक्ति के साथ आंदोलन जल्दी संतृप्त होता है, जबकि एक स्तंभ के साथ आंदोलन की कोई सीमा नहीं है।
यह विशिष्ट वंशावली के पार एक परिषद् को समान रूप से रचना करने का विश्लेषणात्मक आधार है न कि गणना को अधिकतम करने के लिए। पांच मॉडल जो सहमत हैं क्योंकि वे एक ही कोष पढ़ते हैं, तीन से कमजोर साक्ष्य हैं जो वास्तव में विचलित होते हैं।
5.4 लॉग-अंतर में
यदि p सटीकता वाला एक स्वतंत्र गवाह लॉग-अंतर में योगदान देता है
तो N सहसंबद्ध मॉडलों के बीच समझौता लगभग में योगदान देता है
N · L के बजाय। यह मेटा-विश्लेषण में सहसंबद्ध अवलोकनों का साधारण उपचार है, यहां एक सन्निकटन के रूप में उपयोग किया जाता है: यह डिजाइन-प्रभाव-समायोजित गणना को इस प्रकार मानता है जैसे कि यह स्वतंत्र गवाहों की संख्या थी, जो डिजाइन प्रभाव स्वयं स्थापित नहीं करता है। चित्र 1 का पैनल (b) इसे प्लॉट करता है। p = 0.8 पर, इसलिए L ≈ 1.386 nats:
- दस स्वतंत्र गवाह ΔLO ≈ 13.86 nats और लगभग 1.05·10⁶ : 1 के पश्च अंतर देते हैं;
- दस मॉडल ρ = 0.5 पर, इसलिए ≈ 1.82, ΔLO ≈ 2.52 nats और लगभग 12 : 1 के पश्च अंतर देते हैं।
अनुपात लगभग 8.4·10⁴ है। यह कारक है कि एक अपारदर्शी विलय पाठक को अनुर्जित आत्मविश्वास के रूप में प्रस्तुत करता है, और यह है कि रसीद क्यों मौजूद है और क्यों भार-वहन तथ्य चिह्नित हैं। दस्तावेज़ को यह कहना है कि पाठक के सामने समझौता 10⁶ : 1 या 12 : 1 के लायक है, क्योंकि पृष्ठ पर दोनों समान हैं।
5.5 मान्यताएं और अनुमान
मॉडल सरल है और इसकी मान्यताएं तदनुसार मजबूत हैं। यह निम्नलिखित पर निर्भर करता है।
ρ को जोड़ी भर में समान के रूप में माना जाता है। व्यवहार में यह ब्लॉक-संरचित है, क्योंकि एक प्रयोगशाला से मॉडल एक दूसरे के साथ अधिक दृढ़ता से सहसंबद्ध होते हैं बनाय दूसरी जगह के मॉडलों के साथ। एक जोड़ीदार औसत बेहतर होगा और एक ब्लॉक संरचना बेहतर होगी। एक ब्लॉक संरचना के तहत समान सूत्र एक आशावादी देता है और सच्ची छत तालिकाएं दिखाती हैं उससे कम बैठती है।
ρ को प्रश्नों में भी स्थिर के रूप में माना जाता है, जब यह स्पष्ट रूप से डोमेन-आश्रित है। एक विशेषज्ञता विषय पर एक उपलब्ध स्रोत के साथ यह एक तक पहुंचता है। एक समृद्ध बहुभाषी साहित्य वाले प्रश्न पर यह बहुत कम है।
दावों को बाइनरी के रूप में माना जाता है, जबकि वास्तविक उत्तर गद्य हैं, और गद्य को तुलनीय बाइनरी दावों में कम करना अपने आप में एक शोरगुल ऑपरेशन है। सटीकता p को मॉडलों में एकसमान के रूप में माना जाता है, जो यह नहीं है।
ρ फिर भी मापने योग्य है। ज्ञात जमीनी सत्य के साथ Q लेबल किए गए बाइनरी दावों को देखते हुए और परिणामी त्रुटि मैट्रिक्स e_iq i = 1…N और q = 1…Q के लिए, अंतःश्रेणी सहसंबंध सामान्य विश्लेषण-विचरण पथ द्वारा अनुसरण करता है, औसत जोड़ीदार त्रुटि सहसंप्रसरण के अनुपात के रूप में मतलब त्रुटि विचरण के लिए:
ρ का अनुमान प्रयोगशालाओं के भीतर और उनके बीच अलग से लगाने से मोनोकल्चर की लागत के लिए एक संख्या मिलती है (Kleinberg & Raghavan, 2021; Bommasani et al., 2022)। क्रमिक मॉडल पीढ़ियों के दौरान इसे बदलते देखना जनरेट किए गए डेटा पर प्रशिक्षण की लागत के लिए भी यही करता है (Shumailov et al., 2024)।
5.6 यह प्रोटोकॉल में क्या परिवर्तन करता है
एक बार सूत्र स्वीकार किए जाने के बाद, खंड 4 में नियम 5 और 6, और नियम 6 जो संरचना रिपोर्टिंग का अर्थ है, अच्छी प्रथा होना बंद कर देते हैं और आवश्यक हो जाते हैं।
एक साझा स्रोत को फ़्लैग करना, नियम 6, एक एकल दावे के स्तर पर ρ का एक स्थानीय माप है। एक लेख के पाँच उद्धरण का अर्थ है कि उस दावे के लिए ρ ≈ 1 है, इसलिए ≈ 1।
सहमत मॉडलों के बीच रिश्तेदारी की रिपोर्टिंग संरचना के स्तर पर यही माप है।
असहमति को संरक्षित करना, नियम 5, एकमात्र साक्ष्य है जो एक पाठक को कभी मिलता है कि ρ एक से कम है। एक विचलन दिखाता है कि संबंध कुल नहीं है, और यह जानकारीपूर्ण है कि कौन सी पक्ष सही निकले। असहमति एक मापने वाला यंत्र है न कि दूर किए जाने वाली बाधा। एक परिषद जो हमेशा सहमत होती है, पाठक को दुनिया के बारे में कुछ नहीं बताती है, केवल यह कि ρ ≈ 1 है और परिषद अनावश्यक थी।
6. तीन स्तर, एक प्रोटोकॉल
प्रोटोकॉल तीन स्तरों पर चलता है, जो पहुंच वक्र पर तीन बिंदु हैं न कि तीन संस्करण या एक फनल। एक उपयोगकर्ता एक सप्ताह में विभिन्न प्रश्नों के लिए सभी तीन का उपयोग कर सकता है।
6.1 स्तर 0, निःशुल्क पथ
उपयोगकर्ता साइटें खोलता है, प्रश्न पूछता है, प्रत्येक उत्तर की प्रतिलिपि बनाता है, और उन्हें मर्ज प्रॉम्प्ट के तहत किसी भी चैट मॉडल में पेस्ट करता है। कोई लागत नहीं, कोई इंस्टॉलेशन नहीं, कोई भी डिवाइस जिसमें ब्राउज़र है जिसमें फोन भी शामिल है, और एक परिषद जितनी बड़ी है जितनी खातों का समूह उपयोगकर्ता साइन इन है। विलंबता दस से पंद्रह मिनट है, अधिकांश प्रतीक्षा में, और गहरे-अनुसंधान मोड में अधिक।
यह स्तर सख्त अर्थ में संदर्भ कार्यान्वयन है। यह एकमात्र है जहां उपयोगकर्ता प्रत्येक कच्चा उत्तर रखता है, जो इसे एकमात्र बनाता है जहां मर्ज की निष्ठा को सीधे आंका जा सकता है।
6.2 स्तर 1, मोबाइल स्तर
होम स्क्रीन पर एक आइकन और शॉर्टकट लाइब्रेरी में एक प्रविष्टि। टैप करें, प्रश्न टाइप करें, मेनू से एक मोड चुनें, और लगभग एक मिनट बाद तैयार उत्तर स्क्रीन पर और क्लिपबोर्ड में होता है। वॉयस लॉन्च काम करता है।
यह तंत्र न तो ब्राउज़र है और न ही एपीआई। यह विक्रेताओं के स्वयं के ऑपरेटिंग-सिस्टम ऐप इरादों को डिवाइस पर पहले से इंस्टॉल किए गए अनुप्रयोगों और सदस्यताओं के विरुद्ध जंजीरबद्ध करता है। लागत सदस्यता संदेशों में दर्शाई गई है, टोकन में नहीं, जो मोड डिज़ाइन को स्वाद के बजाय संसाधन-आवंटन निर्णय बनाता है। वैकल्पिक मोबाइल प्लेटफॉर्म के पास इरादा-आधारित स्वचालन के माध्यम से एक समकक्ष है।
तालिका 3 तीन मोड को निर्धारित करती है। ये पाइपलाइन के चरण नहीं बल्कि बराबर समानांतर कार्य हैं: एक मोड प्रति आह्वान चलता है।
तालिका 3. मोबाइल स्तर के तीन मोड
| मोड | श्रृंखला | संदेश | उपयोग |
|---|---|---|---|
| पोल | दोनों मॉडल स्वतंत्र रूप से उत्तर देते हैं; उत्तर पक्ष दर पक्ष दिखाए जाते हैं | 1 + 1 | कच्चे विचलन को सीधे देखना |
| आलोचना | मॉडल A उत्तर देता है; मॉडल B दूसरे विशेषज्ञ के रूप में सत्यापित करता है और एक सुधारा हुआ अंतिम उत्तर जारी करता है | 1 + 1 | रोजमर्रा का डिफ़ॉल्ट: दो-संदेश लागत पर एक जांचा हुआ उत्तर |
| संश्लेषण | दोनों अंधे में उत्तर देते हैं; एक आगे की कॉल मध्यस्थता करती है और विलय करती है, विचलन को चिह्नित करती है | 1 + 2 | प्रश्न जो महत्वपूर्ण हैं |
आलोचना मोड को संक्षेप में अध्यक्ष कहा जाता था। तीन मोड बराबर समानांतर कार्य हैं और आलोचना सहकर्मी समीक्षा है: एक विशेषज्ञ उत्तर देता है, एक दूसरा सत्यापित करता है। अध्यक्ष की भूमिका पहले से ही संश्लेषण के अंदर मध्यस्थ के रूप में मौजूद है, और सहकर्मी समीक्षा को एकत्रीकरण के नाम से पुकारना मोड को गलत तरीके से वर्णित करता।
एक फोन वह जगह नहीं है जहां चौड़ाई सस्ती है, जो यहां N = 2 को ठीक करता है। प्रत्येक कॉल सामान्य उपयोग के समान कोटा से एक संदेश खर्च करता है, अनुप्रयोग क्रम में अग्रभाग में आते हैं, और उपयोगकर्ता वहां प्रतीक्षा कर रहा है। धारा 5.3 दिखाती है कि यह जोड़ी क्या मूल्य की है: दोनों मॉडल विभिन्न प्रयोगशालाओं से आते हैं, N = 2 पर उपलब्ध ρ-न्यूनतमकारी विकल्प, और उन चित्रात्मक सहसंबंधों पर ρ ≈ 0.2 पर एक क्रॉस-लैब जोड़ी समान-वंशावली पाँच को ρ ≈ 0.6 पर आउटस्कोर करती है, इसलिए परिषद के लिए अधिकांश चीजें एक टैप और एक मिनट पर बचती हैं।
6.3 स्तर 2, एजेंट पथ
एक मॉडल जो ब्राउज़र चला सकता है नामित साइटों को ब्राउज़र सत्र में खोलता है जो उपयोगकर्ता साइन इन है, प्रश्न जमा करता है, प्रतीक्षा करता है, प्रत्येक उत्तर को एक फाइल में सहेजता है, और दस्तावेज़ बनाता है। परिषद दस या अधिक तक विस्तारित होती है, गहरे-अनुसंधान मोड उपलब्ध हैं, और एक दिनांकित फ़ोल्डर हर मूल चलने से बचता है। लागत एजेंट के लिए एक छोटी मासिक सदस्यता और कोई भी भुगतान किए गए स्तर है जो उपयोगकर्ता के पास पहले से है। विलंबता पाँच से तीस मिनट है।
यह स्तर उपयोगकर्ता को कुछ देता है जो उपयोग के मामले से अधिक रहता है, अर्थात् एक मॉडल जो उनके कंप्यूटर पर कार्य करता है न कि उन्हें कार्य बताता है। एक मॉडल जो उत्तर देता है और एक मॉडल जो कार्य करता है के बीच का अंतर एक मॉडल और दस के बीच के अंतर से बड़ा है।
6.4 विलंबता–चौड़ाई सीमांत
तालिका 4. तीन स्तरों में विलंबता–चौड़ाई सीमांत। प्रभावी गवाह गिनती ρ = 0.2 मानती है
| स्तर 0, निःशुल्क | स्तर 1, मोबाइल | स्तर 2, एजेंट | |
|---|---|---|---|
| कौन क्लिक करता है | उपयोगकर्ता | ऑपरेटिंग सिस्टम | एक ब्राउज़र एजेंट |
| परिषद आकार N | असीमित | 2 | ~10 तक |
| ρ = 0.2 पर | ~4–5 तक | 1.67 | ~3.6 |
| उत्तर तक समय | 10–15 मिनट | ~1 मिनट | 5–30 मिनट |
| सीमांत लागत | शून्य | सदस्यता संदेश | एजेंट सदस्यता |
| स्थापन | कोई नहीं | एक साइन किया शॉर्टकट | एजेंट एप्लिकेशन |
| गहरे-अनुसंधान मोड | हाँ, मैनुअली | नहीं | हाँ |
| कच्चे उत्तर दृश्यमान | हाँ | केवल पोल मोड | हाँ, फाइलों में सहेजा गया |
| डिवाइस | कोई भी | फोन | कंप्यूटर |
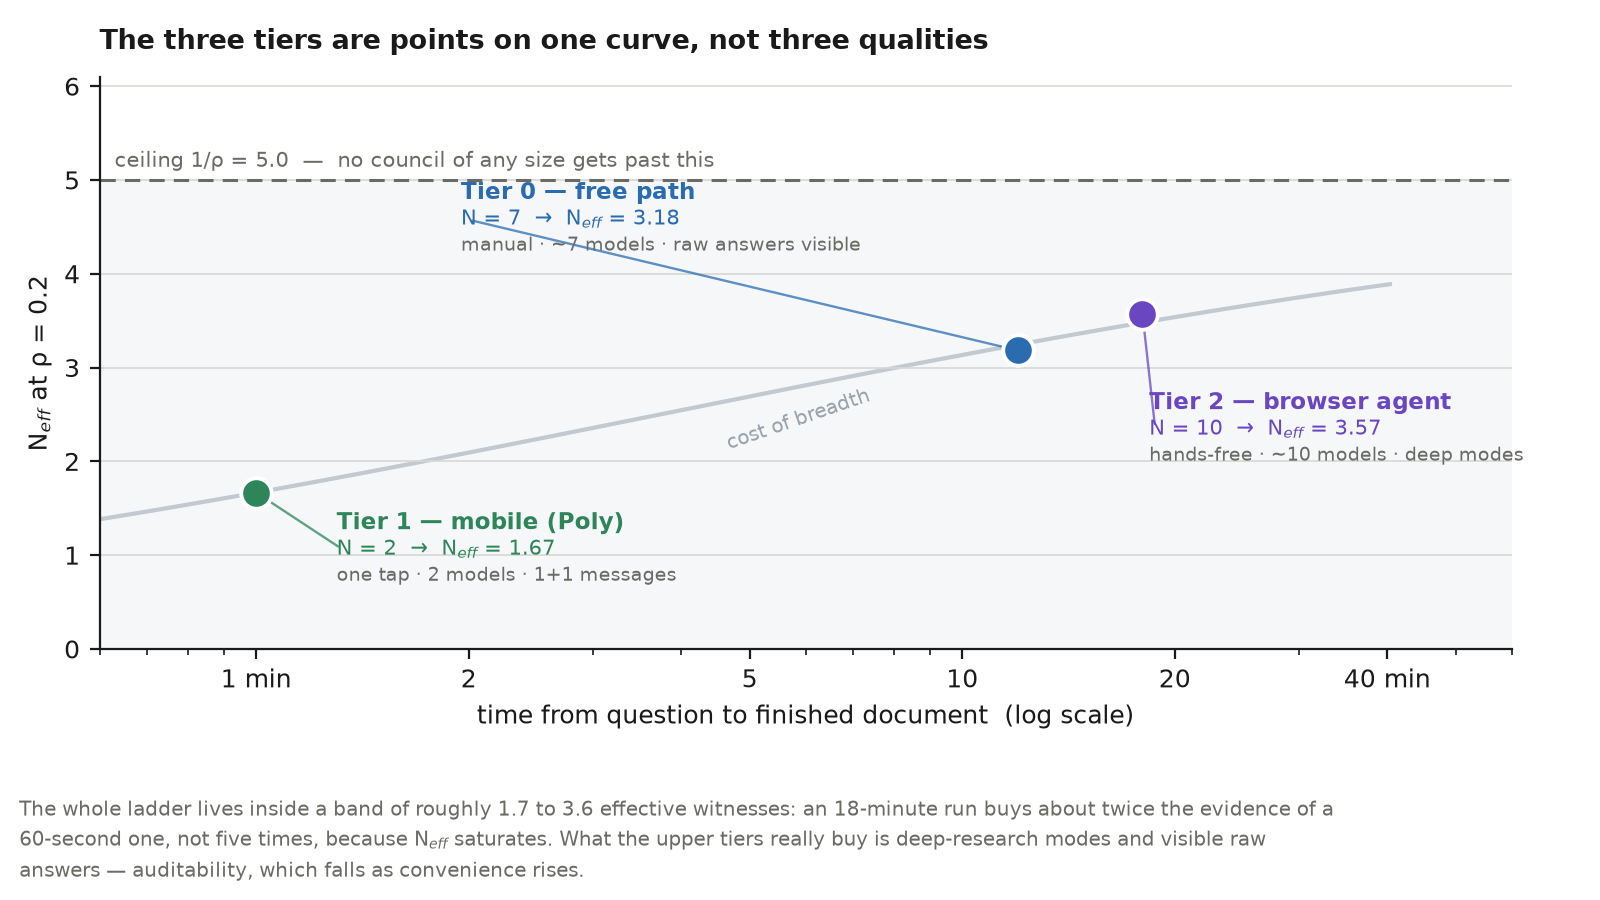
चित्र 3 — विलंबता–चौड़ाई सीमांत। तीन स्तर एक समाप्त दस्तावेज़ के समय के विरुद्ध प्लॉट किए गए, Neff ρ = 0.2 पर परिकलित। क्योंकि Neff 1/ρ पर संतृप्त होता है, दो स्वचालित स्तर लगभग 1.7 से 3.6 प्रभावी गवाहों के बैंड में बैठते हैं: एक अठारह मिनट का रन साठ सेकंड के लगभग दोगुना सबूत नहीं खरीदता। क्या ऊपरी स्तर अतिरिक्त रूप से खरीदते हैं वह गहरे-अनुसंधान मोड और दृश्यमान कच्चे उत्तर हैं।
धारा 5 से इंजीनियरिंग से नहीं बल्कि दो अवलोकन अनुसरण करते हैं।
ये स्तर गुणवत्ता के बजाय चौड़ाई की लागत के आधार पर क्रमित हैं। स्तर 1 वक्र पर उस बिंदु पर स्थित है जहाँ उत्तर किसी दुकान में खड़े व्यक्ति के ध्यान अवधि के अंदर आता है। साक्ष्य के संदर्भ में स्तरों के बीच का अंतर मॉडल गणना में अंतर से बहुत छोटा है, क्योंकि 1/ρ पर संतृप्त हो जाता है, और यही वह है जो सीढ़ी को समझौतों के एक समूह के बजाय सुसंगत बनाता है।
सीडि के साथ-साथ सुविधा की दिशा के विपरीत दिशा में नियंत्रणीयता गिरती है। स्तर 0 पर उपयोगकर्ता के पास हर कच्चा उत्तर है। स्तर 2 पर एजेंट उन्हें फ़ाइलों में लिखता है, इसलिए वे मौजूद हैं लेकिन शायद ही कभी खोली जाती हैं। स्तर 1 पर केवल पोल मोड उन्हें बिल्कुल भी उजागर करता है, क्योंकि समीक्षा और संश्लेषण एक समाप्त पाठ देते हैं। मोबाइल स्तर इस एक संबंध में कमजोर है, और यह समस्या को दोहराता है जिससे पत्र खुलता है: स्तर जितना अधिक सुविधाजनक होता है, उपयोगकर्ता उतना अधिक जाँच करने के बजाय विश्वास कर रहा है। संश्लेषण आउटपुट में विचलन चिह्नों को रखना एक प्रस्तुतिकरण की सूक्ष्मता नहीं है। यह स्तर की शेष नियंत्रणीयता है।
6.5 अंधा-समानांतर और सूचित-अनुक्रमिक निष्कर्षण
मोबाइल स्तर ने एक अक्ष को खोल दिया है जिसे अन्य स्तर निहित छोड़ रहे थे, और यह सिस्टम में सबसे महत्वपूर्ण डिजाइन प्रश्न है। क्या दूसरा मॉडल पहले मॉडल का उत्तर देखता है? चित्र 4 दोनों व्यवस्थाओं को सेट करता है कि प्रत्येक क्या खरीदता है और इसकी कीमत क्या है।
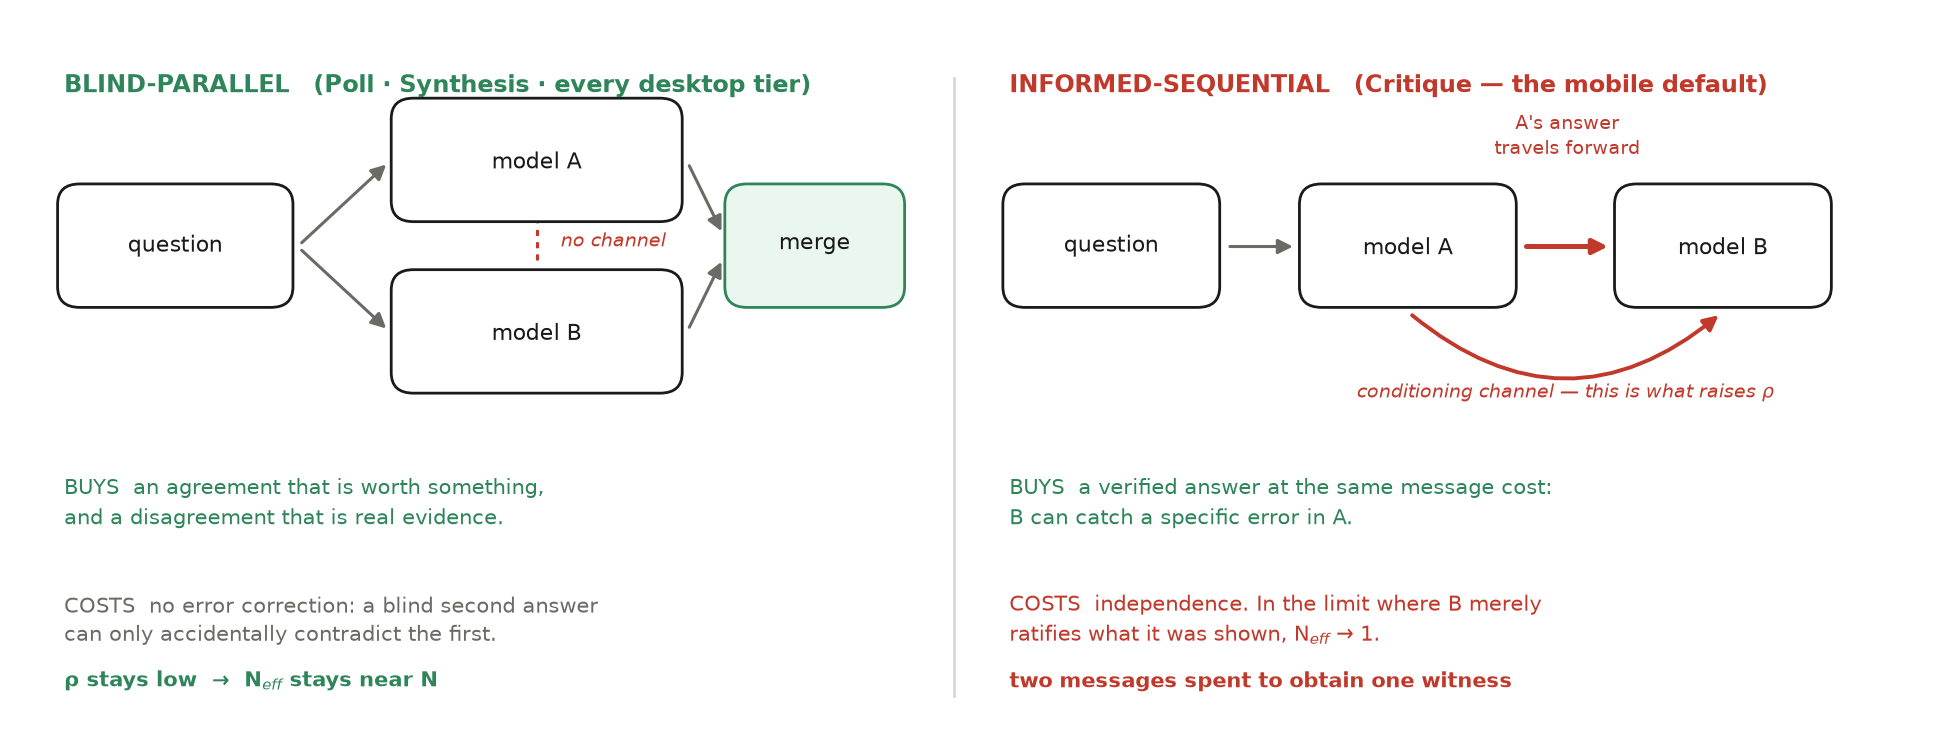
चित्र 4 — अंधा-समानांतर और सूचित-अनुक्रमिक निष्कर्षण। दोनों व्यवस्थाओं की तुलना। अंधा-समानांतर निष्कर्षण के तहत मॉडल के बीच कोई चैनल नहीं है, इसलिए सहमति साक्ष्य वजन रखती है और असहमति वास्तविक साक्ष्य है, लेकिन कोई त्रुटि सुधार नहीं होता है। सूचित-अनुक्रमिक निष्कर्षण में पहला उत्तर दूसरे मॉडल के प्रॉम्प्ट के अंदर जाता है: दूसरा एक विशिष्ट त्रुटि को ठीक कर सकता है, लेकिन कंडीशनिंग चैनल ρ को बढ़ाता है, और सीमा में जहाँ यह जो दिखाया गया था उसे पुष्टि करता है, Neff एक तक पहुँचता है।
पोल और संश्लेषण अंधा-समानांतर हैं। दोनों मॉडल कच्चे प्रश्न का उत्तर देते हैं और न ही एक-दूसरे को देखा है। यहाँ स्वतंत्रता निर्देशित के बजाय आर्किटेक्चरल है: प्रत्येक ऐप-इरादा कॉल कोई मेमोरी नहीं के साथ एक नया सत्र खोलता है, और हर प्रॉम्प्ट स्व-निहित है, प्रश्न और कोई भी पूर्ववर्ती उत्तर अपने अंदर ले जाता है। कोई चैनल मौजूद नहीं है जिसके माध्यम से एक मॉडल दूसरे को प्रभावित कर सके।
समीक्षा सूचित-अनुक्रमिक है। दूसरा मॉडल प्रश्न के साथ पहले मॉडल का उत्तर प्राप्त करता है और उसे तथ्यात्मक त्रुटियों के लिए जाँचने, जो वह भूल गया था उसे जोड़ने और एक सुधरा हुआ अंतिम उत्तर जारी करने के लिए कहा जाता है।
सूचित व्यवस्था पहली नज़र में ऐसी दिखती है जैसे वह सरलता से अंधी व्यवस्था पर प्रभुत्व जमाती है: दूसरा मॉडल वह सब कुछ करता है जो एक अंधा दूसरा मॉडल करता है और पहले उत्तर को भी एक ही लागत पर जाँचता है। यह उपस्थिति भ्रामक है, क्योंकि दोनों व्यवस्थाएँ विभिन्न वस्तुओं को खरीदती हैं और सूचित व्यवस्था स्वतंत्रता में भुगतान करती है।
सूचित-अनुक्रमिक निष्कर्षण त्रुटि सुधार खरीदता है। एक दूसरा मॉडल जो पहले का उत्तर देख सकता है, उसमें एक विशिष्ट गलती को पकड़ सकता है, जबकि एक अंधा दूसरा उत्तर केवल दुर्घटना से इसका विरोध कर सकता है। यह बहु-एजेंट बहस परिणामों (Du et al., 2023) के पीछे की व्यवस्था है, और यही है जो समीक्षा को रोज़मर्रा की डिफ़ॉल्ट बनाता है: पोल के समान दो-संदेश लागत पर यह दो अप्रमाणित लोगों के बजाय एक सत्यापित उत्तर देता है।
यह स्वतंत्रता में भुगतान करता है, अर्थात् ρ में। दूसरे उत्तर को पहले पर कंडीशन करना वह सामाजिक प्रभाव है जो लोरेंज़ et al. (2011) को एक भीड़ के प्रसार को संकीर्ण करते हुए मिला बिना इसे सत्य की ओर बढ़ाए। एक लंगर वाला आलोचक उस उत्तर से अधिक सहमत होता है जो वह था बजाय एक लंगर रहित साथी से, इसलिए परिणामी सहमति वह नहीं है जो दिखता है। सीमा बताना आसान है और असहज है: सीमा में जहाँ आलोचक जो दिखाया गया था उसे पुष्टि करता है, → 1, और दौड़ ने एक गवाह प्राप्त करने के लिए दो संदेश खर्च किए हैं।
यह वह एक जगह है जहाँ खंड 5 एक सलाह बन जाती है जिस पर एक उपयोगकर्ता कार्य कर सकता है। सूचित-अनुक्रमिक निष्कर्षण एक उत्तर की जाँच के लिए सही विकल्प है, और अंधा-समानांतर निष्कर्षण आवश्यक है यदि प्रश्न यह है कि क्या असहमति बिल्कुल मौजूद है। एक असहमति जो दूसरे मॉडल के पहले को पढ़ने के बाद सामने आती है साक्ष्य है, जबकि एक असहमति जो सामने आने में विफल रहती है सहमति का साक्ष्य नहीं है, क्योंकि चैनल जो इसे पैदा किया होता वह बंद था।
संश्लेषण इसलिए समीक्षा का एक गहन संस्करण के बजाय एक अलग मोड है। संश्लेषण अधिक गहन नहीं है। यह अंधा है, जो एक अलग संपत्ति है, और यह एकमात्र मोबाइल मोड है जिसकी सहमति किसी भी साक्ष्य वजन रखती है। इसका अतिरिक्त संदेश आर्बिटर खरीदता है, लेकिन इसका मूल्य इस तथ्य से आता है कि दोनों मध्यस्थ उत्तर कभी नहीं मिले।
स्तर 0 और 2 निर्माण के आधार पर अंधा-समानांतर हैं, क्योंकि हर मॉडल को अपने सत्र में कच्चा प्रश्न मिलता है और लंगर-और-समृद्ध विलय बाद में होता है। लंगर-और-समृद्ध सबसे अच्छा समझा जाता है एक सूचित चरण के रूप में जो एक पूरी तरह से अंधे के बाद रखा जाता है। क्रम स्वतंत्रता लागत का भुगतान किए बिना त्रुटि सुधार प्राप्त करता है, और इसके बजाय विलंबता में भुगतान करता है। मोबाइल स्तर अपने डिफ़ॉल्ट मोड में उस क्रमकरण को वहन नहीं कर सकता है, इसलिए trade-off वहाँ दिखाई देता है और कहीं और नहीं।
6.6 API क्यों नहीं
परिवहन का विकल्प तय करता है कि सिस्टम का उपयोग कौन कर सकता है, इसलिए यह विवरण नहीं है।
एक API प्रजनन क्षमता देता है, अर्थात् एक ज्ञात मॉडल संस्करण, तापमान और बीज; प्रोग्राम्मेटिक विश्वसनीयता; कोई सेवा-की-शर्तें प्रश्न नहीं; और पैमाने पर कम लागत। ब्राउज़र और ऐप इरादे कोई स्थापना नहीं, कोई कुंजियाँ नहीं, कोई अतिरिक्त बिलिंग संबंध नहीं, फ़ोन संगतता, मुक्त स्तरों पर संचालन, गहन-अनुसंधान मोड तक पहुँच जिनके पास अक्सर कोई API समकक्ष नहीं है, और उपयोगकर्ता पहले से ही भुगतान करने वाली सदस्यताओं का उपयोग।
प्रोटोकॉल दूसरे को चुनता है। API कुंजियाँ रखने वाला और टर्मिनल में सहज कोई भी व्यक्ति Karpathy के llm-council जैसे API-आधारित परिषद् से बेहतर सेवा प्राप्त करता है (Karpathy, 2025)। यहाँ संबोधित जनसंख्या वह है जिसके लिए दूसरी सदस्यता एक महत्वपूर्ण निर्णय है, या जो अपने द्वारा उपयोग की जाने वाली मशीन पर सॉफ्टवेयर स्थापित नहीं कर सकते, या जिनकी इंटरनेट पहुंच एक फोन है। उन उपयोगकर्ताओं के लिए यह प्रशंसनीय रूप से विचार के पहले प्राप्य कार्यान्वयन है, क्योंकि इसे कोई कुंजियाँ, कोई स्थापना और कोई दूसरा बिल नहीं चाहिए, और प्राप्य होना यह है कि प्रणाली एक उत्पाद की बजाय एक पाठ फाइल क्यों है।
लागत अपुनरुत्पादनीयता है, और यह अधिक है। किसी वेब इंटरफ़ेस या उपभोक्ता अनुप्रयोग के पीछे का मॉडल संस्करण अज्ञात है और सूचना के बिना बदलता है। तापमान नियंत्रणीय नहीं है, सेवा का सिस्टम प्रॉम्प्ट छिपा है, और खाता व्यक्तिगतकरण उत्तर को प्रभावित करता है। एक रन को सटीक रूप से दोहराया नहीं जा सकता, अगले महीने या किसी अन्य मशीन पर। यह एक व्यक्तिगत निर्णय साधन के लिए स्वीकार्य है न कि वैज्ञानिक माप के लिए। खंड 9 तदनुसार कच्चे उत्तरों को संग्रहीत किए जाने और निष्कर्षों को मॉडल के बारे में दावों की बजाय प्रोटोकॉल के बारे में दावों के रूप में तैयार किए जाने की आवश्यकता है।
6.7 सुरक्षा
मुक्त पथ कोई स्वचालन-विशिष्ट हमले की सतह नहीं जोड़ता है, क्योंकि उपयोगकर्ता साइटों को सीधे संचालित कर रहा है, हालांकि ब्राउज़र और स्वयं खातों के साधारण जोखिम बने रहते हैं। निम्नलिखित एजेंट पथ से संबंधित है।
मुख्य जोखिम अप्रत्यक्ष प्रॉम्प्ट इंजेक्शन है (OWASP, 2025)। प्रत्येक संगृहीत उत्तर अविश्वस्त इनपुट है, क्योंकि एक मॉडल का आउटपुट ऑर्केस्ट्रेटर को संबोधित निर्देश ले सकता है। स्ट्रिंग फ़िल्टरिंग एक बचाव नहीं है: यह वैध सामग्री को नुकसान पहुंचाता है और कुछ भी गारंटी नहीं देता है।
रचनात्मक उत्तर प्राधिकार पर एक सीमा है। संगृहीत पाठ को उद्धृत डेटा के रूप में माना जाता है न कि आदेशों के रूप में। यदि कोई अपस्ट्रीम मॉडल एक टूल-कॉल ब्लॉक उत्सर्जित करता है या एक इंजेक्ट किए गए निर्देश को पुनः प्रस्तुत करता है, तो ऑर्केस्ट्रेटर इसे एक उद्धरण के रूप में विलय करता है और कुछ भी निष्पादित नहीं करता है।
नियम-की-दो फ्रेमिंग के तहत (Meta, 2025), एक एजेंट खतरनाक हो जाता है जब वह इन तीनों को रखता है: अविश्वस्त इनपुट संसाधित करना, संवेदनशील डेटा या प्रणालियों में पहुंच, और बाहरी स्थिति को बदलने या बाहरी रूप से संचार करने की शक्ति। यहां वर्णित एजेंट पहले दोनों को रखता है और तीसरे को एक क्षमता के रूप में संकीर्ण रखता है। इसकी एकमात्र क्रिया जो उपयोगकर्ता की मशीन छोड़ती है वह उपयोगकर्ता के प्रश्न को उपयोगकर्ता द्वारा नामित साइटों को भेजना है; जो यह लिखता है वह उस मशीन पर नामित आउटपुट फाइलें हैं। यह क्रय नहीं करता, प्रकाशित नहीं करता, हटाता नहीं है, सेटिंग्स को बदलता नहीं है, श्रेणियों में प्रवेश नहीं करता या चुनौती-प्रतिक्रिया परीक्षा हल नहीं करता है। अधिक महत्वपूर्ण बात यह है कि जो कुछ भी यह पढ़ता है वह एक नया बाहरी क्रिया नहीं बन सकता: कोई भी संगृहीत उत्तर एक नया चरण या एक नया गंतव्य नहीं ट्रिगर कर सकता है। अविश्वस्त इनपुट और बाहरी क्रिया को अलग रखा जाता है: एकमात्र बाहरी संचार उपयोगकर्ता का अपना प्रश्न है, किसी भी संगृहीत उत्तर को पढ़ने से पहले भेजा गया। एक जहरीले अपस्ट्रीम उत्तर के पास इसलिए प्रचार करने के लिए कहीं नहीं है, और दस्तावेज़ के अंदर यथार्थवादी सबसे बुरी स्थिति एक गलत लाइन है, जिससे प्रवंचन लेबल पकड़ने में मदद करते हैं; सत्र-स्तरीय जोखिमों को नीचे दिए गए परिचालन नियमों द्वारा संबोधित किया जाता है।
यह क्षमता-अलगाववाद साहित्य (Debenedetti et al., 2025) का अनुसरण करता है और बताता है कि शून्य-क्लिक एजेंट शोषण जैसे EchoLeak (CVE-2025-32711; MITRE, 2025) कहीं और क्यों सफल होते हैं: वहाँ, सभी तीन क्षमताएँ एक दूसरे में जुड़ी होती हैं।
परिचालन नियम एक शीर्षहीन की बजाय एक दृश्य ब्राउज़र विंडो हैं, एक सत्र जिसमें उपयोगकर्ता एक अलग ब्राउज़र प्रोफ़ाइल के अंदर साइन इन किए हुए हैं, कोई भंडारण या श्रेणी प्रविष्टि नहीं, और कोई चुनौती-प्रतिक्रिया समाधान, फिंगरप्रिंट स्पूफिंग, प्रॉक्सी रोटेशन या खाता पूलिंग नहीं। हाल के ब्राउज़र संस्करण प्रोटोकॉल-आधारित कुकी चोरी के विरुद्ध प्रतिरक्षा के रूप में डिफ़ॉल्ट प्रोफ़ाइल पर दूरस्थ-डीबगिंग फ्लैग को अनदेखा करते हैं, इसलिए स्वचालन को एक अलग प्रोफ़ाइल निर्देशिका का उपयोग करना होगा। अलग निर्देशिका घर्षण है और यह भी सुरक्षित व्यवस्था है। एक उपकरण जो किसी उपयोगकर्ता के रोज़मर्रा के ब्राउज़र सत्र को चुप्पी से संलग्न करने का दावा करता है वह संदेह का पात्र है।
यह जो अपने आप में आता है वह एक प्रॉम्प्ट-स्तरीय बाधा और एक जानबूझकर छोटी उपकरण सतह है, एक तकनीकी सैंडबॉक्स नहीं। यह विस्फोट त्रिज्या को कम करता है। यह साबित नहीं करता कि त्रिज्या शून्य है।
मोबाइल स्तर की धमकी सतह अलग है और छोटी है। कॉल विक्रेता द्वारा प्रकाशित ऑपरेटिंग सिस्टम आशय के माध्यम से एक संचालित ब्राउज़र की बजाय जाते हैं, डिवाइस को क्रमानुसार अनुप्रयोगों में अग्रभाग में प्रवेश करने के साथ अनलॉक किया जाना चाहिए, और कुछ भी पृष्ठभूमि में नहीं चलता है। यह एक शेड्यूल किया गया स्वचालन नहीं है जो उपयोगकर्ता दबाता है। प्रॉम्प्ट-इंजेक्शन चिंता अभी भी आलोचना और संश्लेषण में लागू होती है, जहाँ एक मॉडल का आउटपुट एक अन्य मॉडल के प्रॉम्प्ट के अंदर जाता है, और इसे उसी तरीके से संभाला जाता है: संगृहीत उत्तर उद्धृत सामग्री है, और प्राप्त करने वाले मॉडल के पास इसके लिए कोई क्रिया उपलब्ध नहीं है।
7. प्रायोगिक खंड
7.1 कोल्ड-स्टार्ट जांच
उपयोगकर्ता की पहली कार्रवाई सिस्टम को किसी मॉडल के हाथ में सौंपना है। यदि वह मॉडल इनकार करता है, या कुछ ऐसा लौटाता है जो केवल परिणाम जैसा दिखता है, तो उपयोगकर्ता चला जाता है और कभी इसकी रिपोर्ट नहीं करता। यह वह क्षण है जिसे कोल्ड-स्टार्ट जांच मापती है, और इसे स्वचालित नहीं किया जा सकता, क्योंकि इसे एक नया सत्र चाहिए जिसे समस्या का कभी सामना नहीं हुआ हो।
प्रॉम्प्ट कोई संकेत, कोई फ्रेमिंग और कोई अनुवर्ती के बिना भेजा जाता है:
इस रिपॉजिटरी से प्रश्न के लिए विधि चलाएं: बहुत कम पानी पीने के तीन सबसे बड़े जोखिम क्या हैं? विधि आपको जो कुछ करने के लिए कहती है वह करें।
तीन वातावरण हैं। A में एक एजेंट क्लोन में बैठा है जिसमें ब्राउज़र नियंत्रण जानबूझकर काट दिया गया है। B एक सामान्य चैट सत्र है जिसमें केवल फ्रंट-पेज दस्तावेज़ीकरण चिपकाया गया है, और C में एक एजेंट के पास कार्यशील ब्राउज़र नियंत्रण है।
केवल पहले उत्तर को छह बाइनरी मानदंडों पर स्कोर किया जाता है। इसे इस तरह सीमित करना जांच का पद्धति संबंधी मूल है, क्योंकि सुधारे जाने के बाद एक मॉडल क्या कहता है वह यह प्रतिनिधित्व नहीं करता कि एक अजनबी को क्या अनुभव होता।
- क्या इसने इस सत्र में उपलब्ध उपकरणों की जांच की, बजाय इसके कि यह किस प्रकार का मॉडल है, इसके बारे में तर्क दिया?
- क्या इसने एक ही संदेश में कोई अगला कदम के बिना एक नग्न इनकार से बचा?
- जहां कुछ लापता था, क्या इसने सीमा की श्रेणी की जगह विशिष्ट लापता घटक का नाम दिया?
- क्या इसने दो बार पूछे बिना एक ही उत्तर में मैनुअल पथ की पेशकश की?
- क्या उपयोगकर्ता तुरंत उत्तर पर कार्य कर सकता था?
- जहां इसने वास्तव में अलग-अलग मॉडल से उत्तर एकत्र नहीं किए, क्या इसने कुछ भी दिखाने से पहले ऐसा कहा?
मानदंड 6 बेसलाइन रन के बाद लिखा गया था और अन्य पाँच को पार करता है। एक उत्तर जो परिषद जैसा पढ़ता है लेकिन एक मॉडल से आया है, जांच को बिल्कुल विफल करता है, भले ही अच्छी तरह से निष्पादित हो, और यह अच्छी तरह से निष्पादित होगा।
7.2 बेसलाइन रन
पाँच मॉडलों को दस्तावेज़ीकरण और कोई संकेत नहीं के साथ एक सामान्य प्रश्न दिया गया। किसी के पास ब्राउज़र नियंत्रण नहीं था, इसलिए रन केवल एक चीज मापता था: एक मॉडल विधि चलाने में अक्षमता की रिपोर्ट कैसे करता है। तालिका 5 परिणामों की रिपोर्ट करती है। वहाँ मॉडलों को उत्पाद नाम के बजाय प्रयोगशाला द्वारा पहचाना जाता है, क्योंकि मुद्दा एक विफलता मोड है जो उनमें से कई साझा करते हैं, न कि एक रैंकिंग।
तालिका 5. कोल्ड-स्टार्ट जांच, बेसलाइन रन। पाँच मॉडल, कोई ब्राउज़र नियंत्रण नहीं, पहला उत्तर स्कोर किया गया
| मॉडल | विकास करने वाली कंपनी | परिणाम |
|---|---|---|
| Model G | Laboratory 1 | उत्तीर्ण। अपने स्वयं के उपकरणों की जांच की, लापता घटक का नाम दिया, कहा कि प्रश्न को कहीं नहीं भेजा गया था, दो आवश्यक विकल्पों के लिए कहा, और पहले से चेतावनी दी कि एक एकल-मॉडल दृष्टिकोण विधि का परिणाम नहीं होगा। |
| Model S | Laboratory 2 | घोषित प्रतिस्थापन के साथ उत्तीर्ण। मॉडल उत्तरों की जगह वेब स्रोतों का उपयोग किया और उन शब्दों में ऐसा कहा, जिसमें यह भी शामिल है कि यह विधि का इरादा रखने वाली परिषद की तुलना में एक छोटी और अलग तरीके से गठित परिषद थी। |
| Model H | Laboratory 2 | उत्तीर्ण। कुछ भी प्रतिस्थापित नहीं किया। प्रॉम्प्ट को उपयोगकर्ता के हाथ में सौंपा और उत्तर वापस पाने के लिए कहा। |
| Model C | Laboratory 3 | विफल। वेब अनुसंधान विधि की अपनी शब्दावली में लिखा गया, कहीं भी कोई चेतावनी नहीं। |
| Model K | Laboratory 4 | विफल। विधि की आउटपुट फाइलनाम के तहत सहेजा गया सही आकार में एक पूर्ण विलीन दस्तावेज़, मॉडल के बजाय वेब पृष्ठों से संग्रहीत, कोई चेतावनी नहीं। |
पाँच में से दो ने ऐसा दस्तावेज़ तैयार किया जिसे उपयोगकर्ता दस की परिषद के रूप में दाखिल करता। यह F5 है, देखा गया।
7.3 हस्तक्षेप और पुनः रन
हस्तक्षेप भूमिका असाइनमेंट का एक वाक्य था, जो मॉडल को बताता था कि यह इस रन के लिए ऑपरेटर है और एजेंट निर्देश फाइल पढ़नी चाहिए। यह दस्तावेज़ीकरण की पहली स्क्रीन पर और मॉडलों को संबोधित एक अलग फाइल में चला गया। तालिका 6 पर्यावरण B में पुनः रन की रिपोर्ट करती है।
तालिका 6. भूमिका-असाइनमेंट हस्तक्षेप के बाद पर्यावरण B में कोल्ड-स्टार्ट जांच। खंड 7.1 में क्रमांकित मानदंड; (web) विक्रेताओं के वेब इंटरफेस के माध्यम से किए गए रन को चिह्नित करता है, और C′ उस सेटिंग में Laboratory 3 का मॉडल है
| मॉडल | 1 | 2 | 3 | 4 | 5 | 6 | निर्णय |
|---|---|---|---|---|---|---|---|
| Model C′ (web), Laboratory 3 | हाँ | हाँ | हाँ | हाँ | हाँ | हाँ | उत्तीर्ण |
| Model P (web), Laboratory 5 | हाँ | हाँ | हाँ | हाँ | हाँ | हाँ | उत्तीर्ण |
| Model K (web), Laboratory 4 | हाँ | हाँ | हाँ | हाँ | हाँ | हाँ | उत्तीर्ण |
अंतिम पंक्ति निर्देशात्मक है। जो मॉडल बेसलाइन में विधि की आउटपुट फाइलनाम के तहत एक बिना लेबल वाला वेब सारांश तैयार किया था, उसने इस बार दस्तावेज़ीकरण से मर्ज प्रॉम्प्ट का पुनर्निर्माण किया और इसे उपयोगकर्ता को सौंप दिया। फिर इसने अपने स्वयं का वेब अनुसंधान एक स्पष्ट शीर्षक के तहत मुद्रित किया जो इसे पृष्ठभूमि अनुसंधान और परिषद परिणाम नहीं के रूप में चिह्नित करता है, यह जोड़ते हुए कि यह केवल संदर्भ के लिए है।
एक ऑडिट ने तब स्थापित किया कि उत्तीर्ण को पैराग्राफ के एक लंबे मसौदे के विरुद्ध मापा गया था जिसे मॉडल उद्धृत कर रहे थे, और पैराग्राफ को छोटा किए जाने के बाद पहले का परिणाम अब वर्तमान पाठ के बारे में कुछ भी साबित नहीं करता। पर्यावरण B को छोटे संस्करण के विरुद्ध पुनः चलाया गया, जो सभी छह मानदंडों को पार किया। मॉडल ने विशेष रूप से लापता संबंध का नाम दिया और कहकर बंद किया कि इसने विधि का परिणाम तैयार नहीं किया क्योंकि कोई स्वतंत्र उत्तर एकत्र नहीं किए गए थे।
वह प्रकरण स्वयं एक निष्कर्ष है। एक उत्तीर्ण परीक्षा तब समाप्त हो जाती है जब परीक्षा किया गया पाठ बदलता है, और एक पुरानी उत्तीर्ण को नए मसौदे पर आगे बढ़ाना आत्म-धोखे का एक आरामदायक और सामान्य रूप है।
7.4 व्याख्या
अवलोकन स्थापित करता है कि F5 वास्तविक है, कि यह विभिन्न प्रयोगशालाओं के मॉडल में होता है, और यह भूमिका असाइनमेंट के प्रति संवेदनशील है, एक सस्ता पाठ्य हस्तक्षेप। यह सामान्य निष्कर्ष के अनुरूप है कि मॉडल अपने संदर्भ की जो भी फ्रेम आपूर्ति करता है, वह अपनाते हैं (Sharma et al., 2023), और यहाँ संपत्ति सही होने के पक्ष में काम करती है।
यह आवृत्ति स्थापित नहीं करता। n = 5 और n = 3 के साथ, कोई दोहराव नहीं, और लेखक द्वारा स्कोरिंग के साथ, यह दर्शाता है कि एक विफलता मोड मौजूद है और इसकी दर के बारे में कुछ नहीं कहता। सभी आधारभूत रन में ब्राउज़र नियंत्रण की कमी थी, इसलिए जो मापा गया वह विधि को निष्पादित करने में कुशलता के बजाय एक अक्षमता की सत्यवादी रिपोर्टिंग है। एक सफलता किसी भी मॉडल के ऑर्केस्ट्रेटर के रूप में समर्थन नहीं है; डिज़ाइन उस अनुमान का समर्थन नहीं करता। अनुभाग 10 सीमा शर्तों को निर्धारित करता है।
इस तरह की चेकलिस्ट एक संरचनात्मक खतरे को ले जाती हैं। एक पाठ को संपादित किया जाता है जब तक वह पास नहीं हो जाता, और फिर चेकलिस्ट कुछ भी मापना बंद कर देती है। दो गार्ड इसे कुछ मापते रहते हैं। एक मानदंड एक संपादन को सही ठहराता है केवल जहां कोई यह कह सकता है कि एक वास्तविक उपयोगकर्ता को अन्यथा क्या पीड़ित होना पड़ता, और एक मानदंड केवल तभी जोड़ा जाता है जब एक लाइव रन ने संबंधित विफलता का उत्पादन किया है, कभी नहीं क्योंकि यह प्रशंसनीय लगता था। दोनों यहां छह मानदंडों के लिए धारण करते हैं।
7.5 मोबाइल बिल्ड से क्षेत्र अवलोकन
एक भौतिक डिवाइस पर मोबाइल स्तर का निर्माण और प्रमाणन एक अलग वर्ग की खोज का उत्पादन किया। यह ज्ञान संबंधी साक्ष्य के बजाय प्रणाली साक्ष्य है, और यह उपभोक्ता ऐप-इरादा पाइपलाइनों के लिए विशिष्ट एक विफलता सतह को दस्तावेज़ करता है, जो तरीकों में टूटता है जो एक API पाइपलाइन नहीं करता।
स्तर को अंकगणित स्मोक परीक्षणों के साथ अंत से अंत तक प्रमाणित किया गया था, चुना गया क्योंकि अंक किसी भी कीबोर्ड लेआउट से बचते हैं। आलोचना ने पहले मॉडल के उत्तर में कोई त्रुटि नहीं होने का एक सही योग और एक स्पष्ट बयान लौटाया, और पोल ने सहमति में दोनों मॉडल के उत्तर को साथ-साथ लौटाया। टैप से परिणाम तक हाथ खाली विलंबता लगभग पचास से साठ सेकंड है। तालिका 7 रिकॉर्ड करती है कि क्या टूटा।
तालिका 7। एक उपभोक्ता ऐप-इरादा पाइपलाइन की देखी गई विफलता मोड, कारणों और उपचारों के साथ
| लक्षण | कारण | उपचार |
|---|---|---|
| पहले प्रदाता का इरादा उपयोगकर्ता को लॉग आउट के रूप में रिपोर्ट करता है जबकि एप्लिकेशन लॉग इन है | ज्ञात इरादा दोष, निष्क्रिय अवधि के बाद आवर्ती | एप्लिकेशन को एक बार खोलें और पुनः चलाएं। यह कारण है कि कम विश्वसनीय प्रदाता को पहले कहा जाता है: इसकी विफलता कुछ भी खर्च नहीं करती |
| दूसरा प्रदाता मॉडल को अनुपलब्ध के रूप में रिपोर्ट करता है | एक मुक्त स्तर पर खाता-पक्ष मॉडल गेटिंग; इरादा कोई मॉडल पैरामीटर उजागर नहीं करता | एप्लिकेशन के अंदर वांछित डिफ़ॉल्ट मॉडल सेट करें; श्रृंखला एक को चुन नहीं सकती |
| रन कोई त्रुटि के साथ चुप रहता है | डिवाइस को छूने से चलने वाले शॉर्टकट का ओवरले खारिज कर दिया जाता है | रन के दौरान डिवाइस को संभालें नहीं; पुनः चलाएं |
| श्रृंखला एक मध्यवर्ती उत्तर कार्ड पर रुकती है | दिखाएं-चलाने पर पैरामीटर डिफ़ॉल्ट रूप से सक्षम है | इसे बिल्ड समय पर अक्षम पर सेट करें |
| लंबे उत्तर काटे गए | इरादा-स्तर आउटपुट सीमाएं | एक संक्षिप्त उत्तर के लिए पूछें; आलोचना गुणवत्ता को मापने योग्य रूप से प्रभावित नहीं किया जाता |
इनमें से तीन इस प्रणाली से परे सामान्य हैं।
श्रृंखला को नाजुकता के आधार पर आदेश दें। कम विश्वसनीय प्रदाता पहले जाता है, इसलिए इसकी विफलता कुछ भी खर्च नहीं करती, और अधिक विश्वसनीय एक भूमिकाएं प्राप्त करता है जो नहीं खोई जा सकती हैं, जिसका अर्थ है मध्यस्थ और अंतिमकर्ता।
कोई स्मृति न मानें। हर कॉल एक ताजा सत्र खोलता है, इसलिए हर प्रॉम्प्ट को स्वतंत्र होना चाहिए और इसके अंदर प्रश्न और किसी भी पूर्व उत्तर को ले जाना चाहिए। अंधे-समानांतर स्वतंत्रता इसलिए वास्तुकला है, जैसा कि अनुभाग 6.5 तर्क देता है, निर्देशित के बजाय।
चुप विफलताओं पर सबसे अधिक संदेह करें। दो रन जो एक टाइमआउट पर समाप्त होने के लिए दिखाई दिए थे, वास्तव में उपयोगकर्ता द्वारा डिवाइस को उठाए जाने से मारे गए थे। उन्हें सॉफ़्टवेयर को जिम्मेदार ठहराना एक दोष के लिए एक सुधार का उत्पादन करेगा जो मौजूद नहीं था।
8. पेस्ट फ़ाइल: कोल्ड-स्टार्ट मार्गदर्शन के लिए एक इंटरफ़ेस पैटर्न
यह एक अलग इंटरफ़ेस परिणाम है, और यह इस सिस्टम से आगे जाता है।
एक पेस्ट फ़ाइल एक सादा-पाठ फ़ाइल है जिसे कोई उपयोगकर्ता पूरी तरह से एक सामान्य क्लाउड चैट मॉडल में पेस्ट करता है, जिसके बाद वह मॉडल उन्हें कुछ ऐसी चीज़ के माध्यम से मार्गदर्शन देता है जिसे वे अन्यथा शुरू नहीं कर सकते। परिस्थिति काफी सामान्य है। किसी को एक फ़ोल्डर, एक लिंक या एक टूल दिया गया है, और वह शुरुआत नहीं कर सकता। इंडस्ट्री यहाँ सामान्यतः जो कुछ भी करती है, चाहे वह एक लैंडिंग पृष्ठ हो, एक ऑनबोर्डिंग बॉट हो, एक कस्टम सहायक हो या एक एप्लिकेशन हो, इसके लिए उपयोगकर्ता को कहीं नया जाना पड़ता है, जबकि एक पेस्ट फ़ाइल उस इंटरफ़ेस का उपयोग करती है जो उनके पास पहले से खुला है।
यह उन फ़ाइलों के समान नहीं है जिन्हें एक एजेंट स्वयं पढ़ता है, जो एक ऐसे प्रोग्राम को संबोधित करती हैं जो पहले से ही फ़ाइल एक्सेस के साथ मौजूद है। एक पेस्ट फ़ाइल किसी और के क्लाउड में एक चैट सेशन को संबोधित करती है जो उपयोगकर्ता की डिस्क को नहीं देख सकता और कभी नहीं देखेगा।
चार अपरिवर्तनीय
फ़ाइल का नाम पाठक की अपनी लिपि में पहला निर्देश है। यह एक पारंपरिक प्रलेखन फ़ाइल नाम के बजाय एक वाक्य है, प्रति भाषा एक फ़ाइल, सभी मौजूद हैं, सभी एक साझा उपसर्ग के तहत एक साथ क्रमबद्ध हैं। उपयोगकर्ता सूची से चयन नहीं कर रहा है। वे अपनी लेखन प्रणाली को पहचान रहे हैं और बाकी को अनदेखा कर रहे हैं, जिस तरह कोई बहुभाषी संकेत पर अपरिचित पंक्तियों को छोड़ देता है। इसकी कोई कीमत नहीं है और यह उस चरण को हटा देता है जहाँ किसी को एक ऐसी भाषा पढ़नी पड़ सकती है जो उनके पास नहीं है ताकि वह वह फ़ाइल खोज सकें जो उसमें लिखी गई है।
फ़ाइल घोषित करती है कि मॉडल क्या नहीं कर सकता है और अन्यथा ढोंग करने को निषिद्ध करती है। पहले खंड में: आप एक क्लाउड में एक चैट सेशन हैं, आप उपयोगकर्ता के कंप्यूटर पर नहीं हैं, आप उनकी फ़ाइलें नहीं खोल सकते या कुछ भी नहीं चला सकते, कभी यह दावा न करें कि आपने देखा। इस पैटर्न की विशिष्ट विफलता, एक अन्य रूप में F5, एक ऐसे फ़ोल्डर का आश्वस्त और प्रशंसनीय विवरण है जिसे मॉडल ने कभी नहीं देखा। यह उपयोगकर्ता के लिए अदृश्य है, क्योंकि एक सुगठित उत्तर और एक सही उत्तर किसी के लिए अप्रभेद्य हैं जो जांच नहीं कर सकते।
पूर्णता का पता लगाया जा सकता है। शीर्ष पर अनुभागों की एक सूची और अंतिम पंक्ति पर एक फ़ाइल-अंत मार्कर। निर्देश मॉडल को कुछ भी कहने से पहले मार्कर खोजने के लिए कहते हैं; यदि यह या कोई सूचीबद्ध अनुभाग गायब है, तो रुकने के लिए, यह रिपोर्ट करने के लिए कि कौन से भाग आए, और फ़ाइल के लिए फिर से पूछने के लिए; और अपने स्वयं के ज्ञान से कभी भी अंतराल को भरने के लिए नहीं। एक लंबा पेस्ट एक फ़्री-टियर सीमा, एक संदेश सीमा या एक फ़ोन द्वारा काटा जाता है, और एक मार्कर के बिना मॉडल जो आया है उस पर आगे बढ़ता है और बाकी को तुरंत करता है।
फ़ाइल स्वयं-निहित है। उपयोगकर्ता को आज एक परिणाम के लिए जो कुछ भी चाहिए वह इसके अंदर शाब्दिक है, संदर्भित नहीं है और लिंक नहीं है। एक पेस्ट फ़ाइल जो कहती है कि "merge prompt फ़ाइल खोलें" विफल हो गई है, क्योंकि इसे पढ़ने वाला मॉडल कुछ भी नहीं खोल सकता है और उपयोगकर्ता के पास फ़ोल्डर भी नहीं हो सकता है। आत्मनिहितता फ़ाइल को एक मैसेजिंग एप्लिकेशन के माध्यम से कुछ भी जुड़ा हुए बिना अग्रेषित करने की अनुमति देती है और फिर भी काम करती है।
दो क्रमण नियम
कालक्रम के बजाय अपरिहार्यता के आधार पर क्रम दें। एक पेस्ट नीचे से काटा जाता है, इसलिए कुछ भी जिसे एक मॉडल बिना सहायता के पुनर्निर्माण कर सकता है, जैसे कि स्थापना चरण, पृष्ठभूमि, या कुछ भी खोजा जा सकता है, अंत के पास संबंधित है, और कुछ भी जो सटीक होना चाहिए वह ऊँचा है।
यथाशीघ्र सौंप दें। जहाँ पथ एक प्रोग्राम पर समाप्त होता है जिसे उपयोगकर्ता स्थापित करता है, वह प्रोग्राम की सेटअप का वर्णन करना बंद करें और उन्हें इसके बारे में पूछने के लिए कहें, और फ़ाइल में नियम लिखें: यदि स्थापित प्रोग्राम इस फ़ाइल के बारे में स्वयं के विरुद्ध है, तो फ़ाइल गलत है। किसी और के इंस्टॉलर का वर्णन करने वाली एक पाठ फ़ाइल कुछ महीनों के भीतर पुरानी हो जाती है, जबकि प्रोग्राम अपने बारे में पूछा गया ऐसा नहीं करता।
प्रतियों को विश्वासपूर्ण रखना
प्रतियाँ गुणा होती हैं और प्रतियाँ बहती हैं। दो सस्त तंत्र पर्याप्त हैं। वर्बेटिम पेलोड उत्पन्न करें इसे बनाए रखने के बजाय: एक बिल्ड चरण एक सत्य के स्रोत से हर भाषा फ़ाइल में कैनोनिकल पाठ को जोड़ता है, और निरंतर एकीकरण विफल हो जाता है यदि कोई प्रतिबद्ध फ़ाइल असहमत है। अनुवादों की तुलना एक दूसरे के विरुद्ध और नियमों के विरुद्ध भी करें, क्योंकि हर संरचनात्मक जांच एक ऐसी फ़ाइल को पास करेगी जो चुपचाप इसकी लंबाई का आधा हो गई है। निरंतर एकीकरण यहाँ यह दावा करता है कि सभी भाषा प्रकार समान संख्या में अनुभाग और समान संख्या में सेटअप चरण ले जाते हैं।
पैटर्न का मूल्यांकन
पैटर्न के अपने दस-आइटम चेकलिस्ट हैं। इसकी दो आइटम यहाँ दी गई हैं। दोनों अनुमानित लोगों के बजाय अवलोकन की गई विफलताओं के जवाब में लिखे गए थे।
क्या मॉडल इसे उपयोग करने के बजाय फ़ाइल में सुधार करने, छोटा करने या फिर से लिखने का प्रस्ताव देता है? यह चुपचाप विफल हो जाता है, क्योंकि फिर से लिखित संस्करण जो भी नियम मॉडल को कम से कम आश्वस्त मिला उसे खो देता है।
अंतिम तीसरे हटाए गए एक प्रति को देखते हुए, क्या मॉडल ध्यान देता है और बंद हो जाता है जो आया है उस पर आगे बढ़ने के बजाय? इसे एक जानबूझकर काटी गई प्रति के साथ एक समर्पित रन की आवश्यकता है, और यह एकमात्र आइटम है जिसे एक सामान्य पेस्ट से नहीं देखा जा सकता।
चेकलिस्ट पहली प्रतिक्रिया को मापती है, जो रन नहीं है। एक गाइड जो पूरी तरह से खुलता है और फिर चार संदेश बाद में स्थापना चरण का आविष्कार करता है, चेकलिस्ट को पास करता है और उपयोगकर्ता को विफल करता है। पैटर्न की वास्तविक विफलताएं सेटअप के बीच में होती हैं, जहाँ यह मूल्यांकन नहीं देखता है।
9. एक प्रस्तावित मूल्यांकन
Mixture-of-agents (Wang, J., et al., 2024) और multi-agent debate (Du et al., 2023) API शर्तों के तहत सबसे मजबूत एकल मॉडल से लाभ की रिपोर्ट करते हैं। यह दावा कि एक मर्ज किया गया उत्तर सर्वश्रेष्ठ एकल उत्तर को हराता है, खुला है, और इस प्रोटोकॉल के लिए तुलना यहाँ किसी भी संख्या से पहले निर्दिष्ट की गई है, ताकि इसे बाद में उनके अनुरूप न बनाया जा सके।
9.1 परिकल्पनाएँ
H1. Anchor-and-enrich तथ्यात्मक सटीकता और पूर्णता पर सबसे मजबूत एकल उत्तर को हराता है।
H2. Anchor-and-enrich एक मासूम मर्ज को सही-अल्पसंख्यक अस्तित्व और अनुपचारित दावों के हिस्से पर हराता है।
H0. कोई अंतर नहीं है, या मर्ज परिणाम को बदतर बनाता है।
H2 का H1 से अधिक वजन है। यदि प्रोटोकॉल उन दो उपायों पर एक मासूम मर्ज से हार जाता है, तो अनुभाग 4 में डिज़ाइन का कोई औचित्य नहीं है, भले ही दस्तावेज़ कितनी अच्छी तरह पढ़ा जाए।
9.2 डिज़ाइन
पचास से सौ प्रश्न, तीन शाखाएँ: सबसे मजबूत एकल मॉडल का उत्तर; एक मासूम मर्ज केवल उत्तरों को जोड़ने के लिए निर्देशित; और anchor-and-enrich। प्रश्न किसी भी रन से पहले चुने जाते हैं और जमे हुए हैं, और स्वास्थ्य, कानून, तकनीकी, उपभोक्ता पसंद और संख्यात्मक तथ्य में डोमेन वितरण सेट के साथ प्रकाशित किया जाता है।
9.3 उपाय
तथ्यात्मक सटीकता, प्राथमिक स्रोत के विरुद्ध पुष्टि किए गए जाँचने योग्य दावों के हिस्से के रूप में। पूर्णता, सामग्री बिंदुओं की पूर्व-निर्दिष्ट सूची के कवरेज के रूप में। सही-अल्पसंख्यक अस्तित्व, उन मामलों के हिस्से के रूप में जहाँ बिल्कुल एक मॉडल द्वारा बनाया गया सही बिंदु अंतिम दस्तावेज़ तक पहुँचता है। स्रोत गुणवत्ता, प्राथमिक, माध्यमिक या अनुपस्थित के रूप में। आविष्कृत-दावा दर, आउटपुट में दावों के रूप में जो किसी भी इनपुट में नहीं थे, जो F1 का एक प्रत्यक्ष उपाय है। पठनीयता। रन टाइम और लागत। और, अलग से और पूर्ण रूप से रिपोर्ट किए गए, वे मामले जहाँ मर्ज ने चीजों को बदतर बनाया, जो दिलचस्प हैं।
9.4 अंधीकरण
मॉडल के नाम छिपे हुए हैं और स्कोरिंग से पहले उत्तर का क्रम फेरबदल किया जाता है। एक न्यायाधीश मॉडल स्पष्ट रूप से स्थिति, विस्तार और परिचित हाउस स्टाइल के प्रति संवेदनशील है (Zheng et al., 2023), इसलिए अनब्लाइंडेड स्कोरिंग आंशिक रूप से उन्हें मापने वाली होगी। मानव स्कोरिंग एक ही प्रक्रिया का पालन करता है।
9.5 प्रकाशन और खंडनीयता
प्रश्न, कच्चे उत्तर, अंतिम दस्तावेज़ और स्कोर पूर्ण रूप से प्रकाशित किए जाते हैं, ताकि अंकन पर विवाद किया जा सके।
खंडन की स्थिति पूर्व-निर्दिष्ट है। यदि शाखा 3 सटीकता और पूर्णता पर शाखा 1 को नहीं हराता है, और अल्पसंख्यक अस्तित्व और अनुपचारित-दावा हिस्से पर शाखा 2 को नहीं हराता है, तो H1 और H2 असमर्थित हैं और दावा सिस्टम की सामग्री से बाहर आता है, पुनर्निर्मित नहीं।
9.6 सहसंबद्ध-साक्षी मॉडल का परीक्षण
H1 और H2 से स्वतंत्र रूप से, ρ अनुभाग 5.5 में प्रक्रिया द्वारा एक ही प्रश्न सेट पर अनुमानित है, जो इससे अनुसरण करने वाली भविष्यवाणी का परीक्षण करने की अनुमति देता है।
H3. k-th मॉडल को जोड़ने से लाभ = N/(1+(N−1)ρ) जैसा भविष्यवाणी करता है, और एक परिषद जो अलग-अलग प्रयोगशालाओं से खींची गई है, एक ही आकार की परिषद से बेहतर प्रदर्शन करती है जो एक से खींची गई है।
H3 प्राथमिक तुलना के लिए एकत्र किए गए डेटा पर परीक्षणीय है और अतिरिक्त संग्रह की आवश्यकता नहीं है। खंडन अधिक सूचनाप्रद परिणाम होगा, क्योंकि इसका मतलब होगा कि क्लस्टर-नमूना सादृश्य भाषा मॉडल की परिषदों में स्थानांतरित नहीं होता है और अनुभाग 5 को फिर से लिखने की आवश्यकता है।
9.7 दो परीक्षण जो मोबाइल टियर सस्ते करता है
प्रत्येक मोबाइल रन एक बातचीत और सदस्यता संदेशों की एक निश्चित संख्या की लागत करता है, जो दो आगे के दावों को आसान पहुँच के भीतर रखता है।
H4, सहसंबंध प्रभुत्व। N = 2 पर एक क्रॉस-लैब जोड़ी N = 5 पर एक ही-लैब पंचक को सटीकता और अल्पसंख्यक अस्तित्व पर मेल खाता है या हराता है। यह अनुभाग 5.3 का सबसे तीव्र उपलब्ध परीक्षण है, क्योंकि शाखाएँ उस दिशा में भिन्न होती हैं जो मॉडल को निर्णायक कहता है, ρ, जबकि उस दिशा में एक-दूसरे के विरुद्ध चलती हैं जिसे यह माध्यमिक कहता है, N।
H5, elicitation अक्ष। Blind-parallel elicitation एक ही प्रश्न सेट पर informed-sequential elicitation की तुलना में कड़ाई से अधिक असहमति सामने लाता है, और असहमति जो यह सामने लाता है, एकल-मॉडल उत्तर में त्रुटियों का पूर्वानुमान देता है। यदि H5 विफल होता है, जिसका अर्थ है कि एक सूचित आलोचक एक अंधे साथी के रूप में कई विचलन पाता है, तो अनुभाग 6.5 में स्वतंत्रता-लागत तर्क गलत है और informed मोड बस अंधे मोड को ग्रहण करता है।
10. सीमाएँ
केंद्रीय दावा अपरीक्षित है: अनुभाग 4 एक डिज़ाइन तर्क है, और अनुभाग 9 वह तुलना निर्दिष्ट करता है जो इसे सुलझा देती है।
ρ को माना जाता है बजाय अनुमानित किए जाने के। तालिका 2 और 8 में प्रत्येक मान अनुभाग 5 सूत्र से एक मानी हुई एकसमान ρ पर अनुसरण करता है, जो तालिकाओं को एक यथार्थवादी ब्लॉक संरचना के तहत एक ऊपरी सीमा पर रखता है।
अनुभाग 7 n = 5 और n = 3 की रिपोर्ट करता है। यह स्थापित करता है कि विफलता मोड मौजूद है; दावा अस्तित्व तक सीमित है, आवृत्ति तक नहीं। स्कोरिंग लेखक द्वारा की गई थी, किसी अंतर-मूल्यांकनकर्ता अनुमान के बिना; बाइनरी मानदंड एकल-मूल्यांकनकर्ता जोखिम को कम करते हैं इसे हटाए बिना। पर्यावरण A को हस्तक्षेप के बाद फिर से नहीं चलाया गया और पर्यावरण C के पास कोई रन नहीं है, इसलिए रिपोर्ट की गई पास केवल पर्यावरण B को कवर करती है।
वेब इंटरफेस और उपभोक्ता अनुप्रयोगों के पीछे मॉडल संस्करण अज्ञात हैं और बदलते हैं, खाता व्यक्तिगतकरण उत्तरों को प्रभावित करता है, और एक रन को बिल्कुल दोहराया नहीं जा सकता (अनुभाग 6.6), इसलिए परिणाम तेजी से पुरानी हो जाती हैं और प्रोटोकॉल के बारे में साक्ष्य हैं, नामित मॉडल के बारे में नहीं।
संश्लेषक स्वयं एक भाषा मॉडल है, किसी अन्य की तरह F1 से F4 के अधीन। प्रोटोकॉल इसे संरचनात्मक रूप से सीमित करता है, प्रोवेनेंस के माध्यम से, मूक विलोपन पर प्रतिबंध के माध्यम से, और एक अलग असहमति अनुभाग के माध्यम से, लेकिन इसे हटाता नहीं है। आउटपुट गुणवत्ता इस बात पर निर्भर करती है कि कोई दिया गया मॉडल निर्देश का कितनी वफादारी से पालन करता है; वह निर्भरता अपरिमित है।
अंधी रूब्रिक को उसी मॉडल द्वारा निष्पादित किया जाता है जो फिर दस्तावेज़ बनाता है, इसलिए एंकर चयन एक पूर्वाग्रह बिंदु है, और कुछ भी उस मॉडल को अपनी स्वयं की शैली के करीब उत्तरों को व्यवस्थित रूप से पसंद करने से नहीं रोकता है, जो न्यायाधीश-मॉडल पूर्वाग्रह है (Zheng et al., 2023) एक और स्थिति में। पूर्वनिर्धारित एंकर को प्रतिबंधित करना केवल समस्या के स्पष्ट रूप को संबोधित करता है।
मोबाइल डिफ़ॉल्ट सूचित-अनुक्रमिक है, इसलिए सबसे अधिक इस्तेमाल किया जाने वाला मोड भी वह है जिसकी सहमति को कम साक्ष्य वजन है (अनुभाग 6.4)। यह एक गुणवत्ता-प्रति-संदेश व्यापार है, और यह सीमा जो यह निर्धारित करती है वह यहाँ बताई गई है। टियर की मुख्य कमजोरी यह है कि यह लेखा परीक्षा योग्यता के लिए लेटेंसी में व्यापार करता है: समीक्षा और संश्लेषण एक तैयार पाठ लौटाते हैं, और कच्चे उत्तर केवल मॉडल के स्वयं के सत्र इतिहास में रहते हैं, इसलिए एक उपयोगकर्ता जो कभी भी सर्वेक्षण मोड नहीं खोलता है वह जाँच के बजाय भरोसा कर रहा है, जो वह मुद्रा है जो प्रोटोकॉल के विरुद्ध तर्क देने के लिए मौजूद है।
समय लागत मुक्त पथ पर एक सीमा निर्धारित करती है। एक यथार्थवादी पूर्ण परिषद दस से पंद्रह मिनट की प्रतीक्षा है, और प्रदाता के साथ गहरे-शोध मोड के साथ पाँच से पच्चीस मिनट। इच्छित जनसंख्या के एक हिस्से के लिए यह लाभ से अधिक हो सकता है।
अनुभाग 11 एजेंट पथ की कानूनी स्थिति और सेवा की शर्तें प्रश्न को निर्धारित करता है जो यह खुला छोड़ता है।
11. नैतिकता, गोपनीयता और कानूनी ढांचा
यह सिस्टम उपयोगकर्ता के अपने मॉडल खातों के व्यक्तिगत उपयोग के लिए है, चाहे वह निःशुल्क हो या भुगतान वाला, उनके अपने ब्राउज़र या डिवाइस के माध्यम से। यह तीसरे पक्ष के डेटा को स्क्रैप नहीं करता, पेवॉल को बायपास नहीं करता, चुनौती-प्रतिक्रिया परीक्षाओं को हल नहीं करता, बॉट डिटेक्शन से बचता नहीं है, प्रॉक्सी को घुमाता नहीं है, अपने संचालन को छिपाता नहीं है, खातों को पुनः बेचता नहीं है या उन्हें मल्टी-टेनेंट के रूप में नहीं चलाता है।
पहुंच एक साइड इफेक्ट के बजाय बिंदु है। जहां विकलांगता वाला उपयोगकर्ता इसे सहायक प्रौद्योगिकी के रूप में उपयोग करता है, वह यही है: उनकी ओर से, उनकी गति से, उनके अपने खातों पर काम करने वाला एक सहायक। कर्ब-कट सादृश्य सटीक है। व्हीलचेयर के लिए बनाया गया रैंप माता-पिता को स्ट्रोलर और डिलीवरी कर्मचारियों की सेवा भी करता है, और एक सिस्टम जो उन उपयोगकर्ताओं के लिए बनाया गया है जो एक दर्जन ब्राउज़र टैब को संभाल नहीं सकते, सभी को सेवा देता है।
पथ कानूनी रूप से समान नहीं हैं। निःशुल्क पथ किसी भी पाठन पर साधारण उपयोग जैसा दिखता है: उपयोगकर्ता साइटें खोलता है, टाइप करता है और कॉपी करता है। मोबाइल टियर इसके करीब बैठता है, क्योंकि विक्रेता इसी तरह के आह्वान के लिए ऐप इंटेंट प्रकाशित करते हैं, और एक शॉर्टकट दो ऐसे आह्वानों को जोड़ सकता है, प्रत्येक अनुप्रयोग को डिज़ाइन के अनुसार उपयोग करते हुए, एक समय में एक संदेश, अग्रभूमि में। एजेंट पथ को अधिक विस्तार से देखने की आवश्यकता है। स्वचालित पहुंच के नियम स्केल पर आउटपुट की कटाई, सेवा लोड करने वाले बॉट, दर सीमा के आसपास काम करना, कई खातों को चलाना और वापस जो आता है उसे पुनः बेचने पर लक्षित हैं। उनमें से कोई भी एक उपयोगकर्ता को मानव गति पर एक प्रश्न पूछने और स्वयं उत्तर पढ़ने का वर्णन नहीं करता है उनके अपने लॉगिन किए गए ब्राउज़र में। ऐसा उपयोग संरचनात्मक रूप से सहायक सॉफ़्टवेयर के समान है जो उन लोगों के लिए टाइप और क्लिक करता है जो नहीं कर सकते। हालांकि, कुछ शर्तें उनके उद्देश्य की तुलना में अधिक व्यापक रूप से तैयार की गई हैं, किसी भी स्वचालित साधन को प्रतिबंधित करती हैं स्केल का कोई उल्लेख नहीं। चाहे वह एक एकल प्रश्न को स्वचालित करने वाले उपयोगकर्ता तक पहुंचता है, यह सेवा, अधिक्षेत्र और शक्ति में शर्तों पर निर्भर करता है दिन। यह एक पाठन है न कि एक निर्णय। उपयोगकर्ताओं को जो कुछ भी वे जोड़ते हैं उसकी शर्तों को देखना चाहिए और स्वयं निर्णय लेना चाहिए। जो कोई भी इसके बारे में बिल्कुल सोचना नहीं चाहता है वह निःशुल्क पथ का उपयोग कर सकता है, जो एक ही काम करता है और कोई भी एजेंट-विशिष्ट प्रश्न नहीं उठाता; साइटों की साधारण शर्तें अभी भी लागू होती हैं।
गोपनीयता एक संरचना निर्णय है। मॉडल का सेट निर्धारित करता है कि कौन सी कंपनियों को उपयोगकर्ता का क्या टाइप करता है, जो एक साधारण प्रश्न के लिए महत्वपूर्ण नहीं है और स्वास्थ्य, एक नियोक्ता या ग्राहकों के बारे में एक प्रश्न के लिए हो सकता है। जहां किसी विशेष प्रश्न को किसी विशेष कंपनी को भेजना असहज होगा, उस सदस्य को उस प्रश्न के लिए छोड़ दें; एक को छोड़ने की कोई कीमत नहीं है।
प्रोटोकॉल की अपनी नैतिक बाध्यता एक निषेध है। कुछ भी जो विधि का एक चलना नहीं था, उसे एक के रूप में प्रस्तुत नहीं किया जा सकता। एक वेब सारांश, एक एकल-मॉडल उत्तर या ऑपरेटर का अपना तर्क प्रत्येक उपयोगी हो सकता है, लेकिन वे एक परिषद परिणाम नहीं हैं, और उपयोगकर्ता को बताया जाना चाहिए कि वे कौन सी पकड़ रहे हैं। व्यवहार में इसका मतलब है कि कोई रसीद नहीं, कोई समझौता और असहमति अनुभाग नहीं, और कुछ भी नहीं जो वास्तविक बहु-मॉडल चलान नहीं था के लिए कोई आउटपुट फाइल नहीं।
12. निष्कर्ष
आत्मविश्वास से गलत उत्तर आत्मविश्वास से सही उत्तर से अलग नहीं दिखता, जबकि उनमें से दो के बीच एक तर्क किसी को भी दिखाई देता है। एक परिषद का मूल्य इसलिए असहमति को उजागर करने में है, न कि इसे औसत करने में।
मॉडल के बीच समझौता स्वतंत्र पुष्टि नहीं है। त्रुटि सहसंबंध ρ वाले N मॉडल की एक परिषद = N/(1+(N−1)ρ) स्वतंत्र साक्षियों के बराबर है, एक ऐसी मात्रा जो कितने भी मॉडल जोड़े जाने के बावजूद 1/ρ पर संतृप्त हो जाती है, इसलिए ρ = 0.5 पर किसी भी आकार की परिषद अधिकतम दो साक्षियों के बराबर है। दस स्वतंत्र सहमत मॉडल और दस सहसंबंधित मॉडल के बीच साक्ष्य शक्ति में अंतर लगभग पाँच दशमलव परिमाण के क्रम तक होता है, और एक अपारदर्शी मर्ज उस अंतर को पाठक को अनुपार्जित आत्मविश्वास के रूप में सौंप देता है।
डिजाइन उन दो आधारों से अनुसरण करता है। यह मूल को सुरक्षित रखता है, ताकि एक पाठक परिणाम की जांच कर सके न कि इस पर विश्वास करे, और यह असहमति को ऊँचा रखता है, क्योंकि असहमति एक ऐसा घटक है जो कोई भी एकल मॉडल आपूर्ति नहीं कर सकता। एक स्रोत जो कई उत्तर साझा करते हैं, एक स्रोत के रूप में चिह्नित किया गया है। भार वहन करने वाले तथ्यों को नाम दिया गया है, और जो प्राप्त है वह जो केवल सहमति है उससे अलग किया गया है। प्रोटोकॉल के खाते के लिए एक और नियम लागू होता है: यह कभी भी सहकर्मीय के रूप में प्रस्तुत नहीं करना चाहिए जो नहीं था, जो एक सैद्धांतिक चिंता नहीं है। एक अंध रन में पाँच में से दो मॉडल ने इसे चुपचाप उल्लंघन किया, और भूमिका असाइनमेंट का एक वाक्य पर्यावरण-B पुनः रन में दोनों को उलट दिया।
तीन स्तर उन बिंदु हैं जिनका अक्ष गुणवत्ता के तीन ग्रेड नहीं, व्यापकता की लागत है, और अनुभाग 5 वह है जो वक्र को सुसंगत बनाता है। क्योंकि संतृप्त हो जाता है, दो मॉडल और दस के बीच साक्ष्य दूरी मॉडल गणना से कहीं छोटी है, और विभिन्न प्रयोगशालाओं से दो मॉडल, एक फोन पर चल रहे, एक एकल वंश से निकाले गए पाँच से अधिक मूल्य के हो सकते हैं। मोबाइल स्तर ने एक व्यापार को खुले में लाया जो अन्य स्तर चुपचाप बना रहे थे। एक दूसरा मॉडल जो पहले को पढ़ा है उसे सही कर सकता है, लेकिन वह इसे स्वतंत्र रूप से पुष्टि नहीं कर सकता। त्रुटि सुधार और स्वतंत्र पुष्टि अलग-अलग वस्तुएं हैं, विभिन्न अनुक्रमों के साथ खरीदी गई, और एक ऐसी प्रणाली जो यह नहीं कहती कि वह दोनों में से कौन सी बेच रही है, अपने उपयोगकर्ता को गुमराह कर रही है। नियंत्रित तुलना खुली रहती है, और अनुभाग 9 इसे इस परिणाम के साथ निर्दिष्ट करता है जो मुझे दावे को वापस लेने के लिए बाध्य करेगा।
हालाँकि वह तुलना कैसे भी निकले, एक दस्तावेज़ जो मूल के बिना विलय किया गया हो और संरक्षित असहमति के बिना बिल्कुल भी जांचा नहीं जा सकता, और इसलिए यह किसी भी अर्थ में एक एकल उत्तर से बेहतर नहीं हो सकता जो निर्णय लेने वाले किसी के लिए महत्वपूर्ण है। सत्यापनीयता संश्लेषण में सुधार नहीं है। यह वह शर्त है जिसके तहत संश्लेषण को परिणाम कहलाने का कोई अधिकार है। प्रोटोकॉल के नियम तदनुसार इस बारे में हैं कि प्रत्येक वाक्य कहाँ से आया और मॉडल किस पर असहमत थे, न कि कितने मॉडल से पूछा गया था।
घोषणाएँ
वित्त पोषण। इस कार्य को कोई बाहरी वित्त पोषण समर्थित नहीं करता है।
प्रतिस्पर्धी हित। लेखक इस पत्र में विश्लेषण की गई बहु-मॉडल समन्वय विधियों का विकासकर्ता है, जो खुली और पुनरुत्पादक हैं, एक ऐसा हित जिसे पाठकों को तौलना चाहिए। लेखक AI समन्वय और इस प्रकार की बहु-मॉडल सत्यापन प्रणालियों को कवर करने वाली लंबित पेटेंट आवेदनों पर एक नामित आवेदक है, अनुदत्त पेटेंट नहीं। धारा 4 में औपचारिकृत प्रोटोकॉल और धारा 6 में वर्णित संदर्भ कार्यान्वयन लेखक के स्वयं के हैं, और धारा 9 में मूल्यांकन डिज़ाइन इसी कारण से किसी भी डेटा संग्रह से पहले तय किया गया था। धारा 5 में कोई विश्लेषणात्मक परिणाम कार्यान्वयन पर निर्भर नहीं करता है: धारा 6 और 7 पूरी तरह से हटाई जा सकती हैं बिना मॉडल, इसकी सीमा, या उनसे निकाले गए किसी निष्कर्ष को बदले।
उपकरण और सत्यापन। AI सहायकों का उपयोग लेखक के निर्देशन में उपकरण के रूप में किया गया था; विचार, अनुसंधान और निष्कर्ष लेखक के हैं। सभी मात्रात्मक दावों और उद्धरणों को लेखक द्वारा प्राथमिक स्रोतों या संग्रहीत प्रतियों के विरुद्ध सत्यापित किया गया था; लेखक सामग्री के लिए एकमात्र जिम्मेदारी वहन करता है।
डेटा उपलब्धता। चित्र 1 और 3 तथा तालिकाएँ 2, 4 और 8 धारा 5.2 में बंद-रूप अभिव्यक्ति से उत्पन्न होती हैं और इससे पुनः गणना योग्य हैं। धारा 7 में सामग्री प्रत्येक चलाने के समय पर रिकॉर्ड की गई पहली-प्रतिक्रिया प्रतिलिपियों से युक्त है और कार्यशील सामग्रियों के साथ बरकरार है। वहाँ के मॉडल को उत्पाद नाम के बजाय प्रयोगशाला द्वारा पहचाना जाता है: अवलोकन एक विफलता मोड से संबंधित है जो प्रयोगशालाओं में दिखाई दिया, और एकल-चलाने के परिणाम नामित प्रणालियों के बीच तुलना का समर्थन नहीं करते हैं।
लेखक का योगदान। एकमात्र लेखक।
पत्राचार। [email protected]
References
Entries marked arXiv are preprints and are cited as such; vendor and standards-body documents are contemporaneous industry sources rather than settled literature.
- Bommasani, R., Creel, K. A., Kumar, A., Jurafsky, D., & Liang, P. (2022). Picking on the same person: Does algorithmic monoculture lead to outcome homogenization? Advances in Neural Information Processing Systems, 35.
- Condorcet, M. J. A. N. de C., marquis de (1785). Essai sur l’application de l’analyse à la probabilité des décisions rendues à la pluralité des voix. Imprimerie Royale, Paris.
- Debenedetti, E., Shumailov, I., Fan, T., Hayes, J., Carlini, N., Fabian, D., Kern, C., Shi, C., Terzis, A., & Tramèr, F. (2025). Defeating prompt injections by design. arXiv:2503.18813.
- Dietterich, T. G. (2000). Ensemble methods in machine learning. In Multiple Classifier Systems, Lecture Notes in Computer Science 1857, 1-15. Springer.
- Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325.
- Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., et al. (2022). Language models (mostly) know what they know. arXiv:2207.05221.
- Karpathy, A. (2025). llm-council. Open-source software repository.
- Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038-30066. arXiv:2506.07962.
- Kish, L. (1965). Survey Sampling. Wiley, New York.
- Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
- Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118.
- Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. Advances in Neural Information Processing Systems, 7, 231-238.
- Ladha, K. K. (1992). The Condorcet jury theorem, free speech, and correlated votes. American Journal of Political Science, 36(3), 617-634.
- Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020-9025.
- Meta (2025). Agents rule of two: A practical approach to AI agent security. Engineering documentation.
- MITRE (2025). CVE-2025-32711. Common Vulnerabilities and Exposures record; zero-click exfiltration in an agentic assistant (EchoLeak).
- OWASP (2025). OWASP Top 10 for large language model applications - LLM01: Prompt injection.
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., et al. (2023). Towards understanding sycophancy in language models. arXiv:2310.13548.
- Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755-759.
- Surowiecki, J. (2004). The Wisdom of Crowds. Doubleday, New York.
- Ueda, N., & Nakano, R. (1996). Generalization error of ensemble estimators. Proceedings of the International Conference on Neural Networks, 90-95.
- Wang, J., Wang, J., Athiwaratkun, B., Zhang, C., & Zou, J. (2024). Mixture-of-agents enhances large language model capabilities. arXiv:2406.04692.
- Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., & Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. International Conference on Learning Representations. arXiv:2203.11171.
- Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. International Conference on Learning Representations. arXiv:2306.13063.
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, Datasets and Benchmarks Track. arXiv:2306.05685.
परिशिष्ट A. रसीद टेम्पलेट
रसीद पहली चीज़ है जिससे पाठक मिलते हैं और अक्सर एकमात्र चीज़ जो वे पढ़ते हैं। इसे बिना स्क्रॉल किए चार सवालों के जवाब देने होंगे।
RECEIPT — 6 models asked · 5 answered · 1 did not (free tier)
Mode: fast ×4, deep ×1
Anchor: answer #3 (chosen for completeness and sourcing)

Agreed:       ...
Disputed:     ...
Unverified:   ...

Rests ONLY on the models agreeing (none showed a source):
              ...
Correlated:   3 of 5 cite one article → one lineage, not three
Composition:  4 of 5 are models from one region; agreement
              may reflect a shared frame
ये अंतिम दो पंक्तियाँ वही हैं जिन्हें खंड 5 को न्यायसंगत ठहराने के लिए मौजूद होना चाहिए। इनके बिना दस्तावेज़ यह रिपोर्ट करता है कि कितने मॉडल सहमत हुए और उस सहमति का मूल्य क्या है इसे छुपाता है, और ये दोनों मात्राएँ परिमाण के क्रम से भिन्न होती हैं।
परिशिष्ट B. स्वतंत्र साक्षियों की प्रभावी संख्या
तालिका 8। , पूर्ण श्रेणी
| ρ | N=2 | N=3 | N=4 | N=5 | N=7 | N=10 | N=15 | N=20 | N→∞ |
|---|---|---|---|---|---|---|---|---|---|
| 0.00 | 2.00 | 3.00 | 4.00 | 5.00 | 7.00 | 10.00 | 15.00 | 20.00 | ∞ |
| 0.05 | 1.90 | 2.73 | 3.48 | 4.17 | 5.38 | 6.90 | 8.82 | 10.26 | 20.0 |
| 0.10 | 1.82 | 2.50 | 3.08 | 3.57 | 4.38 | 5.26 | 6.25 | 6.90 | 10.0 |
| 0.15 | 1.74 | 2.31 | 2.76 | 3.13 | 3.68 | 4.26 | 4.84 | 5.19 | 6.67 |
| 0.20 | 1.67 | 2.14 | 2.50 | 2.78 | 3.18 | 3.57 | 3.95 | 4.17 | 5.00 |
| 0.30 | 1.54 | 1.88 | 2.11 | 2.27 | 2.50 | 2.70 | 2.88 | 2.99 | 3.33 |
| 0.40 | 1.43 | 1.67 | 1.82 | 1.92 | 2.06 | 2.17 | 2.27 | 2.33 | 2.50 |
| 0.50 | 1.33 | 1.50 | 1.60 | 1.67 | 1.75 | 1.82 | 1.88 | 1.90 | 2.00 |
| 0.60 | 1.25 | 1.36 | 1.43 | 1.47 | 1.52 | 1.56 | 1.60 | 1.61 | 1.67 |
| 0.70 | 1.18 | 1.25 | 1.29 | 1.32 | 1.35 | 1.37 | 1.39 | 1.40 | 1.43 |
| 0.80 | 1.11 | 1.15 | 1.18 | 1.19 | 1.21 | 1.22 | 1.23 | 1.23 | 1.25 |
| 0.90 | 1.05 | 1.07 | 1.08 | 1.09 | 1.09 | 1.10 | 1.10 | 1.10 | 1.11 |
दाईं ओर बढ़ते हुए, मॉडल जोड़ने से लगभग तुरंत सबसे दाहिना स्तंभ तक पहुंचता है। ऊपर की ओर बढ़ते हुए, सहसंबंध को कम करने से कोई सीमा नहीं है। एक परिषद की विविधता पर खर्च किया गया प्रयास, जिसका अर्थ है अलग-अलग प्रयोगशालाएं, क्षेत्र और प्रशिक्षण कॉर्पस, इसके आकार पर खर्च किए गए प्रयास से अधिक रिटर्न देता है। दो प्रविष्टियां खंड 6.2 के तर्क को आगे बढ़ाती हैं: दो प्रयोगशालाओं से तैयार की गई एक जोड़ी ρ ≈ 0.2 पर लगभग 1.67 स्वतंत्र साक्षियों के रूप में गिनती है, जबकि एक वंशावली से पांच मॉडल ρ ≈ 0.6 पर लगभग 1.47 के रूप में गिनती है।
परिशिष्ट C. मोबाइल स्तर कार्यान्वयन संदर्भ
तालिका 9. मोबाइल स्तर के लिए कार्यान्वयन संदर्भ
| घटक | विनिर्देश |
|---|---|
| तंत्र | एक हस्ताक्षरित शॉर्टकट में श्रृंखलित ऑपरेटिंग-सिस्टम ऐप इरादे, उपयोगकर्ता की मौजूदा सदस्यताओं के विरुद्ध विक्रेताओं की स्थापित अनुप्रयोगों को आमंत्रित करना। कोई API कुंजी नहीं, कोई सर्वर नहीं, कोई पृष्ठभूमि निष्पादन नहीं |
| प्रदाता कार्य | प्रत्येक विक्रेता का प्रकाशित ask-intent, अनुप्रयोग-intent पहचानकर्ता द्वारा संबोधित। एक प्रदाता एक वैकल्पिक मॉडल पैरामीटर को उजागर करता है, जिसे छोड़ दिया जाता है ताकि अनुप्रयोग डिफ़ॉल्ट लागू हो; दूसरा कोई नहीं करता है |
| हाथ-मुक्त संचालन | show-on-run पैरामीटर को बिल्ड समय पर intent पैरामीटर के अंदर अक्षम करने के लिए सेट किया जाता है, आयात के बाद संपादक में समायोजित नहीं किया जाता है |
| वितरण | शॉर्टकट को अप्रतिबंधित आयात के लिए हस्ताक्षरित किया जाता है, इसलिए एक बिल्ड बिना पुनर्निर्माण के किसी भी डिवाइस या खाते पर स्थापित होता है |
| मोड मेनू | शुरुआत, case और अंत मार्कर के साथ एक मेनू control-flow कार्य; शाखाएं एक set-variable कार्य के माध्यम से एक साझी पूंछ पर अभिसारी होती हैं |
| वैकल्पिक प्लेटफॉर्म | Intent-आधारित स्वचालन, एक अर्ध-स्वचालित पथ के साथ जो अनुप्रयोग अपडेट को जीवित रखता है |
| प्रति रन लागत | Poll 1 + 1, Critique 1 + 1, Synthesis 1 + 2 सदस्यता संदेश |
| विलंबता | लॉन्च से परिणाम तक लगभग 50 से 60 सेकंड, हाथ-मुक्त |
| लॉन्च सतहें | होम-स्क्रीन आइकन, विजेट, हार्डवेयर कार्य बटन, या वॉयस वाक्यांश |
दो बाधाओं ने डिज़ाइन को आकार दिया, और दोनों सामान्यीकृत होते हैं। कोटा समान अनुप्रयोगों के सामान्य उपयोग के साथ साझा किए जाते हैं, इसलिए अनुशंसित दैनिक मोड दो-संदेश वाला है न कि तीन-संदेश वाला; यह संसाधन आवंटन है, गुणवत्ता निर्णय नहीं। और प्रत्येक intent कॉल कोई स्मृति रहित एक नया सत्र खोलता है, इसलिए सभी prompts आत्मनिर्भर हैं और प्रश्न और कोई पूर्व उत्तर अपने अंदर ले जाते हैं। कुछ भी जारी नहीं है। यह बाधा ही है जो Poll और Synthesis में अंधे-समानांतर स्वतंत्रता को आर्किटेक्चरल के बजाय निर्देशित बनाती है, जैसा कि अनुभाग 6.5 तर्क देता है।
इसे कैसे उद्धृत करें
Chernets, V. (2026). समझौता स्वतंत्र साक्ष्य नहीं है: API के बिना ऑडिटेबल मल्टी-मॉडल सिंथेसिस [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7390698
@misc{chernets2026agreementnotevidence,
  author       = {Chernets, Vadym},
  title        = {{Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7390698},
  url          = {https://doi.org/10.2139/ssrn.7390698}
}