Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
Vadym Chernets, PhD, AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7390698 · DOI 10.2139/ssrn.7390698 · Zenodo 10.5281/zenodo.22683716 · GitHub
- 정본: SSRN 7390698 · DOI 10.2139/ssrn.7390698
- 보관된 사본, 인용 및 다운로드 가능: 10.5281/zenodo.22683716 — 개념 DOI, 항상 최신 버전으로 확인됩니다
- 마크다운 및 PDF 형식의 전체 텍스트: GitHub
- 읽기 가능한 HTML: https://polyhelper.ai/research/agreement-not-evidence/
동일한 텍스트가 네 개의 플랫폼에 있어서 그 중 하나를 사용할 수 없을 때 접근할 수 있습니다. SSRN은 정본을 보관합니다. 그것을 인용해주십시오.
키워드: 대규모 언어 모델; 상관된 오류; 집단 지성; Condorcet 배심단 정리; 알고리즘 단일 문화; 다중 에이전트 논쟁; 유효 표본 크기; 설계 효과; 앙상블; 출처. JEL 분류: C11; C18; D71; D83; L86; O33
초록
언어 모델 하나에 질문을 던지는 사람은 자신감 있게 틀린 답변을 자신감 있게 맞은 답변과 구별할 수 없습니다. 둘은 비전문가가 사용할 수 있는 모든 표면적 단서에서 동일합니다. 여러 모델에 질문하는 것이 이 문제를 해결하는 것처럼 보이지만, 대부분 문제를 이동시킬 뿐입니다. 여러 답변을 조화시키면 다시 한 번 자신감 있는 텍스트가 생성되고, 그 텍스트는 이제 "십 개 모두 동의했다"는 차용된 권위를 갖게 됩니다.
여기서 형식화된 프로토콜은 사용자 자신의 브라우저나 휴대폰을 통해 여러 소비자 채팅 모델로부터 답변을 수집합니다. API 키, 설치, 중간 서버가 필요하지 않습니다. 이를 앵커 및 강화를 통해 조화시킵니다. 가장 강력한 가용 답변이 기반이 되고, 다른 각 답변은 기반이 부족한 부분만 기여합니다. 모든 기여는 이를 제공한 모델로 서명됩니다. 합의하지 않는 사항들은 평균화되지 않고 자체 섹션에 유지됩니다.
본 논문은 네 가지 기여를 합니다. 첫째는 프로토콜 자체로, 출처를 보존하고 무음 삭제를 금지하는 알고리즘으로 표현되며, 병합이 실패할 수 있는 다섯 가지 방식의 분류법과 함께 제시됩니다. 그 중 네 가지는 순진한 풀링의 결함이고, 다섯째는 방법이 아닌 운영자의 실패입니다. 단일 모델의 출력을 동료적 결과로 제시하는 종합입니다. 둘째는 프로토콜 설계에 상관된 증인 산술의 적용입니다. 이 산술은 여기서 주장되지 않습니다. Kohli(2026)는 동일한 Kish 보정을 아홉 명의 최첨단 판사 패널에 적용했고 약 두 명의 유효한 투표를 측정했으며, Kim et al.(2025)는 350개 이상의 모델에 걸친 기본 오류 상관을 확립했습니다. 오류가 급내 상관 ρ를 갖는 N개 모델의 협의회는 = N / (1 + (N−1)ρ)명의 독립적인 증인의 가치가 있으며, 그 양은 아무리 많은 모델을 추가하든 1/ρ에서 포화됩니다. 협의회가 1/ρ보다 크면, ρ를 반으로 줄이는 것이 N을 두 배로 늘리는 것을 이기고, 두 실험실에서 추출한 쌍이 하나의 실험실에서 추출한 다섯 개를 능가할 수 있습니다. Kim et al.(2025)는 그 규칙을 복잡하게 합니다. 더 크고 정확한 모델은 아키텍처와 제공자가 다르더라도 가장 상관된 오류를 갖습니다. 따라서 두 실험실은 ρ에 대한 이전 추측이지 측정값이 아니며, 이것이 5.5절의 추정 절차가 하는 일입니다. 셋째는 수동, 원탭 모바일, 브라우저 에이전트의 세 가지 배포 계층에 대한 설명과 그들을 인식론적으로 분리하는 축에 대한 설명입니다. 두 번째 모델이 첫 번째 모델의 답변을 볼 수 있는지 여부입니다. 두 번째 모델을 조건화하면 오류 수정을 위해 ρ가 증가합니다. 넷째는 다섯 모델에 걸친 위조 협의회 실패의 소규모 샘플 관찰, 세 모델 재실행에서 이를 제거한 한 문장의 개입, 그리고 명시된 반증 조건이 있는 맹검 삼원 평가 설계입니다.
상관된 합의는 여기서 발견이 아니라 확립된 것으로 취급됩니다. 모델 패널이 구성원 수보다 훨씬 적은 독립적인 증인의 가치가 있다는 것은 직접 측정되었습니다. 일곱 개 계열에서 추출한 아홉 명의 최첨단 판사는 약 두 명의 유효한 투표를 제공하고(Kohli, 2026), 오류 상관은 제공자 및 아키텍처에 걸쳐서도 모델 능력에 따라 증가합니다(Kim et al., 2025). 5절은 이러한 측정 뒤에 있는 설계 효과 산술을 다시 설명합니다. 왜냐하면 프로토콜의 세 가지 규칙이 이로부터 도출되었고 그것 없이는 까다로운 것처럼 보이기 때문입니다. 그 다음 프로토콜은 동일한 문제의 다른 측면을 취합니다. 그 문헌은 상관을 측정합니다. 이 프로토콜은 이를 낮추기 위해 구축되었으며, 계통을 넘어 구성하고, 합의하지 않는 사항을 평균화하지 않고 유지하고, 모든 기여를 이를 제공한 모델로 서명하고, 반복된 출처를 한 번씩 계산함으로써 그렇게 합니다.
병합된 답변이 최선의 단일 답변을 능가한다는 주장은 설계와 인접한 문헌에서 논의되며, 9절은 아직 실행되지 않은 평가를 명시합니다.
목차
- 소개
- 관련 연구
- 병합이 실패하는 다섯 가지 방식
- 앵커-및-풍부화 프로토콜
- 상관 일치
- 세 계층, 하나의 프로토콜
- 실증 섹션
- 붙여넣기 파일: 콜드 스타트 지도를 위한 인터페이스 패턴
- 제안된 평가
- 제한 사항
- 윤리, 프라이버시 및 법적 프레임워크
- 결론
선언 · 참고문헌 · 부록 A, 영수증 템플릿 · 부록 B, 독립적 증인의 유효 개수 · 부록 C, 모바일 계층 구현 참고서
그림과 표의 목록
- 그림 1. 평의회가 1/ρ에서 포화되며, 동의하는 열 개의 모델이 가치 있는 것 (섹션 5.3)
- 그림 2. 앵커-엔리치 프로토콜, 단계별 (섹션 4.2)
- 그림 3. 하나의 레이턴시-폭 곡선 위의 점으로서 세 계층 (섹션 6.4)
- 그림 4. 블라인드-병렬 및 정보-순차 추출 비교 (섹션 6.5)
- 표 1. 프로토콜 규칙 및 이들이 해결하는 실패 (섹션 4.5)
- 표 2. 독립적 증인의 유효 개수, 선택된 값 (섹션 5.2)
- 표 3. 모바일 계층의 세 가지 모드 (섹션 6.2)
- 표 4. 세 계층에 걸친 레이턴시-폭 경계 (섹션 6.4)
- 표 5. 콜드-스타트 프로브, 기준 실행, n = 5 (섹션 7.2)
- 표 6. 역할 할당 개입 후 콜드-스타트 프로브, n = 3 (섹션 7.3)
- 표 7. 소비자 앱-의도 파이프라인의 관찰된 실패 모드 (섹션 7.5)
- 표 8. 독립적 증인의 유효 개수, 전체 표 (부록 B)
- 표 9. 모바일 계층 구현 참고 (부록 C)
1. 소개
1.1 문제
틀린 답의 대가가 큰 질문을 생각해 봅시다. 학교 선택, 치료법 선택, 공급업체 선택, 계약서의 한 조항. 사용자가 언어 모델에 질문하고 일관되고 확신 있으며 잘 형식화된 답변을 받습니다. 어려움이 바로 거기서 시작됩니다. 확신 있는 틀린 답변과 확신 있는 올바른 답변은 똑같이 보입니다. 어조로도 구조로도 길이로도 인용의 유무로도 구별되지 않습니다. 언어화된 모델 확신은 과장되고 보정이 잘못된 것으로 알려져 있습니다(Kadavath et al., 2022; Xiong et al., 2024). 모델이 질문자의 틀을 채택하는 경향은 거짓 지지의 두 번째 계층을 더합니다(Sharma et al., 2023).
명백한 해결책은 두 번째 의견입니다. 한 모델의 오류는 확신처럼 보입니다. 같은 오류를 두 번째 모델의 답변 옆에 놓으면 논쟁처럼 보입니다. 논쟁은 주제에 전문 지식이 없는 독자도 볼 수 있습니다. 확신은 볼 수 없습니다. 이 비대칭성이 아래의 모든 것의 기초입니다.
이 해결책은 대가와 함정이 있습니다. 대가는 읽는 것입니다. 한 질문에 대한 열 개의 답변은 한 번에 마음에 담으면서 누가 무엇을 말했는지 기억해야 할 열 개의 긴 텍스트입니다. 거의 아무도 그렇게 하지 않습니다. 실제로 독자는 첫 번째 답변을 읽고 두 번째는 훑어보고 나머지는 닫습니다. 여러 답변을 모으는 것은 수년간 수집업체 구독, 나란히 놓인 패널, API 게이트웨이를 통해 해결된 문제입니다. 그것으로 끝내는 것은 해결되지 않았습니다.
함정은 병합입니다. 열 개의 답변을 하나로 줄이는 어떤 방식도 다시 하나의 확신 있는 텍스트를 만들고, 감소가 불투명하면 독자는 처음 위치로 돌아가되, 이번에는 텍스트가 확인할 수 없는 권위를 지닙니다. 순진한 풀링은 또한 올바른 소수 의견을 지우고, 가장 강조된 표현이 무엇이든 그쪽으로 표류하고, 실제 합의가 없는데도 합의의 모습을 만듭니다.
세 번째 문제는 전체 연습을 자명하지 않게 만드는 것입니다. 모델 간의 일치는 독립적 확인이 아닙니다. 왜냐하면 겹치는 말뭉치에서 훈련된 모델은 틀을 공유하고 같은 기사를 인용하고 같은 맹점을 물려받기 때문입니다. "열 개 중 아홉 개가 동의했다"와 "아홉 명의 독립적 전문가가 동의했다"는 다른 진술이고, 그 둘 사이의 간격은 정량적이고 큽니다. 섹션 5에서 이것이 전체 구조에 한계를 두는 것을 보여줍니다.
1.2 시스템
프로토콜은 평문으로 작성되고 세 가지 실행 방식이 있습니다. 세 가지 모두 같은 문서를 만들고, 누가 클릭하는지와 몇 개의 모델을 질문하는지에서 다릅니다.
무료 경로에서 사용자는 사이트를 열고 답변을 복사하여 한 단락의 지시 사항 아래에 붙여넣기하여 어떤 채팅 모델에든 넣습니다. 설치할 것도 없고 지불할 것도 없으며 휴대폰에서 작동합니다.
모바일 계층에서는 홈 화면에 하나의 아이콘이 있습니다. 탭하고, 질문을 입력하고, 모드를 선택하면 약 1분 후 완성된 답변이 화면에 표시되고 클립보드에 들어갑니다. 이미 기기에 설치된 구독에 대한 운영 체제 앱 의도를 통해 두 모델에 도달하며, API 키는 없습니다.
에이전트 경로에서 브라우저를 구동할 수 있는 모델은 사용자의 기존 로그인 세션에서 지정된 사이트를 열고 질문을 제출하고 기다리며 각 답변을 파일에 저장하고 문서를 작성합니다.
건축상 결정적인 사실은 서버가 없다는 것입니다. 보안이 설정된 서버도 아니고 무보유 정책이 있는 서버도 아닙니다. 그러한 구성 요소가 없으므로 질문이 나에게 도달할 수 없습니다. 사용자가 이름을 지정한 모델 서비스에는 도달하며, 이것이 연습의 요점이고, 다른 곳으로는 가지 않습니다. 같은 부재로부터 따르는 두 번째 결과는 이것입니다. 프로토콜은 철회될 수 없습니다. 왜냐하면 허용 라이선스 하의 텍스트 단락이고 사용자의 메모에 있는 사본은 나중에 존재하는 어떤 모델과도 계속 작동하기 때문입니다.
1.3 기여
섹션 3은 병합이 실패하는 다섯 가지 방식을 제시하고 섹션 4는 앵커-및-강화를 그것들에 대해 형식화합니다. 섹션 5는 상관된 증인 모델을 발전시키고, = N/(1+(N−1)ρ)이며 그 한계는 1/ρ에서입니다. 이것이 의회가 어떻게 구성되어야 하는지에 대해 의미하는 바를 끌어냅니다. 섹션 6은 세 계층, 그들이 추적하는 지연시간-폭 프론티어, 그리고 그들을 인식론적으로 분리하는 맹-병렬 대 정보화-순차 구별을 설명합니다. 섹션 7은 위조 의회 관찰 및 모바일 빌드의 현장 조사를 보고합니다. 섹션 8은 냉시작 지도를 위한 인터페이스 패턴을 설명합니다. 섹션 9는 미리 고정된 거짓화 조건이 있는 맹검 평가를 명시합니다. 병합된 답변이 최선의 단일 답변을 능가한다는 주장은 여기서 정착되지 않고, 그 평가는 그것을 정착시킬 비교이며, 나를 그것을 철회하도록 의무지울 결과를 포함합니다.
방향성을 명확히 진술할 가치가 있습니다. 왜냐하면 이것이 이 논문을 그것이 의존하는 측정 문헌과 분리하기 때문입니다. Kohli(2026), Kim et al.(2025), Ding(2026)은 의회의 오류가 얼마나 상관되어 있는지를 측정합니다. 이 논문은 그 상관성을 설계 목표로 취하고 API 키도 없고 서버도 없이 일반적인 소비자 채팅 인터페이스를 통해 작업하는 한 사람이 어떻게 그것을 낮출 수 있고 그들이 그렇게 했음을 보여주는 기록을 남길 수 있는지를 묻습니다. 그 문헌의 한 가지 간격은 언급할 가치가 있습니다. 왜냐하면 그것은 도달 가능하기 때문입니다. 측정은 API를 통해, 벤치마크에서, 아홉 개 모델로 또는 3백 개의 모델로 이루어졌습니다. 아무도 이 프로토콜이 차지하는 소비자 설정에서 상관성을 추정하지 않았습니다. 여기서 사람이 이미 비용을 지불하지 않는 네 개의 채팅 제품을 질문합니다. 섹션 5.5는 절차를 제공하고 섹션 9.6은 설계를 제공합니다.
2. 관련 연구
앙상블과 다양성. 고전 앙상블 이론은 이미 필요한 것을 말해줍니다: 앙상블이 얻는 것은 그 구성원들이 평균적으로 얼마나 좋은지가 아니라 서로 얼마나 다르게 오류를 범하는지에 달려 있다는 것입니다. 앙상블 오류가 평균 구성원 오류에서 평균 모호성을 뺀 것과 같다는 모호성 분해(Krogh & Vedelsby, 1995)와 편향-분산-공분산 분해(Ueda & Nakano, 1996) 모두 오류 공분산이 증가함에 따라 앙상블이 단일 구성원으로 붕괴됨을 보여줍니다. Dietterich(2000)는 이 조건을 필요조건으로 명시합니다. 5절에서는 이를 언어 모델 의회로 확장하고 이를 위반했을 때의 비용을 정량화합니다.
언어 모델을 위한 다중 모델 방식. Self-consistency(Wang, X., et al., 2023)는 하나의 모델에서 여러 표본에 걸쳐 투표하며, 이는 독립성을 생성하지 않으면서 분산을 줄입니다. 다중 에이전트 토론(Du et al., 2023)은 여러 인스턴스가 주장을 교환할 때 사실성 향상을 보고합니다. Mixture-of-agents(Wang, J., et al., 2024)는 한 계층의 출력을 집계기로 전달하고 여러 벤치마크에서 가장 강력한 단일 모델보다의 개선을 보고합니다. 그 문헌은 이 프로토콜과 같은 방향을 가리킵니다. 그러나 그 결과는 API를 통해 그리고 벤치마크에서 얻어졌으므로, 나는 그것들을 5절에서 지정하는 자체 측정 없이 브라우저 매개 소비자 인터페이스의 의회로 이전하지 않습니다.
심판 모델. 모델 심판에 의한 평가는 그 결함과 함께 잘 특징지어집니다: 위치 편향, 장황함 편향, 친숙한 하우스 스타일로의 끌림(Zheng et al., 2023). 이는 설계 제약입니다. 여기서는 곁길이 아니라, 맹검 채점이 부분적으로 이러한 편향을 측정하기 때문입니다. 9.4절에서 이를 다룹니다.
단일 문화. Kleinberg과 Raghavan(2021)은 많은 에이전트가 하나의 알고리즘에 의존할 때, 개별 품질이 향상되더라도 집단적 결과가 악화될 수 있음을 보여줍니다. Bommasani et al. (2022)는 같은 효과를 결과 동질화로 설명합니다. 언어 모델의 의회에서 이것은 처음부터 ρ > 0을 생성하는 메커니즘입니다. 생성된 데이터에 대한 훈련에서의 성능 저하에 대한 연구(Shumailov et al., 2024)는 ρ가 시간이 지남에 따라 상향 표류함을 시사합니다.
군중. 고전적 군중의 지혜 논증(Surowiecki, 2004)은 판단이 독립적이라는 것에 달려 있습니다. Lorenz et al. (2011)은 실험적으로 심지어 미약한 사회적 영향, 단순히 다른 사람들의 추정치를 보는 것이 퍼짐을 좁히지만 진실 방향으로는 옮기지 않음을 보여주었습니다: 군중은 더 확신하지만 더 정확하지는 않습니다. 6.5절은 이를 정보를 받은 순차적 도출에 의해 수용되는 정확한 거래로 식별합니다.
Condorcet와 상관된 투표. Condorcet 배심원 정리(Condorcet, 1785)는 개별 정확성이 2분의 1을 초과할 때, 정확한 다수결의 확률이 N이 증가함에 따라 1로 경향함을 유지합니다. Ladha(1992)는 상관된 투표가 보장을 파괴함을 보였습니다. 5절은 설계 효과(Kish, 1965)를 통해 그 경고의 정량적 버전을 제공합니다.
상관된 오류, 측정됨. 5절이 다시 서술하는 산술은 그 이후로 모델 패널에 직접 측정되었으며, 측정은 분석보다 더 선명합니다. Kohli(2026)는 Kish 유효 표본 크기를 일곱 개 모델 계열에서 끌어온 아홉 개의 최첨단 심판 패널에 적용하고 대략 두 개의 독립적 투표만큼의 가치가 있음을 발견합니다: 대략 패널의 명목상 독립성의 4분의 3이 공유된 실수로 손실되고, 패널의 정확성은 독립적 투표가 제공할 것보다 8에서 22 백분 포인트 부족하며, 최고의 단일 심판은 전체 패널과 동등하거나 이를 능가합니다. 더 많은 심판도 더 나은 집계도 이를 수리하지 않으며, 이는 병목을 알고리즘이 아니라 심판에 위치시킵니다. Kim et al. (2025)은 350개 이상의 모델에 걸쳐 실질적인 오류 상관관계를 발견하고, 중요하게는 의회가 어떻게 구성되어야 하는지에 대해, 더 크고 더 정확한 모델이 아키텍처와 제공자가 다를 때에도 가장 상관된 오류를 가짐을 발견합니다. Ding(2026)은 265,000개의 표본에 걸쳐 신뢰 신호로서의 합의를 감시하고 0.20에서 0.59 사이의 상관관계로 약하지만 양의 예측자이며, 가장 확신할 때 정확히 최악임을 발견합니다: 가장 일관성 있는 최첨단 모델에서, 0.8 이상의 합의는 더 어려운 벤치마크의 항목의 77%를 포함했으며 그 중 48%는 틀렸습니다.
이 논문에 대해 세 가지가 따릅니다. 첫째, 5절의 설계 효과 결과는 나의 기여가 아닙니다. Kohli의 논문은 이것의 첫 게시 이전이며 같은 수정을 사용했습니다; 절은 프로토콜이 그것으로부터 도출하는 것을 위해 유지되며, 그것이 나타나는 곳에서 그렇게 표시됩니다. 둘째, 그 다음의 구성 조언인 개수가 아니라 다양성에 지출하라는 것은 이제 단순히 주장되는 것이 아니라 경험적으로 지원됩니다. 셋째, Kim et al.의 발견은 그 조언을 명시할 가치가 있는 방식으로 복잡하게 합니다: 능력과 오류 상관관계가 함께 상승한다면, 두 개의 실험실에서 끌어온 쌍은 자동으로 다양한 쌍이 아니며, 계보는 브랜드에서 읽혀지기보다는 측정되어야 합니다. 이는 5.5절의 추정 절차에 대한 논증이지, 구성 규칙에 대한 것이 아닙니다.
인접한 시스템. 여러 프로젝트가 다중 모델 의회를 구축합니다. 하나의 잘 알려진 공개 구현인 llm-council(Karpathy, 2025)은 모델을 병렬로 조회하고, 그들이 서로를 익명으로 검토하게 하며, 의장 모델이 최종 답변을 쓰게 합니다. 그것은 집계기 API 키와 토큰당 지불이 필요합니다. 상용 의회 제품은 심판, 합의 견해 및 모순 표시를 제공합니다. 오픈 소스 모바일 애플리케이션은 투표 및 다중 라운드 토론을 추가합니다. 성숙한 다중 모델 전면은 앙상블 기능을 제공하고, 무료 나란히 패널은 사용자가 이미 로그인한 공식 사이트를 사용합니다. 집계기 구독은 많은 모델을 하나의 청구서 뒤에 놓습니다. 이러한 속성 각각은 다른 곳에 자체적으로 존재합니다. 그들의 결합, 한 번에 열 개, 다른 곳에서 이용할 수 없는 것으로 나타납니다: API 키 없음, 설치 없음, 휴대폰 호환, 사용자가 이미 보유한 계정에서 실행 중 무료 티어 포함, 새로운 유료 중개자 없음, 일반 텍스트로 작성된 병합 방법이므로 편집 가능, 불일치 보존, 모든 기여 서명됨, 반복된 소스가 하나의 소스로 표시됨, 그리고 손으로 또는 에이전트 아래에서 실행 가능한 하나의 방법입니다.
위치가 열려 있는 구조적 이유가 있습니다. 실험실은 사용자의 질문을 그 경쟁자에게 라우팅할 인센티브가 적습니다. 각 참가자의 목표는 자신의 답변이 사용자가 유지하는 것이기 때문입니다. 제3자는 교차 모델 도구를 판매하지만, 일반 텍스트로 작성된 방법은 편집 역할을 사용자와 함께 두며, 이는 그들 중 어떤 것과도 다른 배치입니다.
범위. 본 프로토콜은 연구팀의 인프라를 구축하지 않고 한 사람이 신중한 하나의 문서를 작성하는 경우를 다룹니다: 키 없음, 설치 없음, 서버 없음. 재시도, 보장된 실행, 비용 및 오류 모니터링, 감사 로그, 테스트 세트에 대한 평가, 접근 제어, 단일 로그인, 보유 정책, 프롬프트 버전 관리, 그리고 서비스 수준 약정은 엔터프라이즈 오케스트레이션 프레임워크의 영역입니다.
3. 병합이 실패하는 다섯 가지 방식
다섯 가지 중 네 가지는 순진한 풀링의 속성입니다. 순진한 풀링이란 "이 답변들을 조합하고 결과를 최적화하라"는 형태의 모든 지시를 의미합니다. 다섯 번째는 연산자에 속하며, 가장 중요한 것입니다. 독자가 이를 감지할 수 없기 때문입니다.
F1, 합성에서의 조작. 출력에는 입력 중 어느 것에도 없었던 주장이 포함되어 있습니다. 합성기 자체가 언어 모델이므로 출처 간의 이음새를 매끄럽게 하는 과정에서 출처가 있는 자료와 정확히 같아 보이는 연결 자료를 생성합니다.
F2, 소수 의견 삭제. 중요한 이의를 제기한 유일한 답변이 대다수의 의견 때문에 사라집니다. 이것이 평의회가 소집된 이유이며, 순진한 병합이 가장 먼저 잃는 것입니다.
F3, 신뢰도 편향. 두 표현이 충돌할 때, 더 범주적인 표현이 더 잘 지지된 표현을 이깁니다. 이는 판사 모델에서 입장과 스타일 편향을 만드는 것과 같은 메커니즘입니다(Zheng et al., 2023).
F4, 조작된 합의. 실제 불일치가 qualified yes로 평균화됩니다. 독자는 논쟁의 대상이 확정된 것과 구별 불가능한 문서를 받게 되며, 분쟁이 존재했다는 사실조차 알 수 없습니다.
F5, 위조된 평의회. 동료적 검토를 실행하도록 지시받은 모델은 다른 모델에 접근할 수 없습니다. 그렇다고 말하는 대신 일반적인 웹 검색을 수행하고 결과를 동료적 형태로 포맷팅하며, 수신자, 동의 및 비동의 섹션, 출처 귀속을 포함합니다. 실제 모순이 방해하지 않기 때문에 문서가 정직한 것보다 더 나아 보입니다. 독자는 출처 답변에 접근할 수 없기 때문에 이를 감지할 수 없습니다.
F5는 논문의 시작 문제를 한 수준 더 높입니다. 자신감 있게 틀린 답변은 올바른 답변과 구별할 수 없으며, 평의회처럼 형태를 갖추었지만 한 모델이 작성한 문서는 평의회와 구별할 수 없습니다. 7장에서는 맹검 실행에서 5개 모델 중 2개에서 이것이 발생한 것으로 보고합니다.
4. 앵커-앤-인리치 프로토콜
4.1 원리
답변을 모으고 최적화하는 대신, 이 프로토콜은 한 가지 강력한 답변을 점진적으로 발전시키면서 출처와 의견의 불일치를 시각적으로 유지합니다.
4.2 규칙
그림 2는 전체 프로토콜을 보여줍니다.
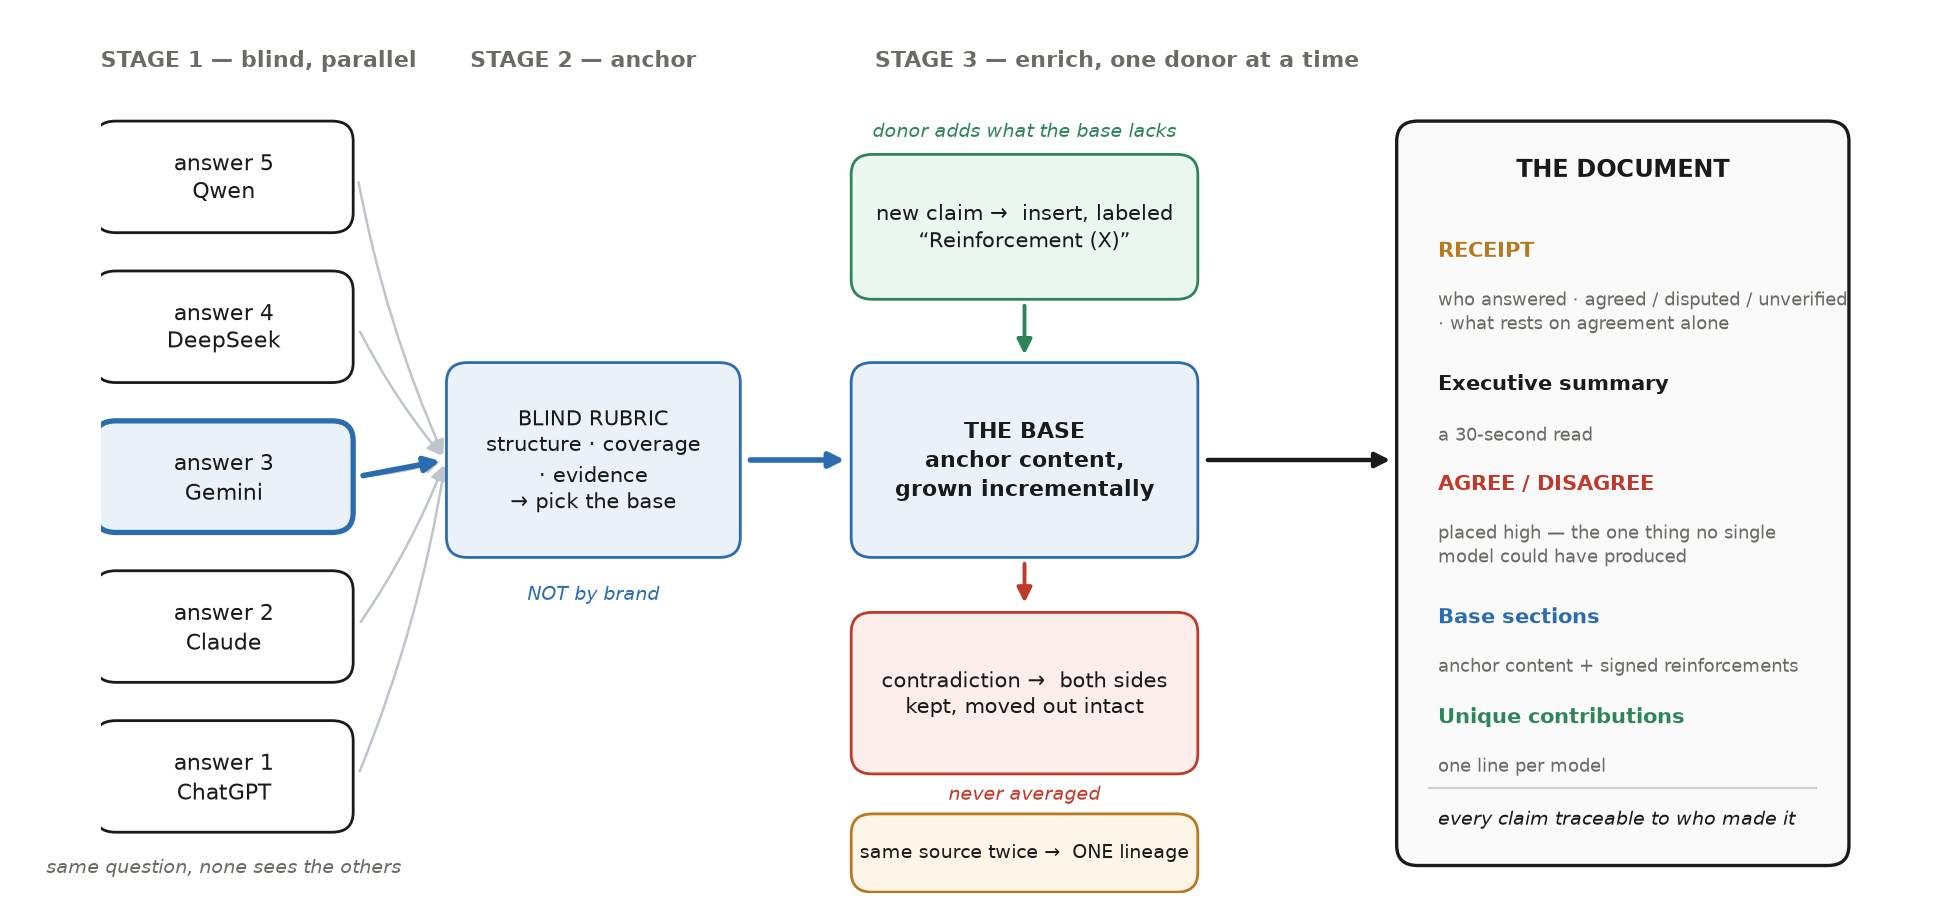
브랜드가 아닌 블라인드 루브릭으로 앵커를 선택합니다. 가장 완전하고 잘 출처가 명시된 가장 강력한 답변이 기반이 됩니다. 내용을 판단합니다: 구조, 범위, 증거. 특정 모델을 선호하도록 미리 설정하는 것은 체계적 편향이며, 한 모델이 다른 모델보다 더 많은 맥락을 받았을 경우 가장 심합니다. 앵커가 선택되면 즉시 구축이 시작됩니다. 늦게 제출되는 답변은 기다리지 않습니다.
한 번에 한 기여자씩 인리치합니다. 각 남은 답변에서 기반에 부족한 부분이나 이미 있는 것을 강화하는 것만 가져옵니다: 선례, 수치, 비유, 관점, 1차 출처 링크. 강화 (모델 이름) 라벨이 붙은 일치하는 섹션에 삽입합니다.
출처를 보존합니다. 모든 기여는 제공자의 표시를 갖습니다. 모델 출처는 증거 출처가 아니며, 원본 출처 링크를 사용할 수 있는 경우에는 기여자 정보뿐만 아니라 함께 전달합니다.
공개적으로 수정합니다. 기반 내용은 우선적으로 유지됩니다. 기여자가 앵커의 오류를 수정할 경우 수정을 하고 변경된 내용과 이유에 대한 한 줄 주석을 남깁니다. 기반을 건드리지 않는 규칙에 대한 존중 때문에 알려진 앵커 오류를 고정시키는 것이 기반을 건드리는 것보다 나쁩니다. 지배적인 규칙은 정보가 조용히 손실되지 않는다는 것이지, 기반이 불변이라는 것이 아닙니다.
불일치를 드러냅니다. 별도의 섹션이 합의를 발산으로부터 분리합니다. 충돌하는 주장은 중간 입장으로 평균화되지 않습니다.
상관관계 있는 증거에 플래그를 지웁니다. 여러 모델이 같은 기사를 인용하는 것은 하나의 증거 계보이지, 여러 독립적 확인이 아닙니다. 이는 구성 수준에서도 마찬가지입니다. 합의하는 모델이 같은 종류의 회사나 같은 관할권의 회사에 의해 구축되었고 분할이 그 선을 따라 떨어지면 그렇게 말합니다.
독특한 기여를 인정합니다, 모델당 한 줄.
오케스트레이터의 견해를 추가합니다 사용자가 요청한 경우 최종 섹션으로.
하중을 견디는 사실을 명명합니다. 권장 사항이 실제로 의존하는 두세 가지 사실, 보통 숫자를 파악하고, 각각을 확인 가능한 출처로 뒷받침되거나 모델이 합의하는 것에만 의존하는 것으로 표시합니다. 그들이 수치에 합의하고 그 중 누구도 출처를 보여주지 않으면 그것은 경고이지, 확인이 아닙니다.
4.3 알고리즘
INPUT   Q — the question
        A = {a_1 … a_N} — answers, arriving asynchronously
OUTPUT  D — a document with a receipt, provenance, and
        a disagreement section

R ← ∅            // receipt: who answered, who did not, why
D ← ⊥            // the base (anchor)

on arrival of a_i:
    R ← R ∪ {source(a_i), timestamp, mode}

    if D = ⊥ and enough_candidates():
        D ← argmax_{a ∈ A_ready} rubric(a)
        anchor ← source(D)         // recorded and disclosed
        // rubric = structure, coverage, sourcing

    else:
        for each claim c ∈ a_i:

            if c ∉ D:                              // new
                insert c into the matching section of D,
                    labeled "Reinforcement (source(a_i))"

            else if c contradicts c' ∈ D:
                if c corrects a factual error in c':
                    replace c' with c, plus a one-line
                    note of what changed
                else:
                    move (c, c') into DISAGREEMENTS,
                    both sides intact

            else:                            // agreement
                if evidence_source(c) = evidence_source(c'):
                    mark as ONE evidentiary lineage,
                    not as confirmation

after all:
    identify the load-bearing facts
    mark each [sourced] or [agreement only]
    assemble RECEIPT, SUMMARY, AGREE/DISAGREE (placed high),
             UNIQUE CONTRIBUTIONS
    emit in a readable and a double-clickable format
수집과 합성이 함께 진행됩니다. 앵커는 도착하는 즉시 기반이 되고, 이후의 각 답변은 들어올 때마다 추가됩니다. 빠른 제공자는 1~2분 내에 응답하고 심층 연구 모드는 5~25분이 걸리므로, 두 단계를 순차적으로 처리하면 아무 이점 없이 실행이 30분 단위로 늘어나게 됩니다.
4.4 출력 형태
섹션 순서는 표현이 아닌 프로토콜의 일부입니다.
영수증이 맨 위에 있습니다: 누가 답변했고, 누가 하지 않았으며 그 이유는 무엇인지, 무엇이 합의되고 논쟁되며 확인되지 않았는지, 증거가 어디에서 상호 연관되어 있는지, 그리고 실행이 대략 얼마나 많은 시간과 할당량이 소요되었는지입니다. 그 다음 30초 요약, 그 다음 목차가 있습니다.
합의와 불합의는 요약 바로 다음에 옵니다: 이것은 어떤 단일 모델도 생산할 수 없었던 유일한 구성요소이며 이 방법을 실행한 이유입니다. 편안한 합의 아래에 맨 끝에 배치하면, 유용한 문서가 명백한 것으로 읽히기 시작하고, 그러면 더 이상 읽히지 않습니다.
그 후에는 기본 섹션들이 있으며, 각각은 앵커 콘텐츠와 서명된 보강으로 구성되고, 각 모델이 고유하게 기여한 것의 목록, 그리고 사용자가 요청한 경우 오케스트레이터의 자체 의견이 있습니다.
4.5 규칙과 해결하는 실패
표 1. 프로토콜 규칙과 해결하는 실패
| 규칙 | 해결하는 실패 |
|---|---|
| 브랜드가 아닌 루브릭으로 앵커 | 선호하는 모델에 대한 체계적 편향 |
| 기증자는 누락된 것만 추가 | F1: 기반이 다시 작성되지 않으므로 더 적은 이음새가 생성됨 |
| 모든 기여에 대한 출처 | F1, 그리고 감사성: 독자는 신뢰하는 대신 확인할 수 있음 |
| 설명 줄이 있는 수정 | 앵커 오류 시멘트 |
| 불합의를 자체 섹션에 배치, 높이 배치 | F2, F4 |
| 공유된 증거 계통 표시 | 거짓 독립성 (섹션 5) |
| 부하 관련 사실을 출처 있음 또는 합의만으로 표시 | 합의를 증거로 취급 |
| 실행되지 않은 것은 실행으로 제시되지 않음 | F5 |
이것은 설계 논증이며, 섹션 9는 이를 검증하는 것을 명시합니다.
4.6 작동 예제
이러한 종류의 프로토콜은 설명에 대해서보다 출력에 대해 판단하는 것이 더 쉽습니다. 다음은 2026년 8월 31일에 자유 경로의 실제 실행에서 발췌한 것입니다: 한 가지 질문을 네 개의 별도 세션에서 네 개의 소비자 채팅 모델에 질문한 다음 위의 규칙으로 병합했습니다. 기증자 이름은 여기에 나타나는데, 섹션 7과 달리 출처가 시연되는 속성이고 익명화된 예제는 아무것도 시연하지 않기 때문입니다.
RECEIPT — 4 models asked · 4 answered
Agreed:    3-2-1 redundancy · JPEG is the safe everyday format ·
           migrate every ~5 years · never let a proprietary app
           be a photograph's only home
Disputed:  how many copies (3 vs 4) · what the archival master
           should be (TIFF/PNG vs original plus JPEG)
To check:  media lifespan figures · whether your export tool
           strips EXIF

— Section 1 of the merged document: how many copies, and where —

Base.  The 3-2-1 rule: three copies, on two kinds of storage,
with one off-site. The off-site copy is what survives a fire,
a flood or a theft.

⚠ Disagreement — is there a fourth copy?
ChatGPT and Gemini both extend this to 3-2-1-1, adding one copy
that is immutable or offline. Their reasoning differs: ChatGPT
frames it as geographic independence, Gemini as protection from
ransomware and from a mass deletion that syncs everywhere.
Claude and DeepSeek stayed at three and did not argue against a
fourth; they simply did not call for one.

(added by Claude)  Whatever you choose, treat cloud as one leg
of the tripod and never the whole thing: it is tied to an
account that can be locked, closed, or repriced.

— Worth checking yourself —

The lifespan figures come from Gemini alone. No other model
gave numbers, so treat them as one source rather than as a
consensus.
그 발췌문에서 네 가지가 설명되는 프로토콜이 아니라 작동하는 프로토콜입니다. 네 번째 복사본에 대한 의견 불일치는 양쪽의 입장을 모두 유지하면서, 그리고 두 모델의 서로 다른 이유를 담으면서 전달되며, 독자가 신경 쓸 수 있는 고려사항이 어느 것인지를 감춘 "위험 선호도에 따라 3개 또는 4개"로 해결되지 않습니다. 클라우드 저장소에 대한 강조는 이를 제공한 모델의 이름을 담고 있으므로, 그 모델을 불신하는 독자는 그 줄을 할인할 수 있고 다른 것은 할인할 수 없습니다. 마지막 주석은 실행 중인 규칙 6입니다. 한 모델이 문서의 유일한 숫자를 제공했으며, 병합은 이들을 단일 출처로 표시했으므로 4개 모델 문서에서의 존재가 합의로 읽히도록 하지 않았습니다.
네 번째는 그 발췌문이 담지 않는 것입니다. 규칙 9보다 앞서므로, 그 실질적인 사실들은 출처가 있는 것과 합의만 있는 것으로 분리되지 않으며, 나온 그대로 재생산됩니다. 이는 그 규칙들을 예시하기 위해 편집된 예시는 더 이상 그들이 작동한다는 증거가 될 수 없기 때문입니다.
5. 상관관계가 있는 합의
우선순위 주석. 이 섹션의 산술은 새로운 것이 아니며 기여로 주장되지 않습니다. Kohli (2026)는 9명의 국경 판사 패널에 동일한 Kish 수정을 적용했으며 이 논문이 처음 게시되기 3개월 전에 약 2개의 유효 투표를 측정했고, Kim et al. (2025)는 350개 이상의 모델에 걸쳐 이를 주도하는 오류 상관관계를 확립했습니다. 섹션은 세 가지 이유로 유지됩니다: 프로토콜의 세 가지 규칙이 이로부터 도출되고, 산술을 보지 못한 독자는 이러한 규칙을 필요성이 아닌 세심함으로 읽을 것이며, 5.5절의 추정 절차는 프로토콜이 아무도 측정하지 않은 설정에서 필요로 하는 것입니다. 그 문헌이 상관관계를 측정하는 곳에서, 이 프로토콜은 이를 낮추려고 시도합니다.
열 개의 모델이 합의하면, 결국 그 주장은 아마도 참일 것입니다. 이것은 4절에 대한 가장 강한 직관적 반대이며, 느끼는 것보다 약합니다. 얼마나 약한지 계산하면 규칙 6과 9를 좋은 관행에서 산술로 바꿉니다.
5.1 설정
N개의 모델이 하나의 이진 주장에 답하고, e_i ∈ {0,1}은 모델 i의 오류를 나타냅니다. 독립성 하에서, 개별 정확도 p > 1/2일 때, N개 모델 간의 합의는 N에서 지수적으로 증가하는 증거입니다. 이것이 Condorcet 정리의 내용입니다 (Condorcet, 1785).
겹치는 말뭉치에서 훈련된 모델은 공유된 틀을 상속하고, 동일한 2차 자료를 인용하며 자신의 시대의 맹점을 공유하므로, 그들의 오류는 상관관계가 있습니다. 법원은 모두 동일한 보안 녹화를 본 10명의 증인과 같은 위치에 있습니다: 10개의 진술, 1개의 관찰, 그리고 증인의 수는 얼마나 많이 독립적으로 보았는지에 대해 아무것도 말하지 않습니다. 그 격차에 숫자를 부여할 수 있으며, 이 섹션의 나머지 부분이 이를 수행합니다. 오류의 급내 상관관계를 다음과 같이 정의합니다
5.2 유효한 증인 수
상관관계가 있는 모델의 의회는 구조적으로 집락 표본입니다. 급내 상관관계 ρ를 가진 1개의 집락 내 N개의 관찰은 N개의 정보 단위를 전달하지 않으며, 표준 수정은 설계 효과입니다 (Kish, 1965):
이는 다음의 유효 표본 크기를 제공합니다
따라서 오류가 ρ에서 상관관계가 있는 N개 모델의 의회는 개의 독립적인 증인만큼 가치가 있습니다. 표 2는 선택된 값을 제공하고, 부록 B의 표 8은 전체 범위를 제공합니다.
표 2. 독립적인 증인의 유효 수, , 선택된 N과 ρ
| ρ (아래) / N (가로) | 2 | 3 | 5 | 10 | 20 | 극한 N→∞ |
|---|---|---|---|---|---|---|
| 0 (독립) | 2.00 | 3.00 | 5.00 | 10.00 | 20.00 | ∞ |
| 0.1 | 1.82 | 2.50 | 3.57 | 5.26 | 6.90 | 10.0 |
| 0.2 | 1.67 | 2.14 | 2.78 | 3.57 | 4.17 | 5.0 |
| 0.3 | 1.54 | 1.88 | 2.27 | 2.70 | 2.99 | 3.33 |
| 0.5 | 1.33 | 1.50 | 1.67 | 1.82 | 1.90 | 2.0 |
| 0.7 | 1.18 | 1.25 | 1.32 | 1.37 | 1.40 | 1.43 |
5.3 상한
맨 오른쪽 열은 이 섹션의 주요 결과입니다. N → ∞일 때,
의회에는 상한이 있으며, 얼마나 많은 모델을 요청했는지에 달려 있지 않습니다. 그림 1의 (a) 패널은 포화를 직접 보여줍니다. ρ = 0.5에서 1000개의 모델로 이루어진 의회는 2명의 독립적인 증인의 가치가 있으며, ρ = 0.7에서는 1.5 미만의 가치가 있습니다. ρ = 0.3일 때 10개의 모델에 11번째 모델을 추가하면 약 0.05명의 증인을 얻습니다. ρ = 0.3에서 ρ = 0.15로 이동하면서 동일한 5개의 모델을 사용하면 약 0.85명을 얻습니다.
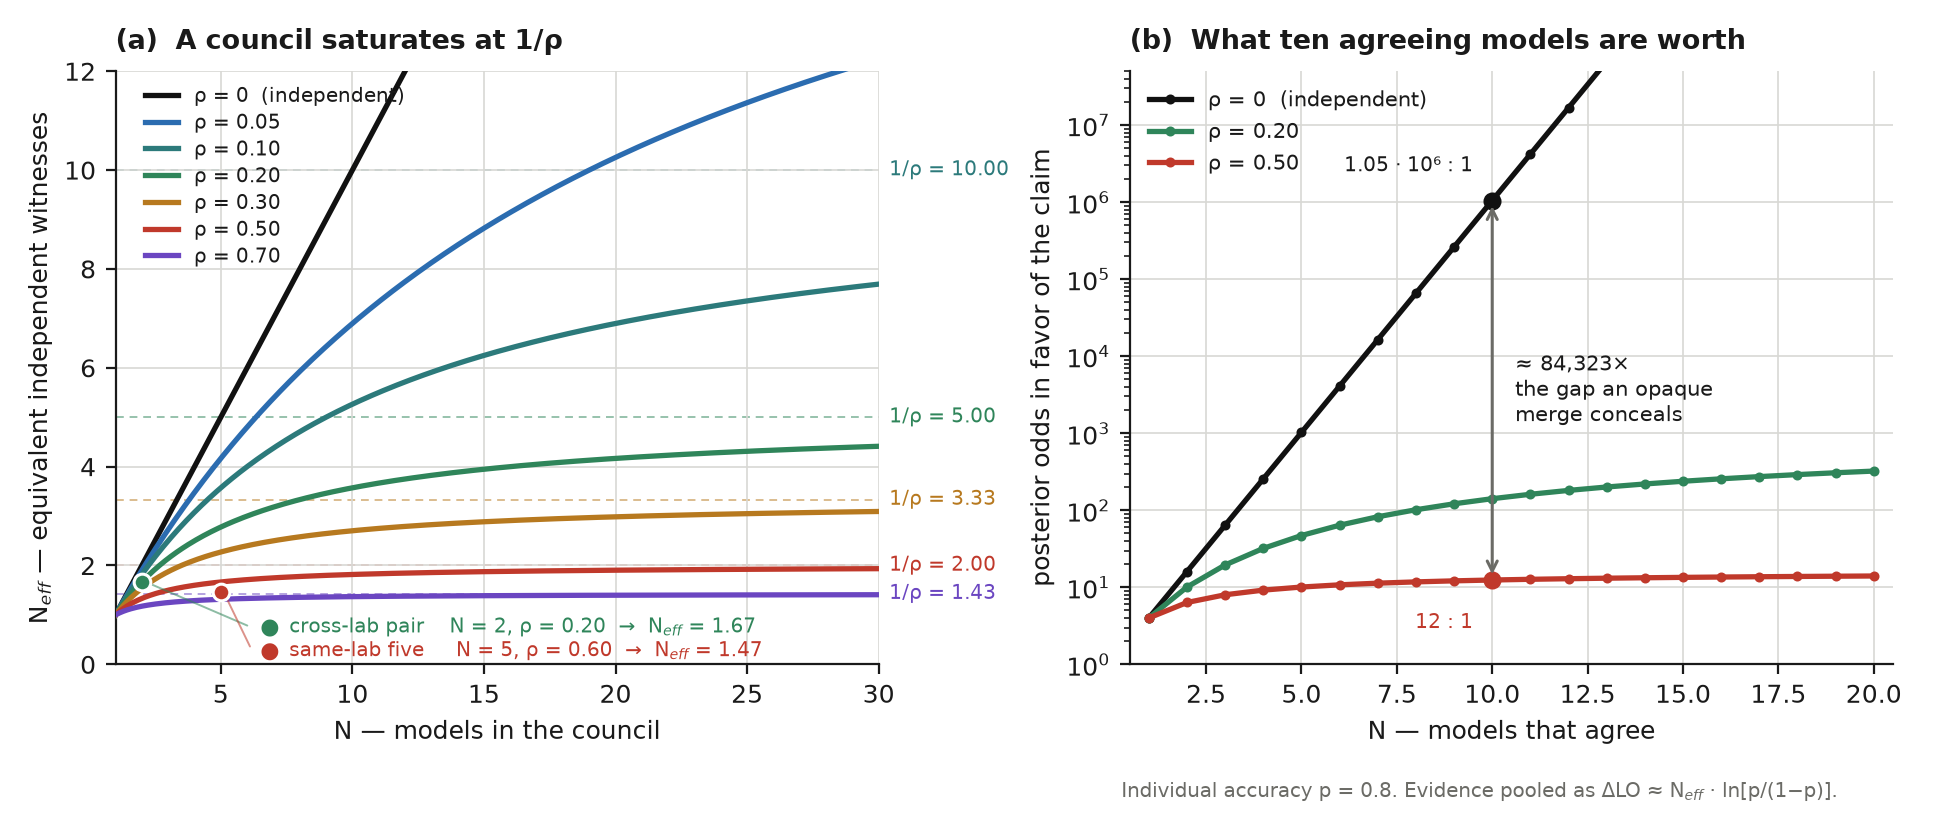
그림 1 — 위원회는 1/ρ에서 포화된다. (a) 여러 급내 오차 상관 ρ 값에 대한 위원회 크기 N에 대한 Neff. 각 곡선은 대시 점근선으로 그려진 천장값 1/ρ에서 포화된다. ρ = 0.20인 교차 연구실 쌍이 ρ = 0.60인 동일 연구실 5개 조합보다 우위에 있다. (b) 동일한 결과를 사후 확률로 나타낸 것으로(5.4절의 근사에서의 설명적 대용치), 개별 정확도 p = 0.8이고 증거는 ΔLO ≈ Neff · ln[p/(1−p)]로 병합된다. 독립적으로 동의하는 10개 모델은 약 100만 대 1의 확률을 제시하고, ρ = 0.5에서 상관된 10개 모델은 12 대 1의 확률을 제시합니다.
실제 결과는 단순히 더 많은 모델을 요청해야 한다는 직관에 어긋납니다. 위원회가 1/ρ보다 커지면 ρ를 반으로 줄이는 것이 N을 두 배로 늘리는 것을 이깁니다. 그 결과는 Kohli의 (2026) 것이기도 하고 그 누구의 것이기도 하며, 그의 패널은 현장에서 관찰된 이 산술입니다. 약 2개의 효과적 투표에 해당하는 9명의 판사는 ρ ≈ 0.44에 해당합니다. ρ를 반으로 줄이는 것이 N을 두 배로 늘리는 것을 이기며, 아래 두 비교는 6절과 관련이 있습니다.
ρ ≈ 0.2인 서로 다른 연구실의 2개 모델은 ≈ 1.67을 제시하는 반면, ρ ≈ 0.6인 한 연구실이나 계통에서 온 5개는 5/(1 + 4·0.6) ≈ 1.47을 제시하므로 교차 연구실 쌍이 5개보다 더 큰 가중치를 갖습니다.
다양성이 그렇지 않은 곳에서는 폭도 급격한 수익 감소를 겪습니다. 표 2의 행을 따라 이동하면 빠르게 포화되지만 열을 위로 이동하면 제한이 없습니다.
이것은 개수를 최대화하는 대신 서로 다른 계통 전반에 위원회를 균등하게 구성하기 위한 분석적 근거입니다. 동일한 말뭉치를 읽어서 동의하는 5개 모델은 진정으로 다양한 3개보다 약한 증거입니다.
5.4 로그 확률에서
정확도 p를 가진 독립적 증인이 로그 확률에 기여하면
상관된 N개 모델 간의 동의는 대략
N · L 대신에 기여합니다. 이것은 메타 분석에서 상관된 관측치의 일반적인 처리이며 여기서 근사로 사용됩니다. 설계 효과 조정 개수를 마치 독립적 증인의 수인 것처럼 취급하는데, 설계 효과 자체는 이를 확립하지 않습니다. 그림 1의 패널 (b)가 이를 표시합니다. p = 0.8에서, L ≈ 1.386 nat입니다:
- 10개의 독립적 증인은 ΔLO ≈ 13.86 nat과 약 1.05·10⁶ : 1의 사후 확률을 제시합니다;
- ρ = 0.5인 10개 모델은 ≈ 1.82로, ΔLO ≈ 2.52 nat과 약 12 : 1의 사후 확률을 제시합니다.
비율은 대략 8.4·10⁴입니다. 그 인수는 불투명한 병합이 독자에게 얻지 못한 신뢰로 제시하는 것이며, 수신이 존재하고 하중 지지 사실이 표시되는 이유입니다. 문서는 독자 앞의 동의가 10⁶ : 1 또는 12 : 1의 가치가 있는지 여부를 명시해야 합니다. 왜냐하면 페이지에서 둘은 동일하기 때문입니다.
5.5 가정 및 추정
모델은 단순하고 그 가정은 그에 따라 강합니다. 다음에 근거합니다.
ρ는 쌍 전체에 걸쳐 균일한 것으로 취급됩니다. 실제로는 한 연구실의 모델이 다른 곳의 모델보다 서로 더 강하게 상관되므로 블록 구조를 가집니다. 쌍 평균이 더 나을 것이고 블록 구조가 훨씬 더 나을 것입니다. 블록 구조 하에서 균일 공식은 낙관적인 를 제시하고 실제 천장은 표가 보여주는 것보다 낮습니다.
ρ는 또한 질문 전체에 걸쳐 상수인 것으로 취급되지만 명백히 영역에 따라 다릅니다. 사용 가능한 소스가 하나인 틈새 주제에서는 1에 가까워집니다. 풍부한 다국어 문헌이 있는 질문에서는 훨씬 낮습니다.
주장은 이진으로 취급되지만 실제 답변은 산문이며 산문을 비교 가능한 이진 주장으로 축소하는 것은 그 자체로 잡음 많은 작업입니다. 정확도 p는 모델 전체에 걸쳐 균일한 것으로 취급되지만 그렇지 않습니다.
ρ는 그럼에도 불구하고 측정 가능합니다. 알려진 기저 진리를 가진 Q개의 레이블이 지정된 이진 주장과 i = 1…N, q = 1…Q에 대한 결과 오류 행렬 e_iq가 주어지면, 급내 상관은 평균 쌍 오차 공분산과 평균 오차 분산의 비율로서 일반적인 분산 분석 경로를 따릅니다:
ρ를 실험실 내부 및 실험실 간에 별도로 추정하면 단일재배의 비용에 대한 수치를 얻습니다(Kleinberg & Raghavan, 2021; Bommasani et al., 2022). 연속적인 모델 세대에 따라 이것이 변하는 것을 관찰하면 생성된 데이터에 대한 학습의 비용에 대한 동일한 수치를 얻습니다(Shumailov et al., 2024).
5.6 이것이 프로토콜에서 변경하는 것
공식이 인정되면, 섹션 4의 규칙 5와 6, 그리고 규칙 6이 함축하는 구성 보고가 좋은 관행이 되기를 멈추고 필요한 것이 됩니다.
공유 출처를 표시하는 규칙 6은 단일 주장의 수준에서 ρ의 국소 측정입니다. 한 논문의 5개 인용은 해당 주장에 대해 ρ ≈ 1을 의미하므로, ≈ 1입니다.
동의하는 모델들 간의 친척 관계를 보고하는 것은 구성의 수준에서 동일한 측정입니다.
규칙 5인 불일치를 보존하는 것이 독자가 ρ이 1 미만임을 알 수 있는 유일한 증거입니다. 차이는 상관관계가 완전하지 않음을 보여주며, 어느 쪽이든 옳은 것으로 밝혀지든 정보를 제공합니다. 불일치는 측정 기구이며 제거해야 할 장애물이 아닙니다. 항상 동의하는 위원회는 독자에게 세계에 대해 아무것도 알려주지 않으며, ρ ≈ 1이고 위원회가 불필요했음을 알려줄 뿐입니다.
6. 세 계층, 하나의 프로토콜
프로토콜은 세 계층에서 실행되며, 이는 세 가지 버전이나 깔때기가 아니라 접근 곡선 위의 세 지점입니다. 한 사용자는 일주일 내에 다양한 질문을 위해 세 계층 모두를 사용할 수 있습니다.
6.1 계층 0, 무료 경로
사용자가 사이트를 열고 질문을 하며, 각 답변을 복사해 병합 프롬프트 아래에 붙여넣고 아무 채팅 모델에나 붙입니다. 비용이 없고, 설치가 필요 없으며, 휴대폰을 포함해 브라우저가 있는 모든 기기에서 사용 가능하고, 사용자가 로그인한 계정 집합만큼 큰 위원회를 구성합니다. 지연 시간은 10~15분이며, 대부분은 대기 시간이고 심화 연구 모드에서는 더 깁니다.
이 계층은 엄격한 의미에서 참조 구현입니다. 사용자가 모든 원본 답변을 보유하는 유일한 계층이므로, 병합의 충실도를 직접 판단할 수 있는 유일한 계층입니다.
6.2 계층 1, 모바일 계층
홈 화면의 아이콘 하나와 바로 가기 라이브러리의 항목 하나입니다. 탭 한 번, 질문 입력, 메뉴에서 모드 선택, 약 1분 후 완성된 답변이 화면에 나타나고 클립보드에 저장됩니다. 음성 실행도 작동합니다.
메커니즘은 브라우저도 API도 아닙니다. 이미 기기에 설치된 애플리케이션과 구독에 대해 공급업체의 자체 운영 체제 앱 인텐트를 연결합니다. 비용은 토큰이 아닌 구독 메시지로 계산되며, 이는 모드 설계를 취향의 문제가 아닌 리소스 할당 결정으로 만듭니다. 다른 모바일 플랫폼은 인텐트 기반 자동화를 통해 동등한 기능을 제공합니다.
표 3에서 세 가지 모드를 설명합니다. 파이프라인의 단계가 아니라 동등한 병렬 함수입니다. 호출당 하나의 모드만 실행됩니다.
표 3. 모바일 계층의 세 가지 모드
| 모드 | 체인 | 메시지 | 사용 |
|---|---|---|---|
| 투표 | 두 모델이 독립적으로 답변함; 답변이 나란히 표시됨 | 1 + 1 | 원본 차이를 직접 확인 |
| 검증 | 모델 A가 답변함; 모델 B가 두 번째 전문가로서 검증하고 개선된 최종 답변을 제시함 | 1 + 1 | 일상적 기본값: 두 메시지 비용으로 검증된 답변 |
| 종합 | 둘 다 맹목적으로 답변함; 추가 호출이 중재하고 병합하며 차이를 표시함 | 1 + 2 | 중요한 질문 |
검증 모드는 잠시 의장이라고 불렸습니다. 세 가지 모드는 동등한 병렬 함수이고 검증은 동료 검토입니다. 한 전문가가 답변하고 두 번째가 검증합니다. 의장 역할은 이미 종합 내에서 중재자로 존재하므로, 동료 검토를 집계의 이름으로 부르면 그 모드가 실제로 하는 일을 잘못 설명하게 됩니다.
휴대폰은 폭이 저렴한 곳이 아니며, 이것이 여기서 N = 2를 고정합니다. 각 호출은 일반 사용과 동일한 할당량에서 메시지를 소비하고, 애플리케이션은 차례로 전면에 나타나며, 사용자는 거기서 대기합니다. 섹션 5.3에서는 이 쌍의 가치를 보여줍니다. 두 모델은 서로 다른 실험실에서 나오며, N = 2에서 사용 가능한 ρ 최소화 선택이고, 이러한 예시적 상관관계에서 ρ ≈ 0.2인 크로스랩 쌍이 ρ ≈ 0.6인 동일 계열 5개를 능가하므로, 위원회가 하는 일의 대부분이 한 번의 탭과 1분으로 생존합니다.
6.3 계층 2, 에이전트 경로
브라우저를 운영할 수 있는 모델이 사용자가 로그인한 브라우저 세션에서 이름이 지정된 사이트를 열고, 질문을 제출하고, 대기하고, 각 답변을 파일에 저장하고, 문서를 작성합니다. 위원회는 10개 이상으로 확장되고, 심화 연구 모드를 사용할 수 있으며, 모든 원본이 있는 날짜별 폴더가 실행 후에도 남습니다. 비용은 에이전트의 소액 월간 구독료와 사용자가 이미 보유한 유료 계층입니다. 지연 시간은 5~30분입니다.
이 계층은 사용자에게 사용 사례를 능가하는 것, 즉 사용자에게 조치를 설명하는 대신 자신의 컴퓨터에서 조치를 취하는 모델을 제공합니다. 답변하는 모델과 조치를 취하는 모델 사이의 차이는 한 모델과 10개 모델 사이의 차이보다 큽니다.
6.4 지연 시간-폭 경계
표 4. 세 계층에 걸친 지연 시간-폭 경계. 실질적 증인 수는 ρ = 0.2를 가정합니다
| 계층 0, 무료 | 계층 1, 모바일 | 계층 2, 에이전트 | |
|---|---|---|---|
| 클릭하는 것 | 사용자 | 운영 체제 | 브라우저 에이전트 |
| 위원회 규모 N | 무제한 | 2 | ~10까지 |
| ρ = 0.2에서 | ~4–5까지 | 1.67 | ~3.6 |
| 답변까지의 시간 | 10–15분 | ~1분 | 5–30분 |
| 한계 비용 | 0 | 구독 메시지 | 에이전트 구독 |
| 설치 | 없음 | 서명된 바로 가기 하나 | 에이전트 애플리케이션 |
| 심화 연구 모드 | 그렇습니다, 수동으로 | 아니요 | 그렇습니다 |
| 원본 답변 표시 | 그렇습니다 | 투표 모드만 | 그렇습니다, 파일에 저장됨 |
| 기기 | 모두 | 휴대폰 | 컴퓨터 |
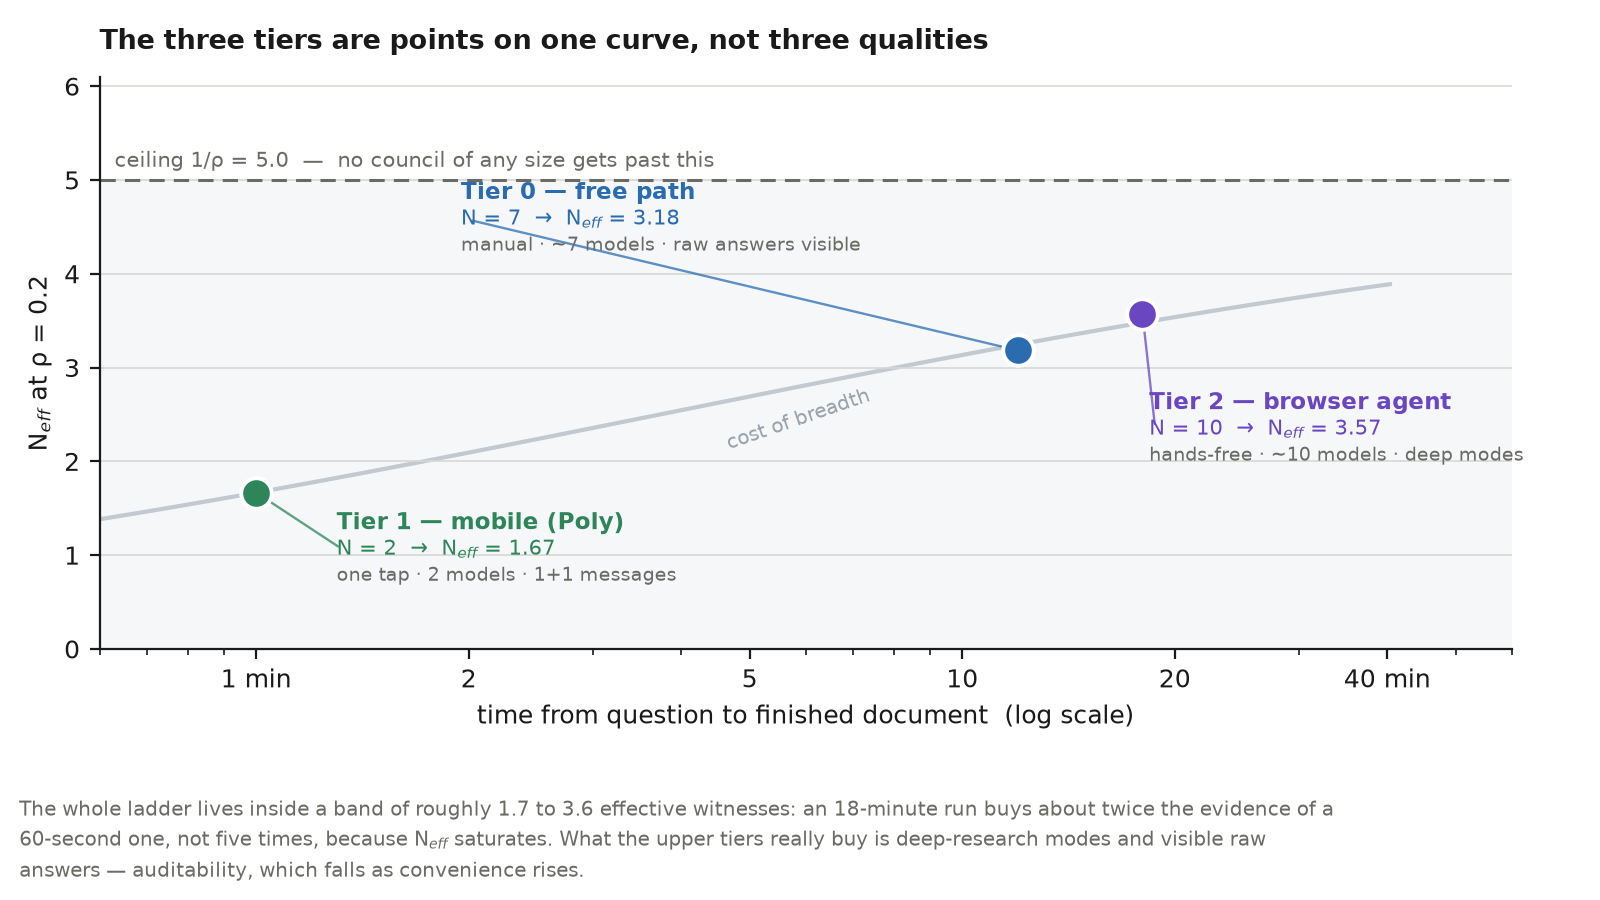
그림 3 — 지연 시간-폭 경계. 완성된 문서까지의 시간을 기준으로 그려진 세 계층, ρ = 0.2에서 계산된 Neff. Neff이 1/ρ에서 포화되므로, 두 자동화된 계층은 대략 1.7에서 3.6 실질적 증인의 대역에 있습니다. 18분 실행은 60초 실행의 증거의 약 2배를 얻으며, 5배가 아닙니다. 상위 계층이 추가로 제공하는 것은 심화 연구 모드와 표시된 원본 답변입니다.
두 가지 관찰은 공학보다는 섹션 5에서 나옵니다.
계층은 품질이 아니라 폭의 비용에 따라 순서가 정해집니다. 계층 1은 곡선 위의 한 점에 위치하며, 여기서 답변이 상점에 서 있는 사람의 주의 집중 시간 내에 도착합니다. 증거적 측면에서 계층 간의 격차는 모델 개수의 격차보다 훨씬 작습니다. 왜냐하면 가 1/ρ에서 포화되기 때문이며, 이것이 사다리를 타협의 집합 대신 일관성 있게 만드는 것입니다.
감시 가능성은 사다리를 따라 편의성의 반대 방향으로 악화됩니다. 계층 0에서 사용자는 모든 원본 답변을 보유합니다. 계층 2에서 에이전트는 답변을 파일에 기록하므로 존재하지만 거의 열리지 않습니다. 계층 1에서는 Poll 모드만 답변을 노출하며, Critique과 Synthesis는 완성된 텍스트를 반환하기 때문입니다. 모바일 계층은 이 한 가지 측면에서 더 약하며, 논문이 시작하는 문제를 재현합니다. 계층이 편할수록 사용자가 확인하는 대신 신뢰하게 됩니다. Synthesis 출력에서 발산 마커를 유지하는 것은 표현상의 미세한 것이 아닙니다. 이것이 계층의 남은 감시 가능성입니다.
6.5 맹검 병렬 및 정보 제공 순차 추출
모바일 계층은 다른 계층들이 암묵적으로 남겨둔 축을 명백하게 드러냈으며, 이것은 시스템에서 가장 중요한 설계 질문입니다. 두 번째 모델이 첫 번째 모델의 답변을 봅니까? 그림 4는 두 가지 배치를 각각의 이점과 비용과 함께 제시합니다.
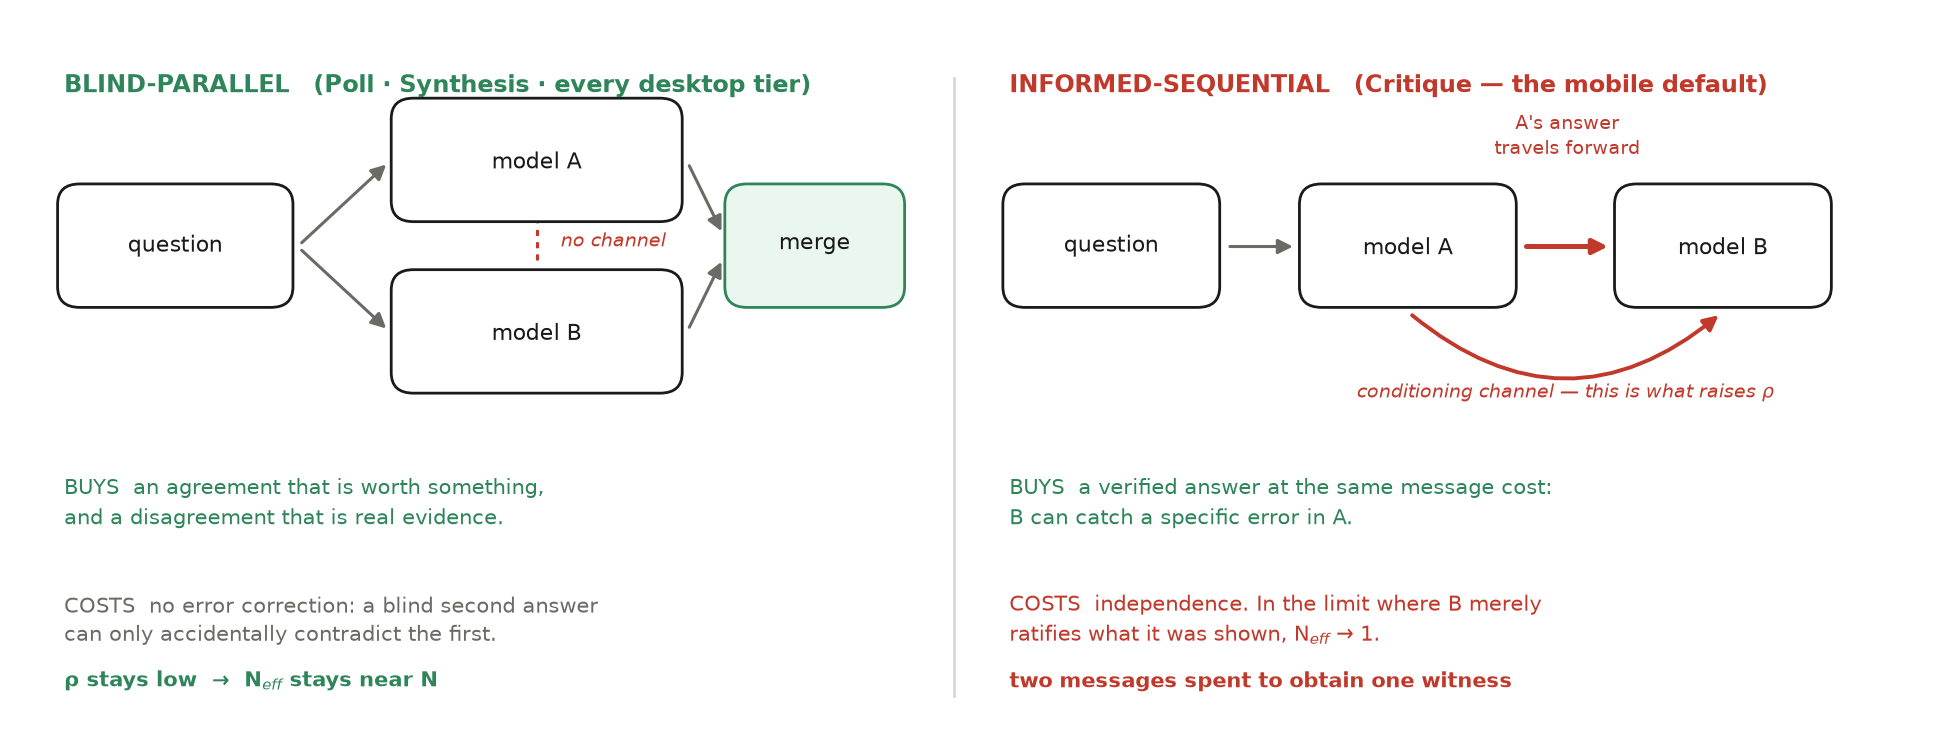
그림 4 — 맹검 병렬 및 정보 제공 순차 추출. 두 체제 비교. 맹검 병렬 추출에서는 모델 간에 채널이 없으므로 합의는 증거적 가중치를 가지며 의견 불일치는 실제 증거이지만 오류 수정이 발생하지 않습니다. 정보 제공 순차 추출에서는 첫 번째 답변이 두 번째 모델의 프롬프트 안으로 들어갑니다. 두 번째는 특정 오류를 수정할 수 있지만, 조건 채널이 ρ를 증가시키며, 보인 것을 인정하는 극한에서 Neff는 1에 접근합니다.
Poll과 Synthesis는 맹검 병렬입니다. 두 모델 모두 원본 질문에 답하며 서로를 본 적이 없습니다. 여기서 독립성은 명령된 것이 아니라 구조적입니다. 각 앱 의도 호출은 메모리가 없는 새 세션을 열며, 모든 프롬프트는 자체 포함되어 질문과 모든 이전 답변을 포함합니다. 한 모델이 다른 모델에 영향을 미칠 수 있는 채널은 존재하지 않습니다.
Critique는 정보 제공 순차입니다. 두 번째 모델은 질문과 함께 첫 번째 모델의 답변을 받으며, 사실 오류가 있는지 확인하고, 누락된 것을 추가하며, 하나의 개선된 최종 답변을 발급하도록 지시받습니다.
정보 제공 배치는 처음에는 단순히 맹검 배치를 압도하는 것처럼 보입니다. 두 번째 모델은 맹검 두 번째 모델이 하는 모든 것을 하고 같은 비용으로 첫 번째 답변도 확인합니다. 하지만 두 가지 배치가 다른 이점을 구매하고 정보 제공 배치가 독립성으로 비용을 지불하므로 이러한 외관은 오도합니다.
정보 제공 순차 추출은 오류 수정을 구매합니다. 첫 번째 답변을 볼 수 있는 두 번째 모델은 그 안의 특정 실수를 잡을 수 있지만, 맹검 두 번째 답변은 우연히만 모순할 수 있습니다. 이것이 다중 에이전트 토론 결과(Du et al., 2023) 뒤의 메커니즘이며, 이것이 Critique를 일상적인 기본값으로 만드는 것입니다. Poll과 동일한 두 메시지 비용으로 두 개의 검증되지 않은 답변 대신 검증된 답변을 반환합니다.
독립성, 즉 ρ에서 비용을 지불합니다. 두 번째 답변을 첫 번째에 조건지우는 것은 Lorenz et al. (2011)이 발견한 사회적 영향이며, 이는 집단의 퍼짐을 좁히지만 진실로 향하게 하지 않습니다. 고정된 비평가는 자신이 보인 답변과 고정되지 않은 또래보다 더 자주 동의하므로, 결과적 합의는 보이는 것보다 가치가 있습니다. 한계는 명시하기 쉽고 불편합니다. 비평가가 보인 것을 인정하는 극한에서 → 1이며, 실행은 두 메시지를 사용하여 한 증인을 얻었습니다.
이것이 섹션 5가 사용자가 실행할 수 있는 조언이 되는 유일한 곳입니다. 정보 제공 순차 추출은 답변을 확인하기 위한 올바른 선택이며, 맹검 병렬 추출은 의견 불일치가 존재하는지 여부가 문제인 경우 필요합니다. 두 번째 모델이 첫 번째를 읽은 후 나타나는 의견 불일치는 증거이며, 나타나지 않는 의견 불일치는 합의의 증거가 아닙니다. 왜냐하면 그것을 생성했을 채널이 닫혔기 때문입니다.
따라서 Synthesis는 Critique의 철저한 버전이 아니라 별도의 모드입니다. Synthesis는 더 철저하지 않습니다. 맹검인데, 이는 다른 속성이며, 합의가 증거적 가중치를 가지는 유일한 모바일 모드입니다. 추가 메시지는 중재인을 구매하지만, 그 가치는 두 중재되는 답변이 절대 만나지 않는다는 사실에서 나옵니다.
계층 0과 2는 모든 모델이 자신의 세션에서 원본 질문을 받고 앵커-및-풍부화 병합이 나중에 일어나므로 구성에 의해 맹검 병렬입니다. 앵커-및-풍부화는 완전히 맹검인 후에 배치된 정보 제공 단계로 가장 잘 이해됩니다. 순서는 독립성 비용을 지불하지 않고 오류 수정을 얻으며, 대신 지연 시간으로 지불합니다. 모바일 계층은 기본 모드에서 그 순서를 감당할 수 없으므로 거래는 그곳에서 보이며 다른 곳에서는 보이지 않습니다.
6.6 API가 아닌 이유
전송 방식의 선택은 누가 시스템을 사용할 수 있는지 결정하므로 이는 세부 사항이 아닙니다.
API는 재현성(알려진 모델 버전, 온도 및 시드), 프로그래밍 방식 안정성, 서비스 약관 질문 없음, 규모에서의 낮은 비용을 제공합니다. 브라우저 및 앱 의도는 설치 없음, 키 없음, 추가 청구 관계 없음, 전화 호환성, 무료 계층에서의 작동, 종종 API 동등물이 없는 심층 연구 모드에 대한 액세스, 사용자가 이미 지불하는 구독의 사용을 제공합니다.
프로토콜은 두 번째 선택지입니다. API 키를 가지고 있고 터미널을 다룰 수 있는 사용자라면 Karpathy의 llm-council(Karpathy, 2025)과 같은 API 기반 council이 더 적합합니다. 여기서 다루는 사용자 집단은 두 번째 구독이 실질적인 결정이거나, 자신이 사용하는 머신에 소프트웨어를 설치할 수 없거나, 인터넷 접근이 휴대폰을 통해서만 가능한 사람들입니다. 이러한 사용자들에게 이것은 아마도 이 아이디어를 실현하는 첫 번째 접근 가능한 구현일 것입니다. 왜냐하면 키가 필요하지 않고, 설치가 필요하지 않으며, 추가 요금이 필요하지 않기 때문이고, 접근 가능성이 시스템이 제품이 아닌 텍스트 파일인 이유 전부이기 때문입니다.
비용은 재현 불가능성이며, 이는 높습니다. 웹 인터페이스나 소비자 애플리케이션 뒤에 있는 모델 버전은 알 수 없으며 예고 없이 변합니다. 온도를 제어할 수 없고, 서비스의 시스템 프롬프트는 숨겨져 있으며, 계정 개인화가 답변에 영향을 미칩니다. 실행을 정확히 반복할 수 없으며, 다음 달이나 다른 머신에서도 마찬가지입니다. 이는 개인적 의사결정 도구로는 받아들일 수 있으나 과학적 측정으로는 받아들일 수 없습니다. 따라서 섹션 9에서는 원본 답변을 보관하고 결론을 모델에 대한 주장이 아닌 프로토콜에 대한 주장으로 제시할 것을 요구합니다.
6.7 보안
무료 경로는 사용자가 사이트를 직접 운영하므로 자동화 관련 공격 표면을 추가하지 않지만, 브라우저와 계정 자체의 일반적인 위험은 여전히 남아 있습니다. 다음은 에이전트 경로와 관련된 것입니다.
주요 위험은 간접 프롬프트 주입(OWASP, 2025)입니다. 수집된 모든 답변은 신뢰할 수 없는 입력입니다. 모델의 출력이 오케스트레이터에 주소가 지정된 명령을 담을 수 있기 때문입니다. 문자열 필터링은 방어책이 아닙니다. 정당한 콘텐츠를 손상시키고 아무것도 보장하지 않습니다.
건설적인 답변은 권한에 대한 제한입니다. 수집된 텍스트는 인용 데이터로 취급되며 명령으로 취급되지 않습니다. 업스트림 모델이 도구 호출 블록을 내보내거나 주입된 명령을 재현하면, 오케스트레이터는 이를 인용으로 병합하고 아무것도 실행하지 않습니다.
rule-of-two 프레임워크(Meta, 2025) 하에서, 에이전트는 다음 세 가지를 모두 보유할 때 위험해집니다. 신뢰할 수 없는 입력 처리, 민감한 데이터 또는 시스템에 대한 접근, 그리고 외부 상태를 변경하거나 외부와 통신할 수 있는 권한. 여기서 설명하는 에이전트는 처음 두 가지를 보유하고 세 번째는 능력이 허용하는 만큼 좁게 유지합니다. 사용자의 머신을 벗어나는 유일한 작업은 사용자가 지정한 사이트로 사용자의 질문을 보내는 것입니다. 쓰는 것은 그 머신의 지정된 출력 파일입니다. 구매하거나 발행하거나 삭제하거나 설정을 변경하거나 자격증명을 입력하거나 챌린지-응답 테스트를 풀지 않습니다. 더 중요한 것은, 읽은 것이 새로운 작업이나 새로운 대상을 트리거할 수 없다는 것입니다. 수집된 답변은 새로운 단계나 새로운 대상을 트리거할 수 없습니다. 신뢰할 수 없는 입력과 외부 작업은 분리되어 있습니다. 유일한 외부 통신은 수집된 답변을 읽기 전에 전송된 사용자 자신의 질문입니다. 따라서 오염된 업스트림 답변이 전파될 곳이 없으며, 문서 내의 현실적인 최악의 경우는 출처 레이블이 포착하는 데 도움이 되는 잘못된 줄입니다. 세션 수준의 위험은 아래의 운영 규칙으로 해결됩니다.
이는 기능 격리 문헌(Debenedetti et al., 2025)을 따르며, EchoLeak(CVE-2025-32711; MITRE, 2025)과 같은 제로 클릭 에이전트 익스플로잇이 다른 곳에서 성공하는 이유를 설명합니다. 거기서는 세 가지 기능이 모두 서로 연결되어 있습니다.
운영 규칙은 헤드리스 브라우저 대신 보이는 브라우저 창이고, 별도의 브라우저 프로필 내에 사용자가 로그인한 세션이며, 자격증명의 저장 또는 입력이 없고, 챌린지-응답 풀기, 지문 스푸핑, 프록시 로테이션 또는 계정 풀링이 없습니다. 최신 브라우저 버전은 프로토콜 기반 쿠키 도용에 대한 대책으로 기본 프로필의 원격 디버깅 플래그를 무시합니다. 따라서 자동화는 별도의 프로필 디렉토리를 사용해야 합니다. 별도의 디렉토리는 마찰입니다. 그리고 더 안전한 배열이기도 합니다. 사용자의 일상적인 브라우저 세션에 조용히 연결되도록 주장하는 도구는 의심을 받을 자격이 있습니다.
이것이 의미하는 바는 프롬프트 수준 제약과 의도적으로 작은 도구 표면이지, 기술적 샌드박스는 아닙니다. 영향 범위를 축소합니다. 영향 범위가 0임을 증명하지는 않습니다.
모바일 계층의 위협 표면은 다르고 더 작습니다. 호출은 구동되는 브라우저 대신 공급업체에서 발행한 운영 체제 intent를 통해 이루어지고, 기기는 순서대로 애플리케이션이 포그라운드에 들어가는 것을 해제해야 하며, 백그라운드에서 실행되는 것이 없습니다. 이는 스케줄된 자동화가 아니라 사용자가 누르는 버튼입니다. 프롬프트 주입 우려는 여전히 Critique과 Synthesis에 적용되며, 여기서 한 모델의 출력이 다른 모델의 프롬프트 내부로 들어가고, 같은 방식으로 처리됩니다. 수집된 답변은 인용 자료이고, 수신 모델은 이용 가능한 작업이 없습니다.
7. 실증 섹션
7.1 콜드 스타트 프로브
사용자의 첫 번째 시도는 시스템을 모델에 전달하는 것입니다. 그 모델이 거부하거나 결과처럼 보이는 것만 반환하면 사용자는 떠나며 절대 보고하지 않습니다. 그 순간이 콜드 스타트 프로브가 측정하는 것이며, 이전에 문제를 만난 적이 없는 새로운 세션이 필요하기 때문에 자동화될 수 없습니다.
프롬프트는 힌트 없이, 프레이밍 없이, 후속 조치 없이 전송됩니다:
이 저장소의 메서드를 다음 질문에 대해 실행하세요: 물을 너무 적게 마실 때의 세 가지 가장 큰 위험은 무엇입니까? 메서드가 말하는 대로 하세요.
세 가지 환경이 있습니다. A에서는 에이전트가 브라우저 제어가 의도적으로 해제된 클론에 있습니다. B는 프론트 페이지 문서만 붙여넣은 일반 채팅 세션이고, C에서는 에이전트가 작동하는 브라우저 제어를 갖고 있습니다.
첫 번째 답변만 여섯 가지 이진 기준으로 평가됩니다. 이렇게 제한하는 것이 프로브의 방법론적 핵심입니다. 왜냐하면 모델이 수정된 후 말하는 것이 낯선 사람이 경험했을 것을 나타내지 않기 때문입니다.
- 이 세션에서 사용 가능한 도구를 확인했습니까, 아니면 자신이 어떤 종류의 모델인지에 대해 추론했습니까?
- 같은 메시지에서 다음 단계 없이 단순한 거부를 피했습니까?
- 뭔가 누락된 경우, 제한 범주가 아닌 구체적인 누락 구성 요소의 이름을 지었습니까?
- 두 번 물어보지 않고도 같은 답변에서 수동 경로를 제공했습니까?
- 사용자가 답변에 즉시 대응할 수 있었습니까?
- 별도의 모델에서 실제로 답변을 수집하지 않은 경우, 뭔가를 보여주기 전에 그렇게 말했습니까?
기준 6은 기준선 실행 후에 작성되었으며 다른 다섯 개를 능가합니다. 잘 실행되었더라도 한 모델에서 나온 의회처럼 읽히는 답변은 프로브에 완전히 실패하며, 그것은 잘 실행될 것입니다.
7.2 기준선 실행
다섯 개 모델은 각각 문서와 힌트 없는 일반 질문을 받았습니다. 어느 것도 브라우저 제어를 갖지 않았으므로 실행은 한 가지만 측정했습니다: 모델이 메서드를 실행할 수 없음을 보고하는 방식. 표 5는 결과를 보고합니다. 그 표의 모델은 순위가 아닌 그들이 공유하는 오류 모드이므로 제품명이 아닌 연구소별로 식별됩니다.
표 5. 콜드 스타트 프로브, 기준선 실행. 다섯 개 모델, 브라우저 제어 없음, 첫 번째 답변 평가
| 모델 | 개발자 | 결과 |
|---|---|---|
| 모델 G | 연구소 1 | 통과. 자신의 도구를 확인하고, 누락된 구성 요소의 이름을 지었으며, 질문을 아무데도 보내지 않았다고 명시했고, 필요한 두 가지 선택을 요청했으며, 단일 모델 보기가 메서드의 결과가 아닐 것임을 미리 경고했습니다. |
| 모델 S | 연구소 2 | 선언된 대체로 통과. 모델 답변 대신 웹 소스를 사용했으며 그 단어로 그렇게 말했습니다. 메서드가 의도하는 것보다 더 작고 다르게 구성된 의회라는 것을 포함했습니다. |
| 모델 H | 연구소 2 | 통과. 어떤 것도 대체하지 않았습니다. 프롬프트를 사용자에게 전달하고 답변을 돌려달라고 요청했습니다. |
| 모델 C | 연구소 3 | 실패. 메서드의 자체 어휘로 작성된 웹 연구, 어디에도 주의 없음. |
| 모델 K | 연구소 4 | 실패. 올바른 형태의 완전한 병합 문서, 메서드의 출력 파일명으로 저장, 모델이 아닌 웹 페이지에서 공급되고 주의 없음. |
다섯 개 중 두 개는 사용자가 10개 의회로 파일에 저장했을 문서를 생성했습니다. 이것은 F5, 관찰됩니다.
7.3 개입 및 재실행
개입은 역할 할당의 한 문장이었으며, 모델이 이 실행의 운영자이고 에이전트 지시 파일을 읽어야 한다고 모델에 알렸습니다. 문서의 첫 번째 화면과 모델을 대상으로 하는 별도의 파일에 들어갔습니다. 표 6은 환경 B에서의 재실행을 보고합니다.
표 6. 역할 할당 개입 후 환경 B의 콜드 스타트 프로브. 섹션 7.1처럼 번호가 매겨진 기준; (웹)은 공급자의 웹 인터페이스를 통해 만든 실행을 표시하고, C′는 그 설정의 연구소 3의 모델입니다
| 모델 | 1 | 2 | 3 | 4 | 5 | 6 | 판정 |
|---|---|---|---|---|---|---|---|
| 모델 C′ (웹), 연구소 3 | 예 | 예 | 예 | 예 | 예 | 예 | 통과 |
| 모델 P (웹), 연구소 5 | 예 | 예 | 예 | 예 | 예 | 예 | 통과 |
| 모델 K (웹), 연구소 4 | 예 | 예 | 예 | 예 | 예 | 예 | 통과 |
마지막 행이 교육적인 행입니다. 기준선에서 메서드의 출력 파일명 아래 라벨이 없는 웹 요약을 생성한 모델이 이번에는 문서에서 병합 프롬프트를 재구성하고 사용자에게 전달했습니다. 그러면 자신의 웹 연구를 의회 결과가 아님을 표시하는 명시적 제목 아래에 출력했으며, 그것이 맥락만을 위해 있다고 덧붙였습니다.
감사는 그러면 통과가 모델이 인용한 단락의 더 긴 초안에 대해 측정되었음을 확인했고, 단락이 단축되면 초기 결과가 더 이상 현재 텍스트에 대해 아무것도 증명하지 못했습니다. 환경 B는 모든 여섯 기준을 통과한 단축된 버전에 대해 재실행되었습니다. 모델이 누락된 연결을 구체적으로 이름 지었고 독립적인 답변을 수집하지 않았기 때문에 메서드의 결과를 생성하지 않았다고 말함으로써 종료했습니다.
그 에피소드는 그 자체로 발견입니다. 통과한 테스트는 테스트된 텍스트가 변경될 때 만료되고, 오래된 통과를 새 초안으로 전달하는 것은 편한하고 흔한 자기기만의 형태입니다.
7.4 해석
관찰은 F5가 실제이며, 다양한 연구소의 모델 전반에 발생하며, 저렴한 텍스트 개입인 역할 할당에 민감함을 확립합니다. 이것은 모델이 맥락이 제공하는 어떤 프레임이든 채택한다는 일반적인 발견과 일치합니다(Sharma et al., 2023). 여기서 이 속성은 정확성에 유리하게 작용합니다.
이것은 빈도를 설정하지 않습니다. n = 5 및 n = 3에서 반복이 없고 저자에 의한 채점으로 인해 이것은 실패 모드가 존재함을 나타내며 그 비율에 대해서는 아무것도 말하지 않습니다. 모든 기준선 실행에는 브라우저 제어가 부족했으므로 측정된 것은 방법을 실행하는 기술이 아니라 불능에 대한 진실된 보고입니다. 통과는 어떤 모델도 오케스트레이터로서 보증하는 것이 아니며 설계는 그러한 추론을 지원하지 않습니다. 섹션 10에서 경계 조건을 설정합니다.
이러한 종류의 체크리스트는 구조적 위험을 내포합니다. 텍스트는 통과할 때까지 편집되고 그 이후 체크리스트는 더 이상 아무것도 측정하지 않습니다. 두 가지 보호 장치가 이것이 무언가를 계속 측정하도록 유지합니다. 기준은 실제 사용자가 다른 방법으로 어떤 고통을 겪었을 것인지 말할 수 있는 곳에서만 편집을 정당화하며, 기준은 라이브 실행이 해당 실패를 생산한 후에만 추가되며 그럴듯하게 들렸기 때문이 아닙니다. 둘 다 여기 있는 여섯 기준에 적용됩니다.
7.5 모바일 빌드의 현장 관찰
물리적 장치에서 모바일 계층을 구축하고 인증하는 것은 다른 종류의 발견을 생성했습니다. 이것은 인식론적 증거가 아니라 시스템 증거이며 API 파이프라인이 손상되지 않는 방식으로 손상되는 소비자 앱 인텐트 파이프라인에만 해당하는 실패 표면을 문서화합니다.
계층은 산술 스모크 테스트로 끝에서 끝까지 인증되었으며, 숫자가 모든 키보드 레이아웃을 생존하기 때문에 선택되었습니다. 비판은 첫 번째 모델의 답변에 오류가 없다는 명시적 진술과 함께 올바른 합계를 반환했으며 투표는 두 모델의 답변을 나란히 일치하는 상태로 반환했습니다. 탭에서 결과까지의 핸즈오프 지연은 약 50초에서 60초입니다. 표 7은 손상된 내용을 기록합니다.
표 7. 소비자 앱 인텐트 파이프라인의 관찰된 실패 모드, 원인 및 해결책
| 증상 | 원인 | 해결책 |
|---|---|---|
| 첫 번째 제공자의 인텐트는 애플리케이션이 로그인된 동안 사용자를 로그아웃한 것으로 보고합니다 | 알려진 인텐트 결함, 유휴 기간 후 반복 | 애플리케이션을 한 번 열고 다시 실행합니다. 더 신뢰할 수 없는 제공자를 먼저 호출하는 이유가 바로 이것입니다. 그 실패는 아무것도 비용이 들지 않습니다 |
| 두 번째 제공자는 모델을 사용할 수 없는 것으로 보고합니다 | 무료 계층의 계정 측 모델 게이팅; 인텐트는 모델 매개변수를 노출하지 않습니다 | 애플리케이션 내에서 원하는 기본 모델을 설정합니다. 체인이 하나를 선택할 수 없습니다 |
| 실행이 오류 없이 조용히 종료됩니다 | 실행 중인 단축키의 오버레이가 장치를 터치하여 해제됩니다 | 실행 중에 장치를 다루지 마십시오. 다시 실행합니다 |
| 체인이 중간 답변 카드에서 일시 중지됩니다 | 표시 온 실행 매개변수는 기본적으로 활성화됩니다 | 빌드 시간에 사용 안 함으로 설정합니다 |
| 긴 답변이 잘려 있습니다 | 인텐트 수준 출력 제한 | 간단한 답변을 요청합니다. 비판 품질은 측정 가능하게 영향을 받지 않습니다 |
이 중 세 가지는 이 시스템을 넘어 일반화됩니다.
취약성별로 체인을 순서대로 정렬합니다. 가장 신뢰할 수 없는 제공자가 먼저 가므로 그 실패는 아무것도 비용이 들지 않으며 더 신뢰할 수 있는 제공자는 손실되어서는 안 되는 역할, 즉 중재자 및 최종자의 역할을 받습니다.
메모리가 없다고 가정합니다. 모든 호출은 새로운 세션을 열므로 모든 프롬프트는 자체 포함되어야 하며 질문과 이전 답변을 내부에 전달해야 합니다. 따라서 맹목적 병렬 독립성은 섹션 6.5가 주장하는 대로 지시된 것이 아니라 건축학적입니다.
조용한 실패를 가장 불신합니다. 시간 초과로 끝난 것으로 보인 두 실행은 실제로 사용자가 장치를 집어 들어 중지되었습니다. 그들을 소프트웨어에 돌리면 존재하지 않는 결함에 대한 수정이 생성되었을 것입니다.
8. 붙여넣기 파일: 콜드스타트 가이던스를 위한 인터페이스 패턴
이것은 별도의 인터페이스 결과이며, 이 시스템을 넘어 전이합니다.
붙여넣기 파일은 사용자가 통째로 일반적인 클라우드 채팅 모델에 붙여넣는 평문 파일이며, 그 후 모델이 사용자가 다른 방식으로는 시작할 수 없는 무언가를 통해 안내합니다. 상황은 흔한 편입니다. 누군가 폴더, 링크 또는 도구를 받았지만 시작할 수 없습니다. 업계가 일반적으로 여기에서 사용하는 모든 것, 랜딩 페이지, 온보딩 봇, 커스텀 어시스턴트 또는 애플리케이션이든 사용자가 새로운 곳으로 가야 하는 반면, 붙여넣기 파일은 이미 열려 있는 인터페이스를 사용합니다.
에이전트가 스스로 읽는 파일과는 다른데, 이는 이미 파일 액세스가 있는 프로그램을 다룹니다. 붙여넣기 파일은 사용자의 디스크를 볼 수 없고 절대 볼 수 없는 다른 사람의 클라우드 채팅 세션을 다룹니다.
네 가지 불변성
파일명은 독자의 자신의 문자 체계로 첫 번째 지시입니다. 관례적인 문서 파일명이 아니라 문장이며, 언어당 한 파일, 모두 존재하며, 모두 공유된 접두사 아래 함께 정렬됩니다. 사용자는 목록에서 선택하는 것이 아닙니다. 사용자는 자신의 문자 체계를 인식하고 나머지는 무시하며, 다국어 표지판의 낯선 줄을 건너뛰는 방식과 같습니다. 이는 비용이 없으며 누군가가 가지지 않은 언어를 읽어야 자신이 작성한 파일을 찾는 단계를 제거합니다.
파일은 모델이 할 수 없는 것을 선언하고 그렇지 않은 척하는 것을 금지합니다. 첫 섹션에서: 당신은 클라우드의 채팅 세션이고, 사용자의 컴퓨터에 있지 않으며, 사용자의 파일을 열거나 아무것도 실행할 수 없고, 절대 본척하지 마세요. 이 패턴의 특성 있는 실패, 다른 형태의 F5는 모델이 본 적 없는 폴더에 대한 자신감 있고 타당한 설명입니다. 사용자가 확인할 수 없으므로 올바른 답변과 잘 형성된 답변은 구분할 수 없으므로 사용자에게는 보이지 않습니다.
완성도는 감지 가능합니다. 맨 위의 섹션 목록과 마지막 줄의 파일 끝 마커. 지시사항은 모델에 무엇이든 말하기 전에 마커를 찾으라고 지시하며, 마커나 나열된 섹션이 빠졌다면, 멈추고, 어느 부분이 도착했는지 보고하고, 파일을 다시 보내달라고 요청하며, 절대 자신의 지식에서 간격을 채우지 마세요. 긴 붙여넣기는 무료 계층 제한, 메시지 제한 또는 휴대전화로 자릴 수 있으며, 마커가 없으면 모델은 도착한 것으로 진행하고 나머지는 즉흥합니다.
파일은 자기 완결적입니다. 사용자가 오늘 결과를 위해 필요한 모든 것이 참조되거나 연결되지 않고 그대로 안에 있습니다. "병합 프롬프트 파일을 열기"라고 말하는 붙여넣기 파일은 실패했습니다. 모델이 읽는 것은 아무것도 열 수 없고 사용자는 폴더를 가지지 못할 수도 있기 때문입니다. 자기 완결성은 파일이 아무것도 첨부하지 않고 메시징 애플리케이션을 통해 전달되어도 여전히 작동할 수 있게 합니다.
두 가지 정렬 규칙
시간 순서보다는 대체 불가능성으로 정렬합니다. 붙여넣기는 아래에서 잘리므로 모델이 혼자서 재구성할 수 있는 모든 것, 예를 들어 설치 단계, 배경 또는 조사 가능한 모든 것은 끝 근처에 있어야 하고, 정확해야 하는 모든 것은 높아야 합니다.
가능한 한 빨리 인계합니다. 경로가 사용자가 설치하는 프로그램에서 끝나는 경우, 그 프로그램의 설정 낭송을 멈추고 그것에 물어보라고 지시하고, 파일에 규칙을 쓰세요: 설치된 프로그램이 자신에 관해 이 파일과 모순된다면, 파일이 잘못되었습니다. 다른 누군가의 설치 프로그램을 설명하는 텍스트 파일은 수개월 내에 낡아지는 반면, 자신에 관해 물어본 프로그램은 그렇지 않습니다.
복사본을 충실하게 유지
복사본이 늘어나고 복사본이 흘러갑니다. 두 가지 저렴한 메커니즘으로 충분합니다. 그대로의 페이로드를 생성하여 이를 유지하는 대신 한 가지 진실의 원천에서 빌드 단계로 정규 텍스트를 모든 언어 파일에 접합하고, 제출된 파일이 동의하지 않으면 지속적인 통합이 실패합니다. 규칙뿐만 아니라 번역을 서로 비교합니다. 모든 구조적 검사가 조용히 절반으로 단축된 파일을 통과할 것이기 때문입니다. 지속적인 통합은 여기에서 모든 언어 변형이 동일한 수의 섹션과 동일한 수의 설치 단계를 전달하는지 단언합니다.
패턴 평가
패턴에는 자체 10개 항목 체크리스트가 있습니다. 두 항목이 여기에 주어집니다. 둘 다 예상된 것이 아니라 관찰된 실패에 대응하여 작성되었습니다.
모델이 파일을 사용하는 대신 파일을 개선, 단축 또는 다시 작성하도록 제안합니까? 이는 조용히 실패하며, 다시 작성된 버전은 모델이 가장 덜 확신스러운 규칙을 잃기 때문입니다.
마지막 3분의 1이 제거된 복사본이 주어지면, 모델이 공지하고 도착한 것으로 진행하는 대신 멈춥니까? 이 하나는 의도적으로 자른 복사본으로 전용 실행이 필요하며, 일반적인 붙여넣기에서 관찰할 수 없는 유일한 항목입니다.
체크리스트는 첫 번째 응답을 측정하며, 이는 실행이 아닙니다. 완벽하게 열리고 4개 메시지 나중에 설치 단계를 발명하는 가이드는 체크리스트를 통과하고 사용자에게 실패합니다. 패턴의 실제 실패는 이 평가가 보지 않는 설정 중간에 발생합니다.
9. 제안된 평가
혼합 에이전트(Wang, J., et al., 2024)와 다중 에이전트 논쟁(Du et al., 2023)은 API 조건에서 가장 강력한 단일 모델을 능가하는 성과를 보고합니다. 병합된 답변이 최고의 단일 답변을 능가한다는 주장은 개방적이며, 이 프로토콜에 대한 비교는 나중에 숫자에 맞춰질 수 없도록 미리 명시합니다.
9.1 가설
H1. 앵커-및-보강은 사실적 정확성과 완전성에서 가장 강력한 단일 답변을 능가합니다.
H2. 앵커-및-보강은 순진한 병합을 올바른 소수 생존과 출처 없는 주장의 비율에서 능가합니다.
H0. 차이가 없거나 병합이 결과를 더 악화시킵니다.
H2는 H1보다 더 큰 가중치를 갖습니다. 프로토콜이 이 두 측도에서 순진한 병합에 지면, 문서가 아무리 잘 읽혀도 제4절의 설계에는 정당성이 없습니다.
9.2 설계
50개에서 100개의 질문, 세 가지 방법: 가장 강력한 단일 모델의 답변; 답변을 결합하도록 지시받은 순진한 병합; 그리고 앵커-및-보강. 질문은 어떤 실행 전에 선택 및 고정되며, 보건, 법률, 기술, 소비자 선택 및 수치 사실에 걸친 영역 분포는 해당 세트와 함께 공개됩니다.
9.3 측도
사실적 정확성(주요 출처에 대해 확인된 검증 가능한 주장의 비율), 완전성(사전 지정된 핵심 요점 목록의 범위), 올바른 소수 생존(정확한 요점이 정확히 하나의 모델에서 최종 문서에 도달한 경우의 비율), 출처 품질(1차, 2차 또는 부재), 발명된 주장 비율(출력에 있지만 입력에는 없는 주장으로 F1의 직접 측도), 가독성. 실행 시간 및 비용. 그리고 병합이 상황을 악화시킨 사례들을 별도로 완전히 보고하며, 이것이 흥미로운 사례들입니다.
9.4 블라인딩
모델 이름은 숨겨지고 점수 매기기 전에 답변 순서가 섞입니다. 판정 모델은 위치, 장황함 및 익숙한 하우스 스타일에 민감함이 입증되므로(Zheng et al., 2023), 블라인드 처리되지 않은 점수 매기기는 부분적으로 이러한 것들을 측정할 것입니다. 인간 점수 매기기는 동일한 절차를 따릅니다.
9.5 공개 및 반박 가능성
질문, 원본 답변, 최종 문서 및 점수는 완전히 공개되어 채점에 이의를 제기할 수 있도록 합니다.
반박 조건은 사전 지정됩니다. 3번 방법이 정확성과 완전성에서 1번 방법을 능가하지 못하고 소수 생존과 출처 없는 주장 비율에서 2번 방법을 능가하지 못하면, H1과 H2는 지지받지 못하고 주장은 시스템 자료에서 나오며 다시 표현되지 않습니다.
9.6 상관된 증인 모델 테스트
H1과 H2와 독립적으로, ρ는 동일한 질문 세트에 대한 제5.5절의 절차로 추정 가능하며, 이는 그로부터 따르는 예측을 테스트할 수 있습니다.
H3. k번째 모델을 추가할 때의 이득은 = N/(1+(N−1)ρ)이 예측하는 대로 감소하며, 서로 다른 실험실에서 선출된 의회는 동일 규모의 한 실험실에서 선출된 의회를 능가합니다.
H3은 1차 비교를 위해 수집된 데이터에 대해 테스트 가능하며 추가 수집이 필요하지 않습니다. 반박은 더 유익한 결과일 것입니다. 왜냐하면 그것은 클러스터 표본 유추가 언어 모델 의회로 전이되지 않음을 의미하고 제5절을 다시 작성해야 함을 의미하기 때문입니다.
9.7 모바일 계층이 저비용으로 만드는 두 가지 테스트
각 모바일 실행은 하나의 상호작용과 고정된 수의 구독 메시지 비용이 들어가며, 이는 두 가지 추가 주장을 쉽게 달성할 수 있도록 합니다.
H4, 상관 지배성. N = 2인 교차 실험실 쌍은 정확성과 소수 생존에서 N = 5인 동일 실험실 5중 집단과 동등하거나 능가합니다. 이는 제5.3절의 가장 날카로운 테스트입니다. 왜냐하면 팔이 모델이 결정적이라고 부르는 방향인 ρ에서 다르면서 그것이 2차적이라고 부르는 방향인 N에서 서로를 향해 움직이기 때문입니다.
H5, 추출 축. 블라인드 병렬 추출은 동일한 질문 세트에 대한 정보된 순차 추출보다 엄격히 더 많은 불일치를 표면화하며, 그것이 표면화하는 불일치는 단일 모델 답변의 오류를 예측합니다. H5가 실패하면, 정보된 비평가가 블라인드 동료만큼 많은 차이를 찾는다는 의미이며, 제6.5절의 독립성 비용 논증이 잘못되었고 정보된 모드가 단순히 블라인드 모드를 포함합니다.
10. 제한사항
핵심 주장은 검증되지 않았습니다: 섹션 4는 설계 논증이며, 섹션 9는 이를 해결할 비교를 명시합니다.
ρ는 추정되지 않고 가정됩니다. 표 2와 표 8의 모든 값은 가정된 균등 ρ에서 섹션 5 공식 에서 따릅니다. 이는 현실적인 블록 구조에서 표들을 상한선에 배치합니다.
섹션 7은 n = 5 및 n = 3을 보고합니다. 실패 모드가 존재함을 확립하며, 주장은 빈도가 아닌 존재 여부로 제한됩니다. 점수 매김은 저자에 의해 수행되었으며 평가자 간 추정치가 없습니다. 이진 기준은 단일 평가자 위험을 줄이지만 제거하지는 않습니다. 환경 A는 개입 후 재실행되지 않았으며 환경 C는 실행이 없으므로, 보고된 통과는 환경 B만을 포함합니다.
웹 인터페이스 및 소비자 애플리케이션 뒤의 모델 버전은 알려지지 않으며 변경되고, 계정 개인화는 답변에 영향을 미치며, 실행은 정확히 반복될 수 없습니다(섹션 6.6). 따라서 결과는 빠르게 노후화되며 명명된 모델이 아닌 프로토콜에 대한 증거입니다.
합성기 자체는 언어 모델이며, 다른 모든 것처럼 F1부터 F4까지의 대상입니다. 프로토콜은 출처, 자동 삭제 금지, 그리고 별도의 불일치 섹션을 통해 구조적으로 이를 제약하지만 제거하지는 않습니다. 출력 품질은 주어진 모델이 지시를 얼마나 충실히 따르는지에 달려 있으며, 그러한 의존성은 측정되지 않습니다.
맹검 평가표는 이후 문서를 작성하는 동일한 모델에 의해 실행되므로, 앵커 선택은 편향 지점이며, 그 모델이 자신의 스타일에 stylistically 가까운 답변을 체계적으로 선호하는 것을 막는 것이 없습니다. 이는 또 다른 위치에서의 판사-모델 편향입니다(Zheng 외, 2023). 사전 설정 앵커를 금지하는 것은 문제의 명시적 형태만을 다룹니다.
모바일 기본값은 informed-sequential이므로, 가장 자주 사용되는 모드는 동의가 가장 적은 증거적 가중치를 갖는 모드입니다(섹션 6.4). 이는 메시지당 품질의 trade-off이며, 이것이 설정하는 경계는 여기에 명시됩니다. 티어의 주요 약점은 감사성을 지연 시간과 교환하는 것입니다: 비평과 합성은 완성된 텍스트를 반환하며, 원시 답변은 모델의 자체 세션 기록에만 존재하므로, Poll 모드를 열지 않는 사용자는 확인하는 대신 신뢰하고 있습니다. 이는 프로토콜이 존재하는 주장입니다.
시간 비용은 무료 경로에 경계를 설정합니다. 현실적인 전체 위원회는 10~15분의 대기 시간과 deep-research 모드의 경우 제공자당 5~25분입니다. 의도한 인구의 일부에 대해 이는 이점을 초과할 수 있습니다.
섹션 11은 에이전트 경로의 법적 위치와 그것이 남겨두는 서비스 약관 문제를 설정합니다.
11. 윤리, 개인정보보호 및 법적 틀
이 시스템은 사용자가 자신의 브라우저나 기기를 통해 자신의 모델 계정(무료 또는 유료)을 개인적으로 사용하기 위한 것입니다. 제3자 데이터를 수집하거나, 유료 콘텐츠 제한을 우회하거나, 챌린지-응답 테스트를 풀거나, 봇 탐지를 회피하거나, 프록시를 순환하거나, 작동을 숨기거나, 계정을 재판매하거나, 다중 테넌트로 실행하지 않습니다.
접근성은 부수 효과가 아니라 핵심 목적입니다. 장애가 있는 사용자가 이를 보조 기술로 활용할 때, 그것이 바로 이 시스템의 목적입니다. 즉, 사용자를 대신하여, 사용자의 속도로, 사용자의 계정에서 작동하는 도우미입니다. 경사로의 비유가 정확합니다. 휠체어 사용자를 위해 만든 경사로는 유모차를 끄는 부모들과 배송 노동자들도 이용하며, 수십 개의 브라우저 탭을 관리할 수 없는 사용자를 위해 만든 시스템은 모두에게 유용한 것으로 드러납니다.
법적으로는 경로가 동등하지 않습니다. 무료 경로는 모든 해석에서 일반적인 사용처럼 보입니다. 사용자가 사이트를 열고, 입력하고, 복사합니다. 모바일 계층은 벤더들이 정확히 이러한 종류의 호출을 위해 앱 인텐트를 공개하기 때문에 이와 가깝습니다. 단축키는 두 가지 호출을 연결할 수 있으며, 각 애플리케이션을 의도대로 사용하여 한 번에 하나의 메시지를 포그라운드에서 실행합니다. 에이전트 경로는 더 자세히 살펴봐야 합니다. 자동화된 접근에 관한 규칙은 규모의 산출물 수집, 서비스에 부하를 주는 봇, 속도 제한 우회, 많은 계정 실행, 그리고 반환 결과 재판매를 목표로 합니다. 그 어느 것도 한 사용자가 자신의 로그인된 브라우저에서 인간 속도로 한 질문을 하고 그 답을 직접 읽는 것을 설명하지 않습니다. 이러한 사용은 구조적으로 할 수 없는 사람들을 위해 입력하고 클릭하는 보조 소프트웨어와 동일합니다. 그러나 일부 약관은 규모에 대한 언급 없이 자동화된 모든 수단을 금지할 정도로 광범위하게 작성되어 있습니다. 그것이 한 질문을 자동화하는 사용자에게까지 미치는지는 서비스, 관할권, 그리고 현재 시행 중인 약관에 따라 다릅니다. 이것은 해석이지 판결이 아닙니다. 사용자는 연결하는 항목의 약관을 살펴보고 스스로 결정해야 합니다. 이 모든 것을 생각하고 싶지 않은 사용자는 무료 경로를 사용할 수 있으며, 이는 동일한 작업을 수행하고 에이전트 관련 질문을 어떤 것도 제기하지 않습니다. 사이트의 일반적인 약관은 여전히 적용됩니다.
개인정보보호는 구성 결정입니다. 모델 세트는 사용자가 입력한 내용을 어느 회사가 받을지를 결정하며, 이는 일반적인 질문에서는 중요하지 않지만 건강, 고용주 또는 클라이언트에 관한 질문에서는 중요할 수 있습니다. 특정 질문을 특정 회사로 보내기가 불편할 경우, 해당 질문에서 그 멤버를 제외합니다. 하나를 빼는 것은 비용이 들지 않습니다.
프로토콜 자체의 윤리적 제약은 금지입니다. 메서드의 실행이 아닌 것은 실행으로 제시될 수 없습니다. 웹 요약, 단일 모델 답변, 또는 운영자 자신의 추론은 각각 유용할 수 있지만, 그들은 위원회 결과가 아니며, 사용자는 자신이 어떤 것을 보유하고 있는지 알려야 합니다. 실제로 이는 수신 확인, 동의 및 불동의 섹션, 그리고 진정한 다중 모델 실행이 아닌 모든 것에 대한 출력 파일이 없음을 의미합니다.
12. 결론
확신 있게 틀린 답변은 확신 있게 맞은 답변과 구별할 수 없지만, 둘 사이의 논쟁은 누구에게나 보입니다. 따라서 평의회의 가치는 불일치를 드러내는 데 있지, 그것을 평균내는 데 있지 않습니다.
모델 간의 합의는 독립적인 확인이 아닙니다. 오류 상관관계 ρ를 가진 N개 모델의 평의회는 = N/(1+(N−1)ρ)개의 독립적인 증인과 같은 가치를 가집니다. 이 수량은 아무리 많은 모델을 추가하더라도 1/ρ에서 포화되므로, ρ = 0.5일 때 어떤 규모의 평의회도 최대 두 명의 증인만큼의 가치를 가집니다. 열 개의 독립적이고 일치하는 모델과 열 개의 상관된 모델 사이의 증거적 강도의 차이는 약 5개 자리 수의 크기이며, 불투명한 병합은 그 차이를 독자에게 정당하지 않은 확신으로 넘깁니다.
설계는 이 두 전제에서 비롯됩니다. 이것은 출처를 보존하여 독자가 그것을 신뢰하기보다는 결과를 확인할 수 있게 하며, 불일치를 높이 두는데, 불일치는 단일 모델이 공급할 수 없는 유일한 구성요소이기 때문입니다. 여러 답변이 공유하는 출처는 하나의 출처로 표시됩니다. 부담이 되는 사실들은 명명되며, 출처가 있는 것은 단지 합의된 것과 분리됩니다. 프로토콜의 자기설명에 적용되는 하나의 규칙이 더 있습니다. 그것은 협력적이지 않았던 것을 협력적인 것으로 제시해서는 안 되는데, 이것은 이론적인 우려가 아닙니다. 맹검 실행에서 5개 모델 중 2개가 조용히 위반했으며, 역할 할당의 한 문장이 환경-B 재실행에서 둘 다 바로잡았습니다.
세 계층은 품질의 세 등급이 아니라 폭의 비용이라는 축을 따른 곡선 위의 점들이며, 제5장이 그 곡선을 일관되게 만듭니다. 가 포화되기 때문에, 두 모델과 열 모델 사이의 증거적 거리는 모델 개수가 시사하는 것보다 훨씬 작으며, 서로 다른 실험실에서 휴대폰으로 실행되는 두 개의 모델은 단일 계열에서 도출된 다섯 개보다 더 많은 가치를 가질 수 있습니다. 모바일 계층은 또한 다른 계층들이 조용히 만들어온 거래를 드러냈습니다. 첫 번째를 읽은 두 번째 모델은 그것을 수정할 수 있지만, 더 이상 독립적으로 확인할 수 없습니다. 오류 수정과 독립적 확인은 다른 상품이며, 다른 순서로 구매되며, 두 가지 중 어느 것을 판매하는지 말하지 않는 시스템은 그 사용자를 오도합니다. 통제된 비교는 공개 상태로 유지되며, 제9장은 그것과 함께 내가 주장을 철회하도록 강제할 결과를 명시합니다.
그 비교가 어떻게 결과나든, 출처 없이 병합되고 보존된 불일치 없이 병합된 문서는 전혀 확인될 수 없으며, 따라서 결정을 내리는 누군가에게 중요한 어떤 의미에서도 단일 답변보다 나을 수 없습니다. 감시 가능성은 합성에 대한 개선이 아닙니다. 그것은 합성이 결과라고 불릴 권리를 가지는 조건입니다. 따라서 프로토콜의 규칙들은 몇 개의 모델이 요청되었는지가 아니라 각 문장이 어디에서 나왔는지와 모델들이 무엇에 대해 불일치했는지에 관한 것입니다.
선언
자금 지원. 이 작업을 지원한 외부 자금은 없습니다.
이해 상충. 저자는 본 논문에서 분석한 다중 모델 오케스트레이션 방법의 개발자이며, 이 방법들은 공개되고 재현 가능하므로 독자들이 이를 고려해야 할 이해 관계가 있습니다. 저자는 이 논문이 검토하는 종류의 AI 오케스트레이션 및 다중 모델 검증 시스템을 다루는 미결 특허 출원의 명시된 출원인이며, 허가된 특허는 아닙니다. 섹션 4에서 형식화된 프로토콜과 섹션 6에서 설명된 참조 구현은 저자의 것이며, 섹션 9의 평가 설계는 이러한 이유로 데이터 수집 전에 고정되었습니다. 섹션 5의 분석 결과는 구현에 의존하지 않습니다. 섹션 6과 7은 모델, 그 상한선, 또는 그들로부터 도출된 결론을 변경하지 않고도 전체적으로 제거될 수 있습니다.
도구 및 검증. AI 어시스턴트는 저자의 지도하에 도구로 사용되었습니다. 아이디어, 연구 및 결론은 저자의 것입니다. 모든 정량적 주장과 인용은 저자가 주요 출처 또는 보관된 사본과 대조하여 검증했으며, 저자가 내용에 대한 전적인 책임을 집니다.
데이터 가용성. 그림 1과 3, 표 2, 4, 8은 섹션 5.2의 폐형식 표현에서 생성되며 이로부터 재계산할 수 있습니다. 섹션 7의 자료는 각 실행 시점에 기록되고 작업 자료와 함께 보관된 첫 번째 응답 기록으로 구성됩니다. 모델들은 제품명이 아닌 실험실로 식별됩니다. 관찰은 여러 실험실에 걸쳐 나타난 실패 모드에 관한 것이며, 단일 실행 결과는 명명된 시스템 간의 비교를 지원하지 않습니다.
저자 기여. 단독 저자.
연락처. [email protected]
References
Entries marked arXiv are preprints and are cited as such; vendor and standards-body documents are contemporaneous industry sources rather than settled literature.
- Bommasani, R., Creel, K. A., Kumar, A., Jurafsky, D., & Liang, P. (2022). Picking on the same person: Does algorithmic monoculture lead to outcome homogenization? Advances in Neural Information Processing Systems, 35.
- Condorcet, M. J. A. N. de C., marquis de (1785). Essai sur l’application de l’analyse à la probabilité des décisions rendues à la pluralité des voix. Imprimerie Royale, Paris.
- Debenedetti, E., Shumailov, I., Fan, T., Hayes, J., Carlini, N., Fabian, D., Kern, C., Shi, C., Terzis, A., & Tramèr, F. (2025). Defeating prompt injections by design. arXiv:2503.18813.
- Dietterich, T. G. (2000). Ensemble methods in machine learning. In Multiple Classifier Systems, Lecture Notes in Computer Science 1857, 1-15. Springer.
- Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325.
- Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., et al. (2022). Language models (mostly) know what they know. arXiv:2207.05221.
- Karpathy, A. (2025). llm-council. Open-source software repository.
- Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038-30066. arXiv:2506.07962.
- Kish, L. (1965). Survey Sampling. Wiley, New York.
- Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
- Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118.
- Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. Advances in Neural Information Processing Systems, 7, 231-238.
- Ladha, K. K. (1992). The Condorcet jury theorem, free speech, and correlated votes. American Journal of Political Science, 36(3), 617-634.
- Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020-9025.
- Meta (2025). Agents rule of two: A practical approach to AI agent security. Engineering documentation.
- MITRE (2025). CVE-2025-32711. Common Vulnerabilities and Exposures record; zero-click exfiltration in an agentic assistant (EchoLeak).
- OWASP (2025). OWASP Top 10 for large language model applications - LLM01: Prompt injection.
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., et al. (2023). Towards understanding sycophancy in language models. arXiv:2310.13548.
- Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755-759.
- Surowiecki, J. (2004). The Wisdom of Crowds. Doubleday, New York.
- Ueda, N., & Nakano, R. (1996). Generalization error of ensemble estimators. Proceedings of the International Conference on Neural Networks, 90-95.
- Wang, J., Wang, J., Athiwaratkun, B., Zhang, C., & Zou, J. (2024). Mixture-of-agents enhances large language model capabilities. arXiv:2406.04692.
- Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., & Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. International Conference on Learning Representations. arXiv:2203.11171.
- Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. International Conference on Learning Representations. arXiv:2306.13063.
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, Datasets and Benchmarks Track. arXiv:2306.05685.
부록 A. 영수증 템플릿
영수증은 독자가 처음 만나는 것이며 종종 유일하게 읽는 것입니다. 스크롤 없이 네 가지 질문에 답해야 합니다.
RECEIPT — 6 models asked · 5 answered · 1 did not (free tier)
Mode: fast ×4, deep ×1
Anchor: answer #3 (chosen for completeness and sourcing)

Agreed:       ...
Disputed:     ...
Unverified:   ...

Rests ONLY on the models agreeing (none showed a source):
              ...
Correlated:   3 of 5 cite one article → one lineage, not three
Composition:  4 of 5 are models from one region; agreement
              may reflect a shared frame
마지막 두 줄이 섹션 5가 존재하는 이유를 정당화합니다. 이 두 줄이 없으면 문서는 몇 개의 모델이 동의했는지만 보고하고 그 동의가 얼마나 가치 있는지는 숨기게 되며, 이 두 수량은 크기 순서가 다릅니다.
부록 B. 독립적 증인의 유효 개수
표 8. , 전체 범위
| ρ | N=2 | N=3 | N=4 | N=5 | N=7 | N=10 | N=15 | N=20 | N→∞ |
|---|---|---|---|---|---|---|---|---|---|
| 0.00 | 2.00 | 3.00 | 4.00 | 5.00 | 7.00 | 10.00 | 15.00 | 20.00 | ∞ |
| 0.05 | 1.90 | 2.73 | 3.48 | 4.17 | 5.38 | 6.90 | 8.82 | 10.26 | 20.0 |
| 0.10 | 1.82 | 2.50 | 3.08 | 3.57 | 4.38 | 5.26 | 6.25 | 6.90 | 10.0 |
| 0.15 | 1.74 | 2.31 | 2.76 | 3.13 | 3.68 | 4.26 | 4.84 | 5.19 | 6.67 |
| 0.20 | 1.67 | 2.14 | 2.50 | 2.78 | 3.18 | 3.57 | 3.95 | 4.17 | 5.00 |
| 0.30 | 1.54 | 1.88 | 2.11 | 2.27 | 2.50 | 2.70 | 2.88 | 2.99 | 3.33 |
| 0.40 | 1.43 | 1.67 | 1.82 | 1.92 | 2.06 | 2.17 | 2.27 | 2.33 | 2.50 |
| 0.50 | 1.33 | 1.50 | 1.60 | 1.67 | 1.75 | 1.82 | 1.88 | 1.90 | 2.00 |
| 0.60 | 1.25 | 1.36 | 1.43 | 1.47 | 1.52 | 1.56 | 1.60 | 1.61 | 1.67 |
| 0.70 | 1.18 | 1.25 | 1.29 | 1.32 | 1.35 | 1.37 | 1.39 | 1.40 | 1.43 |
| 0.80 | 1.11 | 1.15 | 1.18 | 1.19 | 1.21 | 1.22 | 1.23 | 1.23 | 1.25 |
| 0.90 | 1.05 | 1.07 | 1.08 | 1.09 | 1.09 | 1.10 | 1.10 | 1.10 | 1.11 |
오른쪽으로 이동하여 모델을 추가하면 맨 오른쪽 열에 거의 즉시 도달합니다. 위로 이동하여 상관관계를 감소시키면 제한이 없습니다. 위원회의 다양성, 즉 서로 다른 실험실, 지역 및 학습 코퍼스에 투자된 노력은 그 규모에 투자된 노력보다 더 많은 이득을 반환합니다. 두 항목은 섹션 6.2의 논의를 뒷받침합니다: 두 실험실에서 추출한 쌍이 ρ ≈ 0.2일 때 약 1.67개의 독립적 증인으로 계산되는 반면, 한 계열의 5개 모델은 ρ ≈ 0.6일 때 약 1.47로 계산됩니다.
부록 C. 모바일 계층 구현 참조
표 9. 모바일 계층의 구현 참조
| 구성 요소 | 사양 |
|---|---|
| 메커니즘 | 운영 체제 앱 인텐트가 단일 서명된 바로 가기로 연결되어 사용자의 기존 구독에 대해 공급업체의 설치된 애플리케이션을 호출합니다. API 키 없음, 서버 없음, 백그라운드 실행 없음 |
| 공급업체 작업 | 각 공급업체의 게시된 ask-intent로, 애플리케이션-intent 식별자로 처리됩니다. 한 공급업체는 선택적 모델 매개변수를 노출하며, 이를 생략하여 애플리케이션 기본값이 적용되고 다른 공급업체는 노출하지 않습니다 |
| 자동 조작 | show-on-run 매개변수는 가져온 후 편집기에서 조정되지 않고 빌드 시 인텐트 매개변수 내에서 비활성화로 설정됩니다 |
| 배포 | 바로 가기는 무제한 가져오기를 위해 서명되므로 한 번의 빌드로 재빌드 없이 모든 장치 또는 계정에 설치됩니다 |
| 모드 메뉴 | 시작, 케이스 및 종료 마커가 있는 메뉴 제어 흐름 작업입니다. 분기는 set-variable 작업을 통해 공유 끝부분으로 수렴합니다 |
| 대체 플랫폼 | 인텐트 기반 자동화로, 애플리케이션 업데이트에도 지속되는 반자동 경로입니다 |
| 실행당 비용 | Poll 1 + 1, Critique 1 + 1, Synthesis 1 + 2 구독 메시지 |
| 지연 시간 | 실행부터 결과까지 약 50~60초, 자동 조작 |
| 실행 화면 | 홈 화면 아이콘, 위젯, 하드웨어 작업 버튼 또는 음성 명령 |
두 가지 제약이 설계를 형성했으며, 둘 다 일반화됩니다. 할당량은 동일한 애플리케이션의 일반적인 사용과 공유되므로 권장되는 일상적인 모드는 3메시지가 아닌 2메시지 모드이며, 이는 리소스 할당이지 품질 판단이 아닙니다. 그리고 모든 인텐트 호출은 메모리가 없는 새로운 세션을 열므로 모든 프롬프트는 자체 포함되며 질문과 이전 답변을 모두 담고 있습니다. 계속되는 것은 없습니다. 이 제약은 섹션 6.5에서 주장하는 대로 Poll과 Synthesis의 블라인드-병렬 독립성을 지시된 것이 아닌 아키텍처 수준으로 만드는 것입니다.
인용 방법
Chernets, V. (2026). Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7390698
@misc{chernets2026agreementnotevidence,
  author       = {Chernets, Vadym},
  title        = {{Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7390698},
  url          = {https://doi.org/10.2139/ssrn.7390698}
}