Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API
Ceci est une traduction. La version de référence est l’original en anglais ; citez celle-ci.
Vadym Chernets, PhD, architecte de systèmes d'IA · ORCID 0009-0007-4845-3163
SSRN 7390698 · DOI 10.2139/ssrn.7390698 · Zenodo 10.5281/zenodo.22683716 · GitHub
- Version d'enregistrement : SSRN 7390698 · DOI 10.2139/ssrn.7390698
- Copie archivée, citée et téléchargeable : 10.5281/zenodo.22683716 — concept DOI, se résout toujours à la dernière version
- Texte complet au format Markdown et PDF : GitHub
- HTML lisible : https://polyhelper.ai/research/agreement-not-evidence/
Le même texte se trouve sur quatre surfaces afin qu'il soit accessible lorsque l'une d'entre elles ne peut pas le servir. SSRN détient la version d'enregistrement ; citez celle-ci.
Mots-clés : grands modèles de langage ; erreurs corrélées ; sagesse des foules ; théorème du jury de Condorcet ; monoculture algorithmique ; débat multiagent ; taille effective de l'échantillon ; effet de conception ; ensemble ; provenance. Classification JEL : C11; C18; D71; D83; L86; O33
Résumé
Une personne qui pose une question à un seul modèle de langage ne peut pas distinguer une réponse confiante mais fausse d'une réponse confiante et juste. Les deux sont identiques sur tous les indices de surface disponibles pour un non-expert. Consulter plusieurs modèles semble résoudre ce problème, mais cela le déplace surtout : réconcilier plusieurs réponses produit à nouveau un texte confiant, et ce texte porte désormais l'autorité empruntée de « dix d'entre eux ont convenu ».
Le protocole formalisé ici collecte les réponses de plusieurs modèles de chat grand public via le navigateur ou le téléphone de l'utilisateur, sans clés d'API, sans installation et sans serveur intermédiaire. Il les réconcilie par ancrage-et-enrichissement : la réponse la plus forte disponible devient la base, et chacune des autres ne contribue que ce qui manque à la base. Chaque contribution est signée par le modèle qui l'a fournie. Les désaccords sont conservés dans une section qui leur est propre plutôt que d'être lissés.
L'article apporte quatre contributions. La première est le protocole lui-même, énoncé sous forme d'algorithme qui préserve la provenance et interdit la suppression silencieuse, accompagné d'une taxonomie de cinq façons dont une fusion peut échouer. Quatre d'entre elles sont des défauts d'un regroupement naïf ; la cinquième est une défaillance de l'opérateur plutôt que de la méthode : une synthèse qui présente la sortie d'un seul modèle comme un résultat collégial. La deuxième est l'application de l'arithmétique des témoins corrélés à la conception du protocole. Cette arithmétique n'est pas revendiquée ici. Kohli (2026) a appliqué la même correction de Kish à un panel de neuf juges de première ligne et a mesuré environ deux votes effectifs, et Kim et al. (2025) ont établi la corrélation d'erreur sous-jacente sur plus de 350 modèles. Un conseil de N modèles dont les erreurs portent une corrélation intra-classe ρ vaut = N / (1 + (N−1)ρ) témoins indépendants, et cette quantité sature à 1/ρ quel que soit le nombre de modèles ajoutés. Une fois qu'un conseil dépasse 1/ρ, diviser ρ par deux surpasse doubler N, et une paire tirée de deux laboratoires peut surpasser cinq tirées d'un seul. Kim et al. (2025) compliquent cette règle : les modèles plus grands et plus précis portent les erreurs les plus corrélées même lorsque l'architecture et le fournisseur diffèrent, donc deux laboratoires sont une conjecture a priori sur ρ plutôt qu'une mesure de celui-ci, ce à quoi sert la procédure d'estimation de la Section 5.5. La troisième est un compte rendu de trois niveaux de déploiement, manuel, mobile à un clic et agent navigateur, et de l'axe qui les sépare épistémiquement : si le deuxième modèle voit la réponse du premier modèle. Conditionner le deuxième modèle augmente ρ en échange d'une correction d'erreur. La quatrième est une observation sur petit échantillon de la défaillance du faux conseil parmi cinq modèles, l'intervention d'une phrase qui l'a supprimée dans une nouvelle exécution de trois modèles, et un plan d'évaluation à trois bras en aveugle avec une condition de falsification spécifiée.
L'accord corrélé est traité ici comme établi, non comme une découverte. Le fait qu'un panel de modèles vaut bien moins de témoins indépendants qu'il n'a de membres a été mesuré directement : neuf juges de première ligne tirés de sept familles fournissent environ deux votes effectifs (Kohli, 2026), et la corrélation d'erreur augmente avec la capacité du modèle même lorsque l'architecture et le fournisseur diffèrent (Kim et al., 2025). La Section 5 énonce à nouveau l'arithmétique de l'effet de conception derrière ces mesures, car trois des règles du protocole en sont dérivées et se lisent comme une pointillosité inutile sans elle. Le protocole prend alors l'autre côté du même problème. Cette littérature mesure la corrélation ; ce protocole est conçu pour la réduire, en composant entre lignées, en gardant le désaccord au lieu de le lisser, en signant chaque contribution par le modèle qui l'a fournie, et en comptant une source répétée une seule fois.
L'affirmation qu'une réponse fusionnée surpasse la meilleure réponse unique est argumentée à partir de la conception et de la littérature adjacente ; la Section 9 spécifie l'évaluation, qui n'a pas encore eu lieu.
Table des matières
- Introduction
- Travaux connexes
- Cinq façons dont une fusion échoue
- Le protocole d'ancrage et d'enrichissement
- Accord corrélé
- Trois niveaux, un protocole
- Section empirique
- Le fichier de collage : un modèle d'interface pour l'orientation au démarrage à froid
- Une évaluation proposée
- Limitations
- Cadre éthique, confidentialité et juridique
- Conclusion
Déclarations · Références · Appendice A, le modèle de reçu · Appendice B, nombre effectif de témoins indépendants · Appendice C, référence de mise en œuvre du niveau mobile
Liste des figures et tableaux
- Figure 1. Un conseil sature à 1/ρ, et ce que dix modèles d'accord valent (Section 5.3)
- Figure 2. Le protocole anchor-and-enrich, étape par étape (Section 4.2)
- Figure 3. Les trois niveaux comme points sur une courbe latence–largeur (Section 6.4)
- Figure 4. Élicitation aveugle-parallèle et séquentielle-informée comparées (Section 6.5)
- Table 1. Règles du protocole et les défaillances qu'elles traitent (Section 4.5)
- Table 2. Nombre effectif de témoins indépendants, valeurs sélectionnées (Section 5.2)
- Table 3. Les trois modes du niveau mobile (Section 6.2)
- Table 4. La frontière latence–largeur dans les trois niveaux (Section 6.4)
- Table 5. Sonde démarrage à froid, exécution de base, n = 5 (Section 7.2)
- Table 6. Sonde démarrage à froid après l'intervention d'attribution des rôles, n = 3 (Section 7.3)
- Table 7. Modes de défaillance observés d'un pipeline d'intention d'application client (Section 7.5)
- Table 8. Nombre effectif de témoins indépendants, tableau complet (Appendice B)
- Table 9. Référence d'implémentation du niveau mobile (Appendice C)
1. Introduction
1.1 Le problème
Prenez une question où se tromper est coûteux : choisir une école, un traitement, un fournisseur, une clause dans un contrat. L'utilisateur interroge un modèle de langage et reçoit quelque chose de cohérent, confiant et bien formaté, et la difficulté commence là. Une réponse confidemment fausse et une confidemment juste se ressemblent. Le ton ne les distingue pas, ni la structure, la longueur ou la présence de citations. La confiance verbalisée du modèle est connue pour être exagérée et mal calibrée (Kadavath et al., 2022 ; Xiong et al., 2024). La tendance d'un modèle à adopter le cadrage du questionneur ajoute une deuxième couche de faux soutien (Sharma et al., 2023).
Le remède évident est un deuxième avis. L'erreur d'un modèle ressemble à de la confiance. La même erreur placée à côté d'une réponse d'un deuxième modèle ressemble à un argument. Un argument est visible à un lecteur sans expertise sur le sujet ; la confiance ne l'est pas. Tout ce qui suit repose sur cette asymétrie.
Le remède a un prix et un piège. Le prix est la lecture : dix réponses à une question sont dix textes longs à tenir à l'esprit à la fois en se souvenant de qui a dit quoi. Presque personne ne fait cela. En pratique, un lecteur parcourt la première réponse, survole la deuxième et ferme le reste. Rassembler plusieurs réponses est un problème résolu depuis des années, grâce aux abonnements d'agrégateurs, aux panneaux côte à côte et aux passerelles API. Terminer avec eux ne l'a pas été.
Le piège est la fusion. Toute façon de réduire dix réponses à une produit à nouveau un seul texte confiant, et si la réduction est opaque, le lecteur se retrouve où il a commencé, sauf que le texte porte maintenant une autorité qu'il ne peut pas vérifier. L'agrégation naïve efface également les points minoritaires corrects, dérive vers le libellé le plus emphatique et produit l'apparence d'un consensus où il n'y en a pas.
Un troisième problème est ce qui rend tout l'exercice non trivial. L'accord entre les modèles n'est pas une confirmation indépendante, car les modèles entraînés sur des corpus qui se chevauchent partagent des cadrages, citent les mêmes articles et héritent des mêmes angles morts. « Neuf sur dix ont convenu » et « neuf experts indépendants ont convenu » sont des affirmations différentes, et l'écart entre eux est quantitatif et important. La section 5 montre que cela impose un plafond à toute la construction.
1.2 Le système
Le protocole est rédigé en texte brut, avec trois façons de l'exécuter. Les trois produisent le même document, et ils diffèrent par qui fait les clics et par le nombre de modèles interrogés.
Sur le chemin gratuit, l'utilisateur ouvre les sites, copie les réponses et les colle sous un paragraphe d'instructions dans n'importe quel modèle de chat. Rien à installer, rien à payer, et cela fonctionne sur un téléphone.
Sur le niveau mobile, il y a une icône sur l'écran d'accueil. Appuyez dessus, tapez la question, choisissez un mode, et environ une minute plus tard, la réponse finie est à l'écran et dans le presse-papiers. Il atteint deux modèles par le biais d'intentions d'application du système d'exploitation par rapport aux abonnements déjà installés sur l'appareil, sans clé API.
Sur le chemin de l'agent, un modèle capable de piloter un navigateur ouvre les sites nommés dans les sessions connectées existantes de l'utilisateur, soumet la question, attend, enregistre chaque réponse dans un fichier et construit le document.
Le fait architecturalement décisif est qu'il n'y a pas de serveur. Pas un serveur sécurisé, et pas un avec une politique de non-conservation : aucun tel composant n'existe, donc la question ne peut pas m'atteindre. Elle atteint bien les services de modèle que l'utilisateur a nommés, ce qui est l'objet de l'exercice, et elle ne va nulle part ailleurs. Une deuxième conséquence découle de la même absence : le protocole ne peut pas être retiré, car c'est un paragraphe de texte sous une licence permissive, et une copie dans les notes d'un utilisateur continue de fonctionner avec les modèles qui existent plus tard.
1.3 Contributions
La section 3 énumère cinq façons dont une fusion échoue et la section 4 formalise l'enrichissement ancré contre elles. La section 5 développe le modèle de témoin corrélé, = N/(1+(N−1)ρ) avec son plafond à 1/ρ, et en tire les implications pour la composition d'un conseil. La section 6 décrit les trois niveaux, la frontière latence-ampleur qu'ils tracent, et la distinction parallèle-aveugle par rapport à séquentielle-informée qui les sépare épistémiquement. La section 7 rapporte l'observation du conseil contrefait et les résultats de terrain de la compilation mobile ; la section 8 décrit un motif d'interface pour les conseils de démarrage à froid ; la section 9 spécifie une évaluation aveugle avec une condition de falsification fixée à l'avance. L'affirmation qu'une réponse fusionnée surpasse la meilleure réponse unique n'est pas tranchée ici, et cette évaluation est la comparaison qui la trancherait, y compris le résultat qui m'obligerait à la retirer.
L'orientation mérite d'être énoncée clairement, car c'est ce qui sépare cet article de la littérature de mesure sur laquelle il dépend. Kohli (2026), Kim et al. (2025) et Ding (2026) mesurent la corrélation des erreurs d'un conseil. Cet article prend cette corrélation comme cible de conception et demande comment une seule personne, travaillant par le biais d'interfaces de chat ordinaires des consommateurs sans clé API et sans serveur, peut la réduire et laisser un enregistrement qui montre qu'elle l'a fait. Une lacune dans cette littérature mérite d'être nommée car elle est à portée de main : les mesures ont été effectuées sur des API, sur des repères, avec neuf modèles ou avec trois cents. Personne n'a estimé la corrélation dans le cadre des consommateurs que ce protocole habite, où une personne interroge quatre produits de chat pour lesquels elle ne paie déjà rien. La section 5.5 donne la procédure et la section 9.6 la conception.
2. Travaux connexes
Ensembles et diversité. La théorie classique des ensembles indique déjà ce qui est nécessaire ici : ce qu'un ensemble gagne dépend de la façon dont ses membres se trompent différemment, non de leur qualité moyenne. La décomposition de l'ambiguïté, dans laquelle l'erreur d'ensemble égale l'erreur moyenne des membres moins l'ambiguïté moyenne (Krogh & Vedelsby, 1995), et la décomposition biais–variance–covariance (Ueda & Nakano, 1996) montrent toutes deux qu'un ensemble s'effondre vers un seul membre à mesure que la covariance d'erreur augmente. Dietterich (2000) énonce cette condition comme condition nécessaire. La section 5 la transfère aux conseils de modèles de langage et quantifie le coût de la violer.
Schémas multi-modèles pour modèles de langage. L'auto-cohérence (Wang, X., et al., 2023) vote sur plusieurs échantillons d'un seul modèle, ce qui réduit la variance sans produire d'indépendance. Le débat multi-agent (Du et al., 2023) rapporte des gains en factualité quand plusieurs instances échangent des arguments. Le mélange d'agents (Wang, J., et al., 2024) alimente les sorties d'une couche à un agrégateur et rapporte une amélioration par rapport au modèle unique le plus fort sur plusieurs repères. Cette littérature pointe dans la même direction que ce protocole. Les résultats ont été obtenus sur des API et sur des repères, cependant, de sorte que je ne les transfère pas à un conseil médié par navigateur d'interfaces grand public sans mesure de ma part, ce que la section 9 précise.
Modèles juges. L'évaluation par un modèle juge est bien caractérisée ainsi que ses défauts : le biais de position, le biais de verbosité, et une attraction vers un style maison familier (Zheng et al., 2023). C'est une contrainte de conception ici, non une parenthèse, car la notation non aveugle mesurerait en partie ces biais. La section 9.4 le traite.
Monoculture. Kleinberg et Raghavan (2021) montrent que quand de nombreux agents s'appuient sur un algorithme, les résultats collectifs peuvent s'aggraver même si la qualité individuelle s'améliore. Bommasani et al. (2022) décrivent le même effet comme homogénéisation des résultats. Pour un conseil de modèles de langage c'est le mécanisme qui génère ρ > 0 en premier lieu. Le travail sur la dégradation lors de l'entraînement sur les données générées (Shumailov et al., 2024) suggère que ρ dérive vers le haut au fil du temps.
Foules. L'argument classique de la sagesse des foules (Surowiecki, 2004) dépend de l'indépendance des jugements. Lorenz et al. (2011) ont montré expérimentalement que même une influence sociale légère, simplement laisser les gens voir les estimations des autres, rétrécit l'écart sans le déplacer vers la vérité : la foule devient plus confiante sans devenir plus précise. La section 6.5 identifie cela comme exactement le compromis accepté par l'élicitation séquentielle informée.
Condorcet et votes corrélés. Le théorème du jury de Condorcet (Condorcet, 1785) stipule que si la précision individuelle dépasse une moitié, la probabilité d'une majorité correcte tend à un à mesure que N augmente. Ladha (1992) a montré que les votes corrélés détruisent la garantie. La section 5 donne une version quantitative de cet avertissement par l'effet de conception (Kish, 1965).
Erreurs corrélées, mesurées. L'arithmétique que la section 5 énonce a depuis été mesurée directement sur des panneaux de modèles, et les mesures sont plus nettes que l'analyse. Kohli (2026) applique la taille effective d'échantillon de Kish à un panel de neuf juges de première ligne tirés de sept familles de modèles et la trouve équivalente à environ deux votes indépendants : environ les trois quarts de l'indépendance nominale du panel est perdu dans les erreurs partagées, la précision du panel chute de 8 à 22 points de pourcentage en deçà de ce que le vote indépendant livrerait, et le meilleur juge seul égale ou surpasse l'ensemble du panel. Ni plus de juges ni une meilleure agrégation ne le répare, ce qui localise le goulot d'étranglement chez les juges plutôt que dans l'algorithme. Kim et al. (2025), sur plus de 350 modèles, trouvent une corrélation d'erreur substantielle et, crucialement pour comment un conseil doit être composé, trouvent que les modèles plus grands et plus précis ont les erreurs les plus corrélées même quand l'architecture et le fournisseur diffèrent. Ding (2026) audite l'accord comme signal de confiance sur 265 000 échantillons et le trouve un prédicteur positif mais faible, avec corrélation entre 0,20 et 0,59, et pire exactement là où il est plus confiant : sur le modèle de première ligne le plus cohérent, l'accord à ou au-dessus de 0,8 couvrait 77 % des entrées du repère le plus difficile et 48 % de celles-ci étaient fausses.
Trois choses en découlent pour cet article. D'abord, le résultat d'effet de conception à la section 5 n'est pas une contribution de ma part. L'article de Kohli précède le premier envoi de celui-ci et a utilisé la même correction ; la section est conservée pour ce que le protocole en déduit, et elle est étiquetée comme telle où elle apparaît. Deuxièmement, le conseil de composition qui suit, dépenser sur la diversité plutôt que sur le nombre, est maintenant soutenu empiriquement au lieu d'être simplement argumenté. Troisièmement, la conclusion de Kim et al. complique ce conseil d'une façon qui vaut la peine d'être énoncée : si la capacité et la corrélation d'erreur augmentent ensemble, une paire tirée de deux laboratoires n'est pas automatiquement une paire diverse, et la lignée doit être mesurée plutôt que lue sur la marque. C'est un argument pour la procédure d'estimation de la section 5.5, non contre la règle de composition.
Systèmes adjacents. Plusieurs projets construisent des conseils multi-modèles. Une implémentation ouverte bien connue, llm-council (Karpathy, 2025), interroge les modèles en parallèle, les fait se revoir anonymement, et laisse un modèle président rédiger la réponse finale. Elle a besoin d'une clé API agrégateur et d'un paiement par jeton. Les produits de conseil commerciaux offrent un juge, une vue consensuelle et un affichage de contradiction. Les applications mobiles open-source ajoutent le vote et le débat multi-tour. Les interfaces avant multi-modèles matures livrent les fonctionnalités d'ensemble, et les panneaux libres côte à côte utilisent les sites officiels auxquels l'utilisateur est déjà connecté. Les abonnements à l'agrégateur mettent de nombreux modèles derrière une seule facture. Chacune de ces propriétés existe ailleurs de manière isolée. Leur conjonction, dix à la fois, semble être indisponible ailleurs : pas de clé API, pas d'installation, compatible téléphone, s'exécutant sur les comptes que l'utilisateur détient déjà y compris les niveaux gratuits, pas de nouvel intermédiaire payant, une méthode de fusion écrite en texte brut et donc éditable, le désaccord préservé, chaque contribution signée, une source répétée signalée comme une source, et une méthode exécutable soit à la main soit sous un agent.
Il y a une raison structurelle pour que la position reste ouverte. Un laboratoire a peu d'incitation à diriger la question d'un utilisateur vers son rival, puisque l'objectif de chaque participant est que sa propre réponse soit celle que l'utilisateur conserve. Les tiers vendent des outils inter-modèles, mais une méthode écrite en texte brut laisse le rôle éditorial à l'utilisateur, ce qui est un arrangement différent de celui d'aucun d'entre eux.
Portée. Le protocole couvre une personne produisant un document soigné sans assembler l'infrastructure d'une équipe de recherche : pas de clés, pas d'installation, pas de serveur. Les tentatives répétées, l'exécution garantie, la surveillance des coûts et des erreurs, les journaux d'audit, l'évaluation sur des ensembles de test, le contrôle d'accès, l'authentification unique, la politique de rétention, la gestion des versions de prompts et les accords de niveau de service relèvent de la compétence des frameworks d'orchestration d'entreprise.
3. Cinq façons dont une fusion échoue
Quatre des cinq sont des propriétés du pooling naïf, par quoi j'entends toute instruction de la forme « combinez ces réponses et optimisez le résultat ». La cinquième appartient à l'opérateur, et c'est celle qui importe le plus, car le lecteur ne peut pas la détecter.
F1, fabrication dans la synthèse. Le résultat contient des affirmations qui ne figuraient dans aucune des entrées. Le synthétiseur est lui-même un modèle de langage, et en lissant les jointures entre les sources, il génère du matériel de liaison qui ressemble exactement à du matériel issu de sources.
F2, effacement des minorités. La seule réponse qui a relevé une objection matérielle se dissout parce que la majorité a dit le contraire. C'est le cas pour lequel le conseil a été réuni, et c'est la première chose qu'une fusion naïve perd.
F3, dérive de confiance. Lorsque deux formulations entrent en conflit, la plus catégorique l'emporte sur celle qui est mieux étayée. C'est le même mécanisme qui produit le biais de position et de style dans les modèles de jugement (Zheng et al., 2023).
F4, consensus fabriqué. Un désaccord réel est moyenné en un oui nuancé. Le lecteur obtient un document dans lequel le contesté est indistinguable du réglé et ne peut même pas apprendre qu'un différend existait.
F5, le faux conseil. Un modèle auquel on demande d'effectuer un passage collégial n'a accès à aucun autre modèle. Au lieu de le dire, il effectue une recherche ordinaire sur le web et formate le résultat en forme collégiale, avec des sections d'accord et de désaccord, et des attributions de donateurs. Le document semble meilleur qu'un document véridique ne l'était, précisément parce qu'aucune vraie contradiction ne fait obstacle. Le lecteur ne peut pas le détecter, n'ayant pas accès aux réponses sources.
F5 est le problème d'ouverture du document soulevé à un niveau : une réponse confidemment fausse est indistinguable d'une bonne, et un document façonné comme un conseil mais écrit par un modèle est indistinguable d'un conseil. La section 7 rapporte qu'il s'est produit dans deux modèles sur cinq lors d'une exécution en aveugle.
4. Le protocole d'ancrage et d'enrichissement
4.1 Principe
Au lieu de regrouper et d'optimiser les réponses, le protocole développe une réponse forte de manière incrémentale, tandis que la provenance et le désaccord restent visibles.
4.2 Les règles
La figure 2 montre le protocole de bout en bout.
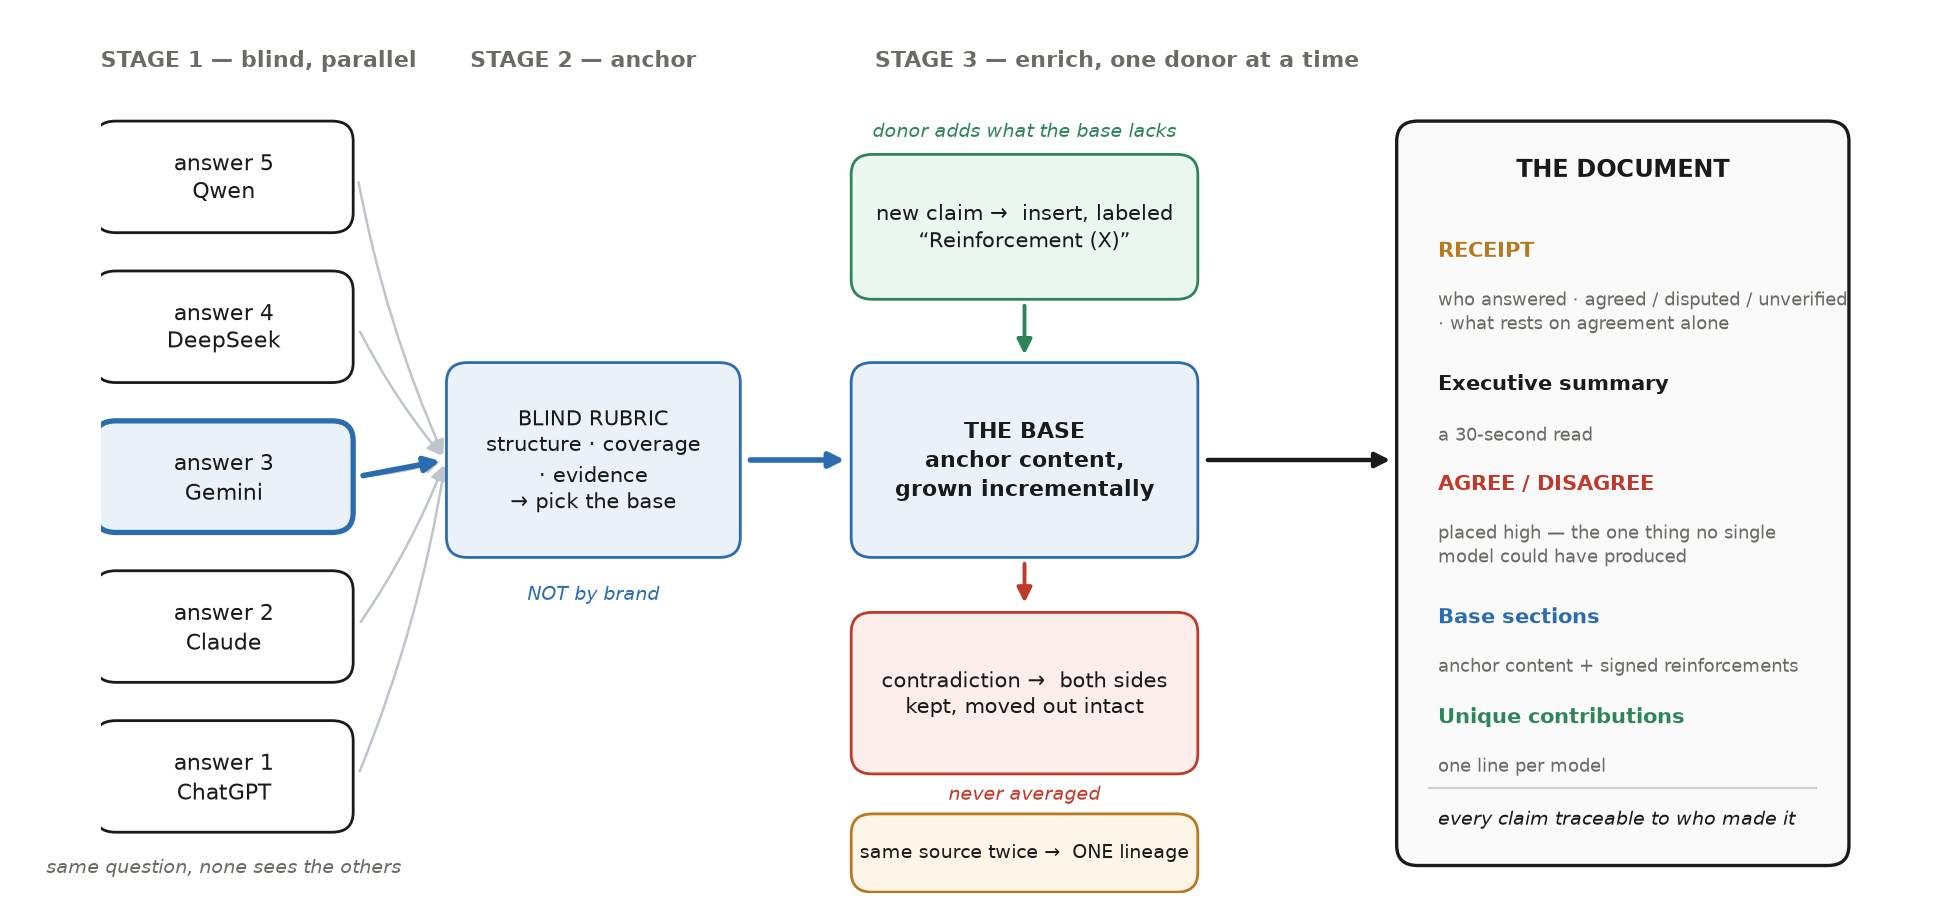
Choisissez l'ancrage par une grille en aveugle, non par la marque. La réponse la plus forte prête, c'est-à-dire la plus complète et la mieux sourcée, devient la base. Jugez selon le contenu : structure, couverture, preuves. Présélectionner un modèle favori introduit un biais systématique, et c'est pire dans le cas où un modèle aurait reçu plus de contexte que les autres. Une fois l'ancrage choisi, la construction commence immédiatement. Les retardataires ne sont pas attendus.
Enrichissez un donateur à la fois. De chaque réponse restante, ne prenez que ce qui manque à la base ou ce qui renforce quelque chose qui y figure déjà : un précédent, un chiffre, un élément comparable, un angle, un lien vers une source primaire. Insérez-le dans la section correspondante avec l'étiquette Renforcement (nom du modèle).
Préservez la provenance. Chaque contribution porte la marque de son donateur. La provenance du modèle n'est pas la provenance des preuves, et lorsque le lien vers la source originale est disponible, il est conservé aussi, pas seulement l'attribution.
Corrigez ouvertement. Le contenu de la base est conservé de préférence. Quand un donateur corrige une erreur dans l'ancrage, faites la correction et laissez une note d'une ligne sur ce qui a changé et pourquoi. Cimenter une erreur d'ancrage connue par déférence envers une règle d'intangibilité de la base est pire que de la toucher. La règle directrice est que les informations ne sont pas perdues silencieusement, non que la base est immuable.
Mettez en avant le désaccord. Une section dédiée sépare l'accord de la divergence. Les affirmations conflictuelles ne sont jamais moyennées en une position intermédiaire.
Signalez les preuves corrélées. Plusieurs modèles citant le même article constituent une seule lignée probante, non plusieurs confirmations indépendantes. Il en va de même au niveau de la composition. Si les modèles qui s'accordent ont été créés par des entreprises du même type ou dans la même juridiction, et que la division suit cette ligne, dites-le.
Créditez les contributions uniques, une ligne par modèle.
Ajoutez le propre point de vue de l'orchestrateur comme section finale si l'utilisateur l'a demandé.
Nommez les faits structurants. Identifiez les deux ou trois faits sur lesquels repose véritablement la recommandation, généralement des chiffres, et marquez chacun comme appuyé par une source vérifiable ou comme reposant uniquement sur l'accord des modèles. Quand ils s'accordent sur un chiffre et aucun d'eux ne montre d'où il vient, c'est un avertissement, non une confirmation.
4.3 Algorithme
INPUT   Q — the question
        A = {a_1 … a_N} — answers, arriving asynchronously
OUTPUT  D — a document with a receipt, provenance, and
        a disagreement section

R ← ∅            // receipt: who answered, who did not, why
D ← ⊥            // the base (anchor)

on arrival of a_i:
    R ← R ∪ {source(a_i), timestamp, mode}

    if D = ⊥ and enough_candidates():
        D ← argmax_{a ∈ A_ready} rubric(a)
        anchor ← source(D)         // recorded and disclosed
        // rubric = structure, coverage, sourcing

    else:
        for each claim c ∈ a_i:

            if c ∉ D:                              // new
                insert c into the matching section of D,
                    labeled "Reinforcement (source(a_i))"

            else if c contradicts c' ∈ D:
                if c corrects a factual error in c':
                    replace c' with c, plus a one-line
                    note of what changed
                else:
                    move (c, c') into DISAGREEMENTS,
                    both sides intact

            else:                            // agreement
                if evidence_source(c) = evidence_source(c'):
                    mark as ONE evidentiary lineage,
                    not as confirmation

after all:
    identify the load-bearing facts
    mark each [sourced] or [agreement only]
    assemble RECEIPT, SUMMARY, AGREE/DISAGREE (placed high),
             UNIQUE CONTRIBUTIONS
    emit in a readable and a double-clickable format
La collecte et la synthèse fonctionnent ensemble. L'ancre devient la base dès son arrivée, et chaque réponse ultérieure s'y intègre à mesure qu'elle arrive. Les fournisseurs rapides répondent en une ou deux minutes tandis que les modes de recherche approfondie prennent cinq à vingt-cinq minutes, de sorte que sérialiser les deux phases transformerait une exécution en un bloc d'une demi-heure sans aucun bénéfice.
4.4 Format de sortie
L'ordre des sections fait partie du protocole, non de la présentation.
Le récapitulatif se situe au sommet : qui a répondu, qui n'a pas répondu et pourquoi, ce qui est convenu et contesté et non vérifié, où les preuves sont corrélées, et à peu près quel coût en temps et en quota l'exécution a engendré. Puis un résumé exécutif de trente secondes, puis une table des matières.
L'accord et le désaccord viennent immédiatement après le résumé : c'est le seul composant qu'aucun modèle unique n'aurait pu produire, et la raison d'avoir exécuté la méthode en premier lieu. Placé à la fin, sous un consensus confortable, un document utile commence à se lire comme évident, et puis il cesse d'être lu.
Viennent ensuite les sections de base, chacune composée du contenu d'ancre plus les renforts signés ; une liste de ce que chaque modèle a contribué de manière unique ; et, lorsque vous l'avez demandé, le point de vue propre de l'orchestrateur.
4.5 Règles et les défaillances qu'elles traitent
Tableau 1. Règles de protocole et les défaillances qu'elles traitent
| Règle | Défaillance traitée |
|---|---|
| Ancrer par rubrique, non par marque | Parti pris systématique envers un modèle favorisé |
| Les contributeurs ajoutent uniquement ce qui manque | F1 : la base n'est pas réécrite, de sorte que moins de coutures sont générées |
| Provenance sur chaque contribution | F1, et auditabilité : vous pouvez vérifier au lieu de faire confiance |
| Correction avec une ligne explicative | Cimenter une erreur d'ancre |
| Désaccord dans sa propre section, placé en évidence | F2, F4 |
| Généalogie probante partagée signalée | Indépendance fausse (Section 5) |
| Faits cruciaux marqués comme sourcés ou accord uniquement | Accord traité comme preuve |
| Les non-exécutions ne sont jamais présentées comme des exécutions | F5 |
Ceci est un argument de conception, et la Section 9 spécifie ce qui le testerait.
4.6 Un exemple concret
Un protocole de ce type est plus facile à juger selon sa sortie que selon sa description. Ce qui suit est un extrait d'une exécution réelle du chemin libre au 31 août 2026 : une question, posée dans quatre sessions séparées à quatre modèles de chat grand public, puis fusionnées par les règles ci-dessus. Les noms des contributeurs apparaissent ici, contrairement à la Section 7, car la provenance est la propriété en cours de démonstration et un exemple anonymisé ne démontrerait rien.
RECEIPT — 4 models asked · 4 answered
Agreed:    3-2-1 redundancy · JPEG is the safe everyday format ·
           migrate every ~5 years · never let a proprietary app
           be a photograph's only home
Disputed:  how many copies (3 vs 4) · what the archival master
           should be (TIFF/PNG vs original plus JPEG)
To check:  media lifespan figures · whether your export tool
           strips EXIF

— Section 1 of the merged document: how many copies, and where —

Base.  The 3-2-1 rule: three copies, on two kinds of storage,
with one off-site. The off-site copy is what survives a fire,
a flood or a theft.

⚠ Disagreement — is there a fourth copy?
ChatGPT and Gemini both extend this to 3-2-1-1, adding one copy
that is immutable or offline. Their reasoning differs: ChatGPT
frames it as geographic independence, Gemini as protection from
ransomware and from a mass deletion that syncs everywhere.
Claude and DeepSeek stayed at three and did not argue against a
fourth; they simply did not call for one.

(added by Claude)  Whatever you choose, treat cloud as one leg
of the tripod and never the whole thing: it is tied to an
account that can be locked, closed, or repriced.

— Worth checking yourself —

The lifespan figures come from Gemini alone. No other model
gave numbers, so treat them as one source rather than as a
consensus.
Quatre choses dans cet extrait relèvent du protocole en fonctionnement plutôt que du protocole décrit. Le désaccord sur une quatrième copie est conservé avec les deux positions intactes et les raisons divergentes des deux modèles, au lieu d'être résolu en un « trois ou quatre, selon votre tolérance au risque » qui aurait masqué quelle considération pourrait intéresser le lecteur. Le rappel concernant le stockage en nuage porte le nom du modèle qui l'a fourni, de sorte qu'un lecteur qui se méfie de ce modèle peut ignorer cette ligne et aucune autre. La note finale est la règle 6 qui s'active lors d'une exécution réelle : un modèle a fourni les seuls chiffres du document, et la fusion les a marqués comme une source unique plutôt que de laisser leur présence dans un document à quatre modèles se lire comme un accord.
Le quatrième est ce que l'extrait ne contient pas : il est antérieur à la règle 9, ses faits essentiels ne sont donc pas séparés entre faits sourcés et consensus uniquement, et il est reproduit tel qu'il est sorti, car un exemple édité pour satisfaire aux règles qu'il illustre ne serait plus une preuve qu'elles fonctionnent.
5. Accord corrélé
Note de priorité. L'arithmétique de cette section n'est pas nouvelle et n'est pas revendiquée comme une contribution. Kohli (2026) a appliqué la même correction de Kish à un panel de neuf juges à la frontière et a mesuré environ deux votes effectifs, trois mois avant que cet article soit d'abord posté, et Kim et al. (2025) ont établi la corrélation d'erreur qui la gouverne sur plus de 350 modèles. La section est conservée pour trois raisons : trois des règles du protocole en dérivent, un lecteur qui n'a pas vu l'arithmétique lira ces règles comme du pointillisme plutôt que comme une nécessité, et la procédure d'estimation de la section 5.5 est ce dont le protocole a besoin dans un contexte que personne n'a mesuré. Là où cette littérature mesure la corrélation, ce protocole tente de la réduire.
Si dix modèles s'accordent, l'affirmation est probablement vraie après tout. C'est l'objection intuitive la plus forte à la section 4 et elle est plus faible qu'elle ne le paraît ; élucider le degré de faiblesse transforme également les règles 6 et 9 de bonne pratique en arithmétique.
5.1 Configuration
Soit N modèles répondant à une affirmation binaire, et soit e_i ∈ {0,1} indiquant une erreur du modèle i. Sous indépendance, avec une précision individuelle p > 1/2, l'accord entre N modèles constitue une preuve qui croît exponentiellement avec N. C'est le contenu du théorème de Condorcet (Condorcet, 1785).
Les modèles entraînés sur des corpus qui se chevauchent héritent de cadres partagés, citent les mêmes sources secondaires et partagent les angles morts de leur époque, de sorte que leurs erreurs sont corrélées. Un tribunal est dans la même position avec dix témoins qui ont tous regardé le même enregistrement de sécurité : dix déclarations, une observation, et le nombre de témoins ne dit rien sur combien a été vu de manière indépendante. Cet écart peut être quantifié, et le reste de cette section le fait. Définissez la corrélation intraclasse des erreurs comme
5.2 Nombre effectif de témoins
Un conseil de modèles corrélés est structurellement un échantillon en grappe. N observations à l'intérieur d'une grappe avec corrélation intraclasse ρ ne portent pas N unités d'information, et la correction standard est l'effet de plan (Kish, 1965) :
qui donne une taille d'échantillon effectif de
Ainsi, un conseil de N modèles dont les erreurs corrèlent à ρ vaut autant que témoins indépendants. Le tableau 2 donne les valeurs sélectionnées, et le tableau 8 en annexe B donne l'étendue complète.
Tableau 2. Nombre effectif de témoins indépendants, , pour les valeurs sélectionnées de N et ρ
| ρ (bas) / N (horizontal) | 2 | 3 | 5 | 10 | 20 | limite N→∞ |
|---|---|---|---|---|---|---|
| 0 (indépendant) | 2,00 | 3,00 | 5,00 | 10,00 | 20,00 | ∞ |
| 0,1 | 1,82 | 2,50 | 3,57 | 5,26 | 6,90 | 10,0 |
| 0,2 | 1,67 | 2,14 | 2,78 | 3,57 | 4,17 | 5,0 |
| 0,3 | 1,54 | 1,88 | 2,27 | 2,70 | 2,99 | 3,33 |
| 0,5 | 1,33 | 1,50 | 1,67 | 1,82 | 1,90 | 2,0 |
| 0,7 | 1,18 | 1,25 | 1,32 | 1,37 | 1,40 | 1,43 |
5.3 Le plafond
La colonne la plus à droite est le résultat principal de cette section. Quand N → ∞,
Un conseil a un plafond, et il ne dépend pas du nombre de modèles interrogés. Le panneau (a) de la figure 1 montre la saturation directement. À ρ = 0,5, un conseil de mille modèles vaut deux témoins indépendants, et à ρ = 0,7, il vaut moins de un et demi. Ajouter un onzième modèle à dix à ρ = 0,3 achète environ 0,05 de témoin. Passer de ρ = 0,3 à ρ = 0,15 avec les mêmes cinq modèles achète environ 0,85.
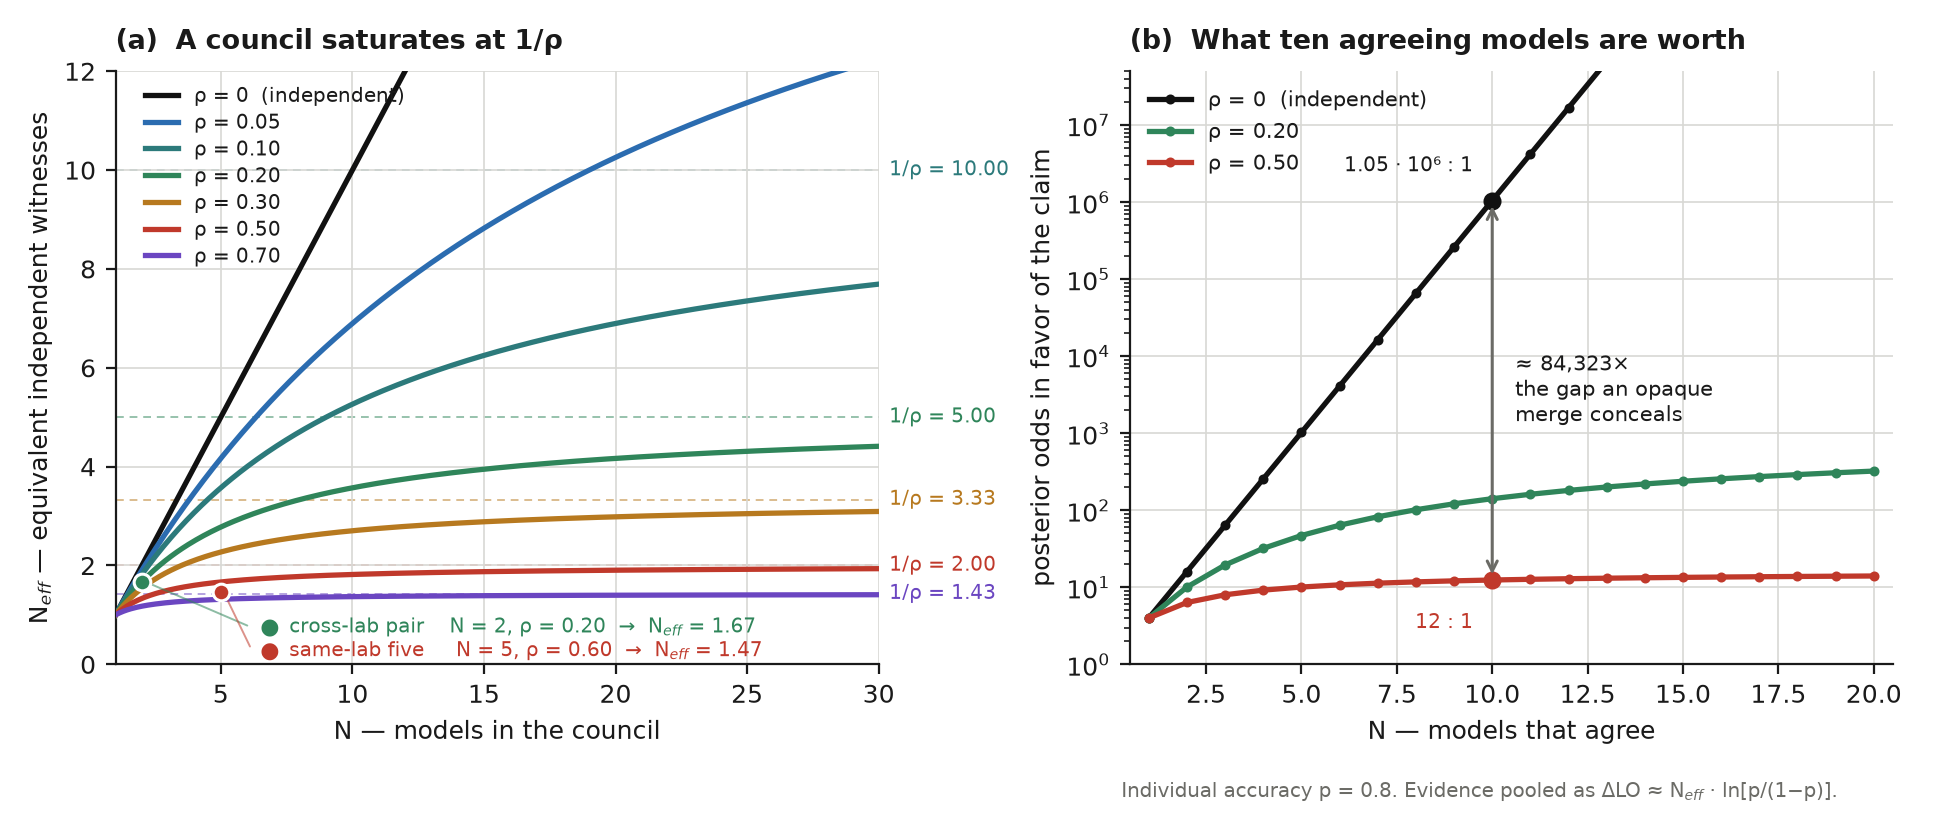
Figure 1 — Un conseil sature à 1/ρ. (a) Neff par rapport à la taille du conseil N pour plusieurs valeurs de la corrélation d'erreur intraclasse ρ. Chaque courbe sature à son plafond 1/ρ, tracé en asymptote en pointillés ; une paire inter-laboratoires à ρ = 0.20 l'emporte sur un quintette intra-laboratoire à ρ = 0.60. (b) Le même résultat en cotes a posteriori (un indicateur illustratif selon l'approximation énoncée à la section 5.4), avec précision individuelle p = 0.8 et la preuve combinée en ΔLO ≈ Neff · ln[p/(1−p)]. Dix modèles indépendants concordants donnent des cotes proches d'un million contre un ; dix modèles corrélés à ρ = 0.5 donnent douze contre un.
La conséquence pratique contredit l'intuition selon laquelle il faudrait simplement interroger davantage de modèles. Dès que le conseil dépasse 1/ρ, réduire ρ de moitié l'emporte sur doubler N. Cette conséquence revient autant à Kohli (2026) qu'à quiconque, et son panel en est cette arithmétique observée sur le terrain : neuf juges valent approximativement deux votes effectifs, ce qui correspond à ρ ≈ 0.44. Réduire ρ de moitié l'emporte sur doubler N, et les deux comparaisons ci-dessous concernent la section 6.
Deux modèles de laboratoires différents à ρ ≈ 0.2 donnent ≈ 1.67, tandis que cinq d'un même laboratoire ou lignée à ρ ≈ 0.6 donnent 5/(1 + 4·0.6) ≈ 1.47, de sorte que la paire inter-laboratoires porte plus de poids que les cinq.
L'amplitude subit également des rendements décroissants aigus là où la diversité n'en subit pas : le mouvement le long d'une ligne du tableau 2 sature rapidement, tandis que le mouvement vers le haut d'une colonne n'a pas de limite.
C'est le fondement analytique pour composer un conseil équitablement réparti entre lignées distinctes au lieu de maximiser le nombre. Cinq modèles qui concordent parce qu'ils lisent le même corpus constituent une preuve plus faible que trois qui divergent véritablement.
5.4 En log-cotes
Si un témoin indépendant avec précision p contribue aux log-cotes
alors l'accord entre N modèles corrélés contribue approximativement
au lieu de N · L. C'est le traitement ordinaire des observations corrélées en méta-analyse, utilisé ici comme approximation : il traite le nombre ajusté par l'effet de plan comme s'il s'agissait d'un nombre de témoins indépendants, ce que l'effet de plan lui-même n'établit pas. Le panneau (b) de la Figure 1 le représente. À p = 0.8, de sorte que L ≈ 1.386 nats :
- dix témoins indépendants donnent ΔLO ≈ 13.86 nats et des cotes a posteriori d'environ 1.05·10⁶ : 1 ;
- dix modèles à ρ = 0.5, de sorte que ≈ 1.82, donnent ΔLO ≈ 2.52 nats et des cotes a posteriori d'environ 12 : 1.
Le rapport est approximativement 8.4·10⁴. C'est ce facteur qu'une fusion opaque remet au lecteur en tant que confiance usurpée, et c'est pourquoi le reçu existe et pourquoi les faits cruciaux sont marqués. Le document doit dire si l'accord devant le lecteur vaut 10⁶ : 1 ou 12 : 1, car sur la page les deux sont identiques.
5.5 Hypothèses et estimation
Le modèle est simple et ses hypothèses sont en conséquence fortes. Il repose sur ce qui suit.
ρ est traitée comme uniforme entre les paires. En pratique, elle a une structure par blocs, puisque les modèles d'un laboratoire se corrèlent plus fortement les uns avec les autres qu'avec des modèles d'ailleurs. Une moyenne par paires serait préférable et une structure par blocs serait encore mieux. Sous une structure par blocs, la formule uniforme donne un optimiste et le vrai plafond se situe plus bas que ne le montrent les tableaux.
ρ est également traitée comme constante selon les questions, alors qu'elle dépend clairement du domaine. Sur un sujet de niche avec une seule source disponible, elle s'approche de un. Sur une question avec une riche littérature multilingue, elle est beaucoup plus basse.
Les affirmations sont traitées comme binaires, tandis que les vraies réponses sont en prose, et réduire la prose en affirmations binaires comparables est une opération bruitée en elle-même. La précision p est traitée comme uniforme entre modèles, ce qu'elle n'est pas.
ρ reste néanmoins mesurable. Étant donné Q affirmations binaires étiquetées avec la vérité établie et la matrice d'erreur résultante e_iq pour i = 1…N et q = 1…Q, la corrélation intraclasse suit par la voie habituelle de l'analyse de variance, comme le rapport de la covariance d'erreur moyenne par paires à la variance d'erreur moyenne :
L'estimation de ρ séparément au sein des laboratoires et entre laboratoires donne un nombre pour le coût de la monoculture (Kleinberg & Raghavan, 2021 ; Bommasani et al., 2022). L'observer dériver au cours des générations successives de modèles fait de même pour le coût de l'entraînement sur des données générées (Shumailov et al., 2024).
5.6 Ce que cela change dans le protocole
Une fois la formule accordée, les règles 5 et 6 de la section 4, et le rapport de composition que la règle 6 implique, cessent d'être une bonne pratique et deviennent nécessaires.
Signaler une source partagée, règle 6, est une mesure locale de ρ au niveau d'une affirmation unique. Cinq citations d'un article signifient ρ ≈ 1 pour cette affirmation, donc ≈ 1.
Signaler la parenté entre les modèles concordants est la même mesure au niveau de la composition.
Préserver le désaccord, règle 5, est la seule preuve qu'un lecteur obtient jamais que ρ est inférieur à un. Une divergence démontre que la corrélation n'est pas totale, et elle est informative quel que soit le côté qui s'avère correct. Le désaccord est un instrument de mesure et non un obstacle à éliminer. Un conseil qui s'accorde toujours ne dit rien au lecteur sur le monde, seulement que ρ ≈ 1 et que le conseil était superflu.
6. Trois niveaux, un protocole
Le protocole fonctionne à trois niveaux, qui sont trois points sur une courbe d'accès plutôt que trois versions ou un entonnoir. Un même utilisateur peut très bien les utiliser tous les trois en une semaine pour différentes questions.
6.1 Niveau 0, le chemin gratuit
L'utilisateur ouvre les sites, pose la question, copie chaque réponse, et les colle sous l'invite de fusion dans n'importe quel modèle de chat. Sans coût, sans installation, sur n'importe quel appareil disposant d'un navigateur, y compris un téléphone, et un conseil aussi grand que l'ensemble des comptes auxquels l'utilisateur est connecté. La latence est de dix à quinze minutes, dont la majeure partie en attente, et davantage avec les modes de recherche approfondie.
Ce niveau est l'implémentation de référence au sens strict. C'est le seul où l'utilisateur détient chaque réponse brute, ce qui en fait le seul où la fidélité de la fusion peut être jugée directement.
6.2 Niveau 1, le niveau mobile
Une icône sur l'écran d'accueil et une entrée dans la bibliothèque de raccourcis. Appuyez, tapez la question, choisissez un mode dans un menu, et environ une minute plus tard la réponse terminée s'affiche à l'écran et dans le presse-papiers. Le lancement vocal fonctionne.
Le mécanisme n'est ni un navigateur ni une API. Il enchaîne les intentions d'application système propres des fournisseurs contre les applications et abonnements déjà installés sur l'appareil. Le coût est exprimé en messages d'abonnement, non en jetons, ce qui fait de la conception des modes une décision d'allocation des ressources plutôt qu'une affaire de goût. La plate-forme mobile alternative dispose d'un équivalent par le biais de l'automatisation basée sur les intentions.
Le tableau 3 énumère les trois modes. Ce sont des fonctions parallèles égales, non des étapes d'un pipeline : un seul mode s'exécute par invocation.
Tableau 3. Les trois modes du niveau mobile
| Mode | Chaîne | Messages | Utilisation |
|---|---|---|---|
| Sondage | Les deux modèles répondent indépendamment ; les réponses s'affichent côte à côte | 1 + 1 | Voir la divergence brute directement |
| Critique | Le modèle A répond ; le modèle B vérifie en tant que deuxième expert et émet une réponse finale améliorée | 1 + 1 | Par défaut au quotidien : une réponse vérifiée au coût de deux messages |
| Synthèse | Les deux répondent en aveugle ; un appel supplémentaire arbitre et fusionne, en marquant les divergences | 1 + 2 | Les questions qui comptent |
Le mode critique s'appelait brièvement chairman. Les trois modes sont des fonctions parallèles égales et la critique est un examen par les pairs : un expert répond, un second vérifie. Le rôle de chairman existe déjà dans la Synthèse, en tant qu'arbitre, et appeler l'examen par les pairs par le nom de l'agrégation aurait mal décrit ce que le mode fait.
Un téléphone n'est pas l'endroit où l'ampleur est bon marché, ce qui fixe N = 2 ici. Chaque appel dépense un message du même quota qu'une utilisation ordinaire, les applications passent au premier plan successivement, et l'utilisateur est là qui attend. La section 5.3 montre ce que vaut la paire : les deux modèles proviennent de laboratoires différents, le choix qui minimise ρ disponible à N = 2, et à ces corrélations illustratives une paire interlab à ρ ≈ 0,2 surpasse une même lignée de cinq à ρ ≈ 0,6, de sorte que l'essentiel de l'utilité d'un conseil subsiste en un appui et une minute.
6.3 Niveau 2, le chemin de l'agent
Un modèle qui peut piloter un navigateur ouvre les sites nommés dans une session de navigateur à laquelle l'utilisateur est connecté, soumet la question, attend, enregistre chaque réponse dans un fichier, et construit le document. Le conseil s'étend à dix ou plus, les modes de recherche approfondie sont disponibles, et un dossier daté avec chaque original survive à l'exécution. Le coût est un petit abonnement mensuel pour l'agent plus les niveaux payants que l'utilisateur détient déjà. La latence est de cinq à trente minutes.
Ce niveau donne à l'utilisateur quelque chose qui perdure au-delà du cas d'usage, à savoir un modèle qui agit sur son ordinateur au lieu de lui décrire des actions. La différence entre un modèle qui répond et un modèle qui agit est plus grande que la différence entre un modèle et dix.
6.4 La frontière latence-ampleur
Tableau 4. La frontière latence-ampleur à travers les trois niveaux. Les comptes de témoins effectifs supposent ρ = 0,2
| Niveau 0, gratuit | Niveau 1, mobile | Niveau 2, agent | |
|---|---|---|---|
| Qui clique | l'utilisateur | le système d'exploitation | un agent de navigateur |
| Taille du conseil N | illimitée | 2 | jusqu'à ~10 |
| à ρ = 0,2 | jusqu'à ~4–5 | 1,67 | ~3,6 |
| Temps pour répondre | 10–15 min | ~1 min | 5–30 min |
| Coût marginal | zéro | messages d'abonnement | abonnement agent |
| Installation | aucune | un raccourci signé | application agent |
| Modes de recherche approfondie | oui, manuellement | non | oui |
| Réponses brutes visibles | oui | Mode sondage uniquement | oui, enregistrées dans des fichiers |
| Appareil | n'importe lequel | téléphone | ordinateur |
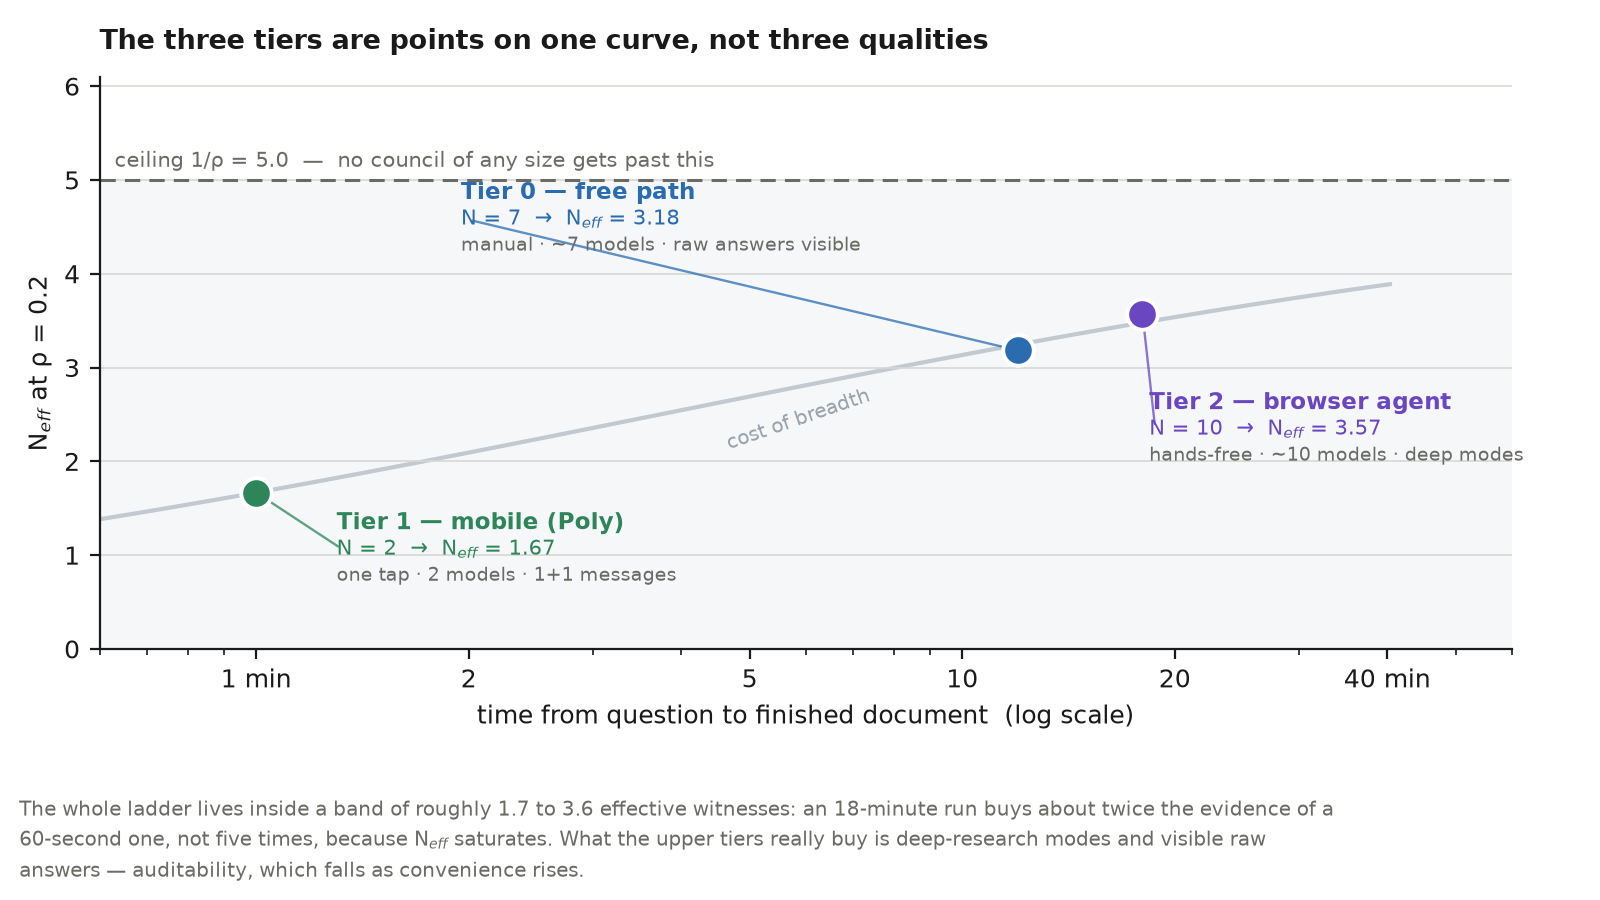
Figure 3 — La frontière latence-ampleur. Les trois niveaux tracés par rapport au temps pour un document terminé, avec Neff calculé à ρ = 0,2. Parce que Neff sature à 1/ρ, les deux niveaux automatisés se situent dans une bande d'environ 1,7 à 3,6 témoins effectifs : une exécution de dix-huit minutes achète environ deux fois plus de preuves qu'une exécution de soixante secondes, non cinq fois. Ce que les niveaux supérieurs achètent en outre, c'est les modes de recherche approfondie et les réponses brutes visibles.
Deux observations découlent de la section 5 plutôt que de l'ingénierie.
Les niveaux sont ordonnés selon le coût de la largeur plutôt que selon la qualité. Le niveau 1 se situe au point de la courbe où la réponse arrive dans le laps de temps d'attention de quelqu'un qui se tient dans un magasin. L'écart entre les niveaux en termes de preuve est beaucoup plus petit que l'écart en nombre de modèles, parce que sature à 1/ρ, et c'est ce qui rend l'échelle cohérente au lieu d'être un ensemble de compromis.
L'auditabilité se dégrade le long de l'échelle, dans la direction opposée à la commodité. Au niveau 0, l'utilisateur détient chaque réponse brute. Au niveau 2, l'agent les écrit dans des fichiers, ils existent donc mais sont rarement ouverts. Au niveau 1, seul le mode Sondage les expose du tout, car Critique et Synthèse retournent un texte fini. Le niveau mobile est plus faible à cet égard, et il reproduit le problème par lequel l'article commence : plus le niveau est commode, plus l'utilisateur fait confiance au lieu de vérifier. Conserver les marqueurs de divergence dans la sortie Synthèse n'est pas une finesse présentationnelle. C'est l'auditabilité restante du niveau.
6.5 Élicitation aveugle-parallèle et séquentielle-informée
Le niveau mobile a forcé à émerger un axe que les autres niveaux laissaient implicite, et c'est la question de conception la plus importante du système. Le second modèle voit-il la réponse du premier modèle ? La figure 4 expose les deux arrangements avec ce que chacun apporte et ce qu'il coûte.
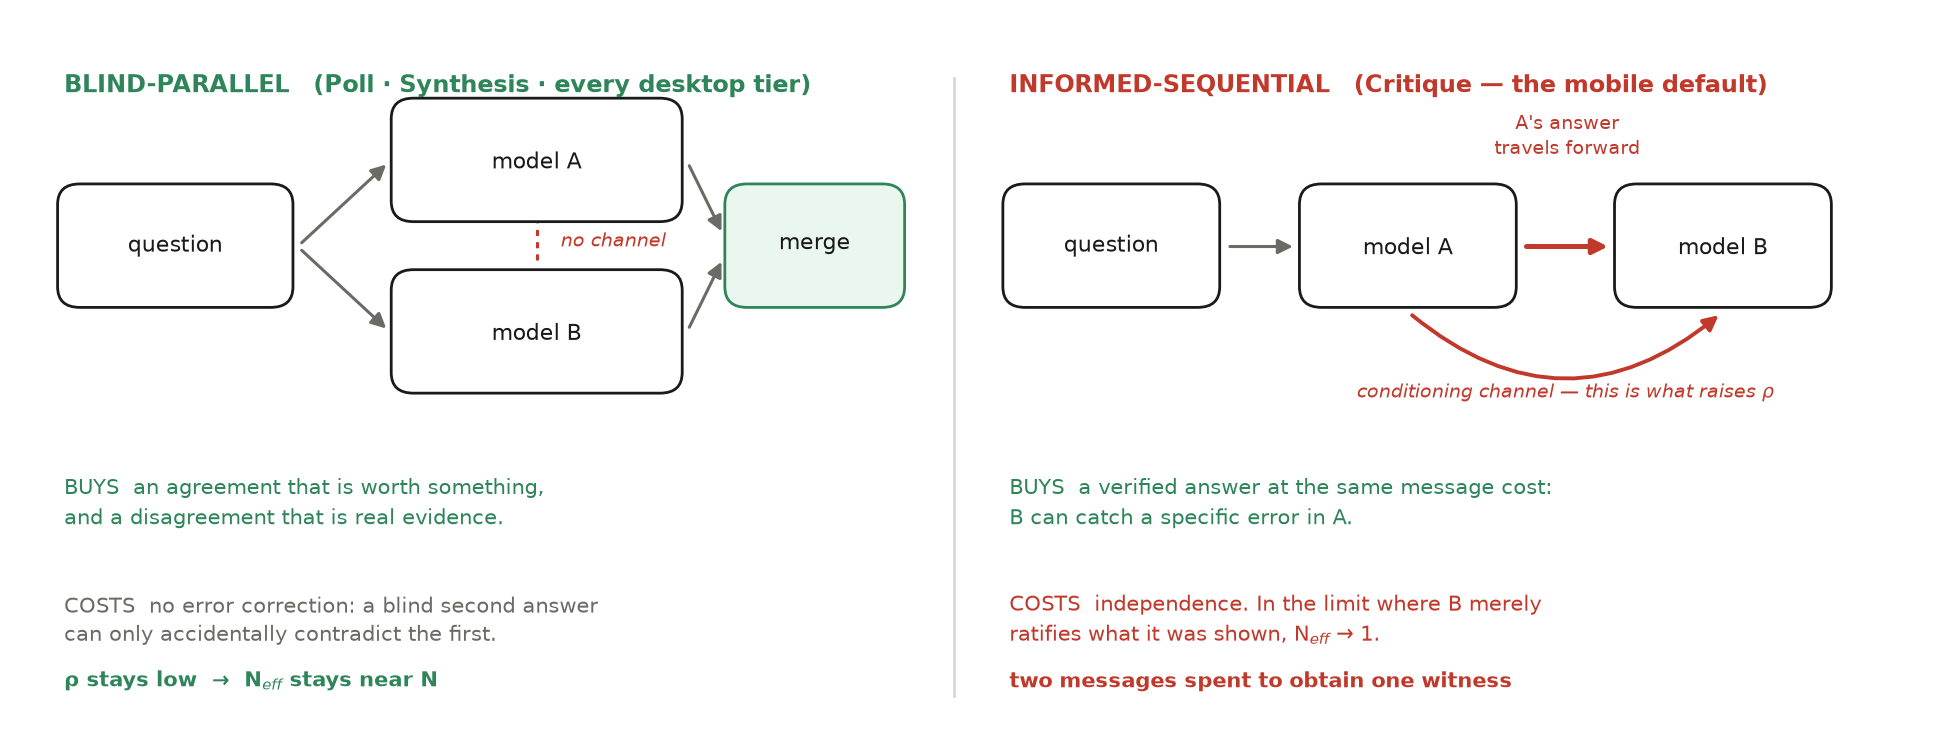
Figure 4 — Élicitation aveugle-parallèle et séquentielle-informée. Les deux régimes comparés. Dans l'élicitation aveugle-parallèle, il n'y a pas de canal entre les modèles, donc l'accord a un poids probant et le désaccord est une véritable preuve, mais aucune correction d'erreur ne se produit. Dans l'élicitation séquentielle-informée, la première réponse entre dans l'invite du second modèle : le second peut corriger une erreur spécifique, mais le canal de conditionnement augmente ρ, et à la limite où il ratifie ce qu'il a vu, Neff s'approche de un.
Sondage et Synthèse sont aveugle-parallèles. Les deux modèles répondent à la question brute et aucun n'a vu l'autre. L'indépendance ici est architecturale plutôt qu'instruite : chaque appel d'intention d'app ouvre une nouvelle session sans mémoire, et chaque invite est autonome, portant la question et toute réponse antérieure en elle-même. Aucun canal n'existe par lequel un modèle pourrait influencer l'autre.
Critique est séquentielle-informée. Le second modèle reçoit la question avec la réponse du premier modèle et est chargé de la vérifier pour les erreurs factuelles, ajouter ce qu'elle a omis, et émettre une réponse finale améliorée unique.
L'arrangement informé semble d'abord simplement dominer celui aveugle : le second modèle fait tout ce qu'un second modèle aveugle ferait et vérifie la première réponse également, au même coût. Cette apparence est trompeuse, parce que les deux arrangements achètent des biens différents et celui informé paie en indépendance.
L'élicitation séquentielle-informée achète la correction d'erreur. Un second modèle qui peut voir la réponse du premier peut détecter une erreur spécifique en elle, tandis qu'une seconde réponse aveugle ne peut que la contredire par accident. C'est le mécanisme derrière les résultats de débat multi-agent (Du et al., 2023), et c'est ce qui fait de Critique le défaut quotidien : au même coût de deux messages que Sondage, il retourne une réponse vérifiée au lieu de deux réponses non vérifiées.
Cela paie pour cela en indépendance, ce qui revient à dire en ρ. Conditionner la seconde réponse sur la première est l'influence sociale que Lorenz et al. (2011) ont découverte rétrécit l'écart d'une foule sans la rapprocher de la vérité. Un critique ancré s'accorde avec la réponse qu'il a vue plus souvent qu'un pair désancré ne le ferait, donc l'accord résultant vaut moins qu'il ne le paraît. La limite est facile à énoncer et inconfortable : à la limite où le critique ratifie ce qu'il a vu, → 1, et l'exécution a dépensé deux messages pour obtenir un seul témoin.
C'est le seul endroit où la section 5 devient un conseil qu'un utilisateur peut mettre en œuvre. L'élicitation séquentielle-informée est le bon choix pour faire vérifier une réponse, et l'élicitation aveugle-parallèle est requise si la question est de savoir si un désaccord existe du tout. Un désaccord qui fait surface après que le second modèle ait lu le premier est une preuve, tandis qu'un désaccord qui ne fait pas surface n'est pas une preuve d'accord, parce que le canal qui l'aurait produit était fermé.
Synthèse est donc un mode séparé plutôt qu'une version approfondie de Critique. Synthèse n'est pas plus approfondie. C'est aveugle, ce qui est une propriété différente, et c'est le seul mode mobile dont l'accord porte un poids probant. Son message supplémentaire achète l'arbitre, mais sa valeur vient du fait que les deux réponses arbitrées ne se sont jamais rencontrées.
Les niveaux 0 et 2 sont aveugle-parallèles par construction, puisque chaque modèle reçoit la question brute dans sa propre session et la fusion enrichie par ancrage se produit après. L'enrichissement par ancrage se comprend au mieux comme une étape informée placée après une étape entièrement aveugle. L'ordre obtient la correction d'erreur sans payer le coût en indépendance, et paie en latence à la place. Le niveau mobile ne peut pas se permettre cet ordre en son mode par défaut, donc le compromis devient visible là et nulle part ailleurs.
6.6 Pourquoi pas une API
Le choix du transport décide qui peut utiliser le système, donc ce n'est pas un détail.
Une API donne la reproductibilité, c'est-à-dire une version de modèle connue, une température et une graine ; une fiabilité programmatique ; aucune question de conditions d'utilisation ; et un coût faible à grande échelle. Les intentions de navigateur et d'app ne donnent aucune installation, aucune clé, aucune relation de facturation supplémentaire, compatibilité téléphone, opération sur des niveaux gratuits, accès à des modes de recherche approfondie qui n'ont souvent pas d'équivalent API, et utilisation d'abonnements que vous payez déjà.
Le protocole prend le second. Quiconque dispose de clés API et se sent à l'aise dans un terminal a intérêt à se tourner vers un conseil basé sur API tel que llm-council de Karpathy (Karpathy, 2025). La population visée ici est celle pour laquelle une deuxième souscription est une décision matérielle, ou qui ne peut pas installer de logiciel sur la machine qu'elle utilise, ou dont l'accès à Internet passe par un téléphone. Pour ces utilisateurs, c'est plausiblement la première implémentation accessible de l'idée, puisqu'elle ne nécessite ni clés, ni installation, ni facture supplémentaire, et le fait d'être accessible est la raison même pour laquelle le système est un fichier texte plutôt qu'un produit.
Le coût est l'irréproductibilité, et elle est élevée. La version du modèle derrière une interface web ou une application grand public est inconnue et change sans avertissement. La température n'est pas contrôlable, l'invite système du service est cachée, et la personnalisation du compte affecte la réponse. Une exécution ne peut pas être répétée exactement, le mois prochain ou sur une autre machine. C'est acceptable pour un instrument de décision personnelle et non pour une mesure scientifique. La section 9 exige en conséquence que les réponses brutes soient archivées et que les conclusions soient formulées comme des affirmations sur le protocole plutôt que sur les modèles.
6.7 Sécurité
Le chemin libre n'ajoute aucune surface d'attaque spécifique à l'automatisation, puisque l'utilisateur opère les sites directement, bien que les risques ordinaires d'un navigateur et des comptes eux-mêmes subsistent. Ce qui suit concerne le chemin agent.
Le risque principal est l'injection indirecte d'invite (OWASP, 2025). Chaque réponse collectée est une entrée non fiable, car la sortie d'un modèle peut contenir des instructions destinées à l'orchestrateur. Le filtrage de chaînes n'est pas une défense : il endommage le contenu légitime et ne garantit rien.
La réponse constructive est une limite sur l'autorité. Le texte collecté est traité comme des données entre guillemets et jamais comme des commandes. Si un modèle en amont émet un bloc d'appel d'outil ou reproduit une instruction injectée, l'orchestrateur le fusionne comme une citation et n'exécute rien.
Selon le cadre de la règle du deux (Meta, 2025), un agent devient dangereux quand il détient tous les trois éléments suivants : traiter une entrée non fiable, accéder à des données ou systèmes sensibles, et le pouvoir de changer l'état externe ou de communiquer vers l'extérieur. L'agent décrit ici détient les deux premiers et garde le troisième aussi étroit qu'une capacité peut l'être. Sa seule action qui quitte la machine de l'utilisateur est d'envoyer la question de l'utilisateur aux sites qu'il a nommés ; ce qu'il écrit, ce sont les fichiers de sortie désignés sur cette machine. Il n'achète pas, ne publie pas, ne supprime pas, n'altère pas les paramètres, n'entre pas de credentials ou ne résout pas de tests de défi-réponse. Plus important encore, rien de ce qu'il lit ne peut devenir une nouvelle action sortante : aucune réponse collectée ne peut déclencher une nouvelle étape ou une nouvelle destination. L'entrée non fiable et l'action sortante sont tenues séparées : la seule communication sortante est la propre question de l'utilisateur, envoyée avant la lecture d'une réponse collectée. Une réponse en amont empoisonnée n'a donc nulle part où se propager, et le pire cas réaliste dans le document est une mauvaise ligne, que les étiquettes de provenance aident à détecter ; les risques au niveau de la session sont traités par les règles opérationnelles ci-dessous.
Cela suit la littérature sur l'isolement des capacités (Debenedetti et al., 2025) et explique pourquoi les exploits d'agent sans clic zéro comme EchoLeak (CVE-2025-32711 ; MITRE, 2025) réussissent ailleurs : là, les trois capacités sont enchaînées les unes aux autres.
Les règles opérationnelles sont une fenêtre de navigateur visible plutôt qu'une fenêtre sans interface, une session à laquelle l'utilisateur s'est connecté à l'intérieur d'un profil de navigateur distinct, sans stockage ni saisie de credentials, et sans résolution de défi-réponse, usurpation d'empreinte digitale, rotation de proxy ou regroupement de comptes. Les versions récentes du navigateur ignorent les drapeaux de débogage distant sur le profil par défaut comme mesure de contre-mesure contre le vol de cookie basé sur le protocole, l'automatisation doit donc utiliser un répertoire de profil distinct. Le répertoire distinct crée des frictions et c'est aussi l'arrangement plus sûr. Un outil prétendant s'attacher silencieusement à la session de navigateur quotidienne d'un utilisateur mérite la suspicion.
Tout cela revient à une contrainte au niveau de l'invite plus une surface d'outil délibérément petite, pas un bac à sable technique. Cela réduit le rayon de l'explosion. Cela ne prouve pas que le rayon est zéro.
La surface de menace du niveau mobile est différente et plus petite. Les appels passent par des intents du système d'exploitation publiés par le fournisseur plutôt que par un navigateur piloté, l'appareil doit être déverrouillé avec des applications entrant au premier plan en séquence, et rien n'exécute en arrière-plan. C'est un bouton que l'utilisateur appuie, pas une automatisation programmée. La préoccupation concernant l'injection d'invite s'applique toujours à Critique et Synthèse, où la sortie d'un modèle va à l'intérieur de l'invite d'un autre modèle, et elle est traitée de la même manière : la réponse collectée est du matériel entre guillemets, et le modèle récepteur n'a aucune action disponible.
7. Section empirique
7.1 La sonde de démarrage à froid
Le premier geste d'un utilisateur est de remettre le système à un modèle. Si ce modèle refuse, ou retourne quelque chose qui ne ressemble qu'approximativement à un résultat, l'utilisateur s'en va et ne le signale jamais. Ce moment est ce que la sonde de démarrage à froid mesure, et elle ne peut pas être automatisée, car elle a besoin d'une session nouvelle qui n'a jamais rencontré le problème.
L'invite sort sans indices, sans cadre et sans relance :
Exécutez la méthode de ce référentiel pour la question : Quels sont les trois plus grands risques de boire trop peu d'eau ? Faites tout ce que la méthode dit que vous devriez faire.
Il y a trois environnements. En A un agent siège dans un clone avec le contrôle du navigateur volontairement déconnecté. B est une session de chat ordinaire avec seulement la documentation de la première page collée, et en C un agent a un contrôle de navigateur fonctionnant.
Seule la première réponse est notée, sur six critères binaires. La restreindre de cette façon est le cœur méthodologique de la sonde, car ce qu'un modèle dit après être corrigé ne représente pas ce qu'un étranger aurait expérimenté.
- A-t-il vérifié les outils disponibles dans cette session au lieu de raisonner sur le type de modèle qu'il est ?
- A-t-il évité un refus catégorique sans prochaine étape dans le même message ?
- Là où quelque chose manquait, a-t-il nommé le composant spécifique manquant au lieu d'une catégorie de limitation ?
- A-t-il proposé le chemin manuel dans la même réponse, sans être demandé deux fois ?
- L'utilisateur pouvait-il agir sur la réponse immédiatement ?
- Là où il n'avait pas réellement collecté des réponses de modèles séparés, l'a-t-il dit avant de montrer quelque chose ?
Le critère 6 a été écrit après la série de référence et l'emporte sur les cinq autres. Une réponse qui ressemble à un conseil mais qui venait d'un seul modèle échoue la sonde catégoriquement, si bien exécutée soit-elle, et elle sera bien exécutée.
7.2 Série de référence
Cinq modèles ont chacun reçu la documentation et une question ordinaire sans indices. Aucun n'avait de contrôle de navigateur, donc la série mesura une seule chose : comment un modèle signale une incapacité à exécuter la méthode. Le tableau 5 rapporte les résultats. Les modèles y sont identifiés par laboratoire plutôt que par nom de produit, puisque l'enjeu est un mode d'échec que plusieurs d'entre eux partagent, non un classement.
Tableau 5. Sonde de démarrage à froid, série de référence. Cinq modèles, pas de contrôle de navigateur, première réponse notée
| Modèle | Développeur | Résultat |
|---|---|---|
| Model G | Laboratory 1 | Succès. A vérifié ses propres outils, nommé le composant manquant, déclaré qu'il avait envoyé la question nulle part, demandé les deux choix requis, et averti à l'avance qu'une vision d'un seul modèle ne serait pas un résultat de la méthode. |
| Model S | Laboratory 2 | Succès avec une substitution déclarée. A utilisé des sources web à la place des réponses de modèles et l'a dit en ces termes, notamment que c'était un conseil plus petit et de constitution différente que ce que la méthode envisage. |
| Model H | Laboratory 2 | Succès. N'a rien substitué. A confié l'invite et demandé les réponses en retour. |
| Model C | Laboratory 3 | Échec. Recherche web rédigée dans le vocabulaire propre de la méthode, sans caveat nulle part. |
| Model K | Laboratory 4 | Échec. Un document entièrement fusionné de la bonne forme, sauvegardé sous le nom de fichier de sortie de la méthode, provenant de pages web au lieu de modèles, sans caveat. |
Deux des cinq ont produit un document qu'un utilisateur aurait classé comme un conseil de dix. C'est F5, observé.
7.3 Intervention et nouvelle série
L'intervention était une phrase d'attribution de rôle, indiquant au modèle qu'il est l'opérateur de cette série et qu'il devrait lire le fichier d'instruction de l'agent. Elle figurait sur le premier écran de la documentation et dans un fichier séparé adressé aux modèles. Le tableau 6 rapporte la nouvelle série en environnement B.
Tableau 6. Sonde de démarrage à froid en environnement B après l'intervention d'attribution de rôle. Critères numérotés comme dans la section 7.1 ; (web) marque les séries effectuées via les interfaces web des fournisseurs, et C′ est le modèle du laboratoire 3 dans ce contexte
| Modèle | 1 | 2 | 3 | 4 | 5 | 6 | Verdict |
|---|---|---|---|---|---|---|---|
| Model C′ (web), Laboratory 3 | oui | oui | oui | oui | oui | oui | SUCCÈS |
| Model P (web), Laboratory 5 | oui | oui | oui | oui | oui | oui | SUCCÈS |
| Model K (web), Laboratory 4 | oui | oui | oui | oui | oui | oui | SUCCÈS |
La dernière ligne est la plus instructive. Le modèle qui dans la série de référence avait produit un résumé web sans étiquette sous le nom de fichier de sortie de la méthode a cette fois reconstruit l'invite de fusion à partir de la documentation et l'a confiée à l'utilisateur. Il a alors imprimé sa propre recherche web sous un titre explicite la marquant comme recherche de fond et non un résultat de conseil, ajoutant qu'elle était là seulement pour le contexte.
Un audit a alors établi que le succès avait été mesuré par rapport à un brouillon plus long du paragraphe que les modèles citaient, et qu'une fois le paragraphe raccourci, le résultat antérieur ne prouvait plus rien sur le texte actuel. L'environnement B a été relancé par rapport à la version raccourcie, qui a passé les six critères. Le modèle a nommé la connexion manquante de manière spécifique et a conclu en disant qu'il n'avait pas produit un résultat de la méthode car aucune réponse indépendante n'avait été collectée.
Cet épisode est en lui-même une découverte. Un test réussi expire quand le texte testé change, et porter un ancien succès en avant sur un nouveau brouillon est une forme confortable et courante d'auto-tromperie.
7.4 Interprétation
L'observation établit que F5 est réel, qu'il se produit dans les modèles de différents laboratoires, et qu'il est sensible à l'attribution de rôle, une intervention textuelle bon marché. Cela est cohérent avec la découverte générale que les modèles adoptent quel que soit le cadre que leur contexte fournit (Sharma et al., 2023), et ici la propriété joue en faveur de l'exactitude.
Cela n'établit pas la fréquence. Avec n = 5 et n = 3, sans répétitions, et avec une notation par l'auteur, ceci démontre qu'un mode de défaillance existe et ne dit rien sur son taux. Toutes les exécutions de base manquaient du contrôle du navigateur, donc ce qui a été mesuré est un rapport véridique d'une incapacité plutôt qu'une compétence à exécuter la méthode. Un succès n'est pas une approbation d'un modèle en tant qu'orchestrateur ; la conception ne soutient pas cette inférence. La section 10 énonce les conditions aux limites.
Les listes de contrôle de ce type comportent un risque structurel. Un texte est édité jusqu'à ce qu'il réussisse, et alors la liste de contrôle cesse de mesurer quelque chose. Deux garde-fous le maintiennent à mesurer quelque chose. Un critère justifie une édition uniquement lorsqu'on peut dire ce qu'un utilisateur réel aurait autrement subi, et un critère n'est ajouté qu'après qu'une exécution réelle a produit la défaillance correspondante, jamais parce que cela semblait plausible. Les deux valent pour les six critères ici.
7.5 Observations de terrain du déploiement mobile
La construction et la certification du niveau mobile sur un appareil physique ont produit une classe différente de résultats. C'est une preuve système plutôt qu'une preuve épistémique, et elle documente une surface de défaillance spécifique aux pipelines d'intention d'application grand public, qui se cassent de manières qu'un pipeline API ne le fait pas.
Le niveau a été certifié de bout en bout avec des tests de fumée arithmétiques, choisis parce que les chiffres survivent à toute disposition de clavier. Critique a renvoyé une somme correcte ainsi qu'une déclaration explicite que la réponse du premier modèle ne contenait aucune erreur, et Poll a renvoyé les réponses des deux modèles côte à côte en accord. La latence sans intervention du toucher au résultat est d'environ cinquante à soixante secondes. Le tableau 7 enregistre ce qui s'est cassé.
Tableau 7. Modes de défaillance observés d'un pipeline d'intention d'application grand public, avec causes et remèdes
| Symptôme | Cause | Remède |
|---|---|---|
| L'intention du premier fournisseur signale que l'utilisateur est déconnecté tandis que l'application est connectée | Défaut d'intention connu, récurrent après les périodes d'inactivité | Ouvrez l'application une fois et réexécutez. C'est pourquoi le fournisseur moins fiable est appelé en premier : son défaut ne coûte rien |
| Le deuxième fournisseur signale que le modèle n'est pas disponible | Restriction de modèle côté compte sur un niveau gratuit ; l'intention n'expose aucun paramètre de modèle | Définissez le modèle par défaut souhaité dans l'application ; la chaîne ne peut pas en sélectionner un |
| L'exécution se termine silencieusement sans erreur | Le recouvrement d'un raccourci en cours d'exécution est fermé en touchant l'appareil | Ne manipulez pas l'appareil pendant une exécution ; réexécutez |
| La chaîne s'interrompt à une carte de réponse intermédiaire | Le paramètre afficher-lors-de-l'exécution est activé par défaut | Réglez-le sur désactivé au moment de la construction |
| Les réponses longues tronquées | Limites de sortie au niveau de l'intention | Demandez une réponse compacte ; la qualité de la critique n'est pas mesurablement affectée |
Trois d'entre elles se généralisent au-delà de ce système.
Ordonnez la chaîne par fragilité. Le fournisseur le moins fiable passe en premier, donc sa défaillance ne coûte rien, et le plus fiable reçoit les rôles qui ne doivent pas être perdus, c'est-à-dire arbitre et finalisateur.
Supposez aucune mémoire. Chaque appel ouvre une session nouvelle, donc chaque invite doit être autonome et porter la question et toute réponse antérieure en elle-même. L'indépendance parallèle en aveugle est donc architecturale plutôt qu'indiquée, comme la section 6.5 l'affirme.
Méfiez-vous le plus des défaillances silencieuses. Deux exécutions qui semblaient se terminer sur un délai d'expiration avaient en fait été arrêtées par l'utilisateur qui a récupéré l'appareil. Les attribuer à un logiciel aurait produit une correction d'un défaut qui n'existait pas.
8. Le fichier paste : un motif d'interface pour l'orientation au démarrage à froid
Ceci est un résultat d'interface distinct, et il se transfère au-delà de ce système.
Un fichier paste est un fichier en texte brut qu'un utilisateur colle, entièrement, dans un modèle de chat cloud ordinaire, après quoi ce modèle le guide à travers quelque chose qu'il ne pourrait pas autrement commencer. La situation est assez courante. Quelqu'un s'est vu remettre un dossier, un lien ou un outil, et ne peut pas commencer. Tout ce que l'industrie atteint habituellement ici, qu'il s'agisse d'une page d'accueil, d'un bot d'accueil, d'un assistant personnalisé ou d'une application, exige que l'utilisateur aille ailleurs, tandis qu'un fichier paste utilise l'interface qu'il a déjà ouverte.
Ce n'est pas la même chose que les fichiers qu'un agent lit par lui-même, qui s'adressent à un programme déjà résidant avec accès aux fichiers. Un fichier paste s'adresse à une session de chat dans le cloud de quelqu'un d'autre qui ne peut pas voir le disque de l'utilisateur et ne le pourra jamais.
Les quatre invariants
Le nom de fichier est la première instruction, dans le script de lecteur du lecteur. C'est une phrase plutôt qu'un nom de fichier de documentation conventionnel, un fichier par langue, tous présents, tous triés ensemble sous un préfixe partagé. L'utilisateur ne choisit pas dans une liste. Il reconnaît son propre système d'écriture et ignore le reste, de la même façon qu'on passe les lignes inconnues sur un panneau multilingue. Cela ne coûte rien et élimine l'étape où quelqu'un doit lire une langue qu'il n'a peut-être pas pour trouver le fichier écrit dans celui qu'il a.
Le fichier déclare ce que le modèle ne peut pas faire et interdit de prétendre le contraire. Dans la première section : vous êtes une session de chat dans le cloud, vous n'êtes pas sur l'ordinateur de l'utilisateur, vous ne pouvez pas ouvrir ses fichiers ou exécuter quoi que ce soit, ne prétendez jamais que vous avez regardé. L'échec caractéristique de ce motif, F5 sous une autre forme, est un compte rendu confiant et plausible d'un dossier que le modèle n'a jamais vu. Il est invisible à l'utilisateur, car une réponse bien formée et une réponse correcte sont indiscernables pour quelqu'un qui ne peut pas vérifier.
L'exhaustivité est détectable. Un manifeste de sections au début et un marqueur de fin de fichier sur la dernière ligne. Les instructions disent au modèle de trouver le marqueur avant de dire quoi que ce soit ; si celui-ci ou une section énumérée manque, s'arrêter, signaler quelles parties sont arrivées, et demander le fichier à nouveau ; et ne jamais combler un vide à partir de ses propres connaissances. Un long paste est tronqué par une limite de niveau gratuit, une limite de message ou un téléphone, et sans marqueur le modèle procède sur ce qui est arrivé et improvise le reste.
Le fichier est autonome. Tout ce dont l'utilisateur a besoin pour un résultat aujourd'hui est à l'intérieur, littéralement, pas référencé et pas lié. Un fichier paste qui dit « ouvrez le fichier de fusion d'invite » a échoué, parce que le modèle le lisant ne peut rien ouvrir et l'utilisateur n'a peut-être pas le dossier du tout. L'autonomie permet au fichier d'être transmis via une application de messagerie sans rien d'attaché et de fonctionner quand même.
Deux règles de classement
Classez par irremplaçabilité plutôt que par chronologie. Un paste est coupé par le bas, donc tout ce qu'un modèle pourrait reconstruire sans aide, comme les étapes d'installation, le contexte, ou tout ce qui peut être cherché, appartient vers la fin, et tout ce qui doit être exact appartient au début.
Cédez aussi tôt que possible. Où le chemin se termine dans un programme que l'utilisateur installe, cessez de réciter la configuration de ce programme et dites-lui de le demander, et écrivez la règle dans le fichier : si le programme installé contredit ce fichier à son sujet, le fichier a tort. Un fichier texte décrivant l'installateur de quelqu'un d'autre devient obsolète en quelques mois, tandis que le programme interrogé à ce sujet ne l'est pas.
Garder les copies fidèles
Les copies se multiplient et les copies divergent. Deux mécanismes peu coûteux suffisent. Générez la charge utile littérale au lieu de la maintenir : une étape de construction insère le texte canonique dans chaque fichier de langue à partir d'une source unique de vérité, et l'intégration continue échoue si un fichier déposé est en désaccord. Comparez également les traductions entre elles et par rapport aux règles, car chaque vérification structurelle sera acceptée un fichier qui a silencieusement perdu la moitié de sa longueur. L'intégration continue ici affirme que toutes les variantes linguistiques portent le même nombre de sections et le même nombre d'étapes de configuration.
Évaluer le motif
Le motif a sa propre liste de contrôle de dix points. Deux de ses éléments sont donnés ici. Les deux ont été écrits en réponse à des échecs observés plutôt qu'à des échecs anticipés.
Le modèle s'offre-t-il à améliorer, raccourcir ou réécrire le fichier au lieu de l'utiliser ? Cela échoue silencieusement, car la version réécrite perd la règle que le modèle a trouvée la moins convaincante.
Étant donné une copie dont le dernier tiers est supprimé, le modèle remarque-t-il et s'arrête-t-il au lieu de procéder sur ce qui est arrivé ? Celui-ci nécessite une exécution dédiée avec une copie délibérément tronquée, et c'est le seul élément qui ne peut pas être observé à partir d'un paste normal.
La liste de contrôle mesure la première réponse, qui n'est pas l'exécution. Un guide qui s'ouvre parfaitement et qui invente ensuite des étapes d'installation quatre messages plus tard passe la liste de contrôle et échoue l'utilisateur. Les vraies échecs du motif surviennent au milieu de la configuration, où cette évaluation ne regarde pas.
9. Une évaluation proposée
Mixture-of-agents (Wang, J., et al., 2024) et multi-agent debate (Du et al., 2023) rapportent des gains par rapport au plus fort modèle unique dans des conditions d'API. L'affirmation qu'une réponse fusionnée surpasse la meilleure réponse unique est ouverte, et la comparaison pour ce protocole est spécifiée ici avant tout chiffre, pour qu'elle ne puisse pas être ajustée rétrospectivement.
9.1 Hypothèses
H1. Anchor-and-enrich surpasse la réponse unique la plus forte en termes de correction factuelle et de complétude.
H2. Anchor-and-enrich surpasse une fusion naïve sur la survie de la minorité correcte et sur la part des affirmations non sourcées.
H0. Il n'y a pas de différence, ou la fusion rend le résultat pire.
H2 a plus de poids que H1. Si le protocole perd face à une fusion naïve sur ces deux mesures, la conception à la Section 4 n'a aucune justification, aussi bien que le document soit rédigé.
9.2 Conception
Cinquante à cent questions, trois bras : la réponse du plus fort modèle unique ; une fusion naïve chargée seulement de combiner les réponses ; et anchor-and-enrich. Les questions sont choisies et figées avant toute exécution, et la distribution du domaine entre santé, droit, technique, choix du consommateur et fait numérique est publiée avec l'ensemble.
9.3 Mesures
Correction factuelle, comme la part des affirmations vérifiables confirmées par rapport à une source primaire. Complétude, comme la couverture d'une liste pré-spécifiée de points matériels. Survie de la minorité correcte, comme la part des cas où un point correct énoncé par exactement un modèle atteint le document final. Qualité des sources, comme primaire, secondaire ou absente. Taux d'affirmations inventées, comme les affirmations en sortie qui n'étaient dans aucune des entrées, ce qui est une mesure directe de F1. Lisibilité. Temps d'exécution et coût. Et, rapporté séparément et en intégralité, les cas où la fusion a dégradé les choses, qui sont les intéressants.
9.4 Mise en aveugle
Les noms de modèles sont cachés et l'ordre des réponses est mélangé avant la notation. Un modèle juge est manifestement sensible à la position, à la verbosité et au style maison familier (Zheng et al., 2023), donc une notation non aveugle mesurerait partiellement ceux-ci. La notation humaine suit la même procédure.
9.5 Publication et falsifiabilité
Les questions, réponses brutes, documents finaux et scores sont publiés en intégralité, afin que le marquage puisse être contesté.
La condition de falsification est pré-spécifiée. Si le bras 3 ne surpasse pas le bras 1 sur la correction et la complétude, et ne surpasse pas le bras 2 sur la survie de la minorité et la part des affirmations non sourcées, H1 et H2 ne sont pas appuyées et l'affirmation émerge des matériaux du système, non reformulée.
9.6 Test du modèle de témoin corrélé
Indépendamment de H1 et H2, ρ est estimable par la procédure à la Section 5.5 sur le même ensemble de questions, ce qui permet un test de la prédiction qui en découle.
H3. Le gain tiré de l'ajout du k-ième modèle décroît comme = N/(1+(N−1)ρ) le prédit, et un conseil tiré de laboratoires distincts surpasse un conseil de même taille tiré d'un seul.
H3 est testable sur des données collectées pour la comparaison primaire et ne nécessite aucune collecte supplémentaire. La réfutation serait le résultat le plus informatif, car elle signifierait que l'analogie d'échantillon en grappes ne s'étend pas aux conseils de modèles de langage et la Section 5 a besoin d'être réécrite.
9.7 Deux tests que le niveau mobile rend bon marché
Chaque exécution mobile coûte une interaction et un nombre fixe de messages d'abonnement, ce qui met deux affirmations supplémentaires à portée facile.
H4, dominance de corrélation. Une paire entre laboratoires à N = 2 égale ou surpasse un quintette du même laboratoire à N = 5 sur la correction et la survie de la minorité. C'est le test le plus tranchant disponible de la Section 5.3, car les bras diffèrent dans la direction que le modèle appelle décisive, ρ, tout en se mouvant l'un contre l'autre dans la direction qu'il appelle secondaire, N.
H5, l'axe d'élicitation. L'élicitation aveugle-parallèle fait émerger strictement plus de désaccords que l'élicitation informée-séquentielle sur le même ensemble de questions, et les désaccords qu'elle fait émerger prédisent les erreurs dans la réponse du modèle unique. Si H5 échoue, ce qui signifie qu'un critique informé trouve autant de divergences qu'un pair aveugle, alors l'argument du coût d'indépendance à la Section 6.5 est faux et le mode informé subsume simplement le mode aveugle.
10. Limitations
L'affirmation centrale est non testée : la section 4 est un argument de conception, et la section 9 spécifie la comparaison qui la trancherait.
ρ est supposé plutôt qu'estimé. Chaque valeur des tableaux 2 et 8 découle de la formule de la section 5 avec un ρ uniforme supposé, ce qui place les tableaux à une limite supérieure selon une structure de blocs réaliste.
La section 7 rapporte n = 5 et n = 3. Elle établit que le mode de défaillance existe ; l'affirmation se limite à l'existence plutôt qu'à la fréquence. Le scoring a été effectué par l'auteur, sans estimation d'accord inter-évaluateurs ; les critères binaires réduisent le risque d'un seul évaluateur sans l'éliminer. L'environnement A n'a pas été réexécuté après l'intervention et l'environnement C n'a pas de passages, de sorte que les réussites rapportées couvrent uniquement l'environnement B.
Les versions de modèles derrière les interfaces web et les applications grand public sont inconnues et changent, la personnalisation des comptes affecte les réponses, et un passage ne peut pas être répété exactement (section 6.6), donc les résultats deviennent rapidement obsolètes et constituent une preuve concernant le protocole, non concernant les modèles nommés.
Le synthétiseur lui-même est un modèle de langage, sujet aux défaillances F1 à F4 comme tout autre. Le protocole contraint cela structurellement, par la provenance, l'interdiction de suppression silencieuse, et une section de désaccord séparée, mais ne l'élimine pas. La qualité de la sortie dépend de la fidélité avec laquelle un modèle donné suit l'instruction ; cette dépendance n'est pas mesurée.
La rubrique aveugle est exécutée par le même modèle qui construit ensuite le document, donc la sélection d'ancrage est un point de biais, et rien n'empêche ce modèle de préférer systématiquement les réponses stylistiquement proches des siennes, ce qui est un biais de juge-modèle (Zheng et coll., 2023) à une autre position. Interdire un ancrage prédéfini n'aborde que la forme explicite du problème.
La valeur par défaut mobile est séquentielle-informée, donc le mode utilisé le plus souvent est aussi celui dont l'accord porte le poids de preuve le moins important (section 6.4). C'est un compromis qualité par message, et la limite qu'il établit est énoncée ici. La principale faiblesse du palier est qu'il échange l'auditabilité contre la latence : Critique et Synthèse retournent un texte finalisé, et les réponses brutes ne vivent que dans les propres historiques de session des modèles, donc un utilisateur qui n'ouvre jamais le mode Sondage fait confiance au lieu de vérifier, ce qui est la posture que le protocole existe pour contester.
Le coût en temps établit une limite à la voie gratuite. Un conseil complet réaliste demande dix à quinze minutes d'attente, et cinq à vingt-cinq minutes par fournisseur avec les modes de recherche approfondie. Pour une partie de la population visée, cela peut dépasser l'avantage.
La section 11 expose la position juridique de la voie de l'agent ainsi que la question de conditions d'utilisation qu'elle laisse ouverte.
11. Éthique, confidentialité et cadre juridique
Le système est destiné à l'usage personnel des comptes de modèles d'un utilisateur, gratuits ou payants, via son propre navigateur ou appareil. Il ne récupère pas les données de tiers, ne contourne pas les murs payants, ne résout pas les tests de défi-réponse, ne contourne pas la détection de robots, ne fait pas tourner les proxies, ne dissimule pas son fonctionnement, ne revend pas les comptes et ne les exécute pas en mode multi-locataire.
L'accessibilité est l'objectif plutôt qu'un effet secondaire. Lorsqu'un utilisateur en situation de handicap s'appuie sur celui-ci comme technologie d'assistance, c'est à cela qu'il sert : un assistant agissant en son nom, à son rythme, sur ses propres comptes. L'analogie de la bordure est exacte. Une rampe construite pour les fauteuils roulants sert aussi les parents avec des poussettes et les livreurs, et un système conçu pour les utilisateurs qui ne peuvent pas gérer une douzaine d'onglets de navigateur s'avère utile pour tous.
Les chemins ne sont pas juridiquement équivalents. Le chemin gratuit ressemble à un usage ordinaire selon toute lecture : l'utilisateur ouvre les sites, tape et copie. Le niveau mobile s'en rapproche, car les fournisseurs publient les intentions d'application pour exactement ce type d'invocation, et un raccourci peut chaîner deux de ces invocations, en utilisant chaque application comme prévu, un message à la fois, au premier plan. Le chemin agent mérite un examen plus attentif. Les règles d'accès automatisé visent la récolte de résultats à grande échelle, les robots chargeant un service, contournant les limites de débit, exécutant de nombreux comptes et revendant ce qui en revient. Rien de tout cela ne décrit un utilisateur posant une question à un robot à vitesse humaine dans son navigateur personnel connecté et lisant lui-même la réponse. Un tel usage est structurellement le même que le logiciel d'assistance qui tape et clique pour les personnes qui ne peuvent pas le faire. Certains termes, cependant, sont rédigés plus largement que leur objet, interdisant tout moyen automatisé sans mention d'échelle. La question de savoir si cela s'étend à un utilisateur automatisant une seule question dépend du service, de la juridiction et des conditions en vigueur le jour. C'est une lecture et non un jugement. Les utilisateurs doivent consulter les conditions de ce à quoi ils se connectent et décider par eux-mêmes. Quiconque préférerait ne pas y réfléchir du tout peut utiliser le chemin gratuit, qui fait le même travail et ne pose aucune question spécifique à l'agent ; les conditions ordinaires des sites s'appliquent toujours.
La confidentialité est une décision de composition. L'ensemble des modèles détermine quelles entreprises reçoivent ce que l'utilisateur tape, ce qui n'a pas d'importance pour une question ordinaire et pourrait en avoir pour une question relative à la santé, à un employeur ou à des clients. Lorsqu'une question particulière serait inconfortable d'envoyer à une entreprise particulière, laissez ce membre de côté pour cette question ; en supprimer un ne coûte rien.
La contrainte éthique propre au protocole est une interdiction. Rien qui n'ait pas été une exécution de la méthode ne peut être présenté comme tel. Un résumé web, une réponse d'un seul modèle ou le raisonnement de l'opérateur peuvent chacun être utiles, mais ce ne sont pas un résultat de conseil, et l'utilisateur doit être informé de ce qu'il tient. En pratique, cela signifie pas de reçu, pas de sections d'accord et de désaccord, et pas de fichier de résultat pour quoi que ce soit qui n'ait pas été une véritable exécution multi-modèle.
12. Conclusion
Une réponse confidemment erronée est indistinguible d'une réponse confidemment juste, tandis qu'une dispute entre deux d'entre elles est visible à quiconque. La valeur d'un conseil réside donc dans l'exposition du désaccord, non dans sa neutralisation.
L'accord entre les modèles n'est pas une confirmation indépendante. Un conseil de N modèles avec corrélation d'erreur ρ vaut = N/(1+(N−1)ρ) témoins indépendants, une quantité qui sature à 1/ρ indépendamment du nombre de modèles ajoutés, de sorte qu'à ρ = 0,5 un conseil de n'importe quelle taille vaut au maximum deux témoins. La différence de poids probatoire entre dix modèles indépendants d'accord et dix modèles corrélés atteint environ cinq ordres de grandeur décimaux, et une fusion opaque confie cette différence au lecteur sous forme de confiance non méritée.
La conception découle de ces deux prémisses. Elle conserve la provenance, afin qu'un lecteur puisse vérifier le résultat plutôt que de lui faire confiance, et elle met le désaccord en avant, puisque le désaccord est la seule composante qu'aucun modèle unique ne peut fournir. Une source que plusieurs réponses partagent est marquée comme une source. Les faits porteurs de charge sont nommés, et ce qui est sourcé est séparé de ce qui n'est que convenu. Une autre règle s'applique au compte rendu du protocole sur lui-même : elle ne doit jamais présenter comme collégial ce qui ne l'était pas, ce qui n'est pas une préoccupation théorique. Dans une exécution en aveugle, deux modèles sur cinq l'ont violée silencieusement, et une phrase d'attribution de rôle a inversé les deux dans la réexécution environment-B.
Les trois niveaux sont des points sur une courbe dont l'axe est le coût de l'ampleur, non trois degrés de qualité, et la Section 5 est ce qui rend la courbe cohérente. Parce que sature, la distance probatoire entre deux modèles et dix est beaucoup plus petite que le nombre de modèles ne le suggère, et deux modèles de laboratoires différents, exécutés sur un téléphone, peuvent valoir plus que cinq issus d'une seule lignée. Le niveau mobile a également forcé à la surface un arbitrage que les autres niveaux avaient fait silencieusement. Un second modèle qui a lu le premier peut le corriger, mais il ne peut plus le confirmer indépendamment. La correction d'erreur et la confirmation indépendante sont des biens différents, achetés avec des ordres différents, et un système qui ne dit pas lequel des deux il vend induit son utilisateur en erreur. La comparaison contrôlée reste ouverte, et la Section 9 la spécifie ainsi que le résultat qui m'obligerait à retirer la revendication.
Quelle que soit l'issue de cette comparaison, un document fusionné sans provenance et sans préservation du désaccord ne peut pas être vérifié du tout, et donc il ne peut pas être meilleur qu'une réponse unique en aucun sens qui importe pour quelqu'un qui prend une décision. L'auditabilité n'est pas une amélioration de la synthèse. C'est la condition sous laquelle la synthèse a le droit d'être appelée un résultat. Les règles du protocole concernent donc l'endroit d'où provient chaque phrase et sur quoi les modèles ont divergé, plutôt que sur le nombre de modèles interrogés.
Déclarations
Financement. Aucun financement externe n'a soutenu ce travail.
Conflits d'intérêts. L'auteur est le développeur des méthodes d'orchestration multi-modèles analysées dans cet article, qui sont ouvertes et reproductibles, un intérêt que les lecteurs doivent considérer. L'auteur est demandeur nommé sur des demandes de brevet en attente, non accordées, couvrant l'orchestration IA et les systèmes de validation multi-modèles du type que cet article examine. Le protocole formalisé à la Section 4 et l'implémentation de référence décrite à la Section 6 sont propres à l'auteur, et la conception de l'évaluation à la Section 9 a été fixée avant toute collecte de données pour cette raison. Aucun résultat analytique à la Section 5 ne dépend de l'implémentation : les Sections 6 et 7 pourraient être supprimées intégralement sans modifier le modèle, son plafond, ou aucune conclusion en découlant.
Outils et vérification. Les assistants IA ont été utilisés comme instruments sous la direction de l'auteur ; les idées, la recherche et les conclusions sont celles de l'auteur. Toutes les affirmations quantitatives et les citations ont été vérifiées par l'auteur par rapport aux sources primaires ou à des copies archivées ; l'auteur porte l'entière responsabilité du contenu.
Disponibilité des données. Les Figures 1 et 3 et les Tableaux 2, 4 et 8 sont générés à partir de l'expression en forme fermée à la Section 5.2 et sont recalculables à partir de celle-ci. Le matériel à la Section 7 consiste en transcriptions de premières réponses enregistrées au moment de chaque exécution et conservées avec les matériaux de travail. Les modèles y sont identifiés par laboratoire plutôt que par nom de produit : l'observation concerne un mode de défaillance qui est apparu dans plusieurs laboratoires, et les résultats d'une seule exécution ne soutiennent pas une comparaison entre les systèmes nommés.
Contributions de l'auteur. Auteur unique.
Correspondance. [email protected]
References
Entries marked arXiv are preprints and are cited as such; vendor and standards-body documents are contemporaneous industry sources rather than settled literature.
- Bommasani, R., Creel, K. A., Kumar, A., Jurafsky, D., & Liang, P. (2022). Picking on the same person: Does algorithmic monoculture lead to outcome homogenization? Advances in Neural Information Processing Systems, 35.
- Condorcet, M. J. A. N. de C., marquis de (1785). Essai sur l’application de l’analyse à la probabilité des décisions rendues à la pluralité des voix. Imprimerie Royale, Paris.
- Debenedetti, E., Shumailov, I., Fan, T., Hayes, J., Carlini, N., Fabian, D., Kern, C., Shi, C., Terzis, A., & Tramèr, F. (2025). Defeating prompt injections by design. arXiv:2503.18813.
- Dietterich, T. G. (2000). Ensemble methods in machine learning. In Multiple Classifier Systems, Lecture Notes in Computer Science 1857, 1-15. Springer.
- Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325.
- Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., et al. (2022). Language models (mostly) know what they know. arXiv:2207.05221.
- Karpathy, A. (2025). llm-council. Open-source software repository.
- Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038-30066. arXiv:2506.07962.
- Kish, L. (1965). Survey Sampling. Wiley, New York.
- Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
- Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118.
- Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. Advances in Neural Information Processing Systems, 7, 231-238.
- Ladha, K. K. (1992). The Condorcet jury theorem, free speech, and correlated votes. American Journal of Political Science, 36(3), 617-634.
- Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020-9025.
- Meta (2025). Agents rule of two: A practical approach to AI agent security. Engineering documentation.
- MITRE (2025). CVE-2025-32711. Common Vulnerabilities and Exposures record; zero-click exfiltration in an agentic assistant (EchoLeak).
- OWASP (2025). OWASP Top 10 for large language model applications - LLM01: Prompt injection.
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., et al. (2023). Towards understanding sycophancy in language models. arXiv:2310.13548.
- Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755-759.
- Surowiecki, J. (2004). The Wisdom of Crowds. Doubleday, New York.
- Ueda, N., & Nakano, R. (1996). Generalization error of ensemble estimators. Proceedings of the International Conference on Neural Networks, 90-95.
- Wang, J., Wang, J., Athiwaratkun, B., Zhang, C., & Zou, J. (2024). Mixture-of-agents enhances large language model capabilities. arXiv:2406.04692.
- Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., & Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. International Conference on Learning Representations. arXiv:2203.11171.
- Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. International Conference on Learning Representations. arXiv:2306.13063.
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, Datasets and Benchmarks Track. arXiv:2306.05685.
Appendice A. Le modèle de reçu
Le reçu est la première chose qu'un lecteur rencontre et souvent la seule chose qu'il lit. Il doit répondre à quatre questions sans défilement.
RECEIPT — 6 models asked · 5 answered · 1 did not (free tier)
Mode: fast ×4, deep ×1
Anchor: answer #3 (chosen for completeness and sourcing)

Agreed:       ...
Disputed:     ...
Unverified:   ...

Rests ONLY on the models agreeing (none showed a source):
              ...
Correlated:   3 of 5 cite one article → one lineage, not three
Composition:  4 of 5 are models from one region; agreement
              may reflect a shared frame
Les deux dernières lignes sont ce que la Section 5 existe pour justifier. Sans elles, le document rapporte le nombre de modèles en accord et dissimule la valeur de cet accord, et ces deux quantités diffèrent de plusieurs ordres de grandeur.
Appendice B. Nombre effectif de témoins indépendants
Tableau 8. , plage complète
| ρ | N=2 | N=3 | N=4 | N=5 | N=7 | N=10 | N=15 | N=20 | N→∞ |
|---|---|---|---|---|---|---|---|---|---|
| 0.00 | 2.00 | 3.00 | 4.00 | 5.00 | 7.00 | 10.00 | 15.00 | 20.00 | ∞ |
| 0.05 | 1.90 | 2.73 | 3.48 | 4.17 | 5.38 | 6.90 | 8.82 | 10.26 | 20.0 |
| 0.10 | 1.82 | 2.50 | 3.08 | 3.57 | 4.38 | 5.26 | 6.25 | 6.90 | 10.0 |
| 0.15 | 1.74 | 2.31 | 2.76 | 3.13 | 3.68 | 4.26 | 4.84 | 5.19 | 6.67 |
| 0.20 | 1.67 | 2.14 | 2.50 | 2.78 | 3.18 | 3.57 | 3.95 | 4.17 | 5.00 |
| 0.30 | 1.54 | 1.88 | 2.11 | 2.27 | 2.50 | 2.70 | 2.88 | 2.99 | 3.33 |
| 0.40 | 1.43 | 1.67 | 1.82 | 1.92 | 2.06 | 2.17 | 2.27 | 2.33 | 2.50 |
| 0.50 | 1.33 | 1.50 | 1.60 | 1.67 | 1.75 | 1.82 | 1.88 | 1.90 | 2.00 |
| 0.60 | 1.25 | 1.36 | 1.43 | 1.47 | 1.52 | 1.56 | 1.60 | 1.61 | 1.67 |
| 0.70 | 1.18 | 1.25 | 1.29 | 1.32 | 1.35 | 1.37 | 1.39 | 1.40 | 1.43 |
| 0.80 | 1.11 | 1.15 | 1.18 | 1.19 | 1.21 | 1.22 | 1.23 | 1.23 | 1.25 |
| 0.90 | 1.05 | 1.07 | 1.08 | 1.09 | 1.09 | 1.10 | 1.10 | 1.10 | 1.11 |
En se déplaçant vers la droite, en ajoutant des modèles, on atteint la colonne la plus à droite presque immédiatement. En se déplaçant vers le haut, en réduisant la corrélation, il n'y a aucune limite. L'effort consacré à la diversité d'un conseil, c'est-à-dire aux laboratoires distincts, aux régions et aux corpus d'entraînement différents, génère donc plus de retours que l'effort consacré à sa taille. Deux entrées soutiennent l'argument de la section 6.2 : une paire tirée de deux laboratoires à ρ ≈ 0,2 compte environ 1,67 témoins indépendants, alors que cinq modèles provenant d'une même lignée à ρ ≈ 0,6 compte environ 1,47.
Annexe C. Référence de mise en œuvre de la couche mobile
Tableau 9. Référence de mise en œuvre pour la couche mobile
| Composant | Spécification |
|---|---|
| Mécanisme | Intentions d'application du système d'exploitation enchaînées dans un raccourci signé unique, invoquant les applications installées des fournisseurs par rapport aux abonnements existants de l'utilisateur. Pas de clé API, pas de serveur, pas d'exécution en arrière-plan |
| Actions des fournisseurs | L'intention ask-intent publiée de chaque fournisseur, adressée par l'identifiant application-intent. Un fournisseur expose un paramètre de modèle optionnel, omis pour que la valeur par défaut de l'application s'applique ; l'autre n'en expose aucun |
| Fonctionnement sans intervention | Le paramètre show-on-run est défini sur désactivé dans les paramètres d'intention au moment de la compilation, non ajusté dans l'éditeur après l'importation |
| Distribution | Le raccourci est signé pour une importation sans restrictions, de sorte qu'une compilation s'installe sur n'importe quel appareil ou compte sans reconstruction |
| Menu de mode | Une action de flux de contrôle de menu avec des marqueurs de début, de cas et de fin ; les branches convergent sur une queue partagée via une action set-variable |
| Plateforme alternative | Automatisation basée sur les intentions, avec un chemin semi-automatique qui survit aux mises à jour d'application |
| Coût par exécution | Poll 1 + 1, Critique 1 + 1, Synthèse 1 + 2 messages d'abonnement |
| Latence | Environ 50 à 60 secondes du lancement au résultat, sans intervention |
| Surfaces de lancement | Icône d'écran d'accueil, widget, bouton d'action matériel ou phrase vocale |
Deux contraintes ont façonné la conception, et toutes deux se généralisent. Les quotas sont partagés avec l'utilisation ordinaire des mêmes applications, de sorte que le mode quotidien recommandé est celui à deux messages et non celui à trois messages ; c'est de l'allocation de ressources, non un jugement de qualité. Et chaque appel d'intention ouvre une session nouvelle sans mémoire, de sorte que toutes les invites sont autonomes et portent la question et toutes les réponses antérieures en elles-mêmes. Rien n'est continué. Cette contrainte est ce qui rend l'indépendance parallèle en aveugle dans Poll et Synthèse architecturale plutôt que d'être instructive, comme l'argument à la section 6.5.
Comment citer cet article
Chernets, V. (2026). Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7390698
@misc{chernets2026agreementnotevidence,
  author       = {Chernets, Vadym},
  title        = {{Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7390698},
  url          = {https://doi.org/10.2139/ssrn.7390698}
}