El acuerdo no es evidencia independiente: síntesis auditable multimodelo sin API
Esta es una traducción. La versión de referencia es el original en inglés; cite esa.
Vadym Chernets, PhD, arquitecto de sistemas de IA · ORCID 0009-0007-4845-3163
SSRN 7390698 · DOI 10.2139/ssrn.7390698 · Zenodo 10.5281/zenodo.22683716 · GitHub
- Versión de registro: SSRN 7390698 · DOI 10.2139/ssrn.7390698
- Copia archivada, citable y descargable: 10.5281/zenodo.22683716 — concepto DOI, siempre resuelve a la versión más reciente
- Texto completo como Markdown y PDF: GitHub
- HTML legible: https://polyhelper.ai/research/agreement-not-evidence/
El mismo texto está en cuatro plataformas para que se pueda acceder cuando una de ellas no pueda proporcionarlo. SSRN mantiene la versión de registro; cite esa.
Palabras clave: grandes modelos de lenguaje; errores correlacionados; sabiduría de las multitudes; Condorcet jury theorem; monocultura algorítmica; debate multiagente; tamaño de muestra efectivo; efecto de diseño; conjunto; procedencia. Clasificación JEL: C11; C18; D71; D83; L86; O33
Resumen
Quien le plantea una pregunta a un modelo de lenguaje no puede distinguir una respuesta confiadamente errónea de una confiadamente correcta. Las dos son idénticas en cada pista superficial disponible para un no experto. Hacer preguntas a varios modelos parece resolver esto, pero simplemente traslada el problema: reconciliar varias respuestas produce un texto confiado de nuevo, y ese texto ahora lleva la autoridad prestada de «diez de ellos estuvieron de acuerdo».
El protocolo formalizado aquí recopila respuestas de varios modelos de chat de consumo a través del navegador o teléfono del usuario, sin claves de API, sin instalación y sin servidor intermediario. Los reconcilia mediante anclaje y enriquecimiento: la respuesta disponible más fuerte se convierte en la base, y cada una de las otras contribuye solo lo que la base carece. Cada contribución está firmada con el modelo que la suministró. Los desacuerdos se mantienen en una sección propia en lugar de ser promediados.
El documento hace cuatro contribuciones. La primera es el protocolo en sí, enunciado como un algoritmo que preserva la procedencia y prohíbe la eliminación silenciosa, junto con una taxonomía de cinco formas en que una fusión puede fallar. Cuatro de ellas son defectos de agrupamiento ingenuo; la quinta es un fallo del operador más que del método: una síntesis que presenta la salida de un único modelo como un resultado colegiado. La segunda es la aplicación de la aritmética de testigos correlacionados al diseño del protocolo. Esa aritmética no se reclama aquí. Kohli (2026) aplicó la misma corrección de Kish a un panel de nueve jueces fronterizos y midió aproximadamente dos votos efectivos, y Kim et al. (2025) establecieron la correlación de errores subyacente en más de 350 modelos. Un consejo de N modelos cuyos errores tienen correlación intraclase ρ vale = N / (1 + (N−1)ρ) testigos independientes, y esa cantidad se satura en 1/ρ sin importar cuántos modelos se añadan. Una vez que un consejo es más grande que 1/ρ, reducir a la mitad ρ supera duplicar N, y un par extraído de dos laboratorios puede superar cinco extraídos de uno. Kim et al. (2025) complican esa regla: los modelos más grandes y más precisos llevan los errores más correlacionados incluso entre proveedores y arquitecturas, por lo que dos laboratorios son una conjetura previa sobre ρ en lugar de una medición de ello, que es para lo que sirve el procedimiento de estimación de la Sección 5.5. El tercero es un relato de tres niveles de despliegue, manual, móvil de un toque y agente de navegador, y del eje que los separa epistemológicamente: si el segundo modelo ve la respuesta del primer modelo. Condicionar el segundo modelo eleva ρ a cambio de corrección de errores. El cuarto es una observación de muestra pequeña del fallo del consejo contrafecho en cinco modelos, la intervención de una sola oración que lo eliminó en una re-ejecución de tres modelos, y un diseño de evaluación ciego de tres brazos con una condición de falsación declarada.
El acuerdo correlacionado se trata aquí como establecido, no como un hallazgo. El hecho de que un panel de modelos valga muchos menos testigos independientes de lo que tiene miembros ha sido medido directamente: nueve jueces fronterizos extraídos de siete familias suministran aproximadamente dos votos efectivos (Kohli, 2026), y la correlación de errores aumenta con la capacidad del modelo incluso entre proveedores y arquitecturas (Kim et al., 2025). La Sección 5 reformula la aritmética del efecto de diseño detrás de esas mediciones, porque tres de las reglas del protocolo se derivan de ella y se leen como meticulosidad sin ella. El protocolo entonces toma el otro lado del mismo problema. Esa literatura mide la correlación; este protocolo está construido para reducirla, componiendo entre linajes, manteniendo el desacuerdo en lugar de promediarlo, firmando cada contribución con el modelo que la suministró, y contando una fuente repetida una sola vez.
La afirmación de que una respuesta fusionada supera la mejor respuesta individual se argumenta a partir del diseño y de la literatura adyacente; la Sección 9 especifica la evaluación, que aún no se ha realizado.
Contenidos
- Introducción
- Trabajo relacionado
- Cinco formas en que una fusión falla
- El protocolo de anclaje y enriquecimiento
- Acuerdo correlacionado
- Tres niveles, un protocolo
- Sección empírica
- El archivo de pegado: un patrón de interfaz para orientación de arranque en frío
- Una evaluación propuesta
- Limitaciones
- Ética, privacidad y marco legal
- Conclusión
Declaraciones · Referencias · Apéndice A, la plantilla de recepción · Apéndice B, número efectivo de testigos independientes · Apéndice C, referencia de implementación del nivel móvil
Lista de figuras y tablas
- Figura 1. Un consejo se satura en 1/ρ, y lo que valen diez modelos que concuerdan (Sección 5.3)
- Figura 2. El protocolo de anclaje y enriquecimiento, etapa por etapa (Sección 4.2)
- Figura 3. Los tres niveles como puntos en una curva de latencia-amplitud (Sección 6.4)
- Figura 4. Elicitación ciega-paralela e informada-secuencial comparada (Sección 6.5)
- Tabla 1. Reglas de protocolo y los fallos que abordan (Sección 4.5)
- Tabla 2. Número efectivo de testigos independientes, valores seleccionados (Sección 5.2)
- Tabla 3. Los tres modos del nivel móvil (Sección 6.2)
- Tabla 4. La frontera de latencia-amplitud en los tres niveles (Sección 6.4)
- Tabla 5. Sonda de inicio en frío, ejecución de línea base, n = 5 (Sección 7.2)
- Tabla 6. Sonda de inicio en frío tras la intervención de asignación de roles, n = 3 (Sección 7.3)
- Tabla 7. Modos de fallo observados de un pipeline de intención de aplicación de consumidor (Sección 7.5)
- Tabla 8. Número efectivo de testigos independientes, tabla completa (Apéndice B)
- Tabla 9. Referencia de implementación del nivel móvil (Apéndice C)
1. Introducción
1.1 El problema
Considérese una pregunta donde equivocarse es costoso: elegir una escuela, un tratamiento, un proveedor, una cláusula en un contrato. El usuario pregunta a un modelo de lenguaje y obtiene algo coherente, confiado y bien formateado, y la dificultad comienza ahí. Una respuesta confidentemente incorrecta y una confidentemente correcta se ven igual. El tono no las separa, ni tampoco la estructura, la longitud o la presencia de citas. Se sabe que la confianza verbalizada del modelo está exagerada y mal calibrada (Kadavath et al., 2022; Xiong et al., 2024). La tendencia de un modelo a adoptar el encuadre del preguntador añade una segunda capa de apoyo falso (Sharma et al., 2023).
El remedio obvio es una segunda opinión. El error de un modelo parece confianza. El mismo error colocado junto a la respuesta de un segundo modelo parece un argumento. Un argumento es visible para un lector sin experiencia en el tema; la confianza no. Todo lo que sigue se basa en esa asimetría.
El remedio tiene un precio y una trampa. El precio es la lectura: diez respuestas a una pregunta son diez textos largos para mantener en mente a la vez mientras se recuerda quién dijo qué. Casi nadie hace eso. En la práctica, un lector lee la primera respuesta, hojea la segunda y cierra el resto. Recopilar varias respuestas ha sido un problema resuelto durante años, a través de suscripciones a agregadores, paneles lado a lado y puertas de enlace API. Terminar con ellas no ha sido resuelto.
La trampa es la fusión. Cualquier forma de reducir diez respuestas a una produce nuevamente un único texto confiado, y si la reducción es opaca, el lector vuelve a donde comenzó, excepto que el texto ahora lleva una autoridad que no pueden verificar. El agrupamiento ingenuo también borra puntos minoritarios correctos, se inclina hacia la frase que fue más enfática, y produce la apariencia de consenso donde no lo hay.
Un tercer problema es lo que hace que todo el ejercicio sea no trivial. El acuerdo entre modelos no es una confirmación independiente, porque los modelos entrenados en corpus superpuestos comparten encuadres, citan los mismos artículos y heredan los mismos puntos ciegos. «Nueve de diez estuvieron de acuerdo» y «nueve expertos independientes estuvieron de acuerdo» son declaraciones diferentes, y la brecha entre ellas es cuantitativa y grande. La Sección 5 muestra que pone un techo en toda la construcción.
1.2 El sistema
El protocolo está escrito en texto plano, con tres formas de ejecutarlo. Los tres producen el mismo documento, y difieren en quién hace clic y en cuántos modelos se consultan.
En la ruta gratuita, el usuario abre los sitios, copia las respuestas y las pega bajo un párrafo de instrucciones en cualquier modelo de chat. Nada que instalar, nada que pagar, y funciona en un teléfono.
En el nivel móvil hay un icono en la pantalla de inicio. Tócalo, escribe la pregunta, elige un modo, y aproximadamente un minuto después la respuesta terminada está en la pantalla y en el portapapeles. Llega a dos modelos a través de intenciones de aplicación del sistema operativo contra suscripciones ya instaladas en el dispositivo, sin clave API.
En la ruta del agente, un modelo que puede controlar un navegador abre los sitios nombrados en las sesiones iniciadas existentes del usuario, envía la pregunta, espera, guarda cada respuesta en un archivo y construye el documento.
El hecho decisivo desde el punto de vista arquitectónico es que no hay servidor. No un servidor seguro, y no uno con una política de no retención: ningún componente de este tipo existe, por lo que la pregunta no puede llegarme. Sí llega a los servicios de modelo que el usuario nombró, que es el punto del ejercicio, y no va a ningún otro lugar. Una segunda consecuencia se deriva de la misma ausencia: el protocolo no puede ser retirado, ya que es un párrafo de texto bajo una licencia permisiva, y una copia en las notas de un usuario sigue funcionando con los modelos que existan después.
1.3 Contribuciones
La Sección 3 expone cinco formas en que una fusión falla y la Sección 4 formaliza el anclaje y enriquecimiento contra ellas. La Sección 5 desarrolla el modelo de testigo correlacionado, = N/(1+(N−1)ρ) con su techo en 1/ρ, y extrae lo que implica para cómo debe componerse un consejo. La Sección 6 describe los tres niveles, la frontera latencia-amplitud que trazan, y la distinción entre lo ciego-paralelo y lo secuencial informado que los separa epistémicamente. La Sección 7 reporta la observación del consejo falso y los hallazgos de campo de la compilación móvil; la Sección 8 describe un patrón de interfaz para orientación de arranque en frío; la Sección 9 especifica una evaluación ciega con una condición de falsificación fijada de antemano. La afirmación de que una respuesta fusionada supera la mejor respuesta única no se resuelve aquí, y esa evaluación es la comparación que la resolvería, incluyendo el resultado que me obligaría a retirarla.
La orientación merece ser enunciada claramente, porque es lo que separa este artículo de la literatura de medición de la que depende. Kohli (2026), Kim et al. (2025) y Ding (2026) miden cuán correlacionados están los errores de un consejo. Este artículo toma esa correlación como el objetivo de diseño y pregunta cómo una sola persona, trabajando a través de interfaces de chat de consumidor ordinarias sin clave API y sin servidor, puede reducirla y dejar un registro que demuestre que lo hizo. Una brecha en esa literatura merece ser nombrada porque está a nuestro alcance: las mediciones se realizaron en APIs, en puntos de referencia, con nueve modelos o con trescientos. Nadie ha estimado la correlación en el entorno de consumidor que este protocolo habita, donde una persona consulta cuatro productos de chat que ya no pagan nada. La Sección 5.5 da el procedimiento y la Sección 9.6 el diseño.
2. Trabajo relacionado
Conjuntos y diversidad. La teoría clásica de conjuntos ya dice lo que se necesita aquí: lo que gana un conjunto depende de cuán diferentemente sus miembros se equivocan, no de cuán buenos sean en promedio. La descomposición de ambigüedad, en la que el error del conjunto es igual al error promedio del miembro menos la ambigüedad promedio (Krogh & Vedelsby, 1995), y la descomposición sesgo–varianza–covarianza (Ueda & Nakano, 1996) muestran que un conjunto colapsa hacia un único miembro conforme la covarianza del error aumenta. Dietterich (2000) plantea la condición como necesaria. La Sección 5 la traslada a consejos de modelos de lenguaje y cuantifica el costo de violarla.
Esquemas multimodelo para modelos de lenguaje. La consistencia automática (Wang, X., et al., 2023) vota entre varias muestras de un modelo, lo que reduce la varianza sin producir independencia. El debate multiagente (Du et al., 2023) reporta ganancias de factualidad cuando varias instancias intercambian argumentos. Mezcla de agentes (Wang, J., et al., 2024) alimenta las salidas de una capa a un agregador e informa mejora sobre el modelo único más fuerte en varios puntos de referencia. Esa literatura apunta en la misma dirección que este protocolo. Sin embargo, sus resultados se obtuvieron sobre API y en puntos de referencia, así que no los traslado a un consejo mediado por navegador de interfaces de consumidor sin mi propia medición, que es lo que especifica la Sección 9.
Modelos juez. La evaluación por un juez modelo está bien caracterizada junto con sus defectos: sesgo de posición, sesgo de verbosidad, e inclinación hacia un estilo de casa familiar (Zheng et al., 2023). Eso es una restricción de diseño aquí, no una observación al margen, ya que la puntuación sin enmascaramiento estaría midiendo parcialmente esos sesgos. La Sección 9.4 lo maneja.
Monocultivo. Kleinberg y Raghavan (2021) muestran que cuando muchos agentes dependen de un algoritmo, los resultados colectivos pueden empeorar incluso cuando la calidad individual mejora. Bommasani et al. (2022) describen el mismo efecto como homogenización de resultados. Para un consejo de modelos de lenguaje, este es el mecanismo que genera ρ > 0 en primer lugar. El trabajo sobre degradación bajo entrenamiento en datos generados (Shumailov et al., 2024) sugiere que ρ se desplaza hacia arriba con el tiempo.
Multitudes. El argumento clásico de la sabiduría de las multitudes (Surowiecki, 2004) depende de que los juicios sean independientes. Lorenz et al. (2011) mostraron experimentalmente que incluso la influencia social leve, simplemente permitir que las personas vean las estimaciones de otros, estrecha la dispersión sin acercarla a la verdad: la multitud se vuelve más confiada sin volverse más precisa. La Sección 6.5 identifica eso como exactamente el canje aceptado por la elicitación secuencial informada.
Condorcet y votos correlacionados. El teorema del jurado de Condorcet (Condorcet, 1785) sostiene que con precisión individual por encima de uno medio, la probabilidad de una mayoría correcta tiende a uno conforme N crece. Ladha (1992) mostró que los votos correlacionados destruyen la garantía. La Sección 5 da una versión cuantitativa de esa advertencia a través del efecto de diseño (Kish, 1965).
Errores correlacionados, medidos. La aritmética que la Sección 5 reafirma ha sido medida directamente en paneles de modelos, y las mediciones son más precisas que el análisis. Kohli (2026) aplica el tamaño de muestra efectivo de Kish a un panel de nueve jueces fronterizos extraídos de siete familias de modelos y encuentra que vale aproximadamente dos votos independientes: aproximadamente tres cuartos de la independencia nominal del panel se pierden en errores compartidos, la precisión del panel cae 8 a 22 puntos porcentuales por debajo de lo que entregaría la votación independiente, y el mejor juez único iguala o supera al panel completo. Ni más jueces ni mejor agregación lo reparan, lo que localiza el cuello de botella en los jueces más que en el algoritmo. Kim et al. (2025), en más de 350 modelos, encuentran correlación de error sustancial y, crucialmente para cómo debe componerse un consejo, encuentran que los modelos más grandes y precisos tienen los errores más correlacionados incluso cuando la arquitectura y el proveedor difieren. Ding (2026) audita el acuerdo como una señal de confianza en más de 265.000 muestras y encuentra que es un predictor positivo pero débil, con correlación entre 0,20 y 0,59, y peor exactamente donde es más confiado: en el modelo fronterizo más consistente, el acuerdo en o por encima de 0,8 cubrió el 77% de las entradas del punto de referencia más difícil y el 48% de aquellas fueron incorrectas.
Tres cosas se derivan para este artículo. Primero, el resultado del efecto de diseño en la Sección 5 no es una contribución mía. El artículo de Kohli predatea el primer envío de este y utilizó la misma corrección; la sección se mantiene por lo que el protocolo se deriva de ella, y se etiqueta como tal donde aparece. Segundo, el consejo de composición que sigue, gastar en diversidad en lugar de cantidad, ahora está respaldado empíricamente en lugar de ser meramente argumentado. Tercero, el hallazgo de Kim et al. complica ese consejo de una manera que vale la pena señalar: si la capacidad y la correlación de error aumentan juntas, un par extraído de dos laboratorios no es automáticamente un par diverso, y el linaje tiene que ser medido más que leído de la marca. Eso es un argumento para el procedimiento de estimación de la Sección 5.5, no en contra de la regla de composición.
Sistemas adyacentes. Varios proyectos construyen consejos multimodelo. Una implementación abierta bien conocida, llm-council (Karpathy, 2025), consulta modelos en paralelo, les permite revisar mutuamente de forma anónima, y deja que un modelo presidente escriba la respuesta final. Necesita una clave API agregador y un pago por token. Los productos comerciales de consejo ofrecen un juez, una vista de consenso y una pantalla de contradicción. Las aplicaciones móviles de código abierto añaden votación y debate de múltiples rondas. Los frontales multimodelo maduros envían características de conjunto, y los paneles gratuitos lado a lado utilizan los sitios oficiales en los que el usuario ya ha iniciado sesión. Las suscripciones agregador ponen muchos modelos detrás de una factura. Cada una de estas propiedades existe en otro lugar por sí sola. Su conjunción, diez de ellas a la vez, parece no estar disponible en otro lugar: sin clave API, sin instalación, compatible con teléfono, ejecutándose en cuentas que el usuario ya tiene incluyendo niveles gratuitos, sin nuevo intermediario pagado, un método de fusión escrito en texto sin formato y por lo tanto editable, desacuerdo preservado, cada contribución firmada, una fuente repetida marcada como una fuente, y un método ejecutable ya sea a mano o bajo un agente.
Hay una razón estructural por la que la posición se mantiene abierta. Un laboratorio tiene poco incentivo para enrutar la pregunta de un usuario a su rival, ya que el objetivo de cada participante es que su propia respuesta sea la que el usuario mantenga. Terceros sí venden herramientas entre modelos, pero un método escrito en texto sin formato deja el rol editorial con el usuario, que es un arreglo diferente del de cualquiera de ellos.
Alcance. El protocolo cubre a una persona que produce un documento cuidadoso sin armar la infraestructura de un equipo de investigación: sin claves, sin instalación, sin servidor. Los reintentos, la ejecución garantizada, el monitoreo de costos y errores, los registros de auditoría, la evaluación en conjuntos de prueba, el control de acceso, el inicio de sesión único, la política de retención, el versionado de indicaciones y los acuerdos de nivel de servicio pertenecen al ámbito de los marcos de orquestación empresarial.
3. Cinco formas en que una fusión falla
Cuatro de los cinco son propiedades de la agrupación ingenua, con lo que me refiero a cualquier instrucción de la forma "combinar estas respuestas y optimizar el resultado". El quinto pertenece al operador, y es el que más importa, porque el lector no puede detectarlo.
F1, fabricación en la síntesis. La salida contiene afirmaciones que no estaban en ninguna de las entradas. El sintetizador es en sí mismo un modelo de lenguaje, y al suavizar las costuras entre fuentes genera material conectivo que se parece exactamente al material procedente de fuentes.
F2, borrado de la minoría. La única respuesta que detectó una objeción material se disuelve porque la mayoría dijo lo contrario. Este es el caso para el cual fue reunido el consejo, y es la primera cosa que una fusión ingenua pierde.
F3, desvío de confianza. Donde dos formulaciones entran en conflicto, la más categórica vence a la mejor respaldada. Es el mismo mecanismo que produce sesgo de posición y estilo en modelos jueces (Zheng et al., 2023).
F4, consenso fabricado. Un desacuerdo real se promedia en un sí calificado. El lector obtiene un documento en el que lo discutido es indistinguible de lo resuelto y ni siquiera puede enterarse de que existió una disputa.
F5, el consejo falsificado. A un modelo se le dice que ejecute una pasada colegial pero no tiene acceso a otros modelos. En lugar de decirlo, realiza una investigación web ordinaria y formatea el resultado en forma colegial, con secciones de registro, acuerdo y desacuerdo, y atribuciones de donantes. El documento se ve mejor de lo que sería uno veraz, exactamente porque ninguna contradicción real se interpone en el camino. El lector no puede detectar esto, no teniendo acceso a las respuestas fuente.
F5 es el problema de apertura del artículo elevado un nivel: una respuesta confiadamente incorrecta es indistinguible de una correcta, y un documento con forma de consejo pero escrito por un modelo es indistinguible de un consejo. La Sección 7 informa que ocurre en dos de cinco modelos en una ejecución ciega.
4. El protocolo de anclaje y enriquecimiento
4.1 Principio
En lugar de agrupar y optimizar respuestas, el protocolo desarrolla una respuesta fuerte de manera incremental, mientras que la procedencia y el desacuerdo permanecen visibles.
4.2 Las reglas
La figura 2 muestra el protocolo de principio a fin.
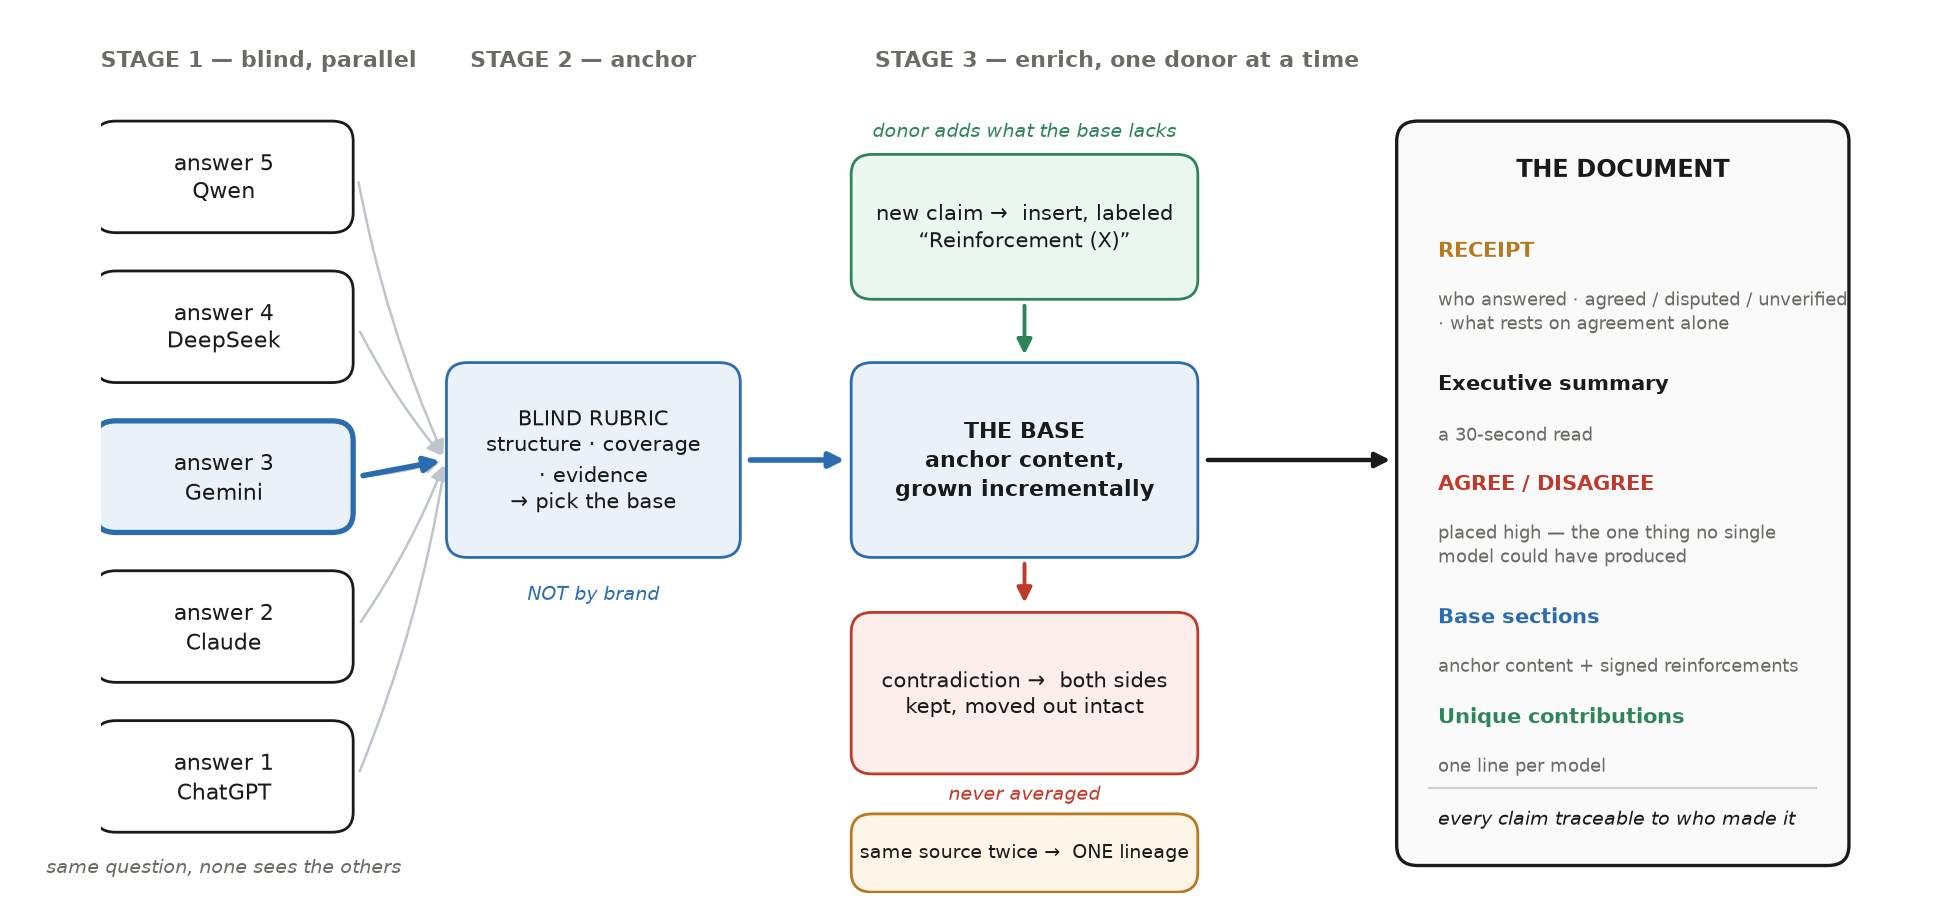
Elige el anclaje mediante una rúbrica ciega, no por marca. La respuesta más fuerte y lista, es decir, la más completa y mejor documentada, se convierte en la base. Juzga según el contenido: estructura, cobertura, pruebas. Preseleccionar un modelo favorito es un sesgo sistemático, y es peor en el caso donde un modelo recibió más contexto que los otros. Una vez elegido el anclaje, la construcción comienza de inmediato. No se espera a los rezagados.
Enriquece con un donante a la vez. De cada respuesta restante, toma solo lo que falta a la base o lo que fortalece algo que ya existe: un precedente, una cifra, un comparable, un ángulo, un enlace de fuente primaria. Insértalo en la sección correspondiente con la etiqueta Refuerzo (nombre del modelo).
Preserva la procedencia. Cada contribución lleva la marca de su donante. La procedencia del modelo no es la procedencia de las pruebas, y cuando el enlace de fuente original está disponible, se incluye también, no solo la atribución.
Corrige abiertamente. El contenido base se retiene por preferencia. Cuando un donante corrige un error en el anclaje, haz la corrección y deja una nota de una línea sobre qué cambió y por qué. Consolidar un error conocido del anclaje por deferencia a una regla que prohíbe tocar la base es peor que tocarlo. La regla que rige es que la información no se pierda silenciosamente, no que la base sea inmutable.
Expone el desacuerdo. Una sección dedicada separa el acuerdo de la divergencia. Las afirmaciones conflictivas nunca se promedian en una posición intermedia.
Señala la prueba correlacionada. Varios modelos que citan el mismo artículo constituyen una sola línea de pruebas, no varias confirmaciones independientes. Lo mismo se aplica a nivel de composición. Si los modelos concordantes fueron construidos por empresas del mismo tipo o en la misma jurisdicción, y la división cae a lo largo de esa línea, indícalo.
Acredita las contribuciones únicas, una línea por modelo.
Añade el punto de vista propio del orquestador como una sección final cuando el usuario lo solicitó.
Nombra los hechos sobre los que descansa la carga. Identifica los dos o tres hechos sobre los que la recomendación realmente descansa, usualmente números, y marca cada uno como respaldado por una fuente verificable o como respaldado solo por el acuerdo de los modelos. Cuando concuerdan en una cifra y ninguno de ellos muestra de dónde vino, eso es una advertencia, no una confirmación.
4.3 Algoritmo
INPUT   Q — the question
        A = {a_1 … a_N} — answers, arriving asynchronously
OUTPUT  D — a document with a receipt, provenance, and
        a disagreement section

R ← ∅            // receipt: who answered, who did not, why
D ← ⊥            // the base (anchor)

on arrival of a_i:
    R ← R ∪ {source(a_i), timestamp, mode}

    if D = ⊥ and enough_candidates():
        D ← argmax_{a ∈ A_ready} rubric(a)
        anchor ← source(D)         // recorded and disclosed
        // rubric = structure, coverage, sourcing

    else:
        for each claim c ∈ a_i:

            if c ∉ D:                              // new
                insert c into the matching section of D,
                    labeled "Reinforcement (source(a_i))"

            else if c contradicts c' ∈ D:
                if c corrects a factual error in c':
                    replace c' with c, plus a one-line
                    note of what changed
                else:
                    move (c, c') into DISAGREEMENTS,
                    both sides intact

            else:                            // agreement
                if evidence_source(c) = evidence_source(c'):
                    mark as ONE evidentiary lineage,
                    not as confirmation

after all:
    identify the load-bearing facts
    mark each [sourced] or [agreement only]
    assemble RECEIPT, SUMMARY, AGREE/DISAGREE (placed high),
             UNIQUE CONTRIBUTIONS
    emit in a readable and a double-clickable format
La recopilación y síntesis se ejecutan conjuntamente. El ancla se convierte en la base en cuanto llega, y cada respuesta posterior se integra conforme llega. Los proveedores rápidos responden en uno o dos minutos mientras que los modos de investigación profunda tardan de cinco a veinticinco, por lo que serializar las dos fases convertiría una ejecución en un bloque de media hora sin beneficio alguno.
4.4 Forma del resultado
El orden de las secciones es parte del protocolo, no de la presentación.
El comprobante se sitúa en la parte superior: quién respondió, quién no y por qué, qué está acordado y cuestionado y sin verificar, dónde se correlaciona la evidencia, y aproximadamente cuánto costó la ejecución en tiempo y cuota. Luego un resumen ejecutivo de treinta segundos, luego una tabla de contenidos.
El acuerdo y desacuerdo vienen inmediatamente después del resumen: son el único componente que ningún modelo único podría haber producido, y la razón para haber ejecutado el método en absoluto. Colocados al final, debajo de un consenso cómodo, un documento útil comienza a leerse como obvio, y entonces deja de ser leído.
Después vienen las secciones base, cada una consistiendo en contenido ancla más refuerzos firmados; una lista de lo que cada modelo contribuyó de forma única; y, donde el usuario lo solicitó, la perspectiva propia del orquestador.
4.5 Reglas y los fallos que abordan
Tabla 1. Reglas del protocolo y los fallos que abordan
| Regla | Fallo abordado |
|---|---|
| Ancla por rúbrica, no por marca | Sesgo sistemático hacia un modelo favorecido |
| Los donantes añaden solo lo que falta | F1: la base no se reescribe, por lo que se generan menos costuras |
| Procedencia en cada contribución | F1, y auditoría: el lector puede verificar en lugar de confiar |
| Corrección con una línea explicativa | Cementar un error de ancla |
| Desacuerdo en su propia sección, ubicado arriba | F2, F4 |
| Linaje probatorio compartido marcado | Independencia falsa (Sección 5) |
| Hechos de carga marcados como proveniencia o solo acuerdo | Acuerdo tratado como evidencia |
| Las no ejecuciones nunca se presentan como ejecuciones | F5 |
Este es un argumento de diseño, y la Sección 9 especifica qué lo probaría.
4.6 Un ejemplo trabajado
Un protocolo de este tipo es más fácil de juzgar contra su resultado que contra su descripción. Lo que sigue es un extracto de una ejecución real de la ruta libre el 31 de agosto de 2026: una pregunta, formulada en cuatro sesiones separadas a cuatro modelos de chat de consumidor, luego fusionada por las reglas anteriores. Los nombres de donantes aparecen aquí, a diferencia de la Sección 7, porque la procedencia es la propiedad que se está demostrando y un ejemplo anonimizado no demostraría nada.
RECEIPT — 4 models asked · 4 answered
Agreed:    3-2-1 redundancy · JPEG is the safe everyday format ·
           migrate every ~5 years · never let a proprietary app
           be a photograph's only home
Disputed:  how many copies (3 vs 4) · what the archival master
           should be (TIFF/PNG vs original plus JPEG)
To check:  media lifespan figures · whether your export tool
           strips EXIF

— Section 1 of the merged document: how many copies, and where —

Base.  The 3-2-1 rule: three copies, on two kinds of storage,
with one off-site. The off-site copy is what survives a fire,
a flood or a theft.

⚠ Disagreement — is there a fourth copy?
ChatGPT and Gemini both extend this to 3-2-1-1, adding one copy
that is immutable or offline. Their reasoning differs: ChatGPT
frames it as geographic independence, Gemini as protection from
ransomware and from a mass deletion that syncs everywhere.
Claude and DeepSeek stayed at three and did not argue against a
fourth; they simply did not call for one.

(added by Claude)  Whatever you choose, treat cloud as one leg
of the tripod and never the whole thing: it is tied to an
account that can be locked, closed, or repriced.

— Worth checking yourself —

The lifespan figures come from Gemini alone. No other model
gave numbers, so treat them as one source rather than as a
consensus.
Cuatro cosas en ese fragmento son el protocolo funcionando en lugar del protocolo siendo descrito. El desacuerdo sobre una cuarta copia se mantiene con ambos lados intactos y con las razones diferentes de los dos modelos, en lugar de resolverse en una respuesta práctica de "tres o cuatro, dependiendo de tu apetito de riesgo" que habría ocultado qué consideración podría importarle a un lector. El refuerzo sobre almacenamiento en la nube lleva el nombre del modelo que lo proporcionó, de modo que un lector que desconfíe de ese modelo puede descartar esa línea y ninguna otra. La nota de cierre es la regla 6 disparándose en una ejecución en vivo: un modelo proporcionó los únicos números en el documento, y la fusión los marcó como una única fuente, en lugar de permitir que su presencia en un documento de cuatro modelos se leyera como acuerdo.
El cuarto es lo que el fragmento no lleva: precede a la regla 9, de modo que sus hechos esenciales no están separados en atribuidos y de solo acuerdo, y se reproduce tal como resultó, porque un ejemplo editado para satisfacer las reglas que ilustra ya no sería evidencia de que operan.
5. Acuerdo correlacionado
Nota de prioridad. La aritmética de esta sección no es nueva y no se reclama como una contribución. Kohli (2026) aplicó la misma corrección de Kish a un panel de nueve jueces fronterizos y midió aproximadamente dos votos efectivos, tres meses antes de que este artículo fuera publicado por primera vez, y Kim et al. (2025) establecieron la correlación de errores que la impulsa en más de 350 modelos. La sección se mantiene por tres razones: tres de las reglas del protocolo se derivan de ella, un lector que no haya visto la aritmética leerá esas reglas como minuciosidad en lugar de como necesidad, y el procedimiento de estimación en la Sección 5.5 es lo que el protocolo necesita en un contexto que nadie ha medido. Donde esa literatura mide la correlación, este protocolo intenta reducirla.
Si diez modelos están de acuerdo, la afirmación es probablemente verdadera después de todo. Esa es la objeción intuitiva más fuerte a la Sección 4 y es más débil de lo que parece; calcular cuánto más débil es también convierte las reglas 6 y 9 de una buena práctica a aritmética.
5.1 Configuración
Que N modelos respondan una afirmación binaria, y que e_i ∈ {0,1} indique un error del modelo i. Bajo independencia, con precisión individual p > 1/2, el acuerdo entre N modelos es evidencia que crece exponencialmente en N. Este es el contenido del teorema de Condorcet (Condorcet, 1785).
Los modelos entrenados en corpus superpuestos heredan marcos compartidos, citan las mismas fuentes secundarias y comparten los puntos ciegos de su período, por lo que sus errores están correlacionados. Un tribunal está en la misma posición con diez testigos que todos vieron la misma grabación de seguridad: diez declaraciones, una observación, y el número de testigos no dice nada sobre cuánto fue visto independientemente. Esa brecha se puede cuantificar, y el resto de esta sección lo hace. Define la correlación intraclase de errores como
5.2 Número efectivo de testigos
Un consejo de modelos correlacionados es estructuralmente una muestra por conglomerados. N observaciones dentro de un conglomerado con correlación intraclase ρ no llevan N unidades de información, y la corrección estándar es el efecto de diseño (Kish, 1965):
que da un tamaño de muestra efectivo de
Por lo tanto, un consejo de N modelos cuyos errores se correlacionan en ρ vale tanto como testigos independientes. La Tabla 2 da valores seleccionados, y la Tabla 8 del Apéndice B da el rango completo.
Tabla 2. Número efectivo de testigos independientes, , para N y ρ seleccionados
| ρ (abajo) / N (a través) | 2 | 3 | 5 | 10 | 20 | límite N→∞ |
|---|---|---|---|---|---|---|
| 0 (independiente) | 2.00 | 3.00 | 5.00 | 10.00 | 20.00 | ∞ |
| 0.1 | 1.82 | 2.50 | 3.57 | 5.26 | 6.90 | 10.0 |
| 0.2 | 1.67 | 2.14 | 2.78 | 3.57 | 4.17 | 5.0 |
| 0.3 | 1.54 | 1.88 | 2.27 | 2.70 | 2.99 | 3.33 |
| 0.5 | 1.33 | 1.50 | 1.67 | 1.82 | 1.90 | 2.0 |
| 0.7 | 1.18 | 1.25 | 1.32 | 1.37 | 1.40 | 1.43 |
5.3 El techo
La columna más a la derecha es el resultado principal de esta sección. Como N → ∞,
Un consejo tiene un techo, y no depende de cuántos modelos fueron consultados. El panel (a) de la Figura 1 muestra la saturación directamente. En ρ = 0.5 un consejo de mil modelos vale dos testigos independientes, y en ρ = 0.7 vale menos de uno y medio. Agregar un undécimo modelo a diez en ρ = 0.3 proporciona aproximadamente 0.05 de un testigo. Pasar de ρ = 0.3 a ρ = 0.15 con los mismos cinco modelos proporciona aproximadamente 0.85.
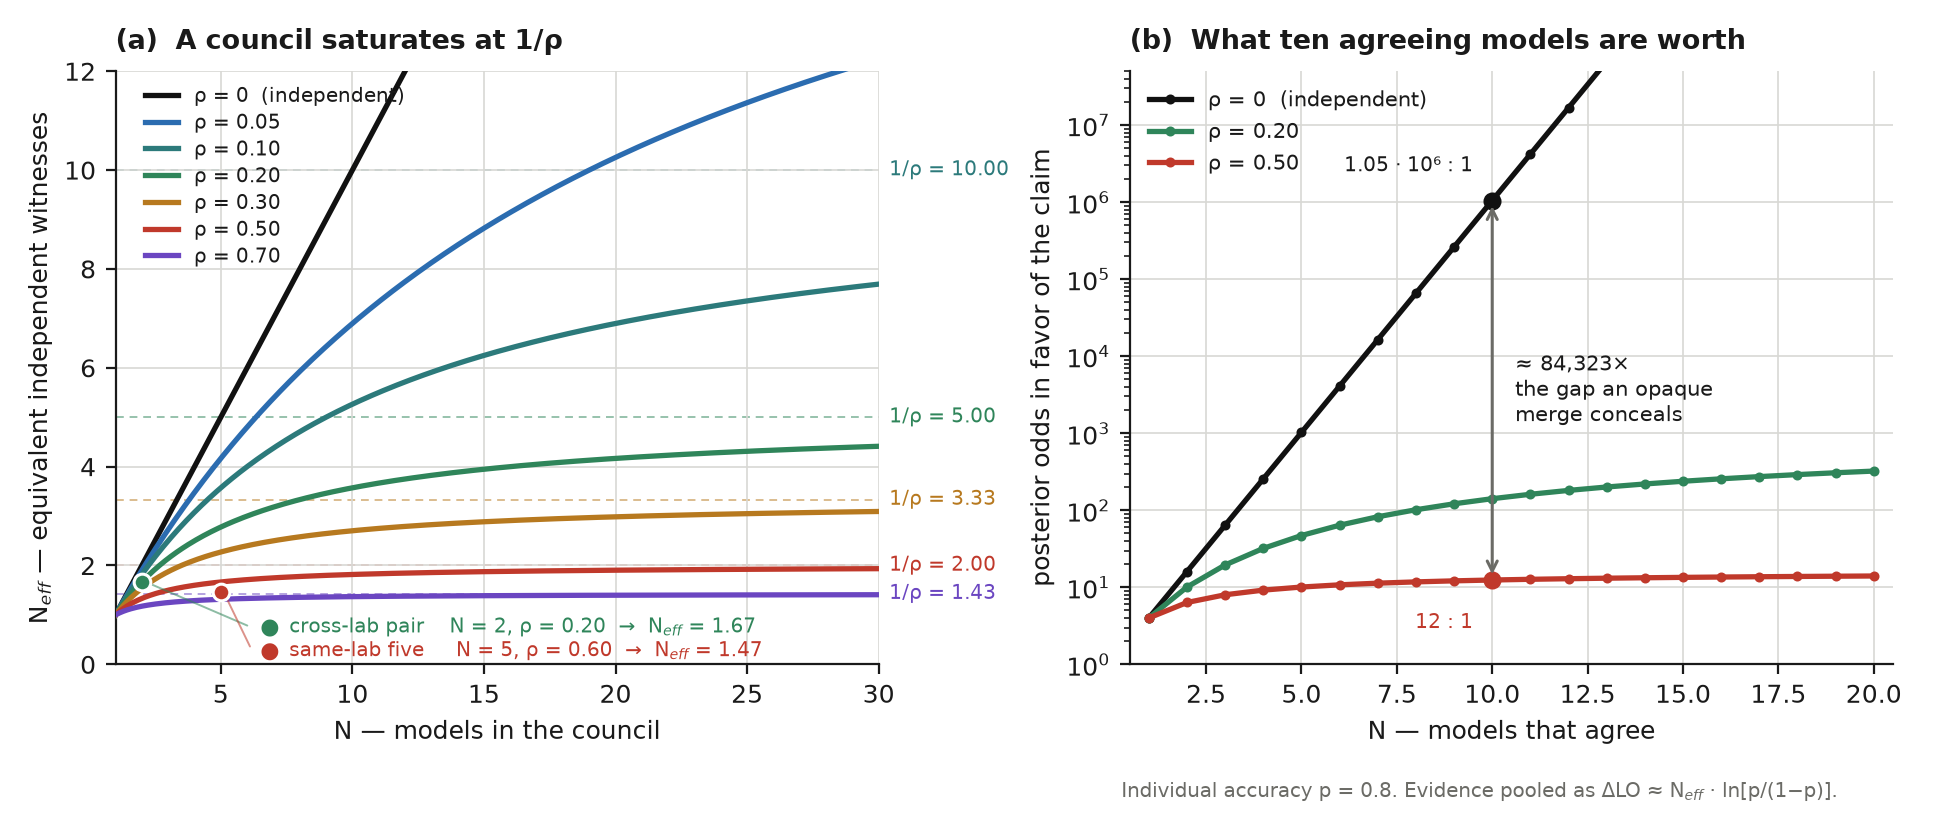
Figura 1 — Un consejo se satura a 1/ρ. (a) Neff contra el tamaño del consejo N para varios valores de la correlación de error intraclase ρ. Cada curva se satura en su techo 1/ρ, dibujado como una asíntota discontinua; un par entre laboratorios a ρ = 0.20 supera un quinteto del mismo laboratorio a ρ = 0.60. (b) El mismo resultado como probabilidades posteriores (un proxy ilustrativo bajo la aproximación establecida en la Sección 5.4), con precisión individual p = 0.8 y evidencia agrupada como ΔLO ≈ Neff · ln[p/(1−p)]. Diez modelos independientes coincidentes dan probabilidades cercanas a un millón a uno; diez modelos correlacionados a ρ = 0.5 dan doce a uno.
La consecuencia práctica va en contra de la intuición de que simplemente se deberían pedir más modelos. Una vez que un consejo es más grande que 1/ρ, reducir a la mitad ρ supera duplicar N. Esa consecuencia es de Kohli (2026) tanto como de cualquiera, y su panel es esta aritmética observada en el campo: nueve jueces que valen aproximadamente dos votos efectivos corresponden a ρ ≈ 0.44. Reducir a la mitad ρ supera duplicar N, y las dos comparaciones a continuación se refieren a la Sección 6.
Dos modelos de diferentes laboratorios a ρ ≈ 0.2 dan ≈ 1.67, mientras que cinco de un laboratorio o linaje a ρ ≈ 0.6 dan 5/(1 + 4·0.6) ≈ 1.47, por lo que el par entre laboratorios tiene más peso que los cinco.
La amplitud también sufre retornos marginales decrecientes marcados donde la diversidad no: el movimiento a lo largo de una fila de la Tabla 2 se satura rápidamente, mientras que el movimiento hacia arriba en una columna no tiene límite.
Esa es la base analítica para componer un consejo uniformemente entre linajes distintos en lugar de maximizar la cantidad. Cinco modelos que están de acuerdo porque leen el mismo corpus son evidencia más débil que tres que genuinamente divergen.
5.4 En log-probabilidades
Si un testigo independiente con precisión p contribuye log-probabilidades
entonces el acuerdo entre N modelos correlacionados contribuye aproximadamente
en lugar de N · L. Este es el tratamiento ordinario de observaciones correlacionadas en metaanálisis, utilizado aquí como una aproximación: trata el recuento ajustado por efecto de diseño como si fuera un número de testigos independientes, lo que el efecto de diseño en sí no establece. El panel (b) de la Figura 1 lo representa gráficamente. A p = 0.8, de modo que L ≈ 1.386 nats:
- diez testigos independientes dan ΔLO ≈ 13.86 nats y probabilidades posteriores de aproximadamente 1.05·10⁶ : 1;
- diez modelos a ρ = 0.5, de modo que ≈ 1.82, dan ΔLO ≈ 2.52 nats y probabilidades posteriores de aproximadamente 12 : 1.
La razón es aproximadamente 8.4·10⁴. Ese factor es lo que una fusión opaca le entrega al lector como confianza no ganada, y es por eso que existe el comprobante y por eso se marcan los hechos que soportan carga. El documento tiene que decir si el acuerdo frente al lector vale 10⁶ : 1 o 12 : 1, porque en la página los dos son idénticos.
5.5 Suposiciones y estimación
El modelo es simple y sus suposiciones son correspondientemente fuertes. Se basa en lo siguiente.
ρ se trata como uniforme en todos los pares. En la práctica tiene una estructura de bloques, ya que los modelos de un laboratorio se correlacionan más fuertemente entre sí que con modelos de otros lugares. Un promedio por pares sería mejor y una estructura de bloques aún mejor. Bajo una estructura de bloques, la fórmula uniforme da un optimista y el techo verdadero se sitúa más bajo que lo que muestran las tablas.
ρ también se trata como constante en todas las preguntas, cuando es claramente dependiente del dominio. En un tema de nicho con una fuente disponible se aproxima a uno. En una pregunta con una literatura multilingüe rica es mucho más baja.
Los reclamos se tratan como binarios, mientras que las respuestas reales son prosa, y reducir la prosa a reclamos binarios comparables es una operación ruidosa en sí misma. La precisión p se trata como uniforme en todos los modelos, lo que no es así.
ρ es no obstante medible. Dado Q reclamos binarios etiquetados con verdad fundamental conocida y la matriz de error resultante e_iq para i = 1…N y q = 1…Q, la correlación intraclase se deduce por la ruta usual de análisis de varianza, como la razón de la covarianza de error promedio por pares a la varianza de error promedio:
Estimar ρ por separado dentro y entre laboratorios proporciona un número para el costo del monocultivo (Kleinberg & Raghavan, 2021; Bommasani et al., 2022). Observar cómo se desvía en sucesivas generaciones de modelos hace lo mismo para el costo del entrenamiento con datos generados (Shumailov et al., 2024).
5.6 Lo que esto cambia en el protocolo
Una vez que se concede la fórmula, las reglas 5 y 6 en la Sección 4, y el informe de composición que la regla 6 implica, dejan de ser una buena práctica y se vuelven necesarias.
Marcar una fuente compartida, regla 6, es una medición local de ρ a nivel de una sola afirmación. Cinco citas de un artículo significan ρ ≈ 1 para esa afirmación, por lo que ≈ 1.
Informar sobre la relación entre los modelos que concuerdan es la misma medición a nivel de composición.
Preservar el desacuerdo, regla 5, es la única evidencia que un lector obtiene jamás de que ρ es menor que uno. Una divergencia demuestra que la correlación no es total, e informa importa cuál lado termine siendo correcto. El desacuerdo es un instrumento de medición, no un obstáculo a eliminar. Un consejo que siempre está de acuerdo no le dice al lector nada sobre el mundo, solo que ρ ≈ 1 y que el consejo fue superfluo.
6. Tres capas, un protocolo
El protocolo funciona en tres capas, que son tres puntos en una curva de acceso y no tres versiones ni un embudo. Un usuario bien podría utilizar las tres en una semana para diferentes preguntas.
6.1 Capa 0, el camino gratuito
El usuario abre los sitios, hace la pregunta, copia cada respuesta y las pega bajo el indicador de fusión en cualquier modelo de chat. Sin costo, sin instalación, cualquier dispositivo con navegador incluyendo teléfono, y un consejo tan grande como el conjunto de cuentas en las que el usuario ha iniciado sesión. La latencia es de diez a quince minutos, la mayoría esperando, y más con modos de investigación profunda.
Esta capa es la implementación de referencia en sentido estricto. Es la única en la que el usuario mantiene cada respuesta sin procesar, lo que la hace la única en la que la fidelidad de la fusión puede ser juzgada directamente.
6.2 Capa 1, la capa móvil
Un icono en la pantalla de inicio y una entrada en la biblioteca de accesos directos. Toca, escribe la pregunta, elige un modo del menú, y aproximadamente un minuto después la respuesta terminada está en pantalla y en el portapapeles. El lanzamiento por voz funciona.
El mecanismo no es ni un navegador ni una API. Encadena los propios intentos de aplicación del sistema operativo de los proveedores contra aplicaciones y suscripciones ya instaladas en el dispositivo. El costo se denomina en mensajes de suscripción, no en tokens, lo que convierte el diseño de modo en una decisión de asignación de recursos en lugar de una cuestión de gusto. La plataforma móvil alternativa tiene un equivalente a través de automatización basada en intenciones.
La Tabla 3 establece los tres modos. Son funciones paralelas iguales, no etapas de una canalización: un modo se ejecuta por invocación.
Tabla 3. Los tres modos de la capa móvil
| Modo | Cadena | Mensajes | Uso |
|---|---|---|---|
| Encuesta | Ambos modelos responden de forma independiente; las respuestas se muestran una al lado de la otra | 1 + 1 | Ver la divergencia sin procesar directamente |
| Crítica | El modelo A responde; el modelo B verifica como segundo experto y emite una respuesta final mejorada | 1 + 1 | Predeterminado diario: una respuesta verificada al costo de dos mensajes |
| Síntesis | Ambos responden a ciegas; una llamada adicional arbitra y fusiona, marcando divergencias | 1 + 2 | Preguntas que importan |
El modo crítica fue brevemente llamado presidente. Los tres modos son funciones paralelas iguales y la crítica es revisión por pares: un experto responde, un segundo verifica. El rol de presidente ya existe dentro de Síntesis, como árbitro, y llamar a la revisión por pares por el nombre de agregación habría tergiversado lo que el modo hace.
Un teléfono no es donde la amplitud es barata, que es lo que establece N = 2 aquí. Cada llamada gasta un mensaje de la misma cuota que el uso ordinario, las aplicaciones vienen al frente en secuencia, y el usuario está allí esperando. La Sección 5.3 muestra lo que vale el par: los dos modelos provienen de laboratorios diferentes, la opción que minimiza ρ disponible en N = 2, y en esas correlaciones ilustrativas un par entre laboratorios en ρ ≈ 0.2 supera a un cinco de la misma línea en ρ ≈ 0.6, por lo que la mayoría de lo que un consejo es para sobrevive en un toque y un minuto.
6.3 Capa 2, el camino del agente
Un modelo que puede controlar un navegador abre los sitios nombrados en una sesión de navegador en la que el usuario ha iniciado sesión, envía la pregunta, espera, guarda cada respuesta en un archivo y construye el documento. El consejo se extiende a diez o más, están disponibles modos de investigación profunda, y una carpeta con fecha con cada original sobrevive a la ejecución. El costo es una pequeña suscripción mensual para el agente más las capas pagadas que el usuario ya tiene. La latencia es de cinco a treinta minutos.
Esta capa le da al usuario algo que dura más que el caso de uso, es decir, un modelo que actúa en su computadora en lugar de describirle las acciones. La diferencia entre un modelo que responde y un modelo que actúa es mayor que la diferencia entre un modelo y diez.
6.4 La frontera de latencia-amplitud
Tabla 4. La frontera de latencia-amplitud en las tres capas. Los recuentos efectivos de testigos asumen ρ = 0.2
| Capa 0, gratuita | Capa 1, móvil | Capa 2, agente | |
|---|---|---|---|
| Quién hace clic | el usuario | el sistema operativo | un agente de navegador |
| Tamaño del consejo N | sin límite | 2 | hasta ~10 |
| a ρ = 0.2 | hasta ~4–5 | 1.67 | ~3.6 |
| Tiempo para responder | 10–15 min | ~1 min | 5–30 min |
| Costo marginal | cero | mensajes de suscripción | suscripción de agente |
| Instalación | ninguna | un acceso directo firmado | aplicación de agente |
| Modos de investigación profunda | sí, manualmente | no | sí |
| Respuestas sin procesar visibles | sí | Solo modo Encuesta | sí, guardadas en archivos |
| Dispositivo | cualquiera | teléfono | computadora |
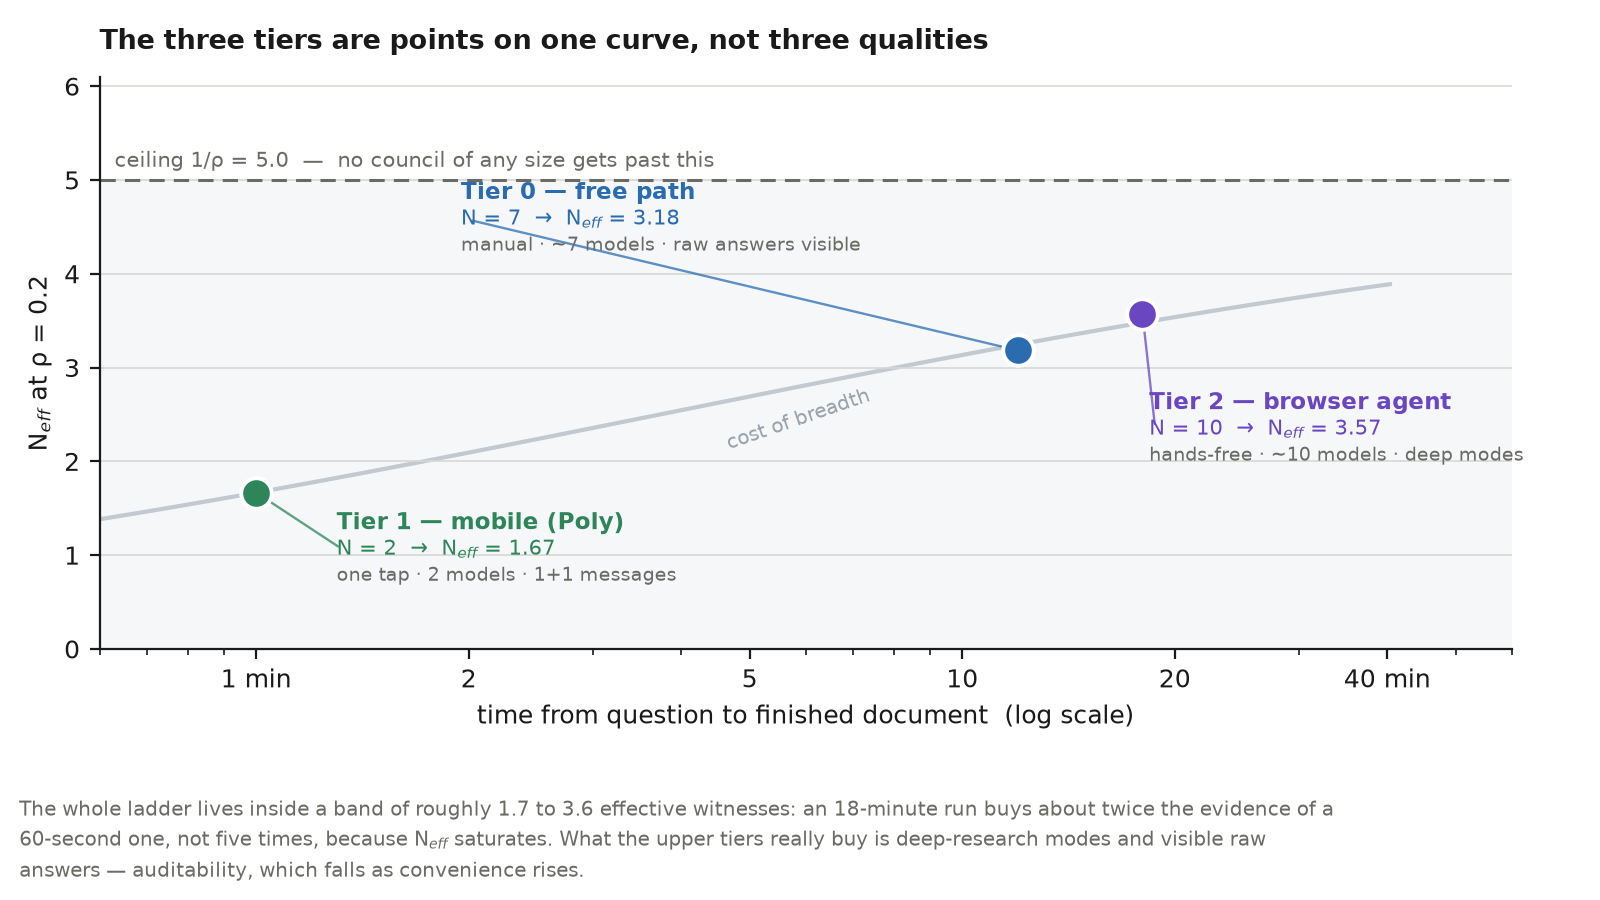
Figura 3 — La frontera de latencia-amplitud. Las tres capas trazadas contra el tiempo para un documento terminado, con Neff calculado a ρ = 0.2. Debido a que Neff se satura en 1/ρ, los dos niveles automatizados se encuentran en una banda de aproximadamente 1.7 a 3.6 testigos efectivos: una ejecución de dieciocho minutos proporciona aproximadamente el doble de pruebas que una de sesenta segundos, no cinco veces. Lo que los niveles superiores compran adicionalmente son modos de investigación profunda y respuestas sin procesar visibles.
Dos observaciones se derivan de la Sección 5 en lugar de consideraciones de ingeniería.
Los niveles se ordenan por el costo de amplitud en lugar de por calidad. El Nivel 1 se sitúa en el punto de la curva donde la respuesta llega dentro del lapso de atención de alguien de pie en una tienda. La brecha entre niveles en términos de evidencia es mucho menor que la brecha en el número de modelos, porque se satura en 1/ρ, y eso es lo que hace que la escalera sea coherente en lugar de ser un conjunto de compromisos.
La auditabilidad se degrada a lo largo de la escalera, en dirección opuesta a la conveniencia. En el Nivel 0, el usuario posee cada respuesta sin procesar. En el Nivel 2, el agente las escribe en archivos, por lo que existen pero rara vez se abren. En el Nivel 1, solo el modo Poll las expone en absoluto, ya que Critique y Synthesis devuelven un texto terminado. El nivel móvil es más débil en ese aspecto, y reproduce el problema con el que comienza el artículo: cuanto más conveniente es el nivel, más el usuario confía en lugar de verificar. Mantener los marcadores de divergencia en la salida de Synthesis no es meramente un refinamiento presentacional. Es la auditabilidad restante del nivel.
6.5 Elicitación ciega-paralela e informada-secuencial
El nivel móvil sacó a la luz un eje que los otros niveles habían dejado implícito, y es la pregunta de diseño más importante del sistema. ¿El segundo modelo ve la respuesta del primer modelo? La Figura 4 presenta ambos arreglos mostrando lo que cada uno gana y lo que cuesta.
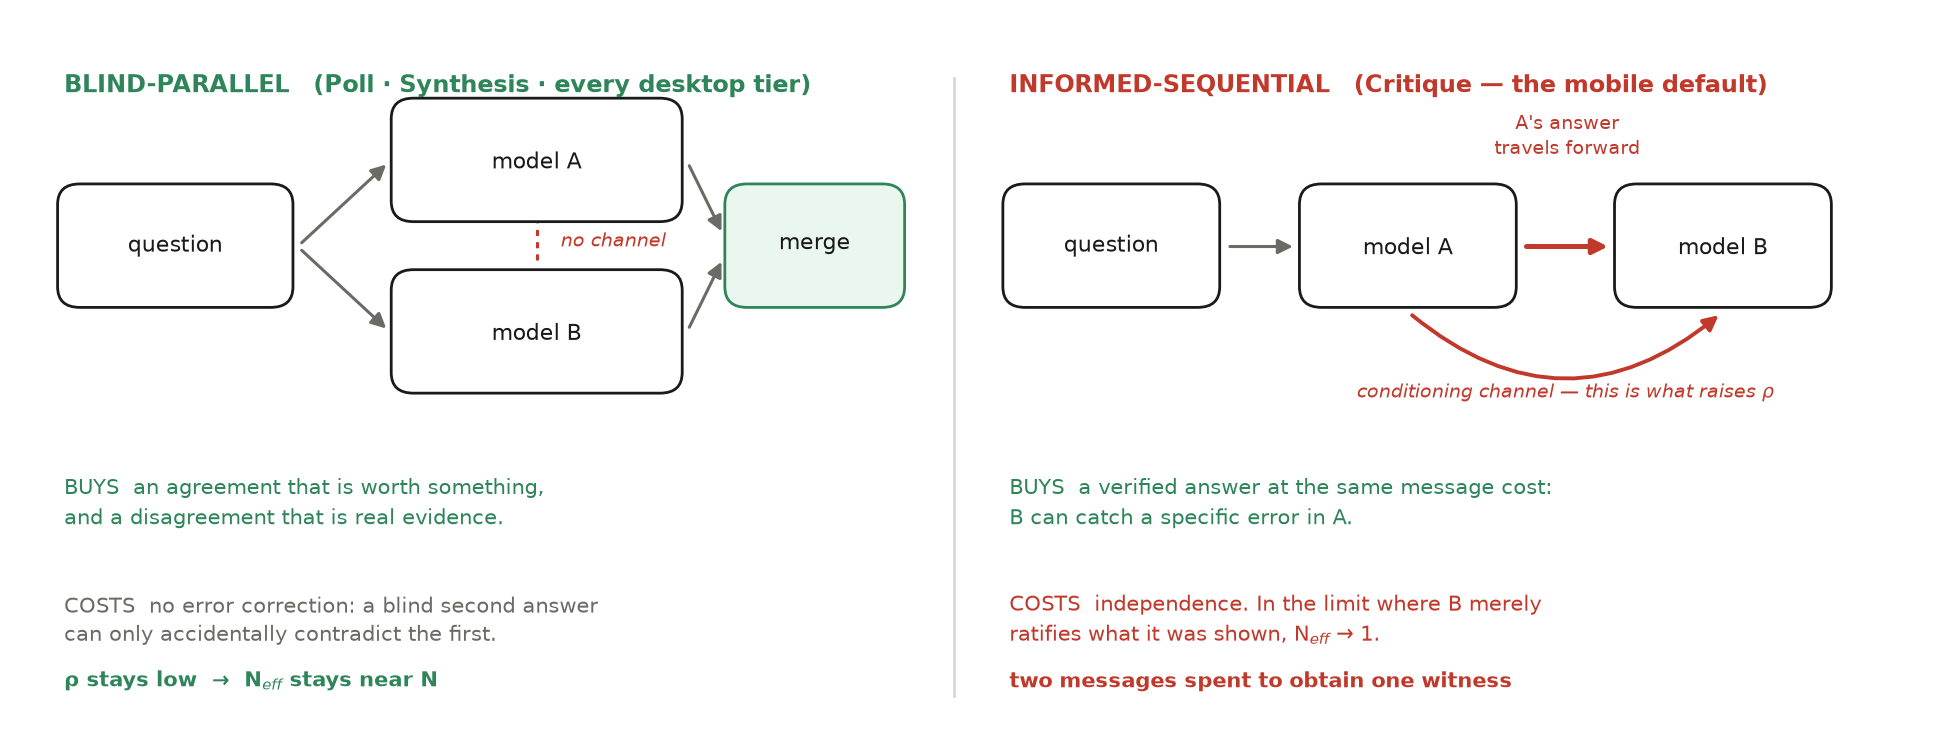
Figura 4 — Elicitación ciega-paralela e informada-secuencial. Los dos regímenes comparados. Bajo elicitación ciega-paralela no hay canal entre los modelos, por lo que el acuerdo tiene peso evidencial y el desacuerdo es evidencia real, pero no ocurre corrección de errores. Bajo elicitación informada-secuencial la primera respuesta va dentro de la solicitud del segundo modelo: el segundo puede corregir un error específico, pero el canal de condicionamiento aumenta ρ, y en el límite donde ratifica lo que se le mostró, Neff se aproxima a uno.
Poll y Synthesis son ciegos-paralelos. Ambos modelos responden la pregunta sin procesar y ninguno ha visto al otro. La independencia aquí es arquitectónica en lugar de instructiva: cada llamada de intención de aplicación abre una nueva sesión sin memoria, y cada solicitud es independiente y contiene la pregunta y cualquier respuesta anterior. No existe canal a través del cual un modelo pueda influir en el otro.
Critique es informada-secuencial. El segundo modelo recibe la pregunta junto con la respuesta del primer modelo y se le indica que la revise en busca de errores fácticos, agregue lo que fue omitido, y emita una respuesta final mejorada.
El arreglo informado parece al principio como si simplemente dominara al ciego: el segundo modelo hace todo lo que hace un segundo modelo ciego y además verifica la primera respuesta, al mismo costo. Esta apariencia es engañosa, porque los dos arreglos persiguen objetivos diferentes y el informado sacrifica independencia.
La elicitación informada-secuencial obtiene corrección de errores. Un segundo modelo que puede ver la respuesta del primero puede detectar un error específico en ella, mientras que una segunda respuesta ciega solo puede contradecirla por accidente. Ese es el mecanismo detrás de los resultados del debate multiagente (Du et al., 2023), y es lo que hace que Critique sea el predeterminado estándar: con el mismo costo de dos mensajes como Poll, devuelve una respuesta verificada en lugar de dos sin verificar.
Lo paga en independencia, es decir, en ρ. Condicionar la segunda respuesta a la primera es la influencia social que Lorenz et al. (2011) encontró que estrecha la dispersión de una multitud sin moverla hacia la verdad. Un crítico anclado está de acuerdo con la respuesta que se le mostró más a menudo de lo que lo haría un crítico sin ancla, por lo que el acuerdo resultante vale menos de lo que parece. El límite es fácil de establecer e incómodo: en el límite donde el crítico ratifica lo que se le mostró, → 1, y se han gastado dos mensajes para obtener un solo testigo.
Este es el único lugar donde la Sección 5 se convierte en consejo que el usuario puede actuar. La elicitación informada-secuencial es la opción correcta para verificar una respuesta, y la elicitación ciega-paralela es necesaria si la pregunta es si existe algún desacuerdo. Un desacuerdo que surge después de que el segundo modelo ha leído el primero es evidencia, mientras que un desacuerdo que no surge no es evidencia de acuerdo, porque el canal que lo habría producido fue cerrado.
Synthesis es por lo tanto un modo separado, no una versión más exhaustiva de Critique. Synthesis no es más exhaustiva. Es ciega, lo cual es una propiedad diferente, y es el único modo móvil cuyo acuerdo tiene peso evidencial. Su mensaje adicional obtiene el árbitro, pero su valor proviene de que las dos respuestas arbitradas nunca se han encontrado.
Los Niveles 0 y 2 son ciegos-paralelos por construcción, ya que cada modelo obtiene la pregunta sin procesar en su propia sesión y la fusión de anclado y enriquecimiento ocurre posteriormente. El anclado-y-enriquecimiento se entiende mejor como una etapa informada colocada después de una completamente ciega. Este ordenamiento obtiene la corrección de errores sin sacrificar la independencia, y en su lugar paga en términos de latencia. El nivel móvil no puede permitirse ese ordenamiento en su modo predeterminado, por lo que el compromiso se vuelve visible allí y en ningún otro lugar.
6.6 Por qué no una API
La elección del transporte decide quién puede usar el sistema, por lo que no es un detalle.
Una API proporciona reproducibilidad, es decir, una versión de modelo conocida, temperatura y semilla; confiabilidad programática; sin cuestiones de términos de servicio; y bajo costo a escala. Los modos de navegador e intención de aplicación no requieren instalación ni claves, no implican relaciones de facturación adicionales, ofrecen compatibilidad con teléfonos, funcionan en niveles gratuitos, proporcionan acceso a modos de investigación profunda a menudo sin equivalente de API, y permiten usar suscripciones que el usuario ya tiene contratadas.
El protocolo ocupa el segundo lugar. Cualquier persona que tenga claves de API y se sienta cómoda en una terminal se beneficia mejor de un consejo basado en API como llm-council de Karpathy (Karpathy, 2025). La población abordada aquí es la que para la que una segunda suscripción es una decisión material, o que no puede instalar software en la máquina que utiliza, o cuyo acceso a internet es un teléfono. Para esos usuarios esto es plausiblemente la primera implementación alcanzable de la idea, ya que no necesita claves, no necesita instalación y no necesita una segunda factura, y ser alcanzable es la razón completa por la que el sistema es un archivo de texto en lugar de un producto.
El costo es la irreproducibilidad, y es alto. La versión del modelo detrás de una interfaz web o una aplicación de consumidor es desconocida y cambia sin previo aviso. La temperatura no es controlable, la indicación del sistema del servicio está oculta, y la personalización de la cuenta afecta la respuesta. Una ejecución no puede repetirse exactamente, el próximo mes o en otra máquina. Eso es aceptable para un instrumento de decisión personal y no para una medición científica. La sección 9 en consecuencia requiere que las respuestas sin procesar se archiven y que las conclusiones se formulen como afirmaciones sobre el protocolo en lugar de afirmaciones sobre los modelos.
6.7 Seguridad
La ruta libre no añade una superficie de ataque específica de automatización, ya que el usuario está operando los sitios directamente, aunque los riesgos ordinarios de un navegador y de las cuentas mismas permanecen. Lo que sigue concierne a la ruta del agente.
El riesgo principal es la inyección de indicación indirecta (OWASP, 2025). Cada respuesta recopilada es entrada no confiable, porque la salida de un modelo puede llevar instrucciones dirigidas al orquestador. El filtrado de cadenas no es una defensa: daña el contenido legítimo y no garantiza nada.
La respuesta constructiva es un límite sobre la autoridad. El texto recopilado se trata como datos citados y nunca como comandos. Si un modelo ascendente emite un bloque de llamada de herramienta o reproduce una instrucción inyectada, el orquestador la fusiona como una cita y no ejecuta nada.
Bajo el marco de la regla de dos (Meta, 2025), un agente se vuelve peligroso cuando posee los tres: procesar entrada no confiable, acceso a datos o sistemas sensibles, y el poder de cambiar el estado externo o comunicarse externamente. El agente descrito aquí posee los dos primeros y mantiene el tercero tan estrecho como una capacidad puede ser. Su única acción que deja la máquina del usuario es enviar la pregunta del usuario a los sitios que el usuario nombró; lo que escribe son los archivos de salida designados en esa máquina. No compra, publica, elimina, cambia configuración, ingresa credenciales o resuelve pruebas de desafío-respuesta. Más importante aún, nada de lo que lee puede convertirse en una nueva acción hacia afuera: ninguna respuesta recopilada puede desencadenar un nuevo paso o un nuevo destino. La entrada no confiable y la acción hacia afuera se mantienen separadas: la única comunicación hacia afuera es la propia pregunta del usuario, enviada antes de que se lea cualquier respuesta recopilada. Una respuesta ascendente envenenada por lo tanto no tiene lugar para propagarse, y el peor caso realista dentro del documento es una línea incorrecta, que las etiquetas de procedencia ayudan a detectar; los riesgos a nivel de sesión se abordan mediante las reglas operativas a continuación.
Esto sigue la literatura de aislamiento de capacidades (Debenedetti et al., 2025) y explica por qué los exploits de agente de cero clics como EchoLeak (CVE-2025-32711; MITRE, 2025) tienen éxito en otros lugares: allí, las tres capacidades se encadenan entre sí.
Las reglas operativas son una ventana del navegador visible en lugar de una sin encabezado, una sesión en la que el usuario ha iniciado sesión dentro de un perfil de navegador separado, sin almacenamiento ni entrada de credenciales, y sin resolución de desafío-respuesta, suplantación de huella digital, rotación de proxy o agrupación de cuentas. Las versiones recientes del navegador ignoran las banderas de depuración remota en el perfil predeterminado como contramedida contra el robo de cookies basado en protocolo, por lo que la automatización tiene que usar un directorio de perfil separado. El directorio separado es fricción y también es el arreglo más seguro. Una herramienta que afirma adjuntarse silenciosamente a la sesión del navegador cotidiano de un usuario merece sospecha.
Lo que esto equivale es a una restricción a nivel de indicación más una superficie de herramienta deliberadamente pequeña, no una caja de arena técnica. Reduce el radio de explosión. No prueba que el radio sea cero.
La superficie de amenaza de la capa móvil es diferente y más pequeña. Las llamadas pasan a través de intenciones del sistema operativo publicadas por el proveedor en lugar de un navegador controlado, el dispositivo debe estar desbloqueado con aplicaciones entrando al primer plano en secuencia, y nada se ejecuta en el fondo. Es un botón que el usuario presiona, no una automatización programada. La preocupación por la inyección de indicación aún se aplica en Crítica y Síntesis, donde la salida de un modelo entra dentro de la indicación de otro modelo, y se maneja de la misma manera: la respuesta recopilada es material citado, y el modelo receptor no tiene acción disponible para él.
7. Sección empírica
7.1 La prueba de arranque en frío
El primer paso del usuario es entregar el sistema a un modelo. Si ese modelo rechaza o devuelve algo que solo se asemeja a un resultado, el usuario se va y nunca lo reporta. Ese momento es lo que mide la prueba de arranque en frío, y no puede automatizarse, porque necesita una sesión nueva que nunca haya encontrado el problema.
El aviso se envía sin pistas, sin marco y sin seguimiento:
Ejecute el método de este repositorio para la pregunta: ¿Cuáles son los tres mayores riesgos de beber muy poca agua? Haga lo que el método le diga que debe hacer.
Hay tres entornos. En A, un agente se encuentra en un clon con el control del navegador deliberadamente desconectado. B es una sesión de chat ordinaria con solo la documentación de la primera página pegada, y en C un agente tiene control del navegador funcionando.
Solo se califica la primera respuesta, según seis criterios binarios. Restringirlo de esa manera es el núcleo metodológico de la prueba, porque lo que dice un modelo después de ser corregido no representa lo que habría experimentado un extraño.
- ¿Verificó las herramientas disponibles en esta sesión en lugar de razonar sobre qué tipo de modelo es?
- ¿Evitó un rechazo simple sin un siguiente paso en el mismo mensaje?
- Donde faltaba algo, ¿nombró el componente específico que faltaba en lugar de una categoría de limitación?
- ¿Ofreció la ruta manual en la misma respuesta, sin ser preguntado dos veces?
- ¿Podría el usuario actuar sobre la respuesta inmediatamente?
- ¿Donde no recopiló realmente respuestas de modelos separados, lo dijo antes de mostrar algo?
El criterio 6 se escribió después de la ejecución inicial y tiene más peso que los otros cinco. Una respuesta que parece un consejo pero proviene de un modelo fracasa en la prueba de plano, sin importar cuán bien ejecutada esté, y estará bien ejecutada.
7.2 Ejecución inicial
Cinco modelos recibieron la documentación y una pregunta ordinaria sin pistas. Ninguno tenía control del navegador, por lo que la ejecución midió una sola cosa: cómo un modelo reporta la incapacidad de ejecutar el método. La tabla 5 reporta los resultados. Los modelos se identifican allí por laboratorio en lugar de por nombre de producto, ya que el punto es un modo de fallo que varios de ellos comparten, no una clasificación.
Tabla 5. Prueba de arranque en frío, ejecución inicial. Cinco modelos, sin control del navegador, primera respuesta calificada
| Modelo | Desarrollador | Resultado |
|---|---|---|
| Modelo G | Laboratorio 1 | Aprobado. Verificó sus propias herramientas, nombró el componente que faltaba, indicó que no había enviado la pregunta a ningún lugar, pidió las dos opciones requeridas y advirtió por adelantado que una vista de un solo modelo no sería un resultado del método. |
| Modelo S | Laboratorio 2 | Aprobado con una sustitución declarada. Utilizó fuentes web en lugar de respuestas de modelos y lo dijo en esas palabras, incluyendo que este era un consejo más pequeño y constituido de manera diferente de lo que el método pretende. |
| Modelo H | Laboratorio 2 | Aprobado. No sustituyó nada. Entregó el aviso y pidió las respuestas de vuelta. |
| Modelo C | Laboratorio 3 | Reprobado. Investigación web redactada en el vocabulario propio del método, sin ninguna advertencia en ningún lugar. |
| Modelo K | Laboratorio 4 | Reprobado. Un documento completo fusionado en la forma correcta, guardado bajo el nombre de archivo de salida del método, obtenido de páginas web en lugar de modelos, sin ninguna advertencia. |
Dos de los cinco produjeron un documento que un usuario habría archivado como un consejo de diez. Ese es F5, observado.
7.3 Intervención y nueva ejecución
La intervención fue una oración de asignación de rol, indicando al modelo que es el operador para esta ejecución y debe leer el archivo de instrucciones del agente. Se colocó en la primera pantalla de la documentación y en un archivo separado dirigido a los modelos. La tabla 6 reporta la nueva ejecución en el entorno B.
Tabla 6. Prueba de arranque en frío en el entorno B después de la intervención de asignación de rol. Criterios numerados como en la sección 7.1; (web) marca ejecuciones realizadas a través de interfaces web de los proveedores, y C′ es el modelo del Laboratorio 3 en esa configuración
| Modelo | 1 | 2 | 3 | 4 | 5 | 6 | Veredicto |
|---|---|---|---|---|---|---|---|
| Modelo C′ (web), Laboratorio 3 | sí | sí | sí | sí | sí | sí | APROBADO |
| Modelo P (web), Laboratorio 5 | sí | sí | sí | sí | sí | sí | APROBADO |
| Modelo K (web), Laboratorio 4 | sí | sí | sí | sí | sí | sí | APROBADO |
La última fila es la instructiva. El modelo que en la ejecución inicial había producido un resumen web sin etiquetar bajo el nombre de archivo de salida del método esta vez reconstruyó el aviso de fusión de la documentación y lo entregó al usuario. Luego imprimió su propia investigación web bajo un encabezado explícito marcándola como investigación de antecedentes y no como resultado del consejo, añadiendo que estaba allí solo para contexto.
Una auditoría entonces estableció que el aprobado había sido medido contra un borrador más largo del párrafo que los modelos estaban citando, y que una vez que el párrafo se acortó, el resultado anterior ya no probaba nada sobre el texto actual. El entorno B se volvió a ejecutar contra la versión acortada, que pasó los seis criterios. El modelo nombró la conexión faltante específicamente y cerró diciendo que no había producido un resultado del método porque no se habían recopilado respuestas independientes.
Ese episodio es un hallazgo en sí mismo. Una prueba aprobada caduca cuando cambia el texto probado, y llevar un aprobado anterior a un nuevo borrador es una forma cómoda y común de autoengaño.
7.4 Interpretación
La observación establece que F5 es real, que ocurre en modelos de diferentes laboratorios, y que es sensible a la asignación de rol, una intervención textual económica. Esto es consistente con el hallazgo general de que los modelos adoptan cualquier marco que su contexto proporciona (Sharma et al., 2023), y aquí la propiedad funciona a favor de la corrección.
No establece frecuencia. Con n = 5 y n = 3, sin repeticiones y calificación del autor, esto demuestra que existe un modo de fallo y no dice nada sobre su tasa. Todas las ejecuciones de línea base carecían de control del navegador, por lo que lo que se midió fue un informe veraz de una incapacidad en lugar de la habilidad de ejecutar el método. Un aprobado no es un respaldo de ningún modelo como orquestador; el diseño no respalda esa inferencia. La sección 10 establece las condiciones límite.
Las listas de verificación de este tipo conllevan un riesgo estructural. Un texto se edita hasta que aprueba, y luego la lista de verificación deja de medir nada. Dos protecciones la mantienen midiendo algo. Un criterio justifica una edición solo donde se puede decir qué habría sufrido un usuario real de otra manera, y se agrega un criterio solo después de que una ejecución en vivo ha producido el fallo correspondiente, nunca porque pareciera plausible. Ambas se cumplen para los seis criterios aquí.
7.5 Observaciones de campo de la compilación móvil
Compilar y certificar el nivel móvil en un dispositivo físico produjo una clase diferente de hallazgo. Es evidencia de sistemas en lugar de evidencia epistémica, y documenta una superficie de fallo específica de los conductos de intención de aplicación del consumidor, que se rompen de formas que un conducto API no.
El nivel fue certificado de extremo a extremo con pruebas de humo aritmético, elegidas porque los dígitos sobreviven a cualquier distribución de teclado. Critique devolvió una suma correcta junto con una declaración explícita de que la respuesta del primer modelo no contenía errores, y Poll devolvió las respuestas de ambos modelos una al lado de la otra en acuerdo. La latencia sin intervención del toque al resultado es de aproximadamente cincuenta a sesenta segundos. La Tabla 7 registra qué se rompió.
Tabla 7. Modos de fallo observados de un conducto de intención de aplicación del consumidor, con causas y remedios
| Síntoma | Causa | Remedio |
|---|---|---|
| La intención del primer proveedor reporta al usuario como desconectado mientras la aplicación está conectada | Defecto de intención conocido, recurrente después de períodos de inactividad | Abra la aplicación una vez y vuelva a ejecutar. Por esto se llama primero al proveedor menos confiable: su fallo no cuesta nada |
| El segundo proveedor reporta el modelo como no disponible | Limitación de modelo del lado de la cuenta en un nivel gratuito; la intención no expone parámetro de modelo | Establezca el modelo predeterminado deseado dentro de la aplicación; la cadena no puede seleccionar uno |
| La ejecución termina silenciosamente sin error | La superposición de un atajo en ejecución se descarta tocando el dispositivo | No maneje el dispositivo durante una ejecución; vuelva a ejecutar |
| La cadena se pausa en una tarjeta de respuesta intermedia | El parámetro mostrar-en-ejecución se establece por defecto en habilitado | Establézcalo como deshabilitado en tiempo de compilación |
| Respuestas largas truncadas | Límites de salida a nivel de intención | Solicite una respuesta compacta; la calidad de la crítica no se ve afectada de manera mensurable |
Tres de estos se generalizan más allá de este sistema.
Ordene la cadena por fragilidad. El proveedor menos confiable va primero, por lo que su fallo no cuesta nada, y el más confiable recibe los roles que no deben perderse, es decir, árbitro y finalizador.
Asumir sin memoria. Cada llamada abre una sesión nueva, por lo que cada indicación tiene que ser autosuficiente y llevar la pregunta y cualquier respuesta anterior dentro de sí misma. La independencia paralela ciega es por lo tanto arquitectónica en lugar de instructiva, como sostiene la Sección 6.5.
Desconfíe más de los fallos silenciosos. Dos ejecuciones que parecían terminar por tiempo de espera habían sido matadas por el usuario al recoger el dispositivo. Atribuirles al software habría producido una corrección para un defecto que no existía.
8. El archivo paste: un patrón de interfaz para guía de inicio en frío
Este es un resultado de interfaz separado y se transfiere más allá de este sistema.
Un archivo paste es un archivo de texto plano que un usuario pega íntegro en un modelo de chat en la nube ordinario, tras lo cual ese modelo lo guía a través de algo que de otro modo no podría comenzar. La situación es lo suficientemente común. Alguien ha recibido una carpeta, un enlace o una herramienta, y no puede empezar. Todo lo que la industria normalmente recurre aquí, ya sea una página de destino, un bot de incorporación, un asistente personalizado o una aplicación, requiere que el usuario vaya a algún lugar nuevo, mientras que un archivo paste utiliza la interfaz que ya tiene abierta.
No es lo mismo que los archivos que un agente lee por sí solo, que se dirigen a un programa ya residente con acceso a archivos. Un archivo paste se dirige a una sesión de chat en la nube de otro que no puede ver el disco del usuario y nunca podrá.
Los cuatro invariantes
El nombre del archivo es la primera instrucción, en el guión del lector. Es una oración en lugar de un nombre de archivo de documentación convencional, un archivo por idioma, todos presentes, todos ordenados juntos bajo un prefijo compartido. El usuario no está eligiendo de una lista. Están reconociendo su propio sistema de escritura e ignorando el resto, de la manera que se omiten las líneas desconocidas en una señal multilingüe. Esto no cuesta nada y elimina el paso donde alguien tiene que leer un idioma que puede no tener para encontrar el archivo escrito en el que sí tiene.
El archivo declara lo que el modelo no puede hacer y prohíbe fingir lo contrario. En la primera sección: eres una sesión de chat en la nube, no estás en la computadora del usuario, no puedes abrir sus archivos ni ejecutar nada, nunca reclames haber mirado. El fallo característico de este patrón, F5 de otra forma, es una descripción segura y plausible de una carpeta que el modelo nunca vio. Es invisible para el usuario, porque una respuesta bien formada y una correcta son indistinguibles para alguien que no puede verificar.
La integridad es detectable. Un manifiesto de secciones en la parte superior y un marcador de fin de archivo en la última línea. Las instrucciones le dicen al modelo que encuentre el marcador antes de decir nada; si falta él o una sección listada, que se detenga, informe qué partes llegaron, y solicite el archivo nuevamente; y nunca rellenar un vacío con su propio conocimiento. Un paste largo se trunca por un límite de nivel gratuito, un límite de mensaje o un teléfono, y sin un marcador el modelo procede con lo que llegó e improvisa el resto.
El archivo es autónomo. Todo lo que el usuario necesita para un resultado hoy está dentro de él textualmente, no referenciado ni vinculado. Un archivo paste que dice "abre el merge prompt file" ha fracasado, porque el modelo que lo lee no puede abrir nada y el usuario puede no tener la carpeta en absoluto. La autonomía permite que el archivo se reenvíe a través de una aplicación de mensajería sin nada adjunto y aún funcione.
Dos reglas de ordenamiento
Ordene por irremplazabilidad en lugar de cronología. Un paste se corta desde la parte inferior, por lo que cualquier cosa que un modelo pudiera reconstruir sin ayuda, como pasos de instalación, antecedentes, o cualquier cosa consultable, pertenece cerca del final, y cualquier cosa que tiene que ser exacta pertenece arriba.
Ceda lo antes posible. Donde el camino termina en un programa que el usuario instala, deje de recitar la configuración de ese programa y dígales que lo pregunten, y escriba la regla en el archivo: si el programa instalado contradice este archivo sobre sí mismo, el archivo es incorrecto. Un archivo de texto que describe el instalador de otra persona se vuelve obsoleto en cuestión de meses, mientras que el programa consultado sobre sí mismo no.
Mantener las copias fieles
Las copias se multiplican y las copias se desvían. Dos mecanismos baratos son suficientes. Genere la carga textualmente en lugar de mantenerla: un paso de compilación empalma el texto canónico en cada archivo de idioma desde una única fuente de verdad, e integración continua falla si un archivo confirmado no está de acuerdo. Compare traducciones entre sí así como contra las reglas, porque cada verificación estructural pasará un archivo que se ha vuelto silenciosamente la mitad de su longitud. La integración continua aquí aserta que todas las variantes de idioma llevan el mismo número de secciones y el mismo número de pasos de configuración.
Evaluación del patrón
El patrón tiene su propia lista de verificación de diez elementos. Dos de sus elementos se dan aquí. Ambos fueron escritos en respuesta a fallas observadas en lugar de anticipadas.
¿El modelo se ofrece a mejorar, acortar o reescribir el archivo en lugar de usarlo? Eso falla silenciosamente, porque la versión reescrita pierde cualquier regla que el modelo encontró menos convincente.
Dada una copia con el último tercio eliminado, ¿el modelo nota y se detiene en lugar de proceder con lo que llegó? Este necesita una ejecución dedicada con una copia deliberadamente truncada, y es el único elemento que no se puede observar desde un paste normal.
La lista de verificación mide la primera respuesta, que no es la ejecución. Una guía que se abre perfectamente e inventa pasos de instalación cuatro mensajes después pasa la lista de verificación y falla al usuario. Los verdaderos fracasos del patrón ocurren en medio de la configuración, donde esta evaluación no mira.
9. Una evaluación propuesta
Mezcla de agentes (Wang, J., et al., 2024) y debate multiagente (Du et al., 2023) reportan mejoras sobre el modelo individual más fuerte en condiciones de API. La afirmación de que una respuesta fusionada supera la mejor respuesta individual está abierta, y la comparación para este protocolo se especifica aquí antes de cualquier número, de modo que no pueda ajustarse a ellos posteriormente.
9.1 Hipótesis
H1. Anchor-and-enrich supera la respuesta individual más fuerte en corrección factual e integridad.
H2. Anchor-and-enrich supera una fusión ingenua en la supervivencia de minorías correctas y en la proporción de afirmaciones sin fuente.
H0. No hay diferencia, o la fusión empeora el resultado.
H2 tiene más peso que H1. Si el protocolo pierde ante una fusión ingenua en esas dos métricas, el diseño en la Sección 4 no tiene justificación, por bien que lea el documento.
9.2 Diseño
De cincuenta a cien preguntas, tres brazos: la respuesta del modelo individual más fuerte; una fusión ingenua instruida solo para combinar las respuestas; y anchor-and-enrich. Las preguntas se eligen y se congelan antes de cualquier ejecución, y la distribución de dominios entre salud, derecho, aspectos técnicos, elección del consumidor y hechos numéricos se publica junto con el conjunto.
9.3 Métricas
Corrección factual, como la proporción de afirmaciones verificables confirmadas contra una fuente primaria. Integridad, como cobertura de una lista previamente especificada de puntos sustanciales. Supervivencia de minorías correctas, como la proporción de casos en los que un punto correcto hecho por exactamente un modelo llega al documento final. Calidad de la fuente, como primaria, secundaria o ausente. Tasa de afirmaciones inventadas, como afirmaciones en el resultado que no estaban en ninguna de las entradas, que es una medida directa de F1. Legibilidad. Tiempo de ejecución y costo. Y, reportado por separado y en su totalidad, los casos en los que la fusión empeoró las cosas, que son los interesantes.
9.4 Enmascaramiento
Los nombres de los modelos están ocultos y el orden de las respuestas se mezcla antes de la puntuación. Un modelo evaluador es demostrablemente sensible a la posición, la verbosidad y el estilo familiar (Zheng et al., 2023), por lo que la puntuación sin enmascaramiento estaría midiendo parcialmente eso. La puntuación humana sigue el mismo procedimiento.
9.5 Publicación y falsabilidad
Las preguntas, respuestas sin procesar, documentos finales y puntuaciones se publican en su totalidad, de modo que la puntuación pueda ser cuestionada.
La condición de falsación está preespecificada. Si el brazo 3 no supera el brazo 1 en corrección e integridad, y no supera el brazo 2 en supervivencia de minorías y proporción de afirmaciones sin fuente, H1 y H2 no tienen apoyo y la afirmación proviene directamente de los materiales del sistema, sin reformulación.
9.6 Prueba del modelo de testigos correlacionados
Independientemente de H1 y H2, ρ es estimable mediante el procedimiento de la Sección 5.5 en el mismo conjunto de preguntas, lo que permite una prueba de la predicción que se deriva de ella.
H3. La ganancia de agregar el k-ésimo modelo decae como = N/(1+(N−1)ρ) predice, y un consejo extraído de laboratorios distintos supera un consejo del mismo tamaño extraído de uno.
H3 es verificable en datos recopilados para la comparación primaria y no requiere recopilación adicional. La refutación sería el resultado más informativo, ya que significaría que la analogía clúster-muestra no se transfiere a consejos de modelos de lenguaje y la Sección 5 requiere ser reescrita.
9.7 Dos pruebas que el nivel móvil hace económicas
Cada ejecución móvil cuesta una interacción y un número fijo de mensajes de suscripción, lo que coloca dos afirmaciones adicionales al alcance fácil.
H4, dominio de correlación. Un par entre laboratorios con N = 2 coincide con o supera un quinteto del mismo laboratorio con N = 5 en corrección y supervivencia de minorías. Esta es la prueba más aguda disponible de la Sección 5.3, porque los brazos difieren en la dirección que el modelo llama decisiva, ρ, mientras se mueven uno contra otro en la dirección que llama secundaria, N.
H5, el eje de elicitación. La elicitación ciega-paralela revela estrictamente más desacuerdos que la elicitación informada-secuencial en el mismo conjunto de preguntas, y los desacuerdos que revela predicen errores en la respuesta de modelo único. Si H5 falla, lo que significa que un crítico informado encuentra tantas divergencias como un par ciego, entonces el argumento de costo de independencia en la Sección 6.5 es incorrecto y el modo informado simplemente engloba el modo ciego.
10. Limitaciones
La afirmación central no ha sido probada: la Sección 4 es un argumento de diseño, y la Sección 9 especifica la comparación que la resolvería.
ρ se asume en lugar de estimarse. Cada valor en las Tablas 2 y 8 se deduce de la fórmula de la Sección 5 en una ρ uniforme asumida, lo que sitúa las tablas en un límite superior bajo una estructura de bloque realista.
La Sección 7 informa n = 5 y n = 3. Establece que el modo de fallo existe; la afirmación se limita a la existencia más que a la frecuencia. La puntuación fue realizada por el autor, sin estimación entre calificadores; los criterios binarios reducen el riesgo de un solo calificador sin eliminarlo. El Ambiente A no se volvió a ejecutar después de la intervención y el Ambiente C no tiene ejecuciones, por lo que los pases reportados cubren solo el Ambiente B.
Las versiones del modelo detrás de interfaces web y aplicaciones de consumidor son desconocidas y cambian, la personalización de la cuenta afecta las respuestas, y una ejecución no puede repetirse exactamente (Sección 6.6), por lo que los resultados envejecen rápidamente y son evidencia sobre el protocolo, no sobre modelos nombrados.
El sintetizador es en sí mismo un modelo de lenguaje, sujeto a F1 a F4 como cualquier otro. El protocolo lo restringe estructuralmente, a través de la procedencia, la prohibición de eliminación silenciosa, y una sección de desacuerdo separada, pero no lo elimina. La calidad de la salida depende de con qué fidelidad un modelo dado sigue la instrucción; esa dependencia no se ha medido.
La rúbrica ciega es ejecutada por el mismo modelo que luego construye el documento, por lo que la selección de anclaje es un punto de sesgo, y nada detiene que ese modelo prefiera sistemáticamente respuestas estilísticamente cercanas a las suyas, lo cual es sesgo juez-modelo (Zheng et al., 2023) en otra posición. Prohibir un anclaje preestablecido aborda solo la forma explícita del problema.
El valor predeterminado móvil es secuencial informado, por lo que el modo más utilizado es también el cuyo acuerdo tiene el menor peso probatorio (Sección 6.4). Ese es un intercambio de calidad por mensaje, y el límite que establece se indica aquí. La debilidad principal de este nivel es que intercambia auditabilidad por latencia: Crítica y Síntesis devuelven un texto terminado, y las respuestas sin procesar viven solo en los historiales de sesión del modelo, por lo que un usuario que nunca abre el modo de Encuesta está confiando en lugar de verificar, que es la postura contra la que el protocolo existe para argumentar.
El costo de tiempo establece un límite en la ruta libre. Un consejo completo realista es de diez a quince minutos de espera, y de cinco a veinticinco minutos por proveedor con modos de investigación profunda. Para parte de la población prevista eso puede exceder el beneficio.
La Sección 11 establece la posición legal de la ruta del agente junto con la pregunta de términos de servicio que deja abierta.
11. Ética, privacidad y marco legal
El sistema está diseñado para el uso personal de las cuentas de modelos propias del usuario, gratuitas o de pago, a través de su propio navegador o dispositivo. No extrae datos de terceros, no elude muros de pago, no resuelve pruebas de desafío-respuesta, no elude la detección de bots, no rota proxies, no oculta su funcionamiento, no revende cuentas ni las ejecuta en modo multi-inquilino.
La accesibilidad es el objetivo, no un efecto secundario. Cuando un usuario con discapacidad depende de esto como tecnología asistiva, para eso sirve: un asistente que actúa en su nombre, a su ritmo, en sus propias cuentas. La analogía de la rampa de acceso es exacta. Una rampa construida para sillas de ruedas también sirve a padres con cochecitos y repartidores, y un sistema construido para usuarios que no pueden gestionar una docena de pestañas del navegador termina siendo útil para todos.
Los caminos no son legalmente equivalentes. El camino gratuito se parece al uso ordinario en cualquier interpretación: el usuario abre los sitios, escribe y copia. El nivel móvil está cerca de él, dado que los proveedores publican intentos de aplicación para exactamente este tipo de invocación, y un atajo puede encadenar dos invocaciones de este tipo, usando cada aplicación según lo diseñado, un mensaje a la vez, en primer plano. El camino del agente requiere un análisis más detenido. Las reglas sobre acceso automatizado están dirigidas a extraer resultados a gran escala, bots cargando un servicio, sorteando límites de frecuencia, ejecutando muchas cuentas, y revendiendo lo que regresa. Nada de eso describe a un usuario haciendo una pregunta a velocidad humana en su propio navegador con sesión iniciada y leyendo la respuesta por sí mismo. Tal uso es estructuralmente igual que el software de asistencia que escribe y hace clic para personas que no pueden. Algunos términos, sin embargo, están redactados más ampliamente que su propósito, prohibiendo cualquier medio automatizado sin mención de escala. Si eso alcanza a un usuario automatizando una sola pregunta depende del servicio, la jurisdicción y los términos en vigor ese día. Esa es una lectura y no un veredicto. Los usuarios deben mirar los términos de lo que sea que conecten y decidir por sí mismos. Cualquiera que prefiera no pensar en ello en absoluto puede usar el camino gratuito, que hace el mismo trabajo y no plantea ninguna de las preguntas específicas del agente; los términos ordinarios de los sitios aún se aplican.
La privacidad es una decisión de composición. El conjunto de modelos determina qué empresas reciben lo que escribe el usuario, lo que no importa para una pregunta ordinaria y podría importar para una pregunta sobre salud, un empleador o clientes. Cuando una pregunta particular sería incómoda de enviar a una empresa particular, omita ese modelo para esa pregunta; omitir uno no cuesta nada.
La restricción ética propia del protocolo es una prohibición. Nada que no fue una ejecución del método puede presentarse como tal. Un resumen web, una respuesta de modelo único o el razonamiento propio del operador pueden ser útiles, pero no son un resultado del consejo, y el usuario debe ser informado de cuál de ellos está sosteniendo. En la práctica, eso significa ningún comprobante, ninguna sección de acuerdos y desacuerdos, y ningún archivo de salida para nada que no fue una ejecución genuina de múltiples modelos.
12. Conclusión
Una respuesta confiadamente equivocada es indistinguible de una confiadamente acertada, mientras que una discrepancia entre ambas es visible para cualquiera. El valor de un consejo, por lo tanto, está en exponer el desacuerdo, no en promediar.
El acuerdo entre modelos no es confirmación independiente. Un consejo de N modelos con correlación de error ρ vale = N/(1+(N−1)ρ) testigos independientes, una cantidad que se satura en 1/ρ independientemente de cuántos modelos se añadan, por lo que a ρ = 0.5 un consejo de cualquier tamaño vale como máximo dos testigos. La diferencia en fortaleza probatoria entre diez modelos independientes concordantes y diez correlacionados asciende a aproximadamente cinco órdenes decimales de magnitud, y una fusión opaca transmite esa diferencia al lector como confianza inmerecida.
El diseño se sigue de esas dos premisas. Mantiene la procedencia, de modo que un lector pueda verificar el resultado en lugar de confiar en él, y destaca el desacuerdo, ya que el desacuerdo es el único componente que ningún modelo individual puede proporcionar. Una fuente que varias respuestas comparten se marca como una fuente. Los hechos críticos se nombran, y lo que tiene fuente se separa de lo que es solo acuerdo. Una regla más se aplica al relato del protocolo sobre sí mismo: nunca debe presentar como colegiado lo que no fue, lo cual no es una preocupación teórica. En una ejecución ciega dos de cinco modelos lo incumplieron silenciosamente, y una oración de asignación de rol revirtió ambos en la re-ejecución del environment-B.
Los tres niveles son puntos en una curva cuyo eje es el costo de la amplitud, no tres grados de calidad, y la Sección 5 es lo que hace coherente la curva. Porque se satura, la distancia probatoria entre dos modelos y diez es mucho menor de lo que sugiere el recuento de modelos, y dos modelos de diferentes laboratorios, ejecutándose en un teléfono, pueden valer más que cinco extraídos de un único linaje. El nivel móvil también sacó a la luz un intercambio que los otros niveles habían estado haciendo silenciosamente. Un segundo modelo que ha leído el primero puede corregirlo, pero ya no puede confirmarlo de forma independiente. La corrección de errores y la confirmación independiente son bienes distintos, adquiridos mediante diferentes ordenaciones, y un sistema que no dice cuál de los dos está vendiendo es engañoso para su usuario. La comparación controlada permanece abierta, y la Sección 9 la especifica junto con el resultado que me obligaría a retirar la afirmación.
Sin embargo, como sea que resulte esa comparación, un documento fusionado sin procedencia y sin desacuerdo preservado no puede ser verificado en absoluto, y por lo tanto no puede ser mejor que una respuesta única en ningún sentido que importe a alguien que toma una decisión. La auditabilidad no es una mejora de la síntesis. Es la condición bajo la cual la síntesis tiene algún derecho a ser llamada un resultado. Las reglas del protocolo tratan, en consecuencia, sobre de dónde procede cada oración y en qué discrepaban los modelos, en lugar de sobre cuántos modelos fueron consultados.
Declaraciones
Financiamiento. Ningún financiamiento externo apoyó este trabajo.
Conflictos de interés. El autor es el desarrollador de los métodos de orquestación multimodelo analizados en este artículo, que son abiertos y reproducibles, un interés que los lectores deberían sopesar. El autor es un solicitante designado en solicitudes de patentes pendientes, no patentes otorgadas, que cubren sistemas de orquestación de IA y validación multimodelo del tipo que este artículo examina. El protocolo formalizado en la Sección 4 y la implementación de referencia descrita en la Sección 6 son propios del autor, y el diseño de evaluación en la Sección 9 fue fijado antes de cualquier recopilación de datos por esa razón. Ningún resultado analítico en la Sección 5 depende de la implementación: las Secciones 6 y 7 podrían eliminarse completamente sin alterar el modelo, su techo, o ninguna conclusión extraída de ellas.
Herramientas y verificación. Se utilizaron asistentes de IA como instrumentos bajo la dirección del autor; las ideas, la investigación y las conclusiones son del autor. Todas las afirmaciones cuantitativas y citas fueron verificadas por el autor contra fuentes primarias o copias archivadas; el autor es responsable únicamente del contenido.
Disponibilidad de datos. Las Figuras 1 y 3 y las Tablas 2, 4 y 8 se generan a partir de la expresión de forma cerrada en la Sección 5.2 y se pueden recomputar a partir de ella. El material en la Sección 7 consiste en transcripciones de primera respuesta grabadas en el momento de cada ejecución y retenidas con los materiales de trabajo. Los modelos allí se identifican por laboratorio en lugar de por nombre de producto: la observación se refiere a un modo de falla que aparecía en todos los laboratorios, y los resultados de ejecución única no apoyan una comparación entre sistemas nombrados.
Contribuciones del autor. Único autor.
Correspondencia. [email protected]
References
Entries marked arXiv are preprints and are cited as such; vendor and standards-body documents are contemporaneous industry sources rather than settled literature.
- Bommasani, R., Creel, K. A., Kumar, A., Jurafsky, D., & Liang, P. (2022). Picking on the same person: Does algorithmic monoculture lead to outcome homogenization? Advances in Neural Information Processing Systems, 35.
- Condorcet, M. J. A. N. de C., marquis de (1785). Essai sur l’application de l’analyse à la probabilité des décisions rendues à la pluralité des voix. Imprimerie Royale, Paris.
- Debenedetti, E., Shumailov, I., Fan, T., Hayes, J., Carlini, N., Fabian, D., Kern, C., Shi, C., Terzis, A., & Tramèr, F. (2025). Defeating prompt injections by design. arXiv:2503.18813.
- Dietterich, T. G. (2000). Ensemble methods in machine learning. In Multiple Classifier Systems, Lecture Notes in Computer Science 1857, 1-15. Springer.
- Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325.
- Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., et al. (2022). Language models (mostly) know what they know. arXiv:2207.05221.
- Karpathy, A. (2025). llm-council. Open-source software repository.
- Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038-30066. arXiv:2506.07962.
- Kish, L. (1965). Survey Sampling. Wiley, New York.
- Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
- Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118.
- Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. Advances in Neural Information Processing Systems, 7, 231-238.
- Ladha, K. K. (1992). The Condorcet jury theorem, free speech, and correlated votes. American Journal of Political Science, 36(3), 617-634.
- Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020-9025.
- Meta (2025). Agents rule of two: A practical approach to AI agent security. Engineering documentation.
- MITRE (2025). CVE-2025-32711. Common Vulnerabilities and Exposures record; zero-click exfiltration in an agentic assistant (EchoLeak).
- OWASP (2025). OWASP Top 10 for large language model applications - LLM01: Prompt injection.
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., et al. (2023). Towards understanding sycophancy in language models. arXiv:2310.13548.
- Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755-759.
- Surowiecki, J. (2004). The Wisdom of Crowds. Doubleday, New York.
- Ueda, N., & Nakano, R. (1996). Generalization error of ensemble estimators. Proceedings of the International Conference on Neural Networks, 90-95.
- Wang, J., Wang, J., Athiwaratkun, B., Zhang, C., & Zou, J. (2024). Mixture-of-agents enhances large language model capabilities. arXiv:2406.04692.
- Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., & Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. International Conference on Learning Representations. arXiv:2203.11171.
- Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. International Conference on Learning Representations. arXiv:2306.13063.
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, Datasets and Benchmarks Track. arXiv:2306.05685.
Apéndice A. La plantilla de recepción
La recepción es lo primero que un lector encuentra y a menudo lo único que lee. Tiene que responder cuatro preguntas sin desplazarse.
RECEIPT — 6 models asked · 5 answered · 1 did not (free tier)
Mode: fast ×4, deep ×1
Anchor: answer #3 (chosen for completeness and sourcing)

Agreed:       ...
Disputed:     ...
Unverified:   ...

Rests ONLY on the models agreeing (none showed a source):
              ...
Correlated:   3 of 5 cite one article → one lineage, not three
Composition:  4 of 5 are models from one region; agreement
              may reflect a shared frame
Las dos últimas líneas son lo que la Sección 5 existe para justificar. Sin ellas, el documento reporta cuántos modelos estuvieron de acuerdo y oculta cuál es el valor de ese acuerdo, y esas dos cantidades difieren por órdenes de magnitud.
Apéndice B. Número efectivo de testigos independientes
Tabla 8. , rango completo
| ρ | N=2 | N=3 | N=4 | N=5 | N=7 | N=10 | N=15 | N=20 | N→∞ |
|---|---|---|---|---|---|---|---|---|---|
| 0.00 | 2.00 | 3.00 | 4.00 | 5.00 | 7.00 | 10.00 | 15.00 | 20.00 | ∞ |
| 0.05 | 1.90 | 2.73 | 3.48 | 4.17 | 5.38 | 6.90 | 8.82 | 10.26 | 20.0 |
| 0.10 | 1.82 | 2.50 | 3.08 | 3.57 | 4.38 | 5.26 | 6.25 | 6.90 | 10.0 |
| 0.15 | 1.74 | 2.31 | 2.76 | 3.13 | 3.68 | 4.26 | 4.84 | 5.19 | 6.67 |
| 0.20 | 1.67 | 2.14 | 2.50 | 2.78 | 3.18 | 3.57 | 3.95 | 4.17 | 5.00 |
| 0.30 | 1.54 | 1.88 | 2.11 | 2.27 | 2.50 | 2.70 | 2.88 | 2.99 | 3.33 |
| 0.40 | 1.43 | 1.67 | 1.82 | 1.92 | 2.06 | 2.17 | 2.27 | 2.33 | 2.50 |
| 0.50 | 1.33 | 1.50 | 1.60 | 1.67 | 1.75 | 1.82 | 1.88 | 1.90 | 2.00 |
| 0.60 | 1.25 | 1.36 | 1.43 | 1.47 | 1.52 | 1.56 | 1.60 | 1.61 | 1.67 |
| 0.70 | 1.18 | 1.25 | 1.29 | 1.32 | 1.35 | 1.37 | 1.39 | 1.40 | 1.43 |
| 0.80 | 1.11 | 1.15 | 1.18 | 1.19 | 1.21 | 1.22 | 1.23 | 1.23 | 1.25 |
| 0.90 | 1.05 | 1.07 | 1.08 | 1.09 | 1.09 | 1.10 | 1.10 | 1.10 | 1.11 |
Moviéndose hacia la derecha, al agregar modelos, se topa con la columna más a la derecha casi inmediatamente. Moviéndose hacia arriba, al reducir la correlación, no hay límite. El esfuerzo dedicado a la diversidad de un consejo, es decir, laboratorios distintos, regiones y corpus de entrenamiento, por lo tanto devuelve más que el esfuerzo dedicado a su tamaño. Dos entradas ilustran el argumento de la Sección 6.2: un par extraído de dos laboratorios con ρ ≈ 0.2 se cuenta como aproximadamente 1.67 testigos independientes, mientras que cinco modelos de un linaje con ρ ≈ 0.6 se cuentan como aproximadamente 1.47.
Apéndice C. Referencia de implementación de capa móvil
Tabla 9. Referencia de implementación para la capa móvil
| Componente | Especificación |
|---|---|
| Mecanismo | Intenciones de aplicaciones del sistema operativo encadenadas en un único atajo firmado, invocando las aplicaciones instaladas de los proveedores en las suscripciones existentes del usuario. Sin clave API, sin servidor, sin ejecución en segundo plano |
| Acciones del proveedor | Intención de solicitud publicada de cada proveedor, dirigida por identificador de intención de aplicación. Un proveedor expone un parámetro de modelo opcional, omitido para que se aplique el valor predeterminado de la aplicación; el otro no expone ninguno |
| Operación sin intervención | El parámetro show-on-run se establece como deshabilitado dentro de los parámetros de intención en tiempo de compilación, no se ajusta en el editor después de la importación |
| Distribución | El atajo está firmado para importación sin restricciones, por lo que una compilación se instala en cualquier dispositivo o cuenta sin necesidad de recompilar |
| Menú de modo | Una acción de menú de flujo de control con marcadores de inicio, caso y fin; las ramas convergen en una cola compartida a través de una acción de establecimiento de variable |
| Plataforma alternativa | Automatización basada en intenciones, con una ruta semiautomática que persiste después de actualizaciones de aplicaciones |
| Costo por ejecución | Encuesta 1 + 1, Crítica 1 + 1, Síntesis 1 + 2 mensajes de suscripción |
| Latencia | Aproximadamente 50 a 60 segundos desde el lanzamiento hasta el resultado, sin intervención |
| Superficies de lanzamiento | Icono de pantalla de inicio, widget, botón de acción de hardware, o frase de voz |
Dos restricciones moldearon el diseño, y ambas son generalizables. Las cuotas se comparten con el uso ordinario de las mismas aplicaciones, por lo que el modo recomendado para uso diario es el de dos mensajes y no el de tres mensajes; eso es asignación de recursos, no un juicio de calidad. Y cada llamada de intención abre una sesión nueva sin memoria, por lo que todas las indicaciones son autónomas y contienen la pregunta y cualquier respuesta anterior dentro de sí mismas. Nada continúa. Esa restricción es lo que hace que la independencia paralela ciega en Poll y Synthesis sea arquitectónica en lugar de programada, como argumenta la Sección 6.5.
Cómo citar
Chernets, V. (2026). Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API [Preimpresión]. SSRN. https://doi.org/10.2139/ssrn.7390698
@misc{chernets2026agreementnotevidence,
  author       = {Chernets, Vadym},
  title        = {{Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7390698},
  url          = {https://doi.org/10.2139/ssrn.7390698}
}