Übereinstimmung ist keine unabhängige Evidenz: Nachprüfbare Multi-Modell-Synthese ohne API
Dies ist eine Übersetzung. Maßgeblich ist das englische Original; bitte zitieren Sie dieses.
Vadym Chernets, PhD, KI-Systemarchitekt · ORCID 0009-0007-4845-3163
SSRN 7390698 · DOI 10.2139/ssrn.7390698 · Zenodo 10.5281/zenodo.22683716 · GitHub
- Fassung von Interesse: SSRN 7390698 · DOI 10.2139/ssrn.7390698
- Archivierte Kopie, zitierbar und herunterladbar: 10.5281/zenodo.22683716 — Konzept-DOI, verweist immer auf die neueste Version
- Volltext als Markdown und PDF: GitHub
- Lesbares HTML: https://polyhelper.ai/research/agreement-not-evidence/
Der gleiche Text befindet sich auf vier Oberflächen, damit er erreichbar ist, wenn eine davon ihn nicht bereitstellen kann. SSRN hält die Fassung von Interesse; zitieren Sie diese.
Schlagwörter: große Sprachmodelle; korrelierte Fehler; Weisheit der Massen; Condorcet-Juroren-Satz; algorithmische Monokultur; Multi-Agent-Debatte; effektive Stichprobengröße; Design-Effekt; Ensemble; Provenienz. JEL-Klassifikation: C11; C18; D71; D83; L86; O33
Zusammenfassung
Wer eine Sprachmodell eine Frage stellt, kann eine selbstsicher falsche Antwort nicht von einer selbstsicher richtigen unterscheiden. Die beiden sind auf jedem oberflächlichen Hinweis, der einem Laien zur Verfügung steht, identisch. Das Abfragen mehrerer Modelle scheint dieses Problem zu lösen, aber es verlagert es größtenteils nur: Das Abstimmen mehrerer Antworten erzeugt erneut einen selbstsicheren Text, und dieser Text trägt jetzt die geliehene Autorität von „zehn von ihnen waren sich einig."
Das hier formalisierte Protokoll sammelt Antworten von mehreren Consumer-Chat-Modellen über den eigenen Browser oder das Telefon des Benutzers, ohne API-Schlüssel, ohne Installation und ohne Server eines Vermittlers. Es stimmt sie durch Anker-und-Anreicherung ab: Die stärkste verfügbare Antwort wird zur Grundlage, und jede der anderen trägt nur bei, was der Grundlage fehlt. Jeder Beitrag ist mit dem Modell unterzeichnet, das ihn geliefert hat. Meinungsverschiedenheiten werden in einem eigenen Abschnitt behalten, anstatt gemittelt zu werden.
Das Papier leistet vier Beiträge. Der erste ist das Protokoll selbst, angegeben als ein Algorithmus, der die Herkunft bewahrt und stille Löschung verbietet, zusammen mit einer Taxonomie von fünf Arten, auf die eine Zusammenführung fehlschlagen kann. Vier von ihnen sind Mängel naiver Zusammenfassung; der fünfte ist ein Versagen des Operators statt der Methode: eine Synthese, die die Ausgabe eines einzelnen Modells als ein kollegiales Ergebnis darstellt. Der zweite ist die Anwendung der korrelierten-Zeuge-Arithmetik auf die Protokollgestaltung. Diese Arithmetik wird hier nicht beansprucht. Kohli (2026) wandte die gleiche Kish-Korrektur auf ein Gremium von neun führenden Richtern an und maß etwa zwei effektive Stimmen, und Kim et al. (2025) etablierten die zugrunde liegende Fehlerkorrelation über mehr als 350 Modelle hinweg. Ein Rat von N Modellen, deren Fehler Intraklassen-Korrelation ρ haben, ist = N / (1 + (N−1)ρ) unabhängige Zeugen wert, und diese Größe sättigt sich bei 1/ρ unabhängig davon, wie viele Modelle hinzugefügt werden. Sobald ein Rat größer als 1/ρ ist, schlägt das Halbieren von ρ das Verdoppeln von N, und ein Paar aus zwei Laboratorien kann fünf aus einem übertreffen. Kim et al. (2025) erschweren diese Regel: Die größeren und genaueren Modelle haben die am meisten korrelierten Fehler, auch wenn die Architektur und der Anbieter unterschiedlich sind, daher sind zwei Laboratorien eine vorherige Vermutung über ρ statt eine Messung davon, wofür das Schätzverfahren von Abschnitt 5.5 da ist. Der dritte ist eine Darstellung von drei Bereitstellungsebenen – manuell, One-Tap-Mobil und Browser-Agent – und der Achse, die sie epistemisch trennt: ob das zweite Modell die Antwort des ersten Modells sieht. Die Bedingung des zweiten Modells erhöht ρ im Austausch für Fehlerkorrektur. Der vierte ist eine Beobachtung bei kleinen Stichproben des Fälschungs-Rats-Versagens über fünf Modelle, die Einzel-Satz-Intervention, die es in einem Neustart mit drei Modellen entfernte, und ein verblindetes Drei-Arm-Evaluierungsdesign mit einer angegebenen Falsifizierungsbedingung.
Korrelierte Übereinstimmung wird hier als etabliert behandelt, nicht als ein Befund. Dass ein Gremium von Modellen weit weniger unabhängige Zeugen wert ist als es Mitglieder hat, wurde direkt gemessen: neun führende Richter aus sieben Familien liefern etwa zwei effektive Stimmen (Kohli, 2026), und die Fehlerkorrelation steigt mit der Modellleistung selbst über Anbieter und Architekturen hinweg (Kim et al., 2025). Abschnitt 5 wiederholt die Design-Effekt-Arithmetik hinter diesen Messungen, weil drei der Protokollregeln von ihr abgeleitet sind und ohne sie wie Kleinlichkeit lesen. Das Protokoll nimmt dann die andere Seite des gleichen Problems. Diese Literatur misst die Korrelation; dieses Protokoll ist gebaut, um sie zu senken, durch Zusammensetzung über Abstammungslinien, Beibehaltung von Meinungsverschiedenheit statt sie wegzumitteln, Unterzeichnung jeden Beitrags mit dem Modell, das ihn geliefert hat, und Zählung einer wiederholten Quelle einmal.
Die Behauptung, dass eine zusammengeführte Antwort die beste einzelne Antwort schlägt, wird aus der Gestaltung und aus benachbarter Literatur argumentiert; Abschnitt 9 spezifiziert die Evaluierung, die noch nicht durchgeführt wurde.
Inhaltsverzeichnis
- Einleitung
- Verwandte Arbeiten
- Fünf Arten, wie eine Zusammenführung fehlschlägt
- Das Anker-und-Anreicherungs-Protokoll
- Korrelierte Übereinstimmung
- Drei Ebenen, ein Protokoll
- Empirischer Abschnitt
- Die Paste-Datei: ein Schnittstellenmuster für die Kaltstart-Anleitung
- Eine vorgeschlagene Evaluierung
- Einschränkungen
- Ethik, Datenschutz und rechtliche Rahmenbedingungen
- Fazit
Erklärungen · Referenzen · Anlage A, die Empfangsvorlage · Anlage B, effektive Anzahl unabhängiger Zeugen · Anlage C, Implementierungsreferenz für die mobile Ebene
Verzeichnis der Abbildungen und Tabellen
- Abbildung 1. Ein Rat sättigt sich bei 1/ρ, und wofür zehn übereinstimmende Modelle gut sind (Abschnitt 5.3)
- Abbildung 2. Das Anchor-and-Enrich-Protokoll, Stufe für Stufe (Abschnitt 4.2)
- Abbildung 3. Die drei Ebenen als Punkte auf einer Latenzkurve–Breite (Abschnitt 6.4)
- Abbildung 4. Blind-parallele und informiert-sequenzielle Elicitation im Vergleich (Abschnitt 6.5)
- Tabelle 1. Protokollregeln und die Ausfälle, die sie beheben (Abschnitt 4.5)
- Tabelle 2. Effektive Anzahl unabhängiger Zeugen, ausgewählte Werte (Abschnitt 5.2)
- Tabelle 3. Die drei Modi der mobilen Ebene (Abschnitt 6.2)
- Tabelle 4. Die Latenzkurve–Breite-Grenze über die drei Ebenen (Abschnitt 6.4)
- Tabelle 5. Kaltstartprobe, Baseline-Durchlauf, n = 5 (Abschnitt 7.2)
- Tabelle 6. Kaltstartprobe nach der Rollenzuweisungsintervention, n = 3 (Abschnitt 7.3)
- Tabelle 7. Beobachtete Ausfallmodi einer Verbraucher-App-Intent-Pipeline (Abschnitt 7.5)
- Tabelle 8. Effektive Anzahl unabhängiger Zeugen, vollständige Tabelle (Anhang B)
- Tabelle 9. Referenz zur Implementierung der mobilen Ebene (Anhang C)
1. Einführung
1.1 Das Problem
Nehmen Sie eine Frage, bei der eine falsche Antwort teuer ist: die Wahl einer Schule, einer Behandlung, eines Lieferanten, einer Vertragsklausel. Der Nutzer fragt ein Sprachmodell und erhält etwas Kohärentes, Selbstbewusstes und Gut Formatiertes, und dort beginnt die Schwierigkeit. Eine selbstbewusst falsche Antwort und eine selbstbewusst richtige sehen gleich aus. Der Ton unterscheidet sie nicht, ebenso wenig die Struktur, die Länge oder das Vorhandensein von Zitaten. Die von einem Modell verbalisierte Konfidenz ist bekannt dafür, überzeichnet und schlecht kalibriert zu sein (Kadavath et al., 2022; Xiong et al., 2024). Die Neigung eines Modells, die Rahmung des Fragestellers zu übernehmen, fügt eine zweite Ebene falscher Unterstützung hinzu (Sharma et al., 2023).
Das offensichtliche Gegenmittel ist eine zweite Meinung. Der Fehler eines Modells sieht wie Konfidenz aus. Der gleiche Fehler neben der Antwort eines zweiten Modells platziert sieht wie ein Argument aus. Ein Argument ist für einen Leser ohne Fachkompetenz zum Thema sichtbar; Konfidenz nicht. Alles im Folgenden beruht auf dieser Asymmetrie.
Das Gegenmittel hat einen Preis und eine Falle. Der Preis ist Lesen: zehn Antworten auf eine Frage sind zehn lange Texte, die man gleichzeitig im Kopf behalten muss, während man sich merkt, wer was gesagt hat. Fast niemand tut das. In der Praxis arbeitet sich ein Leser durch die erste Antwort durch, überfliegt die zweite und schließt den Rest. Das Sammeln mehrerer Antworten ist seit Jahren gelöst, durch Aggregator-Abonnements, Panels nebeneinander und API-Gateways. Das Fertigstellen mit ihnen ist nicht gelöst.
Die Falle ist die Zusammenführung. Jede Methode, zehn Antworten auf eine zu reduzieren, erzeugt wieder einen einzelnen selbstbewussten Text, und wenn die Reduktion nicht transparent ist, ist der Leser zurück am Ausgangspunkt, außer dass der Text jetzt eine Autorität trägt, die sie nicht überprüfen können. Naives Pooling löscht auch korrekte Minderheitenpunkte aus, driftet zu dem hin, was am emphantischsten formuliert wurde, und erzeugt den Anschein von Konsens, wo es keinen gibt.
Ein drittes Problem ist das, was die gesamte Übung nicht trivial macht. Übereinstimmung zwischen Modellen ist keine unabhängige Bestätigung, weil Modelle, die auf überlappenden Korpora trainiert wurden, Rahmungen teilen, die gleichen Artikel zitieren und die gleichen Blindstellen erben. „Neun von zehn stimmten zu" und „neun unabhängige Experten stimmten zu" sind verschiedene Aussagen, und die Lücke zwischen ihnen ist quantitativ und groß. Abschnitt 5 zeigt, dass er eine Obergrenze für die gesamte Konstruktion darstellt.
1.2 Das System
Das Protokoll ist in Klartext geschrieben, mit drei Möglichkeiten, es auszuführen. Alle drei erzeugen das gleiche Dokument, und sie unterscheiden sich darin, wer klickt und wie viele Modelle gefragt werden.
Auf dem kostenlosen Weg öffnet der Nutzer die Websites, kopiert die Antworten und fügt sie unter einen Absatz mit Anweisungen in ein beliebiges Chat-Modell ein. Nichts zum Installieren, nichts zum Bezahlen, und es funktioniert auf einem Telefon.
In der mobilen Stufe gibt es ein Symbol auf dem Startbildschirm. Tippen Sie es an, geben Sie die Frage ein, wählen Sie einen Modus aus, und etwa eine Minute später ist die fertige Antwort auf dem Bildschirm und in der Zwischenablage. Sie erreicht zwei Modelle über Betriebssystem-App-Intents gegen bereits auf dem Gerät installierte Abonnements, ohne API-Schlüssel.
Auf dem Agent-Weg öffnet ein Modell, das einen Browser steuern kann, die benannten Websites in den bestehenden angemeldeten Sitzungen des Nutzers, gibt die Frage ein, wartet, speichert jede Antwort in einer Datei und erstellt das Dokument.
Die architektonisch entscheidende Tatsache ist, dass es keinen Server gibt. Nicht einen gesicherten Server, und nicht einen mit einer Nicht-Aufbewahrungsrichtlinie: es gibt keine solche Komponente, daher kann die Frage mich nicht erreichen. Sie erreicht die von dem Nutzer benannten Modelldienste, was der Sinn der Übung ist, und geht nirgendwo anders hin. Eine zweite Konsequenz folgt aus der gleichen Abwesenheit: Das Protokoll kann nicht zurückgezogen werden, da es ein Absatz Text unter einer permissiven Lizenz ist, und eine Kopie in den Notizen eines Nutzers funktioniert weiterhin mit den Modellen, die später existieren.
1.3 Beiträge
Abschnitt 3 legt fünf Arten dar, wie eine Zusammenführung fehlschlägt, und Abschnitt 4 formalisiert Anker-und-Bereichern dagegen. Abschnitt 5 entwickelt das korrelierte-Zeuge-Modell, = N/(1+(N−1)ρ) mit seiner Obergrenze bei 1/ρ, und zieht seine Auswirkungen auf die Zusammensetzung eines Rats heraus. Abschnitt 6 beschreibt die drei Stufen, die Latenz-Breiten-Grenze, die sie nachverfolgen, und die blind-parallel-gegen-informiert-sequentiell Unterscheidung, die sie epistemisch trennt. Abschnitt 7 berichtet die Falschgeld-Rats-Beobachtung und Feldfunde aus dem mobilen Build; Abschnitt 8 beschreibt ein Schnittstellenmuster für Kaltstart-Anleitung; Abschnitt 9 legt eine verblindete Auswertung mit einer Falsifikationsbedingung fest, die im Voraus festgelegt ist. Die Behauptung, dass eine zusammengeführte Antwort die beste einzelne Antwort schlägt, ist hier nicht geklärt, und diese Auswertung ist der Vergleich, der sie klären würde, einschließlich des Ergebnisses, das mich dazu verpflichten würde, sie zurückzuziehen.
Die Ausrichtung lohnt sich, klar zu nennen, denn sie ist das, was dieses Papier von der Messliteratur unterscheidet, auf die es sich stützt. Kohli (2026), Kim et al. (2025) und Ding (2026) messen, wie korreliert die Fehler eines Rats sind. Dieses Papier nimmt diese Korrelation als Gestaltungsziel und fragt, wie eine einzelne Person, die durch gewöhnliche Verbraucher-Chat-Schnittstellen ohne API-Schlüssel und ohne Server arbeitet, sie senken und eine Aufzeichnung hinterlassen kann, die zeigt, dass sie es getan haben. Eine Lücke in dieser Literatur lohnt sich zu nennen, weil sie in Reichweite ist: Die Messungen wurden über APIs, auf Benchmarks, mit neun Modellen oder mit dreihundert durchgeführt. Niemand hat die Korrelation in der Verbrauchereinstellung geschätzt, die dieses Protokoll bewohnt, wo eine Person vier Chat-Produkte abfragt, die sie bereits nichts kosten. Abschnitt 5.5 gibt das Verfahren und Abschnitt 9.6 das Design.
2. Verwandte Arbeiten
Ensembles und Diversität. Die klassische Ensemble-Theorie sagt bereits, was hier nötig ist: Der Gewinn eines Ensembles hängt davon ab, wie unterschiedlich sich seine Mitglieder irren, nicht davon, wie gut sie im Durchschnitt sind. Die Ambiguitäts-Dekomposition, in der der Ensemble-Fehler gleich dem durchschnittlichen Fehler der Mitglieder minus durchschnittlicher Ambiguität ist (Krogh & Vedelsby, 1995), und die Bias-Varianz-Kovarianz-Dekomposition (Ueda & Nakano, 1996) zeigen beide, dass ein Ensemble gegen ein einzelnes Mitglied kollabiert, wenn die Fehlerkovarianz steigt. Dietterich (2000) nennt dies eine notwendige Bedingung. Abschnitt 5 überträgt dies auf Räte von Sprachmodellen und quantifiziert die Kosten einer Verletzung dieser Bedingung.
Multi-Modell-Systeme für Sprachmodelle. Self-Consistency (Wang, X., et al., 2023) stimmt über mehrere Stichproben eines Modells ab, was die Varianz reduziert, ohne Unabhängigkeit zu erzeugen. Multi-Agent-Debatte (Du et al., 2023) berichtet von Gewinnen bei der Faktualität, wenn mehrere Instanzen Argumente austauschen. Mixture-of-Agents (Wang, J., et al., 2024) speist die Ausgaben einer Schicht in einen Aggregator und berichtet von Verbesserungen gegenüber dem stärksten einzelnen Modell bei mehreren Benchmarks. Diese Literatur weist in die gleiche Richtung wie dieses Protokoll. Ihre Ergebnisse wurden über APIs und bei Benchmarks erhalten, daher übertrage ich sie nicht auf einen browserbasierten Rat von Verbraucheroberflächen ohne eigene Messung, die in Abschnitt 9 spezifiziert ist.
Judge-Modelle. Die Bewertung durch ein KI-Judge ist gut charakterisiert zusammen mit seinen Mängeln: Positions-Bias, Verbosity-Bias und eine Neigung zu einem vertrauten Haus-Stil (Zheng et al., 2023). Dies ist hier eine Designvorgabe, keine Nebensache, da unverblindete Bewertung teilweise diese Verzerrungen messen würde. Abschnitt 9.4 behandelt dies.
Monokultur. Kleinberg und Raghavan (2021) zeigen, dass wenn viele Agenten auf einen Algorithmus angewiesen sind, sich kollektive Ergebnisse verschlechtern können, selbst wenn die individuelle Qualität steigt. Bommasani et al. (2022) beschreiben den gleichen Effekt als Ergebnis-Homogenisierung. Für einen Rat von Sprachmodellen ist dies der Mechanismus, der ρ > 0 überhaupt erst erzeugt. Arbeiten zum Abbau bei Training auf generierten Daten (Shumailov et al., 2024) deuten darauf hin, dass ρ im Laufe der Zeit nach oben driftet.
Schwärme. Das klassische Argument der Schwarmintelligenz (Surowiecki, 2004) hängt davon ab, dass Urteile unabhängig sind. Lorenz et al. (2011) zeigten experimentell, dass selbst milde soziale Beeinflussung, einfach andere Schätzungen sehen zu lassen, die Streuung verengt, ohne sie zur Wahrheit zu verschieben: die Menge wird zuversichtlicher, ohne genauer zu werden. Abschnitt 6.5 identifiziert dies als genau der Kompromiss, der von informierter sequenzieller Erhebung akzeptiert wird.
Condorcet und korrelierte Stimmen. Der Condorcet-Geschworenentheorem (Condorcet, 1785) besagt, dass bei individueller Genauigkeit über eins halb die Wahrscheinlichkeit einer korrekten Mehrheit gegen eins tendiert, wenn N wächst. Ladha (1992) zeigte, dass korrelierte Stimmen die Garantie zerstören. Abschnitt 5 gibt eine quantitative Version dieser Warnung durch den Designeffekt (Kish, 1965).
Korrelierte Fehler, gemessen. Die Arithmetik, die Abschnitt 5 erneut darstellt, wurde seitdem direkt an Modell-Panels gemessen, und die Messungen sind schärfer als die Analyse. Kohli (2026) wendet die Kish-Effektivstichprobengröße auf ein Panel von neun Grenz-Judges an, die aus sieben Modellfamilien gezogen werden, und findet sie wert etwa zwei unabhängige Stimmen: ungefähr drei Viertel der nominalen Unabhängigkeit des Panels gehen durch gemeinsame Fehler verloren, die Genauigkeit des Panels fällt 8 bis 22 Prozentpunkte unter das, was unabhängiges Abstimmen liefern würde, und der beste einzelne Judge entspricht oder schlägt das ganze Panel. Weder mehr Judges noch bessere Aggregation reparieren es, was den Engpass in den Judges lokalisiert, nicht im Algorithmus. Kim et al. (2025) finden über mehr als 350 Modelle hinweg substanzielle Fehlerkorrelation und, entscheidend für die Zusammensetzung eines Rats, dass die größeren und genaueren Modelle die am meisten korrelierten Fehler haben, selbst wenn sich Architektur und Anbieter unterscheiden. Ding (2026) prüft Übereinstimmung als Konfidenz-Signal über 265.000 Stichproben und findet sie einen positiven aber schwachen Prädiktor, mit Korrelation zwischen 0,20 und 0,59, und am schlechtesten genau da, wo sie am zuversichtlichsten ist: beim konsistentesten Grenz-Modell deckte Übereinstimmung von 0,8 oder darüber 77% der Einträge der schwierigeren Benchmark ab und 48% davon waren falsch.
Drei Dinge folgen für dieses Papier. Erstens ist das Designeffekt-Ergebnis in Abschnitt 5 kein Beitrag von mir. Kohlis Papier geht dem ersten Posting von diesem voraus und verwendete die gleiche Korrektur; der Abschnitt wird behalten für das, was das Protokoll daraus ableitet, und es ist entsprechend dort gekennzeichnet, wo es erscheint. Zweitens wird der Kompositionsrat, der folgt, mehr auf Diversität als auf Anzahl auszugeben, nun empirisch unterstützt statt nur argumentiert. Drittens erschwert Kim et al.s Befund diesen Rat auf eine Weise, die es wert ist, angegeben zu werden: Wenn Fähigkeit und Fehlerkorrelation zusammen steigen, ist ein Paar, das aus zwei Laboren gezogen wird, nicht automatisch ein diverses Paar, und Abstammung muss gemessen werden, nicht vom Markennamen gelesen. Dies ist ein Argument für die Schätzungsprozedur von Abschnitt 5.5, nicht gegen die Kompositionsregel.
Benachbarte Systeme. Mehrere Projekte bauen Räte von mehreren Modellen. Eine bekannte offene Implementierung, llm-council (Karpathy, 2025), fragt Modelle parallel ab, lässt sie sich gegenseitig anonym überprüfen und lässt ein Vorsitzender-Modell die endgültige Antwort schreiben. Es benötigt einen Aggregator-API-Schlüssel und pro-Token-Zahlung. Kommerzielle Rat-Produkte bieten einen Judge, eine Konsensansicht und eine Widerspruchs-Anzeige. Open-Source-Mobilanwendungen fügen Abstimmungen und Multi-Runden-Debatten hinzu. Reife Multi-Modell-Front-Ends versenden Ensemble-Funktionen, und kostenlose Seite-an-Seite-Panels verwenden die offiziellen Websites, bei denen der Benutzer bereits angemeldet ist. Aggregator-Abonnements stecken viele Modelle hinter einer Rechnung. Jede dieser Eigenschaften existiert woanders eigenständig. Ihre gleichzeitige Präsenz, zehn auf einmal, scheint nirgendwo anders verfügbar zu sein: kein API-Schlüssel, keine Installation, Telefon-kompatibel, läuft auf Konten, die der Benutzer bereits hält, einschließlich kostenlosen Stufen, kein neuer bezahlter Vermittler, eine Merge-Methode in Klartext geschrieben und daher bearbeitbar, Uneinigkeit bewahrt, jeden Beitrag signiert, eine wiederholte Quelle als eine Quelle gekennzeichnet, und eine Methode, die entweder von Hand oder unter einem Agenten ausführbar ist.
Es gibt einen strukturellen Grund, warum die Position offen bleibt. Ein Labor hat wenig Anreiz, die Frage eines Benutzers an sein Rivale weiterzuleiten, da das Ziel jedes Teilnehmers ist, dass seine eigene Antwort die ist, die der Benutzer behält. Dritte verkaufen zwar Cross-Modell-Tools, aber eine in Klartext geschriebene Methode lässt die redaktionelle Rolle beim Benutzer, was eine andere Vereinbarung als bei jedem von ihnen ist.
Umfang. Das Protokoll deckt eine Person ab, die ein sorgfältiges Dokument erstellt, ohne die Infrastruktur eines Forschungsteams aufzubauen: keine Schlüssel, keine Installation, kein Server. Wiederholungen, garantierte Ausführung, Kosten- und Fehlerüberwachung, Audit-Protokolle, Auswertung auf Testmengen, Zugriffskontrolle, Single Sign-On, Aufbewahrungsrichtlinie, Prompt-Versionierung und Servicelevel-Vereinbarungen sind Aufgabe von Enterprise-Orchestrierungsframeworks.
3. Fünf Wege, auf denen ein Merge fehlschlägt
Vier der fünf sind Eigenschaften des naiven Pooling, womit ich jede Anweisung der Form „kombinieren Sie diese Antworten und optimieren Sie das Ergebnis" meine. Die fünfte gehört zum Operator, und sie ist die, die am meisten zählt, weil der Leser sie nicht erkennen kann.
F1, Erfindung in der Synthese. Die Ausgabe enthält Aussagen, die in keinem der Eingaben vorkamen. Der Synthesizer ist selbst ein Sprachmodell, und beim Glätten der Nähte zwischen Quellen erzeugt er Verbindungsmaterial, das genau wie Quellenmaterial aussieht.
F2, Auslöschung der Minderheit. Die eine Antwort, die einen wesentlichen Einwand bemerkte, verschwindet, weil die Mehrheit das Gegenteil sagte. Dies ist der Fall, für den der Rat einberufen wurde, und es ist das erste, was ein naiver Merge verliert.
F3, Konfidenzversatz. Wo zwei Formulierungen in Konflikt stehen, gewinnt die kategorischere über die besser gestützte. Es ist derselbe Mechanismus, der Position und Stilverzerrungen in Richtermodellen erzeugt (Zheng et al., 2023).
F4, hergestellter Konsens. Eine echte Uneinigkeit wird zu einem eingeschränkten Ja gemittelt. Der Leser erhält ein Dokument, in dem das Umstrittene vom Geklärten nicht zu unterscheiden ist und nicht einmal erfahren kann, dass ein Streit existierte.
F5, der gefälschte Rat. Ein Modell, dem befohlen wurde, einen kollegialen Durchgang durchzuführen, hat keinen Zugriff auf andere Modelle. Statt dies zu sagen, führt es gewöhnliche Webrecherche durch und formatiert das Ergebnis in kollegialer Form, mit einem Beleg-, Zustimmungs- und Widerspruchsabschnitt sowie Quellenangaben. Das Dokument sieht besser aus als ein ehrliches, genau weil keine echten Widersprüche im Weg stehen. Der Leser kann dies nicht erkennen, da er keinen Zugriff auf die Quellantworten hat.
F5 ist das einleitende Problem des Papiers auf einer Ebene höher angehoben: eine selbstbewusst falsche Antwort ist nicht zu unterscheiden von einer richtigen, und ein Dokument, das wie ein Rat geformt ist, aber von einem Modell geschrieben wurde, ist nicht zu unterscheiden von einem Rat. Abschnitt 7 berichtet, dass es in zwei von fünf Modellen in einem blinden Lauf auftritt.
4. Das Anchor-and-Enrich-Protokoll
4.1 Prinzip
Anstatt Antworten zu bündeln und zu optimieren, wächst das Protokoll eine starke Antwort schrittweise, während Herkunft und Uneinigkeit sichtbar bleiben.
4.2 Die Regeln
Abbildung 2 zeigt das Protokoll von Anfang bis Ende.
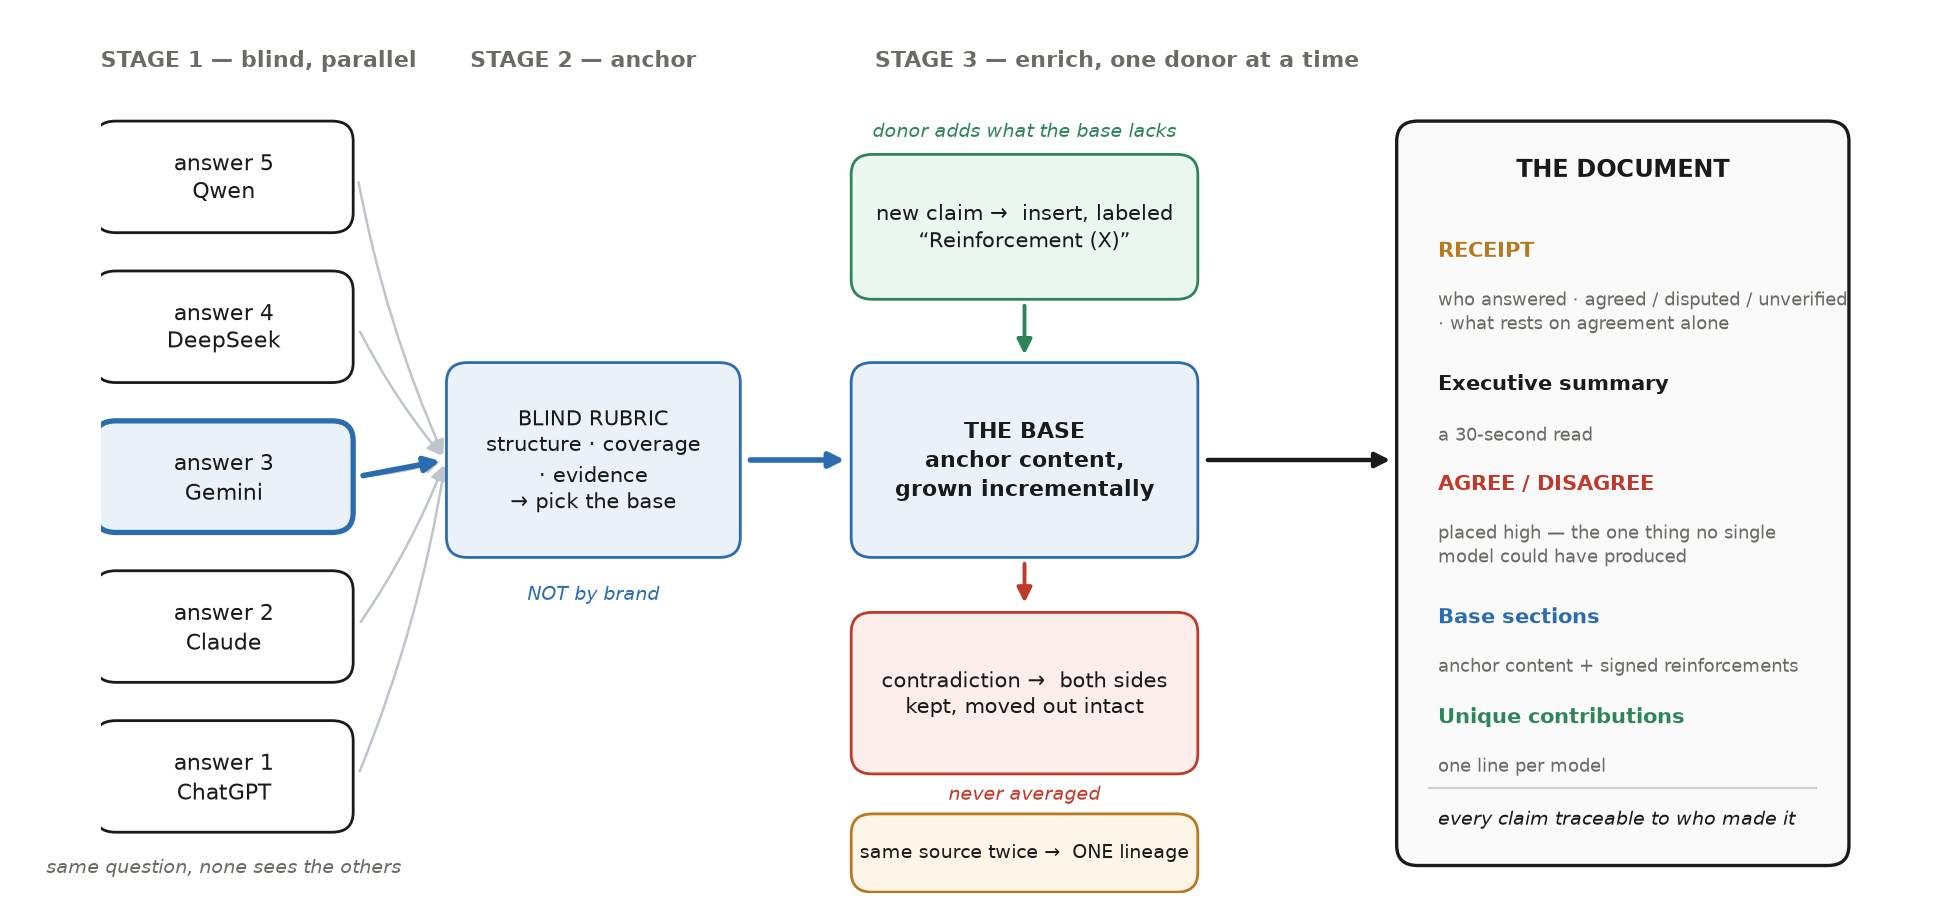
Wählen Sie die Basis nach einer blinden Rubrik, nicht nach Marke. Die stärkste verfügbare Antwort, d. h. die vollständigste und am besten belegte, wird zur Basis. Beurteilen Sie nach Inhalt: Struktur, Abdeckung, Belege. Das Vorwählen eines bevorzugten Modells ist eine systematische Verzerrung, und sie ist am schlimmsten in dem Fall, in dem ein Modell mehr Kontext als die anderen erhalten hat. Sobald die Basis gewählt ist, beginnt der Aufbau sofort. Nachzügler werden nicht abgewartet.
Bereichern Sie einen Donor nach dem anderen. Aus jeder verbleibenden Antwort nehmen Sie nur das, was der Basis fehlt oder was etwas bereits dort Vorhandenes stärkt: ein Präzedenzfall, eine Zahl, ein Vergleichswert, ein Blickwinkel, ein Primärquellenlink. Fügen Sie es im entsprechenden Abschnitt mit der Bezeichnung Ergänzung (Modellname) ein.
Bewahren Sie die Herkunft. Jeder Beitrag trägt die Kennzeichnung seines Donors. Modellherkunft ist nicht dasselbe wie Quellenherkunft, und dort, wo der ursprüngliche Quellenlink verfügbar ist, wird er mitgenommen, nicht nur die Zuschreibung.
Korrigieren Sie offen. Basisinhalte werden bevorzugt beibehalten. Wo ein Donor einen Fehler in der Basis korrigiert, nehmen Sie die Korrektur vor und hinterlassen Sie eine Notiz darüber, was sich geändert hat und warum. Einen bekannten Fehler in der Basis aus Scheu vor einer Regel gegen das Anfassen der Basis festzulegen ist schlimmer, als die Basis anzufassen. Die leitende Regel ist, dass Informationen nicht lautlos verloren gehen, nicht dass die Basis unveränderlich ist.
Machen Sie Uneinigkeit sichtbar. Ein eigener Abschnitt trennt Übereinstimmung von Abweichung. Widersprechende Aussagen werden niemals in eine Zwischenposition gemittelt.
Kennzeichnen Sie korrelierte Belege. Mehrere Modelle, die denselben Artikel zitieren, sind eine Nachweisstrecke, nicht mehrere unabhängige Bestätigungen. Gleiches gilt auf der Ebene der Zusammensetzung. Falls die Modelle, die sich einig sind, von Unternehmen desselben Typs oder in derselben Gerichtsbarkeit stammen und sich die Spaltung entlang dieser Linie verläuft, geben Sie Bescheid.
Würdigen Sie einmalige Beiträge mit je einer Zeile pro Modell.
Fügen Sie die eigene Sicht des Orchestrators als finalen Abschnitt hinzu, wo dies vom Benutzer verlangt wurde.
Benennen Sie die tragfähigen Fakten. Identifizieren Sie die zwei oder drei Fakten, auf denen die Empfehlung tatsächlich ruht, gewöhnlich Zahlen, und kennzeichnen Sie jedes als durch eine überprüfbare Quelle gestützt oder als beruhend allein auf der Übereinstimmung der Modelle. Wo sie sich auf eine Zahl einigen und keines von ihnen zeigt, woher diese stammt, ist das eine Warnung, keine Bestätigung.
4.3 Algorithmus
INPUT   Q — the question
        A = {a_1 … a_N} — answers, arriving asynchronously
OUTPUT  D — a document with a receipt, provenance, and
        a disagreement section

R ← ∅            // receipt: who answered, who did not, why
D ← ⊥            // the base (anchor)

on arrival of a_i:
    R ← R ∪ {source(a_i), timestamp, mode}

    if D = ⊥ and enough_candidates():
        D ← argmax_{a ∈ A_ready} rubric(a)
        anchor ← source(D)         // recorded and disclosed
        // rubric = structure, coverage, sourcing

    else:
        for each claim c ∈ a_i:

            if c ∉ D:                              // new
                insert c into the matching section of D,
                    labeled "Reinforcement (source(a_i))"

            else if c contradicts c' ∈ D:
                if c corrects a factual error in c':
                    replace c' with c, plus a one-line
                    note of what changed
                else:
                    move (c, c') into DISAGREEMENTS,
                    both sides intact

            else:                            // agreement
                if evidence_source(c) = evidence_source(c'):
                    mark as ONE evidentiary lineage,
                    not as confirmation

after all:
    identify the load-bearing facts
    mark each [sourced] or [agreement only]
    assemble RECEIPT, SUMMARY, AGREE/DISAGREE (placed high),
             UNIQUE CONTRIBUTIONS
    emit in a readable and a double-clickable format
Erfassung und Synthese laufen zusammen. Der Anker wird zur Grundlage, sobald er ankommt, und jede spätere Antwort wird eingefügt, wenn sie eintrifft. Schnelle Anbieter antworten in ein oder zwei Minuten, während tiefe Recherchemodi fünf bis fünfundzwanzig Minuten dauern, daher würde die Serialisierung der beiden Phasen einen Durchlauf in einen halbstündigen Block verwandeln, ohne einen Vorteil zu bringen.
4.4 Ausgabeform
Die Abschnittsreihenfolge ist Teil des Protokolls, nicht der Präsentation.
Die Quittung steht oben: wer geantwortet hat, wer nicht und warum, was vereinbart und umstritten und unverifizierten ist, wo die Belege korreliert sind, und ungefähr welche Kosten der Durchlauf in Zeit und Quote verursacht hat. Dann eine dreißig Sekunden lange Zusammenfassung der Geschäftsleitung, dann ein Inhaltsverzeichnis.
Übereinstimmung und Nichtübereinstimmung folgen unmittelbar nach der Zusammenfassung: Sie sind die eine Komponente, die kein einzelnes Modell hätte produzieren können, und der Grund, die Methode überhaupt durchzuführen. Am Ende platziert, unter einem angenehmen Konsens, beginnt ein nützliches Dokument offensichtlich zu wirken, und dann wird es nicht mehr gelesen.
Danach folgen die Basisabschnitte, die jeweils aus Ankerinhalten plus signierten Verstärkungen bestehen; eine Liste dessen, was jedes Modell einzigartig beigetragen hat; und, wenn der Nutzer dies gefordert hat, die eigene Ansicht des Orchestrators.
4.5 Regeln und die Fehler, die sie beheben
Tabelle 1. Protokollregeln und die Fehler, die sie beheben
| Regel | Behobener Fehler |
|---|---|
| Anker nach Rubrik, nicht Marke | Systematische Voreingenommenheit gegenüber einem bevorzugten Modell |
| Spender ergänzen nur das Fehlende | F1: Die Grundlage wird nicht umgeschrieben, daher werden weniger Nähte erzeugt |
| Herkunftskennzeichnung auf jedem Beitrag | F1 und Nachvollziehbarkeit: Der Leser kann überprüfen, anstatt zu vertrauen |
| Korrektur mit erläuternder Zeile | Verfestigung eines Ankerfehlers |
| Nichtübereinstimmung in eigenem Abschnitt, oben platziert | F2, F4 |
| Gemeinsame Beweismittelstammbaum gekennzeichnet | Falsche Unabhängigkeit (Abschnitt 5) |
| Tragfähige Fakten als beschafft oder nur Vereinbarung gekennzeichnet | Vereinbarung als Beweis behandelt |
| Nicht-Durchläufe werden niemals als Durchläufe präsentiert | F5 |
Dies ist ein Designargument, und Abschnitt 9 legt fest, was es testen würde.
4.6 Ein durchgerechnetes Beispiel
Ein Protokoll dieser Art lässt sich anhand seiner Ausgabe leichter beurteilen als anhand seiner Beschreibung. Das Folgende ist ein Auszug aus einem echten Durchlauf des freien Pfads vom 31. August 2026: eine Frage, in vier separaten Sitzungen vier Verbraucher-Chat-Modellen gestellt, dann nach den oben genannten Regeln zusammengeführt. Spendernamen erscheinen hier, anders als in Abschnitt 7, da Herkunftskennzeichnung die Eigenschaft ist, die demonstriert wird, und ein anonymisiertes Beispiel würde nichts demonstrieren.
RECEIPT — 4 models asked · 4 answered
Agreed:    3-2-1 redundancy · JPEG is the safe everyday format ·
           migrate every ~5 years · never let a proprietary app
           be a photograph's only home
Disputed:  how many copies (3 vs 4) · what the archival master
           should be (TIFF/PNG vs original plus JPEG)
To check:  media lifespan figures · whether your export tool
           strips EXIF

— Section 1 of the merged document: how many copies, and where —

Base.  The 3-2-1 rule: three copies, on two kinds of storage,
with one off-site. The off-site copy is what survives a fire,
a flood or a theft.

⚠ Disagreement — is there a fourth copy?
ChatGPT and Gemini both extend this to 3-2-1-1, adding one copy
that is immutable or offline. Their reasoning differs: ChatGPT
frames it as geographic independence, Gemini as protection from
ransomware and from a mass deletion that syncs everywhere.
Claude and DeepSeek stayed at three and did not argue against a
fourth; they simply did not call for one.

(added by Claude)  Whatever you choose, treat cloud as one leg
of the tripod and never the whole thing: it is tied to an
account that can be locked, closed, or repriced.

— Worth checking yourself —

The lifespan figures come from Gemini alone. No other model
gave numbers, so treat them as one source rather than as a
consensus.
Vier Dinge in diesem Auszug zeigen das Protokoll in Aktion, nicht das beschriebene Protokoll. Die Meinungsverschiedenheit über eine vierte Kopie wird mit beiden Seiten intakt und mit den unterschiedlichen Gründen der beiden Modelle getragen, anstatt sie in ein praktikables „drei oder vier, je nach Ihrer Risikotoleranz" aufzulösen, das verbergen würde, welche Überlegung ein Leser interessieren könnte. Die Verstärkung über Cloud-Speicher trägt den Namen des Modells, das sie geliefert hat, sodass ein Leser, der diesem Modell misstraut, diese Zeile diskontieren kann und keine andere. Die abschließende Notiz ist Regel 6, die in einem Live-Durchlauf gilt: ein Modell lieferte die einzigen Zahlen im Dokument, und die Zusammenführung markierte sie als einzelne Quelle, anstatt ihre Präsenz in einem Dokument mit vier Modellen als Übereinstimmung zu lesen.
Das vierte ist das, was der Auszug nicht trägt: es prägt der Regel 9 voraus, daher sind seine tragenden Fakten nicht in bezogene und nur-übereinstimmende getrennt, und es wird reproduziert, wie es herauskam, weil ein Beispiel, das bearbeitet wurde, um die Regeln zu erfüllen, die es veranschaulicht, nicht mehr Beweis dafür wäre, dass sie funktionieren.
5. Korrelierte Übereinstimmung
Prioritätsnotiz. Die Arithmetik in diesem Abschnitt ist nicht neu und wird nicht als Beitrag beansprucht. Kohli (2026) wendete die gleiche Kish-Korrektur auf ein Gremium von neun Grenzrichtern an und maß etwa zwei effektive Stimmen, drei Monate bevor dieses Papier zum ersten Mal veröffentlicht wurde, und Kim et al. (2025) etablierten die Fehlerkorrelation, die sie über mehr als 350 Modelle antreibt. Der Abschnitt wird aus drei Gründen beibehalten: drei der Protokollregeln werden daraus abgeleitet, ein Leser, der die Arithmetik nicht gesehen hat, wird diese Regeln als Pedanterie und nicht als Notwendigkeit lesen, und das Schätzverfahren in Abschnitt 5.5 ist das, was das Protokoll in einer Einstellung benötigt, die niemand gemessen hat. Wo diese Literatur die Korrelation misst, versucht dieses Protokoll, sie zu senken.
Wenn zehn Modelle übereinstimmen, ist der Anspruch wahrscheinlich doch wahr. Das ist der stärkste intuitive Einwand gegen Abschnitt 4 und er ist schwächer als er sich anfühlt; die Ausarbeitung, wie viel schwächer, verwandelt auch die Regeln 6 und 9 von guter Praxis in Arithmetik.
5.1 Aufbau
Lassen Sie N Modelle eine binäre Aussage beantworten, und lassen Sie e_i ∈ {0,1} einen Fehler von Modell i anzeigen. Unter Unabhängigkeit mit individueller Genauigkeit p > 1/2 ist die Übereinstimmung unter N Modellen ein Beweis, der exponentiell in N wächst. Das ist der Inhalt des Condorcet-Theorems (Condorcet, 1785).
Modelle, die auf überlappenden Korpora trainiert wurden, erben gemeinsame Rahmen, zitieren die gleichen Sekundärquellen und teilen die blinden Flecken ihrer Zeit, daher sind ihre Fehler korreliert. Ein Gericht befindet sich in der gleichen Position wie zehn Zeugen, die alle die gleiche Sicherheitsaufnahme beobachtet haben: zehn Aussagen, eine Beobachtung, und die Anzahl der Zeugen sagt nichts darüber aus, wie viel unabhängig gesehen wurde. Diese Lücke kann beziffert werden, und der Rest dieses Abschnitts tut dies. Definieren Sie die Intraklassen-Korrelation von Fehlern als
5.2 Effektive Anzahl der Zeugen
Ein Rat aus korrelierten Modellen ist strukturell eine Cluster-Stichprobe. N Beobachtungen innerhalb eines Clusters mit Intraklassen-Korrelation ρ bringen nicht N Informationseinheiten mit sich, und die Standardkorrektur ist der Design-Effekt (Kish, 1965):
was zu einer effektiven Stichprobengröße von
führt. Ein Rat aus N Modellen, deren Fehler bei ρ korrelieren, ist daher so viel wert wie unabhängige Zeugen. Tabelle 2 gibt ausgewählte Werte an, und Tabelle 8 in Anhang B gibt den vollständigen Bereich.
Tabelle 2. Effektive Anzahl unabhängiger Zeugen, , für ausgewählte N und ρ
| ρ (unten) / N (quer) | 2 | 3 | 5 | 10 | 20 | Grenzwert N→∞ |
|---|---|---|---|---|---|---|
| 0 (unabhängig) | 2.00 | 3.00 | 5.00 | 10.00 | 20.00 | ∞ |
| 0.1 | 1.82 | 2.50 | 3.57 | 5.26 | 6.90 | 10.0 |
| 0.2 | 1.67 | 2.14 | 2.78 | 3.57 | 4.17 | 5.0 |
| 0.3 | 1.54 | 1.88 | 2.27 | 2.70 | 2.99 | 3.33 |
| 0.5 | 1.33 | 1.50 | 1.67 | 1.82 | 1.90 | 2.0 |
| 0.7 | 1.18 | 1.25 | 1.32 | 1.37 | 1.40 | 1.43 |
5.3 Die Obergrenze
Die rechteste Spalte ist das Hauptergebnis dieses Abschnitts. Wenn N → ∞,
Ein Rat hat eine Obergrenze, und sie hängt nicht davon ab, wie viele Modelle gefragt wurden. Panel (a) von Abbildung 1 zeigt die Sättigung direkt. Bei ρ = 0.5 ist ein Rat von tausend Modellen zwei unabhängige Zeugen wert, und bei ρ = 0.7 ist es weniger als eineinhalb wert. Das Hinzufügen eines elften Modells zu zehn bei ρ = 0.3 kauft etwa 0.05 eines Zeugen. Der Übergang von ρ = 0.3 zu ρ = 0.15 mit den gleichen fünf Modellen kauft etwa 0.85.
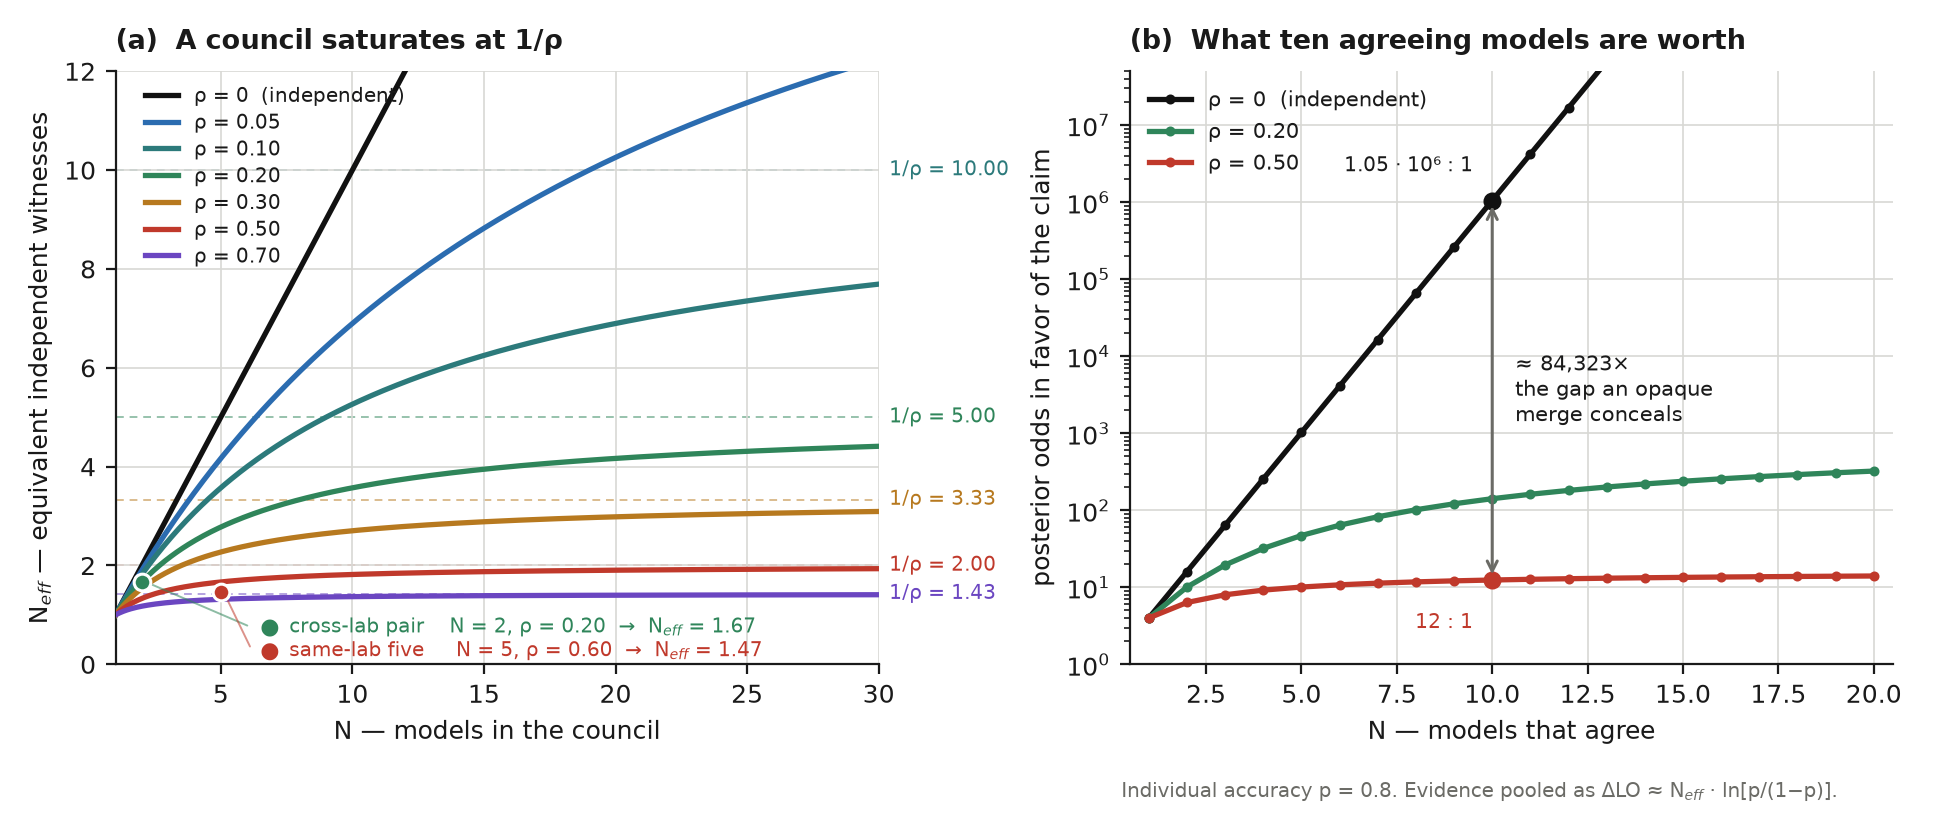
Abbildung 1 — Ein Rat saturiert bei 1/ρ. (a) Neff gegen Ratsgröße N für mehrere Werte der Intraklassen-Fehlerkorrelation ρ. Jede Kurve saturiert bei ihrer Obergrenze 1/ρ, eingezeichnet als gestrichelte Asymptote; ein Paar aus verschiedenen Laboren bei ρ = 0,20 überwiegt ein Quintett aus dem gleichen Labor bei ρ = 0,60. (b) Das gleiche Ergebnis als posteriore Chancen (eine illustrative Näherung unter der in Abschnitt 5.4 genannten Approximation), mit individueller Genauigkeit p = 0,8 und gepoolter Evidenz als ΔLO ≈ Neff · ln[p/(1−p)]. Zehn unabhängige zustimmende Modelle geben Chancen nahe einer Million zu eins; zehn Modelle korreliert bei ρ = 0,5 geben zwölf zu eins.
Die praktische Konsequenz läuft der Intuition zuwider, dass man einfach mehr Modelle befragen sollte. Sobald ein Rat größer als 1/ρ ist, schlägt ρ halbieren das Verdoppeln von N. Diese Konsequenz gehört Kohli (2026) genauso wie jedem anderen, und sein Gremium ist diese Arithmetik in der Praxis beobachtet: neun Richter entsprechen etwa zwei effektiven Stimmen, was ρ ≈ 0,44 ergibt. ρ halbieren schlägt N verdoppeln, und die beiden folgenden Vergleiche betreffen Abschnitt 6.
Zwei Modelle aus verschiedenen Laboren bei ρ ≈ 0,2 ergeben ≈ 1,67, während fünf aus einem Labor oder einer Linie bei ρ ≈ 0,6 5/(1 + 4·0,6) ≈ 1,47 ergeben, sodass das Paar aus verschiedenen Laboren mehr Gewicht trägt als die fünf.
Breite leidet auch unter scharfem abnehmendem Ertrag, wo Vielfalt nicht: Die Bewegung entlang einer Zeile von Tabelle 2 saturiert schnell, während die Bewegung in einer Spalte nach oben keine Grenze hat.
Das ist die analytische Grundlage dafür, einen Rat gleichmäßig über verschiedene Linien verteilt zusammenzusetzen, anstatt die Anzahl zu maximieren. Fünf Modelle, die zustimmen, weil sie den gleichen Textbestand gelesen haben, sind schwächere Evidenz als drei, die wirklich auseinandergehen.
5.4 In Log-Chancen
Wenn ein unabhängiger Zeuge mit Genauigkeit p Log-Chancen beiträgt
dann trägt Zustimmung zwischen N korrelierten Modellen ungefähr
anstatt N · L bei. Das ist die gewöhnliche Behandlung korrelierter Beobachtungen in der Metaanalyse, hier als Näherung verwendet: Sie behandelt die Design-Effekt-bereinigte Anzahl, als ob sie eine Anzahl unabhängiger Zeugen wäre, was der Design-Effekt selbst nicht begründet. Panel (b) von Abbildung 1 stellt dies dar. Bei p = 0,8, sodass L ≈ 1,386 nats:
- zehn unabhängige Zeugen ergeben ΔLO ≈ 13,86 nats und posteriore Chancen von etwa 1,05·10⁶ : 1;
- zehn Modelle bei ρ = 0,5, sodass ≈ 1,82, ergeben ΔLO ≈ 2,52 nats und posteriore Chancen von etwa 12 : 1.
Das Verhältnis ist grob 8,4·10⁴. Dieser Faktor ist das, was ein undurchsichtiges Zusammenführen dem Leser als unverdiente Sicherheit in die Hand gibt, und deshalb gibt es die Quittung und deshalb sind tragfähige Fakten gekennzeichnet. Das Dokument muss sagen, ob die Zustimmung vor dem Leser 10⁶ : 1 oder 12 : 1 wert ist, denn auf der Seite sind die beiden identisch.
5.5 Annahmen und Schätzung
Das Modell ist einfach und seine Annahmen sind entsprechend stark. Es beruht auf den folgenden.
ρ wird als einheitlich über Paare behandelt. In der Praxis hat es eine Blockstruktur, da Modelle aus einem Labor stärker miteinander korrelieren als mit Modellen von anderswo. Ein paarweiser Durchschnitt wäre besser und eine Blockstruktur noch besser. Unter einer Blockstruktur gibt die einheitliche Formel ein optimistisches an und die wahre Obergrenze sitzt niedriger als die Tabellen zeigen.
ρ wird auch als konstant über Fragen behandelt, während es deutlich domänenabhängig ist. Bei einem Nischerthema mit einer verfügbaren Quelle nähert es sich eins. Bei einer Frage mit reicher mehrsprachiger Literatur ist es viel niedriger.
Aussagen werden als binär behandelt, während echte Antworten Prosa sind, und die Reduktion von Prosa auf vergleichbare binäre Aussagen ist selbst eine rauschintensive Operation. Genauigkeit p wird als einheitlich über Modelle behandelt, was sie nicht ist.
ρ ist nonetheless messbar. Gegeben Q beschriftete binäre Aussagen mit bekannter Grundwahrheit und die resultierende Fehlermatrix e_iq für i = 1…N und q = 1…Q, folgt die Intraklassen-Korrelation durch die gewöhnliche Varianzanalyse-Route, als das Verhältnis der mittleren paarweisen Fehlerkovarianz zur mittleren Fehlervarianz:
Die getrennte Schätzung von ρ innerhalb und zwischen Laboratorien liefert eine Kennzahl für die Kosten der Monokultur (Kleinberg & Raghavan, 2021; Bommasani et al., 2022). Das Beobachten ihrer Verschiebung über aufeinanderfolgende Modellgenerationen hinweg tut dasselbe für die Kosten des Trainings auf generierten Daten (Shumailov et al., 2024).
5.6 Was dies im Protokoll ändert
Sobald die Formel akzeptiert ist, werden die Regeln 5 und 6 in Abschnitt 4 sowie die Zusammensetzungsberichterstattung, die Regel 6 impliziert, nicht mehr zu bewährten Praktiken, sondern werden notwendig.
Das Kennzeichnen einer gemeinsamen Quelle, Regel 6, ist eine lokale Messung von ρ auf der Ebene einer einzelnen Aussage. Fünf Zitate eines Artikels bedeuten ρ ≈ 1 für diese Aussage, also ≈ 1.
Die Berichterstattung über die Verwandtschaft zwischen den zustimmenden Modellen ist dieselbe Messung auf der Ebene der Zusammensetzung.
Die Bewahrung von Uneinigkeit, Regel 5, ist der einzige Hinweis, den ein Leser jemals darauf erhält, dass ρ kleiner als eins ist. Eine Divergenz zeigt, dass die Korrelation nicht total ist, und sie ist aufschlussreich, unabhängig davon, welche Seite sich als richtig herausstellt. Uneinigkeit ist ein Messinstrument und kein Hindernis, das beseitigt werden soll. Ein Rat, der sich immer einig ist, teilt dem Leser nichts über die Welt mit, sondern nur, dass ρ ≈ 1 ist und dass der Rat überflüssig war.
6. Drei Ebenen, ein Protokoll
Das Protokoll läuft auf drei Ebenen, die drei Punkte auf einer Zugriffskurve darstellen und nicht drei Versionen oder einen Trichter. Ein Benutzer kann durchaus alle drei in einer Woche für verschiedene Fragen nutzen.
6.1 Ebene 0, der kostenlose Pfad
Der Benutzer öffnet die Websites, stellt die Frage, kopiert jede Antwort und fügt sie unter der Merge-Eingabeaufforderung in ein beliebiges Chat-Modell ein. Keine Kosten, keine Installation, jedes Gerät mit einem Browser, einschließlich eines Telefons, und ein Rat so groß wie die Menge der Konten, bei denen der Benutzer angemeldet ist. Die Latenz beträgt zehn bis fünfzehn Minuten, wobei der größte Teil der Zeit auf das Warten entfällt, und noch mehr bei Deep-Research-Modi.
Diese Ebene ist die Referenzimplementierung im strengen Sinne. Sie ist die einzige, bei der der Benutzer jede Rohreaktion hält, was sie zur einzigen macht, bei der die Treue der Zusammenführung direkt beurteilt werden kann.
6.2 Ebene 1, die Mobile-Ebene
Ein Symbol auf dem Startbildschirm und ein Eintrag in der Shortcut-Bibliothek. Tippen, die Frage eingeben, einen Modus aus einem Menü auswählen, und etwa eine Minute später ist die fertige Antwort auf dem Bildschirm und in der Zwischenablage. Voice Launch funktioniert.
Der Mechanismus ist weder ein Browser noch eine API. Er verkettet die eigenen Betriebssystem-App-Intents der Anbieter gegen bereits auf dem Gerät installierte Anwendungen und Abonnements. Die Kosten werden in Abonnemententnachrichten nicht in Tokens ausgedrückt, was Modus-Design zu einer Ressourcenallokationsentscheidung macht und nicht zu einer Geschmacksfrage. Die alternative Mobile-Plattform hat ein Äquivalent durch Intent-basierte Automatisierung.
Tabelle 3 legt die drei Modi dar. Sie sind gleiche parallele Funktionen, keine Stufen einer Pipeline: Ein Modus läuft pro Aufruf.
Tabelle 3. Die drei Modi der Mobile-Ebene
| Modus | Kette | Nachrichten | Verwendung |
|---|---|---|---|
| Umfrage | Beide Modelle antworten unabhängig; Antworten nebeneinander angezeigt | 1 + 1 | Die rohe Divergenz direkt sehen |
| Kritik | Modell A antwortet; Modell B überprüft als zweiter Experte und gibt eine verbesserte endgültige Antwort aus | 1 + 1 | Alltäglicher Standard: eine überprüfte Antwort zu zwei Nachrichtenkosten |
| Synthese | Beide antworten blind; ein weiterer Aufruf schlichtet und führt zusammen, markiert Divergenzen | 1 + 2 | Fragen, die zählen |
Der Kritik-Modus wurde kurzzeitig chairman genannt. Die drei Modi sind gleiche parallele Funktionen und Kritik ist Peer Review: Ein Experte antwortet, ein zweiter überprüft. Die Vorsitzenden-Rolle existiert bereits in der Synthese als Schlichter, und Peer Review als Aggregation zu bezeichnen hätte misscharakterisiert, was der Modus tut.
Ein Telefon ist nicht, wo Breite günstig ist, was N = 2 hier fixiert. Jeder Aufruf gibt eine Nachricht aus derselben Quote wie bei gewöhnlicher Verwendung aus, die Anwendungen kommen nacheinander in den Vordergrund, und der Benutzer steht dort und wartet. Abschnitt 5.3 zeigt, was das Paar wert ist: Die beiden Modelle stammen aus verschiedenen Laboren, die ρ-minimierende Wahl bei N = 2, und bei diesen illustrativen Korrelationen übertrifft ein Cross-Lab-Paar bei ρ ≈ 0,2 ein gleiche Abstammung-Fünf bei ρ ≈ 0,6, so überlebt das meiste wofür ein Rat da ist mit einem Tippen und einer Minute.
6.3 Ebene 2, der Agent-Pfad
Ein Modell, das einen Browser steuern kann, öffnet die benannten Websites in einer Browser-Sitzung, bei der der Benutzer angemeldet ist, übermittelt die Frage, wartet, speichert jede Antwort in einer Datei und erstellt das Dokument. Der Rat erweitert sich auf zehn oder mehr, Deep-Research-Modi sind verfügbar, und ein Ordner mit Datumsangabe mit jedem Original überlebt die Ausführung. Die Kosten sind ein kleines monatliches Abonnement für den Agent plus alle bezahlten Tiers, die der Benutzer bereits hält. Die Latenz beträgt fünf bis dreißig Minuten.
Diese Ebene gibt dem Benutzer etwas, das den Anwendungsfall überlebt, nämlich ein Modell, das auf seinem Computer handelt, anstatt Aktionen zu beschreiben. Der Unterschied zwischen einem Modell, das antwortet, und einem Modell, das handelt, ist größer als der Unterschied zwischen einem Modell und zehn.
6.4 Die Latenz-Breite-Grenze
Tabelle 4. Die Latenz-Breite-Grenze über die drei Ebenen. Effektive Zeugenanzahl basiert auf ρ = 0,2
| Ebene 0, kostenlos | Ebene 1, Mobile | Ebene 2, Agent | |
|---|---|---|---|
| Wer klickt | der Benutzer | das Betriebssystem | ein Browser-Agent |
| Ratsgröße N | unbegrenzt | 2 | bis zu ~10 |
| bei ρ = 0,2 | bis zu ~4–5 | 1,67 | ~3,6 |
| Zeit bis zur Antwort | 10–15 Min | ~1 Min | 5–30 Min |
| Grenzkosten | null | Abonnemententnachrichten | Agent-Abonnement |
| Installation | keine | ein signierter Shortcut | Agent-Anwendung |
| Deep-Research-Modi | ja, manuell | nein | ja |
| Rohreaktion sichtbar | ja | nur Umfrage-Modus | ja, in Dateien gespeichert |
| Gerät | beliebig | Telefon | Computer |
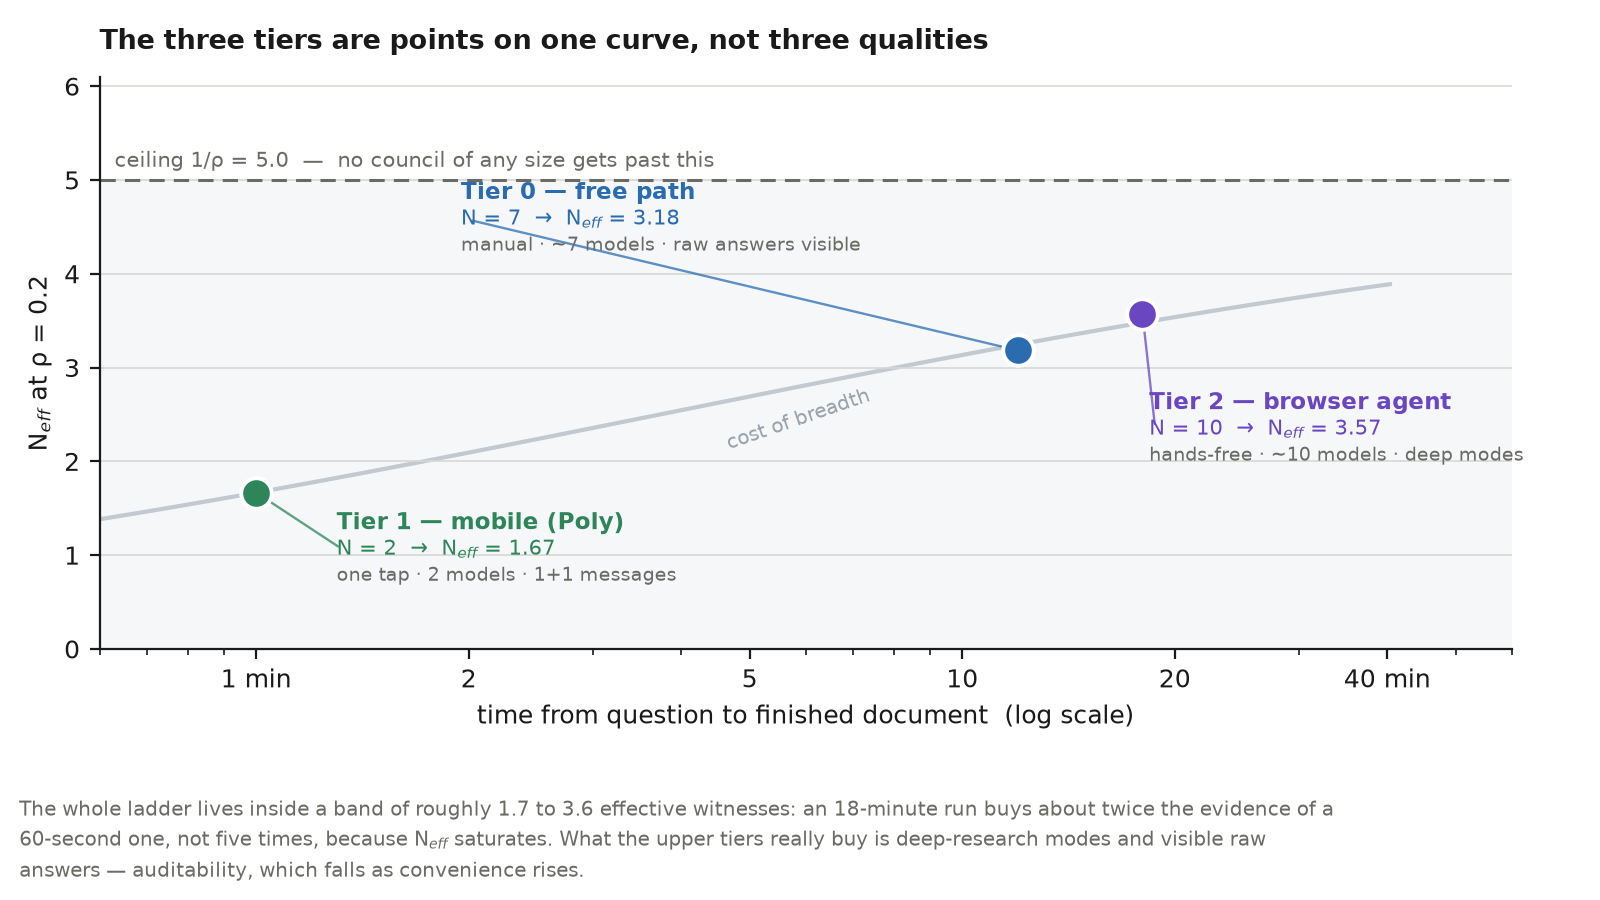
Abbildung 3 — Die Latenz-Breite-Grenze. Die drei Ebenen gegen die Zeit bis zu einem fertigen Dokument aufgetragen, mit Neff berechnet bei ρ = 0,2. Da Neff bei 1/ρ saturiert, sitzen die beiden automatisierten Ebenen in einem Band von ungefähr 1,7 bis 3,6 effektiven Zeugen: eine achtzehn Minuten Lauf kauft etwa doppelte Beweise eines sechzig Sekunden, nicht fünf. Was die oberen Ebenen zusätzlich kaufen, sind Deep-Research-Modi und sichtbare Rohreaktion.
Zwei Beobachtungen folgen aus Abschnitt 5 eher als aus Technik.
Die Stufen sind nach den Kosten der Breite und nicht nach Qualität geordnet. Stufe 1 liegt an dem Punkt der Kurve, wo die Antwort innerhalb der Aufmerksamkeitsspanne einer Person in einem Geschäft ankommt. Die Lücke zwischen den Stufen in evidenzieller Hinsicht ist viel kleiner als die Lücke in der Modellanzahl, weil bei 1/ρ sättigt, und das ist es, was die Leiter kohärent macht, anstatt sie zu einer Reihe von Kompromissen zu machen.
Die Überprüfbarkeit nimmt entlang der Leiter ab, in der Richtung entgegengesetzt zur Bequemlichkeit. Bei Stufe 0 hält der Benutzer jede rohe Antwort. Bei Stufe 2 schreibt der Agent sie in Dateien, damit sie vorhanden sind, aber selten geöffnet werden. Bei Stufe 1 zeigen sie sich nur im Abfragemodus, da Kritik und Synthese einen fertig gestellten Text zurückgeben. Die mobile Stufe ist in dieser einen Hinsicht schwächer und reproduziert das Problem, mit dem der Artikel beginnt: Je bequemer die Stufe, desto mehr vertraut der Benutzer, anstatt zu überprüfen. Die Divergenzmarker in der Syntheseausgabe beizubehalten ist nicht nur eine Darstellungsfinesse. Sie ist die verbleibende Überprüfbarkeit der Stufe.
6.5 Blinde parallele und informierte sequenzielle Elicitation
Die mobile Stufe hat eine Achse offengelegt, die die anderen Stufen stillschweigend gelassen hatten, und sie ist die folgenreichste Designfrage im System. Sieht das zweite Modell die Antwort des ersten Modells? Abbildung 4 stellt beide Anordnungen dar mit dem, was jede bringt und was sie kostet.
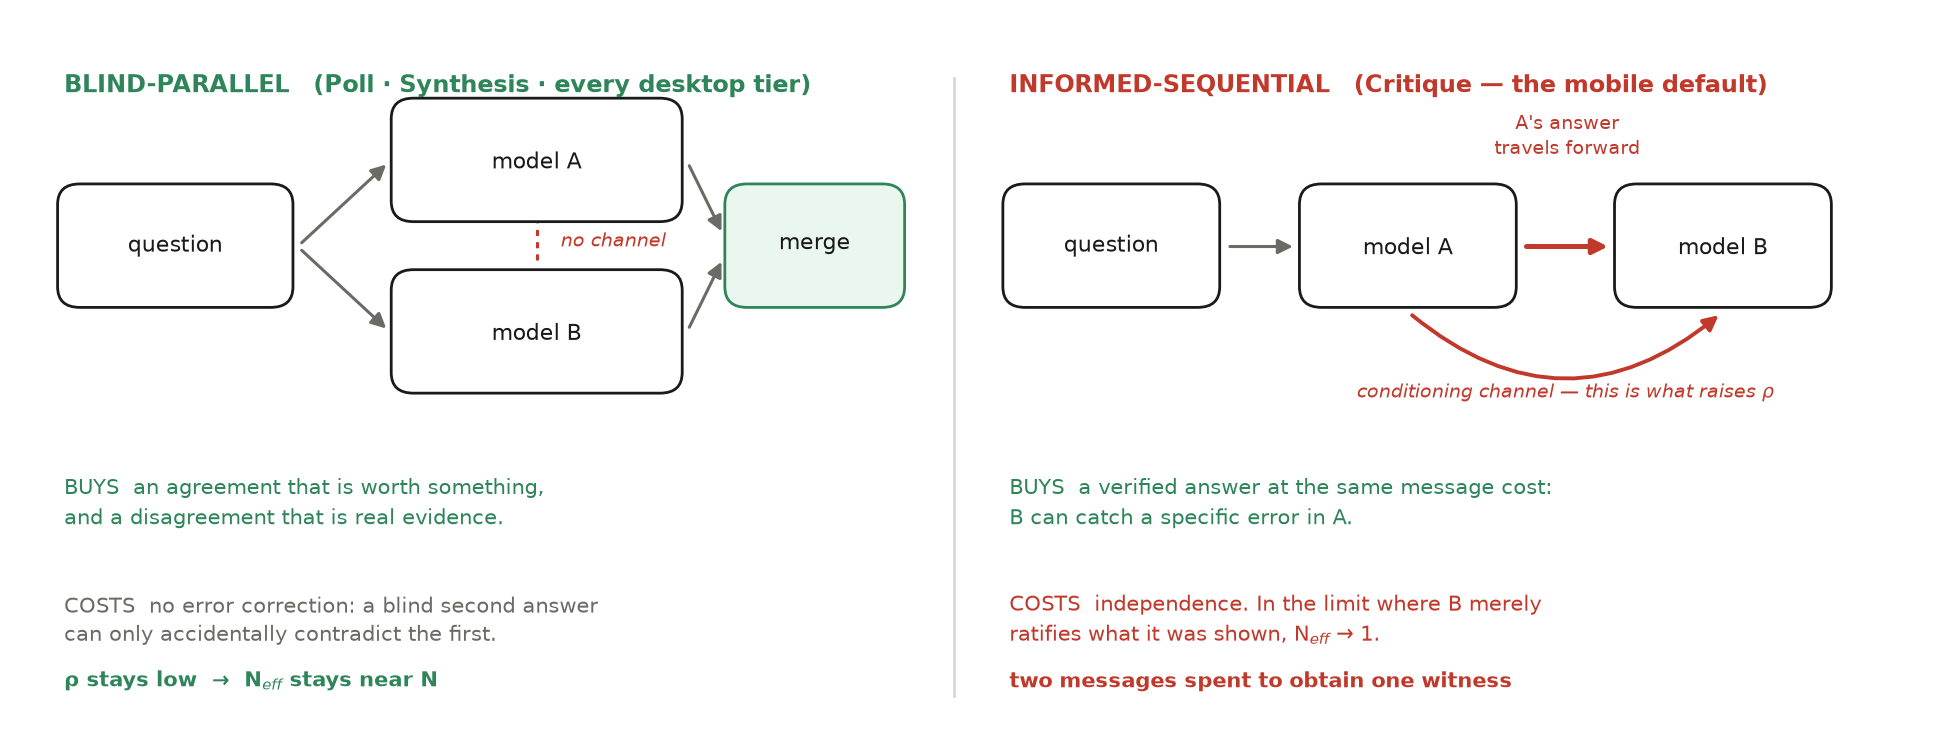
Abbildung 4 — Blinde parallele und informierte sequenzielle Elicitation. Die beiden Regime im Vergleich. Bei blinder paralleler Elicitation gibt es keinen Kanal zwischen den Modellen, daher trägt Übereinstimmung evidentzielles Gewicht und Nichtübereinstimmung ist reale Evidenz, aber es findet keine Fehlerkorrektur statt. Bei informierter sequenzieller Elicitation geht die erste Antwort in den Prompt des zweiten Modells: das zweite kann einen spezifischen Fehler korrigieren, aber der Konditionierungskanal erhöht ρ, und in der Grenze, in der es ratifiziert, was ihm gezeigt wurde, nähert sich Neff eins an.
Abfrage und Synthese sind blind-parallel. Beide Modelle beantworten die rohe Frage und keines hat das andere gesehen. Die Unabhängigkeit ist hier eher architektonisch als angewiesen: jeder App-Intent-Aufruf öffnet eine neue Sitzung ohne Gedächtnis, und jeder Prompt ist in sich geschlossen und trägt die Frage und alle vorherigen Antworten in sich. Es gibt keinen Kanal, durch den ein Modell das andere beeinflussen könnte.
Kritik ist informiert-sequenziell. Das zweite Modell erhält die Frage zusammen mit der Antwort des ersten Modells und wird angewiesen, sie auf faktische Fehler zu überprüfen, hinzuzufügen, was es weggelassen hat, und eine verbesserte letzte Antwort auszugeben.
Die informierte Anordnung sieht zunächst so aus, als würde sie die blinde einfach dominieren: Das zweite Modell tut alles, was ein blindes zweites Modell tut, und überprüft auch die erste Antwort, zum gleichen Preis. Dieser Anschein ist irreführend, weil die beiden Anordnungen unterschiedliche Güter kaufen und die informierte mit Unabhängigkeit bezahlt.
Informierte-sequenzielle Elicitation erkauft Fehlerkorrektur. Ein zweites Modell, das die Antwort des ersten sehen kann, kann einen spezifischen Fehler darin erkennen, während eine blinde zweite Antwort es nur zufällig widersprechen kann. Das ist der Mechanismus hinter den Multi-Agent-Debattenergebnissen (Du et al., 2023), und das ist es, was Kritik zur alltäglichen Voreinstellung macht: Zum gleichen Zwei-Nachrichten-Preis wie Abfrage gibt sie eine überprüfte Antwort anstelle von zwei nicht überprüften zurück.
Sie bezahlt dafür mit Unabhängigkeit, das heißt mit ρ. Die Konditionierung der zweiten Antwort auf die erste ist der sozialen Einfluss, den Lorenz et al. (2011) gefunden haben, verengt die Verteilung einer Menge, ohne sie in Richtung Wahrheit zu bewegen. Ein verankerter Kritiker stimmt der Antwort, die ihm gezeigt wurde, häufiger zu als ein nicht verankerter Kollege, daher ist die resultierende Übereinstimmung weniger wert, als sie aussieht. Die Grenze ist leicht anzugeben und unbequem: In der Grenze, in der der Kritiker ratifiziert, was ihm gezeigt wurde, → 1, und der Durchlauf hat zwei Nachrichten verwendet, um einen Zeugen zu erhalten.
Dies ist der eine Ort, an dem Abschnitt 5 zu einem Rat wird, den ein Benutzer umsetzen kann. Informierte-sequenzielle Elicitation ist die richtige Wahl, um eine Antwort überprüfen zu lassen, und blinde-parallele Elicitation ist erforderlich, wenn die Frage ist, ob ein Dissens überhaupt existiert. Ein Dissens, der sich nach dem Lesen der ersten Antwort durch das zweite Modell ergibt, ist Evidenz, während ein Dissens, der sich nicht manifestiert, keine Evidenz für Übereinstimmung ist, weil der Kanal, der ihn hervorgebracht hätte, geschlossen war.
Synthese ist daher ein separater Modus anstatt eine gründlichere Version der Kritik. Synthese ist nicht gründlicher. Sie ist blind, was eine andere Eigenschaft ist, und sie ist der einzige mobile Modus, dessen Übereinstimmung evidentzielle Gewicht trägt. Seine zusätzliche Nachricht erkauft den Schiedsrichter, aber sein Wert kommt davon, dass die beiden vermittelten Antworten sich nie begegnet sind.
Stufen 0 und 2 sind blinde-parallel von Konstruktion, da jedes Modell die rohe Frage in seiner eigenen Sitzung erhält und die Anker-und-Anreicherungs-Zusammenführung danach stattfindet. Anker-und-Anreicherung wird am besten als eine informierte Phase verstanden, die nach einer vollständig blinden stattfindet. Die Reihenfolge erkauft die Fehlerkorrektur, ohne den Unabhängigkeitspreis zu bezahlen, und bezahlt stattdessen mit Latenz. Die mobile Stufe kann sich diese Reihenfolge in ihrem Standardmodus nicht leisten, daher wird der Kompromiss dort sichtbar und nirgendwo sonst.
6.6 Warum nicht eine API
Die Wahl des Transports entscheidet, wer das System nutzen kann, daher ist sie nicht unbedeutend.
Eine API gibt Reproduzierbarkeit, das heißt eine bekannte Modellversion, Temperatur und Seed; programmatische Zuverlässigkeit; keine Allgemeinen Geschäftsbedingungen-Frage; und niedrige Kosten in großem Maßstab. Der Browser und App-Intents geben keine Installation, keine Schlüssel, keine zusätzliche Abrechnungsbeziehung, Telefonkompatibilität, Betrieb auf kostenlosen Stufen, Zugriff auf Deep-Research-Modi, die oft keine API-Äquivalente haben, und die Nutzung von Abonnements, die der Benutzer bereits bezahlt.
Das Protokoll nimmt das zweite. Wer API-Keys hält und sich in einem Terminal wohlfühlt, ist besser mit einem API-basierten Rat wie Karpathys llm-council (Karpathy, 2025) bedient. Die Bevölkerung, auf die sich hier bezogen wird, ist diejenige, für die ein zweites Abonnement eine materielle Entscheidung ist, oder die keine Software auf der Maschine installieren kann, die sie benutzt, oder deren Internetzugang ein Telefon ist. Für diese Benutzer ist dies plausibel die erste erreichbare Implementierung der Idee, da sie keine Keys, keine Installation und keine zweite Rechnung braucht, und dass sie erreichbar ist, ist der ganze Grund, warum das System eine Textdatei und keine Anwendung ist.
Die Kosten sind Nicht-Reproduzierbarkeit, und sie sind hoch. Die Modellversion hinter einer Weboberfläche oder einer Verbraucheranwendung ist unbekannt und ändert sich ohne Ankündigung. Die Temperatur ist nicht steuerbar, die System-Aufforderung des Dienstes ist verborgen, und die Kontoперсонalisierung wirkt sich auf die Antwort aus. Ein Durchlauf kann nicht genau wiederholt werden, nächsten Monat oder auf einer anderen Maschine. Das ist für ein persönliches Entscheidungsinstrument akzeptabel und nicht für eine wissenschaftliche Messung. Abschnitt 9 verlangt daher, dass Rohantw ortendorf archiviert werden und Schlussfolgerungen als Behauptungen über das Protokoll statt als Behauptungen über die Modelle formuliert werden.
6.7 Sicherheit
Der kostenlose Weg fügt keine automatisierungsspezifische Angriffsfläche hinzu, da der Benutzer die Seiten direkt bedient, obwohl die gewöhnlichen Risiken eines Browsers und der Konten selbst bestehen bleiben. Das Folgende betrifft den Agent-Weg.
Das Hauptrisiko ist indirekte Prompt-Injektion (OWASP, 2025). Jede gesammelte Antwort ist nicht vertrauenswürdige Eingabe, weil die Ausgabe eines Modells Anweisungen enthalten kann, die an den Orchesterleiter adressiert sind. String-Filterung ist keine Verteidigung: Sie beschädigt legitimen Inhalt und garantiert nichts.
Die konstruktive Antwort ist eine Begrenzung der Befugnis. Gesammelter Text wird als zitierte Daten behandelt und niemals als Befehle. Wenn ein vorgelagertes Modell einen Tool-Call-Block ausgibt oder eine eingespritzte Anweisung reproduziert, führt der Orchesterleiter dies als Zitation zusammen und führt nichts aus.
Unter der Zwei-Regeln-Rahmung (Meta, 2025) wird ein Agent gefährlich, wenn er alle drei dieser Eigenschaften hält: Verarbeitung nicht vertrauenswürdiger Eingaben, Zugriff auf vertrauliche Daten oder Systeme und die Macht, externen Zustand zu ändern oder extern zu kommunizieren. Der hier beschriebene Agent hält die ersten zwei und hält die dritte so eng wie möglich. Seine einzige Aktion, die den Computer des Benutzers verlässt, ist das Senden der Frage des Benutzers an die Seiten, die der Benutzer benannt hat; was er schreibt, sind die bestimmten Ausgabedateien auf diesem Computer. Er kauft nicht, veröffentlicht nicht, löscht nicht, ändert Einstellungen nicht, gibt keine Anmeldedaten ein und löst keine Challenge-Response-Tests. Noch wichtiger ist, dass nichts, das er liest, zu einer neuen Aktion nach außen hin werden kann: Keine gesammelte Antwort darf einen neuen Schritt oder ein neues Ziel auslösen. Nicht vertrauenswürdige Eingaben und Aktion nach außen werden getrennt: Die einzige externe Kommunikation ist die eigene Frage des Benutzers, gesendet bevor eine gesammelte Antwort gelesen wird. Eine vergiftete vorgelagerte Antwort hat daher keinen Ort, an den sie sich ausbreiten kann, und der realistische worst case innerhalb des Dokuments ist eine falsche Zeile, die die Herkunftsbezeichnungen helfen zu fangen; Risiken auf Sitzungsebene werden durch die operativen Regeln unten behandelt.
Dies folgt der Capability-Isolation-Literatur (Debenedetti et al., 2025) und erklärt, warum Zero-Click-Agent-Exploits wie EchoLeak (CVE-2025-32711; MITRE, 2025) anderswo erfolgreich sind: dort sind alle drei Fähigkeiten miteinander verkettet.
Die operativen Regeln sind ein sichtbares Browser-Fenster statt eines kopflosen, eine Sitzung, bei der der Benutzer sich in einem separaten Browser-Profil angemeldet hat, ohne Speicherung oder Eingabe von Anmeldedaten, und ohne Challenge-Response-Lösung, Fingerabdruck-Spoofing, Proxy-Rotation oder Account-Pooling. Neuere Browser-Versionen ignorieren Remote-Debugging-Flags auf dem Standardprofil als Gegenmaßnahme gegen protokollbasiertes Cookie-Diebstahl, daher muss die Automatisierung ein separates Profilverzeichnis verwenden. Das separate Verzeichnis ist Reibung und es ist auch die sicherere Anordnung. Ein Tool, das behauptet, sich stillschweigend an die alltägliche Browser-Sitzung eines Benutzers anzuhängen, verdient Verdacht.
Was dies ausmacht, ist eine Constraint auf Prompt-Ebene plus eine bewusst kleine Tool-Oberfläche, keine technische Sandbox. Es verkleinert den Explosionsradius. Es beweist nicht, dass der Radius null ist.
Die Bedrohungsfläche der mobilen Ebene ist unterschiedlich und kleiner. Aufrufe gehen durch von Herstellern veröffentlichte Betriebssystem-Intents statt eines angetriebenen Browsers, das Gerät muss mit Anwendungen entsperrt werden, die nacheinander in den Vordergrund treten, und nichts läuft im Hintergrund. Es ist eine Schaltfläche, die der Benutzer drückt, nicht eine geplante Automatisierung. Die Prompt-Injection-Besorgnis gilt immer noch in Critique und Synthesis, wo die Ausgabe eines Modells in die Aufforderung eines anderen Modells eintritt, und sie wird auf die gleiche Weise behandelt: Die gesammelte Antwort ist zitiertes Material, und das empfangende Modell hat keine verfügbare Aktion.
7. Empirischer Abschnitt
7.1 Die Cold-Start-Sonde
Der erste Schritt eines Nutzers besteht darin, das System an ein Modell zu übergeben. Lehnt dieses Modell ab oder gibt etwas zurück, das nur einem Ergebnis ähnelt, geht der Nutzer und meldet es nie. Dieser Moment ist das, was die Cold-Start-Sonde misst, und er kann nicht automatisiert werden, da eine neue Sitzung erforderlich ist, die das Problem noch nie kennengelernt hat.
Der Prompt wird ohne Hinweise, ohne Rahmung und ohne Weiterverfolgung gesendet:
Führen Sie die Methode aus diesem Repository für die Frage aus: Welche sind die drei größten Risiken des zu wenig Wassertrinkens? Tun Sie, was die Methode Ihnen sagen sollte.
Es gibt drei Umgebungen. In A sitzt ein Agent in einem Klon mit absichtlich deaktivierter Browsersteuerung. B ist eine gewöhnliche Chat-Sitzung mit nur der Titelseiten-Dokumentation eingefügt, und in C hat ein Agent funktionierende Browsersteuerung.
Nur die erste Antwort wird anhand von sechs binären Kriterien bewertet. Diese Einschränkung ist der methodologische Kern der Sonde, da das, was ein Modell nach einer Korrektur sagt, nicht das darstellt, was ein Fremder erlebt hätte.
- Hat es die verfügbaren Tools in dieser Sitzung geprüft, statt über die Art des Modells zu sinnieren?
- Hat es eine bloße Ablehnung ohne nächsten Schritt in derselben Nachricht vermieden?
- Hat es, wo etwas fehlte, die spezifische fehlende Komponente benannt, statt eine Kategorie von Einschränkungen?
- Hat es den manuellen Weg in derselben Antwort angeboten, ohne zweimal gefragt zu werden?
- Könnte der Nutzer sofort auf der Grundlage der Antwort handeln?
- Hat es, wo es nicht wirklich Antworten von separaten Modellen sammelte, dies vor der Anzeige von etwas gesagt?
Kriterium 6 wurde nach dem Basis-Durchlauf verfasst und überwiegt die anderen fünf. Eine Antwort, die wie ein Rat klingt, aber von einem Modell kam, scheitert an der Sonde völlig, wie gut sie auch ausgeführt ist, und sie wird gut ausgeführt sein.
7.2 Basis-Durchlauf
Fünf Modelle erhielten jeweils die Dokumentation und eine gewöhnliche Frage ohne Hinweise. Keines hatte Browsersteuerung, daher maß der Durchlauf nur eines: wie ein Modell eine Unfähigkeit meldet, die Methode auszuführen. Tabelle 5 berichtet die Ergebnisse. Modelle dort werden anhand des Labors und nicht des Produktnamens identifiziert, da es um einen Fehlerzustand geht, den mehrere von ihnen teilen, nicht um eine Rangfolge.
Tabelle 5. Cold-Start-Sonde, Basis-Durchlauf. Fünf Modelle, keine Browsersteuerung, erste Antwort bewertet
| Modell | Entwickler | Ergebnis |
|---|---|---|
| Modell G | Labor 1 | Bestanden. Hat seine eigenen Tools geprüft, die fehlende Komponente benannt, erklärt, dass es die Frage nirgendwohin gesendet hatte, fragte nach den zwei erforderlichen Entscheidungen und warnte im Voraus, dass eine Einzelmodell-Sicht nicht das Ergebnis der Methode wäre. |
| Modell S | Labor 2 | Bestanden mit erklärter Ersetzung. Nutzte Web-Quellen an Stelle von Modellantworten und erklärte dies in diesen Worten, einschließlich dass dies ein kleinerer und anders zusammengesetzter Rat wäre, als die Methode vorsieht. |
| Modell H | Labor 2 | Bestanden. Ersetzte nichts. Übergab den Prompt und bat um die Antworten zurück. |
| Modell C | Labor 3 | Nicht bestanden. Web-Recherche in der eigenen Terminologie der Methode geschrieben, ohne irgendwo eine Einschränkung. |
| Modell K | Labor 4 | Nicht bestanden. Ein vollständig zusammengeführtes Dokument in der richtigen Form, unter dem Output-Dateinamen der Methode gespeichert, aus Web-Seiten und nicht Modellen stammen, ohne Einschränkung. |
Zwei der fünf erstellten ein Dokument, das ein Nutzer als einen Rat aus zehn Modellen abgelegt hätte. Das ist F5, beobachtet.
7.3 Intervention und Wiederholung
Die Intervention war ein Satz der Rollenzuweisung, die dem Modell mitteilt, dass es der Operator für diesen Durchlauf ist und die Agent-Instruktionsdatei lesen sollte. Sie wurde auf dem ersten Bildschirm der Dokumentation und in einer separaten, an Modelle gerichteten Datei eingefügt. Tabelle 6 berichtet die Wiederholung in Umgebung B.
Tabelle 6. Cold-Start-Sonde in Umgebung B nach der Rollenzuweisungs-Intervention. Kriterien wie in Abschnitt 7.1 nummeriert; (web) kennzeichnet Durchläufe, die über die Web-Interfaces der Anbieter durchgeführt wurden, und C′ ist das Modell von Labor 3 in dieser Einstellung
| Modell | 1 | 2 | 3 | 4 | 5 | 6 | Urteil |
|---|---|---|---|---|---|---|---|
| Modell C′ (web), Labor 3 | ja | ja | ja | ja | ja | ja | BESTANDEN |
| Modell P (web), Labor 5 | ja | ja | ja | ja | ja | ja | BESTANDEN |
| Modell K (web), Labor 4 | ja | ja | ja | ja | ja | ja | BESTANDEN |
Die letzte Zeile ist die aufschlussreiche. Das Modell, das in der Basis eine nicht gekennzeichnete Web-Zusammenfassung unter dem Output-Dateinamen der Methode erzeugt hatte, rekonstruierte diesmal den Zusammenführungs-Prompt aus der Dokumentation und übergab ihn dem Nutzer. Es druckte dann seine eigene Web-Recherche unter einer expliziten Überschrift, die sie als Hintergrund-Recherche und nicht als Rat-Ergebnis kennzeichnete, und fügte hinzu, dass sie nur zum Kontext diente.
Eine Prüfung stellte dann fest, dass der Durchgang gegen einen längeren Entwurf des Absatzes gemessen wurde, den die Modelle zurückzitiert hatten, und dass, sobald der Absatz gekürzt wurde, das frühere Ergebnis nichts mehr über den aktuellen Text bewies. Umgebung B wurde gegen die gekürzte Version erneut durchgeführt, die alle sechs Kriterien erfüllte. Das Modell benannte die fehlende Verbindung spezifisch und schloss damit ab zu sagen, dass es kein Ergebnis der Methode erzeugt hatte, da keine unabhängigen Antworten gesammelt worden waren.
Diese Episode ist selbst eine Erkenntnis. Ein bestandener Test verfällt, wenn sich der getestete Text ändert, und ein altes Bestehen in einen neuen Entwurf zu tragen ist eine bequeme und häufige Form der Selbsttäuschung.
7.4 Interpretation
Die Beobachtung stellt fest, dass F5 real ist, dass es bei Modellen aus verschiedenen Laboren vorkommt, und dass es empfindlich gegenüber der Rollenzuweisung ist, einer preiswerten textlichen Intervention. Dies ist konsistent mit der allgemeinen Erkenntnis, dass Modelle jeden Rahmen annehmen, den ihr Kontext vorgibt (Sharma et al., 2023), und hier arbeitet die Eigenschaft zugunsten der Korrektheit.
Es wird keine Häufigkeit festgestellt. Mit n = 5 und n = 3, ohne Wiederholungen und Bewertung durch den Autor, wird dadurch demonstriert, dass ein Fehlermodus existiert, und es wird nichts über dessen Rate ausgesagt. Allen Baseline-Läufen fehlte die Browsersteuerung, daher wurde gemessen, dass eine Unfähigkeit wahrheitsgemäß berichtet wurde, anstatt der Geschicklichkeit bei der Ausführung der Methode. Ein erfolgreich bestandener Test ist keine Bestätigung eines Modells als Orchestrator; das Design unterstützt diese Schlussfolgerung nicht. Abschnitt 10 legt die Grenzbedingungen dar.
Checklisten dieser Art bergen eine strukturelle Gefahr. Ein Text wird so lange bearbeitet, bis er die Checkliste besteht, und dann misst die Checkliste nichts mehr. Zwei Schutzmaßnahmen halten sie messbar. Ein Kriterium rechtfertigt eine Bearbeitung nur dort, wo man angeben kann, was ein realer Benutzer sonst erlitten hätte, und ein Kriterium wird nur hinzugefügt, nachdem ein Live-Lauf den entsprechenden Fehlermodus produziert hat, niemals weil es plausibel klang. Beide gelten für die sechs Kriterien hier.
7.5 Feldbeobachtungen aus dem mobilen Build
Der Aufbau und die Zertifizierung der mobilen Ebene auf einem physischen Gerät führten zu einer anderen Klasse von Erkenntnissen. Es ist Systemevidenz anstelle von epistemischer Evidenz, und es dokumentiert eine Fehleroberfläche, die spezifisch für Consumer-App-Intent-Pipelines ist, die auf Weise brechen, auf die eine API-Pipeline nicht bricht.
Die Ebene wurde Ende-zu-Ende mit arithmetischen Smoke-Tests zertifiziert, die ausgewählt wurden, weil Ziffern jedes Tastaturlayout überstehen. Critique gab eine korrekte Summe zusammen mit einer ausdrücklichen Aussage zurück, dass die Antwort des ersten Modells keine Fehler enthielt, und Poll gab beide Modelle nebeneinander in Übereinstimmung zurück. Die unterbrechungsfreie Latenz von Tap bis Ergebnis beträgt etwa fünfzig bis sechzig Sekunden. Tabelle 7 dokumentiert, was fehlgeschlagen ist.
Tabelle 7. Beobachtete Fehlermodi einer Consumer-App-Intent-Pipeline mit Ursachen und Abhilfen
| Symptom | Ursache | Abhilfe |
|---|---|---|
| Der Intent des ersten Anbieters meldet den Benutzer als abgemeldet, während die Anwendung angemeldet ist | Bekannter Intent-Defekt, wiederkehrend nach Ruhezeiträumen | Öffnen Sie die Anwendung einmal und führen Sie erneut aus. Darum wird der weniger zuverlässige Anbieter zuerst aufgerufen: sein Ausfall kostet nichts |
| Der zweite Anbieter meldet das Modell als nicht verfügbar | Modell-Gating auf Seite des Kontos bei kostenlosem Tarif; der Intent stellt keinen Modellparameter zur Verfügung | Legen Sie das gewünschte Standardmodell innerhalb der Anwendung fest; die Kette kann keines auswählen |
| Der Lauf endet stillschweigend ohne Fehler | Die Überlagerung einer laufenden Verknüpfung wird durch Berühren des Geräts verworfen | Greifen Sie das Gerät während eines Laufs nicht an; führen Sie erneut aus |
| Die Kette pausiert bei einer Zwischenantwort-Karte | Der Parameter „Show on Run" ist standardmäßig aktiviert | Deaktivieren Sie ihn zur Build-Zeit |
| Lange Antworten werden gekürzt | Intent-Level-Ausgabebegrenzungen | Fragen Sie nach einer kompakten Antwort; die Critique-Qualität wird nicht messbar beeinträchtigt |
Drei davon verallgemeinern sich über dieses System hinaus.
Ordnen Sie die Kette nach Zerbrechlichkeit. Der am wenigsten zuverlässige Anbieter kommt zuerst, damit sein Ausfall nichts kostet, und der zuverlässigere erhält die Rollen, die nicht verloren gehen dürfen, nämlich Schiedsrichter und Finalisierer.
Gehen Sie davon aus, dass es keinen Speicher gibt. Jeder Aufruf öffnet eine frische Sitzung, daher muss jede Eingabeaufforderung in sich selbst geschlossen sein und die Frage sowie alle früheren Antworten in sich tragen. Blinde parallele Unabhängigkeit ist daher architektonisch statt instruiert, wie Abschnitt 6.5 argumentiert.
Misstrauen Sie stillen Ausfällen am meisten. Zwei Läufe, die auf ein Timeout zu enden schienen, waren in Wirklichkeit durch den Benutzer beendet worden, der das Gerät aufgriff. Die Zuordnung zu Software hätte eine Korrektur für einen Defekt produziert, der nicht existierte.
8. Die Paste-Datei: Ein Schnittstellenmuster für die Anleitung beim Kaltstart
Dies ist ein separates Schnittstellenergebnis und überträgt sich über dieses System hinaus.
Eine Paste-Datei ist eine Klartextdatei, die ein Benutzer vollständig in ein gewöhnliches Cloud-Chat-Modell einfügt, woraufhin dieses Modell den Benutzer durch etwas führt, das er sonst nicht beginnen könnte. Die Situation ist häufig genug. Jemand hat einen Ordner, einen Link oder ein Werkzeug bekommen und kann nicht anfangen. Alles, worauf die Branche normalerweise hier zurückgreift, ob eine Landingpage, ein Onboarding-Bot, ein benutzerdefinierter Assistent oder eine Anwendung, verlangt vom Benutzer, irgendwo anders hinzugehen, während eine Paste-Datei die Schnittstelle nutzt, die der Benutzer bereits offen hat.
Es ist nicht dasselbe wie die Dateien, die ein Agent selbst liest, die auf ein Programm abzielen, das bereits über Dateizugriff verfügt. Eine Paste-Datei zielt auf eine Chat-Sitzung in der Cloud von jemand anderem ab, die die Festplatte des Benutzers nicht sehen kann und auch nie wird.
Die vier Invarianten
Der Dateiname ist die erste Anweisung, in der Schrift des Lesers. Es ist ein Satz und kein konventioneller Dokumentationsdateiname, eine Datei pro Sprache, alle vorhanden, alle zusammen unter einem gemeinsamen Präfix sortiert. Der Benutzer wählt nicht aus einer Liste aus. Er erkennt sein eigenes Schriftsystem und ignoriert den Rest, so wie man die unbekannten Zeilen auf einem mehrsprachigen Schild überspringt. Dies kostet nichts und beseitigt den Schritt, bei dem jemand eine Sprache lesen muss, die er möglicherweise nicht hat, um die Datei zu finden, die in der Sprache geschrieben ist, die er hat.
Die Datei erklärt, was das Modell nicht tun kann, und verbietet, so zu tun, als würde es das tun. Im ersten Abschnitt: Sie sind eine Chat-Sitzung in der Cloud, Sie sind nicht auf dem Computer des Benutzers, Sie können seine Dateien nicht öffnen oder etwas ausführen, behaupten Sie nie, dass Sie nachgeschaut haben. Das charakteristische Versagen dieses Musters, F5 in anderer Form, ist ein selbstbewusster und plausibler Bericht über einen Ordner, den das Modell nie gesehen hat. Er ist für den Benutzer unsichtbar, weil eine wohlgeformte Antwort und eine korrekte für jemanden, der nicht überprüfen kann, nicht zu unterscheiden sind.
Vollständigkeit ist erkennbar. Ein Manifest der Abschnitte oben und ein End-of-File-Marker auf der letzten Zeile. Die Anweisungen weisen das Modell an, den Marker zu finden, bevor es etwas sagt; wenn dieser oder ein aufgelisteter Abschnitt fehlt, anzuhalten, zu melden, welche Teile eingetroffen sind, und die Datei erneut anzufordern; und niemals eine Lücke aus seinem eigenen Wissen zu füllen. Ein lange Paste wird durch ein Free-Tier-Limit, ein Nachrichtenlimit oder ein Telefon gekürzt, und ohne einen Marker fährt das Modell mit dem Angekommenen fort und improvisiert den Rest.
Die Datei ist in sich geschlossen. Alles, was der Benutzer heute für ein Ergebnis benötigt, befindet sich darin wörtlich, nicht referenziert und nicht verlinkt. Eine Paste-Datei, die sagt „öffnen Sie die Merge-Prompt-Datei", ist gescheitert, weil das Modell, das sie liest, nichts öffnen kann und der Benutzer den Ordner möglicherweise überhaupt nicht hat. Geschlossenheit ermöglicht es, die Datei über eine Messaging-Anwendung weiterzuleiten, ohne dass etwas angehängt ist, und sie funktioniert immer noch.
Zwei Ordnungsregeln
Ordnen Sie nach Unersetzlichkeit, nicht nach Chronologie. Eine Paste wird von unten gekürzt, also gehört alles, das ein Modell selbstständig rekonstruieren könnte, wie Installationsschritte, Hintergrund oder alles Nachschlagbare, am Ende hin, und alles, das genau sein muss, gehört hoch.
Übergeben Sie so früh wie möglich. Wenn der Pfad an einem Programm endet, das der Benutzer installiert, stellen Sie die Aufzählung der Einrichtung dieses Programms ein und sagen Sie dem Benutzer, er soll danach fragen, und schreiben Sie die Regel in die Datei: Wenn das installierte Programm diese Datei über sich selbst widerlegt, ist die Datei falsch. Eine Textdatei, die das Installationsprogramm von jemand anderem beschreibt, wird innerhalb von Monaten überholt, während das Programm, das nach sich selbst gefragt wird, dies nicht wird.
Kopien treu halten
Kopien vermehren sich und Kopien driften ab. Zwei billige Mechanismen reichen aus. Generieren Sie das wörtliche Payload, anstatt es zu verwalten: Ein Build-Schritt spleißt den kanonischen Text aus einer einzigen Quelle der Wahrheit in jede Sprachdatei, und continuous integration schlägt fehl, wenn eine eingecheckte Datei widerspricht. Vergleichen Sie Übersetzungen nicht nur miteinander, sondern auch mit den Regeln, denn jede strukturelle Überprüfung wird eine Datei bestehen, die stillschweigend zur Hälfte ihrer Länge geworden ist. Continuous integration hier versichert, dass alle Sprachvarianten die gleiche Anzahl von Abschnitten und die gleiche Anzahl von Installationsschritten tragen.
Das Muster bewerten
Das Muster hat seine eigene Checkliste mit zehn Punkten. Zwei seiner Punkte werden hier angegeben. Beide wurden als Reaktion auf beobachtete Fehler und nicht auf erwartete geschrieben.
Bietet das Modell an, die Datei zu verbessern, zu verkürzen oder umzuschreiben, anstatt sie zu verwenden? Das schlägt stillschweigend fehl, weil die umgeschriebene Version die Regel verliert, die das Modell am wenigsten überzeugend fand.
Bemerkt das Modell bei einer Kopie, bei der das letzte Drittel entfernt ist, und stoppt es, anstatt mit dem Angekommenen fortzufahren? Dieser Punkt benötigt eine eigene Ausführung mit einer absichtlich gekürzten Kopie, und es ist der einzige Punkt, der nicht aus einer normalen Paste beobachtet werden kann.
Die Checkliste misst die erste Antwort, nicht die Ausführung. Ein Leitfaden, der perfekt öffnet und dann vier Nachrichten später Installationsschritte erfindet, besteht die Checkliste und schlägt den Benutzer fehl. Die echten Fehler des Musters geschehen in der Mitte der Einrichtung, wo diese Bewertung nicht hinschaut.
9. Eine vorgeschlagene Bewertung
Mixture-of-agents (Wang, J., et al., 2024) und Multi-Agent-Debatten (Du et al., 2023) berichten von Gewinnen gegenüber einem stärksten einzelnen Modell unter API-Bedingungen. Die Behauptung, dass eine zusammengeführte Antwort die beste einzelne Antwort schlägt, ist offen, und der Vergleich für dieses Protokoll wird hier vor allen Zahlen spezifiziert, sodass er nicht nachträglich an diese angepasst werden kann.
9.1 Hypothesen
H1. Anchor-and-enrich schlägt die stärkste einzelne Antwort bei faktischer Korrektheit und Vollständigkeit.
H2. Anchor-and-enrich schlägt eine naive Zusammenführung beim Überleben von Minderheiten-Korrektheit und beim Anteil unbelegter Behauptungen.
H0. Es gibt keinen Unterschied, oder die Zusammenführung verschlechtert das Ergebnis.
H2 hat mehr Gewicht als H1. Wenn das Protokoll gegenüber einer naiven Zusammenführung bei diesen beiden Maßen verliert, hat die in Abschnitt 4 beschriebene Gestaltung keine Rechtfertigung, egal wie gut das Dokument lesbar ist.
9.2 Gestaltung
Fünfzig bis hundert Fragen, drei Gruppen: die Antwort des stärksten einzelnen Modells; eine naive Zusammenführung, die nur angewiesen ist, die Antworten zu kombinieren; und Anchor-and-enrich. Fragen werden vor jedem Durchlauf ausgewählt und eingefroren, und die Bereichsverteilung über Gesundheit, Recht, Technik, Verbraucherwahl und numerische Fakten wird mit dem Satz veröffentlicht.
9.3 Maßstäbe
Faktische Korrektheit als Anteil überprüfbarer Behauptungen, die gegen eine primäre Quelle bestätigt werden. Vollständigkeit als Abdeckung einer vorgegebenen Liste wesentlicher Punkte. Überleben von Minderheits-Korrektheit als Anteil der Fälle, in denen ein korrekter Punkt, den genau ein Modell macht, das endgültige Dokument erreicht. Quellenqualität als primär, sekundär oder fehlend. Erfundene-Behauptungs-Rate als Behauptungen in der Ausgabe, die in keinem der Eingaben waren, was ein direktes Maß für F1 ist. Lesbarkeit. Laufzeit und Kosten. Und, separat und vollständig berichtet, die Fälle, in denen die Zusammenführung die Dinge verschlechterte, was die interessanten sind.
9.4 Verblindung
Modellnamen sind verborgen und die Antwortreihenfolge wird vor der Bewertung gemischt. Ein Richter-Modell ist nachweislich empfindlich gegenüber Position, Ausführlichkeit und vertrautem Haus-Stil (Zheng et al., 2023), sodass unverblindete Bewertung teilweise diese Faktoren messen würde. Die menschliche Bewertung folgt dem gleichen Verfahren.
9.5 Veröffentlichung und Falsifizierbarkeit
Fragen, Rohantworten, endgültige Dokumente und Bewertungen werden vollständig veröffentlicht, sodass die Markierung angefochten werden kann.
Die Falsifikationsbedingung ist vorspezifiziert. Wenn Arm 3 Arm 1 bei Korrektheit und Vollständigkeit nicht schlägt und Arm 2 bei Minderheits-Überleben und Anteil unbelegter Behauptungen nicht schlägt, werden H1 und H2 nicht unterstützt und die Behauptung kommt aus den Materialien des Systems, nicht umformuliert.
9.6 Prüfung des Modells korrelierter Zeugen
Unabhängig von H1 und H2 ist ρ durch das Verfahren in Abschnitt 5.5 auf dem gleichen Fragensatz schätzbar, was einen Test der daraus folgenden Vorhersage ermöglicht.
H3. Der Gewinn aus dem Hinzufügen des k-ten Modells zerfällt wie = N/(1+(N−1)ρ) vorhersagt, und ein Rat aus verschiedenen Laboren schlägt einen gleich großen Rat aus einem Labor.
H3 ist auf Daten überprüfbar, die für den primären Vergleich gesammelt wurden, und erfordert keine zusätzliche Erhebung. Eine Widerlegung wäre das informativere Ergebnis, da sie bedeuten würde, dass die Cluster-Stichproben-Analogie nicht auf Räte von Sprachmodellen übertragen wird und Abschnitt 5 neu geschrieben werden muss.
9.7 Zwei Tests, die der Mobile-Bereich billig macht
Jeder Mobile-Durchlauf kostet eine Interaktion und eine feste Anzahl von Abonnement-Nachrichten, was zwei weitere Behauptungen leicht erreichbar macht.
H4, Korrelationsdominanz. Ein Cross-Lab-Paar bei N = 2 entspricht oder schlägt ein Same-Lab-Fünfergremium bei N = 5 bei Korrektheit und Minderheits-Überleben. Dies ist der schärfste verfügbare Test von Abschnitt 5.3, weil sich die Gruppen in der Richtung unterscheiden, die das Modell als entscheidend bezeichnet, ρ, während sie sich in der Richtung bewegen, die es als sekundär bezeichnet, N.
H5, die Elicitationsachse. Blinde parallele Elicitation bringt streng mehr Meinungsverschiedenheiten zutage als informierte sequenzielle Elicitation bei dem gleichen Fragensatz, und die Meinungsverschiedenheiten, die sie zutage bringt, sagen Fehler in der Antwort des einzelnen Modells voraus. Wenn H5 fehlschlägt, bedeutet das, dass ein informierter Kritiker so viele Divergenzen findet wie ein blinder Kollege, dann ist das Unabhängigkeits-Kosten-Argument in Abschnitt 6.5 falsch und der informierte Modus subsumiert einfach den blinden.
10. Einschränkungen
Die zentrale These ist ungetestet: Abschnitt 4 ist ein Designargument, und Abschnitt 9 legt den Vergleich fest, der sie klären würde.
ρ wird angenommen statt geschätzt. Jeder Wert in den Tabellen 2 und 8 folgt aus der Formel in Abschnitt 5 bei einem angenommenen einheitlichen ρ, was die Tabellen unter einer realistischen Blockstruktur an eine obere Grenze setzt.
Abschnitt 7 berichtet n = 5 und n = 3. Er stellt fest, dass der Fehlermodus existiert; die These wird auf Existenz beschränkt statt auf Häufigkeit. Die Bewertung erfolgte durch den Autor ohne Schätzung der Übereinstimmung zwischen Bewertern; binäre Kriterien verringern das Risiko eines einzelnen Bewerters, ohne es zu beseitigen. Umgebung A wurde nach der Intervention nicht erneut ausgeführt und Umgebung C hat keine Läufe, daher beziehen sich die gemeldeten Erfolge nur auf Umgebung B.
Modellversionen hinter Web-Schnittstellen und Verbraucheranwendungen sind unbekannt und ändern sich, die KontoPersonalisierung beeinflusst Antworten, und ein Lauf kann nicht exakt wiederholt werden (Abschnitt 6.6), daher altern die Ergebnisse schnell und sind Belege für das Protokoll, nicht für benannte Modelle.
Der Synthesizer ist selbst ein Sprachmodell, das wie jedes andere den Fehlern F1 bis F4 unterliegt. Das Protokoll schränkt dies strukturell ein, durch Herkunftsangaben, das Verbot stiller Löschung und einen separaten Abschnitt zu Meinungsverschiedenheiten, beseitigt es aber nicht. Die Ausgabequalität hängt davon ab, wie gewissenhaft ein bestimmtes Modell der Anweisung folgt; diese Abhängigkeit ist nicht gemessen.
Die blinde Rubrik wird vom gleichen Modell ausgeführt, das dann das Dokument erstellt, daher ist die Ankerauswahl ein Verzerrungspunkt, und nichts hindert dieses Modell daran, Antworten zu bevorzugen, die seinem eigenen Stil stilistisch nahekommen, was Judge-Modell-Verzerrung (Zheng et al., 2023) an einer anderen Stelle ist. Das Verbot eines vorgegebenen Ankers behandelt nur die explizite Form des Problems.
Die Mobilstandard ist informed-sequential, daher ist der am häufigsten verwendete Modus auch derjenige, dessen Übereinstimmung das geringste Beweisgewicht trägt (Abschnitt 6.4). Das ist ein Qualitäts-pro-Nachricht-Kompromiss, und die Grenze, die er setzt, wird hier dargelegt. Die Hauptschwäche der Stufe ist, dass sie Nachvollziehbarkeit gegen Latenz eintauscht: Kritik und Synthese liefern einen fertigen Text, und die rohen Antworten existieren nur in den Sitzungshistorien der Modelle selbst, daher vertraut ein Nutzer, der Poll-Modus nie öffnet, statt zu überprüfen, was die Haltung ist, gegen die das Protokoll argumentiert.
Die Zeitkosten setzen eine Grenze für den kostenlosen Pfad. Ein realistischer vollständiger Rat benötigt zehn bis fünfzehn Minuten Wartezeit und fünf bis fünfundzwanzig Minuten pro Anbieter mit Deep-Research-Modi. Für einen Teil der beabsichtigten Bevölkerung kann dies den Nutzen übersteigen.
Abschnitt 11 legt die rechtliche Position des Agent-Pfads zusammen mit der Frage zu den Nutzungsbedingungen dar, die er offen lässt.
11. Ethik, Datenschutz und rechtliche Rahmenbedingungen
Das System ist für die persönliche Nutzung der eigenen Modellkonten eines Benutzers, kostenlosen oder kostenpflichtigen, über den eigenen Browser oder das eigene Gerät bestimmt. Es kratzt keine Drittanbieterdaten ab, umgeht keine Bezahlschranken, löst keine Challenge-Response-Tests, umgeht keine Bot-Erkennung, rotiert keine Proxys, verbirgt seinen Betrieb nicht, verkauft keine Konten weiter und betreibt sie nicht mandantenfähig.
Barrierefreiheit ist der Zweck und nicht ein Nebeneffekt. Wenn sich ein Benutzer mit einer Behinderung darauf als Hilfstechnologie verlässt, ist das genau sein Zweck: ein Helfer, der in deren Namen handelt, in deren Tempo, auf ihren eigenen Konten. Die Analogie zur Bordsteinkante ist genau. Eine Rampe, die für Rollstühle gebaut wurde, dient auch Eltern mit Kinderwagen und Lieferboten, und ein System, das für Benutzer gebaut wurde, die nicht ein Dutzend Browser-Tabs verwalten können, dient am Ende jedem.
Die Wege sind rechtlich nicht gleichwertig. Der kostenlose Weg sieht bei jeder Auslegung wie normale Nutzung aus: Der Benutzer öffnet die Websites, tippt und kopiert. Die mobile Stufe steht ihm nahe, da die Anbieter App-Intents genau für diese Art von Aufrufen veröffentlichen, und eine Verknüpfung kann zwei solche Aufrufe verketten, wobei jede Anwendung wie vorgesehen verwendet wird, eine Nachricht auf einmal, im Vordergrund. Der Agent-Weg bedarf einer genauereren Betrachtung. Regeln für automatisierten Zugriff zielen auf die Ernte von Ausgaben im großen Stil, Bots, die einen Service laden, die Umgehung von Ratenlimits, das Betreiben vieler Konten und den Weiterverkauf von dem, was zurückkommt. Keines davon beschreibt einen Benutzer, der eine Frage im menschlichen Tempo in seinem eigenen angemeldeten Browser stellt und die Antwort selbst liest. Eine solche Nutzung ist strukturell identisch mit Hilfssoftware, die für Menschen, die nicht tippen und klicken können, tippt und klickt. Einige Bedingungen sind jedoch breiter formuliert als ihr Zweck und verbieten alle automatisierten Mittel ohne Erwähnung des Umfangs. Ob das einen Benutzer erreicht, der eine einzelne Frage automatisiert, hängt vom Service, der Gerichtsbarkeit und den geltenden Bedingungen des Tages ab. Das ist eine Auslegung und keine Entscheidung. Benutzer sollten sich die Bedingungen dessen ansehen, mit dem Sie verbunden sind, und selbst entscheiden. Jeder, der nicht darüber nachdenken möchte, kann den kostenlosen Weg nutzen, der die gleiche Arbeit leistet und keine agentenspezifischen Fragen aufwirft; die normalen Bedingungen der Websites gelten immer noch.
Datenschutz ist eine Kompositionsentscheidung. Die Menge der Modelle bestimmt, welche Unternehmen das erhalten, was der Benutzer tippt, was für eine gewöhnliche Frage keine Rolle spielt und für eine Frage über Gesundheit, einen Arbeitgeber oder Kunden relevant sein könnte. Wenn eine bestimmte Frage für ein bestimmtes Unternehmen unangenehm wäre, lassen Sie diesen Anbieter für diese Frage aus; eine Auslassung kostet nichts.
Die ethische Einschränkung des Protokolls selbst ist ein Verbot. Nichts, das nicht ein Durchlauf der Methode war, darf als ein solcher dargestellt werden. Eine Websummary, eine Antwort von einem einzelnen Modell oder die eigene Überlegung des Betreibers können jeweils nützlich sein, aber sie sind kein Ratsergebnis, und der Benutzer muss darüber informiert werden, welches davon er in Händen hält. In der Praxis bedeutet das keine Bestätigung, keine Abschnitte mit Zustimmung und Nichtübereinstimmung und keine Ausgabedatei für irgendetwas, das nicht ein echtes Multi-Modell-Durchlauf war.
12. Fazit
Eine zuversichtlich falsche Antwort ist von einer zuversichtlich richtigen nicht zu unterscheiden, während ein Disput zwischen beiden für jeden sichtbar ist. Der Wert eines Rats liegt daher darin, Uneinigkeit aufzudecken, nicht darin, sie auszumitteln.
Übereinstimmung zwischen Modellen ist keine unabhängige Bestätigung. Ein Rat aus N Modellen mit Fehlerkorrelation ρ ist wert = N/(1+(N−1)ρ) unabhängige Zeugen, eine Größe, die sich bei ρ = 0,5 auf höchstens zwei Zeugen beschränkt, unabhängig davon, wie viele Modelle hinzugefügt werden. Der Unterschied in der Beweiskraft zwischen zehn unabhängigen übereinstimmenden Modellen und zehn korrelierten beträgt etwa fünf Dezimalzehnerpotenzen, und eine undurchsichtige Zusammenführung händigt diesen Unterschied dem Leser als unverdientes Vertrauen aus.
Das Design folgt aus diesen beiden Prämissen. Es behält die Herkunft bei, damit ein Leser das Ergebnis überprüfen kann, statt es zu vertrauen, und es stellt Uneinigkeit in den Vordergrund, da Uneinigkeit die eine Komponente ist, die kein einzelnes Modell liefern kann. Eine Quelle, die mehrere Antworten teilen, wird als eine Quelle gekennzeichnet. Die tragenden Fakten werden benannt, und das, was belegt ist, wird von dem getrennt, worüber nur Einigkeit herrscht. Eine weitere Regel gilt für die Darstellung des Protokolls seiner selbst: Sie darf nie das darstellen, was nicht kollegial war, als kollegial, was keine theoretische Sorge ist. In einem verblindeten Durchlauf verstießen zwei von fünf Modellen stillschweigend dagegen, und ein Satz der Rollenzuweisung kehrte beide im Durchlauf der Umgebung B um.
Die drei Stufen sind Punkte auf einer Kurve, deren Achse die Kosten der Breite sind, nicht drei Qualitätsgrade, und Abschnitt 5 ist das, was die Kurve kohärent macht. Da sich absättigt, ist der Beweisabstand zwischen zwei Modellen und zehn viel kleiner als die Modellanzahl vermuten lässt, und zwei Modelle aus verschiedenen Laboratorien, auf einem Telefon ausgeführt, können mehr wert sein als fünf aus einer einzelnen Abstammungslinie. Die mobile Stufe zwang auch einen Handel in die Öffentlichkeit, den die anderen Stufen bisher stillschweigend gemacht hatten. Ein zweites Modell, das das erste gelesen hat, kann es korrigieren, kann es aber nicht länger unabhängig bestätigen. Fehlerkorrektur und unabhängige Bestätigung sind verschiedene Güter, die mit unterschiedlichen Ordnungen gekauft werden, und ein System, das nicht sagt, welches der beiden es seinen Nutzern verkauft, ist irreführend. Der kontrollierte Vergleich bleibt offen, und Abschnitt 9 spezifiziert ihn zusammen mit dem Ergebnis, das mich verpflichten würde, den Anspruch zurückzuziehen.
Wie dieser Vergleich auch ausfallen mag, ein Dokument, das ohne Herkunft und ohne bewahrter Uneinigkeit zusammengeführt wurde, kann überhaupt nicht überprüft werden, und es kann daher nicht besser sein als eine einzelne Antwort in einem Sinne, der für jemanden von Bedeutung ist, der eine Entscheidung trifft. Nachvollziehbarkeit ist keine Verbesserung der Synthese. Sie ist die Bedingung, unter der Synthese das Recht hat, ein Ergebnis genannt zu werden. Die Regeln des Protokolls handeln daher davon, woher jeder Satz stammt und worüber sich die Modelle uneinig waren, statt davon, wie viele Modelle befragt wurden.
Erklärungen
Förderung. Diese Arbeit wurde durch keine externe Förderung unterstützt.
Interessenskonflikte. Der Autor ist Entwickler der in diesem Papier analysierten Multi-Modell-Orchestrierungsmethoden, die offen und reproduzierbar sind – ein Interesse, das die Leser berücksichtigen sollten. Der Autor ist benannter Antragsteller bei anhängigen Patentanmeldungen, nicht gewährten Patenten, die KI-Orchestrierung und Multi-Modell-Validierungssysteme der Art abdecken, die dieses Papier untersucht. Das in Abschnitt 4 formalisierte Protokoll und die in Abschnitt 6 beschriebene Referenzimplementierung stammen vom Autor selbst, und das Evaluierungsdesign in Abschnitt 9 wurde aus diesem Grund vor jeder Datenerfassung festgelegt. Kein analytisches Ergebnis in Abschnitt 5 hängt von der Implementierung ab: Abschnitte 6 und 7 könnten vollständig entfernt werden, ohne das Modell, seine Obergrenze oder irgendeine Schlussfolgerung zu verändern.
Werkzeuge und Verifizierung. KI-Assistenten wurden als Instrumente unter der Leitung des Autors eingesetzt; die Ideen, die Forschung und die Schlussfolgerungen stammen vom Autor. Alle quantitativen Aussagen und Zitate wurden vom Autor gegen Primärquellen oder archivierte Kopien verifiziert; der Autor trägt alleinige Verantwortung für den Inhalt.
Datenverfügbarkeit. Die Abbildungen 1 und 3 sowie die Tabellen 2, 4 und 8 werden aus dem geschlossenen Ausdruck in Abschnitt 5.2 generiert und sind daraus neu berechenbar. Das Material in Abschnitt 7 besteht aus Transkripten der ersten Antwort, die zum Zeitpunkt jedes Durchlaufs aufgezeichnet und mit den Arbeitsmaterialien aufbewahrt wurden. Modelle dort werden nach Labor und nicht nach Produktname identifiziert: Die Beobachtung betrifft einen Ausfallmodus, der in mehreren Laboren auftrat, und Ergebnisse aus einzelnen Durchläufen unterstützen keinen Vergleich zwischen benannten Systemen.
Autorenbeiträge. Einzelautor.
Korrespondenz. [email protected]
References
Entries marked arXiv are preprints and are cited as such; vendor and standards-body documents are contemporaneous industry sources rather than settled literature.
- Bommasani, R., Creel, K. A., Kumar, A., Jurafsky, D., & Liang, P. (2022). Picking on the same person: Does algorithmic monoculture lead to outcome homogenization? Advances in Neural Information Processing Systems, 35.
- Condorcet, M. J. A. N. de C., marquis de (1785). Essai sur l’application de l’analyse à la probabilité des décisions rendues à la pluralité des voix. Imprimerie Royale, Paris.
- Debenedetti, E., Shumailov, I., Fan, T., Hayes, J., Carlini, N., Fabian, D., Kern, C., Shi, C., Terzis, A., & Tramèr, F. (2025). Defeating prompt injections by design. arXiv:2503.18813.
- Dietterich, T. G. (2000). Ensemble methods in machine learning. In Multiple Classifier Systems, Lecture Notes in Computer Science 1857, 1-15. Springer.
- Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325.
- Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., et al. (2022). Language models (mostly) know what they know. arXiv:2207.05221.
- Karpathy, A. (2025). llm-council. Open-source software repository.
- Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038-30066. arXiv:2506.07962.
- Kish, L. (1965). Survey Sampling. Wiley, New York.
- Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
- Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118.
- Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. Advances in Neural Information Processing Systems, 7, 231-238.
- Ladha, K. K. (1992). The Condorcet jury theorem, free speech, and correlated votes. American Journal of Political Science, 36(3), 617-634.
- Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020-9025.
- Meta (2025). Agents rule of two: A practical approach to AI agent security. Engineering documentation.
- MITRE (2025). CVE-2025-32711. Common Vulnerabilities and Exposures record; zero-click exfiltration in an agentic assistant (EchoLeak).
- OWASP (2025). OWASP Top 10 for large language model applications - LLM01: Prompt injection.
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., et al. (2023). Towards understanding sycophancy in language models. arXiv:2310.13548.
- Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755-759.
- Surowiecki, J. (2004). The Wisdom of Crowds. Doubleday, New York.
- Ueda, N., & Nakano, R. (1996). Generalization error of ensemble estimators. Proceedings of the International Conference on Neural Networks, 90-95.
- Wang, J., Wang, J., Athiwaratkun, B., Zhang, C., & Zou, J. (2024). Mixture-of-agents enhances large language model capabilities. arXiv:2406.04692.
- Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., & Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. International Conference on Learning Representations. arXiv:2203.11171.
- Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. International Conference on Learning Representations. arXiv:2306.13063.
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, Datasets and Benchmarks Track. arXiv:2306.05685.
Anhang A. Die Beleg-Vorlage
Der Beleg ist das Erste, das ein Leser sieht, und oft das Einzige, das er liest. Er muss vier Fragen beantworten, ohne dass gescrollt werden muss.
RECEIPT — 6 models asked · 5 answered · 1 did not (free tier)
Mode: fast ×4, deep ×1
Anchor: answer #3 (chosen for completeness and sourcing)

Agreed:       ...
Disputed:     ...
Unverified:   ...

Rests ONLY on the models agreeing (none showed a source):
              ...
Correlated:   3 of 5 cite one article → one lineage, not three
Composition:  4 of 5 are models from one region; agreement
              may reflect a shared frame
Die letzten zwei Zeilen sind das, was Abschnitt 5 zu rechtfertigen hat. Ohne sie würde das Dokument nur berichten, wie viele Modelle übereinstimmten, und verbergen, welchen Wert diese Übereinstimmung hat, und diese beiden Größen unterscheiden sich um Größenordnungen.
Anhang B. Effektive Anzahl unabhängiger Zeugen
Tabelle 8. , vollständiger Bereich
| ρ | N=2 | N=3 | N=4 | N=5 | N=7 | N=10 | N=15 | N=20 | N→∞ |
|---|---|---|---|---|---|---|---|---|---|
| 0.00 | 2.00 | 3.00 | 4.00 | 5.00 | 7.00 | 10.00 | 15.00 | 20.00 | ∞ |
| 0.05 | 1.90 | 2.73 | 3.48 | 4.17 | 5.38 | 6.90 | 8.82 | 10.26 | 20.0 |
| 0.10 | 1.82 | 2.50 | 3.08 | 3.57 | 4.38 | 5.26 | 6.25 | 6.90 | 10.0 |
| 0.15 | 1.74 | 2.31 | 2.76 | 3.13 | 3.68 | 4.26 | 4.84 | 5.19 | 6.67 |
| 0.20 | 1.67 | 2.14 | 2.50 | 2.78 | 3.18 | 3.57 | 3.95 | 4.17 | 5.00 |
| 0.30 | 1.54 | 1.88 | 2.11 | 2.27 | 2.50 | 2.70 | 2.88 | 2.99 | 3.33 |
| 0.40 | 1.43 | 1.67 | 1.82 | 1.92 | 2.06 | 2.17 | 2.27 | 2.33 | 2.50 |
| 0.50 | 1.33 | 1.50 | 1.60 | 1.67 | 1.75 | 1.82 | 1.88 | 1.90 | 2.00 |
| 0.60 | 1.25 | 1.36 | 1.43 | 1.47 | 1.52 | 1.56 | 1.60 | 1.61 | 1.67 |
| 0.70 | 1.18 | 1.25 | 1.29 | 1.32 | 1.35 | 1.37 | 1.39 | 1.40 | 1.43 |
| 0.80 | 1.11 | 1.15 | 1.18 | 1.19 | 1.21 | 1.22 | 1.23 | 1.23 | 1.25 |
| 0.90 | 1.05 | 1.07 | 1.08 | 1.09 | 1.09 | 1.10 | 1.10 | 1.10 | 1.11 |
Nach rechts vorgehen, indem Sie Modelle hinzufügen, stößt fast sofort auf die rechte Spalte. Nach oben vorgehen, indem Sie die Korrelation verringern, hat keine Grenze. Der Aufwand für die Vielfalt eines Rates, das heißt für unterschiedliche Labore, Regionen und Trainingsdaten, bringt daher mehr zurück als der Aufwand für seine Größe. Zwei Einträge tragen das Argument von Abschnitt 6.2: Ein Paar aus zwei Laboren bei ρ ≈ 0,2 zählt als etwa 1,67 unabhängige Zeugen, während fünf Modelle aus einer Abstammungslinie bei ρ ≈ 0,6 etwa 1,47 zählen.
Appendix C. Implementierungsreferenz für die Mobile-Ebene
Tabelle 9. Implementierungsreferenz für die Mobile-Ebene
| Komponente | Spezifikation |
|---|---|
| Mechanismus | Betriebssystem-App-Intents in einer einzelnen signierten Verknüpfung verkettet, die die installierten Anwendungen der Anbieter gegen die bestehenden Abonnements des Benutzers aufruft. Kein API-Schlüssel, kein Server, keine Hintergrundausführung |
| Anbieteraktionen | Jeder veröffentlichte Ask-Intent des Anbieters, adressiert durch den Anwendungs-Intent-Identifier. Ein Anbieter stellt einen optionalen Modellparameter bereit, der weggelassen wird, damit die Anwendungsstandardeinstellung gilt; der andere stellt keine bereit |
| Freihändiger Betrieb | Der Parameter „show-on-run" wird in den Intent-Parametern zur Build-Zeit auf deaktiviert gesetzt, nicht im Editor nach dem Import angepasst |
| Verteilung | Die Verknüpfung ist für den unbeschränkten Import signiert, sodass ein Build auf jedem Gerät oder Konto ohne Neuerstellen installiert wird |
| Modusmenü | Eine Menü-Kontrollflussaktion mit Start-, Case- und End-Markern; Zweige konvergieren auf einen gemeinsamen Ende durch eine Set-Variable-Aktion |
| Alternative Plattform | Intent-basierte Automatisierung mit einem halbautomatischen Pfad, der Anwendungsaktualisierungen übersteht |
| Kosten pro Ausführung | Poll 1 + 1, Critique 1 + 1, Synthesis 1 + 2 Abonnementnachrichten |
| Latenz | Etwa 50 bis 60 Sekunden vom Start bis zum Ergebnis, freihändig |
| Startoberflächen | Startbildschirmsymbol, Widget, Hardwareaktionstaste oder Sprachphrase |
Zwei Einschränkungen prägen das Design, und beide verallgemeinern sich. Kontingente werden mit der normalen Nutzung derselben Anwendungen geteilt, daher ist der empfohlene tägliche Modus der Zweibotschaft-Modus und nicht der Dreibotschaft-Modus; das ist Ressourcenzuteilung, keine Qualitätsbeurteilung. Und jeder Intent-Aufruf öffnet eine neue Sitzung ohne Speicher, daher sind alle Eingabeaufforderungen in sich geschlossen und tragen die Frage und alle vorherigen Antworten in sich selbst. Nichts wird fortgesetzt. Diese Einschränkung ist es, die die blinde parallele Unabhängigkeit in Poll und Synthesis architektonisch statt instruktiv macht, wie Abschnitt 6.5 argumentiert.
Zitierweise
Chernets, V. (2026). Übereinstimmung ist keine unabhängige Evidenz: Nachprüfbare Multi-Modell-Synthese ohne API [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7390698
@misc{chernets2026agreementnotevidence,
  author       = {Chernets, Vadym},
  title        = {{Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7390698},
  url          = {https://doi.org/10.2139/ssrn.7390698}
}