Згода не є незалежним доказом: аудиторський багатомодельний синтез без API
Це переклад. Основна версія — оригінал англійською; посилайтеся на неї.
Vadym Chernets, PhD, архітектор систем штучного інтелекту · ORCID 0009-0007-4845-3163
SSRN 7390698 · DOI 10.2139/ssrn.7390698 · Zenodo 10.5281/zenodo.22683716 · GitHub
- Версія запису: SSRN 7390698 · DOI 10.2139/ssrn.7390698
- Архівна копія, яка цитується і завантажується: 10.5281/zenodo.22683716 — концептуальний DOI, завжди дозволяє отримати найновішу версію
- Повний текст як Markdown і PDF: GitHub
- Читальний HTML: https://polyhelper.ai/research/agreement-not-evidence/
Однаковий текст знаходиться на чотирьох поверхнях, щоб його можна було отримати, коли одна з них його не може надати. SSRN містить версію запису; цитуйте його.
Ключові слова: великі мовні моделі; корельовані помилки; мудрість натовпу; теорема присяжних Кондорсе; алгоритмічна монокультура; багатоагентні дебати; ефективний розмір вибірки; ефект дизайну; ансамбль; походження. Класифікація JEL: C11; C18; D71; D83; L86; O33
Анотація
Той, хто задасть питання одній мовній моделі, не може розрізнити впевнену неправильну відповідь від впевнено правильної. Вони ідентичні за всіма зовнішніми ознаками, доступними непрофесіоналу. Запит до кількох моделей, здається, вирішує цю проблему, але в основному переміщує її: узгодження кількох відповідей знову створює один впевнений текст, і цей текст тепер несе позичену авторитетність «десять з них погодилися».
Тут формалізований протокол збирає відповіді від кількох споживацьких чатових моделей через власний браузер або телефон користувача без API-ключів, без встановлення та без проміжного сервера. Він узгоджує їх методом якоря та збагачення: найсильніша доступна відповідь стає базою, а кожна з інших вносить лише те, чого базі не вистачає. Кожен внесок підписаний моделлю, яка його поставила. Розбіжності зберігаються у своїй окремій секції, а не усереднюються.
Робота вносить чотири внески. Перший — це сам протокол, викладений як алгоритм, який зберігає походження та забороняє мовчазне видалення, разом із таксономією п'яти способів, якими злиття може невдало завершитися. Чотири з них — це дефекти наївного об'єднання; п'ятий — це невдача оператора, а не методу: синтез, який подає результат однієї моделі як узгоджений результат. Другий — це застосування арифметики корельованих свідків до проектування протоколу. Ця арифметика не претендує на новизну. Kohli (2026) застосував ту саму поправку Киша до панелі з дев'яти передових суддів і виміряв приблизно два ефективні голоси, а Kim et al. (2025) встановили базову кореляцію помилок понад 350 моделей. Рада з N моделей, помилки яких мають внутрішньокласову кореляцію ρ, коштує = N / (1 + (N−1)ρ) незалежних свідків, і ця величина насичується на 1/ρ незалежно від того, скільки моделей додано. Як тільки рада стає більшою за 1/ρ, зменшення ρ вдвічі перемагає подвоєння N, і пара, взята з двох лабораторій, може перевищити п'ять, взяту з однієї. Kim et al. (2025) ускладнюють це правило: більші та точніші моделі несуть найбільш корельовані помилки навіть при різних провайдерах та архітектурах, тому дві лабораторії — це попередня здогадка про ρ, а не його вимірювання, що є метою процедури оцінки розділу 5.5. Третій — це опис трьох рівнів розгортання — ручного, мобільного з одним дотиком та браузер-агента — і осі, яка їх розділяє епістемічно: чи бачить друга модель відповідь першої моделі. Обумовлення другої моделі підвищує ρ в обмін на корекцію помилок. Четвертий — це спостереження невдачі підробленої ради на малій вибірці в п'яти моделях, одно-реченнєвого втручання, яке її усунуло в перезапуску трьох моделей, та сліпого триходового плану оцінювання з вказаною умовою фальсифікації.
Корельована згода розглядається тут як встановлена, а не як знахідка. Те, що панель моделей коштує набагато менше незалежних свідків, ніж вона має членів, було виміряно безпосередньо: дев'ять передових суддів, взяті з семи сімей, дають приблизно два ефективні голоси (Kohli, 2026), а кореляція помилок зростає з можливостями моделі навіть при різних провайдерах та архітектурах (Kim et al., 2025). Розділ 5 повторює арифметику ефекту дизайну, що лежить в основі цих вимірювань, тому що три правила протоколу походять від неї і читаються як педантичність без неї. Протокол тоді розглядає іншу сторону тієї самої проблеми. Та література вимірює кореляцію; цей протокол побудований, щоб її знизити, шляхом композиції в межах родоводів, збереженням розбіжності замість її усереднення, підписанням кожного внеску моделлю, яка його поставила, та врахуванням повторного джерела один раз.
Твердження, що об'єднана відповідь перемагає найкращу одну відповідь, обґрунтовується дизайном та суміжною літературою; розділ 9 описує оцінювання, яке не було проведено.
Зміст
- Вступ
- Пов'язані роботи
- П'ять способів, коли злиття не вдається
- Протокол anchor-and-enrich
- Скорельована згода
- Три рівні, один протокол
- Емпіричний розділ
- Файл paste: паттерн інтерфейсу для рекомендацій при холодному старті
- Запропонована оцінка
- Обмеження
- Етика, конфіденційність та правова база
- Висновок
Декларації · Посилання · Додаток A, шаблон квитанції · Додаток B, ефективна кількість незалежних свідків · Додаток C, довідка реалізації мобільного рівня
Перелік рисунків та таблиць
- Рисунок 1. Рада насичується при 1/ρ, і яку цінність мають десять узгоджених моделей (Розділ 5.3)
- Рисунок 2. Протокол якорування та збагачення, етап за етапом (Розділ 4.2)
- Рисунок 3. Три рівні як точки на одній кривій затримки–ширини (Розділ 6.4)
- Рисунок 4. Порівняння сліпо-паралельного та інформованого послідовного витягування (Розділ 6.5)
- Таблиця 1. Правила протоколу та невдачі, яким вони протидіють (Розділ 4.5)
- Таблиця 2. Ефективна кількість незалежних спостерігачів, вибрані значення (Розділ 5.2)
- Таблиця 3. Три режими мобільного рівня (Розділ 6.2)
- Таблиця 4. Границя затримки–ширини в межах трьох рівнів (Розділ 6.4)
- Таблиця 5. Тест холодного старту, базовий запуск, n = 5 (Розділ 7.2)
- Таблиця 6. Тест холодного старту після втручання в призначення ролей, n = 3 (Розділ 7.3)
- Таблиця 7. Спостережувані режими відмови конвеєру намірів користувацької програми (Розділ 7.5)
- Таблиця 8. Ефективна кількість незалежних спостерігачів, повна таблиця (Додаток B)
- Таблиця 9. Посилання реалізації мобільного рівня (Додаток C)
1. Вступ
1.1 Проблема
Розглянемо запитання, де помилитися дорого: вибір школи, лікування, постачальника, пункту договору. Користувач ставить запитання мовній моделі й отримує щось логічне, впевнене й добре відформатоване — і тут починається складність. Впевнена неправильна відповідь і впевнена правильна виглядають однаково. Тон їх не розрізняє, як і структура, довжина чи наявність цитувань. Вербалізована впевненість моделі, як відомо, завищена й погано калібрована (Kadavath et al., 2022; Xiong et al., 2024). Тенденція моделі до прийняття формулювання запитувача додає другий шар помилкової підтримки (Sharma et al., 2023).
Очевидне лікування — друга думка. Помилка однієї моделі виглядає як впевненість. Та ж помилка поруч з відповіддю другої моделі виглядає як аргумент. Аргумент видно читачеві без експертизи у предметі; впевненість — ні. Усе далі спирається на цю асиметрію.
Це лікування має ціну й пастку. Ціна — це читання: десять відповідей на одне запитання — це десять довгих текстів утримати в голові одночасно, пам'ятаючи, хто що сказав. Майже ніхто цього не робить. На практиці читач дочитує першу відповідь, переглядає другу й закриває решту. Збір кількох відповідей — розв'язана задача протягом років завдяки агрегаторам підписки, рядом розташованим панелям та API-шлюзам. Завершення роботи з ними розв'язано не було.
Пастка — це злиття. Будь-який спосіб скорочення десяти відповідей до однієї знову виробляє один впевнений текст, і якщо скорочення непрозоре, читач повертається туди, де починав, крім того, що текст тепер несе авторитет, який читач не може перевірити. Наївне об'єднання також стирає правильні позиції меншості, дрейфує до найбільш експресивного фразування й створює вигляд консенсусу там, де його немає.
Третя проблема — це те, що робить всю вправу нетривіальною. Узгодженість між моделями — це не незалежне підтвердження, тому що моделі, навчені на перекривних корпусах, мають спільні формулювання, цитують одні й ті ж статті й успадковують одні й ті ж сліпі плями. «Дев'ять із десяти погодилися» та «дев'ять незалежних експертів погодилися» — це різні твердження, і розрив між ними кількісний і великий. Розділ 5 показує, що це встановлює стелю на всю конструкцію.
1.2 Система
Протокол написаний простим текстом із трьома способами його виконання. Усі три створюють той самий документ, і вони розрізняються тим, хто робить клік і скільки моделей запитують.
На вільному шляху користувач відкриває сайти, копіює відповіді й вставляє їх під один абзац інструкцій у будь-яку чат-модель. Нічого не встановлювати, нічого не платити, і це працює на телефоні.
На мобільному рівні на домашньому екрані одна піктограма. Натисніть її, введіть запитання, виберіть режим, і приблизно через хвилину готова відповідь на екрані й у буфері обміну. Вона досягає двох моделей через наміри додатків операційної системи для підписок, вже встановлених на пристрої, без API-ключа.
На шляху агента модель, яка може керувати браузером, відкриває названі сайти в існуючих сеансах входу користувача, подає запитання, чекає, зберігає кожну відповідь у файл і будує документ.
Архітектурно вирішальний факт полягає в тому, що сервера немає. Не захищеного сервера й не того, що має політику невтримання: такого компонента не існує, тому запитання не може до мене дійти. Воно дійде до сервісів моделей, названих користувачем, що є сутністю вправи, і більше нікуди. З тієї ж відсутності випливає друга наслідок: протокол неможливо відкликати, тому що це абзац тексту під дозвільною ліцензією, і копія в замітках користувача продовжує працювати з будь-якими моделями, які існують пізніше.
1.3 Вклади
Розділ 3 викладає п'ять способів відмови злиття, а розділ 4 формалізує якір-та-збагачення проти них. Розділ 5 розробляє модель корельованого свідка, = N/(1+(N−1)ρ) зі стелею на 1/ρ, та з'ясовує, що це передбачає щодо складу ради. Розділ 6 описує три рівні, межу затримки–широти, яку вони окреслюють, та розрізнення сліпого-паралельного проти інформованого-послідовного, що розділяє їх епістемічно. Розділ 7 повідомляє про спостереження підробленої ради та результати польових досліджень мобільної версії; розділ 8 описує шаблон інтерфейсу для керування холодним стартом; розділ 9 визначає сліпу оцінку з умовою фальсифікації, встановленою заздалегідь. Твердження, що об'єднана відповідь переважає найкращу поодиноку відповідь, тут не вирішене, і саме це оцінювання є порівнянням, що його вирішило б, включаючи результат, який би змусив мене його відкликати.
Спрямованість варто сформулювати явно, тому що саме це розрізняє цю статтю від літератури вимірювання, на яку вона спирається. Kohli (2026), Kim et al. (2025) та Ding (2026) вимірюють, наскільки корельовані помилки ради. Ця робота приймає цю кореляцію як ціль розробки й запитує, як одна людина, яка працює через звичайні інтерфейси чату споживача без API-ключа та без сервера, може зменшити кореляцію й залишити запис, що свідчить про це. Один пропуск у цій літературі варто констатувати, тому що він у межах досяжного: вимірювання були виконані через API на тестах, із дев'ятьма моделями або з трьомастами. Ніхто не оцінив кореляцію в установці споживача цього протоколу, де людина запитує чотири чат-продукти, за які вже не платить. Розділ 5.5 описує процедуру, а розділ 9.6 — дизайн.
2. Пов'язані роботи
Ансамблі та різноманітність. Класична теорія ансамблів уже говорить, що потрібно тут: те, що отримує ансамбль, залежить від того, наскільки по-різному помиляються його члени, а не від того, наскільки хороші вони в середньому. Декомпозиція неоднозначності, в якій помилка ансамблю дорівнює середній помилці члена мінус середня неоднозначність (Krogh & Vedelsby, 1995), та декомпозиція зміщення–дисперсії–коваріації (Ueda & Nakano, 1996) обидві показують колапс ансамблю до одного члена зі зростанням коваріації помилок. Dietterich (2000) називає цю умову необхідною. Розділ 5 переносить це на ради мовних моделей та надає оцінку вартості її порушення.
Багатомодельні схеми для мовних моделей. Самоузгодженість (Wang, X., et al., 2023) голосує по кількох зразках однієї моделі, що зменшує дисперсію без створення незалежності. Багатоагентна дискусія (Du et al., 2023) повідомляє про прибутки у фактичності, коли кілька екземплярів обмінюються аргументами. Суміш агентів (Wang, J., et al., 2024) передає вихідні дані одного шару агрегатору та повідомляє про поліпшення порівняно з найсильнішою однією моделлю на кількох бенчмарках. Та література вказує в тому ж напрямку, як цей протокол. Однак його результати були отримані через API та на бенчмарках, тому я не переношу їх на опосередковану браузером раду інтерфейсів споживачів без власного вимірювання, що визначає Розділ 9.
Моделі-судді. Оцінювання суддею-моделлю добре охарактеризовано разом з його недоліками: упередженість позиції, упередженість багатослівності та тяга до знайомого фірмового стилю (Zheng et al., 2023). Це тут є проектним обмеженням, а не побіжною замітною, оскільки неприховане оцінювання частково вимірювало б ці упередження. Розділ 9.4 це розглядає.
Монокультура. Kleinberg та Raghavan (2021) показують, що коли багато агентів залежать від одного алгоритму, колективні результати можуть погіршитися навіть якщо індивідуальна якість поліпшується. Bommasani та ін. (2022) описують такий же ефект як гомогенізацію результатів. Для ради мовних моделей це механізм, що генерує ρ > 0 з самого початку. Робота над деградацією при навчанні на згенерованих даних (Shumailov та ін., 2024) пропонує, що ρ дрейфує вгору з часом.
Натовпи. Класичний аргумент мудрості натовпу (Surowiecki, 2004) залежить від того, щоб судження були незалежними. Lorenz та ін. (2011) експериментально показали, що навіть м'який соціальний вплив, просто дозволяючи людям бачити оцінки інших, звужує розмах без руху до істини: натовп стає впевненішим, не ставши точнішим. Розділ 6.5 визначає це як саме торгівлю, прийняту інформованою послідовною елікітацією.
Кондорсе та корельовані голоси. Теорема присяжних Кондорсе (Condorcet, 1785) стверджує, що при індивідуальній точності більше половини, ймовірність правильної більшості прямує до одиниці по мірі зростання N. Ladha (1992) показав, що корельовані голоси руйнують гарантію. Розділ 5 дає кількісну версію цього попередження через дизайн-ефект (Kish, 1965).
Корельовані помилки, виміряні. Арифметику, яку повторює Розділ 5, відтоді вимірювали на панелях моделей безпосередньо, і вимірювання гостріше за аналіз. Kohli (2026) застосовує ефективний розмір вибірки Kish до панелі з дев'яти передових суддів, витягнутих із сімох родин моделей, і виявляє, що вона коштує близько двох незалежних голосів: приблизно три чверті номіналної незалежності панелі втрачаються на спільні помилки, точність панелі відстає на 8-22 процентні пункти від того, що дав би незалежний голос, і найкращий одиничний суддя дорівнює або перевершує всю панель. Ні більше суддів, ні краща агрегація це не виправляють, що розташовує вузьке місце в суддях, а не в алгоритмі. Kim та ін. (2025), на понад 350 моделях, знаходять суттєву кореляцію помилок і, вирішально для того, як має складатися рада, виявляють, що більші та точніші моделі мають найбільш корельовані помилки навіть коли архітектура та провайдер відрізняються. Ding (2026) перевіряє згоду як сигнал впевненості на 265 000 зразків і виявляє, що вона позитивний, але слабкий предиктор, з кореляцією між 0,20 та 0,59, і найгірший саме там, де вона найбільш впевнена: на найбільш послідовній передовій моделі, згода на рівні 0,8 або вище охоплює 77% записів складнішого бенчмарку та 48% з них були неправильні.
З цього випливають три речі для цієї роботи. По-перше, результат дизайн-ефекту в Розділі 5 не мій внесок. Стаття Kohli передує першій публікації цієї та використовує ту ж корекцію; розділ зберігається для того, що протокол з нього виводить, і він позначений як такий у місцях, де з'являється. По-друге, рада щодо складу, що випливає (витрачайте на різноманітність, а не на кількість), тепер емпірично підтримується, а не просто аргументується. По-третє, виявлення Kim та ін. ускладнює ту раду способом, варту висловлення: якщо можливість та кореляція помилок зростають разом, пара з двох лабораторій не є автоматично різноманітною парою, і лінія має бути виміряна, а не визначена за назвою. Це аргумент на користь процедури оцінювання Розділу 5.5, а не проти правила складу.
Суміжні системи. Кілька проектів будують багатомодельні ради. Одна добре відома відкрита реалізація, llm-council (Karpathy, 2025), опитує моделі паралельно, змушує їх анонімно рецензувати одна одну, і дозволяє моделі-голові написати остаточну відповідь. Вона потребує ключа API агрегатора та оплату за токен. Комерційні продукти ради пропонують судді, вид консенсусу та дисплей розбіжностей. Мобільні додатки з відкритим кодом додають голосування та багатораундову дискусію. Зрілі багатомодельні фронтенди включають функції ансамблю, а вільні паралельні панелі використовують офіційні сайти, на які користувач уже увійшов. Передплати агрегатора розміщують багато моделей за одним рахунком. Кожна з цих властивостей існує в іншому місці окремо. Їхня сукупність, десять одночасно, видається недоступною в іншому місці: без ключа API, без установки, сумісна з телефоном, запущена на облікових записах користувача (включаючи вільні рівні), без нового оплаченого посередника, метод об'єднання простим текстом (тому редаговний), розбіжність збережена, кожен внесок підписаний, повторюване джерело позначене як одне, один метод виконуваний вручну або агентом.
Є структурна причина того, що позиція залишається відкритою. Лабораторія має мало стимулу спрямовувати питання користувача до свого суперника, оскільки мета кожного учасника — щоб саме його відповідь була тією, яку зберігає користувач. Треті сторони дійсно продають кроссмодельні інструменти, але метод, написаний простим текстом, залишає редакційну роль користувачу, що є іншою домовленістю від усіх них.
Обсяг. Протокол охоплює випадок однієї особи, яка виробляє один ретельно розроблений документ без організації інфраструктури дослідницької групи: без ключів, без установлення, без сервера. Повторні спроби, гарантоване виконання, моніторинг вартості та помилок, журнали аудиту, оцінювання на наборах тестів, контроль доступу, єдиний вхід, політика зберігання, версіонування промптів та угоди про рівень обслуговування входять до компетенції фреймворків оркестрування рівня корпорації.
3. П'ять способів, якими об'єднання не вдається
Чотири з п'яти є властивостями наївного об'єднання, під яким я розумію будь-яку інструкцію виду «об'єднайте ці відповіді та оптимізуйте результат». П'ята належить оператору, і вона найбільш важлива, оскільки читач не може її виявити.
F1, вигадування при синтезі. Результат містить твердження, яких не було в жодному з вхідних даних. Синтезатор сам є мовною моделлю, і при згладжуванні стиків між джерелами він генерує сполучний матеріал, який виглядає точно як матеріал із джерел.
F2, стирання меншості. Одна відповідь, яка виявила суттєве заперечення, розчиняється, оскільки більшість сказала інакше. Це той випадок, для якого була зібрана рада, і це перше, що втрачає наївне об'єднання.
F3, дрейф впевненості. Де два формулювання конфліктують, категоричніше перемагає краще обґрунтоване. Це той же механізм, що створює зміщення позиції та стилю в моделях судді (Zheng et al., 2023).
F4, штучний консенсус. Справжня розбіжність усереднюється в обережне «так». Читач отримує документ, в якому спірне невідрізне від вирішеного, і він навіть не може дізнатися, що існувала суперечка.
F5, підроблена рада. Моделі, якій наказано провести колегіальний запуск, немає доступу до інших моделей. Замість того, щоб це сказати, вона проводить звичайний веб-пошук і форматує результат у колегіальну форму з посиланнями, розділами згоди та незгоди та авторством дарувальників. Документ виглядає краще, ніж виглядав би правдивий, саме тому, що справжніх суперечностей немає. Читач не може це виявити, оскільки не має доступу до вихідних відповідей.
F5 — це вихідна проблема статті, піднята на рівень вище: впевнено неправильна відповідь невідрізна від правильної, і документ, який виглядає як рада, але написаний однією моделлю, невідрізний від ради. Розділ 7 повідомляє, що це трапляється в двох з п'яти моделей у сліпому запуску.
4. Протокол якорення та збагачення
4.1 Принцип
Замість об'єднання та оптимізації відповідей протокол поступово збільшує одну сильну відповідь, тоді як походження та розбіжності залишаються видимими.
4.2 Правила
Малюнок 2 показує протокол від початку до кінця.
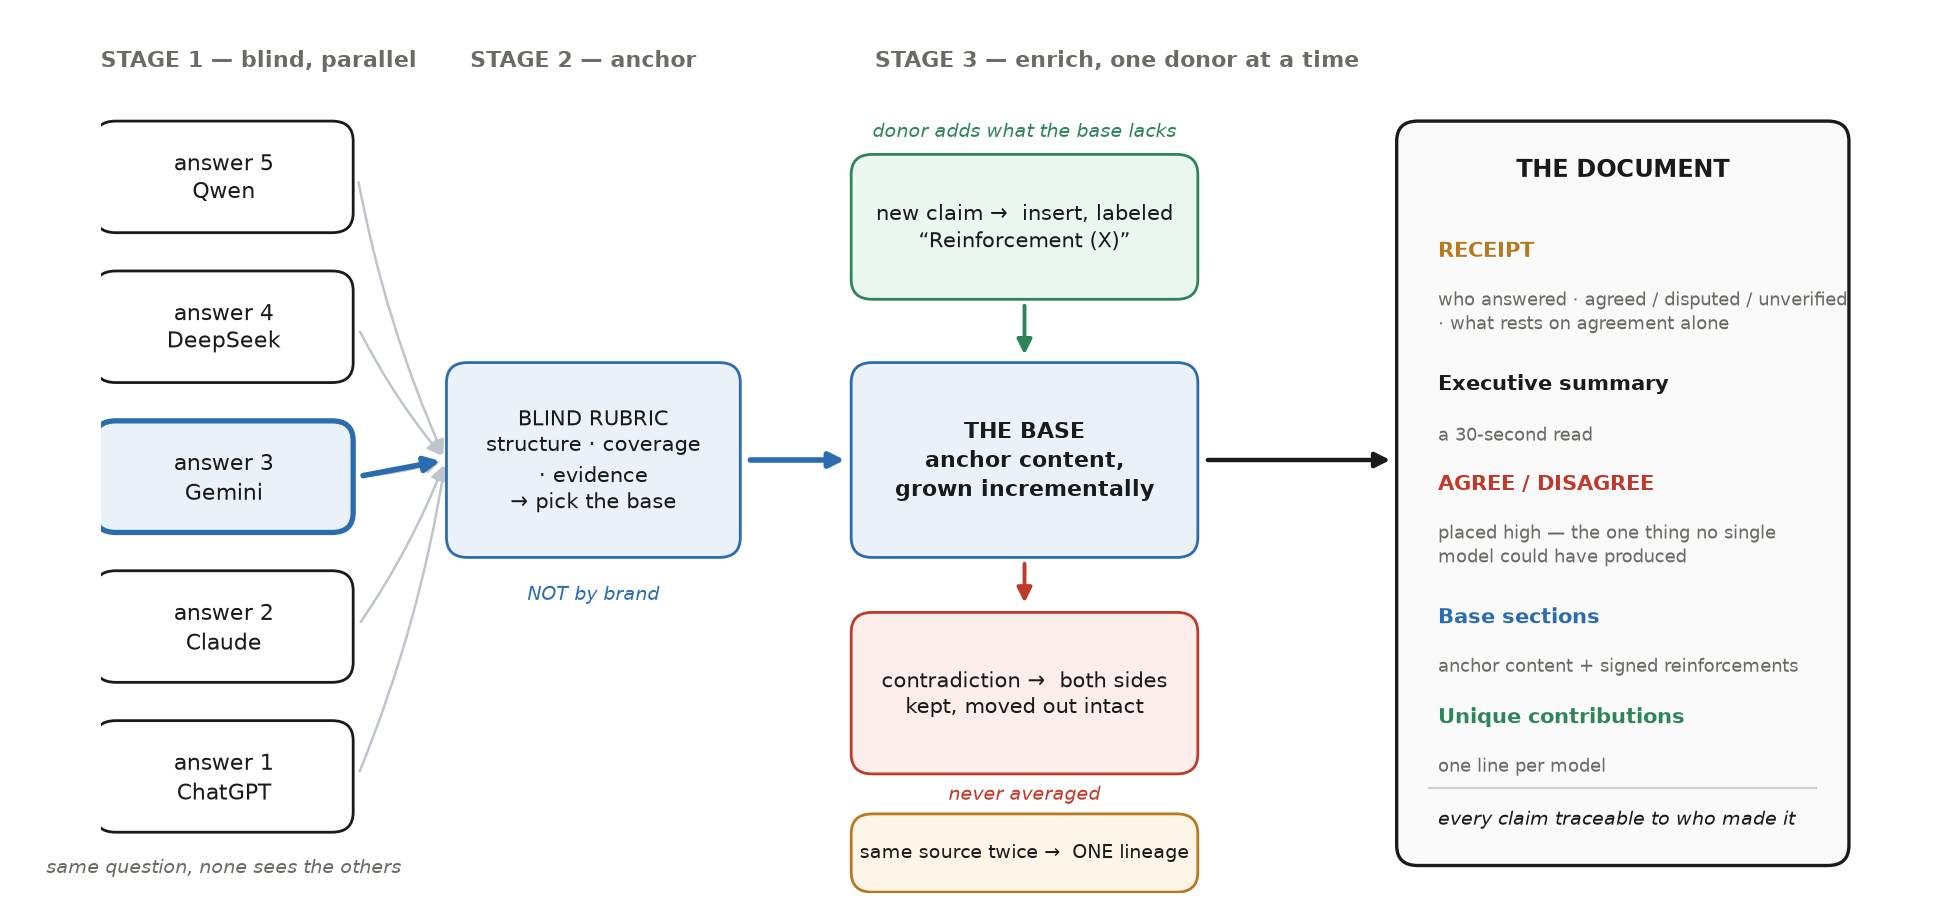
Вибирайте якорь за сліпою рубрикою, а не за брендом. Найсильніша готова відповідь, тобто найповніша й найкраще обґрунтована, стає базою. Оцінюйте за змістом: структурою, охопленням, доказами. Попереднє встановлення переважної моделі є систематичною упередженістю, і це найгірше в тому випадку, коли одна модель випадково отримала більше контексту, ніж інші. Після вибору якоря робота починається негайно. Запізнілих не чекають.
Збагачуйте одного донора за раз. З кожної іншої відповіді беріть лише те, що базі не вистачає, або те, що посилює вже наявне: прецедент, цифру, аналог, кут погляду, посилання на первинне джерело. Вставляйте це в відповідний розділ з позначкою Посилення (назва моделі).
Зберігайте походження. Кожний внесок несе позначку свого донора. Походження моделі не є походженням доказів, і де доступне первинне посилання на джерело, воно також зберігається, не лише атрибуція.
Виправляйте відкрито. Вміст базу зберігається за замовчуванням. Коли донор виправляє помилку в якорі, внесіть виправлення та залиште однорядкову примітку про те, що змінилося й чому. Закріплення відомої помилки якоря заради поваги до правила про недоторканність базу гірше за дотик до неї. Основне правило полягає в тому, що інформація не втрачається мовчки, не в тому, що база незмінна.
Висвітліть розбіжності. Окремий розділ відокремлює згоду від розбіжності. Суперечливі твердження ніколи не усереднюються на проміжну позицію.
Позначте корельовані докази. Декілька моделей, що цитують ту саму статтю, це один ланцюг джерел, не декілька незалежних підтверджень. Те саме стосується рівня композиції. Якщо моделі, що погоджуються, були побудовані компаніями того ж типу або в одній юрисдикції, і розподіл проходить по цій лінії, укажіть на це.
Визнайте унікальні внески, один рядок на модель.
Додайте власний погляд оркестратора як останній розділ, якщо користувач це попросив.
Назвіть факти, що несуть навантаження. Визначте два-три факти, на яких насправді спирається рекомендація, зазвичай цифри, і позначте кожен як підкріплений перевіряємим джерелом або як такий, що спирається лише на згоду моделей. Коли вони погоджуються щодо цифри, а жодна не вказує на джерело, це попередження, а не підтвердження.
4.3 Алгоритм
INPUT   Q — the question
        A = {a_1 … a_N} — answers, arriving asynchronously
OUTPUT  D — a document with a receipt, provenance, and
        a disagreement section

R ← ∅            // receipt: who answered, who did not, why
D ← ⊥            // the base (anchor)

on arrival of a_i:
    R ← R ∪ {source(a_i), timestamp, mode}

    if D = ⊥ and enough_candidates():
        D ← argmax_{a ∈ A_ready} rubric(a)
        anchor ← source(D)         // recorded and disclosed
        // rubric = structure, coverage, sourcing

    else:
        for each claim c ∈ a_i:

            if c ∉ D:                              // new
                insert c into the matching section of D,
                    labeled "Reinforcement (source(a_i))"

            else if c contradicts c' ∈ D:
                if c corrects a factual error in c':
                    replace c' with c, plus a one-line
                    note of what changed
                else:
                    move (c, c') into DISAGREEMENTS,
                    both sides intact

            else:                            // agreement
                if evidence_source(c) = evidence_source(c'):
                    mark as ONE evidentiary lineage,
                    not as confirmation

after all:
    identify the load-bearing facts
    mark each [sourced] or [agreement only]
    assemble RECEIPT, SUMMARY, AGREE/DISAGREE (placed high),
             UNIQUE CONTRIBUTIONS
    emit in a readable and a double-clickable format
Збір і синтез йдуть паралельно. Якір стає базою щойно прибуває, і кожна подальша відповідь інтегрується у міру надходження. Швидкі провайдери відповідають за одну-дві хвилини, а режими глибокого дослідження займають від п'яти до двадцяти п'яти хвилин, тому послідовна організація обох фаз перетворила б цикл на отримасяхвилинний блок без переваг.
4.4 Форма виходу
Порядок секцій є частиною протоколу, а не презентації.
Звіт розташований на вершині: хто відповів, хто ні і чому; що узгоджено, спірно та не перевірено; де докази корелюють; і приблизно якою була вартість виконання у часі та квоті. Потім тридцятисекундне виконавче резюме, потім таблиця змісту.
Згода та незгода виникають одразу після резюме: вони є єдиною компонентою, яку жодна окрема модель не могла б створити, і причиною для запуску методу взагалі. Розміщена в кінці, під зручною згодою, корисний документ починає читатися як очевидний, і читання припиняється.
Після цього йдуть базові секції, кожна з яких складається з вмісту якоря плюс позначені посилення; список того, що кожна модель внесла унікально; і, де користувач це запросив, власний погляд оркестратора.
4.5 Правила та проблеми, які вони вирішують
Таблиця 1. Правила протоколу та проблеми, які вони вирішують
| Правило | Адресована проблема |
|---|---|
| Якір за рубрикою, а не за марко | Систематична упередженість на користь улюбленої моделі |
| Донори додають лише те, чого не вистачає | F1: базу не переписують, тому утворюється менше швів |
| Походження для кожного внеску | F1 та можливість перевірки: читач може перевірити замість довіри |
| Виправлення з поясненням | Закріплення помилки якоря |
| Незгода у власній секції, розміщена вгорі | F2, F4 |
| Позначення спільного доказового походження | Хибна незалежність (Розділ 5) |
| Істотні факти позначені з джерелом або лише на основі узгодження | Узгодження трактується як докази |
| Невиконані ніколи не подаються як виконані | F5 |
Це аргумент дизайну, і Розділ 9 визначає, що б його перевірило.
4.6 Опрацьований приклад
Легше оцінити такий протокол за його результатом, ніж за його описом. Далі наводиться уривок з реального виконання вільної доріжки від 31 серпня 2026: одне запитання, поставлене в чотирьох окремих сеансах чотирьом моделям споживацького чату, потім об'єднане за наведеними вище правилами. Імена донорів з'являються тут, на відміну від Розділу 7, оскільки походження є ознакою, яку демонструють, і анонімізований приклад нічого б не продемонстрував.
RECEIPT — 4 models asked · 4 answered
Agreed:    3-2-1 redundancy · JPEG is the safe everyday format ·
           migrate every ~5 years · never let a proprietary app
           be a photograph's only home
Disputed:  how many copies (3 vs 4) · what the archival master
           should be (TIFF/PNG vs original plus JPEG)
To check:  media lifespan figures · whether your export tool
           strips EXIF

— Section 1 of the merged document: how many copies, and where —

Base.  The 3-2-1 rule: three copies, on two kinds of storage,
with one off-site. The off-site copy is what survives a fire,
a flood or a theft.

⚠ Disagreement — is there a fourth copy?
ChatGPT and Gemini both extend this to 3-2-1-1, adding one copy
that is immutable or offline. Their reasoning differs: ChatGPT
frames it as geographic independence, Gemini as protection from
ransomware and from a mass deletion that syncs everywhere.
Claude and DeepSeek stayed at three and did not argue against a
fourth; they simply did not call for one.

(added by Claude)  Whatever you choose, treat cloud as one leg
of the tripod and never the whole thing: it is tied to an
account that can be locked, closed, or repriced.

— Worth checking yourself —

The lifespan figures come from Gemini alone. No other model
gave numbers, so treat them as one source rather than as a
consensus.
Чотири речі у цьому уривку — це протокол в дії, а не описуваний протокол. Розбіжність щодо четвертої копії зберігається з обома сторонами у цілості та з різними причинами обох моделей, замість того щоб розв'язатися в зручне «три або чотири, залежно від вашого апетиту до ризику», що приховала б, яке міркування читач міг би цінувати. Посилення про хмарне сховище містить назву моделі, яка його надала, тому читач, що не довіряє цій моделі, може дисконтувати цей рядок і жодний інший. Закриваюча примітка — це правило 6, що спрацьовує в живому запуску: одна модель надала єдині числа в документі, а злиття позначило їх як єдине джерело, замість того щоб дозволити їхній присутності в чотирьохмодельному документі читатися як згода.
Четвертий — це те, чого уривок не містить: він передує правилу 9, тому його факти, що несуть навантаження, не розділені на джерельні та засновані лише на згоді, і він відтворюється таким, як він вийшов, тому що приклад, змінений для задоволення правил, які він ілюструє, більше не був би доказом того, що вони працюють.
5. Узгоджена кореляція
Заувага щодо пріоритету. Арифметика в цьому розділі не нова і не претендує на внесок. Кохлі (2026) застосував ту саму поправку Кіша до групи дев'яти судів передової лінії та виміряв близько двох ефективних голосів за три місяці до першого розміщення цієї праці, а Кім та ін. (2025) встановили кореляцію помилок, яка її обумовлює, на більш ніж 350 моделях. Розділ зберігається з трьох причин: три правила протоколу випливають з нього, читач, що не бачив арифметики, прочитає ці правила як скрупульозність, а не як необхідність, і процедура оцінювання в розділі 5.5 — це те, що потрібно протоколу в ситуації, яку ніхто не вимірював. Там, де та література вимірює кореляцію, цей протокол намагається її знизити.
Якщо десять моделей узгоджуються, твердження, мабуть, все ж правдиве. Це найсильніший інтуїтивний аргумент проти розділу 4, але він слабший, ніж здається; з'ясування того, наскільки слабший, також перетворює правила 6 та 9 з доброї практики на арифметику.
5.1 Постановка
Нехай N моделей відповідають на одне бінарне твердження, і нехай e_i ∈ {0,1} вказує на помилку моделі i. За незалежності, з індивідуальною точністю p > 1/2, узгодженість N моделей є доказом, що зростає експоненціально з N. Це зміст теореми Кондорсе (Кондорсе, 1785).
Моделі, навчені на перекриваючихся корпусах, успадковують спільні фрейми, посилаються на одні й ті ж вторинні джерела й розділяють сліпі плями свого періоду, тому їхні помилки корельовані. Суд перебуває в такому самому становищі з десятьма свідками, які всі дивилися той самий запис відеоспостереження: десять показань, одне спостереження, і кількість свідків нічого не говорить про те, наскільки багато було незалежно побачено. Цьому розриву можна дати числове значення, і решта цього розділу це робить. Визначимо внутрішньокласову кореляцію помилок як
5.2 Ефективна кількість свідків
Рада корельованих моделей має структуру кластерної вибірки. N спостережень у межах одного кластера з внутрішньокласовою кореляцією ρ мають не N одиниць інформації, а стандартною поправкою є ефект дизайну (Кіш, 1965):
що дає ефективний розмір вибірки
Отже, рада N моделей, помилки яких корельовані на рівні ρ, коштує стільки ж, скільки незалежних свідків. У таблиці 2 наведені вибрані значення, а в таблиці 8 додатка B подано повний діапазон.
Таблиця 2. Ефективна кількість незалежних свідків, , для вибраних N та ρ
| ρ (вниз) / N (впоперек) | 2 | 3 | 5 | 10 | 20 | границя N→∞ |
|---|---|---|---|---|---|---|
| 0 (незалежні) | 2.00 | 3.00 | 5.00 | 10.00 | 20.00 | ∞ |
| 0.1 | 1.82 | 2.50 | 3.57 | 5.26 | 6.90 | 10.0 |
| 0.2 | 1.67 | 2.14 | 2.78 | 3.57 | 4.17 | 5.0 |
| 0.3 | 1.54 | 1.88 | 2.27 | 2.70 | 2.99 | 3.33 |
| 0.5 | 1.33 | 1.50 | 1.67 | 1.82 | 1.90 | 2.0 |
| 0.7 | 1.18 | 1.25 | 1.32 | 1.37 | 1.40 | 1.43 |
5.3 Стеля
Крайня права колонка — це основний результат цього розділу. Як N → ∞,
Рада має стелю, і вона не залежить від того, скільки моделей було залучено. На панелі (a) рисунка 1 насичення показане безпосередньо. За ρ = 0,5 рада з тисячі моделей коштує двох незалежних свідків, а за ρ = 0,7 вона коштує менше за один з половиною. Додавання одинадцятої моделі до десяти за ρ = 0,3 додає близько 0,05 свідка. Перехід від ρ = 0,3 до ρ = 0,15 з тими ж п'ятьма моделями додає близько 0,85.
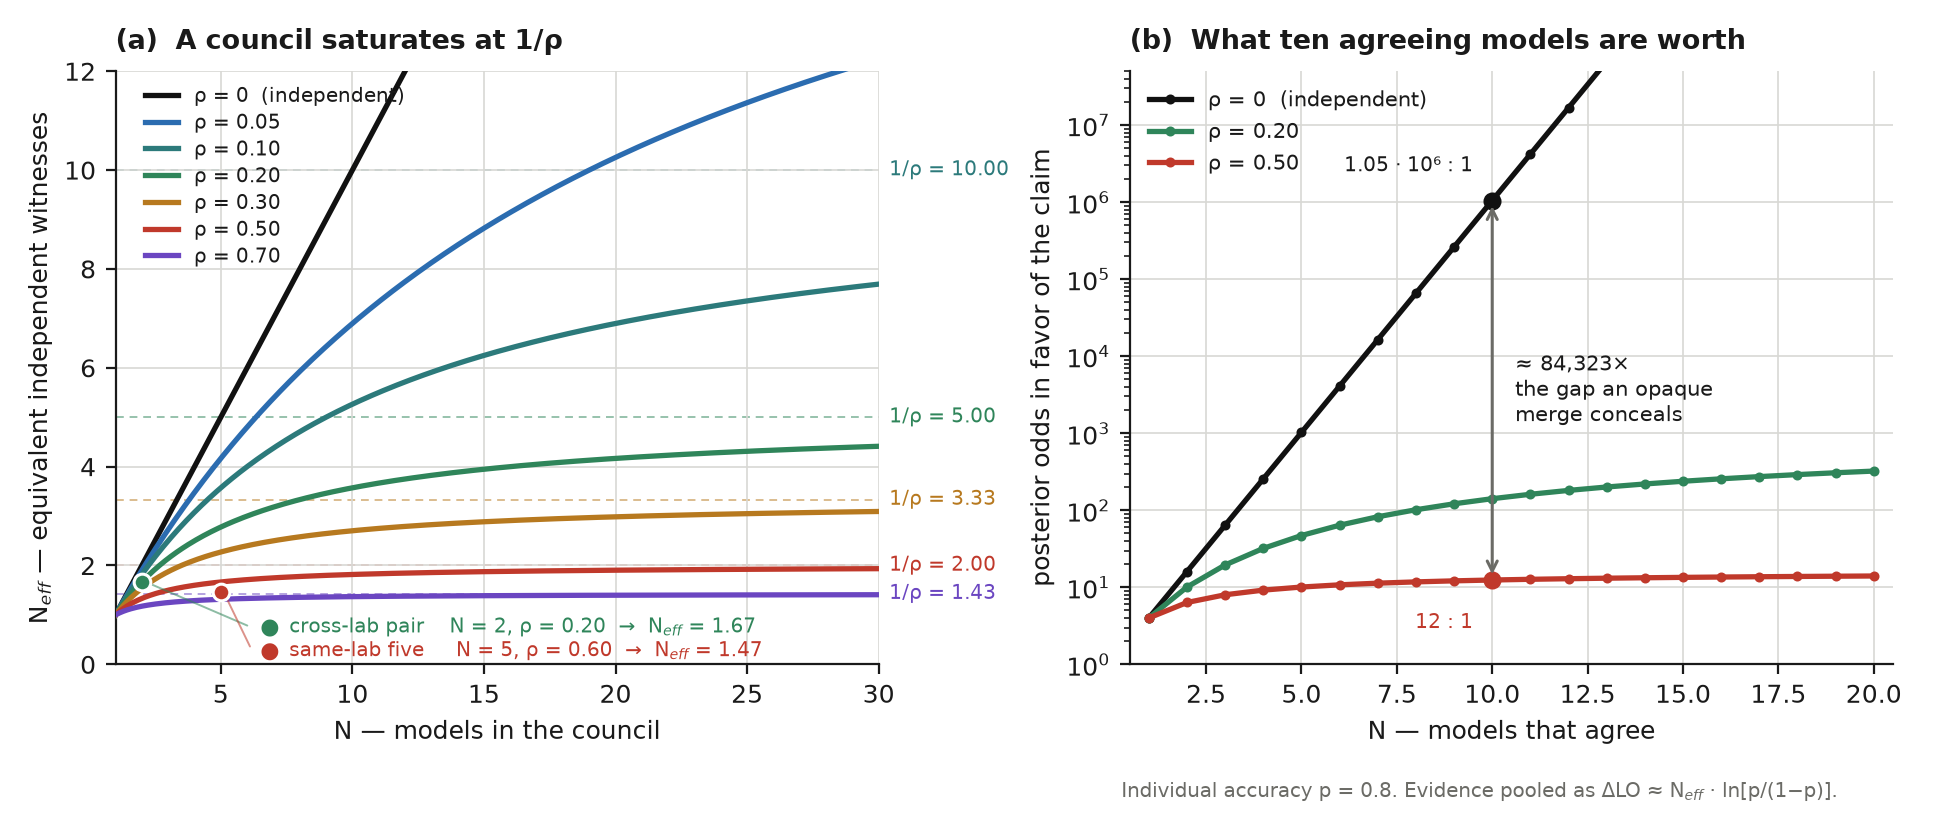
Рисунок 1 — Рада насичується при 1/ρ. (a) Neff проти розміру ради N для кількох значень внутрикласової кореляції помилок ρ. Кожна крива насичується на своїй верхній межі 1/ρ, зображена як пунктирна асимптота; пара з різних лабораторій при ρ = 0.20 переважає квінтет з однієї лабораторії при ρ = 0.60. (b) Той же результат як апостеріорні шанси (ілюстративна проксі під наближенням, сформульованим у розділі 5.4), з індивідуальною точністю p = 0.8 і об'єднаними свідченнями як ΔLO ≈ Neff · ln[p/(1−p)]. Десять незалежних узгоджених моделей дають шанси близько мільйона до одиниці; десять моделей, корельованих при ρ = 0.5, дають дванадцять до одиниці.
Практичний наслідок суперечить інтуїції, що слід просто запитати більше моделей. Коли рада більша за 1/ρ, зменшення ρ вдвічі перевищує збільшення N удвічі. Цей результат в однаковій мірі належить Колі (2026) і іншим, і його панель — це ця арифметика, спостережена в полі: дев'ять суддів, еквівалентних близько двом ефективним голосам, відповідає ρ ≈ 0.44. Зменшення ρ вдвічі перевищує збільшення N удвічі, і два порівняння нижче стосуються розділу 6.
Дві моделі з різних лабораторій при ρ ≈ 0.2 дають ≈ 1.67, тоді як п'ять з однієї лабораторії чи родоводу при ρ ≈ 0.6 дають 5/(1 + 4·0.6) ≈ 1.47, тому пара з різних лабораторій має більшу вагу, ніж п'ять.
Охоп також показує різкі убутки граничного прибутку там, де різноманітність цього не робить: рух вздовж рядка таблиці 2 насичується швидко, тоді як рух вверх по стовпцю не має обмежень.
Це аналітична основа для складання ради рівномірно по різних родоводах замість максимізації кількості. П'ять моделей, які узгоджуються, тому що читають один і той же корпус, є слабкішим доказом, ніж три, які справді розходяться.
5.4 У логарифмічних шансах
Якщо незалежний свідок з точністю p дає логарифмічний коефіцієнт
то згода серед N корельованих моделей дає приблизно
замість N · L. Це звичайна обробка корельованих спостережень у мета-аналізі, використана тут як наближення: вона розглядає скоригований за ефектом дизайну рахунок так, ніби це була кількість незалежних свідків, яку сам ефект дизайну не встановлює. На панелі (b) рисунка 1 це зображено. При p = 0.8, так що L ≈ 1.386 nat:
- десять незалежних свідків дають ΔLO ≈ 13.86 nat і апостеріорні шанси близько 1.05·10⁶ : 1;
- десять моделей при ρ = 0.5, для яких ≈ 1.82, дають ΔLO ≈ 2.52 nat і апостеріорні шанси близько 12 : 1.
Коефіцієнт приблизно 8.4·10⁴. Цей фактор — те, що непрозоре об'єднання вручає читачу як незаслужена впевненість, і це пояснює, чому існує роспис та чому факти, що несуть навантаження, позначені. Документ повинен сказати, чи угода перед читачем коштує 10⁶ : 1 або 12 : 1, тому що на сторінці вони ідентичні.
5.5 Припущення та оцінка
Модель проста і її припущення відповідно сильні. Вона спирається на таке.
ρ розглядається як рівномірна по всіх парах. Практично вона має блокову структуру, оскільки моделі з однієї лабораторії корельюють більш сильно один з одним, ніж з моделями з інших місць. Попарне середнє було б краще, а блокова структура ще краща. При блоковій структурі рівномірна формула дає оптимістичний і справжня верхня межа розташована нижче, ніж показують таблиці.
ρ також розглядається як константа по всіх питаннях, хоча вона явно залежить від домену. На вузькій темі з одним доступним джерелом вона наближається до одиниці. На питання з багатою багатомовною літературою вона набагато нижча.
Твердження розглядаються як бінарні, тоді як реальні відповіді — це проза, і зведення прози до порівнянних бінарних тверджень є шумною операцією сама по собі. Точність p розглядається як рівномірна по всіх моделях, чого вона не є.
ρ, однак, вимірна. Дано Q позначених бінарних тверджень з відомою істиною та результуючої матриці помилок e_iq для i = 1…N і q = 1…Q, внутрикласова кореляція розраховується звичайним шляхом дисперсійного аналізу як відношення середної попарної коваріації помилок до середної дисперсії помилок:
Окремо оцінювання ρ в межах і між лабораторіями дає число для вартості монокультури (Kleinberg & Raghavan, 2021; Bommasani et al., 2022). Спостереження його дрейфу протягом послідовних поколінь моделей робить те ж саме для вартості навчання на згенерованих даних (Shumailov et al., 2024).
5.6 Що це змінює в протоколі
Коли формула прийнята, правила 5 і 6 у розділі 4 та звітування про склад, яке випливає з правила 6, перестають бути хорошою практикою і стають необхідними.
Позначення спільного джерела, правило 6, є локальним вимірюванням ρ на рівні однієї утвердження. П'ять цитувань однієї статті означають ρ ≈ 1 для цієї утвердження, тому ≈ 1.
Звітування про спорідненість узгоджених моделей є тим самим вимірюванням на рівні складу.
Збереження незгоди, правило 5, є єдиним доказом того, що ρ менше одиниці. Розбіжність демонструє, що кореляція не повна, і вона інформативна, незалежно від того, яка сторона виявиться правою. Незгода є вимірювальним приладом, а не перешкодою, яку потрібно усунути. Рада, яка завжди згідна, не розповідає читачу нічого про світ, лише те, що ρ ≈ 1 і що рада була зайвою.
6. Три рівні, один протокол
Протокол працює на трьох рівнях, які являють собою три точки на кривій доступу, а не три версії чи воронку. Один користувач може добре користуватися всіма трьома протягом тижня для різних питань.
6.1 Рівень 0, вільний шлях
Користувач відкриває сайти, задає питання, копіює кожну відповідь і вставляє їх під запит про злиття в будь-яку модель чату. Без витрат, без встановлення, будь-який пристрій з браузером, включаючи телефон, і рада такого розміру, як набір облікових записів, у які користувач увійшов. Затримка становить десять-п'ятнадцять хвилин, більшість часу чекання, і більше з режимами глибокого дослідження.
Цей рівень — еталонна реалізація у строгому сенсі. Це єдиний, де користувач має всі необроблені відповіді, що робить його єдиним, де вірність злиття можна судити безпосередньо.
6.2 Рівень 1, мобільний рівень
Одна іконка на головному екрані та один запис у бібліотеці ярликів. Натисніть, введіть питання, виберіть режим з меню, і приблизно через хвилину готова відповідь буде на екрані й у буфері обміну. Голосовий запуск працює.
Механізм — це ні браузер, ні API. Він ланцюжить власні наміри операційної системи постачальників проти програм та підписок, вже встановлених на пристрої. Вартість виражена в повідомленнях підписки, а не в токенах, що робить дизайн режиму рішенням щодо розподілу ресурсів, а не питанням смаку. Альтернативна мобільна платформа має еквівалент через автоматизацію на основі намірів.
Таблиця 3 описує три режими. Вони являють собою рівноправні паралельні функції, а не етапи конвеєру: один режим запускається для кожного виклику.
Таблиця 3. Три режими мобільного рівня
| Режим | Ланцюг | Повідомлення | Використання |
|---|---|---|---|
| Опитування | Обидві моделі відповідають незалежно; відповіді показані поруч | 1 + 1 | Безпосередній перегляд необробленої розбіжності |
| Критика | Модель A відповідає; модель B перевіряє як другий експерт і видає покращену остаточну відповідь | 1 + 1 | Повсякденна настанова: перевірена відповідь за два повідомлення |
| Синтез | Обидва відповідають вслипу; подальший виклик арбітрує та об'єднує, позначаючи розбіжності | 1 + 2 | Важливі питання |
Режим критики був коротко названий голова. Три режими — рівноправні паралельні функції, а критика — це однорідна рецензія: один експерт відповідає, другий перевіряє. Роль голови вже існує всередині Синтезу як арбітр, а називання однорідної рецензії ім'ям агрегації неправильно описало б те, що робить режим.
Телефон — це не місце, де ширина дешева, і це те, що фіксує N = 2 тут. Кожен виклик витрачає повідомлення з того ж обмеження, що й звичайне використання, програми послідовно переходять на передній план, і користувач стоїть там і чекає. Розділ 5.3 показує цінність пари: дві моделі походять з різних лабораторій, вибір, що мінімізує ρ, доступний при N = 2, і при цих ілюстративних кореляціях міжлабораторна пара при ρ ≈ 0.2 перевищує пару однієї лінії при ρ ≈ 0.6, тому більшість того, для чого призначена рада, збереглася при одному натисненні й одній хвилині.
6.3 Рівень 2, шлях агента
Модель, яка може керувати браузером, відкриває названі сайти в сеансі браузера, у який користувач увійшов, подає питання, чекає, зберігає кожну відповідь у файл і будує документ. Рада розширюється до десяти чи більше, доступні режими глибокого дослідження, і датована папка з кожним оригіналом залишається після запуску. Вартість — невелика місячна підписка для агента плюс будь-які платні рівні, які вже має користувач. Затримка становить п'ять-тридцять хвилин.
Цей рівень дає користувачу щось, що пережить варіант використання, а саме модель, яка діє на його комп'ютері, замість того щоб описувати йому дії. Різниця між моделлю, яка відповідає, і моделлю, яка діє, більша, ніж різниця між однією моделлю й десятьма.
6.4 Границя затримки–ширини
Таблиця 4. Границя затримки–ширини у трьох рівнях. Ефективна кількість свідків припускає ρ = 0.2
| Рівень 0, вільно | Рівень 1, мобільно | Рівень 2, агент | |
|---|---|---|---|
| Хто клацає | користувач | операційна система | браузерний агент |
| Розмір ради N | необмежено | 2 | до ~10 |
| при ρ = 0.2 | до ~4–5 | 1.67 | ~3.6 |
| Час до відповіді | 10–15 хв | ~1 хв | 5–30 хв |
| Граничні витрати | нуль | повідомлення підписки | підписка агента |
| Встановлення | немає | один підписаний ярлик | програма агента |
| Режими глибокого дослідження | так, вручну | ні | так |
| Видимі необроблені відповіді | так | Тільки режим опитування | так, збережено у файли |
| Пристрій | будь-який | телефон | комп'ютер |
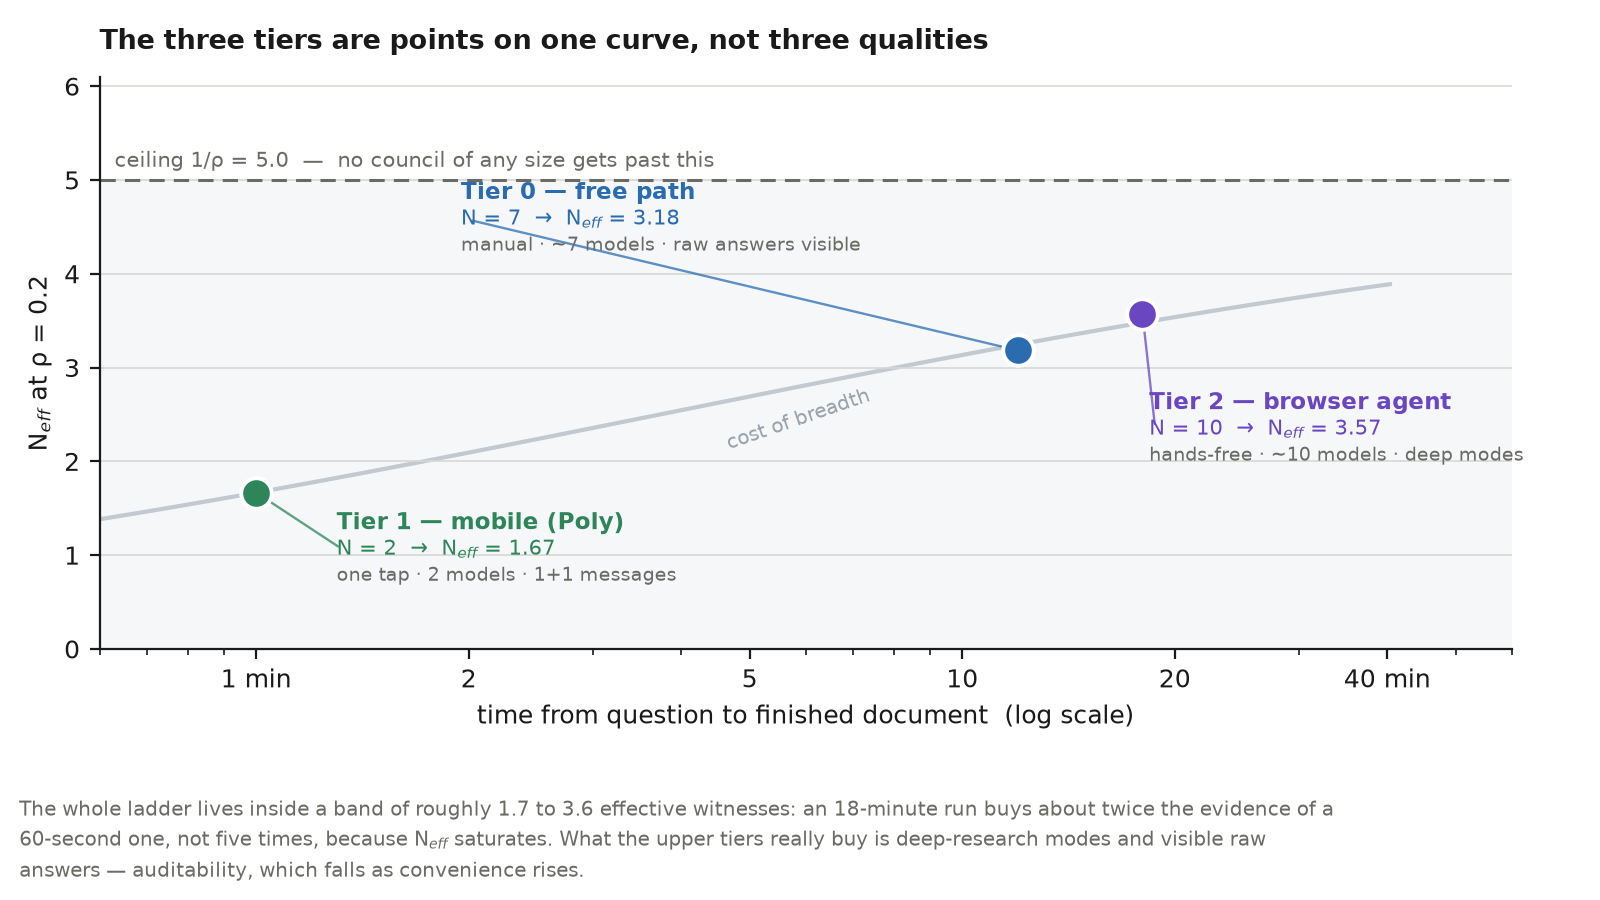
Рисунок 3 — Границя затримки–ширини. Три рівні, побудовані в залежності від часу до готового документа, з Neff обчисленим при ρ = 0.2. Оскільки Neff насичується при 1/ρ, два автоматизовані рівні знаходяться в смузі приблизно 1.7–3.6 ефективних свідків: вісімнадцятихвилинний запуск дає приблизно вдвічі більше доказів, ніж шістдесятисекундний, а не в п'ять разів. Що додатково купують верхні рівні, так це режими глибокого дослідження та видимі необроблені відповіді.
Два спостереження випливають із розділу 5, а не з інженерії.
Рівні впорядковані за вартістю широти, а не якістю. Рівень 1 розташований у точці кривої, де відповідь надходить протягом уваги когось, хто стоїть у магазині. Розрив між рівнями в доказовому сенсі набагато менший, ніж розрив у кількості моделей, тому що насичується при 1/ρ, і це те, що робить драбину когерентною, а не набором компромісів.
Аудитність знижується вздовж драбини у напрямку, протилежному зручності. На рівні 0 користувач має всі сирі відповіді. На рівні 2 агент записує їх у файли, тому вони існують, але рідко відкриваються. На рівні 1 лише режим Poll взагалі їх розкриває, оскільки Critique і Synthesis повертають готовий текст. Мобільний рівень слабший в цьому аспекті, і він відтворює проблему, з якої починається стаття: чим зручніший рівень, тим більше користувач довіряє, замість того щоб перевіряти. Збереження маркерів розбіжності в виході Synthesis – це не просто презентаційна елегантність. Це залишкова аудитність рівня.
6.5 Сліпа паралельна та поінформована послідовна елісітація
Мобільний рівень вніс у відкритість вісь, яку інші рівні залишали неявною, і це найбільш суттєве питання дизайну в системі. Чи бачить друга модель відповідь першої моделі? На рисунку 4 описані обидва розташування з їхніми перевагами та витратами.
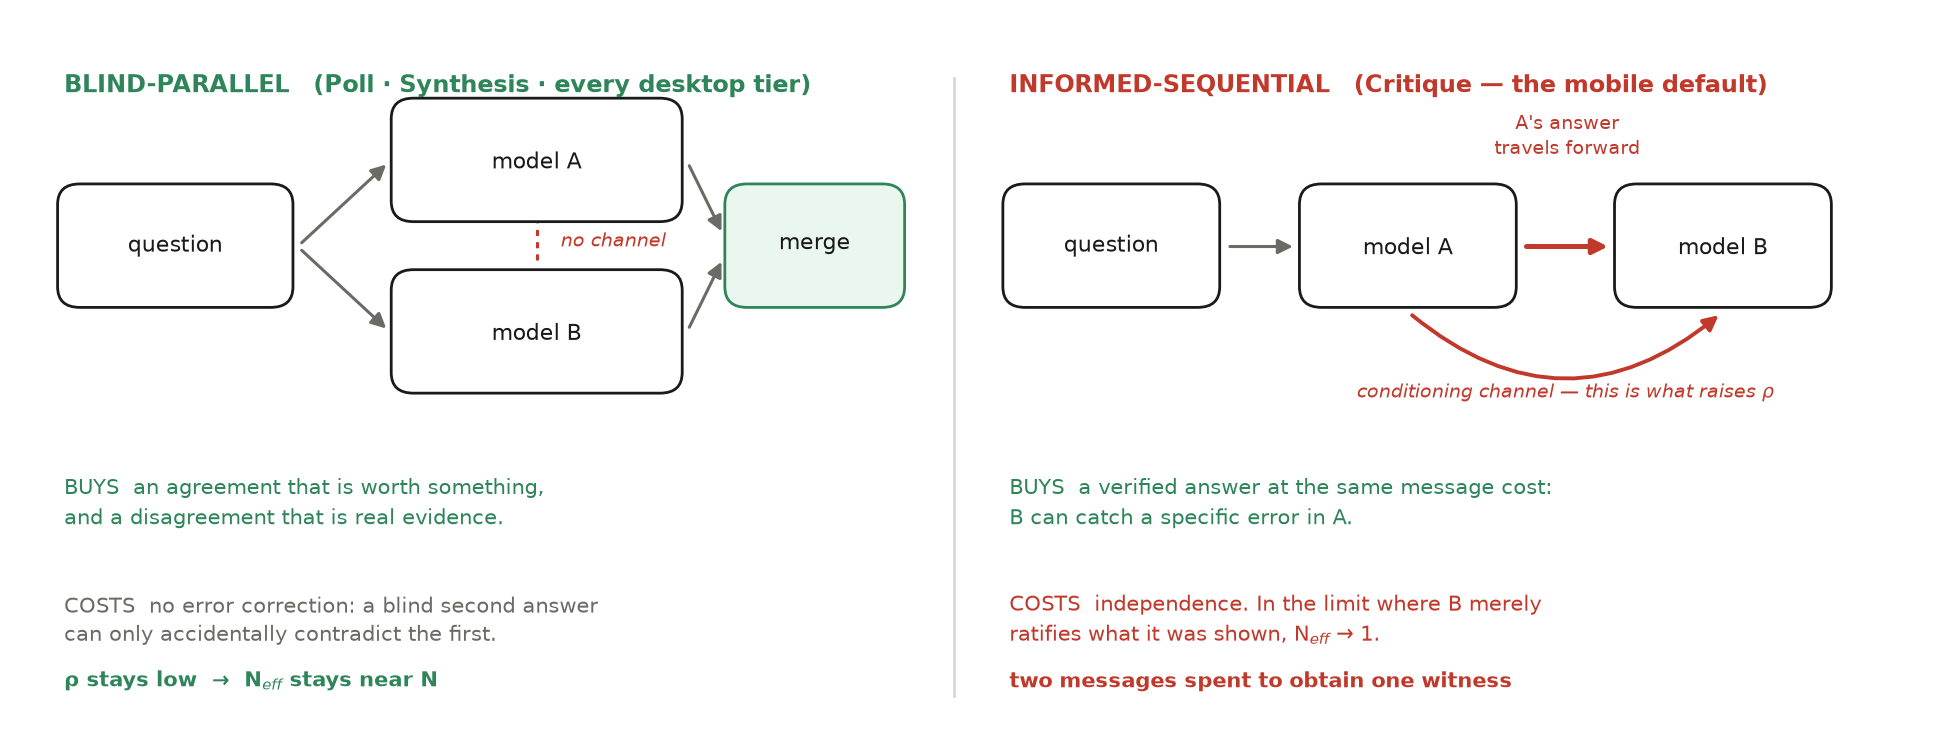
Рисунок 4 — Сліпа паралельна та поінформована послідовна елісітація. Порівняння двох режимів. При сліпій паралельній елісітації між моделями немає каналу, тому згода має доказову вагу, а розбіжність є справжнім доказом, але корекція помилок не відбувається. При поінформованій послідовній елісітації перша відповідь входить у промпт другої моделі: друга може виправити конкретну помилку, але канал кондиціонування підвищує ρ, і в межі, де вона підтверджує те, що їй було показано, Neff наближається до одиниці.
Poll і Synthesis – це сліпа паралельна. Обидві моделі відповідають на сиру запитання, і жодна не бачила іншу. Незалежність тут архітектурна, а не інструктована: кожен виклик app-intent відкриває новий сеанс без пам'яті, і кожен промпт є самодостатнім, містячи запитання та будь-які попередні відповіді всередині себе. Не існує каналу, через який одна модель могла б впливати на іншу.
Critique – це поінформована послідовна. Друга модель отримує запитання разом з відповіддю першої моделі і їй наказується перевірити його на фактичні помилки, додати те, що вона пропустила, і видати одну покращену остаточну відповідь.
Поінформоване розташування на перший погляд виглядає так, ніби воно просто домінує над сліпим: друга модель робить все, що робить сліпа друга модель, і також перевіряє першу відповідь за тією ж ціною. Цей вигляд вводить в оману, тому що два розташування купують різні товари, а поінформоване платить незалежністю.
Поінформована послідовна елісітація купує корекцію помилок. Друга модель, яка може бачити відповідь першої, може виловити конкретну помилку в ній, тоді як сліпа друга відповідь може лише випадково її заперечити. Це механізм, що стоїть за результатами багатоагентних дебатів (Du et al., 2023), і це те, що робить Critique повсякденним за замовчуванням: за тією ж вартістю двох повідомлень, що й Poll, вона повертає перевірену відповідь замість двох неперевірених.
Вона платить за це незалежністю, тобто ρ. Кондиціонування другої відповіді на першу – це соціальний вплив, який Lorenz et al. (2011) виявили звужує поширення натовпу без руху до істини. Якорований критик погоджується з відповіддю, яку йому було показано, частіше, ніж неякорований колега, тому результуюча згода коштує менше, ніж виглядає. Межа легко формулюється і неприємна: в межі, де критик підтверджує те, що йому було показано, → 1, і запуск витратив два повідомлення, щоб отримати одного свідка.
Це єдине місце, де розділ 5 стає порадою, яку користувач може застосувати. Поінформована послідовна елісітація – це правильний вибір для перевірки відповіді, а сліпа паралельна елісітація необхідна, якщо запитання полягає в тому, чи існує розбіжність взагалі. Розбіжність, яка виявляється після того, як друга модель прочитала першу, є доказом, тоді як розбіжність, яка не виявляється, не є доказом згоди, тому що канал, який би її створив, був закритий.
Synthesis тому є окремим режимом, а не більш ретельною версією Critique. Synthesis не є більш ретельною. Вона сліпа, що є іншою властивістю, і вона єдиний мобільний режим, чия згода має доказову вагу. Її додаткове повідомлення купує арбітра, але її цінність випливає з того, що два арбітровані відповіді ніколи не зустрічалися.
Рівні 0 і 2 є сліпою паралельною за конструкцією, оскільки кожна модель отримує сиру запитання у своєму власному сеансі, а злиття anchor-and-enrich відбувається потім. Anchor-and-enrich найкраще розуміється як поінформований етап, розташований після повністю сліпого. Впорядкування отримує корекцію помилок без сплати вартості незалежності, а платить затримкою натомість. Мобільний рівень не може дозволити собі це впорядкування в своєму режимі за замовчуванням, тому компроміс стає видимим там і більше ніде.
6.6 Чому не API
Вибір транспорту вирішує, хто може використовувати систему, тому це не деталь.
API надає відтворюваність, означаючи відому версію моделі, температуру та seed; програмну надійність; відсутність питання про умови обслуговування; і низьку вартість у масштабі. Браузер і намір програми забезпечують відсутність установки, відсутність ключів, відсутність додаткових платіжних зв'язків, сумісність з мобільними телефонами, роботу на безплатних рівнях, доступ до режимів глибоких досліджень, які часто не мають еквівалента API, і використання підписок, які користувач уже має.
Протокол займає друге місце. Будь-хто, хто має ключи API та комфортно почувається в терміналі, краще обслуговується засобом на основі API, таким як llm-council Karpathy (Karpathy, 2025). Населення, про яке йдеться, — це ті, для яких друга підписка є матеріальним рішенням, або які не можуть встановити програмне забезпечення на машину, яку вони використовують, або чий інтернет-доступ — це телефон. Для цих користувачів це, ймовірно, перша досяжна реалізація цієї ідеї, оскільки вона не потребує ключів, встановлення та другого рахунку, а досяжність — це вся причина, чому система є текстовим файлом, а не продуктом.
Вартість — це неповторюваність, і вона висока. Версія моделі за веб-інтерфейсом або споживчою програмою невідома і змінюється без попередження. Температура не контролюється, системний запит сервісу приховано, а персоналізація акаунту впливає на відповідь. Запуск не можна повторити точно в наступному місяці або на іншій машині. Це прийнято для особистого засобу прийняття рішень, а не для наукового вимірювання. Section 9 вимагає відповідно архівування необроблених відповідей та формулювання висновків як тверджень про протокол замість тверджень про моделі.
6.7 Безпека
Безкоштовний шлях не додає поверхні атак, специфічної для автоматизації, оскільки користувач безпосередньо працює з сайтами, хоча звичайні ризики браузера та самих акаунтів залишаються. Далі йдеться про шлях агента.
Головний ризик — це непряма ін'єкція промптів (OWASP, 2025). Кожна зібрана відповідь — це недовірена інформація, оскільки вихід моделі може містити інструкції, адресовані оркестратору. Фільтрування рядків не є захистом: воно пошкоджує легітимний контент і нічого не гарантує.
Конструктивна відповідь — це обмеження на повноваження. Зібраний текст розглядається як цитована інформація і ніколи як команди. Якщо висхідна модель видає блок виклику інструменту або відтворює ін'єктовану інструкцію, оркестратор об'єднує її як цитату і нічого не виконує.
Згідно з рамками правила двох (Meta, 2025), агент стає небезпечним, коли має всі три: обробку недовірених даних, доступ до чутливих даних або систем та владу змінювати зовнішній стан або спілкуватися зовні. Описаний тут агент має перші два та зберігає третій настільки вузьким, наскільки це можливо для можливості. Його єдина дія, яка залишає машину користувача, — це відправлення питання користувача на сайти, названі користувачем; те, що він записує, — це призначені вихідні файли на цій машині. Він не купує, не публікує, не видаляє, не змінює параметри, не вводить облікові дані та не розв'язує тести виклику-відповіді. Більш того, нічого з того, що він читає, не може стати новою зовнішньою дією: жодна зібрана відповідь не може спровокувати новий крок або новий пункт призначення. Недовірена інформація та зовнішня дія розділені: єдине зовнішнє спілкування — це власне питання користувача, відправлене до прочитання будь-якої зібраної відповіді. Отруєна висхідна відповідь тому не має куди поширюватися, і реалістичним найгіршим випадком всередині документа є неправильна строка, яку допомагають виловити етикетки походження; ризики рівня сеансу розглядаються операційними правилами нижче.
Це слідує з літератури про ізоляцію можливостей (Debenedetti et al., 2025) і пояснює, чому експлуатації агентів без кліків, такі як EchoLeak (CVE-2025-32711; MITRE, 2025), успішні в інших місцях: там усі три можливості пов'язані одна з іншою.
Операційні правила — це видиме вікно браузера замість безголовного, сеанс, до якого користувач увійшов у окремому профілі браузера, без збереження або введення облікових даних, і без розв'язування тестів виклику-відповіді, підробки відбитків, ротації проксі-серверів або об'єднання акаунтів. Недавні версії браузера ігнорують прапори дистанційного налагодження в профілі за замовчуванням як контрзахід проти крадіжки файлів cookie на основі протоколу, тому автоматизація повинна використовувати окремий каталог профілю. Окремий каталог створює тертя, але це також безпечніший розподіл. Інструмент, який претендує на тиху підключення до повсякденного сеансу браузера користувача, заслуговує на підозру.
Це зводиться до обмеження на рівні промпту плюс навмисно мала поверхня інструменту, а не технічна пісочниця. Це скорочує радіус вибуху. Це не доводить, що радіус дорівнює нулю.
Поверхня загроз мобільного рівня відрізняється і менша. Виклики проходять через інтенти операційної системи, опубліковані постачальником, замість керованого браузера, пристрій повинен бути розблокований із додатками, які вступають на передній план послідовно, і нічого не працює у фоновому режимі. Це кнопка, яку натискає користувач, а не запланована автоматизація. Проблема ін'єкції промптів все ще застосовується в Критиці та Синтезі, де вихід однієї моделі потрапляє всередину промпту іншої моделі, і це розглядається так само: зібрана відповідь — це цитований матеріал, і приймаюча модель не має доступних їй дій.
7. Емпіричний розділ
7.1 Тест при холодному старті
Перший крок користувача — передати систему моделі. Якщо та модель відмовиться або повернеться щось, що лише нагадує результат, користувач виходить і ніколи про це не звітує. Цей момент — це те, що вимірює тест при холодному старті, і його не можна автоматизувати, бо потрібна свіжа сесія, яка ніколи не зустрічала цю проблему.
Запит виходить без підказок, без фреймування та без подальшого наступу:
Запустіть метод з цього репозиторію для питання: Які три найбільші ризики пиття надто малої кількості води? Робіть все, що каже вам робити метод.
Є три середовища. В А агент сидить у клоні з навмисно відключеним керуванням браузером. В — звичайна сесія чату лише з документацією першої сторінки, вставленою, а в С агент має робоче керування браузером.
Оцінюється лише перша відповідь за шістьма бінарними критеріями. Обмеження таким чином — це методологічне ядро тесту, бо те, що каже модель після виправлення, не являє собою те, що пережив би незнайомець.
- Чи перевірила вона доступні в цій сесії інструменти замість міркування про те, який це тип моделі?
- Чи уникла вона голої відмови без наступного кроку в тому ж повідомленні?
- Де щось було відсутнім, чи назвала вона конкретний відсутній компонент замість категорії обмеження?
- Чи запропонувала вона ручний шлях у тій же відповіді, не питаючи двічі?
- Чи може користувач негайно діяти на основі відповіді?
- Де вона насправді не збирала відповіді від окремих моделей, чи сказала вона це перед показом чогось?
Критерій 6 був написаний після базового запуску і переважає інші п'ять. Відповідь, яка читається як рада, але походить від однієї моделі, не проходить тест повністю, як би вона не була виконана, і вона буде добре виконана.
7.2 Базовий запуск
П'ять моделей отримали документацію та звичайне питання без підказок. Жодна не мала керування браузером, тому запуск вимірював одне: як модель повідомляє про неспроможність запустити метод. Таблиця 5 повідомляє про результати. Моделі там ідентифікуються за лабораторією, а не за назвою продукту, оскільки це режим збою, спільний для кількох, а не рейтинг.
Таблиця 5. Тест при холодному старті, базовий запуск. П'ять моделей, без керування браузером, оцінена перша відповідь
| Модель | Розробник | Результат |
|---|---|---|
| Model G | Лабораторія 1 | Пройшла. Перевірила власні інструменти, назвала відсутній компонент, сказала, що не надсилала питання нікуди, попросила два необхідні вибори та попередила заздалегідь, що погляд однієї моделі не буде результатом методу. |
| Model S | Лабораторія 2 | Пройшла з оголошеною підміною. Використала веб-джерела замість відповідей моделей і сказала так цими словами, включаючи те, що це була менша і інакше складена рада, ніж передбачає метод. |
| Model H | Лабораторія 2 | Пройшла. Нічого не замінила. Передала запит і попросила відповіді назад. |
| Model C | Лабораторія 3 | Не пройшла. Веб-дослідження написане власним словником методу, без жодних застережень. |
| Model K | Лабораторія 4 | Не пройшла. Повний об'єднаний документ у правильній формі, збережений під ім'ям файлу виведення методу, отриманий з веб-сторінок замість моделей, без жодних застережень. |
Два з п'яти створили документ, який користувач подав би як раду десяти. Це F5, спостережено.
7.3 Втручання та повторний запуск
Втручання було одне речення визначення ролі, яке повідомляє моделі, що вона є оператором цього запуску та повинна прочитати файл інструкцій агента. Він з'явився на першому екрані документації та в окремому файлі, адресованому моделям. Таблиця 6 повідомляє про повторний запуск в середовищі B.
Таблиця 6. Тест при холодному старті в середовищі B після втручання присвоєння ролі. Критерії пронумеровані як у розділі 7.1; (web) позначає запуски, здійснені через веб-інтерфейси постачальників, а C′ — модель лабораторії 3 в цьому контексті
| Модель | 1 | 2 | 3 | 4 | 5 | 6 | Вердикт |
|---|---|---|---|---|---|---|---|
| Model C′ (web), Лабораторія 3 | так | так | так | так | так | так | ПРОЙШЛА |
| Model P (web), Лабораторія 5 | так | так | так | так | так | так | ПРОЙШЛА |
| Model K (web), Лабораторія 4 | так | так | так | так | так | так | ПРОЙШЛА |
Останній рядок — це повчальний. Модель, яка в базовому варіанті створила немічену веб-резюме під ім'ям файлу виведення методу, цього разу реконструювала запит об'єднання з документації та передала його користувачу. Вона потім надрукувала власне веб-дослідження під явним заголовком, який позначає його як фонове дослідження, а не результат ради, додавши, що воно було там лише для контексту.
Аудит потім встановив, що пройдення було виміряно проти довшої чернетки абзацу, який моделі цитували, і що як тільки абзац був скорочений, попередній результат більше не доказував нічого про поточний текст. Середовище B було повторно запущено проти скороченої версії, яка пройшла всі шість критеріїв. Модель назвала відсутнє з'єднання конкретно та закрила, сказавши, що не створила результат методу, оскільки не було зібрано незалежних відповідей.
Цей епізод сам по собі є відкриттям. Пройдений тест виходить, коли змінюється протестований текст, а перенесення старого результату на нову чернетку — це комфортна та поширена форма самообману.
7.4 Інтерпретація
Спостереження встановлює, що F5 є реальним, що воно зустрічається в моделях різних лабораторій, і що воно чутливе до присвоєння ролі, простого текстового втручання. Це узгоджується із загальним висновком, що моделі приймають будь-яку рамку, яку надає їхній контекст (Sharma et al., 2023), і тут властивість працює на користь правильності.
Це не встановлює частоту. При n = 5 та n = 3 без повторень і з оцінюванням автором це демонструє, що режим відмови існує, і нічого не говорить про його частотність. Усім базовим запускам не вистачало контролю браузера, тому що вимірювалося чесне повідомлення про неспроможність, а не вмілість виконання методу. Успіх не означає схвалення будь-якої моделі як оркестратора; архітектура не підтримує такий висновок. Розділ 10 окреслює граничні умови.
Контрольні списки цього типу мають структурну небезпеку. Текст редагується, доки він не пройде, а потім контрольний список перестає щось вимірювати. Два охоронні механізми запобігають цьому. Критерій виправдовує редагування лише там, де можна сказати, що реальний користувач інакше страждав би, і критерій додається лише після того, як натурний запуск дав відповідну відмову, ніколи тому, що це звучало правдоподібно. Обидва мають місце для шести критеріїв тут.
7.5 Натурні спостереження мобільної збірки
Побудова та сертифікація мобільного рівня на фізичному пристрої дали інший клас результатів. Це системні докази, а не гносеологічні докази, і це документує поверхню відмови, характерну для конвеєрів намірів мобільних програм, які розбиваються способами, якими конвеєр API не розбивається.
Рівень був сертифікований наскрізь за допомогою арифметичних дим-тестів, обраних тому, що цифри зберігаються при будь-якому розташуванні клавіатури. Critique повернув правильну суму разом з явною заявою про те, що відповідь першої моделі не містила помилок, а Poll повернув обидві відповіді моделей поруч у згоді. Латентність від дотику до результату без втручання становить близько п'ятдесяти до шістдесяти секунд. Таблиця 7 записує, що розбилося.
Таблиця 7. Спостережувані режими відмови конвеєру намірів мобільних програм з причинами та засобами усунення
| Симптом | Причина | Засіб |
|---|---|---|
| Намір першого постачальника повідомляє, що користувач вийшов з облікового запису, тоді як програма входить в нього | Відома помилка наміру, яка повторюється після періодів неактивності | Відкрийте програму один раз і перезапустіть. Ось чому менш надійний постачальник викликається першим: його збій нічого не коштує |
| Другий постачальник повідомляє, що модель недоступна | Контроль моделі на стороні облікового запису на безплатному рівні; намір не розкриває параметр моделі | Встановіть потрібну модель за замовчуванням усередину програми; ланцюг не може обрати модель |
| Запуск закінчується мовчки без помилки | Оверлей запущеного ярлика переривається дотиком пристрою | Не торкайтеся пристрою під час запуску; перезапустіть |
| Ланцюг зупиняється на карточці проміжної відповіді | Параметр show-on-run за замовчуванням увімкнено | Встановіть його вимкнено під час побудови |
| Довгі відповіді усічені | Обмеження виведення на рівні наміру | Попросіть компактну відповідь; якість критики залишається незміненою |
Три з них узагальнюються за межами цієї системи.
Впорядкуйте ланцюг за крихкістю. Найменш надійний постачальник йде першим, тому його збій нічого не коштує, а більш надійний отримує ролі, які не можна втратити, тобто арбітр та фіналізатор.
Припустіть відсутність пам'яті. Кожен виклик відкриває новий сеанс, тому кожен запит має бути самодостатнім і містити запитання та будь-які попередні відповіді всередину себе. Сліпа паралельна незалежність є архітектурною, а не розпорядженою, як стверджує розділ 6.5.
Найбільше не довіряйте мовчазним збоям. Два запуски, які, видавалося, завершилися через тайм-аут, насправді були припинені користувачем, який підняв пристрій. Приписування їх програмному забезпеченню призвело б до виправлення дефекту, який не існував.
8. Файл paste: шаблон інтерфейсу для керівництва із холодного старту
Це окремий результат інтерфейсу, і він виходить за межі цієї системи.
Файл paste — це простий текстовий файл, який користувач вставляє повністю в звичайну модель хмарного чату, після чого та модель керує ним через щось, з чого він не міг би почати іншим способом. Ця ситуація досить часта. Комусь передали папку, посилання чи інструмент, і він не знає, з чого почати. Все, що індустрія зазвичай використовує в такому випадку — цільова сторінка, бот адаптації, користувацький помічник або програма — вимагає від користувача відвідати нове місце, тоді як файл paste користується інтерфейсом, який він уже має відкритим.
Це не те саме, що файли, які агент читає самостійно й які стосуються програми, вже розташованої з доступом до файлів. Файл paste звертається до сеансу чату в чужій хмарі, яка не може бачити диск користувача й ніколи його не побачить.
Чотири інваріанти
Назва файлу — це перша інструкція, написана власним письмом читача. Це речення, а не звичайна назва файлу документації — один файл на мову, всі присутні, всі відсортовані разом під спільним префіксом. Користувач не вибирає зі списку. Він розпізнає свою власну систему письма й ігнорує решту, як людина пропускає незнайомі рядки на багатомовній табличці. Це нічого не коштує й усуває крок, на якому комусь доводилося б прочитати мову, яку він може не знати, щоб знайти файл, написаний мовою, яку він знає.
Файл оголошує, що модель не може робити, й забороняє видаватися інакше. У першому розділі: ви — сеанс чату в хмарі, ви не на комп'ютері користувача, ви не можете відкривати його файли й запускати будь-що, ніколи не стверджуйте, що ви це дивилися. Характерна невдача цього шаблону, F5 в іншому формулюванні, — це впевнена й правдоподібна розповідь про папку, яку модель ніколи не бачила. Для користувача це невидимо, тому що добре сформульована й правильна відповідь невідрізні для того, хто не може перевірити.
Повноту можна виявити. На початку — перелік розділів, на останньому рядку — маркер кінця файлу. Інструкції наказують моделі знайти маркер перед тим, як щось сказати; якщо його або названий розділ відсутні, зупинитися, повідомити, які частини прибули, й запросити файл знову; і ніколи не заповнювати пропуск зі власного знання. Довгий paste може бути обрізаний обмеженням безплатного рівня, обмеженням повідомлень або телефоном, і без маркера модель продовжує з того, що прибуло, й імпровізує решту.
Файл є самодостатнім. Все, що користувачеві потрібно для результату сьогодні, знаходиться всередину дослівно, не посилається й не пов'язується. Файл paste, який каже «відкрийте файл merge prompt», не вдався, тому що модель, яка його читає, не може нічого відкрити, а користувач може взагалі не мати папки. Самодостатність дозволяє файлу пересилатися через програму обміну повідомленнями без прикріпленого додатка й все одно працювати.
Два правила впорядкування
Упорядковуйте за незамінністю замість хронології. Paste обрізується знизу, тому все, що модель могла б реконструювати самостійно — кроки встановлення, фонова інформація чи інформація, яку можна знайти, — належить біля кінця, а все, що мусить бути точним, — високо.
Передавайте якомога раніше. Там, де шлях закінчується в програмі, яку встановлює користувач, припиніть наводити налаштування цієї програми й скажіть їм запитати про це, й напишіть правило в файл: якщо встановлена програма суперечить цьому файлу про себе, файл неправильний. Текстовий файл, який описує чужий інсталятор, застаріває протягом місяців, тоді як програма, запитана про себе, ніколи не застаріває.
Збереження копій верними
Копії розмножуються й розходяться. Двох дешевих механізмів достатньо. Генеруйте вміст дослівно замість його підтримання: крок збірки вставляє канонічний текст у кожний мовний файл з одного джерела істини, а постійна інтеграція не вдається, якщо зафіксований файл з ним не узгоджується. Порівнюйте переклади один з одним і відповідно до правил, тому що кожна структурна перевірка пройде файл, який мовчазно став половиною своєї довжини. Постійна інтеграція тут стверджує, що всі мовні варіанти містять однакову кількість розділів і однакову кількість кроків налаштування.
Оцінювання шаблону
Шаблон має власний десятипункткий контрольний список. Два його елементи наведені тут. Обидва були написані у відповідь на спостережувані невдачі, а не на передбачені.
Чи пропонує модель покращити, скоротити або переписати файл замість його використання? Це не вдається мовчки, тому що переписана версія втрачає те правило, яке модель вважала найменш переконливим.
При отриманні копії з видаленою останньою третиною, чи помічає модель це й зупиняється замість того, щоб продовжити з того, що прибуло? Це потребує спеціального запуску з навмисно обрізаною копією, і це єдиний елемент, який неможливо спостерігати від звичайного paste.
Контрольний список вимірює першу відповідь, яка не є запуском. Керівництво, яке відкривається ідеально й потім придумує кроки встановлення чотирма повідомленнями пізніше, проходить контрольний список й розчаровує користувача. Реальні невдачі шаблону трапляються в середині налаштування, де ця оцінка не дивиться.
9. Запропонована оцінка
Mixture-of-agents (Wang, J., та ін., 2024) та багатоагентні дебати (Du та ін., 2023) повідомляють про покращення порівняно з найсильнішою окремою моделлю в умовах API. Твердження, що об'єднана відповідь перевершує найсильнішу окрему відповідь, залишається відкритим питанням, а порівняння для цього протоколу визначено тут до отримання будь-яких результатів, щоб його не можна було потім коригувати під отримані дані.
9.1 Гіпотези
H1. Anchor-and-enrich перевершує найсильнішу окрему відповідь за точністю фактів і повнотою.
H2. Anchor-and-enrich перевершує наївне об'єднання за виживанням коректних позицій меншості та за часткою тверджень без джерел.
H0. Різниці немає, або об'єднання робить результат гіршим.
H2 має більшу вагу за H1. Якщо протокол програє наївному об'єднанню за цими двома критеріями, дизайн з розділу 4 не має обґрунтування, як би добре документ не читався.
9.2 Дизайн
П'ятдесят до сотні запитань, три варіанти: відповідь найсильнішої окремої моделі; наївне об'єднання з інструкцією лише комбінувати відповіді; та anchor-and-enrich. Запитання вибираються та фіксуються перед будь-яким запуском, і розподіл за областями (охорона здоров'я, право, технічні, вибір споживача та числові факти) опубліковується з набором.
9.3 Показники
Точність фактів як доля перевіримих тверджень, підтверджених проти первинного джерела. Повнота як охоплення заздалегідь визначеного списку суттєвих моментів. Виживання коректних позицій меншості як доля випадків, коли правильна позиція, висловлена рівно однією моделлю, потрапляє до фінального документа. Якість джерел як первинна, вторинна або відсутня. Рівень придуманих тверджень як твердження у результаті, яких не було в жодному з вхідних, що є прямою мірою F1. Читабельність. Час виконання та вартість. І, окремо та повністю, випадки, коли об'єднання погіршило результат, які становлять найбільший інтерес.
9.4 Маскування
Назви моделей приховані, а порядок відповідей перемішується перед оцінюванням. Модель-оцінювач продемонстровано чутлива до позиції, многослівності та знайомого стилю (Zheng та ін., 2023), тому неприховане оцінювання було б частково вимірюванням цих параметрів. Людське оцінювання дотримується тієї ж процедури.
9.5 Публікація та спростовність
Запитання, вихідні відповіді, фінальні документи та оцінки опубліковуються повністю, щоб оцінювання могло бути оскаржено.
Умова спростування заздалегідь визначена. Якщо варіант 3 не перевершує варіант 1 за коректністю та повнотою, і не перевершує варіант 2 за виживанням меншості та часткою необґрунтованих тверджень, то H1 і H2 залишаються недоведеними, а висновок буде сформульований на основі матеріалів системи без переробки.
9.6 Тестування моделі корельованого свідка
Незалежно від H1 і H2, ρ може бути оцінена за процедурою з розділу 5.5 на тому ж наборі запитань, що дозволяє провести тест передбачення, яке з нього випливає.
H3. Виграш від додавання k-ної моделі спадає так, як прогнозує = N/(1+(N−1)ρ), і рада, утворена з різних лабораторій, перевершує раду того ж розміру, утворену з однієї.
H3 може бути протестована на даних, зібраних для основного порівняння, і не потребує додаткового збору. Спростування було б більш інформативним результатом, оскільки це означало б, що аналогія кластер-вибірка не переходить на ради мовних моделей, і розділ 5 потребує переписування.
9.7 Два тести, які мобільний рівень робить дешевими
Кожен мобільний запуск коштує одну взаємодію та визначену кількість повідомлень підписки, що робить два подальших твердження легко досяжними.
H4, домінування кореляції. Міжлабораторна пара при N = 2 відповідає або перевершує однолабораторну п'ятірку при N = 5 за коректністю та виживанням меншості. Це найгостріший доступний тест розділу 5.3, тому що варіанти відрізняються в напрямку, який модель називає вирішальним, ρ, водночас рухаючись проти одне одного в напрямку, який вона називає вторинним, N.
H5, вісь елісиції. Сліпа паралельна елісиція виявляє суворо більше розбіжностей, ніж інформована послідовна елісиція на тому ж наборі запитань, і виявлені розбіжності передбачають помилки у відповіді однієї моделі. Якщо H5 не вдається, тобто інформований критик виявляє стільки ж розбіжностей, скільки сліпий колега, то аргумент про вартість незалежності в розділі 6.5 неправильний, і інформований режим просто замінює сліпий.
10. Обмеження
Центральне твердження не перевірено: розділ 4 — це аргумент конструювання, а розділ 9 визначає порівняння, яке б його розв'язало.
ρ припускається, а не оцінюється. Кожне значення в таблицях 2 і 8 випливає з формули розділу 5 при припущеному рівномірному ρ, що розміщує таблиці на верхній межі в рамках реалістичної блокової структури.
Розділ 7 повідомляє про n = 5 і n = 3. Він встановлює, що режим відмови існує; твердження обмежене існуванням, а не частотою. Оцінювання проводилось автором без міжекспертної оцінки; бінарні критерії зменшують ризик однієї оцінки, не усуваючи його. Середовище A не було повторно запущено після втручання, а в середовищі C немає запусків, тому повідомлені успіхи охоплюють лише середовище B.
Версії моделей, які стоять за веб-інтерфейсами та споживчими додатками, невідомі та змінюються, персоналізація облікового запису впливає на відповіді, а запуск не можна повторити точно (розділ 6.6), тому результати швидко застарівають і є свідченням про протокол, а не про названі моделі.
Синтезатор сам по собі є мовною моделлю, підпадаючи під F1 через F4, як і будь-яка інша. Протокол обмежує це структурно через походження, заборону на мовчазне видалення та окремий розділ розбіжностей, але не усуває його. Якість результату залежить від того, наскільки точно дана модель дотримується інструкції; та залежність не вимірюється.
Сліпий критерій виконується тією ж моделлю, яка потім будує документ, тому вибір якоря є точкою упередження, і нічого не заважає цій моделі систематично віддавати перевагу відповідям, стильово близьким до своїх власних, що є упередженням судді-моделі (Zheng et al., 2023) в іншій позиції. Заборона передустановленого якоря розв'язує лише явну форму проблеми.
Мобільний режим за замовчуванням — informed-sequential, тому режим, який використовується найчастіше, також є тим, чия узгодженість має найменшу доказову вагу (розділ 6.4). Це видалення якості в розрахунку на повідомлення, і межа, яку він встановлює, описана тут. Головна слабкість рівня полягає в тому, що він обмінює перевірність на затримку: Критика та Синтез повертають готовий текст, а сирі відповіді існують лише в історіях сеансів самих моделей, тому користувач, який ніколи не відкриває режим опитування, довіряє замість перевірки, що є позицією, яку протокол розроблений спростовувати.
Витрати часу встановлюють межу вільного шляху. Реалістична повна рада займає десять-п'ятнадцять хвилин очікування та п'ять-двадцять п'ять хвилин на провайдера з режимами глибокого дослідження. Для частини цільової популяції це може перевищити користь.
Розділ 11 викладає правову позицію шляху агента разом із питанням умов обслуговування, яке він залишає відкритим.
11. Етика, конфіденційність і правова база
Система призначена для особистого використання користувачем своїх облікових записів моделей, безплатних чи платних, через його власний браузер чи пристрій. Вона не скрейпить дані третіх осіб, не обходить платіжні стіни, не вирішує тести виклик-відповідь, не ухиляється від виявлення ботів, не ротує проксі, не приховує свою роботу, не перепродає облікові записи і не запускає їх у багатотенантному режимі.
Доступність є основною метою, а не побічним ефектом. Коли користувач з обмеженнями спирається на це як на допоміжну технологію, саме для цього вона й призначена: помічник, який діє від їхнього імені, у їхньому темпі, на їхніх облікових записах. Аналогія обрізу бордюру точна. Пандус, побудований для колясок, також служить батькам з колясками та кур'єрам, а система, розроблена для користувачів, які не можуть керувати дюжиною вкладок браузера, виявляється корисною для всіх.
Ці шляхи мають різний правовий статус. Безплатний варіант виглядає як звичайне використання за будь-яким тлумаченням: користувач відкриває сайти, друкує й копіює. Мобільний варіант близький до нього, оскільки постачальники публікують інтенти програм саме для такого виклику, а ярлик може об'єднати два таких виклики, використовуючи кожну програму як передбачено, одне повідомлення за раз, на передньому плані. Шлях агента потребує детальнішого розгляду. Правила щодо автоматизованого доступу спрямовані на збирання результатів у масштабі, ботів, що обтяжують сервіс, обходу обмежень частоти запитів, керування кількома обліковими записами і перепродажу отримуваних результатів. Жодне з цього не описує одного користувача, що в людському темпі ставить одне запитання у своєму авторизованому браузері й самостійно читає відповідь. Таке використання структурно не відрізняється від допоміжного програмного забезпечення, яке друкує й клацає для людей, які цього не можуть. Однак деякі умови сформульовані ширше за їх призначення, забороняючи будь-які автоматизовані засоби без згадки про масштаб. Чи поширюється це на користувача, який автоматизує одне запитання, залежить від сервісу, юрисдикції та умов, що діють на той день. Це тлумачення, а не рішення. Користувачі повинні ознайомитися з умовами будь-якого сервісу, до якого вони підключаються, і вирішити самостійно. Будь-хто, хто воліє взагалі над цим не думати, може використовувати безплатний варіант, який виконує ту ж роботу і не викликає жодних питань, специфічних для агента; звичайні умови сайтів все ще застосовуються.
Конфіденційність — це рішення щодо складу. Набір моделей визначає, які компанії отримають те, що користувач набирає, що не має значення для звичайного запитання, але може мати значення для запитання про здоров'я, роботодавця або клієнтів. Якщо конкретне запитання було б незручним надсилати конкретній компанії, виключте цю компанію для цього запитання; видалити одну — нічого не коштує.
Власне етичне обмеження протоколу є забороною. Ніщо, що не було запуском методу, не може бути представлено як такий. Веб-резюме, відповідь однієї моделі або власні міркування оператора можуть бути корисні, але вони не є результатом ради, і користувачу має бути сказано, який з них він має. На практиці це означає без квитанцій, без розділів згоди й незгоди та без файлів результатів для всього, що не було справжнім багатомодельним запуском.
12. Висновок
Впевнено помилкова відповідь не відрізняється від впевнено правильної, тоді як спір між ними видний кожному. Цінність ради полягає, таким чином, в розкритті розбіжностей, а не в їх усередненні.
Згода між моделями — не незалежне підтвердження. Рада з N моделей з кореляцією помилок ρ коштує = N/(1+(N−1)ρ) незалежних свідків, величина, яка насичується на 1/ρ незалежно від кількості доданих моделей, тому при ρ = 0,5 рада будь-якого розміру коштує максимум двох свідків. Різниця в доказовій силі між десятьма незалежними моделями, що згідні, і десятьма корельованими досягає приблизно п'яти десяткових порядків величини, а непрозоре об'єднання передає цю різницю читачеві як незаслужену впевненість.
Дизайн випливає з цих двох передумов. Він зберігає походження, щоб читач міг перевірити результат замість того, щоб йому довіряти, і ставить розбіжність на перше місце, оскільки розбіжність — це єдиний компонент, який жодна окрема модель не може забезпечити. Джерело, спільне для кількох відповідей, позначається як одне джерело. Факти, що несуть навантаження, названі, а те, що має джерела, відокремлено від того, що просто узгоджено. Ще одне правило застосовується до звіту протоколу про себе самого: воно ніколи не повинне подавати як колегіальне те, що таким не було, що це не просто теоретична проблема. У сліпому тесті дві з п'яти моделей порушили його мовчки, і одне речення про розподіл ролей виправило обидва при повторному запуску в середовищі B.
Три рівні — це точки на кривій, осьюю якої є вартість охоплення, не три градації якості, і розділ 5 — це те, що робить криву узгодженою. Оскільки насичується, доказова відстань між двома моделями та десятьма набагато менша, ніж пропонує кількість моделей, і дві моделі з різних лабораторій, що працюють на телефоні, можуть бути цінніше за п'ять, отримані з однієї лінії. Мобільний рівень також розкрив торговельну операцію, яку інші рівні проводили мовчки. Друга модель, яка прочитала першу, може її виправити, але вона більше не може її незалежно підтвердити. Виправлення помилок та незалежне підтвердження — це різні товари, обиратимуться в різних порядках, і система, яка не розрізняє, який з цих двох вона пропонує, вводить свого користувача в оману. Контрольоване порівняння залишається відкритим, і розділ 9 деталізує його разом з результатом, при якому я змушений буду відкликати цю заяву.
Як би не закінчилось це порівняння, документ, об'єднаний без збереження походження та без збережених розбіжностей, взагалі не можна перевірити, і тому він не може бути кращим за одну відповідь у жодному сенсі, який має значення для того, хто приймає рішення. Перевіряємість — це не поліпшення синтезу. Це умова, за якої синтез має право називатися результатом. Правила протоколу, відповідно, стосуються того, звідки кожне речення походить і в чому були розбіжності між моделями, а не того, скільки моделей було залучено.
Декларації
Фінансування. Ця робота не отримала зовнішнього фінансування.
Конфлікти інтересів. Автор є розробником методів багатомодельної оркестрації, проаналізованих у цій роботі, які є відкритими та відтворюваними — інтерес, який читачі повинні врахувати. Автор є названим заявником у відкритих патентних заявках, а не у виданих патентах, що охоплюють системи оркестрації штучного інтелекту та валідації багатомодельних систем, які розглядає ця робота. Протокол, формалізований у розділі 4, і еталонна реалізація, описана в розділі 6, є власністю автора, і дизайн оцінки в розділі 9 було зафіксовано до будь-якого збору даних з цієї причини. Жоден аналітичний результат у розділі 5 не залежить від реалізації: розділи 6 і 7 можуть бути повністю видалені без зміни моделі, її верхньої межі або будь-якого висновку, зробленого з них.
Інструменти та перевірка. Асистенти штучного інтелекту використовувалися як інструменти під керуванням автора; ідеї, дослідження та висновки належать автору. Усі кількісні твердження та посилання були перевірені автором порівняно з первинними джерелами або архівованими копіями; автор несе повну відповідальність за вміст.
Доступність даних. Рисунки 1 і 3 та таблиці 2, 4 і 8 генеруються з виразу у замкненій формі в розділі 5.2 і можуть бути переобчислені з нього. Матеріал у розділі 7 складається з розшифрувань першої відповіді, записаних під час кожного запуску та збережених з робочими матеріалами. Моделі там ідентифікуються за лабораторією, а не за назвою продукту: спостереження стосується режиму відмови, який з'явився у різних лабораторіях, і результати одного запуску не підтримують порівняння між названими системами.
Внески авторів. Єдиний автор.
Кореспонденція. [email protected]
References
Entries marked arXiv are preprints and are cited as such; vendor and standards-body documents are contemporaneous industry sources rather than settled literature.
- Bommasani, R., Creel, K. A., Kumar, A., Jurafsky, D., & Liang, P. (2022). Picking on the same person: Does algorithmic monoculture lead to outcome homogenization? Advances in Neural Information Processing Systems, 35.
- Condorcet, M. J. A. N. de C., marquis de (1785). Essai sur l’application de l’analyse à la probabilité des décisions rendues à la pluralité des voix. Imprimerie Royale, Paris.
- Debenedetti, E., Shumailov, I., Fan, T., Hayes, J., Carlini, N., Fabian, D., Kern, C., Shi, C., Terzis, A., & Tramèr, F. (2025). Defeating prompt injections by design. arXiv:2503.18813.
- Dietterich, T. G. (2000). Ensemble methods in machine learning. In Multiple Classifier Systems, Lecture Notes in Computer Science 1857, 1-15. Springer.
- Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325.
- Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., et al. (2022). Language models (mostly) know what they know. arXiv:2207.05221.
- Karpathy, A. (2025). llm-council. Open-source software repository.
- Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038-30066. arXiv:2506.07962.
- Kish, L. (1965). Survey Sampling. Wiley, New York.
- Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
- Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118.
- Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. Advances in Neural Information Processing Systems, 7, 231-238.
- Ladha, K. K. (1992). The Condorcet jury theorem, free speech, and correlated votes. American Journal of Political Science, 36(3), 617-634.
- Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020-9025.
- Meta (2025). Agents rule of two: A practical approach to AI agent security. Engineering documentation.
- MITRE (2025). CVE-2025-32711. Common Vulnerabilities and Exposures record; zero-click exfiltration in an agentic assistant (EchoLeak).
- OWASP (2025). OWASP Top 10 for large language model applications - LLM01: Prompt injection.
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., et al. (2023). Towards understanding sycophancy in language models. arXiv:2310.13548.
- Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755-759.
- Surowiecki, J. (2004). The Wisdom of Crowds. Doubleday, New York.
- Ueda, N., & Nakano, R. (1996). Generalization error of ensemble estimators. Proceedings of the International Conference on Neural Networks, 90-95.
- Wang, J., Wang, J., Athiwaratkun, B., Zhang, C., & Zou, J. (2024). Mixture-of-agents enhances large language model capabilities. arXiv:2406.04692.
- Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., & Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. International Conference on Learning Representations. arXiv:2203.11171.
- Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. International Conference on Learning Representations. arXiv:2306.13063.
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, Datasets and Benchmarks Track. arXiv:2306.05685.
Додаток A. Шаблон резюме
Резюме — це перше, що зустрічає читач, і часто це все, що він читає. Воно має відповісти на чотири запитання без прокручування.
RECEIPT — 6 models asked · 5 answered · 1 did not (free tier)
Mode: fast ×4, deep ×1
Anchor: answer #3 (chosen for completeness and sourcing)

Agreed:       ...
Disputed:     ...
Unverified:   ...

Rests ONLY on the models agreeing (none showed a source):
              ...
Correlated:   3 of 5 cite one article → one lineage, not three
Composition:  4 of 5 are models from one region; agreement
              may reflect a shared frame
Останні два рядки — це те, що Розділ 5 існує, щоб обґрунтувати. Без них документ повідомляє, скільки моделей погодилися, але приховує вартість цього погодження, а ці дві величини розрізняються на порядки величини.
Додаток Б. Ефективна кількість незалежних свідків
Таблиця 8. , повний діапазон
| ρ | N=2 | N=3 | N=4 | N=5 | N=7 | N=10 | N=15 | N=20 | N→∞ |
|---|---|---|---|---|---|---|---|---|---|
| 0.00 | 2.00 | 3.00 | 4.00 | 5.00 | 7.00 | 10.00 | 15.00 | 20.00 | ∞ |
| 0.05 | 1.90 | 2.73 | 3.48 | 4.17 | 5.38 | 6.90 | 8.82 | 10.26 | 20.0 |
| 0.10 | 1.82 | 2.50 | 3.08 | 3.57 | 4.38 | 5.26 | 6.25 | 6.90 | 10.0 |
| 0.15 | 1.74 | 2.31 | 2.76 | 3.13 | 3.68 | 4.26 | 4.84 | 5.19 | 6.67 |
| 0.20 | 1.67 | 2.14 | 2.50 | 2.78 | 3.18 | 3.57 | 3.95 | 4.17 | 5.00 |
| 0.30 | 1.54 | 1.88 | 2.11 | 2.27 | 2.50 | 2.70 | 2.88 | 2.99 | 3.33 |
| 0.40 | 1.43 | 1.67 | 1.82 | 1.92 | 2.06 | 2.17 | 2.27 | 2.33 | 2.50 |
| 0.50 | 1.33 | 1.50 | 1.60 | 1.67 | 1.75 | 1.82 | 1.88 | 1.90 | 2.00 |
| 0.60 | 1.25 | 1.36 | 1.43 | 1.47 | 1.52 | 1.56 | 1.60 | 1.61 | 1.67 |
| 0.70 | 1.18 | 1.25 | 1.29 | 1.32 | 1.35 | 1.37 | 1.39 | 1.40 | 1.43 |
| 0.80 | 1.11 | 1.15 | 1.18 | 1.19 | 1.21 | 1.22 | 1.23 | 1.23 | 1.25 |
| 0.90 | 1.05 | 1.07 | 1.08 | 1.09 | 1.09 | 1.10 | 1.10 | 1.10 | 1.11 |
Рухаючись вправо, додаючи моделі, майже негайно натрапляємо на крайній правий стовпець. Рухаючись вгору, зменшуючи кореляцію, обмежень не має. Зусилля, витрачене на різноманітність ради (тобто окремі лабораторії, регіони та корпуси навчання), тому приносить більше результатів, ніж зусилля, витрачене на її розмір. Два приклади підтримують аргумент розділу 6.2: пара, взята з двох лабораторій при ρ ≈ 0.2, становить приблизно 1.67 незалежних свідків, тоді як п'ять моделей з однієї лінії при ρ ≈ 0.6 становлять приблизно 1.47.
Додаток C. Довідка з впровадження мобільного рівня
Таблиця 9. Довідка з впровадження мобільного рівня
| Компонент | Специфікація |
|---|---|
| Механізм | Наміри додатків операційної системи, пов'язані в одну підписану скорочену команду, що викликає встановлені додатки постачальників за наявних підписок користувача. Жодного ключа API, жодного сервера, жодного фонового виконання |
| Дії постачальника | Опублікований ask-intent кожного постачальника, адресований за ідентифікатором намірю додатку. Один постачальник розкриває необов'язковий параметр моделі, опущений, щоб застосовувалося значення за замовчуванням додатку; інший не розкриває жодного |
| Експлуатація без втручання | Параметр show-on-run встановлено як вимкнений у параметрах намірю під час збірки, не регулюється в редакторі після імпорту |
| Розповсюдження | Скорочену команду підписано для необмеженого імпорту, тому одна збірка встановлюється на будь-якому пристрої або обліковому записі без перебудови |
| Меню режиму | Дія керування потоком меню з маркерами початку, випадку та кінця; гілки збігаються на спільному хвості через дію встановлення змінної |
| Альтернативна платформа | Автоматизація на основі намірів зі напівавтоматичним способом, який зберігається при оновленнях додатків |
| Вартість за запуск | Опитування 1 + 1, Критика 1 + 1, Синтез 1 + 2 повідомлення підписки |
| Затримка | Близько 50–60 секунд від запуску до результату, без втручання |
| Поверхні запуску | Піктограма головного екрана, віджет, кнопка апаратної дії або голосова фраза |
Два обмеження сформували дизайн, і обидва узагальнюються. Квоти спільні зі звичайним використанням тих самих додатків, тому рекомендований повсякденний режим — режим з двома повідомленнями, а не з трьома повідомленнями; це розподіл ресурсів, а не судження про якість. І кожне звернення до намірю відкриває свіжий сеанс без пам'яті, тому всі запити автономні й містять запитання та будь-які попередні відповіді в собі. Ніщо не продовжується. Це обмеження робить сліпу паралельну незалежність у Опитуванні та Синтезі архітектурною замість інструктованої, як стверджує розділ 6.5.
Як цитувати
Chernets, V. (2026). Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API [Препринт]. SSRN. https://doi.org/10.2139/ssrn.7390698
@misc{chernets2026agreementnotevidence,
  author       = {Chernets, Vadym},
  title        = {{Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7390698},
  url          = {https://doi.org/10.2139/ssrn.7390698}
}