合意は独立した証拠ではありません:API なしの監査可能なマルチモデル合成
これは翻訳です。正式版は英語の原文です。引用の際は原文をご参照ください。
Vadym Chernets, PhD、AI systems architect · ORCID 0009-0007-4845-3163
SSRN 7390698 · DOI 10.2139/ssrn.7390698 · Zenodo 10.5281/zenodo.22683716 · GitHub
- 正式版: SSRN 7390698 · DOI 10.2139/ssrn.7390698
- アーカイブされたコピー、引用可能でダウンロード可能: 10.5281/zenodo.22683716 — コンセプトDOI、常に最新版を解決します
- MarkdownおよびPDFの完全なテキスト: GitHub
- 読みやすいHTML: https://polyhelper.ai/research/agreement-not-evidence/
同じテキストが4つのサーフェスにあるため、そのうちの1つが提供できない場合に到達できます。SSRNが正式版を保有しています。その版を引用してください。
キーワード: 大規模言語モデル、相関のあるエラー、集合知、コンドルセの陪審定理、アルゴリズムのモノカルチャー、マルチエージェント議論、実効的サンプルサイズ、設計効果、アンサンブル、由来。JEL分類: C11; C18; D71; D83; L86; O33
要約
ある人が1つの言語モデルに質問をした場合、その人は自信を持って間違っている答えと自信を持って正しい答えを見分けることができません。この2つは、非専門家が利用できるあらゆる表面的な手がかりにおいて同じです。複数のモデルに質問することは解決策のように思えますが、それはほぼ問題を別の場所に移すだけです。複数の答えを調整することで、もう一度自信を持ったテキストが生成され、そのテキストは「10個のモデルが合意した」という借用した権威を持つようになります。
ここで形式化されたプロトコルは、ユーザー自身のブラウザまたは携帯電話を通じて、APIキー、インストール、および仲介サーバーなしに、複数の消費者向けチャットモデルから答えを収集します。アンカーと充実により調整します。最も強力な利用可能な答えがベースになり、他の答えはそれぞれベースが欠いているものだけを提供します。すべての貢献は、それを供給したモデルで署名されています。不同意は平均化されるのではなく、独自のセクションに保持されています。
本論文は4つの貢献をしています。最初は、プロトコル自体です。これは出所を保存し、無言の削除を禁止するアルゴリズムとして述べられており、マージが失敗する5つの方法の分類学が含まれています。そのうち4つは素朴なプーリングの欠陥です。5番目は方法ではなく、演算子の失敗です。単一のモデルの出力を共同の結果として提示する合成です。2番目は、相関証人算術のプロトコル設計への応用です。その算術はここで主張されていません。Kohli(2026年)は同じKish補正を9人の辺境判事のパネルに適用し、約2票の有効投票を測定しました。Kim他(2025年)は350以上のモデル全体にわたる基礎となる誤差相関を確立しました。誤差が級内相関ρを持つN個のモデルの評議会は、 = N / (1 + (N−1)ρ)独立した証人の価値があります。その量は、何個のモデルが追加されても1/ρで飽和します。評議会が1/ρより大きくなると、ρを半減させることはNを倍にすることに勝ります。また、2つの研究室から引き出されたペアは、1つから引き出された5つを上回ります。Kim他(2025年)はそのルールを複雑にします。より大きく、より正確なモデルは、アーキテクチャと提供者が異なる場合でも、最も相関誤差を持つため、2つの研究室はρについての事前推測であり、その測定ではなく、セクション5.5の推定手順は何のためにあるのかです。3番目は、3つの展開層(手動、ワンタップモバイル、ブラウザエージェント)と、それらを認識論的に分離する軸についての説明です。2番目のモデルが最初のモデルの答えを見るかどうか。2番目のモデルをコンディショニングすると、誤り補正と引き換えにρが上昇します。4番目は、5つのモデル全体にわたる偽造評議会の失敗の小規模サンプル観測、3モデルの再実行でそれを削除した1文の介入、および明示的な改ざん条件を持つ盲検3腕評価設計です。
相関協定はここでは確立として扱われており、発見としてではありません。モデルのパネルが持っているメンバーよりもはるかに少ない独立した証人の価値があることは直接測定されています。7つのファミリーから引き出された9人の辺境判事は、約2票の有効投票を供給しています(Kohli、2026年)。また、誤差相関は、提供者およびアーキテクチャ全体でも、モデル能力とともに上昇しています(Kim他、2025年)。セクション5は、これらの測定の背後にある設計効果算術を言い直しています。プロトコルの3つのルールはそれから導出されており、それなしで細心さのように読むからです。プロトコルは、その後、同じ問題の反対側を取ります。その文献は相関を測定します。このプロトコルは、系統全体に渡って構成し、不同意を平均化せずに保持し、提供したモデルですべての貢献に署名し、繰り返されたソースを1回カウントすることで、それを低下させるために構築されています。
マージされた答えが最良の単一の答えを上回るという主張は、設計と隣接する文献から主張されています。セクション9は評価を指定しており、それはまだ実行されていません。
目次
- 導入
- 関連研究
- マージが失敗する5つの方法
- アンカーと拡張プロトコル
- 相関協定
- 3つのティア、1つのプロトコル
- 実証セクション
- ペーストファイル:コールドスタートガイダンスのためのインターフェースパターン
- 提案された評価
- 制限事項
- 倫理、プライバシー、法的枠組み
- 結論
声明 · 参考文献 · 付録A、領収書テンプレート · 付録B、独立した目撃者の有効数 · 付録C、モバイルティア実装リファレンス
図表一覧
- 図1. 審議会は1/ρで飽和し、合意する10個のモデルの価値(セクション5.3)
- 図2. アンカー・アンド・エンリッチプロトコル、段階ごと(セクション4.2)
- 図3. 3つの層は1つのレイテンシ–ブレッドス曲線上の点として(セクション6.4)
- 図4. ブラインド並列と情報付き逐次エリシテーション比較(セクション6.5)
- 表1. プロトコルルールと対応する失敗(セクション4.5)
- 表2. 独立した証人の有効数、選定値(セクション5.2)
- 表3. モバイル層の3つのモード(セクション6.2)
- 表4. 3つの層全体のレイテンシ–ブレッドス境界(セクション6.4)
- 表5. コールドスタートプローブ、ベースラインラン、n = 5(セクション7.2)
- 表6. ロール割り当て介入後のコールドスタートプローブ、n = 3(セクション7.3)
- 表7. コンシューマアプリインテントパイプラインの観測された失敗モード(セクション7.5)
- 表8. 独立した証人の有効数、完全な表(付録B)
- 表9. モバイル層の実装リファレンス(付録C)
1. はじめに
1.1 問題
間違うことが高くつく質問を考えてみてください。学校の選択、治療法の選択、サプライヤーの選択、契約条項の選択です。ユーザーが言語モデルに質問すると、一貫性があり、自信に満ちた、よくフォーマットされた回答が返ってきます。そこから困難が始まります。自信を持った間違った答えと自信を持った正しい答えは同じに見えます。言調もそうですし、構造も、長さも、引用の有無も区別しません。言語化されたモデルの信頼度は過大評価されており、キャリブレーションが不十分であることが知られています(Kadavath et al., 2022; Xiong et al., 2024)。モデルが質問者のフレーミングを採用する傾向は、第二層の誤った支持を追加します(Sharma et al., 2023)。
明白な対策は別の意見です。一つのモデルのエラーは信頼に見えます。同じエラーが二番目のモデルの答えの隣に置かれると、議論に見えます。議論は主題に専門知識を持たない読者に見えます。信頼は見えません。以下のすべてはその非対称性に基づいています。
対策には代償と落とし穴があります。代償は読むことです。一つの質問に対する十の答えは、誰が何を言ったかを覚えながら、一度に十の長いテキストを記憶に留めるために、十の長いテキストです。ほぼ誰もがそうしません。実際には、読者は最初の答えを読み通し、二番目の答えをざっと読み、残りを閉じます。複数の答えを集めることは、アグリゲーター購読、並行パネル、APIゲートウェイを通じて、何年も前から解決されている問題です。それらで終わることは解決されていません。
落とし穴はマージです。十の答えを一つに減らすどのような方法も、再び単一の自信を持ったテキストを生成し、その削減が不透明な場合、読者は最初の場所に戻ります。ただし、テキストは読者が確認できない権威を伴うようになります。単純なプーリングもまた、正しい少数派の意見を消去し、最も強調されたフレーズ方向へ漂い、合意がない場所に合意の見た目を生成します。
三番目の問題は、演習全体を自明でないものにするものです。モデル間の合意は独立した確認ではありません。重なるコーパスで訓練されたモデルがフレーミングを共有し、同じ記事を引用し、同じ盲点を継承するためです。「十のうち九が同意した」と「九人の独立した専門家が同意した」は異なるステートメントであり、それらの間のギャップは定量的で大きいです。セクション5は、それが構築全体に上限を設定することを示しています。
1.2 システム
プロトコルはプレーンテキストで書き出され、それを実行する三つの方法があります。三つすべてが同じドキュメントを生成し、それらは誰がクリックするか、何個のモデルが質問されるかで異なります。
無料パスでは、ユーザーがサイトを開き、答えをコピーして、それらを任意のチャットモデルの指示の段落の下に貼り付けます。インストールするものはなく、支払うものもなく、携帯電話で機能します。
モバイル階層では、ホーム画面に一つのアイコンがあります。それをタップして、質問を入力し、モードを選択すると、約1分後に完成した答えが画面とクリップボードに表示されます。デバイスにインストール済みのサブスクリプションに対するオペレーティングシステムアプリインテントを通じて二つのモデルに到達し、APIキーはありません。
エージェントパスでは、ブラウザを駆動できるモデルがユーザーの既存のログインセッションで指定されたサイトを開き、質問を送信し、待機して、各答えをファイルに保存し、ドキュメントを構築します。
アーキテクチャ的に決定的な事実は、サーバーがないということです。セキュリティされたサーバーではなく、ノーリテンションポリシーを持つサーバーでもなく、そのようなコンポーネントは存在しないため、質問は私に到達することはできません。これはユーザーが指定したモデルサービスに到達します。これは演習のポイントであり、他の場所には行きません。同じ不在から二番目の結果が続きます。プロトコルは段落のテキストで、許可ポリシーの下にあるため、プロトコルは取り消されることはできません。ユーザーの注記内のコピーは、後で存在するどのモデルでも機能し続けます。
1.3 貢献
セクション3はマージが失敗する五つの方法を設定し、セクション4はそれらに対してアンカーと強化を形式化します。セクション5は相関ウィットネスモデル、 = N/(1+(N−1)ρ)とその1/ρでの上限を開発し、評議会がどのように構成されるべきかについてそれが意味するものを引き出します。セクション6は三つの階層、それらが辿るレイテンシー幅フロンティア、そしてそれらをエピステミック的に分離する盲目平行対知識順次の区別を説明しています。セクション7は偽りの評議会の観察とモバイルビルドからのフィールド調査結果を報告します。セクション8は冷たいスタート指導用のインターフェースパターンを説明しています。セクション9は、事前に固定された偽造条件を伴うブラインド評価を指定します。マージされた答えが最高の単一の答えを打つという主張はここで解決されず、その評価は比較であり、それはそれを解決するもので、私がそれを撤回する必要があるという結果を含みます。
向きはこの論文が依存する測定文献と区別するため、明確に述べる価値があります。Kohli(2026)、Kim et al.(2025)、Ding(2026)は、評議会のエラーがどの程度相関しているかを測定します。この論文はその相関を設計ターゲットとして取ります。単一の人が、APIキーやサーバーなしで通常のコンシューマーチャットインターフェースを通じて機能できたとき、それを低下させ、そうしたことを示すレコードを残す方法を尋ねます。その文献の一つのギャップは、達成範囲内であるため、命名する価値があります。測定はAPI、ベンチマーク、九つのモデル、または三百の上で行われました。このプロトコルが居住するコンシューマー設定での相関は誰も推定していません。ここで、人がすでに何も支払わない四つのチャット製品を問い合わせています。セクション5.5が手順を与え、セクション9.6が設計を与えます。
2. 関連研究
アンサンブルと多様性。 古典的なアンサンブル理論は既に、ここで必要なことを述べています:アンサンブルが得るものは、メンバーがいかに異なる方法で誤るか次第であり、平均的にいかに優れているかではありません。アンサンブル誤差が平均メンバー誤差から平均曖昧性を引いたものに等しいという曖昧性分解(Krogh & Vedelsby, 1995)と、バイアス–分散–共分散分解(Ueda & Nakano, 1996)の両者は、誤差共分散が上昇するにつれてアンサンブルが単一のメンバーに向かって崩壊することを示しています。Dietterich(2000)はこの条件を必要条件として述べています。第5章はこれを言語モデルの評議会に適用し、これに違反するコストに数値を付けます。
言語モデルのマルチモデルスキーム。 自己一貫性(Wang, X., et al., 2023)は1つのモデルからの複数サンプルにわたって投票し、独立性を生じさせることなく分散を低減します。マルチエージェント議論(Du et al., 2023)は複数のインスタンスが議論を交換する場合の事実性の向上を報告しています。エージェント混合(Wang, J., et al., 2024)は1つのレイヤーの出力をアグリゲータに供給し、複数のベンチマークで最強の単一モデルよりの向上を報告しています。その文献はこのプロトコルが指し示すのと同じ方向を指しています。ただし、その結果はAPI上とベンチマーク上で得られたので、自分自身の測定なしに、ブラウザ仲介の消費者インターフェースの評議会にそれらを転送しません。これが第9章が指定するものです。
判定モデル。 モデル判定による評価は、その欠陥と一緒に十分に特性化されています:位置バイアス、冗長性バイアス、および馴染みのあるハウススタイルへのプル(Zheng et al., 2023)。これは脇道ではなくここではデザイン制約です。なぜなら、ブラインドなしのスコアリングは部分的にこれらのバイアスを測定することになるからです。第9.4章がそれを処理します。
単一文化。 KleinbergとRaghavan(2021)は、多くのエージェントが1つのアルゴリズムに依存する場合、個々の品質が向上しても集合的な成果が悪化する可能性があることを示しています。Bommasaniら(2022)は同じ効果を結果の均一化として説明しています。言語モデルの評議会の場合、これは最初の場所でρ > 0を生成するメカニズムです。生成データの訓練での劣化に関する研究(Shumailov et al., 2024)はρが時間とともに上向きにドリフトすることを示唆しています。
クラウド。 古典的な集団の知恵の議論(Surowiecki, 2004)は判定が独立していることに依存しています。Lorenzら(2011)は、わずかな社会的影響さえ実験的に示しました。単に他の人の推定値を見ることで、スプレッドを狭めますが、それを真実に向かわせません:クラウドはより自信があり、より正確ではありません。第6.5章は、それを知らされた順序による抽出によって受け入れられた取引として正確に識別します。
コンドルセと相関投票。 コンドルセの陪審団定理(Condorcet, 1785)は、個々の精度が1/2より上の場合、Nが成長するにつれて正しい多数決の確率が1に向かうことを保持しています。Ladha(1992)は相関投票が保証を破壊することを示しました。第5章は設計効果(Kish, 1965)を通じてその警告の定量的なバージョンを提供します。
相関誤差、測定済み。 第5章が述べている算術は、その後、モデルパネルで直接測定されており、測定は分析より鋭いです。Kohli(2026)は9つの最先端の判定からなるパネルに Kish 有効サンプルサイズを適用し、7つのモデルファミリーから引き出し、それは約2つの独立投票の価値があることを見つけます:パネルの名目上の独立性の大約3/4は共有された誤りで失われ、パネルの精度は独立投票が配信するであろう8から22パーセンテージポイント短く落ちます。そして最高の単一判定はパネル全体と一致するか、それを打ち負かします。より多くの判定も、より良い集約も、それを修復しません。これはボトルネックをアルゴリズムではなく判定に位置付けます。Kimら(2025)は、350以上のモデル全体で、実質的な誤差相関を見つけ、評議会がどのように構成されるべきかにとって重要なことに、より大きくより正確なモデルは、アーキテクチャとプロバイダが異なる場合でも最も相関されたエラーを持つことを見つけます。Ding(2026)は265,000サンプルにわたって信頼シグナルとしての一致を監査し、それは肯定的だが弱い予測因子であることを見つけます。相関は0.20から0.59の間であり、最悪の場合、それが最も自信がある正確なところです:最も一貫した最先端モデルでは、0.8以上の一致は、より難しいベンチマークのエントリの77%をカバーし、そのうちの48%は間違っていました。
この論文には3つのことが続きます。第1に、第5章の設計効果の結果は私の貢献ではありません。Kohliの論文はこれの最初の投稿に先行し、同じ補正を使用しました;セクションはプロトコルが導き出すもののために保持され、それが現れるところに標識されています。第2に、その後に続く構成アドバイス、数に関するのではなく多様性に費やす、は単なる議論ではなく実証的に支持されています。第3に、Kimら の検出はそのアドバイスを複雑にする方法で、述べる価値があります:能力と誤差相関が一緒に上昇する場合、2つの実験室から引き出されたペアは自動的に多様なペアではなく、系統発生は商標を読む代わりに測定される必要があります。これは第5.5章の推定手順の議論であり、構成ルールに対する議論ではありません。
隣接システム。 いくつかのプロジェクトは多モデル評議会を構築しています。よく知られたオープン実装の1つ、llm-council(Karpathy, 2025)は、モデルを並行してクエリし、それらに匿名で相互にレビューさせ、会長モデルが最終的な回答を書くことができます。アグリゲータAPIキーとトークンごとの支払いが必要です。商用の評議会製品は、判定、コンセンサスビュー、および矛盾表示を提供します。オープンソースモバイルアプリケーションは投票とマルチラウンド議論を追加します。成熟したマルチモデルフロントエンドはアンサンブル機能を備えており、無料のサイドバイサイドパネルはユーザーが既にログインしている公式サイトを使用します。アグリゲータサブスクリプションは多くのモデルを1つの請求書の背後に置きます。これらの各プロパティは他の場所に単独で存在します。それらの組み合わせ、一度に10個、他のどこでも利用可能に見えません:APIキーなし、インストールなし、電話対応、ユーザーが既に保有しているアカウント(無料ティアを含む)で実行、新しい有料仲介なし、平文で書かれたマージ方法、したがって編集可能、分裂を保持、すべてのコントリビューション署名済み、繰り返されたソースは1つのソースとしてフラグ、1つのメソッドは手動またはエージェントの下で実行可能。
位置が開いたままになる構造的な理由があります。ラボは、ユーザーの質問をライバルにルーティングする動機がほぼありません。各参加者の目的はそれ自身の回答がユーザーが保つものであるからです。第三者はクロスモデルツールを販売していますが、平文で書かれたメソッドは編集者の役割をユーザーと共に置き、これはそれらのいずれとも異なる配置です。
対象範囲。このプロトコルは、研究チームのインフラストラクチャを組み立てずに1人が1つの入念なドキュメントを作成することを対象としています。鍵、インストール、サーバーはありません。再試行、実行保証、コストおよびエラー監視、監査ログ、テストセットでの評価、アクセス制御、シングルサインオン、保持ポリシー、プロンプトバージョニング、およびサービスレベルアグリーメントはエンタープライズオーケストレーションフレームワークの領域です。
3. マージが失敗する5つの方法
5つのうち4つは単純なプーリングの特性です。単純なプーリングとは「これらの回答を組み合わせ、結果を最適化する」という形式の指示を意味します。5番目はオペレータに属するもので、読者がそれを検出できないため、最も重要です。
F1、合成における虚構。出力には、入力のいずれにも含まれていなかった主張が含まれています。シンテサイザー自体が言語モデルであり、ソース間の継ぎ目をなめらかにする際に、ソース化された素材とまったく同じに見える接続素材を生成します。
F2、少数派の抹消。実質的な異議を唱えた唯一の回答が、多数派の意見のために消滅します。これは評議会が集められた理由であり、単純なマージが最初に失うものです。
F3、信頼度のドリフト。2つの表現が矛盾する場合、より確定的な表現がより根拠のある表現に勝ります。これはジャッジモデルにおける位置バイアスとスタイルバイアスを生み出す同じメカニズムです(Zheng et al., 2023)。
F4、製造されたコンセンサス。実際の不同意が適格な「はい」に平均化されます。読者は、争点が決着したものと区別できない文書を受け取り、異議が存在していたことさえ学ぶことができません。
F5、偽りの評議会。協調的なパスを実行するよう指示されたモデルは、他のモデルへのアクセス権がありません。そうではなく、通常のウェブ調査を実行し、結果を協調的な形で、領収書、同意と不同意のセクション、および寄稿者の帰属を備えた形式で提示します。ドキュメントは真実なものより見栄えがよく、これは本当の矛盾が邪魔にならないからです。読者は出力回答にアクセスできないため、これをキャッチできません。
F5は論文の開始問題を1つのレベル上げたものです。自信を持って間違った回答は正しい回答と区別がつかず、評議会のような形をしているが1つのモデルで書かれたドキュメントは評議会と区別がつきません。セクション7は、ブラインドラン中の5つのモデル中2つで発生していることを報告しています。
4. アンカー・エンリッチプロトコル
4.1 原理
回答をプールして最適化する代わりに、このプロトコルは1つの強力な回答を段階的に成長させ、出所と意見の相違を可視のままにしておきます。
4.2 ルール
図2はプロトコル全体を示しています。
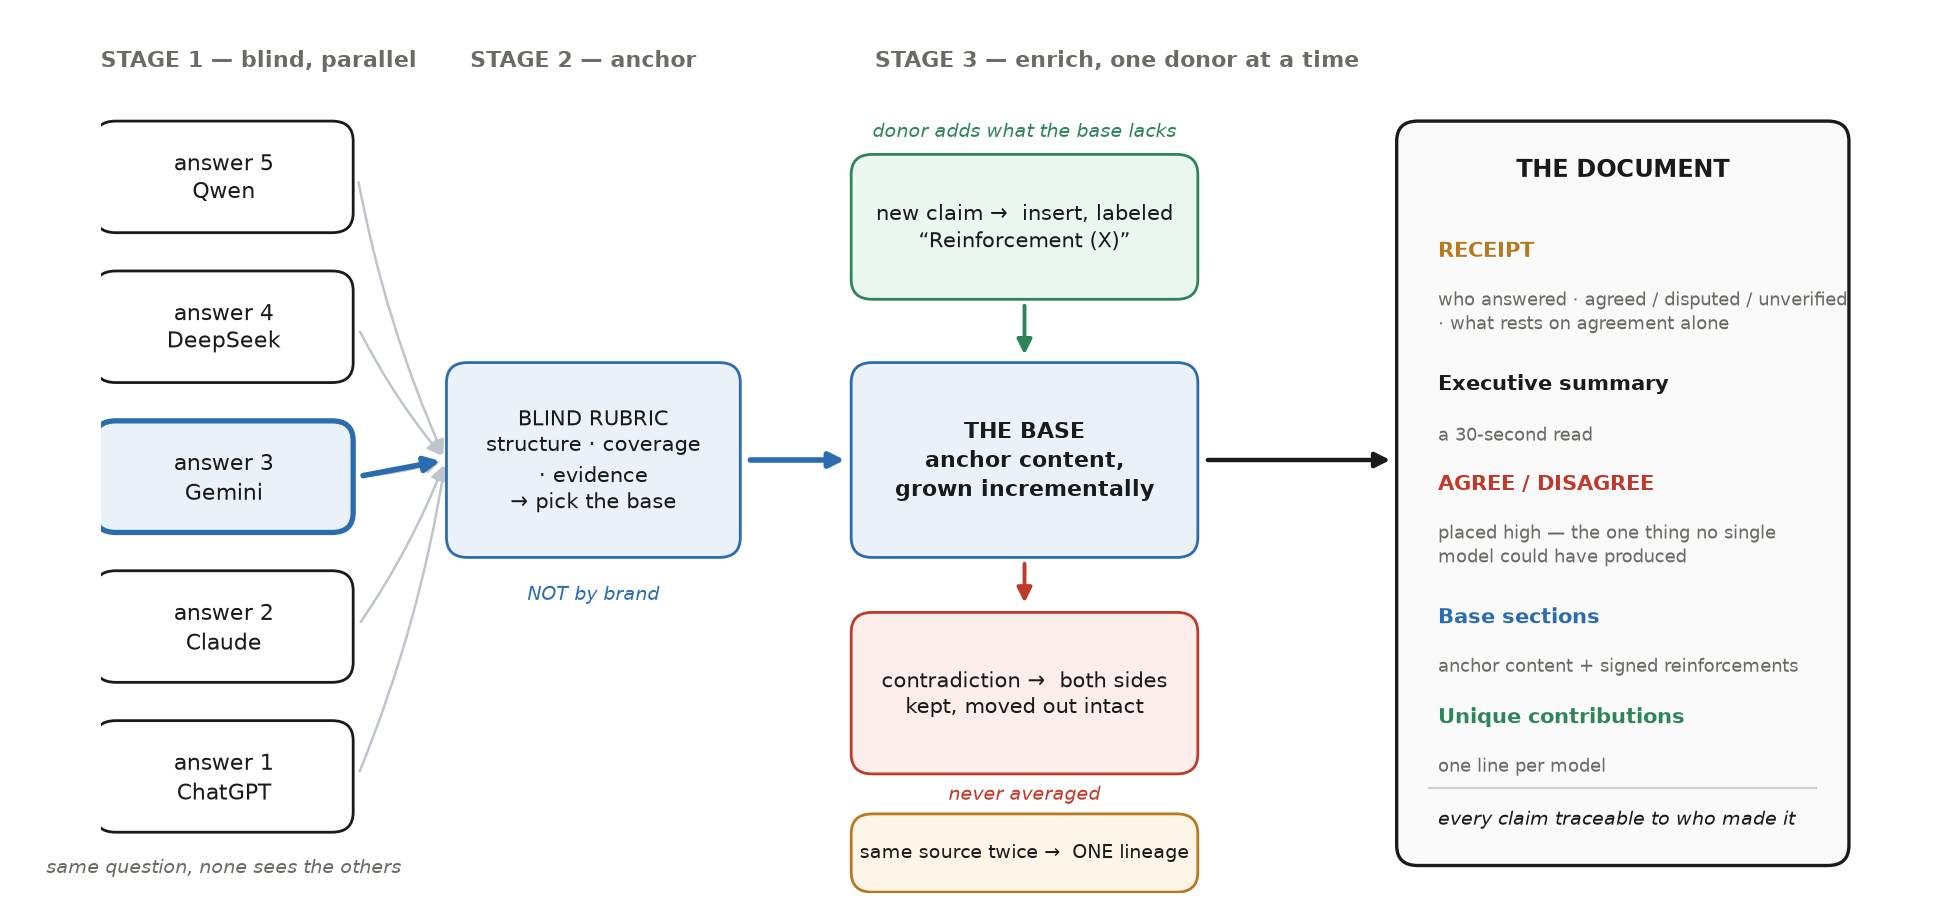
ブラインドルーブリックでアンカーを選び、ブランドでは選ばない。最も完全で最もよく出典がある最も強力な回答がベースになります。内容で判断します。構造、カバレッジ、証拠です。好まれるモデルを事前に設定することは体系的なバイアスであり、1つのモデルがたまたま他のモデルより多くのコンテキストを受け取った場合に最悪です。アンカーが選ばれたら、構築は直ちに開始されます。遅れているものは待たれません。
1度に1つの提供元でエンリッチします。残りの各回答から、ベースに不足しているもの、またはすでにそこにあるものを強化するもののみを取得します。先例、数字、類似例、視点、一次資料リンクです。強化(モデル名)というラベル付きで一致するセクションに挿入します。
出所を保存します。すべての寄稿は提供元の印を持ちます。モデルの出所は証拠の出所ではなく、元のソースリンクが利用可能な場合は、帰属だけでなくそれも運ばれます。
公開で訂正します。ベースコンテンツは優先的に保持されます。提供元がアンカーのエラーを訂正する場合、訂正を行い、変更内容と理由についての1行の注釈を残します。ベースに触れないというルールへの配慮から既知のアンカーエラーを固定化することは、それに触れることより悪いです。支配的なルールは、情報が静かに失われないことであり、ベースが不変であることではありません。
意見の相違を表面化させます。専用セクションは合意と相違を分離します。矛盾する主張は中間位置に平均化されることはありません。
相関のある証拠にフラグを付けます。複数のモデルが同じ記事を引用している場合、それは複数の独立した確認ではなく、1つの証拠系統です。同じことが構成のレベルでも適用されます。同意するモデルが同じタイプの企業によって、または同じ管轄区域内で構築された場合、その分割がその線に沿っている場合は、そのように述べます。
ユニークな貢献にクレジットを付与します。モデルごとに1行です。
オーケストレーターの独自の見解を追加しますユーザーが要求した場合、最後のセクションとして。
負荷を支える事実を名前を付けます。推奨実際に依存する2つまたは3つの事実を特定します。通常は数字で、それぞれが確認可能なソースで支えられているか、または只のモデルが同意しているかに基づいていることを識別します。数字で同意しており、それがどこから来たのかを示すものがない場合、それは確認ではなく警告です。
4.3 アルゴリズム
INPUT   Q — the question
        A = {a_1 … a_N} — answers, arriving asynchronously
OUTPUT  D — a document with a receipt, provenance, and
        a disagreement section

R ← ∅            // receipt: who answered, who did not, why
D ← ⊥            // the base (anchor)

on arrival of a_i:
    R ← R ∪ {source(a_i), timestamp, mode}

    if D = ⊥ and enough_candidates():
        D ← argmax_{a ∈ A_ready} rubric(a)
        anchor ← source(D)         // recorded and disclosed
        // rubric = structure, coverage, sourcing

    else:
        for each claim c ∈ a_i:

            if c ∉ D:                              // new
                insert c into the matching section of D,
                    labeled "Reinforcement (source(a_i))"

            else if c contradicts c' ∈ D:
                if c corrects a factual error in c':
                    replace c' with c, plus a one-line
                    note of what changed
                else:
                    move (c, c') into DISAGREEMENTS,
                    both sides intact

            else:                            // agreement
                if evidence_source(c) = evidence_source(c'):
                    mark as ONE evidentiary lineage,
                    not as confirmation

after all:
    identify the load-bearing facts
    mark each [sourced] or [agreement only]
    assemble RECEIPT, SUMMARY, AGREE/DISAGREE (placed high),
             UNIQUE CONTRIBUTIONS
    emit in a readable and a double-clickable format
収集と統合は一緒に進行します。アンカーは到着するとすぐにベースになり、その後の各回答は到着するたびに折り込まれます。高速プロバイダーは1~2分で応答し、深い調査モードは5~25分かかるため、2つのフェーズを直列化すると、実行は何の利益もなく半時間のブロックになってしまいます。
4.4 出力形状
セクションの順序はプレゼンテーションではなく、プロトコルの一部です。
受領書は上部に位置します:誰が回答し、誰が回答しなかったか、そしてその理由、何が合意され、何が争点となり、何が検証されていないか、証拠がどこで相関しているか、そして実行にかかったおおよその時間とクォータです。その後、30秒の要約、その後に目次があります。
合意と不合意は要約の直後に来ます。これらは単一のモデルが生成できなかった唯一のコンポーネントであり、このメソッドを実行した理由です。快適なコンセンサスの下に最後に配置すると、有用なドキュメントは明白に見え始め、その後読まれなくなります。
その後、ベースセクションが続きます。各セクションはアンカーコンテンツと署名された補強から構成されています。各モデルが独自に貢献したもののリスト。そして、ユーザーがそれを要求した場合、オーケストレータ自身の見解です。
4.5 ルールと対処される失敗
表1。プロトコルルールと対処される失敗
| ルール | 対処される失敗 |
|---|---|
| ブランドではなくルーブリックでアンカー | 好みのモデルに向かった体系的バイアス |
| ドナーは不足しているものだけを追加 | F1:ベースは書き換えられないため、より少ないシームが生成される |
| すべての貢献に由来情報 | F1、および監査可能性:読者は信頼する代わりに確認できる |
| 説明行による修正 | アンカーエラーのセメント化 |
| 独自のセクションの不合意、高く配置 | F2、F4 |
| 共有された証拠の系統フラグ | 偽りの独立性(セクション5) |
| 負荷軸受実は出典または合意のみとしてマーク | 合意は証拠として扱われる |
| ノンランは実行として表示されない | F5 |
これは設計引数であり、セクション9がそれをテストするものを指定します。
4.6 実例
このようなプロトコルは、その説明に対してではなく、その出力に対して判断する方が簡単です。以下は、2026年8月31日の無料パスの実際の実行からの抜粋です:1つの質問が、4つの別々のセッションで4つのコンシューマーチャットモデルに質問され、その後上記のルールでマージされました。由来情報がここで示される理由はセクション7と異なり、匿名化された例では何も示されないでしょう。
RECEIPT — 4 models asked · 4 answered
Agreed:    3-2-1 redundancy · JPEG is the safe everyday format ·
           migrate every ~5 years · never let a proprietary app
           be a photograph's only home
Disputed:  how many copies (3 vs 4) · what the archival master
           should be (TIFF/PNG vs original plus JPEG)
To check:  media lifespan figures · whether your export tool
           strips EXIF

— Section 1 of the merged document: how many copies, and where —

Base.  The 3-2-1 rule: three copies, on two kinds of storage,
with one off-site. The off-site copy is what survives a fire,
a flood or a theft.

⚠ Disagreement — is there a fourth copy?
ChatGPT and Gemini both extend this to 3-2-1-1, adding one copy
that is immutable or offline. Their reasoning differs: ChatGPT
frames it as geographic independence, Gemini as protection from
ransomware and from a mass deletion that syncs everywhere.
Claude and DeepSeek stayed at three and did not argue against a
fourth; they simply did not call for one.

(added by Claude)  Whatever you choose, treat cloud as one leg
of the tripod and never the whole thing: it is tied to an
account that can be locked, closed, or repriced.

— Worth checking yourself —

The lifespan figures come from Gemini alone. No other model
gave numbers, so treat them as one source rather than as a
consensus.
その抜粋にある4つのことは、プロトコルが説明されているのではなく、プロトコルが実際に機能していることです。4番目のコピーについての意見の相違は、両側の主張がそのまま保持され、2つのモデルの異なる理由とともに担われており、「リスク許容度に応じて3つまたは4つ」という読者がどの考慮事項に関心を持つかを隠すような実用的な解決策に解決されていません。クラウドストレージに関する補強には、それを提供したモデルの名前が付けられているため、そのモデルを信頼しない読者はその行を割り引くことができ、他の行は割り引きません。末尾の注記はライブランで発動するルール6です。1つのモデルがドキュメント内の唯一の数字を提供し、マージはそれらを単一のソースとしてマークしました。4モデルのドキュメント内での存在が合意として読まれるのではなく。
4番目はその抜粋が保持していないものです。ルール9より前のものなので、その負荷のかかった事実は情報源のあるものと合意のみのものに分離されていません。そして、ルールを満たすために編集された例はもはやそれらが機能することの証拠ではなくなるため、それが出てきた通りに再現されています。
5. 相関した合意
優先事項に関する注記。本セクションの算術は新しいものではなく、貢献としては主張されていません。Kohli(2026)は同じKish補正を9人のフロンティア判事のパネルに適用し、本論文が最初に投稿される3ヶ月前に約2つの有効投票を測定しました。また、Kim et al.(2025)は350以上のモデルにわたってそれを駆動する誤差相関を確立しました。本セクションが保持されている理由は3つあります。プロトコルの3つのルールがそこから導出されており、この算術を見たことのない読者はこれらのルールを必然性ではなく細心さとして読むでしょう。そしてセクション5.5の推定手順は、誰も測定していない設定でプロトコルが必要とするものです。その文献が相関を測定する場所で、本プロトコルはそれを低下させようとします。
10個のモデルが合意していれば、結局のところ主張はおそらく真実です。これはセクション4に対する最も強い直感的な異論であり、感じるほど強くはありません。どの程度弱いかを働き出すことはまた、ルール6と9を良い実践から算術へ変えます。
5.1 設定
N個のモデルが1つの二項主張に答え、e_i ∈ {0,1}はモデルiの誤差を示すとしましょう。独立性の下では、個々の精度p > 1/2で、N個のモデル間の合意はNで指数関数的に増加する証拠です。これはCondorcet定理の内容です(Condorcet、1785)。
重複するコーパスで訓練されたモデルは共有フレーミングを継承し、同じ二次資料を引用し、その期間の盲点を共有するため、それらの誤差は相関しています。裁判所は同じセキュリティ録画を見た10人の証人と同じ立場にあります。10の陳述、1つの観察、そして証人の数は独立して見られたものがどのくらいあるかについては何も言いません。そのギャップには数値を与えることができ、このセクションの残りはそれを行います。誤差の級内相関を次のように定義します
5.2 独立した証人の有効数
相関したモデルの評議会は構造的にはクラスタサンプルです。級内相関ρを持つ1つのクラスター内のN個の観測はN単位の情報を運びません。標準的な補正は設計効果です(Kish、1965)。
これは有効標本サイズを与えます
つまり、誤差がρで相関するN個のモデルの評議会は、の独立した証人と同じくらいの価値があります。表2は選択された値を示し、付録Bの表8は全範囲を示しています。
表2. 独立した証人の有効数、、選択されたNおよびρの場合
| ρ(下)/ N(横) | 2 | 3 | 5 | 10 | 20 | N→∞の極限 |
|---|---|---|---|---|---|---|
| 0(独立) | 2.00 | 3.00 | 5.00 | 10.00 | 20.00 | ∞ |
| 0.1 | 1.82 | 2.50 | 3.57 | 5.26 | 6.90 | 10.0 |
| 0.2 | 1.67 | 2.14 | 2.78 | 3.57 | 4.17 | 5.0 |
| 0.3 | 1.54 | 1.88 | 2.27 | 2.70 | 2.99 | 3.33 |
| 0.5 | 1.33 | 1.50 | 1.67 | 1.82 | 1.90 | 2.0 |
| 0.7 | 1.18 | 1.25 | 1.32 | 1.37 | 1.40 | 1.43 |
5.3 天井
右端の列はこのセクションの主な結果です。N → ∞として、
評議会には天井があり、それは何個のモデルが尋ねられたかに依存しません。図1のパネル(a)は飽和を直接示しています。ρ = 0.5では、1000個のモデルの評議会は2人の独立した証人の価値があり、ρ = 0.7では1.5未満です。ρ = 0.3で10に11番目のモデルを追加すると、約0.05の証人が購入されます。同じ5つのモデルでρ = 0.3からρ = 0.15に移動すると、約0.85が購入されます。
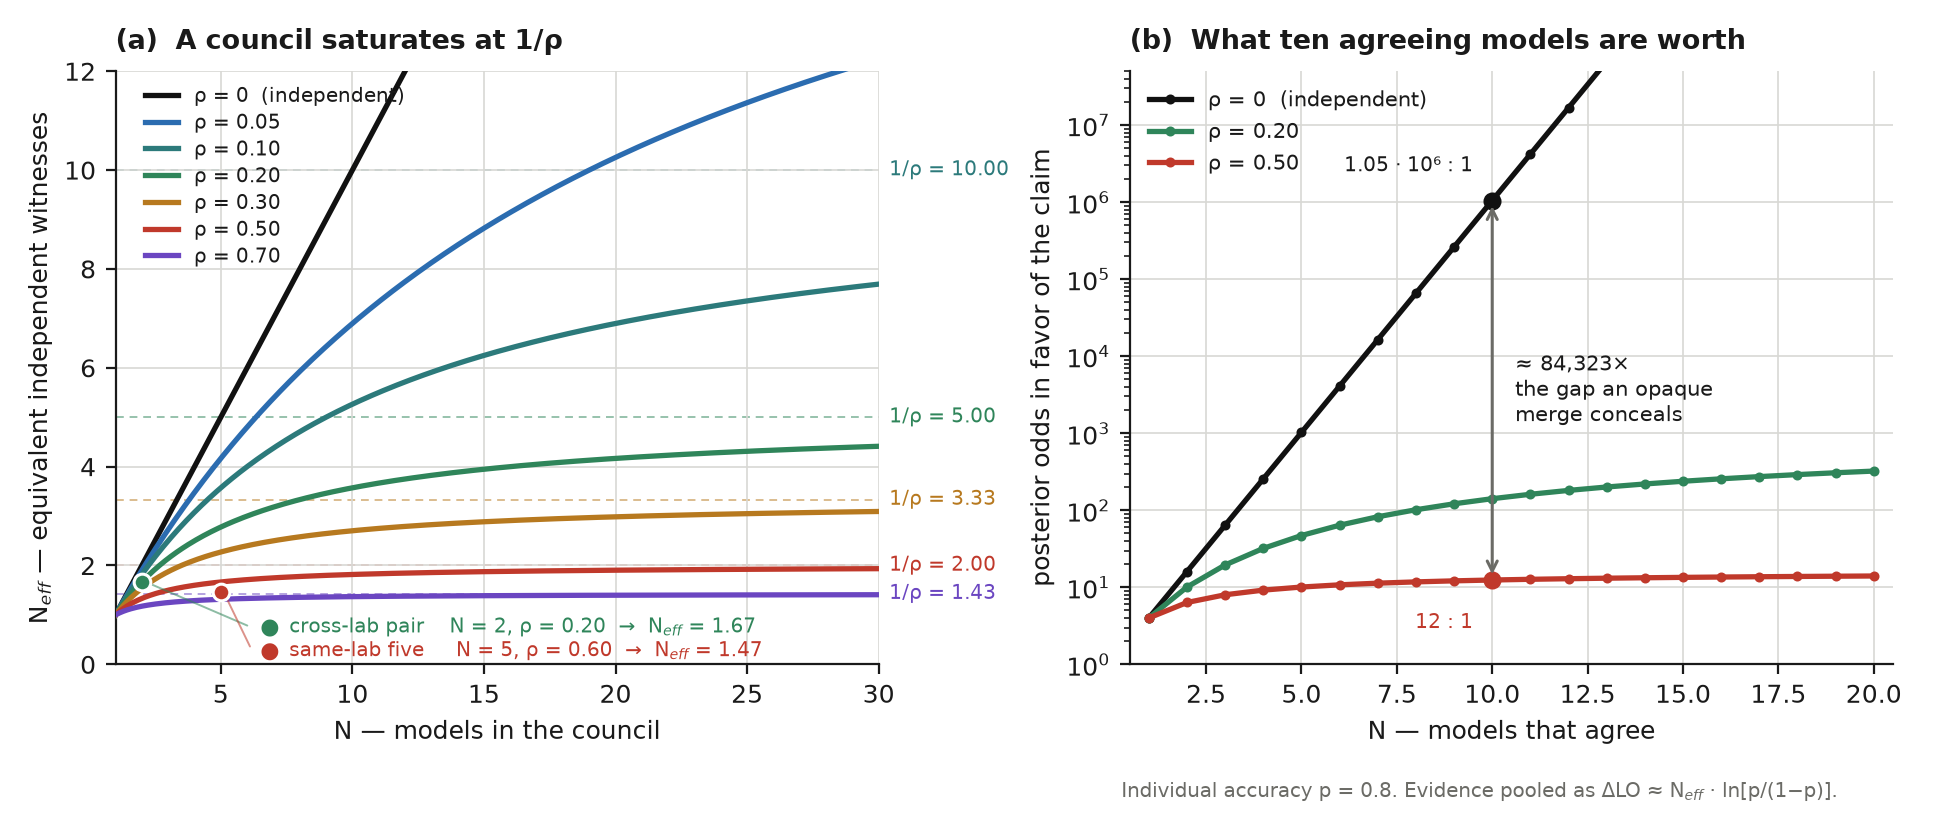
図1 — 評議会は1/ρで飽和する。 (a) Neffと級内誤差相関ρのいくつかの値に対する評議会サイズNの関係。各曲線はその上限1/ρで飽和し、破線の漸近線として描かれています。ρ = 0.20のクロスラボペアはρ = 0.60の同一ラボ5人組を上回ります。(b) 同じ結果を事後オッズで表したもの(セクション5.4で述べられた近似の下での説明的代理)で、個別精度p = 0.8であり、証拠はΔLO ≈ Neff · ln[p/(1−p)]として統合されます。独立して一致する10個のモデルはほぼ100万対1のオッズを与えます。ρ = 0.5で相関する10個のモデルは12対1を与えます。
実際的な結果は、単により多くのモデルを尋ねるべきだという直感に反しています。評議会が1/ρより大きくなると、ρを半分にすることはNを2倍にすることを上回ります。その結果はKohli(2026)と同じくらい誰のものでもあり、彼のパネルはこの算術が実地で観察されたものです。9人の裁判官は約2の有効投票数に相当し、ρ ≈ 0.44に対応しています。ρを半分にすることはNを2倍にすることを上回り、以下の2つの比較はセクション6に関連しています。
異なる研究所からの2つのモデルはρ ≈ 0.2で ≈ 1.67を与え、一方1つの研究所またはラインから5つはρ ≈ 0.6で5/(1 + 4·0.6) ≈ 1.47を与えるため、クロスラボペアは5つより大きい重みを持ちます。
幅広さはまた多様性ではなく飽和が急速に収益逓減を被ります。表2の行に沿った移動は急速に飽和しますが、列に沿った移動には制限がありません。
これが、カウント数を最大化するのではなく、異なるラインアージュにわたって評議会を均等に構成するための分析的基礎です。同じコーパスを読むために一致する5つのモデルは、本当に異なる3つより弱い証拠です。
5.4 対数オッズで
精度pを持つ独立した証人は対数オッズを提供する場合
その場合、N個の相関するモデル間の一致はおよそ
N · Lではなく。これはメタアナリシスにおける相関観察の通常の処理であり、ここでは近似として使用されます。設計効果調整後のカウントを独立した証人の数として扱いますが、設計効果自体はそれを確立しません。図1のパネル(b)はそれをプロットしています。p = 0.8のとき、L ≈ 1.386ナット:
- 10人の独立した証人はΔLO ≈ 13.86ナットと約1.05·10⁶ : 1の事後オッズを与えます。
- 10個のモデルはρ = 0.5で、したがって ≈ 1.82は、ΔLO ≈ 2.52ナットと約12 : 1の事後オッズを与えます。
比率はおよそ8.4·10⁴です。その要因は不透明なマージが読者に根拠のない信頼として提供するものであり、それが領収書が存在する理由であり、負荷を担う事実がマークされている理由です。ドキュメントは、読者の前の一致が10⁶ : 1の価値があるのか12 : 1の価値があるのかを述べる必要があります。ページ上では2つは同一だからです。
5.5 仮定と推定
モデルは単純であり、その仮定はそれに応じて強いものです。以下に基づいています。
ρはペア間で一様として扱われます。実際にはブロック構造を持っており、1つの研究所からのモデルは他の場所からのモデルと比べてお互いとより強く相関します。ペアワイズ平均はより良く、ブロック構造はさらに良いでしょう。ブロック構造の下では、一様公式は楽観的なを与え、真の上限は表で示されているより低く座ります。
ρはまた質問全体で一定として扱われ、それは明らかに領域依存です。入手可能なソースが1つのニッチなトピックでは1に近づきます。豊富な多言語文献を持つ質問ではそれはより低いです。
主張は二項として扱われ、一方、実際の答えは散文であり、散文を比較可能な二項主張に縮減することはそれ自体において騒々しい操作です。精度pは複数のモデル間で一様として扱われ、そうではありません。
ρは測定可能です。既知の地上真実を持つQ個のラベル付き二項主張とそれぞれの結果のエラー行列e_iq(i = 1…Nおよびq = 1…Q)が与えられた場合、級内相関は通常の分散分析ルートに従い、平均ペアワイズエラー共分散と平均エラー分散の比として以下のようになります。
ρを研究室内および研究室間で個別に推定すると、単一栽培(monoculture)の費用に関する数値が得られます(Kleinberg & Raghavan, 2021; Bommasani et al., 2022)。生成データで訓練したことの費用についても、連続するモデル世代にわたってこれがどのように変動するかを観察することで、同じことが分かります(Shumailov et al., 2024)。
5.6 これがプロトコルで変えるもの
式が認められると、セクション4のルール5と6、およびルール6が暗示する構成報告は、推奨される実践ではなく必須となります。
共有源にフラグを立てることであるルール6は、単一の主張のレベルでρの局所測定です。1つの記事の引用が5つあれば、その主張に対してρ ≈ 1であり、したがって ≈ 1です。
同意しているモデル間の親族関係を報告することは、構成のレベルで同じ測定です。
不一致を保持することであるルール5は、読者がρが1より低いことを知るための唯一の証拠です。乖離は相関が完全ではないことを示し、どちらの側が正しいことが判明しても有益です。不一致は測定装置であり、取り除くべき障害ではありません。常に同意する評議会は、世界について何も読者に伝えず、ρ ≈ 1であり評議会は余分であったということだけを伝えます。
6. 3つのティア、1つのプロトコル
プロトコルは3つのティアで実行されます。これらは3つのバージョンまたはファネルではなく、アクセス曲線上の3つのポイントです。1人のユーザーは異なる質問のために1週間で3つすべてを使用する可能性があります。
6.1 ティア0、無料パス
ユーザーはサイトを開き、質問を入力し、各回答をコピーして、マージプロンプトの下にあるチャットモデルに貼り付けます。コスト無し、インストール不要、ブラウザを備えたあらゆるデバイス(電話を含む)、およびユーザーがサインインしているアカウントのセットと同じサイズのカウンシル。レイテンシは10~15分で、ほとんどは待機時間であり、ディープリサーチモードではさらに増加します。
このティアは厳密な意味での参照実装です。ユーザーがすべての生の回答を保持する唯一のティアであり、マージの忠実性を直接判断できる唯一のティアです。
6.2 ティア1、モバイルティア
ホームスクリーンに1つのアイコンとショートカットライブラリに1つのエントリ。タップして質問を入力し、メニューからモードを選択すると、約1分後に完成した回答がスクリーンとクリップボードに表示されます。音声起動も機能します。
メカニズムはブラウザでもAPIでもありません。ベンダー独自のオペレーティングシステムアプリインテントをデバイスにすでにインストールされているアプリケーションとサブスクリプションに対してチェーンします。コストはトークンではなくサブスクリプションメッセージで計算されるため、モード設計はリソース配分の決定になり、好みの問題ではなくなります。代替モバイルプラットフォームは、インテントベースのオートメーションを通じて同等の機能を備えています。
表3は、モバイルティアの3つのモードを示しています。これらはパイプラインのステージではなく、並列の等しい関数です。1回の呼び出しあたり1つのモードが実行されます。
表3. モバイルティアの3つのモード
| モード | チェーン | メッセージ | 用途 |
|---|---|---|---|
| ポール | 両方のモデルが独立して回答。回答を並べて表示 | 1 + 1 | 生の相違を直接見る |
| 批評 | モデルAが回答。モデルBが第2の専門家として検証し、改善された最終回答を発行 | 1 + 1 | 日常的なデフォルト:2メッセージのコストでチェックされた回答 |
| 総合 | 両方が盲目的に回答。さらなる呼び出しが仲裁と統合を実行し、相違を標記 | 1 + 2 | 重要な質問 |
批評モードは簡潔にchairmanと呼ばれていました。3つのモードは並列の等しい関数であり、批評はピアレビューです。1人の専門家が回答し、別の専門家が検証します。chairman役はすでに総合の内部に仲裁者として存在しており、ピアレビューを集約の名前で呼ぶことはモードが実行する処理を誤って説明することになります。
携帯電話は幅が安い場所ではなく、ここではN = 2を固定します。各呼び出しは通常の使用と同じクォータからメッセージを費やし、アプリケーションは順番にフォアグラウンドに来て、ユーザーはそこに待機しています。セクション5.3は、ペアの価値を示します。2つのモデルは異なるラボからのもので、N = 2で利用可能なρ最小化の選択であり、これらの説明的な相関関係では、ρ ≈ 0.2のクロスラボペアは、ρ ≈ 0.6の同じ系統の5つを上回ります。そのため、カウンシルの目的のほとんどは1回のタップと1分で生き残ります。
6.3 ティア2、エージェントパス
ブラウザを駆動できるモデルは、ユーザーがサインインしているブラウザセッションで指定されたサイトを開き、質問を送信し、待機し、各回答をファイルに保存し、ドキュメントを構築します。カウンシルは10以上に拡張され、ディープリサーチモードが利用可能で、すべてのオリジナルを含む日付付きフォルダが実行を生き残ります。コストは、エージェントの小額の月次サブスクリプションにプラス、ユーザーがすでに保有している支払いティアです。レイテンシは5~30分です。
このティアは、ユーザーにユースケースを超えて生き残るもの、すなわち彼らのコンピューターで行動するモデルを与えます。ユーザーにアクションを説明するモデルと行動するモデルの違いは、1つのモデルと10のモデルの違いより大きいです。
6.4 レイテンシ–幅のフロンティア
表4. 3つのティア全体のレイテンシ–幅のフロンティア。有効な証人数ではρ = 0.2と仮定
| ティア0、無料 | ティア1、モバイル | ティア2、エージェント | |
|---|---|---|---|
| クリックするのは誰 | ユーザー | オペレーティングシステム | ブラウザエージェント |
| カウンシルサイズN | 無制限 | 2 | ~10まで |
| ρ = 0.2で | ~4–5まで | 1.67 | ~3.6 |
| 回答までの時間 | 10–15分 | ~1分 | 5–30分 |
| 限界コスト | ゼロ | サブスクリプションメッセージ | エージェントサブスクリプション |
| インストール | なし | 1つの署名付きショートカット | エージェントアプリケーション |
| ディープリサーチモード | はい、手動で | いいえ | はい |
| 生の回答が見える | はい | ポールモードのみ | はい、ファイルに保存 |
| デバイス | 任意 | 電話 | コンピューター |
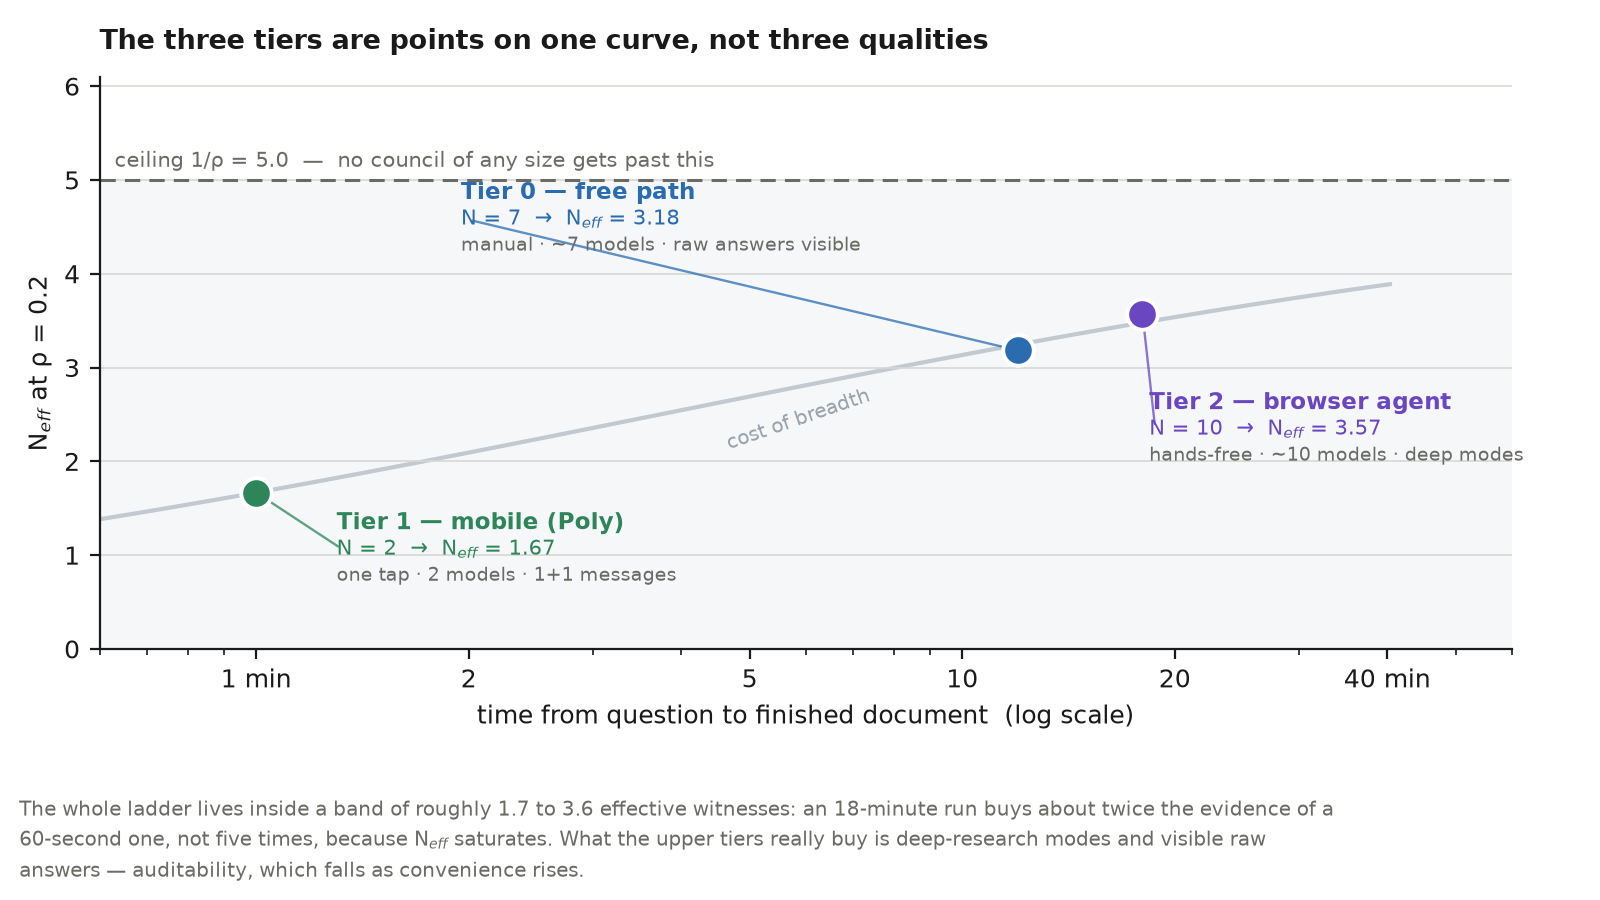
図3 — レイテンシ–幅のフロンティア。完成したドキュメントまでの時間に対してプロットされた3つのティア。Neffがρ = 0.2で計算されます。Neffは1/ρで飽和するため、2つの自動化されたティアはおおよそ1.7~3.6の有効な証人のバンド内に位置します。18分の実行は60秒の実行の5倍ではなく、約2倍の証拠を購入します。上位のティアが追加で購入するのは、ディープリサーチモードと見える生の回答です。
2つの観察がエンジニアリングからではなく、セクション5から続きます。
ティアは品質ではなく幅広さのコストによって順序付けられています。ティア1は、回答が店に立っている人の注意範囲内に到達する曲線上の点に位置しています。証拠の観点からのティア間のギャップは、モデル数のギャップよりもはるかに小さいです。なぜならは1/ρで飽和し、それがこのラダーを妥協の集合ではなく一貫性のあるものにしているからです。
監査可能性はラダーに沿って低下し、利便性とは反対の方向に進みます。ティア0ではユーザーがあらゆる生の回答を保持しています。ティア2ではエージェントがそれらをファイルに書き込むため、存在していますが、めったに開かれません。ティア1では、批評と合成が完成したテキストを返すため、ポーリングモードだけがそれらを公開します。モバイルティアはその一点で弱く、論文が冒頭で提示する問題を再現しています。ティアが便利になるほど、ユーザーは検査するのではなく信頼する傾向が高くなります。合成出力の相違マーカーを保持することは、見た目の良さではありません。それはティアの残された監査可能性です。
6.5 ブラインド並列と情報的逐次抽出
モバイルティアは、他のティアが暗黙のままにしていた軸を明らかにしました。そして、それはシステム内で最も重要な設計上の問題です。2番目のモデルは最初のモデルの回答を見ますか?図4は両方の配置を、各々が獲得するもの、そしてそのコストを示しています。
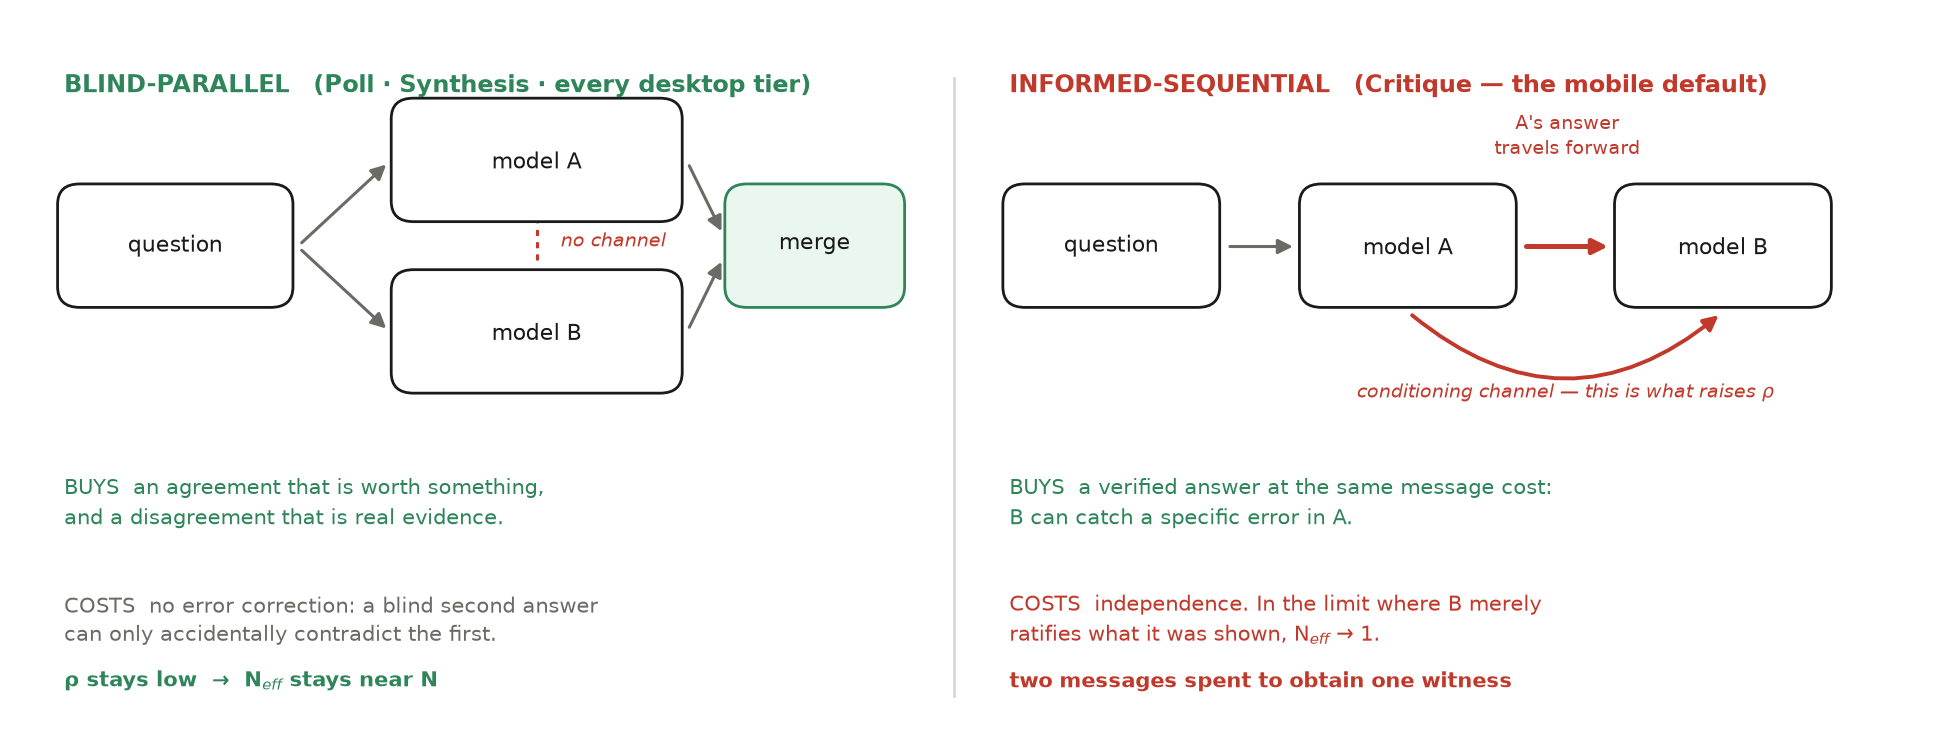
図4 — ブラインド並列と情報的逐次抽出。比較された2つのレジーム。ブラインド並列抽出では、モデル間にチャネルがないため、合意は証拠的な重みを持ち、不一致は実際の証拠ですが、エラー修正は発生しません。情報的逐次抽出では、最初の回答は2番目のモデルのプロンプト内に入ります。2番目は特定のエラーを修正できますが、条件付けチャネルはρを上げ、それが表示されたものを追認する極限では、Neffは1に近づきます。
ポーリングと合成はブラインド並列です。両方のモデルが生の質問に回答し、どちらも他方を見ていません。ここでの独立性は指示されたものではなく、アーキテクチャ的なものです。各アプリインテント呼び出しはメモリなしで新しいセッションを開き、すべてのプロンプトは自己完結型で、質問と以前の回答を含んでいます。1つのモデルが他方に影響を与える可能性のあるチャネルは存在しません。
批評は情報的逐次です。2番目のモデルは、最初のモデルの回答とともに質問を受け取り、事実的エラーについてそれをチェックし、それが省略したものを追加し、1つの改善された最終回答を発行するよう指示されます。
情報的配置は一見、ブラインド配置を単純に支配しているように見えます。2番目のモデルはブラインド2番目のモデルがするすべてのことを行い、最初の回答もチェックします。同じコストで。その見た目は誤解を招きます。2つの配置は異なる商品を購入し、情報的配置は独立性で支払うからです。
情報的逐次抽出はエラー修正を購入します。最初の回答を見ることができる2番目のモデルは、それの特定の間違いをキャッチできます。一方、ブラインド2番目の回答は偶然によってのみそれに矛盾できます。これは、マルチエージェント議論の結果の背後にあるメカニズムです(Du et al., 2023)。そして、それが批評を日常のデフォルトにするものです。ポーリングと同じ2メッセージコストで、検証されていない2つではなく、検証された回答を返します。
それは独立性、つまりρで支払います。最初の回答に2番目の回答を条件付けることは、Lorenz et al.(2011)が群衆の広がりを狭めるが真実に向かわせないという社会的影響です。固定された批評家は、固定されていないピアがするよりも、表示された回答に同意することが多いため、結果として生じる合意は見た目ほどの価値がありません。境界を述べるのは簡単で不快です。批評家が表示されたものを追認する極限では、 → 1であり、実行は2メッセージを費やして1人の証人を得ています。
これは、セクション5がユーザーが行動できるアドバイスになる唯一の場所です。情報的逐次抽出は、回答をチェックするための正しい選択であり、ブラインド並列抽出は、不一致が存在するかどうかという質問に必要です。2番目のモデルが最初のモデルを読んだ後に表面化する不一致は証拠ですが、表面化に失敗する不一致は、それを生成したであろうチャネルが閉じられたため、合意の証拠ではありません。
したがって、合成は批評のより徹底的なバージョンではなく、別のモードです。合成がより徹底的ではありません。それはブラインドです。これは異なる特性です。そしてそれは唯一のモバイルモード。その合意が証拠的な重みを持つモードです。余分なメッセージは仲裁者を購入しますが、その価値は、2つの仲裁された回答が決して出会わないという事実から来ています。
ティア0と2は、構造上ブラインド並列です。すべてのモデルが独自のセッションで生の質問を取得し、アンカーと充実のマージがその後に発生するからです。アンカーと充実は、完全にブラインドなものの後に配置された情報的なステージとして最もよく理解されます。順序付けはエラー修正を取得しますが、独立性コストを支払いません。そして、レイテンシの代わりに支払います。モバイルティアはデフォルトモードでその順序付けを余裕がないため、トレードオフはそこで、他の場所ではなく見えます。
6.6 APIではなく、なぜですか
トランスポートの選択は、誰がシステムを使用できるかを決定するため、それは詳細ではありません。
APIは再現性を提供します。つまり、既知のモデルバージョン、温度、シード、プログラム的な信頼性、サービス規約の問題なし、大規模でのコストの低さです。ブラウザーとアプリのインテントは、インストールなし、キーなし、追加の請求関係なし、電話の互換性、無料ティアでの操作、API同等のものがないことが多い深い研究モードへのアクセス、およびユーザーが既に支払っているサブスクリプションの使用を提供しません。
プロトコルは2番目の選択肢を採ります。APIキーを保有しており、ターミナルに習熟している者は、Karpathyのllm-councilのようなAPIベースの評議会(Karpathy, 2025)の方が恩恵を受けるでしょう。ここで対象とする母集団は、2番目のサブスクリプションが重大な決定であるか、使用するマシンにソフトウェアをインストールできない、またはインターネットアクセスが電話を介している者です。これらのユーザーにとって、本システムはおそらくこのアイデアの最初に到達可能な実装です。キーが不要で、インストールが不要で、2番目の請求がなく、到達可能であることがシステムが製品ではなくテキストファイルである全ての理由だからです。
代償は再現性であり、それは高い。Webインターフェースまたはコンシューマー向けアプリケーションの背後にあるモデルバージョンは未知であり、予告なく変更されます。温度は制御不可能で、サービスのシステムプロンプトは隠されており、アカウントのパーソナライゼーションが回答に影響を与えます。実行は完全に繰り返すことができず、来月や別のマシンでも同様です。これは個人的決定ツールとしては許容可能ですが、科学的測定には許容できません。したがって、セクション9では、生の回答をアーカイブし、結論をモデルについての主張ではなくプロトコルについての主張として構成することを要求しています。
6.7 セキュリティ
フリーパスは自動化固有の攻撃面を追加しません。ユーザーがサイトを直接操作しているためです。ただし、ブラウザと、アカウント自体の通常のリスクは残ります。以下はエージェントパスに関するものです。
主なリスクは間接プロンプトインジェクション(OWASP, 2025)です。すべての収集された回答は信頼できない入力です。なぜなら、モデルの出力はオーケストレーターに向けられた命令を伝達できるからです。文字列フィルタリングは防御ではありません。正当なコンテンツを破損させ、何も保証しません。
建設的な答えは権限の境界です。収集されたテキストは引用データとして扱われ、決してコマンドとしては扱われません。アップストリームモデルがツール呼び出しブロックを発行するか、注入された命令を再現すると、オーケストレーターはそれを引用として統合し、何も実行しません。
ルール・オブ・ツー(Meta, 2025)の枠組みの下では、エージェントが次の3つすべてを保有するとき、危険になります。信頼できない入力の処理、機密データまたはシステムへのリーチ、および外部状態を変更するか外部に通信する力です。ここで説明するエージェントは最初の2つを保有し、3番目を能力が可能な限り狭く保ちます。ユーザーのマシンを離れる唯一のアクションは、ユーザーが名付けたサイトにユーザーの質問を送信することです。それが書くものは、そのマシン上の指定された出力ファイルです。それは購入、公開、削除、設定の変更、認証情報の入力、またはチャレンジレスポンステストの解決を行いません。さらに重要なことに、それが読むものは新しい外向きのアクションにはなり得ません。収集された回答は新しいステップまたは新しい宛先をトリガーすることはできません。信頼できない入力と外向きのアクションは分離されています。唯一の外向きの通信はユーザーの質問そのもので、収集された回答が読まれる前に送信されます。汚染されたアップストリーム回答は、したがって伝播する場所がなく、ドキュメント内の現実的な最悪のケースは間違った行であり、出所ラベルはそれをキャッチするのに役立ちます。セッションレベルのリスクは、以下の運用規則によって対処されます。
これは能力隔離文献(Debenedetti et al., 2025)に従い、EchoLeak(CVE-2025-32711; MITRE, 2025)のようなゼロクリックエージェント悪用がほかの場所で成功する理由を説明します。そこでは、3つの機能すべてが相互に連鎖しています。
運用規則は、ヘッドレスのものではなく目に見えるブラウザウィンドウ、ユーザーが別のブラウザプロフィール内にサインインしたセッション(認証情報のストレージまたは入力なし)、およびチャレンジレスポンス解決、フィンガープリントなりすまし、プロキシローテーション、またはアカウントプーリングなしです。最近のブラウザバージョンは、プロトコルベースのCookie盗難に対する対策として、デフォルトプロフィールのリモートデバッグフラグを無視するため、自動化は別のプロフィールディレクトリを使用する必要があります。別のディレクトリは摩擦ですが、より安全な配置でもあります。ユーザーの日常的なブラウザセッションにサイレントに接続すると主張するツールは、疑いの対象です。
これが意味することは、技術的なサンドボックスではなく、プロンプトレベルの制約に加えて、意図的に小さいツール表面です。これはブラストラディウスを縮小します。ラディウスがゼロであることを証明しません。
モバイル層の脅威面は異なり、より小さいです。呼び出しはベンダー公開のオペレーティングシステムインテント経由で進行し、デバイスはロック解除される必要があり、アプリケーションが順序内でフォアグラウンドに入り、バックグラウンドで何も実行されません。スケジュール付き自動化ではなく、ユーザーが押すボタンです。プロンプトインジェクションの懸念はまだCritiqueとSynthesisに適用され、1つのモデルの出力が別のモデルのプロンプト内に入ります。これは同じように処理されます。収集された回答は引用材料であり、受信するモデルには利用可能なアクションはありません。
7. 実証的セクション
7.1 コールドスタートプローブ
ユーザーが初めて行うことは、システムをモデルに渡すことです。そのモデルが辞退するか、結果に似たものだけを返す場合、ユーザーは去り、二度と報告しません。その瞬間がコールドスタートプローブが測定するもので、問題に遭遇したことのない新しいセッションが必要なため、自動化することはできません。
プロンプトはヒント、フレーミング、フォローアップなしで送信されます:
このリポジトリからメソッドを実行してください。質問:水を飲む量が少なすぎることの3つの大きなリスクは何ですか? メソッドが言うことを何でもしてください。
3つの環境があります。Aではエージェントがブラウザ制御が意図的に切断されたクローンに位置します。Bは通常のチャットセッションで、フロントページドキュメントだけが貼り付けられています。Cではエージェントが動作中のブラウザ制御を持っています。
最初の答えだけが6つのバイナリ基準に対して採点されます。それをそのように制限することはプローブの方法論的コアです。なぜなら、モデルが修正後に言うことは、見ず知らずの人が経験したことを表していないからです。
- このセッションで利用可能なツールを確認しましたか。それとも、それがどのような種類のモデルであるかについて推論しましたか?
- 同じメッセージ内で次のステップなしの単なる拒否を避けましたか?
- 何かが不足していた場合、制限のカテゴリーではなく、特定の不足しているコンポーネントに名前を付けましたか?
- 同じ答えの中で、2回尋ねられることなく手動パスを提供しましたか?
- ユーザーはすぐに答えに対して行動できましたか?
- 実際に個別のモデルから回答を収集しなかった場合、何かを表示する前にそう述べましたか?
基準6はベースラン後に作成され、他の5つより重みがあります。1つのモデルから来たようにも見えるが評議会のように読める答えは、実行がいかに優れていようとも、プローブに完全に失敗します。
7.2 ベースラン
5つのモデルには、ドキュメントと通常の質問が与えられました。ヒントはありませんでした。ブラウザ制御を持つものはなく、そのため実行は1つのことだけを測定しました。モデルがメソッドを実行できないことをどのように報告するかです。表5は結果を報告しています。表のモデルは、ランキングではなく複数のモデルが共有する障害モードであることが重点であるため、製品名ではなく研究室によって識別されます。
表5. コールドスタートプローブ、ベースラン。5つのモデル、ブラウザ制御なし、最初の答えを採点
| モデル | 開発者 | 結果 |
|---|---|---|
| モデルG | 研究室1 | 合格。 自分のツールを確認し、不足しているコンポーネントに名前を付け、質問をどこにも送信していないと述べ、2つの必要な選択肢を求め、単一モデルビューがメソッドの結果ではないことを事前に警告しました。 |
| モデルS | 研究室2 | 宣言された代替で合格。 モデルの回答の代わりにウェブソースを使用し、その言葉を含めてそう述べました。これはメソッドが意図するより小さく、異なる構成の評議会であることを含めて。 |
| モデルH | 研究室2 | 合格。 何も代替しませんでした。プロンプトをユーザーに渡し、答えを返すよう求めました。 |
| モデルC | 研究室3 | 不合格。 メソッド独自の語彙で書かれたウェブリサーチ、どこにも注意書きなし。 |
| モデルK | 研究室4 | 不合格。 メソッドの出力ファイル名の下に保存された、正しい形状の完全にマージされたドキュメント。ウェブページから取得され、モデルではなく、注意書きなし。 |
5つのうち2つは、ユーザーが10人の評議会として提出したであろうドキュメントを作成しました。これはF5、観察されたものです。
7.3 介入と再実行
介入は役割割り当ての1文で、モデルがこの実行の演算子であり、エージェント命令ファイルを読むべきであることを告げています。ドキュメントの最初の画面と、モデルに対処した別のファイルに記載されました。表6は環境Bでの再実行を報告しています。
表6. 役割割り当て介入後の環境Bでのコールドスタートプローブ。セクション7.1の基準を番号付け;(ウェブ)はベンダーのウェブインターフェースを通じて実行されたことを示し、C′は研究室3のモデルです
| モデル | 1 | 2 | 3 | 4 | 5 | 6 | 判定 |
|---|---|---|---|---|---|---|---|
| モデルC′(ウェブ)、研究室3 | はい | はい | はい | はい | はい | はい | 合格 |
| モデルP(ウェブ)、研究室5 | はい | はい | はい | はい | はい | はい | 合格 |
| モデルK(ウェブ)、研究室4 | はい | はい | はい | はい | はい | はい | 合格 |
最後の行が指導的なものです。ベースラインではメソッドの出力ファイル名の下にラベルなしのウェブサマリーを作成したモデルが、今回ドキュメントからマージプロンプトを再構成し、ユーザーに手を渡しました。その後、独自のウェブリサーチを背景リサーチとマークする明示的な見出しの下に出力し、評議会結果ではなく、文脈のためだけにあることを追加しました。
監査はその後、合格がモデルが引き戻していた段落のより長いドラフトに対して測定されたこと、そして一度段落が短縮されると、以前の結果は現在のテキストについてもはや何も証明しなかったことを確立しました。環境Bは短縮されたバージョンに対して再実行され、すべての6つの基準に合格しました。モデルは特定の欠落した接続に名前を付け、メソッドの結果を作成していなかったことを述べることで終了しました。独立した答えが収集されなかったからです。
そのエピソードはそれ自体が検出結果です。合格テストは、テストされたテキストが変更されると満期が来ます。古い合格を新しいドラフトに持ち込むことは、快適で一般的な自己欺瞞の形です。
7.4 解釈
観察はF5が実在すること、異なる研究室からのモデル間で発生すること、役割割り当てに敏感であることを確立します。これは安価なテキスト介入です。これは、モデルがそのコンテキストが提供するフレームを採用することの一般的な発見と一致しています(Sharma et al., 2023)。ここではその特性は正確さに有利に機能します。
周波数を確立するものではありません。n = 5、n = 3、反復なし、著者による採点の場合、これは障害モードが存在することを示しており、その発生率について何も述べていません。すべてのベースライン実行はブラウザ制御を欠いていたため、測定されたのは方法を実行するスキルではなく、無能さの誠実な報告でした。パスは、いかなるモデルがオーケストレータとしての価値があるかを示唆するものではありません。設計はそのような推論を支持していません。第10節は境界条件を記載しています。
このような種類のチェックリストは構造的なリスクを伴います。テキストはそれがパスするまで編集され、その後チェックリストは何も測定しなくなります。2つの保護策がそれを測定し続けます。基準は、実在するユーザーが他の場合に被ったであろうことを述べることができる場合にのみ編集を正当化し、基準はそれが妥当に聞こえたからではなく、ライブ実行が対応する障害を生み出した後にのみ追加されます。両者は、ここに示す6つの基準に対して成り立ちます。
7.5 モバイルビルドからのフィールド観察
物理デバイス上でモバイルティアを構築および認証すると、異なるクラスの知見が得られます。これは認識論的証拠ではなくシステム証拠であり、コンシューマアプリインテントパイプラインに特有の障害面を文書化しており、APIパイプラインが壊れる方法とは異なります。
ティアは算術スモークテストで全体的に認証されました。数字はどのキーボードレイアウトでも生き残るため選択されました。批評は正しい合計と、最初のモデルの回答にエラーが含まれていないという明示的なステートメントを返しました。投票は両方のモデルの回答を並べて一致して返しました。タップから結果までのハンズオフレイテンシーは約50~60秒です。表7は何が壊れたかを記録しています。
表7. コンシューマアプリインテントパイプラインの観察された障害モード、原因および改善策
| 症状 | 原因 | 改善策 |
|---|---|---|
| 最初のプロバイダのインテントは、アプリケーションがログインしている間、ユーザーはログアウトしていると報告します | 既知のインテント欠陥、アイドル期間後に繰り返し発生 | アプリケーションを一度開いて再実行します。これが信頼性の低いプロバイダが最初に呼び出される理由です。その障害は何の費用も発生させません |
| 2番目のプロバイダはモデルを利用不可と報告します | 無料層のアカウント側モデルゲーティング。インテントはモデルパラメータを公開しません | アプリケーション内で目的のデフォルトモデルを設定します。チェーンは選択できません |
| 実行はエラーなしで静かに終了します | 実行中のショートカットのオーバーレイは、デバイスをタッチして閉じられます | 実行中はデバイスを操作しないでください。再実行してください |
| チェーンは中間回答カードで一時停止します | 実行時表示パラメータはデフォルトで有効です | ビルド時に無効に設定します |
| 長い回答が切り詰められます | インテントレベルの出力制限 | コンパクトな回答をお願いします。批評品質は測定可能に影響を受けません |
これらのうち3つはこのシステムを超えて一般化します。
チェーンを脆弱性で順序付けます。信頼性が最も低いプロバイダが最初に来るため、その障害は何の費用も発生させず、より信頼性の高いプロバイダが失われてはいけないロールを受け取ります。仲裁者かつファイナライザーを意味します。
メモリがないと仮定してください。すべての呼び出しは新しいセッションを開くため、すべてのプロンプトは自己完結型である必要があり、質問と以前の回答を内部に保持している必要があります。ブラインド並列独立性は、第6.5節が主張しているように、命令されるのではなく、建築上のものです。
サイレント障害を最も不信します。タイムアウトで終了したように見えた2つの実行は、実際にはユーザーがデバイスを持ち上げたことによって殺されていました。これらをソフトウェアに帰すると、存在しない欠陥に対する修正が生じたでしょう。
8. ペーストファイル:コールドスタートガイダンスのためのインターフェースパターン
これは別のインターフェース結果であり、このシステムを超えて転送されます。
ペーストファイルは、ユーザーが通常のクラウドチャットモデルに全体を貼り付ける平文ファイルであり、その後、そのモデルはユーザーが本来は始めることができなかったことをガイドします。この状況は十分に一般的です。フォルダ、リンク、またはツールを渡されたが、開始することができない人もいます。業界が通常これに到達するすべてのもの、ランディングページ、オンボーディングボット、カスタムアシスタント、またはアプリケーションのいずれであっても、ユーザーを新しい場所に行かせることが必要ですが、ペーストファイルは彼らが既に開いているインターフェースを使用します。
これはエージェントが自分自身で読むファイルと同じものではなく、それは既にファイルアクセスを備えた常駐プログラムに対応しています。ペーストファイルは、ユーザーのディスクを見ることができず、今後も見ることができないクラウド内の誰かのチャットセッションに対応しています。
4つの不変性
ファイル名は最初の指示であり、読み手自身のスクリプトにあります。これは従来のドキュメンテーションファイル名ではなく、文であり、言語ごとに1つのファイルで、すべてが存在し、共有プレフィックスの下に一緒にソートされています。ユーザーはリストから選択していません。彼らは自分の文字体系を認識し、残りを無視しており、多言語標識で見慣れない行をスキップする方法と同じです。これはコストがかかりませんし、それが書かれた言語を見つけるために、人が持たないかもしれない言語を読む必要があるステップを削除します。
ファイルはモデルができないことを宣言し、そうでなければふりをすることを禁止します。最初のセクション:あなたはクラウド内のチャットセッションです。あなたはユーザーのコンピュータ上にはいません。あなたは彼らのファイルを開いたり、何か実行したりすることはできません。あなたが見たと主張しないでください。このパターンの特徴的な失敗、別の形式のF5は、モデルが見たことのないフォルダの自信のある、もっともらしいアカウントです。ユーザーにとっては見えません。なぜなら、よく形作られた答えと正しい答えは、チェックできない人には区別がつかないからです。
完全性は検出可能です。上部のセクションのマニフェストと最後の行のファイル末尾マーカー。指示はモデルに何も言う前にマーカーを探すよう指示します。それまたはリストされたセクションが欠落している場合、停止して、どの部分が到達したかを報告し、ファイルを再度要求してください。ギャップを独自の知識から埋めることはありません。長いペーストは、フリーティア制限、メッセージ制限、または電話で切り詰められます。マーカーがないと、モデルは到達したものに進み、残りを即興します。
ファイルは自己完結しています。ユーザーが今日結果を得るために必要なすべてはそれの中に逐語的に存在し、参照されていない、リンクされていません。「マージプロンプトファイルを開く」と言うペーストファイルは失敗しました。なぜなら、それを読むモデルは何も開くことができず、ユーザーはフォルダを全く持たないかもしれないからです。自己完結性は、ファイルがメッセージングアプリケーションを通じて転送され、何も添付されておらず、それでも機能させます。
2つの順序付けルール
時系列ではなく、置き換え不可能性で順序付けします。ペーストは下部から切られるため、インストール手順、背景、または検索可能なもの、つまりモデルが援助なしで再構築できるものは末尾の近くに属し、正確である必要があるものはすべて高くなります。
できるだけ早く引き継ぎます。パスがユーザーがインストールするプログラムで終わる場合、そのプログラムのセットアップの引用を停止し、それを尋ねるよう伝え、ルールをファイルに書き込みます:インストール済みプログラムがそれ自体についてこのファイルと矛盾する場合、ファイルは間違っています。他の誰かのインストーラーを説明するテキストファイルは数か月以内に古くなりますが、プログラムに尋ねられたプログラムは古くなりません。
コピーを忠実に保つ
コピーが増えて、コピーがドリフトします。2つの安いメカニズムで十分です。ペイロードを逐語的に生成する代わりに、ビルドステップが1つの真実の源からすべての言語ファイルに正規テキストをスプライスし、継続的統合がコミットされたファイルが異なる場合は失敗します。ルールに対してだけでなく、翻訳を互いに比較してください。なぜなら、すべての構造チェックは、静かに長さの半分になったファイルをパスするからです。ここでの継続的統合は、すべての言語バリアントが同じ数のセクションと同じ数のセットアップ手順を実行することを主張しています。
パターンの評価
このパターンには独自の10項目のチェックリストがあります。その項目の2つがここに示されています。どちらも、予想されたものではなく、観察された失敗に応答して書かれました。
モデルは、ファイルを使用する代わりに、ファイルを改善、短縮、または書き直す提案をしていますか?これは静かに失敗し、書き直されたバージョンは、モデルが最も説得力がないと判断したルールを失います。
最後の3番目が削除されたコピーが与えられた場合、モデルは通知を停止して到達したものに進む代わりにしていますか?これには意図的に切り詰められたコピーで専用の実行が必要であり、通常のペーストから観察できない唯一の項目です。
チェックリストは最初の返信を測定し、これは実行ではありません。完璧に開き、その後4つのメッセージ後にインストール手順を発明するガイドはチェックリストをパスし、ユーザーに失敗します。パターンの実際の失敗は、セットアップの途中で発生し、この評価は見ていません。
9. 提案された評価
Mixture-of-agents(Wang, J., et al., 2024)およびmulti-agent debate(Du et al., 2023)は、API条件下で最強の単一モデルに対する利得を報告している。マージされた回答が最良の単一回答を上回るという主張は未解決であり、このプロトコルの比較はいかなる数値が得られる前にあらかじめ指定されているため、後からそれに適合させることはできない。
9.1 仮説
H1。 Anchor-and-enrichは、事実的正確性と完全性において、最強の単一回答を上回る。
H2。 Anchor-and-enrichは、正確な少数派の生存と無出典主張の割合において、ナイーブなマージを上回る。
H0。 差異がない、またはマージが結果を悪化させる。
H2はH1よりも重みが大きい。プロトコルがこれら2つの指標でナイーブなマージに負ける場合、第4節の設計は正当化されない。文書がいくら読みやすくても同様である。
9.2 設計
50から100の質問、3つのアーム:最強の単一モデルの回答、回答を組み合わせるだけのようにとの命令を受けたナイーブなマージ、およびanchor-and-enrich。質問はいかなる実行前に選択および固定され、健康、法律、技術、消費者選択および数値的事実にわたるドメイン分布は、セットとともに公開される。
9.3 指標
事実的正確性は、一次資料に対して確認された検証可能な主張の割合として。完全性は、事前に指定された重要ポイントのリストのカバレッジとして。正確な少数派の生存は、正確なポイントを作成した単一モデルが最終文書に達する場合の割合として。出典の質は、一次、二次、または欠落として。発明された主張のレート(invented-claim rate)は、出力に存在するが入力のいずれにも存在しなかった主張であり、これはF1の直接的な指標である。読みやすさ。実行時間とコスト。そして、別々に完全に報告される、マージが状況を悪化させたケース(これらが興味深いもの)。
9.4 ブラインド化
モデル名は隠され、回答順序はスコアリング前にシャッフルされる。ジャッジモデルは位置、冗長性および馴染みのある家風(Zheng et al., 2023)に敏感であるため、ブラインド化されていないスコアリングは部分的にこれらを測定することになる。人間によるスコアリングは同じ手順に従う。
9.5 公開および反証可能性
質問、生の回答、最終文書およびスコアは完全に公開され、採点は異議を唱えることができる。
反証条件は事前に指定されている。アーム3がアーム1を正確性と完全性で上回らず、かつアーム2を少数派の生存と無出典主張の割合で上回らない場合、H1およびH2は支持されず、主張はシステムの資料から出てくる。
9.6 相関のある証人モデルのテスト
H1およびH2とは独立して、ρは同じ質問セットに対して第5.5節の手順によって推定可能であり、これにより、それから従う予測のテストが可能になる。
H3。 k番目のモデルを追加することからの利得は、 = N/(1+(N−1)ρ)の予測どおりに減衰し、異なるラボから引き出された評議会は同じラボから引き出された同じ規模の評議会を上回る。
H3は一次比較用に収集されたデータでテスト可能であり、追加の収集を必要としない。反証は、より有益な結果となるであろう。なぜなら、それはクラスタサンプルアナロジーが言語モデルの評議会に転送されず、第5節を書き直す必要があることを意味するためである。
9.7 モバイルティアが安価にする2つのテスト
各モバイル実行は1回のインタラクションと固定数のサブスクリプションメッセージを使用し、これは2つのさらなる主張を容易に到達可能にする。
H4、相関優位性(correlation dominance)。 N = 2でのクロスラボペアは、N = 5での同じラボの5人組を正確性と少数派の生存で一致または上回る。これは第5.3節の利用可能な最も鋭いテストであり、アームはモデルが決定的だと呼ぶ方向ρで異なり、二次だと呼ぶ方向Nで互いに対抗するためである。
H5、獲得軸(elicitation axis)。 ブラインド並列獲得は、同じ質問セットに対して情報を知らされた逐次獲得よりも厳密に多くの相違を浮き彫りにし、それが浮き彫りにする相違は単一モデル回答の誤りを予測する。H5が失敗する場合(情報を知らされた批評家がブラインドピアと同数の相違を発見することを意味する)、第6.5節の独立性費用の議論は誤りであり、情報を知らされたモードは単にブラインドモードを包含する。
10. 制限事項
中心的な主張は検証されていません。第4節は設計論証であり、第9節はそれを解決する比較を規定しています。
ρは推定ではなく仮定されています。表2と表8のあらゆる値は、仮定された均一なρにおける第5節の公式から従っており、これらの表は現実的なブロック構造の下で上限にあります。
第7節はn = 5およびn = 3を報告しています。失敗モードが存在することを確立しており、主張は頻度ではなく存在に限定されています。採点は著者によるもので、評定者間信頼性の推定値がなく、二値基準は単一評定者リスクを軽減していますが、それを除去しているわけではありません。環境Aは介入後に再実行されず、環境Cは実行がないため、報告されたパスは環境Bのみをカバーしています。
ウェブインターフェースおよび消費者向けアプリケーションの背後にあるモデルのバージョンは不明であり、変更されており、アカウントの個人化が回答に影響を与え、実行は正確に繰り返すことができません(第6.6節)ので、結果は急速に古くなり、名付けられたモデルについてではなくプロトコルについての証拠です。
シンセサイザー自体は言語モデルであり、他のモデルと同様にF1からF4の対象です。プロトコルはこれを構造的に、出処、無言削除の禁止、および別の不一致セクションを通じて制約していますが、それを除去してはいません。出力品質は、与えられたモデルがいかに忠実に命令に従うかに依存しており、その依存性は測定されていません。
ブラインドルーブリックは同じモデルによって実行され、そのモデルがドキュメントを構築するため、アンカー選択はバイアスポイントであり、そのモデルが自身に文体的に似ている回答を体系的に好む、つまり別の位置における判定者モデルバイアス(Zheng et al., 2023)を停止するものはありません。プリセットされたアンカーを禁止することは問題の明示的な形式のみに対処しています。
モバイルのデフォルトは情報的順序であるため、最も頻繁に使用されるモードはまた、その同意が最小限の証拠の重みを持つモードでもあります(第6.4節)。これは1メッセージあたりの品質トレードであり、それが設定する境界はここで述べられています。階層の主な弱点は、監査可能性と遅延のトレードです。批評と総合は完成したテキストを返し、生の回答はモデル自身のセッション履歴にのみ存在するため、ポーリングモードを開かないユーザーは確認の代わりに信頼しており、これはプロトコルが反対することを主張するための姿勢です。
時間コストは無料パスの境界を設定しています。現実的な完全評議会は10~15分の待機時間であり、深い研究モードで提供者あたり5~25分です。対象人口の一部にとってそれは利益を超える可能性があります。
第11節は、エージェントパスの法的位置と、それが残す利用規約の問題を設定しています。
11. 倫理、プライバシーと法的枠組み
このシステムは、ユーザーが自身のモデルアカウント(無料または有料)を自分のブラウザまたはデバイスを通じて個人的に使用するためのものです。第三者データをスクレイピングしたり、ペイウォールを回避したり、チャレンジ・レスポンステストを解いたり、ボット検出を回避したり、プロキシをローテーションしたり、その動作を隠蔽したり、アカウントを転売したり、マルチテナント方式で実行したりするものではありません。
アクセシビリティは副次的な効果ではなく、本来の目的です。障害のあるユーザーがこれを支援技術として依存する場合、それはまさにその用途です。つまり、ユーザーの代わりに、ユーザーのペースで、ユーザー自身のアカウントに対して機能するヘルパーです。カーブカット類似の概念は正確です。車いす利用者のために建てられたスロープは、ベビーカーを押す親や配達員にも役立ちます。そして、数ダースのブラウザタブを管理できないユーザーのために構築されたシステムは、万人に役立つことが判明します。
パスは法的に等価ではありません。無料パスはどう読んでも通常の使用に見えます。つまり、ユーザーがサイトを開き、入力してコピーします。モバイルティアはこれに近い位置にあります。ベンダーがこの種の呼び出しのためにアプリインテントを公開しており、ショートカットは2つのそうした呼び出しをチェーンでき、各アプリケーションを設計通りに使用し、1メッセージずつ前景で実行するためです。エージェントパスはより詳しく検討する必要があります。自動アクセスのルールは、スケール出力の収集、サービスをロードするボット、レート制限の回避、複数のアカウント実行、および返されたものの転売を目的としています。そのどれもが、ユーザーが自身のログイン済みブラウザで1つの質問を人間のペースで尋ね、答えを自分で読むことを説明するものではありません。そのような使用は、構造的には、マウスとキーボード操作ができない人のためにタイプしてクリックする支援ソフトウェアと同じです。しかし、いくつかの規約は目的よりも広く起案されており、スケールへの言及なしに自動化された手段を禁止しています。それが単一の質問を自動化するユーザーに達するかどうかは、サービス、管轄区域、およびその日に有効な規約に依存します。これは判断であり、裁定ではありません。ユーザーは、接続するものの規約を見て、自分で決めるべきです。それについて全く考えたくない人は、無料パスを使用できます。これは同じ仕事をし、エージェント固有の質問を何も引き起こしません。サイトの通常の規約は依然として適用されます。
プライバシーは構成上の決定です。モデルのセットは、ユーザーがタイプしたものをどの企業が受け取るかを決定します。これは通常の質問には重要ではありませんが、健康、雇用主またはクライアントについての質問であれば重要です。特定の質問を特定の企業に送信することが不快である場合、その質問については、そのメンバーを除いておいてください。1つを削除することは何の費用もかかりません。
プロトコル自体の倫理的制約は禁止です。メソッドの実行ではなかったものを実行として提示することはできません。ウェブサマリー、シングルモデルの回答またはオペレーターの推論のそれぞれは有用ですが、それらは評議会の結果ではなく、ユーザーはそれらが何であるかを知らされなければなりません。実際には、これは受領書がなく、同意と不同意のセクションがなく、本物のマルチモデル実行ではなかったものについては出力ファイルがないことを意味します。
12. 結論
自信を持った間違った答えは自信を持った正しい答えと区別がつかず、その二つの間の議論は誰の目にも見えます。したがって評議会の価値は、意見の相違を平均化することではなく、それを明らかにすることにあります。
モデル間の一致は独立した確認ではありません。エラー相関ρを持つN個のモデルの評議会は、 = N/(1+(N−1)ρ)個の独立した証人の価値があります。この量はモデルがいくつ追加されても1/ρで飽和するため、ρ = 0.5では任意のサイズの評議会は最大2つの証人の価値しかありません。10個の独立した一致するモデルと10個の相関したモデルの間の証拠としての強さの違いは、約5桁の大きさに達し、不透明な統合はその違いを読者に獲得していない信頼として与えることになります。
設計はこれら2つの前提から導かれています。それは出所を保持するため、読者は結果を信頼するのではなく検証でき、意見の相違を高い位置に置きます。というのは、意見の相違は単一のモデルが供給できない唯一の要素だからです。複数の答えが共有するソースは1つのソースとしてマークされます。負荷がかかる事実は名付けられ、何がソース化されているかは何が単に一致しているだけかから分離されています。プロトコルの自己説明に適用される1つのルールがさらにあります。それは、実際にそうではなかったものを同僚的として提示してはならないということであり、これは理論的な懸念ではありません。盲目的な実行では5つのモデルのうち2つがそれを黙って違反し、ロール割り当ての1文がenvironment-Bの再実行でその両方を逆転させました。
3つのティアは、3つの品質レベルではなく、幅のコストを軸とする曲線上の点であり、セクション5がその曲線を一貫性のあるものにするものです。が飽和するため、2つのモデルと10個の間の証拠としての距離はモデル数が示唆するものより大幅に小さく、異なる研究所から来た2つのモデルは携帯電話で実行されている場合、1つの系統から引き出された5つより価値があります。モバイルティアはまた、他のティアが静かに行っていた取引を公に強制しました。最初のモデルを読んだ2番目のモデルはそれを修正できますが、もはやそれを独立して確認することはできません。エラー修正と独立した確認は異なる商品であり、異なる順序で購入され、どちらを売っているのかを言わないシステムはその使用者を誤解させています。比較制御は開かれたままであり、セクション9はそれを指定するとともに、私がその主張を撤回することを義務付ける結果を指定します。
その比較がどのような結果になるにしても、出所なしで統合され、保存された意見の相違のないドキュメントはまったく確認できず、したがって決定を下す誰かにとって重要な意味では単一の答えより優れていることはできません。監査可能性は合成の改善ではありません。それは合成に結果と呼ばれる権利がある条件です。したがってプロトコルのルールは、何個のモデルが質問されたかについてではなく、各文がどこから来たか、そしてモデルが何に反対したかについてのものです。
宣言
資金提供。本研究は外部資金による支援を受けていません。
利益相反。著者は本論文で分析した多モデルオーケストレーション手法の開発者であり、これらは公開かつ再現可能であることを読者は考慮すべき利益相反です。著者は、本論文が検討するようなAIオーケストレーションおよび多モデル検証システムに関連する保留中の特許出願(付与された特許ではない)の指定申請人です。第4章で形式化されたプロトコルおよび第6章で説明される参照実装は著者自身のものであり、第9章の評価設計はそのため任意のデータ収集前に固定されました。第5章の分析結果は実装に依存しません。第6章および第7章は完全に削除することができ、モデル、その上限、またはそこから引き出される結論に変化をもたらしません。
ツールと検証。AI アシスタントは著者の指示下の道具として使用されました。アイデア、研究および結論は著者のものです。すべての定量的主張と引用は、著者により一次資料またはアーカイブされたコピーに対して検証されました。著者がコンテンツについて単独の責任を負います。
データの入手可能性。図1および3ならびに表2、4および8は第5.2章の閉形式表現から生成され、これから再計算可能です。第7章の資料は各実行時に記録された最初の返信トランスクリプトで構成され、作業資料とともに保持されています。そこのモデルは製品名ではなく研究機関によって識別されます。観察は複数の研究機関全体に現れた障害モードに関するものであり、単一実行の結果は名前付きシステム間の比較をサポートしません。
著者の貢献。単著。
References
Entries marked arXiv are preprints and are cited as such; vendor and standards-body documents are contemporaneous industry sources rather than settled literature.
- Bommasani, R., Creel, K. A., Kumar, A., Jurafsky, D., & Liang, P. (2022). Picking on the same person: Does algorithmic monoculture lead to outcome homogenization? Advances in Neural Information Processing Systems, 35.
- Condorcet, M. J. A. N. de C., marquis de (1785). Essai sur l’application de l’analyse à la probabilité des décisions rendues à la pluralité des voix. Imprimerie Royale, Paris.
- Debenedetti, E., Shumailov, I., Fan, T., Hayes, J., Carlini, N., Fabian, D., Kern, C., Shi, C., Terzis, A., & Tramèr, F. (2025). Defeating prompt injections by design. arXiv:2503.18813.
- Dietterich, T. G. (2000). Ensemble methods in machine learning. In Multiple Classifier Systems, Lecture Notes in Computer Science 1857, 1-15. Springer.
- Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving factuality and reasoning in language models through multiagent debate. arXiv:2305.14325.
- Kadavath, S., Conerly, T., Askell, A., Henighan, T., Drain, D., Perez, E., et al. (2022). Language models (mostly) know what they know. arXiv:2207.05221.
- Karpathy, A. (2025). llm-council. Open-source software repository.
- Kim, E., Garg, A., Peng, K., & Garg, N. (2025). Correlated errors in large language models. Proceedings of the 42nd International Conference on Machine Learning, PMLR 267, 30038-30066. arXiv:2506.07962.
- Kish, L. (1965). Survey Sampling. Wiley, New York.
- Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
- Kleinberg, J., & Raghavan, M. (2021). Algorithmic monoculture and social welfare. Proceedings of the National Academy of Sciences, 118(22), e2018340118.
- Krogh, A., & Vedelsby, J. (1995). Neural network ensembles, cross validation, and active learning. Advances in Neural Information Processing Systems, 7, 231-238.
- Ladha, K. K. (1992). The Condorcet jury theorem, free speech, and correlated votes. American Journal of Political Science, 36(3), 617-634.
- Lorenz, J., Rauhut, H., Schweitzer, F., & Helbing, D. (2011). How social influence can undermine the wisdom of crowd effect. Proceedings of the National Academy of Sciences, 108(22), 9020-9025.
- Meta (2025). Agents rule of two: A practical approach to AI agent security. Engineering documentation.
- MITRE (2025). CVE-2025-32711. Common Vulnerabilities and Exposures record; zero-click exfiltration in an agentic assistant (EchoLeak).
- OWASP (2025). OWASP Top 10 for large language model applications - LLM01: Prompt injection.
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., et al. (2023). Towards understanding sycophancy in language models. arXiv:2310.13548.
- Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755-759.
- Surowiecki, J. (2004). The Wisdom of Crowds. Doubleday, New York.
- Ueda, N., & Nakano, R. (1996). Generalization error of ensemble estimators. Proceedings of the International Conference on Neural Networks, 90-95.
- Wang, J., Wang, J., Athiwaratkun, B., Zhang, C., & Zou, J. (2024). Mixture-of-agents enhances large language model capabilities. arXiv:2406.04692.
- Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., & Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. International Conference on Learning Representations. arXiv:2203.11171.
- Xiong, M., Hu, Z., Lu, X., Li, Y., Fu, J., He, J., & Hooi, B. (2024). Can LLMs express their uncertainty? An empirical evaluation of confidence elicitation in LLMs. International Conference on Learning Representations. arXiv:2306.13063.
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems, Datasets and Benchmarks Track. arXiv:2306.05685.
附録A. レシートテンプレート
レシートは読者が最初に目にするものであり、しばしば唯一読むものです。スクロールなしで4つの質問に答える必要があります。
RECEIPT — 6 models asked · 5 answered · 1 did not (free tier)
Mode: fast ×4, deep ×1
Anchor: answer #3 (chosen for completeness and sourcing)

Agreed:       ...
Disputed:     ...
Unverified:   ...

Rests ONLY on the models agreeing (none showed a source):
              ...
Correlated:   3 of 5 cite one article → one lineage, not three
Composition:  4 of 5 are models from one region; agreement
              may reflect a shared frame
最後の2行がセクション5が存在する理由です。これらがなければ、文書は何個のモデルが一致したかを報告しますが、その一致がどの程度の価値があるかは隠蔽され、これら2つの量は桁違いに異なります。
付録B. 独立した証人の有効数
表8. 、全範囲
| ρ | N=2 | N=3 | N=4 | N=5 | N=7 | N=10 | N=15 | N=20 | N→∞ |
|---|---|---|---|---|---|---|---|---|---|
| 0.00 | 2.00 | 3.00 | 4.00 | 5.00 | 7.00 | 10.00 | 15.00 | 20.00 | ∞ |
| 0.05 | 1.90 | 2.73 | 3.48 | 4.17 | 5.38 | 6.90 | 8.82 | 10.26 | 20.0 |
| 0.10 | 1.82 | 2.50 | 3.08 | 3.57 | 4.38 | 5.26 | 6.25 | 6.90 | 10.0 |
| 0.15 | 1.74 | 2.31 | 2.76 | 3.13 | 3.68 | 4.26 | 4.84 | 5.19 | 6.67 |
| 0.20 | 1.67 | 2.14 | 2.50 | 2.78 | 3.18 | 3.57 | 3.95 | 4.17 | 5.00 |
| 0.30 | 1.54 | 1.88 | 2.11 | 2.27 | 2.50 | 2.70 | 2.88 | 2.99 | 3.33 |
| 0.40 | 1.43 | 1.67 | 1.82 | 1.92 | 2.06 | 2.17 | 2.27 | 2.33 | 2.50 |
| 0.50 | 1.33 | 1.50 | 1.60 | 1.67 | 1.75 | 1.82 | 1.88 | 1.90 | 2.00 |
| 0.60 | 1.25 | 1.36 | 1.43 | 1.47 | 1.52 | 1.56 | 1.60 | 1.61 | 1.67 |
| 0.70 | 1.18 | 1.25 | 1.29 | 1.32 | 1.35 | 1.37 | 1.39 | 1.40 | 1.43 |
| 0.80 | 1.11 | 1.15 | 1.18 | 1.19 | 1.21 | 1.22 | 1.23 | 1.23 | 1.25 |
| 0.90 | 1.05 | 1.07 | 1.08 | 1.09 | 1.09 | 1.10 | 1.10 | 1.10 | 1.11 |
右へ移動してモデルを追加すると、ほぼ即座に最右列に達します。上へ移動して相関を減らすことに制限はありません。評議会の多様性、つまり異なるラボラトリー、地域およびトレーニングコーパスに費やされた努力は、その規模に費やされた努力よりも多くのリターンをもたらします。2つのエントリーが第6.2節の主張を裏付けています。2つのラボラトリーから抽出されたペア(ρ ≈ 0.2)は約1.67の独立した証人として数えられますが、1つの系統から得た5つのモデル(ρ ≈ 0.6)は約1.47として数えられます。
付録C. モバイルティア実装リファレンス
表9. モバイルティアの実装リファレンス
| コンポーネント | 仕様 |
|---|---|
| メカニズム | 単一の署名付きショートカットにチェーンされたオペレーティングシステムアプリインテント。ユーザーの既存のサブスクリプションに対してベンダーのインストール済みアプリケーションを呼び出します。APIキーなし、サーバーなし、バックグラウンド実行なし |
| プロバイダアクション | 各ベンダーの公開されたアスクインテント。アプリケーションインテント識別子でアドレス指定されます。1つのプロバイダはオプションのモデルパラメータを公開していますが、アプリケーションのデフォルトが適用されるため省略されています。もう1つはいずれも公開していません |
| ハンズオフ操作 | show-on-runパラメータはビルド時にインテントパラメータ内で無効に設定され、インポート後にエディタで調整されません |
| 配布 | ショートカットは無制限のインポート用に署名されているため、1つのビルドは再構築することなくあらゆるデバイスまたはアカウントにインストールされます |
| モードメニュー | 開始、ケース、終了マーカーを持つメニューコントロールフローアクション。分岐は変数設定アクションを通じて共有されたテールに収束します |
| 代替プラットフォーム | インテントベースのオートメーション。アプリケーション更新に対応する半自動パス |
| 実行ごとのコスト | Poll 1 + 1、Critique 1 + 1、Synthesis 1 + 2サブスクリプションメッセージ |
| レイテンシ | 起動から結果まで約50~60秒。ハンズオフ |
| 起動サーフェス | ホーム画面アイコン、ウィジェット、ハードウェアアクションボタン、または音声フレーズ |
2つの制約が設計を形作り、どちらも一般化されます。クォータは同じアプリケーションの通常の使用と共有されるため、推奨される日常モードは3メッセージモードではなく2メッセージモードです。これはリソース割り当てであり、品質判定ではありません。また、すべてのインテント呼び出しはメモリなしで新しいセッションを開くため、すべてのプロンプトは自己完結しており、質問と以前の答えを含んでいます。何も続行されません。この制約により、第6.5節で主張するように、PollおよびSynthesisの盲目的な並列独立性は指示ではなくアーキテクチャになります。
引用方法
Chernets, V. (2026). 合意は独立した証拠ではありません:API なしの監査可能なマルチモデル合成 [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7390698
@misc{chernets2026agreementnotevidence,
  author       = {Chernets, Vadym},
  title        = {{Agreement Is Not Independent Evidence: Auditable Multi-Model Synthesis Without an API}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7390698},
  url          = {https://doi.org/10.2139/ssrn.7390698}
}