AI 생산성을 토큰이 아닌 검증된 작업으로 측정하는 방법 — 도구
이 문서는 번역본입니다. 기준이 되는 판본은 영어 원문이며, 인용할 때는 원문을 사용해 주세요.
AI 에이전트(Claude Code, Codex, Cursor 등)에 맡겨서 실제 작업을 완료한다면, 어떤 직책, 학위, 이력서 항목도 당신이 무엇을 전달할 수 있는지를 보여주지 않습니다. 많은 고용주가 2026년에 찾은 수치인 한 사람이 소모하는 토큰 수는 더욱 적게 보여줍니다. Delegation Horizon은 AI 에이전트에 맡긴 작업의 단순한 로그를 다음과 같이 변환하는 무료 오픈소스 도구입니다:
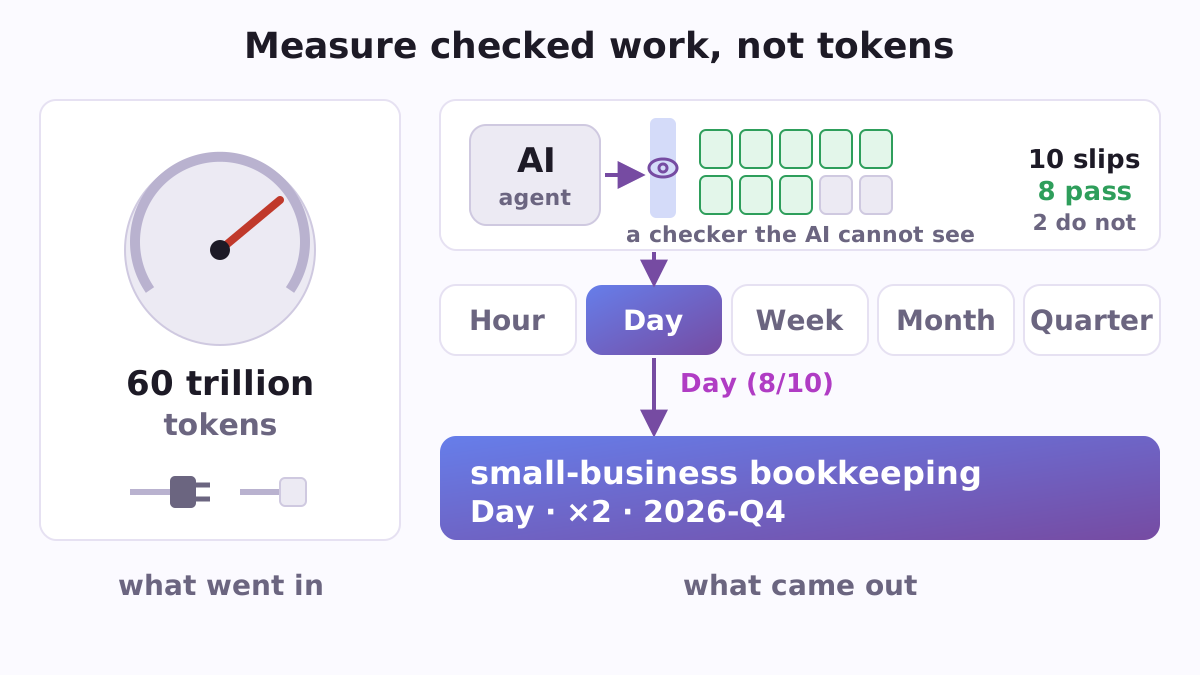
small-business bookkeeping · Day · ×2 · 2026-Q4소규모 사업 회계에서 이 사람은 정기적으로 AI 에이전트에게 전문가가 손으로 약 하루가 걸릴 정도의 업무를 맡기고, 에이전트가 본 적 없는 확인을 통해 검증합니다. 이들의 한 시간 주의력이 최소 두 시간의 검증된 업무를 가져옵니다. 2026년 4분기에 채점되었습니다. 어떤 스프레드시트든 로그를 보관하고, 점수는 자신의 컴퓨터에서 작은 Python 스크립트 또는 오프라인으로 실행되는 웹 페이지로 계산됩니다. 계정 없음, 키 없음, 지불할 것 없음, 그리고 로그는 절대 당신의 컴퓨터를 떠나지 않습니다.
토큰 계산이 실패한 이유
2026년에 여러 대형 기업들이 직원들의 AI 사용량으로 AI를 얼마나 잘 활용하는지 측정하려고 시도했으며, 언론은 이러한 현상을 토큰맥싱이라고 명명했습니다. Meta에서는 직원이 만든 리더보드인 Claudeonomics라는 별명을 가진 것이 30일 동안 85,000명 이상의 직원들로부터 60조 개의 토큰을 기록했습니다 (Shopifreaks). Amazon에서는 "직원들이 점수를 높이기 위해 불필요한 작업을 수행하는 AI 에이전트를 만들었으며", 추적 시스템이 오프라인 상태가 되었습니다 (CIO). 9월에 Meta는 "AI 채택 대시보드나 토큰 수를 영향을 평가하는 데 사용하지 않을 것"이라고 말했습니다 (CIO).
토큰 수는 입력된 것을 측정하며, 출력된 것은 측정하지 않습니다. Google Cloud의 연구 프로그램인 DORA는 이를 "순전히 입력의 측정"이라고 부릅니다 (DORA). 그러나 LeadDev의 2026년 설문 조사에서 응답자의 58%가 자신의 조직이 여전히 토큰 사용량으로 AI 영향을 측정한다고 말했으며, 19%만이 이를 효과적이라고 했습니다 (LeadDev). Delegation Horizon은 대신 모든 직종에서 출력을 계산합니다.
두 개의 숫자와 한 줄
에이전트에게 맡기는 모든 작업은 로그의 한 행이 됩니다: 그 분야, 자격 있는 전문가가 손으로 해야 할 시간("참고 시간"), 당신의 관심이 필요한 시간(분), 통과한 점검, 통과 여부입니다.
- 검증된 위임 범위는 에이전트에게 정기적으로 맡기는 작업의 최대 크기로, 그들이 보지 못한 점검으로 확인되는 것입니다. 5개 단계가 있습니다: Hour, Day, Week, Month, Quarter (1, 8, 40, 160, 500 참고 시간). Hour와 Day는 지난 91일 동안 그 크기의 작업 10개가 필요하고, Week는 182일 동안 6개, Month는 1년 동안 6개, Quarter는 1년 동안 3개가 필요합니다. 부기담당자와 개발자가 같은 규칙을 적용받습니다.
- 증폭 이득은 지난 91일 동안 당신의 관심 시간당 확인된 참고 시간이며, 실패를 포함하고 ×1, ×2, ×5, ×20, ×60 단계로 표시됩니다.
둘 다 분야별로 유지되므로, 같은 사람이 금융 도구에서는 Week 단계이면서 웹 응용프로그램에서는 Day 단계일 수 있습니다. 둘 다 날짜를 기록합니다: 한 단계는 매 분기마다 다시 달성되며, Week 이상에서는 해당 작업 중 하나가 지난 91일 내에 있어야 합니다.
검증된 것으로 간주되는 것
각 단계 크기의 10개 중 최소 8개는 다음 네 가지 검증 중 하나를 통과해야 합니다: 숨겨진 테스트, 자격 있는 전문가, 해당 작업의 대상자가 실제로 사용, 또는 당신이 직접 열어본 자료에 대해 검증하는 다른 AI 계열의 모델. 당신의 자체 검토와 동일 계열 모델 간의 일치는 기록되지만 절대 계산되지 않습니다. 실패하거나 포기한 항목은 로그에 남아 당신에게 불리하게 작용하며, 누군가가 로그 외에서 도움을 준 항목, 나중에 감시가 실패한 항목, 그리고 나중에 철회된 결과도 마찬가지입니다. 돈 송금과 같이 실수를 되돌릴 수 없는 항목은 반드시 통과해야 하며, 다른 AI 계열의 검증만으로는 충분하지 않습니다. Week 이상의 단계에서는 인수 인계 전에 최소한 하나의 작업에 의도적인 오류가 삽입됩니다. 이를 발견하면 당신이 실제로 검증하고 있음을 보여주며, 놓친 경우 Week 이상을 차단합니다.
이러한 엄격함에는 이유가 있습니다: 사람들은 AI를 사용한 자신의 속도를 제대로 판단하지 못합니다. 2025년 METR 연구에서 16명의 경험 많은 개발자는 AI 도구 사용 시 19% 더 오래 걸렸지만, 그 이후 "여전히 AI가 작업 속도를 20% 단축했다고 믿었습니다"(METR).
작업 예시
저장소에는 허구의 부기직원 P07의 로그가 포함되어 있습니다. 2026년 7월부터 9월 사이에 에이전트에 할당된 10개의 작업으로, 각각 전문가의 하루 이상에 해당합니다. 2026년 10월 9일에 평가되었습니다:
P07: small-business bookkeeping . Day (8/10) . x2 . 2026-Q4  (pieces in last 91 days: 10, not verified: 2; gain 4.66; directive share 20%)
  checks: expert 4, hidden_tests 3, self_review 1, real_use 1, other_family_with_sources 1; median accepted size 9.0 h
열 개 중 여덟 개가 통과했는데, 이것이 정확히 Day가 필요한 것입니다. 한 조각은 부기담당자 자신의 검토로만 확인되었고 한 개는 전문가의 확인에 떨어졌습니다. 확인된 여덟 개 조각은 모두 열 개에 대한 약 17.2시간의 주의력에 대해 80 참고 시간으로 합산되며, 이는 4.66의 이득을 얻습니다. 이는 ×2 단계에 해당합니다. 부기담당자가 떨어진 조각을 삭제했다면, 로그는 더 좋아 보이고 점수는 더 나빠졌을 것입니다. 막대는 아홉 개 조각 위에 놓이고, 열 개의 개수를 놓치며 Hour 아래로 떨어지는 반면, 이득은 ×5로 뛰어올랐을 것입니다. 기록을 받는 모든 사람이 이를 즉시 알 수 있는데, 카드의 날짜에 대한 재점수가 더 이상 일치하지 않기 때문입니다. 이것이 실패가 기록에 속해야 하는 이유입니다.
에이전트를 통해 구축하는 사람들을 위해
record_card.py는 스프레드시트를 읽고 줄과 짧은 카드를 출력합니다: 단계, 뒤에 있는 개수("91일 기간 동안 Day 크기 10개 중 8개 확인됨"), 이득, 그리고 확인의 종류.--format md는 프로필이나 고용주에게 보내는 이메일용 카드를 만들고,--format record는 이력서용 줄만 출력합니다.tools/explain.py(버전 1.1.0에서 새로 추가)는 로그가 해당 단계를 얻는 이유를 알려줍니다: 어떤 조건이 유지되거나 실패하고 어떤 항목이 그것을 결정하는지, 단계가 몇 번의 실패를 더 견딜 수 있는지, 새로운 로그를 기록하지 않으면 실패하는 날, 그리고 다음 단계가 아직 필요로 하는 것이 무엇인지. 또한 10개의 항목만으로 얼마나 적게 증명되는지를 보여줍니다: 10개 중 8개는 약 44%에서 97% 사이의 모든 참 통과율에 맞습니다.checker.html은 브라우저에서 동일한 채점을 오프라인으로 수행합니다. 테스트는 이를 작동된 예제와 40개의 무작위 로그에서 Python 채점기와 비교합니다. 둘 다 유럽 스프레드시트가 저장하는 대로 세미콜론, 십진 쉼표 및 day.month.year 형식의 날짜로 저장된 스프레드시트를 읽습니다.tools/log_piece.py는 질문을 하여 로그 줄을 작성합니다. Claude Code에서 작업하는 경우, 준비된 훅(Claude Code가 이벤트에서 실행하는 작은 스크립트)이 에이전트 세션이 끝날 때마다 보류 중인 항목을 열어서, 실패한 항목이 절대 잊혀지지 않도록 합니다. 트랜스크립트를 읽지 않고 어디에도 아무것도 보내지 않습니다. 세션 끝에서 명령을 실행할 수 있는 모든 에이전트 도구가 사용할 수 있습니다.tools/planted.py는 인계 전에 심은 오류 목록을 지문으로 봉인하고 나중에 채점하며, 잘못된 항목과 빠진 것을 따로 계산하고, 봉인 후 변경된 목록을 거부합니다.
네 번째 종류의 확인을 위해, 당신의 소스를 읽는 또 다른 AI 계열은 Sidecall이 컴퓨터의 다른 AI 도구에 작업을 배치합니다.
관리자 및 인사 담당자를 위해
kits/ai-usage-in-reviews.md는 성과 평가에서 AI 사용을 위한 준비된 정책입니다. 토큰이나 지출 대신 각각 통과된 확인이 있는 승인된 작업 항목을 요청하고, "매일 AI를 사용한다"는 대신 지난 분기에 에이전트에게 넘긴 가장 큰 작업 항목과 검증된 항목을 요청합니다. 평가 대화에는 세 가지 질문이 있으며, 첫 번째 질문은 다음과 같습니다: 이번 분기에 에이전트에게 넘긴 가장 큰 작업 항목이 무엇이며, 그것이 올바른 것으로 나타났나요, 그리고 어떻게 나타났나요?
팀은 사람당 만들어진 레이블이 있는 하나의 로그를 유지합니다(채점자는 알 수 없는 열을 거부하므로 실명이 유출될 수 없음). examples/team-log.csv는 다섯 개 필드에 걸쳐 네 명을 보여줍니다. 매 분기마다 record_card.py는 사람과 필드당 하나의 카드를 출력합니다. 하나를 확인하려면 tools/verify_record.py는 기록과 로그를 가져가서 필드별로 로그가 채점된 파일인지, 채점자가 동일한지, 그리고 다시 채점할 때 기록이 동일한지를 말합니다. audit_sample.py는 로그를 받은 후 두 번째 검토자가 선택한 단어에서 재검사를 위한 무작위 표본을 추출하므로 누구도 어떤 항목이 추출될지 추측할 수 없으며, tools/too_clean.py는 너무 좋아 보이는 로그에 플래그를 지정합니다: 실패가 없고, 크기가 거의 변하지 않으며, 모든 항목이 한 가지 방식으로 확인되었습니다.
참고 시간은 팀 외부에서 고정됩니다: 작업 은행에서 또는 작업이 누구인지 모르는 두 명의 평가자에 의해. tools/reference_hours.py는 그들의 추정치를 가져가서 서로 1.5배 이내일 때 기하 평균을 제공하거나 세 번째 평가자를 호출합니다. kits/reference-hours-raters.md는 그들을 선택하고 지시하는 방법을 설명합니다.
학위 대신 검증된 작업으로 채용하려면 kits/hiring-test/는 후보자의 자신의 분야에서 숨겨진 확인, 의도적 오류 및 이력서를 보지 못한 평가자와 함께 유급 1일 작업 테스트를 진행합니다. kits/trade-screen.md는 프로필이나 직책이 보이는 것보다 적게 말하기 때문에 누구든지 입사하기 전에 해당 분야의 첫 주 질문을 추가합니다: 조사 플랫폼의 필터가 부기사로 입사한 60명 중 11명이 그러한 질문을 틀렸고, 그 중 8명은 차변과 대변을 바꿈으로써 틀렸습니다.
사람들과의 첫 번째 테스트가 발견한 것
"전문가의 시간"이라는 측정 방식의 가장 약한 부분은 추정 자체이므로, 먼저 이를 테스트했습니다. 2026년 10월에 Prolific에서 사전 파일럿을 진행했으며, 데이터가 수집되기 전에 OSF에 등록했습니다. 119명의 회계사 및 웹 개발자에게 10가지 작업 각각이 손으로 수행될 경우 소요 시간을 추정하도록 지불했습니다. 무작위로 선택된 두 명의 평가자는 회계 업무의 경우 28%, 웹 업무의 경우 25%만 1.5배 이내로 일치했으며, 이는 계획에서 설정한 70%보다 훨씬 낮습니다. 1주일 분량의 작업으로 작성된 작업은 중앙값이 8~20시간으로 추정되었으며, 마지막에 동일한 작업을 다시 요청했을 때 더 높은 추정치가 더 낮은 추정치보다 훨씬 더 자주 나타났습니다.
이 도구를 사용하는 모든 사람에게 해당하는 내용: 두 명의 낯선 사람의 추측은 작업 규모를 정하기에는 너무 불안정합니다. 더 큰 패널의 중앙값은 빠르게 안정화되며, 회계사 15명 또는 웹 개발자 21명으로 구성된 2개의 별도 패널은 최소 70%의 시뮬레이션에서 1.5배 이내로 일치했습니다. 따라서 참조 시간은 측정된 시간이 있는 작업 은행에서 오거나 패널에서 나오며, 익명 처리된 데이터, 등록된 분석 및 탐색적 분석은 모두 pilot/에 있어 누구나 다시 실행할 수 있습니다.
연구자를 위해
METR은 시간 지평선으로 AI 모델을 측정합니다. 즉, 모델이 안정적으로 완료하는 작업의 길이를 전문가 시간 단위로 나타냅니다. 위임 지평선은 사람에게 같은 질문을 던지며, 그 8할의 비중은 METR의 80% 지평선을 반영합니다. 시뮬레이션된 로그에 대한 책상 사전 파일럿이 규칙(버전 1.1)을 조정했고, 위의 Prolific 사전 파일럿이 기준 시간을 테스트했으며, 사람들과의 전체 파일럿에 대한 프로토콜, 사전등록 초안 및 동의 양식은 pilot/에 있습니다. kits/process-vs-experience-study.md와 kits/matched-task-study.md는 같은 작업에서 그룹을 비교하기 위한 준비된 프로토콜이며, tools/power.py는 그러한 연구에 필요한 사람의 수를 보여줍니다.
이 도구 뒤의 논문은 또한 날짜가 지정되고 검증 가능한 예측을 제시합니다. Anthropic의 약 400,000개의 Claude Code 세션에 대한 연구에서, 코드를 생성한 세션은 소프트웨어 직종에 종사하는 사람들의 경우 34%, 다른 모든 사람들의 경우 29%의 확인된 성공으로 끝났습니다(Anthropic). 41개의 예측이 2026년 10월 9일 OSF에 등록되었으며, 각각 확률과 함께 2027년 말까지 최고의 공개 모델을 위한 METR의 80% 지평선이 근무일에 도달할 것(0.80)과 2027년 동안 500대 기업 중 2개 미만이 토큰 수를 공식적인 평가 기준으로 사용할 것(0.80)이 포함되어 있습니다. 테스트는 등록된 모든 파일이 여전히 바이트 단위로 제출된 파일과 동일함을 보여주며, brier.py, predictions/score.py 및 predictions/skill.py는 매년 이를 채점합니다. 실행되지 않은 연구는 조용히 삭제되지 않고 실패로 계산됩니다.
시작 방법
Python 3.9 이상이 필요하며 그 외에는 아무것도 필요하지 않습니다.
- GitHub 페이지에서 저장소를 다운로드하거나(Code, 그 다음 Download ZIP) 클론합니다.
templates/work-log.csv를 아무 스프레드시트(Excel, Numbers, LibreOffice, Google Sheets)에서 열고, 에이전트에게 넘긴 작업 한 건마다 한 행을 추가합니다: 수락됨, 거절됨 또는 중단됨.templates/README.md는 모든 열을 쉬운 말로 설명하고 있으며,examples/c4-log.csv는 복사할 수 있는 작성된 로그입니다.- CSV로 저장하고 카드를 실행하거나, 브라우저를 선호한다면
checker.html을 더블클릭합니다.
git clone https://github.com/vadimchernets/delegation-horizon
cd delegation-horizon
python3 record_card.py examples/c4-log.csv --as-of 2026-10-09
python3 record_card.py my-log.csv --format md --out card.md
python3 tools/explain.py my-log.csv
어디서 나왔나요
Delegation Horizon은 Vadym Chernets의 논문 프로그래머 분할 이후: AI 에이전트를 통해 구축하는 사람들을 위한 하나의 척도(2026년 10월, SSRN 7589918, DOI 10.2139/ssrn.7589918)의 동반 코드입니다. 2026년 10월 11일의 현재 릴리스 버전 1.1.0은 Python 3.9부터 3.13까지 모든 푸시에서 테스트됩니다. 이 코드는 MIT 라이선스 하에 있으며 Zenodo에 아카이브되어 있습니다(DOI 10.5281/zenodo.23267444, 항상 최신 릴리스를 가리킵니다). 모든 것은 github.com/vadimchernets/delegation-horizon에서 이용할 수 있습니다. 같은 저자의 이전 논문인 After Chat는 왜 그렇게 적은 수의 사람들이 AI와 채팅하는 것에서 에이전트가 자신을 위해 일하도록 하는 것으로 옮겨갔는지를 묻습니다. 그 코드인 After Chat은 여러 AI에 하나의 질문을 제시하고 그들이 의견이 어디서 맞지 않는지를 보여줍니다.
GitHub에서 delegation-horizon 보기
Vadym Chernets는 또한 Poly A1을 개발하고 있습니다. 이는 여러 회사의 AI들이 서로의 업무를 확인하는 앱입니다.