协议反演不是中层属性:一致答案的精确度遵循成对准确度
这是译文。权威版本是英文原文,引用请以原文为准。
Vadym Chernets, 博士, AI系统架构师 · ORCID 0009-0007-4845-3163
SSRN 7682960 · DOI 10.2139/ssrn.7682960 · Zenodo 10.5281/zenodo.24090580 · 分析发布 10.5281/zenodo.24090584 · GitHub
预印本,2026 年 11 月 9 日。 SSRN: 7682960. 存档副本: 10.5281/zenodo.24090580. 数据和代码: 10.5281/zenodo.24090584. PDF: agreement-inversion.pdf. PDF 是权威版本。
摘要
当两个旗舰模型分别被提问时,对最难的SimpleQA问题之一给出相同答案,该答案通常是错误的。在106个SimpleQA问题上,七月中层面板失败的地方,45对没有客户端提供GPT分支的旗舰对,其中网络搜索无法排除,在691个一致的答案中有96个是正确的(13.9%)。仅在第二个模型同意时回答不需要标签或参数,早期的工作将该规则的失败归因于中层模型。在我测量的两个层级上,同意答案的精度遵循配对的准确率,所以反演不是中层属性。在最难的五分位数中,为每个层级以相同方式定义,精度在七月为17.3%,在八月为15.5%;在五个五分位数中,按照每对两个准确率预期的精度,旗舰对与中层对相差-0.2点[-3.1, +2.7]。数据来自SimpleQA,新的两跳问题和产品事实,在2026年七月、八月和十月期间与来自十一个实验室的旗舰模型一起收集。来自第二个实验室的合作伙伴可以发现更多错误,但打开的门槛较低:对于一个发布的模型,来自同一实验室的合作伙伴发现了29个错误中的2个,而来自另一实验室的合作伙伴发现了20个(-62.1点[-79.3, -43.8]),在96%和61%的问题上打开的门槛。当更宽的门槛通过陈述的置信度变得与覆盖范围相等时,这一优势仅在合作伙伴的模型准确率远高得多的地方成立。一个输入测量准确率的小模型以0.037的平均绝对误差预测样本外精度,对比最佳单一模型的0.099,与0.032的独立误差基线相当,在产品事实和公开数据上表现很高。在标识符gpt-5.6-sol在同一100个问题上的客户端提供波中得分92.0%,通过另一努力设置的API得分46.3%,而其他八个模型最多移动4个点。
1. 引言
向来自不同实验室的两个大型语言模型(LLM)分别提出同一个简短的事实性问题,仅当两个答案相同时才公开答案。这个门控装置无需标签、阈值或判断者,只需两次盲目调用。旗舰模型很有吸引力,因为它们声称的置信度几乎没有保护作用:在2026年8月的十个旗舰模型中,10,540个至少以80%置信度陈述的答案中有4,910个是错误的(Chernets, 2026b)。
我之前对专有模型进行的测量(2026年7月收集的中层模型)发现,在SimpleQA最难五分位数上,复制的面板答案在342次中0次是正确的(Chernets, 2026a)。这表明在弱模型上一致性会反转,使得一致的答案往往比正确的答案更多是错误的,而强模型则不然。一个旗舰模型对似乎证实了这一点:gpt-5.6-sol与claude-fable-5在这些相同问题上的37个一致答案中34个是正确的(第3部分的106个)。
在旗舰层级,这种解读不成立。没有单一模型arm后的34个中的37个,gpt-5.6-sol通过其供应商客户端提供,反转现象回归,且用相同方式为两个层级定义的难度使两条曲线在困难端相交。在所有五分位数中,一旦考虑了每对模型的两个准确度,旗舰和中层对的差异为-0.2个百分点[-3.1, +2.7]。精度跟踪两个模型在该阶层上的准确程度,无论其层级如何。
表1总结了四项贡献。第5.1部分给出了旗舰模型的门控级别说明,尽可能在不包括主导准确度范围的arm的情况下进行构建。第5.2部分衡量第二个实验室的贡献,改变发布模型和合作伙伴,使用GPT或不使用。第4部分和第5.3部分给出具有五个常数的门控描述模型,并针对陈述的基准在样本外进行测试;第5.4部分比较了供应商客户端与直接API访问对相同标识符上相同问题的表现。
表1。 主张、证据和边界。
| 主张 | 证据 | 边界 |
|---|---|---|
| 一致答案的精度遵循两个层级上的对精度 | 106中的96/691;最难五分位数7月17.3%,8月15.5%;匹配精度时的层级-0.2 [-3.1, +2.7] | 关联;仅一个五分位数就跨越-1.8 [-22.1, +20.2] |
| 第二个实验室以覆盖率为代价捕获更多错误 | 20/29对比2/29捕获的错误,-62.1 [-79.3, -43.8];覆盖率61%对比96% | 在相同覆盖率下,按置信度,它需要一个更准确得多的合作伙伴;两个实验室在十月 |
| 小模型样本外描述精度 | 错误0.037对比最佳模型的0.099,-0.062 [-0.085, -0.035] | 独立错误处于相同水平,+0.005 [-0.003, +0.012];产品事实上高13个百分点 |
| 访问模式移动一个标识符 | 客户端92.0%对比API 46.3%,相同100个问题 | 模式、工作量和可能的搜索一起改变 |
2. 相关工作
与我的研究问题最相近的是Goel et al. (2025)的工作,他们引入了CAPA,一种衡量模型输出分布之间协议的机会调整度量,并在130个开源权重模型上跨越MMLU-Pro和BBH进行了展示,发现随着能力的提升,错误变得更加相似,他们论证这对AI监督(包括语言模型陪审团)造成了风险。我针对来自不同实验室的专有模型测量,当盲协议控制短开放式答案的发布时,协议证实了什么:一致答案的精确度、不一致揭露的已发布模型错误比例,以及共享有信心错误的下限。结果是一致的:在我的数据中,相似性上升的成本表现在不一致的召回率中,而在准确率高的地方精确度保持高(附录L)。基于协议的级联(Kolawole et al., 2025)使用集合协议作为无训练延迟规则,条件是接受错误的联合率,我的分层结果定位了此类错误的集中位置。
跨提供商的相关错误由Kim et al. (2025)记录,Hossain et al. (2026)发现它们在前沿大语言模型评判者中更强。由不同小型评判者组成的陪审团出现在Verga et al. (2024)中,模型判断自身输出的偏差出现在Panickssery et al. (2024)中,这有利于比较两个盲答案。单个模型样本之间的协议在自洽性(Wang et al., 2023)、SelfCheckGPT(Manakul et al., 2023)和语义不确定性(Kuhn et al., 2023)中是一个信心信号,在Yue et al. (2024)中是一个延迟规则;我将其与实验室之间的协议进行了比较(第5.2节)。门是一个选择预测器(Geifman & El-Yaniv, 2017),所以我在相等覆盖率处比较门。最近的预印本在聚合是否有帮助上存在分歧(附录E)。我不知道有任何工作报告了在对级别上短开放式事实专有旗舰产品的发布门、相等覆盖率下的召回率且一个已发布模型固定,或一个在两种访问模式上在相同问题上测量的标识符。
3. 数据和协议
我之前的工作报告了7月面板(Chernets, 2026a)以及8月和10月选定配对的汇总数据(Chernets, 2026c)。本文的新内容包括不含GPT的旗舰配对、难度的对称定义、同一实验室的配对、等覆盖率比较、样本外和外部测试以及访问模式比较。
数据集。所有答案以盲法收集:每个问题一次调用,任何模型都看不到其他模型的答案。系统提示要求返回包含简短答案和0到100置信度的JSON对象,不要求来源。表A1列出了模型、日期和访问模式,附录F给出了完整的数据集信息。九个API模型和七个本地模型在7月24日至28日回答了1,500个SimpleQA问题(Wei et al., 2024),并在数据收集前在OSF上注册(Chernets, 2026a)。十一个实验室各有一个旗舰模型在8月3日至6日回答了相同的问题,其中1,459个对所有模型都相同,其中九个在温度0.7下回答了其中100个问题并进行三次采样(方差臂)。另外添加了100个从Wikidata通过机器组成的二跳问题,文件哈希在第一次模型调用前固定,以及267个产品事实。10月,gpt-6.1-sol、gpt-6-astra、gpt-6-sol、claude-opus-5-5和claude-fable-5-1回答了300个按7月五分位数分层的SimpleQA问题,包括下方的106个和新集合,三个不相交的集合共有503个问题对所有五个模型都相同(表A2中包含每对模型的情况)。
106个问题。这些是7月面板复现答案的最难五分位数问题(Chernets, 2026a)。它们根据7月模型的失败情况选出,因此7月模型在其上的精度部分是选择的产物,第5.1节将其与不具有此特性的对称难度定义配对。
访问模式。8月,claude-fable-5、gpt-5.6-sol和mistral-medium-3.5通过供应商自有的一方客户端、最终用户部署的官方命令行代理运行,10月每个臂都进行了此操作,因此测量包括用户接收到的供应商端系统提示和服务默认值。7月波和其余8月臂使用固定在供应商的直接API或聚合器路由。表2说明了客户端臂的测量条件。当臂的网络搜索使用不能被排除时,我称其为"搜索可能",我报告主要结果时既包括这样的臂也包括不包括这样的臂。
表2。按臂的测量条件。注:Codex和Claude客户端中未设置温度;Codex事件流未保留。7月和8月波的API臂在温度0下运行。破折号表示无设置或记录中无条目。
| 臂 | 访问方式 | 工作量 | 搜索可能 |
|---|---|---|---|
| gpt-5.6-sol, 8月 | Codex客户端 | 客户端默认,未记录 | 未排除 |
| claude-fable-5, 8月 | Claude客户端 | - | 否,记录了0个搜索请求 |
| mistral-medium-3.5, 8月 | 供应商客户端 | - | 否,工具列表为空 |
| gpt-6.1-sol、gpt-6-astra、gpt-6-sol, 10月 | Codex客户端 | 中等 | 未排除 |
| claude-opus-5-5、claude-fable-5-1, 10月 | Claude客户端 | - | 否,工具已禁用 |
| kimi-k3、gemini-3.8-flash,新集合 | 供应商客户端 | - | 工具未禁用,提示禁止 |
| gpt-5.6-sol,方差臂 | 直接API | 无 | - |
门禁和测度。当两个模型都答应、都不拒绝且确定性等价引擎(对此处每个波都相同)找到两个答案等价时,门禁打开。评分将相同的引擎应用于答案和黄金答案:归一化精确匹配、四个或更多字符的字符串包含以及日期、数字和标识符的规则(附录D,表A3中有重新评分)。一个单元是一对模型在一个问题层级上的组合。覆盖率计算两个模型都回答的问题中打开的门禁。精度PPV是评分器确定为正确或错误的打开答案中正确的比例(K/O),Delta是精度减去已发布模型在单元所有已解决问题上的准确度。召回率是已发布模型错误中门禁保持关闭的比例,报告为捕获的错误。提升度是已发布模型在打开门禁时的准确度除以关闭门禁时的准确度,底层计数两个模型都声称至少80的置信度、一致且错误的问题。当PPV低于二分之一时,我称一致性为反向的。已发布模型是配对的第一个成员,或在合并配对时更准确的模型。为在等覆盖率下比较门禁,我对更宽的门禁进行稀释:打开的答案按两个声称置信度中较小者排名并裁剪到目标覆盖率,平局随机打破。
推断。单个比例采用Wilson区间。差异和导出量采用95% bootstrap区间,对合并结果在问题和模型上进行两向(Owen, 2007; B = 2000,种子固定,在每个复制中重新拟合模型)以及对单个配对在问题上进行。配对准确度比较使用精确McNemar检验,等价性使用双单侧检验(Schuirmann, 1987),边界为2分。单元是相关的,因此它们有区间而无p值。
4. 门的模型
设 和 为两个模型在一个样本上的测量准确度,。设 为两者都错的概率, 为两者都对的概率:
此处 放大了联合错误的独立率。两个正确答案以概率 匹配。两个错误答案以概率 匹配,其中在 106 上 (其错误答案碰撞更频繁),其他地方为 1。于是
在来自不同实验室的335对细胞上进行拟合(7月、8月和10月,其中106对;是所有拟合细胞中两个正确答案的匹配率),常数为、、、(22,536/22,785)和。
该模型以细胞的测量准确度为输入,返回覆盖率、精确率和错误答案一致的比例,其中第3节的下限是置信度至少为80%的部分。给定两个准确度,它返回门添加的内容,并展示精确率必须遵循准确度在顶部的原因:当且正确答案匹配时,一致答案的精确率不能低于,即使每个错误都被共享,因为两个模型至少在个问题上一起正确,在最多个问题上一起错误(在时为0.947)。当时没有界限,可以超过,只要错误答案集中在同一字符串上。
我将其与两个基线进行比较。独立错误基线设置并重新拟合其余部分,因此保留。最佳模型基线预测。准则是该模型击败两个基线,在留一实验室法(LOLO)、留一模型法(LOMO)和从7月、8月到10月的时间分割下,差异的区间低于零。
5. 结果
5.1 反演不是中层属性
表3给出了没有客户端服务GPT臂的门控。在整个SimpleQA中,两个层级看起来很相似:7月精度为72.1%,8月为80.6%,与发布模型相比分别增加了+28.6和+26.0个百分点。在106上,两个波次中精度都很低:7月717个中5个,8月没有GPT的691个中96个。同样从7月端排除GPT臂得出581个中4个,8月减去7月的差异为+13.2个百分点[+2.6, +30.8]。8月精度更高,但仍远低于二分之一,因此在两个波次中协议都是反演的。它也低于该层上最佳单个臂,在7月低-9.5个百分点[-16.3, -3.2],在8月低-43.2[-67.6, -16.1]。没有GPT的情况下,7月提升为0.13[0.00, 1.21],8月为0.65[0.23, 1.22]。
表3。没有客户端服务GPT臂的门控。注:除特别说明外,在不同实验室对之间汇总;覆盖范围是两个模型都回答的问题,K/O是评分员解决的开放性答案;PPV上的区间:双向自举。产品事实:四个没有搜索可能性的臂。
| 层级,问题 | 配对 | 覆盖率 | PPV (K/O) [95%] | 发布模型准确度 | 差异,百分点 [95%] |
|---|---|---|---|---|---|
| 中层,7月,106 | 36 | 19.8% | 0.7% (5/717) [0.0, 3.7] | 4.6% | -3.9 [-8.3, +0.3] |
| 中层,7月,全部SimpleQA | 36 | 20.6% | 72.1% (7743/10745) [53.2, 82.3] | 43.4% | +28.6 [+22.3, +32.4] |
| 旗舰版,8月,106,无搜索可能性臂 | 45 | 19.1% | 13.9% (96/691) [3.3, 31.8] | 19.9% | -6.0 [-14.1, +2.9] |
| 旗舰版,8月,全部SimpleQA,无搜索可能性臂 | 45 | 29.1% | 80.6% (12357/15322) [69.6, 87.9] | 54.7% | +26.0 [+19.9, +30.7] |
| 旗舰版,8月,全新100个(通过API的GPT) | 6 | 37.5% | 88.9% (200/225) [75.6, 97.4] | 66.8% | +22.1 [+7.9, +47.4] |
| 同一实验室,10月,fable-5-1 + opus-5-5,106 | 1 | 39.6% | 47.5% (19/40) | 30.0% | +17.5 [+6.2, +29.7] |
| 10月,kimi-k3 + gemini-3.8-flash,全新100个(未禁用工具) | 1 | 72.0% | 95.8% (69/72) | 74.0% | +21.8 [+14.1, +30.0] |
| 产品事实,267,无搜索可能性臂 | 6 | 63.6% | 75.0% (423/564) [66.4, 82.7] | 62.7% | +12.3 [+5.8, +20.4] |
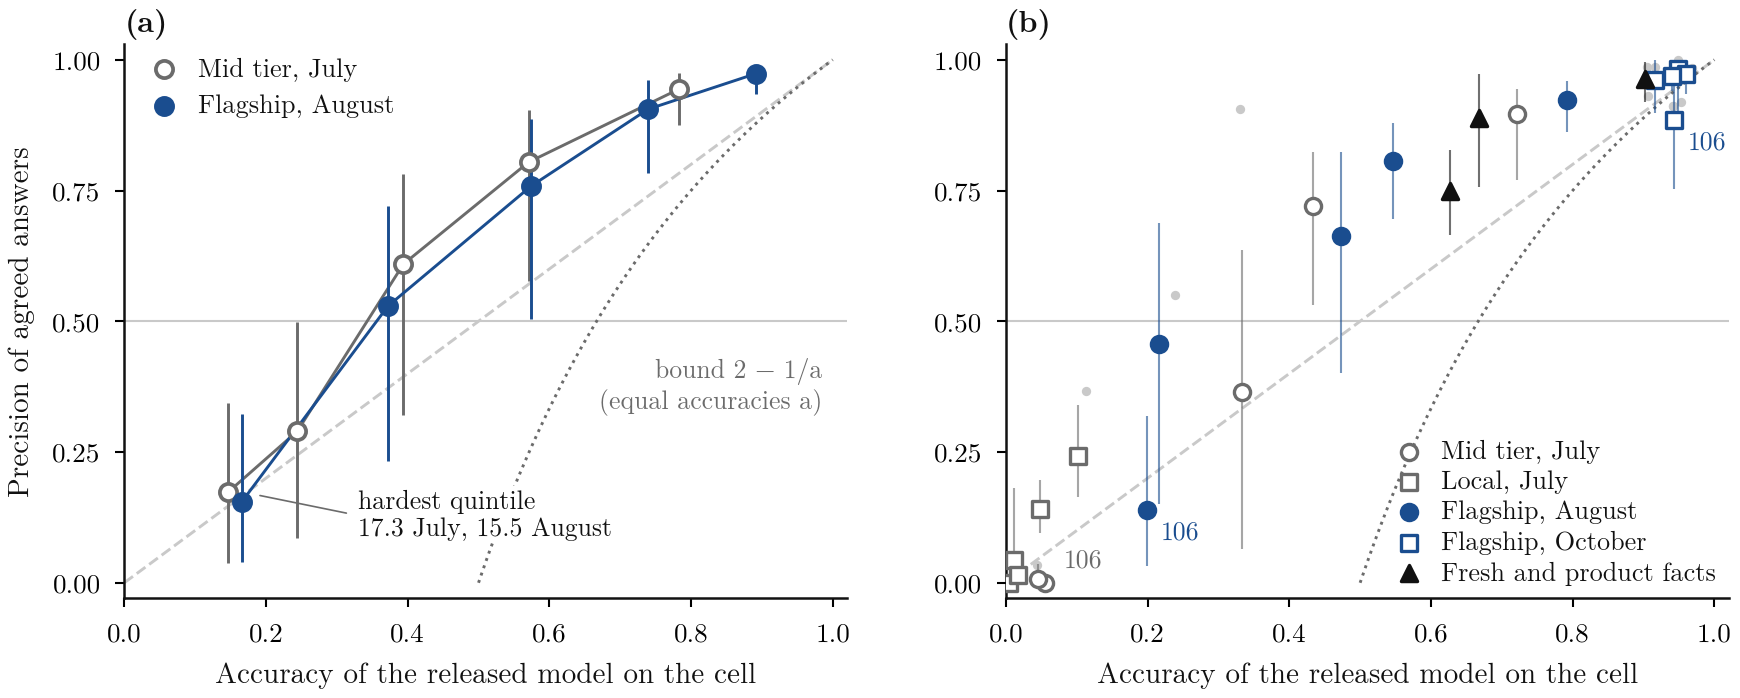
图1。协议答案的精度遵循配对的准确度。注:(a)每个层级内的难度五分位数,7月中层和8月旗舰版,不包括客户端服务的GPT臂。(b)7月至10月的每个带状区域的每个层级,对比发布模型的准确度;标记的单元格是106。须状线是95%自举区间,(b)中的小灰点是单个配对;虚线是等式,点线是相等准确度a时的界限2-1/a。
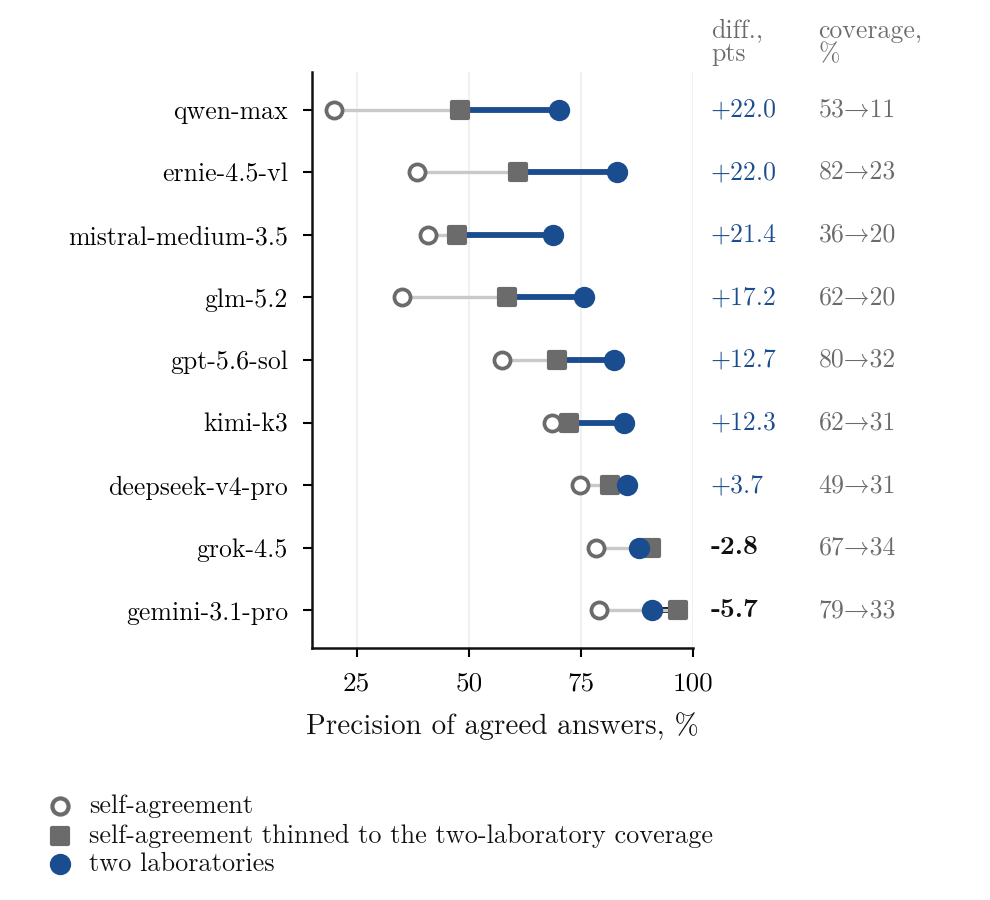
图2。按模型的自协议对比两个实验室。注:方差臂,9个模型,100个问题。空心圆,对同一模型的两次调用;方形,同一通过置信度细化至两实验室门控的覆盖率;实心圆,两个实验室,在合作伙伴上的平均值。右列给出相等覆盖率下的差异(百分点)和两个门控的覆盖率(百分比)。
不包括客户端服务GPT臂的三模型面板给出相同结果。在我的引擎下的106上,7月面板给出318个中0个(第1节的342个中0个是早期匹配规则下最硬的五分位数;上面的717个中5个统计配对)。8月DeepSeek、Qwen和Kimi的面板给出76个中0个,Claude、DeepSeek和Mistral的跨集团面板给出78个中11个(14.1%[2.7, 26.3]),而包含GPT臂的Claude、GPT和Gemini面板给出131个中106个(80.9%)。旗舰版配对与它们在该层上的准确度一致,从fable-5与deepseek-v4-pro的21个中4个到fable-5与gemini-3.1-pro的24个中15个(62.5%[42.6, 82.6]),其成员在这一组中处于领先地位。
由于106是基于7月失败选出的,这降低了它们的7月精度并有利于8月,图1a在每个层级内设置难度。对每个层级,问题按没有待评估配对的同一层级的准确度排入五分位数,因此最硬的五分位数对每个都保持相同排名,发布模型在那里的准确度接近,7月为15.3%,8月为16.0%。没有GPT的情况下,那里的精度在7月为917个中159个(17.3%[3.8, 34.3]),在8月为1,308个中203个(15.5%[4.0, 32.4]),差异为-1.8个百分点[-22.1, +20.2]。汇总所有五个五分位数给出更尖锐的检验。第4节的模型没有层级项。给定每个单元格的两个准确度,它提供了那里预期的精度,层级效应将表现为残差中的差异。旗舰版单元格距离中层单元格-0.2个百分点[-3.1, +2.7],当常数仅在7月单元格上拟合时为-0.5[-3.6, +2.4],因此8月样本外。kimi-k3属于两个集合;不包括它的差异为+0.1[-3.6, +3.8]。在清理的金标准答案上精度保持低:在存活于SimpleQA Verified中的106个中的24个上(Haas等人,2025),8月不包括GPT的配对在18.7%的协议上正确[0.0, 57.1](附录G)。
在每个层级的每个带状区域上(图1b),精度随每个波次中发布模型的准确度上升,在23个单元格中的17个上位于对角线上方。在低于对角线的6个中,3个是106单元格,3个是发布准确度低于0.06的带状区域。在顶部,kimi-k3与gemini-3.8-flash在全新集合上达到95.8%(附录G)。
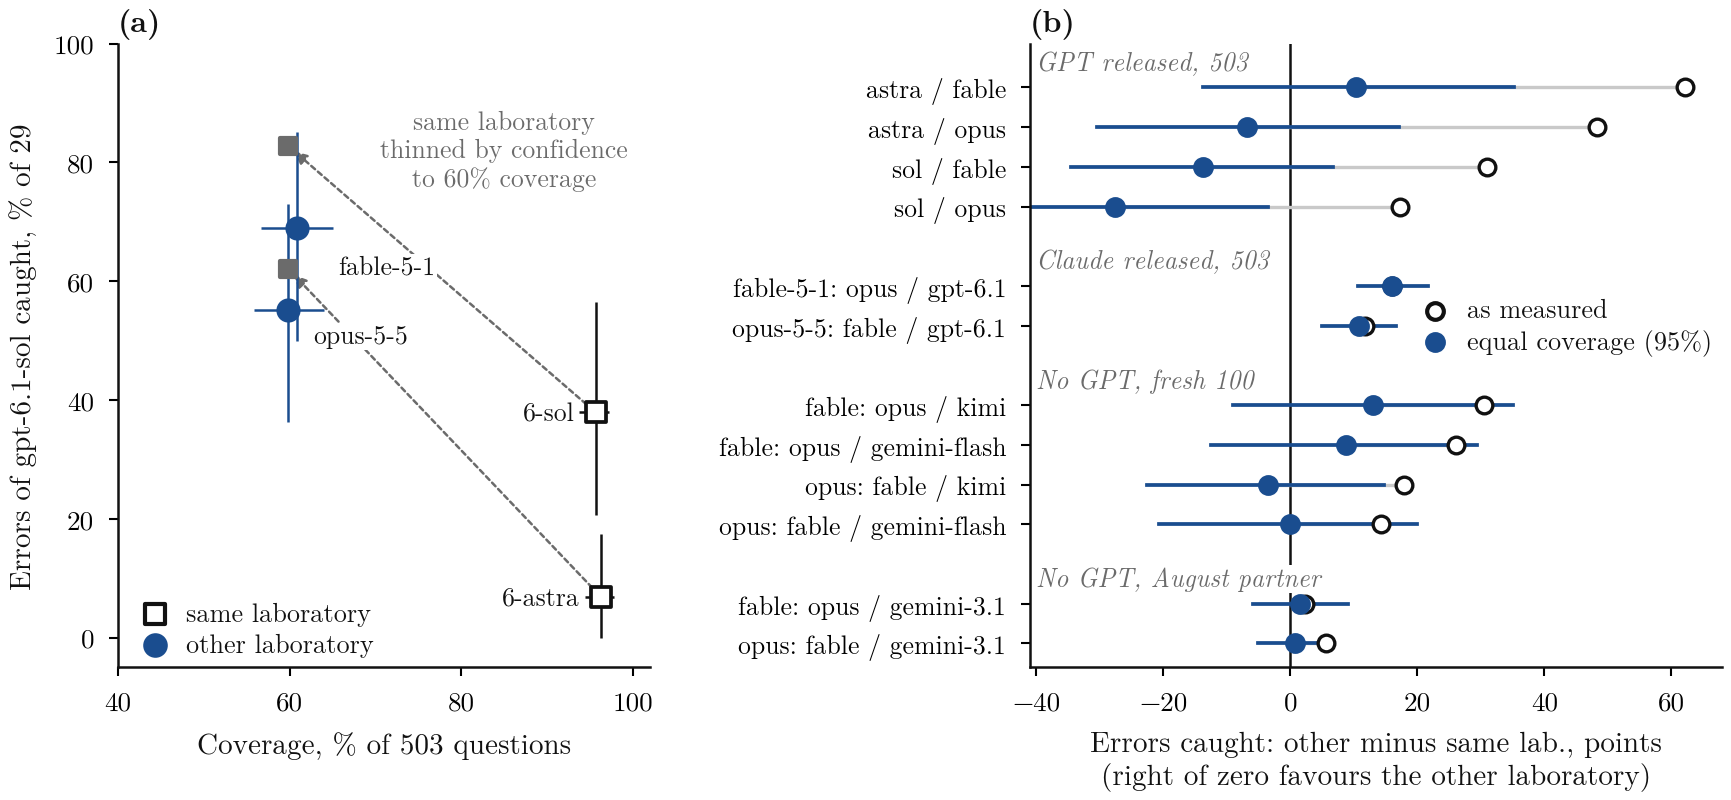
图3。 第二个实验室:覆盖范围和捕获的错误。 注:(a) gpt-6.1-sol在503个常见问题上,29个错误,表A4的四个合作伙伴,95%引导区间;箭头从同一实验室门指向被置信度削减到60%覆盖范围的同一扇门。(b) 表A5的十二个比较:其他实验室捕获的错误减去同一实验室捕获的错误,按测量值(开放)和相等覆盖范围(填充,95%问题引导)。
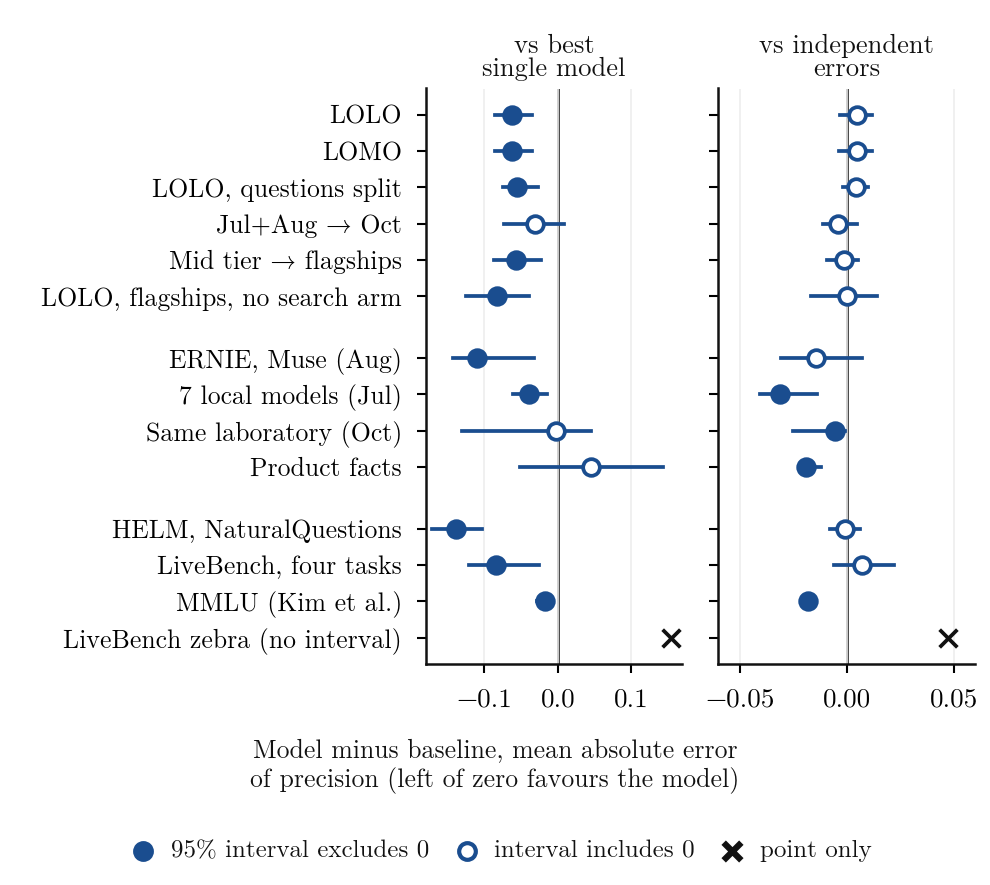
图4。 模型与两个基线的对比,样本外。 注:模型减去基线在预测精度平均绝对误差中的值,零以下有利于模型,95%双向引导区间(表A6和A8)。顶部组,拟合方案;中间,拟合外的集合,常数冻结;底部,公共数据(第5.5节)。填充标记,95%区间排除零;开放标记,包括零;叉号,点估计(LiveBench斑马任务)。
5.2 第二个实验室以覆盖范围为代价捕获更多错误
仅凭精度无法区分这些情况,因为来自一个实验室的准确对也具有高精度。召回率必须与覆盖范围一起读取,因为打开次数较少的门按构造会阻挡更多错误。
我从方差臂开始:对一个模型进行两次调用,温度0.7,与两个不同实验室进行两次调用对比(图2)。在九个模型和100个问题上汇总,自一致性在56.1%的精度下覆盖63.5%,两个实验室在82.9%的精度下覆盖26.1%。精度差异为+26.8个百分点[+16.6, +34.6](测量值)和+9.0 [+0.5, +17.4](相等覆盖范围),其中自一致性被置信度削减,这对它有利。按模型,两实验室门在九个中的七个中领先。该臂不包含Claude模型,GPT通过API,工作量无。不含GPT,在八个模型上,相等覆盖范围下的差异为+7.7个百分点[-1.9, +16.5]。
十月波包含来自两个实验室的两个模型,对503个常见问题进行了直接测试(图3a)。一个发布的模型gpt-6.1-sol在每一行保持相同的29个错误,仅改变合作伙伴。其同一实验室的合作伙伴gpt-6-astra捕获其中2个,fable-5-1捕获20个,差异为-62.1个百分点[-79.3, -43.8];与opus-5-5相比,差异为-48.3 [-66.7, -29.6]。代价是覆盖范围,60到61%相对于96%。精度在各行中相似:同一实验室为94.3%和96.2%,跨实验室为95.6%和97.0%(表A4)。同一实验室的合作伙伴差异很大:gpt-6-sol捕获29个中的11个(附录H)。
要查看这是否不仅仅是沿覆盖范围曲线的移动,以及它是否需要GPT,图3b的每一行保留一个发布的模型并比较其两个合作伙伴,按测量值和相等覆盖范围(表A5)。按测量值,其他实验室在每一行都捕获更多错误。在相等覆盖范围下,其优势仅在Claude与gpt-6.1-sol作为合作伙伴一起发布时才成立,该合作伙伴在分层集上的准确度为93.9%,而同一实验室的为66.6%至69.2%。GPT被发布后,按置信度削减的同一实验室门水平或领先,不含GPT,差异水平相同,或有利于同一实验室,相对于弱合作伙伴。十月有两个实验室,我没有检测到实验室的效果超越合作伙伴准确度和覆盖范围,HELM(有20名开发人员)一旦两者都匹配就没有检测到(第5.5节)。
5.3 模型样本外表现
样本外,模型在读取更好的模型方面明显改进,并与独立错误基线水平相当(图4,表A6)。在LOLO下,其误差为0.037,而最佳模型基线为0.099(-0.062 [-0.085, -0.035]),该区间在LOMO、问题分割和表A6的十行中的七行下方位于零以下。时间分割给出0.019对0.050,-0.031 [-0.074, +0.008],在问题或仅模型上聚类时位于零以下(附录I)。与独立错误相比,模型在所有三种方案下水平相当,在拟合外的四个集中的三个上更好,常数冻结,因此满足第4节的标准,相对于最佳模型基线。
精度由测量的准确度和承载:移除将LOLO误差提高到0.323,保持其常数给出0.046。乘数在主要方案中对精度没有帮助,在覆盖范围和对数损失上有帮助。
在产品事实上,模型运行较高。其误差为0.130,而最佳模型为0.086,全部为过度陈述(13个百分点),与该领域的本地评分器相比为0.190对0.067,同样全部为过度陈述(19个百分点)。附录I将单元格分类为结果类别。
5.4 模型访问和GPT臂
在一组100个SimpleQA问题上,gpt-5.6-sol在主波中得分92/100(92.0%),其中99个通过Codex客户端,在方差臂中通过直接API的300个样本中139个(46.3%),差异为45.7个百分点(图5)。金标准字符串的逐字再现随之下降,从64.0%到26.0%。客户端在其默认工作量设置下运行,在其自己的指令下,温度不可设置,而API在工作量无和温度0.7下运行。
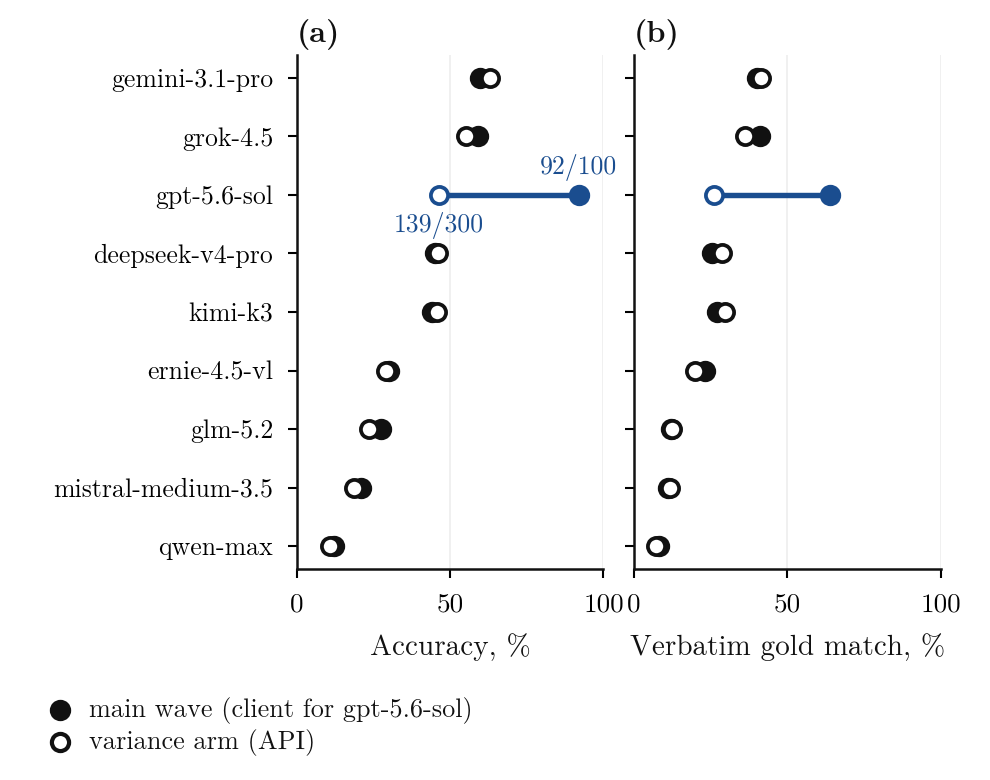
图5。 一组100个问题,两个臂,九个模型。 注:(a) 准确度,(b) 与金标准字符串的逐字匹配。填充,主波(gpt-5.6-sol的客户端提供,92/100);开放,通过API的方差臂(139/300)。对于gpt-5.6-sol,臂还在工作量设置中有所不同。
其他八个模型的温度也在两列之间变化,移动最多4.0个百分点。努力是一个候选因素,虽然在gemini-3.1-pro上进行配对推理预算测量时准确性基本保持不变(Chernets, 2026c)。另一个是网络搜索:同一客户端10月的回复在gpt-6.1-sol的506个答案中有3个包含提示未请求的链接,gpt-6-astra中有18个,8月客户端每次调用的中位数令牌使用量为4,829。
客户端数字是使用该产品的人收到的,API数字是无努力基准测试框架读取的。在8月的新问题上,通过API使用GPT时,gpt-5.6-sol和fable-5在32个协议中的29个上正确,Delta +57.6分 [+46.3, +69.7]。在10月,通过客户端使用较新的GPT在相同问题上,该对与opus-5-5配对时在74个中的72个上正确,Delta +2.3 [-0.7, +6.0]。这两个比较在GPT模型和日期上也不同,在两者中门控值都追踪发布的臂的准确性,如第5.1节所示。
未包含在表3中的客户端服务GPT臂准确性良好:8月臂与fable-5在1,016个协议中的997个上正确(98.1%),在106个中的37个上有34个正确,继承了臂的准确性(Delta -3.3 [-10.3, +2.6];表A7和附录J)。
5.5 公开数据的外部检验
我将冻结常数(无重新拟合)应用于与我的数据既不共享模型也不共享拟合的公开数据:HELM Lite (Liang et al., 2023),来自20个开发者的95个模型回答1,000个闭卷NaturalQuestions; LiveBench (White et al., 2025),来自11个实验室的70个模型回答346个具有简短最终答案的问题;以及Kim et al. (2025)针对70个模型在多选MMLU上的成对汇总(表A8)。结果与第5.3节相符(图4,下组)。该模型在所有三个源上都优于读出较好的模型,与HELM和LiveBench中的独立误差相当。它的运行高5.3至6.6个百分点,在斑马谜题上失败(0.231对0.076)。
在HELM中,当模型不断上升时观察到的曲线趋于平缓(图6):在成对准确性介于0.5和0.6之间,2023年及2024年初模型的精度为74.6%,后期为75.9%,而在该区间中点预测为84.4%。在MMLU上,两个错误答案匹配的中位数概率为0.621,对比的0.368,因为四个选项会强制碰撞。精度随成对准确性增加(在HELM中Spearman +0.575,MMLU上+0.786,超过从属单元格)。
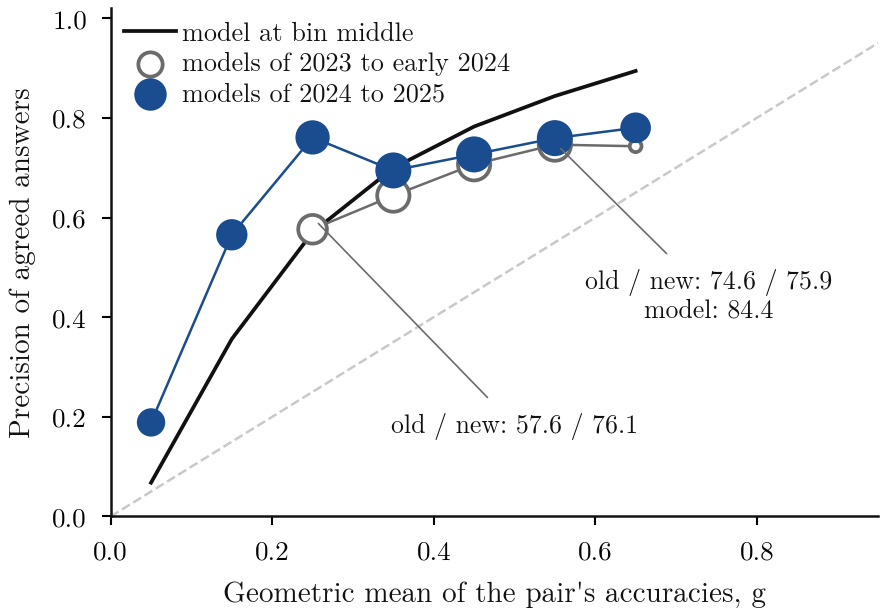
图6。HELM Lite:按成对准确性划分的一致答案精度,旧模型和新模型。注:按成对准确性几何平均数g的分组,不同实验室的成对;标记大小随成对数量增加。该线是各分组中点处的冻结模型。
HELM还允许进行第5.2节的测试,涉及许多实验室且不依赖GPT。在一个已发布模型和准确性相差3个百分点以内的合作伙伴情况下,另一个实验室捕获了75.5%的错误,而同一实验室为72.3%,-3.2个百分点 [-4.2, -2.3],覆盖范围高2.7个百分点。添加覆盖范围相差3个百分点以内的匹配会消除该差异:75.7对比75.9%,-0.2 [-0.6, +0.2]。
6. 讨论
运行门槛无需标签,但验证需要。在将被部署的访问模式下,对相关层的标记样本测量两个模型的准确性。在这些数据中,两个旗舰模型在超出两者能力的问题上达成一致的答案并不比两个中等级模型的一致答案更安全。当没有可信度值时,配对两个实验室是合理的默认做法,但必须在该层进行检查:由可信度筛选的同一实验室对或已发布模型自身的可信度可以达到相同效果(第5.2节、附录J)。
机会调整相似性(Goel et al., 2025)和一致答案的精确性是不同的量,Han(2026)将去相关性命名为杠杆,而我优先考虑准确性和覆盖范围(附录L)。在报告中,模型一致性研究应说明每个分支的访问模式、工作量、工具条件和保留的事件日志。
7. 范围和边界条件
通过两个不同日期和不同访问路由的波次对层级进行比较,层级比较在匹配准确度上精确到约3个百分点,在最难的五分位数单独情况下精度要低得多。新证据是两个日期的100个问题集合和8个模板,其中10月Delta包含零个。成对的准确度和精度在不同日期和不同波次之间的推理设置中一致变化,该设计不能将能力作为因果关系隔离。
无法从保留的文件中确定Codex、kimi和gemini-3.8-flash客户端是否进行了搜索,因此它们的准确度测量的是已部署的客户端,而非模型记忆。第5.1和5.3节显示了不包括这些分支的主要结果。
10月存在来自两个实验室的同实验室配对,没有GPT的同波次比较是100个新问题。10月单元格来自两个实验室的五个模型,因此两向自举的模型维度级别较少,汇总区间是不确定性的下界。等覆盖率比较使用已声明的置信度,而裸门不使用,随机打破平局将最宽行在0.0和+20.7个百分点之间移动(附录H)。
该引擎是基于规则的,其检查是SimpleQA Verified(第5.1节)的清理后黄金数据和答案部分的重新评分。它评估整个答案,长答案可能会产生错误的"错误";仅对第一部分评分会将参考配对的精度最多移动3个百分点,gpt-6-astra与opus-5-5在106个中从80.0%移动到88.9%(表A3)。
该模型以每个单元格的测量准确度作为输入,因此它描述了门的标记检查,不替代一个。它在产品事实和公开数据上运行良好。HELM、LiveBench和Kim et al.的汇总在少样本或多选择格式中保持较旧的模型,因此它们测试其他模型上的关系,而非2026年的旗舰产品。
8. 结论
协议一致答案的精确度随着该层级配对的准确性而提高,在两个层级内以及匹配准确度约3个点的范围内都是如此。只要我测量了配对较弱的地方,就出现了反演,包括旗舰产品。来自第二个实验室的合作伙伴主要通过较少打开门来发现更多错误,在覆盖范围相等的情况下,仅当其模型准确度远高于其他模型时才能保持优势。门的小模型比更优模型更好地描述了样本外精确度,与独立错误一样有效。一个通过两种访问配置测量的标识符相差45.7个点,因此关于模型准确度的声称应该说明访问模式。
影响声明
本文研究了何时可以依赖两个语言模型之间的一致性作为发布简短事实性答案的规则。实践者可以在重要的层级上检查他们部署的访问模式中,两个模型的把关机制是否足够精确,而不是假设更强大的模型或第二个供应商就足够了。主要风险是对困难问题上一致性答案的过度信任,研究结果展示了一致答案大多是错误的层级。该研究仅使用公共基准和机器生成的问题。
References
Chen, J. (2026). When does combining language models help? A co-failure ceiling on routing, voting, and mixture-of-agents across 67 frontier models. arXiv:2606.27288.
Chernets, V. (2026a). Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop: Who Verifies the Agents?
Chernets, V. (2026b). Weakly discriminative, not repaired by profile injection, and manipulable: Self-confidence in LLM evaluation. NeurIPS 2026 Workshop: Can We Trust AI Evaluation? Robustness, Causality, and Risk in Modern AI Assessment.
Chernets, V. (2026c). Architectural trust: When an AI agent buys for you, does trust belong to the model, or the architecture above it? SSRN 7191261.
Denisov-Blanch, Y., Kazdan, J., Chudnovsky, J., Schaeffer, R., Guan, S., Adeshina, S., and Koyejo, S. (2026). Consensus is not verification: Why crowd wisdom strategies fail for LLM truthfulness. arXiv:2603.06612.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Geifman, Y. and El-Yaniv, R. (2017). Selective classification for deep neural networks. In Advances in Neural Information Processing Systems 30. arXiv:1705.08500.
Goel, S., Strüber, J., Auzina, I. A., Chandra, K. K., Kumaraguru, P., Kiela, D., Prabhu, A., Bethge, M., and Geiping, J. (2025). Great models think alike and this undermines AI oversight. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267. arXiv:2502.04313.
Han, J. (2026). Partially correlated verifier cascades in LLM harnesses: Concave log-odds, polynomial reliability, and blind-spot ceilings. arXiv:2607.13918.
Haas, L., Yona, G., D'Antonio, G., Goldshtein, S., and Das, D. (2025). SimpleQA Verified: A reliable factuality benchmark to measure parametric knowledge. arXiv:2509.07968.
Hossain, E., Yousefi, N., and Lim, S.-N. (2026). Agreement overstates evidence: Error dependence in LLM judge consensus. arXiv:2609.22512.
Kim, D. (2026). Are diversity metrics measuring diversity? A capability-controlled audit of majority-vote gain in LLM ensembles. arXiv:2607.20768.
Kim, E., Garg, A., Peng, K., and Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267:30038-30066. arXiv:2506.07962.
Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
Kolawole, S., Dennis, D., Talwalkar, A., and Smith, V. (2025). Agreement-based cascading for efficient inference. Transactions on Machine Learning Research, 07/2025. arXiv:2407.02348.
Kuhn, L., Gal, Y., and Farquhar, S. (2023). Semantic uncertainty: Linguistic invariances for uncertainty estimation in natural language generation. In International Conference on Learning Representations. arXiv:2302.09664.
Liang, P., Bommasani, R., Lee, T., et al. (2023). Holistic evaluation of language models. Transactions on Machine Learning Research. arXiv:2211.09110.
Liu, N. (2026). LLMs as a jury: Cross-model consensus can outperform process reward models for LLM reasoning. arXiv:2607.10139.
Manakul, P., Liusie, A., and Gales, M. J. F. (2023). SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models. In Proceedings of EMNLP 2023. arXiv:2303.08896.
Naik, N. (2024). Probabilistic consensus through ensemble validation: A framework for LLM reliability. arXiv:2411.06535.
Owen, A. B. (2007). The pigeonhole bootstrap. The Annals of Applied Statistics, 1(2), 386-411.
Panickssery, A., Bowman, S. R., and Feng, S. (2024). LLM evaluators recognize and favor their own generations. In Advances in Neural Information Processing Systems 37.
Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657-680.
Tan, H., Sun, F., Liu, S., Su, D., Cao, Q., Chen, X., Wang, J., Cai, X., Wang, Y., Shen, H., and Cheng, X. (2025). Too consistent to detect: A study of self-consistent errors in LLMs. In Proceedings of EMNLP 2025. arXiv:2505.17656.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., and Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., and Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. In International Conference on Learning Representations.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., and Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
White, C., Dooley, S., Roberts, M., et al. (2025). LiveBench: A challenging, contamination-limited LLM benchmark. In International Conference on Learning Representations. arXiv:2406.19314.
Xue, Y., Greenewald, K., Mroueh, Y., and Mirzasoleiman, B. (2026). Verify when uncertain: Beyond self-consistency in black box hallucination detection. arXiv:2502.15845.
Yue, M., Zhao, J., Zhang, M., Du, L., and Yao, Z. (2024). Large language model cascades with mixture of thought representations for cost-efficient reasoning. In International Conference on Learning Representations. arXiv:2310.03094.
声明
利益冲突。作者是待批专利申请的指定申请人,不是已授予的专利,涵盖本文考查的人工智能编排和多模型验证系统。
数据和代码。每次调用响应、分析脚本和所有报告数字到其源表的映射已存档在 Zenodo,doi:10.5281/zenodo.24090584 (CC BY 4.0)。
附录A. 模型和访问模式
表A1. 各波次的集合和访问模式。
| 集合 | 日期 | 模型 | 访问方式 |
|---|---|---|---|
| 七月中层 | 2026年7月24日至28日 | claude-haiku-4-5, gpt-5-mini, gemini-3.6-flash, grok-4-fast, deepseek-chat, qwen-plus, kimi-k3, glm-4.5, mistral-small | 直接API |
| 七月本地 | 2026年7月24日至28日 | 七个本地开源权重模型 | 本地推理 |
| 八月旗舰 | 2026年8月3日至6日 | claude-fable-5, gpt-5.6-sol, mistral-medium-3.5 | 供应商客户端;gpt-5.6-sol在客户端默认努力设置,1500条记录中14条通过API回退 |
| glm-5.2 | 供应商端点 | ||
| deepseek-v4-pro, grok-4.5, kimi-k3, qwen-max | 直接API | ||
| gemini-3.1-pro, ernie-4.5-vl-424b, muse-spark-1.1 | 直接API或固定到供应商的聚合器路由;muse-spark-1.1部分(251个答案) | ||
| 方差组 | 2026年8月6日 | 九个旗舰模型,不含Claude | gpt-5.6-sol通过直接API,努力为零;mistral-medium-3.5通过其供应商客户端,记录请求的温度;其他与八月波次相同;温度0.7,三个样本 |
| 新鲜八月 | 2026年8月6日 | gpt-5.6-sol(努力为零)、claude-fable-5、deepseek-v4-pro、kimi-k3 | gpt-5.6-sol和deepseek-v4-pro通过直接API,claude-fable-5通过供应商客户端,kimi-k3通过聚合器路由 |
| 产品事实 | 2026年8月15日 | 六个模型,15对;四个无搜索可能性,6对 | 混合方式;gpt-5.4和grok通过客户端 |
| 十月 | 2026年10月26日和27日 | gpt-6.1-sol, gpt-6-astra, gpt-6-sol | Codex客户端,努力中等,无搜索标志,事件流未保留 |
| claude-opus-5-5, claude-fable-5-1 | Claude客户端,工具不允许 | ||
| kimi-k3, gemini-3.8-flash(仅新鲜) | 供应商客户端,工具未禁用 |
在八月波次中,claude-fable-5组的19个答案由其他Claude模型提供。该波次的34/37对106的结果不依赖于它们(Chernets,2026a)。
附录 B. 503 个常见问题的配对
表 A2. 所有不同实验室的配对,首个成员已发布,503 个常见问题。
| 配对 | 覆盖率 | PPV (K/O) | Delta,点数 [95%] | 捕获的错误 |
|---|---|---|---|---|
| gpt-6.1-sol + opus-5-5 | 59.8% | 95.6% (285/298) | +1.5 [-0.2, +3.3] | 16/29 |
| gpt-6.1-sol + fable-5-1 | 60.8% | 97.0% (294/303) | +2.9 [+1.1, +4.8] | 20/29 |
| gpt-6-astra + opus-5-5 | 58.3% | 94.8% (275/290) | +2.5 [+0.5, +4.7] | 23/38 |
| gpt-6-astra + fable-5-1 | 61.4% | 95.4% (291/305) | +3.1 [+1.1, +5.3] | 24/38 |
| gpt-6-sol + opus-5-5 | 61.6% | 95.4% (291/305) | -0.7 [-1.9, +0.6] | 5/19 |
| gpt-6-sol + fable-5-1 | 62.8% | 97.1% (301/310) | +1.0 [-0.4, +2.5] | 10/19 |
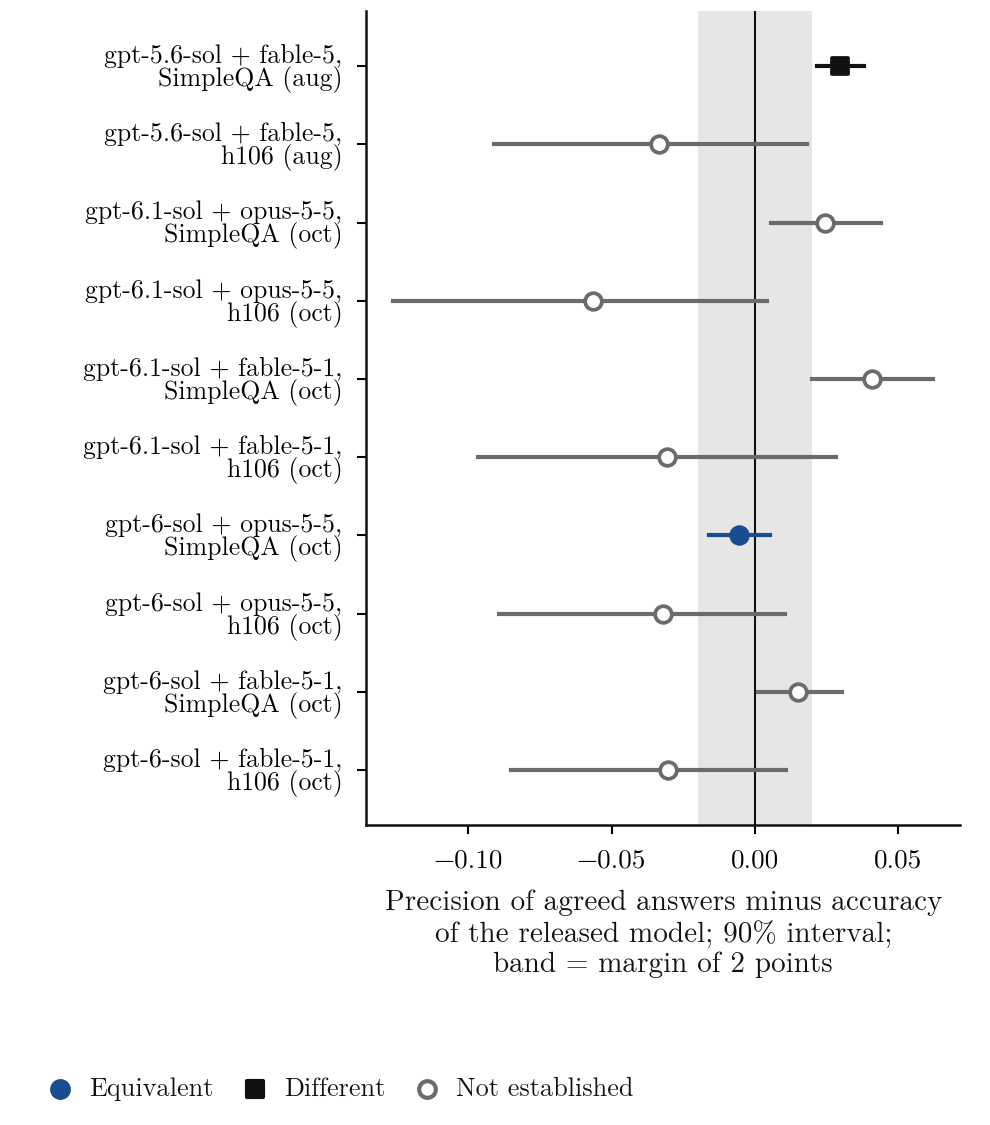
图 A1. 配对精度与已发布模型的等价性检验。 注:90% 问题自助法,2 点边际阴影。带有 Codex 客户端分支的配对已发布。
附录 C. 与金标准字符串的逐字匹配
逐字匹配与 SimpleQA 准确度在九个同时具有 SimpleQA 和新鲜测量的模型中完美秩相关,因为正确答案通常是金标准字符串。其与 SimpleQA 减去新鲜差的相关系数为 +0.47(精确置换 p = 0.21,n = 9),或 +0.29(p = 0.50,不包括 gpt-5.6-sol,其两个准确度来自不同的访问模式(图 A2))。限制于正确答案时,相关系数为 +0.10(p = 0.81)。在正确答案中,gpt-5.6-sol 的比率为 65.7%,fable-5 为 66.4%,deepseek-v4-pro 为 68.6%,kimi-k3 为 64.9%。模型的残差不依赖于此,在 112 个旗舰单元中的斜率为 +0.064 [-0.072, +0.167]。间隔本身对大多数模型接近零或为负,fable-5 为 -3.0 个百分点,deepseek-v4-pro 为 -20.5,opus-5-5 为 -5.4,fable-5-1 为 -7.8,仅对 gpt-5.6-sol 很大(+62.4),其中两个测量之间的访问模式不同。
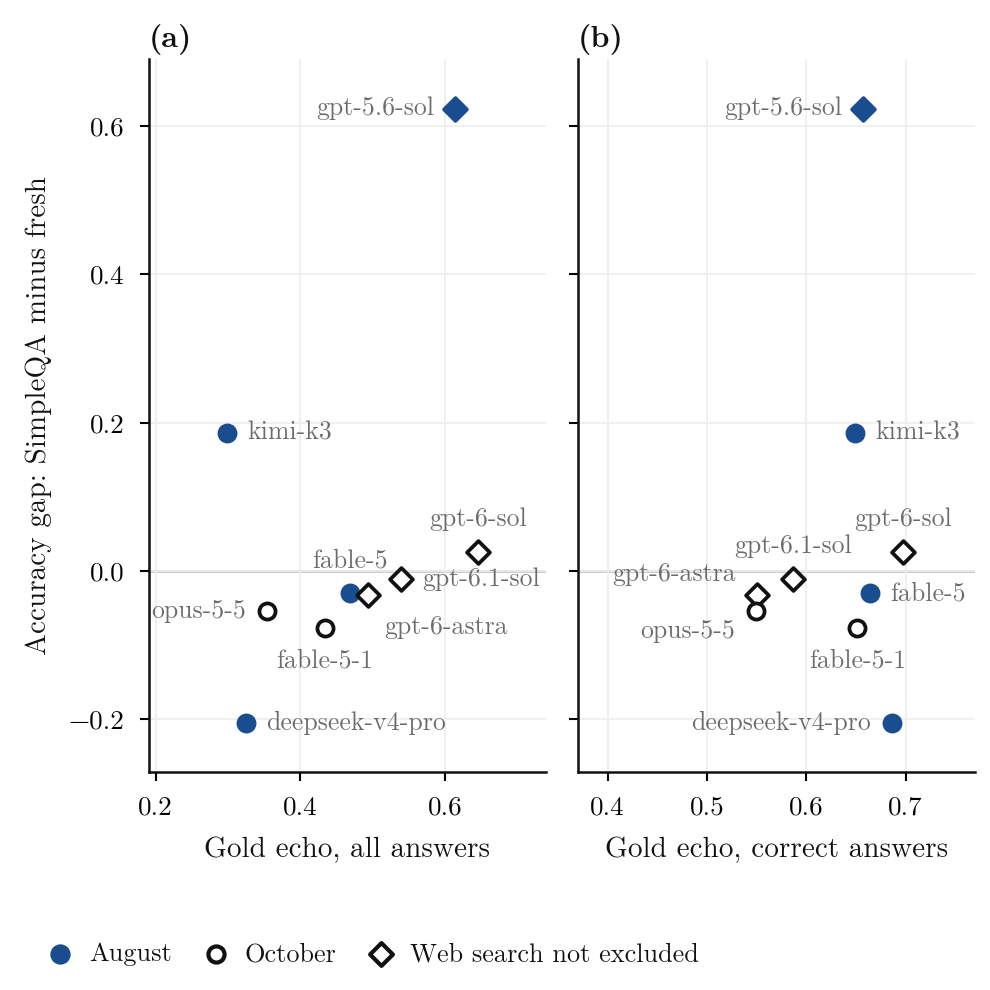
图 A2。 与金标准字符串的逐字匹配相对于准确度差。 注:(a) 所有答案,(b) 仅正确答案。蓝色填充,八月波;空心,十月波。菱形标记不排除网络搜索的组。
附录 D. 评分器敏感性
引擎规范化大小写、冠词和标点符号,接受完全匹配和四个或更多字符字符串的包含,按规则比较日期、数字和字母数字标识符,否则比较内容词;引擎无法根据黄金标准确定的答案为未解决。在表 A3 中,每个答案的第一部分不包含括号和尾部解释,用于匹配和评分,因此开放计数也会改变。
表 A3。 针对完整答案评分与针对第一部分评分。第一个成员已发布。
| 对、集合 | PPV,完整答案 | PPV,第一部分 |
|---|---|---|
| gpt-5.6-sol + fable-5, 全部, 8月 | 997/1016 | 997/1019 |
| gpt-6.1-sol + opus-5-5, 106, 10月 | 31/35 | 30/34 |
| gpt-6.1-sol + fable-5-1, 106, 10月 | 31/34 | 31/35 |
| gpt-6-astra + opus-5-5, 106, 十月 | 28/35 | 32/36 |
| gpt-6.1-sol + opus-5-5, strat, 十月 | 183/190 | 189/195 |
| gpt-6.1-sol + fable-5-1,策略性,十月 | 187/191 | 198/201 |
| gpt-6.1-sol + opus-5-5,新鲜,十月 | 72/74 | 72/74 |
附录 E. 进一步的相关工作
最近的预印本指向两个方向。在怀疑一方,Denisov-Blanch 等人 (2026) 发现在五个基准和模型上进行民调式聚合在推理成本增加 25 倍的情况下没有产生一致的准确度增益,因为错误是相关的。Ding (2026) 对 GPQA Diamond 和 AIME 上的 265,000 个样本进行审计,发现一致性是一个正但较弱的预测因子 (Spearman 0.20 到 0.59),其中最一致的前沿模型中 48% 的高一致性 GPQA 条目是错误的。在对 46 个项目的探索性检查中,gpt-4.1 和 Claude 层级之间的相同错误答案率在三个层级中的两个超过边际保留的零模型。Kohli (2026) 发现三个推理数据集上的九个前沿判官约有两张独立投票,最佳单个判官与面板持平或超过面板。Kim (2026) 对 MMLU-Pro 上 30 个模型的 31,900 个子集进行审计:投票在 9.98% 的大小为 3 的子集中超过最强成员,严格的多样性措施几乎与一减去平均准确度共线 (Spearman +0.991)。Hossain 等人 (2026) 在十个判官中发现平均成对错误相关性为 0.21,其携带的信息约相当于 3.5 个独立投票,不同提供商的前沿判官之间存在更强的依赖性。Chen (2026) 证明输出一个成员答案的任何策略都不能超过所有模型同时出错的速率 的补集,并发现在 67 个模型的开放式数学上 为 0.052,而在高斯 Copula 下为 0.023,在自由回答 GPQA-Diamond 上为 0.127。另一方面,Naik (2024) 报告在 78 个多选题格式的案例中,两个模型的精度从 73.1% 提升到 93.9%,三个模型提升到 95.6%,Liu (2026) 展示四模型面板在七个基准上选择答案优于自洽性,其中一个闭合形式规律在成员准确度、错误相关性和共享错误认知率中预测共识准确度的平均绝对误差为 0.028。Xue 等人 (2026) 报告带有验证器的跨模型一致性改进了自洽性天花板以用于 QA 基准的幻觉检测,Tan 等人 (2025) 报告自洽性错误不随模型规模缩小,往往特定于模型,更好地通过第二个模型检测。Han (2026) 给出了串行验证门理论,其中盲点质量上限可靠性并命名去相关性,通过改变模型族、模态或证据源,作为实践杠杆。第 2 节的两项工作具有与门相关的详细信息。Goel 等人 (2025) 定义 CAPA 使得不同的错误选项计为不一致,除了能力的趋势外,他们还显示九个开放权重的 LLM 判官更高地评分与自己相似的模型,弱到强增益在主管和学生产生更少相似错误的任务上更大 (12 个模型对)。Kolawole 等人 (2025) 在测试分布上接受的错误的联合速率上陈述了一个安全延迟条件,阈值在小验证集上估计。联合速率条件允许接受的错误集中在一个阶层上,第 5.1 节发现这样一个阶层:在 106 上,中层面板认证错误,没有最高准确度臂的旗舰对也是如此。
如第 2 节所述,这些工作中没有任何一项报告对级别发布门、一个已发布模型固定的等覆盖率的召回率,或在两种访问模式中测量的一个标识符。
附录 F. 数据和协议详情
数据集。协议遵循第 3 节,数据集完整如下。表 A1 列出了模型、日期和访问方式。
- 7 月中旬层级(7 月 24 至 28 日)。在 1,500 个 SimpleQA 问题(Wei et al., 2024)上的九个 API 模型和七个本地模型,是基准中 4,326 个问题的固定随机子样本。该数据集在数据收集前已在 OSF 上注册(Chernets, 2026a)。
- 8 月旗舰级(8 月 3 至 6 日)。来自十一个实验室各一个旗舰级模型,在相同的 1,500 个问题上,其中 1,459 个形成共同池。
- 方差组(8 月 6 日)。九个旗舰级模型在其中 100 个问题上,每五分位数 20 个,温度为 0.7,每个问题三个样本。
- 新问题(8 月 6 日和 10 月 26 日)。100 个双跳问题,由机器从 Wikidata 跨八个模板组成,文件哈希在第一次模型调用前固定。
- 产品事实(8 月 15 日)。267 个关于商业产品的问题,同样由 Wikidata 组成,在六个模型上进行,其中四个不具有搜索功能。
- 10 月旗舰级(10 月 26 和 27 日)。gpt-6.1-sol、gpt-6-astra、gpt-6-sol、claude-opus-5-5 和 claude-fable-5-1 在 300 个按 7 月五分位数分层的 SimpleQA 问题上(60、120、120;297 个共同问题;表中标记为"strat"),以下的 106 个问题和新问题集,共 503 个共同问题。kimi-k3 和 gemini-3.8-flash 回答了新问题集。
访问方式。通过第 3 节所述的两种方式访问模型。gpt-5.6-sol 在方差组和 8 月新问题集上也通过直接 API 运行。模型标识符和客户端版本按调用记录。
因为客户端设定了测量条件,我完整地说明这些条件。无法在客户端中设置温度。8 月 Codex 组在客户端推理工作量的默认设置下运行,该调用不设置该参数,记录中也未说明。10 月 Codex 组在每次调用中以中等工作量运行。8 月清单记录了 Claude 组的零个网页搜索请求和 Mistral 组的空工具列表,10 月 Claude 组禁用了工具。Codex 组在没有搜索标志的情况下启动,其事件流未保留,因此无法从文件中确定它们是否进行了搜索。在 kimi 和 gemini-3.8-flash 客户端中,工具未禁用,提示禁止使用它们。
附录 G. 106 及其分级
图 A3 显示了第 5.1 节中 106 的面板和配对,以及另外两个配对:fable-5 与 grok-4.5 在 28 个一致性中占 7 个,gemini-3.1-pro 与 grok-4.5 在 25 个中占 8 个。
第 1 节中的 0/342 取决于难度如何排序。当排除每个面板自身答案的难度排序时,计数变为 78/354,跨集团面板保持 0/116。
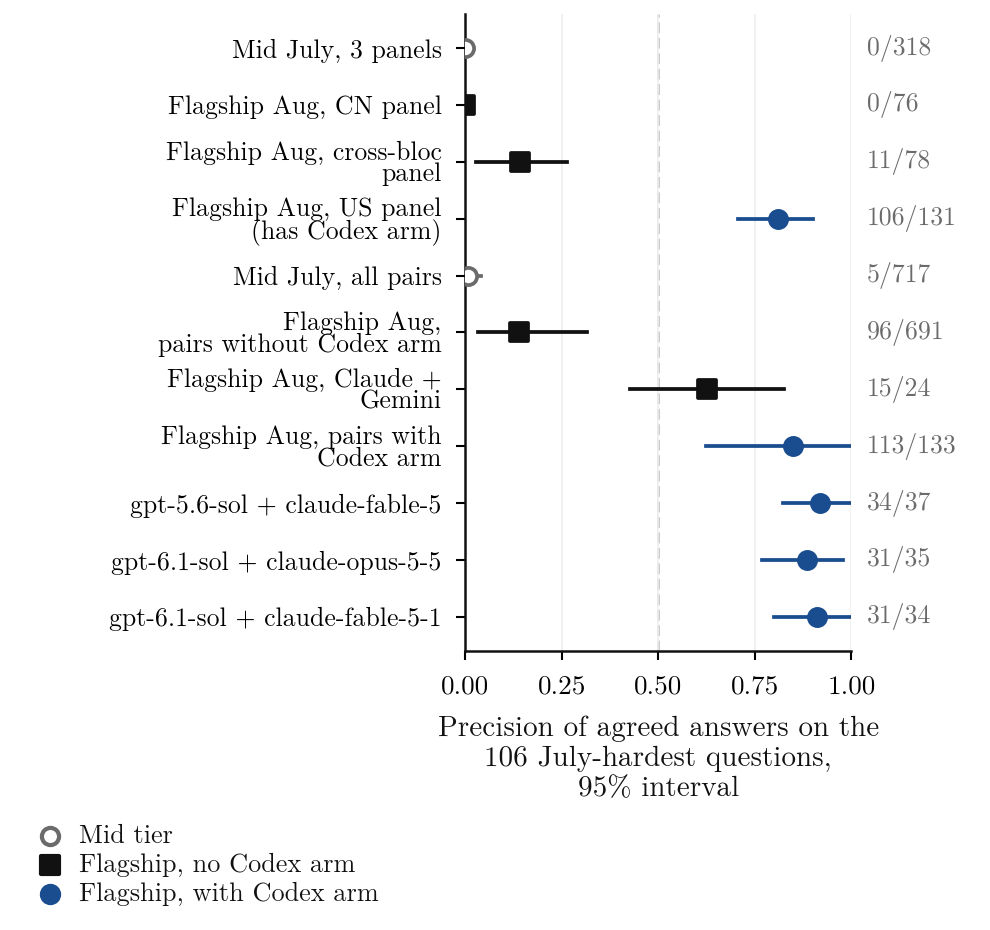
图 A3。 106 道题目一致答案的精度。 注:合并行采用 95% 双向自助法,面板和单一配对采用问题自助法。蓝色行包含 Codex 客户端。8 月和 10 月采集。
图 A4 给出了第 5.1 节自有分级五分位数的完整情况。在所有模型中,8 月在最难五分位数达到 26.6% [6.7, 53.4],比 7 月增加 +9.3 [-18.1, +39.8]。不包括同时出现在两个采集中的 kimi-k3,最难五分位数在 7 月为 147/675(21.8%),8 月为 192/995(19.3%),下降 2.5 个百分点 [-29.7, +28.2]。第 5.1 节的合并检验使用全部五个五分位数,每个分级 180 个单元;中层单元相对冻结模型 +0.3 个百分点 [-2.4, +2.9],旗舰单元 +0.0 [-1.4, +1.6]。最难五分位数的提升在 7 月为 1.15 [0.39, 1.90],8 月为 0.97 [0.42, 1.49]。跨五分位数,8 月不含 GPT 为 15.5、52.9、75.8、90.5 和 97.3%,7 月为 17.3、29.0、60.9、80.4 和 94.4%,而已发布模型的精度分别为 16.0、36.6、56.8、73.3 和 88.5%,对比 15.3、25.0、40.0、57.7 和 78.9%。
在清理后的黄金答案上精度仍然较低。Haas 等人 (2025) 将 SimpleQA 重建为 1000 道清理后的问题集,其中 106 道题目中有 24 道保留其中,超过从基准保留份额预期的 24.5 道,其中 21 道的黄金答案完全相同。清理对这些题目的去除频率不比其他题目更高,虽然其选择也倾向于难题。在相同统计量和自助法下,8 月不含 GPT 的配对在这 24 道题目的 150 个一致性上答对 28 个(18.7% [0.0, 57.1]),在其他 82 道的 538 个上答对 67 个(12.5% [2.8, 28.1];更准确的模型在各子集上发布,所以各部分无需加总为 691 中的 96),7 月配对为 157 个中的 4 个(2.5% [0.0, 15.2])。
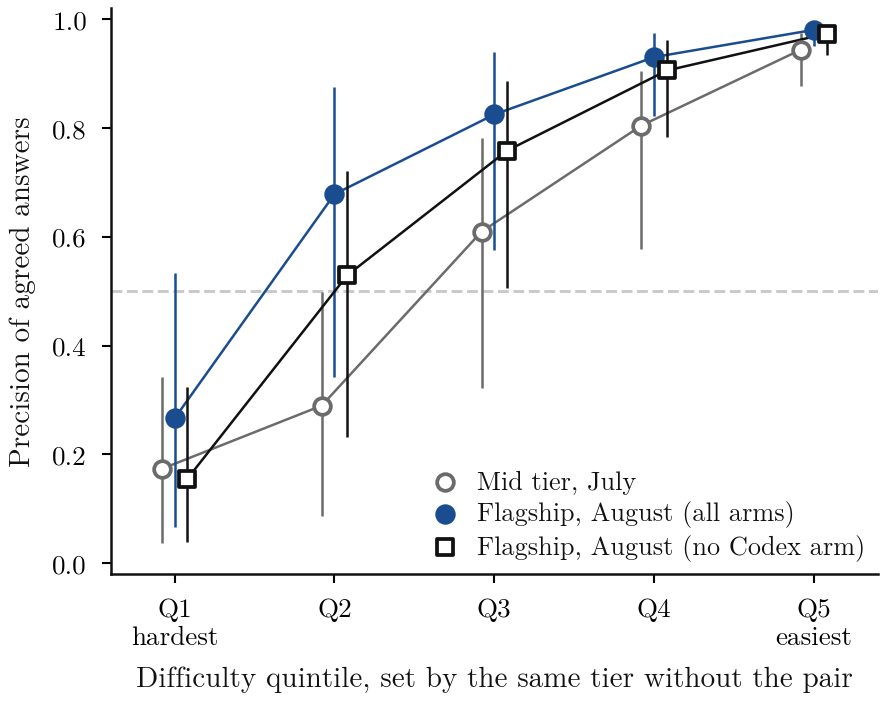
图 A4。 按自有分级难度五分位数划分的一致答案精度。 注:95% 双向自助法。每个配对的难度由不包含该配对的相同分级确定。虚线在 0.5 处。
最准确的配对遵循相同的关系。kimi-k3 和 gemini-3.8-flash 配对在新集合上达到 95.8%,已发布模型的 26 个错误中有 23 个被发现,提升为 5.37 [2.86, 21.36]。基于仅有的 0.74 和 0.82 精度,模型返回 95.1%。两个 Claude 旗舰模型配对,两臂都无搜索能力,在 106 道题上达到 47.5%,而已发布模型精度为 30.0%,在全部 503 道题上达到 86.2%。图 A5 绘制每个分级的每个带对已发布模型精度的关系,23 个单元中 17 个的精度在对角线上方。
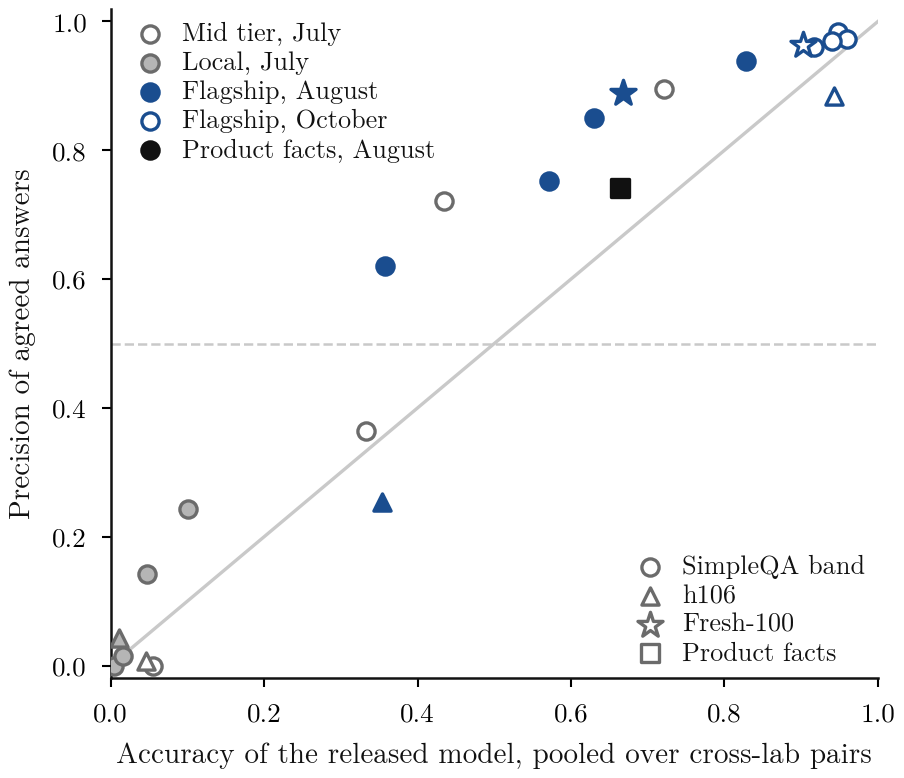
图 A5。 一致答案精度对比已发布模型精度。 注:按不同实验室配对合并,按分级和带分组。颜色和填充表示分级,标记形状表示数据集。虚线在 0.5 处,实线表示相等关系。
附录 H. 第二实验室详解
方差臂。 按模型在相等覆盖率下(图 2),两实验室大门在九个模型中的七个领先,在 gemini-3.1-pro(-5.7 分)和 grok-4.5(-2.8 分)上落后。不含 GPT,在八个模型中,自一致性覆盖率为 61.4%,精确度为 55.9%;两实验室为 24.4%,精确度为 83.3%。精确度差异为 +27.4 分 [+16.0, +35.7](按测定值)和 +7.7 [-1.9, +16.5](相等覆盖率),捕获的错误差异为 +38.3 分 [+26.0, +50.9](按测定值)和 +3.0 [-1.5, +8.4](相等覆盖率)。十月无重复调用,故自一致性仅在八月测定。
一个已发布模型的四个合作伙伴。 表 A4 给出图 3a 的四个合作伙伴:一个已发布模型 gpt-6.1-sol,因此 29 个有问题的错误在每一行中都相同。
表 A4。 一个已发布模型,四个合作伙伴:gpt-6.1-sol 在 503 个常见问题中(495 个已解决的问题中有 29 个错误,95% 问题自助法)。
| 合作伙伴 | 实验室 | 覆盖率 [95%] | 阳性预测值 (K/O) | 差异,分 [95%] | 捕获的错误 [95%] |
|---|---|---|---|---|---|
| gpt-6-astra | 相同 | 96.2% [94.4, 97.8] | 94.3% (449/476) | +0.2 [-0.2, +0.8] | 2/29 = 6.9% [0.0, 17.4] |
| gpt-6-sol | 相同 | 95.6% [93.6, 97.2] | 96.2% (457/475) | +2.1 [+0.9, +3.4] | 11/29 = 37.9% [20.7, 56.5] |
| claude-opus-5-5 | 不同 | 59.8% [55.9, 64.0] | 95.6% (285/298) | +1.5 [-0.2, +3.3] | 16/29 = 55.2% [36.4, 73.0] |
| claude-fable-5-1 | 不同 | 60.8% [56.7, 65.0] | 97.0% (294/303) | +2.9 [+1.1, +4.8] | 20/29 = 69.0% [50.0, 85.2] |
另一个同实验室合作伙伴 gpt-6-sol 捕获 29 个错误中的 11 个,相比 fable-5-1 为 -31.0 分 [-50.0, -10.7],相比 opus-5-5 为 -17.2 [-37.0, +3.0]。Claude 对中两个模型在任一臂中都无搜索可能,覆盖率为 60.6%,在 fable-5-1 的 181 个错误中捕获 140 个,精确度为 86.2%,差异为 +23.5 分 [+19.6, +27.2]。来自一个实验室的两个模型,均远未达到上限,可以足够频繁地不一致来捕获大多数错误。
表 A5 检验这是否不仅仅是沿覆盖率曲线的移动,以及是否需要 GPT。每一行保持一个已发布模型,并将其同实验室合作伙伴与来自另一实验室的合作伙伴进行比较,首先按测定值,然后在相等覆盖率下进行(通过按置信度细化更宽的大门达到,第 3 节)。
表 A5。 用同实验室合作伙伴和来自另一实验室的合作伙伴捕获的错误。差异为同减其他,以分为单位,95% 问题自助法,因此负值有利于另一实验室;前四行的按测定值差异共享表 A4 的自助法。
| 已发布 | 同实验室/其他合作伙伴 | 问题 | 捕获,按测定值 | 差异 [95%] | 捕获,相等覆盖率 | 差异 [95%] |
|---|---|---|---|---|---|---|
| gpt-6.1-sol | astra / fable-5-1 | 503 | 2/29, 20/29 | -62.1 [-79.3, -43.8] | 17/29, 20/29 | -10.3 [-35.3, +13.8] |
| gpt-6.1-sol | astra / opus-5-5 | 503 | 2/29, 16/29 | -48.3 [-66.7, -29.6] | 18/29, 16/29 | +6.9 [-17.1, +30.4] |
| gpt-6.1-sol | gpt-6-sol / fable-5-1 | 503 | 11/29, 20/29 | -31.0 [-50.0, -10.7] | 24/29, 20/29 | +13.8 [-6.7, +34.6] |
| gpt-6.1-sol | gpt-6-sol / opus-5-5 | 503 | 11/29, 16/29 | -17.2 [-37.0, +3.0] | 24/29, 16/29 | +27.6 [+3.4, +51.6] |
| fable-5-1 | opus-5-5 / gpt-6.1-sol | 503 | 140/181, 169/181 | -16.0 [-21.7, -10.6] | 140/181, 169/181 | -16.0 [-21.7, -10.6] |
| opus-5-5 | fable-5-1 / gpt-6.1-sol | 503 | 154/195, 177/195 | -11.8 [-17.8, -5.9] | 156/195, 177/195 | -10.8 [-16.7, -5.0] |
| fable-5-1 | opus-5-5 / kimi-k3 | 新鲜 100 | 13/23, 20/23 | -30.4 [-50.0, -12.5] | 17/23, 20/23 | -13.0 [-35.0, +9.1] |
| fable-5-1 | opus-5-5 / gemini-3.8-flash | 新鲜 100 | 13/23, 19/23 | -26.1 [-45.5, -8.7] | 17/23, 19/23 | -8.7 [-29.4, +12.5] |
| opus-5-5 | fable-5-1 / kimi-k3 | 新鲜 100 | 18/28, 23/28 | -17.9 [-38.5, +0.0] | 24/28, 23/28 | +3.6 [-14.7, +22.6] |
| opus-5-5 | fable-5-1 / gemini-3.8-flash | 新鲜 100 | 18/28, 22/28 | -14.3 [-33.3, +4.5] | 22/28, 22/28 | +0.0 [-20.0, +20.7] |
| fable-5-1 | opus-5-5 / gemini-3.1-pro(八月) | 344 | 107/130, 110/130 | -2.3 [-9.8, +5.3] | 108/130, 110/130 | -1.5 [-9.1, +5.8] |
| opus-5-5 | fable-5-1 / gemini-3.1-pro(八月) | 344 | 118/141, 126/141 | -5.7 [-12.1, +0.8] | 125/141, 126/141 | -0.7 [-6.4, +5.1] |
八月行是唯一不含 GPT 的 SimpleQA 比较,并配对来自不同日期的模型。gemini-3.1-pro 是八月臂中在这些问题上准确度最接近 Claude 模型的(65.4% 对比 60.6% 和 57.7%)。汇总所有七个八月合作伙伴,其中大多数弱得多,差异为 fable-5-1 的 -5.1 分 [-10.1, -0.3] 和 opus-5-5 的 -6.0 [-10.6, -1.2](按测定值),在相等覆盖率下转为分别有利于同实验室的 +7.9 [+4.8, +11.2] 和 +6.8 [+3.6, +10.2]。置信度中的并列在随机时打破,在 200 次抽取中,最宽行在 0.0 和 +20.7 分之间移动。
附录 I. 模型样本外表现详解
表 A6 给出了第 5.3 节背后的样本外误差。时间分割给出 0.019,而最佳模型基线为 0.050,差异为 -0.031 [-0.074, +0.008](双向自举法),当按问题单独聚类或按模型单独聚类时,区间均位于零以下。在 9 和 23 折时,LOLO 和 LOMO 给出的误差精确到小数点后三位相同。
表 A6. 预测正预测值的平均绝对误差,至少包含 20 个开放答案的单元格。双向自举法,按问题和模型分层。
| 方案 | 模型 [95%] | 独立 | 最佳 | 模型减最佳 [95%] | 模型减独立 [95%] |
|---|---|---|---|---|---|
| LOLO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.035] | +0.005 [-0.003, +0.012] |
| LOMO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.036] | +0.005 [-0.004, +0.012] |
| LOLO,问题分割 | 0.054 [0.052, 0.088] | 0.050 | 0.109 | -0.055 [-0.075, -0.027] | +0.004 [-0.002, +0.010] |
| 七月和八月至十月 | 0.019 [0.008, 0.041] | 0.023 | 0.050 | -0.031 [-0.074, +0.008] | -0.004 [-0.011, +0.005] |
| 中端至旗舰机 | 0.030 [0.025, 0.053] | 0.031 | 0.087 | -0.057 [-0.087, -0.022] | -0.001 [-0.009, +0.005] |
| LOLO,旗舰机,无搜索可能分支 | 0.037 [0.029, 0.071] | 0.038 | 0.120 | -0.083 [-0.125, -0.039] | -0.000 [-0.017, +0.014] |
| 保留:ERNIE 和 Muse,八月 | 0.019 [0.015, 0.055] | 0.033 | 0.128 | -0.110 [-0.143, -0.032] | -0.014 [-0.031, +0.007] |
| 保留:7 个本地模型,七月 | 0.037 [0.018, 0.072] | 0.068 | 0.077 | -0.040 [-0.061, -0.015] | -0.031 [-0.041, -0.014] |
| 保留:同一实验室,十月 | 0.038 [0.017, 0.083] | 0.043 | 0.041 | -0.003 [-0.130, +0.045] | -0.006 [-0.025, -0.001] |
| 保留:产品事实 | 0.130 [0.077, 0.187] | 0.149 | 0.086 | +0.045 [-0.051, +0.143] | -0.019 [-0.021, -0.012] |
相比直接读取更好模型的实际收益很大,包括从中端到旗舰机的迁移以及未参与拟合的四个集合中的两个(图 A6)。乘数 对主要方案的精度没有增加,工作由测量的精度和 完成。完全移除 将 LOLO 误差提高到 0.323,将其保持常数给出 0.046。对于覆盖率和对数损失, 确实有帮助:在 LOLO 下,与独立误差的差异为 -0.0079 [-0.0111, -0.0020] 和 -0.0024 [-0.0045, -0.0003]。在四个保留集中的三个上,与独立误差的区间位于零以下,常数冻结。因此联合误差项对覆盖率很重要,而精度取决于测量的精度和 。
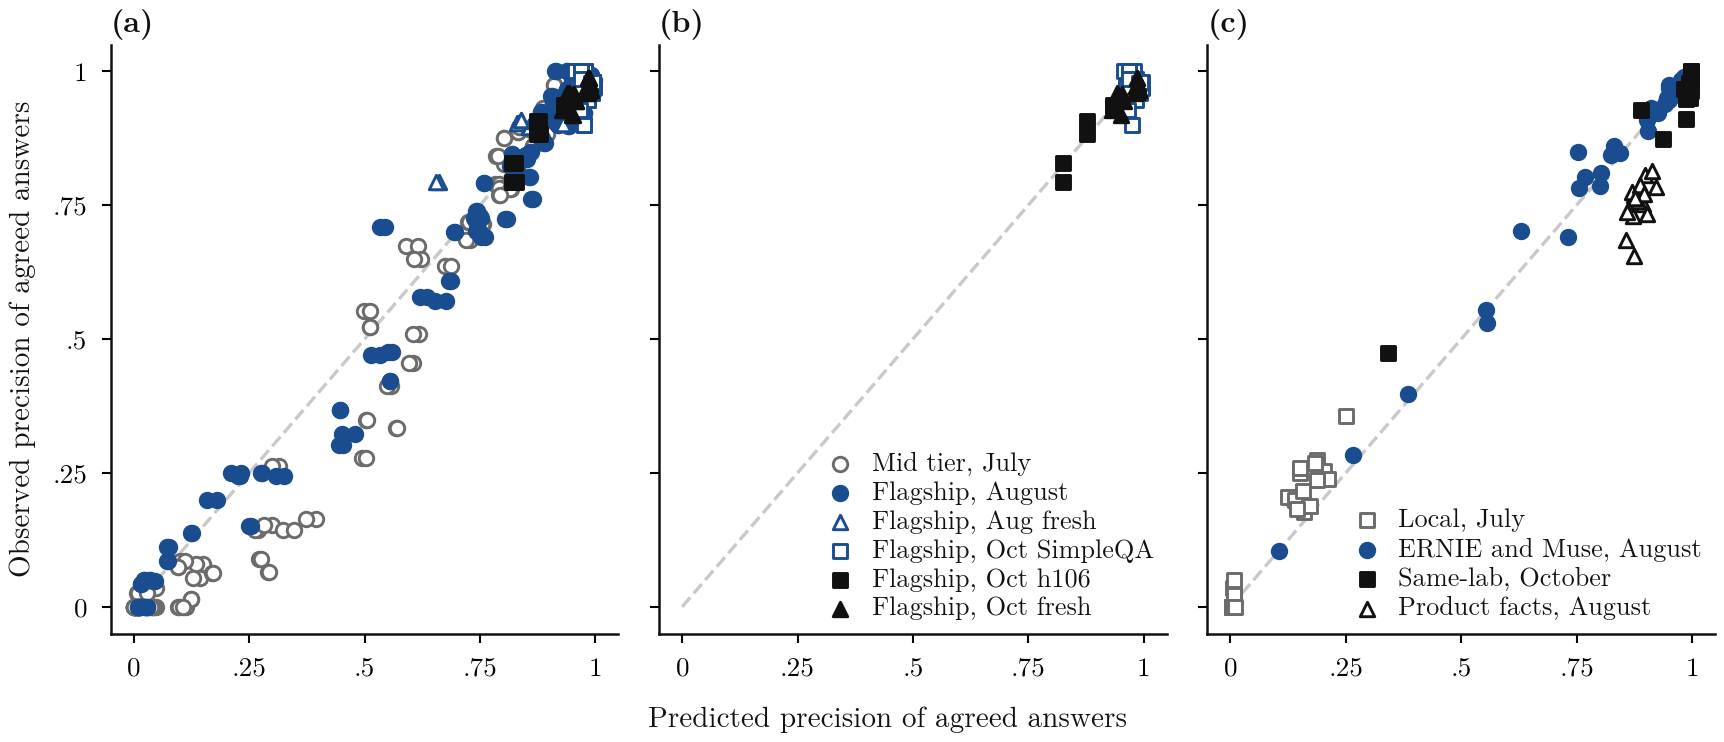
图 A6. 预测的与观察到的一致答案的精度。 注:(a) 留一实验室出法。(b) 在七月和八月拟合,预测十月。(c) 拟合外的集合,常数固定。虚线为等值线。
在产品事实上,模型运行偏高。误差为 0.130,而最佳模型为 0.086,平均高估 13 个百分点。使用该领域的本地评分器,高估上升到 19 个百分点(0.190 对 0.067)。产品事实位于常数拟合所在域之外。
将单元格分为三个结果类别(正预测值低于 0.5 时反转,提升最多 +2 个百分点时无收益,高于此时有收益),时间分割匹配 39 个单元格中的 28 个,九个失误预测无收益而实际有收益。该模型对精度大小是可靠的,但在 +2 百分点线两侧对单元格的分类能力较弱。
附录J. 访问模式和GPT arms详解
相同的标识符,相同的问题。在100个SimpleQA问题的一个集合上,gpt-5.6-sol在主波中得分为92/100(92.0%),其中99条记录通过Codex客户端,一条错误答案通过API备用方案获得,而在方差arm中通过直接API获得139/300个样本(46.3%),差距为45.7个百分点(图5)。仅在99条客户端记录上,数字分别为92/99(92.9%)和139/297(46.8%),差距为46.1个百分点。黄金字符串的逐字重现随之下降,从64.0%降至26.0%。条件如下不同:客户端在其默认工作量设置下按其自己的指令运行,温度不可设置,而API在工作量为none且温度为0.7的条件下运行。
在两列中,arm中的其他八个模型(其温度也会改变)的变化最多为4.0个百分点。工作量是gpt-5.6-sol的一个候选因素,尽管在gemini-3.1-pro上进行的配对推理预算测量使准确性基本保持不变(Chernets, 2026c)。网络搜索是另一个。来自同一客户端的10月响应包含提示未请求的链接,在3/506个gpt-6.1-sol的答案中和在18/506个gpt-6-astra的答案中,包括一个真实的MusicBrainz标识符。每个8月客户端调用的中位令牌使用为4,829,36.4%的调用超过6,000。这些令牌可能是推理或搜索,而分离它们的事件流未被保留。
因此,基准测试框架和产品使用者可能在一个标识符和一个问题集上看到相差45.7个百分点的准确性,对"该模型"的研究必须说明其测量的是哪一个。在8月波中,客户端arm得分为1,392/1,457(95.5%),而14条在客户端失败后由API提供的记录在选定的问题上得分为11(78.6%)。在新数据集上,通过API的gpt-5.6-sol得分为33/100,而fable-5得分为76,而gpt-6.1-sol通过客户端在10月得分为95。第4节的模型在此问题下保持其形式,因为它将测量的准确性作为输入:在没有搜索可能arms的旗舰上,其LOLO误差为0.037,而最佳模型为0.120。
按访问模式划分的门值。在8月的新问题上,通过API使用GPT,gpt-5.6-sol和fable-5这一对在32个一致意见中的29个上是正确的,Delta +57.6个百分点[+46.3, +69.7],捕获了67个错误中的64个,而GPT arm的确信错误从91个中的61个下降到29个中的2个。在10月,通过客户端使用较新的GPT在相同问题上,与opus-5-5配对的一对在74个中的72个上是正确的,与fable-5-1配对的一对在78个中的76个上是正确的,Delta为+2.3[-0.7, +6.0]和+2.4[-0.5, +6.3],捕获了5个错误中的3个。门值在此处跟踪已发布arm的准确性,如第5.1节所示。
SimpleQA上的客户端arms。表A7报告了第5.1节中搁置的arms。在8月,gpt-5.6-sol和fable-5这一对在1,016个一致意见中的997个上是正确的(98.1%),单独为95.4%,Delta +2.8个百分点[+1.9, +3.7],下限为1,459个中的15个。在106个上,其达到37个中的34个(91.9%),所有与GPT arm配对的对在133个中的113个上达到(85.0%[62.2, 100.0%]),而没有它的691个中有96个。该arm单独在105个中的100个上是正确的。这些一致意见继承该准确性:在8月时,106个上的Delta为-3.3个百分点[-10.3, +2.6],在10月与opus-5-5时为-5.7[-13.7, +1.2]。相比之下,同一两个供应商的中等级对gpt-5-mini和claude-haiku-4-5在123个一致意见中的45个上是正确的(36.6%[28.6, 45.4%]),整体上在106个中的0个上,其第一个成员在1,435个中的163个上。
表A7。客户端arm对。第一个成员已发布。PPV上的Wilson区间,Delta上的问题bootstrap。
| 对,集合 | 覆盖率 | PPV (K/O) [95%] | 单独已发布 | Delta,百分点 [95%] | 捕获的错误 |
|---|---|---|---|---|---|
| gpt-5.6-sol + fable-5, 所有SimpleQA, 8月 | 1028/1500 | 98.1% (997/1016) [97.1, 98.8] | 1403/1471 | +2.8 [+1.9, +3.7] | 49/68 |
| gpt-5.6-sol + fable-5, 106, 8月 | 37/106 | 91.9% (34/37) [78.7, 97.2] | 100/105 | -3.3 [-10.3, +2.6] | 2/5 |
| gpt-6.1-sol + opus-5-5, 策略, 10月 | 192/300 | 96.3% (183/190) [92.6, 98.2] | 276/294 | +2.4 [+0.2, +4.9] | 11/18 |
| gpt-6.1-sol + fable-5-1, 策略, 10月 | 193/297 | 97.9% (187/191) [94.7, 99.2] | 273/291 | +4.1 [+1.6, +6.7] | 14/18 |
| gpt-6.1-sol + opus-5-5, 106, 10月 | 36/106 | 88.6% (31/35) [74.0, 95.5] | 98/104 | -5.7 [-13.7, +1.2] | 2/6 |
| gpt-6.1-sol + fable-5-1, 106, 10月 | 35/106 | 91.2% (31/34) [77.0, 97.0] | 98/104 | -3.1 [-10.9, +3.5] | 3/6 |
| gpt-6.1-sol + opus-5-5, 新数据, 10月 | 74/100 | 97.3% (72/74) [90.7, 99.3] | 95/100 | +2.3 [-0.7, +6.0] | 3/5 |
| gpt-6.1-sol + fable-5-1, 新数据, 10月 | 78/100 | 97.4% (76/78) [91.1, 99.3] | 95/100 | +2.4 [-0.5, +6.3] | 3/5 |
接近上限的门值。在熟悉的问题上,该对仍然增加了一些(图A1)。在8月,在没有106的SimpleQA上,其Delta为+3.0个百分点[+2.0, +4.0],有利于该对的差异。在10月,策略对位于零以上,分别为+2.4[+0.2, +4.9]和+4.1[+1.6, +6.7],低于对所有边界的判决。唯一的等价情况是gpt-6-sol与opus-5-5为-0.6(90%区间-1.6到+0.5,p = 0.020),这不能在Holm校正后存活(0.277)。在106上,每一对gpt-6.1-sol和gpt-5.6-sol都是未决定的,方向向下。在该arm之外,效果很大:在相同的8月集上,fable-5与gemini-3.1-pro为+19.3个百分点,fable-5与grok-4.5为+18.0。
该arm自身的置信度在此范围内是一个竞争者。按其自身置信度细化到与opus-5-5配对的覆盖率,gpt-6.1-sol在106个中的34到36个上是正确的(取决于如何处理平局),而该对为35个中的31个,在新数据上为74个中的74个对72个中的72个。在策略上,该对领先,与opus-5-5为+1.6个百分点[-1.4, +4.7],与fable-5-1为+3.2[+0.6, +6.2]。
选择哪个GPT以及哪个合作伙伴。在两个模型都能解决的常见问题上,gpt-6.1-sol在不一致的对比中击败gpt-6-astra的比例为10:1(p = 0.012,+1.83分[+0.61, +3.26]),gpt-6-sol击败gpt-6-astra的比例为21:5(p = 0.002,+3.29分[+1.23, +5.34])。gpt-6.1-sol与gpt-6-sol的对比为5:12(p = 0.143)。opus-5-5与fable-5-1的对比为29:44(p = 0.101,-3.12分[-6.65, +0.21])。两个最强GPT与两个Claude的组合在503个问题中的准确率介于95.4%至97.1%之间(表A2),其中fable-5-1在每次对比中发现了更多的错误。没有GPT的配对kimi-k3与gemini-3.8-flash在新数据集上与它们无法区分:其与gpt-6.1-sol和opus-5-5的差异在精确度上为-1.5分[-6.3, +2.8],在覆盖率上为-2.0分[-10.0, +6.0]。
附录 K. 外部数据详述
第 5.5 节的外部检验使用冻结常数,无需重新拟合。HELM Lite (Liang et al., 2023) 包含来自 20 个开发者的 95 个模型(发布于 2023 至 2025 年)对 1,000 个闭卷 NaturalQuestions 的简短开放答案,由我的引擎评分。LiveBench (White et al., 2025) 包含来自 11 个实验室的 70 个模型对 346 个具有简短最终答案的问题的答案,按其基准真值评分。Kim et al. (2025) 发布了 70 个模型在多选题 MMLU 上的配对聚合结果,给出观察精度作为两个都正确率与一致率的比值。表 A8 给出了结果。Haas et al. (2025) 表 7 中的精度不包含一致结果,因此只能进行预测而无法检验。
表 A8. 冻结模型在其他模型和问题上的表现。不同实验室配对的预测 PPV 平均绝对误差,前两个来源中至少有 20 个开放答案的单元。双向自助法,MMLU 仅按模型。Shift 为预测值减去观察值。
| 来源 | 单元 | 模型 [95%] | 独立 | 最优 | 模型减最优 [95%] | 模型减独立 [95%] | 偏移 |
|---|---|---|---|---|---|---|---|
| HELM, NaturalQuestions | 4,088 | 0.069 [0.054, 0.087] | 0.070 | 0.208 | -0.139 [-0.171, -0.103] | -0.001 [-0.008, +0.006] | +0.053 |
| LiveBench, 四个任务 | 952 | 0.114 [0.101, 0.150] | 0.107 | 0.198 | -0.084 [-0.121, -0.026] | +0.007 [-0.006, +0.022] | +0.056 |
| LiveBench, math_comp | 431 | 0.075 | 0.096 | 0.279 | -0.034 | ||
| LiveBench, zebra_puzzle | 203 | 0.231 | 0.184 | 0.076 | +0.230 | ||
| LiveBench, spatial | 161 | 0.148 | 0.114 | 0.167 | +0.148 | ||
| LiveBench, web_of_lies_v2 | 157 | 0.036 | 0.031 | 0.166 | -0.017 | ||
| Kim et al., MMLU (聚合) | 2,189 | 0.066 [0.060, 0.072] | 0.084 | 0.084 | -0.018 [-0.028, -0.010] | -0.018 [-0.019, -0.017] | +0.066 |
如第 5.3 节所示,该模型在三个整体来源上都优于直接选择更好的模型,但在斑马谜题上失败,达到 0.231 对 0.076。它在 HELM 或 LiveBench 上没有改进独立误差。总体来看,它运行偏高,高出 5.3 至 6.6 个百分点。在 HELM 中,观察曲线在配对精度 0.5 至 0.6 之间趋于平缓,而模型持续上升:对于 2023 年和 2024 年早期的模型,精度为 74.6%,对于后期模型为 75.9%,而在该区间中点预测精度为 84.4%。在 MMLU 上,两个错误答案相匹配的中位概率为 0.621,而来自 的为 0.368,因为四个选项强制碰撞。
在这些模型上,精度随配对精度上升(HELM 中 Spearman +0.575,MMLU 上 +0.786,跨依赖单元)。具有相似精度的较旧和较新模型在配对精度 0.4 至 0.6 之间给出相似精度(70.7% 和 72.7%,74.6% 和 75.9%),而在 0.2 至 0.3 之间差异更大(57.6% 和 76.1%)。第 4 节的下界在全部 4,088 个 HELM 单元中成立。配对精度低于 0.5 的情况在此处罕见,在 4,088 个中有 24 个,因为这些单元未按难度分层。
HELM 还允许用第 5.2 节的检验进行许多实验室的测试且不依赖 GPT,因为伙伴精度可以在没有置信度值的情况下匹配。对于一个已发布模型和精度相差 3 个百分点内的伙伴,同一实验室的伙伴捕获 72.3% 的错误,而另一实验室的为 75.5%,差异为 -3.2 个百分点 [-4.2, -2.3],覆盖率更高 2.7 个百分点 [+2.1, +3.4]。增加覆盖率相差 3 个百分点内的匹配消除了它:75.7% 对 75.9%,-0.2 [-0.6, +0.2],精度 -0.5 [-1.4, +0.1]。两个错误答案在实验室内匹配的概率为 31.6%,跨实验室为 27.0%。
共享错误在第 3 节的集合中也远高于随机水平。在 Ding (2026) 的标签排列零假设下,该假设保留每个模型的错误答案并在问题间打乱它们,非拒绝的两个错误答案在 7 月和 8 月的匹配率分别为 14.0% 和 15.4%,不含 GPT,而零假设为 0.1%。在 106 上,匹配率为 25.7% 和 22.8% 对 0.4% 和 0.5%,在新问题上 8 月为 14.5%,10 月为 32.7%,对比 0.8% 和 3.8%。开放答案很少偶然碰撞,因此观察到的共享远高于此零假设,包括在模型发布后构造的问题上。
附录L. 进一步讨论
与Goel等人(2025)的关系。他们的趋势涉及机会调整相似性,而我的趋势涉及一致答案的精度,因此研究结果不相冲突。数据通过共享错误的条件份额F/W来说明这一点,即两个错误答案相同的概率,在两个答案都被评分且拒绝被计为错误的问题上。对于参考对,它从中层对的63/1,088(0.058)上升到旗舰对的15/42(0.357),约为六倍。在所有对(包括GPT)的汇总中,上升较小,置信区间包含零:7月为0.097,8月为0.132,差异为+0.034 [-0.006, +0.084]。在10月分层集上,F/W为0.493 [0.179, 0.840],与8月的差异为+0.361 [+0.041, +0.712]。在覆盖率相等的情况下,逐个分箱比较,旗舰召回率低0.7至2.5个百分点,效应较小,为0.140 [0.092, 0.192],对比0.113 [0.082, 0.146]。因此方向与他们的一致,尽管汇总置信区间包含零。他们警告的直接理解,即相似性威胁门槛,确实出现在召回中:10月客户端对在覆盖率65.3%的情况下捕捉66.3%的错误,而所有55对8月对在32.5%的覆盖率下捕捉88.2%,这种对比部分由覆盖率解释。精度保持较高主要是因为,在这些精度水平下,第4节的界限留给它下降的空间很小。
与Han(2026)的关系。Han将去相关作为实际杠杆。我的测量将精度和覆盖率放在首位。在相同覆盖率和一个发布模型的情况下,第二个实验室的优势消失,除非其模型的精度远高(第5.2节)。在HELM中,精度匹配时,第二个实验室增加3.2个百分点的召回,覆盖率为2.7个百分点,一旦覆盖率也匹配就消失。去相关在27.0对31.6%的匹配错误答案处可见,且效应较小。Han的理论涉及串联门的深度,而我的理论涉及单个门,因此两者仅在第一步相遇。Liu(2026)区分相同的两件事:选择精度遵循去相关,多模型面板在AIME-2024上以成员精度匹配的情况下超过重采样12.5至16.7个百分点,而一致信号的校准遵循成员精度。这里测量的一致答案的精度是后者。
第2节的两个方面。已发表的数字部分调和了两个方面。Liu的一致面板在0.433的全答精度下在AIME-2025上100.0%正确,在0.458下在MMLU-Pro上70.2%正确。Kohli的一致九名法官,每人接近68%,在90.9%上正确。类似的精度给出相差30个百分点的精度,所以精度单独不能将这些结果联系在一起。答案空间的大小解释更多。两个错误答案匹配的概率在四选项MMLU上为0.621,在NaturalQuestions上为0.270,在8月旗舰的SimpleQA上为0.132。这些是不同任务上的面板和对,跨论文没有联合计算,它们与精度在任务和答案格式内遵循精度一致。
熟悉度。SimpleQA和新鲜精度之间的差距邀请通过基准暴露的解释,与金字符串的逐字匹配看起来像其特征。我的数据不支持这作为协变量(附录C)。在正确答案中,逐字匹配在模型间接近一个值,它不解释模型的残差。8月新鲜集上的F/W,0.145 [0.033, 0.402],显示与SimpleQA上0.132没有可见距离,在宽置信区间内。
如何引用
Chernets, V. (2026). 一致反演不是中层特性:一致大语言模型答案的精度遵循对精度[预印本]。SSRN。https://doi.org/10.2139/ssrn.7682960
@misc{chernets2026agreementinversion,
  author       = {Chernets, Vadym},
  title        = {{Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7682960},
  url          = {https://doi.org/10.2139/ssrn.7682960}
}