Інверсія згоди не є властивістю середнього рівня: точність узгоджених відповідей LLM відповідає точності пари
Це переклад. Основна версія — оригінал англійською; посилайтеся на неї.
Вадим Чернець, PhD, архітектор систем штучного інтелекту · ORCID 0009-0007-4845-3163
SSRN 7682960 · DOI 10.2139/ssrn.7682960 · Zenodo 10.5281/zenodo.24090580 · Analysis release 10.5281/zenodo.24090584 · GitHub
Препринт, 9 листопада 2026. SSRN: 7682960. Архівна копія: 10.5281/zenodo.24090580. Дані та код: 10.5281/zenodo.24090584. PDF: agreement-inversion.pdf. PDF є авторитетним.
Анотація
Коли два флагманські моделі, запитані окремо, дають однакову відповідь на одне з найскладніших запитань SimpleQA, ця відповідь зазвичай неправильна. З 106 запитань SimpleQA, де панелі середнього рівня липня не пройшли, 45 пар флагманів без клієнт-обслуговуваного GPT, де веб-пошук не можна виключити, дають правильну відповідь на 96 з 691 узгодження (13,9%). Відповідати лише коли другої моделі погоджується не потребує міток чи параметрів, а попередні роботи приписували невдачи цього правила моделям середнього рівня. На обох рівнях, які я вимірював, точність узгоджених відповідей відповідає точності пари, тому інверсія не є властивістю середнього рівня. У найскладнішому квінтилі, визначеному однаково для кожного рівня, точність становить 17,3% у липні та 15,5% у серпні; у всіх п'яти квінтилях, з точністю, очікуваною від двох точностей кожної пари, пари флагманів відрізняються від пар середнього рівня на -0,2 пункти [-3,1, +2,7]. Дані — це SimpleQA, свіжі двохскачкові запитання та факти про продукти, зібрані у липні, серпні та жовтні 2026 року з флагманськими моделями від одинадцяти лабораторій. Партнер з другої лабораторії виловлює більше помилок, але відкриває ворота рідше: для однієї випущеної моделі партнер з однієї лабораторії виловлює 2 з 29 помилок, а партнер з іншої лабораторії — 20 з 29 (-62,1 пункти [-79,3, -43,8]), з воротами відкритими на 96% і 61% запитань. Коли ширші ворота звужуються зазначеною впевненістю до рівного охоплення, ця перевага зберігається лише там, де модель партнера значно точніша. Невелика модель з виміряними точностями передбачає точність поза вибіркою з середньою абсолютною помилкою 0,037 проти 0,099 для найкращої однієї моделі, на рівні з базовою лінією незалежних помилок у 0,032, і показує високі результати на фактах про продукти та публічних даних. На тих же 100 запитаннях ідентифікатор gpt-5.6-sol показує 92,0% у своїй хвилі, що обслуговується клієнтом, і 46,3% через API при іншому налаштуванні зусилля, тоді як вісім інших моделей змінюються максимум на 4 пункти.
1. Вступ
Поставте одне й те саме коротке фактичне запитання двом великим мовним моделям (LLM) із різних лабораторій окремо й оприлюднюйте відповідь лише якщо вони збігаються. Затвор не потребує розмітки, порога чи судді, лише двох сліпих викликів. Флагманські моделі роблять це привабливим, оскільки їхня заявлена впевненість забезпечує малий захист: серед десяти флагманських напрямів у серпні 2026 року 4910 з 10540 відповідей, висловлених із впевненістю щонайменше 80, були помилками (Chernets, 2026b).
Мої попередні вимірювання на проприєтарних моделях, колекція середньострокових моделей від липня 2026 року, виявили, що повторені відповіді панелі на найважчому квінтилі SimpleQA були правильними в 0 випадків із 342 (Chernets, 2026a). Це припускає, що згода інвертується для слабких моделей, так що узгоджені відповіді частіше неправильні, ніж правильні, а сильні моделі цьому уникають. Одна флагманська пара, здавалося, це підтвердила: gpt-5.6-sol разом із claude-fable-5 був правильним у 34 із 37 узгоджень на тих самих запитаннях (106 із розділу 3).
На флагманському рівні це прочитання не дотримується. Без єдиного напряму, що стоїть за 34 із 37, gpt-5.6-sol, розповсюджуваного через його клієнта-постачальника, інверсія повертається й з труднощами, визначена однаково для обох рівнів, обидві криві зустрічаються на важкому кінці. Для всіх квінтилів, як тільки враховуються обидві точності кожної пари, флагманські та середньострокові пари різняться на -0,2 пункти [-3,1, +2,7]. Точність відстежує, наскільки точні обидві моделі на шарі, незалежно від їхнього рівня.
Таблиця 1 підсумовує чотири внески. Розділ 5.1 дає облік на рівні затвору для флагманів, побудований де можливо без напряму, що домінує діапазон точності. Розділ 5.2 вимірює, що вносить друга лабораторія, змінюючи випущену модель і партнера, з GPT і без нього. Розділи 4 і 5.3 дають описову модель затвору з п'ятьма константами й тестують її поза вибіркою проти заявлених базових показників, а розділ 5.4 порівнює клієнтів постачальників із прямим доступом до API для того ж самого ідентифікатора на тих же запитаннях.
Таблиця 1. Твердження, докази та межа.
| Твердження | Докази | Межа |
|---|---|---|
| Точність узгоджених відповідей відповідає точності пари на обох рівнях | 96/691 на 106; найважчий квінтиль 17,3% липень, 15,5% серпень; рівень при узгодженій точності -0,2 [-3,1, +2,7] | Асоціація; один квінтиль самостійно охоплює -1,8 [-22,1, +20,2] |
| Друга лабораторія виловлює більше помилок за ціну охоплення | 20/29 проти 2/29 виловлених помилок, -62,1 [-79,3, -43,8]; охоплення 61% проти 96% | При рівному охопленні, за впевненістю, їй потрібен набагато точніший партнер; дві лабораторії в жовтні |
| Невелика модель описує точність поза вибіркою | Помилка 0,037 проти 0,099 для найкращої моделі, -0,062 [-0,085, -0,035] | На рівні незалежних помилок, +0,005 [-0,003, +0,012]; 13 пунктів вище на фактах про продукти |
| Режим доступу переміщує один ідентифікатор | 92,0% клієнт проти 46,3% API, ті ж 100 запитань | Режим, зусилля й можливий пошук змінюються разом |
2. Пов'язані роботи
Найближче до мого питання робота Goel et al. (2025), які представляють CAPA — коригувану за випадковістю міру узгодженості між розподілами виходів моделей, і демонструють на 130 моделях з відкритими вагами на MMLU-Pro та BBH, що помилки стають більш подібними зі зростанням можливостей, що, на їхню думку, ставить під загрозу контроль AI, включно з журі на основі мовних моделей. Я вимірюю для власницьких моделей різних лабораторій, що засвідчує сліпа узгодженість при вратах відпуску короткої відповіді у вільній формі: точність узгоджених відповідей, частку помилок випущеної моделі, яку розкриває неузгодженість, і мінімум спільних впевнених помилок. Результати сумісні: у моїх даних вартість зростаючої подібності проявляється у повноті неузгодженості, в той час як точність залишається високою, де точність висока (Додаток L). Каскадна узгодженість на основі угоди (Kolawole et al., 2025) використовує ансамблеву узгодженість як правило відстрочення без навчання з умовою на спільну частоту прийнятих помилок, а мої стратифіковані результати визначають, де концентруються такі помилки.
Корельовані помилки у різних постачальників документовані Kim et al. (2025), а Hossain et al. (2026) виявляють їх сильнішими серед судів передової мовної моделі. Журі з різноманітних малих суддів з'являються у Verga et al. (2024), а упередженість моделі, яка судить власний результат у Panickssery et al. (2024), що сприяє порівнянню двох сліпих відповідей. Узгодженість серед вибірок однієї моделі є сигналом впевненості в самоузгодженості (Wang et al., 2023), SelfCheckGPT (Manakul et al., 2023) та семантичній невизначеності (Kuhn et al., 2023), і правило відстрочення у Yue et al. (2024); я порівнюю це з узгодженістю між лабораторіями (Розділ 5.2). Врата — селективний предиктор (Geifman & El-Yaniv, 2017), тому я порівнюю врата з однаковим охопленням. Останні препринти розходяться у тому, чи допомагає агрегація (Додаток E). Я не знаю про роботи, які повідомляють врата відпуску на рівні пари для коротких фактів у вільній формі для власницьких флагманів, повноти при однаковому охопленні з однією випущеною моделлю, зафіксованою, або одним ідентифікатором, виміряним у двох режимах доступу на тих же питаннях.
3. Дані та протокол
Моя попередня робота представила панелі липня (Chernets, 2026a) та агрегати серпня і жовтня для вибраних пар (Chernets, 2026c). Новим тут є флагманські пари без GPT, симетричне визначення складності, пари з однієї лабораторії, порівняння при рівному охопленні, позавибіркові та зовнішні тести та порівняння способів доступу.
Збірки. Усі відповіді були зібрані сліпо: один виклик на питання, без того щоб одна модель бачила відповідь іншої. Системний запит запитує об'єкт JSON з короткою відповіддю та впевненістю від 0 до 100 і не запитує джерела. Таблиця A1 наводить моделі, дати та способи доступу, а Додаток F — повні збірки. Дев'ять моделей API та сім локальних моделей відповіли на 1500 питань SimpleQA (Wei et al., 2024) з 24 по 28 липня, зареєстровані на OSF перед збиранням даних (Chernets, 2026a). По одному флагманському від кожної з одинадцяти лабораторій відповіли на ті ж питання з 3 по 6 серпня, 1459 спільних для всіх, і дев'ять з них відповіли на 100 з них при температурі 0,7 з трьома зразками (гілка варіабельності). Додано 100 двоскладових питань, складених машиною з Wikidata, з хешем файлу фіксованим перед першим викликом моделі, та 267 фактів про продукти. У жовтні gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 та claude-fable-5-1 відповіли на 300 питань SimpleQA, розшарованих за квінтилем липня, 106 нижче та свіжий набір, три не пересічні набори зі 103 питаннями спільних для всіх п'яти моделей (кожна пара на них присутня в таблиці A2).
106. Це найскладніші питання квінтиля, на які панель липня повторила відповідь (Chernets, 2026a). Вони були вибрані на основі невдачі липневих моделей, тому точність липня на них частково є продуктом відбору, і розділ 5.1 пару їх із симетричним визначенням складності, яке не має цієї властивості.
Способи доступу. У серпні claude-fable-5, gpt-5.6-sol та mistral-medium-3.5 працювали через власного першопартійного клієнта постачальника, офіційного агента командного рядка, який розгортають кінцеві користувачі, а у жовтні кожна гілка це робила, тому вимірювання включають системні запити постачальника та стандартні значення обслуговування так, як їх отримує користувач клієнта. Хвиля липня та решта гілок серпня використовували прямі маршрути API або агрегатора, закріплені постачальником. Таблиця 2 наводить умови вимірювання гілок клієнта. Я називаю гілку пошуком можливою, коли її використання веб-пошуку не можна виключити, і я повідомляю основні результати з такими гілками та без них.
Таблиця 2. Умови вимірювання за гілками. Примітка: температура не встановлена в клієнтах Codex і Claude; потоки подій Codex не були збережені. Гілки API хвиль липня та серпня працювали при температурі 0. Тирик позначає відсутність установки або відсутність запису.
| Гілка | Досягнено через | Зусилля | Пошук можливий |
|---|---|---|---|
| gpt-5.6-sol, серпень | Клієнт Codex | стандартне значення клієнта, не записано | не виключено |
| claude-fable-5, серпень | Клієнт Claude | - | ні, записаних 0 запитів пошуку |
| mistral-medium-3.5, серпень | Клієнт постачальника | - | ні, порожній список інструментів |
| gpt-6.1-sol, gpt-6-astra, gpt-6-sol, жовтень | Клієнт Codex | середнє | не виключено |
| claude-opus-5-5, claude-fable-5-1, жовтень | Клієнт Claude | - | ні, інструменти заборонені |
| kimi-k3, gemini-3.8-flash, свіжий набір | Клієнт постачальника | - | інструменти не вимкнені, запит забороняє |
| gpt-5.6-sol, гілка варіабельності | прямий API | немає | - |
Шлюз і показники. Шлюз відкривається, коли обидві моделі відповідають, жодна не відмовляється, і детермінований механізм еквівалентності, однаковий для кожної хвилі тут, знаходить дві відповіді еквівалентними. Оцінювання застосовує той же механізм до відповіді та еталонної відповіді: нормалізована точна відповідність, утримання рядків з чотирма або більше символами та правила для дат, чисел та ідентифікаторів (Додаток D, з перевідцюванням у таблиці A3). Клітина — це пара моделей на шарі питань. Охопленням вважаються відкриті шлюзи серед питань, на які відповіли обидві моделі. Точність, PPV, — це частка правильних серед відкритих відповідей, які оцінювач визначив як правильні або неправильні (K/O), а Delta — це точність мінус точність випущеної моделі на всіх розв'язаних питаннях клітини. Повнота — це частка помилок випущеної моделі, на яких шлюз залишається закритим, повідомлена як виловлені помилки. Lift ділить точність випущеної моделі з шлюзом відкритим на точність зі шлюзом закритим, а поверх лічить питання, на яких обидві моделі заявляють впевненість щонайменше 80, погоджуються й помиляються. Я називаю угоду інвертованою, коли PPV нижче однієї половини. Випущена модель — перший член пари або точніша, коли пари об'єднані. Щоб порівняти шлюзи при рівному охопленні, я розраджую ширший шлюз: відкриті відповіді ранжуються за меншим з двох заявлених довір'їв і вирізаються до цільового охоплення, зв'язки розв'язуються випадково.
Висновок. Окремі пропорції містять інтервали Вілсона. Різниці та похідні величини містять 95% бутстреп-інтервали, двосторонні за питанням та моделлю для об'єднаних результатів (Owen, 2007; B = 2000, зернятко фіксоване, модель переналаштована в кожному повторі) та за питанням для однієї пари. Порівняння точності в парах використовують точний тест МакНемара, а еквівалентність — двосторонній тест (Schuirmann, 1987) із межею 2 пункти. Клітини залежні, тому вони містять інтервали й немає p-значень.
4. Модель гейта
Нехай та — виміряні точності двох моделей на комірці, а . Нехай — імовірність того, що обидві помиляються, а — імовірність того, що обидві правильні:
Тут масштабує незалежну частоту спільної помилки. Два правильні відповіді збігаються з імовірністю . Два неправильні відповіді збігаються з імовірністю , де на 106, чиї неправильні відповіді частіше збігаються, і 1 в інших місцях. Тоді
Підігнано на 335 парах клітин різних лабораторій (липень, серпень та жовтень, з 106 серед них; — коефіцієнт збігу двох правильних відповідей по всім підігнаним клітинам), константи складають , , , (22 536 з 22 785) та .
Модель приймає виміряні точності клітини як вхідні дані та повертає охоплення, точність та частку неправильних погоджених відповідей, , частина якої у розділі 3 — це частина з довірою щонайменше 80. За двома точностями вона повертає, що додає шлюз, і показує, чому точність повинна слідувати точності на вершині: з та збігом правильних відповідей, точність погоджених відповідей не може впасти нижче , навіть якщо кожна помилка спільна, оскільки обидві моделі правильні разом щонайменше на питаннях і помиляються разом щонайбільше на (0.947 при ). При межі немає, і може перевищити щокожен раз, коли неправильні відповіді концентруються на одному рядку.
Я порівнюю її з двома базовими версіями. Базова версія незалежних помилок встановлює і перепідганяє решту, тому вона зберігає . Базова версія найкращої моделі прогнозує . Критерій полягав у тому, що модель перевершує обидві, з інтервалом різниці нижче нуля, під час виключення однієї лабораторії (LOLO), виключення однієї моделі (LOMO) та часового розподілу з липня та серпня на жовтень.
5. Результати
5.1 Інверсія не є властивістю середнього рівня
Таблиця 3 представляє гейт без GPT-рук, обслужуваних клієнтом. На всьому SimpleQA два рівні виглядають подібно: точність 72,1% у липні та 80,6% у серпні з дельтою +28,6 та +26,0 пункти в порівнянні з виданою моделлю. На 106 точність низька в обох хвилях: 5 з 717 у липні та 96 з 691 у серпні без GPT. Виключення GPT-руки також з липневої сторони дає 4 з 581, а різниця серпень мінус липень становить +13,2 пункти [+2,6, +30,8]. Точність у серпні вища, але все ще далеко нижче однієї половини, тому узгодженість інвертована в обох хвилях. Вона також нижча за найкращу одиничну руку на страті на -9,5 пункти [-16,3, -3,2] у липні та -43,2 [-67,6, -16,1] у серпні. Ліфт становить 0,13 [0,00, 1,21] у липні та 0,65 [0,23, 1,22] у серпні без GPT.
Таблиця 3. Гейт без GPT-рук, обслужуваних клієнтом. Примітка: об'єднано по парам різних лабораторій, якщо не зазначено; охоплення стосується питань, на які відповіли обидві моделі, K/O на відкритих відповідях, які розв'язує оцінювач; інтервал на PPV: двосторонній бутстреп. Факти про продукт: чотири руки без можливості пошуку.
| Рівень, питання | Пари | Охоплення | PPV (K/O) [95%] | Точність виданої | Дельта, пункти [95%] |
|---|---|---|---|---|---|
| Середній, липень, 106 | 36 | 19,8% | 0,7% (5/717) [0,0, 3,7] | 4,6% | -3,9 [-8,3, +0,3] |
| Середній, липень, весь SimpleQA | 36 | 20,6% | 72,1% (7743/10745) [53,2, 82,3] | 43,4% | +28,6 [+22,3, +32,4] |
| Флагман, серпень, 106, без руки з можливістю пошуку | 45 | 19,1% | 13,9% (96/691) [3,3, 31,8] | 19,9% | -6,0 [-14,1, +2,9] |
| Флагман, серпень, весь SimpleQA, без руки з можливістю пошуку | 45 | 29,1% | 80,6% (12357/15322) [69,6, 87,9] | 54,7% | +26,0 [+19,9, +30,7] |
| Флагман, серпень, свіжа 100 (GPT через API) | 6 | 37,5% | 88,9% (200/225) [75,6, 97,4] | 66,8% | +22,1 [+7,9, +47,4] |
| Та сама лабораторія, жовтень, fable-5-1 + opus-5-5, 106 | 1 | 39,6% | 47,5% (19/40) | 30,0% | +17,5 [+6,2, +29,7] |
| Жовтень, kimi-k3 + gemini-3.8-flash, свіжа 100 (інструменти не відключені) | 1 | 72,0% | 95,8% (69/72) | 74,0% | +21,8 [+14,1, +30,0] |
| Факти про продукт, 267, без руки з можливістю пошуку | 6 | 63,6% | 75,0% (423/564) [66,4, 82,7] | 62,7% | +12,3 [+5,8, +20,4] |
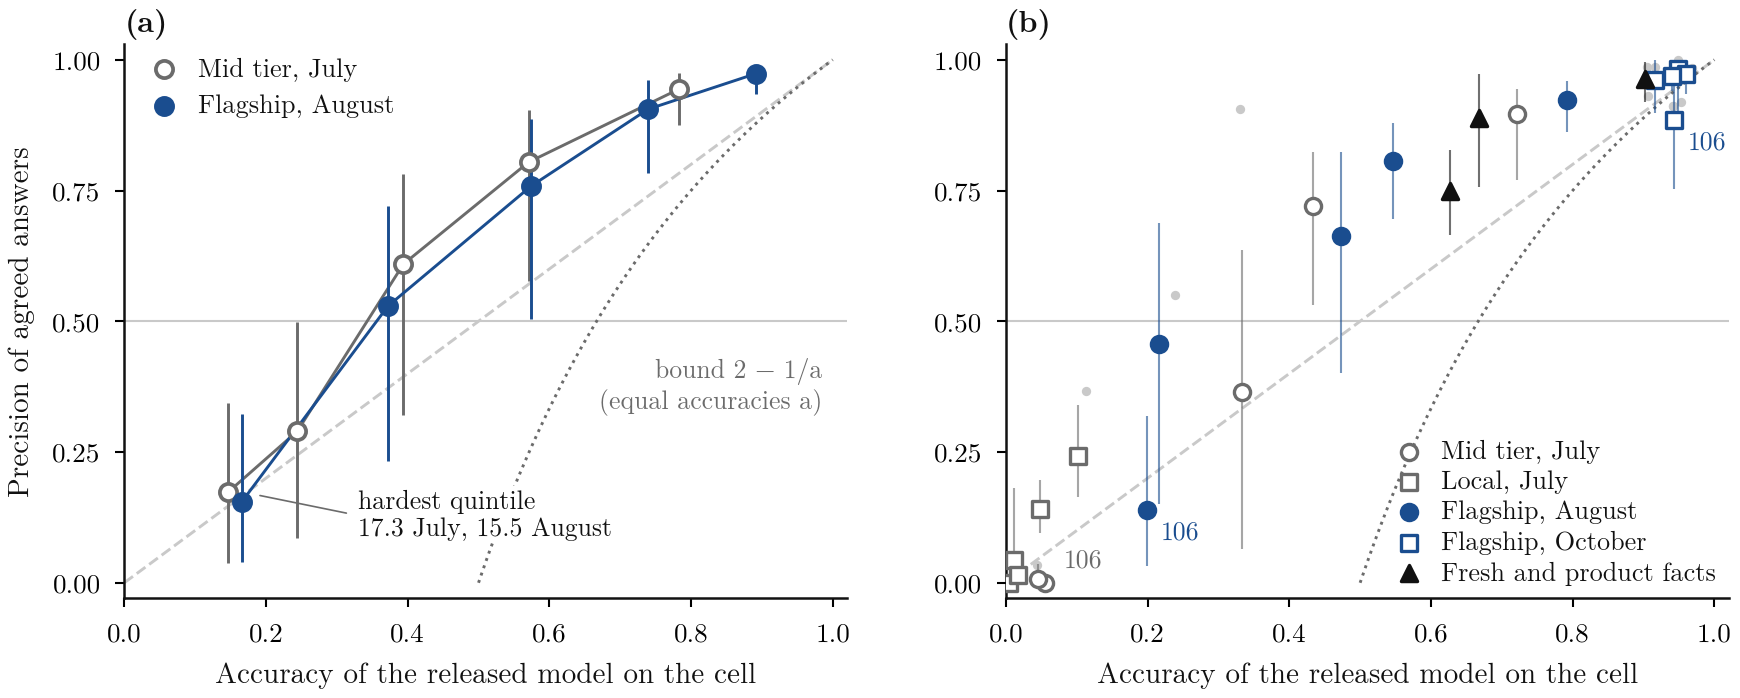
Рисунок 1. Точність узгоджених відповідей відповідає точності пари. Примітка: (a) квінтилі складності, встановлені в межах кожного рівня, липневий середній рівень та серпневі флагмани без GPT-рук, обслужуваних клієнтом. (b) Кожна смуга кожного рівня, липень–жовтень, в порівнянні з точністю виданої моделі; позначені комірки – це 106. Вусики – це 95% інтервали бутстреп, а маленькі сірі точки в (b) – це окремі пари; пунктирна лінія – рівність, точкова лінія – межа 2 - 1/a для рівних точностей a.
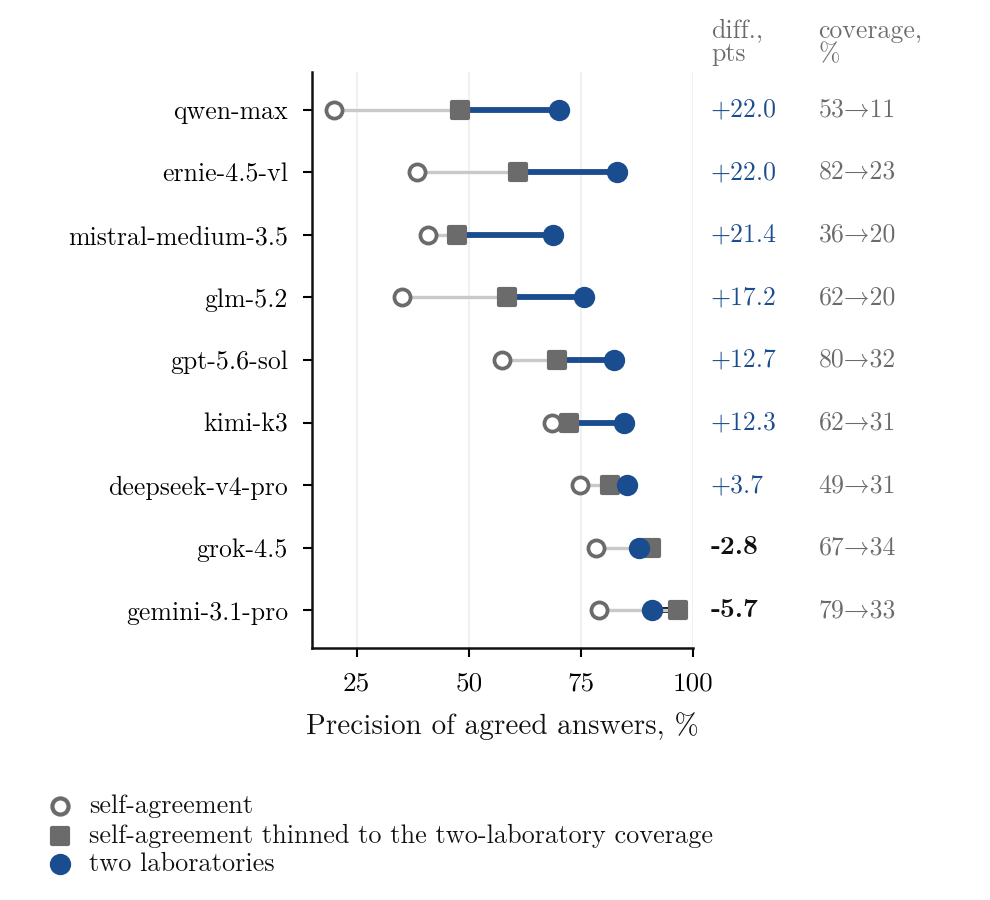
Рисунок 2. Самоузгодженість із двома лабораторіями за моделлю. Примітка: рука дисперсії, дев'ять моделей, 100 питань. Відкритий круг – два звернення до однієї моделі; квадрат – те саме, зменшене за впевненістю до охоплення двомолабораторного гейту; заповнений круг – дві лабораторії, середнє значення за партнерами. Праві колонки дають різницю при рівному охоплені в пунктах та охоплення обох гейтів у відсотках.
Панелі трьох моделей без GPT-руки, обслужуваної клієнтом, дають той же результат. На 106 під моїм рушієм липневі панелі дають 0 з 318 (0 з 342 з розділу 1 – це найважчий квінтиль під раннішою правилом зіставлення; 5 з 717 вище підраховує пари). У серпні панель DeepSeek, Qwen і Kimi дає 0 з 76 та міжблокова панель Claude, DeepSeek і Mistral 11 з 78 (14,1% [2,7, 26,3]), тоді як панель Claude, GPT і Gemini, яка містить GPT-руку, дає 106 з 131 (80,9%). Пари флагмана вишикуються з їх точністю на страті, від 4 з 21 для fable-5 з deepseek-v4-pro до 15 з 24 (62,5% [42,6, 82,6]) для fable-5 з gemini-3.1-pro, чиї члени керівні в цій групі там.
Оскільки 106 були обрані на липневому збої, що знижує липневу точність на них та сприяє серпню, рисунок 1a встановлює складність в межах кожного рівня. Для кожного рівня питання ранжуються в квінтилі за точністю того самого рівня без пари під оцінкою, тому найважчий квінтиль має той самий ранг для кожної, а точність виданої моделі там близька, 15,3% у липні та 16,0% у серпні. Точність там становить 159 з 917 (17,3% [3,8, 34,3]) у липні та 203 з 1,308 (15,5% [4,0, 32,4]) у серпні без GPT, різниця -1,8 пункти [-22,1, +20,2]. Об'єднання всіх п'яти квінтилів дає більш гострий тест. Модель розділу 4 не має члена рівня. З урахуванням двох точностей кожної комірки вона надає точність, очікувану там, і ефект рівня проявився б як різниця в залишках. Комірки флагмана сидять на -0,2 пункти [-3,1, +2,7] від комірок середнього рівня та -0,5 [-3,6, +2,4], коли константи встановлюються лише на липневих комірках, так що серпень виходить з вибірки. kimi-k3 належить обом колекціям; без нього різниця становить +0,1 [-3,6, +3,8]. На очищених золотих відповідях точність залишається низькою: на 24 з 106, які збережені в SimpleQA Verified (Haas та ін., 2025), серпневі пари без GPT мають рацію на 18,7% узгоджень [0,0, 57,1] (Додаток G).
На кожній смузі кожного рівня (рисунок 1b) точність зростає з точністю виданої моделі в кожній хвилі та лежить над діагоналлю в 17 з 23 комірок. З шести нижче неї три – комірки 106 та три – смуги з виданою точністю менше 0,06. У верхній частині kimi-k3 з gemini-3.8-flash досягають 95,8% на свіжій наборі (Додаток G).
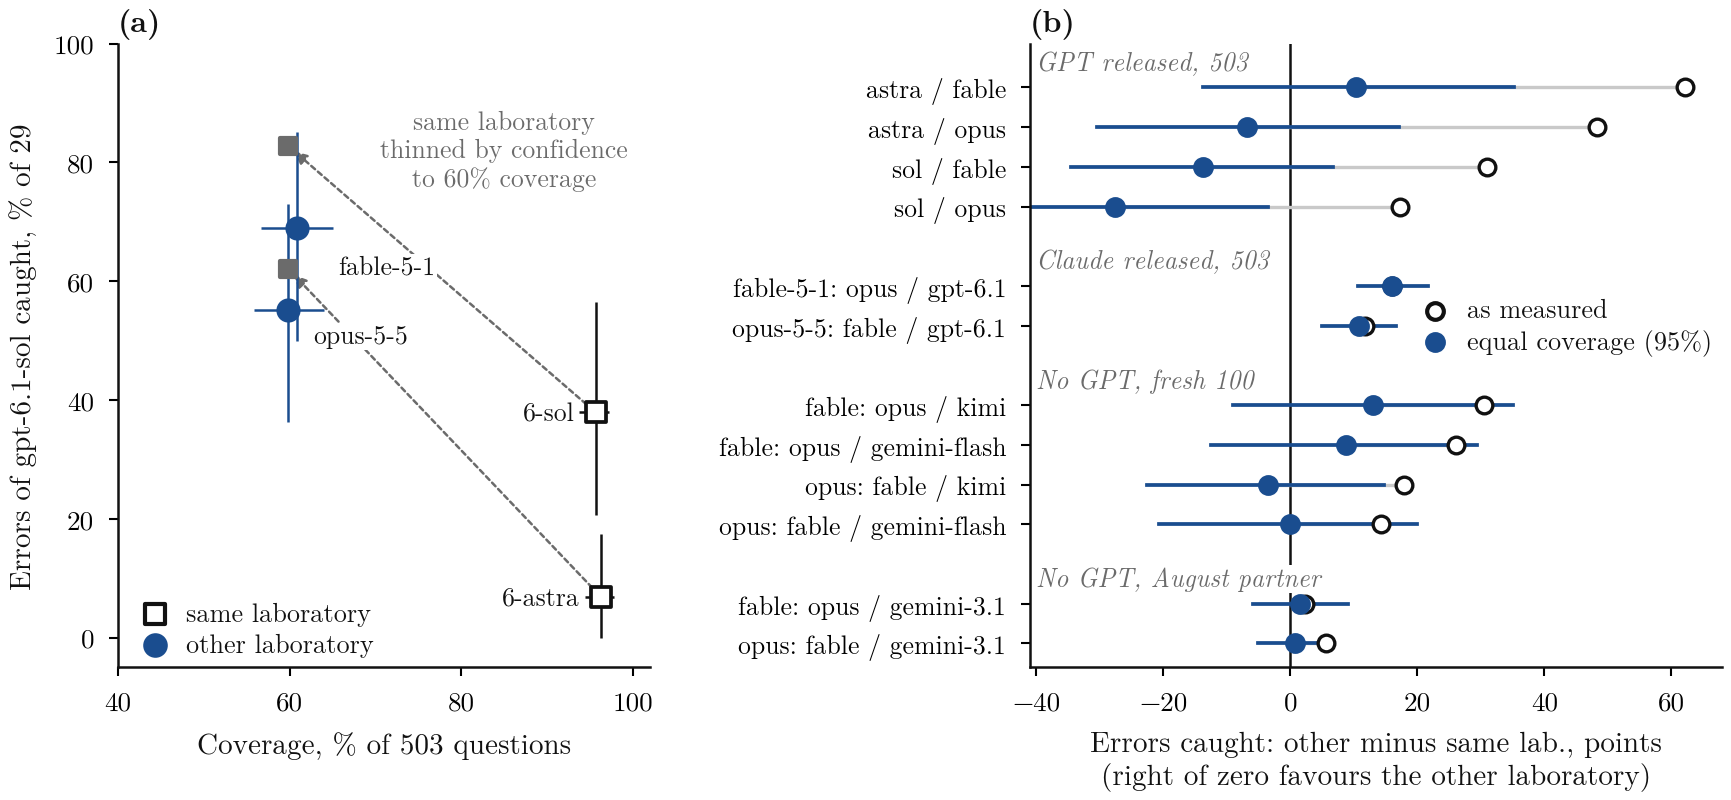
Рисунок 3. Друга лабораторія: охоплення та виявлені помилки. Примітка: (a) gpt-6.1-sol на 503 поширених питаннях, 29 помилок, чотири партнери таблиці A4, 95% бутстреп-інтервали; стрілки ведуть від того самого затвору лабораторії до того самого затвору розрідженого за довіри до 60% охоплення. (b) Дванадцять порівнянь таблиці A5: помилки, виявлені іншою мінус та ж лабораторія, як виміряно (відкрито) та при рівному охопленні (заповнено, 95% бутстреп питання).
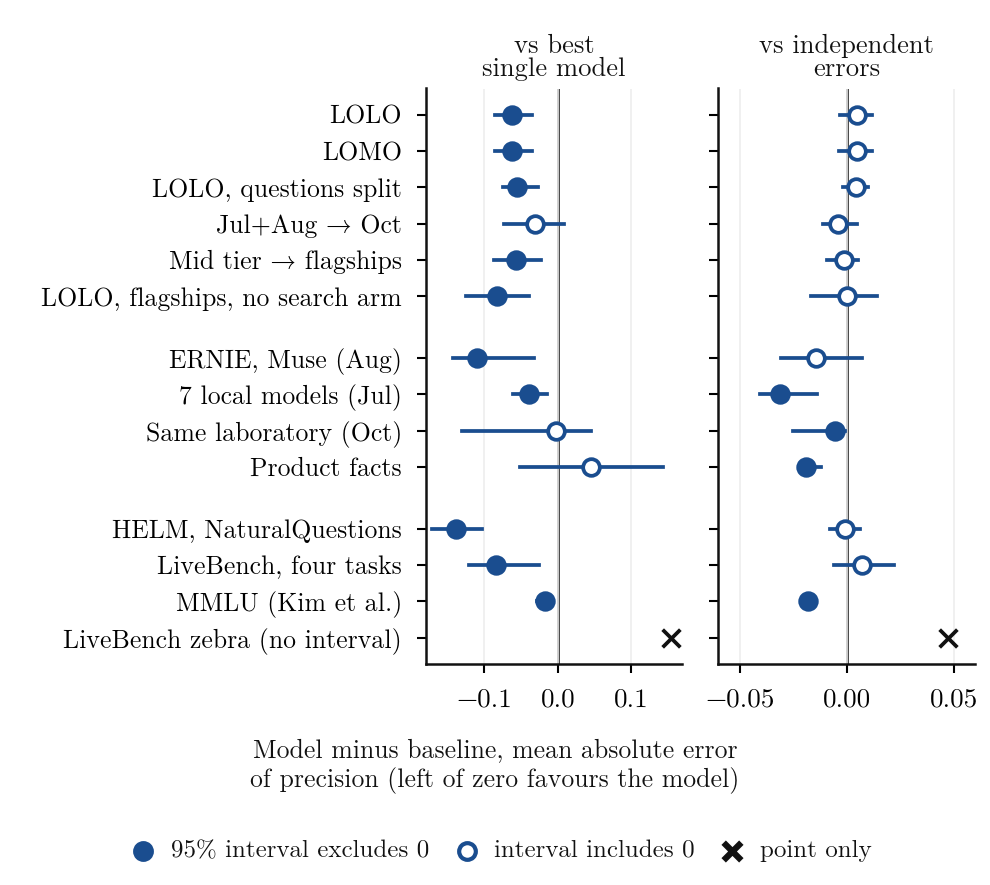
Рисунок 4. Модель проти двох базових ліній, поза вибіркою. Примітка: модель мінус базова лінія у середній абсолютній помилці передбачуваної точності, нижче нуля – на користь моделі, з 95% двосторонніми бутстреп-інтервалами (таблиці A6 та A8). Верхня група – схеми підгонки; середня – набори поза підгонкою зі зморозленими константами; нижня – публічні дані (розділ 5.5). Заповнений маркер – 95% інтервал виключає нуль; відкритий – включає нуль; хрестик – точкова оцінка (завдання zebra LiveBench).
5.2 Друга лабораторія виявляє більше помилок, за ціну охоплення
Точність самостійно не може розрізнити випадки, оскільки точні пари з однієї лабораторії також мають високу точність. Повноту необхідно читати з охопленням, оскільки затвір, який відкривається рідше, за конструкцією блокує більше помилок.
Я розпочинаю з варіаційного плеча: два виклики одної моделі при температурі 0.7 проти двох викликів різних лабораторій (рисунок 2). Усереднено за дев'ять моделей та 100 питань, самоузгодженість охоплює 63,5% при точності 56,1%, а дві лабораторії охоплюють 26,1% при 82,9%. Різниця в точності становить +26,8 пункти [+16,6, +34,6] за вимірюванням та +9,0 [+0,5, +17,4] при рівному охопленні, де самоузгодженість розріджена за довіри, що її вигідує. За моделлю двох-лабораторійний затвір лідирує для семи з дев'яти. Плече не утримує жодної моделі Claude й має GPT через API без зусиль. Без GPT, над восьма моделями, різниця при рівному охопленні становить +7,7 пункти [-1,9, +16,5].
Хвиля жовтня утримує по дві моделі з двох лабораторій, що дає прямий тест на 503 поширених питаннях (рисунок 3a). Одна випущена модель, gpt-6.1-sol, зберігає ті самі 29 помилок у кожному рядку й змінює лише партнера. Її партнер з однієї лабораторії gpt-6-astra виявляє 2 з них, а fable-5-1 виявляє 20, різниця -62,1 пункти [-79,3, -43,8]; проти opus-5-5 різниця становить -48,3 [-66,7, -29,6]. Ціна – охоплення 60–61% проти 96%. Точність подібна в рядках: 94,3% та 96,2% для однієї лабораторії, 95,6% та 97,0% між лабораторіями (таблиця A4). Партнери з однієї лабораторії різняться значно: gpt-6-sol виявляє 11 з 29 (додаток H).
Щоб побачити, чи це більше ніж рух вздовж кривої охоплення, і чи це потребує GPT, кожен рядок рисунка 3b зберігає одну випущену модель й порівнює її двох партнерів за вимірюванням та при рівному охопленні (таблиця A5). За вимірюванням інша лабораторія виявляє більше помилок у кожному рядку. При рівному охопленні її перевага утримується лише якщо Claude випущена з gpt-6.1-sol як партнер, партнер з 93,9% точністю проти 66,6–69,2% для партнера з однієї лабораторії на стратифікованій множині. З випущеним GPT затвір однієї лабораторії розріджений за довіри знаходиться на рівні або попереду, а без GPT різниця рівня або вигідує однолабораторійному затвору проти слабких партнерів. З двома лабораторіями в жовтні я не виявляю ефекту лабораторії крім точності партнера та охоплення, а HELM, з 20 розробниками, не показує жодного після узгодження обох (розділ 5.5).
5.3 Модель поза вибіркою
Поза вибіркою модель явно покращується порівняно з читанням краще моделі й знаходиться на рівні з базовою лінією незалежних помилок (рисунок 4, таблиця A6). Під LOLO її помилка становить 0,037 проти 0,099 для базової лінії найкращої моделі (-0,062 [-0,085, -0,035]), а цей інтервал лежить нижче нуля під LOMO, розділі питання та в семи з десяти рядків таблиці A6. Часовий розділ дає 0,019 проти 0,050, -0,031 [-0,074, +0,008], нижче нуля при кластеризації за питанням чи за моделлю окремо (додаток I). Проти незалежних помилок модель знаходиться на рівні за всіма трьома схемами й краща на трьох з чотирьох множин поза підгонкою зі зморозленими константами, тому критерій розділу 4 задовольняється проти базової лінії найкращої моделі.
Точність переносять виміряні точності та : видалення підвищує помилку LOLO до 0,323, а утримання її константою дає 0,046. Множник нічого не додає до точності в основних схемах й допомагає при охопленні та логарифмічній втраті.
На фактах про продукти модель працює з високими результатами. Її помилка становить 0,130 проти 0,086 для найкращої моделі, усе це переувеличення (13 пунктів), та 0,190 проти 0,067 з вибіркою цієї області, знову лише переувеличення (19 пунктів). Додаток I сортує клітинки на класи результатів.
5.4 Доступ до моделі та GPT плеча
На одній множині 100 питань SimpleQA gpt-5.6-sol набирає 92 із 100 (92,0%) у основній хвилі, 99 з них через клієнт Codex, та 139 із 300 вибірок (46,3%) через прямий API у варіаційному плечі, різниця 45,7 пункти (рисунок 5). Дослівне відтворення золотого рядка падає разом з цим, з 64,0% до 26,0%. Клієнт працює за своїм типовим параметром зусилля за своїми власними інструкціями, з температурою не налаштовуваною, тоді як API працює без зусиль та при температурі 0.7.
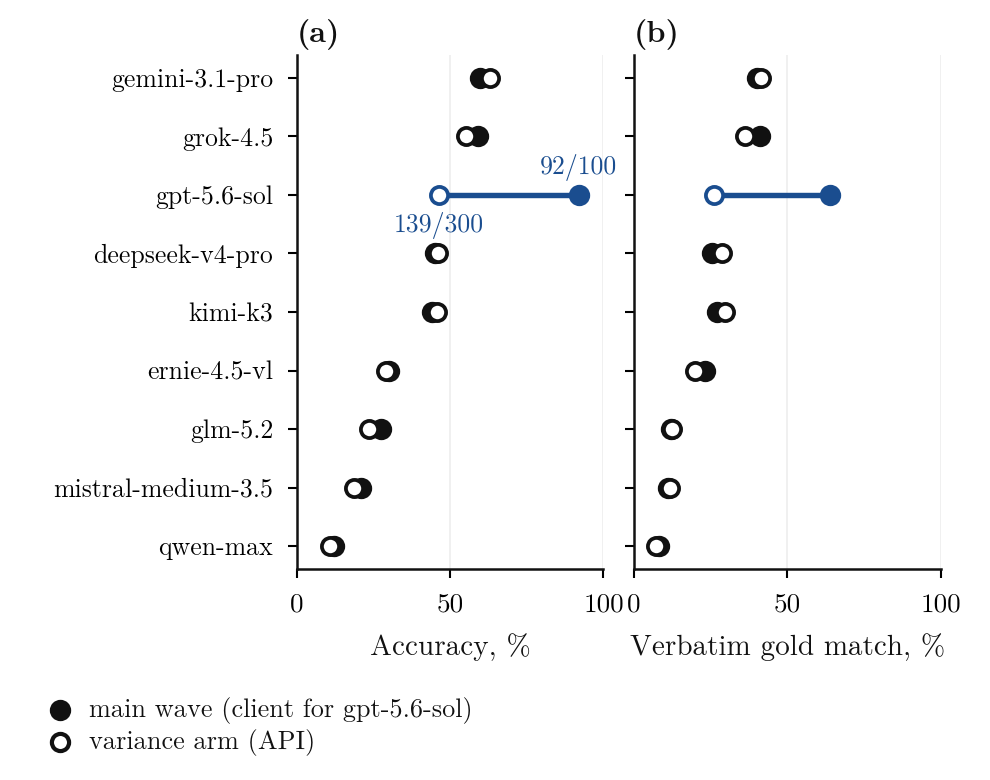
Рисунок 5. Одна множина 100 питань, два плеча, дев'ять моделей. Примітка: (a) точність, (b) дослівна відповідність золотому рядку. Заповнено – основна хвиля (клієнт-обслуговування для gpt-5.6-sol, 92/100); відкрито – варіаційне плече через API (139/300). Для gpt-5.6-sol плеча також відрізняються за параметром зусилля.
Всі вісім інших моделей, температура яких також змінюється між двома колонками, зміщуються максимум на 4,0 пункти в будь-якому напрямку. Effort є одним кандидатом, хоча парне вимірювання reasoning-budget на gemini-3.1-pro залишило точність майже незмінною (Chernets, 2026c). Web search — інший: відповіді за жовтень від того ж клієнта містять посилання, які запит не просить, у 3 з 506 відповідей gpt-6.1-sol і 18 з 506 gpt-6-astra, а медіанне використання токенів на клієнтський виклик за серпень становить 4829.
Цифра клієнта — це те, що отримує людина, яка використовує продукт, а цифра API — це те, що читає тестувальна програма на effort none. На свіжих запитаннях у серпні з GPT через API gpt-5.6-sol і fable-5 правильно на 29 з 32 узгоджень, Delta +57,6 пункти [+46,3, +69,7]. У жовтні з новішим GPT через клієнт на тих самих запитаннях пара з opus-5-5 правильна на 72 з 74, Delta +2,3 [-0,7, +6,0]. Два порівняння також відрізняються моделлю GPT та датою, і в обох випадках значення gate відслідковує точність випущеного рукава, як у розділі 5.1.
Рукави GPT, які обслуговує клієнт і пропущені в таблиці 3, є точними: рукав серпня з fable-5 правильний на 997 з 1016 узгоджень (98,1%) і на 34 з 37 на 106, успадковуючи точність рукава (Delta -3,3 [-10,3, +2,6]; таблиця A7 і додаток J).
5.5 Зовнішня перевірка на публічних даних
Я застосував заморожені константи, без переналаштування, до публічних даних, які не мають спільних моделей і калібрування з моїми: HELM Lite (Liang et al., 2023), 95 моделей від 20 розробників, що відповідають на 1000 закритих запитань NaturalQuestions; LiveBench (White et al., 2025), 70 моделей від 11 лабораторій на 346 запитаннях з короткою остаточною відповіддю; та парні агрегати Kim et al. (2025) для 70 моделей на множинному виборі MMLU (таблиця A8). Результати відповідають розділу 5.3 (рисунок 4, нижня група). Модель перевершує читання з кращої моделі в усіх трьох джерелах і є рівною з незалежними помилками в HELM і LiveBench. Вона виконується вище на 5,3–6,6 пункти і не працює на головоломках з зебрами (0,231 проти 0,076).
У HELM спостережувана крива згладжується там, де модель продовжує зростати (рисунок 6): при точності пари між 0,5 і 0,6 точність становить 74,6% для моделей 2023 року та раннього 2024 року та 75,9% для пізніших, проти 84,4% прогнозованих у середині бін. На MMLU медіанна ймовірність того, що дві неправильні відповіді збігаються, становить 0,621 проти 0,368 з , оскільки чотири варіанти примушують колізії. Точність зростає з точністю пари (Spearman +0,575 в HELM і +0,786 на MMLU, над залежними комірками).
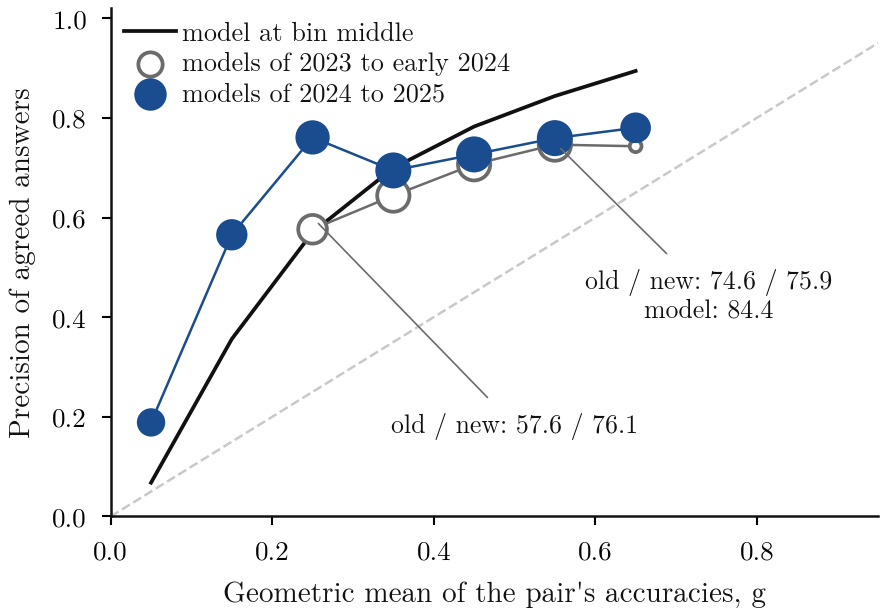
Рисунок 6. HELM Lite: точність узгоджених відповідей за точністю пари, старіші та новіші моделі. Примітка: бін геометричного середнього g точності пари, пари від різних лабораторій; розмір маркера зростає з кількістю пар. Лінія — заморожена модель у середині кожного бін.
HELM також дозволяє тест розділу 5.2 з багатьма лабораторіями без залежності GPT. З однією випущеною моделлю та партнерами в межах 3 пунктів точності інша лабораторія ловить 75,5% помилок проти 72,3% для тієї ж лабораторії, -3,2 пункти [-4,2, -2,3], при покритті вище на 2,7 пункти. Додавання збігу за покриття в межах 3 пунктів видаляє це: 75,7 проти 75,9%, -0,2 [-0,6, +0,2].
6. Обговорення
Запуск шлюзу не потребує міток, але його перевірка потребує. Виміряйте точність обох моделей на позначеній вибірці страти, яка має значення, у режимі доступу, який буде розгорнуто. У цих даних узгоджена відповідь двох флагманів на питання, яке виходить за межі обох, не безпечніша, ніж узгоджена відповідь двох моделей середнього рівня. Парування двох лабораторій — розумна за замовчуванням, коли немає доступних значень впевненості, але це потрібно перевірити на страті: пара однієї лабораторії, розріджена впевненістю, або власна впевненість випущеної моделі можуть дати аналогічні результати (розділ 5.2, додаток J).
Схожість, скоригована на випадок (Goel et al., 2025), та точність узгоджених відповідей — це різні величини, і Han (2026) називає декореляцію важелем, де я ставлю точність та охоплення на перше місце (додаток L). Для звітування дослідження узгоди моделей повинно вказувати режим доступу, затрати, умови інструменту та збережені журнали подій для кожного плеча.
7. Область охоплення та граничні умови
Рівні порівнюються через два хвилі на різні дати та маршрути доступу, і порівняння рівнів точне близько 3 пункти при узгодженій точності, набагато менше тільки на найважчому квінтилі. Свіжі докази — це один набір із 100 питань та восьми шаблонів на двох датах, а October Delta на ньому включає нуль. Точність та прецизійність пари рухаються разом впродовж дат та різних установок міркування, що відрізняються між хвилями, і конструкція не ізолює здатність як причину.
Чи проводили клієнти Codex, kimi та gemini-3.8-flash пошук, не можна встановити зі збережених файлів, тому їхня точність вимірює розгорнутого клієнта, а не пам'ять моделі. Розділи 5.1 та 5.3 показують основні результати без цих напрямів.
Пари однієї лабораторії існують в октябрі для двох лабораторій, і без GPT порівняння в одній хвилі — це 100 свіжих питань. Комірки октябрю спираються на п'ять моделей із двох лабораторій, тому модельний вимір двостороннього бутстрепу має мало рівнів і об'єднані інтервали є нижніми межами невизначеності. Порівняння при рівному охопленні використовують вказану впевненість, яку проста брама не робить, і випадкове розділення нічиї переміщує найширший рядок між 0,0 та +20,7 пунктів (Додаток H).
Двигун базується на правилах, і його перевірки тут — це очищене золото SimpleQA Verified (розділ 5.1) та переоцінка частин відповідей. Він оцінює всю відповідь, і довгі відповіді можуть викликати помилкове «неправильно»; оцінка лише першої частини переміщує точність довідкових пар максимум на 3 пункти, а gpt-6-astra з opus-5-5 на 106 від 80,0 до 88,9% (таблиця A3).
Модель приймає виміряну точність для кожної комірки як вхідні дані, тому вона описує позначену перевірку брами і не замінює її. Вона працює добре з фактами про товари та громадськими даними. HELM, LiveBench та агрегати Kim et al. утримують старіші моделі у кількох-гарячих або форматах множинного вибору, тому вони тестують співвідношення на інших моделях, а не на флагманах 2026 року.
8. Висновок
Точність узгоджених відповідей зростає з точністю пари на досліджуваному шарі, на обох рівнях і в межах близько 3 пунктів при збіжній точності. Інверсія з'являлась скрізь, де я вимірював слабку пару, включаючи флагмани. Партнер із другої лабораторії виявляє більше помилок переважно тим, що рідше відкриває шлюз, і при рівному охопленню зберігав свою перевагу лише там, де його модель була набагато точнішою. Невелика модель шлюзу описує точність поза вибіркою значно краще за кращу модель і так само добре, як незалежні помилки. Один ідентифікатор, виміряний через дві конфігурації доступу, різниться на 45,7 пункта, тому твердження про точність моделі повинно вказувати режим доступу.
Заява про вплив
У цій статті досліджується, коли узгодження між двома мовними моделями можна розглядати як правило для випуску коротких фактичних відповідей. Практики можуть перевірити на рівні, який має значення, та в режимі доступу, який вони використовують, чи є двомодельний фільтр достатньо точним для їхнього застосування, замість того щоб припускати, що сильніші моделі або другий постачальник достатньо. Основний ризик — надмірна довіра до узгодження щодо складних питань, і результати показують рівні, де погоджені відповіді здебільшого помилкові. Дослідження використовує тільки публічні еталони і автоматично складені питання.
References
Chen, J. (2026). When does combining language models help? A co-failure ceiling on routing, voting, and mixture-of-agents across 67 frontier models. arXiv:2606.27288.
Chernets, V. (2026a). Verification theater: Measured failure modes of AI verifier panels. NeurIPS 2026 Workshop: Who Verifies the Agents?
Chernets, V. (2026b). Weakly discriminative, not repaired by profile injection, and manipulable: Self-confidence in LLM evaluation. NeurIPS 2026 Workshop: Can We Trust AI Evaluation? Robustness, Causality, and Risk in Modern AI Assessment.
Chernets, V. (2026c). Architectural trust: When an AI agent buys for you, does trust belong to the model, or the architecture above it? SSRN 7191261.
Denisov-Blanch, Y., Kazdan, J., Chudnovsky, J., Schaeffer, R., Guan, S., Adeshina, S., and Koyejo, S. (2026). Consensus is not verification: Why crowd wisdom strategies fail for LLM truthfulness. arXiv:2603.06612.
Ding, K. (2026). When LLMs agree, are they right? Auditing self-consistency and cross-model agreement as confidence signals. arXiv:2607.08065.
Geifman, Y. and El-Yaniv, R. (2017). Selective classification for deep neural networks. In Advances in Neural Information Processing Systems 30. arXiv:1705.08500.
Goel, S., Strüber, J., Auzina, I. A., Chandra, K. K., Kumaraguru, P., Kiela, D., Prabhu, A., Bethge, M., and Geiping, J. (2025). Great models think alike and this undermines AI oversight. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267. arXiv:2502.04313.
Han, J. (2026). Partially correlated verifier cascades in LLM harnesses: Concave log-odds, polynomial reliability, and blind-spot ceilings. arXiv:2607.13918.
Haas, L., Yona, G., D'Antonio, G., Goldshtein, S., and Das, D. (2025). SimpleQA Verified: A reliable factuality benchmark to measure parametric knowledge. arXiv:2509.07968.
Hossain, E., Yousefi, N., and Lim, S.-N. (2026). Agreement overstates evidence: Error dependence in LLM judge consensus. arXiv:2609.22512.
Kim, D. (2026). Are diversity metrics measuring diversity? A capability-controlled audit of majority-vote gain in LLM ensembles. arXiv:2607.20768.
Kim, E., Garg, A., Peng, K., and Garg, N. (2025). Correlated errors in large language models. In Proceedings of the 42nd International Conference on Machine Learning, PMLR 267:30038-30066. arXiv:2506.07962.
Kohli, G. (2026). Nine judges, two effective votes: Correlated errors undermine LLM evaluation panels. arXiv:2605.29800.
Kolawole, S., Dennis, D., Talwalkar, A., and Smith, V. (2025). Agreement-based cascading for efficient inference. Transactions on Machine Learning Research, 07/2025. arXiv:2407.02348.
Kuhn, L., Gal, Y., and Farquhar, S. (2023). Semantic uncertainty: Linguistic invariances for uncertainty estimation in natural language generation. In International Conference on Learning Representations. arXiv:2302.09664.
Liang, P., Bommasani, R., Lee, T., et al. (2023). Holistic evaluation of language models. Transactions on Machine Learning Research. arXiv:2211.09110.
Liu, N. (2026). LLMs as a jury: Cross-model consensus can outperform process reward models for LLM reasoning. arXiv:2607.10139.
Manakul, P., Liusie, A., and Gales, M. J. F. (2023). SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models. In Proceedings of EMNLP 2023. arXiv:2303.08896.
Naik, N. (2024). Probabilistic consensus through ensemble validation: A framework for LLM reliability. arXiv:2411.06535.
Owen, A. B. (2007). The pigeonhole bootstrap. The Annals of Applied Statistics, 1(2), 386-411.
Panickssery, A., Bowman, S. R., and Feng, S. (2024). LLM evaluators recognize and favor their own generations. In Advances in Neural Information Processing Systems 37.
Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657-680.
Tan, H., Sun, F., Liu, S., Su, D., Cao, Q., Chen, X., Wang, J., Cai, X., Wang, Y., Shen, H., and Cheng, X. (2025). Too consistent to detect: A study of self-consistent errors in LLMs. In Proceedings of EMNLP 2025. arXiv:2505.17656.
Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., and Lewis, P. (2024). Replacing judges with juries: Evaluating LLM generations with a panel of diverse models. arXiv:2404.18796.
Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., and Zhou, D. (2023). Self-consistency improves chain of thought reasoning in language models. In International Conference on Learning Representations.
Wei, J., Karina, N., Chung, H. W., Jiao, Y. J., Papay, S., Glaese, A., Schulman, J., and Fedus, W. (2024). Measuring short-form factuality in large language models. arXiv:2411.04368.
White, C., Dooley, S., Roberts, M., et al. (2025). LiveBench: A challenging, contamination-limited LLM benchmark. In International Conference on Learning Representations. arXiv:2406.19314.
Xue, Y., Greenewald, K., Mroueh, Y., and Mirzasoleiman, B. (2026). Verify when uncertain: Beyond self-consistency in black box hallucination detection. arXiv:2502.15845.
Yue, M., Zhao, J., Zhang, M., Du, L., and Yao, Z. (2024). Large language model cascades with mixture of thought representations for cost-efficient reasoning. In International Conference on Learning Representations. arXiv:2310.03094.
Декларації
Конкуруючі інтереси. Автор є названим заявником у поточних заявках на патенти, не виданих патентах, що стосуються оркестрації ШІ та систем багатомодельної валідації того роду, який розглядається у цій роботі.
Дані та код. Відповіді за кожним викликом, скрипти аналізу та відображення від кожного повідомленого числа до його вихідної таблиці архівовано на Zenodo, doi:10.5281/zenodo.24090584 (CC BY 4.0).
Додаток А. Моделі та режими доступу
Таблиця А1. Колекції та режими доступу за хвилями.
| Колекція | Дати | Моделі | Доступ |
|---|---|---|---|
| July mid tier | 24–28 липня 2026 | claude-haiku-4-5, gpt-5-mini, gemini-3.6-flash, grok-4-fast, deepseek-chat, qwen-plus, kimi-k3, glm-4.5, mistral-small | Прямий API |
| July local | 24–28 липня 2026 | сім локальних моделей з відкритою вагою | Локальне висновування |
| August flagships | 3–6 серпня 2026 | claude-fable-5, gpt-5.6-sol, mistral-medium-3.5 | Клієнт постачальника; gpt-5.6-sol за типовою настройкою зусиль клієнта, 14 із 1500 записів через API fallback |
| glm-5.2 | Endpoint постачальника | ||
| deepseek-v4-pro, grok-4.5, kimi-k3, qwen-max | Прямий API | ||
| gemini-3.1-pro, ernie-4.5-vl-424b, muse-spark-1.1 | Прямий API або маршрут агрегатора прив'язаний до постачальника; muse-spark-1.1 частковий (251 відповідь) | ||
| Variance arm | 6 серпня 2026 | Дев'ять флагманів, без Claude | gpt-5.6-sol через прямий API, зусилля відсутнього; mistral-medium-3.5 через його клієнт постачальника, який записує запитувану температуру; інші як у серпневій хвилі; температура 0,7, три вибірки |
| Fresh, August | 6 серпня 2026 | gpt-5.6-sol (зусилля відсутнього), claude-fable-5, deepseek-v4-pro, kimi-k3 | gpt-5.6-sol та deepseek-v4-pro через прямий API, claude-fable-5 через клієнт постачальника, kimi-k3 через маршрут агрегатора |
| Product facts | 15 серпня 2026 | Шість моделей, 15 пар; чотири без можливості пошуку, 6 пар | Змішаний; gpt-5.4 та grok через клієнти |
| October | 26 та 27 жовтня 2026 | gpt-6.1-sol, gpt-6-astra, gpt-6-sol | Клієнт Codex, зусилля середнього, без прапора пошуку, потік подій не збережено |
| claude-opus-5-5, claude-fable-5-1 | Клієнт Claude, інструменти заборонені | ||
| kimi-k3, gemini-3.8-flash (тільки свіжий) | Клієнти постачальників, інструменти не вимкнені |
У серпневій хвилі 19 відповідей від гілки claude-fable-5 були подані іншими моделями Claude. Показник 34 з 37 хвилі на 106 не залежить від них (Chernets, 2026a).
Додаток B. Пари за 503 частими питаннями
Таблиця A2. Усі пари різних лабораторій, перший член випущений, 503 спільні питання.
| Пара | Охоплення | PPV (K/O) | Дельта, пункти [95%] | Перехоплені помилки |
|---|---|---|---|---|
| gpt-6.1-sol + opus-5-5 | 59.8% | 95.6% (285/298) | +1.5 [-0.2, +3.3] | 16/29 |
| gpt-6.1-sol + fable-5-1 | 60.8% | 97.0% (294/303) | +2.9 [+1.1, +4.8] | 20/29 |
| gpt-6-astra + opus-5-5 | 58.3% | 94.8% (275/290) | +2.5 [+0.5, +4.7] | 23/38 |
| gpt-6-astra + fable-5-1 | 61.4% | 95.4% (291/305) | +3.1 [+1.1, +5.3] | 24/38 |
| gpt-6-sol + opus-5-5 | 61.6% | 95.4% (291/305) | -0.7 [-1.9, +0.6] | 5/19 |
| gpt-6-sol + fable-5-1 | 62.8% | 97.1% (301/310) | +1.0 [-0.4, +2.5] | 10/19 |
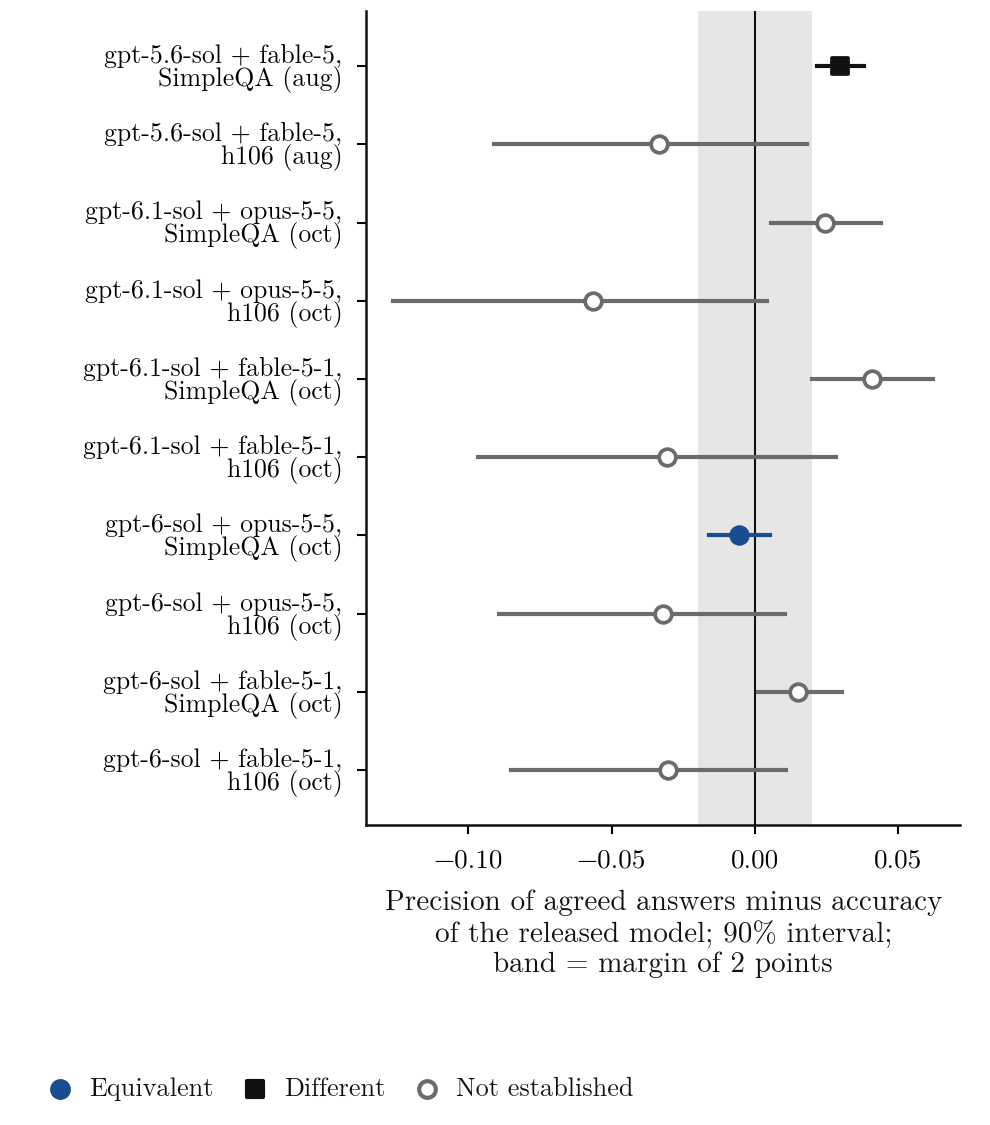
Рисунок A1. Тест еквівалентності точності пари проти випущеної моделі. Примітка: бутстреп 90% питань, границя 2 пункти заштрихована. Пари з випущеним плечем клієнта Codex.
Додаток C. Дослівна відповідність золотому рядку
Дослівна відповідність ідеально корелює за рангом з точністю SimpleQA у дев'яти моделей, для яких є й результати SimpleQA, й свіжого вимірювання, оскільки правильна відповідь часто є золотим рядком. Її кореляція із розривом SimpleQA мінус свіже вимірювання становить +0,47 (точне переставне p = 0,21, n = 9), або +0,29 (p = 0,50) без gpt-5.6-sol, чиї дві точності походять з різних режимів доступу (Рисунок A2). Обмежившись правильними відповідями, вона становить +0,10 (p = 0,81). Серед правильних відповідей показник становить 65,7% для gpt-5.6-sol, 66,4% для fable-5, 68,6% для deepseek-v4-pro та 64,9% для kimi-k3. Залишок моделі від цього не залежить, зі нахилом +0,064 [-0,072, +0,167] у 112 основних клітинах. Розрив сам по собі близький до нуля або від'ємний для більшості моделей, –3,0 пункти для fable-5, –20,5 для deepseek-v4-pro, –5,4 для opus-5-5 та –7,8 для fable-5-1, і він великий тільки для gpt-5.6-sol (+62,4), де режим доступу різниться між двома вимірюваннями.
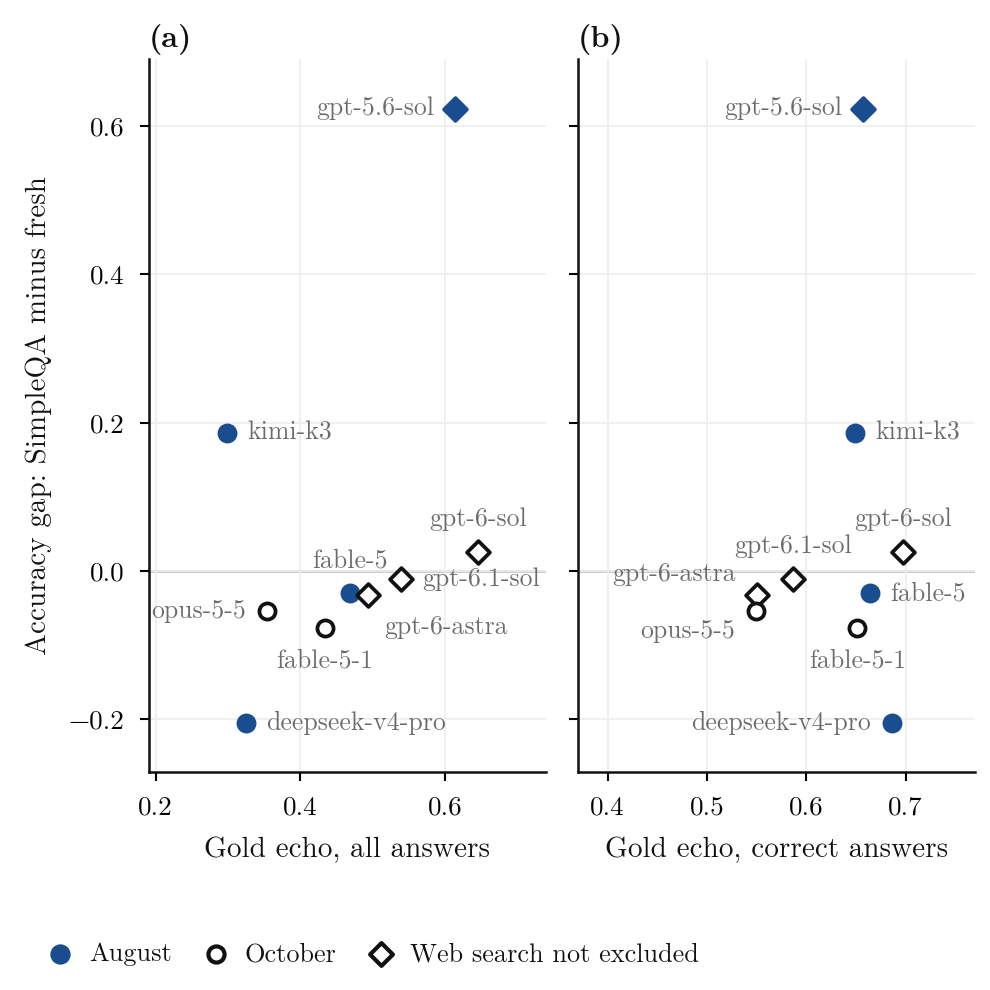
Рисунок A2. Дослівна відповідність золотому рядку порівняно з розривом точності. Примітка: (a) усі відповіді, (b) тільки правильні відповіді. Заповнені синім, хвиля серпня; пусті, хвиля жовтня. Ромби позначають групи, для яких пошук в Інтернеті не виключено.
Додаток D. Чутливість оцінювача
Механізм нормалізує регістр, артиклі та пунктуацію, приймає точні збіги та містить рядки з чотирма або більше символами, порівнює дати, числа та буквено-цифрові ідентифікатори за правилами та в іншому випадку порівнює слова змісту; відповідь, яку він не може розв'язати відносно еталона, залишається невирішеною. У таблиці A3 для узгодження та оцінювання використовується перша частина кожної відповіді без дужок і позаяк пояснення, тому відкритий підрахунок також змінюється.
Таблиця A3. Оцінювання всієї відповіді проти оцінювання її першої частини. Перший елемент випущено.
| Пара, набір | PPV, вся відповідь | PPV, перша частина |
|---|---|---|
| gpt-5.6-sol + fable-5, усі, серпень | 997/1016 | 997/1019 |
| gpt-6.1-sol + opus-5-5, 106, жовтень | 31/35 | 30/34 |
| gpt-6.1-sol + fable-5-1, 106, жовтень | 31/34 | 31/35 |
| gpt-6-astra + opus-5-5, 106, Жовтень | 28/35 | 32/36 |
| gpt-6.1-sol + opus-5-5, strat, жовтень | 183/190 | 189/195 |
| gpt-6.1-sol + fable-5-1, strat, Жовтень | 187/191 | 198/201 |
| gpt-6.1-sol + opus-5-5, fresh, Жовтень | 72/74 | 72/74 |
Додаток E. Подальші пов'язані роботи
Недавні препринти вказують у двох напрямках. З боку скептиків Denisov-Blanch та ін. (2026) виявляють, що агрегація в стилі опитування за п'ять бенчмарків і моделей не дає послідовного приросту точності при 25-кратних витратах на інференцію, оскільки помилки корельовані. Ding (2026) аудитує 265 000 зразків на GPQA Diamond та AIME і виявляє, що згода є позитивним, але слабким предиктором (Спірмен 0,20–0,59), при цьому 48% записів GPQA з високою згодою найкосистентнішої моделі frontier виявляються помилковими. При дослідницькій перевірці на 46 елементах показники однакових неправильних відповідей між gpt-4.1 та Claude рівнями перевищують маржинально збережуваний нуль для двох з трьох рівнів. Kohli (2026) виявляє, що дев'ять судів frontier на трьох наборах даних для інференції мають близько двох незалежних голосів, і що найкращий поодинокий суддя відповідає панелі або перевищує її. Kim (2026) аудитує 31 900 підмножин 30 моделей на MMLU-Pro: голосування перемагає найсильнішого члена в 9,98% підмножин розміру 3, і строга міра різноманітності майже колінеарна з одиницею мінус середня точність (Спірмен +0,991). Hossain та ін. (2026) виявляють середню парну кореляцію помилок 0,21 серед десяти судів, які несуть приблизно стільки ж інформації, скільки 3,5 незалежних, з сильнішою залежністю серед судів frontier від різних провайдерів. Chen (2026) показує, що будь-яка політика, яка видає відповідь одного члена, не може перевищити один мінус показник , при якому всі моделі помиляються разом, і виявляє 0,052 на відкритому математичному завданні серед 67 моделей порівняно з 0,023 за гаусівської копули та 0,127 на вільно сформульованому GPQA-Diamond. З іншого боку, Naik (2024) повідомляє про зростання точності з 73,1% до 93,9% із двома моделями та до 95,6% із трьома на 78 випадках у форматі з кількома варіантами, а Liu (2026) показує, що чотирьохмодельна панель вибирає відповіді краще, ніж самоконсистентність на семи бенчмарках, із закритою формулою в точності члена, кореляції помилок та показнику спільної помилки, що передбачає точність консенсусу зі середньою абсолютною помилкою 0,028. Xue та ін. (2026) повідомляють, що крос-модельна консистентність з верифікатором покращує стелю самоконсистентності для виявлення галюцинацій на бенчмарках QA, а Tan та ін. (2025) — що помилки самоконсистентності не зменшуються зі масштабом моделі, мають тенденцію бути специфічними для моделі та краще виявляються з другою моделлю. Han (2026) дає теорію послідовних верифікаційних затворів, у якій маса сліпої плями обмежує надійність і називає декорельованість, шляхом зміни сімейства моделей, модальності або джерела доказів, як практичний важіль. Дві роботи розділу 2 містять деталі, які стосуються затвору. Goel та ін. (2025) визначають CAPA так, що різні неправильні варіанти лічаться як невідповідність, і крім тренду з можливостями вони показують, що дев'ять судів LLM з відкритою вагою оцінюють моделі більш подібно до себе вище, і що набутки від слабкого до сильного більші на завданнях, де контролер і учень допускають менш подібні помилки (12 пар моделей). Kolawole та ін. (2025) формулюють умову безпечного відходу на спільному показнику прийнятих помилок по розподілу тестів, з порогом, оціненим на малому наборі валідації. Умова на спільному показнику дозволяє прийнятим помилкам концентруватися на одному шарі, і розділ 5.1 виявляє такий шар: на 106, середньорівневі панелі сертифікують помилку, і так само роблять найголовніші пари без найвищоточнішого плеча.
Жодна з цих робіт не повідомляє, як зазначено в розділі 2, про парний затвір випуску, пригадування при рівному охопленні з однією випущеною моделлю, закріпленою, або один ідентифікатор, виміряний у двох режимах доступу.
Додаток F. Дані та деталі протоколу
Збірки. Протокол відповідає Розділу 3, а збірки наведені повністю. Таблиця A1 містить список моделей, дат та режимів доступу.
- Середина липня (24–28 липня). Дев'ять моделей API та сім локальних моделей на 1 500 запитаннях SimpleQA (Wei та ін., 2024), фіксованій випадковій підвибірці з 4 326 запитань в тесті. Збірка була зареєстрована на OSF перед збіранням даних (Chernets, 2026a).
- Серпневі флагмани (3–6 серпня). По одному флагману від кожної з одинадцяти лабораторій на тих же 1 500 запитаннях, з яких 1 459 входять до спільного пулу.
- Рука дисперсії (6 серпня). Дев'ять флагманів на 100 з цих запитань, по 20 на квінтиль, при температурі 0,7 з трьома зразками на запитання.
- Свіжі запитання (6 серпня та 26 жовтня). 100 двоскачкових запитань, складених машиною з Wikidata за восьма шаблонами, з хешем файлу зафіксованим перед першим викликом моделі.
- Факти про товари (15 серпня). 267 запитань про комерційні продукти, також складені з Wikidata, на шести моделях, чотири з яких без можливості пошуку.
- Жовтневі флагмани (26–27 жовтня). gpt-6.1-sol, gpt-6-astra, gpt-6-sol, claude-opus-5-5 та claude-fable-5-1 на 300 запитаннях SimpleQA, розшарованих за липневим квінтилем (60, 120, 120; 297 спільних для всіх п'яти; «strat» в таблицях), 106 запитаннях нижче та свіжому набору, 503 спільних запитання загалом. kimi-k3 та gemini-3.8-flash дали відповіді на свіжий набір.
Режими доступу. До моделей звертались двома способами, описаними в Розділі 3. gpt-5.6-sol також запускався прямим API в руці дисперсії та на серпневому свіжому наборі. Ідентифікатори моделей та версії клієнта записуються для кожного виклику.
Оскільки клієнти встановлюють умови вимірювання, я наводжу їх повністю. Температуру не можна встановити в них. Серпневе плече Codex запускалось з типовим параметром клієнта для витрати обчислень, який виклик не встановлює і записи не фіксують. Жовтневі плечі Codex запускались із встановленням витрати на середній рівень в кожному викликі. Серпневі записи маніфесту фіксують нульову кількість запитів веб-пошуку для плеча Claude та порожній список інструментів для плеча Mistral, а жовтневі плечі Claude запускались з вимиканими інструментами. Плечі Codex запускались без прапора пошуку, та їхні потоки подій не зберігались, тому чи вони проводили пошук, не можна визначити з файлів. У клієнтах kimi та gemini-3.8-flash інструменти не були вимкнені, а підказка їх забороняє.
Додаток G. 106 і рівні
На рисунку A3 показано панелі та пари розділу 5.1 для 106 і ще дві пари: fable-5 з grok-4.5 дають 7 з 28 збігів, а gemini-3.1-pro з grok-4.5 — 8 з 25.
Показник 0 з 342 у розділі 1 залежить від того, як ранжується складність. Коли відповіді кожної панелі виключені з ранжування складності, кількість стає 78 з 354, а міжблоковий панель залишається на рівні 0 з 116.
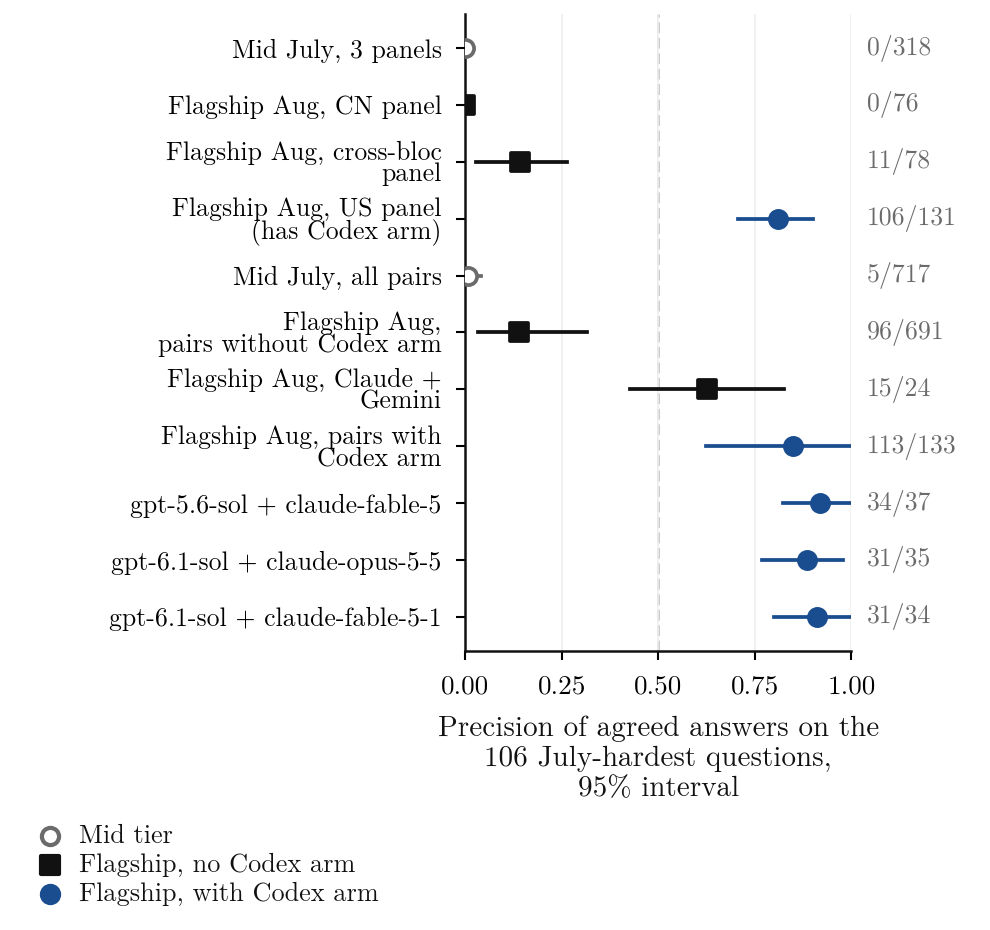
Рисунок A3. Точність узгоджених відповідей на 106 питань. Примітка: 95% двосторонній бутстреп для об'єднаних рядків, бутстреп питання для панелей та окремих пар. Сині рядки містять arm клієнта Codex. Збірки серпня та жовтня.
На рисунку A4 наведені власні квінтилі рівня розділу 5.1 повністю. Зі всіма arms серпень досягає 26,6% [6,7, 53,4] у найскладнішому квінтилі, різниця +9,3 [-18,1, +39,8] від липня. Без kimi-k3, який належить до обох колекцій, найскладніший квінтиль дає 147 з 675 (21,8%) у липні та 192 з 995 (19,3%) у серпні, −2,5 пункти [-29,7, +28,2]. Об'єднаний тест розділу 5.1 використовує всі п'ять квінтилів, 180 комірок на рівень; комірки середнього рівня знаходяться на +0,3 пункти [-2,4, +2,9] і флагманські комірки на +0,0 [-1,4, +1,6] від замороженої моделі. Підйом у найскладнішому квінтилі становить 1,15 [0,39, 1,90] у липні та 0,97 [0,42, 1,49] у серпні. За квінтилями серпень без GPT дає 15,5, 52,9, 75,8, 90,5 та 97,3%, а липень — 17,3, 29,0, 60,9, 80,4 та 94,4%, тоді як точність випущеної моделі становить 16,0, 36,6, 56,8, 73,3 та 88,5% порівняно з 15,3, 25,0, 40,0, 57,7 та 78,9%.
Точність залишається низькою на очищених золотих відповідях. Haas та ін. (2025) переробили SimpleQA в очищений набір з 1000 питань, і 24 з 106 збережені в ньому, проти 24,5 очікуваних від частки збереженого еталона, із золотою відповіддю ідентичною на 21. Очищення не видаляє ці питання частіше, ніж інші, хоча його вибір також переважає складні питання. Під тією ж статистикою та бутстреп серпневі пари без GPT дають результат на 28 з 150 збігів на ці 24 питання (18,7% [0,0, 57,1]) та на 67 з 538 на інші 82 (12,5% [2,8, 28,1]; точніший член випускається на кожній підмножині, тому частини не повинні складатися до 96 з 691), а липневі пари — 4 з 157 (2,5% [0,0, 15,2]).
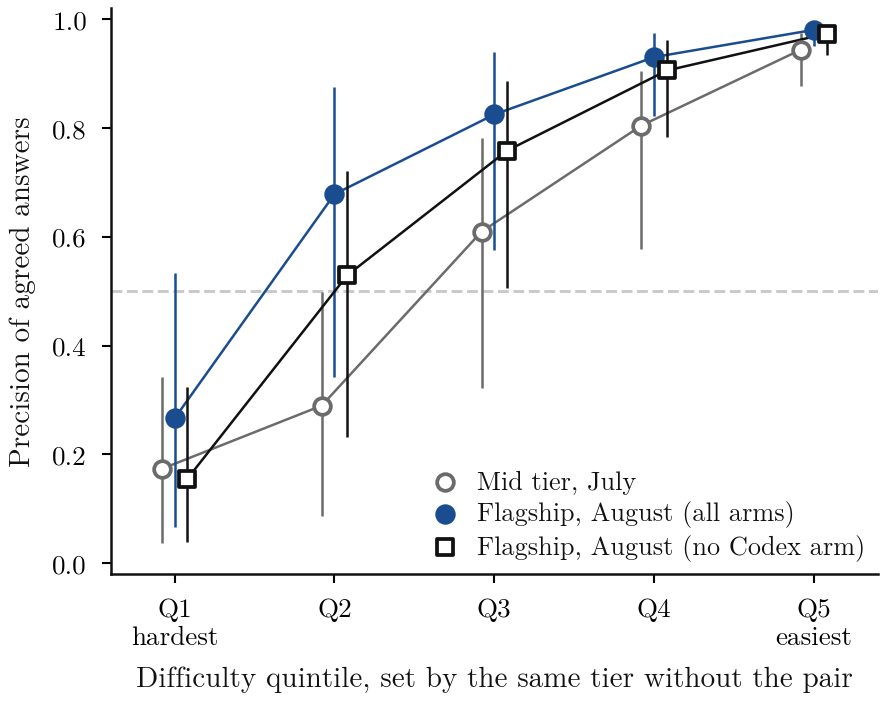
Рисунок A4. Точність узгоджених відповідей за квінтилями складності власного рівня. Примітка: 95% двосторонній бутстреп. Складність для кожної пари встановлюється тим же рівнем без цієї пари. Пунктирна лінія на 0,5.
Найточніші пари відповідають тій же залежності. Пара kimi-k3 та gemini-3.8-flash досягають 95,8% на свіжому наборі, з 23 з 26 помилок випущеної моделі виловленими та підйомом 5,37 [2,86, 21,36]. Модель, враховуючи лише їхню точність 0,74 та 0,82, повертає 95,1%. А два флагманські Claude разом, без можливості пошуку в жодному з arms, досягають 47,5% на 106, де точність випущеної моделі становить 30,0%, та 86,2% на всіх 503 питаннях. На рисунку A5 кожна смуга кожного рівня нанесена порівняно з точністю випущеної моделі, з точністю вище діагоналі в 17 з 23 комірок.
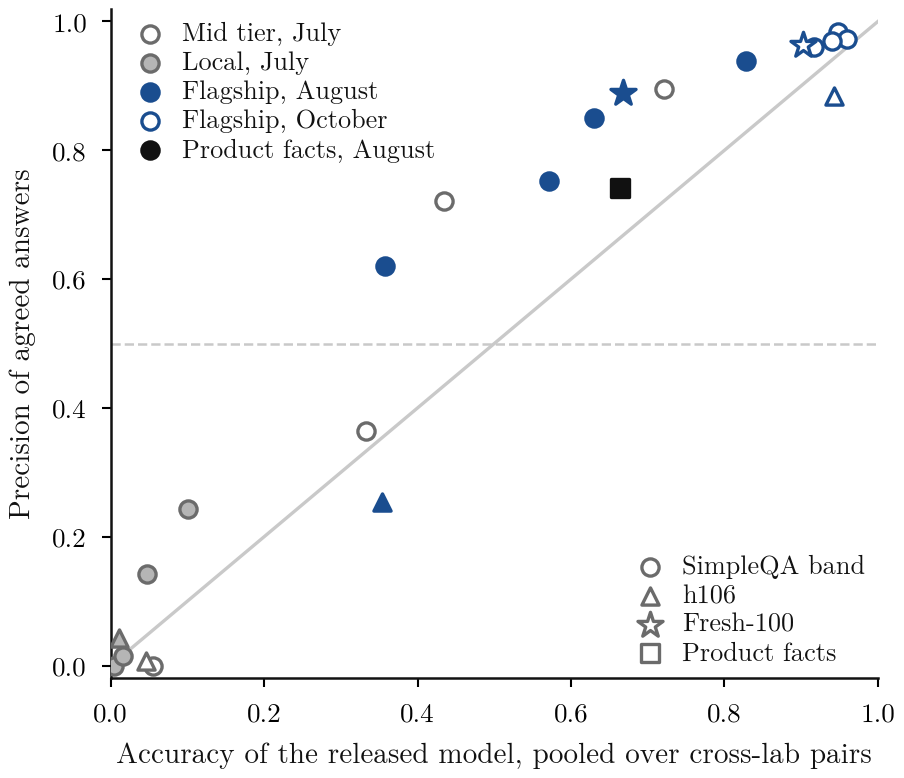
Рисунок A5. Точність узгоджених відповідей порівняно з точністю випущеної моделі. Примітка: об'єднано по парам різних лабораторій, за рівнем та смугою. Колір та заповнення вказують рівень, форма маркера — набір. Пунктирна лінія на 0,5, суцільна лінія — рівність.
Додаток H. Друга лабораторія докладно
Варіаційне плече. За моделлю при рівному охопленню (Рисунок 2), дволабораторний шлюз лідирує для семи з дев'яти і відстає для gemini-3.1-pro (−5,7 балів) та grok-4.5 (−2,8). Без GPT, на восьми моделях, самозгода охоплює 61,4 % при точності 55,9 %, а дві лабораторії 24,4 % при 83,3 %. Різниця в точності становить +27,4 балів [+16,0, +35,7] у вимірюванні та +7,7 [−1,9, +16,5] при рівному охопленню, а виловлені помилки різняться на +38,3 балів [+26,0, +50,9] у вимірюванні та +3,0 [−1,5, +8,4] при рівному охопленню. Жовтень не має повторних викликів, тому самозгода вимірюється лише в серпні.
Чотири партнери однієї випущеної моделі. Таблиця A4 наводить чотирьох партнерів Рисунка 3a: одну випущену модель, gpt-6.1-sol, тому 29 помилок, що стоять на кону, однакові в кожному рядку.
Таблиця A4. Одна випущена модель, чотири партнери: gpt-6.1-sol на 503 спільних питаннях (29 помилок серед 495 розв'язаних, 95 % бутстреп питань).
| Партнер | Лабораторія | Охоплення [95 %] | PPV (K/O) | Дельта, балів [95 %] | Виловлені помилки [95 %] |
|---|---|---|---|---|---|
| gpt-6-astra | однакова | 96,2 % [94,4, 97,8] | 94,3 % (449/476) | +0,2 [−0,2, +0,8] | 2/29 = 6,9 % [0,0, 17,4] |
| gpt-6-sol | однакова | 95,6 % [93,6, 97,2] | 96,2 % (457/475) | +2,1 [+0,9, +3,4] | 11/29 = 37,9 % [20,7, 56,5] |
| claude-opus-5-5 | різна | 59,8 % [55,9, 64,0] | 95,6 % (285/298) | +1,5 [−0,2, +3,3] | 16/29 = 55,2 % [36,4, 73,0] |
| claude-fable-5-1 | різна | 60,8 % [56,7, 65,0] | 97,0 % (294/303) | +2,9 [+1,1, +4,8] | 20/29 = 69,0 % [50,0, 85,2] |
Інший партнер однієї лабораторії, gpt-6-sol, виловлює 11 з 29, що становить −31,0 балів [−50,0, −10,7] проти fable-5-1 та −17,2 [−37,0, +3,0] проти opus-5-5. Пара Claude, без можливості пошуку в жодному плечі, охоплює 60,6 % та виловлює 140 з 181 помилок fable-5-1 при точності 86,2 % та дельті +23,5 балів [+19,6, +27,2]. Дві моделі однієї лабораторії, обидві далеко від стелі, можуть таким чином розходитися часто достатньо, щоб виловити більшість помилок.
Таблиця A5 перевіряє, чи це більше ніж рух уздовж кривої охоплення, і чи потрібна GPT. Кожен рядок зберігає одну випущену модель і порівнює її партнера однієї лабораторії з партнером з іншої лабораторії, спочатку за вимірюванням, а потім при рівному охопленню, досягнутому розрідженням ширшого шлюзу за впевненістю (Розділ 3).
Таблиця A5. Помилки, виловлені з партнером однієї лабораторії та з партнером з іншої лабораторії. Різниці — однакова мінус інша, у балах, з 95 % бутстрепом питань, тому від'ємне сприяє іншій лабораторії; різниці за вимірюванням у перших чотирьох рядках поділяють бутстреп Таблиці A4.
| Випущена | Однакова / інший партнер | Питання | Виловлено, за вимірюванням | Різниця [95 %] | Виловлено, рівне охоплення | Різниця [95 %] |
|---|---|---|---|---|---|---|
| gpt-6.1-sol | astra / fable-5-1 | 503 | 2/29, 20/29 | −62,1 [−79,3, −43,8] | 17/29, 20/29 | −10,3 [−35,3, +13,8] |
| gpt-6.1-sol | astra / opus-5-5 | 503 | 2/29, 16/29 | −48,3 [−66,7, −29,6] | 18/29, 16/29 | +6,9 [−17,1, +30,4] |
| gpt-6.1-sol | gpt-6-sol / fable-5-1 | 503 | 11/29, 20/29 | −31,0 [−50,0, −10,7] | 24/29, 20/29 | +13,8 [−6,7, +34,6] |
| gpt-6.1-sol | gpt-6-sol / opus-5-5 | 503 | 11/29, 16/29 | −17,2 [−37,0, +3,0] | 24/29, 16/29 | +27,6 [+3,4, +51,6] |
| fable-5-1 | opus-5-5 / gpt-6.1-sol | 503 | 140/181, 169/181 | −16,0 [−21,7, −10,6] | 140/181, 169/181 | −16,0 [−21,7, −10,6] |
| opus-5-5 | fable-5-1 / gpt-6.1-sol | 503 | 154/195, 177/195 | −11,8 [−17,8, −5,9] | 156/195, 177/195 | −10,8 [−16,7, −5,0] |
| fable-5-1 | opus-5-5 / kimi-k3 | fresh 100 | 13/23, 20/23 | −30,4 [−50,0, −12,5] | 17/23, 20/23 | −13,0 [−35,0, +9,1] |
| fable-5-1 | opus-5-5 / gemini-3.8-flash | fresh 100 | 13/23, 19/23 | −26,1 [−45,5, −8,7] | 17/23, 19/23 | −8,7 [−29,4, +12,5] |
| opus-5-5 | fable-5-1 / kimi-k3 | fresh 100 | 18/28, 23/28 | −17,9 [−38,5, +0,0] | 24/28, 23/28 | +3,6 [−14,7, +22,6] |
| opus-5-5 | fable-5-1 / gemini-3.8-flash | fresh 100 | 18/28, 22/28 | −14,3 [−33,3, +4,5] | 22/28, 22/28 | +0,0 [−20,0, +20,7] |
| fable-5-1 | opus-5-5 / gemini-3.1-pro (August) | 344 | 107/130, 110/130 | −2,3 [−9,8, +5,3] | 108/130, 110/130 | −1,5 [−9,1, +5,8] |
| opus-5-5 | fable-5-1 / gemini-3.1-pro (August) | 344 | 118/141, 126/141 | −5,7 [−12,1, +0,8] | 125/141, 126/141 | −0,7 [−6,4, +5,1] |
Рядки серпня — це єдине порівняння SimpleQA без GPT, і вони парують моделі з різних дат. gemini-3.1-pro — серпневе плече, найближче за точністю до моделей Claude на цих питаннях (65,4 % проти 60,6 та 57,7 % на цих питаннях). Об'єднано над усіма семома серпневими партнерами, більшість з яких набагато слабші, різниця становить −5,1 балів [−10,1, −0,3] для fable-5-1 та −6,0 [−10,6, −1,2] для opus-5-5 за вимірюванням, і переходить до +7,9 [+4,8, +11,2] та +6,8 [+3,6, +10,2] при рівному охопленню, на користь однієї лабораторії. Нічиї в упевненості розривають навмисне, і над 200 розиграшами найширший рядок переміщується між 0,0 та +20,7 балів.
Додаток I. Модель поза вибіркою докладно
Таблиця A6 дає помилки поза вибіркою, які лежать в основі розділу 5.3. Часовий розподіл дає 0.019 проти 0.050 для базової моделі найкращого типу, різниця -0.031 [-0.074, +0.008] за двосторонньою бутстрапом, і інтервал лежить нижче нуля при кластеризації за запитанням самостійно або за моделлю самостійно. З 9 і 23 складаннями, LOLO і LOMO дають однакову помилку до трьох десяткових знаків.
Таблиця A6. Середня абсолютна помилка прогнозованої ППВ, комірки з щонайменше 20 відкритими відповідями. Двосторонній бутстрап, запитання за моделлю.
| Схема | Модель [95%] | Незал. | Найкращ. | Модель мінус найкращ. [95%] | Модель мінус незал. [95%] |
|---|---|---|---|---|---|
| LOLO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.035] | +0.005 [-0.003, +0.012] |
| LOMO | 0.037 [0.033, 0.055] | 0.032 | 0.099 | -0.062 [-0.085, -0.036] | +0.005 [-0.004, +0.012] |
| LOLO, запитання розділені | 0.054 [0.052, 0.088] | 0.050 | 0.109 | -0.055 [-0.075, -0.027] | +0.004 [-0.002, +0.010] |
| Липень і серпень на жовтень | 0.019 [0.008, 0.041] | 0.023 | 0.050 | -0.031 [-0.074, +0.008] | -0.004 [-0.011, +0.005] |
| Середня категорія на флагманські | 0.030 [0.025, 0.053] | 0.031 | 0.087 | -0.057 [-0.087, -0.022] | -0.001 [-0.009, +0.005] |
| LOLO, флагманські, без можливого пошуку рука | 0.037 [0.029, 0.071] | 0.038 | 0.120 | -0.083 [-0.125, -0.039] | -0.000 [-0.017, +0.014] |
| Відкладено: ERNIE та Muse, серпень | 0.019 [0.015, 0.055] | 0.033 | 0.128 | -0.110 [-0.143, -0.032] | -0.014 [-0.031, +0.007] |
| Відкладено: 7 локальних моделей, липень | 0.037 [0.018, 0.072] | 0.068 | 0.077 | -0.040 [-0.061, -0.015] | -0.031 [-0.041, -0.014] |
| Відкладено: однакова лабораторія, жовтень | 0.038 [0.017, 0.083] | 0.043 | 0.041 | -0.003 [-0.130, +0.045] | -0.006 [-0.025, -0.001] |
| Відкладено: факти про товари | 0.130 [0.077, 0.187] | 0.149 | 0.086 | +0.045 [-0.051, +0.143] | -0.019 [-0.021, -0.012] |
Практичний виграш порівняно з читанням моделі кращого типу великий, включаючи передачу від середньої категорії до флагманських і двох з чотирьох наборів, які не брали участі у підганянні (Рисунок A6). Множник не додає нічого до точності в основних схемах, і роботу виконують виміряні точності та . Вилучення взагалі піднімає помилку LOLO до 0.323, а її утримання на постійному рівні дає 0.046. З охоплення та логістичної втрати, допомагає: під LOLO різниці від незалежних помилок становлять -0.0079 [-0.0111, -0.0020] та -0.0024 [-0.0045, -0.0003]. На трьох з чотирьох відкладених наборів інтервал проти незалежних помилок лежить нижче нуля, з константами зафіксованими. Спільний термін помилки, отже, має значення для охоплення, тоді як точність спирається на виміряні точності та .
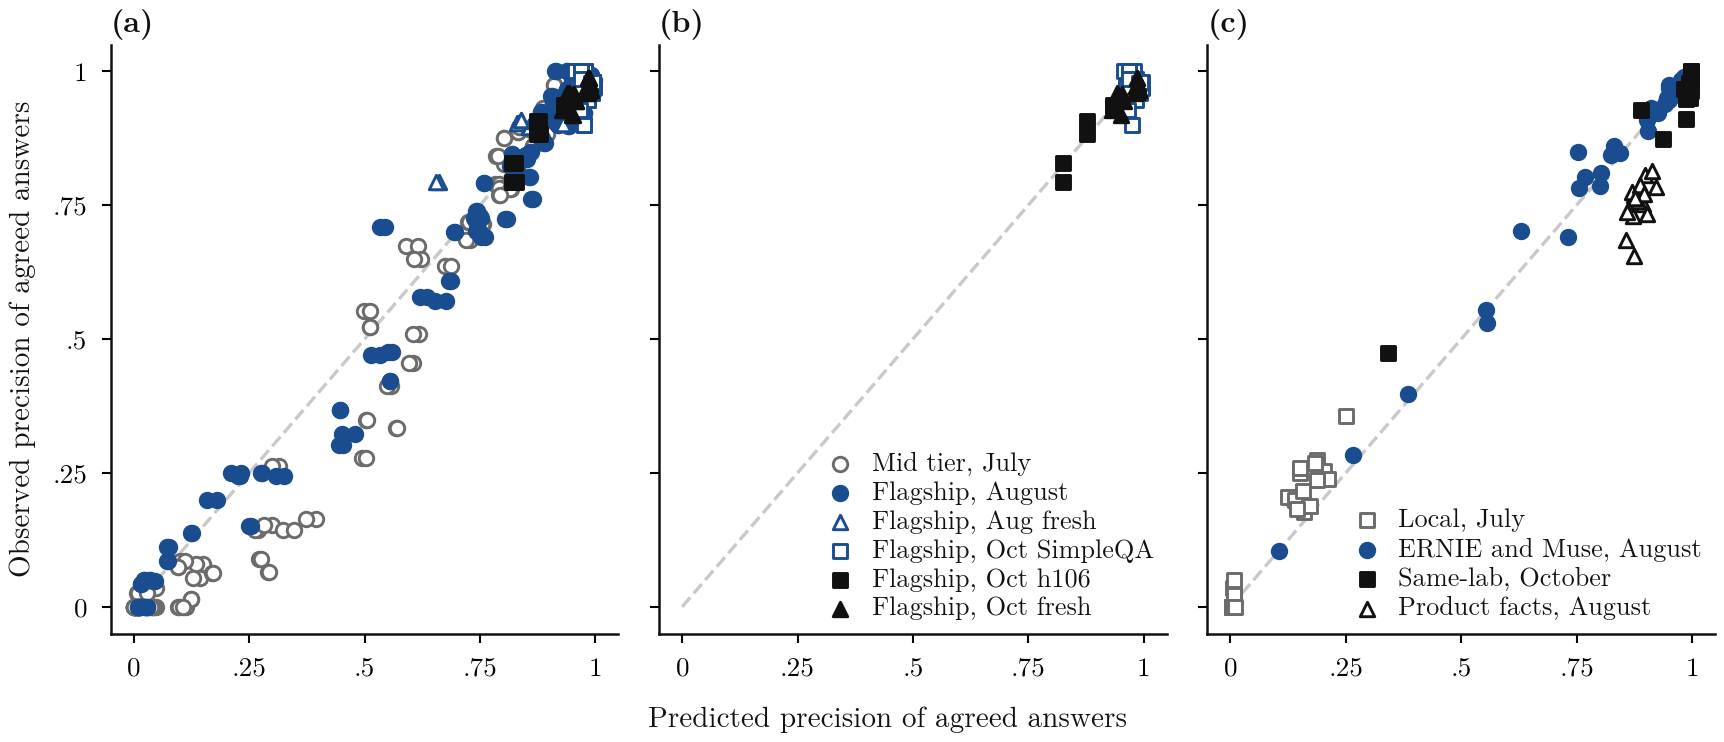
Рисунок A6. Прогнозована проти спостережуваної точності узгоджених відповідей. Примітка: (a) залишити одну лабораторію. (b) Підганяння на липень та серпень та прогнозування жовтня. (c) Набори поза підганяннями, константи зафіксовані. Пунктирна лінія — це рівність.
На фактах про товари модель працює високо. Помилка становить 0.130 проти 0.086 для моделі найкращого типу, з середнім перебільшенням на 13 пунктів. З вкорінювачем цього домену помилка перебільшення піднімається до 19 пунктів (0.190 проти 0.067). Факти про товари лежать поза доменом, на якому були підганяні константи.
Сортування комірок на три класи результатів (інвертовано при ППВ нижче 0.5, немає приросту при Дельта до +2 пунктів, приріст вище цього), часовий розподіл відповідає 28 з 39 комірок, і дев'ять промахів прогнозують відсутність приросту, де спостерігався приріст. Модель надійна щодо розміру точності та слабша під час сортування комірок по обидва боки від лінії +2 пункти.
Додаток J. Режими доступу та GPT-плечі детально
Один і той самий ідентифікатор, одні й ті самі запитання. На одному наборі з 100 запитань SimpleQA gpt-5.6-sol набирає 92 з 100 (92,0%) в основній хвилі, де 99 з 100 записів надійшли через клієнт Codex та одна неправильна відповідь через резервний API, і 139 з 300 зразків (46,3%) через прямий API у варіаційному плечі, різниця становить 45,7 пункту (Рисунок 5). На самих 99 записах клієнта цифри становлять 92 з 99 (92,9%) та 139 з 297 (46,8%), різниця 46,1 пункту. Дослівне відтворення еталонного рядка падає разом з цим, з 64,0% до 26,0%. Умови відрізняються таким чином: клієнт працює при своєму типовому параметру зусилля під своїми власними інструкціями, з температурою, що не встановлюється, тоді як API працює при нульовому зусиллі та температурі 0,7.
Між двома стовпцями інші вісім моделей плеча, температура яких також змінюється, переміщаються максимум на 4,0 пункту в будь-якому напрямку. Зусилля є одним кандидатом для gpt-5.6-sol, хоча парне вимірювання бюджету міркування на gemini-3.1-pro залишило точність практично незмінною (Chernets, 2026c). Веб-пошук є іншим. Жовтневі відповіді від одного й того ж клієнта містять посилання, які підказка не запитує, у 3 з 506 відповідей gpt-6.1-sol та у 18 з 506 gpt-6-astra, включаючи справжній ідентифікатор MusicBrainz. Медіана використання токенів на серпневий виклик клієнта становить 4829, при 36,4% викликів понад 6000. Ці токени можуть бути міркуванням або пошуком, а потік подій, який би їх розділяв, не був збережений.
Тестовий жгут та людина, яка користується продуктом, можуть таким чином мати точність, що відрізняється на 45,7 пункту на одному ідентифікаторі та одному наборі запитань, і дослідження «моделі» повинне вказати, яку саме воно вимірювало. Всередину серпневої хвилі клієнтське плече набирає 1392 з 1457 (95,5%), а 14 записів, обслугованих API після збою клієнта, набирають 11 (78,6%), на запитаннях, обраних цим збоєм. На новому наборі gpt-5.6-sol через API набирає 33 з 100, де fable-5 набирає 76, тоді як gpt-6.1-sol через клієнт набирає 95 в жовтні. І модель з розділу 4 зберігає свою форму під цим запитанням, оскільки вона приймає виміряні точності як вхідні дані: на флагманах без плечей, можливих пошуком, її помилка LOLO становить 0,037 проти 0,120 для найкращої моделі.
Граткова вартість за режимом доступу. На нових запитаннях у серпні з GPT через API пара gpt-5.6-sol та fable-5 є правильною на 29 з 32 узгоджень, Delta +57,6 пункту [+46,3, +69,7], захоплюючи 64 з 67 помилок, і впевнені помилки плеча GPT падають з 61 з 91 до 2 з 29. У жовтні з новішим GPT через клієнт на тих самих запитаннях пара з opus-5-5 є правильною на 72 з 74, а пара з fable-5-1 на 76 з 78, з Delta +2,3 [-0,7, +6,0] та +2,4 [-0,5, +6,3] та 3 з 5 помилок захоплено. Граткова вартість тут відстежує точність випущеного плеча, як у розділі 5.1.
Клієнтські плечі на SimpleQA. Таблиця A7 повідомляє про плечі, відокремлені в розділі 5.1. У серпні пара gpt-5.6-sol та fable-5 є правильною на 997 з 1016 узгоджень (98,1%) проти 95,4% самостійно, Delta +2,8 пункту [+1,9, +3,7], з мінімумом на рівні 15 з 1459. На 106 це досягає 34 з 37 (91,9%), і всі пари з плечем GPT досягають 113 з 133 (85,0% [62,2, 100,0]), проти 96 з 691 без нього. Плече само по собі є правильним на 100 з 105. Ці узгодження успадковують цю точність: Delta на 106 становить -3,3 пункту [-10,3, +2,6] у серпні та -5,7 [-13,7, +1,2] з opus-5-5 у жовтні. На контрасті, середньорівнева пара від одних і тих же постачальників, gpt-5-mini та claude-haiku-4-5, є правильною на 45 з 123 узгоджень (36,6% [28,6, 45,4]) в цілому та 0 з 13 на 106, з її першим членом на 163 з 1435.
Таблиця A7. Пари клієнтських плечей. Перший член випущений. Інтервал Вільсона на PPV, начебто-бутстреп запитання на Delta.
| Пара, набір | Охоплення | PPV (K/O) [95%] | Випущено самостійно | Delta, пункти [95%] | Помилки захоплено |
|---|---|---|---|---|---|
| gpt-5.6-sol + fable-5, весь SimpleQA, серпень | 1028/1500 | 98,1% (997/1016) [97,1, 98,8] | 1403/1471 | +2,8 [+1,9, +3,7] | 49/68 |
| gpt-5.6-sol + fable-5, 106, серпень | 37/106 | 91,9% (34/37) [78,7, 97,2] | 100/105 | -3,3 [-10,3, +2,6] | 2/5 |
| gpt-6.1-sol + opus-5-5, strat, жовтень | 192/300 | 96,3% (183/190) [92,6, 98,2] | 276/294 | +2,4 [+0,2, +4,9] | 11/18 |
| gpt-6.1-sol + fable-5-1, strat, жовтень | 193/297 | 97,9% (187/191) [94,7, 99,2] | 273/291 | +4,1 [+1,6, +6,7] | 14/18 |
| gpt-6.1-sol + opus-5-5, 106, жовтень | 36/106 | 88,6% (31/35) [74,0, 95,5] | 98/104 | -5,7 [-13,7, +1,2] | 2/6 |
| gpt-6.1-sol + fable-5-1, 106, жовтень | 35/106 | 91,2% (31/34) [77,0, 97,0] | 98/104 | -3,1 [-10,9, +3,5] | 3/6 |
| gpt-6.1-sol + opus-5-5, свіжі, жовтень | 74/100 | 97,3% (72/74) [90,7, 99,3] | 95/100 | +2,3 [-0,7, +6,0] | 3/5 |
| gpt-6.1-sol + fable-5-1, свіжі, жовтень | 78/100 | 97,4% (76/78) [91,1, 99,3] | 95/100 | +2,4 [-0,5, +6,3] | 3/5 |
Граткова вартість біля стелі. На знайомих запитаннях пара все ще додає трохи (Рисунок A1). У серпні на SimpleQA без 106 її Delta становить +3,0 пункту [+2,0, +4,0], різниця на користь пари. У жовтні пари strat лежать вище нуля, на +2,4 [+0,2, +4,9] та +4,1 [+1,6, +6,7], і коротко від рішення проти маржі. Єдина еквівалентність — це gpt-6-sol з opus-5-5 на -0,6 (90% інтервал -1,6 до +0,5, p = 0,020), що не витримує коригування Holm (0,277). На 106 кожна пара з gpt-6.1-sol та gpt-5.6-sol нерішучо з напрямком вниз. За межами цього плеча ефект великий: на тому самому серпневому наборі fable-5 з gemini-3.1-pro становить +19,3 пункту та fable-5 з grok-4.5 на +18,0.
Власна впевненість плеча є конкурентом у цьому діапазоні. Розріджена за власною впевненістю до охоплення пари з opus-5-5, gpt-6.1-sol становить 34 до 36 з 36 на 106, залежно від того, як розбиватися нічиї, проти 31 з 35 для пари, та 74 з 74 на свіжих проти 72 з 74. На strat пара лідирує, на +1,6 пункту [-1,4, +4,7] з opus-5-5 та на +3,2 [+0,6, +6,2] з fable-5-1.
Який GPT і який партнер. На загальних питаннях, де обидві моделі дають відповідь, gpt-6.1-sol перевищує gpt-6-astra 10 до 1 на дискордантних парах (p = 0.012, +1.83 пункти [+0.61, +3.26]), а gpt-6-sol перевищує gpt-6-astra 21 до 5 (p = 0.002, +3.29 [+1.23, +5.34]). gpt-6.1-sol проти gpt-6-sol становить 5 до 12 (p = 0.143). opus-5-5 проти fable-5-1 становить 29 до 44 (p = 0.101, -3.12 [-6.65, +0.21]). Пари двох найсильніших GPT з двома Claude становлять від 95.4 до 97.1% за 503 питаннями (Table A2), з fable-5-1, який виявляє більше помилок у кожному порівнянні. А kimi-k3 з gemini-3.8-flash, пара без GPT, не відрізняється від них на новій вибірці: її різниця від gpt-6.1-sol з opus-5-5 становить -1.5 пункти [-6.3, +2.8] за точністю та -2.0 [-10.0, +6.0] за охопленням.
Додаток К. Зовнішні дані детально
Зовнішня перевірка розділу 5.5 використовує заморожені константи без перепідгонки. HELM Lite (Liang et al., 2023) містить короткі відкриті відповіді 95 моделей від 20 розробників, випущені між 2023 та 2025 роками, на 1000 закритих питань NaturalQuestions, оцінених тут моїм рушієм. LiveBench (White et al., 2025) містить відповіді 70 моделей від 11 лабораторій на 346 питань з короткою фінальною відповіддю, оцінені порівняно з його основною правдою. Kim et al. (2025) випускають парні агрегати для 70 моделей на множинному виборі MMLU, які дають спостережену точність як коефіцієнт обох правильних відповідей до коефіцієнта згоди. Таблиця A8 показує результат. Точності в таблиці 7 роботи Haas et al. (2025) не містять результатів узгодження, тому вони дають передбачення, але не тест.
Таблиця A8. Заморожена модель на інших моделях та питаннях. Середня абсолютна помилка передбаченого PPV для пар різних лабораторій, клітинки з принаймні 20 відкритими відповідями в перших двох джерелах. Двостороння бутстрап, лише за моделлю для MMLU. Зсув — передбачено мінус спостережено.
| Джерело | Клітинки | Модель [95%] | Незал. | Найкраще | Модель мінус найкраще [95%] | Модель мінус незал. [95%] | Зсув |
|---|---|---|---|---|---|---|---|
| HELM, NaturalQuestions | 4,088 | 0.069 [0.054, 0.087] | 0.070 | 0.208 | -0.139 [-0.171, -0.103] | -0.001 [-0.008, +0.006] | +0.053 |
| LiveBench, чотири завдання | 952 | 0.114 [0.101, 0.150] | 0.107 | 0.198 | -0.084 [-0.121, -0.026] | +0.007 [-0.006, +0.022] | +0.056 |
| LiveBench, math_comp | 431 | 0.075 | 0.096 | 0.279 | -0.034 | ||
| LiveBench, zebra_puzzle | 203 | 0.231 | 0.184 | 0.076 | +0.230 | ||
| LiveBench, spatial | 161 | 0.148 | 0.114 | 0.167 | +0.148 | ||
| LiveBench, web_of_lies_v2 | 157 | 0.036 | 0.031 | 0.166 | -0.017 | ||
| Kim et al., MMLU (агрегати) | 2,189 | 0.066 [0.060, 0.072] | 0.084 | 0.084 | -0.018 [-0.028, -0.010] | -0.018 [-0.019, -0.017] | +0.066 |
Як у розділі 5.3, модель перевершує читання кращої моделі у всіх трьох джерелах у цілому, і вона не працює на головоломках зебри, з 0.231 проти 0.076. Вона не покращує незалежні помилки в HELM чи LiveBench. Вона працює високо, на 5.3 до 6.6 пункти в цілому. В HELM спостережена крива вирівнюється там, де модель продовжує зростати: при парній точності між 0.5 та 0.6 точність становить 74.6% для моделей 2023 та ранньої 2024 року та 75.9% для пізніших, проти 84.4% передбачено в середині діапазону. На MMLU медіанна ймовірність того, що дві неправильні відповіді збігаються, становить 0.621 проти 0.368 з , оскільки чотири варіанти змушують колізії.
На цих моделях точність зростає з парною точністю (Спірмен +0.575 в HELM та +0.786 на MMLU, над залежними клітинками). Старіші та новіші моделі з подібною точністю дають подібну точність між парною точністю 0.4 та 0.6 (70.7 та 72.7%, 74.6 та 75.9%), і вони відрізняються більше між 0.2 та 0.3 (57.6 та 76.1%). Нижня межа розділу 4 дотримується у всіх 4,088 клітинках HELM. Пари нижче однієї половини там рідкісні, 24 з 4,088, оскільки ці клітинки не стратифіковані за складністю.
HELM також дозволяє тест розділу 5.2 з багатьма лабораторіями та без залежності від GPT, оскільки партнерську точність можна узгодити без значень впевненості. З однією випущеною моделлю та партнерами в межах 3 пунктів точності, партнер однієї лабораторії виловлює 72.3% помилок, а іншої лабораторії 75.5%, різниця -3.2 пункти [-4.2, -2.3], з охопленням вищим на 2.7 пункти [+2.1, +3.4]. Додавання збігу за охопленням в межах 3 пунктів його видаляє: 75.7 проти 75.9%, -0.2 [-0.6, +0.2], з точністю -0.5 [-1.4, +0.1]. Дві неправильні відповіді збігаються в 31.6% випадків в межах лабораторії та 27.0% між лабораторіями.
Спільні помилки також істотно перевищують випадковість у збірках розділу 3. За нульовою гіпотезою перестановки міток Ding (2026), яка зберігає неправильні відповіді кожної моделі та перемішує їх за питаннями, дві неправильні відповіді, які не є відмовами, збігаються в 14.0% випадків у липні та 15.4% у серпні без GPT, проти нулю 0.1%. На 106 коефіцієнти становлять 25.7% та 22.8% проти 0.4% та 0.5%, а на свіжих питаннях 14.5% у серпні та 32.7% у жовтні проти 0.8% та 3.8%. Відкриті відповіді рідко збігаються випадково, тому спостережене спільне використання істотно перевищує цей нуль, на питаннях складених після випуску моделей.
Додаток L. Подальше обговорення
Зв'язок з Goel et al. (2025). Їхній тренд стосується коригованої на випадок подібності, а мій — точності узгоджених відповідей, тому висновки не конфліктують. Дані тестують це через умовну частку спільної помилки, F/W, імовірність того, що дві неправильні відповіді однакові, на питаннях, де обидві відповіді оцінені та відмови рахуються як неправильні. Для еталонних пар вона зростає від 63 з 1,088 (0,058) для середнього рівня пари до 15 з 42 (0,357) для флагманської пари, приблизно в шість разів. Об'єднано по всіх парах, включаючи GPT, зростання менше і інтервал включає нуль: 0,097 у липні та 0,132 у серпні, різниця +0,034 [-0,006, +0,084]. На жовтневому наборі стратифікації F/W дорівнює 0,493 [0,179, 0,840], різниця від серпня +0,361 [+0,041, +0,712]. При рівному покритті, контейнер за контейнером, відзив флагмана нижче на 0,7–2,5 пункти, невеликий ефект, і дорівнює 0,140 [0,092, 0,192] проти 0,113 [0,082, 0,146]. Напрямок таким чином узгоджується з їхнім, хоча об'єднаний інтервал включає нуль. Пряме прочитання їхнього попередження про те, що подібність загрожує затвору, дійсно з'являється в зворотніх викликах: жовтневі клієнтські пари перехоплюють 66,3% помилок при покритті 65,3%, де всі 55 серпневих пар перехоплюють 88,2% при 32,5%, контраст, що покриття частково пояснює. Точність залишається високою в основному тому, що при цих точностях межа розділу 4 залишає їй мало місця для падіння.
Зв'язок з Han (2026). Han називає декореляцію практичним важелем. Мої вимірювання ставлять точність і покриття на перше місце. При рівному покритті з одною випущеною моделлю перевага другої лабораторії зникає, якщо її модель не набагато точніша (розділ 5.2). У HELM з узгодженою точністю друга лабораторія додає 3,2 пункти відзиву за 2,7 пункти покриття, і нічого, коли покриття також узгоджується. Декореляція видна там, при 27,0 проти 31,6% збіжних неправильних відповідей, і вона невелика. Теорія Han стосується глибини послідовних затворів, а моя — одного затвору, тому ці два зустрічаються лише на першому кроці. Liu (2026) розділяє ті ж самі дві речі: точність вибору слідує за декореляцією, причому міжмодельні панелі випереджають перевибірку на 12,5–16,7 пункти на AIME-2024 при узгодженій точності учасника, тоді як калібрування сигналу узгодження слідує за точністю учасника. Точність узгоджених відповідей, виміряна тут, є другою з них.
Дві сторони розділу 2. Опубліковані цифри частково примирюють дві сторони. Одностайна панель Liu правильна на 100,0% AIME-2025 при точності «відповідь на все» 0,433 та на 70,2% MMLU-Pro при 0,458. Дев'ять одностайних суддів Kohli, кожен близько 68%, правильні на 90,9%. Подібні точності дають точність на 30 пункти розділених, тому одна лише точність не приводить ці результати разом. Розмір простору відповіді пояснює більше. Імовірність того, що дві неправильні відповіді збігаються, становить 0,621 на чотирьохбаланній MMLU, 0,270 на NaturalQuestions та 0,132 на SimpleQA для серпневих флагманів. Це панелі та пари на різних завданнях, без спільного розрахунку в документах, і вони узгоджуються з тим, що точність слідує за точністю в межах завдання та формату відповіді.
Знайомство. Розрив між SimpleQA та свіжою точністю запрошує пояснення через експозицію тесту, і дослівна відповідність золотому рядку виглядає як його підпис. Мої дані не підтримують це як коваріант (додаток C). Серед правильних відповідей дослівна відповідність близька до одного значення в моделях, і вона не пояснює залишок моделі. F/W на свіжому наборі у серпні, 0,145 [0,033, 0,402], не показує видимої відстані від 0,132 на SimpleQA, в межах широкого інтервалу.
Як цитувати
Chernets, V. (2026). Інверсія згоди не є властивістю середнього рівня: точність узгоджених відповідей LLM відповідає точності пари [Preprint]. SSRN. https://doi.org/10.2139/ssrn.7682960
@misc{chernets2026agreementinversion,
  author       = {Chernets, Vadym},
  title        = {{Agreement Inversion Is Not a Mid-Tier Property: Precision of Agreed LLM Answers Follows Pair Accuracy}},
  year         = {2026},
  howpublished = {SSRN},
  doi          = {10.2139/ssrn.7682960},
  url          = {https://doi.org/10.2139/ssrn.7682960}
}